前言
本书面向谁
本书面向所有理解单机机器学习、如今又面临使其在大规模下运行的挑战的人。规模化的问题并非单机问题的简单放大,而是本质不同的问题:网络会切分,硬件故障在统计意义上是确定事件,而每一个设计决策的社会影响都会被数百万用户放大。
本书的范围涵盖:设计 AI 数据中心的物理底座,将训练扩展到单个加速器的极限之外,以及思考当生产集群服务全球用户时发生了什么。贯穿始终的焦点是分布的物理本质、以及无论框架、模型还是时代如何,都支配每一个集群级机器学习系统的不变量。
为何是集群级教材
2012 年,在两块 GPU 上训练 AlexNet 需要五到六天 (Krizhevsky 等 2012年)。到 2023 年,公开的 GPT-4 级别估计将前沿训练置于约 25,000 块 GPU 上运行约三个月 (Patel 和 Wong 2023年);OpenAI 未披露实际硬件配置 (OpenAI 等 2023年)。这不是更大规模上的同一工程问题,而是一个根本不同的工程问题。
在单机上,性能受内存墙支配,即处理器速度与内存带宽之间的差距。在分布式集群中,一面新的墙出现:二分带宽墙,即把集群一分为二的最小网络带宽,可能限制必须跨越该切分的流量吞吐量。数据不再仅通过本地层次结构传输;它在机架之间、跨越大陆的光学互连结构中传输,其速度受光速支配。硬件故障在单机上足够罕见、可被视为例外,但在集群规模下则成为常规的统计事件。没有为故障做规划的训练任务,一定会失败。
这些问题并非运维上的烦扰。它们是物理约束,与内存墙、Amdahl 定律或数据移动的能量成本一样根本、一样持久。它们需要自己的工程学科,以及自己的不变量:
- 二分带宽定理:对于必须跨越最小二分的通信模式,吞吐量受该二分带宽限制。
- 集群定律:每一步训练都要支付随集群规模增长而增加、而每节点计算量缩小的通信开销。
- Young-Daly 检查点定律:最优检查点区间在写入状态的成本与因故障丢失工作的预期成本之间取得平衡。
- 服务成本主导定律:对于高流量生产模型,累计推理运维支出可能超过一次性训练成本,使服务效率成为生命周期优化目标。
- 公平性不可能定律:除完美预测或相等基础率等特殊情形外,校准后的风险分数通常无法同时实现各群体间的错误率均等。人口统计平等是独立的选取率约束,可能引入额外的权衡。
如果单机机器学习系统工程问的是“一台机器能构建什么?”,那么集群级机器学习系统工程问的是“一千台机器能共同构建什么,以及它对可靠性、效率和社会的代价是什么?”
正是最后这一句,将集群级工程与单机工程区分开来。一台机器影响它的使用者;而集群影响其输出所触及的每一个人,每秒涉及数百万次决策。在这个规模上,可靠性、效率和公平性不再是功能特性,而成为与带宽或功耗一样具有约束力的工程约束。一个能够扩展却无法被信任的系统,并未真正被工程化,它只是被放大了。
本书提供这一基础。它遵循 Hennessy 与 Patterson 的教学模型,将定量、原则优先的方法扩展到分布式规模 Hennessy 和 Patterson (2017年)。正如他们的工作教会一代人从第一性原理出发思考处理器性能,本书教会读者思考集群性能,以测量取代对分布式系统的直觉,以工程取代临时的扩展做法。
《机器学习系统导论》讲授的是砖块:构成任何单节点系统的张量、内核、内存层次结构和优化循环。集群并非由更多砖块构建而成。它是一个乐团。单个乐手可以奏出令人惊叹的美妙音乐,但乐团并非同时演奏的许多乐手那么简单。它需要指挥、乐谱、精确的同步,以及乐手掉队时优雅恢复的能力。音乐厅的声学以个人乐器无法控制的方式塑造声音。支配乐团演出的原则——协同、通信延迟、容错,以及演出空间的物理——与支配独奏者的原则本质不同。机器学习集群的运作方式相同。训练集群、服务集群和边缘部署是截然不同的系统,但在其之下是相同的构建模块:并行策略、集合通信原语、检查点协议、调度算法,以及吞吐量、延迟、容错与成本之间的权衡。
本书涵盖什么
本书聚焦于机器学习集群:网络即总线、功率密度即限速、故障不是例外而是统计确定性的仓库级计算机。这是现代机器学习计算的单元,其中规模超过任何单台设备的模型在数千块加速器上训练,服务数百万用户,并受跨越工程、经济与社会的约束支配。
内容分为四个部分:
- 第一部分:集群 自下而上构建 AI 数据中心的物理底座:分布式机器学习系统的格局、计算基础设施的芯片与冷却、连接数千块加速器的网络互连结构,以及为训练流水线提供数据的可扩展数据存储。
- 第二部分:分布式机器学习 确立超越单机的分布逻辑:用于训练单设备无法容纳的模型的并行策略(数据、张量与流水线),同步梯度的集合通信原语,确保在故障成为常态时可靠性的容错机制,以及管理集群的编排系统。
- 第三部分:大规模部署 将训练好的模型从集群带到世界:面向效率的性能工程、大规模推理服务、面向资源受限设备的边缘智能,以及管理生产集群所需的运维生命周期。
- 第四部分:负责任的集群 直面决定集群是服务用户还是伤害用户的各种力量:安全与隐私、稳健的系统设计、环境可持续性,以及作为与功率密度或二分带宽同等根本的约束的负责任工程。
这四个部分沿着集群栈展开,这是一种分层抽象,将经典的机器学习系统栈扩展到分布式规模。在最底层,设施与加速器和互连与存储构成物理底座。在其之上,分布式执行和可靠性与控制管理并行工作、通信、调度与恢复。再上一层,运行时与服务将模型交付给用户,运维管理生产生命周期。在最顶层,保障与治理与可持续性将信任、风险、政策与环境成本转化为工程约束。每一层为上一层提供抽象并消费其下的一层。底层的工程决策约束着顶层的可能性。
全书中,页边图会高亮每个章节所涉及的层,在每个章节开头提供导航提示:
上图完整展示了每一行及其范围,并按本书的四个部分分组。罗马数字(I–IV)标记这些部分;行强度标记强调程度。整个栈只使用一种强调色,因此明暗而非色相承载章节焦点信号。
全书页边图中,每一层的强度反映该章节对该层参与程度的强弱:更亮(强度更高)表示该层是本章的主要焦点;更暗(强度更低)表示该层仅具有上下文相关性,作为约束向上传递。以下三章用以说明强调重点如何转移:
上图完整展示了每一行及其范围,并按本书的四个部分分组。罗马数字(I–IV)标记这些部分;行强度标记强调程度。整个栈只使用一种强调色,因此明暗而非色相承载章节焦点信号。
在 Compute Infrastructure 中,最底行占主导地位,因为该章讨论芯片、功耗、冷却与物理部署。在 Distributed Training 中,分布式执行最为突出,而可靠性与控制仍清晰可见,因为大规模训练依赖调度与恢复。在 Responsible AI 中,治理与可持续性是主要焦点,而保障保持较强,因为问责依赖可测量的信任与风险控制。同一个栈,三个不同的故事:某一层的决策会波及上下各层。
小视觉提示出现在页边,位置选择在眼睛最快能理解关系之处。它们是阅读辅助,而非日后引用的图。在集群规模下,这套视觉语法使带宽缺口、故障影响范围、检查点比例和边缘能耗权衡清晰可见,而无需打断论证。当缩略图使用对数刻度时,会在图内注明。
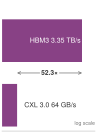

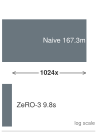
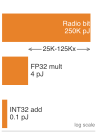
每个部分都建立在上一部分之上,因此建议顺序阅读。以下阅读路径为不同目标的读者提供替代方案。
建议阅读路径
不同背景与目标的读者可以在材料中选择若干条路径:
Conventions
This book uses a small set of typographic conventions to mark what each piece of prose is doing.
Bold marks first definitions
A term in bold within body prose is its formal first introduction in the volume. Each term receives this treatment exactly once. Subsequent appearances are unbolded; by then the term is part of the working vocabulary the chapter carries forward.
Every machine learning system has a dual mandate: it must manage statistical uncertainty and physical constraints simultaneously.
The bold is a contract: register this term because it will recur. A matching index entry in the back of the book points to the defining occurrence (under the definition subentry), providing a way to return to it. Key technical terms are also compiled in the glossary.
Bold also appears in a second, structural role: as a functional label at the start of an item inside a callout box or a summary bullet—for example, Recommendation, Trade-off, or Result. In that context, the bold is scaffolding rather than a first definition.
Italics carry specific rhetorical jobs
Italics are not used for general emphasis. Every italic span in this book performs one of a small number of specific jobs:
- Direct opposition: training vs. inference, logical vs. physical.
- Impossibility, stated as physical, mathematical, or logical law: “sub-10 ms systems cannot use distant cloud infrastructure—physics forbids it.”
- Word used as word: “the term gradient refers to a vector of partial derivatives.”
- Titles of works: Computer Architecture: A Quantitative Approach.
- Thesis punchline: A single italicized sentence that captures the controlling insight of a section, for example, Data is source code.
An italicized word is performing one of these jobs. A word that is not italicized carries no implicit emphasis.
Callouts have visual identities that match their job
Callout boxes are not decoration. Each type signals a specific kind of content, so the visual identity announces what the box contains before the reader engages with it.
| Callout | Contains |
|---|---|
| Definition | Formal definition of a key term, with its significance, distinction from the nearest neighbor concept, and a common pitfall |
| Example | Historical case or concrete scenario, structured as context, insight, and systems lesson |
| Systems Perspective | Analytical observation or mathematical nuance that enriches the surrounding argument |
| Napkin Math | Worked calculation walked through step by step, with values computed inline from the book’s constants; intermediate tables and equations are the math itself |
| Checkpoint | Self-check questions to verify understanding of the preceding section |
| War Story | Documented engineering incident with a sourced failure mode, structured as context, failure, consequence, and lesson |
| Lighthouse | Recurring workloads characterized by a profile (parameters, FLOPs, dominant constraint), used as anchored case studies across multiple chapters |
| Principle | Canonical book principle or invariant referenced from later chapters |
| Theorem | Formal, equation-backed result or bound, stated with its conditions and applied in later quantitative analysis |
| Key Takeaways | Four to seven most important results from a chapter, in summary form |
| Learning Objectives | Skills and concepts that readers should be able to explain or apply after completing the chapter |
| What’s Next | Bridge from the chapter just ended to the chapter beginning, naming the open question the next chapter addresses |
When a callout contains a table, figure, or equation, that artifact is part of the callout’s pedagogical unit, not decoration. A lighthouse’s profile is its characterization. A napkin math box’s intermediate tables are the worked math. Reading these as separated artifacts loses the teaching arc. Standalone reference tables, by contrast, sit between paragraphs as numbered artifacts the reader returns to through cross-references. Both forms are valid; the visual marker (callout vs. standalone) tells the reader which one they are looking at.
学习平台
无论读者选择哪条路径,本书都是更广泛学习生态中的一个组成部分。完整文本、交互式笔记本、讲义幻灯片、练习、动手实验以及每章的补充材料均免费开放于 mlsysbook.ai。
开源教材
本书在开放环境中构建。其完整文本、图形与构建系统均公开于 mlsysbook.ai/git,欢迎每一位读者贡献。
这是一个有意为之的选择。如果 AI 工程要成为一门共享学科,而非彼此孤立的实践集合,其基础文本就必须对所有人开放。机器学习系统是一个由全球产业、学术界与开源社区从业者共同塑造的领域。覆盖该领域的教材应当反映这种广度,并向所有人开放,无论其所在地区或所属机构。
读者的贡献——无论是修正错误、提出更清晰的解释、补充算例,还是提议新内容——都实质性地改善了每一章。发现可以改进之处的读者,被鼓励提交 issue 或 pull request。本书因读者的参与而不断完善。
前置知识
读者应具备以下背景:
- 单机机器学习系统:理解机器学习工作流、神经网络训练、模型优化及在单机上的部署。读者应能从容地推理内存层次结构、计算图与软硬件交互。
- 编程:掌握 Python,包括函数、类及基于 NumPy 的数据操作。熟悉至少一个机器学习框架(PyTorch、TensorFlow 或 JAX)。
- 数学:具备本科水平的线性代数、基础微积分与概率论基础。
以下背景有帮助但非必需:
- 分布式系统:熟悉网络概念(TCP/IP、带宽、延迟)、并行性,以及基础分布式计算,有助于深入理解集群基础设施与训练章节。
- 云基础设施:具备容器化与编排(Docker 与 Kubernetes)或集群调度器(Slurm)的使用经验,可提供有用的运维背景。
- 生产工程:了解监控、可观测性与站点可靠性实践,将丰富部署与运维章节。
本书之外
本书涵盖机器学习集群当前的形态:仓库级训练集群、全球服务基础设施,以及大规模运营所面临的治理挑战。处于研究前沿的主题(包括完全自主的集群管理、下一代互连、大规模神经形态计算,以及集群级安全属性的形式化验证)超出了本书范围,但代表了活跃的研究方向。
在课程中使用本书
本书源自哈佛大学的 CS249r 与 TinyML edX 专业证书 项目。该教学强化了一个贯穿集群规模的洞见:同一套物理规律支配着每一层。带宽、能量与故障对微控制器和数据中心的限制是相同的。随规模变化的是物理并未改变,而是哪种限制成为约束;而一个新的约束性限制就是一个新的工程问题。在单机上,内存墙占主导。在集群中,二分带宽与常规的硬件故障取而代之,而曾经罕见的例外变成了整个系统围绕设计的约束。物理是连续的;工程并非如此。
本书设计用于支撑一门覆盖完整分布式机器学习系统栈的一学期进阶课程。教师也可单独选取部分用于较短的模块:
- 第一、二部分(集群与分布式机器学习)适合关于分布式训练基础设施的进阶半学期课程。
- 第三、四部分(大规模部署与负责任的集群)适合关于大规模生产机器学习的实践半学期课程。
对于综述课程或高管培训项目,仅四个部分导论及其支配原则,即可提供支配集群级机器学习系统的定量定律的浓缩概览。
进阶序列的幻灯片、作业与教师材料可在 mlsysbook.ai 获取。
版权与许可
© Vijay Janapa Reddi and MIT Press. 本作品依据 Creative Commons Attribution-NonCommercial-NoDerivatives 4.0 International License (CC BY-NC-ND 4.0) 分发。源码可在 mlsysbook.ai/git 获取。