网络互连结构
同步骨干网
网络互连结构
目的
在大规模场景下,连接加速器的网络为何比加速器本身更重要?
单块加速器每秒可执行数千亿次运算,但分布式训练需要在数千台设备之间进行协调。梯度平均、激活量交换与参数更新所需的同步,都依赖于网络带宽与延迟。当网络容量无法跟上加速器吞吐量时,加速器会因等待数据而闲置,此时增加加速器数量不仅无法缓解瓶颈,反而可能加剧瓶颈。在足够大的规模下,网络设计可以主导系统性能:拓扑决定哪些通信模式高效,带宽约束模型的切分方式,延迟则限制训练能够达到的耦合紧密程度。将网络视为附属环节的组织,往往只能获得理论加速器性能的一小部分。用 C³ 术语来说,互连结构是协同开销的支付场所,其拓扑与带宽决定了通信如何约束整个集群的计算。
Learning Objectives
- 使用 \(\alpha\)-\(\beta\) 框架建模网络通信开销,并区分带宽主导与延迟主导的扩展形态
- 依据延迟、无丢包保证与运行复杂度,比较高性能传输协议
- 通过计算 \(\text{BW}_{\text{bisect}}\) 与跳数,分析网络拓扑(胖树、以链路优化、龙fly)在机器学习集合通信模式下的表现
- 评估拥塞控制机制及其对分布式训练尾延迟的影响
- 为多租户 GPU 集群设计网络虚拟化策略,采用 SR-IOV 资源分配与流量隔离
- 利用 RDMA 计数器、链路级遥测与带宽测试工具诊断网络性能瓶颈

一条缓慢的链路会使所有依赖该链路的对等节点陷入停滞。
考虑一个参数规模为 1750 亿的语言模型,被划分到 1,024 GPUs 中;此时,密集加速器节点只有在能够作为一个整体协同同步时才真正有用。每个训练步都需要对 350 GB 的梯度数据进行一次 AllReduce,这意味着每一块 GPU 都必须先发送并接收属于自己的份额,下一步才能开始。只要互连结构中的一条链路变慢,所有 1023 其他 GPU 都会等待。网络互连结构并非辅助基础设施;它是决定该集群是高效训练,还是浪费数百万美元闲置计算的同步骨干网。350 GB 这一数字源自贯穿整个集群示例所用的模型规模与梯度数据量假设。
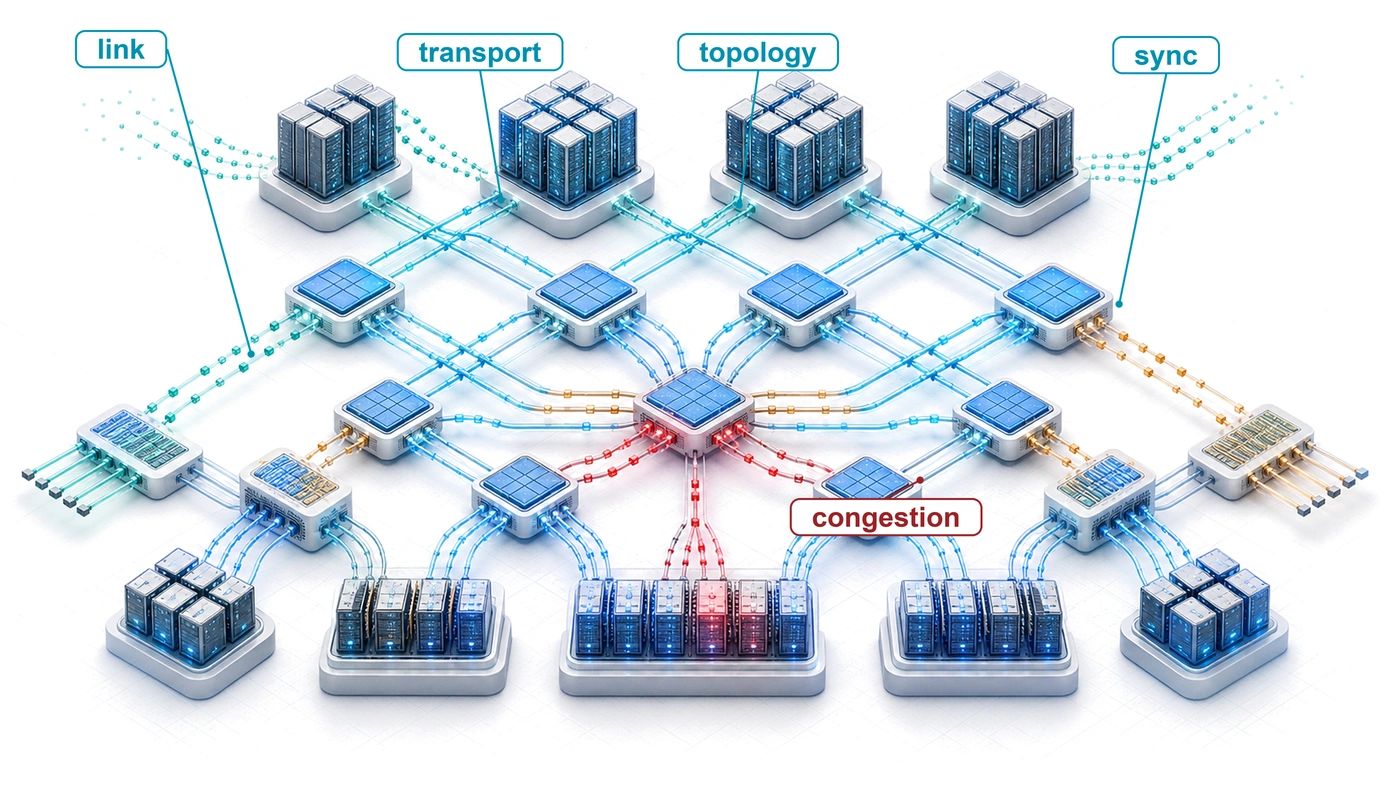
在集群堆栈(集群栈)中,互连结构将彼此隔离的加速器节点转化为一个连贯的训练系统。加速器、供电、冷却、机柜和机舱决定了每个节点在孤立状态下能够完成什么计算;而互连结构则决定这些节点能否在通信开销压倒计算之前协同工作。图 1 将该设计空间划分为五个相互依赖的层级,从物理信号一直延伸到集群级编排。图中的缩写构成了一条路线图:每种机制在其成为约束性瓶颈时才会被定义。
在大规模场景下,通信开销可能主导计算开销。集群定律 中的集群规模定律分解将这一点明确呈现:非重叠通信项 \(T_{\text{comm}}(N) - T_{\text{overlap}}\) 决定了每个训练步骤中有多少部分暴露在网络互连结构上。该互连结构通过决定通信能否重叠、哪些集合通信算法可行,以及网络分区如何与节点故障相互作用,从而影响其上方的各层。
物理网络互连结构承载着三种基本集合通信模式:
- AllReduce:AllReduce(参见 集合通信 中的算法成本模型)在数千块 GPU 之间对梯度求和,使每台设备都持有相同的平均值,从而构成同步训练的心跳机制。
- AllGather:AllGather(参见 集合通信)收集不同的模型部分,使每台 GPU 都能重建完整的模型状态。
- AllToAll:AllToAll 是要求最严苛的模式,需要每台 GPU 向所有其他 GPU 发送各自独有的数据;这一要求对专家并行至关重要(参见 MoE 模型的专家并行)。
集合通信 涵盖编排这些模式的算法;而互连结构层则提供承载这些模式的线缆与交换机的物理特性。这一区分之所以重要,是因为互连结构的物理属性(带宽、延迟和拓扑)决定了哪些模式高效、哪些会成为瓶颈。
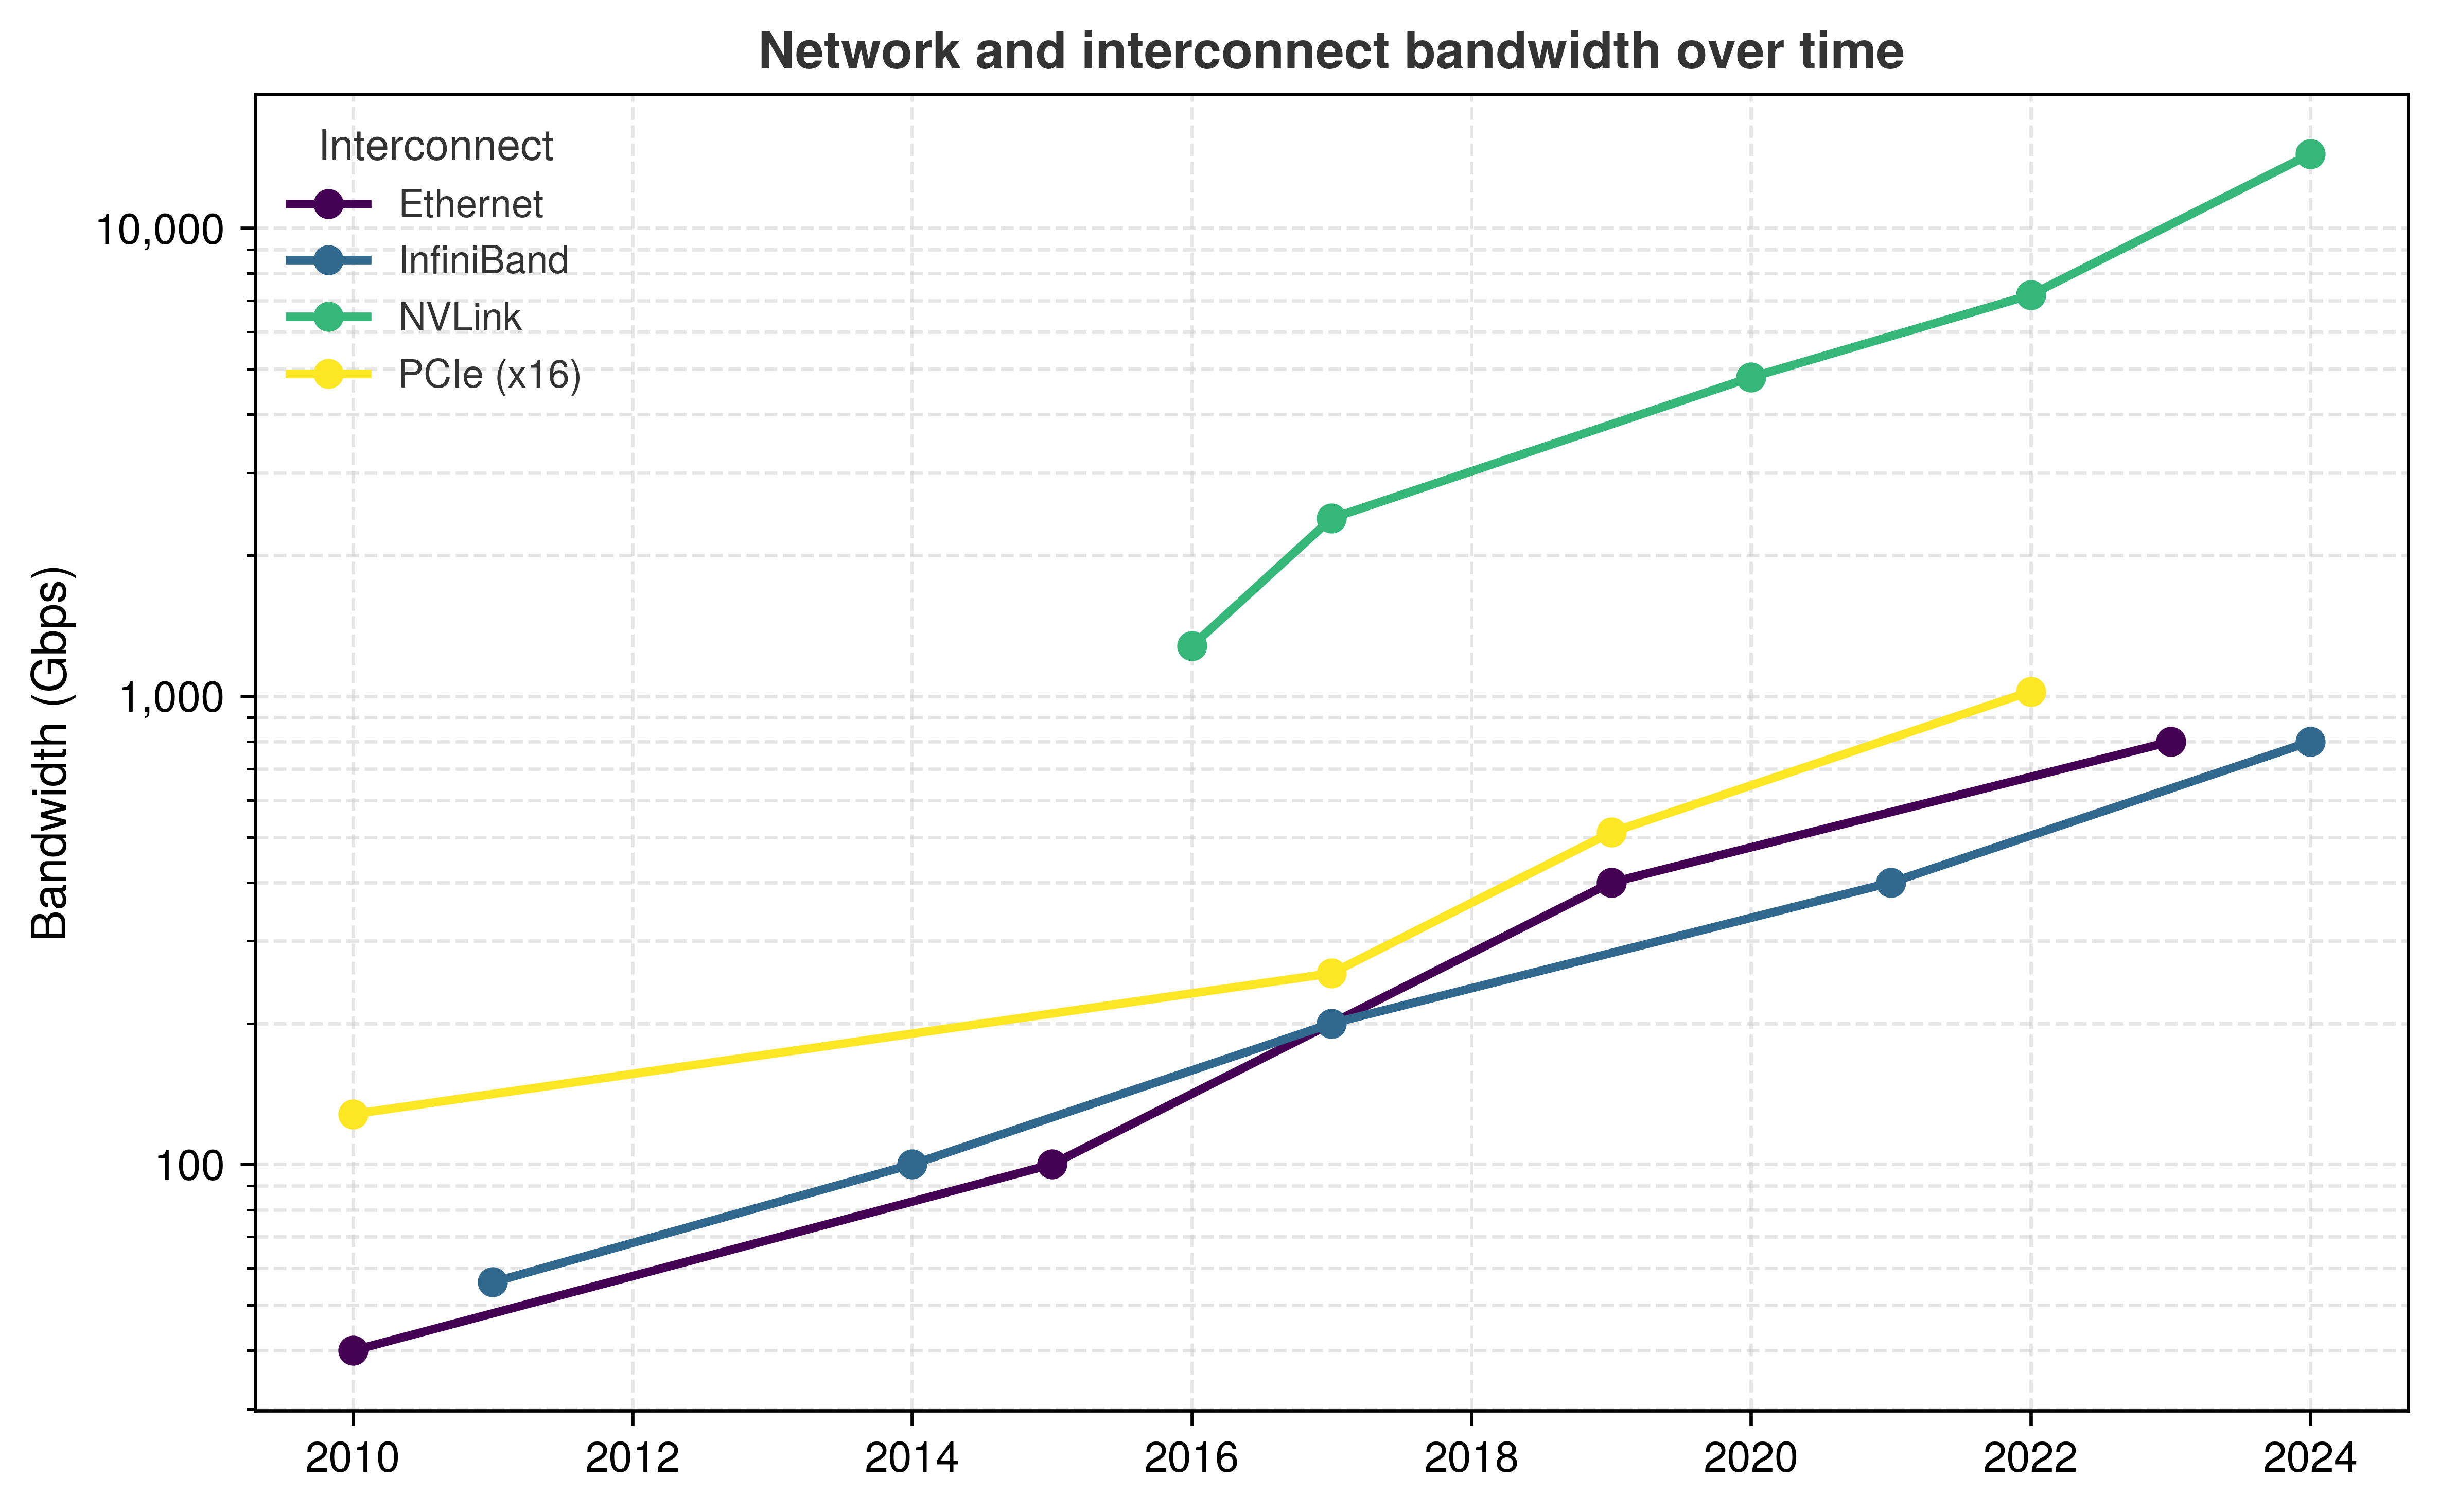
具体带宽断崖将节点内通信与节点间通信区分开来,使得这一梯度总线类比变得精确。计算基础设施 指出,单张 H100 的 FP16 吞吐量为 989 TFLOP/s,内存带宽为 3.35 TB/s。在节点内部,八张这样的加速器通过 NVLink 以 900 GB/s 的聚合双向带宽进行通信。然而,一旦计算跨越节点边界,每个方向的可用带宽就会下降 9× 倍,从 NVLink 的 450 GB/s(该双向链路的一个方向)降至 50 GB/s(每端口 NDR InfiniBand)。这条断崖,即从节点内通信到节点间通信的转变,是网络互连结构设计的核心挑战。Every Fleet Engineer Should Know Numbers 汇总了规范的 NVLink 与 InfiniBand 带宽规格,以及锚定这些数值的 1K-GPU 集群参考配置。对于 175B 模型,通过 350 GB 的梯度经由 50 GB/s 条链路传输,意味着仅 AllReduce 就可能耗时数秒;在此期间,集群中的每张 GPU 都处于空闲状态,除非互连结构与集合通信算法能够将该传输与计算重叠起来。图 3 通过绘制四个 GPU 代际各层级带宽,使这一层级结构具体化。
图 3 表明,这一断崖并非由某一代加速器所造成。其注释将 NVLink 的双向总带宽与一个 InfiniBand 端口进行比较,因此数值显得更大(H100 一代约为 18\(\times\)),而不同于同类对比下的断崖。就单方向而言,从本地 NVLink 域跨越到一个 InfiniBand 端口,带宽会下降约 9\(\times\),尽管每一代都实现了绝对带宽的提升。这一持续存在的断崖反映了基本的物理规律:片上互连(NVLink)在毫米级的铜线上运行,而节点间链路(InfiniBand)跨越数米长的线缆,并且必须经过交换机。该比值决定了哪些并行策略是高效的(参见 系统假设 中详述方向性带宽与聚合带宽、延迟、每比特帧封装以及主机总线、加速器互连和网络互连结构之间每比特能耗的物理规格表)。张量并行需要持续进行高带宽的激活值交换,因此在节点内部可行,但在节点之间则不切实际。流水线并行与数据并行能够容忍较低的节点间带宽,因此必须承担跨节点通信的负担。本章中的每一种拓扑与协议决策,都旨在尽可能降低这一层级对集合通信性能的影响。
该比值会在单个训练步中显现出来。图 4 采用归一化时间线:计算阶段固定为 100 ms,而 AllReduce 块代表一个较小的梯度分片,其选取目的是使节点内与节点间的对比变得可见。它并非完整的 175B 参数梯度交换;它隔离的是跨越节点边界如何改变资源利用率。
\usetikzlibrary{positioning, decorations.pathreplacing}
\providecommand{\mlsysFigureSans}{\sffamily}
\begin{tikzpicture}[font=\small\mlsysFigureSans]
  \definecolor{BlueLine}{HTML}{006395}
  \definecolor{BlueL}{HTML}{D1E6F3}
  \definecolor{GreenLine}{HTML}{008F45}
  \definecolor{GreenL}{HTML}{D4EFDF}
  \definecolor{RedLine}{HTML}{CB202D}
  \definecolor{RedL}{HTML}{F5D2D5}
  \definecolor{OrangeLine}{HTML}{E67817}
  \definecolor{BrownLine}{HTML}{78492A}

  \tikzset{
    ganttbar/.style={draw=none, text=white, font=\scriptsize\mlsysFigureSans, align=center, minimum height=0.8cm, inner sep=0pt, anchor=west},
    fwd/.style={ganttbar, fill=GreenLine!80},
    bwd/.style={ganttbar, fill=BlueLine!80},
    ar/.style={ganttbar, fill=RedLine},
    label/.style={font=\small\mlsysFigureSans\bfseries, anchor=east},
    sublabel/.style={font=\scriptsize\mlsysFigureSans, anchor=east, text=black!60},
    util/.style={font=\scriptsize\mlsysFigureSans, anchor=west}
  }

  %—Scenario A: Intra-node (NVLink) ---
  \begin{scope}[local bounding box=intra]
    \node[fwd, minimum width=4cm] (fwd1) at (0, 1.6) {Forward (100 ms)};
    \node[bwd, minimum width=4cm, right=0pt of fwd1] (bwd1) {Backward (100 ms)};
    \node[ar, minimum width=0.04cm, right=0pt of bwd1] (ar1) {};
    \node[font=\tiny\mlsysFigureSans, anchor=west, text=RedLine, right=2pt of ar1] (ar1_label) {AR (1 ms)};
    \node[util, text=GreenLine, right=10pt of ar1_label] {99.5\% util.};

    \node[label, left=0.3cm of fwd1.west, yshift=0.2cm] {Intra-Node};
    \node[sublabel, left=0.3cm of fwd1.west, yshift=-0.2cm] {8 GPUs, NVLink};
  \end{scope}

  %—Scenario B: Inter-node (InfiniBand) ---
  \begin{scope}[local bounding box=inter, yshift=-1.6cm]
    \node[fwd, minimum width=4cm] (fwd2) at (0, 1.6) {Forward (100 ms)};
    \node[bwd, minimum width=4cm, right=0pt of fwd2] (bwd2) {Backward (100 ms)};
    \node[ar, minimum width=1.2cm, right=0pt of bwd2] (ar2) {AllReduce\\(30 ms)};
    \node[util, text=OrangeLine, right=0.2cm of ar2] {87\% util.};

    \node[label, left=0.3cm of fwd2.west, yshift=0.2cm] {Inter-Node};
    \node[sublabel, left=0.3cm of fwd2.west, yshift=-0.2cm] {64 GPUs, IB};
  \end{scope}

  % Time axis
  \begin{scope}[yshift=-1.0cm]
    \draw[->, line width=1.0pt, black!60] (0, 0) -- (9.8, 0) node[right, font=\scriptsize\mlsysFigureSans] {Time (ms)};
    \foreach \x/\t in {0/0, 4/100, 8/200, 9.2/230} {
      \draw[black!60, line width=1.0pt] (\x, 0.1) -- (\x, -0.1);
      \node[font=\tiny\mlsysFigureSans, below] at (\x, -0.1) {\t};
    }
  \end{scope}

  % Idle cost annotation
  \draw[RedLine, line width=1.2pt, decorate, decoration={brace, amplitude=4pt}]
    (9.2, -0.48) -- (8, -0.48)
    node[midway, below=3pt, font=\scriptsize\bfseries, text=RedLine] {30 ms idle per step};

\end{tikzpicture}12.5 个百分点的利用率差距,在长达数月的训练运行中代表着数百万美元被浪费的计算资源。因此,网络互连结构(network fabric)设计是分布式训练的核心工程挑战,而非被搁置的次要问题。
机器学习网络如何颠覆数据中心假设
来自大规模网络服务领域的网络架构师,会发现分布式训练集群的流量模式难以直观理解。传统数据中心的流量特征为大量小型、相互独立且异步的流。数百万用户访问网络服务所产生的流量模式具有随机性,而标准 TCP/IP 网络以及统计意义上的多路复用、超额订阅网络能够很好地应对这种模式。
机器学习训练工作负载则完全相反:同步、周期性,并且由少数几个规模巨大的集合通信操作主导。这种机器学习网络反转颠覆了传统网络设计的核心假设。table展示了其实际后果:互连结构针对的是全局同步时间,而非平均单流吞吐量。
| Workload pattern | Traditional data-center assumption | ML reality |
|---|---|---|
| Traffic pattern | 异步、随机、多对多 | 同步、周期性的集合通信 |
| Flow type | 数百万个小型、短寿命的流 | 少数几个规模巨大、长寿命的“大象”流 |
| Performance metric | 平均吞吐量、逐流公平性 | 尾延迟、全局同步时间 |
| Loss tolerance | 可容忍(TCP 重传) | 不可容忍(丢一个包,全部阻塞) |
| Congestion | 局部化、相互独立的事件 | 全局性、相关(倒灌 incast) |
同步性反转代表了最根本的对比(table)。网络流量是异步的;一个用户的连接较慢不会影响其他用户。批量同步并行(BSP)1 模型支配着分布式训练:训练任务中的全部 1,024 块 GPU 必须先完成梯度交换,才能进入下一步。因此,最慢的链路决定了整个集群的性能。单个拥塞的交换机端口若将某块 GPU 的报文延迟 100 ms,就相当于浪费了全部 1,024 块 GPU 的 100 ms 计算时间。尾延迟并非异常值,而是瓶颈所在。
1 BSP(批量同步并行):由 Valiant (1990年) 提出,作为并行硬件与软件之间的衔接模型。同步数据并行训练具有相同的同步屏障形态:工作节点计算本地梯度、交换梯度,并从共享的步骤边界处更新,从而使尾延迟成为吞吐量的约束性因素 Li 等 (2020年)。
Valiant, Leslie G. 1990年. 《A bridging model for parallel computation》. Communications of the ACM 33 (8): 103~11. https://doi.org/10.1145/79173.79181.
Li, Shen, Yanli Zhao, Rohan Varma, Omkar Salpekar, Pieter Noordhuis, Teng Li, Adam Paszke, 等. 2020年. 《PyTorch distributed: experiences on accelerating data parallel training》. Proceedings of the VLDB Endowment 13 (12): 3005~18. https://doi.org/10.14778/3415478.3415530.
2 大象流与老鼠流:在网络测量文献中,“老鼠流”指大量短流,“大象流”指罕见的巨型流,主导带宽。在机器学习集群中,一次 AllReduce 大象流 可承载 350 GB,而 ECMP 的静态哈希无法将其在所有可用路径上切分。
流量反转进一步加剧了这一问题。传统网络针对数百万个“老鼠流”2 设计公平性,而机器学习训练则由少数几个“大象流”主导,这些大象流对应梯度 AllReduce。在 175B 参数模型上执行一次 AllReduce,就可能涉及 350 GB 的数据交换。像等成本多路径(ECMP)这样的标准流量控制与路由机制,会将每个流哈希到若干等成本路径中的某一条,并不适合这种流量模式。静态哈希无法将一个大象流在所有可用链路上切分,还可能无意中将多个大象流映射到同一条链路上,造成大规模拥塞,而其他链路上却处于空闲状态。
损失倒置完成了整幅图景。TCP 被设计为在不可靠网络上完成恢复。可靠的 InfiniBand 和 RoCE 传输同样会检测丢包并重传,但恢复粒度与尾延迟取决于传输实现。丢包在采用 Go-Back-N 式恢复的 RNIC 上尤其昂贵,因为它会从缺失的序列点重新开始传输,而不是仅修复丢失区域。因此,生产网络互连结构的目标是让丢包尽可能罕见,并使恢复有界。InfiniBand 通常通过基于信用的流量控制抑制缓冲区溢出丢包。许多基于以太网的 RoCE 部署则使用经过精细调优的优先级流量控制(PFC),这是一种链路层的反向压力机制,在缓冲区溢出前暂停发送方;无 PFC 的设计更依赖端点拥塞控制与丢包恢复(Mittal 等 2018年)。
这些倒置解释了为何在标准企业级以太网网络上运行大规模分布式训练是低效甚至不可能的。面向 ML 的网络互连结构,是为同步的大规模并行而自下而上设计的分布式、高性能“总线”,用于集合通信。
五级模型
每个倒置都可追溯到某个具体的物理或协议约束。面向高性能互连的五级模型将这些约束具体化:
- 第 1 级:导线与链路(节 1.2)。信号完整性(PAM4、SerDes)以及光纤中的光速对延迟与集群几何结构施加硬性约束。
- 第 2 级:传输(节 1.3)。InfiniBand 与 RoCE 提供远程直接内存访问(RDMA)原语;\(\alpha\)—\(\beta\) 模型量化了不同消息尺寸下的延迟—带宽权衡。
- 第 3 级:交换机与拓扑(节 1.4)。胖树、以链路优化的设计以及 dragonfly 通过不同的结构权衡,实现全局集合通信所需的\(\text{BW}_{\text{bisect}}\)。
- 第 4 级:互连结构行为(节 1.5)。拥塞控制机制,如 DCTCP 式显式拥塞通知(ECN)响应、DCQCN 和 HPCC,决定理论带宽能否转化为实际吞吐量;自适应路由与 incast 行为决定该吞吐量能否承受真实集合通信流量Gangidi 等 (2024年)。
- 第 5 级:集群设计(节 1.6)。生产级超级计算机,如 NVIDIA SuperPOD 与 Meta Grand Teton,将这些层次整合为统一的梯度总线Meta Engineering (2024年)。
这些层次并非网络主题的罗列;它们是将同步 ML 流量转化为基础设施需求所构成的因果链。较大的梯度消息首先对导线与传输层造成压力,进而迫使为保持二分带宽而做出的拓扑选择,随后暴露出普通企业级网络可以掩盖的拥塞行为,最终决定整个集群是否表现得像一台训练机器。
流量模式决定哪个互连结构指标最为关键。全局归约对二分带宽和最慢路径造成压力;点对点流水线传输对启动延迟与跳数造成压力;专家交换对路径多样性与出口平衡造成压力;检查点或租户流量则对与同步路径的隔离造成压力。流量模式决定互连结构指标 提供了后续各层次展开所用的紧凑映射。
| 流量模式 | 互连结构压力 | 预测性能的指标 | 主要设计响应 |
|---|---|---|---|
| Global reduction | 跨集群切面的持续流量 | 交付的二分带宽;最慢路径完成时间 | 非阻塞容量、链路对齐、感知拓扑的集合通信 |
| Pipeline point-to-point | 小流量或依赖关键传输 | 启动延迟(\(\alpha\));跳数 | 短路径、就近直连、传输卸载 |
| Expert AllToAll | 大量并发 rank 对 | 路径利用率;出口队列深度;尾延迟 | 自适应路由、路径多样性、均衡的专家放置 |
| Checkpoint and multi-tenant traffic | 与训练流竞争突发流量 | 每类带宽;暂停时长;干扰 | 虚拟车道、QoS、准入控制 |
第 1 级:导线与链路
在评估协议与拓扑之前,必须先确立物理介质约束。网络设计的每一个决策,最终都受限于导线能够承载的内容。在 400 Gb/s 及更高扩展形态下,信号传输的物理规律对线缆长度、功耗和误码率施加了硬性限制。这些并非工程上的不便,而是塑造集群几何形状的根本性约束。
信号完整性与 PAM4
Definition 1.1: PAM4 信号编码
PAM4 信号编码 是一种用于高速机器学习集群互连结构的电调制方案,它在每个符号周期内编码两个比特,采用四个不同的电压电平,从而在不提高符号速率的前提下,使给定物理介质上可达到的数据速率翻倍。
- 重要性:PAM4 支持 400 Gb/s 和 800 Gb/s 的链路速率,能够满足大规模梯度同步所需的 \(\text{BW}\)。然而,电压电平之间间隙的缩小提高了对噪声的敏感性,因此需要前向纠错(FEC),通常是里德—索洛门 RS(544,514);在常见的高速以太网讨论中,它会给每条链路的主机侧 FEC 处理延迟增加约 100 ns (Anslow 2016年; Yin 等 2022年)。在三层胖树(每个方向三跳)中,仅 FEC 一项就可为每个数据包贡献数百纳秒的固定延迟,从而为互连结构的每条消息固定启动延迟设定了硬性下限,而 节 1.3.4 将其形式化为通信成本模型中的 \(\alpha\) 项。
- 区别:与仅使用两个电压电平、噪声裕量更好但每通道数据速率仅为 PAM4 一半的 NRZ(不归零)二进制信号编码不同,PAM4 以信噪比为代价换取带宽密度,即同一根铜质走线承载的数据量是两倍,但代价是每个端口都必须配备 FEC。
- 常见误区:一种常见误解是,将每个符号的比特数翻倍就等于获得了免费的吞吐量提升。PAM4 链路在两端都需要 FEC,因此其延迟从根本上高于等效的 NRZ 链路;对延迟敏感的集合通信(如 AllReduce)会在每个数据包上支付这一 FEC 开销,与消息大小无关。
Anslow, Pete. 2016年. RS(544,514) FEC Performance Including Precoding. IEEE P802.3cd Task Force.
从 NRZ 到 PAM4 的编码
400 Gb/s 及更高线率无法依靠更快地切换电压来实现。铜线中的信号衰减和光纤中的色散限制了符号速率(每秒信号跳变次数)的上限。高速链路通过采用 PAM4 将更多信息打包进每次跳变来突破这一限制。
然而,PAM4 中相邻电压电平之间的间隔相比 NRZ 缩小了三倍,使链路对噪声极为敏感。因此,高速链路必须在可靠检测的物理极限附近运行,并在物理层需要前向纠错(FEC),高速以太网设计中通常使用 Reed-Solomon RS(544,514) 家族码Ethernet Alliance (2025年)。FEC 处理是一个取决于实现方式的延迟项;IEEE 802.3df 运营方材料将主机侧 KP4 FEC 的约 100 ns 以及端到端模块延迟的数百纳秒视为在 AI/HPC 网络互连时间尺度上的有效量(Yin 等 2022年)。对于 175B 模型训练,其在每个步骤通过 1,024 GPUs 产生 350 GB 的梯度流量,这一延迟下限是不可妥协的。一个数据包穿越 fat-tree 中的三个交换机跳点会消耗 300 ns–600 ns 的单程 FEC 解码与编码延迟,或 600 ns–1200 ns 的三跳路径双向延迟。这一“物理税”为网络互连的固定启动延迟设定了硬性下限,并在 节 1.3.4 中形式化为 \(\alpha\) 项,从而限制了 AllReduce 等对延迟敏感的集合通信的速度,无论软件如何优化。图 5 直接展示了这一信号权衡:PAM4 相对于 NRZ 将每符号比特数翻了一倍,但更小的电压间隔降低了噪声裕量,使 FEC 成为链路延迟下限的一部分。
Yin, Shuang, Xiang Zhou, 和 Cedric Lam. 2022年. FEC Requirements for 800GbE/1.6TbE Optics: An Operator’s Perspective. IEEE 802.3df Task Force.
这一信号迁移凸显了一条关键架构规则:在不提高时钟频率的前提下将线路速率翻倍,是以信噪比换取带宽,因而要求前向纠错在接近信道极限的条件下运行。
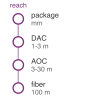
铜线与光学的传输距离与介质
物理介质的选择决定了链路在延迟、功耗和成本重新塑造集群几何结构之前能够达到的距离。线缆与光学的部署取舍下表按决定每种介质各自适用位置的关键属性,比较常见的线缆与光学选项。
| 介质 | 传输距离 | 成本特征 | 延迟影响 | 典型部署位置 |
|---|---|---|---|---|
| DAC(直连铜线) | 约 3 米 | 成本最低(约 $50),且无需光模块功耗 | 介质延迟最低;无源铜线避免了光电转换 | 机架内部 |
| AOC(有源光缆) | 3 至 30 米 | 成本较高(约 $500),源于永久集成的收发器 | 电/光转换加上前向纠错(FEC)会额外增加数百纳秒 | 机架间或行级链路 |
| 可插拔光模块 | 超过 30 米 | 模块与功耗成本最高,但光模块和光纤跳线可更换 | 光电转换与 FEC 会引入延迟;距离则提供了拓扑可达性 | 网络核心与 pod 级链路 |
对于光学链路,FEC3 是延迟预算的一部分,它使传输距离成为拓扑决策,而非简单的线缆选择。线缆与光学的部署取舍 中的比较是集群几何取舍的缩影:铜线成本低、延迟低,但使加速器彼此靠近;光学互连以更高的功耗和延迟扩展一个行或一个 pod;可插拔光模块只有在拓扑对距离的需求超过其对每跳最低成本的需求时,才需要延伸至核心。
3 FEC(前向纠错):在 400G 和 800G 速率下,信号完整性脆弱到足以使以太网 PHY 设计依赖 FEC 来重建受损比特 Ethernet Alliance (2025年)。具体延迟取决于 PHY 与模块架构;就机器学习互连建模而言,将 FEC 视为每跳延迟预算是较为保守的处理方式,因为多跳路径会在软件将其隐藏之前累积该预算。
Ethernet Alliance. 2025年. 2025 Ethernet Roadmap. Ethernet Alliance roadmap.
Systems Perspective 1.2: 距离的成本
在机器学习集群中,距离就是金钱。仅脊层就需要约 20,000 条光链路来支撑 10,000 GPUs 的集群。每条链路以 $500 的成本、每个可插拔链路 20 W 的功耗计算,仅布线成本就达到 $10 million,收发器所需的持续供电为 400 kW。成本决定了集群几何结构:架构师尽可能密集地布置加速器(每机柜 70–100 kW),以最大化廉价铜线的使用并最小化昂贵光模块的使用。
串扰均衡器、链路预算与功耗
每个端口都依赖一个串行器/解串器(SerDes) 电路,该电路将交换机专用集成电路(ASIC)中的并行数据转换为串行流。随着带宽扩展,这些电路已成为网络互连结构中的主要功耗来源。考虑一下 1,024 GPUs 集群的能量影响:为 350 GB 的梯度流量保持完整 \(\text{BW}_{\text{bisect}}\) 需要约 3,000 条高速链路。若每个 400 Gb/s 端口消耗 25 W(SerDes 与光收发模块的合并功耗),则互连部分持续消耗 75 kW,其中 10.5 percent 的集群功耗预算仅用于传输比特,而非计算这些比特。
链路预算 是对信号衰减的严格分贝(dB)额度,决定了这些链路的传输距离。信号在铜缆中传输时,会因趋肤效应和介质吸收而损失能量。链路预算等于发射机的输出功率与接收机灵敏度下限之差。对于标准 50G PAM4 通道,预算可能为 30 dB。若 3 米 DAC 线缆引入 18 dB 损耗、连接器再引入 2 dB 损耗,则仍余 10 dB 余量。然而,当频率翻倍以支持 100G 通道(对应 800 Gb/s 端口)时,每米损耗急剧增加。物理规律迫使一项严苛的权衡:为在不超过功耗预算的前提下保持信号完整性,线缆传输距离必须缩短。运行于 800 Gb/s 的铜缆链路距离上限约为 1–2 米,这在物理上限制了计算机柜的直径,并迫使任何离开机柜的连接都必须使用昂贵且高功耗的光器件。在 1.6 Tb/s 量级的规划场景中,SerDes 与光功耗可占集群能耗的很大比例,使每比特功耗成为首要的扩展约束。线缆对传输距离和速率设定了硬性上限;传输层必须在这类物理链路上构建可靠的通信原语。
第二级:传输与性能模型
大规模训练需要持续、同步的大批量数据传输。跨越 1,024 台加速器的单次 AllReduce 操作可能传输数百 TB 的梯度数据。这种模式有利于采用 RDMA 传输卸载、可靠的完成机制,以及有界的损失恢复时间。物理无损网络互连结构是实现该性能可预测性的一种途径,但它并非唯一的设计方案。
RDMA 与 GPUDirect
Definition 1.2: 远程直接内存访问(RDMA)
远程直接内存访问(RDMA) 是一种用于机器学习训练网络互连结构的网络技术,允许一台机器直接读取或写入另一台机器的内存,通过把传输处理卸载到网卡,从而绕过两端操作系统的内核和 CPU。
- 重要性:RDMA 可将端到端消息延迟从内核 TCP 路径的数十微秒降低到调优后网络互连结构的个位微秒量级,从而削减铁律中的 \(L_{\text{lat}}\) 项。对于一名参与者发送的 350 GB 载荷,GPUDirect RDMA 还能避免约 700 GB 的主机内存流量:一次写入主机 RAM,一次由网卡读回。
- 区别:与常规内核 TCP 路径不同,RDMA 将传输处理卸载到网卡硬件,并允许用户空间访问已注册的内存。由此带来的 CPU 核心与内存带宽节省取决于主机、网卡、I/O 路径、消息大小和软件配置,而不仅仅取决于链路速率。
- 常见误区:RDMA 是一种访问与卸载模型,而非某种损失恢复算法。可靠的 InfiniBand 和 RoCE 传输会检测丢包并重传 (InfiniBand Trade Association 2000年)。部分 RNIC 代际采用类 Go-Back-N 的恢复机制,使丢包代价高昂,而另一些设计则支持更强的选择性恢复,或在不依赖 PFC 的情况下容忍有损以太网 (Mittal 等 2018年)。要求是可靠的完成机制,以及同步工作负载可以承受的恢复尾迹,而非每种实现都必须具备 PFC 或物理无损以太网。
在 400 Gb/s 的链路速率下,传统的内核 TCP 路径成本日益高昂。中断处理、协议处理以及载荷拷贝可能消耗大量 CPU 时间与内存带宽,尤其是在许多流或多个网络接口卡(NIC)同时驱动一台主机时。现代 TCP 栈可以通过分段卸载、接收端扩展、零拷贝接口以及仔细的 NUMA 放置来维持高吞吐量,因此单个流并不必然耗尽双插槽服务器的内存带宽。真正的架构问题在于:主机上用于搬运网络数据所花费的资源会与训练过程竞争,并且随着聚合 I/O 的增长,资源难以被可预测地预留。
RDMA 绕过了内核数据路径。将传输逻辑卸载到 NIC 后,应用程序无需逐消息的内核干预即可读写已注册的远程内存。对于机器学习,GPUDirect RDMA4 将这一原则扩展到加速器内存 (NVIDIA 2026年a)。没有 GPUDirect 时,一个外发载荷必须先经过主机内存暂存,然后由 NIC 发送。GPUDirect 则让 NIC 通过 PCIe 对等内存路径对 GPU 内存直接进行内存访问(DMA),正如 图 6 所对比的那样。对于单个 350 GB 的载荷,避免主机回弹(bounce)可消除约 700 GB 的主机内存流量。网络仍然传输该载荷,PCIe 路径也可能由多个 DMA 事务组成;该优化移除的是暂存拷贝,而非将传输压缩为单个事务。
4 GPUDirect RDMA:由 NVIDIA 为 Kepler 级 GPU 和 CUDA 5.0 引入,GPUDirect RDMA 在 GPU 内存与第三方对等设备(如网络接口)之间建立直接的 PCIe 路径 (NVIDIA 2026年a)。GPUDirect 出现之前,每次梯度传输都必须经过主机内存暂存,消耗与数据加载竞争的 CPU 内存带宽。消除这条回弹路径,是大规模下能够与反向传播计算重叠通信的原因之一。
NVIDIA. 2026年a. GPUDirect RDMA.
InfiniBand 与 RoCE
GPU 集群通常需要在两套 RDMA 传输栈之间做出选择,而这一决策本质上是可靠性与运维之间的权衡。RDMA 传输栈的权衡 比较了各栈在无损性与拥塞控制方面承担负担的位置。
| 栈 | 互连结构行为 | 运维负担 | 典型适用场景 |
|---|---|---|---|
| InfiniBand (IB) | 专为 HPC 设计的交换式互连结构 (InfiniBand Trade Association 2000年),采用基于信用的流量控制,因此在链路层原生具备无损性 | 子网管理器 与虚拟通道(VLs) 负责路由与流量隔离 | 专用训练集群,其中可预测的尾延迟优先于以太网生态的灵活性 |
| RoCE(RDMA over Converged Ethernet) | RoCEv2 通过把 InfiniBand 传输头封装进 UDP/IP 数据包来承载 RDMA 语义 | 基于 PFC 的部署通过 PFC、ECN 和路由策略抑制丢包 (Guo 等 2016年; Gangidi 等 2024年);无 PFC 的设计则将更多负担放在端到端拥塞控制与丢包恢复上 (Mittal 等 2018年) | 多厂商以太网集群,能够承受更多的拥塞控制调优 |
5 InfiniBand:形成于 1999 年,由两项相互竞争的服务器 I/O 标准(Future I/O 与 NGIO)合并而成;InfiniBand 最初被设计为取代 PCI 作为通用系统互连。其向 HPC 网络方向的转变保留了服务器 I/O 所要求的基于信用、硬件管理的流量控制——而这一传统正是 InfiniBand 能够提供原生无损性、且不受以太网基 RDMA 互连的 PFC 脆弱性困扰的原因。
InfiniBand5 这一行反映了一种协议传统,即更看重硬件管理的无损性,而非以太网兼容性。
这一栈选择体现在协议边界上。图 7 比较了这两套栈,展示了基于 RDMA 的协议如何暴露一个用户空间的 verbs API,从而绕过内核传统的 TCP/IP 栈。
可靠的交付与丢包恢复
从 图 7 得出的关键结论是:Verbs API 提供统一的编程模型,而传输层与网络互连结构决定如何达成可靠的完成。InfiniBand 与 RoCE 的可靠连通传输均能检测丢包并重传 (InfiniBand Trade Association 2000年)。InfiniBand 通常通过链路级信用抑制缓冲区溢出丢包。许多 RoCE 部署通过 PFC 与 ECN 抑制该丢包 Gangidi 等 (2024年),但这属于部署约定,而非 RDMA 作为技术族所固有的属性。在存在丢包的以太网之上运行的设计,将更多责任交由端点拥塞控制、报文乱序与选择性恢复 (Mittal 等 2018年)。
因此,恢复粒度至关重要。对于采用 Go-Back-N 式恢复且不支持乱序保留的 RNIC,一次丢弃 900 MB(在 1 GB 传输中)可能使后续到达的报文失效,并迫使从缺失序列点重传。对于采用选择性恢复的 RNIC,重传区域更小,因此同样的物理丢包产生的尾部更短 (Mittal 等 2018年)。在 400 Gb/s 下,两种延迟都远大于单个报文在链路上的传输时间,而同步集合通信会将最慢的恢复暴露给所有等待的 rank。网络互连结构设计师可以通过抑制丢包(PFC)、采用带端点恢复有界时间的容错传输,或将拥塞控制与准入策略相结合使队列很少溢出,来缩短该尾部。每种选择都改变了状态与失效模式在交换机与端点之间的分布。
Checkpoint 1.1: 协议选型
考虑一个 2,048-GPU 训练集群,它将同时运行大语言模型训练(梯度消息为数 GB)与强化学习(频繁的小控制消息)。
The \(\alpha\)-\(\beta\) performance model
协议选型决定互连结构如何提供可靠完成并约束丢包恢复时间;性能建模随后追问它承载给定消息的速度有多快。\(\alpha\)-\(\beta\) 模型 将消息传输时间分解为 \(T(n) = \alpha + n/\beta\),其中 \(\alpha\) 为固定启动延迟,\(\beta\) 为持续带宽 (Hockney 1994年)。The α-β Communication Model 展开完整推导,并在具体消息规模下验证该模型,将传输区分为延迟主导与带宽主导;α-β 成本模型:启动税与传输费 随后将该分解应用于集合算法。拓扑选择直接改变这两个参数:胖树通过提供短且等代价的路径最小化 \(\alpha\),而环状拓扑则随集群规模放大 \(\alpha\),因为消息需要穿越的跳数随参与者数量增长 \(N\)。
Hockney, Roger W. 1994年. 《The communication challenge for MPP: Intel Paragon and Meiko CS-2》. Parallel Computing 20 (3): 389~98. https://doi.org/10.1016/s0167-8191(06)80021-9.
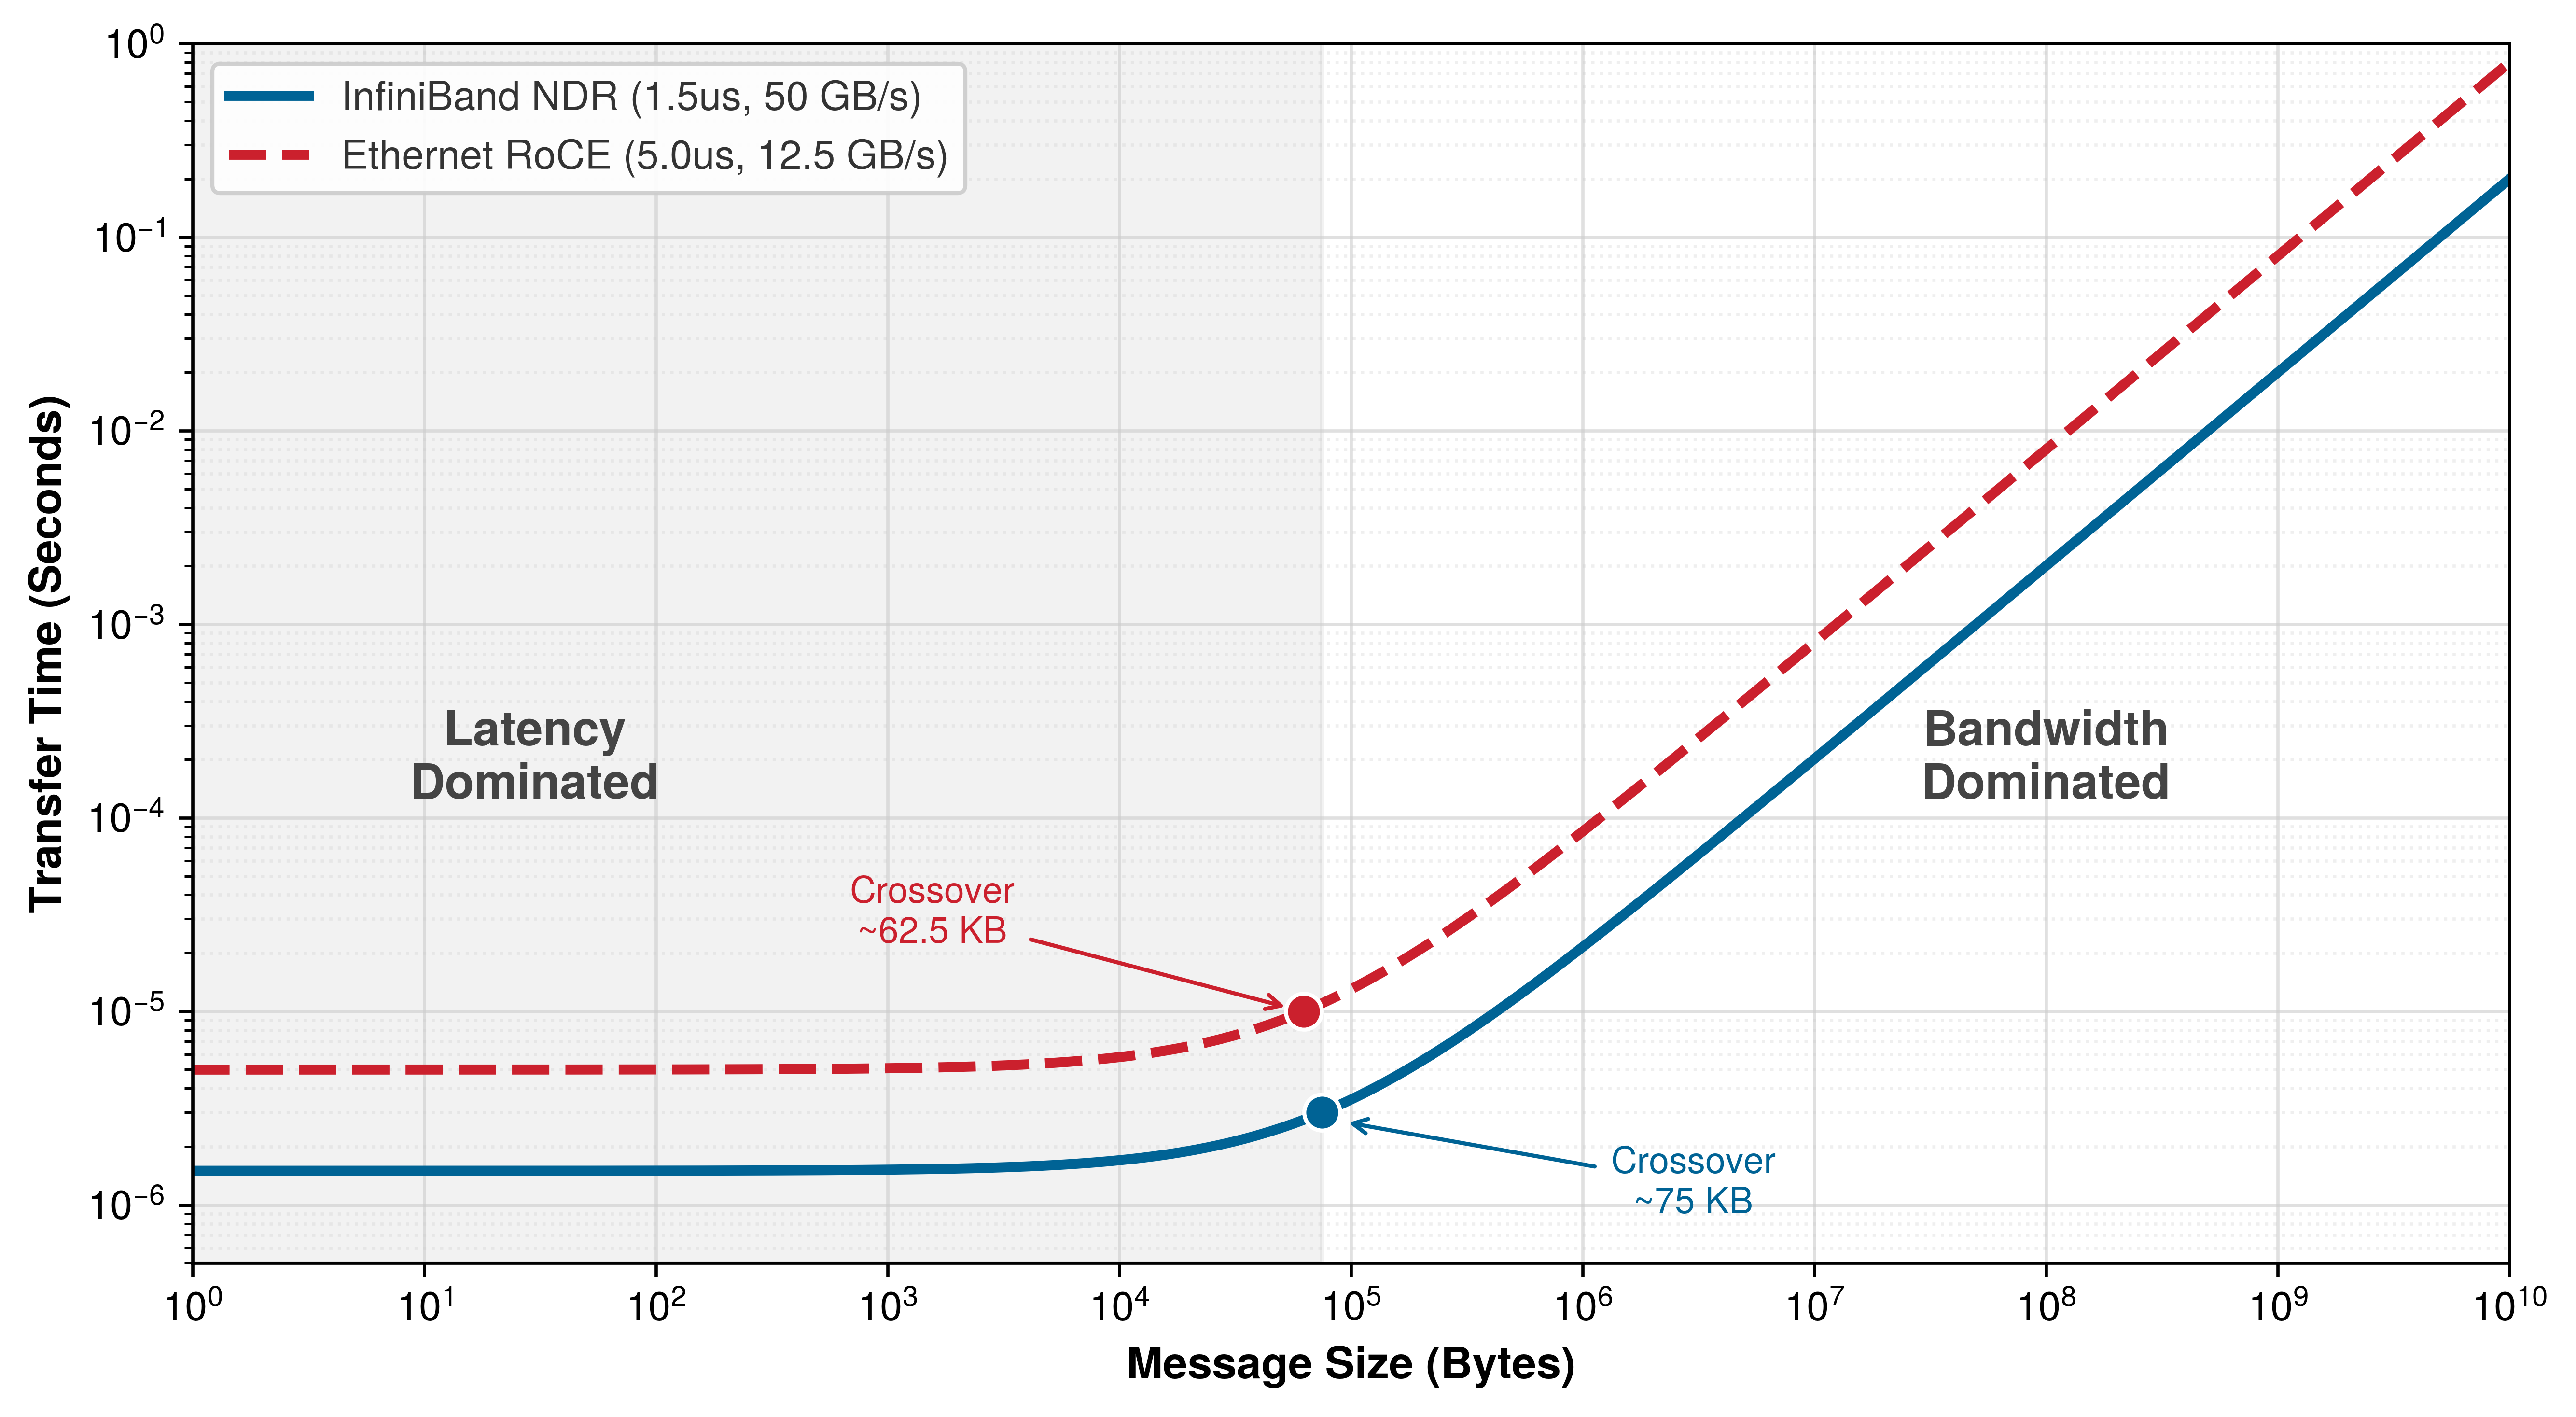
模型揭示了两种扩展形态,它们对应不同的工程应对方式。对于传输量小于 \(n < \alpha\beta\) 的消息,启动开销 \(\alpha\) 主导传输时间;小型控制消息和流水线气泡属于这一延迟受限区域。对于传输量大于 \(n > \alpha\beta\) 的消息,\(n/\beta\) 项占主导;梯度 AllReduce 属于这一带宽受限区域。
对于所建模的 NDR InfiniBand 路径,在 \(\alpha =\) 1.5 μs 和 \(\beta =\) 50 GB/s 条件下,交叉点 \(n^* = \alpha \cdot \beta \approx\) 75 KB。这些是场景参数,而非协议常数:实测启动延迟和交付带宽会随 NIC、交换机路径、软件栈以及拥塞情况而变化。小于实测交叉点的消息从更高带宽中获益有限;大于该交叉点的消息从更低延迟中获益有限。该交叉点将两种根本不同的优化策略区分开来:减少跳数以降低 \(\alpha\),或增加路径交付带宽以提升 \(\beta\)。
Napkin Math 1.1: Alpha-beta 交叉
问题:一位网络互连结构设计师正在比较一条所建模的 InfiniBand NDR 路径(1.5 μs,50 GB/s)与一条所建模的 RoCE 路径(5 μs,12.5 GB/s)。对于一条 4 KB 控制消息和一条 350 MB 梯度分片,\(T(n)=\alpha+n/\beta\) 的哪一部分占主导,以及为什么第一条路径在两种情形下分别以不同原因带来帮助?
数学: 对一条 4 KB 控制消息和一条 350 MB 梯度分片应用 \(T(n) = \alpha + n/\beta\)。
- 小消息(4 KB):
- InfiniBand:\(1.5\,\mu\text{s} + 4\,\text{KB}/50\,\text{GB/s} = 1.5 + 0.08 = \mathbf{1.58}\,\mu\text{s}\)
- Ethernet:\(5.0\,\mu\text{s} + 4\,\text{KB}/12.5\,\text{GB/s} = 5.0 + 0.32 = \mathbf{5.32}\,\mu\text{s}\)
- 结论:在这些假设的路径参数下,NDR 路径快 3.4×,因为其建模的 \(\alpha\) 更低。
- 大消息(350 MB):
- InfiniBand:\(T = \alpha + n/\beta =\) 7.0 ms
- Ethernet:\(T = \alpha + n/\beta =\) 28.01 ms
- 结论:在这些假设的路径参数下,NDR 路径快 4×,因为其建模的 \(\beta\) 更高。
系统洞见:该场景将交叉点 \((n^* = \alpha\beta)\) 置于接近 75 KB 的位置。由于梯度规模为兆字节到吉字节量级,其传输通常由带宽主导,而流水线协同可能仍处于延迟主导状态。更高的线路速率对启动项占主导的消息几乎没有收益;此时改进主要由传输处理、拓扑和跳数决定。
为了看清这一区分在实践中为何重要,考虑 175B 模型训练任务每轮迭代发送的两条消息。第一条是 4 KB 流水线调度控制消息,用于协调流水线各阶段之间的微批次交接。应用模型的开销为:\(T(n) \approx\) 1.58 μs,带宽项仅占总开销的 5.1 percent。将链路速率翻倍只能节省微不足道的几分之一微秒。对于这条消息,缩短传输时间最直接的方式是减少跳数(从而降低 \(\alpha\)),而不是购买更快的链路。
第二条消息是某一层 AllReduce 的 350 MB 梯度分片。此时,\(T(n) \approx\) 7.0 ms。延迟项完全不可见。将带宽翻倍至 100 GB/s 会使该传输时间减半,是一种直接且成比例的收益。这两个案例说明了为何网络设计必须同时兼顾 \(\alpha\) 与 \(\beta\):拓扑结构与跳数决定延迟主导区,而链路速率与路径多样性决定带宽主导区。
图 8 将这两个区间的跨越点呈现在两条建模路径的完整消息尺寸范围内。NDR 场景的交叉点约为 75 KB,而 100 Gb/s RoCE 场景的交叉点约为 62.5 KB。这些位置源自文中假设的 \(\alpha\) 与 \(\beta\) 取值,并非通用的 InfiniBand 与 RoCE 常数。在此对比中,启动延迟差值主导小消息,但在多兆字节梯度面前则微不足道。
除分类单个传输之外,同一模型还会识别通信何时超越计算。本节中的 \(\alpha\)-\(\beta\) 分析关注单个消息在单条链路上的传输时间,将网络视为点对点信道。然而,在数据并行的训练循环中,真正的问题是:整个集群上的集合 AllReduce 是否能在下一个计算步骤就绪之前完成。当梯度向量增长到足够大时,环状 AllReduce 的聚合传输时间将超过每步计算时间,网络便成为整个训练任务的速率约束。
Napkin Math 1.2: AllReduce 瓶颈阈值
问题:何时环状 AllReduce 会成为 1024-GPU H100 集群训练 GPT-2 规模及更大模型时的瓶颈?
设定:该场景假设存在 101 ms 的计算阶段,加速器利用率为 50 percent,并采用由 \(\alpha = 1.5 \;\mu\text{s}\) 和 \(\beta = 50 \;\text{GB/s}\) 建模的 NDR 路径。对于 GPT-2 规模的模型,每个 rank 贡献 6 GB 的 FP32 梯度。
数学:应用环状成本 \(T_{\text{ring}} \approx \frac{2(N-1)}{N}\frac{M}{\beta} + 2(N-1)\alpha\) 可得 \(T_{\text{ring}} \approx 242.8 \text{ ms}\)。建模出的通信占比为:
\[ \text{Comm. fraction} = 70.6 \% \]
集合通信章节推导了环状阶段与成本表达式;本章节仅使用该结果来检验互连结构能否跟上节奏。
系统洞见:将负载增加到 70 billion 情形(280 GB)后,建模出的环状时间变为:
\[ T_{\text{ring}} \approx 11192.1 \text{ ms} \]
在固定的计算假设下,通信主导了纯粹的数据并行。结论是条件性的,而非普适的模型规模阈值:并行度、梯度精度、分桶、重叠、拓扑以及实际交付的带宽都会移动这一边界。
\(\alpha\)-\(\beta\) 模型量化了单条链路的速率,但 175B 参数模型需要 1,024 GPUs 协同工作。将这些传输原语从一对节点扩展到仓库级超级计算机,需要一种网络拓扑:一种特定的连接模式,在最大化 \(\text{BW}_{\text{bisect}}\) 的同时,最小化全局集合通信的跳数与布线成本。
第三级:交换机与拓扑
物理交换机的布局决定了分叉带宽 \(\text{BW}_{\text{bisect}}\) 以及互连结构是否无阻塞。这两个属性决定了网络支持分布式训练中占主导地位的全局通信模式的程度,这一约束由分叉带宽定理(原则 4)刻画。
03 网络互连结构
第一条属性是二分带宽(bisection bandwidth),它量化了拓扑对全局集合通信所施加的最坏情况吞吐量上限。一个集群可能在边缘部署数千条高速链路,但如果交换层级中最窄处的截面容量不足,其 AllReduce 操作仍可能受到拥塞。
Definition 1.3: 二分带宽
二分带宽 是一种网络拓扑指标,定义为将集群划分为两个大小相等的半区时,跨越任意此类划分的链路总容量的最小值。它代表必须跨越该划分的流量(包括全局集合通信)在最坏情况下的吞吐量上限。
- 重要性:二分带宽 \(\text{BW}_{\text{bisect}}\) 直接决定了全局同步的集群级带宽上限。一棵 1,024 GPUs 胖树采用 400 Gb/s 链路,在 1:1 订阅比下可在每个方向提供 \(\text{BW}_{\text{bisect}} = 512 \times 50\,\text{GB/s} = 25.6\,\text{TB/s}\);而采用 4:1 超额订阅的脊柱层会将其降至 6.4 TB/s,使每个 AllReduce 步骤慢 4×,并使网络取代加速器,成为系统铁律中的主导瓶颈。
- 区别:聚合带宽是所有边缘链路速率之和,即使拓扑连通性较差,其值也可能很高;与之不同,\(\text{BW}_{\text{bisect}}\) 衡量的是全局连通性。一个星型拓扑若有 1,000 条边缘链路全部汇聚于同一台中央交换机,其聚合带宽很高,但 \(\text{BW}_{\text{bisect}}\) 受限于该交换机的背板容量。
- 常见误区:一个常见误解是,增加叶交换机总能提高 \(\text{BW}_{\text{bisect}}\)。在三层胖树中,对脊柱层进行超额订阅(每台 pod 交换机的上行链路数量少于下行链路数量)会使 \(\text{BW}_{\text{bisect}}\) 低于边缘链路总容量,无论有多少台叶交换机都是如此。
机器学习训练包含全局集合通信和 AllToAll 阶段,这些阶段可能使流量跨越拓扑划分,因此实现完整的 \(\text{BW}_{\text{bisect}}\) 是常见的性能目标。网络互连结构若无法达到这一目标,跨越最窄区段的同步流量就会在那里遇到瓶颈,导致加速器在梯度通过受限链路传输时处于空闲状态。
二分带宽是一项指标;能够在任意流量模式下提供完整 \(\text{BW}_{\text{bisect}}\) 的拓扑属性,则是网络互连结构的非阻塞性。非阻塞设计保证每一层交换机的上行容量都等于或超过下行容量,因此内部争用不会使横截面吞吐量低于其理论最大值。当网络互连结构采用超额订阅时,有效 \(\text{BW}_{\text{bisect}}\) 会按超额订阅比例下降,每次全局集合通信都会相应地按比例变慢。计算 \cap 通信 展示了如何诊断通信成为主要制约因素的扩展形态,从而在将采用超额订阅的脊柱层误判为加速器缓慢之前,将其识别为网络互连结构问题。
Definition 1.4: 非阻塞网络互连结构
非阻塞网络互连结构 是一种机器学习集群网络拓扑,其中输入与输出端口之间的任意一一配对都能同时以满线速通信,且不会发生内部争用。这通过确保每一层交换机的上行容量等于或超过下行容量来实现。
- 重要性:在机器学习集群中,非阻塞网络互连结构确保来自任意加速器子集的 AllReduce 流量不会争用共享链路,从而为全局集合通信保留完整的 \(\text{BW}_{\text{bisect}}\) 项。采用 2:1 超额订阅的脊柱层会使有效 \(\text{BW}_{\text{bisect}}\) 减半,使全局梯度的 AllReduce 时间翻倍,并相应地降低扩展效率 \(\eta_{\text{scaling}}\);在 30 percent-通信工作负载中,这会造成约 23.1 percent 的集群总吞吐量损失。
- 区别:Web 数据中心常见的超额订阅网络互连结构由许多低层节点共享高层链路,而非阻塞网络互连结构则为发送方与接收方之间所有可能的配对同时提供专用路径容量。
- 常见误区:一个常见误解是,非阻塞意味着零拥塞。如果多个发送方同时向同一个接收端口发送数据,无论内部网络互连结构的可用容量有多大,仍然可能发生端点拥塞(多对一汇聚拥塞,incast)。
胖树基于 Clos 式非阻塞网络原理,提供完整的 \(\text{BW}_{\text{bisect}}\) (Clos 1953年);轨道优化网络以牺牲部分全局路由灵活性换取更低的布线成本;蜻蜓拓扑则在减少光链路数量的同时引入工作负载放置约束 (Kim 等 2008年)。保证二分带宽与经济可扩展性之间的这一根本权衡,决定了大规模机器学习集群中的每一项拓扑选择,正如 节 1.4.2、节 1.4.3 和 节 1.4.4 中的拓扑比较所示。
机架顶部(ToR)与故障域
机架顶部(ToR)交换机是基本的物理汇聚点,既决定了带宽上限,也界定了集群的最小故障域。在采用标准 DGX 节点的高密度 AI 配置中,单个机架通常容纳 4 个节点,每个节点包含 8 个 GPU,总计 32 个加速器。ToR 交换机将这些设备连接起来,但也带来了关键的薄弱点:如果 ToR 发生故障,32 个 GPU 会立即与训练作业隔离,迫使全局调度器停止运行,并从最近一次检查点恢复。
为缓解这一边缘位置的拥塞,网络架构师会尽可能增大交换机的端口数,即其可用端口的数量。一台具有 64 个端口的高端口数交换机将 32 个下行端口分配给服务器(确保 32 个 GPU 均可获得完整带宽),并将 32 个上行端口连接至脊交换机。这种 1:1 的带宽配比保证了机架层面的无阻塞性能。对于包含 1,024 GPUs 的集群,其物理拓扑由约 32 个这样的机架组成。
同一机架边界也影响着恢复策略。作业调度器必须感知拓扑以保障性能,而可靠的副本放置策略必须将冗余状态和替代资源容量置于同一机架故障域之外,以确保单个机架失效不会导致整个训练过程失败(参见 复制位置与故障域)。
胖树(Clos)网络
ToR 在单个机架内提供无阻塞带宽,但要将 32 个机架连接成一个集群,并在所有可能的通信对之间保持完整的 \(\text{BW}_{\text{bisect}}\),就需要一种横截面容量能够随集群规模扩展的拓扑。胖树(也称为 Clos 网络)通过在各层增加并行的脊交换机来实现这一目标,使聚合上行容量始终与汇入其中的边缘总带宽相匹配。在这一术语体系中,叶交换机连接服务器或机架,脊交换机连接同一 pod 内的叶交换机,而在需要第三层时,核心交换机连接多个 pod。
Definition 1.5: 胖树
胖树是一种分层的机器学习集群网络拓扑,其中并行路径数量(以及由此形成的聚合横截面容量)沿着交换机层级向脊层方向逐层增加,从而在任意两个节点之间提供完整的 \(\text{BW}_{\text{bisect}}\) 和多条等代价路由 (Al-Fares 等 2008年)。
- 重要性:一棵 \(k\) 元胖树由端口数为 \(k\) 的交换机构建,在两层(pod)配置下支持 \(k^2/2\) 台主机,在三层配置下支持 \(k^3/4\) 台主机,并提供完整的 \(\text{BW}_{\text{bisect}}\)。当 \(k=64\) 时,两层 pod 支持 2,048 个 GPU,三层网络互连结构支持 65,536 台主机。由于每次 AllReduce 都可以使用任意可用的脊层路径,网络互连结构能够维持所有加速器同时以全速通信,满足全局梯度同步的 \(\text{BW}_{\text{bisect}}\) 要求。
- 区别:标准树的根部带宽是所有叶节点共享的单一瓶颈,而胖树将每个根节点替换为多台脊交换机,其聚合上行容量与边缘总带宽相匹配,从而消除这一瓶颈。
- 常见误区:一种常见误解是胖树能够保证零网络成本。胖树需要 \(\mathcal{O}(N \log N)\) 台交换机和密集布线:在 4,000 个 GPU 的规模下,无阻塞的三层胖树需要数百台交换机和数万根光缆,仅交换硬件的成本就达 $2,000 万至 1 亿。
Al-Fares, Mohammad, Alexander Loukissas, 和 Amin Vahdat. 2008年. 《A scalable, commodity data center network architecture》. ACM SIGCOMM Computer Communication Review 38 (4): 63~74. https://doi.org/10.1145/1402946.1402967.
叶层、脊层和核心层提供多条等代价路径,而非单个带宽超额订阅的根节点,胖树正是通过这种方式实现上述容量保证的(图 9)。
胖树6 是机器学习集群的常见默认选择,因为非阻塞设计可以在任意分区上提供完整的 \(\text{BW}_{\text{bisect}}\)。这种容量有利于全局 AllReduce,尽管环和树等实现并不要求全对全通信同时发生。该网络以分层方式构建:叶交换机(ToR)直接连接服务器,脊交换机在本地域(称为 pod)内互联所有叶交换机,核心交换机则将多个 pod 连接在一起。
6 胖树(Clos 网络):其底层多级交换理论由 Clos (1953年) 在贝尔实验室提出,目的是减少电话交换机中的机电交叉点数量。Leiserson (1985年) 在 MIT 将该概念推广为“胖树”,其中“树”之所以“胖”,是因为链路带宽向根方向增加,从而证明它可以模拟任何同等硬件容量的网络。驱动 1950 年代电话交换的成本最小化逻辑如今同样驱动机器学习集群设计:在确保全局 AllReduce 非阻塞连通性的同时,最小化交换机数量。
Clos, C. 1953年. 《A Study of Non-Blocking Switching Networks》. Bell System Technical Journal 32 (2): 406~24. https://doi.org/10.1002/j.1538-7305.1953.tb01433.x.
Leiserson, Charles E. 1985年. 《Fat-trees: Universal networks for hardware-efficient supercomputing》. IEEE Transactions on Computers C-34 (10): 892~901. https://doi.org/10.1109/tc.1985.6312192.
7 交换机基数:高端交换机(例如 NVIDIA Quantum-2)的基数可达 64 个端口,每个端口的速率为 400 Gb/s。这种端口密度使两层胖树仅需经过两跳交换机即可支持多达 2,048 个 GPU。随着模型规模向 100,000 个 GPU 迈进,提高交换机基数(至 128 或 256)、将加速器组织为更大的本地域,或接受拓扑约束,是避免增加层数及其引发的延迟和成本剧增的主要途径。
由交换机构成的胖树7 \(k\) 支持 \(N_{\text{hosts}} = k^{3}/4\) 台主机,分为三层,并且存在两种不同的两层架构[^fn-two-tier],二者仅区别在于上层是视为集群的边缘,还是视为未来核心层之下的汇聚层。
第一种架构将两层中的每一台交换机都计入主机的线速容量。使用 radix-64 交换机时,每个叶节点的端口一半用于主机、一半用于脊节点的上联,因此整个 pod 拥有 \(k^{2}/2 =\) 2,048 个主机端口。
第二种架构将上层预留为汇聚层,之后通过上联接入核心层,而不是终止主机:每个叶节点仍然提供 \(k/2\) 个主机端口,但 pod 中只包含 \(k/2\) 个叶节点,因此每个 pod 可容纳 \((k/2)^2 =\) 1,024 台主机。
这两种计数方式只是对同一批交换机采用了不同的处理方式:上层究竟是作为集群脊节点终止,还是作为 pod 的汇聚层。无论采用哪种架构,仅使用叶节点和脊节点两层就足以从容地容纳 1,024 参考集群。
一个具体的二分估计展示了超配如何迅速转化为同步延迟。
Napkin Math 1.3: 二分带宽:超额订阅的代价
问题:集群设计者正在为由 1024 GPUs 组成的集群选择“非阻塞”(1:1)胖树或“成本优化”(4:1)脊层网络。在更便宜的网络上,一次每个 GPU 数据量为 100 GB 的全归约会慢多少?
数学分析: 二分带宽(\(\text{BW}_{\text{bisect}}\))是连接集群两半的最小管道直径。 对于带宽最优的环形拓扑,ReduceScatter 加 AllGather 为每个 GPU 带来的流量因子为 \(2(N-1)/N\) = 1.998。
- 非阻塞(1:1):\(\text{BW}_{\text{bisect}} =\) 512 \(\times\) 50 GB/s \(=\) 25,600 GB/s,每个方向均如此。
- 时间:102,300 GB / 25,600 GB/s \(\approx\) 3.996 s。
- 超额订阅(4:1):\(\text{BW}_{\text{bisect}} =\) 25,600 GB/s 除以 4 = 6,400 GB/s,每个方向均如此。
- 时间:102,300 GB / 6,400 GB/s \(\approx\) 15.984 s。
系统洞见:节省核心交换机的开支会给全局同步造成 4× 瓶颈。在一台 $300M 超级计算机上,如果通信占训练过程的 30 percent,这一瓶颈就会因计算资源闲置而浪费约 $142.1M,与本节的二分带宽瓶颈模型相符。对于训练而言,网络超额订阅得不偿失。
这一超额订阅计算将拓扑定义转化为设计规则:每一层的订阅比例决定了胖树能否持续支撑全局集合通信。
Checkpoint 1.2: 胖树拓扑
以下问题用于检验是否理解分层交换网络互连结构中的权衡:
要扩展到更大规模,就需要采用带有核心交换机的三层架构,使网络互连结构能够连接 65,536 台主机,但规模的增加也会带来成本和延迟。一个非阻塞的 \(k=64\) 三层树在核心层、汇聚层和边缘层总共需要约 \(5k^2/4 \approx\) 5,120 台交换机;按每台交换机 $10,000 至 $50,000 计算,仅交换层的成本就达 $50M 至 $250M。典型的跳数 也会从 pod 内流量的 2 跳(叶—脊—叶)增加到 pod 间流量的 4 跳(叶—脊—核心—脊—叶),在数千次同步步骤中,为 \(\alpha\) 延迟项增加串行化延迟和交换机处理时间。轨道优化拓扑通过使物理布线模式与集合通信模式相匹配,来应对这两方面的压力。
轨道优化拓扑
轨道优化拓扑从通信模式出发,而非从通用的交换机层级结构出发。在加速器密集型节点中,可以根据 GPU 在节点内的插槽位置将其分组为轨道;图 10 具体展示了这种物理布线模式。
布线模式通过专用轨交换(rail switch)而非共享 ToR 交换机,将各节点间对应的 GPU 连接起来(GPU 0 连 GPU 0,GPU 1 连 GPU 1)。这一点很重要,因为数据并行会产生一种确定性强且高度分层的通信模式,而标准拓扑结构无法有效利用它。当张量并行组保持在每个节点内部时,每个副本会把对应的模型分片分配给相同的本地 GPU 秩(rank)。秩是分布式运行时分配的 worker 或 GPU 索引,因此某节点上的 GPU 0 会与其他节点上的 GPU 0 同步该分片的梯度,但很少与 GPU 1 同步。一种经过轨优化的拓扑通过将这些同秩通信路径隔离到专用网络,在物理上固化了这一逻辑。具体而言,网络不再将节点内全部 8 个 GPU 连接到同一个 ToR 交换机,而是将整个集群中所有 GPU 0 连接到专用“Rail 0”交换结构,所有 GPU 1 连接到“Rail 1”,依此类推。一个简单的跳数估算即可体现其收益。
Napkin Math 1.4: 优化后的股线
问题:一个团队正在跨 128 nodes 同步按 rank 划分的数据并行梯度。在标准胖树中,同一 rank 的 GPU 之间的每条消息都要经过其源叶交换机、脊交换机和目的叶交换机(3 次交换机穿越)。在优化后的股线网络中,所有对应的 GPU 都位于同一股线交换机上(一次穿越)。优化后的股线设计能带来多少延迟红利?
数学: 通信延迟(\(\alpha\))与交换机穿越次数成正比。
- 标准延迟:3 次穿越\(\times\) 0.6 μs = 1.8 μs。
- 优化后的股线:1 次穿越\(\times\) 0.6 μs = 0.6 μs。
- 结果:3× 更低的延迟。
系统洞见:对于同步数据并行 AllReduce(训练步骤每轮迭代都要等待它),3× 的延迟降低相当于 80% 与 95% 之间的扩展效率差异。扩展效率上界(原则 8)解释了这一点为何重要:将网络物理结构与模型的同 rank 流量模式对齐,消除了对带宽需求最迫切的通信所承担的脊线开销。A 型架构之所以取得性能,是因为其结构经过精心设计,而不仅仅是规模庞大。
正是这种同 rank 延迟红利,使得股线模式出现在大语言模型(LLM)训练集群中,而不再仅仅是一种布线优化。A 型工作负载直接利用了这一结构,因为 3D 并行性产生了与股线布线方向一致的流量模式。
Lighthouse 1.1: A 型架构(GPT-4/Llama-3):优化后的股线集群
A 型架构对 3D 并行性 的使用产生了两种方向相反的流量模式:(1)用于数据并行的海量、高带宽梯度的平均操作,以及(2)用于张量并行的高频、对延迟敏感的激活量交换。优化后的股线设计确保数据并行流量在节点之间仅穿越单个交换机跳点,从而最小化原本会阻塞同步训练循环的延迟。
这种对齐在集群规模上具有可量化的工程后果。由于节点中的每个 8 GPU rank 在数据并行 AllReduce 期间只与其他节点上的同一 rank 通信,股线拓扑将集群划分为 8 个彼此独立的交换机网络,它们可以并发运行而不会产生争用。
对于跨越 1,024 GPUs 的、覆盖 128 nodes 的集群,这会形成 8 个每个包含 128 GPUs 的并行网络,使得同步数据并行所需的逐 rank 数据并行 AllReduce 流量只需穿越单个交换机跳数,而无需标准胖树所要求的 leaf-spine-leaf 多跳路径。该延迟收益对于同步数据并行频繁提出的、带宽需求高的梯度交换而言十分显著。然而,这种架构引入了尖锐的权衡:必须到达不同 rank GPU 的流量(例如 mixture of experts (MoE) 中的专家路由,或未能与导轨布线对齐的流水线阶段交接)需要跨越导轨进行桥接。因此,大规模集群通常采用混合方案:为同 rank 数据并行流量使用针对导轨优化的 leaf,同时用完整胖树 spine 桥接导轨,以支持跨 rank 通信模式。
Checkpoint 1.3: 导轨优化网络
以下问题用于检验是否清晰理解了针对特定工作负载的网络设计权衡:
Dragonfly 与环面替代方案
Dragonfly8 拓扑将高扇出路由器组织为全连接组,并由全局光链路连接。在 Kim 等 (2008年) 分析的均衡配置中,\(a=2p=2h\),其中每个组包含 \(a\) 个路由器,每个路由器拥有 \(p\) 个终端端口和 \(h\) 条全局通道。因此,全局带宽是一个设计参数,而非聚合注入带宽的固定百分比。跨越组的作业性能取决于所选的 \(p/h\) 比值、路由方式与流量矩阵,因此该拓扑并不隐含普遍的 2–4\(\times\) 倍 slowdown。
8 Dragonfly 拓扑:由 Kim 等 (2008年) 在 ISCA 2008 提出,dragonfly 将高扇出路由器分组为全连接的“超级节点”。对于至少 16,000 个终端的系统,该架构相比同等带宽的折叠 Clos 可实现 52 percent 的网络成本降低,但全局光链路的过度订阅可能在 MoE token 路由期间造成 AllToAll 瓶颈。
Kim, J., W. J. Dally, S. Scott, 和 D. Abts. 2008年. 《Technology-Driven, Highly-Scalable Dragonfly Topology》. 2008 International Symposium on Computer Architecture, 77~88. https://doi.org/10.1109/isca.2008.19.
环面 拓扑将每个节点直接连接到多维网格中的邻居,最常见的是 3D 环面,其中每个节点连接到其六个相邻节点(上下、左右、前后)。该设计以最小的交换硬件提供完整的本地带宽,因为连接只需 1–2 跳即可到达邻居。然而,全局通信需要穿越网格直径(\(\mathcal{O}(N^{1/3})\) 跳),导致延迟随集群规模增长不良。Google 采用该架构用于其 Tensor Processing Unit (TPU) pod,因为 Transformer 训练主要由数据并行和流水线并行主导,二者均采用近邻通信模式,能够自然地映射到物理网格。该局限性在使用 MoE 时显现出来,而 MoE 依赖 AllToAll 通信模式。在环面上,这些随机置换会拥塞网格有限的 \(\text{BW}_{\text{bisect}}\),并使其性能劣于非阻塞交换结构。
当针对大规模部署进行量化时,这些拓扑之间的权衡便十分明显。考虑一个 4,096-GPU 集群:在此规模下,由 radix-64 交换机构建的非阻塞胖树需要数百个交换机(两个 2,048-GPU pod 加一个桥接核心层),以及数万条光缆,以提供 100 percent \(\text{BW}_{\text{bisect}}\),从而让任意 GPU 以全速与其他任意 GPU 通信。连接相同节点组的 3D 环面可能使用零个外部交换机(依赖主机到主机直连),且仅使用短铜缆,但只提供 \(\text{BW}_{\text{bisect}}\) 的一小部分(随 \(N^{2/3}\) 缩放)。架构选择源于工作负载的规整性。Google 的 TPU Pods 采用环面拓扑,因为其工作负载(主要是 Transformer 训练)可预测,且结构化的网格能够高效支持映射到 3D 网格的集合通信算法(ring AllReduce、AllGather、ReduceScatter)。通用 GPU 集群则往往更青睐胖树,因为其工作负载更加多样,从推荐系统到图神经网络,且高度依赖需要树才能提供的完整 \(\text{BW}_{\text{bisect}}\) 的全局 AllReduce 模式。环面可节省数百万美元的交换机成本,却 rigidly 限制了软件;胖树成本更高,但提供了通用 AI 研究所必需的普适性。
图 11 给出了一个基于上述带宽与成本假设的示例性比较。定量结果取决于 radix、端点数量、链路速率、路由方式与设备成本;拓扑名称本身并不能单独决定 bisection bandwidth 或每 Gb/s 的成本。
仅做二分分析会假设只有一种工作负载类型。实际上,集群会承载多种工作负载,其通信模式各不相同,因此拓扑选择必须兼顾这些相互竞争的需求。
Checkpoint 1.4: 为你的工作负载选择拓扑
网络拓扑的选择决定了训练效率的上界。先通过把每种单工作负载模式匹配到其理想拓扑来热身,然后设计一种必须同时承载多种工作负载的互连结构。
单工作负载选型
面向混合集群的设计
你正在为一个新的大语言模型集群设计网络,该集群将运行两项主要工作负载:(1) 使用三维并行(张量并行、流水线并行和数据并行)训练一个 175B 参数的语言模型;(2) 服务一个高度依赖 AllToAll 通信的专家混合模型,以便将 token 路由到正确的专家。
拓扑为 1,024 GPUs 集群的通信提供了结构上的容量,但仅有结构并不能保证性能。当所有 1,024 GPUs 同时向网络互连结构注入 350 GB 的梯度流量时,这种理论容量便会受到网络互连结构行为的现实制约:拥塞控制与路由动态决定了这些流量在 BSP 模型的严格同步要求下是顺畅传输,还是陷入阻塞。
第 4 层:网络互连结构行为(拥塞、路由)
由于拥塞,实际网络互连结构无法达到理论上的全 \(\text{BW}_{\text{bisect}}\),而且这种拥塞对机器学习集群的影响与对通用网络的影响存在本质区别。节 1.1 中引入的 BSP 屏障正是造成这种差异的原因:Web 流量具有随机性和异步性,因此一个用户遭遇 50 ms 的延迟不会拖累其他数千名用户;但在 BSP 下,网络互连结构中最慢的数据流决定了整个集群的迭代时间。如果 10,000 条链路中有一条发生拥塞,且其延迟翻倍,那么整个超级计算机在该步的有效吞吐量都会下降。在这种同步形态下,尾延迟是主导性能的约束,而非用于衡量异常情况的指标。
Definition 1.6: 大规模同步并行(BSP)
大规模同步并行(BSP) 是一种并行执行模型:每个工作节点完成本地计算阶段,与所有其他工作节点交换数据,然后在全局屏障处等待,直到所有工作节点到达屏障后才能开始下一阶段,因此最慢的参与者决定了整个集群的推进速度。
- 重要性:BSP 使系统效率 \(\eta_{\text{scaling}}\) 与最慢工作节点的速度直接成正比:如果一个包含 1,024 个 GPU 的集群中有一个 GPU 因热降频或网络抖动而慢了 10%,屏障就会让其余 1,023 个 GPU 在该步相应比例的时间内停滞,每次迭代实际浪费约 102 个 GPU 步的计算量。在 $3/GPU-hour, a 5 percent straggler gap across a $50M 的训练运行中,闲置加速器时间造成的浪费约为 $2.5M。
- 区别:异步并行允许工作节点使用先前步骤中的过期权重继续执行,而 BSP 在每个屏障处强制进行全局状态更新,从而保证与单设备训练在数学上等价,并提供可预测的收敛行为。
- 常见误区:一种常见误解是,BSP 的效率低于异步模型。异步训练往往需要更多的总步数才能收敛,因为过期的梯度更新会引入噪声;在实践中,采取精细的慢节点缓解措施后,BSP 通常能比异步方案用更短的实际时间达到相同的损失值。
因此,决定训练网络互连结构性能的指标是尾延迟(p99),而非平均吞吐量:一个拥塞的交换机端口就会使屏障停滞,而屏障又会使整个集群停滞。因此,将尾延迟控制在一定范围内的机制成为网络互连结构行为的核心关注点。
优先级流量控制(PFC)
BSP 的最弱环节特性意味着,即使只丢失一个数据包,也可能触发重传超时,使全局屏障停滞数毫秒;对于每个计算步仅需数十毫秒的训练循环而言,这段时间极其漫长。RoCEv2 网络互连结构通过优先级流量控制(PFC) 缓解这一问题,并以无损模式运行:网络互连结构利用链路层背压机制,在任何缓冲区达到饱和之前暂停上游发送方,从而避免交换机缓冲区溢出并丢包 (Guo 等 2016年; Gangidi 等 2024年)。
Definition 1.7: 优先级流量控制
优先级流量控制(PFC) 是 RoCEv2 机器学习集群网络互连结构使用的一种链路层机制:当端口的队列深度超过配置的阈值时,向上游发送方发送 PAUSE 帧,按优先级限制流量注入,从而在不丢包的情况下防止交换机缓冲区溢出。
- 重要性:在基于 PFC 的 RoCEv2 部署中,PFC 是无损以太网服务的基础。PFC PAUSE 帧必须在缓冲区溢出之前,于一个往返时间内到达上游发送方(在交换机之间的距离下约为 1–5 μs)。在一个包含 1,000 个节点的集群中,单个慢速接收方就可能触发 PAUSE 帧,使其在 10–50 ms 内向上游传播 3–5 跳,阻断数千对无关 GPU 之间的梯度流量,并使集群吞吐量骤降至接近零。
- 区别:标准 IEEE 802.3 流量控制会暂停链路上的所有流量类别,而 PFC 按优先级类别进行控制,仅暂停拥塞的梯度数据队列,同时允许对延迟敏感的控制消息继续传输。
- 常见误区:一种常见误解是,PFC 能够解决拥塞。它将丢包转化为拥塞扩散:单个收发器发生故障后,背压级联可能在 200 ms 内冻结整个网络互连结构,因为没有机制限制 PAUSE 帧在网络中的传播距离。
PFC 的危险在于其级联特性。当交换机端口的缓冲区填满时,它会向上游发送 PAUSE 帧,这可能将拥塞转移至上游交换机,并触发另一个 PAUSE 帧。因此,慢速接收方、路由热点或真正的扇入突发都可能使与原始队列无关的链路暂停。这种行为称为拥塞扩散,受影响的无关数据流称为受害流,这是基于 PFC 的无损以太网的主要运行风险。真正的多对一汇聚是其中一种触发因素,但并非每种集合通信都固有的特征:带宽最优的环形通信以点对点方式交换数据。多个环形数据流仍可能在共享出口或超额订阅的割集处发生竞争,即使没有单个逻辑上的聚合接收方,也会形成热点。图 12 单独展示了真正的扇入情形。

一个被暂停的接收方就能冻结无关的数据流。
一起生产事故表明,这种级联可能使整个集群陷入冻结。
War Story 1.1: 微软的 PFC 死锁(2016 年)
背景:微软研究院一支由 Chuanxiong Guo 领导的团队在微软各数据中心部署了 RoCEv2,以支持对延迟敏感的服务;这些数据中心组成了规模达数万台服务器的集群。他们的设计通过 PFC 提供无丢包网络互连结构,团队还开发了一种基于 DSCP 的 PFC 机制,将部署范围扩展到 VLAN 边界之外 (Guo 等 2016年)。
机制:PFC 与以太网泛洪相互作用,形成了循环缓冲区依赖。一台故障服务器的 IP 地址与媒体访问控制地址之间的映射不完整,导致上游交换机向所有端口泛洪无丢包数据包;随后,PFC PAUSE 帧响应泛洪流量向上游传播,形成由暂停的缓冲区组成的闭环。
影响:整个集群的流量完全停滞,所有节点间通信冻结,整个集群无法响应。
修复:微软禁止广播和组播流量进入无丢包流量类别,并在对应 ARP 条目不完整时丢弃无丢包数据包,而不再回退到泛洪。
系统启示:PFC 拥塞扩散是超大规模无丢包以太网的一项结构性弱点。RoCE 网络互连结构需要严格管理数据包类别、监测 PFC 暂停遥测数据,并设置硬件级防护措施,因为原本用于避免丢包的机制本身可能成为故障模式。基于 RoCE 构建的机器学习训练网络互连结构直接继承了这一风险:单条过期的 ARP 条目就可能引发级联的 PFC 风暴,使数千个 GPU 参与的训练任务停滞,此时集群看似健康,工作节点之间却没有梯度流动。
Guo, Chuanxiong, Haitao Wu, Zhong Deng, Gaurav Soni, Jianxi Ye, Jitendra Padhye, 和 Marina Lipshteyn. 2016年. 《RDMA over Commodity Ethernet at Scale》. Proceedings of the 2016 ACM SIGCOMM Conference, 202~15. https://doi.org/10.1145/2934872.2934908.
组件暴露量计算量化了集群预计出现至少一个性能退化收发器的频率;它本身并不能估计 PFC 风暴发生的概率。
Napkin Math 1.5: 至少一个收发器发生性能退化的概率
问题:一个 4096-GPU RoCE 集群正在运行。如果每个收发器每天发生性能退化的概率为 0.001 percent,那么在给定的一天中,至少一个收发器发生性能退化的概率是多少?
数学计算: 假设各收发器的性能退化事件相互独立,且各设备的发生概率相同。
- 总暴露量:4096 \(\times\) 3 link tiers = 12,288 条链路,即 24,576 个收发器。
- 没有收发器发生性能退化的概率:\(\Pr(\text{no degradation}) = (1 - 0.00001)^{24,576} \approx 0.782\)。
- 至少一个收发器发生性能退化的概率:\(\Pr(\text{at least one degradation}) = 1 - 0.782 = \mathbf{0.218}\)(约为 21.8 percent)。
系统洞见:在这些假设下,大型 RoCE 集群每天至少出现一个性能退化收发器的概率为 21.8 percent。这一结果说明了采用硬件遥测和自动修复的必要性,但要估计整个网络互连结构陷入停滞的风险,还需要知道一次性能退化触发并传播 PFC 风暴的条件概率。
无丢包网络互连结构的隐患:死锁环路、风暴与看门狗恢复
尽管优先级流量控制营造了物理层无丢包的假象,但依赖链路层背压会引入能够容忍丢包的分组交换网络中不存在的结构性故障模式。当交换机队列无法通过丢弃数据包来缓解拥塞时,压力便会沿网络图向上游传播,造成两种不同的超大规模故障模式:信用死锁和 PFC 风暴。
Definition 1.8: PFC 信用死锁与循环缓冲区依赖
PFC 信用死锁 是一种永久性的分布式锁死状态:一组交换机端口队列形成闭合的依赖环,每个队列都持有发往下一个队列的数据包,同时又因来自同一个下游队列的背压而暂停。
- 重要性:一次信用死锁就会使所有参与端口及其上游链路上的流量永久停滞,需要人工干预,或由看门狗在超时后丢弃数据包,才能恢复。
- 区别:PFC 风暴是由数据排出缓慢的端点触发的暂时性背压级联;信用死锁则是静态的、能够自我维持的拓扑环,即使停止注入流量也无法自行解除。
- 常见误区:认为多级 Clos(胖树)网络互连结构天然不会发生死锁。动态多路径路由、链路故障和地址解析泛洪都可能在交换机的不同层级之间引入循环转发依赖。
信用死锁的图论机制
在无丢包网络中,交换机向下游缓冲区 \(B_j\) 转发数据包的前提是 \(B_j\) 未满;否则,它会将数据包保留在上游缓冲区 \(B_i\) 中,等待可用信用或暂停状态解除。有向的缓冲区依赖图 \(G = (V, E)\) 将这一关系形式化:
- 每个顶点 \(B_k \in V\) 表示交换机端口处的数据包缓冲区或虚拟通道队列。
- 当当前占据缓冲区的数据包必须获得其路由路径上的后续缓冲区才能继续前进时,便存在一条有向边 \((B_i, B_j) \in E\),其中当前缓冲区为 \(B_i\),所需的后续缓冲区为 \(B_j\)。
当且仅当缓冲区依赖图包含有向环时,才会发生 PFC 信用死锁(定义 1.8),其判定依据是 公式 1 中的循环依赖条件:
\[B_1 \to B_2 \to \dots \to B_k \to B_1 \tag{1}\]
当环中每个缓冲区的占用量都超过其配置的暂停阈值时,每个端口都会向其前驱端口发送 PFC PAUSE 帧。由于任何缓冲区都无法将数据包转发到已暂停的后继缓冲区,因此所有缓冲区都无法排空,也没有任何端口能够撤销其 PAUSE 信号。整个环永久陷入停滞。
在生产环境的 AI 网络互连结构中,死锁通常由以下三种运行事件触发:
- 瞬态路由环路:在链路故障或 BGP 收敛期间,相邻交换机的路由表可能暂时不一致,导致数据包进入多跳转发环路。在允许丢包的 IP 路由中,此类数据包会不断循环,直到其生存时间(TTL)耗尽后被丢弃。在采用 PFC 的无损网络中,环路会迅速填满交换机缓冲区,使整条路径陷入无法恢复的信用依赖环。
- 组播与广播泛洪:微软的超大规模系统事故(实战案例 1.1)表明,地址解析请求或被泛洪转发的未知单播数据包会复制到所有端口,可能使出口缓冲区不堪重负,导致暂停帧形成环路并反过来影响交换机的共享内存。
- 非树形物理链路与故障切换路径:叶交换机之间的同级交叉连接或不对称的故障切换路径可能违反严格的分层路由规则,在交换机的不同层级之间形成环路。
PFC 风暴与受害流
与静态拓扑环路不同,PFC 风暴 是一种动态的、失控的放大现象。单个“慢速接收端”——因内存总线饱和、操作系统抢占,或因收发器性能退化而出现误码率升高的加速器——无法以线速接收并处理数据包。
与其相连的机架顶部(ToR)交换机队列被填满,并向发送方发送 PAUSE 帧。由于多端口交换机通过共享数据包缓冲区汇聚来自多个来源的流量,被暂停的队列会阻碍为无关数据包分配缓冲区(队头阻塞)。随后,上游叶交换机的缓冲区也被填满,并向所有相连的脊交换机发送 PAUSE 帧。在数十毫秒内,暂停帧在整个多层网络互连结构中级联传播,使从未与最初停滞的工作节点通信过的节点对之间的流量也被暂停。这些受影响的数据流称为受害流。
看门狗恢复与允许丢包的替代方案
为了在不重启物理交换机的情况下从死锁中恢复,现代以太网交换机操作系统实现了 PFC 看门狗定时器:
- 检测:交换机持续监测每个队列的 PAUSE 状态持续时间。如果某个队列的暂停时间超过配置的阈值 \(T_{\text{watchdog}}\)(通常为 \(50\text{--}200\text{ ms}\)),交换机便判定发生了死锁或慢速接收端异常。
- 缓解:看门狗触发后,会禁用该队列上的 PFC,并通过丢弃数据包清空缓冲区,直到队列为空。
- 系统层面的权衡:看门狗能够成功打破死锁环路,但将无损流量转变为丢包流量会迫使传输层启动恢复机制。在采用 Go-Back-N 恢复机制的 RoCEv2 部署中,一个数据包被丢弃就会使其后所有在途数据包失效,触发重传超时,导致同步全归约集合通信停滞数十毫秒。
这种系统性脆弱性正推动超大规模运营商转向下一代架构,例如超以太网联盟(UEC)(Ultra Ethernet Consortium 2025年) 提出的架构(详见 节 1.9.1),以及可容忍丢包的 RDMA 设计 (Mittal 等 2018年)。现代网络互连结构将覆盖所有多路径链路的数据包喷洒、线速数据包裁剪与硬件加速的选择性重传相结合,彻底消除了对链路层 PFC 的需求,从设计上防止死锁和风暴发生。
主动拥塞控制:DCQCN 与 HPCC
为了避免使用 PFC 暂停这种粗粒度手段,高性能网络互连结构依靠主动拥塞控制,在缓冲区溢出前调节注入速率。在 BSP 工作负载中,主动控制是一项延迟要求,而非可选的吞吐量优化。如果单个数据包因交换机队列拥塞而延迟,整个集群都必须等待这一拖慢整体进度的任务完成同步步骤。网络的尾延迟实际上就成了训练作业的平均单步耗时。
首个广泛部署的解决方案 DCQCN,9 使用 ECN,以反应式反馈回路的方式运行 (Zhu 等 2015年)。当交换机的队列深度超过配置的阈值时,交换机会标记数据包头部中的 ECN 位。接收方通过拥塞通知数据包(CNP)将该标记回传给发送方,促使发送方使用乘法减小算法降低注入速率。DCQCN 得到了广泛支持,但生产环境中的 AI 集合通信暴露出一个调参问题:ECN 阈值和 NIC 固件行为可能需要在避免 PFC、吞吐量、可观测性和尾延迟之间进行权衡,而无法提供一个稳定的最优解 (Gangidi 等 2024年)。
9 DCQCN(数据中心量化拥塞通知):由 Zhu 等 (2015年)(微软和 Mellanox)在 SIGCOMM 2015 上提出,面向大规模 RDMA 网络互连结构。其基于二值 ECN/CNP 信号的反馈回路比使用丰富遥测信息的方案更易部署。然而,它使训练集合通信的调参过程变得复杂而敏感:Meta 在 2024 年的 RoCE 部署表明,激进的 ECN 标记会减少 PFC 暂停,却会延长集合通信完成时间 (Gangidi 等 2024年)。
Zhu, Y., H. Eran, D. Firestone, C. Guo, M. Lipshteyn, Y. Liron, J. Padhye, S. Raindel, M. H. Yahia, 和 M. Zhang. 2015年. 《Congestion Control for Large-Scale RDMA Deployments》. ACM SIGCOMM Computer Communication Review 45 (4): 523~36. https://doi.org/10.1145/2829988.2787484.
Gangidi, Adi, Rui Miao, Sandeep Hebbani, Gaya Nagarajan, Omar Baldonado, Lixin Gao, Hany Morsy Goes, 等. 2024年. 《RDMA over Ethernet for Distributed AI Training at Meta Scale》. Proceedings of the ACM SIGCOMM 2024 Conference, 56~69. https://doi.org/10.1145/3651890.3672233.
10 HPCC(高精度拥塞控制):由 Li 等 (2019年)(阿里巴巴)在 SIGCOMM 2019 上提出。HPCC 用逐数据包的网络内遥测(INT)替代二值 ECN 信号,使发送方能够在一个 RTT 内调整注入速率,防止多对一汇聚流量导致队列积压。系统层面的权衡在于硬件依赖:它需要能够以线速附加 INT 元数据的可编程交换机 ASIC。
Li, Yuliang, Rui Miao, Hongqiang Harry Liu, Yan Zhuang, Fei Feng, Lingbo Tang, Zheng Cao, 等. 2019年. 《HPCC: High Precision Congestion Control》. Proceedings of the ACM Special Interest Group on Data Communication (SIGCOMM), 44~58. https://doi.org/10.1145/3341302.3342085.
一种更精确的替代方案 HPCC,10 使用网络内遥测(INT) 来解决这种不透明性 (Li 等 2019年)。交换机不再仅标记一个比特位,而是在每个数据包头部附加精确的元数据:当前队列深度、链路利用率和时间戳。发送方获得完整的网络状态视图,从而能够在一个往返时间(RTT)内计算出准确的允许传输速率。基于精确遥测而非二值信号进行响应,使 HPCC 能够在所评估的、以多对一汇聚流量(incast)为主的工作负载中减少队列积压并降低尾延迟方差。主要的权衡在于硬件支持:DCQCN 可在支持 ECN 的标准以太网交换机上运行,而 HPCC 需要能够以线速添加 INT 元数据的可编程交换机。
自适应路由
ECMP11 等静态路由协议通过对流的头部字段进行哈希,将流量分配到固定路径上。这种方法适合大量小流,但对于 ML 训练中典型的少量大象流,可能产生持续的哈希碰撞。考虑一个具有 4 条等成本路径和 8 条大型梯度流的场景。均匀分配会使每条链路承载 2 条流。静态哈希却可能将 4 条流分配到同一条链路上,同时让另一条链路闲置。在同步训练步骤中,过载链路将决定完成时间,并可能使该场景中的有效带宽减半。
11 ECMP(等成本多路径):ECMP 通过对五元组(源/目的 IP、源/目的端口、协议)进行哈希来选择路径,这意味着同一条流始终经过同一条路径。这种确定性有利于保持数据包顺序,却对 ML 不利。由于单个 AllReduce 环会产生少量持续存在的流,哈希碰撞并非短暂的统计事件,而是贯穿整个训练过程的持续热点。
12 数据包喷洒:标准以太网通过哈希将每条流映射到单一路径,以避免乱序;数据包喷洒则将同一条流中的各个数据包发送到多条路径上。当传输机制能够容忍乱序或恢复数据包顺序时,这可以改善 AllReduce 大象流的 \(\text{BW}_{\text{bisect}}\)。超以太网联盟(UEC)的规范设计明确包含多路径数据包喷洒和灵活的顺序机制,以减轻 AI/HPC 流量的 ECMP 碰撞问题 (Ultra Ethernet Consortium 2025年)。
Ultra Ethernet Consortium. 2025年. Ultra Ethernet Specification v1.0. Ultra Ethernet Consortium.
自适应路由 允许交换机根据实时队列深度动态选择输出端口,而非依赖静态哈希,从而缓解这一问题。具体实现取决于协议:InfiniBand 网络互连结构执行数据包级自适应路由,将各个数据包喷洒12到所有可用通道上,因为硬件传输机制保证数据包在目的端按序交付。
以太网网络互连结构通常采用 流片交换,仅在检测到足够长的时间间隔时才为数据包突发重新选择路由,以避免数据包乱序带来的性能损失。这一机制对 MoE 模型至关重要。与可预测的环形 AllReduce 模式不同,MoE 模型在专家并行组内的各个 rank 之间使用 AllToAll 通信。64 个专家并行 rank 之间的密集交换,在排除自传输后,最多包含 \(64(64-1)=4{,}032\) 个有向远程 rank 对;实际活跃流量取决于专家布局和 token 路由的稀疏性。在静态 ECMP 下,这些流之间的碰撞可能造成拖后腿的慢任务,因此自适应路由有助于将流量分散到网络互连结构的 \(\text{BW}_{\text{bisect}}\)。
ML 中的多对一汇聚问题
拥塞控制和自适应路由管理穿越网络互连结构内部的流。另一种失效模式发生在边缘:无论网络互连结构内部提供多少容量,流量模式本身都会使单个端口不堪重负。
Definition 1.9: Incast
Incast 是一种多对一的机器学习集群流量模式,其中大量发送方同时向单个接收端口传输数据,将来自多个来源的线速流量汇聚到同一个交换机队列中,即使整个互连结构的其他部分都不拥塞,也会造成缓冲区溢出。
- 重要性:扁平聚合、同步存储读取,或其他扇入阶段都可能将大量发送方导向同一个接收方。在本例刻意构造的最坏情况下,256 个发送方各自以 50 GB/s 的速率向同一个交换机出口传输,产生 12.8 TB/s 的 offered load,而端口容量为 400 Gb/s。在给定假设下,32 MB 缓冲区会在约 2.5 μs 后发生溢出。该例子是一个压力上界,而非环 AllReduce 的流量矩阵。
- 区别:与一般的拥塞(发生在共享内部链路上,当聚合流量超过链路容量时)不同,incast 属于端点瓶颈:即使每一条内部 spine 和 leaf 链路都完全无拥塞,它依然会发生,因为瓶颈是单个目的端口,而非互连结构内部。
- 常见误区:incast 并不必然罕见或不可预测。同步训练可能在反向传播阶段梯度集合开始时产生重复突发。其严重程度取决于集合算法、拓扑、路由以及超配程度,因此必须对其进行测量和缓解,而不能将其视为边缘情况。
incast 计算还揭示了拥塞背后的有限缓冲区机制。设到达某个出口的聚合到达率为 \(\lambda\),出口的服务率为 \(\mu\),瞬时队列占用量为 \(Q(t)\)。当突发持续存在且 \(\lambda > \mu\) 时,队列以净速率
增长:
\[ Q(t) = \min\!\left(B,\; Q(0) + (\lambda-\mu)t\right), \]
其中 \(B\) 为有限的缓冲区容量。比值 \(\rho=\lambda/\mu\) 区分了可排空的工作负载与持续过载:对于 \(\rho<1\),空闲时段可以排空队列;当长期 \(\rho\) 趋近于 1 时,可用于吸收突发流量的余量随之减少;而对于 \(\rho>1\),如果过载持续,缓冲区占用量必然达到控制阈值或缓冲区上限。这是一个分组队列,与 在大规模下运行推理 中分析的请求队列不同。串行化和传播决定了无负载时的路径延迟,而排队的字节会额外增加约 \(Q/\mu\) 的等待时间。
在上述刻意构造的最坏情况多对一汇聚流量中,\(\rho\) 为 256×,因此 32 MB 缓冲区会在约 2.5 μs 内填满。填满后,该缓冲区对应的出口等待时间为 640 μs。相比之下,带宽—延迟积 对于 400 Gb/s 出口链路和用于说明的 5 μs 反馈往返时间而言,仅为 250 KB:它衡量的是路径上尚在传输中的数据量,而非吸收任意多对一汇聚突发流量所需的缓冲容量。ECN 必须足够早地进行标记,使反馈能在缓冲区耗尽之前到达;PFC 可以防止丢包,但其背压可能使拥塞扩散。更大的缓冲区可以延长反应窗口,代价是尾延迟上界增大。
同步机器学习流量既容易受到真实汇聚热点(true fan-in)的影响,也容易受到共享出向热点(shared-egress hot spots)的影响。当某一层完成反向计算后,许多 rank 可以同时注入流量。环形 AllReduce 分发点对点数据块,而不是指向单一逻辑接收方,但由于其放置或路由方式,这些并发流仍可能汇聚到超配比的交换机端口。扁平或分层的聚合阶段则可能产生真实汇聚热点。生产集群通过三项互补技术缓解这两种情况:
- 分层错峰:在反向传播产生每个梯度桶后立即触发其 AllReduce。此时末层梯度正在减少,而较早的层仍在计算,因此通信是错开的,而不是一次性集中释放。
- 算法选择:选择能够限制任意单个端口汇聚量的集合通信。分层和轨内(rail-local)归约将梯度分阶段聚合,因此没有任何交换机端口需要同时接收所有发送方,这与扁平归约形成对比,在扁平归约中每个节点都指向同一个聚合点。带宽最优的环形 AllReduce 本身是点对点的,不会产生单一汇聚热点;incast 压力源于大量此类流汇聚到超配比端口,而拓扑感知的放置和轨优化布线可以缓解这一问题。
- 服务质量(QoS)分类:将梯度流量标记为最高服务等级,避免后台存储或管理流量延迟同步路径。
综合起来,这些缓解措施在时间、空间和优先级上分散了突发流量,但它们并不能消除拥塞或尾延迟。问题随之变成:如何构建能够在这种现实条件下依然表现良好的端到端集群。
第 5 级:集群设计与案例研究
栈的最终层级是集群设计,在此层级,线缆、传输、拓扑和拥塞控制结合为一个连贯的系统。集群设计的目标是提供一条端到端梯度总线,使数千台分布式 GPU 如同单台机器一般工作。在这一层级,抽象层会收敛为具体的工程决策:购买哪些线缆、如何布设机架、部署哪种协议,以及如何验证由此形成的互连结构能够提供训练任务所期望的带宽。两种代表性的大规模架构——一种基于 InfiniBand,另一种基于 Ethernet——揭示了定义机器学习基础设施的取舍Gangidi 等 (2024年)。
GPU 到 GPU 的“梯度总线”
在精心设计的集群中,网络互连结构充当系统总线的调度感知扩展,而非被动的管道。节点内(NVLink)带宽比节点间(InfiniBand/RoCE)带宽高约 9×,而隐藏这一“断崖”的机制之一是通信—计算重叠。反向传播过程中,先计算末层梯度的值。系统不必等待整个反向传播完成,即可针对这些梯度触发异步 AllReduce,同时 GPU 继续计算更早层的梯度。若反向传播需要 500 ms 的计算时间,而 AllReduce 耗时 300 ms,理想的重叠便可让通信成本隐藏在计算之后,将暴露的开销降至 \(\max(0, 300 - 500) = 0\)。实际上,依赖链和资源争用会限制重叠程度,留下最后一公里问题:反向传播末段计算出的梯度,其后续计算量很少,无法用来掩盖其传输时间。
图 3 带宽层级图规定了缓解这一断崖所采用的并行策略。张量并行需要大量带宽以支持频繁的激活交换,因而被限制在节点内的 NVLink 域中。流水线并行涉及激活在流水线各阶段之间的点对点传输,跨越节点间的 InfiniBand 链路。数据并行对较低带宽具有容忍度,通过梯度累积和重叠实现,横跨整个互连结构。
案例研究:NVIDIA DGX SuperPOD
NVIDIA DGX SuperPOD 架构通过 NDR InfiniBand 网络连接 DGX H100 节点,是梯度总线概念的具现实现 (NVIDIA 2023年)。每个节点都是一个密集的计算岛,内部通过 NVSwitch 连接八个 H100 GPU,提供 900 GB/s 的内部带宽。外部方面,每个 GPU 配有一张 ConnectX-7 NIC,提供 400 Gb/s 的注入带宽。在一个标准可扩展单元 32 nodes(256 GPUs)中,聚合注入带宽为 12.8 TB/s(256 \(\times\) 50 GB/s),确保互连结构能以加速器产生梯度的速度摄取梯度。
NVIDIA. 2023年. NVIDIA DGX SuperPOD: Next Generation Scalable Infrastructure for AI Leadership. RA-11333-001 V11. NVIDIA.
该架构明确实现了五级网络模型。在 Level 1,通过在机柜内使用直连铜缆(DAC)、仅对脊节点连接使用有源光模块来最小化延迟。在 Level 2,依赖 InfiniBand 原生的基于信用的流量控制,以保证无损介质,避免以太网 PFC 的脆弱性。Level 3 实现面向链路的胖树:GPU 链路在可扩展单元内对齐,使同链路流量保持就近,跨链路流量则穿越脊层。Level 4 采用硬件自适应路由,可在脊路径之间进行选择,以改善跨 rank 通信的二分行为。Level 5 的设计是模块化的:多个 SuperPOD 可扩展单元通过额外的交换连接形成更大的集群(NVIDIA 2023年)。对于 175B 参数模型,物理基础设施将由约四个 SuperPOD 可扩展单元互联而成,使约 1,024 个 GPU 作为一个同步仪器协同工作。
案例研究:Meta Grand Teton
Meta 披露了两个基于 Grand Teton 的 24,576-H100 集群:一个使用基于 Arista/OCP 以太网 fabric 的 RoCE,另一个使用 NVIDIA Quantum-2 InfiniBand,两者的端点速率均为 400 Gb/s。Meta 将两者都用于 Llama 3 训练,并报告 RoCE 集群上的 Llama 3 训练仍在进行中(Meta Engineering 2024年)。选择以太网的主要动机是运营规模与供应链韧性:使用以太网后,Meta 可从多个厂商采购交换机,并沿用其前端服务集群共享的光学基础设施与管理工具,从而避免专用 InfiniBand 孤岛造成的运营孤岛。
Meta Engineering. 2024年. Building Meta’s GenAI Infrastructure. Engineering at Meta Blog.
要让以太网在该规模上表现出专用 HPC fabric 的性能,需要在 Level 4 进行大量工程工作。Meta 的 RoCE 研究描述了面向长暂停事件的 PFC 看门狗、超越普通 ECMP 的迭代式路由设计、面向未来的 flowlet 交换实验,以及一次 400G 部署经验,其中 DCQCN 调优困难到 Meta 最终放弃 DCQCN,转而依赖 PFC 加上更高层的集合通信控制(Gangidi 等 2024年)。虽然该架构为大梯度传输实现了高线速带宽,但它接受了一项权衡:由于 RoCE 部署依赖以太网缓冲、QoS、PFC/ECN/DCQCN 调优、路由策略以及交换机/NIC 实现选择,而非 InfiniBand 原生的基于信用的 fabric 语义,小消息的延迟可能仍高于 InfiniBand。对于带宽占主导地位的巨型模型,这是一笔可接受的交换;但对于对延迟敏感的 MoE 路由,这一代价需要谨慎的算法补偿。
Systems Perspective 1.3: InfiniBand 与 RoCE:行业结论
InfiniBand(NVIDIA DGX SuperPOD)与 RoCE(Meta Grand Teton、Google)在生产环境中的并存,反映的是一项真实的权衡,而非某一方全面胜出。InfiniBand 能够提供更低的尾延迟和更简单的无损配置;RoCE 能够提供更低的交换机成本和多厂商灵活性。对于以秒为单位衡量迭代时间的训练运行,延迟差异往往被噪声吸收;对于具有严格服务水平目标(SLO)的推理服务,延迟差异则可能具有重要意义。
设计空间正在收敛。NVIDIA 的 Spectrum-4 以太网交换机纳入了受 InfiniBand 启发的自适应路由与拥塞控制;Broadcom 的 Memory DCS 芯片增加了针对 RDMA 优化的交换硬件支持。两个生态系统的区别正在缩小,但尚未消失。
这些案例研究通过展示物理链路、传输协议、拓扑和拥塞控制如何汇聚为一条生产 fabric,从而闭合五级堆栈。剩余的运营问题不再是如何构建单个高速集群,而是如何在牺牲训练所要求的可预测性能的前提下,将该昂贵的底层资源在多团队与多工作负载之间共享。
网络虚拟化
生产 ML 集群很少只服务于单一训练任务,这产生了巨大的经济压力,要求高效的多租户支持。$300 million supercomputer that sits 30 percent idle because it cannot securely isolate concurrent workloads represents a $9000 万美元的资本浪费。为回收这部分效用,网络必须沿三个正交维度支持虚拟化:带宽划分(保证最低吞吐量)、延迟确定性(防止首行阻塞)以及安全隔离(防止租户之间的内存嗅探)。SR-IOV(单根 I/O 虚拟化)和虚拟通道等技术将训练任务与物理链路解耦,正如虚拟机管理程序将操作系统与 CPU 解耦一样。对于 175B 模型,这意味着训练任务可以可靠地占用集群 \(\text{BW}_{\text{bisect}}\) 的 80%,而高优先级的推理服务与后台数据预处理任务共享其余 20%,fabric 会强制硬性边界,防止预处理任务的突发流量阻塞梯度更新。
SR-IOV:硬件 NIC 虚拟化
云服务商可以通过 Single Root I/O Virtualization (SR-IOV) 为虚拟化的 GPU 实例提供接近裸金属的 RDMA 性能,这是一种允许物理 NIC 呈现为多个独立 Virtual Functions (VFs) 的标准。每个 VF 都拥有自己的硬件队列、门铃寄存器(doorbell registers)和 DMA 映射。为每个 VM 或容器分配一个专用 VF,可为 DMA 操作建立一条完全绕过主机内核与 hypervisor 的直接硬件路径。这种直通(passthrough)架构对机器学习训练至关重要,因为它可以将虚拟化开销降至很低水平,在 NIC、hypervisor 和放置策略配置正确时,往往仅比裸金属低几个百分点。其集群管理后果是即时的:VF 成为可分配的网络资源,因此放置逻辑必须与 GPU 一同预留 NIC 容量和 QoS 策略,而不能把网络当作无上限的共享资源池。
然而,硬件层面的隔离仍然需要显式的带宽策略。SR-IOV 会暴露多个共享 NIC 物理资源的 VF;管理员可以添加按 VF 或按组的 QoS 策略来限制或保证带宽,例如在 400 Gb/s NIC 上为八个 VF 各分配 50 Gb/s。对于在多租户集群上训练 175B 参数模型而言,这种配置好的切分可以防止相邻租户抢占带宽,但同时也对峰值吞吐量施加了硬性上限。训练作业必须被架构为在该切片内运行,因为无论采用何种软件优化,都无法突破已配置的 VF 限速。
流量隔离与服务质量
考虑共享集群上的最坏情况争用场景:175B 模型正处于一次对延迟敏感的 AllReduce 操作之中,此时一个相邻作业发起了一次大规模检查点保存。若无严格的隔离机制,一次突发性的 100 GB 写入(在全速 400 Gb/s 线速下耗时 2 秒)可能使共享脊线(spine)链路饱和,引入排队延迟,使 AllReduce 时间增加 50% 甚至更多。为防止这种“吵闹邻居”效应,高性能网络互连结构依赖 quality of service (QoS) 机制,在包级别强制执行公平性。
主要工具是 InfiniBand 中的虚拟通道(virtual lane,VL)(在 RoCE 中为 traffic class),它可在单条物理链路上提供多达 16 条独立的逻辑通道。将不同类型的流量映射到不同的 VL,可确保某一通道发生拥塞不会阻塞另一通道的进展。每个 VL 维护各自独立的基于信用的流量控制:如果检查点的存储流量填满了其缓冲区,交换机只会暂停该特定通道。带有高优先级服务等级标记的梯度更新,则会继续在其预留通道中不受阻碍地传输。在以太网侧,enhanced transmission selection 为每种流量类别提供类似的带宽保证,而先进的交换机 ASIC 还可以将其转发表与缓冲区池划分为隔离的 network slices,确保一个租户切片中的拥塞不会触发另一个租户的 PFC 暂停。
虚拟化解决了共享问题,但也使性能诊断更加困难。当训练作业在多租户集群上变慢时,原因可能是物理链路性能下降、吵闹邻居超出其带宽配额,或是 QoS 策略配置错误。因此,系统性的监控对于区分这些情况至关重要。
监控与调试
机器学习集群中的网络性能问题具有隐蔽性,因为它们表现为静默浪费,而非显式故障。性能退化的收发器导致有效带宽下降 10 percent,可能仅使每次训练迭代变慢 2–3 percent,这种变化很容易被检查点或数据加载过程中的自然波动所掩盖。在为期 30 天、使用 1,024 GPUs 的训练运行中,这种不可见的性能拖累会累积造成约 15,000–22,000 GPU 小时的浪费,耗费约 $45,000–$66,000(按 $3/GPU-hour 计算),却不会触发任何告警。传统的 IT 监控工具(如 SNMP 或 ICMP ping)测量的是连通性,而非 RDMA 所需的持续吞吐量。有效的可观测性 需要采用三层方法:物理层监控(FEC 错误、信号衰减)、传输层监控(PFC 暂停帧、重传率)以及应用层监控(NCCL 算法带宽)(Jeaugey 2017年; Gangidi 等 2024年)。只有将这些层级的信号关联起来,运维人员才能发现,一次“缓慢的训练运行”是由某个机架中一根性能退化的线缆造成的。
Jeaugey, Sylvain. 2017年. NCCL 2.0. GPU Technology Conference presentation.
链路级遥测
在物理层,硬件计数器用于判断物理链路是否仍按模型的假设运行。每个 RDMA NIC 和交换机都维护这些计数器,可通过 perfquery 工具访问 (Linux man-pages project 2026年)。PortXmitData 和 PortRcvData 以四个字节为单位统计数据,因此计算利用率时,需要将各计数器的增量乘以四,以还原字节数。PortXmitDiscards 跟踪交换机丢弃的数据包;在正确配置的无损网络互连结构中,丢弃数应严格为零。物理信号完整性通过 SymbolErrorCounter 和 LinkDownedCounter 进行跟踪:前者在发生由线缆松动或光学器件脏污引起的比特级错误时递增,后者记录链路反复断开和恢复的事件,这些事件通常由间歇性硬件故障或收发器过热触发。
Linux man-pages project. 2026年. perfquery(8): Query InfiniBand Port Counters on a Single Port.
这些指标通常由集中式监控系统(例如 Prometheus 配合 Grafana 仪表盘)以 10–30 秒的间隔轮询,以捕捉静默劣化。一种常见的故障模式是 QSFP56 线缆协商于 HDR 速率(200 Gb/s)而非 NDR(400 Gb/s),或因单个不良连接器引脚而静默地从 4 条通道降至 2 条通道。链路仍保持“up”且功能正常,但其带宽减半。在一个拥有 1,024 GPUs 的集群中,若超过 3,000 条链路,0.1 个百分点的时点组件劣化率意味着期望约有 3 条链路发生劣化,且至少一条链路发生劣化的概率很高。由于像环形 AllReduce 这样的分布式训练算法是同步的,单条劣化链路会将整个作业拖慢至该落后者的速度,从而把轻微硬件故障转化为大量闲置计算周期的浪费。
带宽与延迟验证
一旦计数器排除了可见的链路故障,验证就必须测试训练作业实际可用的带宽和延迟。健康的 NDR InfiniBand 链路在编码和协议开销之后可以接近原始 50 GB/s 速率,但唯一有意义的数字是特定主机对之间交付的有效载荷带宽。运维人员依赖周期性健康检查,常在选定的节点对之间运行 perftest 类工具(例如 ib_write_bw),并将结果汇总为全对带宽矩阵 (linux-rdma project 2026年)。这张热力图能立即直观呈现网络互连结构中的冷点,即特定脊交换机或线缆束表现不佳的位置,从而在调度作业前进行针对性维护。
linux-rdma project. 2026年. perftest: InfiniBand Verbs Performance Tests.
对于对延迟敏感的同步,ib_write_lat 使用小型 RDMA 写执行乒乓测试,并将测得的往返时间的一半报告为单向延迟。直连节点的基线 NDR 延迟应保持在 2 \(\mu\) 秒以下。超过 5 \(\mu\) 秒的延迟提示交换机缓冲区拥塞或路由不均衡,而高于 100 \(\mu\) 秒的突增则表明存在严重的路径、拥塞或配置问题,但这并不意味着回退到 TCP。在启动大规模训练作业之前,稳健的验证还包括应用级测试,例如 nccl-tests,以验证该互连结构能否在作业所用的特定集合拓扑(环形或树形)下维持预期的 AllReduce 带宽。这确保物理网络的实际表现与理论设计一致,再分配昂贵的计算资源。
系统性调试工作流
当训练作业报告低于预期的吞吐量时,诊断顺序应当遵循分层模型,而不是从线缆入手。以下流程从应用层症状走向物理层原因:
- 检查 GPU 利用率:使用
dcgmi或nvidia-smi排除计算瓶颈。若 SM 利用率为 100 百分数,则瓶颈不在网络。然而,利用率低并不自动意味着故障出在互连结构:输入流水线饥饿(数据加载或存储)会产生相同症状,因此应先确认数据路径确实在持续供给加速器,再排查网络。 - 检查 NCCL 日志:设置
NCCL_DEBUG=INFO以显示所选的网络传输方式、节点之间的检测带宽,以及是否回退到较慢的协议。 - 运行点对点测试:在作业中的特定节点之间使用
ib_write_bw。单条劣化链路可能成为环形 AllReduce 中整个环的瓶颈。 - 检查 PFC/ECN 计数器:检查路径上的交换机计数器。持续的 PFC 活动表明存在持久拥塞,应在调度器或路由层进行排查。
- 验证物理层:检查符号错误和 CRC 计数,以定位失效的收发器或线缆。
该诊断顺序遵循本章的分层模型:应用层症状确定故障路径,传输层计数器显示是否涉及拥塞或回退,物理遥测数据则确认线缆本身是否正在劣化。
Checkpoint 1.5: 诊断训练作业变慢
一个 175B 模型训练作业已在 512 块 GPU 上运行 3 天。你注意到每次迭代的耗时从 4.2 秒逐渐增加到 4.8 秒(变慢 14 百分数)。nvidia-smi 报告的 GPU 利用率已从 92 百分数降至 85 百分数。
推动上限的网络技术
监控让已部署的互连结构保持诚实,但可观测性无法突破物理上限,而铜线在高信号速率下正逼近该上限。监控所揭示的物理上限,正是新技术值得关注的理由:只有当它们能够突破同步骨干无法跨越的界限时,才具有重要意义。随着集群规模向 100,000 个节点扩展,持久的设计变量是每比特功耗、传输距离,以及计算、内存与网络容量的比值,而不是某个特定技术路线图上所附的产品名称。
协议收敛与链路密度
第一个压力点是可靠性。Ultra Ethernet Consortium(UEC) 针对这一约束,试图让以太网更像 HPC 互连结构,同时不继承 RoCEv2 的 PFC 脆弱性。其 Ultra Ethernet Transport 设计综合了跨多条路径的报文喷洒、灵活排序、多种传输交付服务、拥塞控制变更,以及面向 AI/HPC 流量的遥测 (Ultra Ethernet Consortium 2025年)。目标是保留以太网的普及性和多厂商经济性,同时使其故障行为更接近 InfiniBand 的无损互连模型。报文修剪或链路层重传等具体机制,只是这一更广泛方向中的实现细节,因此应以同一组持久标准来评估:该互连结构能否在拥塞演变为同步训练落后者之前,在本地完成修复。
Broadcom Inc. 2025年. Broadcom Ships Tomahawk 6: World’s First 102.4 Tbps Switch. Broadcom press release.
更高端口速率同时攻击跳数与原始带宽。XDR InfiniBand 每个端口提供 800 Gb/s,以太网路线图包含 800GbE 与 1.6TbE 链路速率Ethernet Alliance (2025年)。具有 1.6 Tb/s 端口的以太网交换硅芯片将聚合容量推高至 102.4 Tb/s(当前 Tomahawk 6 类设计(Broadcom Inc. 2025年))。单个 1.6 Tb/s 端口提供的带宽相当于 4 个 400G 端口。密度的提升使架构师能够扁平化拓扑:此前需要三层交换机的集群,在 radix、端口速率与布放约束对齐后,可由两层交换机承载,收发器数量减半,并通过消除整跳交换与 FEC 开销降低尾延迟。
光互连
每增加一米,互连便从铜线转向光路。
光互连针对铜线随数据速率提升而恶化的每比特功耗与传输距离两项。在每通道 112 Gb/s(NVLink 4.0 与 InfiniBand NDR 采用的 PAM-4 信号速率)下,铜 SerDes 收发器每比特功耗约为 7–10 pJ,且在 2–3 米距离上受到信号完整性劣化、超出均衡可恢复数据范围的限制。
每通道 224 Gb/s 这一档对铜线更为严苛。在 224 Gb/s 下,SerDes 功耗大致翻倍至 15–20 pJ 每比特,而通过无源铜缆的传输距离缩短至 1–1.5 米。有源电缆(内含中继芯片,用于在线缆中段再生信号)可延长传输距离,但同时增加了延迟与功耗。
共封装光模块(CPO) 通过将这些光收发器直接集成到交换机或加速器的封装内,而非置于可插拔线缆模块的末端,来应对上述限制。在 CPO 中,硅光芯片与处理器位于同一封装基板之上,在芯片边界将电信号转换为光信号;随后光信号以光速沿光纤传输,在数十米距离上衰减可忽略,并在接收端封装中转换回电信号。
CPO 通过三项彼此独立的物理效应改变链路预算:
- 更短的电气路径:将光收发器从交换机面板移至封装基板,使 SerDes 到光模块的路径由厘米级缩短至毫米级,从而降低电气信号调理所消耗的功耗。
- 与距离无关的带宽:光纤在数据中心相关距离(最高 100 米)内不存在随距离变化的带宽劣化,消除了中继器需求,并支持更灵活的物理布局。
- 更轻的线缆:光纤比铜缆更轻、更细,简化了高密度机架中的线缆管理。
综合这些效应,互连问题便从受铜线限制的布局问题,转向受光封装与功耗限制的优化问题。
一个粗略估算可使这一功耗红利具体化。
Napkin Math 1.6: 光学红利
问题:计算将 51.2 Tb/s 交换机从可插拔收发器迁移到共封装光学的功耗节省。
- 可插拔架构:仅用于光学的 128 端口 \(\times\) 20 W = 2.56 kW。
- 共封装架构:128 引擎 \(\times\) 10 W = 1.28 kW。
- 节省:节省量达到每交换机 1.28 kW 的功耗。
系统洞见:在一个包含 1,000 台交换机的集群中,可插拔光学仅用于传输光信号就消耗 2.56 MW;共封装架构将这一“网络税”减半,节省 1.28 MW,并将足够多的功耗重新导向,为约 1,800 个 H100 GPU 供能。在 \(\text{BW}_{\text{bisect}}\) 规模的集群中,可持续性并非一种选择,而是由面板热限制驱动的建筑学要求。
对于 10,000 GPU 集群,消除可插拔模块可以节省超过一兆瓦的功耗,这部分功耗可以重新导向计算。共封装架构还消除了收发器作为独立的现场可更换单元,从而消除了一个常见的机械故障点。
对于机器学习基础设施,共封装可能通过缩小节点内与节点间带宽之间的差距来拉平带宽层级。如果节点间链路的带宽达到与 NVLink 类本地互连相当的水平(每个 GPU 数百 GB/s),那么将张量并行限制在单个节点内的约束就会放松。这将使张量并行能够跨越两到四个节点,而不是局限于单个 8 GPU 节点,从而可能提升大规模模型的扩展效率。
产品路线图不如它所说明的约束那样持久:随着链路速率提升,光学器件正逐渐靠近硅片,以控制功耗和传输距离。将光学器件集成进交换机封装或加速器封装的产品,都是为相同物理距离支付更少功耗和更低延迟的具体尝试。某个具体产品代际能否成功,不如系统方向重要:电气路径缩短,光学路径开始靠近芯片,封装级的热设计成为网络设计的一部分。
然而,共封装也带来了新的挑战。光学器件对温度敏感(激光波长随温度漂移,需要主动热管理),而将光子器件与 1,000 W GPU 集成在同一封装中,会为光学器件营造出不利的热环境。硅光工艺与 CMOS 晶体管工艺相似但并不完全相同,需要独立的制造步骤,从而增加封装的成本和复杂度。这些挑战正通过混合集成方案得到应对:将光子芯片片放置在封装基板较冷的区域,并与 GPU 芯片热隔离。
解耦与可组合架构
传统节点将计算、内存和网络的固定配比捆绑在一起,而 Compute express link (CXL) 解释了为何这一配比是浪费的:当一种工作负载需要每个 GPU 更多内存容量、另一种工作负载需要更多网络带宽时,情况就是这样。Compute Express Link(CXL)内存池化使同一机箱中的处理器能够以加载/存储语义访问另一机箱中的内存,而解耦设计将计算、内存和网络解耦为各自独立可组合的池。这一针对互连的具体影响塑造了互连层级。一旦内存池化和资源组合跨越节点边界,节点内 NVLink 域与节点间 InfiniBand 域之间僵化的区分便逐渐软化为一块统一的内存互连,同步骨干也从固定的节点边界转变为可组合的边界。
这一转变并没有废除高速互连的物理约束。一个组合而成的虚拟节点仍然要在每次跨池访问中支付相同的 \(\alpha\)-\(\beta\) 开销,承担承载该流量的链路相同的每比特功耗上限,以及相同的可观测性要求,以防止超配路径伪装成慢速加速器。系统层面的启示是开销的转移:解耦将同步骨干重新定位,而非将其消除。可组合互连是否可行,由与判断固定节点互连是否可行的相同互连属性决定。
谬误与陷阱
为机器学习设计并运行高性能互连,需要摒弃传统数据中心网络中的若干假设。以下谬误与陷阱概括了最常見的会导致训练停滞并降低集群生产力的错误。
谬误:带宽越高,训练就一定越快。
工程师们假设从 HDR (200 Gb/s) 升级到 NDR (400 Gb/s) 会带来成比例的收益,但 \(\alpha\)-\(\beta\) 模型 (节 1.3.4) 表明,这仅在带宽主导的形态下成立。对于小模型或流水线并行的小消息阶段,延迟项 \(\alpha\) 主要由交换机跳数和 FEC(约 1 \(\mu\text{s}\))决定,并主导性能。如果某项工作负载受延迟限制,带宽提升 2\(\times\) 倍可能只带来线速提升所对应增益的一小部分,同时却显著增加功耗和收发器成本。
考虑一条 10 KB 消息(典型用于控制同步)。在 200 Gb/s 的 InfiniBand 上,其耗时为 1.90 μs。升级到 400 Gb/s 可将该耗时降至 1.70 μs,即 10.5 percent 的性能提升,尽管链路速率翻倍。
Pitfall: 将 InfiniBand 仅仅视为高速以太网。
采购团队仅依据链路速率比较 InfiniBand 与高速以太网,并得出结论:在相同的 Gb/s 下二者等效。真正需要比较的是完整的传输栈,而非 InfiniBand 与 TCP 之间的比较。InfiniBand 在基于信用的网络互连结构之上提供绕过内核的 RDMA;RoCE 同样提供绕过内核的 RDMA,但其承载于以太网之上,并将更多可靠投递、拥塞控制与路由契约置于 NIC 行为和网络配置之中。PFC 与 ECN 是该契约的常见组成部分,不过无 PFC 的 RoCE 设计选择了不同的丢包恢复平衡 (Mittal 等 2018年)。传统的基于内核的 TCP 则是第三种设计取向,其 CPU 成本与恢复成本各不相同。因此,架构决策决定了流量控制状态与运行风险所在,即使标称链路速率一致。
Mittal, Radhika, Alexander Shpiner, Aurojit Panda, Eitan Zahavi, Arvind Krishnamurthy, Sylvia Ratnasamy, 和 Scott Shenker. 2018年. 《Revisiting Network Support for RDMA》. Proceedings of the 2018 Conference of the ACM Special Interest Group on Data Communication, 313~26. https://doi.org/10.1145/3230543.3230557.
Fallacy: 无损以太网与 InfiniBand 同样可靠。
承载于以太网之上的 RoCE 在大规模传输中可达到与 InfiniBand 相当的吞吐量,但无损运行取决于 PFC、ECN、路由、缓冲区与 NIC 行为之间的配置与相互作用 (节 1.5.1)。转发环路、环形缓冲区依赖或固件缺陷都可能触发 PFC storm,此时 PAUSE 帧会扩散至原始队列之外。InfiniBand 的逐跳信用机制可避免这一特定的反应式 PAUSE 帧级联,但网络互连结构仍需无死锁路由、合理的虚拟通道配置以及拥塞管理 (InfiniBand Trade Association 2000年)。两种网络互连结构都要求进行验证与遥测;RoCE 对以太网无损性的配置尤其敏感。
InfiniBand Trade Association. 2000年. InfiniBand Architecture Specification Volume 1. InfiniBand Trade Association.
常见误区:因为大多数流量是局部的,就接受超配。
在通用云环境中,脊节点处 4:1 或 8:1 的超配很常见,因为流量具有随机性。而批量同步的机器学习训练在集合通信开始时反而会产生协同性的流量突发。正如二切瓶颈分析(节 1.4.2)所示,4:1 的超配会使建模出的同步过程变慢 4×。对于一个同步开销占 $300M 集群的 30 percent 比例时,这种情形会浪费超过 $142.1M 的闲置 GPU 周期。
谬误:TCP 带宽测试足以用于验证机器学习互连。
像 iperf 这样的标准基准测试测量基于内核的 TCP/IP 性能。由于 TCP 需要 CPU 管理的缓冲区拷贝和上下文切换,其速率通常被限制在 20–40 Gb/s,与线路速率无关。机器学习训练使用 RDMA,完全绕过内核。某条链路在 iperf 中表现为 30 Gb/s 的“故障”,但在 ib_write_bw 中可能完全健康并达到 390 Gb/s。验证协议必须使用来自 perftest 套件中针对 RDMA 的工具,以匹配工作负载的数据路径。
常见误区:依赖自适应路由,而非感知拓扑的放置。
自适应路由会将流量分配到可用路径上,但它无法创造出并不存在的带宽。如果调度器将一个 1,024-GPU 任务分配到两个超配的脊节点组,自适应路由虽然会均衡流量,但仍会受到组间链路的限速。感知拓扑的放置(见 拓扑感知调度)与自适应路由是互补的:前者确保带宽存在,后者确保带宽被高效利用。
谬误:网络互连问题总是表现为硬性故障。
机器学习集群中的网络性能问题往往表现为训练速度的细微下降,而非错误。由于作业会继续运行而梯度延迟到达,间歇性拥塞导致的 10% 吞吐量下降可能在被察觉之前浪费数千 GPU 小时。
常见误区:把 PFC 和 ECN 计数器当作可选的生产细节。
运维人员必须对 PortXmitDiscards 和 PFC 暂停帧速率设置告警。这些计数器的逐渐增加往往是收发器故障或路由失衡的领先指标,而后者最终会导致作业失败。
Summary
图 1 所示的五层模型组织了对高带宽互连的分析,从信号传输的物理特性上升到仓库级集群的架构。该框架揭示了网络性能是物理可达性、传输协议、拓扑和拥塞控制之间相互作用的乘积,而非孤立链路速率。第 1 层(物理层)确立了 PAM4 编码和 FEC 带来的不可消除的延迟下限,从而限制了集群直径。在第 2 层(传输层),InfiniBand 原生的基于信道的流量控制与 RoCE 随部署方式而不同的 PFC、ECN 和端点恢复组合,产生了不同的可靠性保证;\(\alpha\)-\(\beta\) 模型量化了分布式集合中固有的带宽—延迟权衡。
第 3 层(拓扑层)展示了非阻塞胖树和按链路优化的设计如何为全局 AllReduce 模式提供所需的结构性 \(\text{BW}_{\text{bisect}}\)。然而,第 4 层(行为层)表明仅靠结构并不充分:在 BSP 训练的同步世界中,尾延迟是主导性约束,因此需要 DCQCN 和 HPCC 之类的主动拥塞控制机制来防止因cast 造成的停滞。第 5 层(集群设计层)将这些层次整合到生产架构中,如 NVIDIA SuperPOD 和 Meta Grand Teton,展示了虚拟化与多租户如何使这些大规模设备被安全共享。
在物理极限上,铜缆的约束和以太网的操作复杂性推动了新的互连设计。UEC 标准、CPO 和 CXL 内存池化都旨在拉平拓扑或降低数据传输的功耗代价。然而,正如前述监控工作流讨论所强调的,没有任何技术能够消除对严格可观测性的需求。无论是调试单个性能下降的收发器,还是优化多租户调度器,将物理计数器与应用级吞吐量关联起来的能力,始终是抵御机器学习集群中无声浪费的最终保障。
这种分层理解的实际价值在于诊断精度。当分布式训练作业表现不佳时,抱怨 invariably 是“网络太慢”,但变慢的原因有很多:单个链路因收发器故障而性能下降、PFC 风暴在子网内级联、拓扑瓶颈使某个通信模式受到饿死而另一个通信模式却得到充分服务。理解五层模型的工程师可以隔离出故障所在层次,将物理计数器与传输行为关联起来,并区分拓扑限制与拥塞控制配置错误。这种跨越抽象层次进行推理的能力,从 SerDes 信号完整性一直到集群级的 \(\text{BW}_{\text{bisect}}\),正是将例行排障与真正的系统工程区分开的关键。
同样重要的是,\(\alpha\)-\(\beta\) 成本模型为在采购硬件和布线机架之前做出架构决策提供了定量词汇。在 InfiniBand 与 RoCE 之间、在胖树与按链路优化的拓扑之间、以及在 400G 与 800G 链路速率之间的选择,都是具有数百万美元后果的决策,其结果取决于消息大小分布、集合算法与物理链路特性之间的相互作用。该框架使从业者能够以分析严谨性来评估这些权衡,而非仅依赖厂商基准测试。
Key Takeaways: 互连决定有效计算
- 链路速率不等于互连速率:全局 AllReduce 受限于最窄的二切(依据原则 4),而非最快的 advertised 端口。拓扑决定了所购加速器的吞吐中有多少转化为有效训练吞吐,有多少变成闲置硅片。
- 延迟与带宽以不同方式相互制约:\(\alpha\)-\(\beta\) 模型将启动成本与每字节传输成本分离(依据原则 11),\(n^* = \alpha \cdot \beta\) 标记了形态转变点。是消息大小分布、而非厂商峰值数字,决定了应当优化软件延迟还是硬件带宽。
- 可靠交付将风险转移:RDMA 传输需要可靠的完成与有界的恢复,而非一种通用的无损互连机制。InfiniBand 通常通过链路级信道抑制丢包;许多 RoCE 部署使用 PFC 和 ECN,而无 PFC 的设计则将更多恢复责任放在端点。每种选择都在硬件灵活性、尾延迟与操作复杂性之间进行权衡。
- 拓扑必须匹配流量:胖树以灵活的二切带宽为代价,按链路优化的设计加速同秩 AllReduce,而 dragonfly 或 torus 设计则在布线与局部性之间做出不同取舍。合适的互连取决于工作负载究竟以 AllReduce、AllToAll 还是多租户共享为主。
- 遥测节省 GPU 小时:PFC 计数器、链路错误率、带宽基线和应用吞吐量必须在各层次之间关联。缺少这种可观测性,性能下降的收发器或拥塞风暴就会将高端集群无声地转化为等待中的加速器队列。
链路速率本身并不能决定集群是否作为一个机器进行计算。二切带宽衡量集群一半与另一半之间通信的快慢,而全局 AllReduce 受限于互连中最窄的切面。一个饿死该切面的拓扑会让昂贵的硅片闲置,同时梯度在网络中等待。\(\alpha\)-\(\beta\) 模型通过分离消息启动延迟与带宽受限的传输时间,量化了这种等待。因此,互连是计算机的一部分,而非计算机之间的管线;在集群规模上,互连设计决定了工作负载能够使用多少加速器容量。
What’s Next: 从线缆到数据管线
网络互连如今将计算节点绑定为集群,而每一字节梯度数据与激活张量都要流经它。然而,集群同样需要传输海量数据集和庞大的检查点。数据存储 考察了为集群持续供给数据而设计的并行存储系统与数据加载架构。