规模化机器学习运维
投资组合与控制平面动机
规模化机器学习运维
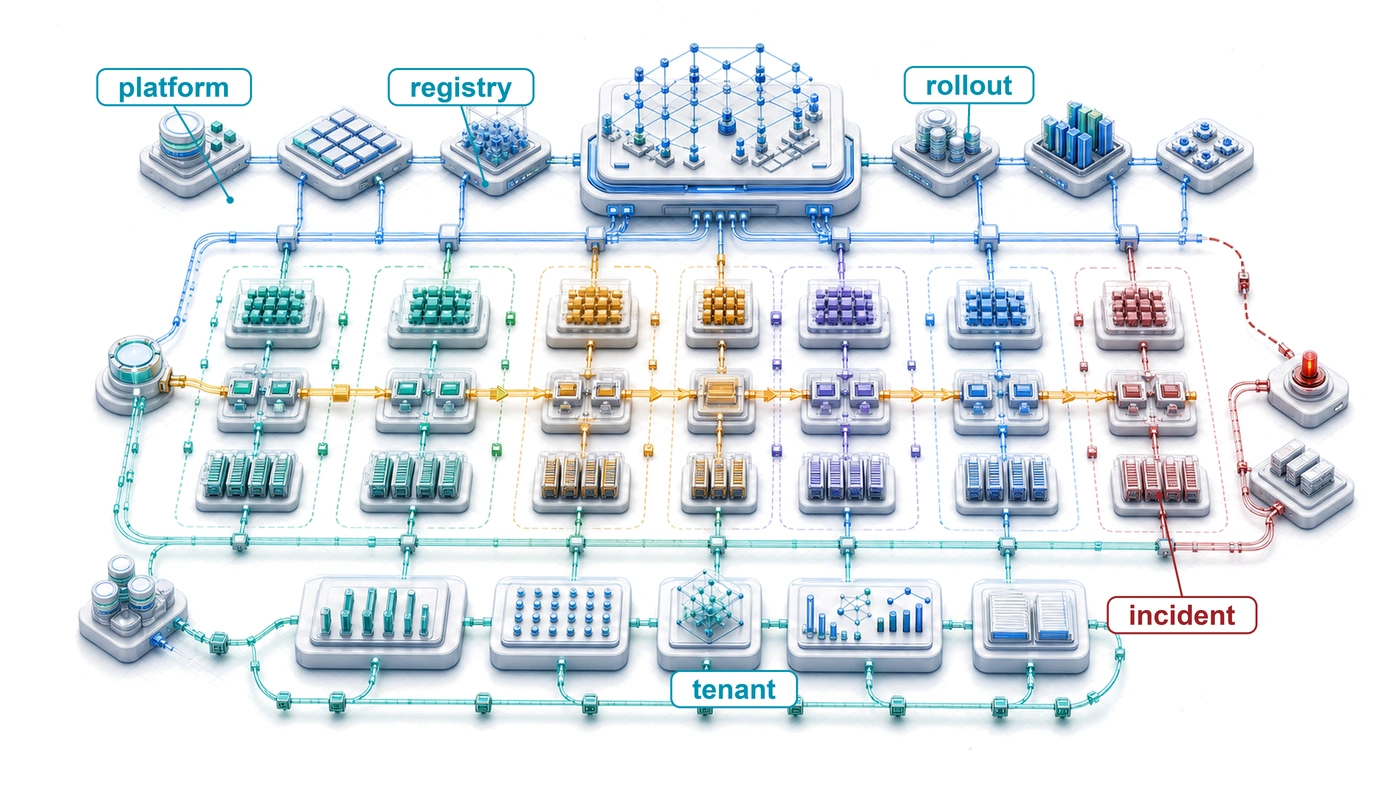
目的
为什么管理单个模型时行之有效的实践,在组织部署数百个模型时会失效?
一个模型是一个项目。一百个模型则构成一个系统之系统,其依赖关系和故障无法通过逐个管理模型来处理。一次数据管道变更可能影响十二个模型,这些模型由四个团队构建;而一次部署失败可能需要在相互关联的服务之间进行协同回滚。在这一规模下,人工部署、临时性的监控和电子表格跟踪都会成为负担。因此,机器学习运维(MLOps)成为共享基础设施,提供一致的 API、自动化质量门禁、集群级监控和依赖感知的治理。用 C³ 的术语来说,规模化运维通过标准化的平台机制维护和治理集群,取代反复进行的人工协同。
Learning Objectives
- 计算面向多个模型组合的共享机器学习平台的投资回报率、利用率和总成本
- 设计注册表、发布门禁和评估契约,以保全血缘关系、保障依赖安全并确保回滚可信
- 使用部署速度、事故发生率、重复性运维劳动和响应时间指标量化技术债务
- 评估监控层级,并跨数据、平台、模型服务和治理层诊断生产事故
- 设计特征存储的运维机制,管理新鲜度、所有权、兼容性以及训练与模型服务之间的不一致
- 根据采用情况、版本管理和退役方面的证据,评估平台的组织方式和生命周期选择
考虑一支由五名工程师组成的团队,负责维护单个推荐模型。当模型发生漂移时,他们手动重新训练;当 API 延迟飙升时,他们手动扩展实例。现在,将这支团队扩展到支持横跨数十个产品界面的五百个模型。此时,人工干预不仅效率低下,而且在数学上不可行。从单模型运营到平台运营的转变,以自动化、系统化的治理取代了“人在回路”的维护。这一“幕”确立了投资组合与控制平面问题:容量规划、可靠性与投资的单位,从单个模型变成了整个集群(fleet)。
管理层即集群栈的控制平面:它是仪表盘、调度与运维系统,负责防止物理基础设施、训练系统、服务路径、边缘部署和治理规则彼此脱节。一旦模型横跨数据中心、服务平台以及异构的边缘集群,可靠性对单个模型本身的依赖减弱,而更多依赖于使整个集群保持可观测、可协同、可恢复的运维机制。
分布式服务架构处理海量请求量,而边缘部署则将智能推向智能手机、微控制器,以及跨越数十亿异构设备的联邦集群。如今的问题是:当组织必须在这整个谱系上维持的不止一个、而是数百个这样的系统时,会发生什么。管理单个模型与运营企业级机器学习平台,本质上是两个根本不同的问题,二者之间隔着运维复杂度的一个相变。平台运营通过集群经济学与总成本模型、多模型管理、CI/CD、监控系统以及特征库基础,吸收这部分复杂度,使数百个模型共享同一套连贯的运维底座。
单模型 MLOps 聚焦于持续集成、部署流水线以及对单个模型的监控;每个组织在扩展过程中都会通过经验发现自身的极限。最初的几个模型可以用电子表格、手动部署和临时监控来管理,每个模型团队都发展出针对自身特定需求优化的实践。这种方法起初奏效,是因为模型彼此独立:推荐系统出了什么问题,不会影响欺诈检测模型。
随着模型数量增长,独立性消失。模型开始共享数据源,上游数据管道的变更会在多个消费者之间级联传播。基础设施变得争用:一个模型的部署会延迟另一个模型的部署。监控仪表盘不断增多,直到没有任何单一团队能够观察到完整的系统状态。值班轮班从单模型责任扩展到跨模型协同,这需要理解由不同团队、基于不同假设开发的系统之间的相互作用。
基础设施效率放大了这些协同挑战。生产机器学习负载很少达到高加速器利用率,因为训练任务间歇运行,而推理负载随用户流量波动。单个模型团队可能接受 20% 的加速器利用率,因为进一步优化不值得工程投入。乘以一百个模型,这种低利用率就代表着数百万美元被浪费的基础设施。同样,单个模型的偶发生产事故尚可应对,但一百个具有各自独立失效模式、彼此独立的模型,会产生持续不断的告警流,耗尽值班工程师的精力,并掩盖真正的紧急事件。
组织的应对方式是平台思维。与其把每个模型视为拥有独立基础设施的独立系统,平台则提供共享服务,将运维成本在整个模型投资组合中摊薄。特征库1消除了冗余的特征计算。统一的部署流水线确保了一致的发布实践。集中式监控跨模型聚合信号,以检测系统级问题并支持容量规划。挑战在于设计、实施和运营这些平台,使它们随投资组合一起扩展,而不是与之相抗。
1 特征库:集中管理机器学习特征的计算、存储与服务。它所解决的核心系统问题是训练—服务偏差;节 1.7 剖析了这一失效模式,以及约束该失效模式的平台不变量。
N 个模型的问题
技术组织在采纳机器学习时,往往遵循可预测的发展路径。第一个模型可能是首页推荐器,随后是搜索排序、欺诈检测和内容审核。每个团队起初都独立运作,分别开发数据处理、训练、验证和部署的自有流水线。模型数量较少时,这种独立性使每个团队都能针对自身需求进行优化。
随着模型数量增长,出现的问题并非“乘法式”的,而是“组合式”的。一百个模型并不需要单模型运维工作量的 100 倍;它们引入了依赖关系与相互作用,从而在运维复杂度 中产生超线性增长。规模化下的运维复杂度增长 从六个运维维度量化了这一增长,涵盖从规模化后成为关键路径的部署协同,到跨越模型边界、需要分布式追踪的调试复杂度。
| 运维方面 | 单个模型 | 10 个模型 | 100 个模型 |
|---|---|---|---|
| 部署协同 | 无 | 临时性 | 关键路径 |
| 共享数据依赖 | 无 | 部分重叠 | 稠密图 |
| 监控仪表盘 | 1 | 10 | 无法管理 |
| 值班轮班范围 | 单一团队 | 多个团队 | 全组织范围 |
| 基础设施利用率 | 经常闲置 | 适度共享 | 效率成为关键 |
| 调试复杂度 | 本地 | 跨团队 | 需要分布式追踪 |
Napkin Math 1.1: 共享红利
问题:一个平台团队管理着一个由 100 GPUs 组成的集群。在团队专属配额下,平均闲置时间为 70 percent。若迁移到跨团队共享资源的多租户机器学习平台,并用闲置训练 GPU 进行推理,则聚合闲置时间降至 30 percent。该平台节省了多少硬件成本?
数学推导: 对于固定的活跃工作负载,所需硬件与利用率成反比,而每块 GPU 的有用工作量与利用率成正比。
- 效率增益:0.70(共享)/ 0.30(专属)= 每块 GPU 多完成 2.33\(\times\) 的工作。
- 硬件缩减:1 - (0.30/0.70) = 57.1 percent。
- 年度节省:57 percent 的 $1.75M 预算 \(\approx\) $1,000,000/年。
系统学洞见:多租户机制充当了基础设施的乘数。打破资源孤岛,可在同等工作负载下将所需硬件减少 57 percent;在同等硬件预算下,可将有用工作量从 30 提升至 70 个活跃 GPU 当量。在机器学习集群中,统计复用(不同团队的峰值需求很少同时出现的这一原理)是使共享平台在经济上可持续的机制。平台团队的主要职责是收获这一共享红利,并将其再投资于未来的容量增长。

一次上游嵌入更新可能劣化所有依赖模型。
根本的洞见在于,逐模型的运行实践无法组合。当 Model A 依赖由 Pipeline B 计算的特征,而 Pipeline B 又使用来自 Model C 的嵌入时,任何组件的变更都会不可预测地级联传播。对 Model C 的嵌入层看似无害的一次更新,可能使 Model A 所依赖的特征分布发生偏移,从而劣化其性能,即使 Model A 本身并未发生变化。这种级联的相互依赖,使规模问题在性质上转变为一种全新的管理问题。
Systems Perspective 1.1: 复杂度爆炸
当集群规模超过某个临界值后,约束性问题便从单个模型的优化转变为系统级的协同:模型之间的相互作用比任何单个模型都更重要。依赖图、共享特征以及对同一基础设施的竞争,意味着第 100 个模型的边际成本,主要取决于它与其余 99 个模型的耦合方式,而非模型本身。
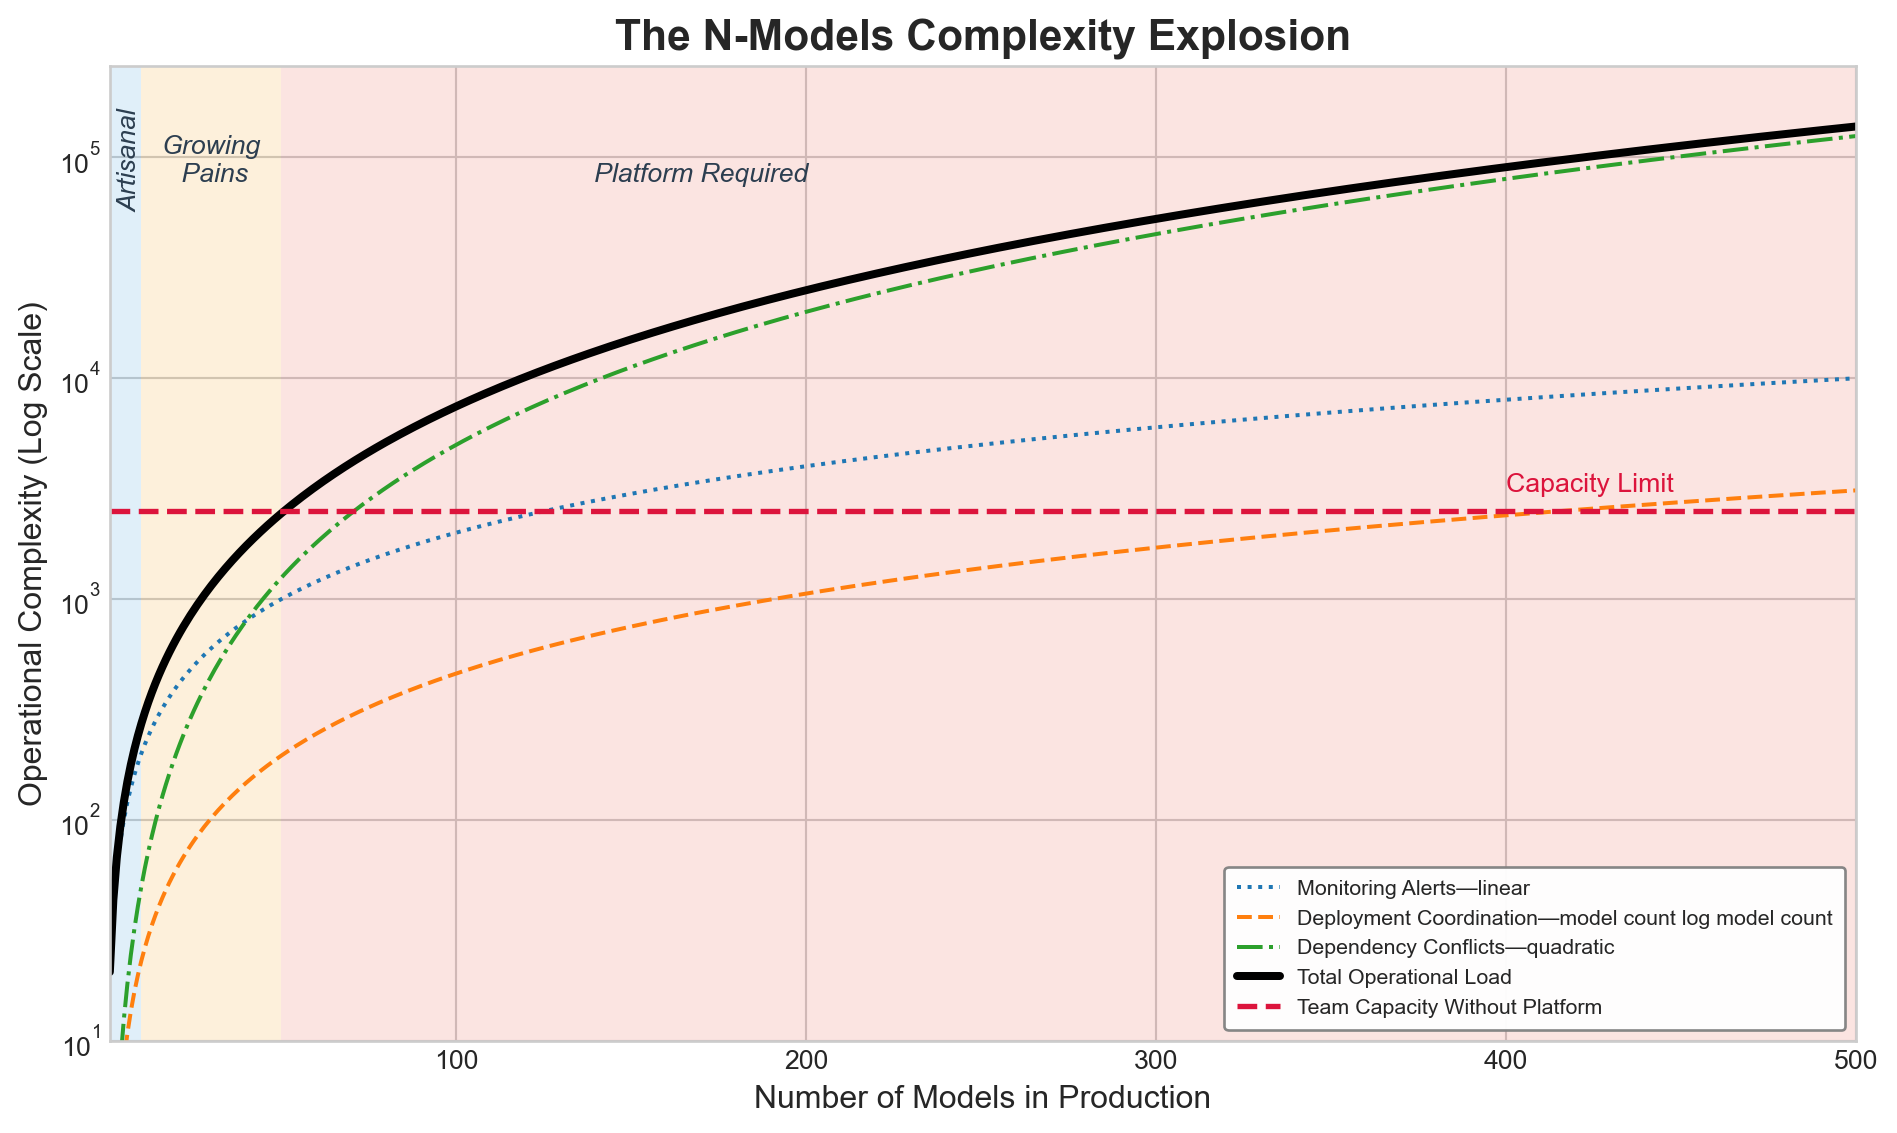
图 1 可视化展示了跨三个复杂度维度的超线性增长。监控告警随模型数量线性增长,而依赖冲突随模型共享特征、数据源和基础设施而呈二次增长。总运行负载在约 50 个模型时跨越团队容量,这正是组织发现自身需要平台工程(platform engineering)的经验性阈值。
当组织跨越 50 个模型的这一门槛后,维护工作面临的组合爆炸迫使结构发生根本性转变。要在这种复杂性中存活下来,就必须从“每个模型各自为政”的手工作坊式做法,转向共享的平台工程,从而从根本上改变机器学习集群的经济性。
量化平台经济性
平台运维的经济性论证,建立在对碎片化做法的成本与共享基础设施所带来的收益两方面都有清晰认识的基础上。公式 1 将平台投资回报率形式化为“所有模型节省的工程时间”与“平台总成本”之比:
\[\text{ROI}_{\text{platform}} = \frac{N_{\text{models}} \times T_{\text{saved}} \times C_{\text{engineer}}}{C_{\text{platform}}} \tag{1}\]
其中,\(N_{\text{models}}\) 表示受益于该平台的模型数量,\(T_{\text{saved}}\) 表示每个模型每期节省的工程时间,\(C_{\text{engineer}}\) 表示每位工程师每小时的完全分摊成本,\(C_{\text{platform}}\) 表示平台总成本,涵盖开发、基础设施与维护三部分。
该公式揭示了为什么平台投资只有在规模足够大时才成立。对于一个只有五个模型的小型组织,即使每个模型的节省量相当可观,分母仍可能超过分子。随着模型数量增长,分子随 \(N_{\text{models}}\) 线性增长,而平台成本增长则缓慢得多,通常呈次线性增长,这是因为基础设施成本被摊薄所致。
Napkin Math 1.2: 平台红利
问题:一家组织管理 50 个模型。一个集中式机器学习平台团队的成本为 $120,000/month。如果该平台每月为每个模型团队节省 20 hours 的人工繁琐工作,那么平台投资是否有利可图?
计算:
- 每月总节省额:50 个模型 \(\times\) 20 hours/模型 \(\times\) $150/hr = $150,000。
- 每月净收益:$150,000(节省额)- $120,000/month(成本)= $30,000。
- 投资回报比率:$150,000 / $120,000/month = 1.25。
系统洞见:平台存在规模阈值。当模型数量达到 50 个时,该平台相对于其成本获得 25 percent 的回报。然而,如果该组织仅有 20 个模型,节省额就只有 $60,000——相对于平台团队的薪资支出,亏损为 50 percent。在 MLOps 中,平台工程是一项固定成本,通过随规模变化的节省额获得回报。建设平台的合适时机,是整个模型集群的“人工繁琐工作开销”超过“平台维护开销”之时。
从手工作坊式运维到工业化运维
平台红利计算给出了通用规则;这个算例将其转化为运维决策。问题不在于共享工具在形式上是否更整洁,而在于平台的固定成本是否小于它在整个模型集群中消除的人工繁琐工作的成本。
考虑一家组织是否要构建一个集中的机器学习平台。当前状态由五个参数定义:
- 8 个团队共 50 个生产模型
- 每个模型每月需要 40 个工程师工时用于运维任务
- 工程师全成本为每小时 150 美元
- 平台开发成本:200 万美元,在 3 年内摊销
- 预期节省时间:平台上线后每个模型每月 30 小时
平台上线前(年度运维成本):
\(C_{\text{current}} = 50 \times 40 \times 12 \times 150 = \$3,600,000\)
平台上线后(年度运维成本加摊销后的平台成本):
\(C_{\text{after}} = 50 \times 10 \times 12 \times 150 + \frac{2,000,000}{3} = \$900,000 + \$666,667 = \$1,566,666.7\)
年度节省达到 $2,033,333.3,相当于运维成本下降 56.5 percent。平台在头一年即可收回成本。
这一经济差距解释了为什么大型科技公司对机器学习平台投入巨大,而规模较小的组织往往难以论证类似的投入。经济门槛通常落在 20 到 50 个模型之间,具体取决于模型复杂度和组织结构。
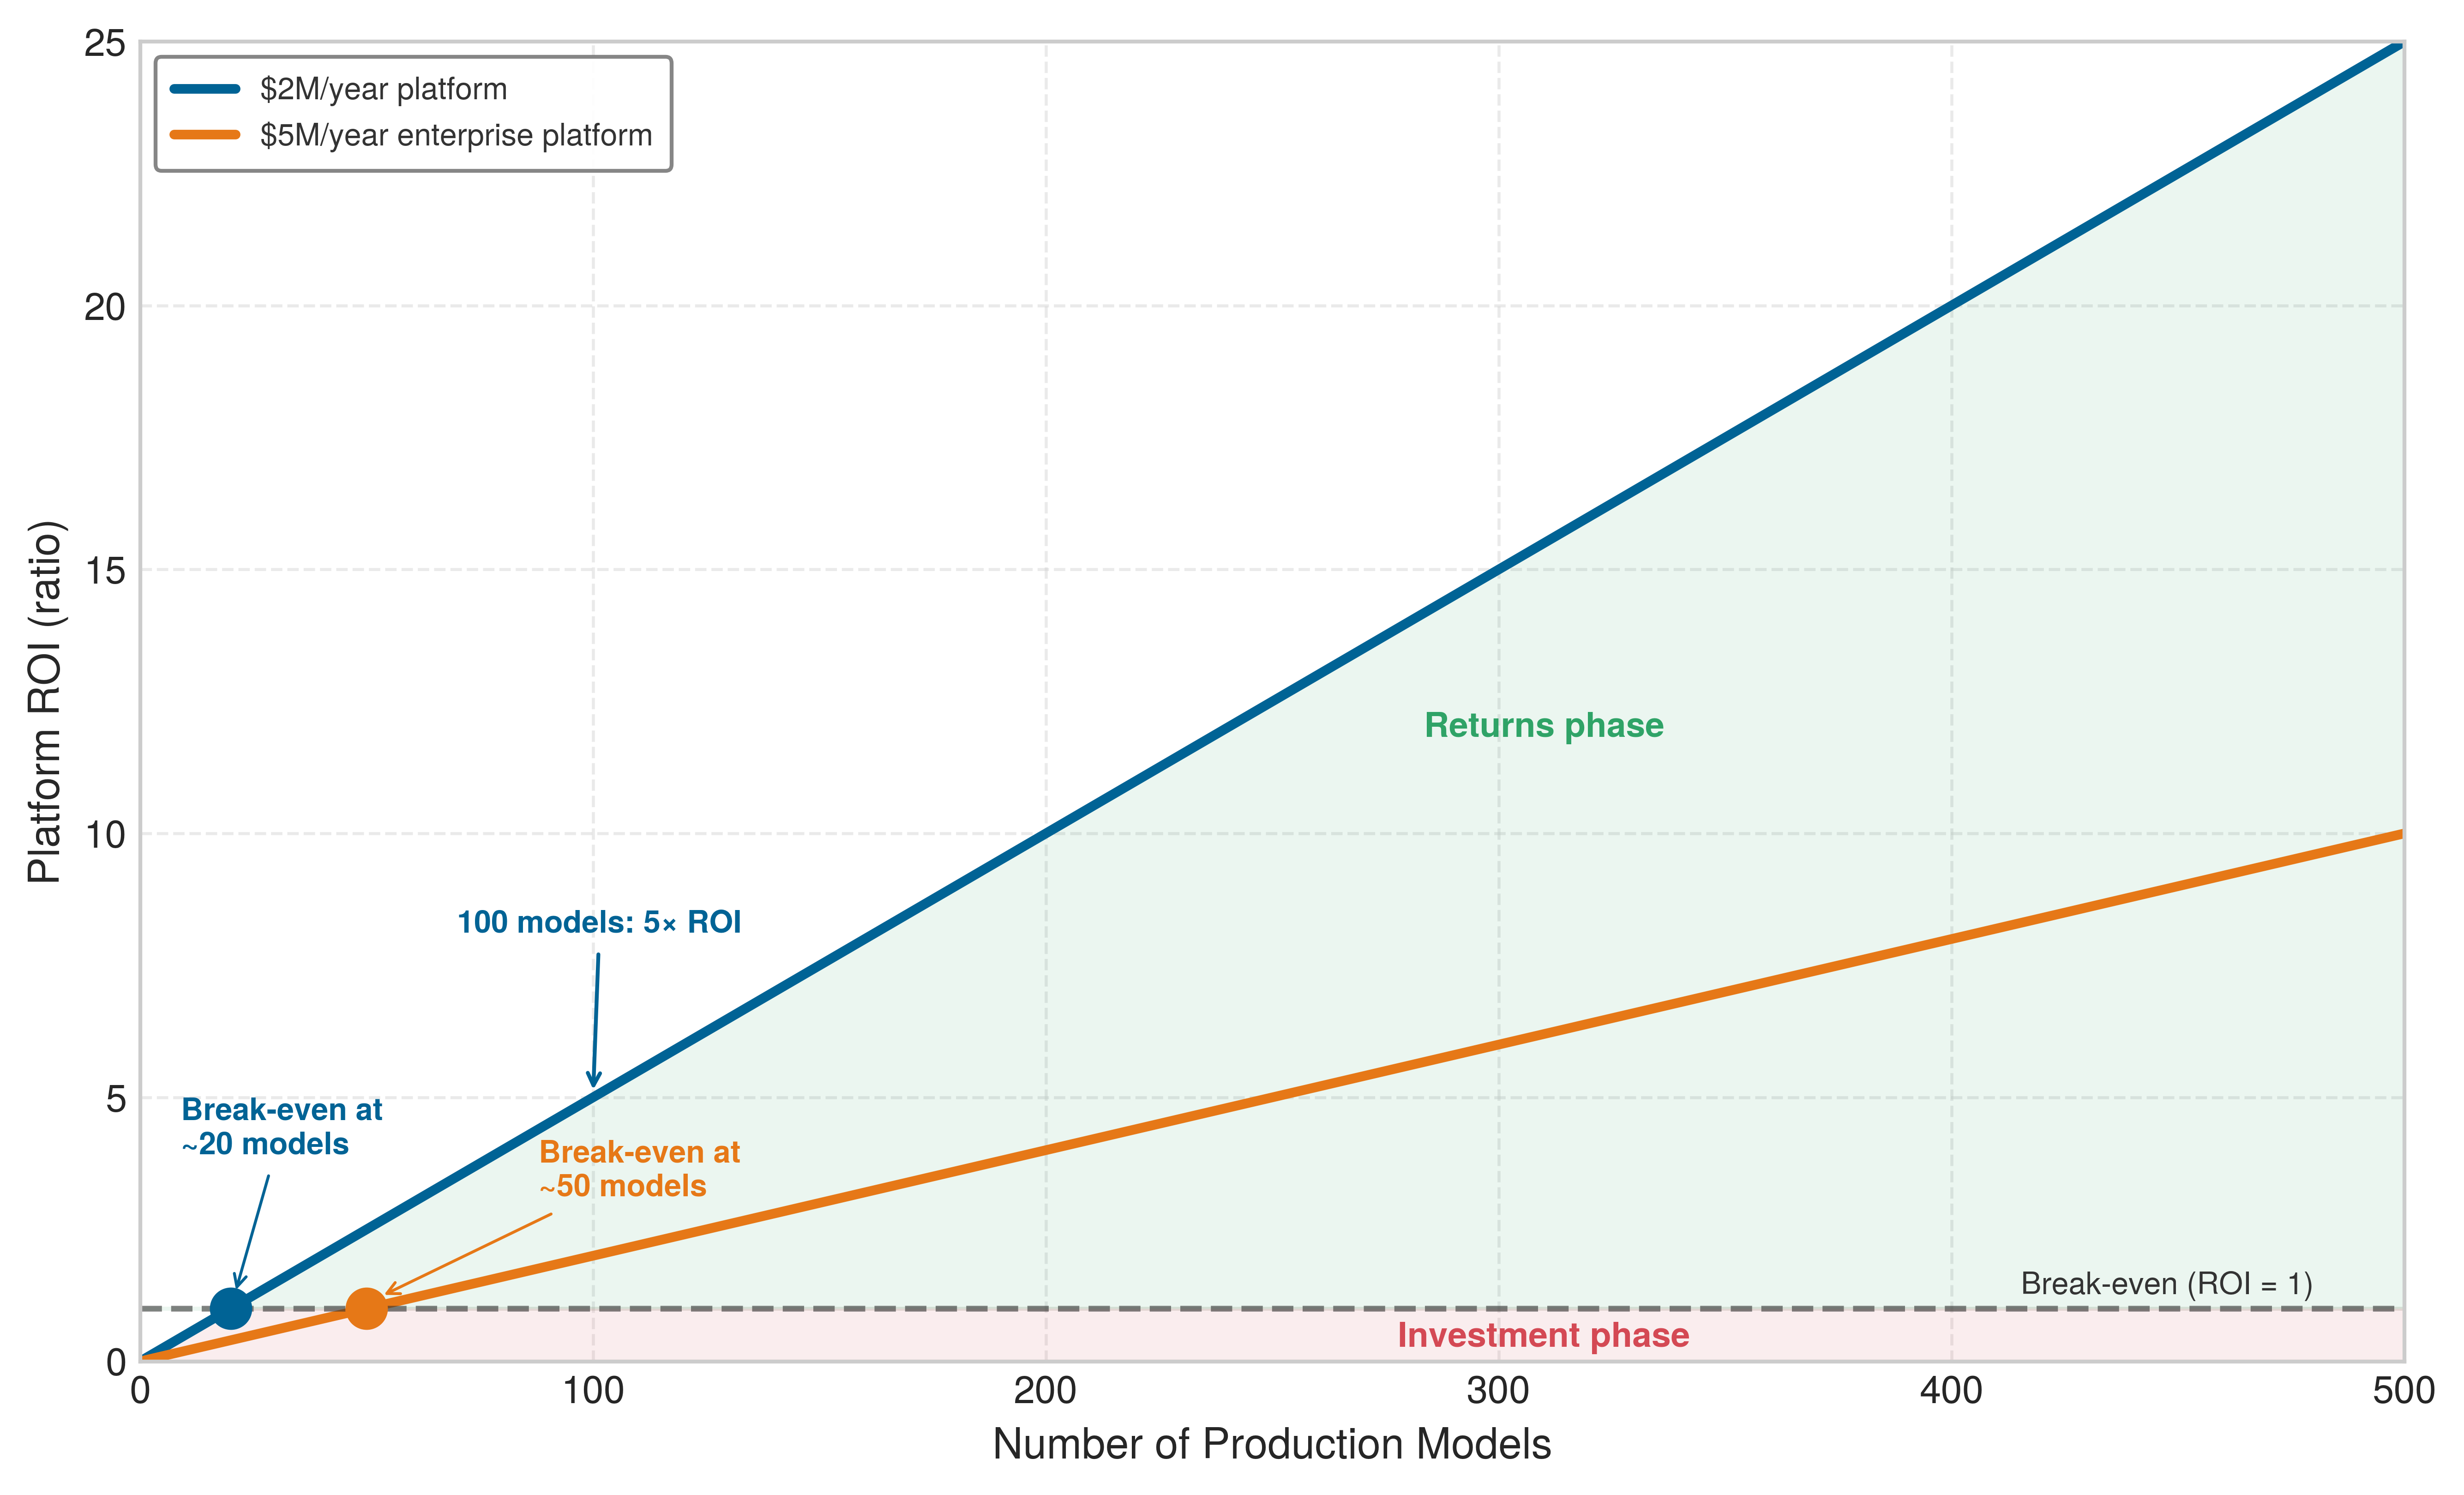
图 2 通过绘制平台投资回报率随模型数量的变化曲线来呈现这一门槛效应,并针对两个平台成本水平分别作图。一个 $2M/year platform breaks even at approximately 20 models, while a more expensive $5M/年 的企业级平台需要大约 50 个模型才能证明投资划算。超过盈亏平衡点后,投资回报率线性增长,因为每个新增模型都会以相同的单模型节省额计入 公式 1 的分子,而平台成本基本保持不变。在 100 个模型时,投资回报为 $2M platform delivers 5$美元。这种线性关系既是平台投资的经济学论证,也解释了为什么那些推迟构建平台直到“达到规模”的组织,往往被累积的运维债务困住:盈亏平衡点来得比直觉预期的更早。
盈亏平衡模型数量并非普适常数;它会随着读者可以控制的那两个输入而变化。notebook 1.2 中的平台红利分析($120K/month platform team saving 20 hours per model) and the worked example (a $2M 建设成本在三年内摊销,每个模型节省 30 小时)所达到的盈亏平衡模型数量与上述数值不同,正是因为它们假设的平台成本基数和单模型节省额不同。该图中的曲线将平台成本固定为一个整数年度金额,并假设每个模型每年节省 10 万美元,以隔离门槛的形状;notebook 和算例则用明确的运行假设来换取这种取整。三者都遵循同一个 公式 1:改变分子(单模型节省额)或分母(平台成本),盈亏平衡点就会移动,但盈亏平衡后的线性斜率不变。
平台投资回报只是其中一个杠杆;单个训练运行的成本以及由此衍生的容量决策是另一个方面。一次 2,048-GPU H100 运行使这一容量问题具体化,并将其与集群经济性联系起来,其中利用率、检查点(checkpointing)和碳核算都成为平台层面的决策,而非孤立的实验成本。
容量规划与训练成本
大规模机器学习系统的容量规划,本质上是优化 GPU 小时的经济性。考虑一个具体案例:一次持续 30 天的训练运行,部署在 256 节点的 H100 集群(2,048 GPUs)上,按示意性市场费率 $2/GPU-hour 计算,相当于约 $2.95M 的直接投资。在这一规模下,每次训练运行的成本 \((C_{\text{run}})\) 成为主要的设计杠杆,决定了整个集群的规模。更快的上市时间会推动规划者增加 GPU 数量,但更大的作业也会面临并行效率递减和硬件中断概率升高的问题。因此,总成本不仅取决于计算时间,还必须计入数据准备、检查点以及从中断中恢复的成本(容错)。
对效率的追求迫使容量表现为一种动态资源,而非静态分配。组织必须决定何时购买额外的永久容量,以及何时通过更好的编排或模型优化来恢复同等有效吞吐量。该决策还具有能源维度:为数千个 GPU 供电数月所消耗的电量,足以使财务成本与碳成本同步变化。因此,容量规划成为在同一决策中平衡性能、预算、能源使用与负责任工程实践的战略杠杆。成本可见性也强化了偿还技术债务的理由:那些揭示失控训练成本的指标,同样暴露了未版本化数据、脆弱流水线与人工 toil 的隐性成本。
量化与管理机器学习技术债务
在集群规模下,技术债务是一个优先级问题:平台必须找出是哪个隐藏依赖拖慢了部署、推高了事故率,或消耗了最多的工程 toil,并优先偿还它。四类债务(数据、配置、模型与基础设施债务)标出了阻力产生的位置,而逐一量化它们可使各集群之间具有可比性,从而优先处理最严重的问题。
Napkin Math 1.3: 维护红利
问题:一个团队每月花费 40 hours/month 手动修复”broken plumbing”(陈旧数据、脚本失败、人工监控)。一次为期一个月的集中清理(160 hours)预计可将该支出降至 8 hours/month。在 3 years 的模型生命周期内,这次清理是否划算?
数学:
- 现状(3 years):36 months \(\times\) 40 hours/month \(\times\) $150/hr = $216000。
- 主动维护路径:(160 hours 投资 + 36 months \(\times\) 8 hours/month)\(\times\) $150/hr = $67200。
- 净节省:$216000 - $67200 = $148800。
- 红利倍数:3.2×。
系统洞察:主动维护可在整个模型生命周期内将总成本降低 3.2× 倍。在 ML Fleet 中,“Plumbing”(管道/基础设施)比”Pipes”(管线)更重要:一个忽视技术债务的组织最终会耗尽全部预算,仅用于维持旧模型运行,而没有任何容量用于新开发。最成功的团队将重构视为高回报投资,而非分心之事。
维护红利只有在平台能够以统一的运营尺度比较不同类型债务时才具有可操作性。ML 技术债务表现为可测量的症状,并直接影响平台速度与可靠性 Amershi 等 (2019年)。
Amershi, Saleema, Andrew Begel, Christian Bird, Robert DeLine, Harald Gall, Ece Kamar, Nachiappan Nagappan, Besmira Nushi, 和 Thomas Zimmermann. 2019年. 《Software Engineering for Machine Learning: A Case Study》. 2019 IEEE/ACM 41st International Conference on Software Engineering: Software Engineering in Practice (ICSE-SEIP), 291~300. https://doi.org/10.1109/icse-seip.2019.00042.
债务类别与度量
债务类别之所以重要,是因为每种失败模式都会留下不同的运营痕迹。技术债务度量映射 将分类体系转化为度量映射:数据债务表现为数据事故与人工管道干预,配置债务表现为未经验证的发布面,模型债务表现为胶水代码拖累,基础设施债务表现为消耗平台容量的 toil(运维劳作)。
| 债务类型 | 运营症状 | 度量信号 | 告警阈值 |
|---|---|---|---|
| 数据债务 | 依赖不稳定、版本缺失、验证薄弱 | 每月数据事故数量与人工管道干预次数 | 每月超过 10 起数据事故,或人工运行比例超过 30%。 |
| 配置债务 | 临时文件、参数重复、缺少验证 | 部署失败次数、配置行数、未经验证的参数 | 每个模型超过 500 行未经验证的配置。 |
| 模型债务 | 胶水代码、未声明的调用方、纠缠的 serving 路径 | 耦合度、未记录文档的调用方、追踪耗时 | 超过 20% 的工程时间用于维护胶水代码。 |
| 基础设施债务 | 脆弱的管道、人工部署、环境漂移 | 运维工时、自动化覆盖率、漂移事故次数 | 超过 50% 的平台容量被运维消耗。 |
量化指标
技术债务优先级指标 将四个债务指标转化为基线—阈值映射,为每个症状配对其在何时升级为升级信号。
| 指标 | 信号 | 健康基线 | 告警阈值 |
|---|---|---|---|
| 部署速度 | 从代码提交到生产部署的时间;暴露发布摩擦。 | 推理代码变更少于一天,训练代码变更少于一周。 | 超过两周表明存在配置复杂度、脆弱依赖或自动化不足。 |
| 事故率 | 可靠性损害表现为每 1000 次部署中的事故数量。 | 每 1000 次部署少于 5 起事故。 | 超过 20 起事故表明测试、验证或部署流程存在债务。 |
| 运维占比 | 团队容量被人工运营工作消耗的比例。 | 用于运维的容量少于 20%。 | 超过 50% 表明存在自动化债务,阻碍团队改进平台。 |
| 依赖陈旧度 | 落后于受支持或当前版本的依赖所占比例。 | 陈旧依赖少于 10%。 | 超过 30% 表明存在升级债务,增加安全风险并限制性能改进。 |
下面的算例将该阈值逻辑应用于按每项修复为平台团队释放的容量来对债务排序。
算例:ML 债务审计与优先级排序
一个支持 40 个生产模型、拥有 15 名工程师的 ML 平台团队正面临部署速度问题:新模型需要 6 周才能进入生产,令平台团队和模型团队都感到沮丧。审计必须按照每项债务释放多少平台容量来排序,而不是按照哪个症状最显眼来排序。
审计在 表 1 中记录三个债务类别,然后对它们进行评分。每一行将运营症状与使该债务在团队之间可比的影响度量配对。
| 债务类别 | 症状 | 影响指标 | 技术措施 | 估算年度成本 |
|---|---|---|---|---|
| 配置债务 | 每个模型都有自定义 YAML 配置文件,平均 847 行,且没有验证 schema | 35% 的部署延迟源于配置错误 | 每次部署都需要人工配置审查 | 12 engineer-hours per deployment \(\times\) 80 deployments/year = 960 hours |
| 流水线胶水代码 | 数据预处理使用 23 个不同脚本,代码重复率 62% | 每周有 12 个工程师工时用于调试流水线故障 | 没有共享的预处理库;每个团队各自实现自定义逻辑 | 12 hours/week \(\times\) 52 weeks = 624 hours |
| 监控债务 | 每个模型使用临时监控方案,没有统一的可观测性平台 | 事件平均检测时间为 4.2 小时 | 40 个模型采用 23 种监控方案 | Extended incident duration costs $50K per incident \(\times\) 15 incidents/year = $750K |
评分方法采用三条标准:影响严重性、发生频率和解决成本,每条标准均按 1 到 3 打分。 债务优先级评分 对上文观察到的三个债务类别进行排序。影响严重性和发生频率越高,优先级越高;解决成本越高,优先级越低。
| 债务类别 | 影响 | 频率 | 修复成本 | 总分 | 优先级 |
|---|---|---|---|---|---|
| 配置 | 3(高) | 3(每日) | 2(中等:6 周) | 4.5 | 第 1 位 |
| 监控 | 3(高) | 2(每周) | 2(中等:8 周) | 3 | 第 2 位 |
| 流水线胶水 | 2(中等) | 2(每周) | 3(高:16 周) | 1.3 | 第 3 位 |
该评分使配置债务成为首个偿还目标:先构建配置模式校验和模板系统,再处理得分较低的流水线胶水。这项投入需要 6 weeks 的工程工作量来构建配置系统。它消除了 35 percent 的重复配置审查劳动:12 engineer-hours 每次部署 \(\times\) 80 deployments 每年 \(\times\) 35 percent = 336 engineer-hours 每年节省。在 $150/hour 下,即 $50K 的年度节省,因此该投入约在 8.6 months 内收回。
决策框架
通用的债务偿还决策在已算出的评分基础上补充了明确的收益估计,其中 Impact 表示严重性,Frequency 表示债务出现的频率,Benefit 表示避免的运营成本,Resolution Cost 表示所需的工程工作量:
\[\text{Paydown Priority} = \frac{\text{Impact} \times \text{Frequency} \times \text{Benefit}}{\text{Resolution Cost}} \tag{2}\]
公式 2 中的偿还优先级公式将自动化工作与运营价值绑定:高影响、高频、高收益的修复优先于收益具有投机性的昂贵工作。
Napkin Math 1.4: 自动化投资的回报
问题:团队在每个模型部署上要花费 10 hours 的人工工作量。投资 120 hours 构建 CI/CD 流水线,预计可将部署工作量降至 0.5 hours。在 3 deploys/week,自动化多久才能收回成本?
数学:
- 自动化成本:120 hours \(\times\) $150/hr = $18000。
- 每周节省:9.5 hours/部署 \(\times\) 3 deploys/week \(\times\) $150/hr = $4275/week。
- 回本周期:$18000 / $4275/week \(\approx\) 4.2 weeks。
系统层面的洞见:自动化是一项高回报的资本投资。回本周期为 4.2 weeks 属于工程时间上的 exceptional 回报。在 MLOps 中,“Toil” 是组织能够背负的最高利息技术债务:尽早偿还它,会为模型整个生命周期带来巨大收益。
决策规则是不对称的。当该比率超过特性开发带来的预期价值时,就偿还债务;债务优先级评分 中的配置债务符合这一条件,因为它具有高影响(阻塞部署)、高频率(每次部署)、高收益(消除 35% 的延迟),且成本适中(6 周)。当债务仅局限于单一团队、频率较低(每月或更少)、系统计划在 12 个月内退役,或解决成本超过 6 个月的工程投入时,则推迟偿还。
同样的优先级逻辑必须转化为组织习惯,否则在审计之间债务会重新累积。量化后的债务首先成为待办事项,包含受影响系统、预估影响、解决成本和优先级评分。随后每季度复核会随平台需求变化更新该待办清单,使排序始终与当前的部署速度、事故率和 toil 挂钩,而不是过时的抱怨。
债务预算将这一排序转化为产能。将冲刺产能的 20% 到 30% 分配给偿还债务,会使修复工作与特性开发显式竞争;而把不到 10% 的投入花在债务上的团队,通常会发现债务增长快于他们处理它的速度。预防则把同样的推理上移到代码和设计评审:每一项提议的变更都应追问,它是否引入了配置复杂度、难以维护的数据依赖,或人工运维流程,因为预防债务的产生比事后偿还更便宜。
规模化后运维的差异
多模型平台的运维需求与 Single-Model Operations 在性质上存在差异。单模型与平台运维 从六个维度对比了这两种方法,揭示了平台级部署需要依赖感知的调度、监控必须从 model-centric 转向 system-centric 聚合,治理则从 team-specific 策略演进为 organization-wide 标准:
| 维度 | Single-Model Operations | Multi-Model Platform (100+) |
|---|---|---|
| Deployment | 简单发布,由团队控制 | 依赖感知调度,由平台协调 |
| Monitoring | 以模型为中心的指标 | 以系统为中心并聚合模型指标 |
| Debugging | 局限于模型与数据本地范围 | 跨模型边界的分布式追踪 |
| Resource Management | 专用分配 | 共享资源池并做多租户隔离 |
| Governance | 团队特定策略 | 组织级标准与自动化 |
| Organization | 单一团队负责 | 平台团队加消费方团队 |
这一定性差距在部署运维中最为明显。单模型部署很简单:验证新版本、部署到金丝雀、监控回归,然后推进全量发布。平台级部署必须考虑依赖顺序,即消费其他模型特性的模型无法独立更新。回滚协调变得至关重要,因为回退一个模型可能需要连带回退其依赖的模型。当多个部署竞争 GPU 内存或网络带宽时,就会出现资源争用。爆炸半径管理则限制任何单次部署失败的影响范围。
对于推荐系统,这种复杂性尤为突出。一个典型的推荐请求可能涉及 10–50 个模型按顺序或并行执行:候选检索模型、排序模型、多样性过滤层和业务规则层。更新任何组件都需要理解它与所有其他组件的交互。
监控需求也发生了类似演变。在单模型规模下,监控聚焦于模型特定指标:预测准确率、推理延迟和数据漂移指标。到了平台规模,这种做法已不可持续。100 个模型会产生 100 个独立仪表盘,造成信息过载,从而妨碍有效的事故响应。
因此,平台监控必须在跨模型聚合的同时,保留深入查看具体细节的能力。这需要分层指标。业务指标通过收入、参与度和用户满意度反映系统的整体健康状况。模型组合指标按领域或业务单元聚合模型性能。模型指标跟踪单个模型的准确率、延迟和漂移。基础设施指标监控 GPU 利用率、内存压力和网络吞吐量。
大规模遥测采集
向平台级可观测性转变,需要从根本上改变大规模遥测范式。当 10,000 个边缘节点或数百个微服务同时生成日志时,监控基础设施本身可能成为瓶颈,产生压垮网络的“惊群效应”。必须对遥测数据进行严格分类和采样,以防止可观测性系统干扰生产系统。大规模遥测范式按数据量增长方式和运维用途区分遥测类型,使平台能够选择哪些数据持续采集、哪些数据进行采样。
| 遥测类型 | 定义 | 数据量 | 主要用途 |
|---|---|---|---|
| 指标 | 聚合的数值数据(计数器、量规、直方图)。 | 低(大小恒定) | 告警、SLA 跟踪和高层概览仪表盘。 |
| 日志 | 关于特定事件的离散文本记录,带有时间戳。 | 高(随请求量增长) | 事故后的根因分析和审计。 |
| 追踪 | 跨分布式微服务的端到端请求路径。 | 非常高 | 诊断延迟瓶颈和分布式故障。 |
请注意,表 2 中的指标始终保持紧凑,而日志和追踪数据随请求率线性增长,且追踪数据的单次请求占用量大得多。因此,有效的平台默认展示高层指标仪表盘,仅在检测到异常时才允许深入更低层级开展调查。
模型类型的运维多样性
除规模因素外,不同模型类型需要根本不同的运维模式。适用于部署大语言模型的实践,对欺诈检测系统完全不适用,反之亦然。三种系统架构原型 中的原型分类体系有助于理解模型类型运维要求,这些要求列于@tbl-ops-scale-model-types:大语言模型(LLMs)需要在数天到数周内分阶段发布,回滚窗口长达数小时;而欺诈检测需要每小时更新,并在数秒内快速回滚,以应对动态变化的对抗行为。
| 模型类型 | 更新频率 | 部署模式 | 主要风险 | 回滚速度 |
|---|---|---|---|---|
| 原型 A(GPT-4/Llama-3) | 每月到每季度 | 分阶段、谨慎部署 | 质量退化、安全风险 | 数小时到数天 |
| 原型 B(大规模 DLRM) | 每天到每周 | 影子部署、交错部署 | 参与度下降 | 分钟级 |
| 欺诈检测 | 每小时到每天 | 快速部署并即时回滚 | 漏报 | 秒级 |
| 视觉(分类) | 每周到每月 | 金丝雀部署 | 准确率退化 | 分钟级 |
| 搜索排序 | 每天 | 带留出组的 A/B 测试 | 相关性下降 | 分钟级 |
该表展示的是风险与更新节奏之间的映射关系,而非模型目录。大语言模型处于更新节奏较慢的一端,因为模型规模、成本和细微的质量退化使每次发布都成为影响重大的事件。响应质量的轻微下降可能不会体现在自动化指标中,却可能导致用户满意度出现可测量的下降,因此,LLM 更新通常涉及较长时间的影子部署、结合自动化指标开展人工评估、在数天或数周内分阶段发布,以及在接入任何生产流量之前进行安全评估。
当一个模型必须同时保留所有能力时,质量退化的成本就会具体显现:
Lighthouse 1.1: 原型 A(GPT-4/Llama-3):质量退化的成本
背景:三种系统架构原型 中介绍的原型 A(GPT-4/Llama-3)代表超大规模通用模型(\(70\text{B}\text{--}405\text{B}\)个参数),为涵盖多种任务的数百万个并发请求提供服务。
机制:当定向微调(例如优化 Python 代码生成)导致未受监控的领域(例如创意写作或推理)发生灾难性遗忘时,就会出现“通用模型的困境”。使用 10,000+ 条基准提示词评估候选权重会产生高昂的验证计算成本 \(O/(R_{\text{peak}} \cdot \eta_{\text{hw}})\),在获批前需要数百 GPU 小时的计算。
影响:次要指标的静默退化迫使系统进行成本高昂的紧急回滚,浪费模型服务容量,并导致延迟超出目标 \(L_{\text{lat}}\)。
系统启示:针对大规模通用 LLM 的发布门禁必须结合广泛的能力基准(例如 Massive Multitask Language Understanding (MMLU) 和 HumanEval)与基于策略的安全性检查。自动门禁评估必须计入运行部署开销 \(O/(R_{\text{peak}} \cdot \eta_{\text{hw}})\),而不能被视为零成本的预飞检查。
LLM 的运行节奏通常以数周至数月计,每次更新都被视为需要跨职能协调的重大事件。推荐系统可以采用更快的节奏,因为用户偏好和内容库会持续变化 (Steck 等 2021年; Gomez-Uribe 和 Hunt 2015年)。因此,陈旧的推荐特征可能在下一批更新追上之前就先降低了相关性,尽管部署风险仍因工作负载而异。
Steck, Harald, Linas Baltrunas, Ehtsham Elahi, Dawen Liang, Yves Raimond, 和 Justin Basilico. 2021年. 《Deep learning for recommender systems: A Netflix case study》. AI Magazine 42 (3): 7~18. https://doi.org/10.1609/aimag.v42i3.18140.
推荐系统运营因此强调四种模式:
- 持续训练:流水线每天或每周产生模型更新。
- 交错实验:多个模型变体在同一批请求上进行比较。
- 快速迭代:变更可在数小时内进入生产环境。
- 严格的 A/B 测试:统计基础设施将真实的参与度变化与噪声区分开来。
捕捉这种运营紧迫性的一个关键指标是特征新鲜度延迟,它衡量用户行为传播到模型预测的速度。
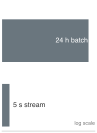
流式处理消除了批处理遗留的新鲜度滞后。
Example 1.1: 特征新鲜度延迟
场景:实时推荐服务处理用户交互日志,在用户会话进行期间计算特征向量。
诊断:每日运行的批处理特征管道存在较高的新鲜度延迟(\(T_{\text{freshness}} \approx 12\text{--}24\text{ h}\)),导致推荐内容保持不变,并使用户放弃会话。流式管道(Kafka/Flink)将新鲜度延迟降至 \(T_{\text{freshness}} \approx 1\text{--}5\text{ s}\),在用户下一次操作之前更新特征向量。
系统启示:特征新鲜度延迟是一项物理系统指标(\(T_{\text{freshness}} = T_{\text{available}} - T_{\text{event}}\))。从批处理摄取转向流式摄取可使用户参与度提升 10% 至 20%,这一收益足以证明实时特征存储的运维成本是合理的。
关键洞见在于,推荐系统运维本质上涉及模型组合管理。单个推荐请求可能调用十到五十个不同的模型,每个模型都需要各自的更新节奏,同时还要维持系统整体行为的一致性。
欺诈检测系统面临一组独特的运维挑战,因为其输入受到自适应对抗者的影响。欺诈者会主动探测系统以寻找可利用的漏洞,并在被发现后迅速改变策略。无法在数小时内作出适应性调整的欺诈检测模型会留下可被攻击的时间窗口。这些对抗性动态提出了四项运维要求:
- 频繁更新:模型每小时或以更高频率更新,以应对新出现的模式。
- 即时回滚:误报率激增时,服务可在数秒内回滚。
- 影子评分:候选模型对所有交易进行评分,以便快速比较。
- 特征变化速率监控:在对抗者利用突发的分布偏移之前检测到这些变化。
风险特征具有不对称性。假阴性(漏检欺诈)会造成直接的财务损失,而假阳性(正常交易被拦截)会给客户带来不便。运维必须实时平衡这些相互冲突的考量。
这些不同的运维模式体现了同一个基本原则:风险特征决定运维节奏。LLM 的部署涉及广泛的风险,包括偏见、滥用和环境危害,因此需要在发布前谨慎分析风险与收益 (Bender 等 2021年)。推荐系统的运维节奏较快,因为陈旧模型会迅速失去相关性,而不良更新造成损害的速度相对较慢。欺诈检测系统持续运行,因为对抗者不会等待预定的部署时间。理解这一原则后,团队就能通过分析新模型类型的风险特征来设计适当的运维实践,而非照搬表面上相似的系统所采用的模式。
Bender, E. M., T. Gebru, A. McMillan-Major, 和 S. Shmitchell. 2021年. 《On the Dangers of Stochastic Parrots: Can Language Models Be Too Big?》 Proceedings of the 2021 ACM Conference on Fairness, Accountability, and Transparency, 610~23. https://doi.org/10.1145/3442188.3445922.
本章其余部分聚焦于企业级集群层面,即为多个相互作用的模型提供共享基础设施,而非讨论从临时性的笔记本工作方式转向自动化单模型管道这一基础性转变。问题在于,这一共享层何时会比让各个团队自行构建运维技术栈更经济、更安全。
设立平台团队的依据
当碎片化的成本高于用于取代它的共享基础设施成本时,设立专门的 ML 平台团队便具有合理性。因此,这一决策需要综合定量因素(成本节约、效率提升)与定性因素(一致性、治理、人才留存)。
前文给出的 ROI 计算提供了主要的定量论据,而辅助指标则说明了共同负责如何转化为整个集群的成本节约:基础设施效率、投产时间以及事故减少。共享 GPU 集群提高了基础设施效率,其利用率可达 70% 至 80%,而各团队专用资源的利用率仅为 30% 至 40%。对于拥有 100 个 GPU 的组织,在 $2 per GPU-hour, moving from 35 percent to 75 percent effective utilization saves approximately $930,000 的年度金额下,同样的 35 个活跃 GPU 当量可由更少的已配置 GPU 承载。平台抽象缩短了从模型训练完成到生产部署的时间,从而减少投产时间;如果这种加速使每季度额外有一个高价值模型投入生产,其业务价值通常会超过平台成本。标准化的部署和监控有助于减少事故,成熟平台往往能将 ML 相关事故减少 60% 至 80%,并将这种减少转化为直接的成本节约和用户体验改善。
定性论据同样源于碎片化成本。平台故障既涉及基础设施失效,也涉及协同失效;共同负责能够改善四个协同方面:
- 一致性:标准化实践确保所有模型在监控、回滚能力和文档方面均达到基本质量标准。
- 知识共享:集中化团队使所有模型团队都能获取运维专业知识,避免这些知识被隔离在各自的团队中。
- 职业发展:平台岗位为对基础设施感兴趣的 ML 工程师提供了职业发展路径。
- 治理准备:随着 AI 监管要求不断增加,平台级控制措施为合规提供了基础。
组织通常在认识到继续放任碎片化所产生的成本超过平台投资时,决定设立平台团队。这种认识往往源于一次重大生产事故,该事故暴露了跨模型依赖关系或运维缺口。由此呈现的经济关系说明了为何随着模型集群扩大,平台运维会变得更有价值。
Systems Perspective 1.2: 每增加一个模型,平台回报都会提高
由于 公式 1 使分子随 \(N_{\text{models}}\) 线性增长,而平台成本大致保持不变,因此平台每多服务一个模型,ROI 比值都会提高:每个模型带来的节约额不断累积,而分母几乎不变。其优势并非回报增长快于线性增长,而是这一比值在越过盈亏平衡点后仍持续上升。这解释了为何推迟平台投资的组织会积累运维债务,而且随着集群扩大,解决这些债务的成本会越来越高。
集群经济性与利用率
虽然运维工具能够节省工程工时,但已部署模型集群的财务成本主要取决于利用率。无论 GPU 是在突发负载之间闲置、为失败的发布而预留,还是因调度瓶颈而无法使用,其成本都与执行有效预测的 GPU 相同。因此,只有平台能够看清容量在哪里被使用、在哪里被预留、又在哪里被浪费,部署实践才能在经济上实现规模化。
划分三个经济层级,可以避免在成本核算中将不同类型的决策归并为一个成本数字。平台经济性考察通用控制平面能力能否通过整个模型组合产生的收益,收回固定的开发和维护成本。集群经济性考察共享硬件、设施和容量承诺能否在可接受的利用率与风险水平下完成有用的工作。工作负载经济性考察单次训练运行、服务端点或实验带来的收益,能否抵偿其边际计算、数据和工程成本。这些层级构成一个层次体系:工作负载优化无法挽救过度建设的集群,而如果平台的采用成本超过它所消除的繁重重复劳动所对应的成本,即使集群利用率很高,也无法证明该平台的合理性。集群内部的边际调度决策属于第 8 章的讨论范围;本章讨论资本规划、模型组合回报、生命周期总拥有成本(TCO)以及跨团队的成本归因。
工程约束归根结底是经济约束:每一项设计决策都是在成本与性能之间进行权衡,而“正确”的基础设施,是那些在整个系统生命周期内最大化每美元有用计算量的基础设施。基于每 8 GPU DGX H100 节点的 $350,000 假设,一个 10,000 GPU 集群的节点硬件 CapEx 约为 $437.5M,此计算尚未计入网络、设施、人力和维护成本。然而,采购价格只是开始。在典型的三年硬件生命周期内,电力、冷却、设施、网络、人力和维护决定了该集群究竟是资产还是闲置负债。TCO2 在此至关重要,因为它将利用率转化为更广泛的 ML 生命周期核算(developed in 节 1.6.12)背后的核心运行不变量。
2 TCO:一种财务框架,由 Gartner 于 1980 年代为 IT 采购而形式化提出,它汇总系统生命周期内的 CapEx(一次性购置)与 OpEx(经常性运营)成本。对于 ML 集群而言,TCO 分析具有独特的关键性,因为电力、冷却、人力、设施和网络成本会实质性地改变三年经济性,而利用率 60 个百分点的波动(从 20% 到 80%)甚至可以在不改变任何硬件规格的情况下,彻底翻转自建与外购(build-vs.-buy)决策。
ML 基础设施的经济性与传统 IT 存在三方面的根本差异。加速器折旧迅速,电力属于一阶运营成本,且利用率敏感性极高:同一集群在 80% 利用率下可能是一项出色的投资,而在 20% 利用率下则可能是一场财务灾难,而硬件与设施成本完全不变。对于规模化运行而言,这就是核心要点。平台必须让昂贵的容量持续承担有用工作,同时仍保留足够的余量以应对故障、回滚和流量尖峰。
成本中心作为运行约束
ML 集群的总成本可分解为两大类。资本性支出(CapEx) 涵盖构建基础设施的一次性成本:加速器、服务器、网络设备、设施建设与安装。 运营性支出(OpEx) 涵盖运行该集群的经常性成本:电费、冷却、网络带宽、人力、维护与软件许可。对于大型本地部署集群,大致的成本构成如下。
表 4 将成本栈划分为资本支出和运营支出两类成本中心,各自对利用率有不同的要求。
| 成本中心 | 成本类别 | 典型占比 | 包含的组件及其影响 |
|---|---|---|---|
| 加速器与服务器 | CapEx | CapEx 的 50–60% | GPU 或 TPU、主机服务器、基板管理控制器和本地存储;该类别在前期采购和折旧中占主导地位。 |
| 网络 | CapEx | CapEx 的 10–15% | InfiniBand 交换机、HCA、线缆和光收发器;为 1,024 个 GPU 配置的胖树网络互连结构可能耗资 $10–20 百万美元。 |
| 设施与冷却 | CapEx | CapEx 的 15–25% | 建筑施工或改造、变压器、UPS 系统、PDU 和冷却设施;液冷使设施成本增加 10–15%,但可降低长期 OpEx。 |
| 电力 | OpEx | OpEx 的 60–70% | 按 $0.07/kWh, a 1,024-GPU H100 cluster consuming 1 MW including cooling at power usage effectiveness (PUE) 1.1 costs about $615,000 每年计算。 |
| 人员配置与维护 | OpEx | OpEx 的 20–30% | 系统管理员、硬件技术人员、替换零部件和软件许可费用。 |
本分析以一个具有 175B 个参数的前沿模型作为贯穿全文的成本示例。对于该模型,最小可行训练集群需要约 1,024 个 H100 GPU,分布在 128 个节点上,以便在 2–4 周内完成一次训练运行。评估三年生命周期内的总拥有成本(TCO),可以看出成本对利用率的显著依赖。硬件 CapEx 占主导地位,为 $44.80M($350,000 per node), supported by a $5 百万美元的两层 InfiniBand 胖树网络投资,以及按比例计算的 $10 million facility allocation. Operational costs add approximately $1.5 百万美元年度电力费用(按 $0.07/kWh with a PUE of 1.1) and specialized staffing, bringing the three-year total to roughly $64 百万美元计算。如果这个专用集群每年仅训练六个大型模型,则每次运行的有效成本为 $3.5 million. Renting the same 1,024-GPU allocation in the public cloud at $4.00 每 GPU 小时,成本约为 $1.3–2.7 million per run (1,024 times 336–672 hours \(\times\) $4),或 $24–48 million over three years for six runs per year. The cloud is cheaper for this bursty cadence because the organization is not paying for idle weeks. The economic advantage of owning hardware only materializes at continuous utilization: if the cluster runs 24/7 (supporting training, inference, fine-tuning, and experimentation), the effective on-premises cost drops to approximately $2.40 每 GPU 小时,显著低于云服务费率。这种对利用率的依赖是每次自建与购买分析中的核心矛盾。
利用率作为经济不变量
最具影响的经济问题是:集群能否持续承载足够的有效负载,以摊薄固定容量成本。自建与购买 是这一问题的一种表现形式,但同样的不变量也存在于已部署的平台内部:预留容量、回退资源池、区域副本和金丝雀发布所需的容量余量,只有在其可靠性价值足以抵偿闲置成本时才具有经济性。图 3 通过绘制自有容量和租用容量的累计成本随时间变化的曲线,直观呈现了这种对利用率的依赖。
所绘制的参考曲线使用 1,024 台 H100 GPU,分布在 128 个节点上,持续利用率为 80 percent。本地部署曲线以 $59.80M 的初始资本支出起步,并每年增加约 $1.5M,而云租赁费用按每 GPU 小时 4 美元计算,每月增长约 $2.39M。经过 30 months 后,云端曲线达到 $71.8M,本地部署曲线在约 26.4 months 时与之相交。
云服务商按 GPU 小时计费,购买价格约为 $4.00 per H100-hour, a single 8-GPU node running at 80 percent utilization costs $224,256 per year. An on-premises DGX H100 node costs approximately $350,000。若按三年摊销,并计入每年每个节点的电费成本 $4,519,则自建基础设施的年度总成本约为每个节点 $121,186。在电力成本按相同利用率进行规模化的前提下求解盈亏平衡方程可知,当持续利用率超过约 42.5 percent 时,自建基础设施更具优势。
同一套计算也解释了为何云定价不能简单视为一张价格清单。预留容量可将每小时费率降低 40–60%,但它把灵活性转化为承诺;竞价或抢占式容量可能便宜 60–80%,但折扣以中断风险的形式到来。因此,低成本容量只有在训练或推理系统已经具备检查点、弹性伸缩和准入控制、从而避免中断演变为丢失的工作或用户可见的故障时,才真正有用。
自建容量将另一组风险转移到了平台。设施建设可能带来每瓦多 \(500--1,000 per kW of IT capacity, and networking, staffing, maintenance, and hardware obsolescence continue to accrue even when the GPUs are idle. A three-year-old GPU may be economically stranded if the next generation delivers 3\)$ 的性能。因此,工程问题不在于哪一种采购渠道普遍更便宜,而在于工作负载组合能否让固定容量保持足够有用,以补偿其生命周期和运行风险。
混合设计源自同一不变量。自建基础设施可以承载可预测的基线工作,而云分配则吸收峰值需求、早期硬件访问或突发式训练任务。混合拆分并非在两类供应商之间做出的折中,而是一项针对资本风险、利用率和截止期限风险的调度策略。
对于 175B 模型,节奏(cadence)是决定答案的变量。每年训练一个大模型、并在其余十一个月进行服务的团队,可能只使用自有训练硬件 15–20% 的时间;而连续运行实验、超参数搜索、微调任务以及模型变体的团队,可以在同一集群上维持 70–80% 的利用率。硬件没有变化,改变的是工作负载构成,因而改变了经济性。在中间形态下,平台拥有足够的容量支撑持续基线,并在需要临时超出基线分配 5–10\(\times\) 的大规模训练任务时,向云端突发扩容。
运行复杂性
总拥有成本(TCO)同样低估了拥有该集群所带来的运行复杂性。硬件维护意味着在局部故障演变为集群级性能下降之前,就需要诊断故障 GPU、NVLink 线缆、InfiniBand HCA 以及冷却组件。一个 10,000 GPU 集群,若按照每个 GPU 故障 50,000 小时这一标准故障间隔所预测的“每五小时发生一次 GPU 故障”的失效分析结果,则需要以小时而非天为单位来规划更换路径。组件故障率 提供了各部件的平均失效时间基线,并将其转换为支撑上述五小时数值所对应的集群级故障率,从而使人员配置论证能够追溯到一项经实测的可靠性预算,而非主观假设。
软件侧产生了同样的耦合关系。CUDA、GPU 驱动、InfiniBand 驱动、容器运行时、调度器、监控系统以及训练框架,都会影响最终实现的利用率数值。驱动或工具包之间的不兼容可能静默地降低性能,而调度器或监控方面的缺口则可能让加速卡滞留在失败任务之后。大规模训练集群通常需要每 10,000 GPU 配备 5–15 名基础设施工程师,因为性能优化是一个持续过程:随着模型、框架和硬件配置的变化,通信模式、内存压力和并行策略也会随之变化。案例 1:利用率不足的集群(Compute) 从计算、通信和协同三个维度对未充分利用的集群进行剖析,为性能工程师提供了一个框架,用以定位损失掉的利用率究竟去了哪里,而不是盲目调优(参见 C³ 基础设施诊断决策树与集群 D·A·M 记分卡 和 C^3 遥测诊断映射 中的 C³ 遥测诊断决策树以及集群 D·A·M 记分卡)。
云服务商会在原始硬件和电力成本之上加收利润,部分原因在于它们吸收了这部分运行负担。重点不在于云在每一个技术层面都更简单,而在于它提供了不同的接口。平台要么自行支付 GPU 内核行为、InfiniBand 运维、分布式系统调试、液冷以及供电基础设施方面的内部专业能力,要么付费给服务商,让其在服务合同中隐藏其中一部分机制。在这两种情况下,经济性仍然由“每美元产生的有效工作”所支配。
从 TCO 到总拥有价值
比 TCO 更完整的框架是总拥有价值(total value of ownership),它包含基础设施所产生的价值,而不只是其成本。两个 TCO 完全相同的集群可能产生不同的结果:其中一个可能提前两周得到结果、维持更高的扩展效率、更快地启动任务、更廉价地完成检查点,或者以更低的每 token 成本服务由此产生的模型。这些价值项难以精确定价,但在系统推理中并非可有可无:结果达成时间影响产品交付期限,扩展效率影响固定训练窗口下的最终模型质量,实验速度影响团队能够验证的假设数量,而推理效率在多年度部署中可能主导训练成本。
这种以价值为导向的视角,将基础设施决策从成本最小化转变为约束管理。一个更便宜的集群,如果拖慢了研究周期,或者产出的模型具有更高的服务成本,那么在整个模型生命周期中可能反而更昂贵。反之,一个更昂贵的训练平台,如果能够启用更小或更高效的部署模型,则可能实现自我回收。
所有权总价值(TVO)的推理维度尤其值得强调,因为它往往主导整体经济成本。训练 175B 模型是一次性成本——即使在 H100 硬件上每百万 token 的成本为 $5 million per training run, it is a bounded expenditure. Serving the trained model, however, is an ongoing operational cost that accumulates indefinitely. A popular LLM serving 10 million queries per day, with each query generating an average of 500 tokens, processes 5 billion tokens daily. At an inference cost of $2.00,每日模型服务成本也为 $10,000, or approximately $3.6 百万/年。累计推理成本超过 $5 million training run after roughly 17 months, and exceeds it several times over during a multi-year deployment. This inversion means that infrastructure decisions optimized for training (maximizing TFLOP/s per dollar) may be suboptimal for the model’s total lifecycle cost. An organization that spends an additional $2 百万的训练基础设施投入;这笔投入用于产出一个推理效率提高 20% 的模型(通过更快的实验实现更优的架构搜索),在这一流量水平下,可在三年的模型服务生命周期内收回。
::: {#nbk-ops-scale-10-000-gpu-cluster .callout-notebook title=” 一万 GPU 集群”}
考虑一个由 1,250 个 DGX H100 节点(10,000 GPUs)组成的集群,用于训练 175B 模型。
本地部署(3 年生命周期):
- 硬件资本支出:1,250 \(\times\) $350,000 = $437.5M
- 网络资本支出:约 $25M(InfiniBand 胖树网络互连结构)
- 设施资本支出:约 $75M(液冷数据中心机房)
- 年度电费:仅计 GPU 的简化估算:10,000 GPUs \(\times\) 700 W \(\times\) PUE 1.1 \(\times\) 8,760 h/year \(\times\) $0.07/kWh = $4.7M/年
- 年度人力成本:约 $5M/年
- 3 年总成本:$537.5M + 3 years \(\times\) $9.7M = 约 $566.7M
云租赁(以 80 percent 的利用率租赁 3 年):
- 年度成本:10,000 GPUs \(\times\) $4/GPU-hour \(\times\) 8,760 h/year \(\times\) 0.80 = $280.3M/年
- 3 年总成本:约 $841.0M
系统洞察:利用率是制约集群总拥有成本(TCO)的关键变量。本地部署在三年内可节省约 $274.3M,对应的利用率为 80 percent;但如果利用率降至约 53.9 percent 以下,这些节省就会消失,因为无论负载如何,本地部署的硬件仍会产生设施和人力成本。
:::
这一利用率阈值解释了为什么基础设施规模能够成为竞争优势。
Systems Perspective 1.3: 基础设施护城河
建设一个拥有 10,000 个 GPU 的集群,相比云租赁可节省数亿美元,但前提是组织拥有足够的工作负载,使集群持续处于忙碌状态。拥有持续训练流水线、频繁模型更新和海量推理工作负载的大型科技公司能够实现 70–90% 的利用率,使本地部署基础设施具有很高的成本效益。训练需求零散的较小组织可能只能实现 20–30% 的利用率,因此,即使云租赁的每小时成本更高,其总成本仍然更低。这种动态形成了基础设施护城河:具备规模的组织有能力建设基础设施,而自建基础设施又降低了扩大规模的成本,从而支持更具雄心的模型,而这些模型又需要更多基础设施。这一差距随时间不断累积,使高利用率组织在训练最大规模的模型时获得结构性优势。
折旧与生命周期
机器学习加速器的折旧速度快于任何其他类别的 IT 设备。传统服务器的使用寿命为 5–7 年;网络交换机的寿命甚至更长。机器学习加速器在 3–4 年内就会在经济上过时,因为每一代新产品都能提供更高的每瓦性能。按照 各代 GPU 的能效 中的低精度效率基准,V100 时代的集群与 H100 级集群的单 GPU 功耗相近,但其每瓦吞吐量仅约为后者的 1/6.8。因此,其每单位有效计算的电费约为使用 H100 级参考硬件的团队的 6.8\(\times\)。
这种折旧的经济影响十分显著。一块购入时售价为 $10,000–12,000 in 2018 could be purchased on the secondary market for $2,000–3,000(2023 年)的 V100 GPU,五年内折旧了 70–80%。一块购入时售价为 $15,000–20,000 in 2021 traded for $8,000–12,000(2024 年)的 A100 GPU,仅经历了三年。这些折旧率远高于传统 IT 设备,反映了加速器创新的迅猛速度。
快速折旧使硬件更新策略成为一个调度问题。出于会计核算目的,大多数组织按三年对机器学习加速器计提折旧,即使硬件在物理上能够运行更长时间。一次性更换整个集群会造成巨大的资本支出峰值,而分批更新虽然降低了支出峰值,却使调度器必须面对混合代际的硬件。训练框架因此必须在同一个集群内处理不同的计算能力、内存容量和通信带宽,于是,会计核算上的选择便成为软件和任务放置的约束。
同样的生命周期逻辑也决定了旧加速器在哪些场景中仍有价值。对于最大规模训练任务而言效率低下的 GPU,仍可能以经济可行的方式运行较小模型、微调任务或受内存限制的推理任务,因为内存带宽的提升速度慢于峰值算术吞吐量。转售、用途调整和容量共享安排,都是在硬件市场价值下降时维持利用率的尝试。只有当平台能够将工作负载分配给合适代际的硬件,同时不向用户隐瞒性能的骤降时,这些措施才会奏效。
折旧对突发型工作负载的影响最为严重。如果一个团队每年只训练一个大模型,那么 GPU 在闲置的月份里仍会贬值,尽管它们没有执行任何有效计算。云计算容量将同样的折旧分摊给众多客户,而自有计算容量必须通过所有者自身的工作负载组合来摊销。这就是利用率不变量再次出现的原因:硬件要么保持忙碌,要么足够便宜,使闲置成本可以承受。
对于 175B 模型,折旧核算十分悬殊。在扣除网络与设施成本之前,该集群的账面价值为 $350,000-per-8-GPU-node assumption, a 1,000-GPU H100 cluster costs $4375 万美元。若该集群的残值为约 $7–10 million after a three-year refresh window because newer accelerators deliver 3–4\(\times\) the performance per watt, its net hardware depreciation is $3375 万至 3675 万美元。若该集群在其生命周期中仅训练了两个大型模型,则每个模型在扣除残值后的有效成本为 $16.9–18.4 million in depreciated hardware alone—before accounting for electricity, staffing, or facility costs. If the same cluster ran continuously at 80 percent utilization for three years (training, fine-tuning, inference, and experimentation), the depreciated hardware cost per GPU-hour drops to approximately $161 万至 175 万美元,仍明显低于云端价格。折旧核算强化了 TCO 分析的核心要点:利用率是决定自有基础设施在经济上是否可行的唯一最关键变量。
功率效率演进轨迹
功率效率 随加速器代际的变化轨迹,为集群刷新决策提供了定量框架。仅凭电力节省,用新一代集群替换旧集群即可实现自偿,尤其在大规模场景下。
| 代际 | 峰值 TFLOP/s(最佳精度) | TDP(W) | 每瓦 TFLOP/s | 相对效率 |
|---|---|---|---|---|
| V100(2017) | 125 TFLOP/s(FP16) | 300 W | 0.42 TFLOP/s/W | 1× |
| A100(2020) | 312 TFLOP/s(FP16) | 400 W | 0.78 TFLOP/s/W | 1.9× |
| H100(2022) | 1,979 TFLOP/s(FP8) | 700 W | 2.83 TFLOP/s/W | 6.8× |
| B200(2024) | 4500 TFLOP/s(FP8) | 1000 W | 4.50 TFLOP/s/W | 10.8× |
硬件更新周期归根结底是关于每美元电力获得多少计算量,而不是更高的峰值 FLOP/s(各代 GPU 的能效)。在大规模部署下,升级到更高能效代际所带来的电力节省,可以在头一年内摊还新硬件采购成本的相当一部分。这一经济动态推动了 ML 加速器快速折旧:三年前的 GPU 不仅比更新的代际更慢,而且每单位有效计算的运行成本也更高。
考虑一个具体的代际更新场景。一家运营 1,000 张 V100 GPU(每张 300 W,共 0.42 TFLOP/s/W)的组织消耗 300 kW 的 IT 电力,提供 125,000 TFLOP/s 的聚合吞吐量。若将其替换为 1,000 张 H100 GPU(每张 700 W,共 2.83 TFLOP/s/W),功耗将升至 700 kW,但可提供 1,979,000 TFLOP/s 的吞吐量,即吞吐量提升 15.8\(\times\),而功耗仅增加 2.3\(\times\)。
另一种选择是,该组织可以用约 63 张 H100 GPU 匹配 V100 集群的吞吐量,仅消耗 44 kW,从而为其他工作负载释放 256 kW 的电力容量。哪种策略更优,取决于该组织是受吞吐量约束(希望训练更大的模型)还是受电力约束(拥有固定的电气预算)。
两个场景都表明,代际效率提升重塑了集群的经济性。受电力约束的情形尤其具有启发性:在固定的 300 kW 电力预算下,数据中心通过用 H100 替换 V100,可以交付约 6.8\(\times\) 更多的计算量,尽管它只能安装 43% 数量的 GPU。15.8\(\times\) 的吞吐量增益适用于 GPU 数量相同、而功耗从 300 kW 提升至 700 kW 的更新场景。对于集群扩展而言,电力而非采购预算正日益成为约束性因素。
CapEx 与 OpEx 之间的相互作用同样影响采购策略。云服务商通常将硬件摊销到更短的周期(通常为 18–24 个月),因为它们可以以更低的价格向价格敏感型客户出售上一代实例,从而提取剩余价值。本地部署的运营商通常将摊销周期设为 3–5 年,并接受硬件的相对性能会随时间下降。
一些组织采用混合策略:在自有基础设施上运行基线工作负载以降低成本,并在峰值需求或需要获取更新硬件(在做出大额采购承诺之前)时向云端突发。这种混合模式适合拥有稳态训练工作负载、因而具备自有硬件正当理由的中大型 AI 公司,但它们会周期性地将基础容量扩展至 2–3\(\times\) 倍,以支持新的模型训练战役。
功率效率演进路径对 175B 模型的训练经济性有着直接影响,而 V100 与 H100 的对比使这一影响具体化。在 1,000 张 V100 GPU 上训练需要每张约 300 W(1,000 张 GPU 的 IT 功耗为 300 kW),耗时约 8 个月(考虑到 V100 的较低吞吐量)。在 1,000 张 H100 GPU 上训练则需要每张约 700 W(1,000 张 GPU 的 IT 功耗为 700 kW),但可在约 2–4 周内完成。H100 集群的单位时间功耗比 V100 多 2.3\(\times\),却快 8–16\(\times\) 完成,因此对于同一训练任务,净能耗降低了 3.5–7\(\times\)。当电费为 $0.07/kWh, the V100 training run costs approximately $120,000 时,H100 运行的成本约为 25,000 美元。新硬件同时更快、运行更便宜、能效更高——这种罕见的协同使有资本投入的组织能够轻松做出硬件更新决策。
容量提前期作为运营风险
机器学习基础设施的经济性并不只关乎硬件规格和电价。容量提前期本身就是一种运营风险:若平台无法足够快地获取、预留或释放容量,就可能错过模型发布、推迟可回滚迁移,或在需求到来前缺乏应对事故所需的余量。
GPU 供给链 的集中度异常突出。NVIDIA 占据约 80–90% 的面向机器学习工作负载的数据中心 GPU 市场。台积电(TSMC)制造几乎所有高端 GPU 裸片。少数几家公司(SK 海力士、三星和 Micron)生产 HBM 堆栈。这种集中度意味着,供应链上任何单点的中断——晶圆厂遭遇自然灾害、高带宽内存(HBM)厂商的设备故障,或影响芯片出口的地缘政治事件——都可能延迟整个行业的 GPU 交付。
这种集中度的实际后果是:大规模下容量变化缓慢。大型部署(1,000+ 张 GPU)的采购周期通常从采购决策到首次可用容量跨越 6–12 个月,需求激增还可能进一步拉长这一时间窗口。对于已部署的集群,这种延迟会改变运营方式:平台必须在需求到来之前预测模型增长、预留更新容量并维持回退方案,而不是等仪表盘转红之后才采取行动。
对于 175B 模型,规划层面的经验是:硬件访问成为部署排程的一部分。最低可行配置为 1,000 台 H100,对应约 $44 million in node hardware under the $350,000 台每 8 GPU 节点的假设,该假设确立于 节 1.2.2;但运营风险不仅在于采购价格。若分配延迟一个季度才到位,平台可能在模型发布窗口内缺乏微调、影子流量、金丝雀扩展或可回滚服务的容量。因此,容量规划是一项可靠性控制,而不只是采购职能。
云容量作为运营约束
对于选择 Cloud Path 的组织,云服务商承担硬件所有权,却将容量、拓扑和中断风险暴露为运营约束。具体实例类型与定价频繁变动,因此持久的区分点并非厂商品牌,而是云分配如何影响通信、调度与容错。
首先,Interconnect Fabric 决定分布式作业和多节点推理路径是否保留设计阶段所用的扩展假设。类 InfiniBand 的互连结构与基于以太网的结构具有不同的固定延迟和每字节成本;The α-β Communication Model 将这两项区分开来,使平台能够判断该拓扑惩罚对特定工作负载是否重要。
其次,Provisioning Granularity 决定平台对拓扑的控制程度。单独实例最大化灵活性,但迫使团队自行组合放置、网络与调度策略;Pod 级分配提供预连接单元,却降低了组合自由度。
第三,Custom Accelerator 选项沿用了硅片层面引入的通用性—效率权衡:对受支持的工作负载,每操作成本更低,但对非标准架构的灵活性下降。该选择与自建加速器决策如出一辙,只是退出路径为云迁移而非硬件更新。
各提供商的定价模型共享同一类风险结构。On-Demand Instances 以最高的小时单价购买灵活性。Reserved Instances 通过承诺换取更低的单位成本。Spot or Preemptible Instances 以接受中断风险换取最低的单位成本。因此,平台选型本质上是一项容错决策:廉价容量只有在检查点、弹性伸缩和准入控制能够防止中断演变为用户可见故障时才有用。
12 ops scale
Spot 实例的经济性值得特别关注,因为对于具备工程能力加以利用的组织而言,它们可以大幅降低训练成本。在 70% 折扣下,spot H100 实例的成本约为 $1.20 per GPU-hour instead of $4.00。对于 175B 模型,1,000 GPU、2–4 周的工作负载消耗约 336,000–672,000 个已分配 GPU 小时。因此,在计入中断之前,按需成本约为 $1.3–2.7 million, while spot pricing would reduce the bill to roughly $0.4–0.8 million。然而,抢占的随机性将训练从确定性过程转变为一个容错工程问题。如果云服务商在训练过程中收回 5% 的节点,标准训练任务会立即崩溃。要捕捉 spot 经济性,就需要一个弹性训练框架(例如 TorchElastic),在新成员资格下重启并重新调度 worker,由应用检查点提供恢复状态。经济上的可行性取决于 Checkpoint Tax:如果系统必须每 10 分钟检查点一次以限制抢占导致的数据丢失,而每次检查点耗时 30 秒,那么约 5% 的“便宜”计算量会被 I/O 开销消耗掉。存在一个盈亏平衡点,在该点上,抢占事件频率与检查点开销共同作用,使得 spot 实例在墙钟时间上比预留实例更昂贵,尽管其小时费率更低。
对于基于云的机器学习基础设施,一个关键的考量是 实例间通信。与可自建网络拓扑的本地集群不同,云实例与其他租户共享服务商的网络互连结构。云服务商可能提供 placement group 或专用网络互连结构,为同一组内实例之间预留类 InfiniBand 或等效带宽。
然而,跨组或跨可用区的通信可能需要穿越共享基础设施,其带宽更低、延迟更高。跨越多个 placement group 或可用区的训练框架必须考虑这种异构带宽拓扑,这是专用本地集群中并不存在的挑战。实际后果是,基于云的训练任务应尽可能按可容纳单个 placement group 的规模设计,因为跨越组边界可能使扩展效率降低 20–40%。
对于 175B 模型,云端路径面临一个特定挑战:需要在单个 placement group 中锁定 1,000+ GPU,以支撑持续数周的训练运行。云服务商通常将 placement group 的规模限制在 256–512 GPU,这意味着大规模训练运行要么需要协商定制分配(往往需要可观的承诺),要么接受跨越多个 group 所带来的性能损失。大规模连续 GPU 分配的可用性因区域和时间而异,在需求高峰期,组织可能需要等待数周才能获得足够大的分配。这种可用性不确定性是云端路径的一项隐性成本,它不会体现在每 GPU 小时的定价中,却可能显著推迟训练时间线。
Checkpoint 1.2: TCO 决策框架
一个组织需要训练 10 models/year,每个训练任务在 H100 上需要 1,000 GPU-hours,现需评估本地集群(配置为 8 GPUs)与云端实例(价格为 $4/GPU-hour)之间的成本对比。
基础设施规划方法论
基础设施规划始于将工作负载需求转化为设施需求。一次大规模训练运行并不只是要求更多 GPU:模型规模决定内存压力,令牌预算决定计算预算,期望的日历时间决定聚合吞吐量,通信模式决定能够发挥集群价值的网络结构。一旦选定加速器,其热设计功耗(TDP)就会约束冷却、机柜密度、机架布局、设施供电,并最终决定总拥有成本。因此,规划本质上是一条因果链,而非一份采购清单。
第一步是工作负载刻画。目标模型规模决定加速器的最小数量与内存策略;数据集规模、目标吞吐量和可接受的训练时长将训练目标转化为 FLOP-hour 需求。通信模式随后改变网络选型答案:稠密模型对 AllReduce 构成压力,混合专家模型对 AllToAll 构成压力,流水线并行模型则引入更多点对点流量。推理需求又增加了一层约束,因为高效训练模型的硬件未必是经济地服务该模型的硬件。
在明确这些约束之后,自下而上容量规划从加速器向外推导。Roofline 分析区分计算受限训练与内存受限推理;计算受限训练优化每美元持续 TFLOP/s,而内存受限推理通常优化每美元带宽与每瓦延迟。
在那一阶段,规划不再是采购清单,而是一系列相互耦合的设计约束。节点规模决定了每个主机上共享多少个加速器,以及哪一层内存承载优化器状态、激活值和数据暂存。对于 175B 模型,这意味着每节点八块 GPU,采用张量并行,并配置约 2 TB 主机 DRAM 用于优化器状态卸载。随后,集群规模通过将总计算预算除以模型 FLOPs 利用率(MFU)损失后的节点持续吞吐量来确定,并额外增加 5–10 个百分点作为维护池和备件。
网络设计紧随主要集合通信,并依据 扩展效率的数学描述 中的扩展效率分析验证预期的扩展表现。网络互连结构在承担性能角色的同时,也带来可观的资本支出:第三级:交换机与拓扑 推导出胖树所需的叶节点交换机和脊节点交换机数量,但每块 InfiniBand NDR 交换机每链路成本为 $15,000–30,000 and active optical cables add $500–1,000,因此 1,024 GPU 集群的网络投资达 $5–15 million depending on oversubscription and optical mix. A RoCE (remote direct memory access (RDMA) over Converged Ethernet) fabric lowers per-port cost but is lossy under the bursty, synchronized traffic of distributed training: even a 1 percent packet-retransmission rate can cut effective AllReduce throughput by 10–20 percent because every GPU waits for the slowest participant. When the GPU fleet is a $3500 万美元以上;InfiniBand 溢价可以通过避免网络成为瓶颈而收回成本。
功耗与散热将 IT 负载通过 PUE 折算,随后在本地对机柜密度进行合理性校验:包含 GPU、主机系统、网络、电源转换和散热开销后,四节点 DGX H100 机柜的设计点约为 30–40 kW。更高的密度除增加功耗外,还会改变冷却架构。TCO 与进度安排仍属于设计变量,因为集群必须按时到位才能发挥作用,而 GPU 供应或电力工作往往主导了提前期。
同样的链条在 175B 训练计划中变得具体。大批量训练受计算能力限制,因此设计以每美元可获得的持续 TFLOP/s 为优化目标,选择 H100,而非针对带宽优化的推理加速器。2.2 TB 的训练状态无法容纳于单个设备,因此必须在每个节点内部采用张量并行,并在更大的数据并行组中采用优化器分片、激活检查点和卸载。这一内存约束在设施规划人员着手处理电力电子表格之前,就已决定了 DGX H100 的节点配置。
随后,集群规模由计算预算决定。按每个参数—词元需要 6 FLOPs、1750 亿参数和 3000 亿词元计算,本次训练需要 3.15 × 10²³ FLOPs。采用保守的 BF16/FP16 规划基准,而非宣传中的 FP8 峰值时,每个 H100 的峰值性能为 989 TFLOP/s,持续性能为 445.1 TFLOP/s,对应的 MFU 为 45 percent。配置 1,024 GPUs 后,集群的持续性能约为 455.7 PFLOP/s,完成本次训练所需的理想化计算时间约为 8 天,计入运行开销则为 2–4 周。TP-8、PP-4、DP-32 配置会产生结构化的全归约流量,适合采用按轨道优化的 InfiniBand 网络互连结构。
128 个节点中,每个容纳 4 个节点的机架耗电 33.5 kW,共分布于 32 个机架,设施侧相关负载约为 1.1 MW,因此必须采用液冷。3 年总拥有成本(TCO)约为 $64M on-premises; renting the six-runs-per-year workload in the cloud is roughly $24–48M,具体取决于每次训练持续 2 周还是 4 周,而持续使用云服务的成本更高。能否达到盈亏平衡,取决于首次训练结束后的持续利用率。GPU 采购(6–12 个月)和设施准备必须立即启动,并通过分阶段部署,争取在 3 个月内提供初始容量。
选址与物理约束
到目前为止,规划链条一直假定已有可用设施,但对于这一规模的集群,场址本身就是一个规划变量,在购买任何加速器之前便会确定多项约束。电力可用性是首要约束,通常也是最具约束力的一项。一个包含 10,000 个 GPU 的计算单元需要 10–15 MW 的持续供电,相当于一家中型工厂;在兆瓦级规模下,优惠电价与高昂电价之间的差额,在一个硬件生命周期内可能累计达到数千万美元。水电站附近的地区(美国太平洋西北地区、斯堪的纳维亚、魁北克)拥有充足的低碳电力,但往往远离人才聚集地和现有光纤网络,因此廉价电力与靠近工程师之间的权衡,成为影响最为深远的选址决策之一。
冷却环境是第二项约束。温带或寒冷地区的场址可在一年中的大部分时间采用自然冷却(直接使用室外空气,无需机械制冷),从而实现较低的 PUE;Meta 位于瑞典吕勒奥的设施,年平均气温为 1 摄氏度,依靠全年自然冷却,PUE 接近 1.03。炎热干旱地区既面临更高的冷却成本,也面临蒸发冷却塔所需水资源短缺的问题。一个采用标准蒸发冷却的 10 MW 设施,每年耗水量可能远超 1 亿升;在水资源紧张地区,这会使数据中心与市政及农业用水需求形成直接竞争,并可能触发许可限制。闭环液冷或干式冷却器系统可将用水量降至接近零,但会提高资本成本,并在炎热气候下提高 PUE。网络连接是第三项约束:摄取地理分散数据的训练集群需要广域网带宽,而模型服务集群需要靠近互联网交换中心,以降低终端用户延迟。因此,一些组织将训练计算单元部署在电力充裕的偏远场址,将模型服务计算单元部署在人口中心附近。
这些约束往往相互冲突,而监管边界可能凌驾于所有这些约束之上。出口管制对某一地区可部署哪些类别的加速器构成硬性筛选条件。欧盟《通用数据保护条例》(GDPR)要求跨境传输具备适用的传输机制,例如充分性决定或适当保障措施,从而对跨境传输施加约束;另行制定的数据本地化法律可能要求在区域内处理数据。由此形成了电力走廊现象,使计算容量集中在少数区域:北弗吉尼亚凭借网络连接优势,美国太平洋西北地区凭借廉价水电,北欧地区凭借自然冷却条件。随着这些区域趋于饱和,当地电网新增变电站容量需要等待多年,促使运营商转向非常规的“棕地”场址(退役铝冶炼厂、废弃燃煤电厂);这些场址已有高压输电设施,但光纤和冷却设施必须从零建设。
建设与部署时间表
场址选择直接影响进度,而从决策到首次计算的时间跨度,是大多数组织低估最严重的规划约束。从零建设一座设施需要 18–30 个月,其中变电站(18–24 个月)和建筑主体(12–18 个月)是交付周期最长的项目;在需求旺盛时,GPU 的交付周期可达 6–12 个月,并与设施建设同步推进。这意味着,基础设施决策必须在实际需要基础设施之前 18–30 个月作出,往往需要为尚未问世的硬件选择设施设计。为应对这种错位,经验丰富的团队会在设计中预留余量:将电力基础设施容量提高 30–50%,使冷却系统能够支持高于初始部署需求的热密度,并采用灵活的机架布局。为此付出的额外成本通常占设施资本支出的 10–20%,换来的是无需重建建筑即可升级计算资源的能力。
建设时间表受一条关键路径支配,这条路径必须协调两条不同的工作流:设施工作流(场址、电力、建筑主体、冷却)和硬件工作流(芯片配额、服务器组装、网络集成)。GPU 采购常成为关注焦点,但真正的瓶颈往往是变电站,其审批和变压器交付周期无法通过增加投入来缩短。这造成了一个事关重大的同步问题:20,000 个 GPU 的配额($500M+) secured before the facility is ready depreciates in a warehouse, while a $200M 建筑主体在芯片到货之前完工,会使资本资产闲置。为对冲这一风险,团队采用分阶段部署,分批将设施投入运行,而非瞄准单一上线日期;通常会在建设仍在继续时,先启用初始容量的 10–20%(10,000 个 GPU 中的 2,000 个)。早期阶段让软件团队能够在真实拓扑上验证分布式训练软件栈、调优集合通信内核,同时对配电和冷却进行压力测试,在小规模下发现热点和布线缺陷。
这些复杂安排的依据是计算资源的时间价值。对于大模型开发,延迟成本可能超过资本利息,因为计算资源延迟到位会推迟实验、产品发布和后续能力的实现。一个预计产生 $10 million per month in value loses $ 的模型,因三个月的建设延迟而损失 3000 万美元,这一损失往往超过设施全部电力基础设施的成本。这种权衡可以成为支付溢价购买预制模块化数据中心,或租用临时托管空间的理由,以弥合芯片交付与设施就绪之间的时间差;这也说明,容量规划是一项调控可靠性和产品推进速度的职能,而不只是采购职能。
Checkpoint 1.3: 基础设施规划练习
某团队需要训练一个参数量为 70B 的模型,训练数据量为 1T 个词元,须在 4 weeks 内完成;使用的 H100 GPU 的 FP8 峰值性能为 1979 TFLOP/s(MFU 为 45 percent),设施功率上限为 2 MW。
虽然平台运维的经济合理性在规模扩大后逐渐清晰,但技术实现始于一个看似简单却十分棘手的问题:防止独立模型之间发生冲突。当数百个模型共享相同的数据、基础设施和用户体验时,会产生隐含的依赖关系,多模型管理需要厘清这些关系。
状态与变更治理
设想一个电商平台,其搜索排序模型使用用户嵌入模型的输出。如果嵌入团队悄然上线一个维度或尺度不同的更新模型,搜索模型就会立即开始产生毫无意义的预测。从单模型运维向多模型运维的成熟度演进,关键就在于管理这种隐形的相互牵连。第二阶段负责治理整个集群的状态与变更:注册中心揭示依赖关系,发布关卡限制部署风险,监控验证不变量,特征运维维护数据契约。
在生产环境中管理多个机器学习模型,会带来单模型运维中不存在的协同挑战。当模型共享特征、将预测结果输入其他模型,或争用共享基础设施资源时,它们各自的行为就会相互依赖。因此,有效的模型组合管理首先需要注册中心、依赖跟踪,以及能够感知集成模型关系的部署实践,使这些关系显式化。
大规模模型注册中心
有效的多模型管理,首先要将制品转化为受治理的接口。模型注册中心是组织内所有机器学习制品的集中目录,但在企业规模下,该目录还必须揭示依赖图,以确定一次更新可能破坏哪些下游系统。
注册中心的核心要求
只有四项常规目录能力都可靠,注册中心才能实施依赖控制。表 5 概述了最低限度的接口要求:版本标识符让下游使用方能够锁定其已验证的确切制品;元数据揭示审核所需的训练和部署背景;制品存储将注册中心条目转化为持久、可部署的资产;访问控制则使所有权边界保持明确。
| 要求 | 存储的内容或实施的控制 | 为何在大规模场景下重要 |
|---|---|---|
| 版本管理 | 唯一的制品标识符,以及训练数据、超参数、代码提交和评估指标的谱系信息。 | 下游使用方可以锁定其已验证的确切制品。 |
| 元数据存储 | 训练配置、评估结果、硬件要求、服务配置和所有权信息。 | 无需对制品进行逆向分析,即可作出部署和审核决策。 |
| 制品存储 | 持久保存的模型二进制文件,以及靠近服务位置的高效检索和缓存机制。 | LLM 等大型模型可能超过 100 GB,不能依赖临时性的文件分发方式。 |
| 访问控制 | 在团队边界和依赖边界设置读写、管理和只读权限。 | 模型开发者、平台运维人员和依赖该模型的团队通过受治理的 API 交互。 |
依赖跟踪
除这些核心要求外,企业注册中心的突出特征是显式的依赖跟踪。图 4 展示了上游模型(如用户嵌入模型)的更新如何自动触发针对所有下游使用方的告警和验证,包括排序模型和检索模型。当模型 A 使用模型 B 计算出的特征时,必须记录这一关系,并据此实施控制。
图 4 的核心启示是:除非注册中心强制要求显式记录依赖边,否则一次上游更新就可能在无任何提示的情况下使所有下游使用方失效。考虑一个包含四类相互依赖模型的推荐系统,就能清楚地看出这种跟踪的必要性:
- 嵌入模型 E 生成用户嵌入和物品嵌入
- 召回模型 R 使用 E 生成的嵌入来生成候选项
- 排序模型 R1、R2、R3 使用 E 生成的嵌入对候选项进行评分
- 集成模型 M 组合 R1、R2、R3 的输出
依赖图必须在注册中心中显式记录,因为更新审批过程本质上就是图遍历。当嵌入模型 E 更新时,注册中心执行四个图遍历步骤:
- 识别所有依赖模型(R、R1、R2、R3、M)
- 触发使用新嵌入对依赖模型进行重新评估
- 在兼容性得到验证之前,阻止部署新的 E
- 如果继续推进更新,则协调部署顺序
如果没有显式的依赖跟踪,组织就只能在上游模型变更导致下游使用方失效、引发生产环境故障时,才发现这些依赖关系。
代码 1 展示了单个 YAML 条目如何记录制品位置、训练来源和评估阈值,从而为依赖跟踪器提供足够的元数据,使其能够在上游嵌入发生变化时识别出哪些下游模型必须重新评估。
model:
  name: user_embedding_v3
  version: "3.2.1"
  type: embedding_model
  domain: recommendation

artifact:
  path: gs://models/user_embedding_v3/3.2.1/
  format: tensorflow_savedmodel
  size_bytes: 4294967296

training:
  data_version: user_interaction_2024_01
  code_commit: abc123def
  started_at: 2024-01-15T10:00:00Z
  duration_hours: 48
  hardware: 8xA100-80 GB

evaluation:
  metrics:
    recall_at_100: 0.342
    embedding_quality: 0.891
  evaluation_set: eval_2024_01

dependencies:
  upstream:
    - feature_store/user_features_v2
    - feature_store/interaction_features_v1
  downstream:
    - models/candidate_retrieval_v4
    - models/ranking_ensemble_v2

serving:
  min_replicas: 10
  max_replicas: 100
  latency_p99_target_ms: 5
  memory_gb: 16

ownership:
  team: recommendation-core
  oncall: recsys-oncall-team
集成管理
推荐系统典型地体现了多模型管理的挑战,因为每次请求都需要由 10–50 个模型组成的集成共同处理。即使各个组件归不同团队负责,平台也必须将整个集成作为统一的生产接口进行管理。
为何集成在推荐系统中占主导地位
现代推荐系统采用集成架构,是因为单个模型无法同时满足所有延迟、质量和业务约束。多样化的目标需要专门的模型:用户参与度、多样性、新鲜度、库存和业务约束往往指向不同方向,因此由独立模型分别专注于各项目标,再由集成组合它们的输出。分阶段过滤是这种专业化分工在系统层面的对应机制。使用单个计算成本高昂的模型处理海量候选项,在计算上不可行,因此多阶段架构会逐步过滤候选项:召回生成规模可控的候选集,排序利用更丰富的特征对该候选集进行评分,后续的重排序或业务规则阶段则生成最终排序 (Covington 等 2016年; Liu 等 2022年)。
Covington, Paul, Jay Adams, 和 Emre Sargin. 2016年. 《Deep Neural Networks for YouTube Recommendations》. Proceedings of the 10th ACM Conference on Recommender Systems, 191~98. https://doi.org/10.1145/2959100.2959190.
Liu, W., Y. Xi, J. Qin, F. Sun, B. Chen, W. Zhang, R. Zhang, 和 R. Tang. 2022年. 《Neural Re-Ranking in Multi-Stage Recommender Systems: A Review》. Proceedings of the Thirty-First International Joint Conference on Artificial Intelligence, 5512~20. https://doi.org/10.24963/ijcai.2022/771.
同样的分解方式也提高了实验迭代速度,因为团队可以更新单个组件,而无需重新训练整个推荐系统栈,但这种独立性也使平台承担了确保版本兼容性的责任。它还改变了风险管理方式。当某个模型失效或产生较差结果时,其他集成组件有时可以进行补偿,但平台必须识别出补偿何时只是掩盖了性能退化,而非解决了问题。
集成部署模式
部署集成更新需要单模型部署所不需要的协同。以更新推荐集成中的精排模型为例。分阶段集成部署模式将分阶段集成部署模式分为四个阶段:影子部署(24–48 小时,仅记录日志而不提供服务)、金丝雀部署(1% 流量,持续 4–8 小时)、分阶段发布(在 24–72 小时内从 5% 增至 100%)以及稳定性观察(监测 7–14 天,以发现延迟效应)。
| 部署阶段 | 操作 | 持续时间 | 回滚触发条件 |
|---|---|---|---|
| 影子部署 | 新模型与生产模型并行评分,记录结果但不向用户提供 | 24–48 小时 | 质量指标低于阈值 |
| 金丝雀部署 | 1% 的流量接收新模型的结果 | 4–8 小时 | 性能退化具有统计显著性 |
| 分阶段发布 | 5% → 25% → 50% → 100% | 24–72 小时 | 业务指标恶化 |
| 稳定性观察 | 承接全部流量,持续延长监测 | 7–14 天 | 出现延迟效应 |
较长的时间跨度反映了在集成系统中检测性能退化的难度。某个组件的变更即使改善了其局部指标,也可能通过与其他组件之间的微妙交互,降低系统整体性能。
交互效应
集成组件之间的交互使局部验证不足以保证整体效果;以下三种反复出现的模式说明了平台为何需要保留对照组、中间结果日志和较长的稳定性观察期:
- 补偿效应:召回模型开始返回质量较低的候选项,排序模型则通过提高质量信号的权重来学习补偿;一旦召回模型得到修复,排序模型可能过度补偿,从而使结果变差。
- 分布偏移传播:上游模型在局部取得改进,却改变了下游模型所接收的输入分布,而这些下游模型是在旧表示上训练的。
- 反馈循环:排序决策影响用户与哪些项目交互,而这些交互会在数天至数周内成为后续模型的训练数据。
管理这些交互需要设置不受任何变更影响的保留对照组,以提供稳定基线;除最终推荐结果外,还要全面记录中间模型输出;长期监测反馈循环的影响;并定期开展集成重置实验,将所有组件一起重新训练。
模型生命周期管理
生命周期管理旨在防止模型依赖演变为永久性负担:每次晋级都会扩大模型的影响范围,而每次退役都必须先迁移其使用方,平台才能回收资源。生命周期的各个阶段描述了从开发到归档的这一演进过程,每个阶段都由其设置的准入条件界定,而非由状态标签界定。
Development → Staging → Canary → Production → Deprecation → Archive在开发阶段,模型以实验产物的形式存在。运维要求被有意设定得较为宽松,但并非可有可无:成功的实验必须保留结果、版本历史以及足够的可复现性元数据,以便日后接受质疑和检验。因此,运维关注的重点是是否已做好阶段转换的准备。一个有潜力的模型,只有在具备明确的生产就绪标准、针对与生产环境等效的数据开展的自动化评估,以及足以支持审查的文档之后,才能进入预发布环境。
预发布阶段将候选模型转化为可部署的服务,同时不向用户开放。预发布模型应在影子模式下处理生产流量,使用生产特征流水线,在与生产环境等效的硬件上执行,并满足延迟和吞吐量要求。随后,晋级门禁将指标阈值、延迟要求等自动化检查,与对模型行为及风险的人工审查相结合。
生产阶段将影响范围从验证流量扩大到线上流量,因此模型此时需要具备带告警的持续监控、应对流量波动的容量、回滚流程以及值班支持。生产并非终点。模型仍需随数据分布变化而重新训练,随上游数据变化而更新特征流水线,随模型服务系统演进而更新基础设施,并定期对照更新的基线重新评估。
只有当模型能够在不破坏其使用方的情况下退役时,生命周期才算闭环。弃用过程需要识别依赖系统,提供迁移路径和时间表,在迁移完成之前维持旧模型,并归档产物以支持复现和审计。组织往往在这一最后阶段投入不足,导致僵尸模型3不断积累:它们消耗资源,却未必提供有价值的服务。平台层面的生命周期管理约束有助于解决这一问题。
3 僵尸模型:已经过时或被替代,却仍在提供服务的生产模型。即使流量很低,模型在被主动退役之前,也会占用模型注册、监控、依赖管理和值班支持的资源。因此,运维成本不仅限于计算:僵尸模型会扩大依赖图,使平台范围内的升级和安全补丁应用变得更慢、风险更高。
按模型数量划分的部署模式
适当的部署模式取决于待更新模型的数量及其相互依赖关系,因为每增加一项依赖,都会扩大回滚单元的范围。表 6 对按规模划分的部署模式进行了分类:单模型部署(每月更新独立的视觉分类器)、流水线部署(每周更新 3–5 个顺序执行的 NLP 模型)、集成部署(每日更新 10–50 个推荐组件)以及平台部署(持续更新数百个企业模型)。
| 模式 | 模型数量 | 更新频率 | 示例 |
|---|---|---|---|
| 单模型 | 1 | 每月 | 视觉分类器 |
| 流水线 | 3-5 | 每周 | NLP 处理流水线 |
| 集成 | 10-50 | 每日 | 推荐系统 |
| 平台 | 数百 | 持续 | 企业 ML 平台 |
对于没有依赖关系的独立模型,标准部署模式即可满足需求。金丝雀部署、蓝绿切换4和渐进式发布都能有效发挥作用,因为回滚只需将一个模型产物恢复到先前版本。
4 蓝绿部署:一种使用两个完全相同的生产环境(“蓝色”和“绿色”)的发布模式。任何时刻都只有一个环境承载线上流量。这种模式支持零停机发布,并在新模型出现故障时实现近乎即时的回滚,代价是所需的模型服务基础设施增加一倍 \((C_{\text{infer}})\)。
流水线会引入顺序约束,因为模型按顺序执行,且每个模型的输出都会作为下一个模型的输入。部署规则是在开放服务之前确保兼容性:先部署上游模型,再部署下游使用方;每个阶段都必须通过验证后才能继续;维持各阶段之间的版本兼容性;若任一阶段失败,则将整个流水线作为一个单元回滚。
集成系统扩大了协同问题的范围,因为多个模型可能并行执行,也可能按图结构执行。不同团队可以按不同的时间安排更新组件,局部更新可能只改变集成系统的一部分,而系统行为则由组件之间的交互共同形成。因此,仅进行独立测试并不充分;集成测试成为部署门禁。
在平台规模下,持续部署意味着总有某处的某个模型正在更新,因此平台必须防止各自安全的变更组合成不安全的集群状态。平台部署需要基于模型风险分类的自动化发布策略、部署批准之前的跨模型影响分析、防止同时进行高风险部署的全局速率限制,以及将事件与近期部署自动关联的能力。
实践中的跨模型依赖
示例:电商模型生态系统
在电商模型图中,单一嵌入接口向检索、排序和业务逻辑分支扩散,使依赖控制的重要性变得具体可见。电商平台通常以嵌入模型作为模型图的起点。用户嵌入模型根据行为历史生成用户表示,而商品嵌入模型则根据属性和交互生成商品表示。这些嵌入并非最终预测,而是供下游服务使用的共享接口。
下一层将共享表示转化为候选集合和业务信号。候选检索模型使用嵌入查找相关商品,价格敏感度模型则估计用户对价格变化的响应强度。随后,排序模型结合嵌入特征和辅助信号,对候选商品进行评分;业务规则模型则在结果呈现给用户之前应用促销和库存约束。
图 5 描绘了这一依赖结构,展示用户和商品嵌入如何流经检索模型和价格敏感度模型,随后在排序层和业务规则层汇合。这张图揭示了关键的运维影响。
电商模型生态系统展示了这一影响范围:对用户嵌入模型的一次更改会传播至两个直接使用方和另外两个传递依赖节点,最终到达业务规则层。因此,运维流程必须满足四项协同要求:
- 部署前,使用新的嵌入重新评估所有下游模型
- 考虑同时部署相关组件
- 同时监控直接指标(嵌入质量)和下游指标(排序性能)
- 保持嵌入版本兼容性,或协同执行同步更新
该示例说明了为什么多模型管理需要显式的依赖跟踪和协同部署流程。然而,依赖图和注册表都是静态产物。要将相互耦合的模型从存储库迁移到在线生产环境,同时避免引发级联故障,就需要自动化且可验证的部署流水线。
大规模机器学习的 CI/CD
多模型管理中讨论的依赖图和集成架构不会自行完成部署。每次模型更新都必须妥善处理依赖网络:嵌入模型更新可能要求重新评估四个具有传递依赖关系的下游组件,其中包括业务规则层,之后任何组件才能安全地进入生产环境。这一协同挑战使 CI/CD 从单个模型层面的问题转变为平台编排问题。软件 CI/CD 独立验证代码,而大规模 ML CI/CD 必须在模型的运行上下文中验证模型,确保上游更改不会破坏下游使用方,并且部署顺序遵循依赖图。
分布式训练详细介绍了数据并行、张量并行和流水线并行如何支持训练规模大到单机无法容纳的模型,所生成的产物需要进行大规模验证和部署。机器学习的持续集成和持续部署实践与传统软件 CI/CD 在一个方面有所不同:软件 CI/CD 侧重于代码正确性和部署可靠性,而 ML CI/CD 还必须验证数据、验证模型性能,并管理代码、数据与学习得到的参数之间的交互。在平台规模下,由于流水线必须协同管理数百个需求各异的模型,这些挑战会成倍增加。
训练流水线自动化
机器学习 CI/CD 的起点是让训练以可复现的方式生成可部署产物,而不是依赖手工操作来运行训练作业。设计良好的训练流水线能够以可复现的方式执行,妥善处理故障,并生成适合进行部署验证的产物。
流水线阶段
完整的训练流水线包括数据验证、训练执行、模型评估、注册表登记和金丝雀部署,各阶段之间均设有质量门禁,防止有缺陷的产物进入下一阶段(图 6)。这一顺序很重要,因为每个阶段都保障集群中不同的不变量。
- 数据验证固定数据版本,并在模式、时效性或分布问题消耗训练资源之前将其拒绝。
- 特征工程维护训练与服务之间的特征契约,避免预处理变更悄然导致生产环境回归。
- 训练记录代码、数据、超参数、硬件资源范围和随机种子,以便日后复现或检验有潜力的产物。
- 评估在引入任何用户流量之前,将候选模型与基线进行比较,并检查分片指标、延迟预算和任务特定的准入条件。
- 产物生成将模型与其服务配置、依赖版本和回滚目标一并打包。
- 注册将产物记录到模型注册中心,并附上血缘信息、审批记录和部署资格。
每个阶段都应能够独立执行,并具有幂等性。如果流水线在评估阶段失败,重新启动时不应再次执行数据验证和特征工程,除非它们的输入发生了变化。
流水线编排
训练流水线需要编排系统,明确依赖顺序、资源分配和故障恢复机制。编排器将工作流表示为有向无环图(DAG),跟踪各阶段之间的依赖关系,在不重新执行未受影响工作的情况下重试暂时性故障,调度 GPU 和内存等稀缺资源,在输入未发生变化时缓存中间结果,并记录日志和产物,以供后续调试。
常见的编排方案包括 Kubeflow Pipelines5 (Bisong 2019年)、带有 ML 扩展的 Airflow,以及 Vertex AI Pipelines 或 SageMaker Pipelines 等云原生解决方案。具体选择取决于平台必须强制执行哪些依赖契约和资源契约,以及现有基础设施、团队专业能力和规模要求。编排确立执行契约;参数化确立变化契约,使同一张图能够针对不同的数据、模型和硬件资源范围运行,而不必每次都变成一个新程序。
5 Kubeflow:Google 于 2018 年发布的开源 ML 平台,将流水线编排与 Kubernetes 资源管理相结合。其关键系统影响在于:由于 Kubeflow DAG 同时表达计算依赖和资源请求,编排器可以仅在加速器可用时调度 GPU 密集型训练步骤,从而避免资源争用;这种资源争用会使多模型训练集群的手动调度难以为继。
Bisong, E. 2019年. 《Kubeflow and Kubeflow Pipelines》. Kubeflow and Kubeflow Pipelines 收入 Building Machine Learning and Deep Learning Models on Google Cloud Platform. Apress. https://doi.org/10.1007/978-1-4842-4470-8_46.
流水线参数化
有效的流水线将配置与代码分离(代码 2)。
training_pipeline:
  model_type: transformer_ranking
  data:
    train_path: gs://data/train/2024-01-*
    eval_path: gs://data/eval/2024-01-15
    schema_version: v3.2
  features:
    user_features: [embedding, history, demographics]
    item_features: [embedding, attributes, popularity]
  training:
    epochs: 10
    batch_size: 4096
    learning_rate: 0.001
    optimizer: adam
    hardware: 4xA100
  evaluation:
    metrics: [ndcg_10, mrr, coverage]
    baseline_model: ranking_v2.1.0
这种分离使配置驱动的训练成为可能,因为平台无需重写流水线代码,就可以调整数据版本、超参数扫描、可复现性记录,以及针对特定环境的资源覆盖配置。参数文件也是一项审计产物。当候选模型随后进入发布关卡时,平台可以准确还原生成该模型所使用的数据切片、特征集、硬件资源范围和阈值配置。这种谱系信息将验证从一次性判断转变为可复现的契约。
验证关卡
验证关卡决定训练完成的模型是否应继续推进至生产环境。有效的关卡需要在验证的全面性与部署速度之间取得平衡。发布关卡依据的是一组证据,而非单一分数:模型性能、延迟、策略与公平性约束、数据质量以及运行就绪程度,分别针对不同的失效模式进行检验,确保模型能够安全地接收流量。
性能关卡
性能验证从三个方面评估候选模型:对于绝对阈值,模型必须超过最低可接受性能;对于相对基线,模型必须达到或超过当前生产模型的性能;对于历史趋势,模型不应偏离近期性能轨迹而出现退化。Performance Gate Evaluation展示了这种多准则评估。
def evaluate_performance_gate(
    candidate_metrics, production_metrics, thresholds
):
    """
    Evaluate whether candidate model passes performance gates.

    Returns tuple of (passed: bool, reasons: list)
    """
    reasons = []

    # Absolute threshold check
    if candidate_metrics["ndcg_10"] < thresholds["min_ndcg"]:
        reasons.append(
            f"NDCG_10 {candidate_metrics['ndcg_10']:.4f} below minimum {thresholds['min_ndcg']}"
        )

    # Relative improvement check
    relative_improvement = (
        candidate_metrics["ndcg_10"] - production_metrics["ndcg_10"]
    ) / production_metrics["ndcg_10"]
    if relative_improvement < thresholds["min_improvement"]:
        reasons.append(
            f"Improvement {relative_improvement:.2%} below minimum {thresholds['min_improvement']:.2%}"
        )

    # Regression check on secondary metrics
    for metric in ["mrr", "coverage"]:
        if candidate_metrics[metric] < production_metrics[metric] * (
            1 - thresholds["max_regression"]
        ):
            reasons.append(
                f"{metric} regression exceeds {thresholds['max_regression']:.2%} tolerance"
            )

    return (len(reasons) == 0, reasons)
延迟门禁
生产模型必须满足延迟要求。验证应在具有代表性的硬件上测量推理延迟,在预期吞吐量水平下进行测试,并在适用时考虑批处理的影响。按模型类型划分的延迟门禁阈值 按模型类型规定了延迟门禁阈值:欺诈检测的要求最为严格(p50 为 5 ms,p99 为 20 ms,超限时立即阻止部署),而 LLM 则接受较宽的范围(p50 为 500 ms,p99 为 2000 ms),这反映了它们不同的运行约束。
| 模型类型 | p50 目标 | p99 目标 | 超限时的门禁动作 |
|---|---|---|---|
| LLM | 500 ms | 2000 ms | 阻止部署,要求优化 |
| 推荐 | 10 ms | 50 ms | 阻止部署 |
| 欺诈检测 | 5 ms | 20 ms | 阻止部署,高优先级 |
| 视觉 | 50 ms | 200 ms | 警告,有条件批准 |
延迟门禁能够发现明显的性能违规,但某些回归问题即使通过了所有门禁,仍会使产品表现恶化。最危险的故障在语义层面悄无声息:输出有效,却基于已损坏的输入。
Example 1.2: 静默模型回归
场景:一个高吞吐量的商品排序模型(\(25,000\text{ QPS}\))通过了离线验证和服务延迟门禁(\(L_{\text{lat}} < 12\text{ ms}\)),但在部署后导致转化率下降了 3.2%。
诊断:上游的一次模式变更导致一个关键的用户偏好特征在 8% 的查询中返回 null。服务层将 null 静默填补为 0.0——一个有效的浮点值——因此,HTTP 错误率和延迟保持正常,而预测质量下降持续了 48 小时,期间未触发告警。
系统层面的教训:语法上有效的特征填补会导致语义层面的静默生产故障。自动化发布流水线和监控系统必须同时评估分布偏移(\(\Delta D_{\text{vol}}\))、系统正常运行时间和延迟服务级别目标(SLO)。
公平性门禁
在发布时,当政策选择被编码为阈值,公平性概念便转化为可执行的运行要求。对于影响用户的模型,公平性验证6 将政策承诺转化为发布门禁。平台不能简单地询问“模型是否公平”,因为不同情境对公平性的定义不同。在运行实践中,这些定义首先体现为可执行的阈值。公式 3 表达了一种运行层面的选择:正向预测概率的差异必须小于阈值 \(\epsilon\),这一差异是在受保护群体 \(a\) 和 \(b\) 之间衡量的。公式 4 编码了均等化几率这一类定义中更严格的一种选择:在以真实结果为条件后,各群体的预测行为必须相似 (Hardt 等 2016年)。
6 机器学习中的公平性验证:公平性存在多种定义—人口统计均等、均等化几率、校准—而在现实条件下,通常不可能同时满足这些定义 (Chouldechova 2017年; Kleinberg 等 2017年)。这迫使系统设计作出选择:自动化验证门禁必须编码组织优先采用哪一种公平性定义,使门禁配置本身成为一项政策决策,无法交由通用阈值来决定。
Chouldechova, Alexandra. 2017年. 《Fair Prediction With Disparate Impact: A Study of Bias in Recidivism Prediction Instruments》. Big Data 5 (2): 153~63. https://doi.org/10.1089/big.2016.0047.
Kleinberg, Jon, Sendhil Mullainathan, 和 Manish Raghavan. 2017年. 《Inherent Trade-Offs in the Fair Determination of Risk Scores》. 8th Innovations in Theoretical Computer Science Conference (ITCS 2017), Leibniz International Proceedings in Informatics (LIPIcs), 卷 67: 43:1~23. https://doi.org/10.4230/LIPIcs.ITCS.2017.43.
Hardt, Moritz, Eric Price, 和 Nathan Srebro. 2016年. 《Equality of Opportunity in Supervised Learning》. Advances in Neural Information Processing Systems (NeurIPS) 29: 3315~23.
\[\text{Demographic Parity: } |\Pr(\hat{Y}=1 \mid A=a) - \Pr(\hat{Y}=1 \mid A=b)| < \epsilon \tag{3}\]
\[\text{Equalized Odds: } |\Pr(\hat{Y}=1 \mid Y=y, A=a) - \Pr(\hat{Y}=1 \mid Y=y, A=b)| < \epsilon, \quad \forall y \in \{0,1\} \tag{4}\]
其中,\(A\) 表示受保护属性,\(\hat{Y}\) 是模型预测,\(Y\) 是真实结果。运行层面的要点并不是每一道门禁都应执行每一种定义。门禁必须记录组织选择了哪一种定义,将测量值与历史基线及绝对阈值进行比较,并将临界情况转交人工审核,因为接近阈值的公平性结果同样涉及治理决策。
数据质量门禁
在训练或部署之前,数据质量验证确保数据满足预期属性 (Caveness 等 2020年)。模式符合性检查验证所有必需字段均存在且类型正确。统计属性检查确保特征分布保持在预期范围内。新鲜度检查确认数据的陈旧程度未超过可接受的阈值。完整性验证确保缺失数据比例保持在容许范围内。
Caveness, E., P. S. G. C., Z. Peng, N. Polyzotis, S. Roy, 和 M. Zinkevich. 2020年. 《TensorFlow Data Validation: Data Analysis and Validation in Continuous ML Pipelines》. Proceedings of the 2020 ACM SIGMOD International Conference on Management of Data, 2793~96. https://doi.org/10.1145/3318464.3384707.
这些门禁能够发现原本会表现为难以解释的模型退化的问题,在部署风险从制品有效性转向线上流量暴露之前,补全发布前的证据材料。下一项控制措施不再是另一个离线评分,而是允许多少生产流量在真实条件下检验该制品。
分阶段上线策略
分阶段上线是一种将部署风险转化为可控暴露预算的机制。只有当模型持续保持可接受的性能,证明其足以承担每一级更大的影响范围后,才会增加流量。
Napkin Math 1.5: 分阶段发布的安全性
问题:某团队正在部署一个新的排序模型。“蓝绿”部署(100 percent 切换)会使所有用户暴露于任何潜在缺陷。“金丝雀”部署从 5 percent 的流量开始。金丝雀方式能将部署的“风险暴露”降低多少?
数学分析: 风险暴露与检测窗口内受影响的流量百分比成正比。
- 蓝绿部署的风险暴露:回滚前,100 percent 的用户受到影响。
- 金丝雀部署的风险暴露:回滚前,5 percent 的用户受到影响。
- 风险缓解:\(100 / 5 = 20\times\)。
系统洞见:分阶段发布是模型质量的保险。将初始暴露范围限制在 5 percent,可使灾难性故障的影响范围缩小 20×。在机器学习集群中,模型行为具有概率性,且难以通过单元测试验证,因此逐步扩大暴露范围是确保“论文中的最先进水平”不会变成“生产环境中的故障”的唯一可靠方式。
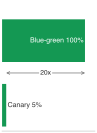
金丝雀发布将初始暴露范围缩小至原来的 1/20。
蓝绿部署
蓝绿部署维护两个相同的生产环境。当前版本(蓝色)处理流量,同时准备新版本(绿色)。准备就绪后,流量立即切换至绿色环境。
对于机器学习系统,这种环境复制所带来的基础设施成本与无状态 Web 服务存在本质区别。如果推荐模型或语言模型需要多个 GPU 才能将其权重容纳在显存中,就无法在两个环境之间共享这部分内存:大型模型的蓝绿部署意味着必须同时在两组并行分配的加速器资源上保存两份完整的模型权重。将模型权重加载到 GPU 内存中也需要不可忽略的时间(对于数 GB 的检查点,需数十秒到数分钟),因此,“即时回滚”这一优势的前提是,在整个部署窗口内,备用环境始终保持这些权重已加载、可立即使用。因此,实际成本不仅是模型服务基础设施翻倍,还包括在整个切换期间预留双倍的 GPU 内存。许多运行大型模型的组织将蓝绿部署视为理论上的选项,而在实践中采用金丝雀部署或影子部署,因为硬件容量和成本使双份资源分配难以实施。
蓝绿部署提供了简单易懂的概念模型,并允许在向用户开放之前,在与生产环境等效的环境中进行全面测试。它也要求在切换期间分配双份 GPU 和内存资源,无法通过逐步扩大暴露范围来检测细微的质量退化,而且依赖一次二元切换,可能遗漏只有在大规模运行时才会出现的问题。这种模式适用于轻量模型的低风险变更:在这些场景中,逐步发布所带来的额外安全保障有限,而双份容量的成本可以接受。
金丝雀部署
金丝雀部署7将一小部分流量路由至新版本,同时监测是否出现退化。如果指标保持在可接受范围内,就逐步提高流量百分比,直至新版本处理全部流量。
7 金丝雀部署:得名于煤矿开采中利用金丝雀检测有毒气体的做法——以小的牺牲保护整体。对于机器学习系统,这一类比十分贴切:模型退化通常表现为准确率逐渐下降,而非崩溃,因此健康检查无法发现,却可以通过对金丝雀流量与对照流量进行统计比较来检测。如果没有金丝雀阶段,出现细微退化的模型可能在任何人察觉性能损失之前,就已接收 100% 的流量。
随着证据不断积累,典型的流量推进顺序是从 1% 到 5%,再到 25%、50% 和 100%。确定每个阶段的持续时间至关重要。公式 5 将阶段持续时间与所需样本量、请求速率和流量百分比联系起来,从而能够精确计算满足统计有效性要求的最短金丝雀阶段持续时间:
\[T_{\text{stage}} = \frac{n_{\text{samples needed}}}{r_{\text{requests}} \times p_{\text{stage}}} \tag{5}\]
其中,\(T_{\text{stage}}\) 是在给定流量百分比下所需的持续时间,\(n_{\text{samples needed}}\) 是达到统计显著性所需的观测数量,\(r_{\text{requests}}\) 是请求速率,\(p_{\text{stage}}\) 是流量百分比。
计算示例:金丝雀阶段持续时间计算
某模型每小时处理 100 万次请求。要以 95% 的置信度检测点击率 1% 的变化,每个变体约需 10,000 个样本。
在 1% 的金丝雀流量下:\(T_{1\%} = \frac{10,000}{1,000,000 \times 0.01} = 1\text{ hour}\)。在 5% 的金丝雀流量下:\(T_{5\%} = \frac{10,000}{1,000,000 \times 0.05} = 0.2\text{ hours} = 12\text{ minutes}\)。
组织可以配置五个发布阶段:
- 1% 持续 2 小时(至少预留 2\(\times\) 作为缓冲)
- 5% 持续 30 分钟
- 25% 持续 30 分钟
- 50% 持续 1 小时
- 100% 部署
发布总耗时:约 4 小时,以确保有充分把握完成部署。
Napkin Math 1.6: 告警延迟的代价
问题:某团队部署了一个推荐模型,其中存在一个未被察觉的缺陷:它使点击率(CTR)降低了 0.5 percentage points(相对下降 10 percent),从 5% 降至 4.5%。如果该服务处理 5,000 requests/s,且每次点击价值 $0.50/click,那么检测和修复耗时 24 hours 会造成多少收入损失?
计算:
- 请求总数:5,000 requests/s \(\times\) 86,400 s/day = 432,000,000 requests。
- 损失的点击次数:432,000,000 requests \(\times\) 0.005 = 2,160,000 lost clicks。
- 经济损失总额:2,160,000 lost clicks \(\times\) $0.50/click = $1,080,000。
系统洞见:对于高流量模型而言,看似“微小”的 0.5 个百分点的性能退化,就是每天损失 $1,080,000 的灾难。MLOps 的本质是经济风险管理。通过金丝雀部署和自动化漂移监控,将“检测耗时”每缩短一小时,都能直接减少收入损失。在集群技术栈中,监控就是保护模型商业价值的“保险单”。
多区域部署协同
容错介绍了用于应对分布式训练作业内部故障的检查点、弹性训练和恢复机制。多区域部署在推理平面中采用了相同的容错思想[在故障发生时保留有用的工作成果和状态],而跨地理区域的协同会引入单区域运行中不存在的挑战。模型版本一致性、过渡期间的流量路由和协同回滚,都需要明确的协议设计,以防止混合版本服务破坏 A/B 测试的有效性和用户体验。
协同挑战
多区域 ML 部署引入了无状态服务发布中不存在的两项协同负担。首先,模型产物体积庞大:生产环境推荐系统中的稀疏模型与稠密模型集成可能需要数十至数百 GB 的检查点数据,而用于推理服务的大语言模型每个副本可能需要数百 GB。在某个区域能够承接流量之前,通过广域网分发这些产物是一个受带宽约束的调度问题,而不只是推送元数据配置。其次,大多数 ML 模型并不从请求中获取其上下文,而是从特征存储中读取。如果区域 B 已收到新的模型二进制文件,但其区域特征存储尚未同步最新的用户嵌入,那么即使部署在技术上成功,该区域仍会提供质量下降的预测。因此,ML 区域的就绪检查必须将模型二进制文件、特征存储一致性和服务健康状况作为一个协调一致的整体状态进行验证。
混合版本服务是贯穿多区域部署的故障模式。即使各区域的时钟、流量、路由和回滚行为存在差异,发布协议也必须维持一致的版本边界。
时钟偏差和时序协同会使金丝雀阶段的边界变得模糊。当部署于 UTC 下午 2:00 开始时,区域 A 可能已开始承接 1% 流量的金丝雀部署,而区域 B 由于网络延迟或操作差异,仍在使用旧版本提供服务。使用墙上时钟时间来定义部署阶段,会导致跨区域的用户遇到不同的模型版本,从而造成用户体验不一致,因此生产系统除了时间戳之外,还需要逻辑发布状态。
区域流量差异意味着相同的百分比会产生不同的统计证据。全局 1% 的金丝雀流量,在低流量区域可能占该区域流量的 5%,足以达到统计显著性;但在高流量区域可能仅占 0.3%,样本量可能不足。在平台将金丝雀结果视为证据之前,必须独立验证各区域的样本量。
跨区域请求路由随后会将区域间的不同步转化为用户可感知的不一致。用户可能因延迟、负载均衡或故障转移而被路由至不同区域。在部署窗口期间,如果某位用户的请求跨越多个区域,就可能收到来自不同模型版本的预测,从而违反 A/B 测试分析所依赖的一致性假设。
回滚是最后一项一致性检验。如果一个区域回滚,而其他区域继续使用新版本提供服务,就会产生同样的混合版本问题,而周密的部署协同原本正是为了避免这一问题。因此,回滚必须成为发布协议的一部分,而不能作为临时的应急操作。
部署策略
多区域协同需要选择以何种方式承担发布开销:更长的部署时间、更强的同步,或有界的区域间不同步。三种架构方法采用了不同的权衡:
- 按区域顺序发布:各区域逐一部署,每个区域完成完整的金丝雀发布流程后,下一个区域才开始。这种方式将故障影响范围限制在单个区域内,最大限度地保障安全,但总部署时长会随区域数量成比例增加。
- 全球同步发布:所有区域同时保持完全相同的部署状态。全局协同服务在同一逻辑时间戳将各区域切换至下一个金丝雀阶段,为用户提供一致的体验,但也使每个区域的问题都成为全局部署决策的一部分。
- 混合发布:部署协调器强制执行各阶段的最小和最大边界,同时允许各区域在这些边界内独立推进。如果本地指标表现良好,区域可以加快阶段推进;如果出现问题,则可以暂停,而全局约束会防止版本差异过大。
具体选择取决于部署最重视的是最小故障影响范围、全局一致性,还是受约束的区域独立性。
对于跨 5 个区域的保守顺序发布,典型流程如下:
- 金丝雀区域(流量最低):完整的金丝雀发布周期,24 至 48 小时
- 早期采用区域(2 个区域,占全球流量的 20%):并行部署,24 至 48 小时
- 主体区域(2 个区域,占全球流量的 70%):并行部署,24 至 48 小时
- 最终验证:跨区域一致性检查,12 至 24 小时
总部署时长:保守发布需要 3.5 至 7 天。
过渡期间的流量管理
在部署过渡期间维持请求一致性,需要三种路由控制机制,以确保实验和用户体验保持一致:
- 粘性路由:在整个部署窗口内,用户的请求始终路由至同一区域,通常通过对用户标识符进行一致性哈希来实现。用户始终体验旧版本或新版本,同一会话内不会混用两个版本。
- 版本固定:客户端在请求中包含模型版本哈希值,模型服务基础设施将请求路由至提供该版本服务的副本。这支持客户端逐步迁移,而不受服务端部署状态的影响。
- 请求隔离:在关键部署阶段禁用跨区域流量。在金丝雀评估期间,这可确保指标反映单个区域的行为,而非混合路由模式。
当用户请求在不断变化的集群中流转时,这些控制机制能够保持部署指标的统计意义。
部署的一致性模型
一致性模型的选择会同时影响部署复杂度和部署指标的有效性。多区域部署的一致性模型比较了多区域系统的部署一致性模型:强一致性保证各区域的版本完全相同(这对金融预测至关重要),但需要较高的协同开销;最终一致性则允许各区域独立推进,适用于内容推荐,但代价是暂时的版本差异:
| 模型 | 保证 | 使用场景 | 协同开销 |
|---|---|---|---|
| 强一致性 | 所有区域均提供相同版本的服务 | 金融预测、安全关键场景 | 高(全局同步) |
| 最终一致性 | 各区域最终收敛至同一版本 | 内容推荐 | 低(独立推进) |
| 有界陈旧性 | 各区域之间的版本差不超过 \(k\) 个版本 | 实时排序 | 中(版本监控) |
为确保 A/B 测试的有效性,模型服务通常需要在各实验组内部保持强一致性。如果部分被分配到实验组的用户因部署时序而收到旧版本的预测结果,测得的处理效应就会被稀释。各实验组之间采用最终一致性是可以接受的,因为每个组都会独立分析。
回滚协同
多区域部署的回滚需要谨慎协同,以防止反复切换和混合版本服务。回滚协议包含两个按顺序执行的阶段:
- 在全球范围内停止向新版本发送流量:部署协调器广播回滚意图,等待每个区域确认已停止将新流量路由至新版本,并让正在处理的请求完成。未在超时前确认的区域会被标记为不健康。
- 在全球范围内恢复旧版本:协调器确认所有区域仅提供旧版本的服务,重新启用正常流量路由,清除部署状态,并为后续重试做好系统准备。
该协议确保任何时刻都不会出现部分区域仍提供新版本服务、其他区域却已回滚的情况,因为这会造成不一致的用户体验。
部分回滚允许对个别区域执行回滚,同时其他区域继续运行。当问题仅涉及特定区域(基础设施问题、区域流量模式),而非模型固有问题时,适合采用这种方式。部署协调器跟踪各区域的状态,防止基于不完整信息作出不一致的全局决策。
算例:多区域协同开销
某推荐系统部署在 5 个区域,区域间平均延迟为 80 ms。协同协议需要五个步骤:
- 宣布部署意图(向所有区域广播):80 ms
- 接收确认应答(等待最慢的区域):80 ms
- 执行部署阶段(在区域本地进行):耗时可变
- 确认完成(广播):80 ms
- 接收完成确认(等待最慢的区域):80 ms
每次阶段转换的最低协同开销:同步协议本身需要 320 ms。对于包含 5 个金丝雀发布阶段的部署,协同使总部署时间增加 1.6 秒,与每个阶段耗费的数小时相比,这一开销可以忽略不计。
然而,协同服务成为一项关键依赖。如果协调器在部署期间发生故障,根据一致性模型的不同,可能出现三种行为:
- 强一致性:所有区域停留在当前状态,直到协调器恢复
- 最终一致性:各区域继续独立推进,可能出现状态分歧
- 有界陈旧性:各区域继续推进,但在协调器故障期间,若陈旧程度超出界限,则触发告警
部署安全关键模型的组织通常通过共识协议(Raft、Paxos)实现协调器冗余,以便在单节点故障后仍能继续运行,同时维持一致性保证。
将生产环境实验作为发布准入关卡
当发布协同能够维持版本边界后,下一个问题便是候选模型是否可以安全地向用户开放。影子流量、交错实验、A/B 测试和网络效应检查构成一个实验阶梯:每上升一级,都以更高的运维成本换取更有力的生产环境证据。因此,生产环境实验是发布准入关卡,而非对指标提升的无休止探索。在开始向用户开放之前,发布记录必须明确需保持不变的指标、决策阈值、对用户和基础设施的最大影响范围、停止规则、回滚负责人,以及晋级所需的证据。即使候选模型改善了主要指标,只要耗尽了延迟、可靠性、公平性或成本方面的余量,就无法通过这一关卡。
影子部署与流量回放
影子部署使新模型与生产模型并行运行,接收相同的输入并记录输出,但不影响用户可见的结果(图 7)。除实际向生产环境用户开放外,这种方式提供了保真度最高的测试环境,能够发现离线验证未能检出的问题。
当影子部署能够回答离线测试无法回答的验证问题时,其额外基础设施成本便是值得的。运行负载测试可证明新模型能够承受完整的生产流量,而不会崩溃、发生内存泄漏或违反延迟 SLO。8 在小规模数据集上通过离线验证的模型,在每小时处理数百万个请求时,可能出现内存泄漏、性能退化或资源争用。影子部署能够在这些运行问题影响用户之前发现它们。
8 服务级别目标(SLO):目标可靠性水平;对于模型服务 API,“三个九”(99.9%)的可用性意味着每年仅允许 8.7 小时的停机时间。对于延迟,200 ms 的 P99 SLO 意味着 99% 的请求必须在不到 200 ms 的时间内完成。要在大规模场景下达到这些目标,需要通过自动扩缩容和熔断来应对负载峰值。
在隔离影子路径之后,验证信号来自对真实流量下模型行为的比较。输出比较能够揭示离线汇总指标所掩盖的分布偏移、异常行为和边缘情况;对于分类模型,这可能暴露置信度分数的系统性偏移,而对于推荐系统,则可能暴露多样性或类别分布的变化。行为验证能够发现长尾输入上的失效:这些输入在验证集中很少出现,却在生产流量中每天出现数千次。性能特征分析测量实际延迟、吞吐量和资源消耗,在模型接收用户可感知的流量之前验证容量假设。
影子部署需要捕获并重放生产流量,而重放方式的选择决定了保真度、成本和时效性之间的权衡。三种架构模式分别满足不同的运行需求。
实时镜像将每个生产请求实时复制到影子模型。生产模型负责提供响应,同时影子模型并行处理相同的输入,从而在完整生产规模下提供即时验证,但这要求影子基础设施能够承受 100% 的流量负载。为了避免这条验证路径成为生产系统的依赖,服务系统必须异步发起影子请求、设置超时限制、在影子处理落后时丢弃部分影子负载,并隔离资源,确保影子任务不会影响生产响应。
采样重放将可配置比例的生产流量镜像到影子模型。这既降低了基础设施成本,又保留了验证所需的统计功效:在大规模场景下,即使影子模型仅接收 10% 的流量,每天仍会处理数十万个请求,足以检测大多数问题。采样策略决定了在较低成本下仍能观察到哪些失效。随机采样简单且无偏,分层采样保留不同用户群体和请求类型的代表性,自适应采样则提高影子输出与生产输出存在分歧的模式的采样率。
批量重放捕获生产流量日志,并异步将其重放到影子模型。这使影子验证与生产延迟约束解耦,支持针对历史流量开展快于实时速度的回归测试,并允许利用非高峰时段优化成本。但这种解耦也削弱了对时效性敏感的系统的验证信号:验证会延迟数小时或数天,需要持久化日志基础设施,可能在过时的上下文中重放具有时间依赖性的特征,而且无法验证实时运行特性。
有效的影子部署需要超越简单准确率的定量比较指标,因为决策的核心是候选模型在真实负载下的行为是否与生产模型一致。输出差异衡量影子预测与生产预测之间的不同:分类系统跟踪预测不一致率、概率偏移以及差异在特定类别中的集中程度,而回归系统则计算影子输出与生产输出之间的均方根误差。性能指标比较延迟分布、吞吐能力和资源消耗;如果影子模型的准确率相当,但 p99 延迟高出 50%,则需要在部署前调整基础设施容量。
这组指标还必须区分运行故障与真正的模型变化。错误模式指标统计超时、异常、格式错误的输出和空预测。若影子模型在 0.1% 的请求上超时,就会在每天 100 万个请求的规模下每天发生 1,000 次失效,而触发这些失效的请求模式可为修复提供指导。随后,统计验证用于判断观察到的差异究竟代表真正的模型变化,还是随机波动。由于生产模型和影子模型处理的是相同的 10 万个请求,其结果是配对的。根据带标签的结果或验证判定器定义二元失效,令 \(b\) 表示生产模型失败而影子模型成功的请求数,令 \(c\) 表示影子模型失败而生产模型成功的请求数。McNemar 大样本检验使用这些不一致的配对:
\[\chi^2 = \frac{(b-c)^2}{b+c}\]
对于在 \(\alpha_{\text{sig}} = 0.05\) 下进行的自由度为 1 的检验,当 \(\chi^2 > 3.84\) 时,拒绝失败概率相等的原假设。仅凭 1% 和 1.5% 的边际失败率无法确定这一统计量;必须保留配对样本中的不一致计数 \(b\) 和 \(c\)。
实例:影子部署工作流
一个欺诈检测模型每天处理 500 万笔交易。团队开发了一种新的模型架构,预期能够在保持召回率的同时提高精确率。影子部署工作流从抽样影子阶段开始,连续三天镜像复制 10% 的流量,因此影子基础设施每天处理 50 万个请求。观测到的影子模型召回率为 94.2%,生产模型为 94.5%,二者差异不具有统计显著性;与此同时,精确率从 82.3% 提高到 87.1%,且提升具有统计显著性。影子模型的 p99 延迟达到 45 ms,生产模型为 38 ms,仍在 50 ms 的 SLO 所允许的范围内,因此团队进入全量影子阶段。
全量影子阶段连续五天镜像复制 100% 的流量。这证实了精确率的提升在全量规模下仍然成立,但也暴露了一个边界情况:由于出现了未预期的特征分布,影子模型将 0.02% 的交易标记为错误,相当于每天 1,000 笔交易。根本原因是模型对交易金额异常值的敏感性增强。调整特征裁剪阈值并重新部署影子模型后,错误率降至 0.001%,满足了进入金丝雀部署的准入条件。
随后,部署后验证将实际生产指标与影子预测结果进行比较。生产环境中的精确率达到 87.3%,影子环境中为 87.1%,差异处于预期波动范围内。在这个案例中,影子部署成功预测了生产环境中的行为。
影子部署基础设施
大规模运行影子部署需要基础设施在不干扰生产环境的前提下保留验证信号。流量镜像层截获生产请求,并将其复制到影子环境,负责处理路由逻辑、采样决策、超时控制和错误隔离,确保影子环境中的故障不会影响生产环境。日志与比较基础设施采集生产模型和影子模型的输出,计算差异指标,并存储结果以供分析;高吞吐量系统可能产生数 TB 的比较数据,因此存储和查询设计也成为验证架构的一部分。
运维界面使这一流程形成闭环。告警和仪表板向部署决策者呈现具有统计显著性的差异、性能退化和错误率升高的情况,而下钻视图则揭示能够解释这些差异的请求模式。资源隔离通过独立的计算资源池、网络带宽分配和数据库容量分配,防止影子工作负载占用生产环境的容量。云部署通常通过独立集群实现这种隔离;本地部署则需要显式划分资源。
何时必须采用影子部署
当重复配置基础设施的成本低于未被发现的生产性能退化所造成的成本时,影子部署最有价值:
- 新的模型架构,离线验证可能遗漏生产环境特有的失效模式
- 高风险模型(金融、医疗、安全关键领域),生产问题会造成严重后果
- 对实时特征存在复杂依赖的模型,离线回放无法充分验证其行为
- 对性能敏感的部署,必须在影响用户之前检测出延迟或吞吐量退化
- 要求提供投产前验证证据的监管环境
当部署风险可控且回滚成本较低时,影子部署的重要性相对较低:
- 小幅模型更新(使用相同架构重新训练),生产环境中的行为已得到充分理解
- 允许快速回滚的低风险模型
- 影子基础设施成本超过验证收益的资源受限环境
因此,这一决策既是技术问题,也是经济问题:当额外配置的容量能够提供离线测试和低成本回滚无法提供的风险信息时,就值得为影子验证付出成本。
交错实验
交错实验9最初用于排序和搜索评估 (Chapelle 等 2012年),也用于推荐系统的个性化实验 (Blog 2017年)。交错实验将两个方案的条目同时呈现给每位用户,然后衡量用户与哪些条目发生交互,而不是将用户分配到不同方案中。
9 交错实验:交错实验最初用于搜索引擎评估,将两个排序器的结果合并为一个列表,展示给每位用户,然后将点击归因于生成相应结果的排序器 (Chapelle 等 2012年)。与 A/B 测试相比,它所需的样本量可以少得多,因为每位用户都提供了直接的被试内比较,而非仅提供群体间比较信号。对于需要迭代众多模型变体的集群规模推荐系统,这种样本效率提升会直接缩短实验周期,并降低生产环境中次优模型带来的机会成本。
Chapelle, Olivier, Thorsten Joachims, Filip Radlinski, 和 Yisong Yue. 2012年. 《Large-scale validation and analysis of interleaved search evaluation》. ACM Transactions on Information Systems 30 (1): 1~41. https://doi.org/10.1145/2094072.2094078.
关键在于统计效率。交错实验所需的样本量可以远少于 A/B 测试,Netflix 报告称,某些排序实验所需的用户数量减少了超过 100\(\times\) (Blog 2017年),因为每位用户都提供直接的比较信号,而非仅为汇总统计量作出贡献。
交错实验的实现:
- 两个模型变体都对所有候选项进行评分
- 使用团队选秀交错或概率交错方法将结果交错排列
- 根据用户交互,将贡献归因于生成相应结果的模型变体
- 通过统计检验确定获胜的模型变体
对于推荐系统而言,交错实验至关重要,因为快速检测用户参与度的微小变化有助于实现快速迭代;图 8 对比了交错实验与传统 A/B 测试的灵敏度。
\begin{tikzpicture}[font=\small\sffamily, node distance=0.5cm and 0.5cm]
  \definecolor{AColor}{HTML}{D1E6F3}
  \definecolor{BColor}{HTML}{FCE4CC}

  \tikzset{
    item/.style={draw=black!50, fill=white, minimum width=2cm, minimum height=0.5cm, line width=0.75pt, align=center},
    edge/.style={->, line width=1.0pt},
    title/.style={font=\bfseries\sffamily\bfseries, anchor=south},
    desc/.style={font=\scriptsize\sffamily, text=black!60}
  }

  \begin{scope}[local bounding box=ab]
    % A/B Testing
    \node[title] (ABTitle) {A/B Testing};
    \node[below left=of ABTitle] (UserA) {User A};
    \node[below right=of ABTitle] (UserB) {User B};

    \node[item, fill=AColor, below=0.2cm of UserA] (ListA) {Model A List};
    \node[item, fill=BColor, below=0.2cm of UserB] (ListB) {Model B List};

    \node[desc, below=1.5cm of ABTitle] (ABDesc) {Split Traffic (Low Sensitivity)};
  \end{scope}

  \begin{scope}[local bounding box=interleave, xshift=7cm]
    % Interleaving
    \node[title] (IntTitle) {Interleaving};
    \node[below=0.5cm of IntTitle] (AnyUser) {Any User};

    \node[item, fill=AColor, below left=0.2cm and 0.1cm of AnyUser, minimum width=1.5cm] (A1) {A1};
    \node[item, fill=BColor, below right=0.2cm and 0.1cm of AnyUser, minimum width=1.5cm] (B1) {B1};

    \node[draw, fill=black!5, minimum width=2.2cm, minimum height=2cm, below=1.5cm of AnyUser, line width=0.75pt, anchor=north] (MixedBox) {Mixed List};

    \node[item, fill=AColor, minimum width=1.8cm, below=0.5cm of MixedBox.north] (MixA1) {A1};
    \node[item, fill=BColor, minimum width=1.8cm, below=0cm of MixA1] (MixB1) {B1};
    \node[item, fill=AColor, minimum width=1.8cm, below=0cm of MixB1] (MixA2) {A2};

    \draw[edge] (A1) -- (MixedBox);
    \draw[edge] (B1) -- (MixedBox);

    \node[desc, below=0.2cm of MixedBox] (IntDesc) {Blended (High Sensitivity)};
  \end{scope}

\end{tikzpicture}A/B 测试的统计学基础
在平台规模下,实验面临的统计挑战成倍增加。A/B 测试为比较模型变体提供了严谨的框架 (Kohavi 等 2009年, 2020年),但需要仔细考虑统计功效、10显著性阈值和多重检验校正。
Kohavi, Ron, Roger Longbotham, Dan Sommerfield, 和 Randal M. Henne. 2009年. 《Controlled experiments on the web: survey and practical guide》. Data Mining and Knowledge Discovery 18 (1): 140~81. https://doi.org/10.1007/s10618-008-0114-1.
Kohavi, Ron, Diane Tang, 和 Ya Xu. 2020年. Trustworthy Online Controlled Experiments: A Practical Guide to A/B Testing. Cambridge University Press. https://doi.org/10.1017/9781108653985.
10 A/B 测试功效:实验正确检测出真实效应的概率(\(1-\beta_{\text{stat}}\),通常设为 0.8)。在集群规模下,系统面临的挑战是统计功效:如果预期改进很小(例如,0.1%),实验可能需要数百万个样本才能达到统计显著性,连续数周消耗大量模型服务资源 \((C_{\text{infer}})\)。
样本量计算
不当的统计实践会导致假阳性,浪费工程资源,或导致假阴性,错失真正的改进,因此,检测某一效应所需的样本量必须根据四个参数确定:显著性水平 \((\alpha_{\text{sig}})\)、统计功效 \((1-\beta_{\text{stat}})\)、基线转化率 \((p)\) 和最小可检测效应 \((\delta)\)。公式 6 将比较两个比例时的这一关系形式化,表明所需样本量与最小可检测效应的平方成反比:

检测更小的效应会使所需样本量急剧增加。
\[n_{\text{sample}} = \frac{(z_{1-\alpha_{\text{sig}}/2} + z_{1-\beta_{\text{stat}}})^2 \times 2p(1-p)}{\delta^2} \tag{6}\]
其中,\(z_{1-\alpha_{\text{sig}}/2}\) 是显著性水平 \(\alpha_{\text{sig}}\) 对应的双侧临界值(通常为 1.96,对应于 \(\alpha_{\text{sig}} = 0.05\)),\(z_{1-\beta_{\text{stat}}}\) 是统计功效对应的临界值(通常为 0.84,对应于 80% 的统计功效),\(p\) 是基线比率,\(\delta\) 是以绝对差值表示的最小可检测效应。
计算示例:推荐模型所需的样本量
某推荐系统的基线点击率(CTR)为 5%。团队希望检测出 10% 的相对提升(绝对提升为 0.5 个百分点),置信水平为 95%,统计功效为 80%。
参数:
- \(z_{1-\alpha_{\text{sig}}/2} = 1.96\)(95% 置信水平,双侧)
- \(z_{1-\beta_{\text{stat}}} = 0.84\)(80% 统计功效)
- \(p = 0.05\)(基线 CTR)
- \(\delta = 0.005\)(提升 0.5 个百分点)
计算:
\[n_{\text{sample}} = \frac{(1.96 + 0.84)^2 \times 2 \times 0.05 \times 0.95}{0.005^2}\]
\[n_{\text{sample}} = \frac{7.84 \times 0.095}{0.000025} = \frac{0.7448}{0.000025} = 29,792\]
每个变体大约需要 30,000 samples,总计 60,000 observations。在每天 100 万次请求的情况下,该实验所需时间不到 2 小时。然而,对于基线 CTR 为 1% 的模型,若要检测到 5% 的相对提升(0.05 个百分点),计算结果为:
\[n_{\text{sample}} = \frac{7.84 \times 2 \times 0.01 \times 0.99}{0.0005^2} = \frac{0.1552}{0.00000025} = 620,800\]
现在,每个变体大约需要 62.1 万个样本。在每天总计 100 万次请求、均匀分配给两个变体的情况下,实验大约需要 30 小时。基线比率越低、效应越小,实验所需的运行时间就越长。
统计显著性检验
数据收集完成后,通过双比例 z 检验判断观测到的差异是否具有统计显著性。公式 7 将观测比率之差除以合并标准误,计算检验统计量:
\[z = \frac{\hat{p}_B - \hat{p}_A}{\sqrt{\hat{p}(1-\hat{p})(\frac{1}{m_A} + \frac{1}{m_B})}} \tag{7}\]
其中,\(\hat{p}_A\) 和 \(\hat{p}_B\) 分别为对照组和处理组的观测转化率,\(m_A\) 和 \(m_B\) 为样本量,\(\hat{p} = \frac{m_A\hat{p}_A + m_B\hat{p}_B}{m_A + m_B}\) 为合并比例。如果 \(|z| > Z_{\alpha_{\text{sig}}}\),则拒绝原假设,并得出各变体之间存在显著差异的结论。
多重检验校正
同时或依次运行多个 A/B 测试而不进行校正,会增大家族错误率。对于 20 个在 \(\alpha_{\text{sig}} = 0.05\) 下进行的独立检验,出现至少一个假阳性的概率为:
\[\Pr(\text{at least one false positive}) = 1 - (1-\alpha_{\text{sig}})^k = 1 - 0.95^{20} = 0.642\]
结果表明,误判存在提升的概率为 64%。有三种校正方法可以解决这一问题。
Bonferroni 校正将显著性阈值调整为 \(\alpha_{\text{sig}}' = \frac{\alpha_{\text{sig}}}{k}\),适用于 \(k\) 个检验。这种方法较为保守,但很简单。对于 20 个在 \(\alpha_{\text{sig}} = 0.05\) 下进行的检验,每个检验使用 \(\alpha_{\text{sig}}' = 0.0025\)。这可以控制家族错误率,但会降低统计功效。
Šidák 校正提供了一种保守程度较低的调整方法。公式 8 计算每个检验的阈值,使家族错误率精确维持在目标水平,其统计功效略高于 Bonferroni 校正:
\[\alpha_{\text{sig}}' = 1 - (1-\alpha_{\text{sig}})^{1/k} \tag{8}\]
对于 20 个检验:\(\alpha_{\text{sig}}' = 1 - 0.95^{1/20} = 0.00256\),比 Bonferroni 校正略宽松。
采用 Benjamini-Hochberg 程序控制错误发现率(FDR),允许在所有被拒绝的假设中存在指定比例的假阳性。这适用于可以接受部分假阳性的情况。将 p 值从小到大排序:\(p_{(1)} \leq p_{(2)} \leq \ldots \leq p_{(k)}\)。找到满足以下条件的最大 \(i\):
\[p_{(i)} \leq \frac{i}{k} \times \alpha_{\text{sig}}\]
拒绝所有假设 \(H_{(1)}, \ldots, H_{(i)}\)。在进行大量检验时,该程序的统计功效高于 Bonferroni 校正。
序贯检验与提前停止
传统 A/B 测试预先固定样本量,并且只评估一次。序贯检验允许在数据收集过程中监测结果,并采用有理论依据的提前停止规则。这可以将实验持续时间缩短 50% 或更多,同时控制错误率。
序贯概率比检验在每次观测后计算似然比:
\[\Lambda_m = \frac{p(X_1, \ldots, X_m \mid H_1)}{p(X_1, \ldots, X_m \mid H_0)}\]
停止并拒绝 \(H_0\) 的条件是 \(\Lambda_m \geq \frac{1-\beta_{\text{stat}}}{\alpha_{\text{sig}}}\),停止并接受 \(H_0\) 的条件是 \(\Lambda_m \leq \frac{\beta_{\text{stat}}}{1-\alpha_{\text{sig}}}\),否则继续收集数据。
对于大规模 A/B 测试,组序贯方法将实验划分为预先规划的分析阶段。在每个阶段,将检验统计量与调整后的阈值进行比较(使用 O’Brien-Fleming 或 Pocock 边界等方法计算),以维持总体 \(\alpha_{\text{sig}}\)。
实际实施中的注意事项
现实中的 A/B 测试面临着教科书统计学之外的复杂情况。当接受过处理的用户在返回对照组后仍保留行为变化时,就会出现残留效应。这违反了独立性假设,因此需要通过足够长的洗脱期或基于 cookie 的一致分组来缓解。
当对用户 A 的处理通过互动影响用户 B 的行为时,就会出现网络效应。这违反了稳定单元处理值假设(SUTVA),因此应在网络社群层面采用整群随机化来缓解,但这会降低统计功效 (Rubin 1980年; Hudgens 和 Halloran 2008年; Eckles 等 2017年)。
当新模型变体由于用户对新奇性的反应,而非其真正的优越性,表现出虚假的提升时,就会出现新奇效应。缓解方法是延长实验持续时间(通常为 2–4 周),以观察稳态行为。
当替代指标(点击量、参与度)与长期目标(留存率、收入)不一致时,指标选择可能产生误导。缓解方法是同时跟踪短期替代指标和长期护栏指标,即使后者需要更长的观察期。
示例详解:多重检验场景
某平台团队每季度开展 30 次 A/B 测试,比较候选模型。在使用 \(\alpha_{\text{sig}} = 0.05\) 且不进行校正的情况下,预计每季度会出现 \(30 \times 0.05 = 1.5\) 个假阳性。一年内,预计约有 6 models 被错误地认定为改进,导致工程资源浪费在没有实际价值的部署上。
应用 Bonferroni 校正:每项测试采用 \(\alpha_{\text{sig}}' = \frac{0.05}{30} = 0.00167\)。这需要更大的样本量。对于 节 1.4.5.8 中的推荐模型示例(基线为 5%,效应为 0.5 个百分点),原先每个实验组需要 30K 个样本。采用双侧 Bonferroni 阈值后,临界值上升至约 3.14,使每个实验组所需的样本量增加至约 60K。
采用 \(q = 0.05\) 水平的 FDR 控制:在重复应用中,Benjamini-Hochberg 程序控制被拒绝假设中错误发现比例的期望值。如果 30 项测试中有 10 项被判定为显著,控制目标是这些发现中错误发现比例的期望值为 5%,而不是对该季度的错误发现数量设置硬性上限。在开展大量测试时,这种方法比 Bonferroni 校正具有更高的统计功效。
校正方法的选择取决于假阳性的后果。对于高风险决策(金融模型、安全关键系统),应使用保守的 Bonferroni 校正。对于遗漏真实效应代价较高的探索性分析,应使用 FDR 控制。
Checkpoint 1.4: 多重检验下的族错误率
校正方法包括 Bonferroni、Šidák 和 Benjamini-Hochberg。将族错误率的推理应用于一个规模较小的平台。
SUTVA 违背与网络效应
前文介绍的统计计算建立在一个基本假设之上:用户之间相互独立。分配给某个用户的处理不能改变另一个用户的结果。如果用户 A 获得了改进后的推荐算法,用户 B 的行为应当不受影响,因为用户 B 从未接触过新算法。这一独立性假设是前文所有样本量计算和显著性检验的基础。
社交平台会系统性地违背这一假设。当用户 A 获得更好的内容推荐时,会将这些内容分享给其社交网络中的用户,其中包括对照组中的用户 B。尽管用户 B 从未接触过处理,其参与度仍会发生变化。对照条件因此受到污染,这并非实验误差所致,而是由网络化产品的自然运行机制引起的。
形式上,标准 A/B 测试依赖于 SUTVA:用户 \(i\) 的结果 \(Y_i(w)\) 仅取决于其自身的处理分配 \(w\),而不取决于分配给其他用户的处理 (Rubin 1980年)。这一假设在网络化产品和分布式机器学习系统中会系统性地失效,导致效应估计产生偏差,从而可能误导部署决策 (Hudgens 和 Halloran 2008年; Eckles 等 2017年)。
Rubin, Donald B. 1980年. 《Randomization Analysis of Experimental Data: The Fisher Randomization Test Comment》. Journal of the American Statistical Association 75 (371): 591~93. https://doi.org/10.2307/2287650.
Hudgens, Michael G., 和 M. Elizabeth Halloran. 2008年. 《Toward causal inference with interference》. Journal of the American Statistical Association 103 (482): 832~42. https://doi.org/10.1198/016214508000000292.
Eckles, Dean, Brian Karrer, 和 Johan Ugander. 2017年. 《Design and analysis of experiments in networks: Reducing bias from interference》. Journal of Causal Inference 5 (1): 1~23. https://doi.org/10.1515/jci-2015-0021.
网络效应的类别
网络效应主要表现为三种形式,每种形式都需要不同的检测和缓解策略:
- 直接网络效应:用户 A 接受的处理通过平台交互直接影响用户 B 的结果。在社交信息流排序实验中,处理组用户可能向对照组用户分享经过算法优化的内容,使测得的效应向零偏移,因为对照组用户通过网络传播部分接受了处理。
- 间接网络效应:市场层面的机制会影响所有用户,无论其各自被分配到何种处理。在网约车定价实验中,提高处理组司机的报酬可能会吸引更多司机加入平台,从而缩短对照组用户的等待时间,使测得的处理效应低估真实收益。
- 溢出效应:处理效应跨越地理或时间边界传播。局部推荐实验可能改变相邻社区的餐厅客流量和热度信号,从而改变附近对照组用户的推荐质量。
在这三种情况下,实验测量的都不再是相互独立的用户层面处理效应。
量化 SUTVA 违背
网络效应偏差的严重程度取决于网络结构和结果之间的相关性。对于整群随机实验,公式 9 给出了一种常用的设计效应近似,用于量化群内相关性如何增大处理效应估计的方差,并直接确定为获得同等统计功效所需增加的样本量:
\[\text{DEFF} \approx 1 + (m - 1)\rho \tag{9}\]
其中,\(m\) 是平均群大小,\(\rho\) 是结果的群内相关性(相互连接的用户群体内部结果的相似程度)。该因子表明,为获得同等统计功效,样本量需要增加到原来的多少倍。网络干扰也可能使处理效应估计本身产生偏差,因此,方差膨胀只是校正的一部分。
检测策略
检测 SUTVA 违例需要通过三项互补检查,显式测量网络暴露:
- 自我中心网络分析:使用 \(e_i = |\{j \in \mathcal{N}_i : W_j = 1\}| / |\mathcal{N}_i|\),测量每位对照组用户通过其关联用户受到的处理暴露,其中 \(\mathcal{N}_i\) 是对照组用户 \(i\) 的关联用户集合,\(W_j\) 表示用户 \(j\) 的处理分配状态。如果对照组结果与 \(e_i\) 相关,则说明存在网络效应;将对照组结果对暴露程度进行回归,可以量化溢出效应的大小。
- 干扰检验:比较处理暴露程度较高与较低的对照组用户的结果。在 SUTVA 成立时,这些用户群体应表现出相同的结果,因此显著差异表明存在网络污染。
- 时间分析:考察处理效应是否随时间传播。如果对照组指标逐日趋近处理组指标,则说明溢出效应正在通过网络累积。
这些检查共同将溢出效应从隐蔽的假设违例转化为可测量的实验条件。
缓解方法
检测到 SUTVA 违例时,可以通过四种实验设计调整恢复有效的因果估计:
- 图簇随机化:在社群层面而非个体层面分配处理。Louvain 或谱聚类等图划分算法将用户图划分为内部连接密集、跨簇边稀疏的簇,然后对簇进行随机分配,使用户主要与处于相同实验条件下的其他用户互动。其代价是统计功效降低:当有 \(k\) 个簇时,有效样本量变为 \(k\),而非用户个体总数。
- 自我中心网络排除设计:将网络暴露超过阈值的用户排除在分析之外。仅分析与处理组关联极少的对照组用户,例如 \(e_i < 0.05\),可以确保对照条件不受污染,但代价是样本量减少。
- 交替切换实验:所有用户以小时或天等时间段为单位,在处理条件与对照条件之间交替切换。由于所有用户都会接受这两种条件,每个时间段内不存在跨用户污染,分析比较的是不同时间段的结果,而非不同用户的结果。
- 基于地理区域的实验:地理边界可以充当网络效应的天然屏障。对于依赖地理位置的服务,城市级或区域级随机化可以消除大多数溢出路径,因为不同城市的用户很少直接互动。
合适的设计应消除主要干扰路径,同时保留统计功效。
实际实施
实施考虑网络影响的 A/B 测试需要投入基础设施:
- 用于计算网络统计量和簇分配的图分析流水线
- 根据每位用户的关联用户的处理状态,计算该用户的暴露程度
- 将簇随机化纳入考虑的改进统计检验
- 展示溢出效应指标的监控仪表板
对于大规模推荐系统,网络效应引入的偏差足以证明这些工程投入的合理性。当真实效应为 +6% 时,如果系统测得的提升仅为 +3%,就可能错误地否决有价值的模型变更,或错误地优先选择较差的替代方案。
端到端评估契约
实验阶梯会产生证据,但来自不同阶段的证据只有在对应同一候选方案和同一决策时才有用。评估契约 是一份经过版本管理的发布记录,将模型及其依赖项与工作负载、指标、统计设计、验收阈值、回滚条件和责任人绑定在一起。表 8 汇集这些记录,确保候选方案无法在一个数据集上通过离线质量评估、在更轻松的负载模式下通过性能评估,又在第三种配置下通过在线评估。
| 证据层面 | 契约必须明确固定的内容 | 验收或失效规则 | 责任主体 |
|---|---|---|---|
| 离线行为 | 评估集版本、主要指标、具有重要影响的切片、基线、不确定性证据,以及来自 Robust AI 的鲁棒性测试 | 仅当预先规定的总体和切片界限均得到满足时才允许晋级;当总体、标签定义或预期用途超出已验证范围时,判定失效 | 模型负责人和领域评审人员 |
| 系统性能 | 硬件与软件运行范围、开环或闭环工作负载模型、并发量、请求构成、预热、p50 和尾部延迟、吞吐量、错误及资源成本 | 仅在符合与生产环境等效的负载契约时才允许晋级;当容量余量或 SLO 预算耗尽时,判定失效 | 模型服务负责人和站点可靠性负责人 |
| 责任与安全 | 公平性切片、隐私与安全证据、受影响方的要求,以及来自 责任人工智能 的保障声明 | 仅当指定声明具备充分证据并经过充分评审时才允许晋级;发生重大变更、控制措施失效或出现无界危害信号时,判定失效 | 风险负责人和治理机构 |
| 在线实验 | 分配单元、留出组、最小可检测效应、统计功效、样本量、置信区间、多重检验校正、停止规则及护栏指标 | 仅在通过计划中的决策规则后才允许晋级;当任何护栏指标越过其预先规定的阈值时,停止并回滚 | 实验负责人和产品决策负责人 |
| 恢复与审计 | 回滚制品及其依赖项、触发窗口、证据保留期限、数据与代码版本、环境、随机种子、原始汇总计数及审批记录 | 若没有经过测试的回滚方案,则拒绝开放流量;当证据无法复现或无法在规定的评审期限内保留时,重新审议决策 | 发布负责人、平台负责人和审计保管人 |
验收职责被有意分散,但晋级权限明确无歧义。模型负责人和领域负责人负责验收预测效用;模型服务负责人负责验收容量和可靠性;各专业领域的风险负责人负责验收有明确边界的鲁棒性、公平性、隐私和安全声明。只有当所有必需的签核均指向同一制品时,指定的发布授权负责人才能批准晋级。平台自动执行门禁并保存证据,但不能选择产品目标,也不能豁免未通过的保障声明。
失效机制是契约中的返回路径。漂移超出已评估总体、特征或标签定义发生变化、延迟余量耗尽、出现有统计证据支持的护栏指标退化,或治理发生重大变更,都会将候选版本送回相应负责人负责的门禁。阈值和回滚目标在开放流量前就已固定,因此,主要指标表面上的提升不能在结果已知后重新定义成功。可复现性要求保留该决策的输入,而不仅仅是其结论:数据集和流量快照、模型与代码版本、环境与硬件运行范围、随机种子、分配与采样规则、充分统计量或获准保留的日志、审批记录,以及确切的回滚制品。
管理边缘设备集群
目前所讨论的运维挑战均以受控的数据中心环境为前提。然而,边缘智能 已经表明,联邦学习和设备端机器学习将“机器学习集群”扩展至数百万台异构边缘设备,这些设备的连接能力、电力和计算能力均受到限制。管理这一分布式设备群体会带来三个不同的 MLOps 挑战。
这三个约束相互作用,因此应将其作为一个统一的运维设计问题来处理,而非分别讨论。表 9 将每个约束映射到其所需的平台控制措施,包括硬件在环验证和联邦分析。
| 边缘设备集群约束 | 产生原因 | 平台控制措施 |
|---|---|---|
| 严重的版本不一致 | 由于设备离线、电量不足或处于受限网络中,部署可能需要数周或数月。在任意时刻,都可能有 50 个模型版本仍在运行。 | 为数月前部署的模型维护向后兼容的数据流水线和模型服务契约。 |
| 考虑设备特性的验证 | 准确率门禁无法揭示模型是否超出微控制器的 1 MB 内存预算,或是否在智能手机 SoC 上触发热降频。 | 在晋级前,增加针对实体或仿真目标设备的硬件在环验证。 |
| 受隐私约束的遥测 | 由于隐私规则和带宽成本限制了可观测性,原始预测结果无法持续回传。 | 使用联邦分析:设备在本地计算错误率或漂移等统计量,然后仅传输经过汇总和匿名化的健康状态信号。 |
发布风险管理
并非所有部署都具有相同的风险。有效的 CI/CD 系统会根据部署的风险特征对其进行分类和处理。基于风险的发布策略选择提供了基于风险的发布策略选择,将四种风险类别映射到适当的发布策略:低风险的小幅修复采用快速金丝雀发布,而关键的核心模型变更则需要完整执行影子部署、人工审核和分阶段发布流程。
风险分类
equation将部署风险形式化为回归概率、影响严重程度和暴露水平三者的乘积,为基于风险的发布决策提供了量化基础:
\[R_{\text{rollout}} = p_{\text{regression}} \times I_{\text{regression}} \times E_{\text{exposure}} \tag{10}\]
其中,\(p_{\text{regression}}\)是变更导致回归的概率,\(I_{\text{regression}}\)是发生回归时的影响严重程度,\(E_{\text{exposure}}\)是发布期间的暴露水平。
发布风险框架提出了三种缓解策略:
- 降低 \(p_{\text{regression}}\):部署前进行更充分的测试
- 降低 \(I_{\text{regression}}\):采用限制影响范围的架构模式
- 降低 \(E_{\text{exposure}}\):放慢发布速度,并降低初始流量比例
这些调节手段将标量风险公式转化为发布策略:每种风险类别决定需要收集多少证据、影响范围必须控制在多小的范围内,以及暴露水平应以多慢的速度增长。
风险类别
只有当平台将测得的风险映射到发布策略时,风险方程才能指导实际行动。基于风险的发布策略选择将概率、影响和暴露水平转化为部署方式:低风险变更可以采用快速金丝雀发布,而涉及安全关键功能的变更则需要影子验证、人工审核,以及更缓慢的流量扩展。
| 类别 | \(p_{\text{regression}}\) | \(I_{\text{regression}}\) | 发布策略 |
|---|---|---|---|
| 低 | 小幅代码修复 | 对用户的影响有限 | 快速金丝雀发布 |
| 中 | 重新训练的模型 | 对用户参与度的影响 | 标准金丝雀发布 |
| 高 | 新架构 | 对收入的影响 | 延长影子部署 + 缓慢金丝雀发布 |
| 关键 | 核心模型变更 | 涉及安全的影响 | 影子部署 + 人工审核 + 分阶段发布 |
自动回滚触发条件
风险类别决定流量扩展应有多谨慎,而回滚触发条件决定何时必须停止扩展。代码 4 中的触发配置通过为每项受监控指标绑定阈值、观测窗口和最小样本数,使这一停止条件能够被系统执行。
rollback_config = {
    "metrics": {
        "engagement_rate": {
            "threshold": -0.02,  # 2% relative decline triggers rollback
            "window_minutes": 15,
            "min_samples": 1000,
        },
        "error_rate": {
            "threshold": 0.01,  # 1% absolute increase triggers rollback
            "window_minutes": 5,
            "min_samples": 500,
        },
        "latency_p99": {
            "threshold": 1.5,  # 50% relative increase triggers rollback
            "window_minutes": 5,
            "min_samples": 100,
        },
    },
    "rollback_action": "immediate",  # or 'gradual' for less severe issues
    "notification": ["oncall", "model-owner"],
}
自动回滚必须在敏感性与误触发之间取得平衡。统计显著性要求(最小样本量、窗口持续时间)既可防止因随机波动而过早回滚,又能支持对真实的性能退化作出快速响应。
不同模型类型的 CI/CD 模式
模型类型决定了哪种 CI/CD 约束起主导作用:语义质量、提升用户参与度的能力、应对对抗行为的紧迫性,或分类准确率。不同模型类型的 CI/CD 模式对比了不同模型类型的 CI/CD 模式:LLM 需要以质量为门控条件的流水线,其中人工评估耗时数天至数周;而欺诈检测采用以阈值为门控条件的流水线,支持在数小时内完成部署、在数秒内完成回滚,以应对对抗性动态变化。
| 模式 | 模型类型 | 验证重点 | 发布速度 | 回滚速度 |
|---|---|---|---|---|
| 质量门控 | LLM | 人工评估、安全性 | 数天至数周 | 数小时 |
| 指标驱动 | 推荐 | 用户参与度指标 | 数小时至数天 | 数分钟 |
| 阈值门控 | 欺诈检测 | 精确率/召回率 | 数小时 | 数秒 |
| 准确率导向 | 视觉 | 分类指标 | 数天 | 数分钟 |
对于 LLM,起主导作用的约束是语义质量和安全性,因此流水线有意采用较慢的节奏。在 MMLU、HumanEval 及类似任务上进行的自动化基准评估用于缩小候选范围;人工评估检查各能力类别的输出样本;安全评估开展红队测试并检验有害内容案例;影子部署衡量用户满意度信号;缓慢的分阶段发布则为此次发布提供较长的持续运行观察期。从候选模型到全面部署,完整周期可能需要 2–4 周,因为主要风险是常规自动化指标无法发现的细微退化。
推荐系统的主导约束是时效性和提升用户参与度的能力,因此流水线优先采用快速且在统计上站得住脚的比较方法。离线归一化折损累积增益(NDCG)和召回率用于筛选候选模型,交错实验在相同请求上比较候选模型与生产基线,显著性检验判断用户参与度是否发生变化,快速金丝雀发布则自动扩大部署或执行回滚。常规更新可能在 24–48 小时内完成,因为过时推荐的代价可能超过严格限定范围的实验所带来的代价。
欺诈检测模型的主导约束是应对对抗行为的紧迫性。流水线仍会评估带标签的欺诈案例,在合法流量上验证假阳性率,并以影子模式对交易进行评分,以比较精确率和召回率;但其设计围绕快速部署和即时回滚能力展开,因为在发布仍在进行时,攻击者就会作出适应性调整。常规更新可能在 4–12 小时内完成,而在出现新的欺诈模式时,紧急更新可能在不到 1 小时内完成部署。
成熟的 CI/CD 流水线确保只有运行健康且经过验证的模型才能进入生产环境,将部署周期从数周缩短至数小时。部署不是终点,而是起点。模型安全部署后,首要的运维问题是:在条件不断变化的情况下,它是否仍能保持预期表现。回答这一问题,需要一种能够随自动化部署一同扩展的监控架构。
大规模监控
应用层的漂移检测依赖于健康的底层物理基础设施。在集群规模下,性能下降的 NVLink 连接或因过热而降频的 GPU,可能表现出类似软件超时的症状。因此,监控应自下而上展开:从集群遥测开始,逐层覆盖告警聚合、模型质量信号、仪表板和成本可观测性,使运维人员能够将症状定位到具备修复能力的层级。
集群遥测与硬件可观测性
由于在计算舱规模下故障是常态,集群监控和硬件可观测性是训练高效开展的先决条件,而非仅仅为运维提供便利。一个拥有 10,000 块 GPU 的集群大约每五小时就会发生一次硬件故障,而恢复耗时是 10 分钟还是中断数小时,取决于运维团队能否在性能劣化演变为故障之前将其发现。监控系统本身也是一个分布式系统,负责从集群中的每块 GPU、每台交换机和每个冷却组件收集遥测数据。
遥测覆盖三个物理层级。在 GPU 层级,最具诊断价值的信号包括结温(可揭示冷却能力的退化)、HBM 和 SRAM 中的 ECC 错误计数(可纠正错误率的上升往往先于会引发崩溃的不可纠正错误),以及 SM 利用率(可区分硬件故障与软件效率低下)。在网络层级,各端口的数据包重试率可揭示正在失效的线缆或交换机。在设施层级,冷却液温度偏差会在热损伤发生之前触发自动负载削减。挑战不在于单独采集这些信号,而在于跨空间和时间维度将它们关联起来。
在运维中最有价值的监控能力,是对这些遥测流进行关联分析。单个 GPU 温度升高,可能表明风扇正在失效或冷却液流动受阻。然而,如果同一节点中的 8 个 GPU 同时出现温度升高,原因更可能是节点级冷却问题。如果一个机架中的所有 GPU 都出现温度升高,原因很可能是机架级冷却液分配单元(CDU)出现问题。如果多个机架中的 GPU 出现同步的温度变化,原因很可能是设施级事件,例如冷水机组故障。监控系统必须在正确的空间尺度上检测这些模式并进行分类,引导运维人员找到实际根因,而不是针对同一个底层问题生成数百条独立告警。
这种遥测的数据规模不容小觑。一个拥有 10,000 个 GPU 的集群每天会生成约 1 TB 的指标数据—仅对 10,000 个 GPU 的结温每秒采样一次,每天就会产生 8.64 亿个数据点,这还未计入 ECC 计数器、功率读数、NVLink 错误率和网络端口统计信息。要以亚秒级延迟摄取、索引和查询如此海量的时间序列数据,需要专门的基础设施。组织通常会将集群总计算和存储容量的 1–2% 分配给监控栈本身:时间序列数据库(Prometheus、InfluxDB 或定制解决方案)、告警引擎和仪表盘系统。这种运维开销是实现大规模可观测性的代价;没有它,集群就如同盲飞。
在将训练作业分配给一组节点之前,调度器会采用自动运行前检查来验证硬件健康状态。控制平面会执行一系列耗时短、强度高的诊断:通过通用矩阵乘法(GEMM)基准测试验证张量核心吞吐量,通过 NCCL AllReduce 测试验证 NVLink 和 InfiniBand 带宽,并通过内存压力测试发现可能在持续负载下产生不可纠正错误的薄弱 HBM 位单元。任何一项诊断中表现不达标的节点都会被自动隔离以待维修,并在作业启动前由健康节点替换。此验证过程会使作业启动时间增加 5–10 分钟;相比于性能退化的 GPU 虽然通过了简单的上电自检,却在持续算术负载下发生故障,导致训练运行中途崩溃并浪费数小时计算,这点代价微不足道。

一个慢速加速器会使所有其他参与者在屏障处停滞。
大规模集群中最隐蔽的威胁并非硬故障,而是灰色故障:组件仍能继续工作,但性能已经退化。一个 HBM 堆栈部分失效的 GPU,其运行带宽可能仅为峰值带宽的 75%。信号完整性处于临界状态的 NVLink 可能会迫使链路频繁重新训练,造成微秒级停顿,而这些停顿会在每个训练步中累积成数秒的时间损失。在同步数据并行工作负载中,单个落后者就会拖慢整个集群,因为其他每个 GPU 都必须等待最慢的参与者完成其 AllReduce 操作。这些灰色故障无法通过简单的“运行/宕机”健康检查发现,需要持续、细粒度的性能基准测试才能检测出来。最有效的方法是在空闲节点上(或在计划维护窗口内)定期运行微基准测试,并将各节点的性能与集群基线进行比较。如果某个节点的 GEMM 吞吐量降至集群中位数的 90% 以下,或其 NVLink 带宽降至集群中位数的 85% 以下,即使尚未出现任何硬错误,也会被标记为需要调查。
Systems Perspective 1.4: 主动维护与被动维护
集群运维人员往往通过代价高昂的经验认识到,主动维护能够显著降低硬件故障对训练生产效率的影响。主动维护的三大支柱是:预测性诊断(使用基于历史遥测数据训练的模型,在组件发生故障前 24–72 小时预测故障)、定期老化测试(在为新安装的节点分配生产任务之前,在其上运行基准测试工作负载),以及滚动维护窗口(轮流对 2–5% 的节点进行健康检查,同时不降低可用容量)。投入主动维护的组织通常能够实现 95–98% 的集群有效利用率,相比之下,依赖被动维护的组织仅能达到 80–90%。
在多个训练作业共享同一物理基础设施的多租户集群中,吵闹邻居问题会引入一种无法通过单个作业指标察觉的性能风险。虽然容器化严格限制了 CPU 和内存使用量,但网络互连结构通常是一种易受干扰的共享资源。如果作业 A 恰好在作业 B 尝试从网络存储获取训练数据时,发起了跨脊交换机的大规模全归约操作,由此产生的数据包争用微突发可能使作业 B 的吞吐量降低 30–40%。这种干扰在启用 RDMA 的集群中尤其有害,因为流量绕过主机 CPU,导致标准的操作系统级数据包调度失效。现代编排系统通过静态网络轨道对齐—在物理上将特定 InfiniBand 子网专门分配给特定作业—或部署拥塞通知协议,在交换机硬件层面对抢占带宽的流量进行限速,以缓解这一问题。对于同时运行 175B 模型训练和较小规模研究实验的组织,最安全的方法是在物理上将集群划分为相互隔离的“岛屿”,每个岛屿配备专用的网络互连结构,接受资源碎片化带来的利用率损失,以换取性能的可预测性。
检查点的保存频率是硬件遥测信息开始对机器学习运维人员可见,而不再仅对数据中心技术人员可见的环节。性能退化的节点若迫使作业频繁从检查点恢复,或存储路径延长了检查点写入时间,都会直接造成训练吞吐量损失。**Young-Daly 模型** 推导了检查点与计算之间的权衡以及 Young/Daly 间隔,杨—达利定律:最优检查点策略 将其应用于检查点策略;这里的运维职责是提供这些公式所依赖的遥测信息:写入时间、故障率、拖尾行为和恢复时长。如果缺乏这种可见性,平台可能仍报告作业正在“运行”,而有效学习却已在反复重试和缓慢的检查点保存过程中悄然崩溃。
在考虑了物理底层之后,监控的重点重新回到已部署的模型集群。通过验证关卡并成功完成金丝雀部署的模型会进入生产环境;在这一环境中,逐渐退化、数据漂移和新出现的交互作用可能在数周或数月内侵蚀模型性能。CI/CD 中讨论的分阶段发布策略和回滚触发条件用于检测部署期间的突发故障;监控系统则必须检测运行期间的长期退化。在数百个模型同时运行的平台规模下,简单地将单模型监控实践独立应用于每个模型,会导致告警疲劳、遗漏关联以及运维混乱。适用于企业级机器学习平台的监控策略需要分层聚合和系统性治理。
告警疲劳问题
大规模监控的数学现实揭示了逐模型告警的局限性。考虑对 100 个模型进行独立告警监控时的数学情况。如果每个模型有 10 个受监控指标,而每个指标以 0.3% 的假阳性率产生告警(采用 3-sigma 阈值判定),那么预期的误报告警数量仍然相当可观。

随着检验次数增加,误报在数学上变得不可避免。
Napkin Math 1.7: 误报开销
问题:考虑一个监控 100 个模型的系统。每个模型有 10 项指标(延迟、准确率、漂移及其他指标)。告警阈值设为 3-sigma(特异度为 99.7%),控制脚本按固定时间间隔重新评估每项指标。这种配置会产生海量误报,值班工程师每天都必须处理这些误报。
数学分析:
- 监控项总数:100 个模型 \(\times\) 10 项指标 = 1,000 个监控项。
- 假阳性率:\(1 - 0.997 = 0.003\)(0.3 percent)。
- 每日检查次数:假设每隔 5 minutes 检查一次(288 次检查/天)。
- 每日误报数量:\(1,000 \times 288 \times 0.003\) \(\approx\) 864 条告警/天。
系统层面的洞见:即使采用高特异度(3-sigma)的告警,规模扩大也会带来问题。对原始指标直接触发告警并不可行。必须采用分层聚合(例如,用“集群健康状况”代替“节点健康状况”),才能承受误报开销。
公式 11 揭示了大规模场景下告警疲劳在数学上的必然性:对于假阳性率为 \(\alpha_{\text{fp}}\) 的单项指标,至少出现一次误报的概率会随着独立检验次数 \(N_{\text{tests}}\) 的增加而呈指数增长:
\[\Pr(\text{at least one false alert}) = 1 - (1 - \alpha_{\text{fp}})^{N_{\text{tests}}} \tag{11}\]
当 \(\alpha_{\text{fp}} = 0.05\) 且 \(N_{\text{tests}} = 1000\) 时(100 个模型 \(\times\) 10 项指标):
\[\Pr(\text{false alert}) = 1 - (1 - 0.05)^{1000} = 1 - 0.95^{1000} \approx 1.0\]
这一概率几乎为 100%。在这一规模下,监控系统会持续产生误报。这会形成一种破坏性的动态:运维人员因为大多数告警都是误报而逐渐学会忽略告警,真正的问题被淹没在噪声中,监控系统带来的价值也因此由正转负。
计算示例:告警量计算
笔记本 1.7 中的 3-sigma 分析已经让团队不堪重负;若放宽至更常见的 2-sigma 阈值(假阳性率为 5%),工作负荷将变得无法承受。某 ML 平台监控 100 个模型,配置如下:
- 每个模型有 10 项指标(准确率、延迟 p50、延迟 p99、吞吐量、错误率、数据新鲜度、特征漂移、内存使用量、GPU 利用率、请求量)
- 告警阈值设为 2 个标准差(每项指标的假阳性率约为 5%)
- 每 5 分钟检查一次指标
预计每日误报告警数:\(\text{Daily false alerts} = 100 \times 10 \times 0.05 \times \frac{24 \times 60}{5} = 14,400\)。
即使其中 99% 的告警被去重或自动解决,每日剩余的 144 alerts 仍会让任何值班团队不堪重负。尽管监控系统实现了全面覆盖(更确切地说,正是因为这种全面覆盖),它却变得毫无用处。
分层监控架构
告警疲劳问题要求采用一种根本不同的方法。解决方案是分层监控(图 9),将监控转变为告警路由系统:全局信号判断集群是否受损,模型组合层面的信号判断事件归属于哪个模型家族或领域,模型信号支持局部诊断,基础设施信号则将故障路由至平台团队。这种层次结构在减少告警数量的同时,保留了从症状到责任方的追溯路径。
这一层级结构之所以有效,是因为每个层级回答不同的事件路由问题。分层监控层级 将各层级与其信号、主要责任方和运维作用对应起来。
| 层级 | 代表性信号 | 主要责任方 | 运维作用 |
|---|---|---|---|
| 业务 | 归因于推荐的收入或转化、用户参与度指标、自动化率以及人工审核量。 | 事件负责人 | 通过少量高置信度告警指示产品或业务受损。 |
| 模型组合 | 推荐的用户参与度提升和多样性、欺诈检出量和误报率,或违规检出量和申诉率。 | 领域团队 | 将调查路由至负责共同目标的模型家族或产品领域。 |
| 模型 | 任务质量、延迟分布、吞吐量、错误率、资源利用率、模型服务饱和度以及近期部署状态。 | 模型负责人 | 在业务或模型组合信号发生变化后,支持局部诊断。 |
| 基础设施 | GPU 集群利用率和可用性、特征存储延迟、训练流水线耗时、模型服务健康状况、网络和存储。 | 平台团队 | 将需要修复容量、放置、网络、存储或控制平面问题的故障路由至相应责任方。 |
多维可靠性预算
集群无法仅凭可用性来概括可靠性。端点可能返回 HTTP 200,却仍在使用过时的特征提供服务、未达到延迟目标,或生成低于质量下限的预测。因此,每项服务都需要一个 SLO 向量
\[ \mathbf{S} = (S_{\text{availability}}, S_{\text{latency}}, S_{\text{freshness}}, S_{\text{quality}}), \]
每个维度均对应一个指标、目标、测量窗口和负责人。对于维度 \(i\),一个窗口内的归一化预算消耗为
\[ b_i = \frac{V_i}{A_i}, \]
其中,\(V_i\) 是符合条件的观测中违反目标 \(i\) 的比例,\(A_i\) 是同一目标和时间窗口内允许的违反比例。因此,在每个维度内,分子与分母的单位完全一致:可用性对应请求失败比例,延迟对应请求延迟超标比例,新鲜度对应预测过时比例,模型质量对应评估结果低于下限的比例。数值为 \(b_i=1\) 时,该维度的预算耗尽;\(b_i>1\) 表示服务消耗的不可靠性预算已超出其契约允许的范围。经过这种逐维度归一化后,各比率可以相互比较,但其原始的延迟、新鲜度和质量数值无法直接比较。只有当 \(\max_i b_i \leq 1\) 时,集群才保持在其可靠性边界内。对各维度取平均会使严重的质量退化被完美的正常运行时间所掩盖,因此发布决策由最大值决定。
预算消耗速率将这一向量转化为运行控制机制。任一维度的预算快速消耗都会呼叫责任团队,并停止版本晋级;持续的中等速率消耗会降低发布推进速度,并要求采取补救措施;预算耗尽则会冻结非必要发布,直到相关指标重新满足其恢复策略。平台负责指标计算、统一时间窗口、告警路由和策略执行。模型团队负责设定任务质量阈值,以及针对模型行为采取补救措施;数据负责人负责新鲜度和有效性;模型服务负责人负责延迟和可用性。这种职责划分将监控转化为连接证据与权限的明确契约,而不是一个人人可见、却无人必须据此采取行动的仪表板。
表 11 将每个预算维度映射到其负责人及其对发布的影响。
| 预算维度 | 代表性指标 | 主要负责人 | 对发布的影响 |
|---|---|---|---|
| 可用性 | 成功的符合条件请求数/请求总数 | 模型服务 | 当快速消耗超出策略规定时,停止发布推进或执行故障转移 |
| 延迟 | 满足尾部延迟目标的请求 | 模型服务/平台 | 减少流量、降低容量压力或候选模型复杂度 |
| 新鲜度 | 使用满足新鲜度 SLO 的特征所生成的预测 | 数据 | 阻止版本晋级,并回退到安全的特征路径 |
| 模型质量 | 考虑数据切片的任务指标高于其质量下限 | 模型/领域 | 回滚、拒绝预测,或路由到经过验证的基线模型 |
集群范围的异常检测
集群范围的异常检测识别整个模型组合中的异常模式,而非根据单个指标阈值发出告警。检测体系依次从局部统计过程控制,推进到模型族之间的相关性分析,再到解释指标为何变化的漂移评分。这一顺序既能控制告警数量,又能保留足够的证据,将事件交由正确的负责人处理。
统计过程控制
统计过程控制起源于工业质量控制 (Shewhart 1931年)。应用于 ML 监控时,控制图11用于跟踪指标分布是否随时间保持稳定,并与监测数据分布变化的漂移检测方法互为补充 (Gama 等 2014年)。其核心思想是区分普通原因变异(正常波动)与特殊原因变异(真正的异常)。
11 统计过程控制(SPC):Shewhart (1931年) 建立了用于制造业质量控制的控制图框架。在正态近似下,3-sigma 控制限对稳定过程产生的误报概率仅为 0.27%。在 ML 集群监控中,即使单次检验的误报率很低,也会在大量模型和指标上累积,因此,告警疲劳管理是在平台规模应用 SPC 时的一项内在约束。
Shewhart, Walter A. 1931年. Economic Control of Quality of Manufactured Product. D. Van Nostrand Company.
Gama, João, Indrė Žliobaitė, Albert Bifet, Mykola Pechenizkiy, 和 Abdelhamid Bouchachia. 2014年. 《A survey on concept drift adaptation》. ACM Computing Surveys 46 (4): 1~37. https://doi.org/10.1145/2523813.
对于指标 \(X\),若其已确定的均值为 \(\mu\)、标准差为 \(\sigma\),则控制上限为 \(\text{UCL} = \mu + 3\sigma\),控制下限为 \(\text{LCL} = \mu - 3\sigma\)。超出控制限的数据点或系统性模式,例如连续 7 个点高于或低于均值,都会触发调查。
集群范围的相关性
当多个模型同时出现类似异常时,根因很可能是共享的基础设施或数据,而非单个模型的问题。跨模型的相关性分析可以在三个方面提高运维效率:
- 自动将异常归因于可能的原因(部署、数据问题、基础设施)
- 对具有共同原因的告警去重
- 根据影响范围确定优先级
代码 5 将相关性转化为事件分诊规则。当异常模型的比例超过集群阈值时,事件就会从多个局部调试任务转变为一次共同原因调查。
def detect_fleet_anomaly(model_metrics, threshold=0.6):
    """
    Detect correlated anomalies across model fleet.

    Returns list of (timestamp, affected_models, likely_cause) tuples.
    """
    anomalies = []

    for timestamp in model_metrics.timestamps:
        # Identify models with anomalous metrics at this time
        anomalous_models = []
        for model in model_metrics.models:
            if is_anomalous(model_metrics[model][timestamp]):
                anomalous_models.append(model)

        # Check if anomaly fraction exceeds correlation threshold
        if (
            len(anomalous_models) / len(model_metrics.models)
            > threshold
        ):
            # Many models affected -> likely shared cause
            cause = attribute_to_shared_cause(
                timestamp, anomalous_models
            )
            anomalies.append((timestamp, anomalous_models, cause))

    return anomalies
该阈值可防止监控系统对个别模型的噪声反应过度,同时仍能捕捉平台范围的故障。超过该阈值时,通常应由共享依赖项的负责人处理,例如部署、特征流水线或基础设施服务的负责人,而非由各模型团队独立处理。
漂移检测
数据漂移是指输入分布逐渐发生变化,导致模型性能随时间推移而下降。检测漂移需要区分两种基本类型。
协变量偏移 是指输入特征的分布 \(p(x)\) 发生变化,但输入与输出之间的关系 \(p(y \mid x)\) 保持不变。通过监控均值、方差和空值率等输入统计量,无需标签即可实时检测这种偏移。
概念漂移 是指关系 \(p(y \mid x)\) 发生变化,例如用户改变了对垃圾信息或相关内容的定义。检测这种漂移需要真实标签,而这些标签往往会延迟数分钟、数天或数周才能获得。
由于标签通常存在延迟,大多数实时监控系统将协变量偏移用作性能可能下降的先行指标。即使计算成本低的漂移分数并不能构成完整的鲁棒性理论,它仍然很有价值,因为它能在结果标签到达之前,告诉运维人员应从何处着手调查。
对于连续特征,群体稳定性指数(PSI)12 用于量化分布偏移 (Yurdakul 和 Naranjo 2020年)。公式 12 将实际与预期分桶占比之差按其比值的对数加权后求和,以计算 PSI。0.1 和 0.25 是业界广泛采用的经验值,并非普适的统计阈值;生产系统必须根据样本量、分桶方式和误报成本校准告警区间。在平台运维中,PSI 的作用较为有限,仅作为一种成本低廉的告警信号。
12 群体稳定性指数(PSI):最初用于信用评分,以检测贷款申请人群体的变化,当时监管机构要求开展定量漂移监控。标准阈值(\(\text{PSI} < 0.1\) 表示稳定,\(\text{PSI} \geq 0.25\) 表示需要采取行动)是金融服务行业根据经验确定的。对于机器学习集群监控,PSI 的优势在于计算成本低——只需对分桶直方图进行一次遍历——因此能够跟踪数百个模型中的数百个特征,而不会耗尽监控预算。
Yurdakul, Bilal, 和 Joshua Naranjo. 2020年. 《Statistical properties of the population stability index》. The Journal of Risk Model Validation 52. https://doi.org/10.21314/jrmv.2020.227.
\[\text{PSI} = \sum_{i=1}^{K_{\text{bucket}}} (A_i - E_i) \times \ln\left(\frac{A_i}{E_i}\right) \tag{12}\]
其中,\(A_i\) 是实际(当前)分布中桶 \(i\) 的占比,\(E_i\) 是预期(参考)分布中桶 \(i\) 的占比,\(K_{\text{bucket}}\) 是桶的数量。
这里有意采用粗粒度的解释方式。PSI 低于 0.1 时,模型通常继续接受常规监控。数值介于 0.1 和 0.25 之间时,会创建调查工单。数值达到或超过 0.25 时,表明偏移已足够显著,即使标签尚未确认结果,平台也应将该模型视为可能已出现性能下降。
Napkin Math 1.8: 检测所需时间:监控滞后
问题:生产环境中的模型基线准确率为 95 percent。一次数据漂移事件导致准确率下降 2 percent。如果带标签的结果以 1000 samples/hour 的速率到达,需要多长时间才能在统计上证明模型性能已退化?
数学分析: 检测需要足够多的样本,才能将信号(2 percent 的下降幅度)与噪声(随机方差)区分开来。双样本比例检验根据基线准确率和退化后的准确率(\(p_1\)、\(p_2\)),以及置信度和统计功效目标(\(z_{\alpha/2}\)、\(z_{\beta}\)),确定所需样本量:
\[n \approx \frac{(z_{\alpha/2} + z_{\beta})^2 \left[ p_1(1 - p_1) + p_2(1 - p_2) \right]}{(p_1 - p_2)^2}\]
- 所需样本量:在 95 percent 的置信度和 80 percent 的统计功效下,标准正态分位数为 \(z_{\alpha/2} = 1.96,\ z_{\beta} = 0.84\),代入后得到所需样本量为 \(n \approx (1.96 + 0.84)^2 \times \left[ 0.95(1 - 0.95) + 0.93(1 - 0.93) \right] / (0.95 - 0.93)^2 \approx 2,207\)。
- 检测延迟:2,207 个样本 / 1000 samples/hour \(\approx\) 2.2 hours。
系统洞见:监控并非瞬时完成。对于 2 percent 的性能退化,模型会在失常状态下运行约 2.2 hours,之后才有足够的数据触发告警。这就是监控滞后。缩短这一滞后,要么增加带标签数据的数量(成本高昂),要么监控 PSI 等“代理”指标(速度更快,但噪声更大)。在高风险集群中,告警以输入漂移作为先行指标来触发,而不会等到准确率下降。
集群范围的漂移监控将这一信号扩展到整个模型组合。某个非关键特征的 PSI 突增可能只需局部调查,但共享特征或多个相互依赖的模型同时发生漂移,则表明数据流水线出现了故障,影响范围更广。
按模型类型进行监控
监控频率取决于故障成本。比较 所标示的按模型类型划分的监控参数,见 表 12:推荐系统要求实时监控 CTR,并将退化阈值设为 5%,而视觉分类器可以接受每日准确率检查,并采用针对具体数据集的阈值,以适应其较低的更新频率。
| 模型类型 | 主要指标 | 告警阈值 | 监控频率 |
|---|---|---|---|
| 推荐 | CTR、参与度提升 | 相对下降 5% | 实时 |
| 欺诈检测 | 精确率、召回率、欺诈率 | 退化 1% | 实时 |
| LLM | 质量评分、安全指标 | 按模型校准 | 每小时 |
| 视觉 | 各类别准确率 | 针对具体数据集 | 每日 |
| 搜索排序 | NDCG、点击位置 | 退化 2% | 实时 |
推荐系统的监控需要实时进行,因为其对产品的影响是实时发生的。应将点击率、停留时间和转化率与相同时段的历史基线、可用时的对照流量,以及发布后的上一模型版本进行比较。仅靠这些快速反馈的参与度指标还不够:多样性、目录覆盖率和信息茧房指标用于保障长期用户体验,而收入归因和促销商品库存指标则将推荐质量与业务结果联系起来。
欺诈监控受制于应对对抗行为的紧迫性。漏检欺诈会造成直接的经济损失,但过多的误报会给客户带来不便,并增加人工审核负担。因此,监控范围必须同时涵盖检测率、避免的损失金额和检测延迟,以及误报率、合法交易被拦截事件、人工审核量和对抗行为指标,例如试探模式或欺诈行为的突然变化。
LLM 监控受制于语义质量,而仅凭服务指标很难衡量这一质量。延迟、词元生成速率、错误率和安全分类器评分用于评估运行健康状况;点赞/点踩率、重新生成率和任务完成代理指标等用户满意度信号,则提供存在滞后的质量证据。有害内容检测、拒绝率和幻觉指标等安全指标仍只能提供部分证据,因此应据此触发审查,而不能宣称已实现全面覆盖。
标准监控无法检测语义层面的安全失效,例如具有说服力的虚假信息或娴熟的操纵行为。在这里,红队测试是生产监控的一种渠道,而非完整的对抗性评估计划:人工评估人员或自动化探测程序在部署前尝试进行越狱攻击,规模较小的持续探测集则验证生产环境中的安全过滤器是否持续生效。对输出进行抽样并交由人工延后审核,可针对自动化指标无法观测的失效形成闭环。
可观测性架构
有效的监控需要可观测性基础设施保留足够的上下文,以便将告警从症状导向责任人。每一种证据渠道都回答不同的运维问题。指标表明服务的某项属性超出了其允许范围,追踪显示请求在哪些环节耗费了时间,日志解释哪个组件产生了异常事件,而预测日志则将系统健康状况与模型行为关联起来。在多模型系统中,单个用户请求可能经过多个模型,因此,由 Google 的 Dapper 系统 (Sigelman 等 2010年) 开创的分布式追踪13,成为将端到端延迟分解到各个推理服务的唯一可靠方法。表 13 将这一架构概括为一张证据地图,而非一组彼此割裂的遥测工具。
Sigelman, Benjamin H, Luiz André Barroso, Mike Burrows, Pat Stephenson, Manoj Plakal, Donald Beaver, Saul Jaspan, 和 Chandan Shanbhag. 2010年. Dapper, a large-scale distributed systems tracing infrastructure. Dapper-2010-1. Google.
13 分布式追踪:Google 于 2010 年发表的 Dapper 论文确立了跨服务边界传播唯一追踪 ID 的模式。对于多模型机器学习流水线,追踪是将端到端延迟归因于特定模型阶段的唯一可靠方法——缺少追踪时,若一个包含 10 个模型的流水线出现 50 ms 的尾延迟突增,就需要独立排查全部 10 个模型。Dapper 以每台主机低于 0.3% 的 CPU 开销实现了这一点,确立了使集群规模下持续启用追踪成为可行方案的性能基准。
| 证据渠道 | 主要问题 | 保留的信息 | 通常揭示的故障 |
|---|---|---|---|
| 指标 | 哪项服务属性超出了允许范围? | 用于告警的实时数据流,以及用于分析趋势的聚合时间序列 | 漂移、饱和、错误率突增、成本异常 |
| 追踪 | 该请求在哪些环节耗费了时间? | 跨模型调用传播的请求 ID、时间信息和资源信息 | 跨模型延迟、扇出故障、热点阶段 |
| 日志 | 哪个组件产生了异常事件? | 具有一致模式和可搜索索引的结构化事件 | 新的错误类别、依赖项故障、有缺陷的发布 |
| 预测日志 | 系统健康状况是否保障了模型行为? | 抽样的输入、输出、特征,以及延后获得的标签 | 准确率下降、表现不佳的群组、数据缺口 |
预测日志是成本最高的证据渠道,因为它记录的是面向模型的数据,而非紧凑的服务计数器。因此,生产系统会有针对性地对其进行抽样,例如记录 1% 的预测,或记录特定用户的全部预测,使集群保留足够的样本,用于离线准确率评估、训练数据生成和故障调试,同时避免监控演变为一项存储工作负载。
仪表板设计
仪表板是监控层级中面向人的注意力界面。它应回答相同的路由问题,同时避免迫使所有读者使用同一个调试控制台:高管需要知道业务是否受到影响,领域负责人需要知道哪个模型组合出现了故障,模型负责人需要获得与其模型有关的证据,而事件响应人员需要从症状追溯到根因的追踪信息。表 14 展示了这一逐层深入的过程。
| 视图 | 回答的问题 | 应呈现的信号 |
|---|---|---|
| 高管 | 业务是否受到影响? | 平台健康状况、业务影响、当前事件、关键趋势 |
| 模型组合 | 哪个领域或模型家族导致了业务受损? | 模型清单、模型组合指标、近期部署、资源利用率和成本 |
| 模型 | 相关模型发生了什么变化? | 当前指标与基线的比较、部署历史、漂移指标、成本归因 |
| 排查 | 为什么会发生这一变化? | 跨模型相关性、时间序列叠加图、日志搜索、请求级追踪详情 |
成本监控与异常检测
ML 基础设施的三个结构性特征使其成本异常检测在本质上比通用 Web 服务更为困难。首先,GPU 自动扩缩容呈阶跃式变化:为大型模型增加一个推理副本意味着需要配置一整个多 GPU 节点,因此少量溢出流量就会触发阶跃式成本增长,而非平滑的线性扩展。其次,分布式训练作业可能因运行失误而造成灾难性后果:配置错误的超参数扫描、不处理竞价实例抢占的 DAG,或检查点失败后无上限的重试循环,都可能在任何告警触发之前耗尽相当于整个集群的 GPU 小时数。第三,僵尸模型(节 1.3)即使承载的流量微乎其微,仍会持续占用 GPU 显存和服务容量,形成长期存在的基线成本,并在整个集群中不断累积。因此,模型平台中的成本异常通常并非由流量突增引起,而是由训练作业配置错误、GPU 粒度边界上的自动扩缩容行为,或模型生命周期管理失效导致。有效的异常检测必须区分这些原因,而不能仅仅报告成本发生了变化。
在大规模运行中,未被检测到的成本异常可能在人工审查发现之前,累积数百万美元的意外费用。成本异常检测的定量框架需要在灵敏度与误报率之间取得平衡。
成本异常检测指标
成本监控的基础是统计异常检测。对于历史均值为 \(\mu\)、标准差为 \(\sigma\) 的成本时间序列,Z 分数 用于量化当前观测值的异常程度:
\[Z = \frac{C_{\text{current}} - \mu}{\sigma}\]
其中,\(C_{\text{current}}\) 为当前周期的观测成本。Z 分数为 3 表示当前成本比历史均值高出 3 个标准差,在正常运行情况下,此类事件的预期发生比例低于 0.3%。
作为 Z 分数分析的补充,百分比变化 检测能够捕捉突变,而不受历史方差影响,因此适合发现阶跃式增长,例如配置错误的自动扩缩容器在一夜之间使实例数量翻倍:
\[\Delta\% = \frac{C_{\text{current}} - C_{\text{previous}}}{C_{\text{previous}}} \times 100\]
告警阈值与误报分析
有效的告警需要校准阈值,以平衡检测灵敏度与运维负担。两种常见配置是 Z 分数阈值,即依据 3-sigma 规则在 \(|Z| > 3\) 时触发告警,以及百分比变化阈值,即在日环比变化满足 \(|\Delta\%| > 50\%\) 时触发告警。阈值的选择决定了误报率。对于每天检查一次、服从正态分布的成本指标,3-sigma 阈值产生的误报率为:
\[\Pr(\text{false positive per day}) = 2 \times (1 - \Phi(3)) \approx 0.0027\]
在持续一年的每日监控中:
\[E[\text{false alerts per year}] = 365 \times 0.0027 \approx 1\]
这一误报率在运维中是可以接受的。将阈值降低至 2-sigma,会使年度误报告警数量增加至约 16 次,很可能导致告警疲劳,却无法显著改善检测效果。
对于基于百分比的告警,误报率取决于成本本身的波动程度。需求自然波动较大的服务可能需要更高的阈值(75% 或 100%)以避免过多告警,而基线稳定的服务可以使用更严格的阈值(25% 或 30%)。
计算示例:检测推理成本突增
某推荐服务的成本通常在一天结束时为 $100 per day for inference compute. The operations team receives an alert: today’s cost has reached $250。
历史数据显示,平均每日成本为 \(\mu = \$100\) with standard deviation \(\sigma = \$15\),因此首先要检查的是,在正常运行条件下,该告警在统计上是否合理:\(Z = \frac{\$250 - \$100}{\$15} = \frac{\$150}{\$15} = 10\)。
Z 分数为 10 在正常运行条件下极不可能出现,但团队仍会先核实账单数据,再将告警视为真实异常。在排除账单延迟、重复计费和流水线错误后,调查转向运行指标。查询量未发生变化,因此流量并非成本激增的原因。P99 延迟从 50 ms 增至 125 ms,这意味着每个请求现在消耗的 GPU 秒数约为原来的 2.5\(\times\)。凌晨 2:00 部署的新模型版本采用了更大的排序模型,并增加了特征以提升质量;与此同时,GPU 利用率保持在 95% 左右,而每个 GPU 的吞吐量下降了 60%。因此,根本原因是模型更新提高了每次预测的计算成本:在流量不变、单请求成本为原来的 2.5\(\times\) 的情况下,总成本从 $100/day to $增至每日 250。平台需要决定,质量提升是否足以抵偿成本增加,还是需要通过量化、缩小批次或模型蒸馏进行优化。
根因分析框架
表 15 将成本异常根因类别划分为五类,每类都有不同的调查路径:
| 类别 | 指标 | 调查路径 |
|---|---|---|
| 流量增加 | QPS 与成本成比例变化 | 检查上游服务、营销活动和病毒式传播事件 |
| 效率退化 | 成本上升、QPS 不变、延迟上升 | 审查近期部署、模型更新和基础设施变更 |
| 资源泄漏 | 成本逐渐增长、利用率稳定 | 检查孤立资源、失败的清理任务和僵尸进程 |
| 价格变化 | 成本上升、所有指标稳定 | 核实云服务提供商的价格及预留实例到期情况 |
| 配置错误 | 成本呈阶跃式增长 | 审核自动扩缩容规则、实例类型和副本数量 |
按服务和团队归因成本
有效的成本管理需要将成本归因到组织单元。基于标签的分配方法根据资源元数据分配成本,如 代码 6 所示。
# Resource tagging schema for cost attribution
cost_allocation:
  dimensions:
    - team: "recommendation"      # Organizational owner
    - service: "ranking-model"    # Specific service
    - environment: "production"   # prod/staging/dev
    - model_type: "inference"     # training/inference
    - cost_center: "CC-4521"      # Finance tracking

  shared_cost_distribution:
    # Platform infrastructure costs distributed by usage
    - resource: "shared-gpu-cluster"
      method: "proportional_gpu_hours"
    - resource: "feature-store"
      method: "proportional_query_volume"
    - resource: "monitoring-infrastructure"
      method: "equal_split"
共享基础设施的成本需要分摊策略。三种常见方法可满足这一需求:
- 按比例分摊:根据使用量指标(GPU 小时数、存储字节数、API 调用次数)分摊共享成本
- 平均分摊:在使用基础设施的团队之间平均分摊成本(适用于固定基础设施)
- 边际成本:按各团队的使用所增加的成本向其收费
分摊策略决定了仪表板能否明确行动责任,而不只是描述支出。
成本仪表板
有效的成本监控仪表板采用与可靠性仪表板相同的注意力引导层级。管理层视图跟踪机器学习基础设施总成本、环比趋势、预算与实际支出的对比,以及每次预测成本和每位活跃用户成本等成本效率指标。业务组合视图随后按业务领域和模型类型细分成本,使平台团队能够判断变化是由推荐、欺诈检测、搜索还是其他领域驱动的。服务视图展示各服务成本、每次推理成本、GPU 利用效率和预算对比。调查视图增加部署标记、运维指标关联和归因细节,使异常能够与具体变更联系起来,而不是被当作会计噪声。
持续成本监控围绕四项关键指标展开:
- 每次推理成本:节 1.6.7 中的 FinOps 论述对这一服务单位经济性指标进行了形式化定义;在此跟踪其趋势,以发现效率下降。
- 每位活跃用户成本:按用户规模归一化的基础设施成本。支持对不同规模的服务进行比较。
- GPU 利用效率:每 GPU 小时产生的收入或价值。将基础设施成本与业务成果联系起来。
- 预算消耗速率:相对于已分配预算的当前支出速度。支持在超支之前主动干预。
将成本监控与分层监控架构集成,可确保成本异常与性能和质量指标一样得到适当关注。为每个产品团队单独构建这些 CI/CD 流水线和分层监控系统,成本高昂,难以承受。为了避免重复投入并让所有团队都能使用这些能力,组织必须将其提升为统一的内部产品,这一实践称为平台工程。
平台工程
如果组织中的每个数据科学团队都独立配置 GPU 集群、配置模型注册中心并接入告警仪表板,就会因重复开展无差异化的基础设施工作而付出巨大成本。平台工程 将机器学习基础设施本身视为产品,以此解决这一问题,并提供标准化路径,使产品团队能够全心专注于建模,而无需处理基础设施的底层搭建与连接工作。
机器学习平台工程构建共享基础设施,使模型团队能够开发、部署和运行模型,而无需管理底层复杂性。有效的平台需要在加速开发的自助服务能力与确保一致性和可靠性的治理要求之间取得平衡。
抽象层级
抽象层级决策 要解决的是:平台应代表模型团队集中承担多少运维判断。抽象程度过低,会使每个团队都承担同样的基础设施开销;抽象程度过高,则会隐藏特殊工作负载所需的控制手段。平台抽象层级 中的四个层级位于这条灵活性与便利性的权衡曲线上,其区别在于哪些事项由平台负责,哪些留给模型团队负责。
| 层级 | 平台负责的事项 | 模型团队仍负责的事项 | 最适用的场景及风险 |
|---|---|---|---|
| 第 1 级 | GPU 容量、存储卷、网络连接,以及 Kubernetes 命名空间等基本编排功能 | 训练代码、服务技术栈、监控和部署路径 | 适用于拥有强大基础设施团队的特殊工作负载;当许多团队重复开展相同运维工作时,成本会变得高昂 |
| 第 2 级 | 标准化容器、面向机器学习的 Kubernetes 集成、持久卷和基本服务网格支持 | 实验结构、训练作业、服务版本发布和监控工作流 | 减少封装工作的重复投入;运维正确性仍高度依赖各个团队 |
| 第 3 级 | 机器学习专用控制循环,例如拓扑感知调度、超参数调优、分布式训练和模型服务 | 建模判断和针对特定工作负载的权衡 | 承担跨团队反复出现的故障模式的处理责任;Kubeflow 和 Ray 等系统通常接近这一层级 |
| 第 4 级 | 全生命周期产品:IDE、特征存储、实验跟踪、注册中心、CI/CD、监控、成本和治理 | 更高层次的产品与建模意图,对底层的直接控制更少 | 最大限度提升速度和一致性;平台团队承担策略、可靠性和经济可见性方面的责任 |
Vertex AI、SageMaker、Google 的 TensorFlow Extended(TFX)14 (Baylor 等 2017年) 以及 MLflow (Zaharia 等 2018年) 等托管平台和生命周期平台,代表了这一谱系中完整平台的一端。其权衡十分明确:团队通过放弃部分底层控制来获得速度和一致性,而平台团队则承担策略、可靠性和经济可见性方面的责任。
14 TensorFlow Extended(TFX):Google 的生产级 ML 平台。TFX 的关键架构洞见在于,通过 TensorFlow Data Validation(TFDV)进行的数据验证会在训练开始前把关流水线,捕获模式违规和分布漂移;否则,这些问题会导致模型性能在无明显报错的情况下下降。这种“训练前即失败”的理念避免了代价最高的一类 ML 浪费:将 GPU 小时耗费在使用损坏数据进行训练上。
Baylor, Denis, Eric Breck, Heng-Tze Cheng, Noah Fiedel, Chuan Yu Foo, Zakaria Haque, Salem Haykal, 等. 2017年. 《TFX: A TensorFlow-Based Production-Scale Machine Learning Platform》. Proceedings of the 23rd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, 1387~95. https://doi.org/10.1145/3097983.3098021.
Zaharia, Matei, Andrew Chen, Aaron Davidson, Ali Ghodsi, Sue Ann Hong, Andy Konwinski, Siddharth Murching, 等. 2018年. 《Accelerating the Machine Learning Lifecycle with MLflow》. IEEE Data Engineering Bulletin 41 (4): 39~45.
平台生命周期与采用
内部 ML 平台是一个持续发布版本的产品,而非一次性的基础设施项目。其接口、支持的工作流、可靠性目标和职责边界必须能够演进,而不必迫使所有模型团队同步迁移。因此,每次平台发布都需要兼容性保证、迁移路径、能够区分新旧路径的遥测,以及弃用行为的停止支持日期。平台团队还需要制定自身的服务级别目标,因为注册中心、特征服务或部署控制器的中断可能同时阻塞所有产品团队。
采用情况衡量的是平台是否减少了工作,而不仅仅是将工作集中起来。有用的指标包括:生产模型中采用受支持路径的比例、从已验证产物到接收限定范围生产流量所需的时间、例外率、迁移完成情况、支持负担,以及标准路径之外反复出现的繁琐运维工作。注册数量很高但自定义流水线持续存在,表明平台在名义上获得了采用,但产品适配度较低。相反,强制迁移可能提高采用比例,同时增加交付周期和运维风险。因此,平台路线图应结合集群层面的成效与用户证据:事故减少和成本归因,与首次部署所需时间以及能够在无平台团队介入的情况下完成常规变更的团队比例同样重要。
生命周期决策必须为约束条件不适合共享路径的工作负载保留退出通道。例外应当是明确、有时限的约定,指定负责人并规定集成义务,而非永久分叉。当围绕同一项缺失能力的例外数量不断增长时,这一模式就成为下一版平台的产品证据。当一项能力所带来的价值不再足以抵偿其维护和迁移成本时,平台应通过可度量的双轨运行、兼容性测试和最终移除关卡来弃用它。这种产品管理纪律可防止共享控制平面成为新的技术债务来源。
自助式模型部署
只有当平台既能让模型团队快速行动,又能将有风险的选择限制在治理边界内时,自助式部署才能发挥作用。因此,设计问题在于:哪些部署决策应继续由团队负责,以及模型接收生产流量之前,平台必须强制保证哪些不变量。
部署 API 设计
设计良好的部署 API 通过以声明式方式表达模型团队的意图,抽象掉运维复杂性。平台设计的要点在于:在将某个模型版本转化为集群流量之前,平台必须明确哪些不变量,而非某个特定 YAML 文件的形式。自助式部署不变量 中的不变量构成了该声明式接口背后的平台契约。Prometheus15 是承接该契约遥测数据的常见运维接收端之一。
15 Prometheus:一个开源监控系统,目前由 CNCF 托管,采用拉取模型从导出器采集指标。对于 ML 集群,Prometheus 是跟踪运行健康状况(CPU/GPU 利用率、请求速率)的标准工具,但其时间序列模型不适合跟踪高维分布漂移,因此需要采用双层监控架构。
| 声明的意图 | 平台不变量 |
|---|---|
| 模型产物与版本 | 模型服务系统从注册中心加载的必须恰好是经过验证的模型。 |
| 资源范围 | GPU、内存和副本请求必须符合配额与调度约束。 |
| 流量策略 | 金丝雀、影子部署和回滚控制在全面上线前限制影响范围。 |
| 质量关卡 | 错误、延迟、漂移和任务质量阈值阻止不安全的上线。 |
| 遥测接收端 | 运维指标流入运维监控系统,模型质量信号则流入漂移和切片监控系统。 |
| 审批边界 | 敏感数据访问、预算超支和高风险发布窗口需要审核。 |
TensorFlow Serving 提供模型服务生命周期管理能力,支持模型加载、版本管理、金丝雀发布和回滚 (Olston 等 2017年)。自助式平台在这些能力之上增加策略层:模型团队声明意图,平台则将其转化为调度、流量路由、遥测和审批控制。
Olston, Christopher, Noah Fiedel, Kiril Gorovoy, Jeremiah Harmsen, Li Lao, Fangwei Li, Vinu Rajashekhar, Sukriti Ramesh, 和 Jordan Soyke. 2017年. 《TensorFlow-Serving: Flexible, High-Performance ML Serving》. CoRR abs/1712.06139. https://doi.org/10.48550/arXiv.1712.06139.
资源管理
高效利用资源对平台的经济性至关重要,因为只有对训练和服务工作负载采用不同的控制机制,共享容量才能带来收益。训练可以用时间换取利用率;服务则用容量换取尾延迟保障,因此单一的调度策略无法同时优化两者。
训练资源管理
训练工作负载以批处理为主,因此可以将其灵活性转化为更高的利用率。作业具有明确的开始和结束时间,GPU 显存需求通常可以提前确定;如果检查点机制能够限制工作损失,许多训练任务就可以被抢占并重新启动。训练调度器使用优先级队列、公平共享和感知截止时间的资源放置策略,决定哪些作业应当等待、哪些应当迁移,以及哪些低优先级作业可以被抢占16,以便为紧急任务让出资源。竞价实例或可抢占实例适合这一控制循环,因为抢占后的自动重试可以在降低成本的同时保留训练进度。
16 作业抢占:终止低优先级工作负载,以释放资源供紧急任务使用的能力。云服务提供商对可抢占实例或竞价实例提供 60–90% 的折扣,但代价是 ML 训练必须支持通过检查点恢复运行:如果不定期保存检查点,一次被抢占的 72 小时训练任务就必须从头开始,使原本 70% 的成本节省变成净损失。检查点保存频率本身也需要在 I/O 开销与计算浪费风险之间进行权衡。
服务资源管理
服务工作负载主要受延迟约束,而非依赖批处理的灵活性。需求会随一天中的时段、事件和季节性因素而波动,但抢占正在处理的请求必然会影响用户。因此,服务控制循环从延迟 SLO 出发,确定在请求到达之前必须有多少容量处于在线状态。
自动扩缩容根据请求速率、延迟或特定模型的队列指标,横向增加容量,但必须考虑模型加载时间和 GPU 显存的分配粒度。资源隔离防止一个模型消耗另一个模型的资源预算;成本优化则结合规格适当的实例、满足基线需求的预留容量,以及仅用于可容忍中断的溢出负载的竞价实例。运行目标并非单纯追求最高利用率,而是制定仍能保障尾延迟的最低成本容量方案。
平台利用率指标
训练与服务的控制机制分离之后,共享平台仍然需要一个汇总指标,用于衡量容量是否被转化为有效工作。公式 13 将平台效率定义为所有资源利用率按容量加权的平均值:
\[U_{\text{platform}} = \frac{\sum_{i} U_i \times \text{Cap}_i}{\sum_{i} \text{Cap}_i} \tag{13}\]
其中,\(U_i\) 是资源 \(i\) 的利用率,\(\text{Cap}_i\) 是资源 \(i\) 的容量。按容量加权使该指标能够如实反映闲置容量的分布:一块闲置 GPU 与一个闲置的八 GPU 节点造成的浪费并不相同,因此,小型低利用率资源对平台平均值的拉低程度不应与大型闲置资源池相同。
然而,原始利用率并不全面。有效利用率还必须考虑利用率质量,以判断 GPU 是在执行有效工作还是在等待数据;考虑利用率公平性,以评估利用率在各团队之间的分布是否合理;并考虑利用率成本,以单位 ML 产出的成本来评估效率。
计算示例:GPU 集群效率
某平台运营着一个拥有 100 个 GPU 的训练集群,GPU 平均利用率为 65%,内存利用率为 80%,平均排队等待时间为 4 小时,成本为 $2.50 per GPU-hour. The high memory utilization suggests jobs are generally sized correctly, while the lower compute utilization points to I/O-bound training steps. Queue waits show that demand already exceeds supply, so the platform decision is not simply whether to buy more GPUs. Daily cluster spend is fixed by provisioned capacity at \(100 \times 24 \times \$2.50 = \$6,000/天\), but only \(100 \times 24 \times 0.65 \times \$2.50 = \$3,900/天\) is currently converted into useful GPU work. If data-loading optimization raises compute utilization to 80 percent, useful work rises to \(100 \times 24 \times 0.80 \times \$2.50 = \$4,800/天\),以上均是在增加任何容量之前。因此,同一组测量结果支持两种不同的行动:先消除 I/O 瓶颈,释放无法有效使用的容量,再通过调度或扩容缓解剩余的排队压力。
Checkpoint 1.5: GPU 集群利用不足的年度成本
使用集群每日支出($6,000/day) and productive GPU-hours ($3,900/天,利用率为 65%),将分析扩展到年度尺度,并与平台投资回报率(ROI)的论证进行比较。
高级集群指标:机器学习生产力有效吞吐量(MPG)
利用率指标虽然能反映资源的忙碌程度,却往往无法体现真正的工程价值。如果某个超参数调优作业最终因配置错误而失败,那么即使 GPU 在运行该作业时的利用率达到 100%,从硬件角度看是“高效的”,从生产力角度看却是“浪费的”。为解决这一问题,机器学习生产力有效吞吐量(ML Productivity Goodput,MPG) 提供了一项衡量集群效率的综合指标 (Wongpanich 等 2025年)。
Wongpanich, A., T. Oguntebi, J. Baiocchi Paredes, Y. E. Wang, P. M. Phothilimthana, R. Mitra, Z. Zhou, N. Kumar, 和 V. J. Reddi. 2025年. Machine Learning Fleet Efficiency: Analyzing and Optimizing Large-Scale Google TPU Systems with ML Productivity Goodput.
Hennessy, J. L., 和 D. A. Patterson. 2011年. Computer Architecture: A Quantitative Approach. Morgan Kaufmann.
MPG 将 集群定律 中介绍的集群定律扩展为机器学习集群效率铁律。正如经典的处理器性能铁律 (Hennessy 和 Patterson 2011年) 对 CPU 执行时间进行分解一样,这一公式将机器学习集群效率分解为三个正交分量:
\[\text{MPG} = \text{Scheduling Efficiency} \times \text{Runtime Efficiency} \times \text{Program Efficiency}\]
- 调度效率:衡量平台将作业分配到可用资源上的能力。排队延迟,以及资源存在却无法分配的碎片化现象,都会降低这一指标。
- 运行时效率:反映执行期间硬件利用的质量。抢占导致的重启开销、数据加载瓶颈导致的空闲时间,以及分布式训练中的拖尾效应等“无效吞吐”,都会降低这一指标。
- 程序效率:评估在硬件上运行的代码是否经过优化。未充分优化的内核、过高的精度(在 BF16 足够时使用 FP32)以及冗余计算,都会降低这一指标。
跟踪铁律的各个分量,有助于平台团队超越简单的“利用率”,转而衡量“有效吞吐量”,即完成有效且有用的模型训练工作的速率。这一转变往往会揭示:利用率很高的集群可能因频繁失败或代码效率低下而具有较低的 MPG,从而引导团队将优化工作集中于影响最大的瓶颈。
多租户与隔离
只有当多个团队能够共享基础设施而不受彼此故障影响时,企业平台才能获得共享红利。因此,多租户首先是隔离问题,其次才是效率问题:平台必须同时限制性能干扰、数据暴露和成本外溢。
隔离要求
在一个团队的工作负载、数据或成本可能影响另一个团队的每一处边界上,租户都需要隔离:
- 性能隔离:资源限制、调度公平性和网络服务质量可防止一个工作负载在训练负载峰值或模型服务请求突增期间导致另一个工作负载的性能下降。
- 安全隔离:访问控制、网络分段和加密可防止具有不同敏感级别的团队意外共享数据路径。
- 成本隔离:计量和成本分摊使每个团队的资源使用都可归属到相应团队。
这三类边界共同保障共享基础设施的安全,使团队能够使用它,而无需对每次部署都进行人工协商。
命名空间架构
典型的多租户架构使用分层命名空间:
Platform
|-- Team A
|   |-- Development
|   |-- Staging
|   `-- Production
|-- Team B
|   |-- Development
|   |-- Staging
|   `-- Production
`-- Shared
    |-- Feature Store
    |-- Model Registry
`-- Monitoring每个团队都获得专用命名空间,并设置资源配额;共享服务则在公共命名空间中运行,并配备适当的访问控制。缺乏控制时,一个团队的高资源需求工作负载可能降低其他团队的性能,这种故障模式称为吵闹邻居问题。17 要预防这一问题,需要在请求、速率、优先级和预算边界上实施控制。
17 吵闹邻居问题:一种多租户故障模式,即一个租户的工作负载降低同机部署的其他租户的性能。ML 工作负载尤其容易出现这一问题,因为训练作业会贪婪地分配 GPU 内存—单个作业若请求共享节点上全部可用的 HBM,就可能使同机部署的推理服务无法获得足够资源,导致延迟骤增并违反 SLO。与 CPU 工作负载不同,GPU 内存无法超额分配,因此物理资源隔离是唯一可靠的预防手段。
以下四种控制措施可防止一个租户压垮共享服务:
- 请求限制:每个请求可消耗的资源都有上限。
- 速率限制:每个租户的请求速率都有上限,以免共享服务不堪重负。
- 优先级类别:即使发生资源争用,关键工作负载也能获得资源。
- 突发预算:允许暂时超额使用资源,同时保持长期公平性。
这些控制措施共同使公平性能够在请求路径中得到强制执行,而不必依赖事后协商。
ML 平台的 FinOps
传统 IT 中的财务运营(FinOps)实践很少考虑 ML 工作负载的成本结构。GPU 计算成本在 ML 预算中占主导地位,单次训练运行的成本可能高达数万美元。模型服务基础设施随流量扩展,形成可变成本,其峰值与谷值之间可能相差一个数量级。ML 开发具有实验性,这意味着许多训练运行并不产生生产价值。有效的 ML FinOps 需要采用专门的实践,将这些现实因素纳入考虑。
Definition 1.1: ML 的 FinOps
ML 的 FinOps 是将计算成本视为首要工程约束的实践:按实验和模型实时计量成本,并将其与模型准确率和延迟联合优化,而不是通过年度预算核对进行事后核算。
- 重要性:ML 计算成本随实验规模急剧增长。一个每天使用 1,000 GPU 小时的团队,按 $3/GPU-hour spends $3,000/天($1.1M/年),且这还仅是训练支出。借助每次实验的成本可见性,工程师可以发现,30% 的运行因发散而提前终止(通过更好的超参数选择可以避免),而竞价实例可为具备容错能力的工作负载降低 60–70% 的成本,从而在不改变输出质量的情况下,将实际支出降低 40–50%。
- 区别:传统 IT 预算在各部门之间分配固定的年度计算预算,而 ML 的 FinOps 则在每次运行和每个模型的层面运作,并提供实时反馈,从而支持这样的决策:当损失曲线表明出现发散时,在第 1,000 步提前停止一次成本为 $50K 的训练运行,而不是等到整次运行完成后才发现浪费。
- 常见误区:一种常见的误解是,FinOps 意味着尽量减少计算支出。其目标是在整个生命周期内最大化每美元所能获得的准确率:一个 $500K training run producing a model serving 10B inferences at $0.0001/查询的模型,可能比一个 $50K run producing a model that requires 10\(\times\) 推理计算资源才能在大规模场景下达到相同准确率的模型具有高得多的成本效益。
成本构成
ML 平台成本明细 涵盖多个类别,各类别采用不同的优化策略。ML 平台成本明细 表明,训练计算占主导地位(占成本的 40–60%),主要由 GPU 小时数和实验规模驱动,竞价实例和提前停止是主要的优化手段:
| 成本类别 | 典型占比 | 主要驱动因素 | 优化手段 |
|---|---|---|---|
| 训练计算 | 40–60% | GPU 小时数、实验规模 | 竞价实例、提前停止 |
| 模型服务计算 | 20–40% | 流量、延迟 SLO | 自动扩缩容、模型优化 |
| 存储 | 10–20% | 数据集大小、检查点频率 | 分层存储、保留策略 |
| 网络 | 5–15% | 多区域部署、数据传输 | 缓存、压缩 |
| 平台开销 | 5–10% | 团队规模、工具 | 自动化、自助服务 |
成本优化策略
成本优化是一项风险分配决策,而不是折扣目录。可中断计算只有在检查点能够限制抢占造成的工作损失时才有收益;模型服务的自动扩缩容只有在延迟预算范围内才有收益;实例规格优化则必须以实测的每步成本或每次推理成本为依据。每种优化手段都以某种特定风险换取某种特定的成本节省。
竞价实例与可抢占实例
云服务提供商为可中断计算容量提供大幅折扣(60–90%)。ML 训练工作负载非常适合使用竞价实例,因为检查点支持从中断中恢复,训练作业比模型服务更能容忍延迟,而且大型批处理作业可以摊薄实例获取开销。
有效使用竞价实例需要采取三项实践:
- 检查点频率调优:在检查点开销与潜在工作损失之间取得平衡。对于一个成本为 $10/hour on spot instances, hourly checkpoints losing at most one hour of work ($10)的作业,远远超过检查点存储成本。
- 实例多样化:跨多种实例类型和多个可用区请求容量,以降低中断概率。
- 回退策略:对于时间敏感的作业,或在竞价实例可用性较低时,自动回退到按需实例。
这些实践共同将廉价但不可靠的资源转化为风险可控的训练选项。
Training Cost Comparison (100 GPU-hours):
|-- On-demand:     100 × $3.00 = $300
|-- Spot (70% discount): 100 × $0.90 = $90 (+ potential reruns)
|-- Reserved (40% discount): 100 × $1.80 = $180 (requires commitment)
`-- Actual spot with interruptions: ~$110 (accounting for 20% rerun overhead)
服务侧的风险分配方式有所不同。服务成本随流量增长,但机器学习服务无法像无状态 Web 应用那样自动扩缩容。大型模型可能需要数秒甚至数分钟才能加载完成,因此,纯粹被动响应的扩容往往在延迟峰值出现之后才生效;平台需要在预期需求到来之前进行预测性扩容。
容量调整也呈阶梯式变化。由于加速器内存的限制,服务容量以 0、1、2 或 4 个加速器为单位跳跃式扩展,而无法像 CPU 资源那样以细粒度份额平滑调整;批处理又引入了另一层耦合,因为等待更大的批次能够提高利用率,却会消耗延迟预算。因此,自动扩缩容策略必须选择仍能保障 p99 延迟 SLO 的最低成本容量档位。
实例选择应从起决定性作用的约束入手,而不是从最新的实例类型入手。对于包含大型嵌入表、受内存限制的训练,应优先考虑 GPU 内存容量和带宽。对于受计算限制的稠密模型训练,应最大化每美元可获得的持续 FLOP/s。
服务场景又需要区分不同的决策目标。延迟敏感型服务应尽量缩短冷启动时间和单请求延迟,而吞吐量导向型服务则通过批处理最大化每美元可处理的请求数。因此,实例选择应以基准测试为依据:比较不同实例类型的每训练步成本或每次推理成本,而不是假定更大的硬件必然更经济。
成本可见性与归属
成本优化需要细粒度的支出可见性,因为团队无法优化那些看不见或不由其负责的成本。成本归属策略是一个激励设计问题,而不仅仅是会计核算问题。直接计量按照团队实际消耗的资源精确计费;这是最准确的模式,但当团队只优化自身账单而忽视服务健康状况时,可能会促使其配置不足的资源。基于分配的成本归属按照预留容量而非实际用量收费,使预算可预测,但也可能掩盖浪费。混合成本归属将资源分配的基础费用与超额使用的可变费用结合起来,在可预测性与效率激励之间取得平衡。
对于服务工作负载,每次推理成本是关键的单位经济性指标。equation将其表示为服务总成本除以推理次数,从而支持直接比较模型效率并进行容量规划:
\[\text{Cost per inference} = \frac{\text{Total serving cost}}{\text{Total inferences served}} \tag{14}\]
每次推理成本由此成为连接基础设施遥测与产品决策的桥梁。团队可以通过判断准确率提升是否足以抵偿 2\(\times\) 的推理成本来比较模型版本,通过衡量量化是否使每次推理成本降低了 40% 来评估优化工作,并根据预测流量估算每月服务成本。按模型、客户细分群体和请求类型跟踪这一指标,可以揭示哪些工作负载值得投入优化资源。
有效的成本回摊通过让这些成本成为可采取行动的依据来闭合反馈回路。这需要细粒度的资源计量、将资源映射到团队的成本归属规则、按团队、项目和模型展示成本的仪表板、帮助团队规划预算的预测工具,以及针对意外成本增长的异常检测。
预算感知型开发
FinOps 的范围超出了基础设施优化,因为成本反馈会改变团队开展哪些实验以及交付哪些模型。不受约束的实验会导致成本失控,但预算控制应在阻碍有价值的工作之前,让权衡变得清晰可见:单次实验限额以成本阈值限制单次训练运行,团队预算分配每月计算预算并提供消耗情况的可见性,审批流程则要求对超过成本阈值的实验进行审查。这些控制措施应为决策提供信息,而不是阻碍工作。其目标是建立成本意识,而不是阻止有价值的实验。
成本与质量的权衡
模型选择应明确将成本与准确率一并纳入考虑。成本与质量的权衡分析展示了成本与质量权衡分析:从小型模型转向中型模型,准确率提高 3 个百分点,训练成本增加 10\(\times\);而从中型模型转向大型模型,准确率仅再提高 1 个百分点,成本又增加 10\(\times\)。这一模式应作为部署决策的依据:
| 模型 | 准确率 | 训练成本 | 每千次服务成本 | 价值判断 |
|---|---|---|---|---|
| 小型 | 92% | $500 | $0.10 | 基准 |
| 中型 | 95% | $5,000 | $0.50 | 3 percentage points for 10× cost |
| 大型 | 96% | $50,000 | $2.00 | Additional 1 percentage point for 10× more |
对于许多应用而言,准确率的边际提升不足以抵偿成本的增加。明确这些权衡,可以避免默认选择可用模型中规模最大的模型。
应将效率指标与模型质量一并审查,使平台能够识别仅看准确率无法发现的浪费。表 17 将每项指标与其所回答的运维问题联系起来。
| 指标 | 浪费信号 | 典型措施 |
|---|---|---|
| 每个百分点准确率的成本 | 准确率提升所需的支出不成比例地高 | 扩大规模前,重新审视模型规模、特征集或服务目标。 |
| 每个生产模型对应的实验次数 | 大量实验运行产生的可部署价值很少 | 改进实验设计、停止规则和上线准入标准。 |
| GPU 利用率 | 已预留容量,却未用于有效工作 | 合理配置实例规格、改进批处理,或对低效代码进行性能剖析。 |
| 竞价实例利用率 | 符合使用条件的工作负载使用了昂贵的按需容量 | 将具备容错能力的作业迁移至支持检查点的竞价实例。 |
定期审查这些指标,可以识别系统性低效问题,并指导平台改进。同样的可见性也必须延伸至现代 ML 应用的知识层。在笔记本环境中,检索、微调和全生命周期成本承担看起来都是模型质量方面的选择;但在集群规模下,它们会成为决定成本落在哪个环节的决策。
检索增强生成与微调:知识运维的权衡
领域知识可以存放在可检索的索引、模型权重或适配器权重中,而每种存放方式都会形成不同的运维成本格局。检索增强生成(RAG) 在推理时检索文档,并将其放入提示词中 (Lewis 等 2020年)。微调将适应性调整存储在模型权重或适配器权重中:监督微调使用经过筛选整理的输入—输出样例进行训练,而低秩适应(LoRA)则存储小规模的适配器权重增量 (Hu 等 2021年)。两种方法都能改善任务表现,但它们会将成本和故障风险转移到集群中的不同环节。
Lewis, Patrick, Ethan Perez, Aleksandra Piktus, Fabio Petroni, Vladimir Karpukhin, Naman Goyal, Heinrich Küttler, 等. 2020年. 《Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks》. Advances in Neural Information Processing Systems 33: 9459~74.
Hu, Edward J., Yelong Shen, Phillip Wallis, Zeyuan Allen-Zhu, Yuanzhi Li, Shean Wang, Lu Wang, 和 Weizhu Chen. 2021年. 《LoRA: Low-Rank Adaptation of Large Language Models》. arXiv preprint arXiv:2106.09685.
RAG 优先考虑知识的时效性和来源可追溯性,而非更低的推理成本。更新文档索引即可改变系统的回答,无需重新训练模型;检索出的段落则为生成的论断提供具体的来源线索。成本转移到了服务路径中:每个查询都可能携带大量检索上下文,例如额外的 10,000 个词元,使预填充阶段的注意力计算量随序列长度近似呈平方增长,同时使 KV 缓存随上下文长度线性增长。FlashAttention 减少了内存流量和中间结果存储,但并未消除长上下文带来的注意力计算量或 KV 缓存占用。长上下文还会引入质量风险,因为当提示词包含过多检索材料时,模型可能无法充分利用相关证据。
微调优先考虑精简的推理输入,而非快速更新知识。平台在部署前需要承担数据整理、验证、训练和评估的成本,但成功的适应性调整可以缩短提示词,并降低每次查询的服务成本。基于适配器的微调改变了集群面临的问题,而没有消除它:数千个客户专属的 LoRA 适配器会带来多租户服务问题,而嵌入权重中的过时或错误事实,比索引中的文档更难移除。
决策边界由知识变化频率、来源追溯要求、延迟预算和适配器管理复杂度共同决定。RAG 适合事实频繁变化、来源追溯要求高且查询量适中的场景,因为索引的更新速度可以快于训练流水线。微调适合专业领域语言、严格的延迟预算和稳定的行为要求,因为模型自身承载了适应性调整,无需为每次查询都承担 10,000 个上下文词元的成本。许多成熟平台同时采用两者:微调教会模型如何使用组织的工具和文档风格,而 RAG 提供必须保持最新的事实。
ML 系统总拥有成本框架
FinOps 实践提供了运维成本的可见性,但战略性的 ML 投资决策需要一个全面的总拥有成本(TCO)框架,以呈现 ML 全生命周期的完整经济图景。节 1.2 确立了硬件总拥有成本:实体集群的资本支出(CapEx)和运营支出(OpEx)。现在,分析视角从硬件扩展到完整的 ML 生命周期:硬件构成训练和推理成本项的基础,数据成本和迭代成本则补全了这一四组成部分模型。与基础设施成本占主导的传统软件不同,ML 系统具有独特的四组成部分成本结构,各部分随规模变化的方式也不同。
Definition 1.2: ML 系统总拥有成本
ML 系统的总拥有成本(TCO) 是对机器学习能力在整个生命周期中开发、部署和运行所涉及的经济成本进行的完整核算。
- 意义:它揭示了规模扩展带来的成本主次反转:训练成本是一次性的前期投入,而累计推理总拥有成本随用户采用程度和时间线性增长,通常在 3 年内达到开发成本的 5\(\times\) 至 10\(\times\)。
- 区别:与传统 IT 总拥有成本(硬件资本支出占主导)不同,ML 总拥有成本受到运行效率 \((\eta_{\text{hw}})\) 的独特影响,即以尽可能低的每次查询能耗和计算成本提供预测的能力。
- 常见误区:一种常见的误解是,初始训练账单是主要的财务风险。实际上,数据债务 和维护开销 才是“隐性利率”,可能使一个准确的模型在生产环境中无法维持经济上的可持续性。
总拥有成本方程
公式 15 将总拥有成本表示为四个不同成本组成部分之和,每个部分都有不同的扩展特征和优化手段:
\[\text{TCO}_{\text{ML}} = C_{\text{train}} + C_{\text{infer}} + C_{\text{data}} + C_{\text{iter}} \tag{15}\]
其中,\(C_{\text{train}}\) 是一次性的训练和评估成本,\(C_{\text{infer}}\) 是持续发生的服务成本,\(C_{\text{data}}\) 涵盖数据获取、存储、清洗和治理,\(C_{\text{iter}}\) 则涵盖重新训练、验证、事件响应和维护等迭代成本。
GPU 计算和存储是显性成本,而隐性的运维成本往往占实际预算的整整一半(图 10)。
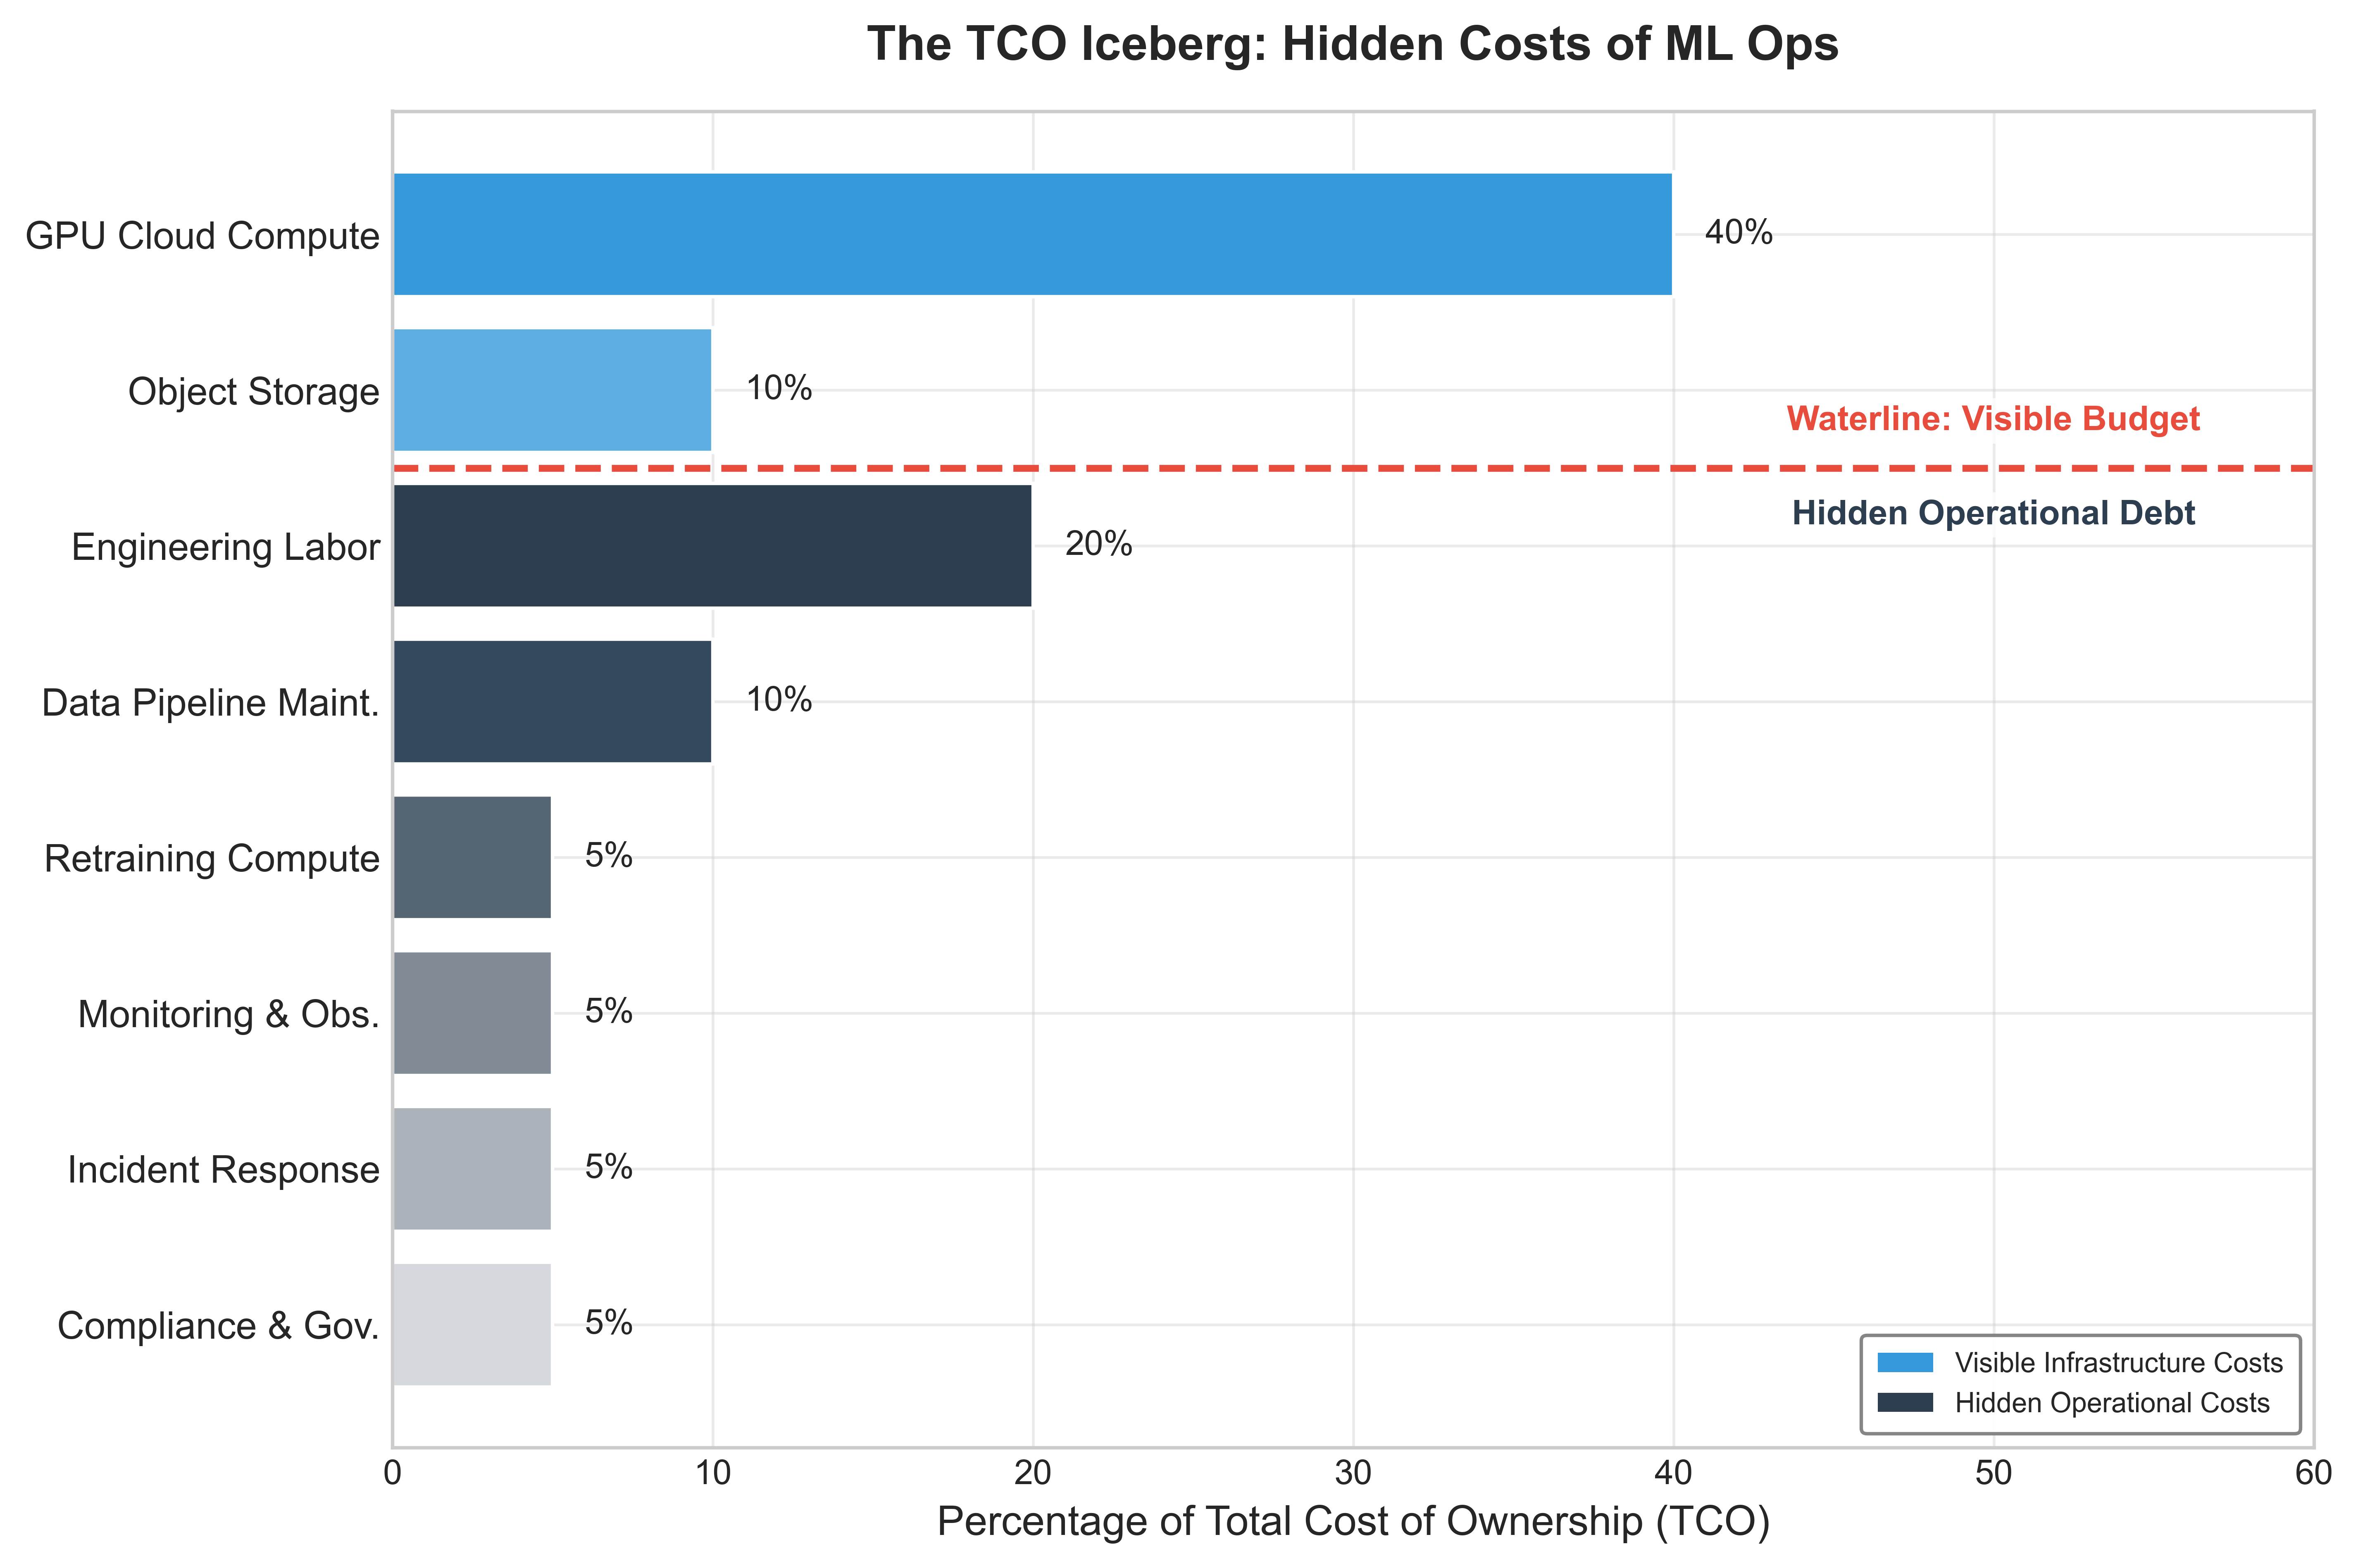
这一分解揭示了一个关键认识:随着组织逐步成熟,主导成本项会发生转移。早期的机器学习工作以 \(C_{\text{iter}}\)(实验探索)为主,成长期以 \(C_{\text{train}}\)(模型开发)为主,达到生产规模后则以 \(C_{\text{infer}}\)(大规模模型服务)为主。优化策略必须与当前的成本结构相匹配。
训练成本模型
训练成本涵盖开发和维护模型所需的计算资源。公式 16 将训练成本形式化为 GPU 数量、训练时长、不含能源费用的加速器小时费率、数据中心能源开销和故障开销的函数:
\[C_{\text{train}} = N_{\text{GPU}} \times T_{\text{hours}} \times \left(R_{\text{GPU/hr}} + P_{\text{GPU}} \times R_{\$/\text{kWh}} \times \text{PUE}\right) \times (1 + F_{\text{fail}}) \tag{16}\]
其中:
- \(N_{\text{GPU}}\) 为分配的 GPU 数量
- \(T_{\text{hours}}\) 为训练时长,单位为小时
- \(R_{\text{GPU/hr}}\) 为不含能源费用的加速器小时成本
- \(P_{\text{GPU}}\) 为每个 GPU 的功耗,单位为 kW
- \(R_{\$/\text{kWh}}\) 为电价
- \(\text{PUE}\) 为应用于能源项的电能使用效率乘数
- \(F_{\text{fail}}\) 为故障开销因子(因故障和重启而损失的训练比例)
PUE 因子反映数据中心的效率:PUE 为 1.2 意味着冷却和基础设施需要额外消耗 20% 的电力。该因子适用于能源消耗,而非整个加速器小时费率。故障开销 \(F_{\text{fail}}\) 用于计入检查点保存与重启的成本;在大规模场景下,容错 阐明了组件故障如何转化为长时间运行的集群作业的检查点与重启开销。
计算示例:训练成本计算
考虑训练一个大语言模型:
- 配置:256 H100 GPUs,持续 14 days
- 加速器小时基础费率:$3.50/GPU-hour
- 能源附加费:700 W,按 $0.07/kWh 和 PUE 1.15 计算,增加 $0.06/GPU-hour
- 实际费率:$3.56/GPU-hour
- 故障开销:15 percent(多节点训练的典型值)
\(C_{\text{train}} = 256 \times (14 \times 24) \times (\$3.50 + \$0.06) \times 1.15 \approx \$352,150\)
如果该模型需要每季度重新训练一次,则年度训练成本约为 $1.4M。然而,对于服务数百万用户的生产系统,训练成本通常只占总拥有成本(TCO)的一小部分。
推理成本模型
在生产规模下,服务(推理)成本在总拥有成本中占主导地位。
对于大规模生产 ML 系统,推理成本在 TCO 中占主导地位。公式 17 根据在代表性批处理条件下测得的单 GPU 持续吞吐量、目标延迟 SLO 和所需的运行余量,确定服务容量:
\[N_{\text{GPU}} = \left\lceil \frac{Q_{\text{daily}}}{86{,}400 \times q_{\text{GPU,target}}} \right\rceil, \qquad C_{\text{infer}} = N_{\text{GPU}} \times 24 \times 365 \times R_{\text{GPU/hr}} \tag{17}\]
其中:
- \(Q_{\text{daily}}\) 是每日查询量
- \(q_{\text{GPU,target}}\) 是在目标延迟 SLO 下每个 GPU 每秒可持续处理的查询数,已计入批处理和运行余量
- \(N_{\text{GPU}}\) 是持续配置的 GPU 数量,取整数值
- \(R_{\text{GPU/hr}}\) 是 GPU 每小时成本
关键在于,推理成本随查询量增长,按离散的容量阶梯上升。利用率和批处理只有在提高目标延迟 SLO 下的实测吞吐量时,才能降低成本;不应再次将它们作为独立除数应用于成本计算。
另一种表达形式
在容量规划中,可用每次查询所需的 GPU 秒数来表示推理成本:
\[C_{\text{infer}} = Q_{\text{annual}} \times S_{\text{GPU/query}} \times \frac{R_{\text{GPU/hr}}}{3600}\]
其中,\(S_{\text{GPU/query}}\) 是在代表性批处理条件和目标 SLO 下测得的每次查询消耗的 GPU 秒数总量。这种表达形式使用资源需求,而非端到端请求延迟,并且已经计入实际达到的利用率和批处理效率。
数据成本模型
由于存储量增长、传输量增加以及处理需求上升,数据成本随用户规模呈超线性增长。公式 18 将数据成本分解为三个具有不同扩展特性的组成部分:存储成本 \(C_{\text{storage}}\)、通过网络向外传输数据的出口流量成本 \(C_{\text{egress}}\),以及处理成本 \(C_{\text{process}}\):
\[C_{\text{data}} = C_{\text{storage}} + C_{\text{egress}} + C_{\text{process}} \tag{18}\]
存储成本随数据保留需求增长: \[C_{\text{storage}} = D_{\text{vol,data}} \times R_{\text{storage/GB}} \times T_{\text{retention}}\]
其中,\(D_{\text{vol,data}}\) 是以 GB 为单位的数据量,\(R_{\text{storage/GB}}\) 是每月存储费率,\(T_{\text{retention}}\) 是以月为单位的保留期限。
出口流量成本随数据传输量增长: \[C_{\text{egress}} = D_{\text{vol,transfer}} \times R_{\text{egress/GB}}\]
云出口流量定价(每 GB $0.08-0.12)使数据传输成为多区域部署和训练数据分发中的一项重要成本来源。
处理成本随提取、转换、加载、特征工程和数据验证的计算需求增长: \[C_{\text{process}} = D_{\text{vol,processed}} \times R_{\text{process/GB}}\]
数据处理成本常常超出组织的预期:一个每天处理 10 TB 数据的特征工程流水线,按 $0.02 per gigabyte costs $ 计算,每年成本为 73,000。
迭代成本模型
开发成本反映了实验和模型改进中的工程投入。公式 19 将其形式化为实验次数乘以每次实验的工程成本与计算成本之和:
\[C_{\text{iter}} = N_{\text{exp}} \times (C_{\text{engineer,per-exp}} + C_{\text{compute,per-exp}}) \tag{19}\]
其中:
- \(N_{\text{exp}}\) 是开展的实验次数
- \(C_{\text{engineer,per-exp}}\) 是每次实验的工程成本
- \(C_{\text{compute,per-exp}}\) 是每次实验的计算成本
一个关键却常被忽视的事实是,失败的实验也会产生实际成本。如果 90% 的实验未能改善生产指标,那么每次成功实验的实际成本就是单次实验名义成本的 10\(\times\)。因此,有必要投资实验基础设施,以降低每次实验的工程成本和计算成本,并提高实验成功率。
计算示例:初创公司与规模化生产公司的 TCO 对比
TCO 对比:初创公司与生产运营公司 通过比较两个组织,说明成本结构如何随规模演变。初创公司运行 1 个生产模型,服务 100,000 名日活跃用户,每月重新训练一次,配备一个由 2 名工程师组成的团队,并采用云原生基础设施。规模化生产公司运行 50 个模型,服务 1,000 万名日活跃用户,对快速迭代的模型每周重新训练一次,配备一个由 15 名工程师组成的专职 ML 平台团队,并采用云端与本地混合基础设施。
| 成本组成 | 初创公司 | 生产运营公司 | 扩展因子 |
|---|---|---|---|
| 训练 | $5,000/month | $150,000/month | 30×(模型更多、规模更大) |
| 推理 | $2,000/month | $400,000/month | 200×(100\(\times\) 用户、优化) |
| 数据 | $500/month | $80,000/month | 160×(随用户数量呈超线性增长) |
| 迭代 | $40,000/month | $350,000/month | 8.75×(团队规模、实验) |
| 总拥有成本(TCO) | $47,500/month | $980,000/month | 20.6× |
| 主导成本 | 迭代(84%) | 推理(41%) |
这一对比揭示了机器学习经济性中的结构性转变。初创公司通过人员投入和实验,在迭代上花费 84 percent,而生产运营公司在推理基础设施上花费 41 percent,因此每个阶段都需要不同的优化策略。TCO 也呈次线性增长:用户数量增长 100\(\times\),TCO 仅为 20.6×,因为推理的规模经济和训练成本的摊销吸收了部分增长。数据成本打破了这一模式,其增长达到 160×,对应用户数量增长 100\(\times\),原因是存储需求随用户历史记录的积累而增长,处理成本随特征复杂度的提高而上升。平台自动化带来了最后一项转变:生产运营公司开展的实验数量增加了 10\(\times\),但迭代成本仅增长 8.75×,因为每次实验的开销有所下降。
TCO 敏感性分析
理解 TCO 如何响应关键参数的变化,有助于开展战略规划。TCO 敏感性分析 展示了关键参数增长 2\(\times\) 对各项成本组成的影响:
| 参数 | 变化 | 训练 | 推理 | 数据 | 总体影响 |
|---|---|---|---|---|---|
| 日活用户数 | 2× | – | 100% | 120% | 45% |
| 模型数量 | 2× | 100% | 100% | 50% | 85% |
| 每用户查询次数 | 2× | – | 100% | 80% | 40% |
| 模型规模 | 2× | 150% | 120% | 30% | 55% |
| 重新训练频率 | 2× | 100% | – | 40% | 25% |
这些非线性效应解释了为什么总体影响列并不简单地对应输入变化。用户规模扩展 使数据成本呈超线性增长(120 percent,对应 2× 用户),因为用户历史记录的积累和跨用户特征计算使状态量的增长速度超过用户数量的增长速度。模型规模扩展 使训练成本增加 150 percent,对应 2× 参数,因为内存需求可能迫使系统采用多 GPU 配置,而无法仅通过在单个设备上运行更大的模型来实现。模型数量带来的乘数效应覆盖范围最广,因为每增加一个模型,都会同时涉及训练、推理、数据、监控、部署和治理,因此模型组合的增长成为成本最高的扩展维度。
决策框架:速度与效率的权衡
TCO 分析有助于依据明确原则,决定何时应优化开发速度,何时应优化运营效率。公式 20 计算优化投资的盈亏平衡点:
\[T_{\text{breakeven}} = \frac{C_{\text{optimization}}}{C_{\text{save,monthly}}} \tag{20}\]
其中,\(C_{\text{optimization}}\) 是实施优化的一次性成本,\(C_{\text{save,monthly}}\) 是该优化带来的每月节省额。
只有明确主要成本组成部分后,盈亏平衡方程才有实际用途。成本结构决策规则 将每种成本结构映射到相应的优化策略和投资回收期阈值,以指导投资决策。
| 主导成本结构 | 运营背景 | 优化策略 | 投资回收期阈值 |
|---|---|---|---|
| 迭代成本占主导(占 TCO 的 \(C_{\text{iter}} > 50\%\)) | 早期阶段 | 优先提升开发速度,在实验仍不断变化时接受较高的单次推理成本,并投资于能够减少 \(T_{\text{exp}}\) 的实验基础设施。在成本结构发生变化之前,暂缓提升基础设施效率的工作。 | 暂缓投资,除非能够直接加快迭代。 |
| 训练成本占主导(占 TCO 的 \(C_{\text{train}} > 40\%\)) | 成长阶段 | 通过混合精度、梯度检查点、支持检查点保存与恢复的竞价实例,以及能够缩短训练时间的架构变更,投资于提升训练效率。 | 可接受 3–6 个月的投资回收期。 |
| 推理成本占主导(占 TCO 的 \(C_{\text{infer}} > 40\%\)) | 规模化阶段 | 优先通过量化、批处理、缓存和蒸馏优化模型服务,因为当每次查询都能重复产生节省收益时,模型优化的投资回报率最高。 | 要求投资回收期为 1–3 个月。 |
示例详解:优化投资决策
一家生产环境中的公司 \((C_{\text{infer}} = \$400K/\text{month})\) 评估 INT8 量化:
- 实施成本:$80,000(工程时间 + 验证)
- 预期推理成本降低:40%
- 每月节省:$400,000 \(\times\) 0.40 = $160,000
\(T_{\text{breakeven}} = \frac{\$80,000}{\$160,000/month} = 0.5 \text{ months}\)
2 周即可收回成本,使这项投资极具吸引力。然而,如果同一家公司 \((C_{\text{train}} = \$150K/\text{month})\) 评估一项训练优化:
- 实施成本:$80,000
- 预期训练成本降低:30%
- 每月节省:$150,000 \(\times\) 0.30 = $45,000
\(T_{\text{breakeven}} = \frac{\$80,000}{\$45,000/month} = 1.8 \text{ months}\)
这项投资仍然具有吸引力,但由于回收期更长、绝对节省金额更小,其优先级低于推理优化。同样的投资回收逻辑可以推广为优化优先级矩阵。优化优先级矩阵 将主导成本结构映射到应优先开展的优化工作:
| 主导成本 | 第一优先级 | 第二优先级 | 应避免的做法 |
|---|---|---|---|
| 迭代 (>50%) | 实验速度 | 开发者工具 | 基础设施优化 |
| 训练 (>40%) | 训练效率 | 竞价/可抢占计算资源 | 对模型服务进行过度工程设计 |
| 推理 (>40%) | 模型优化 | 模型服务基础设施 | 过度重新训练 |
| 数据 (>30%) | 存储分层 | 减少出站数据传输 | 过早扩展特征 |
由 TCO 驱动的架构决策
TCO 分析应与运维优化一道,为架构选择提供依据。节 1.2.2 中基于利用率的自建与采购分析适用于每个模型:当工作负载无法维持足以摊销自有计算容量成本的利用率时,按使用量计费的平台服务可能比自管基础设施具有更低的 TCO,尤其是在迭代成本占主导的情况下。模型架构选择 会改变同一个成本等式,因为一个需要 2\(\times\) 训练成本、但仅需 0.5\(\times\) 推理成本的模型,在推理占主导的大规模场景下可能具有更低的 TCO。重新训练频率 会增加 \(C_{\text{train}}\) 和 \(C_{\text{data}}\),但可能通过更早发现漂移并避免紧急干预来降低 \(C_{\text{iter}}\)。特征复杂度 同样会通过存储和处理增加 \(C_{\text{data}}\),并通过延长训练时间增加 \(C_{\text{train}}\),但它也可能通过更快地提升模型性能来降低 \(C_{\text{iter}}\)。
TCO 框架将这些架构争论从基于观点的讨论转变为具有可衡量结果的定量分析。在这些投资中,有一个特定组件始终既是构建成本最高的组件,也是最值得标准化的组件。由于数据是集群中每个模型的命脉,平台必须解决大规模提供一致特征这一长期挑战。
特征存储运维
考虑一个欺诈检测系统,它需要知道用户在过去十分钟内的交易量。在生产环境中,这要求数据库查询在亚毫秒级完成。然而,在训练过程中,处理一整年的历史数据需要对数十亿行执行大规模分布式连接。当批处理与实时查询中计算“交易量”的逻辑存在哪怕细微的差异时,由此产生的训练与服务偏差就会悄无声息地破坏模型性能。
第一个设计决策是采用双存储架构:在线存储提供低延迟的特征查询,离线存储生成可复现的训练数据。大规模运行这些系统,会在数据新鲜度、一致性和性能方面带来独特挑战。特征存储解决的核心问题是训练与服务之间的鸿沟:训练时计算的特征必须能够在服务时复现,但两者的计算环境存在根本差异:批处理与实时处理、小时级与毫秒级。这一鸿沟通常表现为训练与服务偏差,这是一种关键失效模式:批量训练与实时推理流水线之间的特征处理逻辑存在细微差异,导致准确率悄然下降。
Systems Perspective 1.5: 训练与服务偏差
在集群规模下,关注点从检测单个模型中的训练与服务偏差,转变为将其作为平台级属性加以控制。特征存储让训练和服务流水线尽可能读取共享的特征定义和物化特征值,从而减少偏差,并将 \(f_{\text{train}}(x) \equiv f_{\text{serve}}(x)\) 转化为可测试、可监控的架构不变量,而不再是各团队反复手动遵循的约定。
这一保证必须在两种计算环境中都成立,因此特征存储构成了一道架构边界,而不只是存储上的便利。在训练过程中,特征通过对历史数据进行批处理来计算,流水线可以花费数小时为数百万个样本计算特征,此时优先考虑的是正确性和覆盖度。在服务过程中,同样的特征定义必须能够通过低延迟查询访问,此时优先考虑的是为实时请求提供有界的尾延迟。
特征存储架构
双存储模式(图 11)通过将离线分析存储与在线键值存储分离,并以共享的物化层连接两者,来解决这一冲突。
特征存储不仅仅是数据库;它是一种架构模式,旨在解决模型训练与实时服务的数据访问模式之间的根本冲突。训练需要对海量历史数据集进行高吞吐量的分析扫描,而服务需要针对单个预测请求进行低延迟的点查询。没有任何单一数据库系统能够高效地满足这两项约束,因此必须采用双存储架构,由离线存储和在线存储组成。
离线存储是所有历史特征数据的权威记录系统,通常存储 PB 级的信息。它针对训练数据生成过程中典型的大规模顺序读取进行了优化,在这一过程中,单个查询可能扫描 TB 级的数据,为数百万个样本构建特征集。关键指标是吞吐量,而非延迟。BigQuery、Snowflake,或基于 S3 并采用 Apache Iceberg 等格式构建的数据湖,都是常见选择,其设计旨在并行执行这些大规模分析查询。
在线存储专为服务时的快速访问而构建。当预测请求到达时,模型需要在严格的延迟预算内获取特征——通常要求 p99 延迟低于 10 毫秒。对于为 10,000 个模型提供服务的平台,这可能意味着每秒数百万次查询。这需要采用键值存储范式,使用 Redis、DynamoDB 或 Bigtable 等系统;这些系统针对按特定实体键检索少量值进行了优化。
特征通过称为物化的过程加载到这些存储中。批量计算流水线通常运行在 Spark 上,每天或每小时执行一次,从历史数据中生成特征。使用 Flink 或 Spark Streaming 的流式计算流水线,则从 Kafka 等事件流中近实时地生成特征。当新鲜度要求超出批量更新频率所能满足的范围时,按需计算会在请求到达时计算特征。核心架构挑战是在物化过程中确保两个存储之间的一致性。如果离线存储中用于训练的某个特征值,在预测发生时并未以完全相同的值存在于在线存储中,就会引入一种隐蔽的数据泄漏,可能导致模型在生产环境中的性能悄然下降——这就是在视角 1.5 中形式化定义的训练与服务偏差问题。
对于管理超过 10,000 个模型的平台,这种集中式双存储架构是必需的。它为数据生产与模型消费之间提供了一份可治理的契约,避免出现数千条彼此独立、难以维护的特征流水线,并确保所有模型都基于一致、高质量的权威数据源构建。
新鲜度 SLO
特征新鲜度表示现实世界中的事件发生与其反映在特征值中之间的延迟。表 18 将四种特征类型与其新鲜度要求对应起来:用户人口统计信息等静态特征可容忍天级的数据陈旧程度,并采用批量计算;而捕获用户最近一次操作的实时特征,则要求通过流式计算或按需计算实现秒级新鲜度。
推荐系统对新鲜度的要求尤为迫切,因为陈旧特征会直接损害用户参与度。
Lighthouse 1.2: 原型 B(大规模 DLRM):陈旧性代价
背景:原型 B(大规模 DLRM)的推荐工作负载在分布式内存中维护数 TB 的稀疏嵌入表(\(M_{\text{capacity}} > 1\text{ TB}\)),处理超过 \(100,000\text{ QPS}\) 的负载,同时满足严格的延迟预算(\(L_{\text{lat}} < 10\text{ ms}\))。
机制:真实的用户意图不断变化。如果特征物化流水线存在 10 分钟的更新滞后(\(T_{\text{staleness}} = 600\text{ s}\)),服务查询就会使用陈旧的嵌入向量 \(D_{\text{vol}}\),导致下游排序模型推荐不相关的内容。
影响:摄取延迟 \(D_{\text{vol}}/\text{BW}\) 会使点击率下降 5% 至 15%,造成严重的收入损失(“陈旧性代价”)。
系统启示:DLRM 运维必须优先保障特征物化吞吐量 \(D_{\text{vol}}/\text{BW}\) 和低延迟流式基础设施,而不是优先执行离线批处理作业,使流数据摄取能力直接匹配用户群体实时意图的衰减速率。
各类型特征的新鲜度要求规定了监控与告警系统必须落实的 SLO。
| 特征类型 | 示例 | 新鲜度 SLO | 计算模式 |
|---|---|---|---|
| 静态 | 用户人口统计信息 | 天级 | 批量计算 |
| 缓慢变化 | 用户偏好 | 小时级 | 批量计算 |
| 会话级 | 当前会话上下文 | 分钟级 | 流式计算 |
| 实时 | 最近一次操作 | 秒级 | 流式计算/按需计算 |
只有将 SLO 转化为可测量的量,新鲜度才能成为可操作的运维指标。公式 21 将特征陈旧程度定义为当前时间与最近一次特征更新时间之差,从而可以直接与 表 18 中的阈值进行比较:
\[\text{Staleness} = t_{\text{current}} - t_{\text{feature\_update}} \tag{21}\]
陈旧程度这一标量为批处理路径和流处理路径提供了共同的告警规则。除流水线中断期间外,流式特征的陈旧程度应保持在接近零的水平,而批处理特征的陈旧程度则会在定期更新之间按可预测的规律增加;因此,监控系统应将每个特征与其自身的 SLO 进行比较,而不是采用统一的全局新鲜度阈值。
算例:新鲜度对模型质量的影响
某推荐系统使用具有不同新鲜度水平的用户交互特征。在历史数据上进行测试,得到 表 19 中的用户参与度提升:
| 特征新鲜度 | 相较于基线的用户参与度提升 |
|---|---|
| 实时(< 1 分钟) | +12.3% |
| 近实时(< 5 分钟) | +11.8% |
| 每小时更新 | +10.2% |
| 每日更新 | +8.1% |
每小时更新的特征与实时特征之间,用户参与度相差 2.1 个百分点。如果这一差距对应每年 $10 million 的用户参与度价值,那么当成本低于这一价值时,投资实时特征基础设施可能是合理的。
Checkpoint 1.6: 量化流式与批处理新鲜度决策的经济价值
表 19 表明,将每小时更新的特征改为实时特征,可使用户参与度额外提升 2.1 个百分点。将这一提升视为每年 $10 million 的用户参与度价值,并据此选择流式基础设施或批处理基础设施。
时间点正确性
训练数据必须使用每个训练样本对应时刻的特征值。图 12 展示了“时间穿越”问题:一个在午夜计算 total_clicks_today 的批处理作业得到了数值 10,但用这一数值训练预测中午行为的模型会引入信息泄漏,因为中午的真实值仅为 4。使用当前特征值为历史事件添加标签会造成数据泄漏18,使离线指标虚高,却在生产环境中失效。
18 数据泄漏:未来信息污染训练数据的一种错误。从系统角度看,其危险在于,泄漏会使模型获得极其出色的离线指标——有时准确率达到 99% 以上——却在无法获取未来信息的生产环境中完全失效。在特征存储的规模下,泄漏风险会成倍增加,因为批量计算的特征可能包含模型团队无法察觉、但优化器能够利用的时间信息,因此时间点正确性必须成为基础设施提供的保障,而不是各个团队自行承担的责任。
图 12 中的对比十分鲜明:中午时刻的正确值为 4 次点击,但朴素的批量连接会提供午夜时刻的值,即 10 次点击,将训练信号放大至 2.5 倍,导致模型无法泛化到生产环境。这种 “时间穿越” 失效现象很常见,因为该特征值在数据库中有效,但对于历史预测时刻却无效:total_clicks_today 在午夜时为 10,但中午的预测只能看到截至中午已发生的 4 次点击。使用午夜时刻的值进行训练会将未来信息泄漏到样本中,使模型学会利用生产环境中不可用的信号来“作弊”。结果可能是离线指标极为出色,而当未来数据不再可用时,模型在生产环境中出现灾难性失效。
特征存储实现了时点连接,用于检索截至指定时间戳的特征值,如 代码 7 所示。
SELECT
    e.user_id,
    e.event_timestamp,
    e.label,
    f.feature_1,
    f.feature_2
FROM events e
LEFT JOIN LATERAL (
    SELECT feature_1, feature_2
    FROM features f
    WHERE f.user_id = e.user_id
      AND f.feature_timestamp <= e.event_timestamp
    ORDER BY f.feature_timestamp DESC
    LIMIT 1
) f ON TRUE
此查询检索每个事件发生前已存在的最新特征值,确保训练数据反映生产环境的实际情况。
时间点正确性会带来存储成本,因为特征存储必须保留特征历史,而不能仅保留当前值。防止信息泄漏的这一保证,也会使保留的状态成倍增加:
\[\text{Storage} = N_{\text{entities}} \times N_{\text{features}} \times \frac{T_{\text{retention}}}{T_{\text{update}}}\]
对于 100 million users、1000 features、1 year 的保留期限,以及每 1 hour 更新一次的情况,历史记录包含 876 trillion feature values。按每个值 100 bytes 计算,压缩前的存储量约为 87.6 PB。高效的特征存储使用压缩、列式存储和保留策略来应对这一规模。
特征版本管理与血缘
特征定义是生产接口,因此,在没有版本管理的情况下修改特征定义,可能会破坏所有依赖它的模型。版本管理与血缘使这种演进能够受到治理,而不是隐式发生。
一起具有代表性的 user_engagement_score 事件具体说明了其中的机制。平台团队将特征从基于 30 天窗口的 z 分数改为基于 7 天窗口的最小—最大缩放。输出仍可能是浮点数,因此,即使特征的含义已完全改变,仅靠模式验证仍可能通过。版本管理在语义变更进入生产环境之前为其赋予明确标识;血缘识别所有使用旧语义进行训练或服务的模型;回填按照新语义重新计算历史值;新鲜度与质量检查则判断重写后的历史是否可以安全使用。缺少这一链条,特征迁移就会悄然导致多个模型的性能退化。
安全的特征接口同时记录版本维度和血缘字段。表 20 将这些字段与其运维用途关联起来。
| 组件 | 记录内容 | 运维用途 |
|---|---|---|
| 定义版本 | 特征的计算逻辑 | 在公式改变而类型不变时,阻止无声的语义变更。 |
| 数据版本 | 源数据快照或流契约 | 区分模型变更与上游数据变更。 |
| 模式版本 | 输出类型、形状、单位以及是否允许空值 | 在明确标识语义变化的同时,保留 API 兼容性检查。 |
| 消费方声明 | 每个模型使用的确切特征版本 | 为平台提供在服务前阻止不安全更新的控制点。 |
| 源数据血缘 | 源表、流及其版本 | 将错误预测追溯到产生这些预测的上游数据。 |
| 变换与运行时溯源信息 | 变换代码、时间戳和环境 | 为审计、调试和合规复现历史值。 |
| 质量与新鲜度指标 | 值生成时观测到的验证结果 | 估计影响范围,并判断重写后的历史是否可以安全使用。 |
回填流程
回填是针对历史数据的生产迁移:修改特征定义会重写每个依赖该特征的模型所使用的训练记录,因此,平台必须限定计算成本,验证重新计算的值是否一致,并保留回退路径。将回填视为迁移,会使运维问题从计算能否运行一次,转变为能否在不破坏未来训练数据的前提下重写历史。
Execution semantics for distributed transformations 中的执行契约使这一安全性检验具体化。每个回填分区都需要稳定的标识,以及幂等或事务性的写入路径,以确保重试不会重复产生特征写入效果;事件时间边界和迟到数据策略也必须与训练所用的时间点连接保持一致。否则,一次在执行机制上成功的重放,可能生成在处理时间上完整、但在模型需要复现的预测时间点上不正确的历史。
在大规模场景下,历史数据可能已移入冷存储,因此,重新计算首先成为数据放置问题。随后,较长的历史时间窗口又会与生产工作负载争夺计算资源。即使作业已经完成,平台也不能直接信任新值:它必须将重叠时段的结果与原始计算结果进行比较,并与依赖该特征的流水线协同,避免训练作业在运行过程中混用新旧语义。
实际采用的模式是增量处理。历史数据按日期分区处理,每个分区都在下一个分区开始前完成验证。在双写期间,新旧计算并行运行,从而为平台提供重叠时段的值,以便在切换前进行比较。由于旧特征版本及其血缘会一直保留到依赖它的模型完成重新训练、评估和重新部署,回滚仍然可行。
规模挑战
达到推荐系统规模的特征存储面临一个相互耦合的系统问题:请求量、延迟预算和历史数据存储同时构成约束。
大型推荐系统背后的算术计算解释了为何特征存储会成为服务基础设施,而不再只是提供元数据便利的工具。1 billion daily recommendations,每次推荐需要 100 features,由此每天产生 100 billion feature lookups。在流量高峰到来之前,平均负载约为 1.16M requests/s,而峰值流量通常达到平均值的 5–10×。
特征检索必须控制在总体延迟预算之内,因为每增加一毫秒的查询延迟,都会挤占排序环节的时间。如果推荐的延迟预算为 50 ms,特征存储可能只能分配到 5–10 ms。网络开销可能消耗这部分预算的 1–2 ms,留给存储查询本身的时间约为 3–8 ms。要满足这一预算要求,需要采用内存存储、精心设计的批处理,并在地理位置上足够靠近服务集群进行部署,以避免网络延迟成为主导因素。
生产环境中的特征存储还需要同时覆盖两个时间跨度。在线路径保存数十亿个实体的当前值,每个实体包含数千个特征,在复制之前,存储规模通常就已达到 TB 级。离线路径保存足够的历史状态,以重建训练样本,这可能使保留的特征历史达到 PB 级。多区域复制既能提高可用性,又能降低延迟,但也使数据新鲜度和一致性成为显著的运维关注点。
数据质量运维
数据质量问题是生产环境中机器学习问题的主要来源之一 (Polyzotis 等 2017年)。模型监控用于检测症状,而数据质量监控则从源头预防问题。在大规模场景下,数据质量运维变得与模型质量运维同样关键,需要系统化的监控、验证和事件响应流程。
Polyzotis, Neoklis, Sudip Roy, Steven Euijong Whang, 和 Martin Zinkevich. 2017年. 《Data Management Challenges in Production Machine Learning》. Proceedings of the 2017 ACM International Conference on Management of Data, 1723~26. https://doi.org/10.1145/3035918.3054782.
第一步是测量:必须从与预防关卡直接对应的维度量化数据质量。完整性衡量预期的记录和字段是否齐全。一个每日数据流水线预期产出 10 million user events,但实际仅交付 8.2 million user events,其完整性为 82 percent,这通常表明流水线发生故障或上游数据源存在问题,而非普通的统计波动。一致性涵盖模式合规性和参照完整性:年龄特征应介于 0 和 120 之间,而 999 或 -1 等值则暗示哨兵值泄漏或数据错误。生产系统通常会拒绝未通过超过 5 percent 验证规则的批次,因为放行损坏数据的代价高于延迟处理一个批次的代价。
及时性根据使用这些数据的模型的 SLO 衡量数据新鲜度。欺诈检测可能需要生成时间距今不到 100 毫秒的特征,而人口统计特征可以容忍以天计的数据陈旧程度;因此,告警阈值应与特征的用途挂钩,而不是设为全局常量。准确性关注数值在预期分布内是否仍然正确。例如,未按期校准导致的传感器漂移可能使数值类型正确,但数值本身错误。针对连续特征的 Kolmogorov-Smirnov 检验、针对类别特征的卡方检验,以及针对高维数据的最大均值差异检验等统计检验,可将这些准确性检查转化为定期执行的关卡。
随后,验证将这些测量转化为分层防御。模式验证在数据摄取时强制检查预期的列名、类型和约束;Great Expectations、TensorFlow Data Validation 和 Pandera 等工具提供声明式模式及自动化检查。分布监控持续跟踪特征分布,捕获那些可能并未违反类型约束、却仍表明上游发生变化且可能导致模型性能下降的漂移。跨字段验证补充了模式和边缘分布均无法表达的业务逻辑:如果 country="USA",则 zip_code 应符合美国邮政编码格式;如果 order_status="shipped",则应存在 shipping_date;根据出生日期推算出的年龄应与任何显式年龄字段一致。
实例讲解:排查数据质量事件
某推荐模型的点击率(CTR)下降了 8 percent,这一变化发生在 5 days 期间。最初的假设聚焦于模型漂移,但数据质量调查揭示了根本原因。
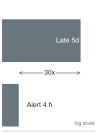
检测每延迟一分钟,成本都会进一步累积。
调查从模型表现出的异常入手,沿数据路径逆向追查。模型指标确认 CTR 从 4.2 percent 降至 3.87 percent,但新鲜度检查表明,特征仍在 1-hour SLO 要求的时间内到达。这排除了流水线数据过时的可能性,并指向语义变化。随后,分布分析显示,user_engagement_score 的均值从 0.42 变为 0.31,下降了 26 percent;血缘追踪则将这一变化关联到此前 5 days 部署的上游流水线版本。根本原因并非模型漂移,而是新流水线版本中的特征计算缺陷。
量化影响等于 CTR 的相对损失乘以每周收入,再乘以一周内受影响的时间比例:8 percent 的相对损失,作用于每周 $15M 的收入,持续 5 days,造成 $857K 的收入损失。配有自动告警的分布监控可在 4 hours 内检测到这一变化,将影响降低 97 percent。解决方案是将流水线回滚至上一版本,使用正确计算的特征重新部署模型,并增加分布验证关卡,防止今后部署特征变化超过 10 percent 阈值的流水线版本。
运维集成
数据质量运维通过将检查转化为可强制执行的契约,融入生产系统。数据契约在数据生产方与消费方之间建立正式协议,规定模式要求、新鲜度 SLO、完整性与准确性的质量阈值,以及违反契约时的升级处理流程。当数据生产方更改模式或计算逻辑时,契约要求其与消费方明确协商,避免接口在未经沟通的情况下发生变更。
契约通过持续验证和事件响应落实到运维中。摄取前验证在接收源数据之前拒绝不合格数据,转换后检查确认计算逻辑仍能产生预期值,最终验证则阻止损坏的特征进入模型。如果质量仍然下降,自动告警会向值班团队发送呼叫通知,说明严重程度和受影响的系统;熔断器阻止已知有问题的数据进入模型服务;回退路径使用最近一次确认正常的数据或缓存特征;有问题的批次则被隔离,以供取证分析。随后,根因分析推动流水线修复,而非仅仅清除当前告警。
在拥有数千个特征的企业规模下,监控必须按可能共有的故障模式进行聚合。逐一监控特征会造成告警疲劳,而分层监控通过沿运维边界对特征进行分组,保留有效信号。按源系统分组可以捕捉共同的上游故障,例如同时影响所有支付相关特征的支付处理服务中断。按计算流水线分组可以捕捉转换代码或依赖项中的错误。按更新频率分组将流式特征与每日批处理特征分开,因为数据过时阈值和告警灵敏度会随更新模式而变化。按业务领域分组则将用户人口统计特征、产品目录特征和交互特征的告警,转发给了解受影响模型的团队。
新鲜度监控将同样的聚合规则应用于时间。对于以不同频率更新的 10,000 features,持续检查新鲜度会产生显著开销,因此,高效的实现会在不丢失系统性信号的前提下减少检查次数。对具有代表性的实体进行 1 percent 采样,而非检查每个特征值,通常就足以检测系统性的新鲜度故障。当一条流水线更新 500 features 时,流水线级聚合的成本更低,因为流水线的更新时间戳反映了该组特征的新鲜度状态。阈值分层为对营收至关重要的特征保留逐特征监控,对陈旧性即时影响较小的特征则采用聚合监控。由此产生的开销随不同特征的数量增长,而非随特征值的总量增长,因此,即使特征值扩展到数十亿个实体,高效的实现仍能维持 \(\mathcal{O}(F)\) 开销。
组织运作与学习
只有当控制平面的技术接口与组织权责相匹配时,它才能持久发挥作用。这第三部分明确平台的归属责任,比较不同组织如何将其制度化,并通过事件响应和事后学习闭合运维循环。
特征存储解决了共享特征由谁负责的问题;更广泛的问题是,共享平台本身由谁负责。仅有技术基础设施不足以支撑大规模 ML 运维:组织结构决定了平台能力会成为共享基础设施,还是另一个瓶颈。核心问题在于,组织将不变量置于何处。部署安全、可观测性、合规性、成本控制和特征一致性,既可以由平台团队统一落实,也可能由各模型团队以不同方式各自重新探索。
集中式平台团队
集中式 ML 平台团队通过构建和维护共享基础设施,最大限度地提高一致性,而模型团队则专注于模型开发。图 13 将这一模式与嵌入式和混合式方案并列比较,各种方案都在一致性与推进速度之间进行权衡。
\begin{tikzpicture}[font=\small\sffamily, node distance=1cm and 0.5cm]
  \definecolor{PlatformColor}{HTML}{D1E6F3}
  \definecolor{ModelColor}{HTML}{FCE4CC}
  \definecolor{RedLine}{HTML}{FF0000}
  \definecolor{GreenLine}{HTML}{00FF00}

  \tikzset{
    box/.style={draw=black!70, line width=0.75pt, minimum width=1.5cm, minimum height=0.8cm, font=\tiny\sffamily, align=center},
    edge/.style={->, line width=1.0pt},
    title/.style={font=\bfseries\sffamily\bfseries, anchor=south},
    risk/.style={font=\scriptsize\sffamily, text=RedLine},
    balance/.style={font=\scriptsize\sffamily, text=GreenLine}
  }

  \begin{scope}[local bounding box=central]
    % Centralized
    \node[title] (CentTitle) {Centralized};
    \node[box, fill=PlatformColor, minimum width=3cm, below=0.5cm of CentTitle] (P1) {Platform Team};

    \node[box, fill=ModelColor, below left=of P1] (M1a) {M1};
    \node[box, fill=ModelColor, right=of M1a] (M1b) {M2};
    \node[box, fill=ModelColor, right=of M1b] (M1c) {M3};

    \draw[edge] (M1a) -- (P1);
    \draw[edge] (M1b) -- (P1);
    \draw[edge] (M1c) -- (P1);

    \node[risk, below=0.5cm of M1b] {Risk: Bottleneck};
  \end{scope}

  \begin{scope}[local bounding box=embedded, xshift=6cm]
    % Embedded
    \node[title] (EmbTitle) {Embedded};

    \node[box, fill=ModelColor, below=0.5cm of EmbTitle, xshift=-1.5cm] (M2a) {M1};
    \node[box, fill=PlatformColor, minimum width=0.5cm, right=of M2a] (P2a) {P};

    \node[box, fill=ModelColor, below=1.5cm of EmbTitle] (M2b) {M2};
    \node[box, fill=PlatformColor, minimum width=0.5cm, right=of M2b] (P2b) {P};

    \node[box, fill=ModelColor, below=0.5cm of EmbTitle, xshift=1.5cm] (M2c) {M3};
    \node[box, fill=PlatformColor, minimum width=0.5cm, right=of M2c] (P2c) {P};

    \node[risk, below=0.5cm of M2b] {Risk: Fragmentation};
  \end{scope}

  \begin{scope}[local bounding box=hybrid, xshift=12cm]
    % Hybrid
    \node[title] (HybTitle) {Hybrid};
    \node[box, fill=PlatformColor, minimum width=3cm, below=0.5cm of HybTitle] (P3) {Core Platform};

    \node[box, fill=ModelColor, below left=of P3] (M3a) {M1};
    \node[box, fill=PlatformColor, minimum width=0.5cm, right=of M3a] (P3a) {P};

    \node[box, fill=ModelColor, below right=of P3] (M3b) {M2};
    \node[box, fill=PlatformColor, minimum width=0.5cm, right=of M3b] (P3b) {P};

    \draw[edge, dashed] (P3a) -- (P3);
    \draw[edge, dashed] (P3b) -- (P3);

    \node[balance, below=0.5cm of M3a, xshift=1cm] {Balanced};
  \end{scope}

\end{tikzpicture}当同样的运维错误可能在整个组织内反复发生时,集中化便能发挥作用。共享团队可以推行一致的部署、监控和治理实践;通过一次性投入建设训练、模型服务和可观测性基础设施;并集中深厚的机器学习系统专业能力,而这些能力很难在众多产品团队中复制。集中化也为基础设施工程师提供了清晰的职业发展路径,避免他们分散在各处,成为仅由一人承担的支持职能。
同样的结构也可能演变为请求队列。如果每项平台请求都必须经过同一个团队,模型团队就只能等待其无法掌控的优先级决策。与产品情境的距离还可能导致平台抽象在技术上优雅,却难以适配使用团队的约束。因此,当共性不变量占主导、局部差异较小时,集中化最能发挥优势;而当模型团队需要快速进行领域特定的变更时,集中化的效果最弱。
嵌入式机器学习工程师
嵌入式模式将机器学习基础设施专业人员配置在模型团队内部,优先考虑贴近业务而非统一性,并通过实践共同体而非单一汇报关系开展协同。其优势在于响应速度:基础设施工程师能够直接了解团队的数据、模型行为、发布压力和历史事故,因此局部变更无需等待跨团队排期。
成本会在后期显现:各团队在部署、监控和特征管理方面都采用了略有不同的解决方案。碎片化会浪费工程投入、增加集成难度,并使平台质量取决于恰好嵌入某个团队的工程师的能力和可投入时间。因此,当局部速度比跨团队一致性更重要时,嵌入式团队最能发挥优势;而当每个团队都在重复实现相同的平台基础层时,其效果最差。
混合模式
大多数成熟组织会采用混合模式,因为纯集中化和纯嵌入式模式都无法兼顾共享基础设施与领域特定需求。核心平台团队负责计算、存储、网络、通用训练和模型服务系统、监控、安全、合规以及成本控制。领域平台工程师则贴近推荐、语言、视觉、欺诈检测或搜索团队;在这些领域,工作负载特定需求的变化速度比共享基础层应有的变化速度更快。
同一理念的联邦式实现将实施工作分散到各团队,同时保留架构控制权。主要贡献团队协助维护平台组件,但标准、职责边界和优先级都需要明确协同。只有当治理具有实际权威时,这种模式才能奏效;否则,联邦式模式就会退化为会议更多的嵌入式模式。
组织模式选择
选择合适的组织模式,取决于在哪些方面标准化比局部自主权创造的价值更高。组织模式决策因素总结了组织模式决策因素:模型数量较多、监管要求较严格以及基础设施尚不成熟时,更适合采用集中式平台;而模型组合异构性较高、规模较小的组织,则可能受益于分布式专业能力:
| 因素 | 倾向于集中式 | 倾向于分布式 |
|---|---|---|
| 模型数量 | 较多(100+) | 较少(10–20) |
| 模型相似性 | 同质 | 异构 |
| 组织规模 | 较大 | 较小 |
| 监管要求 | 较严格 | 较宽松 |
| 基础设施成熟度 | 早期阶段 | 后期阶段 |
在一个具体组织中,这一选择逻辑会更加清晰。一家技术公司有 50 名机器学习工程师,分布在 8 个团队中,在推荐、欺诈检测、搜索和广告领域运行着 80 个生产模型。每个团队都自行维护部署和监控,这造成了基础设施工作的重复以及集成实践的不一致。模型数量已足够多,共享平台投资应当能够带来回报;但领域多样性也确实存在,纯集中式团队很难理解每一种工作负载。
由此形成的是混合式设计。一个由约 12–15 名工程师组成的中央平台团队负责核心基础设施,而领域特定的平台负责人则继续嵌入规模最大的模型团队。实践共同体负责协同标准,共享贡献模式则允许领域团队将可复用组件贡献回上游,而无需长期维护分叉版本。
建立共享贡献模式并配置领域特定的平台负责人,可以使组织对共享控制平面实施标准化,同时避免每项领域特定请求都成为平台瓶颈。在大型技术公司构建的超大规模系统中,同样的平台工程、特征管理和治理权衡会体现得更加具体。
案例研究
这些平台案例具体体现了本章前文阐述的运维权衡:标准化与团队内部迭代速度、抽象与控制、时效性与成本,以及治理与自主权。每个案例都展示了一种不同的方法,使多模型集群的运维具有可重复性,同时避免为每个模型构建专用基础设施。
Uber Michelangelo
Uber 的 Michelangelo 平台说明了为什么在公司规模下,可重复性会成为平台的首要要求 (Hermann 和 Del Balso 2017年)。这一案例体现了平台案例序列中的第一项运维权衡:标准化与团队内部迭代速度。在 Michelangelo 出现之前,Uber 面临着“双重实现”问题:数据科学家使用 Python 开发模型,但工程团队必须为生产环境重写特征流水线,造成交付延误和逻辑分歧。该平台将模型训练、部署、模型服务、工作流管理和特征管理整合在一起,支持预计到达时间预测、欺诈检测和推荐等用例。其特征存储集中管理行程距离聚合值等可复用特征,减少了重复的特征工程工作,并解决了训练与服务的一致性问题。
Hermann, Jeremy, 和 Mike Del Balso. 2017年. Meet Michelangelo: Uber’s Machine Learning Platform. Uber Engineering Blog.
Uber 的运维挑战不仅在于模型数量:基础设施工程师还需要让众多产品团队的模型开发具有可重复性。Michelangelo 为常见工作流提供了一条“黄金路径”:团队可以训练模型、创建离线训练数据集、在线或批量提供预测,并复用由平台管理的特征流水线。这种标准化提高了训练、评估、部署和监控各环节的自动化程度,同时仍要求产品团队对模型行为和业务特定的验证负责。
Michelangelo 这类平台的一项关键演进,是从以批处理为中心的训练转向时效性更高的在线特征和延迟更低的模型服务。早期平台设计通常将用于训练数据的离线存储与用于提供预计算或近期计算特征的在线存储配合使用。外卖配送和欺诈检测等实时产品随之带来一致性挑战:同一特征定义必须为离线训练集和在线推理请求生成相容的值。即使实现细节有所不同,这一经验仍然适用:集中式 ML 平台必须为特征、训练、模型服务、实验和监控提供共享抽象,同时避免为每个模型构建专用基础设施。
Meta FBLearner Flow
Meta 的 FBLearner Flow 展示了如何在普及 ML 基础设施的过程中隐藏资源管理细节,同时保留工作流结构的可见性 (Engineering 2016年)。Facebook 报告称,其工程组织中超过 25% 的人员使用 FBLearner Flow,该系统已训练超过一百万个模型,其在线预测服务每秒执行超过六百万次预测。首要的运维挑战是“N 个模型问题”:许多团队需要可重复的模型工作流,而无需为每个排序、广告、推荐或平台完整性模型手工构建基础设施。FBLearner 通过将训练流水线视为一个抽象底层基础设施的 DAG 来解决这一问题。工程师用代码定义工作流,平台则负责资源分配、依赖管理和容错。
Engineering, M. 2016年. Introducing FBLearner Flow: Facebook’s AI backbone. Engineering at Meta Blog.
大型社交 ML 平台的一个鲜明特征是特征时效性。对于信息流排序等产品,某个特征的价值(例如“用户刚刚对一个相似视频点了赞”)可能迅速衰减。这推动平台采用流处理、在线特征计算,以及同时跟踪数据分布和服务健康状况的监控。CPU 使用率等标准指标不足以检测特征流中的静默故障;生产 ML 系统需要检查特征缺失、分布偏移以及训练与服务偏差。
为了管理部署风险,这一规模的平台通常会在大范围推广之前采用影子模式(或暗发布)、金丝雀发布和在线评估。候选模型可以与当前生产模型并行运行,接收实时流量,但其输出仅被记录,不向用户展示。这一阶段验证运行完整性(延迟、内存使用量、错误率),并有助于在模型影响用户体验之前积累对比数据。
Netflix ML 基础设施
Netflix 的 ML 基础设施展示了个性化平台如何在严格的延迟预算下管理扇出成本 (Gomez-Uribe 和 Hunt 2015年)。推荐系统并非由一个模型作出一个决策,而是结合多种排序和个性化算法,完成页面生成、内容行选择、搜索、“继续观看”和封面图个性化等任务。运维挑战在于扇出成本:每增加一个在线排序器或特征依赖,都会消耗延迟预算。因此,生产系统将候选生成、离线模型训练、在线排序和缓存分离,使首页能够保持个性化,同时避免每个请求都执行数量无上限的高成本模型。
Gomez-Uribe, Carlos A., 和 Neil Hunt. 2015年. 《The Netflix Recommender System: Algorithms, Business Value, and Innovation》. ACM Transactions on Management Information Systems 6 (4): 1~19. https://doi.org/10.1145/2843948.
Netflix 着力解决的一个具体问题是冷启动——即无法向没有历史记录的新用户推荐内容,或无法推荐没有观看数据的全新节目。其基础设施通过采用“在线学习”的多臂老虎机算法来解决这一问题,动态平衡探索与利用。当新节目上线时,系统会分配一小部分曝光“预算”,在不同用户群体中测试该节目,迅速确定合适的受众。这要求基础设施能够近乎实时地更新服务策略、探索预算和推荐状态,而不是等待传统的每日批量训练周期。系统还必须处理“反馈环路”延迟,确保用户与新节目的交互立即反映在后续推荐中。这一要求推动 Netflix 将特征工程的关键部分迁移到服务层本身。
为验证这些复杂的交互,Netflix 从标准 A/B 测试 (Blog 2017年) 转向了“交错测试”。在传统 A/B 测试中,A 组看到排序 1,B 组看到排序 2。这需要极大的样本量和很长的测试周期才能检测到微小的改进。交错测试将排序 1 和排序 2 的结果混合成一个列表,展示给同一用户,并追踪用户点击的结果来自哪个排序。这种方法抵消了用户层面的变异,形成直接的正面对比。基础设施通过支持服务层即时合并排序列表,并高保真地记录归因数据来实现这一点。虽然这增加了日志记录和归因流水线的复杂性,但其量化效果十分显著:Netflix 检测到具有统计显著性的改进所需的用户数量,比传统 A/B 测试少 100\(\times\),从而能够以传统测试框架无法支持的速度迭代排序算法。
Blog, Netflix Technology. 2017年. Innovating faster on personalization algorithms at Netflix using interleaving. Netflix Tech Blog.
Google Vertex AI
Google Vertex AI 展示了托管平台的抽象问题:平台必须消除胶水代码,同时保留足够的控制能力以支持自定义工作负载。Google 旨在解决“胶水代码”问题——即 ML 代码中有 95% 是基础设施样板代码——为此提供了一个涵盖数据标注、训练和服务的统一控制平面。一项关键的架构决策是将 AutoML 与自定义训练并列,作为一等公民集成到平台中。这使平台能够执行神经架构搜索,在给定预算内找到有效的模型结构。这里的运维权衡是“用计算换取人力时间”:平台启动数百个并行试验,替代工程师花费数周调节超参数。这需要一个能够管理“突发容量”的多租户调度器,使高优先级的生产作业能够抢占实验性的 AutoML 试验,同时不丢失状态,从而有效提高集群利用率。
在服务层,Vertex AI 解决了多租户环境固有的“吵闹邻居”问题。当数千个客户将模型部署到同一个底层张量处理单元(TPU)和 GPU 集群时,资源争用可能导致不可预测的延迟峰值。Google 通过严格的容器化策略和“预测边车”架构解决这一问题。每个模型都在隔离的容器中运行,而共享的边车代理负责日志记录、监控和请求批处理。这种分离使平台能够强制执行严格的资源配额(CPU、RAM、加速器 RAM),并提供自动扩缩容功能,同时响应“请求队列深度”等自定义指标和 CPU 负载。其量化收益是尾部延迟更可预测;严格的隔离边界降低了一个租户的繁重批处理作业损害另一个租户实时推理性能的可能性。
Vertex 还着重从一致性与合规性的角度解决特征存储问题。托管特征服务和时间点检索使训练流水线能够仅请求每个训练样本对应时间戳上已经存在的特征值。ML 中一种常见的运维故障是时间性数据泄漏——使用在预测时尚不可用的特征值。托管特征服务还通过统一训练和服务两种场景中的特征定义与服务路径,控制 节 1.7 中阐述的训练与服务偏差。这些设计决策增加了存储和数据血缘开销,但消除了整类隐蔽错误。结合针对训练和服务的成本与利用率控制,托管平台能够帮助团队管理总拥有成本,而不只是提供原始计算资源。
Spotify 机器学习平台
Spotify 的机器学习平台展示了个性化基础设施如何在 5 亿用户的规模下平衡探索与利用。其核心运维挑战在于,严格以即时点击为优化目标(利用)会形成“过滤气泡”,进而降低长期用户留存率。为应对这一问题,该平台直接在服务路径中支持反事实评估和上下文多臂老虎机算法,这些方法用于在部分反馈条件下估计结果并分配探索流量。该架构将“候选生成”阶段(检索 1,000 首潜在歌曲)与“排序”阶段(对前 10 首歌曲进行排序)分离。候选生成器具有多样性——其中一些是每日更新的协同过滤模型 (Koren 等 2009年),另一些则是实时更新的“算法与编辑策划相结合”的启发式方法。这种解耦使平台能够灵活组合检索策略,而无须重写复杂的排序逻辑,从而便于快速试验播客和有声读物等新内容类型。
Koren, Yehuda, Robert Bell, 和 Chris Volinsky. 2009年. 《Matrix Factorization Techniques for Recommender Systems》. Computer 42 (8): 30~37. https://doi.org/10.1109/mc.2009.263.
Engineering, S. 2019年. The winding road to better machine learning infrastructure through TensorFlow Extended and Kubeflow. Spotify Engineering Blog.
其架构的一个核心组件是铺平之路,用于模型编排 (Engineering 2019年)。Spotify 描述了一条围绕 TensorFlow Extended、Kubeflow Pipelines、元数据跟踪和集中式 Kubeflow 集群构建的平台路径,使团队能够从实验转向可重复的生产工作流。这里的运维经验在于血缘关系,而非密码学:模型制品、数据集、代码和流水线元数据之间必须保持足够紧密的关联,使工程师能够将静默退化追溯到产生它的数据或工作流状态。金丝雀部署和回滚仍然是必要的发布控制措施,但它们是叠加在这一元数据基础之上的平台策略,并非 Spotify 原始资料本身所确立的结论。
Spotify 对延迟的约束不容妥协;播放必须让用户感到即时响应。这迫使系统在设计上做出权衡,往往需要预先完成复杂的推理计算。对于“每周发现”播放列表,平台在周末运行大规模批量推理作业,并将结果存储在低延迟键值存储中。然而,对于必须响应用户刚刚听过的歌曲的“首页”,平台采用混合方法。用户嵌入通过流式流水线近乎实时地更新,而计算量较大的物品间相似度矩阵则离线计算。这种分离式架构使首页能够实现低于 100 毫秒的延迟,同时仍能纳入用户最近的收听历史。这里的系统经验是,延迟约束决定了个性化计算在何处执行:预先计算允许存在时效滞后的部分,以流式处理更新必须保持新鲜的部分,并将在线推理留给用户必须即时体验的部分。
严格的延迟要求解释了成熟的个性化平台为何尽可能预先完成计算,但预计算并不能消除运维风险。提高平台效率的共享注册表、特征存储和编排器,也构成了控制平面;这些控制平面一旦发生故障,就需要有纪律的事件响应。
控制平面的比较与综合
这些案例在工作负载和组织形式上有所不同,但都体现了相同的控制平面职责。Michelangelo 强调跨产品团队可复用的特征与工作流契约。FBLearner Flow 强调面向大规模工程师群体的 DAG 级编排和资源抽象。Netflix 强调受延迟约束的组合与高灵敏度实验。Vertex AI 强调跨租户的托管隔离和生命周期集成。Spotify 强调一条保留血缘关系、同时融合批处理、流式处理和在线决策的铺平之路。没有哪一种实现是通用模板;持久适用的模式是,共享状态、发布证据、资源策略和归属责任成为平台接口。
表 22 明确展示了共同契约以及领域团队保留的职责。
| 案例 | 主要压力 | 控制平面侧重点 | 保留的本地职责 |
|---|---|---|---|
| Michelangelo | 重复的特征与部署工作 | 共享特征与可重复的工作流 | 特定产品的模型行为与验证 |
| FBLearner Flow | 众多团队与异构流水线 | DAG 编排与资源抽象 | 工作流意图与领域评估 |
| Netflix | 严格延迟预算下的扇出 | 组合、预计算与实验 | 排序目标与用户体验权衡 |
| Vertex AI | 多租户托管基础设施 | 隔离、策略与生命周期集成 | 工作负载配置与验收标准 |
| Spotify | 混合路径下保持新鲜的个性化 | 血缘关系、铺平之路与混合数据流转 | 领域策略与探索策略 |
这一比较也揭示了采用平台的约束条件。平台要取得成功,其通用路径就必须涵盖反复出现的不变要求,同时不削弱领域判断。平台承担的职责过少,会重新催生定制化基础设施;承担的职责过多,则会让每项特殊工作负载都进入中央团队的处理队列。采用版本化接口、明确的例外机制以及基于结果的采用指标,可以在工作负载组合变化时持续调整这一边界。
生产环境调试与事件响应
凌晨 3:00,PagerDuty 向值班工程师发出告警:核心推荐系统的收入在过去一小时内下降了 15%。服务器运行正常,延迟正常,也没有异常日志。传统软件也可能在不报错的情况下返回错误结果,但机器学习还会引入源于数据和统计行为的故障,而常规的服务健康信号仍然正常。因此,调试生产环境中的机器学习系统需要超越代码和基础设施层面的调查框架。
当生产环境调试占据工程团队大量精力时,平台规模会成倍增加复杂性,因为故障可能源于数据流水线、模型代码、基础设施,或组件之间涌现出的交互,而这些交互并不由任何单一团队端到端负责。因此,有效的事件响应需要遵循诊断顺序:对事件进行分类,将故障归因于正确的依赖项,限制故障影响范围,然后将事件转化为更强的平台控制措施。
War Story 1.1: 消失的控制平面(2021 年)
背景:Meta 的全球骨干网连接着其数据中心,并承载着相关依赖;这些依赖一旦丢失,DNS 和内部恢复工具也会随之不可用 (Janardhan 2021年)。
机制:2021 年 10 月 4 日,一条用于评估骨干网容量的例行审计命令意外切断了所有骨干网链路。这触发了自动化的边界网关协议路由撤销,撤销了所有权威 DNS 路由,导致内部身份验证失效,并使远程修复所需的带外管理工具陷入隔离。
影响:Facebook、Instagram 和 WhatsApp 经历了持续 5.5 小时的全球服务中断,影响超过 35 亿用户,同时模型服务实例失去了对特征存储和控制注册中心的访问能力。
修复:工程师亲自前往圣克拉拉数据中心,对硬件执行强制重置,并通过本地带外访问重建 DNS 控制平面。
系统启示:平台规模下的运维必须将控制平面视为具有明确故障影响范围的硬依赖。机器学习平台在集群规模下存在同样的故障风险:训练调度器、模型注册中心、特征存储和推理路由器共享底层身份验证、DNS 和网络平面。发生网络分区时,恢复工作要求控制平面与推理服务基础设施之间具备严格的物理隔离和逻辑隔离。
Janardhan, Santosh. 2021年. More Details About the October 4 Outage. Meta Engineering postmortem.
事件分类
事件分类是服务中断时的第一个分派决策:类别告诉响应人员应首先检查哪些遥测数据、呼叫哪位负责人,以及可能需要采取回滚、数据修复还是基础设施隔离措施。事件类别围绕这一首要诊断信号进行组织。
数据事件涉及输入数据的问题:阻止新数据到达模型的流水线故障、导致下游使用方失效的模式变更、缺失值或分布偏移造成的数据质量下降,以及特征陈旧程度超过 SLO 阈值。这类事件通常表现为共享数据源的多个模型准确率下降,因此数据流水线的健康状况是首个诊断检查点。
模型事件涉及模型行为的问题,包括准确率下降超出可接受阈值、表明计算问题的延迟突增、不断增长的状态(KV 缓存、缓冲区)导致的内存耗尽,以及公平性监控检测到的预测偏见变化。模型事件通常影响单个模型。如果多个互不相关的模型同时退化,应怀疑共享数据或基础设施存在问题,而非各个模型独立出现问题。
基础设施事件涉及服务平台的问题:导致请求出错的 GPU 故障、模型分片之间的网络分区、造成流量路由不当的负载均衡器配置错误,以及影响部署的容器编排问题。这类事件往往会造成错误率突增和超时模式,而非准确率逐渐下降。
业务指标事件涉及下游 KPI 的意外变化,例如没有明确模型或数据原因的用户参与度下降、模型正常运行期间的收入异常,以及影响模型有效性的用户行为变化。这类事件最难归因,因为它们可能源于外部因素(竞争、季节性、营销活动),而非机器学习系统问题。
归因分析
归因分析确保诊断顺序得到遵循:先确定根本原因,再实施修复。时间相关性分析通过近期变更,逆向追溯性能退化的原因:
Symptom: Recommendation engagement dropped 5% in past hour

Step 1: Check recent deployments
        → No model deployments in past 4 hours
        → Eliminate model change as cause

Step 2: Check feature freshness SLOs
        → user_features: 3 hours stale (SLO: 1 hour)
        → Feature pipeline delayed

Step 3: Check feature pipeline status
        → Kafka consumer lag: 10M events (normal: 10K)
        → Data ingestion bottleneck

Step 4: Investigate Kafka cluster
        → Broker disk 95% full on partition 7
→ Root cause identified当模型的准确率下降时,关键在于区分根因究竟在于数据还是模型。归因流程区分了四类故障:
- 数据漂移:输入分布发生偏移(新的用户人口特征、季节性模式)
- 特征陈旧:流水线延迟导致预测基于陈旧特征
- 模型衰退:真实关系发生变化所引起的概念漂移
- 上游模型变更:本模型所依赖的某个模型已更新
随后,诊断流程先检查概率最高的共性原因,再检查局部模型缺陷:
- 将当前输入分布与训练分布进行比较
- 检查所有输入特征的新鲜度
- 检查模型在稳定评估集上的表现
- 沿依赖图追踪近期变更
Example 1.3: 特征流水线级联故障
场景:核心平台团队原地修改了共享
user_engagement_score 特征的变换逻辑,将其归一化方式从 30 天窗口的 z-score 改为 7 天窗口的 min-max 缩放。
诊断:五个工程团队的十四个下游模型通过未版本化的接口使用该特征。这次原地修改使特征分布假设失效,导致排序准确率下降 12%,并造成了 18 小时的跨团队调试工作。
系统启示:共享特征定义是生产环境中的 API 契约,必须采用显式且不可变的版本管理(user_engagement_score_v2)。原地修改模式会破坏依赖该特征的模型集群对契约的预期。
在平台规模下,故障往往涉及多个模型,因此受影响的模型集合本身就成为诊断信号。跨模型的相关性模式揭示了可能的根因,如 跨模型故障模式 所示:
| 模式 | 可能原因 |
|---|---|
| 所有推荐系统模型性能下降 | 特征存储问题 |
| 所有视觉模型性能下降 | 图像预处理流水线 |
| 单个模型性能下降 | 模型特有问题 |
| 地理模式 | 区域基础设施 |
| 时间模式 | 批处理作业调度 |
运行手册编制
运行手册的价值在于,它能在时间压力下维持诊断顺序。对于机器学习系统,正确的诊断顺序与基础设施运维直觉所暗示的顺序相反:机器学习系统会静默失效。当特征流水线停滞时,特征值会变得陈旧,而模型仍继续处理这些陈旧特征,同时以正常延迟返回 HTTP 200 响应;预测质量在不易察觉的情况下下降,基础设施检查却显示正常。因此,机器学习运行手册必须从数据和语义健康状况入手:验证特征新鲜度,确认输入分布与训练数据一致,并检查模型版本近期是否发生变化。只有确认数据和模型行为均正常后,运行手册才应进一步检查基础设施。如果延迟和错误率正常,但业务 KPI 已下降,运行手册必须立即引导响应人员检查特征新鲜度和分布漂移,然后再开展任何基础设施调查。这一顺序从用户可感知的症状出发,先检查数据和语义依赖,再检查基础设施,并在事件发生之前明确升级处理的阈值,使承受压力的响应人员始终知道下一项应执行的检查,而不仅仅知道应检查哪个系统。
可复用的结构是诊断流程,而非文档模板。当推荐互动指标下降时,响应人员每次都应遵循同一个控制循环。运行手册诊断流程 列出了在压力下维持这一顺序的控制问题。
| 步骤 | 问题 | 证据示例 |
|---|---|---|
| 检测用户影响 | 哪个产品或用户群体的表现下降了? | 点击率、转化率、留存率、收入或投诉率 |
| 定位依赖 | 是否有影响多个模型的共享服务发生了变更? | 特征新鲜度、模型注册表、区域健康状况 |
| 限定影响范围 | 能否减少流量、进行影子流量测试或回滚? | 金丝雀指标、回滚目标、模型服务饱和度 |
| 根据证据升级处理 | 哪个团队负责失效的控制环节? | 数据流水线、平台、模型服务或模型的负责人 |
| 从缺口中学习 | 哪个缺失的信号本可以更早发现问题? | 新鲜度门禁、切片告警、部署防护机制 |
运行手册的反模式通常以三种方式破坏诊断顺序。过于具体的指令,例如“如果 BERT 模型失败,则重启容器”,固化的是某次历史故障的修复方法,而非可复用的调查流程。含糊的指令,例如“调查问题”,则在最不合适的时候将所有判断责任推回给响应人员。当过时的运行手册将响应人员引向已弃用的系统、失效的仪表板或过期的联系人时,它比没有运行手册更糟糕。
事件后复盘
事件后报告(PIR)只有将一次故障转化为更强的平台控制措施,才能将事件转化为组织学习。事件记录应将持续时间和用户影响与检测、归因、缓解及恢复的时间线关联起来。根本原因分析应明确指出失效或缺失的控制措施,纠正措施应明确负责人和截止日期,使复盘推动平台改进,而不仅仅是记录服务中断。
有用的 PIR 字段是那些能够促成控制措施决策的字段。持续时间和影响用于量化严重程度;时间线揭示检测延迟和归因延迟;根本原因指出缺失的控制措施;纠正措施则为下一次平台变更明确责任归属。在特征新鲜度事件中,最重要的发现不是磁盘空间耗尽,而是在用户参与度指标发生变化之前,没有任何新鲜度门控机制发现特征流水线停滞。表 23 中的问题将这条时间线转化为平台改进工作。
| PIR 问题 | 应促成的控制措施决策 |
|---|---|
| 用户受到影响的状态持续了多久? | 检测延迟还是缓解延迟在事件中占主导。 |
| 哪个依赖项最先发生故障? | 缺失的控制措施应归属于数据、平台、模型服务还是模型代码。 |
| 哪个信号到达得太晚? | 是否需要新增新鲜度、切片、饱和度或金丝雀防护机制。 |
| 什么措施本可以限制影响范围? | 是否缺少回滚、流量影子测试、准入控制或回退机制。 |
| 谁负责下一项控制措施? | 复盘是否推动平台改进,而不仅仅是记录责任归咎。 |
有效的 PIR 需要心理安全感和系统视角,而非归咎于个人。复盘应识别哪些系统使事件得以发生,而不是哪个人造成了事件。它应追问哪个信号本可以更早检测到故障,而不是为什么某个人未能发现故障。它应预防这一类故障,而不仅仅是已经发生的那一次具体故障。
分布式故障的集群遥测与责任归属
分布式训练和推理可能在某个进程秩、设备、主机、网络互连结构链路、数据分片或控制平面依赖项上发生故障。这些故障的机制层面诊断与恢复语义属于 容错 的内容。大规模运维负责的是另一个问题:收集足够的关联证据以识别受影响的域,在事件发生前明确处置权限,并保留升级处理和事件后学习所需的证据。
遥测契约从稳定的标识符开始。每个事件都必须携带作业或服务标识符、尝试编号和模型版本、进程秩和主机、设备标识、拓扑位置、数据分片或请求群组、软件构建版本、用于跨主机关联的已同步墙上时钟时间戳或追踪时间戳,以及用于本地持续时间计算和排序的主机本地单调时间或序列号。时钟域和同步不确定性元数据限定了不同主机上的事件排序所能达到的精度。缺少这些维度的日志会迫使响应人员在服务中断期间重建关联;不受限制的高基数标签则可能压垮监控系统。因此,平台存储低基数的健康状态聚合数据用于告警,并保留经过采样或限定在事件范围内的高基数追踪数据用于诊断。决定遥测在运维中是否有用的是关联能力,而非原始日志量。
表 24 将每类证据与首要负责人及升级处理所需的证据关联起来。
| 故障证据 | 集群级信号 | 首要负责人 | 升级处理证据 |
|---|---|---|---|
| 集合通信进度停滞 | 按拓扑域记录进入和完成每次集合通信的进程秩 | 训练运行时团队 | 受阻进程秩集合、最后完成的集合通信、网络互连结构中的局部位置 |
| 某个进程秩接近其内存上限 | 各进程秩已分配内存、预留内存和峰值内存的分布 | 模型/训练团队 | 分配阶段、模型状态、与其他进程秩的比较 |
| 步耗时出现长尾 | 与主机和交换机关联的进程秩级步耗时分布 | 集群基础设施团队 | 慢进程的持续性、温度、网络及输入方面的证据 |
| 损失或梯度在各进程秩间出现分歧 | 与产物和数据分片关联的各进程秩数值摘要 | 模型/训练团队 | 首次出现分歧的步骤、分片、构建版本和检查点 |
| 多次尝试在同一域上失败 | 按主机、机架、设备代际和软件构建版本统计的故障率 | 集群基础设施团队 | 隔离历史及在已知正常域上的复现结果 |
责任归属必须包含控制影响范围的权限。当进度停滞时,训练运行时负责人可以取消或重启作业;集群基础设施团队可以隔离设备、主机或拓扑域;数据负责人可以停止使用已损坏的分片;模型负责人则决定数值发散是否使产出的模型制品失效。当涉及多个领域时,事件指挥者负责协调这些行动。如果仪表板识别出了可能的原因,却没有明确谁有权停止流量、隔离计算资源或判定制品失效,那么最关键的决策仍然悬而未决。
遥测数据的保留使控制闭环得以闭合。常规的正常运行需要汇总分布和采样追踪,而失败的尝试和违反发布门禁的情况则需要保留完整的事件范围内证据,直至事后复盘和纠正措施实施期结束。平台应衡量归因延迟、首次升级时转派给正确负责人的事件比例、按故障类别统计的复发情况,以及从采取纠正措施到部署控制措施所需的时间。这些指标能够揭示可观测性究竟是在降低集群风险,还是仅仅在生成更多数据。
ML 团队的值班实践
ML 系统需要专门的值班实践,因为除了正常运行时间,预测质量、数据新鲜度和依赖关系图也构成可靠性关注事项。本节的调试框架解释了为何事件可能始于业务指标异常,最终却定位到特征流水线、模型注册表或停滞的分布式操作。值班设计必须以成熟的站点可靠性工程(SRE)19原则 (Beyer 等 2016年) 为基础,使团队能够持续承担这种诊断负担。
19 站点可靠性工程(SRE):SRE 由 Ben Treynor Sloss 于 2003 年在 Google 创立,引入了错误预算和 SLO,将其作为量化的可靠性契约。对于 ML 系统,必须扩展经典 SRE:传统服务的故障呈二元状态(正常/宕机),而模型则以概率性的方式退化——准确率可能在数周内下降 5%,却不触发任何健康检查。这就要求采用能够感知漂移的 SLO,将预测质量与正常运行时间一并作为可靠性指标。
Beyer, Betsy, Chris Jones, Jennifer Petoff, 和 Niall Richard Murphy. 2016年. Site Reliability Engineering: How Google Runs Production Systems. O’Reilly Media.
ML 值班特有的一项结构性挑战在于,解决事件所需的专业知识很少集中于一名工程师。一次 ML 生产事件可能需要 ML 平台工程师诊断 Kubernetes GPU 调度器、数据工程师追查更新滞后的特征流水线,以及建模科学家判断分布偏移究竟是缺陷还是预期的概念漂移。传统的单一角色值班轮换难以适应这种情况,因为症状(推荐指标下降)与根因所属领域(上游 Kafka 主题的模式变更)完全脱节。成熟的 ML 组织通过将值班组织为分层或按专业领域构建的矩阵式体系来应对这一问题:主要响应人员负责初步分诊和升级,并设有通向数据工程、模型开发和平台基础设施领域专家的明确升级路径。主要响应人员的职责是在最初 15 至 30 分钟内将事件转派到正确的领域,而不是独自解决每一种故障。
轮换设计决定了团队能否持续承担这种诊断负担。表 25 列出了反映行业实践的指导原则。其基本模式是通过冗余保障有限时段内的工作连续性:较短的轮换周期限制职业倦怠,备班支持处理跨领域事件,交接重叠时段则保留上下文。
| 方面 | 建议 |
|---|---|
| 轮换周期 | 1 周(更短会导致上下文切换,更长会导致职业倦怠) |
| 主班 + 备班 | 始终安排后备人员;ML 事件往往需要多名专家参与 |
| 交接重叠时段 | 重叠 30 分钟,用于传递事件上下文 |
| 随日轮转 | 对于全球团队,按时区交接;每班最长 8 小时 |
告警疲劳持续威胁着值班工作的有效性。其迹象包括值班工程师忽略告警、将告警认定为误报、确认告警所需时间增加,以及告警未经调查便自动解除。缓解措施必须减少那些不会促成 ML 专项处置的呼叫通知:
- 每季度根据误报率调整漂移、数据新鲜度、延迟和业务指标的阈值。
- 将相互关联的模型、特征存储、模型服务和基础设施告警去重合并为一个事件页面。
- 为每条告警附上操作手册,明确可能的负责人和首个诊断查询。
- 跟踪告警转化为行动的比例;目标为 >80%。
除了通用的 SRE 技能,ML 值班还要求能够解读模型质量指标、理解数据流水线依赖关系、区分模型缺陷与数据漂移,并在压力下决定是回滚还是继续调查。减少重复性运维工作同样关键,因为反复出现的手动任务会占用改进平台所需的人力。应跟踪花在重复性手动任务上的时间,目标是将此类工作控制在值班时间的 25% 以下。
常见的 ML 重复性运维工作通常集中在模型与平台的交界处:
- 手动重启失败的训练作业
- 手动审批常规部署
- 调查无需采取行动的告警
- 生成周期性报告
自动化是应对重复性运维工作的长效措施。如果投入一小时开发自动化功能,每次事件可节省 10 分钟,而该任务若不自动化,在一个季度内至少会重复六次,那么这项投入就能在该季度内收回。尽管已有这些运维工具,工程团队在尝试扩展 ML 运维规模时,仍常常被一些普遍存在的误解引入歧途。
谬误与陷阱
运维复杂度不会随模型数量线性增长,因为模型之间共享特征、流水线、基础设施和告警。以下谬误与陷阱揭示了:当这些交互关系成为主导因素时,逐模型运维实践会在哪些方面失效。
谬误:运维复杂度随模型数量线性增长。
在生产环境中,模型间的依赖关系会使复杂度呈超线性增长:100 个模型会形成密集的依赖图,其中模型 A 依赖流水线 B 提供的特征,而流水线 B 又使用模型 C 的嵌入,因此无法进行孤立更新。仅监控负担就足以说明问题:100 个模型,每个模型有 10 项指标,在 5% 的误报率下,每天会产生 14,400 条误报告警。一个支持 40 个模型、采用逐模型运维实践的平台,每月需要 1,600 工程师工时($2.88M annually at $150/小时)。逐模型的 CI/CD、监控和部署模式无法在大规模场景下有效组合。
陷阱:为每个模型和每项指标设置独立告警。
全面的逐模型告警必然导致告警疲劳。公式 11 表明,对于 \(N_{\text{tests}}=1000\) 次独立检验(100 个模型 \(\times\) 10 项指标),在 \(\alpha_{\text{fp}}=0.05\) 时,\(\Pr(\text{at least one false alert}) = 1 - 0.95^{1000} \approx 1.0\)。运维人员逐渐学会忽略噪声,真正的事件也随之被淹没。解决方案是分层监控:业务指标触发管理层关注,模型组合指标对相关模型进行聚合,而模型专属指标用于调查,而非主要告警。
谬误:平台投入可以等到组织拥有 100 个以上模型时再进行。
图 2 表明,平台投资回报率在模型数量达到 20–50 个时就会转正,而非 100 个以上。碎片化实践带来的技术债务会迅速累积:40 个模型各自维护 847 行且没有校验模式的 YAML 文件,导致了 35% 的部署延误;23 个预处理脚本有 62% 的内容重复,每周需要 12 工程师工时进行调试。当组织拥有 100 个模型时,迁移成本会超过最初构建平台的成本,达到后者的 3–5\(\times\)。若有 50 个模型,每个模型每月需要 40 小时的运维工作,那么一笔 $2M 的平台投资可在 12 个月内收回。
陷阱:无论风险特征如何,都采用统一流程处理所有部署。
对每次模型更新都采用相同的分阶段发布流程,要么会给低风险变更带来过重负担,要么会对高风险变更提供不足的保护。表 3 表明,欺诈检测需要每小时更新,并能在数秒内回滚;而 LLM 需要每月分阶段发布,回滚时间窗口则为数小时至数天。无法在一小时内重新部署的欺诈检测模型会留下可被利用的时间窗口;未经多日影子测试就部署的 LLM,则可能在数百万次查询中引发安全违规。基于风险的策略应与 节 1.4 模式相匹配:面向对抗性场景的模型采用即时回滚,推荐模型采用金丝雀部署,LLM 采用影子部署。
谬误:损失和准确率等逐模型指标足以满足大规模场景的需求。
在多模型平台中,系统级指标比单个模型的性能更重要。一个调用 10–50 个模型的推荐集成系统,其延迟可能恶化 30%,而原因只是一个上游检索模型慢了 20 ms,即便所有准确率指标仍处于正常水平。上游嵌入漂移可能同时使 12 个下游模型的性能下降,而逐模型准确率跟踪无法发现这种失效模式。节 1.5 表明,平台可观测性需要以业务指标为顶层,以模型组合指标支持协同,以模型指标支持调查,并以基础设施指标为基础。
陷阱:为简化架构,默认对所有特征采用批处理流水线。
每日更新特征的批处理流水线忽略了陈旧性带来的量化影响。新鲜度公式 \(T_{\text{freshness}} = T_{\text{available}} - T_{\text{event}}\) 表明,每日批处理产生 \(T_{\text{freshness}} \approx 12\text{--}24 \text{ hours}\);流式流水线则达到 \(T_{\text{freshness}} \approx 1\text{--}5 \text{ seconds}\)。表 19 中的推荐系统示例量化了更新鲜的特征带来的用户参与度提升,而对于欺诈检测,陈旧一天的特征会给攻击者留下 24 小时的利用窗口。一个推荐平台每周产生 $15M weekly with 10 percent from ML that improves 15 percent with real-time features gains $225K,足以轻松覆盖流式基础设施的成本。
谬误:技术债务在规模化过程中不可避免,只有当它阻碍关键工作时才应处理。
这一前提误解了技术债务的经济规律。节 1.1.3.2 确立了量化阈值:部署周期超过 2 周(健康目标:\(<1\) 天)表明配置复杂性过高,事故率超过每 1,000 次部署 20 起(健康目标:\(<5\))表明存在测试债务,重复性运维工作占用超过 50% 的产能(健康目标:\(<20\)%)表明存在自动化债务。仅监控债务一项,平均检测时间为 4.2 小时,每年就造成 $50K per incident \(\times\) 15 incidents yearly = $750K 的成本。将债务视为不可避免的组织会眼看着重复性运维工作消耗 70–80% 的工程产能,形成团队只能维护现有系统的恶性循环。
陷阱:让债务指标一直停留在定性层面,直到重复性运维工作耗尽团队的精力。
如果团队将不断增长的部署时间和不断扩大的重复性运维工作视为不可避免的“增长成本”,就会错过平台边界已失效这一运维信号。必须在债务规模仍小、尚可调整方向时对其进行度量:部署前置时间、事故频率、告警噪声、回滚延迟和重复性运维工作占比都是先行指标。识别这些陷阱,便补全了 AI 集群的管理层,随后讨论将转向安全。
总结
规模化机器学习运维为机器学习集群提供了管理层。前后相关章节从物理基础设施出发,经过分布式训练和模型服务,逐步转向支撑数百个模型和大规模设备群体持续运行的运维机制。
从管理单个模型到运营组织级平台的转变,意味着复杂性发生了质的变化。针对单个模型的运维实践无法简单组合;它们会产生组合性债务,而这些债务只能通过集中式注册表、具备集成模型感知能力的 CI/CD 和分层监控等平台抽象来化解。
运维节奏必须匹配模型的风险特征,从 LLM 分阶段、持续数周的发布,到对抗性欺诈检测中数秒内完成的回滚。生产环境实验成为发布门禁,其晋级决策必须遵守可用性、延迟、新鲜度和模型质量的预算约束。TCO 框架 \((\text{TCO}_{\text{ML}} = C_{\text{train}} + C_{\text{infer}} + C_{\text{data}} + C_{\text{iter}})\) 为战略投资决策提供了量化基础,揭示了成本结构如何从早期以迭代为主转变为生产规模下以推理为主,以及优化优先级必须如何随之演进。MLOps 的愿景也延伸至边缘端,在那里,集群版本不一致和硬件在环验证共同约束着数百万台异构设备上的智能功能。
规模化运维的核心教训是,管理一个模型与管理数百个模型存在质的差异。单个模型可以通过人工流程、临时监控和定制部署脚本来运维。在组织规模下,这些实践会因组合复杂性而崩溃:200 个模型各自拥有独立的 CI/CD 流水线、单独的告警配置和独立的成本跟踪,会产生数千个运维接触面,任何团队都无法维持。平台抽象是唯一可行的应对方式,它将逐模型的重复性运维工作转化为共享基础设施,使每增加一个模型所带来的运维成本成为边际成本,而不再按线性累加。
TCO 分析支持对基础设施投资作出量化决策,包括判断一个价值 $2M 的平台何时能够通过消除冗余流水线和降低事故响应成本收回投资。分层监控能够揭示逐模型仪表板遗漏的跨模型故障,而部署速度、事故率和重复性运维工作占比则使平台投资回报率可被度量。缺少这些控制措施,运维债务就会消耗越来越多的工程产能。
Key Takeaways: 以平台为核心,而非流水线
- 单个模型不是管理单元:在模型组合规模下,运维对象变为由模型、特征、流水线、告警和负责人构成的依赖图。注册表、血缘关系和具备集成模型感知能力的 CI/CD,可以防止局部更新在不被察觉的情况下破坏下游使用方。
- 平台使重复性运维工作按边际增长:总结中的 50 个模型、$2M 平台示例说明了为什么消除重复流水线、事故响应和人工协同后,共享基础设施能够收回成本。将平台视为一个进行版本管理的产品,可以避免采用、例外处理、迁移和退役过程重新产生这些重复性工作。
- 拥有成本决定优化目标:拥有成本方程将训练、推理、数据和迭代成本分开,而主导项会随系统生命周期变化(原则 15)。早期集群应投资于速度;成熟的高流量集群应投资于模型服务效率、利用率和成本归因。
- 可靠性是一个向量:当 100 个模型分别产生独立故障时,逐模型仪表板和告警会随着规模扩大而变成噪声。分层遥测将共同原因引发的事故路由至相应处理方,而可用性、延迟、新鲜度和质量各维度中最高的预算消耗速率决定发布决策。
- 评估是一份统一的版本化契约:离线质量、生产负载、统计功效、保障证据、回滚阈值和可复现性元数据必须描述同一个候选版本。每项验收声明都需要负责人和失效条件。
- 运维延伸至边缘端:模型集群并不止于数据中心。持续数周的发布、硬件在环验证、版本不一致和异构设备故障,使边缘部署成为约束云端 CI/CD 的同一套平台管理规范的一部分。
运维规模化并非没有代价。集群的负担更多地由模型之间的交互驱动,而不是由某一个模型驱动,因此,除非平台打破这种耦合,否则工作量的增长速度会超过模型数量的增长速度。将集群而非模型作为构建、监控和资金投入的单元,就能使每个新模型带来的固定运维负担转变为边际负担。
What’s Next: 受到治理的集群仍然是攻击面
运维机制现已就位。平台经济性、集群监控、边缘部署和 FinOps 治理,使数百个模型保持可靠且可观测。然而,可靠性和可观测性并不能说明系统如何应对攻击者。集群暴露的每个模型端点都可能被探测,以实施模型提取或规避攻击;每条共享流水线都可能遭到投毒;每个训练语料库和遥测流都构成隐私风险。安全与隐私 将讨论这些暴露风险,探究集群在规模化运行后如何保护其模型、数据和用户。