分布式训练
为何需要分布式训练
分布式训练
目的
为什么“硬件越多训练越快”的线性逻辑会在二分带宽墙处失效?
分布式训练在将其表述为“将工作划分到多台机器上、再合并结果”时显得简单。然而,随着机器学习集群规模的扩大,通信开销不断上升,而每台机器的计算量不断缩小,直到同步开销占据主导,继续增加硬件反而可能降低性能。当任务在单个加速器上训练时,设计针对算术强度进行优化;当任务在 10,000 个加速器上训练时,设计针对通信强度进行优化。这一扩展上限源于可靠性差距与通信—计算比。协调彼此独立的机器,需要在比片上存储器慢几个数量级的网络上移动 TB 级状态。分布式训练通过以下手段化解这一张力:划分工作以减少协同开销、将通信与计算重叠以隐藏延迟,以及选择兼顾一致性与吞吐量的同步策略。缺乏这一理解,组织可能浪费数百万资金购置闲置等待梯度到达的硬件,或因陈旧更新破坏优化而得到无法收敛的模型。分布式训练将 C³ 分类法付诸实践,每个设计选择都在并行化计算与跨工作节点的受网络通信和协同之间进行权衡。
Learning Objectives
- 运用集群定律诊断受计算、内存、通信或协同约束的分布式训练形态
- 计算数据并行训练任务的扩展效率、关键批大小上限与同步开销
- 设计内存分片方案,以加速器容量换取额外通信
- 将张量并行、流水线并行、专家并行与数据并行映射到硬件带宽层级和模型结构
- 构建微批流水线调度,在最小化气泡的同时保持吞吐量与收敛稳定性
- 在陈旧性、拖后腿节点和数值稳定性约束下评估同步与低精度策略
- 综合混合并行配置,以适配前沿、推荐和对齐训练约束
加速器层级、网络互连结构和存储流水线构成了集群的物理基础。剩下的挑战在于算法:将单个训练任务划分到数千个资源上,同时保留统一且连贯的优化过程的语义。普适规模定律(原则 9)解释了这种压力为何不断增大:前沿模型的质量提升需要计算量、数据量和参数量以更高的比例增长,因此训练问题最终会超出任何单台机器的承载能力。
如果单个加速器拥有 100 TB 内存和每秒百亿亿次浮点运算的算力,就无需进行分布式训练。然而,实际系统的高带宽内存(HBM)容量、互连带宽和可容忍的故障额度都有限,因此必须将训练划分到多个独立芯片上。在 集群栈 所示的集群栈框架中,分布式训练对应分布层:即将数学工作负载划分到物理集群上的逻辑。这里定义的数据并行、张量并行、流水线并行和混合并行等策略,决定了互连结构必须承载的通信流量模式。
集群的物理约束
在优化算法之前,必须理解机器学习集群的物理约束。任何分布式训练任务的性能都受集群定律(原则 10)支配。该定律在 集群定律 中引入,将每步耗时分解为:
\[ T_{\text{step}}(N) = \frac{T_{\text{compute}}}{N} + T_{\text{comm}}(N) + T_{\text{sync}}(N) - T_{\text{overlap}} \]
其中的关键项是通信—计算比,\(\rho = T_{\text{comm}}(N)/(T_{\text{compute}}/N)\)。这一比值决定了集群表现为一台超级计算机,还是一组闲置的加热器。

一旦超过通信与计算之比的阈值,扩展就不再理想。
这一比值对应两种形态。计算受限的集群满足 \(T_{\text{compute}}/N \gg T_{\text{comm}}(N)\),大部分时间用于矩阵乘法;这是理想状态,通常出现在 ResNet 等稠密模型采用大批量训练时。通信受限的集群满足 \(T_{\text{comm}}(N) \approx T_{\text{compute}}/N\),大量时间用于等待梯度或激活到达;这是大语言模型(LLMs)和深度学习推荐模型(DLRM)类推荐模型的常见状态,因为参数同步会使网络饱和。瓶颈诊断表 将这一比值纳入诊断框架,根据实测带宽和算术强度,将工作负载归类为计算受限、内存受限或通信受限,从而将这些定性的形态转化为可重复执行的测试。
多机训练的必要条件
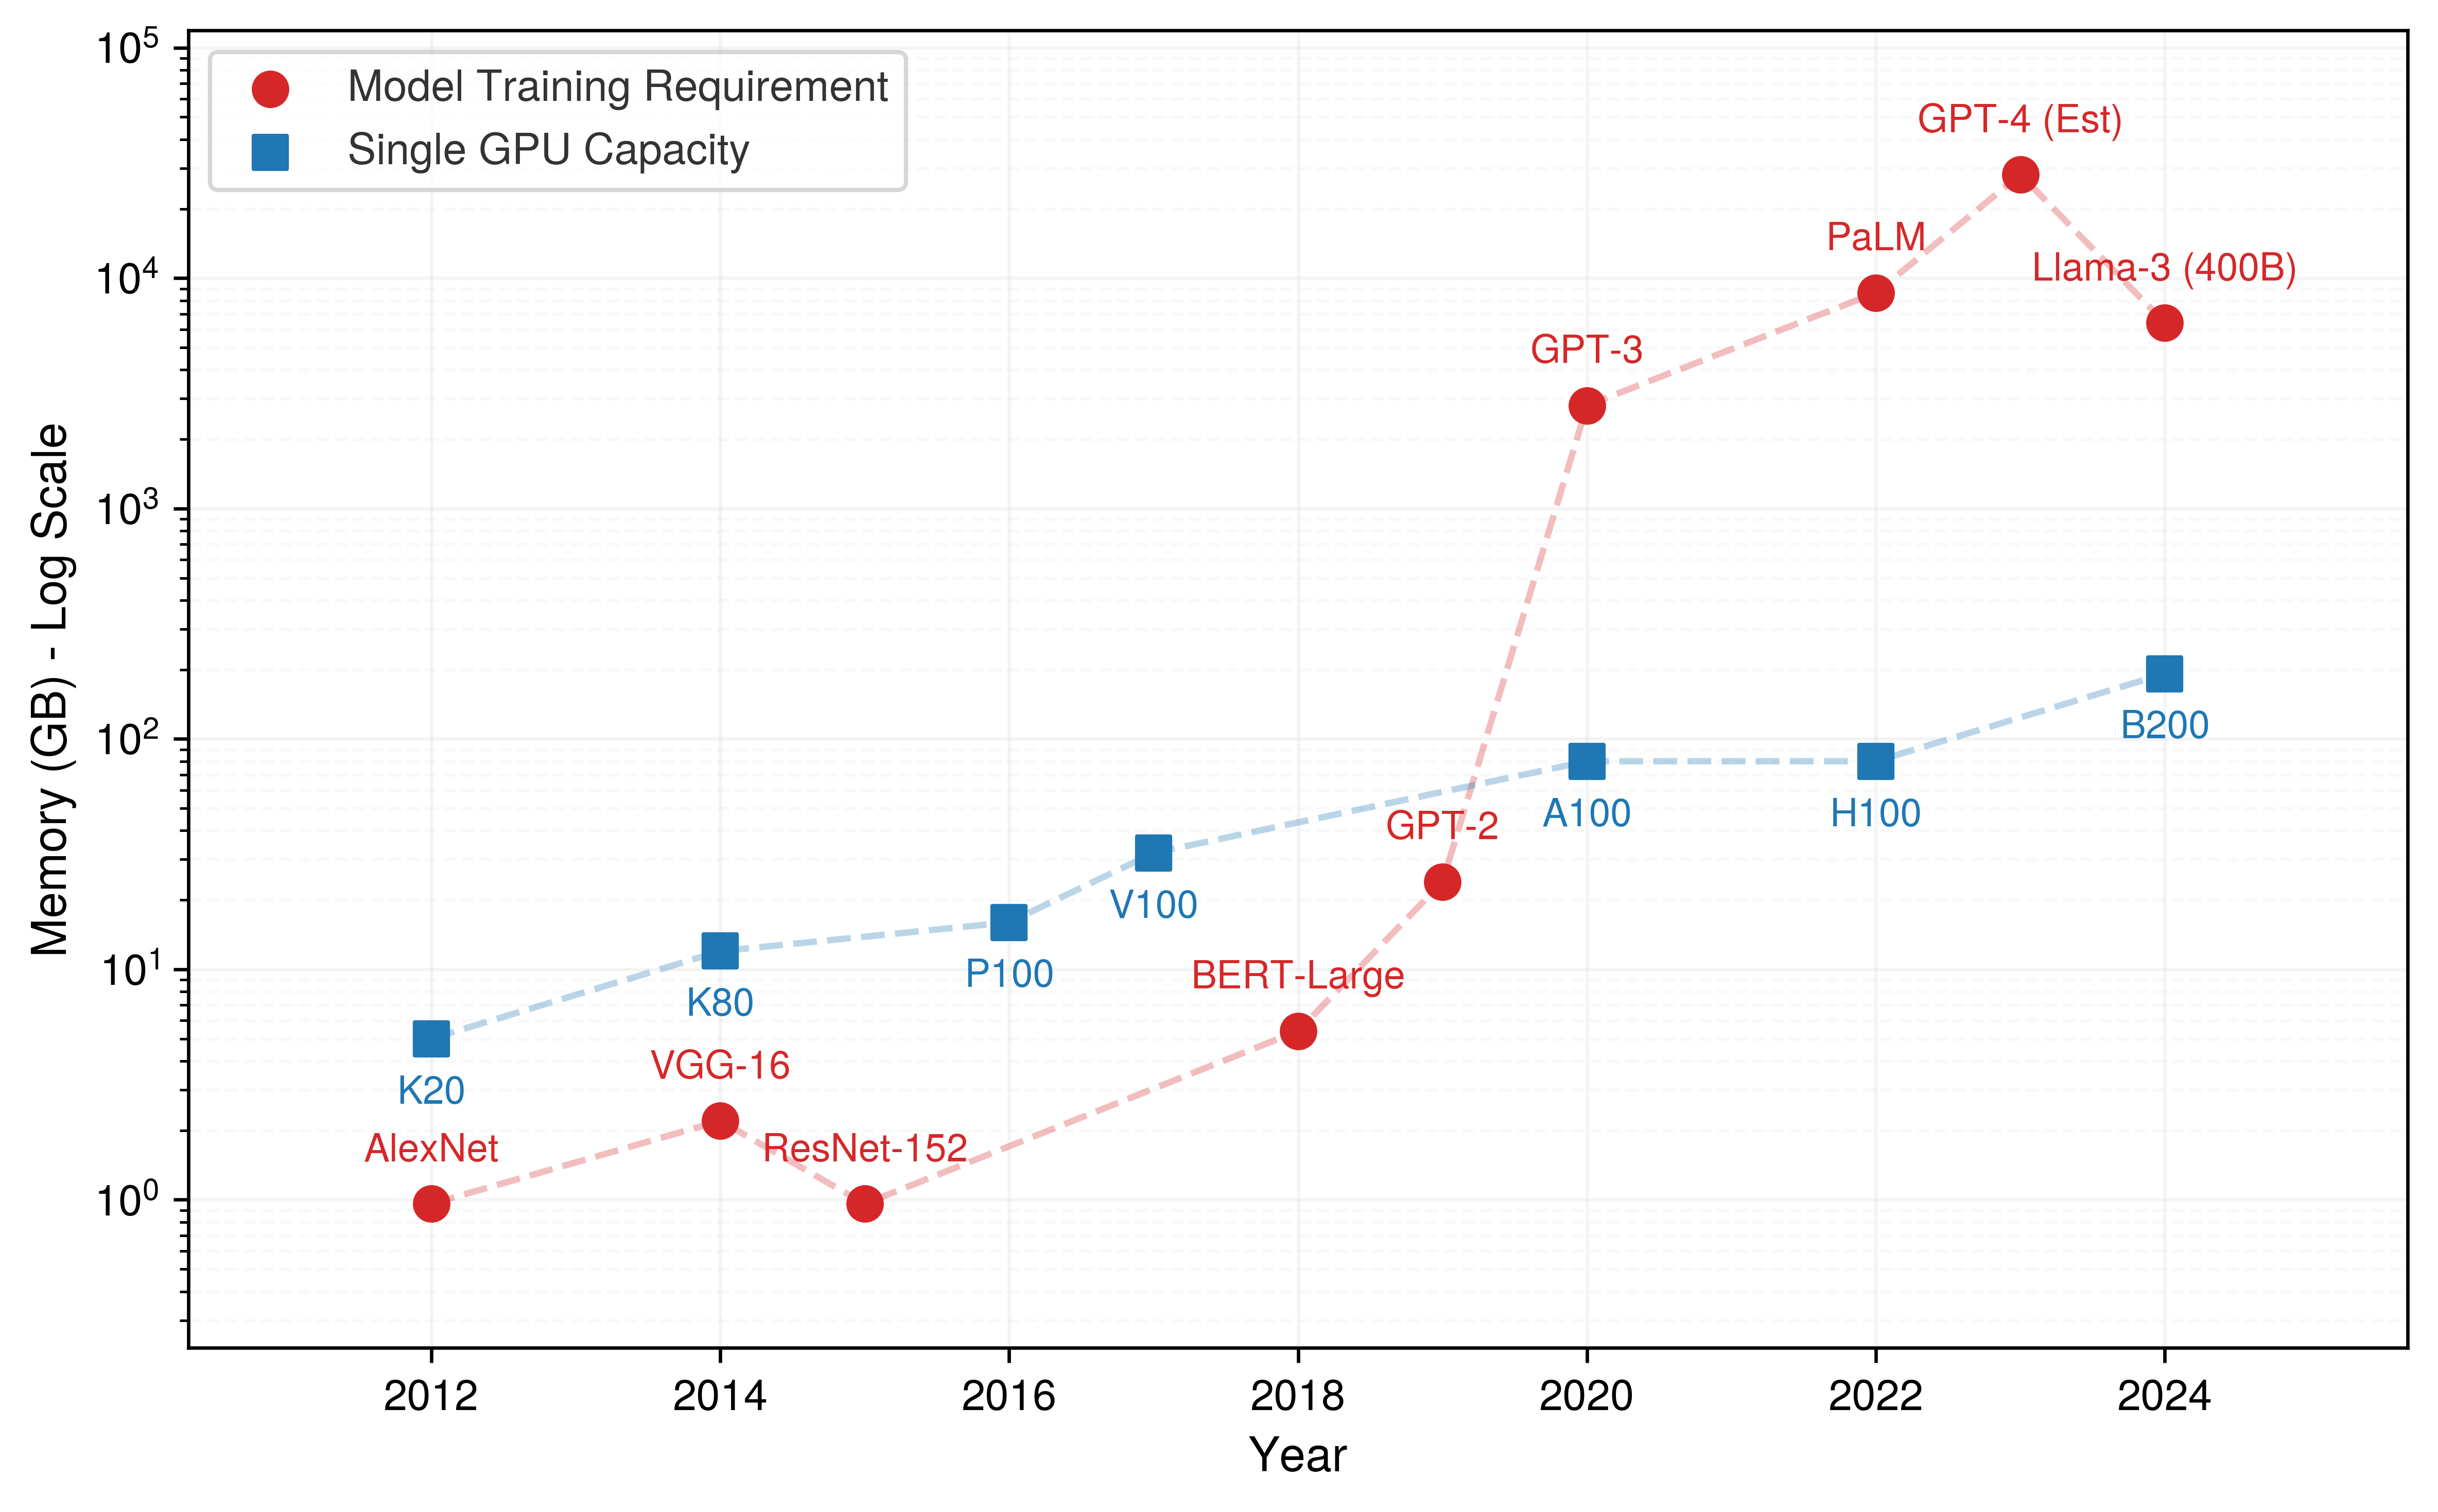
三个具体信号表明,分布式训练何时成为必要条件,而不仅仅是有益的选择。第一个信号是内存耗尽:模型参数、优化器状态和激活的存储需求超过单设备容量。对于使用自适应矩估计(Adam)的完整混合精度训练,仅参数、梯度和优化器状态的内存预算,就可能超过 80 GB 加速器的容量,此时参数量约为 50 亿,且尚未计入激活;更大的 10–20B 模型需要分片、卸载或其他节省内存的技术 (Rajbhandari 等 2020年)。假设来源溯源 记录了本章各项预算所采用的 80 GB H100 和 A100 容量数据,使读者能够将每个内存上限追溯至同一份有据可查的来源。
Brown, Tom B., Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared Kaplan, Prafulla Dhariwal, Arvind Neelakantan, 等. 2020年. 《Language Models are Few-Shot Learners》. Advances in Neural Information Processing Systems 33: 1877~901. https://doi.org/10.48550/arxiv.2005.14165.
第二个信号是无法接受的训练时长。即使模型能够装入单个设备,单设备训练也可能需要数周甚至数月才能收敛,使实际经过的时间本身成为系统约束。GPT-3 的 175B 参数训练使用了 V100 GPU 集群 (Brown 等 2020年),说明在这一规模下,时间要求与 HBM 容量一样,都会迫使训练采用分布式方式。
第三个信号是数据集规模。当训练数据达到数 TB 时,例如在大规模视觉或语言建模任务中,单台机器就不再是存储或输入吞吐量的自然单位。此时,分布式训练既用于向模型供给数据,也用于容纳模型。这三个信号都指向同一个结构性极限。图 1 直接呈现了这一极限:设备内存不断增长,而模型需求增长得更快,两者的交点就是分布式训练从优化手段变为先决条件的位置。
分布式训练的复杂度权衡
分布式训练引入了单机内部不存在的成本,从而改变了优化问题。三个复杂度维度决定了某种并行策略是否可行,因为其中任何一个都可能成为限制其扩展的上限。通信开销 是同步梯度的成本:对于一个具有 \(P\) 个参数、分布在 \(N\) 台设备上的模型,全归约操作每步必须传输约 \(2P(N-1)/N\) 个梯度值,再乘以每个梯度元素的字节数;在普通商用网络上,这一开销可能占据计算时间的主要部分。容错 随集群规模增大而愈发困难,因为单位时间内的预期故障数量随集群规模线性增长,而整个集群在某个时间区间内不发生任何故障的存活概率则呈指数衰减;如果一个包含 100 个节点的集群中,每个节点每小时的存活概率为 99.9 percent,那么集群级故障概率为每小时 9.5 percent,对应的平均故障间隔时间(MTBF)约为 10 hours。MTBF 级联 推导了从单节点存活概率到集群 MTBF 的这一连锁过程,并通过一个完整示例演示同样的计算,使读者能够复现这一推导,理解为什么 MTBF 会随集群规模增大而急剧下降。算法稳定性 是第三个维度,因为数据并行带来的大批次规模会影响收敛行为,需要采用单机训练不需要的学习率缩放和预热策略 (Goyal 等 2017年)。这些成本共同解释了为什么分布式训练是一个约束满足问题,而不是单纯增加硬件数量。
从单机到分布式训练的转变
为单机训练建立的系统化优化方法可以扩展到分布式环境,但需要进行重要调整。性能剖析除了采集计算和内存指标,还必须捕获设备间的通信模式与同步开销。解空间随之扩展,涵盖数据并行、模型并行、流水线并行以及混合方法。图 2 直观展示了这个三维配置空间。
\begin{tikzpicture}[
  font=\small\sffamily,
  >=Stealth,
  card/.style={
    rectangle,
    rounded corners=5pt,
    line width=0.8pt,
    inner sep=6pt,
    align=left,
    font=\footnotesize
  }
]

% Left Panel: 3D Parallelism Configuration Space (Oblique)
\begin{scope}[shift={(0.8, 0.8)}]

  \def\w{3.8}   % width (Tensor Parallel)
  \def\h{3.8}   % height (Pipeline Parallel)
  \def\dx{1.6}  % depth dx
  \def\dy{1.2}  % depth dy

  \def\nt{3} % tensor slices
  \def\np{3} % pipeline slices
  \def\nd{3} % data slices

  % 1. Hidden / Dashed Back Lines
  \draw[thick, dashed, gray!35] (\dx, \dy) -- (\w+\dx, \dy);
  \draw[thick, dashed, gray!35] (\dx, \dy) -- (\dx, \h+\dy);
  \draw[thick, dashed, gray!35] (\dx, \dy) -- (0, 0);

  % 2. Front Face (XY plane at Z=0): Tensor x Pipeline
  \fill[OrangeL!60] (0, 0) rectangle (\w, \h);

  % 3. Top Face (XZ plane at Y=\h): Tensor x Data
  \fill[GreenFill!90] (0, \h) -- (\dx, \h+\dy) -- (\w+\dx, \h+\dy) -- (\w, \h) -- cycle;

  % 4. Right Side Face (YZ plane at X=\w): Pipeline x Data
  \fill[BlueFill!50] (\w, 0) -- (\w+\dx, \dy) -- (\w+\dx, \h+\dy) -- (\w, \h) -- cycle;

  % Grid lines on Front Face (Tensor x Pipeline)
  \foreach \i in {1,2} {
    \draw[OrangeLine!45, line width=0.6pt] (\i*\w/\nt, 0) -- (\i*\w/\nt, \h);
    \draw[OrangeLine!45, line width=0.6pt] (0, \i*\h/\np) -- (\w, \i*\h/\np);
  }

  % Grid lines on Top Face (Tensor x Data)
  \foreach \i in {1,2} {
    \draw[GreenLine!45, line width=0.6pt]
      (\i*\w/\nt, \h) -- (\i*\w/\nt+\dx, \h+\dy);
    \draw[GreenLine!45, line width=0.6pt]
      (\i*\dx/\nd, \h+\i*\dy/\nd) -- (\w+\i*\dx/\nd, \h+\i*\dy/\nd);
  }

  % Grid lines on Right Side Face (Pipeline x Data)
  \foreach \i in {1,2} {
    \draw[BlueLine!45, line width=0.6pt]
      (\w, \i*\h/\np) -- (\w+\dx, \i*\h/\np+\dy);
    \draw[BlueLine!45, line width=0.6pt]
      (\w+\i*\dx/\nd, \i*\dy/\nd) -- (\w+\i*\dx/\nd, \h+\i*\dy/\nd);
  }

  % Solid Outer Edges of the Cube
  \draw[line width=1.1pt, Black!80] (0, 0) rectangle (\w, \h);
  \draw[line width=1.1pt, Black!80] (0, \h) -- (\dx, \h+\dy) -- (\w+\dx, \h+\dy) -- (\w, \h);
  \draw[line width=1.1pt, Black!80] (\w, 0) -- (\w+\dx, \dy) -- (\w+\dx, \h+\dy);

  % Highlight single GPU / Accelerator cell (front-top-right)
  \filldraw[draw=RedLine, fill=RedLine!25, line width=1.0pt]
    (2*\w/3, 2*\h/3) rectangle (\w, \h);
  \filldraw[draw=RedLine, fill=RedLine!30, line width=1.0pt]
    (2*\w/3, \h) -- (2*\w/3+\dx/3, \h+\dy/3) -- (\w+\dx/3, \h+\dy/3) -- (\w, \h) -- cycle;
  \filldraw[draw=RedLine, fill=RedLine!35, line width=1.0pt]
    (\w, 2*\h/3) -- (\w+\dx/3, 2*\h/3+\dy/3) -- (\w+\dx/3, \h+\dy/3) -- (\w, \h) -- cycle;

  % Device callout arrow and label
  \coordinate (devCenter) at (2.5*\w/3 + 0.5*\dx/3, \h + 0.5*\dy/3);
  \draw[->, line width=0.9pt, RedLine]
    (1.4, \h+\dy+0.6)
    node[above, font=\footnotesize\bfseries, text=RedLine] {Single accelerator coordinate $(t_i, p_j, d_k)$}
    to[out=-20, in=115] (devCenter);

  % Outer Dimension Vectors / Axis Arrows
  % 1. Tensor Parallel (Horizontal arrow below front face)
  \draw[<->, line width=1.2pt, OrangeLine] (0, -0.45) -- (\w, -0.45)
    node[midway, below=2pt, font=\bfseries\footnotesize, text=OrangeLine] {
      Tensor Parallel degree ($t$)
    };
  \draw[thin, OrangeLine!40] (0, -0.1) -- (0, -0.55);
  \draw[thin, OrangeLine!40] (\w, -0.1) -- (\w, -0.55);

  % 2. Pipeline Parallel (Vertical arrow along left of front face)
  \draw[<->, line width=1.2pt, GreenLine] (-0.45, 0) -- (-0.45, \h)
    node[midway, above=2pt, rotate=90, font=\bfseries\footnotesize, text=GreenLine] {
      Pipeline Parallel degree ($p$)
    };
  \draw[thin, GreenLine!40] (-0.1, 0) -- (-0.55, 0);
  \draw[thin, GreenLine!40] (-0.1, \h) -- (-0.55, \h);

  % 3. Data Parallel (Depth arrow extending back-right)
  \draw[<->, line width=1.2pt, BlueLine]
    (\w+0.25, -0.1) -- (\w+\dx+0.25, \dy-0.1)
    node[midway, below right=-2pt and -1pt, font=\bfseries\footnotesize, text=BlueLine, rotate=37] {
      Data Parallel ($d$)
    };
  \draw[thin, BlueLine!40] (\w+0.05, 0) -- (\w+0.35, -0.15);
  \draw[thin, BlueLine!40] (\w+\dx+0.05, \dy) -- (\w+\dx+0.35, \dy-0.15);

\end{scope}

% Right Panel: System Specification Cards
% Shifted from 8.0: the rotated "Data Parallel (d)" depth label reaches past
% x = 8 and its tail was hidden behind this column's first card.
\begin{scope}[shift={(9.0, 0.4)}]

  % Card 1: Total Devices Formula
  \node[card, draw=GreenLine, fill=GreenFill, text width=6.3cm] (cTotal) at (3.15, 5.5) {
    \centering\textbf{\normalsize\textcolor{GreenLine}{Total accelerators $N = d \times p \times t$}}\\[2pt]
    \scriptsize\textcolor{Black}{Example: $64 \times 16 \times 8 = 8{,}192$ accelerators in cluster}
  };

  % Card 2: 3D Dimensions Breakdown
  \node[card, draw=GrayL!80, fill=white, text width=6.3cm, below=7pt of cTotal] (cDesc) {
    \textbf{\textcolor{OrangeLine}{\ding{110}\; Tensor Parallelism ($t$)}}\\[1.5pt]
    \scriptsize Splits weight matrices within each layer (Megatron-LM style).\\
    \textbf{\scriptsize Network tier:} \textcolor{OrangeLine}{Intra-node NVLink (900--3,200 GB/s)}\\[5pt]

    \textbf{\textcolor{GreenLine}{\ding{110}\; Pipeline Parallelism ($p$)}}\\[1.5pt]
    \scriptsize Partitions consecutive layer stages across devices (1F1B schedule).\\
    \textbf{\scriptsize Network tier:} \textcolor{GreenLine}{Inter-node fabric (InfiniBand / RoCE 50--400 GB/s)}\\[5pt]

    \textbf{\textcolor{BlueLine}{\ding{110}\; Data Parallelism ($d$)}}\\[1.5pt]
    \scriptsize Replicates model weights; partitions global batch (ZeRO / DDP).\\
    \textbf{\scriptsize Collective:} \textcolor{BlueLine}{AllReduce / ReduceScatter over data replicas}
  };

  % Card 3: Hardware Placement Rule
  \node[card, draw=RedLine!70, fill=RedFill, text width=6.3cm, below=7pt of cDesc] (cRule) {
    \centering\textbf{\small\textcolor{RedLine}{Physical Topology Placement Invariant}}\\[3pt]
    \raggedright\scriptsize
    \textbf{$t$ (Tensor):} innermost domain (within single 8-GPU chassis over NVLink)\\[2pt]
    \textbf{$p$ (Pipeline):} intermediate domain (adjacent nodes within same rack)\\[2pt]
    \textbf{$d$ (Data):} outermost domain (across racks, clusters, or data centers)
  };

\end{scope}

\end{tikzpicture}
图 2 表明加速器总数为 \(N_{\text{total}} = d \times p \times t\)。坐标轴代表不同的数学划分,但它们并非彼此独立的配置旋钮。张量与流水线度数必须能够整除模型结构,数据并行度与微批次调度必须产生可行的全局批次,每个划分都必须适配内存,且每个通信组都必须映射到足够的拓扑与可接受的故障域。因此,训练系统会选择联合可行的坐标,而不是孤立地调整 \(d\)、\(p\) 和 \(t\)。
工程权衡:选择并行策略
选择合适的并行策略并非偏好问题,而是一个受参数数量 \((P)\)、批大小 \((B)\) 和互连带宽约束的约束满足问题。并行通信开销 量化了每种策略的并行通信开销,从而揭示出在给定硬件拓扑下哪些方法在物理上可行。
| 策略 | 通信模式 | 通信量 | 硬件约束 |
|---|---|---|---|
| 数据并行 (DP) | 全归约梯度 | \(\propto M_{\text{grad}}\)(梯度字节) | 需要高双划分带宽 |
| 张量并行 (TP) | 全归约激活值 | \(\propto B \times N_L\)(层) | 关键:需要 NVLink |
| 流水线并行 (PP) | 点对点 (P2P) | \(\propto B \times S \times d_{\text{model}}\)(激活值) | 带宽较低(以太网即可满足) |
带宽需求对硬件部署构成硬性约束:每种并行策略都必须匹配到需要通信的 GPU 之间可用的互连,否则设计在离开白板之前就会失败。一次粗略的带宽可行性估算可以在编写任何代码之前发现这种不匹配。
Systems Perspective 1.1: 带宽可行性检查
张量并行在通过标准以太网连接的服务器机柜之间扩展时将会卡死。通信量随批大小 \(B\) 和层数 \(N_L\) 增长。它需要 NVLink 的 600 GB/s–900 GB/s 级通信吞吐。对于跨机柜扩展,设计必须切换到流水线并行或数据并行,以尊重网络的物理特性。
图 3 将该约束满足过程形式化为决策树,展示模型规模与硬件拓扑如何决定可行的并行策略。
\begin{tikzpicture}[
  font=\sffamily,
  >=Stealth,
  decision/.style={
    diamond,
    aspect=2.2,
    draw=OrangeLine,
    fill=OrangeL,
    line width=1.1pt,
    inner sep=3pt,
    align=center,
    font=\bfseries\footnotesize,
    text=TextDark
  },
  card/.style={
    rectangle,
    rounded corners=5pt,
    draw=CardBorder,
    fill=white,
    line width=0.85pt,
    inner sep=6pt,
    align=left,
    text width=4.3cm,
    font=\scriptsize
  },
  badge/.style={
    rectangle,
    rounded corners=3pt,
    line width=0.7pt,
    inner sep=2pt,
    align=center,
    font=\bfseries\tiny
  },
  fabric chip/.style={
    rectangle,
    rounded corners=3pt,
    line width=0.65pt,
    inner sep=2.5pt,
    align=center,
    font=\scriptsize\bfseries,
    fill=white
  }
]

  % Decision Nodes
  \node[decision] (Q1) at (7.0, 8.2) {
    \textbf{\footnotesize 1. Model \& Activations}\\[1pt]
    \textbf{\footnotesize fit on 1 GPU?}
  };

  \node[decision] (Q2) at (12.2, 5.8) {
    \textbf{\footnotesize 2. Fits in 1 Node}\\[1pt]
    \textbf{\footnotesize ($\le 8$ GPUs)?}
  };

  \node[decision] (Q3) at (12.2, 2.9) {
    \textbf{\footnotesize 3. Sequential Depth /}\\[1pt]
    \textbf{\footnotesize Bubble Tolerable?}
  };

  % Outcome Cards
  % Column 1: Data Parallelism
  \node[card, draw=GreenLine!70, top color=GreenFill!50, bottom color=white] (DDP) at (1.8, 5.8) {
    {\normalsize\textcolor{GreenLine}{\textbf{Data Parallel (DDP)}}}\\[3pt]
    \textcolor{TextDark}{$\bullet$ Replicate weights on all GPUs}\\
    \textcolor{TextDark}{$\bullet$ Partition batch across workers}\\[5pt]
    \begin{tikzpicture}
      \node[fabric chip, draw=GreenLine, text=GreenLine, text width=4.0cm] {
        \ding{51}\; Fabric: Standard IB / RoCE
      };
    \end{tikzpicture}
  };

  \node[card, draw=BlueLine!70, top color=BlueFill!50, bottom color=white] (ZeRO) at (1.8, 2.4) {
    {\normalsize\textcolor{BlueLine}{\textbf{ZeRO / FSDP}}}\\[3pt]
    \textcolor{TextDark}{$\bullet$ Shard optimizer, grads, weights}\\
    \textcolor{TextDark}{$\bullet$ Eliminates memory redundancy}\\[5pt]
    \begin{tikzpicture}
      \node[fabric chip, draw=BlueLine, text=BlueLine, text width=4.0cm] {
        \ding{51}\; Fabric: AllGather + ReduceScatter
      };
    \end{tikzpicture}
  };

  % Column 2: Tensor & Pipeline Parallelism
  \node[card, draw=OrangeLine!80, top color=OrangeL!50, bottom color=white] (TP) at (7.0, 4.4) {
    {\normalsize\textcolor{OrangeLine}{\textbf{Tensor Parallel (TP)}}}\\[3pt]
    \textcolor{TextDark}{$\bullet$ Shard weight matrix columns/rows}\\
    \textcolor{TextDark}{$\bullet$ AllReduce at every linear layer}\\[5pt]
    \begin{tikzpicture}
      \node[fabric chip, draw=OrangeLine, text=OrangeLine, text width=4.0cm] {
        \ding{51}\; Fabric: Strictly NVLink (900 GB/s)
      };
    \end{tikzpicture}
  };

  \node[card, draw=GreenLine!80, top color=GreenFill!50, bottom color=white] (PP) at (7.0, 0.6) {
    {\normalsize\textcolor{GreenLine}{\textbf{Pipeline Parallel (PP)}}}\\[3pt]
    \textcolor{TextDark}{$\bullet$ Partition layer stages sequentially}\\
    \textcolor{TextDark}{$\bullet$ 1F1B micro-batch scheduling}\\[5pt]
    \begin{tikzpicture}
      \node[fabric chip, draw=GreenLine, text=GreenLine, text width=4.0cm] {
        \ding{51}\; Fabric: P2P over IB / Ethernet
      };
    \end{tikzpicture}
  };

  % Column 3: 3D Parallelism Fallback
  \node[card, draw=VioletLine!80, top color=VioletL!60, bottom color=white] (Hybrid3D) at (12.2, 0.6) {
    {\normalsize\textcolor{VioletLine}{\textbf{3D Parallelism (TP+PP+DP)}}}\\[3pt]
    \textcolor{TextDark}{$\bullet$ Combined scaling for $>100\text{B}$ params}\\
    \textcolor{TextDark}{$\bullet$ Intra TP $\times$ Inter PP $\times$ Outer DP}\\[5pt]
    \begin{tikzpicture}
      \node[fabric chip, draw=VioletLine, text=VioletLine, text width=4.0cm] {
        \ding{51}\; Fabric: Tiered NVLink + IB + DC
      };
    \end{tikzpicture}
  };

  % Branch Connectors
  % Branch 1: Q1 -> DDP (YES)
  \draw[->, line width=1.4pt, GreenLine] (Q1.west) -| (DDP.north);
  \node[badge, draw=GreenLine, fill=GreenFill, text=GreenLine] at (3.8, 8.2) {\textbf{Yes}};

  % Branch 1: Q1 -> Q2 (NO)
  \draw[->, line width=1.4pt, RedLine] (Q1.east) -| (Q2.north);
  \node[badge, draw=RedLine, fill=RedFill, text=RedLine] at (10.2, 8.2) {\textbf{No}};

  % Connector DDP -> ZeRO (Memory Pressure?)
  \draw[->, line width=1.2pt, BlueLine, dashed] (DDP.south) -- (ZeRO.north)
    node[midway, fill=BlueFill!80, draw=BlueLine!60, rounded corners=3pt, font=\scriptsize\bfseries, text=BlueLine, inner sep=2.5pt] {
      Memory pressure?
    };

  % Branch 2: Q2 -> TP (YES)
  \draw[->, line width=1.4pt, GreenLine] (Q2.west) -| (TP.north);
  \node[badge, draw=GreenLine, fill=GreenFill, text=GreenLine] at (9.2, 5.8) {\textbf{Yes}};

  % Branch 2: Q2 -> Q3 (NO)
  \draw[->, line width=1.4pt, RedLine] (Q2.south) -- (Q3.north);
  \node[badge, draw=RedLine, fill=RedFill, text=RedLine] at (12.6, 4.45) {\textbf{No}};

  % Branch 3: Q3 -> PP (YES)
  \draw[->, line width=1.4pt, GreenLine] (Q3.west) -| (PP.north);
  \node[badge, draw=GreenLine, fill=GreenFill, text=GreenLine] at (9.2, 2.9) {\textbf{Yes}};

  % Branch 3: Q3 -> Hybrid3D (NO)
  \draw[->, line width=1.4pt, RedLine] (Q3.south) -- (Hybrid3D.north);
  \node[badge, draw=RedLine, fill=RedFill, text=RedLine] at (12.6, 1.8) {\textbf{No}};

\end{tikzpicture}决策树表明,并行策略的选择并非偏好,而是物理约束的必然结果。这是一处约束层面的预览:并行通信开销 中的通信量公式说明了每种策略各自移动了什么,但其完整含义取决于本章后续展开的张量、流水线及混合并行机制。节 1.8 在这些机制就位后完成筛选。下一个问题是:这些约束如何塑造真实集群上一个分布式训练步骤的机制。
分布式训练步骤
将一个训练任务划分到加速器上,需要保持单个优化步骤的数学语义。核心挑战在于确保 1,024 个 GPU 在完全独立运行的情况下,在每个训练迭代结束时达成一致的一组严格数学意义上的更新权重。
Definition 1.1: 分布式训练
分布式训练 是一种训练方法,它将优化循环划分到多个计算节点(分发数据、模型层或单个张量操作),并通过同步通信原语协调各节点输出,从而产生一个连贯的模型。
- 重要性:当模型的内存需求超过单个加速器的容量时,分布式训练便成为必需。GPT-3(175B 参数)在 BF16 下约需 350 GB——超过单个 H100 的 80 GB 容量的 4\(\times\) 倍。仅做模型切分就需要至少 5 个 H100,而大规模运行可能需要数百甚至数千个加速器才能达到可接受的端到端时间。
- 区别:与单节点多线程(各核心共享一致的物理内存空间)不同,分布式训练将状态划分到互不相交的加速器内存中,因而需要借助互连结构上的显式集合通信原语来同步优化状态。
- 常见误区:一种常见误解是分布式训练随节点数线性扩展。实际上,通信开销随集群规模增长,且每个步骤的串行占比(Amdahl 定律)随之增加:若一个步骤的 30% 时间用于同步,则理论扩展上限为 \(1/0.30 \approx 3\times\),无论增加多少加速器。
一个有用的心智模型将这些分布式策略视为循环变换,即编译器用于优化顺序代码的同一套概念工具。如果我们把训练过程看作一个跨越数据与层的巨大循环,那么分布式策略就是集群级编译器施加的循环变换。逻辑训练循环嵌套了三个迭代器(轮次 epochs、批次 batches、层 layers),而每种并行策略只是将其中一个迭代器在设备间展开:
数据并行(data parallelism)是并行 for 循环,将外层循环(批次维度)在设备间展开,使每个设备在不同的数据索引上运行相同的代码体。张量并行(tensor parallelism)是向量化,即单指令多数据(SIMD),将内层循环(矩阵乘法)在集群级 SIMD 中划分到设备间,其中 NVLink 充当向量寄存器文件。流水线并行(pipeline parallelism)是指令流水线,将顺序操作(层)划分到设备间;正如 CPU 流水线将取指、译码和执行分阶段一样,集群将 Layer 1、Layer 2 和 Layer 3 分阶段,以保持所有计算引擎持续忙碌。
无论策略展开的是哪个循环,分布式训练1 都会将工作负载分散到必须协同训练单个模型的机器上。此处的协同意味着保持每个模型分片或副本都位于兼容的训练步骤上。基本的同步屏障可以维持小规模研究运行的有序性,但长周期训练任务还需要超时、检查点与恢复机制,以免单个失败的工作节点浪费数天的计算资源。容错 将深入探讨这些可靠性工程挑战。
1 分布式训练:Google 的 DistBelief(2012)是早期用于在数千台机器上训练神经网络的框架,但其参数服务器架构在中心节点产生了带宽瓶颈。这一局限推动了向后继框架(如 Horovod 和 PyTorch 的分布式数据并行 DDP)中去中心化的 AllReduce 模式的转变,其中复制的数据并行工作节点以每个工作节点 \(2(N-1)/N\) 的代价同步梯度,而非将流量集中在单个服务器上 Patarasuk 和 Yuan (2009年)。
Patarasuk, Pitch, 和 Xin Yuan. 2009年. 《Bandwidth optimal all-reduce algorithms for clusters of workstations》. Journal of Parallel and Distributed Computing 69 (2): 117~24. https://doi.org/10.1016/j.jpdc.2008.09.002.
2 NVLink: NVLink 是 NVIDIA 的点对点 GPU 互连,每个端口提供 600 GB/s–900 GB/s 的双向带宽,约为 24×–36× InfiniBand HDR。这一带宽差距正是张量并行被限制在节点内通信的原因——张量并行要求每一层都执行 AllReduce;而流水线并行与数据并行能够容忍较慢的节点间互连结构。
3 NCCL(NVIDIA Collective Communications Library): NCCL 提供跨 PCIe、NVLink、InfiniBand 和 IP 网络的拓扑感知 GPU 间集合通信原语,包括 AllReduce。当前 NCCL 部署通过运行时选择与调优控制暴露环(ring)、树(tree)等相关算法族,因此训练框架可以避免将所有流量都路由到最慢的节点间路径的朴素映射 (Jeaugey 2017年; NVIDIA 2026年)。
Jeaugey, Sylvain. 2017年. NCCL 2.0. GPU Technology Conference presentation.
NVIDIA. 2026年. NCCL User Guide.
每个扩展阶段都继承前一阶段所面临的挑战。单 GPU 训练只需本地内存管理以及前向/反向传播。扩展到同一节点内的多个 GPU 时,需要增加高带宽通信,通过 NVLink2 或经过 NCCL3 优化的 PCIe 来实现,同时保持单机容错与调度能力。
扩展到多节点训练增加了网络通信开销、容错要求以及集群编排。由于每个阶段都会叠加前一阶段的瓶颈,必须先优化单 GPU 性能再进行横向扩展,以免效率在集群中成倍衰减。尽管框架通过分片数据并行和通信库在很大程度上抽象了这些复杂性,但要高效实现分布式训练,仍然需要仔细的网络配置(InfiniBand 调优、拓扑感知路由)、通过集群调度器进行的基础设施管理,以及对非本地问题(如同步挂起、通信瓶颈)的调试。
尽管存在这种复杂性,核心工作流在机制上十分简单;真正的工程挑战在于如何在大规模下使其既快速又可靠。反复出现的成本是聚合各设备结果的梯度同步,该开销会随系统规模增长而累积,正如 节 1.3 所量化。
四种方法分别针对不同约束形态。数据并行将训练数据划分到各机器,同时每台机器保留完整的模型副本,因此对于能够装入单设备内存的模型,它是分布式训练最自然的起点。模型并行则将模型本身划分到各设备,用于参数超出单设备内存的情况。流水线并行将模型划分为顺序阶段,并发处理微批次,从而改善相对朴素模型并行的资源利用率。混合方法则整合多种策略,使训练能够在任何单一方法都会失效的规模上运行。每种策略都只在其前一种策略达到物理上限之后才成为必需。
数据并行
最简单的方案为每台 GPU 提供完整且完全相同的模型副本,并为其分配数据的一个独立切片。数据并行是分布式训练的自然起点,因为它对单设备训练循环的改动最少。
Definition 1.2: 数据并行
数据并行 是一种分布式训练策略:每个工作节点持有完整的模型副本,处理微批次的独立分片,随后通过 AllReduce 同步梯度更新,使所有副本在每一步都应用完全相同的参数变化。
- 重要性:当 \(N\) 个工作节点各自处理批次大小 \(B\) 时,有效全局批次大小为 \(N \times B\),吞吐量线性扩展,同时保持每个工作节点的内存不变。对于一个 1B 参数、BF16 下占用 2 GB 的模型,1,024 个工作节点可实现 1,024\(\times\) 倍的单 GPU 吞吐量——直到每步的梯度 AllReduce(每个工作节点 2 GB,环最优 \(2(N-1)/N\))超过反向传播计算时间并形成通信瓶颈。
- 区别:与模型并行和流水线并行(将网络的层或操作在加速器之间划分)不同,数据并行会在所有工作节点间复制整个模型,仅划分训练数据集,并在每次反向传播后执行梯度同步。
- 常见误区:一种常见误解是数据并行会随工作节点数量无限扩展。当有效批次大小 \(B\) 超过随工作负载决定的临界批次大小时,统计效率会下降,需要更多训练步骤才能达到目标损失,从而削弱因增加工作节点而获得的吞吐量收益 (Shallue 等 2019年)。
每个设备使用其分配的数据子集训练完整的模型副本。例如,使用 4 个 GPU 对 100 万张图像进行图像分类训练时,每个 GPU 处理 250,000 张图像,同时保持完全相同的模型架构副本。
数据并行在数据集规模较大而模型规模仍然可控时最为有效,因为每个设备都必须将完整模型副本保存在内存中。该方法在图像分类和自然语言处理中广泛应用,因为数据集可以并行处理,且数据样本之间不存在依赖关系。例如,在 ImageNet 上训练 ResNet 模型 (He 等 2016年) 时,每个 GPU 可以独立处理其对应部分的图像,因为单张图像的分类结果不依赖于其他图像的结果。
He, Kaiming, Xiangyu Zhang, Shaoqing Ren, 和 Jian Sun. 2016年. 《Deep Residual Learning for Image Recognition》. 2016 IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 770~78. https://doi.org/10.1109/cvpr.2016.90.
数据并行的有效性源于随机梯度下降(SGD)的一个性质:在不同 minibatch 上计算出的梯度可以取平均,同时保持与单设备训练在数学上的等价性。这一性质使得设备之间能够进行并行计算,其数学基础直接来自期望的线性性。
考虑一个参数为 \(\theta\) 的模型,在数据集 \(D\) 上进行训练。单个数据点 \(x_i\) 的损失函数为 \(\mathcal{L}(\theta, x_i)\)。在标准 SGD、batch size 为 \(B\) 的情况下,minibatch 的梯度更新为: \[ g = \frac{1}{B} \sum_{i=1}^B \nabla_{\theta} \mathcal{L}(\theta, x_i) \]
在使用 \(N\) 个设备的数据并行中,每个设备 \(k\) 都在各自的小批量 \(B_k\) 上计算梯度: \[ g_k = \frac{1}{|B_k|} \sum_{x_i \in B_k} \nabla_{\theta} \mathcal{L}(\theta, x_i) \]
当所有 worker 使用相同的本地 batch size 时,全局更新对这些本地梯度取平均: \[ g_{\text{global}} = \frac{1}{N} \sum_{k=1}^N g_k \]
在该等批次假设下,平均操作在数学上等价于在合并批次 \(B_{\text{total}} = \bigcup_{k=1}^N B_k\) 上计算梯度: \[ g_{\text{global}} = \frac{1}{|B_{\text{total}}|} \sum_{x_i \in B_{\text{total}}} \nabla_{\theta} \mathcal{L}(\theta, x_i) \]
对于不相等的局部批量大小,合并批量的梯度是加权平均值 \(g_{\text{global}} = (1/|B_{\text{total}}|)\sum_k |B_k|g_k\)。这一等价性说明了数据并行为何能够保持 SGD 训练的统计性质:跨设备采样预期的全局批量,独立计算局部梯度之和,再用汇总后的分母进行归一化,即可复现其估计量。归约步骤对局部梯度之和及有效样本数执行全归约(AllReduce);AllReduce 推导了环形和树形 AllReduce 的成本模型,这些模型决定了此次同步的代价,使读者能够预测同步开销何时会超过并行所节省的局部计算成本。
Checkpoint 1.1: 数据并行机制
检验你对数据并行如何分配工作的理解:
该方法与梯度累积类似:单个设备在多次前向传播过程中累积梯度,然后更新参数。两种技术都利用梯度的可加性来高效处理大批量。然而,将同一思路应用于集群会带来超出这一理论等价性范围的运行挑战。通信开销、节点故障和成本约束各自都会产生单机推导未能涵盖的二阶效应。
数据并行实现
实现细节至关重要,因为只有当每个阶段都保持预期的整体采样和加权方式、完整的局部梯度贡献以及一次同步更新时,SGD 等价性才成立。因此,具体工作流程沿着从分配局部批量到同步所计算梯度的路径展开。图 4 展示了五阶段数据并行执行流水线,说明相同的模型副本如何接收互不重叠的批量分片、独立计算局部梯度,并在集合归约屏障处汇合,随后执行一致的权重更新。
\begin{tikzpicture}[
  font=\sffamily,
  >=Stealth,
  phase header/.style={
    font=\bfseries\footnotesize,
    text=NavyBlue,
    align=center
  },
  batch box/.style={
    rectangle,
    rounded corners=5pt,
    draw=OrangeLine,
    fill=OrangeL,
    line width=0.9pt,
    align=center,
    font=\footnotesize
  },
  mini box/.style={
    rectangle,
    rounded corners=3.5pt,
    draw=SteelBlue,
    fill=LightBlue,
    line width=0.8pt,
    align=center,
    font=\scriptsize
  },
  step box/.style={
    rectangle,
    rounded corners=3pt,
    line width=0.7pt,
    align=center,
    font=\scriptsize
  },
  grad box/.style={
    rectangle,
    rounded corners=3pt,
    draw=DarkGreen,
    fill=GreenFill,
    line width=0.8pt,
    align=center,
    font=\scriptsize\bfseries,
    text=DarkGreen
  },
  update box/.style={
    rectangle,
    rounded corners=4pt,
    draw=SteelBlue,
    fill=LightBlue!60,
    line width=0.8pt,
    align=center,
    font=\scriptsize
  }
]

  % Phase Columns & Headers
  \node[phase header] at (0.8, 8.5) {1. Global\\[1pt]Batch};
  \node[phase header] at (2.6, 8.5) {2. Sharded\\[1pt]Inputs};
  \node[phase header] at (6.0, 8.5) {3. Local Compute\\[1pt](Forward / Backward per GPU)};
  \node[phase header] at (10.4, 8.5) {4. Collective\\[1pt]Sync};
  \node[phase header] at (14.2, 8.5) {5. Weight\\[1pt]Update};

  % Vertical guide separators
  \draw[dashed, gray!30, thin] (1.7, 8.9) -- (1.7, 0.4);
  \draw[dashed, gray!30, thin] (3.6, 8.9) -- (3.6, 0.4);
  \draw[dashed, gray!30, thin] (8.5, 8.9) -- (8.5, 0.4);
  \draw[dashed, gray!30, thin] (12.3, 8.9) -- (12.3, 0.4);

  % Phase 1: Global Batch
  \node[batch box, minimum width=1.4cm, minimum height=4.8cm] (GB) at (0.8, 4.4) {
    \textbf{Global}\\[2pt]
    \textbf{Batch}\\[5pt]
    \small $B = 128$\\[2pt]
    \scriptsize samples
  };

  % 4 GPU Swimlanes
  \foreach \i/\y in {0/6.8, 1/5.2, 2/3.6, 3/2.0} {

    % Phase 2: Sharded Mini-batch
    \node[mini box, minimum width=1.6cm, minimum height=0.95cm] (MB\i) at (2.6, \y) {
      \textbf{Mini-batch \i}\\[1pt]
      \tiny $B_i = 32$ samples
    };

    % Phase 3: GPU Compute Blocks
    \node[anchor=south west, font=\tiny\bfseries, fill=NavyBlue, text=white, rounded corners=1.5pt, inner sep=1.5pt]
      at (3.85, \y+0.32) {GPU \i};

    \node[step box, draw=SteelBlue!80, fill=LightBlue, minimum width=1.05cm, minimum height=0.68cm] (FWD\i) at (4.45, \y) {
      \textbf{\scriptsize Fwd}
    };

    \node[step box, draw=RedLine!70, fill=RedFill, minimum width=0.85cm, minimum height=0.68cm] (LOSS\i) at (5.6, \y) {
      \textbf{\scriptsize Loss}
    };

    \node[step box, draw=OrangeLine!80, fill=OrangeL, minimum width=1.05cm, minimum height=0.68cm] (BWD\i) at (6.75, \y) {
      \textbf{\scriptsize Bwd}
    };

    \node[grad box, minimum width=0.85cm, minimum height=0.68cm] (GRAD\i) at (7.95, \y) {
      $g_\i$
    };

    \draw[->, line width=0.7pt, gray!70] (MB\i.east) -- (FWD\i.west);
    \draw[->, line width=0.7pt, gray!70] (FWD\i.east) -- (LOSS\i.west);
    \draw[->, line width=0.7pt, gray!70] (LOSS\i.east) -- (BWD\i.west);
    \draw[->, line width=0.75pt, DarkGreen] (BWD\i.east) -- (GRAD\i.west);

    % Phase 5: Weight Update Block
    \node[update box, minimum width=2.5cm, minimum height=0.95cm] (UPD\i) at (14.2, \y) {
      \textbf{GPU \i: Update}\\[1.5pt]
      $\theta \leftarrow \theta - \eta \cdot \bar{g}$
    };
  }

  % Connect Global Batch to Mini-batches
  \draw[->, line width=0.9pt, OrangeLine] (GB.east) -- ++(0.25, 0) |- (MB0.west);
  \draw[->, line width=0.9pt, OrangeLine] (GB.east) -- ++(0.25, 0) |- (MB1.west);
  \draw[->, line width=0.9pt, OrangeLine] (GB.east) -- ++(0.25, 0) |- (MB2.west);
  \draw[->, line width=0.9pt, OrangeLine] (GB.east) -- ++(0.25, 0) |- (MB3.west);

  % Phase 4: AllReduce Collective Hub
  \node[
    rectangle,
    rounded corners=6pt,
    draw=DarkGreen,
    fill=GreenFill!85,
    line width=1.1pt,
    inner sep=6pt,
    align=center,
    minimum width=3.4cm,
    minimum height=3.8cm
  ] (AR) at (10.4, 4.4) {
    \textbf{\small AllReduce}\\[2pt]
    \scriptsize Ring Topology\\[5pt]
    \normalsize$\bar{g} = \frac{1}{N}\sum_{i=0}^{N-1} g_i$\\[5pt]
    \scriptsize Comm Volume:\\[1pt]
    $\frac{2(N-1)}{N}|P|$\\[6pt]
    \begin{tikzpicture}
      \draw[DarkGreen, line width=1.0pt] (0,0) circle (0.35cm);
      \foreach \ang in {0, 90, 180, 270} {
        \fill[DarkGreen] (\ang:0.35cm) circle (1.8pt);
      }
    \end{tikzpicture}
  };

  % Gradient arrows to AllReduce
  \coordinate (ARin0) at ($(AR.north west)!0.18!(AR.south west)$);
  \coordinate (ARin1) at ($(AR.north west)!0.38!(AR.south west)$);
  \coordinate (ARin2) at ($(AR.north west)!0.62!(AR.south west)$);
  \coordinate (ARin3) at ($(AR.north west)!0.82!(AR.south west)$);

  \draw[->, line width=0.9pt, DarkGreen] (GRAD0.east) -- ++(0.35, 0) |- (ARin0);
  \draw[->, line width=0.9pt, DarkGreen] (GRAD1.east) -- ++(0.5, 0) |- (ARin1);
  \draw[->, line width=0.9pt, DarkGreen] (GRAD2.east) -- ++(0.5, 0) |- (ARin2);
  \draw[->, line width=0.9pt, DarkGreen] (GRAD3.east) -- ++(0.35, 0) |- (ARin3);

  % Synchronized gradient broadcast arrows to Updates
  \coordinate (ARout0) at ($(AR.north east)!0.18!(AR.south east)$);
  \coordinate (ARout1) at ($(AR.north east)!0.38!(AR.south east)$);
  \coordinate (ARout2) at ($(AR.north east)!0.62!(AR.south east)$);
  \coordinate (ARout3) at ($(AR.north east)!0.82!(AR.south east)$);

  \draw[->, line width=0.9pt, SteelBlue] (ARout0) -- ++(0.35, 0) |- (UPD0.west);
  \draw[->, line width=0.9pt, SteelBlue] (ARout1) -- ++(0.5, 0) |- (UPD1.west);
  \draw[->, line width=0.9pt, SteelBlue] (ARout2) -- ++(0.5, 0) |- (UPD2.west);
  \draw[->, line width=0.9pt, SteelBlue] (ARout3) -- ++(0.35, 0) |- (UPD3.west);

  % Footer: Synchronization Invariant
  \node[
    rectangle,
    rounded corners=4pt,
    draw=DarkGreen!70,
    fill=GreenFill!50,
    line width=0.8pt,
    inner sep=5.5pt,
    align=center,
    text width=14.8cm
  ] at (7.6, 0.7) {
    \textbf{\footnotesize Exact Synchronization Invariant:}\;
    \scriptsize Synchronized gradient averaging guarantees that all $N$ workers maintain identical parameters:\;
    $\theta^{(t+1)}_0 = \theta^{(t+1)}_1 = \theta^{(t+1)}_2 = \theta^{(t+1)}_3$.
  };

\end{tikzpicture}关键同步点出现在第 4 阶段(图 4),即全归约(AllReduce)集合通信必须在所有工作器秩完成,任何设备才能执行其参数更新,从而将网络二分带宽确立为绑定的扩展瓶颈。
数据集划分
数据划分是 SGD 等价性可能首先失效的地方,但唯一性与等大小分片只是充分条件,而非不变量本身。聚合示例或 token、它们的采样概率以及它们的梯度权重必须重现预期的全局批次估计器。无放回均匀采样可以分配互不相交的分片;有放回采样可以合法地重复示例;可变长度批次若按每个工作器的有效示例数或有效 token 数作为归约权重,则可以分配不等的 token 数。对不等的局部均值取不加权平均,反而会过度加权分母较小的工作器。
因此,采样器是训练系统的一部分,而不仅是输入加载的便利设施。分布式采样器按秩协调工作器,并可从带种子的采样流中确定性划分或抽取索引。对于一个 120 万示例的数据集,均匀分布在 32 个 GPU 上时,每个 GPU 每轮处理约 37,500 个示例。若采样器通过重复示例来补齐最后一个批次,则在精确的轮次级加权具有意义时,损失归一化或样本权重必须对这些重复加以考虑。已记录的种子与确定性索引流使样本分配可重复;位级运行可复现性还额外依赖于内核确定性、集合归约顺序、数值精度以及检查点化的随机数生成器状态。
计算阶段:前向与反向传播
数据并行的定义性特征是:前向与反向两个计算阶段都是平凡并行的。每台 GPU 作为彼此隔离的孤岛运行,在其分配的 microbatch 上执行模型的同拷贝。此处,microbatch 指用于激活计数的每台 GPU 的本地切片;流水线 microbatching 则使用同一术语指代另一种机制,即将全局批次切分以维持流水线各阶段保持占用。对于我们的 175B 参数参考模型,这种隔离至关重要:在前向传播过程中,每台 GPU 独立计算其本地批次(microbatch 大小 4,序列长度 2048)的激活。若无优化,为反向传播存储这些激活将消耗约 1.1 TB 的 HBM,其量级甚至超过 H100 GPU 的容量。激活检查点化(在反向传播期间重新计算激活而非存储它们)在此场景下变得必要,可将占用量抑制到 ~19.3 GB。
容量测试必须包含激活,而不能只统计每参数字节数。在峰值驻留点, \[ M_{\text{total}} = M_{\text{weights}} + M_{\text{gradients}} + M_{\text{optimizer}} + M_{\text{activations}}, \] with communication buffers and temporary workspaces consuming additional headroom. Sharding reduces the first three terms according to its stage, whereas sequence length, local microbatch size, and pipeline scheduling govern \(M_{\text{activations}}\). Activation checkpointing reduces that last term by retaining only selected boundaries and recomputing the omitted forward operators during backpropagation (Narayanan 等 2021年). The memory saved is therefore purchased with additional FLOPs and a longer critical path; a feasible parallelism plan must budget both effects.
Narayanan, Deepak, Mohammad Shoeybi, Jared Casper, Patrick LeGresley, Mostofa Patwary, Vijay Korthikanti, Dmitri Vainbrand, 等. 2021年. 《Efficient large-scale language model training on GPU clusters using Megatron-LM》. Proceedings of the International Conference for High Performance Computing, Networking, Storage and Analysis, 1~15. https://doi.org/10.1145/3458817.3476209.
The backward pass mirrors this independence but introduces the system’s primary bottleneck. As the GPU traverses the computation graph in reverse, it computes gradients for the parameters held by that replica or shard. Under pure data parallelism, a full 175B FP16 replica would imply a 350 GB gradient tensor per worker, which exceeds single-accelerator memory budgets; large runs therefore combine data parallelism with sharding, tensor parallelism, or pipeline parallelism. The computation itself requires zero communication, yet the resulting gradients represent a fractured view of the true loss surface, valid only for the local micro-batch. Before the optimizer step can occur, the corresponding local gradients or gradient shards must be aggregated across data-parallel workers to form a valid global update. The transition from isolated, high-throughput compute to synchronization defines the rhythm of data parallel training: long periods of silent, intense arithmetic punctuated by bursts of heavy network traffic.
梯度同步
梯度同步是将各个独立的 SGD 估计合并为一次更新之处,因此其开销决定了数据并行是否仍然表现为一种扩展策略,而非一次网络基准测试。训练的直接要求很简单:每个数据并行副本必须在进入下一步之前应用相同的平均梯度。AllReduce 是执行该操作的基元:每个 worker 贡献其本地梯度张量,fleet 对张量求和,每个 worker 都收到相同的归约结果。在分片变体中,ReduceScatter 和 AllGather 在每个设备上移动对应的分片而非完整张量,但同步开销依然相同。小张量由同步延迟主导,因为每次通信轮次都有启动开销;大张量则由带宽主导,因为相关的梯度载荷必须跨越链路。 集合通信 后续将推导在真实互连结构上实现该平均操作的环状、树状和分层算法。
当同步性能偏离理论预期时,fleet stack 框架提供了一种结构化方法来隔离瓶颈。
Example 1.1: 调试缓慢的梯度同步
场景:一个 3 GB 梯度张量在 128 nodes(1,024 GPUs)之间的 AllReduce 耗时为 100 ms。
诊断:延迟明显低于 239.8 ms 环形全归约的理论下界,表明 NCCL 采用了分层算法。然而,交换机计数器显示,节点间的 InfiniBand 链路利用率仅为 60 percent,原因是上行链路拥塞。
系统经验:调试集合通信需要把物理链路利用率与算法性下界结合起来评估。48.5 ms 的理论延迟与 100 ms 的实际观测延迟之间的差距源于网络互连结构的上行链路争用,因此需要采用针对链路优化的拓扑,而非修改算法。
回到该具体集群,从设计空间的角度看,图 5 对比了三种高层同步拓扑:带宽最优的环形 AllReduce、集中式的参数服务器,以及全连接的全对全网格。在稠密同步数据并行场景中,环形 AllReduce 可以通过将流量均匀分配到参与链路上,避免单个归约器形成瓶颈,百度(Baidu)的实现便是如此 (Gibiansky 2017年)。
Gibiansky, A. 2017年. Bringing HPC Techniques to Deep Learning. Baidu Research Technical Blog.
\begin{tikzpicture}[
  font=\sffamily,
  >=Stealth,
  panel title/.style={
    font=\bfseries\footnotesize,
    text=TextDark,
    align=center
  },
  node box/.style={
    rectangle,
    rounded corners=3.5pt,
    line width=0.8pt,
    align=center,
    font=\scriptsize\bfseries,
    inner sep=3pt
  },
  card/.style={
    rectangle,
    rounded corners=5pt,
    line width=0.85pt,
    inner sep=6pt,
    align=left,
    text width=4.3cm,
    font=\scriptsize
  },
  status badge/.style={
    rectangle,
    rounded corners=3pt,
    line width=0.65pt,
    align=center,
    font=\bfseries\scriptsize,
    inner sep=3pt
  }
]

  % Color definitions
  \definecolor{NavyBlue}{RGB}{20,45,85}
  \definecolor{SteelBlue}{RGB}{40,90,140}
  \definecolor{LightBlue}{RGB}{240,245,252}
  \definecolor{RedLine}{RGB}{185,45,45}
  \definecolor{RedFill}{RGB}{253,242,242}
  \definecolor{GreenLine}{RGB}{35,135,75}
  \definecolor{GreenFill}{RGB}{240,249,244}
  \definecolor{DarkGreen}{RGB}{20,110,60}
  \definecolor{OrangeLine}{RGB}{215,105,15}
  \definecolor{OrangeL}{RGB}{254,246,233}
  \definecolor{VioletLine}{RGB}{125,45,150}
  \definecolor{VioletL}{RGB}{248,240,252}
  \definecolor{CardBorder}{RGB}{215,222,230}
  \definecolor{CardFill}{RGB}{248,250,253}
  \definecolor{TextDark}{RGB}{25,35,45}
  \definecolor{TextMuted}{RGB}{95,105,115}

  % ===========================================================
  % VERTICAL SEPARATORS
  % ===========================================================
  \draw[dashed, gray!30, thin] (5.125, 7.8) -- (5.125, 0.1);
  \draw[dashed, gray!30, thin] (10.275, 7.8) -- (10.275, 0.1);

  % ===========================================================
  % PANEL (a): RING ALLREDUCE
  % ===========================================================
  \node[panel title] at (2.55, 7.55) {\textbf{(a) Ring AllReduce}};

  % 4 GPU Nodes: 0 -> 1 -> 2 -> 3 -> 0
  \node[node box, draw=SteelBlue, fill=LightBlue, minimum width=1.35cm, minimum height=0.75cm] (R_G0) at (1.4, 6.15) {GPU 0};
  \node[node box, draw=SteelBlue, fill=LightBlue, minimum width=1.35cm, minimum height=0.75cm] (R_G1) at (3.7, 6.15) {GPU 1};
  \node[node box, draw=SteelBlue, fill=LightBlue, minimum width=1.35cm, minimum height=0.75cm] (R_G2) at (3.7, 4.35) {GPU 2};
  \node[node box, draw=SteelBlue, fill=LightBlue, minimum width=1.35cm, minimum height=0.75cm] (R_G3) at (1.4, 4.35) {GPU 3};

  % Clockwise ring arrows
  \draw[->, line width=1.2pt, SteelBlue] (R_G0.east) -- (R_G1.west)
    node[midway, above=1pt, font=\tiny\bfseries, text=SteelBlue] {chunk 0};
  \draw[->, line width=1.2pt, SteelBlue] (R_G1.south) -- (R_G2.north)
    node[midway, right=1pt, font=\tiny\bfseries, text=SteelBlue] {chunk 1};
  \draw[->, line width=1.2pt, SteelBlue] (R_G2.west) -- (R_G3.east)
    node[midway, below=1pt, font=\tiny\bfseries, text=SteelBlue] {chunk 2};
  \draw[->, line width=1.2pt, SteelBlue] (R_G3.north) -- (R_G0.south)
    node[midway, left=1pt, font=\tiny\bfseries, text=SteelBlue] {chunk 3};

  % Card (a)
  \node[card, draw=SteelBlue!80, fill=white, minimum height=2.45cm] (CARD_A) at (2.55, 2.05) {
    \centering\textbf{\normalsize\textcolor{SteelBlue}{Bandwidth Optimal}}\\[5pt]
    \raggedright
    \textbf{Volume:} $\tfrac{2(N-1)}{N} M$ per GPU\\[3pt]
    \textbf{Latency:} $2(N-1)$ network steps\\[3pt]
    \textbf{BW Util.:} \textcolor{DarkGreen}{\textbf{$\approx 100\%$}} full bidirectional
  };
  \node[status badge, draw=SteelBlue, fill=LightBlue, text=SteelBlue, minimum width=4.3cm, minimum height=0.52cm] at (2.55, 0.45) {
    \ding{51}\; Default for NCCL \& PyTorch DDP
  };

  % ===========================================================
  % PANEL (b): PARAMETER SERVER
  % ===========================================================
  \node[panel title] at (7.7, 7.55) {\textbf{(b) Parameter Server}};

  % Central Bottleneck Badge
  \node[status badge, draw=RedLine, fill=RedFill, text=RedLine, font=\bfseries\tiny, inner sep=2pt] at (7.7, 7.12) {
    Central Bottleneck
  };

  % Parameter Server Node
  \node[node box, draw=RedLine, fill=RedFill, minimum width=2.4cm, minimum height=0.75cm] (PS) at (7.7, 6.15) {
    \textbf{Parameter Server}
  };

  % 4 Workers
  \node[node box, draw=DarkGreen, fill=GreenFill, minimum width=0.85cm, minimum height=0.65cm] (W0) at (6.0, 4.35) {W0};
  \node[node box, draw=DarkGreen, fill=GreenFill, minimum width=0.85cm, minimum height=0.65cm] (W1) at (7.1, 4.35) {W1};
  \node[node box, draw=DarkGreen, fill=GreenFill, minimum width=0.85cm, minimum height=0.65cm] (W2) at (8.3, 4.35) {W2};
  \node[node box, draw=DarkGreen, fill=GreenFill, minimum width=0.85cm, minimum height=0.65cm] (W3) at (9.4, 4.35) {W3};

  % Clean Bidirectional Push/Pull Links
  \draw[<->, line width=1.1pt, RedLine!85] (W0.north) -- (PS.210);
  \draw[<->, line width=1.1pt, RedLine!85] (W1.north) -- (PS.235);
  \draw[<->, line width=1.1pt, RedLine!85] (W2.north) -- (PS.305);
  \draw[<->, line width=1.1pt, RedLine!85] (W3.north) -- (PS.330);

  % Flow Badges
  \node[font=\tiny\bfseries, text=RedLine, fill=white, inner sep=1pt, rounded corners=1pt] at (6.25, 5.35) {push grads $\uparrow$};
  \node[font=\tiny\bfseries, text=SteelBlue, fill=white, inner sep=1pt, rounded corners=1pt] at (9.15, 5.35) {pull params $\downarrow$};

  % Card (b)
  \node[card, draw=RedLine!80, fill=white, minimum height=2.45cm] (CARD_B) at (7.7, 2.05) {
    \centering\textbf{\normalsize\textcolor{RedLine}{Centralized (Legacy)}}\\[5pt]
    \raggedright
    \textbf{Volume:} $2M$ per worker\\[3pt]
    \textbf{Latency:} $\mathcal{O}(1)$ rounds (2 trips)\\[3pt]
    \textbf{BW Util.:} \textcolor{RedLine}{\textbf{Limited}} by PS network NIC
  };
  \node[status badge, draw=RedLine, fill=RedFill, text=RedLine, minimum width=4.3cm, minimum height=0.52cm] at (7.7, 0.45) {
    \ding{55}\; DistBelief / Parameter Server
  };

  % ===========================================================
  % PANEL (c): ALL-TO-ALL MESH
  % ===========================================================
  \node[panel title] at (12.85, 7.55) {\textbf{(c) All-to-All Mesh}};

  % 4 GPU Nodes in Grid
  \node[node box, draw=OrangeLine, fill=OrangeL, minimum width=1.35cm, minimum height=0.75cm] (M_G0) at (11.7, 6.15) {GPU 0};
  \node[node box, draw=OrangeLine, fill=OrangeL, minimum width=1.35cm, minimum height=0.75cm] (M_G1) at (14.0, 6.15) {GPU 1};
  \node[node box, draw=OrangeLine, fill=OrangeL, minimum width=1.35cm, minimum height=0.75cm] (M_G2) at (11.7, 4.35) {GPU 2};
  \node[node box, draw=OrangeLine, fill=OrangeL, minimum width=1.35cm, minimum height=0.75cm] (M_G3) at (14.0, 4.35) {GPU 3};

  % All 6 Bidirectional Mesh Links
  \draw[<->, line width=1.0pt, OrangeLine] (M_G0) -- (M_G1);
  \draw[<->, line width=1.0pt, OrangeLine] (M_G2) -- (M_G3);
  \draw[<->, line width=1.0pt, OrangeLine] (M_G0) -- (M_G2);
  \draw[<->, line width=1.0pt, OrangeLine] (M_G1) -- (M_G3);
  \draw[<->, line width=1.0pt, OrangeLine] (M_G0) -- (M_G3);
  \draw[<->, line width=1.0pt, OrangeLine] (M_G1) -- (M_G2);

  % Link Count Badge in center
  \node[status badge, draw=OrangeLine, fill=white, text=OrangeLine, font=\bfseries\tiny, inner sep=2pt] at (12.85, 5.25) {
    $\binom{N}{2} = 6$ links
  };

  % Card (c)
  \node[card, draw=OrangeLine!80, fill=white, minimum height=2.45cm] (CARD_C) at (12.85, 2.05) {
    \centering\textbf{\normalsize\textcolor{OrangeLine}{Fully Connected Mesh}}\\[5pt]
    \raggedright
    \textbf{Volume:} $M(N-1)$ total network traffic\\[3pt]
    \textbf{Latency:} $\mathcal{O}(1)$ rounds\\[3pt]
    \textbf{BW Util.:} \textcolor{OrangeLine}{\textbf{$\mathcal{O}(N^2)$}} link explosion
  };
  \node[status badge, draw=OrangeLine, fill=OrangeL, text=OrangeLine, minimum width=4.3cm, minimum height=0.52cm] at (12.85, 0.45) {
    \ding{55}\; Impractical beyond 8 nodes
  };

\end{tikzpicture}
图 5 中可见的权衡是在带宽与延迟之间:环形拓扑将带宽均匀铺开,但每个跳点都会增加一步延迟;全对全(all-to-all)网格拓扑则将延迟路径压缩为恒定轮数,代价是链路数量随节点数呈二次增长。高性能库(如 NCCL)会根据消息大小和集群拓扑自动在这些拓扑之间进行选择。集合通信 将每种拓扑的延迟复杂度形式化,并推导出环形拓扑何时优于其他方案。
同步模型
分布式训练系统遵循明确的同步模型,该模型规定了 worker 何时观察到彼此的更新。模型的选择决定系统是保证与单设备训练在数学上等价,还是在一致性上做出让步以换取吞吐量。基线模型——批量同步并行(BSP)4 (Valiant 1990年)——要求所有 worker 完成前向与反向传播中的本地计算,通过带 AllReduce 的屏障同步梯度,然后同时更新参数。
4 批量同步并行(BSP):由 Valiant (1990年) 提出,作为并行计算中硬件与软件之间的“桥接模型”。BSP 将工作划分为超步(计算、通信、屏障),使每个 worker 拥有统一的超步边界。代价在于:迭代时间等于最慢 worker 的时间;在 1,000 个 GPU、每个设备 1% 的拖后腿(straggler)概率下,每一步约有 10 个 GPU 拖后腿,从而使屏障的开销日益增大。
Valiant, Leslie G. 1990年. 《A bridging model for parallel computation》. Communications of the ACM 33 (8): 103~11. https://doi.org/10.1145/79173.79181.
BSP 提供同步更新语义:每个 worker 都基于同一版本的参数进行计算,并一同到达下一个更新边界。在相同的全局批次与归约条件下,这与对应的同步单设备更新在数学上一致。但它本身并不保证逐位可复现性:浮点归约顺序、非确定性的内核、数据顺序状态以及故障恢复都仍可能改变结果。同步开销依然在于最慢 worker 决定了迭代时间,由此产生了拖后腿问题。
陈旧同步并行(SSP) 放宽了这一约束,允许 worker 在最慢 worker 之前最多推进 \(s\) 个迭代后再阻塞。这样既将陈旧性(staleness)限制在界内,又降低了同步延迟。SSP 需要仔细调参学习率,因为 worker 基于略有差异的参数版本计算梯度。有界的陈旧性保证在 BSP 的强一致性与完全异步方法之间提供了折中 (Ho 等 2013年)。
异步 SGD(ASP) 完全消除了同步屏障,worker 独立更新参数。这最大化了硬件利用率,但引入了梯度陈旧性,可能损害收敛性。运行保证决定了系统接受多少收敛风险;节 1.3.4 推导了各模型所需的收敛速率、陈旧性惩罚以及补偿技术。
各同步模型之间的关键权衡汇总于 同步模型权衡,图 6 则展示了每种策略如何在时间上调度 worker 之间的工作。
| 模型 | 一致性 | 吞吐量 | 收敛性 | 使用场景 |
|---|---|---|---|---|
| BSP | 强一致 | 受最慢 worker 限制 | 与同步更新语义相同 | 受控的最终训练运行 |
| SSP | 有界陈旧性 | 高于 BSP | 调参后近似等价 | 超参数搜索 |
| 异步 | 弱一致 | 最大 | 退化,需要补偿 | 大规模异构集群 |
当将调度置于时间轴上时,同样的权衡会更加清晰。
\begin{tikzpicture}[
  font=\sffamily,
  >=Stealth,
  scale=1.0,
  panel card/.style={
    draw=CardBorder,
    fill=white,
    rounded corners=5pt,
    line width=0.8pt
  },
  badge/.style={
    rounded corners=2.5pt,
    font=\bfseries\tiny,
    inner sep=2.5pt,
    align=center
  },
  worker label/.style={
    font=\bfseries\scriptsize,
    text=TextDark,
    anchor=east
  },
  compute block/.style={
    rectangle,
    rounded corners=2pt,
    draw=SteelBlue,
    fill=LightBlue,
    line width=0.7pt,
    inner sep=0pt
  },
  wait block/.style={
    rectangle,
    rounded corners=2pt,
    draw=RedLine,
    fill=RedFill,
    line width=0.7pt,
    inner sep=0pt
  },
  ssp pause/.style={
    rectangle,
    rounded corners=2pt,
    draw=OrangeLine,
    fill=OrangeL,
    line width=0.7pt,
    inner sep=0pt
  }
]

  % Color definitions
  \definecolor{NavyBlue}{RGB}{20,45,85}
  \definecolor{SteelBlue}{RGB}{40,90,140}
  \definecolor{LightBlue}{RGB}{240,245,252}
  \definecolor{RedLine}{RGB}{185,45,45}
  \definecolor{RedFill}{RGB}{253,242,242}
  \definecolor{GreenLine}{RGB}{35,135,75}
  \definecolor{GreenFill}{RGB}{240,249,244}
  \definecolor{DarkGreen}{RGB}{20,110,60}
  \definecolor{OrangeLine}{RGB}{215,105,15}
  \definecolor{OrangeL}{RGB}{254,246,233}
  \definecolor{VioletLine}{RGB}{125,45,150}
  \definecolor{VioletL}{RGB}{248,240,252}
  \definecolor{CardBorder}{RGB}{215,222,230}
  \definecolor{CardFill}{RGB}{248,250,253}
  \definecolor{TextDark}{RGB}{25,35,45}
  \definecolor{TextMuted}{RGB}{95,105,115}

  % ===========================================================
  % TIME AXIS AT TOP
  % ===========================================================
  \draw[->, line width=0.9pt, TextMuted] (2.2, 11.0) -- (14.2, 11.0) node[right=3pt, font=\scriptsize\bfseries, text=TextDark] {Time};
  \foreach \x/\t in {2.2/0, 4.54/1, 6.88/2, 9.22/3, 11.56/4, 13.9/5} {
    \draw[line width=0.8pt, TextMuted] (\x, 10.9) -- (\x, 11.1);
    \node[above=1pt, font=\tiny\bfseries, text=TextMuted] at (\x, 11.1) {$t = \t$};
  }

  % ===========================================================
  % PANEL (a): BSP (s = 0)
  % ===========================================================
  \node[panel card, minimum width=14.4cm, minimum height=3.2cm, anchor=north west] at (0, 10.6) {};

  % Header banner
  \fill[fill=SteelBlue!12, rounded corners=4pt] (0.05, 10.55) rectangle (14.35, 10.05);
  \node[anchor=west, font=\bfseries\footnotesize, text=NavyBlue] at (0.3, 10.3) {(a) Bulk Synchronous Parallel (BSP) $\boldsymbol{\cdot s = 0}$};
  \node[anchor=west, font=\tiny, text=TextMuted] at (6.9, 10.3) {fast workers idle at every barrier};
  \node[badge, fill=NavyBlue, text=white, anchor=east] at (14.1, 10.3) {EXACT SGD};

  % Worker rows
  \node[worker label] at (2.05, 9.55) {W1};
  \node[worker label] at (2.05, 8.95) {W2};
  \node[worker label, text=RedLine] at (2.05, 8.35) {W3 (Straggler)};
  \node[worker label] at (2.05, 7.75) {W4};

  % Step barriers (red dashed lines)
  \foreach \x in {4.54, 6.88, 9.22, 11.56, 13.9} {
    \draw[dashed, line width=1.0pt, RedLine!80] (\x, 9.9) -- (\x, 7.5);
  }

  % Step blocks for BSP (5 steps, width = 2.34cm each)
  \foreach \step/\xstart in {0/2.2, 1/4.54, 2/6.88, 3/9.22, 4/11.56} {
    % W1
    \node[compute block, minimum width=1.48cm, minimum height=0.45cm, anchor=west] at (\xstart, 9.55) {
      \ifnum\step=0\tiny\textcolor{SteelBlue}{Compute}\fi
    };
    \node[wait block, minimum width=0.84cm, minimum height=0.45cm, anchor=west] at (\xstart + 1.49, 9.55) {
      \tiny\bfseries\textcolor{RedLine}{wait}
    };
    % W2
    \node[compute block, minimum width=1.48cm, minimum height=0.45cm, anchor=west] at (\xstart, 8.95) {
      \ifnum\step=0\tiny\textcolor{SteelBlue}{Compute}\fi
    };
    \node[wait block, minimum width=0.84cm, minimum height=0.45cm, anchor=west] at (\xstart + 1.49, 8.95) {
      \tiny\bfseries\textcolor{RedLine}{wait}
    };
    % W3 (Straggler)
    \node[compute block, draw=RedLine, fill=SteelBlue!15, minimum width=2.33cm, minimum height=0.45cm, anchor=west] at (\xstart, 8.35) {
      \ifnum\step=0\tiny\bfseries\textcolor{NavyBlue}{Compute (Slow)}\fi
    };
    % W4
    \node[compute block, minimum width=1.48cm, minimum height=0.45cm, anchor=west] at (\xstart, 7.75) {
      \ifnum\step=0\tiny\textcolor{SteelBlue}{Compute}\fi
    };
    \node[wait block, minimum width=0.84cm, minimum height=0.45cm, anchor=west] at (\xstart + 1.49, 7.75) {
      \tiny\bfseries\textcolor{RedLine}{wait}
    };
  }

  % ===========================================================
  % PANEL (b): SSP (s = 1)
  % ===========================================================
  \node[panel card, minimum width=14.4cm, minimum height=3.2cm, anchor=north west] at (0, 7.1) {};

  % Header banner
  \fill[fill=OrangeLine!12, rounded corners=4pt] (0.05, 7.05) rectangle (14.35, 6.55);
  \node[anchor=west, font=\bfseries\footnotesize, text=OrangeLine!90!black] at (0.3, 6.8) {(b) Stale Synchronous Parallel (SSP) $\boldsymbol{\cdot s = 1}$};
  \node[anchor=west, font=\tiny, text=TextMuted] at (6.9, 6.8) {one step of slack, then wait};
  \node[badge, fill=OrangeLine, text=white, anchor=east] at (14.1, 6.8) {BOUNDED DRIFT};

  % Worker rows
  \node[worker label] at (2.05, 6.05) {W1};
  \node[worker label] at (2.05, 5.45) {W2};
  \node[worker label, text=OrangeLine!90!black] at (2.05, 4.85) {W3 (Slow)};
  \node[worker label] at (2.05, 4.25) {W4};

  % SSP fast workers: 2 compute blocks then s<=1 pause, perfectly budgeted
  \foreach \y in {6.05, 5.45, 4.25} {
    % Cycle 1 (steps 0, 1)
    \node[compute block, minimum width=1.68cm, minimum height=0.45cm, anchor=west] at (2.20, \y) {
      \tiny\textcolor{SteelBlue}{Compute}
    };
    \node[compute block, minimum width=1.68cm, minimum height=0.45cm, anchor=west] at (3.90, \y) {};
    \node[ssp pause, minimum width=0.42cm, minimum height=0.45cm, anchor=west] at (5.60, \y) {\tiny\bfseries $s{\le}1$};

    % Cycle 2 (steps 2, 3)
    \node[compute block, minimum width=1.68cm, minimum height=0.45cm, anchor=west] at (6.04, \y) {};
    \node[compute block, minimum width=1.68cm, minimum height=0.45cm, anchor=west] at (7.74, \y) {};
    \node[ssp pause, minimum width=0.42cm, minimum height=0.45cm, anchor=west] at (9.44, \y) {\tiny\bfseries $s{\le}1$};

    % Cycle 3 (steps 4, 5)
    \node[compute block, minimum width=1.68cm, minimum height=0.45cm, anchor=west] at (9.88, \y) {};
    \node[compute block, minimum width=1.68cm, minimum height=0.45cm, anchor=west] at (11.58, \y) {};
    \node[ssp pause, minimum width=0.42cm, minimum height=0.45cm, anchor=west] at (13.28, \y) {\tiny\bfseries $s{\le}1$};
  }

  % W3 slow workers (matches clock rate 2.34cm)
  \foreach \step/\xstart in {0/2.2, 1/4.54, 2/6.88, 3/9.22, 4/11.56} {
    \node[compute block, draw=OrangeLine, fill=OrangeL!50, minimum width=2.32cm, minimum height=0.45cm, anchor=west] at (\xstart, 4.85) {
      \tiny\textcolor{OrangeLine!90!black}{Compute (Slow)}
    };
  }

  % ===========================================================
  % PANEL (c): ASP (s = \infty)
  % ===========================================================
  \node[panel card, minimum width=14.4cm, minimum height=3.2cm, anchor=north west] at (0, 3.6) {};

  % Header banner
  \fill[fill=DarkGreen!12, rounded corners=4pt] (0.05, 3.55) rectangle (14.35, 3.05);
  \node[anchor=west, font=\bfseries\footnotesize, text=DarkGreen] at (0.3, 3.3) {(c) Asynchronous SGD (ASP) $\boldsymbol{\cdot s = \infty}$};
  \node[anchor=west, font=\tiny, text=TextMuted] at (6.9, 3.3) {no barrier, stale gradients};
  \node[badge, fill=DarkGreen, text=white, anchor=east] at (14.1, 3.3) {MAX THROUGHPUT};

  % Worker rows
  \node[worker label] at (2.05, 2.55) {W1};
  \node[worker label] at (2.05, 1.95) {W2};
  \node[worker label] at (2.05, 1.35) {W3};
  \node[worker label] at (2.05, 0.75) {W4};

  % Time horizon marker in ASP
  \draw[dashed, line width=0.8pt, DarkGreen!50] (13.9, 2.8) -- (13.9, 0.5);

  % W1: Fast (duration 1.28cm, 9 blocks fit within 11.7cm)
  \foreach \i in {0,...,8} {
    \pgfmathsetmacro{\xpos}{2.2 + \i*1.295}
    \node[compute block, draw=DarkGreen!80, fill=GreenFill, minimum width=1.275cm, minimum height=0.45cm, anchor=west] at (\xpos, 2.55) {
      \ifnum\i=0\tiny\textcolor{DarkGreen}{Compute}\fi
    };
  }
  % W2: Medium-Fast (duration 1.64cm, 7 blocks fit within 11.7cm)
  \foreach \i in {0,...,6} {
    \pgfmathsetmacro{\xpos}{2.2 + \i*1.655}
    \node[compute block, draw=DarkGreen!80, fill=GreenFill, minimum width=1.635cm, minimum height=0.45cm, anchor=west] at (\xpos, 1.95) {
      \ifnum\i=0\tiny\textcolor{DarkGreen}{Compute}\fi
    };
  }
  % W3: Slow (duration 2.32cm, 5 blocks fit within 11.7cm)
  \foreach \i in {0,...,4} {
    \pgfmathsetmacro{\xpos}{2.2 + \i*2.335}
    \node[compute block, draw=DarkGreen!80, fill=GreenFill, minimum width=2.315cm, minimum height=0.45cm, anchor=west] at (\xpos, 1.35) {
      \ifnum\i=0\tiny\textcolor{DarkGreen}{Compute}\fi
    };
  }
  % W4: Medium (duration 1.92cm, 6 blocks fit within 11.7cm)
  \foreach \i in {0,...,5} {
    \pgfmathsetmacro{\xpos}{2.2 + \i*1.935}
    \node[compute block, draw=DarkGreen!80, fill=GreenFill, minimum width=1.915cm, minimum height=0.45cm, anchor=west] at (\xpos, 0.75) {
      \ifnum\i=0\tiny\textcolor{DarkGreen}{Compute}\fi
    };
  }

\end{tikzpicture}同步模型的选择会直接影响系统吞吐量和模型收敛性。训练团队常在有控的最终运行中使用 BSP,因为同步步骤简化了比较与回放;而在超参数搜索阶段,则倾向于探索 SSP 或异步方法,此时吞吐量可能比精确的更新等价性更重要。可复现的重放仍然需要确定性的采样、算子、集合通信顺序以及恢复后的随机状态。
屏障语义与故障模式
AllReduce 操作实现了隐式屏障:所有工人贡献梯度之前,没有任何工人可以推进。这种耦合产生了单机训练中不存在的故障模式。
AllReduce 期间的工人故障会导致其他所有工人无限期阻塞,等待缺失的梯度贡献。如果没有超时机制,整个训练任务会挂起,而不是干净地失败。已部署的系统通常实现量级为分钟的看门狗定时器,用于检测并终止卡住的训练任务。

一个缺失的工人会使整个 AllReduce 屏障停滞。
梯度不一致发生在工人对需要同步的张量存在分歧时,原因可能是条件计算路径或动态批处理。AllReduce 操作可能会阻塞,等待某些工人从未发送的张量。这种情况在自然语言处理模型中的变长序列、动态计算图,以及具有不同路由决策的专家混合模型中很常见。
串扰延迟源于迭代时间等于最慢工人的时间加上同步开销。单个慢速工人——无论是由于热节流、网络拥塞还是操作系统抖动——都会延迟所有工人并降低集群利用率。在 1,000 GPU 且每 GPU 每步的串扰概率为 1% 时,每个迭代约有 10 个 GPU 出现串扰。
已部署的系统通过超时、心跳监控和弹性训练机制来处理这些问题。容错 对故障检测、检查点策略以及使训练任务能够在不可避免的硬件故障下完成的重载机制提供了全面覆盖。
参数更新
参数更新完成了数据并行的不变量:聚合之后,每个设备都必须基于相同的梯度值应用相同的优化器更新。每个设备使用所选的优化算法(如带动量的 SGD 或 Adam)独立更新模型参数。这种去中心化的更新策略避免了中央协调服务器,因为同步已经使本地梯度完全一致。
在一个使用 8 个 GPU 训练 ResNet 模型的系统中,每个 GPU 基于其数据子集计算本地梯度。经过环形全归约 (Patarasuk 和 Yuan 2009年) 进行梯度平均后,每个 GPU 都拥有相同的全局梯度值。随后,每个设备使用优化器的更新规则独立应用这些梯度。以 SGD 和学习率 0.1 为例,更新变为 weights = weights - 0.1 * gradients。该示例说明了更新为何可以保持去中心化,同时不牺牲与单机训练在数学上的等价性。
划分数据、计算梯度、同步结果、更新参数这一循环对每个批次重复进行。框架可以自动化这个循环,但它们无法消除使副本保持连贯的顺序约束:每个工人必须等待同步后的梯度完成之后才更新。
权衡:通信墙
数据并行是一种常见起点策略,原因在于:只要模型能够装入内存且通信不是瓶颈,它就能随设备数量线性扩展吞吐量。然而,它会撞上由通信—计算比定义的一道硬性天花板:一旦梯度交换主导了有用的计算,增加更多工人主要只是增加了同步工作 (Ben-Nun 和 Hoefler 2019年)。
Ben-Nun, Tal, 和 Torsten Hoefler. 2019年. 《Demystifying Parallel and Distributed Deep Learning: An In-Depth Concurrency Analysis》. ACM Computing Surveys 52 (4): 1~43. https://doi.org/10.1145/3320060.
数据并行有三个主要优势。对于计算受限的模型,吞吐量线性扩展:将 ResNet-50 在 ImageNet 上从 1 个 GPU 扩展到 256 个 GPU,可获得接近线性的加速,因为相对于计算时间,梯度交换量很小。模型架构也保持不变;框架将模型封装在数据并行容器中,拦截反向钩子以自动触发梯度同步。利用率保持较高,因为与模型并行不同,不存在流水线气泡:所有 GPU 同时执行前向和反向传播。
三个硬性天花板限制了这些优势。内存墙 要求每个 GPU 都保存模型参数、梯度和优化器状态的完整副本;对于一个含 175B 个参数的模型,这要求每个 GPU 拥有超过 1 TB 的内存,在没有 ZeRO 分片的情况下超出了单设备 HBM 预算。带宽墙随着 \(N\) 的增长而出现:AllReduce 成本 \(\frac{2(N-1)}{N} \times \frac{M}{\text{BW}_{\text{net}}}\) 最终会占主导,对于大语言模型,梯度同步可能消耗超过 50% 的单步时间,导致效率崩塌。批大小陷阱进一步加剧了这一问题,因为扩展到数千个 GPU 需要增大全局批大小 \((B_{\text{global}} = N \times B_{\text{local}})\),最终会达到临界批大小,此时每步增加更多数据带来的收敛收益递减。
Napkin Math 1.1: **GPT-2 数据并行扩展:单节点**
一个 GPT-2 扩展场景使效率损失具体化:保持模型固定,只改变通信域。第一种情况将所有 8 个 GPU 保留在同一个 NVLink 节点内。
单 GPU 基线
- 批大小:16(配合梯度检查点,可容纳 32 GB)
- 每步耗时:1.8 s
- 达到 50K 步所需时间:25 hours
8 个 GPU:单节点 NVLink
- 每 GPU 批大小:16,全局批大小:128
- 梯度同步:5.2 GB @ 450 GB/s(NVLink,每个方向)\(\approx\) 11.7 ms
性能结果:
- 计算:1800 ms / 步
- 通信:11.7 ms / 步
- 合计:1811.7 ms / 步
- 加速比(吞吐量):8×
- 并行效率:99.4 percent
训练时间:25 hours ÷ 8 = 3.1 hours
在节点内部,NVLink 使梯度交换相对于计算保持较小规模,因此效率接近 99.4 percent。一旦同一模型需要在节点之间通过商用网络同步,情况便反转。
Napkin Math 1.2: GPT-2 数据并行扩展:商用横向扩展
第二种情形将同一 GPT-2 运行扩展到多个节点,用节点间以太网替换节点内 NVLink 传输,以承担大部分 AllReduce。
通用网络配置: 32 GPUs 跨 4 nodes
- 每 GPU 批: 16, 全局批: 512
- 节点内通信: 11.7 ms (NVLink)
- 节点间通信: 5.8 GB @ 1.25 GB/s (10GbE) \(\approx\) 4650 ms
性能结果:
- 计算: 1800 ms (占 27.9 percent 的时间)
- 通信: 4661.7 ms (占 72.1 percent 的时间), 因此通信占主导并成为瓶颈。
- 总计: 每步 6461.7 ms
- 加速比 (吞吐量): 快 8.9× → 2.8 hours
- 并行效率: 27.9 percent
梯度累积提供了一种直接补救办法, 它把所有通信都限制在单个节点的 NVLink 域内, 同时仍以等效规模较大的有效批进行训练。
Napkin Math 1.3: 梯度累积加速比
问题:在一台商用 10G 网络上运行的 GPT-2 在 32 GPUs 时受通信带宽限制,处理固定数量的样本需要 $1,436。能否通过梯度累积,让单个 8 GPU 节点以更高效的方式达到相同的等效批大小?
数学:
- 等效批大小:8 GPUs \(\times\) 批 16 \(\times\) 4 累积步数 = 512。
- 通信开销:在 4 步累积下,每 4 步执行一次 AllReduce。
- 开销 = 11.7 ms / (4 \(\times\) 1800 ms) \(\approx\) \(0.162\%\)。
- 训练时长:总时间为 3.1 hours。
- 扩展基线成本:4 nodes \(\times\) 2.8 hours \(\times\) $128/hr = $1,436。
- 累积成本:3.1 hours \(\times\) $128/hr = $401。
系统洞察:梯度累积 通过把计算集中在带宽充裕的位置(节点内部的 NVLink)并降低同步频率,节省了 $1,035(72.1 percent)。当网络较慢时,不要向外扩展——而是在本地扩大批大小。
该计算改变了扩展决策:当节点间带宽成为瓶颈时,在带宽充裕的节点上使用梯度累积,即使端到端运行时间略有延长,也能胜过朴素的向外扩展。由此可以得出四点启示。NVLink 使单节点内部的扩展高效(99.4 percent 效率),而节点间通信则损害效率(效率降至 27.9 percent)。对于受通信限制的运行,梯度累积优于朴素扩展,只要扩展网络较慢;因此本 GPT-2 场景的最佳组合是每节点 8 GPU 加梯度累积,而不是朴素地扩展到 32+ GPU。OpenAI 的 GPT-2 论文报告在 4 个节点上的 32 块 V100 上训练,采用优化的通信(很可能是梯度累积与流水线并行的组合),而非纯数据并行。
内存高效的数据并行:ZeRO 与 FSDP
数据并行的内存约束催生了一系列技术,这些技术在将内存状态分片到各工作节点的同时,保留了数据并行训练的简洁性。Zero Redundancy Optimizer(ZeRO)[^fn-zero-redundancy-optimizer] (Rajbhandari 等 2020年) 及其 PyTorch 实现 Fully Sharded Data Parallel(FSDP) (Zhao 等 2023年) 使得训练原本需要模型并行的模型成为可能。
Rajbhandari, Samyam, Jeff Rasley, Olatunji Ruwase, 和 Yuxiong He. 2020年. 《ZeRO: Memory Optimizations Toward Training Trillion Parameter Models》. SC20: International Conference for High Performance Computing, Networking, Storage and Analysis, 1~16. https://doi.org/10.1109/sc41405.2020.00024.
Zhao, Yanli, Andrew Gu, Rohan Varma, Liang Luo, Chien-Chin Huang, Min Xu, Less Wright, 等. 2023年. 《PyTorch FSDP: Experiences on Scaling Fully Sharded Data Parallel》. Proceedings of the VLDB Endowment 16 (12): 3848~60. https://doi.org/10.14778/3611540.3611569.
[^fn-zero-redundancy-optimizer]:ZeRO(Zero Redundancy Optimizer):由微软研究院于 2019 年发布,ZeRO 将优化器状态、梯度(以及可选的参数)划分到各工作节点,而不是进行复制。在 64 GPU 的 ZeRO Stage 3 下,每设备内存从 16 bytes/parameter(完全复制)降至 0.25 bytes/parameter,将 112 GB 的内存占用转化为 1.75 GB。权衡之处:FSDP(PyTorch 的 ZeRO-3 实现)在每个前向和反向层都引入 AllGather 与 ReduceScatter,带来 10–25 percent 的通信开销,只有当内存压力足以支撑这一代价时才划算。
Definition 1.3: 分片数据并行
分片数据并行 是数据并行的一个变体(以 ZeRO 各阶段和 FSDP 的形式实现),它将优化器状态、梯度(在最深的阶段还包括参数本身)划分到数据并行工作节点,并通过集合通信按需重建每个分片,使每工作节点的内存趋近于完整训练状态的 \(1/N\),同时每个工作节点仍处理自己的 minibatch 分片。
- 重要性:混合精度 Adam 训练每个参数携带 16 bytes 状态,因此 7B 参数的模型需要 112 GB 训练状态,在任意 80 GB 加速器上都超出内存容量,尽管该模型在推理时内存需求绰绰有余。跨越 64 个工作节点的 ZeRO Stage 3 将每设备状态降至 1.75 GB(每个参数 0.25 bytes),把内存墙转化为通信成本:按需重组分片的 AllGather 与 ReduceScatter 流量在每个步骤引入 10–25 percent 的开销。
- 区别:与朴素数据并行(在每个工作节点复制完整的训练状态)以及模型并行(对计算本身进行划分)不同,分片数据并行只划分存储:每个工作节点仍执行完整的前向和反向传播,即时获取每一层的参数并在用完后立即丢弃。
- 常见误区:一个常见误解是认为分片是免费的内存。按需 AllGather 将参数流量置于每一层每个步骤的关键路径上;在较慢的互连结构或较小的每工作节点批大小时,暴露出的通信比内存节省更快地侵蚀吞吐量。容量是用带宽购买的。
为了理解 ZeRO 提供的内存节省规模,考虑一个大型语言模型的具体内存预算。
Napkin Math 1.4: **ZeRO 内存节省**
问题:训练一个含 7B 参数的 Llama-2 模型(混合精度)需要每个参数 16 字节,用于权重、梯度和优化器状态。完整的训练状态能否放进单张 A100-80 GB?使用 ZeRO Stage 3 并配合 64 GPUs 后,每设备的内存需求如何变化?
基线:标准 DDP(复制状态) 每参数内存开销:
- 权重(FP16):2 字节
- 梯度(FP16):2 字节
- 优化器状态(FP32):12 字节(4 个主权重 + 4 个动量 + 4 个方差)
- 总计:16 字节/参数
7B 模型的总内存:
\[C_{\text{state,total}} = 7 \times 10^9 \times 16 \text{ bytes} \approx 112 \text{ GB}\]
基线结果:内存不足(OOM) 的 A100-80 GB 上。
优化:ZeRO-3(完全分片) 使用 \(N =\) 64 张 GPU,状态被分区:
- 权重:\(2/N\) 字节
- 梯度:\(2/N\) 字节
- 优化器:\(12/N\) 字节
- 总计:16\(/N =\) 0.25 字节/参数有效存储!
每 GPU 内存:
\[C_{\text{state,ZeRO3}} = \frac{112 \text{ GB}}{64} \approx 1.75 \text{ GB}\]
结果:轻松放下,为激活值(批大小)留下约 78 GB。
ZeRO 通过渐进式分片解决这一冗余问题,图 7 对此作了说明,表 1 则作了总结。
\begin{tikzpicture}[
  font=\sffamily,
  >=Stealth,
  legend item/.style={
    font=\scriptsize,
    text=TextDark
  },
  header card/.style={
    rectangle,
    rounded corners=4pt,
    line width=0.8pt,
    minimum width=2.4cm,
    minimum height=0.75cm,
    align=center
  },
  total pill/.style={
    rectangle,
    rounded corners=4pt,
    line width=0.8pt,
    minimum width=2.4cm,
    minimum height=0.8cm,
    align=center
  }
]

  % Color definitions
  \definecolor{NavyBlue}{RGB}{20,45,85}
  \definecolor{SteelBlue}{RGB}{40,90,140}
  \definecolor{LightBlue}{RGB}{240,245,252}
  \definecolor{RedLine}{RGB}{185,45,45}
  \definecolor{RedFill}{RGB}{253,242,242}
  \definecolor{GreenLine}{RGB}{35,135,75}
  \definecolor{GreenFill}{RGB}{240,249,244}
  \definecolor{DarkGreen}{RGB}{20,110,60}
  \definecolor{OrangeLine}{RGB}{215,105,15}
  \definecolor{OrangeL}{RGB}{254,246,233}
  \definecolor{CardBorder}{RGB}{215,222,230}
  \definecolor{CardFill}{RGB}{248,250,253}
  \definecolor{TextDark}{RGB}{25,35,45}
  \definecolor{TextMuted}{RGB}{95,105,115}

  % ===========================================================
  % TOP LEGEND
  % ===========================================================
  \node[draw=CardBorder, fill=white, rounded corners=4pt, line width=0.8pt, minimum width=13.8cm, minimum height=0.75cm] at (7.0, 7.6) {};

  \node[draw=SteelBlue, fill=LightBlue, rounded corners=2pt, minimum width=0.35cm, minimum height=0.35cm] at (1.0, 7.6) {};
  \node[legend item, anchor=west] at (1.3, 7.6) {\textbf{Weights} (FP16, 2\,B/param)};

  \node[draw=OrangeLine, fill=OrangeL, rounded corners=2pt, minimum width=0.35cm, minimum height=0.35cm] at (5.1, 7.6) {};
  \node[legend item, anchor=west] at (5.4, 7.6) {\textbf{Gradients} (FP16, 2\,B/param)};

  \node[draw=DarkGreen, fill=GreenFill, rounded corners=2pt, minimum width=0.35cm, minimum height=0.35cm] at (9.1, 7.6) {};
  \node[legend item, anchor=west] at (9.4, 7.6) {\textbf{Optimizer States} (FP32, 12\,B/param)};

  % ===========================================================
  % AXIS & GRIDLINES
  % ===========================================================
  % y = 0 GB at y = 1.6 cm, 120 GB at y = 6.4 cm (scale: 1 GB = 0.04 cm)
  \draw[line width=0.8pt, TextMuted] (1.1, 1.6) -- (13.7, 1.6);

  \foreach \gb/\y in {0/1.6, 20/2.4, 40/3.2, 60/4.0, 80/4.8, 100/5.6, 120/6.4} {
    \draw[dashed, gray!25, thin] (1.1, \y) -- (13.7, \y);
    \node[anchor=east, font=\tiny\bfseries, text=TextMuted] at (1.0, \y) {\gb};
  }

  \node[rotate=90, font=\bfseries\footnotesize, text=TextDark] at (0.35, 4.0) {Memory per GPU (GB)};

  % ===========================================================
  % COLUMN 1: DDP (112 GB)
  % ===========================================================
  % Header
  \node[header card, draw=CardBorder, fill=CardFill] at (2.4, 6.85) {
    \textbf{\footnotesize DDP}\\[-1pt]
    \tiny\textcolor{TextMuted}{Baseline Replicated}
  };

  % Stack:
  % OS: 84 GB -> from 1.6 to 4.96
  \draw[draw=DarkGreen, fill=GreenFill, rounded corners=1.5pt, line width=0.8pt] (1.4, 1.6) rectangle (3.4, 4.96);
  \node[font=\bfseries\scriptsize, text=DarkGreen] at (2.4, 3.28) {OS (84\,GB)};

  % G: 14 GB -> from 4.96 to 5.52
  \draw[draw=OrangeLine, fill=OrangeL, rounded corners=1.5pt, line width=0.8pt] (1.4, 4.96) rectangle (3.4, 5.52);
  \node[font=\bfseries\tiny, text=OrangeLine!90!black] at (2.4, 5.24) {G (14\,GB)};

  % W: 14 GB -> from 5.52 to 6.08
  \draw[draw=SteelBlue, fill=LightBlue, rounded corners=1.5pt, line width=0.8pt] (1.4, 5.52) rectangle (3.4, 6.08);
  \node[font=\bfseries\tiny, text=SteelBlue] at (2.4, 5.80) {W (14\,GB)};

  % Total Pill
  \node[total pill, draw=CardBorder, fill=white] at (2.4, 0.95) {
    \textbf{\footnotesize 112\,GB}\\[-1pt]
    \tiny\textcolor{TextMuted}{1.0$\times$ Baseline}
  };

  % ===========================================================
  % COLUMN 2: ZeRO-1 (~29.3 GB)
  % ===========================================================
  % Header
  \node[header card, draw=OrangeLine, fill=OrangeL] at (5.3, 6.85) {
    \textbf{\footnotesize\textcolor{OrangeLine!90!black}{ZeRO-1}}\\[-1pt]
    \tiny\textcolor{OrangeLine!80!black}{Shard Opt States}
  };

  % Stack:
  % OS/N: 1.31 GB -> from 1.6 to 1.78
  \draw[draw=DarkGreen, fill=GreenFill, rounded corners=1.5pt, line width=0.8pt] (4.4, 1.6) rectangle (6.2, 1.78);
  \node[font=\tiny\bfseries, text=DarkGreen, anchor=west] at (6.28, 1.69) {$\leftarrow$ OS/$N$};

  % G: 14 GB -> from 1.78 to 2.34
  \draw[draw=OrangeLine, fill=OrangeL, rounded corners=1.5pt, line width=0.8pt] (4.4, 1.78) rectangle (6.2, 2.34);
  \node[font=\bfseries\tiny, text=OrangeLine!90!black] at (5.3, 2.06) {G (14\,GB)};

  % W: 14 GB -> from 2.34 to 2.90
  \draw[draw=SteelBlue, fill=LightBlue, rounded corners=1.5pt, line width=0.8pt] (4.4, 2.34) rectangle (6.2, 2.90);
  \node[font=\bfseries\tiny, text=SteelBlue] at (5.3, 2.62) {W (14\,GB)};

  % Total Pill
  \node[total pill, draw=OrangeLine, fill=OrangeL!50] at (5.3, 0.95) {
    \textbf{\footnotesize\textcolor{OrangeLine!90!black}{$\approx$ 29.3\,GB}}\\[-1pt]
    \tiny\bfseries\textcolor{OrangeLine!90!black}{3.8$\times$ Reduction}
  };

  % ===========================================================
  % COLUMN 3: ZeRO-2 (~15.5 GB)
  % ===========================================================
  % Header
  \node[header card, draw=SteelBlue, fill=LightBlue] at (8.2, 6.85) {
    \textbf{\footnotesize\textcolor{SteelBlue}{ZeRO-2}}\\[-1pt]
    \tiny\textcolor{SteelBlue}{+ Shard Gradients}
  };

  % Stack:
  % (OS+G)/N: 1.53 GB -> from 1.6 to 1.82
  \draw[draw=DarkGreen, fill=GreenFill, rounded corners=1.5pt, line width=0.8pt] (7.3, 1.6) rectangle (9.1, 1.82);
  \node[font=\tiny\bfseries, text=DarkGreen, anchor=west] at (9.18, 1.71) {$\leftarrow$ (OS+G)/$N$};

  % W: 14 GB -> from 1.82 to 2.38
  \draw[draw=SteelBlue, fill=LightBlue, rounded corners=1.5pt, line width=0.8pt] (7.3, 1.82) rectangle (9.1, 2.38);
  \node[font=\bfseries\tiny, text=SteelBlue] at (8.2, 2.10) {W (14\,GB)};

  % Total Pill
  \node[total pill, draw=SteelBlue, fill=LightBlue!70] at (8.2, 0.95) {
    \textbf{\footnotesize\textcolor{SteelBlue}{$\approx$ 15.5\,GB}}\\[-1pt]
    \tiny\bfseries\textcolor{SteelBlue}{7.2$\times$ Reduction}
  };

  % ===========================================================
  % COLUMN 4: ZeRO-3 (~1.75 GB)
  % ===========================================================
  % Header
  \node[header card, draw=DarkGreen, fill=GreenFill] at (11.4, 6.85) {
    \textbf{\footnotesize\textcolor{DarkGreen}{ZeRO-3 / FSDP}}\\[-1pt]
    \tiny\textcolor{DarkGreen}{+ Shard Parameters}
  };

  % Stack:
  % (W+G+OS)/N: 1.75 GB -> from 1.6 to 1.86
  \draw[draw=DarkGreen, fill=GreenFill, rounded corners=1.5pt, line width=0.8pt] (10.5, 1.6) rectangle (12.3, 1.86);
  \node[font=\tiny\bfseries, text=DarkGreen, anchor=west] at (12.38, 1.73) {$\leftarrow$ State/$N$};
  \node[font=\tiny\bfseries, text=DarkGreen] at (11.4, 2.25) {Fully Sharded};

  % Total Pill
  \node[total pill, draw=DarkGreen, fill=GreenFill!80] at (11.4, 0.95) {
    \textbf{\footnotesize\textcolor{DarkGreen}{$\approx$ 1.75\,GB}}\\[-1pt]
    \tiny\bfseries\textcolor{DarkGreen}{64$\times$ Linear Scaling}
  };

  % ===========================================================
  % FOOTER STRIP
  % ===========================================================
  \node[draw=CardBorder, fill=CardFill, rounded corners=4pt, line width=0.7pt, minimum width=13.8cm, minimum height=0.55cm] at (7.0, 0.25) {
    \footnotesize\textmd{Reference Benchmark: 7B FP16 Model (16\,B/param under AdamW) Sharded Across $N = 64$ Accelerators}
  };

\end{tikzpicture}| 阶段 | 分片内容 | 内存用量减少倍数 | 通信开销 |
|---|---|---|---|
| ZeRO-1 | 仅优化器状态 | ~4\(\times\) | 无(与 DDP 相同) |
| ZeRO-2 | + 梯度 | ~8\(\times\) | ReduceScatter 替代 AllReduce |
| ZeRO-3/FSDP | + 参数 | ~\(N\)(与工作进程数成正比) | 每层之前执行 AllGather |
ZeRO-1 将优化器状态分片存储在各个 GPU 上。每个 GPU 仅存储 Adam 优化器相关状态的 \(1/N\)。对梯度执行 AllReduce 后,每个 GPU 仅更新自己的参数分片,然后将更新广播给其他 GPU。按照将 FP32 主权重、动量和方差合计为 12 字节的计量约定,优化器状态的内存用量从每个参数 \(12N\) 字节降至整个集群合计每个参数 \(12\) 字节。
ZeRO-2 还对梯度进行分片。AllReduce 会在每个 GPU 上保留完整梯度,而 ZeRO-2 使用 ReduceScatter,使每个 GPU 仅接收归约后梯度的 \(1/N\)。按照此处采用的 FP16 梯度计量约定,梯度的内存用量从每个参数 \(2N\) 字节、在 \(N\) 个工作进程上各存一份,降至合计每个参数 \(2\) 字节,即每个 GPU 上每个参数 \(2/N\) 字节。
ZeRO-3 和 FSDP 对参数本身进行分片。每个 GPU 仅存储模型的 \(1/N\)。在每层的前向传播之前,通过 AllGather 收集参数;反向传播之后,通过 ReduceScatter 归约梯度,随后丢弃参数(图 8)。这实现了最高的内存效率,代价是 FSDP 相对于标准 DDP 引入了额外通信。
\begin{tikzpicture}[
  font=\sffamily,
  >=Stealth,
  col card/.style={
    draw=CardBorder,
    fill=white,
    rounded corners=5pt,
    line width=0.8pt,
    minimum width=3.35cm,
    minimum height=5.2cm
  },
  comm badge/.style={
    rectangle,
    rounded corners=2.5pt,
    line width=0.65pt,
    font=\bfseries\tiny,
    inner sep=2.5pt,
    minimum width=3.0cm,
    minimum height=0.45cm,
    align=center
  },
  state block/.style={
    rectangle,
    rounded corners=2pt,
    line width=0.7pt,
    align=center,
    font=\bfseries\scriptsize,
    inner sep=0pt
  }
]

  % Color definitions
  \definecolor{NavyBlue}{RGB}{20,45,85}
  \definecolor{SteelBlue}{RGB}{40,90,140}
  \definecolor{LightBlue}{RGB}{240,245,252}
  \definecolor{RedLine}{RGB}{185,45,45}
  \definecolor{RedFill}{RGB}{253,242,242}
  \definecolor{GreenLine}{RGB}{35,135,75}
  \definecolor{GreenFill}{RGB}{240,249,244}
  \definecolor{DarkGreen}{RGB}{20,110,60}
  \definecolor{OrangeLine}{RGB}{215,105,15}
  \definecolor{OrangeL}{RGB}{254,246,233}
  \definecolor{CardBorder}{RGB}{215,222,230}
  \definecolor{CardFill}{RGB}{248,250,253}
  \definecolor{TextDark}{RGB}{25,35,45}
  \definecolor{TextMuted}{RGB}{95,105,115}

  % ===========================================================
  % TOP LEGEND
  % ===========================================================
  \node[draw=CardBorder, fill=white, rounded corners=4pt, line width=0.8pt, minimum width=14.0cm, minimum height=0.7cm] at (7.1, 8.4) {};

  \node[draw=SteelBlue, fill=LightBlue, rounded corners=2pt, minimum width=0.35cm, minimum height=0.35cm] at (1.2, 8.4) {};
  \node[anchor=west, font=\scriptsize, text=TextDark] at (1.5, 8.4) {\textbf{P:} Parameters (2\,B/param)};

  \node[draw=OrangeLine, fill=OrangeL, rounded corners=2pt, minimum width=0.35cm, minimum height=0.35cm] at (5.5, 8.4) {};
  \node[anchor=west, font=\scriptsize, text=TextDark] at (5.8, 8.4) {\textbf{G:} Gradients (2\,B/param)};

  \node[draw=DarkGreen, fill=GreenFill, rounded corners=2pt, minimum width=0.35cm, minimum height=0.35cm] at (9.6, 8.4) {};
  \node[anchor=west, font=\scriptsize, text=TextDark] at (9.9, 8.4) {\textbf{O:} Optimizer States (12\,B/param)};

  % ===========================================================
  % COLUMN 1: BASELINE DDP
  % ===========================================================
  \node[col card, anchor=north] (COL1) at (1.75, 7.8) {};
  % Header banner
  \fill[fill=CardFill, rounded corners=4pt] (0.1, 7.75) rectangle (3.4, 7.15);
  \node[font=\bfseries\footnotesize, text=TextDark] at (1.75, 7.55) {Baseline DDP};
  \node[font=\tiny, text=TextMuted] at (1.75, 7.3) {Full 16\,B Replication};

  % GPU Rows in Col 1 (y = 6.6, 5.8, 5.0, 4.2)
  \foreach \gpu/\y in {0/6.6, 1/5.8, 2/5.0, 3/4.2} {
    \node[font=\tiny\bfseries, text=TextMuted, anchor=east] at (0.85, \y) {GPU\,\gpu};
    \node[state block, draw=SteelBlue, fill=LightBlue, minimum width=0.68cm, minimum height=0.55cm] at (1.3, \y) {P};
    \node[state block, draw=OrangeLine, fill=OrangeL, minimum width=0.68cm, minimum height=0.55cm] at (2.05, \y) {G};
    \node[state block, draw=DarkGreen, fill=GreenFill, minimum width=0.68cm, minimum height=0.55cm] at (2.8, \y) {O};
  }
  \node[comm badge, draw=CardBorder, fill=CardFill, text=TextMuted] at (1.75, 3.0) {Comm: $2\times$ AllReduce};

  % ===========================================================
  % COLUMN 2: ZeRO-1
  % ===========================================================
  \node[col card, anchor=north] (COL2) at (5.3, 7.8) {};
  % Header banner
  \fill[fill=OrangeLine!12, rounded corners=4pt] (3.65, 7.75) rectangle (6.95, 7.15);
  \node[font=\bfseries\footnotesize, text=OrangeLine!90!black] at (5.3, 7.55) {ZeRO Stage 1};
  \node[font=\tiny, text=OrangeLine!80!black] at (5.3, 7.3) {Shard Optimizer State ($O$)};

  % GPU Rows in Col 2
  \foreach \gpu/\y in {0/6.6, 1/5.8, 2/5.0, 3/4.2} {
    \node[font=\tiny\bfseries, text=TextMuted, anchor=east] at (4.4, \y) {GPU\,\gpu};
    \node[state block, draw=SteelBlue, fill=LightBlue, minimum width=0.68cm, minimum height=0.55cm] at (4.85, \y) {P};
    \node[state block, draw=OrangeLine, fill=OrangeL, minimum width=0.68cm, minimum height=0.55cm] at (5.60, \y) {G};
    \node[state block, draw=DarkGreen, fill=GreenFill, minimum width=0.55cm, minimum height=0.55cm] at (6.32, \y) {O$_{\gpu}$};
  }
  \node[comm badge, draw=OrangeLine!70, fill=OrangeL!50, text=OrangeLine!90!black] at (5.3, 3.0) {Comm: Same as DDP ($1.0\times$)};

  % ===========================================================
  % COLUMN 3: ZeRO-2
  % ===========================================================
  \node[col card, anchor=north] (COL3) at (8.85, 7.8) {};
  % Header banner
  \fill[fill=SteelBlue!12, rounded corners=4pt] (7.2, 7.75) rectangle (10.5, 7.15);
  \node[font=\bfseries\footnotesize, text=SteelBlue] at (8.85, 7.55) {ZeRO Stage 2};
  \node[font=\tiny, text=SteelBlue] at (8.85, 7.3) {Shard Opt ($O$) + Grad ($G$)};

  % GPU Rows in Col 3
  \foreach \gpu/\y in {0/6.6, 1/5.8, 2/5.0, 3/4.2} {
    \node[font=\tiny\bfseries, text=TextMuted, anchor=east] at (7.95, \y) {GPU\,\gpu};
    \node[state block, draw=SteelBlue, fill=LightBlue, minimum width=0.72cm, minimum height=0.55cm] at (8.45, \y) {P};
    \node[state block, draw=OrangeLine, fill=OrangeL, minimum width=0.55cm, minimum height=0.55cm] at (9.22, \y) {G$_{\gpu}$};
    \node[state block, draw=DarkGreen, fill=GreenFill, minimum width=0.55cm, minimum height=0.55cm] at (9.87, \y) {O$_{\gpu}$};
  }
  \node[comm badge, draw=SteelBlue!70, fill=LightBlue!70, text=SteelBlue] at (8.85, 3.0) {Comm: ReduceScatter only};

  % ===========================================================
  % COLUMN 4: ZeRO-3
  % ===========================================================
  \node[col card, anchor=north] (COL4) at (12.45, 7.8) {};
  % Header banner
  \fill[fill=DarkGreen!12, rounded corners=4pt] (10.8, 7.75) rectangle (14.1, 7.15);
  \node[font=\bfseries\footnotesize, text=DarkGreen] at (12.45, 7.55) {ZeRO Stage 3};
  \node[font=\tiny, text=DarkGreen] at (12.45, 7.3) {Shard All State ($P + G + O$)};

  % GPU Rows in Col 4
  \foreach \gpu/\y in {0/6.6, 1/5.8, 2/5.0, 3/4.2} {
    \node[font=\tiny\bfseries, text=TextMuted, anchor=east] at (11.55, \y) {GPU\,\gpu};
    \node[state block, draw=SteelBlue, fill=LightBlue, minimum width=0.55cm, minimum height=0.55cm] at (12.05, \y) {P$_{\gpu}$};
    \node[state block, draw=OrangeLine, fill=OrangeL, minimum width=0.55cm, minimum height=0.55cm] at (12.70, \y) {G$_{\gpu}$};
    \node[state block, draw=DarkGreen, fill=GreenFill, minimum width=0.55cm, minimum height=0.55cm] at (13.35, \y) {O$_{\gpu}$};
  }
  \node[comm badge, draw=DarkGreen!70, fill=GreenFill!80, text=DarkGreen] at (12.45, 3.0) {Comm: $1.5\times$ (+AllGather P)};

  % ===========================================================
  % BOTTOM SUMMARY CARD
  % ===========================================================
  \node[draw=CardBorder, fill=white, rounded corners=5pt, line width=0.8pt, minimum width=14.0cm, minimum height=2.4cm, anchor=north] at (7.1, 2.55) {};

  \fill[fill=SteelBlue!10, rounded corners=4pt] (0.15, 2.50) rectangle (14.05, 2.05);
  \node[anchor=west, font=\bfseries\scriptsize, text=NavyBlue] at (0.35, 2.28) {ZeRO Mechanism: Trading Communication Primitives for Memory Capacity};

  \node[anchor=west, font=\scriptsize, text=TextDark] at (0.35, 1.72) {
    \textcolor{OrangeLine!90!black}{\textbf{ZeRO-1 ($P_{os}$):}} Partitions 12\,B/param optimizer state across $N$ GPUs ($4\times$ reduction). Zero extra communication overhead.
  };
  \node[anchor=west, font=\scriptsize, text=TextDark] at (0.35, 1.32) {
    \textcolor{SteelBlue}{\textbf{ZeRO-2 ($P_{os} + P_g$):}} Also partitions gradients ($8\times$ reduction). Replaces AllReduce with ReduceScatter; zero extra communication volume.
  };
  \node[anchor=west, font=\scriptsize, text=TextDark] at (0.35, 0.92) {
    \textcolor{DarkGreen}{\textbf{ZeRO-3 ($P_{os} + P_g + P_p$):}} Shards parameters; AllGathers parameters layer-by-layer during forward and backward passes ($1.5\times$ communication tax).
  };

  \node[draw=SteelBlue!40, fill=LightBlue!60, rounded corners=3pt, line width=0.6pt, minimum width=13.6cm, minimum height=0.45cm] at (7.1, 0.42) {
    \tiny\bfseries\textcolor{NavyBlue}{Core Principle: ZeRO converts memory redundancy into ring collective operations without changing mathematical output}
  };

\end{tikzpicture}这种分片方式将通信置于 DDP 所避免的关键路径上。前向传播需要一次 AllGather 来重建每一层的参数(\(M_{\text{layer}}\) 字节);如果参数在前向传播后被重新分片,反向传播就需要第二次 AllGather 来重建这些参数(\(M_{\text{layer}}\) 字节),随后通过一次 ReduceScatter 处理梯度(\(M_{\text{layer}}\) 字节)。因此,对于具有 \(N_L\) 层的模型,采用重新分片的全分片 FSDP 每个训练步大约执行 \(3N_L\) 次集合通信操作,而 DDP 只需要一次 AllReduce;总通信量因而增至约 \(3M_{\text{state}}\) 字节,相比之下,DDP 为 \(2M_{\text{state}}\) 字节。不过,这些集合通信分散在更多操作中,也提供了通信与计算重叠的机会:当第 \(i\) 层进行计算时,第 \(i+1\) 层可以预取其参数。
FSDP 与 DDP 之间的选择取决于模型规模和显存约束。当 GPU 显存能够容纳模型并为激活值留出空间时,DDP 通常更有优势,因为它避免了重复的 AllGather 操作。随着显存压力增加,ZeRO-2 更具吸引力,因为它对梯度和优化器状态进行分片,同时保留参数副本;一旦参数本身超出单个 GPU 的显存容量,ZeRO-3/FSDP 就成为必要选择,尽管它会将 AllGather 置于关键路径上。对于 70B+ 模型,在 80 GB 上训练时,FSDP 通常必须与张量并行结合使用,而非取代张量并行。
节省显存的数据并行需要仔细调整分片策略(按层、按 Transformer 块或扁平分片)和混合精度设置。分片粒度决定了其中的权衡:更细的分片会降低每个 GPU 的显存占用,但也会提高通信频率,因为每个训练步都需要执行更多 AllGather 和 ReduceScatter 操作。
通过 ZeRO 和 FSDP 消除显存瓶颈后,将数据并行扩展到数百个 GPU 便显得很有吸引力。然而,这样做会改变优化过程,而这些变化仅凭通信分析无法预测。较大的全局批量大小会改变梯度噪声的统计特性,为八个 GPU 运行调优的学习率调度在 256 个 GPU 上可能发生灾难性发散。一次实验既对这一失效模式进行了具有里程碑意义的大规模展示,也提出了后来产生广泛影响的工程应对方案。
War Story 1.1: 一小时 ImageNet 训练(2017)
背景: Facebook AI Research 着手在一小时内使用 256 个 GPU,在 ImageNet 上训练 ResNet-50,将数据并行推向远超以往实践所认为安全的批量大小 (Goyal 等 2017年)。
机制: 将全局批量大小扩展到 8,192 降低了每个训练步的梯度方差,导致采用标准恒定学习率的 SGD 优化在最初几个训练轮次中发散。
影响: 如果不调整优化过程,训练准确率会骤降,即使硬件吞吐量很高,多 GPU 扩展也无法奏效。
修正方法: 团队引入了学习率线性缩放规则,并配合持续 5 个训练轮次的渐进预热调度,使批量大小为 8,192 时的优化过程保持稳定。
系统启示: 分布式训练不只是并行硬件。扩展会改变优化形态,因此必须将集群、通信调度、批量大小和学习率调度作为一个整体系统进行调优。
扩展效率与收敛性
当 GPU 数量翻倍却只带来 1.5\(\times\) 的加速时,通信开销和同步屏障就消耗了未能转化为加速收益的 25% 计算预算。数据并行揭示了梯度同步和显存分片的实际机制,但要理解扩展效率为什么会下降,以及收敛性如何随并行度变化,就需要一个定量框架。这些指标和收敛性原则适用于所有并行策略(数据并行、模型并行、流水线并行和混合并行),决定了吞吐量、通信成本和优化质量之间的根本权衡。
扩展效率的数学描述
评估具体的并行策略,首先需要定义一个指标,以判断从单个设备扩展到多个设备是否值得:扩展效率。如果一个模型在单个设备上的训练时间为 \(T_1\),那么理想的(线性)扩展会使其训练时间缩短为 \(T_1/N\),所使用的设备数量为 \(N\)。在实践中,通信开销、流水线气泡和负载不均衡会降低加速比。扩展效率由 公式 1 定义:
\[\eta_{\text{scaling}} = \frac{T_1}{N \times T_N} \tag{1}\]
其中,\(T_N\) 是在 \(N\) 个设备上的训练时间。效率为 1.0 表示完美的线性扩展;效率为 0.5 表示仅实现了预期加速比的一半。
Definition 1.4: 扩展效率
扩展效率 \((\eta_{\text{scaling}})\) 是增加机器学习计算设备数量(\(N\))时,实际训练吞吐量与理想线性吞吐量的比值。
- 重要性: 它是衡量集群生产效率的最重要指标(\(\eta_{\text{scaling}} = \frac{T_1}{N \times T_N}\))。扩展效率为 0.50 意味着,一个拥有 10,000 个 GPU 的集群所完成的有效工作仅相当于一个拥有 5,000 个 GPU 的集群,浪费了 50% 的硬件投资。
- 区别: 单节点效率反映局部瓶颈,例如 \(\text{BW}\);扩展效率则反映通信时间 \((T_{\text{comm}}(N))\) 和同步带来的集群级开销。
- 常见误区: 一个常见的误解是认为扩展效率恒定不变。实际上,它是问题规模的函数:随着 \(N\) 增加,通信与计算的比值通常会恶化(阿姆达尔定律),使小模型更难保持高效率。
对于我们的 175B 模型进行数据并行训练时,每一步的通信开销主要由对 350 GB 梯度执行 AllReduce 所主导。
在 InfiniBand 上以 50 GB/s 的有效带宽进行环形 AllReduce 时,原始通信时间约为 \(2 \times (N-1)/N \times 350 / 50\);当 \(N\) 较大时,该时间接近 \(2 \times 350 / 50\) 秒。在梯度通信与反向传播之间具有 75% 重叠的情况下,实际暴露的通信时间降至 \(T_{\text{comm}}(N) \approx 3.5\) 秒。在相同假设下,计算项为 \(T_{\text{compute}}/N \approx 2.1\) 秒,因此暴露的单步时间为约 5.6 s,朴素数据并行扩展效率为 2.1 s/5.6 s \(\approx\) 37.5 percent。配置得当的系统可以通过结合张量并行、流水线并行、感知拓扑的放置以及更有效的通信重叠来大幅回收这部分损失。
扩展效率关键地取决于每通信字节所对应的计算量。在每次更新固定 token 数的情况下,增加参数数量会大致按比例地同时提高 Transformer 的计算量与梯度字节数,因此仅靠模型规模并不能保证更好的扩展性。更大的批次会提高每次优化器步骤的计算量,而不会改变梯度大小;问题在于,大批次可能损害收敛性,因而需要学习率调优和预热调度。网络带宽 会直接产生影响,因为将 InfiniBand 带宽翻倍会使带宽项减半,但效率的变化取决于完整的单步时间分母,而非与带宽成正比。因此,网络互连结构是集群生产力的首要决定因素,而非次要考虑;只要它能将扩展效率提升几个百分点,其成本(占总系统成本的 10–15%)就很容易被证明是划算的,因为较差的扩展效率会浪费其余 85–90% 的投资。
每通信字节对应更多计算的负载更容易扩展。
这些因素相互影响,因此效率无法仅凭模型规模或 GPU 数量推断。以下算例在计算单点效率之前,先固定参数数量、每次更新的 token 数、加速器数量、有效带宽、模型 FLOPs 利用率(MFU)以及重叠比例。改变其中任何一项输入,都需要重新计算完整的单步时间模型。
然而,即便对于大模型,扩展也不会无限持续。存在一条Scaling Cliff,越过该点后,边际加速收益不再值得增加设备。在本文采用的这一显式模型(即 175B 模型,每次更新 2M,1,024 GPUs,50 percent MFU,以及 75 percent 通信重叠)下,朴素的数据并行仅能达到 37.5 percent。因此,该示例并不意味着存在通用的 1,024–4,096-GPU 高效区域,或 8,192-GPU 悬崖。评估另一个集群规模需要重新计算每台设备的计算时间、集合通信的延迟与带宽成本、重叠程度以及拓扑结构。模型架构与集群规模必须协同设计,以保持这些项之间的平衡。
Napkin Math 1.5: 175B 模型的扩展效率
Setup: 在 DGX H100 集群上训练一个 175B 模型,每 GPU 配备 400 Gb/s 条 InfiniBand。
每步计算量(假设批大小为 2M 个 token,每个参数每个 token 需要 6 FLOPs): \(O_{\text{step}} = 6 \times 175 \times 10^9 \times 2 \times 10^6 \approx 2.1 \times 10^{18}\) FLOPs
每 GPU 计算时间(在 1,024 GPUs 上,每个 GPU 的 FP8 峰值为 1979 TFLOP/s,利用率 50 percent): \(T_{\text{compute}}/N \approx 2.1\) 秒
AllReduce 时间,用于传输 350 GB 的梯度,采用带重叠的环形 AllReduce: \(T_{\text{comm}}(N) \approx 3.5\) 秒(原始传输时间约为 14 seconds;本例假设与反向传播重叠 75 percent)
扩展效率:本简化示例中为 \(\eta_{\text{scaling}} \approx \frac{T_{\text{compute}}/N}{T_{\text{compute}}/N + T_{\text{comm}}(N) + T_{\text{sync}}(N) - T_{\text{overlap}}} = 2.1/5.6 \approx 0.375\),其中同步开销已计入 AllReduce 项,且 75 percent 通信重叠已经应用。
较低的效率(37.5 percent)表明,在该规模下朴素的数据并行已经不足。具有层次感知(hierarchy-aware)的系统通过结合数据并行与张量并行(经由 NVLink 通信)以及流水线并行(将计算与通信重叠)来恢复大部分损失掉的效率。
并行基础设施的交互
扩展效率分析表明,有效的并行策略并非仅由模型架构决定,而是由模型通信需求与基础设施带宽层次结构之间的交互决定。每一种并行策略与基础设施拓扑的组合都会产生不同的扩展效率曲线,而选错组合会浪费集群容量的相当一部分。前述速算显示,纯数据并行在该规模下效率接近 37.5 个百分点;恢复这部分损失掉的容量,意味着将每个并行维度映射到能够承载其通信量的带宽层级。节 1.6 通过三种具体配置展开这一组合,并将其形式化为层次感知并行,前提是张量并行与流水线并行已经得到发展。
因此,选择与组合并行策略直接决定了它们所创建的通信流量。网络互连结构 考察了拓扑如何与并行映射协同设计以最大化扩展效率;此处接下来的问题是,集合通信操作本身如何影响单步时间。AllReduce 操作在数据并行系统中可以消耗总训练时间的 10–40 个百分点,且该开销随集群规模增大而增长。BERT-Large 在 128 个 GPU 上运行时,通信开销可能达到总运行时间的很大比例;而 GPT-3 量级的模型则需要张量并行、流水线并行与数据并行,并配合通信重叠,以避免数据并行的梯度同步主导单步时间。
AllReduce 的复杂度取决于两个分量:延迟 \((\alpha)\) 与带宽 \((\beta)\)。环形 AllReduce 以 \((N-1)/N\) 利用率实现带宽高效的通信,而基于树的算法则在 \(\mathcal{O}(\log N)\) 步下提供更低的延迟。选择取决于消息大小:延迟主导的小消息由树算法胜出,带宽主导的大梯度由环形算法胜出。高性能实现(如 NCCL)采用分层算法,在节点内部结合树的延迟、节点之间结合环的带宽。集合通信 提供了详细的算法分析,包括复杂度公式、分层变体以及面向大规模集合通信的拓扑感知优化。
互连结构的选择决定了大规模部署是保持计算受限,还是陷入通信受限的扩展形态;高效分布式训练对带宽的要求相当高,尤其是对于 Transformer 模型。对于 Transformer 架构,高效系统通常要求每个节点具备 100–400 GB/s 的聚合带宽。BERT-Base(110M 参数)在 FP32 下每次迭代需要同步约 440 MB 的梯度,而 BERT-Large(340M 参数)则需要约 1.4 GB。在 64 张 GPU 上,这些同步需求要求具备 100–200 GB/s 的持续带宽,以实现低于 50 ms 的同步延迟。对于具有 175B 个参数的语言模型,确切的带宽需求取决于 3D 并行配置、梯度累积、计算与通信的重叠程度以及互连拓扑,而非某个统一适用的数值。
同步频率涉及通信效率与收敛行为之间的权衡。累积 4 个微步的梯度可将同步频率降低 75%,但实际的训练步耗时降幅取决于计算与通信的构成比例,以及通信能够在多大程度上与反向传播重叠。在标准实现中,梯度累积复用一个驻留的梯度缓冲区,并在其中原地累加;内存压力来自保持该缓冲区驻留,以及采用更大的微批次或其他激活值配置,而非存储 4 个独立的梯度张量。异步方法完全消除了同步成本,但会引入陈旧性,在学习率较大时使收敛性能下降 15–30%。
扩展的物理机制:计入通信开销的 Amdahl 定律
正如处理器性能铁律支配单线程执行一样,分布式训练受 Amdahl 定律扩展版本 的支配,该版本显式计入了通信开销。在 \(N\) 个设备上完成一个训练步骤所需的时间并非简单地等于 \(T_{\text{single}} / N\),而是受到同步过程串行性质的约束。集群规模下的 Amdahl 定律 推导了集群规模下的加速比上限,并通过一个具体示例展开说明;这里的关键结论是,只要同步所占的时间比例固定,无论增加多少加速器,加速比都会受到限制。
图 9 将这种偏离理想线性扩展的现象可视化为扩展税,这是扩展效率界限(原则 8)的直接结果。它展示了通信开销 \((r)\) 如何拖累性能,形成一道通信墙,使增加 GPU 所带来的收益递减。
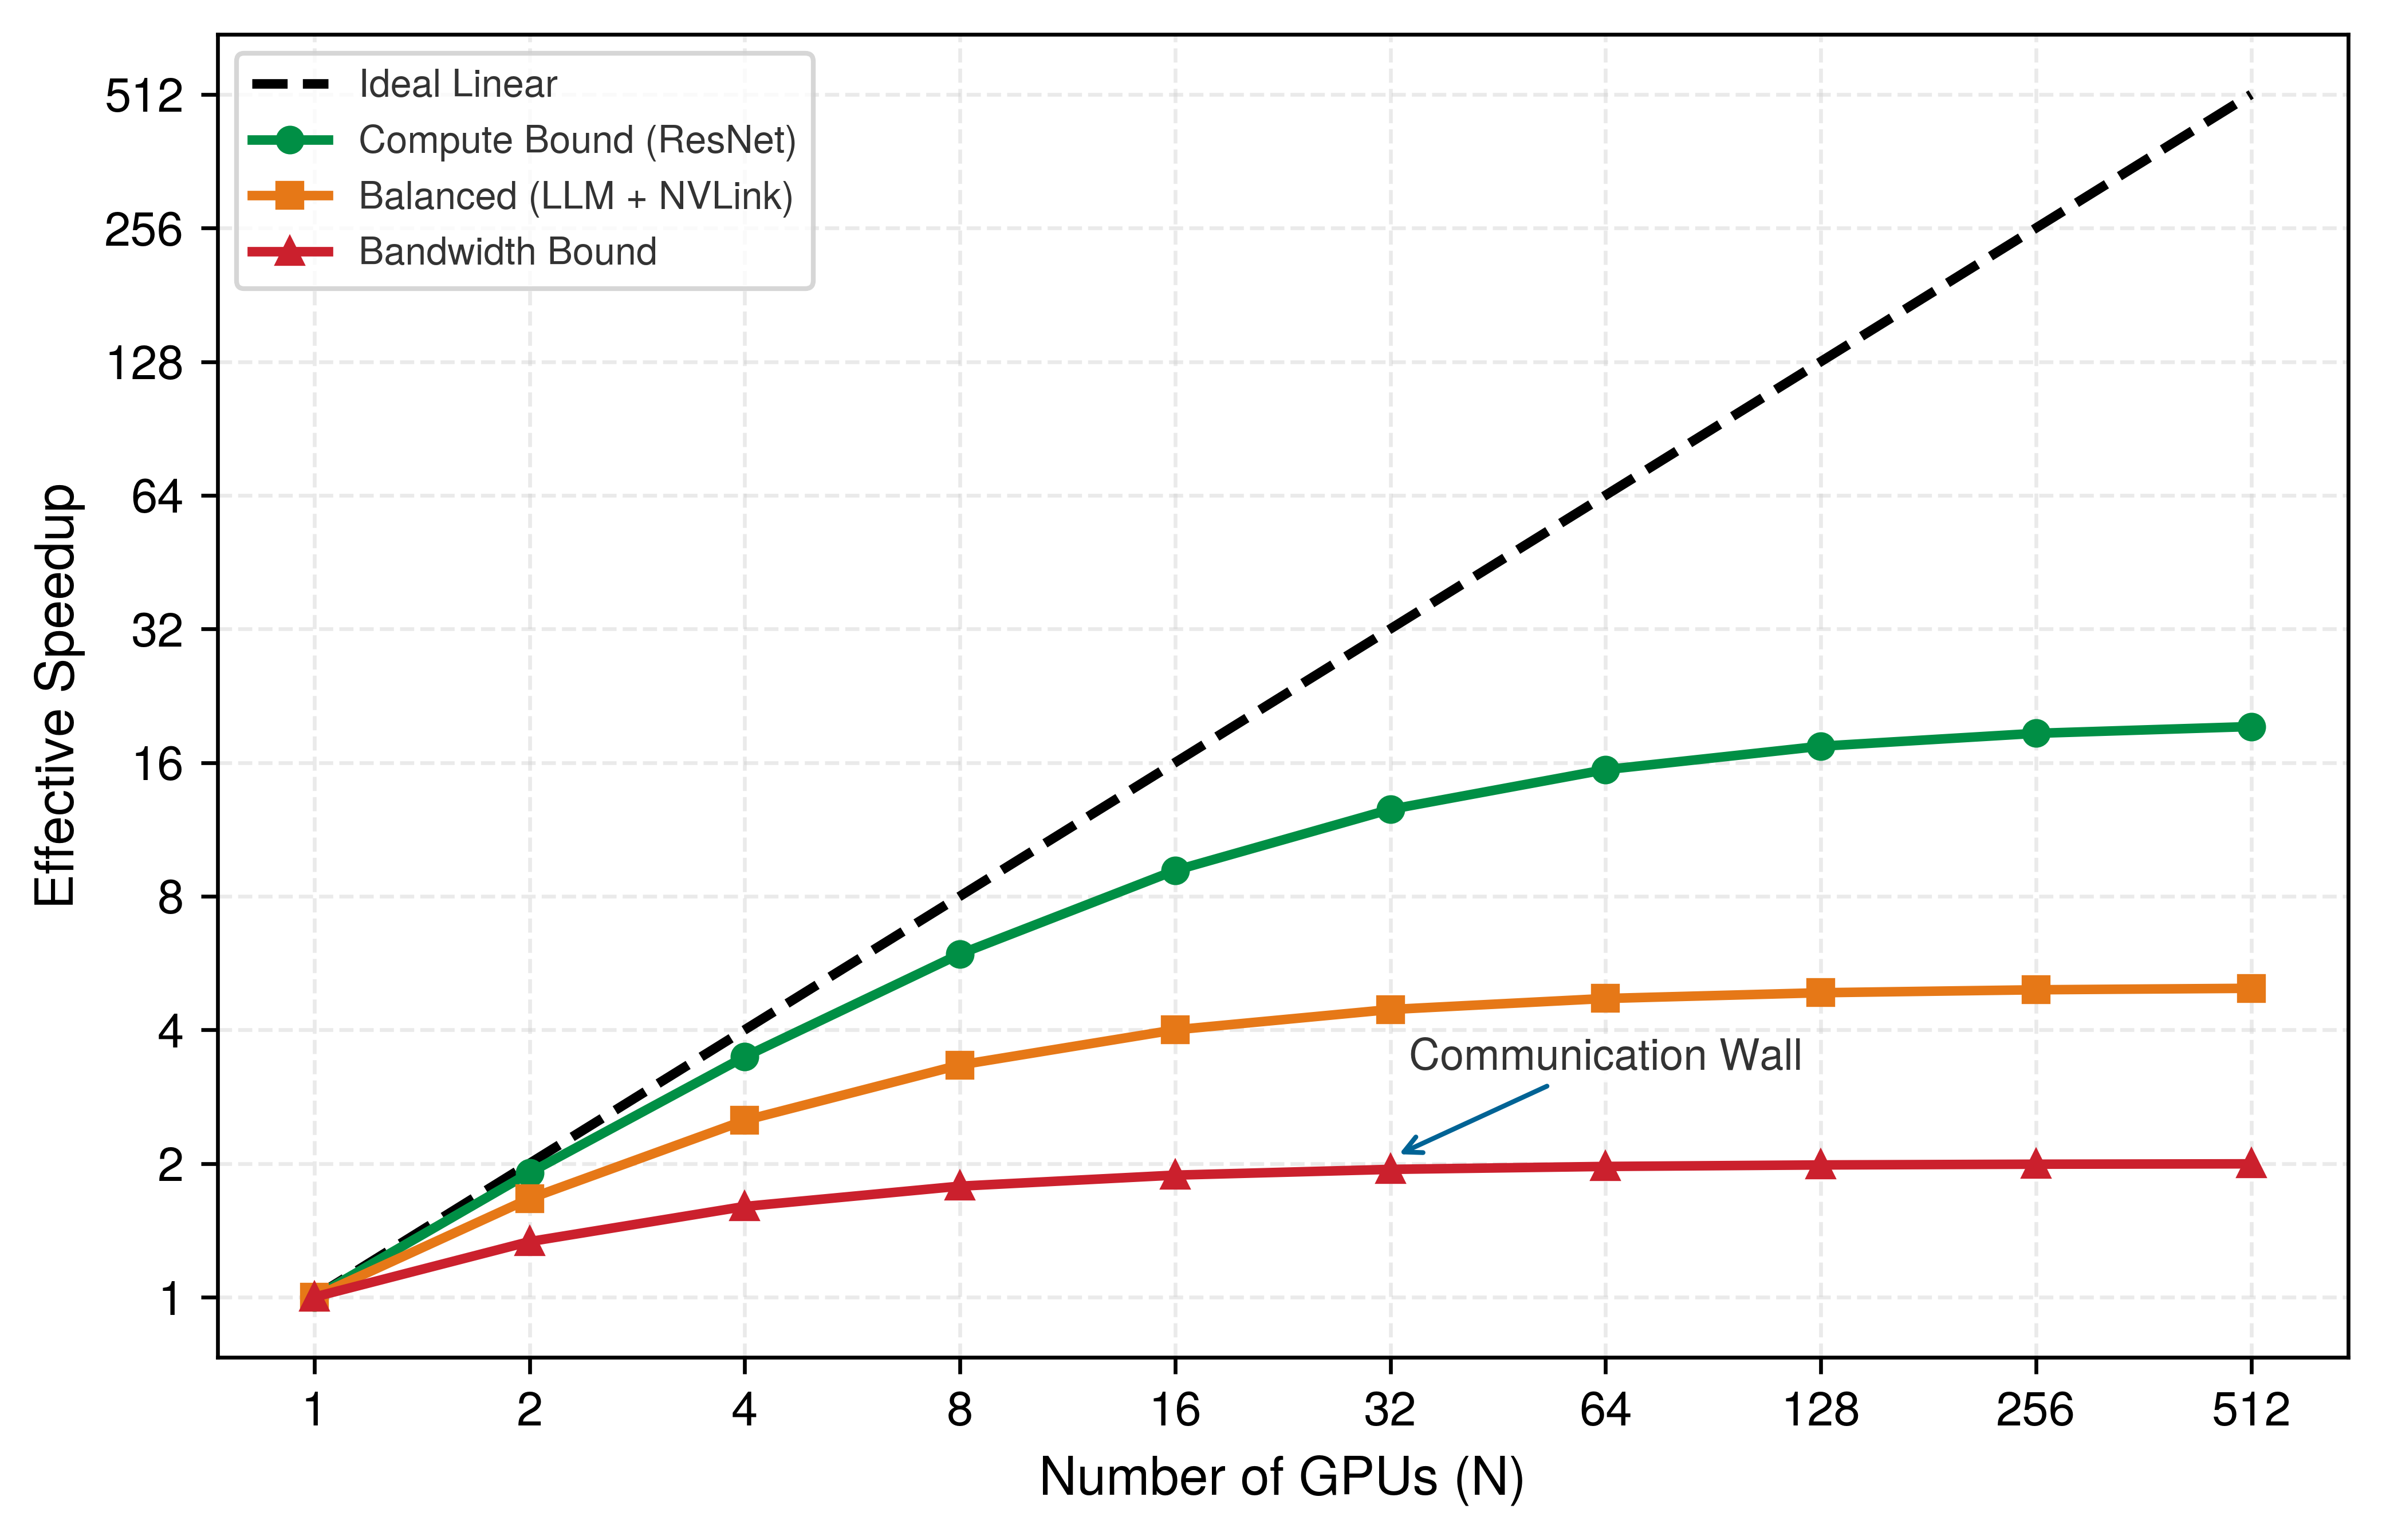
集群定律(原则 10)与铁律的变量直接对应,将计算、带宽和协同拆分为可加项:
\[ T_{\text{step}}(N) = \underbrace{\frac{T_{\text{compute}}}{N}}_{\text{Compute-Time Term}} + \underbrace{T_{\text{comm}}(N)}_{\text{Bandwidth Term}} + \underbrace{T_{\text{sync}}(N)}_{\text{Coordination Term}} - T_{\text{overlap}} \]
集群定律的项将步骤时间分解为四项不同成本:
- 计算时间项 \((T_{\text{compute}}/N)\):在 \(N\) 台设备上进行理想划分后,该批次所需的总计算量。
- 带宽项 \((T_{\text{comm}}(N))\):数据传输所花费的时间。它由铁律中的数据移动项 \(D_{\text{vol}}/\text{BW}\) 决定。对于 Ring AllReduce,该项为 \(\frac{2(N-1)}{N} \times \frac{M}{\text{BW}_{\text{net}}}\),其中 \(M\) 表示通信的梯度或模型状态字节数,\(\text{BW}_{\text{net}}\) 表示网络带宽。
- 协同项 \((T_{\text{sync}}(N))\):屏障、排序和落后节点等待的非重叠成本。
- 重叠 \((T_{\text{overlap}})\):被计算掩盖的通信部分。
集群定律导出了固定全局工作量的扩展效率指标,其中 \(T_{\text{compute}}\) 是该工作在单设备上的计算时间:
\[ \eta_{\text{scaling}} = \frac{T_{\text{compute}}}{N \times T_{\text{step}}(N)} = \frac{1}{1 + \frac{N(T_{\text{comm}}(N) + T_{\text{sync}}(N) - T_{\text{overlap}})}{T_{\text{compute}}}} \]
这就是扩展效率上界(原则 8):完美线性扩展 \((\eta_{\text{scaling}} = 1.0)\) 是理论极限,而非实际目标。配置良好的系统在中度规模下可达到 \(\eta_{\text{scaling}} = 0.85\)–\(0.95\),并随着 \(N\) 增大而进一步下降。\(\eta_{\text{scaling}} = 1.0\) 与实际效率之间的差距即通信税 与协同税:分布式执行的代价。
该方程揭示了扩展墙:随着 \(N\) 增大,计算项 \((T_{\text{compute}}/N)\) 减小,但通信与同步项可能保持不变或继续增长。最终,分母由开销主导,效率趋近于零。除墙钟时间外,这种通信开销还会带来能耗税,其随设备之间的物理距离而增长。
通信能耗从 HBM 一路攀升至网络。
Systems Perspective 1.2: 规模带来的能耗代价
分布式训练不仅是与时间的赛跑,同样也是与能耗的赛跑。在单块 GPU 中,将一个字节从 HBM 移动到核心,成本约为 1–2 pJ/bit。将该字节通过 NVLink 互连传输,成本为 5–10 pJ/bit。通过交换机传输至 InfiniBand 网络,成本则为 20–50 pJ/bit。
在 10,000 GPUs 的规模下,聚合带宽带来的乘法效应才是改变工程问题的关键。一个完整的 H100 NVLink 集群包络约为 9 PB/s 宽;在 7.5 pJ/bit 下,这次传输代表约 540 kW 的开销(冷却与交换机开销之前)。聚合 NDR InfiniBand 包络更小(500 TB/s),但在 35 pJ/bit 下,它仍然代表约 140 kW。因此,通信与计算的重叠对于墙钟效率是必需的,而避免不必要的传输则是直接降低功耗项本身的路径。
墙钟效率与能耗代价会随着 \(N\) 的增长而共同恶化,并遵循 GPU 数量上的可预测规律。作为一条代表性经验法则,处于 2–32 GPU 线性扩展形态的系统通常可实现 85–95% 的并行效率,因为通信开销仍然较小。通信受限形态出现在 64–256 GPU 区间,此时效率可能降至 60–80%,即使互连结构匹配良好。超过 512 GPU 后,协同开销可能成为主导因素,并因集合操作延迟将效率限制在 40–60%。
硬件选型对这些扩展特性具有关键影响。NVIDIA DGX A100 系统为每块 GPU 提供 600 GB/s 的双向 NVLink 带宽,并在系统层面提供聚合 NVSwitch 带宽,从而在配备 8 块 GPU 的节点内部实现较高的并行效率。多节点扩展需要网络互连结构具备足够的二分带宽;EDR 级 100 Gbps 链路可以支撑较小的多节点任务,而 HDR 级 200 Gbps 链路则能在拓扑、放置与通信计算重叠得到良好匹配时支撑更大的集群。
效率指标直接影响并行策略的选择。数据并行在线性扩展形态下表现良好,但在大规模下会受到通信限制。模型并行可以缓解内存约束,但会引入顺序依赖,从而限制效率。流水线并行可以减少设备空闲时间,但会增加微批次管理的复杂度。有效的策略取决于目标工作负载中哪种约束(内存、带宽或同步)占主导地位。
硬件效率指标决定吞吐量,但收敛理论决定分布式训练能否达到与单设备训练相同的解质量。并行性通过三种方式影响优化收敛:收敛速率随批大小变化,超过临界批大小后增加工作器带来的收益递减,以及学习率必须随批大小进行缩放。
同步数据并行 SGD 的收敛速率
分布式 SGD 的基本收敛结果说明了同步平均保留了哪些性质。设 \(\mathcal{L}\) 以 \(\mathcal{L}_{\inf}\) 为下界,且其梯度满足 \(L_s\)-Lipschitz 条件。每个工作器基于 \(b\) 个独立样本计算梯度,聚合估计量 \(g_k\) 是无偏的,其条件方差满足 \(\mathbb{E}[\|g_k-\nabla\mathcal{L}(\theta_k)\|^2\mid\theta_k]\leq\sigma^2/(Nb)\)。这些假设给出了非凸情形下的平稳性保证,但并未断言算法会收敛到全局极小点。
Theorem 1.1: 分布式 SGD 的收敛速率
对于更新 \(\theta_{k+1}=\theta_k-\eta g_k\),采用恒定步长 \(0<\eta\leq 1/L_s\),在 \(K\) 次同步更新之后,
\[ \frac{1}{K}\sum_{k=0}^{K-1}\mathbb{E}\!\left[\|\nabla\mathcal{L}(\theta_k)\|^2\right] \leq \underbrace{\frac{2\bigl(\mathcal{L}(\theta_0)-\mathcal{L}_{\inf}\bigr)}{\eta K}}_{\text{optimization term}} + \underbrace{\frac{\eta L_s\sigma^2}{Nb}}_{\text{stochastic-variance term}}. \]
选择 \(\eta=\min\!\left\{1/L_s,\sqrt{2(\mathcal{L}(\theta_0)-\mathcal{L}_{\inf})Nb/(L_s\sigma^2K)}\right\}\) 用于平衡这两项。在平滑性上限生效之前,随机性贡献按 \(\mathcal{O}(1/\sqrt{NbK})\) 缩放。
该定理隔离了由假设带来的收益。当本地批大小相等且为 \(b\) 时,同步数据并行 SGD 计算出的 minibatch 估计器与单个使用批大小 \(Nb\) 的工人对该更新所计算的估计器相同,估计器方差按 \(1/(Nb)\) 减小。它并未说明批大小的每一次增加都会按比例缩短达到目标损失所需的时间;学习率限制和临界批大小效应仍然适用。这一区别就是分布式训练的统计效率,与硬件效率相区分。
该定理假设完美同步(BSP)。当工人以不同速率推进或使用过期梯度时,随着过期程度增加,收敛保证会退化。
过期程度影响:BSP 与 SSP 与 ASP
节 1.2.1.4 中确立的 BSP、SSP 与 ASP 的操作保证具有收敛性后果,但不存在与目标、步长调度、工人数量和延迟模型无关的普适可加过期惩罚。过期参数 \(\tau_{\text{stale}}\) 量化了在计算梯度与将其应用到全局模型状态之间发生的更新次数,从而将吞吐量与解质量联系起来 Dutta 等 (2018年)。
Definition 1.5: 梯度过期
梯度过期(\(\tau_{\text{stale}}\)) 是指从计算梯度到将其应用到全局模型状态之间发生的参数更新次数。
- 重要性:它代表分布式优化中的同步误差。增加 \(\tau_{\text{stale}}\) 可以通过减少等待阻塞时间来提高吞吐量 \((T_{\text{sync}}(N))\),但通常会降低收敛速率,需要更多操作 \((O)\) 才能达到相同的精度。
- 区别:与网络延迟(一种物理延迟)不同,过期是一种算法性偏移,源于同步协议的选择(例如 ASP、SSP)。
- 常见误区:一种常见误解是过期“总是有害的”。实际上,它是一种吞吐量—收敛权衡:对于某些大规模工作负载,允许有界的过期是保持数千 GPU 投入使用的实用方式之一。
这些模型的收敛行为存在差异,直接影响训练成本和解的质量。在 BSP(\(\tau_{\text{stale}}=0\))中,所有工人基于同一参数版本计算并在更新前聚合。在定理 1.1 的假设下,同步估计器继承了 \(Nb\) minibatch 保证。
SSP(\(\tau_{\text{stale}}\leq s\))允许工人最多领先最慢工人 \(s\) 个时钟。Ho 等 (2013年) 证明了其 SSP 更新序列的平均遗憾速率 \(\mathcal{O}(\sqrt{(s+1)N/T})\),涉及 \(N\) 个工人和 \(T\) 次更新,假设凸 Lipschitz 分量函数、有界域和递减步长。该结果使过期依赖关系显式化,但它不能与非凸平稳性定理 1.1 互换使用。
Dutta, Sanghamitra, Gauri Joshi, Soumyadip Ghosh, Parijat Dube, 和 Priya Nagpurkar. 2018年. 《Slow and Stale Gradients Can Win the Race: Error-Runtime Trade-offs in Distributed SGD》. Proceedings of the Twenty-First International Conference on Artificial Intelligence and Statistics 84: 803~12.
异步 SGD 不施加协议级的有限延迟界。移除阻塞可以提高更新吞吐量,但收敛速率需要关于实际延迟、目标和步长调度的额外假设。Dutta 等 (2018年) 将其分析为一种误差—运行时间权衡,其中工人速度与梯度过期共同决定接受延迟更新是否有益。因此,异步执行本身既不能推出固定的平均延迟平方惩罚,也不能推出 \(N\)-worker 方差缩减的完全丧失。
按同步模型的收敛性质 总结了各同步模型的收敛性质。
| 模型 | 延迟控制 | 限定保证 | 系统效应 |
|---|---|---|---|
| BSP | \(\tau_{\text{stale}}=0\) | 同步 \(Nb\)-minibatch 定理 1.1 | 等待最慢的工人 |
| SSP | \(\tau_{\text{stale}}\leq s\) | \(\mathcal{O}(\sqrt{(s+1)N/T})\) 平均遗憾(凸假设下)(Ho 等 2013年) | 限制延迟同时减少部分等待 |
| ASP | 无协议级有限界 | 无额外延迟与目标假设时不存在普适速率 | 移除全局阻塞,但应用过期更新 |
Ho, Qirong, James Cipar, Henggang Cui, Seunghak Lee, Jin Kyu Kim, Phillip B. Gibbons, Garth A. Gibson, Greg Ganger, 和 Eric P. Xing. 2013年. 《More Effective Distributed ML via a Stale Synchronous Parallel Parameter Server》. Advances in Neural Information Processing Systems (NeurIPS) 26.
学习率缩放规则
当通过数据并行增加有效批大小时,必须调整学习率以维持收敛质量。理论和实践均已提出两条主要的缩放规则。
线性缩放规则 (Goyal 等 2017年) 指出,当批大小乘以 \(k\) 时,学习率也应乘以 \(k\):
\[ \eta_{\text{large}} = k \cdot \eta_{\text{base}} \]
这条规则的依据是:将学习率为 \(k\eta\) 的一次大批次更新近似为 \(k\) 次连续的小批次更新,每次的学习率均为 \(\eta\)。当批次大小为 \(kB\) 时,梯度方差缩小为原来的 1/\(k\),因此较大的更新步具有良好的条件性;当参数在这 \(k\) 次小批次更新中变化不大时,该近似成立。这条规则是经验性的,而非普遍适用:Goyal 等 (2017年) 在全局批次大小为 8,192 且采用渐进预热的条件下,在 ResNet-50/ImageNet 上验证了该规则;逐层自适应学习率缩放(LARS)和基于逐层自适应矩的优化器(LAMB)则通过逐层自适应,将大批次训练方案扩展到 ImageNet 和 BERT 式预训练 (You 等 2017年; You 等 2020年)。预热期将学习率从 \(\eta_{\text{base}}\) 线性增加到 \(k \cdot \eta_{\text{base}}\),这一过程在最初的 \(W\) 次迭代中完成,使模型能够到达损失景观中使用大学习率仍能保持稳定的区域:
\[ \eta_t = \eta_{\text{base}} + \frac{t}{W}(k \cdot \eta_{\text{base}} - \eta_{\text{base}}) \quad \text{for } t < W \]
平方根扩展规则 适用于批大小增长到线性扩展失效的程度:
\[ \eta_{\text{large}} = \sqrt{k} \cdot \eta_{\text{base}} \]
更保守的平方根规则源于如下观察:梯度噪声(不仅是梯度幅值)会影响优化动力学。平方根规则能更好地保持梯度更新的信噪比。经验表明,当批大小超过临界批大小形态时,平方根缩放成为必要。
对于极端批大小(32K–1M),LARS (You 等 2017年) 及其 Adam 变体 LAMB (You 等 2020年) 会根据权重范数与梯度范数之比自动为每一层调整学习率:
\[ \eta_\ell = \eta_{\text{global}} \cdot \frac{\|w_\ell\|}{\|g_\ell\| + \lambda_{\text{wd}}\|w_\ell\|} \]
\(\lambda_{\text{wd}}\) 是 LARS/LAMB 更新规则中优化器的权重衰减系数,以避免与可靠性分析中使用的失效概率参数冲突。逐层缩放可防止权重较小的层获得不成比例的大幅更新。LAMB 使 BERT 训练能够在最高 64K 的批大小下保持收敛质量。
临界批大小与收益递减
分布式训练的一个基本性质是:超过某个阈值后,继续增加 worker 就不再有帮助。临界批大小 \(B^{*}\) 标志着这样一个转折点:在此之后,继续增大批大小带来的收益递减,即每观察到的样本的收敛性收益下降。
Definition 1.6: 临界批大小
临界批大小 \((B^{*})\) 是指分布式训练批大小中梯度噪声尺度足够大的那个点,在此之后继续增大批大小会导致样本效率的收益递减 (McCandlish 等 2018年; Shallue 等 2019年)。
- 重要性:它标志着并行扩展效率的转折点。低于 \(B^{*}\) 时,增大批大小会线性提升每步的收敛性;高于 \(B^{*}\) 时,更大的批大小带来收益递减,需要按比例增加更多样本 \((D)\) 才能达到相同的损失。
- 区别:与受内存限制的批大小(由内存容量和激活占用决定)不同,临界批大小是模型与数据集的算法属性。
- 常见误区:一种常见误解是,通过不断添加 GPU 可以无限加快训练。实际上,\(B^{*}\) 定义了数据并行的物理上限:超过该点后继续增加 worker 只会浪费能量和计算资源 \((O)\),而不会缩短总训练时间 \((T)\)。
临界批大小的梯度噪声尺度代理量可以估计为:
\[ B^{*} \approx \frac{\text{tr}(\Sigma)}{\|\nabla \mathcal{L}(\theta)\|^2} \]
其中,\(\text{tr}(\Sigma)\) 是梯度协方差矩阵的迹(梯度总方差),\(\|\nabla \mathcal{L}(\theta)\|^2\) 是梯度范数的平方(信号强度)。直观地说,\(B^{*}\) 是通过平均使梯度方差降至真实梯度幅值水平时的批大小。
已发表的大批量训练扩展形态展示的是量级,而非固定阈值。在 ImageNet 上,Goyal 等 (2017年) 通过预热使 ResNet-50 在全局批大小为 8,192 时保持训练稳定,而 LARS 在某些设置下进一步扩展了 ImageNet 的大批量训练 (You 等 2017年)。对于 BERT-Large 预训练,LAMB 报告了采用逐层自适应更新、批大小为 32K–64K 的训练结果 (You 等 2020年)。在其他领域,McCandlish 等 (2018年) 表明,有效的批大小上限从类似 ImageNet 的设置中的数万,到强化学习工作负载中的数百万不等,因此,新的前沿语言模型的阈值应通过测量确定,而非照搬。
You, Yang, Igor Gitman, 和 Boris Ginsburg. 2017年. 《Large Batch Training of Convolutional Networks》. arXiv preprint arXiv:1708.03888.
You, Y., J. Li, S. Reddi, J. Hseu, S. Kumar, S. Bhojanapalli, X. Song, J. Demmel, K. Keutzer, 和 C.-J. Hsieh. 2020年. 《Large Batch Optimization for Deep Learning: Training BERT in 76 minutes》. International Conference on Learning Representations (ICLR).
规模定律的扩展形态呈现出三种不同的行为。在临界批大小 \((B < B^{*})\) 以下,线性扩展成立:批大小翻倍,达到目标损失所需的迭代次数减半,吞吐量由硬件效率决定。在临界点 \((B \approx B^{*})\),以每秒处理的样本数衡量的效率达到最大,实现最优权衡。超过该临界点 \((B > B^{*})\) 后,收益递减,因为批大小翻倍会使所需的总样本数增加到原来的两倍以上,因此,增加工作节点会提高吞吐量,但不会提高样本效率。
图 10 展示了批大小与训练效率之间的这一关系。
临界批大小对分布式训练系统设计具有重要意义。当工作节点数超过 \(B^{*}/b\)(其中 \(b\) 为每个工作节点的批大小)时,继续增加工作节点可以提高吞吐量,但不会提升样本效率;不过,如果新增工作节点的边际成本较低,从成本角度看,这样做仍可能值得。学习率调度同样重要,因为当批大小超过 \(B^{*}\) 时,较为激进的预热策略变得不可或缺:初始化位置附近的损失曲面可能无法承受线性缩放所产生的大幅更新。通信方面的权衡也会随之变化,因为当批大小超过 \(B^{*}\) 时,增大批大小的收益降低,使得通信开销的相对代价更高,从而为采用梯度压缩或异步方法提供了更充分的理由。
Checkpoint 1.2: 扩展决策
给定一个 7B 参数模型,分布在 64 张 A100 GPU(每张 80 GB HBM2e)组成的集群中,确定最大有用批大小。使用包含 \(\text{tr}(\Sigma)=1.6 \times 10^6\)、\(\|\mu\|^2=100\)、每 GPU 批大小 \(b=4\) 的试点轨迹,以及建议的梯度累积深度为 32 步,得到 \(B_{\text{global}} = 64 \times 4 \times 32 = 8192\) 个样本。
工作示例:8 与 64 个工作节点的收敛性比较
为具体说明这些概念,考虑将训练 transformer 语言模型的批大小从 8 个工作节点扩展到 64 个工作节点,基线批大小为每个工作节点 \(B = 32\)。
Napkin Math 1.6: 从 8 到 64 个工作节点扩展
设置:Transformer 模型,参数 1.3B,目标困惑度 15,基线训练:100K 次迭代,使用单 GPU 与 \(b =\) 32。
8 个工作节点(BSP)
- 有效批大小:\(B =\) 8 \(\times\) 32 = 256
- 学习率:\(\eta =\) 8 \(\times \eta_{\text{base}}\)(线性缩放并带预热)
- 预期迭代次数:100K \(/\) 8 = 12.5K 次迭代
- 收敛性:在 12.8K 次迭代内达到目标困惑度(98 percent 效率)
- 通信开销:15 percent(NVLink 节点内通信)
- 墙钟加速比:100K \(\times\) 1 \(/\)(12.8K \(\times\) 1.15×)= 6.8×
64 个工作节点(BSP)
- 有效批大小:\(B =\) 64 \(\times\) 32 = 2,048
- 学习率(\(N =\) 64 个工作节点):\(\eta = N \times \eta_{\text{base}}\)(若 \(B < B^*\))或 \(\eta = \sqrt{N} \times \eta_{\text{base}}\)(若 \(B > B^*\))
- 假设 \(B^* \approx\) 4,000(低于临界值):线性扩展成立
- 期望迭代次数:100K \(/\) 64 = 1.56K 次迭代
- 收敛性:在 1.72K 次迭代内达到目标困惑度(91 percent 效率)
- 通信开销:45 percent(InfiniBand 节点间互联,8 nodes)
- 时钟速度提升:100K \(\times\) 1 \(/\)(1.72K \(\times\) 1.45×)= 40.1×
SSP 工作节点:64 个工作节点(\(s =\) 4)
- 相同有效批大小:\(B =\) 2,048
- 学习率:\(\eta' = \eta_{\text{BSP}} / \sqrt{1 + s}\) 配 \(s =\) 4,得到 \(\eta' \approx\) 0.45 \(\times \eta_{\text{BSP}}\)
- 期望迭代次数:因陈旧惩罚而更高
- 收敛性:在 2.1K 次迭代内达到目标困惑度(74 percent 效率)
- 通信开销:25 percent(同步减少)
- 时钟速度提升:100K \(\times\) 1 \(/\)(2.1K \(\times\) 1.25×)= 38.1×
分析(在集群规模上扩展 SGD)
| 配置 | 迭代次数 | 通信开销 | 时钟速度提升 | 样本效率 |
|---|---|---|---|---|
| 1 GPU(基线) | 100,000 | 0% | 1\(\times\) | 100% |
| 8 GPU BSP | 12,800 | 15% | 6.8× | 98% |
| 64 GPU BSP | 1,720 | 45% | 40.1× | 91% |
| 64 GPU SSP | 2,100 | 25% | 38.1× | 74% |
64-GPU BSP 配置实现了 40× 的加速比,尽管样本效率仅为 91 percent,因为通信开销(45 percent)被大规模并行所抵消。SSP 的墙钟时间与之相当,通信开销更低,但需要更多的总样本数。
成本分析(假设 $3/GPU-hour):
- 8:12.8K 次迭代 \(\times\) 0.4 s/次迭代 \(\times\) 8/3600 \(\times\) $3/GPU-hour = $34
- 64 BSP:1.72K 次迭代 \(\times\) 0.58 s/次迭代 \(\times\) 64/3600 \(\times\) $3/GPU-hour = $53
- 64 SSP:2.1K 次迭代 \(\times\) 0.50 s/次迭代 \(\times\) 64/3600 \(\times\) $3/GPU-hour = $56
尽管并行度更高,64-GPU 训练每次运行的成本仍然更高,原因是通信开销增加和样本效率降低。8-GPU 配置更具成本效益,但墙钟时间长 6\(\times\)。如何选择取决于优先考虑最小化成本,还是最小化获得结果所需的时间。
权衡:通信成本与收敛速度
分布式训练中的根本权衡在于通信效率与收敛质量之间。图 11 展示了这一权衡空间。
多种技术在这条权衡曲线上占据不同的位置。梯度压缩 通过量化、稀疏化或低秩近似传输压缩后的梯度信息,从而降低通信量。示例包括基于符号的更新 (Bernstein 等 2018年)、Deep Gradient Compression (Lin 等 2018年)、PowerSGD (Vogels 等 2019年)、带收敛性分析的量化 SGD (Alistarh 等 2017年),以及用于神经机器翻译的经验性稀疏梯度丢弃 (Aji 和 Heafield 2017年)。
Bernstein, Jeremy, Yu-Xiang Wang, Kamyar Azizzadenesheli, 和 Animashree Anandkumar. 2018年. 《signSGD: Compressed Optimisation for Non-Convex Problems》. International Conference on Machine Learning (ICML) 80: 560~69.
Lin, Yujun, Song Han, Huizi Mao, Yu Wang, 和 William J Dally. 2018年. 《Deep gradient compression: Reducing the communication bandwidth for distributed training》. International Conference on Learning Representations (ICLR).
Vogels, Thijs, Sai Praneeth Karimireddy, 和 Martin Jaggi. 2019年. 《PowerSGD: Practical low-rank gradient compression for distributed optimization》. Advances in Neural Information Processing Systems (NeurIPS) 32.
Alistarh, Dan, Demjan Grubic, Jerry Z. Li, Ryota Tomioka, 和 Milan Vojnovic. 2017年. 《QSGD: Communication-Efficient SGD via Gradient Quantization and Encoding》. Advances in Neural Information Processing Systems (NeurIPS) 30: 1709~20.
Aji, Alham Fikri, 和 Kenneth Heafield. 2017年. 《Sparse Communication for Distributed Gradient Descent》. Proceedings of the 2017 Conference on Empirical Methods in Natural Language Processing, 440~45. https://doi.org/10.18653/v1/d17-1045.
Stich, Sebastian U. 2019年. 《Local SGD Converges Fast and Communicates Little》. International Conference on Learning Representations (ICLR).
Local SGD 采取了不同的方法:worker 在执行同步之前先进行 \(H_{\text{local}}\) 本地更新,将通信频率降低为原来的 \(H_{\text{local}}\) 分之一。收敛性分析表明,对于光滑的强凸目标,Local SGD 在适当调优学习率的情况下能够达到与同步式 SGD 相同的渐近速率 (Stich 2019年)。
去中心化 SGD 将 worker 的通信限制为仅与通信图中的邻居通信,而不是执行全局 AllReduce。这降低了带宽需求,但代价是混合速度变慢,因此适用于地理分布式训练,其中全局同步成本高昂。
这些方法之间的选择取决于具体的瓶颈。当网络带宽限制吞吐量时,梯度压缩提供了最佳的权衡。当同步延迟占主导时,Local SGD 或 SSP 更受青睐。当存在网络拓扑约束时,去中心化方法可能是必需的。
Model Parallelism
当模型状态、激活、优化器状态或某个张量操作超出单个加速器组的内存或通信预算时,数据并行会完全失效。这就是以操作形式呈现的内存容量缺口(原则 3):模型参数的增长速度超过设备内存的增长速度,迫使模型的计算和状态被切分。数据并行的内存优化可以扩展复制的适用范围,但最终模型本身必须被切分。
Definition 1.7: Model parallelism
Model Parallelism 是一种分布式训练策略,它将单个神经网络的参数或操作切分到多个设备上,使每个设备计算模型的不同部分。
- 重要性:如果参数状态为 \(S_{\text{model}}\) 的模型被切分到 \(N_{\text{mp}}\) 个设备上,则每个设备的理想参数占用量会趋近于 \(S_{\text{model}}/N_{\text{mp}}\),从而使得训练超出单设备内存容量的模型成为可能。代价是激活和梯度需要额外的通信,以及由顺序依赖引入的空转时间,因此内存收益必须超过切分所引入的传输和流水线气泡开销。
- 区别:与数据并行不同,数据并行在每个 worker 上复制完整模型并切分小批量,而模型并行切分的是模型本身。流水线并行和张量并行是模型并行的实现形式:前者将层切分为阶段,后者将单个张量操作切分。
- 常见误区:一个常见的误解是模型并行会自动加快训练。它的主要收益是容量,而非吞吐量;如果没有仔细调度的重叠,下游设备会等待上游激活,利用率可能低于单设备基线。
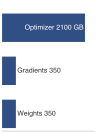
训练预算中占主导的是优化器状态,而非权重。
即使 ZeRO-3 完全部署,将优化器状态、梯度和参数分片到各工作器上,某些架构仍然难以处理。张量并行(见 图 12)通过在每个设备上划分单个权重矩阵来解决这一问题;流水线并行则沿阶段纵向划分层,将在 节 1.4.2.2 中介绍。对于一个 175B 参数量的模型,仅权重就占用 350 GB,即 64 个 GPU 上每个 GPU 约 5.5 GB。完整的混合精度 Adam 训练状态要大得多:全局为 2,800 GB,在激活之前每个 GPU 约 43.8 GB。这一区别很重要,因为优化器分片可以减少静态状态,但它并不能消除迫使模型并行化的激活容量和逐层容量约束。
对于激活内存占主导地位的长上下文 Transformer,一条包含 2048 个 token 的序列通过 175B 参数,会产生约 1 TB 的中间激活;即便是在很小的微批次下(约 1.1 TB,如前文所计算),优化器分片也无法缓解这一约束。模型并行通过把模型架构本身拆分到各个设备上,而不是用分片状态复制它,来应对这些限制。
Napkin Math 1.7: 规模扩展中的内存墙
问题:训练一个具有 175B 个参数的模型(如 GPT-3),使用 NVIDIA A100(80 GB)。采用 ZeRO-3 的数据并行能否胜任?
计算:
- 参数存储:175B 个参数 \(\times\) 2 字节(FP16)= 350 GB。
- 梯度与优化器状态:梯度额外占用 175B 个参数 \(\times\) 2 字节 = 350 GB,而 Adam 的 FP32 主权重、动量和方差额外占用 175B 个参数 \(\times\) 12 字节 = 2,100 GB。
- 静态内存总量:2,800 GB。
- ZeRO-3 分片:在 64 GPUs 的条件下,每个 GPU 的静态内存 = 2,800 GB/64 GPUs \(\approx\) 43.8 GB。
- 激活内存:对于序列长度 2048、批大小 1,标准的全量激活检查点策略在每个 GPU 上存储 \(\approx\) 4.8 GB 的激活值。
系统洞察:43.8 GB(静态)+ 4.8 GB(动态)= 48.6 GB。按照这一简化的内存核算,ZeRO-3 加上全量激活检查点所需的内存可容纳于 80 GB A100 的容量之内,并为框架缓冲区和临时层参数汇集留出可观的余量。如果这些额外分配超出剩余的 HBM 容量,可以通过减小微批大小、卸载状态、提高分片程度,或引入张量并行或流水线并行来调整设计;张量并行并非唯一的应对方式。
模型并行通过将模型架构本身分布到多个设备上来解决这一限制,但放置决策的核心在于在哪里切分模型。基于层的切分将连续的层组分配给不同设备,例如将第 1–4 层放在一台设备上,将第 5–8 层放在下一台设备上。基于通道的切分划分一层内部的通道,例如将 512 个通道放在一台设备上,将其余通道放在另一台设备上。Transformer 架构还引入了注意力头切分,由不同设备分别负责不同的注意力头。每种切分方式影响的成本各不相同:层切分节省内存,但使流水线串行执行;通道和注意力头切分提供更多可并行执行的工作,但需要更快的层内通信。
这些切分方式支持了因不同原因超出单设备能力的大规模应用场景。GPT-3 具有 175B 个参数,其训练依赖模型并行。处理高分辨率 \(16k{\times}16k\) 像素图像的视觉 Transformer 使用模型并行来应对激活存储和内存容量的限制。混合专家架构采用这一方法,将条件计算路径分布到不同硬件上 (Shazeer 等 2017年; Lepikhin 等 2021年; Fedus 等 2022年)。
设备协同分为三个阶段。在前向传播中,数据依次流经不同设备上的模型分段。反向传播则使梯度以相反顺序通过这些分段。在参数更新期间,每台设备只修改分配给自己的模型部分。这种协同确保了与单设备训练的数学等价性,同时支持训练超出单设备内存容量的模型。其代价是阶段之间的顺序依赖:当一台设备执行前向传播计算时,下游设备处于空闲状态,由此产生流水线气泡,成为模型并行系统利用率分析中的主导因素。
Checkpoint 1.3: 模型并行基础
检验你对模型分片的理解:
模型并行实现
一旦模型本身成为划分对象,实现问题便在于放置:每次切分都必须节省足够的内存,才能抵偿其引入的激活传输和空闲时间。图 13 展示了这种双向数据流:输入数据依次通过顺序分配的模型分区向前传播,梯度则反向流动以更新参数,每个阶段的中间结果都会跨设备边界传输。
\begin{tikzpicture}[font=\small\sffamily]
  \tikzset{
    Line/.style={line width=1.0pt, black!50, text=black},
    Box/.style={
      draw=GreenLine,
      fill=GreenL,
      line width=0.75pt,
      text width=23mm,
      align=flush center,
      minimum width=23mm,
      minimum height=10mm,
      node distance=25mm
    },
    Text/.style={
      draw=none,
      line width=0.75pt,
      fill=TextColor!80,
      font=\sffamily\footnotesize,
      align=flush center,
      minimum width=22mm,
      minimum height=6mm
    },
    Connector/.style={
      -latex,
      Line
    },
    ReverseConnector/.style={
      latex-,
      Line
    }
  }

  \node[Box] (B1) {Input Data};
  \node[Box, right=of B1] (B2) {Model Part 1\\ on Device 1};
  \node[Box, right=of B2] (B3) {Model Part 2\\ on Device 2};
  \node[Box, right=of B3] (B4) {Model Part 3\\ on Device 3};
  \node[Box, right=of B4] (B5) {Predictions};

  \begin{scope}[every node/.style={Text}]
    \draw[Connector] (B1) -- ++(0,12mm) node[pos=0.25] {Forward Pass} -| (B2.120);
    \draw[ReverseConnector] (B1) -- ++(0,-12mm) node[pos=0.25] {Gradient Updates} -| (B2.240);

    \draw[Connector] (B2) -- ++(0,12mm) node[pos=0.25] {Intermediate Data} -| (B3.120);
    \draw[ReverseConnector] (B2) -- ++(0,-12mm) node[pos=0.25] {Gradient Updates} -| (B3.240);

    \draw[Connector] (B3) -- ++(0,12mm) node[pos=0.25] {Intermediate Data} -| (B4.120);
    \draw[ReverseConnector] (B3) -- ++(0,-12mm) node[pos=0.25] {Gradient Updates} -| (B4.240);

    \draw[Connector] (B4) -- ++(0,12mm) node[pos=0.25] {Output} -| (B5.120);
    \draw[ReverseConnector] (B4) -- ++(0,-12mm) node[pos=0.25] {Backward Pass} -| (B5.240);
  \end{scope}
\end{tikzpicture}考虑我们的运行示例:该 175B-参数模型在 FP16 下需要 350 GB 内存,超出单张 A100 的 80 GB 容量四倍。模型并行(model parallelism)通过把模型权重切分到多台设备上,从而绕开这道 Capacity Wall,等效地将其拼接为一台超级加速器。与数据并行不同,数据并行中每台 GPU 都持有模型的全量副本,并处理全局批次的不同子集;而模型并行要求每台 GPU 持有模型的一个唯一部分,并顺序处理同一数据流。在 A100 上进行 8 路切分时,仅 BF16 权重就占用约 44 GB/GPU。那只是权重预算:完整训练还需要激活值、梯度和优化器状态,因此单纯的 8 路模型并行本身并不够用。训练还需要对优化器与梯度状态进行额外的切分或卸载,并借助流水线或混合并行来将激活值内存控制在容量之内。
在典型的流水线并行实现中,训练循环以接力赛的方式运行。前向传播从 GPU 1 启动,计算初始的 transformer 层,并将产生的中间激活张量经互连结构传送到 GPU 2。对于我们的 175B 模型(隐藏维度 12,288,微批次为 4 个各 2,048 个 token 的序列),这次交接在每个阶段边界、每步需要移动约 200 MB 数据。GPU 2 必须等待该数据载荷才能开始计算,由此形成贯穿所有阶段的严格依赖链。反向传播则沿该路径反向传播,将误差梯度从最后一层传回输入,每个设备仅计算其本地参数的梯度。
该架构与数据并行相比,从根本上改变了优化动力学。数据并行采用全局 AllReduce 来对副本间的梯度取平均,而在这里,每台 GPU 都在其特定的参数切片上执行本地优化器步骤(Adam (Kingma 和 Ba 2015年)、AdaFactor 或类似方法)。持有 transformer 第 1–12 层的设备仅更新这些层的权重与偏置,优化步骤期间无需跨设备同步。这虽然消除了数据并行中带宽密集的梯度同步,却也以另一种瓶颈替代了它:流水线气泡。如果分配给 GPU 1 的层在计算上比 GPU 2 上的层更重(常见于注意力层头数不同,或嵌入层尺寸不均衡的情况),就会有大量有价值的计算周期浪费在等待上。因此,主要工程挑战从最大化算术强度,转向最小化序列化延迟并确保切分后的集群负载均衡 (Rasley 等 2020年)。
Kingma, Diederik P., 和 Jimmy Ba. 2015年. 《Adam: A Method for Stochastic Optimization》. 3rd International Conference on Learning Representations (ICLR).
Rasley, Jeff, Samyam Rajbhandari, Olatunji Ruwase, 和 Yuxiong He. 2020年. 《DeepSpeed: System Optimizations Enable Training Deep Learning Models With Over 100 Billion Parameters》. Proceedings of the 26th ACM SIGKDD International Conference on Knowledge Discovery & Data Mining, 3505~6. https://doi.org/10.1145/3394486.3406703.
并行方案
切分策略决定了当内存不再能容纳于单台设备时,模型需要付出的代价:分层切分以空闲时间来换取每台设备的内存降低;流水线并行以调度复杂度来隐藏这段空闲时间;张量切分则以 NVLink 带宽为代价来拆分单个层。以下各小节依据使每种方案可行的架构与互连结构,将这些选择分别展开。
分层切分
分层切分是最不侵入式的模型切分方式:它通过将连续层分配给不同设备来节省内存,但保留了模型的顺序依赖关系。在 transformer 架构中,这意味着特定设备负责管理定义好的注意力块和前馈块集合。分层模型并行展示了 16 层 transformer 的该切分方式:四台设备各承载四个连续块,前向激活自左向右流动,反向梯度则跨设备边界自右向左传播。
顺序处理会引入设备空闲时间,因为每个设备都必须等待前一个设备完成其计算后才能开始工作。当设备 1 处理初始块时,设备 2、3 和 4 处于非活动状态。同样地,当设备 2 开始其计算时,设备 1 处于空闲状态。这种等待与空闲的模式,相对于其他并行化策略,降低了硬件利用率效率。
流水线并行
流水线并行通过在层级切分的基础上引入微批次来减少设备空闲时间。与等待整个批次依次通过所有设备相比,计算被划分为更小的片段,称为微批次,并在流水线各阶段之间进行重叠执行(图 15)。在该调度中,每一行代表一个设备在微批次上处理模型层,前向激活沿下游方向流动,反向梯度沿上游方向传播。这种重叠减少了但并未消除空闲流水线槽位。
Definition 1.8: 流水线并行
流水线并行 是一种模型并行技术,它将神经网络的层划分为依次排列的阶段并分配给不同设备,在各阶段之间前向传递激活值、反向传递梯度,并通过微批次在各阶段之间重叠计算以维持吞吐量。
- 重要性:阶段间通信在每个阶段边界仅传输激活张量,其大小为 \(B_{\mu} \times S \times d_{\text{model}} \times 2\) 字节(BF16),其中 \(B_{\mu}\) 为微批次大小。对于隐藏维度 8,192、微批次大小为 1、序列长度为 2,048 token 的情况,每个边界约为 \(8{,}192 \times 2{,}048 \times 2 \approx 32\) MB,相比之下,数据并行所需的梯度 AllReduce 需要数 GB。这种低通信量使得流水线并行成为在通过 50 GB/s InfiniBand 互联的节点之间扩展模型深度的主要技术。流水线气泡浪费约 \((p-1)/(m+p-1)\) 的总计算量,其中 \(p\) 为阶段数,\(m\) 为微批次数——当阶段数为 \(p=8\)、微批次为 \(m=32\) 时,气泡开销约为 18%。
- 区别:与张量并行不同,张量并行对单个层内的矩阵乘法进行切分,并且要求每一层的输出都进行 AllReduce(要求每个阶段内部具备 NVLink 级别的带宽);而流水线并行则在层边界处切分,各阶段之间只需点对点地传输激活值——因此可以容忍节点之间的 InfiniBand 带宽。
- 常见误区:一个常见的误解是,增加流水线阶段总是能提高吞吐量。每增加一个阶段,流水线气泡占比 \((p-1)/(m+p-1)\) 都会上升,除非微批次数 \(m\) 按比例增加,否则硬件将处于空闲状态,从而抵消更深切分带来的收益。
增加更多阶段需要相应增加足够的微批次,否则气泡将主导资源利用率。
在下面的算例中,同样的气泡项被具体化:一个 8 阶段流水线与 32 个微批次,仍然会留下可观的空闲开销。
Napkin Math 1.8: 流水线气泡的成本
问题:一次大规模模型训练运行在 8 stages 上采用流水线并行。为了掩盖顺序延迟,将批次切分为 32 个微批次。那么“气泡税”——即因空闲等待而损失的 GPU 周期占比——是多少?
数学: 在同步流水线(1F1B)中,气泡占比由阶段数与微批次数之比决定。
- 等待时间:在每个批次的开始和结束时,GPU 各有 \(p-1\) 步处于空闲。
- 有效计算时间:GPU 进行计算的时间为 \(m\) 步。
- 气泡占比:\((p-1) / (p-1+m) =\) 7 \(/\)(7 \(+\) 32)\(\approx\) 17.9 percent。
系统洞见:流水线并行是一种利用率—内存的权衡。将气泡从 18 percent 降至 5% 需要更多的微批次 \((m)\),而这些微批次会在每台 GPU 上占用额外的激活内存。在整个机器学习集群中,深度并非免费扩展;集群仅仅为了协调各阶段,就要支付 17.9 percent 容量的税。正因如此,诸如交错流水线之类的技术至关重要:它们将气泡切分成更小的片段,以回收这部分损失的 18 percent 集群容量。
GPipe[^fn-gpipe-pipeline-schedule] (Huang 等 2019年) 引入了带微批次累积的同步流水线并行,而 PipeDream (Narayanan 等 2019年) 则发展出带权重暂存的异步方法。现代系统采用 1F1B(一前向一后向)[^fn-one-forward-backward] 调度,以更早地回收激活内存;较低的内存压力使得更大的微批次数成为可行,而更大的 \(m\) 正是缩小气泡项的原因。
Huang, Y., Y. Cheng, A. Bapna, O. Firat, D. Chen, M. X. Chen, H. Lee, 等. 2019年. 《GPipe: Efficient Training of Giant Neural Networks using Pipeline Parallelism》. Advances in Neural Information Processing Systems (NeurIPS) 32: 103~12.
Narayanan, Deepak, Aaron Harlap, Amar Phanishayee, Vivek Seshadri, Nikhil R. Devanur, Gregory R. Ganger, Phillip B. Gibbons, 和 Matei Zaharia. 2019年. 《PipeDream: Generalized Pipeline Parallelism for DNN Training》. Proceedings of the 27th ACM Symposium on Operating Systems Principles, 1~15. https://doi.org/10.1145/3341301.3359646.
[^fn-one-forward-backward]:1F1B(一前向一后向)调度:与 GPipe(先完成全部前向传递,再进行后向传递)不同,1F1B 将两者交错执行。这样可将峰值激活内存占用从 \(\mathcal{O}(m \times p)\) 降至 \(\mathcal{O}(p)\),其中 \(m\) 为微批次数,\(p\) 为流水线阶段数。这种内存回收正是实现大规模微批次数 \((m \gg p)\)、从而保持流水线气泡较小的前提。
[^fn-gpipe-pipeline-schedule]:GPipe:由 Google 于 2019 年发布,GPipe 引入了同步微批次流水线,在 8 个张量处理单元(TPU) 上训练了 5.57 亿参数的 AmoebaNet,并实现了接近线性扩展。GPipe 所揭示的关键权衡是:流水线气泡占比 \((p-1)/(m+p-1)\) 意味着,在 \(p=4\) 个阶段和 \(m=4\) 个微批次的情况下,有 43% 的计算被空闲浪费——这推动系统设计走向降低激活驻留时间、使更大微批次数成为可行的调度方案。
在调度层面,1F1B 是一个预热、稳态与排空循环。Algorithm 1 明确了这一约定:每个阶段交替执行针对较新微批次的正向工作,并在梯度到达后,对较旧微批次执行反向工作,因此激活可以在整个批次完成之前释放。
\begin{algorithm} \caption{One-forward-one-backward pipeline schedule} \begin{algorithmic} \Require $p$ ordered pipeline stages; $m$ microbatches; activation links $j\to j{+}1$ and gradient links $j{+}1\to j$ \Ensure one optimizer update after gradients accumulate across all $m$ microbatches \State split the global batch into $m$ microbatches; assign consecutive layers to the $p$ stages \State warm-up: launch forwards from stage 0, forwarding each activation downstream as produced \For{each stage in steady state} \State alternate one backward (oldest ready microbatch) with one forward (next microbatch) \State release a microbatch's activation as soon as that stage's backward consumes it \EndFor \State drain: finish the remaining backward passes in reverse stage order \State apply the optimizer update once every stage has accumulated gradients for all $m$ microbatches \end{algorithmic} \end{algorithm}
预热和排空阶段仍会留下约为 \((p-1)/(m+p-1)\) 的气泡,但在稳态下交错执行反向传播计算,可以在反向传播使用完每个激活后立即将其释放,因此峰值激活内存随阶段数而非微批次数增长。这正是相较于 GPipe 式先执行所有前向传播、再执行所有反向传播的调度方式所获得的优势,使系统能够提高 \(m\),直到激活内存、重计算或全局批次约束成为下一个限制因素。在分布于四个设备上的 Transformer 模型中,设备 1 为微批次 \(i+1\) 处理第 1–6 个块,同时设备 2 为微批次 \(i\) 计算第 7–12 个块。与此同时,设备 3 为微批次 \(i-1\) 执行第 13–18 个块,设备 4 为微批次 \(i-2\) 处理第 19–24 个块。每个设备都保有分配给它的 Transformer 块,但处理不同的微批次,从而形成连续的计算流。
设备之间的隐藏状态传输持续进行,而非分成不同的阶段。当设备 1 完成一个微批次的处理后,它会立即将形状为 \(B_{\mu} \times S \times d_{\text{model}}\) 的输出张量传输给设备 2,并开始处理下一个微批次。这种计算重叠模式在保持硬件充分利用的同时,保留了模型的数学性质。
一种重要的变体直接针对剩余的气泡。流水线起始端的 GPU 在等待梯度从末端回传时处于空闲状态,末端的 GPU 也会出现相应的空闲。这些气泡意味着计算资源的浪费。algorithm 1 中的 1F1B 调度使流式多处理器在稳态期间保持忙碌,并缩短激活的驻留时间,但填充和排空阶段的气泡仍然存在,除非系统提高 \(m\),或在这些原本空闲的时隙中调度有用的计算。
零气泡流水线调度 通过将权重梯度计算与激活梯度通信重叠,进一步减少空闲时间。在标准反向传播中,GPU 一并计算 \(\partial \mathcal{L} / \partial W\)(权重梯度)和 \(\partial \mathcal{L} / \partial X\)(激活梯度,发送给前一阶段)。零气泡调度将二者拆分为独立的内核:\(B\) 内核仅计算激活梯度 \(\partial \mathcal{L} / \partial X\) 并将其发送给前一阶段,\(W\) 内核则在本地计算权重梯度 \(\partial \mathcal{L} / \partial W\)。\(B\) 内核必须及时执行(它位于关键路径上),而 \(W\) 内核可以择机调度,以填充气泡。
这种 B/W 拆分提供了相当大的调度自由度。在具有 4 个阶段、8 个微批次的流水线中,标准 1F1B 调度的气泡占比约为 \((p-1)/(m+p-1)\),其中 \(p\) 为阶段数,\(m\) 为微批次数。对于 \(p=4, m=8\),空闲时间占比为 \(3/11 \approx 27\%\)。零气泡调度可以用 W 计算填充启动和收尾阶段的气泡,将这一占比降至接近零。
代价在于内存:零气泡调度需要更长时间地存储中间激活(因为 W 计算被推迟),从而增加峰值内存使用量。一些实现将零气泡调度与激活检查点相结合,通过选择性地重计算某些激活而非存储它们来解决这一问题。这些技术之间的相互作用,在流水线气泡大小、内存消耗和重计算开销之间形成了三方权衡,这是开销转移(原则 13)的一个例子。
张量并行
节 1.4.2.2 中讨论的流水线并行,通过在各阶段之间重叠微批次处理来缓解设备空闲问题。每个设备持有完整的层并依次处理它们,仅在激活跨设备传输时于阶段边界进行通信。这种方法能够适应中等的互连带宽,因为通信发生得不频繁:每个微批次在每个层边界处仅通信一次。然而,当单个层本身就超出设备内存容量,或者层内通信模式更适合采用不同于层边界的粒度时,流水线并行便无法提供帮助。
张量并行采用了根本不同的方法:它将每一层内部的权重矩阵拆分,而不是将完整的层分配给设备。这种算子级并行(也称为层内并行)能够实现更细粒度的分布,但它引入了频繁的层内通信,因此需要高带宽互连。
Definition 1.9: 张量并行
张量并行 是一种模型并行技术,它使用列并行或行并行的权重切分,将各个张量操作——主要是矩阵乘法——划分到多个设备上,在 Megatron 风格的 Transformer 块中,每个 Transformer 层通常需要两次 AllReduce 操作来汇总所有参与设备上的部分结果。
- 重要性:Megatron-LM 风格的张量并行在每个 Transformer 块的前向传播中设置两次 AllReduce 操作——注意力之后一次、MLP 之后一次——每次集合通信都减少一个大小为 \(B_{\text{batch}} \times S \times d_{\text{model}} \times 2\) 字节的激活张量(BF16)。环形 AllReduce 每次 GPU 传输约 \(2(t-1)/t\) 倍该载荷。在 NVLink 上以 \(t=8\) 的度、900 GB/s 带宽运行时,每次 AllReduce 大约需要 0.1–0.5 ms。同样的操作在 InfiniBand 上(50 GB/s)每层需要 2–10 ms;若有 96 个 Transformer 块,则每个前向传播会额外产生 200–960 ms 的纯同步开销,而反向传播会重复这两次集合通信,使 MFU 降至个位数。
- 区别:与流水线并行不同,后者仅在层边界通信并传输较小的激活切片;张量并行则在每一层内部通过 AllReduce 进行同步,因此它对互连结构的单操作延迟敏感,在实践中受限于节点内部的 NVLink 互连结构。
- 常见误区:一种常见误解是张量并行可以简单地跨节点在 InfiniBand 上扩展。NVLink 提供约 900 GB/s 的双向带宽,即每个方向 450 GB/s;InfiniBand NDR 每个端口提供 50 GB/s,形成 9× 的方向带宽差距。在 InfiniBand 上运行张量并行通常会使 MFU 降至个位数百分比,通信开销大于分布矩阵乘法所带来的计算收益。
互连拓扑决定了集群层级中每种模型并行形式的可行性:张量并行的逐层同步要求 NVLink 级别的带宽;流水线并行仅在层边界通信,因而能够容忍 InfiniBand。这种带宽模式催生了一种混合设计:带宽密集的层内切分采用张量并行,较粗的层间切分采用流水线并行。
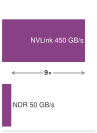
张量并行需要 NVLink 带宽;流水线并行则容忍较慢的网络互连结构。
5 Megatron-LM:NVIDIA 于 2019 年提出的框架,通过在每个 Transformer 块的前向传播中仅战略性地放置两次 AllReduce 操作(注意力之后一次,多层感知机之后一次),训练了 83 亿参数的 Transformer——当时为 24\(\times\) BERT 和 5.6\(\times\) GPT-2。这种先列后行的划分消除了块内两个线性层之间的 GPU 间通信,在 512 个 GPU 上实现了 76% 的扩展效率,并确立了至今仍对大规模 Transformer 训练具有影响力的张量并行模式。
Shoeybi, Mohammad, Mostofa Patwary, Raul Puri, Patrick LeGresley, Jared Casper, 和 Bryan Catanzaro. 2019年. 《Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism》. arXiv preprint arXiv:1909.08053.
Megatron 风格的张量并行5 (Shoeybi 等 2019年) 以两种方式来划分矩阵乘法。考察 图 16:列并行拆分沿列切分权重矩阵(用于 QKV 投影),允许各 GPU 独立计算;而行并行拆分沿行切分,用于输出层,需要在每个块末尾通过 AllReduce 合并部分和。
列并行的线性层沿列切分权重。对于输入 \(X\) 和跨 2 个 GPU 切分的权重矩阵 \(W = [W_1 | W_2]\): \[\mathbf{Y} = \mathbf{X}\mathbf{W} = \mathbf{X}[\mathbf{W}_1 | \mathbf{W}_2] = [\mathbf{X}\mathbf{W}_1 | \mathbf{X}\mathbf{W}_2]\] 每个 GPU 独立计算其分片,当后续操作为行并行时,输出无需通信即可直接拼接。该模式的行并行部分沿行切分权重,\(W = \begin{bmatrix} W_1 \\ W_2 \end{bmatrix}\): \[\mathbf{Y} = \mathbf{X}\mathbf{W} = \mathbf{X}_1 \mathbf{W}_1 + \mathbf{X}_2 \mathbf{W}_2\] 每个 GPU 计算一个部分和,系统只需一次 AllReduce 即可合并部分输出。
图 16 所示的先列后行排列是这一设计的关键洞见。将列并行层与行并行层配对,可使中间激活直接在两者之间流动而无需通信,从而将同步限制在这对层的末尾。Megatron 在每个 Transformer 块中应用该模式两次。QKV 投影采用列并行,其注意力输出投影采用行并行;随后,第一个前馈层采用列并行,第二个前馈层采用行并行。该设计有策略地安排 AllReduce 操作:注意力之后执行一次,前馈网络之后执行一次,因此每个 Transformer 层执行两次 AllReduce。每个 Transformer 层的通信量取决于序列长度 \(S\)、隐藏维度 \(d_{\text{model}}\)、张量并行度 \(t\) 和批大小 \(B\)。激活有效载荷为: \[M_{\text{act}} = B \times S \times d_{\text{model}} \times \text{sizeof(dtype)}\]
环形 AllReduce 在每个 GPU 上传输约 \(2(t-1)/t \times M_{\text{act}}\) 字节,该值接近 \(2M_{\text{act}}\),尤其是在 \(t\) 较大时。在 \(S=2048\)、\(d_{\text{model}}=4096\)、\(B=4\) 和 FP16 条件下,激活有效载荷为 \(4 \times 2048 \times 4096 \times 2 \approx 67\) MB。应用环形通信因子后,每次 AllReduce 的通信量约为 134 MB。对于一个 96 层的模型,每层执行两次 AllReduce,每次前向传播的总通信量约为 25.7 GB;计入对称的反向 AllReduce 后,每个训练步骤的通信量约为 51 GB,需要 NVLink 带宽才能避免通信成为瓶颈。
张量并行超过 8 路并行后,扩展性能迅速下降,因为用于减少内存占用的切分也减少了可用于掩盖通信的计算量。随着张量并行度增大,每个 GPU 的工作量下降,而集合通信延迟和总流量上升;每个 GPU 的环形 AllReduce 传输字节数趋近于激活张量大小的 2\(\times\) 倍,而非无界地线性增长,但更小的本地矩阵乘法使可用于掩盖这一数据交换的有效计算量减少。一旦 NVLink 带宽饱和,再增加一个张量并行分片主要会暴露更多同步开销,而难以提升吞吐量。已公开发表的系统(如 Llama 3 405B)在通过 NVLink 互连的 H100 节点内使用 TP=8 (Dubey 等 2024年),类似的节点内张量并行也是大规模 LLM 训练的常见设计模式 (Jiang 等 2024年)。
Jiang, Ziheng, Haibin Lin, Yinmin Zhong, Qi Huang, Yangrui Chen, Zhi Zhang, Yanghua Peng, 等. 2024年. 《MegaScale: Scaling Large Language Model Training to More Than 10,000 GPUs》. 21st USENIX Symposium on Networked Systems Design and Implementation (NSDI 24), 745~60.
序列并行与上下文并行
虽然张量并行在线性层内部切分权重矩阵,但大规模 Transformer 训练的内存占用正越来越多地由激活主导。随着模型将上下文长度从数千扩展到数十万乃至数百万个词元(\(S \ge 32\text{k}\dots 1\text{M}+\)),激活内存占用按比例增长: \[M_{\text{act}} = \mathcal{O}(B \times S \times d_{\text{model}} \times L)\] 这一关系适用于线性层、归一化层和残差层,而未分块注意力的激活内存占用为 \(\mathcal{O}(B \times h \times S^2 \times L)\)(采用分块 FlashAttention 时则为 \(\mathcal{O}(B \times S \times d_{\text{model}} \times L)\))。在长上下文场景下,激活内存占用远超参数存储量,暴露出内存容量缺口(原则 3)。两种互补的范式通过沿序列轴分片来应对这一约束:张量并行域内的序列并行(SP),以及跨专用长序列进程组的上下文并行(CP)。
Definition 1.10: 序列并行与上下文并行
序列并行与上下文并行 是将词元序列维度切分到多个设备上的分布式执行技术,用于消除长上下文模型中的激活内存瓶颈。序列并行(SP)在非 GEMM 操作(LayerNorm、Dropout)期间,将激活分片到各张量并行进程上,不增加通信量;上下文并行(CP)则将注意力序列分片到独立的进程组,采用脉动式点对点环形传递(环形注意力)或注意力头与序列维度之间的转置(全到全上下文并行)。
- 重要性:当上下文长度超过 32,768 个词元时,即使模型权重已完全分片,存储所有层的完整激活仍会耗尽加速器 HBM。序列并行将非 GEMM 操作的激活内存占用缩减为原来的 1/\(t\)(其中分母为张量并行度),其方法是将 AllReduce 替换为成对的 ReduceScatter 和 AllGather,且不产生额外网络流量。上下文并行使上下文长度随设备数量线性扩展(\(c \times S_{\text{single}}\)),从而支持百万词元训练,避免因内存不足而崩溃。
- 区别:张量并行沿隐藏维度 \(d_{\text{model}}\) 切分权重矩阵,且细粒度的层内 AllReduce 需要 NVLink 级带宽;与之不同,上下文并行切分的是序列轴 \(S\)。环形注意力使用异步点对点传输,可跨越节点间网络互连结构,而 Ulysses 全到全通信则在序列维度与注意力头维度之间执行转置。
- 常见误区:误以为上下文并行消除了注意力计算的二次复杂度。CP 将注意力计算分布到多个设备上,使每个设备的内存占用和 FLOPs 缩减为原来的 1/\(1/c\),但稠密自注意力的集群总 FLOPs 仍按 \(\mathcal{O}(S^2)\) 呈二次增长。
Megatron 序列并行
标准的 Megatron 式张量并行仅切分 Transformer 层内的矩阵乘法:QKV 投影和第一个 MLP 层按列切分权重,而注意力输出投影和第二个 MLP 层按行切分权重(图 16)。然而,这些矩阵乘法前后的操作——LayerNorm、Dropout 和残差加法——均为逐元素操作,传统上会在全部 \(t\) 个张量并行设备上复制执行。因此,每个 GPU 都冗余地存储大小为 \(B \times S \times d_{\text{model}}\) 的完整激活张量。
Megatron 序列并行 (Korthikanti 等 2023年) 通过在所有非张量并行操作中将序列维度分片到 \(t\) 个进程上,消除这一冗余。每个 GPU 不再复制完整激活,而是在 LayerNorm 和 Dropout 期间仅持有一个 \(B \times (S/t) \times d_{\text{model}}\) 切片。
关键在于,这种分片产生的额外通信量为零。在标准张量并行中,行并行矩阵乘法之后执行 AllReduce,以跨进程对部分乘积求和。AllReduce 在数学上可分解为一次 ReduceScatter 后接一次 AllGather: \[\text{AllReduce}(\mathbf{X}) \equiv \text{AllGather}(\text{ReduceScatter}(\mathbf{X}))\] Megatron-SP 将这对操作解耦:
- 行并行线性层之后,ReduceScatter 对部分和进行归约,同时沿序列维度分散所得激活,使每个 GPU 持有 \(S/t\) 个词元。
- LayerNorm、残差加法和 Dropout 在本地 \(S/t\) 切片上执行,无需跨设备通信。
- 紧接着,在下一个列并行线性层之前,沿序列维度执行 AllGather,重新组装出权重已切分的矩阵乘法所需的全部 \(S\) 个词元。
标准 TP 在每个 Transformer 块中执行两次 AllReduce(\(2 \times 2(t-1)/t \times M_{\text{act}}\) 字节),而 Megatron-SP 执行两对 ReduceScatter 和 AllGather(\(2 \times [(t-1)/t + (t-1)/t] \times M_{\text{act}} = 2 \times 2(t-1)/t \times M_{\text{act}}\) 字节),因此总通信量完全相同。序列并行将注意力之外的激活内存占用缩减为原来的 1/\(t\),且不消耗任何额外的互连带宽。
上下文并行:环形注意力与 Ulysses
当序列长度 \(S\) 达到 64,000 至 1,000,000 个词元乃至更多时,即使采用序列并行和激活检查点,激活内存占用仍会超过设备容量。上下文并行(CP 并行度为 \(c\))将序列分片到一个由 \(c\) 个加速器组成的专用组中。上下文并行主要采用两种架构范式:
环形注意力(脉动式 P2P 交换) (Liu 等 2023年):每个 GPU 持有一个查询分块 \(Q_i\),其长度为 \(S/c\),以及一个初始键/值分块 \((K_i, V_i)\)。计算沿逻辑环进行 \(c\) 轮。在每一轮中,GPU \(i\) 使用在线 softmax 累加器,计算其位置固定的 \(Q_i\) 与当前驻留的 \((K_j, V_j)\) 分块之间的块注意力,同时异步传输 \((K_j, V_j)\) 至环上的相邻节点 \((i+1) \bmod c\),并接收 \((K_{j-1}, V_{j-1})\),其来源为 \((i-1) \bmod c\)。当单个分块的计算延迟超过点对点传输时间时,通信开销可被完全隐藏: \[\frac{2 \times (S/c)^2 \times d_{\text{model}}}{\text{FLOP/s}} \ge \frac{2 \times (S/c) \times d_{\text{model}}}{\text{Bandwidth}_{\text{link}}} \iff \frac{S}{c} \ge \frac{\text{FLOP/s}}{\text{Bandwidth}_{\text{link}}}\] 在 HBM 带宽为 3.35 TB/s、链路带宽为 900 GB/s 的加速器上,典型块大小满足这一重叠条件。在因果自回归注意力中,上三角分块会被掩蔽(\(j > i\))。朴素的环形执行方式会在后续轮次中使一半的 GPU 处于空闲状态;生产环境中的实现采用之字形或条带式词元划分,使因果注意力分块均匀分布在所有设备上。
全对全上下文转置(DeepSpeed Ulysses) (Jacobs 等 2023年):Ulysses 利用序列维度与注意力头之间的正交性,无需沿环循环传递分块。在注意力计算核心之外,激活值沿序列维度分片(\(S/c\) 个词元,全部 \(h\) 个注意力头)。在计算自注意力之前,一次 全对全集合通信将张量从按序列分片的
[S/c, h, d_head]转置为按注意力头分片的[S, h/c, d_head]。此时,每个 GPU 持有完整序列,长度为 \(S\),但仅持有注意力头的一个子集 \(h/c\)。每个设备针对其持有的注意力头,在完整序列上执行标准的本地 FlashAttention 计算——原生保留因果掩码,且不会出现负载不均衡。第二次全对全集合通信将注意力输出转置回[S/c, h, d_head]。Ulysses 在概念上简洁,并复用单 GPU 注意力内核,但要求注意力头数能够被上下文并行度整除(\(h \ge c\))。在分组查询注意力(GQA)中,键值头数 \(h_{\text{KV}}\) 较少(通常为 8),因此 \(c\) 的上限为 \(\le 8\)。分层混合上下文并行:Ulysses 依赖需要高对分带宽的全对全集合通信,因此非常适合节点内的 NVLink 域(\(c_{\text{intra}} \le 8\))。环形注意力使用点对点环形通信,尽可能降低对分带宽压力,因此非常适合节点间链路(\(c_{\text{inter}}\))。前沿长上下文训练系统将两者结合为分层二维拓扑:Ulysses 在每个节点内划分注意力头,环形注意力则在节点间循环传递 KV 块,从而在不使集群对分带宽饱和的情况下支持百万词元的上下文窗口。
Jacobs, Sam Ade, Masahiro Tanaka, Chengming Zhang, Minjia Guo, Shuaiwen Zhu, Shuai Song, Samyam Rajbhandari, Ammar Ahmad Awan, Connor Zheng, 和 Yuxiong He. 2023年. 《DeepSpeed Ulysses: System Optimizations for Enabling Training of Extreme Long Sequence Transformer Models》. arXiv preprint arXiv:2309.14509.
参数服务器与嵌入分片
虽然全归约在稠密模型训练中占据主导地位,但参数服务器(PS) 架构经 Li 等 (2014年) 形式化后,在推荐系统及其他稀疏工作负载中仍然常见。参数服务器架构将工作节点(计算梯度)与服务器(存储参数并应用更新)分离。
对于稠密模型(如 ResNet 或 BERT),PS 架构会产生瓶颈:当有 \(N\) 个工作节点时,服务器的入站带宽必须同时承载 \(N\) 条梯度流,导致服务器网络带宽饱和,使其成为通信瓶颈。这种“多对一汇聚(incast)”问题推动了环形全归约的采用。在环形全归约中,每个工作节点均以自身链路速率发送和接收数据,通过将负载分散到所有节点,使聚合带宽提升至 \(N\) 倍。对于使用超过 4–8 个 GPU 的稠密模型,去中心化全归约具有显著优势。
然而,对于推荐系统(具体而言是 DLRM),模型参数主要由庞大的嵌入表构成(通常超过 10 TB),无法容纳在任何单个 GPU 上。此外,更新具有稀疏性:一批用户仅与极小比例(例如 0.001%)的物品发生交互。
在这种稀疏情形下,参数服务器仅传输一个批次所访问的行,从而避免稠密同步:
- 嵌入分片:将庞大的表划分到 PS 集群中的各个节点上(通常是配备海量 DRAM 的 CPU 节点)。
- 稀疏查找:工作节点向 PS 发送 ID 列表。
- 稀疏拉取:PS 仅返回所请求的嵌入向量,而非整张表。
- 稀疏推送:工作节点仅发送所访问嵌入行的梯度。
稀疏拉取/稀疏推送 模式避免了稠密全归约的带宽瓶颈。TorchRec 或 Meta 的分层分片等实现将“热”嵌入放置在 GPU 上,将“冷”嵌入放置在 CPU PS 节点上,为模型参数构建分层存储体系。
专家并行(混合专家)
张量并行将稠密层拆分到多个设备上,而专家并行 通过条件计算,在不增加计算成本(FLOPs)的情况下扩展模型容量(参数量)。在混合专家(MoE) 架构 (Shazeer 等 2017年) 中,每个 Transformer 块的前馈网络被替换为一组 \(E\) 个“专家”(独立的前馈网络)。对于每个词元,门控网络选择少量专家(通常为 top-1 或 top-2)进行处理。
Shazeer, Noam, Azalia Mirhoseini, Krzysztof Maziarz, Andy Davis, Quoc Le, Geoffrey Hinton, 和 Jeff Dean. 2017年. 《Outrageously large neural networks: The sparsely-gated mixture-of-experts layer》. International Conference on Learning Representations (ICLR).
在分布式环境中,专家被划分到各个工作节点上。如果有 8 个 GPU 和 8 个专家,则每个 GPU 承载一个专家。训练过程引入了一种独特的通信模式,如 图 17 所示:
- 门控:每个词元确定其目标专家。
- 全对全分发:词元通过网络被路由到承载所选专家的设备。
- 计算:专家处理分配给自己的词元。
- 全对全合并:处理后的词元被路由回原始设备,以继续序列处理。
主要优势在于将模型规模与计算预算解耦。一个万亿参数的 MoE 模型,每个 token 可能仅使用 10B 参数,从而能够在可行的硬件预算内进行训练。约束在于全对全(All-to-All) 通信,其带宽需求高,且对负载不均衡十分敏感。
Definition 1.11: 专家并行
专家并行 是混合专家模型的分布策略:将不同专家放置在不同设备上,并通过全对全集合通信,将每个 token 的激活值路由到承载其所选专家的设备,从而在整个集群中扩展总参数量,而不增加每个 token 消耗的计算量。
- 重要性:它将模型容量与计算预算解耦:一个万亿参数的 MoE 模型,每个 token 激活的参数量可能为 10B 量级,因此每个 token 的 FLOPs 仍接近 10B 稠密模型,而容量则增长约 100\(\times\)。代价在于通信结构:每个 MoE 层在每次计算过程中都需要执行两次全对全重分布(分发与合并),其通信量随所移动的 token 数量与隐藏维度的乘积增长,给集群的二分带宽带来压力,而非任何单条链路。
- 区别:张量并行拆分稠密运算,使每个设备都计算每个 token 的一部分;与之不同,专家并行属于条件计算:每个设备只计算路由到其专家的 token,因此通信模式与负载分布都依赖于数据,而非由架构固定。
- 常见误区:一种常见误解是专家会均匀分担工作。自然的 token 分布存在偏斜:一个热门专家可能接收到相当于其均衡份额 3–5\(\times\) 的流量,导致其设备的激活缓冲区溢出,而其他设备处于空闲状态。因此,生产环境中的 MoE 系统会限制每个专家的 token 预算,并在训练期间惩罚路由偏斜,而非仅依赖路由器。
专家并行的核心是全对全通信原语,它依据动态路由决策在集群中重新分配 token。考虑如下配置:\(E=64\) 个专家分布在 64 个 GPU 上,处理一个包含 \(B=4\) 条序列的批次,序列长度为 \(S=2048\),隐藏维度为 \(d_{\text{model}}=4096\)。对于每个 MoE 层,系统必须将 \(B \times S\) 个 token 分发到为其分配的专家。采用 FP16 时,单向传输的数据量为 \(B \cdot S \cdot d_{\text{model}} \cdot 2\) 字节(约 67 MB)。由于处理后的嵌入必须返回其原始设备以完成残差连接,每个 Transformer 块的总网络开销约为 134 MB。尽管单独来看尚可承受,但在 Switch Transformer (Fedus 等 2022年)(最多 2,048 个专家)或 GShard (Lepikhin 等 2021年) 这样的深层稀疏架构中,这种延迟会迅速累积。
Fedus, William, Barret Zoph, 和 Noam Shazeer. 2022年. 《Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity》. Journal of Machine Learning Research 23 (120): 1~39.
Lepikhin, Dmitry, HyoukJoong Lee, Yuanzhong Xu, Dehao Chen, Orhan Firat, Yanping Huang, Maxim Krikun, Noam Shazeer, 和 Zhifeng Chen. 2021年. 《GShard: Scaling giant models with conditional computation and automatic sharding》. International Conference on Learning Representations (ICLR).
网络效率依赖于 token 均匀分布的假设,但自然语言本身存在分布偏斜:处理常见语法或连接词的特定专家可能接收到相当于其均衡份额 3–5\(\times\) 的流量。热门专家既会带来内存问题,也会带来调度问题。如果某个专家接收的 token 过多,其 GPU 的激活缓冲区就会耗尽,而其他专家的利用率却很低。
因此,MoE 系统会强制执行由容量因子 \(C\) 定义的硬性上限,该因子通常设为 1.25 到 1.5。对于一个路由组,该参数将每个专家处理的 token 数量上限限定在约 \(C \cdot (B \times S)/E\)。如果路由门控分配的 token 数量超过缓冲区容量,多余的 token 就会被丢弃,即不经过该层处理,直接通过残差连接传递。为减少这种数据损失,训练目标包含一项辅助负载均衡损失,其相对于主交叉熵损失的权重为 0.01–0.1,用于惩罚路由器对特定专家的偏好。Mixtral 8x7B 等模型在 8 个专家之间采用 top-2 路由,在容量扩展与路由稳定性之间取得了良好的平衡。
稀疏通信模式使推荐与 MoE 工作负载(原型 B(大规模 DLRM))区别于稠密 LLM 训练(原型 A(GPT-4/Llama-3))(三种系统架构原型)。
Lighthouse 1.1: 原型 B(大规模 DLRM):DLRM 与 LLM 的扩展
两者通过不同的机制扩展,并受限于不同的资源:
- LLM(稠密):通过张量并行/流水线并行扩展。约束:计算与互连带宽(NVLink)。
- DLRM 类模型(稀疏):通过嵌入分片(参数服务器)扩展。约束:内存容量与互连延迟(随机访问)。
这一区别决定了根本不同的集群设计:LLM 采用稠密 GPU 资源组,推荐系统则采用内存容量充裕的 CPU/GPU 混合架构。
权衡:气泡与带宽的两难
模型并行突破了内存墙,却引入了顺序依赖,从而降低了硬件利用率。工程挑战在于平衡流水线气泡(空闲时间)与全对全带宽(通信时间)。
模型并行
模型并行带来三项主要优势。内存扩展使得可以训练超出单设备容量的模型:在 8-way 张量并行下,175B 模型的 FP16 权重切片在计入优化器状态和激活预算之前即可容纳于 A100 HBM 中。对模型进行切分还允许使用更大的全局批大小而不触发内存不足错误,因为每块 GPU 只处理较小的参数切片。该方法与 Transformer 的物理结构自然对应:注意力头通过张量并行切分,层则通过流水线并行切分。
这些优势以三项根本性限制为代价。流水线气泡使 GPU 在填充和排空流水线期间处于空闲状态;气泡比例约为 \((p-1)/(m+p-1)\),其中 \(p\) 为流水线阶段数,\(m\) 为微批大小,要达到 90% 以上的效率需要 \(m \gg p\),而这会增加激活内存。张量并行中的通信强度同样构成约束:每层的关键路径上有两次 AllReduce 操作,需要极高带宽、低延迟的互连结构(NVLink),并且通常在带宽墙之前无法扩展到单个节点(8 块 GPU)以上。实现复杂度则完成了这一权衡,需要侵入式地修改模型定义(以列并行和行并行变体替换标准线性层),不同于数据并行,后者只是从外部包裹模型而不修改其内部结构。
FP8 for Distributed Training
数值精度可以成为一种分布杠杆,但计算精度与通信精度是两个独立的选择。将通用矩阵乘(GEMM)操作数转换为字节数减半的格式,可以减少操作数存储和局部内存流量;只有当通信路径显式传输该更窄的表示时,才将集合通信负载减半。8 位浮点(FP8)格式利用计算侧这一杠杆,在降低操作数精度的同时保留足够的数值范围以支持稳定优化。
FP8 对分布式训练的重要性,只有在区分四种数据类型之后才显现:存储参数 dtype、GEMM 操作数 dtype、累加器或主状态 dtype,以及集合通信的线型 dtype。传统混合精度训练通常保留 FP32 优化器或主状态,而使用 FP16/BF16 操作数。支持 FP8 的加速器增加了 E4M3 和 E5M2 操作数格式,二者针对不同的张量分布进行了优化 (Micikevicius 等 2022年)。除非运行时应用显式的 FP8 转换或压缩协议,否则集合通信仍可能传输 FP16/BF16 梯度或激活。
因此,两种 FP8 格式之间的选择并非指令集细节;它决定了哪些张量可以在不破坏优化器的前提下被收窄。E4M3(4 位指数、3 位尾数)提供约 \(\pm 448\) 的量程和中等精度,适合前向传播中的 权重和激活,因为其中的数值聚集在可预测的分布中。E5M2(5 位指数、2 位尾数)提供大得多的约 \(\pm 57344\) 量程,但精度更粗,这正是它在反向传播中用于能够跨越多个数量级的 梯度 的原因。若使用 E4M3 表示梯度,将频繁发生溢出和欠溢;而 E5M2 则以更新略更嘈杂为代价,完整覆盖梯度分布。请将 训练精度格式 视为一张分布约束映射表:每一行都改变了量程、精度、内存流量和可训练性之间的平衡。
| 格式 | 指数 | 尾数 | 量程 | 精度 | 典型数值角色 |
|---|---|---|---|---|---|
| FP32 | 8 bits | 23 bits | \(\pm 3.4 \times 10^{38}\) | 非常高 | 主状态或优化器状态 |
| FP16 | 5 bits | 10 bits | \(\pm 65504\) | 高 | Operand,更高精度的累加/输出,或线型 |
| BF16 | 8 bits | 7 bits | \(\pm 3.4 \times 10^{38}\) | 中等 | Operand,更高精度的累加/输出,或线型 |
| E4M3 | 4 bits | 3 bits | \(\pm 448\) | 低 | 缩放的权重和激活 |
| E5M2 | 5 bits | 2 bits | \(\pm 57344\) | 非常低 | 缩放的梯度 |
在这些精度格式(训练精度格式)下,FP8 跨分布式训练的关键工程挑战是 动态缩放。FP8 的窄量程意味着固定的缩放系数会导致溢出或欠溢。逐张量缩放先将每个张量乘以缩放系数再转换为 FP8,然后在 FP8 计算之后除以该系数。缩放系数会动态调整,通常通过跟踪每个张量的当前最大绝对值,并选择一个将该最大值映射到接近 FP8 最大可表示值的缩放系数来实现。
FP8 训练契约将 FP32 主状态或优化器状态与 FP8 GEMM 操作数结合,并采用更高精度的累加和输出。累加器和输出的确切格式取决于操作与硬件实现,而非 FP16/BF16 的通用选择。该方法可以在适合的工作负载上实现接近 FP16 的训练质量,同时提升 FP8 加速器上的有效吞吐量 (Micikevicius 等 2022年)。其系统层面的含义具体但范围有限:FP8 仅对实际以 FP8 存储或传输的张量减半字节数,而操作吞吐量和能效收益则取决于加速器实现。一个将 FP16 梯度降为更小负载的集合通信,仅仅因为前序 GEMM 使用了 FP8,并不会因此减少线型通信量。
Micikevicius, Paulius, Dusan Stosic, Neil Burgess, Marius Cornea, Pradeep Dubey, Richard Grisenthwaite, Sangwon Ha, 等. 2022年. 《FP8 Formats for Deep Learning》. arXiv preprint arXiv:2209.05433.
对于分布式训练,FP8 只有在更低精度的计算改善了本地关键路径,或显式的通信转换减少了负载,同时其累加与缩放策略保护了收敛,才真正占有一席之地。它改变的是表示方式,而非并行化轴。如果精度降低不足,系统就必须决定数据并行、张量并行和流水线并行如何映射到硬件层次结构上。
混合并行
当数据并行因内存不足而受限、模型并行又因网络带宽不足而受限时,需要同时协调这两种策略,横跨三个维度。节 1.2 和 节 1.4 中的分析揭示了一个根本性的张力:数据并行可扩展吞吐量,但需要巨大的内存;而模型并行支持更大的模型,却会挤占计算资源。
混合并行 通过正交地应用两种策略来化解这一张力:模型并行将架构切分以适配可用内存,而数据并行则在多个模型副本之间扩展吞吐量。在一个包含 3000 亿 token 的数据集上训练 175B 参数语言模型,便在实践中体现了这一方法。神经网络层通过模型并行分布在多台 GPU 上,而数据并行则使不同的 GPU 组分别处理不同的批次。这种双重策略同时应对了模型规模带来的内存约束与数据集规模带来的计算需求,而正是这一组合定义了大模型规模下的 Archetype A 训练。
Lighthouse 1.2: Archetype A(GPT-4/Llama-3):三维并行的物理机制
Archetype A(GPT-4/Llama-3) 是混合并行成为主流的主要驱动因素。由于模型参数 \((P)\) 超出任何单台加速器 \((C_{\text{mem,device}})\) 的内存容量,且训练数据集 \((D)\) 需要极高的吞吐量,我们必须沿三个正交维度对问题进行切分:
- 张量并行:将单个层切分,以适配 \(P\) 内的节点内存。
- 流水线并行:当参数占用量超出单个节点时,将层在节点之间切分。
- 数据并行:复制整个切分后的模型流水线,以在 \(D\) 上扩展吞吐量。
只有将三者结合起来,才能高效训练 Archetype A 系统。
为理解组合为何重要,考虑在由 128 个节点、每节点 8 台 GPU 组成的 1024-GPU 集群上训练 175B 模型的三种并行配置。从纯数据并行经由张量并行和流水线并行的演进过程,使效率增益变得具体可见。
配置 A:纯数据并行(DP-1024) 是一种通信反事实,而非该模型可行的放置方案。仅 FP16 权重就占用 350 GB,因此 A100 或 H100 无法复制它们;仅对优化器状态做分片也无法改变这一事实。若复制可行,全部 1024 个 rank 将构成一个数据并行组,每个 rank 都会参与 350 GB 梯度张量的全归约,横跨 InfiniBand 互连结构。节 1.3 中的 37.5% 计算将这一通信开销单独隔离出来。
配置 B:TP-8、DP-128。 在 128 个模型副本中的每一个内部,8 台 GPU 通过 NVLink 上的张量并行协同工作。来自每个副本的对应张量分片构成一个 128-rank 的数据并行组,因此该布局包含 8 个这样的组。每个 rank 全归约其 1/8 的梯度分片(43.75 GB,而非 350 GB),且张量通信仍留在高速 NVLink 域内。节点间全归约时间从 14 秒降至约 1.75 秒。若计算时间仍为 2.1 秒,则效率提升至 \(2.1 / (2.1 + 1.75) \approx 54.5\)%,并且借助通信与计算的重叠,实际效率可达 75–85%。
配置 C:TP-8、PP-4、DP-32。 每个模型副本的 32 个副本中,每个阶段使用 8 路张量并行,节点间跨越 4 个流水线阶段。对于 \(8\times4=32\) 个张量—流水线分片位置中的每一个,所有副本中对应的 rank 构成一个 32-rank 的数据并行组。因此,每个 rank 全归约一个 \(350/(8\times4)\approx10.94\) GB 的梯度分片。流水线通信在阶段之间转发激活值,其数据量低于全模型全归约。权衡之处在于流水线气泡:在每个微批次的开始和结束时,部分流水线阶段处于空闲,等待来自前序阶段的激活值或后序阶段的梯度。气泡占比约为 \((p-1)/(m+p-1)\),因此在 4 个流水线阶段、每个训练步骤 32 个微批次的情况下,气泡浪费约 9% 的计算量(\(3/35 \approx 8.6\%\))。
三方对比表明,将高带宽通信(张量并行)保留在高速 NVLink 域内、仅将低带宽通信(较小梯度分片的数据并行全归约)推送到较慢的 InfiniBand 结构上的配置,取得了最高效率。基础设施层级决定了并行层级。由此得到的原则称为层级感知并行(hierarchy-aware parallelism),它是大规模训练系统的常见做法。
Definition 1.12: 层级感知并行
层级感知并行 是将不同的并行执行模式映射到集群物理带宽层级的策略。
- 重要性:它确保高频同步(例如张量并行)保留在最快的链路上(NVLink),而低频任务(例如数据并行)则使用较慢的层级(InfiniBand)。这种对齐通过减少暴露的通信时间 \((\eta_{\text{scaling}})\) 和延迟 \((T_{\text{comm}}(N))\),最大化扩展效率 \((L_{\text{lat}})\)。
- 区别:与均匀并行 不同,后者将节点间所有链路视为同等,而层级感知策略尊重芯片、节点与机架边界之间的带宽陡降。
- 常见误区:一种常见误解是任何模型都可以跨任意数量的节点切分。实际上,如果层级映射 有误(例如将一个大张量跨较慢的机架间链路切分),通信时间将远远超过计算时间,从而使规模扩展毫无用处。
交互关系也会反向发生:并行策略的选择会影响基础设施设计。采用 TP-8、PP-4、DP-32 的训练系统会产生一种通信模式:带宽最密集的流量(张量并行全归约)被限制在每个节点内部,中等带宽的流量(流水线阶段通信)在相邻 4 个节点组之间流动,最低带宽的流量(缩减梯度分片的数据并行全归约)则横跨整个集群。
这种分层通信模式有利于采用层级化网络拓扑,即邻近节点之间的带宽更高(“感知局部性”拓扑),而非所有节点对带宽相等的平坦拓扑(均匀 fat-tree)。面向机架优化的层级化 fat-tree 设计利用了这一局部性,将通信最频繁的节点置于同一交换机或同一机架内,从而最小化带宽最密集流量所需的交换机跳数。
对基础设施采购的实际启示是,网络拓扑必须与并行策略协同设计,而不能独立选择。若某组织采购了平坦 fat-tree 结构(针对任意到任意通信优化),却仅使用层级感知并行训练(流量大多为本地流量),那么它将过度配置网络的全球带宽,同时可能欠配本地带宽。反之,若某组织采购了面向机架优化的 fat-tree 结构(针对本地通信优化),之后又需要运行全到全通信的专家混合模型,则会发现该结构带宽不足。网络结构占系统总成本的 10–15%,必须与预期的工作负载组合相匹配;部署后再更换结构则代价高昂且会严重干扰运行。
The 3D training loop
训练一个 175B 参数模型需要 三维并行:即数据并行、流水线并行与张量并行在数千台设备上的协同组合。6 这种方法并非简单叠加各并行策略的收益,而是以几何方式组合它们,以匹配硬件的物理拓扑。
6 三维并行:得名于分解的三个正交轴:(1) 数据并行(batch),(2) 流水线并行(depth),(3) 张量并行(layer width)。组织将其训练集群可视化为一个 3D 网格 \((d, p, t)\),其中乘积 \(N_{\text{total}} = d \times p \times t\) 等于 GPU 总数。这种几何视角对于平衡高带宽集群的分层带宽约束至关重要。
考虑一个配置了张量并行(TP)为 8 GPUs、流水线并行(PP)为 16、数据并行(DP)为 128 的训练集群。该配置使用 16,384 GPUs(8 GPUs \(\times\) 16 \(\times\) 128)组织成一系列带宽域(bandwidth domains)的层次结构。
训练步骤从数据并行层开始。每个 128 个模型副本(replica)分别接收全局批(batch)的一个不同切片。在每个副本内部,模型被划分为 16 个流水线阶段(节点),微批次从 Node 0 的嵌入层(embedding layer)依次流向 Node 15 的损失计算。在最细粒度上,在每个节点内部,8 GPUs 通过 TP 融合为单个“超级加速器”(super-accelerator)。前向传播中的每一次矩阵乘法都被切分(fractured)到这些设备上,并且每次运算后都必须通过高带宽 NVLink 交换部分结果。对于 175B 量级的隐藏维度(hidden dimension),激活(activation)载荷约为 201.3 MB;由此产生的张量并行通信量约为 4.2 GB(每个流水线阶段、每个微批次的前向传播),若包含反向传播则为 8.5 GB。在整个 96 层副本上,前向张量并行通信量约为 67.6 GB。该通信量是系统中强度最高的,但由于芯片通过 600 GB/s–900 GB/s 的本地带宽通信,其暴露的延迟可以相对计算保持较小。
反向传播反转了这一数据流,并暴露了各并行维度之间的关键依赖关系。随着梯度沿流水线反向流动,节点之间点对点(point-to-point)交换激活梯度。该通信量相对较小(每个阶段边界约 201.3 MB),因此可以不经停地穿越较慢的节点间 InfiniBand 链路。真正的瓶颈出现在步骤末尾:数据并行同步。完整模型的梯度状态仍然约为 350 GB,但在三维并行布局中,每个数据并行组同步其张量并行与流水线并行副本对应的参数分片(shard),而不是让每块 GPU 移动整个张量。梯度分桶(gradient bucketing)将已就绪的各层梯度张量聚合成更大的消息,随着反向计算推进;当分桶调度与截面带宽相匹配时,同步可以在有用计算期间完成,而不是延长关键路径。
架构上的基本要求是“带宽匹配”(bandwidth matching):每个算法的通信量必须与硬件互连的延迟成反比映射。频繁且阻塞式的 TP 通信保留在 NVLink 域内(600 GB/s 或更高)。经过序列化的点对点 PP 传输以 InfiniBand 速率穿越集群主干(cluster spine)。规模巨大但不频繁的 DP 同步在整个训练步骤中摊薄。试图让 TP 跨越机架运行,或在无梯度累积(gradient accumulation)的情况下运行 DP,都可能违反这一层次结构,使 16,000-GPU 集群等待数据穿越链路。这一带宽匹配原则完成了 节 1.0.5 中引入的可行性检查。
混合并行度工作示例
将这一带宽匹配原则应用于物理基础设施,就把集群设计转化为一个放置(placement)问题:每个并行维度都必须位于能够承受其通信量的网络层级上。张量并行对延迟最为敏感,因为它在 Transformer 块内部频繁启动 AllReduce 操作,因此应放置在节点内 NVLink 域(600 GB/s–900 GB/s)。流水线并行仅在阶段边界移动激活张量,因此可以跨越邻近节点,通过 InfiniBand 连接(50 GB/s–100 GB/s)。数据并行产生最大的载荷(梯度同步),但它每个步骤只发生一次,并且可以与反向计算重叠。每块设备的内存容量(80 GB–80 GB)为每种放置设定了硬性上限。
对于 DGX A100 式部署,这一推理可以得出一个具体布局。将张量并行固定在 \(t=8\),使带宽密集的矩阵乘法集体通信(collectives)保持在单个 8-GPU 节点内。将流水线并行映射到同一高带宽机架或岛(island)内的节点,通常根据内存占用为 \(p=8\) 或 \(p=16\)。使用数据并行作为剩余的横向扩展维度,跨越 pod 使用。结果并非一条通用规则,而是将每种通信模式匹配到能够承载它的最低成本互连层级的必然结果。
放置确定后,下一个问题就是静态模型状态是否适配每块加速器 HBM 的预算。
训练一个 175B-参数模型所需的内存预算主要由模型状态决定,必须采用激进的切分策略,才能适配 H100 级加速器 80 GB HBM 的容量。仅 FP16 权重就消耗约 350 GB(175 \(\times 10^9 \times 2\) 字节)。若仅采用 8-way 张量并行,每台 GPU 将承载 43.75 GB 的权重切片。然而,优化器状态构成了更大的障碍。在本 3D 并行预算中简化的优化器状态约定下,Adam 的 FP32 动量与方差每个参数消耗 8 字节,全局约 1.4 TB;而包含 FP32 主权重的完整 12 字节口径则约为 2.1 TB。即使采用 8-way 张量并行,简化的权重与优化器状态合计也会超过每台 GPU 的 218.8 GB,从而触发内存不足(OOM)错误。因此,我们必须借助流水线并行(\(p\))进一步切分模型层。在张量并行 8 与流水线并行 16 的混合配置下,简化的静态内存占用降至每台 GPU 13.7 GB(通常扣除框架缓冲区后按约 15 GB 预算),剩余的 HBM 可用于前向传播过程中产生的动态激活内存 \((A)\),其规模随 micro-batch 大小与序列长度线性增长。在完整的 12 字节 Adam 约定下,同样的 8-way 张量、16-stage 流水线切分,每台 GPU 的占用为 19.1 GB。
配置一旦适配内存,同一布局还必须满足促成它的通信层级。每个并行维度都会对网络施加不同的流量特征。张量并行最为频繁,每个 Transformer 块需要两次 AllReduce 操作(注意力投影一次、MLP 一次),前向与反向传播均如此。这些消息体量相对较小,但每步发生数千次,因此严格受延迟约束,必须依赖 NVLink。流水线并行则相反,仅在流水线阶段的边界进行激活张量(大小 \(B_{\mu} \times S \times d_{\text{model}}\))的点ToPoint传输。这些消息体量适中但发生频率较低,因此通过标准 InfiniBand 链路即可应对。数据并行会产生最大的一次性流量突发,需要全局 AllReduce 的整个 350 GB 梯度缓冲区。不过,该通信仅在每次全局批次更新时发生一次。利用梯度分桶将该传输与前向传播中计算密集的反向传播重叠,即可掩盖 DP 通信的实际成本,前提是集群具备足够的横截面带宽。
最后一项成本并非带宽,而是调度:流水线模型只有在有足够多的 micro-batch 处于飞行状态、使所有阶段保持忙碌时才高效。这项剩余成本即由 节 1.4.2.2 提出的流水线气泡。将该气泡比例 \(\frac{p-1}{m + p - 1}\) 应用于这一混合布局,一个具有 \(p=16\) 个阶段、\(m=32\) 个 micro-batch 的 GPT-175B 配置会浪费 \(\frac{15}{47} \approx 31.9\%\) 的理论计算能力,接近三分之一。1F1B 调度回收了激活内存,并且使其所需的较大 micro-batch 数量变得可行,从而将该比例渐近地压低。
Blackwell-class scaling example
Blackwell 架构提供了一个具体示例,说明加速器封装如何改变三维并行性的权衡。首先,NVLink 5 为每颗 GPU 提供 1.8 TB/s 的双向带宽,使 Hopper 代际的节点内容量翻倍。这使得可以形成更大的张量并行 \((t)\) 组(例如,跨多个节点的 \(t=\) 16 或 \(t=\) 32),同时具有更低的延迟开销。其次,Blackwell 增加了 FP4 Tensor Core 支持,提升了受支持工作负载的低精度吞吐量和内存效率;FP4 是否用于训练取决于数值配方和软件栈。
对于一个 1 trillion-参数模型,Blackwell 级配置可以使用 \(t=\) 16(通过 NVLink Switch 跨越两个 8-GPU 节点)以及 \(p=\) 8。相对于 Hopper 参考配置的 \(t=8\) 和 \(p=16\),这使模型分片乘积保持为 128,同时将流水线阶段数及其相关的气泡项减半。Blackwell GPU 内的片间互连 10 TB/s 进一步缩小了片内通信与封装内通信之间的区别,使两颗受光罩限制(reticle-limited)的 die 能够作为一个高带宽张量并行单元协同工作。系统层面的普遍启示是:提升局部带宽会把压力向外转移;一旦节点内通信的约束性减弱,针对更大规模机器学习集群(Machine Learning Fleet)配置,基于链路的优化拓扑(轨道优化拓扑)以及 All-to-All 优化将变得更加重要。
同样的布局约束可以通过设计空间搜索转化为可操作的设计。
Example 1.2: 自动设计空间搜索(第 3 层优化器)
场景:一个工程团队将参数规模为 175B 的模型排程到 8,192 台 H100 GPU(80 GB HBM 每卡)上,在多维 3D 并行搜索空间中探索(TP \(\times\) PP \(\times\) DP)。
诊断:人工试错存在内存溢出(超出 80 GB HBM)或 NVLink 饱和的风险。ParallelismOptimizer 评估所有分解方案,选择 TP=8 GPUs、PP=8、DP=128,以最大化 MFU,同时不超出 HBM 容量。
系统启示:自动设计空间搜索将经验性启发式方法形式化:张量并行应限制在单节点 NVLink 范围内(TP=8 GPUs),而流水线并行(PP=8)应尽可能减少,以避免流水线气泡开销,同时满足内存约束,从而实现 36.4 percent 的预计 MFU。
调整任意一个维度都会将压力转移到另外两个维度,使得分解 TP \(\times\) PP \(\times\) DP 成为一个紧密耦合的系统,而非三个彼此独立的旋钮。
Checkpoint 1.4: 混合 3D 并行
验证你对并行策略如何组合的理解:
MFU 数值需要一个历史利用率基线,才能展示已发布系统如何接近 50% 的利用率。MFU 演进 追踪了 2020 至 2024 年间已发布训练系统的 MFU 演进过程。从 GPT-3 的 21% MFU 到 PaLM 的 46% MFU 的提升,反映的并非原始硬件速度的改善,而是并行策略、通信重叠技术和调度优化方面的进展。接近 40–46% 的平台期表明,即使在高度优化的混合并行系统中,由通信开销、流水线气泡和内存管理所构成的理论上限依然十分严峻。值得注意的是,Meta 的 Llama 3 在 16,384 台 H100 GPU 上的训练 MFU(41%)略低于同一模型在 8,192 台 GPU 上的 MFU(43%),证实了 节 1.3.2 所述的扩展税不仅理论存在,而且在大规模已发布运行中可被测量。
:::
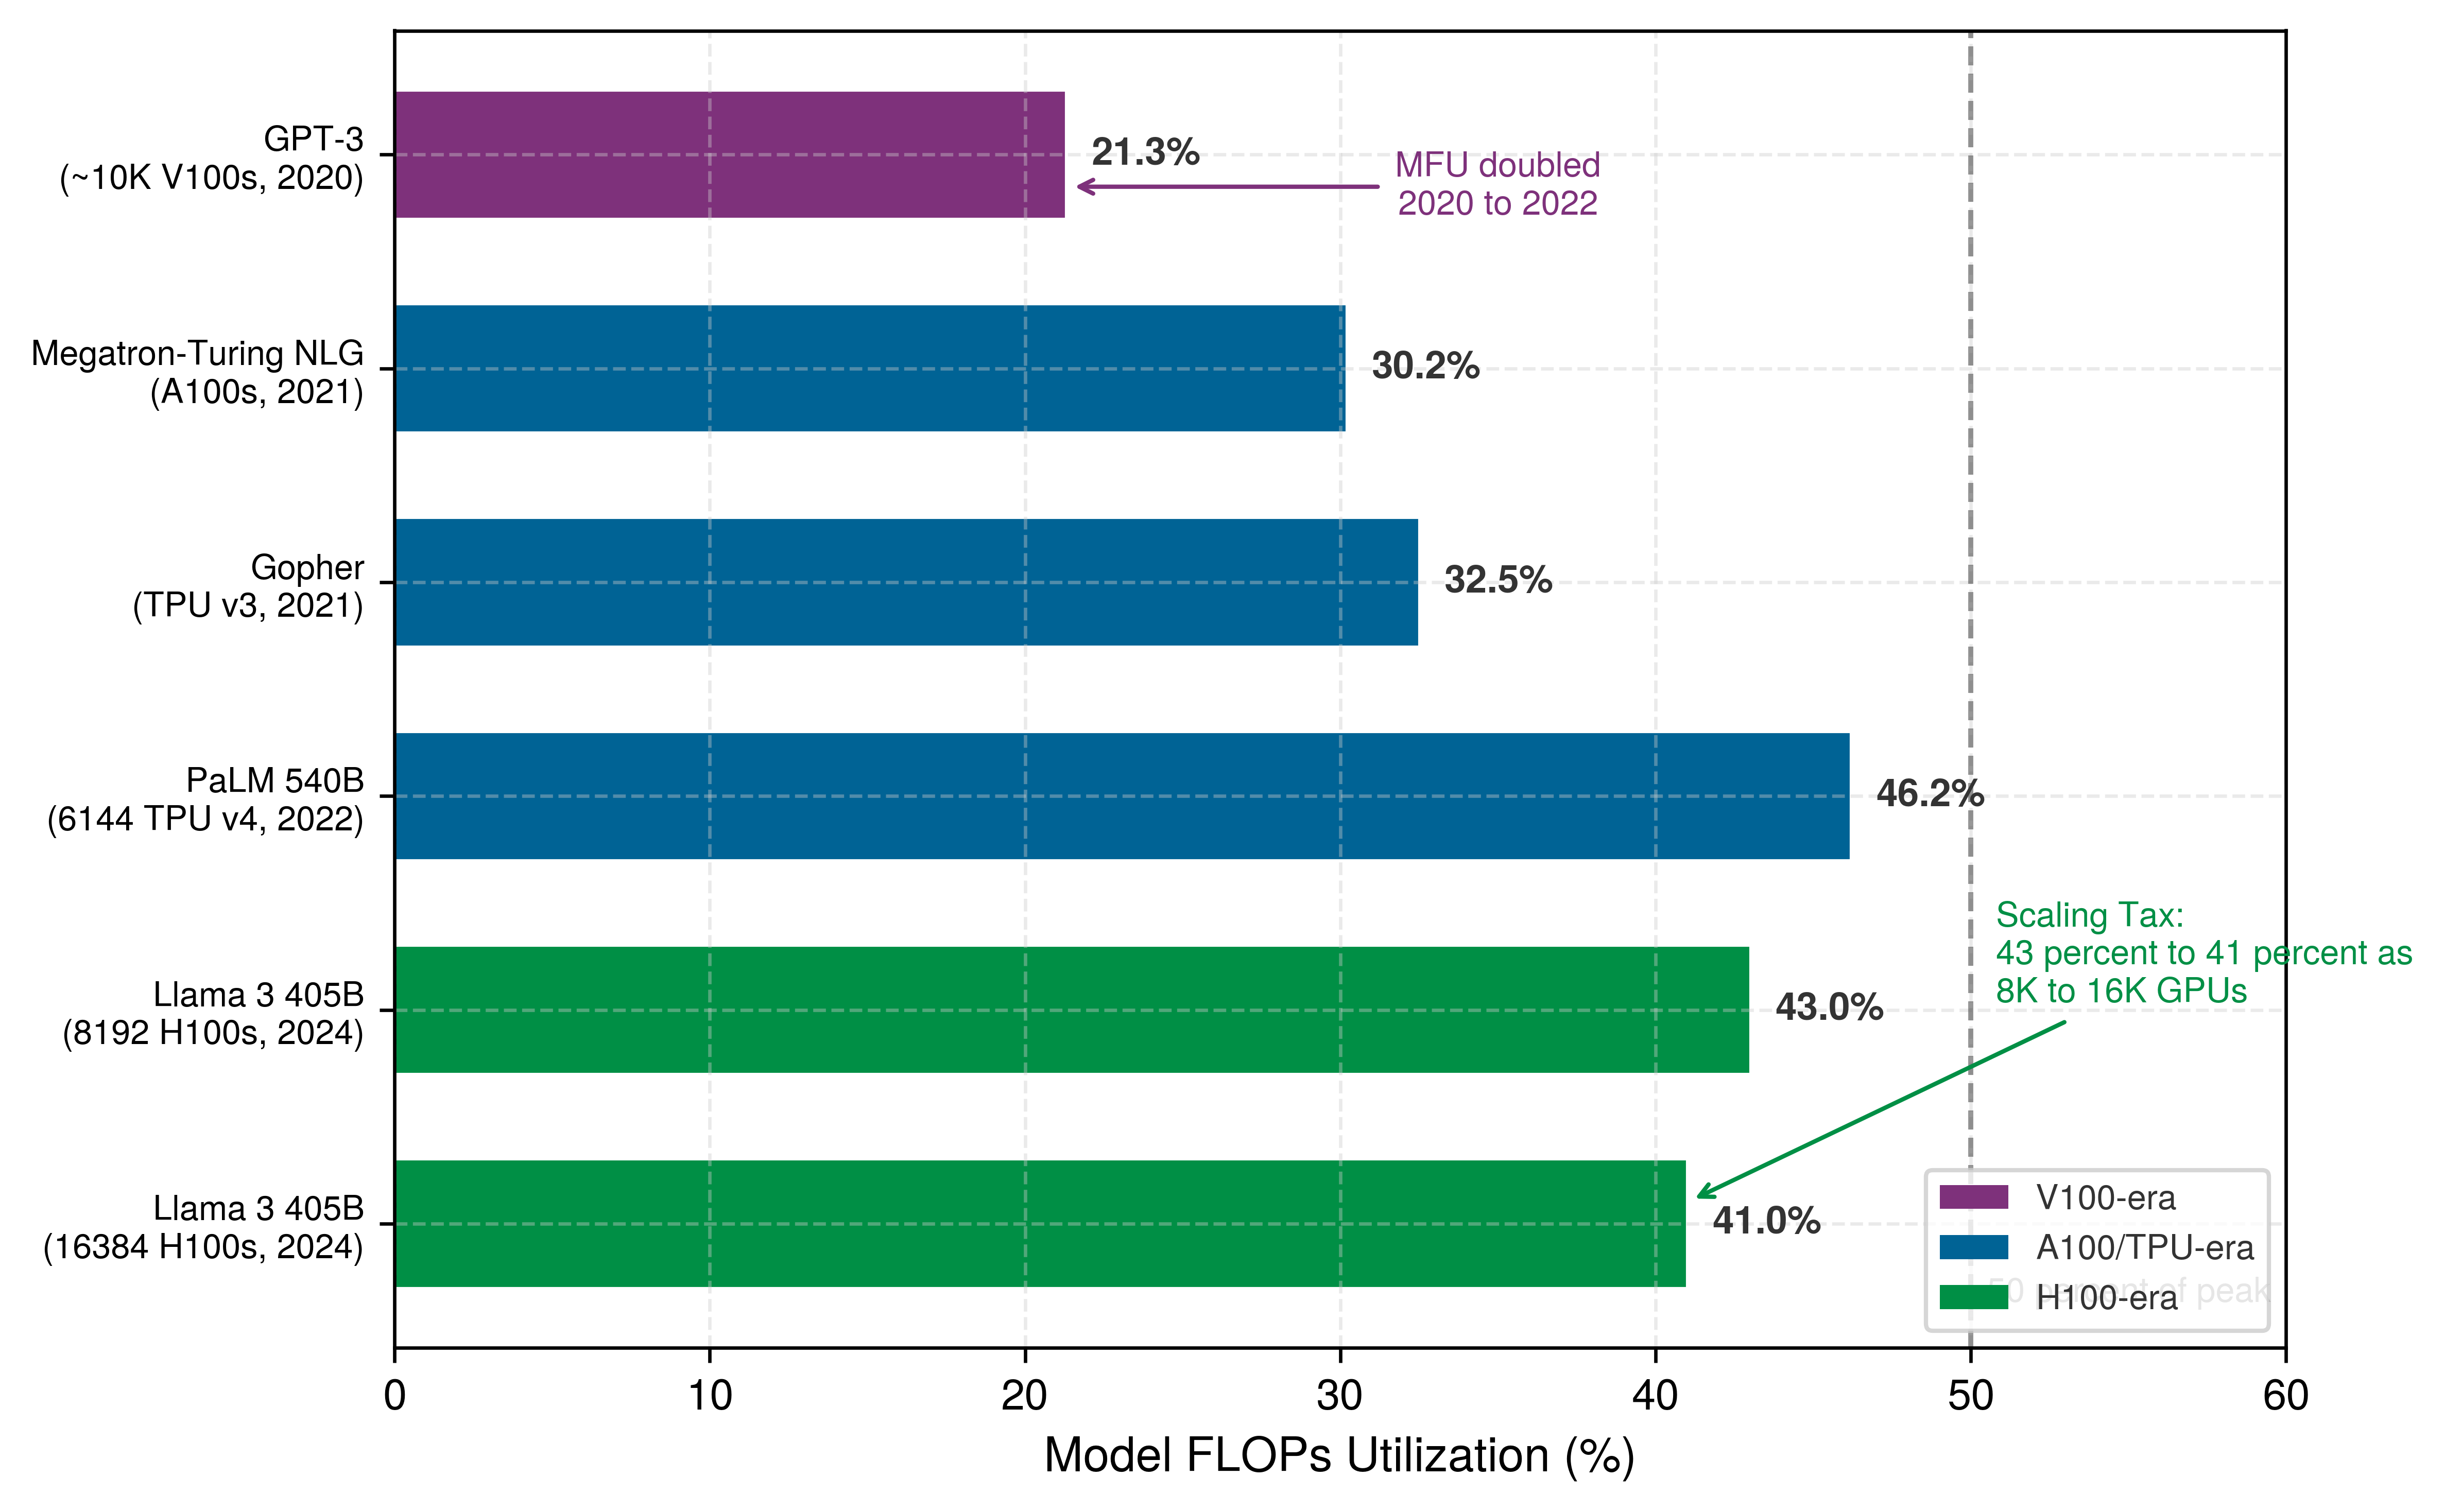
:::
多模型训练:RLHF 与对齐
迄今为止考察的并行策略都假设训练单个模型、优化单个目标。基于人类反馈的强化学习(RLHF) 及其变体打破了这一假设,它们要求多个模型在同一个训练循环内协同工作,各自具有不同的内存占用、计算配置和梯度需求。从高层来看,RLHF 生成模型输出,使用由偏好推导出的奖励信号对其进行打分,以参考模型对更新进行正则化,然后更新策略;近端策略优化(PPO)通过分离的策略、参考、奖励和价值模型实现这一在线循环,而直接偏好优化(DPO)风格的方法则大幅减少了该轮转和价值模型机制。这形成了一个异构集群管理问题,无法由任何单一并行策略解决,并且与标准预训练相比,它代表了一个性质上不同的分布式系统挑战。
多模型协同问题
标准预训练涉及一个模型、一个损失函数和一条梯度流。相比之下,RLHF 对齐编排了一组模型,每个训练步骤中这些模型都会相互交互。在 PPO (Schulman 等 2017年) 中,如 InstructGPT 风格 RLHF 系统 (Ouyang 等 2022年) 所用,四个不同的模型必须协同工作。RLHF 模型协同角色 按角色、执行方式和内存占用将这些模型区分开来。
Schulman, John, Filip Wolski, Prafulla Dhariwal, Alec Radford, 和 Oleg Klimov. 2017年. 《Proximal Policy Optimization Algorithms》. arXiv preprint arXiv:1707.06347, 网络首发. https://doi.org/10.48550/arXiv.1707.06347.
Ouyang, L., J. Wu, X. Jiang, D. Almeida, C. L. Wainwright, P. Mishkin, C. Zhang, 等. 2022年. 《Training language models to follow instructions with human feedback》. Advances in Neural Information Processing Systems (NeurIPS) 35: 27730~44. https://doi.org/10.52202/068431-2011.
| 模型 | PPO 风格 RLHF 中的角色 | 执行方式 | 内存占用 |
|---|---|---|---|
| 策略模型 | 正在被对齐和优化的模型。 | 训练模式,包含梯度、优化器动量和激活。 | 对于一个 70B-参数模型,在混合精度下使用 Adam,内存约为 70B \(\times\) (2 \(+\) 2 \(+\) 12) = 1,120 GB,与标准预训练的预算相同。 |
| 参考模型 | 预训练策略的冻结副本,提供 KL 散度惩罚项。 | 仅推理模式。 | FP16/BF16 参数,不含梯度或优化器状态;70B 模型需要约 70B \(\times\) 2 = 140 GB,比训练配置少约 8\(\times\)。 |
| 奖励模型 | 偏好训练得到的打分模型,为生成的序列输出标量奖励。 | 仅推理模式。 | 通常小于策略模型;13B 奖励模型在 FP16 下约需 26 GB,但它必须处理每一个生成的序列。 |
| 价值模型 | PPO 的评论家,估计预期未来奖励。 | 训练模式,可以是独立的,也可以共享策略主干。 | 一个完整规模的独立评论家会额外增加 1,120 GB;较小的模型或共享主干设计可将这一占用降至 200–400 GB。 |
四模型 PPO 系统的总内存需求远远超过标准预训练。一个朴素的共置方案——将 70B 策略、70B 参考、13B 奖励和 13B 价值模型放在同一批加速器上——需要约 1,494 GB 的加速器内存,这还不包括序列生成过程中产生的 KV 缓存和中间激活。在每张 H100 GPU 配备 80 GB HBM 的情况下,该系统仅参数存储就需要至少 19 GPUs。一旦计入生成阶段的 KV 缓存(随输出序列长度线性增长)和训练阶段的激活,单个 RLHF 训练实例的实际最小内存需求会上升到 64–128 GPUs。
基础设施不对称:训练模型与推理模型
RLHF 最具定义性的基础设施挑战并非模型的总内存占用,而是各模型计算画像之间的不对称性。策略模型和价值模型需要完整的反向传播,包括梯度计算、激活检查点(activation checkpointing)和优化器更新,这些都属于计算密集型操作,能够受益于张量并行和高算术强度。相比之下,参考模型和奖励模型只执行前向传播:它们是嵌入在训练循环中的推理负载,其内存访问模式主要由 KV 缓存管理主导,而非梯度累积。
这种不对称性造成了放置上的两难。将训练模型和推理模型共置于同一批 GPU 上,会在生成阶段浪费计算(此时训练模型处于空闲状态),并在梯度阶段浪费内存(此时推理模型的参数存储可以被回收用于激活)。将它们分离到专用的 GPU 池则消除了浪费,但会为奖励查询引入网络延迟:每个生成的 token 批次都必须经过互连网络到达奖励模型,返回标量信号后,才能计算策略梯度。
章节背景:《Scaling Machine Learning Systems》第二卷,05 分布式训练。
生成阶段
生成阶段本身引入了标准预训练所没有的串行瓶颈。RLHF 要求策略模型先自回归地生成完整序列(通常为 256–2,048 个 token),然后才计算奖励和策略梯度。自回归生成受内存带宽限制,而非计算能力限制:每个 token 都需要对模型执行一次完整的前向传播,才能产生一个输出 token。对于一个 Llama-2-70B 风格的分组查询注意力策略模型,KV cache 每生成一个 token、每条序列约增加 \(2 \times N_L \times H_{\text{KV}} \times d_{\text{head}} \times 2\) 字节。在具有 80 层、8 个 KV head、128 维度的 head、1,024 个生成 token,以及一批 256 个提示的情况下,cache 占用 85.9 GB:\(2 \times 80 \times 8 \times 128 \times 1024 \times 256 \times 2\) 字节。若采用使用完整 8,192 宽隐藏状态的稠密多头注意力模型计算 K 和 V,则会得到 687.2 GB。即便使用分组查询注意力,cache 也大约消耗一台 H100 GPU 的 HBM,用于在奖励计算后被丢弃的中间注意力状态。
RLHF 系统通过时间多路复用来应对这一不对称性。在生成阶段,集群表现得像一个推理系统:策略模型生成序列,参考模型计算对数概率,占主导地位的资源是为逐 token 注意力状态预留的 HBM。进入训练阶段后,同一 fleet 切换回训练模式:通过策略模型和价值模型计算梯度,采用在 节 1.6 中开发的 3D 并行配置。服务系统通过请求批处理和 KV-cache 放置来处理这一阶段;此处的关键是模式切换。RLHF 并非一个持续的训练循环,而是推理形态工作与训练形态工作之间的交替,标准训练框架通常无法自行管理这一过渡。
DPO:简化 fleet
DPO (Rafailov 等 2023年) 通过把对齐目标重新表述为偏好对上的分类损失,彻底消除了奖励模型和价值模型。DPO 不再生成序列、计算奖励和估计优势,而是直接优化策略,使其为偏好响应赋予更高的对数概率,高于非偏好响应,仅使用参考模型计算 KL 散度正则项。
Rafailov, Rafael, Archit Sharma, Eric Mitchell, Stefano Ermon, Christopher D. Manning, 和 Chelsea Finn. 2023年. 《Direct Preference Optimization: Your Language Model Is Secretly a Reward Model》. Advances in Neural Information Processing Systems (NeurIPS) 36: 53728~41. https://doi.org/10.52202/075280-2338.
基础设施层面的影响十分显著。DPO 将多模型系统从四个模型减少到两个:策略模型(训练模式)和参考模型(推理模式)。对于在 节 1.7.4 中量化的 70B 策略模型与 13B 奖励模型和价值模型,静态参数内存从约 1,494 GB 降至 1,260 GB,减少 16%。若 PPO 价值模型与策略模型规模相同,则降幅更大:约 2,406 GB 降至 1,260 GB,即约 48%。DPO 还完全消除了自回归生成阶段。训练在固定的 (prompt, preferred response, dispreferred response) 三元组数据集上运行,恢复了标准预训练数据流水线:固定长度序列、确定性批处理,以及无需逐 token 的串行生成。训练循环变为一个带有修改损失函数的标准监督学习步骤,因而可以沿用预训练所用的 3D 并行、梯度累积和通信重叠技术。
权衡的代价是能力。DPO 基于静态偏好数据集运行,这意味着策略无法在训练过程中探索新响应并获得反馈。PPO 的在线生成允许策略对其自身输出进行迭代改进,从而可能发现静态数据集中并不存在的更优策略。对于偏好数据全面覆盖目标分布的部署场景,DPO 的基础设施简化占优。对于需要自适应探索的场景(例如训练模型解决新颖的推理任务),PPO 的在线反馈循环可能值得 2\(\times\) 的基础设施开销。
定量分析:PPO 与 DPO 的资源需求
为使基础设施权衡具体化,考虑在一个由 256 台 H100 GPU(80 GB HBM 内存)组成的集群上对齐一个 70B 策略模型。
Napkin Math 1.9: RLHF 基础设施预算:PPO 与 DPO
问题:对齐一个 70B 策略模型,需要将其与一个 70B 参考模型共置;对于 PPO,还需要共置一个 13B 奖励模型和一个 13B 价值模型。在 3D 并行(TP=8 GPUs、PP=4、DP=8)下,每种方法在每张 GPU 上消耗多少显存?DPO 通过移除奖励模型、价值模型和生成阶段的 KV 缓存,能释放多少显存余量?
PPO 显存预算(每张 GPU,策略模型采用 TP=8 GPUs、PP=4、DP=8)
在 TP=8 GPUs、PP=4 的 3D 并行配置下,策略模型将其 1,120 GB 训练状态分布到 32 GPUs 上,使每张 GPU 的显存占用为 35 GB。参考模型在推理时仅需 140 GB,可在独立的 8 GPUs 资源池中进行分片,每个分片占用 17.5 GB;也可与策略模型共置于同一组 GPU,每张 GPU 额外占用 4.4 GB(140 GB / 32 GPUs)。13B 奖励模型额外占用 26 GB,分摊到其资源池中。处于训练模式的 13B 价值模型额外占用约 208 GB(13B \(\times\) 16 字节/参数),分摊到其资源池中。
静态显存总量(策略模型与参考模型共置于 32 GPUs):35 GB + 4.4 GB \(\approx\) 39.4 GB,按每张 GPU 计,为激活值和 KV 缓存留下 \(\sim\) 40.6 GB。对于包含 256 sequences 和 1,024 tokens、位于一个 \(TP{\times}PP\) 策略副本内的轨迹采样批次,生成阶段需要 KV 缓存,因此每张策略 GPU 必须为其 KV 缓存分片额外预留 85.9 GB/32 GPUs \(\approx\) 2.7 GB。剩余的 \(\sim\) 37.9 GB 限制了训练阶段的微批次大小。
DPO 显存预算(相同并行配置)
策略模型在每张 GPU 上仍占用 35 GB。参考模型在每张 GPU 上额外占用 4.4 GB(共置)。无需奖励模型、价值模型,也无需用于生成的 KV 缓存。
在策略 GPU 上,静态显存总量为 35 GB + 4.4 GB = 39.4 GB,按每张 GPU 计,与 PPO 中共置的策略模型和参考模型的显存占用相同。然而,从整个集群来看,DPO 避免了 PPO 的奖励模型和价值模型的显存占用,同时也消除了生成阶段的 KV 缓存负担。每张策略 GPU 上剩余的全部 \(\sim\) 40.6 GB 均可用于训练激活值,从而允许采用稍大的微批次(在这一策略模型与参考模型共置的显存预算下,约为 1.07×),或减少对 PPO 所需的激活检查点的依赖。
吞吐量比较
PPO 的两阶段设计(先生成,再训练)带来了根本性的吞吐量损失。如果生成消耗了 60 percent 的训练步耗时(长序列自回归解码通常如此),那么训练硬件在一个 RLHF 训练步中的利用率仅为 40 percent。DPO 以标准训练循环运行,可达到与预训练相同的 40 percent–55 percent MFU。PPO 与 DPO 的显存和 MFU 并列比较了这两种形态。
| 指标 | PPO(70B 策略模型) | DPO(70B 策略模型) |
|---|---|---|
| 所需模型 | 4(策略、参考、奖励、价值) | 2(策略、参考) |
| 参数显存总量 | \(\sim\) 1,494 GB | \(\sim\) 1,260 GB |
| 最少 GPU 数量(按显存需求) | 64–128 GPUs | 32–64 GPUs |
| 生成阶段 | 有(顺序执行,受带宽限制) | 无 |
| 有效训练 MFU | 15–25% | 40–55% |
| 数据流水线 | 在线生成 | 静态偏好对 |
系统洞见:在这个 13B 奖励/价值模型场景中,DPO 将静态参数内存降低 15.7 percent,并通过消除奖励模型、价值模型和自回归生成阶段,将有效计算利用率提升一倍。PPO 与 DPO 之间的选择不仅是建模偏好,也是一项基础设施约束:GPU 预算有限的组织可能更倾向于 DPO,因为它将工作负载恢复到固定数据训练循环。如果 PPO 价值模型的规模是策略模型规模而非 13B,那么内存缩减量将接近 节 1.7.3 中讨论的较大 2,406 GB 到 1,260 GB 对比。
序列长度方差与批处理挑战
PPO 与 DPO 都面临标准预训练所没有的数据工程挑战:序列长度的极端方差。预训练通常使用固定长度序列(2,048 或 4,096 个 token,填充或打包以填满每个位置),从而形成统一的批形状和可预测的内存消耗。RLHF 训练数据由可变长度提示(10–500 个 token)拼接可变长度续写(50–2,048 个 token)组成,产生单个批次内 10–50\(\times\) 的序列长度方差。
长度方差引发两个相互关联的问题。固定尺寸批处理会将所有序列填充到批次中的最大长度,从而在填充 token 上浪费计算。一个包含一条 2,048-token 序列和十五条 128-token 序列的批次,会有 88 percent 的计算浪费在填充上。动态批处理 按相似长度对序列进行分组以最小化填充,但会在数据并行工作器之间引入负载不均衡:一个工作器可能收到一条占用 60 GB 激活内存的长序列批次,而另一个工作器仅用 8 GB 处理短序列,导致短序列工作器在同步屏障处等待,而长序列工作器已完成。
RLHF 系统通过序列打包(将多条短序列拼接为单个固定长度输入,并使用注意力掩码防止交叉污染)和自适应微批处理(根据聚合 token 数而非序列数动态调整每个微批处理中的序列数量)来缓解这一问题。这些技术可以恢复大部分因填充方差而损失的计算,但也为数据流水线增加了标准预训练框架所不具备的复杂度。工作器无需处理相等的 token 数即可保持梯度一致性;不变量在于全局归约将每个本地损失或梯度之和按其有效 token 分母加权。不均衡的 token 数仍然会造成负载不均衡,因此即使加权归约保留了预期的估计器,token 均衡分配依然是性能目标。
因此,RLHF 并非并行策略的旁路;恰恰是它展示了没有任何一种策略单独足够。策略模型可能需要张量并行和流水线并行,参考模型和奖励模型表现为推理服务,价值模型可能需要训练状态,而续写数据流水线会随步变化。鉴于这一压力测试,最终的对比可以回到一般的工程问题:先识别约束瓶颈,再选择移动数据最少且能够容纳所需状态的并行模式。
并行策略对比
一种并行策略只有在移动约束瓶颈而不制造更大的约束时才真正有用。节 1.0.5 的决策树预览了可行性过滤;如今张量并行、流水线并行和混合并行均已发展起来,同一套过滤标准可以表述为工程信号,而非泛化的排序。对于一个 500 亿参数的新模型,决定性问题是:哪种内存状态适用、通信频率如何、流水线气泡出现在哪里,以及工程团队能够容忍多少抽象成本。
标准 3D 核心并未穷尽切分空间。序列并行伴随张量并行,沿序列维度切分张量并行本会复制的那些操作(如层归一化和 dropout)的激活 (Korthikanti 等 2023年)。上下文并行则切分长注意力上下文,并在各 rank 之间交换 key/value 块或部分注意力状态 (Liu 等 2023年)。专家并行切分稀疏前馈容量,并将 token 激活路由到被选中的专家。并行训练策略 将这些扩展与 3D 核心并列呈现,而不假装它们独立于其批处理、内存和拓扑约束。
Korthikanti, Vijay Anand, Jared Casper, Sangkug Lym, Lawrence McAfee, Michael Andersch, Mohammad Shoeybi, 和 Bryan Catanzaro. 2023年. 《Reducing Activation Recomputation in Large Transformer Models》. Proceedings of Machine Learning and Systems (MLSys) 5: 341~53.
Liu, Hao, Matei Zaharia, 和 Pieter Abbeel. 2023年. 《Ring Attention with Blockwise Transformers for Near-Infinite Context》. arXiv preprint arXiv:2310.01889, 网络首发. https://doi.org/10.48550/arXiv.2310.01889.
| 策略 | 约束瓶颈 | 主要通信动作 | 放置决策 | 验证信号 |
|---|---|---|---|---|
| DDP | 模型状态可容纳于一台加速器 | 每步执行 AllReduce 梯度 | 在全量数据并行工作节点间复制完整模型 | 单步耗时由计算主导,而非同步开销 |
| FSDP/ZeRO | 模型状态超出单台加速器容量 | 收集参数;梯度先归约再广播 | 在峰值内存内为预取窗口和重分片窗口分配空间 | 模型状态、激活与工作区均能容纳 |
| 张量并行 | 单层或张量运算超出本地容量 | 归约或收集各分片的层结果 | 将紧密耦合的分区置于高速本地链路上 | 单层延迟低于激活传递开销 |
| 流水线并行 | 层堆栈仅在按阶段切分后才能容纳 | 阶段之间的激活与梯度 | 平衡各阶段负载并维持微批激活驻留 | 气泡激活与峰值激活内存满足预算 |
| 序列/上下文并行 | 激活或注意力上下文超出本地容量 | 交换序列分片或注意力状态 | 在低延迟组内对长序列进行切分 | 更长上下文可容纳,且通信不占主导 |
| 专家并行 | 稀疏专家容量超出本地内存 | 用 AllToAll 路由令牌激活 | 在高二分比组内平衡专家负载 | 专家负载失衡与丢令牌率均受控 |
| 混合并行 | 同时存在多个约束瓶颈 | 在耦合轴上运行多个集合通信 | 满足可整除性、批大小、拓扑与故障域要求 | 在内存与网络预算内提升 MFU |
图 18 将同一套筛选条件转化为决策树。它首先从内存容纳性入手,因为容量不足是不可妥协的;随后判断数据规模本身是否足以支持多副本复制。该决策树有意进行了简化:硬件异构性、通信带宽和工作负载失衡作为次级检查项,在确定约束瓶颈之后才纳入考虑。
表格与流程图有意保持粗粒度,但其目的十分明确:在选择实现栈之前,先识别出约束瓶颈。
从原理到系统
选择 DDP、FSDP/ZeRO 风格的分片、张量并行或流水线并行,本质上是在决定哪些约束由运行时负责,哪些约束必须由工程师直接管理。本章贯穿讨论的并行策略(梯度平均、AllReduce 同步、张量切分、流水线调度)通过这一分层抽象体系,转化为实际部署的训练系统。
在数据并行层,最简单的分布式训练抽象会封装模型,使框架自动在可用加速器之间复制模型,切分每个批次,并在反向传播后平均梯度。历史上,参数服务器系统由存储共享参数的服务器节点组织这项工作,而工作节点向服务器推送和拉取更新 (Li 等 2014年)。正如 节 1.4.3 所述,该设计将梯度带宽集中在服务器层,因此稠密同步训练更倾向于去中心化的集合通信。
Li, M., D. G. Andersen, J. W. Park, A. J. Smola, A. Ahmed, V. Josifovski, J. Long, E. J. Shekita, 和 B.-Y. Su. 2014年. 《Scaling Distributed Machine Learning With the Parameter Server》. Proceedings of the 2014 International Conference on Big Data Science and Computing, 583~98. https://doi.org/10.1145/2640087.2644155.
大规模数据并行通过为每个工作节点分配对称角色来消除中心归约器。训练框架定义进程组、梯度桶,以及反向传播中每次归约变为就绪的时刻;集合通信运行时则将这些归约映射到环状、树状或分层算法。本章负责训练侧的契约:桶的顺序与重叠程度决定了该步骤关键路径上仍然暴露的通信。集合通信 负责算法与互连成本模型,而 性能工程 负责测量工作流,用于证明重叠确实改善了瓶颈,而不仅仅是将瓶颈转移。
模型并行与流水线并行需要根本不同的抽象,因为框架必须管理跨设备的张量放置,以及分区之间的顺序数据流。核心原则是显式设备分配:工程师指定各层位于哪些设备上,框架则在正向传播期间处理设备之间的激活传输,并在反向传播期间沿反向传递梯度。显式设备分配使模型并行的顺序依赖关系变得可见,因为每个下游设备都必须等待其上游邻居完成。工程师必须在架构层面处理流水线气泡与负载均衡,而不能将其隐藏在不透明的封装之后。
对于大规模模型并行,关键架构洞见是:张量切分与流水线调度需要不同层级的框架支持。张量并行以列并行和行并行的线性层变体替换标准线性层,从而在 Transformer 计算图中正确位置自动插入 AllReduce 操作,如 节 1.4.2.3 所述。流水线并行则加入微批次调度逻辑,在各阶段之间交错前向与反向传播,以最小化气泡开销。高效的内存分片通过在每个前向传播前用自动 AllGather 操作包裹模型层、在每个反向传播后用 ReduceScatter 操作包裹,将 ZeRO-3 风格的参数分片集成进来。关键的设计决策是组合哪些抽象层级:当模型可完整装入内存时,纯数据并行已经足够;高效的内存分片将数据并行扩展到内存受限的形态;当单个层或整个模型的深度超出单设备容量时,完整的张量并行或流水线并行才成为必需。
在这些抽象层级中,分布式训练最终归结为一小集合通信原语。与其深入探讨这些原语如何在集群中物理路由数据(这部分在 集合通信 中有详尽覆盖),框架抽象更关注这些原语何时被调用、为何被调用。
这些原语组合成针对每种策略的通信调度。数据并行通常每个优化器步骤归约一次梯度桶。全分片 FSDP 配合重分片会在各层周围触发参数 AllGathers,并在反向传播期间执行 ReduceScatter;而张量并行则在 Transformer 块内部放置归约或收集操作。因此,训练设计决定了消息大小、就绪顺序和频率;集合通信 决定集合通信如何移动这些消息,性能工程 决定如何测量由此产生的关键路径。没有任何框架抽象能够改变底层物理:分布式训练的效率最终取决于互连带宽、内存容量、同步延迟,以及计算图所允许的有用重叠。
谬误与陷阱
许多工程团队通过 \(4\times\) 扩展集群容量后发现,训练迭代完成所需的时间反而更长,这反映了他们对分布式训练物理机制的根本性误解。以下误解概括了那些浪费计算资源并拖延研究进度的错误。
谬误:只要投入足够的工程努力,就能实现线性加速。
阿姆达尔定律确立了硬性限制:无论并行度如何,任何串行部分都会限制最大加速比。在分布式训练中,梯度同步本质上是串行的,因为必须先收集所有梯度,才能进行任何更新。正如 节 1.3 所示,扩展效率方程 \(\eta_{\text{scaling}} = 1/(1 + N(T_{\text{comm}}(N) + T_{\text{sync}}(N) - T_{\text{overlap}})/T_{\text{compute}})\) 揭示了通信和同步开销如何随着 \(N\) 的增加而占据主导地位。即使实现完美的计算与通信重叠并采用理想算法,通信开销仍会随集群规模增长。对于数据并行,随着 GPU 数量增加,采用树形算法时,全归约时间呈对数增长;采用环形算法时,其延迟项呈线性增长。一个包含 1,000 个 GPU 的集群,其训练速度永远不会达到单个 GPU 的 1,000\(\times\);实现 500\(\times\) 的加速比已属非凡,而对于通信密集型工作负载,100–200\(\times\) 更为常见。假定线性扩展并据此编制项目预算的组织,必然会错过截止日期,并在计算资源上超支。
陷阱:优化 MFU 时不考虑扩展效率。
某团队在单个节点上实现了 50% 的 MFU,扩展到 1,024 个 GPU 后,期望获得相当于 512 个 GPU 的有效工作量。对于通信密集型工作负载,1,024 个 GPU 下的扩展效率可能接近 50%,因此实际有效吞吐量约为峰值的 \(0.50 \times 0.50 = 0.25\),即相当于 256 个 GPU:仅为预期值的一半。MFU 与扩展效率是两个相互独立的乘性因子。只优化其中一个而不测量另一个,会使容量估算产生 2\(\times\) 或更大的倍数误差。在大规模集群层面进行容量规划时,必须同时报告这两项指标,并持续跟踪它们的乘积,即“有效吞吐量”。
谬误:在小集群上调优的超参数可以直接迁移到大规模训练。
工程师在配备 8 个 GPU 的工作站上调优超参数,然后部署到包含 256 个 GPU 的集群,期望得到完全相同的行为。规模扩大后,收敛模式会发生根本性变化。最关键的超参数是学习率:正如 节 1.2 所解释的,在数据并行中,批大小随 GPU 数量成比例增加,因此需要调整学习率。“线性扩展规则”7 (Goyal 等 2017年) 建议 \(\eta_{\text{large}} = \eta_{\text{base}} \times (B_{\text{large}}/B_{\text{base}})\),但这一关系仅在一定范围内成立。随着模型规模扩大,最终会达到临界批大小,8 此时每步增加数据量所带来的收敛收益会递减。
7 线性扩展规则:由 Facebook AI Research 的 Goyal 等 (2017年) 确立,他们在一小时内,使用 256 个 GPU,以 8,192 的批大小完成了 ResNet-50 在 ImageNet 上的训练,同时达到了与小批量训练相当的准确率。该规则 – 将学习率乘以 \(k\),对应于批大小增加至原来的 \(k\) – 仅在大批量近似仍然有效时成立。超过该工作负载实测的临界批大小范围后,梯度噪声会降至有效信号尺度以下,额外并行度带来的收敛收益会递减 (McCandlish 等 2018年; Shallue 等 2019年)。
Goyal, Priya, Piotr Dollár, Ross Girshick, Pieter Noordhuis, Lukasz Wesolowski, Aapo Kyrola, Andrew Tulloch, Yangqing Jia, 和 Kaiming He. 2017年. 《Accurate, Large Minibatch SGD: Training ImageNet in 1 Hour》. arXiv preprint arXiv:1706.02677 abs/1706.02677.
Shallue, Christopher J, Jaehoon Lee, Joseph Antognini, Jascha Sohl-Dickstein, Roy Frostig, 和 George E Dahl. 2019年. 《Measuring the Effects of Data Parallelism on Neural Network Training》. Journal of Machine Learning Research 20: 1~49.
8 临界批大小:McCandlish 等 (2018年) 提出的梯度噪声尺度视角,将最大的有效批大小视为一个可测量的统计量,它随领域、模型、优化器和训练阶段而变化。超过这一测量阈值继续扩展,会提高硬件吞吐量,但不会按比例减少达到目标质量所需的优化步数,从而使扩展效率 \((\eta_{\text{scaling}})\) 急剧下降。
McCandlish, Sam, Jared Kaplan, Dario Amodei, 和 OpenAI Dota Team. 2018年. 《An Empirical Model of Large-Batch Training》. arXiv preprint arXiv:1812.06162, 网络首发. https://doi.org/10.48550/arXiv.1812.06162.
超过临界批大小后,这一关系便会失效,具体方式取决于模型、数据和优化器。如果某团队将小集群上的学习率机械地乘以 GPU 数量,并直接采用大得多的全局批大小,那么即使硬件吞吐量有所提高,也可能出现最终质量下降或样本效率降低的情况。学习率预热调度、权重衰减调整、LARS/LAMB 等逐层优化器,以及细致的动量调优,可以在某些范围内恢复准确率,但需要在目标规模下开展系统性实验。跳过这些扩展研究的组织,会在次优训练运行上浪费数千个 GPU 小时。
陷阱:在未对通信进行建模的情况下,为数据并行作业增加 GPU。
工程师们通常认为,GPU 数量越多,训练就越快。但在大规模训练场景下,统计效率带来的限制会压倒硬件收益。正如 节 1.2 所述,数据并行会随 GPU 数量成比例地提升有效批大小 \((B_{\text{total}} = N \times B_{\text{local}})\),但梯度质量在超过模型特定的阈值后会以次线性速度增长。一个 100K 样本的批次可能只提供 10K 样本批次梯度信息的 2\(\times\) 倍,而非 10\(\times\) 倍,这是因为样本在损失曲面中变得冗余。关键批大小界定了边际收益崩塌的位置:节 1.3.6 中的实验表明,ResNet-50 的关键批大小约为 8K–16K,BERT-Large 约为 32K–65K,而具体阈值取决于优化器、训练进度和目标质量。超过该阈值后,GPU 数量翻倍会使成本翻倍,却几乎无法带来收敛加速。在一个典型的成本模型中,1,024-GPU 运行在 $45,000 compute cost may be worse than a 512-GPU run that converges in 19 hours at $22,000 的成本下完成收敛,18 小时,这展示了超出关键批大小如何浪费资源而并未带来有意义的节省。
谬误:仅凭内存容量就决定并行策略。
工程师看到 70B 模型超出 80 GB 内存后,便立即选择张量并行或流水线并行来切分权重。在实际部署运行中,有效策略取决于内存压力、计算模式与通信拓扑三者之间的相互作用。正如 节 1.8 所述,张量并行在每个层之间跨设备切分,并在每层进行 AllReduce 同步,从而实现均匀的内存分布,但通信被置于关键路径上。流水线并行则将完整层分配给各个阶段,阶段之间采用点对点传输,从而降低每步通信量,却引入了流水线气泡开销,浪费 10–30 个周期的计算。对于在 64 张 A100 GPU 上运行的 175B 模型,张量并行(度数为 8)能够支持训练;而具有 8 个阶段的流水线并行则因全对全通信减少,在内存占用相近的情况下实现了 23% 更高的吞吐量。因此,决策需要剖析通信模式与气泡开销,而不能仅仅检查权重是否放得进内存。
陷阱:在未衡量效率权衡的情况下直接套用 FSDP 或 ZeRO。
工程师在读到 FSDP“减少内存并支持更大模型”之后便普遍采用它。在实际部署运行中,分片会引入 10–25% 的通信开销,只有当内存压力足以支撑这一开销时才划算。FSDP 通过在各 GPU 之间分片优化器状态、梯度,以及可选的参数来降低内存占用,但在每次前向传播之前需要 AllGather 操作,反向传播之后需要 ReduceScatter。对于在 A100-80 GB 上以批大小为 4 运行的 7B 模型,标准 DDP 达到 145 samples/second,而 FSDP 仅达到 118 samples/second(慢 19%),因为模型无需分片即可舒适地装入单卡,而额外引入的通信开销并未带来收益。当模型与优化器状态之和超出单卡内存、当增大每卡批大小所获得的收益足以覆盖开销、或当 ZeRO-Offload 将状态卸载到 CPU 内存以扩展容量时,FSDP 才具有价值。一个无法装入 80 GB 的 65B 模型,借助 FSDP ZeRO-3 可以完成训练,代价是接受 15% 的吞吐量损失以换取训练本身。在不测量内存压力的情况下普遍套用 FSDP,只会浪费性能。
谬误:并行开销大致恒定,与模型规模无关。
工程师会在方便的小模型上对并行策略进行基准测试,然后将结论直接套用到大规模训练。在大规模场景下,计算时间与通信时间之间的比值会随模型规模发生显著变化,从而反转策略选择。AllReduce 通信时间主要取决于梯度张量大小和网络带宽,随参数数量近似线性增长;而前向与反向传播的计算时间则因矩阵运算规模增大而超线性增长。对于一个前向/反向传播耗时 50 ms、AllReduce 耗时 25 ms 的 1B 参数模型,通信开销占单步时间的 33%。而对于前向/反向传播耗时 2400 ms、AllReduce 耗时 180 ms 的 70B 参数模型,通信开销降至 7%,尽管梯度大小增加了 70\(\times\)。基于小模型作出的决策(“流水线并行的 15% 气泡开销使其总是比数据并行更慢”)在大规模场景下可能反转,此时数据并行的通信开销会达到 25–40%。可靠的策略选择需要要么在目标规模上进行剖析,要么采用能够刻画计算如何随 \(\mathcal{O}(n^2)\) 到 \(\mathcal{O}(n^3)\) 扩展、而通信如何随 \(\mathcal{O}(n)\) 扩展的分析模型。
陷阱:把扩展效率视为硬件本身的属性。
厂商基准测试会公布“1,024 GPU 下 85% 的扩展效率”,采购团队则将其视为集群常数来规划容量。扩展效率是四项因素共同决定的属性:工作负载的通信与计算之比、并行策略(数据、流水线、张量、混合)、网络拓扑(胖树、环状、Dragonfly),以及软件栈(NCCL 版本、内核融合、重叠质量)。来自大语言模型训练基准的参考数字可能会高估具有不规则通信的图神经网络,也可能会低估以嵌入为主的推荐模型(其计算主要是局部的)。容量规划应当使用目标工作负载实测得到的扩展效率,而不是厂商的旗舰基准。
谬误:梯度累积是免费的。
工程师使用梯度累积来模拟更大的批大小,将同步频率从每步一次降低到每 \(K\) 步一次。该技术表面上零成本,因为它消除了 \((K-1)/K\) 的同步事件。但在真实的训练循环中,累积会引入更新延迟、驻留内存开销以及数值精度风险。标准实现将梯度累积到一个常驻的梯度缓冲区中,而不是为每个微步单独分配完整的梯度张量;对于 7B 模型,该 FP16 梯度缓冲区仍然有 14 GB,并且必须在整个累积窗口期间保持驻留。如果实现保留了计算图、重叠了多个待处理微批,或增大了本地微批大小,激活内存可能进一步增长并耗尽 HBM。有效的优化器步延迟随累积步数成正比增加,因此累积 8 步意味着优化器更新频率降低 8\(\times\),尽管吞吐量更高,却可能拖慢收敛。最关键的是,累积的 FP16 梯度在求和数百个梯度张量时存在溢出风险,尤其是在训练早期损失值较大的阶段。一个以 FP16 训练 16 步梯度累积的 Transformer 团队,在第 1200 步出现了损失尖峰与发散;切换到 4 步累积并提高同步频率后,不稳定性得到解决,尽管通信成本更高。梯度累积是以通信频率换取更新延迟、驻留内存与数值稳定性。
陷阱:不顾系统特性而固定检查点间隔。
工程师依据直觉而非分析,将分布式训练的“检查点间隔”固定为“每小时”或“每 1000 步”。容错 推导出了 Young-Daly 检查点定律(原理 12);这里的训练启示是:检查点节奏并非一个常数。它取决于检查点写入成本与故障率之间的数学关系。
该公式将最优检查点间隔设为 \(\tau_{\text{opt}} = \sqrt{2 \cdot T_{\text{write}} \cdot \text{MTBF}_{\text{system}}}\),其中 \(T_{\text{write}}\) 为检查点写入时间,\(\text{MTBF}_{\text{system}}\) 为系统故障的平均间隔。对于具有 1024 个 GPU 的集群,在标准 50,000-hour 每 GPU MTBF 下,集群级 \(\text{MTBF}_{\text{system}}\) 为 48.8 hours(\(\text{MTBF}_{\text{GPU}}/N\))。若检查点时间为 5-minute,则最优间隔约为 171.2 minutes(约 2.9 hours),并带有不可避免的“检查点加返工”协同开销 5.8 percent。若每 15 minutes 检查一次“以求稳妥”,总开销将升至 33.6 percent;而每 8 hours 检查一次,则存在故障时丢失大量工作的风险。对于更大的模型,由于模型规模与存储带宽,检查点时间增至 15 分钟,最优间隔再次改变。猜测成本随集群规模增长:一次 1024-GPU 运行若采用 15 分钟间隔而非 Young-Daly 最优间隔,将因过度检查点化每天损失约 $13,638。

最优检查点节奏在写入开销与返工风险之间取得平衡。
摘要
本章介绍了“扩展墙”:继续增加 GPU 数量最终会使训练变慢而非变快。分布式训练并非单纯的硬件问题,而是受模型规模、批大小与互连带宽三者相互作用所支配的约束满足问题。
3D 并行性立方体 (图 19) 是扩展大模型的有用框架。数据并行将训练的外层循环展开以扩展吞吐量;张量并行对矩阵乘法内层循环进行向量化以适配内存;流水线并行将顺序层分阶段以降低通信频率。这些策略共同将超出任何单个内存库容量的模型映射到带宽有限的加速器集群上。
并行方式的选择可以理解为集群级编译器施加的一次循环变换。将逻辑通信模式匹配到物理硬件层次结构,可使系统从小型集群的“线性扩展形态”过渡到大型加速器集群的通信受限形态。
本章中的分区策略均直接针对稠密大模型训练和推荐类工作负载展开。各架构类型的分区策略 还展示了同样的约束逻辑如何延伸到联邦边缘场景,此时瓶颈从加速器内存和网络互连结构带宽转移到不可靠的设备、隐私约束和间歇性连接。
Lighthouse 1.3: 分布式架构类型谱系
3D 并行立方体中的运行点随系统的主要瓶颈而变化:
| 架构类型 | 主要分区策略 | 逻辑 |
|---|---|---|
| 架构类型 A(GPT-4/Llama-3) | 混合 3D 并行 | 结合张量并行(宽度)、流水线并行(深度)和数据并行(吞吐量),以容纳 3.5 TB 的权重。 |
| 架构类型 B(大规模 DLRM) | 嵌入分片 | 将规模庞大的 10 TB+ 表分片存储在参数服务器集群中;使用稀疏 AllToAll 更新。 |
| 架构类型 C(联邦 MobileNet) | 联邦学习 | 同样的逻辑可延伸至协同不可靠且受隐私约束的边缘设备上的本地 MobileNet 更新;边缘智能 将详细阐述这一扩展形态。 |
本章探讨的并行策略(数据、张量、流水线和专家)为在集群中划分训练工作负载提供了一套工具。它们并非互斥的替代方案,而是同一优化空间中相互补充的维度。Megatron-LM 等系统通过组合多种策略实现高效扩展:在节点内使用张量并行,在节点组之间使用流水线并行,通过数据并行提升吞吐量,通过专家并行扩展容量。
Key Takeaways: 并行会转移开销
- 拆分工作会转移瓶颈:分布式训练不会减少底层计算量;它将内存压力转化为通信量、同步延迟或流水线空闲时间(原则 8)。最有效的策略,是将开销转移到集群中约束最宽松部分的拆分方式。
- 数据并行的边界由收敛决定:只有当增大全局批次仍能改善优化过程时,增加副本才能顺利提升吞吐量。超过临界批次大小后,AllReduce 的成本和梯度噪声的降低会使“更多工作节点”导致学习速度变慢或稳定性下降,除非相应调整调度、预热和梯度累积。
- 分片以消息通信换取内存空间:ZeRO 和 FSDP 通过对优化器状态、梯度和参数进行分片,使 100B+ 参数模型的训练成为可能(原则 3)。代价是 ReduceScatter 和 AllGather 操作需要更严格的通信调度,必须使这些通信与计算重叠,或隐藏其开销。
- 张量并行应靠近 NVLink:张量并行拆分层内的矩阵运算,因此需要现代节点内加速器互连所提供的高带宽节点内网络互连结构。将这类流量延伸至机架之间,会把解决内存容量问题的方案变成通信瓶颈。
- 流水线并行以通信字节量换取流水线气泡:按层划分流水线阶段可降低通信频率,但填充和排空时隙会使加速器闲置(原则 10)。采用 \(m \gg p\) 的微批次处理机制,可将模型深度转化为吞吐量,而非流水线空闲时间。
- 3D 立方体是一张硬件地图:实际的前沿模型训练会结合数据并行、张量并行、流水线并行、专家并行和分片并行,因为没有任何单一维度能同时适配模型和集群(原则 9)。逻辑分组必须统筹映射到 HBM、NVLink、InfiniBand 和故障域。
立方体及其三条轴背后,是同一种权衡。任何模型拆分方式都不会减少底层工作量;它们只是转移工作,将内存限制转化为通信成本,或将通信成本转化为空闲时间。数据并行、张量并行和流水线并行通过付出通信开销,获得单个加速器无法提供的内存余量,而协同则是保持拆分后各部分一致所付出的代价。这就是开销转移(原则 13),也是本卷其余内容所依据的规律:规模扩展带来的执行开销无法消除,只能在计算、通信和协同之间转移。立方体标示了开销可以转移到哪些位置;工程实践则要选择约束最宽松的位置。
What’s Next: 从逻辑到流量
对数学运算的拆分定义了机器学习集群的逻辑流量模式。这些模式最终会落实到数据中心的物理线路上。集合通信 将揭开维持一致性的集合通信操作(AllReduce、AllToAll)的黑箱,从需要发送什么,深入到如何通过环、树和并行网络通路进行路由。