容错
故障分析(大规模场景)
容错
目的
为什么规模会把硬件故障从罕见的例外变成系统必须持续吸收的常规条件?
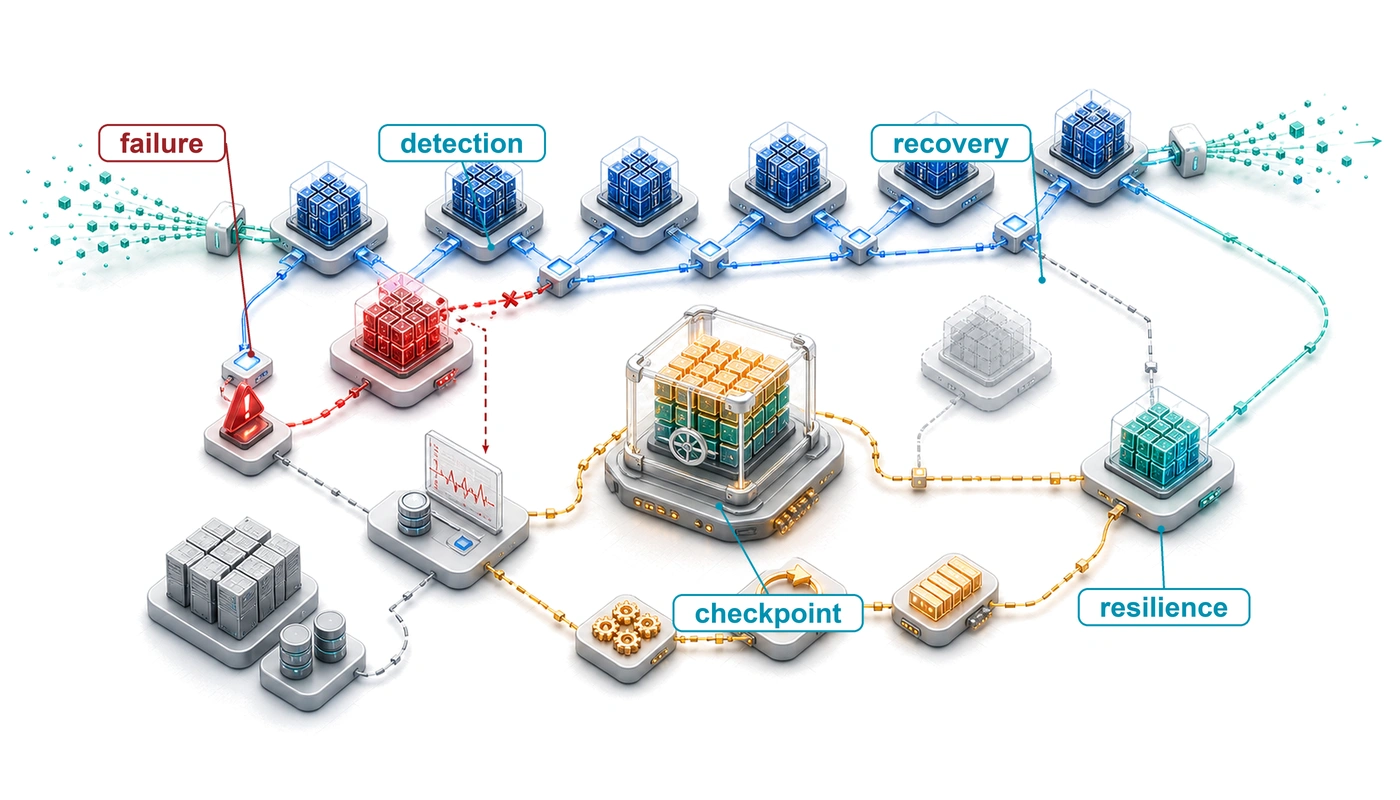
单个加速器可以在硬件故障之间运行数年。一千个加速器会把同样的部件风险变成每几天一次的故障。当主机、电源和网络域一并纳入后,一万设备的集群会看到每几小时一次的故障。单个部件的可靠性并未改变,但随着部件数量增加,系统整体可靠性会下降。在集群规模下,系统必须在不丢失进度的前提下持续吸收重复故障。同样的逻辑适用于服务:全球分布式的推理系统会把区域性中断、网络分区和容量波动视为背景条件而非例外事件。容错系统会预期、检测、隔离并自动恢复这些事件,从而使有用工作得以继续。用 C³ 术语来说,容错在协同上花费计算与通信资源,以保留状态并恢复工作,因为部件故障是集群的统计属性。
Learning Objectives
- 根据部件故障率计算集群级 MTBF,并估算大规模训练集群的故障频率
- 依据可检测性、影响范围(blast radius)和恢复路径,对硬件故障、软件故障和静默数据损坏故障进行分类
- 推导满足写入开销、RPO、RTO 和集群故障约束的检查点间隔与恢复契约
- 为跨 GPU 集群的多 TB 模型状态设计分布式检查点与弹性恢复方案
- 评估故障注入与可观测性证据,以验证检测、隔离和恢复行为
- 在毫秒级延迟和部分故障约束下实现服务冗余、故障切换和状态复制
- 选择优雅降级策略,在模型、特征、区域或容量失效时保留有用服务
设想一个 10,000-GPU 集群,正处于某个新基础模型的三个月训练运行之中。通信层已经完成了它的任务:数千台设备通过 AllReduce、AllGather 和 AllToAll 交换梯度,仿佛它们是一台机器。然而,规模带来的算术代价随之显现。GPU 每隔几小时就会发生故障;如果系统无法吸收这一普通的物理事件,同步训练便会中止,数百万美元的计算资源将闲置。 容错 是使分布式执行在组件故障、降级或消失时仍能持续取得有用进展的系统属性。在 集群栈 所示的集群栈中,容错充当分布式执行的韧性层。所面临的挑战横跨整个故障谱系,从瞬态比特翻转,到间歇性的老化相关错误,直至永久性组件失效,正如 图 1 所示。该图中的各类故障率以及平均故障间隔时间(MTBF)的缩放趋势\(\text{MTBF}_{\text{system}} = \text{MTBF}_{\text{component}}/N\) 仅为预览;后续分析将推导其反向缩放关系,并列出集群故障率。灰色故障与静默数据损坏(SDC)构成了第二重困难:检测率低、影响范围大(参见 静默数据损坏(SDC)注意力扰动模型 中的 FP16 指数位翻转模型与注意力 softmax 扰动推导)。
这种脆弱性正是成功同步的直接后果。分布式训练系统通过协调数千台设备来实现巨大的吞吐量,而集合通信则以严格的交换过程维持这种协调的同步性。同样的同步机制意味着,一台停滞的设备会导致整个集群停滞。容错的机器学习系统通过检测故障、检查点化可恢复状态、重启或弹性重塑作业,并将硬件故障视为常规执行路径而非异常路径,从而保持进度。
从小规模实验走向大规模生产,改变了系统与故障之间的关系。一名在单张 GPU 上训练模型的研究者可能多年不会遇到硬件故障;而同一工作负载运行在 1,000-GPU 集群上,则每几天就会发生仅涉及 GPU 的故障。一旦 PCIe、电源、存储和网络域进入故障预算,生产集群的故障频率会进一步升高。从罕见例外到常规发生的这一转变,要求采用不同的工程方法。以下数学分析将这一转变精确化、量化。
系统 MTBF 随集群规模增长而急剧缩短:从 50,000 小时降至 5 小时。
由于在这一规模下无法消除故障,容错系统会验证任务是否完成,而非假定其已完成;将故障视为常规代码路径;持续演练恢复流程;并考虑简单错误处理可能无法预见的部分故障。这些技术借鉴了数十年的分布式系统研究,但机器学习工作负载改变了其成本效益。训练具有一些特性,使其能够采用通用分布式系统无法采用的策略:随机梯度下降能够容忍某些会破坏其他计算的错误,检查点体积较大但可预测,恢复目标有时可以是近似的,而不必完全精确。利用这些特性,机器学习专用容错的成本可以低于其所继承的通用方法。
故障不可避免的数学原理
系统可靠性工程为理解大规模系统中的故障提供了基础框架 (Birolini 2017年)。单个组件的失效率由失效率参数 \(\lambda\) 刻画,1 单位为每单位时间的失效次数。对于失效率恒定为 \(\lambda\) 的单个组件,直至时间 \(t\) 仍未失效的概率遵循指数分布,2 如 公式 1 所示:
1 失效率(\(\lambda\)):以 FIT(时间失效数)表示,其中 1 FIT 等于每十亿设备小时发生一次失效。数据中心 GPU 的 MTBF 为 50000 hours 时,其失效率为 \(\text{FIT} = 20{,}000\),对应每小时 \(\lambda_{\text{hour}} = 2.0 \times 10^{-5}\) 次失效。对单个设备而言,这似乎微不足道,但在集群规模下却成为主导因素:包含 10,000 GPUs 的集群,仅 GPU 的累计失效率就达到 200,000,000 FIT,相当于预期每隔 5 hours 就发生一次 GPU 故障。
2 泊松过程:一种描述事件以恒定平均速率独立发生的统计模型。可靠性模型假设硬件故障遵循泊松分布,由此得到指数生存函数 \(R(t) = e^{-\lambda t}\)。这一假设简化了集群规划:在包含 10,000 个组件的集群中,至少发生一次故障的概率为 \(1 - e^{-N \lambda t}\),使故障风险随 \(N\) 线性增长,但随 \(t\) 指数增长。
\[ R_{\text{single}}(t) = e^{-\lambda t} \tag{1}\]
该组件的 MTBF 等于 \(1/\lambda\)。按照本书的约定,平均失效时间(MTTF)指单个组件到首次失效的期望时间,而平均故障间隔(MTBF)指可修复系统两次相继故障之间的期望时间;在此处采用的恒定失效率指数模型下,两者在数值上相等,容错模型使用 MTTF 表示单个组件的常量,使用 MTBF 表示组合系统的故障发生频率。数据中心 GPU 通常采用数万小时量级的 MTBF 规划值,其实际运行表现取决于运行条件、冷却效果、制造差异和工作负载压力。3 组件故障率 列出了各类组件的标准 MTTF 值(H100、A100、张量处理单元(TPU)、PCIe、电源、网络),这些值是上述 \(\lambda\) 和 FIT 数值的计算依据,因此读者可以代入任意设备的常量,复现整个容错分析中使用的失效率。
3 GPU MTBF 的差异:本章采用 50,000 小时作为 A100 级 GPU 的规划常量,并非对每个已部署 GPU 的保证。针对 Google TPUv4 pod 和 Meta GPU 集群发表的集群研究表明,实际运行中的可靠性取决于拓扑、冷却、工作负载和运维实践 (Zu 等 2024年; Kokolis 等 2025年; Dubey 等 2024年)。因此,规划常量为数值计算提供基准,而运维人员在获得集群实测失效率后,应将其代入计算。
Zu, Y., A. Ghaffarkhah, H.-V. Dang, B. Towles, S. Hand, S. Huda, A. Bello, 等. 2024年. 《Resiliency at Scale: Managing Google’s TPUv4 Machine Learning Supercomputer》. 21st USENIX Symposium on Networked Systems Design and Implementation (NSDI 24), 761~74.
Kokolis, Apostolos, Michael Kuchnik, John Hoffman, Adithya Kumar, Parth Malani, Faye Ma, Zach DeVito, Shubho Sengupta, Kalyan Saladi, 和 Carole-Jean Wu. 2025年. 《Revisiting Reliability in Large-Scale Machine Learning Research Clusters》. 2025 IEEE International Symposium on High Performance Computer Architecture (HPCA), 1259~74. https://doi.org/10.1109/hpca61900.2025.00096.
Dubey, Abhimanyu, Abhinav Jauhri, Abhinav Pandey, Abhishek Kadian, 等. 2024年. The Llama 3 Herd of Models. arXiv preprint arXiv:2407.21783.
当多个独立组件在一个系统中运行,且任一组件失效都会导致系统失效时,公式 2 以数学形式说明了系统可靠性如何成为各组件可靠性的乘积:
\[ R_{\text{system}}(t) = \prod_{i=1}^{N} R_i(t) = \prod_{i=1}^{N} e^{-\lambda_i t} \tag{2}\]
对于 \(N\) 个相同组件,若单个组件的失效率为 \(\lambda\),则 公式 3 给出了相同组件情况下的简化表达式:
\[ R_{\text{system}}(t) = e^{-N\lambda t} \tag{3}\]
系统失效率变为 \(N\lambda\),而 公式 4 表明系统 MTBF 与组件数量成反比。这种反比关系揭示了集群规模下以多个“9”衡量可靠性时的反直觉现实:
\[ \text{MTBF}_{\text{system}} = \frac{1}{N\lambda} = \frac{\text{MTBF}_{\text{component}}}{N} \tag{4}\]
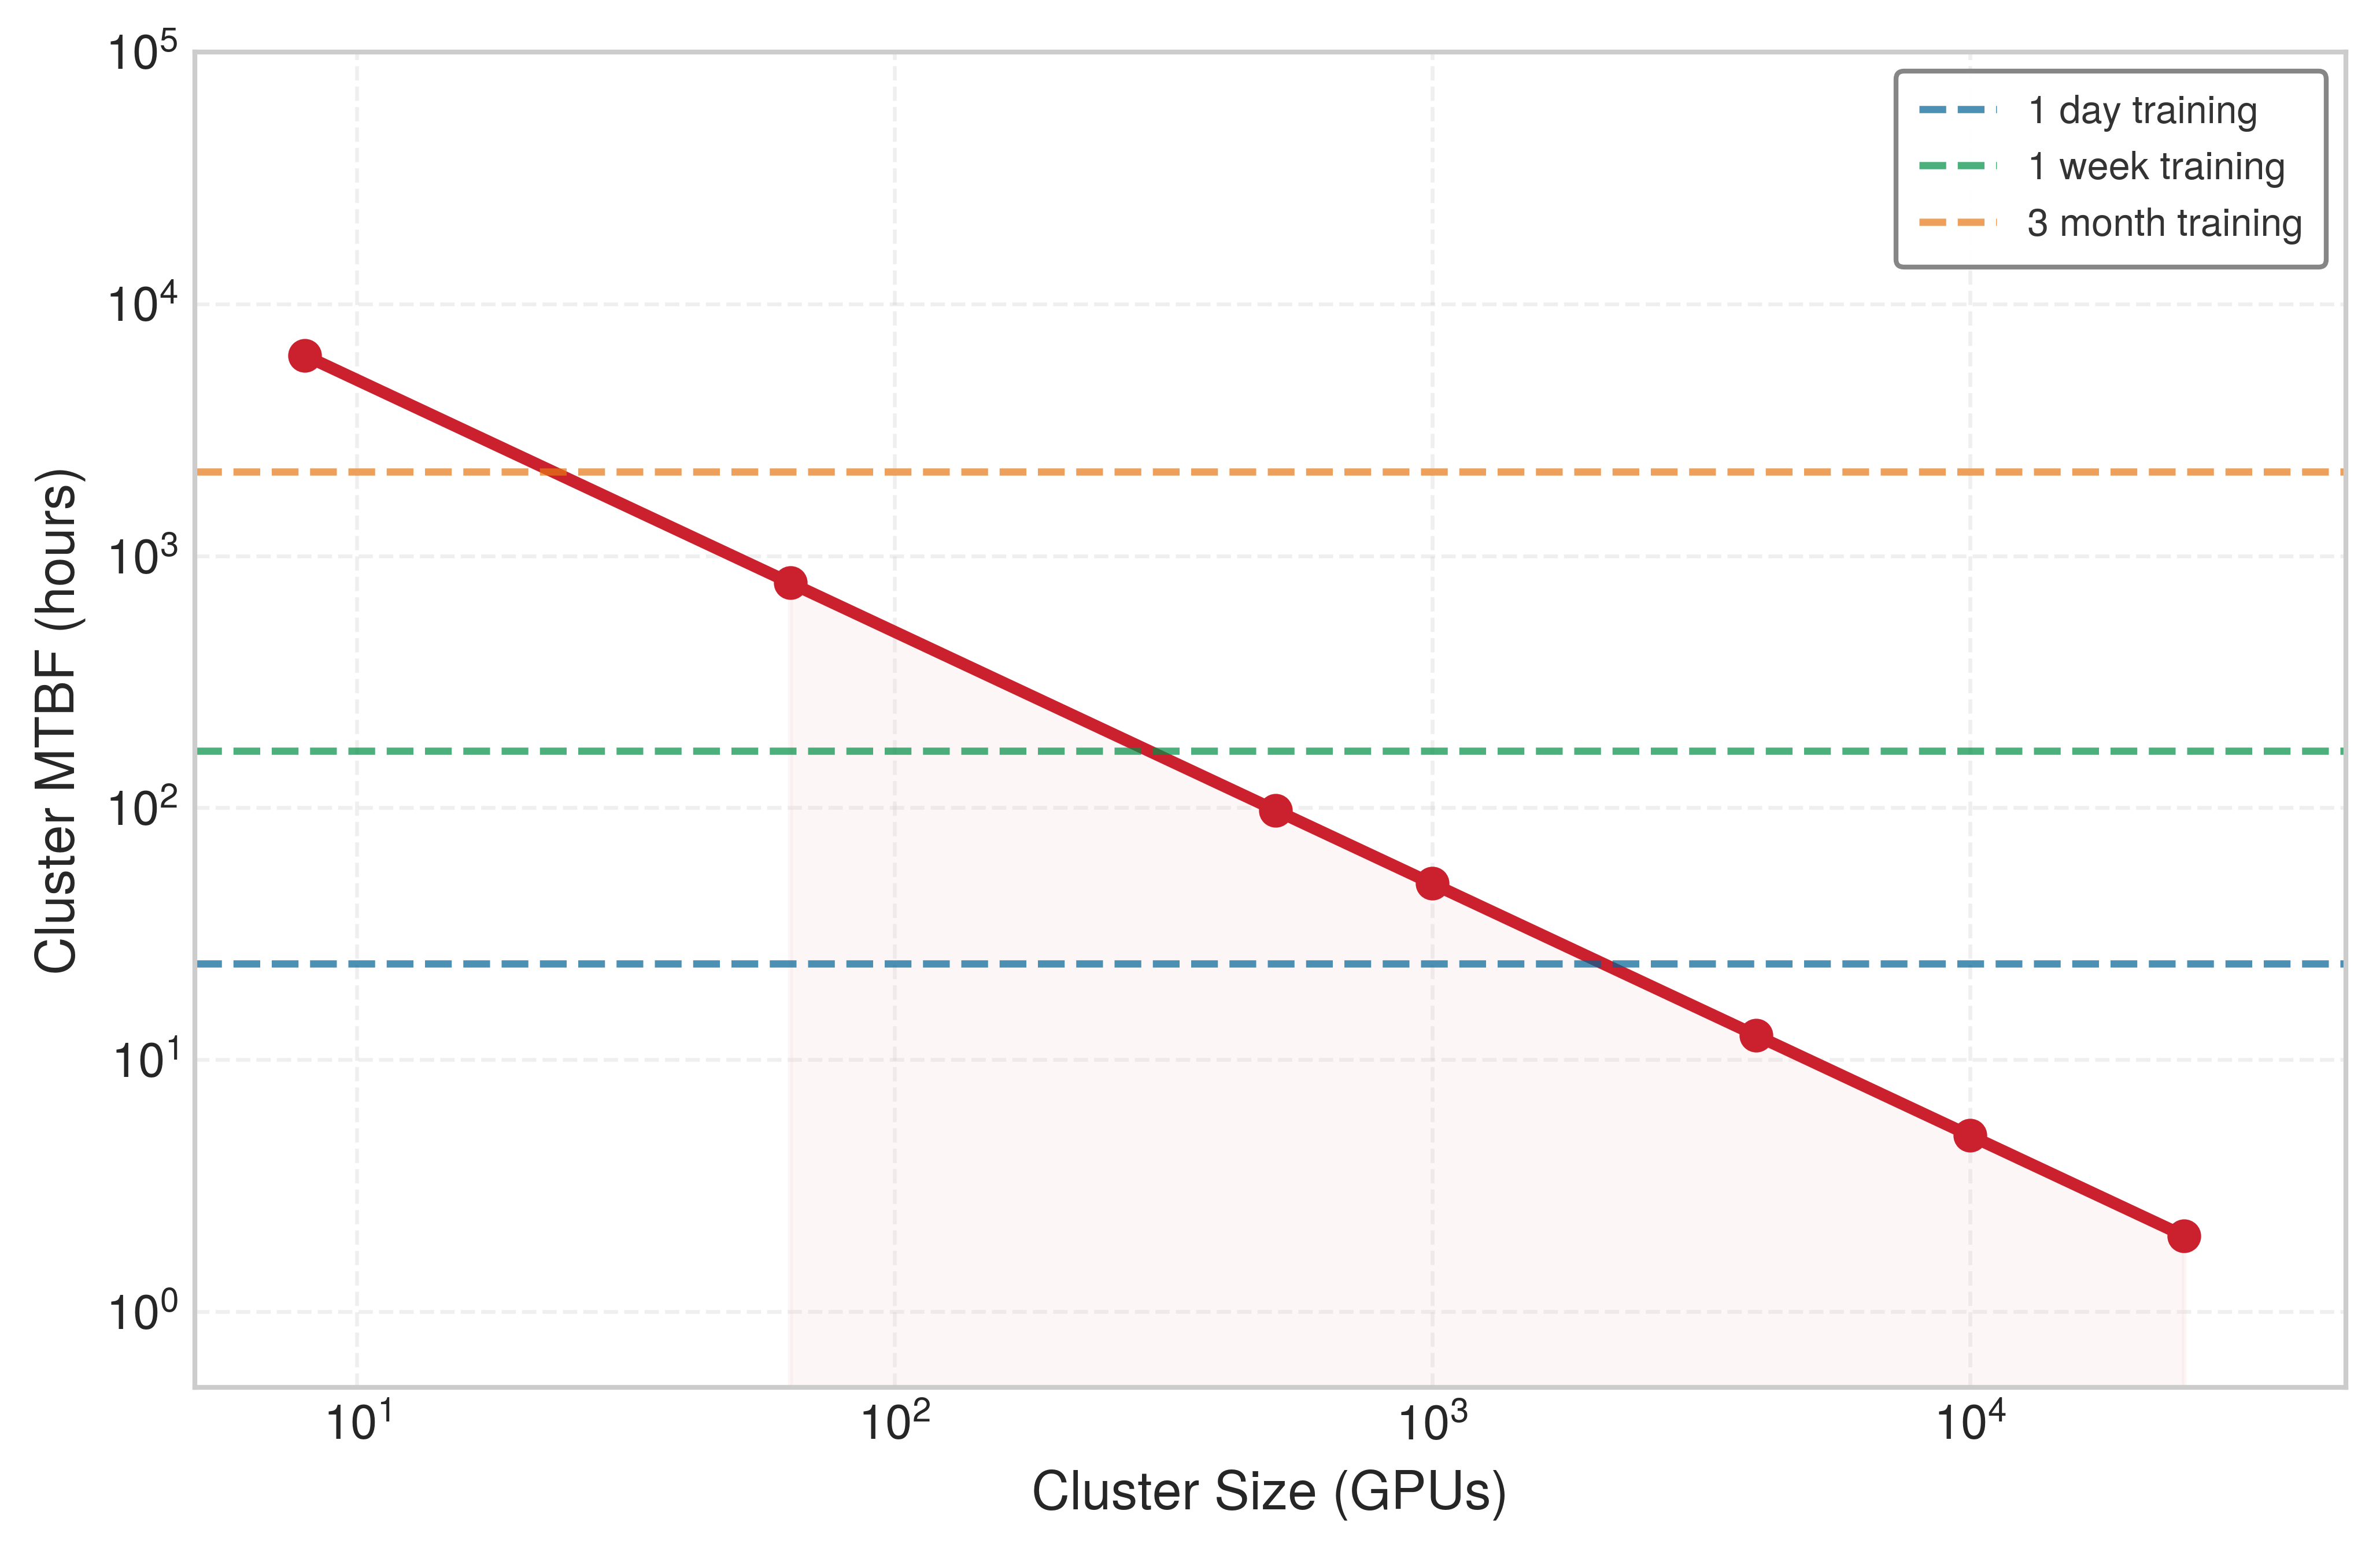
图 2 直观展示了这一根本矛盾:随着集群规模增长,预期故障间隔会缩短至常见训练时长以下,使容错成为长时间运行的集群作业的必要条件。
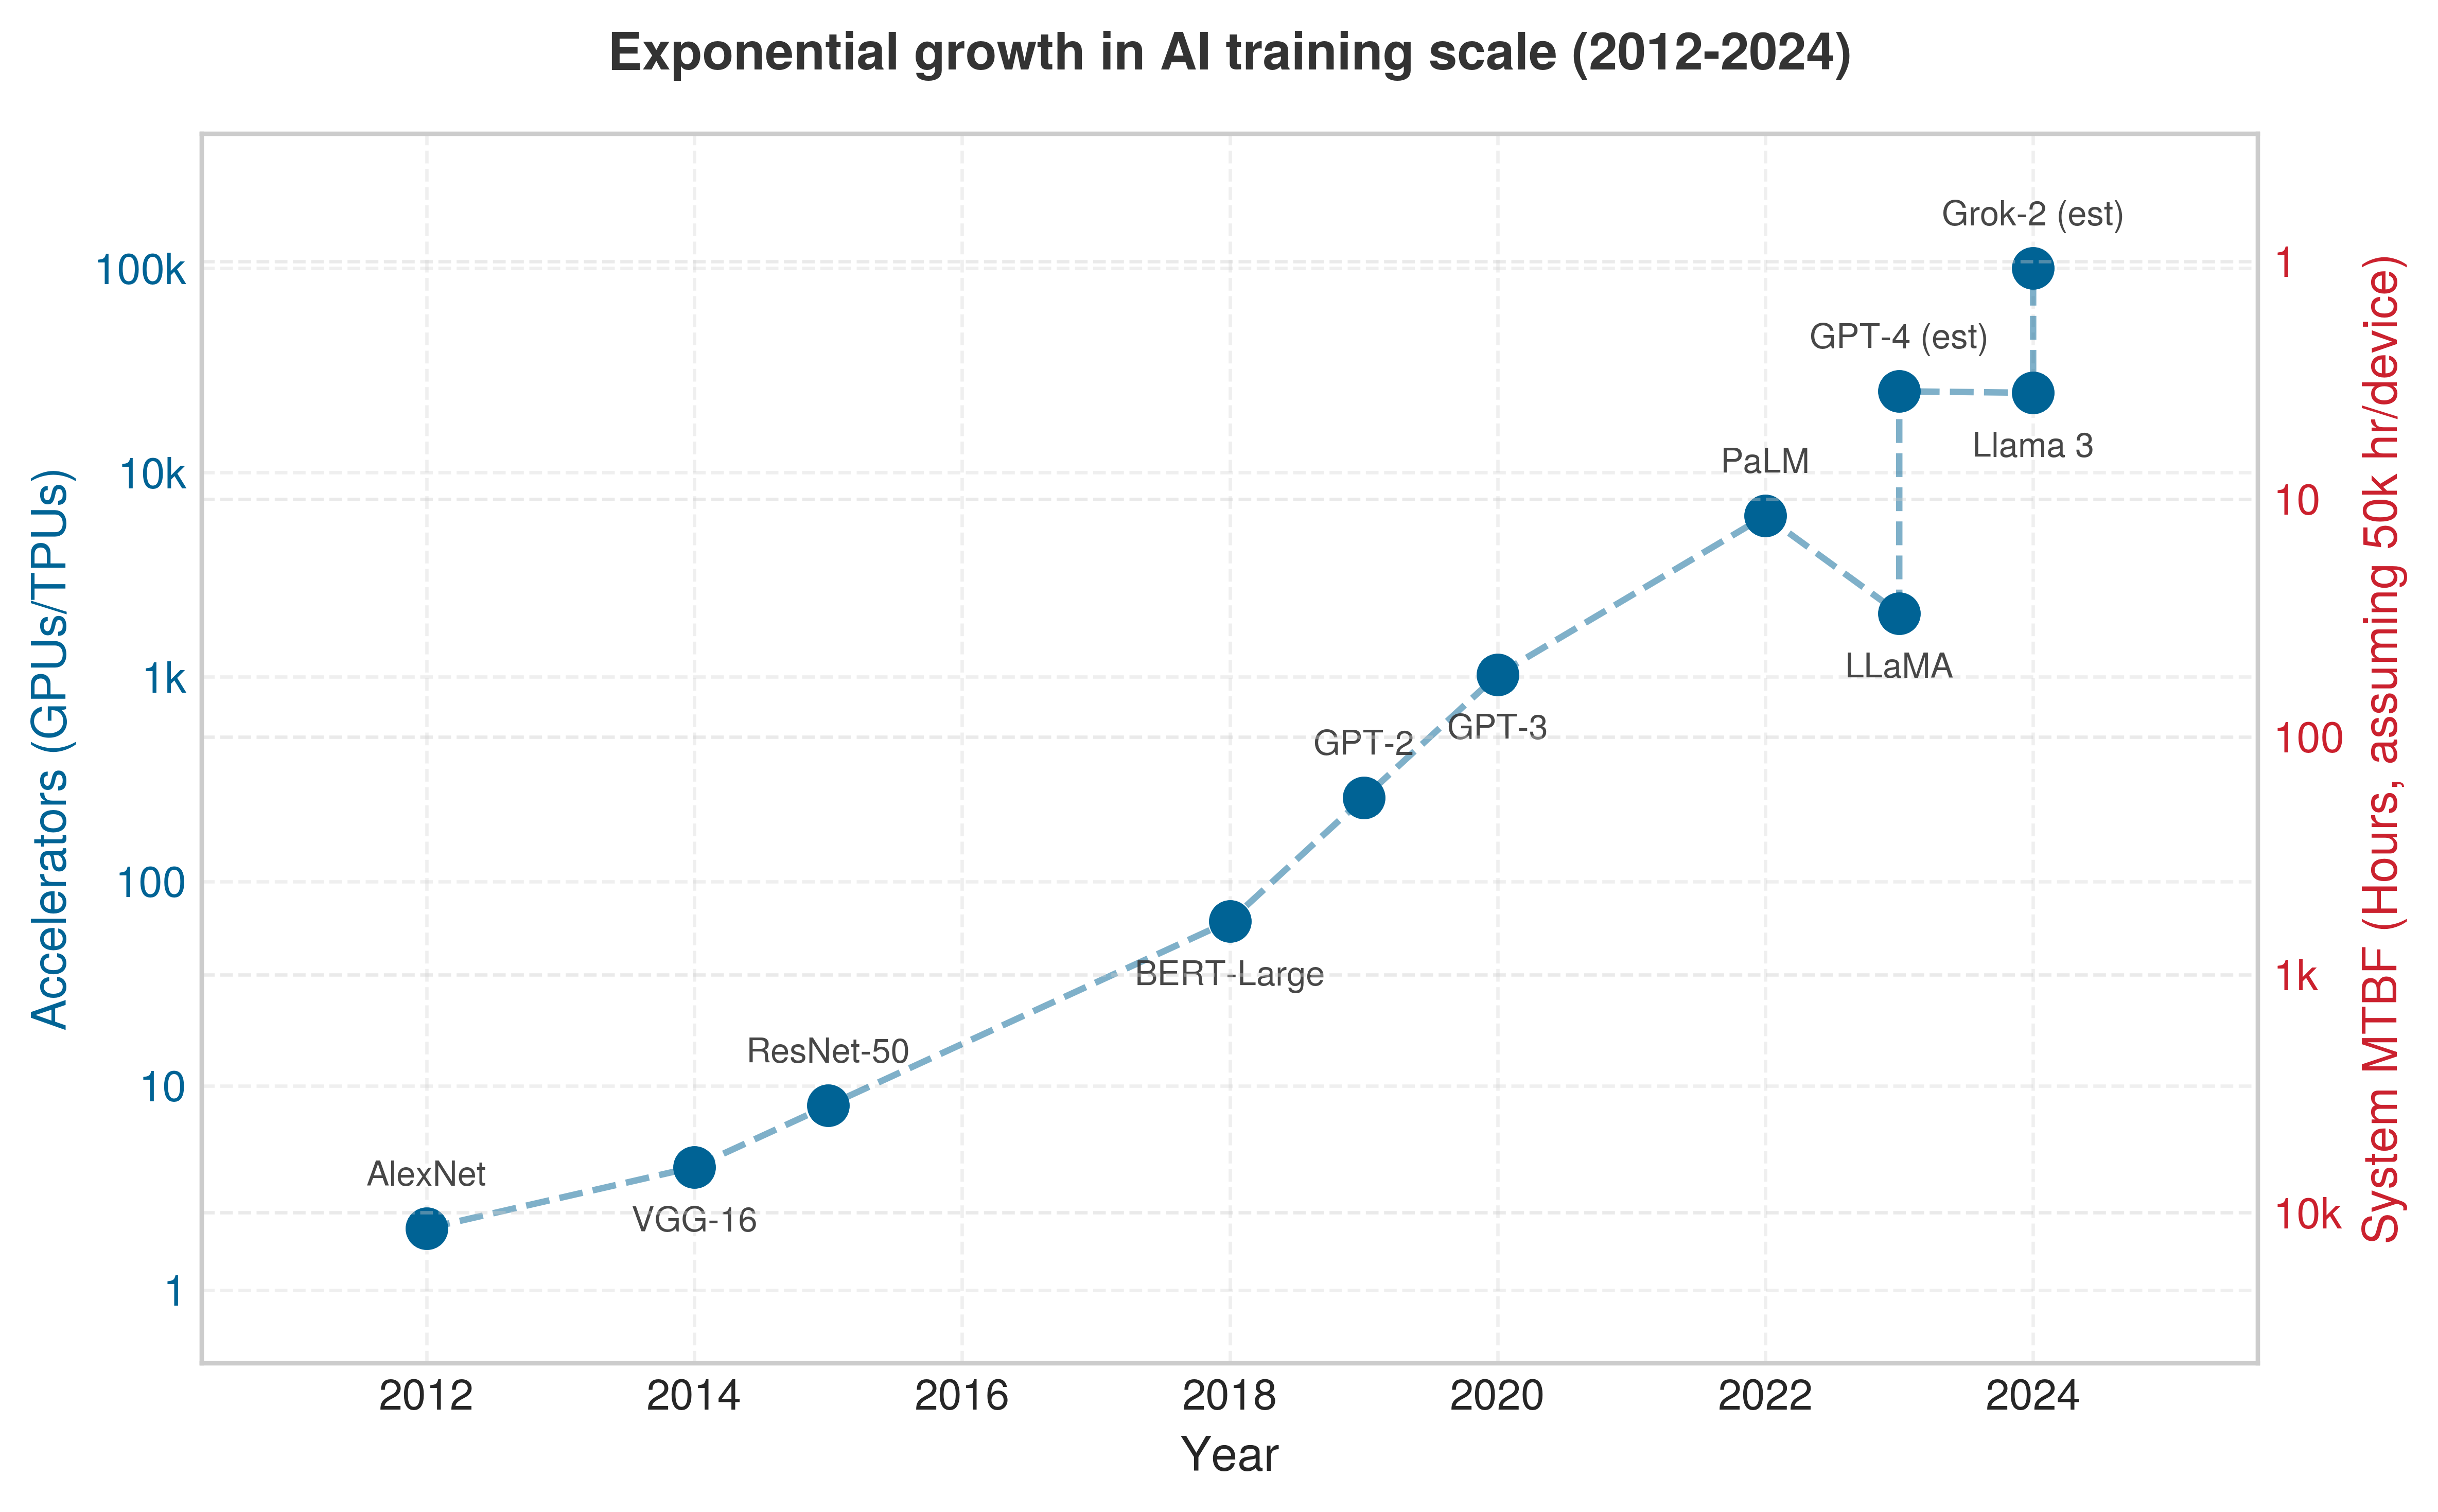
在同一个坐标轴上,规模与可靠性朝相反方向移动。图 3 将二者置于同一坐标轴:随着加速器数量提升约四个数量级,系统平均无故障时间(MTBF)相应下降,直至故障到来快于一次无检查点(checkpoint)的训练运行能够完成。
杨—达利定律:最优检查点策略
当故障不可避免时,关键的工程决策是多久保存一次进度。检查点保存过于频繁会浪费 I/O 时间;保存过于稀疏则会在故障后浪费重新计算已丢失工作量的时间。 杨—达利公式4 (节 1.5.1) 用一个平方根定律化解了这一矛盾:
4 杨—达利公式:Young (1974年) 推导出一阶最优检查点间隔,Daly (2006年) 则独立地以更紧的二阶界对其进行了改进。该公式的平方根关系 \((\tau_{\text{opt}} = \sqrt{2 \cdot T_{\text{write}} \cdot \text{MTBF}_{\text{system}}})\) 意味着系统 MTBF 减半只会使最优检查点频率提高 \(\sqrt{2}\approx 1.4\times\),这也解释了为何集群规模翻倍并不要求检查点 I/O 带宽翻倍。
Young, John W. 1974年. 《A first order approximation to the optimum checkpoint interval》. Communications of the ACM 17 (9): 530~31. https://doi.org/10.1145/361147.361115.
Daly, J. T. 2006年. 《A higher order estimate of the optimum checkpoint interval for restart dumps》. Future Generation Computer Systems 22 (3): 303~12. https://doi.org/10.1016/j.future.2004.11.016.
\[ \tau_{\text{opt}} = \sqrt{2 \cdot T_{\text{write}} \cdot \text{MTBF}_{\text{system}}} \]
\(T_{\text{write}}\) 在分布式机器学习训练中的含义,并不是刷新一个小型进程状态所需的时间,而是将数百 GB 的 FP32 优化器状态(每个可训练参数的动量与方差张量)加上模型权重传输到持久化存储所需的时间。对于一个 70B 参数模型,若使用完整的自适应矩估计(Adam)状态,单个检查点可达数百 GB;对于后文 175B 参数模型的运行示例,该数值超过 1 TB。因此,压缩 \(T_{\text{write}}\) 需要专门设计的高带宽存储;而 \(T_{\text{write}}\) 本身是决定检查点间隔可以设得多紧的核心约束——在 I/O 开销挤占有效训练算力之前,它决定了检查点间隔的收紧程度。
最优间隔是在写入检查点的成本与返工丢失进度的期望成本之间取得平衡,这正是 图 4 所绘制的 U 形权衡曲线。其可迁移的缩放结论是:随着集群规模增长,系统平均无故障时间(MTBF)下降,因而最优间隔随之缩短,需要更高带宽的存储 (数据存储) 来保持 \(T_{\text{write}}\) 较小,以免“检查点税”吞掉集群的计算容量。由于该关系是平方根形式,MTBF 减半只会使最优间隔收紧 \(\sqrt{2}\approx 1.4\times\),因此集群规模翻倍并不要求检查点 I/O 带宽翻倍。**Young-Daly 模型** 给出完整推导以及更紧的二阶界;后文检查点章节 (节 1.5.1) 在获得系统 MTBF 后将该公式应用于本地集群。
一次快速的可用性计算从另一个角度揭示了同样的扩展压力。
Napkin Math 1.1: 可靠性中的 9 秒
问题:一个由 10,000 个 GPU 组成的集群,每个 GPU 的可用性为 99.99 percent(每年仅 52.6 minutes 的停机时间)。整个集群在同一瞬间处于运行状态的概率是多少?
数学:
- 单个 GPU 的可用性概率 \((R_{\text{GPU}})\):可用性为 99.99 percent 的 GPU,在随机选取的时刻处于全运行状态的概率为 \(R_{\text{GPU}} =\) 0.9999。
- 集群的可用性概率 \((R_{\text{cluster}})\):\(R_{\text{cluster}} = (R_{\text{GPU}})^{N}\)。
- 结论:\((R_{\text{GPU}})^{N} \approx\) 0.37。
系统洞见:即便硬件可靠性达到 99.99 percent,一个由 10,000 个 GPU 组成的集群中,所有 GPU 同时可用的概率也只有 37 percent。仅靠硬件可靠性是不够的;软件必须自动处理故障。
Systems Perspective 1.1: 规模放大故障
一个由 10,000 个 GPU 组成的集群,将每个 GPU 的 MTBF 为 50,000 hours 转化为系统 MTBF 为 5 hours。对于可修复系统,稳态可用性 为 \(A = \text{MTBF}/(\text{MTBF}+\text{MTTR})\),其中 平均恢复时间(MTTR) 指恢复间隔。将 MTTR 从 30 minutes 缩短至 5 minutes,可用性将从 90.91 percent 提升至 98.36 percent。该稳态两态模型假设修复能力不受限且完全中断;相关事件、修复竞争以及降级运行都需要直接测量 (Birolini 2017年)。系统必须设计恢复机制,而不仅仅是改进部件。
定量可靠性分析
开篇可靠性示例中的纯 GPU 计算提供了规模直觉;真实的训练系统随后将 GPU、高带宽内存(HBM)、链路、电源、存储路径以及冗余组合进同一个故障预算。在 MTBF 与 FIT 率已经定义的情况下(\(\text{FIT} = 10^9/\text{MTBF}\),即 50,000 小时的 GPU 贡献 20,000 FIT),新的问题是如何组合部件速率。组合规则取决于冗余结构。对于 串联系统(例如,一个节点中 8 个 GPU 必须全部工作),任一部件失效都会导致整个系统失效,因此可靠性相乘、速率相加: \[R_{\text{system}}(t) = \prod_{i=1}^{N} R_i(t), \qquad \text{MTBF}_{\text{system}} = \frac{1}{\sum \lambda_i}\] 这正是增加部件会线性降低系统 MTBF 的原因。对于提供冗余的 并联系统(例如,active-active 模型副本),仅当所有冗余部件同时失效时系统才会失效: \[R_{\text{system}}(t) = 1 - \prod_{i=1}^{N} (1 - R_i(t))\]
组合关系还揭示了哪个子系统主导了预算,而内存是其中后果最严重的部分。考虑在 1,024 块 A100 GPU 上训练一个 70B 的 Archetype A(GPT-4/Llama-3)模型(三种系统架构原型)。未受保护的 HBM 是约束项:按照每兆比特约 250 FIT 的速率,该集群的 1,024 \(\times\) 80 GB 内存会积累出如此多的失效点,以至于未经纠正的损坏大约每 20 seconds 就会发生一次,从而使大规模训练无法实现。因此,纠错码(ECC)内存保护并非可有可无。ECC 内存保护能够检测并纠正常见的单比特错误,将有效软错误率降低约两个数量级,并把内存推回预算中逻辑与互连项之下;不过,残留的多比特错误或逃逸的损坏仍以 SDC 问题的形式存在。
这些分部件 FIT 数值描述的是硅片固有的软错误预算,这正是它们与后续工作示例中使用的 50,000 小时整机 MTTF 不同的原因:整机 MTTF 纳入了各种场失效模式(热应力、电源事件、机械磨损),而此处隔离的只是逻辑与内存的软错误率。级联过程将这些整机速率组合成集群层面的数值,也就是真正决定检查点间隔的数值;该估算仅用于说明为什么内存保护是后续一切工作的前提条件。
工作示例:集群 MTBF 计算
考虑一个用于大语言模型开发的训练集群,其规格如下:
- 10,000 NVIDIA H100 GPU
- 单块 GPU 的 MTBF:50,000 hours
- 每块 GPU 通过 PCIe 连接到主机(MTBF:200,000 hours)
- 每个节点包含 8 块 GPU,并共享电源(MTBF:100,000 hours)
- 每个节点的网络基础设施(网卡(NIC)、线缆):MTBF 150,000 hours
这些组件共同定义了本工作示例中用于速率计算的失效域。
步骤 1:计算每块 GPU 子系统的失效速率
每块 GPU 所处的失效域包括 GPU 本身、其 PCIe 连接,以及电源和网络基础设施的相应分摊份额。
\[ \lambda_{\text{GPU}} = \frac{1}{50{,}000} = 2.0 \times 10^{-5} \text{ failures/hour} \]
\[ \lambda_{\text{PCIe}} = \frac{1}{200{,}000} = 0.5 \times 10^{-5} \text{ failures/hour} \]
\[ \lambda_{\text{power/GPU}} = \frac{1}{8} \times \frac{1}{100{,}000} = 0.125 \times 10^{-5} \text{ failures/hour} \]
\[ \lambda_{\text{network/GPU}} = \frac{1}{8} \times \frac{1}{150{,}000} = 0.083 \times 10^{-5} \text{ failures/hour} \]
步骤 2:计算每块 GPU 的总失效速率
\[ \lambda_{\text{total/GPU}} = (2.0 + 0.5 + 0.125 + 0.083) \times 10^{-5} = 2.708 \times 10^{-5} \text{ failures/hour} \]
步骤 3:计算系统失效速率与 MTBF
\[ \lambda_{\text{system}} = 10{,}000 \times 2.708 \times 10^{-5} = 0.2708 \text{ failures/hour} \]
\[ \text{MTBF}_{\text{system}} = \frac{1}{0.2708} = 3.69 \text{ hours} \]
该结果表明,该集群平均大约每 3.7 hours 发生一次故障。预期的故障节奏为 6.5 failures/day;持续一周的训练运行将大约经历 45 failures 次故障。任何运行在该规模上的训练系统都必须将故障视为一种持续存在的状态,而非异常事件。MTBF 级联 以同样的方式逐步展开这一级联过程,将各组件的速率组合为整个集群的系统 MTBF,以便读者可以针对不同的节点设计或集群规模重新运行该计算。
集群 MTBF 的扩展 在 集群平均无故障时间(MTBF)的扩展规律 中隔离了仅 GPU 的基线,并随集群规模变化。将 PCIe、电源和网络失效域纳入计算后,完整系统的 MTBF 会更低。
| 集群规模(GPU 数量) | 单 GPU 平均无故障时间 | 集群平均无故障时间 | 预期每日故障次数 |
|---|---|---|---|
| 8 | 50,000 hours | 6250 hours (260 days) | 0.004 |
| 64 | 50,000 hours | 781 hours (33 days) | 0.03 |
| 512 | 50,000 hours | 98 hours (4 days) | 0.25 |
| 1,000 | 50,000 hours | 50 hours (2 days) | 0.48 |
| 4,000 | 50,000 hours | 12 hours | 1.9 |
| 10,000 | 50,000 hours | 5 hours | 4.8 |
| 25,000 | 50,000 hours | 2 hours | 12 |
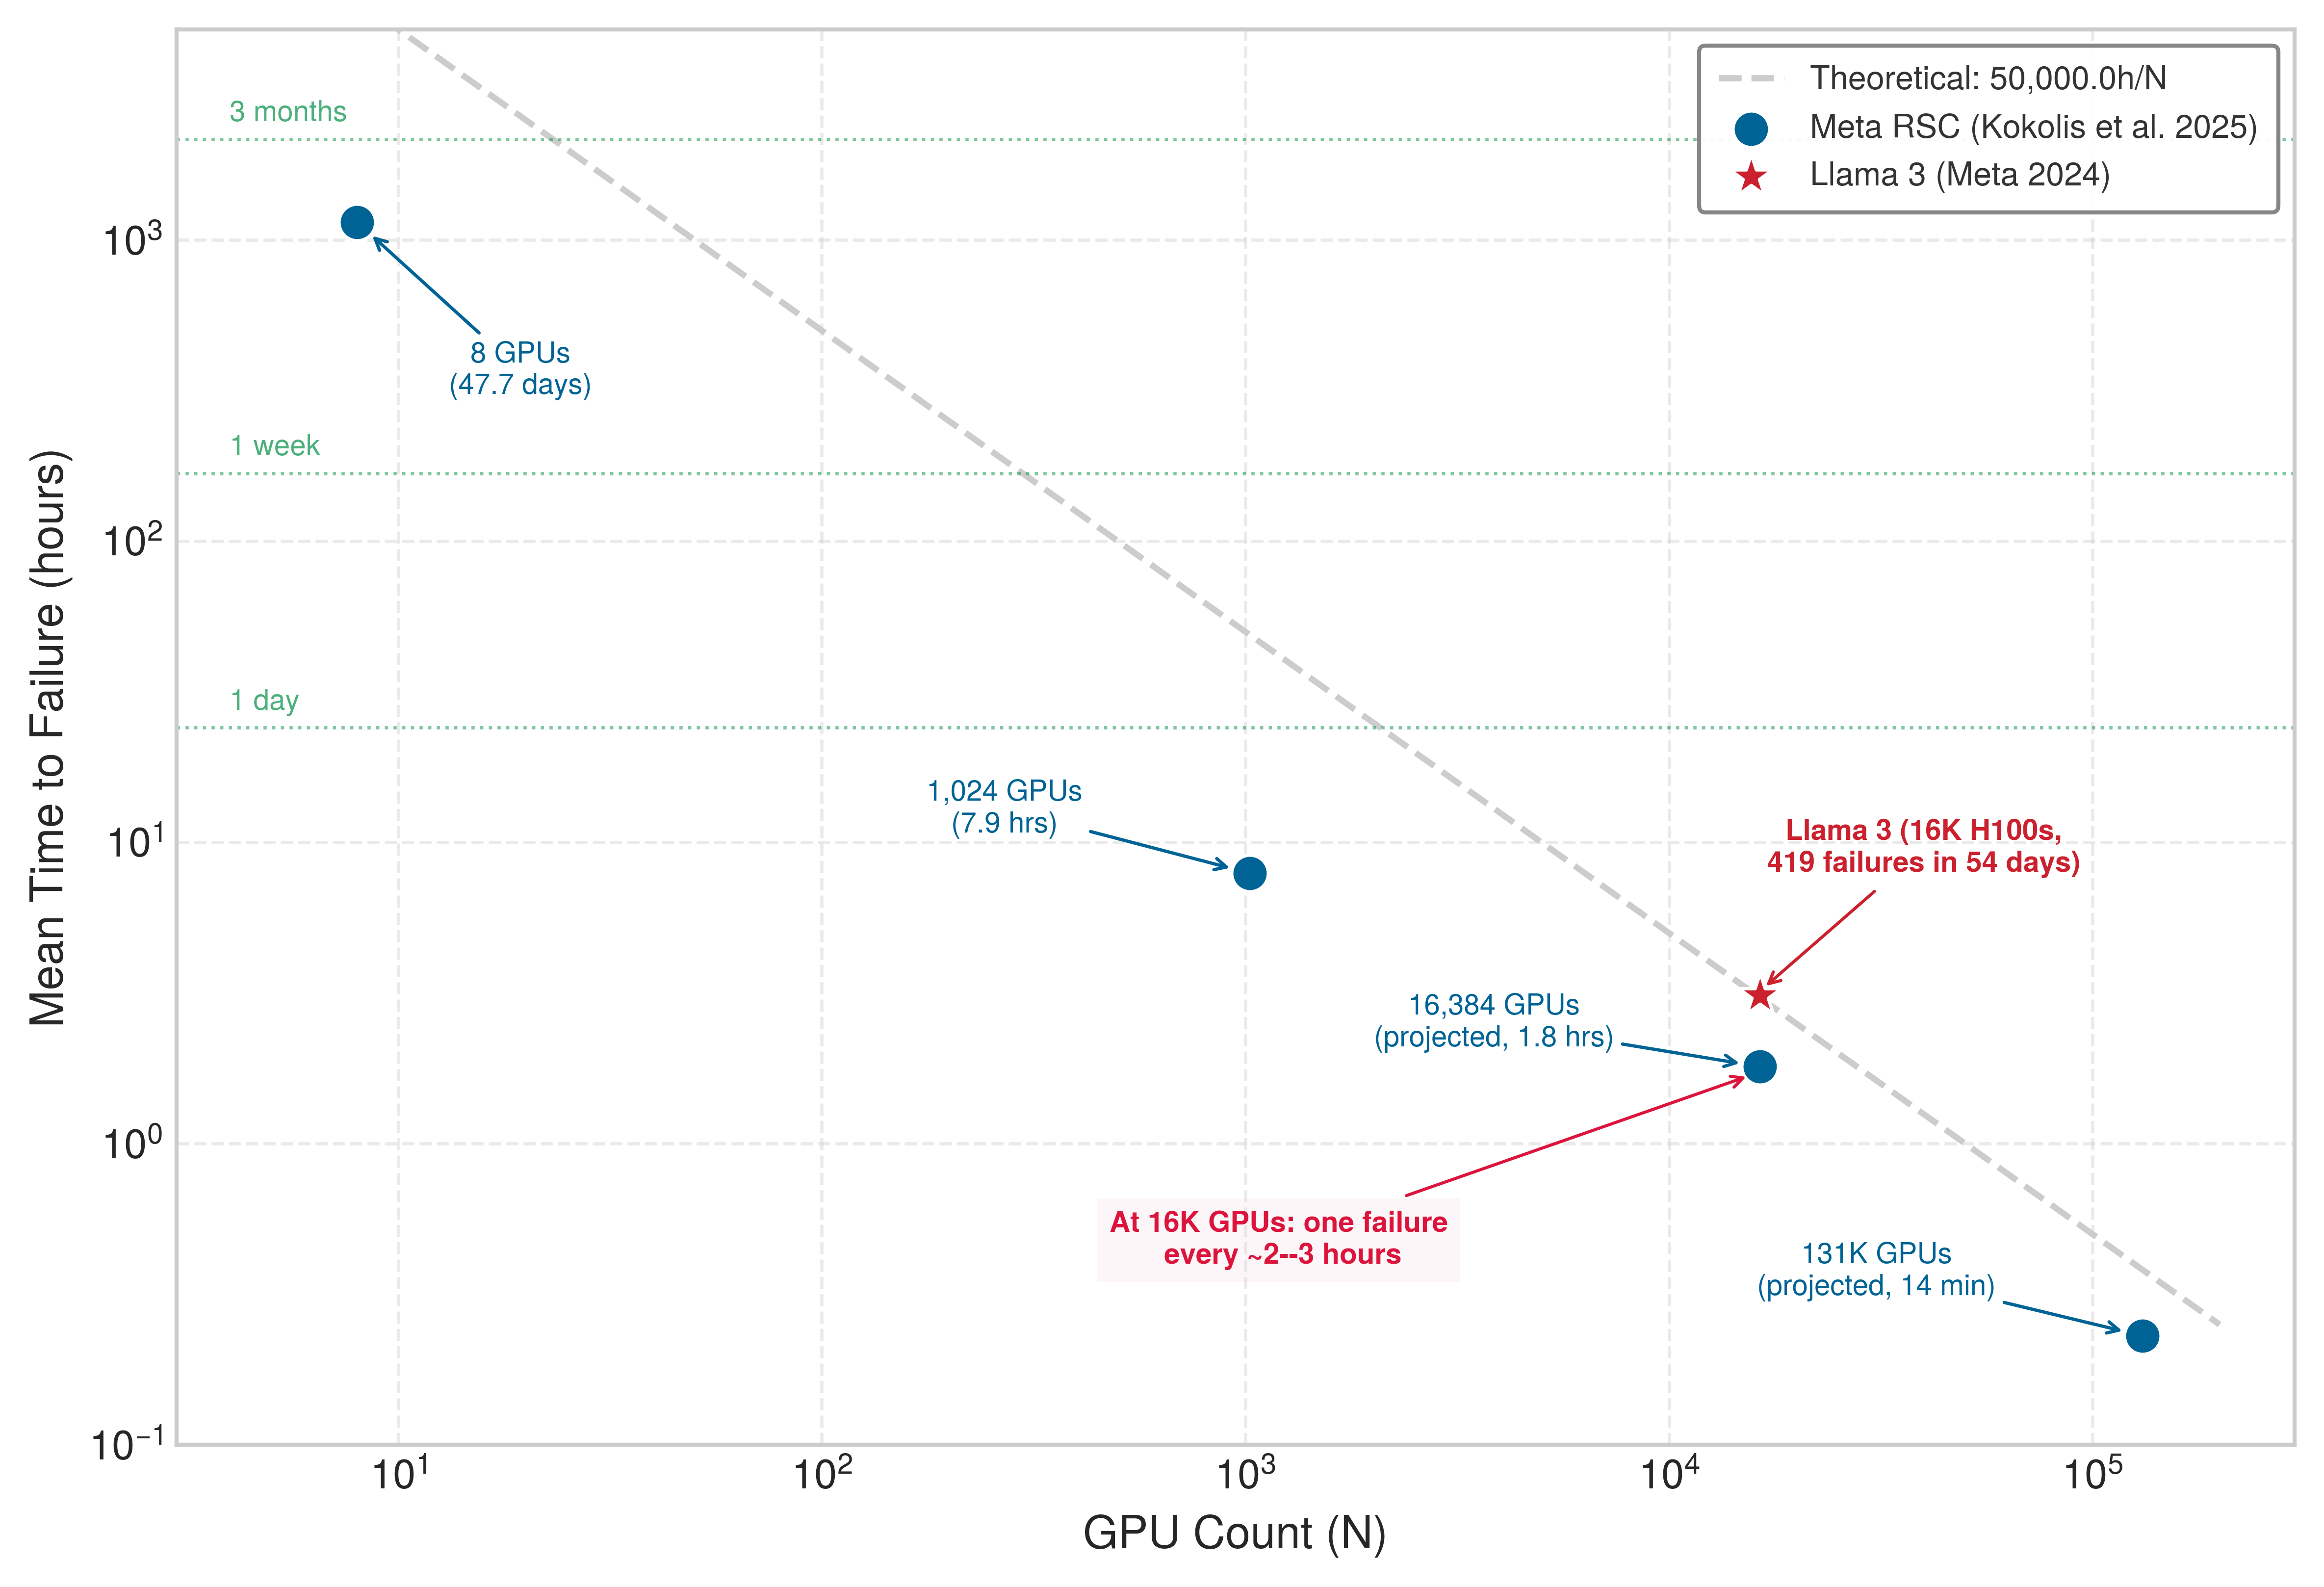
理论上的 \(1/N\) 扩展规律在 集群平均无故障时间(MTBF)的扩展规律 中并不只是教科书式的练习。图 5 将 Meta 生产集群的公开实测数据与拟合出的预测值叠加到理论曲线上。Kokolis 等 (2025年) 对 Meta Research SuperCluster 的研究报告了观测到的 RSC 作业规模的 MTTF 实测值,并预测 16,384 GPU 作业的 MTTF 为 1.8 小时;Meta 的 Llama 3 训练报告独立记录了 16,384 张 H100 GPU 在 54 天期间发生的 419 次故障,观测到的 MTTF 约为 3.1 小时。综合实测的 Llama 运行与 Kokolis 的预测,16,384 GPU 训练处于约两到三小时一次的故障节奏,介于 1.8 小时的预测值和 3.1 小时的实测值之间。这些证据将理论论证从抽象的规模定律转化为决定检查点频率、恢复架构和基础设施投资的工程约束。
故障分类
可靠性分析中的 MTBF 计算量化了故障发生的频率,这对于设定检查点间隔和规划恢复基础设施至关重要。设计有效的容错同样需要了解故障的种类。请谨慎使用术语:故障(fault)是底层缺陷或事件,错误(error)是它产生的损坏状态,失效(failure)是训练系统必须处理的外部可见行为 (Avizienis 等 2004年)。一个数秒内即可恢复的网络分区,所需的处理方式不同于永久性的 GPU 失效;一种静默内存损坏(会产生错误梯度)所需的检测机制,也不同于完全停止响应的节点崩溃。
Avizienis, Algirdas, Jean-Claude Laprie, Brian Randell, 和 Carl Landwehr. 2004年. 《Basic Concepts and Taxonomy of Dependable and Secure Computing》. IEEE Transactions on Dependable and Secure Computing 1 (1): 11~33. https://doi.org/10.1109/TDSC.2004.2.
没有任何单一标签能够涵盖这些差异。可靠性决策需要三个正交维度:持续性(transient、intermittent 或 permanent)、表现形式(fail-stop、degraded 或 value-corrupting),以及失效范围(单个设备、单个节点、一个机架或电源域,或整个任务)。因此,瞬态故障可能表现为可检测的崩溃,也可能表现为静默损坏;而永久性的交换机失效可能仅局限于单个机架,也可能将整个任务切分。以下各小节将这一三维空间投影到对恢复最有用的故障类别上;它们并不定义互斥的桶 (Constantinescu 2008年; Lamport 等 1982年)。
瞬态故障
瞬态故障会暂时发生并在无需干预的情况下自行恢复,因此恢复问题在于:系统能否在损坏状态扩散之前重试或校验受影响的工作。以下四种常见瞬态模式对机器学习系统尤为重要:
- 网络丢包:在重传成功的情况下丢弃数据包。
- 内存比特翻转:通过宇宙射线引起的单粒子翻转(single-event upsets)损坏个别比特。5
- 热节流:在温度尖峰期间暂时降低性能。
- 软件超时:由临时的资源争用引起。
5 单粒子翻转(SEU):源自粒子物理学,其中“upset”指非破坏性的状态改变。宇宙射线和芯片封装产生的 α 粒子可以翻转内存和逻辑中的比特;观测到的翻转率取决于海拔、工艺、封装材料、屏蔽措施和工作负载 (Ziegler 等 1996年; Baumann 2005年)。ECC 内存可以纠正单比特错误,但无法处理同一字内所有的多位翻转,因而留下残余的静默损坏风险,该风险会在大规模机器学习训练的太字节级状态中不断累积。
Ziegler, J. F., H. W. Curtis, H. P. Muhlfeld, C. J. Montrose, B. Chin, M. Nicewicz, C. A. Russell, 等. 1996年. 《IBM experiments in soft fails in computer electronics (1978–1994)》. IBM Journal of Research and Development 40 (1): 3~18. https://doi.org/10.1147/rd.401.0003.
Baumann, R. 2005年. 《Soft Errors in Advanced Computer Systems》. IEEE Design and Test of Computers 22 (3): 258~66. https://doi.org/10.1109/mdt.2005.69.
6 静默数据损坏(SDC):在集群规模下,SDC 可以绕过正常的异常处理路径:基础设施研究已记录到缺陷硬件产生看似有效但实际错误的结果,而 DRAM 现场研究则表明内存错误足够常见,以至于集群级监控十分必要。对机器学习训练而言,其实用调试后果是:没有错误消息并不意味着计算正确;系统需要对损失、梯度和模型状态进行统计校验。
瞬态故障在机器学习训练中尤其具有隐蔽性,因为它们可能不会触发显式错误。梯度计算过程中的瞬态内存比特翻转会产生错误梯度,并传播到后续训练步骤。模型会继续训练,但产出的是略微劣化的结果。大规模 SDC 研究显示损坏会逃逸,DRAM 现场研究则表明内存错误足够常见,以至于集群级监控十分必要 (Dixit 等 2021年; Sridharan 等 2015年; Schroeder 等 2009年)。在机器学习训练中,这种未被检测的损坏模式可能表现为劣化梯度、异常损失曲线,或可回滚的检查点,而不是显式崩溃。6
瞬态故障的应对方式取决于检测能力。能够触发显式异常的错误可以通过有界重试逻辑来处理。静默损坏则需要端到端的校验:校验和(checksums)检测存储或传输中发生变化的字节,跨 rank 摘要(cross-rank digests)揭示对 supposedly 相同的缩减缓冲区的不一致,而统计或重放检查(replay checks)则测试计算本身是否仍然可信。某个 rank 计算出了错误的局部梯度,随后又对这些错误字节正确完成了校验和,那么它会通过普通的校验和;只有独立的重新计算、不变量或模型级证据才能暴露这一错误。
失效型故障
失效型故障会导致组件完全停止运行且可被检测。失效的组件不再响应请求,可以通过超时机制加以识别:
- GPU 硬件失效:使设备无响应。
- 节点崩溃:终止机器上的全部进程。
- 网络分区:将节点与集群隔离。
- 存储失效:阻止检查点的读取或写入。
在同步分布式训练中,故障停机(fail-stop)故障的后果尤其严重:它会阻塞整个作业。AllReduce 集合通信要求每个参与 rank 先贡献自己的梯度分片,缩减才能完成。某一块 GPU 一旦沉默(无论是硬件故障、进程崩溃,还是网络分区),都会让环中的其他所有 GPU 一直阻塞,直到超时到期。在一个 10,000-GPU 的作业中,这意味着 9,999 块加速器处于空闲状态,持续累积计费工时,而该次运行却没有任何前向进展,直到协调器最终判定缺失的 rank 已失败并触发恢复。
故障停机故障是最容易处理的一类,因为检测很简单:该组件停止响应。恢复涉及替换故障组件,并从最近的检查点恢复状态。主要挑战在于最小化检测时间和恢复延迟。
检测时间 \(T_{\text{detect}}\) 通常涉及心跳机制,即每个 GPU rank 定期向协调器发送存活信号。如果在超时周期 \(T_{\text{timeout}}\) 内没有收到心跳,协调器即判定故障。设定 \(T_{\text{timeout}}\) 需要在误报率与检测延迟之间取得平衡。误报会将因瞬时延迟而健康的 worker 判定为已失败;而检测过慢则会在检测窗口期间浪费计算资源,其代价与集合通信中被阻塞的 GPU 数量成正比地线性增长。
对于心跳间隔为 \(H\) 秒、网络延迟标准差为 \(\sigma_d\) 秒的情况,公式 5 定义了超时启发式规则:
\[ T_{\text{timeout}} = H + k\sigma_d \tag{5}\]
其中,\(k\) 是无量纲的安全系数,通常取值范围为三到五,以在保持合理检测速度的同时实现较低的误报率。构建于专用高带宽互连结构(InfiniBand、NVLink)的机器学习训练集群表现出非常低的基线抖动,因此在正常情况下 \(\sigma_d\) 在功能上很小。实际难点在于区分真正死掉的 rank 与只是暂时变慢的 rank,例如某块 GPU 因正在向挂载存储写入大体积检查点而落后,而集合通信此时已经在等待。将 \(T_{\text{timeout}}\) 调得过紧会导致检查点写入触发虚假的失败声明;调得过松则会延长其他所有 rank 在 AllReduce 集合通信中被阻塞空闲的时间窗口。
拜占庭故障
与只是沉默、可被检测并替换的故障停机组件不同,一类更为阴险的故障会持续运行并产生错误结果。不抛出错误却返回错误梯度的 GPU、传递通过 CRC 校验的损坏数据包的网络,以及对相同输入计算出不同结果的 worker,都是 Byzantine Failures 的典型例子,这是分布式系统中最具挑战性的一类故障 (Lamport 等 1982年)。在机器学习系统中,这一类别包括静默数据损坏、数值不稳定、确定性违反 以及对抗性损坏;其共同特征是 worker 仍然参与计算,但其贡献的值可能污染共享状态。
Lamport, Leslie, Robert Shostak, 和 Marshall Pease. 1982年. 《The Byzantine Generals Problem》. ACM Transactions on Programming Languages and Systems 4 (3): 382~401. https://doi.org/10.1145/357172.357176.
静默损坏的物理机制
在先进晶体管纳米量级的尺度上,硬件并非 确定性的,而是 概率性的。静默数据损坏主要由两种机制驱动。单粒子翻转(SEU) 发生在高能粒子(海平面处的宇宙射线、封装材料释放的 α 粒子)击中存储单元或逻辑门时,使一位从 0 翻转为 1;在 10,000+ GPU 的规模下,这是统计上的必然结果。制造差异 则表现为:通过初始质量检查的“临界”芯片仅在特定的电压/温度条件下才出现位翻转,例如反向传播过程中的剧烈 \(di/dt\) 波动。
Facebook 曾记录一起普遍存在的 SDC 问题:硬件故障导致有效文件在解压时被报告为“大小为零”(图 6,来源 (Dixit 等 2021年));系统“正常工作”而未崩溃,但数据被静默删除。在机器学习场景中,这表现为表面上有效但数值已损坏的梯度。
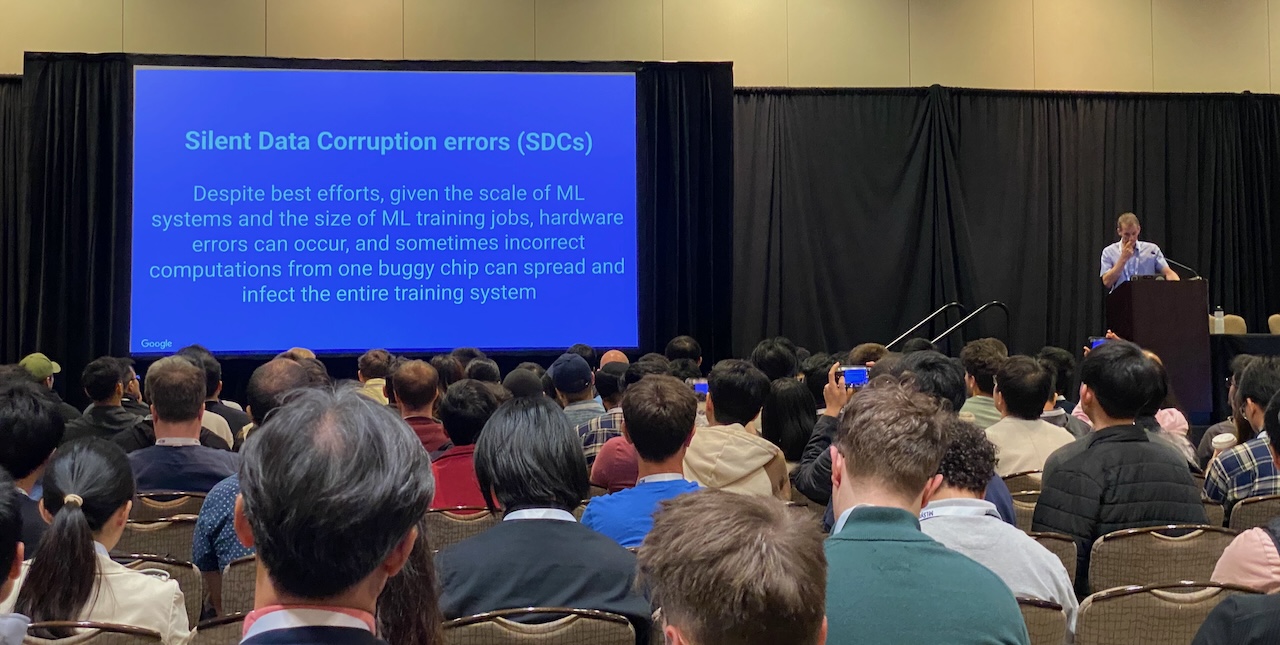
生产系统中的真实证据证实了这些风险。Jeff Dean 在 2024 年 MLSys 大会的邀请报告中指出,在大规模机器学习训练任务的量级上,硬件故障频繁发生,单个故障芯片产生的错误计算会传播并感染整个训练运行 (图 7) (Dean 2024年)。
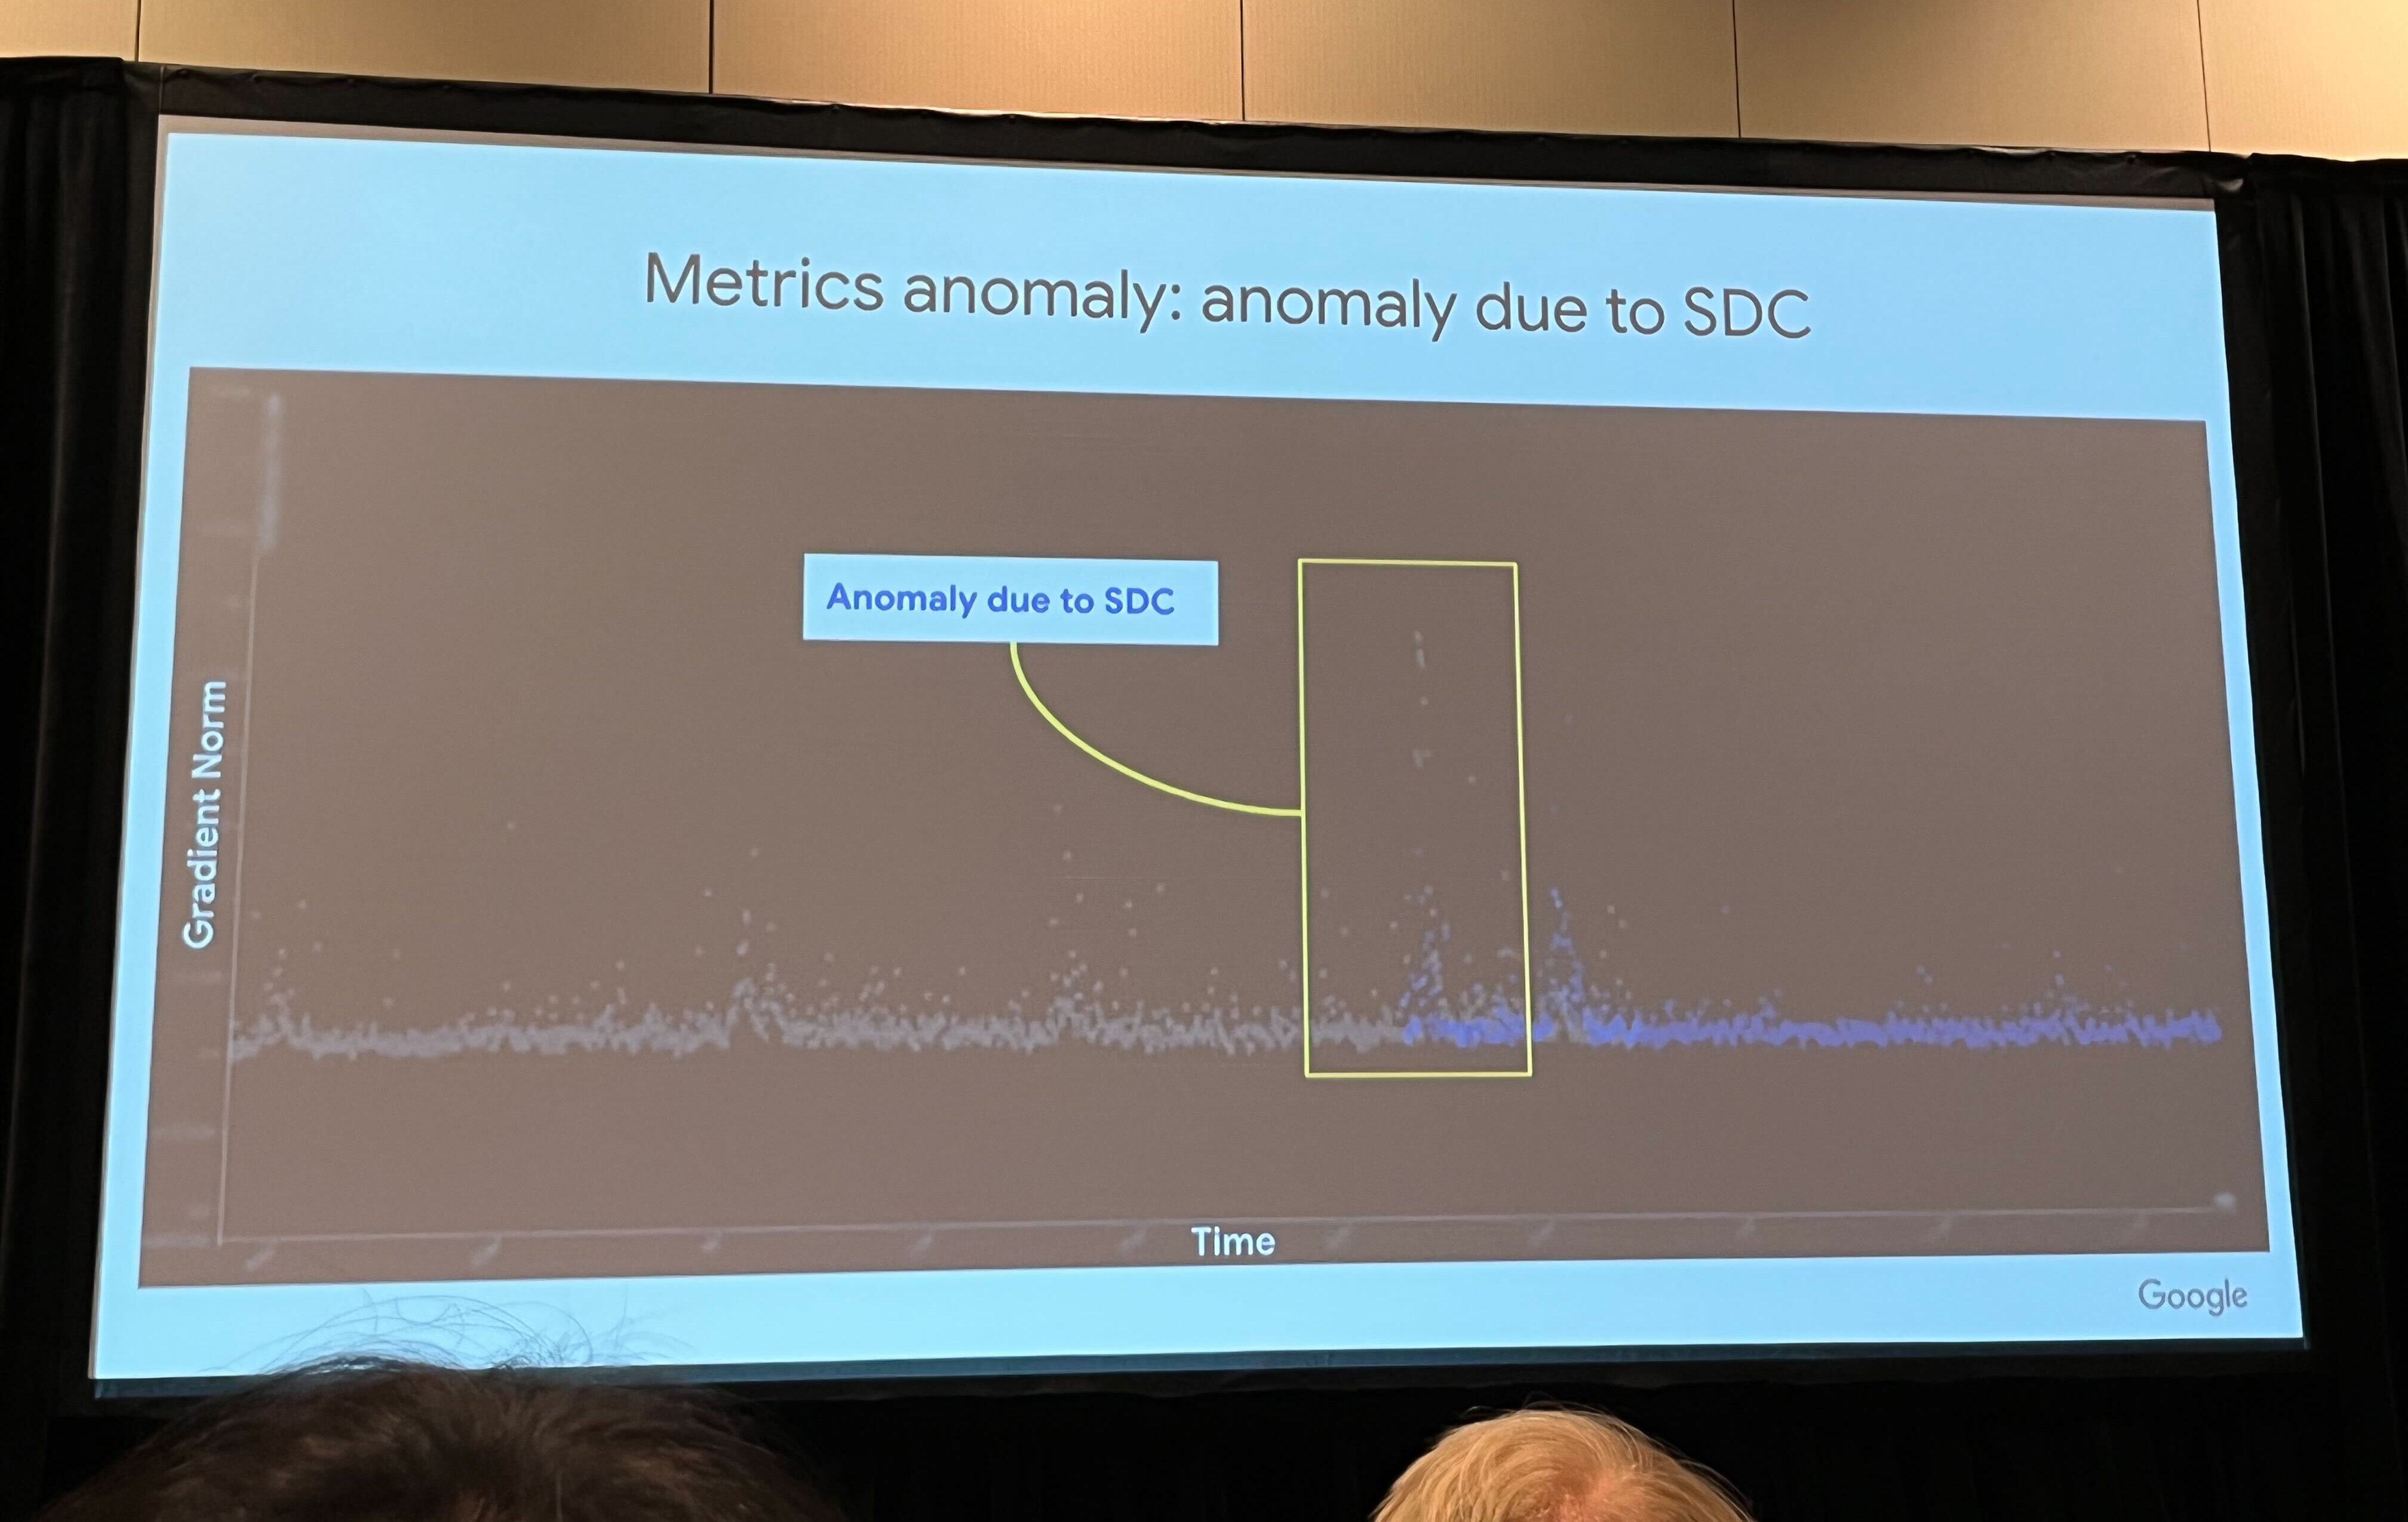
Google 报告称,TPU 机柜中的 SDC 可能表现为梯度范数中突然且无法解释的尖峰 (图 8) (Dean 2024年)。指数位中的一个比特翻转即可将很小的梯度变成数值上极大的值;若该异常未被检出,就会污染训练轨迹。
Google 通过系统级缓解措施应对这一类故障,包括备用容量和健全性检查:当损失或梯度监控器标记出异常时,可以隔离可疑芯片 (图 9) (Dean 2024年)。这种做法将可靠性从不可信组件转移到系统层面,由系统验证结果。
Dean, Jeff. 2024年. Exciting Directions in Systems for Machine Learning. MLSys 2024 invited talk.
图 9 中的热备用(hot spare)模式展示了缓解 SDC 的一种方法,但要首先识别出静默损坏,就必须理解它与良性训练噪声之间的区别。
Checkpoint 1.1: 检测静默损坏
验证你对拜占庭故障与 SDC 的理解:
静默损坏检测是第一道防线,但同样的逻辑也适用于任何输出在语法上仍然有效的拜占庭工作节点。这类故障在分布式训练中尤其危险,因为“相同数据对应相同梯度”这一标准假设不再成立。单个拜占庭工作节点就可能污染平均梯度,甚至导致训练发散或收敛到较差的解。图 10 对比了故障停止(fail-stop)故障的 straightforward 检测 与拜占庭损坏的隐蔽性。
检测拜占庭故障需要冗余计算。多个工作节点对同一数据计算梯度,从而可以比较结果。统计离群点检测能够识别持续产生异常梯度的工作节点。这些检测机制会引入额外的计算开销,并且可能无法捕捉到微妙的数据损坏。
存在具有拜占庭鲁棒性的分布式训练算法,但它们会带来显著的开销。例如 Krum (Blanchard 等 2017年) 和逐坐标裁剪均值 (Yin 等 2018年) 会计算对有限数量拜占庭工作节点具有鲁棒性的聚合结果,但它们所需的通信量和计算量都高于简单平均。这里的系统后果是可见的:被污染的梯度可能将优化器推向不可靠的模型状态,而训练任务本身看起来仍然健康。因此,可靠性必须保护语义正确性,而不仅保护进程存活性。7
Yin, Dong, Yudong Chen, Kannan Ramchandran, 和 Peter Bartlett. 2018年. 《Byzantine-robust distributed learning: Towards optimal statistical rates》. International Conference on Machine Learning (ICML), 5650~59.
7 拜占庭鲁棒机器学习:以 Lamport 1982 年提出的“拜占庭将军问题”命名,这些算法(Krum、裁剪均值、signSGD)能够容忍有限比例的被污染工作节点,具体容限取决于算法和假设。权衡是具体的:对于 \(N\) 个工作节点,Krum 需要在工作节点梯度之间计算两两距离,因此开销随工作节点数量呈二次增长,并直接与数据并行的吞吐量收益相竞争 (Blanchard 等 2017年)。
Blanchard, Peva, El Mahdi El Mhamdi, Rachid Guerraoui, 和 Julien Stainer. 2017年. 《Machine Learning with Adversaries: Byzantine Tolerant Gradient Descent》. Advances in Neural Information Processing Systems (NeurIPS), 119~29.
浴盆曲线与硬件生命周期
故障分类体系对故障类型和故障域进行分类,回答会发生何种故障。对于容错设计,同样重要的是理解部件在其生命周期中的何时最容易发生故障。硬件故障率在部件的整个生命周期内并非恒定。图 12 展示了浴盆曲线,这是可靠性工程中一个成熟的模型,描述了故障率如何在三个不同阶段中变化:
第一阶段为早期失效期,制造缺陷、安装不当以及性能处于合格边缘的部件过早磨损会导致较高的故障率。对于电子部件,这一阶段通常持续数天至数周。老化测试8 在部署前使部件在应力条件下运行,以便在投入生产使用之前诱发早期失效。
8 老化测试:让部件在较高温度(85–125 摄氏度)和较高电压下运行 24–168 小时,以便在投入生产使用之前诱发早期失效。大型运营方可能在部署前对加速器进行老化测试,从而减少新投入使用的裸机硬件可能给早期作业带来的早期失效。
Birolini, A. 2017年. Reliability Engineering: Theory and Practice. 8th 版. Springer Berlin Heidelberg. https://doi.org/10.1007/978-3-662-54209-5.
Klutke, G., P. C. Kiessler, 和 M. A. Wortman. 2003年. 《A critical look at the bathtub curve》. IEEE Transactions on Reliability 52 (1): 125~29. https://doi.org/10.1109/tr.2002.804492.
度过早期失效期后,部件进入有效寿命期,在标准可靠性工程模型下,其故障率相对恒定 (Birolini 2017年; Klutke 等 2003年)。这一阶段占部件生命周期的最长部分,也是 公式 1 中的指数可靠性模型适用得最准确的时期。对于数据中心 GPU,有效寿命窗口是一个运行规划概念,受硬件更新周期、冷却、利用率以及观测到的集群健康状况影响,而非固定的物理时长。
随着部件老化,它们进入磨损期,故障率因累积磨损而上升。对于 GPU,磨损机制包括电路中的电迁移9、焊点承受的热循环应力,以及热界面材料的劣化。磨损期何时开始高度依赖运行条件;在高温下运行或经历频繁热循环的部件会更早进入磨损期。
9 电迁移:电子动量传递使导体中的金属原子逐渐发生位移,这一现象最早在早期电迁移研究中得到表征,后来通过 Black 可靠性方程进行建模 (Black 1969年)。平均失效时间随电流密度和温度的升高而缩短,因此,持续的高功率加速器工作负载使热管理成为集群寿命的直接决定因素。
这对机器学习系统的实际意义在于,整个集群的故障率取决于部件的使用年限分布。完全由新 GPU 构成的集群在最初几周会经历较高的故障率,随后进入稳定期,再随着集群老化而出现越来越多的故障。由不同使用年限的部件构成的集群,其总体故障率更稳定,因为不同批次的部件处于不同的生命周期阶段。
图 12 中的三个阶段具有直接的运行后果:burn-in testing 在部署前筛除早期失效(infant mortality),而基于 GPU 遥测数据的预测性分析(温度趋势、错误计数、性能退化)则针对 wear-out 阶段,从而使得维护窗口内可以进行计划性部件更换,而不是在训练运行中发生非计划中断。机器学习基础设施团队直接将这一模型应用于集群调度与 fleet 准入。运营者通常不会把全新的加速器 pod 视为与经过验证的生产节点完全等价,而是先运行压力负载,再将这些硬件分配给高价值训练。持续的矩阵乘法循环、内存测试和通信测试会在这些边缘设备接触数周长的预训练运行之前将其暴露出来。运营者会在筛选阶段修复或更换在此过程中失效的加速器,使其在接触高价值训练运行之前得到处理;成功通过筛选的加速器则进入 useful-life 阶段,此时恒定速率指数模型适用。这一纪律至关重要,因为成本不对称极为明显:在筛选阶段捕获一次 infant-mortality 失效,代价只是数小时的加速器闲置时间;而同一失效发生在数周长的基础模型预训练运行中,则可能使数天的梯度累积失效,并迫使检查点回滚。调度策略反映了这种不对称性:集群运营者通常先将全新或近期修复的节点分配给短期的探索性任务或推理服务,而不是数月的预训练任务,直到其累积的运行小时数足以脱离 infant-mortality 风险窗口。
模型类型在失效影响上的差异
虽然失效速率的数学在普遍适用,但不同模型类型的失效影响差异巨大。失去一小时训练的影响取决于该训练的成本、需要恢复多少状态,以及恢复需要多长时间。按模型类型的失效影响 跨模型架构量化了这些因素,揭示了从大型语言模型(LLMs)产生数百万美元浪费计算量,到视觉模型仅损失少量进展之间的数量级差异。
| 模型类型 | 典型训练时长 | 检查点大小 | 状态敏感性 | 失效成本 |
|---|---|---|---|---|
| Archetype A(70B-class 稠密 LLM) | 2–4 周 | 350–700 GB | 高(课程表中的位置) | $2–5M 计算量 / 每 24 小时损失 |
| Vision(ViT-Large) | 1–3 天 | 1–2 GB | 中(数据增强状态) | $10–50K / 每天损失 |
| Archetype B(DLRM at Scale) | 持续运行 | 2–4 TB(嵌入) | 极高(嵌入新鲜度) | 每小时收入影响 |
| Speech(Whisper-scale) | 3–7 天 | 5–10 GB | 中 | $50–200K / 每天损失 |
| Scientific(AlphaFold) | 数天至数周 | 10–50 GB | 高(探索状态) | 研究延迟 |
大型语言模型面临最高的绝对故障成本,原因在于其训练周期较长,且每个训练小时的计算开销巨大。例如,一次使用 25,000 GPU、速率约为 $3/GPU-hour 的大规模训练运行,每天的计算成本为 $1.8M。一次损失 24 小时训练进度的故障,将造成 $1.8M 的计算浪费,并带来进度延迟。检查点开销跨度很大:70B 级稠密 LLM 检查点可达数百 GB;而 175B 参数的运行示例,在纳入 FP32 Adam 优化器状态后达到 3.7 TB。
推荐系统面临独特挑战,因为其训练通常是连续的,而非分阶段的。RecSys 模型的价值部分源于其新鲜度:捕捉近期用户行为的嵌入优于陈旧嵌入。损失数小时嵌入更新的故障,可能以直接影响收入的方式降低推荐质量。Meta 已记录,推荐模型的新鲜度与参与度指标直接相关,因此恢复时间成为业务关键指标。10
10 RecSys 新鲜度:Meta 的 DLRM 基础设施文档指出,以小时计量的嵌入陈旧度会带来推荐相关性与参与度指标上可测量的性能下降。这颠倒了典型的容错优先级:对于推荐系统,最小化恢复时间比最小化检查点开销更重要,因为陈旧嵌入会直接减少收入。
视觉模型处于中间地带,训练时长适中,检查点规模可控。相对较小的检查点使得频繁检查点化成为可能,且开销很低。与大型语言模型或嵌入密集型的推荐工作负载相比,1–2 GB 量级的视觉 Transformer(ViT)-Large 检查点几乎不产生额外开销。数据增强状态是除模型权重之外、为保证可复现恢复而必须保留的主要状态。必须捕获增强参数与数据打乱种子。
科学模型(如蛋白质结构预测或气候模拟所用模型)往往具有超出模型参数的独特状态需求。AlphaFold 风格的训练可能维护探索状态跟踪,记录哪些蛋白质家族已被采样,从而在恢复过程中避免重复。药物发现模型可能跟踪哪些分子构型已被评估。这种领域特定的状态使检查点与恢复设计更加复杂。
容错投资的经济框架
容错机制会消耗资源:检查点存储、检查点写入的带宽、冗余计算的计算周期,以及实现与维护所需的工程时间。理性的容错投资需要同时量化故障成本与预防成本。
故障成本包括计算浪费、进度延迟、机会成本与工程时间。计算浪费衡量用于必须重跑的训练步骤的 GPU 小时数。进度延迟反映训练完成所需延长的时间对业务时间线的影响。机会成本承认用于恢复的计算无法用于其他训练。工程成本涵盖调试故障与人工恢复所花费的时间。
预防成本包括存储、吞吐开销、恢复基础设施与复杂度。存储成本随模型规模与检查点频率增长。检查点写入会消耗内存带宽,并可能阻塞训练。恢复基础设施需要备用容量与自动恢复系统。容错系统更难开发与调试。
容错的最优投资是在这些成本之间取得平衡。对于少数 GPU 上的小规模训练,故障罕见,最低限度的容错可能最具成本效益;此时低频检查点与人工恢复已足够。对于数千 GPU 的大规模训练,故障每天发生多次,充分的容错能够带来正的投资回报;频繁检查点、自动恢复与弹性训练因此成为必需。图 4 展示了检查点开销与恢复成本之间的权衡如何达到一个取决于系统 MTBF 与检查点写入时间的最优解。
公式 6 给出了每轮训练预期成本的简化经济模型:
\[ C_{\text{total}} = C_{\text{compute}} + E[N_{\text{failures}}] \times C_{\text{per-failure}} + C_{\text{ft}} \tag{6}\]
其中 \(C_{\text{compute}}\) 为基础计算成本,\(E[N_{\text{failures}}]\) 为训练期间的预期故障次数,\(C_{\text{per-failure}}\) 为每次故障的成本,\(C_{\text{ft}}\) 为容错机制的成本。每次故障的成本包括计算浪费与开销。
公式 7 形式化了容错投资何时成立:
\[ \frac{\partial C_{\text{ft}}}{\partial x} < \frac{\partial (E[N_{\text{failures}}] \times C_{\text{per-failure}})}{\partial x} \tag{7}\]
其中,\(x\) 表示对容错机制的投入。在实践中,这意味着持续投入容错建设,直到增加保护措施的边际成本超过故障成本的边际降幅。
三项基本原则指导着该领域的每一项设计决策。
Systems Perspective 1.2: 大规模系统中的三条故障法则
- 在大规模系统中,故障持续发生,是常态而非例外。 一个拥有 10,000 个 GPU 的集群每隔几小时就会发生故障。系统设计必须将故障视为正常运行的一部分。
- 检查点间隔存在最优值。 Young-Daly 公式 \(\tau_{\text{opt}} = \sqrt{2 \times T_{\text{write}} \times \text{MTBF}_{\text{system}}}\) 为检查点频率提供了定量指导。该公式的推导见 节 1.0.2。
- 训练与服务的容错要求存在根本差异。 训练可以容忍分钟级的恢复时间;服务则要求毫秒级的恢复时间。这种差异要求采用截然不同的方法。
法则 3(训练与服务的差异)决定了讨论顺序:先讨论训练恢复,再讨论服务的故障应对能力。在讨论这两者之前,必须先理解部件失效的物理机制,从触发这些失效的硬件故障入手。
硬件故障分类
设想宇宙射线翻转了 GPU 高带宽内存中的单个比特,或者热膨胀导致 NVLink 连接器出现微观裂纹。这些物理事件会引发级联的软件错误,可能破坏持续数周的训练运行,但恢复系统并不会直接观察到“宇宙射线”或“裂纹”。它观察到的是症状:未伴随进程崩溃的梯度尖峰、从集合通信中消失的 rank,或者仅在持续负载下升温时才失效的节点。只有能够将这些症状转化为恢复决策,硬件故障分类才有实用价值。
硬件故障对机器学习系统的影响
机器学习系统会放大硬件故障的后果,其程度超过传统应用。高计算强度使故障每秒都有数百万次机会破坏计算结果。持续数天或数周的训练运行增加了遭遇故障的概率。模型权重中的微小损坏可能导致输出预测发生大幅变化,而分布式依赖意味着单点故障可能中断整个工作流。
权重矩阵中的单个比特翻转就足以说明其严重性。如果 ResNet-50 模型中的某个关键权重从 0.5 翻转为 -0.5,原因是瞬态故障影响了 IEEE 75411 浮点表示中的符号位,那么特征图的符号就会反转,从而在后续层中引发级联错误。故障注入研究表明,深度神经网络的故障应对能力强烈依赖于模型、层、结构和比特位置,因此脆弱位置上的少量故障也可能造成不成比例的准确率损失 (Reagen 等 2018年)。此类比特错误可能使应用崩溃,但在神经网络中,它也可能转而静默地破坏决定系统行为的已学习表征。
11 IEEE 754:IEEE 754 浮点标准定义的 binary32 格式包含 1 个符号位、8 个指数位和 23 个小数位 (IEEE Standards Association 2019年)。这种比特布局使机器学习系统面临不对称的脆弱性:符号位翻转会使权重完全反号(\(0.5 \to -0.5\)),而指数位翻转可能使数值大小改变多个数量级,因此故障应对机制通常优先保护最敏感的比特位置,而不是将所有比特视为同等重要。
IEEE Standards Association. 2019年. IEEE 754-2019: Standard for Floating-Point Arithmetic. https://doi.org/10.1109/IEEESTD.2019.8766229.
Reagen, B., U. Gupta, L. Pentecost, P. Whatmough, S. K. Lee, N. Mulholland, D. Brooks, 和 G.-Y. Wei. 2018年. 《Ares: A framework for quantifying the resilience of deep neural networks》. 2018 55th ACM/ESDA/IEEE Design Automation Conference (DAC), 1~6. https://doi.org/10.1109/dac.2018.8465834.
随着加速器器件规模扩大,可靠性仍然是设计中必须应对的压力。更小的几何尺寸和更低的工作电压可能减少扰动存储值所需的电荷量,从而提高对某些软错误机制的敏感性 (Baumann 2005年);与此同时,大规模机器学习集群遭遇罕见硬件故障的频率足够高,使软件层面的检测与恢复成为训练系统设计的一部分 (He 等 2023年)。机器学习系统架构师必须将硬件视为不可靠的底层基础,因此,端到端完整性检查、高风险路径的冗余计算或重放计算、权重复制以及周期性一致性检查都成为系统要求,而不再只是高性能计算领域的专门技术。
硬件故障的时间特征决定了相应的应对方式。一次性数据损坏需要检测与回滚,持续性缺陷需要隔离与更换,而反复出现的负载敏感型缺陷则需要在节点破坏更多作业之前收集证据。图 13 总结了对实际运行至关重要的三类故障。
三类故障的区别在于恢复系统应当推断什么:
- 瞬时故障 是由宇宙射线或电磁干扰等外部因素引起的暂时性中断(Ziegler 等 1996年)。其危害在于静默损坏:某个 rank 可能继续参与计算,却发送错误的梯度或激活值。
- 永久性故障 表示由物理缺陷或器件老化造成的不可逆损坏,例如 stuck-at 故障或需要更换硬件的器件失效。其危害在于可重复性:重试同一器件会复现相同的错误计算或硬性失败。
- 间歇性故障 会因松动的连接、老化部件或热应力等不稳定条件而间歇性地出现和消失。其危害在于歧义性:作业在一次运行中可能通过校验,而在略有不同的负载下则失败。
由于各类故障的发生时间尺度不同,且留下的证据也不同,因此恢复策略随之改变。
瞬时故障
故障分类体系依据恢复姿态对瞬时故障进行分类,即询问系统是否能够重试或校验受影响的计算工作。其物理机制决定了所需的检测方法。瞬时故障是最常见的类别,图 14 展示了其基本机制:位翻转错误 是指内存中的单个比特意外改变状态,可能以级联方式改变关键数据或计算,进而波及神经网络各层。
\scalebox{0.8}{%
\begin{tikzpicture}[line join=round,font=\sffamily\small]
\tikzset{%
helvetica/.style={align=flush center,font=\small\sffamily},
cell/.style={draw=BrownLine,line width=0.5pt, minimum size=\cellsize,
    minimum height=\cellheight}
}
\def\columns{6}
\def\rows{1}
\def\cellsize{9mm}
\def\cellheight{9mm}
\colorlet{BrownL}{BrownL!30}

\begin{scope}[local bounding box=M1,shift={(0,0)}]
\foreach \x in {1,...,\columns}{
    \foreach \y in {1,...,\rows}{
        %
        \def\br{MG}
\node[draw=BrownLine, fill=BrownL, minimum width=\cellsize,
                    minimum height=\cellheight,
                    line width=0.5pt] (cell-\x-\y\br) at (\x*\cellsize,-\y*\cellheight) {};
    }
}
\end{scope}

\begin{scope}[local bounding box=M2,shift={(0,-2)}]
\foreach \x in {1,...,\columns}{
    \foreach \y in {1,...,\rows}{
        %
        \def\br{MD}
\node[draw=BrownLine, fill=BrownL, minimum width=\cellsize,
                    minimum height=\cellheight,
                    line width=0.5pt] (cell-\x-\y\br) at (\x*\cellsize,-\y*\cellheight) {};
    }
}
\end{scope}

% One label per cell, so no digit is drawn on top of another.
\foreach \x in {1,4,5}{%
\node[cell,fill=BrownL]at(cell-\x-1MG){1};
\node[cell,fill=BrownL]at(cell-\x-1MD){1};
}
\foreach \x in {2,3,6}{,
\node[cell,fill=BrownL]at(cell-\x-1MG){0};
}
\foreach \x in {2,6}{,
\node[cell,fill=BrownL]at(cell-\x-1MD){0};
}

\node[cell,fill=BrownL,line width=2pt](BF)at(cell-3-1MD){1};
\node[above=3pt of BF]{\textbf{Bit-Flip}};
\node[right=0.3 of cell-6-1MD,font=\sffamily\tiny](DT){$\bullet$ $\bullet$ $\bullet$};
\node[right=0.3 of cell-6-1MG,font=\sffamily\tiny](GT){$\bullet$ $\bullet$ $\bullet$};
\node[right=0.3 of GT]{Memory before};
\node[right=0.3 of DT]{Memory after};
\end{tikzpicture}}暂态故障之所以重要,是因为故障发生后可能找不到任何受损部件。辐射引起的单粒子翻转、不稳定电源路径造成的电压波动 (Reddi 和 Gupta 2013年)、电磁干扰、静电放电、串扰、地弹、时序违例,或组合逻辑中的软错误 (Mukherjee 等 2005年),都可能坍缩为同一个机器学习症状:某个张量、数据包或指令与集合预期值不同。因此,恢复设计强调在线检测、尽可能在线修正,以及从已知良好状态回滚,而不是人工更换硬件。
Reddi, Vijay Janapa, 和 Meeta Sharma Gupta. 2013年. Resilient Architecture Design for Voltage Variation. Synthesis Lectures on Computer Architecture. Springer International Publishing. https://doi.org/10.1007/978-3-031-01739-1.
Mukherjee, S. S., J. Emer, 和 S. K. Reinhardt. 2005年. 《The Soft Error Problem: An Architectural Perspective》. 11th International Symposium on High-Performance Computer Architecture, 243~47. https://doi.org/10.1109/hpca.2005.37.
定量故障率
先进半导体工艺会因节点电容、供电电压和存储电荷的缩小而提高软错误敏感性 (Baumann 2005年)。对于 GPU,实际风险被大规模并行性进一步放大:数千条执行通道和高带宽存储器创造了大量可能影响权重、激活值或梯度的暂态故障发生点。因此,运行期 MTBF12 取决于工作负载、部件和环境,而非普适常数。在 节 1.5 的检查点分析中,关键的系统学规则是叠加效应:一个由 1,000 台加速器组成的集群,若每台加速器的示例性 MTBF 为 50,000 小时,则预期每 50 小时发生一次故障,因而需要健壮的检查点机制。
12 MTBF(平均故障间隔时间):MTBF 由美国军方在 MIL-HDBK-217(1965)中形式化定义,并假设在有效寿命期内服从指数故障分布。对于机器学习训练,MTBF 直接代入 Young-Daly 公式:若每台设备的 MTBF 为 50,000 小时、设备数为 1,000 台,则系统 MTBF 为 50 小时。仅凭 MTBF 并不能确定最优间隔:设定总浪费目标需要权衡预期的返工比例 \(\tau/(2\,\text{MTBF})\) 与检查点写入时间 \(T_{\text{write}}\)。
存储器子系统是最易受故障影响的部件,而容错机制会直接带来带宽开销。表 2 量化了不同存储器技术之间的这一成本:
内存带宽保护分析
展示了错误保护对不同内存技术可能带来的吞吐量代价。
| 内存技术 | 基础带宽 | ECC 开销 | 有效带宽 |
|---|---|---|---|
| DDR4-3200 | 51.2 GB/s | 12.5% | 44.8 GB/s |
| HBM2 | 900 GB/s | 12.5% | 787.5 GB/s |
| HBM3 | 1600 GB/s | 12.5% | 1400 GB/s |
| GDDR6X | 760 GB/s | Typically none | 760 GB/s |
带宽表不应被解读为内存错误率的普适排序。HBM、GDDR 和 DDR 的可靠性取决于器件代际、工作温度、保护方案以及错误如何统计。可持久系统课程给出的教训更为有限:错误保护会消耗带宽和容量,而集群研究表明,内存错误在大规模部署中发生的频率足以证明 ECC、擦除(scrubbing)和监控的必要性 (Schroeder 等 2009年; Sridharan 等 2015年; Dixit 等 2021年)。作为背景内存擦除(周期性读取和重写以检测累积的软错误)通常被设计为使其带宽代价相对前景训练流量较小。
Schroeder, Bianca, Eduardo Pinheiro, 和 Wolf-Dietrich Weber. 2009年. 《DRAM errors in the wild: A Large-Scale Field Study》. ACM SIGMETRICS Performance Evaluation Review 37 (1): 193~204. https://doi.org/10.1145/2492101.1555372.
瞬时故障对机器学习 的影响
图 15 展示了拜占庭故障讨论中引入的同一电荷扰动机制 (节 1.0.5.3),现在从器件层面来看:宇宙射线击中内存单元或晶体管,产生的电荷改变了已存储或已传输的数据。 本小节补充的是对模型的下游影响,而非物理机制本身。
训练期间,存储模型权重或梯度的内存中发生的瞬态故障,可能导致错误的更新,进而损害收敛性与准确性(He 等 2023年)。推理期间,神经网络激活值中的比特翻转可能改变最终的分类或回归输出(Mahmoud 等 2020年)。在安全攸关的应用中,这些故障可能导致错误决策,从而损害安全性Wan 等 (2021年)。资源受限环境会放大这些脆弱性:二值化神经网络(Courbariaux 等 2016年)以单比特精度表示权重,当以 10 percent 概率插入随机比特翻转软错误时,其测试准确率会从 98 percent 下降至 70 percent(Aygun 等 2021年)。在分布式训练中,网络分区13可将部分 rank 隔离,而由 InfiniBand Subnet Manager14管理的 fabric 故障则可能使整个 AllReduce 集合通信陷入停滞。
Wan, Z., A. Anwar, Y.-S. Hsiao, T. Jia, V. J. Reddi, 和 A. Raychowdhury. 2021年. 《Analyzing and Improving Fault Tolerance of Learning-Based Navigation Systems》. 2021 58th ACM/IEEE Design Automation Conference (DAC), 841~46. https://doi.org/10.1109/dac18074.2021.9586116.
Courbariaux, Matthieu, Itay Hubara, Daniel Soudry, Ran El-Yaniv, 和 Yoshua Bengio. 2016年. 《Binarized Neural Networks: Training Deep Neural Networks with Weights and Activations Constrained to +1 or -1》. arXiv preprint arXiv:1602.02830.
Aygun, Sercan, Ece Olcay Gunes, 和 Christophe De Vleeschouwer. 2021年. 《Efficient and robust bitstream processing in binarised neural networks》. Electronics Letters 57 (5): 219~22. https://doi.org/10.1049/ell2.12045.
13 网络分区:网络分区会使一组 worker 无法与另一组通信。在同步训练中,即使单个被隔离的 rank 也会阻塞整个 AllReduce 集合通信,因此分区容错是训练任务能够运行到足以遭遇常规 fabric 或控制面故障的前提条件。
14 InfiniBand 子网管理器(SM):一个集中式软件实体,负责发现所有节点与交换机、分配本地标识符并计算路由表。在网络分区中,SM 的作用至关重要:它必须重新发现新的拓扑并在训练安全恢复之前更新路由。如果 SM 本身被分区,fabric 可能进入”僵尸”状态,即节点物理上连通但无法路由消息,这是大规模训练运行中[\(T_{\text{detect}}\)]延迟的常见成因。
永久故障
永久故障是不可逆的硬件缺陷,会持续存在,直到故障部件被修复或更换。可操作的线索是重复性:同一加速器、内存单元、链路或存储设备在重试后再次发生故障,且往往发生在相同地址、路径或工作负载阶段。制造缺陷(刻蚀不当、掺杂错误、污染)与磨损机制(电迁移,15栅介质击穿,16热应力17)都可能产生这一特征。最常见的抽象模型是 stuck-at 故障(Seong 等 2010年),即信号或内存单元无论输入如何,都会永久固定在 0 或 1。
15 电迁移:电子动量传递使导体中的金属原子逐渐发生位移,这一现象最早在早期电迁移研究中得到表征,后来通过 Black 可靠性方程进行建模 (Black 1969年)。平均失效时间随电流密度和温度的升高而缩短,因此,持续的高功率加速器工作负载使热管理成为集群寿命的直接决定因素。
Black, James R. 1969年. 《Electromigration–A Brief Survey and Some Recent Results》. IEEE Transactions on Electron Devices 16 (4): 338~47. https://doi.org/10.1109/T-ED.1969.16754.
16 栅介质击穿:不可逆的栅介质失效,会在晶体管绝缘层中形成导电通路。栅介质厚度从 1980 年代工艺的约 100 nm 缩小到 FinFET 时代器件的纳米级尺寸,从而提高了易损性。时间依赖的介质击穿限制了芯片可靠性预测,使介质完整性成为覆盖 3–5 年硬件更新周期的机器学习加速器部署的集群规划关注点。
17 热应力:由反复温度循环造成的退化,会开裂焊点并劣化热界面材料。处于持续训练负载下的机器学习加速器可能因时钟频率下降以避免损坏而发生降频。权衡是直接的:激进的冷却(液冷、浸没式)可延长部件寿命并维持训练吞吐量,但会增加数据中心基础设施成本,因此冷却方案必须同时从可靠性与设施成本两方面进行评估。
Seong, N. H., D. H. Woo, V. Srinivasan, J. A. Rivers, 和 H.-H. S. Lee. 2010年. 《SAFER: Stuck-At-Fault Error Recovery for Memories》. 2010 43rd Annual IEEE/ACM International Symposium on Microarchitecture, 115~24. https://doi.org/10.1109/micro.2010.46.
机器学习加速器中最具后果的永久故障,是那些会静默且可重复地破坏算术运算的故障。张量核心乘加数据通路中的 stuck-at 故障,或存储权重分片的 HBM 银行中的缺陷单元,都会使每次执行同一计算时产生相同的错误值。在训练中,这意味着经过受影响矩阵的每一次前向传播都会产生确定性地偏置的结果,而每一次反向传播都会累积出有偏的梯度。由于该错误可复现但数值上很小,训练损失可能在数百步内正常下降,直到累积的偏置表现为梯度发散或验证准确率异常偏低。在推理中,同一缺陷会确定性地使特定输出 logit 产生偏置,这在医疗或自动驾驶等安全攸关部署中属于关键属性:故障不会导致系统崩溃,而是系统性地把涉及该权重块的每一个决策推向一侧。
Intel Pentium FDIV 缺陷(发现于 1994 年)为通用处理器中这一失效模式提供了标准范例。Pentium 处理器除法单元所采用的查找表存在错误,导致特定操作数区域产生错误结果图 16。机器学习加速器的情况在几何形态上有所不同,但原理相同:FDIV 缺陷会破坏标量除法,而张量核心中的 stuck-at 故障则会破坏所有经由该缺陷通道的矩阵乘运算输出的特定行或列,影响计算中触及该分区的特征图或梯度分片。在安全敏感应用中,这种持续的算术错误会构成安全隐患,因为每一个下游决策都会继承该有偏计算。
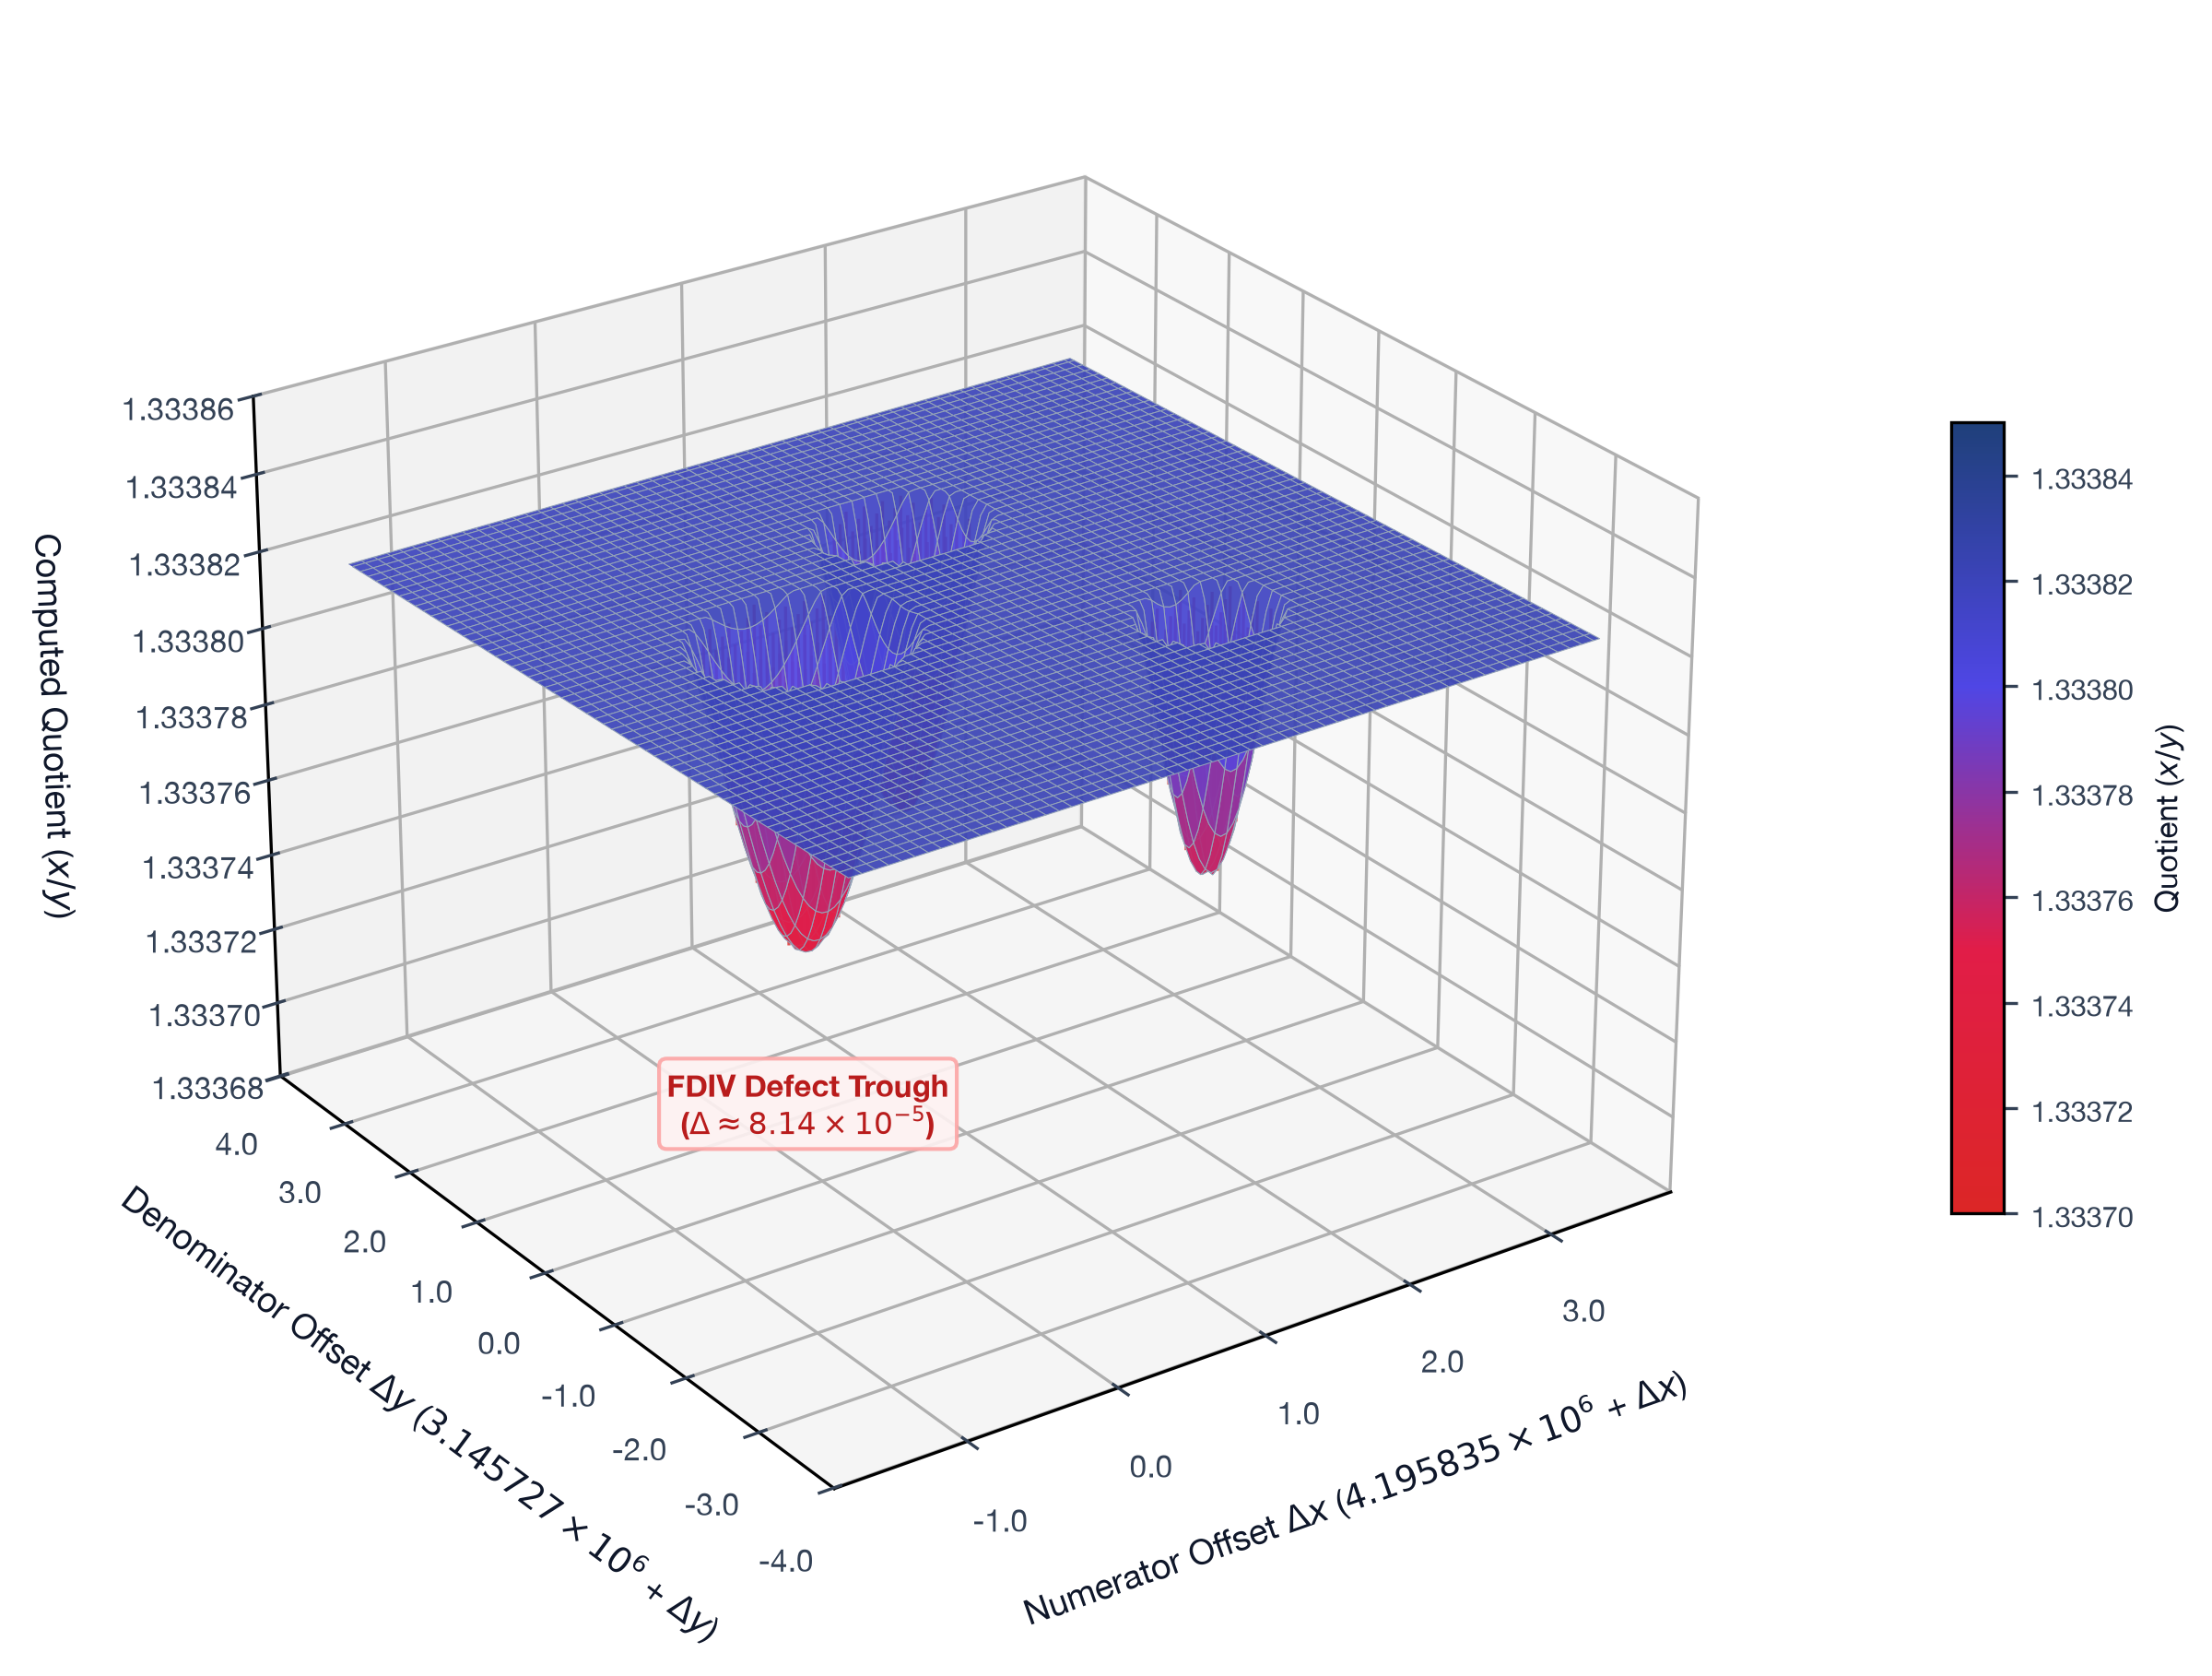
图 17 展示了 stuck-at 故障如何通过逻辑门与互连传播,导致错误计算或持续的数据损坏,进而影响下游模型行为。
\begin{tikzpicture}[line join=round,font=\sffamily\small]
\useasboundingbox(-2,2.5) rectangle (15.7,-4.7);
\tikzset{%
helvetica/.style={align=flush center,font=\small\sffamily},
Line/.style={line width=1.0pt,black!50,text=black},
DLine/.style={draw=OrangeLine!40, line width=1mm, -{Triangle[length=3mm, bend]},
shorten >=1.1mm, shorten <=1.15mm},
}
\colorlet{VioletL}{GreenL!60}
\begin{scope}[scale=1.75, every node/.append style={transform shape},
local bounding box=D1,shift={(0,0)}]
\def\di{D1}
\draw[line width=1pt,fill=VioletL](0,0)--(0,0.76)to[out=357,in=3,distance=25]cycle;
\fill[draw=black,fill=white,line width=1.5pt](0.72,0.38)circle(2pt);
\coordinate(G\di)at(0,0.58);
\coordinate(D\di)at(0,0.18);
\coordinate(IZ\di)at(0.8,0.38);
\end{scope}
\begin{scope}[scale=1.75, every node/.append style={transform shape},
local bounding box=D2,shift={(0,-2)}]
\def\di{D2}
\draw[line width=1pt,fill=VioletL](0,0)--(0,0.76)to[out=357,in=3,distance=25](0,0);
\fill[draw=black,fill=white,line width=1.5pt](0.72,0.38)circle(2pt);
\coordinate(G\di)at(0,0.58);
\coordinate(D\di)at(0,0.18);
\coordinate(IZ\di)at(0.8,0.38);
\end{scope}

\begin{scope}[scale=1.75, every node/.append style={transform shape},
local bounding box=D3,shift={(4,-1)}]
\def\di{D3}
\draw[line width=1pt,fill=VioletL](0,0)--(0,0.76)to[out=357,in=3,distance=25](0,0);
\fill[draw=black,fill=white,line width=1.5pt](0.72,0.38)circle(2pt);
\coordinate(G\di)at(0,0.58);
\coordinate(D\di)at(0,0.18);
\coordinate(IZ\di)at(0.8,0.38);
\end{scope}
\begin{scope}[scale=1.75, every node/.append style={transform shape},
local bounding box=D4,shift={(7,-2)}]
\def\di{D4}
\draw[line width=1pt,fill=VioletL](0,0)--(0,0.76)to[out=357,in=3,distance=25](0,0);
\fill[draw=black,fill=white,line width=1.5pt](0.72,0.38)circle(2pt);
\coordinate(G\di)at(0,0.58);
\coordinate(D\di)at(0,0.18);
\coordinate(IZ\di)at(0.8,0.38);
\end{scope}
%lines
\draw[Line](IZD2)--node[above,pos=0.3](IIZD2){SA0 \textcolor{black}{SA1}}++(0:3)|-
node[below,pos=0.91](ULDD4){SA0 \textcolor{red}{SA1}}(DD4);
\draw[Line](IZD1)--node[above,pos=0.5](IIZD1){SA0 \textcolor{red}{SA1}}++(0:2)|-(GD3);
\draw[Line](IZD3)--node[above,pos=0.9](IIZD3){SA0 \textcolor{red}{SA1}}++(0:1)|-(GD4);
\draw[Line](DD3)--node[above,pos=0.3](ULDD3){SA0 \textcolor{red}{SA1}}++(180:3.6)|-(IZD2);
\draw[Line](GD1)--node[above,pos=0.5](ULGD1){SA0 \textcolor{red}{SA1}}++(180:2);
\draw[Line](DD1)--node[above,pos=0.5](ULDD1){SA0 \textcolor{red}{SA1}}++(180:2);
\draw[Line](GD2)--node[above,pos=0.5](ULGD2){SA0 \textcolor{red}{SA1}}++(180:2);
\draw[Line](DD2)--node[above,pos=0.5](ULDD2){SA0 \textcolor{red}{SA1}}++(180:2);
\draw[Line](IZD4)--node[above,pos=0.5](IIZD4){SA0 \textcolor{black}{SA1}}++(0:2);
%
\draw[DLine,distance=40](ULGD1)to[out=50,in=120](IIZD1);
\draw[DLine,distance=44](ULDD1)to[out=-50,in=-110](IIZD1);
\draw[DLine,distance=40](ULGD2)to[out=50,in=120](IIZD2);
\draw[DLine,distance=44](ULDD2)to[out=-50,in=-110](IIZD2);
\draw[DLine,distance=50](ULDD3)to[out=-50,in=-120](IIZD3);
\draw[DLine,distance=50](ULDD4)to[out=-50,in=-100](IIZD4);
\draw[DLine,distance=63](IIZD3)to[out=50,in=90](IIZD4);
\draw[DLine,distance=80](IIZD1)to[out=50,in=90](IIZD3);
\end{tikzpicture}对于机器学习系统,恢复决策是停止信任该组件。永久性的加速器数据通路故障可能持续产生错误的梯度,直到该设备从集群中耗尽 (He 等 2023年; J. J. Zhang 等 2018年);而永久性的存储故障则会同时损害训练数据集和恢复所需的检查点。校验和验证、复制存储、硬件冗余、纠错码 (Kim 等 2015年) 以及检查点重启恢复18 (Egwutuoha 等 2013年) 协同工作,因为每种机制都有助于识别仍然可信的持久副本。节 1.0.2 中引入的 Young-Daly 公式则给出了经济性边界。硬件加固可以提高 MTBF,但平方根关系意味着可靠性投资必须与更快的检查点化和重启基础设施相权衡。
Zhang, Jeff Jun, Tianyu Gu, Kanad Basu, 和 Siddharth Garg. 2018年. 《Analyzing and mitigating the impact of permanent faults on a systolic array based neural network accelerator》. 2018 IEEE 36th VLSI Test Symposium (VTS), 1~6. https://doi.org/10.1109/vts.2018.8368656.
Kim, Jungrae, Michael Sullivan, 和 Mattan Erez. 2015年. 《Bamboo ECC: Strong, safe, and flexible codes for reliable computer memory》. 2015 IEEE 21st International Symposium on High Performance Computer Architecture (HPCA), 101~12. https://doi.org/10.1109/hpca.2015.7056025.
18 检查点重启:起源于 20 世纪 60 年代主机批处理,当时从头重启耗时数小时的工作极其昂贵。大规模分布式训练任务每 10–30 分钟即可检查点化 100+ GB 的模型状态;Google 的 TPUv4 弹性研究[^fn-tpuv4-resiliency] 报告了协同检查点化与重构,使节点故障造成的浪费计算低于总训练时间的 1 个百分点。
Egwutuoha, I. P., D. Levy, B. Selic, 和 S. Chen. 2013年. 《A survey of fault tolerance mechanisms and checkpoint/restart implementations for high performance computing systems》. The Journal of Supercomputing 65 (3): 1302~26. https://doi.org/10.1007/s11227-013-0884-0.
间歇性故障
间歇性故障属于最难的一类,因为它们会先产生证据,随后又消失。某个节点可能通过重启测试、重新加入集群,但只有当下一个训练任务将该封装驱动到相同的温度、电压或通信工况时才会再次失效。物理退化(焊球接合处的裂纹、老化的球栅阵列、残留物导致的电气连接)会形成这些随负载变化的条件 (图 18) (Constantinescu 2008年; Rashid 等 2015年)。电压降标(voltage-underscaling)研究,如 ThUnderVolt[^fn-thundervolt],展示了另一条独立的时序错误路径:降低电压裕量会使信号传播不可靠,并导致难以复现的错误计算 (J. Zhang 等 2018年)。
Zhang, Jeff, Kartheek Rangineni, Zahra Ghodsi, 和 Siddharth Garg. 2018年. 《ThUnderVolt: Enabling Aggressive Voltage Underscaling and Timing Error Resilience for Energy Efficient Deep Learning Accelerators》. 2018 55th ACM/ESDA/IEEE Design Automation Conference (DAC), 1~6. https://doi.org/10.1109/dac.2018.8465918.
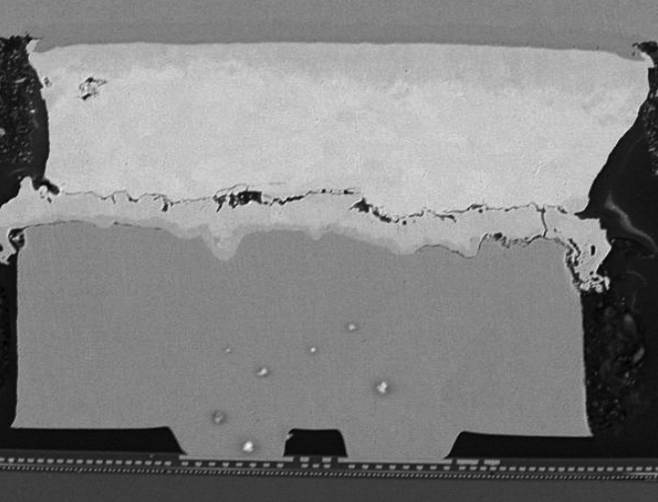
DRAM 残留故障揭示了 DRAM 芯片中的残留物引起的间歇性故障如何形成不可靠的电气连接,进而导致偶发性失效。
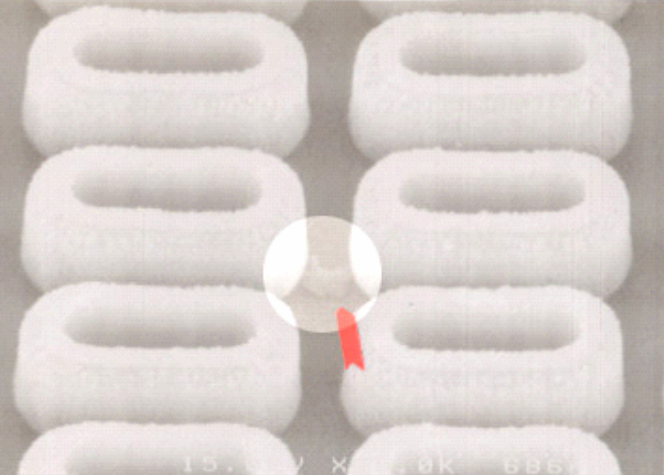
对于机器学习系统,间歇性故障在获得足够证据表明其并非如此之前,都应被视为可疑。偶发的处理或内存错误可能跨越迭代累积,从而在不触发显式失败的情况下损害收敛 (He 等 2023年; Rashid 等 2015年)。运行时监控与异常检测提供了最初的线索,环境控制可降低温度和电压触发因素,自适应资源管理则可以耗尽、降频或避开可疑组件,同时保留任务进度 (Rashid 等 2012年)。目标不仅是让节点保持存活,而是防止非确定性组件使验证和恢复变得不可信。
He, Yi, Mike Hutton, Steven Chan, Robert De Gruijl, Rama Govindaraju, Nishant Patil, 和 Yanjing Li. 2023年. 《Understanding and Mitigating Hardware Failures in Deep Learning Training Systems》. Proceedings of the 50th Annual International Symposium on Computer Architecture, 1~16. https://doi.org/10.1145/3579371.3589105.
Rashid, Layali, Karthik Pattabiraman, 和 Sathish Gopalakrishnan. 2015年. 《Characterizing the Impact of Intermittent Hardware Faults on Programs》. IEEE Transactions on Reliability 64 (1): 297~310. https://doi.org/10.1109/tr.2014.2363152.
Rashid, Layali, Karthik Pattabiraman, 和 Sathish Gopalakrishnan. 2012年. 《Intermittent Hardware Errors Recovery: Modeling and Evaluation》. 2012 Ninth International Conference on Quantitative Evaluation of Systems, 220~29. https://doi.org/10.1109/qest.2012.37.
硬件故障检测与缓解
硬件故障缓解只有在检测机制与故障特征相匹配时才有效。永久缺陷最好在部署前暴露出来,瞬态比特翻转需要在线纠错,而间歇性或静默错误则需要运行时证据。在硬件层面,两种基础机制针对本节确立的故障类别提供保护。
内置自测试(BIST)[^fn-bist] (Bushnell 和 Agrawal 2002年) 通过扫描链19 集成额外的自测试电路,扫描链在系统启动期间将预定义测试模式施加到内部逻辑上。BIST 能在其污染生产工作负载之前捕获制造缺陷和永久故障。
Bushnell, Michael L, 和 Vishwani D Agrawal. 2002年. 《Built-In Self-Test》. Essentials of electronic testing for digital, memory and mixed-signal VLSI circuits 1: 489~548. https://doi.org/10.1007/0-306-47040-3_15.
19 扫描链:将内部触发器连接为移位寄存器的测试基础设施,20 世纪 70 年代为 IC 的可测试性设计而开发。其代价是具体的:5–15 个百分点的硅面积开销换来 95 个百分点以上的制造故障覆盖率。对于矩阵相乘单元中拥有数十亿晶体管的 ML 加速器,烧入期间的基于扫描的测试能够捕获那些本会静默污染生产阶段权重与梯度计算的 stuck-at 故障。
20 汉明码(1950 年): 理查德·汉明(Richard Hamming)在贝尔实验室反复受继电器计算机故障困扰、导致周末批处理作业被破坏之后,发明了纠错码。他的单错误纠正、双错误检测方案在 2 的幂次位置放置奇偶校验位,从而以 \(\mathcal{O}(\log n)\) 的开销定位错误。纠错码(ECC)内存模块源自这一设计,保护机器学习训练中 TB 量级的模型权重与优化器状态,使其免受原本会悄然累积的软错误影响。
Hamming, R. W. 1950年. 《Error Detecting and Error Correcting Codes》. Bell System Technical Journal 29 (2): 147~60. https://doi.org/10.1002/j.1538-7305.1950.tb00463.x.
21 CRC(循环冗余校验): 由 Peterson 和 Brown (1961年) 提出的多项式校验和家族。CRC 的覆盖能力取决于多项式、帧长度与错误模型;它最好被理解为低成本检测层,而非普遍保证。在分布式机器学习训练中,校验和或哈希可用于验证集合通信过程中交换的梯度载荷;若无验证层,被污染的梯度包会悄然毒化集合中每个工作节点的参数更新。
Peterson, W. W., 和 D. T. Brown. 1961年. 《Cyclic Codes for Error Detection》. Proceedings of the IRE 49 (1): 228~35. https://doi.org/10.1109/jrproc.1961.287814.
错误检测与纠错码20 (Hamming 1950年) 通过添加冗余比特来检测并纠正比特错误。图 20 展示了最简单的形式:奇偶校验位为每个数据字附加一个额外比特,从而在发生比特翻转时立即检出。更先进的码,如 CRC21,计算校验和以检出超过 99.9 百分比的传输错误,这一能力对于验证 集合通信 所涵盖的分布式 AllReduce 操作中的梯度载荷至关重要。
硬件冗余通过组件复制与投票来检测并屏蔽故障 (Sheaffer 等 2007年)。双重模冗余(DMR)22 复制计算并在 100% 硅开销下比较输出;三重模冗余(TMR)23 执行三次计算并取多数表决,开销为 200%,从而实现自动单故障纠正 (Arifeen 等 2020年)。通过投票实现错误掩蔽 展示了 TMR 表决电路如何通过选取多数输出,来屏蔽单个故障单元。特斯拉全自动驾驶计算机在两个相互独立的片上系统(SoC)之间采用 DMR(图 21),而波音 777 则在其主飞行计算机中采用 TMR,用于安全关键的航空控制 Bannon 等 (2019年)。
Sheaffer, J. W., D. P. Luebke, 和 K. Skadron. 2007年. 《A hardware redundancy and recovery mechanism for reliable scientific computation on graphics processors》. Graphics Hardware 2007: 55~64. https://doi.org/10.2312/eggh/eggh07/055-064.
22 双重模冗余(DMR): 复制计算并比较输出以检测不一致,硅开销为 100%,而 TMR 为 200%。DMR 能检测失配,但无法自行选出正确输出,因此其覆盖范围取决于比较器、故障模型与安全回退策略。特斯拉全自动驾驶计算机在两个独立 SoC 之间采用 DMR,体现了设计权衡:DMR 将 TMR 的硬件成本减半,但要求输出不一致时具备安全回退策略 (Bannon 等 2019年)。
Bannon, Pete, Ganesh Venkataramanan, Debjit Das Sarma, 和 Emil Talpes. 2019年. 《Computer and Redundancy Solution for the Full Self-Driving Computer》. 2019 IEEE Hot Chips 31 Symposium (HCS), 1~22. https://doi.org/10.1109/hotchips.2019.8875645.
23 三重模冗余(TMR): 执行三次计算并取多数表决,实现自动单故障纠正,硬件开销为 200%。TMR 最早应用于 1950 年代早期的容错主机,至今仍是辐射暴露场景与单故障纠正优先于硬件效率的安全关键推理的长期范式。
Arifeen, Tooba, Abdus Sami Hassan, 和 Jeong-A Lee. 2020年. 《Approximate Triple Modular Redundancy: A Survey》. IEEE Access 8: 139851~67. https://doi.org/10.1109/access.2020.3012673.
:::
:::
在软件层面,同一决策树继续展开,每个故障特征都路由到能够最廉价地暴露它的那一条证据流。当梯度、损失、激活值或延迟不再符合预期分布时,就会出现静默统计漂移;运行时监控与异常检测(统计离群检验、One-Class SVM)会在最廉价的一层捕捉到它,因为这些检查建立在训练循环本身已经输出的指标之上Chandola 等 (2009年)。数据一致性检查会捕捉到“已损坏但仍存活”的状态或检查点,确认其仍然对应可信数据(Lindholm 等 2019年)。心跳机制将故障停机节点与仅仅变慢的节点区分开来(Kawazoe Aguilera 等 1997年),而看门狗定时器会捕捉到那种不崩溃却停滞的任务(Pont 和 Ong 2002年),并在进度丢失时触发恢复。只有当这些被动信号都不足以奏效时——因为计算本身可能出错而没有任何统计迹象——系统才会为软件实现的冗余付费(SWIFT 风格的指令复制、N 版本编程、Reed-Solomon 重建)Reed 和 Solomon (1960年),其重复或重建出的计算是最昂贵的一层,因此只保留给价值最高的状态。
Chandola, Varun, Arindam Banerjee, 和 Vipin Kumar. 2009年. 《Anomaly Detection: A Survey》. ACM Computing Surveys 41 (3): 1~58. https://doi.org/10.1145/1541880.1541882.
Lindholm, Andreas, Dave Zachariah, Petre Stoica, 和 Thomas B. Schon. 2019年. 《Data Consistency Approach to Model Validation》. IEEE Access 7: 59788~96. https://doi.org/10.1109/access.2019.2915109.
Kawazoe Aguilera, Marcos, Wei Chen, 和 Sam Toueg. 1997年. 《Heartbeat: A timeout-free failure detector for quiescent reliable communication》. 收入 Lect. Notes Comput. Sci. Springer Berlin Heidelberg. https://doi.org/10.1007/bfb0030680.
Pont, Michael J, 和 Royan HL Ong. 2002年. 《Using watchdog timers to improve the reliability of single-processor embedded systems: Seven new patterns and a case study》. Proceedings of the First Nordic Conference on Pattern Languages of Programs, 159~200.
Reed, I. S., 和 G. Solomon. 1960年. 《Polynomial Codes Over Certain Finite Fields》. Journal of the Society for Industrial and Applied Mathematics 8 (2): 300~304. https://doi.org/10.1137/0108018.
这些机制降低了不可靠底层(substrate)的风险,但它们并不能防御由软件栈自身引入的故障。下一层必须思考那些“看起来像是有效计算”、却在腐蚀机器学习流水线中引入 bug 的故障。
Checkpoint 1.3: 分类硬件故障
请理解瞬态、永久性和间歇性故障类别,以及故障—错误—失效的演进过程:
软件故障
一个团队花了三个月测试一个大语言模型,面对复杂的提示词级失败案例,却最终发现其预处理脚本意外地在 512 tokens 处截断了所有输入,从而完全静默地丢弃了整个系统提示词。在追求复杂的算法鲁棒性过程中,工程师们常常忽视机器学习故障的一个常见来源:平庸的软件 bug。在机器学习系统中,数据加载器中的逻辑错误不会导致流水线崩溃;它会微妙地劣化梯度,使得软件故障具有独特的破坏性。
软件故障需要不同于硬件故障的恢复视角。硬件故障源自硅片、电子和物理磨损;软件故障则通过设计选择、依赖版本和流水线胶水代码进入系统。容错问题由此从“替换失效部件”转变为“识别出是哪一个看似有效的变换腐蚀了数据、梯度或预测”。
实际挑战在于,软件故障会与系统中的其他每一种威胁相互作用。数据预处理中的 bug 可能引发分布偏移;数值计算中的实现错误可能损坏模型行为,同时保持张量形状有效;分布式训练中的竞态条件可能使不同 worker 基于不一致的状态进行更新。这些相互作用之所以产生,是因为人工智能软件栈横跨框架、库、运行时环境、分布式系统和部署基础设施。每一层边界都为故障的产生与传播提供了机会,因此软件层面的缓解对于生产级可靠性至关重要。
软件故障的属性与传播
机器学习框架中的软件故障范围从语法和逻辑错误延伸到内存泄漏24、并发 bug 以及集成失败。它们会跨越系统边界传播:张量分配例程中的一个错误可能级联扩散,进而扰乱训练、推理或评估中看似毫不相关的模块。有些故障是间歇性的,只在特定条件下显现,例如高系统负载、特定的硬件配置或罕见的数据输入。
24 内存泄漏:一种编程错误,即分配的内存从未被释放。在机器学习系统中,GPU 内存泄漏具有独特的破坏性,因为加速器内存十分稀缺(每台设备 40–80 GB)且在整个训练流水线中共享。每个批次泄漏的单个张量——可能来自遗留在生产环境中的调试钩子——可能在数小时内耗尽 GPU 内存,触发显式的 OOM 错误,从而在没有检查点的情况下杀死一个长期运行的训练任务。
资源管理不当是突出的故障类别之一。GPU 显存分配会随训练迭代不断累积:中间激活、优化器状态和梯度缓冲区被分配后却没有释放,直到分配器耗尽可用容量并在批次中途抛出 out-of-memory 错误。一个 70B 参数模型在 BF16 格式下使用 AdamW 优化器状态,需要约 840 GB 的 GPU 显存,这已经超过了 640 GB 容量的一台 8 \(\times\) 80 GB 节点,甚至尚未计入激活和临时缓冲区。因此,该状态需要在节点之间进行额外切分,或者卸载到别处。内存压力会在数百次迭代中逐渐累积,若没有逐层内存剖析,很难定位根本原因。
并发与同步错误构成另一类反复出现的故障。在分布式或多线程环境中,并行进程之间的协调不正确会导致竞态条件25或状态不一致。
25 竞态条件:一种时序缺陷,系统行为取决于并发事件不受控的先后顺序。在异步分布式训练中,如果多个 worker 同时更新同一个参数权重,而缺少适当的加锁或版本控制,更新可能被丢失或被覆盖,从而导致发散或产生会破坏收敛的“幽灵”权重,而不会触发错误。
26 死锁:一种状态,两个或更多进程被永久阻塞,每个进程都在等待对方释放资源。在流水线训练中,如果 Stage 1 正在等待一个空闲缓冲区以向 Stage 2 发送激活,而 Stage 2 正在等待 Stage 1 回传反向梯度,整个集群都会停摆。
死锁26是相关的同步故障,表现为 worker 无限期等待永远不会到达的资源或消息。一个高层库中的缺陷可能只有与某个特定版本的低层数值库(如 cuDNN 或 MKL)配合使用时才会显现,因此需要系统性地整体审视系统才能定位根本原因。
软件故障检测与预防
由于许多软件故障会让流水线继续运行,同时却会污染梯度,可靠性证据必须回答两个问题:哪条不变量失效了,以及现在哪种恢复动作是安全的?开篇示例中的提示截断缺陷不应延续到运行时:单元测试应捕获分词器边界,集成回放应捕获批次形状和元数据路径,故障注入测试则应证明由此产生的告警会阻止发布,或回滚到已知良好状态。 表 3 按照每项检查所支撑的恢复主张来组织这些关卡。
| 可靠性证据 | 受检不变量 | 所启用的决策 |
|---|---|---|
| 边界单元测试 | 分词器限制、张量形状、掩码和步骤元数据保持有效 | 在分布式执行前拒绝该变更 |
| 确定性回放 | 在已知良好硬件上,记录批次产生等价状态 | 区分输入或软件缺陷与可疑硬件 |
| 检查点恢复演练 | 已提交的清单恢复每个分片,并在其指定的步骤处继续执行 | 接受该轮次为满足恢复契约 |
| 成员故障注入 | 被杀或分片的 worker 失去所有权,无法用过期 epoch 写入 | 验证租约过期、围栏和通信器重建 |
| 污染注入 | 被修改的分片、缩减的缓冲区或检查点未能通过预期校验器 | 在传播前阻止优化器步骤或回滚 |
| 依赖项回滚测试 | 版本化的运行时和制品集可以回到最后一个已知良好组合 | 授权自动回滚,而非人工修复 |
这些保障措施只有在每个关卡都针对一条具体的污染路径时才真正有意义。只检查分词器是否运行的测试过于薄弱;它必须断言系统提示、标签、掩码和序列长度元数据在预处理后仍以预期语义保留。集成回放随后将一条记录批次依次经过加载、切分、聚合和模型输入构建。故障注入更进一步,它证明检测器在污染状态提交之前触发,且恢复满足所声明的 RPO 和 RTO。泛泛的构建成功并不构成可靠性证据;恢复演练、过期 epoch 拒绝或污染分片拒绝才是。
这些软件实践能够捕获那些通过测试或部署关卡显现的实现缺陷。静默污染更难处理,因为系统可能继续运行并产生错误值,因此下一层是显式验证。
检查—验证:抵御静默数据污染
静默数据污染会不断累积,直至成为常态。
当集群规模扩展到 100,000+ GPU 时,即使每个 GPU 的 SDC 发生率都很小,也会在重复的集合通信操作中原样累积。单个集合通信并不保证一定不含 SDC 事件:在后续分析所用的示例性速率下,单步概率仍然很小,而累积概率会在长时间训练过程中不断增长。标准的 AllReduce 算法假设:只要某个节点是 存活的,其数据就是 正确的。而在机器学习集群中,系统设计必须转向拜占庭容错思维:“先信任,再验证。”
检查—验证方法将这种思维转化为数据路径上的不变量,但每种检查都有明确的边界。对梯度分片计算校验和或哈希,只能检测摘要计算之后发生的字节变化。比较复制型归约缓冲区的摘要,只能检测各 rank 之间的一致性差异。两者都无法证明该 worker 在哈希之前计算出了正确的本地梯度。要提出这一更强的主张,需要一次独立计算、一条算法不变量,或针对已知良好 worker 的回放。下面做一个快速估算,使暴露面具体化。
Napkin Math 1.2: SDC 风险累积
问题:在某个示例性的通用 SDC 速率假设下,计算一个由 100,000 个 GPU 组成的集群中,在单个 2 s 训练步内至少有一个 GPU 发生 SDC 事件的概率。
- 集群规模:100,000 个加速器。
- 单个体风险:\(10^{-6}\)(每 GPU 小时;一个示例性的通用 SDC 速率假设)。
- 暴露量:在 2 秒窗口内,集群的暴露量为 \(100{,}000 \times (2/3600) \approx 56\) 个”GPU 小时”。
- 概率:\(\Pr(\text{at least one SDC}) \approx\) 0.0056 percent。
系统洞见:在这个示例性的恒定速率假设下,一个 100k GPU 的集群预计每 18,000 steps(大约每 10 hours)就会发生一次 SDC 事件,尽管单步概率仅为 0.0056 percent。CRC 或哈希可以保护每个分片或归约缓冲区免受传输或存储过程中的损坏,而冗余归约则可以独立地检验算术路径。区别是重要的:相等的摘要只说明字节相等,并不说明梯度正确。鲁棒性只有当验证覆盖了所声称的失效机制时,才会从”重启”问题转变为”验证”问题。
该计算促成了”检查—验证”的思路,但只有当验证针对真实故障进行时,验证才真正赢得信任。因此,下一步是刻意注入故障,并确认相同的检查能在故障影响模型状态之前捕获该损坏。
故障注入工具与框架
只有当注入的故障与系统必须承受的、生产环境中的故障相似时,验证才有价值。一个声称能够容忍网络分区的多节点训练集群,应当在预发布环境中断开该连接,以便工程师观察编排层会做出什么反应。故障注入 是一种工程实践:刻意扰动系统,以经验验证鲁棒性机制是否有效,从而在生产流量暴露出差距之前确认其有效性。面向机器学习/张量/GPU 的故障注入工具覆盖比特翻转、张量故障以及加速器导向的故障 Gräfe 等 (2023年),而网络分区、延迟注入、依赖终止以及 API 响应故障则属于混沌测试与分布式系统测试实践 (Basiri 等 2016年)。
Gräfe, Ralf, Qutub Syed Sha, Florian Geissler, 和 Michael Paulitsch. 2023年. 《Large-Scale Application of Fault Injection Into PyTorch Models -an Extension to PyTorchFI for Validation Efficiency》. 2023 53rd Annual IEEE/IFIP International Conference on Dependable Systems and Networks - Supplemental Volume (DSN-S), 56~62. https://doi.org/10.1109/dsn-s58398.2023.00025.
故障与错误模型
这种相似性是一项建模决策,而非实现细节。瞬态比特翻转、永久性加速器缺陷以及被损坏的梯度需要不同的检测逻辑,因此实验必须在开始之前明确其持续时间、位置、粒度以及传播路径。
这些选择定义了故障模型:硬件故障如何在系统中显现。与之对应的错误模型 描述该故障如何传播并影响系统行为。
第一个建模选择确定了故障的物理特征。持续时间决定恢复过程应当预期瞬态事件、永久性缺陷,还是难以复现的间歇性条件。位置决定注入的故障是通过存储单元、功能单元还是互连结构进入系统。粒度决定实验是研究单个比特(例如比特翻转),还是多比特突发错误。
错误模型将该物理特征带入机器学习系统。它描述初始的硬件级扰动如何演变为被损坏的权重、错误计算的激活值,或机器学习框架中更高层的逻辑错误。抽象层级之所以重要,是因为每一层暴露的传播路径不同,也会掩盖不同的效应。
故障模型或错误模型的选择对于鲁棒性评估至关重要。例如,一个用于研究单比特瞬态故障的系统 (Sangchoolie 等 2017年) 无法为永久性多比特故障的影响提供有意义的洞见,因为其设计与假设完全建立在不同的故障模型之上。
Sangchoolie, Behrooz, Karthik Pattabiraman, 和 Johan Karlsson. 2017年. 《One Bit Is (Not) Enough: An Empirical Study of the Impact of Single and Multiple Bit-Flip Errors》. 2017 47th Annual IEEE/IFIP International Conference on Dependable Systems and Networks (DSN), 97~108. https://doi.org/10.1109/dsn.2017.30.
Binkert, Nathan, Bradford Beckmann, Gabriel Black, Steven K. Reinhardt, Ali Saidi, Arkaprava Basu, Joel Hestness, 等. 2011年. 《The gem5 simulator》. ACM SIGARCH Computer Architecture News 39 (2): 1~7. https://doi.org/10.1145/2024716.2024718.
错误模型的实现语境同样重要。以 gem5 (Binkert 等 2011年) 等模拟器建模的架构寄存器级单比特翻转,与 PyTorch 模型权重张量中类似的单比特翻转存在实质差异。虽然两者都模拟了值级的扰动,但更底层的模型能够捕捉到软件框架中往往被抽象掉的微架构效应。
部分故障行为模式会在抽象层级之间迁移,而另一些则不会。比较单比特与多比特故障模型的研究表明,影响取决于故障落点及其传播方式,因此来自某个注入故障模型的鲁棒性结果不应被视为普适结论 Papadimitriou 和 Gizopoulos (2021年)。其他重要的行为,例如错误屏蔽 (Mohanram 和 Touba 2003年),可能只在更低的抽象层级上才可观察。这种屏蔽现象会导致故障在传播到更高层之前被过滤掉 (图 22) (Ko 2021年),这意味着基于软件的工具有可能完全遗漏这些效应。
Papadimitriou, George, 和 Dimitris Gizopoulos. 2021年. 《Demystifying the System Vulnerability Stack: Transient Fault Effects Across the Layers》. 2021 ACM/IEEE 48th Annual International Symposium on Computer Architecture (ISCA), 902~15. https://doi.org/10.1109/isca52012.2021.00075.
Mohanram, K., 和 N. A. Touba. 2003年. 《Partial error masking to reduce soft error failure rate in logic circuits》. Proceedings. 18th IEEE International Symposium on Defect and Fault Tolerance in VLSI Systems, 433~40. https://doi.org/10.1109/dftvs.2003.1250141.
Ko, Y. 2021年. 《Characterizing System-Level Masking Effects Against Soft Errors》. Electronics 10 (18): 2286. https://doi.org/10.3390/electronics10182286.
\begin{tikzpicture}[font=\small\sffamily]
\tikzset{%
Line/.style={line width=1.0pt,black!50,text=black},
Box/.style={inner xsep=2pt,
    node distance=0.6,
    draw=VioletLine,
    line width=0.75pt,
    fill=VioletL!40,
    align=flush center,
    minimum width=25mm, minimum height=9mm
  },
Box2/.style={inner xsep=2pt,
    node distance=1.4,
    draw=BlueLine,
    line width=0.75pt,
    fill=BlueL!40,
    align=flush center,
    minimum width=29mm, minimum height=9mm
  },
Box3/.style={inner xsep=2pt,
    node distance=1.1,
    draw=BrownLine,
    line width=0.75pt,
    fill=BrownL!40,
    align=flush left,
    minimum width=55mm, minimum height=9mm
  },
   decision/.style={diamond, minimum width=50mm,node distance=0.6,inner sep=-1ex,
     minimum height=25mm, align=flush center, draw=GreenLine, fill=green!30}
}
\node[Box,rounded corners=9pt](B1){Soft error};
\node[Box,decision,below=of B1](B2){Corrupted  data \\are read?};
\node[Box,decision,below=of B2](B3){Incorrect  output \\ or  system crash?};
\node[Box2,right=of B2](B4){\textbf{Masked} \\ (microarchitecture)};
\node[Box2,right=of B3](B5){\textbf{Masked} \\ (software)};
\node[Box,below=of B3](B6){Failure};
%%
\node[Box3,right=of B4](MLA){\textbf{Microarchitecture-level analysis}
\\[0.5ex]
$\bullet$ Errors on unused components
\\[0.5ex]
$\bullet$ Overwritten by write operations
\\[0.5ex]
$\bullet$ Errors on speculative instructions};
\node[Box3,right=of B5](SLA){\textbf{Software-level analysis}
\\[0.5ex]
$\bullet$ Dynamically dead instructions
\\[0.5ex]
$\bullet$ Logical, compare instructions
\\[0.5ex]
$\bullet$ Uninfluential branch instructions};
%%
\draw[Line,-latex](B1)--(B2);
\draw[Line,-latex](B2)--
node[right,font=\footnotesize\sffamily]{Yes}(B3);
\draw[Line,-latex](B3)--
node[right,font=\footnotesize\sffamily]{Yes}(B6);
\draw[Line,-latex](B2)--
node[above,pos=0.3,font=\footnotesize\sffamily]{No}(B4);
\draw[Line,-latex](B3)--
node[above,pos=0.3,font=\footnotesize\sffamily]{No}(B5);
%fitting
\scoped[on background layer]
\node[draw=BackLine,inner xsep=4mm,inner ysep=5mm,
yshift=2.5mm,fill=BackColor!50,fit=(B4)(SLA)(MLA),line width=0.75pt](BB2){};
\node[below=4pt of  BB2.north,inner sep=0pt,
anchor=north]{\textbf{System-level masking effect analysis}};
\end{tikzpicture}理解这些掩蔽效应,对于在设计故障注入实验时选择适当的抽象层次至关重要。
故障注入方法
故障注入方法以实验规模换取真实感。基于硬件的注入是校准基准:它向物理系统注入故障,以便用真实硬件行为来检验软件层面的假设。基于软件的注入是可扩展的对应方案:它能快速覆盖大量模型状态,但在其结论成为生产可靠性主张之前,必须先针对硬件行为进行校准。
基于硬件的故障注入
方法的选择取决于实验是否需要比特级定位,还是物理辐射真实感。基于 FPGA 的故障注入使用现场可编程门阵列(FPGA),27 这类可重构集成电路,可以被编程以实现各种硬件设计。修改 FPGA 配置会在机器学习模型执行过程中于特定位置和时间引入故障。
27 FPGA(现场可编程门阵列):包含数百万个可编程逻辑块的可重构硬件。就故障注入而言,FPGA 提供了软件级工具无法匹敌的比特级定位精度。
Velazco, Raoul, Gilles Foucard, 和 Paul Peronnard. 2010年. 《Combining Results of Accelerated Radiation Tests and Fault Injections to Predict the Error Rate of an Application Implemented in SRAM-Based FPGAs》. IEEE Transactions on Nuclear Science 57 (6): 3500~3505. https://doi.org/10.1109/tns.2010.2087355.
辐射或束流测试 (Velazco 等 2010年) 将运行机器学习模型的硬件暴露于高能粒子(如质子或中子)。专用测试设施能够实施受控的辐射暴露,以诱发比特翻转及其他硬件级故障,从而提供高度真实的故障场景,以镜像辐射丰富环境中的条件。
基于软件的故障注入
基于软件的故障注入 以物理真实感换取实验规模。这些工具通过修改模型的底层计算图、张量值或中间计算来模拟硬件故障的效果。它们与机器学习开发流程直接集成,无需专用硬件,并允许研究人员快速、经济地开展大规模故障注入实验。
PyTorchFI (Mahmoud 等 2020年) 是一款与 Nvidia Research 合作开发的、专为 PyTorch 设计的故障注入库,适用于回答“张量可见的扰动如何影响模型行为”这一问题。它能够向权重、激活值和梯度注入故障,表明即使简单的比特级故障也可能导致严重的视觉和分类错误,包括在并不存在之处出现“幽灵”对象。
Mahmoud, A., N. Aggarwal, A. Nobbe, J. R. S. Vicarte, S. V. Adve, C. W. Fletcher, I. Frosio, 和 S. K. S. Hari. 2020年. 《PyTorchFI: A Runtime Perturbation Tool for DNNs》. 2020 50th Annual IEEE/IFIP International Conference on Dependable Systems and Networks Workshops (DSN-W), 25~31. https://doi.org/10.1109/dsn-w50199.2020.00014.
弥合硬件与软件之间的差距
抽象层次的选择是基于软件故障注入的核心风险。这些工具提供了速度与灵活性,但并不总能捕捉硬件故障对系统所能施加的全部影响范围。抽象差距 由此产生,因为软件级工具运行在更高层级,可能忽略低层硬件交互或细微的错误传播机制。
像 Fidelity (He 等 2020年) 这样的工具通过映射低层硬件错误行为到软件可见的效果来弥合这一差距。研究源自硬件的故障如何在架构寄存器、存储层次结构和数值运算中传递,使得 Fidelity 注入的软件故障能够近似于故障在物理系统中的表现方式。
He, Yi, Prasanna Balaprakash, 和 Yanjing Li. 2020年. 《FIdelity: Efficient Resilience Analysis Framework for Deep Learning Accelerators》. 2020 53rd Annual IEEE/ACM International Symposium on Microarchitecture (MICRO), 270~81. https://doi.org/10.1109/micro50266.2020.00033.
Example 1.1: 软件故障注入的局限
场景:一个工程团队使用软件故障注入验证分布式训练流水线,得出结论:张量比特翻转总会破坏模型的梯度更新。
诊断:物理束流测试表明,软件注入绕过了低层硬件掩蔽效应(例如 ECC 内存纠错和门级掩蔽),而这些效应本可阻止寄存器级比特翻转去修改软件变量。
系统启示:当软件故障注入绕过了电路级硬件防御时,它会夸大脆弱性。生产环境的可靠性验证需要硬件校准的故障模型,而不能仅靠孤立的软件状态突变。
硬件故障摘要
虽然硬件故障与软件故障代表不同的失效机制,但它们最终都会表现为系统级事件,必须由 故障分析(大规模场景) 中建立的可靠性逻辑来管理。表 4 中的故障特性将故障模型到恢复策略的闭环连接起来。该表比较了瞬态、永久和间歇性故障在持续时间、持久性、成因以及对机器学习系统的影响方面的差异,以便检测与缓解策略与所测试的故障类别相匹配。
Constantinescu, C. 2008年. 《Intermittent faults and effects on reliability of integrated circuits》. 2008 Annual Reliability and Maintainability Symposium, 370~74. https://doi.org/10.1109/rams.2008.4925824.
| 维度 | 瞬时故障 | 永久性故障 | 间歇性故障 |
|---|---|---|---|
| 持续时间 | 短暂、临时 | 持续存在,直到修复或更换 | 间歇出现,反复出现与消失 |
| 持续性 | 故障条件消失后随之消失 | 在得到处理前持续存在 | 不规则地反复出现,并非始终存在 |
| 成因 | 外部因素(例如电磁干扰或宇宙射线) | 硬件缺陷、物理损坏、磨损 | 不稳定的硬件条件、松动连接、老化部件 |
| 表现形式 | 比特翻转、毛刺、临时数据损坏 | 卡死故障、部件损坏、设备完全失效 | 偶发比特翻转、间歇性信号问题、偶发异常 |
| 对机器学习系统的影响 | 在计算中引入临时错误或噪声 | 导致一致性的错误或失败,影响可靠性 | 导致间歇且不可预测的错误,难以诊断和缓解 |
| 检测 | 纠错码、与预期值比较 | 内置自测、纠错码、一致性检查 | 监控异常、分析错误模式和相关性 |
| 缓解措施 | 纠错码、冗余、检查点与重启 | 硬件修复或更换、部件冗余、故障切换机制 | 稳健设计、环境控制、运行时监控、容错技术 |
检查点:保存进度
当机架顶部交换机在 1750 亿参数模型训练运行的第两周发生故障时,集群会瞬间失去 64 个 GPU。系统不能简单地从头重新开始;数周计算投入的沉没成本过高。故障分析(大规模场景) 中的故障分析表明,大规模训练系统会频繁出现此类故障,因此需要稳健的机制来保存并恢复进度。
训练容错有三项职责:保存状态、检测并分类故障,以及恢复或调整作业规模。检查点提供第一项职责。后续各节则构建其余恢复机制:故障检测决定发生了什么,恢复程序将进程组恢复到一致状态,弹性恢复则决定作业能否在变更后的工作节点集合下继续运行。
两项恢复目标将这些职责转化为契约。恢复点目标(RPO)——故障后可接受的最大已完成工作量损失——约束了检查点年龄和复制延迟。 恢复时间目标(RTO)——从故障到有用恢复工作之间可接受的最大时间——约束了检测、资源替换、恢复和预热。20 分钟的检查点间隔无法在不引入更频繁的持久化日志或副本的前提下承诺低于 20 分钟的 RPO;如果仅重新加载检查点就需要 8 分钟,那么 5 分钟的 RTO 就不可能实现。Young–Daly 公式 Beyer 等 (2016年) 最小化了预期浪费;而 RPO 和 RTO 施加的服务约束,预期值最优解仍必须满足。
Beyer, Betsy, Chris Jones, Jennifer Petoff, 和 Niall Richard Murphy. 2016年. Site Reliability Engineering: How Google Runs Production Systems. O’Reilly Media.
Definition 1.1: 检查点
检查点 是训练状态(参数、优化器状态和数据加载器位置)的完整训练状态定期序列化到持久化存储。
- 重要性:它通过以检查点 I/O 换取返工来最小化系统故障后的工作损失。写入过于频繁会在存储流量上浪费加速器时间;写入过于稀疏则可能导致故障后重放大量已完成步骤。Young–Daly 公式 \((\tau_{\text{opt}} = \sqrt{2 \cdot T_{\text{write}} \cdot \text{MTBF}_{\text{system}}})\) 通过选择平衡写入成本与预期损失工作量的间隔来刻画这一局部权衡。
- 区别:与增量备份不同,检查点必须捕获精确的执行上下文(包括随机种子和学习率计划),以确保优化循环能够确定性地恢复。
- 常见误区:一种常见误解是认为检查点“只是写入磁盘”。实际上,对于大模型而言,它是一种存储系统压力测试:来自数千个 GPU 的并发写入可能触发检查点风暴,从而将整个网络互连结构饱和 \((\text{BW})\)。
一个在状态保存机制失效时失去电源的训练集群,会损失数周计算出的价值数百万美元的梯度更新。防御手段是定期将模型状态写入持久化存储。检查点捕获了足以从某个记录点继续训练的状态:模型参数、优化器状态、28 训练进度指示符,以及用于可复现性的随机状态。
28 Adam 优化器状态: Adam 优化器(Adaptive Moment Estimation)为每个参数维护一阶矩(\(m\))和二阶矩(\(v\))估计值,与 vanilla 随机梯度下降(SGD)相比,内存需求翻了三倍(3\(\times\): 参数 + 两个状态向量)。对于一个含 175B 个参数的模型,仅优化器状态就达到 2.1 TB,通常主导检查点大小和恢复时间,因而优化器状态是检查点 I/O 设计中的主要瓶颈。

优化器状态而非权重主导了检查点大小。
来自故障分析的检查点间隔
节 1.0.2 中给出的 Young-Daly 公式提供了最优检查点间隔 \(\tau_{\text{opt}} = \sqrt{2 \times T_{\text{write}} \times \text{MTBF}_{\text{system}}}\),但在两个输入都已知之前无法直接应用。故障分析(大规模场景) 中的故障分析提供系统 MTBF 项,本节前文确立的检查点载荷则提供 \(T_{\text{write}}\)。两者齐备后,该公式便不再是一条抽象定律,而成为本章自身集群的具体调度方案。
检查点权衡绘制了这一权衡曲线,示例为一个 175B 参数集群:保存开销随间隔延长而下降,而故障导致的返工成本随之上升,Young-Daly 最优间隔位于两者之和的最小点。其取整的输入传达了曲线的形状;下文计算则依据本章自身算出的 MTBF 与写入时间,确定精确间隔。
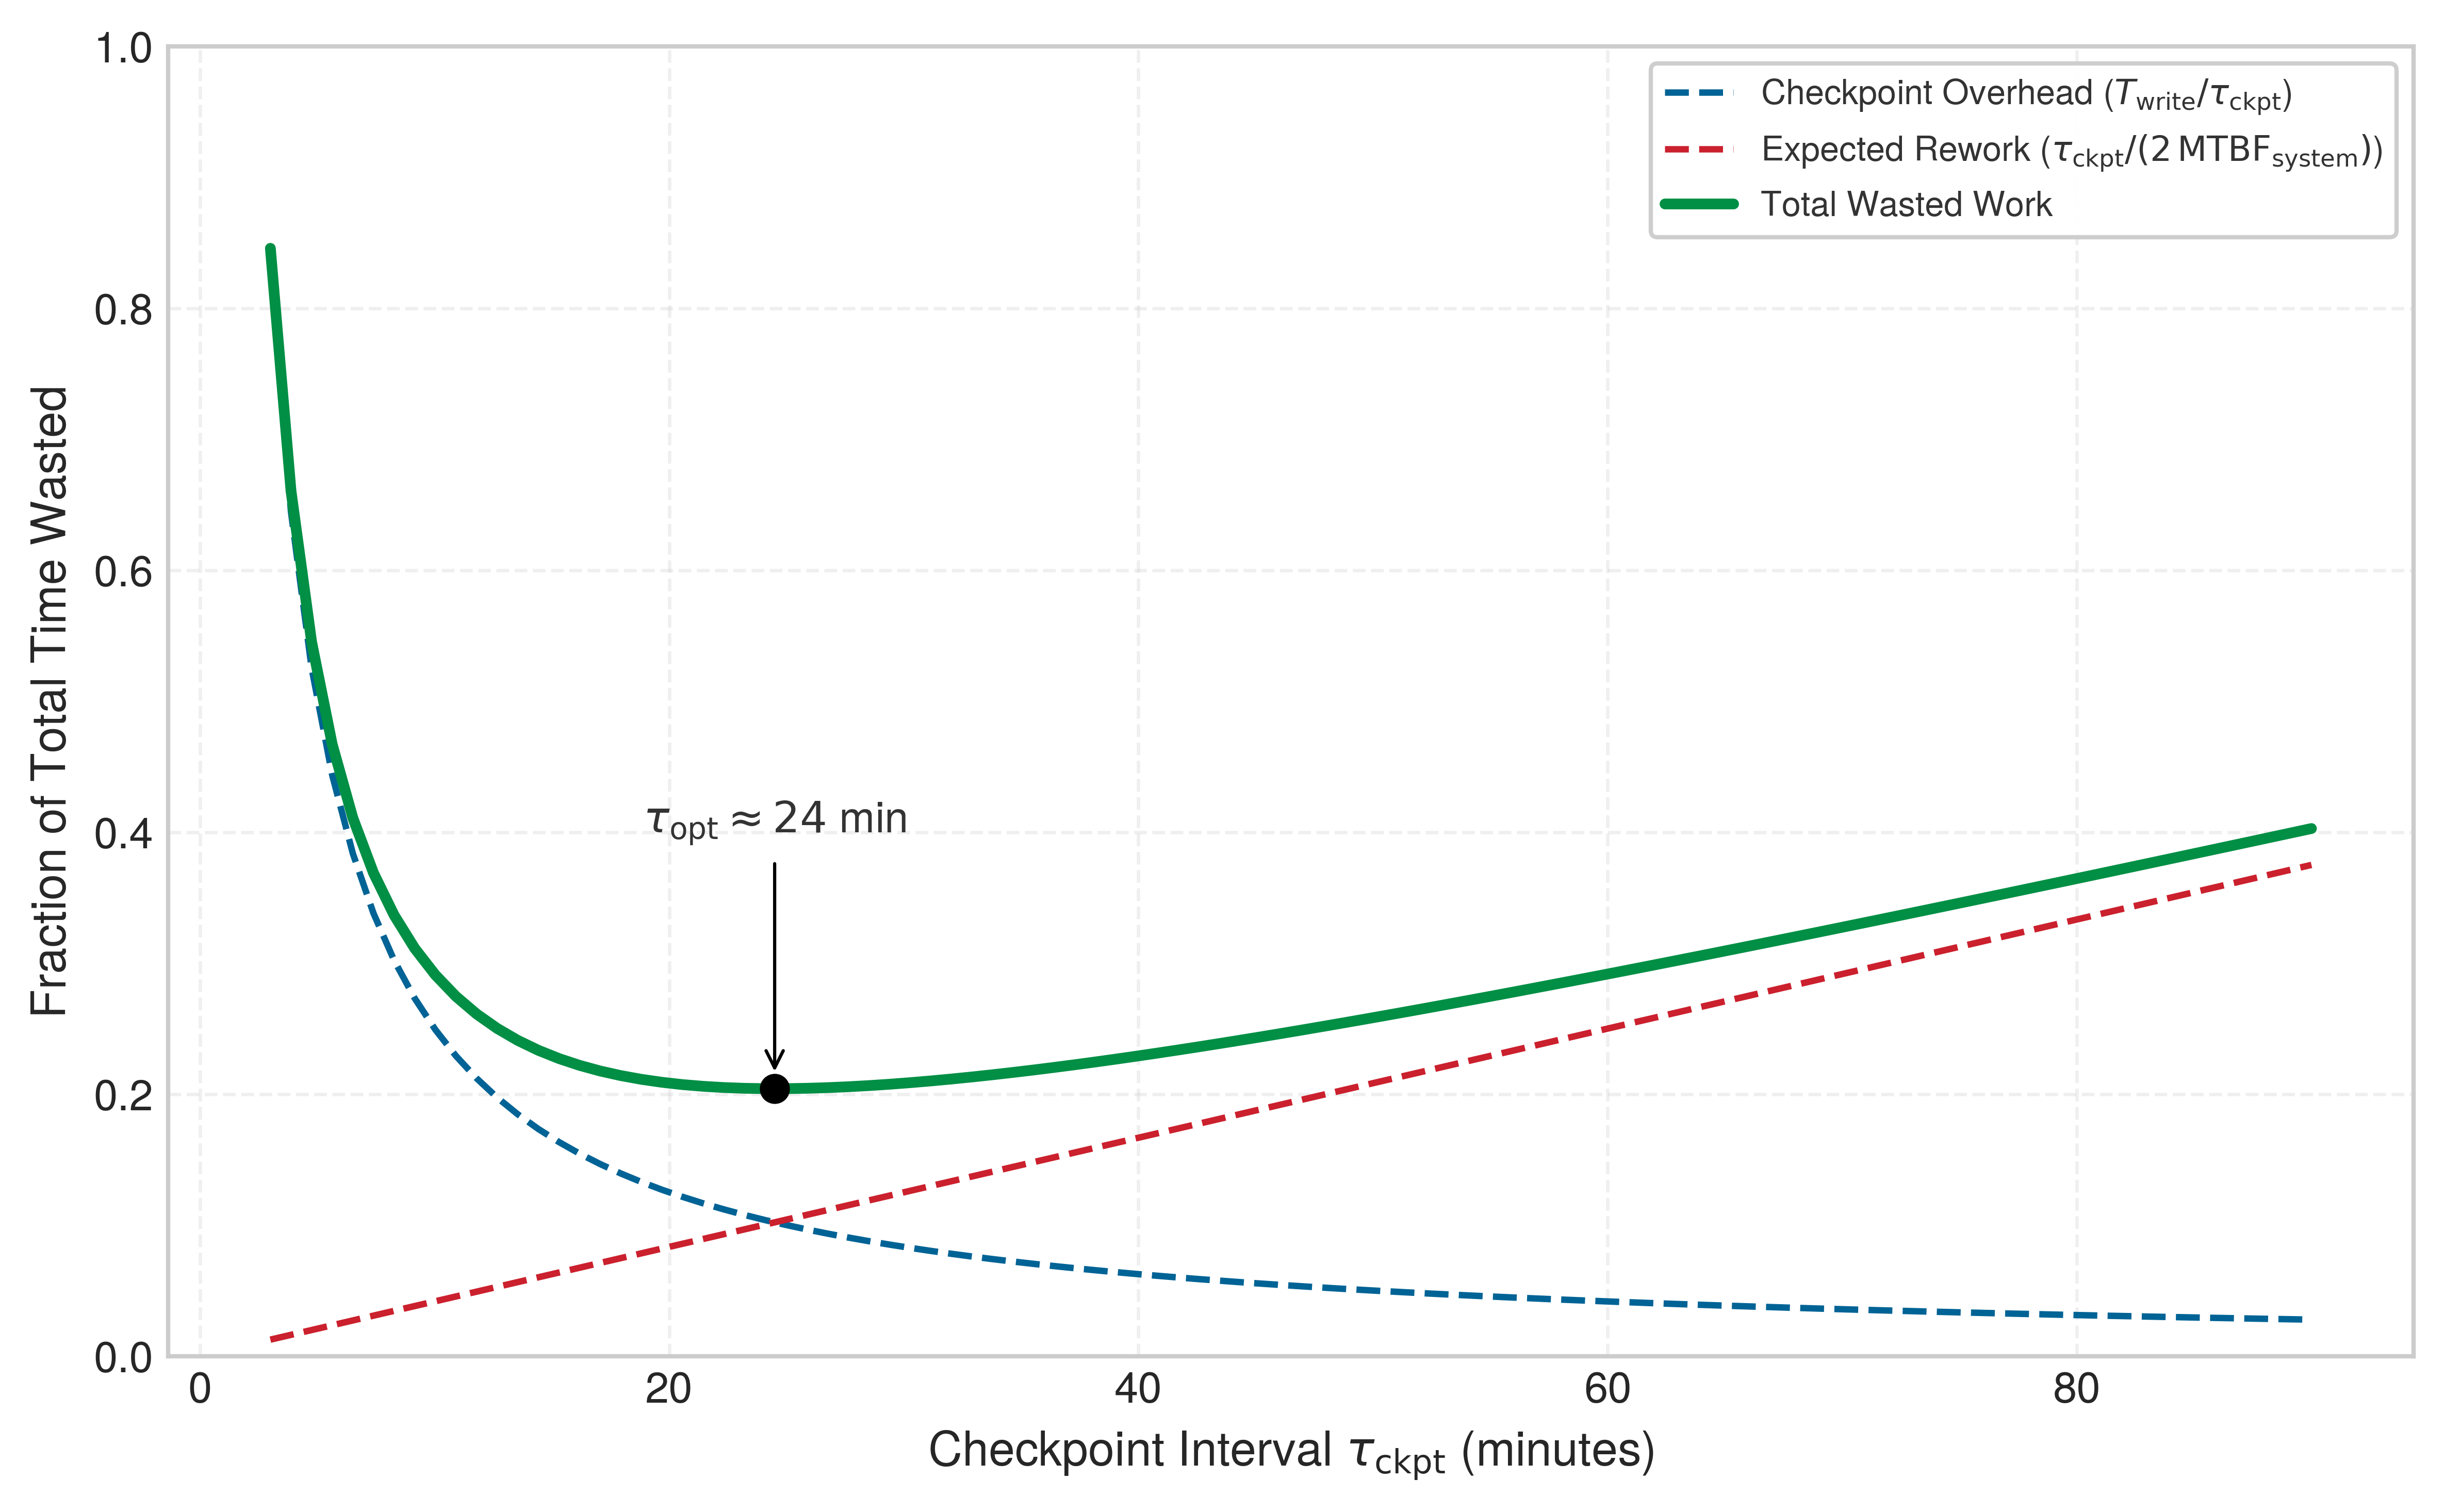
本章自身的 10,000-GPU 集群同时提供两个输入,用计算得到的数值替换 图 23 中的概略数值。该工作级联(节 1.0.4)将系统 MTBF 计算为 3.69 hours,而本节先前计算出的检查点载荷写入 37 s(即 3.7 TB 检查点,大小为 100 GB/s)。将这些值代入 Young-Daly 公式,即得到该集群的标准间隔。
Napkin Math 1.3: **Young-Daly 最优间隔**
问题:一个 10,000-GPU 集群的 MTBF 为 3.69 hours。完整模型检查点写入耗时 37 s。最优的检查点频率是多少?
数学: 应用 Young-Daly 公式:\(\tau_{\text{opt}} = \sqrt{2 \cdot T_{\text{write}} \cdot \text{MTBF}_{\text{system}}}\)
- 换算为统一单位:\(\text{MTBF}_{\text{system}} =\) 3.69 hours \(\times\) 3600 s/hour = 13284 s。
- 代入并求解:在 \(T_{\text{write}} =\) 37 s 与 \(\text{MTBF} =\) 13284 s 条件下,公式给出 \(\tau_{\text{opt}} \approx\) 991.4 s,即约 16.5 min。
系统洞见:在该间隔下,“检查点开销”(保存所花时间 + 重新计算所花时间)被最小化至约 7.5 percent。若改为每小时检查点一次,则会增加故障风险,并浪费约 14.6 percent 的集群容量。随着集群规模扩大,最优间隔必须相应缩短,以跟上不断下降的 MTBF。
这一结果说明了故障分析为何重要:若不知道系统 MTBF,运维人员就无法理性设定检查点间隔。在该间隔下,检查点开销约占训练时间的 7.5 percent,但该估计依赖于那些在生产环境中往往不成立的假设。
Systems Perspective 1.3: **Young-Daly 公式的假设**
一阶 Young-Daly 公式提供了有价值的直觉,但其建立在若干可能不成立的假设之上(当写入时间相对于 MTBF 不可忽略时,尤其如此;参见 二阶 Daly 检查点间隔的推导 中的二阶 Daly Taylor 展开逐步证明与误差分析):
- 故障服从指数分布:假设故障率恒定。真实系统呈现”浴盆曲线”行为,在早期失效(burn-in)与磨损(wear-out)阶段故障率更高。
- 检查点时间确定:假设 \(T_{\text{write}}\) 恒定。实际上,由于存储争用、网络拥塞和内存压力,检查点时间会波动 2–3\(\times\)。
- 恢复时间等于检查点时间:假设恢复过程读取与检查点写入相同的数据。通常由于作业调度延迟、拓扑重建和预热,恢复时间比检查点时间多 3–5\(\times\)。
- 单一故障模式:假设一次只发生一次故障。相关故障(电源、冷却、共享交换机)会违反这一假设。
- 无限时间线:针对长训练运行进行优化。对于总时长与 MTBF 相当的短运行,需要不同的分析。
当假设被违反时,最优间隔可能显著偏移,但重启开销不应被视为在每个检查点都支付一次。在一阶 lost-time 模型中,重启时间会向总期望浪费量中加入一项每次故障的恢复项;除非显式推导并校准了考虑恢复的 Daly 风格模型,否则它并不能替换 \(T_{\text{write}}\) 在 \(\sqrt{2 \cdot T_{\text{write}} \cdot \text{MTBF}_{\text{system}}}\) 中的位置。
检查点—恢复时间线 通过展示训练运行期间的事件序列,使故障的时间成本具体化:生产性计算、周期性检查点、故障事件,以及带有相应浪费工作的恢复过程。
:::
:::
检查点—恢复时间线 中的时间线揭示了为什么 \(T_{\text{restart}}\) 的重要性与 \(T_{\text{write}}\) 同等重要:总失败成本等于损失的工作量(上界为 \(\tau_{\text{opt}}\))与恢复时间之和,而恢复时间包括作业调度、检查点加载和流水线预热。当 \(T_{\text{restart}}\) 超过 \(T_{\text{write}}\) 达 3–5\(\times\) 的生产系统,应将恢复时间计入其总浪费与服务水平目标(SLO)预算,并且应当采用有引用支持的、感知恢复的检查点模型,而不是把重启时间折入每个检查点的写入项。
检查点开销分析
除检查点写入所消耗的时间之外,检查点机制还会通过内存消耗和训练中断带来额外开销。检查点序列化需要内存缓冲区来收集分布式状态并准备写入数据。对于同步检查点,所有 worker 必须在其检查点完成前将检查点数据保留在内存中,这可能需要显著的额外内存分配。
同步检查点会在检查点写入期间暂停训练。即使存储很快,这种暂停也会打断训练流水线,并可能导致 GPU 空闲。数据加载和前向传递在检查点操作期间无法进行。
公式 8 量化了因检查点而浪费的时间:
\[ f_{\text{ckpt}} = \frac{T_{\text{write}}}{\tau_{\text{ckpt}}} + \frac{T_{\text{pause}}}{\tau_{\text{ckpt}}} \tag{8}\]
其中,\(f_{\text{ckpt}}\) 是损失到检查点上的无量纲时间比例,\(T_{\text{write}}\) 是检查点写入时间,\(\tau_{\text{ckpt}}\) 是检查点间隔,\(T_{\text{pause}}\) 是除检查点写入本身之外的任何训练暂停,包括内存分配、协同和序列化。
“停止世界”成本
同步检查点在大规模部署下的经济影响十分严重。当 10,000-GPU 集群因多 TB 检查点在共享存储上通常需要 2 分钟而暂停时,会消耗 \(10,000 \times \frac{2}{60} \approx 333\) 空闲 GPU 小时,而单个检查点浪费的计算量约为 $3 per GPU-hour costs about $1,000。若检查点每小时发生一次,这种空闲时间会累积为每天约 $24,000 的存储 I/O 等待成本。这一经济现实推动了异步检查点策略的积极采用,从而将数据传输移出关键路径。 按模型类型的检查点开销 揭示了检查点特性如何随模型架构而大幅变化:更大的模型需要更长的写入时间,同时也受益于相应更长的最优间隔。
检查点风暴
按模型类型的检查点开销 中的原型 A 行使用混合精度优化器占用空间(2.1 TB),而非引言中引用的完整 FP32 训练状态总量(3.7 TB)。
| 模型类型 | 混合精度检查点大小 | 写入时间 (100 GB/s) | 最优间隔 (5 h 仅 GPU 的 MTBF) | 保存开销 |
|---|---|---|---|---|
| 原型 A(175B 稠密 LLM) | 2.1 TB | 21 s | 14.5 min | 2.4% |
| 20B 稠密 Transformer 类 | 240 GB | 2.4 s | 4.9 min | 0.8% |
| BERT-Large | 1.4 GB | 0.014 s | 22 s | 0.06% |
| 原型 B(大规模 DLRM) | 4 TB | 40 s | 20 min | 3.3% |
| ResNet-50 | 102.4 MB | 0.001 s | 6 s | 0.02% |
| 视觉 Transformer 类 | 1.2 GB | 0.012 s | 21 s | 0.06% |
虽然从理论上看,检查点化的开销对单个模型而言似乎可以接受,但写入这些庞大的状态文件会引入一个新的瓶颈。当数千个 GPU 同时尝试向共享文件系统写入数 GB 数据时,由此产生的 I/O 拥塞可能使整个集群陷入停滞。该 I/O 突发规模的直观体现,是将示例从单个模型扩展到数千个并发写入者。
Example 1.2: 检查点风暴
场景:一个 10,000 GPUs 分布式训练集群在同一时刻将每个工作节点的模型/嵌入分片(每个 10 GB)写入共享存储。
诊断:同时进行的非协调写入会在同一瞬间产生 100 TB 的网络流量。交换缓冲溢出,丢包激增,共享存储控制器卡死,导致整个集群停滞。
系统启示:同时触发工作节点检查点会引发灾难性的 I/O 风暴。分布式平台必须错峰检查点刷新,或通过异步主机内存暂存驱动器缓冲写入。
虽然 按模型类型的检查点开销 所建议的开销百分比看似温和,但真实部署中检查点时间往往远超这些理论估算。诊断此类差异需要审视完整的系统栈。
Example 1.3: 调试检查点开销
场景:一个由 64 nodes 组成的集群训练一个参数规模为 70B 的模型,每次检查点花费 10 minutes(即 30 percent 的吞吐量惩罚),未能达到 2 minutes 的目标。
诊断:所有 64 nodes 同步竞争同一条 10 Gbps 共享 NFS 链路(1.25 GB/s),将每个节点的写入带宽降低到 20 MB/s。这 10 分钟的暂停是物理带宽瓶颈,增加更多 worker 无法解决。
系统经验:当物理 I/O 带宽饱和时,仅靠算法层面的调整无法解决检查点开销问题。实现异步 Non-Volatile Memory Express(NVMe)暂存(GPU \(\to\) 主机 CPU \(\to\) 本地 NVMe \(\to\) 后台 NFS)可将关键路径上的暂停时间降低到 1 percent 以下。
区间计算决定了系统何时保存状态。下一个实现问题是:如何在不使检查点本身成为关键路径的前提下写入并恢复该状态。
同步与异步检查点
同步与异步检查点方法会带来不同的故障恢复权衡。同步检查点 保证全局一致状态,所有 worker 处于同一训练步,简化了恢复逻辑。所有 worker 协调以到达一致状态、写入各自部分,并在所有写入完成后才恢复训练。
异步检查点减少了训练中断,但需要跟踪哪些 worker 完成了哪些检查点,从而增加了恢复协调的复杂度。worker 将自身状态快照到 CPU 内存或暂存存储中,然后继续训练,同时后台进程将快照写入持久化存储。29
29 异步检查点:通过将 GPU 状态经由 CUDA stream 暂存到 CPU 内存,再在后台线程中写入存储,将检查点写入流水线化到训练计算之后。当有充足的 CPU 暂存内存时,DeepSpeed 等实现可以接近非常低的检查点开销,将检查点 I/O 延迟与训练关键路径解耦,代价是更高的主机峰值内存消耗。
检查点存储与恢复
Checkpoint Storage 所描述的分级检查点存储架构——本地 NVMe 提供速度、分布式文件系统提供持久性、对象存储提供长期保留——构成了恢复机制运行的存储基础。容错问题的关键不在于检查点存储在哪里,而在于恢复时读取它们有多快。恢复时间取决于存储层的带宽:本地 NVMe 支持最快的恢复(每个节点 5–10 GB/s),分布式文件系统以中等速度提供持久性(聚合 50–200 GB/s),而对象存储的恢复最慢,但在灾难恢复场景中提供最高的持久性。
检查点协调模式
对于分片模型,从分布式检查点中恢复需要理解确保检查点一致性的协调协议。当训练跨越多个 worker 时,存在两种主要方法:集中式检查点(由协调器收集全部状态并写入单个检查点)和分布式检查点(每个 worker 写入检查点的各自部分)。
集中式检查点
在集中式检查点中,worker 将自身状态发送给协调器进程,由协调器组装并写入完整检查点。这种方法简化了检查点管理并产生自包含的检查点文件,但所有收益都要由协调器来承担:所有状态都要经过协调器的网络链路,协调器需要为整个检查点预留内存,协调器故障会导致检查点操作丢失。该模式在数十个 worker 的规模下可以勉强适用,此时管理上的简洁性可能超过瓶颈的代价;但当 worker 达到数百或数千个时,协调器既成为吞吐量的瓶颈,又成为单点故障源,因而变得不可行。
决策边界是状态的大小和写入者的数量。当操作简洁性比聚合带宽更重要时,集中式检查点具有吸引力;但一旦检查点本身成为集群级对象,就必须采用分布式与分片方法。
分布式检查点
在分布式检查点中,每个 worker 将检查点的各自部分写入共享文件系统或对象存储,正如 图 24 与集中式方法所对比的那样。协调器负责发出何时检查点的信号并确认完成,但状态直接从 worker 流向存储,无需聚合。
协调协议分为六个步骤:
- 协调者广播带有检查点 ID 的检查点请求
- 每个工作节点达到一致状态(屏障同步)
- 每个工作节点向一个与代次相关的暂存前缀写入不可变分片,并记录其字节长度和加密摘要
- 每个工作节点向协调者确认持久化写入完成
- 在所有确认之后,协调者写入不可变清单;该清单指明训练步骤、拓扑、模型与优化器格式、数据加载器位置、随机状态,以及每个分片的长度与摘要,随后发布提交标记或指向该清单的原子指针
- 协调者广播检查点完成,训练继续
清单——而非目录的存在或一组看似合理的分片名称——定义了已提交的检查点代次。恢复仅接受已发布的清单,且所有分片均与其记录的长度和摘要相符;缺少最终发布的暂存分片不可访问,可以垃圾回收。这条规则防止了部分被覆盖的 latest 目录伪装成可恢复状态,并使代次回滚显式化。实际上,清单所记录的一致性切点决定了系统能够声称严格一致性、有界异步一致性还是最终一致性。
Systems Perspective 1.4: 检查点一致性模型
理想化的协议假设第 2 步能够快速完成。在大规模场景下,这种屏障同步会成为主导性的检查点开销,因为 10,000+ GPU 集群中几乎总是至少有一个较慢的工作节点。
严格同步:所有工作节点在完全相同的训练步骤上执行检查点。提供最强的一致性,但屏障同步带来最高的开销。
有界异步:工作节点可以彼此相差 \(k\) 个步骤(通常为 \(1 \le k \le 3\))。检查点管理器跨工作节点跟踪“检查点波前”。恢复使用所有分片中最早的一致性切点。这以完全一致性换取大幅降低的同步开销,也正是生产系统实际采用的方案。
最终一致性:工作节点在方便时执行检查点,在恢复期间进行对账。开销最低,但需要复杂的恢复逻辑来重建一致状态。
基本协议存在一个微妙的正确性缺陷:如果协调者在工作节点准备完分片之后、记录最终决定之前崩溃,系统就不应将这些分片暴露为有效检查点。生产系统可以使用两阶段提交,30 一种经典的分布式系统协议 (Gray 1978年),使检查点决定具有原子性:
30 两阶段提交(2PC):由 Gray (1978年) 形式化,2PC 确保所有参与者原子地提交或中止。该协议已知的弱点是阻塞:如果协调者在参与者准备之后、它们获知决定之前失败,已准备参与者必须等待持久化决定被恢复。超时可以触发协调者恢复,但本身不能授权单方面回滚。
Gray, J. N. 1978年. 《Notes on data base operating systems》. 收入 Operating Systems: An Advanced Course. Springer Berlin Heidelberg. https://doi.org/10.1007/3-540-08755-9_9.
在准备阶段,工作节点写入暂存位置并向协调者报告成功。协调者随后在通知参与者之前记录持久的提交或中止决定;已提交的检查点通过完整元数据或提交标记变得可见。如果协调者在准备阶段之后失败,参与者将保持阻塞,直到原始协调者或替代协调者恢复该持久决定。未提交的暂存分片只有在恢复确认不存在任何提交决定之后才可以垃圾回收。一致性仍然是一个独立的要求:同步梯度更新自然会形成所有工作节点应用了相同更新的步骤边界,但异步训练和流水线并行需要更仔细的协调来定义一致切点。
分片检查点
现代分布式训练框架使用 ZeRO 和 FSDP 等技术,在工作节点之间划分模型状态。在这些配置中,没有任何单个工作节点持有完整的模型状态。每个工作节点只持有其被分配的参数分片以及对应的优化器状态。
分片检查点31 (Rajbhandari 等 2020年) 采用这种分布:每个工作节点只写入自己的分片,从而大幅降低每个工作节点的写入量。恢复加载分片,并根据恢复配置将状态重新分布到工作节点。
31 分片检查点: 每个工作进程只保存其本地分区,而不是将状态汇集到单个写入进程。对于使用 1,024 个工作进程训练 175B 模型的 ZeRO-3 或 FSDP,每个工作进程写入约 3.6 GB,而不是由单个写入进程处理 3.7 TB,从而使所有节点并行执行 I/O。其代价是:恢复要求所有分片均存在且保持一致,这使检查点协议更加复杂,而且任何单个分片的存储故障都会使整个检查点失效。
这种方法使超大规模模型也能高效保存检查点。一个具有 175B 个参数的模型,其大小为 3.7 TB 的检查点分布在 1,024 个工作进程上,每个工作进程只需写入 3.6 GB,使用本地 NVMe 存储即可在数秒内完成。
当恢复时的工作进程数量与保存检查点时不同,分片重分布必须将状态重新映射到新的工作进程配置。这种情况可能由弹性扩展或硬件变更引起。框架对灵活重新分片的支持,使系统即使在工作进程数量变化时也能恢复。然而,仅有有效的检查点还不够。分片检查点缓解了 I/O 风暴,但系统仍须识别故障、触发恢复并协调分布式分片,才能继续训练。检测与恢复的速度决定了中断的实际成本。
Checkpoint 1.4: 思考检查点开销
检验你对故障率和检查点成本如何决定最优检查点间隔的理解:
故障检测与恢复
一个 GPU 静默挂起,利用率降至零,而与其协同工作的其他 GPU 在 AllReduce 屏障处无限期等待。系统发现这个掉队节点并重启它所需的时间,每增加一分钟,就会因集群空转而损失数千美元。检查点保存状态,但恢复过程本身决定了一次故障会浪费多少计算资源。
公式 9 将恢复时间分解为四个主要组成部分:
\[ T_{\text{recovery}} = T_{\text{detect}} + T_{\text{restart}} + T_{\text{load}} + T_{\text{warmup}} \tag{9}\]
其中:
- \(T_{\text{detect}}\): 从实际硬件故障发生到系统将其判定为故障的时间
- \(T_{\text{restart}}\): 作业调度器分配新资源并启动替代进程所需的时间
- \(T_{\text{load}}\): 从分布式存储将检查点状态读入 GPU 内存所需的 I/O 时间
- \(T_{\text{warmup}}\): 系统重新填充数据流水线、即时(JIT)编译内核并使吞吐量稳定所需的时间
每个组成部分都有不同的优化机会,主导项也随集群配置而变化。理解这一分解有助于针对瓶颈投入资源,而不是均匀地改进所有组成部分。
故障检测机制
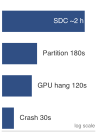
检测延迟从秒级(崩溃)上升到小时级(静默损坏)。
检测是第一道防线,受速度与误报率之间的根本性权衡支配。超时设置若过于激进,会把临时的网络抖动误判为节点故障,从而触发不必要且昂贵的重启;超时设置若过于保守,则会让整个集群在死节点拖慢同步时持续空闲。
心跳监控是标准机制:每个 worker 定期向中央协调器或监控服务发送“我还活着”信号。心跳缺失会触发故障分类。心跳间隔 \(H\) 与超时 \(T_{\text{timeout}}\) 控制这一权衡。在高规模集群中,心跳到达时间常因网络拥塞而服从重尾分布,因此需要自适应超时而非固定阈值。生产系统通常采用 \(T_{\text{timeout}} = H + k\sigma_d\),其中 \(k\) 取值范围为 3 到 5,\(\sigma_d\) 表示网络延迟的观测标准差。
集合通信超时提供第二层检测。在同步训练中,若某个必需 rank 消失,则下一步所需的集合会成为一个不完整的关键路径依赖。AllReduce 需要所有 rank 的贡献才能产生归约结果;其他集合的进度与失败行为取决于所用操作与运行时。传输与进程组超时界定了作业在宣布操作失败并进入恢复前需要等待多久。NCCL32 为此提供可配置的传输与 RAS 超时参数,而更高层框架可能施加进程组操作超时。这些设置通常较为保守,以避免在通信 legitimately 缓慢期间导致作业崩溃,这不幸地延长了 \(T_{\text{detect}}\)。
32 NCCL 超时:NVIDIA 的集合通信库暴露了传输与 RAS 超时控制参数,例如 NCCL_IB_TIMEOUT 和 NCCL_RAS_TIMEOUT_FACTOR (NVIDIA 2026年)。更高层的启动与分布式训练框架可以添加自己的重启与操作超时行为 (PyTorch Contributors 2026年b)。激进的超时设置能加快故障检测,但在大模型上的合法长集合操作期间存在误报风险,从而迫使检测延迟与训练稳定性之间进行权衡,而该权衡没有普适的最优解。
NVIDIA. 2026年. NCCL User Guide.
PyTorch Contributors. 2026年b. torchrun (Elastic Launch). PyTorch documentation.
容器编排健康检查提供第三层。Kubernetes 与 SLURM 提供存活探针(验证进程正在运行)与就绪探针(验证进程已准备好处理请求)。这些检查独立于训练框架运行,能够捕获应用级心跳可能遗漏的故障,例如进程存活但已死锁的情况。
损失尖峰 检测暴露的是异常,而非其成因。静默硬件损坏可能产生突发的损失或梯度范数尖峰,但坏批次、优化器不稳定、数据排序缺陷或分布式状态不匹配同样可能引发此类尖峰。因此,鲁棒系统会在可疑更新提交前暂停,保留输入与 worker 证据,并在已知良好的硬件上重放该步。哈希后校验和可以定位发生变化的字节,而按 rank 重放或冗余计算则可以检验 worker 是否产生了错误的梯度。系统只有在证据指向该设备时才会卸载硬件;否则,它会修复产生相同症状的数据、优化器或同步路径。
训练动态监控将检测扩展到显式错误之外。监控损失值、梯度范数与激活统计量,可以检测出那些不触发异常、却产生错误结果的 Byzantine 故障。突然的损失尖峰、梯度爆炸,或各 rank 梯度分布中的统计异常,都可能指示原本会持续数小时才暴露的静默损坏。
因此,实际的问题是:这些检测层相互作用后,检测真正需要多长时间。
Systems Perspective 1.5: 现实中的故障检测延迟
生产经验表明,故障检测耗时显著长于理论心跳超时时间所暗示的时长。核心挑战在于区分故障与拖慢者(stragglers),正如 tbl-fault-tolerance-detection-latencies 所记录。这些延迟之所以存在,是因为激进的超时会导致误报(杀死健康但较慢的 worker),而保守的超时则会延迟真实故障的检测。生产系统通常采用多阶段检测:快速初始超时触发调查,较慢的确认超时触发恢复。
| 故障类型 | 典型检测耗时 | 原因 |
|---|---|---|
| 进程崩溃 | 5–30 秒 | 心跳超时 + 验证重试 |
| GPU 挂起 | 30–120 秒 | 必须与合法较慢的 kernel 区分 |
| 网络分区 | 60–180 秒 | 必须与临时拥塞区分 |
| 静默数据损坏 | 数分钟至数小时 | 需要统计异常检测 |
恢复流程
故障分类后,恢复流程会执行一系列刚性步骤以恢复一致性:
- 作业终止:向所有存活 worker 广播
SIGTERM。在同步数据并行训练中,单个 worker 的丢失会使全局通信器失效,从而强制进行完整拆除。 - 资源回收:调度器将失败节点标记为“draining”,以防止立即重新调度,并从备用池请求替换资源。
- 作业重启:启动新容器(如有缓存则从缓存中启动),并在所有节点上重新初始化训练二进制。
- 检查点加载:每个 worker 从分布式文件系统读取其状态分片。对于分片检查点,每个 worker 仅加载自己的分区。
- 状态同步:各 rank 握手以建立新的通信器(例如
ncclCommInitRank),worker 确认它们都处于相同的训练步。 - 训练恢复:数据加载器快速推进到正确的批次索引,训练循环从检查点步继续。
自动恢复系统会在无人工干预的情况下执行这些步骤。现代训练框架与集群管理器集成,以自动化该流程的各个环节。DeepSpeed 文档化了模型和 ZeRO 优化器检查点的 save/load 流程,这些流程提供了故障后所需的持久状态 (DeepSpeed Developers 2026年a)。PyTorch 的 torchrun 弹性启动文档通过其 rendezvous 机制记录了故障与成员变更行为,这是一种由协调器支撑的协议,用于在重启后让存活 worker 就成员与 rank 达成一致 PyTorch Contributors (2026年a)。
恢复验证是最后、也常常被忽视的一步。加载检查点后,验证通过确认模型参数与预期形状和数据类型匹配、运行若干训练步并检查损失是否与故障前值一致、以及确认梯度计算产生预期统计量,来确认恢复成功。如果恢复后损失立即发散,则检查点本身可能已损坏,需要回退到更早的快照。
恢复还必须防止失败的 ownership epoch 再次生效。协调器为每个 worker-group incarnation 授予一个单调递增的 epoch,并将成员资格与可续期租约关联。每个状态变更写入都携带该 epoch 作为 fencing token。存储、rendezvous 和检查点服务会拒绝早于其已接受最高 epoch 的 token,因此租约到期后恢复的暂停 worker 无法发布检查点、更新作业进度,或重新加入由替换者拥有的通信器。仅凭租约是不够的,因为到期改变的是协调器的信念,而非旧 worker 访问存储的能力;fencing 使得过期所有权在资源边界上无法执行 (Kleppmann 2016年)。
Kleppmann, Martin. 2016年. Designing Data-Intensive Applications: The Big Ideas Behind Reliable, Scalable, and Maintainable Systems. O’Reilly Media.
Nygard, Michael T. 2007年. Release It!: Design and Deploy Production-Ready Software. Pragmatic Bookshelf.
重试完成了恢复契约。只有当操作是幂等的,或携带稳定的操作标识符使接收方能够去重重复效果时,才允许自动重试。每次尝试继承调用方的绝对截止时间,而不是获得新的超时,并且系统以跨请求或恢复树的共享重试预算限制尝试次数。指数退避与抖动会在时间上分散尝试,但如果每一层都独立重试,它们并不能防止过载。因此,预算应位于唯一负责重试的层;预算耗尽时返回失败或触发降级,而不是放大原始事件 Nygard (2007年)。
Napkin Math 1.4: 恢复时间预算
问题:考虑一个参数规模为 175B 的模型,在 1,024 GPUs 上进行训练。检查点大小约为 3.7 TB(权重 + Adam 优化器状态)。估算单次故障事件的代价。
设定:恢复预算 \(T_{\text{recovery}}\) 包含四项。
- \(T_{\text{detect}}\):60 s(保守的心跳超时设置,包含验证重试)。
- \(T_{\text{restart}}\):3 min(调度器排队时间 + 容器启动 + Python 导入开销 + NCCL 初始化)。
- \(T_{\text{load}}\):37 s(这是从共享存储读取完整 3.7 TB 检查点的总耗时,聚合读取速率为 100 GB/s;若采用速率为 5 GB/s 的分片本地 NVMe 读取,每个 3.6 GB 分片的加载耗时都远小于一秒)。
- \(T_{\text{warmup}}\):2 min(JIT 内核编译、数据流水线缓冲区填充、TCP 连接重建)。
总计:每次故障事件为 \(T_{\text{recovery}} = T_{\text{detect}} + T_{\text{restart}} + T_{\text{load}} + T_{\text{warmup}} \approx\) 6.6 min。
影响:对于这条恢复路径,\(T_{\text{recovery}}\) 是 1.1 中可用性关系式里的实际运行 MTTR 项。随着集群规模增大,恢复时间优化变得更加重要。采用 集群平均无故障时间(MTBF)的扩展规律 中仅考虑 GPU 故障的基线时,一个包含 1,024 个 GPU 的集群,其 MTBF 为 49 hours,经历的故障事件约为 0.49 failures/day,每天损失约 3 minutes,对应较小的 0.2 percent 开销。然而,一个包含 10,000 个 GPU 的集群,其仅考虑 GPU 故障的 MTBF 为 5 hours,经历的故障事件约为 4.8 failures/day,每天损失约 32 minutes(2.2 percent 开销),相当于每天浪费约 5,293 GPU-hours(即每天损失的分钟数乘以全部 10,000 个 GPU)。
热重启与冷重启
节 1.6.2 中描述的标准恢复流程属于冷重启:终止集群中的每个进程,并从持久化存储重新加载全部状态。冷重启稳健且简单(不对内存中状态的有效性作任何假设),但会造成浪费。当一个包含 1,000 个 GPU 的集群中有单个 GPU 发生故障时,冷重启会丢弃 999 个健康工作进程的有效内存状态,迫使它们全部从磁盘重新加载。
热重启 会保留存活工作进程的状态。当某个 rank 发生故障时,存活的 rank 会检测到故障,但不会退出。它们进入等待状态,将已加载的模型权重和优化器状态保留在 GPU 内存中。调度器仅替换故障节点。新节点加入后,从磁盘加载其负责的状态分区(或通过广播从对等节点接收),随后重建通信器。训练以极小的中断代价恢复。
热重启可将集群中 99.9% 的工作进程的 \(T_{\text{load}}\) 和 \(T_{\text{warmup}}\) 降至接近零,使总恢复时间从分钟级缩短到秒级。对于 1,024 GPUs 示例,热重启可避免从存储中重新加载 3.7 TB,为除替换节点之外的所有节点节省 37 s \(T_{\text{load}}\) 以及 2 分钟的 \(T_{\text{warmup}}\)。
代价在于软件复杂度。保留存活工作进程的热重启需要专门的应用程序和运行时支持,以处理动态成员变更,同时避免 CUDA 内存泄漏、共享状态损坏或通信器重建过程中的死锁。TorchElastic 不会在成员变更时保留工作进程:它会停止存活的工作进程,并启动一个新的工作进程组。DeepSpeed 文档中描述的恢复路径以检查点为中心,而非保留存活工作进程的热重启。实现热重启快速路径的部署仍然需要冷重启作为兜底机制。表 5 对比了这两种策略:
| 方面 | 冷重启 | 热重启 |
|---|---|---|
| 恢复时间 | 4–10 分钟(全量重新加载) | 30–90 秒(单节点重新加载) |
| 状态保证 | 状态干净:全部状态来自检查点 | 假定存活工作进程的状态有效 |
| 实现 | 简单:全部终止,全部重新加载 | 复杂:动态成员管理 |
| 恢复过程中的故障 | 重试冷重启 | 回退到冷重启 |
| 最适用场景 | 相关故障、SDC 事件 | 单节点故障、GPU 错误 |
恢复自动化流水线
在 10,000+ GPU 的规模下,对每一次故障都进行人工干预已不可能:故障每天发生多次。恢复必须由集群控制平面管理的自主控制回路来实现。Meta、Google 和 Microsoft 发布的规模化系统展示了多阶段自动化流水线,用于对故障进行分类并选择最小可行修复方案。
该流水线按四个有序阶段运行:
- 健康监控守护进程:持续采集 GPU 遥测数据(ECC 错误计数器、温度、风扇转速、NVLink 状态),同时采集应用指标(如训练损失和步长吞吐),通常通过 sidecar 容器获取。
- 故障分类器:判断某个信号是致命错误(例如,NVIDIA Xid 错误 48:双位 ECC 错误)、瞬时停顿(例如,临时网络拥塞),还是性能退化(例如,热节流)。
- 动作选择器:选择适当的响应。进程挂起触发容器重启(快速、本地);GPU 硬件错误触发节点隔离与替换(较慢,需要备用容量);网络分区触发暂停等待策略(保留内存状态)。
- 验证阶段:恢复后运行一个”金丝雀批次”,以确认损失与故障前数值一致。若损失立即出现偏差,则检查点可能已损坏,触发自动回退到更早的快照。
该自动化将平均恢复时间从人工干预典型的 30–60 分钟缩短到大多数故障类型的 10 分钟以下。分类阶段至关重要:将每次故障都视为冷重启,会在瞬时问题上浪费计算资源;而将硬件故障视为瞬时问题,则会让已损坏的计算继续执行。
区分拖慢者与故障
Definition 1.2: 拖慢者
拖慢者 是分布式训练任务中处理任务速度显著慢于同侪的 worker,从而形成同步瓶颈。
- 显著性:在批量同步并行系统中,集群吞吐量受最慢 rank 的速度限制。单个节点 10% 的性能下降,可能使数千个节点的有效计算能力降低 10%。
- 区分:与硬件故障(节点停止)不同,拖慢者仍持续产生正确结果,但违反了高效并行执行所需的时序一致性。
- 常见误区:一种常见误解是拖慢者仅由”劣质硬件”引起。实际上,它们往往由 System Jitter 引起:数据中心机房内随位置变化的后台操作系统进程、网络拥塞或热节流。
拖慢者是一个功能上仍然正确、但速度显著慢于同侪的 worker。在同步训练中,拖慢者等同于性能毒物:整个集群的速度由其最慢部件决定,因为 AllReduce 必须等待每个 rank 都提交梯度后才能完成。
对于简化的无重叠拖慢者模型,步长时间变为: \[ T_{\text{step,straggler}}(N) = \max(T_{\text{rank}_0}, T_{\text{rank}_1}, \dots, T_{\text{rank}_{N-1}}) + T_{\text{comm}}(N) \]
拖慢者源于不会触发显式错误的”灰色故障“:热节流降低时钟频率,劣化的互连线缆增加通信延迟,操作系统后台进程(内存校验、日志轮转)消耗 CPU 周期,以及从拥塞的网络文件系统加载数据引入可变 I/O 延迟。与硬性故障不同,拖慢者不会触发超时,因而能在数小时内悄无声息地拉低全局效率。
挑战在于区分拖慢者与故障。拖慢者应触发缓解(重新分配工作、替换慢节点),而故障应触发恢复(检查点重启)。激进的超时策略会把拖慢者当作故障处理,导致不必要的作业重启,其浪费的计算量甚至超过拖慢者本身;保守的超时策略则会在等待那些永远不会提速的拖慢者时浪费计算资源。
拖慢者缓解策略覆盖了一个从温和到激进的连续谱系:
- 备份 worker:复制分配给慢 worker 的工作并采用首个结果,以计算资源换取延迟。
- 有界陈旧度:允许训练使用慢 worker 的陈旧梯度继续推进,接受较小的收敛惩罚。
- 动态负载均衡:将数据分片从慢 worker 处重新分配,降低其每步工作量。
- 主动替换:利用 GPU 遥测趋势(温度上升、ECC 错误计数增加)识别性能退化的 worker,并在其成为拖慢者之前将其替换。
一个简单的成本计算表明,为什么替换一个严重落后的工作节点可能比容忍它的成本更低。

单个掉队者使所有正常运行的加速器陷入空闲。
Napkin Math 1.5: 掉队者开销
考虑一个拥有 1,024 个 GPU 的集群,其中一次正常训练迭代耗时 1 秒。单个 GPU 进入热降频状态,运行速度降至正常速度的 50 percent,此时需要 2 秒才能完成计算。
由于 AllReduce 只有在每个进程都提交梯度后才能完成,其余 1,023 个正常运行的 GPU 只能闲置,等待这个掉队者。
影响:
- 正常步骤耗时:1 秒
- 拖慢步骤耗时:2 秒
- 有效集群速度:1 步/2 秒 = 0.5 步/秒
一台故障设备(0.1 percent 的硬件)已将整个集群的吞吐量降低了 50%。在 $3/GPU-hour,这个拖慢节点浪费了 $1,536/hour 的闲置计算资源。
系统洞见:将严重的拖慢节点视为硬性故障在数学上是最优的。检测并杀掉慢节点以强制重启到健康硬件上,比容忍性能退化能获得更高的长期吞吐量。盈亏平衡点:如果一个拖慢节点使集群变慢超过 \(T_{\text{recovery}}/\text{MTBF}_{\text{system}}\)(用于故障恢复所占的时间比例),那么立即替换它比等待更便宜。
不过,杀掉慢节点并重启任务意味着需要等待替换资源才能维持原有的 GPU 数量。当配置了专用备用设备时,\(N+1\) 冗余模型可以在数秒内换入热备用(图 25),从而绕过冗长的分配队列。检查点—重启恢复模型假定恢复相同的资源分配:检查点、等待替换、重启。弹性恢复打破了这一假设,它允许任务以较少的 worker 继续运行,而不是让整个集群闲置,直到恢复原有数量。
Checkpoint: 检测与恢复调优
检验你对检测延迟与恢复策略之间权衡关系的理解:
弹性恢复
假设一个 1,024-GPU 训练任务因硬件故障失去了一个 8-GPU 节点,但集群没有可用的备用节点。在检查点重启恢复机制下,剩余的 1,016 个 GPU 会闲置数小时,等待修复。弹性恢复则允许任务动态调整规模,以略少的计算资源继续运行,从而打破工作节点数量固定的刚性假设。
Definition: 弹性训练
弹性训练 是指分布式训练任务在成员变更时调整工作节点数量的能力,这一调整可能通过工作节点组的协同重启来实现。
- 重要性:它将永久性的容量损失转化为临时中断,随后以较低的吞吐量继续运行。一个 1,024-GPU 任务在失去 8 个 GPU 后,可以以 99.2% 的容量恢复运行,而无需等待补充容量。随着全局批大小变化,需要重新校准学习率并调整梯度累积,以保持数学上的一致性。
- 区别:固定规模的检查点重启恢复需要等待替换硬件,以恢复原有的资源分配;弹性恢复则可以使用不同数量的工作节点重启或恢复运行。在重新确定成员关系、进程编号和状态期间,优化循环可能会暂停。
- 常见误区:一种常见误解是弹性是“自动的”。实际上,恢复需要协同调整:训练框架、数据加载器和编排器必须同步各自的状态,确保在调整规模期间不会丢失数据样本或重复计数。
图 26 展示了恢复流程:检测故障、暂停、在存活的工作节点上重新调整规模,然后恢复运行。
弹性恢复机制
弹性恢复将原本会导致硬性失败的事件转化为从容的容量调整(图 26):丢失的 worker 会减少活跃数量,而无需在作业恢复前补充替换容量。worker 组可能在框架重新建立成员资格、排名和状态(基于较小的资源分配)的同时重启。当失败导致 worker 数量减少时,恢复路径必须在 productive work 恢复之前适配多个训练组件。每种适配都针对一项特定的一致性要求;若违反该项要求,将损坏模型或浪费计算。
batch size adjustment 是首要关注点:worker 减少后,每个 worker 必须处理更多样本以维持全局 batch size,或者必须降低全局 batch size。在恢复过程中降低全局 batch size 可能需要相应调整学习率,以保持收敛性质。
batch size 与最优学习率之间的关系决定了作业能够在不 destabilizing training 的前提下以多快的速度 resize。Goyal 等 (2017年) 表明,对于大 batch 的 ImageNet 训练(含 warmup),线性缩放规则表现良好:当 batch size 按因子 \(k\) 缩放时,学习率也按因子 \(k\) 缩放。公式 10 表达了另一种平方根启发式规则,在恢复期间提供更保守的调整:
\[ \eta_{\text{new}} = \eta_{\text{base}} \times \sqrt{\frac{N_{\text{new}}}{N_{\text{base}}}} \tag{10}\]
其中 \(N\) 表示 worker 数量(因而也表示全局 batch size)。线性规则 (Goyal 等 2017年) 在大 batch 训练(含 warmup)中通常更受青睐,前提是其他优化器假设与原始配方一致;而平方根缩放则是一种保守的恢复策略,而非有论文支撑的定律。
gradient accumulation 为学习率调整提供了替代方案:在 worker 减少的情况下,每个幸存 worker 可以在同步前对多个 micro-batch 累积梯度,以维持原始有效 batch size。若 worker 数量减半,则将 accumulation steps 翻倍即可保持相同的有效 batch size,且无需改变学习率,代价是每步 wall time 翻倍。
data loader redistribution 是恢复必须原子处理的协同要求。当 worker 丢失时,data loader 必须重新分配数据 shard 的分配,以确保所有训练数据仍被处理,且不出现样本重复或丢失。失败的重新分配会静默地破坏训练数据分布。
当使用分片模型并行(ZeRO/FSDP)时,state resharding 进一步增加了复杂性,因为 worker 的丢失意味着模型状态的一个分片不再本地驻留。恢复可以在线进行(将 orphaned shard 迁移到幸存 worker),也可以通过检查点重载(依据最后一个持久化检查点重新分片)。
Spot 实例抢占作为失败类别
硬件故障并非唯一会从运行中的作业移除 worker 的事件。云服务商通常将可抢占(“spot”)实例的价格定得低于按需容量,但附带警告:它们可能在很少提前通知的情况下被回收。从训练框架的视角来看,spot 回收与硬件故障无法区分:worker 消失,作业必须决定是中止还是自适应。
传统的静态作业无法承受 spot 抢占,因为单个丢失节点会摧毁整个运行。弹性恢复以与硬件故障完全相同的方式处理抢占:
- 作业检测到节点丢失(机制相同,即超时或心跳失败)。
- 它短暂暂停,在幸存节点之间重新分配工作负载。
- 训练以缩减的规模恢复。
这项恢复能力可以解锁显著的成本优势。组织可以在更便宜的可抢占硬件上进行训练,因为弹性恢复将每次抢占转化为临时的吞吐量下降,而非致命错误。在 spot 容量价格为 $0.60/hour instead of $3.00/hour 的场景中,节省可以超过偶尔 resize 暂停所带来的效率损失。
框架对弹性恢复的支持
框架层面的问题是:它能够自动强制哪些 resize 不变量——组成员资格、shard 归属、数据覆盖范围,以及 batch 数学。上一节中的恢复适配机制(batch size adjustment、学习率重新标定、data loader redistribution、state resharding)必须由训练框架实现,而各框架在失败后自动化的恢复逻辑程度上存在差异。
PyTorch Elastic(TorchElastic)通过会合机制33检测工作进程故障;每当工作进程组发生变化时,该机制都会重新执行 (PyTorch Contributors 2026年b, 2026年a)。发生故障或成员变更时,TorchElastic 会停止所有仍在运行的工作进程,组建新的工作进程组,并按照新的 RANK 和 WORLD_SIZE 分配结果启动工作进程。它负责处理重启后的进程编号重新分配和通信组重建,但将批大小、学习率和检查点语义交由用户代码处理。
DeepSpeed (Rasley 等 2020年) 为大模型提供基于 ZeRO 的分布式训练和检查点基础组件 (DeepSpeed Developers 2026年a)。其恢复模型基于检查点:发生故障后,作业从最近一次持久化的检查点重新加载,而通用检查点机制(Universal Checkpointing)则解决并行方式和拓扑结构发生某些变化时的可移植性问题 (DeepSpeed Developers 2026年b)。弹性行为仍依赖外围启动器和资源管理器,无法仅由框架本身实现透明化。
Ray Train 基于 Ray 的 actor 模型,为工作进程故障和节点抢占提供以检查点为核心的恢复路径。Ray 可以在发生故障后重启工作进程组,并从最新可用的检查点恢复,而训练函数仍负责保存和加载足够的状态 (Ray Project 2026年)。
Horovod Elastic 基于 Horovod 的数据并行训练系统 (Sergeev 和 Balso 2018年),提供了有文档说明的弹性状态 API,用于处理工作进程的加入和移除 (Horovod Developers 2026年)。工作进程组发生变化时,Horovod 可以重置进程编号并重建通信,而训练脚本仍负责学习率或批大小策略等影响收敛性的选择。
弹性恢复框架比较 汇总了各框架对弹性训练的支持情况,比较了这些框架的恢复自动化和状态管理方式。
| 框架 | 故障检测 | 自动恢复 | 状态重新分片 | 集群集成 |
|---|---|---|---|---|
| PyTorch Elastic | 会合超时 | 是 | 手动 | Kubernetes |
| DeepSpeed | 外部检测 | 基于检查点 | 取决于部署方式 | 外部调度器 |
| Ray Train | actor 监督 | 检查点重试路径 | 重新加载检查点 | Ray 集群 |
| Horovod Elastic | 驱动进程心跳 | 是 | 手动 | SLURM, Kubernetes |
尽管这些框架自动化了恢复的具体操作,但究竟必须保留哪些模型状态并对其重新分片,仍是针对具体工作负载的工程选择。
特定模型的训练容错
节 1.5 和 节 1.6 中提出的检查点与恢复策略需要进行适配,因为不同工作负载在故障时会丢失不同类型的状态。因此,设计问题不仅在于多久保存一次检查点,还在于哪个状态变量的丢失会使重启在数学上或经济上产生错误。对于推荐工作负载,当精确保留完整状态的成本过高时,增量检查点、分层检查点和嵌入版本管理可以保障新鲜度。训练恢复的状态不变量 将这一问题整理为一份简明的恢复映射表。
| 工作负载 | 面临丢失风险的状态 | 对检查点的要求 |
|---|---|---|
| LLM 训练 | 优化器状态、课程学习进度、文档位置、长上下文调度进度 | 在精度至关重要的部分保留 FP32 优化器状态,使用 ZeRO/FSDP 进行分片写入,将序列化移出关键路径,并保存数据调度进度,以便正确恢复优化轨迹。 |
| 推荐 | 嵌入新鲜度、特征存储版本 | 通过增量检查点、分层检查点和嵌入版本管理,优先保障新鲜度,而非精确保留完整状态。 |
| 视觉 | 数据增强随机种子、打乱顺序、批归一化统计量、渐进式分辨率调整进度 | 保存控制输入流的随机状态和归一化状态;仅有权重不足以复现训练轨迹。 |
| 科学机器学习 | 模拟器状态、搜索前沿、已探索的配置、验证随机种子 | 将模型、模拟器、搜索过程和随机状态视为一个一致性单元,确保恢复不会重复探索或使比较失效。 |
共同规律是,恢复正确性涵盖的范围比恢复权重更广。LLM 可以重新加载权重,却从错误的课程学习进度继续训练;推荐模型可以重新加载稠密参数,却使用过时的嵌入提供服务;视觉模型可以重新加载权重,却改变数据增强或归一化状态;科学机器学习模型可以重新加载神经网络,却丢失赋予数据意义的模拟器状态。
弹性伸缩与检查点为长周期批训练任务提供了必要的韧性;但一旦模型部署到用户侧,运维层面的权衡就发生了根本性变化:挑战从保护数周的批计算转变为保护毫秒级的实时延迟。
服务容错
当用户要求语音助手关闭灯光时,他们无法容忍因推理服务器从检查点重新加载而产生的五分钟停顿。服务模型面临着一个根本不同的挑战:即便后端 GPU 发生故障,用户仍期望毫秒级的响应。
服务系统以副本、路由、就绪检查、负载均衡、KV cache 状态(缓存的 Transformer 注意力状态)以及优雅降级作为基本构建模块。服务容错探讨的是:当副本、GPU 或状态存储在线性延迟预算下发生故障时,这些机制如何表现。本文的关注点比完整的服务架构更窄:每个机制都被视为实时推理的可靠性边界。
无状态与有状态服务
服务决策的第一步是请求状态存放于何处,因为这一选择决定了故障切换究竟是重试问题还是状态重建问题。在无状态服务中,每个请求彼此独立;系统不维护任何会话级状态,处理请求所需的全部信息都包含在请求本身以及静态模型权重中。
无状态模式出现在输入本身携带全部上下文时:图像分类器处理一张图像,目标检测器处理一帧,单轮文本分类器处理一段文本,嵌入服务将一个输入映射为一个向量。此时容错可以聚焦于副本健康状态与请求路由。冗余副本并行处理请求,负载均衡仅将流量发送至健康副本,健康检查将失败副本移出轮转,容量不足时自动替换会启动新副本。当某个副本失败时,发往该副本的在途请求可以在别处重试,因为没有任何承载质量的状态丢失。
无状态服务的简洁性使其在应用允许时成为更简单的架构。然而,许多机器学习应用本质上就需要跨请求的状态。以聊天机器人为例:单轮问答系统可以无状态运行,独立处理每个问题;而会记住先前对话的对话式助手则必须维护对话历史,从而将容错从简单的重试转变为状态保存。
只要当前请求依赖于先前请求,就会出现有状态服务。LLM 对话在各轮次中累积 KV cache(此前所有 token 的键与值投影,其管理 在大规模下运行推理 将在后文完整展开),流式语音识别从先前音频中保持上下文,推荐会话累积用户上下文,交互式编辑则在多次编辑之间维护文档状态。容错后果是:故障会损失承载质量的状态,而不只是服务能力。KV cache 丢失需要重新处理先前轮次,会话上下文丢失会迫使用户重复先前交互,累积用户状态丢失则会在上下文不可用时降低质量。缓解手段取决于该状态的大小、更新速率与质量价值:会话亲和性将会话路由到同一副本,状态检查点定期保存会话状态,状态复制维护一份备用副本,优雅降级则在无法恢复状态时以较低质量保持服务可用。
无状态与有状态服务容错对比无状态与有状态服务的容错,展示了这一根本差异如何在设计的每个方面体现,从请求路由到恢复复杂度。
| Aspect | Stateless Serving | Stateful Serving |
|---|---|---|
| Request routing | Any replica | Session-affine replica |
| Failure impact | Retry on another replica | Potential state loss |
| Recovery complexity | Restart and load weights | Reload state + reconstruct context |
| Redundancy approach | Active-active replicas | Replicated state + standby |
| Failover latency | Milliseconds (load balancer) | Seconds (state transfer) |
无论服务架构是无状态还是有状态,要在这些约束下维持可用性,都必须部署冗余容量。
冗余与复制
冗余只有在副本放置位置与备用容量与所防御的故障域相匹配时,才能换来可用性。多份服务能力的副本使系统在单个副本故障时仍能继续运行。
可用性计算
对于单个副本,可用性为 \(A_{\text{single}}\)(任意时刻处于运行状态的概率),公式 11 量化了多个独立副本如何提升系统可用性:
\[ A_{\text{system}} = 1 - (1 - A_{\text{single}})^k \tag{11}\]
其中 \(k\) 为副本数量。对于单个副本可用性为 99% 的服务,冗余的累积效果如下。
对于单个副本,\(A_{\text{single}} = 99\%\) 对应每年 3.65 天的停机时间。增加独立副本会迅速改变失败分布的尾部:两个副本对应 \(A = 1 - (0.01)^2 = 99.99\%\),即每年 52.6 分钟停机;三个副本对应 \(A = 1 - (0.01)^3 = 99.9999\%\),即 31.5 秒。数学很有说服力,但它建立在独立性假设之上;共享电源、共享网络以及共享的软件缺陷都会使实际可用性低于这些理论值。
复制策略
可用性方程说明了冗余能带来多少收益;复制策略则决定这种冗余在正常运行与故障切换期间需要付出多少成本。在主动—主动复制(图 27,左图)中,所有副本都主动处理请求,因此容量利用率高,但某个副本故障会立即增加幸存副本的负载。在主动—被动复制(图 27,右图)中,主副本处理流量,备用副本保持空闲但处于就绪状态,从而简化故障切换,代价是正常运行期间存在资源闲置。
地理复制将同样的选择扩展到不同区域。它能够抵御数据中心或区域网络故障,但路由到遥远区域的用户请求需要支付额外的延迟。多层设计同时组合几种复制策略:边缘缓存用于降低延迟,区域服务集群用于保障可用性,而全局主节点或协同层则保持一致性与新鲜度。
复制位置与故障域
有效的冗余要求将副本部署到相互独立的故障域中。不同的机器可以承受单台机器故障;不同的机架可以承受由电源或机架顶部交换机问题引起的机架级故障;不同的可用区可以承受数据中心分区故障;而不同的区域则可以承受整个数据中心故障。独立性的级别应与可用性要求和成本约束相匹配:区域复制成本较高,因为它重复了计算和网络容量,但在区域故障必须不能表现为用户可见的停机时,它是必需的。
放置副本只是创造了恢复的可能性。服务系统仍然需要一个控制回路,用于发现故障、将受影响的副本移出流量,并保留足够的状态,使用户可见的服务能够以有界的性能退化继续运行。
故障切换机制
当副本发生故障时,流量必须被重定向到健康的副本。该故障切换的速度与可靠性决定了故障对用户的影响。该机制可以分解为三个问题:系统如何检测健康状态、路由层如何响应该信号,以及已经绑定到故障副本的状态型会话如何处理。
健康检查
健康检查决定何时移动流量,因此必须评估存活性、就绪性以及推理正确性。存活性检查验证进程正在运行且响应正常,通常通过一个返回 200 的简单 HTTP 端点实现,并在失败时触发重启。就绪性检查进一步要求:对于机器学习服务,副本必须完成模型权重加载、GPU 初始化并响应、预热完成,以及特征库和缓存等依赖项可用,才算就绪。推理健康检查通过向模型输入一个已知输入并验证预期输出来增加正确性探测,从而捕获那些进程健康但模型响应错误的静默故障。
健康检查参数设定了误报与延迟之间的权衡。例如,5 s 的检查间隔控制采样频率,2 s 的超时控制耐心程度,连续 3 次探测失败将副本标记为不健康,而 2 次干净探测成功则将其恢复为服务中。
负载均衡器集成
负载均衡器设计决定了路由层在故障切换期间能够利用多少请求上下文。L4 负载均衡基于 IP 和端口进行路由,操作简单且快速。L7 负载均衡基于 HTTP 和 gRPC 内容进行路由,能够实现更精细的路由。服务网格则在这些路由决策周围增加了流量管理、可观测性和安全性。
负载均衡器的故障切换延迟取决于健康检查频率和故障检测逻辑。激进的设置能够实现快速故障切换,但会增加误报,在瞬时问题时将健康副本标记为不健康。
会话亲和性与状态型故障切换
对于状态型服务,会话亲和性 将同一会话内的所有请求路由到同一个副本。负载均衡器通过以 cookie、头部或 IP 哈希实现的粘性会话来维护会话到副本的映射。状态故障切换的选择则是在恢复速度与一致性和运维复杂度之间进行权衡:状态丢失通过从头重新生成状态来接受质量退化;检查点机制定期保存会话状态以便恢复;复制将状态复制到备用副本;分布式状态存储则将会话状态迁移到 Redis 或 Memcached 等外部系统中。
该选择取决于状态大小、更新频率以及状态丢失对质量的影响;状态型故障切换方法 总结了四种常见方法之间的权衡:
| 方法 | 恢复延迟 | 一致性 | 运维复杂度 |
|---|---|---|---|
| 状态丢失 | 快速 | 无 | 低 |
| 检查点机制 | 中等 | 最终一致 | 中等 |
| 同步复制 | 快速 | 强一致 | 高 |
| 分布式状态 | 快速 | 可配置 | 中等 |
模型特定的服务容错
模型特定的服务差异源于哪些状态难以承受丢失,以及用户需要响应有多快。因此,策略问题是一个状态丢失预算:哪些状态可以重建、哪些状态必须复制,以及哪些状态可以在不违反产品契约的前提下暂时降级。服务恢复状态不变量 将该问题映射到三种常见形态。
| 服务负载 | 难以承受丢失的状态 | 容错策略 | 降级路径 |
|---|---|---|---|
| LLM 对话 | KV 缓存、对话上下文、前缀状态 | 复制或检查点化高价值会话状态;仅在延迟预算允许时再生成。 | 从对话记录重建、复用缓存前缀,或请求重试。 |
| 推荐服务 | 新鲜用户特征、物品特征、嵌入 | 复制特征存储、缓存热门特征,并将新鲜度作为可靠性信号进行监控。 | 以过期或默认特征提供服务,并承受可度量的质量损失。 |
| 视觉服务 | 预处理状态、设备健康、边缘输入 | 在健康副本上重试无状态请求;在预处理或加速器健康故障时关闭服务。 | 使用较小的本地模型、推迟预测,或返回低置信度结果。 |
KV 缓存34可能相当可观(长上下文在注意力层之间可达数 GB)。丢失 KV 缓存需要重新生成所有先前轮次,耗时可能达到数秒到数分钟。
LLM 服务方案需要在 KV 缓存恢复延迟与内存和存储开销之间进行权衡。最简单的策略是接受重新生成成本,在故障后从对话历史重建 KV 缓存,但这可能使长对话变成数秒甚至数分钟的重新启动。KV 缓存检查点化会周期性保存实时状态并限制重新生成的量,而 KV 缓存复制则保留一份备用副本以实现快速故障切换,代价是额外的内存。前缀缓存 通过单独存储常见的系统提示和共享上下文,缩小了必须恢复的状态范围,因此只有会话特定状态需要重新生成。将其产品化为提示缓存 服务(如云服务商提供的服务)后,该方法会存储并复用常见前缀的 KV 缓存,从而降低故障时的成本与恢复时间。
推荐服务保护的是新鲜度而非对话连续性。推荐依赖特征存储中的用户和物品特征,因此特征存储不可用可能降低排序质量,甚至完全阻断推荐。服务决策即陈旧度预算:复制的特征存储保证各可用区保留近期特征,本地缓存覆盖热门特征,回退到过期特征则接受可度量的质量损失,而默认特征则使服务在查找失败时返回质量较低的结果。实时特征(如最近的用户行为)使新鲜度监控成为容错的一部分,因为持续提供旧特征的管道在操作上可用,但在语义上是错误的。较大的嵌入表也可能位于专门的嵌入服务之后,这些服务需要独立的复制与故障切换方案。
视觉服务通常更接近无状态一端,因为每张图片或每帧都可以在另一个副本上重试。这种简单性并未消除容错工作,而是改变了检查应放在哪里。GPU 健康监控必须在这些副本返回损坏结果之前移除存在热节流或内存错误的副本,而预处理必须在 resize、裁剪、颜色转换或归一化阶段发生故障时关闭服务。对于边缘视觉,主要故障模式可能是断开连接而非数据中心副本崩溃,因此系统通常会通过改用较小的本地模型、推迟非紧急预测,或返回低置信度结果来降级,直到云端连接恢复。
当完全冗余失效时(例如边缘设备失去连接,或大规模流量尖峰压垮了可用的数据中心副本),系统不能直接崩溃。相反,它必须主动以输出质量为代价来维持持续可用性,这种策略称为优雅降级(graceful degradation)。
优雅降级
在一次重大的区域性网络中断期间,一个电商网站突然失去了对其重型 GPU 加速推荐集群的访问。与其向用户展示空页面或崩溃,该网站立即切换到提供预计算的通用热门商品。在 节 1.8 中开发的推理服务容错机制旨在维持完整服务,但优雅降级规定了当这些防御措施被压垮时系统会发生什么。
Definition: 优雅降级
优雅降级 是一种容错策略:当系统遭遇资源耗尽或组件故障时,它会通过刻意降低服务质量(回退到更小的模型、提供缓存结果,或返回部分输出)来应对,而不是完全失败,从而在降低能力的前提下维持可度量的可用性。
- 重要性:优雅降级将完全中断的风险转化为受控的质量下降。当推荐系统因 GPU 故障从 7B 参数排序器回退到协同过滤模型时,点击率可能下降 8–15 个百分点,但系统维持请求可用性,而不是把每个受影响的请求都变成错误。工程上的计算重点也从完全中断持续时间,转变为回退期间的可度量质量损失。
- 区别:与系统完全失败(服务对所有请求返回错误)不同,优雅降级通过预定义的能力层级实现受控过渡;每个回退层级都具有已知的准确率、延迟和资源特性,使系统能够在降低质量的同时继续满足 SLO。
- 常见误区:一个常见的误解是,优雅降级在良好设计的系统中会自动发生。优雅降级需要显式的事前工程:回退模型必须预加载或预计算,切换逻辑必须能够检测故障条件并在无需人工干预的情况下触发过渡,而且每个降级层级都必须经过验证,确保其在生产环境中真正满足其降低后的 SLO。
降级维度
降级计划必须在事件发生之前指明将牺牲哪项服务属性。表 6 总结了主要的杠杆。该表是事前设计检查清单,而非事件期间的临场头脑风暴工具:每个被牺牲的属性都需要在故障发生之前具备可度量的质量预算、激活条件和恢复路径。
| 维度 | 系统牺牲什么 | 典型回退 |
|---|---|---|
| 质量 | 模型准确率或排序质量 | 使用更简单的模型,例如为多塔推荐器提供协同过滤回退。 |
| 延迟 | 响应速度 | 将更多请求合并批处理,以在高负载下保持吞吐量和模型质量。 |
| 覆盖度 | 结果完整性 | 返回前 10 个搜索结果,而不是前 100 个。 |
| 新鲜度 | 计算结果的时效性 | 提供缓存或过期的候选结果,例如中断期间提供小时前的新闻推荐。 |
| 特征完整性 | 输入丰富度 | 当用户历史或实时上下文不可用时,使用内容特征。 |
这些维度并非可以互换。搜索产品可能通过返回更少的结果来牺牲覆盖度,同时保持新鲜度;推荐系统可能通过提供缓存候选来牺牲新鲜度,同时保持延迟;交互式助手可能通过改用更小的模型来牺牲质量,同时保持会话活跃。因此,正确的回退是工作负载特定的:它遵循“暂时损失对该应用危害最小、且其恢复路径可以在事件发生前得到验证”的属性。
优雅降级策略
表 6 中的维度只有在服务将每项被牺牲的属性绑定到具体的回退机制时,才会真正转化为可运行方案。策略阶梯从模型回退开始(当主推理路径过于昂贵或不可用时),随后进入特征回退(当输入质量下降时),最后进入负载 shedding(当需求超过容量、系统必须优先保留最高价值请求时)。
模型回退
模型降级通过维护多个资源需求不同的模型版本,将质量转化为明确的可用性调节手段。主模型以最高的资源成本提供完整能力,次级模型降低能力和资源需求,三级模型保留最低限度的能力,而静态兜底方案则提供预计算的默认结果,完全不执行推理。当主路径不可用或过载时,策略仅降至资源压力所要求的层级,并在主路径恢复健康后回升至更高层级。
图像分类级联使这一权衡具体化。主路径可能运行 ViT-Large 模型,具有 3.07 亿个参数,ImageNet top-1 准确率为 88%;在资源压力下,降级至 EfficientNet-B4,具有 1900 万个参数,准确率为 83%;当资源仅能支持最低限度的分类能力时,再降级至 MobileNet-V3-Large,具有 540 万个参数,准确率为 75%。如果连这条路径也无法满足 SLO,服务可以返回缓存标签、粗粒度类别或“分类不可用”,而不是无限期阻塞请求。要使这套阶梯式策略真正可行,而非停留在设想中,生产系统必须同时部署多个模型,将请求路由至适当层级,监控降级频率,并衡量各层级对质量的影响。
推荐与排序系统也采用相同模式:当主模型服务发生故障时,从复杂的深度学习模型降级至 top-n 热门列表、线性排序器或缓存响应。复杂模型往往致力于争取最后一点准确率提升,而简单的启发式方法就能提供大部分效用,因此必须将降级路径作为核心质量信号加以监控,而不能将其视为静默的故障切换。否则,产品表面上运行正常,质量却在悄然被牺牲以换取可用性。
特征降级
特征降级控制模型在必须阻塞请求之前,允许损失多少输入质量。当特征检索失败时,可以用预计算的群体层面默认值替代缺失的用户或物品特征:推荐系统可以使用平均用户嵌入、按类型设置的物品默认值,或实时信号的最新缓存值。当默认值的效果不足时,系统可以根据可用数据计算近似特征,例如用人口统计特征相似性替代缺失的用户历史,用文本嵌入替代缺失的物品属性,或用基于时间的默认值替代缺失的上下文。
关键的设计步骤是根据特征对预测质量的贡献确定其优先级。特征平稳降级层级概述了一套四级策略:关键特征缺失时阻塞请求,重要特征使用默认值,有用特征使用缓存值,可选特征可以省略,同时将质量影响限制在一定范围内:
| 层级 | 示例特征 | 缺失时的处理 | 质量影响 |
|---|---|---|---|
| 关键 | 用户 ID、物品 ID | 阻塞请求 | 无法提供服务 |
| 重要 | 用户历史、物品属性 | 使用默认值 | 5–10% 质量损失 |
| 有用 | 实时上下文 | 使用缓存值 | 2–5% 质量损失 |
| 可选 | 次要信号 | 省略 | \(< 2\%\) 质量损失 |
当仅靠特征降级不足以在极端负载下维持系统稳定性时,服务基础设施必须开始主动丢弃请求。
负载丢弃
负载丢弃通过牺牲选定的请求来保护系统,防止过载影响蔓延至所有请求。随机丢弃是最简单的策略:丢弃一部分传入请求,为其余请求保留足够的容量。其弱点在于将所有请求视为具有同等价值。基于优先级的丢弃将服务质量降级转化为明确的策略:优先服务高级付费用户,再服务免费用户;优先处理产生收入的请求,再处理分析请求;优先处理交互式流量,再处理后台批处理任务。系统仍在降级,但降级遵循预先声明的服务契约,而不是由哪个队列恰好先被填满来决定。
准入控制将同一思想应用于系统入口。它会拒绝导致容量超限的请求,而不是接收会使系统中所有现有请求的服务表现恶化的任务。熔断器35在模型副本、特征存储或支撑服务不健康时快速失败,从而保护下游依赖。
断路器有三种状态:闭合(正常运行)、打开(快速失败以防止资源耗尽)和半开(探测恢复情况)。图 28 展示了这些状态转换如何既为系统提供抵御级联故障的保护,又自动检验条件是否已经改善。
优雅降级实现
三态循环可防止单个失效依赖耗尽整个系统的连接池:open 状态快速失败,half-open 状态在恢复全量流量之前探测是否可恢复。实现首先将降级阶梯转化为控制回路。尾延迟分位数显示用户何时感受到延迟,错误率显示哪个依赖正在失效,CPU/GPU/内存利用率显示系统是否已饱和,队列深度则显示服务处理工作的速度是否快于完成它的速度。这些健康信号决定何时进入和退出每个降级级别。
降级触发条件定义激活降级的条件。Progressive Degradation Triggers展示了三种常见的触发条件,它们依据延迟、错误率和特征存储健康度逐级激活回退机制。
# Monitor tail latency for user-facing impact
if p99_latency > threshold:
    activate_model_fallback()  # Switch to faster, simpler model

# Track error rates to detect downstream failures
if error_rate > threshold:
    activate_circuit_breaker()  # Fail fast, prevent cascade

# Feature store slowdowns degrade recommendation quality
if feature_store_latency > threshold:
    activate_feature_fallback()  # Use cached/default features
退化应当随着条件恶化而渐进加剧,而不是在某一个断崖点突然切换。系统可以随着负载升高逐步提高回退比例,然后要求持续改善之后,流量才返回到更高能力的路径。迟滞机制可防止主用与回退模式在阈值附近来回振荡。
退化监控与告警
由于优雅降级是以质量换取可用性,监控必须让这一权衡可见,而不能让系统看起来健康,同时实际正在提供保真度更低的结果。监控面必须暴露服务质量被牺牲了多少。退化监控行动地图 将该监控面转化为行动地图:回退比例揭示模型质量被降低的频率,默认特征比例揭示输入质量的损失,丢弃率揭示容量保护,主用与回退之间的质量差则揭示降级路径是否仍然可接受。
| 信号 | 暴露的质量权衡 | 升级规则 | 事后问题 |
|---|---|---|---|
| 回退模型请求占比 | 为保持服务而降低模型能力 | 持续激活超过 5 分钟即升级为告警。 | 回退是否保留了足够的用户价值? |
| 默认特征请求占比 | 因依赖延迟而降低输入丰富度 | 影响超过 50% 请求的严重降级即升级为严重告警。 | 哪个特征依赖需要复制还是缓存? |
| 限流丢弃请求速率 | 为保护服务而降低覆盖度 | 熔断器开启后出现任何增长,都会触发容量调查。 | 准入控制在阻止级联之前是否足够早? |
| 主用与回退质量差 | 事故期间损失的产品质量 | 即使可用性指标看起来健康,超过 1 小时的降级也会升级。 | 回退路径是否仍然是有效的产品体验? |
事件之后,事后分析应当确定根本原因、评估回退的有效性、衡量用户与业务影响,并定义能够防止复发的改进措施。安全地实现这些回退机制,需要对系统运行时状态有深入的可观测性。当一条复杂的推荐流水线开始退化时,运维人员必须迅速判断是哪个微服务发生故障,而这种诊断依赖于分布式调试与可观测性。
分布式调试与可观测性
凌晨 2:00,旗舰生成式 API 的延迟从 200 ms 飙升至 5 秒,但 CPU、内存和网络指标都完全正常。决定是限流、重启副本还是优雅降级,需要确切知道请求在数百个微服务中的哪个位置卡住。分布式调试与可观测性提供了定位这些不可见瓶颈所需的诊断能力。
为什么分布式机器学习系统难以调试
分布式机器学习调试之所以困难,是因为恢复所需的证据分散在时序、状态、规模和模型行为四个方面。分布式系统会表现出非确定性行为36,来源包括多个方面:网络时序抖动会改变执行顺序,线程调度差异会改变竞态条件,GPU 内核执行顺序在不同运行之间不一致,浮点运算顺序会改变结果。某个执行中显现的缺陷可能在后续执行中无法复现。这些”海森堡缺陷”在受到观察时似乎会消失。
部分故障将这种非确定性转化为恢复问题。与单机系统中故障通常是完全的相比,分布式系统会出现部分故障:部分组件发生故障而其他组件继续运行,工作组件与故障组件之间的相互作用会产生复杂的故障模式。随后,规模使得人工检查不再是一种可行的调试方法:当组件数量达到数千时,自动工具必须从海量遥测流中过滤出信号,并识别出能够解释该事件的少数信号。机器学习系统还向同一诊断问题增加了模型行为,因为静默的精度退化会产生错误结果而不报错,NaN 与无穷大等数值问题会在计算中传播,依赖数据触发的缺陷只在特定输入下显现,而学习本身会导致行为变化,看起来可能就像缺陷。
可观测性支柱
只有当可观测性能够将症状连接到某个行动时,它才有用:限流、重启副本、回滚检查点,或优雅降级。假设推荐服务突然违反了延迟 SLO,而模型副本仍报告 GPU 利用率正常。指标确立了症状的时序与范围,链路追踪显示是哪个服务跨度消耗了请求预算,日志则解释了级联开始那一刻该服务内部发生了什么。图 29 总结了这三种证据类型,但运行规则是相关性:除非某个信号能够关联到同一请求、模型版本、特征版本和部署事件,否则它都不充分。
指标是最先出现的证据,因为它们将集群行为压缩为可触发行动的时间序列。在机器学习集群中,有用的指标涵盖基础设施信号,例如 CPU 与 GPU 利用率、内存分配、网络带宽和存储 I/O;应用信号,例如请求速率、延迟分位数、错误计数、队列深度和缓存命中率;以及机器学习专用信号,例如按模型的推理延迟、批处理利用率、特征检索延迟、特征新鲜度,以及用于漂移检测的预测分布。只有当告警映射到恢复决策时,指标流才成为容错基础设施。较高的 p99 延迟可能触发负载 shedding,缓存命中率下降可能触发回退特征,而预测分布的突然偏移则可能在污染面向用户的决策之前阻断发布。
日志提供指标有意丢弃的事件上下文。结构化日志采用 JavaScript Object Notation (JSON) 等格式并使用一致的字段,因此事件工具能够按服务、请求、模型版本、GPU、特征库或追踪标识符进行检索。Structured JSON Log Entry展示了一次 GPU 内存分配失败,既记录了本地失败上下文,也记录了将事件连接到分布式指标与 span 所需的追踪标识符。
{
  "timestamp": "2024-01-15T10:23:45.123Z",
  "level": "ERROR",
  "service": "inference-server",
  "trace_id": "abc123",
  "span_id": "def456",
  "message": "GPU memory allocation failed",
  "gpu_id": 3,
  "requested_bytes": 4294967296,
  "available_bytes": 2147483648
}就容错而言,重要的日志属性是一致性关联,而非具体的后端实现。日志级别应在各组件间一致地将事件映射到升级路径;但恢复系统更依赖运维人员能否依据与指标和 span 中出现的相同请求、trace、模型版本、特征版本及部署标识符来查询事件。因此,日志聚合是有用的,因为它保留了本地故障上下文与集群范围内症状之间的关联。
Trace 展示了延迟或故障如何在分布式组件之间传播。 Trace 是一次请求的端到端旅程, Span 是该旅程中的单个操作, Context Propagation 则负责跨服务边界传递 trace 标识。下图通过机器学习推理流水线中的 trace,说明这些 span 如何组合:
Trace: user-request-12345
|-- Span: api-gateway (5 ms)
|   `-- Span: auth-service (2 ms)
|-- Span: feature-service (15 ms)
|   |-- Span: user-feature-lookup (8 ms)
|   `-- Span: item-feature-lookup (12 ms)
|-- Span: inference-service (45 ms)
|   |-- Span: preprocessing (3 ms)
|   |-- Span: model-inference (40 ms)
|   `-- Span: postprocessing (2 ms)
`-- Span: response-formatting (1 ms)
Total: 66 ms
OpenTelemetry 提供了一套用于分布式追踪的标准 API。Jaeger、Zipkin 或云追踪服务等后端系统负责存储和可视化追踪记录。真正的需求不在于采用哪一种追踪后端,而在于保留足够的上下文信息,以判断故障究竟出在请求路由、特征检索、模型执行、后处理,还是模型服务之外的某个依赖上。
机器学习专用调试
当计算在数值上是有效的,但对模型而言却是错误的,此时仅凭运行信号是不够的。机器学习系统还需要具备专门的调试能力。
数值调试
数值调试针对的是张量仍然是有效对象、但其中包含非法值的情况。NaN 检测37 至关重要,因为 NaN 值会悄无声息地传播到所有下游计算中。代码 3 展示了一个最小检查,可在污染影响用户之前将其捕获。
# Check tensor for NaN values
# (propagate from any corrupted computation)
if torch.isnan(output).any():
    log.error("NaN detected in output", input_hash=hash(input))
    # Log input hash for reproducibility, then fallback or fail fast
训练期间,梯度统计量会在其污染整个运行之前暴露数值故障。梯度范数用于检测梯度爆炸或消失,梯度分布用于检测异常,逐层梯度则用于定位问题层。
混合精度训练38可能引入数值问题。监控损失缩放调整(指示下溢)、超过 FP16 范围的梯度溢出,以及 FP16 与 FP32 结果之间的一致性。
数据调试与验证
数据缺陷表现为“看起来有效但实际错误”的输入,因此调试必须在每个流水线边界除了验证数值有效性之外,还要验证语义正确性。在进入模型之前,验证会检查预期的格式、形状、取值范围、必需字段和编码,从而在故障仍局限于输入路径时捕获畸形样本。
输入通过上述静态检查后,系统还需要关于行为随时间变化的证据。分布监控会跟踪特征漂移、空值率变化和离群点,使其在出现时即被记录;转换遥测则记录中间形状和统计量,使团队能够将每个阶段的性能与已知良好的数据进行比较。这些信号共同区分“被污染的输入路径”与“模型内部的数值故障”。
拖慢者检测与分析
拖慢者诊断要回答的问题是:哪个组件慢到足以成为等效于故障的瓶颈?同一请求可能在所有副本上成功,但最慢的副本仍会决定尾部延迟,并可能触发重试,在负载下看起来就像失败。操作级计时遥测会测量每个操作的耗时,从而支持跨流水线阶段的延迟归因。 代码 4 使用上下文管理器将操作封装起来,以生成每个区段的计时指标,使得跨副本比较性能变得十分方便。
# Wrap operations in timing context managers for latency attribution
with timer("feature_lookup"):
    features = feature_store.lookup(
        ids
    )  # Often the latency bottleneck
with timer("model_inference"):
    predictions = model(features)  # GPU time, compare across replicas
使用百分位分析比较各副本之间的组件时序。p50 反映典型性能,而 p99 反映尾部延迟。跨副本比较 p99 可以识别出那些慢速路径已演变为全集群瓶颈的 worker。
诊断必须进一步区分导致同一“慢 worker”症状的不同根因。硬件问题包括热节流和内存错误;数据倾斜意味着部分输入的处理更慢;资源争用发生在其他进程占用资源时;网络问题则会导致到数据存储的连接变慢。
常见故障模式
可观测性支柱能够识别大规模机器学习系统中已发现的反复出现的故障模式。图 30 汇总了最常见的训练损失特征,每种特征都需要不同的诊断与恢复响应。
训练失败
训练损失特征之所以有用,是因为它将一条曲线映射为一次恢复决策。图 30 首先展示曲线;训练失败响应映射 随后将这一操作性映射明确化,把曲线视为针对特定恢复动作的证据。
| Signature | Likely Interpretation | Recovery Response |
|---|---|---|
| Spike followed by recovery | 瞬时输入或数值异常;仅凭曲线无法确定成因 | 保留可疑批次与步骤证据,然后回放,再决定是否继续。 |
| Spike followed by plateau | 优化器不稳定、状态损坏,或数据通路存在持久缺陷 | 暂停,从已知良好的检查点回放,并比较输入、优化器与 worker 证据。 |
| Gradual divergence | 数据漂移、数值不稳定、状态损坏,或 worker 失步 | 比较各 rank 遥测与评估证据;仅当回放将问题归因于硬件时才隔离硬件。 |
| Hang without an error | 集合通信死锁,或崩溃的 worker 阻塞同步 | 使用超时检测,并重启或重建 worker 组。 |
这些诊断响应保护长运行批处理工作负载,但在实时面向用户的系统中识别故障需要完全不同的延迟预算。
服务故障
服务故障需要在更严格的延迟约束下采用相同的“症状—动作”映射。服务故障响应映射 依据各常见症状所揭示的信息以及服务系统首先必须采取的动作,将它们区分开来。
| Symptom | Likely Interpretation | Immediate Response |
|---|---|---|
| Latency spikes | 资源争用、垃圾回收、冷缓存,或模型重载 | 检查部署位置与容量;反复出现的高峰通常意味着问题已不再是瞬态的。 |
| Rising error rates | 依赖故障、数据格式变更,或模型缺陷 | 立即排查,因为错误会在相互依赖的服务之间累积。 |
| Silent quality degradation | 模型漂移、特征退化,或数据管道故障 | 使用超出标准运维指标之外的质量监控。 |
| Cascade failure | 超时耗尽、资源耗尽,或来自某个故障组件的错误传播 | 在故障扩散前触发断路器并保留隔离边界。 |
级联故障尤其具有隐蔽性,因为其根因被其所产生的症状所掩盖。下面的具体诊断展示了三个可观测性支柱如何协同工作,将级联故障追溯到其源头。
Example: 诊断级联故障
场景:一个推荐系统突然出现延迟尖峰。
诊断:三个可观测性支柱协同工作以定位根因。指标 揭示了症状:p99 延迟从 45 ms 跃升至 800 ms(14:32),错误率从 0.1 百分比上升至 15 百分比。追踪 隔离了瓶颈:特征服务 span 耗时 700 ms,而正常值仅为 12 ms,模型推理 span 则保持在正常的 40 ms。日志 确定了根因:特征服务日志显示,14:31 出现针对用户嵌入缓存的反复连接超时,随后由于请求绕过故障缓存并直接命中嵌入数据库,引发了缓存未命中风暴。
系统经验:缓存节点故障引发了缓存未命中雪崩,压垮了嵌入数据库,并将延迟传播到所有请求。修复方案是在缓存访问上设置断路器,在缓存不可用时回退到默认嵌入。
案例研究
已发布的生产系统使本章的规模经验具体化:故障检测、状态保留与可观测性重新体现为检查点开销、拓扑重构、混沌测试与弹性恢复。本节案例研究使用来自 Meta、Google、Netflix 和 Microsoft 的公开报告,展示具有代表性的工程模式。请将运行中的数字视为反映设计压力的报告量级,而非普适常数。Meta 的 Open Pre-trained Transformer(OPT-175B)训练运行部署在 992-GPU 集群上,提供了第一个例子:训练过程中必须吸收数十次硬件故障,而不能中止训练。
Meta 的大规模 LLM 训练
Meta 对开放预训练 Transformer(OPT-175B)的训练,为研究大规模深度学习任务中的故障物理机制提供了一个记录详尽的案例 (Zhang 等 2022年)。工程团队连续两个月使用由 992 块 NVIDIA A100 GPU 组成的集群,面临一个统计上的必然结果:硬件组件会发生故障,而且会频繁发生。在整个训练过程中,团队记录了约 90 次由硬件故障(ECC 内存错误、NCCL/InfiniBand 网络问题、GPU 丢失)和训练稳定性事件引发的手动重启,同时对超过 100 台主机进行了重启或替换 (Meta AI Research 2022年)。在同步数据并行形态下,单块 GPU 故障就会使整个集群停止运行,使整体系统的平均无故障时间(MTBF)仅为任一单个组件平均无故障时间的一小部分。对于 OPT-175B,大约每天有两台机器宕机,使系统整体的有效 MTBF 降至一天的一小部分,因此必须采用将中断视为常态而非例外的容错策略。
在 OPT 训练期间,团队通过检查训练日志是否及时更新来监控进度:公开日志簿记录了一个 15 分钟的文件修改时间阈值,后来放宽至一小时,用于重启监控 (Meta AI Research 2022年)。检测只是解决问题的一半;关键的工程挑战在于尽量降低“重启开销”——从持久化存储重新加载模型和优化器状态所损失的时间。项目早期,向远程分布式文件系统同步保存检查点消耗了总有效训练时间的近 12%,这一难以承受的开销使项目周期延长了数周。为此,团队实现了异步检查点,先将 350 GB 模型状态的序列化工作卸载到 CPU 内存中,再在后台将其流式写入磁盘,同时立即恢复下一批次的计算。这一优化将检查点开销降至不到 3%,节省了数百个 GPU 小时。
恢复流程还必须考虑非硬件故障,尤其是与数值不稳定性相关的损失尖峰。与故障停机事件不同,这种症状使近期模型状态的有效性受到怀疑,需要进行诊断,而不仅仅是识别故障设备。恢复策略将回滚到最近一个有效检查点与对优化器的干预相结合:当观察到梯度溢出或损失缩放因子触及下限时,团队会回退到更早的检查点,并以降低后的学习率恢复训练(最终采用的学习率约为 OpenAI 训练 GPT-3 时所用学习率的三分之二),以稳定训练轨迹 (Meta AI Research 2022年)。这种双层韧性——同时应对物理硅芯片故障和数学发散——使 Meta 即使每天遭遇中断,仍能维持每块 A100 约 147 TFLOP/s 的性能(接近 FP16 峰值的 50%)(Zhang 等 2022年)。OPT-175B 带来的长期启示是:在大规模场景下,检查点频率与训练吞吐量之间的权衡,是决定可行性的核心变量;过于频繁地保存检查点会浪费计算资源,而保存过于稀疏,则可能因一次故障或无效状态转移而损失数天的训练进展。
Google TPU pod 的韧性
Google 的 TPUv4 超级计算机采用了根本不同的容错架构,其基础是定制的 ICI 网络互连结构,以及能够动态重构拓扑的光电路交换机网络。一个 TPUv4 pod 包含 4,096 个芯片,组织为 64 个“立方体”,每个立方体包含 64 个芯片,并按 \(4{\times}4{\times}4\) 三维网格排列 (Zu 等 2024年)。在这种架构中,网络实际上就是计算机:单个芯片或光链路故障不仅会使容量减少 \(1/4096\) 分之一——还会在通信拓扑中形成一个空洞,导致 AllReduce 等集合操作所需的同步网格发生死锁。
因此,Google 的策略侧重于切片抽象,而非原地修复。OCS 网络将多个健康的立方体组合为逻辑“切片”,其规模与训练任务的需求相匹配。当通过监控链路完整性和机器健康状态的两个软件组件 libtpunet 和 healthd 检测到故障时,编排系统不会尝试在活动切片内部绕过故障。相反,控制平面会抢占该任务,并重新配置 OCS 网络互连结构,将工作负载连接到 pod 内其他位置的备用健康立方体。这种方法将硬件视为任务执行期间的不可变基础设施:系统不修复正在运行的拓扑,而是利用仍然健康的组件重建一个形状完全相同的拓扑。
这种方法在定量上的成效以系统可用性衡量。在 Google 的生产 TPUv4 集群中,动态重配置策略实现了 99.98% 的系统可用性,同时平稳应对了约 1% 的训练作业所遭遇的硬件故障 (Zu 等 2024年)。各组件的每日故障率相对较低——TPU 机器为 0.08%,ICI 线缆为 0.005%,OCS 单元为 0.04%——但在集群规模下,这些故障汇聚成持续不断的重配置事件流,控制平面必须在不影响训练吞吐量的情况下处理这些事件。TPU 经验的关键启示是,对于紧密耦合的高带宽系统,尝试修复正在运行的拓扑往往徒劳无功;更高效的做法是将立方体视为故障的原子单元,并重配置光互连结构,利用仍然正常工作的组件组建新的切片。
Netflix 面向服务依赖的混沌工程
训练韧性关注的是长时间运行的批处理作业,而 Netflix 已发表的混沌工程研究 (Basiri 等 2016年) 则提供了服务侧的对照。其前提很简单,但对运维实践要求很高:由于生产系统包含许多相互作用的依赖项,团队应通过主动注入故障来验证稳态行为,而不是等待真实事故发生后才确认回退机制是否有效。
对于机器学习服务,同样的实践也适用于特征存储、模型服务依赖项、缓存和回退路径。模型端点可能处于正常状态,而特征服务却响应缓慢、数据过时或不可用;如果系统缺乏经过测试的回退机制,局部依赖问题就可能演变为用户可感知的延迟或推荐质量下降。混沌测试通过在受控条件下注入延迟、终止依赖服务或强制启用回退路径,将这些假设转化为可执行的验证。
这些注入故障的恢复过程以分层回退机制为核心。如果主要的深度学习模型发生故障或超时,服务系统可以切换到更轻量的模型、缓存响应,或基于热门程度的简单默认方案。系统层面的启示是,机器学习服务的韧性并非静态属性,而是持续主动验证的实践:从未实际运行过的回退路径只是文档,并不构成容错。
Microsoft DeepSpeed 容错
Microsoft 的 DeepSpeed 库展示了一条适用范围更窄的框架层面经验:大模型容错必须协同处理检查点、分片的优化器状态和资源管理,而不能依赖单体重启脚本。DeepSpeed 为参数量超过 1000 亿的模型提供了基于 ZeRO 的分布式训练和检查点基础构件 (Rasley 等 2020年; DeepSpeed Developers 2026年a)。使用 ZeRO 时,模型参数、梯度和优化器状态被分片到所有可用 GPU 上,而不是在各 GPU 上复制 (Rajbhandari 等 2020年)。因此,单个节点发生故障可能使其持有的状态分片无法访问,恢复过程因而依赖持久化检查点,以及能够恢复或重新分配这些分片的编排机制。
所支持的恢复模型以检查点为中心,并不意味着每次节点丢失后都能在内存中完成修复。每个 rank 都将自身的状态分片作为分布式检查点的一部分写入;发生故障后,作业按照启动器和资源管理器选定的工作进程拓扑,重新加载最近的持久化检查点。通用检查点机制扩展了这一模型,使检查点能够更好地适应特定的并行方式和拓扑变化,但仍然依赖明确执行的保存与加载流程 (DeepSpeed Developers 2026年b)。如果存在可供替换的计算资源,作业就可以按原有规模恢复;如果配套的弹性启动器以更少的工作进程恢复作业,训练脚本仍须保持数据覆盖范围,以及批大小或学习率的不变性约束。
因此,系统层面的启示并不是 DeepSpeed 单独就能让工作进程丢失对作业透明,而是分片训练框架必须提供检查点和状态管理原语,使调度器能够将其组合成弹性恢复策略。将这些原语集成到框架层可以减少定制恢复机制的工程工作,但端到端保证仍然来自框架支持、严格的检查点管理和调度器集成的共同作用。
这些案例研究揭示了三条普遍原则:
- 检测速度决定恢复成本:Meta 的日志新鲜度监控、Google 的自动 ICI 重配置和 Netflix 的混沌实验都表明,检测越快,丢失的状态就越少。
- 故障的原子单元至关重要:Google 重新配置通信互连结构的路由,DeepSpeed 通过检查点恢复分片,Netflix 则验证服务级回退机制。各组织都选择了与自身架构耦合程度相匹配的粒度。
- 容错是一个连续谱,而非二元状态:从 Meta 的检查点回滚到 Netflix 的分层平稳降级机制,系统都实现了多层防御,每一层都在保真度与速度之间进行权衡。
尽管存在这些模式,工程团队在设计具有韧性的机器学习系统时,仍经常陷入常见误区。
谬误与陷阱
基础设施团队可能花费数周时间加固存储层以抵御磁盘故障,最终却因 PyTorch 分布式后端中一个隐蔽的软件缺陷,导致整个训练作业失败。分布式机器学习系统的容错涉及反直觉的数学关系和微妙的权衡,传统数据中心经验在这些问题上往往并不适用。
谬误:硬件故障是主要关注点。
这一直觉源于传统系统,在这些系统中,磁盘故障、断电和网络分区占据主导地位。在机器学习系统中,硬件故障只是更广泛的事故类型中的一部分。
大规模机器学习系统的行业经验表明,故障类型更为广泛,因为机器学习作业运行时间长、具有状态,并且对控制平面的微小失误十分敏感。硬件故障仍然重要,但软件缺陷、配置错误、资源耗尽和跨层原因往往在事故数量上占据主导:格式错误的检查点路径可能使恢复无法进行,不匹配的集合通信库可能导致所有 rank 挂起,过小的共享内存上限可能使数据加载器崩溃,过时的特征模式则可能悄无声息地破坏训练。这些故障不会因为属于“软件”问题就不那么严重;它们同样可能摧毁运行数日的作业,而硬件冗余原本正是为了保护这些作业。
大量投入硬件冗余,却忽视软件鲁棒性(输入验证、渐进式发布、配置管理),会使许多重要的故障模式得不到处理。最可靠的机器学习系统将软件缺陷视为不可避免,并采用防御式设计。
陷阱:凭直觉设置检查点间隔。
组织通常根据“感觉合适”来设置检查点间隔:“每小时一次似乎合理”或“每 1,000 步一次”。Young-Daly 公式揭示,这些直觉往往是错误的。对于 集群平均无故障时间(MTBF)的扩展规律 中包含 1,000 个 GPU 的集群,其仅考虑 GPU 故障时的平均故障间隔时间(MTBF)为 50 小时,检查点写入时间为 5 分钟:
\[\tau_{\text{opt}} = \sqrt{2 \times 5 \times 3000} = \sqrt{30000} \approx 173 \text{ minutes}\]
直觉上的“每小时”并不准确:它比最优策略几乎频繁三倍地做检查点,把差额花在写开销上,而这一开销并不能换来任何恢复收益。若检查点时间增加到 15 分钟(模型更大、存储更慢),最优间隔会拉长到 300 minutes,离某些团队为“求稳”而采用的“每 15 分钟”更是相去甚远。过于频繁的检查点所浪费的计算资源多于其所节省的部分。定量方法表明,基于直觉的间隔往往在两个方向上都偏离最优值 2–3\(\times\)。
谬误:若每台 GPU 的可靠性为 99.99%,那么 10,000-GPU 集群的可靠性同样是 99.99%。
可靠性不能通过平均来合成——它通过相乘来累积。对于 \(N\) 个串联组件,每个组件的可用性为 \(A\),并假设它们的失效相互独立,则整体可用性为 \(A^N\)。当 \(A = 0.9999\) 和 \(N = 10{,}000\) 时,所有 \(N\) 同时处于可用状态的概率为 \(0.9999^{10{,}000} \approx 0.37\):在 63% 的时间里,至少有一台 GPU 处于宕机状态。单个组件的可靠性是必要条件,但在集群规模上远非充分条件。系统级的容错(检查点、弹性恢复、跨失效域的冗余)必须显式设计,而不能假定它会从各组件的 MTTF 中自然涌现。
陷阱:把 MTBF 计算当作失效相互独立来处理。
可靠性方程 \(\text{MTBF}_{\text{system}} = \text{MTBF}_{\text{component}}/N\) 假设组件失效在统计上是相互独立的。而在实际生产中,失效之间存在相关性:
- 共享电源域:不间断电源故障会导致整个机柜宕机。
- 共享交换机:顶置机柜交换机故障会将所有连接的 GPU 隔离。
- 共享软件:由特定输入触发的缺陷会使所有副本同时失效。
- 热相关:冷却故障会导致 GPU 成簇降频。
相关失效会改变简单 MTBF 方程所掩盖的两个量:事件发生频率和影响范围。一个由 1,000 台独立 GPU 组成、每台 MTBF 为 50,000 小时的集群,其首台 GPU 失效的 MTBF 为 50 小时。若某个共享电源、冷却或软件风险带来的事件发生率是该独立首失效率的 10 倍,则有效事件 MTBF 会降至约 5 小时。此外,一次相关事件可能同时带走 10 台 GPU,即使独立的 GPU 失效率本身没有变化,也会推高恢复成本。可靠性工程必须通过多样性来识别并缓解相关性:不同的电源馈线、不同的网络路径、在金丝雀部署中使用不同的软件版本。
谬误:组件的 MTTF 值可以预测单个失效的发生时刻。
工程师看到 GPU 的 MTTF 为 50000 hours,便按每台设备五年一次的更换周期进行规划。MTTF 是总体(population)的统计属性,而非对任何单个部件的预测。一台 MTTF 为 50000 hours 的 GPU 可能在 200 小时后失效,也可能持续 100,000 小时;其分布十分宽泛。MTTF 真正可靠预测的是聚合失效速率:在 10,000 GPUs 规模的集群中,稳态失效速率约为每小时 \(10{,}000/50{,}000 = 0.2\) 次失效,即大约每 5 hours 发生一次失效。集群级可靠性工程正是依赖这种统计规律性,来规划自动恢复、备件池深度以及值班轮班。试图预测下一台具体 GPU 会失效,属于范畴错误,也会白白浪费监控开销。
Pitfall: Ignoring restart overhead in checkpoint planning.
Young-Daly 公式考虑了检查点保存时间,但从业者常常忽略重启开销:
- Job Scheduling Delay:在共享集群中,获取替换 GPU 需要数分钟。
- Checkpoint loading:从存储中读取分布式检查点。
- Warmup Time:学习率预热、批归一化统计量重计算。
- Communication re-establishment:NCCL 环状拓扑重建。
总重启时间可达 3–5\(\times\) 个检查点保存时间。一次 5 分钟的检查点保存后接 20 分钟重启,意味着每次失效在计入自上次检查点以来的丢失工作之前,成本就是 25 分钟。该恢复项应计入预期浪费与恢复 SLO 预算;除非有特定的恢复感知检查点模型推导出该依赖关系,否则不应将其加到 \(T_{\text{write}}\) 中,仿佛每次检查点都要支付一次。
Fallacy: Every failure should be handled as a full restart.
工程师常把所有失效都当作“节点崩溃,从检查点重启”,但不同的失效模式需要不同的响应。瞬时失效(网络拥塞、热节流)应触发重试/暂停而非重启,因为状态仍保留在内存中。永久性失效(GPU 损坏、节点崩溃)需要带迁移的检查点重启,以迁移到新硬件。静默损坏(比特翻转、ECC 错误)需要回滚到更早的检查点,而不只是最新的一个,因此需要保留检查点历史。资源耗尽(OOM、内存碎片)需要在重启前重新配置;否则作业会立即再次崩溃。正如 节 1.0.5 所述,误判失效类型会浪费计算资源:把瞬时的网络抖动当作永久性失效,会浪费数小时重新初始化;而忽略静默损坏,则会使模型权重中毒且无法被察觉。
Pitfall: Assuming checkpoints are consistent without validating state.
现代框架会透明地执行检查点,从而营造出自动一致性的错觉。实际上,分布式检查点需要协调,而协调可能以隐蔽的方式失败:
- Rank Desynchronization:如果 rank 0 检查点迭代 1000,而 rank 1 检查点迭代 1001,则该检查点是不一致的。
- Partial Writes:检查点过程中发生存储故障,会留下不完整的分片。
- Optimizer State Lag:若分片优化器状态与模型权重在不同时刻被捕获,则两者可能不匹配。
- In-Flight Gradients:检查点期间可能正在进行的 AllReduce,是否被纳入并不确定。
生产系统必须实现检查点验证:验证所有分片都存在,验证迭代编号一致,验证优化器状态与模型状态一致。那些在从失效恢复过程中才发现检查点已损坏的组织,除了从更早的(可能早得多)检查点重新启动外别无他法。
Fallacy: Fault tolerance can be tested only when failures happen.
容错机制是那些在正常运行中很少执行的代码路径。就像备份系统直到灾难发生才首次被测试一样,容错代码路径会不断累积缺陷:
- 检查点恢复逻辑从未被测试,因为训练从未崩溃
- 备用模型从未被加载,因为主模型从未失效
- 熔断器阈值是针对旧的流量模式调优的
混沌工程(有意注入失效)将容错从“正确性的假设”转变为“经验性确证”。那些定期在训练期间随机终止 GPU、注入网络分区、并使主模型失效的组织,能在缺陷造成实际影响之前发现它们。定期故障注入的成本(若干次失败的实验、若干次轻微中断)远低于在实际失效过程中才发现容错机制已损坏的成本。
Pitfall: Using elastic training as a substitute for checkpointing.
弹性训练在工作节点发生故障时调整并行度,以缩减后的容量继续训练,看似消除了从检查点重启的开销。然而,状态一致性方面的挑战依然存在:减少活跃工作节点的数量,需要以一致的方式重新分配模型分片、优化器状态和数据任务。当规模低于某个最小可行规模时,训练便无法进行(模型无法容纳、批大小过小),此时仍然需要从检查点重启。每移除一个工作节点,吞吐量都会下降;累积故障会逐步降低训练速度,直到从检查点重启比继续承受性能下降更为可取。如果故障由特定数据触发的软件缺陷引起,该缺陷仍会存在于其余工作节点中。弹性训练是检查点机制的补充,而非替代;即使降低检查点频率,仍需偶尔保存检查点,以应对灾难性故障并保存训练完成时的状态。
谬误:开销预算占训练时间的比例是固定的。
列出“流水线气泡:10%、检查点开销:5%、故障恢复:3%”的参考表,很容易被当作物理定律,并作为容量规划中的条目直接沿用。这些数字是工程目标,而非常数。流水线气泡开销取决于微批次数量和交错调度方式;采用避免完全重启的弹性训练后,故障恢复开销会大幅下降;检查点开销则取决于模型大小、存储带宽,以及检查点采用同步还是异步方式。将这些数字视为固定百分比,会导致人们被动接受本可避免的低效。Young-Daly 公式已经表明,检查点保存频率是一项需要决策的参数;参考表中列出的其他每项开销同样如此。
陷阱:增加 GPU,却未考虑通信与恢复开销。
容量规划通常会考虑 Amdahl 定律和全归约开销,却将可靠性视为固定的背景条件。在极大规模下,每增加一块 GPU,都会提高整体故障率,从而增加每个作业的预期恢复与重放时间。存在一个集群规模阈值,超过该阈值后,故障与恢复损失的时间会超过额外并行度节省的时间,训练的实际耗时会随着 \(N\) 增加而上升,而非下降。这是可靠性层面的边际收益递减效应,并且会叠加在 Amdahl 定律所规定的上限之上。这两种效应必须联合建模:有效吞吐量等于模型 FLOPs 利用率(MFU)\(\times\) 扩展效率 \(\times\)(1 - 故障开销),而故障开销项随 \(N\) 增长。
谬误:硬件具备 ECC,因此静默数据损坏可以忽略不计。
GPU 和内存系统包含广泛的错误纠正机制(ECC、CRC、奇偶校验),使人直觉上认为静默数据损坏可以忽略不计。然而,大规模 CPU 静默数据损坏(SDC)与内存错误研究揭示了相反的事实:在集群规模下,静默损坏和内存故障仍会发生,并且可能逃过常规错误报告 (Dixit 等 2021年; Sridharan 等 2015年)。对于包含 10,000 块 GPU 的集群,即使单个设备上的损坏事件极为罕见,也会在运行层面产生实际影响,因为系统持续执行着海量的内存操作和算术运算。静默损坏可能导致损失突增、梯度出现 NaN 或无法收敛,但这些症状都无法确定硬件就是原因。因此,检测需要结合多种方法:通过校验和验证存储与传输完整性,通过跨进程摘要核对一致性,通过冗余计算或重放验证算术运算正确性,以及通过统计监控发现模型层面的异常。在系统将设备退出使用或回滚状态之前,必须依据证据区分有问题的批次、数值不稳定、同步错误和硬件损坏。
陷阱:仅依赖硬件 ECC,而不进行端到端验证。
ECC 是必要的一层保障,但并不能构成一次训练运行的端到端正确性证明。流水线还需要对数据和检查点分片进行校验和验证,在风险足以支持相应成本时独立核验集合通信结果,检测梯度与激活值异常,并提供可重放的测试,以区分有问题的批次与损坏的状态。端到端验证使静默损坏在机器学习系统边界上变得可观测,但并不意味着摘要能够证明生成其对应字节的计算是正确的。
识别这些谬误,可以避免工程师针对错误的故障模式进行优化。构建具有韧性的机器学习集群所需的核心原则,源自本章贯穿始终的定量推理。
总结
容错将统计上预期会发生的硬件故障转化为可管理的日常运维工作。单个组件的可靠性在数千台设备上累积作用,使系统级平均故障间隔时间(MTBF)从数年缩短至数小时。在集群规模下,系统必须通过自动、快速且对训练或服务干扰极小的恢复过程,应对故障并保持持续推进的进展。
检查点是跨故障保留训练进度的基础机制。同步检查点方法简单,但会产生随模型规模增长的 I/O 开销;异步方法则使检查点写入与计算重叠,代价是增加了一致性方面的复杂性。Young-Daly 公式 \(\tau_{\text{opt}} = \sqrt{2 \times T_{\text{write}} \times \text{MTBF}_{\text{system}}}\) 可最小化预期浪费,而 RPO 和 RTO 则限定可接受的工作损失和恢复延迟。不可变分片与最后发布的清单共同确定哪一代检查点可以安全恢复。在成员变更期间,轮次与隔离机制防止过期工作节点修改该状态,而幂等性、继承的截止时间和重试预算则防止恢复流量加剧故障。当训练算法保持其数据、批大小和优化器不变量时,弹性训练便可在工作节点集合发生变化后恢复运行。
服务容错面临的挑战与训练存在根本差异。训练能够容忍分钟级恢复延迟,并受益于 SGD 在数学上对近似重启的容忍能力;服务则要求毫秒级响应,并且必须保留 KV 缓存和对话历史等会话级状态。无状态服务通过简单的副本冗余和负载均衡实现容错,但面向 LLM 的有状态服务需要主动状态复制、会话亲和路由,以及在主系统不可用时回退到更轻量模型的平滑降级层级。本章考察的案例研究,从 Meta 的 OPT-175B 训练经历约 90 次由硬件故障和训练稳定性事件引发的重启,到 Netflix 针对 ML 服务开展的混沌工程,表明这些原则并非纯粹的理论,而是生产规模下的运行必需。
这些原则为韧性提供了诊断框架。当训练运行停滞时,工程师可以评估瓶颈是检查点 I/O 开销、检测速度不足,还是弹性训练无法应对的故障模式。当服务系统丢弃请求时,他们可以沿冗余层级追踪故障,定位副本健康状况、状态复制滞后或不充分的回退策略。随着 ML 系统规模扩大,非计划停机的成本也随之增长。一个拥有 10,000 个 GPU 的集群闲置一小时,意味着浪费数万美元的计算资源,因此容错既是经济上的要求,也是可靠性方面的需求。
Key Takeaways: 故障是正常运行的一部分
- 规模使故障成为常态: 一个拥有 10,000 个 GPU 的集群,在本章的组件故障率假设下,每隔几小时就会遭遇硬件故障;软件必须将故障视为正常状态。
- 检查点是基础: 同步检查点方法简单,但开销较高;异步方法隐藏 I/O 延迟,代价是增加了一致性方面的复杂性。
- 恢复是一项契约: RPO 限定进度损失,RTO 限定恢复延迟,MTTR 与 MTBF 共同决定稳态可用性,清单标识已提交的状态,而隔离机制防止处于过期轮次的工作节点在被替换后继续写入。
- Young-Daly 公式决定检查点间隔: 最优检查点间隔 \(\tau_{\text{opt}} = \sqrt{2 \cdot T_{\text{write}} \cdot \text{MTBF}_{\text{system}}}\) 在保存状态的成本与工作损失的成本之间取得平衡,对于大型训练作业通常为数十分钟,而对于小型检查点则短得多。
- 弹性使持续运行成为可能: 将训练作业设计为“弹性”作业(在节点丢失后重新配置,如 图 26 所示),可在训练脚本保持必要的数据、批大小、学习率和检查点不变量时,减少闲置时间和工作损失。
- 服务要求有状态故障转移: 训练容错以检查点为中心,能够容忍分钟级恢复;与之不同,有状态 LLM 服务需要亚秒级 KV 缓存复制或迁移(状态型故障切换方法),以避免高延迟的会话重启。
当故障成本能够被限定时,韧性就成为可以有效处理的问题。检查点机制消耗计算和通信资源来保存状态副本,以应对未来可能发生的节点丢失,而 Young-Daly 间隔则决定两次保存之间可以承受多少工作损失。设置得当时,一个节点失效带来的损失是几分钟,而非几天。故障率没有改变,改变的是故障对结果的影响。这使协同开销变得明确:主动承担这项成本,使组件故障不再决定集群规模的作业能否完成。
What’s Next: 从韧性到资源管理
要在不可避免的硬件故障下保持集群运行,需要三层机制:检查点保留进度,弹性应对节点丢失,冗余保护有状态服务会话。然而,容错集群仍然需要编排,以决定哪些作业在哪里运行、何时抢占,以及如何在相互竞争的工作负载之间公平共享资源。集群编排 探讨编排层,涵盖从 Slurm 和 Kubernetes 调度到成组调度、多租户和容量规划的内容;这一层将一组容错节点转化为受管理的生产系统。
Sridharan, V., N. DeBardeleben, S. Blanchard, K. B. Ferreira, J. Stearley, J. Shalf, 和 S. Gurumurthi. 2015年. 《Memory Errors in Modern Systems: The Good, the Bad, and the Ugly》. ACM SIGPLAN Notices 50 (4): 297~310. https://doi.org/10.1145/2775054.2694348.
Dixit, H. D., S. Pendharkar, M. Beadon, C. Mason, T. Chakravarthy, B. Muthiah, 和 S. Sankar. 2021年. Silent Data Corruptions at Scale. arXiv preprint arXiv:2102.11245.
DeepSpeed Developers. 2026年b. DeepSpeed Universal Checkpointing with DeepSpeed: A Practical Guide. DeepSpeed tutorial.
Rajbhandari, Samyam, Jeff Rasley, Olatunji Ruwase, 和 Yuxiong He. 2020年. 《ZeRO: Memory Optimizations Toward Training Trillion Parameter Models》. SC20: International Conference for High Performance Computing, Networking, Storage and Analysis, 1~16. https://doi.org/10.1109/sc41405.2020.00024.
DeepSpeed Developers. 2026年a. DeepSpeed Model Checkpointing. DeepSpeed documentation.
Rasley, Jeff, Samyam Rajbhandari, Olatunji Ruwase, 和 Yuxiong He. 2020年. 《DeepSpeed: System Optimizations Enable Training Deep Learning Models With Over 100 Billion Parameters》. Proceedings of the 26th ACM SIGKDD International Conference on Knowledge Discovery & Data Mining, 3505~6. https://doi.org/10.1145/3394486.3406703.
Basiri, A., N. Behnam, R. de Rooij, L. Hochstein, L. Kosewski, J. Reynolds, 和 C. Rosenthal. 2016年. 《Chaos Engineering》. IEEE Software 33 (3): 35~41. https://doi.org/10.1109/ms.2016.60.
Zhang, Susan, Stephen Roller, Naman Goyal, Mikel Artetxe, Moya Chen, Shuohui Chen, Christopher Dewan, 等. 2022年. OPT: Open Pre-trained Transformer Language Models.
Meta AI Research. 2022年. OPT-175B Training Logbook. Companion repository to the OPT-175B model release.
38 混合精度数值问题:FP16 的动态范围仅覆盖 \(6 \times 10^{-8}\) 到 65,504,而 FP32 覆盖 \(1.2 \times 10^{-38}\) 到 \(3.4 \times 10^{38}\)。损失缩放(反向传播前将损失乘以 1,024,再对梯度进行除法)可防止下溢,但溢出仍会触发自动步长跳过,从而浪费计算。BF16 通过匹配 FP32 的指数范围来缓解这一问题,代价是尾数精度降低,即以训练稳定性换取数值分辨率。
37 NaN 传播:IEEE 754 规定,任何涉及 NaN 的算术运算都会产生 NaN,这意味着单个梯度计算中的 NaN 会悄无声息地污染所有下游参数更新。机器学习训练中的常见触发因素包括归一化层中的除零(方差为零的批归一化)、非正值取对数,以及 FP16 溢出为无穷大。如果没有逐步的 NaN 检测,整个训练运行可能在任何监控告警触发之前,就产出一个充满 NaN 权重的模型。
36 海森堡缺陷:约 1983 年源自黑客文化,由 Jim Gray 在 1985 年分析计算机故障时正式提出,是对海森堡不确定性原理的双关语。缺陷在观察下会消失,因为加入探针会改变时序。在分布式机器学习训练中,这一点尤其有害:插入梯度日志会改变 NCCL 集合通信的时序,从而掩盖了导致静默数据损坏的那一竞态条件。
35 断路器: 以电气安全装置命名,该装置在过载时切断电源。在软件中(Michael Nygard 于 2007 年出版的 Release It! 中推广),该模式包裹服务调用,并在失败阈值触发后“跳闸断开”,从而快速失败,而不是等待一个已经失效的依赖。对于机器学习服务,这可以防止单个失效的模型副本或特征存储耗尽连接池,并在整个推理集群中引发级联故障。
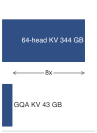
一次长对话承载数十 GB 的实时状态。
34 KV 缓存: 存储所有注意力层中所有先前 token 的键和值投影,随 \(2 \times N_L \times H_{\text{KV}} \times S \times d_{\text{head}} \times \text{bytes}\) 扩展。对于一个 Llama 系列 70B 模型,80 层、8 个键值头、128K 上下文、128 维头以及 BF16 存储,每个对话的 KV 缓存约为 43 GB;若使用 64 个独立的键值头,则约为 344 GB。故障时丢失该状态会迫使重新生成所有先前 token,将亚秒级的故障切换变成数分钟级的重新计算,从而违反服务延迟 SLA。
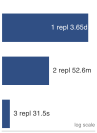
冗余将数天的停机时间压缩为秒级。
Horovod Developers. 2026年. Elastic Horovod. Horovod documentation.
Sergeev, Alexander, 和 Mike Del Balso. 2018年. 《Horovod: fast and easy distributed deep learning in TensorFlow》. CoRR abs/1802.05799.
Ray Project. 2026年. Ray Train: Handling Failures and Node Preemption. Ray documentation.
PyTorch Contributors. 2026年a. Torch Distributed Elastic Rendezvous. PyTorch documentation.
33 会合:源自法语“rendez-vous”(意为“前来集合”),这一协同协议要求重启后的工作进程相互发现,并就新的组成员组成达成一致,之后训练才能恢复。该协议的开销来自一道同步屏障:它会阻塞所有工作进程,直到最慢的工作进程到达,从而产生与集群异构性成正比的恢复延迟。
Goyal, Priya, Piotr Dollár, Ross Girshick, Pieter Noordhuis, Lukasz Wesolowski, Aapo Kyrola, Andrew Tulloch, Yangqing Jia, 和 Kaiming He. 2017年. 《Accurate, Large Minibatch SGD: Training ImageNet in 1 Hour》. arXiv preprint arXiv:1706.02677 abs/1706.02677.