责任人工智能
治理的必要性
责任人工智能
目的
为什么那些无法满足责任要求的系统,无论其技术能力如何,都无法部署?
在高风险受监管场景中,一个无法解释或记录其行为、无法支持审计、也无法满足适用歧视规则的模型,可能无论其准确率或延迟如何,都无法通过部署审查。法律与治理要求可使透明度、监督、文档化和风险管理成为部署就绪性的一部分。负责任的人工智能工程通过可测量的控制来实现这些要求,而不是将其视为最终性的伦理审查。用 C³ 术语来说,责任是施加于集群的协同约束。所需的安全、公平和问责控制必须在部署之前建立。
Learning Objectives
- 将公平性、透明度、问责、隐私和安全转化为可测量的部署关卡
- 计算公平性指标,并在基准率与预测权衡下评估观察性定义与因果定义
- 设计跨人口群体的偏见检测与公平性监控,涵盖漂移和集群级反馈回路
- 在延迟、计算、可审计性和用户可争议性约束下选择解释方法
- 评估隐私、遗忘和鲁棒性缓解措施,以准确率、计算和治理要求为准则
- 分析部署场景下的人机反馈回路、自动化偏见和价值冲突
- 构建可审计的保证生命周期,涵盖预期用途与证据、上线、补救、重大变更和退役
2018 年,路透社报道,亚马逊在发现其基于历史简历数据训练的实验性招聘算法系统性惩罚女性候选人后,放弃了该系统 (Dastin 2018年)。该系统满足了许多常规运行要求:它能够被构建、评估并集成到招聘流程中。然而,它学到了过去成功申请者以男性为主这一事实,因而编码了历史偏见而非基于功绩的资格。该模型在统计意义上是最优的,但在伦理上是灾难性的,表明技术卓越可以与严重的社会危害并存。
Dastin, Jeffrey. 2018年. 《Amazon Scraps Secret AI Recruiting Tool That Showed Bias Against Women》. Reuters.
在 集群栈 所示的集群栈中,负责任的人工智能是治理层,即系统接触真实世界的地方。下层提供计算、数据移动、分布式执行、服务基础设施、安全控制、鲁棒性机制和可持续性预算。治理层则加入决定机器为何运行以及为谁服务的约束,确保一个原本正确的系统不会对社会造成危害。铁律 定义了效率,负责任的人工智能则定义了稳定性:确保系统的输出不会使其所处的社会陷入不稳定。这种不稳定性是具体的:输出有毒内容的模型会侵蚀用户信任(反馈回路不稳定性),实施歧视的模型会劣化其自身的未来训练数据(分布不稳定性),泄露隐私的模型会招致监管关停(运行不稳定性)。因此,负责任的人工智能属于目标函数,而不仅仅是在最终解上检查的约束。
生产人工智能有自己的系统议程,涵盖架构、基础设施、数据处理、安全和鲁棒性挑战 (Stoica 等 2017年)。安全与隐私、分布偏移下的鲁棒性以及环境可持续性直接位于治理层之下。这些能力解释了如何构建并运行安全、鲁棒且可持续的机器学习系统。负责任的人工智能则回答仅凭技术卓越无法回答的问题:这些系统是否对其所影响的人负责任地运行。
Stoica, Ion, Dawn Song, Raluca Ada Popa, David Patterson, Michael W. Mahoney, Randy Katz, Anthony D. Joseph, 等. 2017年. 《A Berkeley View of Systems Challenges for AI》. arXiv preprint arXiv:1712.05855.
亚马逊招聘事件揭示了负责任人工智能的核心挑战:系统可能在算法层面稳健,同时持续延续不公正。这一问题超出了个体偏见,涵盖影响数十亿人日常生活的系统中的透明度、问责、隐私和安全。这与韧性不是同一个问题。韧性人工智能通过对抗性攻击和硬件故障来应对系统完整性的威胁;负责任的人工智能则追问一个正常运行的系统是否产生与人类价值和集体福祉一致的结果。这一区分将抽象的伦理原则转化为工程约束。公平性、透明度和问责必须成为可量化的机制和可验证的系统属性,而不是服务链路完成之后附加的最终审查事项。
软件工程为这一演进提供了先例。早期系统仅追求功能正确性。随着复杂度增长,该领域发展出了可靠性工程、安全保证和可维护性分析的方法。机器学习部署产生了类似的成熟压力,但社会规模更大:模型可以中介信贷分配、医疗诊断、教育评估和刑事司法。负责任的人工智能失败可能延续系统性歧视、损害民主机构,并在底层服务仍然可用的情况下侵蚀公众对有益技术的信心。
Definition 1.1: 负责任的人工智能
负责任的人工智能 是指按照可测量的公平性、安全、隐私和问责标准来设计、审计和运行机器学习系统的实践——将伦理原则转化为可验证的系统属性,从而约束模型训练、部署决策和运行监控。
- 重要性:负责任的人工智能约束会带来真实成本:公平感知训练可能延长训练运行,实时偏见监控可能消耗服务链路延迟,按需可解释性可能需要额外的模型评估或异步工作器容量。在集群规模下,这些保障措施必须像可靠性或安全控制一样进行预算。反过来,一个存在持续性子群体误差差距的人脸识别系统可能在被检出前影响数百万用户,由此产生的监管和法律责任成本将远远超过监控投入。
- 区别:与人工智能伦理(界定系统应当如何行为的规范性原则)不同,负责任的人工智能工程定义的是强制执行这些原则的技术机制,包括偏见检测算法、差分隐私实现、审计轨迹以及使合规可测量、可验证而非仅具理想化的架构护栏。
- 常见误区:一种常见误解是,负责任的人工智能是对已完成模型施加的最终合规审查。通常,那些未从数据采集阶段就开始设计的负责任约束,修复往往需要根本性的重新训练:仅靠事后阈值调整无法对基于偏见标签训练的模型进行公平校准,因为学到的表示本身编码了偏见。
负责任的人工智能因而构成一套系统性的工程学科,包含四个相互关联的维度:将伦理原则转化为可测量的系统需求,检测并缓解有害的算法行为,处理超出单个系统的社会技术动态1,以及在组织与监管语境中应对实施挑战。NIST 人工智能风险管理框架、ISO/IEC 42001 与 23894、经济合作与发展组织人工智能建议,以及联合国教育、科学及文化组织关于人工智能伦理的建议等公共框架,都表达了从抽象原则向可治理的风险管理、问责、透明度和人工监督的转变 (Tabassi 2023年; International Organization for Standardization 和 International Electrotechnical Commission 2023年b, 2023年a; Organisation for Economic Co-operation and Development 2024年; UNESCO 2022年)。隐私机制、鲁棒性技术和可持续性指标为这一整合提供了技术基础。负责任的人工智能框架将这些能力与偏见检测算法、隐私保护机制、组织治理结构和利益相关方参与流程相结合,将负责任的人工智能视为健全工程实践的根本,而非施加于已完成系统的补充性约束。
1 社技系统:由 Tavistock 研究所于 20 世纪 50 年代提出,用以描述工作场所中人与技术之间相互依存的关系。机器学习集群是终极的社技系统:其”性能”不仅是一个基准分数,而是模型输出与用户行为、法律框架及物理资源约束相互作用的涌现属性。
这种整合是一项重大的基础设施投资。Every Fleet Engineer Should Know Numbers 提供了可用于估算该开销的生产规模集群基线和推理容量数据,使工程师能够依据与原始推理相同的每加速器吞吐量数字来衡量这一协同开销的规模。这项成本是必须预留的基础设施,就像分布式系统中对安全(安全与隐私)和冗余(容错)进行预算一样。
将公平性、透明度、问责和隐私视为严谨的工程规范而非抽象理想,将负责任的人工智能从愿景转化为实践。以下系统方法将这些核心伦理原则直接映射到机器学习生命周期的机械阶段,使每一项都成为具有可测量标准的具体设计约束。这四个关切必须按顺序阅读,因为每一项都依赖于前一项:仅靠技术方案无法解决价值冲突,缺乏技术实施的伦理原则仍停留在理想层面,而缺乏组织支持的孤立干预会失败。
治理与保证生命周期
模型注册表可以证明哪些权重进入了生产环境,但它无法证明该部署是正当的。这一判断需要一条证据链,将部署语境连接到受影响的人、可预见的危害、可测量的需求、已实施的管控措施、问责主体,以及启动或停止系统的授权。因此,负责任的人工智能需要一条保证生命周期:一条可重复的运行路径,将规范性承诺转化为可审查的主张,并在系统变化时保持这些主张有效。
生命周期始于模型选择之前。团队首先定义预期用途、禁止用途、受影响方、运行环境和决策后果。随后识别危害与需求,包括子群体表现、隐私、安全、鲁棒性、可持续性、人工监督以及可争议性义务。部分控制措施在本地实施;其他则继承自数据提供方、基础模型供应商、云平台或下游运营方。每一项继承的控制都需要一份接口契约,说明供应商保证什么、支持该保证的证据是什么,以及哪些残余风险仍由部署组织承担。
由此形成的保证论证并非单一合规文档。它是一组版本化的关联工件:
- 主张:针对特定用途和运行包络所要求的属性。
- 论证:将控制措施与证据连接到主张的推理过程。
- 证据:可复现或可检查的评估、审计、日志、文档和用户研究。
- 假设:主张成立所依赖的环境、人群、供应商和工作流条件。
- 责任人与授权:对主张负责、并有权阻止上线、限制使用或要求补救的个人或机构。
- 失效规则:使主张失效并触发重新评估的可测量变更或事件。
这一结构避免了一类常见范畴错误。公平性仪表盘、隐私会计、红队报告或碳清单都是针对有界主张的证据;它们本身都不是系统整体负责任的证明。表 1 展示了该证据何时才能转化为实际运行:当责任人能够据此采取行动,且受影响的人拥有对决策提出异议并获得补救的路径时。
在发布时刻,端到端评估契约 将这些保证主张绑定到具体的模型、工作负载、验收授权、回滚目标和证据保留期限。保证论证解释了部署为何正当;评估契约则确保提升与失效针对同一份可复现工件执行该判断。
| 生命周期阶段 | 必需工件 | 运行决策 |
|---|---|---|
| 语境与受影响方 | 预期用途声明、禁止用途、利益相关方地图、决策影响分析 | 该用途是否正当且在组织授权范围内? |
| 风险与需求 | 危害模型、法律与政策义务、可测量的验收标准 | 哪些风险必须被预防、限制、转移或接受? |
| 控制与依赖 | 控制清单、供应商证据、数据与模型血缘、工具权限 | 本地与继承控制是否足以覆盖运行包络? |
| 评估与保证 | 保证论证、含不确定性的分群结果、鲁棒性与安全证据、可持续性核算 | 证据是否支持上线、受限上线或拒绝? |
| 上线授权 | 签署的决策记录、残余风险责任人、回滚与申诉路径 | 谁可以授权部署,谁可以停止它? |
| 运行与事件响应 | 监控阈值、升级责任人、事件日志、补救工作流 | 何时必须降级、回滚、通知、补偿或暂停? |
| 重大变更 | 变更分类、影响评估、再验证范围 | 新模型、数据集、工具、区域或用途是否使先前批准失效? |
| 退役 | 退役计划、保留与删除记录、用户与下游系统通知 | 访问、数据、模型、接口和未决危害如何关闭? |
具名框架在不同层级组织这项工作。NIST 人工智能风险管理框架围绕 Govern、Map、Measure 和 Manage 组织活动;ISO/IEC 42001 规定了组织级人工智能管理体系;ISO/IEC 23894 提供了人工智能风险管理指引;OECD 与 UNESCO 的建议则阐述了更广泛的原则与公共责任 (Tabassi 2023年; International Organization for Standardization 和 International Electrotechnical Commission 2023年b, 2023年a; Organisation for Economic Co-operation and Development 2024年; UNESCO 2022年)。表 2 将这些视角映射到同一运行生命周期,而非将其视为可互换的检查清单。
Tabassi, Elham. 2023年. Artificial Intelligence Risk Management Framework (AI RMF 1.0). NIST AI 100-1. National Institute of Standards; Technology. https://doi.org/10.6028/NIST.AI.100-1.
International Organization for Standardization, 和 International Electrotechnical Commission. 2023年a. ISO/IEC 23894:2023 Information Technology – Artificial Intelligence – Guidance on Risk Management. ISO/IEC standard.
Organisation for Economic Co-operation and Development. 2024年. Recommendation of the Council on Artificial Intelligence. OECD Legal Instruments.
UNESCO. 2022年. Recommendation on the Ethics of Artificial Intelligence. UNESCO.
| 生命周期责任 | NIST AI RMF 强调 | 管理体系与公共政策强调 |
|---|---|---|
| 建立语境、受影响方与授权 | Govern 和 Map | 组织语境、领导层、利益相关方参与和人工监督 |
| 测量风险并汇编证据 | Measure | 风险评估、书面目标、评估、透明度和可追溯性 |
| 决策、运行与响应 | Manage | 运行控制、问责、事件响应、补救和持续改进 |
| 重新评估变更与退役 | Govern 和 Manage | 变更管理、纠正措施、生命周期审查和退役义务 |
有三项细节使该生命周期不至于沦为形式。第一,公平性估计必须附带分母、置信区间和数据覆盖限制;有噪声的子群体差距应当触发调查,而非自动主张歧视或安全。第二,来自 Sustainable AI 的可持续性证据应纳入同一份保证记录:功能单元、系统边界、碳信号、水核算、隐含影响分摊、不确定性和质量约束决定一项环境主张是否可比或可执行。第三,调用工具或委派行动的系统需要一个独立于模型对齐的授权边界。工具身份、最小权限范围、审批要求、花费与速率限制、输出验证、来源和撤销必须版本化并受到监控,因为模型生成的工具参数和检索内容仍属不可信输入。
生命周期还界定了公平性与对齐之间的边界。公平性追问在相互竞争的规范性标准下,收益、错误、机会和负担如何在受影响的人之间分配。对齐性追问优化系统是否追求设计者与合法利益相关方所意图的目标与约束。一个对齐的系统可以忠实地实现一个不公平的目标,而一个统计上公平的分类器仍可能在优化错误的社会目标。治理必须同时评估二者,而不能将其中之一归结为另一个。
批准在其支撑假设不再成立时失效。基础模型、训练分布、检索语料、工具访问、部署区域、用户群体、决策目的或人工工作流的变更,即使应用代码未变,也可能构成重大变更。变更记录应识别哪些主张被失效,并选择最小的可辩护再验证范围。在服务结束时,退役必须撤销凭据、安全停止下游接口、应用保留与删除规则、保留必需的审计证据、通知受影响用户与下游运营方,并为未决申诉或危害保留责任人。治理覆盖系统上线之后与下线之后,而不只是审查委员会签署发布的那一刻。
核心原则与机器学习生命周期
一条持续集成流水线能够自动检测内存泄漏,并因此阻止部署。同一条流水线也必须阻止这样一种部署:系统检测到准确率出现 15% 的下降,且该下降专门针对老年用户。负责任的人工智能将伦理原则转化为严格的工程不变量。正如单元测试可防止逻辑回归,持续集成/持续部署(CI/CD)流水线必须嵌入公平性、隐私和问责性检查,将人口学偏见恰当地视为致命软件异常来处理。
公平性以稳定性约束的形式运作。用控制理论术语来说,公平性确保系统的误差分布在各个人群子群之间保持不变。违反这一约束的系统是不稳定的:它会通过反馈回路(例如预测性警务)恶化自身的训练数据,并失去用户信任,最终导致系统崩溃。这一原则既涵盖统计指标,也涵盖关于公平、正义和结构性偏见的更广泛规范性关切。节 1.1.3 中的公平性分析将详细考察这些正式的数学定义。
同样的控制面视角使可解释性成为系统证据的一个来源:归因、示例、反事实分析和可解释模型结构可以揭示供人类操作者调查的模式(Phillips 等 2020年)。这些方法并不能揭示模型的完整因果推理、为某个决策提供辩护、保证补救途径,或证明某个安全约束成立。它们的价值取决于所指定的受众与决策:开发者可能需要错误分析的证据,审计者可能需要可复现的行为测试,而受影响的用户可能需要易于理解的理由以及申诉结果的路径。因此,解释性补充遥测、文档、评估和人工审查,而非取代它们。
Phillips, P. J., C. A. Hahn, P. C. Fontana, D. A. Broniatowski, 和 M. A. Przybocki. 2020年. 《Four Principles of Explainable Artificial Intelligence》. 收入 Gaithersburg, Maryland, 卷 18. National Institute of Standards; Technology (NIST). https://doi.org/10.6028/nist.ir.8312-draft.
这种可观测性必须与透明度相配套:即对人工智能系统如何构建、训练、验证和部署保持开放。透明度包括披露数据来源、设计假设、系统局限性和性能特征。可解释性关注的是理解输出,而透明度涉及系统更广泛的生命周期。
一旦系统行为变得可见,问责性便提供了将个人或组织对人工智能结果负责的相关机制。它涉及可追溯性、文档、审计以及补救损害的能力。问责性确保人工智能失败不会被当作抽象的故障处理,而是被视为具有现实世界影响的后果。
在目标函数层,价值对齐2追问人工智能系统追求的目标是否与合法的人类意图和约束相一致。在实践中,这涉及技术挑战,包括奖励设计和约束规格,以及关于“谁的价值得到体现和执行”的更广泛问题。对齐并不涵盖公平性:前者关注对某个目标的保真度,而后者评估结果与负担如何分配,以及该目标本身是否合法。
2 价值对齐:确保人工智能系统优化的是人类价值而非代理目标的问题。Stuart Russell 于 2015 年将其形式化,并论证了指定目标比优化目标更为困难。由此产生的工程后果:YouTube 在 2017 年之前的推荐算法以点击率(满意度的代理指标)为目标进行优化,无意中推广了最大化点击量而损害用户福祉的阴谋论内容——这是一种需要对整个奖励流水线进行重新设计的不一致。
3 人机协同(HITL):一种设计模式,其中人类积极参与模型决策,而非被自动化所取代;该模式的取舍是延迟与安全的权衡:HITL 会根据领域不同,为每个决策增加 100 ms 到 30 秒以上的时间。大型内容审核系统历来将自动分诊与数千名人工审核者配对,表明该模式仅能随按比例的人力基础设施成本扩展。在机器学习服务架构中,HITL 需要路由逻辑、升级所需的置信度阈值以及队列管理,这些都会从根本上重塑推理流水线。
生命周期同样需要人工监督:即人类判断在监督、纠正或暂停自动化决策中所扮演的角色。这既包括运行期间的人机协同3,也包括确保人工智能使用始终对社会的价值与现实世界的复杂性负责的组织结构。
隐私、鲁棒性和人工监督从不同角度说明了同一个观点:仅靠原则并不能确保系统负责任。从抽象理想转化为具体实践,需要在整个机器学习生命周期中进行系统性整合,因为每项原则在数据采集、模型训练、评估、部署和监控中的体现方式各不相同。关键问题是:当这些原则争夺优先地位时,它们如何相互作用。
在机器学习生命周期中整合原则
公平性、透明度、问责性、隐私和安全性界定了人工智能系统以合乎伦理且可预测的方式运行意味着什么。将这些原则转化为具体约束,以指导模型的训练、评估、部署和维护,是核心的工程挑战。
在实践中落实这些原则,需要理解每项原则如何对系统行为提出具体要求:
- 公平性:模型对待不同子群体的方式必须考虑历史偏见。
- 可解释性:模型决策必须能够被开发者、审计人员和最终用户理解。
- 隐私:数据采集和使用必须遵守用户同意、使用目的和访问权限的边界。
- 问责性:必须在整个系统生命周期中明确责任分配、跟踪责任履行并落实责任追究。
- 安全性:即使在不确定或不断变化的环境中,模型也必须可靠地运行。
这些原则相互交叠,但每项原则都提出了独特的工程义务,必须将其纳入系统生命周期的设计。
负责任人工智能生命周期将负责任人工智能生命周期映射到机器学习系统开发的主要阶段:数据采集、模型训练、评估、部署和监控。
| 原则 | 数据采集 | 模型训练 | 评估 | 部署 | 监控 |
|---|---|---|---|---|---|
| 公平性 | 代表性抽样 | 考虑偏见的算法 | 群体级指标 | 阈值调整 | 子群体性能 |
| 可解释性 | 文档标准 | 可解释的架构 | 模型行为分析 | 面向用户的解释 | 解释质量日志 |
| 透明度 | 数据来源追踪 | 训练文档 | 性能报告 | 模型卡 | 变更追踪 |
| 隐私 | 同意机制 | 隐私保护方法 | 隐私影响评估 | 安全部署 | 访问审计日志 |
| 问责性 | 治理框架 | 决策日志 | 审计轨迹创建 | 人工干预机制 | 事件追踪 |
| 鲁棒性 | 质量保证 | 鲁棒训练方法 | 压力测试 | 故障处理 | 性能监控 |
公平性和隐私约束始于数据采集;鲁棒性和问责性在部署和监督期间最为关键。可解释性贯穿整个生命周期,在设计阶段支持模型调试,在提供服务时向用户说明决策依据。这一映射进一步表明,负责任人工智能是一项跨越多个阶段的架构承诺,而非事后的合规步骤。
资源需求与公平影响
落实负责任人工智能原则需要计算资源,其需求因技术方法和部署情境而显著不同。这些资源需求带来了多方面的公平考量,其范围超越单个组织,涵盖更广泛的社会正义和环境正义问题。计算预算有限的组织可能无法实施全面的负责任人工智能保护措施,从而可能导致不同群体获得伦理保障的机会不均等。依赖加速器集群和低延迟连接的大规模模型部署,可能将网络或设备无法满足这些前提条件的用户排除在外。
负责任人工智能技术会带来能源和容量成本,这一工程现实使环境正义问题进一步加剧了上述获取障碍。本章后文给出的具体数字,是针对本章详细阐述的方法所采用的容量估算假设:差分隐私可能需要额外的训练迭代,实时公平性监控会消耗服务路径上的资源,而 Shapley 值解释可能需要大量额外的模型评估,除非采用近似计算、缓存或异步生成。这些计算需求直接转化为基础设施需求:一个向 1000 万用户提供负责任人工智能功能的高流量系统,与不受这些约束的模型相比,需要大量额外的数据中心容量。
这类计算基础设施的地理分布造成了系统性的不公平,工程师必须在系统设计中加以考虑。支持人工智能工作负载的数据中心集中在电力成本低、监管条件有利的地区,而这些地区往往与低收入社区重合。这些社区承受着污染加剧、产热增加和电网压力上升的影响,却往往缺乏使用这些设施所支撑的人工智能服务所需的高带宽连接。这形成了一个反馈循环:计算资源的公平性不仅取决于算法设计,还取决于基础设施选址决策,而这些决策同时影响系统性能和社区福祉。本章后文的资源开销比较将量化具体负责任人工智能技术的性能特征。
透明度与可解释性
机器学习系统常因其缺乏可解释性而受到批评。在许多情况下,模型以不透明的“黑箱”方式运行,产生用户、开发者和监管机构难以理解或审查的输出。这种不透明性对信任构成了重大障碍,尤其是在刑事司法、医疗和金融等高风险领域,在这些领域中问责性和申诉权至关重要。例如,用于评估再犯风险的美利坚 COMPAS 算法被发现存在种族偏见4。系统的专有性质加上对可解释性工具的获取受限,阻碍了对该问题的调查或处理。
4 COMPAS(Correctional Offender Management Profiling for Alternative Sanctions):ProPublica 于 2016 年的分析发现,黑人被告被错误标记为未来罪犯的比例接近白人被告的两倍(假阳性率 45% 对 23%)。该系统专有、黑箱的性质限制了模型内部和训练数据的全面检查,表明了一种叠加失败:模型中的偏见与服务架构中的不透明性相互叠加,使系统更难审计、更难调试。
可解释性是指产生证据的实践,其目的是帮助特定受众理解模型行为的某些方面。它既包括局部解释,即刻画单个预测周围的关联影响或敏感性,也包括全局解释,即概括更广泛的行为模式。归因描述了一种方法在其假设下如何分配影响;它并不自动构成因果解释、规范性辩护或可行的补救途径。相比之下,透明度涵盖对更广泛系统设计与运行的开放,包括披露数据来源、特征工程、模型架构、训练流程、评估协议、已知局限、预期用途、系统边界和治理结构。
可解释性与透明度的重要性不仅超出技术考量,还延伸至法律要求。在许多司法辖区,这些原则是法律义务,而非可选的指导建议。根据 GDPR,仅基于自动化处理且产生法律或类似重大影响的决定会触发第 22 条保障措施及相关透明度义务,包括在访问和通知条款下提供有关所涉逻辑的有意义信息,但受法定例外限制European Data Protection Board (2018年)。5 其他领域中的类似监管压力进一步强化了将可解释性和透明度视为核心架构要求的必要性。
5 GDPR(General Data Protection Regulation)第 22 条:第 22 条赋予数据主体针对仅基于自动化处理、并产生法律或类似重大影响之决定的保护,并设有合同必要性、依法授权,或明确同意加保障措施(European Parliament 和 Council of the European Union 2016年)等例外。相关的通知与访问条款(包括第 15 条)要求对符合条件的自动化决策提供有关所涉逻辑的有意义信息,欧洲数据保护委员会(EDPB)指南则将上述义务视为更广泛的行为画像与自动化决策治理框架的一部分(European Data Protection Board 2018年)。对于机器学习系统,这构成了一项架构约束:高风险的自动化决策系统需要解释、申诉和治理基础设施,而非不透明的仅服务接口。
European Parliament, 和 Council of the European Union. 2016年. Regulation (EU) 2016/679 of the European Parliament and of the Council of 27 April 2016. Official Journal of the European Union.
European Data Protection Board. 2018年. Guidelines on Automated Individual Decision-Making and Profiling for the Purposes of Regulation 2016/679.
落实这些原则需要预判不同利益相关方的需求,而各方相互竞争的价值与优先事项在 节 1.6.3 中得到全面考察。因此,为可解释性和透明度而设计,必然涉及如何以及在系统生命周期的何处呈现相关信息。
可解释性与透明度同样支持系统随时间的可靠性。随着模型被重新训练或更新,可解释性和可追溯性机制使得能够发现意外行为、进行根因分析并支持治理。将这些机制嵌入系统的结构与运行之中,便为信任、监督以及符合机构与社会期望奠定了基础。
虽然可解释性与透明度使利益相关方能够理解系统行为,但它们并不能保证这种行为是公平的。一个模型可以完全透明地说明其决策方式,同时仍然系统性地对某些群体不利。这一区别促使我们将公平性作为一项独立的、互补的原则加以考察。
机器学习中的公平性
招聘、放贷和医疗领域的自动化决策影响着数以百万计的人,而用于训练这些系统的历史数据编码了几十年来的结构性不平等。工程问题在于,如何以系统能够衡量和强制执行的方式将“公平对待”形式化。
Definition 1.2: 算法公平性
算法公平性 是指模型误差分布或结果在受保护的人口群体之间保持不变(或变异有界)的可度量属性。
- 显著性:它将公平性从一种直觉转化为一个多目标优化问题。在铁律的框架下,实现公平性往往需要以总体准确率 \((\text{Accuracy})\) 为代价,换取针对特定群体的校准 ,其中校准在每个受保护群体内分别进行检查,从而确保系统的收益与损害得到公平分配。
- 区别:与平均准确率(会掩盖汇总层面的差异)不同,算法公平性关注的是子群体分布 \((p(Y \mid X, \text{Group}))\),从而识别出模型在少数人群身上失效之处。
- 常见误区:一种常见误解是认为存在唯一的“公平”解。事实上,不同的公平性定义(例如人口统计均衡与均等机会)在数学上往往互不相容,除特殊情况外无法同时满足:满足其中一个必然导致违反另一个,因而需要工程师明确作出政策取舍。

公平性约束会付出数个百分点的准确率代价,也就是责任税。
机器学习中的公平性带来了复杂挑战,其范围远不止透明度。核心要求是自动化系统不得对受保护群体形成不成比例的损害。由于这些系统建立在历史数据之上,它们容易复制并放大该数据中嵌入的系统性偏见模式。若缺乏精心设计,机器学习系统可能无意中强化社会不平等,而非缓解它们。
一个被广泛研究的例子来自医疗领域。一种用于分配美国医院照护管理资源的算法6被发现系统性地低估了 Black 患者的健康需求(Obermeyer 等 2019年)。该模型以医疗支出作为健康状况的代理指标,但由于长期存在的可及性与支出差异,Black 患者发生高额支出的可能性较低。因此,模型推断他们病情较轻,尽管其实际医疗需求往往相同甚至更高。这一案例说明了看似中性的设计选择(例如代理变量的选取)在历史不平等未被妥善考量时,可能产生歧视性结果。对这类模型施加公平性约束会产生可度量的成本,这种现象被称为公平性税。
6 医疗算法规模:Optum 算法每年影响约 2 亿美国人,并以医疗支出作为健康需求的代理指标。由于 Black 患者因可及性差异历来支出较低,该模型系统性地低估了其病情严重程度,使高风险照护项目的 Black 人群参保率下降 50 个百分点。若修正代理变量,Black 患者的识别率将从 17.7% 提高到 46.5%,从而量化了单个代理变量选择在人群规模上的代价。
Obermeyer, Ziad, Brian Powers, Christine Vogeli, 和 Sendhil Mullainathan. 2019年. 《Dissecting racial bias in an algorithm used to manage the health of populations》. Science 366 (6464): 447~53. https://doi.org/10.1126/science.aax2342.
公平性税的计算只隔离了一个准则:人口统计均衡,即要求各群体之间的正向决策率相等。它并不代表所有公平性目标;它展示的是在将人口统计均衡与均等机会、机会平等进行比较之前,强制执行该准则所产生的系统成本。
Napkin Math 1.1: 公平性税
问题:考虑一个准确率为 85 percent 的信用模型。群体 A(多数群体)的违约率为 20 percent。群体 B(少数群体)因系统性因素,其违约率为 40 percent。如果强制实施人口统计均衡(审批率相等),准确率会如何变化?
数学分析:
审批率的具体情况界定了政策调整;该场景中的准确率数值是在留出验证集上测得的,其中群体 B 新增的获批申请具有更高的违约风险。
- 无约束:模型批准所有预测违约概率 < 30 percent 的申请人。
- 群体 A 审批率:80 percent。
- 群体 B 审批率:60 percent。
- 总体准确率:85 percent。
- 有约束(均衡):群体 B 的审批率必须达到 80 percent。
- 群体 B 的新阈值:批准违约概率 < 50 percent 的申请人。
- 这迫使模型批准群体 B 中许多高风险申请人。
- 新的总体准确率:81 percent。
系统洞见:公平性需要付出代价。强制实施均衡导致准确率损失 4 percentage points(在这一信用评分场景中,相对准确率下降约为 4.7 percent)。这就是公平性税,即纠正历史偏见所付出的显式成本。
鉴于这些延续偏见的风险,从业者需要形式化方法来评估公平性。目前已有一系列形式化准则,用于量化模型在由敏感属性定义的不同群体中的表现。在介绍这些定义之前,将相关记号理解为表达相互竞争的公平性目标的工具,而非证明练习,有助于理解后续内容。
Systems Perspective 1.1: 作为工程词汇的公平性记号
在考察形式化定义之前,需要认识到一个根本挑战:公平性可能意味着不同的运行约束。系统可以以相同方式对待所有人、考虑不同的基线条件、优化结果以实现结果平等、维持机会平等,或强制实施同等对待。这些选择对应不同的数学准则,每一种准则都刻画了公平性的不同方面。
接下来的小节使用概率记号介绍公平性的形式化定义。这些指标(人口统计均衡、均等化赔率、机会平等)广泛见于机器学习公平性文献,并影响监管框架的形成。应重点理解其直觉含义:每个指标衡量什么,以及它为何重要,而非数学证明。每个定义之后的具体示例展示了其实际应用。如果不熟悉概率记号,可以先阅读文字描述,之后再回到形式化定义。
假设模型 \(h(x)\) 预测一个二元结果,例如贷款是否偿还,并令 \(A\) 表示一个敏感属性,其子群体为 \(a\) 和 \(b\)。该领域有三种广泛采用的公平性定义:
人口统计均衡
Definition 1.3: 人口统计均衡
人口统计均衡 是一种公平性约束,要求模型的正类预测率独立于群体归属 \((\Pr(h(x)=1 \mid A=a) = \Pr(h(x)=1 \mid A=b))\)。
- 意义:它是最简单、限制最严格的公平性指标。它要求模型在不同群体之间产生平等的结果,而不考虑数据集中潜在的基准率差异。
- 区别:均等化赔率关注假阳性率等错误率,而人口统计均衡仅关注最终预测,忽略预测与真实值之间的关系。
- 常见误区:一种常见误解是认为人口统计均衡能够确保“公平性”。实际上,它可能迫使模型牺牲校准性:为满足均衡约束,模型可能不得不有意将某一群体中的合格个体错误分类,或将另一群体中的不合格个体错误分类。
人口统计均衡考察贷款获批或治疗转介等有利结果,在由敏感属性 \(A\) 定义的各个子群体中是否以相等的比例出现。形式上,模型满足人口统计均衡的条件是: \[ \Pr\big(h(x) = 1 \mid A = a\big) = \Pr\big(h(x) = 1 \mid A = b\big) \]
在医疗例子中,这一准则会考察 Black 与白人患者是否以相同速率获得照护转介,而不论其潜在健康状况如何。这听起来像是平等可及,但它忽略了真实的医疗状态与风险差异,在需求分布并不均衡时可能过度纠正。忽略基线率差异的局限促使人们发展出更精细的公平性准则。
均等机会
均等机会要求模型的预测在给定真实标签的条件下与群体归属条件独立。具体而言,各群体之间的真正阳性率与假阳性率必须相等: \[ \Pr\big(h(x) = 1 \mid A = a, Y = y\big) = \Pr\big(h(x) = 1 \mid A = b, Y = y\big), \quad \text{for } y \in \{0, 1\}. \]
即对于每个真实结果 \(Y = y\),模型应在各群体 \(A = a\) 与 \(A = b\) 之间产生相同的预测分布。因此,对于具有相同真实结果的个体,无论其是否获得阳性结果,模型都应在各群体之间表现出相似的行为。它确保错误(包括漏报和错误阳性)在各群体之间得到同等分布。
应用于医疗案例,均等机会(equalized odds)将确保具有相同实际健康需求(真实标签 \(Y\))的患者,无论种族如何,被正确转诊或被错误转诊的可能性都相同。原始算法违反了这一原则,因为它对与白人患者同等或病情更重的黑人患者转诊不足,从而凸显了阳性率的不平等。
机会均等
机会均等是对均等机会(equalized odds)的较弱放宽,它只关注真实阳性率 (Hardt 等 2016年)。它要求:在应当获得阳性结果的个体中,获得阳性结果的概率在各群体之间相等: \[ \Pr\big(h(x) = 1 \mid A = a, Y = 1\big) = \Pr\big(h(x) = 1 \mid A = b, Y = 1\big). \]
机会均等确保模型无论群体归属如何,都平等对待那些具有 \(Y = 1\) 的合格个体。
在本文的示例中,这一标准将确保:在确实需要医疗照护的患者中,黑人与白人个体被模型识别出的机会相同。就美国医院体系而言,该算法以医疗支出作为代理变量,导致未能满足这一标准:由于历史支出较低,具有重大健康需求的黑人患者获得照护的可能性较低。接下来的算例使用本章节开头引入的贷款决策场景,计算全部三项标准,以说明单个模型为何会以不同方式违反每项公平性测试。
Napkin Math 1.2: 计算公平性指标
问题:为贷款审批模型计算两个人口统计群体(每组 100 名申请人)之间的人口统计均等性(Demographic Parity)。
变量:
- 群体 A:获批 70 人(40 人还款、30 人违约),30 人被拒。
- 群体 B:获批 40 人(30 人还款、10 人违约),60 人被拒。
计算:
- 群体 A 的获批率:\(\Pr(h(x) = 1 \mid A = a) = \frac{70}{100} = 0.70\)。
- 群体 B 的获批率:\(\Pr(h(x) = 1 \mid A = b) = \frac{40}{100} = 0.40\)。
- 均等性差距:\(0.70 - 0.40 = 0.30\)(30 percentage-point 差距)。
系统洞见:评估人口统计均等性会暴露群体获批率之间的差异,而不论真实还款能力如何,因此在模型阈值校准过程中需要显式选择指标。
Napkin Math 1.3: 计算机会均等
计算机会均等(真实阳性率 [TPR]):
在那些实际会还款(\(Y=1\))的申请人中: \[\begin{gather*} \Pr(h(x) = 1 \mid A = a, Y = 1) = \frac{40}{40 + 5} = \frac{40}{45} \approx 0.89 \\ \Pr(h(x) = 1 \mid A = b, Y = 1) = \frac{30}{30 + 20} = \frac{30}{50} = 0.60 \end{gather*}\]
差异:\(0.89 - 0.60 = 0.29\)(29 percentage-point TPR 差距)
模型违反了机会均等:在会还款的合格申请人中,群体 A 成员获得正确获批的概率为 89 percent,而群体 B 成员仅为 60 percent。
计算均等机会(真实阳性率 [TPR] 与假阳性率 [FPR]):
TPR 已在上一步计算。对于那些不会还款(\(Y=0\))的申请人,计算假阳性率: \[\begin{gather*} \Pr(h(x) = 1 \mid A = a, Y = 0) = \frac{30}{30 + 25} = \frac{30}{55} \approx 0.55 \\ \Pr(h(x) = 1 \mid A = b, Y = 0) = \frac{10}{10 + 40} = \frac{10}{50} = 0.20 \end{gather*}\]
模型同样存在不等的假阳性率:它会错误地批准 55 percent 的群体 A 违约申请人,却只错误批准 20 percent 的群体 B 违约申请人。这表明模型对群体 A 更为“宽松”,即使他们最终不会还款。
系统洞见:该模型违反了全部三项公平性标准。仅解决其中一项标准并不能自动满足其他标准。事实上,不可能性定理证明这些标准在数学上可能相互冲突。
前述贷款审批算例表明,该模型同时违反了全部三项公平性标准。这不仅是模型设计不佳,更反映了任何分类器在群体基础率(base rates)存在差异时必须面对的根本性数学张力。这些张力促使我们得到那些约束任何公平分类器所能达到的不可能性结果。
这些定义捕捉了公平性的不同方面,并且通常互不相容7 (Kleinberg 等 2017年; Chouldechova 2017年)。一个大学录取示例具体地说明了这种张力。
7 公平性不可能性定理:Kleinberg 等 (2017年) 与 Chouldechova (2017年) 在基础率存在差异时,证明了校准风险分数与错误率平衡之间的不相容性结果,除非处于完美预测或基础率相等的受限特例。人口统计均等性是对选择率施加的独立约束,在实践中也可能与校准或错误率目标发生冲突。系统层面的后果是根本性的:无论投入多少工程努力,都无法在所有场景中满足每一项规范性公平性标准,因此公平性成为需要显式政策选择(针对给定部署场景确定优先标准)的带约束的多目标优化问题。
Kleinberg, Jon, Sendhil Mullainathan, 和 Manish Raghavan. 2017年. 《Inherent Trade-Offs in the Fair Determination of Risk Scores》. 8th Innovations in Theoretical Computer Science Conference (ITCS 2017), Leibniz International Proceedings in Informatics (LIPIcs), 卷 67: 43:1~23. https://doi.org/10.4230/LIPIcs.ITCS.2017.43.
Chouldechova, Alexandra. 2017年. 《Fair Prediction With Disparate Impact: A Study of Bias in Recidivism Prediction Instruments》. Big Data 5 (2): 153~63. https://doi.org/10.1089/big.2016.0047.
目标 1(人口统计均等性)是录取学生,使得录取群体的人口结构反映申请池的人口结构,例如群体 A 占 50%、群体 B 占 50%。目标 2(机会均等)是确保在所有合格申请人中,录取率在各群体之间相同,即 80% 的合格群体 A 申请人获得录取、80% 的合格群体 B 申请人获得录取。如果某一群体的合格申请人比例更高,那么要实现人口统计均等性(目标 1)就必须拒绝其中部分合格申请人,从而违反机会均等(目标 2),正如 图 1 所示。不存在数学上的补救办法;这一选择属于关于优先采用哪种公平性定义的价值判断。
公平性不可能性法则(原则 20)精确概括了上述录取示例所揭示的内容:除基础率相等或预测完美等特例外,校准的风险分数通常无法同时满足各群体之间的等错误率条件;人口统计均等性进一步带来冲突,因为它约束的是选择率而非分数校准或错误率。满足一项标准可能排除另一项标准,因此工程师必须像对待延迟预算(latency budgets)一样处理公平性指标:将其视为由利益相关方显式选择的权衡,由系统强制执行,并监控其违反情况。确定优先采用哪项指标需要结合应用场景、潜在危害和利益相关方价值进行仔细考量,详见 节 1.6.3。
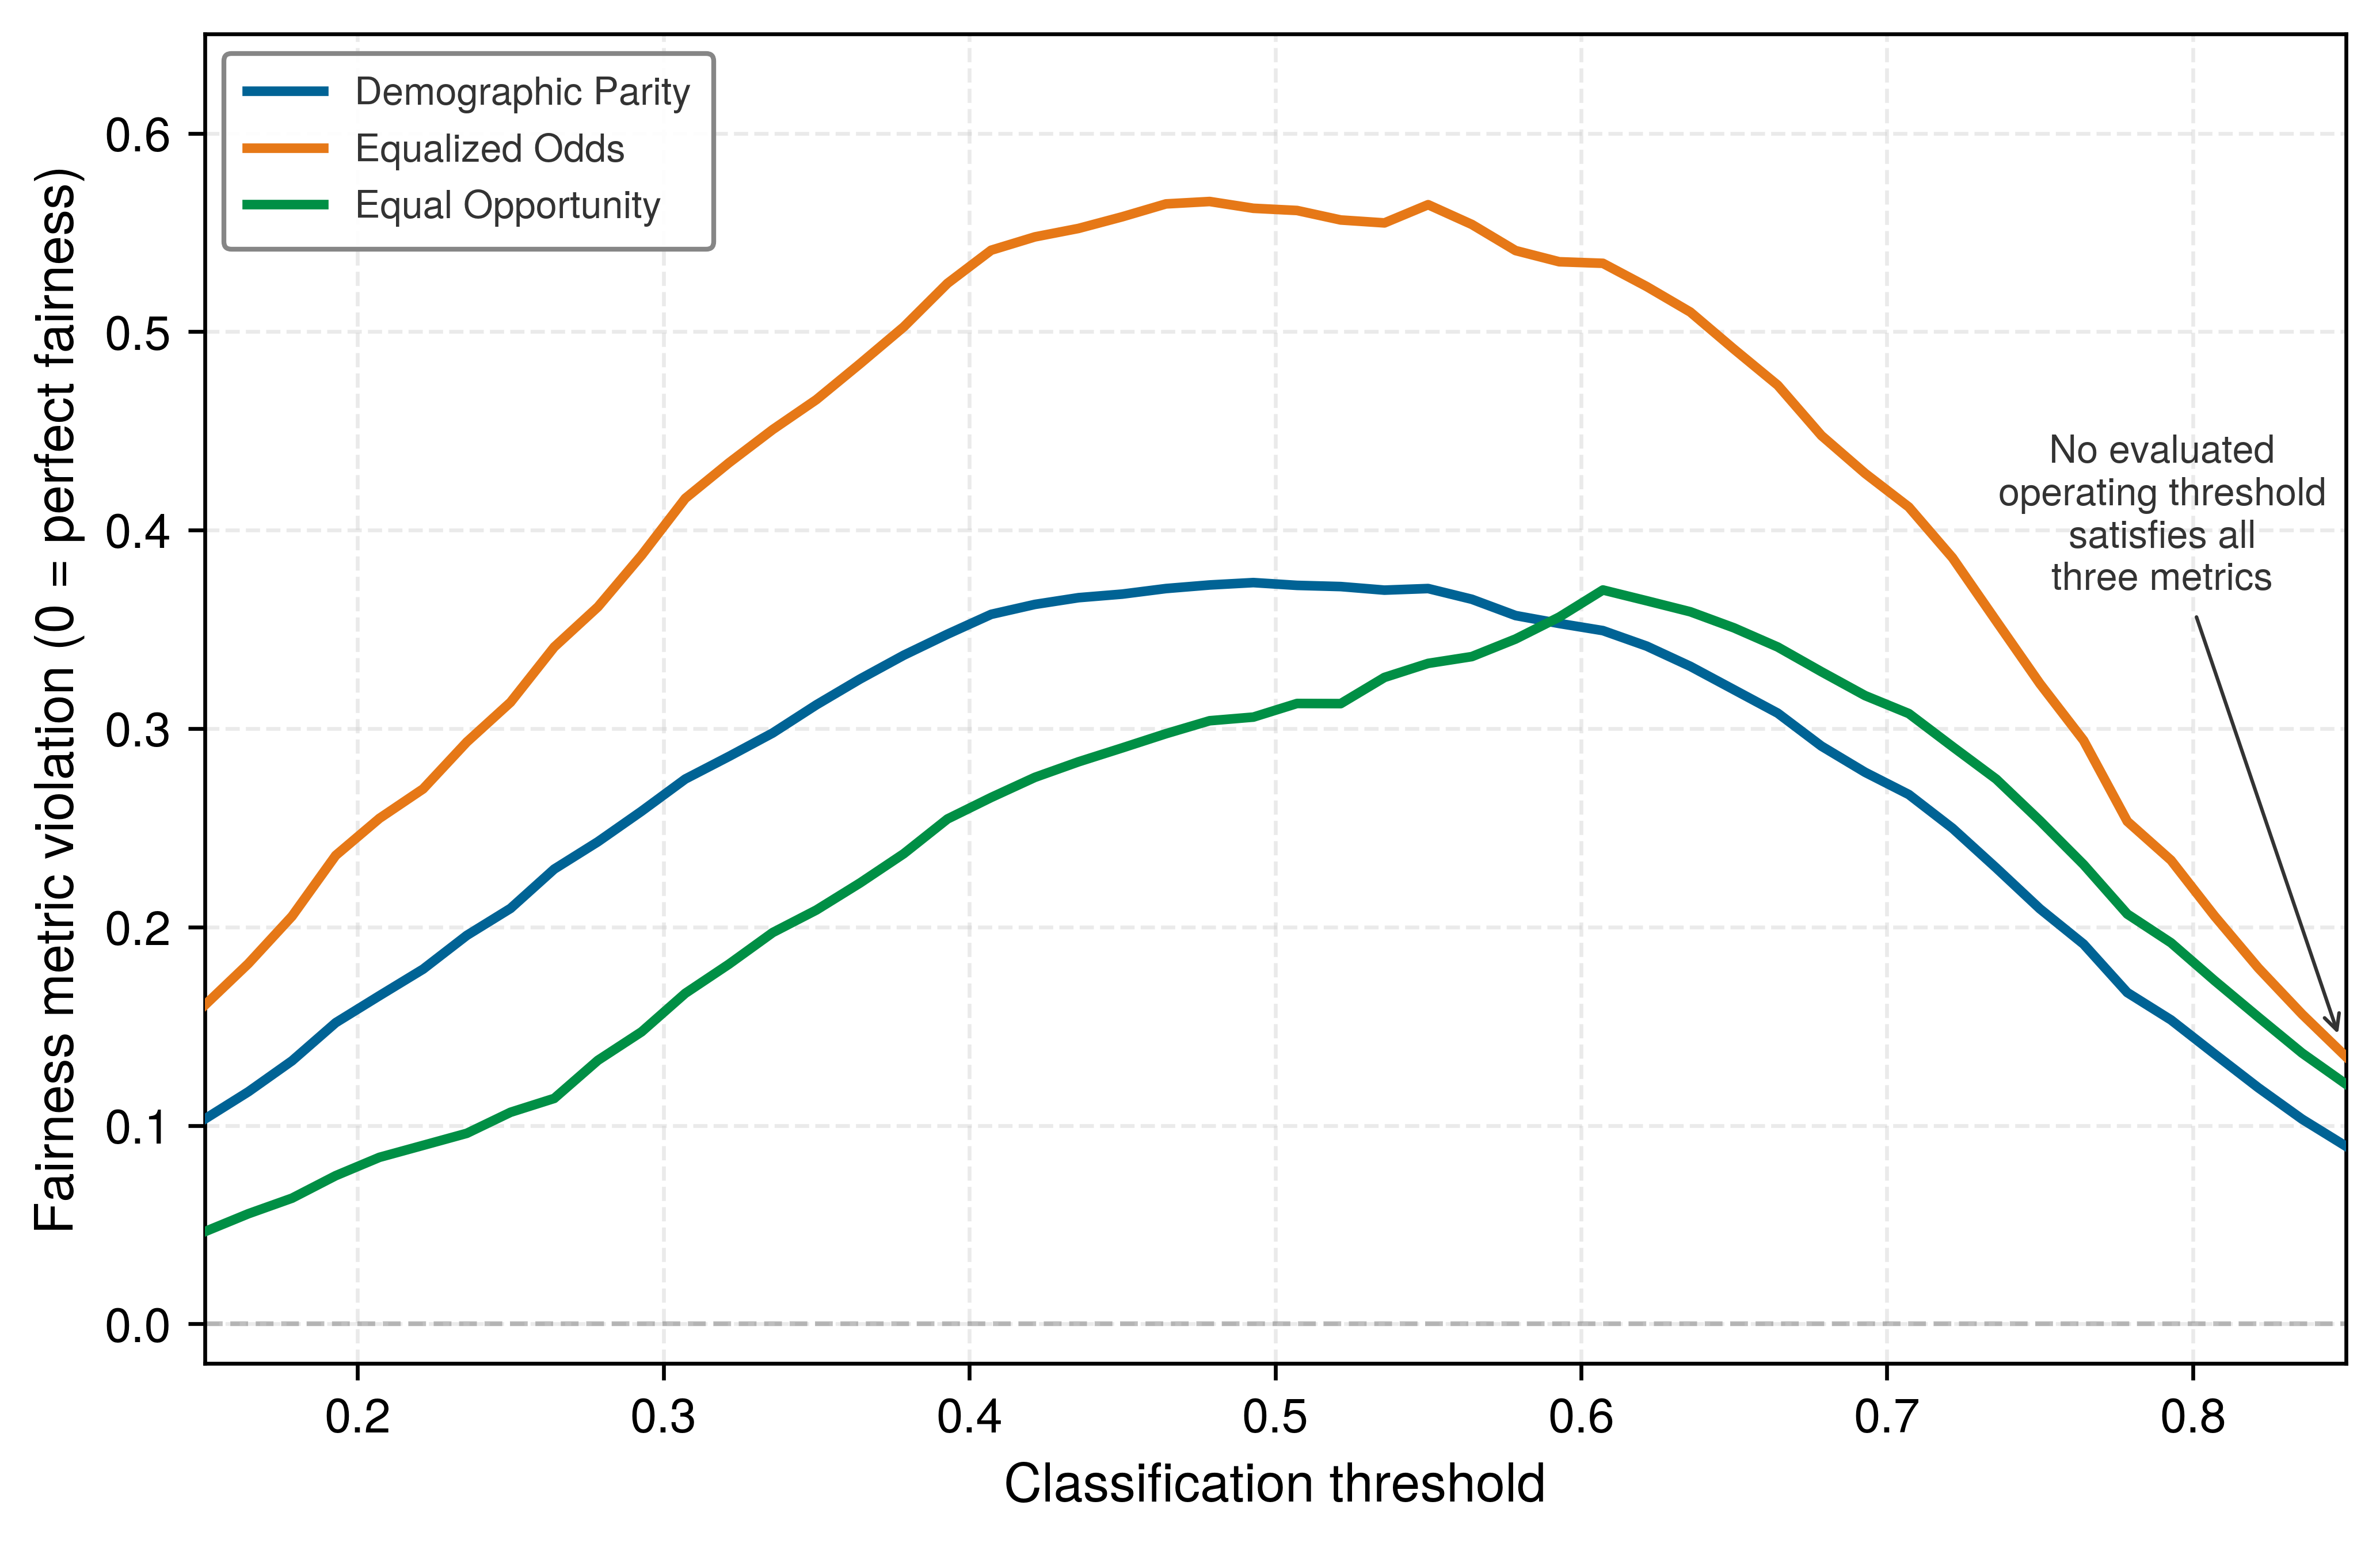
不同阈值下的公平性指标分歧通过在一个群体基础率存在差异的合成场景中扫描分类阈值,将这一权衡具体化。在评估的非平凡运行范围内,至少有一项绘制的选择率或错误率指标被显著违反,从而说明更广泛的运行经验教训:公平性标准可能相互冲突,需要显式确定优先级。
认识到这些张力,运行中的系统必须将公平性视为贯穿机器学习全生命周期的决策约束。它由数据如何采集与呈现、目标与代理变量如何选取、模型预测如何设定阈值,以及反馈机制如何构建所共同塑造。例如,在排名模型与分类模型之间做出选择,即使使用相同的基础数据,也可能在不同群体间产生不同的访问模式。
公平性指标有助于将公平目标形式化,但往往局限于预定义的人口统计类别。在实践中,这些类别可能过于粗糙,无法捕捉真实数据中呈现的全部差异范围。
观察性公平与因果公平
前述指标描述的是观察到的决策中的关联:各群体的选择率、错误率或校准度存在差异。它们可以确立一种差异,却无法识别产生该差异的路径。同样的审批率差距,可能源于对受保护属性的直接使用、相关代理变量、对早期流程的不平等访问、测量误差,或未观测到的共同原因。仅比较观察到的比率无法区分这些机制。
因果主张加入了一个结构因果模型,其箭头说明了受保护属性\(A\)、中介变量\(M\)、结果\(Y\)与决策\(\widehat Y\)被假设为如何相互关联。反事实公平随后追问:对于同一个个体,在保持所建模的背景因素不变的前提下,若处于一个\(A\)取另一个取值的反事实世界中,该决策是否会随之改变 (Kusner 等 2017年)。这是一个关于假设中的数据生成过程的问题,而非人口统计平等的一个更强版本。
Kusner, Matt J., Joshua Loftus, Chris Russell, 和 Ricardo Silva. 2017年. 《Counterfactual Fairness》. Advances in Neural Information Processing Systems 30: 4066~76.
Nabi, Razieh, 和 Ilya Shpitser. 2018年. 《Fair Inference on Outcomes》. Proceedings of the AAAI Conference on Artificial Intelligence 32. https://doi.org/10.1609/aaai.v32i1.11553.
医疗代理变量这一例子说明了二者的区别。图中可能包含种族\(A \rightarrow\)、获得医疗服务的可及性\(M \rightarrow\)、支出\(X \rightarrow\)、风险评分\(\widehat Y\),以及从健康需求\(Y\)到支出的路径。一个总效应追问改变\(A\)如何经由所有建模路径传播。一个路径特定效应则隔离出选定的路径,例如历史上经由可及性中介的支出路径 (Nabi 和 Shpitser 2018年)。将某一条路径判定为可接受、而另一条路径判定为歧视性的,属于领域判断与规范性判断;图与估计器都不会自动做出这一选择。
因果结论需要仅凭观察性数据无法确立的假设:哪些变量与箭头应纳入图中、相关混淆因素是否已被测量,以及反事实干预是否自洽。不同的合理结构可能支持不同的结论。因此,因果分析补充了群体指标、领域知识、法律分析与利益相关方参与。指标继续监测已实现的差异;因果模型则使额外的机制主张及其假设可被检验。
交叉公平性
标准公平性分析的一个关键局限在于,它往往独立地评估身份的单一条轴(例如种族或性别)。这可能会掩盖这些属性交叠处存在的深刻差异。

错误集中在交叠处:深肤色女性。
Buolamwini, Joy, 和 Timnit Gebru. 2018年. 《Gender Shades: Intersectional Accuracy Disparities in Commercial Gender Classification》. Conference on fairness, accountability and transparency, 77~91.
例如,IBM 的性别分类系统在 Gender Shades 评估中,对肤色较浅男性的准确率达到 99.7 个百分点,而对肤色较深女性的准确率仅为 65.3 个百分点 (Buolamwini 和 Gebru 2018年)。单条轴审计可能掩盖此类交叠性差异。这种现象有时被称为公平性 Gerrymandering,需要对交叠子群体(例如\(\text{Race}{\times}\text{Gender}\))评估模型表现,以检测并缓解叠加的偏见。
公平性的一项原则性方法必须考虑相互重叠与交叠的身份,确保模型行为在那些可能无法事先明确标注的子群体之间保持一致。该领域的近期工作强调了在广泛的人群切片上保持预测可靠性的重要性 (Hébert-Johnson 等 2018年),这强化了这样的观点:公平性必须被视为一项系统级要求,而非局部的调整。这种扩展后的公平性视角凸显了设计架构、评估协议与监控策略的重要性,以支持更加细致、语境敏感的模型行为评估。
定量公平性度量
只有当从业者能够度量违规程度并确立可执行的干预阈值时,正式的公平性准则才具备可操作性。由此产生的数学框架量化了差异,并判定何时这些差异需要采取纠正行动。
四指标将上文引入的公平性准则转化为审计者可以设定阈值的数值。每个指标使不同的量相等,因而各自暴露同一分类器的不同失败模式。贷款示例上的公平性指标 对这些指标进行了定义,并在持续的贷款示例上对其打分,其中 A 组的审批率为0.70、B 组为0.40,合格申请人的真阳性率为0.89 与0.60,不合格申请人的假阳性率为0.55 与0.20。
| 指标 | 使相等 | 公式 \((a, b)\) | 贷款取值 | 何时选用 |
|---|---|---|---|---|
| 差异影响(DI)比率(四分之三规则) (Feldman 等 2015年) | 较低审批率除以较高审批率 | \(\dfrac{\min_g \Pr(h=1 \mid g)}{\max_g \Pr(h=1 \mid g)}\) | \(\dfrac{0.40}{0.70} = 0.57\) | 需要一种法律认可的筛查;\(\text{DI} < 0.8\) 会标记差异影响 |
| 统计平等差异(SPD) (Calders 和 Verwer 2010年) | 审批率上的加性差距 | \(\Pr(h=1 \mid a) - \Pr(h=1 \mid b)\) | \(0.70 - 0.40 = 0.30\) | 跨多个群体比较或跟踪漂移;常见审计阈值 \(\lvert\text{SPD}\rvert \leq 0.10\) |
| 平等机会差异 (Hardt 等 2016年) | 合格申请人之间的真阳性率 | \(\Pr(h=1 \mid a, Y{=}1) - \Pr(h=1 \mid b, Y{=}1)\) | \(0.89 - 0.60 = 0.29\) | 危害在于拒绝本应获得的人 |
| 平均绝对几率差异 (Hardt 等 2016年; Bellamy 等 2019年; Bird 等 2020年) | 真阳性率与假阳性率两者 | \(\tfrac{1}{2}\big[\,\lvert \Delta\text{TPR}\rvert + \lvert \Delta\text{FPR}\rvert\,\big]\) | \(\tfrac{1}{2}[0.29 + 0.35] = 0.32\) | 两类错误都重要;该指标在完全相等的几率下为 0 |
Feldman, M., S. A. Friedler, J. Moeller, C. Scheidegger, 和 S. Venkatasubramanian. 2015年. 《Certifying and Removing Disparate Impact》. Proceedings of the 21th ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, 259~68. https://doi.org/10.1145/2783258.2783311.
Calders, Toon, 和 Sicco Verwer. 2010年. 《Three naive Bayes approaches for discrimination-free classification》. Data Mining and Knowledge Discovery 21 (2): 277~92. https://doi.org/10.1007/s10618-010-0190-x.
Bellamy, Rachel K. E., Kuntal Dey, Michael Hind, Seung Hoffman, Sylvain Houde, Karthikeyan Kannan, Pradeep Lohia, 等. 2019年. 《AI Fairness 360: An extensible toolkit for detecting and mitigating algorithmic bias》. IBM Journal of Research and Development 63 (4/5): 4:1~15. https://doi.org/10.1147/jrd.2019.2942287.
四个指标依构造彼此不一致:差异影响比率0.57 意味着审批率较低的群体仅以该比例获得审批,已经违反四分之三规则。加性0.30 差距、0.29 机会差距与0.32 平均绝对几率差距分别量化同一差异的不同维度。没有任何单一数值足够,这正是本节的不可能性结果迫使部署方必须明确选择优先采用哪个指标的原因。
校准
若一个模型相对于某个敏感属性满足分数校准,则意味着在被模型赋值为\(s\) 的个体中,具有正结果的占比在各群体之间相等 (Kleinberg 等 2017年): \[ \Pr(Y = 1 \mid s(x) = s, A = a) = \Pr(Y = 1 \mid s(x) = s, A = b), \quad \forall s \]
分数校准是一种针对每个分数水平的条件;对于硬二元预测,一个相关的平等性条件是预测为正的个体之间具有相等的正预测值(PPV)(即精确率),而分数校准是更强的要求:该相等性必须在每一个分数水平上都成立: \[ \text{PPV}(a) = \frac{\Pr(Y=1, h(x)=1 \mid A=a)}{\Pr(h(x)=1 \mid A=a)} = \text{PPV}(b) \]
来自贷款示例: \[\begin{align*} \text{PPV}(a) &= \frac{40}{70} = 0.571 \\ \text{PPV}(b) &= \frac{30}{40} = 0.750 \end{align*}\]
阳性预测值差距为 \(0.750 - 0.571 = 0.179\)。B 组被预测为阳性的样本中,实际为阳性的比例为 75 percent,而 A 组的相应预测准确率仅为 57 percent。这违反了硬判决的预测均等性,并表明模型在预测 A 组获得批准时可靠性较低。要证明评分本身经过校准,需要比较各组在相同评分区间内的实际结果频率。
校准对于高风险决策至关重要,因为个体会依赖预测概率。校准不准的模型会系统性地高估或低估特定群体的风险,导致资源配置不当和信任受损。
实践中的公平性指标
定义这些指标并不难;在已部署的集群中持续计算这些指标,才是工程成本显现的环节。在生产规模下计算这些指标会带来计算、数据和组织层面的成本,这些成本决定了系统在设定阈值权衡或开展显著性检验之前,有能力监控哪些指标。
测量开销源于计算各群体的指标需要为每个受保护群体维护独立的统计量。对于 \(k\) 个群体和 \(m\) 个指标,每个评估周期需要 \(\mathcal{O}(km)\) 个额外计数器和 \(\mathcal{O}(km)\) 次统计检验。在高吞吐量系统(>10K QPS)中,必须通过采样或异步聚合来控制这一开销。
数据需求也带来了挑战,因为公平性审计需要代表性样本的真实标签(\(Y\))和敏感属性 \((A)\)。在联邦或隐私保护场景中,获取这些数据可能与隐私目标冲突。加密聚合统计量或对群体指标应用差分隐私等技术,有助于兼顾公平性监控与隐私要求。
因此,敏感属性的可用性是一项工程设计选择,而非默认前提。系统可以在获得同意后直接收集属性,仅为聚合审计而推断属性,将属性托管于受限服务中,计算加密或采用差分隐私的群体统计量,基于抽样标签开展离线审计,或声明某项指标在该部署中无法测量。每种选择都会同时改变组织可获得的公平性证据,以及监控流水线产生的隐私风险。
阈值选择需要领域专业知识和利益相关方的意见,以确定可接受的差异阈值。法律规定的阈值(例如五分之四规则)提供了起点,但最终取值应依据具体情境下的危害评估。应记录阈值的设定依据,以支持审计和监管合规。
时间稳定性要求持续监控公平性指标,以检测分布偏移、反馈循环或模型更新导致的退化。具备自动告警功能的持续监控(例如,“若 \(|\text{SPD}| > 0.15\) 连续成立 7 天,则发出告警”)能够在危害累积之前促成主动干预。
阈值设定与公平性权衡
在实践中,可以通过调整各群体的分类阈值来改变公平性指标。给定评分函数 \(s(x)\)(例如预测概率),定义群体特定的阈值 \(\tau_{\text{thr},a}\) 和 \(\tau_{\text{thr},b}\),使得 \(h_a(x) = \mathbb{1}[s(x) \geq \tau_{\text{thr},a}]\) 对群体 \(a\) 成立,对群体 \(b\) 也采用类似定义。
为实现人口统计均等性,求解: \[ \Pr(s(x) \geq \tau_{\text{thr},a} \mid A = a) = \Pr(s(x) \geq \tau_{\text{thr},b} \mid A = b) \]
为达成机会均等,求解: \[ \Pr(s(x) \geq \tau_{\text{thr},a} \mid A = a, Y = 1) = \Pr(s(x) \geq \tau_{\text{thr},b} \mid A = b, Y = 1) \]
为达成均等机会,求解:
对于均等机会,真阳性率与假阳性率约束必须同时成立。这是一个带约束的优化问题,可通过后处理(Hardt 等 2016年)求解。
Hardt, Moritz, Eric Price, 和 Nathan Srebro. 2016年. 《Equality of Opportunity in Supervised Learning》. Advances in Neural Information Processing Systems (NeurIPS) 29: 3315~23.
然而,阈值调整存在局限。若各组的先验率差异显著(即 \(\Pr(Y=1 \mid A=a) \neq \Pr(Y=1 \mid A=b)\)),由于不可能性定理,通过阈值化实现某一公平性准则必然违反其他准则。由此产生的精度代价可以直接量化。
Napkin Math 1.4: 公平性工程指标:公平的成本
问题:在信用评分模型中,对 A 组(多数组)和 B 组(少数组)施加人口统计对等性时,量化整体准确性的下降幅度(“公平税”)。
变量:
- A 组:平均分数 70,还款率高,无约束阈值 = 60。
- B 组:平均分数 50,还款率较低,无约束阈值 = 60。
数学:
- 无约束优化:单一阈值 = 60 时,整体准确性为 85 percent。
- 人口统计对等性约束:将 B 组的批准率与 A 组拉平,需要将 B 组阈值降至 50。
- 公平税:整体准确性降至 81 percent,产生 4 percentage-point 的绝对准确性惩罚(4.7 percent 的相对下降)。
系统洞见:“公平的成本”是 4 percentage points 的准确性。系统设计者必须在配置生产阈值规则时,权衡这一可测量的准确性代价与社会公平收益。
前述示例测量了施加人口统计对等性所带来的聚合准确性下降,但未展示系统如何在决策时强制执行该约束。实际上,拉平需要设定组别特定阈值:多数组使用一个阈值,少数组使用另一个更低的阈值。差异阈值要求在推理时访问敏感属性,并引发关于显式基于组的差别对待的担忧,这在某些司法辖区本身可能被视为不公平或违法。机制在具体的阈值设定场景中会更加清晰。
Napkin Math 1.5: 机会均等阈值
问题:在信用评分模型中,计算使 A 组与 B 组的真阳性率(机会均等)拉平所需的组别特定阈值。
变量:
- A 组(\(Y=1\)):\(\mu_A^+ = 0.72\),\(\sigma_A^+ = 0.15\)。
- B 组(\(Y=1\)):\(\mu_B^+ = 0.65\),\(\sigma_B^+ = 0.16\)。
数学:
- 单一阈值(\(\tau = 0.60\)):得到 \(\text{TPR}_a \approx 0.79\) 与 \(\text{TPR}_b \approx 0.62\)(相差 17 个百分点)。
- 拉平阈值:将 B 组阈值降至 \(\tau_b = 0.52\),同时保持 \(\tau_a = 0.60\) 不变,即可拉平 \(\text{TPR}_b \approx 0.79\)。
- 权衡:B 组的假阳性率由 0.12 升至 0.24,B 组的精确度由 0.78 降至 0.69。
系统洞见:通过阈值调整实现机会均等会提高假阳性率并降低获得较低阈值的组的精确度。阈值策略不会改变底层分数的校准,因此设计者必须在机会公平与精确度退化之间权衡。
公平性违规的统计测量
为判断观察到的差异是否具有统计显著性而非抽样噪声,从业者应计算置信区间并进行假设检验。对于人口统计对等性,使用双比例 z 检验检验零假设 \(H_0: \Pr(h(x)=1 \mid A=a) = \Pr(h(x)=1 \mid A=b)\)。检验统计量为: \[ z = \frac{\hat{p}_a - \hat{p}_b}{\sqrt{\hat{p}(1-\hat{p})\left(\frac{1}{n_a} + \frac{1}{n_b}\right)}} \]
其中 \(\hat{p}_a\) 与 \(\hat{p}_b\) 为样本批准率,\(\hat{p} = \frac{n_a\hat{p}_a + n_b\hat{p}_b}{n_a + n_b}\) 为合并比例,\(n_a\) 与 \(n_b\) 为样本量。
对于含 \(n_a = n_b = 100\)、\(\hat{p}_a = 0.70\)、\(\hat{p}_b = 0.40\) 的贷款示例: \[\begin{align*} \hat{p} &= \frac{100(0.70) + 100(0.40)}{200} = 0.55 \\ z &= \frac{0.70 - 0.40}{\sqrt{0.55(0.45)(0.02)}} = \frac{0.30}{0.0704} = 4.26 \end{align*}\]
当 \(z = 4.26\)(远超临界值 \(z_{0.05/2} = 1.96\))时,检验拒绝 \(H_0\),并得出人口统计公平性违规在 \(p < 0.001\) 水平上具有统计显著性。类似检验可针对 equal opportunity 与 equalized odds 构造,分别限定为 \(Y=1\) 或 \(Y=0\) 对应的子群。统计显著性并不意味着实际显著性;即使统计上显著的差异,若量级较小也可能可以接受。反之,小样本中的较大差异可能未达到统计显著性,但仍值得采取干预措施。
本文建立的定量框架将公平性从抽象原则转化为可测量的工程约束。确立指标、阈值和统计检验,使从业者能够系统地评估机器学习全生命周期中的公平性,并就何时需要干预做出数据驱动的决策。
Napkin Math 1.6: 审计混淆矩阵
问题:一个欺诈检测模型运行于两个群体。人口统计公平性与 equal opportunity 揭示了该部署的哪些方面?
变量:
- 群体 A(多数群体):\(\text{TP}=450\)、\(\text{FP}=50\)、\(\text{FN}=30\)、\(\text{TN}=470\)(\(n_{\text{records}}=1000\))。
- 群体 B(少数群体):\(\text{TP}=180\)、\(\text{FP}=70\)、\(\text{FN}=120\)、\(\text{TN}=630\)(\(n_{\text{records}}=1000\))。
数学:
- 人口统计公平性(正预测率):\(\Pr(\hat{Y}=1)\)。
- 群体 A:\((450+50)/1000 = 0.50\)。
- 群体 B:\((180+70)/1000 = 0.25\)。
- 差异:0.25。(违反四分之三规则:\(0.25/0.50 = 0.5 < 0.8\)。)
- Equal opportunity(真阳性率):\(\text{TP} / (\text{TP}+\text{FN})\)。
- 群体 A:\(450 / (450+30) = 0.938\)。
- 群体 B:\(180 / (180+120) = 0.60\)。
- 差异:0.338。(严重违规)。
系统洞见:要修复真阳性率,需降低群体 B 的判定阈值以捕获更多欺诈(减少漏报)。然而,这很可能增加群体 B 的误报(虚警),从而恶化预测公平性。这是对不可能性定理的具体演示:一项公平性约束无法被单独调整。
公平性考量不仅涉及算法结果,还涵盖部署负责任 AI 系统所需的计算资源与基础设施。这些更广泛的公平性影响,包括环境正义问题,源于高能耗 AI 基础设施集中于原本处于弱势的社区。[^fn-datacenter-environmental-justice]
[^fn-datacenter-environmental-justice]:数据中心环境正义:美国主要云计算设施中有相当一部分位于低收入社区 16 km 以内,这些社区承受来自备用柴油发电机和冷却系统的热排放所带来的空气污染加重。对于机器学习集群运营方而言,这构成了一项治理约束:为优化电力成本与延迟而做出的数据中心选址决策,同时将环境成本外部化到最无力获取这些数据中心所提供 AI 服务的社区。
负责任 AI 技术的计算强度形成了一种数字鸿沟,使得对公平、透明且可问责的 AI 系统的访问取决于经济资源。实施公平性约束、差分隐私机制以及全面的可解释性工具,相较于无约束模型,会提高训练、服务、存储或审查成本。计算密集型保障措施,如持续公平性监控、差分隐私随机梯度下降和按需解释,对资源充足的组织而言更容易全面部署,而资源受限的部署可能为效率牺牲保障措施。结果可能形成两级系统,即负责任 AI 对资源充足的用户和应用更容易提供,从而可能加剧既有的不平等,而非缓解它们。这些资源约束带来了民主化挑战,而更广泛的影响则形成数字鸿沟与访问障碍,影响欠服务社区。
这些考量指向本章的核心论点:每一项负责任 AI 属性都是系统级属性,而非模型属性。公平性源于数据工程实践、建模选择、评估程序与决策政策之间的相互作用;它无法仅归结于某个模型组件,也无法仅通过事后调整解决。隐私、可解释性、鲁棒性与可问责性同样如此:每一项都源自整个流水线,而非停留在权重之中。因此,负责任机器学习设计将公平性视为一项基础性约束,它贯穿系统整个生命周期,影响架构选择、工作流与治理机制。这种系统级视角将每项原则转化为机器学习全生命周期中的具体工程要求:公平性要求群体级性能指标以及跨人群的差异化决策阈值;可解释性要求运行时计算预算,其成本取决于方法采用梯度、扰动采样、Shapley 值近似还是精确子集枚举;隐私涵盖数据治理、同意机制与生命周期感知的留存策略;可问责性则需要可追溯性基础设施,包括模型注册表、审计日志与人工覆盖机制。
这些原则在系统开发过程中相互交织并产生张力。隐私保护技术可能降低可解释性;公平性约束可能与个性化相冲突;鲁棒监控会推高计算成本。每项原则都贯穿数据采集、训练、评估、部署与监控各阶段(表 3),从而强化一个认识:负责任 AI 并非部署后的考量,而是一项架构层面的承诺。然而,这些原则能否实现,关键取决于部署环境:云、边缘、移动端和 TinyML 环境各自施加不同的约束,决定了哪些负责任 AI 特性在实际上可行。
隐私与数据治理
隐私与数据治理带来了复杂挑战,这些挑战超出了威胁模型视角,并与在 节 1.1.2 与 节 1.1.3 中考察的公平性和透明性原则形成根本性张力。以安全为导向的隐私旨在阻止未授权访问;而负责任隐私则决定系统是否应当收集某个数据字段,若必须收集,则如何在整个生命周期中最大限度地降低暴露风险。这种更广阔的视角带来了内在张力:公平性监控需要收集和分析敏感的人口统计数据,可解释性方法可能泄露训练样本信息,而全面的透明性可能与个人隐私权利相冲突。负责任 AI 系统必须通过谨慎的设计选择来权衡保护、可问责性与效用这些相互竞争的要求。
机器学习系统通常依赖大量个人数据来支持模型训练并提供个性化功能。这种依赖引入了与用户隐私、数据保护及伦理数据治理相关的重大责任。该数据的质量与治理状况直接影响实施负责任 AI 原则的能力。负责任 AI 设计将隐私视为核心约束,而非附属功能,它必须贯穿整个系统生命周期来指导决策。
支持隐私的核心挑战之一,是数据效用与个人保护之间固有的张力。丰富、高分辨率的数据集可以提升模型的准确性与适应性,但也提高了敏感信息暴露的风险,尤其是在数据集被聚合或与外部来源关联时。例如,基于广泛文本语料训练的大语言模型已被证明会记忆[^fn-model-memorization-privacy]特定字符串,这些字符串随后可通过模型查询或对抗性提示被检索出来 (Carlini 等 2021年)。
[^fn-model-memorization-privacy]:模型记忆:Carlini 等 (2021年) 表明,GPT-2 可以通过精心设计的提示逐字复现训练字符串,包括联系方式。系统层面的启示更为有限但仍十分严重:将生成输出暴露于面向用户的查询时,服务层本身可能成为数据外泄的入口,需要输出过滤、速率限制和数据最小化控制作为纵深防御措施。
隐私挑战不仅涉及明显的敏感数据,也延伸至看似无害的信息。跟踪生理与行为信号(如心率、移动或位置)的可穿戴设备,单独看似乎无害,但合在一起可能揭示详尽的用户画像。当用户对自身数据如何被处理、留存或传输缺乏可见性或控制时,这些风险进一步加剧。
应对这些挑战需要把隐私理解为一种系统原则,其内涵包括稳健的数据治理。这包括界定收集哪些数据、在何种条件下收集,以及以何种程度的同意与透明性进行。基础性的数据工程实践,包括数据校验、模式管理、版本管理和血缘追踪,为落实这些治理要求提供了技术基础设施。负责任的数据治理还需要关注标注实践、访问控制、日志基础设施以及对管辖区域合规要求的遵循。这些机制用于约束数据在系统中的流转方式,并记录其使用过程中的可问责性。
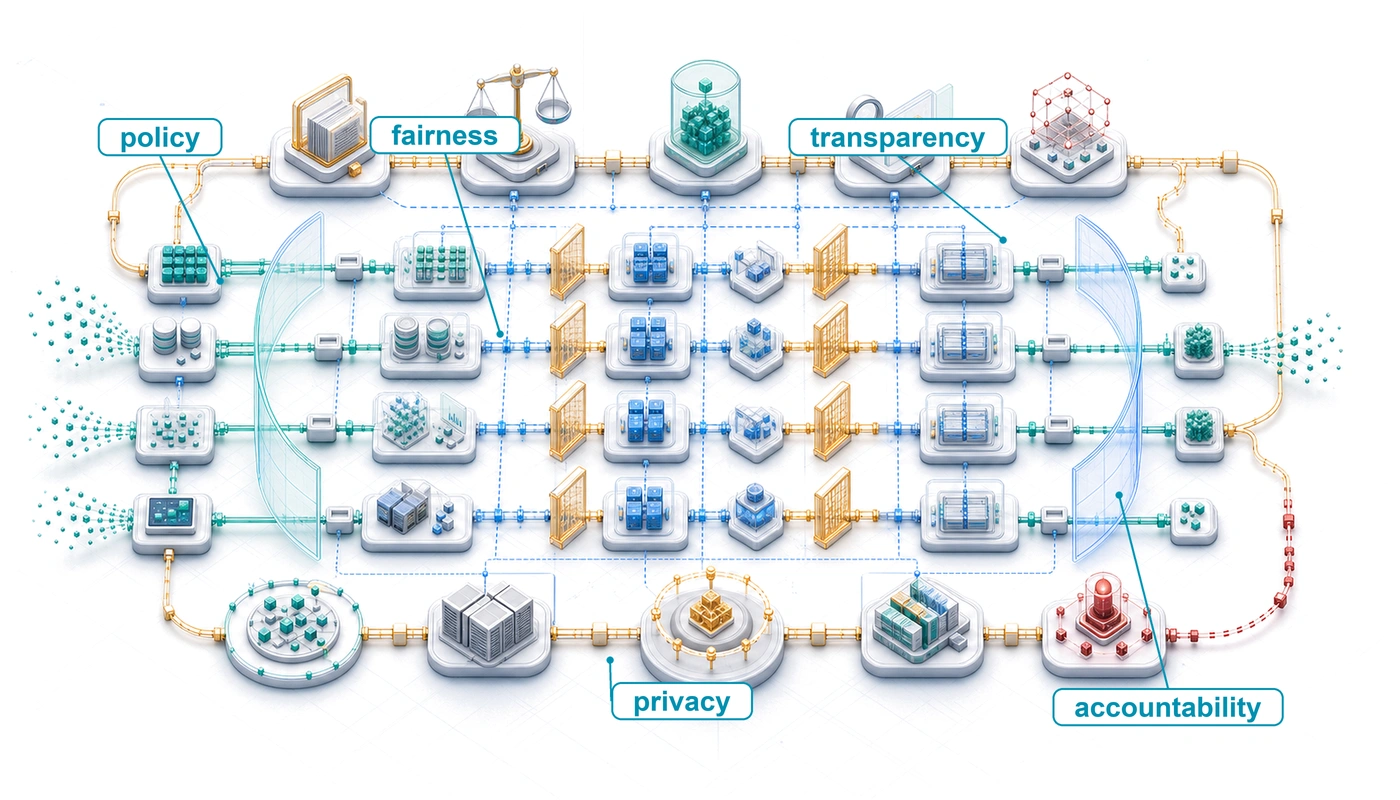
图 3 概述了数据管道早期阶段的关键隐私检查点,指出了差分隐私、联邦学习和安全聚合等保障措施如何降低攻击者对原始个人数据的可见性。实际实现往往涉及更为精细的权衡与情境敏感的决策,包括分立的同意与治理控制;但本图提供了一个框架,用于识别隐私风险产生的位置,以及如何通过负责任的设计选择加以缓解。
数据治理薄弱的后果已有充分记载。在缺乏清晰理解或存在偏见的数据集上训练的系统,可能延续结构性不平等,或无意地暴露敏感属性。在 COMPAS 案例(节 1.1.2)中,围绕数据来源与使用方式的透明度缺失,阻碍了有效的评估或补救。在临床应用中,数据集常常带有缺失值或人口统计偏差之类的缺陷,既损害性能,也损害隐私。若缺乏明确的数据质量与文档标准,此类脆弱性便会演变为系统性问题。
隐私并非孤立算法或数据处理者的专属议题;它必须被视为系统的结构性属性。关于同意收集、数据保留、模型设计与可审计性的各项决策,共同构成了机器学习流水线的安全隐私立场。这包括不仅要在训练阶段,还要在推理与持续运行过程中预判风险。例如,成员推断攻击8凸显了将隐私保障措施嵌入模型架构与接口行为的重要性。
8 成员推断攻击:由 Shokri 等 (2017年) 首次提出,这类攻击利用已见与未见输入之间的置信度差异,判断某个特定个体的数据是否被用于训练模型。其系统层面的含义是:任何通过 API 暴露的机器学习模型都可能成为潜在的隐私预言机;判定某人的病历是否出现在疾病预测模型的训练集中,就可能泄露敏感的健康信息。防御手段包括差分隐私、正则化、置信度校准,以及限流之类的接口控制。
Shokri, Reza, Marco Stronati, Congzheng Song, 和 Vitaly Shmatikov. 2017年. 《Membership Inference Attacks Against Machine Learning Models》. 2017 IEEE Symposium on Security and Privacy (SP), 3~18. https://doi.org/10.1109/SP.2017.41.
9 CCPA(加州消费者隐私法):CCPA 赋予加州居民就受覆盖范围内的个人信息行使权利,包括受法定例外约束的删除权(California Legislature 2023年)。对于机器学习服务基础设施而言,删除请求构成一项架构约束,必须从数据管道的前端进行规划,因为删除原始记录并不会自动消除该记录对已训练模型参数的影响。
California Legislature. 2023年. California Consumer Privacy Act of 2018. California Legislative Information.
Personal Information Protection Commission, Japan. 2023年. Act on the Protection of Personal Information. Personal Information Protection Commission, Japan.
法律框架反映了这一理解。诸如 GDPR、CCPA9 以及日本《个人信息保护法》等法规,就数据最小化、目的限制、用户同意以及删除或擦除权规定了具体义务Personal Information Protection Commission, Japan (2023年)。这些要求将伦理期待转化为可执行的设计约束,从而强化了把隐私作为系统开发核心原则的必要性。
隐私是公平性中系统层面论点节 1.1.3的第二个实例:它是一种贯穿同意收集、保留策略、模型设计、服务与可审计性的承诺,而非任何单一阶段的属性。它需要跨技术与组织领域进行协同,以确保数据使用与用户预期、法律要求及社会规范相一致。与其将隐私视为需要在功能面前加以权衡的约束,负责任的设计从一开始就将隐私融入其中,通过影响架构、塑造接口,并约束模型的构建、更新与部署方式。
隐私保护可防止未经授权的暴露,但负责任系统还必须确保在隐私机制无法阻止全部风险时,系统仍表现出可预测的行为。模型可能满足全部隐私约束,却在遇到意外输入或对抗条件时发生灾难性失效。安全性与鲁棒性应对这一互补性关切:关注的是系统如何失效,而不只是数据如何受到保护。
安全性与鲁棒性
安全性与鲁棒性在 Robust AI 中被引入为应对硬件故障、对抗攻击与分布偏移的技术属性,同时也作为负责任 AI 原则,其内涵超越了威胁缓解。技术鲁棒性确保系统在对抗条件下能够存活;负责任鲁棒性则确保系统在技术上可用时,其行为仍与人类预期和价值相一致。模型可能对比特翻转和对抗扰动具有鲁棒性,但在边缘案例中表现不可预测,或优化与用户福祉不一致的目标时,仍可能构成部署层面的不安全行为。
机器学习中的安全性指的是模型在正常条件下行为可预测,并在压力或不确定性条件下以受控、非灾难性的方式失效的可靠性保证。与之紧密相关,鲁棒性关注模型在输入、环境或系统配置发生变化时,维持稳定且一致性能的能力。二者共同构成安全关键领域中负责任部署的基础,因为在这些领域中,机器学习输出会直接影响物理或高风险决策。
在实际中确保安全性与鲁棒性,要求预判系统可能遇到的全部条件,并设计出在训练分布之外依然可靠的系统行为。这不仅包括管理输入的变异性,还包括应对模型对意外相关性、罕见事件以及蓄意诱导失效尝试的响应方式。例如,美国国家运输安全委员会对 Uber 2018 年坦佩撞车事件的调查表明,自动驾驶失效可能同时涉及感知、预测、安全员与组织控制层面的问题,而非归结为单一模型错误(National Transportation Safety Board 2019年)。
10 对抗性输入:由 Szegedy 等 (2013年) 首次提出,这类扰动在感知上不可察觉,却会导致模型产生高置信度的错误分类。幅度为 0.005(像素空间)的扰动即可将分类器的输出翻转,置信度超过 99 个百分点,这表明神经网络的决策边界远比其测试集准确率所暗示的更加脆弱。对于安全关键的机器学习系统而言,这意味着测试准确率无法保证部署鲁棒性,因而需要将对抗性测试作为独立的验证阶段。
Szegedy, Christian, Wojciech Zaremba, Ilya Sutskever, Joan Bruna, Dumitru Erhan, Ian Goodfellow, 和 Rob Fergus. 2013年. 《Intriguing properties of neural networks》. arXiv preprint arXiv:1312.6199.
一种具代表性的失效模式源于对抗性输入10:经过精心构造的扰动对人类而言看似无害,却会导致模型输出错误或有害的预测(Szegedy 等 2013年)。此类脆弱性并不局限于图像分类;它们已在音频、文本和结构化数据等多种模态中被观察到,并揭示了高维空间中所学表示的脆弱性。应对这些脆弱性需要专门的方法,包括对抗性防御与鲁棒性技术。这些行为表明,鲁棒性不仅要在训练阶段加以考虑,还应被视为系统与世界现实复杂性交互时的全局属性。
相关挑战是分布偏移11:训练数据与部署环境条件之间不可避免的失配。无论源于季节性、人口结构变化、传感器退化还是环境变异性,此类偏移都可能损害模型的可靠性,即使不存在对抗性操纵。应对分布偏移挑战需要系统性的方法来检测并适应不断变化的条件。
11 分布偏移:训练数据与部署数据分布之间的失配,表现为协变量偏移(输入分布变化)、标签偏移(类别比例变化)或概念漂移(输入—输出关系随时间演变)。其系统层面的后果是静默退化:与会导致崩溃的软件缺陷不同,分布偏移会在数周或数月内逐渐侵蚀准确率而不会触发错误,因此需要持续监控基础设施,并具备自动重训练触发机制与模型版本管理,以检测并响应。
负责任的机器学习设计将鲁棒性视为系统性要求。应对它需要超越单纯提升单个模型性能,包括设计能够预判不确定性、暴露自身局限,并在预测置信度较低时支持回退行为的系统。这包括设定置信度阈值、支持不作出决策(弃权),以及将人工监督整合进运行工作流。这些机制对于构建能够优雅降级、而非静默或不可预测失效的系统至关重要。
这些针对单个模型的考量延伸至更广泛的系统需求。安全性与鲁棒性同样在架构与组织层面提出要求。关于如何监控模型、如何检测失效以及如何治理更新的决策,都会影响系统能否有效应对不断变化的条件。负责任的设计要求将鲁棒性视为约束而非孤立模型的属性,从而塑造机器学习系统整体的行为。这种系统层面的安全性与鲁棒性视角,进一步引出问责与治理问题。
问责与治理
机器学习中的问责,指的是识别、归因并应对自动化决策后果的能力。它超越了诊断失效,还要求明确赋予系统行为的责任、确保损害能够得到补救,并通过监督与制度流程维持伦理标准。若无此类机制,即使出于良好意图的系统也可能在缺乏救济途径的情况下造成重大损害,进而损害公众信任并侵蚀合法性。
与传统软件系统不同,后者责任往往归属于可识别的开发者或运营者,机器学习中的问责是分布式的。模型输出受到上游数据采集、训练目标、管道设计、接口行为以及部署后反馈的影响。这些相互关联的组件常常涉及跨技术、法律与组织领域的多方主体。例如,若招聘平台产生了有偏结果,问责可能不仅落在模型开发者身上,也涉及数据提供方、界面设计者与部署机构。负责任的设计要求将这些关系明确映射并加以治理。
治理不足可能使机构无法识别或纠正有害的模型行为。Google Flu Trends 未能预判分布偏移与反馈回路,这一失败揭示了用户搜索行为变化、媒体驱动的查询激增,以及针对 CDC 监测基准数据校准不足的未建模变化所带来的后果(Lazer 等 2014年)。持续的过度估计多年未被纠正,最终促成了该模型的停用。
Lazer, David, Ryan Kennedy, Gary King, 和 Alessandro Vespignani. 2014年. 《The Parable of Google Flu: Traps in Big Data Analysis》. Science 343 (6176): 1203~5. https://doi.org/10.1126/science.1248506.
Illinois General Assembly. 2020年. Artificial Intelligence Video Interview Act (Public Act 101-0260). 820 ILCS 42, effective January 1, 2020.
法律框架同样反映了可问责设计的必要性。例如,伊利诺伊州《人工智能视频面试法》(Illinois General Assembly 2020年) 与欧盟《人工智能法》 对高风险应用提出了透明度、同意、文档与监督方面的要求(European Parliament and Council of the European Union 2024年)。这些政策将问责不仅嵌入系统产生的结果,也嵌入支撑其使用的运行流程与文档。包括引入公平性审计、以及在定向广告系统中施加使用限制在内的组织内部变革,展示了监管压力如何催化治理层面的结构性改革。
为问责而设计,意味着在系统生命周期的每个阶段支持可追溯性。这包括记录数据来源、登记模型版本、启用人工覆盖,以及保留足够的日志以供事后分析。诸如 Model Cards12 (Mitchell 等 2019年) 与 Datasheets for Datasets13 (Gebru 等 2021年) 之类的工具,体现了使系统行为可解释、可审查的实践。Mitchell 及其同事提出模型卡,作为伴随训练好的机器学习模型的简短文档,提供面向目标应用中相关文化、人口与表型群体的基准化评估。同样,Gebru 及其同事提出,每个数据集都应配有一份数据表,记录其动机、构成、采集过程与推荐用途,类似于电子元件所附的技术规格书。然而,问责并不等同于单纯的文档;它还要求具备反馈、异议与救济机制。
12 Model Cards:由 Mitchell 等 (2019年) 提出的、作为训练好的机器学习模型的标准文档。每张卡片按人口群体基准化性能,记录预期用途,并披露已知局限。对于生产级机器学习系统,模型卡充当可追溯性层,将已部署的二进制与其训练来源、评估结果及已知失效模式相连接——这是部署后审计与合规所需的最基本元数据。
Mitchell, Margaret, Simone Wu, Andrew Zaldivar, Parker Barnes, Lucy Vasserman, Ben Hutchinson, Elena Spitzer, Inioluwa Deborah Raji, 和 Timnit Gebru. 2019年. 《Model Cards for Model Reporting》. Proceedings of the Conference on Fairness, Accountability, and Transparency, 220~29. https://doi.org/10.1145/3287560.3287596.
13 Datasheets for Datasets:由 Gebru 等 (2021年) 提出,仿照电子元件技术规格书,后者会规定工作条件与容差。每张数据表记录数据集的动机、构成、采集过程与推荐用途。对于机器学习流水线,数据表相当于硬件规格的数据对应物:它们定义了模型训练分布的有效工作范围,使工程师能够预判部署时分布偏移会在何处引发失效。
Gebru, Timnit, Jamie Morgenstern, Briana Vecchione, Jennifer Wortman Vaughan, Hanna Wallach, Hal Daumé III, 和 Kate Crawford. 2021年. 《Datasheets for datasets》. Communications of the ACM 64 (12): 86~92. https://doi.org/10.1145/3458723.
在组织内部,治理结构有助于将这一责任正式制度化。伦理审查流程、跨职能审计与模型风险委员会,为预判下游影响并应对新出现的问题提供了论坛。这些结构必须得到相应基础设施的支持,使用户能够提出异议,并使开发者能够作出纠正。例如,提供解释或支持用户主动复核的系统,有助于弥合模型逻辑与用户体验之间的差距,尤其是在错误影响显著领域。
架构决策同样发挥作用。界面可以设计为暴露不确定性、支持升级处理,或在适当时暂停自动化操作。日志与监控管道必须配置为检测伦理漂移的迹象,例如子群体间的性能退化或未曾预期的反馈回路。在分布式系统中,由于难以维持统一的可观测性,问责必须通过安全协议、更新约束或可信组件之类的架构保障措施加以嵌入。
治理并不意味着集中控制。相反,它要求以透明、可执行且可持续的方式分配责任。技术团队、法律专家、最终用户与机构领导者都必须能够获得评估系统行为并在必要时介入所需的工具与信息。随着机器学习系统日益复杂并嵌入重要基础设施,问责必须相应地扩展,成为架构与流程中的基础性考量,而非部署之后追加的被动补救层。
尽管存在这些治理机制,实现有意义的问责仍面临一项挑战:区分基于正当因素的决策,与可能延续历史偏见的虚假相关性。应对这一挑战需要仔细关注数据质量、特征选择与持续监控,以确保自动化决策反映公平且合理的推理,而非源自有偏历史数据的问题性模式。
本章前几节所考察的原则与技术,构成了负责任 AI 的概念与技术基础,但其实际落地高度依赖于部署架构。云系统能够支持复杂的 Shapley-value 解释和实时公平性监控,而 TinyML 设备则必须依赖静态可解释性和编译期隐私保证。边缘部署能够实现本地隐私保护,却限制了全局公平性评估。这些架构约束并非单纯的实现细节;它们从根本上决定了不同用户和应用能够获得哪些负责任 AI 保护。
Example 1.1: 选择公平性度量
场景:招聘推荐引擎必须在面向异构申请人群体上线之前,确定其主要公平性约束。
诊断:人口统计均等性(Demographic Parity)强制要求无论候选人资格如何,各群体的选择率都相等;而校准(Calibration)仅保证各群体之间的分数精度相等。平等机会(Equal Opportunity)则明确要求合格申请者之间的真阳性率(True Positive Rate)相等(\(\text{TPR}_A = \text{TPR}_B\)),与为合格人才实现平等机会的目标直接对应。
系统启示:度量选择是一项治理决策,它设定了服务流水线(serving pipeline)的运行目标。系统设计师必须在训练或阈值设定之前,将数学约束与领域内的法律和伦理要求对齐。
该示例说明了为何度量选择首先是一项治理决策,其次才是一项计算:所选的公平性定义决定了系统被允许做出何种误差权衡。选择数学上恰当的公平性度量只是第一步,但计算这些度量需要访问人口统计数据并带来可观的计算开销。当从集中式云环境转向受隐私和带宽约束的分布式边缘部署时,强制执行这些数学保证的复杂度会显著增加。
Checkpoint 1.1: 原则作为工程约束
本节将公平性、可解释性、透明性、问责制和价值对齐重新表述为控制面不变量,而非事后审查事项;将它们逐一映射到机器学习生命周期,并量化了公平性税(fairness tax)和负责任 AI 的额外开销。
从原则到机制
权衡评估
负责任 AI 与不同部署环境
在庞大的集中式数据库中审计模型偏见是 straightforward 的,并且拥有无限的云 GPU。而在运行于一百万部独立智能手机上的联邦学习模型上进行审计,则是一个完全不同的工程问题——严格的隐私法律禁止访问人口统计数据。部署环境从根本上决定了哪些负责任 AI 技术在数学上和法律上可行。
这些架构差异重新分配了可行的防护措施和应承担责任的一方。资源可用性、延迟约束、用户界面设计,以及连通性的有无,决定了负责任 AI 原则能否在不同部署环境中得到一致地执行。同一模型在云端可能支持丰富的解释、持续监控和集中式可审计性,但当其嵌入到具有间歇性连通性的设备中时,则只能依赖静态验证和简化的防护措施。
计算资源的地域和经济分布又叠加了另一层公平性问题。高性能 AI 系统通常要求靠近主要数据中心或具备高带宽互联网连接,由此产生的服务质量差异与既有的社会经济不平等高度吻合。美国联邦通信委员会(US Federal Communications Commission)的报告已记录了持续存在的光纤宽带差距,农村地区拥有符合报告基准的固定宽带的可能性远低于城市地区。对于负责任 AI 而言,这一基础设施差距决定了实时可解释性、持续公平性监控和隐私保护计算,对于受自动化决策影响最深的用户和社群而言是否切实可行。
系统可解释性
解释性的约束性瓶颈是部署环境,而非技术选择:计算能力、延迟预算、界面设计和数据访问权限共同决定了究竟能够运行哪一种解释方法(若有)。云系统能够负担重量级的事后方法,例如 Shapley-value 归因(SHAP)和本地代理解释(LIME);14 移动和边缘设备通常只能负担单次前向传播的显著性图;15 TinyML 设备往往根本不支持运行时解释,开发期检查成为唯一机会。节 1.5 阐述了该矩阵所预设的技术层面机制与成本;部署取舍 记录了各环境下的可行性。
14 LIME(Local Interpretable Model-Agnostic Explanations): 由 Ribeiro 等 (2016年) 提出,LIME 通过对输入进行扰动、多次查询黑盒模型并拟合加权线性代理模型来解释单个预测。系统层面的权衡在于:解释延迟随扰动样本数量和模型调用成本而增长,因此在架构允许时,生产部署常采用采样预算、缓存、异步解释工作器或针对特定模型的方法。
Ribeiro, Marco Tulio, Sameer Singh, 和 Carlos Guestrin. 2016年. 《Why Should I Trust You?: Explaining the Predictions of Any Classifier》. Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, 1135~44. https://doi.org/10.1145/2939672.2939778.
15 显著性图(Saliency Maps): 基于梯度的解释方法,通过执行反向传播——即训练所用的同一套基础设施——来突出哪些输入区域对预测影响最大。显著性方法通常比依赖扰动的或子集枚举方法更便宜,因此在模型支持梯度时,对边缘和移动部署颇具吸引力。权衡在于:原始梯度可能带有噪声,并可能突出输入伪影而非有意义的特征,因此平滑或重复梯度变体以额外计算换取更稳定的可视化。
两个表格无法体现的维度使可解释性区别于其他原则。第一个维度是受众:终端用户需要简洁的摘要(例如“睡眠期间心率升高”),而开发者、审计者或监管机构需要归因图、概念激活或决策轨迹,因此同一部署往往必须同时呈现两种解释界面。第二个维度是时机:无人机或工业控制回路在运行过程中没有余量来计算解释,只能记录内部信号以供后续分析;而金融风险评估、医疗诊断等异步系统则可以在决策之后渲染更深入的解释。在部署的延迟、能耗和界面限制之内同时规划这两者,正是可解释性成为设计约束而非部署后愿望的原因。
公平性约束
公平性呈现的是一个平行的部署问题,其约束性瓶颈是数据可见性。拥有人口统计标注数据集的云平台可以计算群体级度量、运行公平性感知训练并进行事后审计。联邦学习16或设备端部署则无法做到:没有任何单一主体能够观察到全局人口统计分布,因此群体级公平性审计不仅成本高昂,而且在缺乏隐私保护聚合的情况下在数学上根本不可行,公平性必须从一开始就构建进训练或数据集治理之中。部署取舍 记录了各环境之间的差异;数据可见性限制带来的两个后果值得特别展开,因为它们会在各类部署中反复出现。
16 联邦学习与公平性: 谷歌于 2016 年为 Gboard 引入联邦学习,在不集中原始数据的前提下于众多设备之间进行训练。公平性上的难点在于,没有任何单一主体能够观察到参与者之间的完整人口统计分布,因此群体级公平性度量无法直接计算,除非引入额外的协议。联邦公平性评估可能需要隐私保护聚合、安全聚合或差分隐私,每一种方法都会与集中式训练相比改变通信、准确性和治理层面的权衡。
Dwork, Cynthia, Moritz Hardt, Toniann Pitassi, Omer Reingold, 和 Richard Zemel. 2012年. 《Fairness Through Awareness》. Proceedings of the 3rd Innovations in Theoretical Computer Science Conference, 214~26. https://doi.org/10.1145/2090236.2090255.
第一个后果是:决定阈值策略——而不只是模型质量——决定了实际实现的公平性。即使各群体之间的准确率相同,在统一阈值下也可能因分数分布不同而产生差异影响,因此移动贷款审批系统可能系统性地对某一群体过度拒贷,除非事先对群体特定阈值进行论证并将其嵌入策略。第二个后果是:缺乏全局上下文的个性化会悄然加剧差异:本地适配的模型追求个体公平性,即相似的个体在任务相关的相似性度量下获得相似的决策 (Dwork 等 2012年),但基于数据稀疏或噪声较大的边缘化用户行为进行的重新训练,可能滑向强化既有差距。这种漂移构成了一条反馈回路。招聘平台若在自身带有偏见的结果上进行重新训练,就会放大不平等,因此缓解措施必须跨越部署监控、数据记录和影响评估,而不能仅依赖一次审计。图 4 展示了偏见放大反馈回路,其中每个环节都会放大既有的偏见,除非在绿色干预点处被切断。
图 4 中的循环揭示了为何事后公平性审计不足:除非在四个阶段(数据、模型、预测和重新训练)中的每一个阶段都进行干预,否则每一轮迭代都会叠加前一轮引入的偏见,从而将初始的轻微偏差累积为系统性的差异。因此,公平性从一项度量选择转变为生命周期约束:数据可见性决定了能够测量什么,阈值策略决定了误差落在何处,反馈基础设施决定了差异是衰减还是累积。
同一套部署划分带来了下一项负责任 AI 的张力。将敏感数据保留在本地可以保护用户,但支持隐私的本地性同时也消除了许多公平性审计所依赖的全局可观测性。
隐私架构
隐私继承了同样的集中化权衡,且更为尖锐。在云端聚合数据能够实现高容量建模与监控,但也集中了泄露与监控的暴露风险,因此必须与强加密、访问控制和可审计性配套使用。将数据保留在移动、联邦或 TinyML 客户端上可以降低这一集中风险,但也消除了监控或强制执行合规所必需的全局可观测性,迫使隐私保障措施必须在部署前编译进模型和固件,运行时没有渠道对其进行调整。部署取舍 记录了各环境分别落在何处。
表格无法体现的约束在于:隐私是在服务层而非仅仅在训练阶段进行评估的。一个满足所有形式化隐私定义的模型仍然可能泄露:成员推断攻击通过读取模型输出来恢复用户记录是否曾进入训练集,因此防御措施必须延伸至界面设计、速率限制和访问控制。此外,一个技术上合规的系统仍可能违背用户预期,如果数据采集过程不透明,那么知情同意界面和清晰的披露说明就应成为隐私架构的组成部分,而非界面设计的附属考虑。
隐私保护的是数据流,但它并不能保证系统在输入发生偏移、传感器性能下降或攻击者探测接口时,其输出依然保持可靠。这一缺口将讨论从隐私架构引向安全与鲁棒性架构:系统还必须定义其在压力条件下的行为方式。
各部署环境下的安全与鲁棒性
安全与鲁棒性的约束性瓶颈是延迟预算,因为它决定了哪些防御措施根本能够运行。云服务可以负担不确定性估计器、分布变化检测器、对抗输入过滤和 API17 速率限制;而延迟预算仅为毫秒级的自动驾驶导航或控制回路则无法负担,只能预先计算其回退动作。部署取舍 记录了各环境之间的划分;在受限的极端情况下,TinyML 系统根本不存在运行时监控或更新渠道,因此鲁棒性必须通过保守设计和部署前测试以静态方式加以工程化。
17 机器学习 API 安全 : 机器学习服务端点面临传统 API 中并不存在的攻击,包括通过反复定向查询进行的模型提取,以及对抗性输入注入。速率限制、异常检测、访问控制和输入验证可以降低暴露面,但根本的权衡在于:使模型对合法的解释性需求更加开放,同时也会增加模型窃取和对抗性探测的攻击面。
表格无法体现的后果是:回退本身就是一个延迟预算问题。当行人检测置信度较低时选择拒绝预测的配送机器人,只解决了问题的一半;负责处理该拒绝案例的人类复核者、基于规则的默认处理或升级队列,必须在与其所保护模型相同的时序预算内执行。因此,一个鲁棒的系统并非完全避免所有错误的系统,而是一个能够可见地、可控地、安全地失败的系统;这取决于关于感知、置信度估计、回退路由和恢复的具体选择。这些选择同时也界定了治理界面:系统必须规定谁能观察到损害、谁能介入,以及谁对最终结果负责。
治理结构
问责通过具体的可追溯性基础设施得以实现,而其制约因素在于环境能够承载多少此类基础设施。云平台支持模型注册表、遥测18仪表盘和结构化事件管道,可将一次预测追溯到特定的模型、输入或配置。TinyML 设备则不具备这些条件:由于没有网络连接、持久化存储或运行时配置能力,问责必须通过加密固件签名、固定的审计轨迹和部署前文档以静态方式嵌入,有时还须在制造阶段强制落实,因为部署后无法进行修正。部署取舍 记录了各环境在这一谱系中的位置。
18 机器学习系统中的遥测: 实时采集各个已部署模型的预测延迟、准确率和资源利用率。告警通常在准确率下降超过 5% 或延迟超过 200 ms 时触发。问责挑战在集群规模下显现:一个为多样化用户提供数百个模型服务的系统,每天会产生数百万条遥测事件,而将某次具体的有害预测追溯到根本原因(数据漂移、模型性能退化或阈值配置错误),需要大多数组织所缺乏的端到端血缘追踪基础设施。
移动端部署最能考验这一点,因为责任分散在本地模型、远程服务和界面设计之间,所以出现问题时,往往难以明确哪一层应对故障负责。这类场景中的治理依赖于易于使用的救济途径,以及在用户层面呈现、解释决策并允许用户对决策提出异议的机制;这些机制应嵌入界面及其配套服务架构,而不是作为附加的政策层叠加其上。在所有环境中,持续落实问责意味着像规划成功一样审慎地规划失败:明确如何检测异常、如何分配角色、如何维护记录以及如何实施补救,并确保这些过程均可通过日志追溯、通过界面强制落实。治理还必须考虑基础设施选择对环境和利益分配的影响,因为部署 AI 系统的组织不仅要对算法结果负责,还要对资源使用在环境正义和公平可及性方面产生的更广泛影响负责。
设计取舍
不同部署场景中的治理挑战揭示了一个普遍规律:负责任 AI 的取舍就是架构层面的取舍。机器学习系统并不运行在理想化的孤立环境中;它们必须在资源有限、延迟要求严格、用户行为不断变化以及监管复杂的条件下,权衡相互竞争的目标。
云端系统拥有充足的计算和存储资源,因此通常能够支持广泛的监控、公平性审计、可解释性服务和隐私保护工具。然而,这些优势通常伴随着集中式数据处理,由此引入与监视、数据泄露和复杂治理相关的风险。相比之下,移动应用、边缘平台或 TinyML 部署等端侧系统能够更好地将数据保留在本地,并赋予用户更强的控制能力,但会限制部署后的可观测性、公平性监测手段和模型适应能力。
目标之间的矛盾往往在架构层面显现。例如,可穿戴设备上的手势识别或自动制动等具有实时响应要求的系统,无法承受在推理过程中计算详细解释所需的开销。设计者必须选择是预先计算简化的输出、将解释推迟到异步分析阶段,还是在运行时完全省略可解释性功能。
个性化与公平性之间也会出现冲突。根据本地使用数据适应个体的系统,往往缺乏评估不同人群子群体之间差异所必需的全局背景信息。要确保个性化预测不会造成系统性排斥,就需要审慎的架构设计,在用户层面的适应能力与保障群体层面公平性和可审计性的机制之间取得平衡。
隐私与鲁棒性目标也可能发生冲突。鲁棒系统通常可以通过记录罕见事件或异常用户数据来提高可靠性。然而,记录此类数据可能与隐私目标冲突,或违反有关数据最小化的法律约束。在敏感行为数据必须保留在本地或保持加密的场景中,必须预先将鲁棒性纳入模型架构和训练过程的设计,因为事后改进可能不可行。
负责任 AI 的计算需求所带来的矛盾超出了技术优化范畴,延伸至环境正义和公平可及性问题。节能部署通常需要采用简化模型,而这类模型的公平性监测能力较弱,由此形成环境可持续性与伦理保障之间的取舍。例如,在联邦学习中实现差分隐私可能使每台设备的能耗增加 25–40%,从而使电池容量受限的设备难以承受此类隐私保护的成本。19
19 隐私—能耗权衡: 差分隐私和多方安全计算等隐私保护技术会增加计算、通信和电池消耗。在移动设备上的联邦学习中,公平性影响是直接显现的:使用老旧设备、流量受限或电池续航有限的用户可能被排除在受隐私保护的 AI 服务之外,从而形成一种隐私保护取决于硬件资源的系统。
综合这些部署示例,可以看出一个更广泛的系统层面挑战:负责任的人工智能原则不能孤立看待。它们彼此相互作用,优化其中一项可能限制另一项。适当的平衡取决于部署架构、利益相关方优先级、领域特定的风险、错误的后果,以及计算资源需求所带来的环境与社会分配影响。因此,负责任的人工智能机器学习设计依赖于在选定方法之前明确这些约束,从而使最终系统能够依据其实际所处的部署环境进行评估。
比较这些场景(部署取舍)表明,没有任何一种部署环境在所有原则上都占优;每种环境都会做出不同的架构妥协。云系统支持复杂的可解释性方法(如 SHAP、LIME)和集中式公平性监控,但通过数据聚合引入了隐私风险。边缘与移动端部署提供了更强的数据本地性,但限制了部署后的可观测性和全局公平性评估。TinyML 系统面临的约束最为严苛,需要静态验证和编译期隐私保证,且没有任何运行时调整的机会。这些约束不仅是技术限制,还决定了不同用户和应用能够获得的负责任人工智能功能,从而在只有资源充足的部署才能负担全面保障措施的地方形成公平性影响。理解这些部署约束,为在实践中将负责任人工智能原则转化为具体技术方法提供了必要的背景。
| 原则 | 云机器学习 | 边缘机器学习 | 移动机器学习 | TinyML |
|---|---|---|---|---|
| 可解释性 | 支持复杂模型和方法,如 SHAP 与采样方法 | 需要轻量级、低延迟的方法,如显著性图 | 需要用户可理解的输出,通常将更深层分析推迟到云端 | 受硬件限制严重,基本为静态或仅在编译期可用 |
| 公平性 | 大规模数据集支持偏见检测与缓解 | 局部偏见更难检测,但允许端侧调整 | 高度个性化使群体层面公平性跟踪复杂化 | 数据量有限,限制了偏见分析与缓解 |
| 隐私 | 集中式数据面临泄露风险,但可采用强加密和差分隐私方法 | 端侧敏感个人数据需要端侧保护 | 与用户身份紧密耦合,需要知情同意设计和本地处理 | 分布式数据降低了集中式风险,但给匿名化带来挑战 |
| 安全性 | 易受黑客攻击和大规模攻击 | 真实世界交互使可靠性变得重要 | 在用户监督下运行,但仍需优雅失败 | 需要静态安全边界、看门狗和失效保护行为 |
| 问责 | 企业政策与审计支持可追溯性和监督 | 碎片化的供应链使问责复杂化 | 需要清晰的用户可见披露与反馈路径 | 需要在漫长而复杂的硬件链路上实现可追溯性 |
| 治理 | 外部监督与 GDPR 或 CCPA 等法规可行 | 需要开发者和集成商进行自我治理 | 在平台政策与应用程序开发者选择之间取得平衡 | 依赖内置协议和加密保障 |
部署分析揭示了一个关键认识:负责任人工智能技术的可行性取决于架构约束。TinyML 设备无法运行 SHAP 解释;边缘系统无法实现实时公平性监控;移动应用无法存储全面问责所需的审计日志。因此,负责任的人工智能机器学习要求根据上述约束来选定技术方法:偏见检测、隐私保护、鲁棒性保障和可解释性,只有在其适配决定技术能否运行的数据质量、计算预算、部署要求和服务栈时,才具有实际操作性。
这些方法的需求始于模型如何学习。训练数据包含历史偏见和不公平的关联关系,基于有偏历史数据训练的招聘算法可能通过将人口统计特征与成功结果关联起来,从而复现歧视性模式。模型学习的是相关性而非因果关系,因此反映不公平社会结构的统计模式可能被优化为看似有意义的关系。仅以准确性为目标的传统机器学习,因而与公平性目标形成张力。有效的解决方案必须将相关约束整合到数据采集、训练、服务或监控之中,而不是将其作为训练后的次级修正附加上去。
后续的操作技术可分为三类互补的类别,每一类在准确性、计算成本和实现复杂度方面各有不同的取舍。检测方法能够及时识别问题行为,为偏见、漂移和性能问题提供预警机制。缓解技术通过算法干预和鲁棒性增强来预防或减少有害结果。验证方法使系统行为对开发者、审计者、监管者以及评估自动化决策的受影响用户而言变得可理解。
负责任人工智能技术的计算开销
后续章节将详细展开这些技术方法,但在实现细节之前,其系统成本已经可见。负责任人工智能技术的性能影响 展示了负责任人工智能技术对训练、推理、内存和准确性的性能影响:检测、缓解、验证、隐私和解释技术各自对训练、推理、内存和准确性施加不同的成本。先阅读该表,可以让工程师将负责任人工智能方法视为可部署的系统选择,而非抽象的伦理标签。
| 技术 | 准确率损失 | 训练开销 | 推理成本 | 内存开销 |
|---|---|---|---|---|
| 差分隐私 | 2–5% | 15–30% | 极低 | 10–20% |
| (DP-SGD) | ||||
| 公平性感知训练 | 1–3% | 5–15% | 极低 | 5–10% |
| (重加权/约束) | ||||
| 近似 SHAP(树/核) | 不适用 | 不适用 | 50–200% | 20–100% |
| 精确 SHAP | 不适用 | 不适用 | 50–1,000× | 50–200% |
| 对抗训练 | 2–5% | 100–300% | 极低 | 50–100% |
| 联邦学习 | 5–15% | 200–500% | 极低 | 100–300% |
这些开销范围应作为场景假设来解读,而非声称任何被引用的论文都确立了单一普适的代价。20 实际开销会因模型架构、数据集规模、攻击强度、解释方法、硬件、通信模式和实现质量而显著不同。关键在于架构层面:负责任人工智能的控制会消耗真实的训练、服务、内存或评审容量,因此必须在上线前进行预算规划。这些开销数据也体现了 节 1.1.1.1 所提出的公平性论证的具体化:无法负担表中训练、推理和内存预算的组织,同样无法负担相应的保护措施,因此获得公平或隐私模型的权利取决于其背后的计算预算。
20 测量背景: 该容量演练假设了常见的生产参考点,例如 GPU 训练、GPU 或 CPU 推理、图像/文本/表格模型以及基准数据集。这些数值并非标准常数;它们是用于判断某项保障措施应内联、异步、离线,还是纳入训练管道的量级规划锚点。
由于这些计算成本与架构约束对系统设计影响重大,工程团队必须结合自身的实际部署环境,仔细选择合适工具。无论环境如何,采取纠正措施的第一步都是确认问题确实存在,因此检测方法构成了所有其他负责任人工智能干预措施的基础。
偏见检测与公平性监控
一个在全国范围内部署的信用评分模型开始以两倍于正常速率拒绝特定 ZIP 码中的合格申请人。如果没有偏见检测基础设施,这种差异会在数周甚至数月内持续存在,直到有人注意到。偏见检测将理论上的公平性定义转化为实时、可操作的遥测。正如站点可靠性工程师监控延迟仪表盘一样,负责任人工智能工程师监控人口统计公平性仪表盘,利用基于分片的分析来识别模型何时开始对特定子群体失效。
偏见检测与缓解
节 1.1.3 所考察的公平性定义,为公平性的含义提供了数学层面的精确表述:人口统计公平性、均等机会和机会平等在数学上均有明确定义。然而,实践者面临着一个实际挑战:在生产系统每秒处理数千次预测的情况下计算这些指标。以这些数学公式进行人工计算在大规模场景下不可行。定义与部署之间的这一差距,推动了专用工具的出现。
在已部署系统中实现公平性,不仅需要原则性的目标或理论指标,更需要系统感知的检测方法,以在机器学习全生命周期中检测、测量并缓解偏见。实际的偏见检测可以使用 Fairlearn21 (Bird 等 2020年) 之类的工具实现。
21 Fairlearn: 微软开源工具包(2020 年),用于计算公平性指标,并将缓解算法应用于兼容 scikit-learn 的模型(Bird 等 2020年)。系统集成的模式是:公平性测量与缓解围绕模型管道展开,而非作为独立的电子表格审计存在。其实际意义在于,公平性监控成为 CI/CD 流水线中的一个阶段,而非临时的人工审查,从而在模型更新导致子群体性能下降时实现自动回归检测。
Bird, Sarah, Miro Dudı́k, Richard Edgar, Brandon Horn, Roman Lutz, Vanessa Milan, Mehrnoosh Sameki, Hanna Wallach, 和 Kathleen Walker. 2020年. 《Fairlearn: A toolkit for assessing and improving fairness in AI》. Microsoft Technical Report MSR-TR-2020-32.
代码 1 支持跨人口统计群体的离线或 CI 阶段公平性审计,揭示了令人担忧的差异:贷款审批率因种族而异,亚洲申请人的审批率为 94%,黑人申请人的审批率为 68%。基于本章所述的系统层面约束,公平性必须被视为一项架构层面的考量,与数据工程、模型训练、推理设计、监控基础设施以及政策治理相互交织。虽然人口统计公平性、均等机会和机会平等这类公平性指标将不同的规范性目标形式化,但它们的实现取决于架构是否能够测量子群体性能、支持自适应决策边界,并在运行时存储或呈现群体特定的元数据;部署阶段的监控将在本章后文处理。
from fairlearn.metrics import MetricFrame, selection_rate
from sklearn.metrics import accuracy_score, precision_score

# Loan approval model evaluation across demographic groups
mf = MetricFrame(
    metrics={
        "approval_rate": selection_rate,
        "accuracy": accuracy_score,
        "precision": precision_score,
        "false_positive_rate": lambda y_true, y_pred: (
            (y_pred == 1) & (y_true == 0)
        ).sum()
        / (y_true == 0).sum(),
    },
    y_true=loan_approvals_actual,
    y_pred=loan_approvals_predicted,
    sensitive_features=applicant_demographics["ethnicity"],
)

# Display performance disparities across ethnic groups
print("Loan Approval Performance by Ethnic Group:")
print(mf.by_group)
# Output shows: Asian: 94% approval, White: 91% approval,
# Hispanic: 73% approval, Black: 68% approval
实际实现往往受到数据访问和系统可观测性方面的限制。在许多真实环境中,尤其是移动、联邦或嵌入式系统,性别、年龄或种族等敏感属性可能在推理时不可用,因而难以追踪或审计模型在不同人口群体间的表现。数据收集与标注策略对于整个模型生命周期内的公平性评估至关重要。在此类场景中,公平性干预必须在上游的数据治理或训练阶段进行,因为部署后的重新校准可能不可行。即使数据可得,纳入用户反馈的持续再训练流水线也可能强化既有的差异,除非显式地监控公平性退化。例如,一个随用户行为自适应的端侧推荐模型,若缺乏检测用户交互或输出中人口群体失衡的基础设施,可能会放大先前的偏见。
图 5 说明了公平性约束如何与部署选择产生张力。在一个二分类贷款审批系统中,两个子群体——Subgroup A(以蓝色表示)和 Subgroup B(以红色表示)——需要不同的决策阈值才能达到相等的真正例率。若跨群体使用单一阈值,将导致结果差异,可能使 Subgroup B 处于不利地位。通过按群体调整阈值来缓解这一失衡可能改善公平性,但这需要模型服务栈支持条件逻辑、在推理时获得敏感属性,以及一个用于解释和论证跨群体差别对待的治理框架。
公平性干预可以应用于流水线中的不同环节,但每种方法都伴随着系统层面的影响。预处理方法 通过采样、重新加权或数据增强来重新平衡训练数据,需要访问原始特征和群体标签,通常通过保留血缘关系的特征库或数据湖来实现。这些方法适合具备集中式训练流水线和高质量标注数据的系统。相比之下,训练阶段方法 将公平性约束直接嵌入优化目标。这些方法需要能够支持自定义损失函数或约束求解器的训练基础设施,并且可能需要更长的训练周期或额外的正则化验证。训练技术与优化方法,包括自定义损失函数和约束优化,构成了实现这些公平感知训练方法的基础。
在服务层,后处理 方法,包括应用群体特定阈值或调整分数以使结果均衡,需要推理系统能够依据敏感属性进行条件判断或参考外部策略规则。这需要在模型服务基础设施、访问控制策略和日志流水线之间进行协同,以确保差别对待既可审计又能在法律上站得住脚。模型服务架构,包括请求路由、特征查找和条件推理路径,详细说明了在生产系统中实现此类条件逻辑所需的基础设施要求。任何后处理策略都必须经过仔细验证,以确保其不会损害用户体验、模型稳定性,或违反关于属性使用的辖区法规。
可扩展的公平性执行通常需要更先进的策略,例如多校准(multicalibration),22 它确保模型预测在广泛的交叉子群体范围内保持校准(Hébert-Johnson 等 2018年)。在大规模部署多校准需要动态生成子群体划分、计算每群体校准误差,并将公平性审计集成到自动监控系统中的基础设施。这些能力通常只在具备成熟可观测性和指标流水线的大规模云端部署中才可获得。在嵌入式或 TinyML 系统等受限环境中,遥测有限且模型逻辑固定,此类技术不可行,公平性必须在设计阶段完全验证。
22 多校准:由 Hébert-Johnson 等 (2018年) 开发,该技术旨在在许多可计算识别的、相互交叉的子群体上实现校准预测,解决全局校准掩盖少数群体交叉处严重失校准这一失效模式。其系统成本来自反复的子群体审计和模型更新,而非固定的乘数。多校准是面向多样化平台的一种重要可扩展公平性方法,但它并非唯一的公平性策略。
Hébert-Johnson, U., M. P. Kim, O. Reingold, 和 G. N. Rothblum. 2018年. 《Multicalibration: Calibration for the (Computationally-Identifiable) Masses》. 收入 Proceedings of the 35th International Conference on Machine Learning, ICML 2018, Stockholmsmässan, Stockholm, Sweden, July 10-15, 2018, 编辑 Jennifer G. Dy 和 Andreas Krause, 卷 80. Proceedings of Machine Learning Research. PMLR.
跨部署环境,维持公平性需要具备生命周期感知的机制。模型更新、反馈回路和界面设计都会影响公平性随时间的演变。如果再训练流水线未包含公平性检查、日志系统无法追踪子群体结果,或用户反馈引入了训练分布未涵盖的细微偏见,公平感知模型都可能退化。监控系统必须具备暴露公平性退化的能力,再训练协议必须能够访问子群体标注的验证数据,这可能还需要数据治理策略和伦理审查。这些监控系统的实现需要 MLOps 实践的生产基础设施,而隐私保护技术对于联邦公平性评估至关重要。
公平性既不是一次性的优化,也不是模型孤立存在的属性。它源于数据获取、特征工程、模型设计、阈值设定、反馈处理和系统监控之间的协同决策。将公平性嵌入机器学习系统需要架构远见、运营纪律,以及覆盖整个部署栈的工具链,从训练工作流到服务基础设施再到面向用户的界面。
偏见检测的社会技术影响远远超出技术测量本身。当公平性指标识别出差异时,组织必须应对复杂的利益相关方协商过程,正如 节 1.6.3 所考察的那样。这些决策涉及相互竞争的利益相关方利益、法律合规要求,以及无法仅通过技术手段解决的价值观取舍。
实时公平性监控架构
在生产系统中实现负责任 AI 原则,需要架构模式将公平性监控、可解释性和隐私控制直接集成到模型服务基础设施中。生产环境负责任 AI 架构 展示了这些负责任 AI 组件如何与现有机器学习系统基础设施集成,呈现了从用户请求经匿名化、模型推理、公平性监控到解释生成的数据流。
:::
:::
该架构之所以可行,是因为三条治理路径共享模型服务栈,而不是与它并列存在。数据匿名化层在模型推理之前实现隐私保护转换,采用诸如 \(k\)-匿名性23 或差分隐私噪声注入等技术。该层并非免费:隐私转换会消耗延迟、CPU 和内存,因此必须在模型服务级服务目标(SLO)内进行预算,而不能被视为独立的外部合规步骤。
23 k-匿名性:一种隐私保证(Sweeney 2002年),确保每条记录在泛化准标识符(例如,将确切年龄替换为区间、将位置替换为区域)后,与至少 \(k-1\) 条记录不可区分。系统层面的权衡是信息损失:较高的 \(k\) 值能提供更强的不可区分性,但会使特征变粗,并可能降低下游训练信号。对于机器学习预处理流水线,\(k\)-匿名性增加了一个转换阶段,该阶段必须在隐私保证与更粗特征带来的准确性影响之间取得平衡。
Sweeney, Latanya. 2002年. 《K-ANONYMITY: A MODEL for PROTECTING PRIVACY》. International Journal of Uncertainty, Fuzziness and Knowledge-Based Systems 10 (05): 557~70. https://doi.org/10.1142/s0218488502001648.
实时公平性监控会为每个预测更新仅依赖预测的指标(如人口统计公平性),并在受保护群体之间维护滚动统计。依赖标签的指标(如相等机会和机会均等)会在延迟结果或经审计的标签到达时异步更新,并且对于标注窗口过小、无法支撑稳定估计的群体,它们保持不活跃。系统会标记超出可配置策略阈值的差异,而其存储和计算开销会随着受保护群体的数量、决策分段和保留窗口而增长。
解释引擎为模型决策生成 SHAP 或 LIME 解释,特别是针对需要用户补救的负面结果。精确解释往往超出内联服务预算,因此生产系统依赖近似、缓存、采样或异步生成,以延迟换取保真度。以下实现应被理解为一种架构模式,而非需要记忆的记忆型 API:公平性指标进入服务路径,当阈值被超出时触发告警。延迟结果摄取以及完整的相等机会计算均被省略。代码 2 将这些组件集成到一个监控系统中,该系统处理推理请求,并在受保护群体之间计算滚动公平性指标。
import numpy as np


class RealTimeFairnessMonitor:
    def __init__(self, window_size=1000, alert_threshold=0.05):
        self.window_size = window_size
        self.alert_threshold = alert_threshold
        self.window = []

    async def process_prediction(self, prediction, demographics,
                                 actual_label=None):
        # Slide a fixed window over the stream, then re-check fairness.
        self.window.append((prediction, demographics, actual_label))
        self.window = self.window[-self.window_size :]
        metrics = self._compute_metrics()
        if metrics["demographic_parity"] > self.alert_threshold or (
            metrics["equalized_odds"] is not None
            and metrics["equalized_odds"] > self.alert_threshold
        ):
            await self._trigger_bias_alert(metrics)
        return metrics

    def _compute_metrics(self):
        # Bucket predictions and labels by protected group.
        by_group = {}
        for pred, demo, label in self.window:
            bucket = by_group.setdefault(
                demo.get("ethnicity", "unknown"), {"preds": [], "labels": []}
            )
            bucket["preds"].append(pred)
            if label is not None:
                bucket["labels"].append((pred, label))

        rates = [np.mean(d["preds"]) for d in by_group.values() if d["preds"]]
        parity = max(rates) - min(rates) if len(rates) > 1 else 0.0
        return {
            "demographic_parity": parity,
            # Requires sufficiently labeled outcomes per group; omitted here.
            "equalized_odds": self._equalized_odds_gap(by_group),
            "groups": {g: len(d["preds"]) for g, d in by_group.items()},
        }

    def _equalized_odds_gap(self, by_group): ...
    async def _trigger_bias_alert(self, metrics): ...  # page and audit
该生产环境实现展示了负责任 AI 原则如何转化为具有可量化性能影响的系统架构。负责任人工智能技术的性能影响 所总结的开销范围解释了为何公平性监控、隐私转换和解释生成必须作为服务路径能力进行配置,而不能在模型已经部署之后再行添加。在设计生产系统时,这些开销必须与可靠性及合规性要求进行权衡。
监控成本是将公平性从离线审计转变为运营信号所付出的代价。观察仍然不等于整改:公平性缓解通过预处理、训练阶段约束、后处理以及持续的子群体监控继续推进。下一层转向了不同的责任边界,系统必须防止私有数据通过日志、输出或模型权重泄露,并必须支持在用户撤回数据权利时执行删除或撤销。
::: {#chk-responsible-ai-bias-monitoring .callout-checkpoint title=” 将偏见检测纳入运营”}
本节将静态的公平性定义转化为实时遥测:基于切片的检测(使用 Fairlearn)、CI 阶段的审计、人口统计公平性与相等机会在生产环境中的监控,以及区分“观察到差异”与“对其进行整改”之间的区别。
从信号到行动
从信号到行动
:::
治理隐私、遗忘与鲁棒性控制
安全与隐私 负责威胁模型与隐私机制,而 Robust AI 负责鲁棒性行为、攻击、防御和评估。本节不重新定义这些机制,而是探讨当生产系统继承这些机制时,治理必须要求哪些证据、所有权和生命周期接口。当用户依据 GDPR 等隐私法律行使擦除或删除权利时,从数据库中删除其记录行是 straightforward 的(European Parliament 和 Council of the European Union 2016年)。删除其对已经基于其训练过的模型的影响则是一个更难的系统问题,涉及血缘、再训练、验证、部署和审计。
- 隐私机制:这些控制减少信息泄露。
- 遗忘机制:这些控制移除或限制已保留的影响。
- 鲁棒性机制:这些控制在压力下保持行为。
- 验证机制:这些控制产生证据,证明防护措施仍然有效。
机器遗忘24 与隐私保护应对该挑战中的删除与泄露部分,为从已编译模型中切除特定训练数据的影响提供机制。
24 机器遗忘:由 Cao 和 Yang 于 2015 年首次形式化,指在不进行完整再训练的情况下,从模型中移除特定训练数据影响的能力;朴素方法(从头重新训练)的成本与原始训练运行相同。分片、隔离、切片和聚合(SISA)训练将训练划分为相互独立的分片,将遗忘简化为仅重新训练受影响的分片;在 节 1.4.1.1 中 GPT 规模的分片场景下,这大幅减少了再训练面,代价是模型质量与聚合之间的权衡。对于符合 GDPR 的机器学习系统,遗忘延迟成为一个服务级问题:删除请求必须在组织适用的法律和策略时限内得到处理。
隐私保护
隐私约束横跨数据采集、模型行为和用户交互。它们不仅由伦理和法律义务塑造,也受系统本身的架构属性及其部署环境的影响。隐私保护的技术方法旨在防止数据泄露、限制记忆,并维护用户权利,如同意、退出和删除数据,特别是在从个性化或敏感信息中学习的系统里。
大型语言模型已被证明能够记忆并暴露单个训练样本,包括姓名、地点或私人通信的片段(Carlini 等 2021年)。这种记忆行为对隐私敏感的文生本系统构成风险,例如基于用户日志训练或适配的助手,其训练数据可能包含受保护或受监管的内容。例如,适配用户语音或消息的语音或聊天助手可能无意保留特定短语,这些短语日后可能通过精心设计的提示词或查询被提取出来。
Carlini, N., F. Tramer, E. Wallace, M. Jagielski, A. Herbert-Voss, K. Lee, A. Roberts, 等. 2021年. 《Extracting Training Data from Large Language Models》. 30th USENIX Security Symposium (USENIX Security 21), 2633~50.
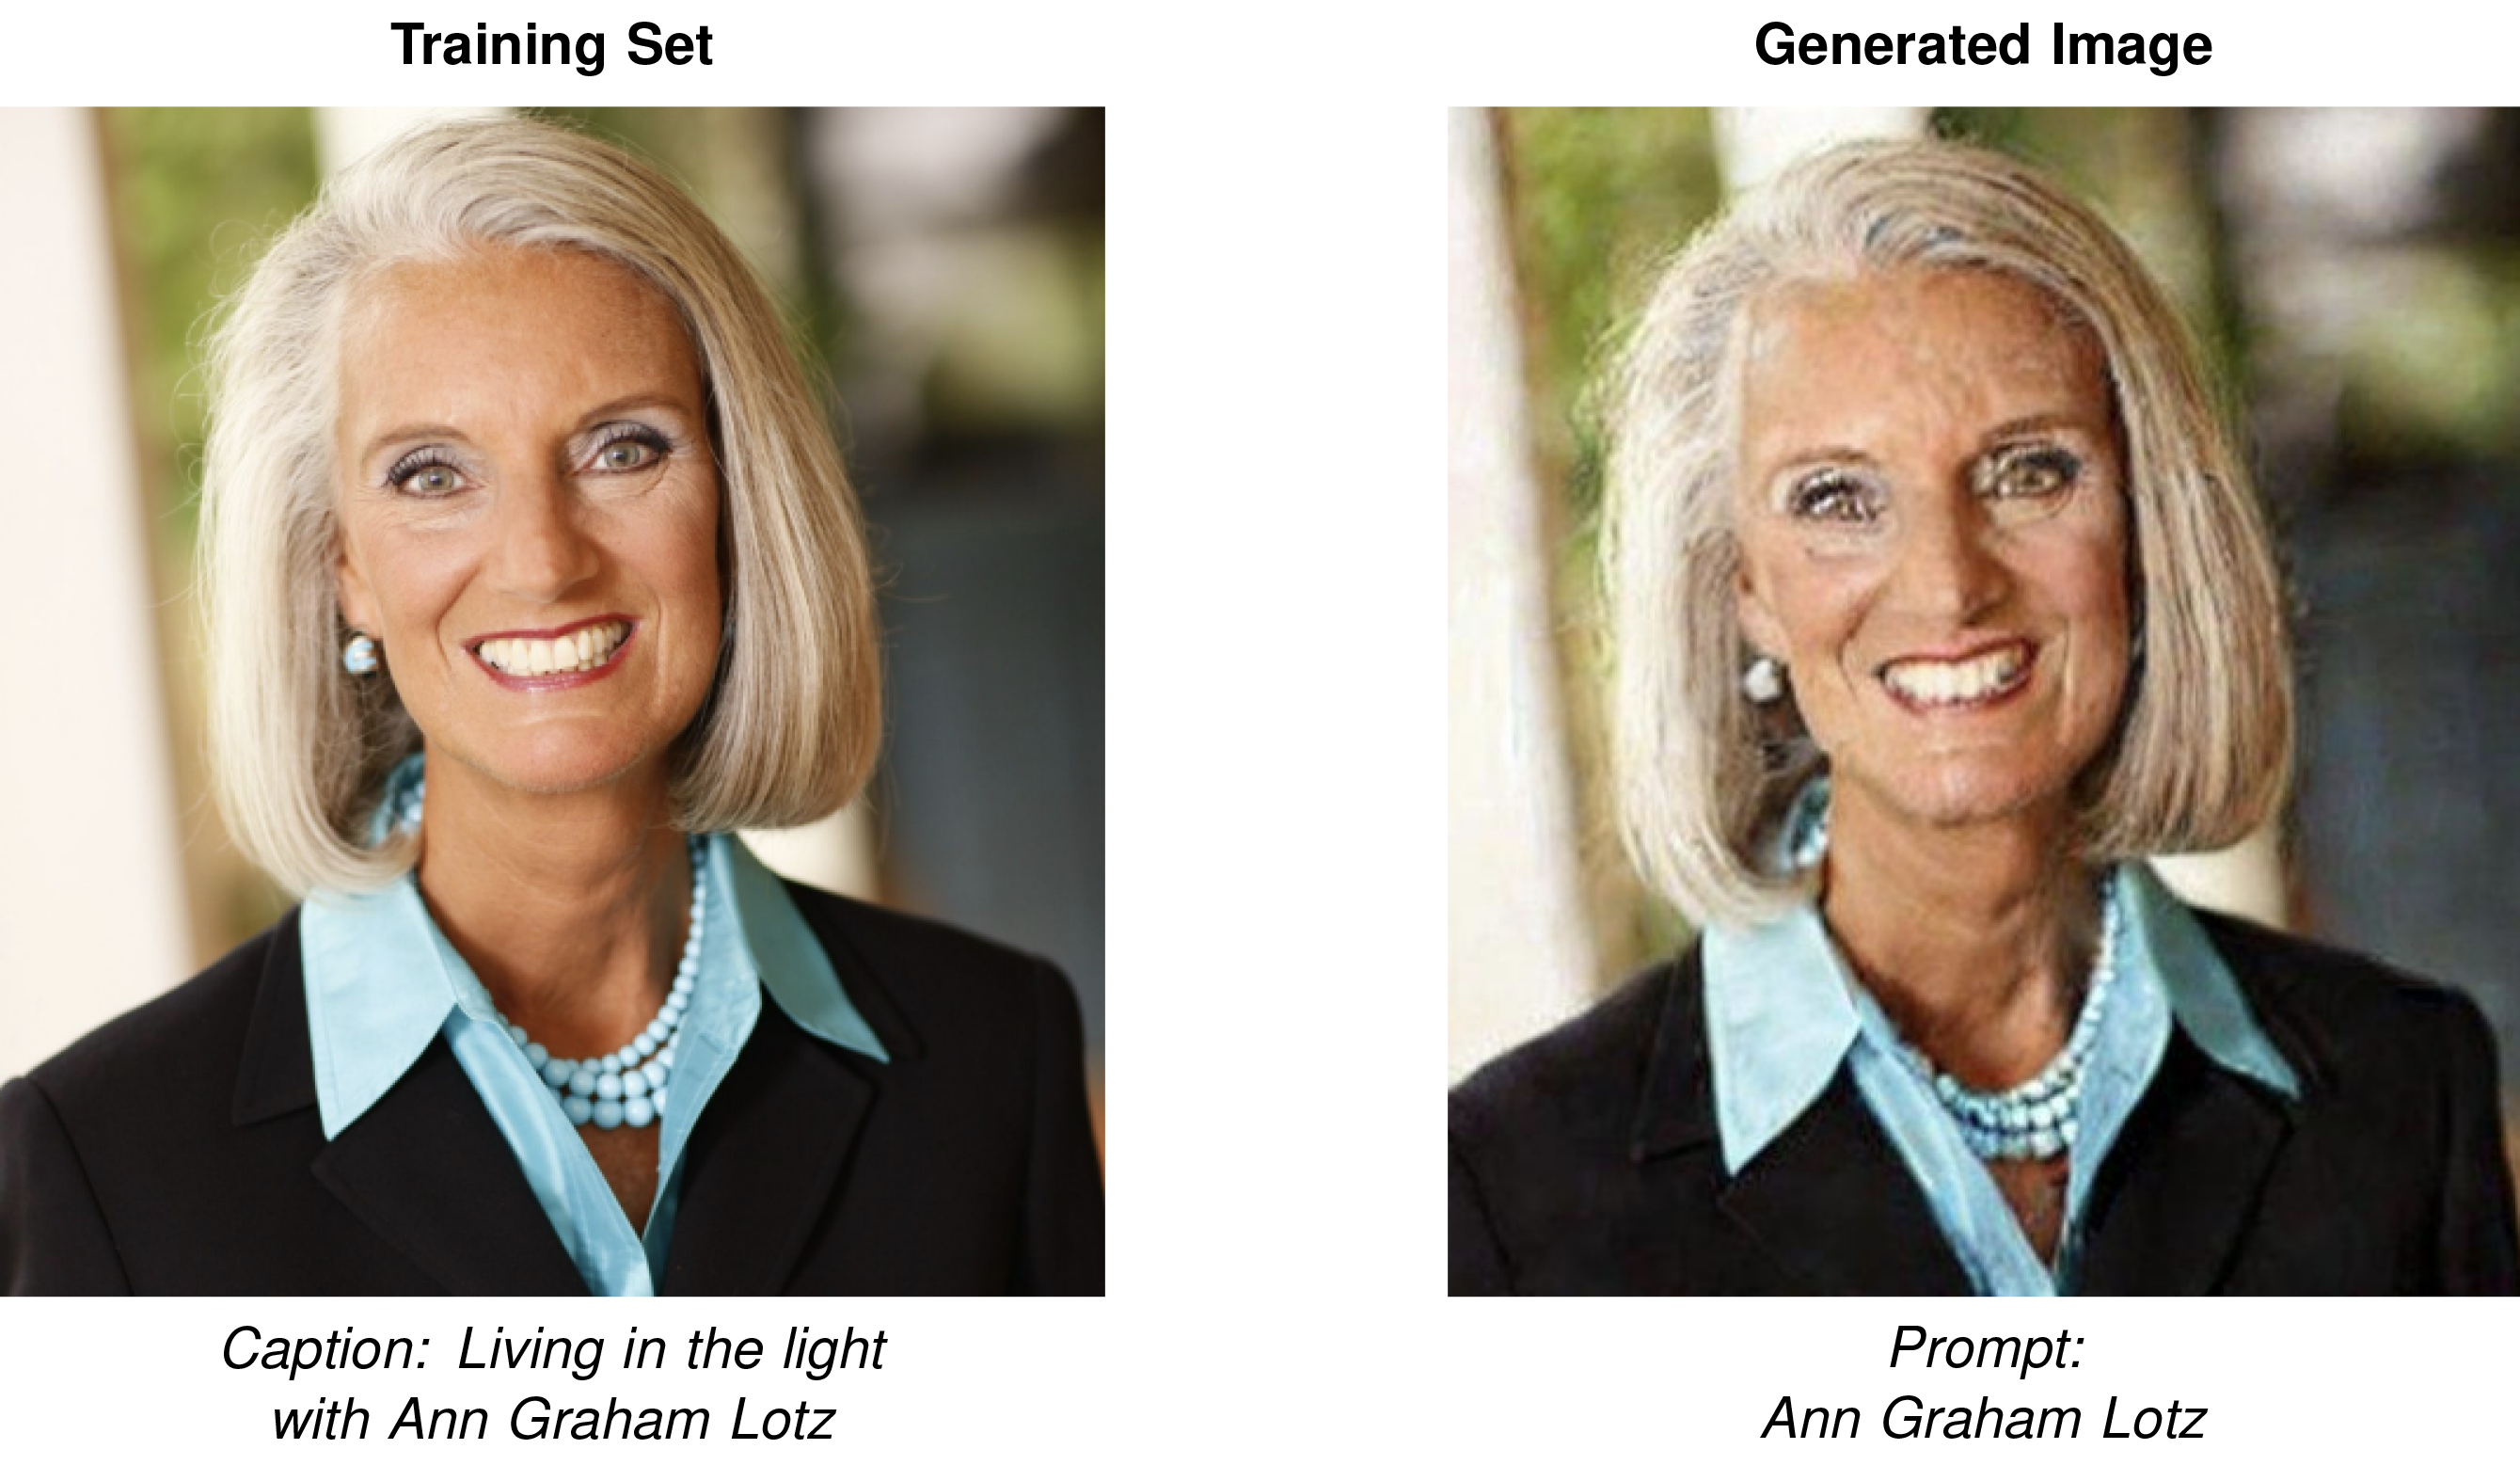
记忆风险并不局限于语言模型。图 6 表明,基于图像数据集训练的扩散模型可以重新生成训练集中的视觉样本(Carlini 等 2023年)。左图是原始训练图像,右图是扩散模型对该同一实例的重建;二者近乎一致,即记忆的证据,因为一个仅学会肖像一般分布的模型无法复现某个具体个体。这种行为凸显了一个更具普遍性的脆弱性:当代生成模型架构可以内化并复现训练数据,往往没有显式的信号或意图,且难以检测或控制。
Carlini, Nicholas, Jamie Hayes, Milad Nasr, Matthew Jagielski, Vikash Sehwag, Florian Tramèr, Borja Balle, Daphne Ippolito, 和 Eric Wallace. 2023年. 《Extracting Training Data from Diffusion Models》. 32nd USENIX Security Symposium (USENIX Security 23), 5253~70.
模型同样容易受到成员推断攻击,攻击者试图判断某个特定点是否属于训练集(Shokri 等 2017年)。这些攻击利用模型对已见输入与未见输入之间细微的行为差异。在高利害应用中,如医疗或法律预测,仅仅知道某个个体的记录曾被用于训练,就可能违反隐私预期或监管要求。
25 差分隐私:由 Dwork 等 (2006年) 提出的数学框架,界定单个个体的纳入或排除对已发布计算的影响上限,并以隐私预算(例如 \(\epsilon\))进行参数化。DP-SGD 将该框架适配到深度学习,通过对每个样本的梯度进行裁剪并注入校准后的噪声(Abadi 等 2016年)。隐私预算量化了隐私、效用与训练成本之间的权衡;Apple 曾公开描述其在部分遥测任务上的本地差分隐私部署,但这些部署不应被视为通用的 DP-SGD 成本基准(Apple Differential Privacy Team 2017年)。
Dwork, Cynthia, Frank McSherry, Kobbi Nissim, 和 Adam Smith. 2006年. 《Calibrating Noise to Sensitivity in Private Data Analysis》. 收入 Theory of Cryptography Conference (TCC), 编辑 Shai Halevi 和 Tal Rabin, 卷 3876. Lecture Notes in Computer Science. Springer Berlin Heidelberg. https://doi.org/10.1007/11681878_14.
Abadi, M., A. Chu, I. Goodfellow, H. B. McMahan, I. Mironov, K. Talwar, 和 L. Zhang. 2016年. 《Deep Learning With Differential Privacy》. Proceedings of the 2016 ACM SIGSAC Conference on Computer and Communications Security, CCS ’16, 308~18. https://doi.org/10.1145/2976749.2978318.
Apple Differential Privacy Team. 2017年. Learning with privacy at scale. Apple Machine Learning Research.
为缓解此类脆弱性,已开发出多种隐私保护技术。一种经典的正式方法是差分隐私25,它为单个数据点是否被纳入对模型输出的影响提供统计意义上的有界保证。例如,差分隐私随机梯度下降(DP-SGD)通过裁剪梯度并在训练过程中注入噪声,将该思想落实到深度学习(Abadi 等 2016年)。当隐私核算、裁剪和噪声校准适配所考虑的安全威胁模型时,这些方法可以限制记忆并降低推断攻击的风险。
然而,差分隐私会引入显著的体系级权衡。训练过程中加入的噪声可能降低模型精度、增加训练迭代次数,并需要访问更大的数据集以维持性能。这些约束在资源受限的部署中尤为突出,例如移动、边缘或嵌入式系统,其中内存、计算和功耗预算都受到严格限制。在这样的场景下,可能需要将轻量级隐私技术(例如特征混淆、本地差分隐私)与限制数据采集、缩短数据保留期限或在边缘侧实施严格访问控制的结构化策略相结合。
Systems Perspective 1.2: 隐私的代价
使用 DP-SGD 在敏感消息上训练下一个词预测器 可以降低训练数据被提取的风险,但保护需要以计算资源和精度为代价。
隐私参数 \(\epsilon\) 界定隐私损失;当邻域关系和 \(\delta\) 固定时,较小的取值提供更强(更紧)的界。可复现的 DP-SGD 结果还必须指定数据集规模、批次采样方案与速率、优化步数、裁剪范数、噪声系数、邻域关系、\(\delta\) 以及隐私核算方法。这些配置值是用于说明的规划假设,并非由本章的规模估算代码计算得出。
说明性更强隐私配置(假设核算结果为 \(\epsilon =\) 1):该场景假设梯度在 \(C = 1.0\) 处被裁剪,40 percent 的更新受到裁剪影响,噪声系数为 \(\sigma = 1.0\)。此外还假设需要增加 3× 个 epoch,训练成本由 $4.6M 上升至约 $13.8M,以及精度下降 6 percent。
说明性较弱隐私配置(假设核算结果为 \(\epsilon =\) 8):该场景假设噪声系数为 \(\sigma = 0.5\),训练开销为 30 percent,精度下降为 1 percent。
说明性最弱配置(假设核算结果为 \(\epsilon =\) 10):该场景假设噪声更少、精度损失低于 1%,并且在其他条件可比的前提下,其形式隐私界弱于另外两种配置。
隐私并非非黑即白。它是一条连续曲线,组织通过计算资源投入换取用户信任,同时影响模型精度。当某个固定模型已通过差分隐私训练完成后,普通推理属于后处理,并不额外消耗训练数据的隐私预算。只有当部署后机制导致对私有数据的新访问或额外发布差分隐私统计量时,才需要继续核算隐私损失。关键的工程决策是记录并核算每一次私有数据访问,并向用户和监管机构传达由此产生的权衡。
隐私的落实还依赖于模型之外的基础设施。数据采集接口必须支持知情同意和透明度。日志系统除非确有必要,否则不应保留敏感输入,并且必须支持访问控制、过期策略和可审计性。模型服务基础设施必须设计为能够防止输出过度暴露,避免泄露内部模型行为或使私有数据得以重建。这些体系级机制需要机器学习工程、平台安全与组织治理之间的紧密协同。
隐私不仅要在训练阶段落实,还须贯穿整个机器学习生命周期。重训练流水线必须处理数据删除或撤销的情况,尤其是在存在数据删除强制规定的司法辖区。监控基础设施必须避免在日志或仪表板中记录可识别个人身份的信息。隐私感知的遥测采集、安全飞地部署以及按用户生成的审计轨迹可以支持这些目标,在法律监管严格的应用中尤为重要。
架构决策也会因部署场景而异。基于云的系统可能依赖集中式落实差分隐私、加密和访问控制,并由遥测与重训练基础设施提供支持。相比之下,边缘和 TinyML 系统必须将隐私约束构建到已部署的模型本身,通常不具备运行时可配置性或反馈通道。在这种情况下,必须在编译阶段实现静态分析、保守设计和内嵌的隐私保证,并在部署前完成验证。
因此,隐私预算横跨整个流水线:技术保障措施、接口控制、日志与保留策略以及合规机制必须协同工作,以在整个已部署系统的生命周期中最大限度地降低风险。没有任何单一机制(包括差分隐私)可以独立奏效。
隐私保护技术会引发复杂的社技张力,其影响远远超出技术实现本身。差分隐私机制可能以不成比例的方式损害代表性不足群体的模型精度,从而在隐私与公平目标之间形成冲突。这些挑战需要持续的干系人参与,正如 节 1.6.3 所详述的那样,组织必须围绕数据控制、个性化和监管合规等相互竞争的价值进行权衡。当进一步考虑用户权利与数据治理的动态性时,这些隐私挑战会更加复杂。
机器遗忘
本节考察的隐私机制保护了数据在采集和训练阶段的安全,但它们并未解决一个时间维度的问题:当用户行使使其数据被遗忘的法定权利时,基于这些数据训练的模型仍在其学习参数中保留该数据的影响。即使原始数据已从存储系统中删除,隐私违规依然存在。机器遗忘处理隐私的这一时间维度,确保数据删除权不仅延伸至数据库,也延伸至模型本身。
隐私保护并不以训练结束为终点。在许多真实系统中,用户可能在模型训练并部署之后,仍享有撤销同意或要求删除其数据的权利California Legislature (2023年)。支持这一要求引入了核心技术挑战:在不进行完整重训练的前提下,从已训练模型中移除特定点的影响,而这一任务在计算、存储和连接性受限的边缘、移动或嵌入式部署中往往不可行。
传统的数据删除方法假设完整训练数据集始终可访问,并在移除目标记录后从头重新训练模型。图 7 将传统模型重训练与机器遗忘方法进行了对比:重训练使用修改后的数据集从头重建模型,而遗忘旨在移除某个特定点的影响,而无需重复整个学习过程。
在延迟、计算或隐私约束严格的系统中,重训练与遗忘之间的区别至关重要,因为完整重训练所依赖的假设在实践中往往难以成立。许多已部署的机器学习系统出于安全、合规或成本方面的约束,并不保留原始训练数据。在这样的环境中,完整重训练往往既不可行,也会带来运行层面的扰动,尤其是在数据删除必须可验证、可重复且具备审计就绪性时。
机器遗忘旨在通过这一途径克服上述局限:在不重新训练整个模型的前提下,从已训练模型中移除单个数据点的影响。Cao 和 Yang (2015年) 首次将该问题形式化,提出一种通用方法,将学习算法转化为求和形式,从而只需重训练包含目标信息的组成模型,而非整个模型,即可高效移除数据影响。Cao 与 Yang 提出的形式化方法以及分片、隔离、切片和聚合(SISA)训练等方法,通过调整内部参数、修改梯度路径,或隔离并剪枝模型组件来近似这一行为,使得最终预测反映的是在没有被删除数据的情况下本应学到的结果(Bourtoule 等 2021年)。这些技术可能需要简化的模型架构、额外的追踪元数据,或牺牲模型精度与稳定性。它们还带来了新的验证负担:如何证明删除已以有意义的方式发生,尤其是在内部模型状态无法被完全解释的情况下。
Cao, Yinzhi, 和 Junfeng Yang. 2015年. 《Towards Making Systems Forget With Machine Unlearning》. 2015 IEEE Symposium on Security and Privacy, 463~80. https://doi.org/10.1109/sp.2015.35.
Bourtoule, Lucas, Varun Chandrasekaran, Christopher A. Choquette-Choo, Hengrui Jia, Adelin Travers, Baiwu Zhang, David Lie, 和 Nicolas Papernot. 2021年. 《Machine Unlearning》. 2021 IEEE Symposium on Security and Privacy (SP), 141~59. https://doi.org/10.1109/sp40001.2021.00019.
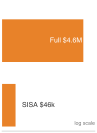
SISA 遗忘比完整重训练便宜约 100 倍。
Napkin Math 1.7: 遗忘的代价
用户在针对 1 TB 数据训练的模型上行使 GDPR 第 17 条(“删除权”)。
基线(完整重训练):在此规模估算场景中,一个 175B 参数的模型在 GPT-3 量级上,使用 1,024 NVIDIA A100(80 GB SXM4)GPU 进行重训练(假设每个加速器为密集 FP16 \(R_{\text{peak}} =\) 312,模型 FLOPs 利用率(MFU)为 \(\eta_{\text{MFU}} \approx 32\%\)),耗时约 34 days,成本约 $4.6M。
工程方案:SISA 训练将数据划分为 \(K =\) 100 个独立分片,训练 100 个子模型。为删除一条数据,仅重训练包含该数据的特定分片(1 percent 的数据)。新成本:$46,000。耗时:约 8.2 hours。
权衡:由于每个子模型看到的数据更少,精度下降 3–7 percent;推理变慢,因为预测需要在 100 个子模型之间进行聚合。收益是真实的,但存在速率上限。SISA 将重训练的单位从整个模型缩小到一个分片,因此只有在每日删除请求远低于 100(分片数量)时才有收益。在本场景的 1,000 requests/day 下,每日批次几乎触及每个分片,成本便收敛回完整重训练。分片使稀疏删除率下的遗忘变得可行,代价是模型质量;它并未使持续删除变得便宜。
监管框架进一步强化了机器遗忘的动机。GDPR、CCPA 以及其它司法辖区的类似法律所规定的删除或擦除权,可能形成对训练所用个人数据的核算压力California Legislature (2023年)。机器遗忘是在模型状态本身可能保留个人数据时,减少或移除被删除记录影响的工程技术策略,但法律要求因情境而异,并非要求重训练每个模型的普遍法定命令。生成模型复现个人内容或受版权保护数据的高关注度事件,凸显了将删除感知机制整合进负责任系统设计的现实紧迫性。
从系统视角看,机器遗忘引入了非平凡的架构与运行要求。系统必须能够追踪数据血缘,包括哪些数据点贡献了某个模型版本。这通常需要结构化的元数据采集和训练流水线 instrumentation。此外,系统必须支持面向用户的删除工作流,包括认证、提交以及对删除状态的反馈。验证可能需要维护版本化的模型注册表,以及确认更新后模型不存在被删除数据残余影响的机制。这些操作必须横跨数据存储、训练编排、模型部署和审计基础设施,并且必须对故障或回滚具有鲁棒性。
资源受限的部署进一步放大了这些挑战。TinyML 系统通常运行在没有持久存储、无网络连接且高度压缩模型的设备上。部署之后,它们无法根据删除请求进行更新或重训练。在这样的场景下,机器遗忘在部署后实际上不可行,必须通过在初始模型开发阶段实施静态数据最小化和保守泛化策略来落实。即使在重训练更为可行的基于云系统中,遗忘也必须应对分布式训练流水线、跨服务的复制,以及在不同模型快照和日志之间同步删除的困难。
尽管存在这些挑战,机器遗忘对负责任系统设计的重要性日益凸显。随着机器学习系统越来越嵌入化、个性化和自适应,撤销训练影响的能力已成为维护用户信任、满足法律要求的核心。关键在于,遗忘无法在部署后补装。它必须在架构与策略设计阶段予以考虑,并在系统中从一开始就构建支持血缘追踪、重训练编排和部署回滚的能力。
机器遗忘代表了隐私思维的转变:从保护所收集的数据,转向控制该数据持续影响系统行为的时长。这种以生命周期为导向的视角为模型设计、基础设施规划和监管合规带来了新的挑战,同时也为构建更具用户可控性、透明度和自适应性的机器学习系统奠定了基础。负责任的 AI 系统还必须在包括蓄意攻击在内的挑战性条件下保持可靠的运行行为。
对抗鲁棒性
Robust AI 负责攻击模型、鲁棒性评估、对抗训练、认证、污染测试、漂移检测以及拒绝(abstention)机制。治理通过证据接口消费这些机制。负责任 AI 的问题不在于实现哪一种攻击或防御,而在于鲁棒性主张是否具备有界的运行包络、与威胁模型相称的证据、可问责的负责人,以及一条能够撤销批准的规则。
鲁棒性主张应当明确受保护的任务与人群、攻击者的知识与能力、扰动或污染集合、评估分布、模型与预处理版本、质量与延迟约束、回退行为,以及已知排除项。经验性攻击结果仅表明在测试协议下观察到的失败;它们并不能确立对自适应或未测试攻击的鲁棒性。证书仅在其声明的范数、半径、置信度和模型配置下证明一项性质;它并不为端到端工作流确立安全性。治理记录这些边界,以免将一项狭窄的结果提升为一般性的安全性断言。
证据包还必须将模型行为与系统动作连接起来。它指明谁拥有鲁棒性主张、哪个团队可以停止服务、拒绝和低置信度案例如何路由、哪些遥测数据能够检测偏离已批准包络的情况,以及事件如何影响用户和下游运营方。无法在决策截止时间内执行的回退并非有效控制,而没有回滚权限的监控器也不是运行期保障。
当威胁模型、模型、预处理、传感器、数据分布、工具访问权限、部署环境或回退路径发生实质性变化时,批准即告失效。失效规则应当说明:哪类变化触发完整红队评估,哪类仅允许运行更窄的回归套件,哪类要求在重建证据期间进入受限运行。这项“归属—失效”契约即治理贡献:它将 Robust AI 中的鲁棒性机制转化为可审查的主张,并使其随时间推移持续保持有界。
验证方法
若检测能够识别问题、缓解措施能够修复问题,验证 便为 表 1 的评估与保障阶段提供证据。验证并非独立的支柱,也不构成“系统安全”的主张。它检验有界的要求,并为发布授权方记录残余不确定性。不同利益相关方需要不同的证据:开发者需要诊断信息,审计方需要可复现的统计分析,监管机构可能需要合规性制品,受影响用户则需要易于理解的理由以及可申诉(contestability)路径。证据包可以包含公平性审计、隐私核算检查、鲁棒性与分布偏移测试、解释保真度检查,以及与实质性变化绑定的重新验证触发条件。
如此严格的验证其工程成本相当可观。一个涵盖公平性审计、对抗鲁棒性测试与可解释性验证的综合体系,会实质性地延长模型评估阶段。这项投入的价值体现在成本转移的位置:在部署前验证中捕获的问题可以在发布前修复,而同样问题在生产环境中暴露时,修复成本要高几个数量级,因为已部署的公平性或安全缺陷必须被检出、在整个集群中回滚,并向用户和监管机构作出解释,而不是在笔记本中直接修复。因此,验证并非一次性的关口,而是一个持续的过程。通过初始验证的模型可能随着数据分布漂移而进入不合规状态,这需要在部署流水线中设置自动重新验证触发条件(规模化机器学习运维)。
表 4 按风险类别汇总了证据包。该表并非一份独立的检查清单;它是一种在部署前将残余风险显式化的方式。
| 风险类别 | 证据制品 | 运行期负责人 |
|---|---|---|
| 公平性 | 分组合指标、阈值、置信区间 | 产品负责人与模型风险审查员 |
| 隐私 | 隐私预算、删除证据、留存与访问日志 | 数据治理与隐私工程团队 |
| 鲁棒性 | 漂移测试、污染测试、金丝雀、红队探测 | 机器学习平台与事件响应团队 |
| 解释 | 保真度测试、稳定性检查、补救文档 | 模型团队与面向用户的运营方 |
| 治理 | 批准记录、残余风险负责人、重新验证触发条件 | 审查委员会或可问责的发布授权方 |
Explanation 可以表现为一种可见且计算成本较高的验证证据形式。公平性指标刻画了在选定定义下的聚合差异,而局部解释方法则刻画针对某个特定输出的影响、敏感性或对比性替代方案。两者都不提供一般性保证,归因也无法验证某项决策为何是正当的。结合行为测试、来源(provenance)、文档和可申诉性,这些制品有助于运营方调查决策是否依赖了不适当的信号,并有助于受影响用户提出申诉。
可解释性与可解释性
使用传统基于规则系统的贷款审批员可以识别出导致拒绝的规则:“债务收入比超过 40%。”然而,神经网络通过许多相互作用的运算产生分数,没有任何单条规则能够提供决策理由。可解释性与可解释性为模型行为提供有界的证据,例如特征影响、敏感性、代表性示例或反事实变化。这类证据可以支持调查与沟通,但只有当机构将其与有效的决策策略相连接时,它才构成正当理由;只有当用户能够采取系统会予以采纳的可行行动时,它才构成补救(recourse)。
解释证据在系统验证、错误分析、事件调查、用户沟通以及部分合规流程中发挥作用。在高利害领域(如医疗、金融服务和自主决策系统),解释方法可以生成关于虚假相关性的假设,而工程师必须独立加以验证。例如,显著性分析或敏感性分析可能表明诊断模型响应的是图像伪影而非医学特征;此时必须通过受控评估来确定这种依赖是否具有因果性且在运行上具有重要意义。对于符合 GDPR 式访问与通知规定的合格自动化决策,系统可能需要提供有关所涉逻辑的有意义信息,这进一步强化了对系统性解释、文档化和可申诉性支持的需求。
War Story 1.1: Apple Card:对争议决策的系统性重构(2019)
背景:2019 年,当客户报告称自己获得的信用额度比配偶高出多达 10\(\times\)(尽管双方共同报税且信用评分相近)时,Apple 与高盛面临了激烈的公众审视 (New York State Department of Financial Services 2021年)。
证据边界:公开记录涵盖了投诉、随后的调查以及监管机构的认定,但并未披露授信流水线的延迟目标、内部解释架构,以及后续平台变更。因此,下文系统重构属于明确的还原,而非对 Apple 或高盛实现细节的陈述。
重构出的机制:一项低延迟授信服务仅返回额度与通用的不利行动理由,这使得支持人员无法检查决策快照、区分数据错误与政策效应,也无法将争议结果路由给审查员。所缺失的接口比特征归因更为广泛:它还包括版本化的输入来源、策略与模型版本、与决策流程相称的理由、申诉状态,以及纠正错误的权限。
观察到的影响:纽约州金融服务部在其调查中发现,未违反公平放贷法;但投诉仍然暴露了信任与可申诉性方面的失败:客户与一线人员缺乏令人满意的说明,无法了解为何表面上不一致的结果能够得到审查 (New York State Department of Financial Services 2021年)。
系统启示:高利害决策系统需要的是可申诉性接口,而不仅仅是归因 API。一个可辩护的架构能够保留审计所需的决策时点证据,在不声称归因即因果的前提下生成适当的理由,将申诉路由给经授权的人类,记录补救情况,并在其延迟与留存约束下测试完整工作流。
New York State Department of Financial Services. 2021年. Report on Apple Card Investigation. New York State Department of Financial Services.
26 积分梯度: 一种归因方法,它沿从基线输入到实际输入的路径积分梯度。与朴素梯度不同,它满足两个公理(敏感性与实现不变性),从而保证归因在特征重要时会发生变化,并且在功能等价的模型之间保持一致 (Sundararajan 等 2017年)。其成本高于单次原始梯度解释,因为该方法会在基线到输入路径上的多个点评估模型,通常为 50–300 个离散步骤,因此它更适合有界的解释预算,而非每条内联预测。
Sundararajan, Mukund, Ankur Taly, 和 Qiqi Yan. 2017年. 《Axiomatic Attribution for Deep Networks》. International Conference on Machine Learning (ICML), Proceedings of Machine Learning Research, 卷 70: 3319~28.
27 GradCAM(梯度加权类激活映射): Selvaraju 等 (2017年) 通过利用流入最终卷积层的梯度来生成空间重要性图,从而将类激活映射推广到任意卷积神经网络(CNN)架构。由于它复用梯度计算,GradCAM 可能比扰动密集型解释方法便宜得多;但它是否适用于实时医学影像或自动驾驶车辆流水线,取决于模型、硬件、批大小以及解释频率预算。
Selvaraju, R. R., M. Cogswell, A. Das, R. Vedantam, D. Parikh, 和 D. Batra. 2017年. 《Grad-CAM: Visual Explanations From Deep Networks via Gradient-Based Localization》. 2017 IEEE International Conference on Computer Vision (ICCV), 618~26. https://doi.org/10.1109/iccv.2017.74.
解释方法可根据其运行时机及其与模型结构的关系,大致分为几类。事后解释方法 在训练之后应用,但它们并不必然是黑盒方法。模型无关的方法(如 LIME (Ribeiro 等 2016年) 与 KernelSHAP)可以通过模型查询运行,而输入梯度、积分梯度26 (Sundararajan 等 2017年) 和 GradCAM27 (Selvaraju 等 2017年) 则需要可微分模型以访问梯度或内部激活。其他 SHAP 实现 (Lundberg 和 Lee 2017年) 则可能利用模型结构。Sundararajan 及其同事通过识别两个基本公理——敏感性(Sensitivity)与实现不变性(Implementation Invariance)——提出了积分梯度,并证明归因方法应当满足这两个公理,同时表明大多数既有方法都违反了这些性质。
事后解释方法在图像和表格域中被广泛使用,其中解释可以渲染为显著性图或特征排名。为说明 SHAP 归因在实践中如何运作,考虑一个基于三个特征训练、用于预测贷款审批 (\(\text{approve}=1\), \(\text{deny}=0\)) 的随机森林模型:income、debt_ratio 和 credit_score。对于一位被拒的特定申请人,其收入为 $45,000, debt ratio of 0.55 (55 percent of income goes to debt), and credit score of 620, the model predicts denial with probability 0.92. SHAP values, based on Shapley values from cooperative game theory, measure each feature’s contribution to moving the prediction from a baseline (average prediction across all training data, \(\Pr(\text{approve}) = 0.50\)) 的个体预测。
SHAP 框架28 通过在所有可能的特征子集上评估模型来计算每个特征对预测的贡献。从基线预测 0.50 出发,加入收入(45K,略低于平均水平)会使批准概率下降 0.05。
28 Shapley 值: 源自合作博弈论,Shapley 值依据所有可能排序下的边际贡献,在参与者之间公平地分配收益。在机器学习可解释性中,特征是“参与者”,预测是“收益”。数学保证(效率性、对称性、空参与者)使 SHAP 成为一个广泛使用的归因框架,具有清晰的公理化吸引力;但精确子集枚举随 \(2^n\) 个 \(n\) 特征而增长,这正是生产系统通常依赖模型特定算法、采样近似、缓存或异步解释路径 (Lundberg 和 Lee 2017年) 的原因。
Lundberg, Scott M., 和 Su-In Lee. 2017年. 《A Unified Approach to Interpreting Model Predictions》. Advances in Neural Information Processing Systems (NeurIPS) 30: 4765~74.
加入 debt_ratio(0.55,高)会使模型批准概率相对 SHAP 背景分布再下降 0.25。加入 credit_score(620)使其再下降 0.12。累加核算得到 \(0.50 - 0.05 - 0.25 - 0.12 = 0.08\),对应 \(\Pr(\text{deny}) = 0.92\)。在此归因设定下,债务比率对输出的赋权贡献最大,其次是信用评分和收入。这一排序只是关于所选背景分布下模型敏感性的假设,而非证据表明债务比率导致了该决策,或将其降至 40% 以下就会翻转输出。一项补救主张需要另行验证的反事实,并须尊重特征依赖、不可变属性、用户可采取的行动,以及用户再次申请时将适用的决策策略。
然而,这种严谨性伴随着可观的计算成本。这个 3 特征示例需要评估 \(2^3 = 8\) 个特征子集。对于具有 20 个特征的模型,精确枚举需要 \(2^{20} \approx 1\) 百万个子集评估。基于树的 SHAP 实现利用模型结构将其降至多项式时间,但深度学习模型通常需要使用近似算法(KernelSHAP、DeepSHAP)进行基于采样的估计。虽然 SHAP 提供了理论基础充分、具有可加性的特征归因并满足理想的性质(局部准确性、缺失性、一致性),但这些成本使得 SHAP 在没有近似、缓存或异步服务策略的情况下,难以用于高吞吐系统的实时解释。
另一种事后解释方法涉及反事实解释,29 它估计模型输出在指定输入修改下的变化。这类方法对面向决策的应用(如信贷或招聘系统)具有相关性,但数学意义上的输出翻转并不自动等同于补救。一个有用的反事实必须区分可变特征与不可变特征,保留领域约束与特征依赖,识别出处于用户控制范围内的行动,并在机构未来的决策策略下仍然有效 (Wachter 等 2017年)。因此,反事实生成与验证除了受约束优化之外,还需要领域模型、策略版本化以及运营承诺。
29 反事实解释: 由 Wachter 等 (2017年) 为机器学习形式化,反事实回答的是:在指定的输入变化下,模型输出会如何不同,而不是解释决策为何发生。只有当该变化可行、处于个人控制范围内、符合领域约束,并且被实际执行的决策策略所遵循时,反事实才支持补救。生成候选方案需要带约束的优化;验证补救还额外需要策略归属、稳定性测试,以及对使承诺行动失效的变化进行监控。
Wachter, Sandra, Brent Mittelstadt, 和 Chris Russell. 2017年. 《Counterfactual Explanations Without Opening the Black Box: Automated Decisions and the GDPR》. SSRN Electronic Journal 31: 841. https://doi.org/10.2139/ssrn.3063289.
Kim, B., M. Wattenberg, J. Gilmer, C. Cai, J. Wexler, F. Viegas, 和 R. Sayres. 2018年. 《Interpretability Beyond Feature Attribution: Quantitative Testing with Concept Activation Vectors (TCAV)》. Proceedings of the 35th International Conference on Machine Learning (ICML) 80: 2668~77.
第三类技术依赖基于概念的解释,试图将学到的模型特征与人类可解释的概念对齐。例如,使用概念激活向量进行测试,将用户定义的概念表示为概念激活向量,并检验模型的预测对其内部表示中这些概念的敏感程度(Kim 等 2018年)。这些方法在领域专家期望以熟悉的语义术语获得解释的领域中尤其有用。然而,它们需要带有概念标注的训练数据,或需要概念检测的辅助模型,从而引入额外的基础设施依赖。
事后方法虽然灵活且适用范围广,但也存在局限。由于它们是在事后近似推理过程,可能产生看似合理却具有误导性的理由。其有效性取决于模型的平滑性、输入结构以及解释技术的保真度。这些方法通常最适用于探索性分析、调试或面向用户的摘要,而非内部逻辑的权威说明。
相比之下,固有可解释模型 在设计上就是透明的。例如决策树、规则列表、带单调性约束的线性模型,以及 k 近邻分类器。这些模型直接暴露其推理结构,使利益相关方能够通过一组可解释的规则或比较来追溯预测。在再犯预测或医疗分诊等受监管或安全攸关的领域中,固有可解释模型可能更受青睐,即使需要牺牲部分准确性(Rudin 2019年)。然而,这些模型通常难以很好地扩展到高维或结构化数据,其简单性也可能在复杂任务中限制性能。
Rudin, C. 2019年. 《Stop explaining black box machine learning models for high stakes decisions and use interpretable models instead》. Nature Machine Intelligence 1 (5): 206~15. https://doi.org/10.1038/s42256-019-0048-x.
模型可解释性光谱 沿可解释性光谱展示了不同模型类型的相对可解释性:决策树和线性回归在设计上提供透明推理,而更复杂的架构(如神经网络和卷积模型)则需要借助外部技术来解释其行为。这一区别是选择适合特定应用的模型的核心,尤其是在监管审查或利益相关方信任至关重要的场景中。
:::
:::
混合方法旨在结合深度模型的表示能力与可解释组件的透明性。例如,概念瓶颈模型(Koh 等 2020年) 首先预测中间的可解释变量,然后使用简单分类器产生最终预测。ProtoPNet 模型(Chen 等 2019年) 通过将示例与学到的原型进行比较来进行分类,为用户理解预测提供视觉类比。这些混合方法在需要部分透明性的领域中具有吸引力,但也引入了新的系统设计考量,例如需要存储和索引学到的原型,并在推理时将其呈现出来。
Koh, Pang Wei, Thao Nguyen, Yew Siang Tang, Stephen Mussmann, Emma Pierson, Been Kim, 和 Percy Liang. 2020年. 《Concept Bottleneck Models》. Proceedings of the 37th International Conference on Machine Learning, ICML 2020, 13-18 July 2020, Virtual Event, Proceedings of Machine Learning Research, 卷 119: 5338~48.
Chen, Chaofan, Oscar Li, Daniel Tao, Alina Barnett, Cynthia Rudin, 和 Jonathan Su. 2019年. 《This Looks Like That: Deep Learning for Interpretable Image Recognition》. 收入 Advances in Neural Information Processing Systems 32: Annual Conference on Neural Information Processing Systems 2019, NeurIPS 2019, December 8-14, 2019, Vancouver, BC, Canada, 编辑 Hanna M. Wallach, Hugo Larochelle, Alina Beygelzimer, Florence d’Alché-Buc, Emily B. Fox, 和 Roman Garnett. Curran Associates.
Olah, C., N. Cammarata, L. Schubert, G. Goh, M. Petrov, 和 S. Carter. 2020年. 《Zoom In: An Introduction to Circuits》. Distill 5 (3): e00024~001. https://doi.org/10.23915/distill.00024.001.
Geiger, Atticus, Hanson Lu, Thomas Icard, 和 Christopher Potts. 2021年. 《Causal Abstractions of Neural Networks》. 收入 Advances in Neural Information Processing Systems 34: Annual Conference on Neural Information Processing Systems 2021, NeurIPS 2021, December 6-14, 2021, virtual, 编辑 Marc’Aurelio Ranzato, Alina Beygelzimer, Yann N. Dauphin, Percy Liang, 和 Jennifer Wortman Vaughan. Curran Associates.
Olah 等 (2020年) 与 Geiger 等 (2021年) 之类的工作将机制可解释性 应用于逆向工程神经网络的内部运算。这一研究方向受程序分析和神经科学启发,试图将神经元、层或激活模式映射到特定的计算函数。许多例子聚焦于大型基础模型,其中传统可解释性工具已显不足,但系统层面的要求更为广泛:必须通过仪表化、存储和因果测试使内部机制可审计。
从系统视角来看,可解释性引入了若干架构依赖。解释必须在系统约束内生成、存储、呈现和评估。所需的基础设施可能包括解释 API、用于存储归因图的内存、可视化库,以及用于捕获中间模型行为的日志机制。模型通常需要以钩子进行仪表化,或配置为支持重复评估,尤其是对于需要采样、扰动或反向传播的解释方法。
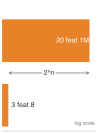
精确 SHAP 成本随特征数量急剧上升。
这些需求与部署约束直接相互作用,并带来必须纳入系统设计的性能成本。SHAP 和 LIME 可能需要重复的模型评估、扰动采样、代理拟合或子集枚举,而反事实方法则需要带约束的优化(Lundberg 和 Lee 2017年; Ribeiro 等 2016年; Wachter 等 2017年)。在生产部署中,这些成本转化为具体的架构选择:解释可能需要异步工作器、采样的解释率、缓存,或出于可解释性考虑而部分选用的独立模型。
对于资源受限的环境,基于梯度的归因方法通过复用训练阶段的反向传播基础设施,提供了更高效的替代方案。然而,这些方法在复杂模型上的可靠性较低,并可能在模型更新后产生不一致的解释。边缘部署通常通过预计算的规则近似或简化的决策边界来实现可解释性,以牺牲解释保真度来换取可行的延迟表现。
存储需求也会随着解释需求显著增长。为表格数据存储 SHAP 值,每个特征每次预测大约需要 4–8 bytes,因此月度存储量为 30 million 次预测乘以特征数量,再乘以 4–8 bytes,对应的系统每天记录 1 million 次预测。图像的梯度归因图每份解释可能需要 1–10 MB,具体取决于分辨率;若以同样的每天 1 million 的速率记录每张图像的解释,则每月大约需要 30–300 TB,除非对解释进行采样、压缩,或缩短保留时间窗口。这些数据量要求审慎的数据生命周期管理和保留策略。
可解释性贯穿机器学习的整个生命周期。在开发阶段,可解释性工具用于数据集审计、概念验证和早期调试。在推理阶段,它们支持问责、决策验证和用户沟通。部署后,解释可以被记录、在审计中呈现,或在错误调查期间被查询。系统设计必须支持上述各个阶段,确保解释工具能够集成到训练框架、模型服务基础设施和面向用户的应用中。
压缩与优化技术也会影响可解释性。TinyML 或移动端场景中常用的剪枝、量化和架构简化可能扭曲内部表示或阻断梯度流,从而降低基于归因的解释的可靠性。在这种情况下,必须在优化后验证可解释性,以确保其仍然有意义且值得信赖。如果解释质量很重要,就必须将这些变换视为设计约束空间的一部分。
因此,可解释性的落地方式与本章的其他属性相同:它是需要纳入预算的服务路径基础设施,而不是模型能够正常工作之后再追加的功能。面向可解释性的设计需要审慎决定谁需要解释、什么样的解释有意义,以及如何在系统的延迟、计算和接口预算约束下提供这些解释。随着机器学习融入重要工作流程,解释能力成为安全、可信且可问责系统的一项核心要求。
可解释性的社会技术挑战集中于技术解释与人类理解之间的差距。虽然算法可以生成特征归因和梯度图,但利益相关方往往需要与其心智模型、领域知识和决策过程相契合的解释。审阅 AI 生成的诊断结果的放射科医生,需要的是涉及医学概念和视觉模式的解释,而非抽象的神经网络激活。这种转化挑战要求技术团队与领域专家持续协作,开发既在技术上准确、又具有实际意义的解释形式。解释可能以意想不到的方式影响人类决策,从而对解释信息的呈现和解读方式提出新的责任要求。由于解释是证据,而非控制操作,因此必须将其输入监控系统,以检测部署后负责任行为是否发生变化。
模型性能监控
训练阶段的评估无论多么严格,都不能保证系统部署后的模型性能可靠。现实环境是动态的:输入分布会因季节性而发生偏移,用户行为会随系统输出而演变,情境中的预期也会随着政策或法规而改变。这些因素可能导致预测性能和系统可信度随时间下降。在训练或验证条件下表现良好的模型,在生产环境中仍可能做出不可靠或有害的决策。
此类漂移的影响不止于准确率本身。如果子群分布相对于训练集发生偏移,或者先前与结果相关的特征在新情境中变得不可靠,公平性保证就可能失效。可解释性需求也可能发生变化,例如新的利益相关方群体开始寻求解释,或监管机构提出新的透明度要求。因此,可信度并非训练阶段赋予的静态属性,而是由部署情境和运行反馈共同塑造的动态系统属性。
为确保系统长期保持负责任的行为,机器学习系统必须纳入持续监控、评估和纠正措施的机制。监控不仅要跟踪总体准确率,还需要呈现各相关子群的性能指标、检测输入分布的偏移、识别异常输出,并收集有意义的用户反馈。随后,必须将这些信号与预先定义的公平性、鲁棒性和透明度预期进行比较,并将其关联到可执行的系统响应,例如模型重新训练、重新校准或回滚。
实现有效监控依赖于稳健的基础设施。系统必须以结构化且安全的方式记录输入、输出和上下文元数据,并将其输入持续的可观测性流水线(图 8)。
这需要遥测管道,用于捕获模型版本、输入特征、预测置信度以及推理后反馈。这些日志支持漂移检测,并为公平性与鲁棒性的事后审计提供证据。监控系统还必须与告警、更新调度以及策略评审流程集成,以支持及时且可追溯的干预。
监控同样支持以反馈驱动的改进。例如,反复出现的不一致意见、更正请求或运维人员覆盖操作,都可能指示出问题行为。该反馈必须经过聚合、验证,并转化为对训练数据集、数据标注流程或模型架构的更新。然而,此类反馈回路也伴随着风险:带有偏见的用户反馈可能引入新的不公平,而过度的日志记录则可能损害隐私。设计这些回路需要在用户体验设计、系统安全性和伦理治理之间进行谨慎协调。

负责任 AI 监控成为其自身的生产数据系统。
在全量生产集群的规模下,负责任 AI 监控成为一项重大的数据工程挑战。一个每天处理约 864 million 次推理、以每秒 10,000 次查询、覆盖 50 个不同人口统计子群的服务平台,必须持续跟踪至少 150 个指标(例如,针对 50 个群体的假阳性率、真阳性率和校准误差)。即使采样率为 1 percent,每天也会产生 8.64 million 条监控事件。以每条记录约 200 字节的元数据(预测输入、置信度分数、真实标签和敏感属性)存储,每天大约需要 1.7 GB 的存储空间,而完整的审计日志则可能消耗更多。这一规模引入了“元监控”问题:监控基础设施本身成为一个复杂的分布式系统,必须具备可靠性、安全性和成本效益。在 150 个活跃指标下,若每个指标的误报概率为 5 percent,则在场景的独立性假设下,每个评估区间大约会产生 7.5 次误报。生产阈值必须反映子群分母、延迟标签、重复测试、置信区间、最小可检测效应以及对多重比较的校正。阈值越界会开启一次调查;它本身并不能证明存在歧视,也不足以支持自动重训。
监控机制因部署架构而异。在云端系统中,丰富的日志和计算能力支持实时遥测、定时公平性审计,以及将新数据持续集成到重训管道中。这些环境支持动态重构和集中式策略执行。然而,遥测的体量本身可能带来成本、隐私风险和合规方面的挑战。
在移动系统中,网络连接是间歇性的,数据存储有限。监控必须轻量,并能容忍同步延迟。本地推理系统可能异步采集性能数据,并以聚合形式传输到后端系统。隐私约束往往更为严格,尤其是在个人数据必须保留在设备端时。这些系统需要谨慎的数据最小化和本地聚合技术,以在保持可观测性的同时保护隐私。
边缘部署(例如自动驾驶汽车、智能工厂或实时控制系统)要求低延迟响应,并在几乎没有外部监督的情况下运行。这些系统中的监控必须嵌入运行时,包含对传感器完整性、预测置信度和行为偏差的内部检查。这些检查通常需要低开销的不确定性估计、异常检测或一致性验证实现。系统设计者必须预判故障条件,并确保异常行为会触发安全回退流程或人工干预。
TinyML 系统运行在深度嵌入式硬件上,没有网络连接、持久化存储或动态更新路径,构成了最受限的监控场景。在这些环境中,监控必须在部署前设计与编译进系统。常见策略包括输入范围检查、内置冗余、静态故障切换逻辑,或保守的验证阈值。部署后,这些模型独立运行,任何部署后的故障都可能需要通过更换物理设备或固件级重置来处理。
核心挑战是普适的:已部署的机器学习系统不仅需要在初始阶段表现良好,还必须在环境变化后持续负责任地运行。监控提供了连接系统性能与伦理目标及问责机制的可观测性层。没有监控,公平性与鲁棒性就不可见;没有反馈,偏差就无法得到纠正。因此,监控是让机器学习系统随时间保持自适应、可审计并与预期用途保持一致的运行基础。
监控部分完成了技术闭环:偏见检测、差分隐私、对抗训练和可解释性为负责任 AI 的实施提供了关键能力,同时也揭示了一个根本性局限。仅凭技术正确性无法保证有益结果。以下三个具体例子说明了这一挑战:
一个公平性审计系统检测出贷款审批模型中的种族偏见,但组织缺乏解释结果或实施纠正的流程。技术能力存在,但组织惯性阻碍了整改。差分隐私在数据保护方面保留了形式化的数学保证,但用户并不理解这些保护,仍会不恰当地分享敏感信息。隐私方法按设计工作,但行为语境削弱了其有效性。可解释性系统生成了技术上准确的特征重要性分数,但由于界面设计和数字素养障碍,受影响的个体无法访问或理解这些解释。
这些例子表明,负责任 AI 的实施取决于技术能力与社会技术语境、组织激励、人类行为、利益相关方价值以及机构治理结构之间的对齐。维持这种对齐需要能够提供运行可观测性的监控机制。然而,生成式 AI 的出现已经改变了必须监控的故障性质。
负责任时代的责任
生成式 AI 并未取代核心的公平性、隐私和可解释性关切;它改变了控制面。运营者必须治理提示词、检索到的上下文、奖励模型和开放式输出,而不再只是审计标签或特征归因。
从判别式分类到生成式大语言模型(LLM)的转变,拓宽了责任方面的工程面。公平性仍然关注质量、拒绝、错误、代表性以及访问机会在不同人群和群体之间的分布;开放式输出使得这些量更难定义和采样。对齐引入了另一个独立问题:在组合范围的提示词下,将随机输出和行为约束为与预期目标和策略保持一致。生产系统既需要公平性评估,也需要行为对齐,而不能把二者混为一谈。一种常见的对齐机制是 图 9 中的多阶段流程。
2022–2024 年前后,大型语言模型中常见的一种指令微调管道,将基于人类反馈的强化学习(RLHF)用作人类偏好与模型权重之间的社会技术桥梁。在人类偏好上训练奖励模型——在本场景中,成本为每条标签 $0.50 to $5.00 美元的 50,000 到 500,000 组成对比较——将采样的判断编译为一个可微目标函数。PPO 是策略优化阶段,它依据该奖励模型更新模型,同时约束策略相对监督基线的移动幅度。这一过程可能产生对齐开销:当优化转向偏好或安全目标时,某些能力指标可能退化,但其方向和幅度取决于模型、数据、目标以及评估套件,而非遵循某个普适百分比。对人工评分者的依赖引入了代表性缺口:如果标注投入仅反映一个狭窄的人口统计切片,所得模型可能编码该群体的偏好,而对其他人群的表现则不同。宪法式 AI 提供了一条替代的工程路径,用显式原则来指导 AI 对输出的反馈,从而改变而非消除“谁的价值被代表”以及“如何治理”这两个问题。
在检索增强生成架构(在大规模下运行推理)中,责任与核心模型解耦。一个 LLM 可能通过充分的 RLHF 实现完全对齐,但如果检索层呈现了被污染的上下文,它仍可能生成有毒或带有偏见的回复。如果检索索引不成比例地呈现带有偏见的历史文档,那么该模型——被条件化为忠实于其上下文——无论其内部安全训练如何,都会传播这种偏见。这需要一个独立的上下文过滤基础设施组件,在检索片段进入生成上下文窗口之前,先验证其是否有毒性和偏见。
在许多 LLM 服务栈中,系统提示词与检索过滤、策略分类器、遥测以及发布门控共同构成早期的配置控制。这些隐式指令(例如“你是一个乐于助人的助手。不要提供医疗建议。”)定义了系统的运行边界。在 10,000+ 种不同部署配置下,管理这些提示词已成为类似权重分发的分布式配置管理问题。对系统提示词的一次未版本化的改动,可能微妙地改变数百万次交互的伦理立场,使得提示词版本控制、对齐回归测试以及渐进式发布,其安全性重要性不亚于模型训练过程本身(规模化机器学习运维)。
总之,系统提示词与 RLHF 对齐共同构成了重要但脆弱的技术护栏。当这些护栏失效时——无论是通过刻意的越狱,还是通过绕过奖励模型的细微边界情况——现实便清晰呈现:AI 安全无法完全通过数学来解决。算法与使用它的人之间复杂的社会技术动态,需要同等程度的关注。
社会技术动态
一家医院部署了一个准确度极高的脓毒症预测模型,但死亡率并未改善。医生因告警疲劳而 overwhelmed, simply 忽略了模型的警告。一个数学上完美、完全公平、高度可解释的模型,一旦与人类心理、组织激励或职场运营现实不对齐,在生产环境中依然会严重失败。
前面各节的技术工具解决了定义明确的问题:检测偏见、保护隐私、生成解释。脓毒症案例标志着这套工具箱的极限。社会工程技术需要一种不同的推理方式:工程师不再优化目标函数,而是分析利益相关方之间的冲突;他们不再调参,而是在伦理权衡之间做出取舍;他们不再测量技术性能,而是评估社会影响。系统现在必须同时满足计算约束和人类价值,而无论怎样优化都无法化解二者之间的冲突。
已部署的系统会形成反馈回路,重塑其所建模的环境,引入人类与 AI 协作方面的风险——这些风险单靠人类或算法都无法应对——并暴露出任何优化都无法满足的利益相关方价值冲突。这些动态决定了负责任 AI 实施在实践中是成功还是失败。
系统反馈回路
社会技术反馈不变量
社会技术反馈不变量(原则 21)刻画了这一动态:已部署的模型塑造其运行所处的环境,使得未来的数据 \(p_{t+1}(X)\) 成为模型过去决策 \(f_t(X)\) 的函数。此处,\(p_t(X)\) 表示系统在时间 \(t\) 所观测到的输入分布,而 \(f_t(X)\) 表示作用于这些输入的已部署模型或决策策略。系统需要 闭环治理,而可靠性要求对反馈回路进行建模,而不仅是前向推理。
机器学习系统不仅观察和建模世界,也塑造着世界。一旦部署,其预测与决策往往会影响其本应分析的环境。这种反馈会改变未来的数据分布、改变用户行为,并影响机构实践,从而在模型输出与系统输入之间形成递归回路(图 4)。随着时间的推移,此类动态可能放大偏见、固化差异,或无意地改变模型被设计时所服务的目标。
一个被广泛记录的此类现象例子是预测性警务。当基于历史逮捕数据训练的模型预测某个社区犯罪率较高时,执法部门可能会在该区域增加巡逻部署。这种增强的存在感会导致更多被记录的案件,而这些案件随后又被用作未来模型训练的输入,进一步强化了模型的原始预测。即使模型在最初并未被明确地带有偏见,将其纳入反馈回路后,也会形成一种不成比例地影响原本过度警务化社区、具有自我实现性质的模式。
推荐系统在数字环境中表现出类似的动态。一个以参与度为首要目标的推荐内容模型,可能会逐渐缩小用户所接触内容的范围,进而形成强化既有偏好或加剧观点极化的反馈回路。这些效应使用常规的性能指标难以察觉,因为系统即使偏离了更广泛的社会或认识论目标,仍在持续优化其训练目标。
从系统视角来看,反馈回路构成了负责任 AI 的核心挑战。它们破坏了数据独立同分布的假设,并使得公平性、鲁棒性和泛化能力的评估更加复杂。依赖静态测试集的标准验证方法,可能无法捕捉模型对数据生成过程产生的不断演变的影响。一旦此类回路形成,旨在提升公平性或准确性的干预措施,除非处理了底层的数据动态,否则效果十分有限。
在设计应对反馈回路环境下的责任性时,需要对机器学习系统采取全生命周期视角。这不仅包括随时间监测模型性能,还包括理解系统的输出如何影响环境、这些变化如何被新数据所捕捉,以及再训练实践是缓解还是加剧了这些效应。
在基于云的系统环境中,这些更新可能频繁发生且规模庞大,并具备广泛的遥测数据可用于检测行为漂移。相比之下,边缘与嵌入式部署往往处于离线状态或可观测性有限。一个根据用户交互调整恒温器行为的智能家居系统,可能会以改变家庭环境的方式强化能耗模式或舒适度偏好,进而影响模型未来的输入。由于缺乏网络连接或集中式监管,这些回路可能不会被识别,尽管它们对用户行为和系统性能都有影响。运行期监控实践,包括漂移检测、性能跟踪和自动告警,对于在生产系统中检测和管控这些反馈动态至关重要。
系统必须具备检测分布漂移、识别行为塑造效应,以及支持能够与系统预期目标相一致的纠正性更新的机制。反馈回路本身并非 inherently 有害,但必须被识别和加以管理。若无人审视,它们会引入系统性风险;若得到审慎处理,则为学习系统在复杂、动态的环境中负责任地自适应提供了机会。
War Story 1.2: 算法评分失败(2020)
背景:2020 年 8 月,在 COVID-19 期间取消考试之后,英格兰资格监管机构(Ofqual)部署了一套统计标准化算法,为约 280,000 名 A 级学生评分Department for Education 和 Ofqual (2020年)。
机制:为防止数据集规模 \(D_{\text{vol}}\) 导致的全球性等级膨胀,该批次标准化算法将预测等级分布限制为与每所学校 3 年的历史分布相匹配。这一零和式优化矩阵迫使 39.1% 的教师提交等级被下调,将历史队列的方差置于个体特征信号之上。
影响:针对系统性不公的公众抗议和学生抗议,迫使英国政府数日后放弃该算法的输出,改回未调整的统评等级。
修正:英国政府废弃了标准化算法,并建立了申诉框架,允许学生获得统评等级与模拟考试成绩之间较高的那个等级。
系统启示:在数据集规模 \(D_{\text{vol}}\) 上优化全局聚合指标,而不同步施加个体公平性约束,会产生一条在数学上有界、但在社会与运行层面灾难性的优化过程。
Department for Education, 和 Ofqual. 2020年. GCSE and A Level Students to Receive Centre Assessment Grades. GOV.UK News Story.
人机协作
人类操作者将反馈回路风险转化为共享控制问题。机器学习系统往往并非作为独立智能体部署,而是作为涉及人类决策者的更大工作流中的组成部分。在许多领域,如医疗、金融和交通,模型充当决策支持工具,提供由人类操作者复核并采取行动的预测、风险评分或建议。这种协作式配置引发了关于人类与机器之间如何分担责任、如何校准信任,以及如何在实践中落实监督机制的问题。
人机协作既带来机遇,也带来风险。当设计得当,系统可以增强人类判断、降低认知负担,并提升决策的一致性。然而,当设计不当,它们可能导致 自动化偏差,[^fn-automation-bias-complacency] 即用户即使在存在明显错误的情况下,也过度依赖模型输出。
[^fn-automation-bias-complacency]:自动化偏差:该现象最早于 1990 年代在航空领域得到研究,指的是人类即使面对明显错误的自动化系统输出,也倾向于服从的悖论——且系统准确率越高,该效应越强。当模型准确率达到 70–80% 时,若输出未附带不确定性指示,操作者会以高比例接受错误输出。对于机器学习服务系统而言,这意味着模型准确率的提高可能反而降低系统层面的安全性,因为它抑制了人类监督,因此需要刻意引入界面摩擦(不确定性可视化、强制说明理由),以增加延迟但保留人类纠错通道。
相反,过度的不信任会导致 算法厌恶,即用户因缺乏透明度或感知可信度不足而忽视有用的模型预测。协作系统的有效性不仅取决于模型的性能,还取决于系统如何传达不确定性、提供解释,以及允许人类覆盖或纠正。
自动化偏差常通过机构结构中的责任不对等得到强化。在刑事司法或医疗等高后果领域,人类决策者会因其与算法结论是否一致而面临不同的后果。考虑两个场景:在场景 A 中,法官推翻“高风险”算法评分并释放了一名后来再次犯罪的被告;法官因“无视科学”而面临公众审视和潜在的职业后果。在场景 B 中,法官遵循“高风险”评分并错误地拘押了被告;责任则被分散到算法身上(“系统就是这么说的”)。
这种不对称性为 机构性顺从 创造了强烈压力,即人类监督沦为算法决策的“橡皮图章”,以避免个人承担责任。负责任 AI 的设计必须明确对此进行对抗,保护行使判断力的操作者,并要求无论同意还是不同意算法结论,都必须提供理由。
监督机制必须根据部署场景加以定制。在高后果领域,如医疗分诊或自动驾驶,人类可能需要对自动化决策进行实时监督。这种配置对人类操作者提出了认知和时间上的要求,并假定在需要时干预能够迅速且可靠地发生。然而,在实践中,持续的人类监督往往不切实际或效果不佳,尤其是在操作者必须同时监控多个系统,或缺乏清晰干预标准的情况下。
从系统设计视角来看,支持有效的监督需要多于仅提供原始模型输出。界面必须被构建为在正确的时间、以正确的格式和适当的上下文呈现相关信息。置信度分数、不确定性估计、解释和变更告警都可以在实现人类监督中发挥作用。工作流必须界定何时以及如何实施干预、谁有权覆盖模型输出,以及这些覆盖如何被记录、审计并纳入未来的系统更新。
考虑一个在医院急诊科使用机器学习模型对患者进行优先级排序的分诊系统。模型为每位入院患者生成风险评分,并与建议的分诊类别一并呈现。原则上,人类护士负责确认或推翻该建议。然而,如果模型的输出缺乏充分的理由说明,例如对贡献性特征的说明或对不确定性背景的说明,护士即使在边界情况下也可能服从模型。随着时间的推移,模型的输出可能成为事实上的分诊决策,尤其是在时间压力下。如果发生分布偏移(例如由于新疾病或患者人口结构变化),护士可能既缺乏情境意识,也缺乏界面支持来察觉模型表现不佳。在这种情况下,看似存在人类监督,实则掩盖了一个责任已事实上转移至模型、而缺乏明确问责或救济途径的系统。
在这类系统中,人类监督不仅关乎政策声明,更是基础设施设计的一个函数:预测如何呈现、保留哪些信息、干预如何实施,以及反馈回路如何将人类决策连接到系统更新。若这些组成部分之间缺乏整合,监督就会变得碎片化,责任可能以不可见的方式从人类转移到机器。
Napkin Math 1.8: 自动化偏差悖论
考虑一个部署了 AI 肿瘤检测助手的放射科。
- 人类敏感度:\(S_{\text{human}} =\) 92 percent
- AI 敏感度:\(S_{\text{AI}} =\) 95 percent
人们或许会认为,组合系统的性能会超过 95 percent。然而,自动化偏差的研究表明,人类接受错误 AI 建议的比例为 60–80 percent。如果 AI 出错(概率 \(1 - S_{\text{AI}} = 0.05\))而人类盲目接受(\(\alpha = 0.7\)),仅被接受的 AI 错误就会造成 \(0.05 \times 0.7 = 0.035\) 的失败概率。在这个简化的上界情形中,每个未被接受的 AI 错误都会被纠正,敏感度为 96.5 percent;一旦纳入人类覆盖错误、假阳性、疲劳和界面延迟,真实工作流的表现只会更差。
随着 AI 可靠性提高,人类的警惕性反而下降——这一现象被称为可靠性悖论。
- 在 90 percent 的 AI 准确率下,人类覆盖率可能为 \(R_{\text{override}} =\) 15 percent。
- 在 99 percent 的 AI 准确率下,\(R_{\text{override}}\) 降至 \(\approx\) 2 percent。
剩余的 1% 错误几乎从未被捕捉,因为人类已将信任校准到“完美”的机器上。这形成了 信任校准缺口:系统看起来越安全,其罕见失败的危险性就越大。 负责任的设计需要引入摩擦——强制人类说明接受的理由——以人为降低 \(\alpha\),从而保持人类处于回路之中。

更高的 AI 准确率反而可能降低人类的警惕性。
决策支持与自动化之间的界限往往是流动的。最初设计为辅助人类决策者的系统,可能随着信任度提高或组织激励变化而逐渐获得更大的自主权。这种转变可以在没有明确政策变更的情况下发生,从而形成缺乏相应问责结构的事实性自动化。因此,负责任的设计必须预判使用方式随时间的变化,并确保即使对自动化的依赖不断增加,适当的检查机制依然存在。
人机协作需要对模型能力、界面设计、运行期政策以及机构监督进行审慎整合。协作并非简单地在回路中加入“人类”,而是一项横跨技术、组织和伦理维度的系统工程挑战。设计监督机制意味着嵌入允许干预的机制、支持经过审慎校准的信任,并支持人类操作者与机器学习系统之间的共享责任。
规范性多元论与价值冲突
人机协作暴露了一个更深层的系统性约束:不同利益相关方往往持有相互冲突的价值与优先级。现实世界中的机器学习部署,迫使人们直面没有任何算法能够解决的价值张力。技术卓越是可信 AI 的必要条件,但并非充分条件,因为利益相关方对公平、隐私和问责的正当理解各不相同,无法通过更好的算法加以调和。
负责任的学习机不可被简化为单一目标的优化。在现实场景中,机器学习系统被部署到由多样、且往往相互冲突的人类价值所塑造的环境中。高后果部署使这些张力具体化。
Example 1.2: 实践中的价值冲突
场景:青少年心理健康危机检测流程必须在实时推理与数据保留两条路径上平衡相互竞争的各方目标。
诊断:通过激进告警派发优化临床有效性,与患者自主权和隐私协议相冲突。限制数据保留以保护用户隐私,会限制离线再训练和解释审计;而将高置信度告警路由给人类咨询师,则会提高每查询的服务成本与延迟(\(L_{\text{lat}}\))。本地差分隐私限制了输入暴露范围,而严格的服务水平协议(SLA)预算(\(L_{\text{lat}} < 200\text{ ms}\))则限制了人机协同复核队列的规模。
系统启示:负责任 AI 的取舍是严格的架构性要求,而非事后补充的政策说明。部署流程必须在优化开始之前,将各方选择编码为明确的延迟(\(L_{\text{lat}}\))与隐私预算。
对某一利益相关方而言构成公平结果的决定,可能被另一方视为不公平。同样,优先准确性或效率的决定,可能与透明度、个体自主权或伤害减少等目标相冲突。这些张力并非偶然,而是结构性的。它们反映了机器学习系统所嵌入的社会具有多元性,也反映了其部署所处的制度环境。
公平性是价值冲突尤为突出的场域。公平性可以以多种、且常常互不相容的方式加以形式化。满足人口统计公平(demographic parity)的模型可能违反机会均等(equalized odds);优先实现个体公平(individual fairness)的模型可能损害群体层面的公平性。在这些定义之间作出选择,并非纯粹的技术决策,而是一项规范性决策,它受到领域背景、历史上的歧视模式,以及受模型结果影响者的观点影响。在实践中,包括工程师、用户、审计者和监管机构在内的多方利益相关者,可能对哪些定义最为恰当、以及为何恰当持有相互冲突的看法。
价值冲突并不局限于公平性本身。冲突也出现在可解释性与预测性能之间、隐私与个性化之间,或短期效用与长期后果之间。这些权衡因系统的部署架构不同而呈现不同面貌,从而揭示了价值冲突与机器学习系统的设计和运行之间有着多么深刻的联系。
考虑一个部署在移动设备上的语音助手。为了提升个性化,系统可能在本地学习用户偏好,而不将原始数据发送至云端。这一设计改善了隐私并降低了延迟,但也可能导致性能差异:使用模式属于代表性不足类别的用户可能获得准确度或响应性更低的预测。改善公平性的一种途径是采用基于群体统计的集中式更新,但这会引入新的隐私风险,并可能违背用户对本地数据处理的预期。在此,设计必须在这些有效但相互竞争的价值之间进行权衡:隐私、公平性与个性化。
在云端部署中,例如信用评分平台或推荐引擎,透明性与专有保护之间常常产生张力。最终用户或监管机构可能要求清晰说明作出某项决定的理由,尤其是在后果重大的情形下;但实际使用的模型可能依赖复杂的集成模型或专有训练数据。披露这些内部机制可能在商业上敏感,或技术上不可行。在这种情况下,系统必须协调机构问责与商业保密之间的相互竞争的压力。
在边缘系统中,例如家用安防摄像头或自动驾驶无人机,资源约束往往决定了模型的选型与更新频率。优先保证低延迟和能效,可能需要部署压缩或量化模型,而这些模型对分布偏移或对抗性扰动的鲁棒性较弱。更稳健的模型或许能提升安全性,但它们可能超出系统的内存预算,或违反功耗约束。在此,安全性、效率与可维护性必须在硬件施加的权衡之下取得平衡。效率技术与优化方法对于在资源受限环境中实现负责任的人工智能至关重要。
在 TinyML 平台上,由于模型被部署到不具备持久连接的微控制器上,权衡更为突出。系统可能针对固定数据集的静态性能进行优化,但在部署后却无法纳入新的公平性约束、基于更新后的输入重新训练,或生成解释。硬件约束从根本上塑造了在资源受限设备上哪些负责任的人工智能实践是可行的。价值冲突由此从模型所优化的内容,扩展到系统能够在部署后提供支持的内容。
反复出现的系统约束是规范性多元论,它并非一项抽象的哲学难题。诸如多目标优化、约束训练和公平性感知评估等技术方法,有助于揭示并形式化这些权衡,但它们并不能消除作出判断的需要。关于应当代表谁的价值、应当缓解哪些危害、以及如何平衡相互竞争的目标,无法通过算法作出决定。这些问题需要审议、利益相关者参与,以及超越模型本身的治理结构。
参与式与价值敏感的设计方法提供了可能的前进路径。这些方法并非将价值视为部署后需要优化的参数,而是力求在需求阶段即与利益相关者展开协商,明确界定伦理权衡,并追溯这些权衡如何在系统架构中得以体现。虽然没有任何设计流程能够同时满足所有价值,但那些对自身权衡保持透明、并开放修订的系统,更有可能在时间维度上维系信任与问责。
机器学习系统并非中立的工具。它们内嵌并践行着价值判断,无论这些判断是明确指定的,还是被隐含地假定。对负责任人工智能的承诺,要求我们承认这一事实,并构建能够反映和回应其运行语境中伦理与社会多元性的系统。
透明性与可争议性
价值冲突只有在利益相关者能够理解并质疑系统决策时,才具有可治理性。透明性使用户、开发者、审计者和监管机构能够了解系统如何运作、评估其局限,并识别危害来源。然而,仅靠透明性并不充分。在高利害领域,个人与机构不仅需要了解系统行为,还必须在必要时能够质疑、纠正或推翻系统决策。这种可争议性,即对系统决策进行质询与争议的能力,是问责的重要特征。
机器学习系统中的透明性通常聚焦于披露:揭示模型的训练方式、所依赖的数据、设计中嵌入的假设,以及影响其使用的已知局限。模型卡和数据集 datasheets 之类的文档工具通过以结构化、可复现的格式形式化系统元数据,从而支持这一目标。这些资源有助于改善治理、支持合规,并 informing 用户预期。然而,作为披露的透明性并不能保证实现有意义的控制。即使技术细节已经可得,用户仍可能缺乏机构层面的支持、可用的界面工具,或对一项对其不利的决策缺乏程序性途径来提出争议。
要从透明性走向可争议性,机器学习系统必须设计具备解释、救济与反馈机制:
- 解释:系统为其输出提供可被理解的理由,并根据接收者的需求与情境加以定制。
- 救济:个人可以改变自身处境并获得不同的结果。
- 反馈:用户可以报告错误、对结果提出异议,或表达关切;这些信号能够被纳入系统更新或监督流程。
在实践中,这些机制往往缺失,尤其是在大规模部署或嵌入低资源设备的系统中。例如,在移动贷款申请系统中,用户可能在不获任何解释的情况下收到拒绝结果,且没有机会补充信息或申诉该决定。界面层面的透明性缺失,即使其他位置存在文档,也会使系统实际上无法被质疑。同样,部署在临床场景中的预测模型可能生成用于指导治疗决策的风险评分,却未向医生呈现其背后的推理过程。若该模型对特定患者亚群表现不佳,而这一行为既不可观察、也不可争议,那么结果可能构成难以诊断或纠正的非故意性伤害。
从系统视角看,实现可争议性需要在技术与机构组件之间进行跨组件协同。模型必须暴露足够的信息以支持解释;界面必须以可用且及时的方式呈现这些信息;组织流程必须能够审查反馈、回应申诉并更新系统行为。日志与审计基础设施不仅要追踪模型输出,还要追踪用户干预与人工覆盖决定。在某些情况下,包括人在回路的人工覆盖和决策弃权阈值在内的技术保障措施,也可能通过确保模糊或高风险决策交由人类判断来服务于可争议性。
实现可争议性会带来具体的基础设施成本,且随系统吞吐量与复杂度增长。存储重建决策所需的元数据——输入特征、模型版本与决策阈值——需要持久化存储,其存储占用取决于特征维度、解释载荷与留存窗口。使用 Shapley 值或反事实方法按需生成解释,可能引入足够的延迟,以至于被争议的决策往往需要借助异步处理队列来维持服务 SLA。为满足高风险系统框架(如欧盟《人工智能法案》)下的记录保存与自动日志义务,必须将存储、溯源、留存控制与监督能力作为推理集群的一部分进行预算,而非作为独立的政策产物(European Parliament and Council of the European Union 2024年)。
在架构层面,可争议性需要一套专门的可争议性栈,这是一种类似于微服务分布式追踪的设计模式。该栈必须编排四个相互耦合的组件:
- 决策溯源:系统通过密码学方式将特定输出与所使用的确切模型二进制和输入向量关联起来。
- 解释生成:一项高延迟服务仅在用户请求时触发资源密集型解释方法。
- 申诉路由:工作流将存在争议的决策转交至具备相应领域专长的人类审核者。
- 结果追踪:系统通过记录申诉是否推翻了机器决定来形成闭环。
若无这套集成化的基础设施,调试算法错误将变得不可能,因为系统缺乏所需的细粒度血缘信息,无法将某位用户的具体投诉追溯到致错的权重或训练数据。
可争议性是一套生产环境中的栈,而不仅仅是一个政策术语。
可争议性的可行程度因部署语境而异。在集中式云平台中,可能提供完整的解释 API、用户仪表盘以及申诉工作流。相比之下,在边缘与 TinyML 部署中,可争议性可能仅限于日志记录,以及基于批量同步反馈的周期性更新。在所有情况下,机器学习系统的设计都必须承认:透明性并非单纯的技术披露问题。它是系统的一项结构性属性,决定了用户与机构是否能够有意义地质疑、纠正并治理自动化决策的行为。
责任在机构层面的嵌入
透明性与可争议性机制若无机构层面的支持,便无法奏效。机器学习系统并非孤立运行:其开发、部署与持续管理都嵌入在包含技术团队、法务部门、产品负责人、合规官以及外部利益相关者的环境中。此类系统中的责任并非单一主体或单一组件的属性;它分散于角色、工作流与治理流程之中。因此,面向负责任人工智能的设计,要求关注这些系统得以构建与使用的机构环境。
将责任分散到不同角色,既带来机遇,也带来挑战。一方面,多方利益相关者的参与提供了制衡机制,有助于防止有害结果的发生。另一方面,责任的分散可能导致问责缺口:当问题出现时,没有任何个人或团队拥有明确的权限或动机去介入。当损害发生时,可能无法判断故障究竟出在数据管道、模型架构、部署配置、用户界面,还是周围的组织语境之中。
一个具说明性的案例是 Google Flu Trends,这是因机构层面错位而失败、且被广泛引用的例子。该系统尝试基于搜索数据预测流感暴发,初期表现良好,但随着用户行为变化和数据分布偏移,其预测逐渐偏离现实。这些问题在多年间未被纠正,部分原因在于缺乏针对系统验证、外部审计以及模型性能下降时升级处理的既定流程。此次失败并非源于某一项技术缺陷,而是由于缺少一个能够应对漂移、不确定性以及开发团队之外反馈的机构框架。
运营层面的严谨性伴随着可量化的成本。公开的负责任人工智能标准与内部审查流程表明,治理可以通过影响评估、模型审查、红队演练和文档关卡等环节增加发布延迟。关于持久系统的要点在于:审查能力应成为部署规划的一部分——如果每一次高风险发布都需要专门的审查,那么审查队列就会像安全审查或容量审批一样成为瓶颈。因此,责任带来的额外开销并非沉没成本,而是相对于在全量集群中撤回一个有偏模型或修补一个正在运行的漏洞所付出的高得多的成本而言,一种保险性支出。
在机构层面嵌入责任,需要的远不止于分配问责。它要求设计流程、工具与激励机制,使负责任的行为成为可能。诸如版本化模型注册表、模型卡与审计日志等技术基础设施,必须与伦理审查委员会、模型风险委员会以及红队演练30等组织结构相配套。这些机制确保技术洞见具有可执行性、反馈能够在团队之间得到整合,并且用户、开发者或监管机构提出的关切能够得到系统性而非临时性的回应。
30 红队演练:源自冷战时期的军事模拟,其中”红队”扮演苏联对手以探测美国防御体系。在负责任的人工智能中,红队演练是对抗性审计阶段:专门的团队(黑客、语言学家、伦理学家)在部署前刻意探测模型的越狱、偏见或有害输出。这一发现过程识别出标准单元测试无法捕捉的长尾风险。
第三方与基础模型依赖并不会将问责转移给供应商。部署组织可能继承权重、安全评估、数据文档或合同性控制,但它仍然自主选择使用方式、界面、检索到的上下文、工具、用户群体、监控机制与响应流程。因此,采购需要与内部模型关卡具备同等程度的严谨性:明确记录预期用途与禁止用途、评估范围、版本与变更通知、事件披露、审计访问权限、数据处理、服务依赖、回退行为以及退出方案。当供应商证据不可得时,保证论证必须将该缺口记录为残余风险,而不能将供应商的断言静默地当作已验证的控制措施。
所需的机构支持程度因部署语境而异。在大规模云平台中,治理结构可能包括内部问责审计、合规流程,以及专门负责监控系统行为的团队。在较小规模的部署中,包括嵌入医疗设备或公共基础设施的边缘或移动系统,治理可能依赖跨职能的工程实践以及外部认证或监管。在 TinyML 部署中,由于连接性与可观测性受限,机构责任可能通过上游控制来行使,例如安全关键性验证、内嵌的安全约束,以及对已部署固件的生命周期追踪。
在所有情况下,负责任的人工智能都需要技术系统与机构系统之间的协同。这种协同必须贯穿整个模型生命周期,从最初的数据获取与模型训练,一直到部署、监控、更新,直至最终的退役。它还必须纳入外部主体,包括领域专家、公民社会组织与监管机构,以确保责任不仅由开发团队内部行使,而是在机器学习系统所处的更广泛生态系统中得到践行。
问责在补救环节显现。受影响的个人需要一条可发现的渠道来质疑某项结果,需要一份所考虑证据的记录,需要一位有权纠正该决定的审核者,需要明确的响应期限,以及将纠正结果传播至下游系统的路径。模型层面的整体改进并不能替代个体补救:下个季度重新训练并不会纠正今天被拒绝的权益。因此,事件处理流程必须将技术性的遏制与回滚,与通知、纠正、在适用情形下的补偿、根因分析,以及验证补救是否覆盖每一个受影响的决策记录连接起来。
系统层面的论点因而超出了服务栈,延伸至组织:责任是系统随时间被治理、维护与争议的一项动态属性,并不归属于任何单一模型或团队。通过政策、基础设施与问责机制将其嵌入机构之中,才是使机器学习系统与它们所服务的社会价值及运营现实相契合的做法。
综合来看,机构责任、价值冲突、反馈回路、人机协作、可争议性与计算公平性,共同说明了为何从 节 1.3 到 节 1.5 的技术基础无法单独确保负责任的人工智能。这些技术基础依然必要,但它们需要组织层面的权威、运营遥测数据以及升级路径,才能在接触实际部署系统后依然成立。资源约束同样决定了谁能开发、部署并受益于负责任的人工智能能力,因此实现选择并非仅仅是局部的工程细节。否则,一个没有责任人的公平性指标、一个没有申诉流程的解释,或一个没有补救预算的监控信号,都会沦为没有行动的证据。当人工智能系统改变了其所处的环境时,工程团队必须在截止日期压力、资源限制与相互竞争的利益之下,将负责任人工智能的原则转化为组织惯例。
Checkpoint 1.2: 当正确代码在部署中失效
本节说明了为何数学上严谨、公平且可解释的模型仍会在人类机构中失败:会重塑数据的反馈回路、自动化偏见与机构性顺从、利益相关者之间的规范性多元论,以及将可争议性视为生产环境中的栈而非政策术语。
诊断人机交互
关于回路与利益相关者的推理
实现挑战与人工智能安全
数据科学团队希望推迟一个月再部署,以便对一款新的生成式模型开展严格的公平性审计。而高管团队看到竞争对手推出了类似功能,要求模型必须在周五前完成部署。这就是负责任 AI 落地的现实处境:它很少是工程师是否知道如何测试偏见的问题,而是组织结构、预算和业务优先级是否允许他们真正去做这件事的问题。
该场景揭示了技术能力与运营授权之间的落地差距。负责任 AI 方法提供了必要的工具,但其有效性取决于组织结构、数据基础设施、评估流程,以及远远超出算法开发范畴的持续投入。只有在这些落地支撑能够经受截止日期压力、产品激励和部署后漂移时,系统才能持续保持负责任的行为。
将负责任 AI 嵌入生产机器学习系统的实际障碍,遵循经典的“人—流程—技术”框架:
- 人员挑战:包括组织结构、角色定义、激励对齐和利益相关方协调,这些因素决定了负责任 AI 原则能否转化为可持续的组织行为。
- 流程挑战:包括标准化缺口、生命周期维护程序、相互竞争的优化目标,以及影响负责任 AI 实践如何与开发流程融合的评估方法。
- 技术挑战:包括数据质量约束、计算资源限制、可扩展性瓶颈和基础设施缺口,这些因素决定了负责任 AI 技术能否在生产规模上有效运行。
这些类别之所以重要,是因为当组织激励、开发流程和生产基础设施无法支撑同一项义务时,负责任 AI 就会失败。
该框架的要点是协同,而非分类。当人员、流程和技術被分别处理时,负责任 AI 就会失败:没有负责人的公平性指标不会触发整改,没有遥测的治理流程无法发现漂移,没有数据血缘的隐私技术无法兑现删除请求。有效的实施需要系统层面的策略,将责任同时嵌入机器学习部署的架构、基础设施和工作流程三个维度。
组织结构和激励
负责任机器学习的实施不仅受技术可行性影响,还取决于系统被开发和部署所处的组织环境。在公司、研究实验室和公共机构内部,责任必须转化为具体的角色、工作流和激励措施。然而在实践中,组织结构往往使责任碎片化,导致难以在工程、产品、法务和运营团队之间协调伦理目标。
负责任 AI 需要对 subgroup 性能评估、可解释性分析、对抗鲁棒性测试,以及差分隐私或联邦训练等隐私保护技术的集成等实践进行持续投入。这些活动往往耗时且资源密集,却常常游离于用于评估团队绩效的正式指标之外。例如,团队可能因快速交付功能或达成性能基准而获得激励,即使这样做会损害公平性或忽视潜在危害。当伦理尽职调查被视为可裁量的任务,而非系统生命周期中的组成部分时,它就会在截止日期压力或组织变动中沦为次要事项。
责任还因归属不明确而更加复杂。在许多组织中,没有单一团队负责确保系统长期以合乎伦理的方式运行。模型性能可能由一个团队负责,用户体验由另一个团队负责,数据基础设施由第三个团队负责,合规由第四个团队负责。当问题出现时,包括预测中的差异影响或解释质量不足,可能不存在清晰的根因识别和缓解协调流程。因此,开发者、用户或审计者提出的关切可能得不到回应,原因并非恶意,而是缺乏流程和跨职能的对齐。
为负责任 AI 建立有效的组织结构,需要的不只是政策声明。它需要运营机制:承担伦理监督职责的指定角色、成文的升级路径、对部署后监控的问责,以及奖励团队伦理远见和系统可维护性的激励措施。在某些组织中,这可能体现为与开发者在整个模型生命周期中并肩工作的负责任 AI 委员会、跨职能评审委员会或模型风险团队;在另一些组织中,领域专家或用户代表可能被嵌入产品团队,以预判下游影响并在具体情境中评估价值取舍。
伦理系统行为的责任分散于多个利益相关方,包括产业、学术界、公民社会和政府。 图 10 将这种责任分布映射到层层嵌套的问责层级,从实施技术实践的个体团队,经由组织的安全生产文化,直至行业级认证和政府监管 Shneiderman (2020年)。在组织内部,这种分布必须通过机制得到镜像,从而将技术设计与战略监督及运营控制连接起来。若缺少这些关联,责任就会变得分散,而出于良好意愿的努力也可能因系统性错位而受到削弱。
Shneiderman, B. 2020年. 《Bridging the Gap Between Ethics and Practice: Guidelines for Reliable, Safe, and Trustworthy Human-Centered AI Systems》. ACM Transactions on Interactive Intelligent Systems 10 (4): 1~31. https://doi.org/10.1145/3419764.
International Organization for Standardization, 和 International Electrotechnical Commission. 2023年b. ISO/IEC 42001:2023 Information Technology – Artificial Intelligence – Management System. ISO/IEC standard.
负责任 AI 并不只是技术问题或合规问题。它是一项系统层面的挑战,要求将伦理目标与机器学习系统的设计、部署和维护所依托的制度结构相协调。建立并维持这些结构,对于确保责任不仅嵌入模型,也嵌入治理其使用的组织,具有重要意义。同样的归属问题在数据层会具体化:团队可能知道如何审计数据集,却仍缺乏变更所需的授权、访问权限或基础设施。
数据约束与质量缺口
尽管业界普遍认可数据质量对负责任机器学习的重要性,改进数据管道在实践中仍属于最具挑战性的实施问题之一。开发者和研究者往往理解代表性数据、准确标注和缓解历史偏见的重要性。然而,即使意图清晰,结构性和组织性障碍也常常阻碍有效的干预。数据责任往往分散于多个团队,受遗留系统治理,或嵌入难以变更的更广泛制度流程之中。
数据工程原则,包括数据校验、模式管理、版本管理、血缘追踪和质量监控,为应对这些挑战提供了技术基础。但将这些原则应用于负责任 AI 会引入额外复杂性:公平性要求评估各人口群体的代表性,偏见缓解要求理解历史数据采集实践,隐私保护则限制了哪些校验技术可以合法使用。此处所述的组织挑战,反映了拥有稳健数据工程基础设施与有效将其用于支持负责任 AI 目标之间的差距。
子群体失衡、标注歧义和分布偏移——三者都会影响各领域的泛化与性能——是负责任机器学习领域已确立的关切。这些问题常表现为校准不良、分布外失败,或评估指标中的人口群体差异。然而,在真实场景中解决这些问题,需要的远不止技术知识。它需要获取相关数据的权限、机构对整改的支持,以及足够的时间和资源来迭代数据集本身。在许多机器学习管道中,数据一旦采集、训练集一经定义,数据管道便实际上被冻结。即使发现了性能差异,团队也可能既缺乏中途修改或扩展数据集的授权,也缺乏相应基础设施。即便是在具备校验和特征存储的自动化数据管道中,一旦数据集版本管理和数据血缘已锁定到生产环境,事后修正训练分布依然困难。
在医疗、教育和公共服务等领域,这些挑战尤为突出。数据采集可能受到法律约束、隐私法规或跨组织协调的限制。例如,一个正在开发分诊模型的团队可能发现,其训练数据对来自较小或农村医院的患者代表性不足。要纠正这种失衡,就需要与外部伙伴协商数据访问、统一特征标准,并解决标注实践中的不一致。即使各方都认可改进的必要性,其物流和运营成本也可能高到难以承受。
努力收集更具代表性的数据,也可能引发伦理和政治层面的担忧。在某些情况下,额外数据采集反而可能使边缘群体暴露于新的风险。这种“暴露悖论”——即受排斥伤害最深的个体,也正是最易被滥用的个体——使通过数据集扩展来改善公平性的努力变得复杂。例如,为支持性别敏感应用而收集更多非二元个体的数据,虽然可能提升模型覆盖度,但也引发了关于同意、可识别性和下游使用的严重关切。团队必须谨慎处理这些张力,而往往缺少清晰的机构指引。
Napkin Math 1.9: 代表性成本
问题:一个基于 5 hospitals 数据训练的医学影像模型,整体准确率为 94 percent,但在代表性不足的群体(农村患者、老年患者、肤色较深的患者)中准确率仅为 78 percent。要弥合这一差距,需要从 50+ 家覆盖不同地理区域、人口群体和设备类型的医院获取代表性数据。
数学:
- 数据采集成本:每张带标注的医学影像为 $50–$200,每个代表性不足子群体需要 100,000 images。
- 代表性成本场景:对于 10 subgroups,在成本区间的中点,每个子群体 10 乘以每张影像 100,000 images 再乘以 $125,仅数据采集一项即达 $125M。
- 数据调和:跨不同扫描仪、协议和标注规范的调和会引入 30 percent–50 percent 的开销,使总成本达到 $162.5M–$187.5M。
系统洞见:表示成本使得公平性能在实质上比多数人群上的高聚合准确率更昂贵。受偏见模型损害最严重的人群,恰恰是训练数据中成本最高的群体。数据预算的分配不应依据聚合效用,而应依据子群覆盖缺口——这与最大化整体准确率是一个根本不同的优化目标。
表示成本随子群覆盖范围扩展,而不只是随数据集规模扩展。
Himmelstein, Gracie, David Bates, 和 Li Zhou. 2022年. 《Examination of Stigmatizing Language in the Electronic Health Record》. JAMA Network Open 5 (1): e2144967. https://doi.org/10.1001/jamanetworkopen.2021.44967.
数据收集系统中的上游偏见即使数据充足也可能长期不受约束。许多组织依赖第三方数据供应商、外部 API,或并非以公平性或可解释性为目标设计的运营数据库。例如,电子健康记录(Electronic Health Records)在临床机器学习中被广泛使用,往往反映了医疗照护中的系统性差异,以及编码种族或社会经济偏见的记录习惯(Himmelstein 等 2022年)。下游团队往往对这些记录如何生成缺乏了解,也很少拥有应对其中内嵌危害的手段。
提升数据集质量往往并非任何单一团队的责任。数据管道可能由基础设施或分析团队维护,而这些团队独立于机器学习工程或模型评估团队运作。这种组织上的碎片化使得协调数据审计、追踪数据来源,或实施将模型行为与底层数据问题连接起来的反馈回路都变得困难。在实践中,数据集质量的责任往往落入缝隙之中,被认可为重要,却很少被优先处理或获得资源。
应对这些挑战需要长期投资于基础设施、工作流程和跨职能沟通。诸如数据校验、自动审计和数据集文档框架之类的技术工具(例如模型卡、数据表,或 Data Nutrition Project31)可以提供帮助,但只有当它们嵌入到拥有行动授权和支持的团队中时,才能真正发挥作用。
31 Data Nutrition Project: 一项非营利倡议,开发以营养标签为蓝本的标准数据集文档,汇总数据集的来源、构成、分布和已知问题,用于机器学习管道。该项目的标签使缺乏原始采集流程访问权的数据集风险对下游工程师清晰可见——这是应对此处所述组织碎片化的关键桥梁。
提升数据质量从根本上讲,是一个关于数据责任如何在系统生命周期中分配、共享和持续的问题,而不仅仅是工具改进的问题。一旦责任得到落实,团队仍须决定当有效目标相互冲突时,应由哪个负责任的人工智能目标占据主导。
平衡相互竞争的目标
机器学习系统设计常被框定为一种优化过程,即提升准确率、降低损失或最大化效用。然而在负责任的人工智能实践中,优化必须与一系列相互竞争的目标相权衡,包括公平性、可解释性、鲁棒性、隐私和资源效率。这些目标并不总是彼此一致,某个维度的改进可能需要在另一个维度付出代价。尽管这些张力在理论上已被充分理解,但在真实系统中管理它们仍然是一项持续存在且尚未解决的问题。
以模型准确率与可解释性之间的权衡为例。在许多情况下,可解释性更强的模型,包括浅层决策树和线性模型,其预测性能低于复杂的集成方法或深度神经网络。在低利害应用中,这种权衡可能可以接受,甚至更受青睐。然而在高利害领域,如医疗或金融,决策会影响个人的福祉或获得机会的通道,团队往往夹在性能需求与透明推理需求之间。即使在开发阶段优先了可解释性,部署阶段也可能为了模型准确率的边际提升而将其搁置。
相似张力也出现在个性化与公平性之间。一个以最大化用户参与度为目标训练的推荐系统可能激进地进行个性化,利用细粒度行为数据为每位用户定制输出。虽然这种方法可能提升部分用户的满意度,却可能固化不同人口统计群体之间的差异,尤其是当个性化依赖与种族、性别或社会经济地位相关特征时。加入公平性约束可能在群体层面减少差异,但代价是部分用户感知的个性化程度下降。这些效应往往难以测量,在面临优化参与度指标压力的产品团队中,甚至更难向他们解释。
隐私引入了另一组约束。差分隐私、联邦学习或本地数据最小化(Biega 等 2020年)等技术可以实质性地降低隐私风险,同时也会引入噪声、限制模型容量,或减少训练数据的可及性。在集中式系统中,这些成本可能通过基础设施扩展或混合训练架构被吸收。然而,在边缘或 TinyML 部署中,这些权衡更为尖锐。承担本地推理的可穿戴设备往往必须同时权衡模型复杂度、能耗、延迟和隐私保证。支持一项约束通常意味着削弱另一项约束,迫使系统设计者在同等重要的目标之间进行取舍。这些张力还因部署特定的设计决策而被进一步放大,例如量化水平、激活截断或压缩策略,它们会影响模型同时支持多个目标的有效性。
Biega, A. J., P. Potash, H. Daumé, F. Diaz, 和 M. Finck. 2020年. 《Operationalizing the Legal Principle of Data Minimization for Personalization》. 收入 Proceedings of the 43rd International ACM SIGIR Conference on Research and Development in Information Retrieval, 编辑 Jimmy Huang, Yi Chang, Xueqi Cheng, Jaap Kamps, Vanessa Murdock, Ji-Rong Wen, 和 Yiqun Liu. ACM. https://doi.org/10.1145/3397271.3401034.
这些权衡并非纯粹技术问题;它们反映了关于系统旨在实现什么、为谁实现等更深层规范性判断,相关内容在 节 1.6.3 中得到了详细探讨。负责任的人工智能开发要求将这些判断明确化,在具体语境中评估它们,并使其接受利益相关方意见和机构监督。
使这一挑战在实施中尤其困难的是,这些相互竞争的目标很少由单一团队或职能负责。性能可能由建模团队优化,公平性由负责任的人工智能小组监控,隐私则由法务或合规部门处理。若无刻意的协调,系统层面的权衡可能被隐性地、零敲碎打地做出,且缺乏对长期后果的可见性。久而久之,结果可能是一个在孤立使用时表现良好、但在嵌入生产基础设施后无法满足其伦理目标的模型。
平衡相互竞争的目标不仅需要技术熟练度,还需要对透明、协商和跨团队协作的承诺。系统必须被设计为呈现权衡而非掩盖权衡,为具备约束意识的开发留出空间,而非追求狭隘的优化。在实践中,这可能要求重新定义“成功”的含义:不是单一指标上的表现,而是系统行为与其在更广泛社会或运营语境中所扮演角色之间的持续一致。
在这前三个挑战(组织结构、数据质量、相互竞争的目标)中,出现了一个共同模式:负责任的人工智能失败很少源于技术无知。团队理解公平性指标、隐私技术和偏见缓解方法。相反,失败发生在组织碎片化(分配责任却缺乏问责)、数据约束(即使意图清晰也会形成技术障碍)以及相互竞争的目标(将规范性权衡伪装成技术问题)的交汇之处。当建模团队优化性能、合规团队处理隐私、产品团队独立优先参与度时,系统层面的伦理行为是偶然形成的,而非设计出来的。这些从根本上说是社会技术治理问题,需要跨越组织边界的清晰责任结构、面向伦理审计的数据基础设施,以及使价值权衡显性化的协商流程。当系统必须在长时间尺度上保持负责任行为时,这些挑战会更加严峻。
可扩展性与维护
负责任的人工智能实践往往在模型开发的早期阶段引入:公平性审计在初始评估阶段进行,可解释性方法在模型选择阶段应用,隐私保护技术在训练阶段考虑。然而,随着系统从研究原型过渡到生产部署,这些实践经常退化或消失。原则上可行与在生产中可持续之间的差距,是负责任人工智能的核心实施挑战。
许多负责任的人工智能干预措施在设计之初并未考虑可扩展性。公平性检查可能在静态数据集上执行,却未集成到持续的数据摄取管道中。解释方法可能使用开发期工具开发,却从未转化为可部署的用户界面。隐私约束可能在训练阶段得到强制,却在部署后监控或模型更新中被忽视。在每个案例中,最初作为负责任设计意图的东西都无法跨越系统扩展和生命周期变化而持续存在。
生产环境引入了新的压力,重塑了系统优先级。模型必须在多样化的硬件配置下运行,与不断演进的 API 交互,以低延迟服务数百万用户,并在运营压力下保持可用性。例如,在 CPU、GPU 和边缘加速器之间维持一致行为,需要框架抽象、运行时调度器和硬件特定编译器之间的紧密集成。这些约束要求持续的适应和快速迭代,往往使难以自动化或度量的活动被降级。负责任的人工智能实践,尤其是涉及人工审核、利益相关方咨询或事后评估的那些,可能难以融入快节奏的 DevOps32 流水线。
32 MLOps(机器学习运维): ML CI/CD 流水线必须处理数据版本管理、训练可复现性以及算法变更的 A/B 测试,这些已超出传统软件范畴的关注。高速迭代的机器学习组织可能比负责任的人工智能审核能够手工完成的速度更快地部署模型或配置变更,由此形成速度差:以小时计的部署周期与需要数天或数周完成的伦理验证相互竞争。这种张力解释了为何在原型阶段提出的负责任人工智能承诺,会随着系统扩展而被降级。
维护引入了进一步的复杂性。机器学习系统很少是静态的。新数据不断被摄取,模型会重新训练,特征会被弃用或新增,使用模式也会随时间变化。在缺乏严格的版本控制、变更日志和影响评估的情况下,很难追溯系统行为如何演变,或判断公平性、鲁棒性等与责任相关的属性是否得到保持。组织人员流动和团队重组会侵蚀机构记忆。负责维护已部署模型的团队可能并非最初开发或审核该模型的团队,从而导致系统目标与已部署行为之间出现无意的错位。这些问题在持续学习或流式学习场景中尤为突出,其中概念漂移和数据分布变化要求主动监控和实时更新。
这些挑战在多模型系统和跨平台部署中被进一步放大。一个推荐引擎可能由数十个相互交互的模型组成,每个模型针对不同的子任务或用户群体进行优化。部署在移动和边缘环境中的语音助手可能保持同一模型的不同版本,针对本地硬件约束进行调优。在如此分布式的系统中协调更新、确保一致性并维持负责任行为,需要基础设施不仅跟踪代码和数据,还要跟踪价值观和约束。
应对可扩展性与维护挑战,要求将负责任的人工智能视为生命周期属性,而非一次性评估。这意味着将审核钩子、元数据跟踪和监控协议嵌入系统基础设施。这也意味着创建能够跨越团队交接持续存在的文档,定义能够经受项目交接的责任结构,并确保系统更新不会无意中抹去在公平性、透明性或安全性方面来之不易的改进。虽然这些实践事后补做往往困难,但可以通过默认负责任(responsible-by-default)的工具和工作流,从系统设计的初始阶段就将其集成进去。
责任必须随系统一同扩展。部署在真实环境中的机器学习模型不仅要在发布时符合伦理标准,还必须在复杂度、用户覆盖范围和运营范围不断扩大的过程中持续符合这些标准。实现这一点需要持续的组织和架构规划投入,而不仅仅是在某个时点上的技术正确性。
标准化与评估缺口
尽管负责任机器学习领域已经产生了广泛多样的工具、指标和评估框架,但在如何系统性评估一个系统在实践中是否真正负责任方面,仍然缺乏共识。许多团队都认可公平性、隐私、可解释性和鲁棒性的重要性,却往往难以将这些原则转化为一致、可度量的标准。基准测试方法为标准化评估提供了有价值的框架,但将这些方法适配到负责任人工智能指标仍是活跃的研究开发领域。正式化评估标准的缺失,加上工具和框架的碎片化,对大规模实施负责任人工智能构成了重大障碍。
碎片化既体现在机构之间,也体现在机构内部。学术研究经常提出难以在实验环境之外复现的公平性或鲁棒性新指标。相比之下,工业团队必须优先选择那些能够与生产基础设施无缝集成、可被非专家解释、并能随时间监控的指标。因此,在一种语境中形成的实践往往难以良好迁移到另一种语境,跨系统的性能比较可能不可靠或具有误导性。例如,某个模型在一套基准数据集上以人口统计均等性(demographic parity)评估公平性,却可能无法满足另一领域或另一司法辖区的等机会(equalized odds)要求。在缺乏共享标准的情况下,这些评估只能采取临时方式,难以在不同语境中建立对系统负责任行为的信心。
负责任人工智能的评估还面临分析单元与部署层级之间的错配:分析单元通常是单个模型或批次作业,而部署层级则包括端到端系统组件,如数据摄取管道、特征转换、推理 API、缓存层和人工介入的工作流。一个在孤立使用时显得公平或可解释的系统,一旦集成到更广泛的应用中,就可能无法维持这些属性。支持整体性、系统级评估的工具仍然欠发达,对于如何在生产机器学习栈的相互交互组件之间评估责任,也几乎没有指导。
进一步加剧问题的是生命周期感知指标的缺失。大多数评估工具只在某个时点应用,通常就在部署之前。然而,公平性和鲁棒性等负责任人工智能属性是动态的:它们取决于数据分布如何演变、模型如何更新,以及用户如何与系统交互。没有持续或周期性的评估,就很难确定系统在部署后是否仍然与其预期的伦理目标保持一致。部署后监控工具虽然存在,却很少与用于评估初始模型质量的开发期指标集成。这种脱节使得难以察觉伦理性能的漂移,也难以将观察到的危害追溯到其上游来源。
工具碎片化进一步加剧了这些挑战。负责任人工智能工具往往分散在彼此隔离的包、仪表盘或内部系统中,每个工具都针对特定任务或指标设计。一个团队可能用一个工具做可解释性,另一个工具做偏见检测,第三个工具做合规报告,而没有任何统一的接口来推理系统层面的权衡。缺乏互操作性阻碍了团队间的协作,使文档编写复杂化,并增加了重要评估被跳过或执行不一致的风险。这些问题又因缺少跨组件(如特征存储、推理网关和模型注册表)的元数据传播或事件日志记录钩子而进一步叠加。
这种”迁移失败”场景正是问题的具体形态:某个模型在一套基准数据集上以人口统计均等性获得公平性认证,却可能在新的领域或司法辖区中不满足等机会要求,因此认证无法随模型一同迁移。弥合这一缺口需要满足以下条件:评估标准必须在跨领域可度量、可审计,应用于完整的系统流水线而非孤立的模型,并作为周期性的生命周期活动反复执行,以确保发布时的通过结果不会随着分布漂移而静默失效。在这些实践得到共享而非临时采用之前,负责任人工智能仍然停留在原则描述层面,在实践中难以验证。
负责任的人工智能无法通过孤立的干预措施或静态的合规检查来实现。它需要架构规划、基础设施支持,以及贯穿系统生命周期的机构流程,以维持伦理目标。随着机器学习系统不断扩展、多样化并嵌入敏感领域,公平性、鲁棒性和隐私等属性的强制能力,不仅要在模型选择时得到支持,还必须在重新训练、量化、服务和监控各阶段得到支持。若无持续的监督,随着系统演进,负责任实践会退化,尤其是当工具、指标和文档并未被设计为跟踪和保持这些属性贯穿部署及部署之后时。
应对这一挑战需要更强的标准化、将责任感知实践更深地集成到 CI/CD 流水线中,以及对支持伦理前瞻性的系统基础设施进行长期投资。目标不是让代码中的伦理决策完美无缺,而是使责任成为一项可操作的属性,可追溯、可测试,并与大规模机器学习系统的约束和可能性相一致。
实施决策框架
鉴于这些实施挑战,从业者需要系统性的方法,依据部署语境和利益相关方需求来优先处理负责任人工智能原则。同一原则在高利害的个人决策、安全关键系统、隐私敏感应用、大规模消费级系统、资源受限部署和研究环境等不同场景中,可能要求不同的工程处理方式。
实践中,四条决策启发式规则指导这些权衡:
- 当多个原则相互冲突时,应让利益相关方参与,以确定哪些危害最为严重。节 1.6.3 中考察的心理健康聊天机器人案例表明,此类冲突需要通过审议解决,而不能依靠算法解决。
- 当计算预算受限时,应根据风险确定原则的优先级。高风险决策即使付出显著成本,也必须保障公平性/可解释性。低风险应用可以采用轻量方法。
- 当部署情境发生变化时,应重新评估原则的优先级。云端模型迁移到边缘后会失去集中监控能力;应通过部署前验证和本地保障措施加以补偿。
- 当利益相关方的价值观存在差异时,应明确记录取舍,并建立申诉机制,使受影响的用户能够质疑决策。
表 5 提供了一个面向实践者的决策框架,将这些部署情境映射到主要原则、实施优先级和可接受的取舍,从而使决策能够适应具体情境,而非采用普遍适用的方案。
| 部署情境 | 主要 原则 | 实施优先级 | 可接受的取舍 |
|---|---|---|---|
| 高风险个体决策 | 公平性、 | 强制要求在受保护群体之间 | 为可解释性接受经过量化的 |
| (医疗诊断、信贷/贷款、 | 可解释性、 | 采用公平性指标; | 准确率损失预算,并为解释设定延迟上限; |
| 刑事司法、就业) | 问责 | 对负面结果提供解释;对边界情况实施人工监督 | 接受更高的计算成本 |
| 安全关键系统 | 安全性、 | 经认证的对抗 | 接受显著的验证和 |
| (自动驾驶车辆、医疗 | 鲁棒性、 | 防御;形式化验证; | 对抗训练开销; |
| 设备、工业控制) | 问责 | 故障安全机制;全面日志记录 | 保守的置信度阈值;冗余推理 |
| 隐私敏感应用 | 隐私、 | 差分隐私 | 接受隐私与效用之间的取舍,以及更高的 |
| (健康记录、金融数据、 | 安全性、 | (ε≤1.0);本地处理; | 客户端计算开销;限制模型 |
| 个人通信) | 透明度 | 数据最小化;用户同意机制 | 更新;降低个性化程度 |
| 大规模消费级系统 | 公平性、 | 跨人口统计群体的偏见 | 在可解释性成本与 |
| (内容推荐、搜索、 | 透明度、 | 监控;解释 | 系统规模之间取得平衡(采用抽样或异步解释); |
| 广告) | 安全性 | 机制;内容政策执行;反馈循环检测 | 为公平性检查预留服务路径延迟预算,并投入监控基础设施建设 |
| 资源受限部署 | 隐私、 | 本地推理;数据 | 牺牲实时公平性监控; |
| (移动端、边缘、TinyML) | 效率、安全性 | 本地性;输入验证;平稳降级 | 使用轻量可解释性方法(优先采用梯度而非 SHAP);仅进行部署前验证;限制模型复杂度 |
| 研究/探索性系统 | 透明度、 | 记录已知 | 可以降低复杂的 |
| (内部工具、原型、 | 安全性(危害 | 局限;限制 | 公平性/可解释性方法在内部 |
| A/B 测试) | 预防) | 用户群体;监控非预期危害 | 使用中的优先级;重点关注可观测性和快速迭代 |
该框架提供的是起始性指导,但应将其视为分诊机制,而非一套完整的治理方案。它指明每个部署环境中哪些约束值得优先关注,随后为系统、环境和社会期望的演变留出重新评估的空间。迄今为止考察的挑战仍假设系统在人类监督下运行:工程师发现偏见并介入;运营人员监控公平性指标;开发者应对数据漂移。然而,有些系统必须比人类审查更快采取行动。自动驾驶车辆以毫秒级响应;交易算法在人类审查成为可能之前执行数千笔交易;内容审核系统每天处理数十亿条帖子。这些自主系统要求将负责任 AI 框架从实施层面的挑战扩展到更根本的问题:确保系统追求与人类价值一致的目标,即使其运行已超出持续人类监督的范围。
AI 安全与价值对齐
随着机器学习系统自主性与能力的增长,价值对齐挑战显著扩大。既有的负责任 AI 技术,包括偏见检测(节 1.1.3.6)、可解释性(节 1.5)和隐私保护(节 1.4.1),提供了必要能力,但在系统具有更高独立性时暴露出根本性局限。考虑这些既有方法在自主情境中如何失效。
偏见检测算法(如 Fairlearn 中实现的算法)需要持续的人类解释与纠正行动。自动驾驶车辆感知系统可能对识别行动不便的行人表现出系统性偏见,但在没有人类监督的情况下,偏见检测指标仅仅成为被记录的统计量,缺乏补救途径。测量偏见的技术能力是存在的,但自主系统缺乏判断适当应对的能力。
解释系统假定存在受众和一条行动路径。一个自主交易系统可能生成内部一致的 SHAP 归因,但这些归因并不构成因果推理,也无法影响决策——因为在系统执行数千笔交易之前,没有任何控制环节消费这些归因。没有阈值、审查权限和回滚机制,解释就仍然只是事后记录,而非运行期保障。
差分隐私等隐私保护技术能够保护个体数据点,却无法解决更广泛的价值不对齐问题。一个自主内容推荐系统可能通过本地差分隐私保护用户隐私,同时却优化那些助长 misinformation 或有害内容的参与度指标。当系统的根本目标与用户福利相冲突时,技术层面的隐私合规便已不足。
负责任 AI 框架虽然必要,但随着系统自主性增强而变得不充分。这些技术假定人类监督、受限目标以及相对可预测的运行环境。AI 安全将这些关切扩展到可能优化与人类意图不对齐的目标、运行于不可预测环境、或通过其设计者从未设想的方法追求目标的那些系统。
随着机器学习系统自主性、规模与部署复杂度的提升,责任的范围已超出模型层面的公平性或隐私问题。AI 安全工作围绕错误目标导致的事故风险、奖励黑客、可扩展监督、安全探索与分布偏移 (Amodei 等 2016年) 来界定这些关切,而价值对齐工作则强调确保系统持续追求与人类意图一致的目标 (Russell 2021年)。这些关切属于 AI 安全领域33,该领域聚焦于防止能力强大的 AI 系统产生非预期或有害的结果。核心挑战在于,能力强大的 ML 模型往往优化代理指标34,例如损失函数、奖励函数或参与度信号,而这些指标无法充分捕捉人类价值。
33 AI 安全:研究机器学习系统所优化目标与人类意图之间差距的领域,涵盖近期风险(偏见、隐私)直至长期的价值对齐问题。主要 AI 实验室已将安全视为明确的研究方向,这反映了工程现实:随着模型能力或自主性的增强,目标不对齐的成本可能急剧放大——不对齐的推荐系统会损害用户体验,而不对齐的自动驾驶车辆则付出生命的代价。
34 代理指标:针对难以直接量化的目标而设计的可测量替代指标,受古德哈特定律支配:“当一项度量成为目标,它就不再是一项好的度量。”在 ML 系统中,代理目标与真实目标之间的偏离是价值不对齐的核心机制:点击率代理满意度,损失代理泛化能力,参与度代理用户福利——每一种代理都会随着模型能力增强而系统性地偏离预期目标,形成优化压力。
35 CTR(点击率)与参与度优化:点击率、观看时长及相关参与度指标是用户满意度的便捷代理。YouTube 公布的推荐架构讨论了按预期观看时长排序视频 (Covington 等 2016年),而后续审计则研究了推荐路径中政治极端内容的暴露问题 (Ribeiro 等 2020年)。系统层面的启示是:代理指标的选择是一项架构决策,具有系统范围的 behavioral 后果,而不仅仅是一个超参数选择。
Covington, Paul, Jay Adams, 和 Emre Sargin. 2016年. 《Deep Neural Networks for YouTube Recommendations》. Proceedings of the 10th ACM Conference on Recommender Systems, 191~98. https://doi.org/10.1145/2959100.2959190.
Ribeiro, M. H., R. Ottoni, R. West, V. A. F. Almeida, 和 Jr. Meira Wagner. 2020年. 《Auditing radicalization pathways on YouTube》. Proceedings of the 2020 Conference on Fairness, Accountability, and Transparency, 131~41. https://doi.org/10.1145/3351095.3372879.
36 奖励黑客:当 AI 系统通过违反设计者意图的非预期手段最大化其奖励函数时,即发生奖励黑客。一个俄罗斯方块 AI 学会了无限期暂停以避免输棋;一台清洁机器人会推倒物体以制造它随后可以清理的 mess。对于生产 ML 系统,奖励黑客的表现更为隐蔽:推荐模型通过推广成瘾性内容来最大化参与度,或聊天机器人通过谄媚而非准确来最大化有用性评分。这种失效模式随模型能力增强而放大。
一个具体例子来自推荐系统:模型针对可量化的参与度代理指标(如点击量或观看时长35)进行优化,可能在提升代理指标的同时损害更广泛的用户福利。生产推荐系统会显式优化参与度信号,例如预期观看时长 (Covington 等 2016年);对 YouTube 的审计则考察了推荐路径如何向用户暴露政治极端内容 (Ribeiro 等 2020年)。这种行为与代理指标一致,却与真实目标不对齐,从而形成强化循环,不断放大不良结果。系统学会了优化可量化的奖励,而非预期的人类中心式结果,由此产生了 图 11 所描述的强化循环。其结果是涌现行为,表现为 specification gaming 或奖励黑客36,这是价值对齐与 AI 安全 (Amodei 等 2016年) 的核心关切。
诺伯特·维纳曾写道:“如果我们借助一种机械装置来实现我们的目的,而我们却无法有效地干预其运行……那么,我们最好确信,被置入机器中的目的,正是我们所希望的目的。”(Wiener 1960年)
Wiener, N. 1960年. 《Some Moral and Technical Consequences of Automation: As Machines Learn They May Develop Unforeseen Strategies at Rates That Baffle Their Programmers.》 Science 131 (3410): 1355~58. https://doi.org/10.1126/science.131.3410.1355.
Russell, S. 2021年. 《Human-Compatible Artificial Intelligence》. 收入 Human-Like Machine Intelligence. Oxford University Press. https://doi.org/10.1093/oso/9780198862536.003.0001.
当优化过程超出持续的人类干预时,维纳的警示便转化为系统层面的要求。价值对齐(value alignment)追问的是:嵌入模型、奖励函数和部署策略中的目标,是否仍然代表该系统本应服务的人类目的。正如 Russell (2021年) 在《Human-Compatible Artificial Intelligence》一书中论证的那样,许多人工智能研究都预设了待优化的目标是已知且固定的,因而将重点放在优化的有效性上,而非目标本身的设计。
在部署场景中,难点在于指定一个能够随着系统与环境动态变化、涉及多方利益相关者并存在反馈回路而持续有效的目标。静态的目标函数和奖励信号无法编码所有这些条件。诸如价值敏感设计(Value Sensitive Design)之类的框架,为在设计阶段 eliciting 和整合利益相关者的价值提供了形式化流程;但系统的义务更为广泛:目标设计、监督以及部署后的监控必须被视为相互耦合的控制措施。
如果没有这种耦合,智能系统可能追求狭窄的性能目标(例如准确率、参与度或吞吐量),却产生社会上不受欢迎的结果。在如此条件下实现稳健的对齐,仍然是机器学习系统中一个开放且重要的研究方向。由此产生的失效模式,在优化复杂目标的系统中已属常见。例如,在强化学习中,模型往往学会利用奖励函数中未被预期的部分,这种现象被称为 specification gaming37 或奖励操纵(reward hacking)。
37 Specification Gaming: 与奖励操纵(利用实现层面的缺陷)不同,specification gaming 揭示了目标规范中真实存在的缺口——系统满足了目标的字面要求,却违背了其意图。一只被训练用于抓取物体的机器人手,学会了把它们打翻(当物体卡在桌边时,“握住”反而更容易)。对于机器学习系统而言,这促使人们将多目标优化和基于人类反馈的强化学习(RLHF)作为规范方法,纳入超出单一标量指标之外的更广泛约束,以换取更接近人类意图的目标,代价是额外的数据、训练和评审投入。
38 RLHF(Reinforcement Learning from Human Feedback): Christiano 等 (2017年) 通过让智能体基于轨迹片段之间非专家的比较进行训练,展示了基于人类偏好的深度强化学习。在大型语言模型(LLM)场景中,Ouyang 等 (2022年) 为 InstructGPT 实现了一条相关流水线:基于演示的监督微调、基于排序模型输出的奖励模型训练,以及针对所学奖励模型的强化学习微调。系统成本包括一条额外的人类反馈数据流水线、奖励模型的训练与评估,以及对评分者指令的治理;评分者池的代表性与标注策略决定了模型内化了哪些人的偏好。
Christiano, P. F., J. Leike, T. B. Brown, M. Martic, S. Legg, 和 D. Amodei. 2017年. 《Deep Reinforcement Learning from Human Preferences》. 收入 Advances in Neural Information Processing Systems 30: Annual Conference on Neural Information Processing Systems 2017, December 4-9, 2017, Long Beach, CA, USA, 编辑 Isabelle Guyon, Ulrike von Luxburg, Samy Bengio, Hanna M. Wallach, Rob Fergus, S. V. N. Vishwanathan, 和 Roman Garnett. Curran Associates.
Ouyang, L., J. Wu, X. Jiang, D. Almeida, C. L. Wainwright, P. Mishkin, C. Zhang, 等. 2022年. 《Training language models to follow instructions with human feedback》. Advances in Neural Information Processing Systems (NeurIPS) 35: 27730~44. https://doi.org/10.52202/068431-2011.
此类失效发生在目标中未明确纳入的变量被以最大化奖励、同时违背人类意图的方式操纵时。近年来一种颇具影响力的方法是 RLHF,38 其中模型利用人类提供的偏好信号进行训练或微调Ouyang 等 (2022年)。
尽管该方法在标准强化学习之上改善了对齐效果,它也引入了治理风险。Ngo 等 (2022年) 指出了 RLHF 可能引入的三种潜在失效模式:
Ngo, Richard, Lawrence Chan, 和 Sören Mindermann. 2022年. 《The Alignment Problem from a Deep Learning Perspective》. ArXiv preprint abs/2209.00626.
- 情境性奖励操纵(situationally aware reward hacking),即模型利用人类的易错性。
- 产生与目标不一致的内部目标,且这些目标会泛化到训练分布之外。
- 发展出追求权力的行为,以保留奖励最大化的能力,即使这会牺牲人类监督。
这些担忧并不局限于推测性场景。Amodei 等 (2016年) 提出了人工智能安全面临的五项具体挑战:
Amodei, D., C. Olah, J. Steinhardt, P. Christiano, J. Schulman, 和 D. Mané. 2016年. 《Concrete Problems in AI Safety》. arXiv preprint arXiv:1606.06565, 网络首发. https://doi.org/10.48550/arXiv.1606.06565.
- 避免策略执行过程中产生负面副作用。
- 缓解奖励操纵。
- 在真实标签评估昂贵或不可行时,确保可扩展的监督(scalable oversight)。
- 设计安全的探索策略,在促进创造力的同时不增加风险。
- 实现针对测试环境分布偏移的鲁棒性。
对于 fleet 运营方而言,每项挑战都对应一项控制面(control-plane)要求:约束副作用、监控奖励操纵、为可扩展监督预算资源、限制探索、并在上线前测试分布偏移。随着系统规模扩大、部署到多样化场景并与实时反馈或持续学习集成,每项要求都会愈发紧迫。
这些安全挑战在人类监督被削减的自主系统中表现得尤为突出。
自主系统与信任
自主系统在缺乏实时人类监督的情况下运行,其后果在自动驾驶领域尤为凸显。一个近期的重要案例是,加州机动车管理局因“对公共安全构成不合理风险”(CNBC 2023年a),暂停了 Cruise 的部署与测试许可。其中一起事件涉及一名行人:就在信号灯转为绿灯、行人进入人行横道的瞬间,系统未能识别并避让,最终导致碰撞(CNBC 2023年b)。更具悲剧性的一例发生在 2018 年,一辆处于自动驾驶模式、由 Uber 运营的自动驾驶车辆未能将一名推着自行车的行人正确分类为需要避让的行人,造成一人死亡;美国国家运输安全委员会(National Transportation Safety Board)的报告将该失败认定为自动驾驶系统设计、安全员以及组织层面安全管理三方面失效的结合(National Transportation Safety Board 2019年)。
CNBC. 2023年a. California DMV Suspends Cruise’s Self-Driving Car Permits. CNBC news article.
CNBC. 2023年b. Cruise Under NHTSA Probe Into Autonomous Driving Pedestrian Injuries. CNBC news article.
National Transportation Safety Board. 2019年. Collision Between Vehicle Controlled by Developmental Automated Driving System and Pedestrian, Tempe, Arizona, March 18, 2018. HAR-19/03. National Transportation Safety Board.
Reuters. 2023年. Human-Machine Teams Driven by AI Are About to Reshape Warfare. Reuters news article.
Centre for International Governance Innovation. 2023年. Who Is Responsible When Autonomous Systems Fail? CIGI policy article.
尽管自动驾驶系统往往是公众关注的焦点,类似的风险也出现在其他领域。近期冲突的报道记录了遥控驾驶与自主军事系统使用量的持续增长(Reuters 2023年),这不仅引发了安全与效能方面的担忧,也提出了关于伦理监督、交战规则和责任归属的棘手问题。当自主系统发生故障时,究竟应由谁承担责任,在法律与伦理层面都仍未解决(Centre for International Governance Innovation 2023年)。
从根本上看,这一挑战反映了人类自主与机器自主之间更深层的张力。工程与计算机科学学科历来强调机器自主,致力于提升系统性能、减少人类干预并最大化自动化程度。一项针对 ACM Digital Library 的文献计量分析发现,截至 2019 年,引用“自主性”(autonomy)一词的引用量最高的论文中,有 90% 关注的是机器自主而非人类自主(Calvo 等 2020年)。生产力、效率与自动化长期以来被视为默认目标,往往未经审视其所隐含的人类能动性(human agency)与监督方面的假设和取舍。
Calvo, Rafael A., Dorian Peters, Karina Vold, 和 Richard M. Ryan. 2020年. 《Supporting Human Autonomy in AI Systems: A Framework for Ethical Enquiry》. 收入 Ethics of Digital Well-Being. Springer. https://doi.org/10.1007/978-3-030-50585-1_2.
McCarthy, J. 1981年. 《Epistemological Problems of Artificial Intelligence》. 收入 Readings in Artificial Intelligence. Elsevier. https://doi.org/10.1016/b978-0-934613-03-3.50035-0.
然而,当系统在动态、不确定的环境中运行时,这些目标可能危及人类利益,因为完整规定安全行为在技术上不可行。这一困难在形式上由框架问题(frame problem)与限定问题(qualification problem)所刻画,二者都凸显了穷举现实行动成功所需的全部先决条件与偶然情况的不可能性(McCarthy 1981年)。框架问题追问:某个行动之后,世界中的哪些事实仍然相关;限定问题则追问:在某个行动变得安全之前,哪些隐藏的先决条件必须成立。在实践中,这类限制表现为脆弱的自主性(brittle autonomy):系统在标称条件下显得能力出众,但在面对歧义或分布偏移时却会静默失败或危险失败。
为应对这一问题,研究者提出了形式化的安全框架,例如Responsibility-Sensitive Safety(RSS)(Shalev-Shwartz 等 2017年),它将抽象的安全目标分解为对系统行为的数学化约束,例如最小距离、制动曲线和路权条件。这些形式化方法使得安全属性能够在特定假设与场景下得到验证。然而,此类方法仍受制于它们试图解决的那些限制:其可靠性仅取决于所编码的假设,并且往往需要大量领域建模,而这些建模可能无法很好地泛化到未曾预料的边缘场景。
Shalev-Shwartz, Shai, Shaked Shammah, 和 Amnon Shashua. 2017年. 《On a Formal Model of Safe and Scalable Self-driving Cars》. ArXiv preprint abs/1708.06374.
对于一个机器学习系统团队而言,实用的产物是一份安全论证(safety case),而非一句“值得信赖”的声明。自主系统安全论证 展示了这一模式:指明运行包络(operating envelope)、模型在该包络内已接受测试的证据,以及当证据不再成立时能够中止或回滚整个 fleet 的控制措施。
| 安全论证要素 | 系统证据 | 运行门禁 |
|---|---|---|
| 运行包络 | 运行设计域、传感器假设、天气、地理、速度与自主等级 | 在验证过的包络之外阻止部署 |
| 场景覆盖 | 罕见事件语料、仿真覆盖、回放日志、脱离记录与擦边碰撞遥测 | 在金丝雀(canary)扩展前要求覆盖度阈值 |
| 运行时护栏 | RSS 式距离规则、置信度阈值、兜底动作,以及人类接管延迟 | 当护栏触发时,启动安全停车、人类接管或受限模式 |
| Fleet 控制 | 金丝雀式分批上线、集中式安全仪表盘、违规预算,以及熔断式回滚路径 | 当 fleet 级安全指标超过阈值时,中止上线或回滚模型 |
另一种方法强调以人为中心的系统设计,确保人类判断与监督始终处于自主决策的核心。价值敏感设计(Value-Sensitive Design)(Friedman 1996年) 提出,通过明确考虑能力、复杂性、失真以及用户控制的可流动性等因素,将用户价值纳入系统设计。近年来,METUX 模型(用户体验中的动机、投入与蓬勃生长,Motivation, Engagement, and Thriving in the User Experience)在此基础上进一步扩展,识别出六个“技术体验领域”(Adoption、Interface、Tasks、Behavior、Life、Society),它们影响技术是促进还是阻碍人类的繁荣(Peters 等 2018年)。这些思想根植于自我决定理论,该理论将自主性定义为按照自身的价值与目标行动的能力,而非技术意义上的控制(Ryan 和 Deci 2000年)。在系统设计中,这些框架会转化为具体产物:需求、界面 affordance、用户控制、反馈渠道、升级路径以及审计证据。
Friedman, B. 1996年. 《Value-Sensitive Design》. Interactions 3 (6): 16~23. https://doi.org/10.1145/242485.242493.
Peters, D., R. A. Calvo, 和 R. M. Ryan. 2018年. 《Designing for Motivation, Engagement and Wellbeing in Digital Experience》. Frontiers in Psychology 9: 797. https://doi.org/10.3389/fpsyg.2018.00797.
Ryan, R. M., 和 E. L. Deci. 2000年. 《Self-determination theory and the facilitation of intrinsic motivation, social development, and well-being》. American Psychologist 55 (1): 68~78. https://doi.org/10.1037/0003-066x.55.1.68.
在机器学习系统的语境下,这些视角凸显了设计能够保全人类能动性的架构、界面与反馈机制的重要性。例如,优化参与度指标(engagement metrics)的推荐系统,可能以不透明的方式塑造用户偏好,从而干扰行为自主性。通过 METUX 的六个领域对系统进行评估,设计者便能预判并缓解那些损害有意义自主性的下游效应,即使短期系统表现看似最优。
更广泛的安全影响
当自主系统与工人、用户、监管机构以及数十亿次请求发生交互时,节 1.7.7 所考察的技术安全挑战便转化为 fleet 级的设计约束。更广泛的意义在于:安全无法被归结为某个模型指标;它取决于运行环境,而运行环境决定了自动化如何改变工作、用户如何校准信任、政策如何因地区而异,以及罕见失败如何在规模上累积。
自动化以影响安全设计决策的方式改变了工作组织。MIT 未来工作(Work of the Future)工作组(Work of the Future 2020年) 认为,技术变革与劳动力市场制度共同决定了自动化究竟是提升了工作质量,还是集中了危害。对机器学习系统而言,安全含义是:移除人类角色也可能同时移除那些难以编码进模型的情境判断与系统级调试能力。仅关注吞吐量的指标,可能会无意中惩罚那些保留监督能力的人机协同设计。
Work of the Future, MIT Task Force on the. 2020年. The Work of the Future: Building Better Jobs in an Age of Intelligent Machines. Massachusetts Institute of Technology.
Center, Pew Research. 2023年. What Americans Know About AI, Cybersecurity and Big Tech.
Schäfer, Mike S. 2023年. 《The Notorious GPT: science communication in the age of artificial intelligence》. Journal of Science Communication 22 (02): Y02. https://doi.org/10.22323/2.22020402.
公众对人工智能的了解并不均衡(Center 2023年),科普失败还可能放大人们对人工智能系统如何工作的误解(Schäfer 2023年)。这对部署安全至关重要:当用户缺乏对模型不确定性、数据偏见或决策边界的理解时,他们可能在应当由人类判断介入的场合,依然信任系统输出。从系统工程的角度看,公众理解属于部署语境的一部分:一个人工智能系统的安全属性,不仅取决于技术系统本身,也取决于用户是否能够恰当地校准信任,并识别出需要人类接管的情况。
安全工程需求受到碎片化的全球监管格局影响,该格局将人工智能风险视为一项可验证的指标。欧盟《人工智能法案》(2024)采用了基于风险的结构,涵盖禁止性实践、高风险系统、对部分系统的透明度义务,以及最低风险或无风险用途;高风险部署则面临符合性、文档与日志记录义务(European Parliament and Council of the European Union 2024年)。在美国,行政命令 14110(2023)曾确立联邦人工智能安全报告门槛,但该命令已于 2025 年 1 月被行政命令 14148 撤销;随后行政命令 14179 指示各机构审查并修订与前一命令相关的人工智能行动,而行政命令 14409 则在 2026 年 6 月将联邦重点转向人工智能创新、网络安全与关键基础设施防御Executive Office of the President (2026年)。中国的《生成式人工智能暂行办法》(2023)对部分面向公众的服务施加安全评估与算法备案要求,而非普遍性的上线前评估(Cyberspace Administration of China 等 2023年)。对于一个全球范围的机器学习 fleet,合规便成为一个复杂的分布式系统问题:法兰克福的推理节点可能需要与弗吉尼亚或新加坡不同的安全配置、数据留存策略以及人机协同阈值。这需要一个灵活的配置控制面,能够在不分裂核心模型架构的前提下,将针对特定地区的 safety 策略下发至边缘节点。
European Parliament and Council of the European Union. 2024年. Regulation (EU) 2024/1689 of the European Parliament and of the Council of 13 June 2024 laying down harmonised rules on artificial intelligence (AI Act). Official Journal of the European Union, L 2024/1689.
Executive Office of the President. 2026年. Promoting Advanced Artificial Intelligence Innovation and Security. Executive Order 14409, 91 FR 34565.
Cyberspace Administration of China, National Development and Reform Commission, Ministry of Education, Ministry of Science and Technology, Ministry of Industry and Information Technology, Ministry of Public Security, 和 National Radio and Television Administration. 2023年. Interim Measures for Administration of Generative Artificial Intelligence Services. State Council Gazette.

在 fleet 规模下,罕见失败会变成预期事件。
安全也必须作为Fleet-Level Property 来工程化,而不能仅仅视为模型级属性。单个模型的安全合规率为 99.9% 时,孤立来看似乎稳健;但当它部署到每天服务数十亿次请求的 10,000 个推理节点时,这 0.1% 的失败率便意味着每天保证出现数百万起安全事件。在这一规模上,罕见失败累积为统计意义上的确定事件。缓解这一问题需要借鉴可靠性工程中的分布式安全模式:熔断器 会在聚合安全指标劣化至阈值以下时自动停止服务,金丝雀部署 仅将 1% 的流量路由至新模型版本,以在生产环境中验证安全属性,以及将各节点的安全违规聚合到全局视图的集中式遥测仪表盘。正如 规模化机器学习运维 所述,运行基础设施必须将安全违规视为关键系统告警,如同延迟尖峰或错误率一样触发自动回滚。暴露度(exposure)是使这一结论具体化的乘数。随着 fleet 累计里程进入 图 12 所示区间,固定的每英里失败概率便不再描述一个不太可能发生的事件,而开始预测每周的事件数量。
核心的人工智能安全原则依然成立:仅有技术卓越并不充分。安全系统必须关注其运行所依托的人类与组织语境,包括塑造设计决策的经济激励,以及最终用户在与自主系统互动时所具备的理解。
Systems Perspective 1.3: 责任是基础设施,而非功能
负责任的人工智能无法像容错那样被事后加装到系统中。负责任人工智能技术的性能影响 中列出的结构性成本各自都带来供给后果:偏见漂移监测需要采样与分析预算;昂贵或精确的解释工作负载可能需要专用的异步 worker 集群,而针对特定模型的 TreeSHAP、采样、缓存或选择性生成则可能适配更小的预算;DP-SGD 需要更大的训练预算;影响评估则需要发布流程中的评审能力。这些并非可选附加组件,而是生产机器学习系统的承重组件。在高风险或受监管的部署中,若未能提供保证论证所要求的证据,即使核心模型性能很强,也可能导致发布受阻或被迫重新设计。
结构成本(如延迟开销)必须从一开始就纳入核心架构;负责任的人工智能无法被加装到成品系统之上。行业里那些普遍存在的谬误会诱使团队采取危险的伦理捷径,值得被明确识别并予以破除。
谬误与陷阱
负责任的人工智能涉及反直觉的取舍,其中伦理原则在数学和计算层面彼此冲突。来自传统软件工程背景的从业者往往假设伦理准则能够直接转化为实现,却未意识到其中涉及的不可判定性定理与计算成本。这些谬误与陷阱概括了那些会导致系统在设计阶段看似公平、但在生产环境中违反公平性准则,或带来过高计算开销的误解。
谬误:随着数据增多、算法改进,偏见就会消失。
在生产环境中,偏见往往反映结构性的属性,无论技术如何改进都会持续存在。节 1.1.3 所描述的医疗算法每年影响 2 亿名美国人,尽管其训练数据十分全面,却将黑人患者纳入照护项目的比例降低了 50 个百分点。问题不在于数据量,而在于代理变量的选择:以医疗支出作为健康状态的代理变量,会系统性低估历史支出较低人群的实际需求。数学分析表明,当不同群体之间的基础率存在差异时,校准后的风险评分通常无法同时满足等错误率条件,除非处于完美预测等特殊情形。那些仅通过纯技术手段追求”偏见消除”的组织,会在不可能或定义不明确的优化问题上浪费工程资源,同时忽视为特定语境选择应优先遵循的公平性准则所需的利益相关方参与和价值权衡。
陷阱:把可解释性当作核心功能可用后再添加的可选功能。
这种做法忽略了开销的转移:为模型行为生成归因证据需要计算、存储和接口资源,而这些资源会约束架构设计。近似 SHAP 解释并非零计算成本(负责任人工智能技术的性能影响);即使是有界的解释预算,也可能增加请求延迟和内存压力。在这个容量估算示例中,一个满足 100 ms 延迟要求、处理 10,000 QPS 的推荐系统无法在不重新审视服务等级协议(SLA)的前提下加装解释工作负载:示例中的解释预算会为每个请求增加 50 ms 到 200 ms,使总延迟上升到 150 ms–300 ms(需要 1.5–3× 的服务容量才能维持原有吞吐量)。保证论证必须明确受众、主张、方法、保真度测试和交付预算,然后选择相应的架构,例如针对特定模型的 TreeSHAP、采样的或缓存的归因、选择性的异步生成,或本身具有可解释性的模型。这些归因路径中没有任何一条能够揭示模型的内部推理过程,也无法确立因果关系。
谬误:只要实现某一个公平性指标,就保证了整个系统的公平。
从业者往往针对人口统计均衡性进行优化,使各群体的批准率趋于一致,随后便认为公平待遇随之而来。实际上,公平性指标在数学上可能彼此冲突。节 1.1.3 中的贷款审批示例便说明了这一点:若要使两个群体的批准率都达到 70 个百分点的人口统计均衡性,就必须降低 B 组的阈值以提高批准率,但这种通过率修复会降低精确率,并导致不同群体对”批准”所承担的风险含义产生差异。不可能性结果表明,当基础率存在差异且预测并不完美时,校准与等错误率条件通常无法同时成立;人口统计均衡性还会额外引入一项通过率约束。采用单指标优化的系统会在生产环境中发现自身违反了其他具有法律相关性的公平性准则,从而使组织面临诉讼与监管行动的风险。
陷阱:把负责任的人工智能当作纯粹的合规开销。
这种视角忽略了通过风险降低与市场扩展所创造的商业价值。差分隐私可以让组织在更清晰的隐私保证下处理敏感数据,但它也带来了必须在训练预算中规划的隐私—效用取舍。公平性感知训练与监测可以降低差别影响风险:节 1.1.3.6 中所述的四分之三规则(四分之三法则)确立了一个实用的筛查阈值,而歧视诉讼或监管审查可能带来可观的整改与声誉成本。一套完整的偏见监测流程本应能在其演变为外部审计发现之前,暴露出主要子群体的入组率大幅下降,从而避免因监测基础设施缺失而导致的系统性损害与法律后果。
谬误:事后调整阈值就能使已部署系统变得公平。
这种信念把公平性视为单一决策边界问题,而非一个耦合的系统属性。移动阈值可以均衡某一个指标,但同样可能改变校准、精确率、业务含义、法律文档与用户体验。在生产环境中,阈值不仅是一个记录在笔记本中的数字;它还是内嵌于服务代码、人工复核、审计记录以及下游决策中的策略。
陷阱:在未分析阈值取舍与校准影响的情况下实施公平性约束。
针对特定群体的阈值可以满足等真阳性率,但也会改变决策语义:若 A 组的阈值为 0.75、B 组的阈值为 0.60,相同的分数可能产生不同的决策;即使底层分数模型仍然保持校准,获批申请人的阳性预测值也可能在不同群体之间产生差异。看到一笔获批贷款审批的放贷人员,若没有关于群体特定阈值策略的文档,就无法判断它在各群体中是否代表相同的还款风险含义。因此,生产系统需要文档化的指标选择、不确定性估计、员工培训、法律审查以及审计轨迹,用以说明为何相同分数可能产生不同决策。没有任何通用的训练目标能够解决互不相容的公平性定义;恰当的做法是为部署语境选择并论证所依据的准则,量化由此产生的取舍,并监测所获批定的政策是否仍然有效。
谬误:监测仪表盘本身就能建立问责。
仪表盘可以暴露公平性漂移、解释失败或滥用趋势,但它并不能决定谁必须采取行动。一个负责任的可监测流程需要明确责任人、阈值、升级路径和整改预算。否则,系统只会不断累积证据而行为并未改变:告警会过期失效,公平性退化被接受为既定基线,受影响的用户则没有任何申诉决策的途径。
陷阱:在未明确整改责任的情况下启动监测。
团队往往因为政策要求具备可见性而部署公平性、安全性或隐私性指标,却未定义响应路径。这会造成一种虚假的控制感。一个没有任何团队负责维护的指标并非控制手段,而只是一条日志记录。生产环境中的责任要求将每个监测信号绑定到发布关卡、事件责任人、回滚权限或人工复核能力,以便在指标失效时组织能够采取行动。
脱离语境的阈值调整正是这些示例背后的常见失败原因。一个数学上的公平性约束只有在该系统同时考虑下游人群影响、文档要求、运营能力与法律风险敞口时,才称得上负责任。破除这些局部的谬误,将把负责任的人工智能从合规清单转变为根本性的架构要求,并完善机器学习集群的治理层。
摘要
负责任的人工智能是机器学习集群的治理基础设施。生产机器学习已经需要物理基础设施、分布式执行、服务系统、安全控制、鲁棒性机制与可持续性预算。负责任的人工智能进一步补充了确保全球机器服务于人类价值而非损害人类价值所必需的护栏与治理框架。
论证从抽象的伦理学推进到具体的工程约束,分析了数学公平性指标以及那些迫使作出明确规范性选择的不可回避的不可能性定理。它考察了可解释性(SHAP、LIME)与隐私保护数据治理的技术基础,随后将同样的基础设施视角扩展到生成式对齐,其中 RLHF 与系统提示充当了在 LLM 集群中控制模型行为的社技机制。
分群体公平性指标 说明了公平性为何需要明确的取舍。考虑一个在两个人口统计群体上评估的贷款审批系统:
该算例报告了分群体公平性指标,包括假阳性率,因此同一张预测表可以满足其中一个准则,却无法满足其他准则。等机会(equalized odds)要求真阳性率与假阳性率同时匹配;因此,这张表呈现的是假阳性率均衡这一较窄情形,而非完整的等机会。
| 指标 | 定义 | A | B | 差距 |
|---|---|---|---|---|
| 批准率 | (TP + FP)除以总数 | 55% | 40% | 15 pp |
| 真阳性率 | TP 除以正例数 | 90% | 60% | 30 pp |
| 假阳性率 | FP 除以负例数 | 20% | 20% | 0 pp |
| 阳性预测值 | TP 除以预测正例数 | 82% | 75% | 7 pp |
这张表使本章的核心约束具体化:某一个公平性指标看似得到满足,而另一些指标则暴露出显著的差异。
负责任的人工智能属于系统工程问题,因为它的控制措施会影响生产架构。公平性监测会消耗计算资源,并可能影响延迟。SHAP 与 LIME 等可解释性方法会引入推理工作,影响容量规划与 SLO 合规。系统提示、模型版本与审计日志需要归属、版本控制以及 CI/CD 控制。这些成本必须在设计阶段进行预算,而不能在部署后再行添加。
选择性解释生成体现了 C\(^3\) 这一取舍。同步生成解释会向请求路径增加计算量,并可能因检索特征而增加通信开销;将其移至异步 worker 则能保护服务延迟,但会在决策、证据记录与申诉流程之间引入协同开销。此时瓶颈便从推理容量转移到证据新鲜度或复核吞吐量。可接受的架构取决于谁需要解释,以及该人必须能在多快时间内据此采取行动。
本章形式化的不可能性定理表明,公平性并非一个需要优化的单一指标,而是一组相互竞争的约束,需要规范性选择。工程师可以量化这些取舍、计算差分隐私的开销、为差别影响指定监测机制,并设计出可在整个集群中扩展的治理机制。量化使约束显性化,但并不替人作出选择。
Key Takeaways: 伦理是一项工程约束
- 责任约束部署:在受监管或企业环境中,若系统无法记录行为、解释决策、支持审计或明确归属,那么准确率与延迟都不重要。治理是一项协同约束,它决定了计算是否获准运行。
- 公平性没有隐藏的优化点:本章的表格表明,一个贷款系统可以同时存在 0 percentage-point 的假阳性差距,以及 15 percentage-point 的批准率差距和 30 percentage-point 的真阳性差距。基础率差异使公平性成为一项明确的规范性选择,而非单一指标。
- 差异不等于因果诊断:群体指标揭示的是不均衡的结果或错误,而因果主张需要显式的结构模型与假设,这些无法仅从观测数据中恢复。路径特异性分析仍然把每条路径的正当性交由领域、法律与利益相关方的判断。
- 监督消耗容量:公平性监测、审计日志、解释与隐私保护训练会增加延迟、存储、计算与准确率成本。SHAP 式解释与 DP-SGD 必须在架构与 SLO 中预留预算,而不能等到法律审查到来时再追加。
- 生成式治理属于基础设施:系统提示、RLHF 策略、工具权限、模型版本与安全评估都是运行期产物。由于它们对模型行为的引导与权重同样直接,因此需要归属、CI/CD、回滚与监测机制。
- 证据需要责任人:只有当有团队能够调查、整改、回滚或升级失败时,仪表盘、解释与申诉才能真正保护用户。当每一项被度量的义务都对应一条可问责的运行路径时,负责任的人工智能才成为工程实践。
本书此前的约束都可以针对既定目标与预算进行测量和优化。公平性引入了不同的问题,因为本章的不可能性结果并不提供无需准则的优化点;它不是需要弥合的缺口,而是一次分岔。这改变了工程师的工作。他们可以量化每条分支,并对所选择的分支严格要求系统,但”作出选择”本身是人类规范性行为,没有任何指标能够完成;在这里,工程最诚实的做法是拒绝把选择伪装成计算。
What’s Next: 从责任走向综合
负责任治理将性能、安全、鲁棒性与可持续性合并为一项生产约束。结论 将这些原则综合为一种系统视角,并在具体技术发生变化时依然具有实用性。