引言
规模时刻
引言
目的
为什么在单机上行之有效的工程原则,到了生产规模会失效?
大规模机器学习有其自身的物理规律。在单个节点上,性能往往受限于内存墙:数据必须足够快地到达加速器,以保持计算持续忙碌。在分布式集群中,同样的问题会跨越机器展开。数据必须经由机架之间的网络链路传输,而最慢的共享通道可能限制整个作业。硬件故障的特征也会随之改变。当单个加速器上的训练作业发生故障时,它只是一个不便;但当 10,000 节点集群中的某个节点发生故障时,就可能使本章所定义的机器学习集群陷入停滞。这一不连续性解释了为什么掌握单机机器学习已不再足够。规模引入了不同的工程地形,需要额外的原则、架构,以及对“什么使系统工作”的思维方式。这片地形还会放大社会影响,因为这些系统可能服务数十亿用户。任何模型中的偏差都可能造成伤害,但广泛复用的基础模型中的偏差,会在许多下游系统中传播。本书所构建的学科,是分布的物理:计算、通信与协同,将算法选择转化为关于拓扑、容错、安全与治理的问题。
Learning Objectives
- 解释 Compute、Communication 与 Coordination 如何扩展 Data-Algorithm-Machine 视角,以适用于生产集群
- 应用集群定律来估算协同开销,并划分扩展形态
- 分析规模定律的极限,当可靠性、网络带宽、功耗或治理约束主导增长时
- 利用可靠性缺口、一致性-可用性权衡、通信强度与常规故障率,诊断集群级分布风险
- 综合集群栈的设计原则,涵盖物理基础设施、运行控制与社会治理
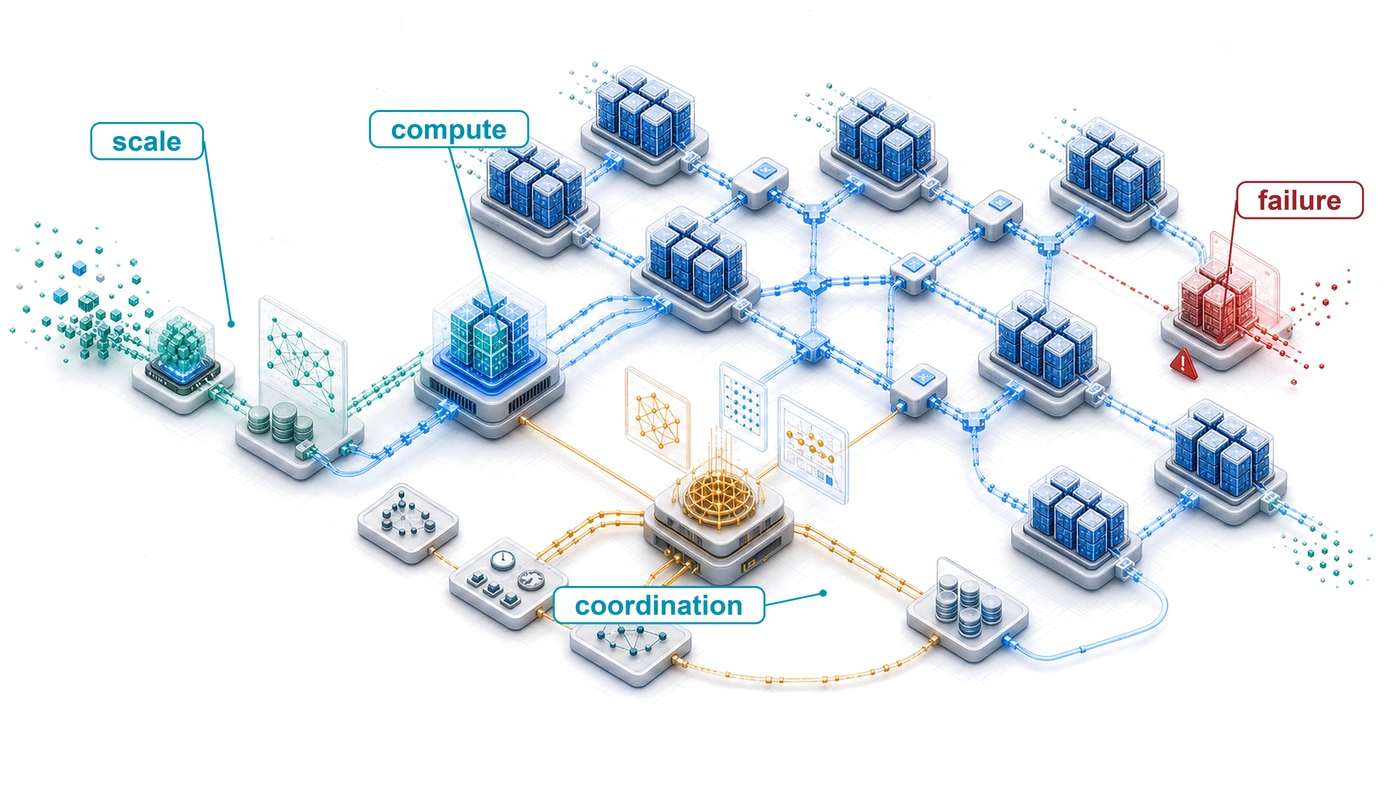
单加速器上的机器学习由本地存储层次结构和算术强度决定:这是硅的物理特性。当这台本地机器不再构成系统本身时,单机系统的边界便显现出来。随着模型从研究原型走向全球服务,约束条件向外迁移至机架、网络、供电以及恢复机制。这一变化并非平滑外推,而是规模时刻。
规模时刻是指模型遭遇三类反复出现的壁垒时,所发生的物理与运行层面的转变:内存、网络与能耗。这三类壁垒构成本书采用的规范三元组。在单加速器上,内存壁垒往往占据主导;当通信密集型任务被分发到数千个节点后,网络壁垒 可能取代本地内存,成为首要的性能瓶颈。其硬性上限包括二分带宽、切分整个集群的最窄切面所对应的聚合带宽,以及光速延迟。服务数十亿用户时,则可能进一步触及能耗壁垒,使热力学效率成为首要的工程要求。穿越这些壁垒的同时,也会打开一道可靠性缺口,使硬件故障从罕见的例外变成常规事件。
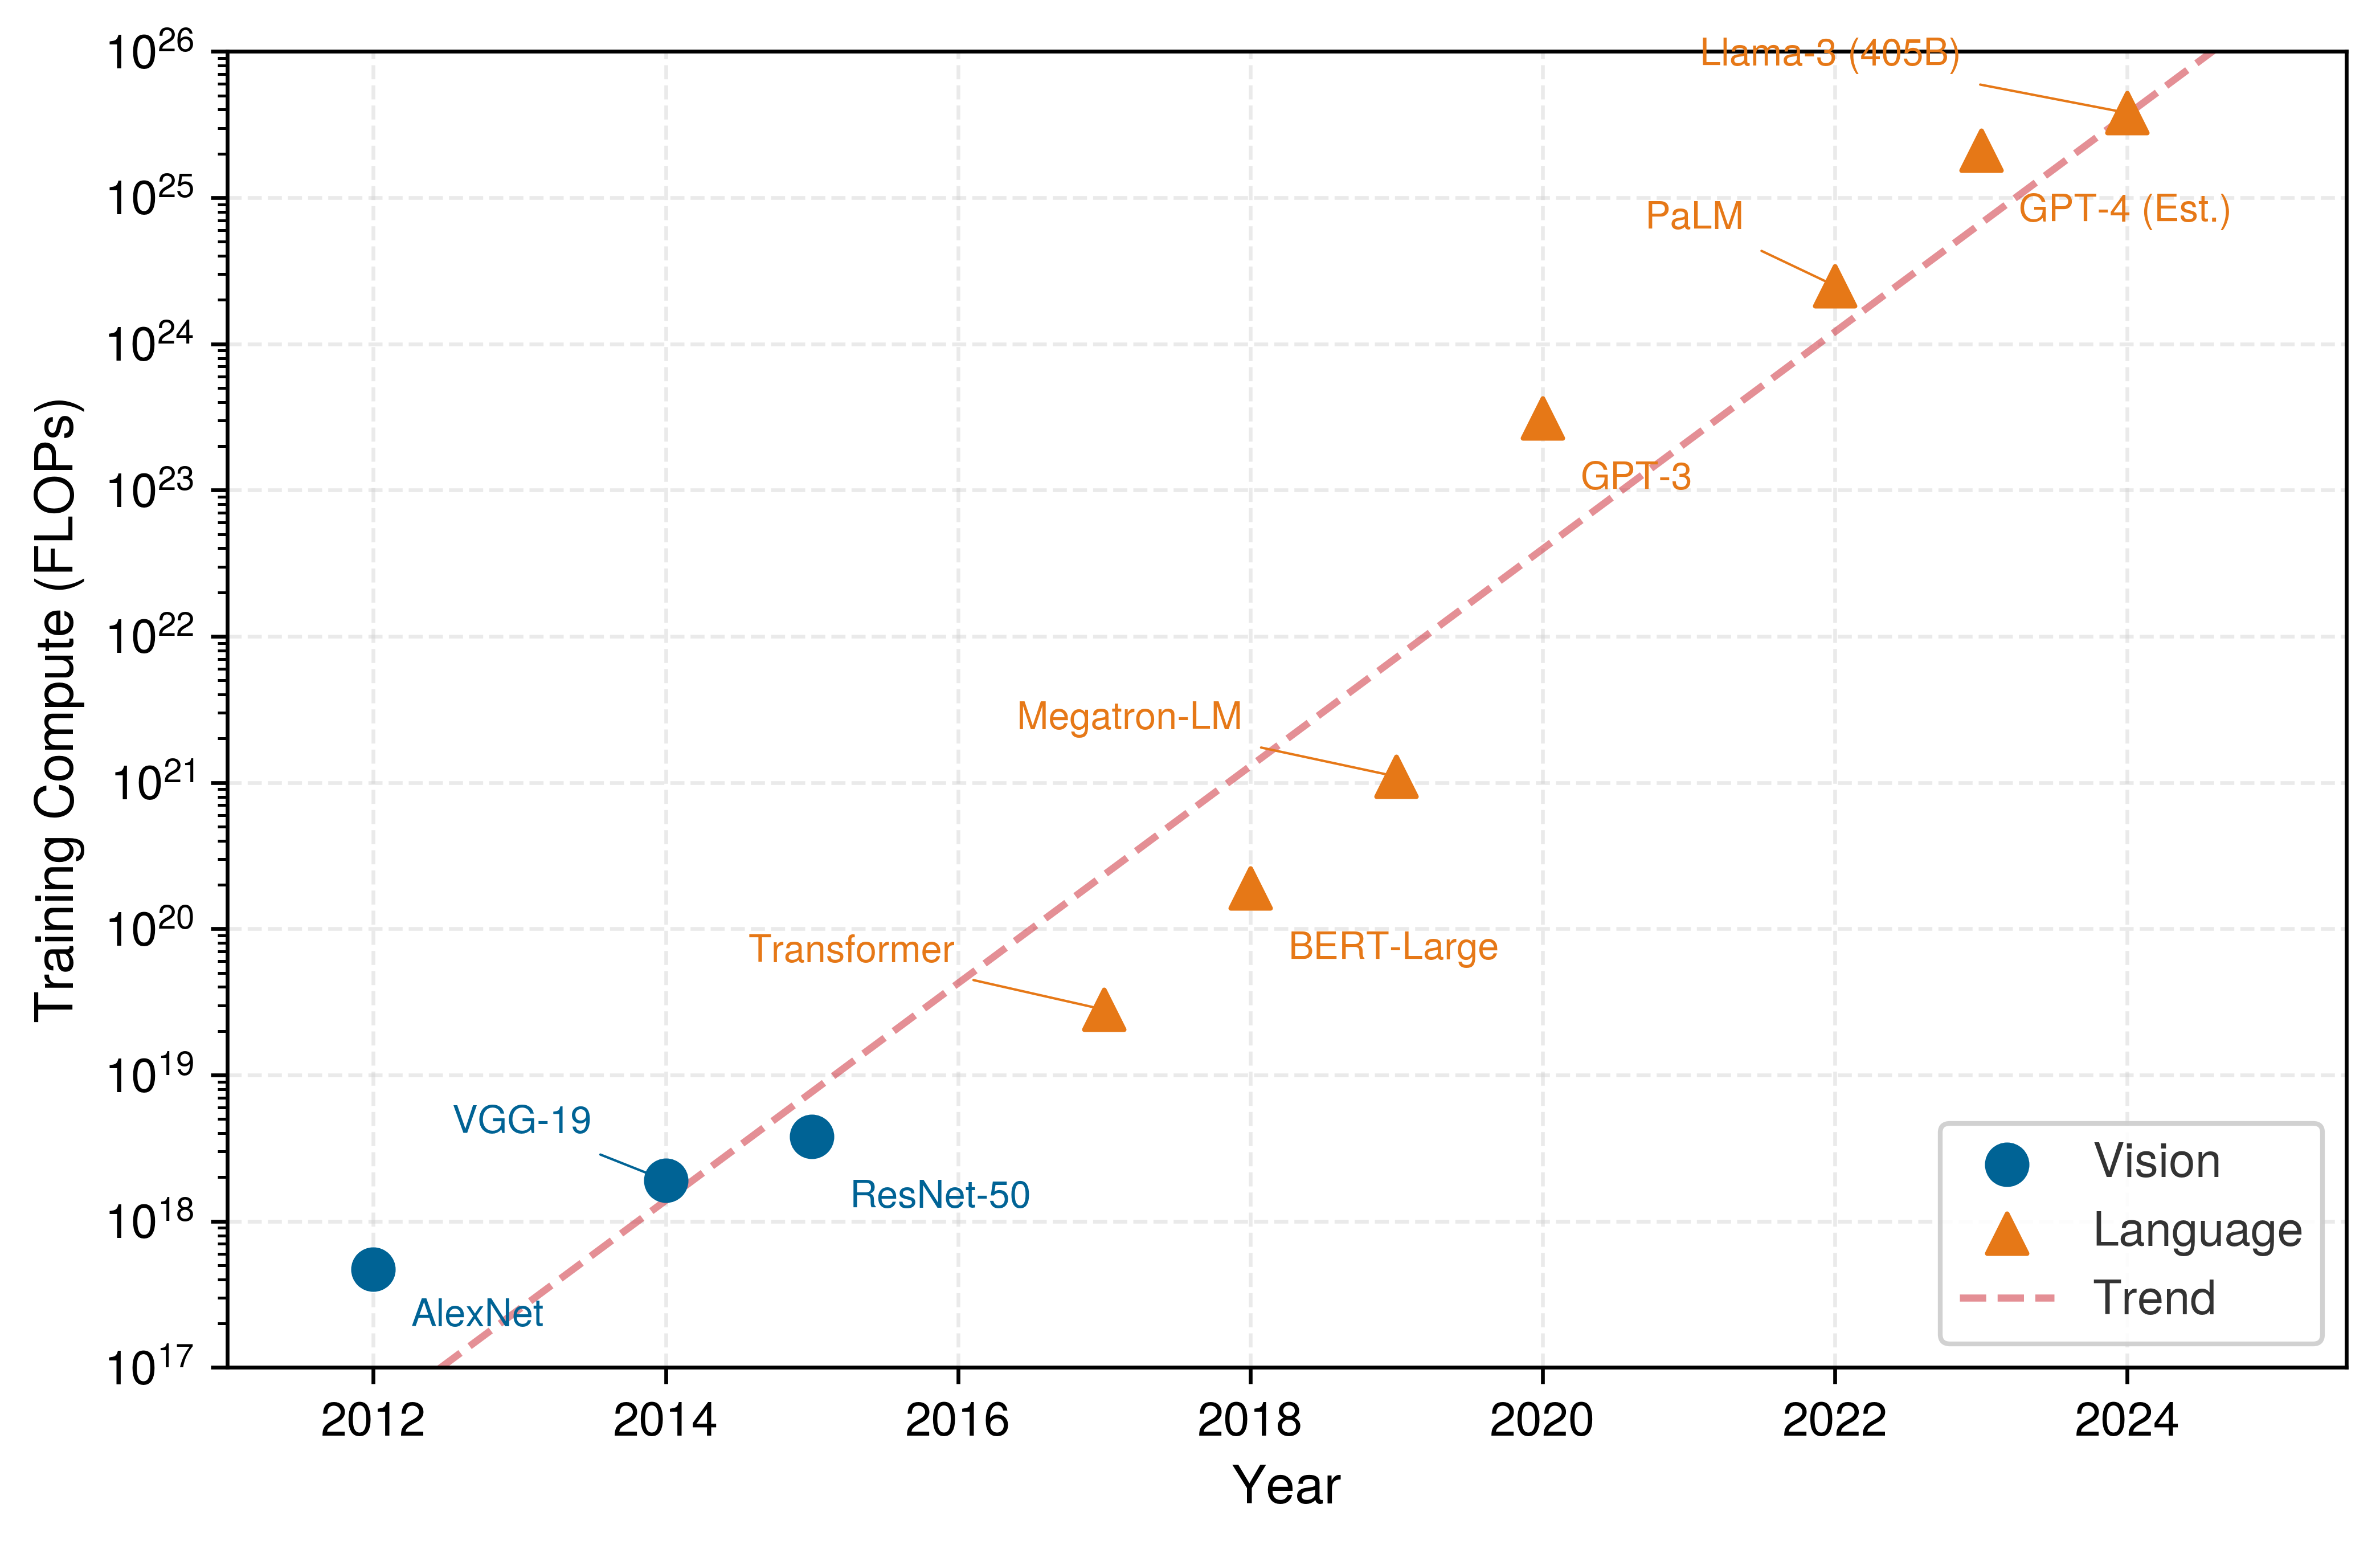
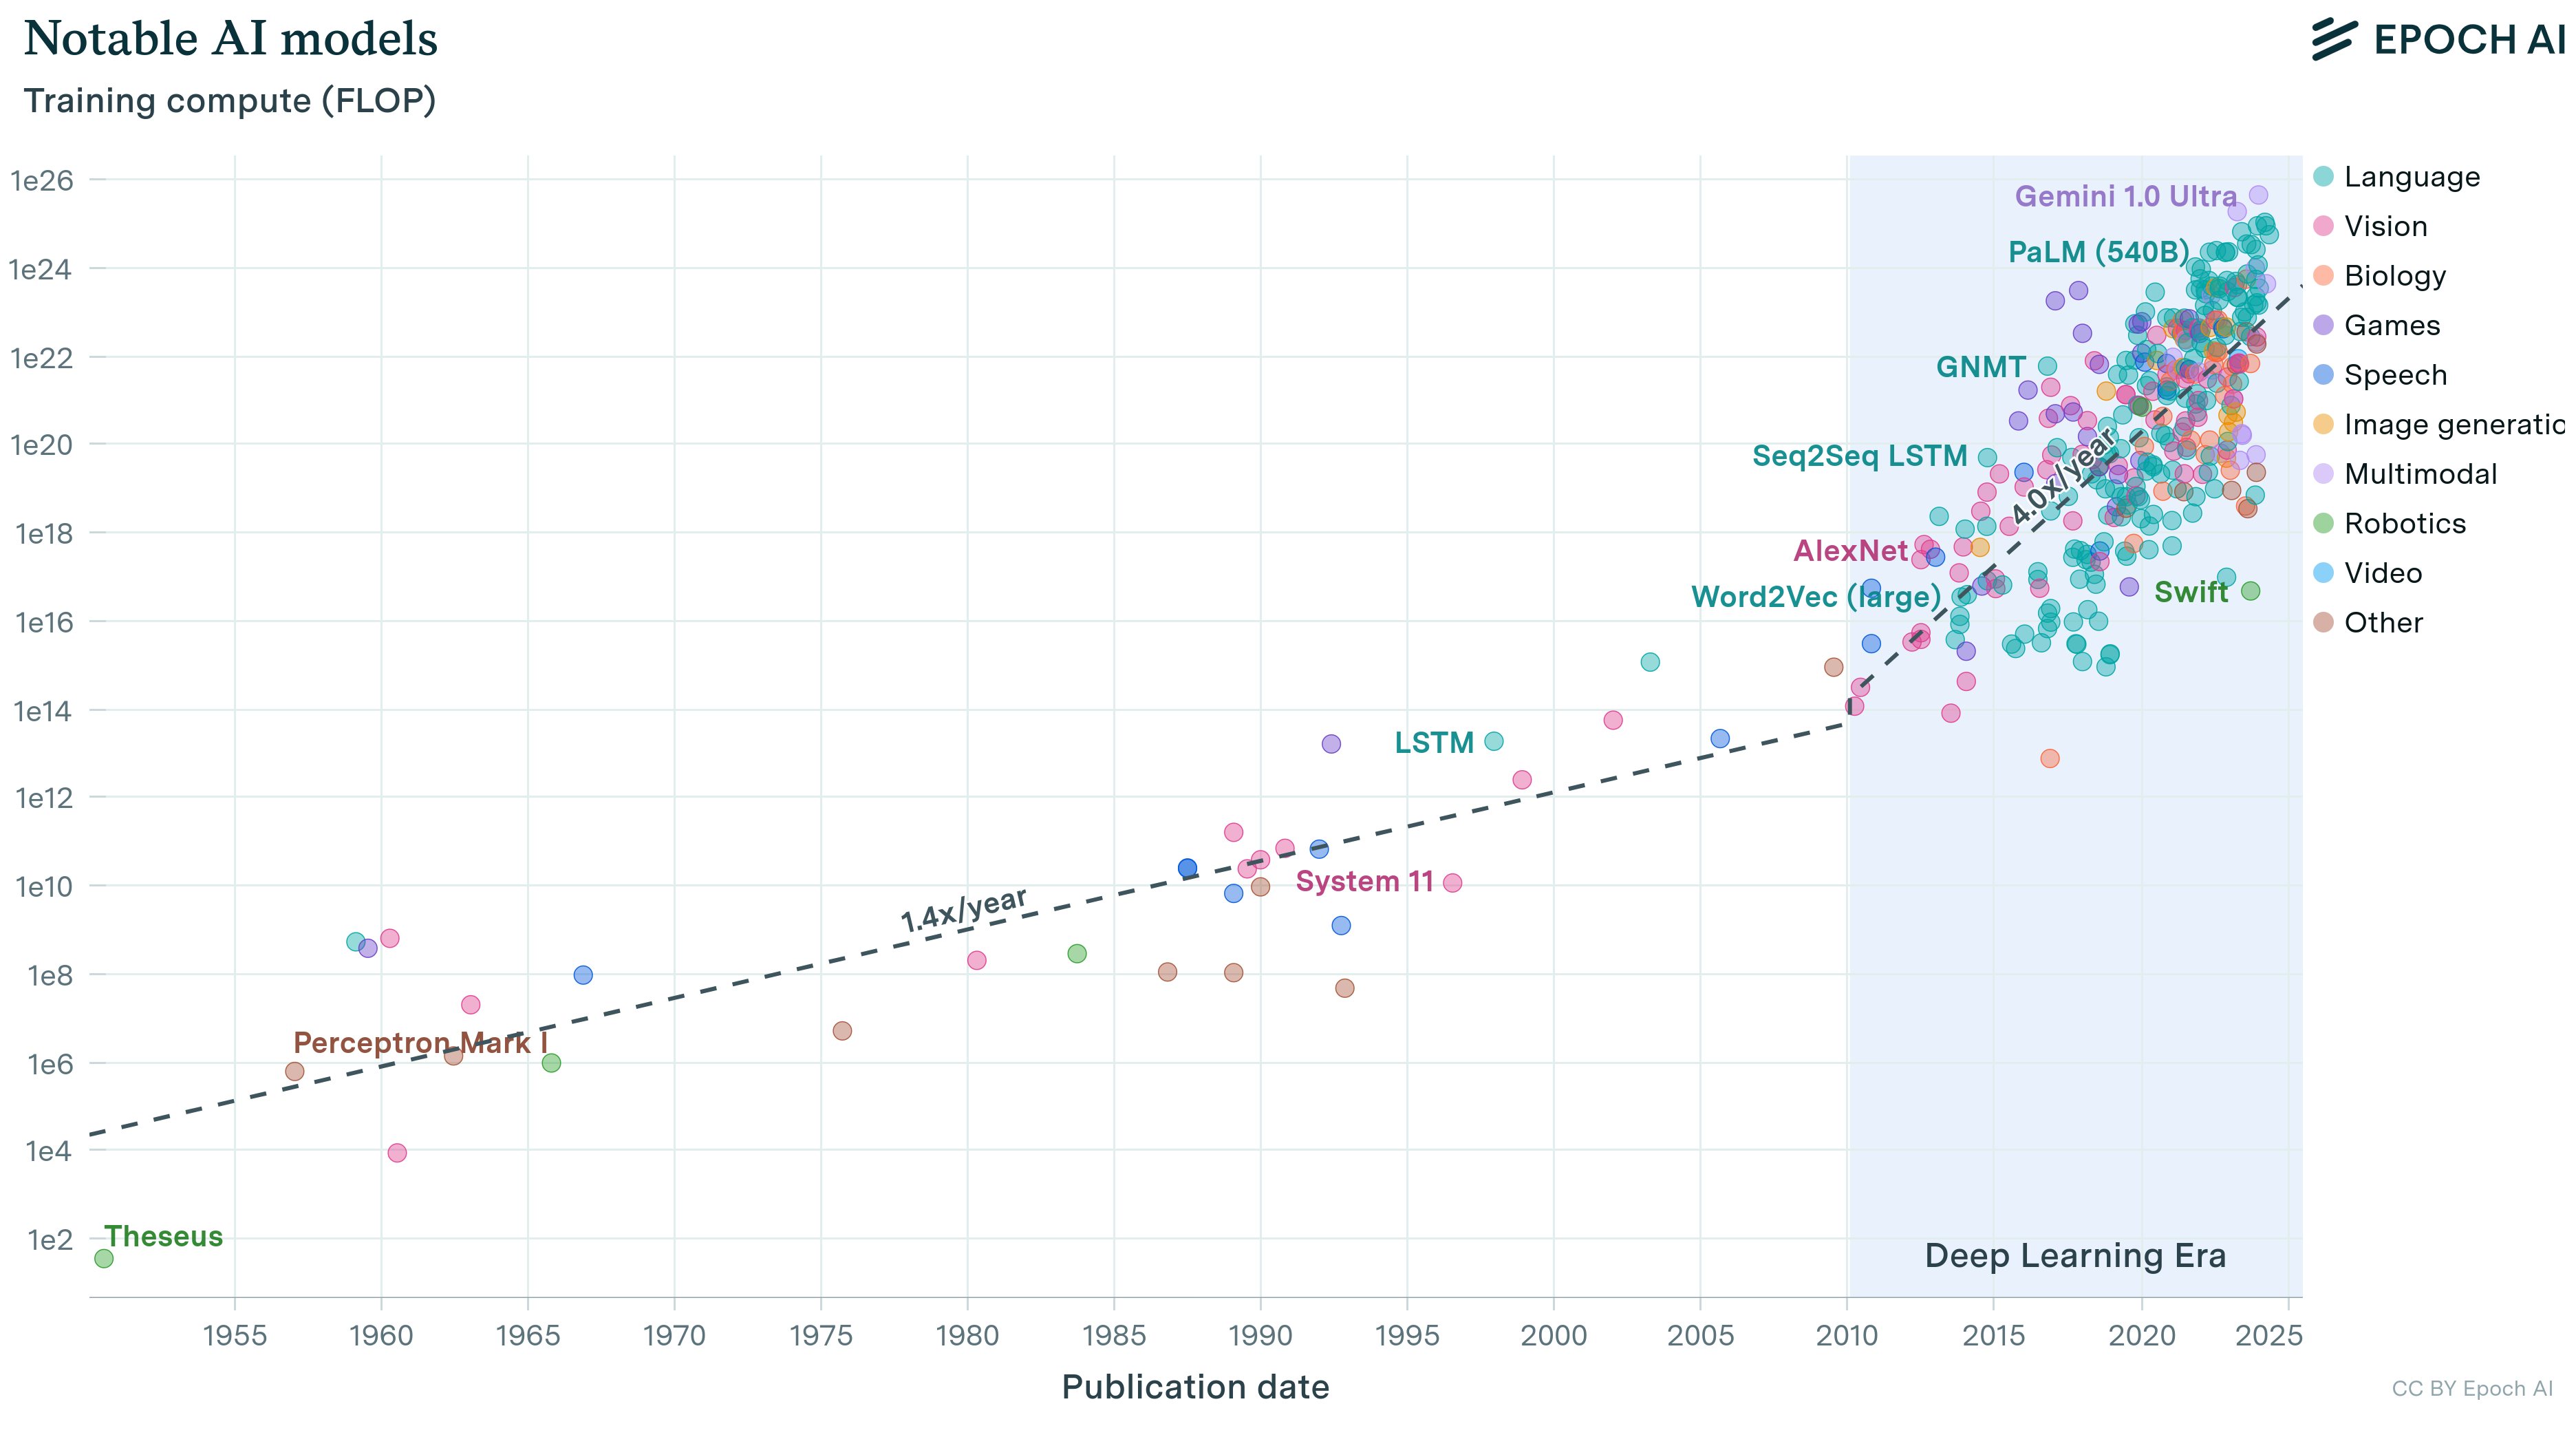
从 2012 年到 2020 年代中期,公开与第三方估算显示,训练算力从 AlexNet 的约 \(10^{18}\) FLOPs 增长到领先大模型的接近 \(10^{25}\) FLOPs,量级约为七个数量级。这一差异是性质上的变化,而不仅仅是数量上的变化。如今,算力、通信与协同已将算法选择转化为关于拓扑、容错、安全与治理的问题。
集群可靠性随节点数量增加而急剧下降。
考虑一个 GPT-4 量级的训练场景,使用一个假设的 A100-class 集群运行 25,000 GPUs,持续 90 days。这些数值仅为示意,并非 OpenAI 披露的数据 (OpenAI 等 2023年)。在如此规模的集群中,区间 \(t\) 内至少发生一次故障的概率(由系统平均故障间隔时间(MTBF)\(\text{MTBF}_{\text{system}}\) 决定)\(\Pr(\text{failure before } t) = 1 - e^{-t/\text{MTBF}_{\text{system}}}\) 便成为一项硬性约束。notebook 1.1 中的算例给出了单个集群的算术推导;MTBF 级联 则形式化了决定多千 GPU 集群故障率的 MTBF 级联关系,使读者能够预测任意集群规模的故障中断节奏。
Napkin Math 1.1: 规模与可靠性
问题:一个 GPT-4 量级模型的训练运行使用 25,000 GPUs。若每块 GPU 的 MTBF 为 50,000 hours(用于集群级可靠性示例的标准数据中心级数值),那么训练任务将因硬件故障而被打断的频率是多少?
数学推导:
- 系统 MTBF:系统 MTBF 等于组件 MTBF 除以独立 GPU 数量。按本场景的数值,50,000 hours 除以 25,000 GPUs 约为 2 hours。
- 每日故障率:24 小时除以 2 hours 约为 12 次故障/天。
- 全年总故障数:25,000 GPUs 乘以(8,760 hours 除以 50,000 hours)约为 4,380 次故障/年。
系统洞见:在该扩展形态下,组件故障在整个长运行过程中反复出现。人工重启无法扩展;系统必须从一开始就针对容错进行架构设计。硬件不能再被视为万无一失的抽象,因此自动状态保存与恢复已成为运行层面的硬性要求。
Meta 公布的 Llama 3 训练运行展示了真实大规模系统中的相同可靠性算术。
War Story 1.1: 该训练运行每隔几小时就会失败(2024)
背景:Meta 报告称,Llama 3 405B 在 16,384 张 H100 GPU 上训练了 54 天(预训练快照)(Dubey 等 2024年)。
机制:该 16,384 GPU 集群经历了 419 次意外中断,平均约每三小时发生一次故障,主要由 GPU 内存错误、静默数据损坏和网络链路抖动驱动。
影响:若无自动恢复,人工干预将消耗超过 80% 的集群墙钟时间,导致有效训练吞吐量停滞。
修复:Meta 部署了自动健康检查、快速检查点写入持久化存储,以及动态节点隔离,将平均恢复时间降至分钟级。
系统教训:规模拐点将可靠性从硬件规格转变为分布式系统设计要求。集群规模模型既由优化器训练,也由恢复机制训练。
Dubey, Abhimanyu, Abhinav Jauhri, Abhinav Pandey, Abhishek Kadian, 等. 2024年. The Llama 3 Herd of Models. arXiv preprint arXiv:2407.21783.
定义 Llama 3 运行的恢复机制之所以存在,是因为集群规模急剧膨胀;要理解为何一次运行如今需要数百次重启周期,追溯推动集群达到该规模的算力演进轨迹会很有帮助。机器学习的发展史就是规模史:每一项重大能力跃迁都源于在先前无法想象的规模上施加计算的能力,因而系统工程成为 AI 进步的核心。
算力需求呈指数增长。AlexNet 在两张 GTX 580 GPU 上训练约 5–6 天(Krizhevsky 等 2012年)。BERT 需要 64 个 Tensor Processing Unit (TPU)1 芯片运行 4 天,约合 6,144 芯片小时(Devlin 等 2019年)。
Krizhevsky, Alex, Ilya Sutskever, 和 Geoffrey E. Hinton. 2012年. 《ImageNet Classification with Deep Convolutional Neural Networks》. Advances in Neural Information Processing Systems (NeurIPS) 25.
1 张量处理单元(TPU):谷歌定制的专用集成电路(ASIC),围绕一个 \(256{\times}256\) 环形阵列 构建,该阵列由一批乘加单元组成,在相邻单元之间传递部分和,以牺牲 GPU 的灵活性为代价,换取矩阵密集型机器学习工作负载上 15–30\(\times\) 倍的每瓦性能提升。真正重要的是集群规模层面的影响:TPU v4 机舱的聚合规模达到 1.1 EFLOP/s,但其专用的片间互连结构——每芯片 4,800 Gb/s——才使它们成为一台单台分布式计算机,而非一堆高速芯片。没有这条互连结构,BERT 的 64 芯片训练在成为算力受限之前,早就变成通信受限了。
Devlin, Jacob, Ming-Wei Chang, Kenton Lee, 和 Kristina Toutanova. 2019年. 《BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding》. Proceedings of the 2019 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies, 4171~86. https://doi.org/10.18653/v1/n19-1423.
Chowdhery, Aakanksha, Sharan Narang, Jacob Devlin, Maarten Bosma, Gaurav Mishra, Adam Roberts, Paul Barham, 等. 2022年. 《PaLM: Scaling Language Modeling with Pathways》. arXiv preprint arXiv:2204.02311.
Amodei, Dario, 和 Danny Hernandez. 2018年. 《AI and Compute》. OpenAI Blog 2.
Sevilla, Jaime, Lennart Heim, Anson Ho, Tamay Besiroglu, Marius Hobbhahn, 和 Pablo Villalobos. 2022年. 《Compute Trends Across Three Eras of Machine Learning》. 2022 International Joint Conference on Neural Networks (IJCNN), 1~8. https://doi.org/10.1109/ijcnn55064.2022.9891914.
GPT-3 在微软高带宽集群的 V100 GPU 上进行训练,估计消耗了 3.14 × 10²³ FLOPs (Brown 等 2020年)。这一时期的微软基础设施规模约为 10,000 张 GPU,这也是 图 2 中使用的集群规模基准。PaLM 在 6,144 张 TPU v4 芯片上训练了约 60 天,消耗约 \(10^{24}\) FLOPs (Chowdhery 等 2022年)。OpenAI 的 GPT-4 报告未披露模型规模、训练硬件或训练算力,因此本节的 GPT-4 级场景应视为示意性说明,而非已发布的配置 (OpenAI 等 2023年)。这些例子处于早期算力趋势研究 (Amodei 和 Hernandez 2018年; Sevilla 等 2022年) 所记录的快速训练算力增长趋势 之中。训练算力演进 明确指出了这一规模转变:训练预算从单机实验转向分布式系统,其中硬件数量、墙钟时间和运行期协同都已成为模型设计的一部分。
| 模型 | 年份 | GPU/TPU | 训练时间 | 估计 FLOPs |
|---|---|---|---|---|
| AlexNet | 2012 | 2 张 GPU | 5–6 天 | ~\(10^{18}\) |
| BERT-Large | 2018 | 64 张 TPU | 4 天 | ~\(10^{20}\) |
| GPT-3 | 2020 | 1,024 V100 GPUs(运行估计) | 至少 29 days | 3.14 × 10²³ FLOPs |
| PaLM | 2022 | 6,144 张 TPU | ~60 天 | ~\(10^{24}\) |
| GPT-4 级场景 | 2023 | ~25,000 GPUs(示意) | ~90 days(示意) | ~\(10^{25}\) 场景 |
训练算力只是其中一个维度。图 2 通过绘制过去十年训练里程碑模型所使用的加速器数量,追踪集群规模本身的相关增长。
图 1 展示了这一增长趋势,涵盖视觉模型与语言模型两个方面。训练算力只是其中一个维度。图 2 则追踪了集群规模本身的相关增长,通过绘制过去十年训练标志性模型所使用的加速器数量来呈现。
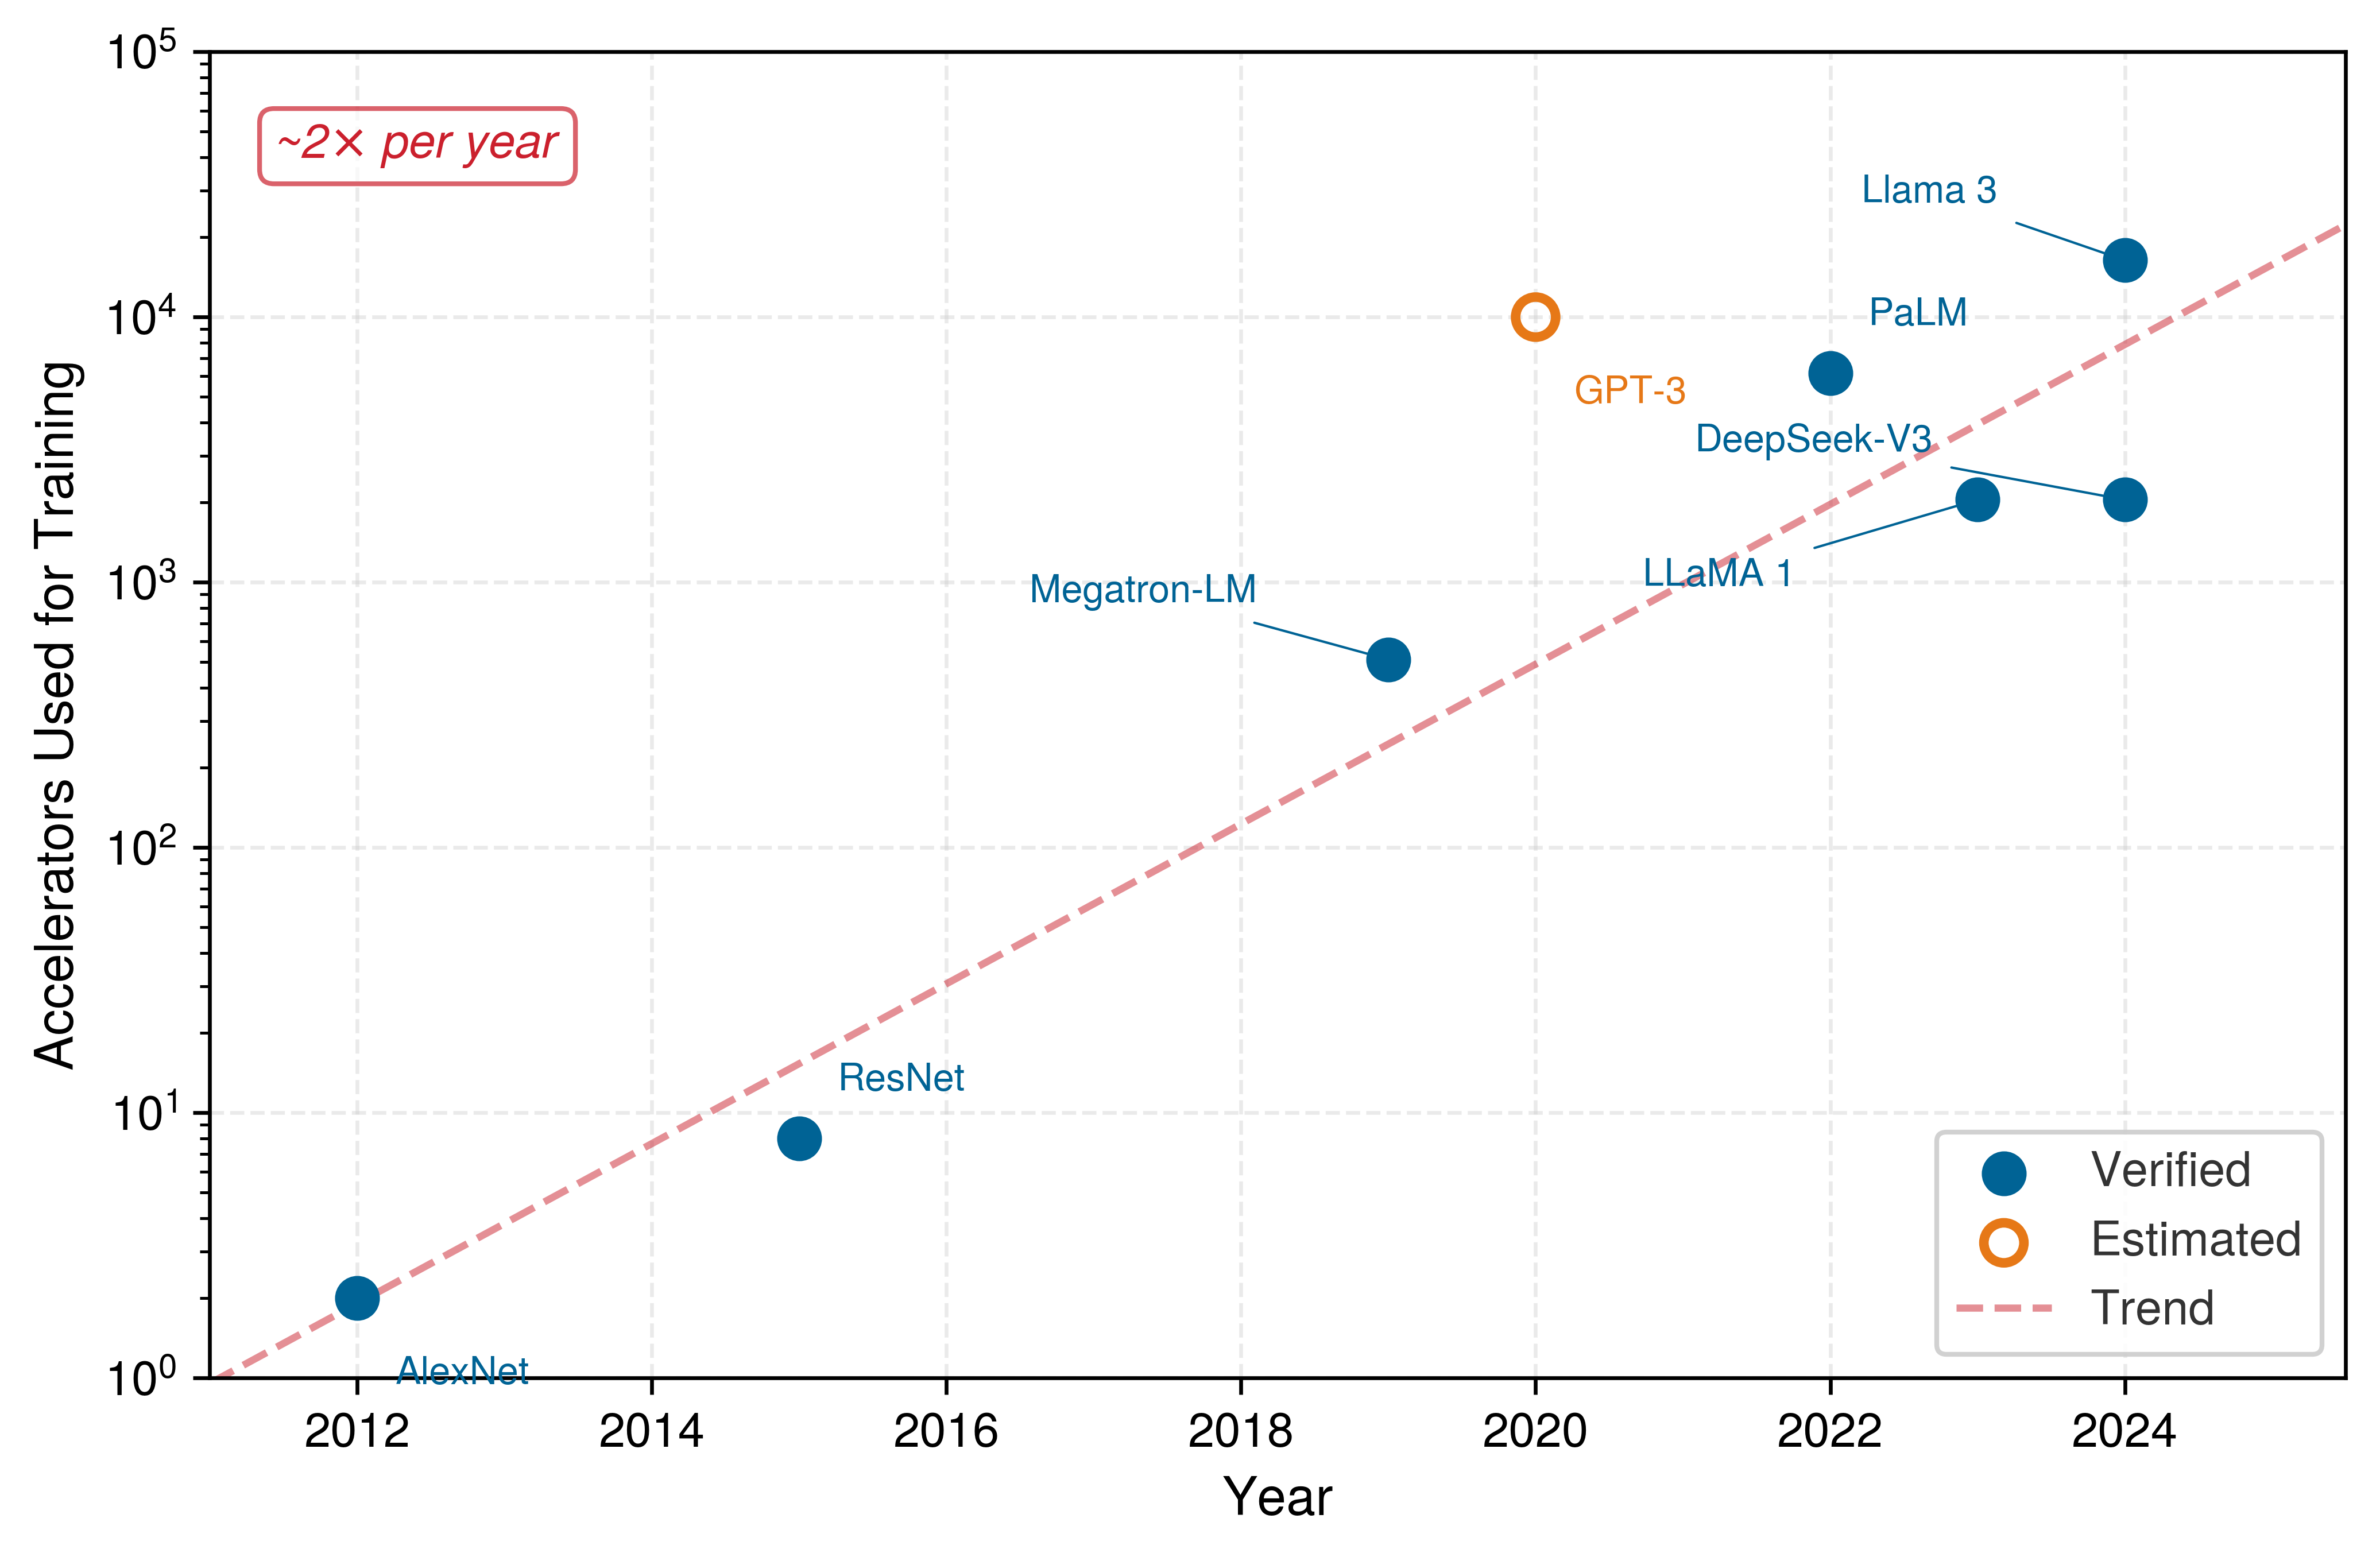
图 2 显示,集群规模在十多年内增长了约四个数量级,从 AlexNet 的两张 GPU 到 Llama 3 的超过 16,000 张 H100。这条实证轨迹构成了规模时刻(scale moment)的基础:领先的模型需要比早期深度学习里程碑大得多的加速器集群。然而,仅凭这条曲线并不能解释哪个约束最先被突破。大语言模型训练、推荐服务以及联邦移动学习都会遇到集群规模问题,但各自施加的压力位于系统的不同部分。
Lighthouse 1.1: 大规模灯塔架构
灯塔架构 是使本书中的规模时刻保持具体化的规范工作负载。在此阶段,它们的作用是表明“更多机器”并非一个工程问题:主导性约束取决于需要跨越集群边界的是什么。完整的架构名单连同 C\(^3\) 分类映射与绑定约束分析见 节 1.5.1.
- 架构 A(GPT-4/Llama-3):非常大的语言模型从单设备的内存边界转向多节点模型并行 与流水线并行,因此通信可能成为通信密集型切分部分的瓶颈。
- 架构 B(大规模 DLRM):深度学习推荐模型(DLRM)工作负载从本地内存中的嵌入表拟合转向在数百个节点上的嵌入切分,因此协调稀疏特征路由、切分放置与请求调度便成为瓶颈。
- 架构 C(联邦 MobileNet):移动推理与端侧自适应从单个设备转向跨越数十亿设备的联邦学习,因此每设备的计算与功耗预算便成为瓶颈。
这些架构将增长曲线转化为工程问题。加速器数量的相同增长可能产生网络墙、稀疏路由的协同瓶颈,或每设备计算上限。架构将注意力导向工作负载,而一组并行的系统视角则对底层设施做同样的处理,将注意力导向数据中心物理、网络拓扑与分布式一致性。结合联邦学习(边缘智能)的兴起,这种多样性使得系统工程在大规模机器学习中居于核心地位。一个无法扩展的复杂算法,往往比在可扩展基础设施上高效部署的更简单算法具有更少的实用价值。
从单机训练到分布式训练的过渡会引入系统行为的定性变化。图 3 对比了这两种形态:单机工作负载通常受内存墙支配,而集群规模工作负载中通信可能占主导,长时间运行中故障成为常态,治理也更加复杂。
图 3 所呈现的不连续性,既包括定性方面,也包括定量方面。在集群(fleet)规模下,约束条件可能从本地芯片转移到网络互连结构,而可靠性(resilience)则与优化并列成为首要关注点。计算单元不再是一台服务器,而是一台机器学习集群,即一个互联的分布式系统,被设计为能够作为一个连贯的计算引擎运行。
Definition 1.1: 机器学习集群
机器学习集群 是由数千台互联加速器、存储阵列和网络互连结构组成的分布式系统,被设计为作为一台单一连贯的计算机运行。
- 重要性:它在所有节点之间协调同步状态,其中总时间 \(T\) 由最慢的 worker(straggler) 决定。它需要与集群聚合计算容量 \(R_{\text{peak}}\) 成比例扩展的二分带宽(bisection bandwidth)\(\text{BW}_{\text{bisect}}\)。
- 区别:与传统的集群(例如 Spark、MapReduce)管理各自独立、异步的作业不同,机器学习集群运行在同步紧耦合 之下:所有 worker 都必须先到达训练步的同步屏障,任何 worker 才能继续推进,因此必须保持近乎完美的可靠性以维持吞吐量。
- 常见误区:一种常见误解是认为机器学习集群“只是更多的服务器”。实际上,它是一台仓库级计算机(WSC),其中网络充当系统总线,而编排器则是操作系统。
当系统规模超过单个节点后,一个基本的物理约束随之显现:二分带宽墙,2 它限制了数据穿越网络中点的速度。在集群规模下,网络往往比计算更能决定模型的吞吐量。
2 二分带宽(源自图论):若切断这些链路,会将网络划分为两个规模相等的节点集合,则这些链路聚合带宽的最小值。在分布式机器学习中,这一“最坏情况”的切分决定了集群的同步瓶颈:无论增加多少 GPU,AllReduce 同步都无法快于二分带宽。
3 规模化后的硬件故障率:在典型条件下,单张 GPU 的故障率为每年 1–2 个百分点,但在高强度训练工作负载下,故障率超过 9 个百分点。乘以集群规模后,故障便成为常态:Meta 报告称,Llama 3 在 16,384 张 H100 上进行的 54 天训练中出现了 419 次意外中断,平均约每三小时一次,其中 GPU 和高带宽内存(HBM3)故障占了一半以上。自动检查点与恢复机制将有效训练时间维持在 90 个百分点以上,这表明在集群规模下,工程挑战的重心已从防止故障转向最小化恢复延迟。
在单张 GPU 上,可复现训练除了固定的代码、数据和随机种子之外,还需要确定性的内核与执行设置。当规模达到数千张 GPU 时,新的现象随之出现。网络分区可以将集群拆分为各自独立训练的组,从而引起模型发散。Stragglers(由于硬件差异或热节流而比同侪处理数据更慢的 worker)可能成为整个训练运行的瓶颈。当运行 10,000 台机器时,原本每台机器每年才会发生一次的硬件故障会变成每日事件。3 系统必须足够频繁地进行检查点(checkpointing),使得丢失一天的进度变得可接受,而非灾难性。
这些由规模引发的挑战推动了大型 AI 组织的基建投资。Meta 的 Research SuperCluster 于 2022 年公布,包含 16,000 台 NVIDIA A100 GPU,并通过 200 Gb/s InfiniBand4 网络连接(AI 2022年)。Google 的 TPU v4 机舱包含 4,096 chips,总计算容量为 1.1 EFLOP/s(Zu 等 2024年)。微软为 OpenAI 打造的 Azure 超级计算机在 2020 年达到超过 10,000 台 GPU,此后 Azure AI 数据中心公告所描述的训练网络则达到数万 GPU 规模Microsoft (2025年)。模型的规模决定了基础设施的规模。The α-β Communication Model 汇总了这些互连带宽常数,并将其输入到 \(\alpha\)-\(\beta\) 通信模型中,使读者能够将链路的带宽与延迟转化为预测的传输成本。
4 InfiniBand:诞生于 1999 年,由 Intel 的 NGIO 与 Compaq/IBM Future I/O 计划合并而来,最初设计用于取代 PCI 总线;其在机器学习中的标志性特性是远程直接内存访问(RDMA),该特性绕过操作系统内核,以微秒级延迟直接在不同机器上的应用内存之间传输数据。HDR InfiniBand 每条链路提供约 25 GB/s 的线速带宽;NDR 则达到约 50 GB/s。与常见以太网链路相比的带宽差距,决定了大规模模型训练是计算受限还是通信受限。
AI, Meta. 2022年. Building the Most Powerful AI Supercomputer: Meta’s AI Research SuperCluster. Meta AI Blog.
Zu, Y., A. Ghaffarkhah, H.-V. Dang, B. Towles, S. Hand, S. Huda, A. Bello, 等. 2024年. 《Resiliency at Scale: Managing Google’s TPUv4 Machine Learning Supercomputer》. 21st USENIX Symposium on Networked Systems Design and Implementation (NSDI 24), 761~74.
Microsoft. 2025年. Inside the World’s Most Powerful AI Datacenter. The Official Microsoft Blog.
规模拐点说明了为何计算需求的指数增长会迫使某些 ML 系统超出任何单台机器的能力,使通信成为潜在瓶颈、长运行中的组件故障成为常态,并使治理义务更加重要。下一个问题是:如何组织工程层面的应对。既有的分布式系统技术依然不可或缺,但全局屏障与大规模共享模型状态会改变其成本,并决定哪些恢复与一致性机制适用。集群规模的架构分层将这些依赖关系明确呈现出来。
集群栈:架构分层
Apache Spark(Zaharia 等 2016年) 通常以显式 shuffle 边界处理数据并行任务;Web 微服务通常处理可隔离失败的请求。而大规模同步训练负载则每隔几百毫秒就在数千台加速器之间更新共享模型状态。全局屏障与大规模状态使得 stragglers、恢复与通信的耦合程度比这些例子中更为紧密,尽管集群仍然依赖既有的分布式系统机制。为了系统性地分析由此产生的依赖关系,本书采用四层集群栈,将原始集群资源连接到全球规模的 AI 应用。
Zaharia, M., R. S. Xin, P. Wendell, T. Das, M. Armbrust, A. Dave, X. Meng, 等. 2016年. 《Apache Spark: A Unified Engine for Big Data Processing》. Communications of the ACM 59 (11): 56~65. https://doi.org/10.1145/2934664.
图 4 可视化了从单机到集群的过渡。左侧概括了 1–8 台加速器的单机形态,此时本地内存可能成为约束瓶颈。缩放箭头跨越到分布式形态,其中数千台节点通过高速交换结构进行协同。对于通信密集型同步负载,瓶颈随后可能转移到二分带宽墙,因为网络拥塞与消息传递延迟占据了逐步时间中越来越多的份额。
\begin{tikzpicture}[font=\sffamily\small]
\tikzset{
Box/.style={align=center, inner xsep=2pt,draw=GreenLine, line width=0.5pt,
node distance=8.5mm,fill=none, minimum width=27mm, minimum height=20mm},
Box1/.style={Box,draw=OrangeLine,fill=none},
Box2/.style={align=center, inner sep=0pt,draw=GreenLine, line width=0.5pt,
anchor=south east,fill=none, minimum width=29mm, minimum height=6mm},
BoxD/.style={Box,font=\small\sffamily\bfseries,anchor=north,
draw=red,dashed,text=black,fill=none, line width=1pt,
minimum width=59mm,minimum height=9mm},
BoxD1/.style={Box,font=\small\sffamily\bfseries,align=center,
draw=none,text=black,fill=black!007, line width=1pt,
minimum width=59mm,minimum height=12mm},
Circle1/.style={circle,  minimum size=33mm, draw=none, fill=BrownLine!20},
LineD/.style={BrownLine!60!black!20,line width=4.0pt,dashed,dash pattern=on 5pt off 2pt,
{-{Triangle[width=1.5*6pt,length=2.0*5pt]}},shorten <=5pt,shorten >=1pt},
LineA/.style={GreenLine!90,line width=7.0pt,font=\sffamily\bfseries\small,
{-{Triangle[width=1.5*8pt,length=2.0*5pt]}},shorten <=7pt,shorten >=8pt},
ALineA/.style={black!60,{Circle[line width=1.0pt,fill=white,round,length=5pt,width=5pt]}-,
line width=1.0pt,shorten <=-3pt,shorten >=-1pt},
Text1/.style={font=\sffamily\footnotesize,text=black!70}
}

%CPU
\tikzset{%
 pics/cpu/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=FUNNEL,scale=\scalefac, every node/.append style={transform shape}]
\node[fill=\filllcolor,minimum width=66, minimum height=66,
            rounded corners=2,outer sep=2pt] (C1) {};
\node[fill=white,minimum width=54, minimum height=54] (C2) {};
\node[fill=\filllcolor!40,minimum width=44, minimum height=44] (C3) {\large GPU};

\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=\filllcolor,minimum width=3, minimum height=15,
           inner sep=0pt,anchor=south](GO\y)at($(C1.north west)!\x!(C1.north east)$){};
}
\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=\filllcolor,minimum width=3, minimum height=15,
           inner sep=0pt,anchor=north](DO\y)at($(C1.south west)!\x!(C1.south east)$){};
}
\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=\filllcolor,minimum width=15, minimum height=3,
           inner sep=0pt,anchor=east](LE\y)at($(C1.north west)!\x!(C1.south west)$){};
}
\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=\filllcolor,minimum width=15, minimum height=3,
           inner sep=0pt,anchor=west](DE\y)at($(C1.north east)!\x!(C1.south east)$){};
}
 \end{scope}
     }
  }
}

%Token style
\tikzset{
pics/token/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\node[draw=\drawcolor,fill=\filllcirclecolor,circle,minimum size=40mm,
line width=\Linewidth](T-\picname){};
\node[draw=white,fill=none,circle,minimum size=0.925*40mm,line width=0.6*\Linewidth]{};
\clip[] circle (0.925*20mm);
\draw[step=5mm,draw=white] (-2,-2) grid (2,2);
\foreach \x/\y[count=\a] in {0/0,1.3/0,1/1,-0.5/1.5,-1.5/0.5,-1.0/-0.9,0.5/-1.3,2.0/0}{
\fill[fill=white,draw=none](\x,0.8*\y)circle(5pt)coordinate(C\a);
}
\draw[white,line width=\Linewidth,fill opacity=0.5,fill=\filllcolor!40](C2)--(C3)--(C4)--(C5)--(C6)--(C7)--cycle;
\foreach \x in {2,...,7}{
\draw[white,line width=\Linewidth](C1)--(C\x);
}
\foreach \x/\y\col[count=\a] in {0/0/red,1.3/0/green,1/1/blue,-0.5/1.5/violet,
-1.5/0.5/magenta,-1.0/-0.9/brown,0.5/-1.3/yellow}{
\fill[fill=\col,draw=none](\x,0.8*\y)circle(5pt)coordinate(C\a);
}
\end{scope}
    }
  }
}
%display
\tikzset{%
    comp/.style = {draw,
        minimum width  =18mm,
        minimum height = 15mm,
        inner sep      = 0pt,
        rounded corners,
       draw = \drawcolor,
       fill=\filllcolor!10,
       line width=2.0pt
    },
 pics/displayG/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
 \node[comp](\picname-COM){};
% \draw[draw = \drawcolor,line width=1.0pt]
% ($(\picname-COM.north west)!0.85!(\picname-COM.south west)$)-- ($(\picname-COM.north east)!0.85!(\picname-COM.south east)$);
\draw[draw = \drawcolor,line width=\Linewidth]($(\picname-COM.south west)!0.4!(\picname-COM.south east)$)--++(270:0.2)coordinate(DL);
\draw[draw = \drawcolor,line width=\Linewidth]($(\picname-COM.south west)!0.6!(\picname-COM.south east)$)--++(270:0.2)coordinate(DD);
\draw[draw = \drawcolor,line width=3*\Linewidth,shorten <=-3mm,shorten >=-3mm](DL)--(DD);
\end{scope}
   }
  }
}

%gear
% #1 number of teeths
% #2 radius intern
% #3 radius extern
% #4 angle from start to end of the first arc
% #5 angle to decale the second arc from the first
% #6 inner radius to cut off
\tikzset{
  pics/gear/.style args={#1/#2/#3/#4/#5/#6/#7}{
   code={
           \pgfkeys{/channel/.cd, #7}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
    \pgfmathtruncatemacro{\N}{#1}%
    \def\rin{#2}\def\rout{#3}\def\aA{#4}\def\aOff{#5}\def\rcut{#6}%
    \path[rounded corners=1.5pt,draw=\drawcolor,fill=\filllcolor]
      (0:\rin)
      \foreach \i [evaluate=\i as \n using (\i-1)*360/\N] in {1,...,\N}{%
        arc (\n:\n+\aA:\rin)
        -- (\n+\aA+\aOff:\rout)
        arc (\n+\aA+\aOff:\n+360/\N-\aOff:\rout)
        -- (\n+360/\N:\rin)
      } -- cycle;
      \draw[draw=none,fill=white](0,0) circle[radius=\rcut];
\end{scope}
  }}
}
%Infinity_loops
\tikzset{%
  radius=2, start angle=-90, line cap=round,
  arr node/.style={sloped, allow upside down, single arrow,
    single arrow head extend=+2mm, thick, minimum height=+9mm, fill=white},
  arr/.style ={  edge node={node[arr node, pos={#1}]{}}},
  arr'/.style={insert path={node[arr node, pos={#1}]{}}},
 pics/infinityL/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=LOOPS,scale=\scalefac, every node/.append style={transform shape}]
\draw[line width=+2.5mm, sloped, text=white,draw=\drawcolor]
  (0, 2) edge[preaction={line cap=butt, line width=+5mm, draw=white, overlay},draw=\filllcirclecolor,
              out=0, in=180, arr=.2, arr=.8] (6, -2)
  (6, -2) arc[delta angle= 180]
    [arr'=.5,draw=\filllcolor] node[very near start]{} node[very near end]{}
  to[out=180, in=0, arr=.2, arr=.8] (0, -2) arc[delta angle=-180,]
    [arr'=.5,draw=\filllcolor] node[very near start]{} node[very near end]{};

 \end{scope}
     }
  }
}

%server
\tikzset {
  pics/server/.style = {
    code = {
     % \colorlet{red}{black}
\pgfkeys{/channel/.cd, #1}
      \begin{scope}[anchor=center, transform shape,scale=\scalefac, every node/.append style={transform shape}]
        \draw[draw=\drawcolor,line width=\Linewidth,fill=\filllcolor](-0.55,-0.5) rectangle (0.55,0.5);
\foreach \i in {-0.25,0,0.25} {
                \draw[line width=\Linewidth]( -0.55,\i) -- (0.55, \i);
}
        \foreach \i in {-0.375, -0.125, 0.125, 0.375} {
          \draw[line width=\Linewidth](-0.45,\i)--(0,\i);
          \fill[](0.35,\i) circle (1.5pt);
        }

        \draw[draw=\drawcolor,line width=1.5*\Linewidth](0,-0.53) |- (-0.55,-0.7);
        \draw[draw=\drawcolor,line width=1.5*\Linewidth](0,-0.53) |- (0.55,-0.7);
      \end{scope}
    }
  }
}
\tikzset{
pics/llm/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\node[circle,minimum size=12mm,draw=\drawcolor, fill=\filllcolor!70,line width=0.5*\Linewidth](C\picname) at (0,0){};
\def\startangle{90}
\def\radius{1.15}
\def\radiusI{1.1}
\foreach \i [evaluate=\i as \j using \i+1] [count =\k] in {0,2,4,6,8} {
\pgfmathsetmacro{\angle}{\startangle - \i * (360/8)}
\draw[draw=black,-{Circle[black ,fill=\filllcirclecolor,length=5.5pt,line width=0.5*\Linewidth]},line width=1.5*\Linewidth](C\picname)--++(\startangle - \i*45:\radius) ;
\node[circle,draw=black,fill=\filllcirclecolor!80!red!50,inner sep=3pt,line width=0.5*\Linewidth](2C\k)at(\startangle - \j*45:\radiusI) {};
}
\draw[line width=1.5*\Linewidth](2C1)--++(-0.5,0)|-(2C2);
\draw[line width=1.5*\Linewidth](2C3)--++(0.5,0)|-(2C4);
\node[circle,,minimum size=12mm,draw=\drawcolor, fill=\filllcolor!70,line width=0.5*\Linewidth]at (0,0){};
\node[draw,rectangle,rounded corners=1pt,minimum width=7mm,minimum height=4mm,fill=orange!10](R1)at(0.1,0.1){};
\draw[BrownLine,shorten <=2pt,shorten >=2pt ]($(R1.north west)!0.35!(R1.south west)$)--($(R1.north east)!0.35!(R1.south east)$);
\draw[BrownLine,shorten <=2pt,shorten >=2pt ]($(R1.north west)!0.7!(R1.south west)$)--($(R1.north east)!0.7!(R1.south east)$);
\node[draw,rectangle,rounded corners=1pt,minimum width=6mm,minimum height=4mm,fill=orange!10](R2)at(-0.05,-0.15){};
\draw[BrownLine,shorten <=2pt,shorten >=2pt ]($(R2.north west)!0.35!(R2.south west)$)--($(R2.north east)!0.35!(R2.south east)$);
\draw[BrownLine,shorten <=2pt,shorten >=2pt ]($(R2.north west)!0.7!(R2.south west)$)--($(R2.north east)!0.7!(R2.south east)$);
\end{scope}
    }
  }
}
\def\inset{3.2pt} %
\def\myshape{%
  (0,1.34) to[out=220,in=0] (-1.20,1.03) --
  (-1.20,-0.23) to[out=280,in=160] (0,-1.53) to[out=20,in=260] (1.20,-0.23) --
  (1.20,1.03)  to[out=180,in=320] cycle
}
\tikzset{
pics/stitC/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
%\draw[draw=none,fill=\filllcolor!60](0,1.34)to[out=220,in=0](-1.20,1.03)to(-1.20,-0.23)
%to[out=280,in=160](0,-1.53)to[out=20,in=260](C1)to(1.20,1.03)to[out=180,in=320]cycle;
\fill[fill=\filllcolor!60] \myshape;
%
\begin{scope}
  \clip \myshape;
  \draw[draw=\filllcolor, line width=2*\Linewidth,fill=white] \myshape; % Color and thickness as desired
\end{scope}
%\fill[fill=\filllcolor!60](0,0)circle(0.4);
\draw[draw=\filllcirclecolor,line join=round,line cap=round,line width=1.85*\Linewidth](-0.65,-0.35)--++(320:0.5)--++(50:1.4);
\end{scope}
    }
  }
}
%code
\tikzset{
pics/interpreter/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\node[black,font=\Large\bfseries]at(-0.75,0.65){\textless\,/\,\textgreater};
\draw[line cap=round,line join=round,green!99!black!90,line width=\Linewidth](-1.32,0.17)--(-1.05,0.17);
\draw[line cap=round,line join=round,red,line width=\Linewidth](-0.8,0.17)--(-0.1,0.17);
\draw[line cap=round,line join=round,green!99!black!90,line width=\Linewidth](-1.15,-0.15)--(-0.45,-0.15);
\draw[line cap=round,line join=round,green!99!black!90,line width=\Linewidth](-1.15,-0.47)--(-0.75,-0.47);
\draw[line cap=round,line join=round,red,line width=\Linewidth](-0.45,-0.47)--(0.45,-0.47);
\draw[line cap=round,line join=round,cyan,line width=\Linewidth](0.75,-0.47)--(1.1,-0.47);
\draw[line cap=round,line join=round,green!99!black!90,line width=\Linewidth](-1.15,-0.79)--(-1,-0.79);
\draw[line cap=round,line join=round,red,line width=\Linewidth](-0.65,-0.79)--(-0.10,-0.79);
\draw[line cap=round,line join=round,cyan,line width=\Linewidth](0.2,-0.79)--(1.1,-0.79);
\draw[line cap=round,line join=round,green!99!black!90,line width=\Linewidth](-1.15,-1.11)--(-0.4,-1.11);
\draw[line cap=round,line join=round,blue!99!black!90,line width=\Linewidth](-0.15,-1.11)--(1.1,-1.11);
\end{scope}
    }
  }
}
\pgfkeys{
  /channel/.cd,
   Depth/.store in=\Depth,
  Height/.store in=\Height,
  Width/.store in=\Width,
  filllcirclecolor/.store in=\filllcirclecolor,
  filllcolor/.store in=\filllcolor,
  drawcolor/.store in=\drawcolor,
  drawcircle/.store in=\drawcircle,
  scalefac/.store in=\scalefac,
  Linewidth/.store in=\Linewidth,
  picname/.store in=\picname,
  tiecolor/.store in=\tiecolor,
  bodycolor/.store in=\bodycolor,
  stetcolor/.store in=\stetcolor,
  tiecolor=red,      % derfault tie color
  bodycolor=blue!30,  % derfault body color
  stetcolor=green,  % derfault stet color
  filllcolor=BrownLine,
  filllcirclecolor=violet!20,
  drawcolor=black,
  drawcircle=violet,
  scalefac=1,
  Linewidth=0.5pt,
  Depth=0.2,
  Height=0.5,
  Width=0.25,
  picname=C
}

% Application
\node[Box1,draw=none](B1){};
\node[above=-1pt of B1.north,Text1]{Training Loop/Inference};
\node[Box2,draw=OrangeLine](BB1)at($(B1.south west)+(-3mm,0)$){Application};
\draw[ALineA](B1.west)--(BB1.north);
\pic[shift={(0,0.08)}] at  (B1){displayG={scalefac=0.95,picname=DD,
filllcolor=brown!60!, drawcolor=BrownLine,Linewidth=0.7pt}};
%\pic[shift={(-0.20,0.23)}] at (D-COM) {gear={11/1.25/1.7/11/2.0/0.6/scalefac=0.26,drawcolor=black,filllcolor=OrangeLine!90}};
\pic[shift={(0.47,0.32)}] at (DD-COM) {gear={10/1.3/1.8/17/1/0.6/scalefac=0.18,drawcolor=RedLine,filllcolor=RedLine}};
\pic[shift={(0.05,0.05)}] at  (DD-COM){interpreter={scalefac=0.5,picname=1,filllcolor=cyan!30!, Linewidth=2.0pt,filllcirclecolor=orange}};
%ML Framework
\node[Box1,draw=none,below=of B1](B2){};
\node[above=-1pt of B2.north,Text1]{PyTorch/JAX/Kernels};
\node[Box2,draw=GreenLine](BB2)at($(B2.south west)+(-3mm,0)$){ML Framework};
\draw[ALineA](B2.west)--(BB2.north);
\pic[shift={(0,0)}] at  (B2){token={scalefac=0.43,picname=2,drawcolor=green!55!black,
filllcirclecolor=green!55!black!90,filllcolor=green!55!black,Linewidth=1.25pt}};
%System Software
\node[Box1,draw=none,below=of B2](B3){};
\node[above=-1pt of B3.north,Text1]{CUDA/PCIe DMA};
\node[Box2,draw=VioletLine](BB3)at($(B3.south west)+(-3mm,0)$){System Software};
\draw[ALineA](B3.west)--(BB3.north);
\pic[shift={(0,0.1)}] at  (B3){displayG={scalefac=0.98,picname=D,
filllcolor=BlueLine, drawcolor=BlueLine,Linewidth=0.7pt}};
\pic[shift={(-0.20,0.23)}] at (D-COM) {gear={11/1.25/1.7/11/2.0/0.6/
scalefac=0.26,drawcolor=black,filllcolor=OrangeLine!90}};
\pic[shift={(0.2,-0.3)}] at (D-COM) {gear={10/1.3/1.8/17/1/0.6/
scalefac=0.2,drawcolor=black,filllcolor=OrangeLine!60}};
%Hardware
\node[Box1,draw=none,below=of B3](B4){};
\node[above=-1pt of B4.north,Text1]{NVLink (900 GB/s)};
\node[Box2,draw=RedLine](BB4)at($(B4.south west)+(-3mm,0)$){Hardware};
\draw[ALineA](B4.west)--(BB4.north);
\pic[shift={(0,0)}] at  (B4){cpu={scalefac=0.49,picname=1,filllcolor=GreenLine, Linewidth=0.7pt}};
%%%%%%%%%%%%%%%
% Governance
%%%%%%%%%%%%%%%
\node[Box1,right=3.2 of B1,draw=none](B1B){};
\node[above=-1pt of B1B.north,Text1]{Responsible AI/Security};
\node[Box2,draw=OrangeLine,anchor=south west](BB1B)at($(B1B.south east)+(3mm,0)$){Governance};
\draw[ALineA](B1B.east)--(BB1B.north);
\pic[shift={(0,0.05)}] at  (B1B){stitC={scalefac=0.63,picname=1,drawcolor=orange,
filllcolor=purple,filllcirclecolor=GreenLine,Linewidth=3.1pt}};
%Serving/Ops
\node[Box1,draw=none,below=of B1B](B2B){};
\node[above=-1pt of B2B.north,Text1]{Orchestration/CI/CD};
\node[Box2,draw=GreenLine,anchor=south west](BB2B)at($(B2B.south east)+(3mm,0)$){Serving/Ops};
\draw[ALineA](B2B.east)--(BB2B.north);
\pic[shift={(-0.6,0)}] at  (B2B){infinityL={scalefac=0.2,picname=1,Linewidth=1.0pt,
 filllcolor=BlueLine,filllcirclecolor=red,drawcolor=GreenLine}};
%Distribution
\node[Box1,draw=none,below=of B2B](B3B){};
\node[above=-1pt of B3B.north,Text1]{NCCL/RDMA/Comms};
\node[Box2,draw=VioletLine,anchor=south west](BB3B)at($(B3B.south east)+(3mm,0)$){Distribution};
\draw[ALineA](B3B.east)--(BB3B.north);
\pic[shift={(0,0)}] at  (B3B){llm={scalefac=0.78,drawcolor=BlueLine,filllcolor=BlueLine!50!, Linewidth=1pt,filllcirclecolor=red}};
%Infrastructure
\node[Box1,draw=none,below=of B3B](B4B){};
\node[above=-1pt of B4B.north,Text1]{Fabric/RDMA (InfiniBand)};
\node[Box2,draw=RedLine,anchor=south west](BB4B)at($(B4B.south east)+(3mm,0)$){Infrastructure};
\draw[ALineA](B4B.east)--(BB4B.north);
\pic[shift={(0,0.1)}] at  (B4B){server={scalefac=1.2,picname=1,
drawcolor=black,filllcolor=cyan!15!,Linewidth=0.57pt,Linewidth=1pt}};
%fitting
\node[draw=none,fit=(B1)(B4)(BB4)](F1){};
\node[draw=none,fit=(B1B)(B4B)(BB4B)](F2){};
\draw[LineA](F1)--node[above]{Scaling}(F2);
%
\node[BoxD,below=10pt of F1]{Bottleneck: Memory Wall};
\node[BoxD,below=10pt of F2]{Bottleneck: Network Wall};
%
\node[BoxD1,above=20pt of F1]{Single-Node Stack \\
{\small\sffamily 1--8 GPUs, Shared Memory}};
\node[BoxD1,above=20pt of F2]{Distributed Fleet Stack \\
{\small\sffamily 1,000--100,000+ GPUs}};
\end{tikzpicture}《Scaling Machine Learning Systems》第二卷 01 引言。
图 4 中的堆栈架构不随规模变化:每个机器学习系统都仍然包含硬件、系统包络、工作负载和任务。真正发生变化的是每一层的物理规律。请自下而上阅读该图。在最底一行,硬件(节点内部的 NVLink,900 GB/s)变为基础设施(跨越机架的 InfiniBand RDMA 网络互连结构,每条链路的带宽为 400 Gb/s),瓶颈也从内存墙转移到二分带宽墙。再往上一层,系统软件(单个 CUDA 运行时管理 PCIe 直接内存访问(DMA))变为分布层(NVIDIA 集合通信库 [NCCL] 与 RDMA 库,协调跨越网络互连结构的数千个进程)。
上层两层同样发生变化。机器学习框架(,PyTorch 或 JAX 在单个节点上执行训练循环)变为服务/运维(编排以及持续集成/持续部署(CI/CD)流水线,用于调度分布式作业并管理滚动部署)。在最顶层,应用(单个训练脚本或推理服务)变为治理(负责任的 AI 政策、安全审计以及多租户访问控制),因为集群规模的部署将组织层面的考量扩展到了单台机器之外。四层共同构成集群堆栈:
- 基础设施(硬件,引擎):物理基础。该层定义了集群的原始能力:每节点 \(R_{\text{peak}}\) 与 \(\text{BW}\),并通过 InfiniBand RDMA 网络互连结构互联。本引言中反复出现的硬件锚点是 NVIDIA H100,它作为具体的参考加速器,而非抽象占位符。
- 分布(系统,车辆):通信底层。该层定义了集群包络:NCCL,即实现 GPU 网络上归约与广播的集合库;RDMA 集合通信,协调数千个加速器;二分带宽;电能利用效率,即 IT 负载之上的设施能耗开销;以及故障率(平均无故障时间 MTBF)。
- 服务/运维(工作负载,路线):编排层。该层通过部署流水线与调度管理分布在集群 \((O, D_{\text{vol}}, \text{CI})\) 上的数学工作负载,其中 \(O\) 表示本地操作数,\(D_{\text{vol}}\) 表示数据量,\(\text{CI}\) 表示通信强度(CI):每个本地 FLOP 对应的网络字节数。代表性工作负载包括 GPT-4 与 DLRM。
- 治理(任务,目的地):任务语境。这是堆栈的顶层,负责任的 AI 政策、安全以及多租户访问控制共同塑造集群范围内的行为。一项任务(例如 Frontier Model Training)会引入高层要求(例如“99.99% 的服务可用性”),并规定其下方每一层的配置。
本层级确保每一项分布式工程决策都建立在其任务语境之上。例如,Frontier Training 任务实例化了本卷标准名单中的 Archetype A(GPT-4/Llama-3)(节 1.5.1),并在 H100 硬件集群上运行。复用这些典型场景,当它们有助于阐明某一章的约束时,可使规模物理可追溯,而无需把每一项工作负载塞进每一章。
独立任务与同步集群动态
许多分布式系统把工作隔离为任务或请求,以便一项失败不会导致无关工作停止。MapReduce(Dean 和 Ghemawat (2004年))将输入划分为任务,并可重新执行失败或缓慢的工作。搜索引擎和银行数据库则采用其他形式的复制、切分与协同;它们并非一律独立或异步。因此,有用的对比是失败域与耦合模式之间的对比,而非“传统”系统与机器学习系统之间的对比。
Dean, Jeffrey, 和 Sanjay Ghemawat. 2004年. 《MapReduce: Simplified Data Processing on Large Clusters》. Proceedings of the 6th Symposium on Operating Systems Design and Implementation (OSDI), 137~50.
Li, M., D. G. Andersen, J. W. Park, A. J. Smola, A. Ahmed, V. Josifovski, J. Long, E. J. Shekita, 和 B.-Y. Su. 2014年. 《Scaling Distributed Machine Learning With the Parameter Server》. Proceedings of the 2014 International Conference on Big Data Science and Computing, 583~98. https://doi.org/10.1145/2640087.2644155.
大规模同步训练任务运行于同步紧耦合 之下。参数服务器架构(Li 等 2014年) 与集合运行时负责管理分布式状态,但同步优化会反复更新一个大型共享模型状态,而非完成彼此独立的单次任务。在每个同步点,进度可能取决于最慢的参与工作节点,因此当该工作节点位于关键路径上时,持续的 10% 降速可能带来接近 10% 的步长时间惩罚。通信密集型切分也可能因大型梯度或激活张量在每个步骤都跨越网络而成为二分带宽瓶颈。这些特性并不否定既有的恢复技术;它们会提高恢复成本,并限制哪些复制、重执行与一致性策略能够保留有用的训练进度。
图 5 直接展示了这一对比:在 MapReduce 中,workers 独立写入共享存储,straggler 只会延迟其自身分区;而在 ML fleet 中,每个 worker 都必须到达 AllReduce 屏障,训练步骤才能继续。
图 5 中的同步模式解释了为什么 MapReduce 风格的任务重执行不能原样移植到每一个训练任务。当所有 worker 都参与同一个步骤时,恢复必须先重建彼此一致的模型、优化器和输入状态,协调性进展才能继续。
::: {#chk-introduction-fleet-mindset .callout-checkpoint title=” 集群思维”}
以下问题用于检验集群思维是否清晰:
:::
向仓库级计算机的转变
机器学习集群要求采用仓库级计算机(WSC)5 视角。机器中心视角把数据中心视为容纳许多计算机的建筑物;仓库级视角则把数据中心本身视为计算机。
5 仓库级计算机(WSC):Barroso 和 Hölzle(后加入 Clidaras)将数据中心本身框定为计算机。对于机器学习集群,电力输送、冷却拓扑、光网络布局和二分带宽都是一阶约束;100 MW 设施对训练吞吐量的限制可能超过任何单加速器 TFLOP/s。
- 网络互连结构:系统总线。
- 分布式存储:本地磁盘。
- 集群调度器:操作系统。
掌握这部分内容需要完成这一思维转变:工程师不再为 CPU 编写代码,而是在为跨越数千机架的 100 兆瓦计算机编写逻辑。仓库级计算机是大模型的一种常见范式,而诸如晶圆级引擎 之类的替代架构则试图将整个层次结构压缩回单一块硅片,以分布式集群的模块化性换取片上通信的极端带宽。
梯度同步成为分布式训练的决定性开销。
通信可能成为主导成本
这些工作负载特征在大规模场景下会进一步产生两项后果,二者都是规模时刻所引入的经典三元组的表现:通信可能成为主导成本(网络墙),以及当作业规模足够大或运行时间足够长时,组件故障会成为常态(可靠性缺口)。在单块 GPU 上,稠密训练工作负载可能将大部分时间用于执行矩阵乘法,且不产生跨节点通信。分布引入了通信,其占比取决于模型、切分策略、集合通信算法、拓扑结构、精度,以及与计算的重叠程度。
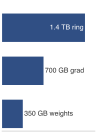
在大规模场景下,通信可能主导通信密集型切分。分布式数据并行训练在每个批次之后跨工作节点同步梯度。对于一个具有 175B 个参数的模型,在应用任何集合通信算法之前,FP32 梯度大约占用 700 GB。在 Ring All-Reduce 中,每个工作节点发送并接收约 \(2(N-1)/N\) 倍的梯度张量大小,因为每个梯度字节大约要在环上往返两次:一次用于归约,一次用于广播回传;集合通信 推导出了这一系数。因此,网络流量取决于精度、工作节点数量、集合通信实现方式以及切分方式。在较慢的互连结构或每通信字节对应计算量很小的切分中,它可能消耗每次迭代的大比例,而非可以忽略的一小部分。
这一比值解释了分布式训练系统为何如此激进地优化通信。Horovod 采用 Ring All-Reduce、NCCL 集成和张量融合来改进集合通信 (Sergeev 和 Balso 2018年);Megatron-LM 应用模型并行 (Shoeybi 等 2019年);ZeRO 则降低内存冗余 (Rajbhandari 等 2020年)。就本节的论证而言,重要的映射是按角色划分的:Horovod 代表集合运行时,NCCL 代表 GPU 通信后端,张量融合代表梯度融合路径,Megatron-LM 代表模型切分,ZeRO 代表优化器状态的切分。在集群规模下,这些技术是系统可行的必要条件,而非可选的性能改进。
Sergeev, Alexander, 和 Mike Del Balso. 2018年. 《Horovod: fast and easy distributed deep learning in TensorFlow》. CoRR abs/1802.05799.
Shoeybi, Mohammad, Mostofa Patwary, Raul Puri, Patrick LeGresley, Jared Casper, 和 Bryan Catanzaro. 2019年. 《Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism》. arXiv preprint arXiv:1909.08053.
Rajbhandari, Samyam, Jeff Rasley, Olatunji Ruwase, 和 Yuxiong He. 2020年. 《ZeRO: Memory Optimizations Toward Training Trillion Parameter Models》. SC20: International Conference for High Performance Computing, Networking, Storage and Analysis, 1~16. https://doi.org/10.1109/sc41405.2020.00024.
故障成为常态
规模时刻已经确立的可靠性算术展示了第二个后果:当使用数千个 GPU 时,硬件每几小时就会发生故障,人工介入已不可能,系统必须通过频繁检查点、冗余工作节点和自动恢复来自我修复。正式的可用性模型及其架构后果将在 节 1.3.1. 中展开。
通信主导与故障常态化是规模时刻的后果,但它们并不能解释推动集群规模持续增长的因素。答案在于一组经验关系,它们将模型质量与资源投入联系起来,正是这些关系使得超大规模基础设施成为经济上的必然,而非工程上的奢侈。
AI 规模定律
训练 GPT-3 消耗了约 \(3 \times 10^{23}\) 次浮点运算 (Brown 等 2020年)。公开的 GPT-4 级别训练估算通常在 \(10^{25}\) FLOPs 量级,尽管 OpenAI 并未披露实际训练算力或硬件配置 (OpenAI 等 2023年; Patel 和 Wong 2023年)。这些估算在此处具有重要意义,因为每提升一个数量级的算力,都要求机器学习集群相应地扩大。
Brown, Tom B., Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared Kaplan, Prafulla Dhariwal, Arvind Neelakantan, 等. 2020年. 《Language Models are Few-Shot Learners》. Advances in Neural Information Processing Systems 33: 1877~901. https://doi.org/10.48550/arxiv.2005.14165.
OpenAI, Josh Achiam, Steven Adler, Sandhini Agarwal, Lama Ahmad, Ilge Akkaya, Florencia Leoni Aleman, 等. 2023年. 《GPT-4 Technical Report》. arXiv preprint arXiv:2303.08774, 网络首发. https://doi.org/10.48550/arXiv.2303.08774.
Patel, Dylan, 和 Gerald Wong. 2023年. GPT-4 Architecture, Infrastructure, Training Dataset, Costs, Vision, MoE. SemiAnalysis Blog.
Sutton, Richard S. 2019年. 《The Bitter Lesson》. incompleteideas.net 43.
这一模式并非偶然。Rich Sutton 的“苦涩一课”阐述了其背后的原理:机器学习中的性能主要由在大规模上应用通用方法驱动,而非将人类知识编码进算法 (Sutton 2019年)。规模定律 将这一观察量化为:模型损失随算力、数据集规模和参数量的幂函数次线性改善,\(\mathcal{L}(X) \propto X^{-\alpha_{\text{scale}}}\) (Kaplan 等 2020年; Hoffmann 等 2022年)。因此,每一次等幅的损失改善都需要不成比例地更多资源,这正是本书后文将其称为普适规模定律 的系统学后果。每个缩放维度(参数、数据和算力)与基础设施约束的相互作用方式各不相同,因此在生产规模下,多维效率优化至关重要。
规模定律的经验证据
2010 年代末以来 AI 能力的快速演进正是这一缩放轨迹的例证。GPT-1(2018)包含 1.17 亿个参数,能够完成基本的句子补全。GPT-2(2019)将参数规模提升至 15 亿,实现了连贯的段落生成。
GPT-3(2020 年)的参数规模扩展至 175B,并在多个领域实现了精细的文本生成。每一次模型规模的提升都带来了显著增强的能力,而成本却呈指数级增长。
这一趋势不仅存在于语言模型中。在计算机视觉领域,参数数量从 AlexNet(2012 年)到大型视觉 Transformer 之间大致增长了一个数量级;每一代模型都以更高的准确率换取了相应比例的更多算力与训练数据,这种耦合关系正是推动视觉训练走向多加速器基础设施的原因。
缩放假设构成了这一进展的基础:更大的模型能够捕捉更复杂的数据模式,从而带来更高的准确率和泛化能力。然而,这一发展轨迹也引入了关键性的资源约束。训练 GPT-3 大约需要 \(3.14 \times 10^{23}\) 次浮点运算,相当于让一台消费级游戏 PC 连续运行数百年,并伴随着可观的财务与环境成本。
这些资源需求揭示了为何需要借助规模定律来实现高效的资源分配。图 6 追踪了大型模型训练的计算需求 的攀升过程,其增速已超出硬件遵循摩尔定律改善的速度。
这些缩放关系为权衡取舍提供了定量框架。模型性能遵循幂律关系,改进幅度保持一致,但收益呈现边际递减。因此,最优的资源分配需要协同考虑模型规模、数据集规模与计算预算,而不能孤立地扩展任何单一维度。驱动这些工作负载资源需求的计算特性,决定了它们对分布式基础设施的压力程度。
Systems Perspective 1.1: Transformer 计算回顾
Transformer 使用自注意力机制处理序列,计算所有 token 对之间的关系。该架构的计算成本随序列长度呈二次方增长(\(\mathcal{O}(S^2)\) 其中 \(S\) 表示序列长度),因此对语言模型的资源分配而言,这一点尤其关键。“FLOPs”(浮点运算次数)用于量化总计算工作量,而”tokens” 表示模型在训练过程中处理的各个文本单元(通常是子词)。
计算最优的资源分配
对大型语言模型(LLMs)的实证研究表明,在固定的计算预算和所研究的扩展形态内,平衡模型规模与数据集规模(以 token 计6) 可以最小化训练损失。
6 Tokens: 由字节对编码(byte-pair encoding)等算法产生的子词单元,该算法在语料库中迭代地合并出现频率最高的字符对。词表规模会形成直接的系统层面权衡:更大的词表可以缩短某些语言和领域中的序列长度,但同时会大致按词表规模的比例扩大嵌入表。GPT-3 使用了 50,257-token 的词表;在新模型中转向 100K+ tokens,因此是以分词效率换取额外的嵌入内存。
7 FLOPs 与 FLOP/s: 一个关键区别:FLOPs 表示总计算量(执行的操作数),而 FLOP/s 表示硬件吞吐量(每秒操作数);混淆两者会导致成本估算错误。GPT-3 需要 3.14 × 10²³ FLOPs 的计算量;一块 A100 提供 312 TFLOP/s 的吞吐量。将计算量除以峰值吞吐量即可得到理想墙钟时间;实际时间约为 \(\text{work}/(\eta_{\text{hw}} R_{\text{peak}})\),因此利用率低于 1 时,理想时间需乘以 \(1/\eta_{\text{hw}}\)。
图 7 通过三个相互关联的视图展示了这一原则。左图展示了 IsoFLOP 曲线,每条曲线对应训练过程中的一个恒定浮点运算次数(FLOPs7)。这些曲线的谷底标出了每个计算预算下最高效的模型规模。中图和右图揭示了最优参数数量与 token 数量如何随计算预算的增加而可预测地扩展,从而确认了计算最优训练 需要协同扩展。标注的标记将这些拟合外推到接近 \(10^{24}\) FLOPs 的前沿规模预算,此时计算最优点落在约 630 亿个参数、约 1.4 万亿个 token 上。这一配对正是 Chinchilla 比例(约 20 个 token 对应 1 个参数)的实际体现:参数与 token 同步增长,而不是任一维度抢先扩张。
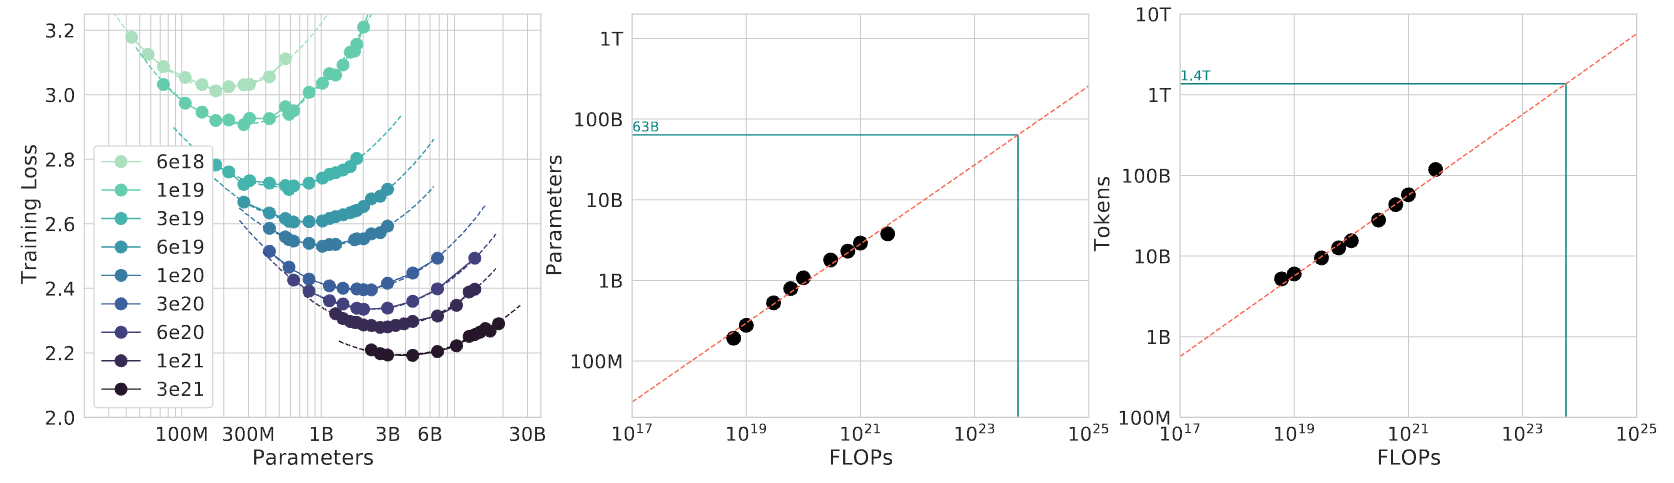
Kaplan 等 (2020年) 表明,基于 Transformer 的语言模型损失与模型参数、数据集规模(以 token 计)以及总计算预算之间遵循可预测的幂律关系。这一结果并非“盲目放大所有维度”的许可;它表明模型质量取决于这些资源之间的协同分配,这一点随后被 Chinchilla 的计算最优扩展分析 (Hoffmann 等 2022年) 进一步澄清。
图 8 给出了从 \(10^3\) 到 \(10^9\) 参数规模模型的测试损失曲线,揭示了两个要点。更大的模型具有更好的样本效率,可以用更少的训练 token 达到目标性能水平。随着计算资源增加,最优模型规模 相应地增大,当计算量被高效分配时,损失可预测地下降。
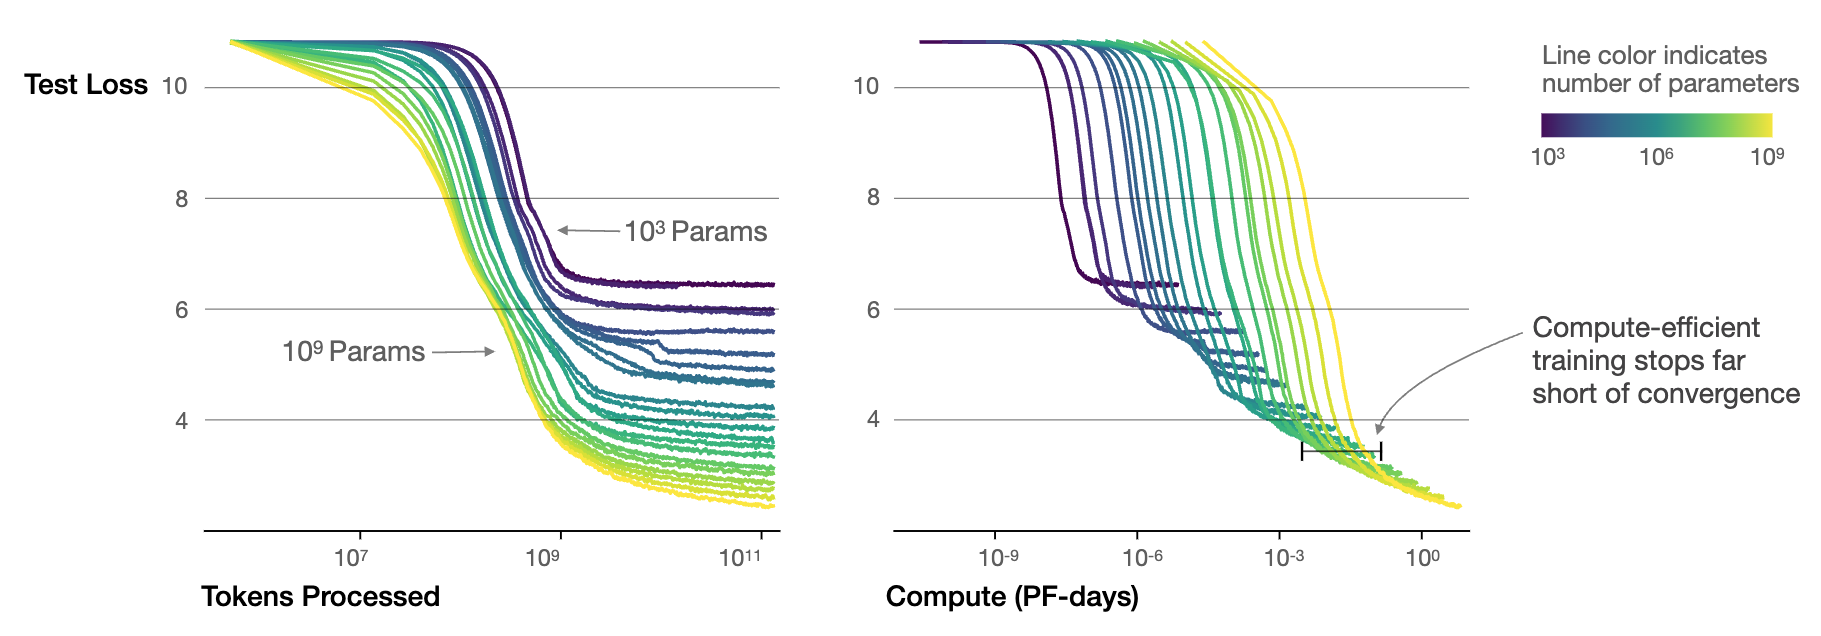
算力最优分配遵循 Chinchilla 结论:对于算力最优训练,模型规模与训练 token 数应大致按相同比例缩放,其比值约为每参数 20 个训练 token (Hoffmann 等 2022年)。这一结论修正了此前偏向“增大模型规模、但用相对更少的 token 进行训练”的指导原则。
Narayanan, Deepak, Mohammad Shoeybi, Jared Casper, Patrick LeGresley, Mostofa Patwary, Vijay Korthikanti, Dmitri Vainbrand, 等. 2021年. 《Efficient large-scale language model training on GPU clusters using Megatron-LM》. Proceedings of the International Conference for High Performance Computing, Networking, Storage and Analysis, 1~15. https://doi.org/10.1145/3458817.3476209.
这些预测假设算力利用率为完美状态,而该假设在分布式训练中并不成立。通信开销随系统规模增长得不利,从而形成带宽瓶颈,降低有效利用率。在数千 GPU 规模下,利用率取决于切分方式与互连结构:Narayanan 等 (2021年) 报告了 Megatron-LM 在 3,072 张 A100 GPU 上的运行结果,峰值设备吞吐量的利用率为 52%,并指出较慢的互连结构或通信密集型切分会阻碍扩展。
数学基础与运行形态
幂律关系以数学形式表达缩放行为,但对系统设计的意义更在于这些模式背后的直觉,而非精确的公式表述。本节中的方程解释了为何同一个集群可能进入不同的运行形态:这取决于算力与数据的分配方式、收益递减何时出现,以及系统在给出答案之前所消耗的计算量。
Theorem 1.1: 幂律缩放公式
缩放定律以幂律关系的形式正式表达。一般形式为:
\[ \mathcal{L}(X) = A_{\mathcal{L}} X^{-\alpha_{\text{scale}}} + C_{\mathcal{L}} \]
其中损失 \(\mathcal{L}\) 随资源数量 \(X\) 的增加而下降,遵循衰减率为 \(\alpha_{\text{scale}}\) 的幂律衰减,并附加一个基线常数 \(C_{\mathcal{L}}\)。此处,\(\mathcal{L}(X)\) 表示在给定资源数量(如参数、token 或算力)下取得的损失;\(A_{\mathcal{L}}\) 与 \(C_{\mathcal{L}}\) 是与任务相关的常数;而 \(\alpha_{\text{scale}}\) 是刻画性能改善速率的缩放指数。\(\alpha_{\text{scale}}\) 的取值越大,表示相对于缩放而言的性能改善效率越高。
这些预测在多种模型配置下获得了强有力的实证支持。图 9 展示了早停测试损失 如何随数据集规模与模型规模的变化而可预测地变化,确认了不同配置下的学习曲线可以通过适当的参数化实现对齐。
资源受限的缩放形态
在实践中应用缩放定律本质上是一种稀缺性诊断:真正有用的问题是,哪一种资源会首先限制均衡增长。算力预算、数据可得性与模型规模共同构成三种具有不同最优响应的形态。
缩放形态分为算力稀缺、数据稀缺或均衡。
三种形态决定了适当的缩放响应:
- 算力受限形态:尽管训练数据丰富,算力稀缺仍限制了缩放潜力,因此学术机构、初创公司以及时间受限的团队往往训练更小的模型并延长训练时间,以最大化资源利用率。
- 数据受限形态:当计算资源超过现有数据集所能支撑的水平时,即出现数据稀缺;因此,处于专业化、专有或隐私受限领域的团队往往训练更大的模型,但减少优化步数,从而从有限的样本中提取更多信息。
- 最优形态:算力与数据保持均衡,遵循算力最优缩放定律,这一点由 DeepMind 的 Chinchilla 模型得到验证——它通过按比例缩放模型规模与训练数据,在远小于自身的模型规模下取得了更好的表现 (Hoffmann 等 2022年)。
识别出主导某一项目的形态,可以避免常见的效率浪费:训练数据不足的过参数化模型,或浪费可用算力的欠参数化模型。
\scalebox{0.85}{
\begin{tikzpicture}[font=\small\sffamily]
\pgfplotsset{
    LineD/.style={line width=1.0pt, dashed, dash pattern=on 3pt off 2pt},
    scatter mark/.style={mark=*, only marks, mark options={line width=0.6pt}, mark size=1.5pt},
}

\begin{axis}[
    width=13cm,
    height=7.5cm,
    xlabel={Tokens in Dataset},
    ylabel={Test Loss},
    xmode=log,
    xmin=1e7, xmax=4e10,
    ymin=2.2, ymax=4.8,
    grid=major,
    major grid style={black!15},
    xtick pos=left,
    ytick pos=left,
    major tick length=2mm,
    xlabel style={font=\small\sffamily},
    ylabel style={font=\small\sffamily},
    yticklabel style={/pgf/number format/.cd, fixed, fixed zerofill, precision=1},
    legend pos=north east,
    legend style={
        font=\footnotesize\sffamily,
        fill=white,
        draw=black!30,
        cells={anchor=west},
        row sep=1pt,
    },
    legend cell align=left,
    /pgf/number format/1000 sep={},
]

    % Scatter data
    \addplot+[BlueLine, scatter mark] coordinates {(3.05e7,4.645)(3.05e7,4.48)(5.9e7,4.415)(1.14e8,4.34)(8.3e8,4.29)(2.3e10,4.28)};
    \addlegendentry{393.2K}

    \addplot+[RedLine, scatter mark] coordinates {(3.05e7,4.25)(5.9e7,4.1)(1.14e8,3.93)(2.2e8,3.867)(4.3e8,3.837)(8.3e8,3.8)(2.3e10,3.77)};
    \addlegendentry{3M}

    \addplot+[BrownLine, scatter mark] coordinates {(3.05e7,4.25)(5.9e7,3.941)(1.14e8,3.735)(2.2e8,3.567)(4.3e8,3.415)(8.3e8,3.325)(2.3e10,3.27)};
    \addlegendentry{25M}

    \addplot+[GreenLine, scatter mark] coordinates {(3.05e7,4.21)(5.9e7,3.941)(1.14e8,3.69)(2.2e8,3.472)(4.3e8,3.31)(8.3e8,3.12)(1.61e9,3.04)(2.3e10,2.97)};
    \addlegendentry{85M}

    \addplot+[VioletLine, scatter mark] coordinates {(3.05e7,4.21)(5.9e7,3.941)(1.14e8,3.69)(2.2e8,3.46)(4.3e8,3.28)(8.3e8,3.01)(1.61e9,2.84)(2.3e10,2.62)};
    \addlegendentry{302M}

    \addplot+[OrangeLine, scatter mark] coordinates {(3.05e7,4.31)(5.9e7,3.941)(1.14e8,3.69)(2.2e8,3.46)(4.3e8,3.28)(8.3e8,3.05)(1.61e9,2.80)(2.3e10,2.42)};
    \addlegendentry{708M}

    % Trend lines
    \addplot+[BlueLine, LineD, smooth, no markers] coordinates {(1.5e7,4.595)(3.05e7,4.47)(5.9e7,4.395)(1.14e8,4.35)(8.3e8,4.3)(3e10,4.290)};
    \addplot+[RedLine, LineD, smooth, no markers] coordinates {(1.5e7,4.46)(3.05e7,4.25)(5.9e7,4.08)(1.14e8,3.96)(2.2e8,3.867)(4.3e8,3.814)(8.3e8,3.789)(3e10,3.756)};
    \addplot+[BrownLine, LineD, smooth, no markers] coordinates {(1.5e7,4.42)(3.05e7,4.17)(5.9e7,3.95)(1.14e8,3.75)(2.2e8,3.58)(4.3e8,3.444)(8.3e8,3.345)(3e9,3.253)(3e10,3.213)};
    \addplot+[GreenLine, LineD, smooth, no markers] coordinates {(1.5e7,4.42)(3.05e7,4.17)(5.9e7,3.93)(1.14e8,3.7)(2.2e8,3.499)(4.3e8,3.32)(8.3e8,3.17)(1.61e9,3.064)(5e9,2.955)(1e10,2.92)(3e10,2.913)};
    \addplot+[VioletLine, LineD, smooth, no markers] coordinates {(1.5e7,4.42)(3.05e7,4.17)(5.9e7,3.93)(1.14e8,3.7)(2.2e8,3.467)(4.3e8,3.25)(8.3e8,3.054)(1.61e9,2.89)(4e9,2.73)(1e10,2.64)(3e10,2.59)};
    \addplot+[OrangeLine, LineD, smooth, no markers] coordinates {(1.5e7,4.42)(3.05e7,4.17)(5.9e7,3.93)(1.14e8,3.7)(2.2e8,3.456)(4.3e8,3.223)(8.3e8,3.013)(1.61e9,2.82)(4e9,2.61)(1e10,2.47)(3e10,2.39)};

\end{axis}
\end{tikzpicture}}性能提升遵循可预测的模式,但相关的设计动作会随着资源可用性,以及计算投入所处的机器学习生命周期阶段而变化。系统设计中还有两个关键区分:性能如何随数据集规模变化,以及额外计算投入在生命周期的哪个阶段发生。
数据集规模经历三个自身阶段(图 10)。当样本较少时,泛化误差较高且波动剧烈;随着数据增长,误差沿幂律可预测地下降,这是额外数据收益最大的阶段;最终误差会饱和于噪声下限,此时更多数据带来的增益可忽略。系统层面的后果是:一旦模型进入饱和阶段,有限的优质数据而非算力便成为约束性瓶颈,这也是数据效率与暴力式扩展互补的原因。分布式训练 进一步探讨这种饱和如何重塑训练数据管线与预算。
\scalebox{0.7}{
\begin{tikzpicture}[line join=round,line cap=round,font=\small\sffamily]
\tikzset{
  axis line/.style={line width=1.0pt},
  dashed line/.style={line width=1.0pt, dashed},
  region box/.style={draw=none, inner sep=0mm, fill=#1},
  region label/.style={above=1pt, anchor=south, align=center},
  best guess error/.style={smooth, BlueLine, line width=1.2pt},
  irreducible error/.style={below=2pt, align=center, text=black},
  node anchor/.style={anchor=south west},
  connecting line/.style={best guess error},
  vertical line/.style={axis line}
}

\def\hi{5.5}
\def\wi{11}
\def\hl{5/7*\hi}

% Axis
\node[axis line] (O) at (0,-1) {};
\node[axis line] (E) at (\wi,-1) {};
\draw (O) -- (E) node[below=3pt] {Training Data Set Size (Log-Scale)};
\draw (O) -- ++(0,\hi) node[above=3pt, midway, sloped] {Generalization Error (Log-Scale)};

% Dashed lines
\draw[dashed line, VioletLine] (0,0) -- (\wi,0);
\draw[dashed line, RedLine] (0,\hl) -- (\wi,\hl);

% Coordinates
\node[node anchor] (A) at (3,-0.7) {};
\node[node anchor] (A1) at (3,-1) {};
\node[node anchor] (B) at (8,-0.7) {};
\node (G1) at (0,\hl - 0.1) {};
\node (G2) at (\wi,0 + 0.1) {};
\node (GG1) at ($(G1)+(1.5,0)$) {};
\node (GG2) at ($(G2)+(-1.5,0)$) {};

% Vertical lines
\path[vertical line] (A) -- ++(90:\hi) coordinate(LG1);
\path[vertical line] (B) -- ++(90:\hi) coordinate(LG2);

% Connecting lines
\draw[connecting line] (G1) -- (GG1) node[above=2pt, align=center, text=black, pos=0.98] {Best Guess Error}
 to[out=360,in=180] (GG2) -- (G2) node[irreducible error, pos=0.1] {Irreducible Error};

% Background regions
\begin{scope}[on background layer]
  \node[region box=OrangeL, fit=(O)(LG1)] (BB) {};
  \node[region label] at (BB.north) {Small Data\\ Region};
\end{scope}

\begin{scope}[on background layer]
  \node[region box=GreenL, fit=(A1)(LG2)] (BB1) {};
  \node[region label] at (BB1.north) {Power-Law\\ Region};
\end{scope}

\begin{scope}[on background layer]
  \node[region box=BlueL, fit=(LG2)(E)] (BB2) {};
  \node[region label] at (BB2.north) {Irreducible Error\\ Region};
\end{scope}

\end{tikzpicture}}生命周期划分指出了集群可以投入计算资源的三个节点,如 图 11 所示:预训练,即以墙钟时间实现规模定律的漫长、对故障敏感的运行;训练后适配,其中微调与偏好优化将一次大规模运行替换为许多更小、协同开销更重的任务;以及测试时计算,其中每次查询的额外推理步骤以延迟和吞吐量为代价换取准确率。三者各自将约束瓶颈转移到集群的不同部分,因此完整处理应与其对应工作负载归为一类:分布式训练 对应预训练与训练后运行,在大规模下运行推理 对应服务中的测试时计算。对于资源受限的部署,训练后与测试时扩展往往比从头重新训练模型更具可行性。
\scalebox{0.75}{
\begin{tikzpicture}[line join=round,line cap=round,font=\small\sffamily,yscale=0.8]
\tikzset{
  axis line/.style={line width=1.0pt},
  Line/.style={line width=1.0pt,RedLine},
  LineD/.style={Line,dashed}
}
\def\hi{7.5}
\def\wi{11}
\draw[axis line](0,0)coordinate(O)--node[below=3pt]{Compute}(\wi,0);
\draw[axis line](0,0)--node[above=3pt,midway,sloped]{Intelligence}(0,\hi)coordinate(Y);

\coordinate(O)at(0.03,0.03);
\coordinate(T1)at(2,0.88);
\coordinate(T2)at(4.2,3.0);
\coordinate(T3)at(6,5.2);
\coordinate(T4)at(7.7,6.35);
\draw[Line](O)
 to (T1)
 to [out=30,in=210](T2)
 to [out=55,in=220](T3)
 to [out=40,in=210](T4);
\draw[Line,-latex](O)--++(23:3.6)node[below right,text=black]{Pretraining scaling};
\draw[BlueLine,-latex,LineD](O)--++(23:7.0);
\draw[Line,-latex](T2)--++(27:1.6)node[below right,text=black]{Posttraining scaling};
\draw[-latex,LineD](T2)--++(27:4.0);
\draw[Line,-latex](T3)to [out=40,in=210]($(T4)+(0.15,0.09)$)
 node[below right,text=black,align=center]{Test-time scaling\\ "long thinking"};
\draw[-latex,LineD](T4)--++(29:2.0);
\node[below right=of Y,align=center,font=\normalsize\sffamily]{From one to three\\ scaling laws};
\end{tikzpicture}}系统设计中实际应用
OpenAI 在确定 GPT-3 的规模时,并未进行穷举式架构搜索;而是基于较小规模的实验外推扩展曲线,预先选定模型规模与令牌预算。这一决策最清晰地说明了规模定律如何指导实际应用中的系统设计与资源规划。在定义明确的运行形态内,模型性能主要取决于规模,而非特异性的架构创新;但由于收益递减,每进一步的性能提升都需要指数级增加的资源,以换取越来越小的收益。
具体而言,作者在当时可得指导信息下,利用规模定律外推来确定模型规模与训练数据 Kaplan 等 (2020年)。他们将一个既有的 transformer 架构扩展至 175B 个参数和约 3000 亿个 token,从而提前预测模型性能与资源需求;后来的 Chinchilla 结果表明,该点在计算最优的 token 分配下属于欠训练 (Hoffmann 等 2022年)。
Kaplan, J., S. McCandlish, T. Henighan, T. B. Brown, B. Chess, R. Child, S. Gray, A. Radford, J. Wu, 和 D. Amodei. 2020年. 《Scaling Laws for Neural Language Models》. ArXiv preprint abs/2001.08361.
规模定律具有多种实用功能。在资源预算方面,经验性规模曲线有助于在固定的计算预算下,估算不同模型规模、数据集扩展与训练时长之间的投资回报。规模趋势还能揭示架构改动在多大程度上带来显著改进,相对于仅靠规模扩展的收益,从而降低对穷举式架构搜索的依赖。当某个模型族表现出有利的规模行为时,扩展现有架构往往比转向未经验证的设计更有效。
同样的原则在资源受限场景中反向适用。在边缘与嵌入式环境中,规模定律使设计者能够选择更小的配置,在部署约束下提供可接受的准确率。量化规模与性能之间的权衡,使这些定律能够识别出暴力式规模何时变得低效,并指向模型压缩、知识迁移与硬件感知设计。
规模定律还充当诊断工具。资源增加而性能出现平台期,可能表明维度饱和(相对于模型规模的数据不足)或计算利用效率低下。这种诊断能力使规模定律兼具预测性与指导性:它们预测目标能力所需资源,并揭示系统为何表现低于其预测轨迹。
可持续性与成本影响
规模定律揭示了性能路径,同时暴露了迅速攀升的资源需求。随着模型规模扩大,训练与部署成本不成比例地增长,从而在性能收益与系统效率之间形成张力。训练最大规模模型需要由数百甚至数千个加速器组成的分布式基础设施,消耗数万 GPU-days 和数百万千瓦时电力。分布式训练 考察了分布式训练如何在通信开销、同步与规模效率方面引入额外复杂性。
大型模型还需要大量高质量数据集才能发挥其潜力。当模型接近可用高质量数据的饱和点,尤其是在自然语言处理领域时,数据扩展带来的性能收益可能变得微乎其微。因此,数据效率是暴力式规模不可或缺的必要补充。
这些成本中最尖锐的一项是环境成本,它取决于集群运营者实际做出的一个决策:集群建在哪里。同样的训练任务,依据电网位置的不同,其 CO2 排放量可相差约 40\(\times\);从魁北克的水电(约 20 g CO2/kWh)到波兰的煤电(约 800 g CO2/kWh)8。这一选址决策本身,连同将工作负载调度到低碳时段的做法,使得数据中心选址成为一项首要的基础设施决策,而非事后补充。财务成本同步上升:训练一个大型基础模型动辄花费数百万美元,这在根本上限制了谁有能力开展大规模研究。Sustainable AI 完整阐述了能量与碳的核算方法,将上述压力转化为设计约束。
8 训练碳强度:GPT-3 训练据估计排放了 552 吨 CO2;已发表的估计将大型语言模型的训练排放置于 \(10^2\) 至 \(10^3\) 吨区间,但具体数值随硬件、利用率与电力结构差异很大 (Patterson 等 2021年)。
Patterson, David, Joseph Gonzalez, Quoc Le, Chen Liang, Lluis-Miquel Munguia, Daniel Rothchild, David So, Maud Texier, 和 Jeff Dean. 2021年. 《Carbon Emissions and Large Neural Network Training》. arXiv preprint arXiv:2104.10350.
9 规模定律饱和:虽然幂律关系 暗示着无限制的提升,但实证证据指出了语义饱和 点,即继续增加数据或参数所带来的下游效用提升可以忽略不计。这种”收益递减”阶段迫使系统工程师从暴力式扩展转向数据效率,并通过模型压缩在固定的算力预算内进一步挖掘价值。
规模定律并不能保证无限制的性能提升。每一项增量性能收益都必须与其资源成本相权衡。当系统接近实际的扩展极限时,重点便从单纯的扩展转向高效扩展:在性能、成本、能耗与环境影响之间取得平衡。9
规模定律失效条件
规模定律在特定的运行形态内成立,但在其边界处会失效。随着系统不断扩展,会遇到那些使”平滑、可预测的扩展”这一假设不再适用的条件。这些失效点暴露出低效之处,因而要求采用更为精细的设计方法。
大多数此类失效模式都源于同一个根本原因:某个维度的增长快于其他维度。Hoffmann 等 (2022年) 显示,许多大型语言模型因模型规模的增长快于训练 token 预算而训练不足,而计算最优的训练要求参数与 token 同步扩展。同样的失衡现象以其他形式出现:未针对更大模型重新调度的训练进度与学习率,使其尽管投入了基础设施资源仍无法达到应有潜力;有限的高质量数据最终会呈现边际效用递减,因此更大的模型开始记忆而非泛化;而硬件对内存带宽、互连容量和 I/O 吞吐量的上限,则限制了万亿参数模型能够分布部署的程度。在最极端的情况下,即使各维度均衡扩展,也会达到训练分布所能教授能力的极限:基准分数持续上升,而泛化能力却没有提升,模型对对抗性或分布外输入变得更加脆弱。Scaling breakdown types 将这些失效模式组织起来,将每种失效类型 映射到其根本原因和一个代表性场景,使实践者能够在投入预算之前预判这种低效。
Hoffmann, Jordan, Sebastian Borgeaud, Arthur Mensch, Elena Buchatskaya, Trevor Cai, Eliza Rutherford, Diego de Las Casas, 等. 2022年. 《Training Compute-Optimal Large Language Models》. Advances in Neural Information Processing Systems (NeurIPS) 35: 30016~30. https://doi.org/10.52202/068431-2176.
| Dimension Scaled | Type of Breakdown | Underlying Cause | Example Scenario |
|---|---|---|---|
| Model Size | Overfitting | Model capacity exceeds available data | Billion-parameter model on limited dataset |
| Training Data Size | Diminishing Returns | Saturation of new or diverse information | Scaling web text beyond useful threshold |
| Compute Budget | Underutilized Resources | Insufficient training steps or inefficient use | Large model with truncated training duration |
| Imbalanced Scaling | Inefficiency | Uncoordinated increase in model/data/compute | Doubling model size without more data or time |
| All Dimensions | Semantic Saturation | Exhaustion of learnable patterns in the domain | No further gains despite scaling all inputs |
Checkpoint 1.1: 应用规模定律
以下问题用于检查规模定律是否被用作资源分配工具:
这些分解点表明,规模定律描述了特定条件下的经验规律,而这些条件在大规模部署时难以维持。辨别规模效应何时、为何失效,推动了不单纯依赖规模提升性能的策略开发。
将效率与扩展性相结合
规模定律揭示了这些“墙”;效率工程则构建了绕过它们的通路。数据饱和、基础设施瓶颈以及收益递减为暴力式扩展所能达到的水平设定了硬性上限。然而,同样的约束也指向三个相互关联的维度上的解决方案:
- 算法效率:稀疏性、蒸馏等技术以每 FLOP 提取更多能力。
- 数据效率:课程学习、主动选择等技术以每个训练样本提取更多信息。
- 系统效率:通信隐藏、流水线重叠等技术以每加速器提取更多利用率。
每个维度分别应对 Scaling breakdown types 中的不同分解条件,并在后续章节中分别得到详细讨论。
规模定律与效率技术决定了大规模模型所需的计算量,以及集群对其的利用程度。然而,它们并不处理集群自身施加的物理与逻辑约束。硬件会故障,带宽会饱和,分布式系统面临根本性的不可能性结果,而大规模部署的社会影响则要求治理。这些约束无法通过优化消除,必须围绕它们进行工程化设计。
规模约束
这三面“墙”描述了性能受限的位置;其背后的约束范围更广。机器学习集群面临三类不可消除的约束:物理约束(内存墙、网络墙、能量墙本身,以及随集群规模增长而出现的可靠性缺口)、逻辑约束(分布式系统面临 CAP 定理之类的不可能性结果)和社会约束(规模放大了每一个技术决策的影响)。理解这些约束,是掌握后续诊断框架的前提。
可靠性缺口
在传统软件中,硬件充当可靠的抽象层。单台服务器的可用性通常为“四个九”(99.99%),即每年约有 53 分钟处于故障状态。然而,机器学习集群的运行规模使得这一抽象失效,从而暴露出可靠性缺口:各组件在孤立使用时是可靠的,并不意味着未复制任务所需的全部组件会同时可用。对于一个 25,000-GPU 的任务,其只有在所有 GPU 都可用时才能取得进展,公式 1 在独立性假设下将各组件的可用性相乘,从而给出所有必需组件在同一时刻均可用的概率(\(A_{\text{all}}\)):
\[ A_{\text{all}} = (A_{\text{component}})^N \tag{1}\]
其中,\(N\) 表示任务同时所需的独立组件数量,\(A_{\text{component}}\) 表示单个组件的可用性。工程含义在于指数项:每增加一个必需组件,都会降低整个组件集同时可用的概率,因此可靠性工程由此成为一个扩展问题,而非清理工作。
若每个节点的可用性为 99.9 percent,且一个不可复制的工作负载需要全部节点,那么 1,000 个必需节点同时可用的概率仅为 36.8 percent。将该工作负载扩展到 10,000 个必需节点,该概率降至 0.0045 percent。图 12 在两个单节点可用性水平下、针对 1 到 10,000 个 GPU 的工作负载规模,描绘了这一指数衰减过程。
图 12 中的指数衰减揭示了架构层面的后果:在集群规模下,未复制的作业无法依赖所有必需节点都可用。本节虽然仅用一个单节点可用性数值来说明这一概念,但 规模下的故障概率 推导出了完整的故障概率级联,用于确定检查点间隔和冗余度。工程层面的启示是:故障才是常态。在规模层面,韧性 取代了预防,成为主导目标:系统以绝对可用性换取恢复速度、检查点质量和自动修复能力。容错 所面临的定义性挑战,正是从让每个组件持续运行,转向确保集群在组件发生故障时能够自愈。
通信强度(CI 比值)
如果单机器铁律 决定了系统如何执行,那么通信强度(CI) 则决定了系统在哪里受阻。在单加速器上,roofline 模型 决定某个内核是计算受限还是内存受限。到了集群规模,这一分析便提升至网络层面。
公式 2 将通信强度定义为跨网络移动的数据量与本地执行操作数之比:
\[\text{CI} = \frac{\text{Bytes Transferred (Network)}}{\text{FLOPs Executed (Local)}} \tag{2}\]
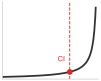
越过通信强度悬崖后,继续增加 GPU 不再有帮助。
低通信强度描述计算密集型负载,其加速器大部分时间都在执行计算,因此扩展相对容易。高通信强度描述网络需求接近可用互连结构带宽平衡的负载;在该形态下,二分带宽可能成为瓶颈,增加更多加速器反而可能拖慢训练而非加快训练。该边界因配置而异,因为它同时取决于本地计算吞吐量和有效网络带宽。
通信与扩展优化——从梯度稀疏化(发送更少的梯度字节)到 3D 并行(将数据、张量和流水线维度划分到不同的网络互连结构层级)——都试图降低暴露的通信强度,使机器学习集群表现得像一台单一、庞大的计算机,而不是等待通信链路的一批闲置处理器。本节仅对这一比率作定性应用,通信—计算比 则在具体扩展形态下分析通信强度,并展示加速卡增加后吞吐量不再提升的带宽饱和点。
Checkpoint 1.2: 规模要求
以下问题用于检验规模思维是否已从本地执行转向分布式约束:
为何分布如此困难
规模迫使分布:没有任何单台机器能够提供最大模型所需的算力,也没有任何集中式系统能够收集全球用户群体产生的全部数据源。然而,协调通过有限带宽网络连接起来的物理分离机器进行计算,会引入任何工程手段都无法消除的约束。
第一个压力源出现在数据中心内部:同步训练必须在分区与故障条件下选择保留多少一致性。第二个压力源出现在边缘侧:设备本身不可靠、受功耗限制,并受策略约束。
CAP 定理的现实
CAP 定理10 确立了这样一个结论:一个异步分布式系统在遭遇网络分区时,无法同时保证原子的一致性 与可用性。分区容错 描述的是该权衡所适用的网络条件,而非系统可以简单丢弃的第三种可互换属性。
10 CAP(Consistency, Availability, Partition Tolerance)定理(Brewer 定理):Brewer 提出了该猜想 (Brewer 2000年),Gilbert 与 Lynch 证明了在网络可能分区时,异步系统无法同时保证原子一致性与可用性 (Gilbert 和 Lynch 2002年)。同步训练与异步训练为这一权衡提供了有用的类比,但梯度的新鲜度并非该定理中的原子一致性属性。
Brewer, Eric A. 2000年. 《Towards robust distributed systems (abstract)》. Proceedings of the nineteenth annual ACM symposium on Principles of distributed computing, 7. https://doi.org/10.1145/343477.343502.
Gilbert, Seth, 和 Nancy Lynch. 2002年. 《Brewer’s conjecture and the feasibility of consistent, available, partition-tolerant web services》. ACM SIGACT News 33 (2): 51~59. https://doi.org/10.1145/564585.564601.
在此类比下,同步训练偏好共享的当前模型状态,但当某个必需的 worker 不可达时,训练会中止。异步训练可以穿越慢节点或不可用的 worker 继续运行,但可能使用过期的模型版本。联邦学习同样接受暂时不一致的本地模型,从而使间歇性连接的边缘设备无需持续联网即可参与。
边缘分布的复杂性
迄今为止讨论的协同挑战都假定了数据中心分布,即机器运行在受管理设施中。在网络边缘,这些挑战在每一个维度上都更加严峻。
数十亿台智能手机和物联网设备在不可控环境中运行,连通性不可靠且电力有限。隐私、同意或策略约束可能阻止原始数据离开设备,这使得联邦学习成为一种自然的架构 (McMahan 等 2017年)。间歇性连接迫使系统容忍跨越数天的异步更新。这些约束要求采用与数据中心机器学习根本不同的架构方法(差分隐私、端侧推理和模型压缩)。
McMahan, Brendan, Eider Moore, Daniel Ramage, Seth Hampson, 和 Blaise Agüera y Arcas. 2017年. 《Communication-Efficient Learning of Deep Networks from Decentralized Data》. International Conference on Artificial Intelligence and Statistics (AISTATS), Proceedings of Machine Learning Research, 卷 54: 1273~82.
当机器学习系统运行到数十亿用户的规模时,其社会影响要求我们超越单纯的技术卓越性来思考。治理因此成为一项工程要求。
为何在大规模下治理至关重要

在集群规模下,一个技术缺陷就会演变为社会风险。
规模与分布将影响放大到工程层面之外。当系统服务数十亿用户时,一个技术缺陷就会变成社会风险。这种放大效应产生了小规模系统可以安全忽略的治理要求。治理充当机器学习集群的控制平面,而非一组外部规则。
该控制平面首先要为集群防御。机器学习系统面临独特的安全威胁,且在生产规模下愈发加剧。模型提取 攻击通过 API 查询窃取专有知识产权。数据投毒 会在模型中植入后门,后门在特定输入触发前保持休眠。在集群规模下,这些威胁会成为 sophisticated 攻击者眼中经济上极具吸引力的目标。防御集群需要系统性的方法:访问控制、差分隐私 (安全与隐私) 以及持续的行为监控,这些都远远超出了传统边界安全。
同一控制平面必须使整个集群具备可审计性。大规模运行的系统会吸引监管关注;欧盟人工智能法案 与本地隐私法规等制度,使可审计性 成为许多部署的架构性要求。要证明在 10,000 张 GPU 上训练出的模型并未摄取被禁止的数据,就需要端到端的数据血缘追踪。要为亚毫秒级的推荐生成可被人理解的解释,就必须采用在推理服务架构中预先设计的技术。满足这些要求,需要自第一天起就构建到基础设施中的技术能力(审计轨迹、偏见测试与授权管理)。
除法律合规之外,机器学习集群还承载着伦理义务。推荐算法塑造公共舆论;招聘算法影响生计。这些系统不会以崩溃日志的方式大声失败,而是通过偏见与极化悄然失效。负责任的 AI 是一种工程实践,即将公平性、透明度和问责性视为不变量:一旦遭到违反,就应当触发系统级暂停。
C\(^3\) 分类法:规模的基础
物理、逻辑与社会层面的约束(上文已述)共同指向一个无法回避的现实:机器学习集群不能仅仅被当作一台更大的服务器来思考。在单台机器上,性能诊断遵循 Data · Algorithm · Machine (D·A·M) 分类法,该分类法由 **D·A·M 基础** 完善为一套完整的单节点框架。在该框架中,Data 决定模型所学到的信息;Algorithm 定义需要执行的数学运算;Machine 提供执行这些运算的芯片与内存层次结构。
当工作负载跨越数千个相互连接的节点时,执行瓶颈随之转移。数据中心硬件围绕三个物理支柱进行采购与布线:Compute(计算)、Network(网络)、Storage(存储)(计算基础设施、网络互连结构、数据存储)。但在运行时,分布式执行的时间消耗分布在三个不同的运行维度上:Compute(计算,\(C_1\))、Communication(通信,\(C_2\)) 和 Coordination(协同,\(C_3\))。三者共同构成 C\(^3\) 分类法。
存储并非缺席于这一运行时模型;相反,存储贯穿全部三个维度的持久物理底层。它是 Compute(\(C_1\))中节点内存层次结构的延伸,是 Communication(\(C_2\))下的高吞吐流式处理管线,也是容错 Coordination(\(C_3\))所必需的持久检查点引擎。
同一集群层面的症状可能源自三个维度中的任意一个。一次涉及 10,000 加速器的训练运行若出现低吞吐量,可能意味着算术内核未能充分利用张量核心(Compute),梯度同步已使二分带宽饱和(Communication),或者单个热慢节点或检查点刷新正在阻塞集群屏障(Coordination)。将每一次 slowdown 都视为网络问题或编译器问题,风险在于优化了错误的组件。一套有用的分布式系统分类法必须将这些成因区分开来,而不能假装它们彼此独立。
每种解释所需的证据各不相同。计算假设要求工程师考察浮点运算利用率(MFU)、算子融合以及内存带宽饱和情况。通信假设要求工程师考察网络链路利用率、集合通信序列化以及丢包。协调假设要求工程师考察慢节点尾部延迟、屏障等待时间以及检查点开销。这些调查彼此不可互换:更快的光开关无法加速因内存带宽停顿而空闲的张量核心,而升级到下一代 GPU 也无法挽回同步屏障处因慢节点而损失的墙钟时间。
与单机系统一样,起支配作用的是约束瓶颈:放松该瓶颈可带来端到端训练时间或推理延迟的降低。因此,C\(^3\) 分类法是一个操作性诊断循环:识别约束轴,施加相应的系统干预,然后重新测量,因为放松一个限制常常会使瓶颈转移到另一个限制。
Definition 1.2: C³ 分类法
C\(^3\) taxonomy 是一个诊断框架,它沿三个操作性维度对分布式机器学习执行时间和系统瓶颈进行分类:Compute(\(C_1\),数学)、Communication(\(C_2\),链路)和 Coordination(\(C_3\),逻辑)。其目标是确定哪个维度约束了集群级性能。
重要性:诊断能力是具体的,甚至无需先检查复杂的分布式追踪。如果加速器因张量核心缺少本地操作数或使用了未融合的核而低 MFU 计算,那么约束轴是计算 (\(C_1\))。如果加速器在网络互连结构上空闲等待 AllReduce 梯度传输或激活张量,那么约束轴是通信 (\(C_2\))。如果进度因慢节点导致的屏障等待、节点恢复回滚或整体调度抢占而停滞,那么约束轴是协同 (\(C_3\))。
区别:与数据中心采购类别(计算、网络、存储)不同,后者对物理硬件资产进行分类,而 C\(^3\) 分类法对运行时执行成本进行分类。存储并不执行模型算术运算;相反,它是贯穿三个维度的持久物理底层(本地 NVMe 位于 \(C_1\),远程数据集流式传输位于 \(C_2\),持久检查点位于 \(C_3\))。
常见误区:将这三个维度视为相互独立的变量。升级到更快的加速器 (\(C_1\)) 往往会把计算受限的作业转化为通信受限的作业 (\(C_2\))。将模型状态切分以消除内存冗余 (\(C_1\)) 会增加集合通信量 (\(C_2\)) 和状态协同复杂度 (\(C_3\))。这些维度会相互影响。
在探讨这三个维度如何相互作用之前,我们必须先分别理解每一个维度。
集群的三个维度
计算 (\(C_1\)): 节点底层
计算 (\(C_1\), 数学)捕获单个服务器节点上的本地执行。它涵盖物理加速器硬件:矩阵乘法单元、张量核心、向量执行单元、片上 SRAM、高带宽内存(HBM3e)堆栈,以及本地 Non-Volatile Memory Express(NVMe)固态存储层。
计算轴的核心张力是内存墙:现代加速器提供数百 teraflops 或 petaflops 的原始算术吞吐量,但从片外内存获取权重和激活所消耗的时间与能量,比算术本身高出几个数量级。节点底层上的高性能 ML 工程聚焦于最大化模型 FLOPs 利用率(MFU),通过算子融合、混合精度数值格式(FP8、BF16)以及内存层次分阶段,使昂贵的张量核心保持饱和而非因缺少操作数而饥饿 (计算基础设施, 数据存储, 性能工程)。
通信 (\(C_2\)): 网络骨干
通信(\(C_2\),链路) 描述数据在物理分离节点之间的传输。它既涵盖服务器机箱内部的扩展形态(scale-up)互连结构(例如 NVLink 与 NVSwitch),也涵盖集群级扩展(scale-out)集群网络(例如 InfiniBand、RoCEv2、光收发模块,以及面向链路的 Clos 拓扑)。
在集群规模下,通信承载三类不同的流量:分布式训练期间的参数更新与梯度同步、流水线各阶段之间的中间激活张量,以及由远程存储阵列交付的流式数据集分片。其主导约束是有限的二分带宽:在光开关之间传输太字节级状态会引入串行化延迟、包抖动与拥塞。通信骨干的工程目标是最小化通信开销\(T_{\text{comm}}\),使加速器不必因等待字节穿越互连结构而闲置(网络互连结构,集合通信)。
协调(\(C_3\)):编排层
**协调(\(C_3\),逻辑) 描述将数千台彼此独立且会出错的机器绑定为一致分布式计算机的软件控制平面、同步协议与状态管理机制。
在单台机器上,协调开销几乎可以忽略——无非平凡的线程同步或内核启动延迟。到了集群规模,协调便成为一等级的性能与可靠性瓶颈。它涵盖集群批量调度器(Slurm、Kubernetes、Ray)、全局屏障语义、分布式共识、故障检测心跳,以及向持久化存储进行的周期性状态检查点。协调受可靠性崩塌(\(A_{\text{all}} = (A_{\text{node}})^N\))与拖慢节点放大 约束:当数千个节点必须在 AllReduce 屏障处同步时,整个集群的推进速度仅由其中最慢的那台设备决定。协调层的工程重点在于通过以异步重叠替代同步屏障、加速故障检测、并限制恢复回滚(容错,集群编排,规模化机器学习运维)来最大化有效吞吐。
展望:从 D·A·M 到 C\(^3\)
单机器 D·A·M 分类法与集群规模的 C\(^3\) 分类法协同运作。D·A·M 描述工作负载:系统的名词(训练数据、所执行的算法、硬件底座)。C\(^3\) 分类法描述执行开销:集群的动词(计算数学、传递结果、协调状态)。**D·A·M 基础** 回顾单节点 D·A·M 视角;C\(^3\) 分类法则将该工作负载投射到分布式集群上。
将算法扩展到节点之间会产生通信(\(C_2\)),例如用于在数据并行副本之间同步梯度的 AllReduce 操作。将数据扩展到节点之间则需要通过分布式采样器、epoch 屏障以及非阻塞检查点来实现协同(\(C_3\))。最后,在仓库级机器上管理硬件故障需要编排与动态节点恢复(\(C_3\))。Fleet 级机器学习系统工程需要解决 D·A·M 与 C\(^3\) 的交叉项,而不是孤立地处理各个维度。
C\(^3\) 交叉领域景观
在分离出这三个维度之后,分布式机器学习系统工程的关键洞见是:它们从来不是彼此独立的。如果 Compute、Communication 和 Coordination 彼此独立,那么分布式系统的扩展将十分简单:只需单独升级加速器、安装更快的网络收发器,或单独优化调度器。实际上,主要的性能瓶颈和架构突破都发生在它们的两两交叉处:
- Compute \(\cap\) Communication (\(C_1 \cap C_2\)) — 隐藏网络延迟:当算术吞吐量快于网络传输时间时,系统必须将计算与通信重叠执行。相关技术包括 1F1B 流水线、CUDA stream 重叠、通过梯度累积调节 comm-to-compute 比值(\(\rho\))、GEMM-AllReduce 内核融合,以及 FP8 线宽压缩(分布式训练、集合通信)。
- Compute \(\cap\) Coordination (\(C_1 \cap C_3\)) — 最大化 Fleet 有效吞吐:分布式编排与恢复开销可能使昂贵的加速器闲置。弥合这两个维度需要向本地 NVMe 层执行非阻塞异步检查点、减少流水线气泡、在内存激活重计算与回滚之间取舍,以及快速节点卸载,以最小化故障影响范围(容错、集群编排)。
- Communication \(\cap\) Coordination (\(C_2 \cap C_3\)) — 集合同步:网络互连结构必须与同步语义保持一致。该交叉领域管理屏障同步的尾延迟(即 straggler 放大效应)、用于将节点内 NVLink 与节点间 InfiniBand 隔离的层级化集合通信、有界陈旧度模型,以及感知拓扑的集合通信调度(集合通信、容错)。
在中心(\(C_1 \cap C_2 \cap C_3\)),三项约束同时汇聚。这正是 Fleet-Scale ML Systems Engineering 的学科内涵:平衡 4D 并行(数据、张量、流水线与专家并行)、管理分片内存状态(FSDP2、ZeRO-3),并在严格的延迟预算下为基座模型提供服务(分布式训练、在大规模下运行推理、边缘智能)。 C$^3$ 交集版图 完整呈现这一协同设计版图,综合了三个运行维度、它们两两之间的相互作用,以及其中的核心学科。
:::
\begin{tikzpicture}[line join=round,outer sep=0pt,inner sep=3pt,font=\sffamily]
\tikzset{%
  TxtC/.style={font=\sffamily\bfseries\small,align=center},
  TxtIT/.style={font=\sffamily\itshape\fontsize{8}{10.5}\selectfont,text=black!70,align=center},
  TxtSM/.style={font=\sffamily\fontsize{7}{9}\selectfont,text=black!85,align=center},
  TxtJM/.style={font=\sffamily\itshape\fontsize{6}{8}\selectfont,text=black!60,align=center},
  TxtCOL/.style={font=\sffamily\fontsize{7.5}{9.5}\selectfont,text=purple!80!black,align=center},
  TxtCENT/.style={font=\sffamily\fontsize{6.5}{8}\selectfont,align=center,text=c1col},
  LineA/.style={black!50,line width=0.9pt,{Circle[black!70,length=3.4pt]}-},
  Box/.style={align=left,
    inner xsep=7pt,
    inner ysep=6pt,
    draw=brown!75!black,
    line width=0.65pt,
    fill=brown!05,
    font=\sffamily\fontsize{7}{9.5}\selectfont,
    text width=70mm,
    minimum width=70mm,
    rounded corners=2pt,
  },
  BoxCenter/.style={align=left,
    inner xsep=7pt,
    inner ysep=6pt,
    draw=brown!75!black,
    line width=0.65pt,
    fill=brown!05,
    font=\sffamily\fontsize{7}{9.5}\selectfont,
    text width=50mm,
    minimum width=50mm,
    rounded corners=2pt,
  },
  BoxBottom/.style={align=left,
    inner xsep=8pt,
    inner ysep=6pt,
    draw=brown!75!black,
    line width=0.65pt,
    fill=brown!05,
    font=\sffamily\fontsize{7}{9.5}\selectfont,
    text width=76mm,
    minimum width=76mm,
    rounded corners=2pt,
  },
}

% Colors matching Volume II C3 Fleet Architecture palette
\definecolor{c1col}{RGB}{2, 132, 199}        % Compute (Sky / Azure #0284c7)
\definecolor{c2col}{RGB}{217, 119, 6}        % Communication (Amber #d97706)
\definecolor{c3col}{RGB}{124, 58, 237}       % Coordination (Purple #7c3aed)
\definecolor{lightc1}{RGB}{224, 242, 254}    % Fill Compute #e0f2fe
\definecolor{lightc2}{RGB}{254, 243, 199}    % Fill Communication #fef3c7
\definecolor{lightc3}{RGB}{243, 232, 255}    % Fill Coordination #f3e8ff

% Circle centers (equilateral triad)
\coordinate (C1) at (0, 2.6);
\coordinate (C2) at (-2.10, -0.60);
\coordinate (C3) at (2.10, -0.60);

\def\R{3.40}

% Filled semi-transparent circles
\fill[lightc1,opacity=0.50] (C1) circle (\R);
\fill[lightc2,opacity=0.50] (C2) circle (\R);
\fill[lightc3,opacity=0.50] (C3) circle (\R);

% Circle borders
\draw[c1col,line width=0.95pt] (C1) circle (\R);
\draw[c2col,line width=0.95pt] (C2) circle (\R);
\draw[c3col,line width=0.95pt] (C3) circle (\R);

% --- PURE ZONE: Compute (C1, Top) ---
\node[TxtC,text=c1col](NC1) at (0, 5.25) {Compute (C\textsubscript{1})};
\node[TxtIT,below=1pt of NC1](TC1) {The Node Substrate};
\node[TxtSM,below=2pt of TC1](SC1) {Accelerators \& Tensor Cores\\HBM3e Memory Wall, SRAM\\\& Local NVMe Storage Tiers};
\node[TxtJM,below=2pt of SC1](JC1) {Ch: Compute Infra, Storage\\\& Performance Engineering};

% --- PURE ZONE: Communication (C2, Bottom-Left) ---
\node[TxtC,text=c2col](NC2) at (-3.10, -0.55) {Communication (C\textsubscript{2})};
\node[TxtIT,below=1pt of NC2](TC2) {The Networking Backbone};
\node[TxtSM,below=2pt of TC2](SC2) {Optical Fabrics \& InfiniBand\\RoCEv2, Rail Topologies\\\& Bisection Bandwidth};
\node[TxtJM,below=2pt of SC2](JC2) {Ch: Network Fabrics\\\& Collectives};

% --- PURE ZONE: Coordination (C3, Bottom-Right) ---
\node[TxtC,text=c3col](NC3) at (3.10, -0.55) {Coordination (C\textsubscript{3})};
\node[TxtIT,below=1pt of NC3](TC3) {The Orchestration Layer};
\node[TxtSM,below=2pt of TC3](SC3) {Gang Schedulers (Slurm, Ray)\\Heartbeats \& State Consensus\\\& Fast Node Reboot};
\node[TxtJM,below=2pt of SC3](JC3) {Ch: Fleet Orchestration\\\& Fault Tolerance};

% --- INTERSECTION: C1 ∩ C2 (Top-Left) ---
\node[TxtC,text=black!80](PC1C2) at (-1.85, 1.75) {C\textsubscript{1} $\cap$ C\textsubscript{2}};
\node[TxtCOL,below=0pt of PC1C2](THNL) {Hiding Network\\Latency};
\node[Box,anchor=south east] (BOX1) at (-3.70, 3.65) {%
  \textbf{Hiding Network Latency (C\textsubscript{1} $\cap$ C\textsubscript{2})}\\[2pt]
  $\bullet$ \textbf{1F1B Pipelining}: CUDA stream compute-comm overlap\\
  $\bullet$ \textbf{Comm-to-Compute Ratio} ($\rho$): Grad accumulation\\
  $\bullet$ \textbf{Kernel Fusion}: GEMM + AllReduce overlap\\
  $\bullet$ \textbf{Wire Compression}: FP8/INT4 gradient transfer\\[3pt]
  {\sffamily\itshape\fontsize{6}{8}\selectfont\textcolor{black!60}{Ch: Distributed Training, Collective Communication}}
};
\draw[LineA]([xshift=-2pt]THNL.150) -- ([xshift=-50pt]BOX1.south east);

% --- INTERSECTION: C1 ∩ C3 (Top-Right) ---
\node[TxtC,text=black!80](PC1C3) at (1.85, 1.75) {C\textsubscript{1} $\cap$ C\textsubscript{3}};
\node[TxtCOL,below=0pt of PC1C3](TMFG) {Maximizing\\Fleet Goodput};
\node[Box,anchor=south west] (BOX2) at (3.70, 3.65) {%
  \textbf{Maximizing Fleet Goodput (C\textsubscript{1} $\cap$ C\textsubscript{3})}\\[2pt]
  $\bullet$ \textbf{Async Checkpointing}: Non-blocking NVMe snapshot\\
  $\bullet$ \textbf{Bubble Reduction}: Optimal 1F1B microbatch schedule\\
  $\bullet$ \textbf{Memory Recovery}: In-memory recompute vs. rollback\\
  $\bullet$ \textbf{Failure Blast Radius}: Fast node drain \& spare re-entry\\[3pt]
  {\sffamily\itshape\fontsize{6}{8}\selectfont\textcolor{black!60}{Ch: Fault Tolerance, Fleet Orchestration}}
};
\draw[LineA]([xshift=2pt]TMFG.30) -- ([xshift=50pt]BOX2.south west);

% --- INTERSECTION: C2 ∩ C3 (Bottom Overlap) ---
\node[TxtC,text=black!80](PC2C3) at (0, -1.55) {C\textsubscript{2} $\cap$ C\textsubscript{3}};
\node[TxtCOL,below=0pt of PC2C3](TCS) {Collective\\Sync};
\node[BoxBottom,anchor=north] (BOX3) at (0, -4.50) {%
  \textbf{Collective Synchronization (C\textsubscript{2} $\cap$ C\textsubscript{3})}\\[2pt]
  $\bullet$ \textbf{Straggler Amplification}: Barrier synchronization tail latency\\
  $\bullet$ \textbf{Hierarchical Collectives}: NVLink intra-node + IB inter-node\\
  $\bullet$ \textbf{Bounded Staleness}: Async / gossip SGD vs. bulk synchronous\\
  $\bullet$ \textbf{Topology-Aware Scheduling}: Placing ranks along fabric rails\\[3pt]
  {\sffamily\itshape\fontsize{6}{8}\selectfont\textcolor{black!60}{Ch: Collective Communication, Fault Tolerance, Fleet Orchestration}}
};
\draw[LineA]([yshift=-3pt]TCS.south) -- (BOX3.north);

% --- TRIPLE INTERSECTION: C1 ∩ C2 ∩ C3 (Center) ---
\node[font=\sffamily\bfseries\fontsize{7}{8.5}\selectfont,text=c1col] at (0, 0.70) (CENT) {C\textsubscript{1} $\cap$ C\textsubscript{2} $\cap$ C\textsubscript{3}};
\node[TxtCENT,below=1pt of CENT](CENT_TITLE) {Fleet-Scale\\ML Systems\\Engineering};
\node[BoxCenter,anchor=east] (BOX4) at (-6.57, 0.88) {%
  \textbf{Fleet ML Systems Engineering}\\[2pt]
  $\bullet$ \textbf{The Fleet Law} ($T_{\text{step}}$ decomposition)\\
  $\bullet$ \textbf{4D Parallelism} (DP + TP + PP + EP)\\
  $\bullet$ \textbf{Memory Sharding} (FSDP2, ZeRO-3)\\
  $\bullet$ \textbf{ML Productivity Goodput}\\[3pt]
  {\sffamily\itshape\fontsize{6}{8}\selectfont\textcolor{black!60}{Ch: Distributed Training, Inference, Edge}}
};
\draw[LineA]([xshift=-3pt,yshift=0.5mm]CENT_TITLE.west) -- (BOX4.east);

% Bottom dividing line and quote
\draw[gray!50,line width=0.5pt] (-8.6, -7.90) -- (8.6, -7.90);

\node[align=center,font=\sffamily\fontsize{7.5}{10.5}\selectfont,text=black!70] at (0, -8.20)
  {The center --- where Compute, Communication, and Coordination converge --- is Fleet-Scale ML Systems Engineering.};

\end{tikzpicture}
:::
阅读 C$^3$ 交集版图 中的维恩图时,应从外部区域逐步向内:先判断哪个独立维度或两两交集构成瓶颈,再采取相应的系统干预措施。
围绕这三个运行维度的是第四部分阐述的、不容妥协的运行不变量:约束数据中心的热力学能耗与冷却极限(Sustainable AI),分布式流水线所需的对抗安全与差分隐私保证(安全与隐私),应对静默数据损坏和分布偏移的鲁棒性(Robust AI),以及在社会规模上运行时必不可少的系统治理、审计与安全不变量(责任人工智能)。与单节点的 D·A·M 版图一样,C\(^3\) 图为后续全部十六章提供了方向指引:先判断哪个交集构成瓶颈,再实施干预。
集群定律
C\(^3\) 交集版图界定了分布式执行的时间花在何处,以及权衡在何处产生实质影响。要把这张诊断图转化为具有预测能力的系统工程方法,就需要一个能够核算分布式步骤中每一微秒的主导方程。在单台机器上,执行时间遵循性能铁律,\(T \approx D_{\text{vol}}/\text{BW} + O/(R_{\text{peak}}\eta_{\text{hw}}) + L_{\text{lat}}\),可分解为数据移动、计算和开销。在集群规模下,这种单机视角已不足以描述系统。公式 3 给出了集群定律,将理想化的分布式训练步骤分解为 C\(^3\) 引擎中的各项:
\[ T_{\text{step}}(N) = \frac{T_{\text{compute}}}{N} + T_{\text{comm}}(N) + T_{\text{sync}}(N) - T_{\text{overlap}} \tag{3}\]
集群定律中的每一项都直接对应 C$^3$ 交集版图 中 C\(^3\) 版图的一个区域:
- \(\frac{T_{\text{compute}}}{N}\) 是计算(\(C_1\))项,假设固定工作负载分配到 \(N\) 个设备后,本地算术运算能够理想地均分。
- \(T_{\text{comm}}(N)\) 是通信(\(C_2\))项,描述梯度、激活值和参数分片在网络互连结构上传输所需的链路传输时间。
- \(T_{\text{sync}}(N)\) 是协同(\(C_3\))项,描述屏障语义、等待慢节点、集群调度决策和故障恢复所消耗的时间。
- \(T_{\text{overlap}}\) 是协同设计(\(C_1 \cap C_2\)、\(C_1 \cap C_3\)、\(C_2 \cap C_3\))项,表示借助 1F1B 流水线、CUDA 流重叠和异步检查点等技术,与有效计算重叠而被隐藏的通信或协同时间。
弱扩展、负载不均衡、内存容量变化和算法变化都要求调整这些项,不能把 \(T_{\text{compute}}/N\) 视为不变量。公式 4 将这一分解改写为计算时间占比,即有效数学运算所占的实际经过时间比例:
\[ f_{\text{compute}} = \frac{T_{\text{compute}}/N}{T_{\text{step}}(N)} \tag{4}\]
这一分解是一种诊断工具。当 \(f_{\text{compute}}\) 降至 0.5 以下时,步骤中超过一半的时间花在有效本地算术运算之外。C\(^3\) 分类体系可以识别时间的去向:若 \(T_{\text{comm}}(N)\) 占主导,应升级互连或让通信与计算重叠;若 \(T_{\text{sync}}(N)\) 占主导,应考虑异步方法或降低屏障频率;若 \(T_{\text{compute}}/N\) 占主导,则本地算术运算决定步骤时间。开销转移是一条诊断性启发原则:减少某种开销,可能会使成本在三个维度之间转移。异步训练消除了部分协同屏障,却引入了梯度陈旧问题;流水线并行可以减少部分暴露的通信时间,却增加了气泡时间。
Google 的机器学习生产效率有效吞吐量(ML Productivity Goodput)指标,将这一框架具体应用于生产规模。有效吞吐量把端到端训练生产效率分解为三个相乘的因子:程序有效吞吐量(Program Goodput)(\(\eta_{\text{program}}\)),衡量代码使用硬件的效率(计算);运行时有效吞吐量(Runtime Goodput)(\(\eta_{\text{runtime}}\)),反映通信停顿和故障造成的损失(通信);以及调度有效吞吐量(Scheduling Goodput)(\(\eta_{\text{scheduling}}\)),反映抢占和重新配置所浪费的时间(协同)。C\(^3\) 分类体系是理论框架,而有效吞吐量是生产团队衡量这一框架的方式。
集群定律从时间维度诊断跨时间与能耗的集群效率:在计入通信、同步与重叠后,每个分布式步骤中还有多少时间用于有效计算。集群规模定律 给出完整推导,并将每一项归因于具体的物理原因。
能耗—规模不变量
集群定律描述时间,而能耗—规模不变量则描述集群的可持续性与经济可行性。在大规模运行中,每个训练步骤都是一次热力学事件。公式 5 将集群能耗生产率(\(\rho_{\text{energy}}\))定义为有效工作量与总能耗之比,单位为 FLOP/J:
\[ \rho_{\text{energy}} = \frac{O_{\text{useful}}}{E_{\text{compute}} + E_{\text{cooling}} + E_{\text{network}}} \tag{5}\]
其中,\(O_{\text{useful}}\) 是以 FLOP 为单位的有效工作量;当通过光互连结构传输数 TB 数据时,\(E_{\text{network}}\) 往往会成为总能耗预算中不可忽略的一部分。驾驭规模意味着沿着这两条定律的帕累托前沿进行优化:在最小化 \(T_{\text{step}}\) 的同时最大化 \(\rho_{\text{energy}}\)。本节从概念上介绍这一不变量;大规模条件下的能耗层级 则详细阐述大规模系统的能耗层级,以及限制 \(\rho_{\text{energy}}\) 提升空间的热力学约束。
能耗指标只完成了扩展诊断的一半。生产团队还需要一个时间维度的效率标量,以判断增加设备是在缩短训练步骤,还是仅仅增加了协同开销。
集群的扩展效率(\(\eta_{\text{scaling}}\))是理想并行步骤时间与实际步骤时间之比: \[ \eta_{\text{scaling}} = \frac{T_1}{N \times T_N} \] 其中,\(T_1\) 是完成相同工作量所需的单设备时间,\(T_N = T_{\text{step}}(N)\) 是在 \(N\) 个设备上的步骤时间。分量分解 提供了将 \(T_{\text{step}}(N)\) 分解为各项的分量分解方法及计算示例,使读者能够通过数值计算求得 \(\eta_{\text{scaling}}\)。
Systems Perspective 1.2: 阿姆达尔定律在分布式系统中的应用陷阱
集群定律将阿姆达尔的推理 (Amdahl 1967年) 应用于强扩展实验:把固定数量的有效工作分配到更多设备上,同时测量该配置下的通信项与协同项。只有在计算加速后,原始工作负载中仍有 20% 无法消除的串行部分时,才会出现 5\(\times\) 的加速上限。在某个设备数量下测得网络时间占比为 20%,并不意味着这一占比必然保持不变;改变任务划分、拓扑、集合通信算法或重叠方式,都可能改变网络传输的绝对时间及其在步骤中的占比。因此,集群定律用于诊断特定工作负载与配置的扩展极限,而不主张存在普遍适用的网络时间占比。
Amdahl, Gene M. 1967年. 《Validity of the single processor approach to achieving large scale computing capabilities》. Proceedings of the April 18-20, 1967, spring joint computer conference on - AFIPS ’67 (Spring), AFIPS ’67 (Spring), 483~85. https://doi.org/10.1145/1465482.1465560.
把这两条定律应用于 GPT-3 级别的同步估算,可以用与扩展方程一致的各项,同时呈现暴露的通信开销及其热力学对应量:使加速器缺少计算时间的同一个 Ring AllReduce,也会在每个步骤中消耗能量。

在大规模运行中,计算仅占步骤时间的约 4%;同步占主导。
Napkin Math 1.2: 通信与能耗开销
问题:在一个示意性的 GPT-3 同步场景中,使用 100 Gb/s 以太网与 200 Gb/s InfiniBand 分别会产生多大的计算时间占比和端点网络能耗成本?
物理: 要同步 175B 个参数(FP16),Ring AllReduce 必须在每个参与加速器的端点上每轮传输约 700 GB 的数据。
分析:集群法则揭示了通信开销。
- InfiniBand(200 Gb/s):在乐观的线速传输模型下,计算时间占比仅为 4.1 percent,即加速器每 100 seconds 中有 4.1 seconds 的时间用于计算,其余为暴露的通信时间。
- 以太网(100 Gb/s):较低的线速进一步将计算时间占比降至 2.1 percent,使加速器每 100 seconds 中仅有约 2.1 seconds 的时间处于有效工作状态。
能耗:能耗墙是同一同步过程的热力学成本。每个端点的梯度同步在整个网络互连结构上消耗约 84 J 的能量(在 15 pJ/bit 条件下)。在 1,000,000 步的训练运行中,仅端点网络传输就消耗约 84 MJ 的能量,在乘以参与加速器的数量之前。
系统洞见:这一下限场景假定以标称链路速率实现有效传输,并忽略了集合通信拓扑、软件开销、竞争与重叠。即便是在这一乐观边界条件下,暴露的同步仍可能使加速器空闲,而相同的数据传输在每一步都会消耗能量。因此,增加加速器并不保证获得成比例的加速,除非具备通信隐藏、压缩,以及匹配工作负载的互连结构。
基础概念
集群栈是本书的组织主线。C\(^3\) 与集群法则为其提供了性能视角:C\(^3\) 将分布式单步时间归因于计算、通信与协同,而集群法则量化了它们对扩展的影响。灯塔原型则提供了工作负载视角,通过在密集训练、稀疏推荐和联邦边缘等形态中检验这些约束。其余构造属于从属映射:D·A·M 描述 C\(^3\) 所分布的工作负载,AI 三元组刻画数据、算法与基础设施之间的依赖关系,五支柱框架则将这些依赖关系映射到运维归属。图 13 将这些视角组织为集群栈,即一个四层框架,其中底层的工程决策约束顶层的可能性。
这一分层演进结构构成了本教材四个部分:物理底层、分布逻辑、规模化部署与负责任集群。详细的章节地图见 节 1.6;此处,该分层结构确立了依赖顺序。
规模化下的 AI 三元组 是该分层结构中的依赖关系提示。每一个机器学习系统都由三个相互依赖的组成部分构成:指导行为的数据、学习模式的学习算法,以及同时支撑训练与推理的计算基础设施。在生产规模下,这些相互依赖关系会进一步强化。一个约 \(10^{25}\) FLOPs 量级的 GPT-4 类场景,将需要支持数万张 GPU 之间高效梯度同步的基础设施。该规模下的训练数据,需要面向机器学习工作负载优化访问模式的分存储系统。图 14 可视化了数据、算法与基础设施之间的这些依赖关系,揭示了机器学习系统工程师必须应对的优化设计空间。
五支柱框架 将这些层级约束转化为职责域。数据工程 定义集群必须摄取、转换和提供服务的对象;模型开发 定义在大规模下消费该数据的架构与训练流程。优化随后将模型与其部署约束衔接起来,当延迟、内存或功耗预算成为约束时,压缩或加速该工作负载。部署基础设施 提供云平台、网络互连结构和存储层级,使集群得以运行。运维则通过闭环,衡量已部署系统在生产数据与硬件条件变化后是否依然保持可靠、安全与有效。
生产框架之所以重要,是因为每个框架都以不同的名称和不同的职责边界实现同一组抽象原语。框架“罗塞塔石碑” 提供跨框架映射,作为集群栈中原语开发的翻译辅助工具,而非用于框架排名的工具。
| 抽象原语 | PyTorch(原生) | DeepSpeed | Megatron-LM | JAX/XLA | Ray |
|---|---|---|---|---|---|
| 数据并行 | DDP | DeepSpeedEngine | DistributedDataParallel | pmap/jit(分片) | Ray Train |
| 分片数据并行 | FSDP | ZeRO-1/2/3 | FullyShardedDataParallel | sharding.Mesh | FSDP 策略 |
| 张量并行 | DTensor | InferenceTP | Column/RowParallel | xmap/spmd | Ray Train TP |
| 流水线并行 | PiPPy | PipelineModule | PipelineParallel | GSPMD | Ray Train PP |
| 梯度累积 | backward(accumulate) | grad_accum_steps | grad_acc_steps | lax.scan | Ray Train Config |
| 检查点 | torch.save/DCP | save_checkpoint | save_checkpoint | orbax | ray.checkpoint |
| 编排 | torchrun | deepspeed CLI | megatron_main.py | jax.distributed | Ray Core |
这些原语贯穿全书;该表是逐一引入各原语时可回查的参考,而非此刻需要背诵的提纲。 六大系统工程原则 为各个设计决策提供标准:先加观测、为 10\(\times\) 余量而设计、预期瓶颈会迁移、将故障视为常态,并在整个集群中累积微小的效率收益,以及将硬件与算法协同设计。在集群规模下,关于性能或可靠性的论断只有在其被观测之后才有用,因为成因可能位于模型、调度器、网络、存储层或服务路径之中。这种测量纪律支撑着 10\(\times\) 的设计:原型在尚未显示出余量究竟还剩在哪里之前,还不能称为架构。随着规模上升,瓶颈会从本地计算转向通信与协同;硬件故障变得习以为常;微小的效率收益因在整个集群中重复出现而变得可观。硬件协同设计源于同一逻辑,因为网络拓扑、存储层次与加速器选型决定了哪些算法仍然实用。这些正是集群工程师所采用的实践;本书最终将这些实践提炼为分布式机器学习系统所遵循的持久原则。
这些框架共同假定读者已熟悉单机机器学习系统:模型如何在单个设备上训练、优化与部署。本书则教授工程师如何在全球机器学习集群中扩展、分布并治理这些系统。
三种系统架构原型
抽象框架通过具体工作负载变得具体。三种灯塔式原型在大规模场景下反复出现,用于照亮各章的核心约束;并非每章都必须将三者全部纳入论证。三者分别以不同方式施加通信、协同或计算压力,从而采样不同的 C\(^3\) 形态。
原型 A(GPT-4 / Llama-3)
GPT-4 与 Llama-3 是自回归 Transformer 架构,逐 token 生成文本。在单加速器规模下,自回归语言模型是内存带宽探针;在数百亿参数量级(某些专有系统甚至更多)下,训练需要 ExaFLOP/s 的持续计算能力,并分布在数千到数万个加速器之间,而服务则需要足够的内存带宽,以便为每个生成 token 载入数十亿权重。集群层面的挑战,是在加速器集群中划分超大规模模型,采用 3D 并行(数据、张量与流水线),同时避免产生过量的梯度或激活流量,致使网络成为绑定瓶颈。因此,原型 A 探查的是 C\(^3\) 的通信维度,尽管其实际主导项取决于模型、划分方式、拓扑结构以及重叠程度。
原型 B(大规模 DLRM)
DLRM 是 Meta 用于个性化内容排序的生产架构。与 LLM 主要由稠密矩阵乘法主导不同,推荐模型的能力来自庞大的嵌入表,以及将数十亿用户与物品特征映射为稠密向量的稀疏查找结构。单个生产 DLRM 实例可能包含 10 TB 或更多的嵌入参数,远超任何单块加速器的内存容量。集群挑战在于,在数百个节点之间分片这些嵌入表的同时,以每秒数百万次查询(QPS)处理请求,并保持 <100 ms 的尾延迟,同时管理 \(\mathcal{O}(N^2)\) 嵌入分片与稠密层之间的全对全通信争用。在 C\(^3\) 分类体系中,原型 B 的压力集中在协同方面:稀疏特征路由、分片放置、请求调度以及嵌入更新一致性,共同决定全对全流量能否在尾延迟限制内得到服务。
原型 C(联邦 MobileNet)
MobileNet 是一族为在严格功耗与内存预算下实现端侧推理而设计的轻量卷积神经网络。在联邦学习 设定下,MobileNet 实例在数百万台异构边缘设备(智能手机、物联网传感器、医疗可穿戴设备)上本地训练,原始数据始终不离开设备。约束形态与数据中心原型存在本质差异:计算预算以瓦特而非兆瓦计量,且隐私或策略约束可能禁止集中式数据聚合。在 C\(^3\) 分类体系中,原型 C 由设备级计算主导:每个本地训练步骤受限于边缘设备的瓦特级硅片算力包络,而非集群级网络带宽或协同协议。集群挑战在于,借助联邦平均——协调器定期对各设备更新求平均——来协调数百万台此类受计算约束且不可靠的设备,同时维持收敛性保证,即使数据分布并非独立同分布(i.i.d.),且存在间歇性连接。
将这三个原型视为约束探针,而非模型族清单。LLM 情形探讨稠密同步能否让数千台加速器持续有用;DLRM 情形探讨稀疏特征路由能否满足尾延迟预算;联邦 MobileNet 情形探讨能否将各设备的本地约束协调为统计上一致的全局更新。大规模灯塔架构原型 汇总了本书全程跟踪的三个标准工作负载。
| 原型 | C\(^3\) 主导约束 | 集群挑战 |
|---|---|---|
| 原型 A(GPT-4/Llama-3) | 通信(集群范围内) | 将数百亿参数,以及可能更大的专有模型,切分为数百块,分布到数千至数万台 GPU 上,采用 3D 并行,同时避免网络成为瓶颈。 |
| 原型 B(大规模 DLRM) | 协同(路由与放置) | 将 10 TB+ 的嵌入表切分到数百个节点;处理百万级 QPS,尾延迟低于 100 ms,同时管理稀疏特征路由、切分放置与 \(\mathcal{O}(N^2)\) 全对全争用。 |
| 原型 C(联邦 MobileNet) | 计算(每设备预算) | 通过联邦更新协调跨越数百万台计算受限、不可靠的边缘设备上的学习;原始数据无法离开设备。 |
本教材的结构
本教材围绕集群栈组织,从物理底层出发,经由分布的逻辑,直至社会治理。章节序列是一张依赖关系图,而非主题清单:硅与冷却的物理约束决定了网络布线;网络限制决定了训练划分;划分后的算法决定了容错与编排;而集群编排则决定了生产运行、安全与治理。每个部分都针对一项阻碍单机方案在生产规模上运行的根本性规模障碍(图 15)。
基础设施这条线索始于没有任何算法可以忽视的障碍:没有任何一台服务器具备足够的内存、算力、散热或 I/O,来训练最大的模型。计算基础设施 因此从高密度芯片与设施物理出发,网络互连结构 将孤立的机器汇聚为集群规模的”梯度总线”,数据存储 则通过持续为加速器供能、同时避免存储成为隐性瓶颈,完成这一底层基础。
分布这条线索始于物理集群形成、协同开销变得不可避免之时。将数学运算拆分到不同机器上,会引出两个新问题:副本必须足够快地交换状态,才能表现得如同一个优化器;故障也从偶发事件变成了常规事件。分布式训练 针对拥有数百亿至万亿参数的模型,发展切分策略;集合通信 解释将独立节点结合为连贯计算机的通信原语;容错 将恢复速度视为比单个节点的可用性更为重要;集群编排 管理多租户集群,在其中决定这些任务的放置、隔离与重新调度。
部署这条线索将讨论重心从训练模型转向经济地提供服务。当模型进入生产环境后,关键问题不再仅仅是训练耗时;而是延迟、利用率与全生命周期服务成本是否仍处在运行包络之内。性能工程 通过内核融合与编译,弥合硬件峰值与实际吞吐量之间的差距;在大规模下运行推理 将这些局部优化转化为面向数百万用户的推理服务系统;边缘智能 将智能推向功耗预算仅为毫瓦级的设备;规模化机器学习运维 则开发用于监控全球部署中健康状态、漂移与性能的控制平面。
治理这条线索将责任视为一个工程层,而非附录。在全球规模下,技术缺陷会演变为社会风险:攻击者可以投毒数据或提取权重,开放世界输入可能破坏脆弱模型,能耗会成为集群层面的约束,而治理失效则可能将技术能力转化为社会危害。安全与隐私、Robust AI、Sustainable AI 与 责任人工智能 将这些义务作为必须设计、度量与运行的系统属性加以发展。
谬误与陷阱
下列谬误与陷阱涵盖了那些浪费开发资源、错失性能目标,或部署出与运行约束严重不匹配的系统架构错误。每一种都代表了从单机机器学习向机器学习集群过渡过程中反复出现的模式。
谬误:只关注算法效率,而忽视硬件系统一致性。
工程师经常优化 FLOPs 和参数数量,假设这些指标能够预测部署性能。真正的效率取决于数学运算与底层硬件的契合程度。例如,非结构化剪枝可实现 80 percent 稀疏度,但在稠密硬件(如 NVIDIA Tensor Cores)上却没有任何加速;而结构化剪枝在 50 percent 稀疏度下,可以在支持的硬件和内核上带来最高 2\(\times\) 的稀疏计算吞吐量,但并不保证端到端加速。一个参数从 10B 减少到 3B(FLOPs 减少 70 percent)的模型,可能只获得 20 percent 的延迟改善,因为内存带宽瓶颈占主导地位,且剪枝模式缺乏对硬件友好的结构。
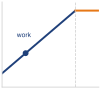
仅削减 FLOPs 会使延迟受内存限制。
陷阱:只优化单一指标,而不检查系统层面的权衡。
普遍效率谬误 假设量化或蒸馏之类的优化是“免费的胜利”。在生产环境中,每次优化都会引入特定的权衡。INT8 量化可实现 4\(\times\) 的内存减少,但通常会带来 1–2 percent 的精度损失。知识蒸馏可实现 2–4\(\times\) 的压缩,却需要昂贵的教师模型训练。最优架构需要在精度、延迟和功耗之间取得平衡,而不仅仅是最小化资源消耗。
谬误:边缘部署的效率要求只是云部署效率要求的缩小版。
本段 “云端轻量”谬误 将边缘系统视为资源受限的云端系统。边缘设备面临的约束在性质上截然不同。例如,一辆以 120 km/h 行驶的汽车,在每次 100 ms 的处理延迟期间会行驶 3.33 m 的距离,从而增加其反应距离。而云端部署可扩展至千瓦级功率,边缘系统则运行在 5–15 W 的功率预算之下。一个针对云端优化、准确率为 95% 且延迟为 50 ms 的模型,在边缘设备上可能完全不可用:热节流会使延迟升至 200 ms,并在一小时内耗尽电池。
陷阱:假设规模定律在所有尺度上都线性地预测效率需求。
当团队利用幂律关系推算资源需求,却未考虑协同开销时,就会出现线性扩展谬误。\(\mathcal{L}(X) = A_{\mathcal{L}} X^{-\alpha_{\text{scale}}} + C_{\mathcal{L}}\) 在经过验证的范围内有效,但在边界处会失效。 一个团队根据 10B 参数模型的实验结果推算 100B 参数模型的训练表现,可能会预测出 3× 的性能提升;但如果协同与通信开销占扩展后步骤时间的 40 percent,实际提升可能只有 1.8×。 在设计时假定能够线性扩展的生产系统,一旦超出已验证的阈值、实际性能偏离幂律预测,就曾出现成本超出预算 2–3\(\times\) 的情况。
总结
本书以一个核心挑战开篇:支撑单机系统成功的原则,在大规模系统中仍然必要,却已不充分。这一领域已从实验室走向机器学习集群。在集群中,通信可能主导计算,故障在长期运行中成为常态,而社会影响则要求严格的治理。
从构建能够正常工作的系统,到构建能够扩展的系统,这一转变代表着工程实践进入了下一种形态。机器学习系统的核心原则——全面测量、优化瓶颈、面向故障设计——仍然至关重要,但当系统横跨数千个节点时,这些原则的应用方式会发生根本变化。网络拓扑变得与内存层级同等重要,而集群协同引入了节点间同步:更新、故障和共享状态都必须在多台机器之间进行管理。
这些原则共同重塑了工程师思考系统设计的方式。当故障成为常态,并且通信成本在特定工作负载与任务划分下可能超过计算成本时,就必须拓展在单机上形成的诊断直觉。真正理解这些约束的工程师,会从关注局部加速转向关注集群治理:协同开销出现在哪里,节点消失时哪些环节会失效,以及哪些一致性保证可以放宽。从优化组件转向治理集群,正是能够设计大规模系统的实践者与只能在单机上构建原型的人之间的区别。
Key Takeaways: 规模造就一台新的机器
- 更多 GPU 会改变问题本身:在单个节点上有效的技术,到了集群规模下,可能不仅变慢,还会变得不适用。二分带宽、供电、可靠性和治理带来了单加速器实验中不存在的约束。
- 网络会消耗每一份加速收益:增加加速器会摊薄本地计算时间,却也增加同步、梯度流量和尾延迟带来的影响。一个 175B 参数模型在每个步骤中可能传输数百 GB 的梯度,因此,有效 FLOP 取决于通信,而不仅取决于峰值算术运算能力。
- 故障成为稳态的一部分:在使用 25,000 个 GPU 的训练任务中,即使每个 GPU 的平均故障间隔时间(MTBF)达到数万小时,集群仍会每隔几小时发生一次故障。检查点、恢复和可观测性是基本设计要求,而非事后的补救工作。
- C\(^3\) 拓展了局部直觉:数据、算法、机器这一视角仍然描述工作负载与底层平台;计算、通信和协同则揭示了分布式执行引入的成本。集群定律明确给出了这一拓展:扩展能力不仅取决于硬件数量,也取决于同步、重叠和一致性。
- 社会影响需要控制平面:基础模型规模的系统会在庞大的用户群体中放大安全、隐私、公平性和政策方面的失误。治理是决定集群被允许优化和部署什么的机制,是基础设施不可分割的一部分。
上述论述最终指向一个转变:在大规模系统中,决定性的约束可能转移到节点之外。在单个加速器上,内存层级可能决定性能上限;而当加速器达到一万个时,通信与协同可能限制集群利用本地计算能力的效率。这就是分布式系统的物理规律:数据、算法和机器仍然定义工作负载与底层平台,而计算、通信和协同则揭示了在整个集群上执行这些工作负载的成本。本书后续内容将详细阐述这一拓展,从底层芯片一直讲到决定集群被允许做什么的治理机制。
What’s Next: 从需求到芯片
规模化的需求已经确立:采用分布式系统的理由、物理成本,以及支配机器学习集群的原则,都已得到明确界定。然而,单靠需求无法计算梯度。集群需要一个能够持续支撑这些工作负载的物理基础,包括芯片、电力和冷却。计算基础设施 将开始构建这一基础,考察构成集群技术栈基础设施层的加速器架构、内存层级和供电系统。