计算基础设施
基础设施之墙
计算基础设施
目的
为什么是基础设施,而非仅仅算法,决定了谁能够参与大规模推进机器学习?
机器学习系统除了代码之外,还具有物理现实。虽然训练大模型的算法可能公开,但能否以大规模方式执行它们,受到基础设施的约束。训练必须在热限制、供电容量和数据移动成本之内运行。在大规模情况下,进步因此部分取决于谁能建造和运营使大规模成为可能的物理系统。构建一个 ML 集群需要跨越四个物理层次进行工程:加速器(硅物理)、节点(互连密度)、机架(热管理)和机柜(仓库级网络)。在每个层次,目标都是减少数据移动所花费的时间,并增加用于有用计算的时间。一个大型加速器集群同样代表着重大的资本支出和兆瓦级的持续供电,因而使基础设施成为在最大规模上工作的组织所面临的参与边界。该物理栈从堆叠的内存 die 一直延伸到电网级供电。以 C³ 术语而言,这一底层结构确立了后续各章所考察的计算与通信边界。
Learning Objectives
- 比较 GPU、TPU 和 ASIC 的数据流,以解释加速器谱系上的专用性差异
- 应用 roofline 分析,识别训练与推理中的计算受限、内存受限或带宽受限瓶颈
- 根据 HBM 容量、带宽、精度和模型状态大小,计算 token 延迟或内存预算
- 将张量并行、流水线并行和数据并行映射到 NVLink、机架和机柜的带宽层级
- 依据功率密度、冷却限制、拓扑和设施可靠性约束,评估机架与机柜设计
- 依据持续吞吐量、功率、工作负载适配性以及集群所有权分析输入,选择加速器基础设施
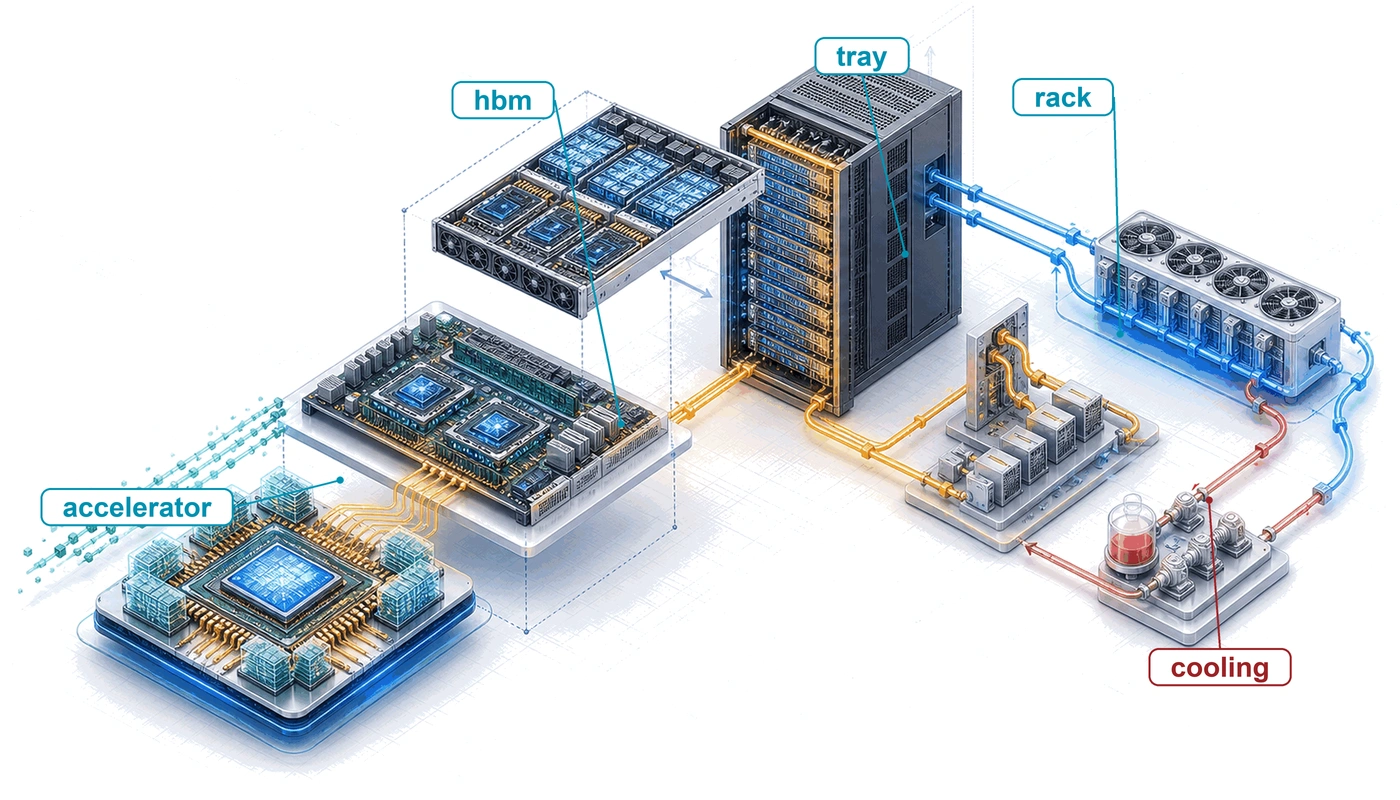
规模迫使系统走向分布式:计算、通信与协同取代了单机时代的数据、算法与机器直觉。如今,集群层面的这些限制必须依靠硬件来买单。随着系统从单张加速器扩展至仓库级机柜,有四项物理约束反复出现:内存带宽、供电能力、通信带宽与可靠性(图 1)。
从晶体管到数据中心的演进路径,由 175B 模型锚定,该模型作为贯穿各层级的线索。
加速器谱系
基础始于硅片:一块专用芯片之所以占据一席之地,是因为它能完成通用处理器无法高效完成的一项任务——反复以最高吞吐量执行同一种稠密算术运算。考虑 CPU 执行一次矩阵乘法时会发生什么:处理器取指、译码,检查数据相关,将操作数经由深层流水线转发,最后将结果写回寄存器文件。对于每一次乘加运算,芯片都要在分支预测、投机执行、乱序调度和缓存一致性上耗费能量。
这些机制之所以存在,是因为 CPU 必须高效处理任意指令序列,从指针遍历的链表到系统调用。然而,对于神经网络工作负载,操作几乎总是相同的:将两个已知维度的矩阵相乘,加上偏置,再应用一个非线性函数。CPU 那套繁复的控制逻辑对每一次操作都是一笔开销,而工作负载并不需要这种灵活性。这一概念与计算机体系结构中的经典精简指令集计算机(RISC)与复杂指令集计算之争遥相呼应:正如 RISC 处理器通过简化指令集获得了更高的吞吐量,机器学习加速器则通过简化计算模型以匹配主导性的工作负载模式来获得更高的吞吐量。
Systems Perspective 1.1: 通用性税
一台现代服务器 CPU 大约将 30–40% 的芯片面积用于缓存,20–30% 用于控制逻辑(分支预测器、重排序缓冲区、指令译码器),只有 5–10% 用于算术单元。这种分配对于通用代码是合理的,因为分支不可预测、数据访问模式不规则。但矩阵乘法具有规则的访问模式和可预测的控制流。用于分支预测或投机执行的硅片面积,为这一工作负载提供了很少会使用的灵活性。这就是通用性税(原则 5):即投入到主导性工作负载之外的能力所占的面积与能量。
专用加速器降低了这笔税。沿着从 CPU 到定制专用集成电路(ASIC)的谱系,通过移除通用控制逻辑,可以将更多芯片面积用于算术运算。这一演进是可量化的:CPU 将约 5–10% 的芯片面积用于算术,GPU 约为 50–60%,张量处理单元(TPU)约为 70–80%,而专为特定用途设计的 ASIC 可以将超过 90% 的芯片面积用于目标计算。
从通用硅基芯片转向专用硅基芯片,遵循着一条合乎逻辑的发展路径。在光谱的一端,GPU 保留了可观的可编程性,同时提供 CPU 矩阵吞吐量的 10–100\(\times\) 倍。在另一端,定制 ASIC 将特定的数据流硬编码进硬件,以牺牲灵活性为代价换取最大效率。
理解每种架构在这一光谱上的位置及其原因,对于选择与给定工作负载相匹配的硬件至关重要。这一光谱并非从“差”(通用 CPU)到“好”(定制 ASIC)的排序,而是一条权衡的连续谱:每个位置都为不同组合的工作负载特征与部署约束提供最佳匹配。
GPU 代表了从通用计算迈向大规模并行性的第一步,同时保留了可编程性。例如,NVIDIA H100 包含 16,896 个 CUDA 核心,组织为 132 个流式多处理器(SM)。每个 SM 可利用 单指令多线程(SIMT)1 执行模型同时执行数千个线程。与 CPU 不同,CPU 针对单线程延迟进行优化,而 GPU 通过保持大量线程处于活跃状态,并在某个线程因访问内存而停顿时在它们之间切换,从而隐藏内存延迟。
1 SIMT(单指令多线程): 由 NVIDIA 提出,用以将其 GPU 架构区别于经典意义上的单指令多数据(SIMD)。在 SIMT 中,32 个线程构成一个 warp,共享同一条指令流,但在分支处可能产生分歧;分歧会强制两条路径串行执行,使每条分支的吞吐量减半。对于机器学习工作负载,矩阵运算具有统一的控制流,因此 warp 分歧较为罕见,这也是 GPU 在通用矩阵乘法(GEMM)上接近峰值利用率,却在稀疏注意力或动态路由等不规则运算中表现下降的原因。
程序员编写单个函数(一个 kernel),硬件将其映射到一张规模庞大的线程网格上。该模型足够灵活,可以运行任何数学 kernel,从卷积到注意力机制再到自定义损失函数,同时为数据并行计算提供比 CPU 高几个数量级的吞吐量。
权衡之处在于,不规则的、分支密集的代码运行效果较差,因为 warp(一组 32 个同步执行的线程)内的发散线程必须串行执行。当同一 warp 中的线程分别取 if-else 语句的不同分支时,硬件必须按顺序执行两个分支,并在每个分支期间禁用走另一条路径的线程。对于机器学习工作负载,这种发散惩罚通常很小,因为神经网络操作具有高度一致的控制流:矩阵乘法中的每个元素都遵循相同的计算路径。
TPU 更进一步,通过固化数据流本身,以牺牲部分可编程性为代价,换取单一运算类型上的最高效率。Google 的 Tensor Processing Units(张量处理单元)采用 systolic array(脉冲阵列)2 架构:一个固定的乘加(MAC)单元网格,数据在相邻单元之间以规则的、波浪状的方式流动。与为每个运算分别取指和解指不同,脉冲阵列在一个边缘接收一张矩阵,并将其脉冲式推过整个网格,每个单元执行一次 MAC,并将结果传递给相邻单元。这样完全消除了取指和解指的开销,也无需将中间结果写入内存,因为每个部分和都会直接流向下一次计算。
2 脉动阵列: 脉动阵列模型源自希腊语 systole(收缩),由 H. T. Kung 与 Charles E. Leiserson (Kung 和 Leiserson 1979年; Kung 1982年) 提出,数据以类似心脏搏动的节奏流经处理单元组成的网格。每个单元执行一次 MAC,并将部分结果直接传递给相邻单元,从而消除了寄存器文件的往返开销。Google 的 TPU v1 部署了一个 \(256{\times}256\) 阵列(65,536 MACs),通过将该数据流硬连线,在 75 W 功耗下实现 92 TOPS 的算力,使数据中心规模的推理在经济上可行 (Jouppi 等 2017年)。
Kung, Hsiang Tsung, 和 Charles E Leiserson. 1979年. 《Systolic arrays (for VLSI)》. Sparse Matrix Proceedings 1978 1: 256~82.
Kung, H. T. 1982年. 《Why systolic architectures?》 Computer 15 (1): 37~46. https://doi.org/10.1109/mc.1982.1653825.
Jouppi, Norman P., Cliff Young, Nishant Patil, David Patterson, Gaurav Agrawal, Raminder Bajwa, Sarah Bates, 等. 2017年. 《In-Datacenter Performance Analysis of a Tensor Processing Unit》. Proceedings of the 44th Annual International Symposium on Computer Architecture, ISCA ’17, 1~12. https://doi.org/10.1145/3079856.3080246.
这种效率的代价是编程能力下降。模型必须通过 Accelerated Linear Algebra(XLA)编译,XLA 将高层运算映射到固定的数据流上。控制流不规则或形状动态变化的工作负载可能难以映射到该架构;而且编译过程本身可能耗时(复杂模型的编译需要数分钟到数小时),从而拖慢模型开发阶段的迭代周期。
GPU 与 TPU 之间的编程模型差异,对组织层面的决策具有实际影响。经常修改模型架构的研究团队(加入自定义注意力模式、试验新的激活函数、原型化新型训练算法)通常更偏好 GPU 的 CUDA 生态,因为新运算可以以自定义内核的形式实现,无需等待编译器支持。而在大规模运行既定架构的团队(标准 Transformer 训练、大规模微调)可能更偏好 TPU,因为 XLA 编译器可以优化整个计算图,对于标准运算往往能达到优于手写 CUDA 内核的硬件利用率。
Example 1.1: TPU 的起源故事
场景:2013 年,Google 预测,如果用户每天用语音搜索与 Android 手机通话 3 分钟,那么仅靠通用 CPU 处理推理负载,就需要将数据中心算力翻倍,而代价高昂 (Jouppi 等 2017年)。
诊断:标准 CPU 架构付出了沉重的通用性代价——将大量硅片面积和功耗用于乱序执行、分支预测和复杂缓存,而非矩阵乘法吞吐量。
系统启示:当某个工作负载规模巨大、保持稳定,且主要由单个数学核(MatMul)主导时,硬件专用化在经济上才站得住脚。TPU v1 将 \(256 \times 256\) 脉动阵列硬连线,在 75 W 的功耗预算下提供 92 TOPS(INT8)算力,从而在生产级服务基础设施中确立了定制 ASIC 加速器。
定制 ASIC 位于频谱的专用端,此时硅片的经济性足以支撑放弃大部分通用可编程性。当某个组织以极大规模运行稳定工作负载时,专门为该工作负载设计芯片在经济上可能变得理性。定制 ASIC 可以通过移除计算并不需要的功能,改善目标工作负载的每操作能耗与持续利用率。
以特斯拉 Dojo D1 芯片为例,它针对视频视觉模型的空间与时间结构进行了优化。其数百个紧密耦合的处理节点围绕特斯拉视觉流水线的数据流需求设计,片上 SRAM 的容量经过调整,使空间 tile 能够靠近计算单元。这样减少了通用 GPU 执行同一计算时所需的、反复往返片外内存的次数。
AWS Trainium 采取了不同的思路,它面向 Transformer 训练这一大类,而非单个模型。Trainium 系统把编译器管理的内存调度与硬件辅助的集合通信结合起来,因此张量并行的同步和数据并行的归约等常见训练模式,都可以在加速器互连结构中进行优化,而无需完全交由主机软件处理。
定制芯片的风险同样十分明确:如果主导模型架构发生变化——正如 2017 到 2020 年间从卷积神经网络(CNNs)转向 Transformer 那样——为旧架构设计的定制 ASIC 就会变成搁浅资产。一款新 ASIC 从概念到部署的设计周期为 2–3 年,这意味着架构决策必须能够预判未来数年的工作负载趋势。这一预测挑战并不轻松:2015 年,很少有人会预测基于注意力的 Transformer 会在五年内取代 CNN,成为主导架构;在此期间承诺采用 CNN 优化 ASIC 的组织,最终发现其硬件因架构转变而搁浅。
因此,定制芯片本质上是对工作负载稳定性的押注,而做出这一押注的组织通常具备足够的规模来支撑 $50–$2 亿美元的开发成本,也具备足够的工作负载量,从而把单芯片 NRE(非重复性工程)成本分摊到数百万片芯片上。谷歌能够承担 TPU 的开发成本,是因为搜索、YouTube 推荐和 Gmail 垃圾邮件过滤等高吞吐服务,可以把共享加速器平台分摊开来。而运行几百台 GPU 的研究实验室则无法承担同样的投资。
当工作负载保持稳定时,这种押注可能获得回报:专为特定用途打造的 ASIC 可以为其目标操作提供 5–10\(\times\) 倍于通用 GPU 的能效。工作负载的转移则可能使这一优势落空,因为芯片的固定数据流可能无法容纳差异较大的计算模式。将局部性论证进一步推演,还会引出关于物理规模的问题:计算互连结构是否能够扩展到一整片晶圆的大小。
晶圆级引擎
晶圆级引擎(WSE) 追求硅片大部分区域上的数据局部性。与由 chiplet 或离散 die 并通过封装级或板级互连构建的架构不同,像 Cerebras WSE-3 这样的晶圆级引擎使用了一块直径相当于餐盘大小的连续计算互连结构。由于该硅片并未被切割成独立芯片,因此可以在该表面上维持片上互连。
对于 2024 年 WSE-3 配置,Cerebras 在其注册备案文件中报告了 900,000 个面向 AI 优化的核心、44 GB 分布式片上 SRAM,以及 21 PB/s 的聚合内存带宽(Cerebras Systems 2024年)。这些规格无法与 GPU 集群的峰值 FLOP/s 或高带宽内存(HBM)带宽直接比较,因为不同架构暴露的数据流、内存组织、精度和工作负载映射方式各不相同。可持久比较的是拓扑层面:片上互连避免了针对映射到互连结构上的工作负载所涉及的封装级、板级和机架级传输。
Cerebras Systems. 2024年. Cerebras Systems, Inc. Registration Statement on Form S-1.
Systems, Cerebras. 2021年. 《Wafer-Scale Deep Learning Acceleration with the Cerebras CS-2》. Cerebras Technical Paper 2021.
晶圆级集成的挑战是物理层面的:必须在单一硅片表面上解决制造工艺良率、供电和热膨胀问题(图 2)。在标准芯片上,单个缺陷可能使整片芯片失效;但在晶圆级引擎上,软件必须”感知缺陷”,在硅片互连结构中的局部制造缺陷周围进行路由。在已记录的 CS-2 配置中,9+3 冗余排列的十二个电源最多可向 WSE-2 提供 23 kW 功率(Systems 2021年)。这种针对特定配置的设计说明了为何晶圆级供电与散热需要系统级液冷硬件,而非传统加速器的散热片。
晶圆级引擎位于频谱上的一个独特位置:其物理架构高度专用,而其计算模型则具有灵活性,因为底层核心通常通用性足够,可执行多种机器学习内核。它们代表了一种”向上扩展”的哲学,试图通过将集群变成芯片来消除通信墙。
晶圆级权衡以制造复杂度和缺陷感知布线为代价,换取片上互连结构,从而避免其 900,000 个核心之间的封装级和板级通信。图 3 将这些架构置于可编程性与效率的连续谱系上,而 加速器谱系 则将这一连续谱系转化为工程师必须比较的架构特征。
| Feature | CPU | GPU (H100) | TPU (v5p) | Wafer-scale | Custom ASIC |
|---|---|---|---|---|---|
| Arithmetic core | Scalar/vector | Tensor Core | Systolic array | RISC-style core | Fixed dataflow |
| Execution | Instruction | SIMT | Data-driven | Dataflow | Hardwired |
| Memory control | Cache | L1/L2 + HBM | Scratchpad | On-chip SRAM | Explicit mesh |
| Flexibility | Extreme | High | Moderate | High | Low |
| Efficiency | Low | High | Very High | High | Extreme |
对于我们的 175B 模型,加速器谱系 所概括的硬件选型并不仅仅关乎峰值 FLOP/s。如果我们是一家每周都在尝试新颖架构的研究实验室,那么 GPU 的灵活性足以证明其通用性所带来的代价是合理的。如果我们要在多年内以大规模方式部署一个固定的 Transformer,那么 TPU 的数据流效率或定制 ASIC 的功耗优势,可能会主导总成本。加速器的选型光谱,归根结底是一个经济学问题:在给定工作负载稳定性的前提下,可以牺牲多少灵活性。
基于芯片块的加速器
一个重要的加速器设计模式是 Chiplet 架构,NVIDIA 的 Blackwell 与 AMD 的 Instinct MI300 系列均采用了该架构。基于 chiplet 的设计并非制造单一的整体 die,而是将处理器划分为多个较小的 die,并通过高带宽的 die-to-die 互连连接,共同置于同一封装基板之上。这一方法解决了制约整体式设计的两项物理限制。
首先,最大 die 尺寸受到光刻 reticle 极限的限制(即 858 mm² 单次曝光上限,参见 节 1.1.3),这限制了单体 GPU 所能集成的 Tensor Cores、SM 和 HBM 堆栈数量。chiplet 设计通过在同一封装中放置多个 die 来规避这一限制,B200 的双 die 设计实际上等效于一个 1,600 mm² 处理器。
其次,制造良率随 die 面积呈指数下降,因为 die 上任意位置的一处缺陷都会使整片芯片无法使用。较小的 chiplet 具有更高的单片良率,而封装级的集成允许部分良率(某个有缺陷的 chiplet 可以被替换为良品)。这一良率优势直接转化为更低的单位算力制造成本,这在晶体管密度持续提高、工艺节点日益昂贵的背景下尤为重要。
相应的代价是 die-to-die 互连。封装内 chiplet 之间的通信快于封装之间的通信(NVLink),但慢于同一枚单体 die 内部的通信(on-die mesh 网络)。那些在处理器元素之间产生频繁、细粒度通信的工作负载(例如在相邻 SM 之间共享数据的操作)可能在 SM 分处不同 chiplet 时承受延迟惩罚。GPU 厂商通过使 die-to-die 链路对程序员透明来缓解这一问题,因此软件无论底层 chiplet 拓扑如何,看到的都是单个逻辑 GPU。
GPU 架构的演进
过去十年间 NVIDIA GPU 架构的快速演进,展示了加速器设计如何适应机器学习工作负载不断变化的需求。每一代架构都针对生产 ML 工作负载所暴露的具体瓶颈引入了架构创新,而非仅仅增加晶体管数量。
Volta 架构(2017 年)引入了第一代 Tensor Core,其认识到神经网络训练的大部分时间都消耗在矩阵乘法上。在既有的 CUDA 核心旁加入专用的矩阵相乘累加硬件,使 Volta 能够在不牺牲让 GPU 对研究具有吸引力的通用可编程性的前提下,加速主导性的工作负载模式。Volta 的旗舰产品 V100 在 300 W 下提供了 125 TFLOP/s 的 FP16 Tensor Core 吞吐量。
Ampere 架构(2020 年)将 Tensor Core 支持扩展至 TF32 和 BF16,这是在 Turing 引入用于量化推理的 INT8 和 INT4 Tensor Core 模式之后。A100 还引入了多实例 GPU(MIG),可将单个 GPU 划分为最多七个相互隔离的实例,从而高效地在多个推理任务之间共享昂贵的硬件。对基础设施而言,最具决定性意义的变化是 Ampere 的第三代 NVLink,其双向带宽较 Volta 的 300 GB/s 提升了一倍,达到每 GPU 600 GB/s,直接应对张量并行所面临的通信墙问题,而张量并行会将每一层的矩阵拆分到各 GPU 上。
Hopper 架构(2022 年)引入了 Transformer Engine,其 FP8 配方与自动缩放(autocast)集成支持以受控缩放方式运行 Transformer 操作,同时在配置配方或实现要求的地方保留更高精度。Hopper 还引入了每 GPU 900 GB/s 的 NVLink 4.0 以及 NVLink Switch,从而支持突破 8 GPU 边界的 NVLink 连接。
H100 的 FP8 Tensor Core 吞吐量达到 1979 TFLOP/s,相当于 V100 的 700 W,较 V100 提升了 6.8\(\times\) 的效率,这一提升得益于制程工艺(TSMC 4N)、架构创新(Transformer Engine)以及精度工程(FP8 支持)三方面的共同作用。
Blackwell 架构(2024)通过 B200 延续了这一发展路径:它利用高带宽片间链路将两个 GPU die 封装在同一个封装内,从而形成一块“双 die GPU”,在 1000 W 下提供约 4,500 TFLOP/s 的密集 FP8 Tensor Core 吞吐量。FP16/BF16 对比时,应采用较低的精度相关厂商数值,而非 FP8 峰值。
双 die 方案承认,单 die GPU 的尺寸已接近光刻设备的 reticle 极限,而进一步扩展则需要采用 chiplet 式设计。reticle 极限是光刻的一项根本性约束:EUV 光刻机的镜头系统在一次曝光中只能将图案投影到约 \(26{\times}33\) mm(858 mm²)的面积上。超过该面积的 die 需要借助多次曝光进行拼接,这在技术上可行,但会大幅增加成本并显著降低良率。
Blackwell 还推出了第五代 NVLink,每块 GPU 达到 1800 GB/s,再次将节点内带宽翻倍。B200 封装内的芯片间链路速率达到 10 TB/s,快得足以让两块 die 对软件而言在许多操作上表现为单个逻辑 GPU。
演进过程揭示了一个一致的规律:每一代都针对上一代所暴露的瓶颈。Volta 增加了专用的矩阵硬件以应对计算瓶颈;Ampere 扩展了混合精度支持;Hopper 针对 Transformer 专用精度引入 FP8;Blackwell 则通过多 die 封装突破了 die 尺寸限制。
在每一步,加速器的设计都反映了其时代的一项重要 workload,展示了 workload 的物理特性如何驱动硅片的物理特性。workload 与硬件之间的这种协同演进并非偶然:加速器架构师会剖析 ML workload 以识别瓶颈,然后设计后续各代以应对它们。结果,硬件演进与模型架构演进紧密耦合,这正是 2017 年以来 Transformer workload 强烈塑造加速器设计的原因。
演进还揭示了基础设施规划者一个令人警醒的采购规律:高端加速器各代的更替速度可以快于承载它们的设施。V100 作为旗舰训练 GPU 保持了约三年(2017–2020);A100 保持了约两年(2020–2022);Hopper 与 Blackwell 在 2020 年代中期延续了这一短周期模式。
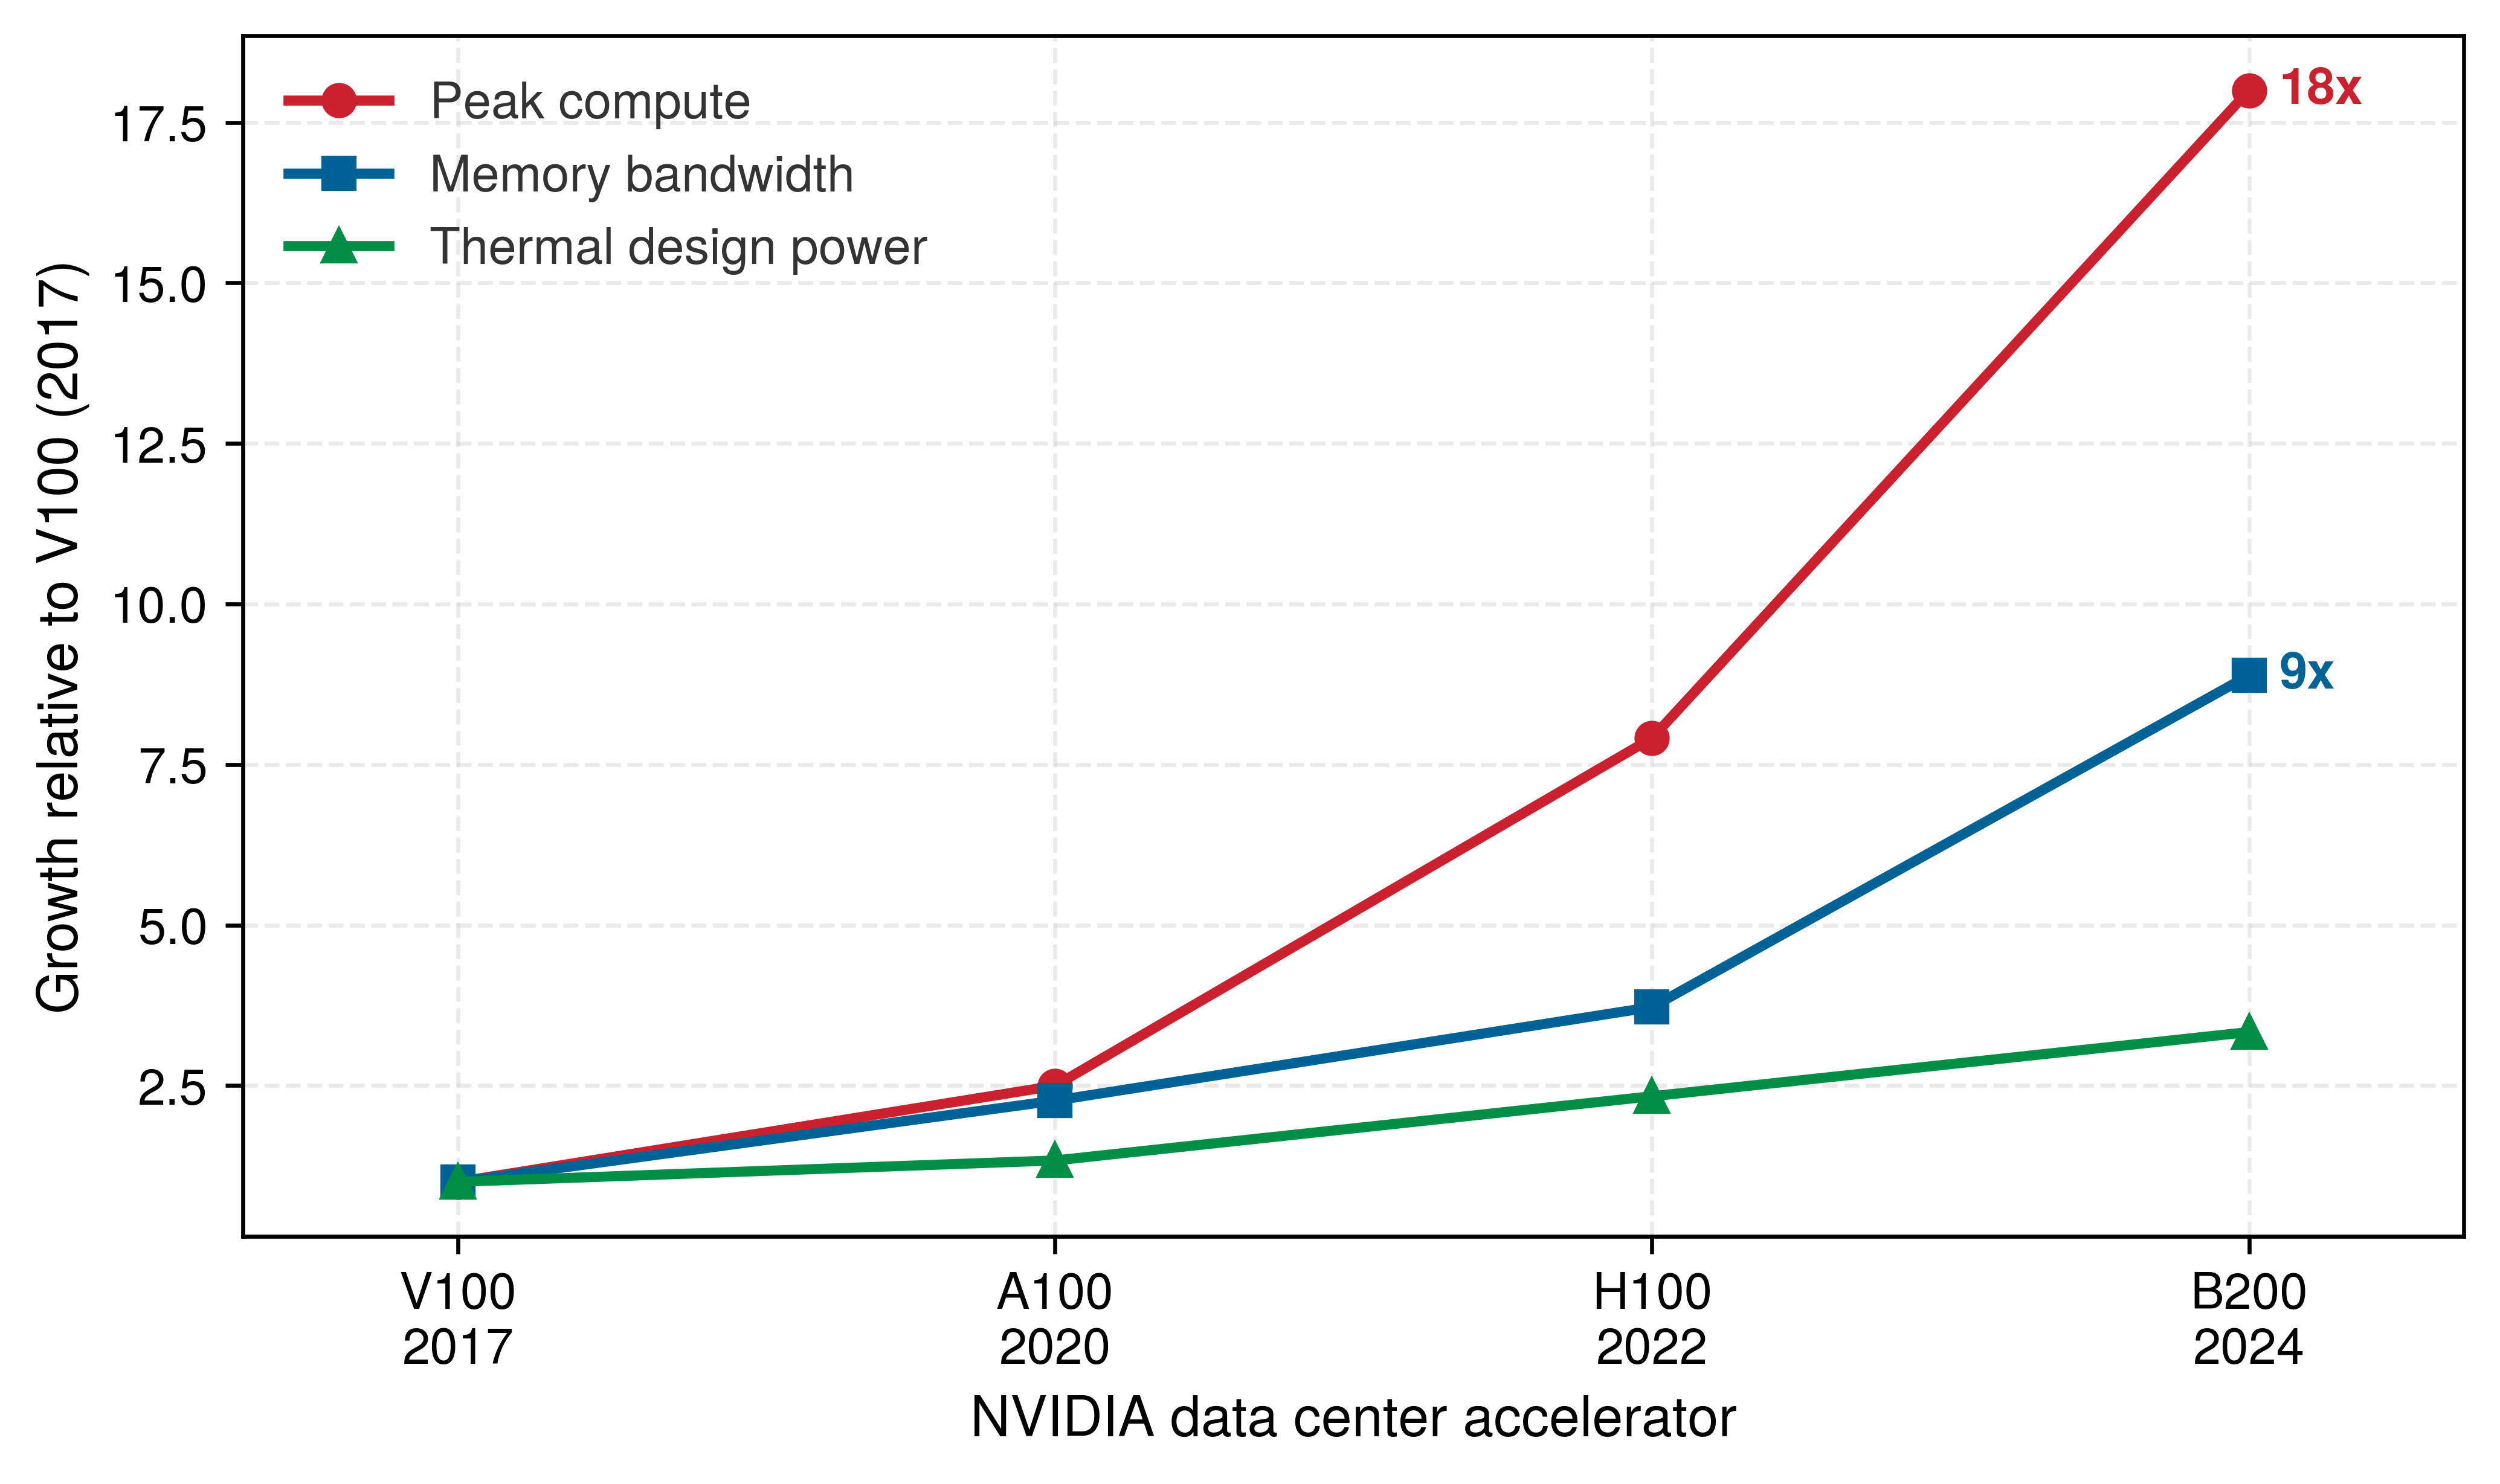
规划含义是:为加速器而建的数据中心必须在第一台机柜到货之前就要预判刷新周期。因此,硬件刷新规划是初始采购决策的组成部分,而非事后补充。NVIDIA GPU 架构演进 将这些节奏压缩为 NVIDIA GPU 各代及其伴随出现的互连与功耗变化。这三个量并非同步扩展:计算能力以两倍于带宽、五倍以上于功耗的速度增长,因此按算术能力刷新机柜的机架会同时跑赢其内存系统和功耗预算。图 4 将三者区分开来。
影响集群一致性的一个微妙之处是硅片抽奖——制造现实是:4nm 光刻工艺中的微观偏差会在每片晶圆上产生芯片质量的分布。NVIDIA 通过激进的分级(binning)来管理这条良率曲线:能够在严格控制的电压下、在全额热设计功耗(TDP)条件下维持高时钟频率的芯片被指定为高端 H100 SXM 模块,而那些漏电电流较高或存在轻微缺陷的芯片则成为 H100 PCIe 卡,或被降级为更低档的产品。即使在顶级 SXM 分档内部,可实现的 boost 时钟也会因硅片特性而有所不同。在同步训练集群中,集合通信原语会被最慢的参与者阻塞。单块芯片的运行频率低于集群平均频率 50 MHz,就可能使整个集群的有效吞吐量下降 5–10 个百分点,因此复杂的集群管理系统会跟踪每块 GPU 的性能指标,并将表现不足的硅片隔离到推理池中,因为在那里单块芯片差异的影响不那么明显。
| 架构 | 年份 | 关键创新 | 峰值张量 | TDP | NVLink 带宽 |
|---|---|---|---|---|---|
| Volta (V100) | 2017 | 首个 Tensor Core | 125 TFLOP/s | 300 W | 300 GB/s |
| Ampere (A100) | 2020 | 多精度、MIG | 312 TFLOP/s | 400 W | 600 GB/s |
| Hopper (H100) | 2022 | Transformer Engine、FP8 | 1979 TFLOP/s | 700 W | 900 GB/s |
| Blackwell (B200) | 2024 | 双芯片、NVLink 5 | 4,500 TFLOP/s FP8 | 1000 W | 1,800 GB/s |
从 NVIDIA GPU 架构演进 中拆解原始吞吐量和能效,揭示了一个根本性的硬件分化 (图 5)。
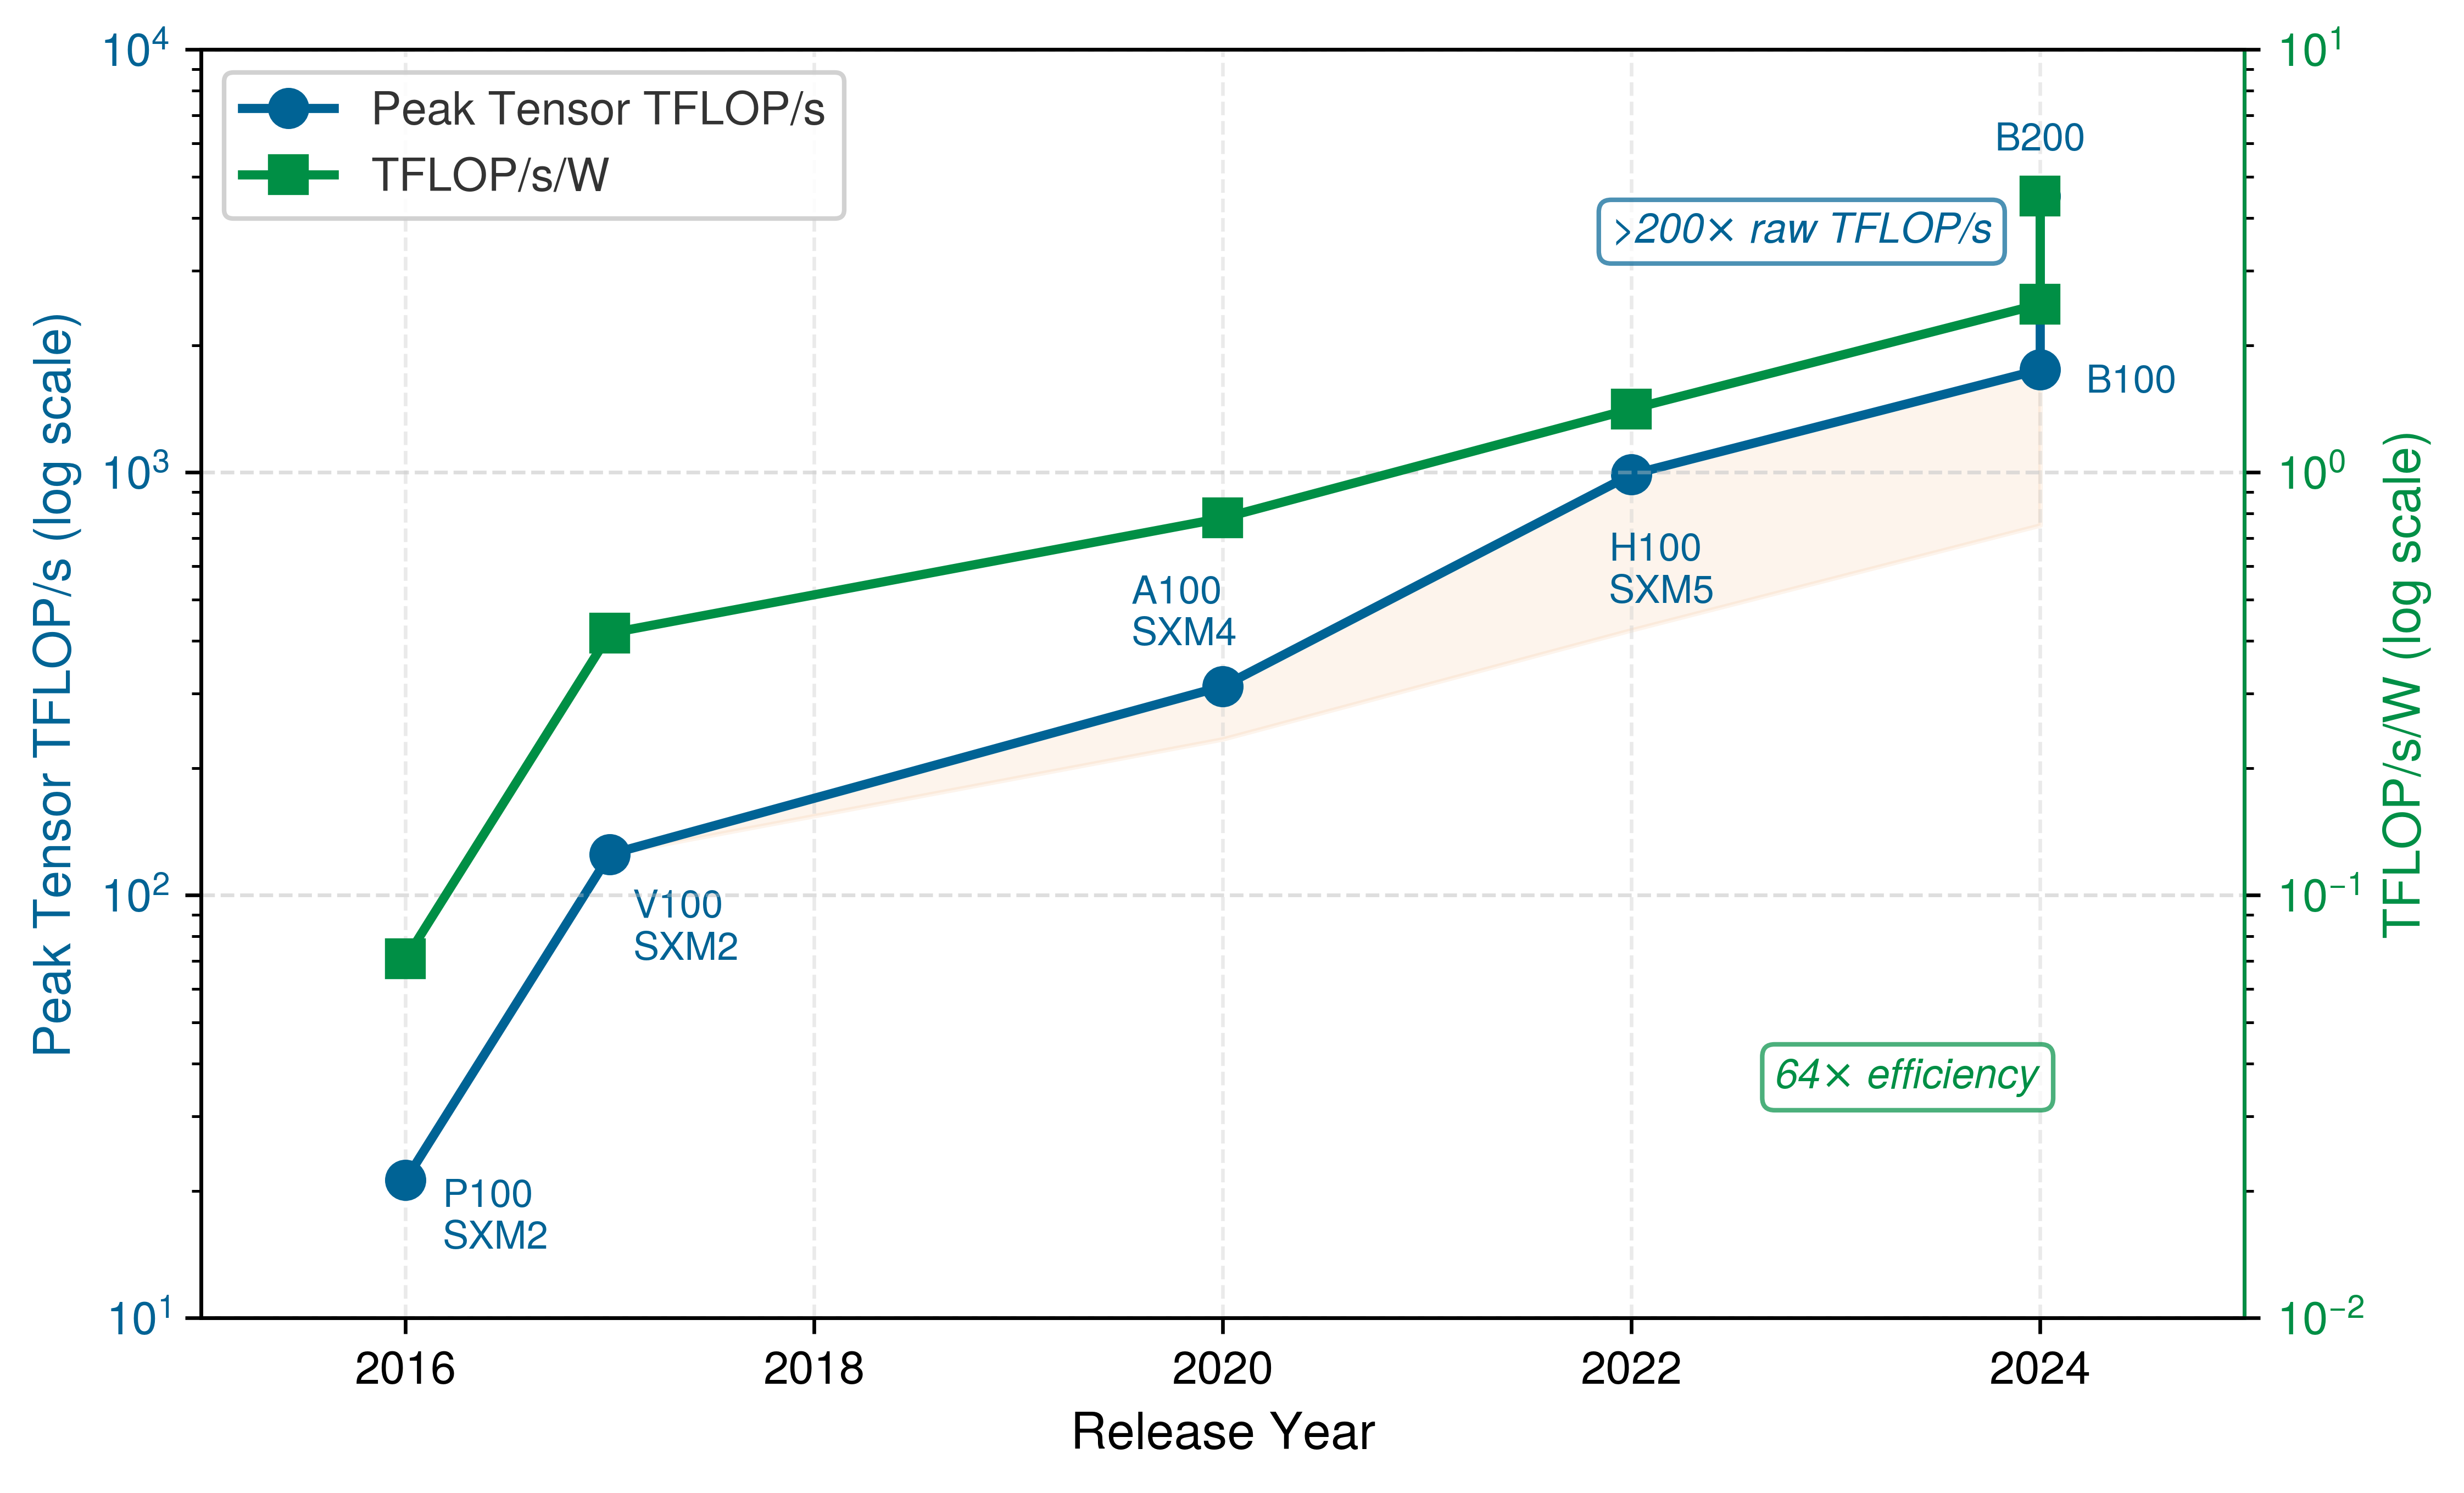
图 5 量化了一项重要的不对称性:从 P100 到 B200,广告的低精度 Tensor Core 峰值吞吐量增长了 200\(\times\) 以上,而每瓦 TFLOP/s 的增长则远为有限。各代产品的精度模式并不相同,但这种差异属于硬件演进趋势的一部分,因为新一代产品通过采用更低精度的格式,在一定程度上提升了算力密度。这一分歧加剧了 节 1.2.4 中讨论的功率墙问题,也有助于解释在密集加速器设施中液冷、兆瓦级供电和热管理的重要性。
TPU 架构演进
Google 的 TPU 发展路径遵循另一条路线,聚焦于分布式效率与 XLA 编译器的集成。GPU 强调单芯片峰值吞吐量和软件灵活性(CUDA),而 TPU 从一开始就被设计为“Pod 级”资源。每一片 TPU 芯片都从属于更大的集群,并配备专用的片间互连(ICI)链路,完全绕过主机 CPU。
代际演进序列展示了这种“先 Pod”的设计如何从推理走向训练。TPU v1(2015)是一款专用推理芯片,采用 \(256{\times}256\) systolic array,为矩阵运算提供 92 TOPS(INT8)的算力,而矩阵运算正是 Google 生产推理工作负载的主要部分。随后,TPU v2(2017)和 TPU v3(2018)将架构转向训练,通过加入 bfloat16(BF16)来规避标准 FP16 的动态范围问题,并将 Pod 概念扩展至 1,024 片芯片和 100+ PFLOP/s 的总算力。TPU v4(2021)将同样的思路延伸至网络本身,加入了光路交换器,使物理拓扑能够根据不同工作负载重新配置,同时将单芯片 BF16 吞吐量提升至 275 TFLOP/s。
The TPU v5p(2023)延续了这一面向 pod 规模的高端训练设计。它具备 459 TFLOP/s 的 BF16 算力、95 GB 的 HBM2e 显存以及每芯片 2,760 GB/s 的双向 ICI 带宽,并针对十亿参数模型所需的大规模 AllReduce 操作进行了优化。Google TPU 架构演进 展示了该以 pod 为先的设计在 TPU 各代产品中的演进过程。AllReduce 则建立了集合通信的复杂度模型,并分析了 AllReduce 背后的算法选择,从而解释了为何随着模型规模增大,片间带宽而非单芯片算术性能决定了训练吞吐量的上限。
| Generation | Year | Key innovation | Peak BF16 | HBM | ICI BW (aggregate, one direction) |
|---|---|---|---|---|---|
| TPU v1 | 2015 | Systolic array (inference) | 92 TOPS* | — | — |
| TPU v2 | 2017 | High-bandwidth memory | 45 TFLOP/s | 16 GB | 248 GB/s |
| TPU v3 | 2018 | Liquid cooling, pod scale | 123 TFLOP/s | 32 GB | 280 GB/s |
| TPU v4 | 2021 | Optical circuit switching | 275 TFLOP/s | 32 GB | 300 GB/s |
| TPU v5p | 2023 | SparseCore, HBM2e | 459 TFLOP/s | 95 GB | 600 GB/s |
这一对比揭示了架构理念上的根本分歧(Google TPU 架构演进)。GPU 的演进是一场竞赛,目标是把更多的算术单元和更高精度的 Tensor Cores 塞进单个封装,并借助 chiplets(Blackwell)来突破物理 die 尺寸的限制。TPU 的演进则是一场竞赛,目标是构建更高效的大规模仓库级计算机,其中单芯片的性能次于 pod 的整体带宽与可重构性(Barroso 等 2019年)。
H100 的算术引擎在其标称的低精度模式下可接近 2,000 TFLOP/s,但只有当数据能够以足够快的速度送达计算单元时,工作负载才能实现这一吞吐量。对于许多机器学习工作负载,内存墙设定了这一上限。
内存墙
随着算术吞吐量的增长速度超过数据访问速度,计算单元会花费更多时间在等待操作数上。这种差异被称为内存墙(Wulf 和 McKee 1995年)。虽然晶体管缩放使逻辑性能提升了数个数量级,但向这些核心供数据的互连却未能同步跟上。神经网络可能需要较大的权重与激活数据流,使得带宽而非计算能力成为某些推理与训练形态下的主导约束。诊断摘要 提出了诊断框架,用于将这种内存受限条件与其他瓶颈模式一并分类,从而使实测到的症状能够对应到具名的约束,而非猜测。
Wulf, Wm. A., 和 Sally A. McKee. 1995年. 《Hitting the memory wall: Implications of the Obvious》. ACM SIGARCH Computer Architecture News 23 (1): 20~24. https://doi.org/10.1145/216585.216588.
这些影响在我们的运行示例中具体而可感。我们 175B 模型的权重以 FP16 格式占用 350 GB。在自回归解码过程中,这整个 350 GB 张量必须被逐 token 地从片外内存流式传输到处理器的寄存器中。单个 H100 无法容纳该张量,因此这是在分片或量化解决容量问题之后的带宽下限计算。在 H100 级别的 HBM 带宽(约 3.35 TB/s 每加速器)下,仅数据移动就决定了每个 token 超过 100 ms 的延迟下限,前提是必须通过一条加速器等效的带宽路径来流式传输权重。内存墙并非抽象的架构概念:它正是聊天机器人逐词之间出现可感知停顿的物理原因。三项工程对策应对这一约束:HBM 拓宽数据通路,roofline 模型严格诊断某项工作负载究竟是数据受限还是计算受限,而 Tensor Cores 则最大化每个被获取字节所对应的算术价值。正如 图 6 所示,内存带宽也是一种放置权衡:将工作集移近计算单元会提高带宽,但通常会减少能够保留在该处的状态量。
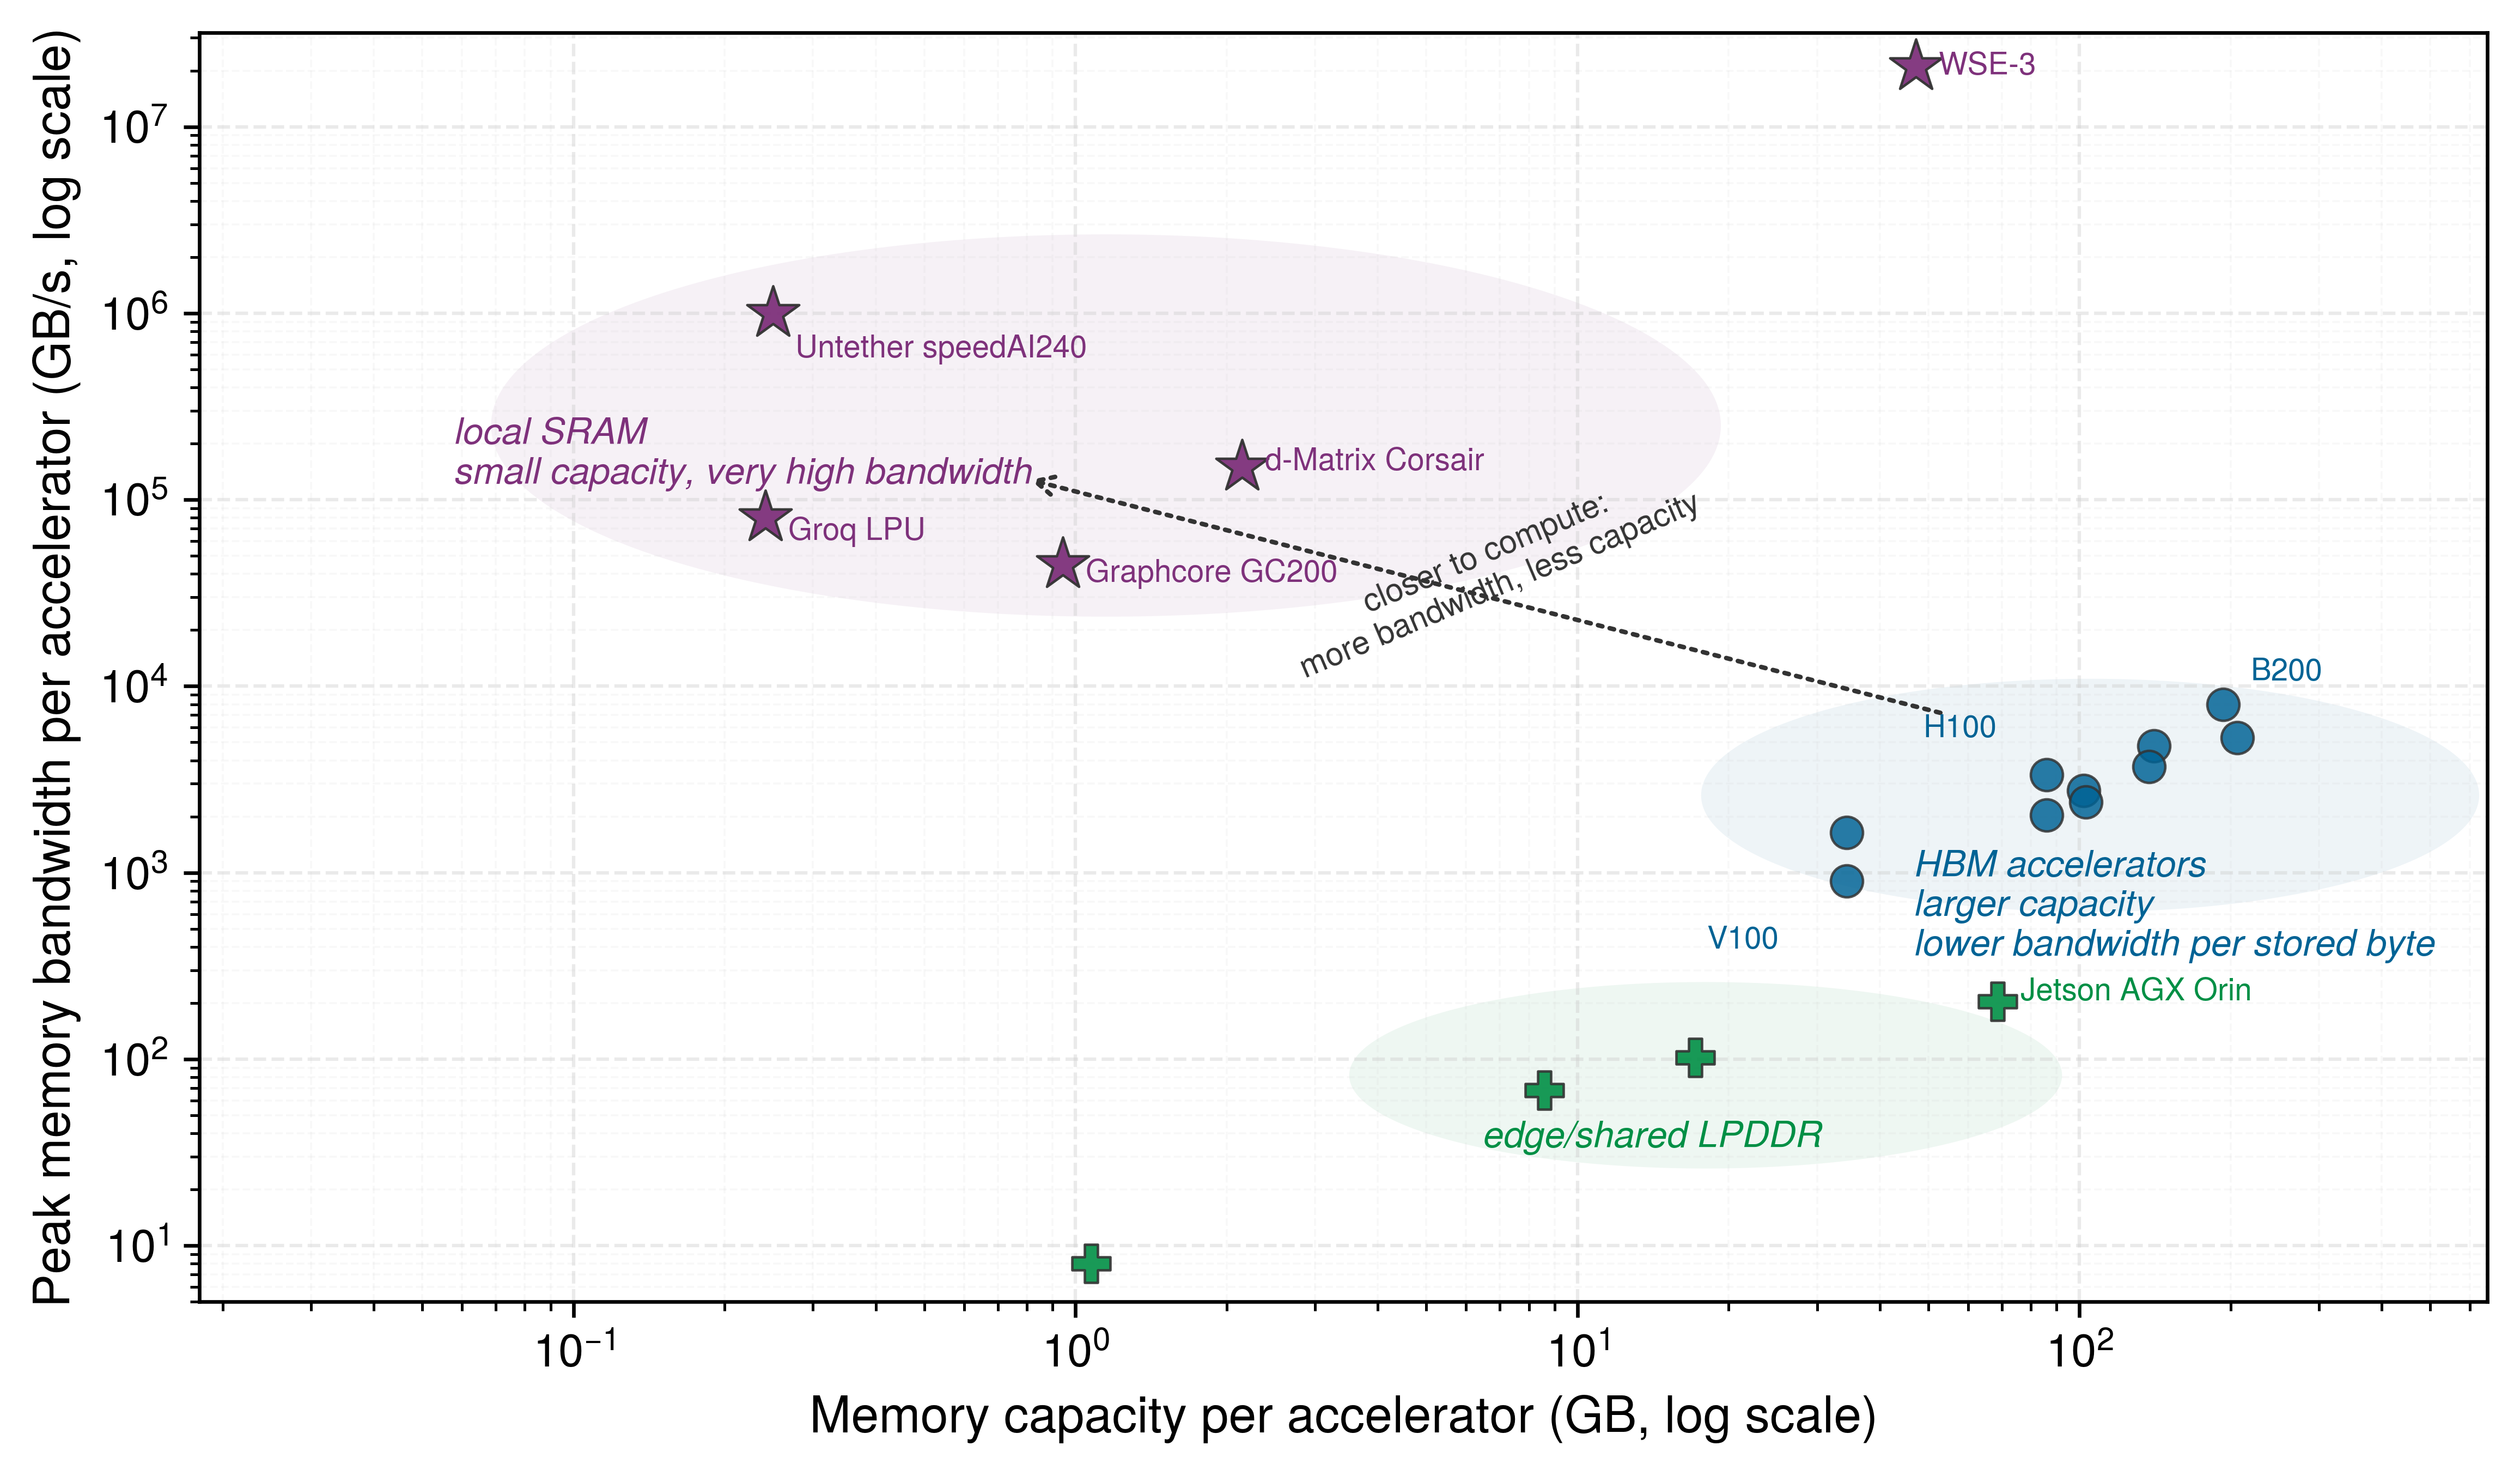
图 6 并非加速器之间的排名,而是一张各设计方案将字节放置在哪里的地图。边缘设备将内存保持得便宜而紧凑,但带宽仍然偏低。HBM 将内存集成到加速器封装中,为活跃模型状态换取了足够的容量与带宽。Local-SRAM 设计则进一步将工作集推向算术单元,以极小的驻留容量换取了极高的带宽。这张分层地图解释了 HBM 为何是下一个工程响应:它并非系统中速度最快的内存,而是能够紧邻计算核心容纳数十到数百吉字节、且带宽最高的那一层。
HBM:突破内存墙
计算基础设施
一颗 H100 能够执行接近 2,000 TFLOP/s 的低精度矩阵运算;然而,在我们 175B 模型的自回归解码过程中,其 Tensor Cores 在带宽受限模型下每个周期会有超过 99% 的时间处于空闲状态。瓶颈不在于 乘法 的速度,而在于 数据交付 的速度:一旦模型已被切分或压缩至权重可以容纳,服务路径仍然必须为每个输出 token 将活跃的权重分片流式传输至算术单元。当现有 Tensor Cores 已经因数据饥饿时,再增加 Tensor Cores 也无济于事。加速器对此根本性限制的应对方式是 HBM.3
3 HBM 起源: 由 JEDEC 于 2013 年标准化,是 AMD 与 SK Hynix 联合开发的产品,最初用于显卡。机器学习加速器采用 HBM,是因为神经网络呈现出与高端渲染相同的“高带宽、中等容量”访问模式。每一代 HBM 的带宽大致翻一番(从 HBM1 的 128 GB/s 到 HBM3e 每堆栈 1.2 TB/s),但内存带宽与算术吞吐之间的差距仍在持续扩大——这使得 HBM 成为应对内存墙的必要但远非充分的方案。
4 寄存器文件带宽:在 H100 GPU 中,寄存器文件向 CUDA 核心提供超过 300 TB/s 的聚合带宽。这比 HBM3 带宽高出约 100\(\times\) 倍,这也解释了为何分块(tiling)是必需的:任何在执行期间未驻留寄存器中的操作数都会迫使算术单元等待 100 多个时钟周期才能取到数据,从而使利用率急剧下降。
5 SRAM 能耗(pJ/bit):从 SRAM(共享内存)中读取一位约消耗 0.1–0.5 pJ,而从 HBM 中读取则消耗 2–5 pJ。这 10\(\times\) 倍的能耗差异是内核融合背后的物理动因:将每个中间结果保留在 SRAM 中而非写入 HBM,既能节省时间,也能显著节省功耗和热余量。
单个加速器内部的存储层次在容量和带宽上都跨越了数量级。最顶层是 寄存器文件4——约 20–30 MB,分布于所有 SM——带宽近乎无限(数百 TB/s),但容量极小。其下是 L1 缓存和 共享内存(SRAM),5 每个 SM 约 256 KB(总计约 33 MB),聚合带宽约 19 TB/s。再往下是 50 MB L2 缓存(约 12 TB/s),最底层则是 HBM3 的 80 GB,带宽为 3.35 TB/s。
Lighthouse 1.1: B 型架构(大规模 DLRM):容量墙
与 A 型架构(GPT-4) 主要受吞吐率限制(需要更高的 TFLOP/s)不同,B 型架构(大规模 DLRM),即 DLRM 工作负载,主要受容量限制。一张 10 TB 的嵌入表既无法装入单张 H100 的 80 GB HBM,也无法装入单个 8-GPU 节点的 HBM 聚合容量(640 GB)。仅凭容量一项,就需要至少 16 个这样的节点,这还尚未计入复制、热表余量以及带宽均衡;生产规模下的推荐系统往往会扩展到更大的多节点分片,从而将一个内存访问问题转化为巨大的 All-to-All 网络协同问题。
带宽寄存器与 HBM 之间的差距约为 100\(\times\)。若某个操作数必须从 HBM 中取回以执行单个运算,算术单元大约 99% 的时间处于停顿状态。只有借助激进的分块(tiling) 策略,才能实现高模型 FLOPs 利用率(MFU)——即峰值硬件 FLOP/s 中用于有效模型计算的比例:将庞大的权重矩阵切分为能够完全容纳于共享内存与寄存器中的小块,然后对每个块尽可能多地执行乘加运算,再将其淘汰。该分块策略将数据一次性加载至 SM 的快速 SRAM,并在多个 Tensor Core 运算之间复用(图 7),从而有效放大了从 HBM 取回的每个字节所对应的算术价值。
尽管 175B 模型的整体内存占用量巨大,但在任意给定微秒内,活跃的工作集都必须被精心管理,以驻留在顶部 30 MB 的寄存器空间中;否则,该芯片的理论性能便只是海市蜃楼。HBM 提供了大部分容量,但分块(tiling)决定了这部分容量能否以足够快的速度供给算术单元,从而真正产生影响。
Definition 1.1: HBM
HBM 是机器学习加速器采用的三维堆叠动态随机存取存储器(DRAM)架构:多个存储芯片在垂直方向上键合并连接,并通过共享硅中介层上的数千个硅通孔(TSVs)与处理器相连,从而消除了传统 DRAM 的厘米级印刷电路板(PCB)走线,并将其替换为微米级的垂直路径。
- 重要性:H100 中的 HBM3 提供约 3.35 TB/s 的内存带宽(约为 DDR5 的 ~200 GB/s 的 16\(\times\) 倍),功耗约为 2–5 pJ/bit,而 DDR5 约为 20 pJ/bit。该带宽设定了铁律中的 \(\text{BW}\) 上限:H100 的 FP16 峰值约为 \(989\,\text{TFLOP/s} / 3.35\,\text{TB/s} \approx 295\) FLOP/byte,因此任何算术强度低于 295 FLOP/byte 的算子(例如,注意力算子在 5–20 FLOP/byte 之间)即使采用 HBM 仍然受内存墙限制。
- 区别:与通过厘米级 PCB 走线连接的 DDR 内存(会引入电容、衰减和较高的驱动电流)不同,HBM 采用 1,024 位宽的 TSV 总线,路径长度以微米计,信号传输距离缩短了 1,000\(\times\) 倍,从而可以在功耗不成比例增加的情况下实现更宽的总线。
- 常见误区:一种常见误解是 HBM 解决了内存墙。HBM 只是将内存墙推移,而非消除它:张量核心吞吐量 \((R_{\text{peak}})\) 在各代产品中的增长速度快于 HBM 带宽(从 V100 的 900 GB/s 与 125 TFLOP/s FP16 到 H100 的 3.35 TB/s 与 989 TFLOP/s FP16),因此峰值点持续上移,尽管 HBM 有所改进,仍有更多算子受内存墙限制。
传统 DDR 内存通过印刷电路板边缘的引脚连接到处理器。每个 DIMM 通过 64 位总线通信,即便拥有多个通道(高端服务器 CPU 通常为 8 个通道),现代服务器的聚合内存带宽也仅有约 200 GB/s。
从 DIMM 插槽到处理器芯片的物理距离以厘米计,而每厘米铜走线都会引入电容、信号衰减和能量损耗。在 DDR5 数据速率下(每个引脚 4,800–6,400 MT/s),信号调理电路必须补偿严重的通道损伤,因而每传输一位所消耗的功率相当可观。提高这些长走线上的数据速率需要逐级增加信号调理功率,形成一条收益递减曲线,而 DDR5 已经接近该曲线的拐点。
HBM 通过彻底改变物理拓扑来解决这一问题(图 8)。HBM 不再将信号沿 PCB 横向布线,而是将多个 DRAM 芯片垂直堆叠,一个叠在另一个之上,并通过硅通孔(TSVs):6 在硅衬底本身内蚀刻出的微型铜柱将它们连接起来。
6 TSV(through-silicon via):一种垂直铜柱,直径为 5–10 微米,被蚀刻穿过硅 die 以连接堆叠的各层。TSV 最初是为智能手机相机的 CMOS 图像传感器开发的,它通过用数十微米垂直硅互连替代厘米级 PCB 走线来促成 HBM——信号路径缩短了 1,000\(\times\) 倍,使每比特能耗从约 20 pJ(DDR5)降至约 2 pJ(HBM),从而在加速器功耗预算内使每秒太字节级的带宽在经济上可行。
垂直堆叠代表了内存架构的根本性变革:与其通过让信号沿长铜线更快地传输来提高带宽(DDR 方案,收益递减),HBM 则是通过极短的垂直互连来增加并行信号路径的数量,从而提高带宽。单个 HBM 堆栈将 8–12 个 DRAM die 垂直键合,在每个 die 中穿入数千个 TSV,形成每堆栈 1024 位宽的接口,而 DDR5 通道仅为 64 位。这一宽 16\(\times\) 倍的接口,加上更高的每引脚信号速率,正是 HBM 带宽优势的来源。处理器与 HBM 堆栈共享同一个封装,并通过硅中介层通信,相对插座的 DIMM 缩短了电学路径。这种封装主要改善了每传输比特所消耗的带宽与能耗;它本身并不直接意味着完整的 HBM 加载延迟只有几个纳秒。
缩短的距离带来三项直接的物理收益:
- 每比特能耗:传输成本下降约 4–10\(\times\),从 DDR5 的约 20 pJ/bit 降至 HBM 的约 2–5 pJ/bit,因为更短的走线具有更低的电容,所需的驱动电流也更小。
- 延迟:电信号在硅中以约为光速三分之二 的速度传播,因此路径变短会减少传播时间。
- 信号速率:更低的电容允许更高的信号频率,而无需长 PCB 走线所必需的复杂均衡电路,从而支持较高的每引脚数据速率,与较宽的总线宽度相配合。
综合起来,这些效应解释了为何 HBM 选择加宽接口并缩短路径,而不是仅仅加快 off-package 引脚的驱动速度。
Checkpoint 1.1: HBM 与内存墙
这些问题用于检验 3D 堆叠内存的物理优势是否清晰:
HBM 与标准 DRAM 对比 总结了这一物理权衡:HBM 通过把内存放到封装内部并加宽接口来获得带宽优势,而不是通过加快每个板外信号。
| 指标 | CPU 本地主机 DRAM(DDR5) | GPU 本地加速器 HBM(H100 HBM3) | 缩放倍数 |
|---|---|---|---|
| 机制 | 2D PCB 走线 | 3D 芯片堆叠 | - |
| 位置 | 插槽式 DIMM | 封装内(基板) | 物理邻近性 |
| 带宽 | ~200 GB/s | ~3.35 TB/s | ~17\(\times\) 倍更快 |
| 接口宽度 | 64 位 | 每堆 1024 位 | 16\(\times\) 倍更宽 |
| 能耗 | ~20 pJ/bit | ~2–5 pJ/bit | 4–10\(\times\) 能效 |
如 HBM 与标准 DRAM 对比 所示,这一带宽优势 是有代价的。HBM 的成本约为每 GB $10–15 per GB, compared to roughly $3,而 DDR5 服务器内存的成本约为每 GB 的几分之一。对于配备 80 GB HBM3 的 H100,仅内存成本就占加速器制造成本的约 $800–1,200。对于配备 180 GB HBM3e 的 B200,内存成本升至每台加速器 $1,800–$2,700,使 HBM 成为系统中成本最高的组件之一。
高级封装工艺需要对多层芯片中的数千个 TSV 进行精密对准,其制造良率较低、工艺复杂度较高。堆叠过程中的每一步(芯片减薄、对准、键合和 TSV 刻蚀)都可能引入缺陷。12 个堆叠步骤的累积良率意味着,完整 HBM3e 堆栈的整体良率显著低于单个 DRAM 芯片的良率。硅中介层本身必须足够大,以容纳处理器芯片和多个 HBM 堆栈(总面积通常超过 1,000 mm²),而 TSV 中的任何缺陷都可能使整个堆栈无法使用。
HBM 生产的供应链动态进一步影响其成本与可用性。HBM 供应链高度集中于少数几家制造商,且生产过程(芯片减薄、TSV 刻蚀、芯片间键合)所需的专用资本设备与标准 DRAM 制造设备在根本上不同。扩大 HBM 产能需要 12–18 个月的设备采购与验证,这意味着产能无法迅速响应需求激增。当需求超过供给时,正如 2023 年大语言模型需求爆发之后,交期会延长至 12–18 个月,价格可能翻倍。
对于基础设施规划者而言,这种供应链集中意味着 HBM 的可用性——而不只是其规格——可以决定训练集群的构建时间表。规划大规模部署的组织必须提前 12–18 个月锁定 HBM 配额,在系统其余部分设计完成之前先行投入资本。该采购提前期长于堆栈中任何其他组件,使 HBM 成为集群扩展的节拍环节。
对于我们的 175B 模型,仅集群中的 HBM 就约相当于 $0.8–1.2 million at 80 GB/accelerator (or $2–3 million(按每加速器 192 GB、单位成本 10–15 美元/GB 的定价模型计算)。这一成本与容量之间的权衡解释了为何加速器通常提供 80–192 GB 的 HBM,而主机服务器则提供 512 GB 到 2 TB 的 DDR:快速内存承载活跃计算(权重、激活值、每个周期都会访问的梯度),而 廉价内存承载其余所有内容(优化器状态、检查点缓冲区、数据加载队列)。
HBM 与 DDR 之间的边界是训练框架的关键设计参数,而高效管理这一边界正是 **内存高效的数据并行**:ZeRO 与 FSDP 所描述的 ZeRO(Zero Redundancy Optimizer)分片与卸载策略所应对的关键挑战之一。分片将优化器、梯度和参数状态分布在各个 worker 之间;卸载则在 HBM 容量成为瓶颈时,将较冷的状态放置到主机 DRAM 或非易失性内存扩展(NVMe)中。这一边界若朝任一方向设置错误,代价都很高:将过多数据放入 HBM 会浪费昂贵的容量,而将过多数据放入 DDR 则会引发带宽停顿,使算术单元闲置。
HBM 代际与扩展边界
HBM 的演进与模型规模的增长紧密对应。每一代都增加了堆叠裸片数量、每引脚的信号速率以及每堆的总容量,其驱动力是模型参数持续增长。高带宽内存的演进 展示了扩展边界:HBM4 必须加宽接口,因为仅靠提升引脚速率已不足以支撑所需带宽增长。
| 指标 | HBM2e(A100) | HBM3(H100) | HBM3e(B200) | HBM4(未来) |
|---|---|---|---|---|
| 峰值带宽 | ~2.0 TB/s | ~3.3 TB/s | ~8.0 TB/s | 12–16 TB/s(预计) |
| 典型容量 | 40–80 GB | 80–96 GB | 180 GB | 288 GB+ |
| 接口宽度 | 1024-bit | 1024-bit | 1024-bit | 2048-bit |
| 堆叠高度 | 8 dies | 8–12 dies | 12 dies | 16 dies |
如 高带宽内存的演进 所示,从 HBM3 到 HBM3e 的演进对我们的示例而言尤其重要。配备 80 GB HBM2e 的 A100 只能容纳我们 175B 模型的 23% 权重(以 FP16 计)。配备 80 GB HBM3 的 H100 可以容纳相同比例的权重,但数据传输速度快 65%。配备 180 GB 的 HBM3e 的 B200 可以容纳 55.2 percent 的权重,并以约 8 TB/s 的速率提供它们。三者都无法容纳完整模型,这正是节点中需要多台加速器(accelerator)的原因,相关内容见 节 1.3。
然而,一旦应用量化,容量情况便显著改变。同一个 175B 模型量化到 INT8 仅需 175 GB,可装入 3 张 H100 GPU,或一张 B200。量化到 INT4 则仅需 87.5 GB,可装入两张 H100 GPU。驱动训练需要多加速器节点的那些容量约束(训练通常要求 FP16 或 BF16 精度)在推理场景中得到大幅缓解(推理中 INT8 或 INT4 量化通常可以接受)。这也是训练与推理基础设施具有不同最优配置的另一原因。
带宽提升的重要性独立于容量。一旦容量问题已通过分片或量化得到处理,每一代 HBM 在自回归推理中都会带来近乎等比例的每 token 延迟下降。
一个 70.6B FP16 模型拥有 141 GB 权重,因此带宽下限计算给出约 141 GB/2.04 TB/s = 69.2 ms 每 token(A100 级带宽),141 GB/3.35 TB/s = 42.1 ms(H100 级带宽),以及 141 GB/8 TB/s = 17.7 ms(B200 级带宽)。A100 与 H100 的情形并不意味着整个 FP16 模型能装进单块设备;它们仅隔离由单条等效加速器 HBM 路径所决定的延迟下限。对于交互式应用(聊天机器人、代码助手、实时翻译),用户将超过 50 ms 的延迟视为“慢”,这些带宽提升会直接转化为更好的用户体验,并提升在延迟预算内服务更大模型的能力。
面向 HBM4 的预计跃升首次将接口宽度从 1024 位翻倍至 2048 位,这是 HBM 引入以来首次实现。这表明仅靠每引脚信号速率的提升无法无限期地支撑带宽增长,总线必须加宽。接口宽度的翻倍需要相应更大的中介层(interposer)面积以完成布线,这也是加速器封装随带宽目标提高而趋于增大的原因之一。
HBM4 级封装所预测的聚合量级为 12–16 TB/s,体现了万亿参数规模模型所带来的规划压力。一个 1T 参数的模型大约需要 2 TB 的权重存储量(FP16 格式)。在 B200 级 HBM3e 带宽(约 8 TB/s)下,以批大小为 1 服务该模型,将产生 2000 GB/8 TB/s = 250 ms 的每 token 速率,这远远慢于交互式应用的需求。即便在 16 TB/s 下,未考虑批处理、量化或张量并行切分时的带宽下限仍约为每 token 125 ms。这一计算表明,万亿参数模型即使在单请求推理场景下,也亟需激进的量化与多加速器张量并行。模型规模与存储技术的共同演进持续推动着基础设施需求。
一个重要的架构考量是每颗加速器上的 HBM 堆栈数量,以及它们如何连接到处理器。H100 拥有 5 个 HBM3 堆栈,每个堆栈提供约 670 GB/s 的带宽,总聚合带宽为 3.35 TB/s。B200 级 Blackwell GPU 封装使用 8 个 HBM3e 堆栈,聚合带宽约为 8 TB/s。堆栈数量受限于可用于放置 HBM 的中介层(interposer)面积:每个 HBM 堆栈约占中介层面积的 100 mm²,而中介层总面积必须同时容纳处理器 die(s) 和全部 HBM 堆栈。更大的中介层可以容纳更多 HBM 堆栈(因而带来更高的带宽和容量),但成本更高、制造也更困难。
中介层面积约束带来了一个具体的设计张力。增大处理器 die(更多 Tensor Cores、更多 SM)会挤占留给 HBM 堆栈的中介层面积,可能降低带宽;缩小处理器 die(更少 Tensor Cores)则释放中介层面积以容纳更多 HBM,但会降低峰值计算吞吐量。最优平衡取决于目标工作负载在 Roofline 图上的位置:计算受限型工作负载受益于更大的处理器 die(更多 Tensor Cores),而带宽受限型工作负载则受益于更多 HBM 堆栈。**单个加速器的顶线** 通过算术强度与 ridge point 方程推导出区分这两个形态的 ridge point,从而允许工作负载的算术强度在投入任何硅片之前预测其落在平衡的哪一侧。
内存带宽与令牌延迟
内存容量(HBM 能存储多少 GB)与内存带宽(每秒能交付多少 TB)之间的区别,是机器学习基础设施中最重要的实用概念之一。容量决定模型的权重是否放得下;带宽决定模型能跑得多快。对于自回归文本生成,每个 token 都需要完整遍历模型权重,因此带宽几乎总是约束性因素。The α-β Communication Model 将同样的“延迟 vs. 带宽”分解推广到网络中的数据移动,使读者获得一个代数模型,该模型既适用于此处的内存系统,也适用于后续节点间传输。
Napkin Math 1.1: 令牌延迟的物理机制
问题:从 Llama-3 70B(141.2 GB 的 FP16 权重)生成一个 token,既需要算术运算,也需要从 HBM 完整加载权重。假设容量问题已经解决(通过分片、更高容量的设备,或量化),那么在 H100 上,每个 token 的时间主要由什么决定:计算还是内存传输?
- 计算时间:每个 token 需要 \(2 \times 70 \times 10^9 = 1.4 \times 10^{11}\) 次浮点运算。在 989 TFLOP/s 的 FP16/BF16 Tensor Core 峰值吞吐率下,算术运算耗时 \(T_{\text{compute}} \approx \mathbf{0.14 \text{ ms}}\)。
- 内存时间:
以 141.2 GB 的权重从 HBM 以 3.35 TB/s 的速度加载,耗时 \(T_{\text{mem}} \approx \mathbf{42.1 \text{ ms}}\)。
系统洞见:处理器有 99.7 percent 的时间处于等待内存数据的状态。算术单元在整个 token 生成过程中几乎始终处于空闲。即使假设一个具有无限计算吞吐率的处理器,生成 token 的速度也只会有微不足道的提升,因为内存传输时间完全占主导地位。这就是 HBM 带宽提升能够为推理负载带来近乎线性加速的原因。
该带宽下限还为我们提供了一个清晰的方法,用于比较相邻的硬件代际:若算力保持不变,而 HBM 容量与带宽得到提升,则解码延迟应随存储系统变化,而非随算术单元变化。
Napkin Math 1.2: 内存墙:H100 与 H200
将 NVIDIA H100 与其继任者 H200 进行比较,说明了为何“内存墙”是现代大语言模型(LLMs) 的首要约束。这两款芯片共享相同的算力核心(峰值 TFLOP/s 相同),但 H200 提供了1.4× 更高的内存带宽和1.6× 更大的 HBM 容量。
这一 LEGO 式比较使用了一个具有70.6B 参数、序列长度2,048、批大小1 的 Llama 3 模型;所报告的加速比是服务求解器对 token 间延迟的估计值,而非单纯的带宽比值。一张便笺估算将这一求解器数值框定:解码在每个 token 的时间上花费99.7 percent 于权重加载,因此预期收益为 HBM 带宽比值,即4.8 TB/s \(\div\) 3.35 TB/s \(\approx\) 1.4×。
系统洞见:对于 LLM 解码,H200 比 H100 快1.4×,尽管其算力完全相同;求解器的估计值几乎精确地落在带宽比值上,因为解码受带宽限制。这证明对于大规模自回归模型,“墙”是内存接口,而非算术逻辑。
便笺演算揭示了现代 ML 基础设施核心的深刻不对称性。加速器厂商投入数十亿美元设计更快的算术单元(更多 Tensor Cores、更高的时钟频率、更宽的 datapath),但对于单请求推理,算术运算只需几毫秒即可完成,而内存传输却需要几十毫秒。就这一工作负载而言,算术单元比存储系统快约 300\(\times\) 倍,这意味着超过 99% 的专用计算硅片在推理期间处于空闲状态。这种计算与内存之间的不对称,是 ML 推理最重要的物理事实,并塑造了关于服务基础设施的每一项架构与经济决策。
工作负载在等待内存上所花费的 token 时间占比,本例中为 99.7 percent,称为该工作负载的内存受限度。若某工作负载有 99% 的时间受内存限制,那么它几乎无法从更快的处理器(更高的 TFLOP/s)获益,却几乎可以从更快的内存(更高的 TB/s 带宽)获得线性加速。
内存受限度是对内存墙这一现象的定量表达:处理速度与内存速度之间的差距数十年间持续扩大,在机器学习推理工作负载中尤为突出。内存墙最早由 Wulf 和 McKee 于 1995 年提出,他们观察到处理器速度每年提升 60%,而 DRAM 速度每年仅提升 7%。这种日益扩大的差距意味着处理器将越来越多地把时间花在等待数据上,而不是处理数据。三十年后,他们的预测已被证明准确,而机器学习推理工作负载则是现代计算中内存墙最极端的体现。
其实际含义是:针对推理工作负载选择加速器时,应优先关注每美元带宽,而非每美元 FLOP/s。一台上一代 GPU 若具备高内存带宽但计算吞吐适中,可能比最新一代 GPU(计算能力极强但带宽提升不足)带来更好的每美元推理性能。
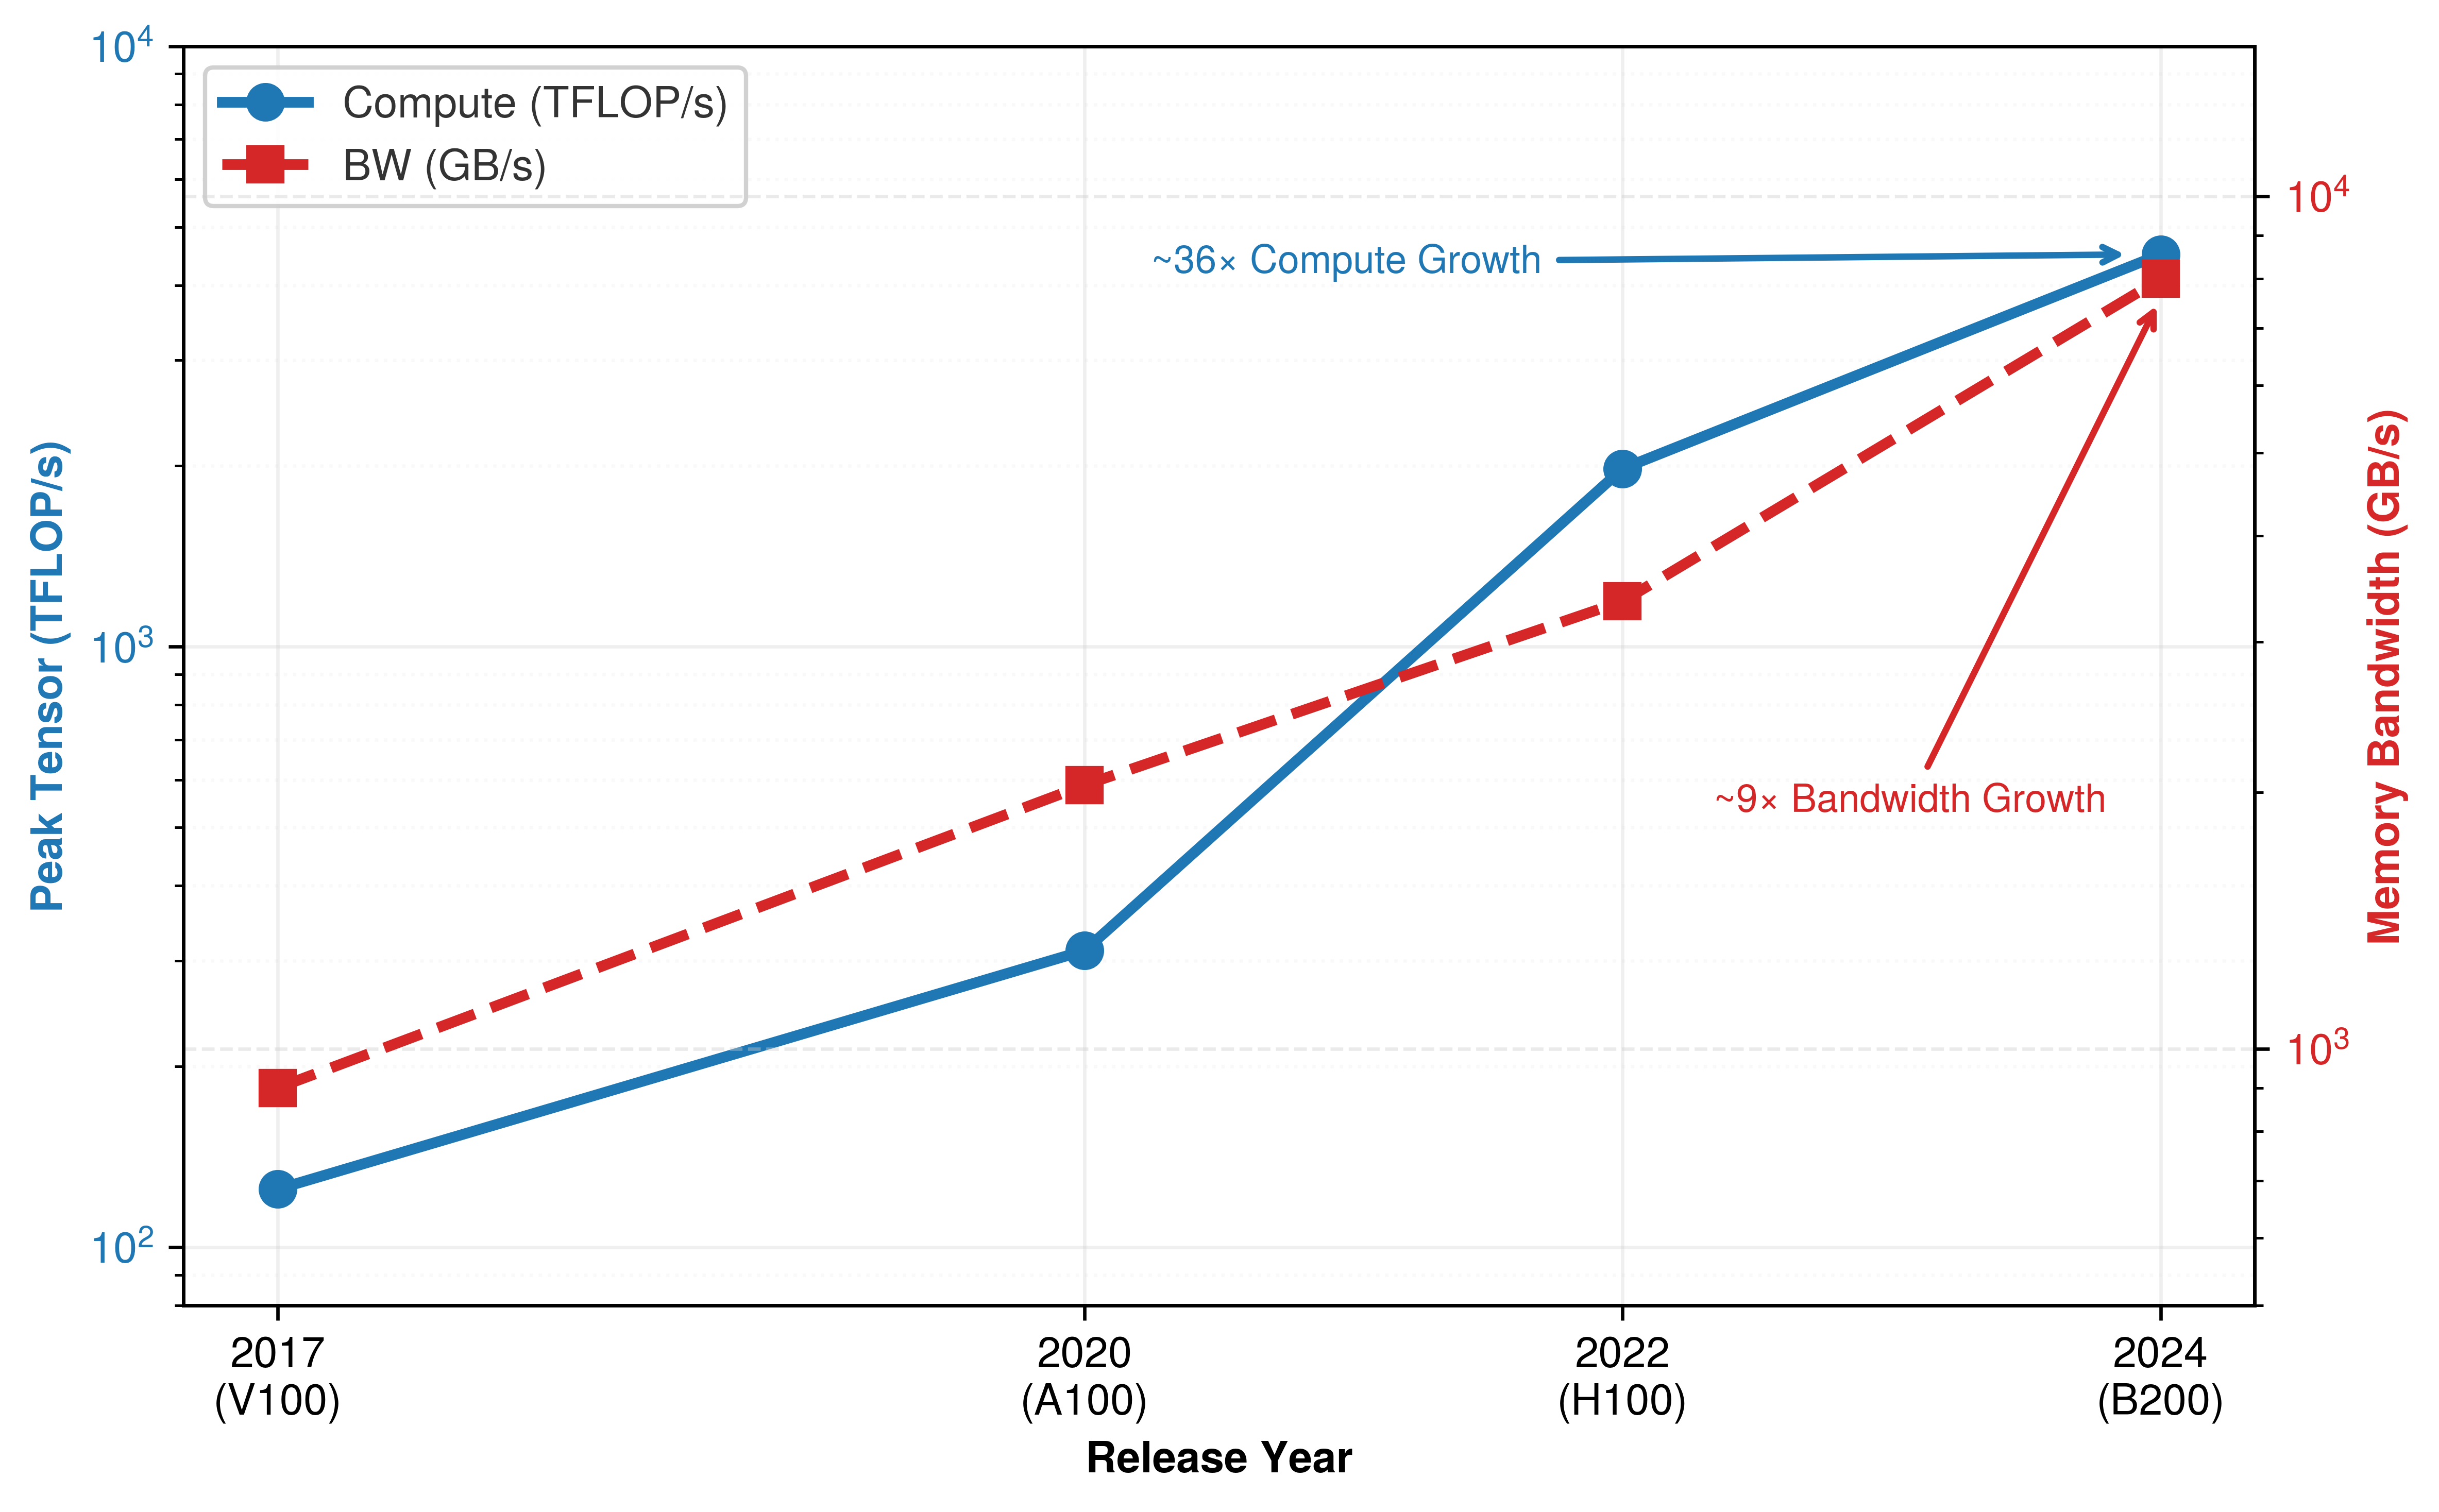
图 9 通过四代 GPU 展示了这一背离。当遵循各代产品宣传的低精度模式时,峰值 Tensor 吞吐从 V100 到 B200 增长了 36\(\times\),而同期的 HBM 带宽仅增长 9\(\times\)。计算增长与带宽增长之间不断拉大的差距就是内存墙:每一代加速器在算术运算上越来越强,但在数据供给上却按比例更加匮乏。
对于训练工作负载,由于较大的批处理量会提高算术强度,权衡的重心便转向算力:每美元峰值 TFLOP/s 成为相关指标,因为从 HBM 加载的权重数据会在整个批处理中的许多 token 之间被摊薄。Roofline Model 为精确刻画这一权衡、并确定任何给定工作负载下哪个指标才是关键,提供了形式化的框架。
Roofline model
notebook 1.1 中的 token 延迟计算表明,在 H100 上运行的 70B 模型几乎完全受内存带宽限制。问题在于,如何系统地针对任意工作负载和任意硬件判断这一点。roofline model,7 由 Williams、Waterman 和 Patterson (Williams 等 2009年) 提出,它提供了一个可视化与分析性的框架,用一个数字回答这一问题:工作负载的算术强度。
7 Roofline model: 该模型由加州大学伯克利分校的 Williams、Waterman 和 Patterson 于 2009 年提出,它以双对数坐标绘制可达 FLOP/s 与算术强度,产生两条相交的直线,其交点——即脊点(ridge point)——将内存受限与计算受限两种形态区分开来。
Williams, Samuel, Andrew Waterman, 和 David Patterson. 2009年. 《Roofline: An Insightful Visual Performance Model for Multicore Architectures》. Communications of the ACM 52 (4): 65~76. https://doi.org/10.1145/1498765.1498785.
对于 H100(989 TFLOP/s FP16,3.35 TB/s HBM),脊点约为 295 FLOP/byte;大多数 LLM 推理算子都远低于这一阈值,这正是 roofline 模型仍然是判断“增加计算能力还是增加带宽更能提升性能”的首选诊断工具的原因。将该工作负载置于该图中的量是它的算术强度 \((I)\),定义为 \(I = \text{FLOP}/\text{byte}\):即决定工作负载属于带宽受限还是计算受限的计算量与内存流量之比。同一量会延续到集群规模的性能分析中,见 The roofline model。
解码深度位于内存受限区,远低于脊点。
roofline 模型将工作负载可达到的最大性能表示为两个上限中的较小者:
\[ \text{Achievable FLOP/s} = \min\left(R_{\text{peak}},\ \text{BW} \times I\right) \tag{1}\]
公式 1 具有直接的物理含义。若工作负载的算术强度较低(每个操作需要许多字节),则性能受限于内存交付这些字节的速度。可达 FLOP/s 随 \(I\) 线性增长,在对数-对数图中呈现为一条斜线。若算术强度较高(每个字节驱动许多操作),则性能在硬件峰值计算速率处趋于饱和,即使 \(I\) 继续增加也不会改变。该饱和平台就是模型中的平坦“屋顶”。
Definition 1.2: 脊点
脊点 是机器学习加速器中内存带宽上限与计算上限相交处的算术强度 \((I_{\text{ridge}} = \frac{R_{\text{peak}}}{\text{BW}})\)。
- 重要性:它定义了硬件效率阈值。强度低于脊点的工作负载属于带宽受限 \((\text{BW})\),高于脊点则属于计算受限 \((R_{\text{peak}})\)。
- 区别:与峰值 FLOP/s(仅描述水平上限)不同,脊点描述的是架构的平衡性。硬件代际之间脊点上升,表明计算能力增长快于带宽,使得利用率更难提升。
- 常见误区:一种常见误解是所有 GPU 的脊点都相同。实际上,脊点随精度而异:由于 \(R_{\text{peak}}\) 在 INT8 下高于 FP32,而 \(\text{BW}\) 保持不变,因此 INT8 的脊点要高得多,需要更多数据复用才能让硬件饱和。
不同的机器学习工作负载会根据操作类型和批大小,落在该图中不同的区域:
- LLM 解码(批大小为 1):每个 token 都需要加载完整的权重张量(约 2 字节/参数),而每个参数仅产生 2 FLOPs,因此得到 \(I \approx 1\) FLOP/byte。该点深位于内存受限区域内,远低于脊点 295.2 FLOP/byte。我们的 token 延迟计算也证实了这一点:算术运算在微秒级完成,而内存传输耗时达毫秒级。
- LLM 预填充:并行处理提示词 token 会将大量矩阵-向量乘积转化为矩阵-矩阵乘积,从而提高权重复用率。其算术强度取决于提示词长度、批处理形状、分块方式、注意力实现方式,以及模型计入的内存流量;因此预填充可能位于某设备的脊点之下、附近或之上。
- CNN 训练:卷积可以在批处理和空间维度上复用权重与激活值,但其位置取决于张量形状、数据布局、融合方式、精度以及缓存行为。决定其 roofline 区域的是实测值或针对具体操作的字节数,而非模型族标签。
- 注意力(长序列):自注意力机制的 FLOPs 随序列长度呈二次增长,而 key-value 缓存的内存流量则随序列长度线性增长,因此其算术强度依赖于序列长度。短序列受内存限制;长序列受计算限制。
关键在于,在 roofline 上对每个阶段和批处理形状分别进行分类,而不是为整个模型族指定一个永久不变的区域。
阅读 Roofline 图需要先理解各坐标轴的含义。横轴为算术强度(FLOP/byte),采用对数刻度;纵轴为可达性能(FLOP/s),同样采用对数刻度。两条直线定义了”roofline”形状:一条在对数-对数图中斜率为 1 的对角线,代表内存带宽上限;另一条水平线代表峰值计算上限。这两条线相交于脊点。
任何工作负载都可以通过计算其算术强度并测量其实际性能,作为图中的单个点来绘制。若该点位于对角线上,则该工作负载受内存限制,改进内存将带来收益。若该点位于水平线上,则该工作负载受计算限制,增加算术单元将带来收益。
若该点位于任一条线之下,则说明该工作负载未能充分利用可用资源。这一差距表明软件层面存在优化机会:内核效率不足、内存访问模式不佳,或同步开销过大。消除这一差距属于内核工程与通信优化的范畴,相关内容将在 性能工程 中讨论。
The Roofline 的诊断能力不仅限于单个核,还延伸至整个训练运行。对于我们的 175B 模型,计算图包含数千个具有不同算术强度的不同操作。稠密的前馈网络层主要由高算术强度的大型 GEMM 主导,因而明确处于计算受限(compute-bound)形态,此时 Tensor Core 的利用率成为瓶颈。相反,诸如层归一化和逐元素激活之类的操作具有低算术强度,深陷于内存受限(memory-bound)区域,计算单元在等待数据时处于空闲状态。自注意力机制会根据序列长度在两种形态之间波动:虽然注意力分数的二次复杂度提示其处于计算受限,但 Key 与 Value 矩阵的加载会在较短序列下产生内存压力。这一诊断性区分决定了优化策略:内存受限的层受益于核融合(减少 HBM 往返次数),而计算受限的层受益于精度降低(从 FP16 降至 FP8,从而有效提高硬件的计算上限)。
图 10 使这些关系在 H100 上清晰可见:Batch-1 解码处于深度内存受限区域,而本章简化的大批量训练点则越过脊线进入计算受限区域。训练点按照假设的批大小 2048 理想化地缩放权重复用;它属于对照案例,而非训练强度的普遍取值。实际定位需要统计被建模内存层级的字节数,并考虑张量形状、融合与复用。在这一显式简化下,解码与训练强度之间的 2,048× 差距(约 1 FLOP/byte 对约 2,048 FLOP/byte)解释了为何同一硬件在不同阶段会表现出截然不同的利用率。
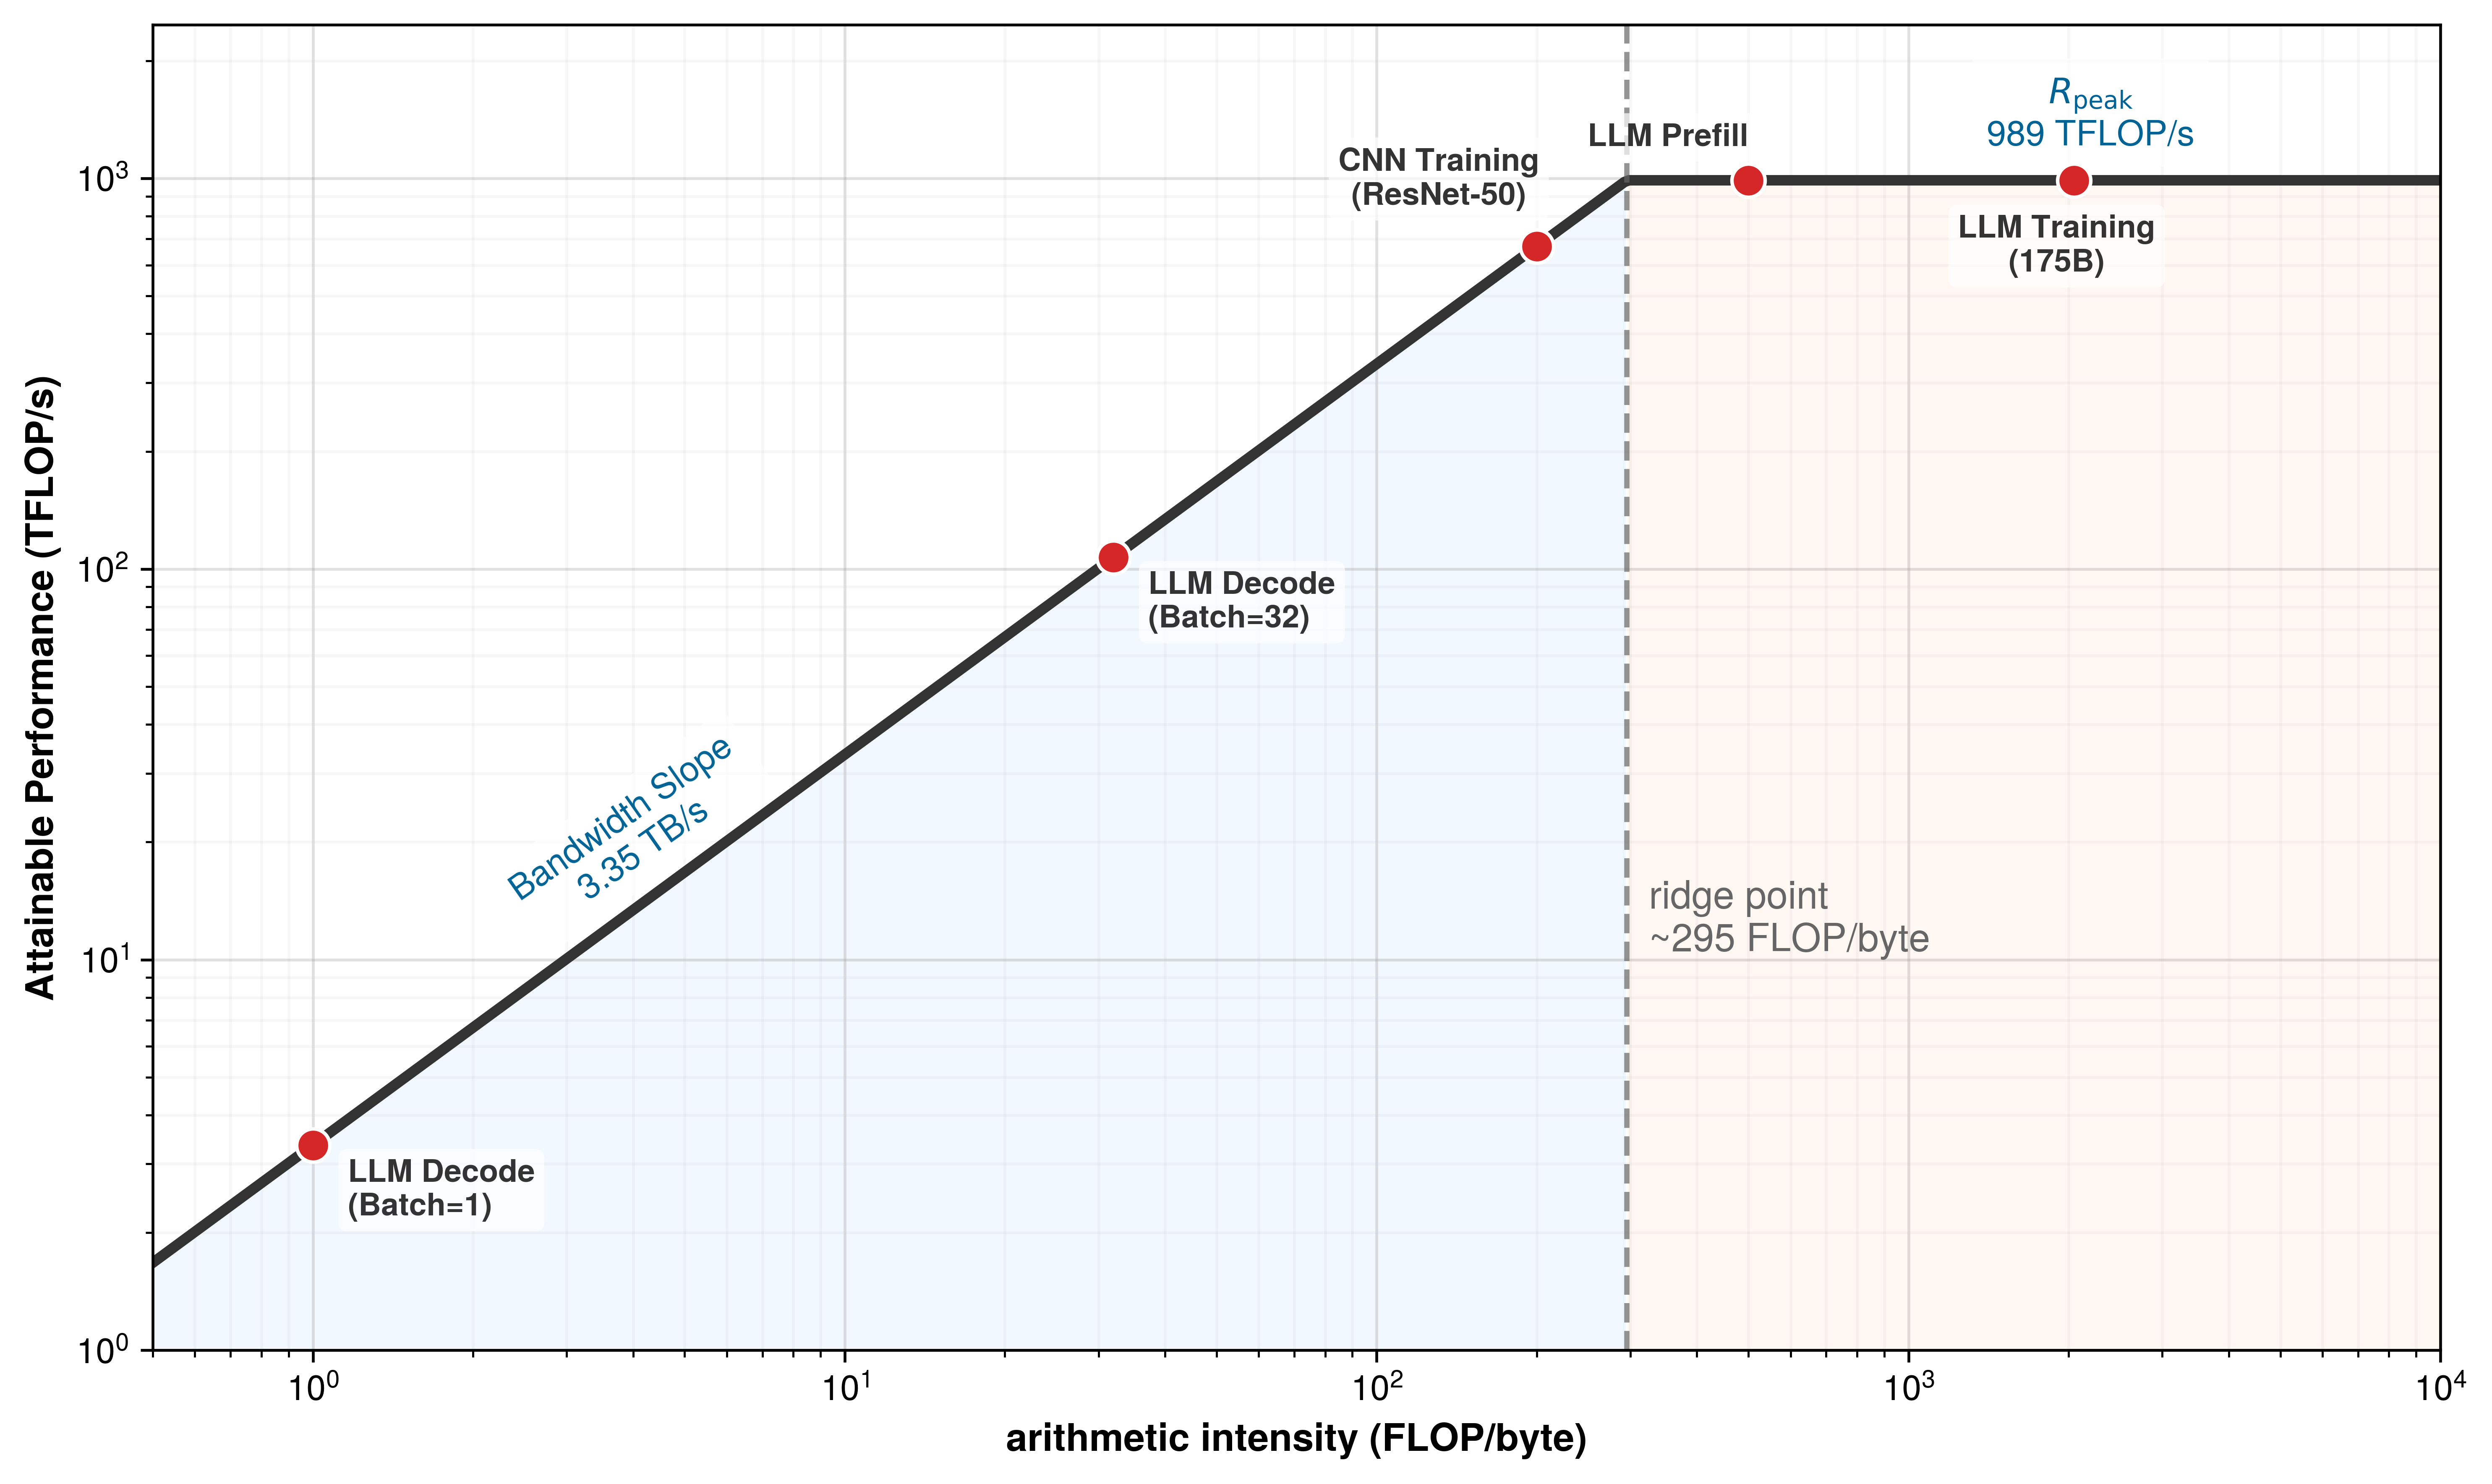
图 10 中的 roofline(屋顶线)由两个上限决定:内存带宽(对角线)和峰值算力(水平线),二者在 FP16 的 ridge point(脊点,约为 295.2 FLOP/byte 的 989 TFLOP/s 除以 3.35 TB/s)处相交。ML 工作负载覆盖整个范围:batch size 为 1 的 LLM 解码深度受内存带宽限制,而大批量 LLM 训练则受算力限制。每个工作负载在图中的位置决定了是加快内存还是加快算力能够提升性能。
Roofline Model 还揭示了关于 batch size 与硬件利用率之间相互作用的微妙而重要的洞见。对于给定模型,增大 batch size 会提高算术强度,因为权重矩阵只加载一次,却要与更大的激活矩阵相乘(传输的字节数不变,FLOPs 增加)。这使得工作负载点在图中右移,可能从内存受限区域跨越到算力受限区域。算术强度随 batch size 线性增长(batch size 翻倍会使 FLOPs 翻倍,而权重加载保持不变),从而在 batch size 与硬件利用率之间形成简单且可预测的关系。
对于推理服务,将多个请求批处理在一起会大幅提高硬件利用率和吞吐量。一个在 batch size 为 1 时达到峰值 FLOP/s 1% 的模型,在 batch size 为 64 时可能达到峰值 FLOP/s 的 50%,仅仅因为从 HBM 加载的权重数据会在 64 个独立请求之间复用,而不是仅复用一次。这 50\(\times\) 倍的硬件利用率提升是有代价的:这 64 个请求必须等待整个批次组装完成才能开始处理,从而引入排队延迟。服务系统必须仔细权衡吞吐量(更大的批次、更高的利用率)与延迟(更小的批次、更快的单请求响应)之间的取舍。
对于训练,batch size 是一个超参数,同时影响统计量收敛和硬件效率,形成实践者必须谨慎处理的权衡。更大的 batch size 能够改善硬件利用率(把工作负载推向算力受限区域),但可能需要调整学习率和 warmup 调度以维持训练质量。最优 batch size 取决于模型架构和硬件的 Roofline 特性,构成一个横跨 ML 理论与系统工程的跨学科优化问题。
Roofline Model 的实用价值在于,它告诉我们应当优化哪一项资源。如果工作负载受内存带宽限制,购买更快的加速器(更高的 TFLOP/s)不会带来任何收益;只有提高内存带宽才有帮助。反之,如果工作负载受算力限制,升级 HBM 代际则属于浪费。这种诊断能力正是经验丰富的基础设施工程师总是先计算目标工作负载的算术强度、并将其与候选硬件的 Roofline 作图的原因:该图会立即揭示哪些硬件特性是相关的、哪些是无关的。
对于我们的 175B 模型,使用大批量训练属于计算受限(优化 TFLOP/s),而单独服务请求则属于内存受限(优化带宽)。这种双重性解释了为何一些组织会为训练和推理采用不同代际的硬件。A100 由于成本较低且内存带宽足够,尽管其峰值 FLOP/s 低于 H100,在推理场景下可能比 H100 更具成本效益。
Roofline 模型同样为评估不同优化的投资回报提供了定量框架。若某工作负载的计算利用率仅为计算上限的 10\(\times\),却已经触及带宽上限,那么将工程投入用于内核优化(向计算上限靠拢)不会产生任何收益。投入应转而用于减少内存流量(在图中将工作负载右移),可通过批处理、内核融合或量化等技术实现。
Roofline 的诊断能力使其成为基础设施工程师工具箱中最具实用价值的分析工具之一。在承诺任何硬件采购或优化投入之前,将工作负载绘制到 Roofline 图上,可以立即看出该投资是否能够带来回报。跳过这一分析的团队可能花费数月去优化错误的资源,而 GPU 小时的成本每天高达数千美元,这是一笔昂贵的错误。
同一算术强度计算区分了运行模型的推理与训练两种形态。
Example 1.2: Roofline 分析:训练与推理
场景:一个工程团队评估硬件选型,用于服务(解码批大小为 1)与训练(批大小为 2048)一个含 175B 个参数的模型,运行于 H100 GPU(ridge point 295.2 FLOP/byte)。
诊断:单 token 解码的算术强度为 \(I =\) 1 FLOP/byte \(\ll\) 295.2 FLOP/byte,受 HBM 带宽限制,将吞吐量上限约束为峰值 FLOPs 的 0.34 percent。训练批处理将强度提升至 \(I =\) 2,048 FLOP/byte \(\gg\) 295.2 FLOP/byte,使工作负载转向计算受限的峰值 TFLOPs。
系统经验:硬件选型必须与运行算术强度相匹配:训练平台优先追求峰值算力(TFLOPs),而单批次推理平台优先追求每美元内存带宽。
当拟议的升级改变了错误的上限时,同一套诊断方法最具价值。
Checkpoint 1.2: Roofline 诊断
一个团队正在 H100 上以批大小为 1 服务一个 13B 参数模型,并观察到每个 token 25 ms。性能剖析显示,解码阶段 tensor core 利用率偏低。
Tensor Cores 与矩阵单元
计算基础设施
roofline 模型告诉我们,某项 workload 能否达到峰值算力。下一个问题是:究竟是什么决定了这一峰值?答案在于占据现代加速器 die 面积大部分的专用算术单元:Tensor Cores8(NVIDIA GPU)与 Matrix Multiply Units(Google TPU)。
8 Tensor Core:随 NVIDIA Volta(2017)推出,是 \(4{\times}4{\times}4\) FP16 融合矩阵乘加单元。每一代都加宽了 tile:Turing(2018)加入 INT8,Ampere(2020)加入 TF32/BF16,Hopper(2022)达到 \(16{\times}16{\times}16\) 并支持 FP8。这一精度演进序列与机器学习自身向低精度训练和推理的转变相吻合——每一种新格式都在同一块硅上解锁 \(2\times\) 的吞吐量提升,因此 Tensor Core 的代际演进可作为衡量软硬件协同设计循环加快提升 Roofline 算力上限速度的代理指标。
一颗标准 CPU 浮点单元每个周期每通道执行一次乘加。即便采用宽 SIMD 单元(AVX-512 提供 16 条 FP32 通道),CPU 核心每个周期最多执行 16 次 MAC。32 个核心时,高端服务器 CPU 的吞吐约为每个周期 512 次 MAC,对通用计算而言是一个可观的数字,但完全无法满足神经网络规模下矩阵乘法的需求。
相比之下,Tensor Core 在专用硬件上针对小型 tile 矩阵执行形如 \(\mathbf{Y} = \mathbf{A} \times \mathbf{B} + \mathbf{C}\) 的矩阵乘加指令。在 H100 上,这些 tile 操作分布于每个 SM 的 Tensor Core 阵列中,每条指令可产生数百个累加结果,同时保持操作数位于寄存器与共享内存中。这便将神经网络中的主导运算集中到了仅占芯片面积很小一部分的硬件中。
芯片共有 528 个 Tensor Core(每个 SM 4 个,共 132 个 SM),H100 因此达到 roofline 分析中使用的 989 TFLOP/s FP16/BF16 峰值。关键的系统学要点并非逐条指令的精确计数,而是架构层面的专用性:该芯片将自身算术面积的大部分用于稠密分块矩阵运算,而非通用标量执行。
Google 的 MXU 将这一思路进一步推演,把乘法器组织成 systolic array。在 systolic MXU 中,一个矩阵被载入数组的权重寄存器,另一个矩阵则逐行流过该数组。每个单元将传入的激活值乘以其存储的权重,把结果累加到来自上方单元的部分和,随后将激活值向右传递、将部分和向下传递。这种流水线式数据流意味着数组在每个周期都在执行有效计算,流水线满后不存在空闲单元。TPU v5p 每片芯片包含两个 \(128{\times}128\) MXU,提供 459 TFLOP/s 的 BF16 吞吐量。该 systolic 数据流消除了张量核心仍需要的操作间寄存器文件访问,从而以牺牲运行非矩阵类工作负载的灵活性为代价,获得了略高的能效。
对于我们的 175B 模型,Tensor Cores 与 MXU 之间的选择体现在编译栈中。CUDA 内核可以将 Tensor Core 运算与任意线程级代码交织,从而形成融合内核,将矩阵乘法与激活函数、dropout 和层归一化合并为一次 launch。这种融合对性能至关重要,因为它消除了原本会在各运算之间发生的中间内存读写,使数据保留在寄存器与共享内存中,而那里的访问速度最快。
TPU 的 XLA 编译必须将计算分解为一系列映射到脉动式数据流(systolic dataflow)的矩阵运算序列;这虽然对标准 Transformer 架构可能更有效,但对自定义运算的灵活性较差。XLA 编译器执行全程序优化,分析整个计算图,为脉动阵列找到最优的切分(tiling)、内存布局和执行调度。对于标准 Transformer 层,这种全程序优化可能比手工调优的 CUDA 内核获得更高的硬件利用率,因为编译器可以针对整个计算进行推理,而不是孤立地优化各个运算。
硬件决定了软件抽象,进而塑造了哪些架构在实践中值得实验。硬件与软件之间的这种耦合是机器学习基础设施的一个显著特征,也解释了硬件选型会对研究推进速度和模型设计灵活性产生下游影响。
Definition 1.3: Tensor core
Tensor Core 是一种专用的机器学习加速器硬件单元,它通过一条硬件指令对小型 tile(例如,\(16{\times}8{\times}16\) 的 BF16)执行融合矩阵相乘累加运算 \(\mathbf{Y} = \mathbf{A} \times \mathbf{B} + \mathbf{C}\),以牺牲可编程性换取固定功能矩阵算术,从而提供远高于通用 CUDA 核心的吞吐量。
- 重要性:Tensor Core 提供了 H100 的 989 TFLOP/s FP16/BF16 峰值(以及约 1,979 TFLOP/s 的 FP8 峰值)——约为仅由 CUDA(矢量)核心提供的 67 TFLOP/s 的 ~14.8×。然而,该峰值仅适用于可分解为 tile 矩阵相乘的运算。层归一化和 softmax 涉及归约和逐元素运算而非矩阵相乘,因此在同一硬件上仅以约 3–8% 的峰值吞吐量运行。
- 区别:Tensor Core 是固定功能的矩阵相乘累加单元,而非更快的通用核心。CUDA 核心可执行任意标量和矢量工作负载;Tensor Core 仅执行 tile \(\mathbf{Y} = \mathbf{A} \times \mathbf{B} + \mathbf{C}\) 原语,因此峰值吞吐量和实际交付吞吐量会因工作负载而急剧分化。
- 常见误区:一种常见误解是,GPU 的所有运算都能从 Tensor Core 中获益。只有能够映射到 \(\mathbf{Y} = \mathbf{A} \times \mathbf{B} + \mathbf{C}\) tile 计算(稠密线性层、注意力分数计算、卷积)的运算才会使用 Tensor Core;逐元素激活、层归一化和嵌入查找会回退到 CUDA 核心,并且每个 FLOP 的耗时可能比 Tensor Core 运算慢 10–30\(\times\)。
Tensor Core 的精度支持随每一代而扩展,其驱动力在于发现神经网络训练与推理可以容忍比先前假设更低的数值精度。Volta 的 Tensor Core 接受 FP16 乘数并支持 FP16 或 FP32 累加;Turing 为推理增加了 INT8 和 INT4 模式;Ampere 增加了 BF16 和 TF32;Hopper 通过 Transformer Engine 增加了 FP8(E4M3 和 E5M2 两种格式),并支持张量级缩放。
Transformer Engine 配方与 FP8 自动转换(autocast)决定了哪些受支持的运算以 FP8 运行。缩放机制会记录张量范围并应用缩放系数,使数值适配所选的 FP8 格式;它不会独立判断某一层在数值上是否安全用于 FP8,也不会将其切换到 FP16。因此,精度策略本质上仍属于软件配置与验证决策。
理解两种 FP8 格式之间的区别,有助于从业者明白这一点为何重要。E4M3 格式(4 位指数、3 位尾数)可表示的数值上限约为 \(4.48 \times 10^{2}\),3 位尾数提供约 1/8 的相对精度。经过逐张量缩放后,许多神经网络权重与激活值的实际取值范围落入 FP8 窗口,因此该范围与精度对多数网络是足够的。
E5M2 格式(5 位指数、2 位尾数)提供了更宽的动态范围,最大有限值约为 \(5.73 \times 10^{4}\),代价是精度降低(仅 2 位尾数,即约 1/4 的相对精度)。更宽的范围对反向传播过程中的梯度尤为重要,因为梯度跨越的数值量级往往多于前向激活值,尤其是在深层网络的早期与末层。
所配置的 Transformer Engine 配方决定了这两种格式的使用方式;一种常见的混合配方是前向张量使用 E4M3、反向张量使用 E5M2。缩放系数与张量范围元数据由实现机制维护,而更新规则则由所选的缩放配方决定。
对集群设计的实际启示是:峰值 TFLOP/s 指标依赖于精度。H100 在 FP16 下的性能为 989 TFLOP/s,而在 FP8 下是其两倍(1,979 TFLOP/s)。为 FP8 训练设计的集群,其计算密度相当于同样规模但以 FP16 运行的集群的两倍,而无需额外硬件。这使得精度工程成为基础设施规划者的一等优化杠杆,而不仅仅关乎模型精度。
为在实际中实现这一峰值吞吐量,必须将整个加速器视为一条刚性流水线:数据从 HBM 出发,经过不断加深的缓存层级,最终到达 Tensor Cores。基本约束是流水线平衡:数据送入寄存器的速率必须达到或超过算术单元消耗它的速率。当某个操作的算术强度低于临界点时,流水线会停顿,导致大量 TFLOPs 的计算潜力在等待数据时闲置。因此,内核融合 是大规模训练中最重要的软件优化。将多个操作(矩阵乘法、偏置相加、激活函数)融合进单个内核,可以消除若逐个顺序执行各操作时产生的 HBM 往返。
考虑注意力机制:朴素且未融合的实现会先将 \(S{\times}S\) 注意力矩阵写入 HBM,再读取它执行 softmax 操作,从而产生一次受 3.35 TB/s 内存带宽限制的往返。而像 FlashAttention 这样的硬件感知精确注意力算法,则将这些中间矩阵完全保留在片上 SRAM 中,绕过 HBM,使 Tensor Cores 接近其理论峰值运行。对于我们的 175B 模型,每个训练步涉及跨越 96 个 Transformer 层的数千个矩阵操作,融合与未融合内核之间的差异可能带来 2–3\(\times\) 倍的吞吐量提升,从而将训练运行周期从 2 周缩短至 6 周。
峰值与持续吞吐量
对于基础设施规划而言,一个关键区别在于 peak 吞吐量(针对厂商指定的操作与精度所能达到的最大速率)与 sustained 吞吐量(完整工作负载实际交付的速率)之间的差异。Peak TFLOP/s 假设符合条件的算术单元在指定的稀疏度、精度和时钟条件下持续获得数据供给;它并不包含内存停顿、不符合条件的操作、通信开销或软件开销。因此,持续吞吐量的比例会随模型形状、批大小、精度、实现方式和规模而变化。这一差距源于多个来源,每个来源都对应一种不同的物理或软件层面的限制。
内存停顿发生在张量核心完成当前 tile 的乘法运算、而下一个 tile 尚未从 HBM 载入时。即便 H100 的 3.35 TB/s HBM 带宽,张量核心对某些矩阵维度而言仍可能比 HBM 的交付速度更快,从而在算术单元等待数据时产生空闲周期。
流水线气泡出现在某个操作必须先完成、下一个操作才能开始时,导致部分处理单元处于空闲。在 Transformer 层中,注意力计算必须先完成,前馈网络才能开始;前馈计算必须先完成,下一层的注意力才能启动。这些顺序依赖会形成硬件资源被短暂闲置的时段。其局部机制很简单:气泡就是依赖阶段之间的空闲槽位,而微批次化通过向本会等待的阶段注入后续微批次来减少浪费。在基础设施层面,这一经验教训是:峰值吞吐量假设流水线被完全填满,而真实训练包含依赖间隙,从而降低了持续利用率。
AllReduce 操作(张量并行)或梯度同步(数据并行)带来的通信开销,会在加速器之间交换数据期间完全暂停计算。即使通信与计算进行了重叠(使用独立的通信与计算流),通常仍有一些操作无法重叠,因为它们依赖于通信的结果。
来自内核启动延迟、内存分配以及 Python 级控制流的软件开销,额外贡献了 5–10 percent 的开销。每个 CUDA 内核启动在主机侧约产生 5–10 微秒的延迟,而单个 Transformer 层可能涉及 20–30 次内核启动。对于每个内核都在微秒级时间内完成的小微批次,启动开销可能占总执行时间的可观比例。
内核融合部分缓解了这一差距,它将多个操作(矩阵乘法、偏置相加、激活函数、dropout)合并为单个 GPU 内核,从而消除了原本会在操作之间使张量核心停顿的中间内存读写。实现高持续利用率的关键,很大程度上在于最大限度地减少张量核心的空闲时间,这也正是 FlashAttention 和 Transformer Engine 等专用内核库存在的原因。
容量规划
容量规划必须使用实测或保守建模得到的持续速率,而非峰值规格。若某次运行的峰值 FLOP/s 估算为 1,000 GPU 小时,则当其实测利用率分数为 \(u\) 时,所需成本为该估算的 \(1/u\) 倍。基础设施团队跟踪 MFU,即模型的有效 FLOP 数与硬件峰值 FLOP/s 乘以墙钟时间的比值;但只有当模型 FLOP 约定、精度、硬件峰值和系统规模一致时,比较才有意义。The fleet efficiency metric 形式化了 MFU,并发展了其在集群规模上的应用。
功耗墙与热约束
存储墙限制了数据到达计算单元的速度;Roofline 模型用于诊断计算还是内存是瓶颈约束;Tensor Cores 则最大化每个字节取回的算术价值。第三种物理约束同样限制了加速器的性能:所有这些计算所产生的热量。每个 FLOP 都会耗散能量,而系统计算得越快,必须移除的热量就越多。这就是功耗墙。图 11 追溯了能量从电网到晶体管的传输路径。
图 11 所示级联揭示了为何供电属于基础设施层面的问题,而不仅仅是一个电气问题:这些转换损耗,加上移除热量的开销,共同决定了设施的总体取电,而机架 PDU 到 VRM 过渡处集中的 10–40 kW 决定了整个设施冷却架构的设计。公式 2 通过单一设施指标——电能使用效率(PUE)——来刻画这一冷却开销:
\[ \text{PUE} = \frac{P_{\text{facility}}}{P_{\text{IT}}} \tag{2}\]
其中,\(P_{\text{facility}}\) 表示数据中心总取电量,\(P_{\text{IT}}\) 表示服务器、加速器、存储和网络设备所消耗的功率。PUE 为 1.5 意味着设施每向 IT 设备提供 1 瓦功率,就从电网取用 1.5 瓦;多出的 0.5 瓦用于冷却、电源转换、照明以及其他开销。
每个浮点运算都会以热的形式耗散能量。大规模矩阵乘法期间密集的 Tensor Core 活动会产生与数十亿晶体管开关活动成正比的热。加速器厂商根据产品不同,分别公布热设计功耗(TDP)、总图形功耗(TGP)、板级功耗或可配置功耗限制;这些数值是厂商特定的持续设计包络,而非可互换的物理定义。9 集群设计必须将适用的持续包络与任何已记录的瞬态超驰要求结合起来。在密集集群规模下,这形成了功率墙:决定能够安装并持续运行多少算力的是设施供电与散热能力,而非可用的算术单元。
9 功率包络:TDP、TGP、板级功耗额定值以及可配置功耗限制遵循各厂商特定的约定。它们提供持续的热与电设计目标,而非对瞬时功耗的通用测量。供电部件也必须能够承受产品已记录的瞬态超驰,而散热设计则采用适用的持续热包络与运行条件。
这正是热力学极限(原理 1)的体现:现代 AI 数据中心的瓶颈不是 FLOP/s,而是每平方英尺的瓦特数。当机柜产生 100 kW 热量时,风冷即告失效。集群的物理设计由将热量从硅片处移走的能力所决定。与之密切相关的功率密度墙(原理 2)使这一后果具体化:对于大规模训练集群,液冷已成为设施层面的硬性要求,而非可选项。
Definition 1.4: 热设计功耗(TDP)
热设计功耗(TDP) 是针对特定产品配置和运行条件定义的厂商持续热设计目标,单位为瓦特。
- 重要性:本章使用的 H100 SXM5 配置带有 700 W 设计目标。维持预期的运行点需要一条针对该目标、并在厂商规定的进风与冷却液条件下经过验证的热路径和设施回路。
- 区别:TDP 并不表示某个通用的瞬时功率上限。TGP、板级功耗、可配置限制以及瞬态规范描述的是各厂商和产品约定不同的相关电约束。
- 常见误区:一种常见误解是,广告中的瓦特数单独即可规定机柜功率与散热。集群设计必须将持续热目标、配置后的功耗限制、工作负载行为、部件开销以及瞬态功率要求结合起来。
TDP 的发展轨迹讲述了一个扩展形态达到其极限的故事。三十年来,** Dennard 缩放**10 使芯片设计者能够在缩小晶体管的同时保持近似恒定的功率密度:较小的晶体管需要更低的电压,因此将更多晶体管集成到相同面积并不会增加单位面积的发热量。随着电压缩放和漏电流限制使该扩展形态终结,架构师不得不将能耗、散热与并行性视为一阶约束,而非工艺缩小带来的免费副产品 (Dennard 等 1974年; Hennessy 和 Patterson 2019年)。此后的每一代加速器都不得不以性能换取功率与热量。通过工艺缩小实现“免费”性能提升的时代已经结束;如今每一点吞吐量的提升都必须以瓦特、散热能力或专用化来支付。
10 Dennard 缩放: 以 Dennard 等 (1974年) 在 IBM 的命名,他展示了 MOSFET 的尺寸、电压和电流如何缩放,从而使功率密度大致保持不变。后来的电压缩放极限和漏电流效应终结了这一恒定功率密度时期;Hennessy 和 Patterson 将由此产生的后 Dennard 功率墙描述为现代架构转向并行与专用化的原因之一 (Hennessy 和 Patterson 2019年)。对于机器学习基础设施,V100 到 B200 的 TDP 轨迹(300 W 至 1,000 W)是后 Dennard 规划问题的一个例证:如今冷却与供电已成为与硅片本身同等重要的设计约束。
Dennard, Robert H., Frank H. Gaensslen, Hwa-Nien Yu, Victor L. Rideout, Elias Bassous, 和 Antoine R. LeBlanc. 1974年. 《Design of ion-implanted MOSFET’s with very small physical dimensions》. IEEE J. Solid-State Circuits 9 (5): 256~68. https://doi.org/10.1109/jssc.1974.1050511.
Hennessy, John L., 和 David A. Patterson. 2019年. 《A new golden age for computer architecture》. Communications of the ACM 62 (2): 48~60. https://doi.org/10.1145/3282307.
数字十分触目:V100(2017)的 TDP 为 300 W,A100(2020)提升至 400 W,H100(2022)达到 700 W,B200(2024)的功耗为 1000 W。七年间,TDP 增长超过三倍,年均增长率约为 18%。
若该增长率持续作为规划情景,则黑威尔一代之后,单加速器功率将接近 1,200–1,400 W,再进一步跃升则可能达到 1,500–2,000 W。在每加速器 2,000 W 的功率水平下,单个 8-GPU 节点仅 GPU 功耗一项就需消耗 16 kW,因而需要液冷11基础设施,其散热速率接近工业流程冷却设备。
11 液冷流量:一机架 GB200 NVL72 节点(120 kW)约需 150–200 升/分钟的冷却液流量。在这些流量下,主要风险由热节流转向机械故障(泄漏、泵的气蚀),因而需要化工处理厂中常见的工业级歧管与快换接头。
::: {#psp-compute-infrastructure-end-dennard-scaling .callout-perspective title=” Dennard 缩放律的终结”}
三十年来,Dennard 缩放律使架构师能够在不提高功率密度的前提下增加晶体管数量,因为更小的晶体管所需电压按比例降低。这场“免费午餐”在 2006 年前后结束,当时工艺节点缩小至 28nm 以下,亚阈值泄漏和栅氧化层隧穿等量子效应使得电压进一步降低不再可行。结果是,当电压不再按比例缩放时,功率密度随晶体管密度上升:提供更高 TFLOP/s 的加速器往往需要更多瓦特。从 V100(12nm)到 H100(4nm)的转变正是这一物理规律的体现:晶体管密度翻了三倍,但由于电压无法按比例缩放,TDP 由 300 W 增至 700 W。硅时代的“免费”能效收益已经终结;每瓦性能的提升越来越多地来自架构专业化——Tensor Cores、脉动阵列、精度工程——或来自接受更高的功耗与冷却要求。对于机器学习基础设施规划者而言,功率与冷却能力必须依据算力需求进行规划,设施设计不能假定后续硬件会自动降低功率密度。
:::
适用的持续功率包络并不只是数据表上的一项规格;它会贯穿基础设施栈的每一层。供电链路、冷却系统、机架设计与设施电气基础设施都必须能够容纳已部署的加速器、其文档化的瞬态功率,以及未来刷新周期中合理的功率包络范围。
加速器实现了复杂的功率管理机制,以在自身 TDP 包络内运行。当工作负载并未充分利用全部 SM(例如训练步的通信阶段,GPU 在等待 AllReduce 完成时),GPU 固件可以通过时钟门控 关闭空闲电路的时钟信号,从而消除动态开关功耗,为活跃 SM 腾出热余量。另一项机制动态电压与频率缩放(DVFS) 会调整芯片的时钟频率与供电电压,以保持在功率和热限制之内;当一次大规模矩阵乘法同时激活全部 SM 时,DVFS 会降低时钟频率,使总功率保持在 TDP 以内。当部分 SM 处于空闲时,活跃 SM 可以因芯片总功率低于 TDP 而提升频率,因此训练步过程中的实际时钟频率、进而实际吞吐量,都会随之变化。
动态功耗管理意味着 GPU 的实际功耗在训练过程中持续变化。一个典型的训练步可能看到功耗在 400 W(通信阶段,大多数 SM 处于空闲)到 700 W(前向与反向传播阶段,所有 Tensor Cores 都处于活跃状态)之间摆动,每次转换都在微秒级完成。主板上的 VRM 必须足够快地响应这些转换,以维持稳定的供电电压,尽管电流需求变化迅速。
为直观感受这一物理挑战,考虑 700 W 在热通量方面意味着什么。H100 芯片的功耗约为 814 mm²(约 \(29{\times}28\) mm 见方)。从该面积耗散 700 W 会产生约 86 W/cm² 的热通量。作为对比,高火力的电炉灶炉面产生的热通量约为 10 W/cm²。H100 芯片产生的热通量是炉灶炉面的 8.6×,却集中在相当于大张邮票面积的区域内。
B200 更是如此:在双芯片封装上达到 1,000 W 时,平均热通量仍保持可比水平,但每个封装必须移除的总能量增加了 43%。要在不使结温超过 83 摄氏度(HBM 可靠性的典型工作上限)的前提下移除这些热量,就需要具有极低芯片到冷却剂热阻的热管理方案。
这条热路径中的关键部件是热界面材料(TIM)——位于硅芯片与冷板(用于液冷)或散热器(用于风冷)之间的微观相变材料层或液态金属层。在深度学习工作负载的极端热循环下,矩阵乘法期间芯片温度会在毫秒内从 40 摄氏度飙升至 80 摄氏度,而在通信阶段又回落;劣质的 TIM 会被泵出(从接触面迁移)或开裂。TIM 导热系数仅下降 5%,就会迫使 GPU 进行热节流,将时钟频率降低数百 MHz 以保护硅片。这种劣化属于灰度故障,即故障会削弱而非中止功能:GPU 仍继续运行,但性能下降,从而在静默中损害整个集群的吞吐量——这是集群监控所考察的故障类别。跟踪各 GPU 结温随时间变化的集群管理系统,可以将 TIM 劣化识别为恒定工作负载下温度的逐渐上升趋势,从而在性能影响变得严重之前实现主动更换。
在机架规模上,八个这样的芯片共四个节点需要 33.5 kW 的设施相关电力,足以在冬季为几户人家供暖。用更直观的说法:一台满功率运行的 ML 机架可同时驱动约 33 台家用空间加热器,且集中在约相当于一个大冰箱体积的空间内。
在机柜(pod)规模上,电力需求达到兆瓦级,需要专用变电站和工业级冷却设施。一个 10,000-GPU 集群消耗 7–10 MW,相当于大型工厂或数千居民小镇的用电需求。
在如此功率密度下,10,000-GPU 机柜的物理体积 surprisingly 紧凑:计算硬件(不含网络与存储)约需 300 个机架的空间,占用约 1,500 平方米的数据中心地面面积(约为一个美式橄榄球场的三分之一)。密度正是关键:让加速器在物理上彼此靠近,可缩短线缆长度,从而降低信号传播延迟并提高互连带宽。
然而,物理密度使电力分配与冷却的难度呈指数级上升,由此形成了定义机架与 pod 层级架构的工程挑战。现代 ML 基础设施的悖论在于:计算效率要求物理邻近,而热管理要求物理分离。每一代机架设计都是这两种相反力量之间的权衡。
这种频率可变性与软件优化之间存在微妙的相互作用。占用率较高的内核(每个 SM 上活跃 warp 较多)功耗更大,可能触发频率降低,部分抵消占用率带来的收益。相反,占用率适中的内核可能以更高的时钟频率运行,以较低功耗实现相当的吞吐量。因此,归一化后的吞吐量(每瓦 TFLOP/s)比原始 TFLOP/s 是更稳健的比较指标,这也解释了为何同一款 GPU 会因工作负载和冷却方案的不同而表现出不同的持续时钟频率。
在集群(fleet)规模上,DVFS 同样会影响电力规划。平均工作负载功耗可能低于配置的上限,因为通信阶段和占用率不足会使部分电路闲置;但平均值并不能替代持续负载与瞬态设计工况。部分运营商会主动降低加速器功耗上限,以便在固定的设施预算内部署更多设备,以吞吐量的工作负载依赖性损失换取更低的单设备功耗。功耗限制是操作层面计算效率权衡的一种形式。
功率效率轨迹为不断攀升的 TDP 提供了一部分反向抵消。虽然绝对功耗有所上升,但每瓦可提供的低精度 TFLOP/s 宣称值却大幅改善:从 0.42 TFLOP/s/W(V100 FP16)到 2.83 TFLOP/s/W(H100 FP8)再到 4.50 TFLOP/s/W(B200 FP8)。这些并非严格同口径的 FP16 数值;精度模式本身也是硬件演进趋势的一部分。对于能够使用新精度模式的固定算力预算,每一代所需的芯片数量更少,因而总功耗更低。然而,大模型能力目标的增长可能快于效率的改善,因此训练下一个更大模型所需的绝对功耗仍可能继续上升。这正是基础设施的 treadmill(跑步机)效应:效率提升买来的是时间,而规模增长则将其消耗掉。
功率包络的影响贯穿整个基础设施层级。在节点层面,配置限制约束了机箱中可以共享的加速器数量(节 1.3)。在机柜层面,聚合的持续负载与热通量有助于确定工程风冷或液冷能否满足设计点(节 1.4)。在 pod 层面,并发需求与瞬态行为共同塑造了兆瓦级功率交付(节 1.5)。因此,die 以上的每一层都必须同时管理持续散热与电气波动。
加速器选型:面向 ML 工作负载
加速器的算力吞吐、内存带宽、内存容量和功耗,只有相对于特定工作负载才有意义。同一款 H100 在大批训练时可能接近峰值利用率,但在单请求推理时利用率可能不足 5%,因为瓶颈约束已从算术能力转移到内存带宽。因此,正确选择加速器 要求将每种工作负载范式映射到 Roofline 图上,并识别出主导其性能的物理资源。
从运行示例 175B 开始。训练期间,大批次使前向与反向传播越过 Roofline 曲线上的脊点,因此首要约束是算术吞吐量。峰值低精度 TFLOP/s 固然重要,但前提是内存容量足以容纳分片后的模型状态,并且互连结构能够维持张量并行与数据并行组之间的同步。H100、B200 以及 TPU v5p 集群都是该训练问题的可行答案;最终选择取决于软件栈,其重要性不亚于芯片本身。以 PyTorch 为首的研究团队更看重 GPU 生态,而以 JAX/XLA 为核心的组织则可能接受更严格的编译约束,以换取 TPU 的成本效益。
为同一语言模型提供服务会改变结论。在自回归解码过程中,每个生成 token 都会将权重流式传输到内存中,因此关键指标变为每美元内存带宽,而非峰值 TFLOP/s。在批处理大小为 1 时,H100 的 3.35 TB/s 带宽决定吞吐量,而大量算术硅片处于等待状态。批处理通过让相同权重移动被更多请求复用,从而提高算术强度,这正是推理服务系统如此努力地进行批处理、同时又不违反尾延迟服务水平目标(SLOs)的原因。工作负载的名称没有改变,但铁律中的约束项发生了变化,加速器的选择也随之改变。
推荐模型 再次将决策一分为二。嵌入表查找主要受随机访问和内存容量支配,因为每个请求都会从 TB 级表中检索出局部性较差的小向量。消耗这些嵌入的稠密塔则受计算量支配。这种分裂自然引出 CPU-GPU 混合设计:CPU 与 DRAM 容量负责稀疏查找路径,而 GPU 加速稠密神经网络层。由于单个请求内部存在两个不同的瓶颈,一个头条 TFLOP/s 数值无法描述这类工作负载。
视觉与扩散类工作负载则重新趋向于算术吞吐量,因为卷积、注意力块和去噪网络对数据进行了大量复用。扩散推理尤其明显:MLSysIM 中的 Stable Diffusion v1.5 配置使用 50 denoising steps,因此服务需要支付一整段模型评估序列的费用,而不是每个 token 执行一次解码步骤。对于这类工作负载,当模型状态能够容纳于内存时,每美元 TFLOP/s 往往比每美元带宽更具决定性。
混合专家(MoE) 引入了一种路由约束:稀疏门控层对每个 token 只激活一个更大的参数集中的部分参数 (Shazeer 等 2017年)。例如,Mixtral-8x7B (Jiang 等 2024年) 共有 46.7B 个参数,但每个 token 只有 12.9B 个活跃参数,因为路由器从 2 experts 个专家中选出 8 experts 个。这种计算节省引入了多对多的 token 交换模式,即 集合通信 中考察的 AllToAll 集合通信,以及负载平衡风险,因为 token 必须被路由到不同的专家放置位置。高双切分互连结构,以及负载平衡机制——例如惩罚过载专家的辅助损失,或限制每位专家可接受 token 数量的容量因子——决定了理论上的节省是否体现在训练轨迹中 Lepikhin 等 (2021年)。
Shazeer, Noam, Azalia Mirhoseini, Krzysztof Maziarz, Andy Davis, Quoc Le, Geoffrey Hinton, 和 Jeff Dean. 2017年. 《Outrageously large neural networks: The sparsely-gated mixture-of-experts layer》. International Conference on Learning Representations (ICLR).
Jiang, A. Q., A. Sablayrolles, A. Roux, A. Mensch, B. Savary, C. Bamford, D. S. Chaplot, 等. 2024年. 《Mixtral of Experts》. arXiv preprint arXiv:2401.04088.
Lepikhin, Dmitry, HyoukJoong Lee, Yuanzhong Xu, Dehao Chen, Orhan Firat, Yanping Huang, Maxim Krikun, Noam Shazeer, 和 Zhifeng Chen. 2021年. 《GShard: Scaling giant models with conditional computation and automatic sharding》. International Conference on Learning Representations (ICLR).
多模态模型引入的是异构性,而不仅仅是路由。它们将文本解码、视觉处理、音频特征,有时还有视频结合起来,每种任务具有不同的算术强度与批处理行为。这类工作负载更青睐具备灵活调度能力和强双切分带宽的平台,而非针对某种规整数据流优化的加速器。
Systems Perspective 1.2: 匹配硬件与工作负载
Roofline Model 得出的基本洞见是:没有任何一种加速器对所有工作负载都是最优的。一款 H100 可以为 175B LLM 提供出色的训练吞吐量,但在以批处理大小为 1 服务同一模型时,可能大部分时间处于空闲状态。一款为 Transformer 训练提供卓越成本效率的 TPU pod,可能并不适合具有不规则内存访问模式的推荐模型。
因此,成熟的集群在设计上就是异构的,因为每种工作负载都会使不同的资源成为关键。训练集群投资于算术吞吐量和快速的加速器到加速器链路,因为同步位于关键路径上。服务集群投资于每美元内存带宽和延迟控制,因为解码流在尾延迟 SLO 下承载权重。嵌入系统投资于 DRAM 容量和局部性管理,因为稀疏查找主导了请求。微调集群介于这两种形态之间,在内存余量与足够的计算能力之间取得平衡,以保持迭代速度。加速器谱系是一个设计空间,必须针对每种工作负载独立探索。为所有工作负载部署单一硬件配置的组织必然多付成本:要么硬件对简单工作负载过度配置,要么对 demanding 工作负载配置不足。
精度与吞吐量的权衡
数值精度与硬件吞吐量之间的关系是基础设施规划中最重要的考量之一,因为它直接影响每台加速器每秒能够完成多少有用的工作。更低的精度表示方式使用更少的比特数来表示每个数字,这带来两个相互叠加的好处:同样的 HBM 容量可以容纳更多数字(降低内存压力),算术单元每个周期可以处理更多运算(提高吞吐量)。
面向机器学习的数值精度格式演进迅速。精度格式与 H100 硬件吞吐量 总结了 H100 级加速器上的代表性精度格式及其常见用途。
| 格式 | 位数 | 指数 | 尾数 | H100 稠密峰值 | 典型用途 |
|---|---|---|---|---|---|
| FP32 | 32 | 8 | 23 | ~67 TFLOP/s | 主权重、损失计算 |
| TF32 | 19 | 8 | 10 | 494 TFLOP/s | 训练(NVIDIA 默认) |
| BF16 | 16 | 8 | 7 | 989 TFLOP/s | 训练、微调 |
| FP16 | 16 | 5 | 10 | 989 TFLOP/s | 带损失缩放的训练 |
| FP8 (E4M3) | 8 | 4 | 3 | 1,979 TFLOP/s | 前向传播、权重 |
| FP8 (E5M2) | 8 | 5 | 2 | 1,979 TFLOP/s | 反向传播、梯度 |
| INT8 | 8 | N/A | N/A | 1,979 TOPS | 训练后量化 |
基础设施层面的影响十分可观。为 BF16 训练设计的集群——这是大模型常见的基线——在 H100 上每 GPU 提供 989 TFLOP/s。同一集群运行 FP8 训练时每 GPU 提供 1,979 TFLOP/s,在不增加硬件的情况下有效将计算密度提升一倍。对于一个由 10,000 个 GPU 组成、价格约为每 8-GPU 节点 $350,000 的集群,BF16 与 FP8 训练之间的差异,相当于额外增加 10,000 个 GPU,或约 $438 百万的节点硬件成本。
然而,并非所有工作负载都能无精度损失地使用 FP8。由于尾数精度降低(E4M3 为 3 位),数值必须经过仔细缩放,以避免溢出(超出可表示范围的数值会饱和或变为非有限值,具体取决于格式与实现)或下溢(小数值被舍入为零)。Transformer Engine 的动态逐张量缩放应对了这一挑战,适用于标准 Transformer 架构;但对于激活分布特殊的自定义模型架构,则可能需要人工进行精度调优。因此,基础设施团队必须与模型团队紧密协作,确定在保持可接受精度下的最低精度,因为该决策直接影响有效吞吐量,进而影响所需的集群规模。
对于推理,量化 是对服务经济性最具影响力的优化之一,因为它直接改变了大模型所需的硬件拓扑。我们的 175B 模型在 FP16 下需要 350 GB,仅加载参数就需要至少五张 80 GB H100 GPU。在 INT8 下,这一需求降至 175 GB,可容纳三张 GPU。在 INT4 下,它缩小到 87.5 GB,可容纳两张 GPU。对于受内存带宽限制的推理,读取 4-bit 权重而非 16-bit 权重,实际上使权重加载的可用带宽翻为四倍,从而按比例降低每个 token 的延迟。一个在生产环境以 INT4 而非 FP16 部署的团队,可以大幅降低推理集群的内存占用和带宽需求,但需考虑所选量化方法和工作负载带来的质量损失。
对于训练,许多工作负载采用混合精度训练,这是一种将存储精度与算术精度解耦的策略。权重的“主副本”以 FP32 保留以确保数值稳定性,而计算密集的 forward 和 backward 前向/反向传递则转换为 BF16 或 FP16,以充分利用 Tensor Cores 的吞吐能力。梯度以 FP32 累加,以避免优化器更新主权重时发生下溢。H100 的 Transformer Engine 通过配置的 FP8 配方、autocast 集成以及缩放元数据扩展了这一范式,对于在较低精度下仍能保持数值稳定的受支持操作,峰值吞吐能力可能提升一倍。训练阶段的收益取决于模型覆盖范围以及剩余的瓶颈。
数据移动的能量成本
Roofline Model 与 token 延迟分析表明,数据移动限制了性能。数据移动同样主导了能耗消耗,这对集群经济性具有直接影响。一个有用的归一化基准是 FP16 操作数:从 HBM 读取一个 16-bit 值约需 4 pJ/bit,成本约为 64 皮焦耳(pJ),而一次 FP16 乘加运算约需 1 pJ。因此,原始操作数读取的成本约为算术运算的 64\(\times\) 倍,在分块(tiling)与复用将该次数据移动分摊到许多 MAC 之前。
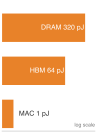
数据搬运的能量开销远远超过算术运算。
这一操作数层面的比值解释了加速器架构为何将如此多的硅片面积用于数据复用。张量核心基于 tile 的执行模型会将一个小矩阵载入本地寄存器,并将每个元素复用数百次(对侧矩阵中的每个元素各一次),从而把 HBM 访问成本分摊到数百个 1 pJ 的运算上。若无这种复用,能量预算将被内存访问主导,芯片的大部分功耗将用于加热导线,而非驱动晶体管开关。
在集群规模下,数据移动的能耗决定了电费账单。对于一个以每 GPU 700 W 运行的 10,000-GPU 集群,预算中约有一半用于内存子系统(HBM 的读取与写入、片上网络传输、寄存器文件访问),仅四分之一用于执行有用算术运算的 Tensor Cores,其余部分则消耗在时钟分配、I/O 和漏电上。通过内核融合、FlashAttention 和激活值检查点(checkpointing)等技术改善数据复用率,可以降低数据移动所浪费的能耗,并提高执行有用计算所占的功率比例。
能量视角为理解为何不同的并行策略具有不同的效率提供了物理基础。张量并行(tensor parallelism)需要在 NVLink 上进行数据移动(链路层每比特约 5 pJ,另需计入 NVSwitch 芯片的能耗)。数据并行(data parallelism)需要在 InfiniBand 上进行数据移动(每比特约 15–20 pJ,包括 HCA 和交换机的能耗)。流水线并行(pipeline parallelism)移动的数据较少,但需要更复杂的调度。每种并行策略都对应通信能耗与计算效率之间权衡的不同位置。
Napkin Math 1.3: 数据移动的能耗
现代计算的铁律是:移动数据的能耗远高于处理数据的能耗。分析 4nm 工艺节点上单个操作的能耗层级可以证明这一点。
执行一次 FP16 乘加运算(MAC)——深度学习的基本原子操作——约消耗 1 皮焦耳(pJ)。这是有用工作的基准成本。从 HBM 读取单个 FP16 操作数(16 比特)约消耗每比特 4 pJ,总计 64 pJ。从板外 DRAM 读取同一个操作数约消耗每比特 20 pJ,即 320 pJ。这种不对称性令人震惊:从 HBM 读取一个数值比对其进行计算多消耗 64\(\times\) 倍的能量;从标准 DRAM 读取该数值则多消耗 320\(\times\) 倍。
当我们的 175B 模型进入服务阶段时,宏观影响便显现出来。生成单个 token 需要加载整个 350 GB 权重张量(来自 HBM):
\[\text{Data Movement Energy} = 350 \text{ GB} \times 8 \text{ bits/byte} \times 4 \text{ pJ/bit} \approx \mathbf{11.2 \text{ Joules}}\]
相比之下,与之相关的 \(\approx\) 1750 亿次 MAC(约 3500 亿次 FLOPs)的计算开销微不足道:
\[\text{Computation Energy} = 175 \times 10^9 \text{ MACs} \times 1 \text{ pJ/MAC} \approx \mathbf{0.175 \text{ Joules}}\]
将权重移动至计算单元所消耗的能耗,比本次简化解码模型中的计算本身多出 64\(\times\)。这一能耗代价,正是 HBM 被设计为与 GPU 裸片物理邻近的原因——更短的走线意味着更小的电容和更低的每比特能耗。这也解释了为何减少数据移动的技术,例如量化(减少传输的比特数)与算子融合(避免往返内存),是提升系统性能与能效的主要杠杆。
基准加速器性能
采购团队在比较加速器时,需要一个能够预测组织实际达成性能的公开数字。峰值 TFLOP/s、内存带宽和 TDP 描述的是潜在性能,而非实际性能,因此决策的关键在于应当信任谁的实测结果,以及这些结果是在何种规则下产生的。行业标准的参考基准是 MLPerf(由 MLCommons 维护):MLPerf Training 报告将参考模型训练至目标准确率所需的时间,MLPerf Inference 则在真实的批处理与流式条件下报告服务吞吐量与延迟。两者均涵盖完整的系统性能,包括软件栈效率、通信开销与内存管理,而不仅仅是裸硅本身的性能。
真正能够预测组织实际结果的数字是闭集(closed-division)结果,理解其背后的原因正是正确解读 MLPerf 的核心。闭集要求所有提交使用相同的模型架构、超参数与训练配方,从而将硬件与系统软件隔离为唯一的变量,使不同厂商的结果具有直接可比性。开集允许任意模型修改、自定义内核与软件优化,这虽然展示了平台的性能上限,却使跨厂商比较不可靠。基础设施团队应更重视闭集结果,因为它们反映的是使用标准框架与配置即可达到的性能,而非仅由厂商自身优化团队所能达到的性能。
对于我们的 175B 模型,没有任何单一基准能够全面反映情况。训练阶段在大批长批量下受计算能力限制,因此峰值 TFLOP/s 与扩展效率是主导指标;推理阶段在批量大小为 1 时受内存带宽限制,因此每美元 GB/s 是相关指标。微调阶段介于这两个极端之间,适中的批量大小会将工作负载置于 Roofline 脊点附近。全面的评估必须在候选硬件上对这三个阶段分别进行基准测试,并使用组织自身的模型与数据管线,而不能仅依赖已发布的 MLPerf 数字。
Systems Perspective 1.3: 超过峰值规格
在评估加速器选项时,以下指标比单纯的峰值 TFLOP/s 更能提供完整图景:
- MFU:真实训练中实现的 FLOP/s 与硬件峰值 FLOP/s 之比。MFU 为 50% 意味着硬件有一半的时间用于有效计算,另一半时间则在等待数据、同步或空闲。
- 训练耗时:将参考模型训练至目标指标所需的墙上时钟时间。它涵盖了 MFU 单独无法反映的全部系统级效应,包括 I/O 停顿、检查点开销以及作业重启延迟。
- 每 token 成本:对于语言模型训练,总成本(硬件折旧加上电费)除以处理的 token 数量。该指标可在不同硬件代际、集群规模和定价模型之间进行归一化比较。
- 每美元每秒 token 数:每 token 成本的倒数,适用于比较不同系统的经济效率。
没有任何单一指标能够说明全部情况。MFU 较高但每 GPU 小时成本较高的系统,可能不如 MFU 较低但硬件更便宜的系统经济。合适的指标取决于组织是在优化时间(训练必须在截止时间内完成)、成本(最小化总支出)还是吞吐量(在单位时间内最大化处理的 token 数)。
推理专用基础设施考量
计算基础设施
虽然训练基础设施提出了最严苛的硬件要求,但在大规模部署已训练模型 会引入根本不同的设计约束。训练基础设施针对吞吐量进行优化:最大化整个集群在单位时间内处理的令牌总数。该工作负载是一项单一、长期运行的任务,会占用整个集群数天甚至数周。通信模式可预测且具有重复性。任何单个操作的容许延迟为毫秒到秒级。
服务基础设施针对延迟和每次查询的成本进行优化:在将每次查询的成本控制在商业模式可承受的低水平的前提下,最小化每位用户等待响应的时长。该工作负载由数百万个相互独立、生命周期短暂的请求组成,且以不规则间隔到达。通信模式极为精简(每个请求都在单个节点或一小组节点上独立处理)。可接受的延迟对于交互式应用为数十毫秒。
这些不同的需求驱动了不同的硬件与架构选择,汇总于 表 1。
| 维度 | 训练基础设施 | 服务基础设施 |
|---|---|---|
| GPU 利用率 | 大批量训练将工作负载推入计算受限形态,因此集群通常可实现 30–50% MFU。 | 小批量的服务深度受内存受限,利用率可能低于 5% MFU,因此批量化在牺牲延迟的同时提升了利用率。 |
| 模型放置 | 张量并行与流水线并行将单个模型分布到许多 GPU 上。 | 模型的副本,或其较大的分片,处理相互独立的请求,因此内存需求随并发服务能力增长。 |
| 网络流量 | 梯度同步需要高带宽、低延迟的 GPU 间通信。 | 相互独立的请求所需的 GPU 间流量很小,但每秒数百万次 API 请求需要可观的对客户端带宽。 |
| 成本指标 | 训练成本是一次性固定支出,以每次运行的美元数计量。 | 服务成本是可变支出,以每生成 1,000 个令牌的美元数计量,热门模型可能在数周内超过其训练成本。 |
上表说明了为何服务不能以“缩小批量的训练”来规划:优化目标已从同步吞吐量转变为受延迟约束、持续计费的请求。
其含义是,有效的推理服务基础设施往往与训练基础设施采用不同的硬件、不同的软件以及不同的设施设计。一些组织使用上一代 GPU(A100)进行推理服务,因为每美元内存带宽可以与较新的 GPU 竞争,且更低的 TDP(400 W 对 700 W)允许更高的机架密度和更低的制冷成本。
02 计算基础设施
推理工作负载本身分为两个瓶颈方向相反的不同阶段。prefill 阶段处理输入提示词,执行一次大规模矩阵-矩阵乘法,属于计算受限,并可实现很高的 Tensor Core 利用率。decode 阶段逐个生成 token,执行矩阵-向量乘法,深度受内存带宽限制。为最大化硬件利用率,高性能 serving 系统采用连续批处理,即在迭代层而非请求层调度请求。这使得引擎能够将等待请求的新 prefill 计算注入到进行中的 decode 批次的空闲计算槽位中,动态填满 GPU 的算术流水线。对于我们的 175B 模型,要在每秒服务 10,000 个请求、并满足 50 ms 首 token 服务级别协议(SLA)的前提下,需要将流量分发到数百个 8-GPU 副本(每个副本通过张量并行持有完整模型),并由负载均衡器将请求路由到队列深度最低的副本。与训练不同,训练在具备检查点(checkpointing)的情况下,99.9% 的可靠性尚可接受;而推理架构必须考虑尾延迟,单个慢副本就可能违反整个请求批次的 SLA。
加速器决策矩阵
一套实用的决策框架将这些工作负载特有的特征综合起来,通过将每种工作负载类型(三种系统架构原型)映射到主导其性能与成本的那类硬件资源来实现。加速器决策矩阵 明确了选择规则:针对约束条件(binding constraint)进行选择,而不是选择宣传中最大的峰值数字。
| 工作负载 | 约束条件 | 关键指标 | 推荐类别 |
|---|---|---|---|
| LLM 训练 (\(>100\text{B}\)) | 计算(大批量) | 峰值 TFLOP/s、NVLink 带宽 | H100/B200、TPU v5p |
| LLM 推理(batch=1) | 内存带宽 | GB/s 每美元 | A100、H100(带宽/$) |
| LLM 推理(批处理) | 计算 + 带宽 | TFLOP/s 和 GB/s | H100、B200 |
| 视觉模型训练 | 计算(大空间维度) | 峰值 TFLOP/s | H100/B200,优先 GPU |
| 推荐系统(嵌入) | 内存容量 | GB 每美元 | CPU DRAM + GPU 混合 |
| 微调 (\(<13\text{B}\)) | 内存容量 | HBM 容量 | A100(性价比高) |
| 研究/原型开发 | 灵活性 | 软件生态 | GPU(CUDA),避免 ASICs |
约束瓶颈随生命周期阶段而变化,正如 加速器决策矩阵 所示的 175B 运行示例。训练阶段,大批量使工作负载进入计算受限(compute-bound)形态,峰值 TFLOP/s 成为主导指标。H100 或 B200 凭借高张量核心吞吐量和用于张量并行的快速 NVLink,是自然之选。推理阶段在低批次量下,同一模型会深度陷入内存受限,相关指标随之变为每美元带宽。一款具备充足 HBM 带宽且价格更低的 A100,可能比 H100 提供更好的每 token 成本,因为 H100 的额外 TFLOP/s 并未被使用。
组织维度又带来进一步的考量。每周修改模型架构的研究实验室需要 GPU 的 CUDA 生态所提供的灵活性,以便在数小时内编写和测试自定义内核。在大规模上以固定 Transformer 架构运行数月的生产团队,可能从 TPU 中获益,因为 XLA 编译器的全程序优化可为标准操作实现高于手工调优 CUDA 内核的持续利用率。定制 ASIC 只有在组织具备足够规模以摊薄 $50–$2 亿 NRE 成本、并具备足够的工作负载稳定性以支撑 2–3 年设计周期时,才具备经济合理性。加速器谱系归根结底是一个经济学问题,其答案取决于工作负载物理、组织规模与时间跨度的交汇。
Checkpoint 1.3: 加速器选型
一个工程团队需要部署一个 70B 参数模型,用于训练与推理。训练将使用 2048 的批次量,在 256 张 GPU 上运行 3 个月。推理将以每秒 10,000 次请求、批次量为 1 的方式运行 2 年。
加速器的物理特性确立了一个具体问题:我们的 175B 模型仅权重部分就需要 350 GB 内存(FP16 格式),而包含优化器动量、梯度和激活的 Adam 风格训练状态会把需求推高到多个 TB。单张 H100 仅提供 80 GB HBM,没有任何一张加速器能够容纳该模型。系统必须扩展到下一个物理层级:节点,其中 图 12 对比了在单个机箱内连接多张加速器的两种主流方案。
节点
节点是加速器选型首次成为互连问题的规模层级。多张 GPU 如今可以共享同一机箱,但它们的有效行为取决于本地 fabric 是表现为慢速环形 、密集网状 ,还是交换机背板的交叉开关 。
聚合加速器只有在它们之间的互连足够快、使整个组表现得像一台机器而非几台互相传递消息的机器时,才能解决容量问题。175B 模型的权重至少分布在五个加速器上,完整的训练状态则跨越一整台 8-H100 节点 乃至更多,因此单个层的参数如今分散在不同芯片上,必须在每次前向和反向传播中重新组装。这种重新组装是廉价还是灾难性的,完全取决于本地网络互连结构,这也正是节点成为首个加速器规格重要性让位于加速器之间连线的重要性的规模层级。训练系统必须将张量并行与优化器分片以及显存卸载结合起来,而每一种策略对互连结构都提出不同的要求。
Definition 1.5: Node
Node 是机器学习训练集群的物理服务器机箱,它通过高速节点内互连(NVLink 或 ICI)聚合多个加速器(通常为 8 个),从而形成高带宽本地通信与低一个数量级的节点间网络互连之间的基本边界。
- 重要性:DGX H100 节点内的 NVLink 带宽达到 900 GB/s 双向带宽,即每个方向 450 GB/s,而节点间 InfiniBand NDR 提供 50 GB/s 的带宽,方向间存在 9× 的差距,这一差距限制了每种并行策略可以运行的位置。张量并行(对每一层的输出执行 AllReduce)必须保持在节点内部;流水线并行(仅传输阶段边界激活)则可以跨越节点,通过 InfiniBand 进行通信。节点同时也是主要的故障域:在批量同步并行训练中,所有 worker 在步长屏障处同步推进,单个节点故障会使整个集群在该步骤期间处于空闲状态,直到恢复。
- 区别:与单个加速器(提供快速的 HBM 带宽但容量有限)不同,节点聚合了 8\(\times\) 个加速器的 HBM 容量和 8\(\times\) 个加速器的计算能力——足以容纳较大的 FP16 权重分片(DGX H100 上为 8 \(\times\) 80 GB = 640 GB),但不足以将完整的 Adam 训练状态保留在 HBM 中。
- 常见误区:一种常见误解是,分布式训练任务中的节点彼此独立运行。在批量同步并行训练中,所有节点在每个步长屏障处同步耦合:某个节点的性能下降(源于热节流、故障网卡或较慢的存储读取)会使整个集群停滞,并在该步骤期间降低整体 MFU。
节点之所以存在,是因为内存层次结构中存在缺口。HBM 提供了足够的带宽以供给加速器的算术单元,但容量不足以容纳完整的 175B 参数运行样本;主机 DRAM 提供了容量(每台服务器 512 GB 到 2 TB),但带宽不足。
节点通过这一缺口,将多个加速器的 HBM 聚合为通过高速互连连接起来的分布式容量。每个加速器的 HBM 仍专属该设备:软件必须显式地对张量进行分片或复制,并在操作跨越设备边界时使用集合通信或设备间传输。因此,将 8 个加速器置于同一机箱中,可提供 8\(\times\) 的聚合容量和 8\(\times\) 的聚合计算能力,但这并不等同于单个共享内存加速器;性能取决于划分方式在多大程度上限制了互连上的流量。
多加速器节点的经济性论证同样有力。考虑另一种方案:制造一个 HBM 容量足以容纳 175B 模型(FP16 下为 350 GB)的单个加速器。当前封装每堆 HBM 约提供 16–24 GB,因此这种单加速器设计需要约 15–22 堆 HBM,远超 5 堆 H100 或 8 堆 B200 级封装。此类封装的制造成本将高得不可行(良率随封装和中介层面积增大而下降),而且为单个芯片提供足以支撑全部张量核心、以使用完该带宽的供电,将超出任何可行的散热方案。将计算分布在 8 个通过 NVLink 连接的加速器上,使节点能够在可制造和可散热的边界内,达到这一假设超级芯片的聚合内存容量与计算吞吐。
理解节点内存分区
理解节点如何在各组件间划分内存,对于选择并行策略至关重要。考虑训练我们 175B 模型的内存预算。模型权重以 FP16 精度需要 350 GB。Adam 优化器为每个参数额外维护两份副本(一阶与二阶矩),以 FP32 精度,增加 175 \(\times 10^9 \times 2 \times 4\) 字节 = 1,400 GB。梯度又需要 350 GB。总计约为 2.1 TB(激活值之前),远超单个加速器 80 GB HBM,以及 8 卡 H100 节点 640 GB 聚合 HBM。
当使用 ZeRO 或 FSDP 风格的优化(将优化器状态、梯度,以及可选的参数,在数据并行工作器之间分片)时,训练系统避免了在每个 GPU 上复制这份完整的 2.1 TB 状态。张量并行首先降低每张 GPU 的活跃权重分片;数据并行分片则将优化器状态和梯度分散到众多工作器;激活值检查点化降低激活值峰值;卸载则将冷优化器状态经 PCIe 移至主机 DRAM。因此,该节点是一个高带宽的计算与通信单元,而非整个训练状态的独立容器。
节点内部的内存层次结构——由 HBM(快速、容量小)、主机 DRAM(中等速度、容量较大)和 NVMe 存储(慢速、容量极大)——构成一个分层系统,分布式训练框架对其利用得极为激进。分布式训练 将详细考察这些内存优化策略。
带宽层次结构
多加速器系统的决定性特征并非 芯片数量,而是 它们交换数据的速度。数据移动速度在跨越物理边界时会呈数量级下降。每个边界都对应不同的物理介质、不同的连接器技术,以及不同的一组工程约束。这种数据传输速率的物理排序——从高速端片上 SRAM 到低速端广域网络——即 带宽层次结构;该排序决定了每种并行类型可以在层次结构的哪个位置高效运行。
该层次结构反映了距离的物理成本:在更密集的走线上传输更短的信号路径,能以更低的每比特能耗获得更高吞吐量,因此在每个边界,有效带宽 \((\text{BW})\) 下降约一个数量级,而延迟 \((L_{\text{lat}})\) 上升。这一梯度为分布式训练设定了扩展上限。常见错误是把集群通信一律视为同等,但并行策略的放置必须遵循层次结构:将高频同步(如张量并行)置于慢速层级,会使计算单元闲置 \((R_{\text{peak}})\),并导致扩展效率崩塌 \((\eta_{\text{scaling}})\)。
带宽层次结构最好地理解为围绕每个加速器的同心区域序列。最内层区域是同封装内的 HBM,带宽达每秒太字节级,延迟为亚微秒级。下一层区域涵盖同一节点内的其他加速器,经 NVLink 可达数百吉字节每秒,延迟为微秒量级。最外层区域覆盖集群中的其他所有节点,经 InfiniBand 连接,带宽为数十吉字节每秒,延迟为个位微秒量级。在每个区域边界,带宽下降约一个数量级,而延迟上升约一个数量级。带宽层级 将这些区域映射到它们所能支持的并行策略。
| 域 | 互连 | 带宽 | 延迟 | 扩展上限 |
|---|---|---|---|---|
| 片内 | 硅中介层 | ~3.3 TB/s | \(<100\text{ ns}\) | 单芯片 |
| 节点内 | NVLink/ICI | ~900 GB/s | ~1 μs | 节点(8–16 个芯片) |
| 节点内(I/O) | PCIe Gen5 x16 | ~64 GB/s | ~2 μs | CPU-GPU、NIC-GPU |
| 节点间 | InfiniBand NDR | ~50 GB/s | ~5–10 μs | 机(数千) |
基础设施带宽层级 中所示的同心视图在空间上呈现了同一层级,因此每次向外穿越边界都同时表现为带宽下降和延迟增加。
::: 同心椭圆区域,中心标注 HBM,向外依次为 NVLink/NVSwitch、InfiniBand NDR,最外层为 Storage/Network File System。每次边界穿越使带宽下降约十倍。
:::
并行策略必须遵守这些物理边界;一个简单的同步计算即可使带宽差距具体化。
Napkin Math 1.4: 阶梯的物理机制
问题:一个 10 GB 缓冲区在整个集群中同步。集群的物理“层”对传输时间有多大影响?
数学: 传输时间为 \(T_{\text{transfer}} = D_{\text{vol}} / \text{BW}\)。
- HBM(片内):10 GB / 3,350 GB/s \(\approx\) 3.0 ms。
- NVLink(节点内):10 GB / 450 GB/s \(\approx\) 22.2 ms。
- InfiniBand(节点间):10 GB / 50 GB/s \(\approx\) 200 ms。
系统洞见:在集群内跨节点传输数据比在节点内部传输慢 9×。这种“带宽阶梯”是所有并行化策略的主要驱动因素:在带宽充裕处(NVLink)使用张量并行,在带宽稀缺处(InfiniBand)使用数据并行。一个“放得下”但忽略了阶梯的模型,将有 90% 的时间花在等待网络上。
带宽阶梯中的每一道断崖都源于不同距离尺度下的信号传播机制。片内 互连之所以能达到每秒太字节级的带宽,是因为信号在硅中介层上的光刻图案化铜走线中传输,路径长度以毫米计。在这些距离下,信号衰减可以忽略,无需放大,信号速率仅受走线几何和收发器设计限制。
NVLink 借助高速 SerDes12 收发器,通过机箱内的短铜缆或走线实现每秒数百吉字节的带宽,路径长度为数十厘米。在这些距离下,信号衰减可测但可通过简单的均衡电路加以补偿。SerDes 收发器采用 PAM-4(四级脉冲幅度调制)信号,每通道 112 Gb/s,每个符号承载 2 比特,从而将数据速率相对 NRZ(不归零)信号提高一倍。
12 SerDes(serializer/deserializer): 源自拉丁语 serialis(排成一行)与 de-(反向);指将并行数据转换为串行比特流进行传输、并可反向转换的电路对。现代高速链路采用 PAM-4 信号编码(四级脉冲幅度调制,每个符号编码 2 个比特),线路速率非常高,收发器能耗因而成为节点功耗的重要组成。正因如此,诸如 NVLink、InfiniBand 和 PCIe 等密集互连必须被视为功耗与散热负载,而不能仅仅视为带宽规格。
PCIe 采用标准化协议,并带有流控开销,因此有效带宽有所降低。虽然 PCIe Gen5 与 NVLink 的单个通道使用相同的 32 GT/s 信号速率,但协议开销(数据包头部、流控信用、错误校验)消耗了约 20% 的原始带宽。使 PCIe 具备普遍兼容性的标准化,也使其效率低于专有互连。
InfiniBand 通过机架之间的数米线缆传输信号,需要信号放大、纠错以及交换机跳接,这些都会同时增加延迟与协议开销。有源光模块(active optical cable)在发射端将电信号转换为光信号,经光纤传输,并在接收端转换回电信号。每次电光转换会引入约 2–5 纳秒的延迟,并消耗激光驱动器与光电探测器的功耗。每次交换机跳接还会额外增加 100–300 纳秒,用于数据包路由与缓冲。
对模型切分而言,其实际后果是:张量并行(TP)将各个矩阵乘法拆分到加速器之间,并在每一层之后都需要执行一次 AllReduce 操作,由此产生的通信量与模型的隐藏维度成正比,且每秒产生数百次。在 NVLink 带宽下,该同步操作每层约需 1 ms;在 InfiniBand 带宽下,同样的同步操作需要 10–20 ms,这将使加速器在训练步的绝大部分时间内处于空闲状态。
因此,TP 被限制在单个节点内部,而数据并行(每个训练步仅同步一次梯度)则跨越节点间网络。带宽层级是决定分布式训练拓扑的物理定律。
带宽层级同样解释了流水线并行为何处于带宽需求的中间位置。在流水线并行中,模型被划分为顺序阶段,每个阶段分配给不同的一组加速器。阶段之间的通信由前向传播时的激活值前向流动和后向传播时的梯度反向流动构成,其通信量与批大小乘以隐藏维度成正比。
对于我们的 175B 模型,隐藏维度为 12,288,每个微批次包含 4 个序列、处于 2,048 时,各阶段边界处的激活张量约为 \(4 \times 2,048 \times 12,288 \times 2 B\) 字节(FP16)\(\approx\) 201 MB。这远小于数据并行所要求的 350 GB 梯度 AllReduce,这也是流水线并行对节点间网络提出较低要求的原因。
激活传输在每个微批次、每个阶段边界各发生一次,其频率远低于张量并行的逐层 AllReduce。因此,流水线并行能够容忍节点间链路较低的带宽,这也使其成为跨越多个节点的首选策略,当模型深度超出单个节点的容量时尤其如此。
并行类型与互连域的映射关系:节点内部的张量并行(NVLink)、邻近节点之间的流水线并行(InfiniBand)、以及整个集群范围内的数据并行(带梯度压缩的 InfiniBand)。这一映射如此基础,以至于它已成为生产级 Transformer 训练系统中的 de facto 标准,细节差异主要体现在流水线阶段的数量、张量并行的程度以及数据并行的程度上。
该映射还决定了作业调度器如何将节点分配给训练任务。同一张量并行组内的节点应当在物理上相邻(理想情况下位于同一机箱,通过 NVLink 连接)。同一流水线并行组内的节点应位于同一机架或相邻机架(以最小化 InfiniBand 交换机跳数)。数据并行组可以跨越整个集群,因为它们的通信(梯度 AllReduce)是三种并行类型中带宽需求最低、对延迟容忍度最高的。在该映射到达调度器之前,仍有一个节点内部的边界:连接加速器与主机 CPU、网卡(NIC)、存储和 DRAM 的 PCIe 层次结构。
节点内部的 PCIe 层次结构
NVLink 为 GPU 到 GPU 通信提供了一条高带宽的“高速公路”,而 PCIe Gen5 则是连接节点内异构组件的通用“粘合剂”。它把 GPU 连接到主机 CPU、GPU 连接到 InfiniBand 主机通道适配器(HCAs)、主机 CPU 连接到 NVMe 存储,以及主机 CPU 连接到系统 DRAM。理解这一拓扑结构至关重要,因为 PCIe 带宽虽然可观(每个 x16 链路每个方向约 64 GB/s,双向 128 GB/s),却常常是跨越加速器边界的操作的瓶颈,例如数据加载、检查点(checkpointing)以及节点间梯度同步。
标准 DGX H100 节点配备两个主机 CPU,每个 CPU 各自管理一个 PCIe root complex,包含 128 条通道。这些通道被分配以最大化并发吞吐量:8 个 GPU 各自获得一条专用的 x16 链路,8 个 InfiniBand HCA 也各自获得一条 x16 链路。该配置在机箱内可提供接近 2 TB/s 的聚合理论带宽。然而,这些带宽需要在相互竞争的交通流之间共享。在单个训练步中,PCIe 总线同时承载主机到 GPU 的数据批次、GPU 到 HCA 的梯度分片(用于节点间 AllReduce,经由 GPUDirect RDMA),以及周期性的 CPU 到 NVMe 检查点写入。这些流之间的竞争可能导致意外的流水线停顿,尤其是在梯度同步饱和了通常用于数据加载的链路时。
双 CPU 架构引入了显著的 非一致内存访问(NUMA) 效应。8 个 GPU 在物理上被划分,其中 4 个连接到 CPU 0 的 root complex,另外 4 个连接到 CPU 1 的。连接到 CPU 0 的 GPU 可以通过其本地 PCIe root complex 访问 CPU 0 的 DRAM,而访问 CPU 1 的 DRAM 则还需要经过跨插槽(inter-socket)链路。延迟与带宽的开销取决于处理器、插槽互连、PCIe 拓扑、传输大小以及并发流量,因此不同节点之间并不存在一个固定的百分比。数据加载流水线应当测量这一拓扑,并在本地路径能够提升持续摄取性能时,将 worker 进程、固定缓冲(pinned buffers)、网卡(NIC)和目标 GPU 置于同一个 NUMA 域内。
实际后果是:放置策略本身就是并行策略的一部分:一个忽略 PCIe 根节点、NIC 局部性和 NUMA 域的调度器,可能把一个原本有效的张量并行或流水线并行方案,变成受主机绑定的瓶颈。分布式训练 形式化了这些节点内与节点间边界如何与数据并行、张量并行和流水线并行相互作用。
高密度节点设计
鉴于带宽层次结构,节点内部的工程挑战是明确的:用足够的带宽将 8 个加速器连接起来,以支持其私有内存之间的张量并行操作。解决方案是一种专用交换互连结构,在加速器对之间提供全二分带宽。要理解该结构的设计,需要理解为什么更简单的替代方案会失效。
最简单的方案是把 8 个 GPU 连接成一个环,每个 GPU 与两个邻居相连。环的代价较低(\(N\) 个 GPU 只需 \(N\) 条链路),并且适合环 AllReduce,其中数据沿环以圆形方式依次流动。环 AllReduce 算法在梯度同步中实现了最优带宽利用率,因为每个 GPU 同时向右侧邻居发送数据、从左侧邻居接收数据,整个操作期间所有链路都处于忙碌状态。
然而,张量并行需要频繁的集合通信,在分片矩阵操作之后常见 AllReduce、ReduceScatter 和 AllGather。物理环可以高效执行环 AllReduce,但其固定的多跳路径会限制其他并发流量模式,因此拓扑感知的调度变得重要。全连接网格中,每个 GPU 都与其他每个 GPU 直接相连,消除了多跳约束,但 8 个 GPU 需要 \(N(N-1) / 2 = 28\) 条链路,当链路数量以平方方式增长时,布线挑战便难以实现。NVSwitch 交叉开关 以可管理的交换机芯片数量提供全二分交换式连接。
考虑 NVIDIA DGX H100 架构。八块 H100 GPU 安装在一块主板(baseboard)上,每块 GPU 通过 18 条 NVLink 4.0 通道连接到四个 NVSwitch 芯片。NVSwitch 芯片构成一个非阻塞交叉开关13,任何 GPU 都能经由它访问任何其他 GPU。每块 GPU 的端口预算为 900 GB/s 双向,或 450 GB/s 单向,由该 GPU 的并发传输共享;它并非每对 GPU 之间都有一条独立的满带宽链路。
13 交叉开关:一种为每一对输入—输出同时提供专用路径的拓扑。一个 \(N{\times}N\) 交叉开关具有 \(N^2\) 个交叉点,从而实现满二分带宽。NVSwitch 采用三阶段交叉开关,使用四个交换芯片(每个芯片 64 个 NVLink 端口),总功耗约 800 W——超过一整块 V100 GPU——但这一功耗成本是合理的,因为它支持节点内的全对全张量并行,而该通信模式原本会主导训练时间。
结果是这样一个节点:其聚合 HBM 容量为 640 GB,峰值计算吞吐量为 8 \(\times\) 1979 TFLOP/s,而每块 GPU 仍保留私有 HBM。训练框架会在这些设备之间显式地对张量进行切分,NVSwitch 则在降低分片之间通信开销的同时,并未使放置或集合同步变得透明。
DGX H100 主板的物理布局体现了这一设计目标。8 块 GPU 布置在主板上,4 个 NVSwitch 芯片位于中央位置。每块 GPU 通过 NVLink 通道连接到全部 4 个 NVSwitch 芯片,而每个 NVSwitch 芯片拥有 64 个 NVLink 端口,用于在 GPU 之间进行交叉连接。
NVSwitch 芯片本身的功耗约为每片 200 W(NVSwitch 互连结构总计 800 W),这是一笔可观的功耗开销,但由其所提供的全二分带宽所支撑。为便于比较,NVSwitch 互连结构自身的功耗就超过了一整片上一代 GPU(V100 的功耗为 300 W)。若无 NVSwitch,要实现完全的全对全连接,就需要 28 条直接的 GPU 到 GPU 链路,这既是一桩布线噩梦,也会消耗更多的 NVLink 通道容量。
在张量并行的前向传播过程中,每块 GPU 持有每个权重矩阵的一个分片,并计算该矩阵乘法中属于自己的那一部分。对于一个隐藏维度为 12,288(典型地用于 175B 模型)的 Transformer 层,每块 GPU 持有该权重矩阵的 8 个 GPU 中的一个 \(12{,}288{\times}1{,}536\) 切片。
每块 GPU 计算出自己的部分结果后,一次 AllReduce 操作会通过 NVLink 在所有 8 块 GPU 之间对这些部分结果求和。
单个 AllReduce 的逻辑输出张量包含 \(4 \times 2{,}048 \times 12{,}288 \times 2\) 字节(FP16)。对于 4 个序列的微批次、每个序列 2,048 个 token,该载荷约为 201 MB。理想环状 AllReduce 在 8 个参与方之间移动 \(2(p-1)/p =\) 次 1.75 的载荷每块 GPU,即约 352 MB。在单向带宽为 450 GB/s 的情况下,传输时间的下界约为 0.783 ms。
在 96 个前向层与 96 个反向层之间,192 的传输量在重叠之前合计约为每步 150.3 ms。NVSwitch 提供了该集合通信所需的通信路径,但该数值仍只是理想带宽下限,未计入启动延迟、软件开销以及竞争流量。
对照示例 1.3 中使用的 200 ms 计算时间基准,未重叠的 NVLink 下限使计算时间占“计算加通信”总时间的 57.1 percent。当集合通信与有用的计算重叠时,实际的张量并行效率可能更高;而当延迟、拥塞、负载不均衡以及非并行工作引入额外延迟时,效率则可能更低。因此,必须通过测量来确定,而不能仅凭峰值链路带宽推断。
Example 1.3: NVLink 带宽的意外情况
场景:多 GPU 节点早期用户尝试通过 PCIe Gen5 互连进行张量并行(64 GB/s 带宽),并预期性能足够。
诊断:张量并行在每个步骤执行 192 次 AllReduce 事件,跨越 96 个层。PCIe 传输延迟在每个步骤累积到 1057 ms,导致 GPU 有 84.1 percent 的执行时间处于通信等待状态。
系统启示:通信密集的张量并行需要高带宽互连,例如 NVLink(每次 AllReduce 的带宽为 0.783 ms),这可将传输延迟降低一个数量级,并将计算效率提升至 57.1 percent。
除 NVLink 外,该节点还通过 InfiniBand 主机通道适配器(HCA)连接到外部网络,并通过 PCIe 连接到主机存储。DGX H100 包含八个 InfiniBand ConnectX-7 HCA,每个 GPU 一个,从而支持 GPUDirect RDMA:网络适配器可以直接读写 GPU HBM,无需将数据经主机 DRAM 中转,也不涉及主机 CPU 的数据路径。
GPUDirect RDMA 对节点间梯度同步至关重要,因为每个 GPU 的梯度分片必须发送给其他节点上的对等 GPU。没有 GPUDirect,每次梯度传输都需要额外复制两次:先从 GPU HBM 到主机 DRAM(经 PCIe),再从主机 DRAM 到网络适配器(经另一条 PCIe 路径)。双重复制增加了延迟(一次直接内存访问(DMA)操作变成了两次 PCIe 穿越),并将有效带宽减半(每个字节都要穿越 PCIe 总线两次)。
GPUDirect RDMA 通过允许 InfiniBand HCA 直接读取 GPU HBM 来消除这两次复制,完全绕过主机 CPU 和主机 DRAM。数据路径从 GPU HBM 经 NVLink-to-PCIe 桥接到 InfiniBand HCA,只需一次传输。单跳数据路径是现代化训练集群能够实现接近原始 InfiniBand 线路速率的节点间通信带宽的原因之一。
主机 CPU 负责作业调度、数据预处理、从存储加载数据以及网络协议处理,但它位于 GPU 到 GPU 计算的关键路径之外。这种分离是有意为之:主机处理“慢速”操作(磁盘 I/O、网络管理、作业协调),而 GPU-NVSwitch 互连负责“快速”操作(矩阵运算、梯度同步)。
主机 CPU 的作用类似于传统计算机中的操作系统内核:它管理资源、处理异常并协调 I/O,但不执行应用程序的核心计算。在优化良好的训练循环中,主机 CPU 几乎从不位于关键路径上,其性能规格(核心数、时钟频率)不如 I/O 能力(PCIe 通道数、内存通道数、NVMe 控制器带宽)重要。
主机 CPU 还运行训练框架的 Python 运行时,负责编排内核启动、管理计算图并协调集合通信操作。在优化良好的训练循环中,主机 CPU 会在 GPU 执行当前批次的正向与反向传播的同时,流水线式地执行下一批数据的加载与预处理,使各部件同时保持忙碌。
随着主机 CPU 上的“数据中心税”不断攀升——网络协议处理、存储虚拟化与安全功能最多可消耗 30% 的 CPU 周期——机器学习节点可以集成 数据处理单元(DPU) 或 SmartNIC。例如 NVIDIA BlueField DPU 会将这些基础设施任务卸载到集成在网络适配器自身的专用 ARM 核心与硬件加速器上。将 RDMA、防火墙规则及存储协议的控制面迁移到 DPU,可以回收用于机器学习流水线主机 CPU 的周期:数据加载、分词与内核编排。DPU 同时充当一个隔离的安全域,使云服务商能够通过 DPU 管理网络与存储层,同时让客户获得对主机 CPU 和 GPU 的完全访问权限。对于我们的 175B 模型训练,DPU 卸载可将 RDMA 协议处理移出主机 CPU 的关键路径,梯度同步数据流从 GPU HBM 流向网络互连结构,无需经过主机 CPU。
替代节点架构
这些替代方案属于加速器系统设计,而非可互换的产品名称。AMD MI300X 属于 GPU 级加速器,其封装强调极大的 HBM 容量;而 Intel/Habana Gaudi 的设计则将以太网/RDMA 连接作为一等通信路径加以强调。将它们与 DGX H100 节点对比,可以揭示各架构如何分配其稀缺预算。
DGX H100 通过使本地加速器之间的交换变得廉价,来回答通用的节点设计问题。这种富交换机设计将功耗、板级面积和成本都花在通用的任意到任意交换上。当张量并行是临界路径时,这一选择很容易得到辩护,因为每个 Transformer 层都会把本地加速器通信变成模型内循环的一部分。因此,900 GB/s 的 H100 NVLink 互连为软件提供了一层抽象:训练框架可以将八个加速器视为一台紧密耦合的设备,用于那些必须跨芯片切分的层。
其他系统则移动了这一边界。TPU pod 使用片间互连和面向网格的拓扑,而不是把中央交换机作为节点的定义性组件;MLSysIM 中的 TPU v5p 配置在 1,200 GB/s 处建模 ICI。网格可以降低交换机成本,并向编译器暴露规则结构,但它也让放置关系更加显见:运行时必须遵守邻居关系,而不能假定每对芯片之间的通信路径都相同。当工作负载足够规则、编译器与集合通信库能够把通信映射到拓扑上时,这是一笔合理的交易。
MI300X 将压力点从本地交换转向了内存容量。其封装暴露了 192 GB 的 HBM,容量为 5.3 TB/s,而 H100 级加速器的对应值为 80 GB。因此,一个八加速器的 MI300X 节点能够提供 1,536 GB 的聚合 HBM,足以容纳我们 175B 运行模型所需的 350 GB FP16 权重张量。这并不能消除本章前面引入的优化器、梯度、激活和碎片化问题,但它改变了系统必须将状态溢出到更慢内存层级的频率,以及在下发成为必需之前剩余的微批次余量。
Gaudi 采取了不同的路线,将支持 RDMA 的以太网集成到加速器中,并采用更具网络中心化的通信设计。Gaudi 2 配置通过 24 个连接的 100 GbE 端口暴露 300 GB/s 的聚合 RoCE 带宽,而 H100 级 NVLink 节点提供 900 GB/s 的本地 GPU 交换带宽,更新一代的 Gaudi 3 级加速器则仍暴露 128 GB 的 HBM。问题在于,简化互连结构并在节点和 pod 中一致地使用以太网,是否值得放弃富交换机 NVLink 设计所提供的极高本地交换带宽。当数据并行、推理服务或集群成本占主导时,这种权衡具有吸引力;而当张量并行的集合通信存在于每一层内部时,则不那么有吸引力。
这些替代方案并非厂商排名,而是稀缺资源的不同部署位置:节点内的交换带宽、pod 中的规则拓扑、package 内的 HBM 容量,以及加速器上的网络挂载。对于本章全程使用的 175B 模型,训练中的张量并行部分使本地加速器通信显得尤为重要,因此 DGX 式方案是自然的。在其他扩展形态下,尤其是内存密集型推荐系统、或对成本敏感的 serving 集群,不同的边界可能变得最为关键。软件生态成熟度、供应可得性以及总拥有成本,最终决定理论上的架构契合能否转化为可部署的系统。
节点健康与可靠性
节点是集群层级中的基本故障域。当节点内的单个 GPU 发生故障时,整个节点通常对训练任务不可用,因为张量并行要求全部 8 个 GPU 参与每一次 AllReduce 操作。单个缺失的 GPU 会破坏集合通信,使节点内其余 GPU 全部陷入停滞。因此,决定节点有效平均无故障时间(MTBF)的是可靠性最低的部件,而非平均部件。
节点内最易发生故障的部件构成诊断清单,大致按频率排序:
- GPU 显存:HBM 可能遇到纠错码(ECC)无法纠正的错误,从而使 GPU 退出服务。
- NVLink 连接:信号完整性可能随时间退化,导致链路重新训练或通信错误。
- 电源模块:电容在持续高负载运行下会老化。
- 冷却部件:液冷系统中的水泵和风冷系统中的风扇轴承会引入机械故障模式。
管理良好的集群会跟踪每个部件的故障率,并在出现早期预警迹象时主动将工作负载迁移到其他节点。最重要的早期预警指标包括:升高的可纠正 ECC 错误率(通常比无法纠正的错误提前数小时至数天出现)、恒定负载下升高的结温(指示冷却能力退化),以及间歇性的 NVLink 重新训练事件(指示线缆或连接器退化)。对出现这些预警迹象的部件进行主动更换,可以避免多周训练运行中非计划任务失败这一代价高得多的结果。
因此,节点级健康监控是一项关键的运维实践。现代集群管理系统会持续采集每个 GPU(温度、功耗、ECC 错误计数、NVLink 错误率)以及主机 BMC(基板管理控制器)的遥测数据。自动健康检查器会在空闲节点上运行简短的诊断工作负载,以在作业调度器将该节点分配给训练任务之前,验证所有 GPU、NVLinks 和 InfiniBand 连接均正常工作。若无这种主动监控,一个已静默退化的节点可能损坏训练梯度(若错误位于算术路径),或拖慢整个任务(若错误导致 NVLink 重新训练,从而暂时降低带宽)。容错 将详细讨论集群级容错策略。
对于我们的 175B 模型训练,在横跨 128 个节点的整个两周训练运行中,至少有一个节点发生硬件故障的概率相当可观。在复合节点级 MTBF 假设 1,000 hours 下(该假设涵盖 GPU、主机部件、电源、冷却和网络链路),一次 336 hours 的训练运行期间预计的节点故障数量约为 43。这意味着训练运行平均会经历约 3.1 failures/day 次故障。仅从标准单 GPU MTBF 50,000 hours 得出的 GPU 专用下界,在同样的运行期间只会预测 6.9 次由 GPU 触发的节点中断,而这还尚未计入主机、电源、冷却和网络故障项。每次故障都需要检测出降级节点、释放其工作负载、替换为备用节点,并从最近一次检查点恢复——借助自动化工具,这一过程耗时 10 minutes–30 minutes。在具备自动恢复的情况下,直接重启开销约为运行总时长的 2.1 percent–6.4 percent;若没有备用节点且缺乏自动恢复,多小时的干预过程可将开销推高到 20–30% 的量级,从而浪费数百万美元 GPU 小时。
节点内存划分
一种常见误解是,模型的内存占用等于其权重存储量。在这个混合精度的 Adam 示例中,FP32 主权重、优化器动量、梯度和激活值合计比仅 FP16 参数多消耗约 7–8\(\times\) 的内存,而且这些组件分别位于节点内存层次结构的不同层级。
对于我们的 175B 模型,训练内存划分为六个不同的组成部分(训练内存构成(针对一个 175B 参数的前沿模型))。
| 组件 | 精度 | 每个参数的内存 | 175B 模型的总计 |
|---|---|---|---|
| 模型权重 | FP16 | 2 bytes | 350 GB |
| 梯度 | FP16 | 2 bytes | 350 GB |
| 主权重 | FP32 | 4 bytes | 700 GB |
| 优化器(Adam \(m\)) | FP32 | 4 bytes | 700 GB |
| 优化器(Adam \(v\)) | FP32 | 4 bytes | 700 GB |
| 激活值 | Mixed | Variable | 100–400 GB |
| 总计 | 2.9–3.2 TB |
训练内存构成(针对一个 175B 参数的前沿模型) 使切分方案具体化。此前确立的同一份 2.9–3.2 TB 预算在此重现,但已按组件与层级分解:Adam 优化器状态以 FP32 形式存在,而非 FP16 权重,是主导项;激活值峰值(随批大小与序列长度变化)则最为波动。对并行策略选择的启示是:权重只是节点必须承载内容中最小的一块,因此仅对权重进行切分的策略会留下最大的消费者——优化器状态与激活值——未受影响。
一个 DGX H100 节点在其 8 个 GPU 上提供 640 GB 的聚合 HBM,另有 2 TB 的主机 DDR5 DRAM。仅凭 HBM 容量不足以容纳完整的训练状态。要理解这一点,可以考察不同并行策略下的内存算术。在纯数据并行 下,每个 GPU 必须保存完整的模型:350 GB 权重 + 350 GB 梯度 + 1,400 GB 优化器状态 = 2,100 GB —— 这在物理上无法在一台 80 GB 设备上实现。即便是 ZeRO stage 3,也仅将这三个组成部分分片到 8 个 GPU 上,每个 GPU 的占用为 2,100 GB / 8 ≈ 262.5 GB,仍然超过可用 HBM 的三倍。解决方案是将张量并行(将模型的层在 GPU 之间拆分,使每个 GPU 的权重降至 350 GB / 8 = 43.75 GB)与跨大量副本的数据并行分片相结合。在每节点采用 TP-8、跨集群采用 128 路数据并行的配置中,每个 GPU 持有 43.75 GB 的权重分片。优化器状态同样被划分:先按 8 路的张量切分,再在 128 个数据并行副本之间分布,因此每个 GPU 大约持有 1,400 GB / (1024) ≈ 1.4 GB 的优化器状态,即每个 8 GPU 的张量并行组中为 10.9 GB,此外还要计入梯度、激活值、缓冲区以及碎片开销。权重与优化器状态合计约 45.1 GB 只是起点;节 1.3.3.1 中的内存预算分析说明了为什么梯度与激活值仍然需要检查点化和卸载。正是这种算术决定了张量并行、优化器分片、激活值检查点化和内存分层在大模型训练中需要协同使用。
ZeRO Stage 3 会在参与数据并行的全部 GPU 上对优化器状态、梯度和参数进行完整分片。在节点内跨 8 个 GPU 分片时,每个 GPU 只持有每个组成部分的 1/8,使每 GPU 内存降至约 262.5 GB 的等效存储量(2,100 GB 状态总量 ÷ 8)。这仍然超过每 GPU 的 80 GB,因此分片必须与其他技术结合使用。激活值检查点化 只为反向传播存储一部分中间激活值,并从最近的检查点重新计算其余激活值。它以约多 33% 的 FLOPs 为代价,换取高达 10\(\times\) 的激活值内存降低。
CPU 卸载 将优化器状态保存在主机 DDR5 DRAM 中,仅在参数更新需要这些数据时才将其传输到 GPU HBM。64 GB/s 处的 PCIe Gen5 链路会引入传输延迟,但由于参数更新仅占单步总时间的一小部分,该开销仍然可控。NVMe 卸载 将同一思路扩展到 SSD,以支持更大的模型,其顺序读取带宽为 5–7 GB/s,并且延迟惩罚更大,因此需要仔细的流水线调度,以与计算过程重叠。
因此,节点的存储层次结构可视为一个分层系统。HBM 承载活跃计算:当前层矩阵乘法所需的权重分片、当前微批次的激活值,以及反向传播过程中正在累积的梯度。DDR5 承载 bulk 优化器状态,仅在每次训练迭代的末尾参数更新步骤中被访问。NVMe 则为最大模型提供溢出容量,存储很少被访问的分片,这些分片可以在计算期间被预取。
训练框架的内存管理器负责协调数据在这些层次之间的流动,其工作方式类似于硬件缓存控制器,但粒度更粗。与硬件缓存的类比具有启发性:正如 CPU 的缓存控制器利用预取来掩盖内存延迟(在处理器需要数据之前将数据载入),训练框架的内存管理器则利用软件层面的预取来掩盖 PCIe 传输延迟,即在 GPU 需要权重之前将其载入。在层 \(\ell\) 的正向传播过程中,管理器会同时从 DDR5 向 HBM 预取层 \(\ell+1\) 的权重(如果它们已被卸载),并从 HBM 将层 \(\ell-2\) 的权重淘汰回 DDR5(如果内存紧张)。
流水线调度确保每一层的计算都可以在不等待数据传输的情况下进行,代价是软件复杂度增加以及对预取深度的仔细调优。如果预取过浅,计算会因等待数据而停滞;如果预取过于激进,HBM 将被数层后才用得到的数据填满,从而挤占当前计算所需的激活值和梯度。这些层次之间的容量–带宽权衡决定了训练框架可以将哪些数据保持为“热”数据、又必须预取哪些数据;节点内存层次结构 量化了内存管理器必须跨越的三数量级带宽差距。
| 内存层级 | 容量 | 带宽 | 延迟 | 角色 |
|---|---|---|---|---|
| GPU HBM3 | 80 GB \(\times\) 8 = 640 GB | 3.35 TB/s / GPU | \(<1\text{ }\mu\text{s}\) | 活跃计算 |
| Host DDR5 | 2 TB | 数百 GB/s 聚合带宽 | ~100 ns | 优化器状态 |
| NVMe SSD | 8–30 TB | up to 7 GB/s / 每块驱动器 | ~100 μs | 溢出数据、检查点 |
编排十分复杂,但至关重要:没有它,我们的 175B 模型在 H100 级硬件上就无法训练。分布式训练 将详细考察这些内存优化策略及其与并行性的相互作用。
将其综合起来:内存预算练习
为巩固内存规划概念,考虑针对我们的 175B 模型在 DGX H100 节点上的具体容量估算练习。
Example 1.4: DGX H100 上 175B 训练的内存预算
场景:一个工程团队计算使用 8-way 张量并行在 8 GPU 的 DGX H100 节点上训练一个 175B 参数模型的内存预算(80 GB HBM 每 GPU)。
诊断:仅非分片(un-sharded)优化器状态就需要 175 GB 每 GPU,这已经超过权重与梯度的总和(88 GB)。它把每 GPU 的预算推高到 288 GB,远超 80 GB HBM 上限。该预算已经假设了激活值检查点化(activation checkpointing);若没有它,仅激活值就会额外占用每 GPU 100–200 GB。
系统经验:训练内存的容量估算需要整体管理权重、梯度、优化器状态、激活值和缓冲区,因为缓解某个组成部分并不必然腾出内存预算。将优化器状态卸载到主机 DDR5 可以消除主导项,但每 GPU 仍会留下 113 GB,因为 8-way 张量并行要求在每个 GPU 上都驻留完整的权重分片和梯度分片。因此,在该节点上适配该模型需要采用第二个分片维度,例如使用 ZeRO Stage 3 分布梯度和参数,而不能仅靠优化器卸载。
该示例说明了为什么大模型的内存规划是一项严谨的工程练习,而非简单的容量计算。除了内存层级的放置之外,带宽层级会对必须跨越节点边界的数据施加严厉惩罚,这是下一处计算明确指出的成本。
Napkin Math 1.5: 穿越悬崖的成本
问题:一个训练步长必须同步一个 1 GB 梯度缓冲区。当同步跨越节点边界(InfiniBand)时,相比保持在节点内部(NVLink),同步耗时增加了多少?
节点内(NVLink):带宽 = 450 GB/s 单向有效带宽;双向聚合带宽为 900 GB/s,但本转移耗时计算只将单个缓冲区沿一个方向传输。 \(T_{\text{intra}} = 1\text{ GB} / 450\text{ GB/s} \approx \mathbf{2.2 \text{ ms}}\)
节点间通信(InfiniBand NDR):带宽为 50 GB/s。 \(T_{\text{inter}} = 1\text{ GB} / 50\text{ GB/s} \approx \mathbf{20 \text{ ms}}\)
系统层面的启示:跨越节点边界会使通信时间增加约 9×。在每一步都进行梯度同步的训练循环中,这一开销会使加速器在每次迭代的绝大部分时间内处于等待状态,利用率降至远低于 50%。因此,训练框架在节点内部采用张量并行(高速 NVLink),在节点之间采用数据并行(对较慢的 InfiniBand 具有容错性)。
数据加载与 I/O 流水线
此前的讨论聚焦于数据在节点内部的移动方式(HBM 到 Tensor Core,GPU 到 GPU 通过 NVLink,GPU 到 host 通过 PCIe)。训练同样需要从外部存储向节点持续供给训练数据。如果数据加载流水线无法跟上 GPU 的消耗速率,那么系统中成本最高的部件(GPU)就会因等待数据而空闲。这就是 I/O 瓶颈,避免它需要对数据加载流水线进行精心工程化设计。
对于语言模型训练,训练吞吐量决定了数据消耗速率。如果集群每秒处理 500,000 个 token,且每个 token 需要 2 字节输入数据(token ID),那么原始数据摄取速率仅为 1 MB/s,任何存储系统都能轻松应对。然而,实际的 I/O 需求要大得多,因为训练数据必须经过分词、打乱、批量化,并传输到 GPU 内存。一条合理的数据流水线通过五个有序阶段,将原始字节转换为 GPU 就绪的批次:
- 读取:从分布式文件系统(NFS、Lustre,或云对象存储如 S3)将原始文本读入 host 内存。对于大规模数据集(太字节级文本),数据通常以二进制格式(TFRecord、WebDataset,或内存映射文件)存储,以最小化解析开销。
- 预处理:在 host CPU 上执行分词、序列打包和随机裁剪。这些操作通过数据加载器 worker 在多个 CPU 核心之间并行化(通常每个 GPU 配置 4–8 个 worker)。
- 批量化:将各个序列组装为微批次,填充至统一长度,并组织为张量。
- 传输:组装好的批次通过 PCIe 从 host DRAM 传输到 GPU HBM。对于分词后的语言建模,该传输量通常较小,因为 token ID 和掩码较为紧凑;而多模态批次或会在 host 上生成 FP16 嵌入的流水线,传输量可达 100–200 MB,在 PCIe Gen5 带宽下耗时为毫秒级。
- 预取:在 GPU 处理当前批次时,数据加载器并行预取并预处理接下来的 2–4 个批次,确保当前计算完成时,下一个批次已经位于 GPU HBM 中。
02 计算基础设施
关键的设计目标是让数据管线对 GPU 不可见:预取必须足够深,使得无论存储带宽或预处理时间的瞬时波动如何,批次在 GPU 需要时都始终就绪。当该管线被良好调优时,GPU 的利用率仅受计算和通信限制,而不受数据加载限制。当管线调优不佳时,GPU 可能将 10–30 percent 的时间用于等待数据,从而直接降低训练吞吐量。
传统数据路径将每个字节都经由主机 CPU 转发:从存储控制器到主机 DRAM(一次 PCIe 穿越),再从主机 DRAM 到 GPU HBM(第二次 PCIe 穿越)。这种”回弹缓冲区”架构使 PCIe 根复合体上的流量翻倍,并使 CPU 成为 I/O 密集型工作的瓶颈,受内核上下文切换和中断处理开销影响,有效带宽被限制在每个 NVMe 驱动器 3–4 GB/s。GPUDirect Storage (GDS) 通过建立 NVMe 控制器与 GPU 内存之间的直接 DMA 路径,完全绕开主机 CPU,消除了这一低效之处。通过 GDS,单个 NVMe 驱动器可直接向 GPU HBM 提供 5–7 GB/s 的带宽,达到驱动器内部带宽的上限,而非受限于主机的 I/O 子系统。对于配备四个 NVMe 驱动器的标准节点,GDS 可解锁 20–28 GB/s 的聚合存储到 GPU 带宽,使 CPU 能够专注于预处理任务,如分词和序列打包。存储章节中关于 GPUDirect Storage 的讨论见 GPUDirect Storage and the CPU Data-Copy Bypass,其中详细分析了这条直接路径。
所需的预取深度并非任意设定,而是由 I/O 延迟的方差统计特性决定。如果 GPU 每 \(T_{\text{compute}}\) 秒处理一个批次,而存储系统每 \(T_{\text{I/O}}\) 秒交付一个批次、标准差为 \(\sigma_{\text{I/O}}\),则维持 99.7 percent 零停顿概率所需的最小预取深度 \(k\) 为 \(k \ge \lceil T_{\text{I/O}} / T_{\text{compute}} + 3\sigma_{\text{I/O}} / T_{\text{compute}} \rceil\)。在我们的 175B 模型训练运行中,\(T_{\text{compute}} = 2.0\) 秒处理一个批次、存储层每 \(T_{\text{I/O}} = 1.5 \pm 0.5\) 秒交付一个批次,所需深度为 \(\lceil 0.75 + 0.75 \rceil = 2\) 个批次。在生产环境中,共享文件系统上的”嘈杂邻居”会引发重尾延迟,工程师通常将该缓冲区超额配置为 4–8 个批次,以隔离 GPU 免受分布式存储不稳定物理特性的影响。相对于令牌化语言工作负载中 GPU 停顿的成本,该预取缓冲区的内存开销可以忽略不计,但多模态管线必须为宿主侧的批次缓冲区预留更大的空间。
集群规模不断扩大的同时,一个新的存储瓶颈也随之浮现。当我们在 128 个节点上训练 175B 模型时,系统会表现为一种同步的”惊群”(thundering herd)行为:所有 128 个节点都会在每个训练步骤开始时同时请求下一 microbatch 的 token。即使像 Lustre 这样的共享并行文件系统具备 500 GB/s 的聚合吞吐量,当 128 个客户端同时拉取数据时,它也会不堪重负,导致读取延迟从毫秒级飙升至秒级。架构层面的解决方案是分层存储 配合激进的本地缓存。为每个训练节点配置本地 NVMe SSD,使其能够提供 25 GB/s 的节点级带宽,从而将集群的即时数据依赖与共享文件系统解耦。一个后台进程会从中心存储异步地将数据预取到本地 NVMe 缓存中,从而平滑 I/O 尖峰。对于 128 节点的集群,本地 NVMe 能够提供 3.2 TB/s 的聚合读取带宽(\(128 \times 25\) GB/s),其能力甚至超越了最昂贵的集中式存储阵列,确保 GPU 永远不会因数据饥饿而受限。
Systems Perspective 1.4: 数据加载陷阱
一种微妙的失效模式出现在:本地数据加载基准测试能够满足单个节点,但共享路径却无法满足整个集群。硬件契约是:在预期的并发度下提供端到端的持续带宽,涵盖存储服务器、网络路径、预处理、主机内存以及加速器传输。数据存储 将构建满足该契约的存储层级与数据路径。
对于我们的 175B 模型,单个 DGX H100 节点提供 640 GB 的聚合 HBM 容量,足以容纳 FP16 模型权重,但不足以在不分片和卸载的情况下容纳完整的 Adam 训练状态。训练还需要处理万亿级 token,而单个节点的算力吞吐量将训练时间限制在数月量级。要在合理的时间框架内(数周而非数月)完成训练,就需要数十甚至数百个节点。将这些节点堆叠进物理机柜,便定义了下一层基础设施,此处的约束也从带宽与容量转向原始功率与散热。
机柜
传统数据中心中的标准 42U 服务器机柜 功耗为 5–10 kW,可通过穿过穿孔地板瓷砖的常温空气进行冷却。本章节的四节点 DGX H100 机柜场景在建模的 IT 边界处消耗 33.5 kW。在这一功率密度下,工程约束的重心已从硅片与信号完整性转移到供电 与热力学。机柜正是功率墙与传热定律 成为主导设计因素之处。

现代 GPU 机柜已越过风冷包络。
对于我们的 175B 模型,在 1,024 块 GPU 上进行训练需要 32 个机架(每个机架 4 个节点,每个节点 8 块 GPU)。在整个集群范围内,建模的机架 IT 功耗合计约为 1.1 MW,此数值尚未计入设施冷却开销。可靠地输送该功率,并在不使任何部件超出其热限制的前提下移除所产生的热量,是一项涵盖电气工程、机械工程与土木工程的多学科工程挑战。电力输送链上的任何一点发生故障,从公用变电站到单块 GPU 的电压调节器,都可能使整个训练运行中断,浪费数小时计算量,并可能损坏训练状态。
Definition 1.6: Rack
Rack 是物理基础设施单元,即标准化的 42U 机柜,其中容纳多个计算节点、机柜顶部交换机(ToR,即连接机架内所有节点至更大集群网络互连结构的第一级网络汇聚点)、电源分配单元以及冷却分配主管,并由此界定功率与冷却容量必须规划的最小粒度。
- 重要性:AI 机架的功率密度增长极为迅速。本章的四节点 DGX H100 场景包含 32 块 GPU,单块为 700 W,在建模的 IT 边界处总功耗为 33.5 kW。这超过了通用数据中心机架典型的 5–10 kW,因而需要专门设计的电气分配与冷却能力。该冷却方式是工程化风冷还是液冷,取决于系统配置与设施设计。
- 区别:与节点(计算单元)不同,机架是基础设施单元:它是冷却主管、电源分配与 ToR 交换机被集成的物理层级,因此机架是设施运维中的最小可更换、可服务单元,而非节点。
- 常见误区:一种常见误解是,机架的放置位置只是后勤上的次要考虑。同一机架内的节点共享 ToR 交换机,具备单跳连接;不同机架内的节点至少跨越两个交换机跳。将训练作业的流水线并行各阶段全部置于同一机架内,可最小化阶段间延迟并降低机架间网络互连结构的负载。
机架开篇部分承诺:在如此层级上,传热定律会成为主导性的设计力量。空气的体积比热容远低于液体,因此风冷机架需要足够的风量、风压和温升,才能带走其产生的热量。并不存在通用的 30 kW 上限:实际限制取决于服务器与设施的设计。本章节的 33.5 kW 场景可以采用适合设施的风冷工程方案;更密集的系统则可能使液冷成为更实际的选择。
因此,冷却方式的选择取决于配置,而非某个机架功率阈值的必然结果。直连芯片的液冷提高了散热能力,并可能降低风扇能耗;而工程风冷对于按其风量需求设计的系统和设施仍然可行。冷却 比较了这些架构,以及每种选择在每个运行小时所承担的设施功率开销。
机架设计考量
机器学习机架的物理设计与传统服务器机架存在显著差异,且这种差异超出了功率与冷却的范畴。在传统 42U 机架中,服务器以独立的 1U 或 2U“披萨盒”式单元安装,每个单元各自配备风扇、电源和线缆连接。机器学习机架采用了根本不同的外形规格。一台 DGX H100 占用 8U,包含 8 个 GPU、NVSwitch 互连结构、多个电源,以及(在液冷配置中)带快接接头的冷却液分配管。42U 机架中放置四台 DGX 单元后,仅余 10U 用于网络交换机、线缆管理和 PDU。
从传统服务器外形规格向机器学习优化设计的转变,是由与推动风冷向液冷转变相同的功率密度挑战所驱动的。一台传统 1U 服务器的耗散量为 300–500 W,冷却所需的风量仅 modest。一台 DGX H100 节点在其 8 个 GPU、NVSwitch 和配套组件上的耗散量约为 8.4 kW,因此需要极大的风量(风冷配置)或液冷管路(液冷配置)。外形规格必须同时容纳计算硬件与热管理基础设施,这正是机器学习节点明显高于传统服务器(8U 对 1U)的原因。
布线管理
布线管理是一项非平凡的工程挑战。每个 DGX H100 节点配备 8 条 InfiniBand 线缆(每块 GPU 一条)、2 条以太网管理线缆、电源线,以及(对于液冷机型)冷却液软管。一个满配机柜拥有超过 40 条高速线缆,每一条都必须仔细布设。
布线受三项物理约束支配:
- 气流净空:线缆不得阻碍风冷设计中的气流,因为即使部分遮挡也可能产生热点,进而限制邻近组件的性能。
- 弯曲半径:高速线缆具有最小弯曲半径,通常为活动光缆线径的 10–15\(\times\) 倍;低于该半径时,信号路径会受损,并可能产生比特错误甚至导致链路完全中断。
- 电磁干扰:将过多的高速铜缆捆扎在一起,会劣化相邻链路的信号质量。
在大型部署中,仅线缆系统(cable plant)的安装与测试就可能耗时数周,而布线错误是装机构造后调试延迟最常见的原因之一。
随着液冷集群的机柜功率密度攀升至 100 kW 量级,逐服务器 AC 转换的能效已难以为继。传统设计在每个机箱中为冗余 AC 电源单元(PSU)预留空间,而许多高密度机柜设计则采用机柜级 DC 配电。在这种架构中,集中式电源柜将市电 AC 转换为贯穿整个机柜高度的48V DC 母线,取代各服务器的独立 PSU。这一整合消除了一个转换环节,带来系统级 2–3 个百分点的效率提升——在数千块 GPU 上训练 175B 参数模型时,这意味着热负荷的显著降低。电力通过 48V 母线直接送达服务器背板,再由紧凑型 DC-to-DC 转换器降压至 12V,最终降至 GPU 的亚 1V 工作电压。该拓扑由 Google 与 Meta 通过 Open Compute Project 率先提出,减少了故障点,并回收了宝贵的机箱空间用于液压冷却回路和高带宽互连。
功率配电网络与瞬态动态
从 48V 降至亚 1V 的工作电平,在硅片级引入了严峻的物理挑战:管理跨功率配电网络(PDN) 的动态电流 slew rate(\(di/dt\))。
现代 AI 加速器在低于 1 伏的供电电压下运行(\(V_{\text{core}} \approx 0.7\text{--}0.9\text{ V}\)),而每次运行消耗 \(700\text{--}1{,}200\text{ W}\)。根据功率守恒定律(\(P = V \cdot I\)),单个加速器会持续抽取超过 \(I_{\text{core}} \approx 1{,}000\text{--}1{,}500\text{ A}\) 的电流。在一台容纳 36 至 72 个加速器的密集液冷机柜中(例如抽取 \(100\text{--}120\text{ kW}\)),硅层面的聚合核心电流达到 \(50{,}000\text{--}100{,}000\text{ A}\)。
Definition 1.7: 供电网络(PDN)与瞬态动力学
供电网络(PDN) 是连接设施供电与片上晶体管栅极的物理电气分配层级,其寄生环路电感(\(L_{\text{parasitic}}\))会在处理器开关活动快速变化时诱发瞬态电压波动(\(\Delta V = L \frac{di}{dt}\))。
- 重要性:同步分布式训练会在数千个 GPU 同时从通信停顿切换到密集矩阵乘法时产生严重的阶跃电流瞬变,威胁电压崩溃或灾难性的介质击穿。
- 区别:与热约束(由于热容,其作用时间尺度为秒或分钟)不同,PDN 瞬变发生在纳秒至微秒量级,远快于数据中心供电架中反馈回路所能补偿的速度。
- 常见误区:仅依赖被动板级电容来抑制瞬变。高频瞬变必须通过跨越片上沟槽电容、封装电容以及固件协同的软件功率斜坡的多级去耦层级加以缓解。
在高速电路中,任何流经电感路径的电流变化都会产生由法拉第电磁感应定律所决定的感应电压偏移,该定律表述为 公式 3:
\[\Delta V = L_{\text{parasitic}} \frac{di}{dt} \tag{3}\]
其中 \(L_{\text{parasitic}}\) 表示 PDN 的环路电感总和(涵盖机柜汇流条、板级电源平面、电压调节模块(VRM)走线、插座连接器引脚以及芯片封装中介层),而 \(\frac{di}{dt}\) 表示电流变化率。
在分布式深度学习中,由于批量同步并行(BSP)执行模型的同步特性,这一物理属性会转化为运行层面的风险:
- 瞬时触发:在全局通信屏障(例如 AllReduce 或流水线气泡)期间,Tensor Cores 处于空闲状态,等待网络数据包,核心电流降至约 \(200\text{ A}\) 的空闲基准。通信完成的瞬间,机架内全部 32 至 72 个 GPU 在纳秒级时间内同时发出稠密 Tensor Core GEMM 指令。
- 瞬态幅度:核心电流在不到 \(10\text{ ns}\) 的时间内从 \(200\text{ A}\) 跃升至 \(1{,}200\text{ A}\),产生超过以下阈值的电流变化率: \[\frac{di}{dt} \approx \frac{1{,}000\text{ A}}{10^{-8}\text{ s}} = 10^{11}\text{ A/s}\]
- 电压跌落:即使 VRM 与硅片 die 之间的寄生电感仅有 \(1\text{ nH}\)(\(10^{-9}\text{ H}\)),公式 3 仍会导致电压跌落: \[\Delta V = 10^{-9}\text{ H} \times 10^{11}\text{ A/s} = 100\text{ mV}\] 当以标称 \(V_{\text{core}}\) 的 \(0.8\text{ V}\) 运行时,\(100\text{ mV}\) 的跌落相当于 \(12.5\) 的电压降幅——远超标准 \(\pm 5\) 的正常工作容差窗口。
该瞬态 excursion 会产生两种不同的失效模式:
- 欠压跌落:若核心电压跌落至最低工作阈值(\(V_{\text{min}}\))以下,栅极传播延迟将增大(\(t_{\text{prop}} \propto 1/V\))。逻辑路径无法满足时钟建立时间,进而导致静默数据损坏(激活值中的位翻转)或立即触发处理器 machine-check 异常及不可恢复的节点重置。
- 过压尖峰:当一次大规模 GEMM 突然完成时,电流的骤然下降会使寄生电感(\(\frac{1}{2} L I^2\))中储存的磁能向电路放电,从而产生正向电压尖峰。若该尖峰超过晶体管栅极介质击穿电压,将造成物理击穿穿透,永久损坏硅片栅极。
为抑制这些瞬态(定义见 1.7),现代 AI 计算基础设施采用多级去耦层级,并配合软件功率平滑:
- 高频片内去耦:直接嵌入或位于硅片 interposer 内部的深槽电容(DTC)和面侧电容(LSC)。凭借极低的寄生电感(\(<10\text{ pH}\)),它们为电流转换最初的 \(0.1\text{--}1\text{ ns}\) 提供即时电荷存储。
- 中频封装与插槽去耦:高密度多层陶瓷电容(MLCC)直接安装在封装基板、紧邻主板插槽,在 \(1\text{--}100\text{ ns}\) 窗口内缓冲瞬态。
- 低频大电容去耦:VRM 与电源架上的聚合物钽电容和铝电解电容,在微秒量级维持电荷,直至开关模式电源调整其占空比。
- 固件与软件功率平滑:由于物理电容会占用宝贵的硅片与板卡面积,现代 GPU 架构会实现由软件协调的功率斜坡。在屏障之后启动大规模 GEMM 内核时,GPU 微码或 CUDA 运行时会在数十微秒内引入微节流或错开的流水线爬坡周期,将最大 \(\frac{di}{dt}\) 斜率限制在安全范围内,确保电压 excursion 始终处于正常工作裕度之内。
机架顶部交换机(Top-of-Rack,ToR 交换机) 值得特别关注。在传统数据中心中,ToR 交换机为每台服务器提供 1–10 Gb/s 的以太网连接,并汇聚为更高层级交换机的上行链路。在机器学习机架中,ToR 交换机是 InfiniBand 或高速以太网交换机,每个端口提供 400 Gb/s,并且必须处理分布式训练产生的突发式、同步型流量模式。
ToR 交换机的部署位置与配置会直接影响网络拓扑。针对机架优化的设计(Meta 等机构采用)会将节点内的每一块 GPU 分配到一条特定的“导轨”(rail),该导轨连接到专用的 ToR 交换机。在传统设计中,节点内的全部 8 块 GPU 都连接到同一台 ToR 交换机,当多块 GPU 同时发送 AllReduce 流量时,可能形成瓶颈。在针对机架优化的设计中,每个节点中的 GPU 0 连接到 ToR 交换机 0,GPU 1 连接到 ToR 交换机 1,依此类推。这样可确保并行组内的 AllReduce 流量(即不同节点中所有参与者的 GPU 索引相同)仅限制在单个交换机内,而不必穿越整个网络互连结构。
针对机架优化的设计会额外消耗交换机、端口和布线,以将通信路径与加速器导轨对齐。其收益取决于集合通信流量矩阵、路由、超配以及作业放置,而非固定的效率提升。网络互连结构 建立了这些条件,以及用于评估它们的网络互连结构指标。
设施可靠性与环境控制
机架设计同样界定了物理故障域。部署机器学习基础设施的数据中心会实施多层物理安全与环境监控,这不仅出于合规要求,也因为单排 DGX H100 节点(仅硬件价值就达 140 万美元)集中了足够的价值、热量和液冷风险,因而有必要采取在传统服务器设备中会被视为过度的控制措施。
因此,环境监控是计算设计的一部分,而非设施方面的权宜之计。抬高地板瓷砖下方和液冷管道周围的水浸检测传感器能够在数秒内识别泄漏并触发自动冷却液隔离阀。吸顶式烟雾探测系统持续抽取机架内部空气,检测燃烧副产物的浓度远低于喷淋探测器能够感知的水平。安装在建筑结构上的振动传感器可捕捉地震事件或施工引起的振动,这些振动可能损坏磁盘驱动器或使线缆连接松动。湿度控制将相对湿度维持在 40–60 个百分点,以防止静电放电和冷凝。
这些环境控制并非权宜之计,而是基础设施设计的组成部分,会影响可靠性与可用性。水泄漏蔓延到 DGX H100 的底板可能造成数百万美元损失和数周停机。单个机架发生的火灾可能在消防系统重新充装并对受影响区域进行去污的期间,使整个数据中心大厅停机数天。2021 年斯特拉斯堡 OVHcloud 火灾展示了在缺少正确分区的情况下,单栋建筑事故如何升级为全站故障域。
War Story 1.1: 成为故障域的数据中心(2021)
背景:OVHcloud 在斯特拉斯堡站点运营了四座数据中心,为依赖该站点物理供电、消防与恢复设计的客户提供服务(OVHcloud 2021年)。
机制:2021 年 3 月 10 日,SBG2 建筑发生起火。由于缺乏围护措施,火势蔓延,共用的供电通路摧毁了 SBG2 建筑,损坏了相邻的 SBG1,并迫使 SBG3 和 SBG4 紧急停机。
影响:数千台服务器被物理摧毁,导致全球超过 360 万个网站离线,并毁坏了未备份的客户数据。
修复:OVHcloud 以独立的物理防火隔断、按建筑隔离的配电以及强制性的异地免费备份存储重建了该站点。
系统经验:计算基础设施并不只有 GPU 和网络拓扑。防火分区、供电隔离、备份地理分布以及灾难恢复假设,决定了机架级事故是否会演变为站点级中断。多节点机器学习训练集群继承了这种物理依赖:单个数据中心的供电或冷却域故障会中止正在进行的训练任务,并摧毁未复制的检查点状态,除非恢复路径跨越物理设施边界。
OVHcloud. 2021年. Strasbourg Datacentre: Latest Information. OVHcloud incident update.
一旦部署了机架级控制措施,可靠性问题便上升到设施冗余层面。与隔离泄漏机架相同的故障域逻辑,也决定了站点应当采购多少冗余供电、冷却和恢复能力。
数据中心可靠性通常依据 Uptime Institute 的 Tier 体系进行分类,其中 Tier III 和 Tier IV 代表关键计算任务的常见选项(Uptime Institute 2026年)。Tier III 设施具备并发可维护性:冗余容量部件和配电路径使运维人员能够在不中断 IT 业务的情况下维护或更换设备。Tier IV 通过独立且物理隔离的系统进一步实现容错,因此单台设备故障或配电路径中断不应影响 IT 业务。二者的实际差异并非某个神奇的可用性数值,而是建筑在电气与机械基础设施层面为故障预防投入了多少,以及软件层韧性接手前承担了多少。
Uptime Institute. 2026年. Tier Classification System. Uptime Institute web page.
对于机器学习训练基础设施,其权衡计算与传统企业计算有所不同。训练任务是一个长期运行的批处理过程,而非实时事务系统。如果设施级中断发生在为期两周的训练任务期间,代价通常是自最后一个检查点重新启动,而非永久数据丢失。因此,许多机器学习训练部署将并发可维护的设施设计与激进的应用层容错相结合:工程师不再为建筑层面的每一层冗余买单,而是投资于检查点、任务重启和能够吸收罕见设施中断的存储系统。这种软件韧性将部分设施风险商品化,把数据中心视为一个会出故障的公用事业,而非固若金汤的堡垒。由此节省的设施可靠性支出可以重新投向加速器容量、网络或存储,从而在相同预算下取得更多训练进展。
Checkpoint 1.4: 基础设施物理
一个团队计划在现有风冷数据中心部署 256 个 H100 GPU(32 个节点),可用供电容量为 250 kW,冷却容量为 200 kW,PUE 为 1.5。
机架与机柜
机架将电力与热量集中到一个物理体积中,而限制因素是热力学,而非软件。然而,单台包含 32 张 GPU 的机架,对于我们的 175B 模型而言远不足以支撑训练,该模型可能需要数千张加速器才能在合理的时间窗口内完成训练。下一层基础设施将数百个机架聚合为一个统一的计算系统,即机柜(pod),其网络拓扑 (图 13) 围绕工作负载必须维持的通信模式而设计。全任意到任意的二分带宽是一种设计取向;环面(torus)与轨线优化设计则以牺牲这种普适性来换取更低的成本或更好的局部性。
机柜
将我们的 175B 模型部署在单台 DGX H100 节点(8 张 GPU,约 16,000 TFLOP/s 聚合算力)上进行训练,需要数月时间,前提是模型能够完整装入该节点。将训练时间压缩到数周量级,则需要 100–1,000 台节点协同工作。机柜正是使这一目标成为可能的集群级单元:许多机架共享一套高速互连结构、电力预算与冷却设计。机柜设计是拓扑、电力与故障域首次汇聚为共享基础设施、而非按机架分别处理的关键环节。
Pod 的工程挑战在于,如何将这些节点快速互联成网络,以避免梯度同步成为瓶颈。Pod 将数百个机架汇聚为一个协调统一的计算系统,其中网络互连结构承担单台机器内系统总线所承担的角色。
该挑战的规模值得具体地加以认识。一个 1,024 节点 DGX H100 集群包含 8,192 个 GPU、4,096 个 NVSwitch 芯片、8,192 个 InfiniBand HCA,以及数百个 InfiniBand 交换机、数万个线缆,并消耗约 7–10 MW 的功率。它占据约 250 个机架,分布在 1 个或更多数据中心大厅中。
这种集群的物理重量同样可观。每台 DGX H100 节点重约 130 kg(287 磅),因此 1,024 个节点的总重量超过 133 公吨。加上机柜、交换机、线缆和冷却基础设施,总重量可超过 300 公吨。数据中心楼面必须进行结构工程以支撑这一集中载荷;机器学习集群的典型楼面承载要求为每平方米 1,500–2,500 kg,而传统服务器安装则为每平方米 500–1,000 kg。这一结构要求在设施规划中往往被忽视,并可能成为改造既有建筑的阻断性约束。
数据中心的物理布局反映了这些密度约束。机器学习训练机架的极端功率密度要求风冷区段采用刚性热通道/冷通道封闭(hot aisle/cold aisle containment),将冷空气强制送入机架封闭的前部,并在机架后部排风口立即捕获废热。大厅的“脊柱”——连接所有机架到汇聚交换机的中央线缆走廊——必须容纳数千根光纤线缆和供电馈线。优先采用头顶线缆桥架而非地板下走线,以改善气流和可维护性,承载沉重的铜制供电馈线和脆弱的纤线互联,这些线缆构成了集群的“神经系统”。物理布局决策同样需要容纳液冷基础设施:冷却液分配单元(coolant distribution unit)的布置位置、冷却液管路的走向,以及允许对单个机架进行维护而无需排空整个冷却回路的隔离阀。这些物理布局决策在设施设计阶段作出,会在数年后约束训练团队可用的网络拓扑选项。
在这样一个集群上训练一个 175B 模型需要 \(6 \times 175 \times 10^{9} \times 300 \times 10^{9}\) 次浮点运算(假设 300 billion 个训练 token)。若 MFU 为 45%——这是针对调优良好的大模型训练而言的较强但可实现的数值——集群的持续吞吐量为 \(8,192 \times 1979 \times 10^{12} \times 0.45\) FLOP/s,约合 7.30 EFLOP/s,因而得到约 12 小时的物理极限训练时间。
实际上,通信开销、流水线气泡、检查点 I/O、硬件故障和维护窗口会叠加,使实际墙钟时间超出物理极限。一条简化的倍率链可得到约 18 小时的系统最小时间;一旦排队、数据就绪、调试、重跑以及站点特定的运维余量进入计划,生产排程可被拉长到数天甚至数周。核心主题不变:在 pod 规模下,基础设施的不完美程度超过了硅片的原始能力。夺回这部分损失的时间,是分布式系统工程的中心挑战,其解决方案横跨硬件(更好的网络)、软件(重叠通信)和运维(主动维护以最小化停机时间)。
Napkin Math 1.6: 训练 175B
我们 175B 模型的训练时间可以从基本原理推导出来。
总 FLOPs:使用近似式 \(6 \times P \times D\),其中 \(P = 175 \times 10^9\) 和 \(D = 300 \times 10^9\) 表示 token: \(3.15 \times 10^{23}\) FLOPs
集群吞吐量:8,192 个 H100 GPU,峰值为 1979 TFLOP/s,以 45 percent 的 MFU 运行: 持续 \(8,192 \times 1979 \times 10^{12} \times 0.45\) FLOP/s\(\approx\) 7.30 EFLOP/s
理想化训练时间(即“物理极限”): (\(3.15 \times 10^{23}\) FLOPs)/(\(8,192 \times 1979 \times 10^{12} \times 0.45\) FLOP/s) \(\div 3600 \approx\) 12.0 hours
现实世界的乘数:
- 通信开销(扩展效率 \(\approx 0.85\)):\(\div 0.85 \rightarrow\) 14.1 hours
- 流水线气泡(\(\approx 5\%\)):\(\times 1.05 \rightarrow\) 14.8 hours
- 检查点开销(\(\approx 3\%\)):\(\times 1.03 \rightarrow\) 15.3 hours
- 硬件故障与重启(\(\approx 10\%\) 的墙钟时间):\(\times 1.10 \rightarrow\) 16.8 hours
- 维护窗口(\(\approx 5\%\)):\(\times 1.05 \rightarrow\) 17.6 hours
总计:在这个简化的系统最小链中为 17.6 hours,以周为单位表示则为 0.1 weeks。纳入排队、调试、重跑以及站点特定的运营余量后,实际生产日历仍可能延长到数天甚至数周。恢复这部分损失的时间属于分布式系统工程的范畴——即 分布式训练 的主题。
在本规模下,分析单元不再是一排机架或一组独立服务器;设施必须表现得像一台连贯的机器。
Definition 1.8: WSC
WSC 是一种建筑规模的计算系统,其中数千台服务器被作为一台连贯的机器运行(以网络互连结构充当系统总线,分布式存储充当磁盘子系统,集群编排器充当操作系统),从而支持在任何单台机器上物理上无法实现的训练工作负载。
- 重要性:一个由 10000 张 H100 GPU 组成的 WSC 可提供约 9.89 EFLOP/s 的 FP16 峰值性能(FP8 下约为 19.8 EFLOP/s),从而支持 175B 量级的训练工作负载,其规模远超单节点所能达到的范围。然而,该系统的速度仅受其二分带宽限制:每 GPU 50 GB/s 的非阻塞 InfiniBand 提供 500 TB/s 的聚合注入带宽;若互连结构存在 4:1 的过度订阅,有效二分带宽将降至 125 TB/s,可能成为 AllReduce 的瓶颈,并使训练吞吐量下降 30%–60%。
- 区别:与通用计算集群(在各自节点上运行多个相互独立的作业,且不要求紧密耦合)不同,WSC 训练集群作为一台同步仪器运行,每个节点都必须参与每次 AllReduce,因此单个节点的故障或变慢都会成为整个集群的性能事件。
- 常见误区:一种常见误解是,WSC 设计主要属于软件工程或 IT 运维范畴。实际上,WSC 设计属于建筑级计算机体系结构:机架布局(以最小化机架间跳数)、供电链路(PUE 目标、液冷分配管路)和网络拓扑必须作为统一系统进行协同设计:任何一层上的失误都会通过所有其他层传播。
Luiz Andre Barroso、Urs Holzle 与 Parthasarathy Ranganathan 在《The Datacenter as a Computer》(Barroso 等 2019年) 中形式化了这一概念。在 Google 的规模下,the data center is the computer,因此计算机体系结构原理不仅适用于芯片层级,也适用于建筑层级。
WSC 体系结构原则
集群级 MTBF 随 GPU 数量呈反比下降。
Barroso, Luiz André, Urs Hölzle, 和 Parthasarathy Ranganathan. 2019年. The Datacenter as a Computer: Designing Warehouse-Scale Machines. Synthesis Lectures on Computer Architecture. Springer International Publishing. https://doi.org/10.1007/978-3-031-01761-2.
Warehouse-Scale Computer 概念将数据中心从“一整间放满计算机的房间”重新表述为“一台恰好填满房间的计算机”(Barroso 等 2019年)。这一视角改变了工程师对物理设计的思路。
在传统数据中心中,每台服务器都是一个独立单元,拥有自己的操作系统、存储和网络标识;设施仅提供供电、冷却和物理安全。服务器可以独立地添加、移除或更换,运行在不同服务器上的工作负载彼此无关。
在 WSC 中,单个服务器相当于多核处理器中的一个核心:它没有独立效用,只作为更大系统的一部分而存在。一台孤立运行的 DGX H100 节点无法训练 175B 模型;只有当它通过精心设计的网络互连结构连接到数百个其他节点时,才变得有用,此时由分布式存储系统提供训练数据和检查点存储,并由集群编排器协调所有节点上的工作。
这一重新表述直接带来两项物理层面的后果。第一项是:决定上限的是网络而非算力——在单个节点内部,NVLink 已提供张量并行所需的带宽,但跨节点时,互连结构必须承载梯度张量、激活检查点和流水线阶段输出,因此建筑级机器仅能达到连接其核心的线缆所能提供的速度。网络互连结构 对该互连结构作了完整展开;WSC 的重新表述使互连成为一等体系结构组件,而非附属部件。
第二个后果是:故障是物理必然,而非异常事件。单张 GPU 的 MTBF 约为 50,000 小时(本书贯穿使用的规范 GPU 平均失效时间(MTTF)基准,见 容错),但可靠性随组件数量线性下降:由 10,000 张此类 GPU 组成的集群大约每五小时就会发生一次故障。MTBF 级联 解释了集群级故障率为何仅仅等于单组件寿命除以组件数量。这是物理机器层面的固有属性,也正因如此,WSC 必须从一开始就设计为:单个组件的故障只会使运行中的工作负载降级,而不会使其中断——各级都要采用双路供电、冗余交换结构,以及持久化检查点存储。
第三个后果是,这些基本构建模块会根据其所承载的工作负载而组合方式不同。一个 pod 并非由一份标准部件清单拼装而成;互联方式、交换结构以及内存布局,都是针对主导工作负载所施加的通信与容量模式分别选定的。按工作负载划分的 pod 架构 通过对比三个生产级 pod 来说明这一点:NVIDIA SuperPOD 通过 InfiniBand 胖树将 GPU 互联起来,以支持任意到任意的灵活性;Google TPU pod 将芯片硬连线成环面,以换取数据流吞吐量;Meta 的 Grand Teton 则将同一类加速器围绕嵌入内存而非裸算力进行布局。
| 系统 | NVIDIA SuperPOD | Google TPU Pod | Meta Grand Teton |
|---|---|---|---|
| 互联方式 | InfiniBand 胖树 | 3D 环面 ICI | RoCE(以太网上的 RDMA) |
| 交换结构 | 外部交换机 | 芯片到芯片直连 | 叶/脊以太网 |
| 拓扑 | 任意到任意 | Nearest-Neighbor Mesh | 分层 Rail |
| 优化目标 | 灵活性 | 数据流吞吐量 | 嵌入内存 |
| 主导工作负载 | 多样化研究 | LLM 训练 | 推荐系统 |
Grand Teton 是内存布局而非算力布局驱动设计的典型案例。Meta 的推荐与排序模型使用嵌入表,其规模可达 TB 级,远超任何单张加速器 HBM 的容量,而直接操作这些嵌入的稠密神经网络层则相对较小。该设计在内存层次结构中将两者分开:TB 级的嵌入表存放在主机 CPU 的 DRAM 中(其 HBM 成本约为 $3–5/GB), and the dense layers execute on GPUs, where the compute density justifies the $10–15/GB)。嵌入查找受内存容量约束,但不受带宽约束:每次请求只触及庞大表中的一小部分,因此便宜且高容量的 DRAM 才是它们的合适归宿,而昂贵的加速器内存则留给能够将其带宽用满的工作。系统层面的启示是:最优的基础设施是面向特定工作负载的,而非一味追求规格最大化——为受内存容量约束的工作负载部署以算力优化为主的节点,会使加速器的大部分吞吐量闲置,而该问题本身从未是其芯片的瓶颈。
物理设计提供的是约束条件,而非运行策略。后续章节将利用其功耗、容量、拓扑、可靠性与持续吞吐的测量结果,推导出放置、恢复、监控与归属决策;集群经济性与利用率 负责完整的自建与外购分析以及容量规划分析。
这些物理约束界定了仓库级计算机的设计。新技术并不会消除这些边界,只会移动它们。节 1.6 中的技术之所以重要,是因为它们改变了内存、通信或功耗约束的约束位置。
推动边界移动的底层基础设施技术
一个数据中心将在其 15 年结构寿命内承载三到四代加速器,因此只有当某项技术改变了持久的规划约束时,它才具有前瞻性意义。有用的判据不是某项技术是否新颖,而是它把哪一面墙挪走了、移动之后出现了哪一面新墙,以及由此改变了哪项集群设计决策。Compute Express Link(CXL)移动了内存容量边界。晶圆级集成移动了芯片间通信边界。先进封装移动了加速器封装内部的裸片边界。光路交换移动了网络互连结构与功耗边界。它们都没有推翻数据移动的物理规律;每一项只是把基础设施团队必须投入功耗、冷却、成本与软件复杂度的位置重新安置了。
Compute express link (CXL)
一项重要的节点架构技术是 CXL,14 即构建于 PCIe 物理层之上的缓存一致性互连,使 CPU、加速器与内存扩展设备能够共享一致的寻址空间。它的价值不在于让远程内存变快。它的价值在于让容量不再僵化。与其把每个节点的宿主 DRAM 视为固定的本地内存池、把每个加速器的 HBM 视为彼此隔离的高速孤岛,CXL 互连可以在训练步骤的特定阶段向需要容量的设备暴露内存扩展器或池化内存。
14 CXL(Compute Express Link):一项开放标准(由 Intel 于 2019 年创立的 CXL Consortium),通过 CXL.io、CXL.cache 和 CXL.mem 在 PCIe 物理层之上增加缓存一致性内存语义。CXL 3.0 将该模型向内存池化方向扩展,使容量能够通过互连共享,而非永久固定地保留在一台服务器机箱内。
对于机器学习训练,自然的目标是冷态或局部相状态,而非活跃的矩阵相乘工作集。我们 175B 模型的 Adam 优化器状态占用 1,400 GB,它在参数更新过程中被访问,而不是被每个 Tensor Core 操作流式传输。因此,共享的 CXL 池可以通过将优化器分片、嵌入表溢出数据或本地数据缓存缓冲区置于加速器 HBM 层级之外,从而降低单节点内存压力。训练框架仍需仔细调度这些状态,但放置问题不再是非黑即白的“放得进本节点”或“溢出到存储”。
新的墙(瓶颈)是带宽。一条典型的 CXL 内存路径(经 PCIe Gen5 x16)提供 64 GB/s,而 H100 HBM 提供 3.35 TB/s。这 52× 的差距意味着前向与反向传递所需的权重和激活数据仍应位于 HBM 中。CXL 属于容量层级,而非 HBM 的替代品。其集群设计含义是具体的:规划者应询问服务器平台、机架布局和编排软件能否吸收 CXL 内存池化,而不是 CXL 是否消除了对高带宽加速器内存的需求。
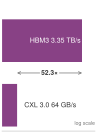
HBM 仍比 CXL 快 52× 倍,因此 CXL 仅用于容量。
晶圆级规划约束
在 CXL 的另一极端,是 节 1.1.1 引入的晶圆级引擎。其片上互连消除了已映射操作的封装级和板级传输,但这并不意味着通信可以免费。基础设施规划因而转向容量、放置和注入带宽。
我们 175B 的运行时模型仅 FP16 权重就需要 350 GB,远超片上 SRAM 的 44 GB。Cerebras 通过权重流式传输解决这一问题:外部 MemoryX 单元在晶圆执行每一层时,经 1.2 TB/s 路径将权重送入晶圆,从而将模型容量与片上内存解耦。这可能很适合推理以及计算阶段划分清晰的负载,但训练会重新引入更难的调度问题,因为激活、梯度和优化器更新必须在正向与反向传递之间协同。晶圆以通信墙换取了流式带宽墙。
基础设施规划者应当吸取的教训,并不是片上系统会取代 GPU 集群;而是内存的邻近性与容量彼此制约。WSE 风格的设计通过将工作集靠近算术单元,以换取异常高的本地带宽;CXL 则通过将内存放到更远处,换取灵活的容量。HBM 介于这两个极端之间:位于芯片之外、封装之内,容量小于主机内存,但速度足以支撑活跃计算。正确的架构,是内存层级与负载的复用模式相匹配的那一种。
高级封装
高级封装是这两个方向共同的基础。封装将边界移入加速器封装内部,而不是完全放到机架层面,也不是完全收进单片晶圆;这一点之所以重要,是因为单次曝光的掩模(reticle)尺寸上限仅为约 858 mm²。 2.5D 中介层(例如台积电的 CoWoS)将计算 die 与 HBM 堆叠安装在共用的硅基板上,使基于 chiplet 的加速器对大多数软件而言表现得如同单一器件。 3D 堆叠(例如 SoIC 方案)将 SRAM 缓存或逻辑直接上下堆叠,进一步缩短数据通路。从 H100 到 B200 的演进展示了集群层面的后果:封装能够提供远更多的本地算术资源与 die 间带宽,但机架必须承受更高的功率密度、更严格的散热要求,以及对电源瞬变的容忍度更低;在硅基优势转化为真正可用的基础设施之前,这些约束必须被吸收。
可重构拓扑与光电路交换
当 CXL 与高级封装分别处理内存边界和 die 边界时,仓库级计算(warehouse-scale computing)越来越多地面临互连的功耗与拓扑约束。在现代覆盖数万加速器的集群中,传统多层 Clos 网络依赖电交换式分组交换机。每个网络跳点都会引入光电转换(OEO):入射光子打到光电二极管,高速 SerDes 电路完成电信号解串,交换 ASIC 通过交叉开关缓冲并路由分组,输出 SerDes 则驱动激光器,将光重新发射到光纤中。
计算基础设施
在 800 Gb/s 和 1.6 Tb/s 的每端口数据速率下,SerDes 与收发电子器件消耗大量能量——通常占数据中心总功耗的 10% 到 20%。此外,固定的电学 Clos 拓扑采用静态布线,将设施锁定为单一 oversubscription 比例和刚性的二分模式,无论当前负载是流水线主导、数据并行,还是全对全专家路由。
Definition 1.9: **光电路交换**
光电路交换(OCS) 是一种物理网络架构,它利用微机电系统(MEMS)镜面阵列直接路由光信号,无需光电光(OEO)转换,从而在仓库级规模下实现动态的软件定义拓扑重构和高能效。
- 重要性:由于光子通过镜面反射传输而无需数字处理,OCS 的活跃交换功耗几乎为零(\(<5\) W/交换机机箱,相比之下电学交换机机箱为多千瓦级),并且天然对协议和比特率无关。采用 OCS 的光纤基础设施可从 400 Gb/s 扩展至 800 Gb/s 和 1.6 Tb/s,而无需更换交换机。
- 区别:与电学分组交换机(检查报头、在 SRAM 中缓冲分组,并为每个分组做出纳秒级路由决策)不同,OCS 建立半静态的物理光路,其交换延迟为毫秒量级(\(10\)–\(30\) ms),因此适用于拓扑级重构,而非动态分组路由。
- 常见误区:误以为 OCS 完全取代分组交换。OCS 工作在电路粒度:它配置集群级拓扑(如 3D 环面或针对特定任务的子集群),并绕开硬件故障进行路由;而分组交换或加速器原生互连负责细粒度的、步内消息路由。
Google 的 TPU v4 超级计算机 (Jouppi 等 2023年) 在生产环境中展示了光电路交换架构的强大能力。该系统没有将 4,096 个芯片刚性地布线为电学 fat-tree,而是将加速器分组为 \(4 \times 4 \times 4\) 节点立方体,并通过一组 3D MEMS 光电路交换机(代号 Palomar)路由立方体之间的链路。
Jouppi, Norm, George Kurian, Sheng Li, Peter Ma, Rahul Nagarajan, Lifeng Nai, Nishant Patil, 等. 2023年. 《TPU v4: An Optically Reconfigurable Supercomputer for Machine Learning With Hardware Support for Embeddings》. Proceedings of the 50th Annual International Symposium on Computer Architecture, 1~14. https://doi.org/10.1145/3579371.3589350.
这一架构提供了两项基本运行能力:
面向工作负载的拓扑:物理互连结构可以动态重构,以匹配正在运行工作负载的通信结构。采用 1D 流水线并行的模型可以将自己的切分配置为细长的圆柱体;采用 2D/3D 张量并行的模型可以配置为紧凑的立方 3D 环面,平均跳数最小;而 MoE 工作负载则可以最大化特定专家组之间的二分带宽。
动态故障恢复与边界封装:在大规模加速器 pod 中,光收发模块和光纤属于故障率最高的部件。在静态环面或树状拓扑中,单条链路或单个节点的故障可能隔离某个维度,甚至导致整个 pod 失效。借助 OCS,集群管理器能够检测出故障的托架或光纤,并指令 MEMS 反射镜旋转,从而在光学层面绕过故障单元,将健康节点拼接为一个完整但更小的环面切分,整个过程在几十毫秒内完成,无需人工干预线缆。
代价是交换延迟。由于 MEMS 反射镜需要物理旋转来偏转准直光束,重构需要 \(10\) 到 \(30\) 毫秒——比电交换包交换(\(10\) 到 \(100\) 纳秒)慢七个数量级。因此,OCS 承担了供电与协议层面的开销,而将重构延迟作为其绑定的调度纪律:它被用于作业级的拓扑分配与故障隔离,而非逐消息的动态路由。
共同主题不是消除,而是迁移。CXL 将容量向外迁移至互连结构,带宽成为限制性的约束;片上集成将通信向内迁移,容量与良率成为限制性的约束;先进封装压缩了芯片间距离,功率密度成为限制性的约束;光电路交换消除了收发器 OEO 功耗,而交换重构延迟成为限制性的约束。因此,基础设施规划仍然始于识别下一个字节如何移动、必须以多快的速度到达,以及必须构建何种物理系统,才能确保移动本身不会主导工作负载。
谬误与陷阱
由于瓶颈是迁移而非消失,计算基础设施团队常常优化可见的规格,却忽略了真正起约束作用的物理限制。本节中的谬误与陷阱,将本章关于节点、机架、机舱和设施的教训转化为可操作的警示。
谬误:更多的 GPU 总是意味着更快的训练。
工程师经常假设训练时间随 GPU 数量线性缩放:GPU 数量翻倍,训练时间应减半。实际上,通信开销随集群规模增长,最终会占据主导。
Amdahl 定律 确立了理论上限:计算中的串行部分(梯度同步、流水线气泡时间、数据加载停顿)界定了最大加速比,与并行度无关。对于一个含 175B 个参数的模型,其梯度为 350 GB,则每个训练步骤中的 AllReduce 要求每一块 GPU 与其他所有 GPU 交换数据。
在 1,024 块 GPU 的集群上,若网络未得到精心设计,该同步过程可能消耗总步骤时间的 30–50%。从 1,024 块 GPU 扩展到 2,048 块 GPU 会使硬件成本翻倍,但训练时间可能仅缩短 30–40%,收益迅速递减。扩展效率曲线是凹的:前 100 块 GPU 带来近乎线性的加速比,接下来的 900 块 GPU 收益递减,而在 2,000–4,000 块 GPU 以上,大多数模型规模下每增加一块 GPU 的边际收益趋近于零。
正确的做法是,在购买下一批 pod 之前,先在当前规模下剖析有用计算时间、暴露的通信时间和空闲时间。若新增 GPU 主要增加了暴露的通信时间,那么采购买到的是空闲时间而非训练进展。扩展效率的数学描述 随后将该局部比值转化为扩展效率估计,供采购决策参考。
Pitfall: 仅凭峰值 FLOP/s 规划训练吞吐量。
采购团队常通过比较峰值 FLOP/s 规格来挑选加速器。这种推理忽略了 Roofline Model 的核心洞见:如果工作负载的算术强度低于拐点,限制性能的是内存带宽,而非算力。H100 的拐点约为 295.2 FLOP/byte。LLM 推理的每字节运算量为 1–2 FLOP/byte,其性能不足峰值 FLOP/s 的 1%。即便是受益于批处理的 LLM 训练,也因注意力内核受内存带宽限制、激活值重计算以及通信停顿,通常只能达到峰值 FLOP/s 的 30–50%。仅凭峰值 FLOP/s 挑选硬件,就如同只依据最高车速选车,却忽略了日常通勤所需的燃油效率。
Fallacy: 加速器采购后,再处理功耗与散热约束。
团队依据算力需求规划 GPU 采购,却没有核实目标设施能否提供所需的功耗与散热能力。这些属于硬性物理限制,且交付周期漫长。
计算基础设施
单个 DGX H100 机架需要 33.5 kW 的功率。升级数据中心电气基础设施(新变压器、开关设备和 UPS 容量)需要 12–18 个月的建设周期。冷却系统升级(冷水机组、管道、水泵)需要 6–12 个月。即使是看似简单的改动,例如将单个机架的 PDU 从 20 kW 升级到 60 kW,也可能需要新增线缆和断路器配电盘。
未先确认设施就绪情况就订购硬件的组织,可能面临数百万美元 GPU 滞留在停车场集装箱中的风险,而建筑改造仍在进行中。这一场景并非空想:在 2023–2024 年的 GPU 抢购期间,多家机构确实遇到了这种情况,GPU 的交付周期缩短速度快于数据中心建设周期。
陷阱:购买更新的加速器,却没有检查该工作负载的算术强度。
一个团队部署了 B200 GPU(4,500 TFLOP/s FP8 峰值)用于推理工作负载,以批处理大小为 1 服务一个 7B 参数模型。其算术强度约为 1 FLOP/字节,因此该工作负载深陷于内存受限区域。
B200 的内存带宽(8 TB/s)仅比 H100 的(3.35 TB/s)高 2.4\(\times\) 倍,因此该批处理大小为 1 的工作负载受带宽而非标称算力主导。若以标称对比,即 B200 FP8 对 H100 FP16/BF16 类吞吐量,则算力峰值高约 4.6\(\times\) 倍,但解码性能仅提升约 2.4\(\times\) 倍。该团队为无法使用的算力付费。对于这一特定工作负载,采用单位内存带宽成本更低的 H100 会是更具成本效益的选择。
谬误:为 AI 工作负载提供风冷已足够。
老旧设施的运营者可能认为,只要增加风扇和冷水机组容量,就足以应对任何更高密度的 AI 机柜。实际上,冷却方式取决于系统的散热设计以及设施可用的风量、风压、进风温度和封闭环境。工程化的风冷对某些高密度配置仍然可行,而更高的机柜密度可能需要直接液冷,以避免热节流或超出设施限制。
谬误:在总拥有成本(TCO)分析中,所有 GPU 小时都同等昂贵。
成本比较中一个常见错误,是把 H100 上的一小时 GPU 计算与 A100 或 V100 上的一小时 GPU 计算视为完全等价。实际上,单位有效计算量的有效成本在不同代际 GPU 之间差异极大:更新一代加速器每美元能带来多得多的有效吞吐量。一个 H100 GPU 小时提供 6.3× 个 A100 GPU 小时的 TFLOP/s,以及 15.8× 个 V100 GPU 小时的 TFLOP/s。一个需要 10,000 个 V100 GPU 小时才能完成的训练运行,使用 H100 只需约 632 个 GPU 小时即可完成同等计算量。相关指标不是每 GPU 小时的成本,而是每有效 TFLOP 小时的成本,该指标同时考虑每小时价格与所交付的有效吞吐量。仅按 GPU 小时成本对云选项进行基准测试的组织,会系统性高估更新一代、更高效硬件的开销。
Pitfall: 在识别出训练瓶颈之前升级网络。
团队有时会投入重金升级网络互连结构(例如从 200 Gb/s 升级到 400 Gb/s InfiniBand),期望训练速度获得等比例的改善。这种改善完全取决于训练循环在当前网络带宽下是否受通信限制。若每个训练步骤的计算时间为 20 秒、通信时间为 2 秒,则该工作负载受计算限制:将网络速度提高一倍,总步骤时间仅从 22 秒降至 21 秒,改善幅度仅为 4.5%。同样的投资用于增加 GPU(降低计算时间)或进行更高 MFU 的软件优化(降低被浪费的计算)将带来大得多的收益。Roofline Model 适用于整个集群,而不仅适用于单个芯片:在投资之前,先诊断瓶颈究竟是计算还是通信。
谬误:仅凭平均功耗进行散热设计是不足的。
加速器的功耗在通信、内存和计算阶段之间各不相同。低于配置持续包络的工作负载平均值并不能确定散热需求,因为同步的计算阶段可能使许多设备同时接近该包络。热设计必须采用供应商在预期进风条件和冷却条件下给出的持续设计目标,而电气路径则必须单独容忍已记录的瞬态。否则,热节流会降低持续吞吐量,却不会引发崩溃或明确的应用错误。
陷阱:仅依据 HBM 容量选择模型,而不检查带宽。
采购团队有时只关注模型的权重是否“放得下”可用的 HBM,而忽略了带宽这一维度。一个模型即使放得进 HBM,却因带宽不足而无法以可接受的延迟提供服务,与一个放不下的模型同样不可用。考虑为服务一个 700 亿参数的模型而比较两个场景:(a) 一个具有 192 GB 的 HBM2e、带宽为 2.04 TB/s 的加速器;(b) 一个具有 80 GB 的 HBM3、带宽为 3.35 TB/s 的加速器。选项 (a) 的容量绰绰有余(该模型在 FP16 下仅需 141 GB),但其出 token 速度为 141 GB/2.04 TB/s = 69.2 ms 个 token。选项 (b) 需要仔细量化才能放得下(141 GB 的 FP16 放不进 80 GB,而 71 GB 的 INT8 可以放得下),但其出 token 速度为 71 GB/3.35 TB/s = 21 ms 个 token,比选项 (a) 快 3.3×。对于延迟敏感的服务场景,尽管选项 (b) 的容量较小,它仍是更好的选择。合适的加速器,是那个其带宽与容量共同满足工作负载需求的加速器。
谬误:部署之后才能修复数据加载问题。
只将部署前的优化全部押注在 GPU 内核性能和通信效率上的团队,有时会在部署后发现 GPU 因数据不足而饥饿。数据加载管线(存储 I/O、预处理、主机到 GPU 的传输)必须能够提供不低于 GPU 集群消费速率的吞吐量。对于语言模型训练,原始数据摄取速率并不高(每秒几兆字节),但预处理管线(分词、序列打包、打乱)可能在每个 GPU 的数据消费速度快于单个 CPU 核心所能准备的速度时,成为 CPU 瓶颈。修复方案虽然 straightforward(直截了当),但必须提前规划:为数据加载 worker 分配足够的 CPU 核心(通常每个 GPU 4–8 个),将训练数据部署在快速的本地 NVMe 存储上,而不是依赖共享网络文件系统,并将数据加载管线化,与 GPU 计算重叠执行。
陷阱:采购同质集群,却不建模工作负载的多样性。
计算基础设施
认为“硬件越统一,调度越简单、拖后腿的节点越少”这一直觉,常常导致组织过早退役性能尚可的旧代硬件。对于我们的 175B 模型,成本最优策略往往涉及混合代际的集群。训练需要 H100 的原始 FLOP/s 与互连带宽,以最小化同步开销;而推理服务受限于内存带宽,而非计算能力。
A100 提供 2.04 TB/s 的带宽,其资本支出显著低于 H100 的 3.35 TB/s。将 H100 节点专用于训练、A100 节点专用于推理,可使组织的总拥有成本(TCO)较全 H100 集群降低 15–25%。谬误在于混淆了 任务级 的同质性——这是防止单个分布式训练运行中出现拖后腿节点所必需的——与 集群级 的同质性。一个成熟的调度器可以有效地管理异构集群:将带宽密集型推理任务路由到单位价格带宽比具有竞争力的旧硬件上,同时为训练吞吐量保留峰值算力节点。
陷阱:把上线与老化测试当作调度余量。
上线属于系统构建环节,而非可以在硬件交付延迟时消耗掉的缓冲。老化测试、线缆验证、固件验收、热 soak 以及 NCCL 压力测试,是节点、机柜、网络与设施各层首次作为一个整体协同运行的时刻。压缩这一阶段,会把安装缺陷转化为生产故障,而每个调试周期都会让整个集群闲置,而非仅占用一个较小的验收测试窗口。
摘要
机器学习的物理基础设施从晶体管延伸至数据中心,并以训练一个 175B 参数模型的运行示例,将每个概念锚定在定量现实之中。本章的核心教训是一条约束级联:加速器功耗决定机柜散热,机柜密度决定 pod 布局,pod 拓扑决定扩展效率,而扩展效率决定经济上是否划算。
这条级联始于加速器。矩阵乘法负载催生了 Tensor Cores 与 systolic arrays;权重流式传输暴露了内存墙,并推动了 HBM;超出单芯片容量的模型状态则需要多加速器节点与 NVLink。级联延续到服务器之外:同步训练会产生功率瞬变,超过 100 kW 的机柜密度迫使液冷方案,而 pod 级通信则决定增加 GPU 究竟是加速训练,还是仅仅在网络中等待。
两条分析主题将这些细节组织起来。通用性税(generality tax)在每一层级都会重现:加速器以控制灵活性换取算术吞吐,网络以任意到任意的灵活性换取面向特定负载的效率,冷却系统则以通用风冷交换匹配高密度机柜的液冷回路。在 节 1.2.2 中引入的 Roofline Model 提供了共同的诊断任务:识别每个边界处的有用工作究竟受计算还是受数据移动所限。
由此得到的层级结构在仓库规模上对应经典的内存层级:HBM 快而小,NVLink 在节点内快,InfiniBand 在节点间较慢,分布式存储最慢但容量最大。在 节 1.3.1 中引入的带宽层级因此决定了并行层级:张量并行对应 NVLink,流水线并行对应机柜内网络,数据并行则跨越整个 pod。软件参数——精度、检查点间隔、批大小与梯度累积——并非彼此独立的旋钮;它们是对这些物理极限的响应。
我们拥有参数量为 175B 的模型,它作为贯穿该层级结构中每一层的架构性驱动因素。在加速器层面,处理一个 token 大约需要 3500 亿次浮点运算,但算术本身并不是 Tensor Core 上的瓶颈资源。在内存层面,350 GB 的 FP16 权重张量超过了单张加速器的 HBM 容量;即便经过分片或压缩解决了容量问题,以 3.35 TB/s 的速率流式传输权重,也会为单张加速器等效的 HBM 路径带来超过 100 ms/token 的延迟下限。在节点层面,训练状态规模超过 2 TB,需要张量并行、数据并行分片以及内存卸载。在机柜层面,32 张加速器每张消耗 700 W,加上主机和网络开销,需要 33.5 kW 的供电与液冷。在机架(pod)层面,可行的训练窗口需要在一个非阻塞网络互连结构上同步超过 1,000 张 GPU,并对不可避免的故障进行检查点。归根结底,经济性取决于持续利用率能否摊薄硬件、供电、冷却与设施风险。每一项约束都可追溯到同一个事实:这个模型无法装进单块芯片。
该方法可以推广到更广泛的模型:在每个层级识别出约束性瓶颈,量化其影响,并将后果向上传播。如果冷却无法带走更快的加速器产生的热量,那么加速更快的加速器是适得其反的;如果电网无法为更密集的机柜供电,那么更密集的机柜毫无意义;如果工作负载无法利用更宽网络提供的带宽,那么更宽的网络只是浪费。因此,基础设施工程是一门定量学科,用于将芯片级的选择追溯到机柜供电、设施冷却、网络拓扑、可靠性与归属成本。
通过 C\(^3\) 应用该方法,为高密度加速器机柜选择液冷,并不仅仅是一次设施升级。它使每机柜的计算能力更强,从而将通信流量集中到更少的机柜顶部链路上,并提高了供电限流、故障隔离与运维的协同负担。原有的热设计上限随之退居其次,但约束性瓶颈可能转移到机柜供电或网络注入;如果设计没有为这些下游限制预留余量,就会把冷却余量浪费成闲置硅片。
Key Takeaways: 数据中心就是计算机
- 通用性税:加速器通过把硅片面积专门用于矩阵运算,而非分支预测和乱序执行,比 CPU 获得 10–100\(\times\) 倍的更高吞吐量(原则 5)。代价是灵活性降低。从 GPU 到 TPU 再到定制 ASIC 的每一步,都回收了更多芯片面积用于算术运算。
- 内存墙诊断始于屋顶线:对于单请求 LLM 解码,权重流量通常决定了延迟下限。屋脊点(\(I_{\text{ridge}}\) = 峰值 FLOP/s 除以内存带宽)区分了带宽受限与计算受限的运算,但批处理形状、融合、精度、复用以及建模的内存层级决定了每个训练或推理阶段处于哪个位置。
- 带宽层级决定了并行方式:NVLink 与 InfiniBand 之间每个方向的带宽悬崖(9×)将张量并行限制在节点内部,将数据并行限制在节点之间。当模型深度超出单个节点的容量时,流水线并行才跨越节点展开。
- 峰值与持续吞吐:容量规划必须使用在一致的模型 FLOP 约定、精度、系统规模和负载形状下测得的持续吞吐量,而非峰值规格。
- 设施效率是计算机的一部分:冷却架构会改变机架密度上限和设施开销;在机架群规模下,网络拓扑、冷却和供电必须针对主导负载协同设计。
- 大规模下的故障:一个 10,000-GPU 集群大约每五小时发生一次 GPU 故障。检查点策略是一项一阶性能考量,必须从一开始就纳入系统设计。
- 全生命周期成本胜过采购价格:拥有成本包括电费、设施建设、网络以及人力,而不只是采购价格,因此只有当利用率超过某个硬件价格单独无法揭示的门槛时,拥有基础设施才划算。集群经济性与利用率 计算了自建与购买的盈亏平衡点,以及整个集群在何处运行和付费时的总成本。
在计算历史的大部分时间里,计算机就是芯片。本章标志着这一说法不再成立。当一个模型已经无法装入单个加速器之后,一个事实会沿着每一层向上传播:芯片决定节点的功耗,节点决定机柜的热负荷,机柜决定 pod 的拓扑结构,而拓扑结构决定经济账是否算得过账。没有任何一层可以孤立地调优,因为每一层都从它下方的那一层继承了自身的限制。在这个规模上,计算的基本单位不再是处理器,而是建筑,这也是本书其余部分把数据中心而非 GPU 视为被工程化设计的机器。
What’s Next: 从硅片到线缆
物理基础设施从 Tensor Core 晶体管一直延伸到兆瓦级数据中心变电站。然而,一组彼此隔离的节点并不构成计算机,而只是一堆昂贵的加速器仓库。网络互连结构通过在这些节点之间传输梯度、激活值和检查点,将它们转变为一个统一的训练系统。本章反复揭示了同一个约束:通信带宽限制了扩展效率。带宽层级显示,NVLink 与 InfiniBand 之间存在一道 9× 断崖;拓扑示例则表明,互连设计可以将 AllReduce 时间改变 2–3\(\times\)。网络互连结构 考察了决定一万 GPU 集群究竟表现为同一台连贯机器还是数千台孤立设备的物理、协议、集合通信与拓扑决策。