在大规模下运行推理
推理的经济性与架构
在大规模下运行推理
目的
推理成本为何最终会远远超过训练成本?
训练是一次性支出;而服务会持续贯穿模型整个运行周期。一个花费数百万美元训练出的模型,可能服务数十亿次请求,每次请求都会消耗计算、内存、网络与能源。对于成功的生产模型,推理运行成本可能比原始训练成本高出几个数量级。这种成本结构塑造了架构设计。毫秒级的延迟与百分点级的加速器利用率,在数十亿次请求上不断累积。性能工程提供了本地工具集——融合、精度、编译,以及诸如猜测性解码之类的算法改进——本章将这些工具应用于服务规模。批处理、分片、路由、自动伸缩与隔离必须在实时流量下严格保持延迟预算。可靠性要求同样因势而增,因为停机意味着收入损失与用户体验中断,而非实验延期。用 C³ 术语来说,服务批处理为吞吐量而计算,同时将协同开销控制在尾延迟预算之内。
Learning Objectives
- 根据请求量、token 混合、加速器价格、利用率与延迟目标,量化全生命周期服务成本
- 为视觉、大语言模型、推荐与流式负载选择批处理与调度策略
- 分析注意力缓存容量、碎片化以及解码阶段的策略,以应对内存受限的语言模型服务
- 依据通信、内存与质量约束,比较分片、解耦与量化服务设计
- 针对尾延迟与噪声邻居风险,评估路由、负载均衡与隔离控制
- 设计自动伸缩与多区域故障切换策略,在冷启动、成本与 SLO 合规性之间取得平衡
- 综合各层服务架构,管理跨请求、副本、服务与平台层的 C³ 权衡
设想一个语言模型,其推理计算成本为每周 $5 million to train over two months. Once deployed to a global user base serving thousands of queries per second, that same model can consume $500 万美元。推理已不再是临时的一次性批处理作业,而是一项持续性的、对延迟敏感的服务。
算子融合、精度工程与图编译可以最大化单次前向传播的吞吐量。下一个挑战出现于:单个优化后的模型必须为分布在大规模全球集群中的数千名并发用户提供服务。单机推理优化,包括批处理、缓存、模型优化和硬件加速,提供了构建基础。当这些技术达到其极限时,分布式方法就变得必要。
分布式推理系统必须解决在单机规模下并不存在的问题。当请求必须分配到数百个 GPU 实例上并维持延迟保证时,负载均衡1变得至关重要。请求路由必须考虑模型特有的特性:具有万亿参数嵌入表的推荐系统与逐 token 生成响应的语言模型需要不同的放置策略。自动伸缩必须预判需求波动——请求量可能在几分钟内变化几个数量级,同时仍需维持用户所期望的延迟上限。
1 推理的负载均衡:请求服务时间可能从毫秒级跨越到数十秒级,具体取决于模型、提示长度和生成输出。基于队列感知的路由比仅依据分配数量更能直接暴露剩余工作量。
大规模推理的经济性在根本上不同于训练经济性。训练成本主要由计算时间主导,并可在所生成模型的整个生命周期内摊薄。推理成本则直接取决于用户流量与收入。例如,电子商务推荐系统在购物高峰期可能每秒服务数百万次请求,每次请求都直接贡献潜在收入。静默期过度配置或高峰期供给不足的成本会立即转化为业务影响。推理效率因此在某种程度上成为首要关切,而训练效率很少达到这种程度。构建此类服务需要三项相互关联的决策:何时分布变得必要、架构如何在不同负载下保持延迟上限、以及如何将资源利用率维持在足够高的水平,使服务成本不会侵蚀模型所创造的价值。
当单机服务不足时
有三个不同的信号表明分布式推理变得必要,而非仅仅可选。分布式推理的触发条件 按约束类型和相应策略对这些触发条件进行分类。
第一个信号是内存耗尽,发生在模型参数、键值缓存或嵌入表超出单设备容量时。单张 NVIDIA H100 GPU 提供 80 GB 的 HBM32 内存;假设来源溯源 记录了该容量数值的来源,以及后续分析中使用的其他标准硬件常数。GPT-4 级模型远超这一容量:公开的约 1.8T 参数混合专家估计意味着仅权重就需要 ~3.5 TB(FP16 精度),因此无论吞吐量需求如何,都必须跨多张 GPU 进行分布。具有万亿参数嵌入表的推荐系统面临类似约束:Meta 的 DLRM 架构3 存储的嵌入表需要多个太字节的内存。
2 HBM3 容量与带宽:H100 集成了 80 GB 的 3D 堆叠 DRAM,带宽为 3.35 TB/s,而 A100 上的 HBM2e 为 2.04 TB/s。容量决定模型与缓存状态是否能够容纳;带宽则限制了内存受限的解码吞吐量。
3 DLRM(深度学习推荐模型):Meta 于 2019 年提出的参考架构将稠密特征——GPU 受限的多层感知机(MLP)——与稀疏特征(CPU 受限的嵌入查找)分离,从而形成混合服务拓扑(Naumov 等 2019年)。生产推荐系统的实测特征说明了这种结构对服务的重要性:以嵌入表为主的推荐模型会形成与稠密卷积神经网络(CNN)、循环神经网络(RNN)或语言模型(LLM)推理不同的内存访问与容量约束(Gupta 等 2020年)。
Naumov, Maxim, Dheevatsa Mudigere, Hao-Jun Michael Shi, Jianyu Huang, Narayanan Sundaraman, Jongsoo Park, Xiaodong Wang, 等. 2019年. 《Deep Learning Recommendation Model for Personalization and Recommendation Systems》. arXiv preprint arXiv:1906.00091.
Gupta, Udit, Carole-Jean Wu, Xiaodong Wang, Maxim Naumov, Brandon Reagen, David Brooks, Bradford Cottel, 等. 2020年. 《The Architectural Implications of Facebook’s DNN-Based Personalized Recommendation》. 2020 IEEE International Symposium on High Performance Computer Architecture (HPCA), 488~501. https://doi.org/10.1109/HPCA47549.2020.00047.
除内存约束外,当请求量超过单机容量(即使采用最优批处理)时,吞吐量限制也会出现。例如,一个每秒服务 100,000 次查询的推荐系统,其延迟预算为 10 ms。若单机吞吐量的峰值为 10,000 QPS,那么无论对该机器进行何种优化都无法满足需求。跨多个副本的水平扩展因此成为强制要求。
最后,严格的延迟要求会驱动分布式部署:即使批大小为 1,模型执行时间也超过了延迟预算。逐 token 生成响应的大语言模型面临这一约束尤为突出。一个 700 亿参数的模型在 FP16 下需要约 140 GB 内存,在 KV cache 被考虑之前就已经超过单张 80 GB 的 H100 类 GPU。即使量化或更大内存的硬件使得单副本配置成为可能,解码吞吐量也常常受限于内存带宽。将模型分片到多张 GPU 上,能够实现并行计算,从而将首 token 延迟降至可接受阈值以下。
| 约束 | 单机上限 | 示例工作负载 | 分布策略 |
|---|---|---|---|
| 内存 | 80 GB (H100) | GPT-4 (~3.5 TB FP16) | 张量/流水线并行 |
| 吞吐量 | ~10K QPS(视觉) | 100K QPS RecSys | 水平复制 |
| 延迟 | Forward pass \(> \text{SLO}\) | 500 ms LLM TTFT | 模型分片 |
一旦交互式端点开始流式返回,内存、吞吐量和延迟三类触发条件都会对用户可见。首 token 延迟(TTFT)4决定用户何时看到响应开始,而每个输出 token 的耗时(TPOT)决定响应的其余部分是否以可读的节奏送达;这正是推理反转了许多训练阶段的优化优先级。
4 TTFT 与 TPOT:首 token 延迟衡量从排队和预填充开始的初始等待时间;每个输出 token 的耗时衡量流式开始后解码的节奏。服务策略必须同时保护这两项,而不能以快速的首次响应掩盖缓慢的流式过程。
Checkpoint 1.1: **分布策略的选择**
验证你对何时从单机推理转向分布式推理的理解:
根本性的反转:训练与推理
训练与推理的优化对比,超出了基本的吞吐量对延迟的区分。训练优化的是每小时处理的样本数,并容忍延迟波动;推理优化的是响应时间,必须满足严格的延迟约束。在大规模场景下,这一反转体现在系统架构、资源分配和运维优先级中。训练与推理的系统需求 详细说明了这些差异显现的六个关键系统方面。
| 方面 | 分布式训练 | 分布式推理 |
|---|---|---|
| 主要指标 | 吞吐量(样本/小时) | 延迟(P99 ms) |
| 可接受的波动 | 小时 | 毫秒 |
| 状态管理 | 检查点(周期性) | 会话状态(持续) |
| 批处理形成 | 较大、受控 | 请求驱动、可变 |
| 故障容错 | 从检查点重启 | 重定向且不影响用户 |
| 成本结构 | 固定时长、可变费率 | 可变时长、固定 SLO |
训练能够容忍大幅的延迟波动,因为其优化目标是数小时或数天内的总体进度。一次耗时 2 秒而非通常 1 秒的训练迭代属于可接受的波动。而一次耗时 2 秒而非 100 毫秒的推理请求则属于灾难性失败,可能导致用户流失,或在依赖服务中引发级联超时。
状态管理存在根本差异。训练维护模型状态(参数、优化器状态),该状态逐渐演化,并可被周期性检查点捕获。推理则经常维护会话状态(对话历史、键值缓存、用户上下文),该状态必须跨请求保持,且无法容忍基于检查点恢复所带来的陈旧性。
故障处理随之分化。训练故障会触发检查点恢复并继续执行,损失数分钟进度是可以接受的。推理故障必须对用户不可见:请求重定向至健康副本,以降级结果替代不可用的模型,并且尽管基础设施不稳定,服务级目标(SLO)仍须得到维持。
服务开销:分布的代价
将推理分布到多台机器会引入单机服务中不存在的开销。这一“服务开销”必须在延迟约束内被理解和预算。
网络通信为每一次跨机器交互都引入延迟。在数据中心内,网络往返时间随拓扑与拥塞程度在 50–500 微秒之间变化。对于需要在不同机器上的 GPU 之间进行同步的模型切分,每个同步点都会叠加这部分开销。若模型切分在 8 台机器上,且每次推理包含 4 个同步点,则网络延迟会额外增加 200 微秒到 2 毫秒。The α-β Communication Model 提出了 \(\alpha\)–\(\beta\) 模型,将每次此类传输分解为固定启动延迟与随带宽变化的项,从而为在延迟 SLO 下预算这些同步成本提供了定量框架。
序列化开销进一步加剧了这一问题,它将内存中的张量转换为可经网络传输的格式。传统的序列化器(如 Protocol Buffers、JSON 以及 Python 的 pickle)在每次传输时都会执行“解析—分配—拷贝”循环;一个 1 GB 的激活张量通过此类格式进行序列化与反序列化约需 100 毫秒。Zero-copy(零拷贝)替代方案(如 FlatBuffers 和 Cap’n Proto5)通过在原地访问线格式数据来规避大部分成本,但它们对 schema 布局提出了更严格的要求,并非所有生产环境栈都会采用。
5 零拷贝序列化:FlatBuffers 与 Cap’n Proto 等格式能够原地访问线格式数据,从而避免额外的“解析—分配—拷贝”循环。其收益取决于载荷大小、语言运行时,以及下游算子是否能够消费同一缓冲区表示。
负载均衡延迟又增加了另一层开销。请求必须被路由到合适的副本,这需要检查请求元数据、查询路由表,并将请求转发至选定的后端。优化良好的负载均衡器会引入 100–500 微秒延迟;配置不当的负载均衡器则可能引入毫秒级延迟。
当请求需要扇出到多个服务时,协同开销随之产生。一个并行查询用户模型、物品模型与排序模型的建议系统,必须协调这些查询并聚合结果。协同逻辑本身会消耗 CPU 周期并引入延迟抖动。最后,排队延迟 (\(T_{\text{queuing}}\)) 会在请求到达速率暂时超过可用副本的处理能力时不断累积。
总服务开销经常占用分布式系统中 10–30% 的延迟预算,正如 公式 1 所示:
\[T_{\text{total}} = T_{\text{compute}} + T_{\text{network}} + T_{\text{serialization}} + T_{\text{coordination}} + T_{\text{queuing}} \tag{1}\]
要最小化这一开销,需要让通信组件共址部署、采用高带宽互连结构,并设计能够最小化往返次数的通信模式。
服务成本可能主导训练成本
全生命周期服务成本远超一次性训练成本。
公式 1 中量化的服务开销仅占每次请求延迟预算的一小部分。推理的真实经济影响只有在评估模型整个运行周期的成本时才会显现。服务成本主导定律(原则 15)指出,服务成本可能以数量级优势主导训练成本,因为训练属于一次性资本支出(CapEx),而服务属于持续运营支出(OpEx),并随用户增长而扩展。一次快速成本计算即可使这一倍数具体化。
Napkin Math 1.1: 服务成本乘数
问题:一个团队花费 $2,000,000 训练了一个 70B 参数模型,现在为 1,000,000 名日活跃用户提供服务,每位用户每天发出 50 次请求。在 1 年内,训练成本还是服务成本占主导?
计算:
- 训练成本:$2,000,000(一次性)。
- 指标:年度推理量为 \(10^{6}\,\text{users} \times 50\,\text{reqs} \times 365\,\text{days} \approx\) 18.25B 次请求/年。
- 每次请求成本:假设一个 70B 模型在 H100 上的成本为 \(\approx\) $0.001/request(输入 + 输出)。
- 年度服务成本:18.25B 次请求 \(\times\) $0.001/request = $18,250,000。
系统洞见:仅在第一年内,服务成本就比训练成本高 9.1×。服务成本或与延迟相关的效率若改善 10 percent,第一年便可节省约 $1.8M,几乎抵得上最初那次训练的成本。
运行一个模型的总成本由训练成本(一次性支出)和服务成本(持续性支出)构成,如 公式 2 所示:
\[C_{\text{total}} = C_{\text{training}} + C_{\text{serving}} \times T_{\text{deployment}} \times Q_{\text{rate}} \tag{2}\]
其中,\(C_{\text{training}}\) 是训练模型的一次性成本,\(C_{\text{serving}}\) 是处理每次查询的成本,\(T_{\text{deployment}}\) 是以适当时间单位表示的部署时长,\(Q_{\text{rate}}\) 是查询速率。
同一杠杆效应可以适用于成本结构不同的各类应用。在本书示例推荐场景中,一个训练成本为 $12,000($3000 硬件,1,000 GPU-hours 于 $3/GPU-hour,另加 3× 用于数据与实验的额外工程成本)的 DLRM,在 10,000 QPS 以 730 天提供服务期间累计 \(6.31 \times 10^{11}\) 次生命周期查询。按照假设的 $10/million queries,这些查询的服务成本为 $6,307,200,从而在该场景中形成 525.6× 的比率。示例性训练与服务成本比率 给出了若干示例性负载包络的敏感度区间,而非市场价格估算:
| 应用 | 训练成本 | 年度服务成本 | 比率 |
|---|---|---|---|
| 推荐(高 QPS) | $10K–$100K | $1M–$10M | 100–1000\(\times\) |
| 搜索排序 | $100K–$1M | $10M–$100M | 100–1000\(\times\) |
| LLM API | $1M–$100M | $10M–$1B | 10–100\(\times\) |
| 内部分析 | $1K–$10K | $10K–$100K | 10–100\(\times\) |
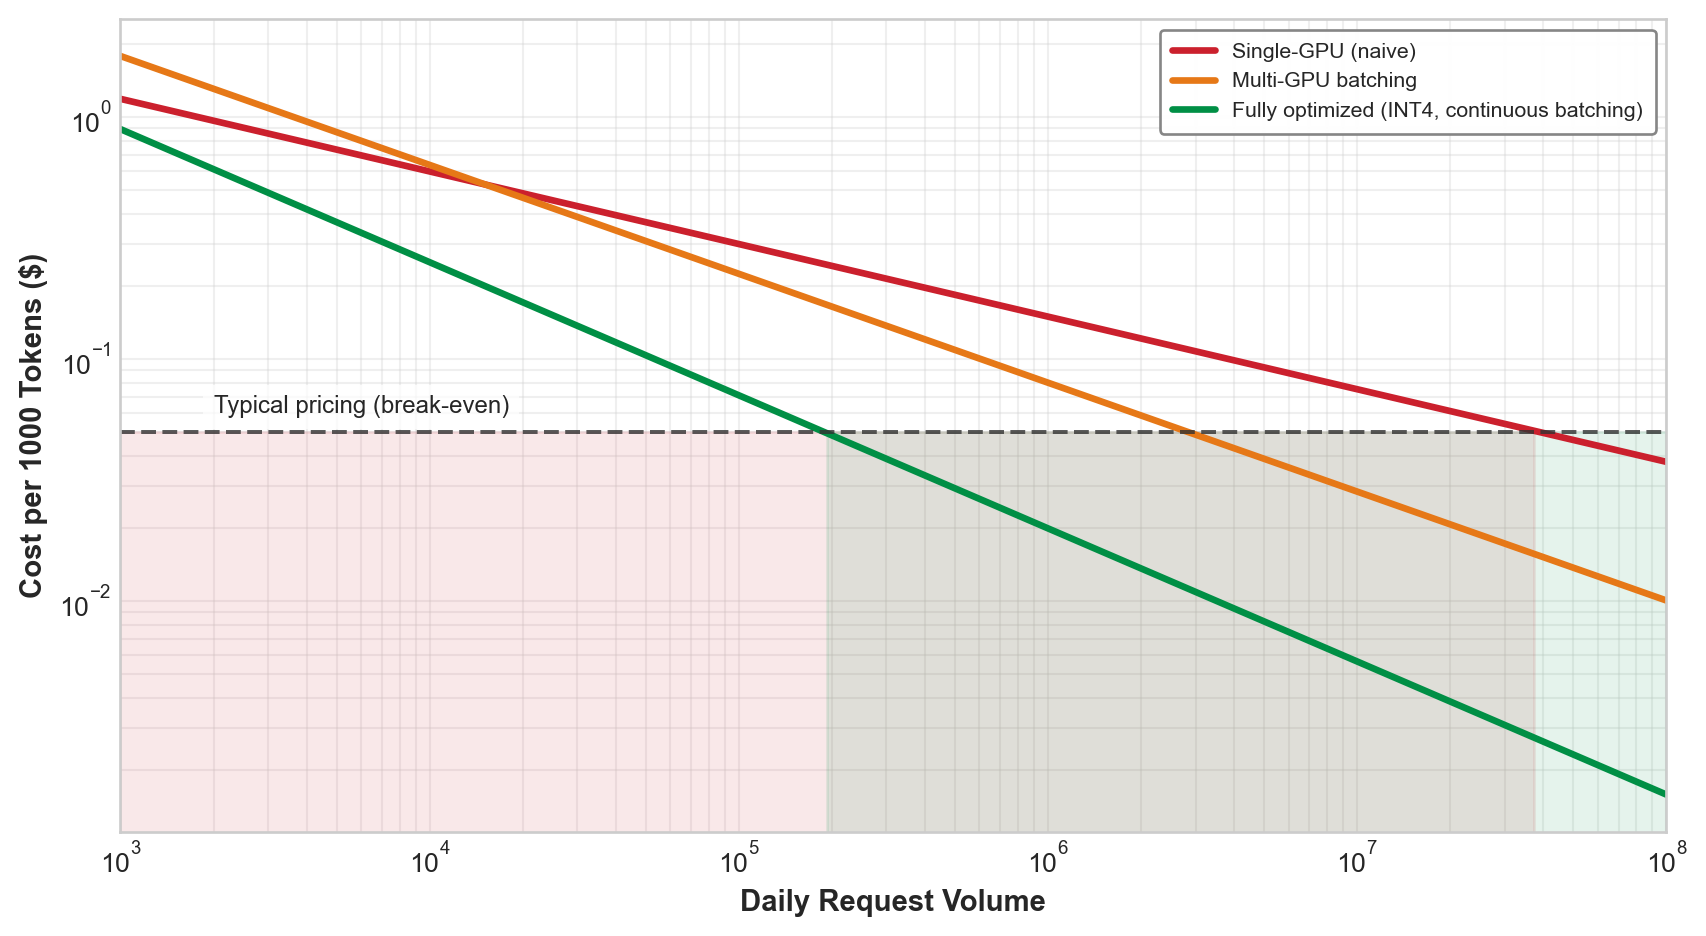
成本结构促使了对服务环节的优化:每提升 1 个百分点的效率,都会在整个模型运行寿命内带来持续的降本。图 1 通过展示朴素服务与优化服务之间的差距如何决定推理服务是盈利还是持续亏损,来说明优化为何重要。
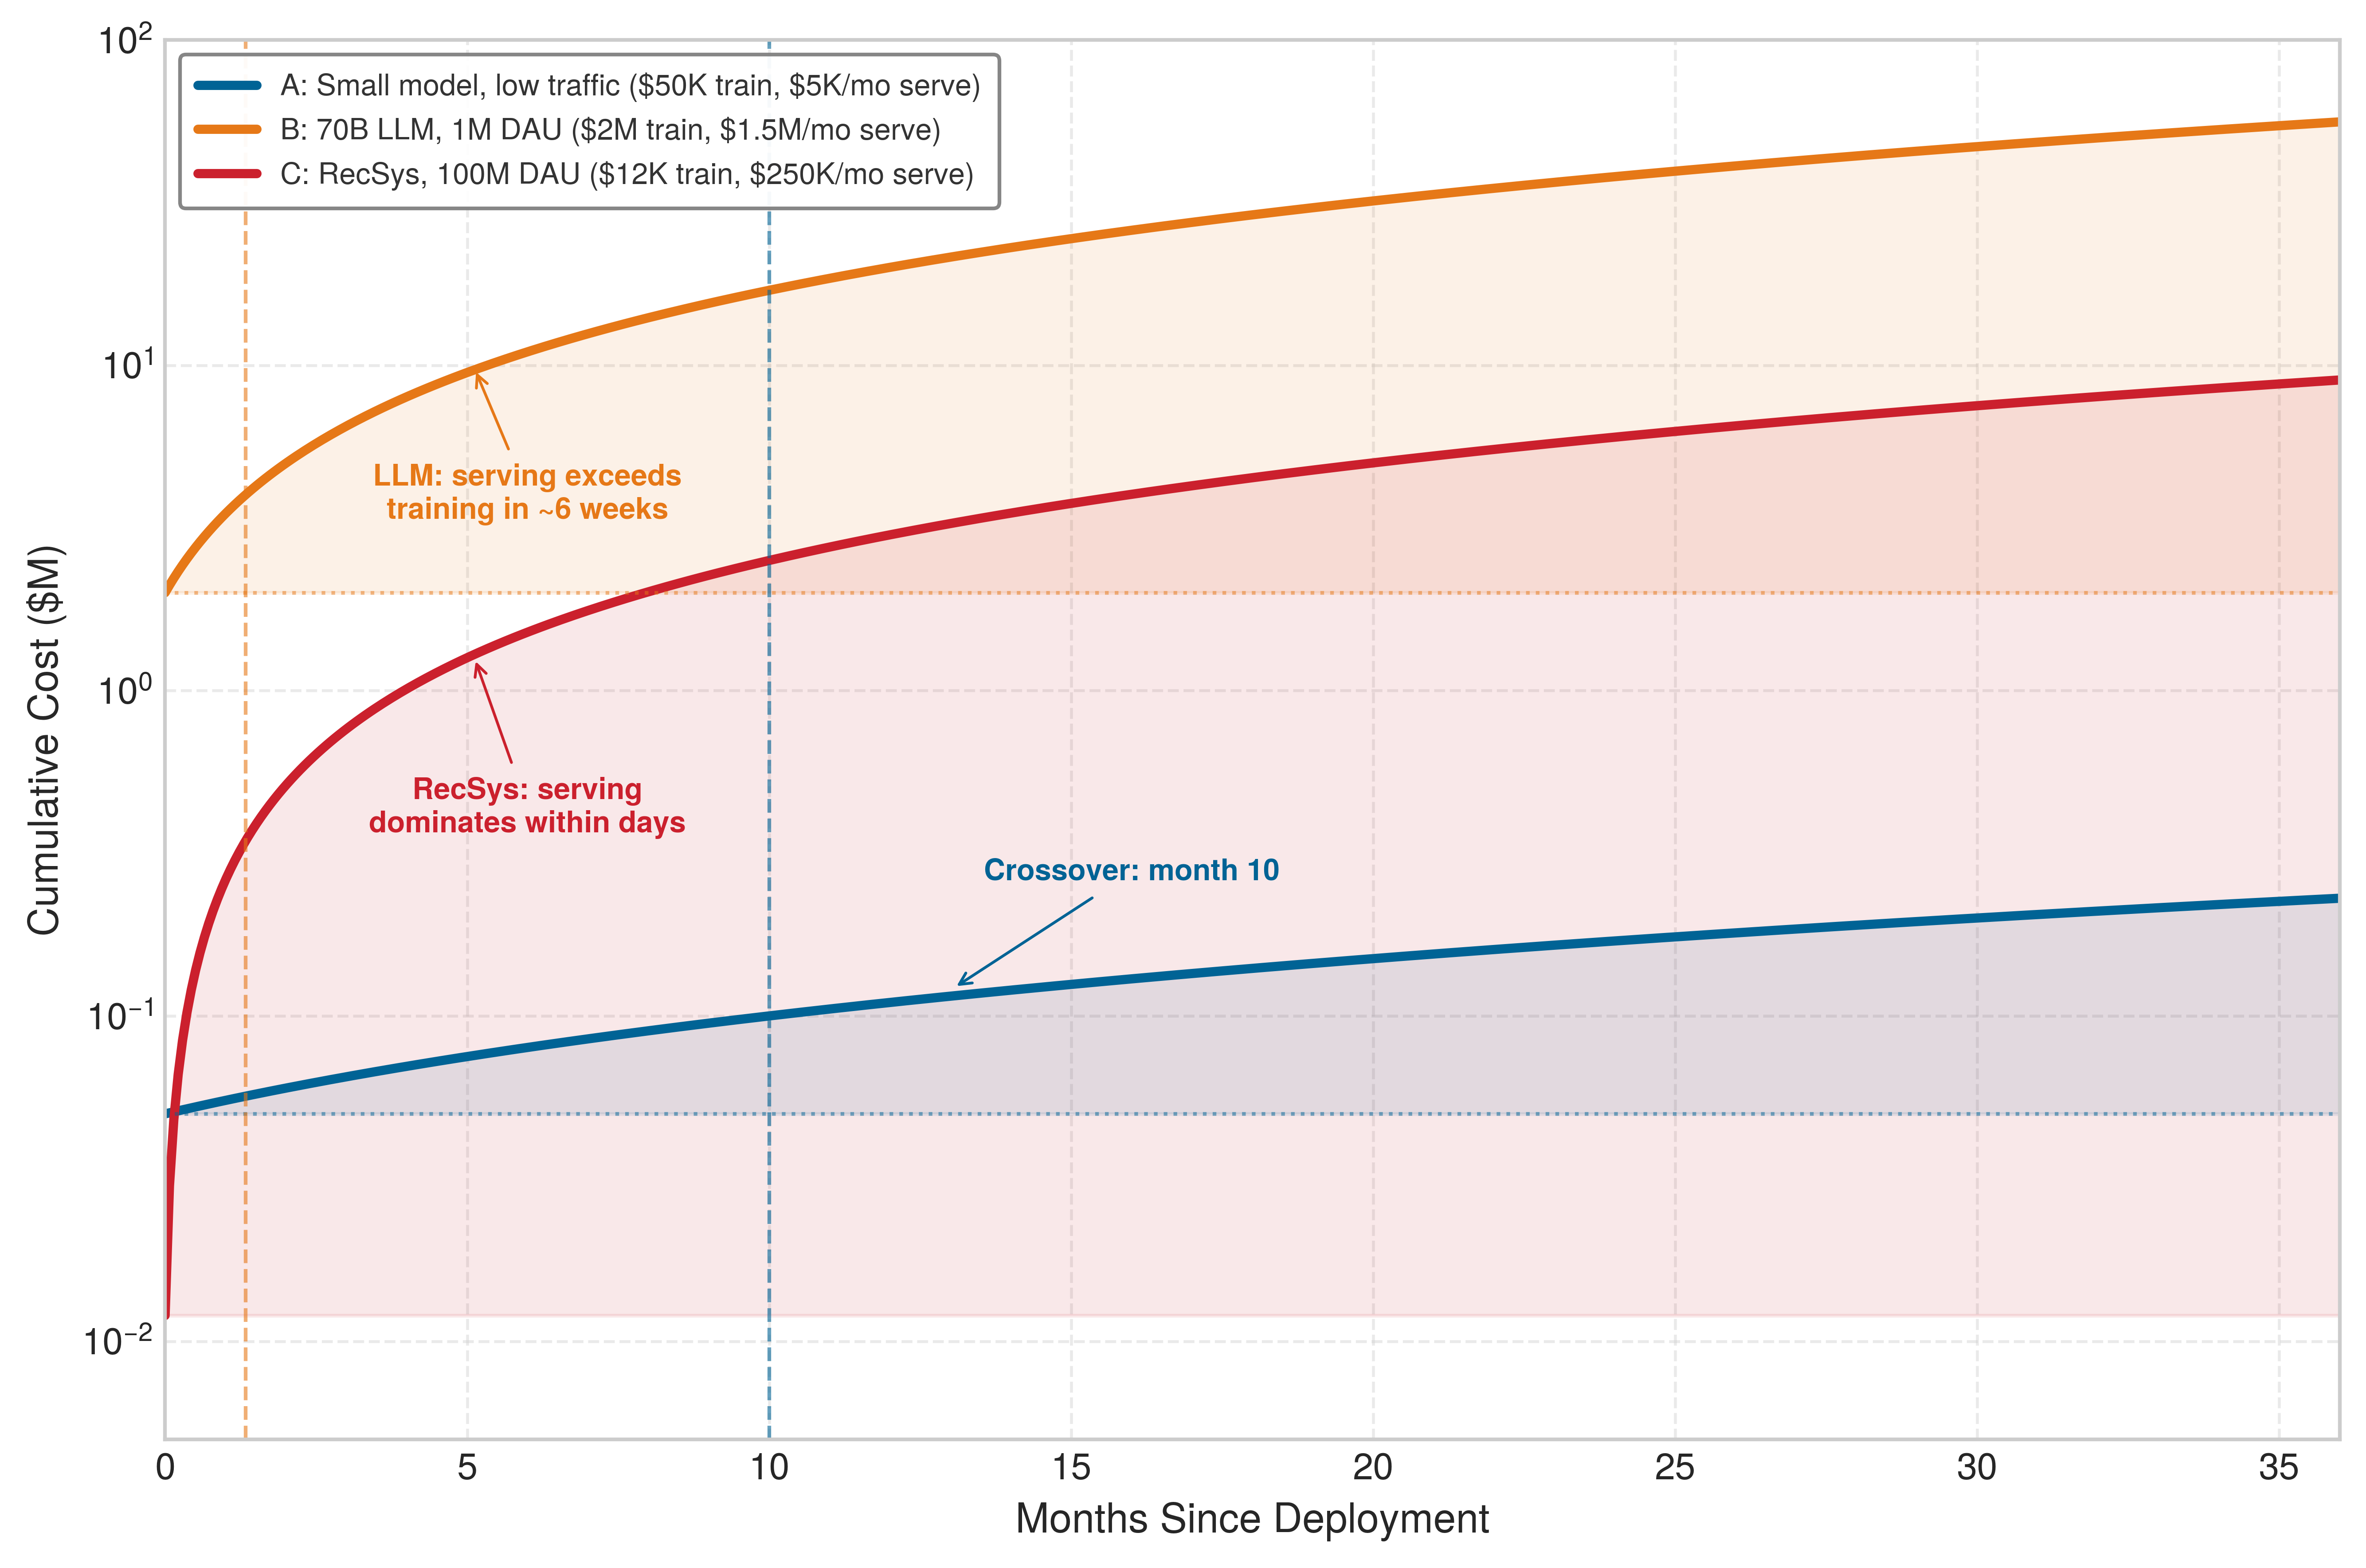
示例性训练与服务成本比率 中的成本比率讲述的是一个静态故事,但成本累积的动态过程揭示了一个更为引人注目的模式。服务成本交叉点 在 36 个月的时间窗口内绘制了三种代表性场景的累计总部署成本:一个小型模型且流量较低、一个 70B 大语言模型服务一百万日活跃用户、以及一个服务一亿用户的推荐系统。纵向上的交叉标记表示累计服务支出等于原始训练成本的时刻;由于所绘曲线同时包含训练与服务的成本,在该标记处总成本曲线约为训练基线的两倍。对于推荐系统,服务成本在数天内即占主导;对于高流量大语言模型,则约为六周。只有训练成本高而流量低的小型模型,才会看到训练成本在较长时间内占据主导。这一时间维度的视角进一步印证了为何在生产规模下,推理优化值得尽早投入工程关注。对于生成式大语言模型服务,面向服务的专门设计可以直接转化为吞吐量、成本与功耗方面的收益 (Patel 等 2024年)。
Patel, Pratyush, Esha Choukse, Chaojie Zhang, Aashaka Shah, Íñigo Goiri, Saeed Maleki, 和 Ricardo Bianchini. 2024年. 《Splitwise: Efficient Generative LLM Inference Using Phase Splitting》. 2024 ACM/IEEE 51st Annual International Symposium on Computer Architecture (ISCA), 118~32. https://doi.org/10.1109/isca59077.2024.00019.
:::
:::
超出大语言模型的推理
规模推理的一个常见误解,是把其等同于大语言模型(LLM)服务。大语言模型确实呈现出独特的挑战并备受关注,但它只是生产推理的一部分。在大型消费级平台上,推荐与排序工作负载可以主导 AI 推理周期与容量 (Gupta 等 2020年; Hazelwood 等 2018年)。视觉与图像处理、自然语言处理(NLP)与 LLM 工作负载、欺诈检测、广告以及其他分类任务则构成了其余部分。生产推理格局 按照服务压力与优化挑战对这些模型类型进行比较。推荐系统受嵌入查找(embedding lookup)约束,视觉系统受批处理效率约束,LLM 受内存带宽约束,语音系统受顺序解码约束。没有任何一种优化方法能同时适用于这四种类型。
推荐系统往往主导高吞吐消费级推理,因为它们需要为大量用户交互提供服务预测。每一次页面加载、滚动或点击都可能触发排序或检索推理。一名浏览电商网站的用户,可能在单个会话中产生许多推荐请求。相比之下,LLM 查询通常需要有意识的用户操作,因而发生频率较低。
该分布对技术选型具有直接影响。推荐系统推动了多项重要的生产推理创新:动态批处理(dynamic batching)、嵌入分片(embedding sharding)、特征库(feature store)架构以及低延迟服务,均主要是为推荐工作负载开发的 (Naumov 等 2019年; Gupta 等 2020年)。LLM 专属技术如连续批处理(continuous batching)与 KV cache 管理,则针对生产推理的另一部分。文本生成图像系统(如 DALL-E)提供了一个多模态模型示例 (Ramesh 等 2021年),但多模态服务的吞吐量与延迟目标仍因产品而异。
Ramesh, A., M. Pavlov, G. Goh, S. Gray, C. Voss, A. Radford, M. Chen, 和 I. Sutskever. 2021年. 《Zero-Shot Text-to-Image Generation》. 收入 Proceedings of the 38th International Conference on Machine Learning, ICML 2021, 18-24 July 2021, Virtual Event, 编辑 Marina Meila 和 Tong Zhang, 卷 139. Proceedings of Machine Learning Research. PMLR.
| 模型类型 | 服务压力 | 延迟目标 | 关键挑战 |
|---|---|---|---|
| 推荐/排序 | 消费级平台中量高 | \(<10\text{ ms}\) P99 | 嵌入查找 |
| 视觉(CNN) | 随工作负载变化 | 20–100 ms | 批处理效率 |
| LLM | 每次请求成本高 | 100 ms–10s | 内存带宽 |
| 语音/音频 | 流驱动 | 实时 | 顺序解码 |
| 多模态/文本生成图像 | 新兴且因产品而异 | 视情况而定 | 跨模态协同 |
服务层级
优化技术组织成一个服务层级,与计算机体系结构中的存储层级类似。每一层各自对应一个不同的瓶颈,因此有助于某一层的优化可能不会改变另一层。请求层沿一条请求追踪其处理过程,包括预处理、批处理、缓存与模型执行,其目标是用户所感知的延迟。副本层则观察单个模型实例的内部,GPU 利用率、内存管理、内核效率与模型优化共同决定该副本在饱和之前能够提供多少有效吞吐量。服务层随后跨越同一模型的多个副本,借助负载均衡、请求路由与自动伸缩,将单个副本转化为聚合容量。平台层跨越服务与租户,资源分配、多租户、调度与放置决定共享服务集群能否保持高效,同时不使一个工作负载的降级影响另一个。
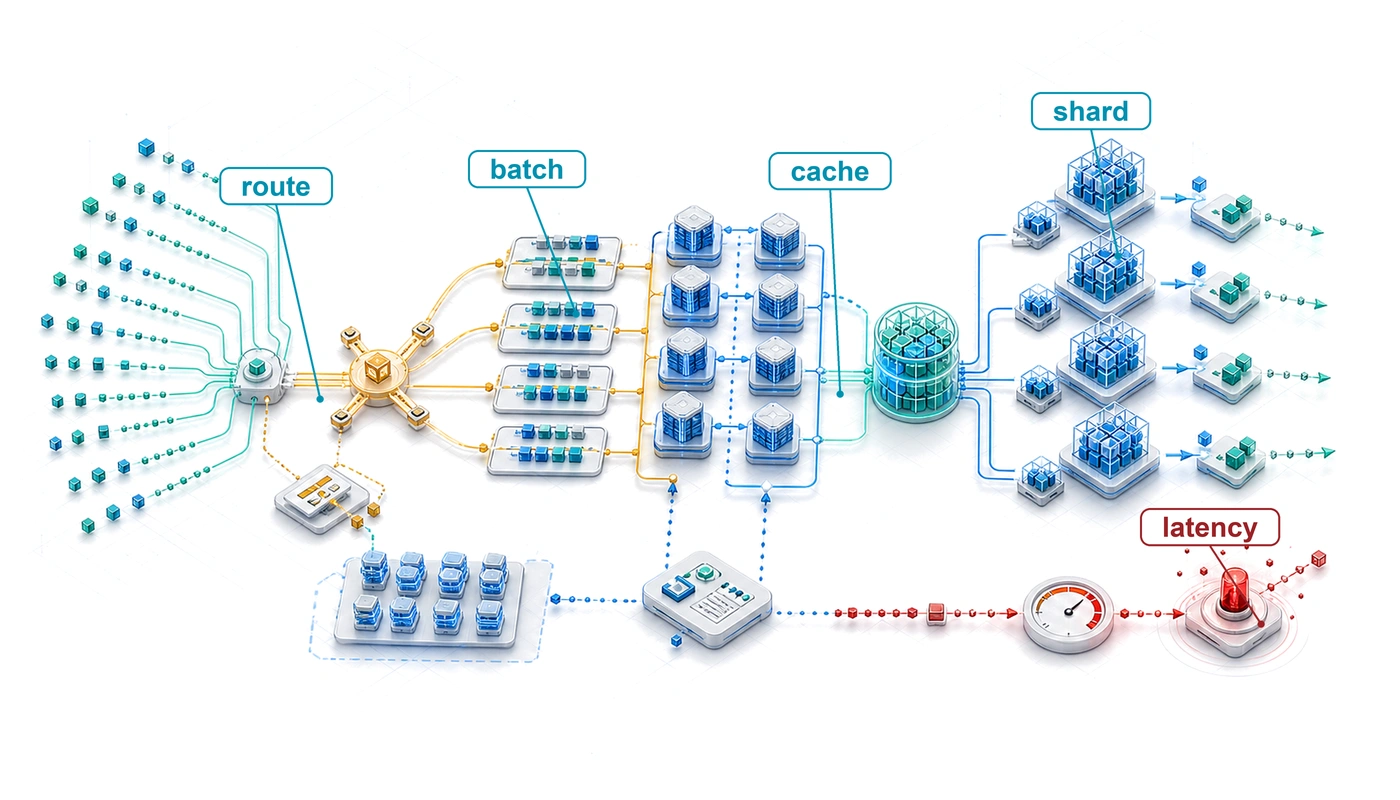
该层级之所以重要,是因为每一层改变不同的指标,并在不同的边界上失效。相关的部署栈出现在 图 2,展示了生产环境中请求如何经过边缘、路由与模型服务基础设施。
每一层都有各自独特的优化杠杆,推理服务层级优化目标 展示了为何该杠杆具有层级特异性:请求级(request-level)调整可降低单次请求延迟,副本级(replica-level)调整可提高资源利用率,服务级(service-level)调整可增加聚合容量,平台级(platform-level)调整则可改善跨租户的集群效率。优化错误的层级,就会推动错误的指标。
| 层级 | 优化目标 | 关键技术 |
|---|---|---|
| 请求 | 单次请求延迟 | 动态批处理、缓存、预取 |
| 副本 | 吞吐量、利用率 | 内存优化、算子融合 |
| 服务 | 聚合容量 | 负载均衡、路由、自动伸缩 |
| 平台 | 资源效率 | 多租户、调度、放置 |
Checkpoint 1.2: 服务层级
验证你对具体优化措施在服务层级中所在位置的理解:
该层级指导后续设计,同时允许少量技术跨越层级。批处理、KV 缓存布局和解码期优化始于请求层。量化、适配器状态和模型分片会改变副本的内存与计算预算。解耦式服务(disaggregated serving)、负载均衡和自动伸缩将副本协调为服务,而多租户与资源隔离则统辖平台。量化贯穿整个层级,因为它是表示层杠杆,只要模型状态或 KV 状态存在,就会改变内存、带宽和成本预算。
服务架构维度
一个每秒处理 100,000 次嵌入查找、且跨越分片特征存储的推荐系统,与一个 700 亿参数、逐 token 生成的语言模型,需要不同的服务架构。仅凭框架选择无法解释这一差异。这些工作负载对批处理、内存管理、调度和部署拓扑施加了不同的约束。本节将识别这些架构维度,并以具体框架作为示例,而非研究对象。
批处理策略:吞吐量—延迟权衡
服务系统中最具决定性意义的架构决策,是如何将入站请求聚合成批次。这一选择决定了系统的基本吞吐量—延迟工作点。
静态批处理 在将请求调度至加速器之前,先收集固定数量的请求。对于处理固定尺寸输入的视觉模型,这种方法可最大化 GPU 利用率,因为批次中的所有请求执行相同的计算图,且内存访问模式可预测。一个 ResNet-50 推理服务器可以批处理 32 或 64 张图像,并实现接近线性的吞吐量扩展,因为批处理摊薄了固定的启动开销,并在多个输入之间复用驻留权重。
自回归语言模型打破了这一假设。每个请求生成的输出 token 数量各不相同,因此静态批处理会迫使所有请求等待批次中最长的一次生成,并可能在较短请求完成后使加速器容量闲置。连续批处理通过允许请求在每个解码步骤进入和退出批次来解决这一问题,这是一种由 Orca (Yu 等 2022年) 提出的迭代级调度方法。当某个请求完成生成时,新的请求会立即填补其位置。vLLM6 等系统将该调度方式与基于 PagedAttention 的 KV 缓存管理相结合,通过减少内存浪费,在既有 LLM 服务系统上实现 2–4\(\times\) 倍的吞吐量提升 (Kwon 等 2023年)。
6 vLLM 与虚拟内存:名称提示了其与操作系统的类比:逻辑 KV 缓存页与其在 GPU 内存中的物理位置相互解耦。
推荐系统引入了第三种模式:特征并行批处理。由于瓶颈是分布式嵌入查找而非稠密矩阵乘法,这些系统会按特征类型对请求进行批处理,并将批次分片到各嵌入服务器上。随后进行的稠密 MLP 计算则可以基于预取并预批处理的特征向量运行。批处理策略一节(节 1.2)将完整展开这些方法的定量细节。
内存管理:从预分配走向分页
服务系统在加速器内存管理方式上存在根本差异,而这种差异决定了最大并发请求容量。
Definition 1.1: KV 缓存
KV 缓存 是 LLM 推理中按请求分配的内存缓冲区,用于存储此前所有已生成 token 的 Key 与 Value 注意力张量,以便无需重新计算整个前缀注意力即可生成下一个 token。
- 重要意义:它将每个 token 的注意力计算量随序列长度增长的复杂度从 \(O(n^2)\) 降至 \(O(n)\),但其内存占用随上下文长度和批大小线性增长,往往比模型权重本身消耗更多 HBM,并成为限制服务容量的关键约束。KV 缓存基础 推导了基本的容量计算公式。
- 区别:与模型权重(由所有请求共享且静态分配)不同,KV 缓存为请求私有,且大小动态变化;每个并发用户都会单独产生与序列长度成正比的内存开销,调度器必须为此安排预算。
- 常见误区:一种常见误解是,按比例缩小模型规模就能按比例减少服务所需的内存。实际上,在长上下文场景下,KV 缓存占据了大部分 HBM,因此,即使是经过量化的 70B 模型,也可能在仅考虑权重时本可轻松容纳的批大小下受到容量限制。
预分配内存管理 在接纳请求时,根据最大可能输出长度为每个请求预留固定的内存预算。对于支持输出 4,096 个 token 的模型,每个请求都会预留可容纳 4,096 个 token 的内存,无论实际生成的是 50 个还是 4,000 个 token。这种方法简单且可预测,但浪费的内存与最大输出长度和实际输出长度之差成正比。在实践中,预留的 KV 缓存内存有 60–80% 未被使用。
分页内存管理 借鉴操作系统虚拟内存的机制,以固定大小的块(页)分配内存,并通过块表将逻辑序列位置映射到物理内存位置。随着请求生成 token,系统按需分配新的物理块。生成完成后,这些块立即返回空闲池。以 PagedAttention(在 节 1.3.3 中介绍)为代表的方法,通过消除内部碎片(预分配空间仅部分填满)和外部碎片(已分配空间之间无法利用的空隙),实现接近 100% 的内存利用率。
内存管理策略直接决定批容量:在相同硬件上,分页系统能够处理的并发请求数量是预分配系统的 2–4\(\times\),因为分页系统回收了预分配所浪费的内存。对于 GPU 预算固定的服务,这直接意味着单次请求成本降低至原来的 1/(2–4\(\times\))。
调度策略:FCFS、抢占式与优先级感知
调度策略决定哪些请求获得 GPU 时间,以及执行顺序。当请求组合具有异构性时,例如有些请求需要输出 50 个 token,而另一些需要输出 4,000 个 token,这一决策就尤为关键。先来先服务(FCFS)调度 按到达顺序处理请求。FCFS 公平且简单,但存在队首阻塞问题:一个生成过程较长的请求会延迟所有后续请求。对于输出长度方差较大的工作负载,FCFS 的尾部延迟表现较差。
抢占式调度 允许系统停止为某个请求分配解码迭代,以便另一个请求运行。在 token 边界进行抢占是可行的,但并非没有代价:调度器必须将该请求的 KV 页保留在高带宽内存(HBM)中,将其换出到主机内存,或者丢弃这些页并在请求恢复时重新执行预填充。一种有效的被抢占请求选择策略,是将这三种代价与等待请求距截止时间的剩余时长进行比较,而不是在生成长度达到固定值时进行抢占。保留状态会消耗稀缺的容量,换出会消耗互连带宽,重新计算会消耗预填充计算资源;在高负载下,拒绝低优先级任务的代价可能低于反复迁移或重建其状态的代价。
优先级感知调度 为请求分配不同的服务等级,并保证高优先级请求先于低优先级请求获得 GPU 执行槽位。生产环境中的 API 可以将带来收入的客户请求划为关键级,将内部批处理划为标准级,将免费层流量划为尽力而为级。调度策略随后确保,即使在负载激增期间,关键请求也不会排在尽力而为级流量之后等待。
部署拓扑:从单 GPU 到解耦部署
部署拓扑决定模型计算如何映射到物理硬件,而这一映射取决于模型大小与单设备内存容量之比。单 GPU 部署是最简单的拓扑:整个模型能够装入一台设备的内存,所有推理计算都在本地完成。对于参数量低于 150–200 亿(FP16 格式下为 30–40 GB)的模型,这种拓扑能够提供最低延迟,因为它消除了所有设备间通信。
多 GPU 张量并行将每一层的权重矩阵切分到多个通过高带宽互连(H100 上为 NVLink,每个方向 900 GB/s 双向 [450 GB/s])连接的 GPU 之间。每个 GPU 计算每一层的部分结果,随后通过一次 all-reduce 操作在下一层之前同步这些部分结果。当模型权重超出单设备内存容量时,这种拓扑是必需的,它能够提供与并行度成比例的延迟降低,代价是每层的通信开销。模型分片部分(节 1.4)对通信开销进行定量分析。
分离式服务(disaggregated serving)将预填充阶段(处理输入提示词,属于计算受限)与解码阶段(逐个生成 token,属于内存带宽受限)分别部署到针对各自工作负载画像优化的不同硬件池(图 3)。预填充节点采用高 FLOP/s 加速器;解码节点采用高带宽内存配置。这种分离消除了预填充/解码之间的相互干扰,并允许各自独立规划并行度和容量,但同时也将状态迁移置于关键路径上 (Zhong 等 2024年)。分块预填充(chunked prefill)提供了与之相对的共置方案:它在无需支付网络传输开销的前提下限制了相互干扰 (Agrawal 等 2024年)。
Zhong, Yinmin, Shengyu Liu, Junda Chen, Jianbo Hu, Yibo Zhu, Xuanzhe Liu, Xin Jin, 和 Hao Zhang. 2024年. 《DistServe: Disaggregating Prefill and Decoding for Goodput-Optimized Large Language Model Serving》. 18th USENIX Symposium on Operating Systems Design and Implementation (OSDI 24), 七月, 193~210.
因此,解耦决策取决于定量契约,而不仅取决于阶段标签。如果预填充产生 \(S_{\mathrm{KV}}\) 字节的注意力状态,且资源池间的可用带宽为 \(B_{\mathrm{net}}\),那么交接至少耗时
\[T_{\mathrm{handoff}} = L_{\mathrm{net}} + \frac{S_{\mathrm{KV}}}{B_{\mathrm{net}}}, \tag{3}\]
其中,\(L_{\mathrm{net}}\) 包含传输建立和排队时间。公式 3 将部署位置纳入服务契约:预填充池必须支撑已接纳的提示词元速率,解码池必须支撑已接纳的输出词元速率,而且两个资源池都需要为请求长度分布预留容量余量。有效的容量指标是 SLO 有效吞吐量:即 TTFT 和 TPOT 均保持在各自目标范围内时的请求到达速率。只有当消除阶段间干扰并平衡两个资源池能够提高 SLO 有效吞吐量时,解耦带来的收益才足以抵偿传输开销。否则,将预填充与解码共置并采用分块预填充是更简单的设计。
有状态与无状态:扩展的分界
服务系统的有状态性决定了水平扩展是轻而易举,还是需要精心的工程设计。视觉模型和嵌入查找通常是无状态的:由于请求之间不保留会话级状态,任何副本都可以处理任何请求。水平扩展很直接——在负载均衡器后增加副本即可——而且故障恢复可以即时完成,因为负载均衡器会将请求路由至健康副本。
自回归请求在生成过程中是有状态的,因为其 KV 缓存属于正在处理的序列。跨请求的有状态性则是可选的。API 可以在每一轮发送完整的对话历史,并在预填充期间重建 KV 状态,使任何副本都能处理下一次请求。服务平台也可以将已完成轮次的 KV 状态保留为会话缓存,从而减少重复预填充,代价是需要处理副本亲和性、缓存生命周期管理和恢复复杂性。粘性路由是针对这种保留缓存的优化,并非自回归模型保证正确性所必需的条件。
因此,扩展的分界取决于接口和缓存策略的选择。每个正在进行的生成过程都需要请求级状态,但是否在请求结束后继续保留状态,由服务决定。跨轮次无状态服务需要重复预填充,但故障切换成本较低;采用会话缓存的服务可以节省预填充工作,但在扩展和故障期间必须逐步清空、迁移或重建缓存状态。只有当实测的缓存复用收益超过由此产生的负载失衡和恢复成本时,架构才应选择亲和性。
架构比较
表 1 总结了主要工作负载类型中批处理、内存、调度、拓扑和状态各维度之间的相互作用。该表表明,没有一种服务架构对所有工作负载都最优;每种工作负载类型的约束特征决定了各维度上适宜的设计点。
| 维度 | 视觉/嵌入 | LLM(自回归) | 推荐系统 |
|---|---|---|---|
| 批处理 | 静态/动态(输入一致) | 连续(输出可变) | 特征并行(嵌入分片) |
| 内存 | 预分配(可预测) | 分页(KV 缓存可变) | 分布式(嵌入表) |
| 调度 | FCFS(成本一致) | 抢占式(方差较高) | 感知优先级(SLO 分层) |
| 拓扑 | 单 GPU 副本 | 张量/流水线并行 | CPU-GPU 混合分片 |
| 状态 | 无状态 | 请求级状态;可选会话缓存 | 无状态或会话特征 |
Checkpoint 1.3: 服务维度
检验你对工作负载约束如何驱动架构选择的理解:
架构维度决定了针对给定工作负载应选择哪种服务系统。工程师会确定工作负载在各维度上的位置(批处理模式、内存特征、调度要求、部署拓扑和有状态性),并选择与之匹配的系统,而非逐项比较框架功能。本章的优化技术都在这一架构框架内发挥作用,每种技术针对一个特定维度。
大规模批处理策略
每秒都有数百个各不相同的聊天请求到达推理服务器。逐个处理这些请求会使 GPU 在大部分时间里处于空闲状态,在规模较小的解码步骤之间缺乏足够的工作。等待凑齐一个大型静态批次,又会迫使队列中的第一个请求承受不可接受的延迟。大规模批处理策略需要动态算法,在运行过程中即时合并请求,同时满足严格的尾延迟时限。
将多个请求一起处理,可以把固定成本(模型加载、内核启动开销和内存传输延迟)分摊到更多有效工作上,以更高的单请求延迟换取吞吐量的大幅提升。单机服务通过 动态批处理 应用这一思路:在一个时间窗口内收集请求,然后统一处理。
在大规模场景下,批处理变得更加复杂,因为不同模型架构有不同的批处理要求。对视觉模型最优的策略可能对 LLM 造成灾难性影响,而为推荐系统开发的技术可能对两者都不适用。
在大型消费级平台中,推荐系统可能占据 AI 推理计算周期的大部分,或构成容量压力的主要来源,而视觉、语言、排序、欺诈检测、广告及其他分类工作负载占据其余部分 (Gupta 等 2020年; Hazelwood 等 2018年)。尽管工作负载分布如此,本节仍按概念复杂度介绍批处理策略:视觉模型(直接的批处理)、LLM(带 KV 缓存的连续批处理)以及推荐系统(带分布式嵌入的特征并行批处理)。这一顺序有助于逐步建立理解,尽管生产系统往往首先遇到推荐工作负载。接下来的分类将批处理策略与模型特征相匹配,定量分析每种方法的适用条件及其预期性能。
为什么不同模型类型需要不同的批处理方式
批处理效率取决于计算量随批大小增长的规律,以及这一规律与内存和通信需求增长规律的关系。不同模型架构呈现不同的扩展关系,因此需要不同的批处理策略,如 图 4 所总结。
对于视觉模型(包括处理固定尺寸图像的卷积神经网络(CNNs)和视觉 Transformer(ViTs)),计算量随批大小线性增长,而由于权重共享,内存需求则以次线性方式增长。较大的批大小能以极小的开销提升 GPU 利用率,因此采用大批大小的静态批处理或动态批处理是最优的。
对于处于解码阶段的 LLM,每个 token 的计算量相对于加载模型权重所需的内存带宽需求而言很小。瓶颈是内存带宽,而非计算。较大的批大小可将权重加载分摊到更多 token 上,从而显著提升吞吐量,但随着批大小增大收益递减。
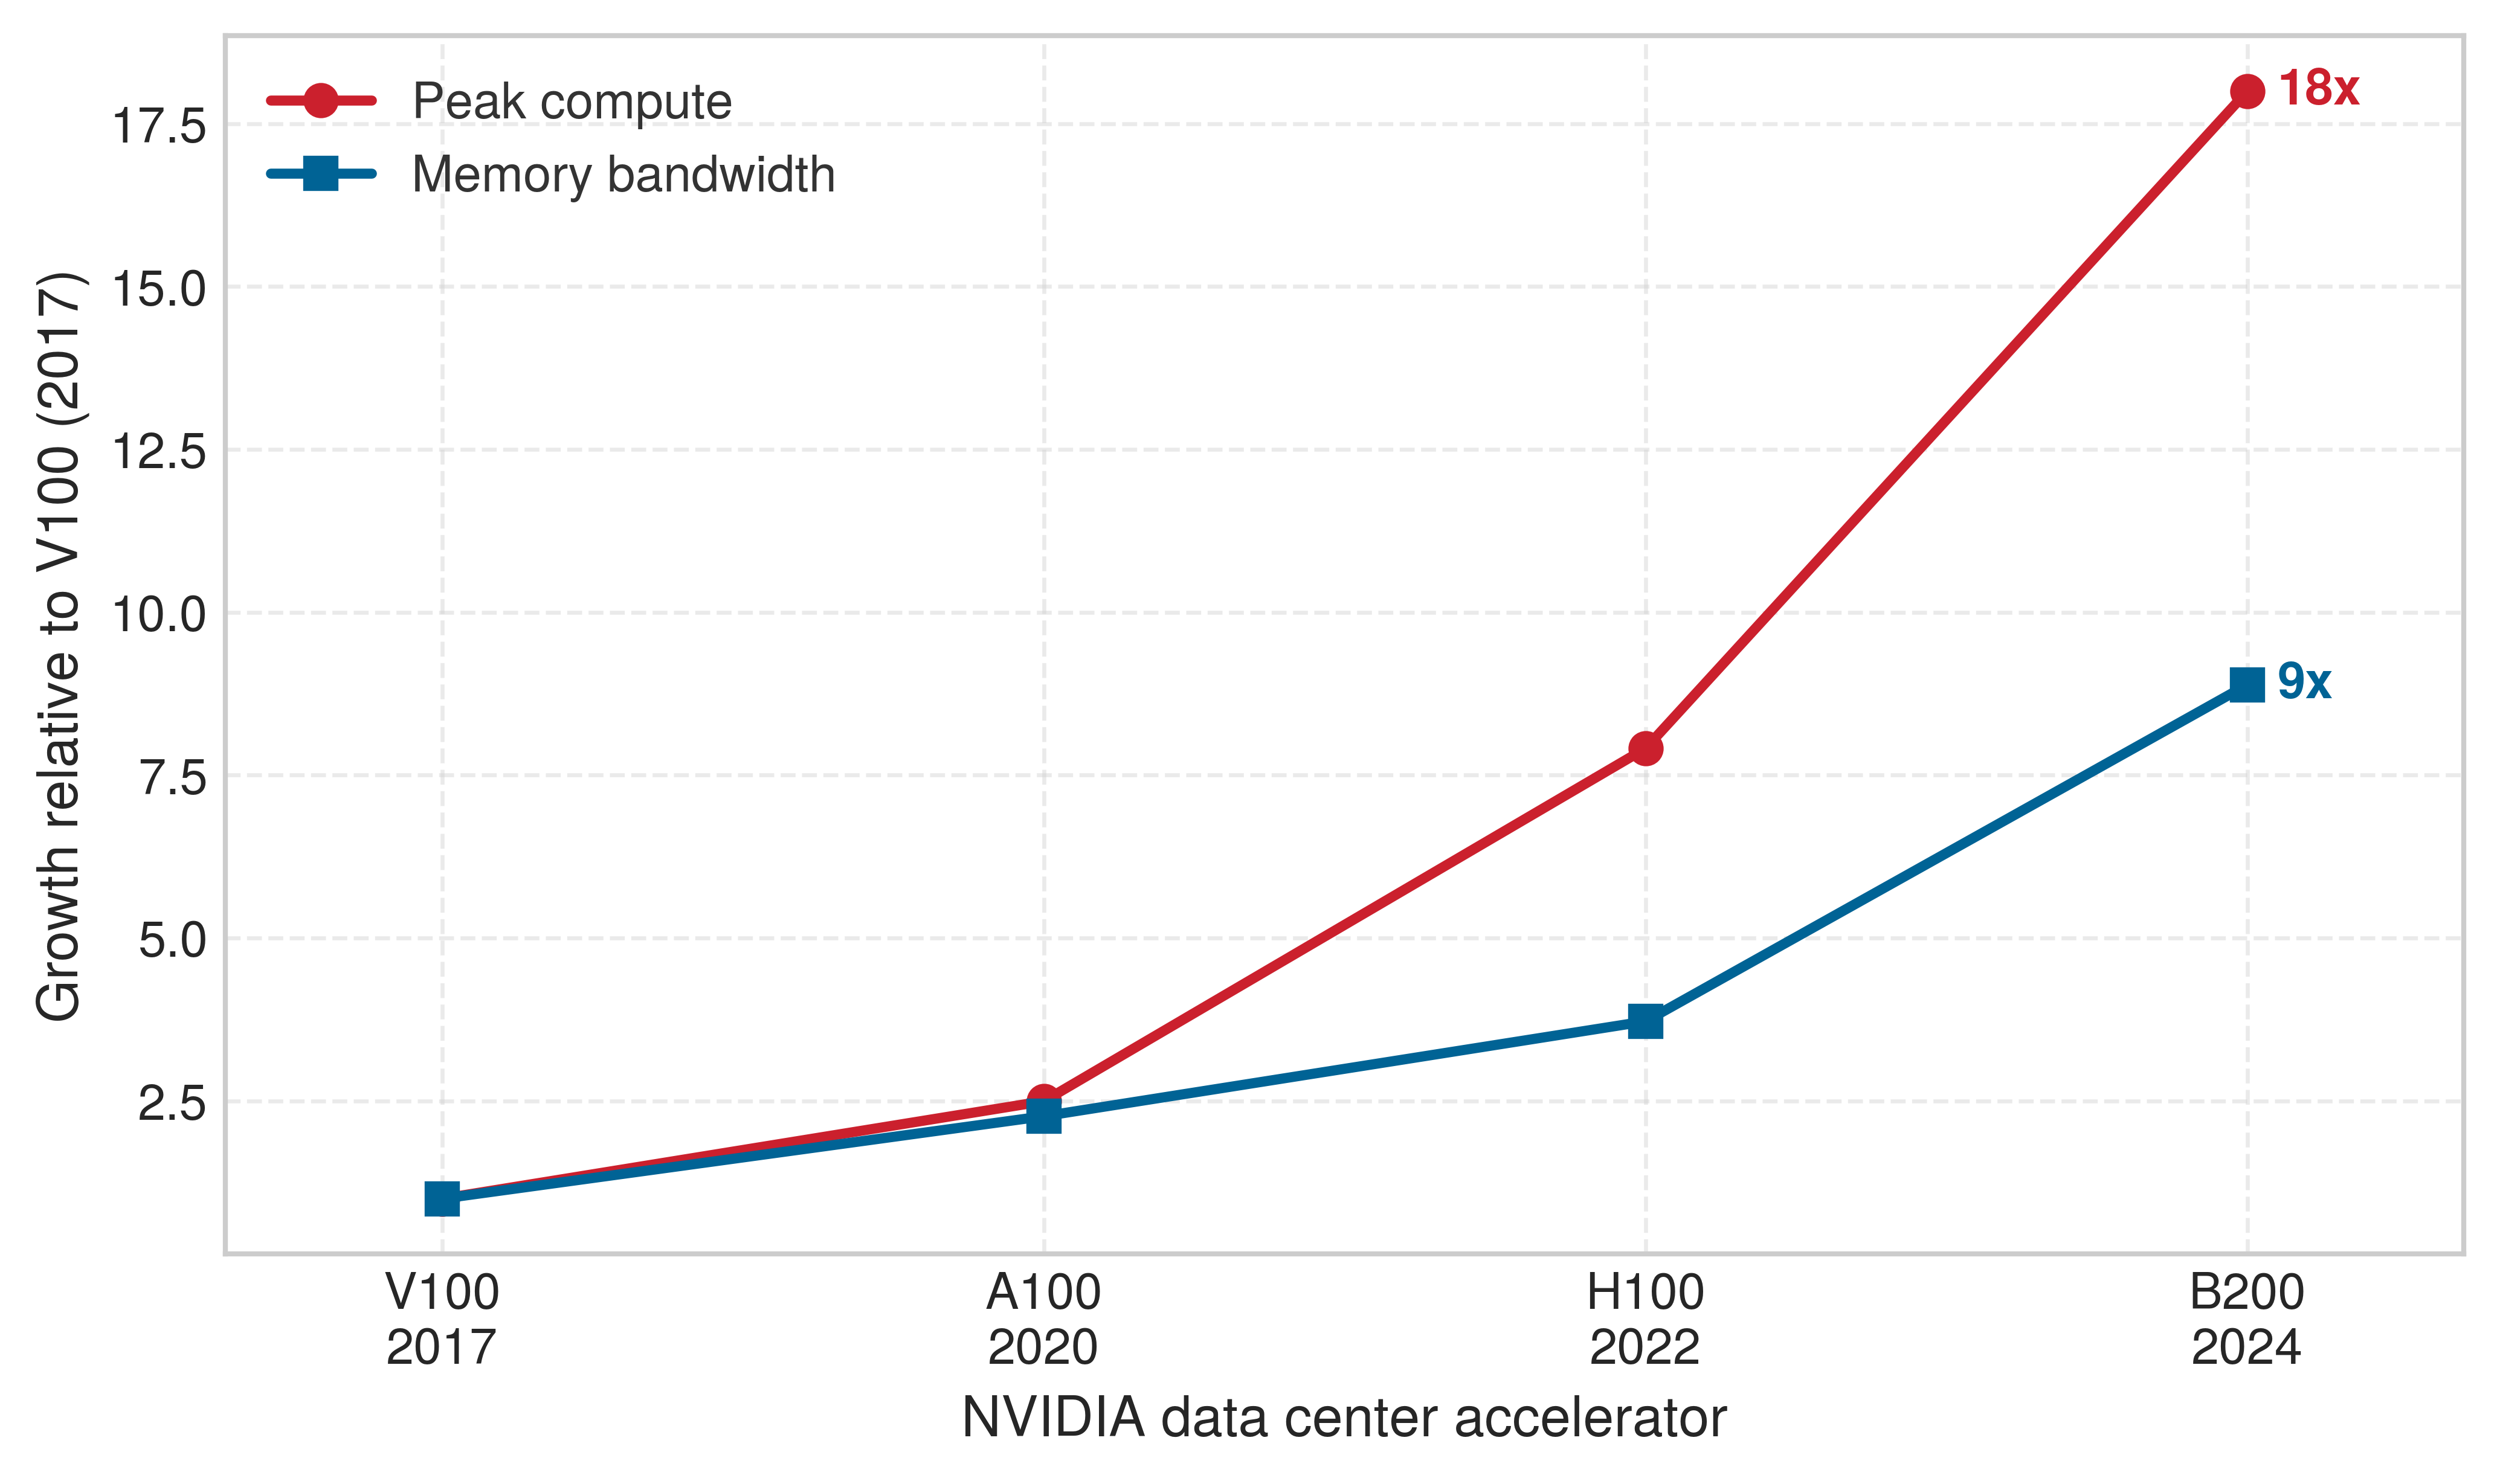
对于推荐系统,瓶颈通常是嵌入查找而非稠密计算。批处理策略必须针对并行的嵌入访问模式进行优化,而非矩阵乘法吞吐量。因此,解码并不继承该头条计算指标。图 5 将这两种增长率分离开来,而逐 token 的解码步骤则跟踪较慢的那一种,这就是为什么同一代升级虽然使预填充吞吐量翻倍,却几乎不会改变解码吞吐量的原因。
批处理的物理:效率曲线
批处理不仅是一种启发式方法;它受硬件利用率物理规律的支配。对批大小 \((B)\)、请求延迟 \((T_{\text{lat}})\) 与吞吐量 \((X)\) 之间关系的建模,可以确定推理系统的最佳运行点。
此处 \(T_{\text{lat}}\) 采用本书标准排队记号中的请求时间。本书其他部分,\(L_{\text{lat}}\) 表示固定延迟开销或延迟分量;本小节保留 \(T_{\text{lat}}\) 表示端到端请求时间变量,该变量用于 Little 定律和批处理方程。
延迟方程将每次请求的延迟分解为固定开销(内核启动、内存加载)和可变成本(每个样本的计算):
\[T_{\text{lat}}(B) = T_{\text{fixed}} + B \times T_{\text{variable}}\]
- \(T_{\text{fixed}}\):每批支付一次的开销(例如,从 HBM 加载权重、内核启动延迟)。
- \(T_{\text{variable}}\):增加一个请求的边际成本(例如,该样本的计算时间)。
吞吐量方程描述了系统的容量:
\[X(B) = \frac{B}{T_{\text{lat}}(B)} = \frac{B}{T_{\text{fixed}} + B \times T_{\text{variable}}}\]
由此得到的批处理效率曲线 呈现三个不同的区域。对于小批大小(\(B\)),吞吐量主要由 \(T_{\text{fixed}}\) 主导,使系统处于延迟受限(或开销受限)状态,此时增大 \(B\) 会带来可观但递减的吞吐量收益。随着 \(B\) 增大,\(T_{\text{fixed}}\) 项变得可忽略,吞吐量渐近逼近硬件极限 \(1/T_{\text{variable}}\),使系统处于计算受限(对 LLMs 则为带宽受限)。最佳批大小位于曲线的拐点,即吞吐量收益开始递减而延迟仍线性增长的点。
吞吐量在延迟达到 SLO 的批大小处趋于饱和。
工程目标是找到最大的 \(B\),使得 \(T_{\text{lat}}(B) \le \text{SLO}\)。这一表述解释了为什么视觉模型(高 \(T_{\text{variable}}\))的饱和批大小小于大语言模型(高 \(T_{\text{fixed}}\),源于权重加载),因而需要不同的调优策略。
Napkin Math 1.2: 批次效率曲线
问题:一名工程师优化两项服务:一个视觉模型(ResNet)和一个大语言模型(70B)。每个模型在多大的批大小下达到其效率曲线的“拐点”?
数学: 拐点出现在可变计算成本 \((B \times T_{\text{var}})\) 开始超过固定开销 \((T_{\text{fixed}})\) 的位置。
- 视觉模型 \((T_{\text{fixed}} = 2\text{ ms}, T_{\text{var}} = 1\text{ ms})\):
- 拐点:\(B \approx 2\text{ ms}/1\text{ ms} =\) 2。
- 结果:该简化延迟模型在很小的批大小处就达到首个开销摊薄拐点。生产 CNN 通常会在硬件饱和之前持续获得更高的吞吐量,直到批大小达到 32–64+。
- LLM 解码 \((T_{\text{fixed}} = 40\text{ ms}, T_{\text{var}} = 0.5\text{ ms})\):
- 拐点:\(B \approx 40\text{ ms}/0.5\text{ ms} =\) 80。
- 结果:LLM 需要极大的批大小来摊薄昂贵的权重加载开销。
系统层面的洞见:由于 LLM 的“固定开销”(从 HBM 加载 140 GB 权重)极其巨大,系统直到批大小达到 80 才达到效率拐点。因此,LLM 服务需要连续批处理(continuous batching)和分页内存:系统必须把数百个并发用户打包进单个批次,仅仅为了克服内存带宽瓶颈。
将这些批处理层面的方程转化为系统级容量规划,需要借助排队论中的一个经典结论:Little 定律,[^fn-littles-law-queuing] 它把任何稳定系统中的并发量、吞吐量和延迟联系起来。跨模型架构,按模型类型的批处理策略 表明批处理策略遵循其主导瓶颈:视觉模型是计算,LLM 的预填充和解码是内存容量或带宽,推荐系统的嵌入查找,语音是实时延迟。
[^fn-littles-law-queuing]:Little 定律:源自排队论,\(Q_{\text{req}} = \lambda_{\text{arr}} T_{\text{lat}}\),即并发量等于到达率乘以延迟。对于一个服务集群,这定义了容量包络:如果一块 GPU 能处理 32 个并发请求、每个请求耗时 100 ms,则最大到达率为 320 req/s。超过这一数值后,随着利用率趋近于 1,队列迅速增长,尾部延迟 \((L_{\text{lat}})\) 急剧上升。
| 模型类型 | 批处理策略 | 典型批大小 | 关键约束 | 吞吐量扩展 |
|---|---|---|---|---|
| 视觉(CNN) | 静态/动态 | 32–256 | GPU 计算 | 接近线性,直到 64+ |
| LLM(预填充) | 动态 | 1–64 | 内存容量 | 次线性 |
| LLM(解码) | 连续 | 100–1000s | 内存带宽 | 对数线性 |
| 推荐系统 | 特征并行 | 1000–10000s | 嵌入查找 | 取决于切分方式 |
| 语音 | 流式 | 1 | 实时 | N/A(延迟受限) |
Theorem 1.1: 推理中的利特尔定律
概念:在任何稳定的排队系统中,系统内请求的平均数量 \((Q_{\text{req}})\) 等于到达率 \((\lambda_{\text{arr}})\) 乘以请求在系统中停留的平均时间 \((T_{\text{lat}})\)。
\[ Q_{\text{req}} = \lambda_{\text{arr}} \cdot T_{\text{lat}} \]
应用:并发规划
- 目标吞吐量 \((\lambda_{\text{arr}})\):1,000 请求/秒
- 延迟 SLO \((T_{\text{lat}})\):100 ms(0.1 s)
所需并发量 \((Q_{\text{req}})\):\(Q_{\text{req}} = 1000 \times 0.1 =\) 100 个并发请求
容量规划: 若单个 GPU 副本处理的批大小为 8,延迟为 80 ms:
- 副本吞吐量 \(=\) \(8/0.08 =\) 100 请求/秒
- 仅考虑吞吐量的副本数下界 \(=\) \(\lceil 1000/100\rceil =\) 10 个副本
- 按 SLO 确定的副本数 \(=\) \(\lceil 100/8\rceil =\) 13 个副本
验证: 系统总并发量为 \(=\) \(13\text{ replicas} \times 8\text{ batch} =\) 104,因此多出 4 个请求槽位,超过利特尔定律要求的 100。仅按吞吐量下界配置的系统会运行在稳定性边界上;按 SLO 确定规模的集群则以约 76.9 percent 的服务利用率运行,为排队波动和尾延迟留出有限的余量。
只有当负载生成器遵守所声明的工作负载时,才能准确测量这一稳定性边界。Measurement at Scale 中的契约区分了固定的外部到达过程与固定并发测试,因为按响应节奏生成请求可能在系统停顿期间减少请求到达,使系统看起来拥有比实际更多的余量。吞吐量容量与延迟容量之间的区别,正是排队论所形式化描述的内容;批处理推理的排队论 推导了 M/D/1 等待时间分布,该分布决定了服务 SLO 需要多少余量。
视觉模型的静态与动态批处理
视觉模型是最简单的批处理情形,因为输入在预处理后具有统一的大小,且计算遵循可预测的模式。单机批处理原则可直接适用,而规模扩大后,还需要考虑多个副本上的批次形成问题。
静态批处理在开始处理前收集恰好 \(B\) 个请求。当请求到达可预测时,这能最大化 GPU 利用率,但在低流量期间会导致无界延迟。
动态批处理在最长时间窗口 \(T_{\text{window}}\) 内收集请求,或直到达到最大批大小 \(B_{\text{max}}\),以先发生者为准。当请求以到达率 \(\lambda_{\text{arr}}\) 按泊松过程到达时,期望延迟遵循 公式 4:
\[E[T_{\text{total}}] = E[T_{\text{queue}}] + T_{\text{batch}} + T_{\text{inference}}(B) \tag{4}\]
其中,\(E[T_{\text{queue}}]\) 是期望排队延迟,\(T_{\text{batch}}\) 是批次形成延迟(最长为 \(T_{\text{window}}\)),\(T_{\text{inference}}(B)\) 是批大小为 \(B\) 时的推理时间。到达率通过排队项和批次形成项发挥作用:在泊松到达过程中,平均到达间隔为 \(1/\lambda_{\text{arr}}\),因此较高的 \(\lambda_{\text{arr}}\) 会更快填满批次,并同时缩短 \(E[T_{\text{queue}}]\) 和 \(T_{\text{batch}}\),而较低的到达率则使它们趋近于 \(T_{\text{window}}\) 这一上限。接下来的算例将具体展示这些相互作用。
Example 1.1: ResNet-50 的动态批处理
场景:一项视觉分类服务以 5,000 QPS 的请求到达率运行,并需在 50 ms 的 P99 延迟 SLO 下,在 10 个副本上提供服务。
诊断:逐个请求地提供服务(不做批处理)会使系统过载(\(\rho_{\text{serv}} = \lambda_{\text{arr}} \times T_{\text{svc}} = 500 \times 0.005 = 2.5\) 利用率)。采用动态批处理窗口(方案 B:10 ms,方案 C:20 ms)可将请求打包,从而降低每个请求的计算时间,在延迟 SLO 内实现高达 33 percent 的每副本容量提升。
系统启示:当延迟预算存在未使用的余量时,动态批处理是有效的。服务策略将延迟余量转化为吞吐量,但需要仔细调优以避免 SLO 违规。
在大规模多副本场景下,批次的形成可以发生在单个副本内部,也可以发生在集中式批处理层。副本本地批处理由每个副本独立地从其分配到的流量中形成批次。这种方法实现起来更简单,但在负载不均衡时可能导致副本之间的批大小不一致。集中式批处理则使用批处理服务收集请求,并将形成的批次分派到副本。这实现了更均匀的批大小,但会引入中心化瓶颈和额外的网络跳数。生产系统通常采用副本本地批处理,并配合负载均衡以确保流量大致均匀分布,从而在不增加复杂度的前提下获得集中式批处理的好处。
连续批处理用于大语言模型(LLM)推理
自回归瓶颈(原则 14)支配着这一场景:在生成式模型中,解码阶段严格受内存带宽限制,因为生成每个 token 都必须加载整个模型权重集。吞吐量随批大小而扩展,通过在不同请求之间共享权重加载来实现,而非依靠计算能力。
Definition 1.2: 连续批处理
连续批处理 是一种服务策略,它将批次的成员关系与迭代边界解耦,使得新请求在每个解码步骤都能进入,已完成请求也能在每个解码步骤退出。
- 重要性:它通过消除静态批处理固有的填充浪费和队头阻塞,最大化系统吞吐量 \((X)\),即使请求的序列长度差异很大,也能保证 GPU 保持饱和。
- 区别:与静态批处理或动态批处理(在请求级别对请求进行分组)不同,连续批处理在迭代级别运行,在每个时钟周期动态重塑计算张量。
- 常见误区:一种常见误解是认为连续批处理“纯粹是调度器的改动”。实际上,它需要动态内存管理器(如 PagedAttention),因为不同请求的 KV 缓存以不同速率增长和收缩,无法进行静态内存预分配。
将批次成员关系与迭代边界解耦就是槽位复用:当某个请求到达停止 token 时,调度器会在下一个解码步骤将其 KV 缓存槽位交给等待的请求,而不是让容量闲置直到最长的序列完成。
自回归语言模型提出了一个独特的批处理挑战,静态和动态方法都难以应对。Orca 系统7 (Yu 等 2022年) 暴露了这一限制。传统批处理强制批次中的所有序列完成之后,任何新序列才能加入,当序列完成时间不一致时会浪费计算资源。
7 Orca 与迭代级调度:Orca 的术语强调,准入和驱逐决策发生在解码迭代之间,而不仅是在整个请求级批次完成时 (Yu 等 2022年)。
Yu, Gyeong-In, Joo Seong Jeong, Geon-Woo Kim, Soojeong Kim, 和 Byung-Gon Chun. 2022年. 《Orca: A Distributed Serving System for Transformer-Based Generative Models》. 16th USENIX Symposium on Operating Systems Design and Implementation (OSDI 22), 521~38.
假设有 8 个序列的批次。如果其中一个序列在 10 个 token 后完成,而其他序列需要 100 个 token,那么该已完成序列的 GPU 资源将闲置 90 个迭代。使用传统批处理:
\[\text{Wasted compute} = \frac{(100 - 10) \times 1}{100 \times 8} = 11.25\%\]
对于具有高度方差的实际输出长度分布,被浪费的计算可能超过 50%。连续批处理(也称为迭代级批处理)将批次成员关系与迭代边界解耦。Algorithm 1 将调度器表述为解码循环:已完成的请求释放 KV 缓存页,等待的请求进入释放出的槽位,下一个批处理内核在重组后的活跃集合上运行。这一技术是定义大规模 LLM 服务吞吐—延迟权衡的核心——对于 A 类原型工作负载(GPT-4/Llama-3,三种系统架构原型),如果没有它,在经济上就不可行,因为其受内存带宽限制的解码阶段会让计算核心闲置等待权重加载,只有交错无关的请求才能饱和带宽。
\begin{algorithm} \caption{Continuous batching decode scheduler} \begin{algorithmic} \Require waiting queue $Q$; active set $A$; KV-cache page allocator; active-token capacity $C_{\text{tok}}$; batched decode kernel \Ensure generated tokens for completed requests; a continually refreshed active batch \While{the service is running} \State admit requests from $Q$ while capacity and free KV-cache pages remain; allocate state, append to $A$ \State run one batched decode kernel over all sequences in $A$ \State append each sampled token; extend its KV-cache pages \State remove completed or length-limited sequences from $A$; return their pages to the allocator \If{HBM pressure exceeds the policy threshold} \State preempt low-priority sequences by paging their KV-cache to CPU DRAM \EndIf \State fill freed capacity from $Q$, or resume paused sequences whose pages now fit \EndWhile \end{algorithmic} \end{algorithm}
在每次迭代中接纳、完成并补充槽位,可以避免活跃令牌容量因批内最长序列而闲置;而抢占路径则在内存压力下引入了 HBM 到 CPU-DRAM 的传输延迟。因此,吞吐量增益随输出长度方差而增长,必须与 KV-cache 移动相权衡。静态批处理会使 GPU 在等待批内最长请求时处于空闲状态,而连续批处理则能保持加速器执行饱和(静态批处理与连续批处理)。
:::
:::
连续批处理吞吐量分析
静态批处理与连续批处理 中的对比促成了吞吐量分析:静态批处理会让槽位在批次中最长序列完成前一直空闲,而连续批处理可以在每次迭代边界处补充这些槽位。输出长度方差创造了这一机会,但它本身并不能决定吞吐量收益。实际收益还取决于批处理容量、完整长度分布、请求到达、KV 缓存准入、预填充调度以及调度器开销。因此,不存在仅基于变异系数(CV)的、与负载无关的收益公式\(\text{CV} = \sigma / \mu\);服务团队必须在相同的到达轨迹、延迟目标和内存预算下比较不同策略。
示例1.2中的实现研究考察了 vLLM 如何通过迭代级调度、分页内存管理、抢占、吞吐量和 GPU 利用率来实现连续批处理。
Example 1.2: vLLM 中的连续批处理
场景:一个 LLM 服务引擎(vLLM)管理来自不同请求的自回归生成,其输出序列长度差异很大(Kwon 等 2023年)。
诊断:静态批处理会使计算核心在等待批次中最长请求完成时,超过 50% 的解码步处于空闲。连续批处理在每个迭代步评估序列终止,立即释放已完成的 KV 缓存页并接纳等待中的请求。在内存压力下,低优先级请求会被交换到 CPU DRAM。
系统启示:连续批处理将批处理成员关系与请求级边界解耦。将迭代级调度与动态分页内存(PagedAttention)相结合,可带来 2–4\(\times\)倍的吞吐量收益,相对静态批处理。
吞吐量数字表明,当输出长度存在差异时,连续批处理优于传统批处理;但这并未说明收益从何而来,以及收益最多能增长到多大。量化传统批处理白白浪费的开销,才能把这种直觉转化为调度器可以据此行动的数值。
定量分析:传统批处理与连续批处理
第一个基线是传统 LLM 批处理,其中不等的输出长度会把请求异构性转化为浪费的解码轮次。批处理浪费的数学分析揭示了吞吐量损失的确切数量,以及连续批处理在何种条件下带来最大改进。
传统批处理的浪费函数
传统批处理(也称为静态批处理)会让批次中的所有请求都经过所有解码迭代,直到最长序列完成。对于批处理大小\(B\)与输出长度\(\{S_1, S_2, ..., S_B\}\),执行的计算总量为:
\[O_{\text{traditional}} = B \times S_{\text{max}} \times c_{\text{decode}}\]
其中\(S_{\text{max}} = \max_i(S_i)\)与\(c_{\text{decode}}\)表示每个解码迭代、每条序列的计算开销。然而,真正有用的计算仅为:
\[O_{\text{useful}} = \sum_{i=1}^{B} S_i \times c_{\text{decode}}\]
equation定义了浪费率,用于量化这种低效:
\[W = 1 - \frac{O_{\text{useful}}}{O_{\text{traditional}}} = 1 - \frac{\sum_{i=1}^{B} S_i}{B \times S_{\text{max}}} = 1 - \frac{\bar{S}}{S_{\text{max}}} \tag{5}\]
其中\(\bar{S}\)表示平均输出序列长度。由此可见,浪费完全取决于批处理内平均长度与最大长度之比。当输出长度均匀\((\bar{S} = S_{\text{max}})\)时,浪费为零。当长度高度可变时,浪费可以超过 50%。
算例:具有可变长度输出的 LLM 服务
考虑一个 GPT 类模型同时服务四个请求,其生成长度如@tbl-batching-request-lengths 所示(单位为 token):
| 请求 | 提示词长度 | 输出长度 | 总令牌数 |
|---|---|---|---|
| R1 | 100 | 50 | 150 |
| R2 | 80 | 200 | 280 |
| R3 | 120 | 100 | 220 |
| R4 | 90 | 150 | 240 |
Napkin Math 1.3: 连续批处理浪费计算
问题:给定四个输出长度不等的 LLM 请求,量化传统批处理平均延迟的浪费量,以及连续批处理如何回收这些空闲槽位时间。
变量:
- 每次迭代的解码时间(批次为 4):20 ms
- 批次中的最大输出长度:200 tokens(R2)
- 平均输出长度:\((50 + 200 + 100 + 150) / 4 =\) 125 tokens
传统批处理:四个请求都必须等待 R2 完成其 200 个 token。
- 总解码迭代次数:200
- 总批处理时间:\(200 \times 20\text{ ms} =\) 4,000 ms
- 请求完成时间:
- R1 在第 50 次迭代完成有用工作,但需等待至第 200 次迭代 → 延迟 = 4,000 ms
- R2 在第 200 次迭代完成 → 延迟 = 4,000 ms
- R3 在第 100 次迭代完成有用工作,但需等待至第 200 次迭代 → 延迟 = 4,000 ms
- R4 在第 150 次迭代完成有用工作,但需等待至第 200 次迭代 → 延迟 = 4,000 ms
使用 公式 5 计算浪费:
\(W = 1 - \frac{125}{200} = 1 - 0.625 = 37.5\%\)
GPU 执行 \(4 \times 200 =\) 800 个“序列迭代”,但其中只有 500 个是有用的。
连续批处理:序列在完成时离开批次,新请求可以加入。
- 第 50 次迭代:R1 完成 → 槽位释放,新请求 R5 可以加入
- 第 100 次迭代:R3 完成 → 槽位释放,新请求 R6 可以加入
- 第 150 次迭代:R4 完成 → 槽位释放,新请求 R7 可以加入
- 第 200 次迭代:R2 完成
连续批处理下的请求延迟(假设无排队延迟):
- R1:\(50 \times 20\text{ ms} =\) 1,000 ms(较传统批处理改善 4×)
- R3:\(100 \times 20\text{ ms} =\) 2,000(改善 2×)
- R4:\(150 \times 20\text{ ms} =\) 3,000(改善 1.33×)
- R2:\(200 \times 20\text{ ms} =\) 4,000(最长请求无改善)
平均延迟对比
- 传统:4,000 ms(全部请求)
- 连续:(1,000 ms + 2,000 + 3,000 + 4,000) / 4 = 2,500
结果:连续批处理将平均延迟降低 37.5 percent,恰好等于浪费比例。
系统洞见:连续批处理并不会让最长请求更快;它防止较短请求在等待最长请求期间占用已完成的槽位。收益来自在迭代边界复用槽位,即 静态批处理与连续批处理 所示的槽位复用模式。
当连续批处理提供最大收益时
连续批处理分析表明,收益随输出长度方差而增长。一个有用的上界直觉来自比较传统批处理中最长序列与平均序列长度。设 \(\text{CV} = \sigma / \mu\) 为输出长度的变异系数。若批处理中最长的请求比平均值高出约 \(k\) 个标准差,则:
\[\text{Improvement} \approx \frac{S_{\text{max}}}{\bar{S}} = \frac{\mu + k\sigma}{\mu} = 1 + k \cdot \text{CV}\]
其中 \(k\) 表示最大输出超出平均值的标准差个数。真实系统实现的收益低于该上界,因为调度开销、KV-cache 压力和回填间隙消耗了部分理论收益。因此,下表报告的是有效浪费和加速比,其中 \(\text{speedup} \approx 1/(1 - W_{\text{effective}})\)。
表 2 量化了这种关系在不同工作负载类型下的表现,包括检索增强生成(RAG)(Lewis 等 2020年):
Lewis, Patrick, Ethan Perez, Aleksandra Piktus, Fabio Petroni, Vladimir Karpukhin, Naman Goyal, Heinrich Küttler, 等. 2020年. 《Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks》. Advances in Neural Information Processing Systems 33: 9459~74.
| Workload Type | CV | k | Waste (Trad.) | Speedup (Continuous) |
|---|---|---|---|---|
| 代码补全 | 0.3 | 2.5 | 16.7% | 1.2× |
| 对话(短回复) | 0.6 | 2 | 33.3% | 1.5× |
| 通用文本生成 | 1 | 2.5 | 50% | 2× |
| 创意写作 | 1.5 | 3 | 64.3% | 2.8× |
| RAG(文档长度可变) | 2 | 2.5 | 71.4% | 3.5× |
系统层面的模式十分清晰:当输出长度不可预测、不同工作负载类型共享同一集群、请求量足够高以填满腾出的槽位,且延迟 SLO 使得提前完成具有价值时,连续批处理最为有价值。当输出长度均匀(如分类或嵌入生成)、批大小过小以致槽位复用无关紧要,或请求量过低以致无法填满腾出的槽位时,其收益微乎其微。
实现复杂度权衡
使连续批处理具有价值的那份可变性,同时也使其更难运行。其性能收益伴随着必须权衡的实现复杂度。
内存管理复杂度显著上升。传统批处理在批形成时为每条序列分配固定的 KV cache 区域,仅在整批完成时才释放;连续批处理则需要随着序列增长进行动态分配,并在完成时立即释放,因而需要类似操作系统虚拟内存那样精细的内存管理。
调度器复杂度相应上升。传统批处理采用简单的 FIFO 调度:收集请求直至批满或超时,然后执行;连续批处理则需要在每个迭代中决定接纳哪些序列、在内存压力存在时抢占哪些序列,以及如何处理优先级类别。这使得调度器开销从每批 \(\mathcal{O}(1)\) 增加到每次迭代 \(\mathcal{O}(B)\)。
内核设计也必须相应调整。批处理 GPU 内核传统上假定批的组成固定;连续批处理则需要能够高效处理变长序列的内核,通常借助诸如将多个短序列打包进共享注意力掩码,或采用支持动态批成员资格的特殊内存布局等技术。
传统批处理与连续批处理的权衡总结了这些权衡:
| 维度 | 传统批处理 | 连续批处理 |
|---|---|---|
| 实现工作量 | 低(标准框架) | 高(自定义调度器、内核) |
| 内存开销 | 固定分配 | 动态分配 + 碎片管理 |
| 调度器延迟 | ~0.1 ms per batch | ~0.5-1 ms per iteration |
| 调试复杂度 | 确定性行为 | 状态依赖,更难追踪 |
| 吞吐量(可变) | 基线 | 1.5–3.5\(\times\) 提升 |
| 吞吐量(均匀) | 基线 | ~1.0\(\times\)(无提升) |
对于新的 LLM 服务部署,vLLM、TensorRT-LLM 或 Text Generation Inference 等连续批处理框架提供了成熟的实现路径。决策问题在于:是采用这些框架,还是自建自定义服务基础设施。对于已有传统批处理系统的组织,必须用 表 2 权衡迁移成本与工作负载的输出长度方差。
即便使用成熟的服务框架,诊断尾延迟异常仍需对系统栈进行系统性排查。一个典型的 P99 延迟回归展示了集群栈方法如何在基础设施层、执行层和服务层中应用。
Example 1.3: 调试高 P99 延迟
场景:一个 LLM 服务系统表现出高尾延迟:P50 = 100 ms、P95 = 180 ms 满足 SLO,但 P99 飙升至 \(L_{\text{lat}} =\) 500 ms,而目标为 200 ms,尽管 GPU 利用率仅为 \(\eta_{\text{hw}} =\) 85 percent。
诊断:该系统跨 4 张 A100 GPU 运行,通过 PCIe Gen4(每张 GPU 32 GB/s)互联,而非 NVLink。对于 100 MB 张量并行传输,跨 GPU 通信延迟为 PCIe 上的 \(T_{\text{comm}} \approx\) 3.1 ms,而 NVLink 上为 0.17 ms。调度策略使用最大批大小 32 和超时 50 ms,导致 5 percent 的批次经历队首排队延迟 \(T_{\text{queue}}\):短提示请求需等待长序列生成。
系统经验:尾延迟的根因在于调度策略与互连瓶颈。实现感知优先级的调度,并按请求类型差异化批大小上限:
- 请求分类:按预期输出长度分类(短:少于 50 个 token;中:50 至 200 个 token;长:超过 200 个 token)
- 差异化批处理:将短批限制为 8,中批限制为 16,长批限制为 32
此举将 P99 延迟降至 \(L_{\text{lat}} =\) 185 ms。
分块预填充与提示—解码交织
连续批处理将批次的准入与迭代边界解耦,但在生产工作负载中,请求的提示长度差异极大。处理这些提示暴露了自回归语言模型两个运行阶段之间的根本性系统张力:
预填充阶段:并行计算所有提示 token 的键值表示(\(S_{\text{prompt}}\))。由于所有提示 token 并行处理,线性投影通用矩阵乘(GEMM)运算作用于较大的序列维度(\(M = S_{\text{prompt}}\))。对于隐藏维度为 \(d_{\text{model}}\) 的注意力层,算术强度随提示长度增长: \[\text{AI}_{\text{prefill}} \approx \frac{2 \cdot S_{\text{prompt}} \cdot d_{\text{model}}^2}{2 \cdot d_{\text{model}}^2} = S_{\text{prompt}} \quad \left[\frac{\text{FLOPs}}{\text{byte of weights loaded}}\right]\] 当 \(S_{\text{prompt}}\) 超过加速器的运行临界点(现代张量核心硬件上的 \(\sim 150\text{--}250\text{ FLOP/byte}\))时,预填充严格处于计算受限状态。
解码阶段:逐序列顺序生成单个 token。在典型批大小(\(B_{\text{dec}} \le 64\))下,算术强度为 \(\text{AI}_{\text{decode}} \approx B_{\text{dec}} \ll \text{ridge point}\),因此解码严格处于内存带宽受限状态。每个解码步骤都需要将整个模型参数集从高带宽内存(HBM)流式传输到片上 SRAM,以执行单次向量—矩阵乘法。
Definition 1.3: 分块预填充
分块预填充 是一种 LLM 服务机制,将长提示的评估划分为大小不超过 \(C_{\text{chunk}}\) 的离散 token 块,在共享 token 预算内将预填充计算与持续的解码迭代交织在一起。
- 重要性:它解决了提示—解码相互干扰问题,即整体预填充会阻塞数百毫秒的活跃解码流,从而保证有界的 Token 间间隔(TBT),并保留交互式流式服务级目标(SLO)。
- 区别:与整体连续批处理(先完整执行整个提示,再启动解码)不同,分块预填充将预填充视为与内存受限解码 token 协同调度的多步迭代过程。
- 常见误区:将块预算 \(C_{\text{chunk}}\) 设置得过小,会引入内核启动和注意力掩码开销,从而降低整体预填充吞吐量;设置得过大,则会使预填充计算独占执行时间,导致 TBT 尾延迟尖峰。
在标准连续批处理中,来到的提示会先整体处理,然后才进入解码池。如果来到的请求包含 \(8{,}192\) 个提示 token,在 8-GPU 张量并行集群上以单个整体内核评估其预填充需要 \(100\text{--}300\text{ ms}\)。由于现代加速器无法在不产生高昂上下文切换和内存转储开销的前提下抢占正在运行的计算内核,因此服务引擎中所有活跃的解码流都会在整个预填充内核运行期间被阻塞。
这会在 Token 间间隔(TBT)(也称为 token 间延迟)中造成严重的尾延迟。虽然来到的请求获得了最优的首个 Token 时间(TTFT),但现有交互式用户会感受到明显的卡顿,违反交互式流式 SLO(通常要求 \(\text{P99 TBT} \le 30\text{--}50\text{ ms}\))。
分块预填充调度机制
为消除这种干扰,分块预填充(定义见 1.3,由 Sarathi-Serve (Agrawal 等 2024年) 首创,并被现代服务引擎如 vLLM 采用)将提示划分为大小不超过 \(C_{\text{chunk}}\) 个 token(通常为 \(256\text{--}512\) 个 token)的固定块。长度为 \(S_{\text{prompt}}\) 的提示需跨越 \(\lceil S_{\text{prompt}} / C_{\text{chunk}} \rceil\) 个独立调度迭代进行评估。
在每个迭代中,调度器在全局迭代 token 预算 \(T_{\text{budget}}\) 下构建一个混合批次,将活跃解码请求与预填充块结合,如 公式 6 所定义:
\[B_{\text{dec}} + \sum_{k \in \mathcal{P}_{\text{active}}} C_k \le T_{\text{budget}} \tag{6}\]
其中 \(B_{\text{dec}}\) 为活跃解码 token 数,\(C_k\) 为分配给等待预填充请求 \(k\) 的 token 块。Algorithm 2 将该迭代级混合调度循环形式化。
\begin{algorithm} \caption{Chunked prefill and hybrid batch scheduler} \begin{algorithmic} \Require waiting prefill queue $\mathcal{Q}_{\text{prefill}}$; active decode set $\mathcal{D}$; iteration token budget $T_{\text{budget}}$; maximum chunk size $C_{\text{chunk}}$ \Ensure generated tokens for decode requests; incremental KV-cache construction for prefills \While{serving engine is active} \State $B_{\text{dec}} \gets |\mathcal{D}|$ \State $T_{\text{rem}} \gets T_{\text{budget}} - B_{\text{dec}}$ \State $\mathcal{B}_{\text{prefill}} \gets \emptyset$ \While{$T_{\text{rem}} > 0$ \textbf{and} $\mathcal{Q}_{\text{prefill}}$ not empty} \State select head prefill request $R_i \in \mathcal{Q}_{\text{prefill}}$ \State $C_i \gets \min(C_{\text{chunk}}, T_{\text{rem}}, \text{remaining\_prompt\_tokens}(R_i))$ \State $\mathcal{B}_{\text{prefill}} \gets \mathcal{B}_{\text{prefill}} \cup \{(R_i, C_i)\}$ \State $T_{\text{rem}} \gets T_{\text{rem}} - C_i$ \EndWhile \State run unified hybrid forward pass over $(\mathcal{D}, \mathcal{B}_{\text{prefill}})$ \State append newly generated tokens for all $R \in \mathcal{D}$ \For{$(R_i, C_i) \in \mathcal{B}_{\text{prefill}}$} \State update prompt offset: $R_i.\text{offset} \gets R_i.\text{offset} + C_i$ \If{$R_i.\text{offset} = R_i.\text{prompt\_length}$} \State promote $R_i$ from $\mathcal{Q}_{\text{prefill}}$ to $\mathcal{D}$ \EndIf \EndFor \EndWhile \end{algorithmic} \end{algorithm}
通过搭车摊薄权重加载成本
将预填充块与解码迭代交错执行,可显著提升硬件效率,这种机制称为解码搭车。
在单独的解码步骤中,将模型参数(\(W_{\text{model}}\) 字节)从 HBM 流式传输到寄存器时,算术强度较低,因为只有 \(B_{\text{dec}}\) 个 token 使用这些权重执行矩阵—向量乘法。计算单元在内存传输周期的大部分时间内处于空闲状态。
在混合迭代中,从 HBM 加载到片上缓存和寄存器中的模型权重,同时被计算密集型预填充块(\(C_{\text{chunk}}\) 个 token)和受内存带宽限制的解码 token(\(B_{\text{dec}}\) 个 token)复用。迭代执行时间由 公式 7 决定:
\[T_{\text{step}} = \max\left(\frac{W_{\text{model}}}{\text{BW}_{\text{mem}}}, \frac{2 \cdot (B_{\text{dec}} + C_{\text{chunk}}) \cdot P_{\text{model}}}{P_{\text{peak}}}\right) \tag{7}\]
其中,\(P_{\text{model}}\) 为活跃参数数量,\(\text{BW}_{\text{mem}}\) 为 HBM 内存带宽,\(P_{\text{peak}}\) 为加速器的峰值计算吞吐量。当选取的 \(C_{\text{chunk}}\) 使计算时间与内存流式传输时间相匹配时,从内存带宽的角度看,解码 token 实际上可“免费”执行,从而大幅提高解码吞吐量,同时保证 \(T_{\text{step}} \le \text{SLO}_{\text{TBT}}\)。
Example 1.4: Sarathi:分块预填充实现
场景:一个 LLM 推理服务器接收长输入提示(\(10{,}000+\) 个 token)与交互式短解码请求混合的工作负载 (Agrawal 等 2024年)。
诊断:未分块的提示预填充会独占 GPU 计算引擎数百毫秒,阻塞并发请求的解码步骤,并引发严重的 token 间延迟尖峰。
系统启示:分块预填充(Sarathi-Serve)将长提示的预填充划分为固定大小的块(例如,\(512\) 个 token/块),使预填充块与解码迭代交错执行。限制每次迭代中的预填充执行时间,可以避免解码停滞,并满足 token 间延迟的 SLO。
Agrawal, Amey, Nitin Kedia, Ashish Panwar, Jayashree Mohan, Nipun Kwatra, Bhargav S. Gulavani, Alexey Tumanov, 和 Ramachandran Ramjee. 2024年. 《Taming Throughput-Latency Tradeoff in LLM Inference with Sarathi-Serve》. 18th USENIX Symposium on Operating Systems Design and Implementation (OSDI 24), 117~34.
迄今为止考察的批处理策略,依据一条根本性的约束边界划分为两类。视觉工作负载受计算能力限制,且张量形状固定,因此批次中的每张图像都执行相同的算术运算,批次构建问题便归结为尽可能充分地利用 GPU 计算流水线。LLM 工作负载受内存限制,且序列长度可变,因此 KV 缓存随每个请求和每个 token 的推进而增长,批次构建问题随之转向内存用量核算、淘汰策略,以及连续批处理提供的迭代级调度。两种形态各自产生了不同的主导策略,因为其稀缺资源不同:视觉工作负载的稀缺资源是计算吞吐量,语言工作负载的稀缺资源是内存容量。
推荐系统呈现出第三种约束形态,与前两者均不相似。主导计算时间和内存流量的是稀疏嵌入查找,而非稠密矩阵乘法。单个推荐请求可能访问分散在各个分片中的数百万个嵌入表条目,而后续的稠密排序头则相对较小。这种访问模式要求批处理策略围绕特征类型和嵌入局部性组织,而不是围绕请求形状或序列长度组织。
推荐系统的特征并行批处理
推荐系统的批处理首先围绕嵌入局部性组织工作,而非围绕请求形状。图 6 展示了请求如何先拆分为各特征对应的路径,再由稠密排序头重新组合检索到的表示。
推荐系统以另一种瓶颈暴露了相同的调度原则。其计算模式包含四个阶段:
- 稀疏特征查找:检索用户、物品和上下文特征的嵌入
- 稠密特征处理:转换并归一化稠密特征
- 特征交互:计算特征之间的交互(通常通过注意力或分解实现)
- 排序头:产生最终分数
稀疏嵌入查找通常主导延迟并决定批处理策略。特征并行批处理并行处理不同的特征类型,而不是批处理整个请求:
Request 1: [user_id_1, item_ids_1, context_1]
Request 2: [user_id_2, item_ids_2, context_2]
Request 3: [user_id_3, item_ids_3, context_3]

Feature-parallel view:
User embeddings:  [lookup(user_1), lookup(user_2), lookup(user_3)]  → parallel
Item embeddings:  [lookup(items_1), lookup(items_2), lookup(items_3)]  → parallel
Context features: [process(ctx_1), process(ctx_2), process(ctx_3)]  → parallel

Then: Combine features per request for ranking
当嵌入向量在服务器间分片时,特征并行批处理是自然的:每个嵌入服务器负责处理该分片在所有请求中的查找。在 Meta 量级的请求规模下,特征分片由此成为一种服务策略,而非单纯的存储细节。
Example 1.5: Meta 规模下的 RecSys 批处理
场景:Meta 规模的推荐基础设施为 10 million QPS 提供服务,每次请求查询 5,000 embedding lookups,覆盖 1,000 shards。
诊断:单线程逐请求的嵌入查找在每分片的 50 million lookups/秒 下无法满足需求。将请求累积到 1 ms 时间窗内,形成每分片 50K lookups 的批次,从而把随机内存读取转化为顺序访问。
系统启示:推荐批处理围绕稀疏特征局部性组织,而非稠密张量形状。在分片层面对查找进行批处理,可在 5.2 ms 端到端延迟预算内最大化内存带宽利用率。
面向实时应用的流式推理
流式负载界定了批处理本身成为错误应对方式的边界。实时语音识别、视频分析和机器人技术都需要在输入到达时即时处理,并保持尽可能低的延迟。
流式推理会增量处理输入,而不必等待批次形成。在语音识别中,它处理来自麦克风的音频帧(10–20 ms 的块)。在视频分析中,它以捕获速率处理帧(30–60 FPS),无需缓冲。在机器人技术中,它以控制回路频率处理传感器读数(100–1000 Hz)。
对于流式应用,相关指标不是吞吐量,而是处理每个输入所需的时间:
\[T_{\text{streaming}} = T_{\text{capture}} + T_{\text{transfer}} + T_{\text{inference}} + T_{\text{action}}\]
其中所有组件都必须在帧间隔内完成。流式语音转文本流水线展示了这些延迟分量在严格实时约束下的组合方式。
Example 1.6: 流式语音识别流水线
场景:实时流式语音转文本流水线在严格的 100 ms 端到端延迟预算下处理 20 ms 的音频帧(最大 5 帧延迟)。
诊断:传统批处理会引入无法承受的等待延迟。该流水线必须增量处理帧(\(T_{\text{streaming}} = T_{\text{capture}} + T_{\text{transfer}} + T_{\text{inference}} + T_{\text{action}}\)),将音频捕获与声学模型评估重叠执行。
系统启示:流式推理将每帧延迟置于批次吞吐量之上。当帧间隔很紧时,应移除批处理,并将执行优化为连续的增量流水线。
自适应批处理策略
一旦批处理成为负载特定的机制,固定参数便显得脆弱。生产系统会根据当前条件自适应地调整批处理行为:
流量自适应批处理会根据到达率调整批处理窗口:
\[T_{\text{window}} = \min\left(T_{\text{max}}, \frac{B_{\text{target}}}{\lambda_{\text{current}}}\right)\]
当流量较高时,窗口会缩小,因为目标批处理大小很快填满;当流量较低时,窗口会延长,但会受到上限约束以限制最大延迟。
SLO 自适应批处理采取了互补的方法,通过监控延迟分位数并激进地调整参数:
if P99_latency > 0.9 * SLO:
    reduce B_max by 20%
    reduce T_window by 20%
elif P99_latency < 0.5 * SLO:
    increase B_max by 10%
    increase T_window by 10%
反馈回路在正常运行期间保持延迟余量,同时最大化吞吐量。请求感知批处理在形成批次时考虑请求特征,从而引入第三个维度。对于 LLM,这意味着按预期输出长度(根据提示类型推断)对请求分组,按提示长度分组以尽量减少填充,并优先将延迟敏感的请求安排在较小的批次中。
生产环境中的服务基础设施体现了这些自适应原则。NVIDIA Triton Inference Server 实现了可配置的自适应批处理系统,展示了 SLO 感知和请求感知策略在实践中的运作方式。Triton 提供三个可调参数:Max_batch_size(批大小的上限)、Batching_timeout_ms(等待批次形成的最长时间)和 Preferred_batch_size(与内核执行效率相匹配的目标批大小)。在内部,调度器为每个首选批大小维护独立队列,并通过路由请求来最小化总延迟:
\[\text{Queue selection} = \operatorname{arg\,min}_{q} \left( \text{wait}_q + \text{exec}(|q| + 1) \right)\]
这一优化同时权衡当前队列长度和所得批大小对应的内核执行效率。Triton 自适应批处理:V100 上的 ResNet-50 展示了 ResNet-50 在 V100 上的结果:随着流量增长,调度器自动增大批大小以维持吞吐量,实测吞吐量随输入负载增长,直到接近 2,000 QPS 时达到饱和。
| 流量水平 | 平均批大小 | 平均延迟 | 吞吐量 |
|---|---|---|---|
| 100 QPS | 2.1 | 8 ms | 100 QPS |
| 500 QPS | 6.3 | 12 ms | 500 QPS |
| 1000 QPS | 12.4 | 18 ms | 1000 QPS |
| 2000 QPS | 24.1 | 28 ms | 1980 QPS |
到目前为止,每一种批处理策略都假设,请求一旦被接纳,其工作量便固定不变:连续批处理和自适应窗口调节请求何时加入批次以及系统等待多长时间,但每个请求所需的解码步数被视为既定值。需要大量推理的模型推断打破了这一假设。当模型可以在作答前使用更多 token 进行思考时,每个请求的工作量就成为调度器必须设定的变量,而不再是只能观测的属性。
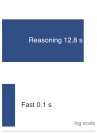
与快速模式匹配相比,推理使延迟增加到约 128 倍。
逻辑墙:测试时计算扩展
测试时扩展将推理转化为一种服务资源。请求在产生答案前,可能生成更多输出 token、内部思维链(CoT)token,或执行更多搜索步骤。大模型能力研究描述了涌现行为 (Wei 等 2022年),而后续分析提醒,某些看似涌现的现象可能是指标选择造成的假象 (Schaeffer 等 2023年)。
Wei, Jason, Yi Tay, Rishi Bommasani, Colin Raffel, Barret Zoph, Sebastian Borgeaud, Dani Yogatama, 等. 2022年. 《Emergent Abilities of Large Language Models》. Transactions on Machine Learning Research 4. https://doi.org/10.48550/arXiv.2206.07682.
Schaeffer, Rylan, Brando Miranda, 和 Sanmi Koyejo. 2023年. 《Are Emergent Abilities of Large Language Models a Mirage?》 Advances in Neural Information Processing Systems (NeurIPS), 55565~81. https://doi.org/10.52202/075280-2425.
从服务系统的角度来看,相关变化在于每个请求所产生的工作量。额外推理会消耗延迟预算,占用 KV 缓存驻留空间和加速器时间。模型从“快思考”(即时模式匹配)转向“慢思考”(审慎推理)时,会将压力从 HBM 带宽转移到测试时计算:调度器必须决定一个请求可以消耗多少搜索步骤或 CoT token。逻辑墙 是由此产生的服务约束:对于复杂问题,每个请求的计算量随任务难度增加,而针对每秒 token 数进行优化的集群也需要一套分配思考时间的策略。这与上一节的批处理窗口调优属于不同的控制方式:自适应批处理决定请求何时一起运行,而测试时计算决定每个请求获准执行多少工作。
Napkin Math 1.4: 推理深度
问题:计算一个使用 128 “Thinking Tokens” 来解决复杂数学证明的模型,与一个标准答案之间的延迟影响。
- 标准响应:1 个 token 的答案 = 100 ms。
- 推理响应:答案之前有 128 的内部搜索/CoT。
- 延迟:128 \(\times\) 100 ms = 12.8 seconds。
系统洞见:测试时扩展将服务架构从吞吐量工厂转变为搜索引擎。标准服务优化的是每秒 token 数,而推理密集型模型受限于每秒步数。这形成了一个“推理 SLO”:用户可能容忍 12 秒的正确证明,但不容忍一个简单的问候。在 Machine Learning Fleet 中,这推动了动态计算分配,调度器根据提示难度向更难的问题分配更多思考时间。
每次请求的工作量差异关闭了批处理这一叙事:连续批处理和自适应批处理处理系统所观察到的差异,而测试时计算则是系统主动选择的差异。动态计算分配 根据任务难度、延迟容忍度和集群负载为每个请求分配计算预算,而不是对每个提示都应用固定的解码预算。既然批处理机制和每个请求的计算预算都摆在了桌面上,剩下的任务就是决定某个工作负载应该运行哪一种组合。
定量总结:批处理策略选择
选择问题在于将批处理机制与模型形态、流量方差和延迟预算相匹配。这种匹配取决于延迟预算在请求路径的哪个环节被消耗。
Checkpoint 1.4: 批处理策略权衡
验证你对不同批处理机制的理解:
在选择批处理策略之前,理解整个请求生命周期中延迟在哪里累积至关重要。图 7 将每个阶段从客户端到响应逐一映射,揭示了序列化、路由和协同在 GPU 计算之外所施加的“服务开销”。
非计算阶段(序列化、排队、路由)消耗了总延迟预算的相当大一部分(图 7),因此批处理策略的选择必须考虑完整的端到端流水线,而不能仅考虑 GPU 执行时间。一棵决策树指导策略选择。
Is it autoregressive text generation?
|- Yes → Continuous batching with chunked prefill
`- No → Is it real-time streaming speech/video/robotics?
        |- Yes → Streaming pipeline with minimal or no batching
        `- No → Do embedding lookups dominate latency?
                |- Yes → Feature-parallel batching (RecSys)
                `- No → Dynamic batching with adaptive parameters
批处理策略参数 表明,每种策略都会朝着不同的目标进行调优,因此“值得调优的参数”由绑定的目标决定:静态策略调吞吐,动态策略调延迟与吞吐的平衡,连续策略调解码方差,特征并行策略调特征分片的容量,流式策略调实时截止时间。
| 策略 | 关键参数 | 调优目标 |
|---|---|---|
| 静态 | 批大小 | 最大化吞吐量 |
| 动态 | 窗口、最大批大小 | 平衡延迟与吞吐 |
| 连续 | 分块大小、最大批大小 | 最小化解码延迟方差 |
| 特征并行 | 累积窗口 | 匹配嵌入分片的容量 |
| 流式 | 流水线深度 | 满足实时截止时间 |
即便是一个调优良好的连续批处理策略,也无法消除大语言模型中更深层次的、架构特定的瓶颈。每个活跃请求的上下文窗口都必须存储在 GPU 内存中,因此 KV 缓存管理成为服务吞吐量的下一个绑定约束。
内存与解码期管理
当 LLM 生成一篇 2,000 词的散文时,它必须不断回读此前写下的每一个词。它通过把中间注意力状态存储在一个快速膨胀的内存缓冲区——KV Cache——来实现这一点。如果不加管理,这个缓存会激烈地碎片化 GPU 内存,甚至导致内存溢出崩溃,即使从技术上讲仍有 40% 的显存处于空闲状态。
有两类技术在这一边界上交汇。KV 状态容量技术(如 PagedAttention 和前缀缓存)决定注意力状态存放在哪里,以及内存管理器容忍多少碎片化。解码期延迟技术(如投机解码)则改变每个输出 token 所需的目标模型工作量。投机解码并非 KV 缓存压缩;它在相同的内存预算下,以额外的草稿模型状态、目标模型验证和调度器复杂度为代价,换取每个输出 token 更低的耗时。
KV 缓存墙:内存受限的容量
在 LLM 服务中,为最大化吞吐量而增大批大小,受到 KV 缓存墙的限制。模型权重对 GPU 内存构成固定的“静态开销”,而 KV 缓存随批大小和序列长度线性增长(图 8)。
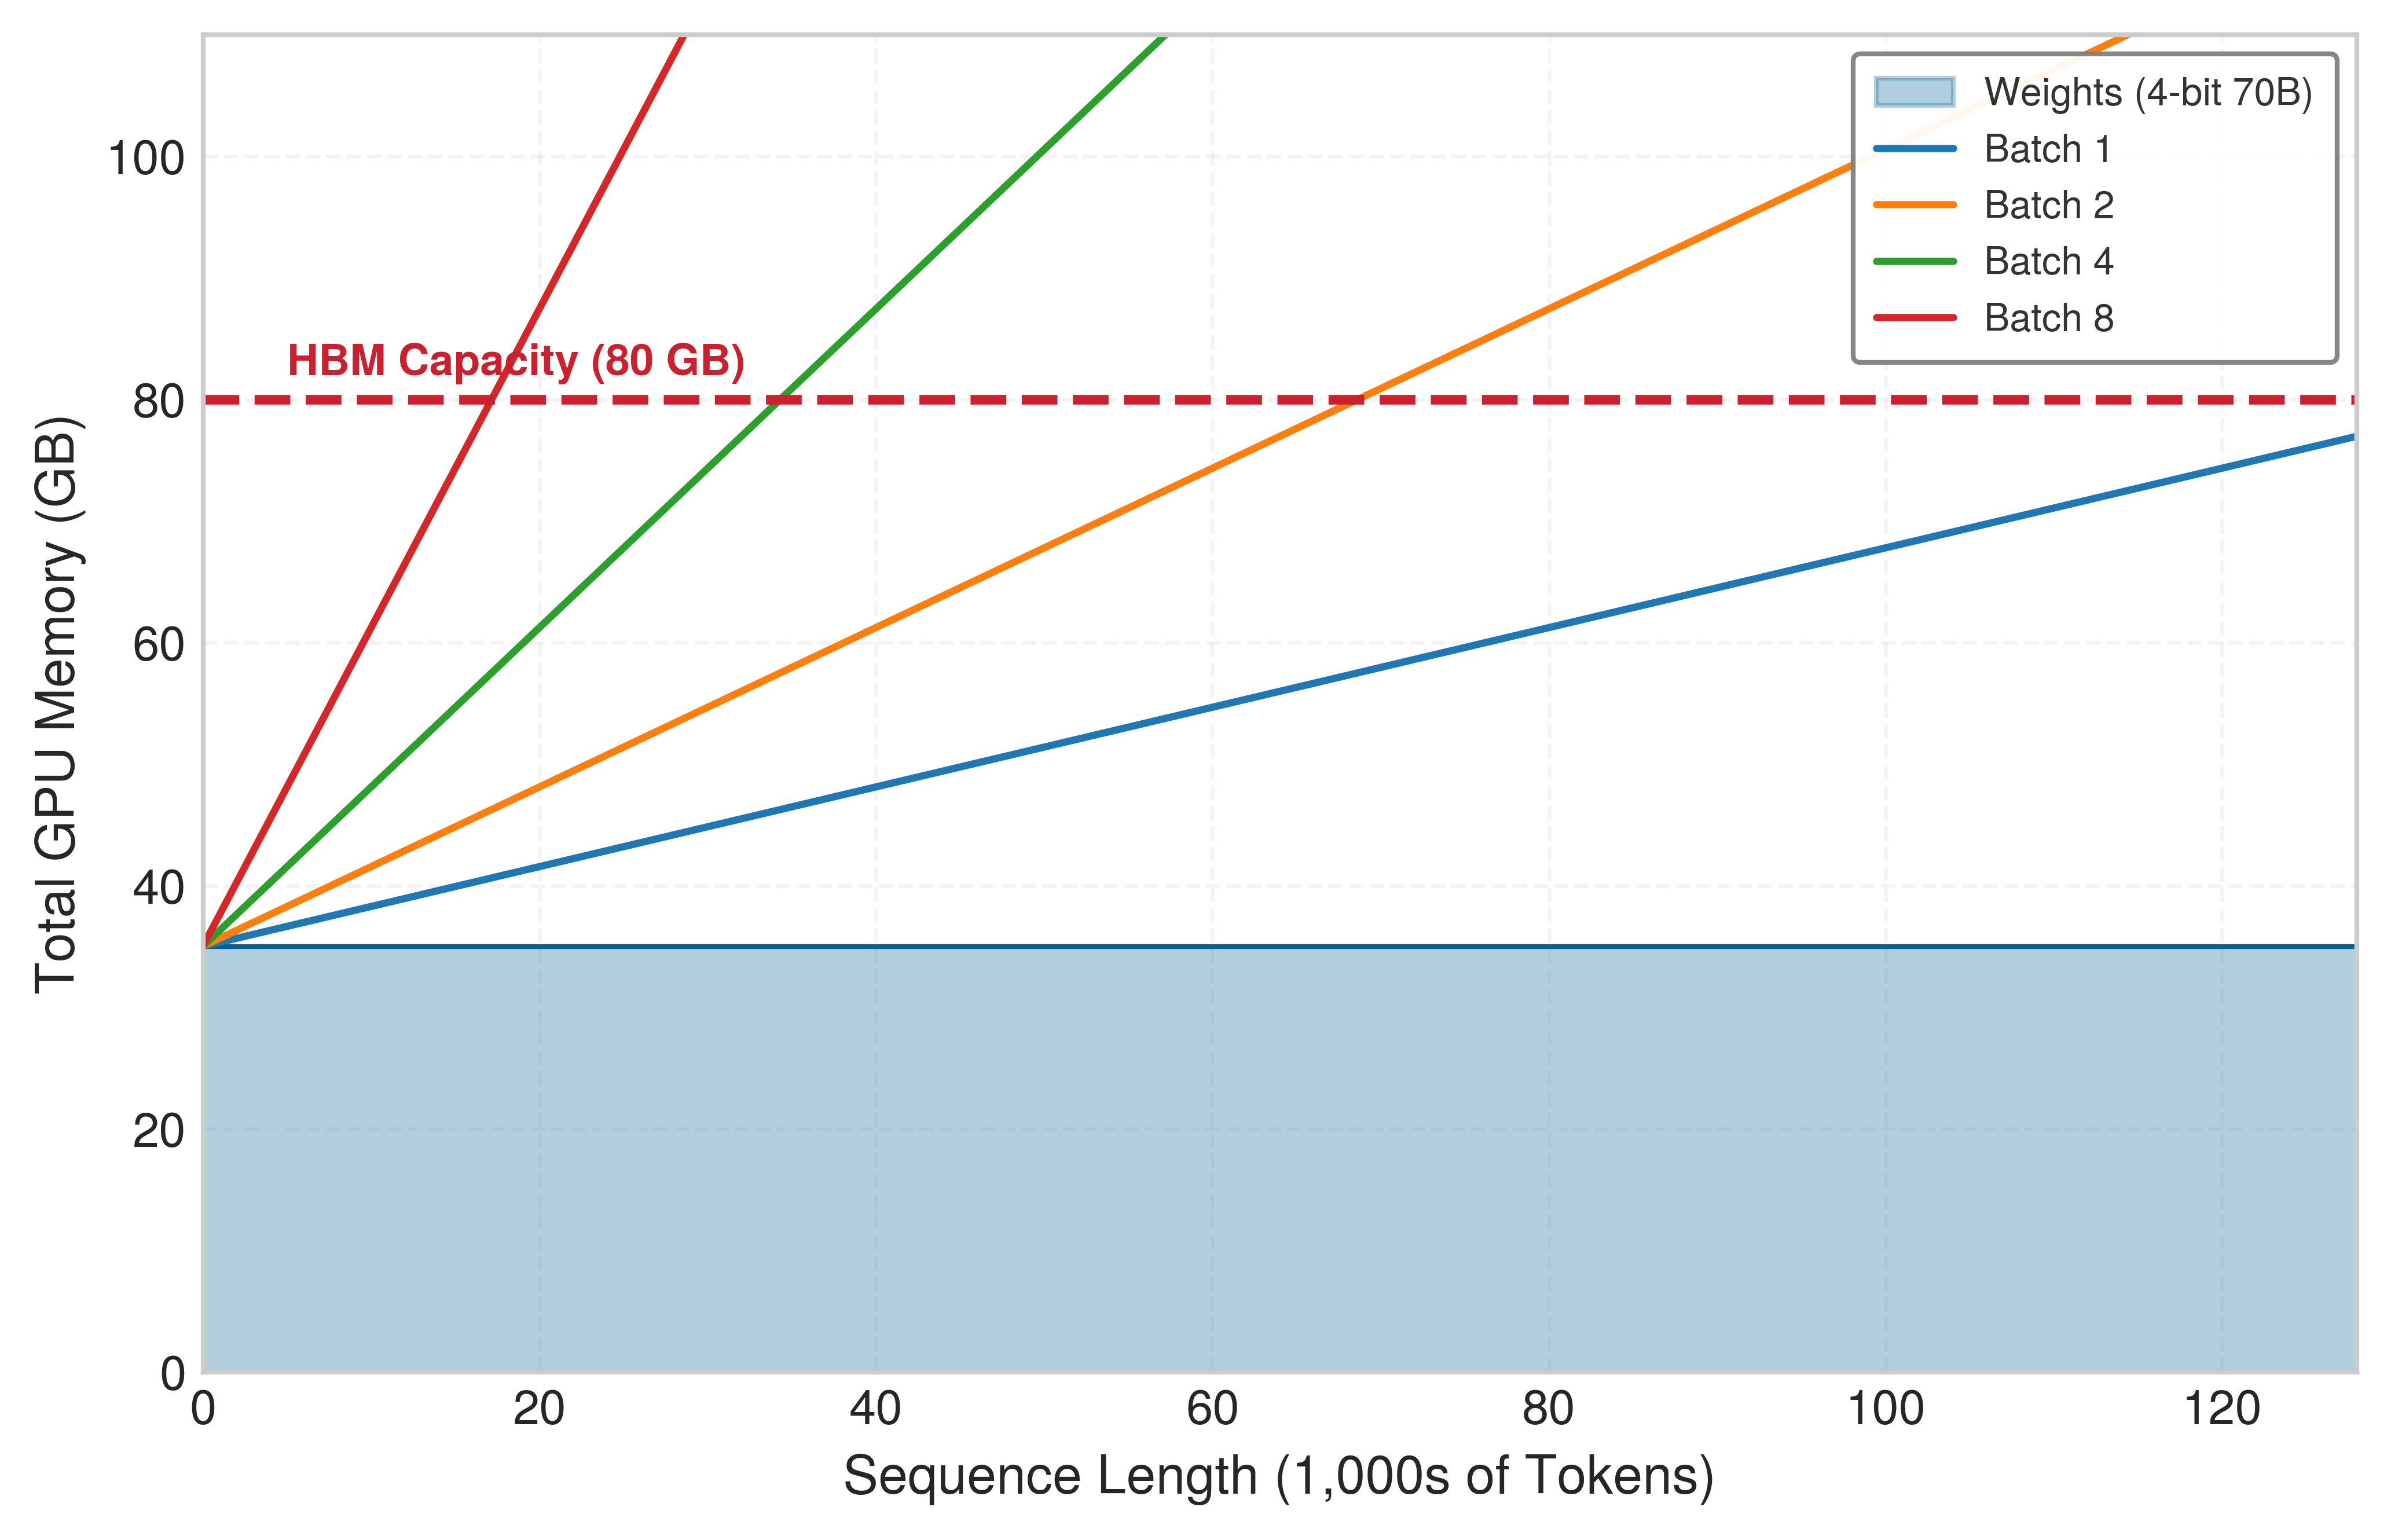
可视化揭示了为何副本层有时必须对原本可以完整放入单张 GPU 的模型进行切分。切分提供了维持高批处理量的内存余量,以支持长上下文请求。如果不进行切分,一个 128K 上下文的请求实际上会“驱逐”掉 GPU 上的所有其他用户。
同样的公式可以转化为生产硬件上的显式批处理量上限。
Napkin Math 1.5: KV 缓存容量估算器
问题:某部署为 Llama-3-70B(FP16 权重 \(\approx\) 141.2 GB)提供服务,使用一个 8\(\times\) H100 节点(HBM 总容量为 640 GB)。目标是确定上下文长度为 128K 个词元时的最大批大小。
公式: \[ M_{\text{KV}} = 2 \times N_L \times H_{\text{KV}} \times d_{\text{head}} \times s_{\text{elem}} \] \[ M_{\text{total}} = M_{\text{weights}} + (B \times S \times M_{\text{KV}}) \]
参数:
- 对于 Llama-3-70B 的 GQA,\(N_L = 80\)、\(H_{\text{KV}} = 8\),\(d_{\text{head}} = 128\)。
- \(s_{\text{elem}} = 2\) 字节(FP16)。
- 上下文为 \(= 131,072\) 个词元。
步骤 1:计算每个词元的内存占用。 \[ M_{\text{KV}} = 2 \times 80 \times 8 \times 128 \times 2 = 327,680 \text{ bytes} \approx 0.33 \text{ MB/token} \]
步骤 2:计算每个请求的缓存占用。 \[ 131,072 \text{ tokens} \times 0.33 \text{ MB/token} \approx 42.9 \text{ GB/request} \]
步骤 3:确定最大批大小。 可用于 KV 缓存的内存 = 687.2 GB(总容量)- 141.2 GB(权重)- 20 GB(系统)= 526.0 GB。 \[ \text{Max Batch} = \left\lfloor \frac{526.0}{42.9} \right\rfloor = 12 \]
系统洞察:即使采用分组查询注意力(GQA),即 Weight-only vs. weight-activation quantization 中共享 KV 头的注意力变体,本计算中的 8 个头已体现了这种设计,128K 上下文请求仍会消耗数十 GB 的 KV 缓存,因此,在内存成为制约因素之前,系统只能处理少量并发长上下文请求。解决这一问题需要采用 PagedAttention(以减少碎片),以及 KV 缓存量化或分片。
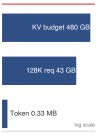
不同序列长度下的 KV 缓存容量阶梯图,与可用内存预算进行对比。
碎片问题
传统的 KV 缓存内存分配方式根据最大预期长度,为每个序列预分配连续内存。这会造成两种形式的浪费。
内部碎片会浪费每次分配内部的内存。序列长度小于所分配内存能够容纳的最大长度时,未使用的部分便会闲置。如果最大长度为 4,096,而平均输出为 100 个词元,则所分配内存的 97.5% 都被浪费了。
外部碎片会在多次分配之间进一步加剧这一问题。随着序列完成和新序列开始,内存逐渐碎片化,形成不连续的空闲块。即使空闲内存总量充足,也可能没有任何一个块足够大,能够满足一次新的最大长度内存分配。
考虑一个简化示例:有 8 个内存槽位,最大序列长度为 4。固定大小的预留首先会产生内部碎片:
Time 0: Allocate Seq A (slots 0-3), Seq B (slots 4-7)
        [A][A][a][a][B][B][B][b]
        lowercase = reserved but unused
外部碎片化会在序列结束且新序列开始后出现:
Time 1: Active Seq C and Seq D leave two 2-slot gaps
        [ ][ ][C][C][ ][ ][D][D]

Time 2: Try to allocate Seq E (needs 4 contiguous slots)
        [ ][ ][C][C][ ][ ][D][D]  <- Total free slots = 4, largest block = 2

Result: enough total free capacity exists, but no contiguous block is large enough.
生产系统报告,在真实工作负载下,碎片化导致 60–80 百分比的内存浪费,严重限制了批大小和吞吐量。
PagedAttention
这个碎片化例子暴露了分配器(allocator)的失效之处:聚合层面可能已经存在足够的 KV-cache 容量,但下一个序列却无法获得任何连续块。PagedAttention 通过把 KV-cache 存储当作虚拟内存而非一块预先分配的整体 slab 来处理,从而修复了该服务问题。
Definition 1.4: PagedAttention
PagedAttention 是一种大语言模型(LLM)服务内存管理技术,它将虚拟内存原理应用于 KV cache 分配,把注意力状态存储在非连续的、固定大小的物理块中。
- 重要性:它消除了内部碎片化和外部碎片化,而在连续预分配下,这可以浪费分配给 KV cache 的 60–80 百分比内存。允许序列动态增长,可以在相同硬件上实现 2–4\(\times\) 倍更高的并发吞吐量 \((X)\)。
- 区别:与连续分配(需要预先保留最大上下文长度)不同,PagedAttention 使用块表(block table)将逻辑序列索引映射到物理内存页,只分配当前实际使用的部分。
- 常见误区:一个常见的误解是,PagedAttention 加快了单个 token 的数学运算。实际上,它是一种容量优化:它通过允许更大的批大小来提升系统级效率,尽管指针查找会引入一小部分间接开销 \((L_{\text{lat}})\)。
虚拟内存的转变改变了分配问题:容量不再需要在请求开始之前预留为单一连续块。
Systems Perspective 1.1: 类比:低效的酒店
想象一家酒店,每位客人可能入住 1 到 10 天,但他们事先并不知道。
在连续分配下,酒店经理会为每位客人提前预留一套 10 天套房。一家 100 间客房的酒店仅入住 10 位客人便“满员”,浪费了 90 百分比的容量(内部碎片化)。
在 PagedAttention(虚拟内存)下,经理每次只给客人分配 1 间房。如果客人继续入住,就分配下一个可用的房间,即使它在不同的楼层。前台维护一张“块表”(Block Table)来记录哪些房间属于哪位客人。现在酒店可以同时容纳 100 位客人,回收了 90 百分比被浪费的容量。
PagedAttention (Kwon 等 2023年) 由 vLLM 引入,将虚拟内存概念应用于 KV cache 管理。与连续分配不同,KV cache 被划分为固定大小的页,在 vLLM 的默认配置中使用 16-token 块,序列按需分配页。图 9 展示了关键概念,包括将逻辑序列位置映射到物理内存页的页表(page tables)、定义每页 token 数量的块大小(block size,通常为 16 个 token),以及为任意序列提供固定大小内存分配的物理块(physical blocks)。
Kwon, Woosuk, Zhuohan Li, Siyuan Zhuang, Ying Sheng, Lianmin Zheng, Cody Hao Yu, Joseph Gonzalez, Hao Zhang, 和 Ion Stoica. 2023年. 《Efficient Memory Management for Large Language Model Serving With PagedAttention》. Proceedings of the 29th Symposium on Operating Systems Principles, 611~26. https://doi.org/10.1145/3600006.3613165.
PagedAttention 提供四项容量收益:
- 内部碎片化:仅分配实际 token 所需的页面。
- 外部碎片化:任何空闲页面都可以被任何序列使用。
- 动态增长:序列无需预先分配即可增长。
- 前缀共享:公共前缀可以共享物理页面。
综合起来,这些特性将 KV cache 容量转化为可调度资源,而非每个请求的固定预留。
Example 1.7: PagedAttention 实现细节
场景:一个 LLM 推理服务器根据最大序列长度(例如 4,096 个 token)为 incoming 序列连续分配 KV cache 内存。
诊断:连续预分配会遭受内部和外部内存碎片化,浪费 60% 到 70% 的 GPU HBM(池利用率仅 30% 到 40%)。PagedAttention 通过每序列的页面表将虚拟序列页面映射到非连续的物理 HBM 块(例如每块 16 个 token),并在自定义注意力内核中执行非连续 gather 操作。
系统启示:PagedAttention 消除了内部和外部内存碎片化。将 KV cache 池利用率从 30% 到 40% 提升至 95% 以上,使服务引擎能够容纳显著更多的并发序列,从而实现 2.5–4\(\times\) 倍的更高吞吐量。
前缀缓存
许多 LLM 工作负载在不同请求之间共享公共前缀。系统提示词(如”You are a helpful assistant…“)会被追加到每个请求开头;少样本示例会对许多查询使用相同示例;文档上下文则涉及对同一文档的多个问题。重新计算这些共享前缀既浪费计算(prefill),也浪费内存(重复的 KV cache 条目)。
前缀缓存通过在具有公共前缀的请求之间共享 KV cache 条目。图 10 展示了共享系统提示词如何避免冗余计算。
\begin{tikzpicture}[font=\small\sffamily, scale=0.9, transform shape]
  \definecolor{SharedColor}{HTML}{D4EFDF}
  \definecolor{UniqueColorA}{HTML}{D1E6F3}
  \definecolor{UniqueColorB}{HTML}{F5D2D5}
  \definecolor{BlockColor}{HTML}{F5F5F5}

  \tikzset{
    block/.style={draw=black!60, fill=BlockColor, minimum width=0.8cm, minimum height=0.6cm, font=\scriptsize\sffamily, inner sep=0pt},
    ptr/.style={->, >=stealth, thick}
  }

  % Physical Memory Blocks (Central)
  \node[anchor=north] (phys_title) at (4, 4) {\textbf{Physical Blocks (GPU)}};

  % Shared Blocks 0-5
  \node[block, fill=SharedColor, below=0.2cm of phys_title.south west, anchor=north west, xshift=-1cm] (pb0) {B0};
  \node[block, fill=SharedColor, right=0.1cm of pb0] (pb1) {B1};
  \node[block, fill=SharedColor, right=0.1cm of pb1] (pb2) {B2};
  \node[block, fill=SharedColor, right=0.1cm of pb2] (pb3) {B3};
  \node[block, fill=SharedColor, right=0.1cm of pb3] (pb4) {B4};
  \node[block, fill=SharedColor, right=0.1cm of pb4] (pb5) {B5};

  \node[right=0.2cm of pb5, font=\scriptsize\sffamily] {(System Prompt)};

  % Unique Blocks for A
  \node[block, fill=UniqueColorA, below=0.4cm of pb0] (pb10) {B10};
  \node[block, fill=UniqueColorA, right=0.1cm of pb10] (pb11) {B11};

  % Unique Blocks for B
  \node[block, fill=UniqueColorB, below=0.4cm of pb3] (pb12) {B12};
  \node[block, fill=UniqueColorB, right=0.1cm of pb12] (pb13) {B13};
  \node[block, fill=UniqueColorB, right=0.1cm of pb13] (pb14) {B14};

  % Logical View - Request A
  \node[anchor=east] (reqA_title) at (-1, 1) {\textbf{Request A}};
  \node[block, fill=SharedColor, right=0.2cm of reqA_title] (la0) {P0};
  \node[block, fill=SharedColor, right=0.1cm of la0] (la1) {P1};
  \node[font=\scriptsize\sffamily, right=0.1cm of la1] (la_dots) {...};
  \node[block, fill=UniqueColorA, right=0.1cm of la_dots] (la6) {P6};

  \draw[ptr, SharedColor!70!black] (la0) -- (pb0);
  \draw[ptr, SharedColor!70!black] (la1) -- (pb1);
  \draw[ptr, UniqueColorA!70!black] (la6) -- (pb10);

  % Logical View - Request B
  \node[anchor=east, below=0.5cm of reqA_title.east] (reqB_title) {\textbf{Request B}};
  \node[block, fill=SharedColor, right=0.2cm of reqB_title] (lb0) {P0};
  \node[block, fill=SharedColor, right=0.1cm of lb0] (lb1) {P1};
  \node[font=\scriptsize\sffamily, right=0.1cm of lb1] (lb_dots) {...};
  \node[block, fill=UniqueColorB, right=0.1cm of lb_dots] (lb6) {P6};

  \draw[ptr, SharedColor!70!black] (lb0) to[in=220, out=45] (pb0);
  \draw[ptr, SharedColor!70!black] (lb1) to[in=220, out=45] (pb1);
  \draw[ptr, UniqueColorB!70!black] (lb6) -- (pb12);

  % Annotations
  \node[align=left, font=\scriptsize\sffamily, anchor=west, right=2cm of la6] {Both requests point\\to same physical blocks\\for blocks 0-5};

\end{tikzpicture}借助 PagedAttention,前缀缓存可通过写时复制(copy-on-write)语义自然地集成:
System prompt → Physical blocks [0, 1, 2, 3, 4, 5]

Request A page table: [0, 1, 2, 3, 4, 5, 10, 11]  <- shares prefix blocks
Request B page table: [0, 1, 2, 3, 4, 5, 12, 13, 14]  <- shares prefix blocks
Request C page table: [0, 1, 2, 3, 4, 5, 15]  <- shares prefix blocks
这三个请求都引用存储系统提示词的同一组物理块。只有在生成各自独有的词元时,它们才会分配新块。当大量并发请求共享同一个系统提示词时,节省的存储空间可能相当可观;笔记本 1.6 针对典型的聊天机器人部署量化了这种节省。
Napkin Math 1.6: 大规模前缀缓存
场景:一个聊天机器人服务使用 2,000 个 token 的系统提示词,并服务 1,000 个并发用户。
无前缀缓存:
- 每个用户的 KV 缓存:\(2000 + 500\text{ (avg response)} =\) 2,500 tokens
- KV 缓存总量:2,500 tokens \(\times 1000 \times 2 \times 80 \times 8192 \times 2 =\) 6.6 TB
使用前缀缓存:
- 共享前缀:2,000 个 token(仅一次)
- 每个用户独有的部分:500 个 token
- 总量:\((2000 \times 1) + (500 \times 1000) =\) 502,000
- 内存:502,000 \(\times 2 \times 80 \times 8192 \times 2 =\) 1.3 TB
结果:前缀缓存可将 KV 缓存的内存降低 79.9 percent,从而支持 5× 个更多并发用户。
系统启示:当前缀命中率较高时,前缀缓存才划算,因为许多请求共享一个长前缀。前缀缓存敏感性示意 使用示意性的命中率包络,展示该技术在哪种情况下能够提升服务能力、在哪种情况下无法提升;生产环境中的容量规划必须从请求轨迹中推导分布。
| Workload | Prefix Hit Rate | Memory Savings |
|---|---|---|
| Chatbot (same system prompt) | 95%+ | 70-80% |
| Document QA (same doc) | 80-90% | 50-70% |
| General API (diverse) | 20–40% | 10–30% |
KV 缓存压缩与架构优化
节 1.3.3 和 节 1.3.4 中的容量管理技术可以容忍缓存,而压缩则能缩小缓存。此处的计算以 64-KV-head 多头注意力(MHA)为基线,以便将分组查询注意力小节单独隔离出来,将 head 数量减少作为独立的架构杠杆进行分析。对于一个 70B 参数模型,包含 80 层、64 个 head、head 维度 128、序列长度 4096,且采用 FP16 格式时,KV 缓存所需内存为:
\[\text{KV cache} = 2 \times 80 \times 64 \times 128 \times 4096 \times 2 \approx 10.7\text{ GB (FP16)}\]
仅单个请求的 KV 缓存就占用了 H100 的 80 GB HBM 的相当大一部分。对于 8 个并发请求的批次,KV 缓存将需要 85.9 GB,超出单 GPU 的容量。缩小这一占用需要两项互补的策略:量化与架构优化。
KV 缓存量化
通过降低精度来减小缓存值的大小,能够直接带来内存节省。仅权重量化会降低权重精度,同时保持激活值的高精度。虽然这对存储有效,但并不能减小 KV 缓存。KV 缓存量化 则明确针对激活值,将缓存的键和值以 INT8、FP8,甚至 INT4 存储。
将 KV 缓存压缩到 INT4,每个请求约为 2.7 GB,降幅为 4×。释放出的内存直接转化为更大的批处理规模和更高的服务吞吐量。KV 缓存值与模型权重的分布不同:KIVI 在键中观察到通道方向的离群点,并采用逐通道键量化;而值没有这种通道方向的模式,因此按 token 进行量化。
分组查询注意力(GQA)
分组查询注意力 (Ainslie 等 2023年),即 Weight-only vs. weight-activation quantization 确立的共享 KV 头架构,是缓存大小的第二个杠杆,与量化互补:量化减少了每个缓存元素的字节数,而 GQA 减少了每层需要缓存的键值头数量。其服务层面的后果体现在头数量算术上。对于代表性的 70B 模型,从 64 个 KV 头的 MHA 基线切换到 8 个 KV 头的 GQA,可将 KV 缓存缩小 8\(\times\):
Ainslie, Joshua, James Lee-Thorp, Michiel de Jong, Yury Zemlyanskiy, Federico Lebron, 和 Sumit Sanghai. 2023年. 《GQA: Training Generalized Multi-Query Transformer Models From Multi-Head Checkpoints》. Proceedings of the 2023 Conference on Empirical Methods in Natural Language Processing, 4895~901. https://doi.org/10.18653/v1/2023.emnlp-main.298.
\[\text{KV cache (GQA)} = 2 \times 80 \times 8 \times 128 \times 4096 \times 2 \approx 1.3\text{ GB (FP16)}\]
在 1.3 GB,GQA 的缓存规模明显小于 MHA 所需的 10.7 GB。将 GQA 与 INT8 KV 缓存量化结合,可获得每个请求亚 GB 级的缓存大小,通常能在单 GPU 上支持大幅更大的批处理。GQA 已成为面向推理优化的 LLM 的常见架构选择,因为它在许多部署中能以相对较小的质量影响降低 KV 缓存的带宽与容量压力。
Napkin Math 1.7: 精度红利
问题:一个团队在 4\(\times\) H100 GPU 上部署一个 70B 模型以提供推理服务。FP16 权重占用 140 GB(35 GB/GPU)。FP16 KV 缓存每个请求占用 10.7 GB。将权重量化为 INT4、将 KV 缓存量化为 INT8 后,最大批大小会如何变化?
优化前(全部采用 FP16):
- 权重:35 GB/GPU
- 可用于 KV 缓存的容量:80 GB \(-\) 35 GB = 45 GB/GPU
- 每个请求的 KV 缓存:10.7 GB \(\div\) 4 \(\approx\) 2.7 GB/GPU
- 最大批大小:\(\lfloor\) 45 GB 除以 2.7 GB \(\rfloor\) \(\approx\) 16 个请求
优化后(INT4 权重、INT8 KV 缓存):
- 权重:35 GB \(\times (4/16) =\) 8.75 GB/GPU(INT4)
- 可用于 KV 缓存的容量:80 GB \(-\) 8.75 GB = 71.25 GB/GPU
- 每个请求的 KV 缓存(INT8):5.4 GB \(\div\) 4 \(\approx\) 1.3 GB/GPU
- 最大批大小:\(\lfloor\) 71.25 GB 除以 1.3 GB \(\rfloor\) \(\approx\) 53 个请求
系统洞见:精度工程通过支持更大的批大小,从根本上改变了推理服务的经济性。更大的批次分摊了权重加载的固定成本,使运算从内存受限转向计算受限。
作为服务策略的推测解码
推测解码在 Speculative decoding 中被确立为一种算法优化:一个小型草稿模型提出 \(K\) 个词元,目标模型在一次并行前向传播中验证这些词元,拒绝采样保证输出词元严格遵循目标模型的分布,因此该技术是无损的,其收益受草稿接受率的限制 \(\alpha_{\text{acc}}\)。推理服务层面的问题则有所不同。在服务水平协议(SLA)的压力下,推测解码成为一种资源准入策略:调度器必须决定何时启用它、其内存开销如何与 KV 缓存准入相互作用,以及它会如何影响服务端点所受约束的 SLA。
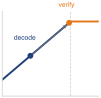
解码受限于内存;并行验证使工作负载向屋脊移动。
延迟收益确实存在,但有一个前提条件,即接受率。当草稿模型提出 \(K\) 个词元时,较高的接受率使目标模型能够在一次前向传播中验证并输出多个词元。当接受率下降时,被拒绝的词元会被丢弃,使有效生成速率回落至接近逐词元解码的水平。从数学上看,每轮输出的词元数量的期望值(包括修正词元)为 \(\frac{1 - \alpha_{\text{acc}}^{K+1}}{1 - \alpha_{\text{acc}}}\),随着接受率下降,该值趋近于 1。对于 \(K = 5\) 个草稿词元,以及速度为目标模型 20\(\times\) 倍的草稿模型,收益对接受率极为敏感:
- 高接受率 \((\alpha_{\text{acc}} = 0.9)\): 每轮预期 4.69 tokens,加速比为 3.7×。
- 中等接受率 \((\alpha_{\text{acc}} = 0.7)\): 每轮预期 2.94 tokens,加速比为 2.4×。
- 低接受率 \((\alpha_{\text{acc}} = 0.5)\): 每轮预期 1.97 tokens,加速比为 1.6×。
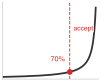
推测解码在 70% 接受率下的加速效果。
可预测性高的文本能达到 \(\alpha_{\text{acc}} > 0.9\),而创造性推理或代码生成可能低于 0.5;训练数据与架构一致的模型对通常落在 0.6–0.8。由于接受率是工作负载的属性而非硬件属性,单一的全局设置在混合集群中并不适用:同样的推测策略虽然可以将每个 token 的时间减半,却可能拖慢接受率低于盈亏平衡点的代码生成端点。因此,服务系统必须按端点分别决策,而这一决策受三项服务关注点支配。
推测开销与 KV 缓存准入
首要关注点是内存。草稿模型并非免费状态:它需要独立的 GPU 权重分配,并且每个使用推测的在途请求都需在目标模型的 KV 缓存之外额外预留一小块草稿模型的 KV 缓存。将 7B 的草稿模型与 70B 的目标模型配对,每个副本需额外占用约 14 GB 权重,加上每次请求的草稿缓存。这项 推测开销 与在 节 1.3.1 中开发的 KV 缓存准入预算直接竞争:草稿模型每占用 1 GB,准入控制器就无法为并发请求分配 1 GB。因此,推测会缩小节点可接纳的最大批大小,以聚合吞吐量为代价换取单个请求的延迟。准入控制器与推测策略无法独立调优;启用推测会降低 KV 缓存墙已经施加的并发上限。
SLA 约束下的延迟—吞吐量权衡
第二项关注点是端点受何种服务水平目标约束。推测会缩短每个输出 token 的时间,但通过降低并发上限,也会减少副本可维持的请求数每秒。受严格首 token 延迟或 per-token 延迟 SLA 约束的端点(如交互式聊天)因此受益:推测开销为关键延迟目标提供了余量。受吞吐量 SLA 约束的端点(如批量文档处理或批量摘要)则受损:推测将批处理能力用于改善一个无人度量的延迟指标,而损失的并发直接威胁吞吐量目标。因此,这一决策本质上是一个 SLA 问题。调度器会在延迟受限的端点上启用推测、在吞吐量受限的端点上禁用推测;当同一副本同时服务两类端点时,必须权衡草稿模型的常驻成本与两者中更严格的那项预算。
按端点调度
第三项关注点是这些决策具有动态性,而非静态配置。接受率会随流量构成漂移,且在高负载下推测的收益会急剧下降:当副本已接近并发上限时,解码阶段更接近计算受限,推测的边际延迟收益随之缩小,而其内存开销却保持不变。生产调度器因此将推测视为受观测负载与接受率门控的运行时开关:在正常运行期间为延迟敏感型端点启用,在流量尖峰时禁用以回收 KV 缓存页供准入使用,并可按端点切换草稿策略。Self-speculative Decoding 以目标模型自身的提前退出作为草稿,消除了独立模型的内存开销,代价是接受率降低;Medusa (Cai 等 2024年) 为目标主干添加轻量预测头;Lookahead Decoding 利用 Jacobi 迭代,完全避免使用草稿模型。各变体以推测开销的不同部分换取接受率,调度器依据约束的 SLA 以及剩余多少 KV 缓存预算,在每个端点上选择相应变体。
Cai, Tianle, Yuhong Li, Zhengyang Geng, Hongwu Peng, Jason D. Lee, Deming Chen, 和 Tri Dao. 2024年. 《Medusa: Simple LLM Inference Acceleration Framework with Multiple Decoding Heads》. Proceedings of the 41st International Conference on Machine Learning (ICML).
分布式场景下的 KV 缓存
当对话被移动、重新平衡或拆分到不同设备时,其 KV 状态必须随之迁移,或逐 token 重建。节 1.4 提出了将模型分布到设备上的张量并行与流水线并行策略;每种策略对 KV 缓存管理带来不同的后果:
在张量并行下,KV 缓存与注意力头一起在各设备间分片,每个设备仅存储其对应头子集的缓存。
8-way tensor parallelism:
Device 0: KV cache for heads 0-7
Device 1: KV cache for heads 8-15
...
Device 7: KV cache for heads 56-63
跨设备共享引入了一个约束:张量并行设备之间的前缀缓存必须在所有设备上采用相同的分片方式。当使用前一致的张量并行配置处理前缀时,这一点会自动满足。
KV 缓存迁移带来了进一步的挑战。当路由器因故障或重新平衡(以会话 ID 的哈希值为键的恒定哈希方案,见 节 1.5.6)将某个会话迁移到另一个副本时,KV 缓存也必须随之迁移:
Migration options:
1. Rebuild: Re-run prefill on new replica (500 ms+ for long context)
2. Transfer: Send KV cache over network (100 MB at 100Gbps = 8 ms)
3. Hybrid: Transfer if small, rebuild if large

Decision threshold:
if cache_size_bytes/network_bandwidth < prefill_time:
    transfer()
else:
    rebuild()
对于上下文长度为 4K 的 Llama-70B GQA,每个序列的 KV 缓存总量约为 1.3 GB,在 8 路张量并行下,每台设备约为 162.5 MB。在 100 Gbps(12.5 GB/s)的带宽下,传输一个分片约需 13 ms,而传输完整缓存约需 100 ms。这两种传输方式通常都优于耗时约 500 ms 的预填充重建,因此在带宽可用时,传输仍是更好的选择。
内存管理最佳实践
有效的 KV 缓存管理始于容量核算,而非淘汰策略。服务进程首先为权重、激活值、运行时开销和安全余量预留内存,然后将剩余的 HBM 作为用于活跃序列的受管内存池:
Available GPU memory = Total - Weights - Activations - Overhead
KV pool size = 0.9 * Available  # Leave 10% headroom

Max concurrent sequences = KV pool size / (avg_seq_length * per_token_cache)
该预算决定了调度器在拒绝、抢占或换出之间做出选择之前,可以有多少个序列共存。当缓存满时,LRU 淘汰会移除访问时间最早的序列,基于大小的淘汰会优先释放最长的序列,基于优先级的淘汰则保护付费档或延迟敏感请求。连续批处理随后将淘汰转化为调度决策:一个无法容纳的高优先级请求会触发受害者选择,将受害者的 KV 缓存交换到 CPU 内存,为新的请求分配 GPU 内存,并在其服务水平目标仍允许该延迟时,稍后恢复受害者。
Example 1.8: KV 缓存内存层次结构
场景:一个多租户 LLM 服务系统在峰值并发期间出现 KV 缓存 HBM 耗尽(80 GB 上限)。
诊断:纯 HBM 分配将节点并发限制为 50 个活跃序列。淘汰或丢弃请求会损害用户体验。实现三级内存层次结构(HBM \(\to\) CPU DRAM \(\to\) Non-Volatile Memory Express (NVMe) SSD)允许将非活跃序列页面交换到 CPU DRAM(1–5 ms 交换延迟)或 NVMe(10–50 ms)。
系统启示:多级 KV 缓存分页将并发序列容量提升 10\(\times\) 倍(从 50 个增加到 500 个序列)。向 CPU DRAM 分页可作为非紧急流量的吞吐量杠杆,但交换延迟使其无法用于延迟敏感的解码步骤。
机器学习中的上下文切换
KV 缓存管理使单个 GPU 能够安全地服务许多并发请求;多租户适配器服务则要求同一个服务进程管理另一类驻留状态。KV 缓存是逐 token 的注意力状态。低秩适配(LoRA)适配器是每租户的权重增量。二者都必须在解码步骤执行的那一刻可用,并且如果调度器忽略局部性,二者都可能抹去批处理带来的收益。随着服务平台扩展以支持单个基础模型上的数千名并发用户,个性化引入了新的内存瓶颈。LoRA 存储一组用户或任务特定的适配器权重,用于修改共享的基础模型,而无需复制整个模型。当 10,000 名用户各自拥有一个唯一的 LoRA 适配器并应用于同一个 140 GB 基础模型时,为每个用户复制基础权重在物理上是不可能的。相反,基础模型保持固定驻留在 HBM 中,而用户特定的适配器按需被调入片上快速工作集。
Systems Perspective 1.2: 机器学习中的上下文切换
这种多租户服务模式将根本性的性能约束从计算吞吐量转移到适配器局部性。当连续批处理调度器交织来自不同用户的请求时,适配器权重可能需要在每次生成步骤之前反复从 HBM 移动到 SRAM 或寄存器。其效果与操作系统上下文切换类似:加速器有待处理的工作,但它必须先等待属于下一个租户的状态。如果适配器交换延迟超过生成步骤的计算时间,GPU 计算核心就会停转。因此,高效的多租户性会尽可能按活跃适配器对请求进行批处理,并将适配器放置与 KV 缓存分页相协调,使个性化不会抹去共享基础模型所带来的收益。
多 LoRA 服务与批处理适配器执行
在多租户环境中,数千个微调适配器共享同一个基础基础模型。对于线性投影层,基础权重 \(W_0 \in \mathbb{R}^{d_{\text{out}} \times d_{\text{in}}}\),适配器 \(k\) 使用低秩分解矩阵 \(A_k \in \mathbb{R}^{r_k \times d_{\text{in}}}\) 和 \(B_k \in \mathbb{R}^{d_{\text{out}} \times r_k}\) 以秩 \(r_k \ll \min(d_{\text{in}}, d_{\text{out}})\)(通常为 \(r \in \{8, 16, 64\}\))参数化前向变换,如 公式 8 所给出的公式:
\[y = x W_0 + \frac{\alpha_k}{r_k} x A_k^T B_k^T \tag{8}\]
其中 \(\alpha_k\) 是一个固定的缩放因子。对于一个具有 70B 参数的基础模型,为 1,000 个微调变体存储完整的参数副本需要 140 TB 的 GPU 显存。相比之下,1,000 个秩为 16 的适配器总共仅占用 \(\sim 150\text{ GB}\),使共址部署在物理上成为可能。
然而,在单个连续批次中处理使用异构适配器的请求,会引入一个关键的执行难题:
- 按适配器分组的批处理:如果调度器按适配器 ID 将到达的请求分组为不同批次,连续批处理就会退化为小而零散的批次(对于低流量适配器,批大小通常为 1 或 2)。这会丧失共享权重流式处理带来的高吞吐量,并使冷门适配器承受不可接受的排队延迟。
- 顺序分派适配器内核:如果将使用不同适配器的请求打包到同一批次中,基础投影 \(X W_0\) 可以通过一次覆盖所有 token 的稠密 GEMM 高效执行。然而,计算各个适配器的增量,需要针对每个请求所使用的独特适配器 \((A_{k(i)}, B_{k(i)})\),分别分派小型矩阵乘向量内核。每层启动数百个小型 GEMM 会导致严重的 CPU 启动串行化、内核启动延迟(每个内核 \(\sim 3\text{--}5\ \mu\text{s}\)),以及较低的 GPU 流式多处理器(SM)占用率。
Definition 1.5: 批量收集矩阵乘向量运算(BGMV)
批量收集矩阵乘向量运算(BGMV) 是一种专用 GPU 内核,可在一次统一的内核启动中计算不同适配器的异构低秩矩阵乘向量积,并根据逐 token 的适配器索引向量,从内存池中动态收集适配器权重。
- 重要性:它消除了多适配器服务中的内核启动串行化和内存利用不足问题,使数百个不同的 LoRA 适配器能够在同一次前向传播中并发计算,相对于基础模型执行,其额外开销可忽略不计。
- 区别:标准 GEMM 要求批次中的所有元素都与同一个权重张量相乘。BGMV 执行分段矩阵乘法,每个批次元素通过间接指针索引,与各自的适配器权重切片相乘。
- 常见误区:将所有适配器权重存储在连续的 HBM 空间中,会导致严重的外部内存碎片化。生产系统使用类似于虚拟内存页表的分页适配器表来支持 BGMV。
Punica (Chen 等 2024年) 和 S-LoRA (Sheng 等 2024年) 等系统通过两种架构机制(定义见 1.5)解决这一执行难题:
Chen, Liyuan, Zihao Ye, Yonghao Wu, Danyang Zhuo, Luis Ceze, 和 Arvind Krishnamurthy. 2024年. 《Punica: Multi-Tenant LoRA Serving》. Proceedings of the 7th Conference on Machine Learning and Systems (MLSys).
批量收集矩阵乘向量(BGMV)内核
BGMV(及其广义分段 GEMM 变体)在一次内核启动中执行所有适配器投影,无须为每个请求分别启动内核。
对于输入激活 \(X = [x_1; x_2; \dots; x_B] \in \mathbb{R}^{B \times d_{\text{in}}}\),调度器构建一个整数映射向量 \(M \in \mathbb{Z}^B\),其中 \(M[i] = k(i)\) 表示分配给请求 \(i\) 的适配器 ID。BGMV 内核将线程块分配给批次中的 token:
- 收集:每个线程块将对应 token 的激活 \(x_i\) 加载到共享内存,并从 \(M[i]\) 读取适配器指针。
- 下投影:线程块执行向量乘矩阵运算 \(v_i = x_i A_{k(i)}^T \in \mathbb{R}^{1 \times r_{k(i)}}\)。由于 \(r \ll d_{\text{in}}\),\(v_i\) 可以轻松容纳在 GPU 寄存器中。
- 上投影:线程块将 \(v_i\) 乘以 \(B_{k(i)}^T \in \mathbb{R}^{r_{k(i)} \times d_{\text{out}}}\),得到适配器增量 \(\Delta y_i = \frac{\alpha_{k(i)}}{r_{k(i)}} v_i B_{k(i)}^T\)。
- 累加:内核将 \(\Delta y_i\) 原位加到基础模型投影 \(y_i = x_i W_0 + \Delta y_i\) 的输出上。
通过融合适配器投影,并由各线程动态收集权重,BGMV 实现了超过峰值内存带宽 90% 的带宽利用率,并避免了每步数百次微型内核启动。
统一分页适配器内存管理
为了在不耗尽 GPU HBM 的情况下管理数千个适配器,S-LoRA (Sheng 等 2024年) 将适配器存储组织为由分页内存管理机制控制的多级内存层次结构:
Sheng, Ying, Shiyi Cao, Dacheng Li, Coleman Hooper, Shuo Chen, Daxin Jiang, Christopher Rodriguez, 等. 2024年. 《S-LoRA: Serving Thousands of Concurrent LoRA Adapters》. Proceedings of the 7th Conference on Machine Learning and Systems (MLSys).
- 分页适配器池:GPU HBM 分配一个静态内存池,并将其划分为固定大小的物理页(例如 2 MB 块)。适配器矩阵 \(A_k\) 和 \(B_k\) 在非连续的可用页之间分配,从而消除了不同秩适配器动态加载和卸载时的外部碎片(\(r \in \{8, 16, 32, 64\}\))。
- 经 PCIe 的异步预取:访问频率较低的适配器保留在主机 CPU DRAM 或 NVMe 存储中。当针对未缓存适配器的请求进入等待队列时,调度器会在 GPU 执行当前解码迭代的同时,通过 PCIe Gen5 发起异步直接内存访问(DMA)复制。
- 张量并行的适配器切分:在 Megatron 风格的张量并行下,适配器权重按照基础模型的切分方式进行划分:
- 列并行层:基础权重 \(W_0 = [W_0^{(1)} \mid W_0^{(2)}]\) 按列切分。适配器下投影 \(A_k\) 在所有秩上复制,而上投影 \(B_k\) 按列切分(\(B_k = [B_k^{(1)} \mid B_k^{(2)}]\)),适配器操作前后所需的通信量为零。
- 行并行层:基础权重 \(W_0 = [W_0^{(1)} / W_0^{(2)}]\) 按行切分。适配器下投影 \(A_k\) 按行切分(\(A_k = [A_k^{(1)} / A_k^{(2)}]\)),\(B_k\) 也按行切分。各秩的部分输出通过基础层已有的 AllReduce 集合通信进行求和。
由于适配器切分与基础模型完全一致,多 LoRA 执行在分布式互连结构上引入了零额外的通信集合。
当模型本身超出单 GPU 容量时,同样的局部性问题会在更大规模上重现。对于一个 1750 亿参数的基础模型,仅权重就需要超过 140 GB 的 VRAM(FP16 格式),超过了单张 80 GB GPU 的容量。因此,服务该模型需要将其架构切分到多台协同工作的 GPU 上,形成单个逻辑副本。借鉴分布式训练并行技术,特别是张量并行和流水线并行,并将其适配到低延迟推理场景,会引入一组独特的约束。
推理中的模型切分
一个 700 亿参数的模型需要超过 140 GB 的 VRAM 才能以 FP16 格式容纳其权重,这超出了单张 80 GB GPU 的容量。服务该模型需要将其架构切分到多台协同工作的 GPU 上,形成单个逻辑副本。借鉴分布式训练并行技术,特别是张量并行和流水线并行,并将其适配到低延迟推理场景,会引入一组独特的约束。
何时必须进行分片
推理中的模型分片由两类不同的需求驱动。表 4 指出了使分片成为必要选择的内存和延迟约束:
第一个驱动因素是内存容量。无论性能方面有何考量,无法装入单个 GPU 内存的模型都必须进行分片。对于具有 \(P\) 个参数、精度为 \(b\) 位的模型,权重内存占用按 公式 9 计算:
\[M_{\text{weights}} = P \times \frac{b}{8} \text{ bytes} \tag{9}\]
一个 700 亿参数的模型在 FP16(16 位)精度下需要:
\[M_{\text{weights}} = 70 \times 10^9 \times \frac{16}{8} = 140 \text{ GB}\]
该结果超过了 H100 GPU 的 80 GB 容量,因此至少需要分为 2 个分片。
第二个驱动因素是延迟。即使模型能够装入内存,分片也可以通过并行计算降低延迟。公式 10 将潜在加速比形式化为并行化效率的函数:
\[T_{\text{parallel}} = \frac{T_{\text{compute}}}{N} + T_{\text{comm}}(N) + T_{\text{sync}}(N) - T_{\text{overlap}} \tag{10}\]
其中,\(N\) 是分片组中的设备数量,\(T_{\text{comm}}(N)\) 是通信开销,\(T_{\text{sync}}(N)\) 是同步开销,\(T_{\text{overlap}}\) 是通过与有效计算重叠而被隐藏的通信。在常见的无重叠简化情形下,若额外同步开销可忽略,该式简化为 \(T_{\text{compute}}/N + T_{\text{comm}}(N)\)。只有当未被重叠隐藏的开销小于并行化所节省的时间时,分片才能带来延迟收益。
| 分片触发因素 | 模型示例 | 最小分片数 | 策略 |
|---|---|---|---|
| 内存(权重) | Llama-70B(140 GB) | 2 个 | 张量并行或流水线并行 |
| 内存(KV 缓存) | GPT-4(长上下文) | 4–8 个 | 张量并行(用于缓存) |
| 内存(嵌入) | DLRM(100 TB) | 1000 个以上 | 嵌入分片 |
| 延迟 | 任意大型模型 | 视情况而定 | 张量并行 |
张量并行
张量并行 (Shoeybi 等 2019年) 将单个层分布到多个设备上,从而在每层内部实现并行计算。分布式训练 中为训练引入的列—行划分方案在此同样适用:按列划分第一个线性层、按行划分第二个线性层,每个 Transformer 块只需一次全归约。对于 Transformer 模型,主要划分对象是注意力机制和前馈层,它们承担了大部分计算。
Shoeybi, Mohammad, Mostofa Patwary, Raul Puri, Patrick LeGresley, Jared Casper, 和 Bryan Catanzaro. 2019年. 《Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism》. arXiv preprint arXiv:1909.08053.
多头注意力计算天然适合按注意力头进行划分。对于具有 \(N_{\text{heads}}\) 个注意力头、按张量并行度 \(t\) 分布的模型,每个设备计算 \(N_{\text{heads}}/t\) 个注意力头:
\[\text{Attention}_i = \text{softmax}\left(\frac{Q_i K_i^T}{\sqrt{d_k}}\right) V_i \text{ for heads } i \in \{1, ..., N_{\text{heads}}/t\}\]
完成本地注意力计算后,全归约操作(见 集合通信)合并各设备的结果,所增加的通信开销与激活数据大小除以互连带宽成正比。
前馈层(通常由两个线性变换及激活函数组成)沿隐藏维度进行划分。第一个线性层按列分布,第二个线性层按行分布。这种列—行划分使每个前馈块只需一次全归约。
张量并行推理的通信模式在每层执行两阶段同步。图 11 展示了这一流程:
\begin{tikzpicture}[font=\small\sffamily, scale=0.9, transform shape]
  \definecolor{GPUColor}{HTML}{E6D4E5}
  \definecolor{OpColor}{HTML}{D1E6F3}
  \definecolor{SyncColor}{HTML}{F5D2D5}

  \tikzset{
    gpu_bg/.style={fill=GPUColor, draw=none, minimum width=3.5cm, minimum height=6.5cm, anchor=south},
    opbox/.style={draw=black!70, fill=OpColor, minimum width=2.5cm, minimum height=0.6cm, align=center},
    syncbox/.style={draw=black!70, fill=SyncColor, rounded corners, minimum width=6cm, minimum height=0.6cm, align=center}
  }

  % GPU Columns
  \node[gpu_bg] (gpu0_bg) at (-0.25, -0.5) {};
  \node[above, font=\bfseries\sffamily\bfseries] at (gpu0_bg.north) {GPU 0};

  \node[gpu_bg] (gpu1_bg) at (4.25, -0.5) {};
  \node[above, font=\bfseries\sffamily\bfseries] at (gpu1_bg.north) {GPU 1};

  % Attention Block
  \node[anchor=center] (att_title) at (2, 5.5) {\textbf{Attention Layer}};

  \node[opbox] (att0) at (-0.25, 4.5) {Heads 1..H/2};
  \node[opbox] (att1) at (4.25, 4.5) {Heads H/2+1..H};

  \node[syncbox] (allreduce1) at (2, 3.5) {\textbf{AllReduce} (Combine Heads)};

  \draw[->, thick] (att0) -- (allreduce1.north -| att0);
  \draw[->, thick] (att1) -- (allreduce1.north -| att1);

  % MLP Block
  \node[anchor=center] (mlp_title) at (2, 2.5) {\textbf{Feed-Forward (MLP)}};

  % Col Split
  \node[opbox, minimum width=1.2cm] (mlp1a) at (-0.9, 1.5) {Col};
  \node[opbox, minimum width=1.2cm] (mlp1b) at (0.4, 1.5) {Col};
  \node at (-0.25, 1.5) {...}; % Visualizing big matrix split

  \node[opbox, minimum width=1.2cm] (mlp2a) at (3.6, 1.5) {Col};
  \node[opbox, minimum width=1.2cm] (mlp2b) at (4.9, 1.5) {Col};
  \node at (4.25, 1.5) {...};

  % Row Split
  \node[opbox] (mlp1_out) at (-0.25, 0.5) {Row Split};
  \node[opbox] (mlp2_out) at (4.25, 0.5) {Row Split};

  \draw[->, thick] (allreduce1.south -| att0) -- (mlp1a.north); % Simplified connection
  \draw[->, thick] (allreduce1.south -| att1) -- (mlp2a.north);

  \draw[->] (mlp1a.south) -- (mlp1_out.north);
  \draw[->] (mlp2a.south) -- (mlp2_out.north);

  \node[syncbox] (allreduce2) at (2, -0.5) {\textbf{AllReduce} (Sum Outputs)};

  \draw[->, thick] (mlp1_out.south) -- (allreduce2.north -| mlp1_out);
  \draw[->, thick] (mlp2_out.south) -- (allreduce2.north -| mlp2_out);

\end{tikzpicture}张量并行下的推理时间遵循 公式 11:
\[T_{\text{inference}} = \frac{T_{\text{compute}}}{t} + 2 \times T_{\text{allreduce}}\left(\frac{A}{t}\right) \tag{11}\]
其中 \(T_{\text{compute}}\) 表示顺序计算时间,\(t\) 表示张量并行度,\(A\) 表示被压缩的激活大小。因子 2 对应每个 Transformer 层的两次全归约操作(注意力与前馈)。
Example 1.9: Llama-70B 的张量并行
场景:一个工程团队将 Llama-70B(70B 参数,FP16 占用空间 140 GB)部署到一台 8 GPU H100 节点上,节点间通过 NVLink (Touvron 等 2023年) 互联。
诊断:在 2 个 GPU(140 GB/80 GB)上部署模型会因计算瓶颈(30 ms 每层)而受限。应用 8 路张量并行后,注意力层和前馈层被切分到全部 8 个 GPU 上,每层执行时间降至 4.35 ms,尽管存在 AllReduce 通信开销。
系统经验:在 NVLink 上采用 8 路张量并行,端到端加速比为 6.9\(\times\)(prefill 时间由 2,400 ms 缩短至 348 ms)。将注意力层和前馈层切分到节点内 NVLink 互连结构,是以低开销的 NVLink 传输换取计算加速,从而牺牲延迟。
Touvron, Hugo, Louis Martin, Kevin Stone, Peter Albert, Amjad Almahairi, Yasmine Babaei, Nikolay Bashlykov, 等. 2023年. 《Llama 2: Open Foundation and Fine-Tuned Chat Models》. arXiv preprint arXiv:2307.09288.
推理阶段的流水线并行
流水线并行将各层按顺序分配到不同设备上,每个设备负责若干层子集。与张量并行不同,层内不存在同步,同步仅发生在流水线阶段之间。
在推理场景中,流水线并行产生的气泡与训练阶段不同。图 12 对比了单次请求的延迟(气泡主导)与流水线吞吐(气泡被摊薄):
对于单个请求,流水线并行不提供任何延迟收益:请求必须按顺序遍历所有阶段。流水线填充时间等于顺序执行时间。
然而,流水线并行可以通过流水线化多个请求实现吞吐量扩展:
Time →
Device 0: [Req1] [Req2] [Req3] [Req4] ...
Device 1:        [Req1] [Req2] [Req3] [Req4] ...
Device 2:               [Req1] [Req2] [Req3] [Req4] ...
Device 3:                      [Req1] [Req2] [Req3] [Req4] ...
10 推理
流水线填满后,吞吐量等于 \(p\) 倍单级吞吐量,其中 \(p\) 为流水线级数。稳态延迟仍近似于单设备延迟(各阶段时间之和),但吞吐量随并行度扩展。
流水线并行适用于以下三种推理场景:
- 内存约束要求进行切分,但延迟要求较为宽松
- 吞吐量比单个请求的延迟更重要
- 设备之间的网络带宽受限(仅支持点对点通信)
流水线与张量并行对比 概括了这两种切分方式之间的取舍:
| Aspect | Tensor Parallelism | Pipeline Parallelism |
|---|---|---|
| Single-request latency | Reduced by ~\(t\times\) | No improvement |
| Throughput | \(t\times\) | \(p\times\) (when pipelined) |
| Communication pattern | AllReduce (bandwidth-intensive) | Point-to-point (latency-sensitive) |
| Memory efficiency | Activations replicated | Activations passed along |
| Complexity | Higher (requires custom kernels) | Lower (layer-level partitioning) |
决策规则是:先延迟,后拓扑。当单个请求延迟重要且具备 NVLink 级带宽时,张量并行是默认选择;流水线并行则适用于延迟要求宽松的工作负载,或仅能负担点对点阶段通信的部署场景。
MoE 模型的专家并行
混合专家(MoE)模型,例如 DeepSeek-V3 或 Mixtral,在稠密模型之外引入了独特的服务挑战。在 MoE Transformer 层中,前馈网络被多个并行的“专家”子网络和一个为每个 token 选择专家子集的轻量路由器所取代。
MoE 架构使得可以在保持每 token 计算量不变的同时扩展总参数量。然而,大规模服务此类模型需要专家并行,即不同专家托管在不同的 GPU 上。
MoE 的经济性与容量规划
MoE 服务的经济性存在一个悖论:总参数量决定最低硬件数量(内存方面),而激活参数量决定每个 token 的计算成本。这使得 MoE 模型在计算方面高效,但在显存“租金”方面昂贵。
性能优势十分显著。在批大小为 1 的自回归解码中,主导成本是从 HBM 读取权重。一个 400B 稠密模型以 FP16 格式每步读取 800 GB。DeepSeek-V3 虽然总参数量更多,但每步只读取 37B 的活跃参数(FP16 下约 74 GB),即每 token 带宽降低 10.8×。计算量的节省是等比例的:每个 token 的 FLOPs 减少 10.8×。
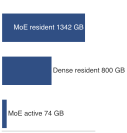
MoE 保留每个专家常驻,但每个 token 只激活少数专家。
权衡的代价是内存容量:所有专家都必须驻留在内存中,尽管任意时刻只激活其中一部分。DeepSeek-V3 的完整模型以 FP16 格式需要约 1342 GB,因此必须分布在许多 GPU 上。
Napkin Math 1.8: MoE 容量规划
问题:一个团队为聊天机器人应用部署了 DeepSeek-V3(671B 总参数,37B 每个 token 的激活参数)。模型使用 FP8 权重(每个参数 1 字节)。集群中的节点各有 8 个 GPU,每个节点配备 8\(\times\) H100 GPU(80 GB HBM/GPU,640 GB/节点)。需要多少个节点?每个 token 的解码延迟是多少?
计算:
- 内存:权重占用的总内存 = 671 GB。单个节点(640 GB)不足以容纳。2 可提供 1,280 GB,为 KV 缓存留出足够空间。
- 延迟:每个解码步骤读取 37B 个激活参数(37 GB)。这些参数分布在 16 GPUs 上,每个设备读取约 2.3 GB。在 3.35 TB/s HBM 带宽下,\(T_{\text{read}} \approx\) 0.69 ms。AllToAll 路由额外增加约 0.3 ms。
- 下限:估计解码延迟为 \(\approx\) 1.0 ms/token,或在批量大小为 1 时达到 1,000 tokens/s。
系统洞见:MoE 使一个 671B 模型的每 token 带宽成本接近规模小得多的稠密模型,但容量规划仍取决于必须常驻内存的完整参数集。
专家并行与负载均衡
将 MoE 模型分布到多个 GPU 上会引入专家并行:每个 GPU 保存一部分专家,token 被路由到保存其指定专家的 GPU。在 MoE 层中,门控网络为每个 token 选择 \(k\) 个专家(专家总数为 \(E\)):
\[\text{Output} = \sum_{i \in \text{top-}k} g_i \cdot \text{Expert}_i(\text{input})\]
专家并行将专家分布到多个设备上,每个设备承载 \(E/N\) 个专家,其中 \(N\) 是参与专家并行的设备数量。图 13 展示了路由、分派和汇集操作:
\begin{tikzpicture}[font=\small\sffamily, scale=0.9, transform shape]
  \definecolor{GateColor}{HTML}{FCE4CC}
  \definecolor{ExpColor}{HTML}{D4EFDF}
  \definecolor{CommColor}{HTML}{F5D2D5}

  \tikzset{
    box/.style={draw=black!70, fill=white, minimum height=0.8cm, minimum width=2cm, align=center},
    expbox/.style={draw=black!70, fill=ExpColor, minimum height=0.8cm, minimum width=2cm, align=center},
    idlebox/.style={draw=black!70, fill=black!20, minimum height=0.8cm, minimum width=2cm, align=center},
    gatebox/.style={draw=black!70, fill=GateColor!30, minimum height=1cm, minimum width=2cm, align=center},
    comm_arrow/.style={->, dashed, thick, CommColor}
  }

  % Host Device
  \node[gatebox] (gating) at (0, 1.5) {Gating\\(Top-2)};

  % Input Token
  \node[box, above=0.5cm of gating] (token) {Input Token};
  \draw[->, thick] (token) -- (gating);

  % Expert Devices
  \node[idlebox, right=3cm of gating] (exp3) {Device X\\Expert C (Idle)};
  \node[expbox, above=0.5cm of exp3] (exp1) {Device 1\\Expert A};
  \node[expbox, below=0.5cm of exp3] (exp2) {Device 2\\Expert B};

  % Interconnect
  \node[text=CommColor!80!black, font=\bfseries\sffamily\bfseries] at (2.5, 1.5) {All-to-All Dispatch};
  \draw[comm_arrow] (gating.east) -- (exp1.west);
  \draw[comm_arrow] (gating.east) -- (exp2.west);

  % Gather
  \node[box, rounded corners, right=1.5cm of exp3] (agg) {Weighted\\Sum};

  \node[text=CommColor!80!black, font=\bfseries\sffamily\bfseries] at (6.5, 2.5) {All-to-All Gather};
  \draw[comm_arrow] (exp1.east) -- (agg.north west);
  \draw[comm_arrow] (exp2.east) -- (agg.south west);

  % Output
  \node[right=0.5cm of agg] (out) {Output};
  \draw[->, thick] (agg) -- (out);

\end{tikzpicture}通信模式与张量并行不同:张量并行采用全归约(所有设备接收相同数据),而专家并行采用全对全通信(不同设备接收不同数据,依据路由结果)。这种 AllToAll 模式带来了一个关键的系统挑战:负载均衡。如果路由器持续向某些专家发送多于其他专家的令牌,这些专家的 GPU 会成为瓶颈,而其他 GPU 则处于空闲状态。有三种机制可以缓解负载均衡问题:
- 辅助损失:训练损失中增加的一项,通过对均匀的路由概率给予奖励来惩罚专家利用率的不均衡。
- 容量因子:每个专家在每个批次中会接受的令牌数存在上限(通常为公平份额的 1.25\(\times\) 倍)。超出该上限的令牌会被丢弃或重新路由。
- 专家缓冲:令牌会被缓冲,并在后续迭代中处理;当专家容量已满时,这一机制可以平滑负载尖峰,代价是延迟方差增大。
这些机制将专家利用率维持在足够均衡的水平,使路由仍然构成吞吐量优势,而不是引入新的拖慢者来源。
路由失效模式
路由行为会直接影响系统性能和模型质量。专家坍塌(expert collapse)是一种训练阶段的路由失效:路由器收敛到一小部分专家,导致其他专家训练不足;此时被服务的模型表现得像一个小型稠密模型,却拥有巨大的内存占用。路由不稳定是另一种训练阶段失效:分配结果发生振荡,使专家无法形成专业化。服务阶段还会引入运行时过载条件。分布偏移可能使在正式文本上训练的路由器,在服务于口语化聊天数据时过载特定的“语法专家”,从而形成热点。令牌丢弃发生在容量受限的专家丢弃令牌、跳过相应计算、仅依赖残差连接时,这会降低输出质量。
这些失效模式源于基本的 MoE 服务权衡:计算依据输入动态路由到不同专家,因此路由模式成为系统层面的工作负载,而不仅仅只是模型内部的选择。像 Mixtral (Jiang 等 2024年) 这样的主流模型利用 MoE 实现高容量,同时降低推理成本。
Jiang, A. Q., A. Sablayrolles, A. Roux, A. Mensch, B. Savary, C. Bamford, D. S. Chaplot, 等. 2024年. 《Mixtral of Experts》. arXiv preprint arXiv:2401.04088.
Example 1.10: Mixtral-8x7B 的专家并行
场景:Mixtral-8x7B(总参数量为 46.7B,每个词元激活约 12.9B 个参数)在一个由 4 台 GPU 设备组成的集群上提供服务,采用 top-2 路由。
诊断:将全部 8 个专家复制到全部 4 块 GPU 上会造成严重的显存冗余。每块 GPU 分配 2 个专家分片(4 路专家并行)需要通过 AllToAll 分发/汇集集合通信(约 0.4 ms)将词元路由到专家所在的设备。
系统启示:专家并行以 AllToAll 通信换取每块 GPU 参数显存占用的降低。通过每块 GPU 上的 2 个分片专家处理词元,可将 MoE 层的执行时间降至约 1.5 ms(等效稠密层约为 4 ms)。
专家并行代表了模型分片复杂度的最高水平,需要模型架构、路由算法和物理互连拓扑之间的紧密集成。下一节将探讨推荐系统如何使用类似的分片技术处理大规模嵌入表。
推荐系统的嵌入分片
推荐系统通常包含规模远超稠密模型权重的嵌入表。Meta 的 DLRM 参考架构在嵌入表上采用模型并行,以缓解内存约束,同时单独扩展稠密层 (Naumov 等 2019年)。在生产规模下,这种以嵌入为主的结构需要采用有别于张量并行或流水线并行的分片策略。
按行分片依据行(实体 ID)划分嵌入表:
\[\text{Shard}_i = \{e_j : \text{hash}(j) \bmod N_{\text{shards}} = i\}\]
每个分片包含约 \(N_{\text{entities}}/N_{\text{shards}}\) 个嵌入,其中 \(N_{\text{entities}}\) 是实体总数,\(N_{\text{shards}}\) 是分片数量。
按列分片将每个嵌入向量划分到多个设备上:
\[e_j = [e_j^{(0)}, e_j^{(1)}, ..., e_j^{(N_{\text{shards}}-1)}]\]
每台设备存储每个嵌入的一部分。混合分片结合了这两种方法:频繁访问的嵌入按列分片,以加快访问速度,而长尾部分采用按行分片。嵌入分片策略的选择取决于查找模式和通信开销。表 5 比较了按行、按列和混合三种方法:
| 分片策略 | 查找模式 | 通信 | 最适用场景 |
|---|---|---|---|
| 按行 | 每次查找使用单台设备 | AllToAll 汇集 | 均匀访问模式 |
| 按列 | 每次查找使用全部设备 | AllGather | 热点嵌入 |
| 混合 | 随嵌入而异 | 混合 | 生产环境中的推荐系统 |
这里需要权衡局部性与负载均衡。按行分片将每个嵌入向量完整保存在一台设备上,使查找具有局部性,但需要通过 AllToAll 汇集来收集按实体 ID 分散存储的向量;按列分片使每次查找都能跨设备并行执行,代价是一次 AllGather;混合分片则折中处理,对热点嵌入按列复制,同时对冷门长尾嵌入按行分片。图 14 展示了这三种布局,其中按行分片的“网络汇集”就是 表 5 中提到的 AllToAll 集合通信。
\begin{tikzpicture}[font=\small\sffamily, scale=0.85, transform shape]
  \definecolor{TableColor}{HTML}{D1E6F3}
  \definecolor{ShardColor}{HTML}{E6D4E5}

  % A. Row-Wise
  \node[anchor=west, font=\bfseries\sffamily\bfseries] at (0, 4.5) {A. Row-Wise Sharding};

  \draw[fill=TableColor] (0, 2.5) rectangle (1, 4);
  \node[rotate=90] at (-0.3, 3.25) {Users 0..U};

  \draw[->, thick] (1.2, 3.25) -- (2.2, 3.25);

  % Server 1
  \draw[fill=ShardColor] (2.5, 3.5) rectangle (3.5, 4.0);
  \node[right, font=\scriptsize\sffamily] at (3.5, 3.75) {Svr 1: Users 0..K};

  % Server 2
  \draw[fill=ShardColor] (2.5, 2.5) rectangle (3.5, 3.0);
  \node[right, font=\scriptsize\sffamily] at (3.5, 2.75) {Svr 2: Users K..U};

  \node[font=\scriptsize\sffamily, align=center] at (1.7, 2.0) {Partition by ID\\(Network Gather)};

  % B. Column-Wise
  \node[anchor=west, font=\bfseries\sffamily\bfseries] at (6, 4.5) {B. Column-Wise Sharding};

  \draw[fill=TableColor] (6, 2.5) rectangle (7, 4);
  \node[rotate=90] at (5.7, 3.25) {Dims 0..d};

  \draw[->, thick] (7.2, 3.25) -- (8.2, 3.25);

  % Server 1 (Col split)
  \draw[fill=ShardColor] (8.5, 2.5) rectangle (9.0, 4.0);
  \node[above, font=\scriptsize\sffamily] at (8.75, 4.0) {Svr 1};

  % Server 2
  \draw[fill=ShardColor] (9.1, 2.5) rectangle (9.6, 4.0);
  \node[above, font=\scriptsize\sffamily] at (9.35, 4.0) {Svr 2};

  \node[font=\scriptsize\sffamily, align=center] at (7.7, 2.0) {Partition Vector\\(AllGather)};

  % C. Hybrid
  \node[anchor=west, font=\bfseries\sffamily\bfseries] at (0, 0.5) {C. Hybrid Sharding};

  \draw[fill=RedL] (0, -1.0) rectangle (1.5, 0);
  \node[font=\scriptsize\sffamily] at (0.75, -0.5) {Hot (Top 1\%)};

  \draw[fill=BlueL] (0, -2.5) rectangle (1.5, -1.1);
  \node[font=\scriptsize\sffamily] at (0.75, -1.8) {Cold (Tail)};

  \draw[->, thick] (1.7, -1.25) -- (2.7, -1.25);

  \node[draw, fill=RedL, font=\scriptsize\sffamily] at (4, -0.5) {Replicated/Col-wise};
  \node[draw, fill=BlueL, font=\scriptsize\sffamily] at (4, -1.8) {Row-wise Sharded};

\end{tikzpicture}三种切分策略在生产环境中都实现了大规模运行。Meta 的推荐系统基础设施提供了一个具体案例,展示了行切分、列切分和混合切分如何结合,以服务于万亿级实体嵌入表。
Lighthouse 1.1: B 型架构(大规模 DLRM):Meta 的嵌入切分
对于 Meta 的 Archetype B 推荐工作负载,其基础设施在极端规模上展示了嵌入切分:
表 6: Meta 嵌入切分查找性能:推荐查找路径在批量加感知分片调度优化前后的网络往返次数、查找延迟和带宽测量结果,展示了这些优化带来的量级效应。
规模:
- 嵌入表:总计 100+ TB
- 唯一实体:10+ 万亿
- 嵌入维度:128–256
- 分片:1,000+ 服务器
这些规模条目描述的是基础设施层面的总量,而非一张稠密常驻表,其中每个唯一实体都对应一个 128–256 维的向量。一张包含 10 万亿实体、维度为 128 的稠密 INT8 表至少需要 1,280 TB,而同一实体数量下 100 TB 的平均每个实体仅 10 字节。因此,生产系统依靠压缩、分层、冷存储以及实体覆盖不均,而非单一完全物化的稠密矩阵。
切分策略:
- 热嵌入(按访问频率最高的 1%):在所有分片上复制
- 温嵌入(接下来的 10 percent):按列切分,并行度为 8
- 冷嵌入(其余 89 percent):按行切分,采用一致性哈希
每次推理请求大约需要 5,000 次嵌入查找。若不进行优化,则需要 5,000 次网络往返。相反,系统应用了多项优化:批量归集将 1 ms 内的查找收集起来;查找去重移除跨请求的重复实体;感知分片的批量按目标分片对查找进行分组;并行调度将批量请求同时发送至所有分片;流式组装在响应到达时重建嵌入。
这些优化对往返次数、查找延迟和带宽的影响量级见 表 6:
| 指标 | 无优化 | 有优化 |
|---|---|---|
| 网络往返次数 | 5,000 | 1(批量) |
| 查找延迟 | 50 ms | 2 ms |
| 网络带宽 | 10 Gbps | 40 Gbps(突发) |
灯塔式启示是:DLRM 规模的服务主要受稀疏嵌入放置和查找协同支配,而非稠密加速器的 FLOP/s。
混合切分策略
生产系统经常组合多种切分策略,因为没有任何单一切分轴能满足所有推理约束。混合切分将内存容量、延迟和通信需求组合起来:一个切分轴可使权重常驻,另一个可降低每 token 延迟,第三个可将稀疏分量路由到正确设备,而无需将稠密层放到错误设备上。三种反复出现的组合体现了这一模式:
张量并行与流水线并行在模型同时需要内存分布和延迟降低时结合使用:
8 GPUs organized as 2 by 4 (pipeline stages by tensor parallel):

Stage 0 (Layers 1-40):  TP across GPUs 0,1,2,3
Stage 1 (Layers 41-80): TP across GPUs 4,5,6,7
The combination achieves 4\(\times\) 倍延迟降低(相对于 TP),同时可处理需要 8 路切分以容纳显存的模型。
对于各个专家较大的 MoE 模型,专家并行与张量并行相结合:
Mixtral with large experts:

- Expert parallelism: Distribute 8 experts across 8 GPU groups
- Tensor parallelism: Each expert spread across 2 GPUs
- Total GPUs: 16
嵌入与稠密并行共同服务于同时包含大量嵌入与大量稠密分量的推荐模型:
DLRM-scale model:

- Embedding sharding: 1,000 shards across CPU servers
- Dense model: 8-way tensor parallel across GPUs
- Communication: Embeddings gathered to GPU, processed, returned
混合切分通过在切分块之间的每个边界引入新的通信模式,来换取适配性(fit)或延迟(latency)。接下来的问题是:通信开销是否仍然落在延迟与吞吐量的预算之内。
通信开销分析
切分带来的实际加速比,关键取决于通信效率。每种切分策略都具有特征性的通信模式,对带宽和延迟的要求各不相同。
公式 12 量化了张量并行下的 AllReduce 通信时间,其中数据由所有设备聚合,结果在所有设备上均可获得。
\[T_{\text{allreduce}} \approx 2(N-1)\alpha + \frac{2(N-1)}{N} \times \frac{M}{\beta} \tag{12}\]
其中,\(N\) 表示设备数量,\(M\) 表示集合通信的载荷大小,\(\alpha\) 表示启动延迟,\(\beta\) 表示互连带宽。系数 2 对应 reduce-scatter 与 all-gather 两个阶段。AllReduce 推导了这一环形 AllReduce 的成本及其带宽最优的 \(2(N-1)/N\) 扩展方式,从而说明了为什么逐层的通信开销会随着张量并行度增长而保持有界。
公式 13 表达了流水线并行中更简单的点对点通信,其中数据从一个设备流向下一个设备。
\[T_{\text{p2p}}(n) = \alpha + \frac{n}{\beta} \tag{13}\]
其中,\(n\) 表示点对点载荷大小,\(\alpha\) 表示网络延迟,\(n/\beta\) 表示传输时间。公式 14 刻画了专家并行中更为复杂的 AllToAll 通信,其中每个设备与其他每个设备交换不同的数据。
\[T_{\text{alltoall}} = (N-1) \times \left(\alpha + \frac{M/N}{\beta}\right) \tag{14}\]
两个公式都清楚地表明,底层互连的可达带宽 \(\beta\) 与延迟 \(\alpha\) 决定了实际切分性能。生产硬件在这两个维度上的差异足够大,以至于互连方式的选择可以决定某个切分方案是否可行。
通信开销高度依赖于互连技术。数据中心互连规格 记录了每种候选互连技术的物理带宽、延迟和预期用途:
| 互连技术 | 带宽 | 延迟 | 应用场景 |
|---|---|---|---|
| NVLink (H100) | 900 GB/s | 500 ns | 节点内张量并行 |
| PCIe Gen5 | 64 GB/s | 1 μs | 节点内(无 NVLink) |
| InfiniBand HDR | 200 Gb/s (25 GB/s) | 7 μs | 节点间 |
| Ethernet 100G | 100 Gb/s (12.5 GB/s) | 50 μs | 节点间(通用型) |
按互连技术的 AllReduce 成本 将这些带宽换算为 8 路张量并行层的 AllReduce 时间(每次全归约的激活为 8 MB;batch=1,hidden=8,192),并以 30 ms 的 Transformer 层预算为分母:
| 互连技术 | AllReduce 时间 | 占 30 ms 层的比例 |
|---|---|---|
| NVLink | 0.03 ms | 0.10% |
| InfiniBand | 0.56 ms | 1.9% |
| 100G Ethernet | 1.12 ms | 3.7% |
工程边界是局部的:NVLink 使节点内张量并行高效可行,InfiniBand 可为精心挑选的工作负载使跨节点张量并行变得可接受,而通用以太网通常因延迟过高而不适合对延迟敏感的推理。
NVLink 带宽8 随 GPU 代际演进显著。
8 NVLink 带宽演进: 每一代 NVLink 都提高了本地通信上限,但实际张量并行开销仍取决于消息大小、集合通信实现、拓扑结构,以及能够与传输重叠的计算量。
分片策略选择
分片策略的选择取决于模型架构与部署优先级。 表 7 从四个关键因素评估每种方法:
| 因素 | 张量并行 | 流水线并行 | 专家并行 | 嵌入张量分片 |
|---|---|---|---|---|
| 延迟优先 | 最佳 | 最差 | 中等 | 不适用 |
| 吞吐优先 | 良好 | 最佳(流水线) | 良好 | 最佳 |
| 受互连限制 | 适配差 | 适配良好 | 中等 | 适配良好 |
| 实现复杂度 | 高 | 低 | 中等 | 高 |
策略选择从部署瓶颈出发。当延迟占主导且互连能够支撑频繁的集合通信时采用数据并行;当吞吐比单次请求延迟更重要时采用流水线并行;当 MoE 路由定义了模型结构时采用专家并行;当大规模稀疏表主导容量时采用嵌入分片。
一旦组装出大规模分片的多 GPU 副本,就必须并行运行数十个副本来处理全局流量。挑战由此从单个副本的内部机制转移到流量控制层,该层负责在集群中路由数百万用户查询。
负载均衡与请求路由
假设有十个模型副本正在服务流量,而一个新请求要求对 5,000 词文档进行摘要,将其发送到已经过载的副本,将导致分配给该节点的所有用户出现巨大的延迟尖峰。简单的轮询负载均衡对生成式机器学习会灾难性失败。生产级服务需要智能请求路由,评估集群中每个副本的内部内存与队列状态。
Lighthouse 1.2: 原型 B(DLRM 大规模部署):大规模下的尾部延迟
原型 B(DLRM 大规模部署)的性能边界取决于 \(P_{99} \le 100\text{ ms}\)。由于高吞吐服务聚合了 \(10^7\) QPS,\(10^{-4}\) 尾部延迟事件每秒发生 \(1{,}000\) 次。这要求采用二选一路由,以抑制排队延迟 \(T_{\text{queue}}\),否则排队延迟会主导物理计算 \(T_{\text{compute}}\)。
负载均衡原则
二选一路由拉平了随机放置的尾部不均衡。
负载均衡服务于两个主要目标,二者有时相互冲突:延迟最小化与利用率最大化。延迟最小化将请求路由到能够最快服务它们的副本,考虑当前队列深度与处理时间;利用率最大化则将负载均匀铺开,以避免空闲副本与过载副本。张力源于延迟最优路由可能将负载集中到快速副本上,降低其性能,同时使其他副本利用率不足。
因此,评估需要四个信号,同时覆盖尾部延迟与负载均衡:
- 最大队列长度:决定最差情况延迟。
- 负载方差:衡量工作分布的均匀程度。
- 利用率跨度:显示是否存在部分副本空闲而其他副本饱和的情况。
- 决策开销:反映做出路由选择本身的成本。
仅优化其中单一信号的策略,在总体上可能看起来健康,却会把不幸运的请求送入尾部。
轮询与随机分配
最简单的负载均衡策略在不考虑服务器状态的情况下分配请求。轮询将请求 1 发送给服务器 1,请求 2 发送给服务器 2,依此类推;只有当服务器完全同质且请求处理时间相同时,才能达到完美分布。随机分配为每个请求均匀随机选择一个服务器;当请求数量很多时,其均值分布趋近均匀,但方差高于轮询。这两种策略对相同服务器都是合理的基线,然而生产级服务很少满足该假设。异构 GPU 代际、不同的内存配置、变化的请求大小、预热行为,以及接近内存上限的副本,都使得服务器集群的状态至关重要。
在这些现实条件下,无信息策略表现很差,因为不幸运的分配会在尾部累积。随机分配下的最大队列长度遵循经典的 balls-into-bins 结果 (Mitzenmacher 2001年),如 公式 15 所示:
\[E[\text{max queue}] = \Theta\left(\frac{\log R}{\log \log R}\right) \tag{15}\]
其中 \(R\) 表示服务器或副本数量。在 \(R = 1{,}000\) 处评估该比值得到 \(\log R/\log\log R \approx 6.9/1.9 \approx 3.6\),前导常数将其提升至最差情况队列约 4–5 个请求。这看似很小,但长队列中的不幸运请求会经历显著更高的延迟。二选一的威力(原则 16)提供了理论上的回应:多探测一个队列长度,就能将尾部行为从 \(\mathcal{O}(\log R / \log \log R)\) 改善为 \(\mathcal{O}(\log \log R)\)。
二选一的威力
负载均衡理论中的一个基础性结论 (Mitzenmacher 2001年) 表明,在做出路由决策前仅查询两个随机服务器,就能比随机分配获得指数级更好的负载分布。9
Mitzenmacher, M. 2001年. 《The power of two choices in randomized load balancing》. IEEE Transactions on Parallel and Distributed Systems 12 (10): 1094~104. https://doi.org/10.1109/71.963420.
9 balls into bins(二选一): 随机放置时最大分箱负载为 \(\Theta(\log R / \log \log R)\);选择两个随机分箱中负载较低的一个,可将其降至 \(\Theta(\log \log R)\)。服务收益取决于探测到的队列长度在多大程度上准确反映剩余工作。
该流程刻意保持简洁,但负载信号必须与服务工作负载相匹配。对于同质的视觉模型集群,当前队列长度可能已经足够。对于 LLM 集群,活跃 token 数、估计的剩余解码工作量,以及 KV-cache 压力更能近似副本已接受的工作量。 Algorithm 3 给出了一个代表性路由循环:探测两个副本,比较归一化后的工作量,并在不轮询整个集群的情况下完成路由。
\begin{algorithm} \caption{Power-of-two choices request routing} \begin{algorithmic} \Require replica set $\mathcal{S}$; request $r$; capacity weights $w_s$; per-replica work signal $W_s$ (queue length, active tokens, predicted work, or KV-cache occupancy) \Ensure a selected replica for $r$ \State sample two candidate replicas $s_a, s_b$ from $\mathcal{S}$ \Comment{capacity-weighted} \State query $W_{s_a}, W_{s_b}$; estimate incremental work $\hat{c}(r)$ (expected output tokens or KV pages) \State $u_s \gets (W_s + \hat{c}(r)) / w_s$ for $s \in \{s_a, s_b\}$ \Comment{post-admission load} \State $s^\star \gets$ candidate with smaller $u_s$ \Comment{ties: cache affinity} \State route $r$ to $s^\star$ \State update $s^\star$'s local admission state \State \Return $s^\star$ \end{algorithmic} \end{algorithm}
每个请求的两次探测和一次状态更新属于 \(\mathcal{O}(1)\) 协同,而非扫描所有副本;只有当负载信号反映真实工作量时,尾延迟方面的收益才会显现:在 LLM 服务中,仅凭请求数量可能会使一个 10-token 请求被一个 500-token 请求掩盖,而活跃 token 数和 KV 缓存信号则能揭示这一风险。公式 16 中的队列长度界形式化地说明了这一小改动为何重要,它将最大队列长度从 \(\mathcal{O}(\log R / \log \log R)\) 降至 \(\mathcal{O}(\log \log R)\):
\[E[\text{max queue}]_{\text{two choices}} = \Theta(\log \log R) \tag{16}\]
对于 1,000 台服务器,随机分配产生的最大队列长度约为 4–5 个请求,而二选一策略将最大队列长度降至约 2 个请求。这种改进是指数级的:在 1,000 台服务器上采用二选一策略,所实现的负载均衡优于在仅 10 台服务器上采用随机分配。
Theorem 1.2: 二选一策略的负载均衡界
对于接收独立请求的 \(R\) 台服务器,随机分配会以高概率产生 \(\mathcal{O}(\log R / \log \log R)\) 的最大队列长度,而将每个请求路由到两个随机采样队列中较短的那个,则可将最大队列长度降至 \(\mathcal{O}(\log \log R)\)。
其实际意义在于,接近最优的负载均衡并不需要轮询整个集群。两次探测避免了精确选择负载最低服务器所需的 \(R\) 次探测开销,改进效果随系统规模增大而增强,而且该方法足够简单,可以在普通负载均衡器中实现。二选一策略的变体被用于大规模系统,是因为它们无需全局轮询就能提供良好的尾部表现。
这一机制直观易懂:随机分配偶尔会做出不佳的选择,将请求路由到已经繁忙的服务器,而这些错误会不断累积。采用二选一策略时,算法几乎不会做出最差的选择,从而避免了造成长队列的尾部行为。从数学上看,当 \(m\) 台服务器的队列长度为 \(k\) 时,随机分配使长度为 \(k+1\) 的队列增长的概率与 \(m/R\) 成正比。采用二选一策略时,该概率降至 \((m/R)^2\),使队列长度分布呈超指数衰减。
加权与自适应负载均衡
当服务器容量不同时,朴素的负载均衡会导致负载失衡。在混合部署 A100 GPU 和容量较低的 T4 GPU 时,若它们接收相同速率的请求,T4 服务器就会过载,而 A100 的容量则会闲置。加权轮询通过按服务器容量的比例路由请求,修正平均分配速率:
\[\Pr(\text{route to server } i) = \frac{w_i}{\sum_j w_j}\]
其中,\(w_i\) 是服务器 \(i\) 的权重,即容量。加权二选一策略将同一思路应用于尾部控制:按与权重成正比的概率采样两台服务器,比较当前负载相对于容量的比值,并将请求路由到相对负载较低的服务器。加权路由示例具体展示了这一策略在混合 GPU 硬件环境中的应用。
Example 1.11: 异构 GPU 集群
场景:一个服务集群混合了 10 张 H100 GPU(每张 1000 QPS)和 20 张 A100 GPU(每张 600 QPS),处理 15,000 QPS 的目标流量。
诊断:不加权的轮询路由将数量相等的请求(500 QPS)分发到所有节点,导致 H100 利用率不足(50 percent),而 A100 则过载(83.3 percent)。加权路由为 H100 分配权重 4.5 percent,为 A100 分配权重 2.7 percent,从而在各层级之间均衡利用率(68.2 percent 对比 68.2 percent)。
系统启示:异构推理集群需要基于容量加权的路由。当硬件层级的服务速率不同时,相等的请求量会产生不平衡的负载。
静态权重可以处理已知的容量差异,但生产环境中的副本会随时间发生变化。自适应负载均衡根据观测到的性能动态调整权重:
For each server i:
    latency[i] = exponential_moving_average(observed_latency)
    weight[i] = 1 / latency[i]  # Inverse latency weighting
反向延迟加权会降低将请求路由到观测延迟已上升的服务器(无论原因是内存压力、热节流、请求混合,还是背景任务占用资源)的概率。
最少连接负载均衡
随机选择的一种替代方案是路由到活跃连接最少或队列最短的服务器。最少连接法为每台服务器维护活跃请求计数,将新请求路由到计数最小的服务器,在调度时递增、在完成后递减。对于长尾请求(在 LLM 服务中很常见),它优于轮询,因为它考虑了仍在进行中的工作,而轮询只考虑历史分配顺序。
挑战在于分布式系统中如何维护准确的连接计数。集中式计数器提供单一事实来源,但可能成为瓶颈;基于 gossip 的分布式计数器扩展性更好,但可能依据过期信息路由。采样的最少连接法将这一思路与两选一并结合:只探测服务器子集,并选择其中连接最少者。
Example 1.12: LLM 服务的最少连接法
场景:一个 LLM 服务集群处理输出序列长度变化极大的请求(10 个 token 需 500 ms,500 个 token 需 25 秒)。
诊断:轮询路由依据历史请求数分配工作,导致处理长生成的节点过载(P99 = 45s),而空闲节点在等待。最少连接法则将新工作路由到活跃在途请求最少的节点。
系统启示:最少连接路由考虑的是仍在进行的工作量,而非历史分配计数。对于输出长度可变的 LLM 服务,最少连接法将 P99 尾延迟降低 38%(从 45s 降至 28s)。
一致哈希用于有状态路由
许多推理工作负载维护对路由亲和性有益的状态。LLM 服务可能将已完成回合的 KV 状态保留为会话缓存,推荐会话可能携带用户上下文和近期交互,流式推理可能依赖先前帧的模型状态。对于这些工作负载,将同一用户或会话路由到同一服务器可以避免缓存未命中与状态重建。无需亲和性的无状态 LLM API 会在每次请求时接收完整会话,因此不需要这种亲和性;但当可复用前缀恰好被缓存时,它仍可能使用感知前缀的路由。
一致哈希10 (Karger 等 1997年) 依据路由键(用户 ID、会话 ID)的哈希值将请求映射到服务器:
10 一致哈希:该环形算法最初是为 Akamai 的大规模分布式缓存开发的 (Karger 等 1997年)。其“有限重映射”特性后来使其适用于任何需要保持缓存局部性的成员变更场景。
Karger, D., E. Lehman, T. Leighton, R. Panigrahy, M. Levine, 和 D. Lewin. 1997年. 《Consistent hashing and random trees: Distributed Caching Protocols for Relieving Hot Spots on the World Wide Web》. Proceedings of the twenty-ninth annual ACM symposium on Theory of computing - STOC ’97, 654~63. https://doi.org/10.1145/258533.258660.
\[\text{server}(request) = \operatorname{arg\,min}_{s \in \mathcal{S}_{\text{srv}}} \text{distance}(\text{hash}(key), \text{hash}(s))\]
其中 \(\mathcal{S}_{\text{srv}}\) 表示映射到环上的服务器集合,每个请求路由到顺时针方向最近的服务器。
关键属性是确定性、有限扰动和均衡性。在环成员固定的情况下,同一键会路由到同一服务器。成员变更时只重映射受影响的区间:新增服务器会移动约 \(1/(N+1)\) 比例的键,移除服务器则移动其约 \(1/N\) 的份额。虚拟节点通过平滑物理服务器之间不均衡的哈希区间来近似这些比例。对于会话缓存的 LLM 服务,收益在于提高后续回合到达带有可复用状态的副本的概率。亲和性无法避免过载路由、故障、驱逐或成员重映射后重复的预填充;若所选副本过载程度过高而无法在请求截止时间内完成,缓存命中反而有害。
Example 1.13: 一致哈希用于 KV 缓存亲和性
场景:一个多回合 LLM 聊天服务在无会话亲和性的情况下,将用户查询路由到一组推理副本。
诊断:在该场景中,未建立亲和性的路由会将后续会话回合发送到不同副本,迫使每个回合都从头重建 KV 缓存(每次 500 ms 开销,10 回合会话共浪费 4.5s)。在成员固定的情况下,一致哈希将用户 ID 确定性地映射到某个副本,并在成员变更时保留大部分映射。
系统启示:一致哈希在不要求缩容时进行完整键重映射的前提下,改善了多回合会话的 KV 缓存局部性。当首选副本保持健康且及时时,它能减少冗余预填充;但过载路由、驱逐、故障以及被重映射的键比例仍然需要缓存传输或重建。
当缓存状态属于特定用户时,同一套有状态路由机制会成为一个正确性边界。
War Story 1.1: 当缓存状态跨越用户(2023 年)
背景:ChatGPT 通过 redis-py 客户端使用 Redis Cluster 缓存用户信息和会话标题,该系统具有高吞吐量服务特征 (OpenAI 2023年)。
机制:在 Asyncio 连接池并发竞态条件下,被取消的请求会在回收的连接缓冲区中留下未读取的响应,导致后续请求收到属于先前用户的缓存数据。
影响:2023 年 3 月 20 日,OpenAI 在用户报告看到其他活跃用户的会话标题和支付信息后,将 ChatGPT 下线。
修复:OpenAI 向 Redis 维护者提交了 redis-py 取消路径的补丁,并增加了冗余检查,确认缓存返回的数据属于发起请求的用户。
系统启示:有状态推理基础设施需要在缓存、连接池和路由键周围提供隔离保证。缓存是服务正确性边界的一部分,而不仅仅是一种优化。
OpenAI. 2023年. March 20 ChatGPT Outage: Here’s What Happened. OpenAI incident report.
分片模型的请求路由
节 1.4 中考察的分片策略引入了路由复杂度:单个推理请求可能需要在多个设备上计算,因而需要协同。路由模式取决于分片策略。
在张量并行下,每个请求都会广播到分片组中的所有设备。每个设备处理各自分片中的每一层部分,结果通过 AllReduce 同步。图 15 展示了这一广播—计算—归集模式。
图 15 中可见的关键约束是:每个请求都需要在分片组内的所有设备之间进行一次 AllReduce 同步,因此互连带宽成为决定延迟的因素,而非模型规模。
在流水线并行中,每个请求按顺序穿越各个阶段,每个阶段将激活值转发给下一个阶段。图 16 展示了流水线并行如何使多个请求的流水线化实现吞吐量扩展,即使单个请求的延迟等于所有阶段时间的总和。
从 图 16 得出的关键洞见是:流水线并行并不带来单请求的延迟收益:单个请求仍需依次穿越所有阶段。只有当多个并发请求填满流水线时,吞吐量才会扩展,达到与阶段数成正比的稳态吞吐量。
在专家并行下,每个请求依据门控决策被调度到承载其选定专家的设备上。两个 AllToAll 通信步骤分别位于专家计算的前后(图 17)。
这两级 AllToAll 通信步骤使专家并行对负载不均衡具有独特的敏感性:如果门控函数将 token 集中在少数专家上,这些设备会成为瓶颈,而其他设备则处于空闲状态。
当多个分片组提供水平扩展时,负载均衡器会路由到组,而不是单个设备。图 18 展示了这一两级层次结构:标准的负载均衡算法(轮询、二选一、一致性哈希)在组级别运行,而每个组都在本地处理其内部的 AllReduce。
《图 18》中的两级层次结构分离了不同关注点:负载均衡器将每个分片组视为一台逻辑服务器,并使用标准算法处理;而组内的 AllReduce 协同则仅局限于各分片组内部。增加分片组可使吞吐量线性扩展;增加每组 GPU 数量则可降低单次请求的延迟。
健康检查与故障切换
负载均衡器只有在健康信号与故障模式相匹配时,才能绕开故障进行路由。对于机器学习服务而言,一个进程可能仍然存活却已无法使用,因为权重尚未加载、GPU 内存池已耗尽,或首个请求将触发漫长的预热过程。因此,生产系统会按照由最廉价到最贴近实际的顺序,叠加多层健康检查。
存活探测用于验证服务器进程是否正在运行:
GET /health/live
Response: 200 OK (process alive) or timeout (process dead)
就绪探测进一步验证服务器能否处理请求(模型已加载、GPU 已初始化):
GET /health/ready
Response: 200 OK (ready to serve) or 503 (not ready)
深度健康检查通过运行测试请求,验证实际推理是否正常工作:
POST /health/inference
Body: {"prompt": "test"}
Response: 200 OK with valid output, or error
深度健康检查
深度健康检查是针对传统 Web 服务器中并不存在的一种故障模式的主要防线:静默的硬件劣化。一块 HBM 模块劣化的 GPU 可能仍会继续响应进程级 HTTP 200 检查,却因内存压力或未预热(un-warmed)的模型状态而在真实请求上静默失败。
Example 1.14: GPU 推理健康检查
场景:GPU 推理服务器通过标准的进程级 HTTP 200 检查,却在真实请求上因内存压力或未预热模型状态而静默失败。
诊断:标准探针无法检查 GPU 内存分配(MIN_REQUEST_MEMORY)或模型预热状态,导致劣化节点接收生产流量并引发生成失败。
系统经验:GPU 推理健康检查需要分层探测(Liveness、Readiness、Deep Health)。Readiness 探针必须验证 GPU 内存可用性与预热状态,而深度健康检查则验证 logit 输出分布是否符合预期范围。
定量分析:负载均衡的影响
负载均衡算法的选择对系统性能具有定量影响。考虑一个由 100 台服务器组成、QPS 为 10,000、且请求大小可变(CV = 0.5)的系统。负载均衡算法对比 量化了延迟与开销之间的权衡:
| 算法 | 最大队列 | P99 延迟 | CPU 开销 |
|---|---|---|---|
| 随机 | 4.2 个请求 | 45 ms | 极低 |
| 轮询 | 2.8 个请求 | 32 ms | 极低 |
| 二选一 | 1.9 个请求 | 24 ms | 每次请求 2 次探测 |
| 最少连接 | 1.4 个请求 | 19 ms | 全局状态 |
| 二选一 + 最少连接 | 1.2 个请求 | 17 ms | 2 次探测 + 状态 |
负载均衡算法对比 展示了熟悉的模型服务权衡:随机与轮询路由将 CPU 开销维持在接近零的水平,但队列更长、延迟方差更高;二选一仅以每次请求两次探测为代价,将 p99 延迟大致减半;最少连接在请求成本波动较大时进一步改善,但需要全局状态;将二选一与最少连接结合则产生最短队列,同时实现复杂度最高。
对许多模型服务系统而言,二选一在性能改善与实现复杂度之间提供了很强的权衡。最少连接对于请求大小方差较大的工作负载(LLM 服务、推荐排序)具有额外价值。
熔断器与反向压力
当 GPU 推理服务器变慢时,继续向其路由更多请求可能将局部变慢演变为整个集群的失败。热节流是典型触发因素:一个原本每请求 50 ms 的副本开始需要 500 ms,队列在其背后堆积,客户端超时产生重试,而这些重试又进一步将负载压到邻近副本上。负载均衡器需要一种机制,不再将该副本仅仅视为“慢”,而是将其视为不可用。
熔断器模式11 (Nygard 2007年) 提供了这一控制手段。在关闭状态下,服务器接收正常流量。当错误率、超时率或延迟超过阈值时,熔断器打开,请求快速失败或路由到其他位置,而不是排队等待饱和队列。经过恢复区间后,熔断器变为半开状态:它先放行少量探测请求,探测成功则关闭,探测失败则重新打开。关键的系统属性是故障影响范围有界:失效副本的流量流失足够快,其队列无法将过载扩散到集群其余部分。
11 熔断器:名称取自电气安全装置,它在过载电路造成更大范围损坏之前切断电流。
反向压力传播通过在上游使过载可见来补充熔断器。当队列深度越过阈值时,服务器返回某种信号,例如 503 Service Unavailable;负载均衡器将该副本标记为劣化并减少向其路由的请求。若所有副本都变为劣化,系统便从路由控制转向准入控制,在边缘拒绝部分请求,而不是接受那些无法在延迟 SLO 内完成服务的工作。熔断器隔离不健康副本;反向压力则在重试放大故障之前告知系统其余部分减速。
反向压力只有在请求契约贯穿整个服务图时才有效。网关将客户端超时转换为绝对截止时间,每个下游阶段在接纳更多工作前扣除已消耗时间。若客户端断开或截止时间到期,取消信号必须传递到已排队的 CPU 工作、加速器批次、检索调用以及流式输出。停留在连续批次中的取消请求属于僵尸工作:它消耗 KV 页与解码带宽,却不产生任何有用响应。某些内核无法在启动过程中被中断,因此取消通常要到下一个批次或 token 边界才生效;调度器必须测量这一取消延迟,而不能承诺瞬时抢占。
同一个请求标识符必须贯穿路由、排队、prefill、decode、缓存分配与响应流式输出。有用的服务追踪会记录已接纳与已拒绝的请求、排队延迟、TTFT、TPOT、输入与输出 token、缓存页、批次归属、抢占、取消以及回退决策。聚合加速器利用率无法区分有用工作与迟到或已取消的工作。SLO 有效吞吐与浪费 token 速率填补了这一缺口,通过报告完成的工作中有多少符合其契约、以及系统在结果失去价值后执行了多少计算来加以说明。
在 KV 缓存压力下,一个饱和的 LLM 集群有三个通用反向压力无法提供的缓解手段:
- 上下文驱逐:从 KV 缓存中驱逐较早的对话轮次,以缩小上下文窗口并释放内存。
- 投机解码:关闭投机解码,以回收草稿模型所占用的 GPU 内存。
- 回退路由:将新请求路由到较小的量化回退模型,直到主队列排空。
每种响应都以输出质量或延迟为代价来维持可用性,从用户视角看,这往往优于直接拒绝。系统设计师必须为每个压力层级规定哪些劣化模式是可接受的,因为正确的权衡取决于具体应用:实时助手对上下文截断的容忍度优于静默的质量劣化。
Example 1.15: 防止级联故障
场景:在一支多副本服务集群中,单台 GPU 推理服务器发生热节流(延迟从 50 ms 飙升至 500 ms)。
诊断:未受保护的负载均衡器继续向慢速副本发送流量,队列被填满,并产生客户端重试,进而将过载级联到健康的相邻服务器。
系统启示:熔断器在重试流量引发集群级故障之前隔离性能下降的 GPU 副本。当错误率或延迟阈值被突破时打开熔断器(50 percent 错误率),可快速失败并保留剩余副本的容量。
高效的路由假设推理服务器拥有底层硬件。然而,在企业环境中,关键生产模型往往与实验模型和开发者端点运行在同一批物理集群上。防止恶意查询劣化生产服务需要严格的多租户和资源隔离。
多租户与隔离
考虑一个与实验计算机视觉脚本运行在同一台 GPU 服务器上的关键客户支持聊天机器人。如果实验工作负载意外占满了 PCIe 总线或内存带宽,面向客户的聊天机器人开始超时,违反服务等级协议(SLA)。多租户与隔离确保共置工作负载能够节省成本,同时不牺牲旗舰服务的可预测性。
多租户挑战
多租户通过成本效率、运维简单性和统计复用节省成本。共享基础设施提高了资源利用率,减少了需要管理的集群数量,并使聚合流量比任何单一租户的流量更具可预测性。

一个租户的突发流量可以劣化共享该资源池的每一个工作负载。
同样的共享机制也带来了隔离问题以及 表 8 所界定的多租户权衡:嘈杂邻居可能使一个租户的突发流量劣化其他租户,资源争用横跨 GPU 内存、网络带宽和 CPU 周期,当租户需求不同时,服务等级目标(SLO)的复杂度也会增加。
| 方面 | 单租户 | 多租户 |
|---|---|---|
| 资源利用率 | 30–50% | 70-90% |
| 每次请求成本 | 更高 | 更低 |
| SLO 保证 | 简单 | 复杂 |
| 隔离 | 完全隔离 | 需要工程实现 |
| 运维开销 | 更高(集群数量多) | 更低(集群数量少) |
嘈杂邻居问题
嘈杂邻居问题发生在某个租户的工作负载劣化了共享同一基础设施的其他租户的性能时。干扰同时体现在三个资源维度上。
GPU 内存争用最为严重:一个意外出现超长序列的租户可能消耗不成比例的 KV 缓存池份额。假设有三个租户共享 60 GB 的 KV 缓存池,各自分配 20 GB。当其中一个租户开始发出长上下文请求时,其分配可能膨胀至 45 GB,迫使驱逐,使其他租户的并发序列数从各自 200 个降至 75——即批次大小直接下降 62 个百分点,进而劣化其吞吐量。当一个租户流式传输大量大响应时,网络带宽饱和会加剧这一效应,消耗可用的出口容量。租户之间的 GPU 时间共享会引入上下文切换开销和不可预测的延迟方差。测量嘈杂邻居影响需要同时捕获这三个干扰维度。
Example 1.16: 量化嘈杂邻居影响
场景:推理平台在共享的 H100 GPU 上服务 10 个租户,每个租户的配额为 100 QPS,并遵循 50 ms P99 SLO。
诊断:租户 3 突发流量至 500 QPS(为 \(\times\) 基线的 5 倍)。在没有隔离的情况下,KV 缓存内存和计算争用级联为共享池上全部 10 个租户的 P99 延迟违规(22–45 ms)。
系统启示:共享容量只有在与严格隔离相结合时才提高利用率。未受保护的共享池会将有效 SLO 崩溃到任何单一租户的最坏情况突发水平。
Example 1.17: 带租户配额时的嘈杂邻居
场景:租户 3 在启用租户资源配额的共享推理集群上突发流量至 500 QPS。
诊断:配额执行将租户 3 限流至 120 QPS(仅违反租户 3 的 SLO),而租户 1–2 和 4–10 保持正常的 15 ms 延迟。
系统启示:租户配额将平台级故障转化为隔离的准入控制决策,保护共置租户免受嘈杂邻居突发流量的影响。
资源配额与公平共享
资源配额限制了每个租户可以消耗的份额,防止任何单一租户垄断共享资源。硬性配额将共享服务转变为准入控制。请求速率和并发度约束准入压力,而输入 token、输出 token、KV 缓存页、加速器时间和出口字节则约束准入后所执行的工作。单个标量配额无法保护所有这些资源,因为两个请求可能具有相同的计数,却在提示长度或生成输出上相差几个数量级。 代码 1 展示了代表性的门控,使租户可以在稀缺资源边界处被限流,而不是劣化整个批次。
class TenantQuota:
    max_concurrent_requests: int  # e.g., 100
    max_kv_cache_mb: int  # e.g., 20,000
    max_qps: int  # e.g., 1,000
    max_input_tokens_per_minute: int
    max_output_tokens_per_minute: int
    max_batch_tokens: int  # e.g., 50,000


def admit_request(tenant_id, request):
    quota = get_quota(tenant_id)
    usage = get_usage(tenant_id)

    if usage.concurrent >= quota.max_concurrent_requests:
        return RateLimitError("concurrent request limit")
    if usage.kv_cache_mb >= quota.max_kv_cache_mb:
        return RateLimitError("memory limit")
    if usage.qps >= quota.max_qps:
        return RateLimitError("rate limit")
    if usage.input_tokens + request.input_tokens > quota.max_input_tokens_per_minute:
        return RateLimitError("input-token limit")
    if usage.output_tokens + request.max_output_tokens > quota.max_output_tokens_per_minute:
        return RateLimitError("output-token limit")

    return admit(request)
不变量是“先拒绝,再干扰”:任何会超出租户配额限额的请求都不会进入调度器,从而避免受保护租户因其他租户的突发流量而承受更高的排队延迟或 KV 缓存压力。
带公平共享的软配额提供了一种更灵活的替代方案。每个租户都有一个标称令牌生成配额(例如 10,000 tokens/sec),但当集群利用率不足时(容量 50%),租户可以突增到其配额的 2\(\times\) 倍;当集群饱和时(容量 90%),配额得到严格执行。这种方法在低流量期间最大化利用率,同时在竞争期间保护租户。
当总需求超过容量时,max-min 公平性分配资源以最大化各租户之间的最小分配量。该算法首先给每个租户分配相等的份额,然后将未使用的容量从需求低于其相等份额的租户那里重新分配。原始请求计数是不适合该计算的度量单位,因为相等的请求数并不等于相等的负载:发出长上下文摘要请求的租户,其预填充计算和 KV 容量消耗远高于发出短分类查询的租户。令牌速率提供了有用的记账单位,但输入令牌与输出令牌必须保持分开,因为它们施加的压力阶段不同。内存预留与并发还需要额外的限制。假设有三个租户,输出需求分别为 30,000、20,000 和 80,000 tokens/sec,竞争一个每秒可处理 100,000 tokens/sec 的解码池,max-min 公平性得到的分配量为 30,000、20,000 和 50,000。该分配保护了解码带宽;一个独立的输入令牌预算则保护预填充池。
优先级调度
当租户具有不同的 SLO 要求时,优先级调度确保高优先级请求优先获得资源。优先级调度等级 表明,抢占权与资源保障沿三个等级同步变化:关键流量可以抢占任何更低等级并预留容量,尽力而为流量则永不抢占且没有任何保障,因此一个 SLO 等级直接对应抢占阶梯中的一个位置。
| Class | Use Case | Preemption | Resource Guarantee |
|---|---|---|---|
| Critical | Revenue-generating | Can preempt lower | 100% reserved |
| Standard | General traffic | Can preempt best-effort | Weighted share |
| Best-effort | Background, batch | Cannot preempt | No guarantee |
调度器按优先级等级对 incoming 请求排序,然后在每个等级内部按到达时间排序。当新的关键请求到达时,它会跃至队列中所有标准类和尽力而为请求之前,确保产生收益的流量永远不会排在后台批处理作业之后。
抢占将该原则扩展到已经在执行中的请求,但优先级并不意味着状态迁移是免费的。在令牌边界处,调度器可以停止向低优先级请求下发解码工作,同时保留其 KV 页面,将这些页面交换到主机内存,稍后重新计算并丢弃它们,或者在其截止时间已无法得到满足时拒绝该请求。保留策略在 HBM 相对计算资源更为充裕时可行;交换仅在传输时间能够适应截止时间且不引起其他流量拥塞时可行;重新计算则在重复预填充的成本低于迁移成本时可行。受害者策略必须考虑剩余服务时间、状态大小和截止时间余量,否则激进的抢占可能消耗比其释放的容量更多的容量。
舱壁模式
舱壁模式12 (Nygard 2007年) 对租户工作负载进行物理隔离,防止故障在租户之间传播。该模式得名于将洪水限制在隔离舱室中的船舱隔板。
12 舱壁限额:只有当隔板关闭了相关边界时,它才能隔离故障。泰坦尼克号的不完整隔板使水在舱室之间逐级蔓延;同样,软配额无法隔离仍然全局可耗尽的共享内存或带宽。
Nygard, Michael T. 2007年. Release It!: Design and Deploy Production-Ready Software. Pragmatic Bookshelf.
最强形式的舱壁是将整个副本专用给特定租户或租户组。图 19 展示了金级与标准级之间这种部署层面的隔离:
\begin{tikzpicture}[font=\small\sffamily, scale=0.9, transform shape]
  \definecolor{GoldColor}{HTML}{FCE4CC}
  \definecolor{StdColor}{HTML}{F5F5F5}
  \definecolor{FailColor}{HTML}{F5D2D5}

  \tikzset{
    lb/.style={draw=black!70, fill=white, rounded corners, minimum height=0.8cm, minimum width=1.5cm, align=center},
    replica/.style={draw=black!70, minimum height=0.6cm, minimum width=2cm, align=center}
  }

  % Gold Tier System
  \node[anchor=west] (gold_title) at (0, 4) {\textbf{Gold Tier} (Dedicated)};
  \node[lb, below=0.2cm of gold_title.south west, anchor=north west, xshift=1cm] (gold_lb) {Gold LB};

  \node[replica, fill=GoldColor!30, right=1.5cm of gold_lb, yshift=0.5cm] (r1) {Replica 1};
  \node[replica, fill=GoldColor!30, right=1.5cm of gold_lb, yshift=-0.5cm] (r2) {Replica 2};

  \draw[->, thick] (gold_lb.east) -- (r1.west);
  \draw[->, thick] (gold_lb.east) -- (r2.west);

  % Standard Tier System
  \node[anchor=west, below=2cm of gold_title.west, xshift=-0.8cm] (std_title) {\textbf{Standard Tier} (Shared)};
  \node[lb, below=0.2cm of std_title.south west, anchor=north west, xshift=1.8cm] (std_lb) {Std LB};

  \node[replica, fill=StdColor, right=1.5cm of std_lb, yshift=1cm] (r3) {Replica 3};
  \node[replica, fill=FailColor, right=1.5cm of std_lb] (r4) {Replica 4\\(Failure)};
  \node[replica, fill=StdColor, right=1.5cm of std_lb, yshift=-1cm] (r5) {Replica 5};

  \draw[->, thick] (std_lb.east) -- (r3.west);
  \draw[->, thick] (std_lb.east) -- (r4.west);
  \draw[->, thick] (std_lb.east) -- (r5.west);

  % Isolation Barrier
  \draw[dashed, ultra thick, black!50] (-0.5, 2.24) -- (5.5, 2.24);
  \node[fill=white, inner sep=2pt, font=\scriptsize\sffamily, align=center] at (8.0, 2.24) {\textbf{Complete Isolation}\\No Shared Resources};

  % Impact Annotation
  \node[align=left, font=\scriptsize\sffamily, color=FailColor!80!black, right=0.5cm of r4] {Failure constrained\\to Shared Pool};
  \node[align=left, font=\scriptsize\sffamily, color=GoldColor!50!black, right=0.5cm of r1, yshift=-0.5cm] {Gold Tier\\unaffected};

\end{tikzpicture}部署级隔离为优质租户提供完整的隔离保障,确保其性能不受其他工作负载影响。相应的代价是整体资源利用率降低,以及管理专用基础设施带来的运维开销增加。
请求级隔离通过限制单个请求在共享进程内可消耗的额度来补充这种物理隔离。将输入长度(例如 8,000 个 token)、输出长度(2,000 个 token)和执行时间(30 秒)设为上限,可以防止某个异常请求独占 GPU 数分钟,而其他请求在其后排队。
故障隔离是隔离边界(bulkhead boundaries)的自然结果。当租户提交的畸形输入触发模型错误时,隔离边界将该故障限制在该租户的请求范围内;其他租户继续正常处理,而不是共享一个已崩溃的推理 worker。在多租户部署中,这些边界通常与服务等级相对应,各自具有不同的资源保障。
Example 1.18: 隔离边界配置(API 服务等级)
场景:一个 LLM API 平台在共享硬件和专用硬件上分别提供 Enterprise、Professional 和 Free 三个服务等级。
诊断:未划分的多租户资源池允许 Free 等级流量尖峰或畸形请求恶化 Enterprise 的服务水平目标(SLO)。隔离边界将 Enterprise 隔离在专用 GPU 资源池(99.9 percent 可用性)中,为 Professional 分配 70 percent 容量,并将 Free 等级限制为 30 percent 尽力而为容量。
系统启示:隔离边界将隔离开销集中到业务需求所要求的层级上。硬件划分保障了高价值层级的 SLA 合规性,同时在低层级上最大化资源利用率。
多租户隔离限制了超额需求的扩散范围,但它并不创造容量。一旦受保护的队列接近其延迟预算,服务就需要一个控制回路,以便在准入开始失败之前增加副本。
自动伸缩与容量控制
仅根据平均加速器利用率做出反应的伸缩器可能朝错误的方向伸缩。解码阶段可能饱和内存带宽,而算术单元看起来处于空闲状态;长提示会在请求数量上升之前消耗预填充容量;排队中的工作可能违反 SLO,而集群整体利用率仍处于中等水平。控制信号必须表示相对于各阶段服务容量的待处理工作量。
对于常规固定成本模型,队列延迟和每个就绪副本的请求速率可能已经足够。自回归服务至少需要分别的 prompt-token 到达速率和 output-token 到达速率、活跃 KV-cache 占用量,以及预填充池和解码池的观测服务速率。控制器将每个信号转换为所需的副本数量,然后取最大需求加上故障余量和预测余量。基于 SLO 吞吐量的伸缩可以防止控制器将超出 TTFT 或 TPOT 目标的请求计入可用容量。
扩容与缩容需要不对称的证据。扩容针对持续的队列增长、预测需求或下降的截止时间余量,因为冷启动延迟使得延迟反应代价高昂。缩容则需要更长时间窗口内的低需求、足以承受单个副本故障的 spare 容量,以及对在途请求和任何可选会话缓存的 draining 方案。这种迟滞可以防止副本反复加载大权重、接受工作并在摊销启动成本之前终止的振荡。
控制器还需要能够区分需求与受损供给的可观测性。请求速率、输入和输出 token、队列等待时间、TTFT、TPOT、截止时间未达标、准入拒绝、就绪副本、模型加载失败,以及分阶段服务速率共同构成最小反馈集。缺少副本就绪和服务速率测量,伸缩器可能对一个故障副本不断添加冷副本,而原始故障始终被隐藏。
Example 1.19: Llama-70B 冷启动时间线
场景:一个自动伸缩引擎在 H100 GPU 实例上为突发的流量增长配置一个新的 Llama-70B 服务副本。
诊断:在场景假设下,拉起一个新副本需要约 7 分钟(\(T_{\text{cold start}} = T_{\text{provision}} + T_{\text{load}} + T_{\text{warmup}}\)),其中 5 分钟用于从对象存储获取 140 GB 模型制品,1 分钟用于设备加载和预热。反应式自动伸缩无法在请求超时之前吸收这次流量增长。
系统启示:冷启动延迟取决于制品大小、有效存储带宽、配置延迟、编译和预热。控制器必须测量这一分布,并提前足够远的时间开始配置,使其高百分位落在预测时间窗内;5–10 分钟的前置时间针对本场景。
Example 1.20: ChatGPT 流量尖峰
场景:ChatGPT 在两个月内从 0 增长到 1 亿活跃用户,在全球推理集群上产生了前所未有的流量尖峰。
诊断:快速的采用引发了严重的冷启动瓶颈和极端的 KV cache 内存压力,导致在未经优化的服务栈下出现集群级队列饱和和请求超时。
系统启示:互联网规模的流量尖峰将冷启动延迟和 KV-cache 占用量从基础设施调优细节转变为具有约束力的系统架构要求。要支撑如此快速的增长,需要将预热的 GPU 池与迭代级持续批处理以及有状态的路由结合起来。
Example 1.21: 流量预测式伸缩
场景:一个商用聊天机器人服务面对可预测的昼夜流量模式,从夜间 500 QPS 上升到峰值 3,000 QPS。
诊断:反应式伸缩只在流量到达之后才触发扩容,导致在上午流量爬坡期(06:00 和 09:00 UTC)出现 7 分钟冷启动延迟过载。
系统启示:预测式伸缩将昼夜时间序列预测转换为计划中的预热窗口,如调度明细所示(预测式伸缩调度)。在预期爬坡前 30 分钟触发扩容动作,可确保流量到达之前副本已完全预热。
| 时间 | 动作 | 活跃副本 | 正在启动的副本 |
|---|---|---|---|
| 05:30 | 扩容 | 5 | +10 预热 |
| 06:00 | 流量爬坡 | 15 | - |
| 08:30 | 扩容 | 15 | +15 预热 |
| 09:00 | 峰值流量 | 30 | - |
| 17:00 | 缩容 | 20 | -10 终止 |
| 20:00 | 缩容 | 10 | -10 终止 |
| 00:00 | 缩容 | 5 | -5 终止 |
系统洞察:仅反应式的伸缩器必须在每次爬坡期间过度配置(峰值约 45 个副本),因为它无法预判流量曲线。预测式伸缩将集群规模设定为实际峰值(30 个副本),在不牺牲延迟余量的前提下节省约 33 percent 的 GPU 支出。
示例 1.21 所展示的成本节省,取决于在流量到达之前预测其变化。主动配置容量可避免仅采用反应式伸缩的系统在流量爬坡期间出现 SLO 违规(图 20)。
\begin{tikzpicture}[font=\small\sffamily, scale=0.8]
  \definecolor{BlueLine}{HTML}{006395}
  \definecolor{BlueL}{HTML}{D1E6F3}
  \definecolor{GreenLine}{HTML}{008F45}
  \definecolor{GreenL}{HTML}{D4EFDF}
  \definecolor{OrangeLine}{HTML}{E67817}
  \definecolor{OrangeL}{HTML}{FCE4CC}
  \definecolor{RedLine}{HTML}{CB202D}
  \definecolor{RedL}{HTML}{F5D2D5}
  \definecolor{VioletLine}{HTML}{7E317B}
  \definecolor{VioletL}{HTML}{E6D4E5}
  \definecolor{BrownLine}{HTML}{8B4513}
  \definecolor{BrownL}{HTML}{F5DEB3}
  % Axes
  \draw[->, thick] (0,0) -- (10,0) node[right] {Time};
  \draw[->, thick] (0,0) -- (0,5) node[above] {Load/Capacity};

  % Traffic Curve (Sine-like spike)
  \draw[black!50, ultra thick, dashed, domain=0:9, samples=100] plot (\x, {1 + 3*exp(-(\x-5)^2/2)});
  \node[black!50, anchor=west] at (6, 4.2) {Actual Traffic};

  % Reactive Capacity (Lagging)
  \draw[RedLine, thick] (0,1.2) -- (5.2,1.2) -- (5.2,4.2) -- (9,4.2);
  \node[RedLine, anchor=west] at (5.5, 1.5) {Reactive (Late)};

  % Predictive Capacity (Early)
  \draw[BlueLine, thick] (0,1.2) -- (3.5,1.2) -- (4.5,4.2) -- (9,4.2);
  \node[BlueLine, anchor=west] at (2, 4.5) {Predictive (On Time)};

  % Deficit Area
  \fill[RedL, opacity=0.5] (5, 1.2) -- (5.2, 1.2) -- (5.2, 4.2) -- (5, 4.2) -- cycle;
  \node[RedLine, font=\tiny\sffamily, rotate=90] at (5.1, 2.7) {SLO VIOLATION};

\end{tikzpicture}预热池管理
维护一组预热的副本,可以在需求到来之前提前购买空闲就绪能力,从而降低有效冷启动时间。预热池的规模从预期的突发峰值和每副本的吞吐量出发:
\[\text{Warm pool size} = \frac{\text{Max expected spike}}{\text{Per-replica throughput}} \times \text{Headroom factor}\]
例如,如果预期的最大突发峰值为 2\(\times\) 个正常副本,而余量系数为 1.5,那么在突发到来之前,集群所需的预热池容量是最低池容量的三倍:
\[\text{Warm pool} = 2 \times 1.5 = 3 \times \text{minimum pool capacity}\]
维护预热副本的成本为 \(\text{Pool size} \times \text{GPU cost/hour} \times \text{Idle fraction}\),这直接构成了响应速度与空闲容量开销之间的权衡。分层的预热池(见 表 9)通过在不同就绪级别上维护副本来解决这一权衡,每一级具有不同的激活延迟和成本:
| 层级 | 状态 | 响应时间 | 成本(相对) |
|---|---|---|---|
| 热 | GPU 已加载,正在运行 | 瞬时 | 100% |
| 温 | GPU 已分配,模型已加载 | 30s | 60% |
| 冷 | GPU 未分配 | 5+ 分钟 | 0% |
当流量突发发生时,扩展序列会立即激活热副本,在 30 秒内提升温副本,并且只有当需求持续超过温池容量时,才启动新的实例进行冷启动。典型的配置会维护 2 个热副本以瞬时吸收突发流量,以及 5 个温副本以应对持续突发,同时拥有来自云服务商的无限冷容量。
扩展响应时间分析
扩展响应预算是控制环路的检测、决策、 provisioning 和 warmup 延迟之和。 公式 17 将这些阶段明确列出:
\[T_{\text{response}} = T_{\text{detect}} + T_{\text{decide}} + T_{\text{provision}} + T_{\text{warmup}} \tag{17}\]
表 10 将每个阶段分解,并识别其主要优化路径:
| 组件 | 持续时间 | 优化手段 |
|---|---|---|
| 检测 | 10–60s | 缩短指标采集间隔 |
| 决策 | 1–5s | 更快的自动伸缩器 |
| Provisioning | 30s–5min | 预热池 |
| Warmup | 5–30s | 预编译 |
每个组成环节都提供了不同的优化机会。检测速度可以通过以 1 秒间隔而非 60 秒间隔采集指标来提升,代价是信号更嘈杂、指标量更大。决策速度可以通过预先计算预测场景的伸缩计划来提升,这样当触发条件命中时,系统执行预计算好的计划,而不是从头计算。Provisioning 速度通过预热池得到最显著的改善,因为预热池完全消除了预期需求下的 provisioning 阶段。Warmup 速度通过预编译的推理引擎来提升,跳过即时编译(JIT),将最后阶段的耗时从 30 秒降低到 5 秒以下。
抢占式与可预占实例
云服务商可能提供折扣价的 GPU 实例13,并且可以提前很短的通知时间回收,因此调度决策在于该工作负载能否在回收前完成 drain、reroute 或 recompute,而不违反其 SLO。 表 11 列出了三类 GPU 实例以及各自最适合的工作负载:
13 抢占式实例经济学:服务商的折扣和终止通知因区域、实例类型和时间而异。对于推理而言,撤销会破坏进行中的请求和 KV-cache 状态,因此任何节省都必须覆盖 drain、reroute 和恢复容量的成本。
| 实例类型 | 折扣 | 中断通知 | 使用场景 |
|---|---|---|---|
| 按需 | 0% | 从不 | SLO 关键型 |
| 预留 | 30-60% | 从不 | 稳定的基线流量 |
| 抢占式/可预占 | 60–90% | 30s–2min | 突发容量 |
抢占式终止处理是与服务商警告窗口的一场赛跑。 代码 2 将关机路径排序为:首先停止新工作,在剩余时间内让进行中的工作完成 drain,持久化可恢复状态,并在实例消失之前让负载均衡器停止发送流量。
async def handle_spot_termination():
    # Received 2-minute warning
    # 1. Stop admission and remove the replica from routing
    stop_accepting_requests()
    deregister_from_loadbalancer()

    # 2. Complete in-flight requests (if possible)
    await complete_inflight(timeout=90)

    # 3. Save state for resumption elsewhere
    save_kv_cache_to_storage()

    # 4. Terminate gracefully
    shutdown()
步骤顺序很重要,因为这些步骤不可互换。先停止接收并注销,可以防止在 draining 窗口期间有新请求到达;随后处理器完成进行中的工作、持久化可恢复状态,并在终止截止时间前关闭。
感知 spot 的架构依据 SLO 类别在 on-demand 与 spot 副本之间分流流量(图 21)。SLO 关键请求始终路由到 on-demand 容量,而 best-effort 请求则吸收 spot 实例带来的成本节约与中断风险。
图 21 中的拆分架构,在代表性折扣场景下相比完全按需的集群可实现约 18–27% 的成本降低,同时仅对尽力而为流量吸收抢占风险,并将 SLO 关键请求保留在有保障容量上。
全球推理基础设施
将资源隔离与故障边界扩展到单个数据中心之外,就形成了全球基础设施。当距离、故障域或数据驻留约束超出单个区域所能掩盖的范围时,全球服务便成为必需。东京的用户无论模型在哪里训练、公司总部在哪里,都期望获得低延迟响应;工程上的选择在于:是复制计算、缓存重复工作,还是集中模型并支付网络惩罚。只有与这一选择挂钩,架构模式才有用。
多区域为何重要
单区域部署会带来三项根本性局限。最直接的是网络往返时延(RTT)对远处用户设定的延迟下限,量化结果见 表 12:
| 用户位置 | 到 US-East 的 RTT | 到本地区域的 RTT |
|---|---|---|
| 纽约 | 10 ms | 10 ms |
| 伦敦 | 75 ms | 10 ms |
| 东京 | 150 ms | 10 ms |
| 悉尼 | 200 ms | 10 ms |
对于交互式应用(聊天机器人、自动补全),这些延迟会在每个请求的多次模型调用之间叠加。除延迟外,单区域部署还会形成单点故障:云区域中断虽然罕见,却会同时影响所有用户。监管约束又增加了第三个维度,因为数据驻留要求(如《通用数据保护条例》和数据主权法律)可能要求用户在特定地理边界内处理数据。由此形成的模式构成了一条决策阶梯:区域副本部署成本最高,但可将 RTT 降至最低并隔离区域故障;边缘缓存仅在查询重复时才付出运行复杂度;跨区域分片则是容量短缺时的最后手段,因为跨区域延迟会淹没各阶段的计算能力。
模式 1:带区域副本的全局负载均衡
每个区域运行独立的推理副本,使用完全相同的模型。全局负载均衡器根据实测往返延迟(图 22)将每个用户路由到最近的区域。共享的模型注册表在模型发布过程中同步各区域的权重。
独立的区域副本可将远距离用户的往返时延(RTT)从 150–200 ms 降低到 10 ms 以下,而共享的模型注册表则确保各部署之间的一致性。模型同步是首要架构问题:更新必须传播到所有区域。基于推送的同步允许中央注册表向每个区域推送更新,虽然简单,但会产生可能的不一致窗口;基于拉取的同步让区域主动轮询更新,以更高的发布延迟换取更强的强一致性;混合同步则将推送通知与拉取验证结合起来。版本一致性是第二个问题。在发布过程中,不同区域可能短暂地服务不同版本。对大多数应用而言这是可接受的,但需要严格一致性的应用则需要在请求路由中进行版本固定(version pinning)。
模式 2:边缘缓存与中央推理
对于规模过大而无法在全球复制的模型,在边缘缓存响应可消除重复查询带来的冗余推理。图 23 展示了两条路径:缓存命中时从最近的边缘节点返回,耗时低于 10 ms;缓存未命中时则穿越整个后端,并在返回时填充缓存。
图 23 中的两条路径凸显了延迟差异:缓存命中可避免后端往返,而缓存未命中则需承担该往返开销。有效性取决于各类工作负载之间的请求可重复性,例如自动补全、FAQ 聊天机器人、开放式聊天和代码生成。示例边缘缓存命中率包络 提供了用于敏感性分析的示例命中率包络;实际设计必须从生产轨迹中推导命中率与正确性。
| Workload | Cache Hit Rate | Suitability |
|---|---|---|
| Autocomplete | 60–80% | Excellent |
| FAQ chatbot | 40-60% | Good |
| Open-ended chat | 5-15% | Poor |
| Code generation | 20–40% | Moderate |
语义缓存14(基于嵌入相似度而非精确匹配进行缓存)可以提高开放式工作负载的命中率。
14 语义缓存:相似度查找可以复用超出精确字符串匹配的响应,但会增加检索开销,并且当表面相似但实际需要不同响应的查询时,可能返回无效答案。因此,相似度阈值在缓存覆盖范围与正确性之间进行权衡。
模式 3:跨区域模型切分
跨区域模型切分属于最后的容量策略,而非常规的延迟优化手段。对于最大的模型,流水线并行理论上可以跨越区域:路由器将早期层分配到一个区域、将后续层分配到另一个区域。该模式很少具有实际可行性,因为跨区域网络延迟(75–150 ms)主导了每个阶段的计算时间(1–5 ms),使得跨区域流水线并行的速度比同址部署慢 10–100\(\times\) 倍。该模式仅适用于没有任何单个区域具备完整模型所需 GPU 容量的场景。
由于跨区域切分在稳态路径上代价极高,大多数生产设计将推理保持同址部署,并仅利用其他区域来保证可靠性。因此,跨区域问题由此从“如何将单个请求拆分到不同区域”转变为“区域故障后流量能够多快迁移”。
跨区域故障切换
当某个区域不可用时,流量必须重新路由至健康区域。代码 3 展示了主动—主动故障切换路由逻辑,在超时或不可用后回退到下一个健康区域。
# Simplified global routing logic
def route_request(user_region, request):
    primary = get_nearest_healthy_region(user_region)
    secondary = get_second_nearest_healthy_region(user_region)

    try:
        return call_region(primary, request, timeout=2.0)
    except (Timeout, RegionUnavailable):
        # Failover with increased latency
        return call_region(secondary, request, timeout=5.0)
有状态的 LLM 服务比普通的 HTTP 路由更难实现故障切换(failover),因为接收区域必须同时承接流量和丢失的会话状态。会话亲和性丢失意味着正在对话中的用户会失去 KV cache 状态,因此回退区域必须根据对话历史重新生成上下文。接收区域还会看到突发的容量尖峰,需要预留预置余量,通常比稳态高 30–50 个百分点,或者接受故障切换期间的降级延迟。当故障区域恢复后,流量应缓慢切回,以避免振荡。
全局模型部署
跨区域部署模型更新需要仔细协调。分阶段发布(phased rollout)首先向单个区域部署金丝雀版本(通常为 1% 的流量),监控 1–4 小时,然后逐步扩展到更多区域。每个扩展点都是一个关卡(gate):如果错误率超过 0.1% 或 P99 延迟超过目标值,发布即中止。回滚(rollback)将受影响的区域切回上一版本模型,同时保留新版本以供调试。关键不变量是:没有任何区域推进到新版本,直到前一区域在足够的监控窗口内表现出健康的指标。
全局部署健康度需要在区域级和全局两个粒度上监控四项指标,如 表 13 所述:
| 指标 | 区域级 | 全局 |
|---|---|---|
| 错误率 | \(< 0.1\%\) | \(< 0.1\%\) |
| P99 延迟 | \(< \text{target}\) | \(< 2\times\) 单区域目标 |
| 吞吐量 | 稳定 | 稳定 |
| 模型质量 | 在界限内 | 跨区域一致 |
跨区域成本优化
GPU 定价因供应商、合同、区域和时间而异。 表 14 使用一个假设的价格快照,来说明部署如何权衡成本与延迟要求;该快照不得用于采购决策:
| 区域 | H100 Spot 价格 | 按需 | 到美国用户的延迟 |
|---|---|---|---|
| 美国东部 | $2.50/hr | $4.00/小时 | 10–50 ms |
| 美国西部 | $2.30/hr | $3.80/小时 | 30–70 ms |
| 欧盟西部 | $2.80/hr | $4.20/小时 | 75–100 ms |
成本感知的路由将容忍延迟的工作负载(批量推理、后台处理)导向最便宜的可用区域(代码 4)。
def route_batch_request(request):
    if request.priority == "low":
        # Route to cheapest region with capacity
        return get_cheapest_region_with_capacity()
    else:
        # Route to nearest region
        return get_nearest_region(request.user_location)
按时间路由可以为批处理工作负载降低成本 20–40%,同时保持交互流量的 SLO。
激进地扩展全球基础设施非常有效,但成本也异常高昂。为了进一步压低大规模部署的成本曲线,系统设计师会改变模型的基本数值表示,通过量化来加快执行并降低内存占用。
权重量化用于服务
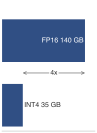
INT4 将双 GPU 模型变为单 GPU 候选方案。
用于服务的权重量化本质上是一个瓶颈选择决策:将权重从 16 位浮点数降为 8 位或 4 位整数,可以把一个需要两块 A100 GPU 的 140 GB FP16 语言模型,压缩为可容纳在单块 GPU 上的 35 GB INT4 表示。代价是精度出现小幅损失,以换取内存带宽和容量需求的 4\(\times\) 倍下降。
Systems Perspective 1.3: 量化作为服务约束
在服务系统中,量化不仅是模型压缩技术,它还会改变约束资源本身。训练后量化可以在不重新训练的情况下缩小已部署模型,而感知量化训练则通过训练投入来保持较低精度下的精度。系统层面的问题是:这种低精度表示放松了哪一项约束——GPU 内存容量、解码阶段的 HBM 带宽、加速器指令支持,还是每个已服务 token 的成本。精度基础内容见 Precision Engineering 和 Post-training vs. quantization-aware training。
量化会降低模型权重与激活值的数值精度,使内存占用减少 2–4\(\times\) 倍,同时提高解码吞吐量;该阶段受内存带宽限制而非计算限制。服务决策要回答的是应当缩小哪一项:用于拟合的驻留权重、每次解码步骤移动的字节数(带宽)、用于预填充的激活值,还是目标硬件支持的精度路径。大规模服务还会带来不同的挑战:模型必须在无法访问训练数据的情况下完成训练后量化,质量必须在多样化输入下得到保持,硬件部署目标也从数据中心 GPU 扩展到边缘加速器。因此,生产推理需要一套决策模型,而不是方法清单。用于服务的量化决策模型 中的决策模型将方法选择与约束服务系统的那一项资源绑定在一起。
| 约束服务的瓶颈 | 表示方式变化 | 方法族 | 上线前需要验证的风险 |
|---|---|---|---|
| 模型无法装入内存 | 仅对权重量化 | GPTQ、AWQ | 校准不匹配与质量退化 |
| 解码受带宽限制 | 减少每个 token 读取的字节数 | 仅权重 W4A16 路径 | 内核支持与 KV 缓存余量 |
| 预填充受计算限制 | 权重与激活值同时量化 | SmoothQuant W8A8 | 激活值离群点与 INT8 硬件路径 |
| 离群点阻碍低精度 | 在量化前改变坐标基 | 旋转类方法 | 变换开销与运行时路径受限 |
面向大语言模型的量化挑战
大语言模型存在区别于视觉或推荐模型的独特量化挑战。激活值离群点问题源于某些注意力头的激活量级比典型值高出多个数量级。朴素量化会裁剪这些离群点,导致显著的质量退化。
考虑一个大语言模型层:大多数激活值较为温和,但特定通道会产生大得多的离群点 (Xiao 等 2023年)。对称 INT8 量化(范围 [-127, 127])没有无痛苦的标度选择:宽范围能保留离群点,却会把典型值压缩进过少的分箱;窄范围则能保留典型值的分辨率,却会裁剪离群点并引入较大误差。
离群点分布解释了后续各专门方法为何彼此不同:每一种方法都保护服务契约的不同部分。
GPTQ:逐层权重量化
广义训练后量化(GPTQ)(Frantar 等 2023年) 适用于训练后部署需要 4 位压缩且能够提供校准数据的仅权重量化场景。其在模型服务中的价值在于,无需完整重训练即可减小模型体积。风险在于,对一个权重进行舍入会改变该层输出,而后续权重必须吸收这一变化。GPTQ 使用校准激活来估计哪些权重误差影响最大,15 随后在逐列舍入时补偿其余未量化的权重,从而应对这一风险。
Frantar, Elias, Saleh Ashkboos, Torsten Hoefler, 和 Dan Alistarh. 2023年. 《GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers》. 收入 CoRR, abs/2210.17323. https://doi.org/10.48550/ARXIV.2210.17323.
15 量化中的 Hessian 矩阵:近似式 \(\mathbf{H} = \mathbf{X}^T \mathbf{X}\) 对校准输入下的局部输出敏感度进行排序。GPTQ 利用这些信息补偿量化误差,而不是假设每个权重的贡献都相同。
16 GPTQ(广义训练后量化)的逐列更新:GPTQ 通过 Cholesky 分解对逆 Hessian 矩阵 \(H^{-1}\) 进行因式分解,使补偿成为稳定的三角更新:对列 \(q\) 舍入后,残余误差传播至列 \(q{+}1{:}\),并按 \([H^{-1}][:,q{+}1{:}] / [H^{-1}]_{qq}\) 加权。该分解避免了对每一列重新计算完整的逆矩阵,使计算量为 \(\mathcal{O}(d_{\text{row}} \cdot d_{\text{col}}^2)\),而朴素方法需要 \(\mathcal{O}(d_{\text{row}} \cdot d_{\text{col}}^3)\)。分组缩放(组大小为 128)相比每个矩阵使用单一缩放系数,能为离群通道提供更细的量化步长。
GPTQ 逐层处理模型,逐列量化每个权重矩阵16,并补偿尚未量化的列,使该层输出的偏移尽可能小。这会带来两部分部署成本:一是使用 128–256 个代表性样本进行一次校准,这些样本必须与生产流量匹配;二是逐层执行二阶更新,使量化成为耗时数分钟至数小时的离线工作,而非一次性类型转换。这两项成本都在部署前一次性承担,因此不会影响服务延迟;但如果校准集无法代表部署后的流量构成,就会形成一种失效模式,需要在上线前进行测试。
GPTQ 在不同规模的 Llama 模型上的性能 汇总了 GPTQ 在不同规模的 Llama 模型上的性能:
| 模型 | 位数 | 困惑度增量 | 内存缩减 | 量化时间 |
|---|---|---|---|---|
| Llama-7B | 4 | +0.3 | 4\(\times\) | 15 分钟 |
| Llama-13B | 4 | +0.2 | 4\(\times\) | 30 分钟 |
| Llama-70B | 4 | +0.15 | 4\(\times\) | 3 小时 |
GPTQ 的优势包括无需重训练即可快速量化、4 位权重下质量损失极小,以及广泛的硬件兼容性。其局限包括需要校准数据、对校准集选择敏感,以及逐层处理无法利用跨层信息。
AWQ:激活感知权重量化
激活感知权重量化(AWQ)(Lin 等 2024年) 从激活的角度实现同样的仅权重量化服务目标。一次校准过程会测量各通道的激活幅值,并在量化前放大连接到少数高幅值通道的权重(同时将相应的缩放系数折叠到下一层中),使这些显著权重保留其分辨率,而其余权重则采用更激进的量化。相较于 GPTQ,它在模型服务中的优势是,保护显著通道可以避免逐列误差反馈过程,因此校准更轻量,且无需任何参考输出;需要测试的风险在于,显著通道的缩放必须融合到部署计算图中,且不能引入单独的运行时算子,否则额外的内核开销会抵消内存收益。
Lin, Ji, Jiaming Tang, Haotian Tang, Shang Yang, Guangxuan Xiao, 和 Song Han. 2024年. 《AWQ: Activation-Aware Weight Quantization for On-Device LLM Compression and Acceleration》. GetMobile: Mobile Computing and Communications 28 (4): 12~17. https://doi.org/10.1145/3714983.3714987.
AWQ 与 GPTQ 的对比 汇总了 AWQ 与 GPTQ 在误差补偿、校准成本、质量、速度和硬件兼容性方面的对比。
| 方面 | GPTQ | AWQ |
|---|---|---|
| 误差补偿 | 调整其余权重 | 缩放显著通道 |
| 校准数据 | 128–256 个样本 | 128 个样本 |
| 质量(4 位) | 高 | 优秀 |
| 速度 | 更快 | 略慢 |
| 硬件兼容性 | 广泛 | 广泛 |
在这里的代表性设置中,AWQ 在相同位宽下的困惑度退化可比 GPTQ 低 0.5-1%,因此,当可接受的质量损失很有限时,它是一个合理的选择。
SmoothQuant:迁移量化难度
SmoothQuant (Xiao 等 2023年) 是 W8A8 部署中适用于激活量化至关重要的场景的服务路径,尤其适用于计算受限的预填充。激活值中存在难以预测的离群值,使 INT8 量化难以奏效;权重则不存在这一问题。SmoothQuant 将激活值除以逐通道的缩放因子,并将对应权重乘以相同的缩放因子。这一变换在代数上完全等价,保持层输出不变,同时将难以量化的数值范围从激活值迁移到更易处理这一范围的权重中。在模型服务中,缩放因子可合并到现有权重中,再配合一次低成本的激活值除法,因此平滑后的模型能够沿标准 INT8 路径运行,运行时开销接近零;需要测试的风险在于,迁移只是转移离群值,并未将其消除,因此,如果校准集中的激活极值与生产环境不同,仍可能发生截断。
Xiao, Guangxuan, Ji Lin, Mickaël Seznec, Hao Wu, Julien Demouth, 和 Song Han. 2023年. 《SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models》. International Conference on Machine Learning (ICML), 38087~99.
在 W8A8 部署形态下,SmoothQuant 支持对权重和激活值同时进行 INT8 量化。W8A8 SmoothQuant 与仅权重量化的对比 展示了 W8A8 与 FP16 基线及仅权重量化的对比:
| 配置 | 内存 | 预填充加速比 | 解码加速比 | 质量 |
|---|---|---|---|---|
| FP16(基线) | 1\(\times\) | 1\(\times\) | 1\(\times\) | 基线 |
| W8A16(仅权重) | 2\(\times\) | 1.3\(\times\) | 1.8\(\times\) | \(<0.5\%\) 损失 |
| W8A8(SmoothQuant) | 2\(\times\) | 1.8–2\(\times\) | 1.3–1.5\(\times\) | \(<1\%\) 损失 |
关键区别在于,W8A8 可为计算受限的预填充(以大批量处理初始提示)提供接近 2\(\times\) 的加速比,但为内存受限的解码(每次生成一个词元)提供的加速比仅为 1.3–1.5\(\times\)。LLM 服务通常以解码为主,因此 W8A8 在实际场景中的吞吐量提升往往为 1.3–1.7\(\times\),而非 INT8 张量核心理论计算吞吐量所对应的 2\(\times\)。
基于旋转的量化
传统量化方法(GPTQ、AWQ、SmoothQuant)通过补偿或迁移来处理离群值。基于旋转的量化 (Ashkboos 等 2024年) 是在激活离群值阻碍采用更低精度时的一种激进路径:它通过数学变换改变权重和激活值所在的空间,从而彻底消除离群值。
Ashkboos, Saleh, Amirkeivan Mohtashami, Maximilian L. Croci, Bo Li, Pashmina Cameron, Martin Jaggi, Dan Alistarh, Torsten Hoefler, 和 James Hensman. 2024年. 《QuaRot: Outlier-Free 4-Bit Inference in Rotated LLMs》. Advances in Neural Information Processing Systems (NeurIPS), 100213~40. https://doi.org/10.52202/079017-3180.
其核心洞察在于,离群值是坐标基表示所产生的现象。旋转到不同的基可将极端值均匀分散,使所有数值都易于量化。
QuaRot(结合旋转的量化)
QuaRot 使用正交 Hadamard 变换17旋转权重和激活空间,使任意单个离群值均匀分散到所有维度,从而得到不存在主导数值、可由均匀低比特量化表示的分布。由于旋转具有正交性,层输出保持不变,且该变换无需校准数据,这使 QuaRot 能够达到 W4A4,而补偿和迁移方法只能停留在更高精度。在模型服务中,这会产生其他方法无需承担的运行时成本:每次前向传播都要内联执行旋转,增加约 3% 的开销,因此在上线前,需要测试 W4A4 带来的内存和带宽收益能否在目标硬件上抵消这一持续开销。
17 QuaRot(量化旋转)中的 Hadamard 旋转:QuaRot 将激活值变换为 \(X' = X \cdot H\),将权重变换为 \(\mathbf{W}' = \mathbf{H}^T \cdot \mathbf{W}\),其中 \(H\) 是正交 Hadamard 矩阵,利用其结构进行计算,无需存储。正交性保持 \(\mathbf{X} \mathbf{W} = \mathbf{X}' \mathbf{W}'\),因此层输出不变。离群值的分散效果十分具体:含有一个极端值的向量 \([1000, 1, 1, 1]\) 在变换后大致变为 \([502, 500, 500, 500]\),因此没有任何单个坐标主导量化范围。
QuaRot 与 SmoothQuant 的对比 对比了 QuaRot 基于旋转的方法与 SmoothQuant 的迁移方法。实际运行中的权衡在于校准成本与运行时成本:SmoothQuant 在校准后没有运行时开销,但最低精度止步于 W8A8;QuaRot 则通过承担内联旋转成本达到 W4A4。
| 方面 | SmoothQuant | QuaRot |
|---|---|---|
| 校准数据 | 需要 | 不需要(无需数据) |
| 最低精度 | W8A8 | W4A4 |
| 运行时开销 | ~0% | ~3%(Hadamard 变换) |
| 离群值处理 | 迁移 | 消除 |
Llama 2 70B 上的量化困惑度 比较不同量化方法与精度选择在 Llama 2 70B 上的困惑度:
| 方法 | 精度 | Llama 2 70B 困惑度 | 相对基线 |
|---|---|---|---|
| FP16 | W16A16 | 3.12 | 基线 |
| SmoothQuant | W8A8 | 3.18 | +0.06 |
| GPTQ | W4A16 | 3.24 | +0.12 |
| QuaRot | W4A4 | 3.31 | +0.19 |
QuaRot 同时实现 4 位权重与 4 位激活,其质量与 GPTQ 仅 4 位权重的质量相当,从而为量化权重和激活带来约 4\(\times\) 的内存减少(相对 FP16)。SpinQuant 在 QuaRot 基础上扩展,通过一个较短的微调阶段学习最优旋转矩阵,以提高质量,代价是训练算力。因此,旋转方法扩展了低精度覆盖范围,但这种权衡是否划算取决于部署硬件对目标精度的支持。
硬件—部署协同设计
量化方法只有在部署硬件加速所选精度时才真正奏效。不同加速器对 BF16、INT8 和 INT4 等格式的支持程度不同,性能倍率也不同。
Tensor Core 精度支持与加速 汇总了 NVIDIA Tensor Core 精度支持情况(Ampere 与 Hopper):
| 格式 | Ampere (A100) | Hopper (H100) | 相对 FP16 加速 |
|---|---|---|---|
| FP16 | Yes | Yes | 1\(\times\) |
| BF16 | Yes | Yes | 1\(\times\) |
| INT8 | Yes | Yes | 2\(\times\) |
| FP8 (E4M3) | No | Yes | 2\(\times\) |
| INT4 | Yes(原生 Tensor Core) | H100 上依赖软件/框架;原生 FP4 是 Blackwell 的特性 | 随工作负载而定 |
自回归 LLM 解码吞吐量受内存带宽主导,因为每个 token 都要读取整个模型:
\[\text{Decode throughput} \propto \frac{\text{Memory bandwidth}}{\text{Model size in bytes}}\]
在理想的内存受限情况下,将 FP16 权重降至 4 位值可将权重流量削减 4\(\times\),但实际解码吞吐量取决于内核支持、反量化开销、KV 缓存精度、批处理形状,以及 HBM 带宽是否确实是瓶颈。因此,4 位服务的价值主要体现在提升模型驻留或批处理容量时,吞吐量收益应在目标服务工作负载上验证。
量化部署配置 表明该配置遵循部署预先确定的两件事:目标硬件支持的精度路径,以及目标是内存驻留还是吞吐量。内存受限的消费级 GPU 采用 W4A16,INT8 加速器采用 W8A8 以获得 Tensor Core 吞吐量,H100 级硬件则采用其原生 FP8 路径。
| 量化方案 | 最佳适用 | 框架支持 |
|---|---|---|
| W4A16 (GPTQ/AWQ) | 消费级 GPU、内存受限 | vLLM、TensorRT-LLM、llama.cpp |
| W8A8 (SmoothQuant) | INT8 加速器、高吞吐量 | TensorRT-LLM、ONNX Runtime |
| FP8 | H100/H200 部署 | TensorRT-LLM |
| W4A4 | 研究、极端压缩 | Limited |
量化服务的运行时契约
生产服务框架至关重要,因为量化权重只有在运行时保留理论收益时才降低成本。持久有效的契约是框架无关的:服务栈必须在不静默反量化的情况下加载量化产物,选择执行预期低精度路径的内核,围绕较小的权重占用分配 KV 缓存,并提供足够的遥测以检测质量或延迟退化。量化服务运行时契约 列出了这些职责,以及运行时在未能满足每项职责时如何静默流失理论收益的方式,正因如此,这四项共同构成框架在量化成为生产服务收益之前必须满足的最小契约。
| 运行时职责 | 为何重要 |
|---|---|
| 保留量化产物 | 静默去量化会恢复 FP16 的内存与带宽开销。 |
| 选择兼容的低精度内核 | 不受支持的算子会回退到更慢或更高精度的执行。 |
| 围绕权重与 KV cache 规划内存 | 容量收益只有在释放出的内存真正转化为有效批处理余量时才成立。 |
| 同时校验质量与延迟 | 满足延迟但任务质量不达标的低比特路径,并不是服务上的收益。 |
量化模型与 PagedAttention 结合可实现最高的内存效率:
\[\text{Max batch} = \frac{\text{GPU Memory} - \text{Quantized Weights}}{\text{KV Cache per Sequence}}\]
一个采用 4 位权重的 70B 模型需要约 35 GB,为 KV 缓存留下 45 GB 的空间,所用硬件为一张 80 GB A100。对于 MHA 基线,采用 FP16 的 KV 缓存时,每个 1K token 序列约需 2.6 GB,因此在尚未计入其他运行时开销的情况下,可支持约 17 个并发的 1K token 序列。若采用 FP16 权重,同一个 70B 模型根本无法装入单张 A100,因此仅对权重进行量化既改变了部署的可行性,也改变了批处理容量。
量化选择指南
最终选择应使量化方法与起决定作用的约束相匹配。对于延迟敏感的处理路径,当量化开销会占主导时,应优先采用 FP16 或 BF16;而以吞吐量为导向的处理路径则更有可能从量化中受益。硬件支持缩小了可行选项的范围:使用 H100 和 H200 的部署可以考虑 FP8,因为硬件提供原生支持,且质量损失极小;使用 A100 和 A10G 的部署通常根据工作负载在 W8A8 与 W4A16 之间选择;消费级 GPU 往往需要采用 W4A16 才能容纳模型。随后,可接受的质量损失决定了精度下限。若可接受低于 0.5% 的质量下降,AWQ 4 位量化是一个合理的目标;若可接受低于 1% 的质量下降,GPTQ 4 位量化或 SmoothQuant W8A8 可能可行;若不允许任何质量下降,FP16 或 BF16 仍是最稳妥的选择。起决定作用的资源约束决定了最终取舍:计算受限的预填充阶段更适合 W8A8,因为它可带来 2\(\times\) 的加速,而内存受限的解码阶段更适合 W4A16,因为它可带来 4\(\times\) 的有效带宽提升。
量化对服务成本的影响 展示了量化如何改变每百万 token 的模型服务成本:
| 配置 | 每 100 万 token 的成本(估算) |
|---|---|
| FP16 在 8\(\times\) A100 | $2.40 |
| AWQ 4-bit 在 4\(\times\) A100 | $1.20 |
| AWQ 4-bit 在 2\(\times\) A100 | $0.60 |
量化可以在保持可接受质量的同时,将服务成本降低 2–4\(\times\) 倍,因此它是实现成本有效的大语言模型部署的重要杠杆。
这些服务优化涵盖连续批处理、PagedAttention、全局负载均衡和极端量化。后续的案例研究展示了全球规模的生产系统如何将这些技术组合起来,以满足特定的成本与延迟目标。
案例研究
生产规模的服务系统迫使本章的技术应对真实的工作负载波动、延迟预算和运行约束。这些案例分别绑定不同的约束:嵌入规模、可变长度生成、级联成本或多模态新鲜度。示例展示了系统如何结合批处理、分片、缓存、路由和量化,以满足特定的成本与延迟目标。本章前文开发的 Orca 与 vLLM 机制提供了大语言模型服务的原语;本节中的案例研究则将视野扩展到推荐服务、全球请求路由、排序级联和多模态新鲜度。
Meta 推荐服务
Meta 的推荐基础设施绑定的是嵌入规模,而非稠密前向计算。它为 Facebook、Instagram、WhatsApp 和 Messenger 上的信息流、广告和内容排序提供预测,使其成为全球最大的生产推理部署之一。
规模数字解释了为什么嵌入局部性主导了设计:
- 请求量:每天数十亿次请求
- 延迟目标:\(<10\text{ ms}\) P99
- 模型多样性:数百个模型变体
- 特征基数:万亿级唯一实体
服务栈将稀疏查找与稠密排序分离:
User request → Feature collection → Embedding lookup → Model inference → Response

                    |                     |                  |
                    v                     v                  v
             Feature Store        Embedding Servers      GPU Inference
             (CPU, DRAM)         (CPU + SSD, 1000s)     (GPU, 100s)
在 Meta 的架构中,绑定的设计约束是嵌入规模:表格总量超过 100 TB,需要 1,000+ 个分片。Meta 采用混合分片策略:
- 热嵌入(前 1%):在所有推理服务器上内存复制
- 温嵌入(接下来 10%):列分片,8 路并行
- 冷嵌入(其余 89%):行分片,使用一致哈希,SSD 后端
混合分片通过批处理和局部性优化,将嵌入查找延迟从朴素架构的 50 ms 降低到 2 ms。
Meta 并非对整个请求进行批处理,而是在特征层面进行批处理。每个推理请求会触发 5,000+ 次嵌入查找,但这些查找会在 1 ms 窗口内跨请求进行批处理,从而在嵌入服务器上实现 90%+ 的内存带宽利用率。
由此得到的 GPU-CPU 混合架构在 GPU 上运行稠密模型计算(排序塔),而稀疏嵌入查找则在内存大、SSD 存储的 CPU 服务器上运行。Meta DLRM 混合 CPU/GPU 架构 将每个组件放置到与其瓶颈相匹配的硬件上:内存受限的稀疏查找落在 SSD 后端的 CPU 服务器上,低强度特征处理留在 CPU 上,只有计算密集的排序前向传播使用 GPU。
| 组件 | 硬件 | 延迟 | 吞吐量 |
|---|---|---|---|
| 嵌入查找 | CPU + SSD | 2 ms | 50M 次查找/s |
| 特征处理 | CPU | 1 ms | 10M 次运算/s |
| 稠密排序 | GPU | 1.5 ms | 100K 个推理/s |
服务侧的启示是:推荐延迟往往由嵌入查找而非稠密模型推理主导。特征级并行批处理与混合 CPU-GPU 架构将硬件与工作负载的稀疏和稠密两部分相匹配,这与 GPT 式 API 服务形成对比,后者由请求方差和自回归状态主导。
OpenAI API 基础设施
OpenAI 式 API 基础设施按请求方差进行绑定:短提示、长上下文请求和不同模型规模共享容量,而用户期望可预测的 TTFT。该基础设施为大规模开发者与应用工作负载服务 GPT 级模型,同时在不同工作负载之间维持服务质量。
规模数字解释了为何连续批处理和准入控制占据主导地位:
- 请求量:每小时数百万次请求
- 延迟目标:TTFT \(<2\text{s}\),吞吐量随模型而异
- 模型规模:数十亿至数百亿参数
- 上下文长度:最高 128K 个 token
服务栈将路由、调度、缓存管理和分片组分离:
API Gateway → Rate Limiting → Request Router → Model Cluster → Response Streaming

                                     |
                                     v
                              +-------------+
                              | Model Pool  |
                              | +---------+ |
                              | | Large   | |
                              | | 8×H100  | |
                              | +---------+ |
                              | +---------+ |
                              | | Smaller | |
                              | | 4×A100  | |
                              | +---------+ |
                              +-------------+
主要设计决策是防止长提示词阻塞其他人的解码服务。
采用 Orca 式长上下文服务设计时,通过连续批处理来维持高 GPU 利用率,以应对输出长度可变的情况。分块预填充则通过让长提示词以分块形式与持续进行的生成交错处理,来限制解码延迟。批处理策略对比 对比了这三种方法:
| 批处理策略 | GPU 利用率 | 128K 提示词行为 |
|---|---|---|
| 静态批处理 | 45% | 30s TTFT;解码被阻塞 |
| 连续批处理 | 75% | 30s TTFT;解码仍被预填充阻塞 |
| 连续 + 分块 | 85% | 30s TTFT;解码停顿被限制在约 3s |
大型 GPT 类模型通常需要 8 路或以上的张量并行,以满足内存容量和延迟需求:
- 每个大模型分片组 8\(\times\) H100
- 节点内通信使用 NVLink
- 会话亲和性(KV 缓存复用)采用一致性哈希
OpenAI 在多个层级实现速率限制,以防止噪声邻居:
- 每个 API key 的请求速率限制
- 每个 API key 的每分钟令牌数限制
- 组织级容量配额
- 全局模型容量限制
在需求高峰期,OpenAI 会根据队列深度在模型之间调整容量:
if large_model_queue_depth > threshold:
    # Migrate some smaller-model capacity to the larger model
    reallocate_cluster_capacity(from="smaller-model", to="large-model", fraction=0.2)
LLM API 由方差控制机制治理。连续批处理、前缀缓存和多级速率限制,防止长提示、重复的会话上下文和流量尖峰把某个用户的一次请求变成其他人的延迟。搜索排序面对的是同一问题的另一种形态:许多更便宜的模型必须在同一个严格的截止期限下协同工作。
Google 搜索排序
Google 搜索绑定级联成本:每个查询协调许多较小的模型,服从端到端延迟预算,而不是服务一个大型模型。该集成组合了针对查询理解、文档相关性和结果排序的专用模型。
规模数字说明了级联为何是必需的:
- 请求量:每天数十亿次搜索
- 延迟目标:\(<200\text{ ms}\) 端到端
- 模型数量:每个查询数十个模型
- 结果处理:每个查询数千份文档
为满足这一延迟预算,同时评估数千份文档,系统采用排序级联(图 24),通过越来越昂贵的模型逐步收窄候选集。
\begin{tikzpicture}[font=\small\sffamily]
  \definecolor{L0Color}{HTML}{F5F5F5}
  \definecolor{L1Color}{HTML}{EBEBEB}
  \definecolor{L2Color}{HTML}{E0E0E0}
  \definecolor{L3Color}{HTML}{D6D6D6}

  \tikzset{
    stage/.style={draw=black!70, thick, align=center, minimum height=0.8cm}
  }

  % The Funnel
  \node[stage, fill=L0Color, minimum width=6cm] (L0) {\textbf{Retrieval}\\1,000,000 → 10,000 items\\Cheap: Embeddings, BM25};
  \node[stage, fill=L1Color, minimum width=4.5cm, below=0.3cm of L0] (L1) {\textbf{L1 Ranking}\\10,000 → 1,000 items\\Fast: Linear Models, Decision Trees};
  \node[stage, fill=L2Color, minimum width=3cm, below=0.3cm of L1] (L2) {\textbf{L2 Ranking}\\1,000 → 100 items\\Moderate: Small Neural Nets};
  \node[stage, fill=L3Color, minimum width=1.5cm, below=0.3cm of L2] (L3) {\textbf{Final Rank}\\100 → 10 items\\Expensive: Large Transformers};

  % Down arrows
  \draw[->, ultra thick, black!60] (L0) -- (L1);
  \draw[->, ultra thick, black!60] (L1) -- (L2);
  \draw[->, ultra thick, black!60] (L2) -- (L3);

  \node[anchor=west, font=\scriptsize\sffamily, text=red!80, right=0.2cm of L0] {Low Precision, High Recall};
  \node[anchor=west, font=\scriptsize\sffamily, text=green!60!black, right=0.2cm of L3] {High Precision, Low Recall};

\end{tikzpicture}核心设计决策是渐进式细化:Google 没有让一个昂贵的模型处理全部候选项,而是采用级联排序(ranking cascade)。Google 排序级联 展示了级联所付出的权衡:每个阶段都在更小的候选集上投入更大的延迟预算,因此昂贵的 L3 集成模型之所以负担得起,只是因为 L0 到 L2 已经先把候选项削减了四个数量级。
| 阶段 | 模型复杂度 | 候选数量 | 延迟预算 |
|---|---|---|---|
| L0(检索) | 嵌入查找 | 1,000,000 → 10,000 | 10 ms |
| L1(第一轮) | 线性模型 | 10,000 → 1,000 | 20 ms |
| L2(第二轮) | 小型 Transformer | 1,000 → 100 | 50 ms |
| L3(最终排序) | 大型集成模型 | 100 → 10 | 100 ms |
级联将最终 L3 评估次数减少了 10,000×,相对于在所有候选上运行 L3。在此简化的请求预算模型下,L3 阶段的成本为每个候选 1 ms。因此,将 L3 应用于全部一百万候选集将消耗约 1000 s 的模型工作,而级联预算合计为 180 ms。由此得到的模型工作减少量约为 5,600×。
鉴于严格的延迟预算,Google 对模型集成采用投机执行。此处,投机指的是在截止期限下并行启动候选排序工作,而非针对 LLM 解码的草稿 token 验证:
# Instead of sequential:
#   q1 = model1(query)
#   q2 = model2(query)
#   q3 = model3(query, q1, q2)

# Speculative parallel:
async_q1 = async model1(query)
async_q2 = async model2(query)
async_q3 = async model3(query, predicted_q1, predicted_q2)

# Use actual results if they arrive in time, otherwise use speculative搜索排序部署可以在张量处理单元(TPU)18 上运行针对 Transformer 推理优化的排序模型。TPU pod 提供:
18 用于推理的 TPU: 脉动阵列执行可以为固定形状的排序工作负载提供规整的时序轮廓。尾延迟仍然取决于批处理、输入准备、通信以及加速器周围的排队。
- 二维网格拓扑,以实现高效的 AllReduce
- 高内存带宽,用于注意力操作
- 定制量化,以提高服务效率
每个子请求都带有截止时间,而工作器按照截止时间临近程度进行优先级排序:
Worker queue: [Doc1: 50 ms left] [Doc2: 30 ms left] [Doc3: 80 ms left]
                                      ↑ Process first

If deadline will be missed:
  Return cached/default result rather than timing out
服务领域的经验表明,排序级联通过只在不断缩小的候选集上调用昂贵模型来降低成本,而截止时刻传播与优先级调度则确保整个模型集合严格位于延迟预算之内。当工作负载与加速器匹配时,定制硬件可以提升可预测性,但下一个案例引入了新鲜度约束,仅靠硬件无法解决。
TikTok 多模态推荐
TikTok 的推荐系统建立在严格排序 SLO 下的新鲜度约束之上:视频理解成本高昂,新内容持续涌入,用户建模仍需在线运行。它将视频理解(视觉)与用户建模(推荐)结合用于个性化内容排序,由此形成一个多模态推理挑战,其中不同类型的模型必须协同工作。
规模数字说明了在线/离线分离为何重要:
- 请求量:每秒数百万次视频排序
- 延迟目标:\(<50\text{ ms}\) P99
- 内容量:每日数百万条新视频
- 模态:视频、音频、文本、用户信号
服务栈将内容与用户路径分离:
User request → User embedding → Candidate videos → Video understanding → Ranking

                    |                  |                    |
                    v                  v                    v
             User Tower          Video Cache          Vision Models
           (Transformer)        (Pre-computed)        (On-demand)
TikTok 的架构通过双塔架构与缓存,将用户理解(在线)与内容理解(离线)分离起来。19 表 15 对比了在线塔与离线塔的更新节奏:
19 双塔架构: 通过两个独立的神经网络(“塔”)分别编码用户特征与物品特征为嵌入向量,再通过点积进行打分。其服务优势:物品嵌入可离线预计算并缓存,从而将在线推理降为用户塔的向前传播加一次亚毫秒级向量相似度查找。其代价是模型表达能力下降,因为两个塔在编码阶段无法互相关注彼此的特征。
| 塔 | 更新频率 | 延迟 | 计算 |
|---|---|---|---|
| 用户塔 | 实时 | 5 ms | GPU(在线) |
| 视频塔 | 每小时 | N/A | GPU(批量) |
视频嵌入被预计算并缓存,从而消除了大多数请求的关键路径中的视觉推理。只有新上传的视频(每小时之内上传的)才需要在线进行视觉推理。
与 Meta 一样,TikTok 使用 CPU 执行嵌入操作、使用 GPU 执行稠密模型计算:
User features → CPU preprocessing (1 ms)
             → Embedding lookup (2 ms, CPU+DRAM)
             → Dense ranking (10 ms, GPU)
             → Response formatting (1 ms)
新视频内容会根据不同的优先级进行处理,如 TikTok 视频摄取优先级分层 所示:
| 优先级 | SLA | 使用场景 |
|---|---|---|
| 关键 | 5 min | 拥有大量粉丝的创作者 |
| 标准 | 30 min | 普通上传内容 |
| 后台 | 2 hours | 批量导入内容 |
该优先级方案既确保热门创作者的内容能够快速进入推荐,又能够控制计算成本。
TikTok 通过延迟融合(late fusion)将多种理解模态结合起来,即在排序的较后阶段将各模态独立计算出的模态嵌入或分数进行融合,而不是对所有原始模态运行一个联合模型:
Video embedding (512d) -+
Audio embedding (256d) -+- Concat → Fusion MLP → Final embedding (256d)
Text embedding (256d)  -+
延迟融合与推理服务架构
延迟融合允许各模态模型独立更新,而无需重新训练整个系统。
服务方面的经验教训在于:新鲜度要求将在线工作与离线工作分离。双塔架构之所以能够实现激进的缓存,是因为物品嵌入可以异步刷新;而基于优先级的处理则把最新鲜的计算资源用在用户影响最大的地方。
跨领域观察
在这些案例中,共同的模式是专业化,而非通用的服务栈。系统会将嵌入与检索同排序与生成分离,采用混合 CPU-GPU 架构以匹配工作负载特征,在多级缓存的同时接受数据陈旧,渐进式地细化候选集以避免对不太可能出现的物品进行昂贵计算,并传播截止时间,使压力下的质量/延迟权衡保持明确。案例研究总结 标出了每个系统的主要技术与关键创新。这四个系统之所以各不相同,正是由于各自针对自己的工作负载进行了专业化;这种专业化就是共同的模式,而非对它的否定。
| 系统 | 主要技术 | 关键创新 |
|---|---|---|
| Meta | 嵌入分片 | 特征并行批处理 |
| OpenAI | 连续批处理 | 分块预填充 |
| 排序级联 | 投机执行 | |
| TikTok | 双塔缓存 | 多模态融合 |
案例研究表明,服务架构必须针对其工作负载进行调整。将传统 Web 服务的假设套用到以 GPU 为瓶颈的系统上,会产生接下来讨论的谬误与陷阱。
谬误与陷阱
一个 DevOps 团队将其标准 Web 服务器负载均衡规则应用于一批新的 GPU 推理节点,结果尾延迟急剧上升,因为他们忽略了自回归令牌生成的极端方差。在大规模推理中,系统打破了传统微服务的规则,为从标准 Web 开发转向机器学习系统的工程师制造了危险的谬误。
谬误:大规模推理等同于 LLM 服务。
这一误解被以 LLM 为中心的讨论进一步强化,导致过度聚焦于 LLM 专用技术,而忽视更广阔的推理领域。生产数据显示,推荐模型产生了超大规模集群中每日查询流量与容量需求的大部分,而视觉、欺诈检测与分类模型则占其余部分 (Gupta 等 2020年; Hazelwood 等 2018年)。只了解连续批处理和 KV 缓存管理的从业者,无法应对在高吞吐推荐推理中占据主导的特征并行批处理与嵌入分片。技术选型必须与实际工作负载相匹配。
Hazelwood, Kim, Sarah Bird, David Brooks, Soumith Chintala, Utku Diril, Dmytro Dzhulgakov, Mohamed Fawzy, 等. 2018年. 《Applied Machine Learning at Facebook: A Datacenter Infrastructure Perspective》. 2018 IEEE International Symposium on High Performance Computer Architecture (HPCA), 620~29. https://doi.org/10.1109/hpca.2018.00059.
陷阱:用训练基础设施承担生产服务。
训练与服务有不同的需求。训练追求数小时或数天内的聚合吞吐量;服务追求严格 SLO 下的单次请求延迟。训练可以容忍数千的批大小;服务往往需要个位数的批大小。训练接受基于检查点的恢复;服务需要无用户感知的优雅故障切换。为服务部署训练集群的团队,常常发现延迟方差不可接受、资源利用率差,以及难以满足 SLO。专门构建的服务基础设施,配合适当的批处理、负载均衡与自动伸缩,是必不可少的。
谬误:连续批处理可以解决整个 LLM 服务问题。
连续批处理显著改善了 LLM 服务的 GPU 利用率,但它只解决了问题的一个维度。长上下文中,预填充仍然是瓶颈,因为二次方注意力计算无法避免,无论后续解码迭代如何批处理。节 1.3 表明,KV 缓存内存而非计算能力,往往限制了批大小。分片模型组件之间的网络带宽在大模型上可能主导延迟。连续批处理是高效 LLM 服务的必要条件,但并非充分条件。
陷阱:按平均吞吐量规划集群规模。
排队论表明,为平均负载规划容量的系统在流量峰值期间会违反 SLO。当平均利用率为 80 百分数时,25 百分数的流量尖峰会使利用率超过 100 百分数,导致队列无界增长。预测式自动扩展与 SLO 管理 详细说明了冷启动问题如何加剧这一情况:当新容量可用时,可能需要数分钟(GPU 实例尤其如此),而 SLO 违规已经发生。容量规划必须考虑峰值负载加余量,而非平均负载。
谬误:负载均衡对推理影响不大。
简单的负载均衡策略如轮询,在定量考察之前似乎已经足够。节 1.5 表明,随机分配会在 \(\mathcal{O}(\log R / \log \log R)\) 台服务器上产生最大队列为 \(R\)。二选一会将其降低到 \(\mathcal{O}(\log \log R)\),实现指数级改善。对于 1,000 服务器的集群,这意味着最大队列从约 4-5 个请求降至约 2 个请求。在决定 SLO 合规性的尾延迟上,这一差异十分显著。负载均衡算法的选择对系统性能具有一阶影响。
陷阱:忽视服务开销。
分布式推理引入了单机服务中不存在的开销:网络往返、序列化、负载均衡器决策,以及分片模型的协同。这项“服务开销”往往消耗 10–30 百分数的延迟预算。一个团队在单张 GPU 上实现了 70 ms 的模型推理,但在生产环境中端到端延迟达到 100 ms 时会感到意外,因为这些开销所致。延迟预算必须显式计入分布开销,而不仅是计算时间。
谬误:更大的 GPU 内存总是意味着更大的批大小和更高的吞吐量。
更大的 GPU 内存只有对吞吐受容量约束的模型才能带来更大的批大小。LLM 解码中的约束瓶颈是内存带宽而非容量:一旦 HBM 带宽饱和,增加内存并不会提高每秒令牌数。瓶颈层级使这一错误显而易见。
虽然更大的 GPU 显存能让可装入显存的模型采用更大的批次,但瓶颈往往会在显存耗尽之前转移。对于受带宽限制的操作(LLM 解码),内存带宽限制了吞吐量。对于受计算限制的操作(预填充、视觉推理),计算能力限制了吞吐量。在配备 80 GB 显存的 H100 上,受带宽限制的解码工作负载最终会在 HBM3 带宽(3.35 TB/s)饱和时进入平台期;一旦达到这一点,仅增加显存容量并不能提高词元吞吐量。判断工作负载究竟受计算、内存带宽还是容量限制,有助于合理分配资源。
陷阱:直到上线生产环境才考虑多租户隔离。
在开发和预发布环境中,单租户部署运行良好。在生产环境中,产生资源干扰的相邻租户会造成突发且不可预测的性能下降,难以诊断和解决。某个租户的流量突增至正常流量的 5\(\times\),就可能导致共享基础设施上所有其他租户的延迟恶化。正如 节 1.6 所强调的,资源配额、优先级调度和舱壁隔离必须从一开始就纳入系统设计,而不能在生产事故发生后才补上。
避免这些陷阱,能使服务基础设施从容应对流量变化,在固定 SLO 下保持成本效益,并持续为各租户提供及时响应。
总结
大规模推理是将训练好的模型和分布式硬件转化为低延迟全球预测的服务层。训练在一次固定运行中优化总体吞吐量(\(O/R_{\text{peak}}\)),而生产服务则颠覆了其中的每一项假设:运营支出(OpEx)随每个请求持续累积,用户可感知的尾延迟(\(L_{\text{lat}}\))则决定了服务能否在严格的 P99 服务级别目标下维持可行性。
服务性能的核心在于计算与内存带宽之间根本性的物理差异。预填充阶段受计算限制(\(O/R_{\text{peak}}\)),通过并行处理提示词元实现较高的算术强度。相比之下,自回归解码阶段严格受内存带宽限制(\(D_{\text{vol}}/\text{BW}\)):每生成一个词元,都必须从 HBM 中完整读取模型参数和不断增长的键值缓存。这种差异意味着单副本效率(\(\eta_{\text{hw}}\))在一个请求的生命周期内会剧烈波动,使静态批处理效率低下。
为了在内存带宽约束下最大化吞吐量,现代服务架构对内存层次结构与迭代调度器进行协同设计。连续批处理通过在词元边界插入新请求来消除加速器的空闲周期;PagedAttention 通过动态分配 KV 缓存页来消除物理内存碎片(\(D_{\text{frag}}\));预填充与解码分离则将受计算限制的提示处理和受带宽限制的词元生成分配至专门的硬件资源池。
当模型占用的内存或请求量超出单设备 HBM 容量时,模型分片(张量并行和专家并行)与全局负载均衡会将状态分布到多个加速器上。然而,分布式执行会带来网络同步开销(\(L_{\text{comm}}\)),其大小受互连延迟下限(\(\alpha\))和传输带宽(\(\beta\))制约。在服务层次结构的所有层级中,从请求级批处理到平台级多租户,工程目标都是最大化资源利用率和可接纳请求容量,同时将尾延迟严格限制在用户的 SLO 预算之内。
Key Takeaways: 服务颠覆了每一项假设
- 服务成本会持续累积:训练只需支付一次费用,但推理运营支出会随每个请求累积(原则 15);对于高流量生产系统,在模型的整个生命周期内,推理运营支出可能达到训练成本的 100\(\times\) 或更高。毫秒级时间、内存碎片和利用率的每一个百分点都是影响财务结果的杠杆,而非局部优化事项。
- 尾延迟决定架构:推理系统在 P99 SLO 约束下进行优化,因此批处理、分片、缓存和自动扩缩容必须提高利用率,同时不突破用户可感知的响应时限。当一个缓慢请求就可能导致下游服务失效时,总体吞吐量虽是必要条件,却并不足够。
- 解码将内存转化为容量:LLM 预填充受计算限制,而自回归解码会逐词元重新读取权重,并扩展各请求私有的 KV 状态(原则 14)。连续批处理、PagedAttention、前缀复用和 KV 压缩之所以重要,是因为它们能将稀缺的 HBM 带宽和内存转化为可接纳的请求量。
- 模型类别决定基本机制:视觉模型受益于可预测的静态或动态批处理,推荐模型受益于按特征并行的嵌入分片,LLM 则受益于迭代级调度。集群调度器必须匹配工作负载的形态,而不能套用一条通用的批大小规则。
- 分布式执行总有代价:张量并行、专家路由、全局负载均衡、多租户和故障转移(原则 16)都通过增加通信与协同来换取容量或隔离。只有在延迟、成本和可靠性约束范围内明确为这些开销分配预算,生产服务才能有效运行。
归根结底,服务效率受服务成本主导定律(原则 15)支配:训练资本支出(CapEx)只需支付一次,但推理运营支出会在模型的整个运行生命周期内随每个请求持续累积。由于自回归解码在物理上受 HBM 带宽(\(D_{\text{vol}} / \text{BW}\))而非原始算术计算能力(\(R_{\text{peak}}\))约束,系统效率取决于能否将闲置的内存容量和带宽转化为可接纳的并发请求量。在集群规模下,回收一兆字节碎片化的 KV 缓存,或减少十毫秒同步开销,都能直接转化为数百万美元的持续运营成本节省。