集合通信
目的
为什么机器之间的通信会制约大规模机器学习系统?
计算通过增加处理器来扩展;通信则通过在它们之间移动数据来扩展。二者的扩展方式并不相同。增加处理器会使总计算量线性增长,但要与其他处理器协同该处理器,则需要传输更多总数据量;对于最一般的同步模式,逻辑连接数还会随工作器数量呈二次方增长。当规模足够大时,交换梯度、激活值和参数所花费的时间将超过计算它们的时间。这一交叉点决定了哪些并行化策略可行,以及哪些模型规模可以训练。光速延迟、带宽限制以及数据移动的能量开销,对通信的制约与晶体管物理对计算的制约同样牢固。用 C³ 术语来说,集合通信构成了集群的指令集,定义了通信限制计算的物理操作。
Learning Objectives
- 应用通信成本模型,以界定集合通信的延迟、带宽和消息尺寸交叉点
- 将集合通信原语与 AllToAll 调度匹配到并行化策略、拓扑、消息粒度及数据倾斜
- 使用随规模变化的成本模型,比较环状、树状、蝴蝶、双树和分层归约算法
- 在匹配算法、进程组与拓扑的测量数据上校准集合通信成本模型
- 为 NVLink、InfiniBand、面向铁路优化的、环面以及网络内归约互连结构,设计感知拓扑的集合通信调度
- 通过权衡通信节省与收敛风险,评估压缩、稀疏化和误差反馈
- 实现重叠策略,包括桶融合、异步操作以及逐层梯度调度
从并行化到通信模式
当 10,000 个 GPU 需要应用一次权重更新时,数据并行、张量并行、流水线并行和专家并行所产生的切分必须重新保持一致。工作器发送的并非任意消息,而是在执行编排好的集合操作。在 集群栈 所示的集群栈中,这些操作位于分布层,逻辑并行性在此转化为物理流量。
三维并行性立方体假设副本、分片、阶段和专家能够以足够快的速度交换梯度、激活值、参数和 token,从而使优化器看到一次连贯的训练运行。这一假设即从并行化到通信的交接:模型的任何切分方式都会将工作重新分配到网络上。
该假设与链路之间的差距,揭示了计算与通信扩展方式的不对称性。计算是局部的,因为每个 GPU 都在处理自己的数据,因此总计算量随 GPU 数量增长。通信是全局的,因为要保持集群同步,信息必须跨越具有有限延迟、带宽、拓扑和能耗的物理链路。梯度同步是核心情形;alpha-beta 成本模型、集合通信原语、AllReduce 调度、感知拓扑的路由、压缩和重叠使其机制具体化。
Definition 1.1: 梯度同步
梯度同步 是同步数据并行训练中的一次集合通信步骤:每个 worker 将其本地计算出的梯度张量贡献给一次聚合归约,随后接收相同的归约结果,从而让所有模型副本执行完全一致的更新。
- 重要性:一个含 70B 参数、以 BF16 表示的模型,每个 worker 每步产生 140 GB 的梯度数据。通过 1,000 GPUs 上的环形 AllReduce 在每条链路上以 50 GB/s 的速率传输,每步所需的通信量约为 \(2 \times 140/50\) \(\approx\) 5.6 s,使得带宽(数据搬运)项大到足以主导铁律,除非通过重叠、层次化或压缩来减少暴露的传输量。
- 区别:与参数服务器方法(所有 worker 将梯度发送给集中式聚合器,其带宽随 worker 数量按 \(\mathcal{O}(N)\) 增长)不同,环形 AllReduce 将通信分散到所有 worker 之间,因此每个 worker 的每步通信成本恒定在 \(2 \times (N-1)/N \times M\),不随集群规模变化。
- 常见误区:一种常见误解是,环形 AllReduce 的行为等同于全对全交换。在环形 AllReduce 中,每个 worker 按照调度表与邻居通信,且随集群规模增长,单节点的通信量大致保持不变。规模压力来自延迟步数、拓扑结构以及每步的梯度体积,而不是每个 worker 向其他每个 worker 各自打开一条独立流。
对于标准同步数据并行的随机梯度下降(SGD),梯度同步并非一种设计上的便利;它是保持一条共享优化轨迹的机制。如果不同的 GPU 对其本地模型副本应用了不同的梯度更新,副本之间就会分叉。经过足够多的步数后,不同 GPU 上的模型将代表完全不同的函数,训练过程也就不再近似于全局损失上的随机梯度下降。同步确保所有副本在每一步都保持相同(在浮点精度范围内),从而通过 AllReduce1 原语2 保留优化算法的理论收敛保证。
1 全归约(AllReduce):源自 MPI 的复合术语,表示先执行 Reduce 操作(将所有节点的数据求和并汇聚到一个节点),再执行 Broadcast 操作(将总和发送给所有节点)。基于环的全归约依次执行 ReduceScatter 阶段和 AllGather 阶段,每个阶段需要 \(N-1\) 轮,总计 \(2(N-1)\) 轮;各进程秩在每轮内并发发送和接收,每个 GPU 最终都获得全局总和,且不存在集中式瓶颈。
2 参数服务器:Google 的 DistBelief 采用参数服务器架构进行大规模神经网络训练,此后参数服务器系统随着 worker 数量增长而将服务器侧的带宽与一致性权衡明确化 Li 等 (2014年)。集合通信的启示是:星型聚合将流量集中在服务器层,而点对点集合(如环形 AllReduce)则将流量分散,使每个 worker 的带宽成本能够保持有界。
Li, M., D. G. Andersen, J. W. Park, A. J. Smola, A. Ahmed, V. Josifovski, J. Long, E. J. Shekita, 和 B.-Y. Su. 2014年. 《Scaling Distributed Machine Learning With the Parameter Server》. Proceedings of the 2014 International Conference on Big Data Science and Computing, 583~98. https://doi.org/10.1145/2640087.2644155.
3 环形 AllReduce:该算法源自高性能计算集合通信文献;Patarasuk 与 Yuan 分析了面向工作站集群的带宽最优 AllReduce 算法,百度公司的 Andrew Gibiansky 于 2017 年 2 月推广了环形 AllReduce 用于深度学习,Horovod 与 NVIDIA NCCL 则帮助使其成为分布式训练的常见原语 Jeaugey (2017年)。
Jeaugey, Sylvain. 2017年. NCCL 2.0. GPU Technology Conference presentation.
需要同步的数据量与模型规模成正比。以 BF16(每个参数 2 字节)存储的、含 \(P\) 参数的模型,每个训练步每个 GPU 产生 \(2P\) 字节梯度数据。对于一个 700 亿参数的模型,这相当于每个 GPU 都必须发送和接收的 140 GB 梯度。3
在大规模场景下(数千个 GPU 上承载数百亿参数),除非应用激进的优化技术,否则梯度同步可能主导训练步时间。下一步是将该数据搬运建模为物理过程,而非作为一次 API 调用。
数据搬运的物理规律
物理约束在算法设计之前便已决定数据搬运的代价。第 1 级:导线与链路 确立了这些算法背后的线路级物理规律:光速设定了延迟下限4(光纤中每公里约 5 \(\mu\text{s}\)),带宽—距离乘积限制了快速链路在需要光模块之前能够达到的距离(PAM4 信号编码以及铜线与光模块的传输距离在 信号完整性与 PAM4 中展开讨论),而绕过内核的传输方式(如远程直接内存访问 RDMA 与 GPUDirect RDMA)将每条消息的软件开销降至数微秒 (RDMA 与 GPUDirect)。集合通信还带来移动一位比特所需的能量开销,算法必须像对待延迟和带宽一样严格尊重这一约束。
4 光速约束:光在光纤中的传播速度约为 200,000 km/s,即每微秒 200 米。在机柜间线缆跨度为 100 米的大型数据中心中,仅“线路延迟”就会为每条消息增加 500 ns;这是无论网络硬件如何改进都无法降低的物理极限。
移动数据需要消耗随距离指数增长的能耗。图 1 展示了跨越四个物理层级的数据搬运能耗层次:片上本地 SRAM ($\(0.5\,pJ/bit)、板载高带宽内存(HBM)\index{HBM}\index{High-Bandwidth Memory|see{HBM}} (\)\(20\,pJ/bit)、节点内 NVLink (\)\(100\,pJ/bit) 以及节点间光互连 InfiniBand (\)\(1{,}000\,pJ/bit)。该图绘制了各区间的高值端公开估计,其中包含链路侧、交换机侧与收发器侧功耗;本书其他章节的正文在粗略估算中采用各区间下界。两种观点都认同同一个核心热力学事实:从板载 SRAM 跨越到 50 米光互连数据中心网络,需要付出 2{,}000\)$ 的能耗代价,因此物理数据局部性成为可持续分布式机器学习系统设计的首要驱动因素。
\begin{tikzpicture}[
  font=\small\sffamily,
  >=Stealth,
  tier label/.style={
    font=\footnotesize,
    text=TextDark,
    align=right,
    % 3.4cm, not 2.5cm: "InfiniBand NDR" did not fit and hyphenated as
    % "Infini-/Band NDR". Labels are right-aligned on an east anchor, so the
    % extra width grows into empty space and the shorter labels do not move.
    text width=3.4cm,
    anchor=east
  },
  energy box/.style={
    rectangle,
    rounded corners=3pt,
    line width=0.85pt,
    align=center,
    inner sep=3.5pt
  },
  context card/.style={
    rectangle,
    rounded corners=3pt,
    draw=CardBorder,
    fill=white,
    line width=0.7pt,
    align=left,
    inner sep=4.5pt,
    anchor=west
  },
  multiplier badge/.style={
    rectangle,
    rounded corners=3pt,
    line width=0.85pt,
    align=center,
    inner sep=3.5pt,
    minimum width=1.7cm,
    minimum height=1.05cm
  },
  law card/.style={
    rectangle,
    rounded corners=4pt,
    draw=SteelBlue!40,
    fill=LightBlue!40,
    line width=0.7pt,
    inner sep=6.5pt,
    align=left,
    text width=14.4cm
  }
]

% Tier 1: SRAM (y = 6.4)
\node[tier label] (lbl1) at (2.5, 6.4) {
  \textbf{\normalsize SRAM}\\[1.5pt]
  \scriptsize\textcolor{TextMuted}{On-Chip Cache}\\[1pt]
  \tiny\textcolor{TextMuted}{$\sim$0--1\,mm die}
};

\node[energy box, draw=DarkGreen, fill=GreenFill, minimum width=1.4cm, minimum height=1.05cm] (eng1) at (3.4, 6.4) {
  \textbf{\footnotesize$\sim$0.5\,pJ}\\[1pt]
  \tiny\textcolor{DarkGreen}{per bit}
};

\node[context card, text width=7.7cm, minimum height=1.05cm] (ctx1) at (4.3, 6.4) {
  \textbf{\footnotesize Tiling \& Kernel Fusion}\\[1.5pt]
  \scriptsize Maximized via FlashAttention tiling; keeps intermediate activations inside SRAM.
};

\node[multiplier badge, draw=DarkGreen, fill=GreenFill, text=DarkGreen] (mul1) at (13.5, 6.4) {
  \textbf{\small 1$\times$}\\[1pt]
  \tiny Baseline
};

% Tier 2: DRAM / HBM (y = 4.9)
\node[tier label] (lbl2) at (2.5, 4.9) {
  \textbf{\normalsize DRAM / HBM}\\[1.5pt]
  \scriptsize\textcolor{TextMuted}{On-Package Stack}\\[1pt]
  \tiny\textcolor{TextMuted}{$\sim$1--10\,mm 2.5D}
};

\node[energy box, draw=SteelBlue, fill=LightBlue, minimum width=2.7cm, minimum height=1.05cm] (eng2) at (4.05, 4.9) {
  \textbf{\footnotesize$\sim$20\,pJ / bit}\\[1pt]
  \tiny\textcolor{SteelBlue}{HBM3e PHY read}
};

\node[context card, text width=6.4cm, minimum height=1.05cm] (ctx2) at (5.6, 4.9) {
  \textbf{\footnotesize Memory Bandwidth Wall}\\[1.5pt]
  \scriptsize Requires memory-bound operator recomputation to avoid HBM round-trips.
};

\node[multiplier badge, draw=SteelBlue, fill=LightBlue, text=SteelBlue] (mul2) at (13.5, 4.9) {
  \textbf{\small 40$\times$}\\[1pt]
  \tiny vs.\ SRAM
};

% Tier 3: NVLink 4.0 (y = 3.4)
\node[tier label] (lbl3) at (2.5, 3.4) {
  \textbf{\normalsize NVLink 4.0}\\[1.5pt]
  \scriptsize\textcolor{TextMuted}{Intra-Node Mesh}\\[1pt]
  \tiny\textcolor{TextMuted}{$\sim$0.5--1\,m PCB}
};

\node[energy box, draw=OrangeLine, fill=OrangeL, minimum width=5.2cm, minimum height=1.05cm] (eng3) at (5.3, 3.4) {
  \textbf{\footnotesize$\sim$100\,pJ / bit}\\[1pt]
  \tiny\textcolor{OrangeLine}{NVSwitch copper trace}
};

\node[context card, text width=3.9cm, minimum height=1.05cm] (ctx3) at (8.1, 3.4) {
  \textbf{\footnotesize Intra-Node Locality}\\[1.5pt]
  \scriptsize Enables Tensor Parallelism (TP).
};

\node[multiplier badge, draw=OrangeLine, fill=OrangeL, text=OrangeLine] (mul3) at (13.5, 3.4) {
  \textbf{\small 200$\times$}\\[1pt]
  \tiny vs.\ SRAM
};

% Tier 4: InfiniBand NDR (y = 1.9)
\node[tier label] (lbl4) at (2.5, 1.9) {
  \textbf{\normalsize \mbox{InfiniBand NDR}}\\[1.5pt]
  \scriptsize\textcolor{TextMuted}{Inter-Node Fabric}\\[1pt]
  \tiny\textcolor{TextMuted}{$\sim$10--100\,m optics}
};

\node[energy box, draw=VioletLine, fill=VioletL, minimum width=9.7cm, minimum height=1.05cm] (eng4) at (7.55, 1.9) {
  \textbf{\footnotesize$\sim$1{,}000\,pJ / bit (Laser Transceiver + Serialization + Optical Fiber)}\\[1.5pt]
  \scriptsize\textcolor{VioletLine}{Dominates cluster power budget during all-to-all collectives}
};

\node[multiplier badge, draw=RedLine, fill=RedFill, text=RedLine] (mul4) at (13.5, 1.9) {
  \textbf{\small 2{,}000$\times$}\\[1pt]
  \tiny\textbf{\textcolor{RedLine}{Energy Cliff}}
};

% Log-scale axis bar (y = 1.0)
\draw[line width=0.8pt, CardBorder!90] (2.7, 1.0) -- (12.4, 1.0);

\draw[line width=0.8pt, CardBorder!90] (4.1, 0.9) -- (4.1, 1.1);
\node[below=2pt, font=\scriptsize, text=TextMuted] at (4.1, 0.9) {0.5\,pJ};

\draw[line width=0.8pt, CardBorder!90] (5.4, 0.9) -- (5.4, 1.1);
\node[below=2pt, font=\scriptsize, text=TextMuted] at (5.4, 0.9) {20\,pJ};

\draw[line width=0.8pt, CardBorder!90] (7.9, 0.9) -- (7.9, 1.1);
\node[below=2pt, font=\scriptsize, text=TextMuted] at (7.9, 0.9) {100\,pJ};

\draw[line width=0.8pt, CardBorder!90] (12.4, 0.9) -- (12.4, 1.1);
\node[below=2pt, font=\scriptsize, text=TextMuted] at (12.4, 0.9) {1{,}000\,pJ};

\node[below=15pt, font=\footnotesize\bfseries, text=TextDark] at (7.55, 1.0) {
  Energy Cost per Bit Transferred (pJ / bit, Log Scale)
};

% Bottom Thermodynamic Law Card (y = -0.95)
\node[law card] (law) at (7.25, -0.95) {
  \centering\textbf{\footnotesize Thermodynamic Law of Distributed ML Systems}\\[3pt]
  \raggedright\scriptsize
  % Second column is a fixed-width p{} so the rows wrap inside the card; a
  % plain 'l' column takes its natural width and overruns the node's text width.
  \begin{tabular}{@{}l p{10.8cm}@{}}
    \textbf{The Distance Penalty:} & Moving a bit across a 50-meter optical datacenter fabric costs 2,000$\times$ more energy than inside SRAM. \\[2pt]
    \textbf{Algorithmic Defense:} & Hierarchical AllReduce and FP8/FP4 quantization exist primarily to avoid paying this 2,000$\times$ optical tax. \\
  \end{tabular}
};

\end{tikzpicture}在exascale(数万 GPU)规模下,通信的功耗预算与计算本身的功耗预算不相上下。一个 10,000 GPU 集群在每步交换 1 GB 梯度时,以 30 pJ/bit 的能耗运行,每次 AllReduce 约消耗 4.8 kJ(计入数据搬运的 2 倍系数),占每步总能耗预算中不可忽略的一部分。
这三项约束以乘积方式相互作用。延迟为任何规模的消息设定了下限。带宽限制了大传输的吞吐量。协议开销为每条消息增加固定成本,从而惩罚细粒度通信,这正是 RDMA 与 GPUDirect 中回顾的旁路传输(kernel-bypass)对集合通信性能至关重要的原因。一次快速的 AllReduce 估算,可使这些成本在一个现实训练场景中的综合影响具体化。
Napkin Math 1.1: 70B 模型的全归约通信开销
问题:一个包含 70B 个参数的模型,通过数据并行在 64 GPUs 台 GPU 之间训练,这些 GPU 通过 InfiniBand NDR 互联(每个端口 50 GB/s)。每台 GPU 以 BF16(每个参数 2 字节,这是 Llama 类训练的常见设置)计算梯度。一次全归约需要多长时间?
步骤 1:估算梯度载荷大小。 每台 GPU 生成一个完整的梯度张量:\(7 \times 10^{10} \times 2\ \text{bytes}\) \(=\) 140 GB。
步骤 2:套用环形全归约的带宽公式。 \[T_{\text{bandwidth}} = 2 \cdot \frac{N-1}{N} \cdot \frac{n}{\beta}\]
代入后:\(T_{\text{bandwidth}}\) = 1.96875 \(\times\) 140 GB / 50 GB/s \(\approx\) 5,512.5 ms。
步骤 3:加入延迟项。 \[T_{\text{latency}} = 2(N-1) \cdot \alpha\]
代入后:\(T_{\text{latency}} =\) 126 \(\times\) 1.5 μs = 0.2 ms。
步骤 4:总通信时间。 总计:\(T_{\text{AllReduce}} \approx\) 5,512.5 ms + 0.2 ms \(\approx\) 5,512.7 ms。
系统洞见:仅梯度全归约就需要超过五秒。这是为每个训练步骤额外增加的纯通信开销。在这个规模上,通信主导了单步时间,除非与反向传播计算进行重叠。这就是大规模训练系统会将全归约与反向传播流水线化、在后续层仍在计算时提前启动通信的原因。
在大规模下,梯度同步吞噬了每一步 30% 到 70% 的时间。
5 零拷贝通信:RDMA 允许 NIC 将数据直接从一个节点的应用程序内存传输到另一个节点的应用程序内存,绕过操作系统的内核缓冲区。对于 140 GB 的梯度交换,零拷贝避免了在 CPU 与主内存之间搬移 280 GB 的数据,从而释放大量内存带宽(\(\text{BW}\))。
这一计算揭示了为什么在大规模下,数据移动而非计算会成为主导性约束。对 70B 模型梯度的单次 AllReduce 会消耗数秒的墙钟时间,在此期间所有 GPU 本可以空闲。内核旁路之所以重要,是因为 RDMA 的零拷贝路径5 避免了将每次传输经由主机内存中转。这种局部计算(可完美并行化)与全局协同(需要实际数据移动)之间的不对称性,驱动了后续每一个集合算法。将该多秒级的 AllReduce 减半,可以在一次典型训练战役中节省数千 GPU 小时,直接转化为更低的成本和更快的部署时间。
成本分析还解释了为什么集合算法的选择比大多数从业者意识到的更重要。使用一种仅达到理论带宽 60% 的子优算法(在较差的拓扑映射下很常见)会把五秒的 AllReduce 膨胀到超过九秒,为每个训练步增加数秒的纯浪费。由于这种浪费会贯穿整个集群,通信算法位于集群堆栈的 Distribution Layer:其下方的 Infrastructure Layer 通过 NVLink、InfiniBand 和网络拓扑提供原始带宽(见 网络互连结构),而其上方的 Serving Layer 则依赖高效的梯度同步来完成训练运行并产出可部署的模型。当通信算法无法饱和可用带宽时,训练会更慢,模型交付更晚,整个集群的经济潜力都无法发挥。
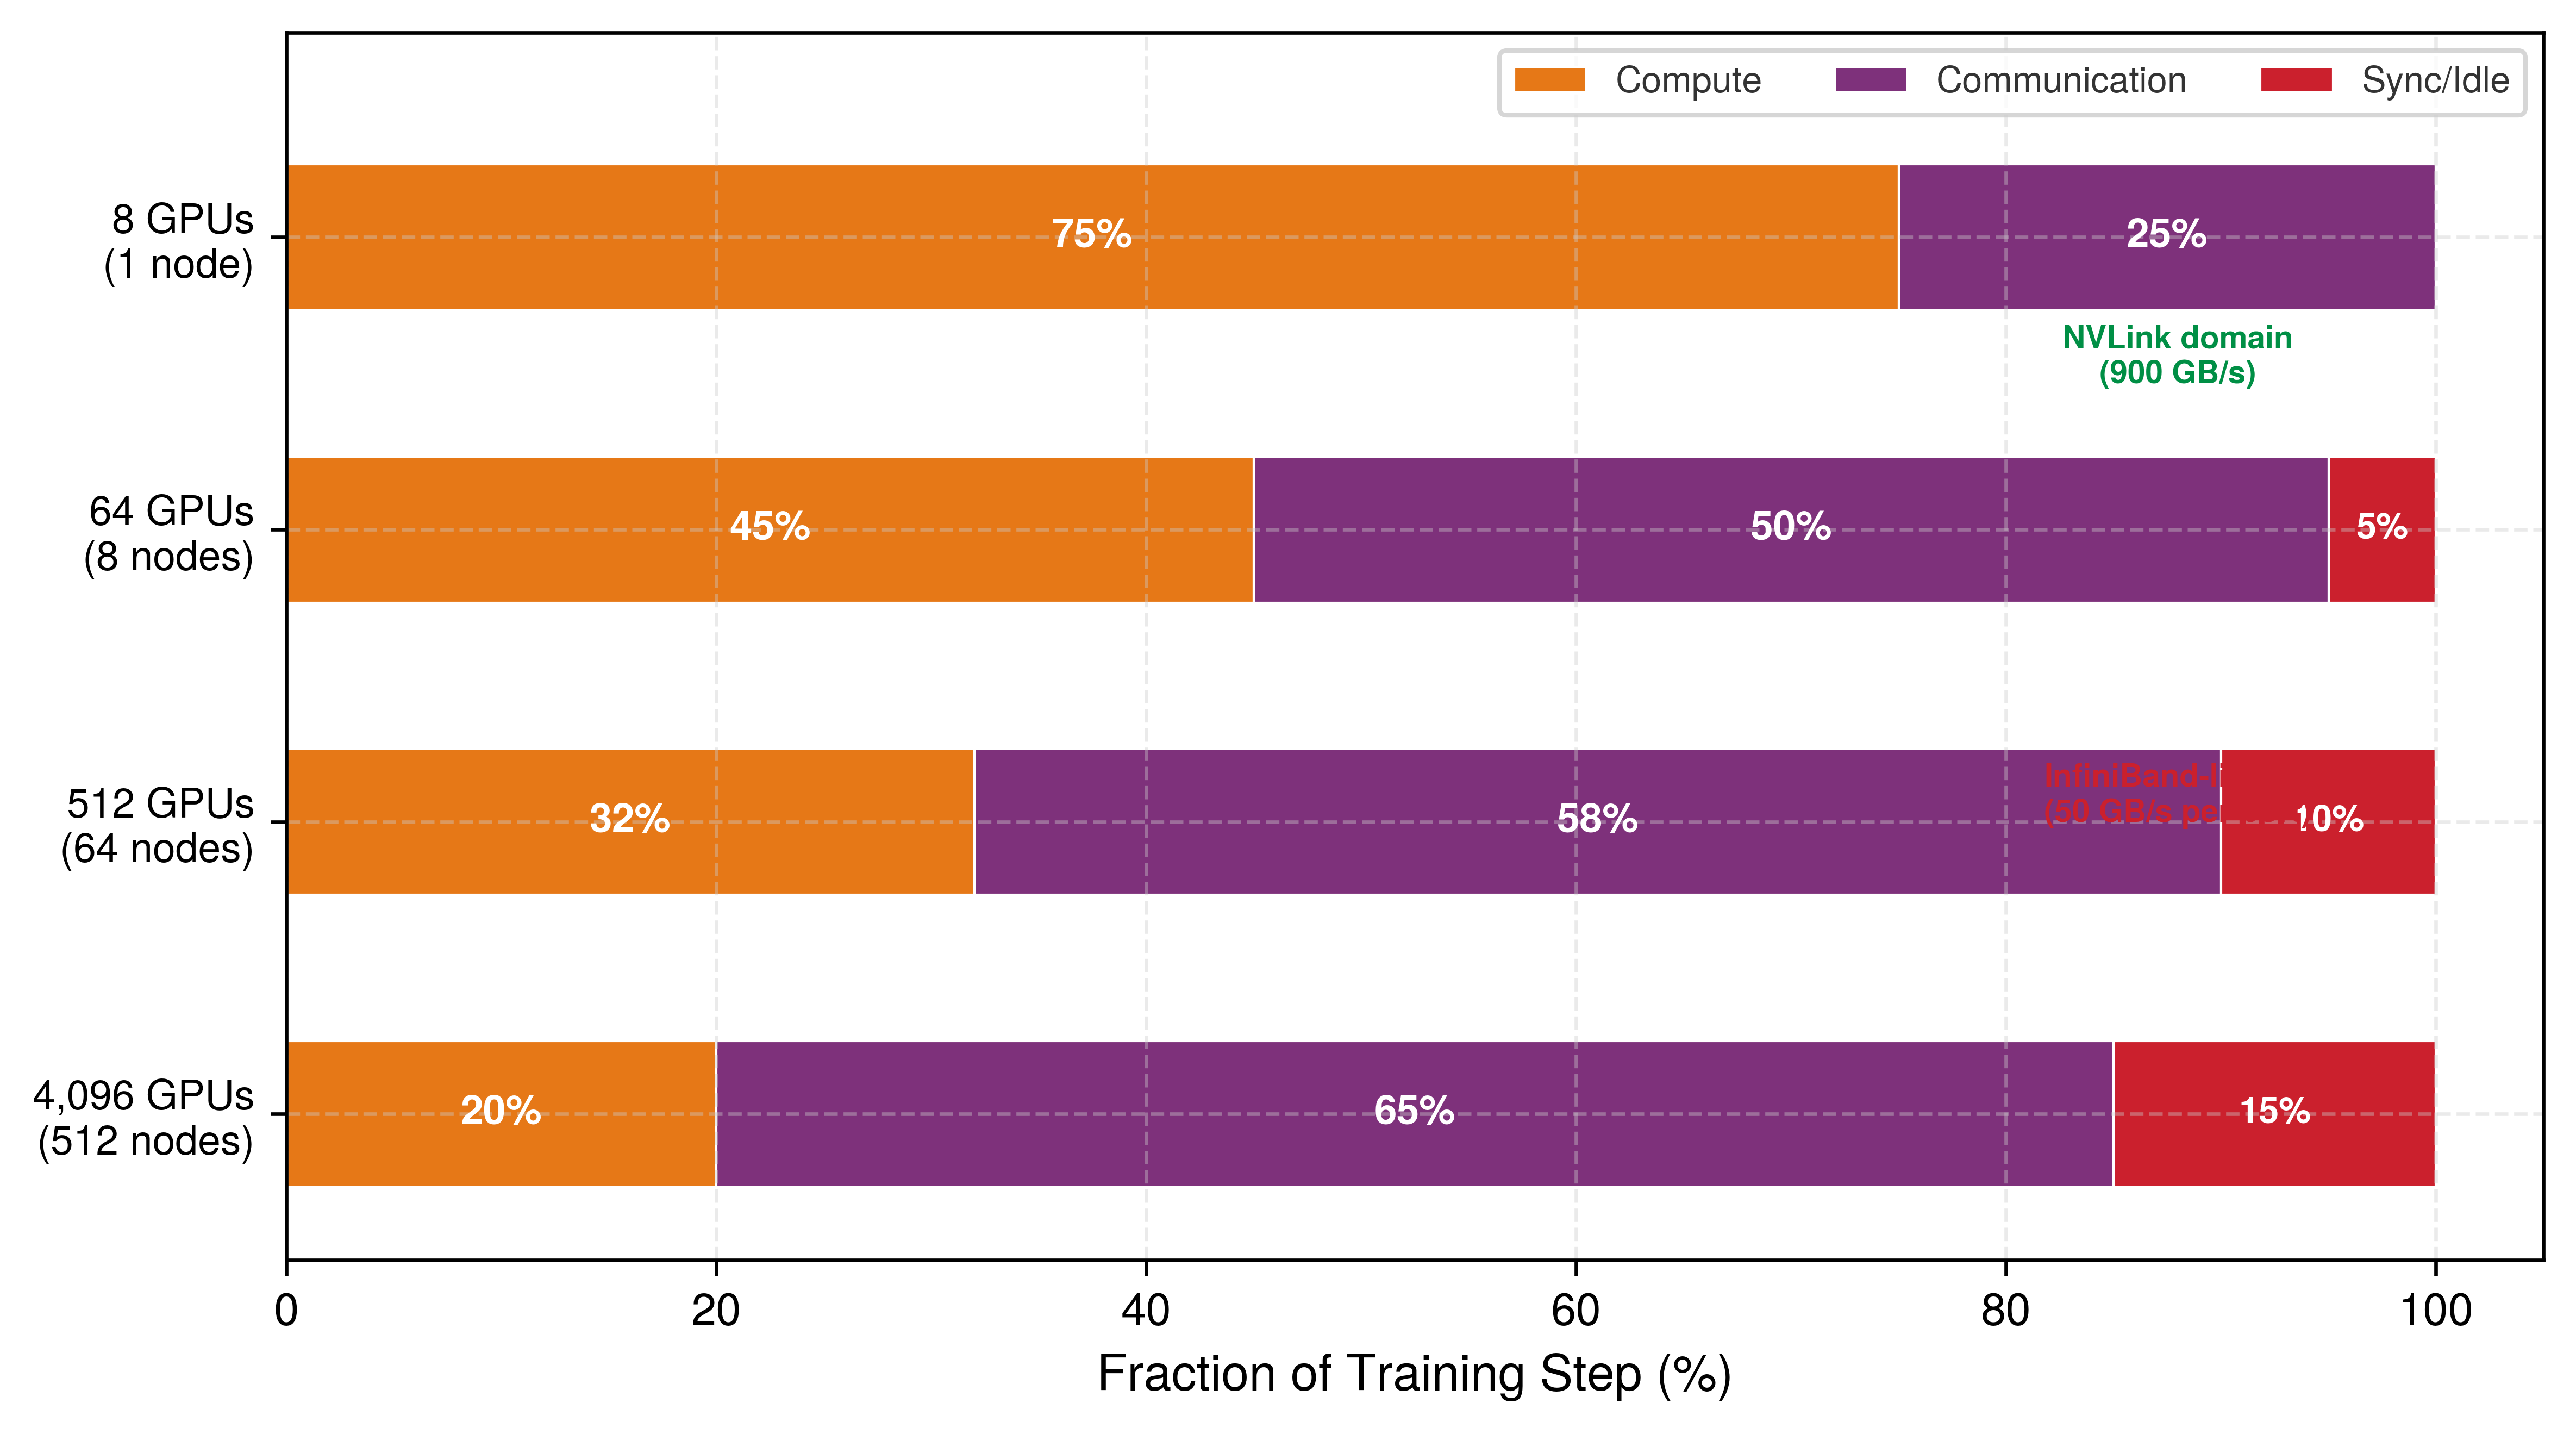
图 2 量化了这种通信开销随集群规模增长而累积的方式。在单个 NVLink 互联节点内的 8 个 GPU,通信约占每个训练步的 25%,因为 900 GB/s 的互联带宽与梯度体积保持同步。当集群扩展到 64 个 GPU(8 个节点)时,切换到 InfiniBand(50 GB/s 每端口)改变了平衡:通信在约 50% 的步时间中占主导,另有 5% 因依赖工作等待同步而损失。在 4,096 GPU 规模下,通信与依赖停顿合计消耗训练步的 80%,仅余 20% 用于有效计算。这一演进解释了为什么集合算法至关重要:没有分层集合、梯度压缩和通信—计算重叠,大规模训练将把其数百万美元的计算预算中的绝大部分浪费在等待数据到达上。
梯度的传输清单
旅程始于反向传播完成的时刻。在单台机器上,故事到此便结束了:权重得到更新,神经元完成学习。然而,在生产规模下,梯度诞生时处于孤立状态。它存在于一块 GPU 上,而模型的“真实状态”则分布在数千块 GPU 上。为了实现全局收敛,梯度必须找到其他梯度。
这段旅程的具体“传输清单”由 分布式训练 中选择的并行策略决定。数学计算的划分方式决定了数据的移动方式。对于灯塔原型(三种系统架构原型),这些清单存在根本差异。对于原型 A(GPT-4/Llama-3),梯度是一个巨大稠密张量的一部分,必须与集群中的所有其他梯度汇合,以计算全局平均值,因此其主要传输手段是全归约(AllReduce)。对于原型 B(大规模 DLRM),6 梯度或激活是稀疏且定向的:它无需与所有 GPU 通信,只需找到持有其嵌入分片的特定 GPU。混合专家(MoE)路由形成了相同的定向模式,将每个词元发送到承载其指定专家的 GPU,因此两者都依赖全对全(AllToAll)通信。
6 DLRM(Deep Learning Recommendation Model):Meta 于 2019 年提出的点击通过率预测架构使用分片嵌入表,并在工作节点之间交换由此产生的稀疏查找。由此产生的全对全可能在每个目的节点接收细粒度消息时为启动受限,随聚合负载增长变为注入或接收受限,或在过度订阅、路由不利或分片访问倾斜时变为网络互连受限。因此,DLRM 提供的是面向目的地的流量模式,而非通用的延迟形态。
理解这一映射至关重要:采用何种并行方式,直接决定了如何通信。在大规模系统中,这些策略并不互斥。大型语言模型的一次训练通常采用三维并行(同时结合数据并行、张量并行和流水线并行),这意味着多个集合通信原语会在彼此重叠的 GPU 子集上并发执行。张量并行驱动各节点内部的 AllReduce 操作(通过 NVLink),流水线并行驱动流水线阶段之间的点对点发送(通常跨节点),而数据并行则驱动跨节点组的 AllReduce 操作(通过 InfiniBand)。
每个原语作用于不同的进程组,即全部 GPU 中参与该特定集合通信的一个子集。经典消息传递接口(MPI)使用通信子作为标识此类参与集合的对象;通信子大小就是该集合中的进程秩数量。MPI 库早已根据通信子大小和消息大小选择集合通信算法 (Thakur 等 2005年)。GPU 通信库继承了这一算法选择问题,同时还面临额外挑战:协调彼此重叠的进程组,避免并发集合通信之间产生资源争用。
传输清单 概览了从并行策略到集合通信原语的映射。下一节将正式介绍这些原语的名称;目前可将此表视为一张流量地图,用来说明哪些参与者必须彼此交换数据。
| 并行策略 | 梯度的目标 | 主要原语 | 主要约束 |
|---|---|---|---|
| 数据并行 | 与所有参与者汇合,计算全局平均值 | AllReduce | 带宽(大载荷) |
| FSDP/ZeRO | 找到分片,重构整体 | AllGather + ReduceScatter | 带宽(高频率) |
| 张量并行 | 在节点内快速握手 | AllReduce | 延迟(速度就是生命) |
| 流水线并行 | 交接给下一个相邻参与者 | 点对点(发送/接收) | 延迟(顺序依赖) |
| 专家并行(MoE) | 定向路由到特定专家 | AllToAll | 启动开销、注入带宽/二分带宽或负载倾斜 |
在此表中,专家并行指的是混合专家7架构模式。这一映射表明,不同并行策略会带来根本不同的通信模式。数据并行和完全分片数据并行(FSDP)通常产生大消息,可受益于基于环的算法和分层分解。张量并行和流水线并行通常产生较小的消息,可受益于低开销软件栈。专家并行产生面向特定目的地的流量,其瓶颈项取决于消息粒度、端点注入与接收能力、网络互连结构的二分带宽、超额订阅、路由和专家负载倾斜。要对这些差异进行定量推理,需要建立网络性能模型。
7 混合专家(MoE):一种架构,其中每个词元仅激活专门化子网络(专家)的一个子集,在保持模型总容量的同时,减少每个词元所需的 FLOPs。MoE 用按目标节点区分的全到全通信流量取代均匀的稠密归约。细粒度分发可能使启动开销显现出来,较大的批次可能受注入或接收带宽限制,而超额订阅、路由或专家负载倾斜可能使二分带宽容量或热点成为关键路径。
绘制地形图:网络性能建模
如果不了解两个不同的变量,数据中心工程师就无法预测在集群中传输十兆字节数据需要多长时间:启动一条消息需要多久,以及数据进入传输过程后移动得有多快。梯度一踏上旅程,便立即面临数据中心网络的物理现实。
α-β 成本模型:启动税与传输费
梯度发送的每条消息都遵循线性成本模型 \(T(n) = \alpha + n/\beta\),该模型将启动税(\(\alpha\))和每字节传输费(\(n/\beta\))形式化。这两项决定了整个集群中的集合通信算法选择。
Definition 1.2: α-β 模型(Hockney 模型)
α-β 模型(Hockney 模型) 是线性通信成本模型 \(T(n) = \alpha + n/\beta\),它将消息传输时间分解为固定的启动延迟(\(\alpha\),即每条消息的开销)和随消息大小变化的带宽项(\(n/\beta\),与传输字节数成正比),使算法设计者能够预测消息融合或梯度压缩何时可以提高吞吐量 (Hockney 1994年)。
- 意义:对于参数为 \(\alpha \approx 2\,\mu\text{s}\) 和 \(\beta \approx 50\,\text{GB/s}\) 的 InfiniBand NDR,交叉点对应的消息大小为 \(n^* = \alpha \cdot \beta \approx 100\,\text{KB}\)。一条 4 KB 的路由消息远小于 \(n^*\),因此启动税占主导;将 100 条这样的消息融合为一条 400 KB 的消息,可将通信成本从 \(100\alpha = 200\,\mu\text{s}\) 降至单条消息的 \(\alpha + n/\beta \approx 10\,\mu\text{s}\),实现 20\(\times\) 的性能提升。大小为 140 GB 的梯度张量远大于 \(n^*\),因此带宽占主导,减少载荷字节数是有效的优化手段。
- 区别:与将带宽视为唯一通信成本的理想化吞吐量模型不同,α-β 模型揭示,\(N\) 条大小为 \(n/N\) 的小消息,其成本最多可比一条大消息高出 \(N\times\),这条大消息的大小为 \(n\),上述情况发生在 \(n/N \ll n^*\) 时。这解释了为什么 NCCL 会融合小型 AllReduce 调用,以及为什么 MoE 路由算法会在启动集合通信之前缓冲词元。
- 常见误区:一种常见误解是梯度压缩总能带来收益。如果压缩后的梯度大小仍远大于 \(n^*\),压缩会减少带宽项,却不会改变延迟项。即使将 70B 模型的梯度载荷从 140 GB 缩减至 1.4 GB,消息仍然明显受带宽限制;这并不会使该操作变成低延迟交换。
Hockney, Roger W. 1994年. 《The communication challenge for MPP: Intel Paragon and Meiko CS-2》. Parallel Computing 20 (3): 389~98. https://doi.org/10.1016/s0167-8191(06)80021-9.
这两个参数具有不同的物理含义。延迟(\(\alpha\))是发送一条消息所需的固定启动成本,与消息大小无关,涵盖软件开销(内核启动、NCCL 初始化)、经过 PCIe 的耗时,以及网络交换时间。带宽(\(\beta\))是以字节/秒计量的持续数据传输速率。临界消息大小 \(n^* = \alpha \cdot \beta\) 标志着交叉点:小于 \(n^*\) 的消息受延迟限制;更大的消息受带宽限制。The α-β Communication Model 通过具体的消息大小区间和屋顶线分析详细阐释了此模型,希望了解交叉点背后完整推导的读者可参阅该处;表 1 中的参数可直接用于集合通信设计。
表 1 展示了数据中心互连的典型参数值,其中临界大小一列体现了关键规律:节点内 NVLink 在消息大小达到数百千字节之前一直受延迟限制,而节点间网络的交叉点在 100 KB 附近,因此,一条在节点内已足够大、受带宽限制的消息,在跨节点传输时仍可能受延迟限制。
| 互连结构 | 延迟 (\(\alpha\)) | 带宽 (\(\beta\)) | 临界大小 (\(n^*\)) |
|---|---|---|---|
| NVLink 4.0(节点内) | 1–2 μs | 450 GB/s | ~0.7 MB |
| InfiniBand NDR 400 Gbps | 1–3 μs | 50 GB/s(每端口) | ~100 KB |
| InfiniBand HDR 200 Gbps | 2–5 μs | 25 GB/s | ~87.5 KB |
| PCIe Gen5(GPU\(\leftrightarrow\)CPU) | 2–5 μs | 64 GB/s | ~224 KB |
| 以太网 100 Gbps(RoCE) | 5–10 μs | 12.5 GB/s | ~93.7 KB |
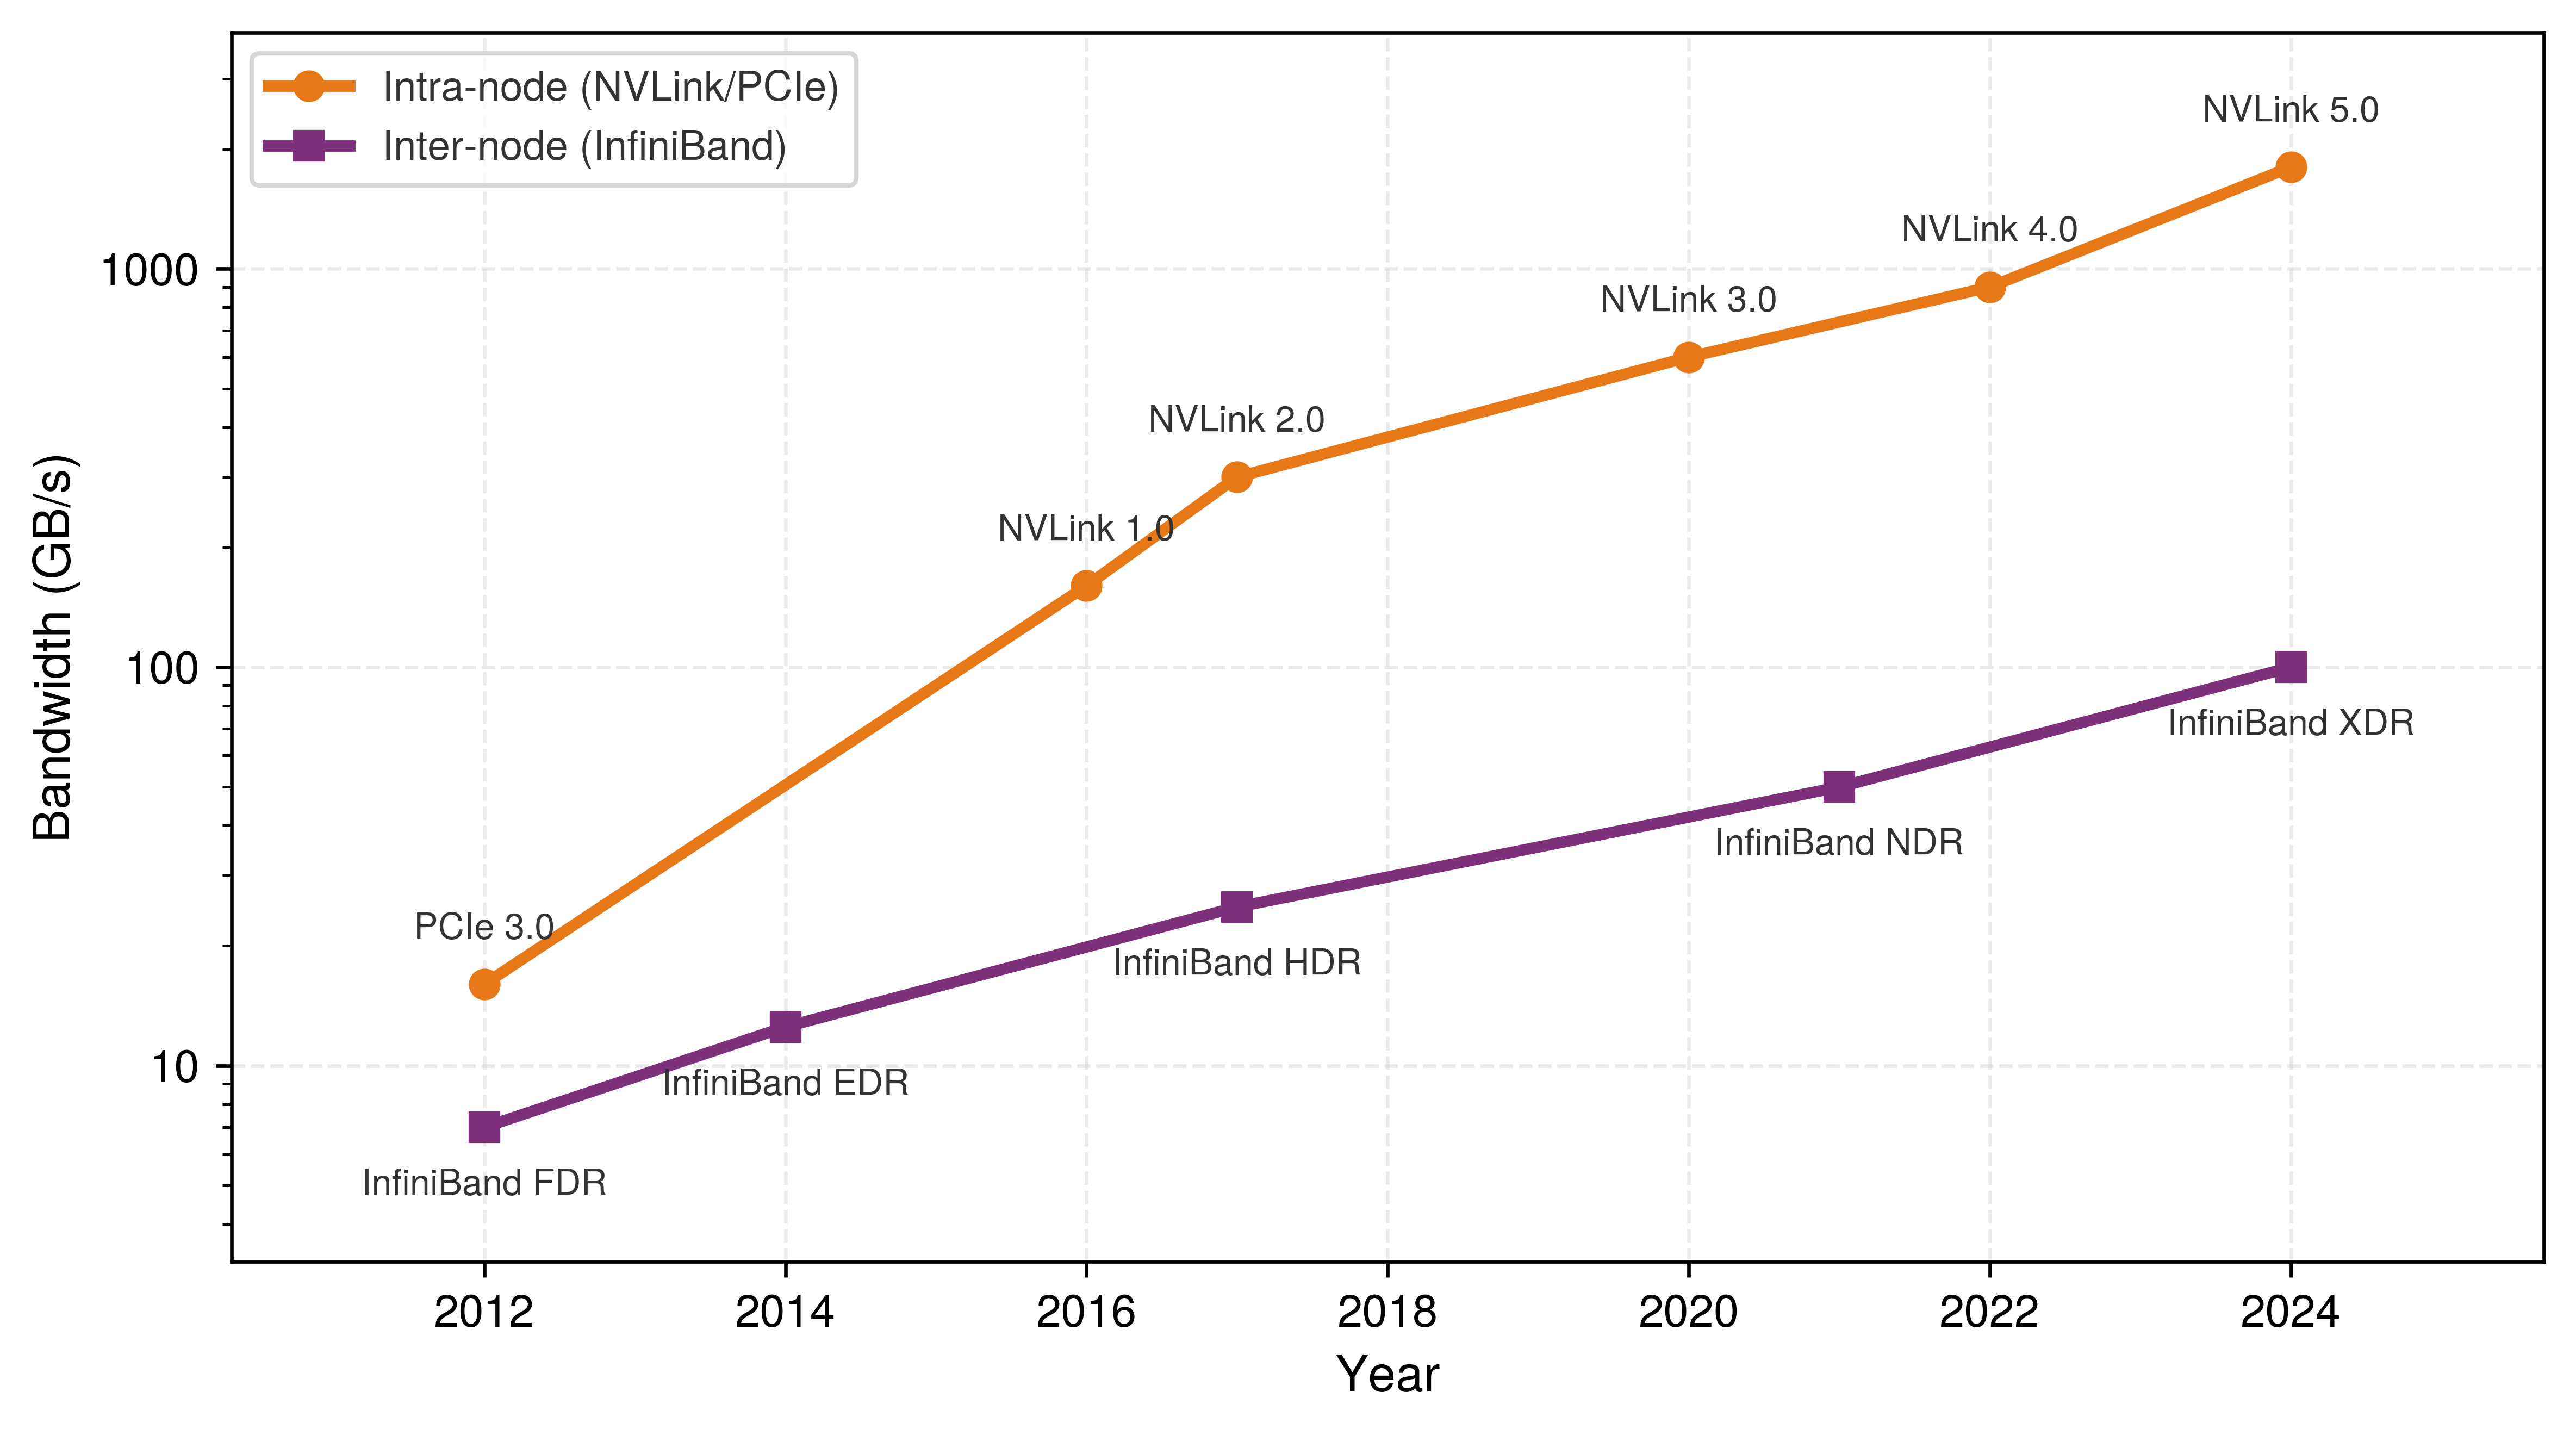
该表中的 \(\alpha\) 和 \(\beta\) 两项并未趋于收敛。图 3 表明,节点内带宽与节点间带宽的差距正在持续扩大,因此,有利于采用分层算法的临界消息大小不断变化,而非趋于稳定。
将关键消息大小公式应用于一个具体工作负载,可以揭示哪种优化策略最为关键:
Napkin Math 1.2: 关键消息大小
问题:考虑一个使用 InfiniBand NDR 400 Gbps 的集群,其 \(\alpha =\) 2 μs 和 \(\beta =\) 50 GB/s。在多大的消息大小下,优化带宽开始比优化延迟更重要?
数学:
\(n^* = \alpha \cdot \beta =\) \(2 \times 10^{-6}\) s \(\times\) \(5 \times 10^{10}\) B/s \(=\) 100 KB
系统洞见:小于 100 KB 的消息(例如 MoE token 或流水线激活)受延迟约束,需要更低延迟的交换机和更低的软件开销。大于 100 KB 的消息,例如大型语言模型(LLM) 梯度,受带宽约束,需要更高的链路带宽和数据压缩。应用错误的优化会浪费资源而不会提升性能。
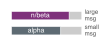
小消息受延迟约束,大消息受带宽约束;成本方向相反。
关键消息大小将通信划分为两个不同的运行形态。低于该阈值时,小消息(如 MoE 路由 token 或标量归约)受延迟约束 \((n < n^*)\),此时时间主要由 \(\alpha\) 主导,优化重点在于融合(将小消息批处理)、拓扑(减少跳数)以及软件栈调优(通过 RDMA 绕过内核)。高于该阈值时,大消息(如 LLM 梯度或优化器状态)受带宽约束 \((n \gg n^*)\),此时时间主要由 \(n/\beta\) 主导,优化重点转向压缩(降低精度或稀疏化)、算法选择(Ring 与 Tree)、以及链路聚合(多轨网络接口卡(NIC))。区分受延迟约束与受带宽约束的通信,正是应当练习的诊断技能。
Checkpoint 1.1: Alpha-beta 诊断
验证你对网络性能形态的理解:
LogP 模型
α-β 模型假设处理器在通信期间处于空闲状态。对于通信与计算重叠的流水线系统,这一假设不成立。LogP 模型 (Culler 等 1993年) 在 α-β 的基础上扩展为四个参数:
Culler, David, Richard Karp, David Patterson, Abhijit Sahay, Klaus Erik Schauser, Eunice Santos, Ramesh Subramonian, 和 Thorsten von Eicken. 1993年. 《LogP: towards a realistic model of parallel computation》. ACM SIGPLAN Notices 28 (7): 1~12. https://doi.org/10.1145/173284.155333.
- \(L_{\text{lat}}\)(延迟):消息穿越网络所需的时间(类似于 \(\alpha\))。
- \(o\)(开销):处理器用于发起或完成一次传输所花费的时间。在此期间,同一执行资源无法进行计算,因此 \(o\) 是不可重叠的成本。在分布式训练语境下,调度、设备内核启动、内存注册以及运行时推进都可能贡献这部分开销。该值是针对特定软件与硬件路径的有效参数,因此必须使用工作负载实际采用的同一集合通信、进程组与拓扑进行测量。
- \(g\)(间隔):相邻消息注入之间的最小时间间隔(消息速率的倒数)。它刻画了链路拥塞。
- \(N_{\text{rank}}\)(秩数量):通信组中的秩数量。
LogP 将网络延迟(\(L_{\text{lat}}\),可能被隐藏)与处理器开销(\(o\),不可被隐藏)区分开来。只有当计算内核的运行时长超过开销时,系统才能将通信与计算重叠。下面做一个小的重叠量计算,使这一区分具体化:
Napkin Math 1.3: 隐藏通信于计算之后
问题:一条训练流水线试图将梯度 AllReduce 与下一层的反向传播重叠执行。反向传播耗时 500 μs。AllReduce 的网络延迟为 100 μs,但处理器开销为 \(o =\) 50 μs 用于发起、\(o =\) 50 μs 用于接收。通信能否被隐藏?
数学:
- 可重叠部分:网络延迟 \(L_{\text{lat}}\) = 100 μs(GPU 计算期间处于传输中的数据)。
- 不可重叠部分:\(2o\) = 100 μs(GPU 正忙于发起/接收)。
- 可用计算:500 μs。
- 已隐藏:所有 100 μs 的 \(L_{\text{lat}}\) 都可以与计算重叠。
- 已暴露:100 μs 的 \(2o\) 开销无法与计算重叠。
结果:有效时间为 100 μs + max(500 μs, 100 μs) = 600 μs。网络延迟已被隐藏,但处理器开销仍然暴露。图 4 以图形方式展示了这一重叠。
系统洞见:α-β 模型刻画了通信的总时间;LogP 模型揭示了其中有多少部分可以被隐藏。在设计流水线训练时,应优化较低的 \(o\)(内核旁路、GPUDirect),而非仅仅追求较高的 \(\beta\)。
\scalebox{0.8}{%
\begin{tikzpicture}[line join=round, line cap=round, font=\small\sffamily]

  % Define Layer Order
  \pgfdeclarelayer{background}
  \pgfdeclarelayer{foreground}
  \pgfsetlayers{background,main,foreground}

  % Styles
  \tikzset{
    stream_label/.style={font=\small\bfseries\sffamily, align=right, text=TextBlack},
    compute_box/.style={
      draw=OrangeLine, fill=OrangeFill!75, line width=0.8pt, rounded corners=2.5pt,
      minimum height=1.2cm, minimum width=2.4cm, anchor=west, align=center, font=\small\sffamily
    },
    comm_box/.style={
      draw=VioletLine, fill=VioletFill!85, line width=0.8pt, rounded corners=2.5pt,
      minimum height=1.2cm, minimum width=2.4cm, anchor=west, align=center, font=\small\sffamily
    },
    stall_compute/.style={
      draw=RedLine, fill=RedFill!75, line width=0.9pt, rounded corners=2.5pt,
      minimum height=1.2cm, minimum width=2.4cm, anchor=west, align=center, font=\small\sffamily
    },
    stall_comm/.style={
      draw=RedLine, fill=RedFill!75, line width=0.9pt, rounded corners=2.5pt,
      minimum height=1.2cm, minimum width=2.4cm, anchor=west, align=center, font=\small\sffamily
    },
    opt_box/.style={
      draw=BlueLine, fill=BlueFill!75, line width=0.8pt, rounded corners=2.5pt,
      minimum height=1.2cm, minimum width=2.2cm, anchor=west, align=center, font=\small\sffamily
    },
    hook_arr/.style={
      ->, >=Latex, line width=0.9pt, OrangeLine!90!black
    },
    axis_arr/.style={
      ->, >=Latex, line width=0.75pt, GrayLine
    }
  }

  % Stream Header Labels (Left side)
  \node[stream_label, anchor=east] at (-0.4, 2.0) {Compute Stream\\[-1pt]\footnotesize\color{OrangeLine!90!black}(Tensor Cores / Default)};
  \node[stream_label, anchor=east] at (-0.4, 0.0) {Network Stream\\[-1pt]\footnotesize\color{VioletLine}(NIC / NCCL Comms)};

  % Compute Stream Blocks (y = 2.0, height = 1.2, spans y from 1.4 to 2.6)
  \node[compute_box] (C_L4) at (0.0, 2.0) {\textbf{Backward $L_4$}\\[1pt]\footnotesize Compute $\nabla W_4$};
  \node[compute_box] (C_L3) at (2.4, 2.0) {\textbf{Backward $L_3$}\\[1pt]\footnotesize Compute $\nabla W_3$};
  \node[compute_box] (C_L2) at (4.8, 2.0) {\textbf{Backward $L_2$}\\[1pt]\footnotesize Compute $\nabla W_2$};
  \node[compute_box] (C_L1) at (7.2, 2.0) {\textbf{Backward $L_1$}\\[1pt]\footnotesize Compute $\nabla W_1$};
  \node[stall_compute] (C_STALL) at (9.6, 2.0) {\textbf{Compute Stall}\\[1pt]\footnotesize\color{RedLine!90!black}Wait for $\nabla W_1$};
  \node[opt_box] (C_OPT) at (12.0, 2.0) {\textbf{Optimizer}\\[1pt]\footnotesize Weight Update};

  % Communication Stream Blocks (y = 0.0, height = 1.2, spans y from -0.6 to 0.6)
  % Idle / warmup slot on comms stream
  \draw[draw=black!25, fill=black!3, dashed, rounded corners=2.5pt, line width=0.6pt]
    (0.0, -0.6) rectangle (2.4, 0.6)
    node[pos=0.5, font=\footnotesize\color{black!40}\sffamily\itshape] {Comms Idle};

  \node[comm_box] (M_L4) at (2.4, 0.0) {\textbf{AllReduce $L_4$}\\[1pt]\footnotesize\color{GreenLine!90!black}\textbf{100\% Hidden}};
  \node[comm_box] (M_L3) at (4.8, 0.0) {\textbf{AllReduce $L_3$}\\[1pt]\footnotesize\color{GreenLine!90!black}\textbf{100\% Hidden}};
  \node[comm_box] (M_L2) at (7.2, 0.0) {\textbf{AllReduce $L_2$}\\[1pt]\footnotesize\color{GreenLine!90!black}\textbf{100\% Hidden}};
  \node[stall_comm] (M_L1) at (9.6, 0.0) {\textbf{AllReduce $L_1$}\\[1pt]\footnotesize\color{RedLine!90!black}\textbf{Exposed Latency}};

  % Idle on comms stream during optimizer step
  \draw[draw=black!25, fill=black!3, dashed, rounded corners=2.5pt, line width=0.6pt]
    (12.0, -0.6) rectangle (14.2, 0.6)
    node[pos=0.5, font=\footnotesize\color{black!40}\sffamily\itshape] {Comms Idle};

  % Vertical Droplines & Hook Arrows
  % L4 -> M_L4 hook at x = 2.4
  \fill[OrangeLine] (2.4, 1.4) circle (2pt);
  \draw[hook_arr] (2.4, 1.4) -- (2.4, 0.6);
  \node[right=2pt, font=\tiny\bfseries\sffamily\color{OrangeLine!90!black}] at (2.4, 1.0) {hook};

  % L3 -> M_L3 hook at x = 4.8
  \fill[OrangeLine] (4.8, 1.4) circle (2pt);
  \draw[hook_arr] (4.8, 1.4) -- (4.8, 0.6);
  \node[right=2pt, font=\tiny\bfseries\sffamily\color{OrangeLine!90!black}] at (4.8, 1.0) {hook};

  % L2 -> M_L2 hook at x = 7.2
  \fill[OrangeLine] (7.2, 1.4) circle (2pt);
  \draw[hook_arr] (7.2, 1.4) -- (7.2, 0.6);
  \node[right=2pt, font=\tiny\bfseries\sffamily\color{OrangeLine!90!black}] at (7.2, 1.0) {hook};

  % L1 -> M_L1 trigger at x = 9.6 (Critical Path!)
  \fill[RedLine] (9.6, 1.4) circle (2pt);
  \draw[->, >=Latex, line width=1.1pt, RedLine] (9.6, 1.4) -- (9.6, 0.6);
  \node[right=2pt, font=\tiny\bfseries\sffamily\color{RedLine}] at (9.6, 1.0) {tail hook};

  % M_L1 -> Optimizer Step release at x = 12.0 (Sync Barrier!)
  \fill[BlueLine] (12.0, 0.6) circle (2pt);
  \draw[->, >=Latex, line width=1.1pt, BlueLine] (12.0, 0.6) -- (12.0, 1.4);
  \node[right=2pt, font=\tiny\bfseries\sffamily\color{BlueLine}] at (12.0, 1.0) {sync release};

  % Background Shaded Regions
  \begin{pgfonlayer}{background}
    % Overlap Shading (x: 2.35 to 9.55, y: -0.85 to 2.95)
    \draw[draw=GreenLine, fill=GreenFill!25, line width=0.85pt, dashed, rounded corners=5pt]
      (2.35, -0.85) rectangle (9.55, 2.95);

    % Critical Tail Barrier Shading (x: 9.65 to 11.95, y: -0.85 to 2.95)
    \draw[draw=RedLine, fill=RedFill!25, line width=0.85pt, dashed, rounded corners=5pt]
      (9.65, -0.85) rectangle (11.95, 2.95);
  \end{pgfonlayer}

  % Region Title Badges above
  \node[anchor=south, font=\footnotesize\bfseries\sffamily\color{GreenLine!90!black}, fill=white, inner sep=2.5pt, rounded corners=2pt]
    at (5.95, 3.05) {Pipelined Overlap Region ($L_{\text{lat}}$ Hidden)};

  \node[anchor=south, font=\footnotesize\bfseries\sffamily\color{RedLine!90!black}, fill=white, inner sep=2.5pt, rounded corners=2pt]
    at (10.8, 3.05) {Critical Tail Barrier (Exposed)};

  % Time Axis below (y = -1.4)
  \draw[axis_arr] (-0.4, -1.4) -- (14.6, -1.4) node[right, font=\footnotesize\sffamily\bfseries] {Time ($t$)};

  % Milestone Ticks & Droplines
  \foreach \x/\txt in {
    0.0/{$t_0$},
    2.4/{$L_4$ done},
    4.8/{$L_3$ done},
    7.2/{$L_2$ done},
    9.6/{Compute ends},
    12.0/{AllReduce ends},
    14.2/{Step Boundary}
  } {
    \draw[GrayLine, line width=0.6pt] (\x, -1.3) -- (\x, -1.5);
    \node[below, font=\scriptsize\sffamily, text=TextBlack] at (\x, -1.5) {\txt};
  }

  % Subtle background vertical guide lines
  \begin{pgfonlayer}{background}
    \draw[GrayLine!35, dotted, line width=0.5pt] (0.0, 2.9) -- (0.0, -1.3);
    \draw[GrayLine!35, dotted, line width=0.5pt] (2.4, 2.9) -- (2.4, -1.3);
    \draw[GrayLine!35, dotted, line width=0.5pt] (4.8, 2.9) -- (4.8, -1.3);
    \draw[GrayLine!35, dotted, line width=0.5pt] (7.2, 2.9) -- (7.2, -1.3);
    \draw[RedLine!40, dotted, line width=0.6pt] (9.6, 2.9) -- (9.6, -1.3);
    \draw[RedLine!40, dotted, line width=0.6pt] (12.0, 2.9) -- (12.0, -1.3);
    \draw[BlueLine!40, dotted, line width=0.6pt] (14.2, 2.9) -- (14.2, -1.3);
  \end{pgfonlayer}

  % Tight Architectural Legend (Integrated Table Structure)
  \node[
    draw=black!15, fill=black!2, line width=0.5pt, rounded corners=3pt,
    anchor=north, minimum width=14.8cm, inner sep=6pt
  ] at (7.0, -2.3) {
    \begin{minipage}{14.5cm}\footnotesize\sffamily
      \begin{tabular}{@{}p{7.3cm}@{\hspace{0.3cm}}p{6.9cm}@{}}
        \textbf{Execution Streams \& Mechanics} & \textbf{Systems Timing Invariants} \\[2pt]
        \tikz[baseline=-2pt]\fill[OrangeFill!75,draw=OrangeLine,line width=0.5pt,rounded corners=1pt] (0,-0.12) rectangle (0.32,0.12);
        \textbf{Compute:} Reverse autograd ($L_4 \to L_1$), non-blocking &
        $\bullet$ \textbf{Hidden Latency:} $\sum_{i=2}^4 \text{Time}(L_i)$ masked by compute \\
        \tikz[baseline=-2pt]\fill[VioletFill!85,draw=VioletLine,line width=0.5pt,rounded corners=1pt] (0,-0.12) rectangle (0.32,0.12);
        \textbf{Network:} Concurrent AllReduce transfers via NCCL &
        $\bullet$ \textbf{Exposed Barrier:} $\text{Time}(L_1)$ sets sync stall floor \\
        \tikz[baseline=-2pt]\fill[BlueFill!75,draw=BlueLine,line width=0.5pt,rounded corners=1pt] (0,-0.12) rectangle (0.32,0.12);
        \textbf{Optimizer:} Weights updated after global barrier &
        $\bullet$ \textbf{Step Time:} $T_{\text{step}} = T_{\text{backward}} + T_{\text{tail}} + T_{\text{optimizer}}$
      \end{tabular}
    \end{minipage}
  };

\end{tikzpicture}%
}模型之间的选择取决于分析语境。\(\alpha\)-\(\beta\) 模型是进行粗略估算、算法选择(Ring 与 Tree)以及阻塞式通信(其完成位于依赖路径上)时的合适工具。它的优势在于简单性,因为两个参数都可以从延迟和带宽测量中估算出来。它的弱点在于假设处理器在通信期间处于空闲状态,这使得它在存在重叠时过于悲观。LogP 模型在分析转向流水线执行、计算—通信重叠,或诊断某个理论上快速的算法为何表现不佳时,其额外的参数是物有所值的。它区分网络延迟 \(L_{\text{lat}}\) 与处理器开销 \(o\),从而决定某种给定的重叠策略是否能够隐藏通信。System Profiling 中的剖析方法测量这些项并归因于残差;本章使用它们来选择通信调度。
在实践中,大多数工程计算首先使用 \(\alpha\)-\(\beta\) 模型进行初步定容和算法选择,然后在通信—计算重叠成为优化目标时,用 LogP 分析加以细化。两种模型共享一个共同局限:它们都假设单条链路上只有一条流量。真实的通信模式涉及多条同时进行的流量竞争共享带宽,这可能导致两种模型都无法捕捉的拥塞。对于拥塞敏感型工作负载(尤其是 MoE 的 AllToAll),在目标集群上进行实证基准测试仍然是必要的验证步骤。
将模型付诸实践:Llama 70B 通信预算
alpha-beta 模型在应用于真实训练配置时最为有价值。考虑一个具体场景:使用 128 个 GPU 的数据并行来训练一个 Llama 量级的 70B 参数模型,这 128 个 GPU 分布在 16 个节点上,每个节点 8 个 GPU。梯度张量为 140 GB(BF16,700 亿个参数,每个参数 2 字节,这是 Llama 类训练的常见配置)。在每个训练步骤中,必须将所有工作进程上的整个梯度同步。
该计算使用本章尚未正式化的带宽层级:先在节点内部的快速 NVLink 层级尽可能多地减少数据,仅将减少后的分片通过较慢的 InfiniBand 层级发送,然后在本地重建结果。原语名称在层级部分会变得精确;工程思路在带宽预算中已经可见。
使用 BF16 梯度(一种常见做法,可将通信量减半至 140 GB)时,对比十分鲜明。像扁平环形 AllReduce 那样,将完整梯度经由缓慢的节点间互连结构传输,耗时约为 5,557 ms。将大部分流量限制在 NVLink 上,仅通过 InfiniBand 发送归约后的分片,可将耗时降至约 1200.8 ms。这一差异并非微不足道;它决定了通信能否被计算掩盖,还是会成为关键路径。
这些数字背后的分阶段分析(节点内归约、归约后的节点间交换,以及节点内重新分发)基于 节 1.3 中介绍的集合通信原语。节 1.5.1 列出了这些原语,并给出了完整的三阶段推导;这里的开销估算说明了遵循带宽层级的价值,以及收益的具体大小。
理论与实践:校准集合通信模型
带宽与延迟之间的权衡(原则 11)能够提供有用的一阶预测,但有效的比较必须针对基准测试实际执行的同一种集合操作建模。对于在 \(N\) 个 rank 上执行的环形 AllReduce,以及大小为 \(M\) 字节的张量,其一阶成本为 \(2(N-1)\alpha + 2(N-1)M/(N\beta)\),而不是点对点表达式 \(\alpha+M/\beta\)。树形算法、分层调度和交换机辅助归约具有不同的步骤数和流量系数。NCCL 还会根据消息大小和检测到的拓扑选择协议、通道和算法,因此这些选择也构成实验条件的一部分 (Jeaugey 2017年; NVIDIA 2026年)。
因此,经过校准的集合通信模型需要记录操作、归约数据类型、rank 数量、张量大小、算法与协议、拓扑、rank 布置方式,以及实际达到的总线带宽。随后,模型使用同一配置下的测量结果拟合有效的 \(\alpha\) 和 \(\beta\)。在这些约定下比较预测时间与实测时间,可以揭示软件开销或拓扑造成的性能损失,同时避免将集合操作的算法流量系数误判为通信库效率低下。所得参数仅适用于测量所覆盖的运行范围;改变集合操作、进程组、拓扑或库版本后,需要重新校准。本章讨论算法成本模型,以及使用该模型的重叠调度方案。System Profiling 中关于性能剖析的内容则讨论更广泛的测量规范,以便将观测到的训练步骤性能退化归因于内核、内存、通信或资源争用。
选择载体:集合操作原语
如果 GPU 只是打开一个套接字,将巨大的梯度发送给另一个 GPU,整个集群就会迅速陷入难以管理的死锁与拥塞网络。地形已经摸清,梯度现在必须选择其载体:严格编排的组内交换,即集合操作。这套术语由 MPI 标准化,并被现代机器学习通信库沿用 (Message Passing Interface Forum 2015年)。图 5 展示了其中四个核心原语:AllReduce、AllGather、ReduceScatter 和 AllToAll。每个面板都展示了整个进程组操作前后的对照,每行对应一个 rank:蓝色单元格表示各 rank 初始持有的输入,绿色单元格表示聚合或重构后的输出张量,紫色表示 AllToAll 的成对重分布过程,该过程将不同分片在所有 rank 之间转置。另外两个原语 Broadcast(rank 0 向所有 rank 发送)和 Reduce(所有 rank 将数据归约到 rank 0)是基础构件,在 节 1.3.1 中定义,并隐含用于图中展示的复合模式。集合操作复杂度 对各原语的语义、延迟复杂度和带宽复杂度作出了形式化描述;此处正文通过工作负载用例介绍这些原语,希望在继续阅读前了解形式化复杂度界的读者,可以先查阅该处。
Definition 1.3: 集合操作
集合操作 是一种分布式通信模式,其中进程组内的每个 rank 都调用相匹配的操作,以聚合、广播或重新分发数据。操作契约规定了每个 rank 上的输出;它不要求各 rank 同时进入操作,也不会自行在调用前后施加通用屏障 (Message Passing Interface Forum 2015年)。
- 重要性:合适的集合通信算法决定了通信开销是随集群规模增长,还是保持不变。环形 AllReduce 实现了带宽最优的每节点开销 \(2(N-1)/N \times M / \beta\)(相对于 \(N\) 为常数),而朴素的先归约再广播方法成本为 \(\mathcal{O}(N \times M / \beta)\),其开销高出 500\(\times\) 倍,对应的条件为 \(N=1024\)。因此,算法选择直接决定了铁律中的 \(\text{BW}\) 项是否成为训练瓶颈。
- 区别:与点对点通信不同,集合操作在整个进程组上定义一个操作。各 rank 可以在不同时刻进入操作,某些算法允许一个 rank 在另一个 rank 尚未进入时就完成操作;正确性取决于各 rank 的操作序列和参数契约是否匹配,而不是屏障语义。
- 常见陷阱:在非阻塞集合操作的发起调用返回时,就认为该操作已经完成。返回的请求或流事件表示仍在执行中的工作。依赖其结果的后续操作必须等待完成,而较晚进入的 rank 可能延长这一依赖的等待时间,尽管集合操作本身并不是屏障。
Message Passing Interface Forum. 2015年. MPI: A Message-Passing Interface Standard, Version 3.1.
\begin{tikzpicture}[
    font=\small\sffamily,
    >=Stealth,
    panel/.style={
      draw=CanvasBorder,
      fill=CanvasBg,
      rounded corners=5pt,
      line width=0.6pt,
      inner sep=8pt
    },
    in node/.style={
      draw=BlueLine,
      fill=white,
      text=TextDark,
      line width=0.75pt,
      rounded corners=2.5pt,
      font=\scriptsize\sffamily,
      minimum height=0.48cm,
      text centered
    },
    out node green/.style={
      draw=GreenLine,
      fill=GreenFill!60,
      text=TextDark,
      line width=0.75pt,
      rounded corners=2.5pt,
      font=\scriptsize\sffamily,
      minimum height=0.48cm,
      text centered
    },
    out node violet/.style={
      draw=VioletLine,
      fill=VioletFill!70,
      text=TextDark,
      line width=0.75pt,
      rounded corners=2.5pt,
      font=\scriptsize\sffamily,
      minimum height=0.48cm,
      text centered
    },
    op orange/.style={
      draw=OrangeLine,
      fill=OrangeFill,
      text=OrangeLine!90!black,
      line width=0.9pt,
      rounded corners=3.5pt,
      font=\footnotesize\bfseries\sffamily,
      inner sep=4pt,
      text centered
    },
    op violet/.style={
      draw=VioletLine,
      fill=VioletFill,
      text=VioletLine,
      line width=0.9pt,
      rounded corners=3.5pt,
      font=\footnotesize\bfseries\sffamily,
      inner sep=4pt,
      text centered
    },
    wire in/.style={
      draw=BlueLine!80!black,
      line width=0.7pt
    },
    wire green/.style={
      ->,
      draw=GreenLine,
      line width=0.8pt
    },
    wire violet/.style={
      ->,
      draw=VioletLine,
      line width=0.8pt
    }
  ]

  % Define Layer Order
  \pgfdeclarelayer{background}
  \pgfsetlayers{background,main}

  % ========================================================
  % 1. TOP-LEFT: ALLREDUCE
  % ========================================================
  \begin{scope}[shift={(0, 5.0)}, local bounding box=boxAllReduce]
    % Header
    \node[anchor=west, text=TextDark] at (0, 4.35) {\textbf{\small AllReduce} \footnotesize(Sum Reduction)};
    \node[anchor=east, font=\bfseries\scriptsize, text=BlueLine] at (7.1, 4.35) {All Hold Total Sum};
    \node[anchor=west, font=\tiny\sffamily, text=TextMuted] at (0, 4.02) {Aggregates arrays; every device receives the identical sum.};

    % Inputs (Blue)
    \node[in node, minimum width=1.55cm] (ar_in0) at (0.95, 3.35) {G0: [ 1 ]};
    \node[in node, minimum width=1.55cm] (ar_in1) at (0.95, 2.70) {G1: [ 2 ]};
    \node[in node, minimum width=1.55cm] (ar_in2) at (0.95, 2.05) {G2: [ 3 ]};
    \node[in node, minimum width=1.55cm] (ar_in3) at (0.95, 1.40) {G3: [ 4 ]};

    % Central Operator
    \node[op orange, minimum width=1.8cm, minimum height=0.75cm] (ar_op) at (3.55, 2.375) {AllReduce $\Sigma$};

    % Outputs (Green)
    \node[out node green, minimum width=1.65cm] (ar_out0) at (6.15, 3.35) {G0: [ \textbf{10} ]};
    \node[out node green, minimum width=1.65cm] (ar_out1) at (6.15, 2.70) {G1: [ \textbf{10} ]};
    \node[out node green, minimum width=1.65cm] (ar_out2) at (6.15, 2.05) {G2: [ \textbf{10} ]};
    \node[out node green, minimum width=1.65cm] (ar_out3) at (6.15, 1.40) {G3: [ \textbf{10} ]};

    % Wires In -> Op
    \draw[wire in] (ar_in0.east) -- ++(0.5, 0) |- ($(ar_op.west)+(0, 0.15)$);
    \draw[wire in] (ar_in1.east) -- ++(0.3, 0) |- ($(ar_op.west)+(0, 0.05)$);
    \draw[wire in] (ar_in2.east) -- ++(0.3, 0) |- ($(ar_op.west)+(0, -0.05)$);
    \draw[wire in] (ar_in3.east) -- ++(0.5, 0) |- ($(ar_op.west)+(0, -0.15)$);
    \draw[->, wire in] ($(ar_op.west)-(0.15,0)$) -- (ar_op.west);

    % Wires Op -> Out
    \coordinate (ar_out_fork) at ($(ar_op.east)+(0.25,0)$);
    \draw[wire green, -] (ar_op.east) -- (ar_out_fork);
    \draw[wire green] (ar_out_fork) |- (ar_out0.west);
    \draw[wire green] (ar_out_fork) |- (ar_out1.west);
    \draw[wire green] (ar_out_fork) |- (ar_out2.west);
    \draw[wire green] (ar_out_fork) |- (ar_out3.west);

    % Footer Note
    \node[anchor=north, font=\scriptsize, text=TextDark] at (3.55, 0.95) {\textbf{Core Usage:} Data Parallel gradient sync (DDP)};
  \end{scope}

  \begin{pgfonlayer}{background}
    \node[panel, fit=(boxAllReduce)] {};
  \end{pgfonlayer}

  % ========================================================
  % 2. TOP-RIGHT: ALLGATHER
  % ========================================================
  \begin{scope}[shift={(7.8, 5.0)}, local bounding box=boxAllGather]
    % Header
    \node[anchor=west, text=TextDark] at (0, 4.35) {\textbf{\small AllGather} \footnotesize(Concatenation)};
    \node[anchor=east, font=\bfseries\scriptsize, text=GreenLine] at (7.1, 4.35) {All Hold Full Tensor};
    \node[anchor=west, font=\tiny\sffamily, text=TextMuted] at (0, 4.02) {Collects each device's partial shard into the full tensor.};

    % Inputs (Blue)
    \node[in node, minimum width=1.55cm] (ag_in0) at (0.95, 3.35) {G0: [ $a$ ]};
    \node[in node, minimum width=1.55cm] (ag_in1) at (0.95, 2.70) {G1: [ $b$ ]};
    \node[in node, minimum width=1.55cm] (ag_in2) at (0.95, 2.05) {G2: [ $c$ ]};
    \node[in node, minimum width=1.55cm] (ag_in3) at (0.95, 1.40) {G3: [ $d$ ]};

    % Central Operator
    \node[op orange, minimum width=1.8cm, minimum height=0.75cm] (ag_op) at (3.55, 2.375) {AllGather $\boxplus$};

    % Outputs (Green)
    \node[out node green, minimum width=2.1cm] (ag_out0) at (6.05, 3.35) {G0: [ $a, b, c, d$ ]};
    \node[out node green, minimum width=2.1cm] (ag_out1) at (6.05, 2.70) {G1: [ $a, b, c, d$ ]};
    \node[out node green, minimum width=2.1cm] (ag_out2) at (6.05, 2.05) {G2: [ $a, b, c, d$ ]};
    \node[out node green, minimum width=2.1cm] (ag_out3) at (6.05, 1.40) {G3: [ $a, b, c, d$ ]};

    % Wires In -> Op
    \draw[wire in] (ag_in0.east) -- ++(0.5, 0) |- ($(ag_op.west)+(0, 0.15)$);
    \draw[wire in] (ag_in1.east) -- ++(0.3, 0) |- ($(ag_op.west)+(0, 0.05)$);
    \draw[wire in] (ag_in2.east) -- ++(0.3, 0) |- ($(ag_op.west)+(0, -0.05)$);
    \draw[wire in] (ag_in3.east) -- ++(0.5, 0) |- ($(ag_op.west)+(0, -0.15)$);
    \draw[->, wire in] ($(ag_op.west)-(0.15,0)$) -- (ag_op.west);

    % Wires Op -> Out
    \coordinate (ag_out_fork) at ($(ag_op.east)+(0.25,0)$);
    \draw[wire green, -] (ag_op.east) -- (ag_out_fork);
    \draw[wire green] (ag_out_fork) |- (ag_out0.west);
    \draw[wire green] (ag_out_fork) |- (ag_out1.west);
    \draw[wire green] (ag_out_fork) |- (ag_out2.west);
    \draw[wire green] (ag_out_fork) |- (ag_out3.west);

    % Footer Note
    \node[anchor=north, font=\scriptsize, text=GreenLine] at (3.55, 0.95) {\textbf{Core Usage:} FSDP / ZeRO-3 parameter un-sharding};
  \end{scope}

  \begin{pgfonlayer}{background}
    \node[panel, fit=(boxAllGather)] {};
  \end{pgfonlayer}

  % ========================================================
  % 3. BOTTOM-LEFT: REDUCESCATTER
  % ========================================================
  \begin{scope}[shift={(0, 0)}, local bounding box=boxReduceScatter]
    % Header
    \node[anchor=west, text=TextDark] at (0, 4.35) {\textbf{\small ReduceScatter} \footnotesize(Reduce-Scatter)};
    \node[anchor=east, font=\bfseries\scriptsize, text=OrangeLine] at (7.1, 4.35) {One Shard Each};
    \node[anchor=west, font=\tiny\sffamily, text=TextMuted] at (0, 4.02) {Reduces across devices, then scatters disjoint slices.};

    % Inputs (Blue)
    \node[in node, minimum width=2.1cm] (rs_in0) at (1.15, 3.35) {G0: [$a_0,b_0,c_0,d_0$]};
    \node[in node, minimum width=2.1cm] (rs_in1) at (1.15, 2.70) {G1: [$a_1,b_1,c_1,d_1$]};
    \node[in node, minimum width=2.1cm] (rs_in2) at (1.15, 2.05) {G2: [$a_2,b_2,c_2,d_2$]};
    \node[in node, minimum width=2.1cm] (rs_in3) at (1.15, 1.40) {G3: [$a_3,b_3,c_3,d_3$]};

    % Central Operator
    \node[op orange, minimum width=1.8cm, minimum height=0.75cm] (rs_op) at (3.90, 2.375) {ReduceScatter};

    % Outputs (Green)
    \node[out node green, minimum width=1.65cm] (rs_out0) at (6.15, 3.35) {G0: [ $\sum a$ ]};
    \node[out node green, minimum width=1.65cm] (rs_out1) at (6.15, 2.70) {G1: [ $\sum b$ ]};
    \node[out node green, minimum width=1.65cm] (rs_out2) at (6.15, 2.05) {G2: [ $\sum c$ ]};
    \node[out node green, minimum width=1.65cm] (rs_out3) at (6.15, 1.40) {G3: [ $\sum d$ ]};

    % Wires In -> Op
    \draw[wire in] (rs_in0.east) -- ++(0.35, 0) |- ($(rs_op.west)+(0, 0.15)$);
    \draw[wire in] (rs_in1.east) -- ++(0.20, 0) |- ($(rs_op.west)+(0, 0.05)$);
    \draw[wire in] (rs_in2.east) -- ++(0.20, 0) |- ($(rs_op.west)+(0, -0.05)$);
    \draw[wire in] (rs_in3.east) -- ++(0.35, 0) |- ($(rs_op.west)+(0, -0.15)$);
    \draw[->, wire in] ($(rs_op.west)-(0.15,0)$) -- (rs_op.west);

    % Wires Op -> Out
    \coordinate (rs_out_fork) at ($(rs_op.east)+(0.25,0)$);
    \draw[wire green, -] (rs_op.east) -- (rs_out_fork);
    \draw[wire green] (rs_out_fork) |- (rs_out0.west);
    \draw[wire green] (rs_out_fork) |- (rs_out1.west);
    \draw[wire green] (rs_out_fork) |- (rs_out2.west);
    \draw[wire green] (rs_out_fork) |- (rs_out3.west);

    % Footer Note
    \node[anchor=north, font=\scriptsize, text=OrangeLine] at (3.55, 0.95) {\textbf{Core Usage:} FSDP / ZeRO sharded reduction};
  \end{scope}

  \begin{pgfonlayer}{background}
    \node[panel, fit=(boxReduceScatter)] {};
  \end{pgfonlayer}

  % ========================================================
  % 4. BOTTOM-RIGHT: ALLTOALL
  % ========================================================
  \begin{scope}[shift={(7.8, 0)}, local bounding box=boxAllToAll]
    % Header
    \node[anchor=west, text=TextDark] at (0, 4.35) {\textbf{\small AllToAll} \footnotesize(Matrix Transpose)};
    \node[anchor=east, font=\bfseries\scriptsize, text=VioletLine] at (7.1, 4.35) {Pairwise Shuffle};
    \node[anchor=west, font=\tiny\sffamily, text=TextMuted] at (0, 4.02) {Each rank sends distinct shard $i$ to peer rank $i$ (transposition).};

    % Inputs (Blue)
    \node[in node, minimum width=2.1cm] (ata_in0) at (1.15, 3.35) {G0: [$a_0,b_0,c_0,d_0$]};
    \node[in node, minimum width=2.1cm] (ata_in1) at (1.15, 2.70) {G1: [$a_1,b_1,c_1,d_1$]};
    \node[in node, minimum width=2.1cm] (ata_in2) at (1.15, 2.05) {G2: [$a_2,b_2,c_2,d_2$]};
    \node[in node, minimum width=2.1cm] (ata_in3) at (1.15, 1.40) {G3: [$a_3,b_3,c_3,d_3$]};

    % Central Operator
    \node[op violet, minimum width=1.8cm, minimum height=0.75cm] (ata_op) at (3.60, 2.375) {AllToAll $\rightleftarrows$};

    % Outputs (Violet)
    \node[out node violet, minimum width=2.1cm] (ata_out0) at (6.05, 3.35) {G0: [$a_0,a_1,a_2,a_3$]};
    \node[out node violet, minimum width=2.1cm] (ata_out1) at (6.05, 2.70) {G1: [$b_0,b_1,b_2,b_3$]};
    \node[out node violet, minimum width=2.1cm] (ata_out2) at (6.05, 2.05) {G2: [$c_0,c_1,c_2,c_3$]};
    \node[out node violet, minimum width=2.1cm] (ata_out3) at (6.05, 1.40) {G3: [$d_0,d_1,d_2,d_3$]};

    % Wires In -> Op
    \draw[wire in] (ata_in0.east) -- ++(0.35, 0) |- ($(ata_op.west)+(0, 0.15)$);
    \draw[wire in] (ata_in1.east) -- ++(0.20, 0) |- ($(ata_op.west)+(0, 0.05)$);
    \draw[wire in] (ata_in2.east) -- ++(0.20, 0) |- ($(ata_op.west)+(0, -0.05)$);
    \draw[wire in] (ata_in3.east) -- ++(0.35, 0) |- ($(ata_op.west)+(0, -0.15)$);
    \draw[->, wire in] ($(ata_op.west)-(0.15,0)$) -- (ata_op.west);

    % Wires Op -> Out
    \coordinate (ata_out_fork) at ($(ata_op.east)+(0.25,0)$);
    \draw[wire violet, -] (ata_op.east) -- (ata_out_fork);
    \draw[wire violet] (ata_out_fork) |- (ata_out0.west);
    \draw[wire violet] (ata_out_fork) |- (ata_out1.west);
    \draw[wire violet] (ata_out_fork) |- (ata_out2.west);
    \draw[wire violet] (ata_out_fork) |- (ata_out3.west);

    % Footer Note
    \node[anchor=north, font=\scriptsize, text=VioletLine] at (3.55, 0.95) {\textbf{Core Usage:} MoE token dispatch \& combine routing};
  \end{scope}

  \begin{pgfonlayer}{background}
    \node[panel, fit=(boxAllToAll)] {};
  \end{pgfonlayer}

\end{tikzpicture}原语选择是第一个扩展决策,因为它决定了哪些 rank 必须协同、哪些数据需要移动,以及哪个通信项将占主导地位。不同的模型架构对不同的操作施加压力,而为某个工作负载选择错误的原语会引入不必要的瓶颈。
六种核心原语
六种集合原语 中的六种原语构成一条决策阶梯:使用能够保持模型数学不变性的最窄操作,因为每一种更宽的模式都会增加数据移动、协同开销或竞争。
| 原语 | 它做什么 | 主要用途 | 通信开销 |
|---|---|---|---|
| 广播 | 一个发送方将数据发送给所有接收方。 | 在启动时从 rank 0 分发初始模型权重,适用于各种并行策略。 | \(\mathcal{O}(\log N)\) 延迟(树形);\(\mathcal{O}(M)\) 带宽。 |
| 归约 | 聚合所有工作节点的(求和、取最小值、取最大值)数据到一个根节点。 | 将验证指标(如损失和准确率)聚合到日志进程。 | \(\mathcal{O}(\log N)\) 延迟(树形);\(\mathcal{O}(M)\) 带宽。 |
| 全归约 | 聚合所有工作节点的数据,然后将结果分发给所有(\(y_i = \sum_{j=0}^{N-1} x_j\) 用于所有 \(i\))。 | 数据并行(数据并行):同步梯度,使每个 GPU 计算相同的更新。 | 环形在 \(2\frac{N-1}{N}\frac{M}{\beta}\) 下带宽最优,但延迟为 \(\mathcal{O}(N)\);树形给出 \(\mathcal{O}(\log N)\) 延迟,带宽较差。 |
| 全收集 | 每个工作节点的数据都发送给所有节点;结果拼接所有输入(\(x_i \rightarrow [x_0, \dots, x_{N-1}]\))。 | 分片数据并行(FSDP/ZeRO):在正向或反向传播前收集分片参数。 | 环形 \(\frac{N-1}{N}\frac{M}{\beta}\);驻留数据从 \(M/N\) 分片增长到完整 \(M\)。 |
| 归约散射 | 在工作节点之间归约,但散射使得每个节点保留一个不同的块(worker \(i\) 接收 \(i\) 块中的 \(\sum x_j\))。 | 分片数据并行:归约梯度同时保持分片以节省内存。 | 环形 \(\frac{N-1}{N}\frac{M}{\beta}\);即全收集的反向操作。 |
| 全对全 | 最通用的模式:worker \(i\) 向每个 worker \(j\) 发送一个不同的块,即分布式矩阵转置。 | MoE 将路由 token 发送给专家;DLRM 在工作节点之间交换嵌入查找。 | 每个工作节点的负载 \(\frac{N-1}{N}M\);限制因素可能来自启动、注入/接收、二分、过度订阅、路由或倾斜。 |
环形在全归约上实现带宽最优的开销,而树形以带宽换取对数延迟;AllReduce 给出了形式化定义以及比较这两种方案的算例,因此希望阅读该推导的读者可以前往那里获取完整论述 Thakur 等 (2005年)。
8 FSDP(Fully Sharded Data Parallel):PyTorch 的完全分片实现遵循 ZeRO-3 的思路,将参数、梯度和优化器状态分片到 \(N\) 加速器上 (Rajbhandari 等 2020年)。权衡在于通信频率:完全分片增加了层级的全收集与归约散射操作,而数据并行仅依赖步骤级的全归约,因此它对 \(\alpha\) 开销更加敏感。
Rajbhandari, Samyam, Jeff Rasley, Olatunji Ruwase, 和 Yuxiong He. 2020年. 《ZeRO: Memory Optimizations Toward Training Trillion Parameter Models》. SC20: International Conference for High Performance Computing, Networking, Storage and Analysis, 1~16. https://doi.org/10.1109/sc41405.2020.00024.
一个关键见解是,全归约可以分解为先归约散射、再全收集。这不仅是数学上的等价;它正是环形全归约在内部的工作方式(Scatter-Reduce 阶段即归约散射,AllGather 阶段即全收集)。以 ZeRO 风格分片、在 PyTorch 中实现为 FSDP 的分片方法8 利用这一分解:在全局模块需要参数分片之前先执行全收集,在反向传播之后执行归约散射,使得每个 rank 只保留其分片用于优化器步骤 (Rajbhandari 等 2020年)。这种方法在工作节点之间分片参数、梯度和优化器状态,将持久模型状态内存大致降低 \(N \times\),而峰值内存由完整的参数缓冲区和预取决定。
同一对全收集/归约散射操作也按顺序出现在序列并行中:一次全收集重建本地操作所需的激活视图,随后一次归约散射沿序列维度重新分布结果。这个例子稍后会很重要,因为它表明原语语义保持不变,即使被分片的张量维度发生变化。
这条阶梯之所以重要,是因为原语在算法优化开始之前就已确定通信依赖关系。全归约建立全局一致性,全收集与归约散射以重复分片移动换取内存,而全对全则以面向目的地的流量取代均匀归约。
集合正确性既包含接口维度,也包含数学维度。进程组中的每个 rank 必须以兼容的顺序发出集合操作;操作顺序不匹配可能导致死锁或错误配对缓冲区。操作还会施加形状和数量契约。全归约要求兼容的元素数量和数据类型,而可变大小交换则需要显式的每个目的地的数量和位移。这些不变量位于并行分解与通信运行时之间的边界:模型决定每个 rank 拥有哪个张量切片,而集合契约证明这些切片可以被重新组合。
归约顺序引入了第二个、数值层面的契约。浮点加法不满足结合律,因此环形、树形和交换辅助的归约可能以不同顺序累加相同的值,从而产生不同的低位比特 (Goldberg 1991年)。因此,正确性保证的是对所有贡献执行指定的归约,而不是跨算法、rank 数量或硬件的逐位一致。对可复现性敏感的负载必须固定算法和进程组配置,或使用可复现的累加方案;普通训练应将小的顺序依赖差异视为数值行为,同时仍然检查更大的 rank 间不一致。
Goldberg, David. 1991年. 《What every computer scientist should know about floating-point arithmetic》. ACM Computing Surveys 23 (1): 5~48. https://doi.org/10.1145/103162.103163.
全对全与全归约之间的对比凸显了集合操作随集群规模扩展的根本差异。
Systems Perspective 1.1: 全对全与全归约:为何扩展性不同
环形全归约可以通过邻居交换对均匀负载进行流水线化。全对全则呈现了一个不同的扩展问题:每个 rank 的流量都是面向目的地的,但逻辑对端数量本身并不能决定其开销。
对 \(N\) 个 rank 执行的全对全会产生 \(N(N-1)\) 个逻辑源—目的传输,但每个 rank 的聚合负载在弱扩展下可以保持不变。其下界由四项中的最大值决定:源端注入时间、目的端接收时间、穿越网络互连二分的流量,以及每条消息的启动或调度开销。过度订阅和路由决定这些流共享多少物理容量;消息粒度决定它们支付 \(\alpha\) 的频率。路由倾斜决定某个目的节点或链路是否成为关键路径。因此,承载均衡粗粒度流量的全二分网络尽管逻辑连接数为二次增长,仍可能扩展良好,而过度订阅的网络互连或倾斜的专家分配可能在更小的 \(N\) 处发生停滞。
专家并行与大规模推荐系统 可能在标准数据并行更早触及通信墙,当它们的流量耗尽注入、接收或二分容量时,或者当路由与目标偏斜造成热点时。原语决定流量矩阵;物理互连结构与路由分布决定扩展上限。
逻辑对等体对数呈二次增长;物理成本取决于互连结构。
为使 AllToAll 模式具体化,考虑一个混合专家模型,其中 64 个专家分布在 8 个 GPU 上(每个 GPU 8 个专家)。在每次前向传播中,门控网络将每个输入 token 分配给一个或多个专家。分配给远程 GPU 上专家的 token 必须在计算开始之前被物理传输到这些 GPU,计算结果也必须在此后传回。
Napkin Math 1.4: 用于 MoE 令牌路由的 AllToAll
问题:一个 MoE 模型处理包含 4096 tokens 个令牌的批次,这些令牌分布在 8 个 GPU 上(每个 GPU 上有 512 tokens 个令牌)。每个令牌是一个采用 BF16 格式的 2048 维隐藏状态(每个令牌占 4.096 KB)。门控网络将每个令牌恰好分配给 1 个专家,共有 64 个专家(每个 GPU 上有 8 个专家)。假设采用均匀路由(每个专家接收 64 tokens),每个 GPU 发送和接收的数据量是多少?
数学推导:
每个 GPU 持有 512 tokens,需要将其送达 64 个不同的专家,这些专家分布在 8 个 GPU 上。在均匀路由下,每个 GPU 向其他 GPU 各发送 64 tokens,接收方共有 7 个 GPU(将 64 tokens 保留在本地)。
- 每次 GPU 间传输的数据量:64 tokens \(\times\) 4.096 KB/令牌 = 262.144 KB
- 每个 GPU 发送的总数据量:7 \(\times\) 262.144 KB = 1.84 MB
- 每个 GPU 接收的总数据量:1.84 MB(对称)
延迟分析(InfiniBand NDR,\(\alpha =\) 3 μs,\(\beta =\) 50 GB/s):
这 7 次传输中的每一次都传输一条大小为 262.144 KB 的消息。根据 \(\alpha\)-\(\beta\) 模型:\(T_{\text{transfer}}\) = 3 μs + 5 μs = 8 μs,这是每次传输的延迟。
若串行执行:7 \(\times\) 8 μs = 56 μs。若全部 7 次传输并发发起,它们仍然共享 GPU 的 50 GB/s 注入端口。因此,在计入争用和额外的集合通信开销之前,总体注入延迟的下界为 \(\alpha + \text{total bytes sent}/\beta =\) 39.7 μs。全双工允许同时发送和接收;它并不会为每个对等节点提供一个独享全带宽的出站端口。
系统洞察:上述注入延迟结果只是一个下界。如果拓扑的可用二分带宽为 \(B_{\mathrm{bisect}}\),且有 \(V_{\mathrm{cut}}\) 字节必须跨越其最小割,则此次交换还须满足 \(T\geq V_{\mathrm{cut}}/B_{\mathrm{bisect}}\)。超额订阅会降低 \(B_{\mathrm{bisect}}\),细粒度的对等节点消息会增加启动开销,而专家负载偏斜会使最大接收量超过均匀路由下的估计值。此外,每层都要执行两次 AllToAll,一次用于令牌分发,一次用于结果收集。
MoE AllToAll 中的动态路由与专家负载失衡
笔记本 1.4 中的演算示例假设令牌采用均匀路由:每个专家接收的令牌份额完全相同。在生产环境的 MoE 模型中,路由决策是动态的,并且依赖于数据,这从根本上改变了集合通信的特征。
分发与合并的生命周期
在一个 MoE Transformer 层中,\(E\) 个专家分布在 \(P\) 个进程上(每个进程有 \(E/P\) 个专家),每个进程持有一个包含 \(T\) 个令牌的本地批次。门控路由器为每个令牌计算 top-\(k\) 路由概率,候选范围覆盖全部 \(E\) 个专家。这使每个 MoE 层产生两个连续的集合通信阶段:
- 令牌分发(All-to-All):每个进程将其 \(T\) 个本地令牌激活向量(\(\mathbf{x} \in \mathbb{R}^{d_{\text{model}}}\))按承载所选专家的目标进程进行划分。设备执行 AllToAll 集合通信(或可变大小的
AllToAllv),通过网络互连结构将令牌路由到承载专家的进程。 - 令牌合并(All-to-All):每个进程在分配给它的本地专家前馈网络(FFN)上完成前向传播后,第二次 AllToAll 集合通信将生成的输出向量路由回原始进程。随后,每个进程计算专家输出的加权组合: \[\mathbf{y}_i = \sum_{j \in \text{top-}k} g_{i,j} \cdot \text{Expert}_j(\mathbf{x}_i)\]
容量因子与有界分配
在稠密模型中,集合通信缓冲区的大小是静态且确定的。在稀疏 MoE 模型中,路由到专家 \(e\) 的令牌数量是一个随机变量 \(N_e \sim \text{Binomial}(P \cdot T, p_e)\)。为避免通信期间动态内存分配和缓冲区重新分配的开销,系统预先分配静态专家缓冲区,并以专家容量因子 \(C \ge 1.0\) (Lepikhin 等 2021年; Fedus 等 2022年) 为参数确定其大小: \[\text{Capacity}_e = \left\lceil \frac{P \times T \times k}{E} \times C \right\rceil\]
Lepikhin, Dmitry, HyoukJoong Lee, Yuanzhong Xu, Dehao Chen, Orhan Firat, Yanping Huang, Maxim Krikun, Noam Shazeer, 和 Zhifeng Chen. 2021年. 《GShard: Scaling giant models with conditional computation and automatic sharding》. International Conference on Learning Representations (ICLR).
Fedus, William, Barret Zoph, 和 Noam Shazeer. 2022年. 《Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity》. Journal of Machine Learning Research 23 (120): 1~39.
容量因子体现了一项根本性的系统权衡:
- 当 \(C = 1.0\):缓冲区严格按照均匀预期进行 sizing。在路由偏斜(routing skew)下,任何分配给某个专家、超出其容量的 token 都会被 丢弃(通过残差连接绕过专家计算),从而损害训练收敛与下游任务精度。
- 当 \(C > 1.0\):缓冲区能够容纳路由方差(通常为 \(C = 1.25\)–\(1.5\)),从而避免 token 丢弃。然而,为了维持均匀的集合通信,缓冲区必须用虚拟 token 填充至固定容量,这会使穿越网络的物理数据量增加 \(C\times\),并迫使 GPU 对填充的零 token 执行矩阵乘法。
- 无丢弃的动态路由:现代高吞吐框架采用可变大小的
AllToAllv与动态内存缓冲区,在消除填充开销的同时保留全部 token。然而,动态路由将执行时间直接暴露于路由偏斜之下。
二分饱和与慢节点尾部
由于 token 路由由输入语义决定,某些“明星”专家不可避免地会接收到不成比例的 token 量。如果某个专家接收的负载为平均负载的 \(\gamma \times\)(\(\gamma > 1\)),那么承载该专家的 GPU 在分派过程中接收到的入向数据将多出 \(\gamma \times\)。
这种偏斜会形成两个相互叠加的性能瓶颈:
- 入向接收瓶颈:分派集合通信的完成时间受最慢接收方约束。即使 95 percent 的 GPU 能在数十微秒内完成其 AllToAll 交换,整个集群仍会因等待最热的目标 rank 摄取其超大载荷而全面停滞: \[T_{\text{dispatch}} \ge \frac{M_{\text{max}} \times d_{\text{model}} \times \text{sizeof(dtype)}}{\text{BW}_{\text{rx}}}\] 其中 \(M_{\text{max}} = \max_p \sum_{e \in \text{rank } p} N_e\)。
- 二分互连饱和:与 Ring AllReduce(将通信映射到近邻环状链路上)不同,AllToAll 生成一个完整的双二分交换,其中 \((P-1)/P \approx 1\) 的全部 token 必须穿越集群网络互连结构。在 oversubscription 比为 \(R:1\) 的 oversubscribed 互连中,可用二分带宽 \(\text{BW}_{\text{bisect}} = (P \cdot \text{BW}_{\text{inject}}) / (2R)\) 会限制该交换: \[T_{\text{dispatch}} \ge \frac{V_{\text{cut}}}{\text{BW}_{\text{bisect}}}\]
分层 MoE 交换
为了在数千块 GPU 上同时缓解二分饱和与小消息开销,分层 MoE 运行时将扁平的 AllToAll 分解为两级集合通信 (Hwang 等 2023年):
- 节点内聚合:GPU 利用节点内 NVLink 将发往同一远程服务器节点上任意专家的 token 合并。
- 节点间交换:节点在 InfiniBand 或 RoCE 上执行节点间 AllToAll,交换经过聚合的粗粒度载荷,而非数千条细粒度点对点消息。
- 节点内分发:接收 GPU 利用 NVLink 将入向 token 散射到承载目标专家的精确 GPU。
这种分层分解将并发节点间网络流的数量从 \(P(P-1)\) 降低到 \(N_{\text{nodes}}(N_{\text{nodes}}-1)\),以会饱和带宽的消息突发替换细粒度、对延迟敏感的分组,从而保护数据中心二分互连免受分组碎片影响。
选择 AllToAll 调度
AllToAll 指定的是面向特定目标的交换,而非承载该交换的调度方式。运行时应当依据流量矩阵与物理层次结构来选择合适的调度,而不是将每次交换都视为同一种扁平模式。AllToAll 调度选择 比较了三种常见形态;Tutel 的两维交换等分层设计展示了为何最佳调度会随消息大小、规模与拓扑而变 (Hwang 等 2023年)。
Hwang, Changho, Wei Cui, Yifan Xiong, Ziyue Yang, Ze Liu, Han Hu, Zilong Wang, 等. 2023年. 《Tutel: Adaptive Mixture-of-Experts at Scale》. Proceedings of Machine Learning and Systems (MLSys) 5.
| 调度方式 | 适用场景 | 暴露的开销 |
|---|---|---|
| 直接点对点交换 | 小规模或全二分过程组中,面向每个对等节点的均衡粗粒度分块 | 每个 rank 直接向其对等节点注入;细粒度会重复启动与调度开销,而过载可能限制二分带宽 |
| 分层/合并交换 | 多 GPU 节点或链路上存在大量小远程分块;按远程节点打包,交换聚合载荷,再在本地重新分发 | 合并摊薄了节点间启动开销并尊重快速的本地链路,但会增加打包、本地拷贝、同步与临时缓冲器的开销 |
| 可变大小交换 | 各目标的 token 或嵌入数量不同,且填充至最大数量会浪费大量带宽 | 显式计数与位移避免了填充,但计数交换与非规则传输会增加控制开销;最热的接收方仍决定完成时间 |
章节背景:《Scaling Machine Learning Systems》第二卷,06 集合通信。
选择测试遵循上文推导出的下界。若每个对等节点的块较粗,且源注入或网络互连二分已占主导,则合并既无法消除字节项,甚至可能只增加副本。若 \(N\alpha\) 占主导,因为每个远程目标仅接收一个小块,则分层结构可以用更少的聚合传输替代许多跨节点启动。若计数呈偏斜分布,则可变大小接口可防止填充放大 \(V_{\mathrm{cut}}\),但调度仍须为最大接收量与专家计算负载预留资源。因此,运行时应以观测到的计数分布、放置方式和拓扑对候选调度进行基准测试;均衡的固定大小微基准测试无法选出生产环境中的 AllToAll 调度。
集合操作选择指南 将这些原语映射到 分布式训练 中引入的并行策略,以及 三种系统架构原型 中引入的灯塔原型。
| 训练策略 | 主要集合通信操作 | 瓶颈特征 |
|---|---|---|
| 数据并行 | AllReduce | 带宽受限(梯度较大) |
| FSDP/ZeRO-3 | AllGather, ReduceScatter | 带宽受限,频率高 |
| 张量并行 | AllReduce, AllGather | 延迟受限(需要 NVLink) |
| 流水线并行 | 点对点(Send/Recv) | 延迟受限(微批次交接) |
| 序列并行 | AllGather, ReduceScatter | 带宽受限(激活交换) |
| MoE(专家) | AllToAll | 启动开销、注入/二分,或偏斜 |
| DLRM(推荐系统) | AllToAll | 粒度、网络互连容量,或偏斜 |
FSDP 通信模式

FSDP 以一次步级集合通信换取每层两次集合通信。
FSDP/ZeRO 策略值得特别关注,因为其通信模式与标准数据并行存在根本差异 (Rajbhandari 等 2020年)。在标准数据并行中,每块 GPU 保存模型完整副本,本地计算梯度,并在反向传播结束时通过一次 AllReduce 进行同步。全分片通过在各 GPU 之间划分模型参数来消除这种冗余,因此每块 GPU 仅在需要重建某一层时,才持有其本地分片。
由于每块 GPU 现在只保存 \(1/N\) 的参数,它必须在使用某一层之前先重建完整张量,而正是这一重建过程改变了通信模式。在每个层的正向传播之前,GPU 调用 AllGather 以收集其他所有 GPU 的分片。反向传播结束后,梯度通过 ReduceScatter 进行归约与重新分发,因此每块 GPU 只保留属于自身参数分片的梯度。分片参数随后可以丢弃(释放内存),直到下一次正向传播需要它们为止。
其后果是开销发生了转移:分片缓解了内存瓶颈,却提高了通信频率。标准数据并行在每个训练步中通信一次(一次完整梯度的 AllReduce)。FSDP 在每个步的每层中通信两次(正向的 AllGather、反向的 ReduceScatter),但每次通信的规模更小(仅该层的参数,按秩分片)。对于一个具有 \(N_L\) 层的模型,FSDP 每步发出 \(2N_L\) 次集合通信操作,而非 1 次;在所有这些操作中,通信总量可以与单次完整梯度 AllReduce 相当,但分散在多个更小的操作中。
较高的操作次数使 FSDP 对延迟(\(\alpha\))比标准数据并行更为敏感。对于 \(2N_L\) 次集合通信和 \(N_L\) 层,有效的启动开销 \(\alpha_{\mathrm{eff}}\) 在重叠之前贡献约 \(2N_L\alpha_{\mathrm{eff}}\)。FSDP 实现通过预取 和通信流流水线来缓解这一开销,但相关的 \(\alpha_{\mathrm{eff}}\) 必须来自匹配的集合通信基准测试,而非线卡延迟规范。
在每个调用处选择正确的集合算法,需要理解这些非对称模式。FSDP 中的 AllGather 操作规模中等(一个层的参数,对于 Transformer 模型通常为 10–100 MB),且对延迟敏感(因为计算需等待完整参数可用)。ReduceScatter 操作规模相近,但可以与该层的下一个反向传播重叠。这种非对称性意味着 AllGather 操作更多受益于低延迟算法(Tree 或混合算法),而 ReduceScatter 操作可以使用带宽最优算法(Ring),因为其延迟被计算所掩盖。
章节背景:《Scaling Machine Learning Systems》第二卷,06 集合通信。
上一节中的集合原语目录定义了必须通信的内容;现在的问题变成如何在真实网络上高效执行这些原语。性能最关键的 AllReduce 原语存在多种算法实现,其延迟与带宽特性相差几个数量级。算法的选择可使 AllReduce 时间相差一个数量级,因此它是分布式训练中最重要的实现决策。
设计通信流:AllReduce 算法
正确的 AllReduce 必须让全部 1,000 张 GPU 获得全部 1,000 个 1 吉字节梯度的精确和;提供该结果的算法决定了集群的扩展上限。朴素方案(每张 GPU 都发送给一台中心服务器,其网卡瞬间饱和)首先失效,因此它是合适的起点。
朴素方案与带宽瓶颈
考虑一种使用 Parameter Server(星型拓扑)的朴素实现。所有 \(N\) 个工作节点将其梯度发送给 rank 0;rank 0 对它们求和并回发结果。约束条件是 rank 0 的带宽:它必须接收 \(N \times M\) 字节并发送 \(N \times M\) 字节,因此时间随 \(T \propto N \times M / \beta\) 增长。在 1,000 张 GPU 的规模下,中心 rank 成为扩展瓶颈,而非算术计算。
这种朴素方案体现了早期分布式机器学习框架所面临的压力:参数服务器系统通过服务器层接收、聚合并重分发模型更新,而实际实现则将参数空间分片以摊薄该负载 Li 等 (2014年)。分片将每台服务器的流量从 \(N \times M\) 降至 \(N \times M/K_{\text{srv}}\)(其中 \(K_{\text{srv}}\) 为服务器数量),但服务器层仍会随着工作节点与模型状态的增长而增长,并且引入了参数切分与一致性管理方面的额外复杂度。
根本局限在于,任何星型拓扑方案都会将流量集中到中心点。无论参与的服务器数量有多少,通过中心层的聚合流量都随 \(\mathcal{O}(N \times M)\) 增长。真正的可扩展性要求每个节点的通信量不随 \(N\) 变化。这一性质称为 Bandwidth Optimality,即可扩展集合算法的设计目标。
War Story 1.1: 当参数服务器成为瓶颈(2017 年)
背景:2017 年,Uber 的 Alexander Sergeev 与 Mike Del Balso 团队开源了 Horovod,作为 Uber 的 Michelangelo ML 平台的一部分,使 TensorFlow 训练任务能够在多张 GPU 之间扩展,而无需强迫每位模型作者重写训练代码的大部分 (Sergeev 和 Balso 2018年)。
机制:TensorFlow 原生的分布式训练依赖参数服务器模式,梯度流量集中在中心层。随着工作节点数量 \(N\) 增长,中心服务器链路饱和,扩展效率下降。
影响:扩展到单个节点之外进行训练会导致严重的吞吐量瓶颈,并且需要复杂且针对具体模型的参数切分。
修复:Uber 采用了 Baidu 的环形 all-reduce 算法 (Gibiansky 2017年),以轻量级 API 将带宽最优的集合归约封装起来,用环形通信替换参数服务器。
系统经验:集合算法也是一种开发者接口。当通信原语既带宽高效又足够易用、使团队能够正确使用它时,扩展性才会得到改善。
Gibiansky, A. 2017年. Bringing HPC Techniques to Deep Learning. Baidu Research Technical Blog.
Sergeev, Alexander, 和 Mike Del Balso. 2018年. 《Horovod: fast and easy distributed deep learning in TensorFlow》. CoRR abs/1802.05799.
带宽最优下界
在考察具体算法之前,先确立一个理论下界是有用的。在任何正确的 AllReduce 中,每张 GPU 都以 \(M\) 字节的本地数据开始,以 \(M\) 字节的全局归约结果结束。最终结果的每个字节都融合了来自全部 \(N\) 张 GPU 的信息,这意味着每张 GPU 至少必须接收 \(M \cdot (N-1)/N\) 字节“新”信息(即来自其他所有 GPU 的贡献)。对称地,每张 GPU 至少必须发送 \(M \cdot (N-1)/N\) 字节(即它对其他 GPU 结果的贡献)。
因此,每张 GPU 的最小总传输量为 \(2 \cdot M \cdot (N-1)/N\) 字节(发送加接收)。除以链路带宽 \(\beta\) 即得 Bandwidth Lower Bound:
\[T_{\text{bandwidth}}^{\text{min}} = \frac{2(N-1)}{N} \cdot \frac{M}{\beta}\]
当 \(N\) 足够大时,该结果趋近于 \(2M/\beta\),而后者与 \(N\) 无关。达到该界限的算法是带宽最优的。Ring AllReduce 精确达到该界限;简单的树状变体则不能 (Patarasuk 和 Yuan 2009年; Thakur 等 2005年)。这一区别具有实际影响:在 64 GPU 集群上同步 1 GB 梯度时,最优算法与仅仅达到对数级带宽的算法之间的带宽差异,相当于每一步数毫秒,在多日训练运行中累积起来可达数小时。
Ring AllReduce
Ring AllReduce9 将节点组织成一个逻辑环 (\(0 \to 1 \to \dots \to N-1 \to 0\))。它通过流水线实现带宽最优:每个节点在每个链路上同时发送和接收 (Patarasuk 和 Yuan 2009年)。
9 带宽最优:Ring AllReduce 达到每个节点的信息论下界 \(2(N-1)/N \cdot M/\beta\) 字节,即无论采用何种拓扑或策略,任何正确的 AllReduce 算法都无法在每个节点上移动更少的字节。这种最优性成立的原因是:每台 GPU 都必须从其他 GPU 接收 \(M(N-1)/N\) 字节“新”信息并贡献同等数量的字节,而 Ring 在每个步骤中都会使每条链路饱和。
Patarasuk, Pitch, 和 Xin Yuan. 2009年. 《Bandwidth optimal all-reduce algorithms for clusters of workstations》. Journal of Parallel and Distributed Computing 69 (2): 117~24. https://doi.org/10.1016/j.jpdc.2008.09.002.
该算法将大小为 \(M\) 的向量划分为 \(N\) 个块,随后在两个具名阶段中交替执行通信与本地归约:Scatter-Reduce,随后是 AllGather。Algorithm 1 在图与轨迹之前说明其工作机制。
\begin{algorithm} \caption{Ring AllReduce} \begin{algorithmic} \Require $N$ ranks in a logical ring; each rank $i$ starts with tensor $G_i$ of $M$ bytes, split into $N$ chunks \Ensure every rank holds $G = \sum_{i=0}^{N-1} G_i$ \State assign the ring order $0\to 1\to\dots\to N{-}1\to 0$ \For{$N-1$ scatter-reduce steps} \State each rank sends one chunk (or partial sum) right, receives one from the left, and adds it into the matching local sum \EndFor \State each rank now owns one fully reduced chunk of $G$ \For{$N-1$ all-gather steps} \State each rank forwards a reduced chunk around the ring and stores the chunks it receives \EndFor \State \Return the complete reduced tensor $G$, held on every rank \end{algorithmic} \end{algorithm}
在 \(2(N-1)\) 轮发送/接收过程中,每个 rank 每轮传输 \(M/N\) 字节,总计发送 \(2(N-1)M/N\) 字节,并接收相同数量的字节:带宽项达到信息论下界,而延迟项随 \(2(N-1)\alpha\) 增长。分散归约阶段的数据流如 图 6 所示。
\begin{tikzpicture}[line join=round, line cap=round, font=\small\sffamily]

  % Define Layer Order
  \pgfdeclarelayer{background}
  \pgfdeclarelayer{foreground}
  \pgfsetlayers{background,main,foreground}

  % Styles
  \tikzset{
    gpu_chassis/.style={
      draw=BlueLine, fill=white, line width=0.85pt, rounded corners=3pt,
      minimum width=2.85cm, minimum height=1.5cm
    },
    shard_idle/.style={
      draw=black!25, fill=black!3, line width=0.5pt, rounded corners=1.5pt,
      minimum width=0.56cm, minimum height=0.65cm, font=\scriptsize\sffamily, text=black!50
    },
    shard_reduced/.style={
      draw=GreenLine, fill=GreenFill!85, line width=0.8pt, rounded corners=1.5pt,
      minimum width=0.56cm, minimum height=0.65cm, font=\scriptsize\bfseries\sffamily, text=GreenLine!90!black
    },
    ring_arr_blue/.style={
      ->, >=Latex, line width=1.2pt, BlueLine
    },
    ring_arr_green/.style={
      ->, >=Latex, line width=1.2pt, GreenLine
    }
  }

  % ==========================================
  % PHASE 1: SCATTER-REDUCE
  % ==========================================
  \begin{scope}[shift={(0, 5.0)}]
    % Section Header Band
    \node[anchor=west, font=\normalsize\bfseries\sffamily, text=TextBlack] at (-0.2, 1.9)
      {Phase 1: Scatter-Reduce \mdseries\footnotesize($N-1 = 3$ Transmission Steps)};
    \node[anchor=east, font=\scriptsize\bfseries\sffamily, text=BlueLine] at (14.2, 1.9)
      {Each GPU Obtains 1 Reduced Shard};

    % GPUs (0 to 3)
    \foreach \idx/\rank/\reduced in {
      0/{GPU 0 (Rank 0)}/1,
      1/{GPU 1 (Rank 1)}/2,
      2/{GPU 2 (Rank 2)}/3,
      3/{GPU 3 (Rank 3)}/4
    } {
      \pgfmathsetmacro{\xpos}{\idx * 3.6 + 1.4}
      % Chassis
      \node[gpu_chassis] (G1_\idx) at (\xpos, 0.8) {};
      \node[font=\footnotesize\bfseries\sffamily, text=TextBlack] at (\xpos, 1.28) {\rank};

      % 4 Shard Blocks inside GPU
      \foreach \sidx/\slabel in {1/A, 2/B, 3/C, 4/D} {
        \pgfmathsetmacro{\sxpos}{\xpos - 0.90 + (\sidx - 1) * 0.60}
        \ifnum\sidx=\reduced
          \node[shard_reduced] at (\sxpos, 0.55) {\slabel\,\ding{51}};
        \else
          \node[shard_idle] at (\sxpos, 0.55) {\slabel};
        \fi
      }
    }

    % Forward Ring Links
    \draw[ring_arr_blue] (G1_0.east) -- (G1_1.west);
    \draw[ring_arr_blue] (G1_1.east) -- (G1_2.west);
    \draw[ring_arr_blue] (G1_2.east) -- (G1_3.west);

    % Wrap-Around Ring Link (3 -> 0)
    \draw[ring_arr_blue, rounded corners=4pt]
      (G1_3.south) -- ++(0, -0.45) -| (G1_0.south);
    \node[below=1pt, font=\scriptsize\bfseries\sffamily, text=BlueLine] at (6.8, -0.45)
      {Unidirectional Ring Wrap-Around Link (Rank 3 $\to$ Rank 0)};

    % Phase 1 Completion Status Callout
    \node[anchor=north, font=\scriptsize\sffamily, text=GreenLine!90!black] at (6.8, -0.78)
      {\textbf{Scatter-Reduce Result:} Rank $i$ holds global sum $\sum x^{(i)}$ (A\,\ding{51} on G0, B\,\ding{51} on G1, C\,\ding{51} on G2, D\,\ding{51} on G3)};

    % Background Container
    \begin{pgfonlayer}{background}
      \draw[draw=black!15, fill=black!1, rounded corners=4pt, line width=0.5pt]
        (-0.4, -1.15) rectangle (14.4, 2.25);
    \end{pgfonlayer}
  \end{scope}

  % ==========================================
  % PHASE 2: ALLGATHER
  % ==========================================
  \begin{scope}[shift={(0, 1.2)}]
    % Section Header Band
    \node[anchor=west, font=\normalsize\bfseries\sffamily, text=TextBlack] at (-0.2, 1.9)
      {Phase 2: AllGather \mdseries\footnotesize($N-1 = 3$ Transmission Steps)};
    \node[anchor=east, font=\scriptsize\bfseries\sffamily, text=GreenLine] at (14.2, 1.9)
      {All GPUs Obtain All Reduced Shards};

    % GPUs (0 to 3)
    \foreach \idx/\rank in {
      0/{GPU 0 (Rank 0)},
      1/{GPU 1 (Rank 1)},
      2/{GPU 2 (Rank 2)},
      3/{GPU 3 (Rank 3)}
    } {
      \pgfmathsetmacro{\xpos}{\idx * 3.6 + 1.4}
      \node[gpu_chassis, draw=GreenLine] (G2_\idx) at (\xpos, 0.8) {};
      \node[font=\footnotesize\bfseries\sffamily, text=TextBlack] at (\xpos, 1.28) {\rank};

      % All 4 Shards are now fully reduced!
      \foreach \sidx/\slabel in {1/A, 2/B, 3/C, 4/D} {
        \pgfmathsetmacro{\sxpos}{\xpos - 0.90 + (\sidx - 1) * 0.60}
        \node[shard_reduced] at (\sxpos, 0.55) {\slabel\,\ding{51}};
      }
    }

    % Forward Ring Links (Green)
    \draw[ring_arr_green] (G2_0.east) -- (G2_1.west);
    \draw[ring_arr_green] (G2_1.east) -- (G2_2.west);
    \draw[ring_arr_green] (G2_2.east) -- (G2_3.west);

    % Wrap-Around Ring Link (3 -> 0)
    \draw[ring_arr_green, rounded corners=4pt]
      (G2_3.south) -- ++(0, -0.45) -| (G2_0.south);
    \node[below=1pt, font=\scriptsize\bfseries\sffamily, text=GreenLine] at (6.8, -0.45)
      {AllGather Forwarding Around Ring (Rank 3 $\to$ Rank 0)};

    % Phase 2 Completion Status Callout
    \node[anchor=north, font=\scriptsize\sffamily, text=GreenLine!90!black] at (6.8, -0.78)
      {\textbf{AllGather Final State:} Every GPU possesses the complete synchronized gradient tensor [A\,\ding{51}, B\,\ding{51}, C\,\ding{51}, D\,\ding{51}]};

    % Background Container
    \begin{pgfonlayer}{background}
      \draw[draw=black!15, fill=black!1, rounded corners=4pt, line width=0.5pt]
        (-0.4, -1.15) rectangle (14.4, 2.25);
    \end{pgfonlayer}
  \end{scope}

  % ==========================================
  % ANALYTICAL INVARIANTS FOOTER CARD
  % ==========================================
  \node[
    draw=black!15, fill=black!2, line width=0.5pt, rounded corners=3pt,
    anchor=north, minimum width=14.8cm, inner sep=6pt
  ] at (7.0, -0.2) {
    \begin{minipage}{14.5cm}\footnotesize\sffamily
      \begin{tabular}{@{}p{7.1cm}@{\hspace{0.4cm}}p{7.0cm}@{}}
        \textbf{Bandwidth Optimality (Lower Bound)} & \textbf{Latency Scaling Penalty (Ring Diameter)} \\[2pt]
        $\bullet$ \textbf{Per-GPU Traffic:} $2 \cdot \frac{N-1}{N} \cdot M \to 2M$ as $N \to \infty$ &
        $\bullet$ \textbf{Ring Steps:} $2(N-1)$ sequential point-to-point transfers \\
        $\bullet$ \textbf{Link Utilization:} $100\%$ of links active concurrently in every round &
        $\bullet$ \textbf{Latency Overhead:} $T_{\text{lat}} = 2(N-1) \cdot \alpha$ (scales linearly with $N$)
      \end{tabular}
    \end{minipage}
  };

\end{tikzpicture}在 图 6 中可见的关键特性是:每条链路在每个步骤中都同时传输数据,没有任何链路空闲。这种均匀的链路利用率正是 Ring AllReduce 带宽最优的原因:每个节点在两个阶段合计恰好发送 \(2(N-1)/N \cdot M\) 字节,与信源—信道容量界限一致。环形 vs. 树状 vs. 递归减半加倍 通过并列示例比较 Ring、树状和递归减半—加倍算法,并展示最优算法如何随消息大小变化,为读者提供可与本文各算法推导所得结果对照的具体交叉点数值。
为使 Ring 算法具体化,考虑一个逐步追踪:4 个 GPU 通过求和方式缩减一个包含 4 个元素的向量。每个 GPU \(i\) 初始拥有一个本地梯度向量 \(g_i = [a_i, b_i, c_i, d_i]\)。该向量被划分为 4 个分片(每个 GPU 一个),算法分为两个阶段执行。
Example 1.1: 环形全归约:逐步追踪(4 个 GPU)
场景:四个 GPU(\(0 \to 1 \to 2 \to 3 \to 0\))对局部向量 \([1, 5, 3, 7]\)、\([2, 6, 4, 8]\)、\([3, 7, 5, 9]\) 和 \([4, 8, 6, 10]\) 执行环形全归约,以计算逐元素之和 \([10, 26, 18, 34]\)。
诊断:标准参数服务器存在中央归约器的带宽瓶颈(\(O(N)\) 数据传输)。环形全归约将向量划分为 \(N=4\) 个分块,执行 \(N-1\) 个分散归约步骤以聚合求和,随后执行 \(N-1\) 个全收集步骤以分发结果。
系统启示:环形全归约实现了最优带宽利用率:每个 GPU 发送的总数据量为 \(2\frac{N-1}{N}M\),与集群规模 \(N\) 无关,从而将字节传输量与节点数量解耦。
在继续之前,该追踪过程还有两项机制需要验证:\(2(N-1)\) 步骤数,以及每个进程秩在每一步中都发送和接收数据这一点。
环形延迟随 N 增长;树形延迟保持对数增长。
Checkpoint 1.2: 环形全归约机制
检验你对带宽最优归约的理解:
示例 1.1 中的追踪过程说明了环形全归约的关键特性:在每一步中,环上的每条链路都处于活跃状态,数据沿同一方向流动。没有任何 GPU 处于空闲状态,也没有任何链路未得到充分利用。这种均匀的链路利用率正是环形全归约具有带宽最优性的原因。
其性能直接由算法结构决定。每个节点每一步发送和接收的数据量均为 \(\frac{M}{N}\) 字节,共执行 \(2(N-1)\) 个步骤。 \[ T_{\text{ring}} = \underbrace{2(N-1)\alpha}_{\text{Latency Term}} + \underbrace{2\frac{N-1}{N} \frac{M}{\beta}}_{\text{Bandwidth Term}} \]
- 带宽:随着 \(N \to \infty\),该指标趋近于 \(2M/\beta\)。这在理论上是最优的(每个字节只需发送一次、接收一次)。
- 延迟:延迟随 \(N\) 线性增长。对于 10,000 个节点,20,000 次顺序跳数会产生巨大的延迟。这就是 Ring 不适合小消息的原因。
Tree AllReduce
Ring AllReduce 为其带宽最优性付出了高昂的延迟代价。当集群扩展到数千 GPU、消息规模适中(几兆字节)时,\(2(N-1)\alpha\) 延迟项会压倒带宽项,算法的大部分时间都花在顺序跳数上,而非有效数据传输。为了解决这种线性延迟,Tree AllReduce 采用一棵二叉树结构,分为两个阶段。在归约阶段,叶子节点向父节点发送数据,父节点对收到的值求和并向上传递,在 \(\log_2 N\) 步后到达根节点。在广播阶段,根节点将结果再次向下广播到叶子节点,同样需要 \(\log_2 N\) 步。
Tree AllReduce 的带宽效率较差,原因是链路利用率不足。在 Ring AllReduce 中,每个节点都同时发送和接收,因此在每一步所有 \(N\) 条链路都处于活跃状态。在 Tree AllReduce 中,任意时刻只有部分链路处于活跃状态,且该比例在每一层都会下降。在叶子层,\(N/2\) 个节点向 \(N/2\) 个父节点发送,有一半的节点处于空闲接收状态;在上一层,\(N/4\) 个节点向 \(N/4\) 个父节点发送,四分之三的节点处于空闲;在根节点,只有两个节点通信,其余 \((N-2)\) 个节点处于空闲。结果是,Ring 在大消息的平衡环上可实现接近 100% 的链路利用率,而简单的树形结构会让许多链路空闲,并将流量集中在根节点或内部链路上。
由此得到的时间复杂度取决于具体的树形变体。一个简单的“先归约后广播”树具有对数级延迟,但存在非均匀流量以及根节点/内部节点瓶颈;递归加倍风格的变体可能带来 \(\mathcal{O}(\log N)\) 每节点的完整消息带宽。以下简化模型刻画了树形集合通信的延迟优势以及潜在的带宽惩罚: \[ T_{\text{tree-like}} \approx \underbrace{2\log_2 N \cdot \alpha}_{\text{Latency}} + \underbrace{2 \log_2 N \frac{M}{\beta}}_{\text{Bandwidth penalty in full-message exchange variants}} \]
延迟项呈对数增长(\(\mathcal{O}(\log N)\)):对于 1024 个节点,Ring 需要 2046 步,而 Tree 只需 20 步;这 100\(\times\) 步的减少使得 Tree 成为对延迟敏感的集合通信(例如张量并行逐层 AllReduce,消息较小但频率较高)的首选算法。带宽项则承担了惩罚,因为树形算法可能浪费链路利用率,或将流量集中在内部链路上;递归加倍风格的完整消息交换还会额外增加 \(\log_2 N\) 带宽因子;这些惩罚使得朴素的树形变体不适用于数据并行的大梯度 AllReduce,因为在数据并行中,带宽效率决定了网络是饱和还是部分空闲。
当实现反复交换完整消息或产生根节点/内部节点瓶颈时,这种带宽惩罚在大规模数据并行中是灾难性的。对于一个 70B 参数模型的 140 GB 梯度 AllReduce 跨越 1,000 个 GPU,一个带宽效率不足的树形变体可能抹去促使采用它的延迟优势。优化的双树算法正是为了在保持对数级延迟的同时,避免这种朴素的带宽惩罚。
然而,当延迟是主要瓶颈时,Tree AllReduce 才是正确选择,通常适用于消息较小的较小规模集合通信。典型用例是张量并行所要求的对延迟敏感的 AllReduce,它作用于单个层内的激活或权重梯度。在一个节点内的 8 GPU 组通信一个 1 MB 张量时,延迟从 Ring 的 \(2(8-1)\alpha = 14\alpha\) 降至 Tree 的 \(2\log_2(8)\alpha = 6\alpha\)。在该规模下带宽惩罚较为温和,因此减少顺序启动步数所带来的收益更大。
递归减半加倍(蝴蝶)
环与树代表了延迟—带宽权衡的两个极端:环的带宽最优,但延迟表现较差;树的延迟最优,但带宽表现较差。第三种方法将树的对数级延迟与更高的带宽利用率结合起来。递归减半—加倍 算法(有时称为蝴蝶算法)总共执行 \(2\log_2 N\) 轮:先执行 \(\log_2 N\) 轮 ReduceScatter,再执行 \(\log_2 N\) 轮 AllGather。在任一阶段的每一轮 \(k\) 中,每个 GPU 都与逻辑编号中距离为 \(2^k\) 的伙伴交换数据,消息大小减半(在 ReduceScatter 阶段)或加倍(在 AllGather 阶段)。
在 ReduceScatter 阶段(前 \(\log_2 N\) 轮),GPU \(i\) 与 GPU \(i \oplus 2^k\)(索引的异或结果)配对,并交换各自当前数据的一半。接收后,每个 GPU 将保留的一半数据与接收到的一半数据相加,然后丢弃另一半。经过 \(\log_2 N\) 轮后,每个 GPU 持有 \(M/N\) 字节的完整归约结果。AllGather 阶段则逆向执行这一过程:在每一轮中,配对双方交换各自的归约数据块,使每个 GPU 持有的数据量加倍,直到所有 GPU 都获得完整结果。
递归减半—加倍的性能如下: \[ T_{\text{butterfly}} = 2\log_2 N \cdot \alpha + 2\frac{N-1}{N} \cdot \frac{M}{\beta} \]
这兼具两者的优势:对数级延迟(\(\mathcal{O}(\log N)\),与树相同)和带宽最优的数据传输(\(2(N-1)/N \cdot M/\beta\),与环相同)。代价是它需要非相邻通信(GPU \(i\) 必须与 GPU \(i \oplus 2^k\) 通信,而两者在物理上可能相距很远),并且要求 \(N\) 为 2 的幂。对于 \(N\) 不是 2 的幂的集群,需要引入额外的复杂性来处理这些不规则情况。
递归减半—加倍用于 MPI 风格的集合通信实现,也可作为研究延迟—带宽权衡的一个理论参照点 (Thakur 等 2005年)。NCCL 的实现类别包括环、树的衍生形式、分层形式,以及感知 NVLink/NVSwitch 和通信模式的方案;具体名称和可用性随版本与拓扑而变化 (Jeaugey 2017年; NVIDIA 2026年)。始终成立的核心结论不在于某个版本中采用的名称:实际通信库通过感知拓扑的成本模型选择算法,因为非局部通信模式可能导致共享网络链路上的争用,从而削弱理论优势。
Thakur, Rajeev, Rolf Rabenseifner, 和 William Gropp. 2005年. 《Optimization of Collective Communication Operations in MPICH》. The International Journal of High Performance Computing Applications 19 (1): 49~66. https://doi.org/10.1177/1094342005051521.
序列并行和混合专家路由最鲜明地体现了递归减半—加倍对拓扑的敏感性。在序列并行中,AllGather 重建激活值分片,ReduceScatter 沿序列维度重新分配这些分片;进程间的交换调度遵循与蝴蝶算法相同的距离加倍逻辑。在 MoE 路由中,每个词元都必须能够到达 \(N\) 个专家 GPU 中的任意一个,从而形成相同的扇出模式:蝴蝶式调度会在最后一轮产生跨边界配对,因为词元分发必须跨越整个集群的直径。下面的八 GPU ReduceScatter 执行轨迹准确展示了这些长距离跨越是如何产生的。
具体而言,考虑 8 个 GPU 的 ReduceScatter 阶段,该阶段共执行 \(\log_2(8) = 3\) 轮。在第 \(k=0\) 轮,每个 GPU \(i\) 与 GPU \(i \oplus 1\) 配对,形成相邻配对:(0,1)、(2,3)、(4,5)、(6,7)。它们交换各自一半的数据并进行归约。在第 \(k=1\) 轮,距离加倍:GPU \(i\) 与 GPU \(i \oplus 2\) 配对,形成配对 (0,2)、(1,3)、(4,6)、(5,7)。在第 \(k=2\) 轮,距离再次加倍:GPU \(i\) 与 GPU \(i \oplus 4\) 配对,形成配对 (0,4)、(1,5)、(2,6)、(3,7)。
这种模式的问题在实际硬件上就显现出来了。第 \(k=2\) 轮的配对迫使通信跨越物理边界。如果 GPU 0–3 位于一个节点上,而 4–7 位于另一个节点上,那么最后一轮会在这两个节点之间产生跨节点流量。对于包含 1,000 个 GPU 的集群(在算法中近似为 1,024 个),最后一轮将 GPU \(i\) 与 GPU \(i \oplus 512\) 配对,迫使集群前半部分的 GPU 与后半部分的伙伴通信,并可能使连接服务器机架的高层网络互连结构承受过量流量。这种不考虑拓扑的通信模式,正是蝴蝶算法的理论最优性无法转化为其在大规模分层集群上的实际优势的原因。
双二叉树
NCCL 可以针对多种消息大小和拓扑使用双二叉树,这种方法解决了标准二叉树的带宽效率不足问题,同时无需采用蝴蝶算法所要求的非局部通信 (Jeaugey 2017年; NVIDIA 2026年)。其思路是构建两棵彼此独立的二叉树,使它们共同覆盖所有链路,然后同时运行两棵树,每棵树承载一半的数据。
双二叉树
在标准二叉树中,每一层只有一半的链路处于活动状态(另一半处于空闲,因为这些节点是在接收而非发送)。构建第二棵互补树(根节点不同,其边覆盖第一棵树未使用的链路)后,两棵树可以并行运行。每棵树承载 \(M/2\) 字节,由于两棵树的链路利用率互补,链路总利用率接近 100%,既达到 Ring 的带宽效率,又保留 Tree 的 \(\mathcal{O}(\log N)\) 延迟。
合并后的性能约为: \[ T_{\text{double-tree}} \approx 2\log_2 N \cdot \alpha + \frac{2M}{\beta} \]
实际上,带宽项接近 \(2M/\beta\)(最优),同时保持对数级延迟。这使得 Double Binary Tree 在很宽的消息尺寸范围和集群规模下都具有很强的竞争力,这也是通信库在许多配置中选择它的原因。该算法需要仔细构建这两棵互补树,以确保它们不会产生链路争用;NCCL 的感知拓扑图搜索会在初始化阶段处理这一问题。
双二叉树在消息尺寸上的广泛竞争力解释了为什么 PyTorch 的 DistributedDataParallel(DDP)和 FSDP 分桶大小(通常为 25–100 MB)经常恰好落在 Ring 与纯 Tree 都不占优的交叉区域。25 MB 的分桶位于中等规模集群的 Ring-Tree 交叉点附近,而 100 MB 的分桶在慢速网络上开始偏向 Ring。双二叉树很好地处理了这一中间地带,这也是 NCCL 在许多 DDP/FSDP 梯度同步调用中动态选择它、而非无条件固定选择 Ring 的原因之一。
评估 AllReduce 算法比较 (表 2) 与交叉边界 (图 7) 表明,算法选择完全取决于消息尺寸:小消息由 Tree 主导,大消息则由 Ring 胜出。
| 算法 | 延迟 | 带宽 | 带宽最优? | 约束 |
|---|---|---|---|---|
| Ring | \(\mathcal{O}(N)\alpha\) | \(2\frac{N-1}{N}\frac{M}{\beta}\) | Yes | None |
| Tree | \(\mathcal{O}(\log N)\alpha\) | \(\mathcal{O}(\log N)\frac{M}{\beta}\) | No | None |
| Butterfly | \(\mathcal{O}(\log N)\alpha\) | \(2\frac{N-1}{N}\frac{M}{\beta}\) | Yes | \(N = 2^k\) |
| Double Tree | \(\mathcal{O}(\log N)\alpha\) | \(\approx\frac{2M}{\beta}\) | Near-optimal | Complementary tree construction |
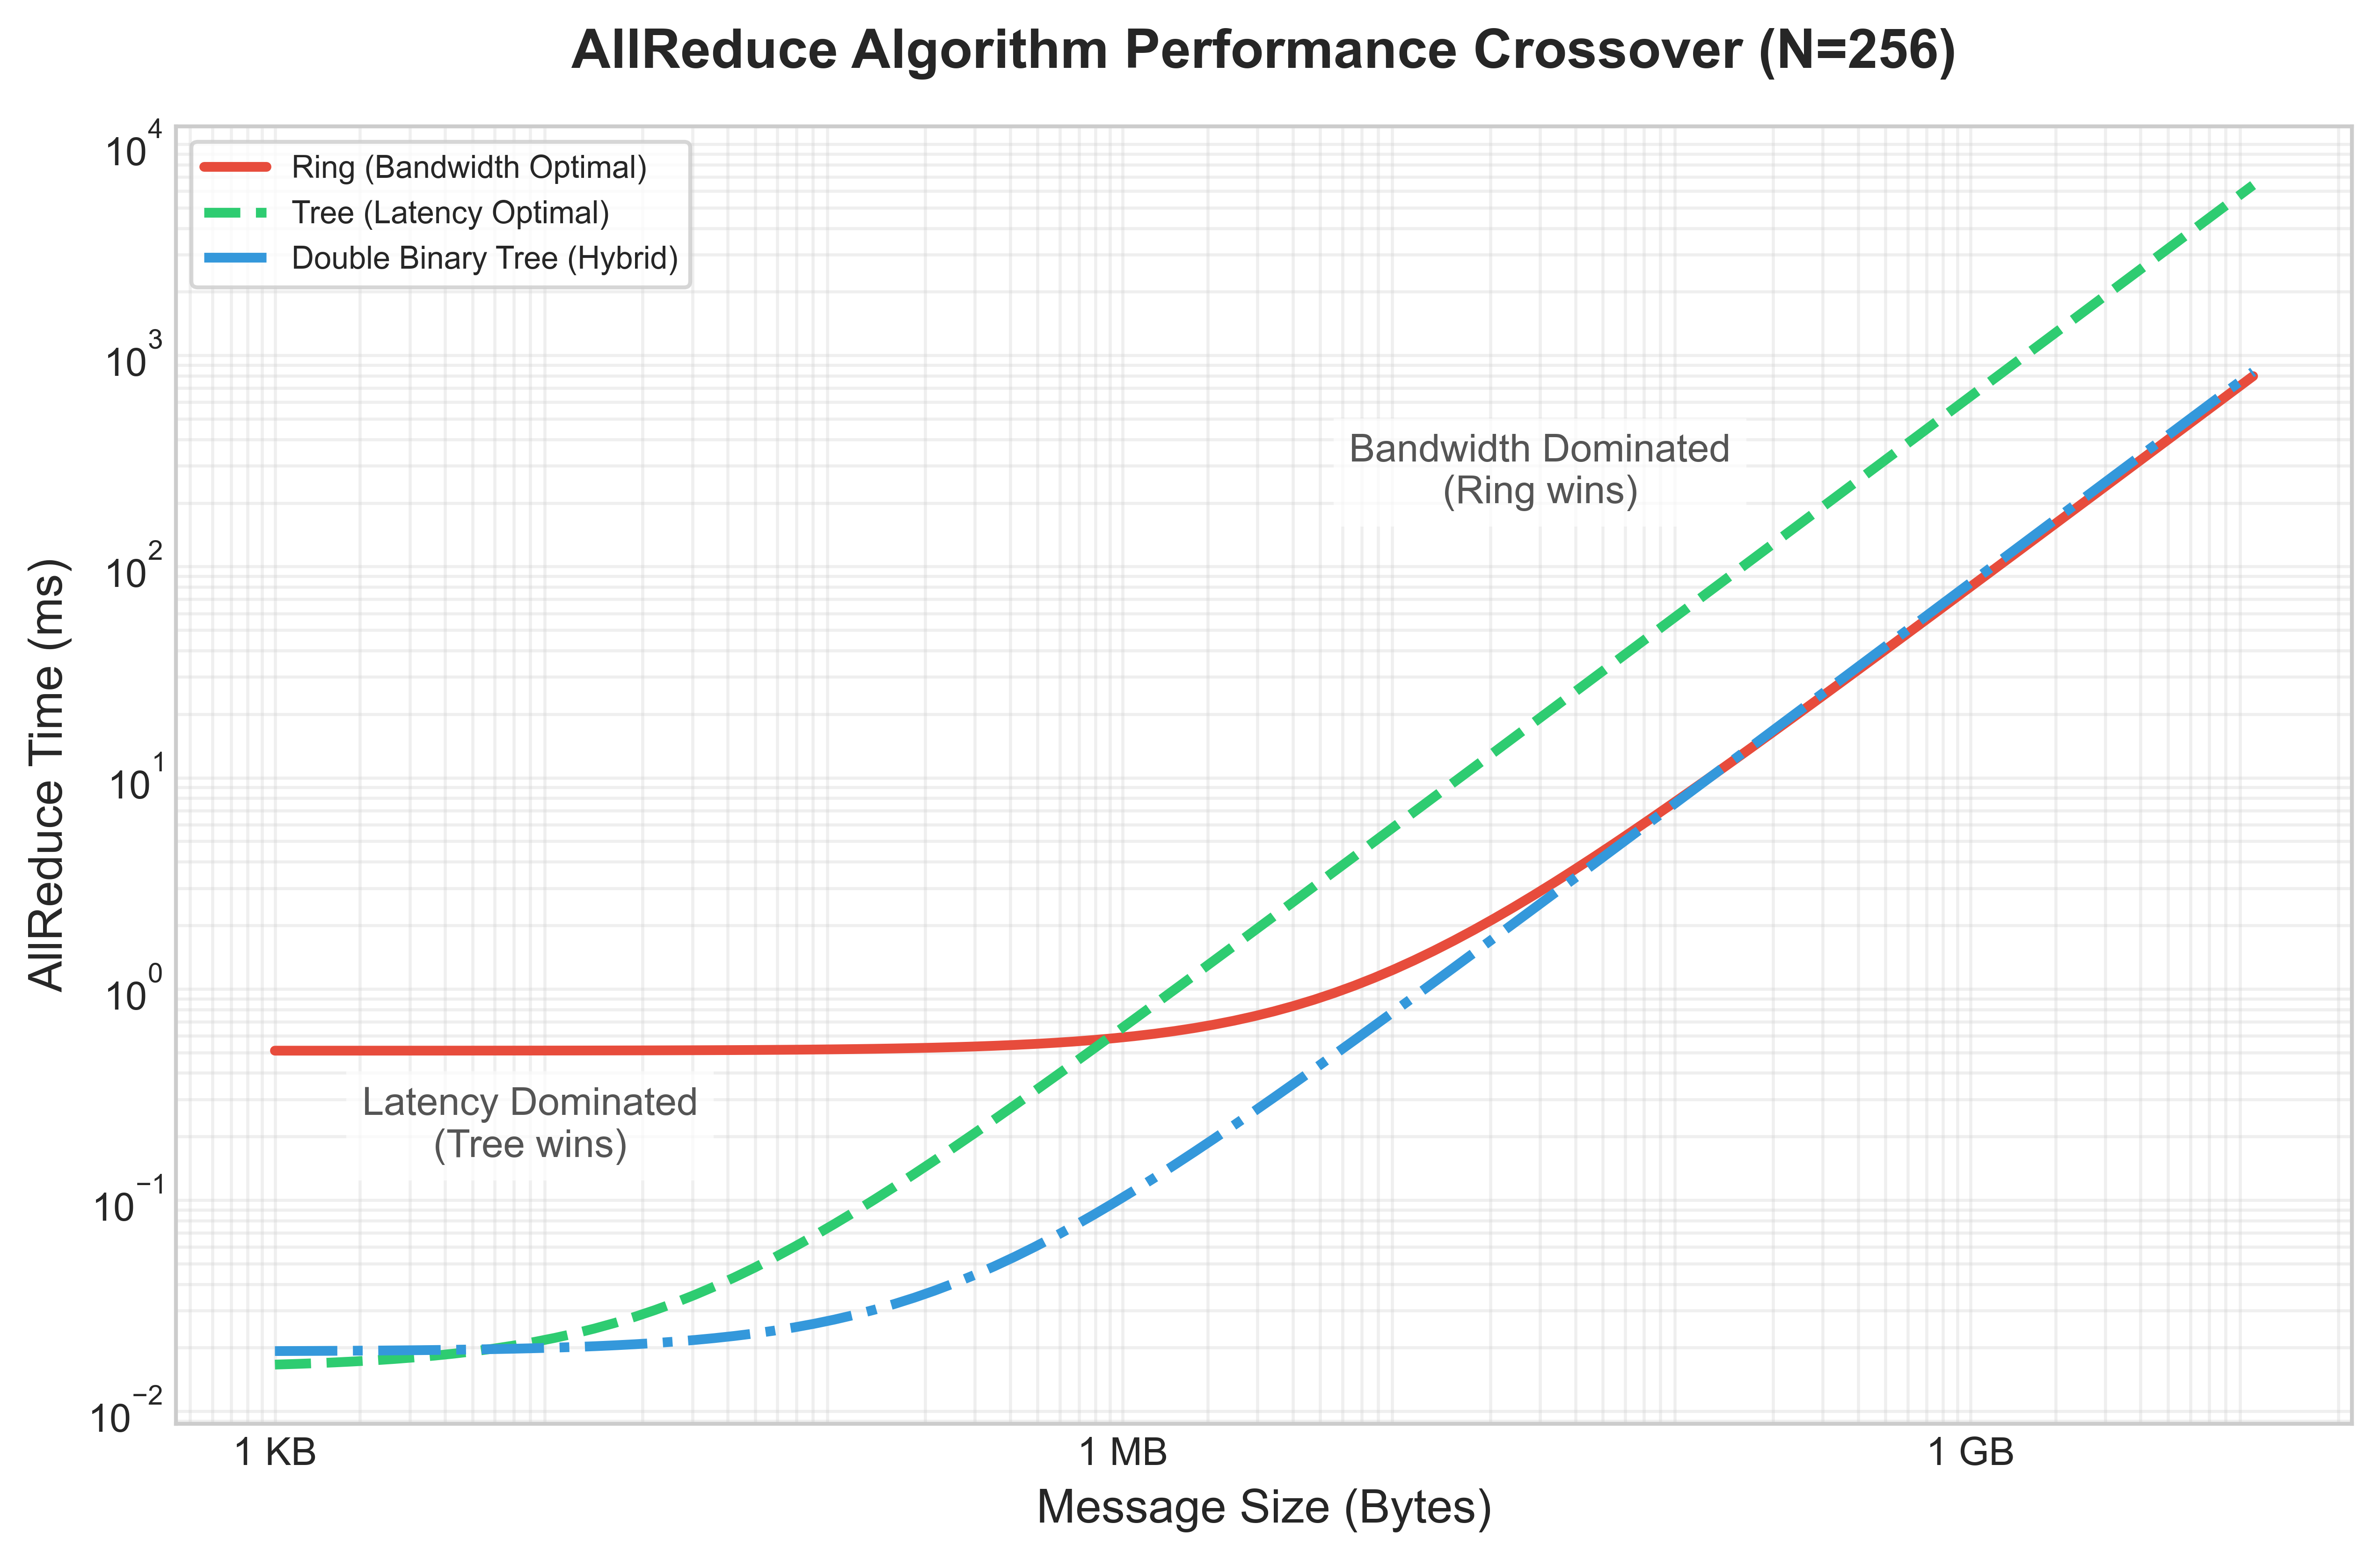
算法切换点
在 图 7 中,Ring 超越 Tree 的切换点源于令 \(T_{\text{ring}} = T_{\text{tree}}\) 并求解 \(M\)。完整的时间方程明确展示了这一权衡:
\[ T_{\text{ring}} = 2(N-1)\alpha + 2\frac{N-1}{N}\frac{M}{\beta} \] \[ T_{\text{tree}} = 2\log_2 N \cdot \alpha + 2\log_2 N \cdot \frac{M}{\beta} \]
对于较大的 \(N\),\((N-1) \approx N\) 和 \(\frac{N-1}{N} \approx 1\),因此环路的延迟项与 \(N\) 成正比,同时每个字节接近带宽上限:
\[ T_{\text{ring}} \approx 2N\alpha + \frac{2M}{\beta}, \quad T_{\text{tree}} \approx 2\log_2 N \cdot \alpha + \frac{2\log_2 N \cdot M}{\beta} \]
Tree 的形状则相反:启动成本是对数级的,但每个消息字节需要经过更多阶段。令两个估计值相等,即可隔离出延迟路径不再以额外带宽开销补偿时的消息大小:
\[ 2N\alpha + \frac{2M}{\beta} = 2\log_2 N \cdot \alpha + \frac{2\log_2 N \cdot M}{\beta} \] \[ \frac{2M}{\beta} - \frac{2\log_2 N \cdot M}{\beta} = 2\log_2 N \cdot \alpha - 2N\alpha \] \[ \frac{2M}{\beta}(1 - \log_2 N) = 2\alpha(\log_2 N - N) \]
由于在大规模集群中 \(N \gg \log_2 N\),\((\log_2 N - N) \approx -N\) 和 \((1 - \log_2 N) \approx -\log_2 N\),可得:
\[ \frac{2M}{\beta}(-\log_2 N) \approx 2\alpha(-N) \] \[ M_{\text{crossover}} \approx \frac{N \cdot \alpha \cdot \beta}{\log_2 N} \]
作为粗略的上限规模直觉模型,工程师有时会忽略对数因子: \[ \boxed{M_{\text{crossover}} \approx N \cdot \alpha \cdot \beta} \]
对数感知的切换公式提供的是有用的直觉,而非硬性选择规则。在切换点之上,消息大小占主导,Ring 的带宽效率胜出;在切换点之下,启动延迟占主导,Tree 的对数深度胜出。
对于具有 \(\alpha=5\ \mu\text{s}\)、\(\beta=50\ \text{GB/s}\) 和 \(N=100\) 的集群,直接近似给出: \[M_{\text{crossover}} \approx \frac{100 \times 5\cdot 10^{-6} \times 50\cdot 10^9}{\log_2 100} \approx 3.8 \text{ MB}\]
实际上,NCCL 的算法选择比简单的二选一划分更为细致。Double Binary Tree 算法提供对数级延迟与接近最优的带宽,因此在较宽的消息大小范围内与 Ring 和 Tree 都具有竞争力。NCCL 还会考虑通道数(并行通信流)、网络拓扑,以及是否使用节点间或节点内链路。有效的选择逻辑类似于以(消息大小、GPU 数量、拓扑类型)为索引的多路决策树,而非单一的切换点。
尽管如此,切换公式仍然是理解库为何做出相应选择的关键直觉模型。当库选择了出乎意料的算法时,切换分析提供了评估该选择是否正确、或是否需要进行手动覆盖的推理框架。一个具体的缓冲区大小计算将该框架应用于一个现实决策:
Napkin Math 1.5: 环形与树形算法的交叉点
问题:一个集群将一个 1 MB 缓冲区同步到 64 个 GPU。网络的延迟为 \(\alpha =\) 10 μs,带宽为 \(\beta =\) 10 GB/s。哪种算法性能更好:环形还是树形?
数学推导:
延迟:
- 环形算法延迟:\(2(N-1)\alpha =\) \(2 \times 63 \times 10\ \mu\text{s}\) = 1260 μs。
- 树形算法延迟:\(2(\log_2 N)\alpha =\) \(2 \times 6 \times 10\ \mu\text{s}\) = 120 μs。
带宽(注意两者的差异):
- 环形算法带宽:\(2\frac{N-1}{N}\frac{M}{\beta} \approx\) \(2 \times \frac{1\text{ MB}}{10\text{ GB/s}}\) = 196.9 μs(最优:每个字节只发送一次)。
- 树形算法带宽:\(2\log_2 N \cdot \frac{M}{\beta} =\) \(12 \times \frac{1\text{ MB}}{10\text{ GB/s}}\) = 1200 μs(每一层都发送完整消息)。
1 MB 缓冲区在 64 个 GPU 上的环形与树形全归约耗时 将延迟和带宽贡献项相加,直接比较两种算法:
| 算法 | 延迟 | 带宽 | 总时间 |
|---|---|---|---|
| 环形 | 1260 μs | 196.9 μs | 1456.9 μs |
| 树形 | 120 μs | 1200 μs | 1320 μs |
树形算法胜出,但优势仅为 9 percent。对于这条 1 MB 消息,其有效载荷大小接近交叉点。
系统洞见:环形算法的延迟劣势(比树形算法差 10\(\times\))与树形算法的带宽劣势(比环形算法差 6\(\times\))几乎相互抵消。考虑对数项的交叉点估计预测结果为 \(M_{\text{crossover}} \approx N \alpha \beta / \log_2 N = 64 \times 10\ \mu\text{s} \times 10\ \text{GB/s} / 6 \approx\) 1.1 MB。在 1 MB 时,有效载荷大小略低于交叉点,因此树形算法胜出。在 10 MB 时,环形算法将占据主导。
交叉点位于 DDP 和 FSDP 工作负载在正常训练过程中会跨越的范围内。一条 1 MB 消息对应较小 Transformer 中单个前馈层产生的梯度,或 MoE 的词元路由有效载荷,两者都处于树形算法的适用范围。一个 10 MB 的 DDP 梯度桶来自中等规模 Transformer 的某一层,其大小接近交叉点。覆盖多个层的融合 DDP 桶达到 50–300 MB,而一个 70B parameters 模型的完整 BF16 梯度张量达到 140 GB;两者都明确处于环形算法的适用范围。随着桶大小的调整,大多数实际训练工作负载会遍历这一完整范围,而交叉点分析划定了算法边界,将桶级树形操作与全模型环形同步区分开来。
交叉点分析表明,算法选择并非固定不变,而是取决于消息大小、集群规模和网络参数的具体组合。在实践中,NCCL 等通信库维护着内部查找表,将消息大小、GPU 数量、拓扑和协议设置映射到所选算法,例如环形、树形或混合方案。理解交叉点背后的数学原理,可以帮助工程师预测通信库的内置选择何时可能并非最优,并在必要时手动覆盖这些选择。
Checkpoint 1.3: 全归约算法选择
检验你对环形与树形全归约权衡的理解:
分层通信
节 1.4 中的全归约算法假设网络是扁平的,每条链路的带宽都相同。真实数据中心中的链路带宽差异可达一个数量级甚至更多,因此这一假设并不成立。并非所有链路都具有相同的性能。
分层通信是对这种差异的应对方式。节点内链路充足且快速,节点间链路稀缺且昂贵,因此算法必须尽可能在有效载荷跨越资源稀缺的层级之前缩减其大小。这就是为什么同一个全归约操作可以通过节点内归约分散、跨节点归约和节点内全收集来实现,而不是通过覆盖所有进程秩的一次扁平交换来实现。
A GPU 节点提供的节点内带宽比节点间带宽高一个数量级(NVLink 为 900 GB/s,InfiniBand 为 50 GB/s)。
分层全归约
扁平的集合算法假设集群中的每条链路都提供相同的带宽。虽然这一假设在单个节点内成立(所有 GPU 通过 NVLink 以统一速率互联),但在 9× 的多节点集群中却不再成立。真实集群是分层网络,每一层的带宽都截然不同,正如 带宽分层 所量化所示。
| 层级 | 互连方式 | 带宽 | 相对速率 |
|---|---|---|---|
| 节点内 | NVLink 4.0 | ~900 GB/s | 9× 更快 |
| 节点间 | InfiniBand NDR 400G | ~50 GB/s | 1\(\times\)(基准) |
一个朴素的扁平 Ring AllReduce 忽略了这种结构,会在 NVLink 已经足够时仍通过 InfiniBand 路由数据,从而耗尽稀缺的节点间带宽。分层全归约 将全局操作分解为三个阶段,以利用带宽分层(图 8)。
分层集合通信在数据跨越低速层级之前先缩小载荷。
\begin{tikzpicture}[
    font=\small\sffamily,
    >=Stealth,
    panel/.style={
      draw=CanvasBorder,
      fill=CanvasBg,
      rounded corners=5pt,
      line width=0.6pt,
      inner sep=7pt
    },
    gpu box/.style={
      draw=BlueLine,
      fill=white,
      line width=0.85pt,
      rounded corners=3pt,
      minimum width=1.25cm,
      minimum height=1.15cm,
      align=center
    },
    leader box/.style={
      draw=OrangeLine,
      fill=OrangeFill!75,
      line width=1.1pt,
      rounded corners=3pt,
      minimum width=1.25cm,
      minimum height=1.15cm,
      align=center
    },
    step card/.style={
      draw=CanvasBorder,
      fill=white,
      rounded corners=3pt,
      line width=0.5pt,
      inner sep=5pt
    }
  ]

  % Define Layer Order
  \pgfdeclarelayer{background}
  \pgfsetlayers{background,main}

  % ========================================================
  % TOP LEGEND BAR
  % ========================================================
  \node[draw=BlueLine, fill=BlueFill, rounded corners=3pt, font=\scriptsize\bfseries, text=BlueLine, inner sep=4pt] at (2.2, 8.4)
    {Step 1: Intra-Node ReduceScatter};
  \node[draw=OrangeLine, fill=OrangeFill, rounded corners=3pt, font=\scriptsize\bfseries, text=OrangeLine!90!black, inner sep=4pt] at (7.25, 8.4)
    {Step 2: Inter-Node AllReduce (Leaders)};
  \node[draw=GreenLine, fill=GreenFill, rounded corners=3pt, font=\scriptsize\bfseries, text=GreenLine, inner sep=4pt] at (12.3, 8.4)
    {Step 3: Intra-Node AllGather};

  % ========================================================
  % STEP 2 BRIDGE (OPTICAL SPINAL FABRIC)
  % ========================================================
  \node[draw=OrangeLine, fill=OrangeFill!50, rounded corners=3pt, line width=0.9pt, font=\footnotesize\bfseries, text=OrangeLine!90!black, inner sep=5pt] (bridge) at (5.0, 7.55)
    {Step 2: Optical Spine Fabric ($50\text{ GB/s} \cdot \frac{1}{G}\text{ Traffic}$)};

  % ========================================================
  % NODE 0 CONTAINER
  % ========================================================
  \begin{scope}[shift={(0, 1.8)}, local bounding box=node0]
    % Header
    \node[anchor=west, font=\bfseries\small, text=TextDark] at (0, 4.9) {Node 0 (8-GPU Chassis)};
    \node[anchor=east, font=\scriptsize\bfseries, text=BlueLine] at (6.8, 4.9) {NVLink 4.0 Mesh};

    % GPUs
    \node[leader box] (g0) at (1.15, 3.65) {\textbf{G0}\\[1pt]\scriptsize\color{OrangeLine!90!black}\textbf{Leader}};
    \node[gpu box, right=0.35cm of g0] (g1) {\textbf{G1}\\[1pt]\tiny\color{TextMuted}Rank 1};
    \node[gpu box, right=0.35cm of g1] (g2) {\textbf{G2}\\[1pt]\tiny\color{TextMuted}Rank 2};
    \node[gpu box, right=0.35cm of g2] (g3) {\textbf{G3}\\[1pt]\tiny\color{TextMuted}Rank 3};

    % Ring links
    \draw[->, BlueLine, line width=1.1pt] (g0.east) -- (g1.west);
    \draw[->, BlueLine, line width=1.1pt] (g1.east) -- (g2.west);
    \draw[->, BlueLine, line width=1.1pt] (g2.east) -- (g3.west);
    \draw[->, BlueLine, line width=1.1pt, rounded corners=3pt] (g3.south) -- ++(0, -0.32) -| (g0.south);

    \node[font=\tiny\bfseries, text=BlueLine] at ($(g1.south)!0.5!(g2.south) - (0, 0.44)$) {Intra-Node NVLink Ring (900 GB/s)};

    % Step 1 Card
    \node[step card, anchor=north west, minimum width=6.6cm] at (0.1, 2.35) {
      \begin{minipage}{6.4cm}
        \textbf{\scriptsize Step 1: Intra-Node ReduceScatter}\\[1pt]
        \tiny Ranks $0 \dots 7$ reduce partial gradients over 900 GB/s NVLink. G0 accumulates the fully reduced slice for rank index 0.
      \end{minipage}
    };

    % Step 3 Card
    \node[step card, anchor=north west, minimum width=6.6cm] at (0.1, 1.30) {
      \begin{minipage}{6.4cm}
        \textbf{\scriptsize\color{GreenLine} Step 3: Intra-Node AllGather}\\[1pt]
        \tiny\color{GreenLine!80!black} G0 receives global aggregate from optical fabric and broadcasts via NVLink AllGather to ranks $1 \dots 7$.
      \end{minipage}
    };
  \end{scope}

  \begin{pgfonlayer}{background}
    \node[panel, fit=(node0)] (p_node0) {};
  \end{pgfonlayer}

  % ========================================================
  % NODE 1 CONTAINER
  % ========================================================
  \begin{scope}[shift={(7.4, 1.8)}, local bounding box=node1]
    % Header
    \node[anchor=west, font=\bfseries\small, text=TextDark] at (0, 4.9) {Node 1 (8-GPU Chassis)};
    \node[anchor=east, font=\scriptsize\bfseries, text=BlueLine] at (6.8, 4.9) {NVLink 4.0 Mesh};

    % GPUs
    \node[leader box] (g4) at (1.15, 3.65) {\textbf{G4}\\[1pt]\scriptsize\color{OrangeLine!90!black}\textbf{Leader}};
    \node[gpu box, right=0.35cm of g4] (g5) {\textbf{G5}\\[1pt]\tiny\color{TextMuted}Rank 5};
    \node[gpu box, right=0.35cm of g5] (g6) {\textbf{G6}\\[1pt]\tiny\color{TextMuted}Rank 6};
    \node[gpu box, right=0.35cm of g6] (g7) {\textbf{G7}\\[1pt]\tiny\color{TextMuted}Rank 7};

    % Ring links
    \draw[->, BlueLine, line width=1.1pt] (g4.east) -- (g5.west);
    \draw[->, BlueLine, line width=1.1pt] (g5.east) -- (g6.west);
    \draw[->, BlueLine, line width=1.1pt] (g6.east) -- (g7.west);
    \draw[->, BlueLine, line width=1.1pt, rounded corners=3pt] (g7.south) -- ++(0, -0.32) -| (g4.south);

    \node[font=\tiny\bfseries, text=BlueLine] at ($(g5.south)!0.5!(g6.south) - (0, 0.44)$) {Intra-Node NVLink Ring (900 GB/s)};

    % Step 1 Card
    \node[step card, anchor=north west, minimum width=6.6cm] at (0.1, 2.35) {
      \begin{minipage}{6.4cm}
        \textbf{\scriptsize Step 1: Intra-Node ReduceScatter}\\[1pt]
        \tiny Ranks $4 \dots 7$ reduce partial gradients over 900 GB/s NVLink. G4 accumulates the fully reduced slice for rank index 4.
      \end{minipage}
    };

    % Step 3 Card
    \node[step card, anchor=north west, minimum width=6.6cm] at (0.1, 1.30) {
      \begin{minipage}{6.4cm}
        \textbf{\scriptsize\color{GreenLine} Step 3: Intra-Node AllGather}\\[1pt]
        \tiny\color{GreenLine!80!black} G4 receives global aggregate from optical fabric and broadcasts via NVLink AllGather to ranks $5 \dots 7$.
      \end{minipage}
    };
  \end{scope}

  \begin{pgfonlayer}{background}
    \node[panel, fit=(node1)] (p_node1) {};
  \end{pgfonlayer}

  % Bridge connections: route up from the top edge of node0/node1 above G0/G4
  \draw[<->, draw=OrangeLine, line width=1.3pt, dashed]
    (g0.north |- p_node0.north) -- ++(0, 0.5) -| (bridge.west);
  \draw[<->, draw=OrangeLine, line width=1.3pt, dashed]
    (bridge.east) -| (g4.north |- p_node1.north);

  % ========================================================
  % BOTTOM ANALYTICAL PERFORMANCE CARD
  % ========================================================
  \begin{scope}[shift={(0, -1.9)}, local bounding box=boxCard]
    \node[anchor=north west, font=\normalsize\bfseries, text=TextDark] at (0.1, 3.4)
      {Hierarchical Traffic Scaling Advantage ($18\times$ Bandwidth Multiplier)};

    % Bar 1: NVLink
    \draw[fill=OrangeFill, draw=OrangeLine, line width=0.8pt, rounded corners=2pt]
      (0.1, 2.4) rectangle (9.2, 2.8);
    \node[anchor=west, font=\scriptsize\bfseries, text=OrangeLine!90!black] at (0.3, 2.6)
      {Intra-Node NVLink 4.0: 900 GB/s Bidirectional};

    % Bar 2: InfiniBand
    \draw[fill=VioletFill, draw=VioletLine, line width=0.8pt, rounded corners=2pt]
      (0.1, 1.85) rectangle (1.4, 2.25);
    \node[anchor=west, font=\scriptsize\bfseries, text=VioletLine] at (1.55, 2.05)
      {InfiniBand NDR: 50 GB/s per port (400 Gb/s)};

    % Red Callout Gap Badge
    \node[draw=RedLine, fill=RedFill, line width=1.1pt, rounded corners=4pt, align=center, inner sep=6pt] at (12.3, 2.32) {
      \textbf{\large\color{RedLine} 18$\times$}\\[-2pt]
      \scriptsize\bfseries\color{RedLine} Bandwidth Gap
    };

    % Explanatory text
    \node[anchor=north west, text width=14.0cm, font=\footnotesize, text=TextDark] at (0.1, 1.6) {
      \textbf{Traffic Elimination Law:} By completing the first reduction tier inside the node over 900 GB/s NVLink, inter-node traffic across optical switches drops by exactly $G\times$ ($8\times$), preventing bisection bandwidth exhaustion.\\[3pt]
      \textbf{\color{GreenLine}NCCL Runtime Invariant:} Multi-node communication runtimes automatically decompose process-group collectives into this 3-step hierarchical pipeline.
    };
  \end{scope}

  \begin{pgfonlayer}{background}
    \node[panel, fit=(boxCard)] {};
  \end{pgfonlayer}

\end{tikzpicture}
图 8 展示了这种三阶段分解如何将昂贵的节点间通信限制在 Phase 2,此时每台 GPU 仅传输 \(M/G\) 字节,而非 \(M\) 字节。在每台节点配置 \(G = 8\) 个 GPU(标准 DGX 配置)时,节点间光互连流量被精确地缩减为原来的 \(8\times\) 分之一,从而将稀缺的 InfiniBand 带宽乘以每台机箱的加速器数量。
这些阶段构成一条因果链:
- 节点内 ReduceScatter over NVLink:每个节点内对 \(G\) 个 GPU 进行局部归约,使每台 GPU 获得 \(1/G\) 的局部归约数据,仅使用充裕的节点内带宽。
- 节点间 AllReduce over InfiniBand:每台 GPU 将其节点分片发送至对应 GPU 位置,传输 \(M/G\) 字节而非 \(M\) 字节。
- 节点内 AllGather over NVLink:每个节点在内部重新分配最终分片,从而在不额外消耗节点间带宽的情况下完成结果。
一个简单的 8 节点预算使这一带宽倍增具体化:
Napkin Math 1.6: 分层带宽倍增效应
问题:一个集群包含 8 nodes,每个节点配有 8 GPUs(总计 64)。系统必须对一个 1 GB 的梯度缓冲区执行全归约。比较扁平环形全归约与分层全归约。
扁平环形全归约(忽略层级结构):
- 每块 GPU 总共发送约 2 GB(带宽最优的环形全归约公式)。
- 环形通信多次跨越节点边界。
- 有效带宽:受最慢链路限制 = 50 GB/s(InfiniBand)。
- 时间:\(\approx\) \(2 \times 1\ \text{GB} / 50\ \text{GB/s}\) = 40 ms(带宽项占主导)。
分层全归约(三步分解):
节点内归约散播:每块 GPU 发送 875 MB,每个方向的速率为 450 GB/s → 约 1.94 ms
节点间全归约:每块 GPU 对大小为 \(1\ \text{GB}/8\) = 125 MB 的分片通过 InfiniBand 执行全归约;环形通信传输的数据量约为该载荷的 \(2(N-1)/N\) 倍,加上较小的延迟项后,该阶段耗时约 4.42 ms,带宽为 50 GB/s
(只有 1/8 的数据跨越 InfiniBand!)
节点内全收集:每块 GPU 接收 875 MB,每个方向的速率为 450 GB/s → 约 1.94 ms
总时间:\(\approx\) 1.94 ms + 4.42 ms + 1.94 ms = 8.3 ms
系统洞见:分层全归约实现了 4.8× 的加速,其原因是在应用环形通信流量乘数之前,将每块 GPU 的节点间载荷从 1 GB 降至 125 MB。每个节点配有 8 块 GPU 时,层级结构实际上使表观节点间带宽达到原来的 8\(\times\)。这就是 NVIDIA 的 NCCL 及类似库在拓扑支持的情况下,往往会为多节点集群选择分层算法的原因。
这三个阶段先将大部分流量限制在各节点内部,然后才跨越较慢的节点间网络互连结构;同样的思路也可以推广到两级以上。大型集群包含多个通过脊交换机连接的机架,由此引入第三个带宽层级(机架间通信的二分带宽较低)。对于 128 块 GPU,按 4 个机架、每个机架 4 个节点、每个节点 8 块 GPU 的方式部署,且跨机架超额订阅比为 2:1 时,在每个层级应用相同的分解,可使每块 GPU 的跨机架载荷相对于原始梯度缩小 32\(\times\);总耗时约为 15 ms,而扁平全归约为 160 ms。分层分解将流量集中在带宽充裕的位置,并尽量减少带宽稀缺位置的流量。
网络内归约:SHARP 及其后续发展
图 9 对比了基于软件的树形全归约与交换机内硬件聚合。在标准的软件树形全归约(面板 a)中,工作 GPU 将完整的梯度张量沿网络互连结构的层级向上传输至指定的根 GPU,使算术运算与 PCIe 带宽瓶颈集中在这一端点,然后再向下广播结果。相比之下,NVIDIA 的可扩展分层聚合与归约协议(SHARP)(面板 b)等网络内归约架构,将满足结合律的归约运算直接卸载到交换机的专用集成电路(ASIC),以线速执行,确保只有聚合后的部分和上传至更高的网络互连层级,从而完全消除根 GPU 的串行化开销。
\begin{tikzpicture}[
  font=\small\sffamily,
  >=Stealth,
  header node/.style={
    font=\bfseries\normalsize,
    text=TextDark,
    align=center
  },
  subhdr node/.style={
    font=\scriptsize,
    text=TextMuted,
    align=center,
    text width=6.9cm
  },
  banner node/.style={
    rounded corners=3pt,
    inner sep=5pt,
    align=center,
    font=\footnotesize,
    text width=6.3cm,
    line width=0.6pt
  },
  gpu node/.style={
    rectangle,
    rounded corners=3pt,
    draw=SteelBlue,
    fill=white,
    line width=0.8pt,
    align=center,
    inner sep=3.5pt,
    font=\footnotesize,
    minimum width=1.35cm,
    minimum height=1.05cm
  },
  root node/.style={
    rectangle,
    rounded corners=3pt,
    line width=1pt,
    align=center,
    inner sep=5pt,
    font=\footnotesize,
    minimum width=3.4cm,
    minimum height=1.2cm
  },
  switch node/.style={
    rectangle,
    rounded corners=3pt,
    line width=0.8pt,
    align=center,
    inner sep=4pt,
    font=\footnotesize,
    minimum width=2.5cm,
    minimum height=1.2cm
  },
  badge node/.style={
    rectangle,
    rounded corners=2pt,
    fill=DarkGreen,
    text=white,
    font=\scriptsize\bfseries,
    inner sep=2.5pt,
    minimum width=2.1cm
  },
  footer node/.style={
    font=\scriptsize,
    text=TextMuted,
    align=center,
    text width=6.8cm
  }
]

% Left panel: (a) Standard Tree AllReduce
\node[header node, text=RedLine] (hdrA) at (3.65, 9.3) {(a) Standard Tree AllReduce};
\node[subhdr node] (subA) at (3.65, 8.85) {Full gradients traverse all switch tiers to Root GPU};

\node[banner node, draw=RedLine!80, fill=RedFill] (bannerA) at (3.65, 7.8) {
  \textbf{\textcolor{RedLine}{Bottleneck: Full Tensor Incast}}\\[1.5pt]
  All $N$ workers stream full tensors\\
  Root saturates at $N \times \text{Bandwidth}$
};

% Root GPU
\node[root node, draw=RedLine, fill=RedFill!60] (rootA) at (3.65, 5.75) {
  \textbf{\textcolor{RedLine}{Root GPU (Worker 0)}}\\[1.5pt]
  $\text{sum} = g_0 + g_1 + g_2 + g_3$\\[1.5pt]
  \textit{\scriptsize\textcolor{RedLine}{Compute \& PCIe Bottleneck}}
};

% Switches Level 1
\node[switch node, draw=SteelBlue!60, fill=LightBlue!70] (swA1) at (1.825, 3.3) {
  \textbf{Switch L1-A}\\[2pt]
  \scriptsize\textcolor{TextMuted}{Packet Forward Only}
};
\node[switch node, draw=SteelBlue!60, fill=LightBlue!70] (swA2) at (5.475, 3.3) {
  \textbf{Switch L1-B}\\[2pt]
  \scriptsize\textcolor{TextMuted}{Packet Forward Only}
};

% Leaf GPUs
\node[gpu node] (gA0) at (1.0, 1.0) {\textbf{GPU 0}\\[1.5pt]\scriptsize$\text{grad} = g_0$};
\node[gpu node] (gA1) at (2.65, 1.0) {\textbf{GPU 1}\\[1.5pt]\scriptsize$\text{grad} = g_1$};
\node[gpu node] (gA2) at (4.65, 1.0) {\textbf{GPU 2}\\[1.5pt]\scriptsize$\text{grad} = g_2$};
\node[gpu node] (gA3) at (6.3, 1.0) {\textbf{GPU 3}\\[1.5pt]\scriptsize$\text{grad} = g_3$};

% Connections Panel A
\draw[->, thick, RedLine] (gA0.north) -- (gA0.north |- swA1.south) node[midway, left=1pt, font=\scriptsize\bfseries] {$g_0\text{ (full)}$};
\draw[->, thick, RedLine] (gA1.north) -- (gA1.north |- swA1.south) node[midway, left=1pt, font=\scriptsize\bfseries] {$g_1\text{ (full)}$};
\draw[->, thick, RedLine] (gA2.north) -- (gA2.north |- swA2.south) node[midway, right=1pt, font=\scriptsize\bfseries] {$g_2\text{ (full)}$};
\draw[->, thick, RedLine] (gA3.north) -- (gA3.north |- swA2.south) node[midway, right=1pt, font=\scriptsize\bfseries] {$g_3\text{ (full)}$};

% Switch to Root (Upstream solid on outside, Downstream dashed on inside)
\draw[->, thick, RedLine] ($(swA1.north)-(0.25,0)$) -- ($(rootA.south)-(1.15,0)$)
  node[midway, left=2pt, font=\scriptsize\bfseries] {$g_0 + g_1$};
\draw[<-, thick, dashed, RedLine!70] ($(swA1.north)+(0.35,0)$) -- ($(rootA.south)-(0.45,0)$);

\draw[->, thick, RedLine] ($(swA2.north)+(0.25,0)$) -- ($(rootA.south)+(1.15,0)$)
  node[midway, right=2pt, font=\scriptsize\bfseries] {$g_2 + g_3$};
\draw[<-, thick, dashed, RedLine!70] ($(swA2.north)-(0.35,0)$) -- ($(rootA.south)+(0.45,0)$);

\node[footer node] at (3.65, 0.05) {Upstream: 4 full tensors. Downstream: 4 broadcast copies.};

% Divider
\draw[dashed, CardBorder!90, line width=0.8pt] (7.3, -0.25) -- (7.3, 9.6);

% Right panel: (b) SHARP In-Network Reduction
\node[header node, text=DarkGreen] (hdrB) at (10.95, 9.3) {(b) SHARP In-Network Reduction};
\node[subhdr node] (subB) at (10.95, 8.85) {Switch ASICs reduce inline; only aggregates go up};

\node[banner node, draw=DarkGreen!80, fill=GreenFill] (bannerB) at (10.95, 7.8) {
  \textbf{\textcolor{DarkGreen}{Optimization: Line-Rate Reduction}}\\[1.5pt]
  ASICs aggregate inline at wire speed\\
  $2\text{--}3\times$ AllReduce speedup
};

% Root Switch (ASIC)
\node[root node, draw=DarkGreen, fill=GreenFill!60] (rootB) at (10.95, 5.75) {
  \textbf{\textcolor{DarkGreen}{Root Switch (ASIC)}}\\[1.5pt]
  Aggregates Subtree Sums\\[1.5pt]
  \scriptsize\textcolor{DarkGreen}{\textbf{Final sum:} $g_0 + g_1 + g_2 + g_3\,\text{\ding{51}}$}
};

% SHARP Switches Level 1
\node[switch node, draw=DarkGreen, fill=GreenFill!35] (swB1) at (9.125, 3.3) {
  \textbf{SHARP Switch A}\\[3pt]
  \tikz\node[badge node] {ASIC REDUCE};
};
\node[switch node, draw=DarkGreen, fill=GreenFill!35] (swB2) at (12.775, 3.3) {
  \textbf{SHARP Switch B}\\[3pt]
  \tikz\node[badge node] {ASIC REDUCE};
};

% Leaf GPUs
\node[gpu node] (gB0) at (8.3, 1.0) {\textbf{GPU 0}\\[1.5pt]\scriptsize$\text{grad} = g_0$};
\node[gpu node] (gB1) at (9.95, 1.0) {\textbf{GPU 1}\\[1.5pt]\scriptsize$\text{grad} = g_1$};
\node[gpu node] (gB2) at (11.95, 1.0) {\textbf{GPU 2}\\[1.5pt]\scriptsize$\text{grad} = g_2$};
\node[gpu node] (gB3) at (13.6, 1.0) {\textbf{GPU 3}\\[1.5pt]\scriptsize$\text{grad} = g_3$};

% Connections Panel B
\draw[->, thick, DarkGreen] (gB0.north) -- (gB0.north |- swB1.south) node[midway, left=1pt, font=\scriptsize\bfseries] {$g_0$};
\draw[->, thick, DarkGreen] (gB1.north) -- (gB1.north |- swB1.south) node[midway, left=1pt, font=\scriptsize\bfseries] {$g_1$};
\draw[->, thick, DarkGreen] (gB2.north) -- (gB2.north |- swB2.south) node[midway, right=1pt, font=\scriptsize\bfseries] {$g_2$};
\draw[->, thick, DarkGreen] (gB3.north) -- (gB3.north |- swB2.south) node[midway, right=1pt, font=\scriptsize\bfseries] {$g_3$};

% Switch to Root (Upstream solid on outside, Downstream dashed on inside)
\draw[->, thick, DarkGreen] ($(swB1.north)-(0.25,0)$) -- ($(rootB.south)-(1.15,0)$)
  node[midway, left=2pt, font=\scriptsize\bfseries] {$(g_0 + g_1)\,\text{\ding{51}}$};
\draw[<-, thick, dashed, DarkGreen!70] ($(swB1.north)+(0.35,0)$) -- ($(rootB.south)-(0.45,0)$);

\draw[->, thick, DarkGreen] ($(swB2.north)+(0.25,0)$) -- ($(rootB.south)+(1.15,0)$)
  node[midway, right=2pt, font=\scriptsize\bfseries] {$(g_2 + g_3)\,\text{\ding{51}}$};
\draw[<-, thick, dashed, DarkGreen!70] ($(swB2.north)-(0.35,0)$) -- ($(rootB.south)+(0.45,0)$);

\node[footer node] at (10.95, 0.05) {Only aggregated payloads cross the switch fabric; zero GPU root stall.};

\end{tikzpicture}分层 AllReduce 减少了跨节点流量,但聚合过程仍然需要多次网络往返。NVIDIA 的 可扩展分层聚合与归约协议 (SHARP)10 实现了这一思路:梯度不必传输到目标 GPU 处求和,而是在 InfiniBand 交换机聚合树的数据包经过时,由交换机直接聚合部分和。
10 SHARP (Scalable Hierarchical Aggregation and Reduction Protocol):在 Quantum InfiniBand 交换机上进行的片上计算,数据包穿越聚合树时执行归约操作(如求和、最小值和最大值)(Graham 等 2020年)。同一项工作还报告了相比基于主机的算法,归约带宽有显著提升,并描述了交换机资源对未决聚合组数量和聚合树数量的限制;当大量集合通信竞争同一类片上网络资源时,可能产生拥塞。
Graham, R. L., D. Bureddy, P. Lui, H. Rober, G. Bloch, G. Shainer, J. Poole, 等. 2020年. 《Scalable hierarchical aggregation and reduction protocol (SHARP) streaming-aggregation hardware design and evaluation》. International Conference on High Performance Computing, 41~59. https://doi.org/10.1007/978-3-030-50743-5_3.
收益有两方面。首先,SHARP 减少了端点内存流量,并且可以在数据包离开交换机层级之前完成聚合,从而减轻上层链路的压力。在基于软件的树形归约中,数据先到达 GPU,写入内存,与本地数据求和,然后再向下一层传输。使用 SHARP 时,交换机合并飞行中的入向数据包,并转发该聚合结果。其次,SHARP 消除了经过中间 GPU 的存储转发路径。每个软件跳变都会增加完整的 \(\alpha\)-\(\beta\) 开销;而在交换机内聚合时,归约发生在交换机 ASIC 内部,而非端点内存中。
实际影响在消息尺寸较大时最为明显,此时聚合延迟对总 AllReduce 时间有实质贡献。对于非常大的消息,无论采用何种算法,带宽都占主导,SHARP 的延迟降低带来的收益会按比例缩小。对于非常小的消息,固定的交换机处理开销可能限制收益。Graham 等 (2020年) 报告称,在 HDR/Quantum InfiniBand 交换机上启用 SHARP Streaming-Aggregation 后,PyTorch 工作负载的归约带宽提升数倍,而应用层面的收益则更小。
强扩展训练(在加速器数量增加而批大小不成比例增长的情况下训练固定模型)正是 SHARP 的延迟降低能够转化为步长时间降低的工作负载。随着每个加速器的批大小缩小,每个梯度张量仍然保持较大(与模型大小成正比),但每个加速器的反向传播变短,因此通信在步长时间中占据的比例越来越大,环公式中的延迟项 \(\alpha\) 成为瓶颈。交换机内聚合直接削减了这一延迟成本。交换机 ASIC 厂商已明确扩展 InfiniBand ASIC,以支持面向机器学习的数据类型,包括 FP16 和 BF16,这表明 SHARP 正与机器学习工作负载需求共同演进,而非仅仅服务于其原始设计所针对的传统 HPC 浮点运算。为强扩展训练选择 SHARP 基础设施的机器学习系统团队,应验证特定交换机代际是否支持 FP16/BF16 聚合,因为早期 ASIC 仅支持 FP32 和 INT32。
SHARP 确实带来了一些约束。交换机必须支持特定的归约操作(通常仅限于浮点类型和整数类型的求和、最小值和最大值)。并发 SHARP 聚合树的数量受交换机资源限制,因此同时运行大量训练任务的大规模集群可能耗尽 SHARP 容量。此外,SHARP 需要 InfiniBand 基础设施;基于以太网的网络互连结构不支持 SHARP。
拓扑感知路由
分层 AllReduce 减少了节点间流量,SHARP 则消除了其中一部分,但两者都没有解决一个更微妙的问题:逻辑通信模式如何映射到物理网络拓扑。64 个 GPU 之间的 Ring AllReduce 形成逻辑环,但承载每个跳变的物理链路决定了该环是达到峰值带宽还是产生拥塞。在同一硬件上运行同一训练任务的两次运行,其通信吞吐量可能相差 2\(\times\),具体取决于 rank 如何分配到 GPU,以及由此产生的流量模式与物理网络结构的相互作用。
NCCL 之类的通信库在初始化时执行 拓扑检测,运行图搜索算法以发现物理网络结构并找到高带宽通信路径(NVIDIA 2026年)。库必须为每一对 rank 确定其通信对端是位于本地 NVLink 交换机上,还是通过 InfiniBand 网络互连结构相距 100 米,因为逻辑 rank 映射到物理硬件的方式不同,同一集合通信算法的吞吐量可能相差 2\(\times\) 倍甚至更多。
拓扑检测过程始于硬件枚举。NCCL 查询 PCIe 总线以发现 GPU 的部署位置、GPU 之间的 NVLink 连接,以及 NIC 与 PCIe 交换机之间的亲和性。基于这些信息,它构建内部图,其中节点表示 GPU,边表示物理链路并标注带宽和延迟。随后,图搜索算法找出最大化总带宽、同时最小化跨域跳变数量(NVLink、PCIe 与 InfiniBand 域之间的转换)的通信路径。这种拓扑感知的路径选择使 NCCL 能够在配置良好的系统上接近理论峰值带宽,而缺乏拓扑感知的实现则可能浪费大量带宽。
环面拓扑(TPU 机舱)
图 10 展示了 2D 环面网格上的按维度排序的归约(即 3D Tensor Processing Unit (TPU) 机舱的示意性投影)。该做法不把整个集群视为不受约束的全连接互连结构,而是沿坐标轴分解集合通信:Phase 1 沿每条水平行并行执行独立的 Ring AllReduce,随后 Phase 2 沿每条垂直列执行独立的 Ring AllReduce。这种轴对齐的调度仅通过直接的物理邻居链路传输流量,从而避免二分拥塞,同时将步长延迟从平坦 16 节点环上的 \(2(N-1) = 30\) 步降低到 \(2(X-1) + 2(Y-1) = 12\) 步(\(2.5\times\) 延迟降低)。
\begin{tikzpicture}[
  font=\small\sffamily,
  >=Stealth,
  node box/.style={
    rectangle,
    rounded corners=3pt,
    draw=SteelBlue,
    fill=white,
    line width=0.85pt,
    align=center,
    inner sep=3pt,
    font=\footnotesize,
    minimum width=1.25cm,
    minimum height=0.95cm
  },
  card/.style={
    rectangle,
    rounded corners=4pt,
    line width=0.7pt,
    inner sep=6pt,
    font=\footnotesize,
    text width=6.2cm,
    align=left
  },
  badge/.style={
    rectangle,
    rounded corners=2pt,
    draw=DarkGreen!60,
    fill=GreenFill,
    text=DarkGreen,
    font=\scriptsize\bfseries,
    inner sep=3pt,
    align=center
  }
]

% 4x4 Torus Grid (x: 1.0, 2.7, 4.4, 6.1; y: 5.8, 4.2, 2.6, 1.0)
\foreach \x/\col in {1.0/0, 2.7/1, 4.4/2, 6.1/3} {
  \foreach \y/\row in {5.8/0, 4.2/1, 2.6/2, 1.0/3} {
    \pgfmathtruncatemacro{\rank}{\row*4 + \col}
    \node[node box] (n_\col_\row) at (\x, \y) {\textbf{Node(\col,\row)}\\[1.5pt]\scriptsize\textcolor{TextMuted}{rank \rank}};
  }
}

% Direct Horizontal Arrows (Phase 1 - Orange)
\foreach \row in {0, 1, 2, 3} {
  \draw[->, very thick, OrangeLine] (n_0_\row.east) -- (n_1_\row.west);
  \draw[->, very thick, OrangeLine] (n_1_\row.east) -- (n_2_\row.west);
  \draw[->, very thick, OrangeLine] (n_2_\row.east) -- (n_3_\row.west);
}

% Direct Vertical Arrows (Phase 2 - Violet)
\foreach \col in {0, 1, 2, 3} {
  \draw[->, very thick, VioletLine] (n_\col_0.south) -- (n_\col_1.north);
  \draw[->, very thick, VioletLine] (n_\col_1.south) -- (n_\col_2.north);
  \draw[->, very thick, VioletLine] (n_\col_2.south) -- (n_\col_3.north);
}

% Wrap-around Horizontal Links (Phase 1 - Dashed Orange)
\foreach \row in {0, 1, 2, 3} {
  \draw[->, thick, dashed, OrangeLine]
    (n_3_\row.east) -- ++(0.35,0) -- ++(0, 0.58)
    -- ($(n_0_\row.west)+(-0.35, 0.58)$) -- ++(0, -0.58)
    -- (n_0_\row.west);
}

% Wrap-around Vertical Links (Phase 2 - Dashed Violet)
\foreach \col in {0, 1, 2, 3} {
  \draw[->, thick, dashed, VioletLine]
    (n_\col_3.south) -- ++(0, -0.35)
    -- ++(-0.85, 0)
    -- ($(n_\col_0.north)+(-0.85, 0.38)$)
    -- ++(0.85, 0)
    -- (n_\col_0.north);
}

% Right Side Cards
% Card 1: Phase 1
\node[card, draw=OrangeLine!80, fill=OrangeL] (card1) at (11.0, 6.30) {
  \textbf{\large\textcolor{OrangeLine}{Phase 1: X-Dimension Rings}}\\[2pt]
  \small Ring AllReduce along each row in parallel.\\[3pt]
  \scriptsize\textbf{Topology:} 4 rings parallel \hfill \textbf{Steps:} $2(X{-}1) = 6$
};

% Card 2: Phase 2
\node[card, draw=VioletLine!80, fill=VioletL] (card2) at (11.0, 3.90) {
  \textbf{\large\textcolor{VioletLine}{Phase 2: Y-Dimension Rings}}\\[2pt]
  \small Ring AllReduce along each column in parallel.\\[3pt]
  \scriptsize\textbf{Topology:} 4 rings parallel \hfill \textbf{Steps:} $2(Y{-}1) = 6$
};

% Card 3: Latency & Step Complexity
\node[card, draw=CardBorder, fill=CardFill] (card3) at (11.0, 1.20) {
  \textbf{\normalsize Latency \& Step Complexity}\\[3pt]
  % \scriptsize and tight math: at \footnotesize the second row was wider than
  % the 6.2cm card and spilled past its border.
  \scriptsize
  \begin{tabular}{@{}ll@{}}
    1D Global Ring ($N = 16$): & \textbf{\textcolor{RedLine}{30 steps}} \\[2pt]
    2D Torus $4\times4$ ($2(X{-}1)+2(Y{-}1)$): & \textbf{\textcolor{DarkGreen}{12 steps}} \\
  \end{tabular}\\[4pt]
  \centering
  \tikz\node[badge, minimum width=5.8cm] {\textbf{2.5$\times$ Step Latency Reduction}};
};

% Card 4: Bandwidth Invariant
\node[card, draw=CardBorder, fill=CardFill] (card4) at (11.0, -1.26) {
  \textbf{\normalsize Bandwidth Volume Invariant}\\[2pt]
  \small$\text{Total volume} = 2 \times \frac{N-1}{N} \times M \approx \frac{2M}{\beta}$\\[2pt]
  \scriptsize\textcolor{TextMuted}{Identical link utilization to a flat ring}
};

% Legend
\coordinate (legBase) at (7.8, -2.75);
\draw[very thick, OrangeLine] ($(legBase)+(0,0)$) -- ++(0.7,0)
  node[right, font=\scriptsize, text=TextDark] {Phase 1: X-dim horizontal ring};
\draw[very thick, VioletLine] ($(legBase)+(0,-0.35)$) -- ++(0.7,0)
  node[right, font=\scriptsize, text=TextDark] {Phase 2: Y-dim vertical ring};
\draw[thick, dashed, gray!80] ($(legBase)+(0,-0.70)$) -- ++(0.7,0)
  node[right, font=\scriptsize, text=TextDark] {Dashed: wrap-around torus boundary links};

\end{tikzpicture}Google 的 TPU pod 采用 3D 环面(torus)拓扑,其中每个 TPU 直接连接到 6 个邻居\((\pm X, \pm Y, \pm Z)\);图 10 以二维简化形式展示了同样的按维度排序的思想。与 InfiniBand 集群的分层 fat-tree 拓扑不同,环面提供均匀的直接连通性:无论芯片在网格中的位置如何,每个 TPU 芯片都具有相同数量的链路(6)和相同的每链路带宽。该拓扑下的最优 AllReduce 策略是按维度排序的归约(Dimension-Ordered Reduction):
- 对每条固定的 \((Y,Z)\) 线沿 X 维度进行归约,产生 X 维度上的部分和
- 对每条固定的 \((X,Z)\) 线,将上述部分和沿 Y 维度进行归约,产生 \(X \times Y\) 平面上的部分和
- 对每条固定的 \((X,Y)\) 线,将上述部分和沿 Z 维度进行归约,从而完成全局结果
每个按维度排序的归约本身都是一条沿单一轴对齐环面环进行的 Ring AllReduce。对于一个包含 \(X{\times}Y{\times}Z\) 个 TPU 的 pod,第一步针对每个固定的 \((Y,Z)\) 坐标运行独立的 X 维度环,因此每个参与者收到该 X 线上的部分和。第二步运行 Y 维度环,将这些 X 部分和沿 Y 维度合并;第三步运行 Z 维度环,完成全局归约。这种级联归约的总带宽开销为 \(2M/\beta\)(与单个 Ring 相同),但延迟与 \(2(X + Y + Z)\) 成正比,而非与 \(2(X \times Y \times Z)\) 成正比,因为每个维度环都比全局环更短。
按维度排序的归约最小化了网络直径,并确保每条链路在同一时刻只承载一个方向的流量,从而避免拥塞。环面拓扑还通过备用路由路径提供自然的容错能力:如果 X 维度中的一条链路发生故障,流量可以绕行至 Y 或 Z 维度(代价是延迟增加)。Google 的 Accelerated Linear Algebra 编译器在针对 TPU pod 时会自动生成按维度排序的集合通信,从而将拓扑细节对用户屏蔽。
按链路优化路由(NVIDIA DGX)
在 NVIDIA DGX 系统中,每个 GPU 都配有专用的 NIC。按链路优化路由利用这一特性,确保位于各自节点中相同位置的 GPU 之间只相互通信:
- Node A 上的 GPU 0 仅与 Node B 上的 GPU 0、以及后续节点上的 GPU 0 通信。
- Node A 上的 GPU 1 仅与其他节点上的 GPU 1 通信。
- 依此类推,覆盖 GPU 2–7。
由此形成 8 条彼此独立、可并行运行且互不竞争的通信“链路”,如 按链路优化的流量分布 所示。
| 链路 | 参与者 | 流量 |
|---|---|---|
| 链路 0 | Node0-GPU0 \(\leftrightarrow\) Node1-GPU0 \(\leftrightarrow\) Node2-GPU0 \(\leftrightarrow\) … | \(M/8\) 每次 |
| 链路 1 | Node0-GPU1 \(\leftrightarrow\) Node1-GPU1 \(\leftrightarrow\) Node2-GPU1 \(\leftrightarrow\) … | \(M/8\) 每次 |
| … | … | … |
| 链路 7 | Node0-GPU7 \(\leftrightarrow\) Node1-GPU7 \(\leftrightarrow\) Node2-GPU7 \(\leftrightarrow\) … | \(M/8\) 每次 |
链路对齐至关重要,因为如果没有对齐,节点上的 8 个 GPU 可能同时向同一个远程 GPU 发送数据,从而在单个 NIC 上产生 8\(\times\) 倍的竞争。按链路对齐的路由确保每个 NIC 恰好处理 1/8 的流量,从而实现全量的二分带宽利用率。
按链路优化路由与分层 AllReduce 相互强化。在 节 1.5.1 所描述的分层分解中,第 2 步(节点间 AllReduce)与链路拓扑自然对齐:每个节点上的 GPU \(i\) 仅与其他节点上的 GPU \(i\) 通信,这恰好就是链路模式。这种对齐并非偶然;NVIDIA 在设计 DGX 硬件时便考虑了按链路优化的通信,而 NCCL 的分层算法在正确检测拓扑并将 rank 映射到位时可以利用这一结构。当逻辑通信模式与物理拓扑相匹配时,每个 NIC 承载其预期的流量份额,集群即可接近其理论峰值二分带宽。
逻辑拓扑与物理拓扑之间的错位
逻辑拓扑与物理拓扑之间的错位是性能退化的常见来源,若不做仔细的剖析,很难诊断。如果进程 rank 被任意分配(例如由不感知拓扑的作业调度器分配),分层 AllReduce 可能会将跨节点流量路由到错误的 NIC,从而形成热点,使有效带宽降低 2–4\(\times\)。大规模部署使用感知拓扑的 rank 分配(通过 NCCL 的 CUDA_VISIBLE_DEVICES 以及调度器的 GPU 绑定策略配置),以确保二者对齐。
分层集合执行,结合感知拓扑的路由,可在复杂网络拓扑下最大化有效 fabric 带宽:\(\alpha\)–\(\beta\) 模型识别出瓶颈(节点间带宽),分层分解降低该瓶颈上的流量,而 rail 优化则确保减少后的流量无争用地传输。这些技术合在一起,弥合了理论峰值带宽与配置良好的集群上实际达到的带宽之间的差距。
梯度压缩:应对带宽稀缺
即使经过拓扑调优和算法选择,系统仍可能因物理 fabric 无法足够快地传输梯度载荷而处于带宽受限状态。在这种情形下,减少发送的比特数是一项有意的设计选择,而非普遍的最后手段。上一节从调度和拓扑侧应对通信瓶颈;载荷压缩则通过改变穿越 fabric 的内容来应对同一瓶颈。
带宽墙在两种场景中最为突出:通过广域网连接的数据中心之间的训练(其带宽比 InfiniBand 低 10–100\(\times\) 倍),以及在云实例上使用商用以太网进行训练的场景(其中 RDMA 不可用或受到限制)。在这些带宽受限的设置中,梯度压缩技术可将通信量减少 4–1000\(\times\) 倍,代价是向优化过程引入噪声。核心张力在于带宽缩减与优化过程对噪声的容忍度之间:优化器在收敛性受损之前能够吸收多少压缩量。
量化:降低精度
当带宽成为约束时,量化是干扰最小的压缩手段,因为它保留梯度中的每个元素,只是减少表示每个元素所用的比特数。大多数梯度以 FP32(32 位浮点)或 BF16(16 位 brain float)计算,因此降低位宽会直接减少通信量。真正值得关注的问题是优化器能够容忍多少梯度保真度损失,而从温和量化到激进量化的演进过程,正体现了压缩比与梯度保真度之间的权衡:
- FP16(16 位):加速器训练常用的基线。FP32 比特数的一半,对许多模型的收敛影响极小。相比 FP32 提供 2\(\times\) 倍的压缩。
- INT8(8 位):将每个梯度向量量化为 256 个离散电平。这需要在每个张量上计算一个缩放因子:\(g_{\text{int8}} = \text{round}(g/s)\),其中 \(s = \max(|g|) / 127\)。接收方重建 \(\hat{g} = g_{\text{int8}} \times s\)。相比 FP32 提供 4\(\times\) 倍的压缩,但会引入与梯度幅值成正比的量化噪声。
- 1-bit SGD:极端情形:仅传输每个梯度元素的符号(+1 或 -1)。接收方使用学习得到的或自适应的缩放因子进行重建。相比 FP32 实现 32\(\times\) 倍的压缩,但会引入大量噪声,可能在不引入其他机制的情况下损害收敛 Karimireddy 等 (2019年)。
梯度通信的分块量化
上一节中的量化演进对每个整个张量只使用一个缩放因子,这隐式地假设梯度分布在张量内是均匀的。实际上,梯度分布具有高度的非均匀性:注意力层产生具有重尾的梯度,嵌入层产生极其稀疏的梯度,归一化层产生集中在零附近的梯度。当梯度分布在张量内部存在差异时,每个张量一个缩放因子是次优的。梯度较小的区域在用一个由张量最大值主导的缩放因子进行量化时,会损失大部分信息。分块量化 通过将梯度张量划分为 \(b_{\text{block}}\) 个元素的块(通常为 \(b_{\text{block}} = 64\) 或 \(128\))并针对每个块计算独立的缩放因子来解决这一问题。每个块的缩放因子会适应该块的局部梯度分布,从而降低量化误差,代价是需要额外传输 \(d_{\text{grad}}/b_{\text{block}}\) 个缩放因子。
对于维度为 \(d_{\text{grad}}\)、量化为 INT8 且块大小为 \(b_{\text{block}}\) 的梯度向量,量化值占用 \(d_{\text{grad}} \times 1\ \text{byte}\),FP32 缩放因子占用 \((d_{\text{grad}}/b_{\text{block}}) \times 4\ \text{bytes}\),总消息大小为 \(d_{\text{grad}} + 4d_{\text{grad}}/b_{\text{block}}\) 字节。因此,有效压缩比为 \(4d_{\text{grad}} / (d_{\text{grad}} + 4d_{\text{grad}}/b_{\text{block}}) = 4b_{\text{block}} / (b_{\text{block}} + 4)\);当 \(b_{\text{block}} = 128\) 时,该比值达到 3.88\(\times\),接近理论值 4\(\times\)。质量增益源于替换全局误差界:块量化将最大量化误差从 \(s \cdot 0.5\)(其中 \(s\) 为全局缩放因子)降低到 \(s_b \cdot 0.5\)(其中 \(s_b\) 为块局部缩放因子);对于注意力层中常见的重尾梯度分布,块量化相比逐张量量化可将量化误差削减 2–5\(\times\)。
融合量化—归约操作的接口使块量化在通信压缩中具备可行性,但每降低一档比特宽度都会引入量化噪声。该噪声对真实梯度方向构成有偏扰动。对于激进的量化(INT8,尤其是 1-bit),系统性的偏差会阻碍收敛,除非系统在各步之间携带误差反馈校正。因此,量化应仅沿精度阶梯下探到收敛预算所允许的程度。
稀疏化:仅传输重要梯度
量化通过降低每个梯度元素的比特数来压缩通信量,但会传输全部元素。正交的方法,稀疏化,则从相反方向处理该问题:保持全精度,但仅传输梯度元素的一个子集,将其余元素置零。
Top-k 稀疏化
最常见的方法是 Top-k 压缩:对于梯度向量 \(g \in \mathbb{R}^{d_{\text{grad}}}\),仅传输绝对值最大的 \(K_{\text{top}}\) 个元素,将其余元素置零 Lin 等 (2018年):
Lin, Yujun, Song Han, Huizi Mao, Yu Wang, 和 William J Dally. 2018年. 《Deep gradient compression: Reducing the communication bandwidth for distributed training》. International Conference on Learning Representations (ICLR).
\[\text{TopK}(g) = g \odot \mathbf{1}_{|g| \geq |g|_{(K_{\text{top}})}}\]
其中 \(|g|_{(K_{\text{top}})}\) 表示按绝对值排序后的第 \(K_{\text{top}}\) 大元素。当 \(K_{\text{top}} = 0.001 \times d_{\text{grad}}\)(仅保留 0.1% 的元素)时,可实现 1000\(\times\) 的压缩。
压缩的头条数字必须扣除稀疏表示的编码开销。传输稀疏梯度需要同时发送非零值及其索引。对于一个维度为 \(d_{\text{grad}}\)、非零元素数为 \(K_{\text{top}}\) 的梯度向量,编码后的消息包含 \(K_{\text{top}}\) 个值(每个为 FP32 或 FP16)以及 \(K_{\text{top}}\) 个索引(通常为 INT32)。总消息大小为 FP32 值配 INT32 索引时的 \(K_{\text{top}} \times (4 + 4) = 8 K_{\text{top}}\) 字节。因此,有效压缩比为 \(4d_{\text{grad}} / (8 K_{\text{top}}) = d_{\text{grad}} / (2 K_{\text{top}})\)。
对于 \(K_{\text{top}} = 0.001 d_{\text{grad}}\),编码后的消息得到的压缩比为 500\(\times\),而非仅由保留元素比例所暗示的 1000\(\times\),因为索引开销显著。将索引大小降至 INT16(对应 \(d_{\text{grad}} < 65536\)),或对结构化稀疏模式采用游程长度编码,均可改善有效压缩比。
Top-k 并非唯一的稀疏化规则。随机 k 稀疏化 均匀随机地选取 \(K_{\text{rand}}\) 个元素,并按 \(d_{\text{grad}}/K_{\text{rand}}\) 缩放,以维持无偏的梯度估计。随机 k 的优势在于无需误差反馈即可作为无偏压缩器,因为 \(\mathbb{E}[\text{RandomK}(g)] = g\)。然而,它引入了高于 Top-k 的方差,因为它以相同的概率丢弃大梯度与小梯度。在实践中,在相同压缩比下,带误差反馈的 Top-k 比随机 k 收敛更快,因为 Top-k 在每个步骤中保留信息量最大的梯度分量。
收敛问题
直接丢弃小梯度会造成系统性偏差。如果某个参数持续接收到小梯度(例如,每步 0.01),它就不会被更新,因为 0.01 始终低于 Top-k 阈值。经过数千步后,这些“丢失”的梯度会累积成显著误差,使模型无法收敛到真正的最优解。
这一问题不仅是实际应用中的问题,更是根本性的数学障碍。如果不加以修正,稀疏化 SGD 就是真实梯度的有偏估计量,而有偏梯度下降可能收敛到偏离正确解任意远的解。激进量化也存在同样的问题:将梯度舍入为 INT8 或 1 位表示会引入系统性舍入误差,并在训练步骤间不断累积。错误反馈能够处理量化梯度 (Seide 等 2014年) 和稀疏化梯度 (Stich 等 2018年; Karimireddy 等 2019年) 中的这种误差累积。
Seide, Frank, Hao Fu, Jasha Droppo, Gang Li, 和 Dong Yu. 2014年. 《1-Bit Stochastic Gradient Descent and Its Application to Data-Parallel Distributed Training of Speech DNNs》. Interspeech 2014, 1058~62. https://doi.org/10.21437/interspeech.2014-274.
错误反馈与残差累积
错误反馈化解了压缩与收敛之间的矛盾。系统立即应用压缩器以节省带宽,随后将丢弃的残差存入本地累加器,并将其重新注入下一步的梯度:误差只是被推迟,而没有被消除。本地误差累加器 \(e_t\) 保存压缩残差。

错误反馈将残差带入下一个压缩步骤。
Definition 1.4: 错误反馈机制
错误反馈 是一种用于梯度压缩的分布式训练技术,为每个工作节点维护一个残差累加器 \(e_t\),将压缩误差重新注入下一次梯度更新,从而确保被压缩器推迟传输的信息不会被永久丢弃。
- 重要性:保留比例为 1% 的 Top-k 稀疏化仅保留绝对值最大的 1% 梯度值,将全归约数据量从 140 GB 降至 1.4 GB(对于一个 70B 模型),在计入稀疏索引开销之前实现 100\(\times\) 的载荷缩减。如果没有错误反馈,被丢弃的 99% 梯度值会造成有偏更新,可能损害收敛;有了错误反馈,残差会不断累积,直到被推迟传输的分量在后续步骤中越过压缩阈值,从而在相应假设条件下恢复针对带记忆或错误反馈的变体所分析得到的收敛保证 (Stich 等 2018年; Karimireddy 等 2019年)。
- 区别:与有损压缩(永久丢弃低于阈值的梯度分量)不同,错误反馈是一种延迟传输策略:残差 \(e_t\) 在各步骤间通过望远镜求和相消,使得 \(\frac{1}{K}\sum_{t=1}^{K} v_t \to \frac{1}{K}\sum_{t=1}^{K} g_t\) 在 \(K \to \infty\) 时成立,从而使传输梯度的长期平均值等于真实梯度的平均值。
- 常见误区:一种常见误解是,只要使用压缩器,错误反馈就会自动生效。事实并非如此:训练系统必须显式保留并重新注入残差。如果缺少这条残差路径,Top-k 和 1 位量化就会引入系统性偏差,并可能在各步骤间不断累积 (Karimireddy 等 2019年)。
错误反馈能够随时间保留累计的梯度信息。考虑经过 \(K\) 步后的情况:
\[\sum_{t=1}^{K} v_t = \sum_{t=1}^{K} \left[(g_t + e_t) - e_{t+1}\right] = \sum_{t=1}^{K} g_t + e_1 - e_{K+1}\]
如果误差累加器保持有界(合理的压缩方案确实满足这一条件),那么当 \(K \to \infty\) 时:
\[\frac{1}{K}\sum_{t=1}^{K} v_t \to \frac{1}{K}\sum_{t=1}^{K} g_t\]
传输梯度的长期平均值等于真实梯度的长期平均值。没有任何梯度信息被永久丢失;它只是被延迟传输了。反复被丢弃的小梯度最终会在 \(e_t\) 中累积,直到超过压缩阈值并被传输。
压缩误差随时间通过望远镜求和相消的性质,正是错误反馈能够将有偏压缩器转化为可收敛训练方法的原因。理论分析表明,在各自所述的假设条件下,带记忆的稀疏化 SGD,以及采用广泛类别压缩算子的 EF-SGD,都具有收敛保证 (Stich 等 2018年; Karimireddy 等 2019年)。一个简短的执行轨迹展示了错误反馈如何保留朴素压缩会丢失的梯度信息。表 3 使用没有残差路径的贪心压缩器运行该执行轨迹,仅传输满足 \(\geq 0.5\) 的值:
Stich, S. U., J.-B. Cordonnier, 和 M. Jaggi. 2018年. 《Sparsified SGD with Memory》. Advances in Neural Information Processing Systems 31.
Karimireddy, Sai Praneeth, Quentin Rebjock, Sebastian U. Stich, 和 Martin Jaggi. 2019年. 《Error feedback fixes SignSGD and other gradient compression schemes》. Proceedings of the 36th International Conference on Machine Learning (ICML), Proceedings of Machine Learning Research, 卷 97: 3252~61.
| 步骤 | 真实梯度 \(g_t\) | 传输值 \(v_t\) | 累计传输值 | 累计真实值 |
|---|---|---|---|---|
| 1 | 0.4 | 0 | 0 | 0.4 |
| 2 | 0.3 | 0 | 0 | 0.7 |
| 3 | 0.2 | 0 | 0 | 0.9 |
| 4 | 0.4 | 0 | 0 | 1.3 |
| 5 | 0.3 | 0 | 0 | 1.6 |
表 4 中的误差反馈轨迹采用相同的序列,并使用残差累加器 \(e_t\),将丢弃的余量重新注入下一步。示例 1.2 逐步推演这两条轨迹,表明延后传输的信息得以保留,而非丢失。
Example 1.2: 误差反馈机制
场景: 在分布式数据并行训练期间,梯度压缩流水线在 5 个训练步骤中对较小的梯度值(<0.5)进行阈值处理。
诊断: 朴素的贪心压缩丢弃低于阈值的数值,传输值为 0,而真实累计梯度为 1.6(100 percent 的梯度损失)。加入误差反馈(\(e_t\))后,各步骤间的残差误差通过望远镜式求和相消,传输值为 2,残差误差为 −0.4。
系统启示: 误差反馈能够保持有损梯度压缩的收敛性。通过将未传输的残差向量存储在本地主机内存中(\(e_{t+1} = g_t + e_t - v_t\)),小梯度在各步骤间不断累积,直至超过传输阈值,而不会造成信息损失。
| 步骤 | \(g_t\) | \(e_t\) | \(g_t + e_t\) | \(v_t\) | \(e_{t+1} = (g_t + e_t) - v_t\) | 累计 \(v\) |
|---|---|---|---|---|---|---|
| 1 | 0.4 | 0 | 0.4 | 0 | 0.4 | 0 |
| 2 | 0.3 | 0.4 | 0.7 | 1 | −0.3 | 1 |
| 3 | 0.2 | −0.3 | −0.1 | 0 | −0.1 | 1 |
| 4 | 0.4 | −0.1 | 0.3 | 0 | 0.3 | 1 |
| 5 | 0.3 | 0.3 | 0.6 | 1 | −0.4 | 2 |
1 位 Adam:考虑压缩的优化
在明确给定的假设下,误差反馈可以为合适的压缩器恢复收敛性保证,但它将优化器视为黑箱。梯度经过压缩、传输、解压后,被送入优化器,仿佛未经过任何处理。这种分离未能充分发挥性能潜力:优化器维护的内部状态(动量、方差估计)包含梯度分布的信息,但压缩完全忽略了这些状态。需要决定的是,压缩应作用于原始梯度,还是作用于已经概括了这些梯度的优化器状态。
微软 DeepSpeed 团队率先提出了一种更为一体化的方法,压缩优化器的通信内容,而非原始梯度。1 位自适应矩估计(Adam) (Tang 等 2021年) 利用了这一观察:Adam 的二阶矩估计(\(v_t\))在初始训练阶段之后趋于稳定。随后,该方法将通信中的一阶矩状态(\(m_t\))压缩为每个参数 1 位外加一个缩放因子,同时保留已稳定的二阶矩作为自适应预条件子。
该算法分两个阶段进行。在预热阶段,标准 Adam 使用全精度通信运行,使二阶矩估计趋于稳定。随后,算法冻结该方差估计,并将其用作固定的自适应预条件子。在高效通信阶段,工作节点使用 1 位压缩(符号加缩放因子)传输动量,并在本地保留每次压缩的残差,以便在下一次压缩之前将其加回。
其理论依据将冻结的自适应预条件子与带误差补偿的动量压缩相结合。残差将量化误差反馈到后续的动量消息中,从而控制累积的压缩误差,并支持论文给出的收敛性结果,而无需将压缩后的更新视为无偏估计量。
1 位 Adam 论文报告,通信量最多可缩减至原来的 1/5\(\times\),同时达到与未压缩 Adam 相同的收敛速度;使用最多 256 个 GPU 的实验表明,BERT-Large 预训练的吞吐量最高可达到原来的 3.3\(\times\),SQuAD 微调的吞吐量最高可达到原来的 2.9\(\times\) (Tang 等 2021年)。实践启示的适用范围比“压缩总能带来收益”更窄:与节省的通信时间相比,压缩开销必须足够小。
1 位 Adam 的成功说明了一个更普遍的原则:当压缩与优化算法协同设计时,压缩最为有效。压缩原始梯度会无差别地丢弃信息。压缩优化器状态则利用优化轨迹的结构,以更小的收敛性影响实现更高的压缩比。
Napkin Math 1.7: 压缩的回报
问题:一次训练任务需要同步梯度缓冲区,耗时 40 ms。系统实现了 1-bit Adam,通信量减少 32\(\times\),但压缩逻辑增加了 2 ms 的 CPU/GPU 开销。缩放因子、优化器状态协同和协议开销将实际获得的网络收益降低到 8× 的有效吞吐量。实际的通信加速比是多少?
数学:
- 压缩后的通信时间:40 ms 除以 8 = 5 ms。
- 新增总时间:5 ms(通信)+ 2 ms(开销)= 7 ms。
- 有效加速比:40 ms 除以 7 ms \(\approx\) 5.7×。
系统洞见:压缩是以计算换取带宽。只有当 \(T_{\text{overhead}} < T_{\text{comm}}(N) \times (1 - 1/\text{Ratio})\) 时,它才划算。在这种情况下,用 2 ms 节省 35 ms 的网络时间属于极佳的交换。然而,在高速 NVLink 网络上,\(T_{\text{comm}}(N)\) 仅为 1 ms,同样的压缩逻辑反而会拖慢训练。在加入压缩之前,务必先对网络进行剖析。
收益计算使压缩成为一种条件优化:它必须节省足够的通信时间,以覆盖编码开销和收敛风险。
Checkpoint 1.4: 梯度压缩决策
验证你对何时以及如何应用梯度压缩的理解:
压缩权衡:带宽与收敛
梯度压缩并非免费;它以降低通信量为代价,换取优化过程中更高的方差或偏差。梯度压缩方法 中的比较总结了来自量化、稀疏化、误差反馈和面向优化器压缩工作的有据可循的模式 Tang 等 (2021年)。
Tang, Hanlin, Shaoduo Gan, Ammar Ahmad Awan, Samyam Rajbhandari, Conglong Li, Xiangru Lian, Ji Liu, Ce Zhang, 和 Yuxiong He. 2021年. 《1-bit Adam: Communication efficient large-scale training with Adam’s convergence speed》. Proceedings of the 38th International Conference on Machine Learning (ICML), Proceedings of Machine Learning Research, 卷 139: 10118~29.
| 方法 | 压缩比 | 收敛影响 | 最佳使用场景 |
|---|---|---|---|
| FP16 | 2\(\times\) | 可忽略 | 常见加速器基线 |
| INT8 + 误差反馈 | 4\(\times\) | 轻微变慢(约 5–10%) | 带宽受限集群 |
| Top-k(1%)+ 误差反馈 | 100\(\times\) | 中等变慢(约 10–20%) | 跨数据中心训练 |
| 1-bit + 误差反馈 | 32\(\times\) | 显著变慢(约 20–30%) | 极端带宽约束 |
何时使用压缩
决策规则并不只是压缩比本身。只有当每步节省的墙钟时间超过编码开销以及因收敛变慢而增加的步数时,压缩才有价值。当通信时间主导计算时间(即 \(T_{\text{comm}}(N)/(T_{\text{compute}}/N)\) 比值较高)时,激进的压缩才划算,这通常出现在小模型运行于大规模集群的场景;而当计算时间主导时,收敛变慢带来的损失不值得节省,因为系统并未受通信瓶颈所限。独立于该比值,任何超出 FP16 的有损压缩都应携带误差反馈,除非优化器分析和收敛测试足以证明可以省略它;否则,缺少校正会导致收敛失败。
\(\alpha\)-\(\beta\) 来自 节 1.2 的分析有助于判断压缩何时划算:如果梯度足够大、受带宽限制(\(M > n^*\)),压缩会直接减少墙钟时间;如果梯度受延迟限制(\(M < n^*\)),压缩不会带来帮助,因为延迟项无论消息大小如何都占主导。
压缩是否划算的决策,需要比较通信时间的节省与收敛惩罚。考虑一个具体场景:一次训练运行在不压缩的情况下需要 100,000 步才能收敛,每步耗时 500 ms(300 ms 计算、200 ms 通信),总训练时间为 50,000 秒。应用带误差反馈的 INT8 压缩可将每步通信时间减少 4\(\times\)(从 200 ms 降至 50 ms),但所需步数增加 10%(从 100,000 增至 110,000)。新的总时间为 \(110{,}000 \times 0.35 = 38{,}500\) 秒,改善 23%。由于每步通信节省(150 ms)大于所需增加的步数,压缩是划算的。
现在考虑同一模型部署在更快的网络上,通信耗时仅为每步 30 ms。压缩将这一耗时降至 7.5 ms(每步节省 22.5 ms),但仍需增加 10% 的步数。新的总耗时为 \(110{,}000 \times 0.3075 = 33{,}825\) 秒,而未经压缩时为 \(100{,}000 \times 0.33 = 33{,}000\) 秒。压缩使总训练时间增加 2.5%,因为每步节省量(22.5 ms)相对于所选方法的收敛惩罚(307.5 ms 每一步的 10,000 个额外步)而言太小。这个例子说明了为什么压缩只有在通信—计算比(\(T_{\text{comm}}(N)/(T_{\text{compute}}/N)\))超过某个阈值时才应使用,而该阈值取决于所选方法的具体收敛惩罚。
通信库与运行时
从头用 C++ 编写一个高度优化、感知拓扑的分层 Ring AllReduce 需要一支专职工程团队数月的努力。工程决策在于:选择哪个库能在目标硬件上保留本章的模型、拓扑与重叠假设。前面几节提出了三种互补的降低通信成本策略;生产级库通过四个决策轴来实现这些策略:设备内存路径、拓扑感知、可移植性与可观测性。
NCCL:为何它是 NVIDIA GPU 工作负载的核心
NVIDIA 集合通信库(NCCL)11 是许多 NVIDIA 多 GPU 训练部署的核心,因为它将集合算法(见 节 1.4 与 节 1.5)转化为驻留 GPU 的数据移动 NVIDIA (2026年)。其被广泛采用源于三项针对 GPU 的优化,而 MPI 与 Gloo 在缺乏硬件厂商支持的情况下无法复制这些优化。内核融合(kernel fusion)将归约算子(求和、平均)直接并入内存拷贝内核,因此不必先拷贝数据到缓冲区、再归约、最后把结果拷回;NCCL 在传输过程中直接执行归约,从而消除了原本会限制 HBM 带宽利用率的中间内存流量。通道流水线(channel pipelining) 开启多个并行通信通道,以同时饱和所有网络接口,因此配备 8 个 NIC 的 DGX 节点可达到单通道实现的 8\(\times\) 倍带宽。GPUDirect RDMA 允许网卡通过 PCIe 直接从 GPU 内存读取,完全绕过 CPU;若无此项,数据将沿 GPU → CPU 内存 → NIC → 网络的路径传输,从而增加微秒级延迟并消耗 CPU 周期。综合这些因素,可以解释为何 NCCL 通常是 NVIDIA GPU 集合通信基准测试的首选后端,之后才回退到通用的 MPI 实现。
11 NCCL(NVIDIA 集合通信库): 在配置良好的 NVIDIA 集群上,NCCL 通过结合驻留 GPU 的集合通信、GPUDirect RDMA 以及感知拓扑的路由选择,可以逼近理论峰值带宽NVIDIA (2026年)。其面向 NVIDIA 的专用设计带来了一种厂商锁定权衡:组织可以获得针对 NVIDIA GPU 互连结构优化的集合通信后端,但会牺牲对 AMD(RCCL)或 Intel(oneCCL)硬件的移植性。
NVIDIA. 2026年. NCCL User Guide.
除了原始性能之外,NCCL 的拓扑自动发现能力是一个关键的差异化优势。来自 节 1.5.3 的拓扑检测阶段,在 NCCL 中由 NVIDIA Management Library 查询以及 NVLink 连接与 NIC 部署的 PCI 总线枚举驱动。库层面的收益在于硬件感知的算法选择:在配备 NVSwitch 的 DGX H100 上,NCCL 识别出全部 8 个 GPU 完全互联,因而选择基于 NVSwitch 的算法,这与点对点 NVLink 连接系统所使用的环形算法不同。
NCCL 还实现了基于消息大小与 GPU 数量的自动算法选择。内部地,它维护一套调优逻辑,将消息大小、GPU 数量与拓扑映射为选定的算法或协议族。用户可通过文档化的环境变量(如 NCCL_ALGO、NCCL_PROTO 与 NCCL_DEBUG)覆盖或检查部分内置选择,以便在基准测试揭示特定工作负载存在次优选择时进行调整 (NVIDIA 2026年)。调试输出为性能调试提供了必要的可见性。
NCCL 的一项较新能力是对用户自定义归约算子的有限支持,例如针对某个通信域与数据类型的文档化预乘和归约 (NVIDIA 2026年)。这种支持范围窄于 MPI 风格的任意归约与自定义数据类型,因此诸如离群值裁剪之类的应用特定聚合通常仍需单独的内核或框架级逻辑。
尽管已被广泛采用,NCCL 并非没有局限。它是开源的,但与 NVIDIA GPU 和网络紧密耦合,无法作为 AMD 或 Intel 加速器上的原生集合通信库使用。对于构建多厂商基础设施、或需要完全掌控通信栈的组织而言,这些局限促使人们采用替代库。
MPI:高性能计算(HPC)基础
MPI12 在深度学习出现之前数十年就标准化了集合通信操作。MPI Forum 的标准发展史记录了 1994 年 5 月发布的 Version 1.0,它定义了一套面向点ToPoint 消息传递、集合通信操作和进程管理的厂商中立 API,并成为高性能计算领域的通用语言Message Passing Interface Forum (1993年)。当可移植性、CPU 侧协同或 HPC 集成成为约束性要求时,MPI 在机器学习系统中依然具有相关性。
12 MPI(消息传递接口): 在多年社区协作之后,MPI 于 1994 年完成标准化,定义了 AllReduce、Broadcast 和 Scatter 等集合通信操作,这些操作后来被机器学习框架采用。传统 MPI 实现需要为 GPU 缓冲区执行显式的设备到主机拷贝,而 CUDA 感知实现可以使用 GPUDirect 路径。不过,NCCL 仍然是 NVIDIA GPU 集合通信中通常的性能导向选择,而 MPI 则常用于作业启动(mpirun)和 CPU 侧协同。
Message Passing Interface Forum. 1993年. 《MPI: A Message Passing Interface》. Proceedings of the 1993 ACM/IEEE conference on Supercomputing - Supercomputing ’93, 878~83. https://doi.org/10.1145/169627.169855.
对于基于 CPU 的分布式计算,MPI 实现(OpenMPI、MPICH、Intel MPI)已经成熟且经过充分优化,并在多种网络互连结构上积累了数十年的性能调优经验。早于 GPU 训练时代的 HPC 设施往往已将 MPI 深度集成到其作业调度器和资源管理器中,因此在这些系统上部署机器学习工作负载时,MPI 是阻力最小的路径。
MPI 规范包含 NCCL 所缺乏的一些特性,最突出的是持久化集合通信和非阻塞集合通信操作(具备细粒度完成语义)。持久化集合通信(MPI 4.0 引入)允许应用程序“预注册”集合通信操作,从而将设置开销分摊到数千次调用中。这对于训练循环非常有用,因为相同的 AllReduce 形状会在每一步重复出现。非阻塞集合通信(MPI_Iallreduce)提供显式的请求句柄,可以检测其完成状态,从而支持比 NCCL 异步操作更灵活的重叠模式。
MPI 还提供了单向通信(MPI_Put、MPI_Get、MPI_Accumulate),能够自然地映射到 RDMA 硬件。这些操作允许进程读取或写入另一个进程的内存,而无需远程进程显式参与,从而支持仅用集合通信操作难以表达的通信模式。参数服务器架构和某些异步训练算法都能从单向通信语义中获益。
机器学习从业者面临的主要限制是 GPU 感知能力。标准 MPI 实现假定使用主机内存缓冲区;对 GPU 内存调用MPI_Allreduce 通常需要进行显式的设备到主机拷贝,这会抵消将数据保留在 GPU 上的性能优势。CUDA 感知 MPI 扩展(OpenMPI 和 MVAPICH2 可用)可以直接接受 GPU 指针,但其内部实现很少能匹配 NCCL 的算子融合与通道流水线优化。实际指导原则因硬件而异:当硬件栈支持时,NVIDIA GPU 到 GPU 的集合通信操作使用 NCCL,CPU 集合通信操作、进程管理(mpirun,mpiexec)或非 NVIDIA 硬件上的跨平台可移植性则使用 MPI。
Gloo:跨平台灵活性
Gloo 是 Meta 的开源集合通信库,作为 PyTorch 中的后端选项之一与 NCCL 集成。虽然 NCCL 通常是性能关键型 NVIDIA GPU 训练的首选方案,但 Gloo 在 PyTorch 生态中扮演着互补角色:当可移植性比完全饱和 GPU 互连结构更重要时,Gloo 能够保留分布式语义。
Gloo 的主要优势在于其可移植性。它支持 Linux、macOS 和 Windows,无需 CUDA 或任何厂商特定的运行时。这使得 Gloo 成为开发和调试流程中的自然选择,工程师可以在笔记本电脑或 CI 服务器上原型化分布式训练逻辑,然后再部署到 GPU 集群。Gloo 的 TCP/IP 传输可在任何网络栈上工作,包括单机器多进程测试所用的环回接口,从而消除了 NCCL 所要求的设施条件。
对于仅使用 CPU 的训练(数据预处理流水线、特征工程、基于 CPU 的模型架构),Gloo 的实现在小到中型集群规模上与 MPI 具有竞争力。Gloo 针对 PyTorch 分布式训练的常见场景进行了优化:对存储在 CPU 内存中的张量执行 AllReduce 和 Broadcast 的进程组。其共享内存传输能够在不产生网络开销的情况下实现节点内高带宽通信,为本地进程组达到接近 memcpy 的吞吐量。
Gloo 同时充当 PyTorch 的 torch.distributed 模块中的回退后端。当 NCCL 不可用或不适用(非 NVIDIA 硬件、驱动缺失、平台不受支持)时,PyTorch 配置可以使用 Gloo 执行集合通信操作。这种回退行为对多厂商环境很有价值,也能确保分布式训练代码在不同硬件配置之间保持可移植。
主要限制是 GPU 集群上的性能。Gloo 缺少内核融合、GPUDirect RDMA 以及对 NVLink 感知的路由,因此 GPU 张量集合通信需要显式的设备到主机拷贝。在 NVIDIA GPU 集群上,Gloo 在大消息量 AllReduce 操作上的带宽远低于 NCCL。对于延迟敏感的少量消息操作,差距进一步扩大,因为 Gloo 无法绕过操作系统内核访问 GPU 内存。对实践者的建议很直接:开发、CPU 工作负载以及可移植性方面使用 Gloo;对于性能关键的 GPU 训练,则切换到针对硬件优化的后端。
通信库选择指南
表 5 中的选择矩阵汇总了这些维度。重点不在于记忆库名,而在于选择其内存路径、拓扑模型、可移植性约束和调试可见度与任务相匹配的后端。
| 场景 | 推荐库 | 理由 |
|---|---|---|
| 多 GPU 训练(NVIDIA) | NCCL | GPUDirect、内核融合、NVLink 感知 |
| 仅 CPU 的分布式训练 | Gloo 或 MPI | CPU 优化成熟 |
| 开发/调试 | Gloo | 跨平台、无 CUDA 依赖 |
| 混合厂商 GPU | Gloo(回退) | NCCL 仅支持 NVIDIA |
| HPC 集成 | MPI + NCCL | MPI 用于作业启动,NCCL 用于 GPU 集合通信 |
该表直接源自本章的成本模型。后端并非抽象意义上更快;只有当它的内存路径避免了主机拷贝、拓扑模型与网络互连结构相匹配、且其故障信号暴露了限制该任务的 \(\alpha\)、\(\beta\) 或处理器开销部分时,它才更快。
厂商专用库
这三个库(节 1.7.1、节 1.7.2 和 节 1.7.3)并未穷尽所有可用选项,因为同一集合算法在不同加速器平台上具有不同的有效 \(\alpha\)、\(\beta\) 和拓扑约束。其规律是一致的:使用理解实际运行该任务的硬件的设备内存路径与互连结构的后端。AMD 的 RCCL(ROCm Communication Collectives Library) 为 AMD GPU 和 ROCm 栈实现集合通信,而 Intel 的 oneCCL(oneAPI Collective Communications Library) 面向 Intel 加速器与 CPU 部署。它们的名称不如那些持久的选择标准重要:设备内存访问、拓扑感知、集合语义,以及目标互连结构上的可测量性能。
更一般的模式是:在硬件专用后端之下提供标准化的前端 API。PyTorch 的 torch.distributed 模块根据已配置的过程组和可用后端,将集合调用路由到 NCCL、RCCL、oneCCL 或 Gloo。实践中,团队往往混合使用后端,而不是全局只选一个:GPU 进程组可能使用 NCCL 进行梯度 AllReduce,而 CPU 侧的协调组则使用 Gloo 执行屏障、标量广播或采样器状态。本章的算法保持通用,但高效的执行方案是硬件特定的。当该方案性能不足时,通信后端也会成为诊断的起点。
通信诊断首先将工作负载与匹配的裸集合基线进行比较,并记录所选算法、协议、rank 放置以及实际达到的带宽。健康的基线但训练步骤较慢,问题出在调用粒度、竞争、慢节点或重叠不足,而非网络互连结构本身。System Profiling 中的剖析器追踪与归因工作流将这些原因区分开来;此处需要的输出是用于选择集合调度方案的校准后 \(\alpha\)、\(\beta\) 和重叠窗口。
当后端与硬件正确匹配并相对于裸集合基线完成测量后,剩余的暴露通信时间必须被计算掩盖。
通信—计算重叠
20 毫秒的网络延迟可以有效地“消失”,方式不是升级物理网络,而是将通信隐藏在算术运算之后。前面的各节通过算法选择、拓扑感知和载荷压缩降低了通信成本。重叠针对的是残差部分,它改变通信发生的时间。
逐层重叠
06 集合通信
反向传播过程中的梯度计算逐层进行,从输出层回溯到输入层。第 \(\ell\) 层的梯度在该层的反向传播完成后即可得到,而此时第 \(\ell-1, \ell-2, \ldots\) 层仍在计算。这带来了一个机会:可以立即开始传输第 \(\ell\) 层的梯度,同时让 GPU 计算第 \(\ell-1\) 层的梯度。
在 PyTorch 的 DistributedDataParallel 中,这种重叠通过 Gradient Hooks 实现。每个参数注册一个钩子,当其梯度就绪时触发。钩子会针对该参数的梯度桶触发一次异步 AllReduce。与此同时,反向传播继续计算更早层的梯度。如果剩余层的反向计算耗时超过 AllReduce(在大模型中这是常见情况),通信就完全被隐藏了。
这种重叠策略的有效性取决于各层计算与通信的相对开销。对于 Transformer 模型,最大的梯度张量属于注意力与前馈权重矩阵,而这些也正是计算最昂贵的层。这种有利的相关性意味着需要通信数据最多的层,也正是能够用来隐藏通信的最多计算量的层。
重叠策略与来自 节 1.4 和 节 1.5 的算法选择相互影响。Ring AllReduce 虽然延迟更高,但带宽最优,因此比 Tree AllReduce 更能受益于重叠:Ring 的延迟惩罚(否则会在中等大小消息中占主导)可以被计算量掩盖。这也是 NCCL 在检测到框架支持异步操作时,即使低于理论上的交叉点也可能选择 Ring 的原因之一:Ring 的延迟劣势被重叠抵消,而其带宽优势得以保留。
一项关键依赖限制了这种重叠:优化器步长必须等到所有必需的梯度归约完成才能开始。最后处理的层(最接近输入层)的梯度暴露了其通信延迟,因为没有任何后续反向计算来掩盖它们。
Bucket fusion
节 1.8.1 所述的逐层重叠假设每层梯度作为一个单独的消息进行通信。实际上,一个 Transformer 层包含数十个独立的参数张量(query、key、value 投影矩阵、输出投影、层归一化参数、前馈权重和偏置)。为每个单独参数启动一次 AllReduce 会产生数千个小消息的集合通信,每次都要付出完整的 \(\alpha\) 开销。为避免这种情况,DDP 使用 Bucket Fusion 将参数分组到桶中(通常配置为数十 MB,25 MB 是 PyTorch 的常见参考点),并为每个桶启动一次 AllReduce。桶大小代表一种权衡:更大的桶可以摊薄 \(\alpha\) 开销,但会推迟通信的启动(因为桶中的所有参数都计算出梯度后才能发送)。较小的桶能更早启动通信,但要付出更多 \(\alpha\) 开销。
最优桶大小取决于模型架构和网络特性。对于层数很多的小层模型(例如深层残差网络),较小的桶(5–10 MB)通过更早启动通信来改善重叠。对于层数很少的大层模型(例如具有多 GB 嵌入表的语言模型),较大的桶(50–100 MB)更可取,因为大层同时主导计算和通信时间。PyTorch 的 bucket_cap_mb 参数允许调整这一权衡。
参数加入桶的顺序决定了重叠的有效性。DDP 按照参数在前向传播中的使用顺序的逆序将参数分配到桶中,这与反向传播中梯度变得可用的顺序相对应。这种逆序分配确保第一个填满的桶(因而也是第一个启动的 AllReduce)包含前向传播最后层的参数,也就是反向传播中最早的层。这种排序最大化了重叠窗口:最早的桶拥有最多的后续计算量来掩盖其通信。
Overlap limits: When hiding fails
通信—计算重叠存在根本性的限制。LogP 模型的开销参数 \(o\) 表示启动和完成传输所消耗的不可消除的 GPU 时间。即使重叠是完美的,GPU 每次 AllReduce 操作也至少需要 \(2o\) 用于启动和完成。如果模型层数很多但每层的反向传播都很短(小于 \(o\)),GPU 在通信开销上花费的时间会超过计算时间,此时重叠没有任何收益。
此外,反向传播的首层和末层无法重叠。最先完成的层(输出层)没有可与之重叠的先前通信。最后通信的层(输入层)没有可与之重叠的后续计算。对于浅层模型(2–3 层),这些边界效应占用了总时间的相当大一部分,使可达到的重叠程度限制在 50–60%。对于深层模型(数十层或更多),边界效应可以忽略,重叠可以隐藏 90–95% 的通信时间。
第三种限制来自内存压力。将通信与计算重叠需要额外的 GPU 内存缓冲:正在通信的梯度必须保留在内存中,同时反向传播继续为更早层生成新的梯度。对于 FSDP 工作负载,内存优化是主要动机,因此这一额外的缓冲需求可能与 FSDP 带来的内存节省相冲突。工程上的挑战在于找到这样一个平衡点:重叠足够激进以隐藏通信,但又不至于激进到把 GPU 推向显存不足(OOM)的状态。PyTorch FSDP 设置,例如 limit_all_gathers、backward_prefetch、forward_prefetch,以及重分片或预取选择,都提供了调整这一权衡的旋钮。
一个实际的训练配置展示了重叠之后仍然暴露的通信量。
Napkin Math 1.8: 7B Transformer 的重叠预算
问题:一个 32 层的 Transformer 模型(7B 个参数)在 64 GPUs 上训练。每层的反向传播耗时 15 ms。在此重叠预算中,通信桶采用保守的 FP32 梯度数据量估算,因此每层梯度(每层约 880 MB)的分层全归约耗时 26.4 ms,使用 100 MB 的桶。有重叠和无重叠时,单步时间分别是多少?
无重叠(顺序执行):
\(T_{\text{sequential}} = T_{\text{backward}} + T_{\text{comm}}(N)\) = 480 ms + 32 \(\times\) 26.4 ms = 1324.8 ms.
有重叠(流水线执行):
每层的全归约(26.4 ms)与下一层的反向传播(15 ms)并行执行。由于 26.4 ms > 15 ms,每层有 11.4 ms 的通信耗时无法被隐藏。
\(T_{\text{pipelined}} = T_{\text{backward}} + T_{\text{first layer comm}} + (N_L - 1) \times T_{\text{exposed}}\) = 859.8 ms.
系统洞见:重叠使总单步时间减少了 35.1 percent。剩余未被隐藏的通信耗时源于全归约比每层的反向传播更慢。要消除这部分剩余耗时,可以增加反向传播的计算量(增大批大小),或缩短全归约时间(采用更激进的压缩方法、更好的拓扑)。当 \(T_{\text{backward per layer}} > T_{\text{AllReduce per layer}}\) 时,重叠最为有效。
06 集合通信
即便只是单节点这一基础情形,这套通信栈在无需任何多节点机制时就已取得成功:单节点 8 张 NVLink 互联 GPU 上部署一个 70B 参数模型,每步必须执行 BF16 梯度的 AllReduce 140 GB。采用 NVLink 的 450 GB/s 单向速率与 \(\alpha\)–\(\beta\) 模型,以及 Ring 的 \(2(7/8)\) 流量因子,可得 \(2(7/8) \times 140\ \text{GB}/(450\ \text{GB/s})\) \(\approx\) 0.54 s,约占每步计算预算的 26 percent 个 2.1 s。这一定量上的成功,恰恰引出了 节 1.9 中的谬误与陷阱,因为每一个都始于优化错误的项、选择错误的原语,或信任一条已不再匹配工作负载的拓扑假设。
谬误与陷阱
通信优化容易招致持续存在的误解,因为延迟、带宽、拓扑与压缩之间的相互作用会产生简单的思维模型难以捕捉的非显然失败模式。
谬误:带宽是唯一重要的指标。
对于小消息(流水线并行的激活、MoE token),延迟 (\(\alpha\)) 占主导。若消息在软件中序列化需要 5 μs,那么购买 400G 网络并无帮助。关键的消息规模 \(n^* = \alpha \cdot \beta\) 决定了应优化哪个指标:低于 \(n^*\) 时降低延迟;高于该值时则提高带宽。
陷阱:假定 AllReduce 适用于一切。
AllReduce 仅对兼容的元素个数与数据类型计算一次归约,并不实现面向目的地的路由。在专家并行与推荐系统中,每个 worker 反而向不同的对等节点发送各自不同的数据。这类工作负载需要 AllToAll 或其可变计数形式,其性能取决于注入带宽、二分带宽、超配、消息粒度、路由与倾斜,而非仅仅逻辑连接数。
谬误:流水线并行消除了通信开销。
流水线并行以相邻阶段之间的点对点激活传输替代 AllReduce,单消息成本确实更低。流水线引入的是另一种开销:气泡空闲。在 \(p\) 个流水线阶段下,至少 \((p-1)/(p-1+m)\) 的 GPU 时间处于空闲,直到流水线填满与排空,其中 \(m\) 为微批次数。对于深层流水线 (\(p \geq 8\)),需 \(m \geq 32\) 个微批次才能将气泡控制在 20 个百分点以下,而这会约束批大小、激活内存与收敛性。数据并行与流水线并行之间的选择,并非“有通信 vs. 无通信”,而是带宽受限的 AllReduce 与时间受限的气泡开销之间的权衡。
陷阱:默认使用 Ring AllReduce,而不检查消息规模与拓扑。
Ring 实现了带宽最优的 \(2\frac{N-1}{N}\frac{M}{\beta}\),却付出了 \(\mathcal{O}(N)\) 的延迟代价。对于跨越 64 张 GPU 的 1 MB 梯度,在 \(\alpha = 10\ \mu\text{s}\) 条件下,Tree AllReduce 更优,因为 Ring 的 1,260 μs 延迟惩罚超过了 Tree 的 1,000 μs 带宽惩罚。感知日志的交叉点估计 \(M_{\text{crossover}} \approx N \alpha \beta / \log_2 N\) 决定何时切换算法;\(N\alpha\beta\) 仅是一种粗略的上界启发式方法。
谬误:无需错误反馈即可安全使用梯度压缩。
Top-k 稀疏化可实现 99 百分比压缩,但若简单地丢弃小梯度,则会导致发散。在缺少错误反馈 (\(e_{t+1} = (g_t + e_t) - v_t\)) 的情况下,低于阈值的梯度将永久丢失,累积出系统性偏差,最终使训练失稳。
陷阱:仅凭通信加速比来评估梯度压缩。
一种实现 100\(\times\) 通信加速比的压缩方案,若其模型质量退化到需要 2\(\times\) 次更多训练迭代才能达到目标精度,则毫无价值。正确的指标是达到目标精度所需的时间,而非每次迭代的耗时。通信微基准测量的是每次迭代耗时,而工程决策取决于达到目标精度所需的时间,两者在压缩引入梯度偏差或方差、从而拖慢收敛时会出现分歧。应在部署训练调度下于目标收敛基准上验证压缩,而不能仅依赖合成的 AllReduce 微基准。
谬误:异步集合通信总能隐藏延迟。
Python 的 dist.all_reduce(..., async_op=True) 只会将控制流返回给 CPU。LogP 模型将网络延迟 \(L_{\text{lat}}\)(可重叠)与处理器开销 \(o\)(不可重叠)区分开来。若 GPU 计算内核短于通信开销,GPU 仍会停顿。通信只有在 \(T_{\text{compute}} > o\) 时才能被隐藏。
陷阱:网络中的数据静默损坏。
网络并不完美。劣质线缆、故障 NIC 或固件缺陷都可能在训练框架无法检测到显式错误的底层损坏数据。在 10,000 个节点全天候(24/7)运行的情况下,即使罕见的位错误也可能频繁到足以产生影响。通信方面的教训是:没有端到端验证,带宽调优就不完整;校验和、集合通信结果检查、梯度范数合理性测试以及容错机制必须在受损梯度用于模型更新之前将其检测出来。
谬误:扁平全归约足以满足多节点训练的需求。
扁平环形全归约将所有链路视为等同,通过 50 GB/s InfiniBand 路由数据,即使节点内有 900 GB/s NVLink 可用。对于一个包含 8 个节点、每个节点配备 8 个 GPU 的集群,分层全归约相比扁平环形全归约可将节点间流量降低 8\(\times\),达到约 4.8×,具体算例见 节 1.5.1。忽略带宽层次结构会使大部分节点内带宽闲置,同时使稀缺的节点间带宽过载。
陷阱:将环形全归约公式用于节点内通信。
NVSwitch 在受支持的 DGX 硬件代际中提供高端口数、非阻塞的节点内连接,但它并不会将任意全归约操作变成一步归约。除非相应交换机代际和软件路径支持网络内归约,否则端点仍需通过 NVLink 路径执行环形、树形或其他调度算法;较新的交换机辅助设计需要采用其文档中专门给出的成本模型。因此,容量规划应采用运行时实际选择的算法和硬件代际。应应用相应的节点内流量因子、节点间环形或树形流量因子及其分层组合,而不是用一次通用交叉开关跳转来替代归约工作。
谬误:秩到 GPU 的映射不影响集合通信性能。
如果作业调度器将秩分配给 GPU 时不考虑物理拓扑,分层全归约和轨道优化路由就可能采用次优的流量路由方式。一个常见症状是,nccl-tests 在集群上能够达到满带宽,但实际训练作业只能达到满带宽的 50–60%,因为跨节点的秩分配方式妨碍了轨道对齐。在对通信性能进行基准测试之前,应验证秩分配是否符合预期拓扑(例如,秩 0–7 位于节点 0,秩 8–15 位于节点 1)。
陷阱:对集合通信进行基准测试时不记录放置上下文。
集合通信基准测试只有记录了秩顺序、NIC 轨道绑定、NCCL 拓扑配置和节点分配,才能构成可复用的证据。缺少这些上下文,团队就会比较不同物理布局下的结果,并将放置差异误认为库或硬件的性能退化。
总结
通信是规模扩展中的摩擦。计算是局部的,但学习是全局的,而 \(\alpha\)-\(\beta\) 和 LogP 模型将通信瓶颈分析从猜测转变为定量工程。临界消息大小 \(n^* = \alpha \cdot \beta\) 区分了延迟受限和带宽受限两种形态。针对相同的集合通信操作、算法、进程组和拓扑校准这些模型,可以刻画软件开销,同时避免将集合通信的流量因子与库的低效率混为一谈。
集合通信原语(AllReduce、AllGather/ReduceScatter、AllToAll)直接对应于并行策略,每种原语都会产生不同的流量矩阵。较大的 AllReduce 载荷通常受带宽限制。AllToAll 则可能受注入带宽、二分带宽、消息启动开销或路由偏斜限制,因此其实际性能上限取决于网络互连结构,而不只是对等端点的数量。直接成对交换适用于均衡的粗粒度数据块,分层合并可以摊薄小规模节点间传输的开销,而可变大小交换可以在数据分布偏斜时避免填充,但无法消除热点本身。
环形和树形全归约算法分别位于延迟与带宽权衡的两端,考虑对数项的交叉点估计 \(M_{\text{crossover}} \approx N \alpha \beta / \log_2 N\) 决定了给定配置下哪种算法最优。分层全归约和轨道优化路由利用 GPU 集群的带宽层次结构,使有效节点间带宽成倍提升;网络内归约(SHARP)则通过在网络交换机内部执行部分聚合,减少主机可见的通信量。
当最快的链路仍不足以满足需求时,梯度压缩提供了另一种调节手段。量化、稀疏化以及 1-bit Adam 等压缩感知优化器可将通信量降低 4–1000\(\times\)。在 节 1.6.3 中提出的假设下,误差反馈能够在训练步骤之间保留残差信息。随后,通过逐层流水线和桶融合实现通信与计算重叠,可以用有效计算掩盖剩余通信;在配置得当的系统中,有效开销可降至每步总时间的 5–15%。
不同灯塔原型的通信流量模式存在根本差异。
Lighthouse 1.1: 通信原型模式
梯度的“运输清单”取决于系统的目标函数和约束形态。每种灯塔原型都面临不同的通信挑战,集合通信技术与这些挑战的对应方式也各不相同,原型与集合通信操作的映射 对此进行了总结。
| 原型 | 主要集合通信操作 | 潜在限制因素 | 优化策略 |
|---|---|---|---|
| 原型 A(GPT-4/Llama-3) | 全归约 | 带宽(\(\beta\)) | 分层全归约;通信轨道优化 |
| 原型 B(大规模 DLRM) | 全互换 | 粒度、互连结构容量或倾斜 | 消息合并;拓扑感知路由;分片均衡 |
| 原型 C(联邦 MobileNet) | 点对点/异步通信 | 连通性与延迟 | 激进量化;误差反馈 |
尽管这些原型都用于训练神经网络,但它们面临的通信瓶颈各不相同。原型 A(GPT-4/Llama-3)通常承载较大的全归约载荷,并受益于分层归约与通信和计算重叠的结合。原型 B(大规模 DLRM)会产生面向特定目的节点的全互换流量,其限制项可能在启动开销、注入/接收、二分容量、超额订阅、路由以及分片访问倾斜之间变化;消息合并、拓扑感知路由和分片均衡分别针对不同的限制项。原型 C(联邦 MobileNet)受间歇性连接和小型设备的限制,因此激进量化与误差反馈比数据中心拓扑更为重要。将不合适的优化方法应用于某种原型,会浪费工程投入,却无法提升性能。
压缩与误差反馈机制在数据中心之外同样重要:对于原型 C 以及类似的连接间歇中断或带宽匮乏的场景,主导成本可能在于能否发送任何有用的更新,而非能否使高速互连结构达到饱和。
分布式训练既是网络工程问题,也是机器学习问题。\(\alpha\)-\(\beta\) 模型提供了一个框架,可根据通信决策对延迟和带宽的影响,评估从算法选择到压缩与重叠的各种方案。这些模型帮助工程师诊断瓶颈、优化拓扑配置,并达到所需的扩展效率;这种效率决定了万亿参数训练任务是在数周还是数月内完成。
Key Takeaways: 每个字节都有传输成本
- \(\alpha\)-\(\beta\) 模型揭示瓶颈:临界消息大小 \(n^* = \alpha \cdot \beta\) 决定了应优化软件延迟(小消息)还是硬件带宽(大载荷)(原则 11)。使用与工作负载的集合通信操作和拓扑相匹配的基准测试来拟合有效参数。
- 算法选择取决于规模:环形全归约在带宽方面最优,但需付出 \(\mathcal{O}(N)\) 的延迟代价;树形全归约在延迟方面最优(\(\mathcal{O}(\log N)\)),但带宽效率较低。使用考虑对数项的交叉点估计 \(M_{\text{crossover}} \approx N \alpha \beta / \log_2 N\) 来判断切换点,并仅将 \(N\alpha\beta\) 视为规模上界的粗略启发式估计。
- 分层算法成倍提升带宽:通过先在快速 NVLink 上执行本地归约,再跨越较慢的 InfiniBand 桥接链路,分层集合通信实际上使节点间带宽提升至原来的每节点 GPU 数量倍。
- AllToAll 调度选择取决于当前起主导作用的约束:对于均衡的粗粒度数据块,直接交换可保持实现简单;分层结构可在稀缺的节点间链路上摊薄启动开销;可变大小交换则可在存在倾斜时消除填充。注入带宽、二分容量、超额订阅、消息粒度以及负载最重的接收方共同决定哪种调度方案更优。
- 误差反馈控制有损压缩误差:稀疏化可以丢弃每次传输更新的 99%,同时在本地累积压缩残差,并在下一次压缩前将其加回。在所分析的假设下,这能够约束累积压缩误差并恢复收敛保证,即使单次压缩后的更新仍可能存在偏差。
- 重叠是最终的倍增因素:通过梯度钩子和桶融合实现通信与计算的流水线重叠,可以将深层模型 90–95% 的通信时间隐藏在反向传播计算中(原则 10)。
- 拓扑发现不可或缺:NCCL 等高性能库会将逻辑环动态映射到物理线路,以避免“热点”并最大化二分带宽(原则 4)。进程秩与 GPU 的映射不匹配可能使性能下降 2–4\(\times\)。
如果说并行性决定了必须通信的内容,那么集合通信则衡量了这些通信的成本。每种集合通信操作(AllReduce、AllGather、AllToAll)都是集群指令集中的一条指令,α-β 模型通过固定的启动延迟和每字节传输时间为其定价。工程师通过在带宽受限时选择环形算法、在延迟受限时选择树形算法,在跨越较慢的节点间链路之前减少载荷,以及将传输与计算重叠来降低成本。通信是计算资源作为一台机器协同运行所付出的代价。
What’s Next: 从逻辑到韧性
集群如今已具备其逻辑(并行性)和流量模式(通信)。然而,在生产环境中,GPU 会过热,网络会丢包,节点会在计算过程中发生故障。容错 探讨了检查点、恢复和弹性训练如何在不完美的硬件上维持协调一致的计算。