集群编排
调度问题
集群编排
目的
当硬件已经充足时,为什么资源分配会成为首要瓶颈?
一千台闲置的加速器等待调度决策,其代价与一千台加速器计算有用工作完全相同。在大规模场景下,限制因素从“硬件是否够用”转变为“能否高效使用”。作业在队列中等待,而资源闲置;碎片化留下过小以致无法容纳待调度作业的间隙;死锁则使作业持有部分资源却仍在等待更多资源。编排通过决定哪些作业运行在哪些节点、何时抢占、如何在公平性与利用率之间取得平衡,以及如何避免协同机制本身成为瓶颈,从而从共享基础设施中提取有用工作。糟糕的编排会把昂贵的硬件变成浪费;有效的编排则把一堆机器转化为一个连贯的计算资源。用 C³ 术语来说,编排会主动支付协同开销,以牺牲部分峰值利用率来避免负载下的死锁与碎片化。
Learning Objectives
- 分析分布式训练作业在共享集群约束下的调度目标、碎片化与死锁风险
- 比较 HPC、云原生与混合编排范式,以支撑批训练和自愈式服务负载
- 在 NVLink 域与交换机层级中应用 gang、bin-packing 与感知拓扑的放置策略
- 设计弹性训练与抢占策略,以在吞吐量、恢复开销与 spot 实例节省之间取得权衡
- 使用作业时长、迭代进度、主导资源公平性与自适应资源分配信号来评估面向 ML 的调度器
- 基于队列深度、尾延迟与 GPU 内存压力,设计集群级推理容量、隔离与放置策略
- 诊断由配额囤积、噪声邻居、碎片化、拓扑不匹配与数据饥饿导致的利用率损失
假设有两个共享 1,000-GPU 集群的研究团队:Team A 提交了一个 512-GPU 的作业,运行一个月;而 Team B 提交了数百个 8-GPU 的实验,每个运行一小时。如果调度器简单地按作业到达顺序处理,Team B 的微小实验可能会无限期地阻塞 Team A 的大规模训练运行。调度问题,正是在吞吐量、公平性与集群利用率之间这种多维冲突中寻求权衡的挑战。
划分计算、高效地同步计算,以及从硬件故障中恢复,解决的是单作业扩展问题。编排(orchestration)则应对集群层面的挑战:决定哪些作业运行、在哪里运行,以及如何在相互竞争的需求之间共享资源。
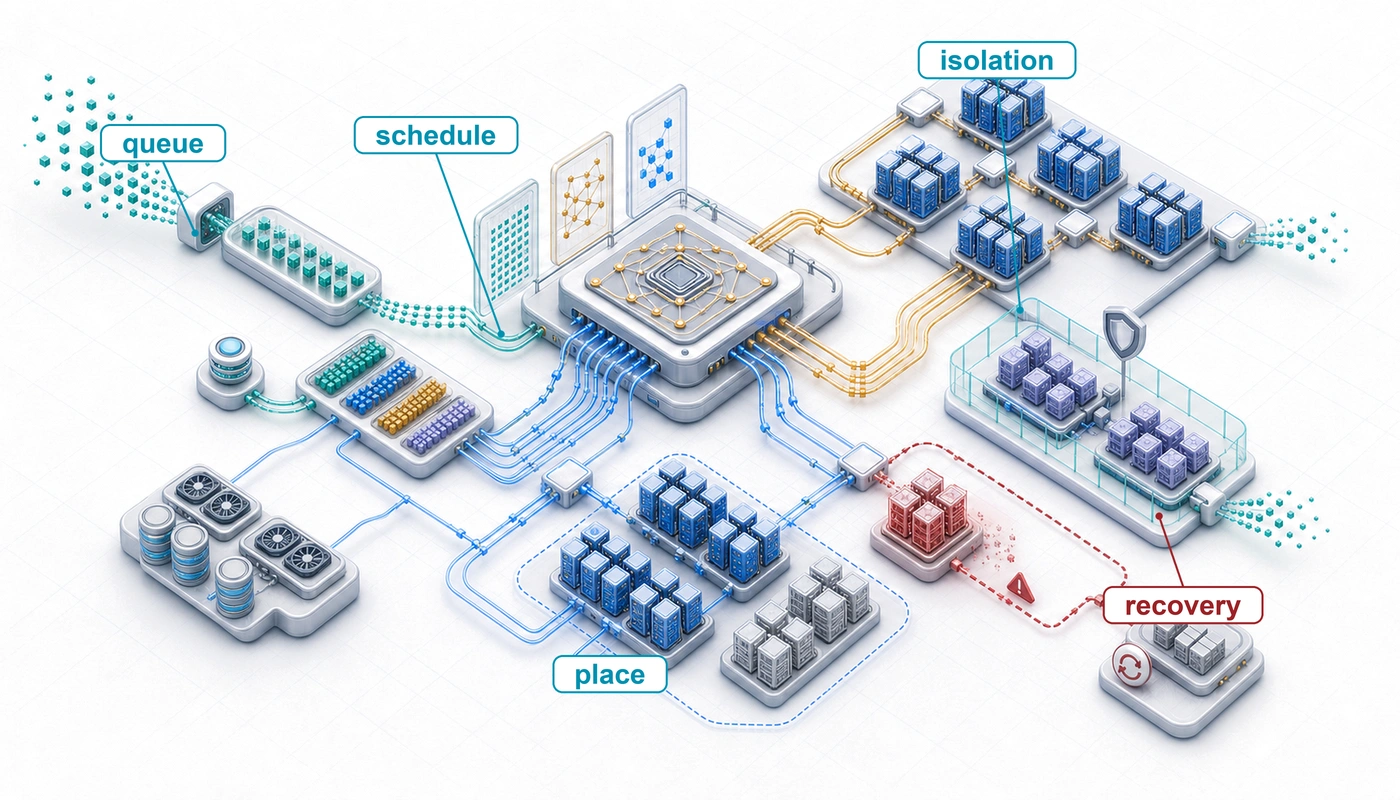
在集群栈(见页边图示)中,编排位于分布层,但基础设施层会约束其决策。调度器必须考虑 GPU 异构性、NVLink 拓扑、机架功率限制以及网络二分带宽。当调度出错时,调试需要检查全部四层,以判断根本原因是基础设施(硬件约束)、分布(算法局限)、服务(工作负载不匹配)还是治理(策略误配置)。编排将物理基础设施连接到分布式算法,把资源请求转换为同时尊重硬件拓扑与组织策略的放置方案。
为使调度问题具体化,考虑一家运行着一个 10,000-GPU 集群的研究机构。Brown 等 (2020年) 报告称,在 V100 GPU 集群上训练 GPT-3 175B 使用了 \(3.14 \times 10^{23}\) 次浮点运算。假设有 100 个此类大规模训练任务正在排队,同时还有数千个较小的实验和推理工作负载,全部竞争同一批资源。系统必须决定哪些任务运行、何时运行以及在哪里运行。朴素的先到先得策略会让最初几个大任务垄断集群数周,使研究人员为快速迭代所需的小型实验长期得不到资源。严格的公平份额策略则会将 GPU 分散到许多小规模资源分配中,使任何大任务都无法获得所需的连续资源分配。这两个极端都不可行。调度器必须在多维权衡空间中作出选择,每项决策都会同时影响吞吐量、公平性、成本和研究人员的生产力。
Brown, Tom B., Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared Kaplan, Prafulla Dhariwal, Arvind Neelakantan, 等. 2020年. 《Language Models are Few-Shot Learners》. Advances in Neural Information Processing Systems 33: 1877~901. https://doi.org/10.48550/arxiv.2005.14165.
经济成本使这些决策在任何规模下都影响重大。一个 10,000-GPU 集群按 $2/GPU-hour 的费率计算,每天的运行成本为 $480,000,无论 GPU 是在执行有用的计算,还是在队列中闲置。如果调度低效导致 30 percent 的 GPU 闲置,就相当于每天浪费价值 $144,000 的计算容量,每年约为 $52.6M。反过来,将利用率从 50 percent 提升到 80 percent,可以在不购买额外硬件的情况下,增加相当于 3,000 个充分利用的 GPU 的有效计算容量。这一增益相当于购买 6,000 个 GPU,并让它们以原先 50 percent 的利用率运行。在这一规模下,利用率提升 1 个百分点所带来的年度价值,超过了实现这一提升的工程师的年薪。调度并非单纯的运维开销;它是机器学习基础设施中投资效益最高的工程投入之一。
决定调度灵活性的是工作负载的语义,而非机器学习与 HPC 之间的领域界限。两个领域中的刚性同步任务都要求一组固定的进程秩接受协同调度,而可伸缩任务则可以在声明的资源数量范围内持续推进。成组调度1 体现了同步分布式训练的关键约束:需要 1,024 个 GPU 的任务无法仅凭 512 个 GPU 完成有效的迭代。每个工作进程都必须参与每次集合通信,缺少一个工作进程就会阻塞所有其他工作进程。AllReduce 推导了环形和树形全归约成本模型,说明了这一约束的物理根源:集合通信会停滞,直到最后一个工作进程到达,因此,分配 \(N\) 个 GPU 却仅实际落实 \(N-1\) 个,会使缺失进程秩的其他对等进程在同步点闲置。部分分配资源的调度器会造成死锁:多个刚性任务各自占用一些 GPU,同时等待更多 GPU,结果没有任何任务能够继续推进。可伸缩的数据并行训练则可以在明确的重新配置边界处改变副本数量,但张量并行和流水线并行组通常仍需维持固定的基础资源分配。因此,调度器必须对每个任务的最小可行进程组和允许调整规模的时点进行建模,而不能根据工作负载所属的领域推断其刚性。
1 成组调度:由 Ousterhout (1982年) 针对并行系统进行形式化定义,其中“Ousterhout 矩阵”在同步时间片内跨处理器协同调度相关线程。在机器学习集群中,这一约束更为严格:同步全归约要求所有工作进程同时参与,因此部分分配会浪费已占用资源的 100%,而不仅仅是降低吞吐量。按本章的云端等效成本口径,$2/GPU-hour scenario, a 1,024-GPU job holding 900 idle GPUs while waiting for 124 more burns approximately $1,800/小时。
Ousterhout, John K. 1982年. 《Scheduling Techniques for Concurrent Systems》. Proceedings of the 3rd International Conference on Distributed Computing Systems (ICDCS), 22~30.
2 放置组:一种云原生抽象,用于请求将实例放置在高带宽、低延迟的网络域内。对于机器学习集群,放置组可以减少资源放置的分散程度,并且可能提供比无约束放置更高的网络性能上限。它们并不保证工作负载层面的二分带宽:拓扑超额订阅、并发流量、路由和集合通信模式仍共同决定实际可用的全归约带宽。
如果成组调度是第一项硬性约束,那么通过放置组2 实现的拓扑感知就是第二项:为支持张量并行,调度器必须确保 GPU 位于同一个高带宽 NVLink 域内,而不是分散在整个数据中心。
GPU 异构性是第三个维度。许多集群包含 A100 与 H100 加速器的混合部署,其计算吞吐量不同,高带宽内存(HBM)容量相近(A100 为 80 GB,H100 为 80 GB),互联带宽也不同。对于 Transformer 类工作负载,H100 的训练吞吐量约为 A100 的两倍,但成本也相应更高。部分模型在采用适当的并行策略后能够装入 A100 内存;另一些模型则必须依赖更大的 H100 内存,以避免过度的模型切分。调度器必须依据实际需求而非用户偏好,将工作负载匹配到合适的硬件,同时维持异构资源池的高利用率。当用户出于习惯而非必要请求特定 GPU 类型时,请求资源与所需资源之间的不匹配,可能使整个硬件池闲置,而偏好硬件上的队列却溢出。
作业时长不可预测进一步加剧了这些挑战。一次训练运行可能提前收敛,在数天内完成而非数周。硬件故障可能意外中止作业,并在不可预测的时间释放资源。超参数搜索可能较早地揭示某些配置注定无法成功,从而引发主动终止。传统科学计算工作负载(如气象模拟或分子动力学)的运行时长更具可预测性,因而能够支持更优的调度决策:调度器可以预测资源何时可用并据此规划。机器学习工作负载则无法享有这一便利,迫使调度器在关于当前作业何时释放资源存在深度不确定性的情况下运行。
这些挑战之间的相互作用产生了组合式复杂度。调度器必须同时处理 gangscheduling 约束(原子分配)、异构资源(能力匹配)、拓扑要求(张量并行所需的 NVLink 局部性)、优先级与公平性策略(组织层面的公平)、抢占决策(中断哪些正在运行的作业)以及成本优化(spot 与 on-demand 部署)。每个维度都会约束其他维度:拓扑最优的部署可能违反公平性策略,成本最优的 spot 部署可能违反可靠性要求,而由公平性驱动的分配可能以阻碍 gangscheduling 的方式造成资源碎片化。
这些约束定义了编排(orchestration)的核心问题:调度器不仅是在将作业打包到 GPU 上,而是在维护一个一致且具有经济价值的、针对故障且异构的集群的视图。第一步是理解为何集群调度在根本上比单机进程调度更难。在集群规模下,部署不再仅仅是优化问题,而成为一个分布式系统问题,需要在数千台机器之间保持状态一致性。
分布式调度复杂度
单机调度器享有集群调度器无法享有的便利:它能够即时、一致地看到所有资源状态;它能够作出立即生效的原子决策;故障是二元的(机器要么在线,要么宕机)。集群调度则放弃了这三项属性,由此涌现出若干基础分布式系统问题。
部分故障构成第一个挑战。节点可能在分配与作业启动之间发生故障,从而在调度器的决策与其生效之间形成间隙。调度器可能成功地在 4 台节点上分配 32 个 GPU,但其中一台节点在作业启动前发生故障。其余 24 个 GPU 处于闲置状态,直到调度器检测到故障、更新自身状态并重新规划分配。与此同时,本可使用这 24 个 GPU 的其他作业已经被部署到别处,可能部署在次优的硬件上。容错 中的容错机制处理执行过程中的故障;调度器必须处理部署过程中的故障,这是一个根本不同的问题,因为作业尚未建立任何可恢复的状态。
网络分区引发第二个、且仅存在于分布式调度中的问题。调度器可能失去对部分节点的连通性,而这些节点仍在正常运行。从调度器的视角看,这些节点表现为故障、其 GPU 表现为不可用;从节点自身的视角看,作业仍在运行并产生有用的工作。这种歧义性带来了一个没有普遍正确解法的困境:将这 24 个 GPU 重新分配给新作业,若分区随后自愈,则存在重复分配的风险;等待重新连接则会浪费可能完全可用的容量。分区的持续时间事先无法预知,因此任何固定的超时时间都是一种关于网络行为的猜测,可能最终被证明是错误的。
状态不一致是第三个挑战,它进一步加剧了前两个挑战。调度器所看到的资源状态可能与各节点上的实际状态不同。调度器认为空闲的 GPU 可能仍在执行上一项任务的清理操作:刷新缓存、释放设备内存、运行失败容器遗留的僵尸进程,或在出错后完成 CUDA 驱动重置。反过来,被标记为“使用中”的 GPU 可能已由在两次心跳之间终止的任务释放。这种不一致意味着,调度器所依据的集群状态模型始终略微滞后,而滞后程度因节点而异,取决于心跳频率、网络延迟以及清理操作的复杂度。
缺少全局时间的情况下如何确定顺序,是第四个根本问题。没有全局时钟时,要判断不同节点上的分配 A 是否先于分配 B 发生,就需要使用逻辑时钟或共识算法,精心设计协议。如果系统不通过共识协议或集中式协同来强制保证顺序,两个任务可能都认为自己“拥有”同一块 GPU。这种情形并非仅存在于理论中:在从网络分区中恢复时,分区发生前后的分配消息可能在不同节点上以错误的顺序到达,造成相互冲突的资源分配,必须检测并解决这些冲突。
这四个挑战呼应了 CAP 定理所描述的一致性、可用性与分区容错性之间的权衡。3 CAP 是关于分布式数据系统的定理,并不是对每个调度器都直接适用的证明,但这一类比很有用:控制平面必须在做出分配决策之前,确定自己愿意容忍多少过期或不确定的状态。Slurm 是一种 HPC 工作负载管理器,像它这样的集中式批处理控制系统强调在任务启动前建立权威的分配视图。Kubernetes 是一种容器编排平台,像它所采用的对账循环则强调持续推动实际集群状态趋近于声明的期望状态。定制的 ML 调度器通常接受有界的不一致性,以换取调度吞吐量;它们采用乐观并发,在事后检测并解决冲突,而不是通过加锁来预防冲突。
3 CAP(一致性、可用性、分区容错性)定理:由 Brewer (2000年) 提出猜想,并由 Gilbert 和 Lynch (2002年) 证明。CAP 定理指出,任何分布式数据系统都无法同时保证一致性、可用性和分区容错性。对于 ML 调度器,应将 CAP 用作设计类比,而不是产品声明:具体的策略问题是,控制平面在分配、回收或重新调度昂贵的加速器之前,愿意接受多少不确定性。
Brewer, Eric A. 2000年. 《Towards robust distributed systems (abstract)》. Proceedings of the nineteenth annual ACM symposium on Principles of distributed computing, 7. https://doi.org/10.1145/343477.343502.
Gilbert, Seth, 和 Nancy Lynch. 2002年. 《Brewer’s conjecture and the feasibility of consistent, available, partition-tolerant web services》. ACM SIGACT News 33 (2): 51~59. https://doi.org/10.1145/564585.564601.
PyTorch Contributors. 2026年b. torchrun (Elastic Launch). PyTorch documentation.
PyTorch Contributors. 2026年a. Torch Distributed Elastic Rendezvous. PyTorch documentation.
当调度器在网络分区期间与 ML 框架自身的分布式协同平面交互时,控制平面面临的矛盾便具体显现出来。调度器可能判定一部分节点不可用,而这些节点上的工作进程仍阻塞在集合通信操作中。这会形成一个短暂的意图冲突窗口:调度器希望回收已分配的资源,但训练任务尚未就新的成员视图达成一致。TorchElastic 等弹性启动和集结机制通过心跳与重新集结来减少这种歧义,使框架能够重新组成可运行的工作进程组,或正常终止,从而为调度器提供比不透明的集合通信超时更明确的恢复信号 (PyTorch Contributors 2026年b, 2026年a)。这种分层协同——由调度器层面的策略负责粗粒度资源分配,由框架层面负责工作进程的成员管理——是生产环境中分布式训练集群的典型架构。
准入、放置与对账
调度器控制平面将单一队列可能掩盖的三项决策分离开来。准入控制决定任务在配额、优先级、成组调度和安全约束下是否可以进入可运行集合。放置将已获准进入的任务绑定到一组可行的节点,同时考虑加速器能力、拓扑、功率、存储和网络容量。对账将期望的资源分配与观测到的节点及任务状态进行比较,然后启动、重试、驱逐或隔离任务,直到两者一致。明确区分这些阶段,可以防止放置失败在无明确提示的情况下变成准入决策,也可以防止过期的观测结果导致同一资源被重复占有。
控制面架构以不同方式分配这些决策 (Hindman 等 2011年; Burns 等 2016年)。集中式调度器基于单一权威状态,串行执行准入与放置决策,这简化了冲突处理,但也使调度延迟和故障影响集中于一处。两级设计向框架调度器提供资源,以资源邀约延迟或被拒绝为代价,实现策略的专门化。共享状态设计允许多个调度器基于共同状态并发规划,并通过版本检查或乐观并发机制解决冲突。在每一种设计中,状态协调都负责闭合控制回路:节点租约和分配代次必须防止旧决策在新的放置决策接管所有权后重新生效。
Hindman, Benjamin, Andy Konwinski, Matei Zaharia, Ali Ghodsi, Anthony D. Joseph, Randy Katz, Scott Shenker, 和 Ion Stoica. 2011年. 《Mesos: A Platform for Fine-Grained Resource Sharing in the Data Center》. 8th USENIX Symposium on Networked Systems Design and Implementation (NSDI 11), 295~308.
Burns, Brendan, Brian Grant, David Oppenheimer, Eric Brewer, 和 John Wilkes. 2016年. 《Borg, Omega, and Kubernetes》. Communications of the ACM 59 (5): 50~57. https://doi.org/10.1145/2890784.
可行性也不只取决于空闲加速器的数量。功耗感知的准入机制会拒绝或推迟最坏情况下功耗超出机架或设施功率上限的放置决策;仅依赖平均功耗,会在共置作业同时进入计算密集型阶段时带来相关性限频风险。I/O 感知的放置机制将数据集读取和检查点写入带宽视为可预留容量,因此,即使一组需要同时调度的任务能够装入 GPU 内存,也不会在并发输入流水线或检查点写入突发会使同一存储路径饱和的位置启动。这些约束可能有意让加速器保持空闲。空闲容量是为保障已准入作业持续推进所需的功耗和数据移动预算而付出的代价。
大规模下的故障率
在大规模系统中,故障是正常运行的一部分,而非例外。这一原则已在 容错 的可靠性分析中确立,对调度有直接影响:调度器不仅必须容忍故障,还必须在每一次分配决策中主动为故障做好规划。组件可靠性不随集群规模变化,但系统整体可靠性会以乘法方式下降。仅统计 GPU 硬件故障会低估故障率;在 GPU 年可靠性为 99.9%(数据中心硬件的典型水平)时,一个拥有 4,096 个 GPU 的集群仅由硬件故障产生的预期故障数量并不高:

正常的组件故障率使集群故障成为常态。
\[ \text{Expected failures per day} = 4096 \times \frac{0.001}{365} \approx 0.01 \text{ GPU failures/day} \]
这一计算仅涵盖 GPU 硬件故障。计入软件故障(驱动程序崩溃、CUDA 上下文损坏)、热事件(限频、紧急关机)、网络接口故障、主机操作系统问题以及容器运行时错误后,大型集群可能出现每天 1 到 4 次故障,按每 1,000 个 GPU 计。一个拥有 10,000 个 GPU 的集群每天就会经历 10 到 40 次组件故障。因此,在 4,096 个 GPU 上持续数周的训练运行极有可能遇到多次故障。组件故障率 列出了支撑 99.9% 年可靠性假设的 FIT 故障率和平均失效时间(MTTF)数据,使运维人员能够代入实测硬件故障率,并确认每天 1 到 4 次故障这一经验区间是否仍然成立。
这对调度的影响十分深远,几乎决定了调度器的每一项设计决策。调度器不能将集群视为静态资源池,认为资源一旦分配,就会一直可用,直到被主动释放。相反,它必须预见到已分配的资源可能在作业执行期间消失,维持备用容量或实现快速重新调度,使作业在硬件不断进入和退出运行状态的过程中持续运行,并区分暂时性故障(可能在几分钟内自行恢复,不应触发代价高昂的资源重新分配)与永久性故障(需要分配新资源并从检查点恢复)(Tiwari 等 2015年)。
Tiwari, Devesh, Saurabh Gupta, James Rogers, Don Maxwell, Paolo Rech, Sudharshan Vazhkudai, Daniel Oliveira, 等. 2015年. 《Understanding GPU Errors on Large-Scale HPC Systems and the Implications for System Design and Operation》. 2015 IEEE 21st International Symposium on High Performance Computer Architecture (HPCA), 331~42. https://doi.org/10.1109/hpca.2015.7056044.
考虑调度器未收到节点心跳时的决策。调度器有三个选项:
- 等待恢复:调度器等待观察心跳是否恢复;如果节点确实已经失效,则可能浪费 GPU 时间。
- 立即重新分配:调度器将该节点的资源分配给其他作业;如果节点恢复且原有作业仍在运行,则可能发生冲突。
- 标记为可疑:调度器将节点标记为可疑,并在等待确认的同时开始预先准备替代资源,这会消耗本可用于其他工作的备用容量。
每个选项都需要在响应速度与正确性之间权衡,而有效的选择取决于集群中特定硬件的故障模式分布,调度器必须从历史故障数据中学习这些信息。恢复时间的构成 将恢复时间分解为检测、重新调度、重新加载和重放四个阶段,这些阶段限定了调度器在未收到心跳后最多可以等待多久,随后便必须决定重新分配资源,而不能继续寄希望于暂时性故障自行恢复。
这些要求将调度器直接与 容错 中的检查点与恢复基础设施联系起来:有关备用容量、抢占策略和弹性训练支持的调度决策,决定了系统从统计上可预期的故障中恢复的速度。预留备用容量或支持弹性恢复的调度器,恢复吞吐量的速度可以远快于要求每个失败作业都等待重新分配完整资源并重新加载的调度器,但合适的预留比例和恢复时间是取决于具体工作负载和集群的参数,而非普适常数。
调度目标及其冲突
每项调度决策都体现了四个基本且往往相互矛盾的目标之间的权衡:
- 吞吐量:单位时间内完成的有效工作总量,自然倾向于规模大、运行时间长的作业,因为这些作业能充分利用硬件,并最大限度地减少上下文切换和数据移动开销。
- 公平性:在用户或团队之间公平分配资源,可防止单个大型团队垄断集群。主导资源公平性 (Ghodsi 等 2011年) 使各用户在 GPU、CPU 和内存等资源上的最大归一化份额相等。
- 延迟:快速完成短作业有助于保持研究人员的工作效率,但激进的抢占可能使大型训练作业陷入饥饿。
- 成本效率:可中断的竞价实例、非高峰时段调度和紧凑的资源分配可减少预算消耗,但往往会提高故障率或延长完成时间。
这些目标相互冲突,是因为每个目标都偏向不同的调度行为。吞吐量最大化策略会用大规模训练作业填满集群,实现接近完美的利用率,却迫使其他所有用户等待数周才能获得运行机会。以公平性为导向的分配会使资源碎片化,留下大型作业无法利用的小块空闲资源,并以牺牲总体吞吐量为代价换取用户之间的和谐。延迟最优的调度器类似于最短作业优先策略,会激进地抢占长时间运行的训练作业,以服务交互式调试会话或小型实验。成本优化往往意味着接受更高的故障率和更长的完成时间,以牺牲研究人员的生产力来节省预算。
公平性需要结果指标,而不能仅靠配额规则。对于作业 \(j\),减速比 \(S_j=(W_j+T_j)/T_j\) 将其排队时间与运行时间之和同其独占资源时的运行时间 \(T_j\) 进行比较;一个运行一小时却等待九小时的作业,其减速比为 \(S_j=10\),即使它所属的团队最终获得了名义上的 GPU 份额。调度器应报告按用户和作业类别划分的减速比分布,以及等待时间最长、满足运行条件的待调度作业已等待的时长。主导资源份额是否相等可用于检测资源分配不均,减速比可揭示延迟不均,而对满足运行条件的作业设置最大等待时间上限,则可检测饥饿现象。这些指标能够区分按已分配 GPU 小时数衡量的公平策略与按用户等待获得有效结果的时间衡量的公平策略。
如 图 1 所示,同时优化这四个目标是不可能的;每种调度策略都对应这个四维权衡空间中的一个特定点。最直接的冲突存在于吞吐量与延迟之间,这种矛盾类似于计算机体系结构中的吞吐量与延迟权衡。吞吐量最优的调度器优先安排规模最大、最易并行化的作业,因为它们利用硬件的效率最高。然而,这种策略会给小型作业带来灾难性的延迟:研究人员提交一个 10 分钟的调试任务,可能需要等待数天,直到大型作业完成。反过来,延迟最优的调度器会尽量缩短平均等待时间,却可能让大型作业无限期地陷入饥饿;在等待“再一个”小型作业完成时,大块资源处于闲置状态,从而降低集群的总体吞吐量。
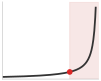
利用率超过约 70% 后,排队等待时间急剧飙升。
考虑我们 175B 模型的 64-GPU 微调运行,这是一项调度演示工作负载,与全文档中反复出现的完整 1,024-GPU 预训练运行不同。从吞吐量角度看,这是一份理想任务:启动后以高利用率运行数天,调度开销为零。从延迟角度看,它却是流中的巨石。若要调度该任务,系统可能必须清空其他工作占用的 64 个 GPU,迫使数百个较小任务等待。任务一旦运行,便牢牢占据这些资源。若调度器优先该任务(吞吐量),小任务的 P99 延迟将急剧飙升。若调度器优先小任务(延迟),允许它们抢占或碎片填充整个集群,那么 64-GPU 任务可能永远无法凑齐启动所需的连续资源块。这场零和博弈迫使组织做出明确的策略选择。在调度器术语中,这些选择常体现为服务质量等级:决定当吞吐量、延迟、公平性和成本相互冲突时,哪项目标优先的任务优先级层级。
Napkin Math 1.1: GPU 集群的排队论
GPU 集群可以建模为一个 M/G/1 排队系统,其中作业按照泊松过程到达 \((\lambda_{\text{job}})\),服务时间服从一般分布 \((G)\),其均值为 \(1/\mu\)、标准差为 \(\sigma\)。Pollaczek-Khinchine 公式给出了队列中的预期等待时间 \((W_q)\):
\[ \frac{W_q}{1/\mu} = \frac{\rho}{1-\rho} \cdot \frac{1+C_s^2}{2} \]
此处,\(\rho = \lambda_{\text{job}}/\mu\) 表示集群的利用率,\(1/\mu\) 表示平均作业时长,而 \(C_s = \sigma \mu\) 是作业时长的变异系数。因此,右端表示以平均作业时长为倍数的等待时间。
在标准 Web 服务中,请求服务时间常以指数分布近似,得到 \(C_s \approx 1\)。在机器学习集群中,作业时长服从重尾分布:大量短暂的调试作业(分钟级)与少数规模巨大的训练运行(周级)混合。本提示框中的代表性 \(C_s=3\) 计算捕捉了这种方差,但并未声称存在普适的集群常数。其对等待时间的影响是乘性的。就本文的调度论证而言,单服务者乘数已经足够;批处理推理的排队论 则将这一结果推广到 M/G/c/K 排队系统,并针对 Little’s Law 对其进行验证,供读者为调度器在重尾到达下的准入队列进行容量估算。
在 80 percent 利用率 \((\rho = 0.8)\) 下:对于指数型负载 \((C_s = 1)\),\(W_q =\) 4 \(\times\) 等于平均作业时长。对于典型的 ML 负载 \((C_s = 3)\),\(W_q =\) 20 \(\times\) 等于平均作业时长。这解释了 ML 基础设施中的“利用率墙”。Web 服务器集群在 80 percent 负载下会感觉响应迅速,但 ML 集群在相同利用率下会显得异常卡顿,作业会在队列中滞留数天。服务分布的重尾充当了延迟乘数,迫使运维人员将 ML 集群运行在更低的利用率(通常为 60% 到 70%)以维持对交互式用户的可接受响应性。
工作示例:主导资源公平性(Dominant-resource fairness)
主导资源公平性(DRF) 通过对每个租户的分配相对于集群容量进行归一化并取其最大份额,使多资源配额具有可比性 (Ghodsi 等 2011年)。考虑 DRF 工作示例分配 中刻意设置的小规模集群:8 个 GPU、32 个 CPU 核心、256 GB 内存和 80 Gb/s 网络容量。租户 A 的副本需要 1 个 GPU、4 个核心、32 GB 和 10 Gb/s;租户 B 的分布式 worker 需要 2 个 GPU、2 个核心、16 GB 和 20 Gb/s。
Ghodsi, Ali, Matei Zaharia, Benjamin Hindman, Andy Konwinski, Scott Shenker, 和 Ion Stoica. 2011年. 《Dominant Resource Fairness: Fair Allocation of Multiple Resource Types》. 8th USENIX Symposium on Networked Systems Design and Implementation (NSDI 11), 323~36.
| 租户 | 分配 | GPU 份额 | CPU 份额 | 内存份额 | 网络份额 | 主导份额 |
|---|---|---|---|---|---|---|
| A | 4 个副本 | \(4/8=0.50\) | \(16/32=0.50\) | \(128/256=0.50\) | \(40/80=0.50\) | \(0.50\) |
| B | 2 个 worker | \(4/8=0.50\) | \(4/32=0.125\) | \(32/256=0.125\) | \(40/80=0.50\) | \(0.50\) |
对于租户 \(i\),将其主导份额定义为 \(d_i=\max_r(a_{i,r}/C_r)\),其中 \(a_{i,r}\) 是其对资源 \(r\) 的分配量,\(C_r\) 是该资源上的集群容量。该计算均衡的是 \(d_i\),而非每一项资源份额。增加一个 A 副本会使 A 的主导份额提升 \(1/8\);增加一个 B worker 会使 B 的主导份额提升 \(2/8\)。因此,渐进填充会大致为每个 B worker 分配两个 A 副本,直到两个主导份额都达到 \(0.50\)。这是一个公平的策略目标,但尚不构成可行的放置方案。若 B 的两个 worker 组成一个四 GPU 的 gang,则四个 GPU 必须原子地可用;若张量并行需要同一 NVLink 域,则分散在各节点上的四个空闲 GPU 无法满足该分配;若作业需要 80 GB HBM 加速器,则四个不兼容的 GPU 根本不计入。因此,生产调度器会先对可行集施加能力、gang 和拓扑约束,再在能够实际运行的分配中用 DRF 公平地选择。当不存在等份额放置方案时,调度器应报告导致偏差的约束,而不是将不可行的配额静默呈现为已交付的服务。
Lighthouse 1.1: 灯塔原型:放置方式决定公平性
在 三种系统架构原型 中引入的三个灯塔工作负载中,相同的资源份额具有不同的含义:
- 原型 A(GPT-4/Llama-3) 需要刚性且拓扑兼容的 gang。低于其最小并行配置的分量分配不会带来任何进展,因此公平性必须包含连续放置的最大可行等待时间,而不能仅考虑 GPU 小时数。
- 原型 B(Scale 上的 DLRM) 将加速器内存与稀疏路由带宽耦合。当嵌入分片或网络容量无法跟随时,名义上的 GPU 分配不可行,因此网络与内存必须进入主导份额,且放置必须保护服务延迟包络。
- 原型 C(联邦 MobileNet) 调度的是参与权,而非数据中心 GPU。针对功耗、连接性和设备能力的资格过滤可能系统性排除部分人群,因此公平性必须通过各设备与用户组的参与率和结果率进行审计,而不能以每轮中相等的设备数量来衡量。
共同规则是:先定义可行资源包,再评估有用进展层面的公平性。将每个加速器或客户端视为可互换,会掩盖使每种原型都难以处理的约束。
装箱(Bin packing)
最基本的调度算法是装箱:4 将不同规模的作业装入固定容量的节点。该问题在其一般形式下是 NP-hard,即不存在已知能在多项式时间内找到最优解的算法。幸运的是,实际启发式算法(如 first-fit decreasing 和 best-fit decreasing)在 ML 集群典型的工作负载分布下能达到接近最优的结果,其中作业规模服从重尾分布(大量小作业、少量大作业)。
4 装箱:一维版本是 NP-hard;ML 调度增加了四到五个维度(GPU、CPU、内存、网络、拓扑),使得在数百个节点以上的集群上求得精确解变得不可行。first-fit-decreasing 启发式算法在典型工作负载下可达到最优解的 11/9 以内,但在 ML 集群中真正的成本并非装箱次优,而是碎片化:那些单独无法满足任何待调度作业、但合起来却代表数百万美元闲置容量的“滞留”GPU。
考虑一个 64 节点集群,每个节点配备 8 个 GPU,总计 512 GPUs。若每个任务请求 6 个 GPU,则每个任务占用一个完整节点,但每个节点会浪费 2 个 GPU,使有效容量降至 75 percent。每个节点剩余的 2 个 GPU 无法跨节点合并,因为 GPU 工作负载需要本地内存访问。这种碎片化 会随着任务规模的异构性而加剧:1-GPU、3-GPU 和 7-GPU 任务的混合会在许多节点上形成不规则的空闲间隙,没有任何单个待调度任务能够适配其中任何一个间隙,但若这些间隙能够连成一体,总空闲容量本可满足需求。
机器学习工作负载使装箱问题呈现多维特性,而传统调度器很少遇到这种情况。每个任务都需要同时获得 GPU、用于数据预处理的 CPU 核心、用于数据加载与增强流程的主机内存,用于数据集缓存的本地 SSD 存储,以及用于梯度同步的网络带宽。一个请求 4 个 GPU、32 个 CPU 核心和 256 GB 内存的任务,可能无法被调度到某个拥有 4 个空闲 GPU 但仅有 16 个空闲 CPU 核心的节点上,因为其他任务已经占用了该节点的主机 CPU 用于预处理。调度器必须同时满足所有资源维度,且任务只有在所选节点的每个维度都具备足够容量时才能被放置。与单维装箱相比,这种多维约束会大幅缩小解空间,因为任何单一资源维度上的瓶颈都可能使其他维度的容量无法被利用。
locality 约束进一步限制了放置范围,超出了简单的资源可用性。使用张量并行的训练任务要求 GPU 通过 NVLink 连接到同一节点内的其他 GPU,因为通过 InfiniBand 的跨节点通信比节点内通信慢一个数量级(每个方向节点内 450 GB/s,每个端口节点间 50 GB/s)。请求“4 个具备 NVLink 连通性的 GPU”的任务,无法使用节点 A 的 2 个 GPU 和节点 B 的 2 个 GPU,即使这 4 个 GPU 各自均可用且总容量足够。这类拓扑约束将装箱问题转化为放置问题,其中具体资源的重要性与资源数量同等重要。放置问题严格难于装箱问题,因为它在原有的容量约束之上增加了空间约束。
调度器通过几种互补的策略应对碎片化,每种策略针对问题的不同方面。回填调度(backfill scheduling)允许较小的任务填补空闲间隙,而较大的任务等待连续资源,从而在不违反优先级排序的前提下提升资源利用率。其核心洞察是:小任务可以在间隙中执行并完成,从而在大任务的目标开始时间之前释放这些资源。回填调度需要对当前任务的完成时间进行估算(以判断回填候选任务是否能在大任务开始之前完成),这也是准确的运行时间估计如此重要的原因。
周期性的去碎片化 会迁移或抢占低优先级任务,将空闲资源整合为连续块,这与操作系统中的内存整理(memory compaction)类似。调度器会识别出因部分分配而在节点上留下孤立资源的节点,抢占占用这些资源的任务,并将它们重新调度到能够更有效地打包的节点上。去碎片化的成本(抢占正在运行的工作负载,从而在最后检查点与抢占事件之间浪费了计算资源)必须与收益(使大任务更早开始,提升整体吞吐量)相权衡。运维人员通常选择在低需求时段执行去碎片化,以降低抢占带来的影响。
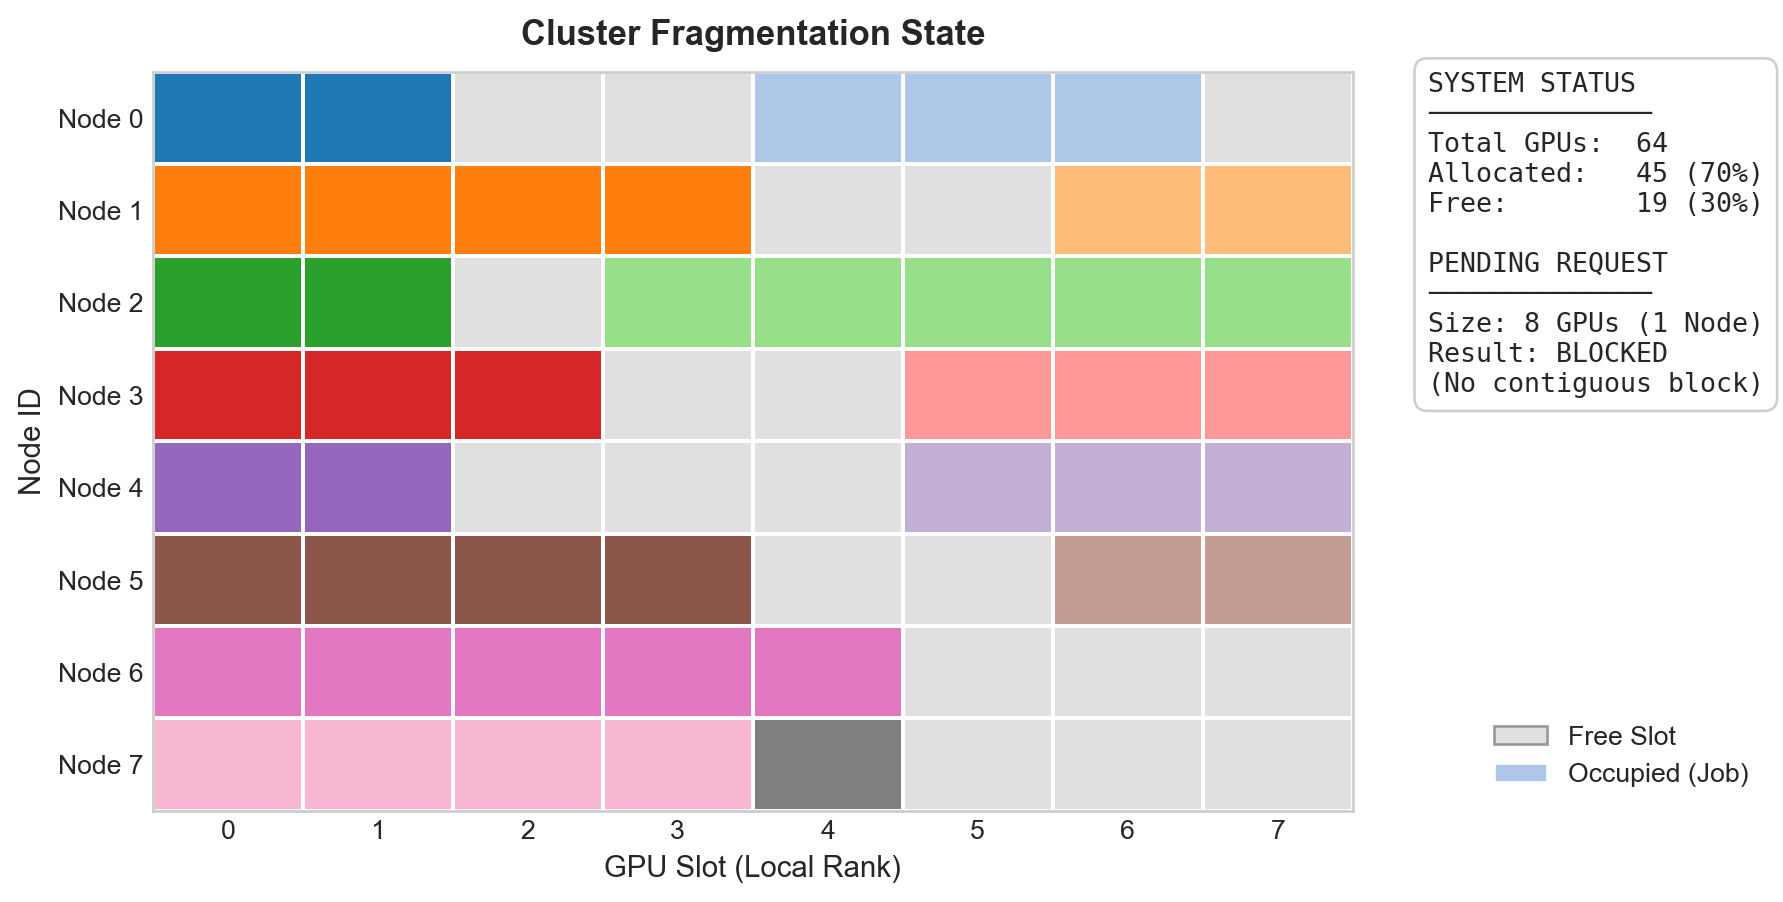
第三种策略是超额预留,即允许超出某个容量维度所能持续承载的需求量,但仅限于资源可被分割、且调度器能够界定干扰程度的场景。平均 SM 利用率并不会产生分数个完整 GPU:占用设备内存、需要独占 CUDA 上下文或属于刚性 gang 的任务,即使内核处于空闲状态,也仍占用其分配到的设备。统计多路复用对于显式可共享的 CPU、网络、存储或分区 GPU 容量可能是安全的,前提是租户具有可测量的、弱相关的峰值,并且限制可被强制执行。将 70% 的平均 GPU 利用率转换为 1.4\(\times\) 的设备超卖比例是不安全的。完整设备容量应通过抢占、弹性伸缩,或 MIG、MPS 之类的隔离机制来回收,这些机制的内存、计算和故障共享契约需要由调度器显式建模。图 2 展示了独立的装箱问题:尽管集群中有 19 个 GPU(约占集群容量的 30%)处于空闲状态,但没有任何单个节点存在连续的 8 个 GPU 块,因此无法放置一个需要完整节点的任务。
gang scheduling
多 GPU 任务的部分分配会在机器学习集群中产生一种独特的失效模式:两个任务各自占用其所需资源的一半,彼此永久阻塞,而所有已分配的 GPU 都处于空闲状态。图 3 将这一死锁场景与消除死锁的原子分配 方法进行了对比。
::: {#dfn-fleet-orchestration-gang-scheduling .callout-definition title=” Gang scheduling”}
*** Gang scheduling *** 是一种机器学习集群调度策略,它会原子地(非此即彼)分配某个任务的全部加速器,因为同步分布式训练使得部分分配的边缘价值为零:每个 worker 都必须到达每个集合通信操作,所以任务无法以较少的 GPU 换取按比例放慢的进度。
- 重要性:一个占用 512 个 GPU 的 1,024-GPU 同步任务会完成零个训练步,而不是减半:每个 AllReduce 都会阻塞,直到所有 rank 都到达,因此被占用的 GPU 以 0% 的有效产出消耗电力和资本。如果没有原子分配,两个这样的任务各自可以获取集群的一半资源并陷入死锁,两者进度均为零,同时消耗整个集群的运行成本。
- 区别:与可以在一定资源范围内取得进展的可伸缩服务或并行任务不同,刚性同步训练具有阶梯式效用:要么是最小可行 gang,要么就是没有。这一区别源于执行图的性质,而与负载是否被标记为机器学习、云或 HPC 无关。
- 常见误区:一种常见误解是,仅靠优先级或配额就能解决这个问题。原子性必须扩展到该任务取得进展所需的每一个共调度资源(加速器、高带宽互连域、用于集合通信的网络容量);仅在 GPU 粒度上强制原子性,会在下一层资源上重新制造死锁。
:::
Example 1.1: 死锁的物理机制
场景:一个拥有 1,024 个 GPU 的集群接收到 2 个大型分布式训练任务,每个任务需要 1,024 个 GPU。一个朴素的调度器向团队 A 分配 512 个 GPU,向团队 B 分配 512 个 GPU。
诊断:两个任务都必须获得完整的节点分配才能继续执行,从而形成占有并等待死锁:团队 A 等待团队 B 的 GPU,而团队 B 等待团队 A 的 GPU。总吞吐量降至零,同时产生每小时 $2048 的闲置计算成本。
系统启示:分布式训练工作负载需要原子的、全有或全无的成组调度。集群编排器必须严格执行任务级准入边界,使任务在所请求的全部 GPU 配额同时可用之前始终处于排队状态。
部分分配模式是一种占有并等待死锁5,其中两个任务各自占用集群的一半,且都无法继续执行。实现层面的保证很明确:对于任务 \(J\),若其请求 \(N\) 个 GPU,调度器必须保证,要么以原子方式分配全部 \(N\) 个 GPU,要么让该任务留在队列中,不占用任何资源。这种非此即彼的结果从设计上消除了死锁,因为不占用任何资源的任务无法阻塞其他任务。然而,如何高效实现这一保证,正是集群调度算法设计中许多工作的核心挑战。
5 占有并等待:资源分配系统中导致死锁的四个经典条件之一,这四个条件共同成立时足以导致死锁。成组调度通过原子分配消除了这一条件,代价是降低了资源装箱的灵活性。
Lifka, David A. 1995年. 《The ANL/IBM SP Scheduling System》. 收入 Job Scheduling Strategies for Parallel Processing, 编辑 Dror G. Feitelson 和 Larry Rudolph, 卷 949. Lecture Notes in Computer Science. Springer. https://doi.org/10.1007/3-540-60153-8_35.
朴素的成组调度会以可预见的方式造成浪费。如果集群有 900 个空闲 GPU,而某个任务请求 1,024 个 GPU,那么这 900 个 GPU 就会一直闲置,直到另外 124 个 GPU 可用,这可能浪费数千 GPU 小时。回填调度通过识别队列中能在这 900 个可用 GPU 上运行、且不会推迟大型任务预期启动时间的任务来解决这一问题;这一思路因 ANL/IBM SP 调度系统而得到推广 (Lifka 1995年)。一个需要 128 个 GPU、预计运行 2 小时的任务可以安全地用于回填,前提是大型任务所需的另外 124 个 GPU 至少在未来 2 小时内仍不可用,且回填任务预计会在大型任务的预留启动时间之前完成。回填任务利用了原本会闲置的资源,从而在不违反大型任务调度保证的前提下提高利用率。
运行时间估计的准确性决定了回填的有效性,这也带来了博弈论层面的挑战。如果用户持续高估运行时间,回填时间窗口就会被人为压缩,能够容纳的任务更少,从而降低利用率。如果用户低估运行时间,回填任务可能在大型任务所需资源变得可用时仍在运行,因而不得不被抢占,浪费回填任务已经完成的工作。在实践中,用户有强烈的动机高估运行时间(以避免任务在完成前被终止),却缺乏准确估计的动机,这导致运行时间估计系统性地偏高,进而降低回填性能。Tiresias 等研究型调度器 (Gu 等 2019年) 通过彻底取消对运行时间估计的要求来解决这一根本问题,转而利用观测到的资源消耗动态调整优先级。这一方法将在 节 1.5.1 中详细讨论,它将运行时间估计问题从用户承担的负担转变为系统层面的观测工作。
粗略的成本估算表明,即使在这种平衡上取得适度改进,也足以证明工程投入的价值。
Systems Perspective 1.1: 闲置 GPU 的经济账
本章开头介绍的集群经济决定了赌注;调度器在 gang scheduling( gang 调度)决策中首次赢得或消耗它。以同样的 10,000-GPU 集群为例:
- 运行成本:$480,000/天($175.2M/年)
- 较低利用率(60 percent):6,000 处于生产状态,4,000 处于闲置状态,即 $192,000/天被浪费
- 较高利用率(80 percent):8,000 处于生产状态,2,000 处于闲置状态,即 $96,000/天被浪费
- 改进价值:从 60 percent 提升到 80 percent 每天可节省 $96,000,约合 $35.0M/年
gang scheduling 通过消除死锁来带来这一利用率提升。单个 hold-and-wait 死锁就可能使整个集群陷入停滞,一次事件就会抹去超过一整天的收益。
gang scheduling 消除了利用率示例中的 hold-and-wait 死锁,但另一种 wait-for(等待)模式依然存在:优先级反转(priority inversion)仍可能让预留 GPU 滞留在无法完成自身退出路径的作业之后。

优先级反转是一种 wait-for 链,而非根因故障树。
死锁预防与检测
gang scheduling 消除了 hold-and-wait 条件,即死锁的四个正式 Coffman 条件之一,但它并不能使集群对所有形式的资源争用免疫。死锁仍可能源于优先级规则、抢占策略与辅助资源依赖之间的相互作用。在一个拥有数千 GPU 和 PB 级状态的集群中,这些边缘情况会从理论上的好奇问题变成每日运营事故。
其中最有害的是优先级反转,这是一种借自实时系统的场景:高优先级作业被低优先级作业无限期阻塞。考虑一个 175B 参数训练任务(高优先级)请求 64 GPU 的 gang。调度器已预留 60 个可用 GPU,但其余 4 个被一个低优先级的数据处理作业占用。正常情况下,调度器会抢占低优先级作业以满足高优先级请求。然而,如果一批中等优先级的开发作业占满了集群的 CPU 或网络带宽,饿死了低优先级作业完成检查点与退出所需的资源,低优先级作业就会停滞。它无法释放 GPU,因为无法完成退出序列。高优先级作业则在等待低优先级作业,而后者实际上被中等优先级作业阻塞。结果是一个持续 60 GPU 的闲置块,直到运营人员手动介入才结束。
Definition 1.1: 优先级反转
优先级反转 是一种机器学习集群调度病理,其中高优先级任务被迫等待低优先级任务释放共享资源。
- 重要性:它把整个集群的推进速率降低到低优先级作业的水平。在 ML 集群中,这通常发生在持有 GPU 的低优先级作业因辅助资源(例如 \(\text{BW}\) 用于检查点)而被饿死,因而无法完成并释放高优先级工作负载所需的加速器。
- 区别:与标准排队(任务依次等待)不同,优先级反转涉及一种主动阻塞:高优先级任务已就绪运行,但它对调度器不优先的任务存在传递性依赖。
- 常见误区:一种常见误解是严格的优先级级别可以解决这个问题。实际上,如果没有整体性抢占(为任务退出预留其所需的全部资源),提高优先级级别反而可能增加反转发生的概率,因为依赖链变得更加复杂。
解决这个问题需要在预防与检测之间做出选择。预防机制(如严格的 gang scheduling 和激进的超时)通过构造消除死锁状态,但往往牺牲利用率。检测机制则允许系统进入潜在不安全状态以最大化吞吐量,依靠监控来识别并解决死锁。
对于大规模集群,精确的放置搜索在计算上并不简单。一个拥有 10,000 个 GPU 且有待调度任务的集群,其状态空间超过 \(10^{15}\) 种可能的分配方案,因此穷举分配搜索不可行。相比之下,检测已构建的等待图(wait-for graph)中的环,其代价与图的顶点和边成线性关系。实际困难在于:当资源状态在分布式控制平面中发生变化时,如何维护一份完整且最新的全球图。因此,大规模调度器会在等待检测之外,补充能够在状态不完整时保持活性的机制。
基于租约的资源 为每次分配设置生存时间(time-to-live),使调度器能够在作业停止续期其占用声明时回收 GPU。进度监控 随后检查作业是否确实在推进,利用 GPU 利用率、步数计数器或心跳时间戳等信号来识别僵尸分配。当调度器必须抢占一个低优先级作业时,整体抢占 会为该作业检查点并干净退出所需的全部 CPU、网络与存储带宽预留资源;否则,被抢占方可能因资源被过度饥饿而无法释放加速器。这些策略以非零的误报率为代价,来保障集群的活性。
异构 gang 调度
传统的 gang 调度模型假设工作负载是同质的批量同步并行(bulk synchronous parallel)任务:\(N\) 即完全相同的 worker 执行完全相同的计算图。一些训练工作流会打破这一假设,因为一个逻辑作业可能包含多个资源画像不同的角色。例如,在偏好训练流水线(如基于人类反馈的强化学习,RLHF)中,一个组件可能负责更新策略,而另一个组件负责为输出打分或提供参考行为。调度器仍然只看到一个作业,但其 gang 中包含训练器、评估器和推理式 worker,它们所需的 GPU 数量、内存占用和生命周期各不相同。
Systems Perspective 1.2: 按同步性进行路由
异构 gang 调度 将这一分配问题重新表述。调度器必须原子地分配一组资源异构的“星座”:既包括面向内存受限的推理生成、以高 HBM 为优化目标的节点,也包括面向计算受限的反向传播、以高计算能力为优化目标的节点。编排挑战由此从静态的拓扑装箱,转变为动态的数据路由。激活与梯度不再仅仅在同质的环内归约;相反,数据必须在生成 rollouts 的推理节点与计算策略更新的训练节点之间持续流式传输。如果异构 gang 分配在这些不同的工作负载画像之间未能实现完美平衡,整个集群就会失去同步,昂贵的加速器将因数据饥饿而闲置。
异构 RLHF gang 属于例外情况;对于常见的同质训练作业,反复出现的张力是 gang 调度的安全性与回填(backfill)的利用率之间的权衡。gang 调度可以防止死锁,但会浪费资源;回填能够提升利用率,却需要用户无法准确提供的运行时估计。两种常见的编排范式通过根本不同的架构理念来化解这一张力。
编排范式
gang 调度与回填之间的张力并没有“工具中立”的答案:编排范式决定了平台优先保障哪一项保证。Slurm 受 HPC 批量系统影响,倾向于显式的资源请求和可预测的分配;Kubernetes 受云原生服务管理影响,倾向于声明期望状态并进行持续的对账。因此,选择并非 Slurm 与 Kubernetes 之间的产品之争,而是哪种控制模型最好地契合该集群的工作负载构成、故障行为与运维文化。
正如 架构范式:Slurm 与 Kubernetes 所对比的,根本区别在于命令式与声明式的资源管理。在命令式系统中,用户精确指定所需资源,系统直接为其分配;在声明式系统中,用户声明期望运行的状态,系统则不断向该状态收敛。这一区别源自程序设计语言的设计,并决定了机器学习工作负载如何被调度、监控以及从故障中恢复。
:::
:::
Slurm:高性能计算(HPC)传统
Slurm 工作负载管理器6 源自劳伦斯利弗莫尔国家实验室(Lawrence Livermore National Laboratory),是一款可扩展、具备容错能力的 Linux 集群资源管理器 (Yoo 等 2003年)。其批处理(batch)导向的设计契合科学计算的独特需求:长运行时间作业、昂贵的共享硬件,以及用户能够预先指定资源需求。在机器学习基础设施中,同一模型映射到 GPU 训练,即针对异构加速器池划分分区(partitions),并为长运行的分布式作业提供可预测的分配。
6 Slurm 工作负载管理器:最初名为“SLURM”,是 Simple Linux Utility for Resource Management 的缩写;该项目于 2012 年取消了缩写大写。该项目自 2002 年起在劳伦斯利弗莫尔国家实验室开发,Slurm 的集中式控制器 (slurmctld) 维护资源分配的唯一权威视图。在非常大的规模下,运维人员可以划分集群(partition fleets)或联邦调度器(federate schedulers),以保持调度延迟、策略隔离和故障域处于可控范围。
Yoo, A. B., M. A. Jette, 和 M. Grondona. 2003年. 《SLURM: Simple Linux Utility for Resource Management》. 收入 Job Scheduling Strategies for Parallel Processing. Springer Berlin Heidelberg. https://doi.org/10.1007/10968987_3.
Slurm 采用指令式调度模型:用户提交作业脚本,指定确切的资源需求,调度器依据优先级、公平性和资源可用性将作业分配到分区中。这种直接性使得对分配保证的推理变得 straightforward。当用户提交 sbatch --gres=gpu:8 --nodes=4 时,Slurm 保证:若该作业启动,它将恰好获得横跨 4 个节点的 32 个 GPU。用户清楚自己将获得什么,调度器也清楚自己必须提供什么。这种直接性的代价是,用户必须精确理解自身的资源需求;请求超出所需数量的资源会造成浪费,而请求不足则会导致内存不足(out-of-memory)错误或性能下降。
Slurm 的架构由一个集中式控制器守护进程(daemon)(slurmctld) 组成,该守护进程维护集群状态的全球视图并做出调度决策;此外还有每个节点的节点守护进程 (slurmd),负责管理本地资源并执行作业。这种集中式架构提供了 节 1.0.1 中讨论的权威分配模型:控制器是资源分配的事实来源(source of truth),从而降低了分配冲突的风险。代价是潜在的单点故障(通过主动—被动故障切换 active-passive failover 解决)以及调度吞吐量的上限。随着集群规模增长,组织可以划分集群或联邦调度器,以限制调度延迟和故障影响。
典型的机器学习集群配置会根据加速器类型和互连方式定义 Slurm 分区 (表 1)。
| 分区 | 每节点 GPU 数 | 互连方式 | 典型用途 |
|---|---|---|---|
| dgx-a100 | 8\(\times\) A100 | NVLink + IB NDR | 大规模 LLM 训练 |
| a100-pcie | 4\(\times\) A100 | PCIe + IB HDR | 中等规模训练 |
| inference | 2\(\times\) A10G | Ethernet | 模型服务 |
| debug | 1\(\times\) V100 | Ethernet | 开发调试 |
这些分区使 GPU 分配策略具体化,Slurm 还提供了若干机制来控制作业放置。--gres=gpu:N 标志请求 N 个 GPU/节点,而 --gpus=N 标志请求作业所需的 GPU 总数。朴素的分配方式会导致节点碎片化:若作业在 8 GPU 节点上请求 6 个 GPU,则每个节点浪费 2 个 GPU,有效容量降至 75 个百分点。Slurm 的 select/cons_tres 插件支持感知 GPU 的可消费资源调度,跟踪单个 GPU 而非将节点视为不可分割的整体。--gpus-per-node 标志要求在 NVLink 通信模式使部分节点分配得不偿失时,为每个已分配节点请求固定的 GPU 数量,而 --gpus-per-task 则将 GPU 在任务间均匀分布,以适配数据并行工作负载。
GPU 分配与节点选择之间的交互会产生一些细微之处,同时影响性能与资源利用率。请求 --gpus=16 --gpus-per-node=8 的作业将始终获得恰好 2 个完整节点,确保每个节点内的 8 个 GPU 均通过 NVLink 通信。同一作业若请求 --gpus=16 且不带每节点约束,则可能获得分散在 3 个或 4 个部分占用节点上的 GPU,从而降低节点内通信性能。对于使用张量并行的训练作业,每节点约束至关重要;对于仅通过 AllReduce 通信的数据并行作业,不受约束放置的灵活性则提升了调度器寻找有效分配的能力,并减少了碎片化。
公平份额调度 机制可防止任何单一用户或项目长期独占资源。其核心思想是:历史使用量应当影响未来优先级——当集群争用(contended)时,高用量用户应向低用量用户让出资源。有效优先级启发式算法综合了基础优先级、用户的目标公平份额 (\(F_{\text{target}}\))、用户近期的实际消费 (\(F_{\text{actual}}\)),以及一个用于稳定的小常数 (\(\epsilon\)):
\[\text{Priority}_{\text{effective}} = \text{Priority}_{\text{base}} \times \frac{F_{\text{target}}}{F_{\text{actual}} + \epsilon}\] \(\)
equation 中的公平份额公式会自然地降低高用量用户的优先级,同时允许其在资源空闲时快速抢占资源。某个研究者消耗了自身公平份额的两倍,其优先级便会减半,新提交的作业因此被那些用量较少的同事的作业排在其后。相反,近期未使用任何资源的研究者将获得最高优先级,从而在其返回活跃工作时获得快速访问。
使用历史的衰减速度决定了系统“宽恕”过去高用量行为的快慢。半衰期为一周意味着,研究者两周前的高用量仅对其当前用量计算贡献 25%。较短的半衰期能实现快速的再平衡,但也可能导致振荡行为,即用户在资源饥饿与过度占用之间来回切换。较长的半衰期则能形成稳定的优先级排序,却可能惩罚那些完成了合法的大型项目、如今又希望为较小项目获取资源的研究者。大多数生产集群将半衰期配置在 3 到 14 天之间,在响应速度与稳定性之间取得平衡。
抢占策略允许高优先级作业从正在运行的任务中回收资源;对于机器学习训练而言,这需要与检查点基础设施进行仔细协调。Slurm 可以使用 SIGTERM 通知选定的作业,并使用 GraceTime 延迟最终终止,通常会在最终 SIGKILL 之前为检查点预留 60 到 300 秒。PreemptMode=REQUEUE 会重新排队符合条件的批量作业(例如使用 --requeue 提交的作业,或具有 JobRequeue=1 的集群),而该作业的重启路径必须从最新的检查点恢复。容错 中开发的检查点与恢复基础设施使这种抢占成为可行;如果没有可靠的检查点机制,抢占就会丢失自上次手动触发保存以来的全部进展,从而对长时运行的训练作业在经济上造成毁灭性损失。
抢占会引入调度悖论:它提升了调度器服务高优先级工作负载的能力,却可能降低整个集群的总体吞吐量。每一次抢占都会浪费自上次检查点至抢占事件之间的计算量,以及重启并从检查点重新加载所需的时间。若检查点间隔较长(例如每小时一次)而抢占频繁,被浪费的计算量可能相当可观。生产系统会在抢占频率与检查点开销之间进行权衡,通常会配置抢占冷却期,以防止同一作业在可配置的间隔内被抢占超过一次。
Slurm 用于机器学习训练的优势十分明确:可预测的分配保障、成熟的公平份额策略、与基于 MPI 的分布式训练框架的 straightforward 集成,以及在管理大规模科学计算方面数十年的运行经验。其劣势则体现在推理工作负载和混合训练—服务集群中,批处理导向的模型难以应对服务流量动态、对延迟敏感的特性。Slurm 没有“应当持续运行的服务”这一原生概念,因此对于必须持续响应请求的推理端点而言颇为不便。增加或删除推理副本需要提交或取消 Slurm 作业,其操作开销远大于扩展 Kubernetes 部署。
面向 ML 的 Slurm 高级配置
当 Slurm 接管批处理训练后,剩余的问题便是批处理系统能够看到多少机器学习语义。标准分区与公平份额策略仅用于调度普通作业;大规模深度学习则需要配置来暴露 sweep 结构、非对称流水线资源、作业边界处的硬件健康状态,以及不同类型加速器之间的经济权重。
作业数组(job arrays)将成千上万次实验超参数 sweep 提交的混乱过程转化为一个连贯、可调度单元。用户无需向控制器灌入大量独立的 sbatch 请求,而是提交单个数组作业:#SBATCH --array=0-99。Slurm 将其视为单个对象以处理解析与排队开销,但将每个元素作为独立任务进行调度,从而使调度器能够用单个试验填补集群中的小空洞。每个任务都会获得一个唯一的 SLURM_ARRAY_TASK_ID 环境变量,训练脚本借此索引超参数配置文件(例如为任务 0 选择学习率 \(\eta = 10^{-4}\),为任务 1 选择 \(\eta = 3 \times 10^{-4}\))。这一机制在大规模消融研究中十分常见,使研究者能够以单个命令启动 1,000 个实验,同时保持调度器吞吐量。
异构作业针对预处理瓶颈,即昂贵的 GPU 处于空闲状态,而 CPU 正在准备数据。传统作业会为每个节点分配对称资源,迫使用户在整个流水线期间预留 GPU 节点。Slurm 的异构作业支持允许单个提交跨越不同的资源类型,通过在命令行中用 : 分隔组件,或在脚本中使用 #SBATCH hetjob。我们 175B 模型的 64-GPU 微调运行(即调度演示工作负载,而非完整的 1,024-GPU 预训练运行)采用这一模式:它请求 8 个 GPU 节点(64 个 A100)用于模型,以及 2 个仅 CPU 节点用于即时数据分词。srun --het-group=0 命令在 GPU 上启动训练进程,而 srun --het-group=1 启动数据工作器,使昂贵的加速器专注于梯度计算,而较便宜的 CPU 节点为其提供数据。
Prolog 和 epilog 脚本充当集群的免疫系统,在作业开始之前和结束之后运行管理代码。在机器学习集群中,典型的 prolog 脚本会对已分配硬件执行预检:使用 nvidia-smi topo -m 验证 NVLink 拓扑,检查 ECC 错误计数器,并验证 InfiniBand 链路宽度。如果某个节点未通过这些检查,prolog 返回非零退出码,导致 Slurm 将该节点隔离并重新排队到其他位置,从而避免一次静默的硬件故障破坏为期一周的训练运行。Epilog 脚本通过清理遗留的 Python 进程、清除共享内存段(/dev/shm),并将最终的 GPU 利用率指标记录到计费数据库中,确保卫生性。对于 64-GPU 微调运行,prolog 脚本专门验证每个节点上的全部 8 个 GPU 都具有完整的 P2P 带宽访问,防止单条退化的 NVLink 链路成为整个张量并行组的瓶颈。
最后,可跟踪资源(TRES) 将 Slurm 的记账能力从简单的 CPU/内存跟踪扩展到 GPU 小时、许可令牌或电力预算等资产。真正重要的是按加速器类别进行的经济权重记账:每个受跟踪的资源都带有一个计费权重,因此公平份额可以依据实际经济成本驱动,而非原始核心数。这确保使用 100 台较旧 GPU 的团队不会像使用 100 台旗舰 H100 的团队那样快速耗尽预算,并让组织能够在调度器自身的公平性计算中直接实现针对昂贵资源的项目计费。
这些扩展使 Slurm 更加具备机器学习感知能力,同时保留其批处理调度模型。Kubernetes 则基于不同的契约:用户声明服务与作业的目标状态,控制器持续将集群调节至该状态。
Kubernetes:声明式编排
Kubernetes 是机器学习基础设施的常见平台,尤其适用于需要统一管理训练与推理工作负载的组织Cloud Native Computing Foundation (2024年)。Slurm 的模型是命令式的(“在这些资源上运行这个作业”),而 Kubernetes 采用声明式模型(“确保该状态存在”),使用持续将目标状态与实际状态进行调节的控制回路。这一根本差异影响了机器学习工作负载管理的方方面面,从作业提交到故障恢复。
Cloud Native Computing Foundation. 2024年. Kubernetes: Production-Grade Container Orchestration.
声明式模型的力量在于其对故障处理的方式。Slurm 的恢复依赖于配置且面向批处理:slurmctld 可以通过 slurmd 心跳检测节点故障,并在设置 Requeue=1 时重新排队作业,但恢复语义需要显式配置才能表现为持续调节的控制回路。在 Kubernetes 中,控制回路持续将目标状态(例如 Deployment 的”该推理工作器应有 4 个副本在运行”,或 Job 的已配置重试策略)与实际状态进行比较,当检测到偏差时,会自动在健康节点上创建替换 Pod。就分布式训练而言,副本替换语义通常来自更高层的 operator,如 Kubeflow 的 PyTorchJob 或 MPIJob,而非 Kubernetes 的核心原语。这种自愈行为降低了运维负担,但也引入了复杂性:系统行为源于控制回路之间的相互作用,而非显式命令,因此在出现问题时调试更加困难。
Kubernetes 的控制回路架构建立在控制器模式[^fn-controller-k8s-reconciliation]之上:控制器监视集群的实际状态(存储在 etcd 中,即 Kubernetes 用于 API 状态的分布式键值存储),将其与目标状态(用户通过 Deployment、Job 和 StatefulSets 等 API 对象指定)进行比较,并采取纠正措施以消除差距。该模式在每个层级重复出现:Deployment 控制器确保存在正确数量的 Pod,调度器将 Pod 分配给节点,每个节点上的 kubelet 确保容器正在运行,节点控制器检测节点故障。每个控制器独立运行,仅通过 etcd 中的共享状态进行通信,这使得系统对单个控制器故障具有鲁棒性,但当多个控制器相互作用时可能产生难以逐步骤调试的涌现行为。
[^fn-controller-k8s-reconciliation]:控制器模式(调节回路):一种”电平触发”设计,控制器持续将目标状态与实际状态进行比较,区别于对单个事件作出反应的”边沿触发”系统。这一区别对机器学习集群至关重要:如果控制器崩溃并重启,它会重新读取当前状态并实现自愈,而无需事件日志。代价是,多个独立控制器之间的涌现交互可能产生难以顺序调试的意外调度行为。
原生 Kubernetes 缺乏机器学习感知的调度,但扩展填补了这一空白。GPU 调度依赖于设备插件,它将加速器暴露为可调度扩展资源。NVIDIA 设备插件将 GPU 注册到 kubelet(节点级代理),从而使得 Pod 规范能够通过标准 Kubernetes 资源模型声明式地请求 GPU 资源。代码 1 展示了由此产生的 Pod 片段。
nvidia.com/gpu resource name follows Kubernetes extended resource conventions, where the domain prefix identifies the device plugin vendor. This declarative syntax enables portable GPU workload definitions across any Kubernetes cluster with the NVIDIA device plugin installed.
# Kubernetes pod resource specification for GPU allocation
resources:
  limits:
    nvidia.com/gpu: 4  # Request exactly 4 GPUs for this pod
  requests:
    cpu: "32"
    memory: "256Gi"
这种二值分配模型为推理工作负载带来了显著的效率损失。一个处理少量请求的小模型可能只需占用 GPU 计算与内存容量的一小部分,但 Kubernetes 会分配整个 GPU,从而浪费剩余容量。对于饱和 GPU 计算能力的训练工作负载,全设备分配是合适的;而对于资源需求波动且通常不大的推理工作负载,它造成了与 Slurm 中部分节点分配相同的碎片化问题。
多实例 GPU (MIG)7
7 Multi-Instance GPU (MIG): MIG 随 A100(2020 年)一同推出,可将单个 GPU 划分为多达 7 个硬件隔离实例,每个实例配备专用的内存控制器、L2 缓存切片和计算单元(NVIDIA Corporation 2020年)。隔离在硬件层面强制执行,而非通过时间分片实现,因此相比纯软件共享,嘈杂邻居干扰有所降低。代价是刚性:分区配置无法在不卸载全部工作负载的情况下更改,这使得 MIG 不太适合工作负载构成快速变化的集群。
NVIDIA Corporation. 2020年. NVIDIA A100 Tensor Core GPU Architecture. NVIDIA Whitepaper, V1.0.
8 Noisy Neighbor: 源自多租户住房的隐喻,指一位居民的某种活动(如大声放音乐)打扰了另一位居民的安宁。在 GPU 集群中,当某个任务的突发网络流量或内存总线利用率拖慢了同一节点上的共置任务时,就会出现这种现象。对于分布式训练,嘈杂邻居会严重损害效率,因为最慢的那条流量决定了全局 AllReduce 时间。
MIG 技术通过把 A100 (80 GB) 和 H100 (80 GB) GPU 划分为硬件隔离的实例,来消除这种低效。与基于软件的 GPU 共享不同,MIG 会为每个实例专门分配内存、缓存和计算资源,从而避免不同工作负载之间的相互干扰,并消除嘈杂邻居8 效应。A100 MIG 配置 在@tbl-fleet-orchestration-mig-profiles 中展示了调度后果:单个物理 A100 被划分为若干固定大小的资源,设备插件可以将其暴露为各自可独立调度的加速器。
| MIG Profile | GPU Memory | SM Count | Typical Workload |
|---|---|---|---|
| 1g.10gb | 10 GB | 14 SMs | Small inference |
| 2g.20gb | 20 GB | 28 SMs | Medium inference |
| 3g.40gb | 40 GB | 42 SMs | Large inference |
| 7g.80gb | 80 GB | 98 SMs | Training |
正如@sec-fleet-orchestration-gang-scheduling 所述,Kubernetes 默认的 Pod 调度彼此独立,因此机器学习平台会在“全有或全无”的启动要求下加入 admission 或 gang 语义。默认调度器逐个评估 Pod,并把每个 Pod 放到最佳可用节点上。对于一个包含 64 个 Pod 的分布式训练任务,这意味着 64 次相互独立的调度决策,没有任何保证说 64 个 Pod 都能成功。如果集群只能容纳 60 个 Pod 的资源而不足以容纳 64 个,默认调度器可能会放置 60 个 Pod,而让其余 4 个保持待调度状态,从而产生恰好等同于 gang 调度所避免的部分分配浪费。PodGroup 风格的抽象——无论是通过调度器插件还是更高层的批处理控制器实现——都为平台提供了一个与训练任务相匹配、而非与单个 Pod 相匹配的 admission 单元。
Volcano9 批处理调度器和 Coscheduling 调度器插件通过 PodGroup 抽象来弥补这一缺口。PodGroup 声明一组 Pod 必须被同时调度,并指定一个最小成员数,在该组中所有成员都满足之前,组内任何 Pod 都不会开始调度。调度器对整组进行原子评估:要么所有最小成员都能被放置并同时调度,要么一个都不放置,该组则在队列中等待。这便将 Kubernetes 的 Pod 级调度转变为尊重分布式训练“全有或全无”要求的任务级调度。
9 Volcano: 由华为开源、现为中国云原生计算基金会(CNCF)孵化项目的 Volcano,完全取代 Kubernetes 默认调度器,通过其 PodGroup CRD 添加 gang 调度。这种替代方案为多 Pod 机器学习训练任务提供了强原子性保证,但也带来运行风险:Volcano 中的任何缺陷都会影响集群上的全部调度决策,而不只是批处理工作负载。
优先级类别与抢占
优先级类别(PriorityClass)控制 Kubernetes 中的抢占行为,并建立一套决定哪些工作负载向其他工作负载让出资源的层级。典型的生产配置会赋予推理工作负载高优先级(确保满足服务级目标(SLO)),训练工作负载中等优先级,开发任务低优先级。默认优先级类别行为 preemptionPolicy: PreemptLowerPriority 允许优先级更高的待调度 Pod 在为其腾出空间时驱逐优先级较低的 Pod。带有 preemptionPolicy: Never 的优先级类别不会抢占:其 Pod 可以排在优先级较低的 Pod 之前进入调度队列,但不会驱逐正在运行的 Pod,并且仍可能被优先级更高的 Pod 抢占。组织必须谨慎权衡优先级层级:过于激进的推理抢占会导致训练任务反复被抢占和重启,而过于宽松的训练优先级则可能在需求高峰期饿死推理。Kubernetes 的优先级与抢占机制与后续在 容错 中开发的检查点感知抢占模式相集成,其中被抢占的训练任务在让出资源前保存状态,从而最大限度地减少无效计算。
Kueue,10 是一种较新的、原生于 Kubernetes 的作业排队系统,代表了一种将准入控制与调度分离开来的新兴方法。与完全替换 Kubernetes 调度器的 Volcano 不同,Kueue 管理作业何时进入集群,而默认调度器(或任何兼容的调度器)负责 Pod 被放置在哪里。这种职责分离具有实际优势:Kueue 可以与现有 Kubernetes 基础设施并行部署,而不会干扰正在运行的工作负载;同时,它能够自然地融入面向拓扑感知的 Pod 放置等功能的调度器插件生态。
10 Kueue: 由 Google 开发的 Kueue 将准入控制(作业何时进入集群)与调度(Pod 被放置在哪里)分离开来,这与完全替换调度器的 Volcano 不同。这种侵入性较低的设计可以并行部署于现有 Kubernetes 基础设施而不会干扰正在运行的工作负载,但它缺少 Volcano 所提供的强 gang scheduling 保证,迫使团队在部署安全性与调度原子性之间做出取舍。
Kueue 通过代表组织团队或项目的 ClusterQueue 提供公平份额调度。每个队列都设有资源配额、借用策略(允许队列使用其他队列的闲置容量)以及抢占策略(在资源所属队列需要时回收被借用的资源)。例如,一个研究团队队列可能在非高峰时段借用生产团队队列的闲置容量,并在生产团队提交紧急工作、通过抢占机制自动归还资源。这种借用机制与 Slurm 中的分层公平份额方法类似,但通过 Kubernetes 的声明式模型而非 Slurm 的命令行配置来表达。
Kubernetes 生态中的 ML 训练
Kubernetes 提供了编排原语,但要弥合微服务编排与高性能训练之间的差距,还需要一套专门的 operators 与 plugins 生态。每个扩展都会将原本隐藏的运行约束暴露给平台:作业原子性、网络旁路、检查点存储或遥测。该生态为 Kubernetes 补充了 HPC 环境中的批处理、硬件加速和可观测性能力。
训练 operators 生态 通过为 Kubernetes 扩展作业特定的 Custom Resource Definitions(CRDs)来简化分布式训练。Kubeflow Training Operator 为 PyTorchJob、TFJob 和 MPIJob 资源提供控制器,从而自动化分布式工作负载的复杂生命周期。PyTorchJob 规范定义了工作节点数量、容器镜像和资源需求;随后 operator 会创建所需的 Pod,并配置分布式环境变量,例如 MASTER_ADDR、MASTER_PORT、WORLD_SIZE 和 RANK。如果某个工作节点 Pod 发生故障,operator 可以检测到这一偏差并创建替换 Pod 以恢复期望的副本数,但训练状态的恢复仍然依赖于框架的检查点与 rendezvous 逻辑。
要在 Kubernetes 中实现高网络性能,往往需要旁路那些为普通微服务而非紧密同步的集合通信而设计的网络层。容器网络接口(Container Network Interface)配置、overlay 网络以及 CPU 切换都可能为关键的反向梯度同步路径引入额外延迟或降低有效带宽。对于带宽敏感的训练,Host Networking (hostNetwork: true) 允许 Pod 完全旁路容器网络,直接访问宿主机的网络命名空间以及远程直接内存访问(RDMA)设备。NVIDIA Network Operator 自动完成实现该性能所需的底层配置,管理 RDMA 设备插件、SR-IOV 虚拟函数分配以及 GPUDirect RDMA 配置。当其余各层得到正确配置时,这种旁路能力可使容器化工作负载接近裸金属互连性能。
存储集成与调度范式
存储集成解决了“检查点风暴”问题,即数千台 GPU 同时写入 TB 级状态。Kubernetes 的 PersistentVolumeClaims(PVC)抽象了底层存储互连结构,该结构可能是 Lustre 或 GPFS 等并行文件系统,也可能是通过 Container Storage Interface 驱动器提供的高性能对象存储。关键的架构挑战在于防止这些同步写操作耗尽存储后端。具备服务质量策略的存储类别(storage classes)与客户端侧限流(client-side throttling)对于确保一个写入 2 TB 检查点的 1,024-GPU 训练任务不会饿死其他工作负载或导致存储元数据服务器崩溃至关重要。
训练集群的可观测性栈 将通用集群监控与专用硬件遥测相结合。Prometheus 和 Grafana 提供采集与可视化层,而 Data Center GPU Manager(DCGM)导出器则暴露细粒度的 GPU 指标:利用率、内存带宽、温度和 ECC 错误。该栈提供了多租户效率所必需的利用率仪表板,使运维人员能够区分真实的计算饱和与 I/O 受限的空闲。
我们 175B 模型的 1,024-GPU 预训练运行使用这套完整的 Kubernetes 栈。工作负载以 PyTorchJob 定义,包含 128 个 worker pod,每个 pod 申请 8 台 GPU。启用 Host networking,以便 NVLink 直连节点直接访问 InfiniBand。由高性能 Lustre 文件系统支撑的 PVC 提供对 100 TB 训练数据集的访问,并吸收周期性检查点。DCGM 指标流式传输至 Prometheus,当任何 GPU 报告不可纠正的 ECC 错误,或 NVLink 带宽低于预期基线时触发告警。
选择范式
Slurm 与 Kubernetes 之间的选择很少是非黑即白的;它取决于工作负载构成、组织背景以及不同系统质量要素的相对重要性。理解每种范式的优势所在,有助于指导架构决策。
Slurm 在纯训练集群中表现最佳,因为可预测性和接近裸金属的性能最为重要。其直接的资源管理避免了 Kubernetes 引入的容器开销(容器网络会增加微秒级延迟,并将有效网络带宽降低 1 到 5 个百分点),其批处理调度模型与需要获得有保障、不间断的特定硬件访问的长运行训练任务自然契合。Slurm 的集中式调度器对集群状态具有全局可见性,从而支持综合考虑公平份额、作业规模、队列深度和资源可用性的复杂多因素优先级决策。国家实验室、大学研究集群以及专用训练基础设施通常更青睐 Slurm,因为这些环境优先追求最高硬件利用率和尽可能低的开销,且其批处理工作负载相对同质。
Kubernetes 在混合训练—服务集群中表现最佳,因为统一管理、滚动更新和 service mesh 集成降低了运维复杂度。同时运行训练流水线与生产推理端点的组织,能够从单一控制平面通过一致的 API 管理这两类工作负载。Kubernetes 的声明式模型简化了运维流程:部署一个新模型版本意味着更新 Deployment 规格,而 Kubernetes 会自动处理滚动更新、健康检查和回滚。云原生组织、将 ML 作为微服务部署的团队,以及已有 Kubernetes 经验的组织通常更青睐 Kubernetes,因为将 ML 工作负载添加到现有平台的边际成本,低于运行一套独立的调度系统。
许多生产环境已经认识到,单一范式无法满足全部需求,因此会同时部署两套系统并承担互补角色。一种常见架构是:Slurm 用于专用训练集群,那里最看重原始性能和调度精细度;Kubernetes 用于推理服务、流水线编排以及更轻量的训练工作负载(微调、小规模实验)。正在形成的模式是,将 Kubernetes 用作外层编排层,通过 Kubernetes operator 提交 Slurm 作业以执行大规模训练运行。这种混合架构在保留 Slurm 批处理调度能力(用于最需要的任务)的同时,实现了统一管理并兼顾可观测性。
Slurm 与 Kubernetes 的取舍 围绕与 ML 工作负载最相关的维度 Slurm 与 Kubernetes 用于机器学习工作负载 展开。
| 维度 | Slurm | Kubernetes |
|---|---|---|
| 调度模型 | 命令式:用户指定确切资源,调度器为其分配资源 | 声明式:用户指定期望状态,系统持续进行对账 |
| 故障处理 | 依赖配置的重新排队与检查点工作流 | 通过控制回路实现自愈 |
| 组/原子多节点启动 | 原子作业分配加回填;Slurm 的“组调度”(gang scheduling)具体指时间分片/抢占 | 生产集群通常使用基于 PodGroup 的支持,如 Volcano、Coscheduling、Kueue,或上游 alpha 组调度 |
| 公平共享 | 成熟的、多因素优先级,可配置衰减 | Kueue 提供基础公平共享,支持 ClusterQueue 借用 |
| 容器开销 | 当作业直接在节点上运行时,容器运行时不产生开销 | 依赖配置的通信开销与容器启动时间 |
| 服务管理 | 没有对长运行服务的原生支持 | 原生 Deployment、滚动更新、健康检查 |
| 生态 | MPI、OpenMP、科学计算库 | 云原生、微服务网格、可观测性栈 |
调度范式的选择也反映了组织的演进路径(Slurm 与 Kubernetes 用于机器学习工作负载)。以 HPC 导向训练基础设施起步的团队可能先使用 Slurm,再为服务加入 Kubernetes。以云原生应用基础设施起步的团队可能先使用 Kubernetes,再为训练加入 HPC 导向的扩展(Volcano、Kueue)。两条路径都可以形成功能完备的混合架构,但起点决定了哪些能力最强、哪些需要投入最多资源进行开发。
实践中的混合架构
Slurm 与 Kubernetes 之间的选择往往看似非此即彼,但工程组织可以部署混合架构,以同时发挥两个系统的优势。相关的边界同样遵循工作负载语义而非标签。刚性的、对拓扑敏感的作业适合批处理调度器的原子分配契约,而可塑性的服务则适合持续调整副本数的对账回路。部分训练作业具有弹性,部分服务副本则是刚性的多加速器组,因此“训练”和“服务”本身都无法单独确定控制平面。
Kubernetes 覆盖 Slurm 模式将 HPC 调度器封装在云原生控制平面之内。Kubernetes 通过自定义 operator 管理训练作业的生命周期,同时将批处理准入和放置委托给 Slurm。核心的工程问题在于归属权:每个放置必须由且仅由一个控制平面授权,而外层控制器对账生命周期状态,且不发出冲突的分配。这种安排结合了声明式管理界面与 Slurm 的批处理及拓扑策略,但也产生了跨控制平面的故障边界,必须由操作者显式隔离。
Slurm 与 Kubernetes 并行 模式采取更粗粒度的方法,为训练和服务分别维护独立的集群,二者共享同一批物理节点。元调度器或容量代理充当仲裁者,依据需求信号在 Slurm 分区与 Kubernetes 集群之间动态重新分配节点。在密集训练期间,节点从 Kubernetes 释放并加入 Slurm;在产品发布或流量突增期间,流向则相反。主要挑战是模式切换成本:释放节点、变更其归属与配置、并使其进入另一个控制平面,耗时远长于一次普通的放置决策。这种延迟将共享限制为计划性的容量转移,而非逐秒的推理突发。
新兴的统一平台(如 Ray)试图彻底消除这种二分法,为训练和服务提供单一运行时。Ray 实现了自己的分布式调度器,原生处理 actor 放置、任务调度与资源管理。这消除了训练(有状态 actor)与服务(无状态副本)之间的阻抗失配,使得单个 Python 脚本即可定义训练循环,并无缝过渡为部署流水线。代价是成熟度:Ray 在编排灵活性方面表现出色,但其调度逻辑缺乏 Slurm 数十年加固积累,也缺少 Kubernetes 的庞大生态支持,实际上要求平台团队承担更多可靠性与隔离责任。
将这些模式串联起来,考虑我们 175B 参数模型的整个生命周期。训练阶段在 Slurm 上运行,以最大化 NVLink 拓扑效率并为多个月份的长运行提供组调度可靠性。训练完成后,模型产物移交 Kubernetes 进行服务,滚动更新与自动伸缩确保终端用户的高可用性。两者之间的桥梁是一个 Kubernetes operator,它监控训练进度;当验证损失趋于稳定时,会自动触发量化流水线,并将生成的模型部署到推理集群。
这些选择对运行环境的影响是可量化的,但具体数值取决于工作负载构成与本地平台的成熟度。纯 Slurm 环境可最小化批处理作业开销,并保持专用训练集群的高利用率,但需要额外的工程投入来构建生产级服务基础设施。纯 Kubernetes 环境通过采用标准云原生工具减少了运维碎片化,但分布式训练可能需要批处理扩展,以避免调度碎片化。混合方案则面向效率前沿:在保留强批处理训练放置保证的同时,为服务与流水线工作负载提供统一的管理面,代价是架构复杂度增加。
Systems Perspective 1.3: HPC 与云的原生调度正在融合
HPC 与云原生调度之间的鲜明界限正迅速模糊,因为两个社区都在相互借鉴特性。Kubernetes 正通过 Volcano 和 Kueue 项目演进批处理能力,引入队列、优先级和 gang 调度等原本仅见于 HPC 的概念。反过来,Slurm 也在采用云特性,如 REST API、容器运行时支持和弹性伸缩。行业正趋向于统一的 fleet 操作系统:一个兼具云的原生声明式 API 与容错能力、又具备超级计算机严格放置保证与性能的系统。
这种融合将范式选择转变成了面向工作负载的设计决策:团队必须在叠加拓扑约束之前,先确定哪些调度保证是重要的。
Checkpoint 1.1: 调度范式权衡
在章节转向拓扑感知调度之前,先回顾以下核心权衡:
编排范式将分区内的 GPU 视为可互换单元,但物理位置的重要性与数量同等:同样的 64 个 GPU,若分散部署在不同机柜中,运行速度会远慢于集中部署于同一机柜。拓扑感知调度正是利用这一结构。
拓扑感知调度
将 64 个 GPU 随机分配到庞大的数据中心中,会严重损害同步训练作业,使其比将这 64 个 GPU 集中部署于同一机柜时慢 15% 到 30%。此前讨论的调度算法将 GPU 视为可互换单元,而拓扑感知调度则认识到,在网络互连结构中的物理邻近性几乎与原始算力同等关键。
拓扑层级
现代 GPU 集群呈现出一套多级通信层次结构,每一层的带宽逐级下降、延迟逐级升高。这一层次结构并非调度器可以忽略的实现细节,而是一项直接决定通信密集型工作负载训练吞吐量的物理约束。理解该层次结构,是做出能够将已分配资源转化为有效工作的放置决策的前提。
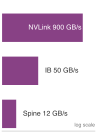
从 NVLink 到脊背交换机的带宽断崖。
在单个节点内部,GPU 之间通过 NVLink 通信,为 A100 系统提供每 GPU600 GB/s 的聚合双向带宽(每个方向 300 GB/s),H100 系统则为900 GB/s(每个方向 450 GB/s)。这种高带宽、低延迟的互连使得张量并行能够高效运行:矩阵运算被拆分到必须逐层交换中间结果(激活值与梯度)的 GPU 之间。NVLink 带宽足以让通信与计算相互重叠,因此在同一节点内受限的张量并行操作可以达到接近理想状态的吞吐量。
同一机架内节点之间,或Leaf Switch Domain 之间,通信经由 InfiniBand 或 RoCE 传输,带宽为400 Gb/s(NDR InfiniBand),每条链路约50 GB/s。这相当于 NVLink 带宽的一个数量级下降。数据并行性在每个训练步骤之后需要对梯度执行 AllReduce,该操作在这一层级能够高效运行,因为分桶后的梯度同步可以与剩余的反向传播计算相互重叠。延迟代价相对有限(微秒级对比纳秒级),且聚合带宽足以承载梯度张量——梯度张量通常小于张量并行中交换的激活值张量。
在通过Spine Switches 连接的机架之间,通信需要跨越额外的交换机跳数,从而引入更高的延迟,并可能因网络拥塞而降低有效带宽。胖树(Clos)网络 中分析的胖树拓扑在理论上提供完整的双划分带宽,但在实践中,并发流量、路由效率不足以及交换机缓冲区限制带来的拥塞,会使跨机架有效带宽较机架内通信降低 10% 到 30%。跨机架通信还会带来尾延迟波动:中位延迟可能仅略高,但在拥塞事件期间 P99 延迟会显著升高,从而在同步训练中产生 straggler 效应——最慢的通信方决定所有 worker 的整体进度。
这一层次结构意味着:完全部署在单个机架内的 64 GPU 作业(8 个节点,全部位于同一 leaf switch 下)将优于将同一作业分散到 8 个机架(每机架 1 个节点,每次 AllReduce 都要跨越脊背交换机)的部署方式。性能差异直接源于@sec-collective-communication 中的通信分析:环形 AllReduce 的延迟随环中最慢链路而增长,跨机架跳数既带来更高延迟,也增加了竞争风险。对于同步训练,每个迭代都必须等待最慢 worker 完成其 AllReduce,因此即使偶发的跨机架拥塞事件,也会造成持续性的吞吐量下降。
因此,调度器必须将集群建模为一张分层图,而不是扁平的计算槽位列表,并在每一层级设置明确的带宽断崖(GPU、Node、Rack 和 Pod 分别对应 NVLink、InfiniBand 和脊背交换机边界@fig-fleet-orchestration-topology-hierarchy)。每次跨越边界都会引入一个数量级的带宽下降;在机架和 pod 层级,网络超配(脊背交换机处通常为 2:1 或 4:1)会进一步限制双划分带宽,使其低于裸链路速率所暗示的水平。一个感知拓扑的调度器会显式针对这些约束进行优化,将“局部性”视为一等资源。对于一个需要 1,024 GPU 的分布式训练作业,若采用碎片化放置将 worker 随机分散到不同机架,端到端训练吞吐量相比部署在单个 pod 内的紧凑放置会下降 15% 到 30%。
unaware vs. topology-aware placement 对比了 4-GPU 张量并行组的最佳放置与分散放置,展示了通信路径如何决定 GPU 是只经过单个叶交换机,还是必须穿越更慢的叶—脊—叶跳数。
:::
:::
Placement 算法
unaware vs. topology-aware placement 所示的带宽差距是关键约束:从机柜内 leaf 路径到跨 rack leaf-spine-leaf 路径的约 4\(\times\) 倍带宽缩减意味着,分散式放置会迫使张量并行组花费更多时间通信而非计算,这一惩罚会在模型的每个 Transformer 层上叠加。拓扑感知的放置算法将作业分配到通信成本最低的节点上,从而把抽象的装箱问题转化为基于集群物理拓扑的图优化问题。最简单的做法使用局部性成本,定义见 公式 1,用于惩罚跨越多个拓扑域的分配:
\[ \text{Cost}_{\text{locality}} = \sum_{i < j} w(d(g_i, g_j)) \tag{1}\]
其中 \(g_i\) 和 \(g_j\) 是分配给该作业的两块 GPU,\(d(g_i, g_j)\) 是它们之间的拓扑距离(同一节点为 0,同一 rack 为 1,不同 rack 为 2),\(w(\cdot)\) 是随距离增加的权重函数。调度器在从可行放置集合中选取分配时最小化该分数。权重函数编码了每一级拓扑的性能影响:\(w(0) = 0\)(同一节点,NVLink,无惩罚)、\(w(1) = 1\)(同一 rack,一跳交换机)、\(w(2) = 10\)(不同 rack,多跳交换机)。同一 rack 与跨 rack 放置之间十倍量的权重差异,反映了穿越 spine 交换机所带来的不成比例的性能影响。
Algorithm 1 将这些要素整合为单一决策:节 1.0.5 的全有或全无 gang 约束、公式 1 的局部性成本,以及上文所述的并行策略与拓扑映射。调度器枚举所有满足约束的分配,按通信成本对每个分配打分,并选取成本最低者;若无可行分配,则让作业排队,而不是让加速器闲置。
\begin{algorithm} \caption{Topology-aware placement} \begin{algorithmic} \Require job requesting $N$ accelerators with tensor-, pipeline-, and data-parallel groups; cluster topology with per-level link costs $w(\cdot)$ \Ensure an all-or-nothing placement of least communication cost, or the job stays queued \State enumerate the feasible slots: sets of $N$ free accelerators that satisfy every resource dimension \Comment{gang: all or nothing} \If{no feasible slot exists} \State leave the job queued without holding any accelerators \Comment{prevents hold-and-wait deadlock} \EndIf \For{each feasible slot} \State map tensor-parallel ranks within an NVLink domain, pipeline stages within a rack, data-parallel replicas across racks \State score the slot by $\text{Cost}_{\text{locality}} = \sum_{i < j} w(d(g_i, g_j))$ \EndFor \State \Return the feasible slot of least $\text{Cost}_{\text{locality}}$ \Comment{topology-optimal, atomic} \end{algorithmic} \end{algorithm}
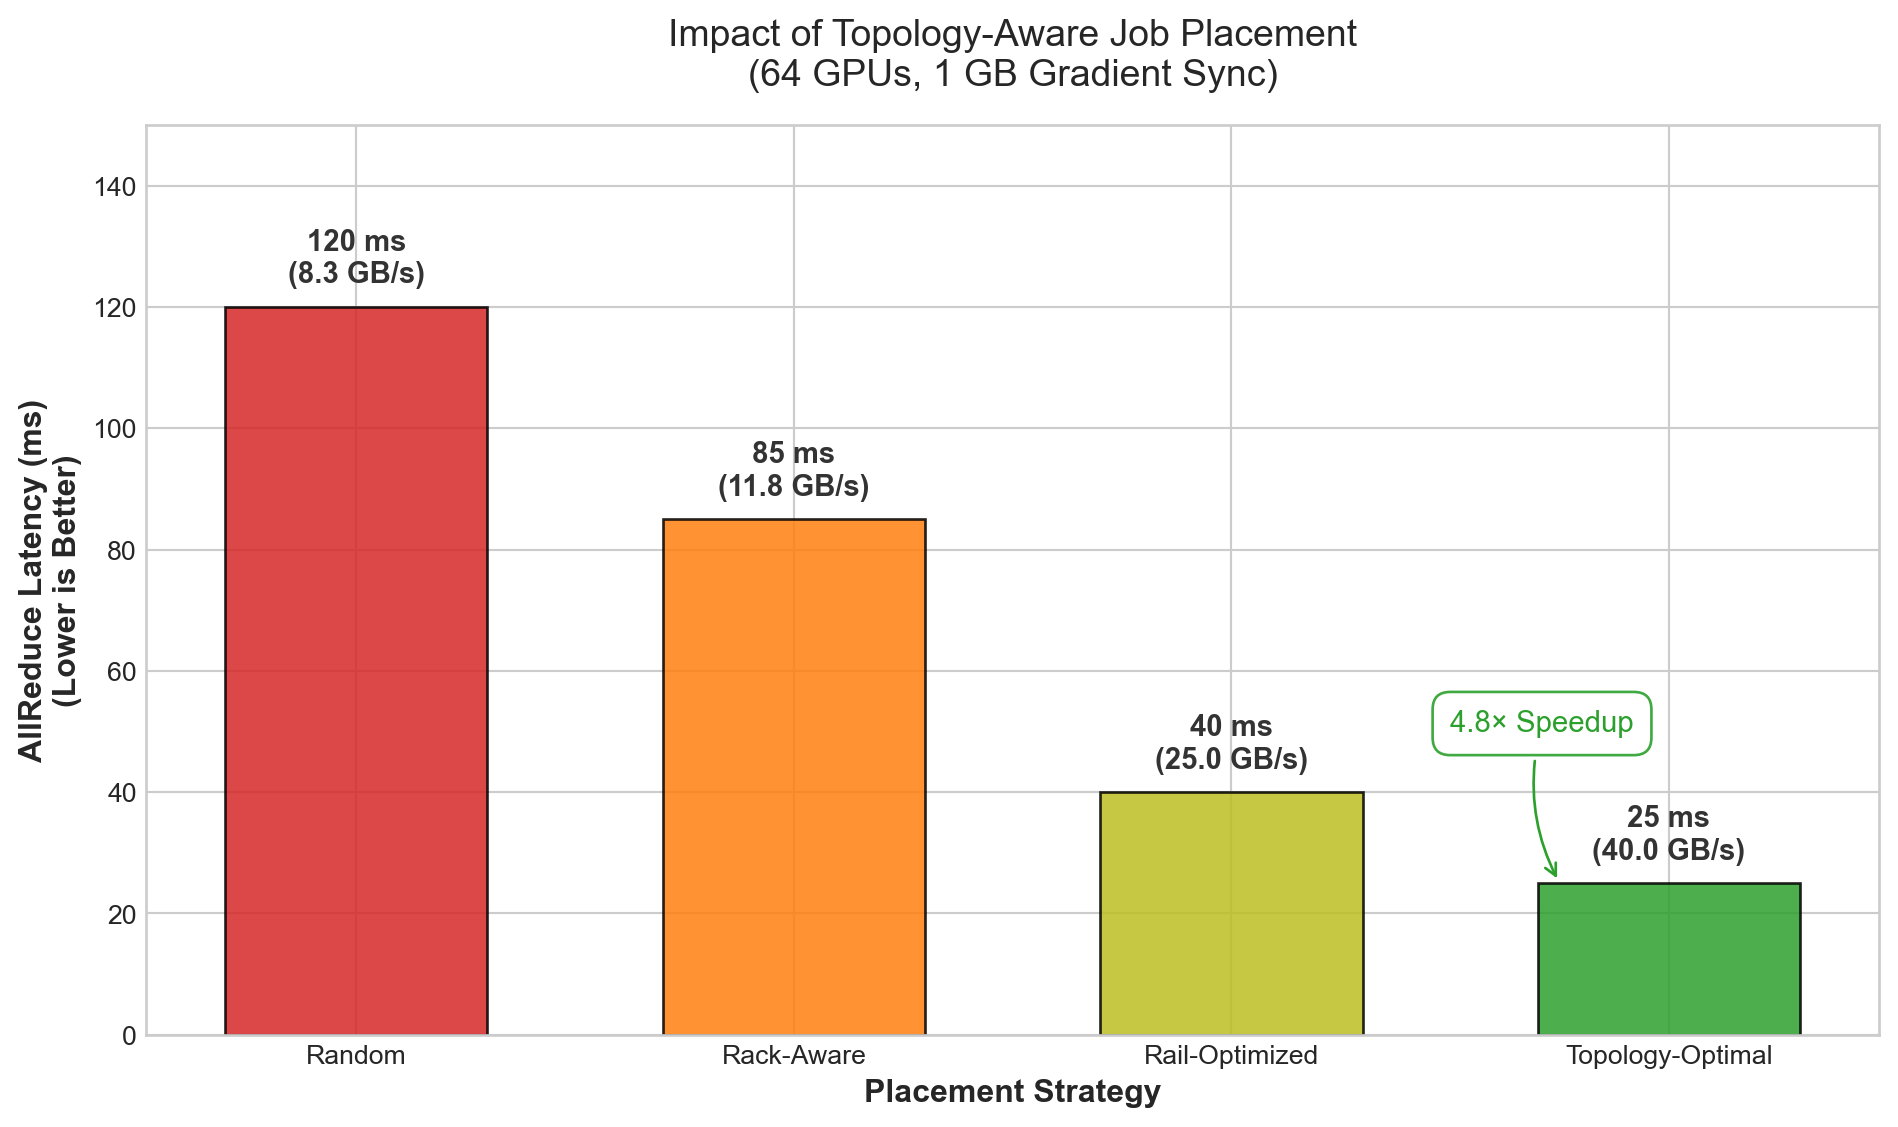
分散式部署比感知拓扑的槽位慢 4.8\(\times\) 倍,这一差距@fig-topology-placement 跨越四种部署策略,从随机到拓扑最优。
分层放置 算法按照与这一并行层次结构相匹配的层级来分配资源。首先,它将张量并行组分配给各个节点,确保张量并行组内的所有 GPU 共享 NVLink 连接。其次,它在机架内将这些节点分组为流水线阶段,将连续的流水线阶段放置在与同一叶交换机相连的节点上。第三,它在机架之间分发数据并行副本,确保每个数据并行组都能访问集群的全部分割带宽,以支持 AllReduce 操作。这种三级放置方式与三级拓扑结构以及三级并行策略相对应,从而在逻辑结构与物理结构之间形成自然的对齐。
Napkin Math 1.2: 拓扑放置的影响
GPU 在网络交换结构上的物理位置会显著影响集合通信性能。考虑一次横跨 64 台 GPU 的 AllReduce 操作:
- 随机放置:分散在多个机柜中 \(\rightarrow\) 流量需穿越核心交换机 \(\rightarrow\) 120 ms 延迟。
- 机柜感知:限制在单个机柜内(Top-of-Rack 交换机) \(\rightarrow\) 85 ms。
- Rail 优化:对齐到专用 “rails”(专用标准 IB 交换机) \(\rightarrow\) 40 ms。
- 拓扑最优:所有 GPU 位于同一 leaf 交换机 \(\rightarrow\) 25 ms。
恰当的调度仅通过遵循网络拓扑即可带来 4.8× 倍的加速,而无需改动模型代码。
拓扑感知放置的计算成本并不小。评估 256-GPU 作业在 10,000-GPU 集群上的所有可能放置方式在组合意义上不可行。生产调度器采用启发式方法:贪心算法自底向上构建放置(先填满 NVLink 域,再填满机柜,然后跨机柜铺开)、带剪枝的树搜索算法(优先探索最有希望的放置),或基于评分的方法(评估一组可行放置的样本并选出最佳)。拓扑感知算法引入的调度延迟(取决于集群规模和算法复杂度,为毫秒到秒量级)相对于数小时到数周的工作负载运行时间可以忽略不计,因此吞吐量提升值得付出调度开销。
Napkin Math 1.3: 拓扑对 3D 并行训练的影响
场景:考虑一个使用 3D 并行性的 256-GPU 训练作业:8 路张量并行、4 路流水线并行、8 路数据并行。
良好放置(拓扑感知):
- 张量并行组:32 个由 8 台 GPU 组成的组,每组限制在同一个 8-GPU 节点内(NVLink:900 GB/s)
- 流水线阶段:同一机柜内的 4 个连续节点(1 次交换机跳,InfiniBand:50 GB/s)
- 数据并行副本:8 个机柜(跨机柜 AllReduce 需 2 次交换机跳)
不良放置(拓扑不感知):
- 张量并行组被拆到 2 个节点(改用 InfiniBand 而非 NVLink)
- 流水线阶段分散在不同机柜(2 次交换机跳,而非 1 次)
- 数据并行副本随机分布
数学:仅张量并行通信就足以说明影响程度。NVLink 每个方向的吞吐为 450 GB/s,一次 1 GB 激活传输约需 2.2 ms。在 50 GB/s 的 InfiniBand 上,同样的传输约需 20 ms,即慢 9×。
系统洞察:4.8× 的 AllReduce 延迟差值 图 5 仅是通信测量的结果;由于同步训练会将大部分该通信与下一轮迭代计算重叠,它并不会转化为 4.8× 的端到端惩罚。由于张量并行在每个 Transformer 层都进行通信(大型模型通常有 80 多层),暴露出的通信开销会累积为 15% 到 30% 的总训练吞吐量下降,这是 3D 并行作业中应当沿用的数值。
Rail 优化调度
大型 GPU 集群越来越多地采用 Rail-Optimized Topologies:节点中的每个 GPU 连接到不同的网络交换机,从而在网络互连结构中形成并行的 “rails”。该设计(见 轨道优化拓扑)通过在独立的交换机层级之间分配流量,为所有 GPU 提供均衡的带宽。不过,它也带来了一个调度约束:当通信 GPU 位于同一 rail(连接到同一交换机链)时,AllReduce 效率最高,因为同 rail 通信可以避免跨 rail 流量,从而消除共享交换机端口上的拥塞。
Rail 感知调度将数据并行副本分配到对应 GPU 共享同一 rail 的位置。对于每节点 8 台 GPU、共 8 条 rail 的集群,所有节点的 GPU 0 连接到 rail 0,GPU 1 连接到 rail 1,以此类推。调度器将数据并行 rank \(r\) 放置在所选节点的 GPU \(r \bmod 8\) 上,确保每个数据并行组的 AllReduce 仅穿越单条 rail 交换机层级,而不是跨越 rail。这种对齐意味着 AllReduce 流量被限制在相互独立的交换机树中,消除了数据并行组之间的争用,并为每个组提供其专用 rail 的完整带宽。
Rail 感知调度与拓扑感知放置之间的相互作用构成了一个多维优化问题。调度器必须同时优化节点内 NVLink 局部性(张量并行要求 GPU 位于同一节点)、机柜内交换机局部性(流水线并行受益于阶段间的最小交换机跳数)以及 rail 对齐(数据并行受益于同 rail 通信)。这三个目标部分相互冲突:将数据并行副本限制在每个节点内的特定 GPU 位置(用于 rail 对齐)会削弱调度器依据机柜局部性选择节点的能力;而为 NVLink 局部性要求整节点分配,则妨碍了在不同作业之间共享节点,从而降低打包效率。
生产调度器使用加权评分函数来解决这些冲突,并根据工作负载特性对约束进行优先级排序(图 6)。对于使用 3D 并行性的大型训练作业,张量并行局部性获得最高权重(因为 NVLink 到 InfiniBand 的性能下降幅度最大),其次是 rail 对齐(因为它消除了最高频通信模式下的拥塞),再次是机柜局部性(因为性能收益较小,且可通过计算—通信重叠部分补偿)。对于纯数据并行作业,rail 对齐获得最高权重。对于单节点作业,拓扑约束无关紧要,调度器仅优化打包效率。
拓扑发现与动态适配
像 Slurm 的 topology.conf 或 Kubernetes 节点标签这类静态配置文件,为集群提供了一张基线地图,但它们表示的是预期状态,而非实际生效状态。真正的拓扑发现 需要运行时内省,以验证物理硬件是否与架构示意图相符。例如 NCCL 之类的库完全绕过静态配置,在 /sys/class/infiniband 解析 Linux 虚拟文件系统,以映射 PCIe 总线层级、枚举 NVLink 连接,并验证网卡(NIC)的邻近性。由此得到的是一张“真值”图,其中边表示已验证、可运行的链路,而非理论上的线缆。
集群拓扑是一种运行状态,而非固定示意图。硬件故障、维护窗口和热节流会不断重塑调度器实际可用的有效拓扑。Clos 网络中单个脊交换机的故障并不会完全切断连通性,但会大幅降低跨越受影响机架的作业可用的二分带宽。如果承载我们 175B 参数模型的并行数据 AllReduce 组所依赖的脊交换机发生故障,跨机架带宽可能下降 50%。调度器面临一个关键的优化决策:以降低后的吞吐量继续训练,相当于让昂贵的 GPU 周期白白等待 25% 的滞后梯度;或者启动感知拓扑的迁移。
迁移并非免费:它需要一次协同检查点、一次作业终止、在健康节点上的重新调度事件,以及一个预热阶段。该过程通常消耗 5 到 15 分钟的空闲时间。然而,对于持续数周的训练运行,从数学上看迁移往往更有利。如果网络劣化带来 20% 的吞吐量惩罚,那么 10 分钟迁移的盈亏平衡点不到一小时训练时间。精妙的编排器会持续监控由集合通信库上报的有效带宽指标;当分配拓扑得分与实测吞吐量之间的差值超过阈值时,调度器会触发“先排空、再迁移”的工作流,将网络劣化与 GPU 硬件故障同等对待。
Example 1.2: 跛脚的交换机
场景:一个多节点基础模型训练作业出现 30% 的吞吐量下降,而静态拓扑图显示带宽完整,GPU 硬件健康检查也报告为正常。
诊断:单个叶交换机的收发器出现高 CRC 错误率和数据包重传。二进制上下探测均通过,但劣化的二分带宽使整个训练作业的 AllReduce 通信陷入停滞。
系统启示:二进制健康检查不足以支撑分布式训练互连。调度器需要感知性能的拓扑监控,跟踪重传与集合带宽,并动态隔离性能劣化的网络链路。
一般的调度思路是隔离(quarantine):当运行时证据表明某个节点、机架或链路已劣化时,即使名义资源数量看起来仍然可用,调度器也不应再将敏感任务放置其上。Kubernetes 通过污点与容忍度,11 实现这一模式,而 Slurm 集群通常使用 drain 状态、节点特性或分区规则。互补的问题是:当可用资源动态变化时,作业应如何自适应。与其将资源分配视为作业整个生命周期内固定不变,弹性训练允许作业在无需完全重启的情况下增长、收缩并恢复。
11 污点与容忍度:Kubernetes 中用于隔离专用硬件的节点排斥原语。通过对 A100 或 H100 节点打污点,编排器可防止通用 Web 微服务占用昂贵的 GPU 容量,确保这些节点仅被声明了显式容忍度的训练作业独占。
弹性调度
当集群需求波动时,刚性分配会产生两类浪费。在低峰时段,运行在 256 GPU 上的作业无法吸收空闲资源以加快训练;在高峰时段,同一作业也无法释放多余资源以容纳更高优先级的任务,除非被完全抢占。调度器仅有的选项是“让它保留全部资源”或“彻底终止它”,中间别无其他。
弹性调度消除了这种二元选择。弹性训练在 弹性恢复 中发展的恢复机制,展示了分布式作业如何在故障后调整工作节点数量、重新校准批大小与学习率,并重建其通信组。从调度器的视角看,同一套能力可以解决需求波动下的资源分配问题。一个训练作业可能以 128 GPU 起步(达到合理吞吐量的最小数量),在资源可用时扩容至 256,当更高优先级的任务到来时收缩至 192,同时始终保持训练进度连续。这种灵活性将调度器的动作空间从二元的 {继续, 抢占} 转变为一个连续的资源分配水平谱系。
调度器—框架契约
弹性调度要求调度器与训练框架之间存在定义明确的契约。调度器保证资源变更通过定义明确的信号传达,并给出足够的提前通知以便优雅适配。框架保证能够在不损坏模型状态的前提下处理资源变更,利用在 弹性恢复机制 中发展的批大小调整、学习率重新校准和通信组重建机制。工作节点成员生命周期遵循 弹性训练工作节点生命周期与状态机 所示的状态机,将工作节点依次经历资源 provisioning、活跃训练、动态再平衡和自愈故障恢复。
:::
:::
从调度器一侧来看,该契约包含三个参数:
- 弹性范围:\([N_{\text{min}}, N_{\text{max}}]\) 指定了该作业可以运行的工作节点数量区间。
- 切换成本: rendezvous 周期通常为 10 到 60 秒,它决定了调度器在不使开销抵消吞吐量增益的前提下能够调整规模的频率。
- 扩展效率曲线:每增加一个工作节点所带来的吞吐量增益,决定了将空闲 GPU 分配给该作业,是否比将其保留给待 gang-scheduled 的作业更具成效。
该契约为调度器提供了足够的信息来调整作业规模,而无需将弹性视为免费容量。
调度器还必须考虑弹性扩展会改变有效批大小这一约束(\(B_{\text{effective}} = B_{\text{per-worker}} \times N\))。处理该约束的两种策略(固定全局批大小与自适应学习率)对调度器调整规模的激进程度施加了不同的限制:固定全局批大小能够保持收敛性,但在低工作节点数量时可能违反每个 GPU 的显存限制;自适应学习率则简化了工作节点管理,却会在快速扩展时引入收敛风险。
TorchElastic 之类的框架会在其启动配置中暴露工作节点成员范围,代码 2 对此进行了说明。
--nnodes=4:16 range configures the elastic worker group to admit 4 to 16 nodes, or 32 to 128 workers. A separate cluster scheduler or operator must acquire, launch, and release nodes within that range.
# Launch elastic training with min 32 to max 128 workers
torchrun \
  --nnodes=4:16 \
  --nproc_per_node=8 \
  --rdzv_backend=c10d \
  --rdzv_endpoint=head-node:29500 \
  --max_restarts=3 \
train.py《--nnodes=4:16》规范将 TorchElastic 的 rendezvous 与 worker 成员范围配置为 4 到 16 个节点(每个节点 8 个进程,即 32 到 128 个工作进程)。它不会获取或调整集群资源。必须由独立的集群调度器或 operator 来放置节点,并在容量变化时启动或停止弹性代理。
Systems Perspective 1.4: 弹性调度与刚性调度对比
考虑一个拥塞的集群,其中一项 128-GPU 作业需要等待 8 小时才能获得完整 gang 分配。
刚性调度:等待 8 小时,然后以满速训练 24 小时。总墙钟时间:32 小时。
弹性调度(最小 32,最大 128):
- 立即以 32 个 GPU 启动(吞吐量=满速的 25%)
- 2 小时后扩容至 64(吞吐量=50%)
- 4 小时后扩容至 128(吞吐量=100%)
- 训练在整个等待期间持续推进
8 小时“排队等待”期间近似完成的工作量:
- 第 0 到 2 小时:\(25\%\) 吞吐量 \(\times\) 2 小时 = 0.5 小时等效量
- 第 2 到 4 小时:\(50\%\) 吞吐量 \(\times\) 2 小时 = 1.0 小时等效量
- 第 4 到 8 小时:\(100\%\) 吞吐量 \(\times\) 4 小时 = 4.0 小时等效量
- 总计:5.5 小时等效满速工作量
弹性作业约在 26.5 小时完成(8 小时扩容训练加上 18.5 小时满速训练),相比刚性调度节省 5.5 小时。这 17% 的提升完全来自在原本会闲置的排队时间内有效利用资源。
调度器不能把每个作业都当作弹性作业来调度。最重要的约束是与模型并行的不兼容。弹性扩展本质上是一个数据并行操作:调度器增加或删除模型副本,改变全局批大小,但保持模型架构不变。对于一项依赖每个节点内 8 路张量并行的 175B 参数作业,弹性只能在节点级别严格操作。该作业可以在 128 个节点(1,024 个 GPU)与 32 个节点(256 个 GPU)之间以整节点为步长进行伸缩,从而改变数据并行度。它无法从张量并行组中弹性移除单个 GPU;这样做需要重新切分模型权重,等同于一次完整的检查点与重启周期。流水线并行原则上允许有限的弹性,但增加或删除阶段会迫使重新计算流水线调度,往往抵消了收益。
转换成本同样限制了调度器的伸缩频率。每次伸缩事件都会带来 10 到 60 秒的吞吐量下降,期间框架正在重建其通信组。调度器必须将该成本分摊到后续运行时长中,因此只有当作业在新规模下运行显著长于转换窗口时,小幅伸缩增量才值得;节 1.3.3 则逐步分析了该规则所排除的抖动(thrashing)区间。
调度器集成
弹性训练的价值在很大程度上取决于调度器集成。若无调度器感知,弹性训练仅仅是一种容错机制(替换失败的工作进程)。有了调度器集成,它就成为一种从根本上改变集群利用率经济性的调度优化。调度器必须理解弹性作业可以在一定范围的资源分配内运行,该范围以 \([N_{\text{min}}, N_{\text{max}}]\) 个工作进程表示,从而启用三项关键调度优化。
最直接有价值的收益是作业启动更快。请求 32 到 128 个 GPU 的弹性作业可以在 32 个 GPU 可用时立即启动,而不是在 gang 调度队列中等待 128 个连续 GPU。在大型作业排队时间可达数小时甚至数天的拥塞集群中,以较低规模立即启动往往比等待满规模分配更早完成作业,这是笔记本 1.4 定量分析的权衡。调度器可以动态计算它,选择使预期总时间(等待时间加执行时间)最小的启动时间与初始规模。
机会式扩容使调度器能够将弹性作业用作灵活的容量吸收器。当资源变得可用(其他作业完成、spot 实例被分配、抢占释放的资源)时,调度器可以扩大正在运行的弹性作业以提高其吞吐量。当资源被需要(高优先级作业到来、预留容量被回收)时,调度器可以缩小弹性作业,而无需将其完全抢占。这种双向灵活性将弹性作业转化为吸收利用率波动的缓冲,平滑已分配容量与有效容量之间的差距。
Graceful preemption 将调度器对资源压力的响应转化为一种渐进式过程。传统调度会直接终止训练任务以回收资源,而调度器可以请求缩容,将任务占用的资源减少,从而为更高优先级的任务释放容量。任务以较少的 worker 继续运行,以较低的吞吐量维持进展,而不是丢失自上次检查点以来的全部进展并付出重启开销。因此,调度器获得的是从“全量资源”到“完全抢占”之间的连续谱系,而非传统调度中的二元选择。Graceful preemption 与基于检查点的抢占能够良好组合:当调度器需要回收全部资源时,它先将任务缩容至最小规模,然后启动检查点并抢占流程,从而最大限度地减少丢失的工作量。
上述全部收益的代价是复杂度。弹性训练需要框架支持(并非所有训练框架都支持它),会引入因批大小变化而带来的潜在收敛性担忧(因此需要验证弹性缩放不会降低模型质量),并会使性能建模更加复杂(任务吞吐量不再恒定,容量规划因而更加困难)。并非所有工作负载都能同等受益于弹性缩放:通信与计算比值较高的任务,随着 worker 数量增加而获得的收益递减(因为通信开销随 worker 数量增长),因此从扩容中获得的收益较少;而计算受限、通信开销较低的任务则更接近线性扩展,更能从机会式缩放中获益。调度器必须针对每个任务建模这些扩展特性,才能做出最优的弹性缩放决策。
弹性缩放策略
为运行中的任务增加资源并不总是能够加快收敛时间。朴素假设“吞吐量随 worker 数量线性扩展”会在通信开销的拖累下失效,因此调度器必须依据经验效率曲线来强制实施弹性缩放策略,而不能仅依据资源可用性。任务在 个 worker 下的缩放效率\(\eta_{\text{scaling}}(k)\),定义为在 \(k\) 个 worker 下观测到的吞吐量与理想线性加速比之比,通常呈现三个不同阶段:计算主导通信的线性阶段、梯度同步延迟开始掩盖计算收益的次线性阶段,以及 AllReduce 环成为瓶颈的饱和阶段。盲目将可用 GPU 分配给处于饱和阶段的任务的调度器,会浪费本可清空队列的集群容量;反之,将任务运行在其 Minimum Viable Scale 以下,则迫使任务以不成比例地低的进展占用内存和网络租赁。
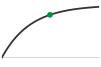
弹性缩放的收益在饱和阶段趋于平坦。
正如 图 7 所示,扩容决策因此是边际效用函数,而非单纯的资源空缺。对于我们 175B 参数的模型,效率曲线来自性能剖析:从 64 到 512 个 GPU 呈线性扩展,在 512 到 1,024 之间转为次线性,超过 1,024 后收益递减。因此,调度器强制弹性范围为 \([256, 1024]\)。若集群存在空闲资源但任务已达到 1,024 个 GPU,调度器会扣留这些额外节点,预测 5% 的边际吞吐量增益不足以抵消重分片开销,或造成排队任务被饿死的机会成本。同样,若仅有 128 个 GPU 可用,调度器可能选择将任务排队而非运行,因为每个 GPU 上的训练强度过低,无法掩盖通信延迟。
这套逻辑同样适用于时间维度:调度器必须权衡较小分配立即取得的进展,与等待更大分配所带来的延迟满足。若一个 512-GPU 作业可以立即使用 128 个 GPU 启动,也可以等待两小时以获取完整请求,那么最优选择取决于对吞吐量随时间的积分。抢占开销(即停止、检查点并重启以调整规模的成本)必须分摊到后续运行时长中。一种“机会式扩展”策略——每当单个节点释放时就调整作业规模——由于分布式进程组持续抖动,往往导致净进展为负。
Napkin Math 1.4: 弹性扩展决策
考虑一个大语言模型训练任务,其目标批大小需要 512 个 A100 才能达到最高效率。在 24 hours 的时间窗口内评估三种调度策略。
给定:在 128 GPUs 时,吞吐量为 1 轮/小时(基线)。在 256 GPUs 时,吞吐量为 1.8 轮/小时(扩展效率为 90 percent)。在 512 GPUs 时,吞吐量为 3.2 轮/小时(扩展效率为 80 percent)。重新扩展的成本为 10 minutes(0.17 hours),用于保存检查点、重新分片和重启。
策略 1 – 立即启动(不扩展):任务立即使用 128 GPUs 启动,并运行完整的 24 hours。总工作量:\(24 \times 1.0 = 24\) 轮。
策略 2 – 等待容量(成组调度):任务在队列中等待 4 hours,直到 512 GPUs 可用,然后运行 20 hours。总工作量:\(20 \times 3.2 = 64\) 轮。
策略 3 – 弹性扩展(逐步扩容):任务立即使用 128 GPUs 启动。经过 4 hours 后,256 GPUs 变为可用。任务暂停、扩容并恢复运行。阶段 1:\(4 \times 1.0 = 4\) 轮。阶段 2:\((24 - 4 - 0.17) \times 1.8 \approx 35.7\) 轮。总工作量:4 + 35.7 = 39.7 轮。
弹性策略完成的等效训练轮数接近立即以小规模运行时的 1.7× 倍,但仍比成组调度少约 38 percent。当排队等待时间延长或峰值容量持续紧缺时,这一差距会缩小;重新扩展的开销仅为 10 minutes,如果这项开销超过 2 hours(由于检查点传输缓慢或编译耗时),策略 3 将进一步落后于策略 2。
迄今讨论的放置与弹性机制着眼于单个任务的效率,优化每个任务使用所分配资源的方式。集群经济性则将目标转向整体层面:当每次放置、抢占和预留都会产生机会成本时,分配策略必须最大化所有任务完成的有效工作量。
成本优化
调度问题 中建立的利用率与美元成本之间的关系,在这里成为调度信号,而非完整的财务模型。编排器在决定是否接纳、延迟、抢占任务或调整任务规模时,会综合考虑资源价格、预留承诺、中断风险、检查点成本和任务截止时间。规模化机器学习运维 负责资本规划、平台回报、成本展示与成本分摊,以及全生命周期总拥有成本等更宏观的问题。
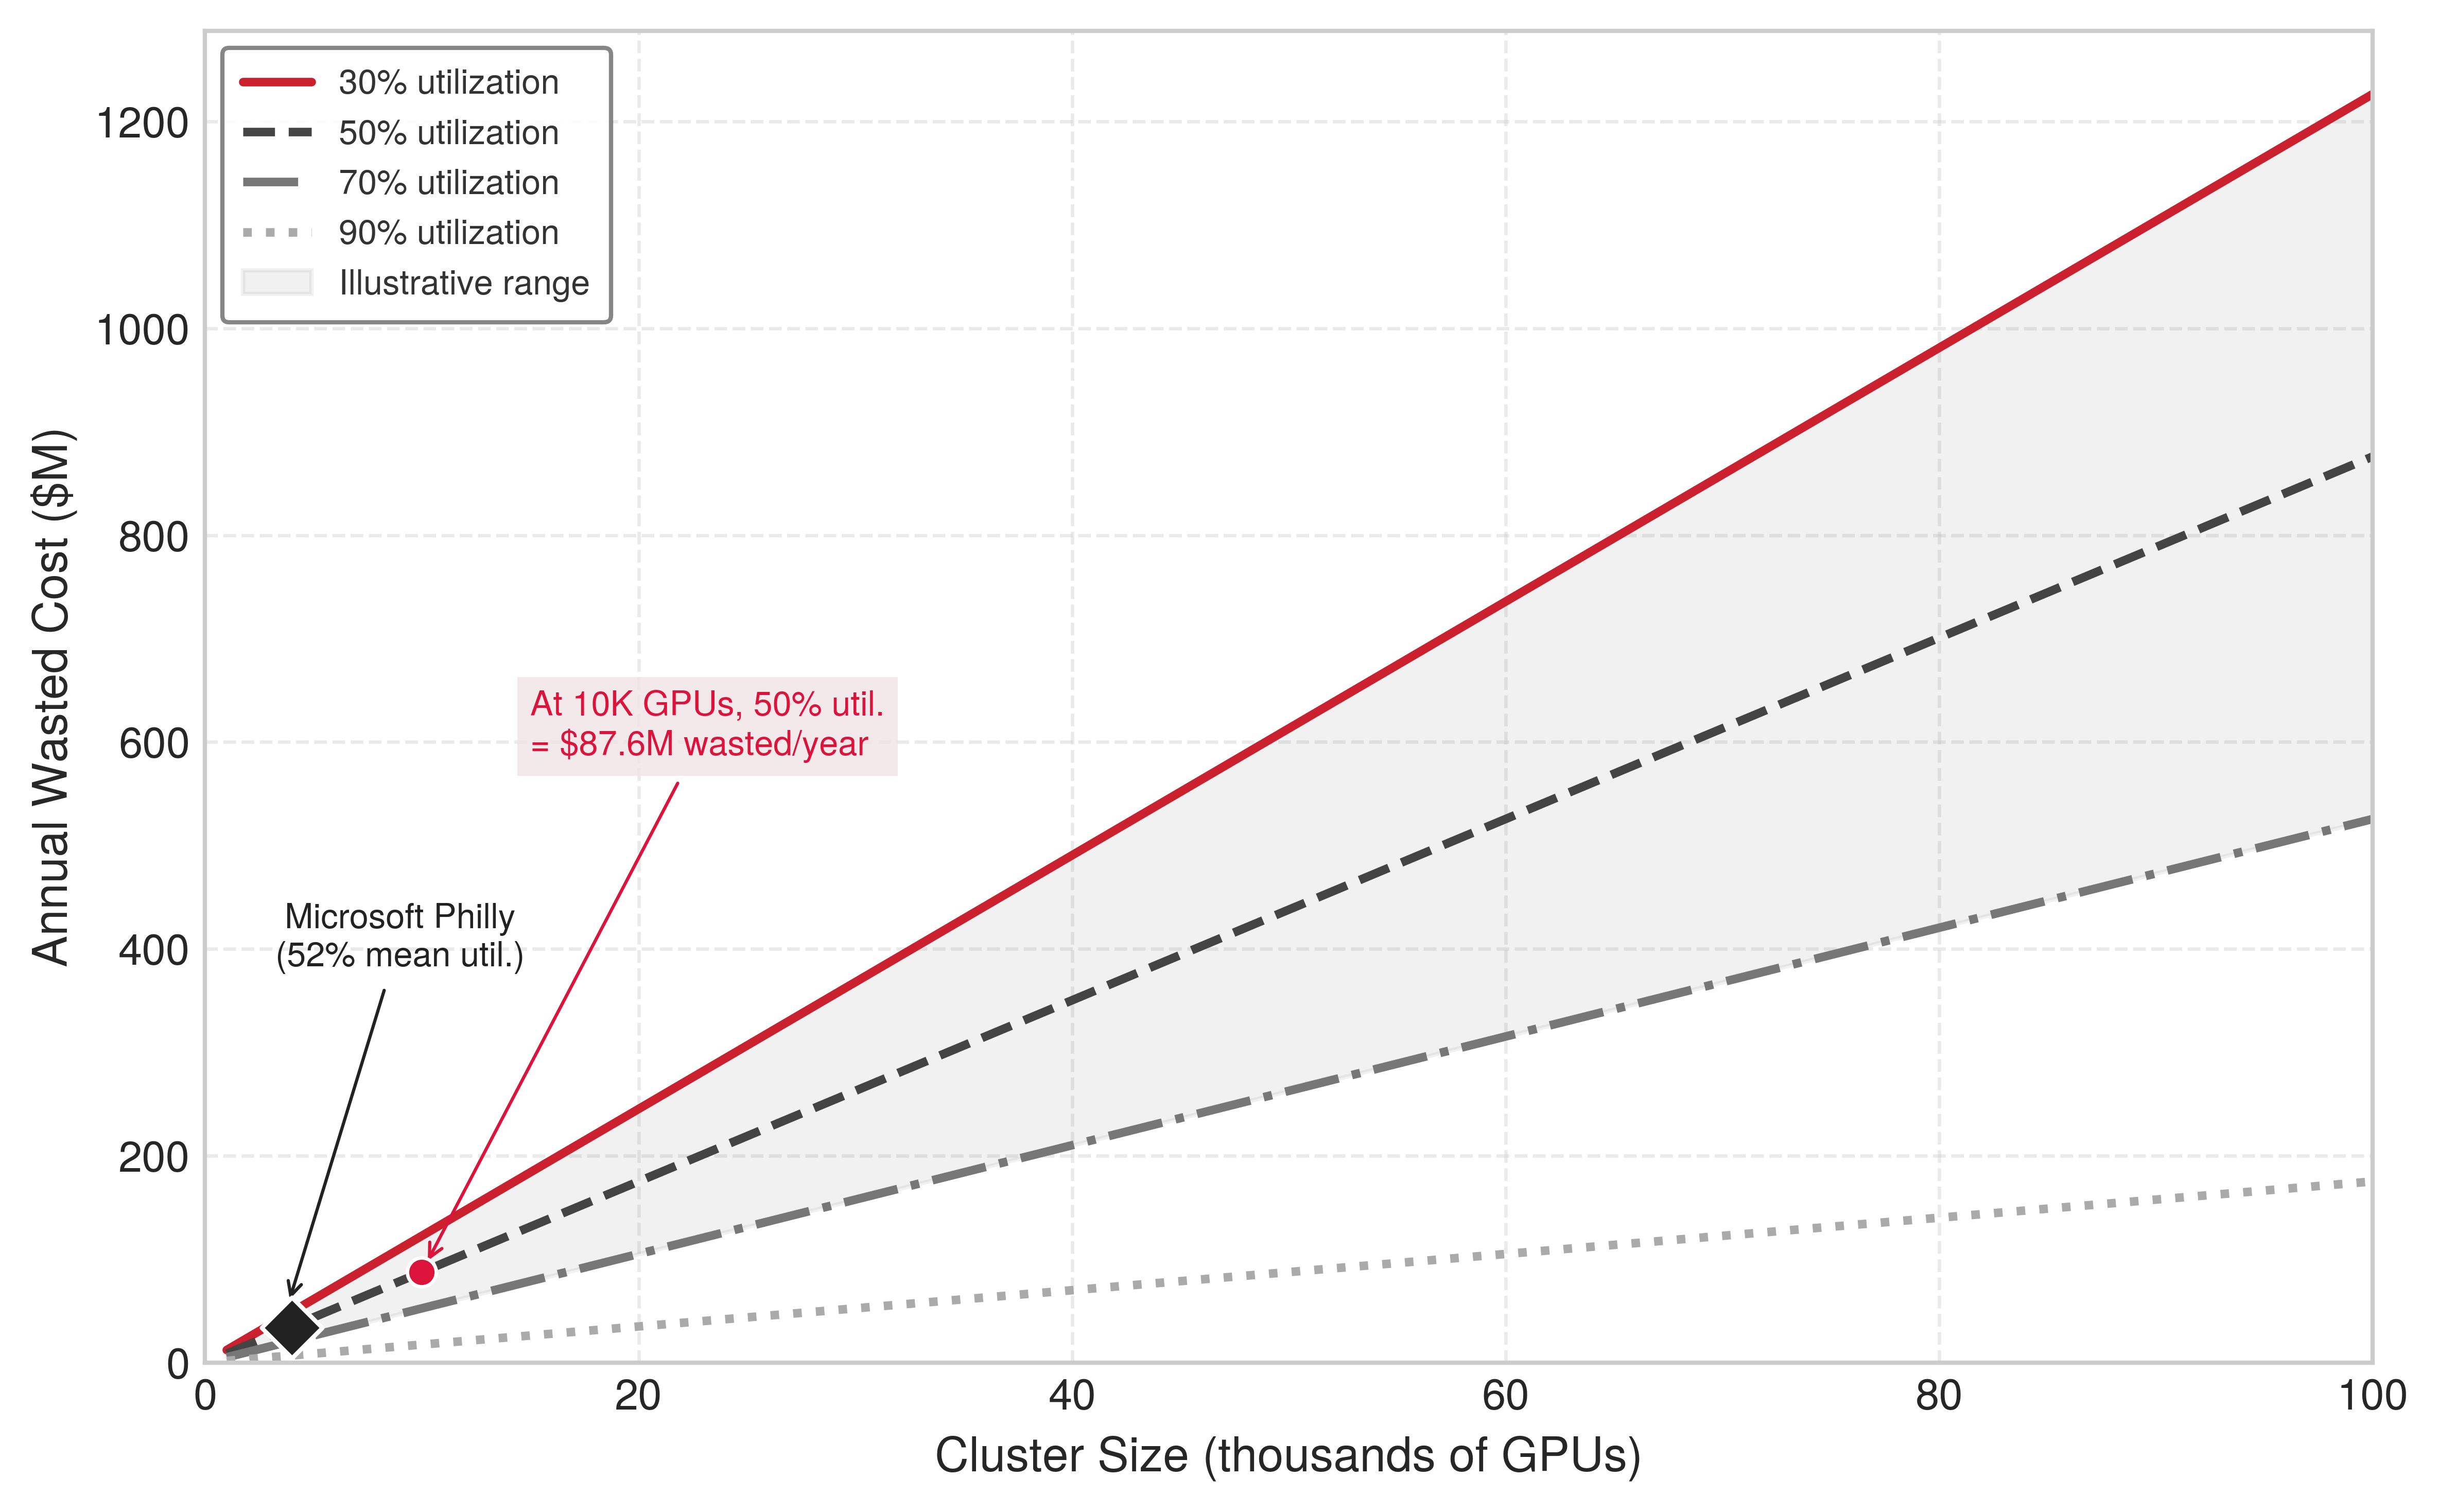
图 8 通过绘制年度浪费成本随集群规模和利用率水平变化的曲线,具体呈现这种浪费。在 10,000 个 GPU、利用率为 50% 时,年度浪费超过 $87 million under the chapter’s $2/GPU 小时核算场景中的相应金额。生产集群的公开测量结果表明,利用率不足是实际存在的运营问题:微软的 Philly 集群研究 (Jeon 等 2019年) 测得平均 GPU 利用率约为 52%,而 Li 等 (2023年) 发现,NERSC 的 Perlmutter 超级计算机上有 50% 的任务使用的 GPU 显存不足所分配显存的 25%。图中 30% 至 70% 的阴影带是该成本模型的示例运行区间,并非适用于所有生产集群的普遍实证结论。在此场景中,将利用率从 50% 提高至 70%,对于拥有 10,000 个 GPU 的集群,每年可节省超过 $35 million(3,500 万美元),且无需购买任何额外的 GPU。
Jeon, Myeongjae, Shivaram Venkataraman, Amar Phanishayee, Junjie Qian, Wencong Xiao, 和 Fan Yang. 2019年. 《Analysis of Large-Scale Multi-Tenant GPU Clusters for DNN Training Workloads》. 2019 USENIX Annual Technical Conference (USENIX ATC 19), 947~60.
Li, Jie, George Michelogiannakis, Brandon Cook, Dulanya Cooray, 和 Yong Chen. 2023年. 《Analyzing Resource Utilization in an HPC System: A Case Study of NERSC’s Perlmutter》. Lect. Notes Comput. Sci., Lecture Notes in Computer Science, 卷 13948: 297~316. https://doi.org/10.1007/978-3-031-32041-5_16.
闲置容量指标确立了经济目标;其余成本控制机制则解释了调度器如何朝该目标推进。可中断容量降低了容错型工作的价格,预留与配额策略决定哪些作业值得稀缺的有保障容量,而问责机制则使产生需求的团队能够看到闲置 GPU。
Spot 实例与可抢占虚拟机
云服务商提供 Spot Instances12(AWS)或 Preemptible VMs(GCP),相比按需定价提供 60% 到 90% 的折扣,但需注意实例可能在服务商为按需客户腾出容量时以 30 秒到 2 分钟的通知被回收。在 $0.70/GPU-hour 而非 $2/GPU-hour 的情况下,spot 实例改变了大规模训练的经济学,可能将数周预训练运行的成本从数十万美元降至十万美元以下。
12 Spot Instances:得名于商品交易中的“spot price”(即时交付的当前市场价格),spot 实例以 60% 到 90% 的折扣出售云服务的闲置容量,服务商保留回收权。对机器学习训练而言,关键的非对称性在于中断通知窗口:AWS 提供 2 分钟,GCP 提供 30 秒。一个 175B 参数模型需要 3 到 5 分钟完成检查点,因此 GCP 的 30 秒通知迫使训练者要么承担持续检查点化的开销,要么接受每次中断都损失工作。
spot 实例用于机器学习训练的可行性取决于两个决定折扣能否转化为实际节省的因素:每次中断的成本(检查点开销加上重启时间,再加上自上次检查点以来的损失工作)以及中断的频率(因实例类型、区域、时段和整体云需求而异)。公式 2 给出了 spot 训练的 Effective Cost:
\[ C_{\text{effective}} = C_{\text{spot}} \times \frac{T_{\text{total}}}{T_{\text{productive}}} \tag{2}\]
其中 \(T_{\text{total}}\) 包括有效训练时间、检查点开销以及中断后的重启开销,而 \(T_{\text{productive}}\) 是推进训练所花费的时间。若中断罕见(每天少于一次)且检查点高效(开销低于 5%),有效成本仍接近 spot 价格,节省几乎等于全部折扣。若中断频繁(每几小时一次)且重启昂贵(模型较大、检查点加载慢、GPU 缓存冷),有效成本可能接近甚至超过按需定价,从而把表面上的折扣变成隐性的溢价。
spot 节省与容错基础设施之间的关系在重要意义上是循环的。来自 容错 的容错机制(频繁异步检查点、快速检查点加载、弹性恢复)通过最小化每次中断的成本,直接促成了 spot 实例的使用。弹性训练允许在部分 spot 实例被回收时以较少的 worker 数量继续运行,从而完全避免整体重启。出于可靠性考虑而投入容错的组织发现,同一套基础设施通过 spot 实例利用释放了可观的成本节省,其容错投资的回报远远超出避免硬件故障造成的工作损失。
战略层面的洞见是:容错基础设施具有双重回报——它既抵御非自愿损失(硬件故障),又促成自愿成本节省(spot 实例)。这种双重回报常常使得仅凭可靠性理由难以论证的容错投资变得合理,因为 spot 利用带来的成本节省是具体而可度量的,而硬件故障防护带来的成本规避则是统计性的、较难量化。
Spot instance strategies for ML training
为在最大化 spot 实例利用率的同时最小化干扰,精妙的调度器采用了超越简单“失败后重试”逻辑的多样化与预测策略。可用区(AZ)多样化降低了整个集群同时被回收的概率。云服务商通常按可用区独立管理 spot 池。如果一个训练任务需要 1,024 个 GPU,将其作为单个区块分配在同一个可用区,会使该任务在该可用区的 spot 池被回收时面临完全停止。将任务分散到多个可用区,可确保某个可用区的回收事件只影响集群的一部分。调度器仍然需要仔细建模相关性:各实例的独立中断使大规模同时损失不太可能,但池级或 AZ 级的回收可能一次移除数百个 GPU,必须作为弹性收缩或故障切换事件处理,而不能视为普通的孤立故障。
实例类型多样化利用不同 GPU SKU 之间相互独立的竞价市场。严格要求单一实例类型的作业只能在一个拥挤的市场中竞争。接受多种等价实例类型的作业,其调度成功概率会显著提高。调度器应维护一份按优先级排序的可接受实例类型列表,在首选类型不可用时回退到内存更大的实例。虽然这种组合需要谨慎管理点对点带宽,但它能够有效利用这种“升级”来维持作业进度,同时使综合成本仍远低于按需价格。
竞价容量信号可以指导部署位置选择,但不一定能够预测中断频率。例如,AWS Spot Placement Score 估计容量请求当前在某个区域或可用区内成功的可能性;它明确不预测中断风险。调度器可以利用这一信号选择请求容量的位置,但要估算每日中断次数,仍需针对该实例类型和区域单独进行历史测量。如果由此得到的工作负载专属恢复模型表明,中断开销抵消了折扣收益,调度器就应将作业迁移到按需容量或其他区域。
竞价实例的检查点频率优化与标准的可靠性逻辑不同。杨—达利定律:最优检查点策略 中推导的 Young-Daly 公式针对不可预测的硬件故障进行优化。然而,竞价中断会提前发出通知:AWS 提前 2 分钟,GCP 提前 30 秒。两级检查点方法将按 Young-Daly 间隔执行的周期性检查点与终止通知触发的尽力而为检查点相结合。通知触发的检查点只有在预警窗口内完成,才能减少丢失的工作量。当大型模型的完整检查点耗时超过这一窗口时,作业必须依赖已经在执行的异步或增量检查点,并接受回滚到最近一次已持久化的状态。
当竞价中断相互关联而非孤立发生时,同样的应急规划需求就会变得尤为迫切。
容量预留策略
依赖云基础设施的组织(或从经济角度考量本地基础设施的组织)需要在三个计算容量层级之间取得平衡,每个层级在成本、可用性和承诺之间提供不同的权衡。表 2 从成本、可用性、中断风险和工作负载适配性几个方面比较了这些层级。
| 容量层级 | 成本与承诺 | 可用性与中断风险 | 最适合的工作负载 |
|---|---|---|---|
| 预留容量 | 一至三年期承诺,相比按需价格享有 30–60% 的折扣。 | 为已承诺的基线容量提供可用性保证。 | 可预测的持续工作负载:24/7 推理、计划内训练、CI 与回归测试、受 SLA 约束的作业。 |
| 按需容量 | 按全价计费,无长期承诺。 | 在无法接受排队或中断时立即配置资源。 | 紧急重新训练、交互式调试,以及不值得进行竞价容量管理的短期作业。 |
| 竞价容量 | 以折扣价格提供的可中断容量。 | 可用性随云需求而变化,工作节点可能被回收。 | 能容忍重启的作业:超参数搜索、消融实验、采用检查点的预训练和探索性研究。 |
如 图 9 所示,最优组合取决于工作负载特征和组织的优先事项。对于稳态利用率为 60%、突发需求为 40% 的组织,可以为峰值需求的 60% 预留容量,对需要立即配置资源且对延迟敏感的突发需求使用按需容量,其余需求则使用竞价容量。调度系统必须理解这些容量层级,并据此分配工作负载:将推理工作负载分配到预留容量,以保证可用性;为大型训练作业组合使用预留容量(用于基础资源分配)和竞价容量(通过弹性扩展增加工作节点);对于能够最大限度节约成本且中断容忍度最高的探索性工作,则完全使用竞价容量。
Systems Perspective 1.6: Spot 与按需训练
考虑训练一个参数规模为 70B 的模型,所需计算量为 512 GPUs,用于 14 days。
按需训练:512 GPUs \(\times\) 336 hours \(\times\) $2/GPU-hour = $344,064
抢占式(Spot)(折扣 65 percent、检查点开销 5 percent、每天 14 interruptions 的重启成本,每次重启 30 minutes):
- 基础成本:512 GPUs \(\times\) 336 hours \(\times\) $0.70/GPU-hour = $120,422
- 检查点开销:\(5\%\) \(\times\) 336 hours = 16.8 hours
- 重启开销:196 interruptions \(\times\) 0.5 hours = 98 hours
- 总时长:336 hours + 16.8 hours + 98 hours = 450.8 hours
- 总成本:512 GPUs \(\times\) 450.8 hours \(\times\) $0.70/GPU-hour = $161,567
节省:$182,497(53.0 percent),代价是墙钟时间大约延长 34.2 percent。
当容错基础设施已经就位时,这种经济性颇具吸引力。如果没有检查点机制,单次中断将迫使训练从头重新开始,可能浪费数天计算资源,从而抵消全部节省。
面向成本效率的调度
成本感知调度将调度器的优化目标从仅考虑资源利用率和公平性,扩展到包含财务效率。传统调度器最小化单一目标(例如平均作业完成时间或最大等待时间),而成本感知调度器必须在多目标权衡中做出取舍,其中时间、金钱和可靠性都是决策变量。调度器必须经常在三类决策之间进行选择:
- 等待 vs. 立即运行:在预留的 A100 上立即运行作业,或者等待 2 小时使用抢占式 H100,后者能以一半的成本将作业完成时间缩短 3\(\times\)。
- 抢占 vs. 支付更多:抢占一个低优先级的超参数搜索,为预留容量上的高优先级训练运行腾出空间;或者将训练运行放到更昂贵的按需实例上。
- 回退 vs. 弹性收缩:当抢占式容量被回收时,将作业迁移到按需容量以维持较高的吞吐量(但成本更高),或者弹性收缩规模以维持较低成本(但吞吐量下降)。
每项决策对时间、金钱和可靠性赋予不同的权重,因此成本感知调度属于策略设计,而非简单的装箱。
这些决策要求调度器同时建模计算的时间价值(2 小时延迟对研究人员生产力的组织成本、产品发布计划或竞争地位的影响)以及不同资源分配方案的财务成本。时间价值因工作负载类型差异极大:将生产模型的重新训练延迟 2 小时可能违反服务等级协议(service level agreement (SLA))并产生数千美元的违约罚金,而将探索性实验延迟 2 小时则只损失研究人员的时间,不产生其他成本。
生产系统通常按工作负载类别定义成本策略,将这些权衡编码为配置,而不需要针对每个决策进行人工判断。推理工作负载固定使用预留容量,以保证可用性和可预测的延迟,因为一次推理中断(收入损失、用户体验下降)的成本远高于预留定价的溢价。大规模训练运行则混合使用预留容量(用于最小可行分配)和抢占式容量(用于弹性扩展),并在抢占式容量被回收、且作业处于可配置截止时间之内时,自动回退到按需容量。探索性工作负载则被限制在抢占式容量上以最小化成本,同时明确接受可能被中断、完成时间可变。
调度器并不实现组织的财务核算系统。它只消费由此产生的价格与策略信号:各容量层级的边际价格、项目可申请的预留量、可接受的中断风险,以及必须满足的截止时间。成本可见性与归属 研究 showback、chargeback 与 attribution;本章仅将这些输出用于对可行的调度动作进行排序。
消费总成本信号
总拥有成本(TCO)决定了向调度器暴露的价格信号,但它本身并不是调度机制。集群经济性与利用率 研究自建与外购分析以及生命周期 TCO。编排器只需最终得到的各资源机会成本和政策约束,包括容量属于自有、预留、按需还是可中断。
Checkpoint 1.2: 成本感知调度的权衡
在转向机器学习专用调度器之前,先回顾成本优化机制之间的相互作用:
Spot 定价与预留策略会压缩运行一个任务的成本,但它们并未触及第二个效率来源:训练循环内部的 learning dynamics。此前的成本模型最优化的是完成时间(time-to-completion),而研究机构真正关心的指标是 time-to-accuracy,即一次运行达到目标验证指标所需的墙钟时间。一个对收敛性无感知的调度器无法判断某次运行处于陡峭的早期阶段还是收益递减的尾部阶段,因而无法将资源导向最能带来进展的地方。弥合这一差距,正是下文考察的 ML-aware schedulers 所承担的任务,参见 节 1.5。
自定义 ML 调度器
通用调度器将训练任务视为不透明的黑盒,因而无法判断模型处于学习的陡峭早期阶段还是最后的收益递减阶段。自定义 ML 调度器则以实现复杂度换取这种可见性:它们进入训练循环内部,最优化 time-to-accuracy,而不仅仅最优化 time-to-completion。选型问题在于,哪个内部信号能够应对该 fleet 的瓶颈约束;四个系统之间的差异,与其调度器精妙程度相去不远,更在于它们要求平台信任的信号:已消耗服务量、iteration 边界、完成值,或实测 goodput。
Tiresias:Duration-agnostic scheduling
Tiresias (Gu 等 2019年) 针对 节 1.0.5 所揭示的根本问题:ML 任务的运行时长不可预测,而依赖精确时长估计的调度策略,在估计不可得或不可靠时会做出糟糕的决策。与其对抗这种信息不对称,Tiresias 则完全取消了时长估计的要求。它采用 Two-Dimensional Attained Service13 调度器,依据任务已经消耗了多少服务量来做出优先级决策,而不是依据它声称将要消耗多少。任务根据已消耗的 GPU 时间累积“服务”,优先级随服务量增加而降低。两个维度分别是时间(任务已运行多久)和资源(任务使用多少 GPU),从而同时捕捉到已耗时长度和资源强度。
Gu, J., M. Chowdhury, K. G. Shin, Y. Zhu, M. Jeon, J. Qian, H. H. Liu, 和 C. Guo. 2019年. 《Tiresias: A GPU Cluster Manager for Distributed Deep Learning》. Proceedings of the 16th USENIX Symposium on Networked Systems Design and Implementation (NSDI ’19), 485~500.
13 Attained Service Scheduling:源自操作系统排队论的一种机制,优先级随资源累计消耗量增加而降低,在不要求 SRPT 所需未来知识的前提下近似理论上最优的 shortest remaining processing time(SRPT)策略。在 ML 集群中,这种近似尤其有效,因为任务时长呈重尾分布:绝大多数提交的任务都是短实验,因此将高服务量任务降级,恰好能正确识别出那些运行时间很长的异常任务,而无需用户提供他们无法准确计算的运行时长估计。
离散化版本将任务划分为服务量分箱(例如,少于 1 GPU-hour、1 到 10 GPU-hours、10 到 100 GPU-hours、大于 100 GPU-hours),将低分箱中的任务提升为队列前端。这种分箱结构意味着,所有短任务(提交工作的绝大多数)获得高优先级并快速运行,而少数消耗集群资源最多的长任务则逐渐失去优先级,相对新到达的任务被降级。关键洞见在于,这种行为近似于理论上最优的 shortest remaining processing time(SRPT)策略,而无需 SRPT 所要求的那类未来知识:已消耗服务量较少的任务在统计上更可能是短任务,因此优先调度它们是最小化平均完成时间的良好启发式方法。
来自 Microsoft 与 Alibaba 生产集群轨迹的实验显示,与 FIFO 调度相比,平均任务完成时间降低 40 到 60 percent,改善幅度最大的正是原先要排队等待长训练运行的短任务。这一改善并非免费的:长训练任务的完成时间因被系统性降级而增加。然而,总体收益为正,因为短任务的数量远多于长任务,且短任务的改善在总量上超过了长任务的惩罚。
Gandiva:Iteration-aware scheduling
Gandiva (Xiao 等 2018年) 利用迭代边界处的时间分片,通过受控的资源超额分配提高利用率。一个拥有 100 张 GPU 的集群可能支持 120 个并发作业,条件是每个作业都将 20% 的迭代时间用于等待数据,因为调度器可以在同一设备上交错执行一个作业的数据加载与另一个作业的 GPU 计算。使这一方法切实可行的关键认识是:迭代边界提供了自然的抢占点,此时 GPU 上需要保留的状态最少。在两次迭代之间,GPU 上仅保留模型权重和优化器状态;前向传播和反向传播产生的中间激活值均已释放。这种极少的状态使上下文切换成本很低(耗时以秒计,而非以分钟计),而在迭代中途抢占时,完整的激活内存仍在使用中。
Xiao, Wencong, Romil Bhardwaj, Ramachandran Ramjee, Muthian Sivathanu, Nipun Kwatra, Zhenhua Han, Prabal Patel, 等. 2018年. 《Gandiva: Introspective Cluster Scheduling for Deep Learning》. 13th USENIX Symposium on Operating Systems Design and Implementation (OSDI 18), 595~610.
Gandiva 还实现了扩缩容弹性,其粒度比 节 1.3 中讨论的框架级弹性训练更细。Gandiva 根据实时资源可用性自动调整数据并行度,并利用性能剖析获得的迭代时间,预测增加或减少工作进程对吞吐量的影响。当高优先级作业到来时,Gandiva 通过减少低优先级作业的工作进程数量来缩小其规模,而不是将其完全终止,从而在释放资源的同时保留作业进度。当资源再次可用时,它会将作业扩展回其偏好的并行度。这种以实际迭代级性能剖析数据为依据的细粒度弹性,支持通用系统无法做出的调度决策,因为通用系统缺乏对作业内部状态的可见性。
War Story 1.1: 性能退化的交换机(2021)
背景: 在一个拥有 16,384 张 GPU 的分布式集群中,一个基础模型训练作业出现了严重的吞吐量下降,尽管 GPU 执行指标正常 (Sigler 2021年)。
机制: 一台连接不同机架的脊交换机上的单个收发器出现了较高的比特错误率,使链路吞吐量从 100 Gbps 降至 1 Gbps(\(100\times\) 带宽骤降)。标准的 ping/在线状态健康检查显示正常,但全归约梯度同步 \(T_{\text{sync}}\) 在全部 16,384 张 GPU 上停滞,等待这条性能落后的链路。
影响: 整个集群的硬件效率 \(\eta_{\text{hw}}\) 从 45% 骤降至 8%,每天浪费 \(>15,000\) GPU 小时,直到网络级遥测标记出性能退化的交换机端口。
修复措施: 工程师部署了自动化微基准探测和数据包错误遥测,在调度作业资源分配之前自动定位并隔离性能退化的交换机端口。
系统启示: 二元的在线/离线健康监控不足以支撑分布式扩展。调度器需要持续、能够反映性能的遥测数据(交换机计数器、数据包重传率、集合通信基准测试),以自动隔离性能退化的网络路径。
Themis:完成时间公平性
传统的公平份额调度将所有 GPU 秒视为等价,即使相等的资源份额会产生截然不同的完成延迟。Themis (Mahajan 等 2020年) 则以归一化完成时间衡量公平性:每个作业将其在资源竞争条件下的完成时间,与独占集群中按公平原则分配给它的资源份额时所需的完成时间进行比较。
Mahajan, Kshiteej, Arjun Balasubramanian, Arjun Singhvi, Shivaram Venkataraman, Aditya Akella, Amar Phanishayee, 和 Shuchi Chawla. 2020年. 《Themis: Fair and Efficient GPU Cluster Scheduling》. 17th USENIX Symposium on Networked Systems Design and Implementation (NSDI 20), 289~304.
Themis 通过分配资源来改善所有作业中最差的完成时间公平性比值。当短暂延迟对某个接近完成的作业的归一化完成时间造成的增幅,大于同等资源分配调整对另一个作业的影响时,该作业可能获得更多资源。等待不会浪费已经消耗的 GPU 小时;它只是推迟结果可用的时间。因此,该指标比较的是完成延迟,而非已经投入的计算量,并避免某种策略仅仅因为最终均衡了 GPU 秒数就显得公平。
这种方法有利于耗时较短和接近完成的作业,同时不会对耗时较长的作业造成过大的不利影响;它还使调度决策与完成工作的经济价值相一致,而非仅依据资源消耗的简单核算。Themis 通过拍卖机制落实这一指标:作业根据当前的边际价值(每分配一个 GPU 小时能缩短多少完成时间)对资源竞价,从而形成类似市场的动态机制,自然地将资源引导至价值最高的用途。
Pollux:自适应资源分配
Pollux (Qiao 等 2021年) 通过联合优化资源分配和训练超参数,在这四种研究型调度器中采取了最激进的方法。Tiresias、Gandiva 和 Themis 针对作业做出调度决策(何时运行、如何共享),而 Pollux 则针对作业内部做出决策(使用多少张 GPU、采用多大的批大小)。其关键观察是,训练作业的最优 GPU 数量取决于当前的批大小、学习率和梯度噪声水平,而这些因素都会随着模型经历不同的收敛阶段,在训练过程中发生变化。
Qiao, Aurick, Sang Keun Choe, Suhas Jayaram Subramanya, Willie Neiswanger, Qirong Ho, Hao Zhang, Gregory R. Ganger, 和 Eric P. Xing. 2021年. 《Pollux: Co-adaptive Cluster Scheduling for Goodput-Optimized Deep Learning》. 15th USENIX Symposium on Operating Systems Design and Implementation (OSDI 21), 1~18.
Pollux 会动态调整每个任务的 GPU 分配和批大小,以最大化集群-wide 吞吐率,即所有任务同时取得的有效训练进展速率。Goodput 指标将权衡关系的两端合成为一个数值:统计效率(每个梯度步推进收敛的程度,取决于批大小)和系统吞吐量(每秒的梯度步数,取决于 GPU 数量和通信开销)。某个任务因当前 GPU 数量出现收益递减(因为通信开销以超线性方式增长)时,其 GPU 可能被重新分配给更能受益的任务(因为它正处于较大批量能提升统计效率的训练阶段)。
这种调度与超参数的联合优化,相比固定资源分配的调度,平均任务完成时间提升了 37% 到 50%。改进来自两个来源:更优的资源分配(GPU 流向能产生最大进展的任务)和更优的批大小调优(每个任务在其当前训练阶段运行于统计效率与计算效率相平衡的批大小)。两种效应的结合效果优于任一单独优化。
调度器比较框架
自定义 ML 调度器体现了实现复杂度与调度精度之间的渐进权衡,因此 表 3 中的比较更适合作为部署筛选标准,而非排名。通用调度器只能看到声明的资源与粗略的运行期元数据;这些研究系统则额外加入 ML 专用信号,例如迭代结构、弹性、收敛阶段和实测 goodput。
| 调度器 | 关键洞察 | 调度信号 | 优化目标 | 开销 | 生产就绪度 |
|---|---|---|---|---|---|
| Tiresias | 已达成服务量可预测剩余时间 | 已消耗的 GPU 小时数 | 最小化平均 JCT | 低(无需剖析) | 中等 |
| Gandiva | 迭代边界即抢占点 | 迭代时序 | 最大化资源利用率 | 中等(需剖析) | 中等 |
| Themis | 完成延迟决定公平性 | 归一化完成时间 | 改善最差公平性 | 低(任务元数据) | 低(拍卖复杂度) |
| Pollux | 批大小与分配相互耦合 | Goodput(统计 + 系统) | 最大化集群 goodput | 高(持续剖析) | Low(框架集成) |
这一设计空间揭示了调度复杂度与调度质量之间的根本性张力(表 3)。Tiresias 以最少信息运行,基本上是在猜测“年轻”任务将很快完成,却仅靠阻止大任务阻塞小任务就取得了显著收益。它之所以稳健,是因为无需用户或训练框架的任何配合。在另一端,Pollux 需要深度的双向集成:调度器必须了解该任务的扩展曲线和梯度噪声尺度,而任务也必须接受实时改变批大小和学习率的指令。当这种集成奏效时,它能产生最高的集群-wide 吞吐量;当假设被违反时(例如收敛动态不稳定、无法容忍批大小变化的模型),优化便会崩溃。
失效模式大体沿着这条复杂度梯度展开。Tiresias 会优雅降级:如果其假设(过去用量可预测未来用量)不成立,它只会退化到标准的公平共享策略。Gandiva 的失效模式表现为性能抖动:如果剖析阶段对迭代方差估计有误,它可能把不兼容的任务打包到同一节点上,从而产生相互干扰。Pollux 的失效模式最为脆弱,因为它直接修改了训练语义本身;一个错误的 goodput 模型在理论上可能损害模型收敛,这是部分生产团队即便面对其报告的任务完成收益也不愿承担的风险。
对于我们 175B 参数模型,这些权衡决定了混合式生命周期。Pollux 在训练早期、不稳定阶段具有最高的潜在改进空间,此时批大小较小且任务具有弹性;它可以动态调整任务规模以适配集群中的可用空洞。然而,有效使用 Pollux 需要修改训练循环以支持弹性感知。Tiresias 则提供了最简单的部署路径:它会将 175B 模型视为“重型”任务,并相对于小型实验降低其优先级,从而确保集群对研究人员保持响应能力,而无需改动 175B 模型的代码。实际上,大多数基础设施团队通常先采用类似 Tiresias 的策略来解决“阻塞队列”问题,然后再尝试 Pollux 所需的深度集成。
四个系统贯穿始终的共同主题是:利用机器学习工作负载的领域知识(可预测的迭代耗时、并行扩展的收益递减,以及固有的检查点与重启能力),能够比仅依赖静态资源请求取得显著更好的调度结果。通用调度器看到的是一项请求 64 个 GPU、运行 3 天的作业;面向机器学习的调度器看到的则是一个非线性收敛的随机梯度下降过程,它会在性能进入平台期时释放资源,并且可以以极小的损失被抢占。在这些调度器之间进行选择的决策框架取决于主要瓶颈:对于作业频繁进出的探索性集群,Gandiva 的时间切片可最大限度地降低排队延迟;对于以作业完成时间为首要 SLA 的生产训练,Tiresias 基于作业年龄的优先级排序可防止饥饿;对于资源效率至关重要的大规模训练,Pollux 的自适应扩展可弥补静态分配留下的“弹性缺口”。
生产系统面临的挑战是,在融入这些洞见的同时,保持生产环境所要求的运行可靠性、策略灵活性和组织治理。生产平台通常有选择地采纳调度器的设计思想,因为可靠性、治理、异构硬件和用户策略都会制约纯研究设计。
从研究走向生产
研究调度器只有在其核心信号经受住异构数据中心环境的考验时,才能在生产中发挥作用。在研究中,集群通常被假定为具有统一互连拓扑的同构加速器资源池,作业则是行为规范、能够准确声明资源需求的实体。在生产中,“集群”却像是由不同代际硬件构成的地质层:V100 与 A100、H100 并存,通过 InfiniBand 和以太网拼接而成的网络连接,运行着经常崩溃、挂起或错误声明内存需求的作业。因此,没有哪家主要的超大规模云服务商会简单地“安装”一个研究调度器;它们会通过 Kubernetes Operator 或 Slurm 插件,有选择地将特定算法移植到标准编排器中。
以我们的 175B 参数模型训练运行为例。完全遵循 Pollux 的实现可能会根据全局集群负载积极调整作业规模,通过增减 GPU 数量来最大化有效吞吐量。然而,改变同步训练作业的工作进程数量需要经历一次检查点与重启周期,对于这种规模的模型,这意味着要将数 TB 的优化器状态写入持久化存储。如果重新调整规模的间隔过短,检查点的 I/O 开销就会抵消吞吐量收益。实践中,生产团队采用混合方法:主要在训练早期的波动阶段或超参数扫描中使用 Pollux 式自适应分配,但在学习率预热完成、作业进入长达数月的稳态后,将 175B 模型固定在静态且感知拓扑的资源分配方案上。
生产决策要判断的是,某种专用策略对边际资源分配的改善是否足以抵偿其运维负担。本章通过排队延迟、有效 GPU 小时数、抢占开销和放置效率来评估这一决策。规模化机器学习运维 负责讨论更广泛的平台投资决策,包括人员配置、资本规划、生命周期成本和投资组合回报。
风险不仅在于实现成本;调度器的行为还可能与分布式训练的执行语义不匹配。
War Story 1.2: OpenAI 的成组调度死锁(2021)
背景:OpenAI 将 Kubernetes 集群扩展到 7,500 个节点,用于运行包括 GPT-3、CLIP 和 DALL-E 在内的工作负载。其大型训练作业采用 MPI 式执行方式,组内所有工作进程必须同时被调度,训练才能取得进展 (Sigler 2021年)。
机制:默认的 Kubernetes 调度逐个放置 pod,没有施加全有或全无的约束。当两个大型实验请求集群容量时,Kubernetes 将每个作业的一半 pod 调度到各个节点上。
影响:两个训练作业都无限期停滞,同时占用已分配的 GPU,训练进展为零,集群资源陷入死锁。
修复:OpenAI 开发了定制的 Kubernetes 成组调度 Operator,强制以原子方式执行全有或全无的 pod 放置。
系统启示:分布式机器学习调度必须将作业的执行语义纳入调度逻辑。对于 MPI 式训练,“部分 pod 已被调度”并不意味着取得了部分进展,而是资源分配的浪费。生产调度器需要成组调度、配额控制和感知工作负载的策略,而不能仅依赖通用的 pod 放置。
Sigler, Eric. 2021年. Scaling Kubernetes to 7,500 Nodes. OpenAI Blog.
为通用 pod 放置设计的调度器会错误处理需要成组执行语义的工作负载,而仅加入成组调度感知也无法解决相互竞争的训练作业之间的优先级冲突。本节考察的四个研究调度器分别处理了这一问题的一个方面(运行时间估计、迭代边界抢占、完成时间之间的公平性,或资源与超参数的联合调优),但没有一个能同时处理所有方面。因此,设计空间是一组明确的权衡,而不是单一的最优策略。
Checkpoint 1.3: 自定义调度器设计空间
考虑四种研究级调度器之间的取舍:
自定义调度器旨在最大化长周期训练作业吞吐量,但当模型部署用于推理时,运行环境现实会急剧改变。目标函数从最大化集群利用率翻转为保证毫秒级响应性。服务资源管理必须处理突发且不可预测的流量模式,同时严格遵守 SLO。
服务资源管理
训练作业是可预测的、批处理导向的工作负载,运行周期以周计;服务作业则是易变的、面向用户的服务,必须在毫秒内响应不可预测的流量尖峰。当电商平台启动大型促销活动时,服务集群必须即时自动伸缩以处理每秒数千次请求。服务资源管理迫使编排器在严格的延迟约束与原始硬件利用率之间取得平衡。
就编排而言,关键的服务事实是:推理容量是围绕用户流量的实时包络,而非围绕训练作业的批分配。集群编排器通过随需求增减副本数量、将服务作业与干扰隔离、以及平衡推理资源需求与训练对同一共享基础设施的占用,来管理该包络。
推理自动伸缩
Kubernetes Horizontal Pod Autoscaling (HPA) 依据观测指标调整副本数量,负载升高时增加实例,负载下降时移除实例。通用云工作负载的默认伸缩指标是 CPU 利用率,目标区间为 50 至 70 个百分点。该默认指标对 GPU 推理工作负载的适配很差,原因有二。首先,GPU 利用率 是一个噪声较大的指标,即使系统并未处理用户请求(如后台维护、模型预热),利用率也可能很高。其次,GPU 利用率与推理延迟之间的关系高度非线性:当利用率越过某个阈值(GPU 推理通常为 70 至 80 个百分点)时,延迟会急剧飙升,使得基于利用率的伸缩属于反应式而非预测式。因此,指标选择本身就是服务侧的首个调度决策:推理自动伸缩指标 列出了可预测用户侧性能劣化的自定义推理指标。
| Metric | Target Range | Considerations |
|---|---|---|
| GPU utilization | 60 to 80% | Varies by model batch efficiency |
| Request queue depth | 10 to 50 requests | Prevents latency spikes before they manifest in P99 metrics |
| P99 latency | Below SLO target | Reactive metric that lags demand changes by seconds to minutes |
| Pending tokens | Model-specific | Tokens queued or currently being decoded across active requests |
除 推理自动伸缩指标 中面向 HPA 的指标外,Vertical Pod Autoscaling (VPA) 沿另一条轴运行,针对单个 pod 调整资源请求与限制。HPA 改变运行实例的数量,而 VPA 改变每个实例获得的资源量。对于推理,VPA 可依据观测到的使用模式对内存分配进行合理 sizing,从而避免过度配置 CPU 内存与主机资源,进而减少每个节点可容纳的推理 pod 数量。GPU 资源无法在不重启 pod 的情况下进行垂直伸缩(必须重新初始化 CUDA 上下文),这限制了 VPA 在模型加载耗时数分钟的加速工作负载中的效用。然而,VPA 对推理流水线中的 CPU 组件(如预处理、后处理和分词)很有价值,这些组件的资源需求可能与初始估计显著不同,并且可通过一次短暂的 pod 重启进行调整。
08 集群编排
大语言模型(LLM)推理需要专门的扩展考量,HPA 和 VPA 都无法完全应对,原因是 键值(KV)缓存14 的内存增长模式。一个 70B 参数模型在提供长上下文请求时,仅 KV 缓存就可能需要超过 80 GB 的 GPU 内存,即使服务引擎将该缓存以分页的、非连续块的形式存储。因此,LLM 服务的 GPU 内存瓶颈并非模型权重(其大小是固定的),而是 KV 缓存(其大小随请求数量和上下文长度增长)。扩展决策必须同时考虑请求速率和上下文长度分布,而不能只考虑计算负载。请求数量的突然增加(例如,从短对话查询转向文档摘要工作负载)即使请求速率处于中等水平,也可能耗尽 GPU 内存,从而需要横向扩展,而此时 GPU 的计算利用率却很低。反过来,大量短上下文请求的突发可能给计算资源带来压力,却不会威胁内存上限。
14 分页 KV 缓存:分页改变了缓存的分配方式并降低了碎片化,但它并未改变缓存随序列长度和并发请求增长的特性。因此,自动伸缩器必须监控内存压力,即使计算利用率仍然很低。
这一双资源维度(计算与内存)表明,有效的 LLM 自动伸缩应当同时监控 GPU 计算利用率和 GPU 内存压力,并在任一指标接近临界阈值时触发横向扩展。一些生产系统定义了一个综合伸缩指标,将这两个维度结合起来,当归一化后的计算利用率和归一化后的内存压力中的最大值超过阈值时触发横向扩展。这种综合方法可以避免系统对任一类资源耗尽措手不及。图 10 展示了这一闭环控制架构,其中双信号遥测数据同时馈送给预测式控制器和反应式控制器,以协调 pod 的供给和副本预预热。
推理自动扩展还必须处理冷启动延迟,这造成了成本效率与响应性之间的张力,且没有简单的解法。服务中的冷启动问题在数量级上比标准 Web 服务更为严重,原因是模型权重的体量极其庞大。一个 70B 参数的模型在 FP16 下约占 140 GB,且全部权重必须在首个请求被服务之前传输到 GPU 内存中,该传输受 PCIe 或 NVLink 带宽限制。即使按每方向 PCIe Gen4 x16 的 32 GB/s 速度计算,原始传输仍需超过 4 秒;而在实践中,模型初始化、图编译和安全检查会将其延长至 60–120 秒。从 Non-Volatile Memory Express (NVMe) SSD 以 7 GB/s 读取带宽加载约需 20 秒;从网络存储加载则可能超过 2 分钟。
过于激进的缩容策略会在流量短暂回落时终止副本,当流量数分钟后恢复时会产生痛苦的冷启动,进而形成延迟尖峰,违反 SLO 并损害用户体验。根本问题在于推理流量在多个时间尺度上表现出突发特性(秒级、分钟级、小时级),短期回落并不能可靠地预测持续的低需求。一段五分钟静默期之后可能紧接着流量尖峰,而该尖峰期间冷启动的成本(模型加载期间所有请求的延迟劣化)可能超过释放少量 GPU 容量所带来的成本节约。
生产系统通过三项互补的策略应对冷启动:
- 最低副本数:保持至少一个处于预热状态的副本(大于零),可以消除首波流量中的冷启动,但在真正空闲期间仍会产生基线成本。
- 预测式扩展:依据历史流量模式(如昼夜周期、星期模式、已知事件)进行扩展,在预期峰值到来之前预先增加容量,而不是在负载到达后再被动扩容。
- 预预热:将模型副本加载到待命 GPU 的内存中,可将激活时间从数分钟的模型加载缩短为数秒的过程初始化,但待命副本会占用无法用于其他工作负载的 GPU 内存。
多个模型共享同一 GPU 池的组织必须权衡预预热开销与冷启动惩罚,依据各模型的流量模式与延迟要求,选择保留哪些模型处于预热状态。
预测式自动扩展与 SLO 管理
反应式自动扩展(如 Kubernetes HPA)本质上是向后看的:它先观察到某个指标被突破(例如 GPU 利用率超过 80 percent),等待一个稳定窗口,然后才触发扩容事件。对于毫秒级启动的容器,这种滞后可以忽略;但对于一个从磁盘加载权重到 GPU 内存需要 3 分钟的 175B 参数模型,这种滞后对 SLO 是致命的。如果流量在 30 秒内翻倍(产品发布或病毒式传播事件期间的典型场景),反应式扩展器将在流量尖峰已经使现有集群饱和之后才部署新副本,从而造成 3 分钟的延迟劣化窗口以及请求丢失。
针对冷启动滞后的集群级响应是容量规划与预预热。编排器会保留足够的预热副本或分阶段模型状态,使得新放置的容量在预测需求超过现有容量包络之前就已经就绪。连续批处理、请求准入、排队和负载 shedding 决定了服务平面如何在该容量包络内使用资源,而新副本启动期间的逐请求机制由 在大规模下运行推理 负责。

反应式自动扩展在冷启动期间打开了 SLO 缺口。
预测式自动扩展将扩展动作与当前负载解耦。通过分析历史流量模式(昼夜周期、星期季节性)并结合实时先行指标(例如登录请求激增往往先于推理查询激增),调度器可以在需求到来之前预先配置容量。将我们的 175B 模型以 500 ms P99 SLO 提供服务需要这种预判。如果模型需要 3 分钟才能就绪,预测式扩展器必须在预期流量爬升至少提前 4 分钟发出扩容指令。这便将扩展问题从控制理论问题(对误差做出反应)转变为预测问题(预测未来)。
有效的扩展策略必须是SLO 驱动的,而非利用率驱动。设定固定利用率(例如“保持 GPU 利用率在 70 percent”)只是一种近似手段,往往并不奏效:某个模型可能因内存带宽争用而在 60 percent 利用率下满足其延迟 SLO,也可能在请求为计算受限且均匀时安全地在 90 percent 利用率下运行。SLO 驱动的策略会明确针对真正重要的指标:“当 P99 延迟超过 400 ms(500 ms 目标的 80 percent)时扩容。”这种方法会自动适应工作负载特性的变化。如果新模型版本效率更低,延迟指标将上升得更快,扩展器会部署更多副本以维持 SLO,而无需人工调整利用率阈值。
为防止振荡(扩展器在噪声流量期间频繁地增加和移除副本),生产系统会实现迟滞和冷却期。典型策略会激进地扩容(不设稳定窗口)以保护 SLO,但保守地缩容(15 分钟冷却期)以避免反复震荡。这种不对称性承认了不必要的扩容成本(15 分钟浪费的计算资源)远低于漏扩容的成本(SLO 违规与用户流失)。
Napkin Math 1.5: 自动扩缩容延迟
考虑一个服务集群,包含 10 个副本,每个副本能够处理 5 QPS 的请求,同时满足 500 ms 的服务水平目标(SLO)。总容量为 50 QPS。
场景:流量从 40 QPS 线性增长到 80 QPS,历时 60 seconds。模型加载时间为 3 minutes(180 seconds)。
反应式扩缩容:HPA 在 \(t =\) 15 秒检测到过载(此时流量达到 50 QPS),请求新增 10 个副本。这些副本在 \(t =\) 195 秒就绪(15 + 180 seconds)。从 \(t =\) 15 秒到 \(t =\) 195 秒,需求超过容量。在爬坡期间,超额需求从 0 线性增长到 30 QPS;当爬坡达到 80 QPS 后,完整的 30 QPS 过载持续存在,直到新副本就绪。容量曲线之上的面积约为 4,725 个请求当量(request-equivalents)的累计超额需求。这些请求根据服务策略转为积压或丢弃;将该数量转换为 SLO 违规次数需要跟踪请求延迟与丢弃的排队模型。
预测式扩缩容:扩缩容器预测流量爬坡,并在 \(t =\) -180 秒触发扩容。新增的 10 个副本在 \(t = 0\) 秒上线,将容量推至 100 QPS,恰好赶上爬坡开始。在这些理想化假设下,爬坡不会造成由容量不足引起的积压。
资源隔离
当多个推理工作负载共享同一台物理硬件时,若某个工作负载的资源消耗劣化了另一个工作负载的性能,就会出现“吵闹的邻居”(noisy neighbor)问题。在 GPU 上,干扰通过四条共享资源通道体现:
- 显存带宽:某个工作负载的数据移动可能使 HBM 接口饱和。
- L2 缓存争用:某个工作负载的工作集可能将另一个工作负载的缓存数据淘汰出 L2 缓存。
- PCIe 瓶颈:并发的主机—设备传输会竞争总线带宽。
- 热效应:某个工作负载产生的热量可能触发热节流,进而影响同一 GPU 上的所有工作负载。
对于延迟敏感的推理,即使是很轻微的干扰,也可能使 P99 延迟超过 SLO 阈值,使一个看似配置充足的系统变成违反 SLO 的系统。
MIG 位于该设计空间中资源隔离性较强的一端。A100 MIG Profiles 已经展示了固定分区(fixed profiles);其运行层面的含义是,硬件分区降低了跨工作负载的干扰,但把分区选择变成了放置约束。MIG 可用于支持 MIG 的 NVIDIA 数据中心 GPU;分区配置可能需要先 draining(停止并释放)受影响的 workload 才能重新配置;固定分区大小也可能与工作负载的实际需求不匹配。例如,一个需要 15 GB GPU 显存的工作负载,在 20 GB 的 MIG 实例上会浪费 5 GB,或者根本放不进 10 GB 的实例。
软件隔离方法提供了更强的灵活性,但代价是保证较弱。高效地为推理共享 GPU 需要遍历一系列隔离机制的层级,每一层都在性能与安全之间进行权衡。在最简单的层级,CUDA Time-Slicing 通过上下文切换计算资源,使多个进程共享一块 GPU。虽然灵活,但它提供的性能隔离较弱,因为上下文会随时间竞争整个设备。NVIDIA 的 Multi-Process Service(MPS)15 允许不同进程的 kernel 与内存拷贝重叠执行,从而降低上下文切换开销,并在某个进程无法填满设备时提升利用率(NVIDIA 2026年)。在 Volta 及更新架构的 GPU 上,每个 MPS 客户端拥有独立的 GPU 虚拟地址空间,但客户端仍然共享执行引擎、缓存、显存带宽以及 MPS 故障域的一部分。因此,地址空间的分离并不意味着 MIG 所提供的性能隔离或故障隔离。
15 CUDA MPS(Multi-Process Service):NVIDIA 的客户端—服务器运行时通过共享的 GPU 调度资源对 CUDA 进程进行多路复用。Volta 及更新一代客户端获得独立的 GPU 虚拟地址空间,而计算能力、缓存、带宽和设备内存容量仍为共享。致命故障仅被限制在与同一 MPS 服务器共享受影响 GPU 的那部分客户端内,因此 MPS 并不等同于硬件分区或整设备隔离(NVIDIA 2026年)。
NVIDIA. 2026年. NVIDIA CUDA Multi-Process Service.
GPU 显存记账仍然必须防止某个模型消耗为另一个模型预留的容量。独立的虚拟地址空间可以阻止某个客户端直接寻址另一个客户端的分配,但它并不会形成固定的显存容量分区。如果没有可强制执行的按客户端显存上限,内存泄漏或意外过大的 batch 都可能耗尽共享设备显存,进而干扰同址运行的工作负载。因此,MPS 适合那些互相信任、且其聚合显存占用与干扰程度已经经过测量的工作负载;而 MIG 或整卡分配则更适合对信任强度和可预测性要求更强的场景。
此外,长期运行的服务实例还会面临动态内存碎片化问题。关键诱因是 Transformer 推理中的 KV cache,它会随请求序列长度增长和收缩。标准分配器难以应对这种高度可变的生命周期,导致 GPU 内存中出现空洞:单个空洞太小无法容纳新请求,但累积起来却浪费数 GB 内存。服务引擎越来越多地采用分页内存管理来将 KV cache 分配到非连续块中,从而减少因碎片化导致的内存耗尽(out-of-memory)故障;在大规模下运行推理 完整展开分页分配机制。
在 CPU 层面,核心固定(core pinning)将特定 CPU 核心分配给推理 pod,防止 Linux 调度器以破坏处理器缓存有效性的方式在核心之间迁移进程。对于延迟敏感型工作负载,使用 isolcpus 内核参数和 taskset 亲和性隔离核心,可消除表现为随机延迟尖峰的操作系统调度抖动。结合感知非一致内存访问(NUMA)16 的放置策略,确保推理 pod 通过最近的内存控制器访问内存(避免会因每次访问增加 50 至 100 ns 的远程 NUMA 访问),可将亚毫秒级推理任务的 P99 延迟降低 10 至 30 个百分点。其原理十分直接:推理延迟主要由内存访问模式决定,任何内存访问不可预测性来源——无论是核心迁移导致的缓存淘汰、远程 NUMA 访问,还是地址空间切换导致的 TLB 缺失——都会直接劣化尾延迟。
16 NUMA(Non-Uniform Memory Access):本地内存访问耗时约 100 ns,而跨插槽远程访问为 150 至 200 ns,即存在 50 至 100 个百分点的惩罚。对于机器学习推理预处理,若 CPU 核心相对于 GPU 的 PCIe 连接被放置到错误的 NUMA 域,则每次主机—设备传输都会增加该惩罚,从而使亚毫秒级推理任务的 P99 延迟膨胀 10 至 30 个百分点。修复方案十分直接(CPU 固定与感知 NUMA 的 pod 调度),但在 Kubernetes 部署中往往被忽视,因为默认调度器完全忽略 NUMA 拓扑。
本文讨论的隔离技术构成了一条光谱,从更强的资源分区(MIG)到更灵活的软件共享(MPS 与时间分片),其选择取决于共置工作负载之间的信任边界。MIG 本身并不构成完整的外部租户安全边界。多租户平台必须将设备分区与 VM 或容器隔离、IOMMU 配置、驱动与运行时加固、认证与授权以及网络和存储控制结合起来。信任边界较窄、属于单一组织的工作负载,在可接受较弱故障隔离与性能隔离时,可以使用 MPS 或时间分片。
GPU 共享经济学
将多个模型共置到同一张 GPU 上的决策,定义了推理集群的效率前沿。这一选择处于一条光谱的两端:一端是独占访问,提供设备资源隔离,但会闲置容量;另一端是激进共享(通过 MPS 或时间分片),最大化利用率,但存在延迟干扰风险。独占设备分配仍然依赖周围主机、驱动、身份、网络和存储控制来保障租户安全。打包权衡的物理规律由内存碎片化和计算争用决定。
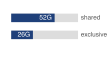
共享将两个租户打包在一起,将浪费的内存从 67% 降至 35%。
考虑一块 80 GB A100 GPU 承载一个 7B 参数模型。模型权重以 FP16 格式占用约 14 GB。计入典型的 KV cache 与激活开销后,该模型的运行时占用总量约为 26 GB。在独占访问策略下,该单一模型会使 GPU 的高带宽内存中约 54 GB(67 百分比)闲置,造成硅资本浪费。使用 MIG 对 GPU 进行切分(例如 3g.40gb 配置档)后,容器更加紧凑,分区内部的浪费降至约 35 百分比,但 GPU 的其余部分仍然被严格隔离。启用 MPS 将两个这样的模型打包到同一块 80 GB 设备上,总内存浪费降至 35 百分比。对于运行数百个小模型的集群,从独占托管切换到共享托管,可将所需 GPU 数量减少 2–3 倍\(\times\)。
这种密度是以干扰 为代价的。当两个工作负载通过 MPS 共享同一块 GPU 时,它们会竞争 SM 与内存带宽。这种性能退化取决于工作负载:两个计算受限型模型(例如大批次处理)争夺 ALU 时,每个模型通常会出现 15 到 20 百分比的吞吐量退化。然而,一个计算受限型模型与一个内存受限型模型(例如以解码为主的生成)共置时往往相安无事,仅出现 5 百分比的退化,因为它们各自受限的硬件资源不同。因此,调度器的工作便成为一个多维装箱问题:寻找互补的工作负载,在满足延迟 SLO 的同时最大化密度。
对于异构集群,这一逻辑要求采取分层的策略。我们 175B 参数模型仅 FP16 权重就需要约 350 GB;在 80 GB A100 上,这意味着在计入 KV cache、激活缓冲区、运行时工作区以及张量并行粒度之前,至少需要五块 GPU。实际上,8-GPU 张量并行副本是更清晰的调度单元,并且是独占访问的候选。相反,数十个 1B 到 7B 参数量的辅助模型,例如毒性分类器、查询嵌入编码器以及辅助生成模型,则是共享的理想候选。将这些较小模型打包到共享的“效用节点”上,可以释放高性能集群,用于基础模型推理的重计算任务。
Napkin Math 1.6: GPU 共享的投资回报率
考虑一个集群,为 100 个不同的 7B 模型(每个占用 26 GB 内存)和 10 个不同的 175B 模型(每个占用 350 GB 内存)提供服务。
策略 A – 独占访问(每个 GPU 部署一个模型):7B 模型需要 100 个 A100 GPU(每个配备 80 GB 内存),内存利用率仅为 32.5 percent(已使用 100 \(\times\) 26 GB,总容量为 8000 GB)。175B 模型需要 80 GPUs(10 个模型 \(\times\) 每个使用 8 GPUs 进行张量并行)。集群总规模:180 GPUs。
策略 B – 混合共享(小模型使用 MPS,大模型独占):在每个 A100 上部署 2 个模型,以容纳 7B 模型(2 \(\times\) 26 GB = 52 GB,远低于 80 GB),仅需 50 GPUs,内存利用率为 65 percent。175B 模型的资源需求保持不变,仍为 80 GPUs。集群总规模:130 GPUs。
共享使集群规模减少 27.8 percent(减少 50 个 GPU)。按 $2/GPU-hour 计算,仅通过调度策略,每年即可节省约 $876,000 的计算成本。
模型路由与流量管理
在集群层面,路由始于容量契约:调度器必须将每个服务副本作为不可分割的执行组进行放置和维护,为其 SLO 预留足够的容量余量,并向服务平面提供当前的就绪状态和内存压力信息。对于一个拥有 1750 亿参数的模型,可调度的副本可能是由八个 GPU 组成的张量并行组,而非单个 GPU 或单个进程。集群编排器决定此类组的数量、部署位置,以及需求变化时哪些低优先级资源分配可以让出容量。在大规模下运行推理 负责在这一容量范围内制定请求级策略,包括批处理、感知 KV 缓存的路由、准入控制、流量迁移和尾延迟控制。
训练与服务之间的资源边界
机器学习集群中最显著的资源利用率鸿沟,是训练与服务之间的壁垒。大多数组织将二者作为各自独立的领地来管理:一个必须应对峰值流量的“生产服务”集群(夜间有 50% 的资源闲置),以及一个任务始终积压的“研究训练”集群。这种静态划分 虽然安全,但经济效率低下。动态共享 将这些资源池整合起来,却引入了一项根本性的阻力:模式切换成本。
将 GPU 从训练用途改为服务用途并非瞬间就能完成。编排器必须为训练任务保存检查点(1 至 5 分钟)、终止容器、启动推理服务器、从存储中加载模型权重(2 至 10 分钟),并运行预热查询(1 至 5 分钟)以填充编译缓存。这种 5 至 20 分钟的切换延迟意味着 GPU 无法响应逐秒变化的突发流量,而必须根据昼夜规律调整分配。
推理流量通常遵循一条“人类活动曲线”:凌晨 3 点处于低位,上午 8 点开始上升,下午 2 点达到峰值,晚上 10 点逐渐回落。智能编排器会提前 30 分钟预测这条曲线。上午 7:30,它会抢占低优先级训练任务(例如超参数搜索),以预热推理副本。晚上 10:30,随着流量下降,它会让推理副本停止接收新请求并完成现有请求,然后将 GPU 交还给训练调度器。图 11 展示了这一 24 小时昼夜周期,说明编排器如何在服务与训练之间调配 GPU,以回收夜间闲置容量。
Napkin Math 1.7: GPU 的昼夜波动
考虑一个由 1,024 GPUs 管理的集群,并采用两种调度策略:
场景 A —— 静态划分:服务池预留 400 GPUs 以应对峰值需求,但平均使用率仅为 150 GPUs(37.5 percent 利用率)。训练池预留 618 GPUs,积压任务确保 100 percent 利用率。结果:150 GPUs + 618 GPUs = 768 个活跃 GPU。集群利用率:75 percent。
场景 B —— 动态共享:服务仅按需申领 GPU(平均 150 GPUs)。训练回收服务未使用的 GPU(平均 250 GPUs),并扣除 117 GPU 的安全缓冲。编排器依据昼夜预测,每天约两次在两种角色之间迁移约 133 GPUs。结果:服务(150 GPUs)+ 训练(618 GPUs + 133 GPUs)= 901 个活跃 GPU(训练项中的第二项为回收的服务容量)。集群利用率:88 percent。
动态共享回收了 133 GPUs 的有效容量。在 $2/GPU-hour 下,每年可产生约 $2.3M 的价值,而无需购买任何额外的加速器。
针对单一部署优化隔离并不复杂,但当数千个训练与推理工作负载共存于同一基础设施时,维持严格保障会变得不稳定。高优先级推理 SLA 与资源需求巨大的训练任务相互碰撞,产生了“吵闹的邻居”问题,而简单的容器化无法解决。多租户与配额因而成为治理层,仲裁公平访问,并防止共享集群中的“公地悲剧”场景。
多租户与配额
当计算机视觉团队囤积 500 个 GPU 使用一周,而自然语言处理团队却因无法将关键缺陷修复推送到生产环境而阻塞时,共享集群便退化为公地悲剧。提交率最激进、任务规模最大的团队,或重提交脚本最顽固的团队,会消耗与其需求不相称的资源;而那些需求较为克制或间歇性的团队,则发现集群始终处于占用状态。这造成了组织内摩擦、向管理层升级的政治博弈,以及对那些推进较慢但潜在价值更高的项目的投资不足,因为这些团队缺乏争取资源的工程投入。
多租户与配额提供了防止这种退化的组织与技术防火墙。本文讨论的配额系统为资源分配、借用和回收建立了正式策略,从而使公平访问和较高的整体利用率成为可强制执行的调度器属性,而非管理层协商的结果。
突发容量与配额借用
在共享 GPU 集群中,静态配额会产生突发容量悖论:Team A 有 64 个 GPU 的保证,但一次跨越周末的训练运行需要 256 个 GPU,而 Team B 的保证份额则闲置。解决方案是将保证配额与最大配额分离开来。Team A 最多可以借用其最大配额内的闲置整机设备,但这些设备仍属于物理集群容量,而非虚拟容量。如果 Team B 回收其保证份额,调度器会抢占或缩小 Team A 的机会式工作。
突发容量扩展的是期望中的最大值和公平份额权重,而非同时保证的容量。平台承诺并发满足的保证之和,必须能够在不可抢占预留和安全余量之后适配可回收的物理容量。团队可以宣传更高的最大值或权重,因为借用作业会在保证需求回归时让路,但这些数值并非保证。准入控制器必须区分保证分配与借用分配,而借用作业会首先面临抢占。分数共享是另一套独立机制,需要显式的 MIG、MPS 或时间切片合同。
为了安全地管理这一点,集群必须实现严格的优先级类别:
- Production Serving:Priority 0 工作负载不可抢占。
- Production Training:Priority 1 工作负载处理核心模型更新,仅会被服务中断抢占。
- Interactive/Debug:Priority 2 工作负载具有较高的调度优先级,但时间限制较短。
- Batch/Research:Priority 3 工作负载完全可抢占且具备容错能力。
这一层级确保一次大规模的超参扫描可以填满集群的“缝隙”,但在关键重训练作业到来时会瞬间消失。
安全突发上限源于可回收性,而非平均 SM 利用率。调度器必须测量借用作业能够多快完成检查点、缩小或终止;为该转换预留所需的 I/O 和网络带宽;并限制在保证响应时间目标内可回收的机会式容量数量。一个平均 SM 活动度为 70% 的作业,仍可能占用全部设备内存,并且需要其整个 gang 中的每个 rank,因此剩余 30% 并不构成可分配的整机比例。
资源核算与可观测性
因研究人员忘记取消预留而在周末闲置的 64 个 GPU,在多租户云集群中代表了不可见的浪费。在专用集群中,这种浪费至少是可见的:灯是亮着的,但风扇是安静的。在共享环境中,成本被隐藏,并在数千个作业之间累积。有效的治理要求超越简单的“分配”指标,转向分层核算模型,以区分“请求了什么”“使用了什么”以及“真正有用的是什么”。
三层测量揭示了这一差距:
- 已分配容量 (Allocated capacity):调度器为某个作业预留的资源对其他作业不可用。
- 计算利用率 (Compute utilization):GPU 内核处于活跃状态的时间百分比,衡量硬件的繁忙程度。
- 有效利用率 (Productive utilization):GPU 推进模型状态所占的时间比例,不包括数据加载停顿、通信开销和检查点。
这里的区别是操作层面的,而不仅仅是财务层面的。某团队可能被分配 500 台 GPU,但只使用 350 台(70% 的计算利用率),而有效使用 280 台(占分配量的 56%)。这 44% 的缺口告诉调度器容量在哪里消失,但它本身并不能证明该作业可以共享或释放整台设备。

已分配、活跃和有效利用率会大幅偏离。
在共享集群中,作业归属(attribution)构成一个控制问题。每个被接纳的作业都需要拥有者、项目、工作负载类别和抢占合约,这样调度器才能一致地应用配额和恢复策略。Kubernetes 标签和 Slurm 账号承载这一调度身份。规模化机器学习运维 阐述了组织如何将由此产生的使用记录转化为 showback、chargeback、组合责任(portfolio accountability)和平台投资决策。
这些数据驱动利用率仪表板,即集群运维人员监控集群健康度的主要工具。该视图必须综合各团队的利用率与配额、按优先级类别的队列深度,以及碎片化指数 (Fragmentation Index),后者衡量因拓扑约束而无法分配的可用 GPU。它还必须跟踪抢占率、抢占式中断、检查点流量,以及这些操作所引入的恢复开销。这些测量使调度器能够区分可以回收的闲置容量,与看似闲置但实际源于通信、I/O 或僵化的 gang 依赖的已分配容量。
自动异常检测将这些指标转化为可操作的信号。某团队消耗量突然跃升至其历史基线的 3\(\times\) 倍,可能表明存在失控脚本,不断生成无限数量的作业。队列的增速快于其排空速度,则表明存在容量不足,必须通过自动伸缩加以解决。相反,集群整体功耗的突然下降通常先于大规模作业失败事件,往往源于共享依赖(如存储故障)。这些告警使运维人员能够在预算耗尽或队列失控之前介入。
Systems Perspective 1.7: 三个利用率指标
为调试集群效率,应在三个不同层次上测量利用率。已分配利用率 (Allocated Utilization) 指调度器预留的物理 GPU 百分比;数值偏低表明需求不足或配额过于严格。计算利用率 (Compute Utilization) 指已分配 GPU 执行内核的时间百分比(由
nvidia-smi 报告);数值偏低表明代码效率低下、I/O 瓶颈或通信停滞。有效利用率 (Productive Utilization) 指分配时间中真正用于有效训练的比例(排除开销);数值偏低表明分布式扩展效果不佳、检查点过于频繁,或重启过于频繁。
安全与命名空间隔离
多租户不仅要求公平的资源分配,还要求安全隔离,以防止各团队之间相互干扰或观察彼此的工作负载。风险是切实存在的:机器学习模型代表重要的知识产权,训练数据可能包含受隐私法规约束的敏感信息,而模型本身可能编码专有业务逻辑。如果没有适当的隔离,某个团队命名空间中遭到破坏或配置错误的作业,就可能访问其他团队的模型权重、训练数据或推理流量。
在 Kubernetes 环境中,命名空间分离提供了基础隔离边界。每个团队在专用命名空间中运行,基于角色的访问控制将可见性限制在其自身资源范围内。基于角色的策略控制谁可以在每个命名空间内提交作业、查看日志、访问模型产物以及修改调度策略,从而对集群使用形成组织层面的治理。
网络策略将隔离延伸至网络层,阻止跨命名空间的通信,除非通过显式允许的服务。面向机器学习工作负载的网络策略必须在隔离与分布式训练通信需求之间取得平衡。一项实用的策略可能允许命名空间内部不受限制的全对全通信(这是环状 AllReduce 所必需的,正如 集合通信 中分析的那样,每个 worker 都必须与其他每个 worker 通信),同时阻止来自其他命名空间的所有入向流量(防止外部工作负载截获梯度流量或模型更新)。出向策略可以阻止训练作业访问外部网络,降低因训练代码被破坏或依赖被投毒而导致的数据外泄风险。
GPU 虚拟化隔离谱系 比较了几种 GPU 虚拟化方案,维度包括隔离强度、资源效率和工作负载适配性。
| 选项 | 隔离强度 | 效率与灵活性 | 适用工作负载或信任边界 |
|---|---|---|---|
| 时间分片 | 分离的上下文;共享性能与设备故障域。 | 灵活;无空间预留。 | 可信的突发型任务。 |
| MPS | 分离的地址空间;共享性能与 GPU 故障域。 | 并发内核;可配置限制。 | 相互信任且需求可测的任务。 |
| MIG | 硬件划分的内存、缓存与计算单元。 | 可预测;固定配置。 | 对 SLO 敏感的工作;外部租户同样需要平台安全控制。 |
| 整机直通 | 对 GPU 的独占访问。 | 最强的设备隔离;最低的填充效率。 | 饱和使用设备或禁止共享的任务。 |
选择取决于共置工作负载之间的信任边界,以及各类工作负载的性能敏感度。多租户环境中的安全性超出了简单的资源公平性。针对共享 GPU 的旁道攻击是一项已记录的漏洞;通过监控共享缓存或内存控制器的争用,恶意租户可以推断出同驻模型的架构,甚至数据属性。在敏感环境中,MIG 或专用设备可以增强设备资源隔离,但两者都只是更大范围的主机与平台安全边界中的一个组成部分。
优先级抢占级联

一次驱逐会波及许多任务:抢占级联。
当高优先级任务进入一个已饱和的集群时,调度器必须决定终止哪些正在运行的工作负载以释放资源。这一决策很少是孤立的。在紧密打包的集群中,驱逐一个中等优先级任务以容纳高优先级请求,往往会触发抢占级联,即被驱逐的任务立即尝试通过抢占更低优先级的工作负载来重新调度自己。若无抑制控制,单个紧急推理服务部署就会沿队列扩散, destabilizing 数十个训练任务,并引发一轮抢占式检查点重载,从而占满存储带宽。
抢占的工程成本远远超出调度延迟本身。抢占税 是自上次检查点以来损失的计算量、持久化状态产生的开销,以及恢复时的冷启动惩罚之和。对于大规模分布式训练,这项税是非线性的。以我们 175B 参数模型的 64-GPU 微调运行为例:若被抢占,该任务将损失自上次快照以来完成的工作(平均 15 分钟)。重启后,需要从分布式存储中重新加载庞大的优化器状态,耗时 20 分钟;随后还需要 10 分钟预热时间,用于数据管线回填预取缓冲区、即时(JIT)编译器重新优化内核以及 GPU 缓存重新填充。
另有隐藏成本会进一步叠加这项税:重建分布式数据管线状态。抢占大规模训练任务并不只是中断梯度计算:它还丢弃数据加载器的确定性状态,包括用于打乱的随机种子、施加于 epoch 的打乱顺序,以及记录已消费样本的字节偏移。若无法精确恢复该状态,重启后的任务要么重新读取已经处理过的样本(通过放大某些示例来污染梯度统计),要么使用不同的打乱顺序(破坏 epoch 之间的统计独立性)。将 petabyte 级分布式数据管线恢复到抢占前的状态,通常需要在所有数据加载器 worker 上回放元数据日志,这一过程往往使有效预热窗口远远超过仅重新加载优化器状态所消耗的时间。存储了紧凑数据加载器检查点(记录种子、采样的排列索引和当前分片偏移)的框架可以显著降低这一成本,但大多数生产训练管线仍需要一段人工预热期,以在梯度质量回到基线之前近似原始数据顺序。
45-minute
在此期间,GPU 处于活跃状态,但实际产出近乎为零。到 $2/GPU-hour,单次抢占事件造成的浪费计算资源为 $96。若调度器允许无限制抢占,则每天 12 次抢占会浪费该任务分配中 9 hours 的计算资源,或对于这次 64-GPU 运行,每天浪费 576 GPU-hours。为缓解这一问题,调度器实施抢占预算。这些速率限制约束了中断发生的频率,例如,防止某个任务在一小时内被抢占超过一次,或将整个集群在任意 10 分钟窗口内的抢占抖动总量限制为容量的 5%。这迫使调度器等待任务自然完成,而不是触发级联抢占,以略高的待调度时间为代价,换取显著更高的整体吞吐量。
配额治理与组织动态
调度器管理硅片的逐秒分配,而配额治理管理组织意图的按月分配。配额是工程约束与业务优先级之间的接口。在成熟的机器学习组织中,这些配额很少是静态的;它们会通过周期性的配额评审周期进行调整,依据实际利用率而非预测需求重新校准分配。一个团队长期只使用其 128-GPU 配额中 40% 的部分,实际上是在阻碍其他团队启动实验,制造出一种虚假的稀缺,推高了排队时间,尽管物理容量绰绰有余。
配额管理的核心张力是囤积问题。工程团队出于缩短等待时间的理性诉求,往往”以防万一”地申请最大容量。这导致平均利用率偏低、突发需求偏高。两种机器学习特有的模式会进一步放大这种行为,超出一般的资源焦虑。第一种是 RLHF 评估阶段:分配给策略模型的 GPU 节点大多处于空闲状态,团队在等待人类标注者的评分。团队保留该预留以避免标注批次到达后再次排队,但标注窗口内的实际 GPU 占用率可能低于 10%。第二种模式出现在团队为某个训练运行预留 GPU 区块,而其预处理流水线尚未完成时。针对大规模语料库的 CPU 密集型数据分词与词表归一化通常耗时超过团队预估;GPU 处于预留且空闲状态,而分词器正在处理数据集,因为释放预留存在被竞争团队抢占的风险。这两种情形从团队角度看都是理性的,但在集群层面代表了系统性的资源浪费。对此,平台团队实施基于利用率的回收:如果某个配额池在设定时间内利用率不足,系统会自动降低分配,将资源返还至公共池。这种技术性强制把举证责任转移回团队,要求其为自己的预留提供 justification。
配额计费应尽量贴近调度决策。针对预留计费的 GPU 小时、借用份额或抢占类别,使囤积的机会成本变得可见,并让控制面能够回收空闲的配额保证。规模化机器学习运维进一步围绕这些度量构建更广泛的财务体系,包括费用回显、费用分摊、平台回报、资本规划与全生命周期成本。
一个具体的配额场景展示了闲置预留如何迅速变得昂贵。
Example 1.3: 配额囤积
场景:一个研究团队为即将到来的模型刷新预留了 500 GPU 的固定配额块。
诊断:上游数据延迟推迟了训练,但团队仍保留该预留以确保未来的可用性。GPU 闲置了三周,累积了 $504,000 的资本浪费,而其他团队的队列也因此积压。
系统教训:固定配额预留会导致严重的容量囤积。Fleet orchestrators 必须实现动态的“用则留,不用则收”回收策略,自动将闲置的预留节点(72 小时内利用率低于 20%)降级为可抢占的 spot 池。
“用则留,不用则收”回收策略解决了配额囤积中最显眼的症状,但它提出了一个二阶问题:当闲置容量借给其他团队时,系统必须区分借用容量(可被短期抢占)与保证预留(受 SLO 保护)。将借用、抢占和保证层级定义为首等策略原语,是核心的多租户设计决策。
Checkpoint 1.4: 多租户设计决策
考虑一个 2,000 GPU 集群,由研究团队(60% 分配)和生产团队(40% 分配)共享:
即使已经部署了精细的多租户和配额策略,集群仍可能沦为复杂系统性瓶颈的受害者,而这些瓶颈难以通过简单监控发现。当利用率 inexplicably 下降而队列却已满时,运维人员必须从仪表盘转向系统化的利用率调试。
调试集群利用率
集群仪表盘显示平均 GPU 利用率一直卡在 60%,但开发者却抱怨小型调试任务需要三天排队时间。数百台 GPU 处于闲置状态,却没有任务启动。弥合理论容量与生产现实之间的这一差距,需要系统性的取证分析,以理清硬件拓扑、调度策略与用户行为之间的相互作用。利用率高于 80% 会导致队列等待时间非线性爆炸(利用率悖论)。
:::
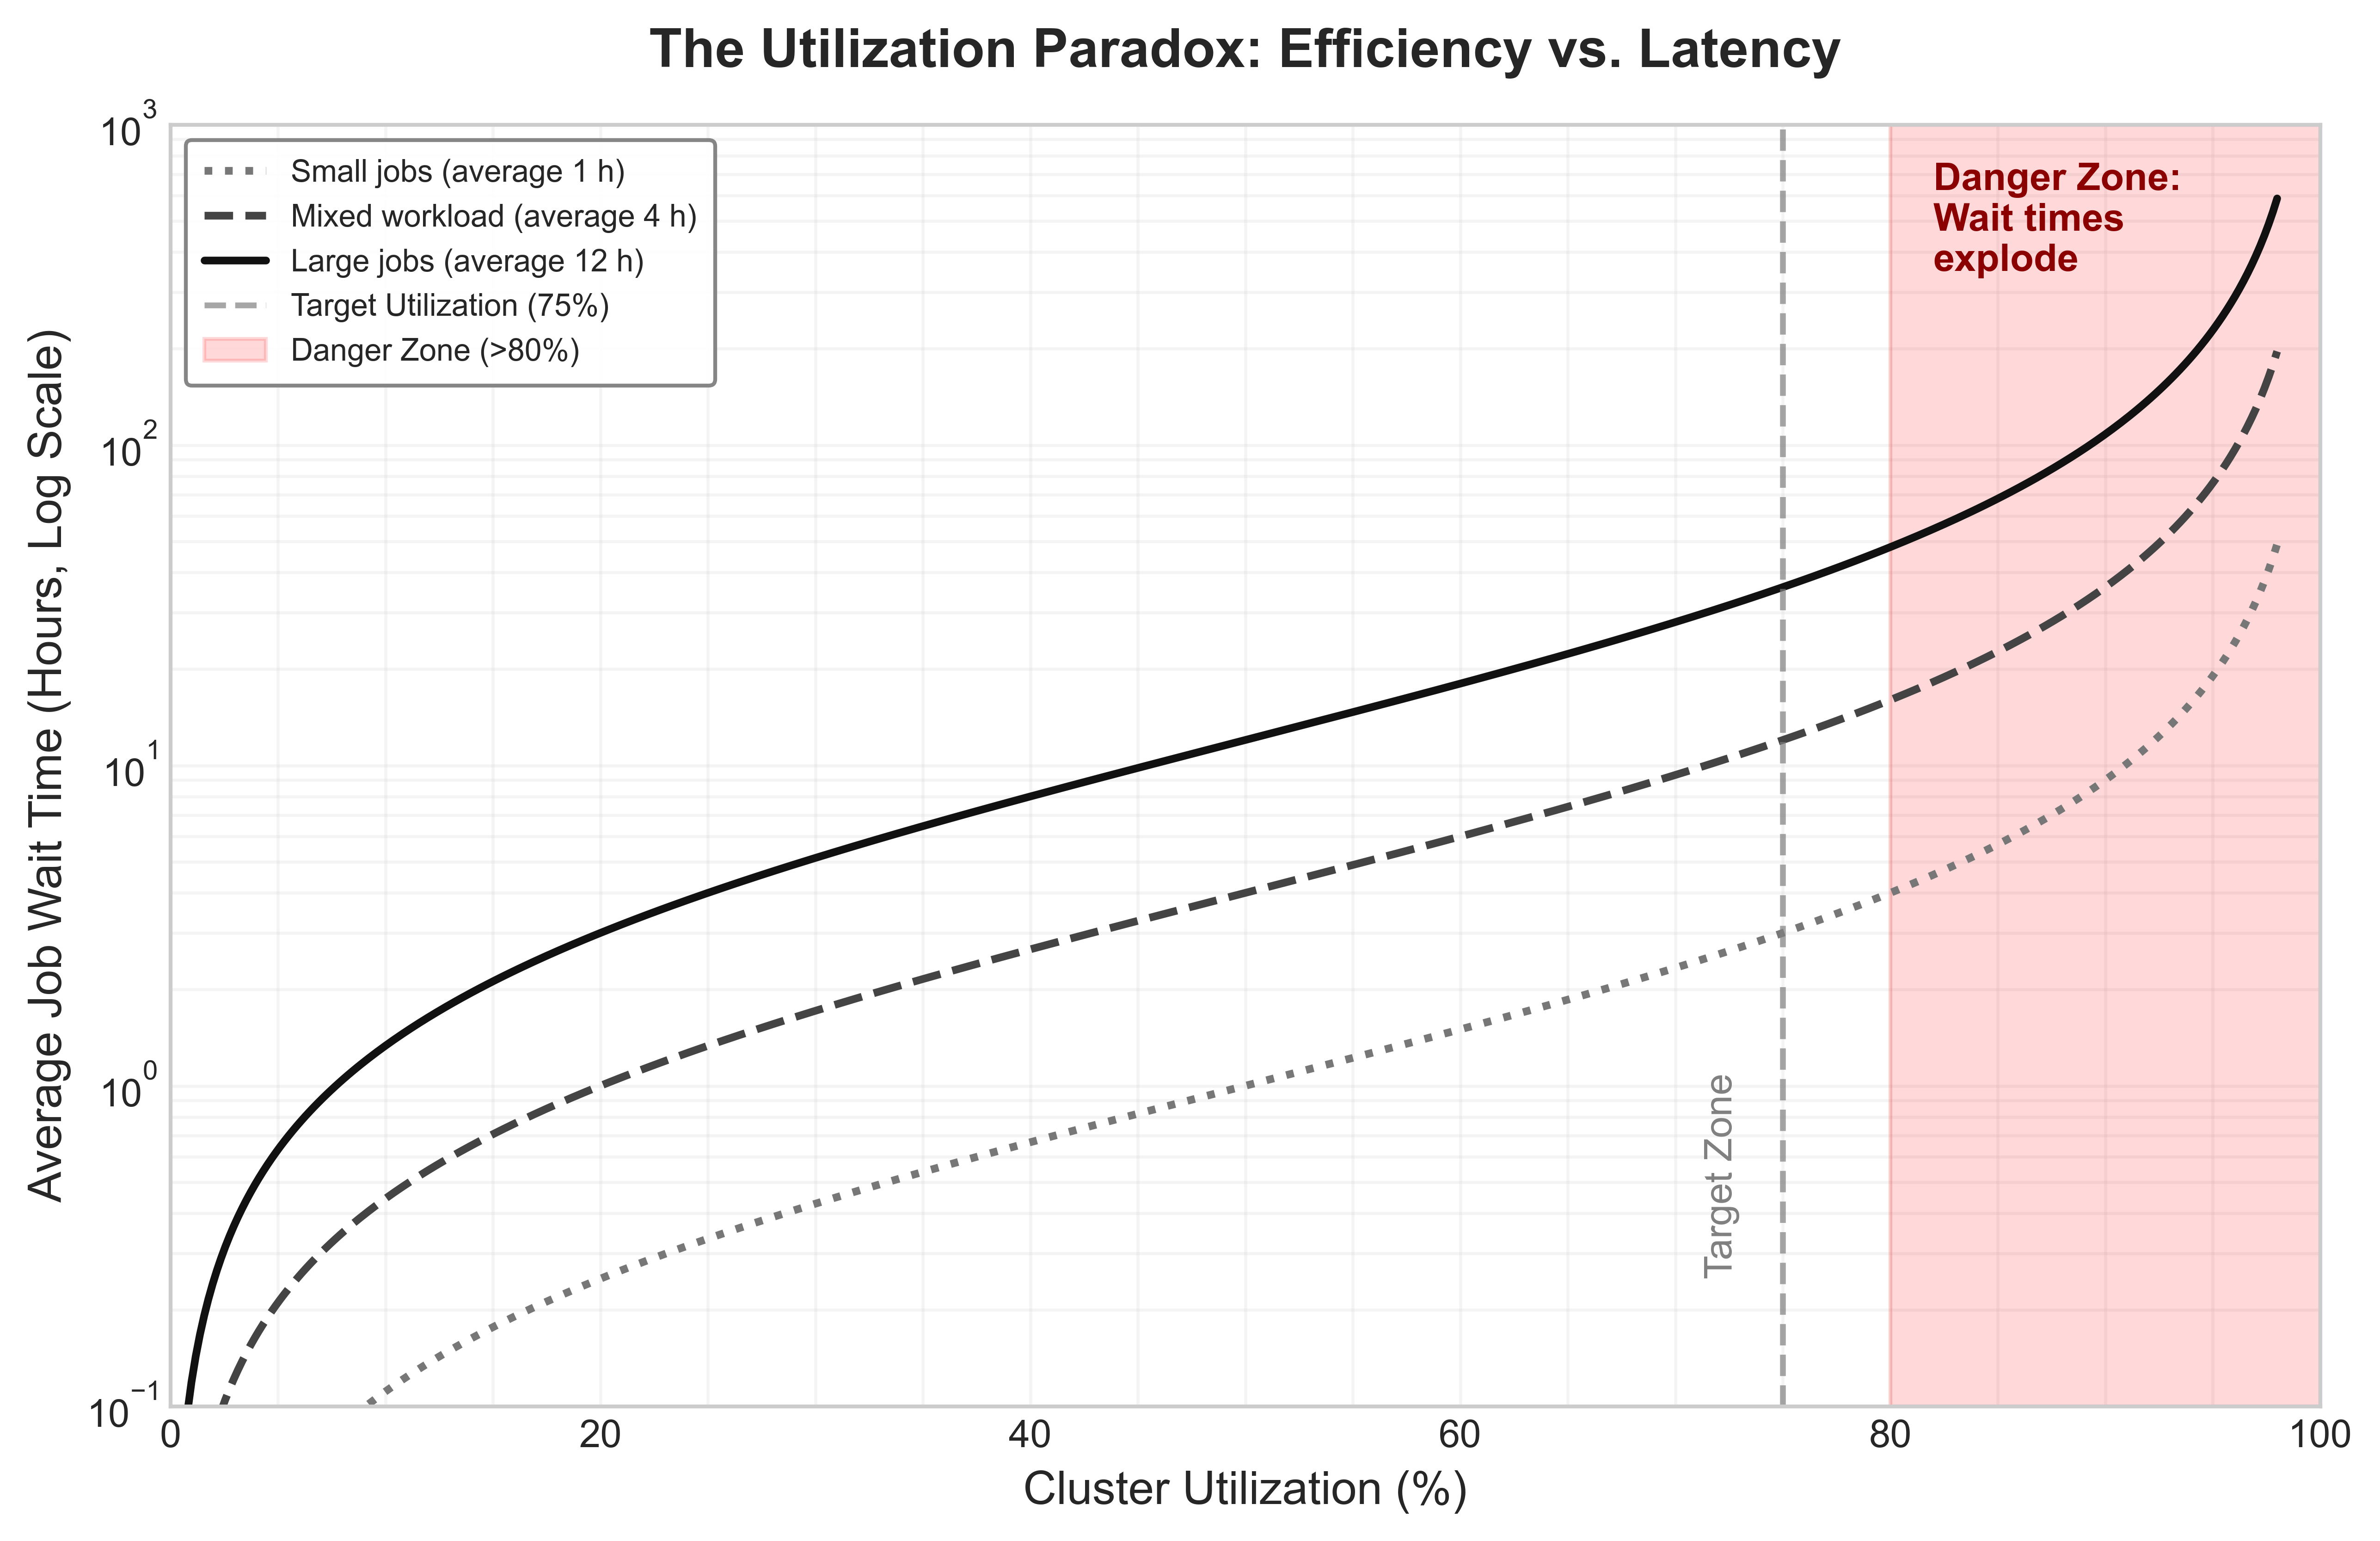
:::
调试方法是将调度器状态与物理能力进行比较,对照实际硬件资源池检查作业请求,然后检验是否存在策略与基础设施不匹配的问题。当调度器遵守的约束在仪表盘的聚合展示中被隐去时,队列满载与加速器空闲可能同时存在。示例 1.4 中的集群运行着 表 4 所列的异构硬件,这些硬件是经过三个采购周期逐步积累的。
| GPU 类型 | 数量 | 显存 | 互连 | 节点 |
|---|---|---|---|---|
| A100-80 GB | 400 GPUs | 80 GB HBM2e | NVLink (600 GB/s) | 50 nodes \(\times\) 8 GPUs |
| A100-40 GB | 424 GPUs | 40 GB HBM2e | NVLink (600 GB/s) | 53 nodes \(\times\) 8 GPUs |
| V100-32 GB | 200 GPUs | 32 GB HBM2 | PCIe Gen3 (15.8 GB/s) | 50 nodes \(\times\) 4 GPUs |
Example 1.4: 调试 GPU 利用率低的问题
场景:一个拥有 1,024 个 GPU 的集群报告平均利用率为 60 percent,尽管队列中有超过 50 个待调度作业。
诊断:资源需求指定过高(用户为显存需求为 35 GB 的作业复制 A100-80 GB 模板)、资源池碎片化,以及对旧款 V100 的回避,导致 A100-40 GB 和 V100 节点闲置,而大型作业仍在等待分配 A100-80 GB。调度器正确执行了为同构集群制定的策略,但这些策略已不再适用于当前的异构基础设施。
系统经验:表层诊断常常将策略与基础设施不匹配误判为调度算法缺陷。更新分布层策略,使其支持自动能力匹配、动态显存需求分析和回填调度,可将集群利用率提高至 84 percent,每年释放出 $7M 的计算容量。
| 资源池 | 修复前 | 修复后 | 变化 |
|---|---|---|---|
| A100-80 GB | 95% 分配利用率,72% 有效利用率 | 89% 分配利用率,94% 有效利用率 | +22 pp |
| A100-40 GB | 64% 分配利用率 | 88% 分配利用率 | +24 pp |
| V100 | 0% 分配利用率 | 71% 分配利用率 | +71 pp |
| 集群整体 | 60% | 84% | +24 pp |
这一利用率提升增加的有效工作量,相当于约 246 个充分利用的 GPU 所完成的工作量(表 5)。这相当于额外购买 410 个 GPU,前提是这些 GPU 仍以原来的 60 percent 利用率运行。按 $2/GPU-hour 计算,这一等效硬件容量每年可挽回约 $7M 的价值,而实现这一收益的策略变更无需任何额外硬件投资。
常见的利用率反模式
宏观指标常常掩盖深层的低效。集群仪表盘可能报告 85% 的分配率,但有效利用率,即实际推动模型状态更新的计算周期占比,可能显著更低。调试这些差距需要识别 GPU 遥测数据中的特定特征,以揭示底层瓶颈。
僵尸作业是最严重的浪费形式:训练进程已经崩溃或死锁,却仍然占用 GPU 资源。在训练一个具有 1750 亿参数的模型的分布式运行中,如果进程清理失败,单个 rank 的故障就可能使 128 个 GPU 仍处于已分配状态,却全部闲置。其特征是显存分配量很高(大于 300 GB),同时 SM 利用率接近零(小于 5%),且这一状态持续时间超过心跳超时时间(通常为 10 分钟)。这种状态通常源于 CUDA 上下文损坏或驱动层死锁,使容器运行时无法成功回收进程,需要在节点层面采取强制修复措施才能收回设备资源。
08 集群编排
数据饥饿模式表现为 GPU 利用率中的高频锯齿波,设备在 100% 负载(前向/后向传播)与 0% 负载(等待下一批数据)之间振荡。虽然平均利用率可能看起来尚可,处于 60% 到 70%,但 GPU 实际上有三分之一的时间处于空转。这种情况发生在 CPU 受限的数据流水线无法维持 GPU 所需的吞吐量时,这在计算机视觉中很常见,JPEG 解码与数据增强会耗尽主机 CPU。利用率方差超过 30% 标准差是主要的诊断指标,提示需要启用主动预取、提高加载器并行度,或进行本地 NVMe 缓存,以填满加速器。
通信瓶颈通过分布式组内所有 rank 的 SM 利用率出现周期性、同步下降而显现。对于 175B 模型,同步 350 GB 参数的梯度需要极大的带宽;如果网络容量不足或拥塞,GPU 用于等待 AllReduce 完成的时间将超过执行计算的时间。诊断指标是步骤时间比。若总迭代时间超过 1.5\(\times\) 仅计算时间(隔离的前向加后向传播),则非计算开销超过 0.5\(\times\) 计算时间,这虽然可观但并不占主导。在简化的分解 \(T_{\text{total}} = T_{\text{compute}} + T_{\text{comm}}\) 下,只有当该比值大于 2\(\times\) 时,通信才会超过计算;剖析时还必须将通信开销与输入和运行时开销分开。补救措施需要感知拓扑的放置策略,将流量保留在高带宽交换机层级,或通过梯度累积之类的算法调整来提高计算与通信之比。
内存碎片陷阱是长运行推理服务器中一种隐蔽的失效模式。一个 175B 模型在服务于多种请求长度时,可能最终有 80% 的 HBM 分配给了 KV 缓存,却因可用内存分散在多个小的、非连续的块中而无法接受新请求。GPU 对调度器而言看似已满,但从吞吐量角度看却处于欠用状态。这类似于经典的堆碎片问题,但后果更为严重:单次重启以整理碎片会倾倒数百 GB 的状态。监控请求 token 槽位与已分配内存字节之比常常能暴露这一缺口,而分页缓存分配器通过将逻辑序列连续性解耦于物理内存布局来应对,从而回收可用内存,并在不增加硬件的情况下将服务吞吐量提升 2–4\(\times\)。
这个调试示例说明了一个更广泛的原理,适用于 fleet 栈中的每一个系统:调度系统的有效性仅取决于其所实现策略的完善程度,而策略必须随着基础设施一同演进。当基础设施发生变化(新增硬件代际、网络拓扑升级、工作负载构成从训练主导转向服务主导),编码于调度器配置、作业模板和组织实践中的策略都必须重新评估并更新。最昂贵的调度缺陷往往并非软件缺陷,而是一项针对旧基础设施正确、却从未针对新基础设施更新的策略。
这一原理将调度机制与集群治理联系起来。技术策略(GPU 类型匹配、gang 调度超时、抢占宽限期)与组织策略(团队配额、优先级层级、成本分摊)以及人类行为(作业模板复用、资源申请习惯、队列提交模式)相互交织。有效的集群编排需要同时兼顾这三个层次。
谬误与陷阱
这些策略与基础设施之间的错配会以一小类误解的形式反复出现,它们可能使一个表面上健康的调度器浪费昂贵的集群容量。看到集群利用率高达 98% 就宣布胜利,很容易让人产生这种想法,但随后可能发现研究人员已经完全停止提交作业,因为等待时间已经延长到数周。集群编排充满了这类违反直觉的陷阱,优化单个指标会摧毁整个系统的价值。
谬误:更复杂的调度算法总能提高利用率。
面对低利用率的工程师往往会转向更先进的调度器,误以为算法才是瓶颈。正如 节 1.8 中的调试示例所示,根因通常是策略配置错误,而非算法能力受限。一个策略正确的简单 FIFO 调度器(基于能力的匹配、带超时的回填、适当的 gang 调度约束)往往胜过策略错误的复杂调度器。在升级调度器之前,先审计策略:确认用户没有申请他们并不需要的资源,异构资源是否得到正确暴露,以及 gang 调度超时是否已配置。
陷阱:在衡量利用率时,将全部 GPU 小时视为同等价值。
集群仪表板与调度决策
集群仪表板通常将“GPU 利用率”报告为单一百分比,跨所有 GPU 和所有工作负载取平均。该指标掩盖了关键信息。某个集群可能报告 80% 的利用率,其中 60% 是有效的训练计算,15% 是分配给等待 gang 完成的作业的空闲 GPU,5% 是运行数据加载、没有活跃计算的 GPU。有效的监控应当在已分配利用率(分配给作业使用的 GPU)、计算利用率(执行内核的 GPU)和有效利用率(推进有用训练或处理服务请求的 GPU)之间加以区分。只有最后一个指标与实际交付的价值相关。
谬误:分布式训练总是需要 gang 调度。
gang 调度可以防止同步训练中的死锁,但并非所有分布式训练都是同步的。异步训练方法能够容忍 worker 的到达与离开,弹性训练框架可以处理变化的 worker 数量。对于能够异步运行或弹性运行的工作负载,放宽 gang 调度要求能显著提升调度灵活性并缩短排队等待时间。代价是可能因梯度过期或批大小波动导致收敛性下降,但对于许多实际工作负载(超参数搜索、微调、自适应批大小的预训练),这一权衡是划算的。
陷阱:依据峰值需求设置固定配额。
组织通常按最坏情况需求为团队设置配额,理由是团队在高峰期需要获得保障。如果 A 团队的峰值需求为 500 个 GPU,B 团队为 300 个 GPU,那么在固定配额下集群需要 800 个 GPU。实际上,峰值很少同时出现。采用可借用机制的分层公平共享,可以用 600 个 GPU 的集群同时满足两个团队的峰值需求,因为当 A 团队处于峰值时,B 团队通常处于中等需求,可以借出容量。按峰值水平设置的固定配额,会浪费 25% 到 40% 的集群容量于“有保障但未被使用”的分配上。
谬误:spot 实例总是更便宜。
spot 实例 60% 到 90% 的折扣会让人误以为可以自动省钱。实际成本取决于中断频率、检查点开销和重启时间。对于一个需要 15 分钟检查点、30 分钟重启时间的大模型,一次 spot 中断会消耗 45 分钟的有效时间。如果每 2 小时发生一次中断,实际成本会上升到足以使名义上的 65% 折扣缩减为约 52% 的节省。对于参数量在 100B 以上、且所在集群 spot 中断频繁、检查点较慢的模型,在计入全部开销后,按需实例反而可能更便宜。该决策需要对具体工作负载和 spot 市场条件进行定量分析,而不是笼统地假设成本节省。
陷阱:调度分布式训练时忽略拓扑结构。
把 GPU 视为可互换单元的调度器会产生跨节点的张量并行组(迫使以 NVLink 速率的通信经过 InfiniBand),或跨脊交换机的 AllReduce 组(增加延迟和拥塞)。不良拓扑放置带来的 15% 到 30% 吞吐量惩罚会在多周训练运行中累积,可能浪费的资源多于等待拓扑感知分配所损失的资源。拓扑感知的调度会增加调度复杂度,并可能降低打包效率,但对于大规模分布式训练任务,吞吐量的提升通常足以证明这一权衡是合理的。
谬误:仅凭 GPU 利用率就足以作为自动扩缩放的信号。
GPU 利用率是推理健康度的糟糕代理指标。GPU 可能达到 90% 的利用率,却仍然违反延迟 SLO,因为该利用率来自处理排队请求的积压。反过来,利用率只有 40% 的 GPU 可能完全健康,因为它正在处理低延迟请求,并且有余量应对突发流量。正确的指标是队列深度、相对 SLO 的 P99 延迟,以及 LLM 工作负载的 KV cache 内存压力。依赖利用率会产生滞后指标,只能在性能已经下降后才触发扩缩放,而队列深度和 SLO 余量则提供前向指标,使集群能够在用户体验受损之前完成扩缩放。此外,对于 LLM,KV cache 增长导致的内存耗尽可能发生在计算利用率较低的情况下,使请求停滞或失败。只监控计算利用率的自动扩缩器将完全遗漏这一故障模式,尽管表面上容量充足,服务仍处于降级状态。
误区:以弹性训练来规避 gang 调度决策。
弹性训练对 gang 调度具有补充作用,但不能取代它。虽然弹性训练允许作业调整规模,但这些调整步骤本身往往具有原子性要求。弹性训练适用于数据并行,但不适用于张量并行(因为每个组需要固定数量的 GPU)。一个使用 8 路张量并行的 175B 模型,每个张量并行组必须恰好有 8 个 GPU 才能运行;这是一种 gang 约束,弹性训练无法放宽。弹性训练调整的只是数据并行副本的数量,而非副本内部的并行配置,因此调度器仍然必须对模型的基本单元强制执行 gang 约束。如果调度器简单地将这 8 个 GPU 分散到不同机架,或者无法原子地分配它们,那么张量并行组要么无法初始化,要么性能严重退化。
谬误:调度器无需针对具体工作负载进行验证。
调度器配置需要随着工作负载的演进而持续调优。Slurm 或 Kubernetes 中的默认配置是针对通用工作负载优化的,往往更看重简单的公平性而非吞吐量。针对机器学习场景的调优(gang 调度超时时间、感知拓扑的放置权重、抢占宽限期以及公平份额衰减率)可以将资源利用率提升 15% 到 25%。部署了调度器却从不复查其配置的组织,等于放弃了可观的价值。默认抢占宽限期可能过短,导致大模型来不及完成检查点,从而造成工作浪费;而未调优的拓扑权重则可能不必要地碎片化集群。随着集群规模扩大和工作负载构成变化(例如从训练为主转向推理为主),有效的调度参数也会随之变化。把调度器当作“设置一次、永久不管”的设备,会让整个集群逐渐滑向低效。
误区:把高利用率当作集群健康的证明。
一个利用率达到 95% 的集群听起来效率很高,但可能存在问题:容量不足正在拖慢实验推进速度。当利用率持续超过 85% 到 90% 时,排队时间会按照随机过程理论中众所周知的 M/M/1 排队结果迅速增长。在该模型中,平均等待时间与 \(\rho/(1-\rho)\) 成正比,其中 \(\rho\) 表示利用率;当利用率为 90% 时,平均等待时间是服务时间的 9\(\times\),当利用率为 95% 时,则为 19\(\times\)。需要等待数小时甚至数天才能获取资源的科研人员会减少实验数量、减少假设验证,并更慢地迭代模型设计。这种实验速度的下降具有真实代价,虽然比 GPU 小时更难量化,但在总体上可能更为严重。有效的利用率目标需要在资源效率与研究人员生产力之间取得平衡,训练集群通常落在 70% 到 85% 之间,因为排队响应速度直接影响研究产出。对于请求要么立即得到服务、要么完全得不到服务的推理集群,目标利用率往往更低(50% 到 70%),以保留应对流量突增的延迟余量。
认识到这些谬误,可以避免平台团队去追求那些在仪表板上看起来不错、却会损害开发者速度的虚假优化。成功驾驭这些权衡的核心编排原则有一条共同主线:它们把调度视为一门工程学科,而非一项行政职能。
Summary
集群编排通过将原始数据中心容量转化为有生产力的机器学习基础设施,来规范硅片、带宽和状态在时间与空间上的相互作用。就性能铁律(\(T \approx D_{\text{vol}}/\text{BW} + O/(R_{\text{peak}} \cdot \eta_{\text{hw}}) + L_{\text{lat}}\))而言,编排器是系统的核心优化器:放置策略保护互连带宽(\(\text{BW}\)),多租户与配额策略决定硬件的实际效率(\(\eta_{\text{hw}}\)),分布式调度算法则限制排队延迟与协同开销(\(L_{\text{lat}}\))。高性能集群与成千上万台闲置加速器之间的差别,不在于硬件能力,而在于调度器在部分故障和突发需求下,于原子一致性、容错与放置拓扑之间权衡取舍的能力。
集群编排
本章统一的技术洞见是:放置方式直接决定了物理性能。通过将模型并行与物理网络层次结构对齐,拓扑感知的调度可以避免跨机架二分瓶颈,从而保护 \(D_{\text{vol}}/\text{BW}\) 通信项,并将吞吐量提高 15% 到 30%。面向特定领域的调度器——例如 Tiresias、Gandiva、Themis 和 Pollux——利用机器学习工作负载的结构(迭代式进展、长尾运行时间和可预测的收敛性缩放)来最小化协同与等待时间项(\(L_{\text{lat}}\)),相比通用 FIFO 策略,将平均作业完成时间降低 40% 到 60%。弹性训练与抢占式资源管理通过以工作器连续性换取经济灵活性来延伸这种控制,前提是作业能够动态适应,而不至于产生不可接受的抢占代价。
公平性同样是一个受约束的分配问题,而非单一的配额百分比。DRF 均衡每个租户的最大归一化资源份额,但 gang 大小、拓扑局部性和加速器兼容性决定了哪些名义分配是可行的。延迟与最大可行等待时间随后揭示:均等的资源份额是否能在时间维度上转化为公平的访问。
在服务阶段,集群调度器保留一个容量包络,而不是为单个请求选择路由。它会放置不可分割的副本,维护 SLO 余量,并利用实测需求来移动训练—服务边界。在大规模下运行推理 在该包络内实现请求准入、批处理、路由、KV-cache 策略以及尾延迟控制。多租户隔离与公平份额配额治理仍然是编排层面的问题,因为它们决定哪些工作负载可以共享硬件,以及在压力下哪些分配能够成立。
最终,集群编排既具有诊断性也具有经济性,而不仅是算法性。诸如僵尸作业、数据饥饿、拓扑失配和池碎片化之类的运行期病理,是策略与基础设施失配的症状,而非硬件不足的表征。当计算节点被定义、网络被布线、存储被挂载、容错被集成、以及编排器被对齐时,集群便从一组彼此隔离的服务器转变为一个连贯的、具备自愈能力的计算平台。
拓扑感知的放置使 C\(^3\) 交换具体化。将张量并行 gang 共置于同一位置,通过让其集合通信保留在 NVLink 上并减少跨机架通信,从而提高有效计算效率;但调度器在等待可行连续分配期间需要付出更高的协同成本。因此,瓶颈可能从集合带宽转移到队列延迟或碎片化。这次迁移是否划算,取决于端到端作业完成时间,而不仅仅是迭代吞吐。
Key Takeaways: 调度是系统工程
- 分布式调度本质上非常困难:集群调度 面临单机调度器从未遇到的挑战(部分故障、网络分区、状态不一致)。CAP 定理迫使系统在一致性与可用性之间做出取舍,而这些取舍塑造了每一个调度系统的设计。
- gang 调度可以防止死锁,但降低了灵活性:gang 调度 为分布式训练提供原子资源分配,以防止 hold-and-wait 死锁;但与回填超时和弹性训练替代方案结合使用时,僵化的 gang 调度会浪费资源。
- 公平性是在可行组合上度量的:DRF 均衡每个租户在 GPU、CPU、内存和网络上的主导归一化份额。gang、拓扑和兼容性约束必须先过滤掉不可行组合,而延迟与最大可行等待时间则检验由此产生的策略是否避免了延迟与饥饿。
- 拓扑决定性能:GPU 在集群层次结构中的放置位置 与作业获得的 GPU 数量同样重要。NVLink 与 InfiniBand 的放置决策,可能使同一作业在同一硬件上产生 15% 到 30% 的吞吐量差异。
- 面向 ML 的调度优于通用方法:利用工作负载特性(可预测的资源需求、迭代式计算、收益递减)可实现作业完成时间较通用 FIFO 或公平份额策略提升 40% 到 60%。
- 资源利用率是一阶经济驱动因素:在大集群上将利用率从 50% 提升至 80%,实际上等同于增加了数千个 GPU 的容量。通过策略与算法工作来弥合这一差距,比额外购买加速器回报更快。
- 策略必须随基础设施演进:调度算法 的有效性仅取决于其所实现的策略。当基础设施发生变化(异构硬件新增、拓扑升级、工作负载构成变化)时,策略必须重新评估并更新(原则 13)。
集群现已具备计算、通信、存储,以及保持这些能力持续运行的韧性。它仍然需要一个策略来决定“在哪里运行什么”。一味追求峰值利用率的调度器可能在大型作业争夺相同节点时陷入死锁,而保证进展的调度器则可能有意闲置部分容量。理论吞吐量与可安全持续运行的吞吐量之间的差距,就是协同的代价。在集群规模上,性能因此不仅取决于硬件速度,也取决于分配该硬件的策略。