Robust AI
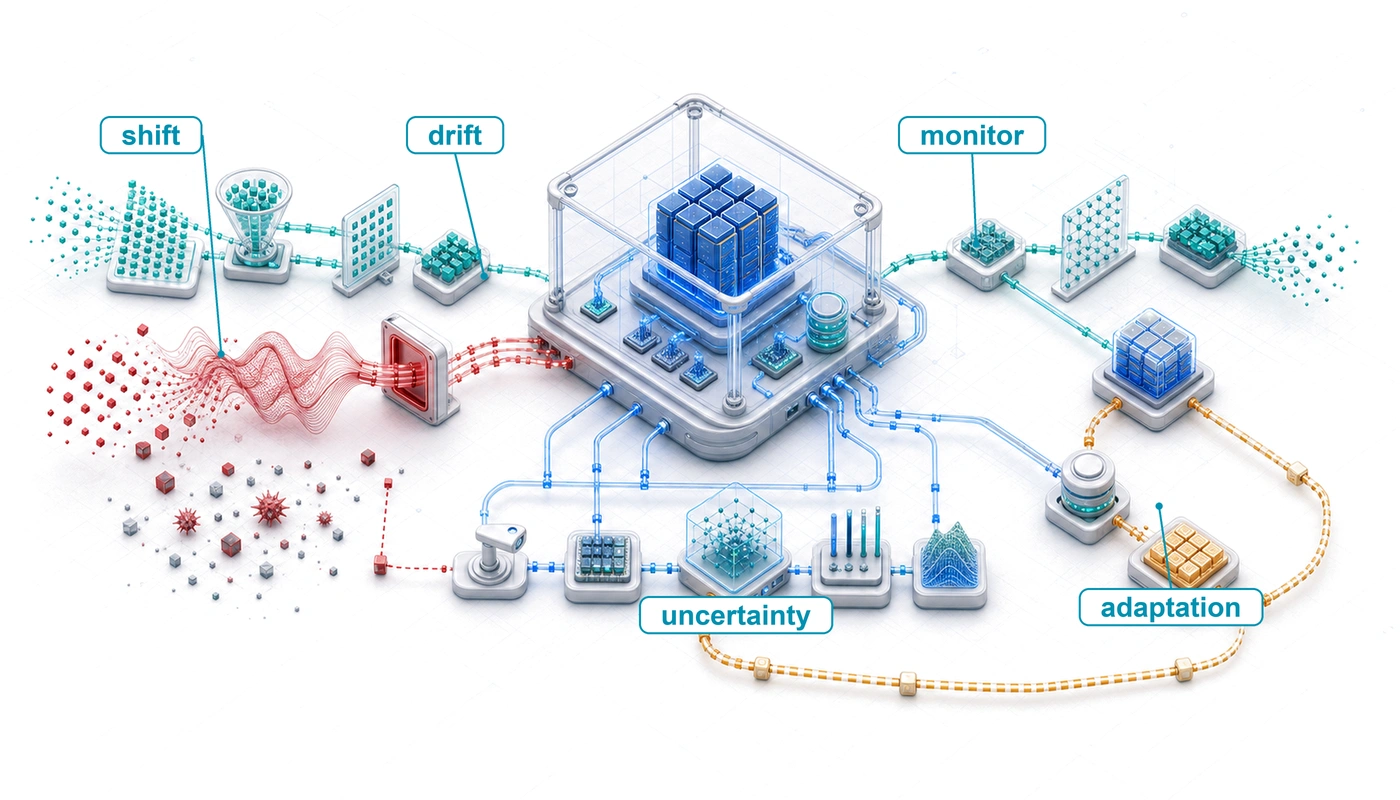
目的
为什么机器学习系统即使常规健康信号保持正常,也可能发生静默失败?
许多软件缺陷会“大声”暴露:异常会崩溃进程,类型错误会中止编译,断言失败会停止执行。常规软件也可能静默返回错误结果,但机器学习引入了普通健康信号无法揭示的统计性失败模式。面对分布外输入时,模型可能继续以完全自信地输出结果,却不发出这些输出不可靠的信号。遭遇对抗攻击的系统可能提供与合法结果无法区分的被操纵预测。在分布漂移下退化的模型可以维持稳定的延迟和可用性,而其准确率却在悄然下降。这种“沉默”使得机器学习失败格外危险:当退化在业务指标中显现时,损害可能已经累积数周;当对抗攻击被检出时,它可能已经影响了数千项决策。鲁棒性工程正是为了“让不可见变为可见”而存在,它构建能够识别自身是否脱离能力范围、抵抗操纵、并优雅降级而非输出自信却错误的结果的系统。用 C³ 术语来说,这种可见性需要付出有意的计算代价。持续验证则是捕捉这种静默统计性衰减所需的协同工作。
Learning Objectives
- 将鲁棒性挑战划分为环境偏移、输入级攻击和系统级故障
- 说明软件故障如何放大或伪装为模型失败,并使用定量可靠性指标加以解释
- 评估对抗攻击技术,并选择防御手段,如对抗训练、认证和输入净化
- 利用异常检测、统计验证和鲁棒训练构建数据投毒防御
- 应用统计漂移指标,以选择监控、调查或重新训练等响应
- 在模型与系统两个维度上整合鲁棒性,同时权衡准确率、计算、能耗与韧性预算
静默失败问题
鲁棒 AI 位于集群栈的治理层。安全与隐私界定对抗边界:谁能操纵、抽取或经由模型进行推断,以及哪些控制措施能够限制这种访问。鲁棒性则提出下一个系统层面的问题:当输入、数据分布、硬件或软件不再符合训练与验证期间所假设的条件时,集群是否仍能产生有界且可恢复的行为?安全视为滥用的那些对抗样本,在这里成为需要度量、防御并认证的模型级扰动;非对抗性的漂移与故障则接受同样的工程处理。一个“安全但脆弱”的系统在运营上毫无用处,因此鲁棒性工程确保集群在扰动与退化条件下仍能持续运行。
自动驾驶汽车的视觉系统可能在加州的晴天中运行得完美无缺,却在科罗拉多州的暴风雪改变了视觉分布时静默失败。它不会抛出未处理的异常,也不会打印堆栈跟踪;它可能将积雪覆盖的停车标志完全自信地分类为限速标志。鲁棒性正是约束这种行为在运营压力下的工程学科:分布偏移、传感器噪声、对抗性构造的输入,以及使服务表面上健康、而模型答案却变得不可靠的硬件或软件故障。
“沉默”正是这一学科区别于其他领域的关键。自动驾驶汽车感知系统在将卡车误分类为天空时不会崩溃;需求预测模型在产生严重失真的预测时不会报错退出;医疗诊断系统在悄然提供可能危及患者生命的错误分类时不会停机。这种静默失败模式使鲁棒性成为 AI 系统中独特而关键的挑战:工程师必须防御一个拒绝服从训练数据的世界,而不仅仅是防御代码中的缺陷。
静默失效挑战
随着机器学习系统扩展到不同的部署场景,静默失效挑战愈发严峻。在基于云的服务、边缘设备和嵌入式系统中,硬件与软件故障会直接影响性能与可靠性。这些系统日益增长的复杂性,以及它们在安全关键应用1中的部署,使得鲁棒且容错的设计对于维持系统完整性至关重要。
1 安全关键应用 : 安全标准通过领域特定的危害分析、开发流程和系统证据来赋予完整性要求,而不是采用一个通用的模型准确率百分比。因此,机器学习组件必须为系统级安全论证贡献证据,而不能仅凭测试准确率宣称合规。
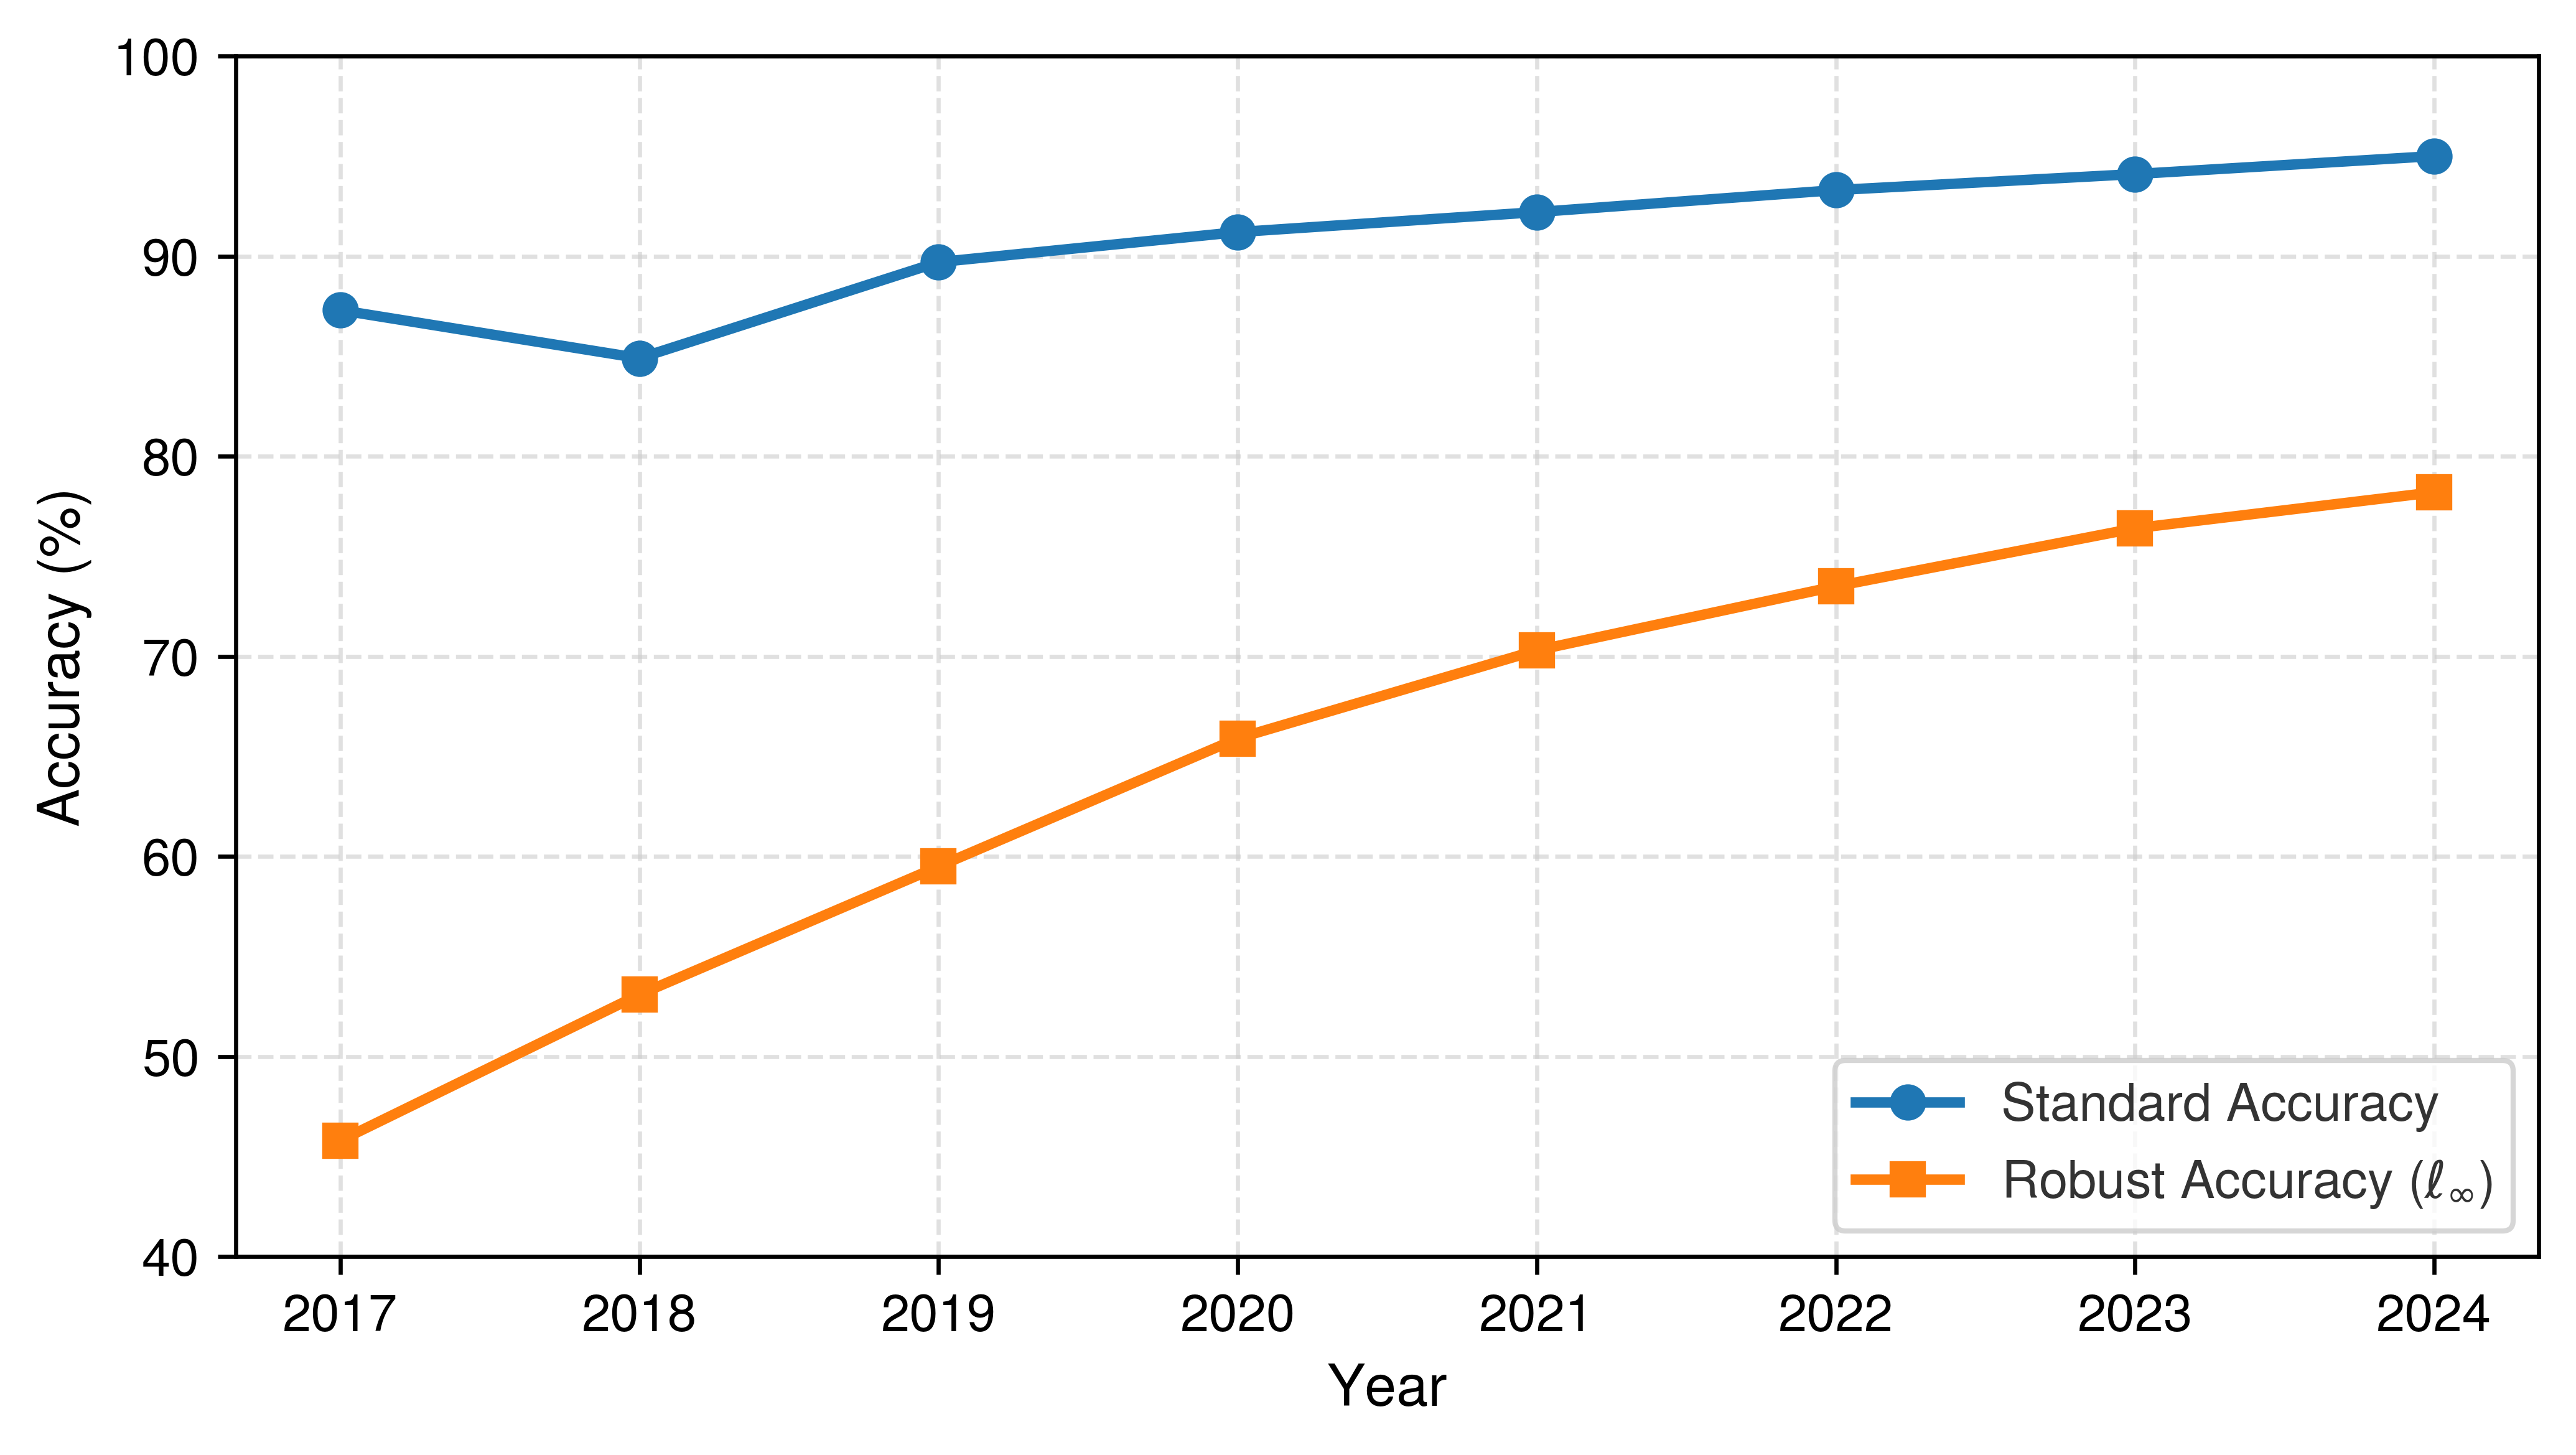
检查点与恢复机制让训练任务得以延续,访问控制则在系统边界处强制认证。二者都没有解决以下情形:当部署的模型接收到与合法输入无法区分的对抗输入时;当数据分布漂移得如此严重以至于预测变得毫无意义;或者当预处理流水线中的软件故障在静默中损坏了每一次推理。这些失效模式贯穿完整的机器学习生命周期,需要超越任何单一防御手段的故障检测、隔离与恢复技术。忽视它们的后果,从经济层面的中断一直延伸到安全关键领域中危及生命的情况。对抗鲁棒性与标准准确率的对比 中的差距正是这一论证的经验形式:七年的进展让两条曲线同时上移,却从未弥合二者之间的距离,因为被测量的属性是在训练过程中决定的,而非事后添加的。
这些失效模式促使我们对 Robust AI 给出精确定义:
Definition 1.1: Robust AI
Robust AI 是指在分布偏移、对抗扰动以及硬件或软件故障条件下,模型预测仍然有效(处于指定的误差范围内)这一可度量的系统属性,相对于在理想独立同分布(i.i.d.)条件下获得的平均情况准确率。
- 重要性:鲁棒性相对于明确的运行集或威胁集进行量化。一个经过认证的分类器可以证明,对于扰动集内的任意输入,其预测都不会改变,例如围绕某个测试点半径为 \(\ell_\infty\) 的 \(\epsilon\) 球。经验性压力测试则仅测量在指定的损坏、偏移或攻击上的性能,而不证明被评估情形之外的行为。
- 区分:标准泛化度量衡量的是在从训练分布中抽取的留出 i.i.d. 数据上的平均情况准确率。鲁棒性度量的是在偏离该分布的指定情形下的行为,包括自然偏移、语义变换、物理变化、恶意查询以及范数有界的扰动。部分评估在形式化集合内采用最坏情况;另一些则提供在采样部署包络上的经验性证据。
- 常见误区:一种常见误解是,鲁棒性可以作为一个事后监控层添加到任何已有模型上。模型鲁棒性属性主要是在训练过程中确定的:未经对抗样本或鲁棒性目标训练的模型,仅凭推理阶段的过滤 无法 实现经认证的鲁棒性,因为脆弱性存在于学到的决策边界之中,而非在于哪些输入能够到达模型。
:::
:::
三类威胁导致了这些静默失败,而每一类都需要不同的工程应对。第一类、也是最普遍的一类是环境变化:分布偏移、概念漂移以及不断演进的运行环境,都会挑战模型训练所依赖的核心假设。一个基于去年交易模式训练出来的模型,会随着客户行为的演变而悄然变得不可靠,这需要超越标准运维实践的持续监控与自适应策略。
第二类是恶意操纵,它直接针对模型行为。对抗性攻击、数据投毒尝试以及提示注入漏洞会导致模型对输入产生错误分类或输出不可靠的结果;这类失败无法通过认证和访问控制(安全与隐私)来阻止,因为攻击者是在模型自身的输入空间内进行操作。
第三类是系统级故障:硬件故障、软件缺陷、依赖失败以及运行期错误,它们会破坏模型周围的机制。这些故障还可能放大、掩盖或模仿其他鲁棒性失败。算法、库和框架中的缺陷、设计缺陷与实现错误会在系统层面传播,形成超越单个组件失败的系统性脆弱性2。一个预处理缺陷可能人为制造分布偏移;一个数值错误可能以与对抗性攻击无法区分的方式破坏模型行为;一个竞态条件可能损坏学到的表示。由于这些故障源自系统层,其详细分类与缓解策略在 容错 中讨论;本章聚焦于系统级故障如何与环境偏移和输入级攻击相互作用。
2 系统性脆弱性: 会跨层级联、而非局限于单个组件的架构弱点。Log4Shell(CVE-2021-44228)通过单个日志库影响了数亿台设备。机器学习流水线面临类似风险:在整个数千个模型中固定同一个 CUDA 或 PyTorch 版本,意味着单个漏洞会同时危及整个集群,从而使依赖管理成为可靠性关键职能。
3 加固策略: 应用于机器学习流水线中的纵深防御:模型加载(签名验证)、输入处理(对抗性过滤)以及输出验证(置信度阈值)。在资源受限的边缘设备上,选择性加固优先保护关键路径—保护推理引擎,同时接受日志方面的较弱保证—因为完整的冗余会超出使边缘部署可行的功耗与内存预算。
适当的防御手段取决于系统运行在哪里。大规模云环境可以负担冗余和复杂的错误检测机制,而这些机制会超出边缘设备的功耗与内存预算。边缘设备(边缘智能) 反而必须依赖有针对性的加固策略3,在保护最关键推理路径的同时接受其他方面的较弱保证。
尽管存在这些环境差异,一个鲁棒的机器学习系统仍需要在所有部署环境中具备容错能力、错误恢复能力以及持续的性能,而这些保证并非免费。错误纠正会增加内存带宽开销,冗余处理会倍增能耗,持续监控则占用一部分计算资源;这些措施还会产生额外热量,加剧限制部署密度的热管理挑战。鲁棒性问题在于:这部分额外的资源投入是否提供了足够的可靠性价值以证明其合理性。
鲁棒性,因而不是附加到已完成系统上的事后补丁。它是一种架构约束,塑造机器学习流水线的每一层,从输入验证和对抗性训练,一直到漂移检测与软件故障隔离;忽视它的工程代价会静默累积,直到系统在上线后失败。静默失败已在云、边缘和嵌入式部署的生产系统中造成了重大损害。
真实世界中的鲁棒性失败
在云、边缘和嵌入式环境中,当堆栈中某个隐藏假设变成系统并未监控的依赖时,机器学习系统就会失败。下列事件在规模和领域上各不相同,但都呈现同一模式:系统继续运行,而一个未被观察到的条件正在破坏结果。
War Story 1.1: 暴露测试缺口的标签(2015 年)
背景:2015 年 6 月,Google Photos 使用自动图片标签来组织用户照片(Kasperkevic 2015年)。
机制:一个深度卷积图像分类器遭遇了严重的切片级故障模式:Jacky Alciné 为自己和一位黑人朋友拍摄的照片被错误地归入 “Gorillas” 专辑标签。评估流程仅依据 \(D_{\text{vol}}\) 上的聚合 top-1/top-5 准确率,因而掩盖了高风险切片级失败。
影响:这一高可见性的误分类引发了公众强烈愤慨,也暴露了多分类视觉模型安全验证的重大缺口。
修复:Google 发布了紧急热修复,将分类体系中的 “gorilla”(大猩猩)、“chimpanzee”(黑猩猩)和 “monkey”(猴子)标签禁用,同时在开发切片级评估与自动安全过滤流水线。
系统经验:生产 ML 的鲁棒性不能由聚合测试集准确率来定义。高风险分类任务需要切片级评估、自动毒性防护,以及直接构建在 serving 流水线中的稳健回退机制。
Kasperkevic, Jana. 2015年. 《Google Says Sorry for Racist Auto-Tag in Photo App》. The Guardian, 七月.
该测试缺口失败是更广泛可靠性问题在模型侧的体现。在云基础设施中,隐藏假设往往是一个共享依赖项保持可用且正确。
云基础设施故障
稳健 ML 系统继承了早于机器学习形成的可靠性传统。诸如 2017 年 AWS S3 中断4这类响亮的非 ML 基础设施故障——一次拼错的维护命令移除了过多容量,并级联到所有将区域对象存储视为可用性不变量的服务(Amazon Web Services 2017年)——正是其检测与恢复机制在 容错 中详述的依赖故障与故障故障。它们表现为”响亮”而非”静默”,并促成了本章所依托的这门学科,而非本章聚焦的、静默的模型级故障。大规模训练的经济性放大了这些后果:S3 中断会同时使数千台加速器失去数据分片,而中断窗口内任何失败的检查点写入都意味着,当预emption 最终将集群交还给调度器时,数小时甚至数天的梯度更新已无法恢复。真正新颖且独特地属于 ML 的问题出现在故障是”静默”的时候:系统持续提供服务,而未被观测到的损坏在传播。
4 AWS S3 中断(2017):例行维护期间的一条拼错命令,从 S3 的索引与放置子系统中移除了过多容量。在这些子系统重启期间,S3 无法处理请求,依赖的 AWS 服务出现错误率升高或功能受损。该事件暴露了一种单区域依赖模式:即使自身的应用代码与模型服务逻辑保持不变,依赖区域存储可用性的系统仍可能失败。
Amazon Web Services. 2017年. Summary of the Amazon S3 Service Disruption in the Northern Virginia (US-EAST-1) Region. AWS service event summary.
5 静默数据损坏(SDC):会损坏数据但不触发任何检测机制的硬件错误。Meta 报告称,每百万台机器中有六到八台每天发生 SDC,速率”比软错误预测高出几个数量级”。在 ML 系统中,SDC 之所以格外危险,是因为被损坏的权重或激活值会产生看似合理但错误的输出,从而通过全部健康检查,躲开了能够捕获响亮故障的监控。
在另一个案例中(Dixit 等 2021年),Facebook 在其分布式查询基础设施中遇到了静默数据损坏(SDC)5问题(图 1)。SDC 指计算或数据传输过程中未被检测到的错误,并会静默地在系统各层之间传播。Facebook 的系统在数据集之间处理类 SQL 查询,并支持一个用于减少数据存储占用的压缩应用。文件在未被使用时被压缩,在读取请求时解压。解压前会执行一次大小检查以确保文件有效。然而,一次意外故障偶尔会将有效文件的大小返回为零,导致解压失败以及输出数据库中条目缺失。该问题呈间歇性出现,部分计算仍返回正确的文件大小,因而诊断尤其困难。
在分布式机器学习训练中,静默数据损坏(SDC)的破坏性在性质上远强于传统数据处理系统:一个被污染的梯度或激活值会扰动优化器状态并影响后续步骤,而非仅仅局限于某一次查询的结果。数据库查询中丢失的一行属于局部数据丢失,其影响范围限于该次查询的输出;而在机器学习场景中,补救措施通常是回滚到最后一个干净检查点并重启受影响的训练任务。因此,SDC 可能在完全不触发任何告警的情况下损害模型精度,且其影响范围会随着同步与检查点设计而扩大,而非保持局部化。Meta 的生产环境报告显示,SDC 是横跨 CPU 与软件各层的系统性集群问题(Dixit 等 2021年);近期的大语言模型(LLM)训练研究表明,现实世界中的 SDC 会改变子模块输出、优化器步骤、损失尖峰以及最终模型权重(Ma 等 2025年)。Dean 在 MLSys 2024 的受邀演讲将同样的可靠性问题置于工业级规模,指出在大规模机器学习训练任务中硬件故障频繁发生,以至于单个缺陷芯片的错误计算会传播并感染整个训练运行(Dean 2024年)。
Ma, Jeffrey, Hengzhi Pei, Leonard Lausen, 和 George Karypis. 2025年. Understanding Silent Data Corruption in LLM Training. https://doi.org/10.48550/arXiv.2502.12340.
Dean, Jeff. 2024年. Exciting Directions in Systems for Machine Learning. MLSys 2024 invited talk.
边缘设备漏洞
分布式边缘部署6暴露了机器学习系统在计算、功耗与连接性受到严重约束时的脆弱性。自动驾驶车辆是这一脆弱性的典型例子,因为它们需要在开放世界环境中运行,具有严格的实时延迟要求,且对故障零容忍。
6 边缘计算:将数据处理放在本地而非集中式云端,将推理延迟从约 100 ms(云端往返)降低到 <10 ms。其鲁棒性权衡十分悬殊:边缘设备获得了低延迟,却失去了使云系统具备韧性的冗余、弹性扩展与集中监控能力。失效的边缘模型无法切换到备用集群——它必须在其自身的功耗与内存包络内优雅降级,或在数毫秒内安全失败。
7 Autopilot:2016 年的这起事故涉及特斯拉当时现行的 SAE Level 2 驾驶辅助系统与 Mobileye 时代的感知栈,而非后来配备 8 摄像头全自动驾驶硬件或双 FSD 芯片计算单元的车型。此后特斯拉推出的车辆扩展了摄像头覆盖范围并配备了专用的 FSD 计算,但鲁棒性教训是相同的:集群级数据采集并不能自动覆盖诸如“明亮天空背景下的白色挂车”这类罕见场景。
8 Autopilot:2016 年的这起事故涉及特斯拉当时现行的 SAE Level 2 驾驶辅助系统与 Mobileye 时代的感知栈,而非后来配备 8 摄像头全自动驾驶硬件或双 FSD 芯片计算单元的车型。此后特斯拉推出的车辆扩展了摄像头覆盖范围并配备了专用的 FSD 计算,但鲁棒性教训是相同的:集群级数据采集并不能自动覆盖诸如“明亮天空背景下的白色挂车”这类罕见场景。
National Transportation Safety Board. 2017年. Collision Between a Car Operating With Automated Vehicle Control Systems and a Tractor-Semitrailer Truck Near Williston, Florida, May 7, 2016. HAR-17/02. National Transportation Safety Board.
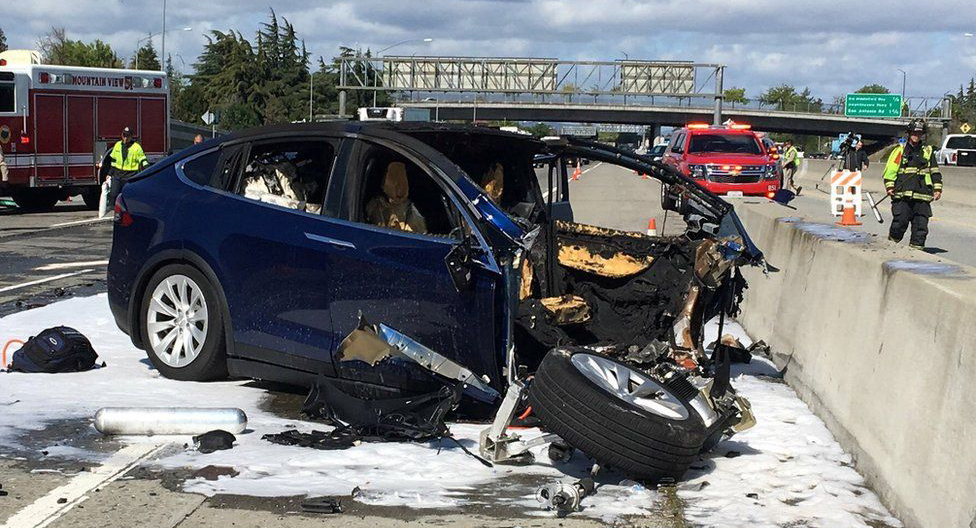
2016 年 5 月,一辆处于 Autopilot 模式7的 Tesla Model S 发生致命碰撞8,展示了感知失败可能带来的灾难性后果(National Transportation Safety Board 2017年)。该车以 74 mph 的速度行驶于限速 65 mph 的路段,未能识别出横穿其路径的半挂卡车,前向碰撞预警与自动紧急制动均未触发。调查显示,系统并未设计用于识别横穿交通,从而将一种未被建模的运行条件转化为高速撞击碰撞(图 2)。
另一起同样悲惨的失败发生在 2018 年 3 月的亚利桑那州坦佩市,一辆 Uber 自动驾驶测试车辆撞死了一名行人(National Transportation Safety Board 2019年)。感知系统在撞击发生前六秒检测到了该行人,但在物体分类稳定性方面根本性地失效。随着行人横穿道路,系统将分类在“未知物体”“车辆”和“自行车”之间反复切换,并随每次变化重置轨迹预测历史。由于系统缺少持久的物体跟踪,它在撞击前 1.3 秒才预测出碰撞路径——此时已来不及让安全员介入。
National Transportation Safety Board. 2019年. Collision Between Vehicle Controlled by Developmental Automated Driving System and Pedestrian, Tempe, Arizona, March 18, 2018. HAR-19/03. National Transportation Safety Board.
除汽车外,工业边缘部署面临类似的隐患。巡检无人机在勘察高压输电线时可能依赖视觉里程计进行稳定;突然的光照变化或重复纹理会导致定位算法发散,进而引发碰撞或失控事件。边缘设备缺乏Fallback Redundancy:当主推理引擎变得不确定时,不存在可切换流量的备用集群。系统必须在毫秒级时间内优雅降级或安全失败。资源弹性缺失使边缘 AI 对环境差异格外脆弱,而数据中心则通过大规模超额配置来应对。
嵌入式系统约束
嵌入式系统9所受的约束比边缘设备更为严苛,且往往处于安全关键环境中,一旦失败便无法恢复。这些也正是机器学习继承自前机器学习时代可靠性传统中最具挑战性的部分:以下经典的嵌入式软件故障属于 loud, non-ML failures,其机理属于 容错,但它们设定了决策回路中任何机器学习组件都必须达到的验证门槛。
9 Embedded Systems:专用处理器,从 8 位微控制器(仅数 KB RAM)到复杂的片上系统(SoCs),每年出货超过 300 亿台。实时约束(微秒到毫秒级截止时间)以及无人值守运行(多年无需维护)使机器学习部署格外困难:模型难以更新,空中补丁可能导致设备变砖,且决策回路中无人介入来捕捉静默退化。
NASA Mars Program Independent Assessment Team. 2000年. Report on the Loss of the Mars Polar Lander and Deep Space 2 Missions. National Aeronautics; Space Administration.
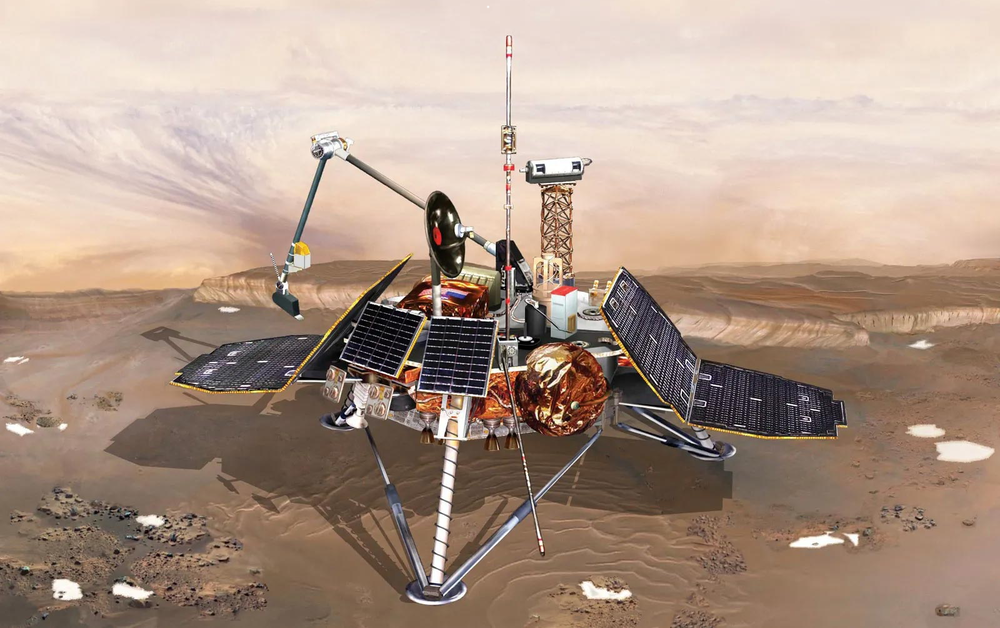
NASA 火星极地着陆器(Mars Polar Lander)于 1999 年丢失,评审委员会将其归因于过早的着陆检测,很可能在着陆前关闭了发动机 (NASA Mars Program Independent Assessment Team 2000年)。这是经典案例:在无法恢复的场景中,严格的软件验证是前提条件,而非奢侈品,且同样的严格性适用于决策回路中的任何机器学习组件 (图 3)。
商业航空表现出同样的继承性隐患:2015 年 FAA 适航指令10 遵循了波音的一项发现——787 连续供电 248 天后,若四个发电机控制单元同时进入 failsafe 模式,将完全失去交流电,[因此] 可用性本身成了风险因素。安全关键系统11 正因为存在此类潜在隐患,才要求严格的可靠性要求。
10 Failsafe Mechanism:系统在检测到故障后切换到安全状态,遵循断路器模式(闭合/断开/半开)。在机器学习服务中,failsafe 包括基于置信度的拒绝(将低于阈值的预测推迟给人工处理)、回退到更简单的模型,以及漂移监控触发时的自动回滚。其代价是可用性:激进的置信度阈值会拒绝 5% 到 15% 的正常流量,因此调整拒绝边界本质上是在可靠性与吞吐量之间进行优化。
11 ASIL(Automotive Safety Integrity Levels):ISO 26262 采用汽车安全完整性等级,依据风险分析按比例扩展功能安全义务。ASIL D 为最严格的等级,但它并非通用的组件可靠性百分比。机器学习感知组件会使由此得出的安全论证变得复杂,因为其行为依赖于运行分布,仅凭聚合测试准确率无法为其辩护。
“如果四个主发电机控制单元(对应机载发电机)同时上电,在连续供电 248 天之后,四个 GCU 将同时进入 failsafe 模式,导致交流电全部丢失,无论飞行阶段如何。”——美国联邦航空管理局(Federal Aviation Administration)指令 (Federal Aviation Administration 2015年)
Federal Aviation Administration. 2015年. Airworthiness Directive: Boeing 787 Generator Control Units Failsafe Reset. FAA Airworthiness Directive 2015-10066.
当人工智能应用于航空领域,包括自动驾驶飞行控制与预测性维护等任务时,嵌入式系统的鲁棒性会影响乘员安全。这些先于机器学习(pre-ML)的失效模式,设定了任何共享这些环境的机器学习组件都必须达到的验证门槛。运行于行星探测车上的神经网络若执行视觉里程计,就必须容忍由辐射引起的权重、激活和控制状态故障。其系统设计可根据任务故障模型,将加固组件、错误检测与纠正、状态擦除、冗余以及看门狗机制组合起来;没有任何单一机制能够确立模型级安全。安全论证必须将硬件故障遏制连接到行为错误检测与经验证的降级路径。在飞行控制路径中,低置信度可能促成该触发条件,但置信度本身并非安全性的确定性证明;控制权的转移还必须源自经过校准的证据、传感器与系统健康状态,以及一个经过独立验证的降级模式。
对于可植入医疗设备,风险甚至更高。假想智能心脏起搏器中的软件或硬件故障,都可能危及患者生命。随着人工智能系统在此类应用中承担感知、决策与控制角色,新的脆弱性来源随之出现,包括数据相关错误、模型不确定性12,以及罕见边缘情形下不可预测的行为。某些 AI 模型的不可解释性,使故障诊断与恢复更加复杂。
12 模型不确定性(认识论不确定性): 模型学到的表示与真实数据生成过程之间可缩减的差距,区别于随机性不确定性(不可缩减的数据噪声)。量化认识论不确定性使一项关键的鲁棒性机制成为可能:安全关键系统可以在预测超出训练分布时,将决策权让渡给人工操作员。系统代价显著——贝叶斯近似或 Monte Carlo dropout 需要多次推理轮次,从而在不确定性感知与服务延迟之间形成直接的权衡。
每种失效都揭示了需要系统性鲁棒性评估与缓解的共性模式:AWS 中断扰乱了依赖 S3 的云服务,自动驾驶车辆感知错误导致致命事故,航天器软件缺陷造成任务损失。这些结构性模式跨越不同的部署环境,而统一的鲁棒性框架必须捕捉不同失效模式如何在系统规模上相互作用并叠加放大。
统一鲁棒 AI 框架
GPU 内存模块中翻转的一位比特,可能导致语言模型生成有毒文本。用户人口统计特征的渐进变化,可能触发推荐延迟的突然飙升。生产机器学习系统不能将这些现象视为彼此孤立的缺陷。统一的框架必须映射出低层硬件故障、软件缺陷、数据漂移与对抗性输入如何逐级向上级联,最终摧毁模型输出的完整性。
与先前概念的关联
容错 中的容错机制,原本设计用于从硬件崩溃中恢复训练任务,在鲁棒性方面还承担着第二重角色:推理阶段的可用性。训练恢复聚焦于检查点恢复,而鲁棒性将其扩展为优雅降级,确保服务系统在输入具有对抗性、或组件发生退化时仍能保持运行。分布式训练 中的分布式训练架构引入了独特的脆弱性:单个节点在全归约(AllReduce)操作期间传输被污染的梯度,就可能污染全局模型权重,因而需要拜占庭容错协议,在聚合前验证各节点的更新。
安全与隐私 中的安全框架提供了威胁建模原则,为对抗性防御策略提供指导。规模化机器学习运维 中的运行监控体系,为在生产环境中检测鲁棒性威胁提供了基础设施基础。在大规模下运行推理 中的服务基础设施则带来了新的攻击面:批处理、模型路由与流水线并行会暴露调度逻辑和各个流水线阶段,使其面临对抗性查询。

在切分推理中,单个阶段失效会导致整个请求失败。
大型稠密模型会放大这些风险。一个 GPT-3 量级的、具有 175B 个参数的模型(\(P = 1.75 \times 10^{11}\))所需的权重内存占用为 \(D_{\text{vol}} = P \times b_{\text{param}} = 1.75 \times 10^{11} \times 2\text{ B} = 350\text{ GB}\),采用的服务精度为 FP16/BF16(\(b_{\text{param}} = 2\text{ B/param}\))。由于 350 GB 的权重内存占用(\(D_{\text{vol}}\))超过了任何单个加速器的板载内存容量 \(M_{\text{mem}}\)(例如,A100 或 H100 的容量为 80 GB),部署时必须将权重和激活分片到多个设备上。与单体部署相比,每增加一个流水线或张量并行阶段,都会扩大故障面:单次比特翻转、网络分区或针对某一阶段的对抗性输入,都可能导致整个推理请求失败。INT8 量化和激进剪枝等提高效率的技术会降低模型的鲁棒性裕量,从而进一步加剧这一问题。鲁棒性裕量是指模型在预测发生变化之前能够承受的输入扰动、数值误差或表示变化的程度。因此,鲁棒性工程需要持续权衡前面各章确立的效率与可扩展性约束。
从机器学习性能到系统可靠性
一旦静默故障成为系统层面的属性,准确率、延迟和吞吐量就不再能完整描述系统的可靠性范围。已部署的模型还依赖于执行它的底层计算平台,而该平台可能在不引发可见服务故障的情况下破坏原本正确的模型。
硬件可靠性直接影响机器学习性能(图 4):IEEE 754 权重张量中指数部分的单次比特翻转,可以瞬间将一个正常参数变成极大的离群值;随着误差在前向传播过程中扩散,下游神经元会发生饱和。定向比特翻转攻击会刻意选择易受攻击的权重比特,因此不应将其结果解释为单次随机硬件异常的影响。训练期间的内存子系统故障同样可能破坏梯度更新,使模型无法收敛。GPT-3 等具有 175B 个参数的现代 Transformer 模型会执行海量浮点运算(\(\text{FLOP}\) 运算次数和吞吐量 \(R_{\text{peak}}\) 见 \(\text{FLOP/s}\)),使前向传播过程中出现硬件故障的机会大幅增加。V100 HBM2 等 GPU 内存子系统的单向峰值内存带宽可达 900 GB/s(\(\text{BW}_{\text{mem}}\)),但峰值传输带宽并不能决定设备的软错误率;要定量评估故障暴露程度,需要有来源依据的特定设备或内存的错误率,以及相应的存储容量和时间基准。
硬件可靠性与机器学习性能之间的联系,需要可靠性工程的概念:13 描述故障如何发生的故障模型、在影响结果之前识别问题的错误检测机制,以及恢复系统运行的恢复策略。这些可靠性概念通过确保优化后的系统在真实世界条件下仍能正确运行,补充了诸如量化、剪枝和知识蒸馏等性能优化技术。
13 可靠性工程:起源于 20 世纪 50 年代航空航天领域,采用平均故障间隔时间分析与故障模式分析;将系统可靠性量化为 \(R_{\text{system}}(t)=e^{-N\lambda t}\) 的 \(N\) 个独立组件。机器学习系统继承了这些方法,但增加了传统可靠性从未预见到的故障模式:模型漂移(系统在没有任何硬件故障的情况下性能退化)、对抗鲁棒性(系统在测试集上正确,但在人工构造的输入上失败)和认识论不确定性(系统无法区分它知道什么与它不知道什么)。
Dixit, H. D., S. Pendharkar, M. Beadon, C. Mason, T. Chakravarthy, B. Muthiah, 和 S. Sankar. 2021年. Silent Data Corruptions at Scale. arXiv preprint arXiv:2102.11245.
容错 表明,设备级静默损坏会在 \(N\) 设备的集群中累积,正如 \(\Pr(\geq 1) = 1 - (1 - p)^N\) 所揭示的:同一套算术使得单个比特翻转在训练规模下几乎必然发生。其鲁棒性后果体现在 图 5。扫描设备级速率展示了集群级概率随设备数增加而急剧上升的幅度。该曲线采用示意性压力测试速率,即每台设备每小时 0.01 percent。在该速率下,10,000 设备的集群更有可能(63.2 percent 概率)每小时出现一次静默错误,而概率在约 29,956 台设备处超过 95%。Meta 的 SDC 报告证实了可观集群规模下的损坏现象 (Dixit 等 2021年)。
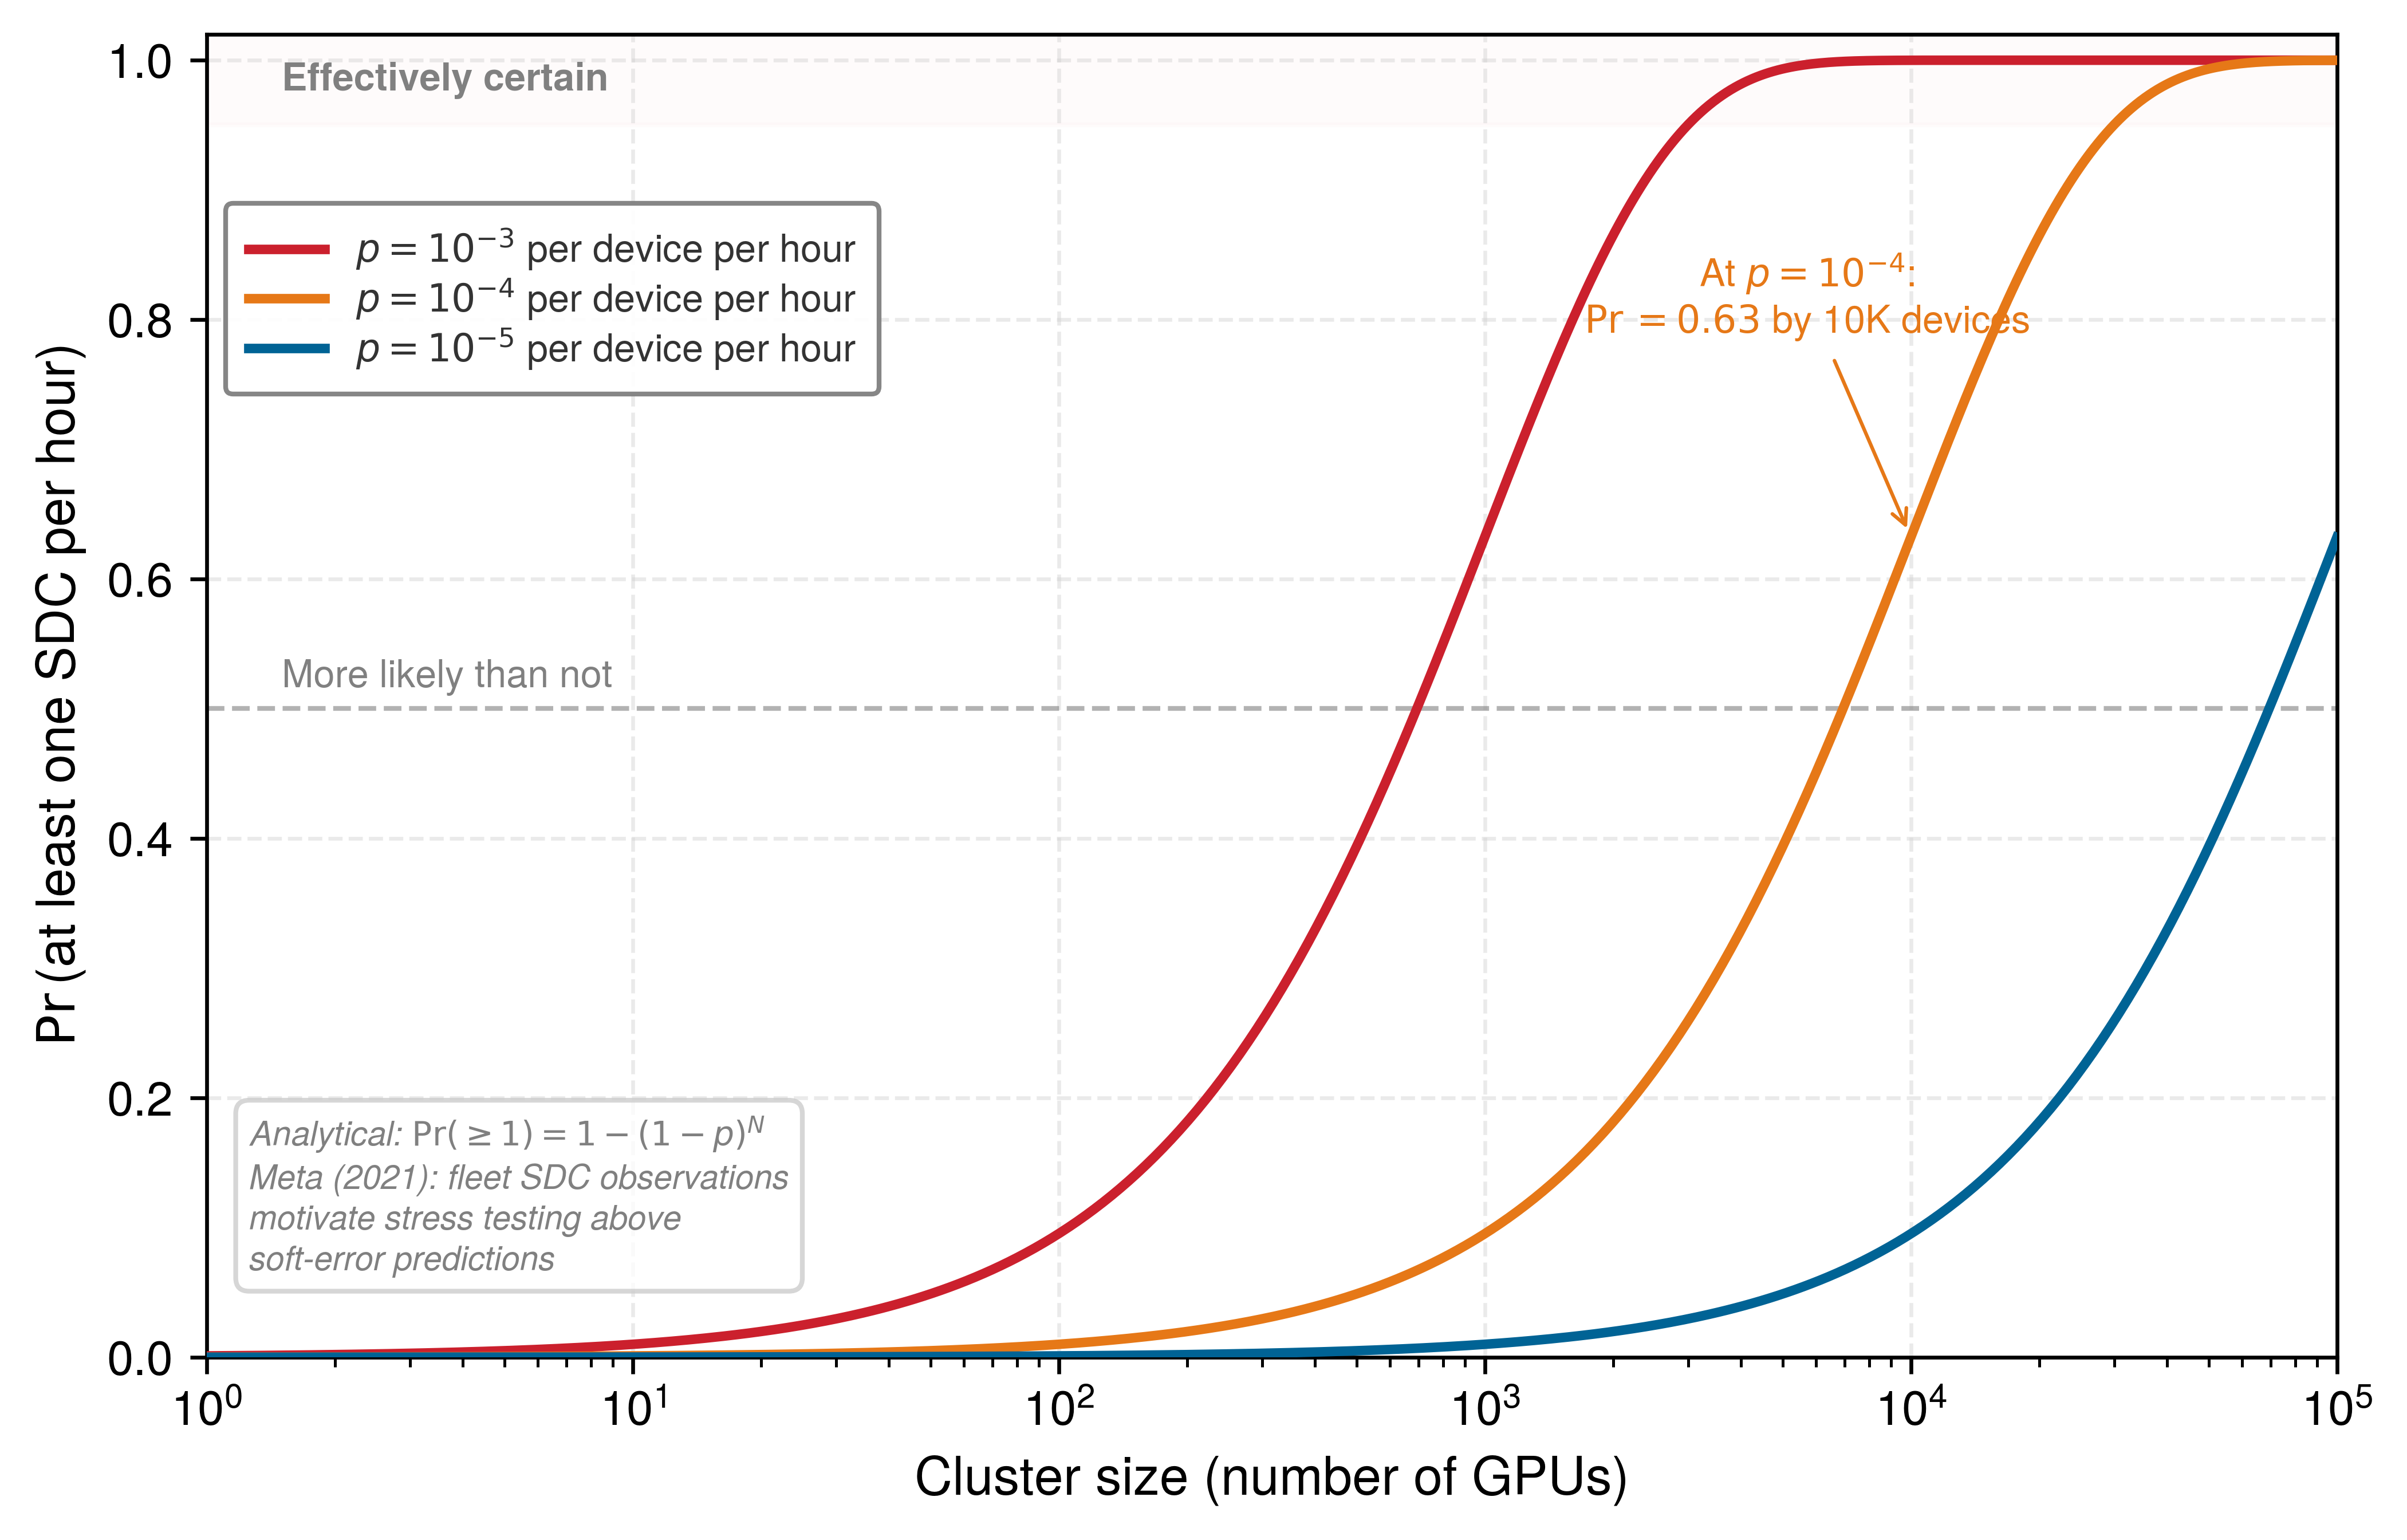
集群规模下的累积效应促使我们构建一个涵盖机器学习系统所有维度的统一鲁棒性框架。源自硬件、对抗性输入和软件缺陷的故障具有共同特征,可以通过系统化的方法加以应对。
鲁棒 AI 的三大支柱
统一框架有助于工程师在选择防御措施之前,先判断所观察到的故障信号属于哪一类。环境变化、输入级攻击和系统级故障会产生不同的证据,需要采取不同的应对措施;软件故障贯穿这三类威胁,因为它们可能放大其中任何一类威胁,或表现为其中任何一类威胁。三大支柱框架在 图 6 中将这些威胁归纳为相互关联的脆弱性,需要通过互补的防御策略加以应对。
该图在前文介绍的三类问题之外补充了两项内容:每个支柱所产生的证据,以及它所要求的防御族。环境漂移产生统计信号:输入或标签分布相对于参考分布持续移动,因此证据是分布距离,响应族为监控、校准与重训练。
输入级攻击产生对抗信号:被精心构造的输入或投毒样本旨在最大化误差,因此证据是梯度对齐扰动或异常训练样本,响应族为对抗训练、认证与输入净化。由于攻击者只能在模型自身的输入空间内行动,认证与访问控制(安全与隐私)无法触及这一失效。
系统级故障涵盖由支撑机器学习系统的硬件、代码、框架与部署基础设施所引发的故障:梯度计算中的数值不稳定、由预处理缺陷导致的数据管道损坏、分布式训练中的竞态条件、会劣化长运行服务的内存泄漏、由版本不匹配导致的依赖失败,以及位翻转或掉电等硬件故障。故障机制本身及其检测与恢复属于 容错。第三支柱之所以是鲁棒性问题而非纯粹的可靠性问题,在于这些故障很少自我暴露为故障:它们伪装成另外两个支柱,而误读这种伪装的工程师会投入错误的防御预算。
诊断伪装
考虑一位运维人员,他看到三个支柱呈现出的同一表面症状:模型准确率下降,而延迟与可用性保持稳定。一个会静默重缩放特征的预处理缺陷,对漂移监控器而言与协变量漂移完全无异,因为特征统计量确实发生了移动。一个损坏了某层激活值的数值溢出,会产生看似对抗样本的自信错分类,因为决策发生了翻转而输入本身没有可见变化。伪装本身就是全部难点:廉价的分支柱检测器触发于症状,而非成因。
三个信号可将这些情形区分开来:
- 变化边界:真实的环境漂移持续移动,并随世界演化影响整个输入总体;而管道故障表现为与部署、依赖版本升级或 schema 变更同步出现的阶跃不连续,并且可能移动任何真实世界流程都不会一起移动的特征。
- 固定输入可复现性:通过版本固定的预处理与模型产物回放黄金输入。一个确定性的管道或数值缺陷应在同一阶段复现,而偶发的硬件故障往往不会复现,可通过重复执行或冗余硬件加以隔离。漂移与对抗行为也可能在固定输入下复现,因此仅靠回放无法确定成因;应结合回放结果,比较原始与预处理后的张量、产物版本以及总体级统计量。
- 跨层相关性:真实的对抗活动与输入空间异常相关,例如不寻常的查询模式或梯度对齐扰动;而伪装成其他问题的软件故障则与系统级信号相关,包括代码发布、ECC 计数器、SDC 检查器或内存压力告警,这些信号 容错 已经进行了埋点。
因此,诊断纪律是:在采纳表面症状所提示的漂移或攻击假设之前,先读取系统级证据,因为各支柱所要求的响应各不相同,且其中只有一种是正确的。
通用鲁棒性原则
在全部三类问题中,共有的工程问题在于决定哪个信号触发哪种响应。鲁棒系统需要检测阈值、退化路径与自适应机制,并且每项都需明确的成本预算。
检测与监控构成该策略的基础。各支柱所需的信号各不相同。系统级监控采样硬件与运行时指标,以便在它们污染模型状态之前捕捉温度异常、电压波动、内存错误或静默的数据损坏。输入级攻击监控使用统计或激活空间测试,在对抗输入与投毒尝试到达决策边界或训练循环之前将其标记。环境漂移监控则使用最大均值差异(MMD)、14 人群稳定性指数(PSI)或 Kolmogorov-Smirnov(KS)检验,将生产流量与参考分布进行比较。同样的定量纪律适用于防御成本:鲁棒性机制必须被预算,而不能仅仅被启用,因为每个检测器都在灵敏度与误报、延迟以及计算开销之间进行权衡。
14 最大均值差异(MMD):一种基于核的统计检验,用于度量两个分布之间的距离,且不需要参数化假设。与单变量检验(KS、PSI)不同,后者需要对每个特征分别评估,而 MMD 原生地在联合分布上运行——这对机器学习输入至关重要,因为漂移往往体现在特征相关性上,而非单个特征上。代价是计算量:MMD 随样本量呈 \(\mathcal{O}(n^2)\) 增长,因此在没有子采样或随机特征近似的情况下,其实时监控并不实用。
Napkin Math 1.1: 防御的代价
问题:一个团队正在为自动驾驶车辆训练一个鲁棒分类器,采用对抗训练,并使用七步投影梯度下降攻击(PGD-7)为每个训练批次搜索规范范数球内的高损失扰动。这项额外的攻击生成工作会使训练运行变慢多少?
数学: 生成一个对抗样本需要每个训练样本额外执行 \(K\) 个梯度步。
- 前向/反向传递:1(标准)+ 7(攻击生成)= 8 次传递。
- 训练变慢:8× 变慢。
- 效用代价:针对最坏情况攻击的准确率为 70 percent,而标准模型的干净数据准确率为 95 percent。
系统洞见:鲁棒性是一种效率—效用权衡。在这个 PGD-7 例子中,团队付出了 8× 的训练成本,并观察到标准干净数据准确率与在指定数字扰动威胁模型下鲁棒准确率之间的 25 percentage-point 跨条件差距。该减法并不能分离出干净准确率的代价;节 1.6.1 解释了为定价这一权衡所需的四项同类测量。在 Machine Learning Fleet 中,“鲁棒性”并非一个可以开关的设置,而是团队需要投入的预算。这种预算压力常常使检测在低风险组件上更具吸引力,而认证和鲁棒训练则更容易在安全关键路径上得到论证。
优雅降级将检测转化为一种有界的运行模式,而非崩溃。单错误纠正、双错误检测的内存通过纠正每个码字内的任意单比特错误、并检测该码字内的任意双比特错误来保护每个码字。一种常见的 72 位码字使用 8 个校验位承载 64 个数据位,存储开销为 12.5 百分比;其延迟与带宽开销取决于具体实现。模型量化从 FP32 到 INT8 可将内存需求降低 75 百分比,推理时间降低 2–4\(\times\),以牺牲 1 到 3 百分比的准确率来换取在资源受限条件下继续运行。集成回退系统以峰值准确率换取连续性:当主模型失效时,保留大部分峰值性能,并以足够快的切换速度保持在实时服务预算之内。
自适应响应通过改变系统行为来完成闭环,当信号持续存在时进行自适应。自适应可能包括激活错误纠正机制、应用输入预处理技术,或动态调整模型参数。关键原则在于,鲁棒性并非静态,而是需要持续调整以维持有效性。
检测、降级和自适应不仅用于故障恢复,还构成一套贯穿机器学习系统设计的系统性性能自适应策略。图 7 将相同的三根支柱从 图 6 展开为具体的故障子类型,然后将共用的响应模式附加到每个子类型:检测策略构成监控系统的基石,优雅降级指导组件失效时的回退机制,自适应响应使系统能够随条件变化而演进。
图 7 中的分类体系表明,没有任何单一防御措施能够覆盖全部三大支柱:环境偏移、输入级攻击和系统级故障各自需要不同的检测、降级和自适应机制,因此纵深防御是生产系统的核心策略。
评估计划必须保留这些区分。鲁棒性评估矩阵 定义了每类失效所需的最低证据要求,并防止将某一列中通过的测试用作对另一列作出鲁棒性声明的依据。
| 失效类别 | 评估集或干预措施 | 主要证据 | 必需切片 | 决策边界 |
|---|---|---|---|---|
| 自然偏移 | 按时间、地理位置、设备和环境划分的留出数据 | 准确率或损失、校准误差和漂移统计量 | 关键群体和尾部条件 | 继续、调查、重新校准、重新训练或回退 |
| 单次请求胜任能力 | 分布内错误以及近分布外(OOD)和远分布外输入 | 风险—覆盖率曲线、OOD 分数和回退负载 | 后果严重的请求类别 | 回答、路由、拒答或拒绝 |
| 对抗性操纵 | 与威胁模型匹配的白盒、黑盒、迁移和物理攻击 | 按攻击预算衡量的鲁棒准确率;在可获得时采用经认证的准确率 | 目标类别和攻击者能力 | 接受、加固、限制或阻止发布 |
| 投毒 | 数据来源被攻破、标签翻转、后门、女巫攻击和拜占庭贡献者场景 | 干净数据上的指标和攻击成功指标、切片损失及检测器召回率 | 来源、贡献者和子群体 | 隔离、排除、重新加权或回滚 |
| 系统故障 | 在数据、运行时、加速器和网络路径上注入故障 | 静默错误率、检测延迟和恢复成功率 | 相关故障和多组件故障 | 重试、隔离、降级或进入安全失效状态 |
贯穿机器学习流水线的集成
鲁棒性不能简单附加到已训练的模型上;它是在机器学习生命周期的每个阶段都必须落实的质量属性,这一原则通常称为纵深防御。在数据摄取阶段,清洗过滤器必须在格式错误或统计异常的记录进入训练集之前将其拒绝,从而在源头防止数据投毒攻击。在训练期间,对抗训练直接让模型接触最坏情况下的扰动,而随机平滑随后将带噪声的重复预测转化为可认证的鲁棒性界。这两类方法都试图限制输入变化时输出的变化速度,这正是模型的 Lipschitz 常数背后的直观含义。15 验证不再局限于简单的准确率指标,还包括在分布外数据集上进行压力测试,以确保模型的决策边界在开放世界中表现良好。
15 Lipschitz 连续性:一种数学性质,用于约束函数输出相对于输入变化的变化幅度(\(\lVert f(x) - f(x') \rVert \le K \lVert x - x' \rVert\))。较小的 Lipschitz 常数 \((K)\) 可以限制分数变化,但其本身并不能防止标签翻转。鲁棒性认证还要求最高分类别相对于次高分类别的分数差超过扰动半径内最坏情况下的分数变化;减小 \(K\) 可以扩大这一认证半径,但强制采用较小的常数可能会牺牲干净数据上的准确率,并增加训练成本。
部署之后,重点转向运行时防御。鲁棒的推理服务器通过 节 1.6.1.2 中的检测技术完善其服务架构,包括在对抗性查询到达加速器之前将其拦截的输入过滤机制。对于生产环境中的欺诈检测流水线,这种分层方法会带来叠加收益:成本低廉的统计验证在数据摄取阶段只能捕获最粗糙的投毒尝试,而服务阶段的语义输入过滤则能阻止比例大得多的复杂规避攻击。监控层充当安全网,检测分布漂移—例如交易金额或用户地理位置的突然变化—并触发调查及性能相关性分析。只有当经过验证的结果证据、根因分析和发布门禁表明模型更新是恰当的应对措施时,才会进行重新训练。
这一整体视角与硬件实际情况相结合。硬件故障分类 详细讨论了硬件故障(瞬态、永久性和间歇性),并将其纳入分布式系统中更广泛的故障检测与恢复机制。鲁棒的软件流水线将 ALU 中的静默数据损坏或高带宽存储器(HBM)中的比特翻转视为另一种需要过滤或通过重试处理的噪声,而不是异常崩溃。在确立生命周期和硬件框架之后,本章接下来将讨论模型性能退化最常见的来源:真实世界不断演变,而训练数据集却冻结在某一时刻。
Checkpoint 1.1: 诊断失效信号
统一框架要求你在选择防御措施之前,先指出三大支柱中的哪一个导致了静默失效,并认识到软件故障可能呈现为其中任何一类。
威胁分类
选择响应
环境漂移
训练数据冻结了一个过去的世界,而生产流量持续变化。环境漂移正是源于这种不匹配而产生的鲁棒性失败:模型学会其边界之后,数据分布、用户行为和运行环境都会发生变化。这些漂移还会与其他脆弱性类型相互作用:经历分布偏移的模型更容易受到对抗性攻击,而软件错误在环境条件改变后可能表现出不同的形态。
分布偏移与概念漂移
一个基于资源充足医院的 X 射线图像训练出的医学诊断模型,在部署到设备较老旧的乡村诊所后,准确率会急剧下降。其背后的医学状况并未改变,改变的只是图像特征。模型所遇到的世界与它所学到的世界并不相同,其结果就是分布偏移。
Napkin Math 1.2: 检测真实分布偏移
问题:模型使用一个已知标准差为 0.3 的关键输入特征进行监控。基线均值为 0.5。在最近 1,000 次请求中,均值已偏移至 0.55。工程问题在于:这究竟是随机波动,还是真实的分布偏移。
数学: 检测需要证明,在基线分布下,观察到的这一变化在统计上不太可能发生。
- 均值之差:0.05。
- 标准误:\(0.3/\sqrt{1,000} \approx 0.009\)。
- 统计显著性:该偏移量距均值约 5.3 个标准误。
- P 值:< 0.001。
系统洞见:统计显著性就是该监控系统中的信噪比。偏移量 0.05 乍看之下似乎“很小”,但在基线模型下,观察到样本均值至少偏离基线如此之远的概率小于 0.1 percent。在机器学习集群中,这是一条已确认的漂移告警,而非已确认的模型退化。系统应当触发调查、加强监控,并与精度、召回率、延迟和业务指标进行关联;只有在偏移特征具有高重要性、漂移跨越严重阈值,或服务级指标恶化时,才需要进行模型回退或重新训练。
图 8 中的分类法区分了漂移检测器可能呈现的三种失效模式:输入可能发生变化,标签先验可能发生变化,或者输入与标签之间的关系本身可能改变。
这些偏移会随着环境演化而自然发生。用户偏好会随季节变化,语言会随新俚语而演变,经济模式会随市场条件而改变。与需要恶意意图的对抗性攻击不同,这些偏移源于真实世界系统的动态特性而有机产生。
技术分类
协变量偏移发生在输入分布发生变化而输入与输出之间的关系保持不变时 (Quiñonero-Candela 等 2009年)。自动驾驶感知模型在白天图像上训练后,若在夜间条件下部署,尽管底层目标识别任务本身没有改变,其准确率会下降约 15% 到 30% 量级,偏移量取决于亮度变化和传感器特性。天气条件会引入额外的协变量偏移:在自动驾驶评估中,与晴朗天气基线相比,雨、雪和雾被广泛报告会使目标检测 mAP 下降约 10% 到 25%。这些数字应当读作来自自动驾驶感知基准的代表性量级,而非某一条单独引用的结果。这些环境变化实际上将数据点相对学到的决策边界进行了偏移(图 9),从而在不改变模型本身的情况下导致误分类。
Quiñonero-Candela, Joaquin, Masashi Sugiyama, Anton Schwaighofer, 和 Neil D. Lawrence, 编. 2009年. Dataset Shift in Machine Learning. Neural Information Processing series. The MIT Press.
图 9 展示了输入分布发生移动而真实映射 \(p(y \mid x)\) 保持不变的情形。一种更为隐蔽的变体发生在映射本身发生变化时:某个输入今天对应的正确标签与训练期间所对应的标签不同。
Definition 1.2: 概念漂移
概念漂移 是分布偏移的部署模型子类型,其中统计关系 \(p(y \mid x)\) 随时间发生变化,这意味着决策边界本身变得不正确,而不仅仅是输入分布。它的孪生类型是数据漂移 (参见 大规模监控),其中 \(p(x)\) 发生变化而 \(p(y \mid x)\) 保持稳定。
- 显著性:它会导致模型静默退化,因为模型学到的历史映射已不再代表当前现实。在铁律 下,它在重新训练之前压缩了有效部署窗口:欺诈检测模型、推荐系统以及其他依赖行为的模型可能需要周期性重新训练或重新校准,因为对手、用户和政策会不断变化。修复成本可以从重新校准或增量微调一直到一个完整训练运行,因此漂移速度会影响摊薄后的每次预测成本,而无需以牺牲原始运行的代价来修复每一个响应。
- 区分:在数据漂移下,\(p(x)\) 发生变化而 \(p(y \mid x)\) 保持稳定,因此重采样、重新加权或重新校准可能有所帮助,但仅凭新鲜输入并不能保证性能恢复。概念漂移则需要针对新的 \(p(y \mid x)\) 进行自适应,通常使用近期的真实结果。这使得概念漂移在结构上比重新采样一个已有的标注分布更昂贵。
- 常见误区:一个常见误解是可以通过监控输入特征统计量来检测概念漂移。由于 \(p(x)\) 可能完全没有变化,输入层面的监控(如 PSI、特征上的 KL 散度)不会显示任何信号。概念漂移只能通过将预测结果与真实结果进行比较才能确认 ,这使得它在实时检测上困难得多,并且必须在修复开始之前建立真实结果反馈回路。
概念漂移代表输入与输出之间底层关系随时间的变化 (Widmer 和 Kubat 1996年)。在生产环境中,这常出现在欺诈检测或推荐等领域,其中对手、季节模式和用户偏好会改变标签关系,迫使周期性重新校准或重新训练。
Widmer, Gerhard, 和 Miroslav Kubat. 1996年. 《Learning in the Presence of Concept Drift and Hidden Contexts》. Machine Learning 23 (1): 69~101. https://doi.org/10.1023/a:1018046501280.
Lipton, Zachary, Yu-Xiang Wang, 和 Alexander Smola. 2018年. 《Detecting and Correcting for Label Shift with Black Box Predictors》. International Conference on Machine Learning (ICML), 3122~30.
当标签边缘分布 \(p(y)\) 发生变化而类别条件输入分布 \(p(x \mid y)\) 保持不变时,就发生标签偏移 (Lipton 等 2018年)。例如,在 COVID-19 期间,医院病例构成和疾病流行率迅速变化,因此诊断模型可能需要重新校准阈值,即使图像特征所承载的临床含义完全相同。随着季节、政策或用户人群的变化,也可能出现类似的类别流行度偏移,此时需要进行重新校准或重新加权,而不是假定特征与标签之间的关系本身已经改变。
模型也可能因为从训练数据中学到了错误的经验而失败,而非因为世界发生了变化。一个经典例子是模型通过检测“草地”背景来识别“牛”。当被呈现沙滩上的牛时,模型会失败。其根本原因是伪相关:一个在训练集中具有预测性但与标签不存在因果关系的特征。
经验风险最小化的标准训练会鼓励这类捷径,因为它们往往比鲁棒特征(形状、纹理)在统计上更容易学习。诸如群体分布鲁棒优化 之类的技术则通过最小化最坏情况群体损失(例如沙滩上的牛)而非平均损失来显式缓解这一问题。该方法要求事先已知或推断出群体,但当这些群体可用时,它会迫使模型学习在所有语境下都有效的特征。
监控与自适应策略
漂移监控只有在将分布信号转化为运行决策时才值得其位置:调查、自适应、重新训练,或继续观察。
统计距离度量通过测量训练数据与部署数据分布之间的差异,来量化分布偏移的程度。在这个示意性的 H100 级监控场景中,使用径向基函数核的 MMD(\(\gamma = 1.0\))处理 10,000 个样本,共 150 ms;其灵敏度取决于偏移模型和核的选择。Kolmogorov-Smirnov 检验可以在 1,000+ 个样本下检测单变量偏移,但难以扩展到高维数据,并且会遗漏保持边缘不变而发生的联合变化。本示例中的服务使用来自 0.1 到 0.25 的 PSI16 值作为调查触发信号,而非普适的统计阈值。
16 人群稳定性指数(PSI):PSI 最初在信用风险监控中作为参考人群与当前人群之间的比较而普及。其对称对数比形式为分箱特征提供了一个方便的标量告警,但该数值取决于分箱、平滑、样本量和所选基线。PSI 可以触发调查;但它本身既不能表明预测性能已经退化,也不能表明重新训练就是正确响应。
高维和时序流量需要不止一个集群级标量。边缘特征监控可能保持平坦,而相关性、序列结构或某个小队列却发生变化。因此,生产设计将廉价的单特征告警与嵌入空间或核空间检验、队列切片、多个时长上的滚动窗口以及变化点检查结合起来。窗口必须保留季节性和事件上下文:将周一流量与周日流量比较可能制造出告警,而将一周平均则可能掩盖突发的单小时故障。监控设计属于假设的一部分,而非对模型的无偏封装。
监控触发之后,自适应便成为一项有预算的响应,而非自动重新训练指令。在线学习从顺序观测中更新模型 (Shalev-Shwartz 2012年);保留先前行为则仍然是独立的设计目标。自适应预算取决于模型大小、漂移速率和反馈延迟:更新过于激进会追逐噪声,而更新过于缓慢则会让性能漂移。在生产环境中,在线学习系统通常会显式地限制更新频率、状态大小和服务延迟,而不是假定自适应是免费的。诸如弹性权重巩固(Elastic Weight Consolidation)之类的技术通过惩罚对先前任务重要的参数变化来减轻灾难性遗忘 (Kirkpatrick 等 2017年)。
Shalev-Shwartz, S. 2012年. 《Online Learning and Online Convex Optimization》. Foundations and Trends in Machine Learning 4 (2): 107~94. https://doi.org/10.1561/2200000018.
Kirkpatrick, J., R. Pascanu, N. Rabinowitz, J. Veness, G. Desjardins, A. A. Rusu, K. Milan, 等. 2017年. 《Overcoming catastrophic forgetting in neural networks》. Proceedings of the National Academy of Sciences 114 (13): 3521~26. https://doi.org/10.1073/pnas.1611835114.
自适应集成方法会维护多个模型或假设,并根据近期性能对其加权或选择,因此在渐进式概念漂移下很有用 (Gama 等 2014年)。这种方法以额外的服务与监控复杂度为代价,换取在单个静态模型不再匹配部署分布时仍能响应的能力。
联邦学习在数据因隐私、监管或带宽原因无法集中时,使分布式自适应成为可能。此时,适应过程必须转移到数据所在处,因而通信预算而非计算成为约束性因素:每个轮次都要向众多参与者传输模型参数,因此设计问题在于部署能够承受多少轮次以及每轮次传输多少数据。联邦机制属于 边缘智能;与鲁棒性相关的要点是,为保护参与者而添加的任何隐私噪声都带有效用成本,必须针对具体应用进行测量,而不能假定其可以忽略。
定量漂移检测
定量漂移检测必须回答一个运行层面的问题:模型应当继续服务、接受更密切的监控,还是进入根因调查,而后者可能为重新校准、数据修复或重新训练提供依据。PSI 提供了一个廉价的集群级告警,从而启动该决策;下面的数学基础展示了服务如何校准阈值,而不至于将其误当作普适策略。
人群稳定性指数(PSI)
漂移检测 将 PSI 引入为廉价的集群级告警信号,其信用评分起源和常用的约定分档。该信号背后的完整统计机制决定了 PSI 的计算方式、分箱与平滑选择如何决定其灵敏度,以及它在调查中如何与 KL 散度、显著性检验和延迟的性能证据相结合。PSI 通过计算离散化分箱上的对称对数比差异,来度量期望(基线)分布 \(p_{\text{base}}\) 与实际(当前)分布 \(p_{\text{curr}}\) 之间的发散。
对于一个被离散化为 \(k\) 个分箱的特征,PSI 定义如下:
\[ \text{PSI} = \sum_{i=1}^{k} (p_i - q_i) \times \ln\left(\frac{p_i}{q_i}\right) \]
\(p_i\) 表示基线分布中落在分箱 \(i\) 内的观测比例,\(q_i\) 表示当前分布中对应的比例。对数项惩罚较大的相对变化,而 \((p_i - q_i)\) 项则按绝对量级加权。团队常先使用惯例分档作为初始告警级别,再依据历史波动和下游误差对其进行校准。
示例 PSI 告警分档 汇总了常用的 PSI 区间以及每一档推荐的监控措施。这些阈值分档属于监控惯例,尤其常见于信用评分实践,而非普适的统计保证;PSI 应与特征重要性及下游模型性能指标结合解读 (Yurdakul 和 Naranjo 2020年)。
Yurdakul, Bilal, 和 Joshua Naranjo. 2020年. 《Statistical properties of the population stability index》. The Journal of Risk Model Validation 52. https://doi.org/10.21314/jrmv.2020.227.
| PSI 值 | 解释 | 推荐措施 |
|---|---|---|
| \(\text{PSI} < 0.1\) | 可忽略的漂移 | 继续监控 |
| \(0.1 \le \text{PSI} < 0.2\) | 轻微漂移 | 排查根因 |
| \(0.2 \le \text{PSI} < 0.25\) | 中等漂移 | 升级排查 |
| \(\text{PSI} \ge 0.25\) | 严重漂移 | 立即排查 |
若干实现选择决定了 PSI 是否足够灵敏而具有实用性。分箱选择对 PSI 的灵敏度影响显著。对于分类特征,每个类别构成一个自然分箱;对于连续特征,等宽分箱(通常 10–20 个分箱)或分位数分箱提供了不同的权衡:等宽分箱保留了特征空间的绝对尺度,而分位数分箱确保每个分箱都有足够的样本量,但可能会掩盖尾部区域的漂移。生产系统常使用 10 个分箱,并保证每个分箱至少包含 5% 的观测,以确保统计稳定性。
当某个分箱在两种分布中的观测数均为零时,加入一个小的平滑常数(通常为 \(\epsilon_{\text{smooth}} = 10^{-8}\))可以避免出现未定义的对数,同时对 PSI 值的影响极小。下标使这一数值保障措施与本章后文引入的对抗性扰动半径 \(\epsilon\) 相区分。随时间监控总体稳定性指数 (图 10) 可以揭示模型何时从稳定区(绿色区域)漂移至警告区(橙色)和关键区(红色),从而触发升级路径,该路径可能最终导致在性能相关性确认后进行重新训练。
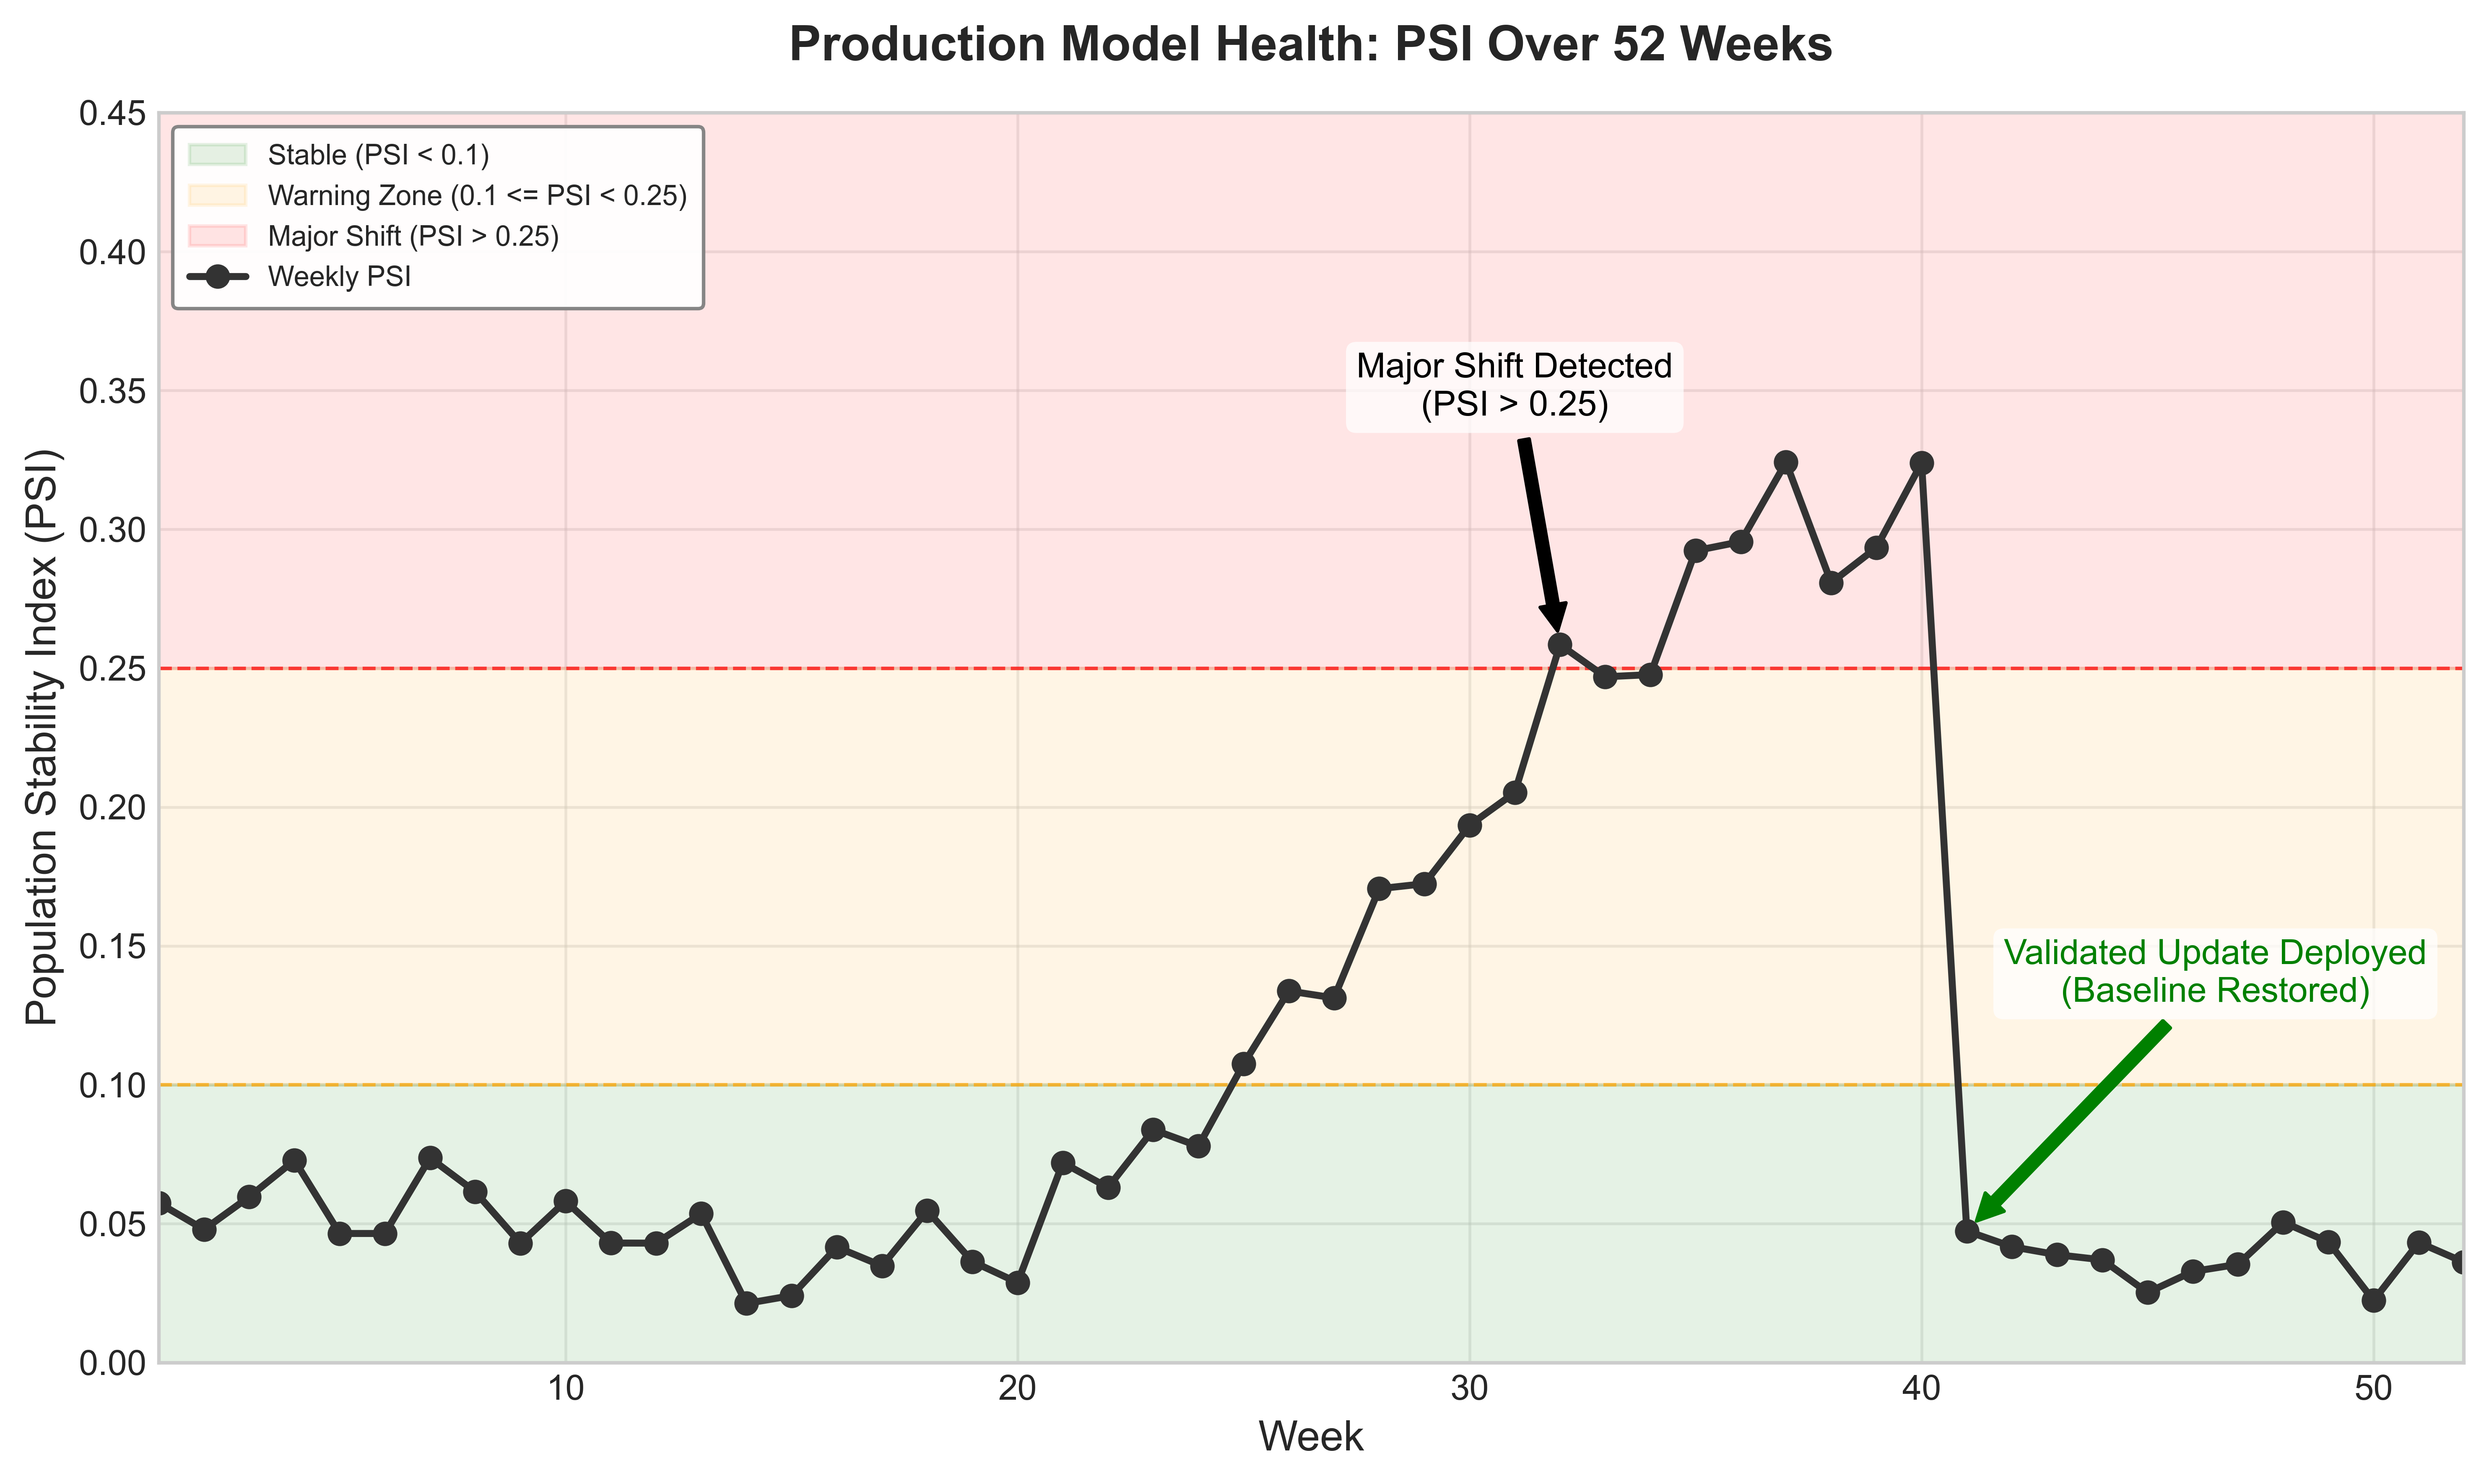
这条基于阈值的路径实现的是告警自动化,而非修复。操作者仍需提供标签或其他结果证据、进行根因分析,并在改变模型前评估响应措施。将连续变量强制离散化为分箱也会丢弃关于分布形状的信息,从而促使人们采用连续漂移指标。
Kullback-Leibler 散度
对于可能因分箱而损失信息的连续特征,Kullback-Leibler(KL)散度 提供了更直接的分布差异度量。从基线分布 \(p_{\text{base}}\) 到当前分布 \(p_{\text{curr}}\) 的 KL 散度定义如下:
\[ \mathcal{D}_{\text{KL}}(p_{\text{base}} \lVert p_{\text{curr}}) = \int_{-\infty}^{\infty} p_{\text{base}}(x) \ln\left(\frac{p_{\text{base}}(x)}{p_{\text{curr}}(x)}\right) dx \]
其中 \(p_{\text{base}}(x)\) 和 \(p_{\text{curr}}(x)\) 分别是基线分布与当前分布的概率密度函数。与 PSI 不同,KL 散度是不对称的:\(\mathcal{D}_{\text{KL}}(p_{\text{base}} \lVert p_{\text{curr}}) \neq \mathcal{D}_{\text{KL}}(p_{\text{curr}} \lVert p_{\text{base}})\)。漂移检测通常计算 \(\mathcal{D}_{\text{KL}}(\text{baseline} \lVert \text{current})\),即使用当前分布近似基线时所损失的信息量。
为了解决不对称性问题,从业者常采用 Jensen-Shannon 散度:
\[ \mathcal{D}_{\text{JS}}(p_{\text{base}} \lVert p_{\text{curr}}) = \frac{1}{2} \mathcal{D}_{\text{KL}}(p_{\text{base}} \lVert p_{\text{mix}}) + \frac{1}{2} \mathcal{D}_{\text{KL}}(p_{\text{curr}} \lVert p_{\text{mix}}) \]
其中 \(p_{\text{mix}} = \frac{1}{2}(p_{\text{base}} + p_{\text{curr}})\) 是混合分布。Jensen-Shannon 散度 的取值范围在 0 与 \(\ln(2)\)(约 0.693)之间,这使得阈值选择比无界的 KL 散度更加直观。
针对该欺诈监控示例,场景校准的 KL 告警分档 定义了团队将依据其历史流量进行验证的初始 KL 告警分档。
| \(\mathcal{D}_{\text{KL}}\) 值 | 解释 |
|---|---|
| \(\mathcal{D}_{\text{KL}} < 0.05\) | 散度极小 |
| \(0.05 \le \mathcal{D}_{\text{KL}} < 0.1\) | 中等散度 |
| \(\mathcal{D}_{\text{KL}} \ge 0.1\) | 显著散度 |
就实际计算而言,采用高斯核的核密度估计可提供适合积分的平滑密度近似,尽管计算成本随 \(\mathcal{O}(n^2)\) 个 \(n\) 样本而增长,因此对于大规模数据集必须进行采样。
统计显著性检验
PSI 与 KL 散度量化了分布变化看起来有多大;统计假设检验则回答互补的问题:观察到的差异是否大于采样噪声。两样本 Kolmogorov-Smirnov(KS)检验 (Berger 和 Zhou 2014年) 比较两个样本的经验累积分布函数(CDF),且不假设任何特定参数形式。检验统计量如下:
\[ D_{n,m} = \sup_x |F_n(x) - G_m(x)| \]
其中 \(F_n\) 与 \(G_m\) 分别是大小为 \(n\) 和 \(m\) 的样本的经验累积分布函数(empirical CDFs)。原假设(无分布差异)在满足以下条件时予以拒绝:
\[ D_{n,m} > c(\alpha) \sqrt{\frac{n + m}{nm}} \]
其中 \(c(\alpha)\) 取决于显著性水平(例如 \(c(0.05) \approx 1.36\))。KS 检验特别适用于检测位置(均值)和离散程度(方差)的偏移,但对分布形状的变化敏感度较低。
对于分类特征,卡方拟合优度检验 将观测频数与基线分布下的期望频数进行比较:
\[ \chi^2 = \sum_{i=1}^{k} \frac{(n_i^{\text{obs}} - n_i^{\text{exp}})^2}{n_i^{\text{exp}}} \]
其中 \(n_i^{\text{obs}}\) 是类别 \(i\) 中的观测计数,\(n_i^{\text{exp}}\) 是基于基线分布的期望计数。在自由度为 \(k-1\) 时,当 \(\chi^2\) 超过显著性水平 \(\alpha\) 对应的临界值,原假设即被拒绝。
当同时监控多个特征时,显著性检验还必须考虑重复比较问题。应用 Bonferroni 校正(将 \(\alpha\) 除以检验次数)或错误发现率控制,可以避免过多的误报。对于 \(m\) 个特征、显著性水平 \(\alpha = 0.05\),Bonferroni 要求每个检验达到 \(p < 0.05/m\) 才能判定显著。
工作示例:生产环境欺诈检测模型
考虑一个为电商平台服务的欺诈检测模型,其两个关键输入特征为:用户所在国家(分类特征)和交易金额(连续特征)。上线六个月后,运营团队怀疑分布发生了漂移,需要决定是否重新训练。
步骤 1:分类特征分析
表 1 比较基线(训练)分布与当前(生产)分布在四个具名国家及 Other 桶上的分布。
| 国家 | 基线 (\(p_i\)) | 当前 (\(q_i\)) | \(p_i - q_i\) | \(\ln(p_i/q_i)\) | 贡献 |
|---|---|---|---|---|---|
| USA | 0.45 | 0.38 | 0.07 | 0.169 | 0.0118 |
| UK | 0.20 | 0.18 | 0.02 | 0.105 | 0.0021 |
| Germany | 0.15 | 0.14 | 0.01 | 0.069 | 0.0007 |
| France | 0.10 | 0.12 | -0.02 | -0.182 | 0.0036 |
| Other | 0.10 | 0.18 | -0.08 | -0.588 | 0.0470 |
将逐国贡献求和得到 \(\text{PSI}_{\text{country}} = 0.0118 + 0.0021 + 0.0007 + 0.0036 + 0.0470 = 0.065\)。
0.065 的 PSI 仍位于该欺诈服务针对用户国家校准的基线范围内,因此该特征不会独立触发当前调查。
步骤 2:连续特征分析
对于交易金额特征(已做对数变换以满足正态性),使用核密度估计计算 KL 散度:
- 基线分布:\(\mu = 4.2\)、\(\sigma = 1.1\)(对数美元)
- 当前分布:\(\mu = 4.5\)、\(\sigma = 1.3\)(对数美元)
对于近似高斯分布,KL 散度具有闭式解:
\[ \mathcal{D}_{\text{KL}} = \ln\frac{\sigma_{\text{curr}}}{\sigma_{\text{base}}} + \frac{\sigma_{\text{base}}^2 + (\mu_{\text{base}} - \mu_{\text{curr}})^2}{2\sigma_{\text{curr}}^2} - \frac{1}{2} \]
The closed-form solution evaluates to \(\mathcal{D}_{\text{KL}} = \ln\frac{1.3}{1.1} + \frac{1.30}{3.38} - 0.5 = 0.167 + 0.385 - 0.5 = 0.052\). 0.052 的 KL 散度表明漂移程度适中,值得进一步调查,但无需立即重新训练。
第 3 步:通过 KS 检验进行统计显著性检验
使用 KS 检验,对 10,000 个基线样本和 10,000 个当前样本的 transaction amount 进行检验:
\[ D_{10000,10000} = 0.089 \]
临界值 \(\alpha = 0.05\) 为 \(c(0.05) \sqrt{\frac{20000}{10^8}} \approx 0.019\)。
由于观测统计量 0.089 超过临界值 0.019,该差异具有统计显著性 \((p < 0.001)\)。然而,仅有统计显著性并不强制重新训练;实际显著性(PSI、KL 值)提示应进行监控而非立即采取行动。
第 4 步:决策框架的应用
表 2 汇总了定量证据。
| 指标 | 数值 | 阈值 | 行动级别 |
|---|---|---|---|
| PSI(国家) | 0.065 | \(< 0.1\) | 监控 |
| \(\mathcal{D}_{\text{KL}}\)(金额) | 0.052 | \(< 0.1\) | 监控 |
| KS 检验 | \(p < 0.001\) | \(\alpha = 0.05\) | 显著 |
决策:继续以更高频率监控该欺诈模型(由每月改为每周)。跨越该场景的 PSI 或 KL 阈值即启动根因调查。只有当延迟标签显示出超出团队经验证容忍度的性能下降,且调查发现可通过重新训练解决的偏移时,模型更新才成为候选。数值截断值属于本工作示例服务;其他模型必须依据自身的基线变化、失败后果和响应能力校准阈值。
重新训练决策框架
一套系统的决策框架将漂移指标与性能监控相结合,以确定最优的重新训练时机。以下三个层级刻意将检测、关联和响应行动分开,以免指标告警直接变成自动重新训练指令。
第 1 级:自动监控
针对该欺诈监控场景,团队从其历史基线配置三个调查阈值:
- \(\text{PSI} > 0.1\) 针对任何高重要性特征
- \(\mathcal{D}_{\text{KL}} > 0.05\) 针对连续特征
- KS 检验 \(p\)-值 \(< 0.01\)(经 Bonferroni 校正)
第 2 级:性能关联
当上述按场景校准的告警之一触发时,三项性能关联指导调查:
- 若性能下降超出服务的经验证容忍度且与漂移同时发生:确定受影响的切片,并测试重新校准、数据修复或重新训练是否能够解决该原因
- 若检测到漂移但性能保持稳定:继续监控,调查漂移来源
- 若性能下降但未检测到漂移:调查概念漂移或标签偏移
经校准的服务专属拐点标记调查紧迫度上升的位置;它并非通用的 PSI 边界。
第 3 级:重新训练与调查
并非所有漂移都需要重新训练。表 3 将立即修复与调查、持续监控区分开来。
| 行动 | 触发条件 | 响应逻辑 |
|---|---|---|
| 更新模型 | 性能超出经验证的错误容忍度,标签确认发生偏移,根因分析表明模型更新能够解决该问题,且离线与影子评估通过发布门禁 | 证据表明重新校准或重新训练是适当的响应,而非仅仅检测到总体变化 |
| 先调查 | 按场景校准的漂移告警触发而性能保持稳定,偏移局限于非预测性特征,或季节性/一次性事件较为合理 | 该信号支持诊断,但不预设具体的修复措施 |
| 继续监控 | 漂移统计量仍位于服务校准的基线范围内,性能保持在容忍度内,且没有外部证据表明环境发生变化 | 证据尚不足以支持修改模型,但基线仍处于观察之中 |
定量框架将漂移检测从被动排障转变为主动的模型维护,使机器学习系统能够在生产环境演化过程中保持可靠性 (Gama 等 2014年)。没有任何 PSI 区间是通用的重新训练规则:非预测性特征上的大幅偏移可能无害,而安全关键子群上的小幅偏移则可能要求立即采取遏制措施。
Gama, João, Indrė Žliobaitė, Albert Bifet, Mykola Pechenizkiy, 和 Abdelhamid Bouchachia. 2014年. 《A survey on concept drift adaptation》. ACM Computing Surveys 46 (4): 1~37. https://doi.org/10.1145/2523813.
逐请求能力与选择性预测
总体监控考察的是流量在总体上是否发生变化。而一个服务系统在每个请求上都要面对不同的决策:该特定输入是否位于模型已验证的能力范围内,以及系统是否应当依据其预测采取行动。稳定的每日 PSI 可以与罕见的、危险的 OOD 请求并存,而大幅的总体偏移也可能使个体预测依然得到良好支撑。因此,集群鲁棒性既需要总体监控器,也需要逐请求决策契约。
该契约综合三项信号。校准 检验某个分数(如 0.8)在定义好的验证总体上的正确率是否约为 80 百分比 (Guo 等 2017年)。分布外检测 对请求与模型已验证输入分布的相异程度进行打分 (Hendrycks 和 Gimpel 2017年)。选择性预测 将这些信号转化为行动策略:高于接受阈值的回答、将不确定案例路由至更强的模型或审核者,以及在两条路径都无法满足风险界限时拒绝回答。三者中的任何一项都不能替代其他两项。一个经过校准的分类器可能在 OOD 输入上自信地出错,而 OOD 检测器可以标记新颖性却无需估计任务错误。
Guo, Chuan, Geoff Pleiss, Yu Sun, 和 Kilian Q. Weinberger. 2017年. 《On Calibration of Modern Neural Networks》. International Conference on Machine Learning (ICML) 70: 1321~30.
Hendrycks, Dan, 和 Kevin Gimpel. 2017年. 《A Baseline for Detecting Misclassified and Out-of-Distribution Examples in Neural Networks》. International Conference on Learning Representations (ICLR).
对于接受集 \(A_\tau = \{x : s(x) \ge \tau\}\)(阈值 \(\tau\)),覆盖率为 \(\Pr(x \in A_\tau)\),选择性风险为条件于接受的平均损失:
\[ \operatorname{coverage}(\tau)=\Pr(x\in A_\tau), \qquad \operatorname{risk}(\tau)=\mathbb{E}[\ell(f(x),y)\mid x\in A_\tau]. \]
对 \(\tau\) 进行扫描会产生一条风险—覆盖曲线,而非单一的准确率数值。提高阈值通常会通过降低覆盖率来降低已接受请求的风险,但被拒绝的流量并不会消失。回退路径需要有足够的队列、审核者或次级模型容量,以在原有延迟和安全预算内吸收拒绝率。若标签要数天之后才到达,系统可以立即监控分数和回退负载,但在结果返回之前无法确认选择性风险。在此期间,限流、保守阈值以及一个安全的默认暴露边界可以缓解影响。
有限样本覆盖与 conformal prediction
校准描述预测概率是否与经验频率一致;选择性预测则决定系统会回答哪些请求。Conformal prediction 提供了一种不同的契约:它用一个不符合度分数 \(s(x,y)\) 和留出校准集包裹一个拟合好的预测器。对于 \(n_{\mathrm{cal}}\) 按升序排列的校准分数,设定 \(k=\min\{\lceil(n_{\mathrm{cal}}+1)(1-\alpha)\rceil,n_{\mathrm{cal}}\}\) 和 \(\widehat q_{1-\alpha}=s_{(k)}\)。预测集为
\[ C_\alpha(x)=\{y:s(x,y)\leq \widehat q_{1-\alpha}\}, \qquad \Pr\!\left(Y_{n+1}\in C_\alpha(X_{n+1})\right)\geq 1-\alpha. \]
对于可交换的校准与测试样本,\((n_{\mathrm{cal}}+1)\) 秩校正使该保证成为有限样本下的边际覆盖保证:在重复样本上,该集合至少以目标速率包含真实结果 (Lei 等 2018年)。改用普通的经验 \((1-\alpha)\) 分位数则可能在有限样本量下产生欠覆盖。该保证并不针对每个输入或子群成立条件。即使总体覆盖正确,一个罕见的子群也可能具有较差的覆盖,尤其是当它贡献的校准样本很少时。
Lei, Jing, Max G’Sell, Alessandro Rinaldo, Ryan J. Tibshirani, 和 Larry Wasserman. 2018年. 《Distribution-Free Predictive Inference for Regression》. Journal of the American Statistical Association 113 (523): 1094~111. https://doi.org/10.1080/01621459.2017.1307116.
系统方面的义务是保留保证所依赖的前提条件。分布偏移或校准集过期会破坏可交换性论证,而反复依据同一批校准结果调整模型、分数或阈值,会使留出证据变成自适应而非独立的。因此,生产系统会将预测器、分数、校准快照和目标 \(\alpha\) 一并版本化;在标签到达后按具有后果的切片监控实际覆盖率;并在流量发生变化时刷新或隔离该契约。Conformalization 并不能抵御任意偏移。
集合大小或区间宽度提供了可操作的负载信号。更大的输出传达的预测更不具体,可能触发拒绝回答、更强的模型或人工审核,因此其尾部分布决定了回退容量,正如风险—覆盖曲线决定被拒绝的流量一样。目标覆盖率因此并非免费:提高它通常会加宽集合、增加审核需求,或降低系统能够自动采取行动的请求比例。
生成式 AI 的鲁棒性
大语言模型将失败面从错误分类转移到语义可靠性:一个流畅的回答可能缺乏事实依据,而系统看起来仍然健康。此前的鲁棒性问题关注的是扰动后标签是否发生变化;生成式版本关注的是:在提示词变化下,开放式输出是否保持事实性、策略约束和任务意图。在法律或医疗建议等专业领域的评估显示,幻觉率 会随模型、检索上下文、提示词设计和采样温度而显著变化。Token 熵和对数概率可以暴露生成过程中的不稳定性,但二者都不是事实性分数。模型可能对其数据中学到的错误陈述赋予高概率,也可能对正确但罕见的陈述赋予低概率。因此,生产路由必须将这些信号针对任务特定的错误进行校准,并与证据检查、检索支持或外部验证相结合。
Self-Consistency 对同一查询采样多条推理路径或答案。不一致提供了不稳定性信号,可用于将请求路由至审核;而一致则提供较弱的证据,因为相关样本可能重复同一误解或未获支撑的论断。序列级熵存在同样的局限:它可以作为具名任务的校准路由特征,但并不能将不确定性转化为真实性。运行契约必须测量条件于路由分数的错误,并为被标记的生成结果提供拒绝、检索、工具或人工路径。
在检索增强生成架构 (在大规模下运行推理) 中,鲁棒性在很大程度上取决于检索上下文的质量。Retrieval Noise 指将不相关或相互冲突的文档注入提示词,可能分散模型注意力,使其忽略自身的参数化知识并传播来自上下文的错误。鲁棒的 RAG 部署可以使用重排序模型和上下文验证器,在生成步骤之前过滤噪声。
生成式模型还面临提示词注入 Prompt Injection 这一独特威胁,攻击者将指令嵌入输入数据以覆盖模型的系统提示。虽然它常在 安全与隐私 中被作为安全问题讨论,但提示词注入同样属于鲁棒性失败:一个容易被操纵而忽略自身行为约束的模型,未能对抗性输入下维持其输出不变量。一种常见的部署模式是加入 Output Guardrails——轻量级分类模型,在将响应返回用户之前扫描生成的文本,检测策略违规、毒性或逻辑错误。这一最终验证步骤有助于即使核心模型进入失败模式,整个系统依然保持可靠。
本轮是独立翻译任务,只翻译本轮原文,不重复之前的译文;本轮占位符编号从头开始,必须按本轮原文顺序保留;原文行首的占位符仍放在行首,独占一行的占位符仍独占一行。粗体术语、图片标题和替代文本中的自然语言也必须翻译。
章节背景:《Scaling Machine Learning Systems》第二卷,14 robust ai。
While prompt injection exploits the linguistic flexibility of generative models, it represents a bridge between natural environmental shifts and deliberate adversarial manipulation. The interaction runs both directions: distribution monitoring systems themselves can be exploited by adversaries who craft inputs that evade drift detection thresholds, turning a defensive tool into a blind spot. When an adversary stops relying on natural drift and actively begins reverse-engineering the model’s decision boundaries to force specific errors, the threat model moves from the domain of environmental robustness into the mathematically rigorous battleground of input-level attacks.
Checkpoint 1.2: 漂移检测与是否重新训练的决定
环境变化可分为不同类型,本章的漂移框架刻意将“指标触发”与“重新训练指令”区分开来。
区分变化类型
关于阈值与代价的推理
输入级攻击与模型鲁棒性
向良性皮肤病变图像添加一层微观的、经过数学计算的噪声,噪声细微到人类皮肤科医生无法察觉,却会使生产环境中的诊断模型以 99.9% 的置信度将其诊断为恶性。深度神经网络学到的高维决策边界存在反直觉的盲点,攻击者可以有意加以利用。实际要问的问题是攻击者能看到或能控制什么:梯度、查询、物理传感器,还是训练数据。对抗性攻击正是暴露了这些盲点。
对抗性攻击
Definition 1.3: 对抗性攻击
对抗性攻击 是对模型输入、交互或环境的有意操纵,旨在使其违反某个指定的行为目标。这种操纵可能具有范数有界且视觉上隐蔽的特点,但也可能是语义性的、物理性的、基于查询的,或明显可见的。
- 重要性:对抗性评估考察攻击者能否选择输入或变换,从而将模型驱使其意图的行为包络之外。高维、范数有界的图像扰动是其中一种重要情形,但补丁、旋转、印刷物体、恶意文本以及反复的黑盒查询,则暴露出不同的系统边界。
- 区别:与独立于目标随机采样的随机扰动不同,对抗性操纵是专门为了引发失败而选取的。它未必使用梯度:攻击者可能借助代理模型、仅决策的查询、搜索、语义编辑,或对物理感知环境的控制。
- 常见误区:一种常见误解是把对抗性脆弱性视为需要修补的“缺陷”。实际上,它是许多通过经验风险最小化训练的标准神经网络的结构性脆弱性;鲁棒的防御通常需要对目标函数进行根本性改变(例如对抗性训练)。
对抗性攻击类别编码了访问方式与代价。白盒攻击者可以直接使用梯度,黑盒攻击者依赖迁移,物理攻击者则必须经受住相机、光照与距离的考验。图 11 展示了这一共同机制:对输入数据施加微小而精心设计扰动,即可导致高置信度的误分类,这些扰动对人类肉眼不可见,却对模型准确率具有毁灭性影响。
本轮是独立翻译任务,只翻译本轮原文,不重复之前的译文;本轮占位符编号从头开始,必须按本轮原文顺序保留;原文行首的占位符仍放在行首,独占一行的占位符仍独占一行。粗体术语、图片标题和替代文本中的自然语言也必须翻译。
这些攻击的有效性源于人类与机器感知之间的根本性不匹配。17 神经网络在高维特征空间中绘制非线性决策边界,而对抗性扰动正是利用这些边界的几何结构:输入维度众多,使攻击者可以在多个方向上同时施加推动,因此某个在任一维度上都过于细微的变化,仍然可能跨越边界。
17 人类与机器感知的差异 :首次由 Szegedy 等 (2013年) 提出,神经网络在像素空间中学习统计相关性,而非人类视觉所强制的语义不变性。这一差距并非需要修补的缺陷,而是基于梯度的优化在有限训练数据下产生的结构性后果:模型找到使经验风险最小的决策边界,而对抗性扰动则利用这些边界未加防护的广阔输入空间区域。
Szegedy, Christian, Wojciech Zaremba, Ilya Sutskever, Joan Bruna, Dumitru Erhan, Ian Goodfellow, 和 Rob Fergus. 2013年. 《Intriguing properties of neural networks》. arXiv preprint arXiv:1312.6199.
攻击类别与机制
有用的划分维度并非攻击名称本身,而是攻击者的访问方式。每种机制都揭示了防御必须抬高的不同代价:梯度访问、优化时间、代理模型构建,或对物理传感环境的控制。
最直接的情形是白盒梯度访问。神经网络计算梯度以学习参数变化如何降低损失;拥有梯度访问权的攻击者可以将这套逻辑反向施加于输入。对于一个正确识别出猫的图像分类器,相对于输入图像的梯度揭示了哪些像素级变化最有可能增大预测误差。快速梯度符号法(FGSM)18 将这一思路转化为单步攻击,即沿损失增长最快的方向移动每个输入特征。
18 快速梯度符号法(FGSM):由 Goodfellow 等 (2015年) 在 ICLR 上提出,FGSM 通过单个梯度步生成对抗样本,使其在训练期间易于使用。这种双重角色构成了其持久的系统学意义:正是这一攻击暴露了神经网络的脆弱性,随后又成为简单的对抗性训练原语,其中由 FGSM 生成的扰动会扩充干净批次,加入那些被选以增大损失的样本。
Goodfellow, I. J., J. Shlens, 和 C. Szegedy. 2015年. 《Explaining and Harnessing Adversarial Examples》. International Conference on Learning Representations (ICLR).
其底层数学形式化捕捉了这一直观过程:
\[ x_{\text{adv}} = x + \epsilon \cdot \text{sign}\big(\nabla_x \mathcal{L}(\theta, x, y)\big) \]
本轮是独立翻译任务,只翻译本轮原文,不重复之前的译文;本轮占位符编号从头开始,必须按本轮原文顺序保留;原文行首的占位符仍放在行首,独占一行的占位符仍独占一行。粗体术语、图片标题和替代文本中的自然语言也必须翻译。
章节背景:《Scaling Machine Learning Systems》第二卷,14 robust ai。
其中:
- \(x\) 是原始输入
- \(x_{\text{adv}}\) 是对抗样本
- \(\mathcal{L}(\theta, x, y)\) 是预测损失
- \(\nabla_x \mathcal{L}\) 标识出那些最增大该损失的输入变化
- \(\text{sign}(\cdot)\) 仅保留最陡上升方向
- \(\epsilon\) 控制攻击者被允许添加的扰动量
图 12 展示了该方法如何生成对抗样本:沿损失增长最快的方向迈出单步,扰动的 \(\ell_\infty\) 幅度受 \(\epsilon\) 约束。
本轮是独立翻译任务,只翻译本轮原文,不重复之前的译文;本轮占位符编号从头开始,必须按本轮原文顺序保留;原文行首的占位符仍放在行首,独占一行的占位符仍独占一行。粗体术语、图片标题和替代文本中的自然语言也必须翻译。
FGSM 之所以成本低,是因为它只走一步。投影梯度下降攻击(PGD 攻击) (Madry 等 2018年) 则付出更多计算以换取更强的攻击:它反复施加梯度更新,并将每一步投影回原始输入周围的允许范数球内。这种迭代式精修使 PGD 成为白盒鲁棒性的标准基准。 雅可比张量显著性图攻击(JSMA) (N. Papernot 等 2016年) 利用雅可比矩阵识别最具影响力的输入特征,并扰动较小的一组维度以趋向目标类别。这些方法在白盒场景中最为有效,19 因为攻击者了解模型架构与梯度。
Papernot, N., P. McDaniel, S. Jha, M. Fredrikson, Z. Berkay Celik, 和 A. Swami. 2016年. 《The Limitations of Deep Learning in Adversarial Settings》. 2016 IEEE European Symposium on Security and Privacy (EuroS&P), 372~87. https://doi.org/10.1109/eurosp.2016.36.
19 白盒攻击:指攻击者掌握完整模型知识(架构、权重、梯度)的对抗性攻击;PGD 与 Carlini-Wagner(C&W)攻击之所以强大,是因为它们直接针对模型进行优化,而非从外部探测模型。尽管对许多已部署系统而言,白盒分析不如黑盒场景现实,但它会在给定的范数、扰动预算与攻击流程内确立一个严苛的基准。通过 PGD 只是该威胁模型下的证据,而非对一切看似较弱攻击的普遍保证。
20 Carlini and Wagner(C&W)攻击:2016 年提出(IEEE S&P 2017),C&W 将对抗样本生成形式化为一个约束优化问题,寻找引发误分类的最小扰动。其意义在于方法论层面:C&W 突破了防御蒸馏(一种早期防御,通过遮蔽梯度来削弱较弱攻击)以及若干其他防御,这些防御此前能够抵御 FGSM 与 PGD。由此确立了原则:鲁棒性主张必须基于优化类攻击进行评估,而不能仅依赖梯度符号启发式方法。
Carlini, Nicholas, 和 David Wagner. 2017年. 《Towards Evaluating the Robustness of Neural Networks》. 2017 IEEE Symposium on Security and Privacy (SP), 39~57. https://doi.org/10.1109/sp.2017.49.
当攻击者更看重隐蔽性而非速度时,攻击便成为一个优化问题。Carlini 与 Wagner(C&W)攻击20 (Carlini 和 Wagner 2017年) 搜索能引发误分类、同时保持与原始输入感知相似性的最小扰动。C&W 并非仅仅跟随梯度的符号,而是优化一个自定义目标函数,在扰动大小与错误答案的置信度之间进行权衡。
C&W 攻击难以检测,因为扰动通常对人类不可察觉,并且可以在不同的范数约束下优化,例如 \(\ell_2\) 或 \(\ell_\infty\)。 弹性净攻击(EAD) 加入弹性净正则化,结合 \(\ell_1\) 与 \(\ell_2\) 惩罚项,以生成稀疏且局部的扰动。这些基于优化的方法比梯度符号攻击计算量更大,但为攻击者提供了对对抗样本几何结构的更精细控制。
黑盒攻击者失去了直接的梯度访问权,但仍可利用可迁移性。21 可迁移性 是指为某个模型构造的对抗样本能够欺骗其他模型的现象,即使架构或训练数据集不同。攻击者可以训练或获取代理模型,离线构造攻击,然后将所得样本提交给目标 API,而无需看到其权重或梯度。
21 可迁移性:指为某个模型构造的对抗样本能够欺骗不同架构的现象,该现象在 Nicolas Papernot, McDaniel, 和 Goodfellow (2016年) 中得到了分析。这改变了已部署机器学习系统的威胁模型:攻击者无需看到目标模型的权重——他们可以在本地训练替代模型,离线构造攻击,再将其迁移到生产 API。基于集成模型的对抗性训练针对多个模型的扰动进行训练,以提升迁移鲁棒性,但额外的攻击生成与模型多样性使其成为一项有意的训练预算决策,而非免费的缓解措施 (Tramèr 等 2017年)。
Papernot, Nicolas, Patrick McDaniel, 和 Ian Goodfellow. 2016年. 《Transferability in Machine Learning: from Phenomena to Black-Box Attacks using Adversarial Samples》. arXiv preprint arXiv:1605.07277.
Tramèr, Florian, Alexey Kurakin, Nicolas Papernot, Ian Goodfellow, Dan Boneh, 和 Patrick McDaniel. 2017年. 《Ensemble Adversarial Training: Attacks and Defenses》. International Conference on Learning Representations abs/1705.07204.
迁移成功取决于模型相似度、训练数据重叠与正则化。攻击者可以通过利用输入多样性(例如随机缩放或裁剪)以及优化过程中的动量来增强迁移效果。该威胁模型对商业 API 尤其相关,因为攻击者可以观察到输入与输出,却无法窥见内部计算。

一个由代理模型构造的对抗样本可迁移到多个模型。
物理世界攻击者面临最严苛的约束:扰动必须经受传感器、距离、光照、观察角度以及普通部署差异的考验。对抗补丁是印在物体上的图案,使相机和检测器对场景产生误读。经过修改的路牌、衣物补丁和 3D 打印物体,将攻击从数字输入张量推进到物理环境。这使得鲁棒性问题具有了操作性,而不仅仅是数学问题:一种在保存图像上有效的防御,一旦攻击经过相机镜头、压缩、运动模糊以及不断变化的光照,就可能失效。这些威胁对部署于物理空间的 AI 系统最为重要,例如自动驾驶车辆、无人机和监控系统,在这些系统中,模型错误会转化为现实世界中的安全、安全与问责问题。
Example 1.1: 路牌攻击
场景:物理对抗补丁(贴在停车标志上的黑白贴纸)针对自动驾驶车辆视觉模型 (Eykholt 等 2018年)。
诊断:物理扰动能够经受传感器噪声、相机角度、距离变化(最远可达 30 英尺)和光照变化,诱使检测器将停车标志误分类为 45 mph 限速标志。
系统启示:鲁棒性必须针对完整的物理传感链路进行评估,而不能仅依赖数字基准图像。面向安全关键感知的系统栈需要时空验证与传感器融合,以防止单补丁物理攻击。
Eykholt, K., I. Evtimov, E. Fernandes, B. Li, A. Rahmati, C. Xiao, A. Prakash, T. Kohno, 和 D. Song. 2018年. 《Robust Physical-World Attacks on Deep Learning Visual Classification》. 2018 IEEE/CVF Conference on Computer Vision and Pattern Recognition 1707.08945: 1625~34. https://doi.org/10.1109/cvpr.2018.00175.
表 4 的要点在于防御选择,而非术语本身。一个在白盒 PGD 测试中失败的模型,不具备可信的最坏情况鲁棒性声明;面向 API 的模型必须为代理迁移和探测预留预算;面向安全关键的视觉系统必须测试完整传感链路,而不能只测试保存图像。因此,各行指出了攻击者用于跨越决策边界的手段:梯度、优化、代理迁移,或物理传感操纵。
| 类别 | 方法 | 机制 |
|---|---|---|
| 梯度 | FGSM | 沿损失梯度扰动输入 |
| PGD | 迭代式多步 FGSM 细化 | |
| JSMA | 针对最具影响力的特征 | |
| 优化 | C&W | 在满足误分类的前提下最小化扰动大小 |
| DeepFool | 寻找跨越决策边界的最小扰动 | |
| EAD | 用于稀疏扰动的弹性网正则化 | |
| 迁移 | 可迁移性 | 对抗样本可在模型之间迁移(黑盒) |
| 物理 | 补丁 | 印刷补丁在真实世界中欺骗检测器 |
| 3D 物体 | 雕刻物体在部署中欺骗传感器 |
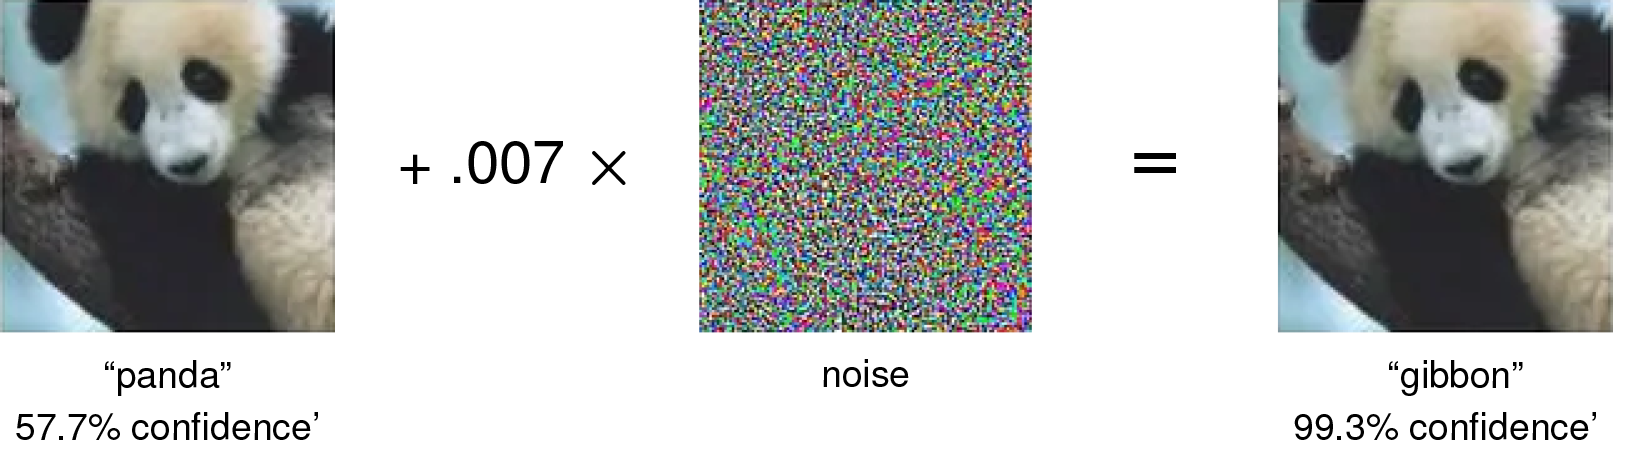
防御无法通用选择。对抗训练提高了基于梯度攻击的成本,输入变换在推理前破坏部分小扰动,集成模型降低了迁移的可靠性,而物理评估则暴露出数字测试遗漏的失败。这一防御预算之所以重要,是因为对抗攻击远远超出了 图 13 所说明的基本误分类,在该示例中,不可察觉的扰动使 GoogLeNet 将熊猫重新标记为大猩猩,而图像本身在人眼中几乎完全相同。这一单图像失败只是入口;同一原理可扩展为物理、可迁移和系统性攻击,从而在部署领域之间制造风险。
对停车标志的物理贴纸攻击(标准案例见 安全与隐私 中的案例研究)在移动车辆视频帧中,将停车标志误分类为限速标志的比例为 84.8%,而该扰动对人类可见,但对分类器而言具有决定性。对自动驾驶车辆的启示是直接而明确的:实际道路上部署的贴纸可能导致自动驾驶车辆将停车标志误读为限速标志,进而造成缓慢停车或意外加速驶入路口 (图 14)。
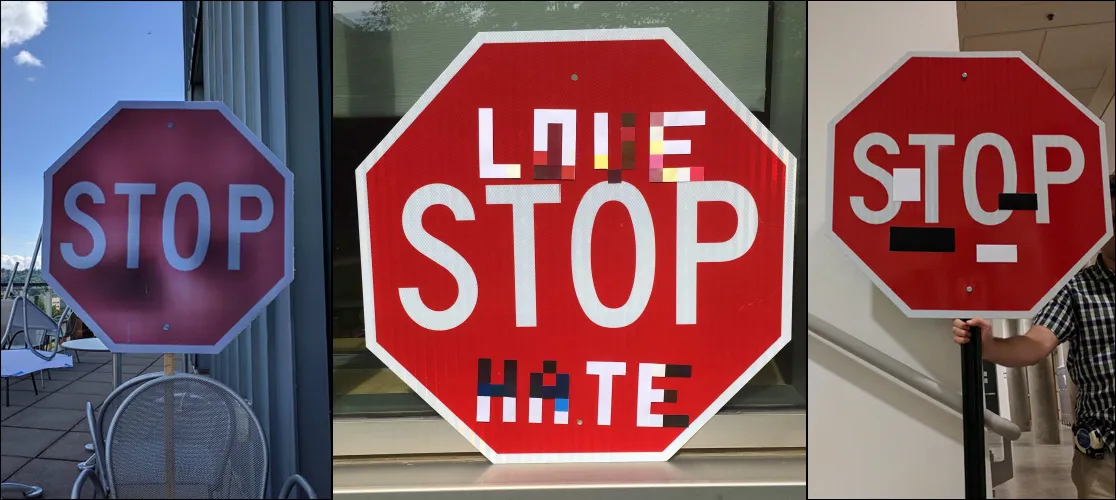
Eykholt, Kevin, Ivan Evtimov, Earlence Fernandes, Bo Li, Amir Rahmati, Chaowei Xiao, Atul Prakash, Tadayoshi Kohno, 和 Dawn Song. 2017年. 《Robust Physical-World Attacks on Deep Learning Models》. ArXiv preprint abs/1707.08945 (七月).
除性能退化之外,对抗性漏洞还会引发级联的系统性风险。在医疗领域,对医学影像的攻击可能导致误诊 (Tsai 等 2023年)。当情感分析、欺诈检测或交易模型依赖脆弱的输入模式时,金融系统也面临类似的操纵风险。对抗性漏洞暴露了模型对某些特征的依赖:这些特征在训练分布上具有预测能力,却在人为构造的扰动下表现不稳定,从而削弱模型的可信度 (Goodfellow 等 2015年; Madry 等 2018年)。而针对这些漏洞的每项防御措施也各有代价:对抗训练增加训练成本 (Bai 等 2021年),特征压缩等运行时检测方法 (Xu 等 2018年) 则增加推理阶段的评估次数,因此防御本身也成为需要纳入预算的项目,而非免费的保障措施。因此,对抗性漏洞凸显了采用 节 1.6 中所探讨的防御策略的迫切需求。
Tsai, Min-Jen, Ping-Yi Lin, 和 Ming-En Lee. 2023年. 《Adversarial Attacks on Medical Image Classification》. Cancers 15 (17): 4228. https://doi.org/10.3390/cancers15174228.
数据投毒
此前讨论的攻击都在推理阶段扰动一个固定模型。投毒则追溯到模型学习所用的数据,通过污染这些数据来破坏模型本身,微软的 Tay 聊天机器人就是典型例证。Tay 采用在线学习循环,对抗性用户借此塑造系统未来的行为;这类攻击并非对图像施加范数有界的扰动。上线后 24 小时内,有组织的用户便操纵其学习机制,使其生成不当且具有冒犯性的内容。该系统缺乏内容过滤、用户输入验证和行为监控,其中任何一项措施都可能检测并阻止这种攻击利用。从用户交互中学习的系统,需要将输入验证、内容过滤和持续行为监控作为基本保障措施。

数据投毒的生命周期包括:注入、学习、触发。
Definition 1.4: 数据投毒
数据投毒 是指通过注入恶意样本或修改现有标签来污染训练数据,从而破坏模型在推理阶段的行为。
- 重要性:它破坏了数据完整性这一基础假设。即使投毒样本只占很小的比例(例如 <1%),也可能植入后门或造成系统性偏差,这些问题会一直潜伏,直到在服务阶段被特定输入触发。
- 区别:与发生在推理阶段的对抗攻击不同,数据投毒发生在数据采集或训练阶段,从源头污染模型学到的映射。
- 常见误区:一种常见误解是,增加数据就能“修复”投毒。实际上,投毒往往利用训练的聚合特性:加入更多干净数据,未必能“冲淡”一个经过精心设计、使用独特触发器的定向后门。
数据投毒以训练数据本身为目标,在部署开始之前就污染模型学到的映射。它与对抗攻击存在根本区别:对抗扰动在推理阶段欺骗已经训练好的模型,而投毒则从一开始就让模型学习错误的模式。随着 ML 系统越来越多地摄取来自自动化流水线、网页抓取和众包标注的数据,投毒既成为模型鲁棒性问题,也成为流水线完整性问题:系统必须在学习器将污染内化之前检测到它。
机器学习安全领域一种经典的早期攻击形式,是 Biggio 等 (2012年) 针对支持向量机提出的攻击22。较新的投毒研究将目标扩展到互联网规模的数据流水线和生成模型的数据流水线 (另见 Shan 等 2023年)。投毒攻击 会修改现有训练样本、引入恶意样本,或干扰数据采集流水线 (图 15)。在医疗等高风险领域,其后果尤为严重:即使训练数据受到轻微干扰,也可能导致危险的误诊 (Marulli 等 2022年)。
Biggio, Battista, Blaine Nelson, 和 Pavel Laskov. 2012年. 《Poisoning Attacks against Support Vector Machines》. Proceedings of the 29th International Conference on Machine Learning, ICML 2012, Edinburgh, Scotland, UK, June 26 - July 1, 2012.
22 数据投毒:在这一经典攻击形式中,攻击者注入恶意训练样本,以破坏学习过程本身。对抗样本针对推理阶段,有时可以在服务阶段缓解;而投毒会在训练期间将漏洞嵌入模型权重。在互联网规模下,这使系统面临的问题从过滤单个推理请求,转变为维护数据来源的可追溯性、清理可疑数据批次,以及在训练样本转化为模型行为之前对其进行审计。
Marulli, Fiammetta, Stefano Marrone, 和 Laura Verde. 2022年. 《Sensitivity of Machine Learning Approaches to Fake and Untrusted Data in Healthcare Domain》. Journal of Sensor and Actuator Networks 11 (2): 21. https://doi.org/10.3390/jsan11020021.
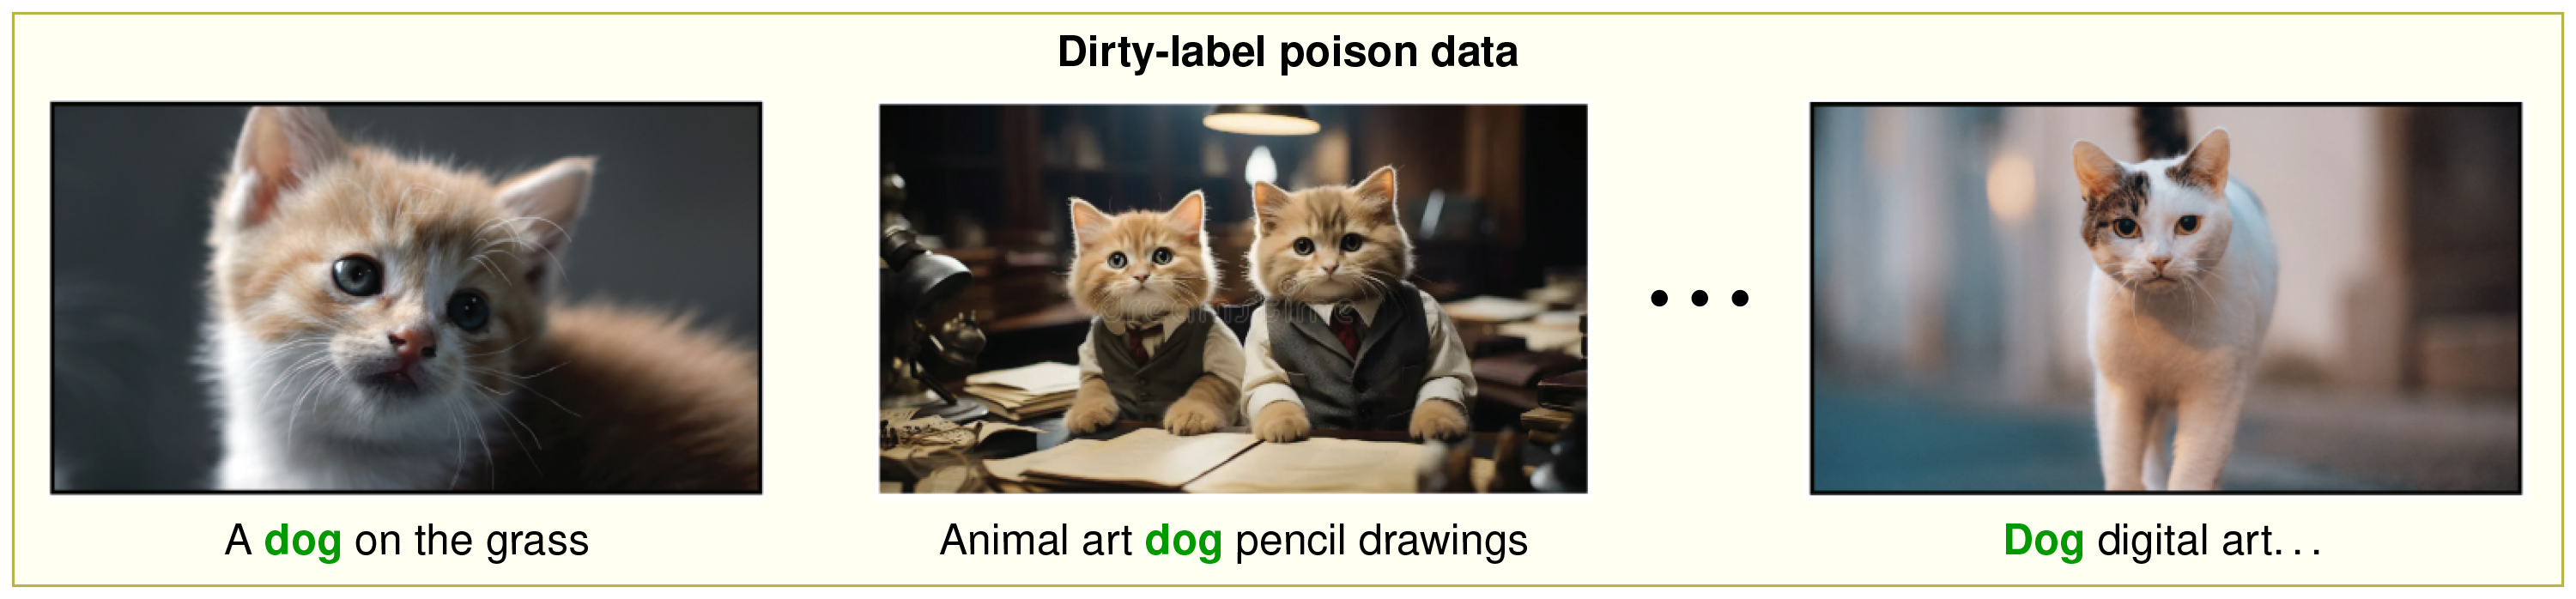
数据投毒通常分为三个阶段展开。在注入阶段,攻击者将投毒样本引入训练数据集——即现有数据的修改版本,或完全新构造、旨在与干净样本混入的实例。攻击者可能针对特定类别,插入恶意触发器,或构造旨在扭曲决策边界的离群样本。在训练阶段,模型吸收这些样本并学到虚假或误导性的模式;由于投毒数据在统计上与干净数据相似,标准评估过程中不会察觉这种污染。最后,在部署阶段,攻击者利用被污染的模型——触发后门误分类、降低整体准确率,或以难以追溯到训练数据的方式操纵预测。
投毒类别的差异在于攻击者希望训练好的模型做出什么 (Oprea 等 2022年)。在可用性攻击中,训练数据的大部分内容被投毒,目的是降低模型的整体性能。一个经典例子是翻转标签,例如在二分类任务中系统性地将真实标签为 \(y = 1\) 的样本改为 \(y = 0\)。这类攻击使模型在广泛输入范围内不可靠,实际上使其无法使用。
Oprea, Alina, Anoop Singhal, 和 Apostol Vassilev. 2022年. 《Poisoning Attacks Against Machine Learning: Can Machine Learning Be Trustworthy?》 Computer 55 (11): 94~99. https://doi.org/10.1109/mc.2022.3190787.
相比之下,定向投毒攻击只针对特定类别或样本。此时,攻击者只修改足够的数据,使一小部分输入被误分类,而整体准确率仍保持相对稳定。定向攻击的隐蔽性使其尤其难以检测。
后门投毒23 会在训练数据中引入隐藏触发器,即模型学会与某个特定输出关联的细微模式或特征。当触发器在推理阶段出现时,模型会被操纵为产生预设的响应。即使触发器模式对人类观察者不可察觉,这类攻击往往依然有效。
23 后门攻击:由 Gu 等 (2017年) 提出,后门攻击在训练数据中嵌入隐藏触发器,当特定模式出现时,在推理阶段激活恶意行为。BadNets 表明,基于触发器的攻击可以在保持干净数据准确率的同时实现定向误分类,因此仅凭普通测试准确率是一个弱检测器。防御挑战是不对称的:攻击者只需一个很小的触发器补丁,而防御方必须审计训练数据集,或在高维激活空间中检查谱异常 (Tran 等 2018年)。
Gu, Tianyu, Brendan Dolan-Gavitt, 和 Siddharth Garg. 2017年. 《BadNets: Identifying Vulnerabilities in the Machine Learning Model Supply Chain》. arXiv preprint arXiv:1708.06733.
Tran, Brandon, Jerry Li, 和 Aleksander Madry. 2018年. 《Spectral Signatures in Backdoor Attacks》. Advances in Neural Information Processing Systems (NeurIPS).
子群投毒 会污染数据总体中的特定子集。其意图与定向攻击相似,但子群投毒将可用性式退化施加于局部群体(例如某个特定人群或特征簇),而保持模型其余部分的表现完好。这类攻击的局部性使其既高度有效,又对公平敏感型应用尤其危险。
Lighthouse 1.1: 原型 B(大规模 DLRM):伪造档案注入
原型 B(大规模 DLRM)即 DLRM 工作负载,尤其容易受到 伪造档案注入 的影响。由于推荐系统常使用在线学习实时适应用户趋势,攻击者可以创建“女巫”账户网络——即由同一攻击者控制的虚假身份,与特定物品互动,从而人为提升这些物品的受欢迎程度,或将其与高价值人群关联。这类投毒绕过了传统防火墙,因为恶意互动看起来就像合法的用户行为,需要依赖谱特征防御(在激活模式中搜索可疑的低秩簇)或其他激活空间检测方法才能发现。
四类攻击贯穿的一条共同线索是它们的隐蔽性:被操纵的样本通常与干净数据无法区分,因此难以通过标准验证识别。攻击可能来自拥有特权流水线访问权限的内部人员,也可能来自外部攻击者,他们利用数据采集中的薄弱环节,尤其是在缺乏完整性检查和血缘追踪的众包环境或开放数据流水线中。
分布式与联邦训练为同一威胁增加了贡献者维度。恶意客户端无需向中央语料库插入可见记录;它可以提交一个经过选择的模型更新,以推动聚合结果、植入后门,或利用 sybil 身份获取与其贡献不相称的权重。评估必须变化恶意贡献者的数量与协同程度、其数据异构性、参与调度,以及它们对聚合规则的掌握程度。全局干净准确率再次不足:门禁需要触发或目标子群上的攻击成功率、贡献者层面的异常召回率,以及鲁棒聚合的干净效用代价。Krum、逐坐标中位数和截尾均值仅在各自声明的假设下仅能容忍有界的 Byzantine 行为Yin 等 (2018年);高维度和非独立同分布的客户端更新可能使诚实贡献者看起来异常。因此,溯源、参与限制、鲁棒聚合和留出的诱饵必须协同工作,而不能把某一条距离规则当作投毒证明。
Yin, Dong, Yudong Chen, Kannan Ramchandran, 和 Peter Bartlett. 2018年. 《Byzantine-robust distributed learning: Towards optimal statistical rates》. International Conference on Machine Learning (ICML), 5650~59.
数据投毒攻击方法
上述四类描述的是攻击者的目标;攻击机制则取决于攻击者对系统的访问权限以及对数据管道的了解。它们都具有相同的形态:一条投毒记录随干净数据进入训练管道,并污染该管道产出的模型(图 16)。最直接机制是标签篡改,攻击者选取训练样本的一个子集并修改其标签,将\(y = 1\)翻转为\(y = 0\),或在多分类场景下重新分配类别。即使小规模的标签污染也可能显著移动决策边界。
在标签篡改之后,攻击者可以保留标签不变,转而污染特征。不可察觉的图像扰动、结构化字段中的细微偏移,以及固定的触发模式,都追求同一结果:训练样本看上去仍然合法,却把学到的决策边界推向未来的失败。生成式方法和数据合成工具在更大规模上带来同样的风险,因为它们可以生成看似自然的样本,唯一目的便是扭曲模型所学到的内容。
这些样本是否构成投毒,取决于数据边界。网络抓取、社交媒体信息流、众包标注和不可信的用户提交,都允许投毒记录以“可信”形式进入上游并通过薄弱的清洗检查。物理系统提供了第二条路径:贴在路牌上的贴纸,当汽车看到它时属于推理阶段的对抗性攻击,但如果车队学习管道后来采集该图像并将其并入语料库,它就变成了训练阶段的投毒。在线学习系统进一步收紧了反馈回路,使攻击者能够逐步引入少量恶意数据,直到模型行为发生漂移,而全程没有一处明显异常。协作场景再次拓宽了边界:当许多客户端各自向中央聚合器贡献模型更新时,单个恶意参与者即可污染聚合产生的共享全局模型(图 17)。
内部协作增加了最后一层复杂性。拥有训练数据合法访问权限的恶意行为者,例如标注者、研究人员或数据供应商,能够设计出比外部攻击更具针对性、更隐蔽的投毒策略,因为他们了解模型架构或训练流程。无论结果表现为精度下降、隐藏的后门,还是对某个人口统计子群的偏见放大,数据投毒最终都会损害系统本身的可靠性:在投毒数据上训练的模型不能被认定为可靠,即使它在基准评估中表现良好。
案例研究:通过投毒保护艺术作品
数据投毒并非总是恶意的。研究人员已经开始将其作为防御工具加以探索,尤其是用于保护创意作品,防止生成式 AI 模型未经授权地使用。
Nightshade 由芝加哥大学的研究人员开发,可帮助艺术家防止自己的作品被抓取并用于训练图像生成模型,而无需获得许可(Shan 等 2023年)。Nightshade 允许艺术家在将图像发布到网上之前,对其施加细微扰动。这些变化对人类观看者不可见,但会导致将其纳入训练的生成模型出现严重退化。
Shan, S., W. Ding, J. Passananti, S. Wu, H. Zheng, 和 B. Y. Zhao. 2023年. 《Nightshade: Prompt-Specific Poisoning Attacks on Text-To-Image Generative Models》. 2024 IEEE Symposium on Security and Privacy (SP) abs/2310.13828: 807~25. https://doi.org/10.1109/sp54263.2024.00207.
当 Stable Diffusion 仅用 300 张投毒图像训练时,模型开始产生怪诞输出,例如被提示“car”时输出牛,或被提示“dog”时输出猫类生物(图 18)。该实验展示了概念投毒:投毒样本可以扭曲模型的语义关联。
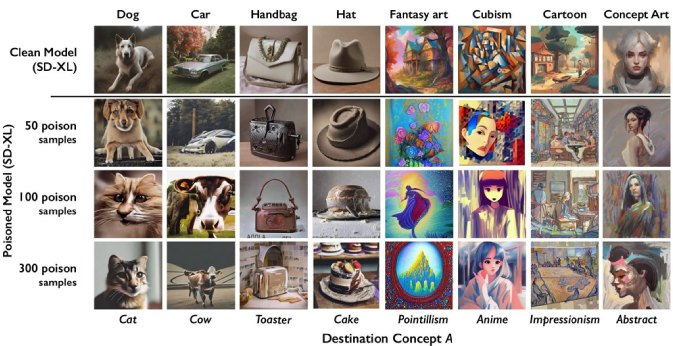
Nightshade 之所以尤其有力,在于投毒概念的级联效应。由于生成模型依赖类别之间的语义关系,被投毒的“car”会蔓延到相关概念,如“truck”“bus”或“train”,从而引发广泛的幻觉。这种保护艺术内容的技术,同样可能被改用于破坏合法训练管道,凸显了机器学习安全核心的双重用途困境24。
24 双重用途困境:防御性机器学习能力(对抗训练、数据投毒工具、红队框架)同时也是进攻性能力所形成的结构性张力。这形成了一场军备竞赛,防御性研究论文变成了攻击手册。对机器学习系统工程而言,后果是架构层面的:鲁棒性机制必须假定攻击者了解防御手段,从而排除“以隐蔽性换取安全”,并在可行处要求形式化可验证的保证。
在从投毒机制转向防御之前,一次快速的分类检查可将针对性投毒与更广泛的可用性攻击区分开来。
Example 1.2: 针对性投毒分类
场景:攻击者修改训练数据中一小部分样本的标签,使得一个已部署的分类器始终将某个受保护类别或对象模式映射到错误输出。
诊断:这是一次针对性攻击。攻击者并非试图降低模型的整体性能,而是在保留足够的一般准确率、使聚合验证指标仍可能看起来健康的同时,诱导特定错误。
系统启示:防御针对性投毒需要切片级评估、溯源检查和高风险类别的诱饵样本。仅凭聚合准确率是弱检测器,因为攻击被设计为隐藏在原本正常的性能之中。
这些输入层面的攻击机制,从对抗性扰动和数据投毒到它们与自然分布偏移的相互作用(节 1.4),界定了威胁面。下一个问题是:如何为保护生产模型所需的算法防御进行工程化设计。
对抗性防御
对抗性防御是针对特定威胁模型的一种预算化响应。保证越强,系统在干净准确率、训练计算量、推理延迟或运行覆盖范围上的付出就越大。
对抗性防御工作流
对抗性防御工作流包含四个有序层次:
- 定义威胁模型:明确扰动预算、攻击者知识,以及攻击发生在推理阶段还是训练阶段。
- 确定鲁棒性预算:决定预算是花在训练、认证、输入检测还是服务期护栏上。
- 衡量权衡:评估防御的两面,因为改善最坏情况行为可能降低干净准确率、提高推理延迟,或成倍增加训练成本。
- 保持对抗性评估:用强于设计所用攻击的攻击来测试防御。
顺序很重要,因为未校准的威胁模型会使预算和评估循环失去意义。
针对面向模型的扰动威胁,最直接的训练阶段防御是对抗训练,它将对抗样本纳入训练过程本身。
Systems Perspective 1.1: 正确衡量鲁棒性代价
假设一个标准 ResNet-50 在干净的 ImageNet 数据上取得 76 percent 的 Top-1 准确率,而一个经过对抗训练的模型取得约 50 percent 的准确率,评估采用指定的 \(\ell_\infty\) 攻击,条件为 \(\epsilon=8/255\)。将这两个值相减得到 26 percentage points,但这一差距比较的是不同模型在不同评估条件下的表现。它并不代表鲁棒性带来的干净数据准确率损失。
衡量干净数据准确率的代价,必须在同一个干净测试集上比较标准模型与鲁棒模型。衡量鲁棒性收益,则必须在相同的攻击、扰动预算和攻击强度下比较这些模型。报告全部四个单元格的结果,可以避免在表面上的权衡中混淆模型效应与评估条件效应。
系统洞见:鲁棒性可能降低干净数据准确率并增加计算量,但每一种代价都需要在相同条件下进行基线比较。部署准入检查应分别报告干净数据准确率、经验鲁棒准确率、攻击设定和评估成本。
鲁棒性计算惩罚(原则 18)量化了这一成本:PGD 式对抗鲁棒性可能使每轮训练的计算量达到标准优化的数倍,因为每个批次都要执行内层攻击步骤。对于许多应用而言,依赖外部防护措施(输入过滤、输出验证)比通过训练将内在鲁棒性融入模型权重更高效。
每种防御都会带来工程代价,体现在准确率、计算量或两者上。因此,选择防御措施应首先考虑威胁模型,以及可用于承担这一成本的预算。
Example 1.3: 根据威胁模型选择防御措施
场景:生产团队必须为三种不同的系统场景选择防御措施:面临规避攻击的图像分类器、面临训练数据投毒的推荐系统,以及面临自然分布偏移的欺诈检测器。
诊断:对这三个系统采用统一的防御措施会失败:它会增加图像分类器的推理延迟,忽视推荐系统中的训练数据投毒,并遗漏欺诈检测中的统计漂移。
系统经验:防御措施的选择必须适配威胁模型。对抗训练可应对实时规避攻击,鲁棒矩阵分解和数据修剪可阻止投毒,而结合漂移触发机制的持续监控可应对分布偏移。
可认证防御
对抗训练是一种经验方法;它能够抵御训练期间遇到的特定攻击,但面对新型或更强的扰动时往往失效。可认证鲁棒性 提供数学保证:对于给定的输入 \(x\) 和半径 \(\epsilon\),不存在能够改变模型预测的扰动 \(\|\delta\|_p < \epsilon\)。将这一思路扩展到 ImageNet 等高维输入的一种广泛使用的技术是随机平滑。它不直接对 \(x\) 进行分类,而是对平滑后的函数 \(g(x)\) 进行分类,该函数定义为基分类器 \(f\) 在高斯噪声下的期望预测:\(g(x) = \operatorname{arg\,max}_c \Pr(f(x+\delta) = c)\) 其中 \(\delta \sim \mathcal{N}(0, \sigma^2 I)\)。
Cohen 等 (2019年) 证明了认证半径 \(R\) 的一个紧的多分类界,所用依据是最高概率类别的概率下界 \(p_A\) 和次高概率类别的概率上界 \(p_B\):\(R = \frac{\sigma}{2}\left(\Phi^{-1}(p_A) - \Phi^{-1}(p_B)\right)\),其中 \(\Phi^{-1}\) 是标准正态分布累积分布函数的逆函数。在二分类特例中,当 \(p_B = 1 - p_A\) 时,该界简化为 \(R = \sigma\Phi^{-1}(p_A)\)。该界将鲁棒性转化为统计估计问题。如果某个二分类决策的最高类别概率为 \(p_A\) = 0.999,所处噪声条件为 \(\sigma\) = 0.5,则简化后的半径约为 1.5,但多分类 ImageNet 认证还必须考虑次高概率类别。然而,这一保证在准确率和计算量两方面都代价高昂。在 ImageNet 上,同一研究报告了随机平滑的非平凡认证准确率,包括半径为 0.5 时的认证,但认证需要在每次推理时采样大量噪声向量,以足够的置信度估计类别概率。推理延迟的大幅增加使认证防御的应用局限于异步审计或高风险场景中的安全联锁,而难以用于实时服务路径。
Cohen, Jeremy, Elan Rosenfeld, 和 Zico Kolter. 2019年. 《Certified Adversarial Robustness via Randomized Smoothing》. International Conference on Machine Learning (ICML), Proceedings of Machine Learning Research, 卷 97: 1310~20.
认证防御覆盖了对抗工作流的一部分。生产系统仍需要针对可疑输入的检测路径、改变训练或服务行为的缓解策略,以及验证仍覆盖哪些威胁模型的评估流程。
检测技术
在对抗样本到达模型之前进行检测,只有当检测信号落实到服务决策中时,才能构成第一道防线:拒绝、变换、路由或审计。成本最低的信号用于判断当前输入总体是否仍与参考总体相似。科尔莫戈罗夫–斯米尔诺夫检验25 (Berger 和 Zhou 2014年) 或安德森–达林检验等统计检验可以衡量分布差异,并标记偏离已知良性基线的输入。
25 科尔莫戈罗夫–斯米尔诺夫(KS)检验:一种比较两个概率分布的非参数检验,其计算复杂度为 \(\mathcal{O}(n \log n)\),计算效率较高,但仅适用于单变量分布。在对抗检测中,KS 检验将各特征的输入分布与训练基线进行比较,并根据 \(p\) 值 \(< 0.05\) 标记偏离。它对机器学习系统的关键局限在于:对抗扰动往往在保持边际分布的同时破坏联合结构,因此 KS 检验可能漏检 MMD 或嵌入空间度量能够捕捉到的攻击。
Berger, Vance W., 和 YanYan Zhou. 2014年. 《Kolmogorov–Smirnov Test: Overview》. 收入 Wiley StatsRef: Statistics Reference Online. Wiley. https://doi.org/10.1002/9781118445112.stat06558.
26 特征挤压:由 Xu 等 (2018年) 提出的防御方法,通过降低输入精度(例如,将颜色级别从 256 降至 16)或空间分辨率(中值滤波),破坏对抗样本所依赖的细粒度扰动。在其评估中,特征挤压消除了许多对抗样本,同时保持了较高的干净样本准确率;在将该防御视为可用于生产环境之前,必须针对自适应攻击进行验证。检测机制比较原始输入与挤压后输入的预测:较大的预测差异会触发对抗操纵标记,且延迟开销较低。
Xu, Weilin, David Evans, 和 Yanjun Qi. 2018年. 《Feature Squeezing: Detecting Adversarial Examples in Deep Neural Networks》. Proceedings 2018 Network and Distributed System Security Symposium 26. https://doi.org/10.14722/ndss.2018.23198.
这一信号对保持边际分布的攻击检测能力较弱,因此生产环境中的防御通常会增加一项破坏扰动的检查。特征挤压26 (Xu 等 2018年) 通过降维或离散化降低输入空间的复杂度,然后比较变换前后的模型预测。预测发生大幅变化,说明原始输入依赖不稳定的高频细节。
成本最高的信号用于判断模型是否对自身答案存在不确定性。对抗样本往往位于决策边界附近的不稳定区域,因此可以根据不确定性将输入路由至拒绝处理、人工复核或更鲁棒的模型。贝叶斯神经网络 通过将权重视为分布来估计不确定性,而集成方法则比较独立训练的模型所给出的预测,并将预测分歧作为告警信号 (Lakshminarayanan 等 2017年)。两者都能提高检测质量,但需要额外的推理计算量,因此在批量评分或安全联锁中使用它们,比在每个低延迟请求中使用更容易在成本上得到合理解释。
Lakshminarayanan, Balaji, Alexander Pritzel, 和 Charles Blundell. 2017年. 《Simple and Scalable Predictive Uncertainty Estimation Using Deep Ensembles》. Advances in Neural Information Processing Systems (NeurIPS) 30.
27 随机失活:由 Srivastava 等 (2014年) 提出的正则化方法,在训练过程中随机停用一部分隐藏单元,抑制共同适应并提高泛化能力。它对鲁棒性的作用是间接的,并不保证能够抵御神经元或权重失效:同一随机掩码机制可以在推理时保持启用,通过蒙特卡洛随机失活近似贝叶斯不确定性 (Gal 和 Ghahramani 2016年)。
Srivastava, Nitish, Geoffrey E. Hinton, Alex Krizhevsky, Ilya Sutskever, 和 Ruslan Salakhutdinov. 2014年. 《Dropout: a simple way to prevent neural networks from overfitting》. Journal of Machine Learning Research 15 (1): 1929~58.
Hinton, G. E., N. Srivastava, A. Krizhevsky, I. Sutskever, 和 R. R. Salakhutdinov. 2012年. 《Improving neural networks by preventing co-adaptation of feature detectors》. arXiv preprint arXiv:1207.0580.
28 蒙特卡洛随机失活:由 Gal 和 Ghahramani (2016年) 提出,通过在重复的随机前向传播中保持随机失活启用,蒙特卡洛随机失活将随机失活重新解释为近似贝叶斯推断。各次预测之间的方差提供了不确定性估计,无需修改架构。每增加一个样本都会增加推理工作量,因此部署时必须根据延迟和不确定性预算选择采样数量。
Gal, Yarin, 和 Zoubin Ghahramani. 2016年. 《Dropout as a Bayesian Approximation: Representing Model Uncertainty in Deep Learning》. Proceedings of the 33rd International Conference on Machine Learning (ICML) 48: 1050~59.
随机失活,27 最初被设计为一种正则化技术,用于防止训练过程中的过拟合 (Hinton 等 2012年),它在每次训练迭代中随机停用一部分神经元,迫使网络避免过度依赖特定神经元,从而提高泛化能力。同一机制也可以在推理时通过 蒙特卡洛随机失活28 用于不确定性估计:使用不同的随机失活掩码执行多次前向传播,近似不确定性分布。所得估计的精度低于贝叶斯方法,因为随机失活是为正则化而设计的,而非为不确定性量化而设计。将随机失活与轻量级集成方法或贝叶斯近似相结合的混合方法,在计算效率与估计质量之间取得平衡,使基于不确定性的检测更适合生产部署。
防御策略
检测层标记出对抗输入后,防御策略用于减轻其影响并提高模型鲁棒性。最常见的策略是对抗训练:使用对抗样本扩充训练数据,使模型学会正确分类受扰动的输入。代码 1 实现了这一模式,使用 FGSM 即时生成扰动,并在每个训练批次中混合干净数据与对抗样本。该方法提高了鲁棒性,但也带来了显著的计算开销,生产系统必须谨慎管理这些开销。
生成对抗样本会增加训练时间,因为每个训练步骤都需要对模型执行额外的前向和反向传播 (Madry 等 2018年; Bai 等 2021年)。内存开销取决于实现是否将干净样本与对抗样本一起存储、重新计算扰动,或复用梯度信息。PGD 等迭代攻击需要多个优化步骤,因此需要专门的基础设施来高效生成对抗样本;优化后的变体通过复用计算来降低开销,而不是将每个攻击步骤都作为一次独立的完整训练传播过程 (Shafahi 等 2019年)。
干净样本准确率的代价取决于威胁模型和防御方法。必须在同一个干净测试集上比较标准模型与鲁棒模型来衡量这一代价,并将其与匹配攻击条件下的鲁棒准确率比较分开进行。扰动预算、训练方案、模型容量和认证方法都会改变结果,因此一次跨条件的相减不能作为普适的代价度量。当鲁棒性训练方案使用更宽的网络或其他架构改动时,模型容量也可能增加,从而在测得的准确率权衡之外增加内存和训练成本。
在平衡鲁棒性与性能目标时,超参数调优会变得复杂得多。验证流程必须使用多种攻击方法,同时评估干净样本和对抗样本上的性能;部署基础设施也必须支持额外的计算需求,包括用于梯度计算的 GPU 内存,以及用于对抗样本缓存的存储空间。
function adversarial_training_step(model, clean_batch, labels, epsilon):
    logits = model(clean_batch)
    clean_loss = loss(logits, labels)

    input_gradient = gradient(clean_loss, clean_batch)
    perturbation = epsilon * sign(input_gradient)
    adversarial_batch = clip(clean_batch + perturbation, valid_input_range)

    mixed_batch = concatenate(clean_batch, adversarial_batch)
    mixed_labels = concatenate(labels, labels)

    return loss(model(mixed_batch), mixed_labels)
代码 1 中的实现在训练过程中即时生成对抗样本:对损失关于输入求导,应用符号函数提取扰动方向,再将生成的对抗样本与干净训练数据混合。裁剪使输入保持在有效范围内,而拼接则通过合并干净样本与对抗样本,使有效批次大小翻倍。这种方法需要仔细调节扰动预算 \(\epsilon\);优化后的变体可以通过复用梯度计算来降低对抗训练开销 (Shafahi 等 2019年)。
Papernot, Nicolas, Patrick McDaniel, Xi Wu, Somesh Jha, 和 Ananthram Swami. 2016年. 《Distillation as a Defense to Adversarial Perturbations Against Deep Neural Networks》. 2016 IEEE Symposium on Security and Privacy (SP), 582~97. https://doi.org/10.1109/sp.2016.41.
一旦对抗样本成为训练循环的一部分,部署时就必须将鲁棒性技术与 MLOps 流水线、监控策略以及在多个节点之间同步更新的分布式训练基础设施协调起来。其余策略只是转移成本发生的环节,而非消除成本。防御蒸馏 (Nicolas Papernot, McDaniel, Wu, 等 2016年) 在训练阶段承担这一成本,通过教师模型的软标签训练学生模型,这可以使决策行为更平滑,但仍须针对更强的攻击进行评估。输入预处理在模型服务阶段承担这一成本:图像去噪、JPEG 压缩、随机调整尺寸、填充和随机变换都试图在输入进入模型之前消除扰动。集成方法通过冗余承担这一成本,将架构、训练数据或预处理路径不同的模型组合起来,使能够欺骗其中一个成员的扰动更难欺骗所有成员。
评估与测试
评估对抗防御使预算形成闭环:系统必须衡量防御实际覆盖哪些攻击,以及在受控攻击条件下牺牲了哪些性能。鲁棒性指标通过对抗样本上的准确率、欺骗模型所需的失真程度,以及不同攻击预算下的性能来量化抵御能力。MNIST-C (Mu 和 Gilmer 2019年)、CIFAR-10-C 和 ImageNet-C (Hendrycks 和 Dietterich 2019年) 等标准化基准衡量的是常见的数据损坏,而非恶意攻击下的最坏情况行为,因此其结果对应 鲁棒性评估矩阵 中的另一个单元格。
Mu, Norman, 和 Justin Gilmer. 2019年. MNIST-C: A Robustness Benchmark for Computer Vision.
Hendrycks, Dan, 和 Thomas Dietterich. 2019年. 《Benchmarking Neural Network Robustness to Common Corruptions and Perturbations》. arXiv preprint arXiv:1903.12261.
基于实验的攻击评估必须针对防御进行适配。评估者应了解预处理、检测器、随机性、集成方法和拒绝规则;通过可微组件进行优化;对随机性采用变换期望方法;在梯度不可用时测试迁移攻击和基于查询的攻击;并将完整流水线纳入评估,而非仅评估保存的模型。多次随机重启和不同攻击预算可以增强该威胁模型内的证据,但通过 PGD 测试既不能证明 PGD 找到了内层最大值,也不能证明防御覆盖了语义攻击、物理攻击或采用不同范数的攻击。只有认证证明才能确立保证,而且保证仅适用于其声明的输入、范数、半径和假设。
对抗训练和可认证防御在有界威胁模型内应对推理时针对模型输入的攻击。它们不能证明模型是在可信数据上训练的。如果攻击者早在模型编译之前就破坏了数据流水线,推理阶段的证据仍无法解决训练过程遭到破坏的问题。前文所述的数据投毒攻击需要专门的防御方法。
Checkpoint 1.3: 选择对抗防御并规划预算
对抗防御是在预算约束下针对特定威胁模型作出的应对。更强的保证通常会改变干净样本准确率、计算量、延迟或覆盖范围,但变化的方向和幅度取决于工作负载、模型、防御方法和评估边界。
使防御与威胁相匹配
预算推理
数据投毒防御
投毒防御保护的是训练供应链,而非推理边界。防御流程依次应用四个层次:
- 来源追溯与访问控制:确定哪些来源有权修改数据。
- 异常检测与清洗:在训练前拦截可疑记录。
- 鲁棒目标函数:降低残留投毒数据的影响。
- 表示学习:降低模型对脆弱特征的依赖。
每一层覆盖数据路径上的不同环节;任何单一检测器都无法替代端到端的控制措施。
考虑一家使用金融推文训练情感分析模型的对冲基金。如果竞争公司组织一个机器人网络,在训练窗口内系统性地将“增长”一词与负面情感关联起来,新部署的交易算法就会在财报传递积极盈利信息时激进地做空股票。数据投毒攻击(图 19)针对机器学习供应链,在模型开始学习之前就操纵智能的原材料。如图所示,防御此类攻击需要一个主动拦截层,在投毒记录进入训练循环之前分析并清洗数据集。
入口与异常控制
投毒防御始于数据边界,先于任何统计检测器运行。管道必须知道哪些来源获准贡献训练数据、如何验证其真实性,以及哪些角色可以修改已接受的记录。强有力的治理机制会贯彻最小权限原则29,记录数据访问和修改事件,并为每个已接受的批次赋予来源标识。这些控制并不能证明每条记录都是干净的,但它们限定了攻击面,并为异常发现提供了可追溯的源头。
29 最小权限原则: 由 Saltzer 和 Schroeder (1975年) 阐述,该原则将访问权限限制为每个组件所必需的最小范围;应用于机器学习管道:推理容器不应访问训练数据,训练任务不应访问生产数据库,模型不应拥有超出所需 API 的网络访问权限。违规情况会构成数据投毒的攻击面——如果训练管道可以读取未经验证的来源,它最终会摄入对抗性数据;同一原则也适用于模型注册表,即把版本标识映射到权重文件并控制某个别名(例如 staging、production)解析为哪个检查点。提升为 production 别名的权限应仅限于一小批经过审计的自动化评估服务和具名的发布工程师;如果研究人员凭据遭到泄露,最小权限访问控制可以阻止该泄露扩散为被替换注入后门模型并进入线上流量。
Saltzer, J. H., 和 M. D. Schroeder. 1975年. 《The Protection of Information in Computer Systems》. Proceedings of the IEEE 63 (9): 1278~308. https://doi.org/10.1109/proc.1975.9939.
在来源边界之后,异常检测要判断某个候选训练样本是否属于管道预期学习的分布。最经济的测试将每条记录与批量分布进行比较:Z 分数过滤、Tukey 方法和 Mahalanobis 距离会标记出特征值明显偏离正常范围的样本。这些测试之所以有用,是因为它们足够快,可以在摄入阶段运行;但它们只能捕获那些在原始特征空间中看起来像统计离群点的投毒样本。对于高维或多模态数据,原始特征距离是一个弱信号:被投毒的图片块或略微错误的标题,逐像素测量时显得平平无奇,但在预训练视觉或语言模型的稠密嵌入空间中却表现为语义离群点。因此,生产管道越来越多地不再对原始特征,而是对基础模型编码器产生的隐表示应用 Mahalanobis 距离和聚类方法,在那里,原始统计量遗漏的语义异常往往表现为远离类别中心的孤立点或低密度簇。
针对更协同的攻击,则需要具备结构感知能力的检查。聚类方法(如 K 均值、DBSCAN 和层次聚类)寻找异常群组或孤立点,而不是单个极端值。自编码器 为同一道闸门增加了学习得到的表示:模型能够很好地重建正常样本,因此高重建误差会将记录标记为异常,并可能标记为投毒(图 20)。每种方法都有其失效模式。离群点测试会漏掉干净标签投毒,聚类方法依赖于特征表示,而自编码器可能在参考语料本身已被污染的情况下学会攻击模式。
清洗与预处理
清洗将异常信号转化为训练集变更,发生在投毒影响优化之前。可疑记录可以被拒绝、隔离待审、在训练期间降低权重,或者保留并附带明确的来源标识。常规的清理仍然重要:去重、缺失值处理、类型检查、范围约束以及跨字段校验可以消除许多低成本的投毒尝试,同时提升普通数据质量。
数据溯源 与谱系追踪使这些决策可逆。每个数据点都需要记录其来源、所经历的转换、校验结果以及在管道中的流转情况。当模型日后表现出投毒症状时,谱系可以让运维人员将可疑行为追溯到来源批次,估算哪些已训练模型消费了被污染的样本,并决定是移除、重新标注还是重新加权受影响的记录。
当可疑数据已经进入语料后,清洗便从来源检查转向表示检查。谱签名 (Tran 等 2018年) 利用了这样一个观察:后门触发器——为强制目标标签而添加到输入中的特定模式——会在网络内部表示中引入可检测的统计异常。当分析被污染类别的激活时,投毒样本往往与协方差矩阵的最大奇异向量高度对齐。将样本投影到这一主方向上并移除离群点,可以在不掌握触发器模式本身的情况下净化数据集,因为后门信号必须足够强以覆盖自然特征,因而必然留下表示层面的痕迹。
Koh, Pang Wei, 和 Percy Liang. 2017年. 《Understanding Black-box Predictions via Influence Functions》. International Conference on Machine Learning (ICML), Proceedings of Machine Learning Research, 卷 70: 1885~94.
影响函数 (Koh 和 Liang 2017年) 则承担更窄的调试角色。它在不重新训练的前提下,近似移除单个训练点 \(z\) 对模型针对某个特定测试点 \(z_{\text{test}}\) 的损失所产生的影响。通过逆 Hessian-向量积计算出的影响 \(I(z, z_{\text{test}}) \approx -\nabla_\theta \mathcal{L}(z_{\text{test}}, \hat{\theta})^T H_{\hat{\theta}}^{-1} \nabla_\theta \mathcal{L}(z, \hat{\theta})\),这一指标可以识别出对某个特定预测”负责”的训练样本。如果模型将停车标志误分类为限速标志,影响函数能够高亮促成该决策的候选训练图像。该方法通过迭代近似来避免显式构造逆 Hessian,但其在现代深度非凸网络中的结果仍然只是近似。因此,在现代模型规模下,影响分析需要针对具体的架构、近似方法和调试任务进行验证,而不能充当精确归因。
如果投毒样本在数据获取和净化后仍然留存,训练目标就成为限制其影响的最后一道关口。鲁棒优化通过修改目标函数,尽可能减小离群值或投毒样本的影响。Huber 损失、30 Tukey 损失 (Beaton 和 Tukey 1974年) 和截尾均值损失等鲁棒损失函数,会在训练过程中降低异常样本贡献的权重,或忽略其贡献。正则化技术(\(\ell_1\) 或 \(\ell_2\) 正则化)限制模型复杂度,并能降低模型对某些投毒数据的敏感性。在更高层面上,极小极大31目标和分布鲁棒目标在指定的不确定性集合上优化性能。目标函数提供了形式化的目标;近似优化器本身并不能证明训练后的模型达到了该目标,也不能证明模型能够抵御该集合之外的攻击。
30 Huber 损失: 这一分段函数在固定阈值(通常为 1.0–1.5)处从二次形式(均方误差)转变为线性形式(平均绝对误差),从而限制极端样本的梯度幅值。在数据投毒场景中,Huber 损失可防止少量恶意样本产生过大的梯度,进而主导参数更新—标准 MSE 不具备这一性质,因为误差为正常误差 100× 的单个离群值,会贡献 10,000× 的平方误差损失和 100× 的残差梯度幅值。
Beaton, A. E., 和 J. W. Tukey. 1974年. 《The Fitting of Power Series, Meaning Polynomials, Illustrated on Band-Spectroscopic Data》. Technometrics 16 (2): 147~85. https://doi.org/10.1080/00401706.1974.10489171.
31 极小极大: 源自 Neumann (1928年) 的博弈论策略,用于最小化可能出现的最大损失。在对抗鲁棒性研究中,Madry 等 (2018年) 将训练形式化为 \(\min_\theta \max_{\|\delta\| \leq \epsilon} \mathcal{L}(f_\theta(x + \delta), y)\):模型学习在所选范数球内的最坏情况扰动下最小化损失。内层最大化的计算成本很高,因为通常需要使用 PGD 等迭代攻击来近似求解,因此,PGD 对抗训练是一种受计算预算约束的鲁棒性选择,而非无需成本的目标函数变更 (Bai 等 2021年; Shafahi 等 2019年)。
Neumann, John von. 1928年. 《Zur Theorie Der Gesellschaftsspiele》. Mathematische Annalen 100 (1): 295~320. https://doi.org/10.1007/bf01448847.
Madry, Aleksander, Aleksandar Makelov, Ludwig Schmidt, Dimitris Tsipras, 和 Adrian Vladu. 2018年. 《Towards Deep Learning Models Resistant to Adversarial Attacks》. International Conference on Learning Representations (ICLR).
Bai, Tao, Jinqi Luo, Jun Zhao, Bihan Wen, 和 Qian Wang. 2021年. 《Recent Advances in Adversarial Training for Adversarial Robustness》. Proceedings of the Thirtieth International Joint Conference on Artificial Intelligence, 4312~21. https://doi.org/10.24963/ijcai.2021/591.
Shafahi, Ali, Mahyar Najibi, Amin Ghiasi, Zheng Xu, John Dickerson, Christoph Studer, Larry S. Davis, Gavin Taylor, 和 Tom Goldstein. 2019年. 《Adversarial Training for Free!》 arXiv preprint arXiv:1904.12843, 网络首发. https://doi.org/10.48550/arXiv.1904.12843.
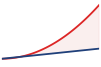
Huber 损失限制了平方损失所放大的离群值影响。
数据增强通过对现有数据(图 21)施加随机变换或扰动,生成额外的训练样本,从而提高训练数据集的多样性和鲁棒性。受控变化使模型对投毒样本中包含的特定模式或伪影不那么敏感。随机子采样或自助聚合等随机化技术,通过在不同子集上训练多个模型并结合它们的预测结果,进一步减小投毒数据的影响。
操作原则是分层实施:在数据摄取前验证并治理数据源,在训练前净化可疑数据,32在优化过程中限制残留离群值的影响,并保留数据血缘,以便将事件追溯到遭到破坏的数据源。数据投毒仍是一个活跃的研究领域,但生产系统应将训练语料视为一条供应链,而非被动的数据集。
32 数据净化: 从训练流水线中移除敏感或恶意数据;在投毒语境中,净化是指在对抗性训练样本破坏模型权重之前识别并移除它们。机器学习特有的挑战在于,投毒样本被设计成在统计上与干净数据无法区分,因此简单的过滤方法(离群值移除、标签验证)会漏掉复杂攻击。有效的净化需要激活空间分析(谱特征)或影响函数审计,而这两种方法在大规模场景下的计算成本都很高。
Pan, Sinno Jialin, 和 Qiang Yang. 2010年. 《A Survey on Transfer Learning》. IEEE Transactions on Knowledge and Data Engineering 22 (10): 1345~59. https://doi.org/10.1109/tkde.2009.191.
因此,数据边界只是鲁棒性的一个层次,并非完整的防御体系。在训练供应链得到治理、可疑记录被过滤之后,模型仍然需要能够适应常规部署变化的表征。除了在分布偏移发生后检测并纠正偏移(节 1.4),一种互补的方法是基于迁移学习和领域适应的基础,从一开始就构建能够抵御分布偏移的表征 (Pan 和 Yang 2010年)。
表征层面的防御:自监督学习
自监督学习(SSL) 改变了监督的来源。模型不再仅依赖任务标签,而是通过学习需要数据本身结构的前置任务(pretext task)来学习。这对鲁棒性至关重要,因为许多脆弱模型会过度拟合于任何最容易利用的标签捷径:例如背景纹理、标注瑕疵,或某种狭窄的措辞模式。一个奖励不同视图间稳定结构、缺失 token,或掩码图像块的前训练任务,能让表示有机会学到能够经受更多部署变化的信号。
SimCLR (Chen 等 2020年) 之类的对比学习方法将这一思路具体化,通过推动同一示例的不同视图趋向共享表示。模型因将裁剪、颜色偏移或数据增强视为同一个底层对象而非针对特定类别的线索而获得奖励。掩码语言建模(BERT (Devlin 等 2019年))与视觉中的掩码自编码 (He 等 2021年) 则采用另一条路径:它们隐藏输入的一部分,并迫使模型根据上下文重建或预测它。这两类方法都降低了对单一监督标签信号的依赖,这也是 SSL 表示在部署分布与带标签训练集不一致时往往迁移得更好的原因。
Chen, Ting, Simon Kornblith, Mohammad Norouzi, 和 Geoffrey Hinton. 2020年. 《A Simple Framework for Contrastive Learning of Visual Representations》. Proceedings of the 37th International Conference on Machine Learning, ICML’20, 卷 119: 1597~607.
Devlin, Jacob, Ming-Wei Chang, Kenton Lee, 和 Kristina Toutanova. 2019年. 《BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding》. Proceedings of the 2019 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies, 4171~86. https://doi.org/10.18653/v1/n19-1423.
He, K., X. Chen, S. Xie, Y. Li, P. Dollár, 和 R. Girshick. 2021年. 《Masked Autoencoders Are Scalable Vision Learners》. 2022 IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR) 18: 15979~88. https://doi.org/10.1109/cvpr52688.2022.01553.
这种迁移收益是在鲁棒性流水线中使用 SSL 的主要系统学理由。更大的无标签语料库能让模型接触到那些若逐一标注成本过高的域、变换和罕见情况。在生产环境中,SSL 通常作为基础而非完整防御:先在广泛的无标签数据上进行预训练,再在监督任务上进行微调,然后对任务特定模型应用本章前面建立的对抗、漂移和投毒防御。多任务训练可以通过在监督任务将表示拉向部署指标的同时保持自监督目标活跃,来保留部分这一收益。
其局限在于,SSL 并非鲁棒性保证。对比式或掩码式预训练目标仍可能学到脆弱的捷径,而理解前置任务的攻击者可以直接针对这些捷径。解释 SSL 何时能提升鲁棒性的理论仍不完整,且计算成本可能相当可观,因为预训练将工作提前到了生命周期早期。因此,系统层面的决策在于:更广泛的表示学习是否足以降低漂移、重新标注和鲁棒微调的预期成本,从而证明所增加的预训练预算是合理的。
谬误与陷阱
鲁棒性涵盖环境偏移、输入级攻击和系统级故障。每个威胁域都会引入误解,进而导致防御不足或工程资源错配。
谬误:对抗样本只是学术上的好奇,对现实世界没有实际影响。
已发表的物理世界攻击,例如衣物上的对抗补丁或停车标志上的贴纸,在受控的补丁和路牌设置下已经欺骗了经过评估的视觉模型,而无需数字访问。防御这些攻击需要针对威胁模型的评估、物理世界数据增强、补丁感知训练,以及服务时检测;相关的 PGD 式数字对抗训练通常会使训练成本增加数倍,具体取决于攻击步数。忽视这些防御,会让开放环境系统暴露于普通数字测试集无法揭示的故障风险。
陷阱:将测试集上的成功视为鲁棒性证明。
标准测试集与训练数据来自同一个独立同分布(i.i.d.)分布,因而无法衡量对现实世界偏移的韧性。在生产环境中,未受监控的分布偏移可能导致性能静默退化;所报告的分布外评估往往显示,当部署人群与训练分布出现偏离时,准确率会出现大幅下滑。
谬误:部署之后,分布偏移监控是可有可无的。
模型往往会静默退化,即使预测性能因漂移而下降,置信度分数仍可能保持高位。监控指标(如 PSI)可以在准确率跌破服务级别协议(SLA)阈值之前暴露人群偏移,从而在监控特征能够预测下游性能时实现主动干预。
陷阱:除非攻击者控制训练流水线,否则可以忽略投毒防御。
干净标签投毒 攻击通过向公开数据集或抓取的数据源注入恶意样本来破坏模型,无需访问内部代码。其定义性特征是杠杆效应:攻击者可以通过污染训练数据中极小比例的部分(远低于 1%)嵌入后门触发器,并在触发器于推理阶段出现之前保持潜伏,因此投毒切片的大小本身不构成任何防御。
谬误:平均准确率足以作为鲁棒性度量。
较高的平均准确率常常掩盖脆弱性:一个准确率为 95% 的模型,仍可能对关键边缘情况下的定向扰动实现 100% 的脆弱性。可靠的评估需要计算认证鲁棒性半径,或在特定扰动预算下的最坏情况准确率。
陷阱:将对抗训练视为完整的鲁棒性解决方案。
鲁棒性并非普适;它严格受制于训练期间所使用的特定威胁模型。针对 \(\ell_\infty\) 攻击进行对抗训练的模型,可能对 \(\ell_2\) 或几何攻击提供零保护,因而需要一套多样化的防御策略。
谬误:当模型正确时,软件故障无关紧要。
仅关注算法鲁棒性,会忽略这样一个现实:数据管道和服务基础设施中的软件缺陷是机器学习故障的主要原因之一。事故分析往往发现,故障的根源在于管道与数据问题,而非单纯的模型架构或对抗攻击。这些系统层故障的分类与缓解是 容错 的主题;而且,即使模型已经针对对抗扰动进行了加固,若预处理缺陷会静默地损坏其输入,模型依然脆弱。
陷阱:加固模型,却未对管道检查进行测试。
鲁棒性工作可以集中于对抗训练、认证半径或投毒防御,而让 schema 校验、预处理一致性、特征新鲜度和回滚演练长期缺乏充分测试。这种失衡会造就一个能够抵御某一类攻击、却在普通运行故障中失效的系统。鲁棒的部署会同时验证模型与管道,因为模型只能看到周围系统交付给它的输入。
这些误解有着共同的根源:将鲁棒性视为单维度的问题,而非分层的工程学科。
摘要
鲁棒 AI 将系统可靠性从一种经验性的期望转化为明确的工程预算。传统软件健康度以可用性和延迟来衡量,而机器学习系统会静默失效:预测准确率会在环境漂移下退化,模型会遭受输入级对抗扰动或投毒训练数据的影响,而管道缺陷则伪装成真实的分布偏移。系统层的软件故障(容错)通过损坏数据流或梯度更新而不触发硬件异常,从而放大这些脆弱性。要使这些静默失效可见,需要在整个模型生命周期中嵌入诊断机制——从最坏情况评估和谱滤波,到分布偏移指标(PSI、KL 散度、两样本 KS 检验)以及不确定性量化。
机器学习系统中的资源再分配遵循铁律(\(T \approx D_{\text{vol}}/\text{BW} + O/(R_{\text{peak}}\eta_{\text{hw}}) + L_{\text{lat}}\))。训练期间的多步 PGD 会增加计算项 \(O\);它是否也会降低干净准确率、以及降低多少,取决于模型、数据、扰动集合和训练配方。认证半径(如随机平滑)和推理时不确定性方法(如自洽采样)在启用时会增加前向评估次数,从而提高服务工作量,并往往增加延迟。持续的分布监控与投毒净化会消耗跨服务入口的数据传输带宽 \(D_{\text{vol}}/\text{BW}\)。鲁棒性工程将这些针对特定工作负载的成本,与在失效后果最高的地方所降低的静默风险相比较。
Conformal 路由将这一 \(^3\) 分配付诸实践。计算预测集会增加有界的计算量,返回或转移更大的预测集会增加通信量,而放弃阈值加上升级归属则会增加协同开销。覆盖机制可以在分布偏移使预测集变大时,将瓶颈从模型推理转移到人工复核或兜底容量。因此,有效的覆盖估计并不充分,除非部署方为消耗不确定案例的路径提供相应资源。
Key Takeaways: 静默失效才是真正的威胁
- 静默是失效模式:鲁棒性之所以存在,是因为漂移、对抗扰动、投毒和数值故障往往在损坏预测的同时,仍保持可用性和延迟。生产系统需要监控机制,在用户投诉或下游业务指标暴露问题之前,先显现能力损失。
- 鲁棒性是显式购买的:强对抗训练(原则 18)可能降低干净准确率并成倍增加训练计算量,而认证防御与不确定性采样则会增加服务成本。在决定投入多少韧性之前,先针对同类基线逐一核算每种效应。
- 漂移需要校准的距离度量:统计距离度量将环境偏移转化为复核、重新训练、回滚或路由的阈值。只有当该度量连接到响应路径,并针对误报进行校准时,它才有用。
- 覆盖保证有其运行条件:Conformal 预测在可交换性假设下提供有限样本边际覆盖,而非针对单个输入或子群的确定性保证。需要更新和刷新校准证据,并为较大的预测集预留兜底容量。
- 威胁彼此伪装:软件故障可能表现为概念漂移,投毒样本可能表现为罕见离群点,而对抗输入可能隐藏在自然的变异之中。鲁棒系统会结合入口校验、训练防御、不确定性信号和输出验证。
- 生成式可靠性具有语义性:LLM 幻觉是自信而流畅的失败,而非简单的标签错误。熵与自洽性是路由信号,而非事实性保证;接地检查、外部验证和升级策略必须约束系统被允许断言的内容。
没有任何有限的评估能够确立对每一种冲击的鲁棒性。每种防御都会改变特定工作负载的预算:对抗训练会增加攻击生成工作,并可能改变干净准确率;证书与不确定性采样在启用时会增加评估次数;漂移监控则会持续消耗流式带宽。工程问题在于,失效后果所支持的究竟是哪一项有界的韧性主张,以及该主张所施加的实测资源、效用与覆盖成本。保护不足会使静默失效无法被察觉,而过度的防御则可能违反服务级别目标(SLOs),或使服务在经济上失去竞争力。
本章负责行为学证据:针对威胁模型的测试、风险覆盖曲线、证书、漂移调查、投毒控制,以及经过验证的兜底行为。 责任人工智能 则消费这些证据,以回答另一个问题:谁定义可接受的残余风险,谁拥有发布与回滚权限,受影响的各方如何对结果提出异议,以及何时材料性变更会使保证论证失效。将证据与权限区分开来,可以避免鲁棒性分数偶然变成治理决策。
端到端评估契约 中的发布记录将这些证据带入生产环境,将每项鲁棒性主张绑定到所评估的制品、运行包络、责任人和失效规则。这一交接可防止证书、压力测试或覆盖结果在支撑它的工作负载或模型版本发生变化后被重复使用。
What’s Next: 从韧性走向可持续性
我们如何平衡系统防护与运行它所需的物理资源?鲁棒性建立在威胁建模(安全与隐私)与容错(容错)之上,以保护集群免受分布漂移、输入操纵和系统级故障的影响。然而,通过放大计算与延迟预算来实现韧性,会增加能耗与硬件占用。可靠的系统还必须长期处于行星与资源约束之内。可持续性(Sustainable AI)将这一要求转化为资源核算问题,涉及生命周期碳、碳感知调度与算法效率。