Sustainable AI
能源上限
Sustainable AI
目的
为什么能耗决定了机器学习系统能够存在什么,而不只是运行它们需要花费多少?
电力既是运营支出,也是物理约束,决定了可以建设什么。数据中心拥有一项由电气基础设施和冷却能力确定的固定预算;超出该预算的训练运行无法执行,无论其财务预算如何。电网容量和冷却可行性同样限制了部署地点。在最大规模下,物理可行性取决于能效与算法能力同等程度。因此,可持续性应与设计中的准确性和延迟并列。用 C³ 术语来说,计算、通信或协同的任何组合都不能超过设施的电力容量。
Learning Objectives
- 解释设施电力与冷却限制如何约束哪些机器学习系统在物理上能够存在
- 分析计算增长、硬件能效与需求反弹,以预测集群资源需求
- 根据能耗、电能使用效率、制造和电网强度计算运营、隐含和全生命周期碳
- 分析来自运营、内存移动、冷却、用水和供电约束的能源瓶颈
- 比较训练、推理、边缘和联邦工作负载的能源、碳和电池预算
- 在设计算法、基础设施、调度、硬件寿命和碳感知运营方面制定缓解策略
- 评估政策、碳抵消和环境公正主张,对照可测量的集群排放减少量
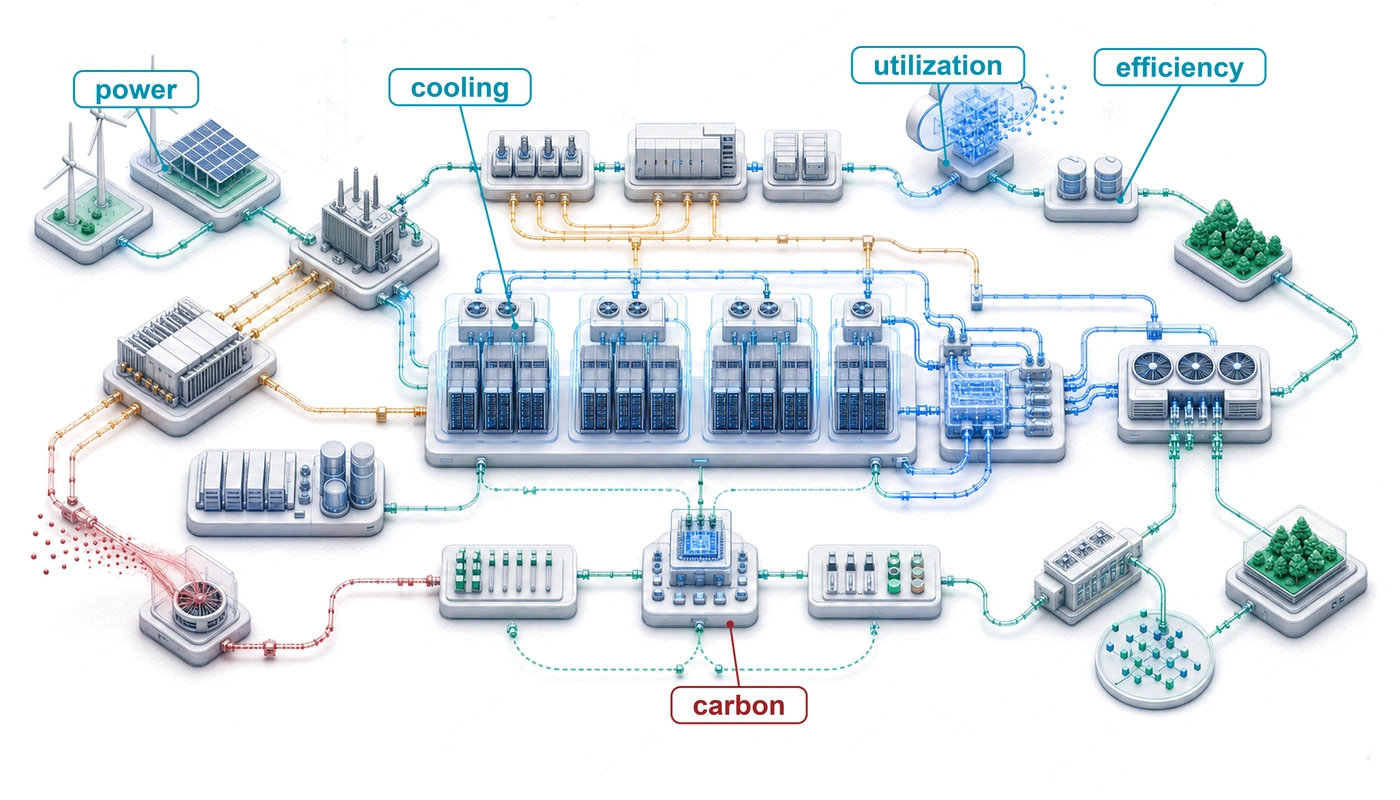
模型可以抵御对抗攻击,并且在分布偏移下保持鲁棒,但仍可能失败:如果可用电网无法为其加速器供电,或者设施无法为其散热。 可持续性 始于这一边界:当系统还必须同时满足电力、冷却、用水、碳和硬件寿命预算时,仅靠准确性、延迟和可靠性已不再足够。能源是机器学习最终的货币,而功率密度是数据中心计算容量的上限。1
1 焦耳能耗量级:单张 A100 GPU 在峰值负载下每秒消耗约 400 焦耳(400 W)。大模型训练没有单一可辩护的焦耳量级:模型规模、硬件数量、实际功率、利用率以及运行时长都可能使总能耗相差多个数量级。工程要点在于将每次操作的重复成本转换为设施能耗,因此本章报告实测或建模得到的工作负载能耗,而不是为每次大运行都指定一个固定范围。
当工程师优化一条数据库查询以节省 100 ms 时,那属于常规的性能调优。在集群规模下,每天重复数十亿次的同一项节省会转化为兆瓦级的电力、冷却负荷和避免的碳排放(Lacoste 等 2019年)。一个超出其运行包络的系统,在运营意义上与崩溃的系统同样属于失败,因为它无法在预期规模上部署。
这一上限使可持续性成为设计约束,而非仅一种报告类别。与预算内存、带宽和容错相同的工程纪律,也必须预算焦耳、冷却负荷、隐含碳和硬件更换周期。
当代机器学习应用运行在工业规模上,其环境影响与成熟的重工业相当。训练单个大型 AI 模型所消耗的电力,可能相当于约 120 户美国家庭一整年的用电量。计算需求的增长快于硬件能效(Sevilla 等 2022年);本书将由此产生的差距称为 可持续性悖论。可持续 AI 将这一差距视为一等系统问题,而非部署后需要事后管理的负外部性。
Sevilla, Jaime, Lennart Heim, Anson Ho, Tamay Besiroglu, Marius Hobbhahn, 和 Pablo Villalobos. 2022年. 《Compute Trends Across Three Eras of Machine Learning》. 2022 International Joint Conference on Neural Networks (IJCNN), 1~8. https://doi.org/10.1109/ijcnn55064.2022.9891914.
Definition 1.1: 可持续 AI
可持续 AI 是系统工程实践:测量并优化机器学习系统的全生命周期环境成本(训练、推理和硬件制造过程中的能源、用水和隐含碳),并将这些成本作为显式约束纳入架构决策,与性能、准确性目标并列Henderson 等 (2020年)。
- 重要性:训练 GPT-3 消耗了约 1,287 MWh 的能源(Li 2020年),相当于约 120 户美国家庭一整年的用电量。训练之后的生命周期逻辑同样适用:预训练模型往往可以用远少于从头训练的工作量完成适配,而高吞吐推理最终可能主导总能耗。因此,可持续 AI 同时跟踪一次性训练运行和周期性服务工作负载,而不是将模型训练视为整个环境足迹。
- 区别:与企业的可持续发展披露(将能耗汇总为年度 CO2 披露)不同,可持续 AI 工程工作在单个工作负载层面运行,依据每瓦 FLOPs 效率选择硬件,在可再生能源可用性高的时段安排训练,并选择最小化推理 FLOPs 的模型架构,而非简单地最大化准确性。
- 常见误区:一种常见误解是,改用可再生能源就能解决可持续性问题。对于硬件密集型机器学习,隐含碳(制造芯片、服务器和冷却设备、在其运行任何训练任务之前就已排放的碳)往往等于甚至超过运营碳;边缘设备超过 50% 的全生命周期碳可能来自制造,因此硬件使用寿命和利用率与能源来源同等重要。
Li, Chengwei. 2020年. Estimating the Training Cost of GPT-3.
AI 系统的环境影响覆盖完整生命周期:从半导体制造和数据中心建设,到模型训练、推理部署和电子废弃物Luccioni 等 (2023年)。将这一全生命周期视为工程问题而非企业责任活动,就把可持续性从模糊目标转化为可测量的工程要求。优化这一足迹,首先要将直觉建立在单个大模型训练运行的原始物理能耗之上。
Checkpoint 1.1: 智能的能耗
一个含 175B 参数的模型训练需要约 \(3.14 \times 10^{23}\) FLOPs。假设数据中心的 PUE 为 1.1,端到端实际训练效率为 50 GFLOP/J:
这一户年数值是核心量级;它同时也只是进入建筑的电量。下一个问题是这些能量在物理上去了哪里:有多少到达加速器,有多少被冷却和供电开销消耗,以及计量表后的电网如何将这些千瓦转化为碳。
环境影响的量级
以兆瓦时计的训练运行难以直观理解:很少有工程师对兆瓦时电网电对大气造成的代价有直观感受。将该能量换算为排放,再换算为已知的碳锚点——一次跨大西洋航班的 CO2——就把一个抽象数字变成了具有物理分量的数字。
Napkin Math 1.1: 训练的碳成本
问题:一个团队训练了一个大型模型(GPT-3 规模),消耗 1,287 MWh。排放了多少 CO2,与一次跨大西洋航班相比如何?
计算:
- 能耗:训练能耗 为 1,287 MWh = 1,287,000 kWh。
- 碳强度(美国平均):\(\approx\) 0.429 kg/kWh。
- 总排放:训练排放 为 1,287,000 kWh \(\times\) 0.429 kg/kWh \(\approx\) 552,123 kg。
- 比较:
- 一名乘客,纽约至伦敦(往返):\(\approx\) 1000 kg。
- 比值:552,123 kg / 1000 kg = 552.1。
系统洞见:单次训练运行的碳排放量相当于数百次跨大西洋乘客往返航班。优化至关重要。在这一运营电力边界下,将任务转移到以水电为主的电网(0.020 kg/kWh)可将排放减少 21.4×,降至约 25.7 次乘客往返航班。该比较并未使水电的全生命周期碳归零,也未消除当地的用水和生态影响。
该算式展示了单次运行的碳成本;在大规模集群层面,下一个约束是究竟能否向集群交付足够的电力。
Lighthouse 1.1: 原型 A(GPT-4/Llama-3):能耗墙
原型 A(GPT-4 级训练)最尖锐地暴露了电力问题。单个由 25,000 个 GPU 组成的集群,每个芯片需要 700 W 的功率,在服务器、网络和冷却开销之前,就需要 17.5 MW 的加速器功率。这一约束是物理性的,而非财务性的:它属于电网容量问题。运行原型 A 类工作负载的组织可能需要专用电力基础设施,或位于富余可再生能源的地区;这使得碳感知调度(将非紧急工作推迟到更清洁的电网时段)与地理优化(将工作负载部署在电力、冷却和碳约束与任务需求相匹配的位置)成为与学习率调优同属一个层级的关键集群决策。
仅加速器这一项的功率需求,在服务器、网络和冷却开销之前,就已经与重工业争夺电网容量,这使得工作负载的部署地点与运行时机成为主导杠杆,也是下文计算的讨论主题。
两区域之间的比较可以通过手工计算处理,但真实的集群需要同时权衡多个区域随时间变化的碳强度与区域电价,其设计空间之大,无法通过目测判断。到了这个阶段,选址决策便成为一个优化问题,由求解器完成搜索。
Example 1.1: 自动化的碳感知选址
场景:一个团队正在规划一次需要 10,000 MWh 能量的大规模训练运行,并在三个候选数据中心区域之间进行选择,这些区域的电价和碳强度各不相同。
诊断:仅依据原始电价进行评估,会偏向使用廉价化石电力的区域。若内部设定碳税为 $100/tonne,则 PlacementOptimizer 将电网碳强度与区域电价综合起来,选出 Quebec,总成本为 $0.66M。
系统启示:碳感知选址将环境外部性内化为集群调度目标。优化器证明,当碳惩罚被纳入机器学习工作负载的选址时,高可再生能源电网能够最小化真实的总拥有成本(TCO)。
调度优化器将碳强度视为随时间变化的输入,将工作负载转移到同一区域内的低碳时段。地理选址则将同样的逻辑扩展到空间维度:由于各国电网的碳强度相差约一个数量级,选择在哪里运行任务可能远远超过选择何时运行任务所带来的收益。notebook 1.2 中的计算通过保持能耗需求不变、仅改变电网来隔离这一地理因素。
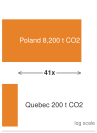
同一任务产生的碳排放在很大程度上取决于其运行地点。
Napkin Math 1.2: 碳的地理分布
问题:一个团队正在为一次 10,000 MWh 的训练运行选择数据中心。
- 站点 A(魁北克):水电,20 g/kWh \(\text{CO}_2\)。
- 站点 B(波兰):以煤电为主,820 g/kWh \(\text{CO}_2\)。 选址如何影响模型的碳足迹?
数学: 碳 = 能量 \(\times\) 电网碳强度。
- 站点 A 的排放量:10,000,000 kWh \(\times\) 20 g/kWh = 200,000,000 g = 200 t \(\text{CO}_2\)。
- 站点 B 的排放量:10,000,000 kWh \(\times\) 820 g/kWh = 8,200,000,000 g = 8200 t \(\text{CO}_2\)。
- 比值:8200 t / 200 t = 41× 倍的差异。
系统启示:站点选择主导了模型中的各项杠杆。魁北克与波兰这一组对比产生了 41× 倍的差异,其幅度超过许多常见的算法效率提升。效率的提升不仅体现在 FLOPs 上,还体现在这些 FLOPs 的碳强度上,从而使碳感知调度成为机器学习集群中一项首要的运营能力。
魁北克与波兰这一组对比,是贯穿全章地理杠杆的规范锚点。全球电网的碳强度跨度约为十倍到八十倍,而代表性区域组合落在八到四十倍的区间内,具体数值取决于比较的是哪两个电网,以及是否纳入时间维度的变化。后文引用的数字均位于这一区间内;每一处都会说明推动该数值变化的假设。
上文 GPT-3 家庭年度计算锚定了工作负载的规模。集群层面的影响则更大:IEA 预测,到 2030 年全球数据中心的用电量将达到约 945 TWh,占全球电力需求的不到 3%,其中由 AI 加速服务器驱动了大部分增长。2 计算需求从 2012 年到 2019 年增加了 350,000\(\times\) 倍 (Schwartz 等 2020年),而硬件效率的提升速度远慢得多,由此形成了不可持续的增长轨迹。
2 数据中心工业级规模:IEA 2025 年《能源与 AI》分析预测,到 2030 年数据中心将消耗约 945 TWh 电力,占全球电力需求的不到 3%。这是一个电力需求指标,与航空或水泥占全球排放的比例并不直接可比,但它仍然意味着 AI 基础设施正在与重工业争夺电网容量:无法扩展发电能力的地区,无论需求如何,都无法扩展 AI 部署。
3 GPU 制造的隐含碳:NVIDIA HGX H100 的产品碳足迹报告显示,一块八卡 H100 基板为 1,312 kg CO2e,若按八张 GPU 均摊,则每张 H100 约为 164 kg CO2e (NVIDIA Corporation 2025年)。先进制程制造同样需要大量超纯水、特种气体、化学品以及高温工艺步骤。这种隐含成本意味着,在清洁电网区域(水电、核电),制造环节的排放可能与运行期碳排放在量级上相当甚至超过,因此硬件寿命与循环经济式复用成为关键的可持续性杠杆。
除了直接的能源消耗,AI 系统还通过硬件制造和资源消耗推动环境影响。训练与推理工作负载依赖专用处理器,而稀有金属的开采与加工会产生污染。3 AI 应用需求的持续增长加速了电子废弃物的产生,全球电子废弃物已达到每年 5,400 万吨 (Forti 等 2020年)。由于性能要求不断加速,AI 硬件迅速过时。
这些环境挑战属于能源上限的一部分,而非其附加项:承载土地、水资源、电网容量和废弃物流的社区,同样分担着系统成本。这些规模计算将可持续性转化为分配问题。AI 的进步在一个部分创造收益,却将电力、水、土地和处置成本分配给另一个部分,因此环境责任必须被视为系统设计的一部分,而非部署后的报告工作。
环境正义与负责任发展
因此,选址本质上是一项环境正义决策,而不仅仅是一项设施决策。环境可持续性将机器学习系统的责任从模型行为扩展到生态 stewardship (Vinuesa 等 2020年)。AI 开发所需的计算资源将环境成本集中于特定社区,同时在全球人口中不均衡地分配收益。数据中心既带来电网需求,也带来冷却水需求,而当地负担取决于能源结构、流域以及区域间的竞争性用途。
Vinuesa, Ricardo, Hossein Azizpour, Iolanda Leite, Madeline Balaam, Virginia Dignum, Sami Domisch, Anna Felländer, Simone Daniela Langhans, Max Tegmark, 和 Francesco Fuso Nerini. 2020年. 《The Role of Artificial Intelligence in Achieving the Sustainable Development Goals》. Nature Communications 11 (1): 233. https://doi.org/10.1038/s41467-019-14108-y.
4 数据中心选址中的环境正义:数据中心倾向于选址于低成本土地和廉价电力,这往往意味着经济欠发达地区。其结果是外部性不对称:承载 AI 基础设施的社区承受水资源枯竭、热岛效应和电网压力,而经济收益则集中于遥远的科技中心。对机器学习系统工程师而言,这构成了一项设计约束:选址必须同时考虑社会许可与电网碳强度,因为社区反对可能阻碍或推迟设施扩建。
这种地理集中所形成的环境正义风险,与更广泛的负责任 AI 框架相契合。4 此处的公平性主张是有限且针对系统层面的:机器学习集群会在不同社区之间分配收益、电力需求、水资源使用、土地压力与电子废弃物。承载 AI 基础设施的社区可能承受与其获得 AI 经济收益不成比例的过重环境负担,因此选址成为工程设计空间的一部分,而非设施规划中的附带考虑。
指数增长与物理约束
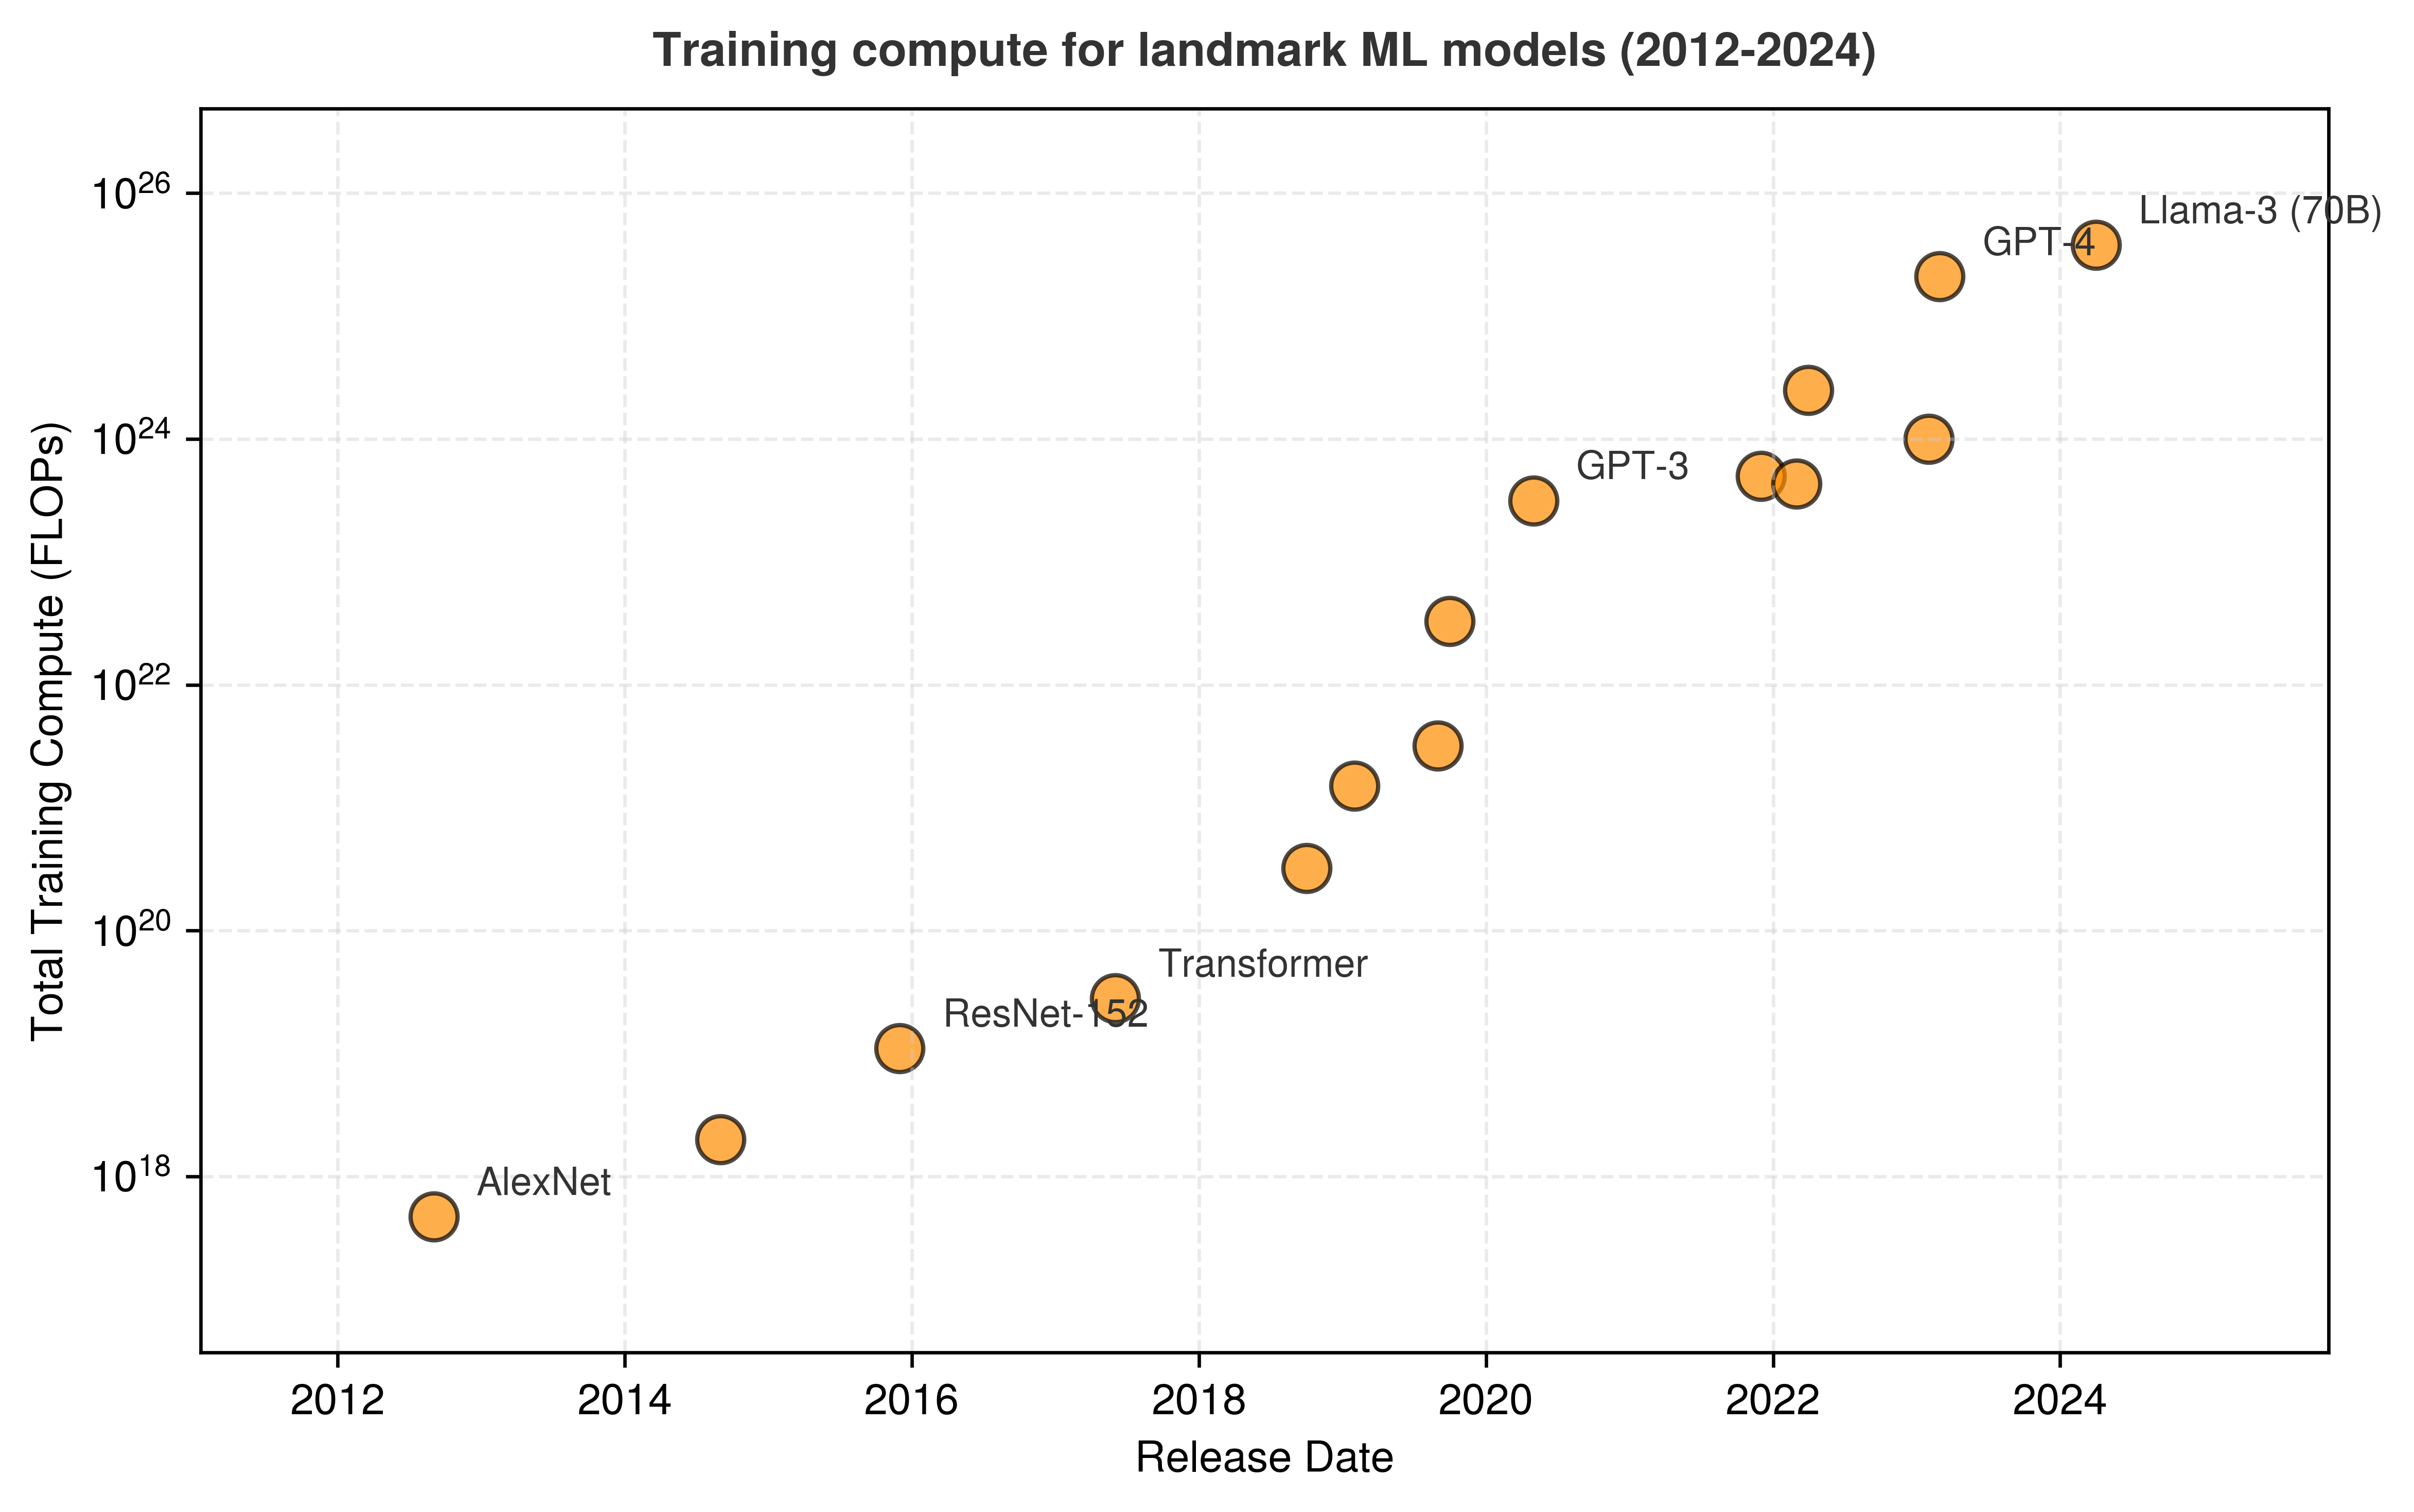
计算需求的快速增长,对 AI 训练与部署的长期可持续性构成了挑战。在本研究中考察的 2012–2019 窗口内,报告的 AI 训练算力增长了 350,000×。5 (Schwartz 等 2020年) 此后的许多大模型训练范式依然倾向于更大的模型、更大的训练数据集,或更高的计算预算。当硬件效率的提升无法跟上工作负载需求时,维持这一增长轨迹就会带来可持续性挑战。单位操作的效率有所提升,但总需求提升得更快。图 1 使这一不匹配变得可见,也正是它解释了为何每 FLOP 的效率提升并不会转化为单次运行更低的能耗账单。
5 AI 计算增长速率: 从 2012 年到 2019 年的350,000× 增长,意味着其倍增周期约为4.6 months,比摩尔定律的 2 年倍增快约5.3×。这一背离是能源墙的主要驱动因素之一:硅器件效率的任何物理可实现改进都无法匹配仅凭工艺缩放就以月为单位测得的倍增节奏,因此算法效率与碳感知调度成为规模化后的核心可持续性杠杆。
Schwartz, Roy, Jesse Dodge, Noah A. Smith, 和 Oren Etzioni. 2020年. 《Green AI》. Communications of the ACM 63 (12): 54~63. https://doi.org/10.1145/3381831.
历史上,计算效率随着半导体技术的进步而提升。摩尔定律预测,芯片上的晶体管数量大约每两年翻一番,从而带来处理能力和能效的持续改进。6 然而,先进工艺节点面临核心物理极限,进一步缩小晶体管变得困难且成本高昂。曾保证更小晶体管以更低功耗运行的 Dennard 缩放也已终结,导致每晶体管能效改进陷入停滞。7
6 摩尔定律: 戈登·摩尔 1965 年提出的观察指出,晶体管密度每两年翻一番,这推动了半导体行业数十年的“免费”效率收益。在个位数纳米工艺节点,物理极限使得进一步收益更加困难:单个原子本身成为约束条件。就 AI 可持续性而言,工艺缩放的放缓意味着额外的效率收益必须来自架构专用化和算法优化,而不能仅靠工艺缩小。
7 Dennard 缩放: Robert Dennard 在 1974 年观察到,通过按比例降低电压,较小的晶体管可以以恒定功率密度运行。这种缩放模式在 2005 年前后终结,因为漏电流使得进一步降低电压变得不切实际。其对 AI 可持续性的影响是直接的:在 Dennard 缩放消失后,每个工艺节点不再带来成比例的功耗节省,这促使效率工作转向专用加速器——GPU 和张量处理单元(TPU)——这些加速器利用架构并行性,而非仅仅依赖晶体管物理。
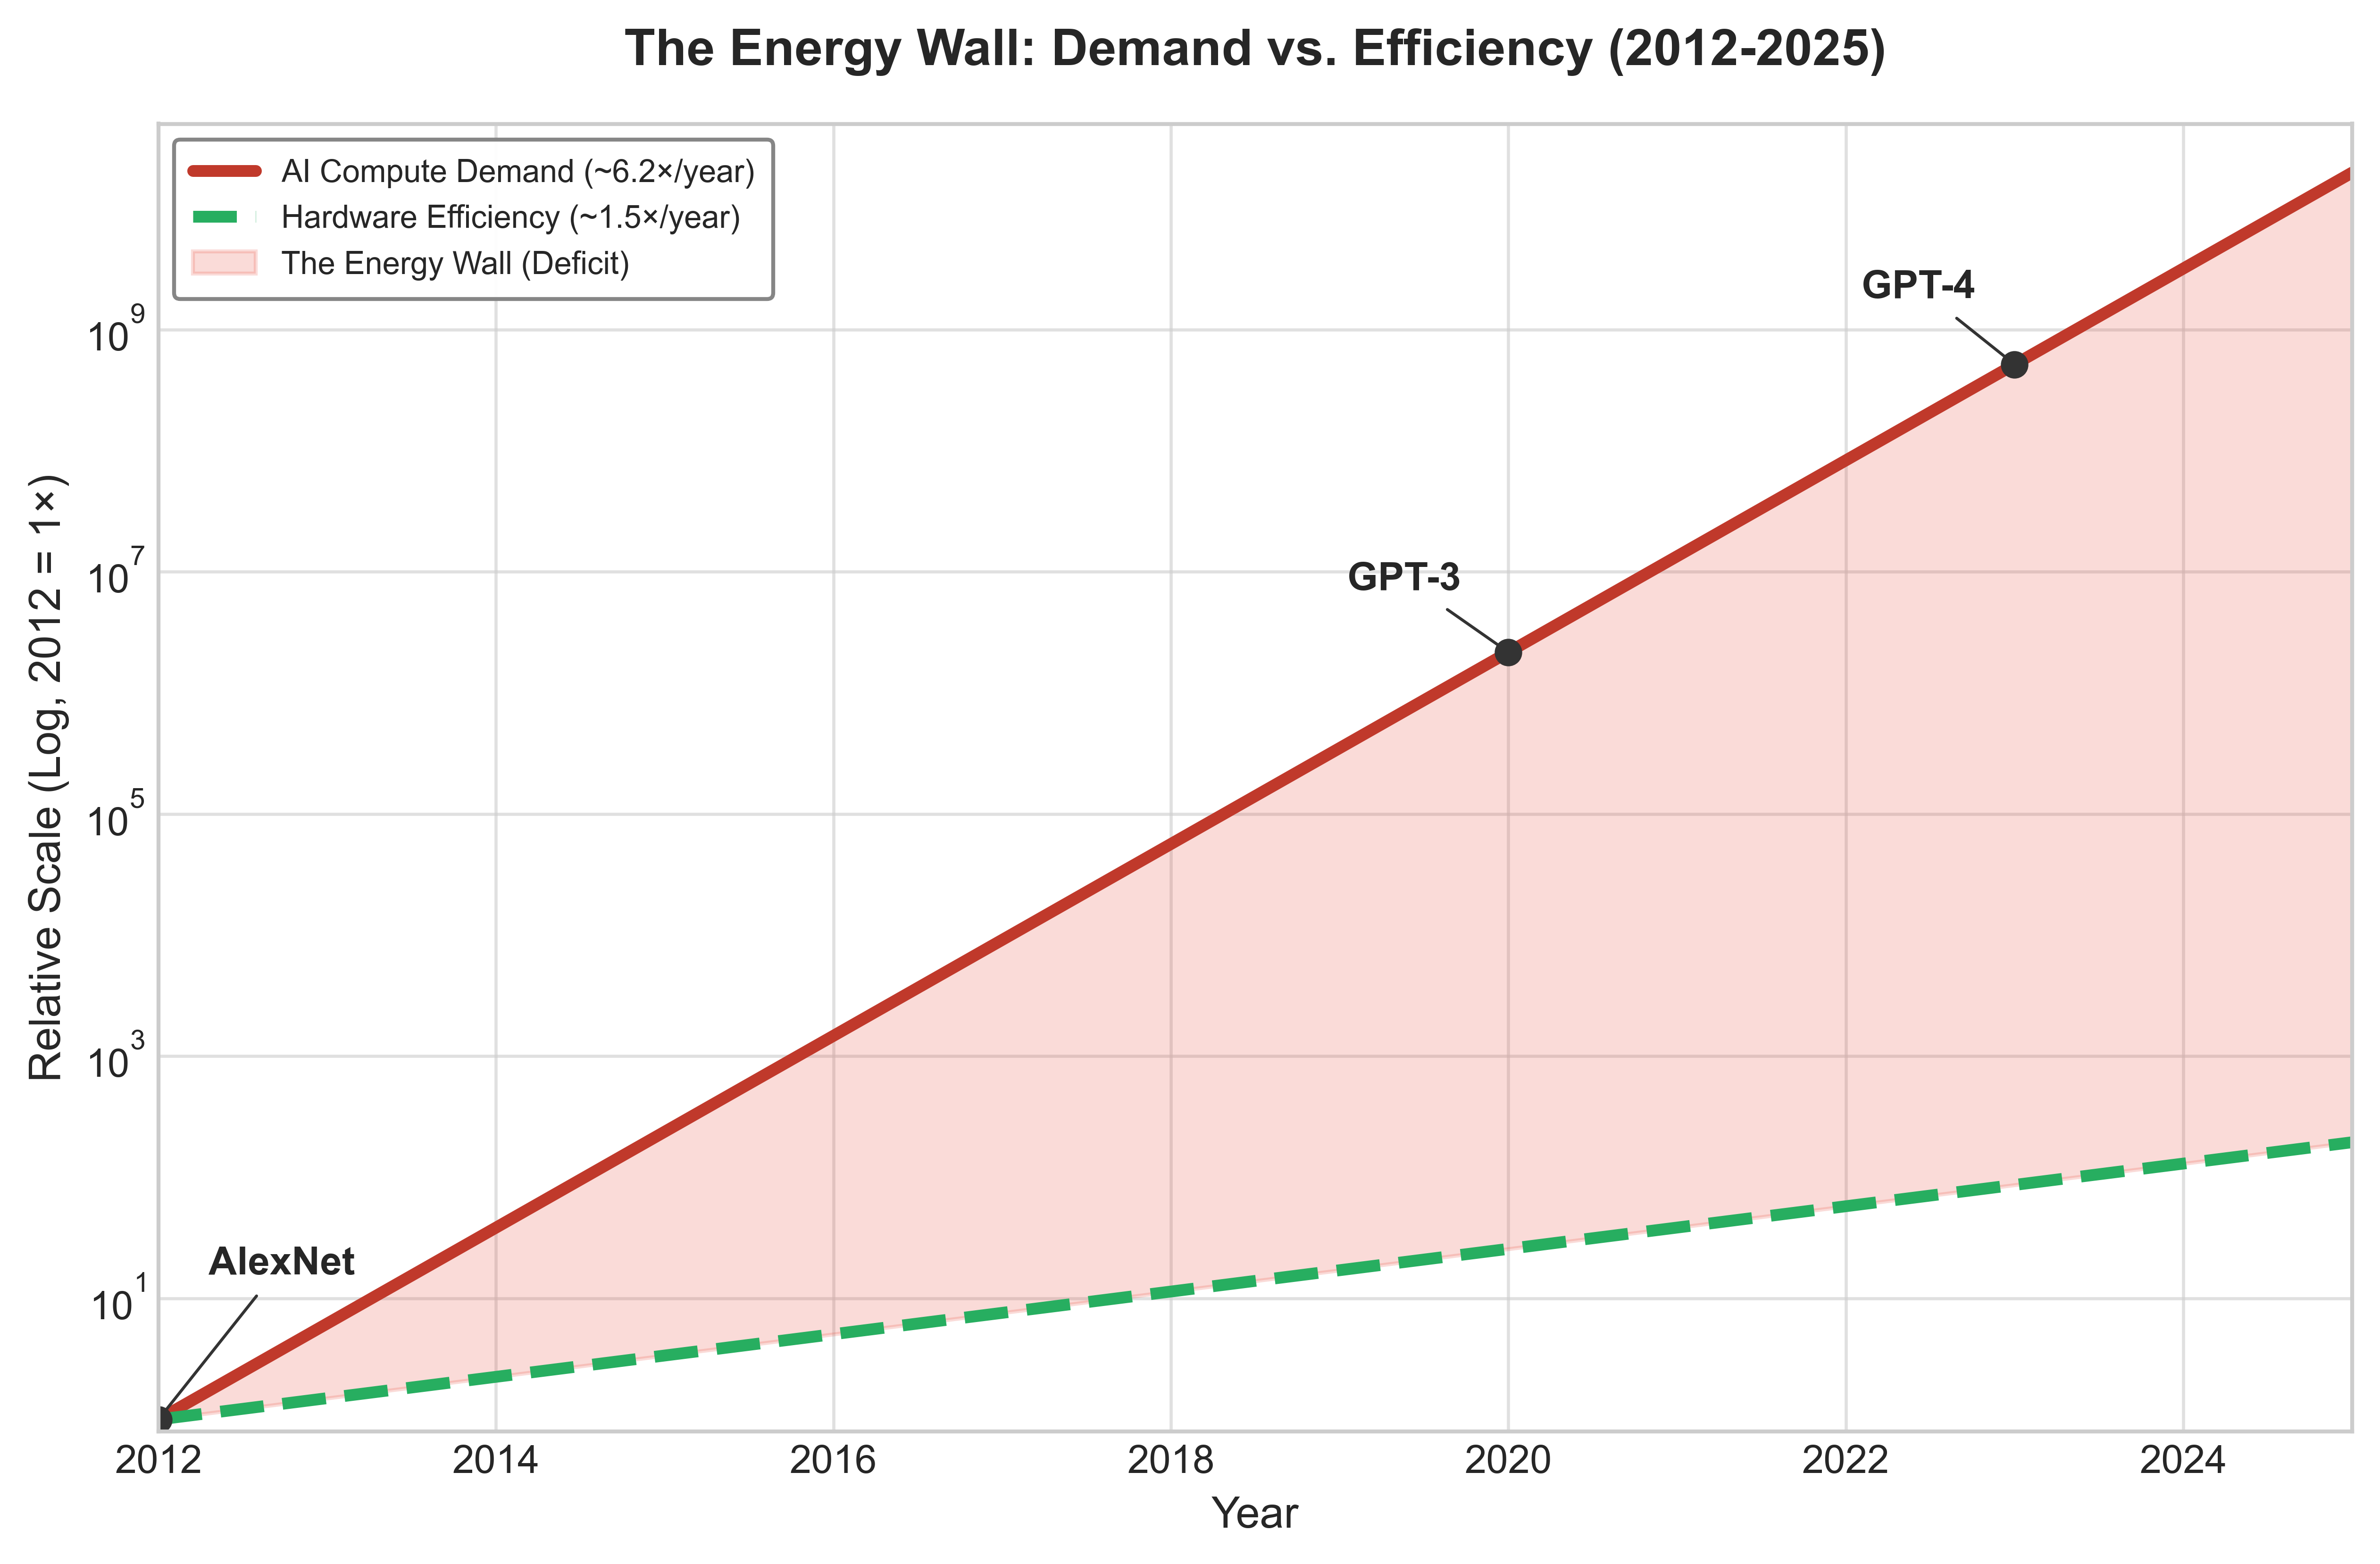
当 AI 模型的扩展速度快于运行它们的硬件的改进速度时,能源预算便出现缺口,必须由算法效率来弥补。计算需求与硬件效率之间的背离(图 2)为 2012–2019 计算增长窗口带来了不可持续的轨迹。这一技术现实使得整个系统栈的协同行动至关重要,从单个算法选择一直延伸到基础设施设计与政策框架。
为将不确定性直观呈现出来,图 3 展示了数据中心用电量 的高增长敏感性情景,而非此前的 IEA 基准预测。最佳、预期和最坏情况之间的差异,体现了结果对效率改进与需求增长假设的依赖程度。
能源墙:发散式缩放
图 2 将能源墙界定为计算需求与硅器件效率之间的背离,但硅器件效率只是其中一道上限。即使每台加速器都达到其理论极限,仍会存在第二道上限:电池能量密度与电网效率所构成的物理能源基础设施,其扩展速度远慢于计算需求。AI 可持续性呈现出一项独特的工程挑战,因为它是一场两种根本不同物理规律之间的竞赛:逻辑器件的指数级扩展与能源基础设施的线性级扩展。
AI 计算量在 2012–2019 期间增长了约 350,000\(\times\) 倍(图 4),而电池能量密度与电网效率每年仅提升约 2% 至 5%。
人工智能的逻辑遵循软件优化的“铁律”,而能耗则遵循化学与热力学定律。在同样的七年区间内,电池能量密度仅能以每年 5% 的速率提升约 40.7 percent,电网效率仅能以每年 2% 的速率提升约 14.9 percent。这两条曲线之间的 248,738.5× 差距即“能耗墙”,也就是无法再依靠增加算力来“绕开”效率问题的那个临界点。
数据中心电网动态
可持续人工智能要求我们超越服务器机柜的视角,转而关注电网接口。传统数据中心属于“稳态”负载,全天候 24/7 持续取用恒定功率;然而,机器学习训练集群属于瞬态负载。
War Story 1.1: 当电网成为瓶颈(2022 年)
背景:2022 年 7 月,爱尔兰政府发布《数据中心的角色在爱尔兰企业战略中的作用》政府声明,正式确立该国对这一领域的立场——到那时,该领域已消耗爱尔兰总计量电量的约 18%,且几乎全部集中在都柏林都会区 International Energy Agency (2024年)。
机制:数据中心并网申请的速度超过了输电网络的扩建速度,将当地都柏林电网推至其物理热容量与电压容量的极限,而强化工程的时间表则延伸至下一个十年。
影响:EirGrid 对都柏林地区的新增数据中心电网连接实施暂停,直至 2028 年,从而阻断了新的 AI 计算集群部署。
对策:数据中心运营商建立了现场可再生能源储能、电池负载平滑,并将地理布局分散至可再生能源富余的区域。
系统层面的启示:可持续人工智能受到并网、地理条件和电力系统充裕度的约束。高效的加速器固然有帮助,但集群的扩展速度无法快于为其供电的电网,约束性瓶颈由此从芯片转移到变电站。
International Energy Agency. 2024年. Data Centre Electricity Demand Estimates as a Share of Total Electricity Demand in Ireland and Virginia, 2023. IEA chart.
同样的电网接口约束在毫秒尺度上同样显现,而供电硬件正是其背后的机制。一个 10,000-GPU 集群可以在一次 AllReduce 同步步骤期间将负载在 5–10 兆瓦之间波动。对于电力公用事业而言,这属于噪声事件:当数千个 GPU 突然停止计算以等待网络时,会在电网上造成电压尖峰;而当它们恢复计算时,则会造成电压跌落。管理这些瞬态过程需要能量缓冲:利用现场电池阵列或大容量电容来平滑训练迭代,确保机器学习集群不会 destabilize 当地市政电网。
热是配对的设施约束,因为数据中心在物理上将高质量能量(电能)转化为低质量能量(废热)。可持续集群将这部分热量视为可回收的副产品,而非污染物。例如,北欧地区的现代设施利用区域供热 将废热输送至市政供暖系统,而工业耦合 则可将约 45°C 的低品位废热导向温室气候控制或海水淡化。这些数据中心废热回收模式抵消了周边的热需求,而不是将全部热量排放到大气中[^fn-pue-efficiency-evolution] (Ebrahimi 等 2014年)。
The Green Grid. 2007年. Green Grid Data Center Power Efficiency Metrics: PUE and DCIE. The Green Grid.
[^fn-pue-efficiency-evolution]:PUE(电能利用效率):PUE 将设施总用电量与供给 IT 设备的电量进行比较 (The Green Grid 2007年)。降低非 IT 部分的开销可提升设施效率,但该指标并未捕捉电力的碳强度,也未涵盖冷却所消耗的水量。因此,碳使用效率与水量使用效率揭示了仅凭 PUE 无法显现的约束。
训练规模下的能量集中
电网、选址与废热复用等约束之所以变得严峻,是因为大规模训练战役将能量需求集中到长时程、同步进行的运行中。GPT-3 锚点确立了总量规模;新的系统层面的问题则在于其时间上的集中程度,以及分布式训练通信所带来的额外能耗[^fn-comm-energy-overhead]。
[^fn-comm-energy-overhead]:训练通信开销:分布式训练会在能耗账目中增加网络传输、同步停顿以及检查点 I/O。该比例取决于工作负载与拓扑结构:并行策略、张量规模、链路技术、利用率损失以及任何额外迭代,共同决定通信究竟属于次要项还是成为约束性的能量成本。因此,测量契约必须针对实际运行来计量或建模这些项,而不能套用统一的百分比。
这种集中性使得效率提升成为一项工程层面的必然要求。随着后续各代大模型在参数数量、令牌预算或两者方面持续增长,大型生成式模型会加剧这一问题。
在 Kaplan 等 (2020年) 所研究的范围内,模型规模定律 表明,增大模型规模、数据集规模以及训练所用算力,均能使性能平滑提升。图 5 则表明,随着这三个因素中的每一个增加,测试损失都会在这些所研究的范围内可预期地下降。训练之外,大规模部署系统(如大规模推荐系统与生成式服务)需要持续进行规模化推理,在训练完成后仍会持续消耗能量。因此,累积的能耗负担既取决于一次性训练运行,也取决于部署后持续的查询量。
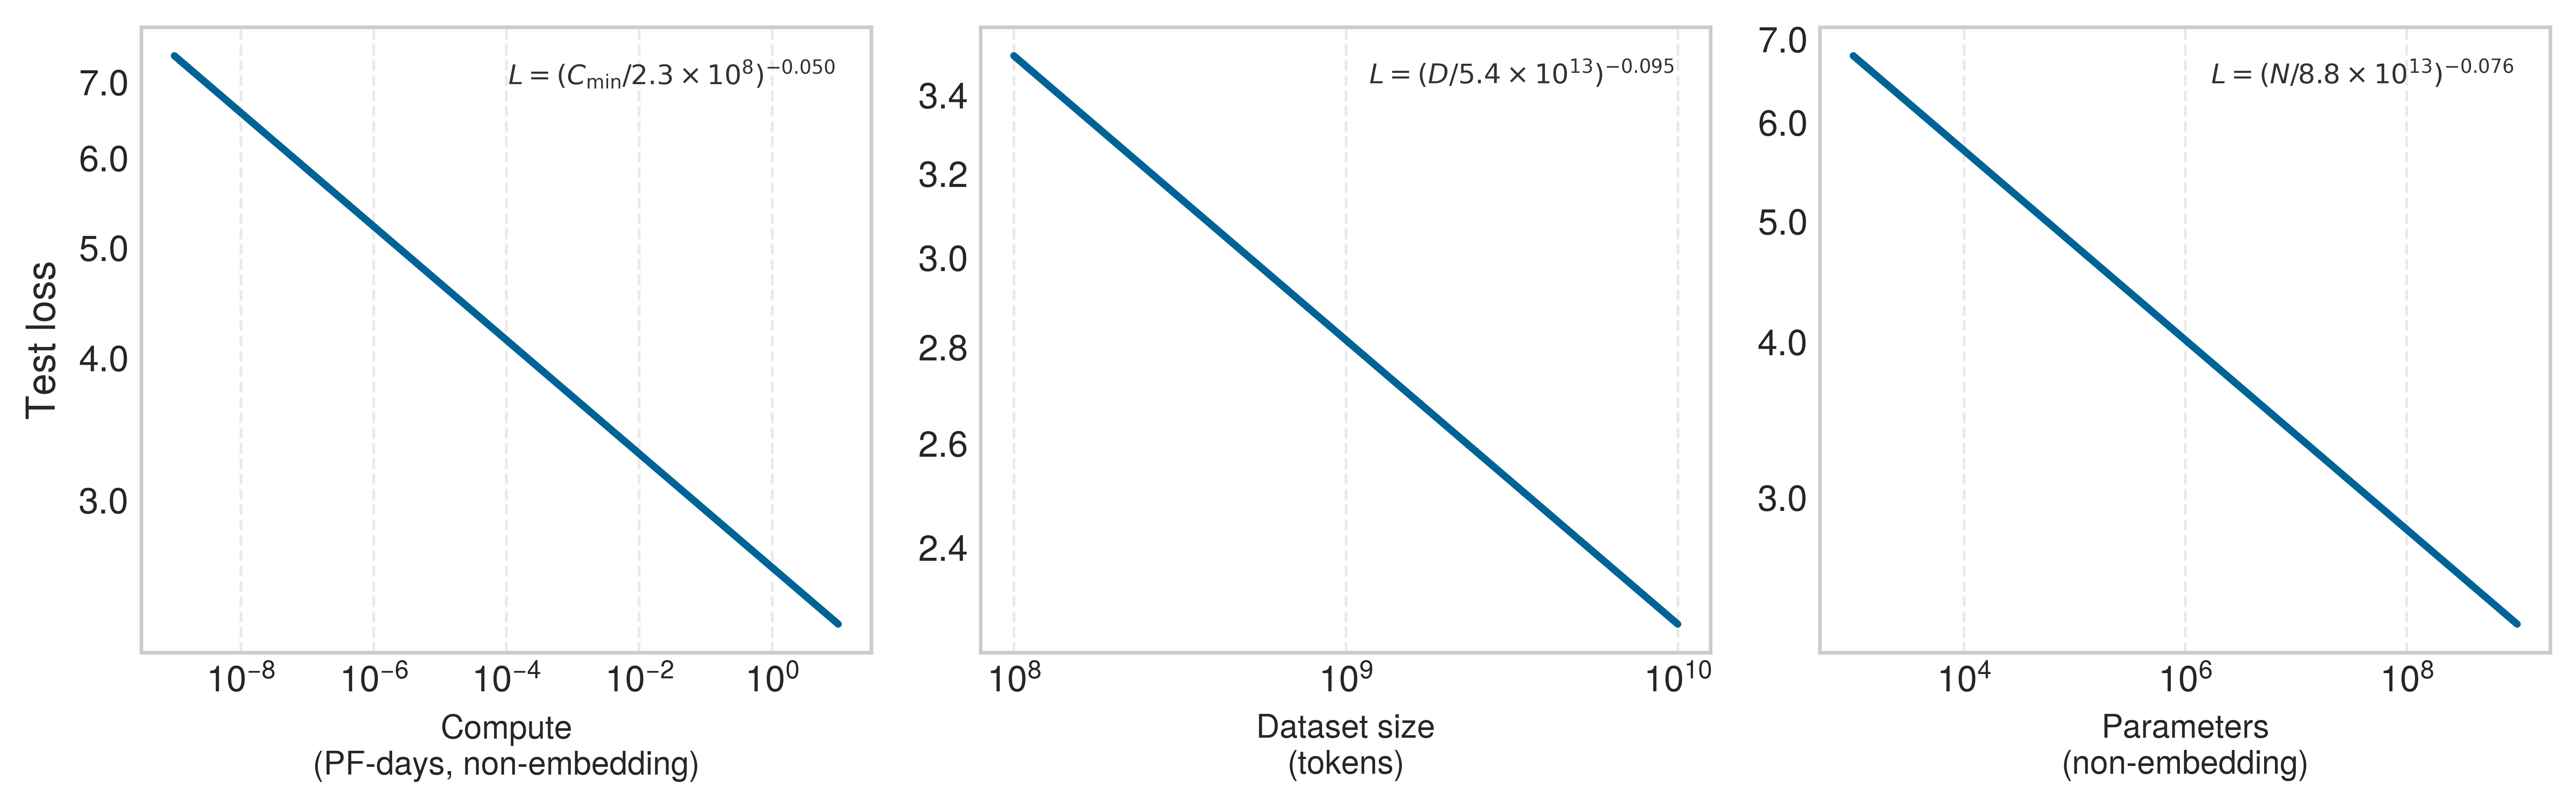
Kaplan, J., S. McCandlish, T. Henighan, T. B. Brown, B. Chess, R. Child, S. Gray, A. Radford, J. Wu, 和 D. Amodei. 2020年. 《Scaling Laws for Neural Language Models》. ArXiv preprint abs/2001.08361.
硬件选型是能量物理首次转化为架构决策的地方。不同类型的处理器通过其能耗特性影响环境足迹。以 pJ/FLOP 作为共同比较基准,中央处理器(CPU)的能耗约为 100 pJ/FLOP,图形处理器(GPU)在稠密张量运算下约为 10 pJ/FLOP,专用张量处理器(TPU)约为 1–2 pJ/FLOP,而固定功能低精度加速器则接近 0.1 pJ/operation[^fn-pjmac-energy-hierarchy]。这些硬件平台依赖稀土金属,并涉及复杂的制造工艺,因而带有隐含碳。
[^fn-pjmac-energy-hierarchy]:pJ/FLOP 与 pJ/multiply-accumulate(MAC):能效规格常常混合浮点运算与乘加运算(1 MAC = 2 FLOPs),因而需要在单位约定与精度层级之间进行换算。此处采用的简化层级与本章后续比较保持一致:CPU 约 100 pJ/FLOP,GPU 在稠密张量运算下约 10 pJ/FLOP,TPU 约 1–2 pJ/FLOP,定制低精度专用集成电路(ASIC)接近 0.1 pJ/op(详见 系统假设,其中给出从 FP64 到 INT4 数据格式、以及 7nm、5nm 与 3nm 硅工艺节点的每操作能耗缩放)。为特定工作负载选择合适的硬件层级,可在不改变任何算法的前提下将能耗降低 100–1,000\(\times\)。
AI 芯片的生产属于高能耗过程,涉及多个制造步骤,温室气体协议将其归类为 Scope 3 价值链排放,而非运营方直接用电。随着模型规模持续增长,对 AI 硬件的需求也随之上升,进一步加剧了半导体生产与废弃所带来的环境足迹。
理论效率极限作为可持续性模型
为理解 AI 所面临能量挑战的量级,可以将大型数字系统与计算效率的理论极限进行比较。大型语言模型(LLMs)与高效物理及生物模式识别系统相比,其能效差距约为 \(10^6\times\)。这一比较是近似性的,而非“FLOP 对突触”的等价换算:它表明稠密数字模型在持续运算与全局数据移动上耗费巨大能量,而稀疏物理系统往往仅在信号发生变化时才进行计算。这一差距正是能耗墙留给我们的余量。
该差距指向的是一种机制,而非另一轮模型规模的比较:稠密硅基器件在持续激活与全局数据移动上消耗能量,而稀疏的、事件驱动的计算则可以在信号未变化时避免执行相应工作。这推动了一种计算范式,即以能效感知架构优先于原始吞吐量。
高效计算的原则
高效计算所蕴含的可持续性启示,正在于稠密机器学习浪费能量的地方:持续激活、数据饥渴式学习,以及全局数据移动。以下三条原则将这些损耗通道明确呈现出来:
- 选择性、事件驱动的激活:高效系统并非持续处理全部信息,而是异步的。它们在任何时刻仅激活网络中的小部分,并且只在主动处理变化的信号时才消耗能量[^fn-eventdriven-energy-efficiency]。
- 本地学习与样本效率:稠密语言模型的规模扩展往往需要在万亿级 token 上进行训练,才能达到较为全面的胜任力。高效模型借助强归纳偏置与自监督的本地学习,从动机性生物比较中少 10,000\(\times\) 倍的数据即可获得相应能力,从而降低训练阶段的累计能耗。
- 稀疏性与稀疏互连:在高数据移动与全局同步的加速器工作负载中,能量往往被用于搬运操作数,而非执行算术运算。高效系统采用稀疏表示,对任何给定任务而言仅 1-2% 的参数处于激活状态,当稀疏性映射到硬件可见的工作移除时,可将带宽与开关能耗降低 50–100\(\times\)。
[^fn-eventdriven-energy-efficiency]:事件驱动计算:一种仅在输入发生变化时才触发计算、而非依赖连续时钟周期的范式。类脑芯片(如 Intel 的 Loihi)利用这一机制,在输入保持静止时近乎零功耗,从而为时序任务(音频、视频、传感器数据)实现 100–1,000\(\times\) 的能耗降低。相应的权衡是:事件驱动架构在全部数据同时变化的批量工作负载上会牺牲吞吐量。
生物模型为可持续人工智能指出了富有前景的研究方向。实现脉冲神经网络(SNNs)、通过离散脉冲进行通信的事件驱动模型,或稀疏激活模式,均可通过模仿稀疏通信模型实现显著的能耗降低[^fn-snn-neuromorphic-efficiency] (Prakash 等 2023年)。本地学习算法与自监督方法则提供了通往更具样本效率、更节能系统的其他路径。
[^fn-snn-neuromorphic-efficiency]:脉冲神经网络(SNNs):第三代神经网络,通过离散脉冲而非连续激活进行通信。SNN 仅在脉冲发生时处理信息,在时序数据(音频、视频、传感器流)上可实现 10–100\(\times\) 的能耗节省。可持续性方面的权衡是:对于许多已评测的工作负载,SNN 训练算法的成熟度仍不及反向传播,但 Intel Loihi 2 等硬件实现展示了这些架构所能逼近的效率上限。
实现可持续人工智能,需要系统性地转变系统设计,从持续活跃、稠密的架构转向事件驱动、稀疏的计算模型。随着算力需求的增长快于硅基制造的增量效率提升,要应对 AI 的环境影响,就必须基于这些效率原则重新思考算法的根本“物理”基础。
figure展示了六步能耗差距干预级联 如何将近乎 10,000\(\times\) 倍的能耗差距缩小,从而将不可处理的发散转化为工程挑战。六个分步因子相乘在账面上得到更大的数值,但头条的 10,000\(\times\) 是一个刻意保守的综合值:各干预措施之间并非干净地叠加,因为每一项干预都会侵蚀留给下一项的节省空间。没有任何单一杠杆足以奏效;弥合差距需要算法、硬件与系统层面同步推进。
指数级增长的算力需求与难以突破的物理效率极限相互叠加,形成了一条不可持续的发展路径,威胁到 AI 扩展的长期可行性。要改变这一路径,就必须超越粗略估算,为衡量和评估整个 ML 基础设施的能耗建立严谨、系统性的框架。
能耗测量与建模
工程师无法优化他们无法测量的东西。一个在大语言模型训练运行期间消耗五兆瓦的集群,只将其中一小部分功率用于矩阵乘法;其余部分被宿主机处理器、内存、网络、电源转换和冷却所消耗。有效的能耗建模,需要将数据中心那笔“一揽子”电费账单分解为细粒度、组件级的指标,供工程师针对性地优化。
来自 计算基础设施 的数据中心基础设施基础,确立了功耗与冷却作为主导性的工程约束。系统性的测量将这些约束转化为三个关键领域的可操作可持续性指标:训练与推理过程中的能耗追踪、系统全生命周期内的碳足迹分析,以及硬件与基础设施的资源使用评估。正如性能工程要求在优化之前先进行剖析一样,可持续 AI 工程要求在缓解之前先进行测量。
本章的决策流程始终如一:测量生命周期中的主导项,找出其背后的物理瓶颈,选择能够改变该主导项的干预措施,并检查回弹效应是否抹去了收益。运行电力、隐含碳、冷却开销、用水量和电子废弃物各自需要不同的杠杆。调度器无法解决制造环节的排放,硬件寿命也无法解决高碳密集的运行位置选择,因此可持续设计始于定位真正主导该工作负载的那一项。
可持续性主张只有在满足测量契约 时才具有可比性。该契约首先界定功能单位,例如一次完整完成的训练运行,或是在指定输出质量下的 1,000 次服务请求。随后,它固定系统边界,包括哪些计算、内存、网络、设施、制造和寿命末期项计入账目 International Organization for Standardization (2006年b)。记录还必须说明共享基础设施与隐含排放的归属规则;碳信号及其是平均值还是边际值;运行时间与地点;界定有用工作的质量、延迟与可靠性约束;以及不确定性区间和对关键假设的敏感性。若结果遗漏上述任何字段,它或许仍能诊断某个组件,但无法支撑端到端的比较。
Present, Elaina, Pieter Gagnon, Eric J. H. Wilson, Noel Merket, Philip R. White, 和 Scott Horowitz. 2024年. Choosing the Best Carbon Factor for the Job: Exploring Available Carbon Emissions Factors and the Impact of Factor Selection. NREL/CP-5500-86682. National Renewable Energy Laboratory.
该契约将两个原本容易被混淆的问题区分开来。归属式核算 将观测到的排放清单分配给工作负载以供报告,通常采用电网平均强度,并明确计入共有基础设施的份额。后果式核算 则估计某项决策如何改变排放,例如建模调度器移动一度电需求时所影响的发电机组。前者回答“现有碳足迹中有多大份额属于某项工作负载”;后者回答“改变工作负载是否会改变碳足迹”(Present 等 2024年)。因此,即使组织的事后清单采用归属式平均值,碳感知调度仍然需要采用适合后果式分析的信号。可用的边际因子可能是历史估计、预测,也可能在工作负载所需的时间与地点上不可得,所以契约必须记录其来源、分辨率与不确定性,而不能把“边际”当作普遍可观测的数据。
碳足迹分析
碳足迹分析将可持续性从一项普遍义务转化为设计约束。它将能耗、电网碳强度与生命周期资源需求,与已经支配性能和效率决策的同一组决策联系起来。因此,构建和部署 AI 系统的团队,在从更大的模型、低功耗硬件、更清洁的区域或推迟训练中进行选择之前,必须先具备工作负载级的核算模型。
核算模型之所以重要,是因为它使伦理权衡变得可审计。追求更大模型可能将准确性与能力置于能效之上,当算力增长快于效率提升时,碳排放随之增加。以可持续性为目标优化,可能引入额外的调优投入、硬件约束或随任务变化的准确性改变等工程权衡,因此工程任务在于将这些成本与环境收益明确对照。将环境考量融入 AI 系统设计,因而是一项工程义务,具体体现为能效感知训练技术、低功耗硬件设计以及低碳部署策略 Patterson 等 (2021年)。
可追溯性是连接可持续性测量与问责的技术桥梁。透明性、公平性与问责性构成可持续性约束 (图 7):透明性缺口会掩盖能耗与碳成本,公平性失败会导致危害分配不均,问责性薄弱则使资源消耗难以追溯。问责性意味着资源主张的可审计性。团队应当能够以足够充分的程度将模型版本、训练运行、服务工作负载、区域、能源来源与生命周期估计相互关联,从而使碳与用水主张能够被核查。
要使测量真正约束设计,所报告的指标必须暴露工作负载级的成本,而非停留在公司总量层面的聚合云规模主张——后者在报告口径上依然不透明。因此,实践标准是在整个 AI 生命周期中对资源使用承担问责;它需要与延迟、准确性和可靠性所采用的同一套证据链:主张应当能够连接到日志、电表、模型版本和部署决策,而不能仅依赖聚合性的可持续性承诺。碳足迹计算通过结合工作负载能耗、设施 PUE、电网碳强度与隐含碳,使这条证据链明确呈现出来。
Napkin Math 1.3: 生命周期碳估算
问题:计算训练一个 70B 参数模型所产生的总碳足迹。
变量:2,048 H100 GPU、30 days、700 W 热设计功耗(TDP)、机架配置支持功耗、PUE 1.12、电网强度 429 g \(\text{CO}_2\)/kWh。
算式:加速器功耗 = 2,048 \(\times\) 0.7 kW \(\approx\) 1433.6 kW。应用 DGX H100 机架配置中的宿主机、内存、网络与转换支持,将 IT 负载提升至 1971.2 kW;设施功耗 = 1971.2 kW \(\times\) 1.12 \(\approx\) 2,207.7 kW。能耗 = 2,207.7 kW \(\times\) 24 h/day \(\times\) 30 days \(\approx\) 1,589,575.7 kWh。排放 = \(\approx\) 681.9 t \(\text{CO}_2\)。
隐含碳:假设每台 H100 GPU 的制造碳足迹为 \(\approx\) 164 kg \(\text{CO}_2\),即 NVIDIA HGX H100 主板产品碳足迹在其八颗 GPU 之间均摊 (NVIDIA Corporation 2025年)。该示例核算采用基于时间的分摊:将作业所占 1 个月使用期对应的制造排放份额,计入其 3 年服务寿命。按照这一声明的规则,(2,048 \(\times\) 164 kg) / 36 \(\approx\) 9.3 t \(\text{CO}_2\)。
结果:681.9 t + 9.3 t \(\approx\) 691.3 t \(\text{CO}_2\)。
系统洞见:运行项主导了这一训练窗口,但隐含碳并非为零。生命周期核算防止团队将制造排放排除在训练预算之外。
时间是可辩护的分摊依据之一,而非普遍适用的唯一依据。共享集群可能改按加速器小时数、预留容量,或工作负载对有用计算的份额来分摊隐含排放。所选分母必须被报告并一致地应用;否则,利用率低的作业可能仅仅因为其他租户吸收了闲置容量而显得异常便宜。采购决策既需要未分摊的集群总量,也需要归属于工作负载的份额,因为摊提只是改变了账目中排放的归属,并不会使其从大气中消失。
因此,每项生命周期估算都应附带不确定性区间,而非仅给出一个权威总量。平均工作负载功耗、PUE、电网强度、硬件寿命、利用率与制造碳足迹,各自以不同的误差方式被测量或建模。敏感性分析会变动那些可能逆转决策的假设,包括清洁电网与高碳密集运行、三至五年服务寿命、以及低服务量与高服务量;随后报告首选设计是否仍然首选。算术上的精确无法弥补不稳定的系统边界。
将功耗转化为碳排放,只是第一个测量挑战。对完整硬件生命周期开展系统性的生命周期评估,才能揭示碳排放集中于何处,以及工程干预在何处获得最大回报。
三阶段生命周期评估框架
实际要回答的问题是:哪个生命周期阶段主导了某项工作负载,因为答案决定了优化杠杆。有效的碳足迹测量因此将环境影响的三个决定性阶段分开。
对于以训练为中心的研究工作负载,训练阶段往往主导运行排放,因为数学优化需要持续的并行计算[^fn-optimizer-memory-overhead]。随后,地理部署会改变运行结果,因为相同的工作负载可能遇到差异极大的电网强度[^fn-grid-carbon-variance]。
[^fn-optimizer-memory-overhead]:优化器内存作为能耗成本:自适应矩估计(Adam)为每个参数存储一阶与二阶矩估计,而普通的随机梯度下降(SGD)则不然。对于一个 70B 模型的 FP32 表示,这两个矩缓冲区合计 560 GB,参数与矩的总和达到 840 GB(不含梯度)。可持续性含义是直接而明确的:更大的优化器状态意味着每个训练步骤需要更多高带宽内存(HBM)访问;在 DRAM 的 160 pJ/byte 下,内存搬运可能主导参数更新的能耗预算。
[^fn-grid-carbon-variance]:电网强度差异:电网碳强度跨越两个数量级:燃煤为 820 g CO2/kWh,水电为 10–30 g CO2/kWh。关键的是,强度还存在时间维度上的差异:得州在一天之内会随风电出力波动 10\(\times\)。这种地理与时间上的双重差异,正是碳感知调度可行的原因:将地理杠杆(来自 节 1.0.1 的 8 至 40 倍区间)与时间平移相结合,可使可实现差异趋近于 10 至 80 倍区间的上限,因此完全相同的训练运行仅因执行时间与地点不同,其排放便可相差数倍。
对于高吞吐生产服务,推理阶段可能主导整个生命周期排放,因为训练运行完成后,模型服务会持续重复执行。虽然单次推理所需的计算量小于训练,但其累积影响会随着部署广度与使用频率而放大。为数百万用户提供服务时,持续产生的排放可能在较长的部署期内超过训练成本。
制造阶段贡献来自硬件生产的隐含碳,包括半导体制造、稀土开采与供应链物流8。在碳密集型电网下运行的高时长工作负载中,其份额较小;但在清洁电网或低利用率硬件条件下,它可以占到生命周期排放的 30–50%。这一阶段常被忽视,它代表与运行效率无关的不可消除基线排放。
8 隐含碳: 指设备完成首次 FLOP 计算之前,在制造、运输和处置过程中排放的 CO2。将 NVIDIA HGX H100 主板产品的碳足迹均匀分摊到其八张 GPU 上,每张 H100 约为 164 kg CO2e(NVIDIA Corporation 2025年);在美国平均电网条件下,连续运行约三到四周即可抵消隐含碳[700 W]。随着数据中心转向可再生能源,隐含碳在总生命周期排放中的占比上升,可能超过 30 个百分点,从而使硬件更新周期成为一项首要的可持续性决策。
NVIDIA Corporation. 2025年. Product Carbon Footprint Summary for NVIDIA HGX H100. NVIDIA Datasheet.
地理与时间维度的优化
碳强度因地理位置和时间段而异,由此产生优化机会。当对截止时间的容忍度较高时,将工作负载调度至低碳时段或低碳地区,可以降低排放,而实际收益取决于工作负载的灵活性、电网构成,以及调度器采用平均排放还是边际排放Radovanovic 等 (2021年)。具备碳感知能力的调度系统可以自动将非紧急训练任务转移到碳强度更低地区和时段。
Anthony, L. F. W., B. Kanding, 和 R. Selvan. 2020年. Carbontracker: Tracking and Predicting the Carbon Footprint of Training Deep Learning Models. ICML Workshop on Challenges in Deploying and monitoring Machine Learning Systems.
开发阶段的碳追踪 在影响部署与复杂度决策时尤为重要,而非仅仅在事后形成一份报告。CarbonTracker(Anthony 等 2020年) 与 CodeCarbon(Schmidt 等 2021年) 等工具会界定工作负载边界,依据硬件计数器或利用率模型估算能耗,附加当地电网强度,并将由此产生的排放与实验元数据一并记录。关键的系统模式并不在于 API 调用,而在于测量的时机:估算必须在模型规模、训练时长、地区和调度仍然可调时出现,即在该次运行已经消耗完其能耗之前。
功耗建模基础
要理解 AI 系统中能量的去向,必须立足于数字计算的物理基础。CMOS 功耗方程 为推理数字处理器能耗提供了基础,但真正有用的模型需要跨越三个层次:芯片功耗解释了电压、精度和活动度为何重要;优化技术展示了算法如何改变这些变量;设施级指标则揭示了芯片层面的节能能否在冷却与供电开销中得以保留。
CMOS 功耗方程
每个数字电路都通过两种基本机制消耗功率。动态功耗 源于晶体管在状态之间的切换,而静态功耗 则源于即使晶体管名义上处于关断状态也会流动的漏电流。公式 1 将总功耗形式化:
\[P_{\text{total}} = P_{\text{dynamic}} + P_{\text{static}} = \alpha_{\text{sw}} C V^2 f + V I_{\text{leak}} \tag{1}\]
动态功耗分量\(P_{\text{dynamic}} = \alpha_{\text{sw}} C V^2 f\) 取决于四个参数。开关活动因子 \(\alpha_{\text{sw}}\) 表示每个时钟周期内发生状态翻转的晶体管所占比例,取值范围从 0 到 1。通用 CPU 通常表现出 \(\alpha_{\text{sw}} \approx 0.1\) 到 \(0.3\) 的水平,这是因为指令混合较为多样;而经过优化的数据流使更多电路在计算过程中保持活跃,专用 AI 加速器可以达到 \(\alpha_{\text{sw}} \approx 0.6\) 到 \(0.8\)。负载电容\(C\) 随晶体管数量和互连线长度而增大。供电电压\(V\) 以平方关系进入方程,因此降低电压是提升能效影响最大的杠杆。时钟频率\(f\) 决定每秒可执行的操作数。
静态功耗分量\(P_{\text{static}} = V \cdot I_{\text{leak}}\) 代表随温度呈指数增长的漏电流,温度每升高 10 摄氏度,漏电流大约翻倍。这种热依赖关系形成了一个正反馈回路:更高的功耗产生更多热量,进而增加漏电流,又进一步产生更多热量。对这种热失控进行管理会限制可达到的功率密度,也解释了冷却基础设施为何在数据中心能耗中占据如此大的比例(Dayarathna 等 2016年)。
Dayarathna, Miyuru, Yonggang Wen, 和 Rui Fan. 2016年. 《Data Center Energy Consumption Modeling: A Survey》. IEEE Communications Surveys & Tutorials 18 (1): 732~94. https://doi.org/10.1109/comst.2015.2481183.
AI 系统的实际影响直接源于上述物理规律。电压的平方依赖关系意味着,将电压从 1 V 降至 0.8 V,动态功耗将下降 36 percent,这还尚未计入较低电压往往还能带来线性额度的额外节省。这一关系解释了为何工作在较低电压但较高利用率下的专用 AI 加速器,可以比通用处理器取得数量级上的能效提升。
优化技术为何能够节能
功耗方程揭示了特定优化技术能够提升能效的原因。量化(Quantization)会降低数值精度,从而缩小算术单元规模并减少经由存储层次移动的字节数。实际能耗变化取决于所实现的核、打包与转换开销、内存流量、利用率以及原始瓶颈所在环节(Gholami 等 2022年)。较低的精度本身并不能直接允许降低供电电压:电压与频率仍受物理实现、工艺和时序余量的约束。因此,量化会改变运算与数据移动项,但只有实测才能确定端到端的整体降幅。
剪枝(Pruning)会从神经网络中移除权重,通过消除原本会消耗切换能耗的计算路径,从而降低有效电容\(C\)。结构化剪枝会移除整个通道或注意力头,其能效提升大于非结构化剪枝,因为它消除的是完整的电路路径,而非硬件仍需调度的单个操作。
专用加速器通过针对矩阵乘法和卷积运算专门设计电路,来提高活动因子\(\alpha_{\text{sw}}\)。例如,CPU 在典型机器学习工作负载中可能仅激活 10% 的晶体管,而脉动阵列(systolic array)架构可以使其计算单元保持 70% 或更高比例的活跃,从而在每瓦功耗下完成更多有效工作。
设施级功耗指标
除芯片级功耗之外,数据中心基础设施还会带来额外的能耗开销。公式 2 通过电能利用效率(PUE)指标刻画了这一关系:
\[\text{PUE} = \frac{P_{\text{total facility}}}{P_{\text{IT equipment}}} \tag{2}\]
Definition 1.2: 电能利用效率(PUE)
电能利用效率(PUE) 是数据中心运营者用于比较设施总功耗与 IT 设备专用功耗的效率比[\((P_{\text{facility}} / P_{\text{IT}})\)]。
- 重要性:它衡量数据中心的 Infrastructure Overhead。PUE 为 1.0 是理论上的理想值;PUE 为 1.10 意味着每 100 瓦的计算功耗,还需要额外 10 瓦用于冷却与配电。
- 区别:与 Computing Efficiency(关注每瓦 FLOPs)不同,PUE 关注 Facility Efficiency:它捕捉了在能量真正到达处理器之前有多少能量被”浪费”。
- 常见误区:一种常见误解是,较低的 PUE 就意味着”绿色”数据中心。实际上,PUE 仅衡量 Efficiency,而非能源来源的 Carbon Intensity;燃煤供电的数据中心可能比太阳能供电的数据中心具有更好的 PUE,但其环境影响却大得多。
Napkin Math 1.4: PUE:冷却成本
问题:某团队运营着一个 2 MW 集群。如果设施能够将 PUE 从行业平均水平(1.58)优化到最先进水平(1.10),那么每年能够节省多少能量和资金?
数学推导: 节省的能量等于 IT 负载上的基础设施开销差异\((\text{PUE}-1)\)。
- 开销削减:1.58 - 1.10 = 0.48。
- 年度节能量:2 MW \(\times\) 0.48 \(\times\) 8760 h/year \(\approx\) 8,409.6 MWh。
- 财务节省:8,409.6 MWh \(\times\) $70/MWh \(\approx\) $588,672。由于该节省仅来自设施侧,模型保持不变,且与可削减的非 IT 开销成正比,因此冷却优化在效率较低的设施中最为关键。
PUE 为 1.0 表示完全理想的高效状态,即所有能量都用于计算;但这在物理上不可能,因为冷却、配电和照明都需要非零能量。行业平均水平的数据中心 PUE 为 1.5 到 2.0,意味着除计算之外还有 50% 到 100% 的额外能量用于基础设施(Uptime Institute 2022年)。领先的超大规模设施借助先进的冷却技术,将 PUE 控制在 1.1 到 1.2 之间,包括寒冷气候下的风冷、高密度 GPU 集群的液冷以及优化的配电。
Uptime Institute. 2022年. Uptime Institute Global Data Center Survey 2022. Uptime Institute.

PUE 是计算之外的基础设施能耗税。
公式 3 形式化了水耗效能(WUE),用于捕捉蒸发冷却及其他流程所需的水消耗:
\[\text{WUE} = \frac{W_{\text{annual\_water\_usage}}}{E_{\text{IT\_equipment}}} \tag{3}\]
单位为每千瓦时升水,典型取值随气候和冷却技术从 0.5 到 2.0 L/kWh 不等。一个 WUE 为 1.8 L/kWh 的数据中心训练一个需要 10,000 MWh 的模型,将消耗 1,800 万升水,相当于在每年 380,000–450,000 升的家庭用水基准下约 40–50 户家庭一年的用水。
设施级指标指出了工程干预能够取得最大回报的环节。节 1.1.2.4 中的案例研究展示了机器学习驱动的 PUE 优化如何直接转化为可量化的节能效果。
案例研究:DeepMind 能效
Google 的数据中心支撑着 Search、Gmail、YouTube 等服务,每天处理数十亿次查询(2023年)。这些设施需要大量电力,尤其是确保服务器性能最优的冷却基础设施。提升数据中心能效长期以来都是重要议题,但受冷却系统复杂性和高度动态的环境条件影响,传统工程方法逐渐面临收益递减(Buyya 等 2010年)。为应对这些挑战,Google 与 DeepMind 合作开发了一套机器学习优化系统,以规模化地自动化并增强能源管理。
Centers, Google Data. 2023年. Efficiency: How We Do It.
Buyya, Rajkumar, Anton Beloglazov, 和 Jemal Abawajy. 2010年. 《Energy-Efficient Management of Data Center Resources for Cloud Computing: A Vision, Architectural Elements, and Open Challenges》. arXiv preprint arXiv:1006.0308, 6~17. https://doi.org/10.48550/arXiv.1006.0308.
在超过十年的数据中心设计优化、高效硬件以及可再生能源整合工作之后,DeepMind 的 AI 方法将冷却系统作为数据中心中能耗最集中的环节之一作为目标。传统冷却依赖人工设定的启发式规则,需综合考虑服务器发热量、外部天气条件和架构约束。这些系统存在非线性相互作用,简单的基于规则的优化往往无法捕捉其运行的全部复杂性,结果是冷却效率次优,造成不必要的能源浪费。
DeepMind 团队使用 Google 的历史传感器数据训练了一个神经网络模型,这些数据包括实时温度读数、功耗水平、冷却泵运行状态以及其他运行参数。基于 Jim Gao 早期关于机器学习能够以 99.6% 精度预测数据中心 PUE 的工作(Gao 2014年),该模型学习了这些因素之间错综复杂的关系,并能够动态预测最高效的冷却配置。与依赖人工工程师定期调整系统设置的旧方法不同,AI 模型会随环境和工作负载条件的变化实时持续自适应。
Gao, J. 2014年. Machine Learning Applications for Data Center Optimization. Google; Google White Paper.
9 通过机器学习优化 PUE:Google 表现最好的设施 PUE 为 1.08,意味着冷却与配电的能耗开销仅为 8%。DeepMind 的强化学习控制器通过利用冷水机组、水泵与室外环境条件之间基于规则的系统所忽略的非线性相互作用,将冷却能耗降低了 40%。这是一个罕见的正反馈回路:AI 提升了驱动 AI 的基础设施效率。
Evans, Richard, 和 Jim Gao. 2016年. DeepMind AI Reduces Google Data Centre Cooling Bill by 40%. DeepMind Blog.
实验结果表明能效显著提升。在真实数据中心环境中部署后,DeepMind 的 AI 驱动冷却系统使冷却能耗降低 40%,整体 PUE 开销降低 15%9 Evans 和 Gao (2016年)。对于运行于行业平均 PUE 1.5 的设施(来自 公式 2),削减开销可以回收相当大比例的冷却损失能量。这些改进无需额外的硬件改动,展示了软件驱动优化在降低 AI 碳足迹方面的潜力。
DeepMind 的案例研究揭示了一个罕见的正反馈回路:机器学习优化驱动机器学习的基础设施。该框架可推广到不同的设施设计与气候条件,为全球数据中心网络提供了可扩展的方法。
碳强度与区域差异
电力消费的碳影响高度依赖于发电结构,碳强度以每千瓦时二氧化碳当量克数(g CO2eq/kWh)衡量。按能源来源的碳强度 按能源来源量化碳强度,展示了这些强度差异之大:
| 能源来源 | 碳强度(g CO2eq/kWh) | 区域示例 |
|---|---|---|
| 燃煤 | 820 到 1,200 | 波兰、西弗吉尼亚 |
| 天然气 | 350 到 500 | 德州联合循环电厂 |
| 太阳能光伏 | 20 到 50 | 加利福尼亚、亚利桑那 |
| 风能 | 7 到 15 | 丹麦、苏格兰 |
| 水电 | 10 到 30 | 魁北克、挪威 |
| 核电 | 5 到 20 | 法国、安大略 |
通过战略性地选择训练地点,地理优化可以将碳排放降低 10–50\(\times\),图 8 展示了代表性区域之间的差异。
系统性能指标
量化能效需要系统性的指标,以支持跨硬件架构与算法方法的比较。指标阶梯从每次操作的能耗,推进到每次字节的能耗,再到算术强度与数据移动之间的 roofline 关系。这一推进之所以重要,是因为一项降低 FLOPs 的优化,对于能量主要耗费在字节移动上的工作负载可能收效甚微。
每次操作的能耗
计算能效的基本指标是每次操作的能耗,通常以皮焦耳(picojoules)计量。对于 AI 工作负载,最相关的指标是每次浮点运算的能耗和每次乘加运算的能耗,其中一次 MAC 操作同时完成一次乘法与一次加法,相当于两次 FLOPs。
硬件架构决定能效,其跨度达近四个数量级,从通用 CPU 到专用模拟加速器。按架构的能效按架构量化能效 :
| 架构 | 能效(pJ/FLOP 或 pJ/MAC) | 特性 |
|---|---|---|
| 通用 CPU | 100 pJ/FLOP | 利用率低,灵活性强 |
| GPU(张量核心) | 10 pJ/FLOP | 高吞吐量,并行执行 |
| TPU(脉动阵列) | 1–2 pJ/FLOP | 专用矩阵运算,优化的数据流 |
| Google Edge TPU | 2–4 pJ/FLOP | 端侧推理,INT8 优化 |
| ARM Ethos-U55 | 0.5–2 pJ/MAC | 微控制器 NPU,亚瓦 TinyML |
| Maxim MAX78000 | 0.3–1 pJ/MAC | 带本地权重存储的 CNN 加速器 |
| ASIC(INT8) | 0.1 pJ/operation | 固定功能,低精度 |
| 模拟/存内计算 | 0.01–0.1 pJ/MAC | 新兴技术,在内存阵列中计算 |
四个数量级的差异既反映电路层面的效率,也反映影响利用率(utilization)的架构选择。CPU 执行多样的指令混合,算术单元的利用率平均较低。GPU 通过大规模并行性实现更高的利用率。TPU 与 ASIC 则通过针对特定操作类型优化的专用数据通路,最大化利用率。
精度通过实现特定的算术与数据移动影响每次操作的能耗。更窄的格式可以减少电路面积、开关电容和内存流量,但位宽本身并不决定墙侧(wall)能耗,也不带来普适的电压降低。按架构的能效 中的架构数值来自不同平台的代表性数据点,而非受控的 INT8 与 FP32 之间的规模定律;测量契约要求在固定质量下于同一平台进行比较。
每次字节的能耗
数据移动在算术强度较低的 AI 工作负载中往往主导能耗。存储层次中内存访问的能耗成本跨越五个数量级:
每次字节的移动能耗跨越五个数量级,从寄存器到网络。
存储层次的能耗成本揭示了关于存储层次能耗成本的关键洞见 :将数据从 DRAM 移动所需的能耗,比执行算术运算高出 10 到 100 倍。各行描绘了从寄存器经 L1 缓存 与 L2 缓存 到 DRAM、非易失性内存扩展(NVMe)以及网络传输的路径。对于以 10 pJ/FLOP 运行的 GPU,从 DRAM 读取一个 FP32 操作数(4 字节 × 160 pJ/字节 = 640 pJ)的代价,比计算本身高出 64 倍。这张表使能耗层次明确。
| 存储层级 | 能耗成本(pJ/字节) | 访问延迟 |
|---|---|---|
| 寄存器 | 0.1 pJ/byte | 1 个周期 |
| L1 缓存 | 1 pJ/byte | 3–5 个周期 |
| L2 缓存 | 5 pJ/byte | 10–20 个周期 |
| DRAM | 160 pJ/byte | 200–300 个周期 |
| NVMe SSD | 1000 pJ/byte | 50,000–100,000 个周期 |
| 网络 | > 10000 pJ/byte | 数百万个周期 |
由此产生的设计杠杆针对数据移动而非算术:
- 片上内存用于数据复用(NVIDIA 张量核心共享内存)
- 优化的数据布局以最小化 DRAM 访问(Google TPU 脉动阵列)
- 压缩以减少数据移动(稀疏张量表示)
这些杠杆共同使可持续性成为一个局部性与复用问题,而非单纯追求更快的算术。
算术强度与能耗 roofline
计算与数据移动之间的平衡决定了能耗是计算受限还是内存受限。 公式 4 定义算术强度,即决定哪种资源主导能耗的比值。在这些公式中, \(O\) 是 FLOPs 下的操作数, \(D_{\text{vol}}\) 是字节数据量, \(E_{\text{compute}}\) 是每次 FLOP 的能耗, \(E_{\text{move}}\) 是每次移动字节的能耗:
\[\text{AI} = \frac{O}{D_{\text{vol}}} \tag{4}\]
以 FLOP/字节 度量的算术强度决定主导能耗来源。 公式 5 将总能耗表示为计算与内存贡献之和,而 公式 6 则分离出 roofline 式的主导项:
\[E_{\text{total}} = O \times E_{\text{compute}} + D_{\text{vol}} \times E_{\text{move}} \tag{5}\]
\[E_{\text{dominant}} = \max\left(O \times E_{\text{compute}}, D_{\text{vol}} \times E_{\text{move}}\right) \tag{6}\]
最大项识别 roofline 推理中的主导瓶颈;在平衡情形下它并非总能耗。 公式 7 定义交叉点算术强度 ,即计算与内存能耗达到平衡之处:
\[\text{AI}_{\text{crossover}} = \frac{E_{\text{move}}}{E_{\text{compute}}} \tag{7}\]
对于具有 \(E_{\text{compute}}\) 的 10 pJ/FLOP 与 \(E_{\text{move}}\) 的 160 pJ/byte(DRAM 访问)的 GPU:
\[\text{AI}_{\text{crossover}} = \frac{160 \text{ pJ/byte}}{10 \text{ pJ/FLOP}} = 16 \text{ FLOP/byte}\]
能耗 roofline 模型(图 9)可视化算术强度与能效之间的关系,揭示不同类型工作负载如何受到不同瓶颈的约束。该能耗 roofline 将性能 roofline 转换到能耗轴上:**单个加速器的顶线** 推导原始上限,并进行脊点分析,以区分内存受限与计算受限的形态,这与此处划分内存主导与计算主导能耗的交叉点相同。
本框架直接适用于深度学习中最常见的运算:矩阵乘法。
Napkin Math 1.5: MatMul 能量分析
问题:矩阵维度 \(N_{\text{mat}}\) 如何决定算术能量 \(E_{\text{compute}}\) 还是存储器能量 \(E_{\text{move}}\) 主导矩阵乘法 \(\mathbf{C} = \mathbf{A} \times \mathbf{B}\)?
表 2: 能量瓶颈比较:同一能量模型依据主导能量项,将小稠密工作、大稠密工作和逐元素工作分别归类。
数学:
- 运算与字节数:\(2N_{\text{mat}}^3\) FLOPs 和 \(12N_{\text{mat}}^2\) 字节(FP32 精度)。
- 算术强度:\(\text{AI} = \frac{N_{\text{mat}}}{6}\) FLOP/字节。
- 形态比较:表 2 在小矩阵、大矩阵和向量工作负载之间比较能量项。
| 工作负载 | 算术强度 | 计算能量 | 存储器能量 | 优化优先级 |
|---|---|---|---|---|
| 小矩阵 (\(N_{\text{mat}}=\) 96) | \(\text{AI} = 96/6 = 16\) FLOP/字节 | \(2 \times 96^3 \times 10 \text{ pJ} = 17.69\,\mu\text{J} = 0.0177\text{ mJ}\) | \(3 \times 96^2 \times 4 \times 160 \text{ pJ} = 17.69\,\mu\text{J} = 0.0177\text{ mJ}\) | 在交叉点处达到平衡 |
| 大矩阵 (\(N_{\text{mat}} = 1000\)) | \(\text{AI} = 1000/6 = 167\) FLOP/字节 | \(2 \times 10^9 \times 10 \text{ pJ} = 20\text{ mJ}\) | \(3 \times 10^6 \times 4 \times 160 \text{ pJ} = 1.92\text{ mJ}\) | 提升计算效率 |
| 向量加法 (\(N_{\text{vec}} = 1000\)) | \(\text{AI} = 1000/12000 = 0.083\) FLOP/字节 | \(1000 \times 10 \text{ pJ} = 0.00001\text{ mJ}\) | \(12000 \times 160 \text{ pJ} = 0.00192\text{ mJ}\) | 通过融合减少数据搬运 |
系统洞见:能量优化遵循与延迟优化相同的瓶颈逻辑。稠密矩阵乘法受益于高效的算术单元;逐元素工作则受益于减少存储器搬运。
能量 roofline 模型揭示了为何不同的优化策略适用于不同的工作负载。较大的稠密矩阵运算受益于更快的算术单元。存储器受限的运算(如逐元素内核)受益于数据布局优化、通过内核融合减少存储器往返,以及片上存储器利用率的提升。该框架为可持续 AI 系统设计的架构与算法选择提供了指导。
能量测量技术
量化 AI 系统能耗需要在硬件栈的多个层级进行测量,从芯片级仪表化到设施级监控。方法选择本身即是一项工程权衡:硬件计数器提供细粒度的归属,移动剖析器暴露平台特定的子系统,边缘仪表捕捉占空比行为,而系统级工具则将组件测量连接到组件计数器所遗漏的设施开销。
硬件功耗计数器
现代处理器通过设备接口暴露厂商提供的功耗遥测数据,软件可以查询这些数据。这些计数器提供与负载相关的估计值,范围限于设备报告的各条轨和采样窗口;它们并非墙插能耗的通用基准真值,其更新率、校准方式和组件覆盖范围因平台而异。当比较需要可追溯的总能耗或更细的时间分辨率时,仍需借助外部仪表。
Intel 的 Running Average Power Limit (RAPL) 接口通过型号特定的寄存器,为 CPU 封装、DRAM 和集成显卡提供能量测量。RAPL 报告的是累计能量,因此测量模式基于边界:在受控工作负载区域之前采样计数器,运行工作负载,再次采样,然后将能量增量除以经过的时间以恢复平均功率。这使得 RAPL 适用于 CPU 预处理、数据加载和主机侧训练工作,同时也界定了其覆盖边界。RAPL 不覆盖离散 GPU 能耗,可能需要提升权限,并且必须结合封装范围和计数器溢出情况加以解读。
NVIDIA GPU 通过 NVIDIA Management Library 暴露功耗测量,可通过 nvidia-smi 命令行工具或程序化接口访问。GPU 功耗监控 通常从瞬时功耗开始,该功耗在计算过程中动态变化,因为动态电压与频率缩放会在不同内核之间改变设备状态。因此,可靠的测量将推理或训练区间视为一条轨迹:同步工作负载边界,以固定节奏采样功耗,随时间对这些采样进行积分,并报告平均功耗与峰值功耗。当数据中心 GPU 提供累计能量计数器时,应优先使用这些计数器,因为它们可以避免在采样之间将短内核混入其他内核。
边缘设备与微控制器呈现出不同的测量问题。它们往往缺少内置功耗计数器,工作在毫瓦而非千瓦量级,并且需要外部仪表才能进行准确的能量剖析。关键决策在于:该工作负载所要求的时序分辨率、轨归属和成本各是多少。INA219 和 INA226 这类基于 I2C 的电流传感器为开发与验证提供了经济实惠的测量手段,其采样率足以捕捉推理级能耗。对于需要测量单个操作纳秒级分辨率的研究,Joulescope JS220 等仪表可从亚微安睡眠态电流测量至安培级活跃峰值电流,从而刻画边缘 AI 工作负载的完整动态范围。对于大规模 TinyML 集群,边缘能耗测量对于全面的可持续性评估至关重要,因为微小的单设备误差会随部署规模累积放大。
移动平台能耗剖析
在移动平台上,测量取决于平台暴露了多少归属信息。可用的剖析器以直接的瓦特读数换取各组件的诊断价值:
- Android PowerStats HAL:为 CPU、GPU、NPU 和射频子系统提供分组件功耗归属,使开发者能够识别哪些模型运算主导了能耗。
- 高通 Trepn Profiler:在 Snapdragon 平台上提供毫秒级功耗测量,将功耗轨迹与代码执行关联起来,以优化 NPU 工作负载。
- ARM Streamline:为 Cortex-A 和 Mali GPU 平台提供带能量标注的剖析,从而识别效率低下的内核实现。
- Apple Instruments Energy Log:为 iOS 应用报告热状态和能量影响分数,但不提供直接的瓦特测量。
移动剖析工具与开发工作流集成,使开发者能够在模型部署过程中迭代优化设备端推理能耗。 表 3 汇总了跨平台的边缘功耗测量仪表,包括分辨率、精度和集成要求。
| 仪表 | 分辨率 | 精度 | 使用场景 |
|---|---|---|---|
| INA219/INA226 | 100 微秒采样 | \(\pm 1\%\) | 低成本嵌入式剖析 |
| PAC1934 | 1 毫秒,4 通道 | \(\pm 2\%\) | 多轨 MCU 测量 |
| Joulescope JS220 | 亚微秒,纳安量程 | \(\pm 0.1\%\) | 专业 TinyML 基准测试 |
| Otii Arc Pro | 10 微秒,自动化 | \(\pm 0.5\%\) | 自动化电池寿命测试 |
边缘测量方法
边缘能耗测量只有在反映实际部署占空比、而非最佳情况下的活跃推理运行时时才具有意义。可复现的结果需要四项控制:
- 要求:测量所有睡眠态下的基线功耗,因为典型微控制器的基线功耗可能从深度睡眠的 1 微安变化到空闲活跃态的 1 毫安。
- 设置:在测量前执行 100 次或更多次推理迭代,进入 预热期 以达到热平衡,因为初始迭代可能因缓存预热和电压调节器稳定而表现出不同的功耗特性。
- 约束:考虑 占空比,即在现实占空比下同时报告峰值推理功耗和平均功耗,因为边缘设备在两次推理之间通常存在显著的空闲时段。
- 隔离:测量模型推理能耗时,禁用或计入 外围设备 的功耗,例如传感器、射频模块和显示屏,因为这些部件可能主导整个系统的总功耗。
对于占空比核算,公式 8 表达了活跃功耗与空闲功耗之间的关系:
\[P_{\text{average}} = P_{\text{active}} \times \delta_{\text{duty}} + P_{\text{idle}} \times (1 - \delta_{\text{duty}}) \tag{8}\]
其中 \(\delta_{\text{duty}}\) 表示占空比(执行推理所占的时间比例)。
系统级能耗剖析
全面的能耗核算需要将芯片级测量与基础设施开销结合起来。 公式 9 将总能耗形式化为各组件贡献按设施开销缩放后的求和:
\[E_{\text{total}} = (E_{\text{CPU}} + E_{\text{GPU}} + E_{\text{memory}} + E_{\text{network}}) \times \text{PUE} \tag{9}\]
没有任何单个计数器覆盖完整的能量路径,因此系统级剖析器(如 Intel VTune、NVIDIA Nsight Systems,以及开源工具 PowerJoular)会跨组件聚合测量。片上计数器估计设备功耗,其采样率、覆盖范围和校准方式可能各不相同;机架级电源分配单元(PDU)则提供下游 IT 负载的独立测量。机架 PDU 并不测量中央冷水机组、水泵、照明或上游转换损耗。设施能耗必须来自设施电表,或对已测量的 IT 负载施加显式匹配的 PUE。
公式 10 表达了已测组件功耗与设施总能耗之间的关系:
\[P_{\text{facility}} = P_{\text{IT}} \times \text{PUE} = (P_{\text{servers}} + P_{\text{network}} + P_{\text{storage}}) \times \text{PUE} \tag{10}\]
上述 PUE 计算已经说明了 IT 负载如何转化为设施负载。不过,运行功耗只是其中一项;下一个模型将该计量能耗与声明的电网信号和隐含分摊结合起来,而不是重复设施示例。
碳足迹计算
考虑一个由水电为主的电网供电的数据中心。其运行碳强度可能远低于化石能源为主的电网,但水电发电并非全生命周期零排放,AI 系统也并非无碳。水库的建设与运行会产生影响,而硅片开采、GPU 制造以及数据中心混凝土浇筑都在服务器通电之前排放了碳。完整的足迹计算必须涵盖运行电力、隐含碳,以及仅碳指标所排除的生态影响。
节 1.1.1 中的生命周期笔记本已经针对一次 70B 运行计算了运行碳、隐含碳和总碳。本节将该算例转化为正式的核算模型:为每一项给出方程,使其能够推广到不同工作负载、电网和摊销假设,而不是只给出一个数值答案。
运行碳计算
运行碳排放源于训练与推理过程中的电力消耗,并按电网碳强度折算。 公式 11 将其量化为能量、电网碳强度与设施开销的乘积:
\[C_{\text{operational}} = E_{\text{total}} \times \text{CI}_{\text{grid}} \tag{11}\]
其中 \(E_{\text{total}}\) 表示来自 公式 9(已按 \(\text{PUE}\) 缩放的分量能耗)的设施级能耗,\(\text{CI}_{\text{grid}}\) 表示电网的碳强度。设施开销仅通过 \(E_{\text{total}}\) 进入一次,因此不会再次出现在碳方程中。一个具体的训练排放计算示例将说明这一框架。
Napkin Math 1.6: 训练碳排放计算
问题:量化在 64 A100 GPU 上训练一个 7B 参数模型的运行期碳足迹,训练时长为 14 days。
数学:
- 计算能耗:64 GPU \(\times\) 400 W \(\times\) 336 hours = 8,601.6 kWh。
- 应用 PUE 与 IT 侧支持:设施总能耗 = 11,827.2 kWh \(\times\) 1.12 = 13,246.5 kWh。
- 计算排放:在美国平均电网(429 g/kWh \(\text{CO}_2\)/kWh)下,排放 = 5.7 t。在魁北克水电电网(20 g/kWh)下,排放 = 264.9 kg。
系统洞察:仅地理位置的选择就带来 21.4× 的训练排放差异。碳感知选址在不改变模型架构的前提下改变了环境成本。
隐含碳评估
对于典型部署,运行能耗主导总拥有成本(图 10),但随着电网向可再生能源转型,半导体制造产生的隐含碳成为约束性因素。
随着电网脱碳,瓶颈转向芯片制造与数据中心建设带来的隐含碳,使硬件利用率和使用寿命成为首要的可持续性杠杆。
隐含碳涵盖原材料开采、半导体制造、组装、运输以及报废处置等环节产生的排放。对于 AI 硬件,制造排放主要受先进半导体工艺的高能耗特性主导。
先进工艺节点的 AI 加速器具有可观的制造足迹:单块 NVIDIA A100 GPU 的隐含碳约为 150 kg CO2eq (Luccioni 等 2023年);NVIDIA HGX H100 产品的碳足迹隐含约 164 kg CO2e/H100,前提是基板足迹在八块 GPU 之间均摊 (NVIDIA Corporation 2025年),其中包含先进工艺节点的晶圆制造、高带宽内存生产以及封装。公式 12 将这部分隐含碳按硬件使用寿命摊薄,以计算每次使用的排放:
\[C_{\text{embodied,daily}} = \frac{C_{\text{manufacturing}}}{T_{\text{lifetime}} \times 365} \tag{12}\]
理解隐含碳随时间的累积过程,揭示了为何硬件利用率和使用寿命主导全生命周期排放。
Systems Perspective 1.1: 隐含碳摊薄
租用一块 GPU 一小时时,会浮现出一项隐性成本:费用不仅覆盖电力,还摊薄了制造环节的碳债。
隐含碳摊薄公式 将这一分摊过程明确写出: \[C_{\text{total}} = C_{\text{operational}} + \left( \frac{C_{\text{manufacturing}}}{T_{\text{lifetime,years}} \times 365 \times 24} \times T_{\text{job,hours}} \right)\]
Scenario: 在 10 hours 台 NVIDIA H100 上训练一个模型,用于 8。
- 运行期:8 \(\times\) 0.7 kW \(\times\) 10 hours = 56 kWh。在 0.429 kg/kWh(美国平均电网)下 = 24 kg。
- 隐含碳:8 \(\times\) 164 kg = 1312 kg。
- 摊薄:使用寿命 = 3 years(26280 hours)。
- 每小时“租金” = 1312 kg / 26280 hours \(\approx\) 0.050 kg/h。
- 作业成本 = 0.050 kg/h \(\times\) 10 hours = 0.5 kg。
系统洞察:对于长寿命硬件,在污染电网中电力占主导(24 kg 对比 0.5 kg)。然而,在清洁电网(水电,0.020 kg/kWh)中,运行期排放降至 1.1 kg,使隐含碳成为总足迹的显著组成部分(约 30.8 percent)。
本工作示例假设服务寿命为 4-year,略长于早期生命周期估算中使用的 3 年摊销窗口;这一假设很重要,因为更长的寿命会把相同的制造碳分摊到更多的服务量上,从而降低每任务的占比。对于一台具有 150 kg 隐含碳(引用前文 A100 估算值)且数据中心寿命为 4-year 的加速器,第一步是每日摊销:150 kg / (4 years \(\times\) 365 d/year) \(\approx\) 0.103 kg/天。
第二步将该每日份额分配给任务。一次持续 14 days、在 64 加速器上运行的训练任务,承载 64 \(\times\) 14 days \(\times\) 0.103 kg \(\approx\) 92.1 kg CO2 的摊销隐含碳。
92.1 kg 的隐含碳贡献约占此前针对美国平均电网计算的运行排放(1.6 percent)的 5682.7 kg。若训练发生在美国魁北克的低碳电网,则同一运行产生的运行排放为 264.9 kg,隐含碳贡献约占总排放的 25.8 percent。
生命周期碳核算
完整的生命周期评估会跨所有阶段合并运行与隐含排放。公式 13 汇总这些贡献:
\[C_{\text{lifecycle}} = C_{\text{training}} + C_{\text{inference}} + C_{\text{embodied}} \tag{13}\]
训练主导了这一单部署生命周期快照(图 11),而制造与推理仍是重要因素。
图 11 中的这一单部署快照只说明了部分情况。累计图景则相反:一个每天服务数百万次查询的模型,可能在数月内超过其整个训练碳足迹,对于流量更高的服务甚至可能在数天内,从而使推理优化成为模型服务期内生产系统影响最高的可持续性干预措施。
累计推理排放超过一次性训练成本。
对于大规模部署的模型,推理排放经常主导整个生命周期。假设一个模型每天服务 10 million 次查询,每次查询消耗 0.001 kWh,则年度推理能耗与排放的分解如下:
- 每日能耗:10 million 次查询 × \(\times\) × 0.001 kWh = 10,000 kWh
- 年度能耗:10,000 kWh × \(\times\) × 365 d/year = 3,650,000 kWh
- 年度排放(美国电网):3,650,000 kWh × \(\times\) × 0.429 kg/kWh = 1,565,850 kg = 1565.9 t
与前述 7B/64-A100 训练示例 (5.7 t) 相比,在该部署规模下,累计推理排放大约在部署 1.3 days 后超过训练排放。对于更大的训练运行,交叉点可能因查询量、每次查询能耗和电网强度而推移到数周或数月。因此,生命周期视角确立了优先级:对广泛部署的模型优化推理效率,而对经常重新训练或进行实验迭代的模型,则将训练效率的改进重点放在其上。
区域电网强度数据来源
准确的碳核算需要与所决策事项相匹配的电网强度数据。实时碳强度随发电结构变化,而发电结构按小时变化,取决于需求、可再生能源可用性以及电厂调度决策。数据源的选择取决于团队是在估算未来的作业、调度实时工作负载,还是在审计已完成的运行。
美国能源信息管理局按区域发布历史电网排放因子,每年更新。这些平均值可为清单或早期规划提供粗略基线,但无法解析调度灵活工作负载所需的逐小时边际效应。Electricity Maps 为所覆盖电网提供随时间解析的平均强度和全生命周期强度估算,而 WattTime 提供边际运行排放信号,用于估算增加或减少负荷时发电机的响应。对于已完成训练运行的回顾性分析,时间匹配的平均因子支持归属式清单;边际因子则用于估计调整或取消某次运行将如何改变系统排放。 代码 1 实现了一个生命周期碳计算器 ,它将能耗测量与明确选定的电网强度信号结合起来:
def calculate_carbon_footprint(
    gpu_power_watts: float,
    num_gpus: int,
    training_hours: float,
    it_power_multiplier: float,
    pue: float,
    grid_intensity_gco2_kwh: float,
    gpu_embodied_kg: float,
    gpu_lifetime_years: float,
) -> dict:
    """Calculate lifecycle carbon footprint for a training run."""

    # Operational emissions
    energy_wh = gpu_power_watts * num_gpus * training_hours
    gpu_energy_kwh = (energy_wh * watt * hour).to(kWh).magnitude
    it_energy_kwh = gpu_energy_kwh * it_power_multiplier
    facility_energy_kwh = it_energy_kwh * pue
    # g CO2 → kg (mlsysim does not export mass pint units yet).
    operational_kg = (
        facility_energy_kwh * grid_intensity_gco2_kwh / THOUSAND
    )

    # Embodied emissions (amortized)
    daily_embodied = gpu_embodied_kg / (gpu_lifetime_years * 365)
    training_days = training_hours / 24
    embodied_kg = num_gpus * training_days * daily_embodied

    return {
        "energy_kwh": facility_energy_kwh,
        "operational_carbon_kg": operational_kg,
        "embodied_carbon_kg": embodied_kg,
        "total_carbon_kg": operational_kg + embodied_kg,
        "embodied_fraction": embodied_kg
        / (operational_kg + embodied_kg),
    }


# Example: 7B model training
_us_grid = Infrastructure.Grids.US_Avg
result = calculate_carbon_footprint(
    gpu_power_watts=400,
    num_gpus=64,
    training_hours=336,  # 14 days
    it_power_multiplier=TrainingEmissions.it_power_multiplier,
    pue=_us_grid.pue,
    grid_intensity_gco2_kwh=_us_grid.carbon_intensity_g_kwh,
    gpu_embodied_kg=Hardware.Cloud.A100.embodied_carbon_kg,
    gpu_lifetime_years=4,
)
print(
    f"Total carbon footprint: {result['total_carbon_kg']:.0f} kg CO2"
)
print(f"Embodied fraction: {result['embodied_fraction']:.1%}")
团队可以通过这种程序化方法,将总生命周期碳核算直接集成到其编排仪表盘中。然而,针对单次训练运行分别计算运行排放和隐含排放,只捕捉了该问题的一个维度。大规模密集 AI 数据中心在资源消耗上的宏观模式揭示了额外的约束和优化机会。
数据中心能耗与资源消耗
当传统 Web 服务器处理一个 HTTP 请求时,CPU 会短暂冲高到 20% 的利用率,随即回到空闲状态。当 GPU 集群训练一个基础模型时,数千个处理器以 100% 的利用率运行,持续三个月不间断地抽取最大功率。这种前所未有的、无法缓解的热密度从根本上打破了传统数据中心设计,迫使工程师采用液冷并重新设计整个配电网络。
因此,设施可持续性必须被解读为一条约束链,而不是单一的 PUE 数值。持续的兆瓦级需求决定了电网与排放敞口,电力输送决定了有多少电能转化为有用的 IT 负载,冷却决定了密集机柜能否在不降频的情况下运行,而用水则决定了一个技术上高效的站点在当地是否可持续。
数据中心能耗与 AI 工作负载
在设施规模上,优化目标不再只是单个模型,而是围绕每一瓦 IT 功率所产生的开销及其电网环境。PUE 与地理计算此前已经说明了为何同样的 IT 负载会带来不同的设施与碳成本;此处的关键变化是聚合需求。IEA 在其 2025 年 Energy and AI 分析中,将数据中心用电排放估算为约 180 Mt,并在其基准情景下预测 2035 年约为 300 Mt,同时仍低于能源部门总排放的 1.5%。10 能源负担会随着数据中心容量、训练工作负载和推理需求的增长而增加 (Patterson 等 2021年),因此组件效率必须结合集群扩展来评估 Dodge 等 (2022年)。
10 数据中心排放规模:在 IEA 的 2025 年 Energy and AI 分析中,数据中心消耗了全球电力的约 1–2%,其中 AI 推动了需求增长。IEA 估算数据中心用电排放约为 180 Mt,并在其基准情景下预测 2035 年约为 300 Mt,同时仍低于能源部门总排放的 1.5%。规模最大的超大规模设施可连续抽取超过 100 MW 的电力,相当于为数万家家庭供电。
Dodge, Jesse, Taylor Prewitt, Remi Tachet des Combes, Erika Odmark, Roy Schwartz, Emma Strubell, Alexandra Sasha Luccioni, Noah A. Smith, Nicole DeCario, 和 Will Buchanan. 2022年. 《Measuring the Carbon Intensity of AI in Cloud Instances》. 2022 ACM Conference on Fairness Accountability and Transparency, 1877~94. https://doi.org/10.1145/3531146.3533234.
数据中心能耗需求
相关的设施量级是持续的兆瓦级负载,而不仅仅是模型名称本身。例如 Meta 运营着占地数片足球场、容纳大规模 AI 优化服务器的超大规模数据中心。11 非官方估算曾提示 GPT-4 可能在数月内使用了数万台 A100 级 GPU (Patel 和 Wong 2023年),但 OpenAI 尚未披露 GPT-4 的硬件、训练算力、模型规模或训练时长。这些设施依赖高性能 AI 加速器,例如 NVIDIA H100 GPU,其架构面向高吞吐张量工作负载,并在每瓦性能上较前代有所提升 (Choquette 2023年)。当模型精度允许时,较低精度的方法可以通过以低精度运算替代全精度运算来改善计算与内存效率 (Gholami 等 2022年)。
11 超大规模数据中心占地:Meta 的 Prineville 设施占地 230,000 m²,容纳超过 150,000 台服务器;主要云集群每年消耗相当于国家规模的电力。这些物理规模对可持续性至关重要,因为每个设施的电力需求(100–300 MW)锁定了数十年的电网依赖决策,而任何算法层面的优化都无法将其逆转。
Patel, Dylan, 和 Gerald Wong. 2023年. GPT-4 Architecture, Infrastructure, Training Dataset, Costs, Vision, MoE. SemiAnalysis Blog.
Choquette, Jack. 2023年. 《NVIDIA Hopper H100 GPU: Scaling Performance》. IEEE Micro 43 (3): 9~17. https://doi.org/10.1109/mm.2023.3256796.
AI 在各行业的快速采用推动了这一急剧增长的能耗。 图 12 展示了一个高增长情景,其中 AI 工作负载在 2024 年后对数据中心总能源需求构成实质性贡献。 Masanet 等 (2020年) 说明了为何应将该情景置于历史背景下解读:效率提升此前曾缓和数据中心的能源增长,但持续的需求增长可以抵消这一效应。
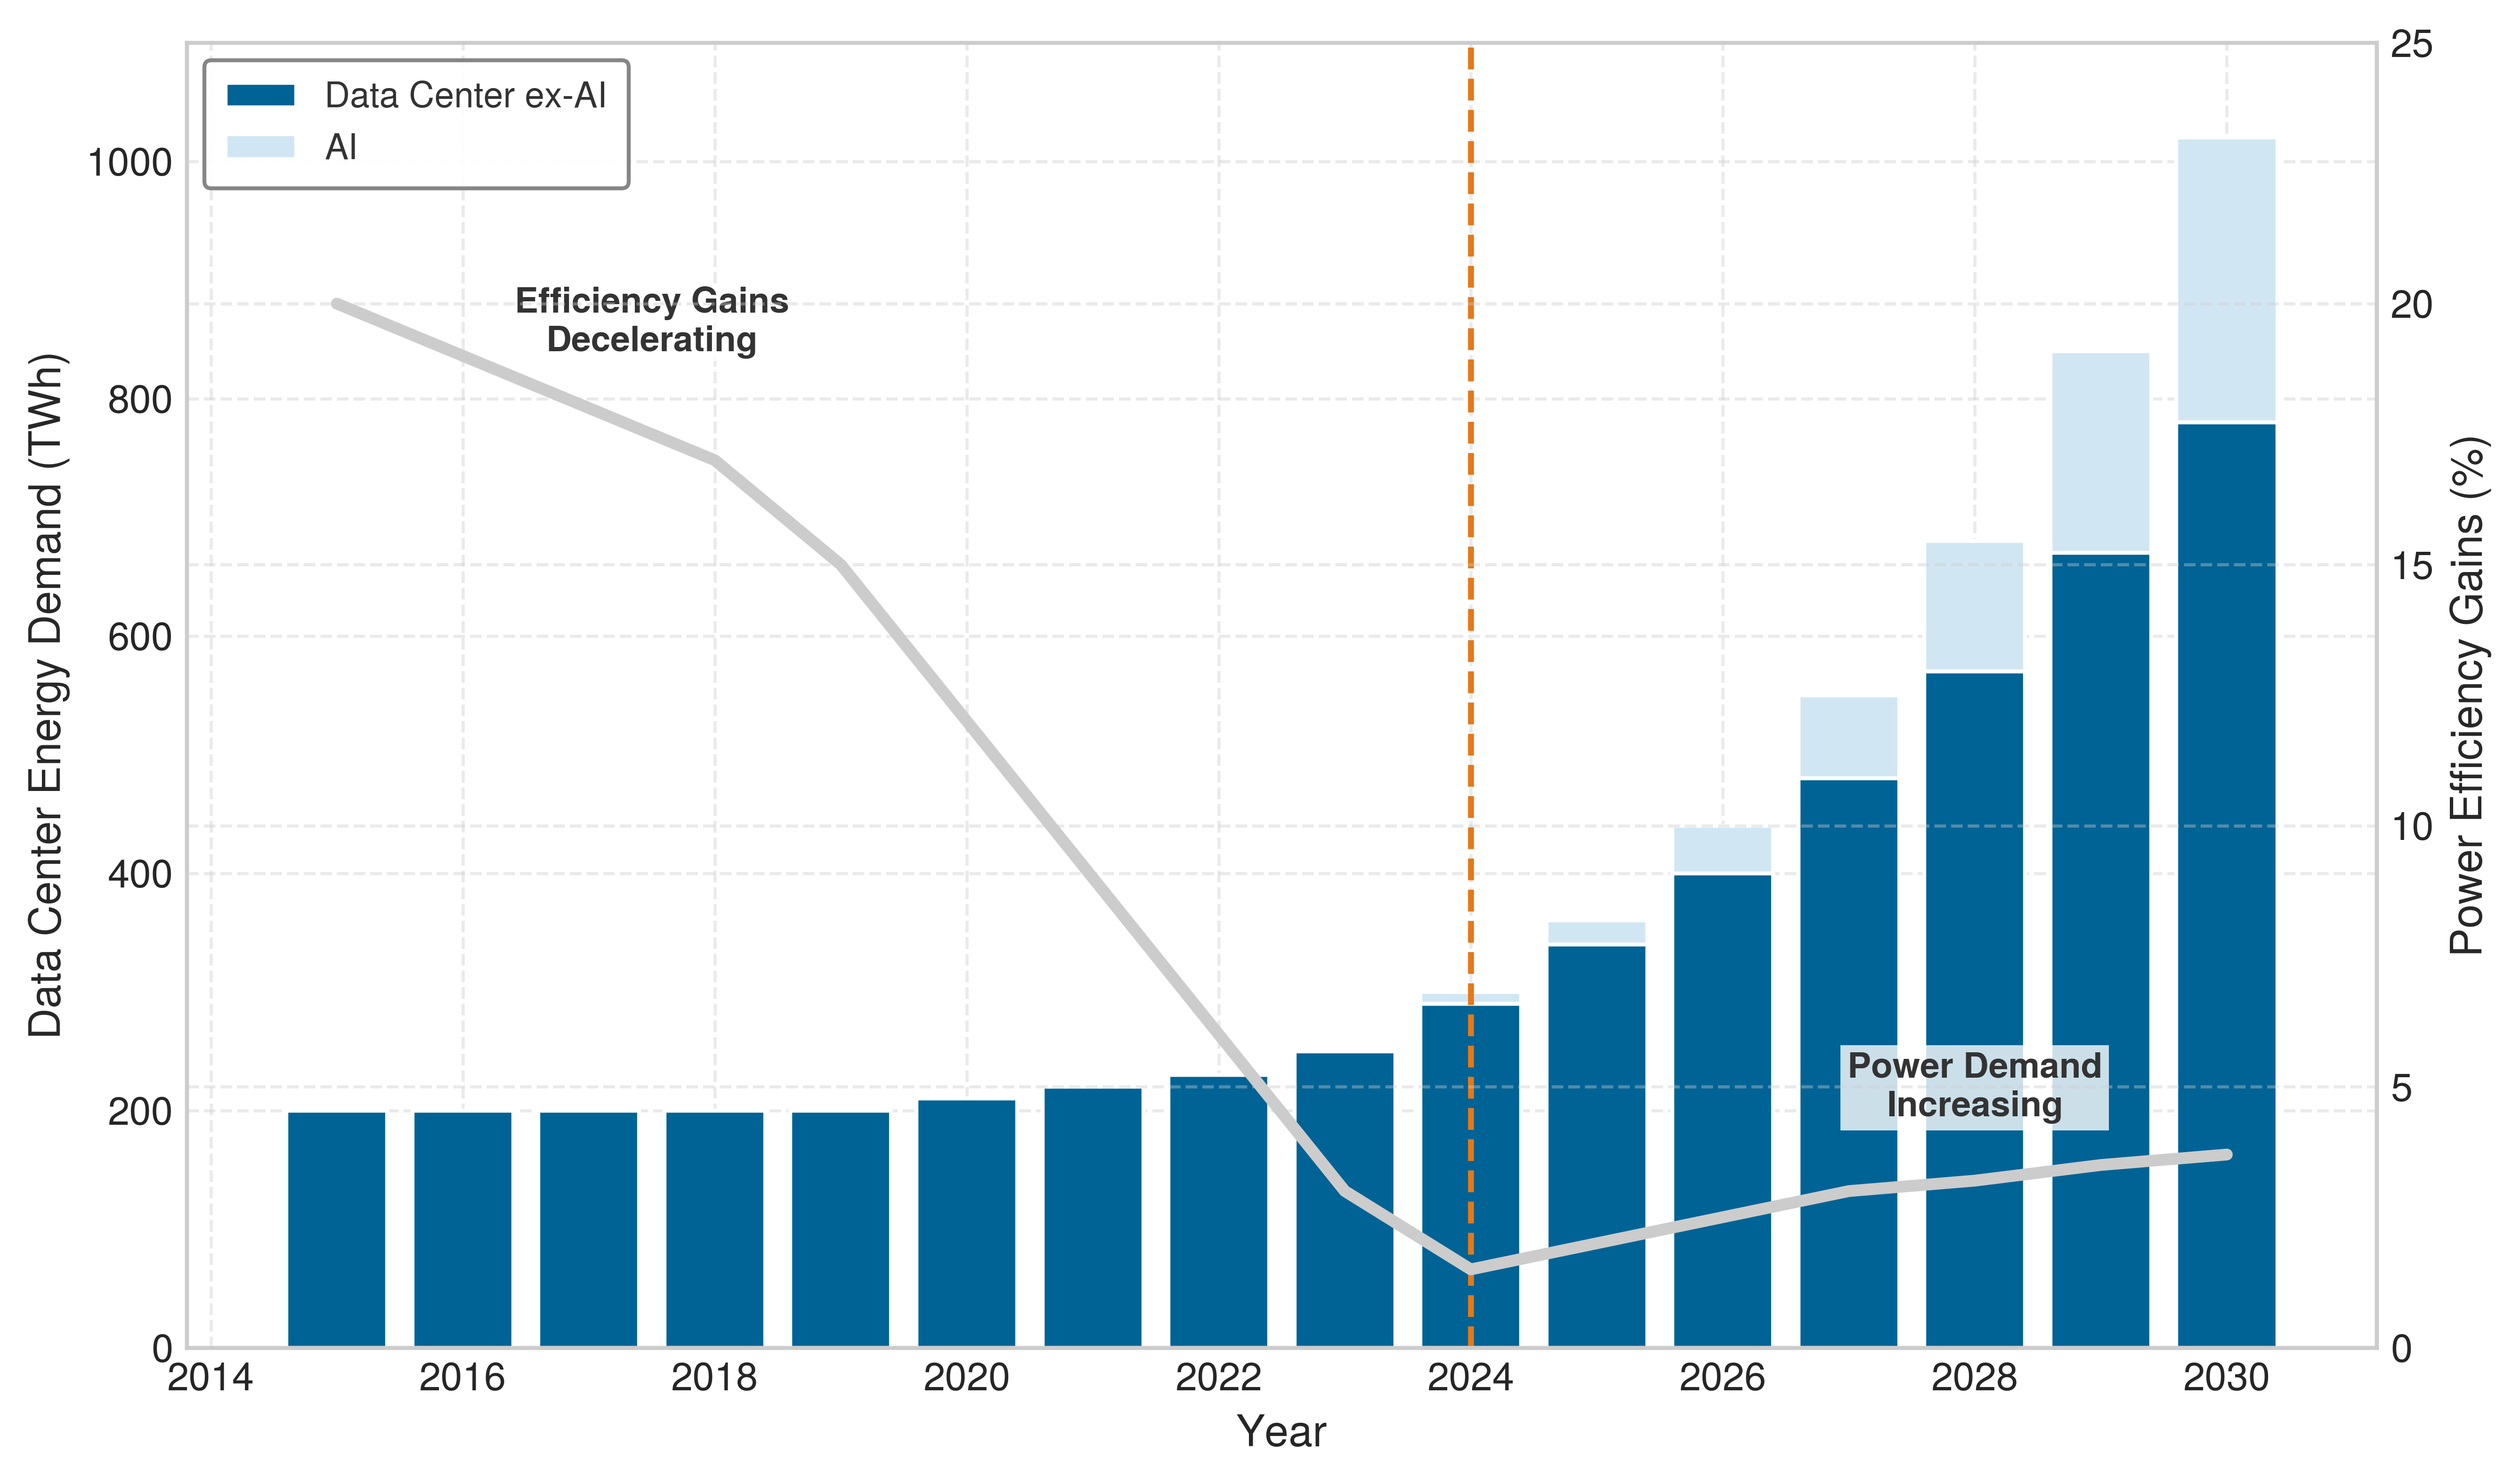
Masanet, Eric, Arman Shehabi, Nuoa Lei, Sarah Smith, 和 Jonathan Koomey. 2020年. 《Recalibrating global data center energy-use estimates》. Science 367 (6481): 984~86. https://doi.org/10.1126/science.aba3758.
除计算需求外,冷却在传统风冷数据中心设计中可占设施能耗的 30–40%(据 Ebrahimi 等 (2014年) 所调研的设计)。这是一个设计形态区间,而非现代超大规模或液冷设施的固定值;节 1.3.6 通过 PUE 与冷却架构推导出站点特定的开销。
Ebrahimi, K., G. F. Jones, 和 A. S. Fleischer. 2014年. 《A review of data center cooling technology, operating conditions and the corresponding low-grade waste heat recovery opportunities》. Renewable and Sustainable Energy Reviews 31: 622~38. https://doi.org/10.1016/j.rser.2013.12.007.
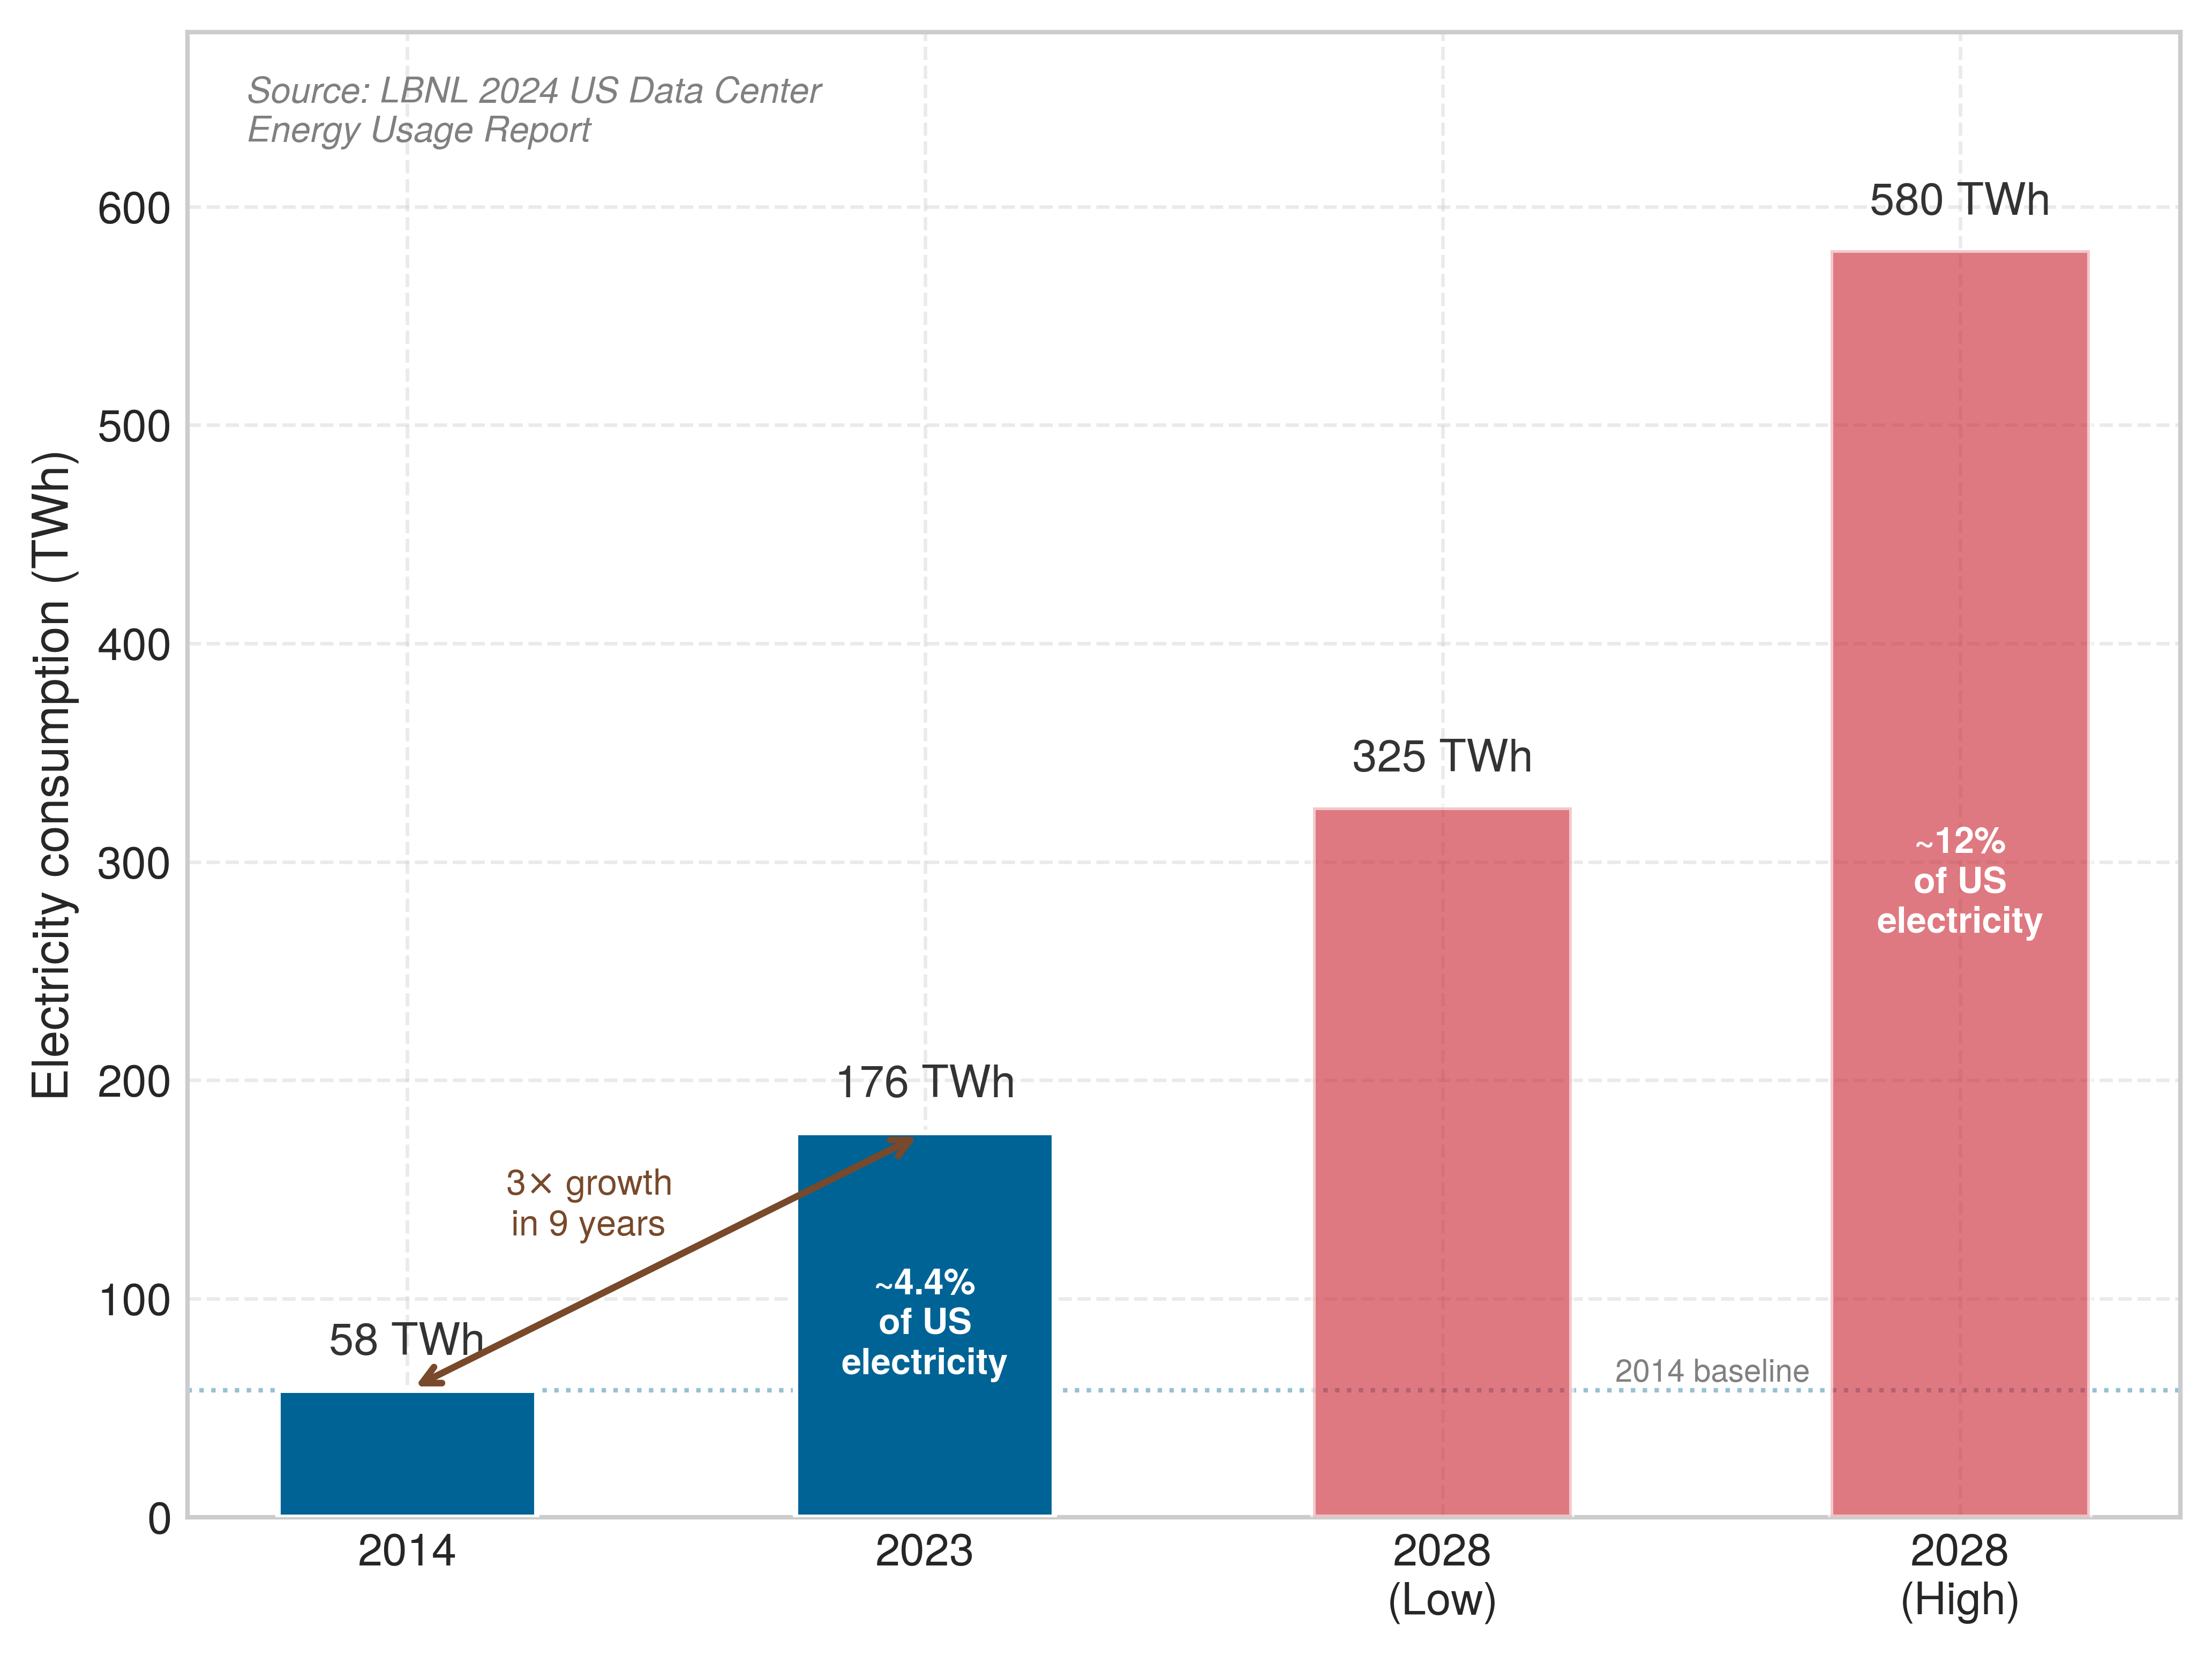
虽然 图 12 呈现了全球趋势,但仅美国一地便足以说明云与 AI 基础设施如何重塑国家能源规划。 图 13 展示了来自劳伦斯伯克利国家实验室(LBNL)的美国数据中心用电量数据,显示其消耗从 2014 年的 58 TWh 增至 2023 年的 176 TWh。LBNL 的预测将 AI 工作负载视为进一步增长的重要驱动因素,并预测到 2028 年将实现翻倍或翻三倍,其中高端情景意味着数据中心将消耗约 12% 的美国电力。这一轨迹构成了 AI 扩展的物理约束,仅靠软件优化无法消除。
分布式系统能耗优化
大规模 AI 训练本质上需要分布式系统的协同,由此产生额外的能耗开销,并与计算需求叠加。分布式训练 中考察的并行策略交换梯度、参数或激活值,而由于同步造成的停顿期间,其他部件仍处于通电状态。12 由此产生的能耗占比无法仅凭集群规模推断,因为拓扑、集合通信算法、消息量、重叠程度和利用率共同决定了这一账目。某些全连接(all-to-all)模式还会随着参与集合的扩大,使流量增长快于聚合有用工作量的增长。
12 并行能耗开销:数据并行、张量并行和流水线并行分别带来不同的通信与空闲功耗成本。数据并行会缩减梯度,张量并行交换部分激活值,流水线并行则引入气泡。有效的比较在保持模型质量和训练时间不变的前提下,测量网络能耗以及协同所导致的额外通电时间。
针对这些通信开销,集群级能耗优化需要超越单台服务器效率的协同资源管理。集群规模上有四个运行杠杆可以调整能耗预算:
- 动态工作负载放置:在这样做能让真正闲置的硬件进入更低功耗状态时,合并兼容任务;应在设施电表处验证节省量,而不是根据节点数量推断。
- 碳感知调度:在满足数据移动、截止时间和可靠性约束的前提下,将可灵活安排的工作转移到决策相关排放因子较低的时间或区域。
- 多租户共享:在不引入干扰、排队或额外迭代从而抵消能耗收益的前提下,提高加速器的有用占用率。
- 批处理:当较高的利用率足以抵消批处理延迟以及任何质量或收敛影响时,合并兼容的小任务。
共同的模式是利用率纪律:系统通过避免为执行无用模型工作而通电的容量来节省能耗。
跨 AI 工作负载的碳基准
AI 工作负载的环境影响已成为一项关注事项,其碳排放量已接近成熟的高碳行业水平。Strubell 等 (2019年) 将这一关注具体化,估计大规模 NLP 模型的开发级训练与架构搜索在整个生命周期内可能排放的碳,相当于数辆乘用车的累计排放。Patterson 等 (2021年) 随后表明,被引用最多的架构搜索估算值高度依赖于代理任务、硬件、数据中心效率和电网碳强度等假设。为将 AI 的环境足迹置于背景之中,更大且更准确的 BERT 家族模型具有明显更高的每查询碳成本(图 14)。散点图显示,最高准确度的变体位于图中右上区域,且碳成本随准确度的提升而上升得更快。13 这一相同的权衡也强化了推行更具可持续性 AI 实践的需要。
13 神经架构搜索(NAS)的碳成本:Strubell 等 (2019年) 给出的约 284,000 kg CO2e 数值代表未优化的 Evolved Transformer 搜索,在计入 TPU 硬件、电网组合和代理任务后该数值会急剧下降 (Patterson 等 2021年)。系统层面的经验教训是边界纪律:搜索、调优和失败试验都应纳入碳核算边界,但可复用的架构搜索应分摊到所有下游部署中。高效的 NAS 技术(权重共享、硬件感知搜索)能够降低这一搜索预算,使元优化成为主要的可持续性杠杆 (Elsken 等 2019年)。
Strubell, Emma, Ananya Ganesh, 和 Andrew McCallum. 2019年. 《Energy and Policy Considerations for Deep Learning in NLP》. Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics, 3645~50. https://doi.org/10.18653/v1/p19-1355.
Patterson, David, Joseph Gonzalez, Quoc Le, Chen Liang, Lluis-Miquel Munguia, Daniel Rothchild, David So, Maud Texier, 和 Jeff Dean. 2021年. 《Carbon Emissions and Large Neural Network Training》. arXiv preprint arXiv:2104.10350.
Elsken, Thomas, Jan Hendrik Metzen, 和 Frank Hutter. 2019年. 《Neural Architecture Search》. 收入 The Springer Series on Challenges in Machine Learning, 卷 20. Springer International Publishing. https://doi.org/10.1007/978-3-030-05318-5_3.
大型自然语言处理模型的训练阶段可能产生与数百次跨洲际航班相当的二氧化碳排放。在更广泛的行业规模上,AI 与数据中心排放正在快速增长,但本章中的 IEA 级估算尚不足以支持与商业航空的直接对等性论断。随着 AI 应用扩展以在全球服务数十亿用户,持续推理运行累积的排放最终可能超过训练阶段产生的排放。
经验教训在于,碳估算必须将仅训练结果与已部署的推理区分开来。图 15 对 Meta 各种大规模机器学习任务的碳排放 进行了详细分析,展示了不同 AI 应用与架构的环境影响。这一对 AI 碳足迹的定量评估,将缓解策略建立在实测环境成本而非估算之上。
全面的碳核算方法
AI 的影响不仅限于运行能耗。全面的碳足迹评估将三阶段生命周期分析(训练、推理、制造)与温室气体(GHG)协议定义的三个标准排放范围相结合。鉴于 AI 预计到 2030 年将快速增长,理解各阶段、各范围下的全生命周期成本,对于识别最具影响力的可持续性干预措施至关重要。
在自有数据中心设施边界内,范围一(Scope 1)排放 来自现场发电,包括备用柴油发电机、设施冷却系统和自有电厂。虽然许多 AI 数据中心主要使用电网电力,但那些拥有化石燃料备用系统或自有发电的设施会直接贡献排放。
范围二(Scope 2)排放 代表报告组织所购电力、蒸汽、热能和冷却所导致的间接排放。所购电力通常是运营商自有设施的主要类别,且因地理位置和电网能源组合而异。云服务商使用的电力对该服务商而言属于范围二,而客户购买的云服务通常计入客户范围三的价值链。物理电子并未改变;改变的只是报告边界。正如 节 1.0.1 所确立的,运营电网强度杠杆在代表性区域对之间处于 8 到 40 倍的区间,尽管水电的全生命周期排放仍非零,并伴随本地生态影响。
范围三(Scope 3)排放 构成最复杂的类别,涵盖硬件制造、云供应链、运输、处置以及下游使用。半导体制造属于高碳密集。14 对于低利用率硬件或清洁电网部署,隐含加速器排放可与数月甚至数年的运行排放相当;而在高碳密集电网上进行持续高功率训练时,盈亏平衡点可能短得多。在公司整体或价值链 AI 核算下,范围三甚至可能主导,即使范围二主导了单一自有设施的运行足迹。
14 EUV 光刻能耗成本:每台 ASML EUV 光刻机持续耗电 1 MW,每日消耗 30,000 升超纯水,较旧式深紫外系统能耗增加 10\(\times\) 倍。由于 EUV 是制造许多先进 AI 加速器所用 7 nm 以下节点所必需的,每一代芯片的隐含能耗都会叠加:每片晶圆上的晶体管数量更多意味着更多 EUV 曝光步骤,使先进节点制造成为 AI 范围三排放的重要组成。
15 边缘 AI 能耗悖论:边缘推理将每查询延迟从云端 100–200 ms 降低到 1–10 ms,但将功耗分散到大量常开设备。特斯拉 FSD 计算机在行驶过程中持续耗电 72 W;若将同等车载算力扩展至全球车辆车队,将意味着约 100 GW 的集体功耗,相当于数十座大型电厂。可持续性权衡在于:边缘计算消除了网络能耗,却产生了无法计量、分布式的能耗足迹,因而对碳核算框架不可见。
除制造之外,范围三排放还包括 AI 部署后的下游影响。搜索引擎、社交媒体平台和基于云端的推荐系统等 AI 服务以巨大规模运行,需要在数百万甚至数十亿次用户交互之间持续进行推理。推理工作负载累积的电力需求最终可能超过训练所用的能源,进一步放大 AI 的碳影响。终端用户设备(包括智能手机、物联网设备和边缘计算15 平台)同样会贡献范围三排放,因为其 AI 赋能功能依赖于持续计算。在大型科技公司的可持续发展报告中,范围三往往主导公司整体排放;要将该份额具体归属于 AI 驱动服务,需要进行工作负载级的核算,而不能仅依赖公司整体总量。
运行排放仅涵盖 AI 的生产阶段。软件开发本身又增加了另一层环境影响,而这一层往往很少被纳入核算。
温室气体(GHG)协议16 框架 (World Resources Institute 和 World Business Council for Sustainable Development 2023年) 为这些排放提供了标准分类,摘要见 图 16。三个范围构成一份工程分类检查清单:
16 温室气体(GHG)协议:该框架由世界资源研究所与世界可持续发展工商理事会共同制定,被超过 90% 的向 CDP 报告的世界五百强公司采用。其三范围分类对机器学习系统尤为重要,因为大多数 AI 碳足迹隐藏在范围三(硬件制造、云计算供应链)中,而公司历来较范围一和范围二少报告 50% 到 70%。
World Resources Institute, 和 World Business Council for Sustainable Development. 2023年. Greenhouse Gas Protocol: Corporate Standard.
- 范围一(直接排放):源于公司直接运营——备用发电机、公司自有发电。
- 范围二(间接能源排放):报告组织所购能源;云运营商的电力出现在此处,而其客户的云采购通常出现在客户的范围三清单中。
- 范围三(价值链排放):超出直接控制范围——半导体制造、硬件运输、AI 加速器的报废处置。
将这些排放划分为 Scope 1、2、3 框架,为企业环境报告提供了标准化的术语体系。在实践中正确应用这一框架,需要对典型机器学习平台运行全生命周期中的各类隐性排放源进行分类。
Checkpoint 1.2: 核算不可见的碳
审计机器学习平台的碳足迹,请将下列排放源划分为 Scope 1(直接排放)、Scope 2(间接能源)或 Scope 3(价值链):先指明报告主体,再为每一项分配范围:
准确分类这些隐性排放,迫使工程团队对其部署的整个价值链承担责任。设施抽象的能源指标及其最终形成的碳足迹,最终受机柜的物理热力学规律支配。向单个机柜输送 120 kW 并抽出相应热量,已超出传统空调的能力范围。
电力输送
当工程师仅按加速器 TDP 进行容量规划时,规划就会失败。电力在每次转换过程中都会损失能量和可靠性余量,因此在到达 GPU 的电压调节器之前,输送路径既决定了设施侧的瓶颈,也决定了冷却系统必须移除的热量。该路径始于建筑之外:电力以高压交流电形式接入,通常为 13.8–69 kV,具体取决于所在国家和设施规模;随后由专用变电站或变压器场将其降至中压。规模最大的机器学习设施需要自建变电站,建设周期为 18–24 个月,并且需要与当地电网运营方协调。电网接入是最终的瓶颈:无论建筑内部如何进行工程优化,都无法输送超过电网所能提供的电力。
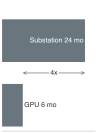
变电站的提前期可能比 GPU 采购长 4\(\times\) 倍。
Systems Perspective 1.3: 并网排队
部署 10,000 GPUs 与部署为 IT 负载供电所需的电气变电站(9.6 MW,在 7 MW GPU 小计扩展为机柜支持功率之后)遵循不同的时间线。在芯片路径上,GPU 供应链波动较大,但典型的企业采购提前期为 6 months。在基础设施路径上,新建 10+ MW 变电站所需的许可、工程设计、采购、施工和电网接入,平均需要 24 months。因此,基础设施部署比加速器本身耗时 4× 更长。
系统洞见:在机器学习集群时代,首要瓶颈并非硅片的供应链,而是电网的并网排队。截至 2024 年,仅在美国,就有超过 2000 GW 的容量正在等待电网接入。一位只优化 GPU 利用率、而没有两年期电力规划路线的工程师,会发现自己的集群”在电气上被搁浅”:昂贵的硅片停留在没有供电的暗房里,等待变压器。
在设施内部,不间断电源(UPS) 对 incoming 电力进行调节,并在短暂停电期间提供电池备份。现代在线双变换 UPS 系统将交流电转换为直流电,为电池组充电,然后再转换回交流电,这保证了电力的纯净度,但会损失 3–5% 的效率。高效率的节能模式设计在正常运行时绕过这一级双变换,以 98–99% 的效率运行,只是对输入异常的保护能力略低。配电单元(PDU) 随后将 UPS 调节后的电力分配至机柜,通常提供从 480 V 到 208/240 V 的最后一级交流降压,为服务器供电。
部分机器学习设施采用 48 V 直流配电,这消除了一个转换环节,效率提升 2–3%。这一改进并非只是通用数据中心场景下的边际收益;对于高密度的机器学习加速器基板,它解决了硬件自身电流需求所施加的一项硬性物理约束。一个搭载八张 H100 GPU、每张功耗 700 W 的训练节点,仅加速器就需要超过 5,600 W。在传统的 12 V 供电下,满足该需求需要在基板汇流排上推动接近 470 A 的电流。在该电流水平下,铜导体自身的 \(I^2R\) 损耗会产生可观的热量,并形成压降,破坏 VRM 的严格电压容差。改用 48 V 可将输送电流降低四倍,从而将 \(I^2R\) 的配电损耗降低十六倍。对于高度集成的机器学习基板——例如 NVIDIA 的 HGX——48 V 直流供电与其说是一种设计偏好,不如说是在额定功率密度下运行而不熔化电源连接器的必要条件。Google 率先在其数据中心中采用 48 V 直流配电,Open Compute Project 也已为高密度计算标准化了机柜级 48 V 直流供电母线。
在机器学习机柜的功率密度下,95 percent 与 98 percent 之间的配电效率差异具有实际意义。对于一个 33 kW 机柜,3 percent 的效率提升可节省约 0.99 kW 的功率。在拥有 300 个机柜的设施中,这相当于节省 297 kW,足以支撑约 36 个额外的 GPU 节点,或约 9 个四节点机柜。在 3 年的生命周期内,按 $0.07/kWh 计算,该效率提升可节省 ~$546,361 的电力成本。
最终的转换发生在服务器和基板上。每台服务器都包含电源模块,将机柜级电压转换为 12 V 直流电,或直接转换为基板组件所需的多个电压。例如,DGX H100 采用多个高效率电源模块,总额定功率为 10 kW,并具备 N+1 冗余,因此单个模块故障不会导致节点离线。电压调节模块随后将 12 V 直流电转换为 GPU 核心所需的 0.7–1.0 V,以及 HBM 所需的 1.1–1.2 V。这些调节器必须在 GPU 从空闲切换到满载计算时于微秒级时间内响应负载变化,并以 90–95% 的效率运行。
Checkpoint 1.3: 供电的物理原理
核查数据中心的供电链路:
当每个 GPU 的功率为 700 W 时,电压调节模块会产生 35–70 W 的热量,这部分热量必须与 GPU 本身产生的热量一同散去。电压调节模块产生的热量在热设计中有时会被忽视:在冷板覆盖 GPU 的液冷系统中,电压调节模块通常仍由小型风扇进行风冷,这给其余未与液冷装置直接接触的组件带来了热管理挑战。
全部五个阶段的总效率通常为 85–90%,这意味着每有 100 W 功率进入供电链路,就有 10–15 W 在到达晶体管之前以热量形式损失。IT 边界上游的设施侧转换损耗计入 PUE,而基板电压调节模块的损耗仍属于实测 IT 负载的一部分。
为具体说明这一点,考虑一个包含四个 DGX H100 节点的机柜的功率预算:
四节点 DGX H100 机架的功率预算 逐项列出了整机架的功率预算,因此设施容量规划需包含主机、网络、功率转换和冷却的开销,而不仅限于 GPU TDP。
| 组件 | 功率 (kW) | 占机架总功率比例 |
|---|---|---|
| GPU 计算 | 22.4 kW | 67% |
| 主机 CPU 与 DRAM | 3.2 kW | 10% |
| NVSwitch 互连结构 | 1.6 kW | 5% |
| InfiniBand 高带宽网卡 (HCAs) | 0.8 kW | 2% |
| 功率转换损耗 | 2.8 kW | 8% |
| 冷却开销(PUE 约 1.09) | 2.7 kW | 8% |
| 总计 | 33.5 kW | 100% |
评估 DGX H100 的功率分配 (四节点 DGX H100 机架的功率预算) 表明,32 个 GPU 每个 700 W 的功率,合计提供 22.4 kW,但仅 GPU 小计会低估机架的真实功率需求约 50%。仅依据 GPU TDP 规划设施供电容量的基础设施规划者会低估电气负载,并可能在调试阶段发现供电容量不足。
机器学习训练负载对这条供电链路提出了独特挑战:同步瞬变。在传统 Web 服务数据中心,数千台服务器各自处理相互独立的任务请求,功率消耗彼此不相关。总负载平滑且可预测,一天之内仅变化约 10–20%。
在训练集群中,情况截然不同。所有加速器同步执行同一计算。当一次大规模矩阵乘法开始时,集群中的数千个张量核心同时激活,功率需求在微秒级时间内骤增 40–60%。当计算因梯度同步而暂停时,需求同样急剧下降。这些功率爬升 会给供电链路的每个环节带来压力,从主板上的电压调节模块一直到变电站中的变压器。
Example 1.2: 功率爬升容量设计
场景:一个 512 GPU 的训练集群在同步训练步骤期间出现间歇性节点复位。
诊断:同步矩阵乘法步骤在微秒级时间内产生 300 kW 的负载阶跃(每个 GPU 的闲置至峰值功率摆动为 600 W),超出上游功率调节的响应时间。由此产生的电压跌落触发了加速器的欠压保护并导致硬复位。
系统经验:同步训练步骤会产生微秒级的功率爬升,给数据中心供电带来压力。增加本地穿越能力(超级电容组)可平滑瞬态负载阶跃,直至 UPS 和设施系统响应。
现代机器学习数据中心通过分层防御策略应对功率瞬变,每一层覆盖不同的时间尺度。超级电容组是第一道防线,可在微秒级时间内提供数百千瓦功率以平滑初始突增。与响应时间以毫秒计的电池不同,超级电容通过静电方式储存能量,可瞬时放电。典型安装为每个机架配置 50–100 kJ 的超级电容储能,足以支撑 100 kW 的瞬态持续 0.5–1.0 秒。
具备快速逆变器响应的电池后备 UPS 系统(切换时间低于 10 ms)处理更长的瞬变,并在持续数分钟的短暂电网扰动期间提供穿越能力。
专用变电站与定制变压器设计服务于最大规模的部署。这些变压器针对机器学习负载的高 di/dt(电流变化率)特性进行额定设计,并采用定制绕组配置,可在负载快速摆动时承受而不会产生电压畸变。标准公用变压器是为缓慢变化的负载设计的,当承受机器学习训练造成的快速负载变化时,可能出现磁饱和。
为直观感受这些瞬变的量级,考虑一个 1024 GPU 集群从通信阶段(每个 GPU 平均 400 W)切换到矩阵乘法阶段(每个 GPU 700 W)。功率差为 300 W \(\times\) 1024 = 307 kW,该切换在约 100 μs 内完成。因此,功率变化率为 307 kW/100 μs = 3.07 GW/s。没有任何无源电气元件能以如此速率响应;只有物理上靠近负载的储能器件(超级电容)才能在瞬变传播到建筑配电系统之前吸收它。
训练阶段的切换会产生微秒级功率冲击。
供电链路本身在每个环节都会引入效率损失。公用高压到中压的变压损耗为 1–2%。UPS 损耗为 3–5%(现代双变换设计)或 1–2%(eco 模式设计,正常运行时旁路逆变器)。PDU 损耗为 2–3%。主板上的电压调节再损失 5–8%。累计而言,从电网取用的功率中有 10–15% 在送达晶体管之前于供电链路中以热的形式耗散。仅 IT 边界上游的损耗计入 PUE;主板电压调节属于 IT 负载的一部分。PUE 为 1.10 意味着所有非 IT 设施负载(包括设施侧的转换和冷却)比 IT 负载高出 10%。
在最大规模下,数据中心的取电占当地电网容量的相当大比例。一个 100,000 GPU 集群,每个 GPU 700 W,其加速器小计为 70 MW,但在计入 PUE 之前,机架供电配置下的支持功率将 IT 负载提升至 96.2 MW。计入 PUE 后,设施总取电接近 107.8 MW,相当于为一座小型城市供电。此类部署需要从电网获得专用供电,通常包括专门建设的变电站和输电线路。电网接入的周期可能超过两年,使其成为构建机器学习基础设施时最长提前期之一的约束。
在大规模集群层面,同样的供电限制转化为电网采购问题,而非单纯的电费问题。后期的大型系统往往缺少与本章开篇基准相当的能耗披露,这恰恰说明测量契约要求使用工作负载遥测数据,而不能仅依赖公开的模型卡片。
当模型与数据规模相互放大时,这一电网采购问题会进一步恶化。在每参数训练 token 数固定的前提下,将模型参数翻倍也会使 token 数翻倍,因此训练工作量与能耗约按 4\(\times\) 增长。更一般地,当模型规模与数据集规模同时增长时,总训练能耗约按二者乘积增长。因此,参数为 10\(\times\) 的模型,在 10\(\times\) 的数据上训练,所需能耗约为 100\(\times\)。
单次大型模型训练战役所消耗的电力,相对于一座发电厂的发电量可能已不可忽略。一座 100 MW 训练设施满负荷运行一年,消耗 876 GWh,而一座 100 MW 风电场无法与之匹敌(在 30 percent 的容量因子下,风电场每年发电约 262.8 GWh,因此该训练设施所需的等效风电场数量约为 3.3 座)。
因此,电力可用性与电力来源成为同一个基础设施决策。训练大型模型的组织可能希望将自身的用电与可再生能源发电相匹配,方式包括将数据中心选址于可再生能源来源附近(水电、风电、太阳能),或购买可再生能源证书(RECs)以抵消其电网用电。
直接投资清洁能源发电是这一决策中最强的形式,因为它增加了实际发电容量,而不仅仅是重新分配信用额度。例如,微软已签署协议,从重启的核电反应堆购买核能,并认识到机器学习训练负载的规模与一致性要求具备基荷电源,仅靠可再生能源的间歇性来源无法满足。谷歌同样投资了地热能源项目,可提供不受天气条件影响的稳定电力输出。
电网的碳强度 决定了训练运行的真实环境成本。由太平洋西北部的水电站供电的设施,每千瓦时排放约 50 g CO2/kWh;而以天然气为主的电网每千瓦时排放约 400 g CO2/kWh,以煤炭为主的电网则约为其两倍。对 175B 模型执行单次训练运行、耗电量约 1,287 MWh,其碳影响随地点不同在 64 吨到 515 吨之间变化——8\(\times\) 倍的差异使得选址成为首要的脱碳杠杆。将太平洋西北部的水电与中等煤炭电网配对,处于 节 1.0.1 所界定的地理跨度中较为保守的一端;更清洁的水电电网会使这一跨度进一步扩大。这一环境核算可以驱动基础设施决策:能够把训练集群部署到低碳地区的组织,可能同时实现更低的电力成本(水电通常比化石燃料发电更便宜)和更低的碳足迹,这是经济与环境激励罕见的协同。
冷却
每一瓦特送达 GPU 的电能最终都会转化为热量。热力学第一定律保证了这一点:电能被转化为计算功(翻转晶体管),但“功”的产物只是内存中的位翻转,其本身所消耗的能量可以忽略不计。所有输入能量都以热能形式离开系统,必须从芯片中物理移除、运出机柜,并排放到环境中。传热的基本物理规律确立了一项无法回避的约束:由 33.5 kW 所代表的机柜级电负载必须被冷却介质吸收,并以相同的速率持续带走。即使冷却稍有滞后,芯片温度也会升高,触发热节流,从而降低时钟频率和吞吐量。在极端温度下,硅片可能遭受永久性损坏。
在热极限以下芯片安全运行;越过该极限后,节流急剧上升。
风冷是几十年来占主导地位的技术,其工作原理是将室温空气吹过安装在芯片上的散热器。空气以由其比热容决定的速率吸收热量,约为 1.0 kJ/kg/K。被加热的空气从机柜后部排出,通常比进风温度高 15–20 摄氏度,并被送入计算机房间空调(CRAC)机组进行冷却后再循环使用。
基本问题在于空气是不良的热导体。其导热系数仅为 0.026 W/m/K,而水为 0.6 W/m/K,铜为 400 W/m/K。仅用空气从机柜移除 100 kW 热量时,风扇必须推动极大的空气流量并以高风速运行,仅用于冷却就消耗了机柜总功耗预算的 30–40%。
可以用一个简单的计算把物理关系精确化。流体流动的取热能力为:
\[Q = \dot{m} \times c_p \times \Delta T\]
其中 \(Q\) 为移除的热量(瓦特),\(\dot{m}\) 为质量流量(kg/s),\(c_p\) 为比热容(J/kg/K),\(\Delta T\) 为出口与入口之间的温差。对于密度为 \(c_p\)、温差为 1,005 J/kg/K 的空气,以及典型的 \(\Delta T\) 为 15 K(入口 20 摄氏度、出口 35 摄氏度),移除 100 kW 所需的流量为 100,000 \(\div\)(1,005 \(\times\) 15)\(\approx\) 6.6 kg/s。在海拔海平面空气密度为 1.2 kg/m³ 的条件下,这对应于体积流量 5.5 m³/s,约合 11,713 CFM(立方英尺每分钟)。将如此多的空气输送到服务器机柜的受限空间内,需要大功率风扇,而风扇本身也消耗可观的功率。
在更高的功率密度下,冷却机柜所需的空气流量和压力会推高风扇能耗,并可能在 IT 负载本身达到功率上限之前,使风冷变得不切实际。精确的临界点取决于机柜几何结构、进风温度、压降和风扇控制策略,而非某个普适的机柜功率阈值。PUE17 指标反映设施侧的总体开销:PUE 为 1.5 意味着每 1 瓦 IT 负载对应 0.5 瓦的非 IT 设施负载,其中包括冷却和设施侧的功率转换。
17 PUE 集群节能:Google 全集群 PUE 平均为 1.10,而行业平均约为 1.58。对于机架支持负载后 IT 功耗为 9.62 MW 的 10,000-GPU 集群,将 PUE 从 1.58 降至 1.10 可节省 4.62 MW 的冷却开销——相当于每年节省约 $2.8M 的电力,以及从电网中移除 3,800 户住宅用电的等效量。采用直连芯片液冷的 ML 专用设施已实现 1.03–1.08 的 PUE 值。
降低 PUE 是 ML 数据中心的首要工程目标,因为冷却开销是产生无用计算的浪费性能耗。在 10,000-GPU 集群的规模上,机架支持负载之后的 IT 功耗为 9.62 MW,PUE 从 1.5 降至 1.1 可节省 3.85 MW 的浪费功率,每年约节省 $2.4M 的电力,同时需要按比例增加更多的冷却基础设施来耗散这部分热量。
水的比热容为 4.18 kJ/kg/K,是空气的四倍多,导热系数则约高出 25\(\times\)。这些物理特性使水天然成为更优的传热介质。要理解这一差异的量级,可以考虑从单个 GPU 移除 700 W 所需的流体流量。空气在温升为 15 度时,需要每秒数十升的气流(相当于一个小型风洞)。水在相同温升下仅需每秒约 0.01 升的流量(相当于一股细流)。体积流量上的这种数千倍差异,解释了为什么风冷需要大型风扇和精心设计的气流通道,而液冷仅需细管和小型泵。
芯片直冷式液冷将冷冻水(或专用介电冷却液)输送至直接安装在各个 GPU 封装上的机加工铜制冷板。冷板通过一层薄薄的导热界面材料与 GPU 的散热盖接触,形成热阻低于 0.1 K/W 的传热路径。冷却液在距芯片裸片表面数毫米处吸收热量,再通过歧管和管道将热量输送至机架级或机架行级的冷却液分配单元(CDU)。
CDU 将芯片级冷却液回路(使用去离子水或介电流体的闭式回路)中的热量传递至建筑的冷冻水回路,后者通过冷却塔或干式冷却器将热量排放至外部环境。这种双回路设计将芯片级冷却液(必须具有极高的纯度,以避免在冷板上形成矿物沉积)与建筑级用水(过滤要求相对宽松)隔离开来。
由于液体冷却介质单位体积的吸热能力要强得多,服务器级风扇可以完全取消(或缩减为用于 DIMM 和 VRM 等辅助部件的小型风扇)。冷却功耗开销降至 IT 功耗的 3–8%,使 PUE 达到 1.03–1.08。另一个好处是降低噪声:液冷数据中心比风冷数据中心安静得多,这对于与办公区位于同一场址或处于噪声管制区域的设施十分重要。
更为激进的方案是浸没式冷却,即将整个服务器主板浸没在装有非导电介电流体的槽体中。流体通过直接接触每个部件的表面吸收热量,从而省去冷板、风扇,甚至散热器。其原理很简单:如果主板的每个表面都与冷却液接触,热量便无处积聚,并会从整个组件中均匀移除。
单相浸没式冷却使用在整个过程中始终保持液态的流体,通过槽内的对流带走热量。受热流体上升至液面,被泵送通过热交换器,将热量传递至建筑的冷冻水回路,然后返回槽底。
两相浸没式冷却则更进一步:流体在芯片表面沸腾,吸收汽化潜热(每克流体吸收的能量约比单纯温度变化多 100\(\times\)),随后在槽顶的冷表面上冷凝,再滴落回槽内。这一循环可自行维持且效率极高,每个机架可移除超过 200 kW 的热量,PUE 接近 1.02。
其代价在于可维护性:检修故障部件需要排空流体,或在部分浸入流体的情况下操作,而介电流体本身也十分昂贵(仅冷却液成本就达 $20–50 per liter). A single immersion tank holding four server boards may contain 500-1,000 liters of fluid, representing $10,000-50,000。浸没式冷却设施的操作规程与风冷设施差异显著,需要对技术人员进行专门培训,并采用不同的线缆管理方式,因为所有连接器都必须能够长期接触流体。标准铜缆和连接器接触某些介电流体后可能腐蚀或膨胀,因此必须使用专用耐流体材料,这会增加成本,并减少可用的供应链选择。向液冷转变 比较了风冷与液冷两种形态,说明这些运行成本何时会变得不可避免。
| 指标 | 风冷(传统) | 液冷(现代) |
|---|---|---|
| 最大功率密度 | ~20–30 kW/机架 | \(>120\) kW/机架 |
| 冷却效率 | PUE ~1.5–2.0 | PUE ~1.05–1.10 |
| 机制 | 风扇强制送风 | 冷却液直接冷却芯片 |
| 传热介质 | 空气(1.0 kJ/kg/K) | 水(4.18 kJ/kg/K) |
| 风扇功耗 | IT 负载的 30–40% | IT 负载的 \(<5\%\) |
风冷与液冷架构对比 中的架构对比展示了这一阈值的物理原因:空气通过大量气流传递热量,而液体则通过从芯片到冷却液的直接传热路径传递热量。
风冷与液冷架构对比 与 向液冷转变 共同展示了这两种冷却方案之间的鲜明对比。这些冷却技术的资本成本相差一个数量级。标准风冷基础设施的成本为每机架 $2,000–5,000 per rack (fans, CRAC units, raised floor tiles). Direct-to-chip liquid cooling costs $15,000–25,000(cold plates、manifolds、CDUs、piping)。全浸没式冷却的成本为每槽 $30,000–50,000(介电冷却液、密封槽、专用热交换器)。风冷与液冷之间的盈亏平衡分析取决于机架功率密度:在每机架 20 kW 时,风冷较低的 CapEx 在 3 年生命周期内胜出。在每机架 40 kW 时,液冷较低的 PUE(1.08 对 1.5)带来的电费节省在 18–24 个月内抵消了较高的 CapEx。在每机架 60+ kW 时——这是高密度 ML 基础设施的常见形态——风冷在物理上已不可行,比较也就失去了意义。对于 175B 模型的 32 机架训练集群,在每机架 33.5 kW 的条件下,直连芯片的液冷是参考方案,它在密度、可维护性与成本之间取得了平衡。浸没式冷却仅带来边际的 PUE 改善(1.03 对 1.08),却引入了许多组织可能认为在当前机架密度下并不划算的运行复杂性。
Napkin Math 1.7: **冷却税**
考虑一个由 1,024 个 H100 GPU 组成的集群,每个价格为 700 W。
- IT Power: 1,024 \(\times\) 700 W = 716.8 kW
- 风冷(PUE 1.49):设施总功耗 = 716.8 kW \(\times\) 1.49 = 1068.0 kW。冷却开销 = 351.2 kW。
- 液冷(PUE 1.08):设施总功耗 = 716.8 kW \(\times\) 1.08 = 774.1 kW。冷却开销 = 57.3 kW。
节省:液冷可节省 293.9 kW 的持续功耗。在 $0.07/kWh 的条件下,年度节省约为 $180,212。在 3 年硬件生命周期内,仅冷却节省就合计达到 $540,636,通常超过安装液冷基础设施的资本成本。
:::
:::
冷却链的最后一环是排热:将建筑 chilled water loop 中的热量输送到室外环境。主导技术是冷却塔,它向 fill medium 上喷洒温水,利用蒸发将热量带入大气。蒸发冷却在热力学上高效(水的汽化潜热为 2,260 kJ/kg,而显热加热仅为 4.18 kJ/kg/K),但会消耗水资源。
一座 10 MW 的数据中心若采用蒸发式冷却塔,每年耗水量可超过 1 亿升,具体取决于气候与冷却设计,这在水资源紧张地区已成为重要关切。为直观比较,1 亿升约相当于约 1,000 户家庭的年用水总量。随着 ML 数据中心规模增长至 100 MW 以上,其用水足迹已成为地方资源规划中的实质性因素。
干式冷却器(dry coolers)利用风机将空气吹过散热器而不发生蒸发,从而消除了用水,但仅在环境空气温度明显低于冷却液温度时才能高效运行,因此在炎热气候下效果受限。许多设施采用混合方案:冷季使用干式冷却器,热浪期间使用蒸发式冷却塔。
余热再利用 将数据中心的产热视为资源而非废弃物。ML 加速器集群的热密度带来了一个传统 CPU 基础设施容易被忽视的优势:其产热的品位。传统风冷 CPU 机架排出的热空气温度约为 35 摄氏度,这一温度区间对大多数无需高能耗热泵的实用余热利用而言过低。相比之下,液冷 ML 集群的冷却液从其 CDU 返回时的温度为 50–65 摄氏度——属于高品位热量,非常适合区域供热网络、温室气候控制与工业工艺应用。正是这种要求直连芯片冷却的加速器热密度,使 ML 机架在传统 IT 基础设施面前成为市政余热项目的热力学更优候选。北欧已有若干数据中心向市政供热网络输送余热,从而抵消冬季为建筑供暖所需的天燃气或电力。一座 10 MW 的 ML 数据中心可提供约 8–9 MW 的有效热量(计入热泵效率),足以供暖数千套公寓。计入再利用热量可降低净运行成本,但不会使 PUE 低于 1.0,因为 PUE 等于设施总能耗除以 IT 能耗。余热利用应以能源再利用效率(energy reuse effectiveness)或单独的净能耗平衡来报告,二者在导出的有效能量超过设施开销时都可能低于 1.0。
余热再利用的可行性取决于热用户的距离。城市数据中心尽管土地与电力成本更高,往往比偏远设施更具备余热再利用的条件,因为它们靠近居民与商业供暖负荷。结果是一种反直觉的经济优化:位于北欧城市的数据中心可能电费成本更高,但在计入余热收入后净运行成本反而低于虽有更便宜电力却附近没有热用户的偏远设施。
对于 175B 模型的训练集群,冷却技术的选型并非可有可无。1,000 个 H100 组成的集群仅 GPU 自身就耗散 700 kW 热量,这还不包括 CPU、内存、网络以及电源转换损耗。只有液冷才能在所需密度下带走这些热量。机架是问题从计算转向物理学的层级,而冷却基础设施的设计往往决定训练集群能否满负载运行,还是必须降频以避免热失控。
冷却系统可靠性
由于功率密度更高,冷却系统故障在 ML 集群中造成的后果比传统数据中心严重得多。在传统风冷数据中心中,每机架 10 kW,CRAC 单元失效会使温度在数十分钟内缓慢上升,为运维人员留出充分响应时间。而在每机架 100+ kW 的液冷 ML 机架中,冷却液流量中断会在 30–60 秒内使温度达到 GPU 的热保护阈值,因为 cold plate 的热容以及管道中冷却液的小体积所提供的热缓冲极小。
快速热失控推动了一系列设计决策。冷却回路采用 N+1 冗余设计:每个 CDU 配备一台备用泵,管道 manifold 设有旁通阀,可将冷却液重新路由至失效的 CDU 周围。每个 cold plate 处的温度传感器在冷却液出口温度超过阈值(通常为 65 摄氏度)时立即触发告警;当结温接近 83 度上限时,GPU 固件将在数毫秒内降低功耗。
部分设施还保留应急风冷能力作为最后手段的备份。虽然风冷无法在 ML 机架密度下维持满功率运行,但它足以让硬件在降频状态下长时间运行于损坏阈值以下,为运维人员修复液冷系统争取时间。这种“纵深防御”式的冷却可靠性设计反映出:在 10,000 GPU 集群中,一次冷却故障可能同时影响数百个 GPU,冷却中断的潜在财务影响远大于冗余本身的成本。
液冷系统的失效模式与风冷系统在性质上截然不同。风冷是优雅失效:风机故障会降低 airflow,使温度在数分钟内缓慢上升,为自动负载 shedding 留出充分时间。液冷则可能灾难性失效:冷却液泄漏既可能损坏硬件(若冷却液导电),也会移除冷却能力(若泄漏导致回路排空)。允许在不排空整个冷却回路的情况下热插拔服务器节点的快拆接头,是一项关键的设计特性,可将维护停机时间从数小时缩短至数分钟。然而,这些接头也正是冷却回路中最常见的失效点,因为 O-ring 密封件会在数千次连接/断开循环后老化。频繁更换硬件的设施(研究环境中节点经常重新配置的情况很常见)必须为季度性 O-ring 更换预留预算,并储备备用接头。
从独立的推理服务器转向紧密耦合的训练集群时,冷却可靠性的经济性会发生显著变化。在采用同步并行的分布式训练运行中,冷却回路故障若使一个 pod 规模的资源分区闲置,就可能导致整个任务停摆。假设一次冷却故障导致一个配备 256 个 GPU 的 pod 因过热而关机,该 pod 所在的集群配备 10,000 个 GPU。直接硬件成本可以忽略不计,但机会成本极其巨大。若 CDU 泵的修复时间为 4 hours,则 256 个 GPU 按每 GPU 小时 $4 计算,即时损失仅为 $4,096。然而,由于训练算法要求所有工作进程严格同步推进,其余 9,744 个 GPU 也会闲置,消耗电力却无法取得进展。这种拖慢者效应使损失的计算时间成本增至 $160,000。再加上检查点读取和回滚至最近一次保存状态的开销—通常会损失 30 到 60 分钟的计算成果—单次冷却部件故障的总财务影响很容易超过 $200,000。故障成本的非线性增长使冷却回路中的 N+1 冗余成为保障训练经济性的数学必然要求。

一次冷却故障就可能使整个训练任务闲置。
维护液冷回路的物理完整性需要管理复杂的流体与化学动力学过程。芯片直冷系统中循环的流体通常是混有特定缓蚀剂的去离子水,而非普通自来水。电导率必须严格保持在每厘米 1 微西门子(\(\mu\)S/cm)以下,以防止电偶腐蚀,即回路中不同金属(铜冷板和不锈钢歧管)之间的电位差侵蚀冷却表面的现象。这种化学平衡并不稳定:缓蚀剂会随时间逐渐消耗,溶解气体也会累积,因此需要每月检测水质,并每年更换全部冷却液。生物污染同样构成严重威胁。冷板内部微翅片上生长的生物膜会形成隔热层;仅 50 微米厚的有机生长层就可能使传热系数下降 30%,迫使泵以最大功率运行以作补偿。因此,定期使用杀生剂和周期性冲洗系统,对集群性能的重要性与驱动程序更新或固件补丁相当。
训练与推理能耗分析
冷却基础设施负责处理集群的高强度热负荷,但这一负荷的总量取决于集群是在执行集中的训练运行,还是在处理全球分布式推理工作负载。训练一个超大规模语言模型是一场壮观且备受瞩目的能源消耗事件,如同发射火箭。部署同一个模型以服务每日十亿次查询,则如同运营一家国际航空公司的机队。训练在数月内通过一次集中的运行消耗数千兆瓦时的电能;推理则逐次查询、年复一年地持续消耗能源。了解能源预算的主要去向,决定了优化工作必须集中于何处。
不同生命周期阶段的优化机会各不相同。训练优化侧重计算效率和硬件利用率,而推理优化强调延迟、吞吐量和边缘部署策略。针对每种应用的主要能耗来源采取相应的可持续性干预措施,能够获得最大的收益。
训练能耗需求
训练大型 AI 模型可能需要拥有数十万个核心和专用 AI 加速器的计算基础设施,并持续运行数月。微软在 2020 年披露的 OpenAI 专用超级计算机是当时专为大规模 AI 训练构建的,配备 285,000 个 CPU 核心、10,000 个 GPU,每台服务器的网络带宽超过每秒 400 吉比特 (Langston 2020年)。这一 2020 年的数据仍可作为经过校准的参考点,而不应被视为对后续几代最大可用基础设施规模的断言。
Langston, Jennifer. 2020年. Microsoft Announces New Supercomputer, Lays Out Vision for Future AI Work. Microsoft Source.
高强度计算负载会产生热量,冷却基础设施必须持续将其移除;节 1.3.6 中关于冷却的讨论量化了这一开销。降低这一开销需要协同优化硬件架构、并行策略和算法效率。
每个模型的训练能源成本只发生一次,但这一一次性成本仍决定了设施规模、检查点存储和该次运行的碳核算。主要的可持续性挑战往往出现在部署阶段,此时推理工作负载持续服务数百万或数十亿用户,并可能在请求量足够大时超过训练能耗。
推理能源成本
每当 AI 模型响应查询、对图像进行分类或作出预测时,都会执行推理工作负载。与训练不同,推理在搜索引擎、推荐系统和生成式 AI 模型等应用中动态且持续地扩展。尽管单个推理请求消耗的能源远少于训练,但高请求量的已部署服务所累积的能耗可以与训练相关能耗相当,甚至超过后者 (Wu 等 2022年)。
例如,AI 驱动的搜索引擎每天处理数十亿次查询,推荐系统持续提供个性化内容,而 ChatGPT 或 DALL-E 等生成式 AI 服务的单次查询计算成本也相当可观。基于 Transformer 的模型对内存带宽和计算带宽的需求很高,因此其推理能源足迹较大。
早期市场预测已预见了这一转变:麦肯锡在 2017 年发布的预测(图 17)预计,数据中心推理市场将从 40-50 亿美元大致翻倍至 90-100 亿美元,边缘推理市场将从接近零增至 40-45 亿美元,时间点为 2025 年;两者的增速都将超过增长较慢的训练市场。更有力的证据来自物理层面的测量,而非经济预测。图 15 中的 Meta 生命周期测量表明,对于已部署的推荐模型,大规模推理服务的排放量与训练相当,甚至超过训练;本章自身的核算也表明,一旦请求量足够大,持续推理服务的能耗就会超过一次性训练运行的能耗。
与传统具有固定能源足迹的软件应用不同,推理工作负载会随用户需求动态扩展。像 Alexa、Siri 和 Google Assistant 这样的 AI 服务依赖持续性的云端推理,每分钟处理数百万次语音查询,因而需要能源密集型数据中心基础设施不间断运行。
The energy inefficiency of the decode phase
在大规模下运行推理 将预填充(prefill)和解码(decode)引入为延迟阶段;可持续性分析复用这一划分作为能源模型。预填充倾向于使计算资源饱和,而解码会为每个生成 token 反复将模型状态和 KV 缓存状态流式传输通过内存。由于解码与预填充的能耗浪费方式不同,服务能源足迹随之增大,两个推理阶段之间的差距十分显著(图 18)。
图 18 所总结的预填充/解码区分,不仅适用于延迟,也适用于能源效率。近期分析 (Ma 和 Patterson 2026年) 表明,自回归生成相比批处理在本质上是能源浪费的,因为两个阶段分别对不同的硬件限制形成压力。在预填充 阶段,较高的算术强度使 GPU 每从内存读取一个字节就能执行数千次运算,从而接近 pJ/FLOP 的峰值能源效率。在解码 阶段,模型必须从 HBM 读取整个权重集才能生成单个 token;由于算术强度较低,计算单元在大部分周期内处于空闲状态。
Ma, Xiaoyu, 和 David Patterson. 2026年. Challenges and Research Directions for Large Language Model Inference Hardware. No. 5. 卷 59. https://doi.org/10.1109/mc.2026.3652916.
由此产生静态功耗浪费:GPU 在等待内存传输期间会消耗可观的漏电流和时钟功耗。因此,通过 1,000 个顺序解码步骤生成 1,000 个 token,其能耗可能比在单个预填充批处理中处理同样 1,000 个 token 高出 10–50\(\times\) 倍。这种低效推动了对专用、面向内存优化的 NPU 和 TPU 的需求,相关内容见 计算基础设施,这些器件将每瓦带宽置于原始 TFLOP/s 之上。
边缘 AI 影响
边缘智能 提出的边缘智能架构使推理得以扩展到集中式数据中心之外。这种分布式方法通过降低数据传输的能源成本、减少对高功耗云基础设施的依赖,带来了独特的可持续性优势。AI 请求不必全部路由到集中式云服务器,模型可以直接部署在用户设备上或边缘计算节点。
然而,在边缘执行推理并不能消除能源问题,尤其是在 AI 大规模部署时。例如,自动驾驶车辆需要毫秒级延迟的 AI 推理,这意味着云处理并不现实。车辆转而使用车载 AI 加速器,其功能相当于”行驶中的数据中心” (Sudhakar 等 2023年)。这些嵌入式计算系统处理相当于小型数据中心的实时传感器数据,即使不依赖云端推理,也会消耗可观的功率。
Sudhakar, Soumya, Vivienne Sze, 和 Sertac Karaman. 2023年. 《Data Centers on Wheels: Emissions From Computing Onboard Autonomous Vehicles》. IEEE Micro 43 (1): 29~39. https://doi.org/10.1109/mm.2022.3219803.
同样,智能手机、可穿戴设备和 IoT 传感器等消费级设备各自仅消耗毫瓦到瓦级的功率,但由于数量极其庞大,其合计能耗为全球能源使用量贡献了太瓦时级别的量级。因此,边缘计算的效率收益必须与设备部署的庞大规模相权衡。
若设计得当,边缘部署可以比云部署更具可持续性。消除数据传输、本地处理效率以及按需启停(duty-cycled)运行这三者的结合,可使系统总能耗相比始终在线的云推理降低数个数量级。
边缘与移动设备的功耗预算
基于 ARM 的边缘设备所面临的功耗约束,与数据中心加速器有着根本性的差异。工程上的选择是:将每个推理工作负载匹配到满足延迟与精度要求的最小功耗档位。
功耗预算反映了电池容量、热耗散和部署环境所构成的物理约束。表 4 汇总了边缘 AI 功耗预算类别,并展示了这些约束如何传导:TinyML 设备依靠硬币电池或能量采集供电,平均功耗不得超过毫瓦;移动设备必须在用户体验与电池续航之间取得平衡;车载系统虽然可以使用车辆供电,但仍面临封闭车舱内的热约束。
| 平台类别 | 空闲功耗 | 活跃功耗 | 峰值功耗 | 示例设备 |
|---|---|---|---|---|
| TinyML(MCU) | 1–100 \(\mu\)W | 1–50 mW | 100 mW | Arduino Nano 33, STM32H7, Nordic nRF5340 |
| 移动 NPU | 10–100 mW | 0.5–5 W | 10 W | Pixel Tensor, Apple Neural Engine, Snapdragon NPU |
| 边缘 GPU/TPU | 1–5 W | 5–30 W | 75 W | NVIDIA Jetson Orin NX(10–25 W)和 AGX Orin(15–60 W)、Google Edge TPU、RPi AI Kit |
| 自动驾驶车辆 | 10–50 W | 50–200 W | 500 W | Tesla FSD Computer, Mobileye EyeQ, NVIDIA Drive |
TinyML 功耗状态动态
虽然 边缘智能 从系统架构角度考察 TinyML,但设备端推理的能源效率同样是一项可持续性考量:数十亿次边缘推理调用在集群规模上会汇聚为可观的碳足迹。TinyML 的效率高度依赖按需启停(duty cycling),即设备在深度睡眠与活跃推理之间切换。公式 14 将平均功耗表示为活跃功耗与睡眠功耗的加权求和:
\[P_{\text{average}} = P_{\text{active}} \times \frac{t_{\text{inference}}}{T_{\text{period}}} + P_{\text{sleep}} \times \frac{T_{\text{period}} - t_{\text{inference}}}{T_{\text{period}}} \tag{14}\]
对于一个运行在 Cortex-M4 微控制器上的关键词检测模型(Archetype C(联邦 MobileNet)机制,三种系统架构原型):
- 活跃推理功耗:每次检测周期 20 ms 的 15 mW
- 深度睡眠功耗:3.3V 下 10 微安(33 微瓦)
- 检测周期:1 秒(持续监听)
\[P_{\text{average}} = 15 \text{ mW} \times \frac{20 \text{ ms}}{1000 \text{ ms}} + 0.033 \text{ mW} \times \frac{980 \text{ ms}}{1000 \text{ ms}}\]
\[P_{\text{average}} = 0.30 \text{ mW} + 0.032 \text{ mW} = 0.33 \text{ mW}\]
在如此平均功耗下,一颗 250 mAh 硬币电池(标称 3.0V)可提供约 2,270 小时的工作时间,接近 95 天不间断的始终在线 AI 推理。这一计算展示了 TinyML 如何使高功耗平台无法实现的可持续 AI 部署场景成为可能。这些面向功耗感知的设计原则可以直接应用于实际的工业部署场景。
Napkin Math 1.8: TinyML 电池寿命
问题:计算部署在工厂传感器节点上的异常检测 TinyML 自编码器的运行寿命,该节点使用两节 AA 电池(3000 mAh,3.0V)。
变量:
- MCU:80 MHz 的 ARM Cortex-M4
- 活跃功耗:10 Hz 下 5 ms 推理期间的 12 mW(占空比 5%)
- 睡眠功耗:95 ms 睡眠期间的 16.5 \(\mu\text{W}\)(3.3V 下为 5 \(\mu\text{A}\))
计算:
- 平均功耗:\(P_{\text{avg}} = 12 \text{ mW} \times 0.05 + 0.0165 \text{ mW} \times 0.95 = 0.616 \text{ mW}\)。
- 电池容量:\(E_{\text{battery}} = 3000 \text{ mAh} \times 3.0 \text{ V} = 9000 \text{ mWh}\)。
- 电池寿命:\(t_{\text{life}} = \frac{9000 \text{ mWh}}{0.616 \text{ mW}} \approx 14,610 \text{ hours} \approx 1.7 \text{ years}\)。
系统洞见:该部署在标准电池上实现了接近两年的持续 AI 监控,展示了遵循面向功耗感知原则设计的 TinyML 系统的可持续性潜力。
设备端学习与电池墙
TinyML 设备上的推理虽然效率很高,但设备端学习引入了陡峭得多的能源挑战。将模型个性化为用户的特定语音或步态需要进行反向传播,其所需的计算和内存比前向推理多 2–3\(\times\) 倍。
移动处理器的 TDP 会对端侧学习策略的方方面面形成硬性约束。现代智能手机通常将 2–3 W 的持续处理能力用于机器学习任务,以避免热不适;但在发生热节流之前,可以短暂突增到 5–10 W。该 TDP 决定了自适应算法的整个可行空间。
Napkin Math 1.9: 学习能耗
问题:考虑在一台用户的智能手机上,用一夜的时间对小型语言模型进行微调(1B 参数)。这是否能在 5 percent 的电池预算内实现?
数学:
- 手机电池:典型容量约为 15 Wh,即约 54000 J。
- 预算:5 percent 的 54000 J = 2700 J。
- 训练成本:
- 前向传播:\(\approx\) 2 nJ/参数。
- 反向传播:\(\approx\) 4 nJ/参数。
- 每个 token 的总成本:6 nJ/参数 \(\times 10^9\) 参数 = 6 J/token。
- 容量:2700 J / 6 J/token = 450 tokens。
系统洞见:完整的微调在合理的每日电池预算内无法实现。可持续的端侧学习需要采用参数高效微调或稀疏更新,将每个 token 的能耗降低 100\(\times\) 倍以上。
能耗的基本物理规律揭示了为什么只要模型足够紧凑,本地处理几乎总是优于云端卸载。
::::{#psp-sustainable-ai-energy-hierarchy .callout-perspective title=“能耗层级”}
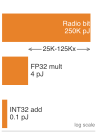
无线传输的能耗远大于本地算术运算。
权衡:在本地处理数据与将其发送到云端之间进行架构选择,由能量预算决定。能耗的物理规律基于能耗与通信之比给出了清晰的答案。
每次操作的能耗成本(近似):
- 32 位整数加法:0.1 pJ
- 32 位浮点乘法:4 pJ
- 无线传输(1 比特):100,000–500,000 pJ(蓝牙/Wi-Fi)
系统洞见:按照上述操作成本假设,传输单个比特数据所需的能量,大致相当于执行 25,000 到 125,000 次 FP32 乘法,或 100 万到 500 万次 32 位整数加法。当每比特的数据可以用少于约 100,000 次浮点运算提取出洞察时,本地处理通常比云端卸载更节能。该比值驱动了联邦学习的架构:计算便宜;射频传输昂贵。
为自主边缘 AI 而设的能源采集
经过充分的优化,TinyML 能够实现能源自主运行,设备从环境能源中采集能量,而不再依赖电池:
考虑能量采集功率预算(见 表 5):一个经过优化、平均功耗为 0.5 mW 的关键词检测模型,可以依靠约 5 cm² 的室内太阳能采集无限期运行,但仅限于室内光照明亮、接近所列范围上限的条件。典型的室内部署需要更大的采集面积、储能、占空比控制,或平均功耗更低的模型,以为转换损耗和昏暗光照留出余量。这种永续运行模式代表了可持续边缘 AI 部署的终极形态,其运行所需的能量完全来自环境。
| 采集来源 | 典型功率 | 可行的 TinyML 应用 |
|---|---|---|
| 室内太阳能(1 cm²) | 10–100 微瓦 | 周期性传感器分类 |
| 室外太阳能(1 cm²) | 1–10 毫瓦 | 连续关键词检测 |
| 热电(人体热量) | 10–100 微瓦 | 可穿戴手势识别 |
| 射频能量采集(Wi-Fi) | 1–10 微瓦 | 超低占空比传感器节点 |
| 振动压电 | 100 微瓦–1 mW | 工业监测 |
级联推理架构
除了单个设备的效率之外,架构模式还决定了跨边缘与云端边界的系统总能耗。级联架构部署一个小型边缘模型(小于 100 KB),在云端推理之前过滤输入。公式 15 将总能耗表示为本地处理能耗与按概率触发的云端能耗之和:
\[E_{\text{cascade}} = E_{\text{edge}} + p_{\text{escalate}} \times (E_{\text{transmit}} + E_{\text{cloud}}) \tag{15}\]
其中,\(p_{\text{escalate}}\) 是需要云端推理的概率(对于设计良好的级联架构,通常为 5–20%)。
对于一个视觉检测系统:
- 边缘模型(MobileNet-v3 tiny):每次图像分类耗能 0.5 mJ
- 云端模型(ResNet-152):每次分类耗能 50 mJ
- 传输能耗:每张图像 10 mJ(蜂窝网络)
- 转交云端的比例:10%(仅将难以判定的样本发送到云端)
\[E_{\text{cascade}} = 0.5 + 0.10 \times (10 + 50) = 0.5 + 6.0 = 6.5 \text{ mJ/image}\]
与每张图像耗能 60 mJ 的始终使用云端推理的方式相比,级联架构实现了 89% 的能耗降低,同时通过选择性地将样本转交云端处理来保持准确率。
唤醒词触发系统
常开系统采用分层唤醒检测,以尽可能降低平均功耗:
- 超低功耗模拟前端:以 10 微瓦的功耗持续进行语音活动检测
- 微型神经网络唤醒检测器:检测到语音时功耗为 100 微瓦
- 完整模型推理:以 10 mW 的功耗运行 50 ms,在确认唤醒词后触发
在典型语音活动率 5 个百分点和唤醒词出现率 0.1 个百分点的条件下:
\[P_{\text{average}} = 0.01 + 0.05 \times 0.1 + 0.001 \times 10 \times 0.05 = 0.0155 mW\]
分层方法将平均功耗降至 15.5 μW,而常开式完整推理为 10 mW,实现了 645.2× 的降低,从而支持具备多年运行能力的电池供电语音助手。
联邦学习能耗分析
在边缘端训练将原始数据保留在本地,但用重复的模型下载和客户端更新上传来替代其传输。公式 16 对比了联邦式与集中式方法之间的能耗权衡,其中 \(R\) 表示轮次数量,\(N_{\text{clients}}\) 表示每轮参与的客户端数量:
\[E_{\text{federated}} = R \left[N_{\text{clients}} \left(E_{\text{local\_train}} + E_{\text{download}} + E_{\text{upload}}\right) + E_{\text{aggregation}}\right]\] \[E_{\text{centralized}} = N_{\text{clients}} \times E_{\text{raw\_data\_upload}} + E_{\text{cloud\_train}} \tag{16}\]
只有当重复的模型通信、本地训练和聚合所消耗的能耗低于原始数据传输与集中式训练的能耗时,联邦学习才更具能耗效率。数据量超过单个模型更新本身并不足以说明问题,因为下载和上传会在各轮次中反复发生。对于具有丰富传感器数据且对隐私敏感的应用,当完整的通信与计算项都更利于本地训练时,联邦式方法仍能同时实现隐私与能耗收益。边缘分析还留下了生命周期中的另一项:生产设备与加速器的物理供应链。
水、化学品与关键材料
AI 的环境足迹不仅限于电力消耗,还包括需要采用不同评估方法的物理资源——水、危险化学品和关键材料。全面的评估需要测量额外的生态影响,包括用水消耗、危险化学品使用、稀有材料开采以及对生物多样性的破坏,尽管这些影响在生态重要性上往往受到较少关注。生产 AI 芯片的现代半导体制造厂每天需要数百万升水,其工艺使用超过 250 种危险物质。在台湾、亚利桑那和辛加坡等已经面临用水压力的地区,这种高强度用水威胁着当地生态系统和社区。AI 硬件也高度依赖镓、铟、砷和氦等稀缺材料,这些材料既面临地缘政治供应风险,也面临耗竭问题 Chen (2006年)。
Chen, H.-W. 2006年. 《Gallium, Indium, and Arsenic Pollution of Groundwater From a Semiconductor Manufacturing Area of Taiwan》. Bulletin of Environmental Contamination and Toxicology 77 (2): 289~96. https://doi.org/10.1007/s00128-006-1062-3.
The Green Grid. 2011年. Water Usage Effectiveness (WUE): A Green Grid Data Center Sustainability Metric. White Paper 35. The Green Grid.
水核算需要超过单一的 WUE 比值。取水衡量从水源中取出的水量,而消耗衡量未能以可用形式返回同一流域的部分。该核算必须将现场直接冷却用水与发电和制造硬件所用的间接用水区分开来,然后将每一条水流分别对应到其流域、季节和当地稀缺程度 The Green Grid (2011年)。低压力流域湿润季节消耗的一升水,并不等同于高压力流域干旱期间消耗的一升水,因此决策级比较会同时报告物理水量和经压力加权的结果。回用率百分比也需要声明分母,因为设施内部的水循环回用可以降低取水量,但并不能消除蒸发消耗。
半导体制造是一个异常耗水的过程 (Cooper 等 2011年)。TSMC 位于亚利桑那的制造厂预计每天消耗 3,400 万升水18 (Reuters 2024年),约占该市总供水量的 3 个百分点。完成一整片 300mm 硅片的全部制造过程需要超过 8,300 升水。图 19 展示了典型的制造厂水循环,其中先进的循环回用可以回收 60–80 个百分点的水,但仍留下可观的消耗足迹。
Cooper, Tom, Suzanne Fallender, Joyann Pafumi, Jon Dettling, Sebastien Humbert, 和 Lindsay Lessard. 2011年. 《A semiconductor company’s examination of its water footprint approach》. Proceedings of the 2011 IEEE International Symposium on Sustainable Systems and Technology, 1~6. https://doi.org/10.1109/issst.2011.5936865.
18 半导体用水规模 :TSMC 亚利桑那制造厂每年将消耗 120 亿升水(约相当于 4,800 个奥林匹克标准泳池),而先进节点的 AI 芯片每片所需的用水量比旧工艺节点多 5–10\(\times\),这是因为增加了 EUV 和清洗步骤。这种用水依赖形成了直接的可持续性约束:在亚利桑那和台湾等干旱易发地区,半导体用水需求可能达到一座城市总配给量的 3 个百分点。
Reuters. 2024年. Water-guzzling chipmaker TSMC and drought-plagued Arizona are an unlikely pair, but Phoenix says it has enough water. Fortune magazine, 8 April 2024.
从 图 19 得出的关键结论是:即使回收率达到 60%–80%,先进制程晶圆厂消耗的超纯水绝对量依然巨大,从而对 AI 芯片制造可持续运营的地域形成了硬性物理约束。
制造过程也高度依赖蚀刻、掺杂和清洗所用的危险化学品。强酸(氢氟酸、硫酸)、易挥发有机化合物(如二甲苯)以及高毒性气体(砷化氢、磷化氢)被大量使用——一家大型晶圆厂每年可能消耗超过 2,000 公吨酸类 (Kim 等 2018年)。这些物质会产生危险废弃物流,需要大规模处理以避免生态危害。
Kim, Sunju, Chungsik Yoon, Seunghon Ham, Jihoon Park, Ohun Kwon, Donguk Park, Sangjun Choi, Seungwon Kim, Kwonchul Ha, 和 Won Kim. 2018年. 《Chemical use in the semiconductor manufacturing industry》. International Journal of Occupational and Environmental Health 24 (3-4): 109~18. https://doi.org/10.1080/10773525.2018.1519957.
Rhodes, Christopher J. 2019年. 《Endangered Elements, Critical Raw Materials and Conflict Minerals》. Science Progress 102 (4): 304~50. https://doi.org/10.1177/0036850419884873.
AI 硬件依赖于一整套稀缺且具有地缘政治敏感性的 关键材料。虽然硅储量丰富,但高性能芯片需要镓、铟、钽和氦等稀有元素。铟等材料之所以出现在关键材料分析和濒危元素分析中,是因为其供应可能依赖副产物提取、替代方案以及回收限制 (Rhodes 2019年)。稀土精炼的地域集中造成了显著的供应链脆弱性。表 6 量化了这一材料依赖挑战的规模。
| 材料 | 在 AI 半导体制造中的应用 | 供应担忧 |
|---|---|---|
| 硅 (Si) | 芯片、晶圆、晶体管的主要衬底 | • 加工限制 • 地缘政治风险 |
| 镓 (Ga) | 氮化镓功率放大器、高频器件 | • 供应有限 • 铝和锌生产的副产物 |
| 锗 (Ge) | 高速晶体管、光电探测器、光互连 | • 稀缺 • 地理分布集中 |
| 铟 (In) | 氧化铟锡、光电子器件 | • 储量有限 • 依赖回收 |
| 钽 (Ta) | 电容、稳定型集成电路组件 | • 冲突矿产 • 供应链脆弱 |
| 稀土元素 | 磁体、传感器、高性能电子器件 | • 地缘政治风险高 • 环境提取担忧 |
| 钴 (Co) | 边缘计算设备的电池 | • 人权问题 • 地理集中(刚果) |
| 钨 (W) | 互连、阻挡层、散热片 | • 生产地点有限 • 地缘政治担忧 |
| 铜 (Cu) | 互连、阻挡层、散热片 | • 高纯来源有限 • 地缘政治担忧 |
| 氦 (He) | 半导体冷却、等离子体蚀刻、EUV 光刻 | • 不可再生 • 大气逸失不可回收 • 提取能力有限 |
晶圆厂和数据中心的建设与运营也会直接通过栖息地破坏、水资源压力以及化学排放造成的污染影响自然生态系统。半导体行业的排放物可能污染附近河流沉积物中的重金属和痕量元素 (Hsu 等 2016年)。制造产生的废弃物——包括气体排放、含 VOC 的空气以及含金属的工业废水——需要先进的处理系统;而 AI 硬件的报废处置则加剧了电子废弃物危机,全球仅 17.4% 的电子废弃物得到妥善回收 (Singh 和 Ogunseitan 2022年)。
Hsu, Liang-Ching, Ching-Yi Huang, Yen-Hsun Chuang, Ho-Wen Chen, Ya-Ting Chan, Heng Yi Teah, Tsan-Yao Chen, Chiung-Fen Chang, Yu-Ting Liu, 和 Yu-Min Tzou. 2016年. 《Accumulation of heavy metals and trace elements in fluvial sediments received effluents from traditional and semiconductor industries》. Scientific Reports 6 (1): 34250. https://doi.org/10.1038/srep34250.
计算需求的环境代价远远超出大气碳排,表现为制造枢纽周边严重的水资源压力与生态破坏。这些供应链成本汇聚到下一个设计杠杆:大规模、资源密集型硬件集群在变成废弃物之前能够保持有用状态多长时间。
硬件生命周期与电子废弃物
AI 加速器的环境成本早在其首个 FLOP 被计算之前就已经开始 (Gupta 等 2022年; Luccioni 等 2023年; NVIDIA Corporation 2025年)。节 1.2.1.1 中量化的单块 H100 制造足迹完全发生在制造环节。19 训练 175B 参数模型所需的数千台此类处理器——耗电 1,287 MWh——在产生任何计算之前即构成显著的初始碳投入。一项全面的 生命周期评估 (LCA) 量化了跨越四个关键阶段(设计、制造、使用、报废)的累计环境影响。LCA 可以揭示制造环节占生命周期影响的很大比重,使其成为仅靠运行效率改进无法解决的可持续性关键杠杆。
Gupta, Udit, Young Geun Kim, Sylvia Lee, Jordan Tse, Hsien-Hsin S Lee, Gu-Yeon Wei, David Brooks, 和 Carole-Jean Wu. 2022年. 《Chasing Carbon: The Elusive Environmental Footprint of Computing》. IEEE Micro 42 (4): 37~47. https://doi.org/10.1109/MM.2022.3163226.
19 生命周期评估 (LCA):依据 ISO 14040/14044 标准化,LCA 追踪从原材料开采到报废全过程的环境影响 (International Organization for Standardization 2006年a, 2006年b)。对于 AI 硬件,LCA 将制造环节的隐含排放与运行期能耗区分开来,使硬件更新周期和加速器寿命延长成为仅靠运行效率无法替代的一级可持续性杠杆。
International Organization for Standardization. 2006年a. ISO 14040:2006 Environmental Management – Life Cycle Assessment – Principles and Framework. ISO standard.
International Organization for Standardization. 2006年b. ISO 14044:2006 Environmental Management – Life Cycle Assessment – Requirements and Guidelines. ISO standard.
Checkpoint: 训练与推理的翻转
考虑一个视觉模型:训练需要 2,000 GPU 小时,平均功耗为 300 W。部署后,该模型每天服务 100 万请求,每次请求耗时 50 ms,平均功耗为 100 W。
生命周期评估可以表明,仅仅为了小幅效率提升而丢弃仍可正常工作的硬件,其隐含碳造成的环境危害可能超过运行能耗节省。评估“新硬件何时才具备环境合理性”这一临界点,需要估算训练成本、推理规模与硬件寿命三者之间的交点。
AI 系统总环境足迹的四个主要生命周期阶段各自都有贡献。图 20 将这一过程从设计到报废的演进可视化,凸显各阶段之间的相互依赖关系,以及每个阶段所对应的环境影响类别。
生命周期序列并非一成不变的分类体系。随着系统成熟,约束性可持续性问题的重心会不断转移:设计产生实验性浪费,制造锁定隐含碳,使用阶段将工作负载与电网和冷却约束耦合,报废将电子废弃物外部化,而延长寿命则成为摊薄此前所有排放、覆盖更多有用工作的杠杆。
设计与实验阶段
设计阶段涵盖 ML 模型在部署之前的研究、开发与优化。公开的训练能耗数据通常描述的是最终一次运行,而非其之前的试错过程。自动架构搜索可以评估大量配置,但其足迹取决于边界是否涵盖代理搜索、完整运行、数据中心开销、电网结构,以及下游模型之间的复用 (Strubell 等 2019年; Patterson 等 2021年)。后续更高效的 NAS 方法通过权重共享、连续松弛和硬件感知搜索来降低搜索预算 (Elsken 等 2019年)。表 7 比较了不同模型规模下最终运行的足迹,并未计入未披露的实验过程。
| AI 模型 | 训练 FLOPs | 估算 CO2 排放 (kg) | 等效驾车里程 |
|---|---|---|---|
| GPT-3 | \(3.1 \times 10^{23}\) | 502,000 kg | 1.9 million km |
| T5-11B | \(2.3 \times 10^{22}\) | 85,000 kg | 338,000 km |
| BERT (Base) | \(3.3 \times 10^{18}\) | 650 kg | 2,400 km |
| ResNet-50 | \(2.0 \times 10^{17}\) | 35 kg | 129 km |
要应对设计阶段的可持续性挑战,需要训练效率方面的创新:稀疏训练、低精度运算、权重共享,以及面向能效的 NAS 方法。迁移学习和对预训练模型的微调复用预训练表示,而无需为每个任务从头训练 (Raffel 等 2020年)。
制造阶段
AI 硬件的制造资源消耗极为巨大,在产生任何计算之前就已承载了 节 1.2.1.1 中确定的单块 H100 隐含碳。半导体制造需要极高的精度,涉及 EUV 光刻(每台设备持续耗电约 1 MW)、化学气相沉积和离子注入等工艺。节 1.4.3 中详列的资源需求揭示了其规模:台积电亚利桑那晶圆厂每天消耗 3,400 万升水,制造过程依赖超过 250 种危险物质,供应链则依赖地缘政治高度集中的关键材料。
AI 加速器的两项结构性特征放大了其相对传统芯片的制造足迹。其一,高性能 AI 芯片通常制造在或接近掩模版极限——即单次光刻曝光能够印出的最大芯片面积。更大的芯片意味着每片晶圆产出的芯片数量更少,且对随机缺陷的脆弱性不成比例地更高:缺陷密度若会淘汰 5% 的小芯片,可能淘汰接近掩模版极限的芯片的 20% 或更多,从而实际上浪费掉制造每个缺陷单元所消耗的水、化学品和 EUV 能量。其二,大规模推理与训练对内存带宽的需求催生了先进的 2.5D 与 3D 封装——例如台积电的 Chip-on-Wafer-on-Substrate (CoWoS) 工艺——将高带宽内存堆栈直接键合到加速器芯片上。这种集成引入了额外的制造工序、化学清洗周期和精密烘烤步骤,而传统单体 CPU 并不需要这些步骤。结果是,每块可用的 AI 加速器所蕴含的水消耗、危险化学品用量和工艺能耗,都远高于仅凭其晶圆面积所能推断的水平,因此硬件寿命与高利用率成为一级可持续性杠杆,而非次要考量。
制造 AI 硬件所需的能量十分可观,在清洁电网区域,制造环节的隐含影响在整个使用期内可以与运行环节的影响相媲美。关于环保电子的研究指出了低毒性材料、改进的回收以及更绿色的器件与制造方法,作为电子产品生产的可持续性方向 (Cenci 等 2021年; Irimia-Vladu 2014年)。
Cenci, Marcelo Pilotto, Tatiana Scarazzato, Daniel Dotto Munchen, Paula Cristina Dartora, Hugo Marcelo Veit, Andrea Moura Bernardes, 和 Pablo R. Dias. 2021年. 《Eco-Friendly Electronics—a Comprehensive Review》. Advanced Materials Technologies 7 (2): 2001263. https://doi.org/10.1002/admt.202001263.
Irimia-Vladu, M. 2014年. 《〈Green〉 electronics: biodegradable and biocompatible materials and devices for sustainable future》. Chemical Society Reviews 43 (2): 588~610. https://doi.org/10.1039/c3cs60235d.
使用阶段
训练与推理期间消耗的运行能耗详见 节 1.4。此处值得关注的是这一消耗的模式,以及它与电网基础设施之间的相互作用。训练 175B 模型所需的 1,287 MWh 代表高而连续的功率取用——但这种取用的性质并非在所有工作负载类型之间都一致,这一区别决定了哪些调度干预措施切实可行。
大规模分布式训练运行在数千台加速器上持续消耗相关电力,通常被描述为缺乏弹性。这一特征低估了分布式训练本身已经内置的调度弹性:由于千节点集群中单点硬件故障就可能毁掉一次训练运行,生产训练系统会每隔几分钟到几小时将状态检查点化到持久化存储中。正是这项检查点机制,为碳感知调度提供了可能:训练任务可以在傍晚电网高峰时段(此时太阳能发电下降、化石燃料调峰机组并网)暂停,将集群状态保存为检查点,并在夜间风电发电提升可再生能源可用度时恢复。保护硬件故障的同一套工程,同时也成为电网脱碳的调度杠杆——故障容错与可持续性之间的这种耦合,在同步推理服务中没有任何对应物,因为同步推理无法在请求处理过程中暂停。
这种弹性与训练集群在持续运行时确实加剧的“鸭曲线”问题形成鲜明对比。鸭曲线 描述的是电网运营商在傍晚太阳能发电下降时必须填补的陡峭爬坡:数据中心在过渡期持续抽取恒定兆瓦级功率,会加深这一爬坡并增加对化石燃料调峰机组的依赖。冷却系统进一步加剧了这一问题,在计算功耗之上叠加了 节 1.3.6 所量化的额外开销。利用检查点机制、在高碳窗口暂停训练的碳感知调度器——通常是跨越太阳能到调峰机组过渡的约两到四小时——可以将训练能耗的相当一部分转移到边际电网碳强度较低的时段。地理优化(节 1.2)针对的是基线问题,而时间调度针对的是同一电网区域内随时间变化的部分。
处置、电子废弃物与嵌入式 AI
AI 硬件创新步伐的加快催生了一个不断升级的循环 (Slade 2007年),加剧了全球电子废弃物(e-waste)危机的蔓延。全球每年产生超过 5000 万吨电子废弃物,其中仅 17.4% 被正式记录为已收集并得到妥善回收(Singh 和 Ogunseitan 2022年)。用于训练大模型的服务器具有三到五年的典型使用寿命,之后即被视为过时。被丢弃的 AI 硬件含有有毒物质——铅、汞、镉和铍——当其在填埋场或非正规回收设施中处置时,会渗入土壤和地下水(Grossman 2007年)。
Slade, G. 2007年. Made to Break: Technology and Obsolescence in America. Harvard University Press. https://doi.org/10.4159/9780674043756.
Singh, Narendra, 和 Oladele A. Ogunseitan. 2022年. 《Disentangling the worldwide web of e-waste and climate change co-benefits》. Circular Economy 1 (2): 100011. https://doi.org/10.1016/j.cec.2022.100011.
Grossman, E. 2007年. High tech trash: Digital devices, hidden toxics, and human health. Island press.
两种仅存在于机器学习基础设施中的机制,使得这种过时来得更快、更加浪费。AI 加速器很少达到其物理硅片的寿命终点;相反,它们会因新模型架构暴露出的内存带宽和互连带宽瓶颈而过时。通过 PCIe Gen 4 互联的 GPU 集群可能拥有完全可用的计算硅片,却低于维持更新一代更大模型所需集合通信模式的最小互连带宽。由于互连集成在主板上而非芯片中,整个节点——而不只是加速器——都必须更换。与可插入标准化 ATX 或 OCP 主板的传统 CPU 不同,现代 AI 节点将加速器安装到围绕特定一代 NVLink、NVSwitch 和 HBM 设计的专用主板上。当集群升级面向新的模型架构时,主板、网络主机通道适配器和主机服务器往往需要一并更换,而不是仅仅更换一张 PCIe 卡。这种架构上的紧密耦合,使得每次升级周期产生的电子废弃物质量,远远超过按单芯片硅片量推算的结果。
嵌入式 AI 的兴起进一步加剧了这一问题,机器学习能力被集成到数十亿台消费类设备中。物联网设备增长 追踪了联网设备数量的增长,从 2019 年的 86 亿台增至 2030 年预计的 294.2 亿台,十年间增长超过三倍,历史数据与预测数据的分界点大约在 2024 年(Statista 2022年)。这一趋势形成了一种分布式的、低价值且极难回收的电子废弃物形式。许多 AI 赋能的物联网传感器、可穿戴设备和智能家电采用短寿命设计且升级空间有限,使得它们难以甚至无法维修或回收(Baldé 等 2017年)。不可更换的锂离子电池、密封外壳和专有部件,使得即使发生轻微故障,也必然导致整机更换。
Statista. 2022年. Number of Internet of Things (IoT) connected devices worldwide from 2019 to 2030.
Baldé, Cornelis P, Vanessa Forti, Vanessa Gray, Ruediger Kuehr, 和 Paul Stegmann. 2017年. 《The Global E-Waste Monitor 2017: Quantities, Flows and Resources》. United Nations University, International Telecommunication Union, International Solid Waste Association.
:::
较短的产品生命周期加速了这一循环:有限的软件支持窗口、阻止维修的专有部件,以及使拆解困难的结构化密封设计,都推动设备走向更换而非复用。电子废弃物负担中不成比例的部分落在发展中国家,这些国家往往接收来自富裕国家的废弃电子产品,给最缺乏管理能力的人群带来了显著的环境和社会成本。
延长硬件使用寿命
要应对线性的“获取—制造—处置”模式,必须转向以复用、翻新和回收为优先的循环经济(Stahel 2016年)。当 embodied carbon(embodied carbon 指产品全生命周期内直接排放的碳)在生命周期核算中占主导地位时,延长 AI 硬件的功能性使用寿命是减排最大的杠杆之一,因为它将高额的制造排放分摊到更长的时间跨度上。将服务器使用寿命从三到五年延长,可使每服务年对应的 embodied carbon 减少 40%,这一收益可以超过许多本地软件优化。
Stahel, Walter R. 2016年. 《The circular economy》. Nature 531 (7595): 435~38. https://doi.org/10.1038/531435a.
四项生命周期干预措施通过使系统可维修、可升级、受支持和可复用,来延长硬件使用寿命:
- 维修权:立法与监管运动通过强调对零部件、工具、诊断信息和服务信息的获取权,来抵制维修限制(Federal Trade Commission 2021年)。
- 模块化设计:允许对加速器、内存或网络接口进行独立升级的 AI 硬件设计,可以避免仅当某个部件过时时就丢弃整个系统,遵循 Framework 公司在消费级笔记本电脑上所体现的原则(Incorporated 2022年)。
- 延长支持周期:更长的软件与固件支持使可用硬件保持安全运行更长时间,推迟其进入电子废弃物流的时间(Forti 等 2020年)。
- 二手使用项目:将较旧的加速器转入研究、批处理或较低优先级的工作负载,进一步分摊 embodied carbon,而不是将硬件直接送去处置。
Federal Trade Commission. 2021年. Nixing the Fix: An FTC Report to Congress on Repair Restrictions. Federal Trade Commission.
Incorporated, Framework Computer. 2022年. Modular Laptops: A New Approach to Sustainable Computing.
Forti, V., C. P. Baldé, R. Kuehr, 和 G. Bel. 2020年. The Global E-waste Monitor 2020: Quantities, Flows and the Circular Economy Potential. United Nations University/United Nations Institute for Training and Research; International Telecommunication Union; International Solid Waste Association.
这些干预措施将可持续性从处置管理推进到生命周期工程。一旦量化了 AI 系统所产生的硬件、能源和碳足迹规模,问题便转向:具体有哪些工程手段可以减轻这一影响。
缓解策略
当数据中心达到其绝对功率上限时,运营商无法简单地再购买更多 GPU。唯一的前进路径是在每一瓦特上提取更多智能,通过算法层面的干预:将 FP32 权重量化到 INT4,剪枝不活跃的神经通路,并调度训练运行,使其恰好在本地电网富余太阳能发电时执行。缓解(mitigation)即把能效视为核心算法约束的过程。
前几节开发的测量框架揭示了环境成本集中的位置:研究负载以训练为主,已部署服务以推理为主,而制造贡献了一个运营效率无法消除的基线。这些发现指导实施策略沿三个维度展开:算法优化降低每次操作的开销,基础设施选择决定这些节省能否转化为实际的排放减少,政策框架确保行业范围内的采纳。
实施必须考虑 Jevons 悖论[^fn-jevons-efficiency-paradox](原则 19):将模型的效率提升 10\(\times\) 倍,可能使总使用量增加得足够多,从而抵消甚至超过预期的能源节省,因为更廉价的计算使得此前在经济上不可行的全新应用成为可能。这就是回弹效应 的原因:可持续性策略必须聚焦于绝对上限(碳预算、可再生能源采购),而不仅是效率速率(每瓦特 FLOP/s),将技术优化与使用治理相结合,以防止部署规模的指数增长抵消效率收益。
多层缓解策略框架
可持续 AI 最具反直觉的障碍不是低效,而是成功,因此缓解策略必须同时确定每一层减排由谁负责,以及哪一绝对预算能够防止回弹。能效模型设计、优化的硬件部署、可持续的基础设施运营和碳感知调度,分别针对生命周期足迹中的不同项。框架选择的重要性仅在于它是否改变了计算、内存移动、利用率或报告。生命周期感知的(lifecycle-aware)设计通过检查节省是否能在训练、推理、制造和使用各阶段存续,避免优化在部署阶段即告终止。
[^fn-jevons-efficiency-paradox]:Jevons 悖论:以 Jevons (1865年) 命名,他观察到瓦特效率更高的蒸汽机通过使蒸汽动力对新的应用在经济上可行,反而增加了煤炭的总消耗。这一模式在 AI 中重现:将推理成本降低 10\(\times\) 倍,可使 100\(\times\) 个应用(聊天机器人、代码助手、实时翻译)成为可能,从而产生净增的总能耗。这就是为什么仅靠每次查询的效率提升,在缺乏使用治理的情况下无法保证可持续性。
Jevons, William Stanley. 1865年. The Coal Question: An Inquiry Concerning the Progress of the Nation, and the Probable Exhaustion of Our Coal Mines. Macmillan; Co.
AI 工作负载中的 Jevons 悖论 概括了这一效应:随着单位计算成本下降,使用量的增长速度快于效率降低单位成本的速度,因此总消耗和环境影响上升而非下降。
:::
:::
这一悖论对可持续 AI 战略具有深远影响,因为总能耗同时取决于每次查询的成本和需求弹性。
::: {#chk-sustainable-ai-efficiency-trap-jevons-paradox .callout-checkpoint title=” 效率陷阱(Jevons 悖论)“}
一个工程团队优化了翻译服务,将每次查询的计算成本降低 50%(2\(\times\) 的效率提升)。
:::
Jevons 悖论并未否定效率作为战略的有效性;它只是意味着效率必须与治理和容量规划相结合。在单个系统层面,效率仍然是核心杠杆,因为它直接降低了每次有效操作的成本、延迟和能耗。
::: {#psp-sustainable-ai-efficiency-as-sustainability .callout-perspective title=” 效率即可持续性”}
只有当模型优化在固定质量下降低了实测生命周期成本时,模型优化才成为可持续性的工具。剪枝可以在硬件跳过相应结构时移除计算和内存流量;量化可以减小表示规模,并可能加速受支持的核函数;知识蒸馏则以额外的训练换取更小的服务模型。每种技术也可能因其开销或部署形态未改变主导项,而无法降低墙侧(wall)能耗。
性能工程与环境责任汇聚于同一目标。将模型优化为运行更快或占用更少内存,同时会减小其碳足迹。设计高效架构或实现软硬件协同设计,会产生既高性能又环境可持续的系统。
根本的洞见在于:可持续的 AI 工程与高效的 AI 工程高度重叠,但又超出了后者。使系统能够扩展、表现更好、运行成本更低的工程原则,同样使其更具环境责任感;而可持续性在此基础上增加了生命周期核算、碳感知部署、绝对资源预算、水与材料约束,以及对回弹效应的治理。可持续性是好系统工程的组成部分,而非效率的同义词。
:::
生命周期感知的开发方法
生命周期感知的开发从工作负载中最大的环境项出发,然后选择能够改变该项的干预措施。算法设计、基础设施优化、运营实践和治理,只有围绕实测瓶颈而非作为通用检查清单套用,才能降低影响(Uddin 和 Rahman 2012年)。
Uddin, Mueen, 和 Azizah Abdul Rahman. 2012年. 《Energy efficiency and low carbon enabler green IT framework for data centers considering green metrics》. Renewable and Sustainable Energy Reviews 16 (6): 4078~94. https://doi.org/10.1016/j.rser.2012.03.014.
能效算法设计
许多深度学习模型依赖数十亿参数,训练和推理需要数千亿次 FLOPs。20 尽管这些大模型取得了基准测试的最高分,但研究表明,其计算复杂度的很大一部分是不必要的。许多参数对最终预测贡献甚微,导致资源被浪费。可持续的 AI 开发将能效视为设计约束,而非优化过程中的附带考虑,要求采用软硬件协同设计方法,在单位计算能力上同时优化算法选择及其硬件实现,以实现最大效率。
20 FLOP/s 与 FLOPs: FLOP/s 表示速率(每秒运算次数);FLOPs 表示运算次数。这一区别对可持续性至关重要,因为能耗随 FLOPs(次数)而非 FLOP/s(速率)增长。GPT-3 总共需要 \(3.1 \times 10^{23}\) FLOPs,而每次运算的能耗跨越 1000× 区间:CPU 约为 100 pJ/FLOP,GPU 约为 10 pJ/FLOP,TPU 约为 1 pJ/FLOP,定制 ASIC 则接近 0.1 pJ/FLOP。
当测得的瓶颈是未使用的结构、位宽或服务规模时,可持续设计杠杆会随之改变。按瓶颈划分的算法能耗杠杆 将瓶颈映射到能够改变能耗项的干预措施。
| 技术 | 测得的瓶颈 | 能耗机制 | 代表性证据 |
|---|---|---|---|
| 剪枝 | 未使用的模型结构 | 移除冗余权重,降低推理过程中的模型规模、计算量与内存传输 | 结构化剪枝可在 ResNet-50 等模型中移除高达 90% 的权重,同时保持相当的准确率 |
| 量化 | 位宽 | 降低数值精度,使算术单元和内存传输处理的位数更少 | Q8BERT 展示了 8 位 BERT 表示,具有更小的模型占用,并按任务保留质量 (Zafrir 等 2019年) |
| 知识蒸馏 (Hinton 等 2015年) | 服务规模 | 将重复推理成本转化为一次性的师生训练过程 | DistilBERT 保留了 BERT 97% 的准确率,参数减少 40%,推理速度提升 60% (Sanh 等 2019年) |
Zafrir, Ofir, Guy Boudoukh, Peter Izsak, 和 Moshe Wasserblat. 2019年. 《Q8BERT: Quantized 8Bit BERT》. 2019 Fifth Workshop on Energy Efficient Machine Learning and Cognitive Computing - NeurIPS Edition (EMC2-NIPS), 36~39. https://doi.org/10.1109/emc2-nips53020.2019.00016.
Sanh, Victor, Lysandre Debut, Julien Chaumond, 和 Thomas Wolf. 2019年. 《DistilBERT, a distilled version of BERT: smaller, faster, cheaper and lighter》. arXiv preprint arXiv:1910.01108, 网络首发. https://doi.org/10.48550/arXiv.1910.01108.
21 剪枝的能耗影响: 90% 稀疏度的结构化剪枝可将推理能耗降低 2–10\(\times\),因为被消除的权重既无需存储也无需计算,从而直接降低内存带宽与算术开销。SparseGPT 在 LLM 上实现了 60% 的非结构化稀疏,准确率损失不到 1%,但要从非结构化稀疏中实现能耗收益,则需要具备原生稀疏执行支持的硬件(例如 NVIDIA 的 Sparse Tensor Cores)。
22 量化的能耗收益: 降低精度会减小表示规模,并可能降低算术与内存能耗,但这两项并不普遍随位宽平方或比值缩放。硬件支持、算子融合、转换成本、批处理,以及执行是计算受限还是内存受限,共同决定实际结果 (Gholami 等 2022年)。请分别报告模型规模与实测墙侧能耗,并在所需质量与延迟条件下进行比较。
Gholami, Amir, Sehoon Kim, Zhen Dong, Zhewei Yao, Michael W. Mahoney, 和 Kurt Keutzer. 2022年. 《A Survey of Quantization Methods for Efficient Neural Network Inference》. 收入 Low-Power Computer Vision: Improve the Efficiency of Artificial Intelligence. Chapman; Hall/CRC. https://doi.org/10.1201/9781003162810-13.
23 知识蒸馏: 由 Hinton 等 (2015年) 提出,蒸馏利用较大“教师”模型的软概率目标训练紧凑的“学生”模型,捕捉硬标签会丢弃的类间关系。DistilBERT 保留了 BERT 97% 的准确率,参数减少 40%,推理速度提升 60%。可持续性账目是决定性的:训练教师与学生的一次性成本分摊到数百万次推理查询中,使蒸馏成为已部署服务中投资回报率最高的可持续性干预措施之一。
Hinton, Geoffrey, Oriol Vinyals, 和 Jeff Dean. 2015年. 《Distilling the Knowledge in a Neural Network》. arXiv preprint.
表格中的三种杠杆各有不同的部署注意事项:剪枝21 依赖于稀疏结构及硬件支持,量化22 可能影响算术与内存传输,而知识蒸馏23 则将其额外的训练成本分摊到重复服务中。
剪枝、量化和蒸馏构成了可持续 AI 开发的核心工具箱,但其可持续性价值取决于测得的瓶颈。设计问题不在于如何从基本原理出发实现每种压缩方法,而在于如何针对内存传输、服务量、碳强度与全生命周期成本对这些杠杆进行排序。
虽然模型压缩、高效架构和碳感知调度提供了效率的技术机制,但零散部署只会带来递减收益。要实现最大影响,工程团队必须将这些孤立技术综合为连贯且有优先级的策略,优先削减最大的排放来源。
Checkpoint 1.4: **优先去碳策略**
针对延迟敏感型应用部署 70B LLM:
TinyML 优化栈
TinyML 使生命周期论证具体化,因为环境预算表现为一个硬性物理上限,而非仅仅一个报告类别。微控制器部署必须将模型及其峰值激活适配到千字节级的 SRAM 中,在传感器或用户可见的截止时间前完成推理,并保持在毫瓦或微瓦级的功耗预算内。将 FP32 值替换为 INT8 值可将其存储表示缩减为原来的四分之一字节;能耗是否随之下降,取决于整数内核支持以及剩余系统负载。结构化剪枝在稀疏结构对应到硬件可见的工作移除时,可以带来额外收益。这些技术往往能把模型带入合适区间,但能源采集型设备需要更严格的顺序:首先使内存规划可行,其次降低开关活动,最后才搜索能够充分利用所采集能耗预算的架构 表 5。极端 TinyML 优化技术 总结了该序列末端的极端 TinyML 优化技术。
| 技术 | 典型准确率影响 | 内存缩减 | 能耗缩减 |
|---|---|---|---|
| 二值神经网络 | 依任务而定 | 最高 32\(\times\) | 当位运算占主导时可达数量级 |
| 面向 MCU 的神经网络架构搜索 | 因任务而异 | 依任务而定 | 2–5\(\times\) 相对基线 |
Prakash, Shvetank, Matthew Stewart, Colby Banbury, Mark Mazumder, Pete Warden, Brian Plancher, 和 Vijay Janapa Reddi. 2023年. 《Is TinyML Sustainable? Assessing the Environmental Impacts of Machine Learning on Microcontrollers》. ArXiv preprint abs/2301.11899.
该序列包含三个阶段:
- 内存适配:微控制器使用 64 KB 到 2 MB 的 SRAM,因此内存阶段从峰值激活分析开始,而非仅看参数数量。 即使模型权重较小,仍可能失败,因为某个中间张量可能超出张量暂存区;因此 TinyML 运行时依赖原地操作、 张量暂存区规划、 算子融合 来复用缓冲区并避免碎片化。
- 开关能耗:一旦内存规划可行,能耗阶段就要判断普通的 INT8 算术对该部署是否仍然过于昂贵。在由太阳能、振动或射频采集供电的设备上,二值神经网络 可能具有合理性,因为类 XNOR 的运算 以位运算替代乘加工作 (Courbariaux 等 2016年)。这一权衡并非免费:准确率损失依任务而定,因此二值网络应应用于那些在采集能耗预算内持续感知比全精度分类余量更重要的场景 表 5。
- 架构搜索:只有当 SRAM、延迟与采集能耗约束明确之后,自动设计才有用。MCUNet 联合搜索网络与推理调度,面向内存受限的微控制器,并在 256 KB SRAM 设备上展示了 ImageNet 量级的准确率 (Lin 等 2020年);Once-for-All Networks 通过训练超网络来摊薄搜索成本,从而可提取针对特定设备的子网络 (Cai 等 2020年);ProxylessNAS 直接针对硬件延迟与能耗进行优化 (Cai 等 2019年)。
Courbariaux, Matthieu, Itay Hubara, Daniel Soudry, Ran El-Yaniv, 和 Yoshua Bengio. 2016年. 《Binarized Neural Networks: Training Deep Neural Networks with Weights and Activations Constrained to +1 or -1》. arXiv preprint arXiv:1602.02830.
Lin, Ji, Wei-Ming Chen, Yujun Lin, John Cohn, Chuang Gan, 和 Song Han. 2020年. 《MCUNet: Tiny Deep Learning on IoT Devices》. 收入 Advances in Neural Information Processing Systems 33: Annual Conference on Neural Information Processing Systems 2020, NeurIPS 2020, December 6-12, 2020, virtual, 编辑 Hugo Larochelle, Marc’Aurelio Ranzato, Raia Hadsell, Maria-Florina Balcan, 和 Hsuan-Tien Lin. Curran Associates.
Cai, Han, Chuang Gan, Tianzhe Wang, Zhekai Zhang, 和 Song Han. 2020年. 《Once-for-All: Train One Network and Specialize it for Efficient Deployment》. International Conference on Learning Representations (ICLR).
Cai, Han, Ligeng Zhu, 和 Song Han. 2019年. 《ProxylessNAS: Direct Neural Architecture Search on Target Task and Hardware》. 7th International Conference on Learning Representations, ICLR 2019, New Orleans, LA, USA, May 6-9, 2019.
这些方法不应被读作可持续技术的菜单。它们是针对一个特定失效的回应:手工设计的模型无法同时满足 SRAM、延迟与采集能耗约束。生命周期预算必须记录由此产生的权衡,因为准确率损失、额外的搜索或蒸馏训练,以及由回弹效应驱动的部署增长,都可能抹去名义上的每次推理节省。
生命周期感知系统
许多 AI 部署持短期心态:训练一个模型、部署它、几个月后更换,并把被丢弃的训练运行或设备代际视为过去的成本。生命周期感知系统则将这种频繁更迭视为足迹的一部分。如果模型需要反复更新,首要的可持续性问题就是下一次更新是否需要完整重训。增量学习与迁移学习减少了这种浪费,因为在新数据集上微调预训练模型,相比从头训练可将计算成本降低数个数量级 (Raffel 等 2020年)。
Raffel, C., N. Shazeer, A. Roberts, K. Lee, S. Narang, M. Matena, Y. Zhou, W. Li, 和 P. J. Liu. 2020年. 《Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer》. Journal of Machine Learning Research 21 (140): 1~67.
Xu, Dianlei, Tong Li, Yong Li, Xiang Su, Sasu Tarkoma, Tao Jiang, Jon Crowcroft, 和 Pan Hui. 2020年. 《Edge Intelligence: Architectures, Challenges, and Applications》. arXiv preprint arXiv:2003.12172.
部署边界的重要性与训练边界同等。边缘部署可以通过在使用点上的专用低功耗硬件运行推理来降低通信能耗 (Xu 等 2020年),但生命周期账目必须包含这些设备的制造与更换所体现的碳。将生命周期评价(LCA)方法融入 AI 工作流,使团队能够尽早看到这一权衡:云模型、边缘模型与混合级联方案可能因查询量、设备寿命、电网碳强度以及重训频率的不同而各有胜出者 (International Organization for Standardization 2006年a, 2006年b)。Henderson 等 (2020年) 主张系统地报告机器学习能耗与碳足迹,正是为了使这些比较能够一致地进行。正如杰文斯悖论所警示的,核算还必须包含使用量的增长,因为对某一阶段的优化若因成本下降而促成更广泛的部署,反而可能增加总影响。
基准与运行指标
当基准能够在采购与设计阶段使效率可见时,基准才具有重要意义。ML.ENERGY Leaderboard (ML.ENERGY Initiative 等 2023年) 依据能效与碳足迹对模型进行排名,鼓励研究者在优化准确率的同时兼顾可持续性。MLCommons 将同一思路扩展到标准化测量:MLPerf 基准套件为数据中心与边缘部署定义了功耗测量协议,从而使可持续性声明能够在硬件、软件栈与负载类别之间进行比较。
ML.ENERGY Initiative, Jae-Won Chung, Jiachen Gu, Zhewei Yan, Tony Lo, Yejin Park, 和 Mosharaf Chowdhury. 2023年. The ML.ENERGY Leaderboard. SymbioticLab, University of Michigan.
合适的效率指标取决于服务形态。批处理推理自然地以每焦耳正确样本数表达, 延迟敏感型服务以每焦耳符合 SLO 的查询数表达, 生成式负载则以每个被接受的输出 token 的焦耳数表达, 且需声明质量阈值。原始每焦耳吞吐量会奖励那些降低准确率、截断输出或错过延迟目标的系统。标准化并不意味着某个平台普遍更绿色;它只是将有用工作、质量、测量窗口与能耗分母界定得足够明确,使采购与架构决策能够以定量方式展开论证。
对于亚瓦级 TinyML 部署,MLPerf Tiny 基准套件 在微控制器规模上提供了同样的规范。MLPerf Tiny 基准套件 总结了基准任务与典型的能耗需求,范围从亚毫焦耳到多毫焦耳。测量方法需要外部功率监测仪,例如 INA219、INA226 或 Joulescope 类仪器,并规定了预热期、测量窗口与统计报告要求,以便跨提交复现微小的效率主张。
| 基准 | 任务 | 参考 模型 | 典型能耗 (mJ/推理) |
|---|---|---|---|
| 视觉唤醒词 | 图像分类(人物检测) | MobileNetV1 0.25 (250 KB) | 0.1-1.0 mJ |
| 关键词 spotting | 音频分类(12 个关键词) | DS-CNN (19 KB) | 0.05-0.5 mJ |
| 异常检测 | 时间序列(设备健康) | Deep Autoencoder (5 KB) | 0.01-0.1 mJ |
| 图像分类 | 视觉识别(CIFAR-10) | ResNet-8 (70 KB) | 0.5-5.0 mJ |
能耗与延迟仍须通过能耗延迟积(EDP)(公式 17)结合起来解读,该指标以惩罚“仅靠拖慢速度来省电”的解法来平衡能耗与响应时间:
\[\text{EDP} = E \times T = P_{\text{average}} \times T^2 \tag{17}\]
其中 \(E\) 为能耗,\(T\) 为执行时间,\(P_{\text{average}}\) 为平均功率。二次延迟项惩罚那些通过过度延迟来实现低能耗的解法。较低的 EDP 表示更好的效率,从而能够比较具有不同能耗—延迟权衡的系统。
对于 TinyML 部署,EDP 有助于识别最优运行点。以降低时钟频率运行的微控制器功耗更低,但完成推理所需时间更长。使 EDP 最小的配置通常运行在中等频率,此时可以降低电压(利用 CMOS 功耗中的二次电压项),而无需承受过大的延迟惩罚。
可持续性指标通过建立兼顾能力与环境影响的评估框架,补充了传统性能基准。欧盟《人工智能法案》2024 年对通用人工智能模型提供者要求记录已知或估算的模型能耗,正说明这些指标如何从自愿报告实践走向合规要求。
基础设施优化
算法优化降低了每次运算的能耗,但运行环境决定这些节省能否转化为实际的排放减少。基础设施层面的创新针对数据中心堆栈中实现计算效率收益的物理环境:可再生能源接入、碳感知工作负载调度与 AI 驱动的冷却优化分别针对数据中心堆栈的不同层次。
绿色数据中心
单个超大规模数据中心可消耗超过 100 MW 的电力——相当于一个小城市的用电量24。缩小这一足迹需要三项互补的策略:可再生能源接入、先进冷却技术,以及 AI 驱动的优化。
24 PUE 缺口:节 1.1.2.3 中的 PUE 模型表明,设施开销随每瓦 IT 负载线性增长。在 100 MW 的规模下,即使 PUE 出现微小变化,也对应着兆瓦级的冷却与电力输送能力;但其碳减排价值仍取决于电网信号。
25 24/7 无碳能源(CFE):Google 公布的 2030 年目标要求将每一小时的用电与实时无碳发电相匹配,其难度远高于年度平均碳抵消。弥合剩余差距需要大规模储能、输电和清洁能源投资。这一区别至关重要:年度平均碳中性允许用可再生能源信用抵消化石燃料时段,而按小时计算的 CFE 则要求真正从供应链中消除碳排放型发电。
主要云服务商已公布可再生能源承诺,但间歇性仍是挑战。AI 基础设施必须纳入储能方案,以及将负载智能调度到可再生能源富集时段的技术。Google 公布的 2030 年 24/7 无碳能源目标25 展示了这一目标的困难版本:将所消耗的每单位电力实时匹配到可再生能源发电,而非依赖年度碳抵消。
冷却占数据中心电力的很大比例(PUE 处理中确立的冷却开销数值,见 节 1.3.6)。26 液冷通过专用冷却剂直接从加速器转移热量,相比传统风冷显著更有效,并应用于高密度 AI 集群。冷却的软件控制是另一个杠杆:节 1.1.2.4 中的 DeepMind 优化在不进行任何硬件改造的情况下回收了相当比例的冷却能耗,展示了 AI 改善其自身基础设施的可持续性。
26 冷却能耗密度:AI 加速器机柜的功率可超过每柜 100 kW,远高于许多传统风冷设施的设计上限。直接液冷将热量更靠近设备处移除,可减少风机与冷水机组的做功,但实际实现的设施能耗下降取决于冷却剂温度、泵、散热、气候以及风冷基线。对于 AI 数据中心,冷却系统已不再是被动的基础设施开销,而是决定能够物理共置的加速器数量的主动约束。
碳感知调度
电网碳强度会随可用电源结构而剧烈波动——从核电占比高的法国 50 g CO2/kWh,到煤电依赖的波兰 820 g/kWh。碳感知调度 将 AI 计算动态调整到低碳能源可得的时间与地点。对于具有地理或时间灵活性的可放宽截止时间的负载,它是杠杆效应最高的减排手段之一。
碳感知调度本质上是一个负载迁移软件问题。调度器查询实时电网碳强度 API(例如 ElectricityMap、WattTime),在碳强度高的时段(如晚间高峰)暂停非紧急训练任务,并将负载迁移到可再生能源富余的地理区域,例如加利福尼亚的太阳能高峰或爱荷华的风能高峰。
Google 的碳智能计算平台27 已在大规模上验证了这一方法,在其全球负载迁移假设下实现了 40% 的碳足迹下降(Radovanovic 等 2021年)。在 图 21 所示的更广泛能耗缺口级联中,碳感知调度属于系统性阶段步骤之一,为混合生产集群贡献了更为保守的 1.3\(\times\) 平均减排量,因为只有部分任务具备足够的时间或地理灵活性以跨时段或跨地域迁移。
27 大规模碳感知调度:Google 的碳感知数据中心研究显示,仅通过区域内时间维度的迁移即可实现 15% 的碳减排,并通过跨时区调度非紧急批处理计算以追踪可再生能源高峰,在全球范围内实现 40% 的减排(Radovanovic 等 2021年)。关键洞察在于:可放宽截止时间的负载无需对模型或基础设施做任何改动,即可访问差异极大的电网碳强度。
Radovanovic, Ana, Ross Koningstein, Ian Schneider, Bokan Chen, Alexandre Duarte, Binz Roy, Diyue Xiao, 等. 2021年. 《Carbon-Aware Computing for Datacenters》. arXiv preprint arXiv:2106.11750, 网络首发. https://doi.org/10.48550/arXiv.2106.11750.
碳感知调度的有效性取决于准确的实时电网排放数据。电网平均强度适用于事后报告,因为它估算的是已经消耗能源所对应的排放。边际排放对调度更有用,因为它估算的是当负载增加或减少需求时由哪一台机组响应。Electricity Maps API 提供全球电力电网的实时 CO2 排放数据28,而 WattTime 提供边际排放数据,显示下一时刻将启停的是哪些电厂。 图 22 展示了调度机会:将训练任务迁移到低碳区域的低碳时段,可在不改动任何一行模型代码的情况下将排放降低最多 8\(\times\)。
28 边际排放与平均排放:WattTime 的边际排放数据能够识别负载增加时下一时刻将启动的是哪座电厂,相比电网平均强度可实现 2–5\(\times\) 倍的更好碳优化。这一区别至关重要:平均强度会抹平峰值,而边际数据表明,在错误的小时增加 1 MW 负载,即使是在名义上“清洁”的电网中,也可能激活碳强度达 900 g/kWh 的燃煤调峰机组。
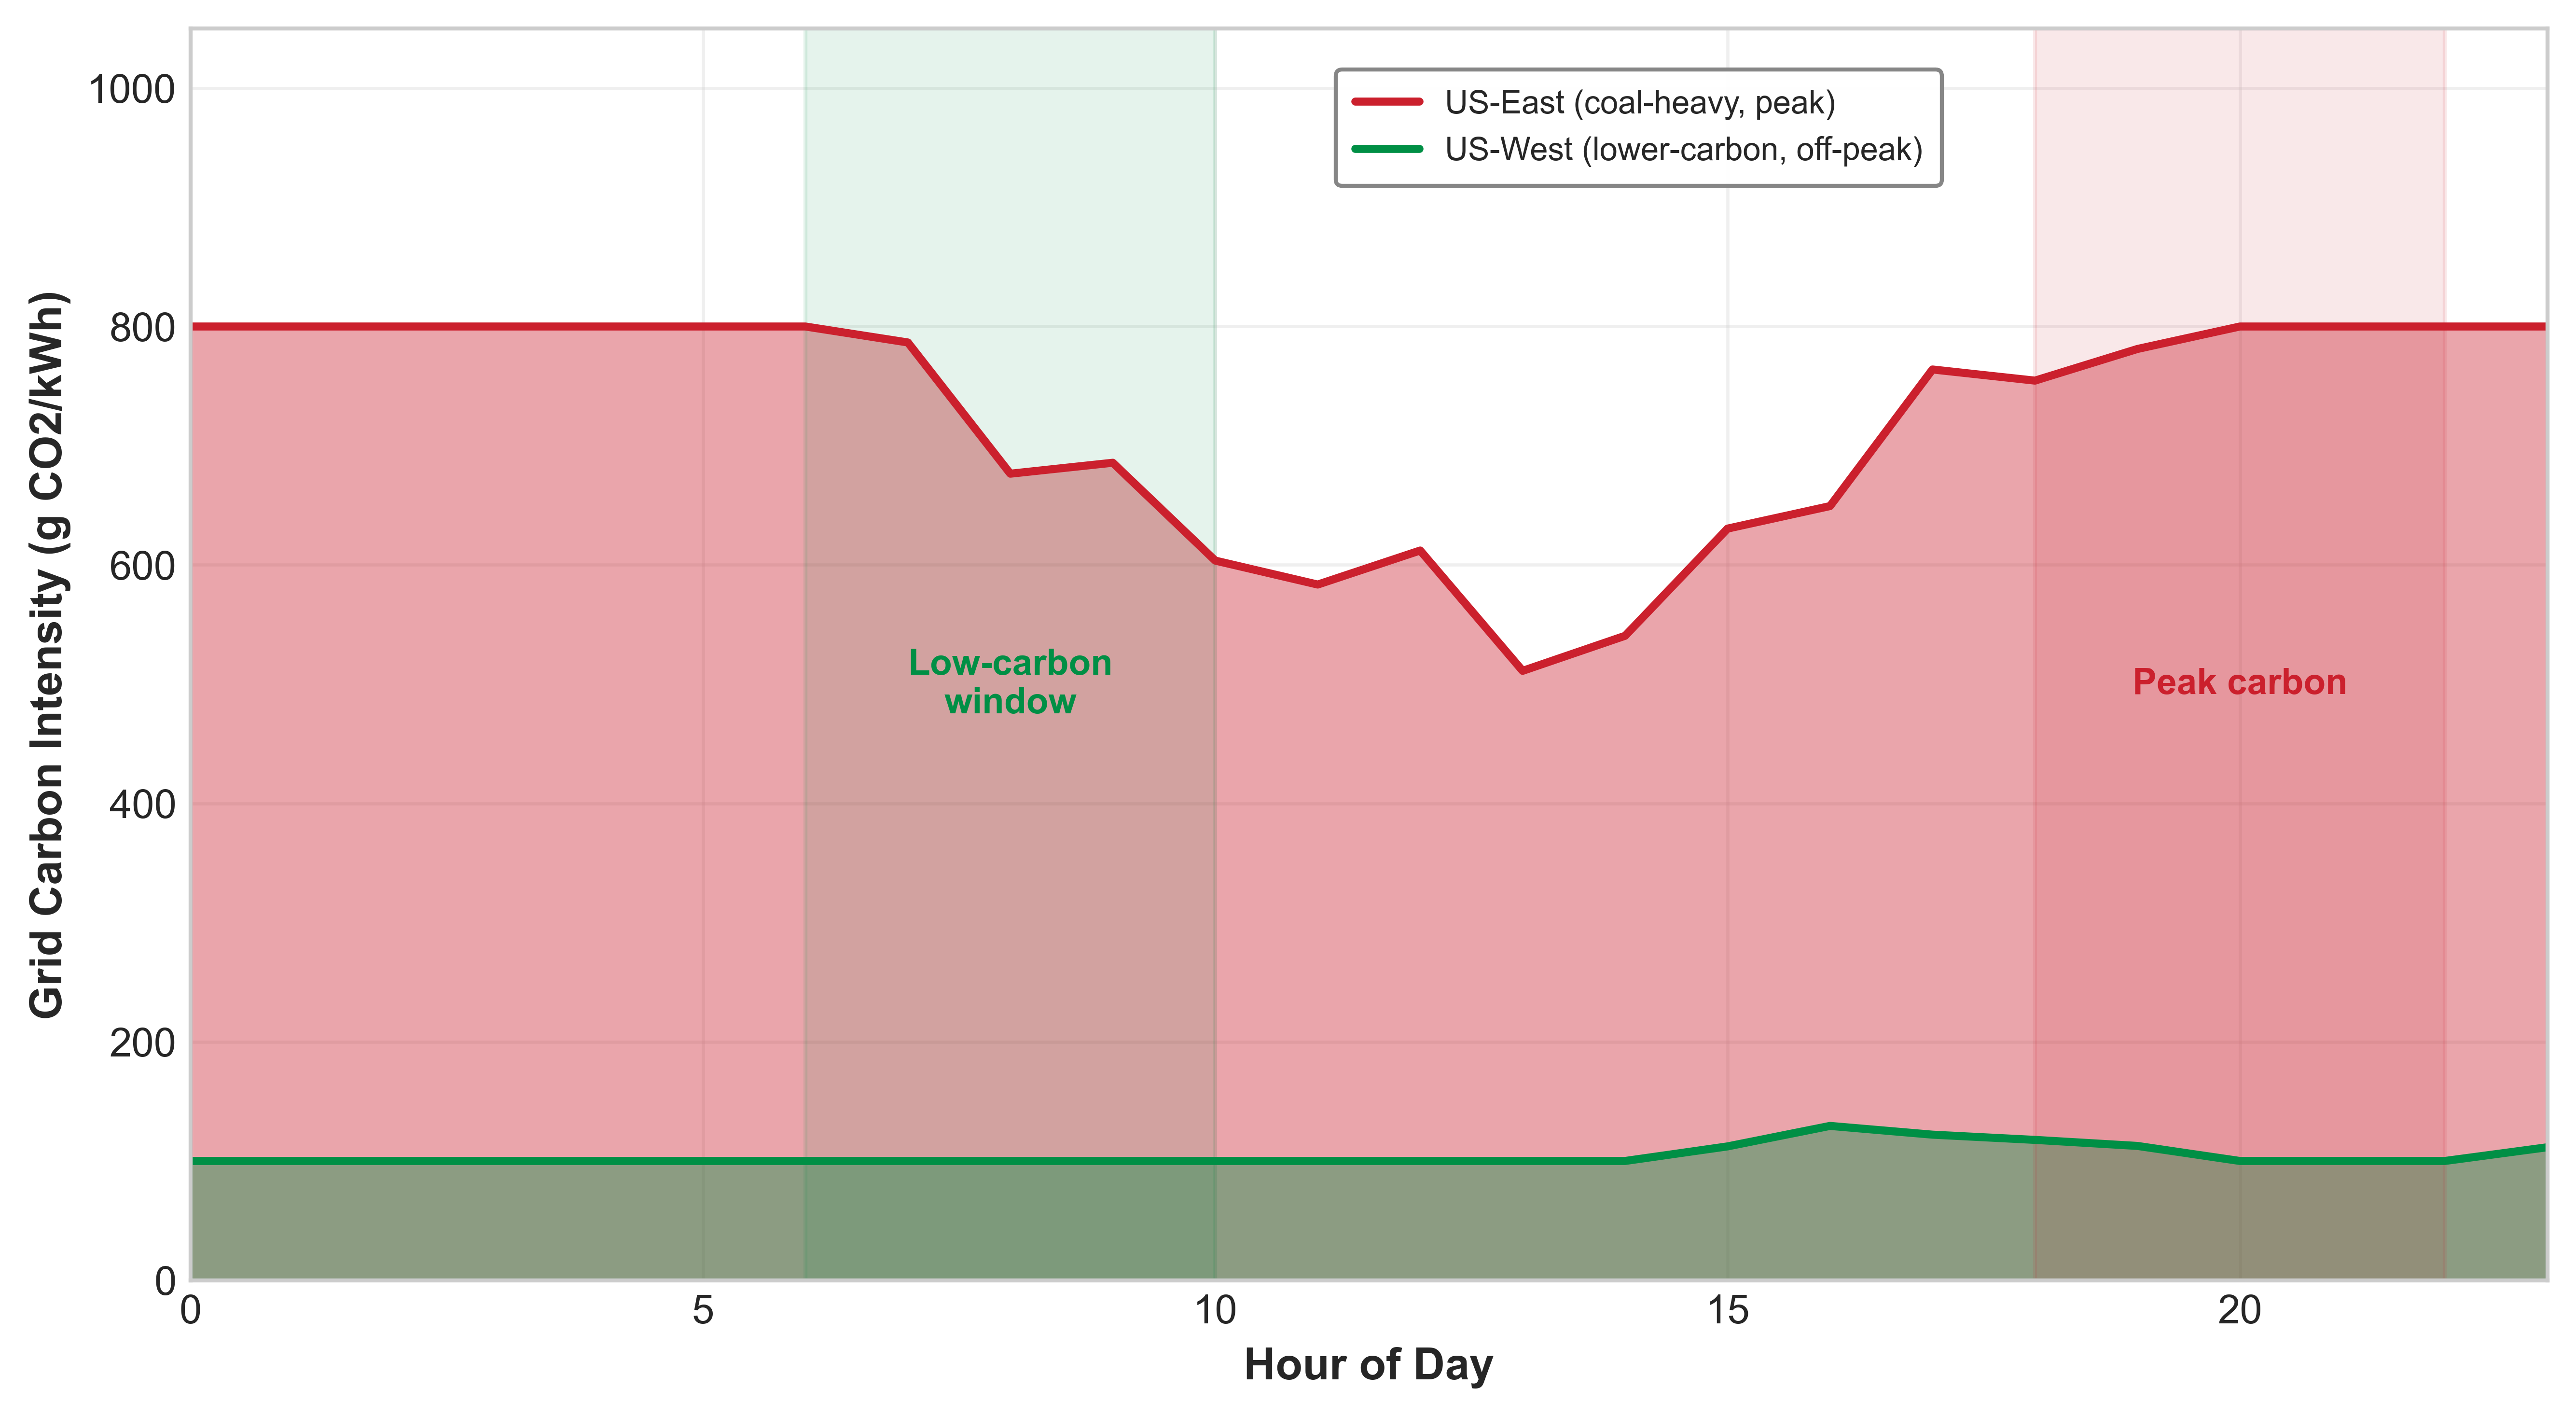
可再生能源的波动性为碳感知调度带来了关键挑战。图 23 展示了欧洲电网的动态特征:太阳能在正午达到峰值,风能在早晨和傍晚呈现明显峰值,化石燃料发电则填补缺口。这种时间变化模式决定了 AI 工作负载能够在何时使用清洁能源运行。
能耗感知 AI 框架通过优化工作负载,而不仅仅是改变其运行位置,与调度形成互补。Zeus 通过自动寻找能耗与性能之间的权衡,使其所评估工作负载的训练能效提升了 15.3–75.8% (You 等 2023年);Perseus 则通过缓解能耗膨胀,将大模型训练能耗最多降低了 30% (Chung 等 2023年)。这些工具连同用于排放追踪的 CodeCarbon (Schmidt 等 2021年),使超大规模企业之外的组织也能开展能耗优化。
You, Jie, Jae-Won Chung, 和 Mosharaf Chowdhury. 2023年. 《Zeus: Understanding and Optimizing GPU Energy Consumption of DNN Training》. 20th USENIX Symposium on Networked Systems Design and Implementation (NSDI 23), 119~39.
Chung, Jae-Won, Yile Gu, Insu Jang, Luoxi Meng, Nikhil Bansal, 和 Mosharaf Chowdhury. 2023年. 《Reducing Energy Bloat in Large Model Training》. Proceedings of the ACM SIGOPS 30th Symposium on Operating Systems Principles abs/2312.06902: 144~59. https://doi.org/10.1145/3694715.3695970.
当设施具备充分的传感能力和可控的冷却设备时,AI 驱动的冷却优化是一种可通过软件部署来降低数据中心能耗的手段。传统冷却系统依赖具有预设温度阈值的固定控制策略,往往消耗超出实际需要的能源;能够适应实时条件的学习型控制器可以消除其中大部分浪费,正如 节 1.1.2.4 中分析的 DeepMind 部署所展示的那样,无须任何硬件改动。
作为软件优化的补充,液冷和浸没式冷却改变了高密度加速器集群的热设计空间。液冷利用体积热容远高于空气的流体,在加速器附近带走热量,从而减少机柜所需的气流量。浸没式冷却将计算设备浸入非导电冷却液中,取代机柜中大部分空气处理路径。这些方法能够实现更高的计算密度,但并不必然降低设施功耗,因为泵、冷却液分配和散热仍属于系统边界内的组成部分。
案例研究:Google 的框架
Google 案例研究的价值在于,它将减排措施分解到本章一直考察的相同层次:模型、机器、自动化和地理布局。表 8 总结了 Google 工程师为降低快速扩张的 AI 工作负载的碳足迹而提出的“4 Ms”(Patterson, Gonzalez, Holzle, 等 2022年)。
| 手段 | 干预措施 | 报告的效率效果 | 示例机制 |
|---|---|---|---|
| 模型 | 选择高效的 AI 架构,例如稀疏模型或通过神经架构搜索得到的设计 | 5–10\(\times\) 倍的计算需求降幅,同时不损害模型质量 | Evolved Transformer 和 Primer |
| 机器 | 使用 AI 专用硬件,而非通用系统 | 2–5\(\times\) 倍的每瓦性能提升;TPU 相对于未优化 GPU 的碳效率提升为 5–13\(\times\) 倍 | 张量处理单元 |
| 自动化 | 以高利用率运行经过优化的云基础设施 | 1.4–2\(\times\) 倍的能耗降幅,相对于传统本地数据中心 | 设施 PUE 低于 2021 年研究采用的行业平均基线 |
| 地理布局 | 将数据中心部署在电力供应碳强度较低的地区 | 5–10\(\times\) 倍的总排放降幅 | 实时监测整个基础设施中的可再生能源使用情况 |
这些实践的综合效果带来了乘法式的效率提升。例如,在经过策略性选址的数据中心内,使用 TPU 运行优化后的 Transformer 模型,使能耗降至原来的 1/83,CO2 排放降至原来的 1/747。
Patterson, Gonzalez, Holzle, 等 (2022年) 所研究的时期内,系统性的效率改进在 AI 部署于 Google 产品生态体系不断扩展的同时,依然约束了能耗增长。这一进展的重要指标是:在报告期间,AI 工作负载占 Google 总能耗的比例始终低于 15%。随着 AI 功能在 Google 各项服务中的扩展,相应的计算周期增加被算法进步、专用硬件、基础设施设计以及地理优化所带来的提升所抵消。
Patterson, David, Joseph Gonzalez, Urs Holzle, Quoc Le, Chen Liang, Lluis-Miquel Munguia, Daniel Rothchild, David R. So, Maud Texier, 和 Jeff Dean. 2022年. 《The Carbon Footprint of Machine Learning Training Will Plateau, Then Shrink》. Computer 55 (7): 18~28. https://doi.org/10.1109/mc.2022.3148714.
Du, Nan, Yanping Huang, Andrew M. Dai, Simon Tong, Dmitry Lepikhin, Yuanzhong Xu, Maxim Krikun, 等. 2022年. 《GLaM: Efficient Scaling of Language Models with Mixture-of-Experts》. 收入 International Conference on Machine Learning (ICML), 编辑 Kamalika Chaudhuri, Stefanie Jegelka, Le Song, Csaba Szepesvari, Gang Niu, 和 Sivan Sabato, 卷 162. Proceedings of Machine Learning Research. PMLR.
实证案例研究展示了可持续 AI 工程如何同时改善能力与环境影响。例如,Patterson, Gonzalez, Holzle, 等 (2022年) 将 GPT-3 与 Google 的 GLaM 进行比较,报告了质量指标的提升,同时训练计算量减少、能源来源的碳含量更低;而 GLaM 模型论文则解释了支撑这一高效扩展的专家混合(mixture-of-experts)架构 (Du 等 2022年)。
案例研究中的策略——结合系统性测量、碳感知开发、报告透明度和可再生能源转型——可作为可持续 AI 扩展的框架。分析还指出,早期的外推高估了机器学习能耗需求数倍,原因是它们既未计入效率改进,也未考虑工作负载的测量边界,从而凸显了实证测量相对于理论预测的重要性。
面向可持续 AI 开发的工程指南
测量、优化与调度框架提供了分析基础,但实施需要优先级排序。以下清单应作为决策辅助来阅读:首先测量占主导的生命周期项,然后选择能够改变该项的杠杆。
- 先测量:CarbonTracker 和 CodeCarbon 等工具可追踪训练运行的排放。团队无法改进其未测量的内容,而建立基线指标对于验证优化工作的有效性至关重要 Schmidt 等 (2021年)。
- 选择区域:在由可再生能源供电的数据中心训练模型。正如 节 1.0.1 所确立的,代表性区域对之间的电网碳强度覆盖 8 到 40 倍的区间;将工作负载调度至清洁能源最充裕的地区可立即带来减排。
- 优化模型:不要默认训练尽可能大的模型。当由此得到的实现能够保持所需的质量、延迟和可靠性目标时,剪枝、量化和知识蒸馏可以降低资源使用。量化并不保证能耗按比例下降:实际节省取决于内核支持、内存流量、转换开销、批处理,以及工作负载是否仍受成本发生变化资源所约束。
- 避免从头重新训练:迁移学习和微调相比完整重新训练可将计算需求降低数个数量级。
- 选择高效硬件:节能加速器(如 TPU 或专用推理芯片)可降低部署成本。完整的硬件生命周期以及针对工作负载的平台选择,与原始吞吐率同等重要。
- 考虑完整生命周期:更长的硬件更新周期和负责任的电子废弃物政策可以降低总环境影响。在清洁电网或低利用率条件下,制造环节可能占主导;而在碳强度高的电网下持续运行,则可能主导同一硬件的生命周期。因此,硬件寿命是一个有条件的权衡,而非自动的环境收益。
Schmidt, Victor, Kamal Goyal, Aditya Joshi, Boris Feld, Liam Conell, Nikolas Laskaris, Doug Blank, Jonathan Wilson, Sorelle Friedler, 和 Sasha Luccioni. 2021年. CodeCarbon: Estimate and Track Carbon Emissions from Machine Learning Computing. Zenodo software citation. https://doi.org/10.5281/zenodo.4658424.
各项技术选择累积影响取决于系统性的、全行业范围的采纳。若无外部压力,市场力量将优先追求速度与规模而非效率。政策与监管框架通过将可持续选择转化为财务和法律上的必然要求,把工程可能性转化为全行业实践。
政策、监管与未来路径
如果一家公司可以通过将训练集群迁移到完全由廉价、高排放煤炭供电的地区来削减其云计算账单,那么仅凭市场力量无法阻止其这样做。工程巧思可以提供高效计算的工具,但需要政策、监管和碳定价,才能确保使用这些工具成为财务和法律上的必然要求,而非仅仅停留在企业公关说辞层面。
对系统领域读者而言,政策是改变目标函数的控制平面。报告规则使隐蔽的能耗与隐含碳成本变得可测量,碳定价将地理位置转化为调度变量,采购标准则将全生命周期核算纳入基础设施设计。节 1.7.1 中的监管机制之所以重要,是因为它们决定了在集群规模下哪些优化在经济上变得理性。
监管机制
有效的 AI 可持续性治理通过强制报告、排放限制和金融激励的组合来实现,尽管全球政策碎片化构成了实施挑战。欧盟在强制性方法方面发挥了引领作用,例如欧盟《人工智能法案》29 和 《企业可持续发展报告指令》(CSRD).30 《人工智能法案》为通用人工智能模型和具有系统性风险的通用人工智能模型分别设定义务,包括计算资源文档以及已知或估算的模型能耗。CSRD 要求大型公司披露其环境影响,包括来自 AI 运营的 Scope 1、2 和 3 排放,并依据标准化、经审计的报告框架进行披露。这一监管转变将能耗监测从可选优化转变为法律必需。
29 欧盟《人工智能法案》(2024):欧盟《人工智能法案》于 2024 年通过,是早期较为全面的 AI 监管框架,为通用人工智能模型设定义务,并为具有系统性风险的模型设定额外义务,包括训练计算量高于 \(10^{25}\) FLOPs 的模型(推定具有高影响能力)。技术文档必须包含计算资源以及已知或估算的模型能耗。对于通用人工智能模型提供者的违规,第 101 条允许处以最高相当于全球年营业额 3% 或 1500 万欧元的罚款;单独的 7% 上限适用于禁止性行为的违规。
30 《企业可持续发展报告指令》(CSRD):经《指令 (EU) 2026/470》修订后,CSRD 的适用范围涵盖员工超过 1,000 人且年净营业额超过 4.5 亿欧元的欧盟公司。受覆盖公司按照标准化的欧洲可持续发展报告标准框架报告实质性可持续发展信息。对于 AI 基础设施,此类报告可以暴露此前被隐藏的成本,例如 GPU 采购的隐含碳、外包云训练的能源,以及价值链中硬件的报废处置。
31 面向计算的排放交易:欧盟 ETS(2005)率先对工业排放实行上限与交易;将该模式应用于 AI 计算,将为训练集群设定总能耗预算,并允许组织交易富余容量。该机制将可持续性从自愿优化转化为有价格约束:投资于效率的组织可以将未使用的配额出售给效率较低的竞争对手,从而形成与铁律利用率项(\(\eta_{\text{hw}}\))相一致的财务激励。
除测量强制要求外,各国政府正在探索直接的排放限制机制。这些机制包括为训练大型 AI 模型可用的计算能力设定上限,并参照环境政策中使用的 排放交易体系 (ETS)31。此类针对计算的”上限与交易”系统会迫使组织在预定的能源预算内运行,或采购额外容量,从而形成计算碳信用产品的市场。碳定价可使电力来源和工作负载地理位置成为经济意义上的调度变量。相比之下,欧盟 碳边境调节机制 适用于指定进口商品和电力中的嵌入排放;它通常不会根据工作负载实际计算所在区域的电网来对 AI 服务定价。
为平衡这些限制,政府激励措施发挥着主动作用。对绿色 AI 研究提供的资金支持、税收优惠和拨款,可使可持续性成为竞争优势。政府还可以利用公共采购权力,强制供应商满足可持续性基准,例如在碳中和数据中心运行或使用节能模型。更广泛的企业合作报告框架——温室气体协议、气候相关财务信息披露工作组和国际可持续发展准则理事会——审查 Scope 3 排放,涵盖 GPU 采购与数据中心建设所涉及的实质性隐含碳,以及外包云计算的运行排放。
行业自律与标准
除政府强制要求外,AI 行业正通过自律和共同标准推动显著的环境改善。来自主要云服务商——Google、Microsoft 和 Amazon——最显见的承诺,聚焦于使数据中心电力消耗与可再生能源采购相匹配,并增加直接清洁能源供应。更进一步,24/7 无碳能源(CFE)的推进旨在将每一小时的能源消耗与实时清洁能源采购相匹配,从而超越年度平均值和可能掩盖化石燃料依赖电网实际排放的碳抵消 (Monyei 和 Jenkins 2018年)。
Monyei, C. G., 和 Kirsten E. H. Jenkins. 2018年. 《Electrons have no identity: Setting right misrepresentations in Google and Apple’s clean energy purchasing》. Energy Research & Social Science 46: 48~51. https://doi.org/10.1016/j.erss.2018.06.015.
Lacoste, Alexandre, Alexandra Luccioni, Victor Schmidt, 和 Thomas Dandres. 2019年. 《Quantifying the Carbon Emissions of Machine Learning》. arXiv preprint arXiv:1910.09700.
内部碳定价是另一种有效的自律工具。为碳排放赋予”影子价格”,可将环境成本直接纳入 AI 项目的财务决策,从而自然优先投资于节能硬件和低排放模型。自愿性清单和开源工具在它们能够影响同一批项目决策时,有助于促进问责:例如 CodeCarbon 和 ML CO2 Impact 提供了框架,使开发者能够在自身工作流中直接估算和追踪模型的碳足迹 Lacoste 等 (2019年)。
标准化的基准测试为验证这些努力提供了客观数据。MLCommons 通过其 MLPerf 基准套件,纳入了数据中心与边缘部署的功耗测量协议。建立”每焦耳样本数”和”每令牌焦耳数”等指标,使 MLCommons 能够在不同硬件和软件平台上实现公平、透明的 AI 系统效率比较。这些基准测试与 Green Software Foundation 等机构开展的独立可持续性审计相结合,形成了可测量的问责机制,推动行业竞争走向真正更绿色的 AI。
公众参与与环境正义
有效的 AI 可持续性治理需要公众支持,而这取决于透明度、清晰沟通和公平可及性。目前,公众对 AI 环境影响的理解有限,且往往在”技术救赎”与”生态灾难”两种叙事之间摇摆。培养知情的公共讨论,需要超越 漂绿32——即对环境责任作出误导性声明的做法——走向真实、可验证的透明度。
32 AI 中的漂绿:表现为通过碳抵消宣称”碳中和”,同时扩大数据中心容量;或突出单次查询的效率提升,而总计算量增长 10\(\times\)。绿色声明规则可以要求环境声明提供可验证的证据。对机器学习工程师而言,技术试金石在于可持续性报告是否覆盖温室气体协议的全部三个范围,还是方便地省略了 Scope 3(硬件制造、云供应链),而 AI 的大部分碳往往存在于其中。
承诺式披露只有在能够产生可审计数据而非仅为声誉掩护时才有用。蒙特利尔碳承诺 最初是机构投资者每年测量并披露碳足迹的承诺,其价值恰恰在于所披露的数据本身,而非承诺本身;同一标准适用于 AI 组织,其可持续性声明的可信度仅取决于其背后工作负载级的测量。
透明度建立了证据基础;环境正义则追问这些证据所揭示的负担与收益如何在不同群体间分配。正如 节 1.0.2 所述,机器学习集群会在各社区之间分配电力需求、用水、土地压力和电子废弃物,而这些社区往往并不共享其经济收益,因此选址属于工程设计空间的一部分。在政策层面,这一分配问题转化为报告要求:大规模 AI 项目的社会影响评估和公平可及性条款,将公平性关切转化为可审计的义务,而非仅仅是愿景。
未来研究方向
研究议程遵循与缓解框架相同的工程逻辑:消除数据移动、弥合测量差距、避免冗余计算。其中一个重要方向是开发 非冯·诺依曼计算架构,33 例如类脑计算 和 存内计算。这些范式在数据所在位置直接处理数据,旨在消除”冯·诺依曼瓶颈”——即数据在存储器与处理单元之间往返传输所消耗的高昂能量,可能占系统功耗的 60–80%。成功实现可为某些 AI 工作负载带来 100–1000\(\times\) 的能效提升。
33 冯·诺依曼瓶颈:John von Neumann 于 1945 年提出的存储程序架构将处理与存储分离,需要持续的数据往返传输,消耗系统 60–80% 的功耗。对于以矩阵乘法为主、算术强度较低的 AI 工作负载,这一瓶颈意味着大部分能量用于移动数据而非计算结果。存内计算和类脑计算架构直接针对这一问题,通过消除存储—处理器往返,推理能耗可能降低 100–1,000\(\times\)。
Henderson, Peter, Jieru Hu, Joshua Romoff, Emma Brunskill, Dan Jurafsky, 和 Joelle Pineau. 2020年. 《Towards the Systematic Reporting of the Energy and Carbon Footprints of Machine Learning》. CoRR abs/2002.05651 (248): 1~43. https://doi.org/10.48550/arxiv.2002.05651.
一个关键的实施障碍是“测量缺口”:AI 团队需要标准化的工作负载级能耗与碳排放报告,而不能仅依赖粗粒度的代理指标 (Henderson 等 2020年)。粗粒度方法通常依赖 GPU 小时数乘以平均电网碳强度等代理指标,无法捕捉重视时间、地点和工作负载边界的报告制度所要求的实际动态。开发并标准化细粒度、实时的能耗与碳核算工具,对于合规和有效优化都至关重要。
第二个研究方向是在计算任务到达加速器之前减少冗余计算。数据选择、模型设计和训练流程都会影响学习的环境成本 (Wu 等 2022年)。更智能的数据采样、主动学习和数据价值评估可以减少在低价值样本上耗费的计算,但由此产生的模型质量和覆盖范围必须通过测量确定,而不能凭空假设。必须采取综合方法,将算法效率、硬件创新、可再生能源应用和透明治理结合起来,使 AI 发展与环境约束相协调。
Wu, Carole-Jean, Ramya Raghavendra, Udit Gupta, Bilge Acun, Newsha Ardalani, Kiwan Maeng, Gloria Chang, 等. 2022年. 《Sustainable AI: Environmental implications, challenges and opportunities》. Proceedings of Machine Learning and Systems 4: 795~813.
通过更智能的数据整理最大限度地减少冗余计算,可以直接使监管合规与运行效率相一致。可持续 AI 面临的最危险障碍并非技术局限,而是错误的假设和计算失误,它们会使初衷良好的团队无意中增加自身的环境足迹。
谬误与陷阱
可持续性涉及反直觉的物理现象:效率提升可能增加总消耗量,而地理位置选择的影响可能超过部件层面的优化。这些谬误与陷阱揭示了因优化投入分配不当而浪费计算预算和地球资源的错误。
谬误:云计算会自动提高 AI 系统的环境可持续性。
工程师假定云服务提供商的运行既高效又可持续。云基础设施可以提高利用率和设施效率,但并不会使物理足迹或客户的核算责任消失。训练一个 7B 模型,使用 64 台 A100,持续 14 days,在美国平均电网条件下会产生 5.7 t CO2(429 g/kWh),而在魁北克水电电网条件下仅产生 264.9 kg CO2(20 g/kWh,按运行阶段核算);在这组美国平均电网与魁北克电网的对比中,差异约为 21.4×。燃煤电网的排放为 800–1000 g CO2/kWh,而管理良好的水电能源在运行阶段核算中的排放为 10–50 g CO2/kWh,并非全生命周期零排放。如 节 1.2 所示,云服务对比必须披露地区、能源核算边界、利用率、隐含碳分摊,以及所用电力对服务提供商而言属于范围 2,还是对客户而言属于范围 3。
陷阱:只关注运行阶段的能耗,而忽视隐含碳和生命周期影响。
团队在优化训练效率的同时忽略了制造排放。在低碳电网中,隐含碳可能在集群层面的足迹核算中占据主导地位。如 节 1.2.1.1 中的量化结果所示,一台 A100 加速器制造过程中的隐含碳约为 150 kg CO2 (Luccioni 等 2023年);对于前述持续 14 天、使用 64 台 A100 的训练任务,未经摊销的初始碳负担约为 9.6 公吨 CO2。按 4 年使用寿命摊销后,归属于这一特定 14 天任务的份额约为 90 kg,但在总足迹核算中占主导地位的是未经摊销的集群层面数值:它超过了该任务在魁北克清洁电网条件下的运行排放,因为该电网下的运行排放极低。将硬件使用寿命从三年延长至五年,可使摊销后的隐含碳减少 40%。只关注运行效率的组织会忽略采购与折旧这一调节手段,却致力于获取 PUE 或计算效率的边际改善。
Luccioni, Alexandra Sasha, Sylvain Viguier, 和 Anne-Laure Ligozat. 2023年. 《Estimating the Carbon Footprint of BLOOM, a 176B Parameter Language Model》. Journal of Machine Learning Research 24 (253): 1~15.
谬误:TDP 就是实际功耗。
热设计功耗是冷却系统必须应对的最大持续功耗,而非加速器在给定工作负载下消耗的实际功率。实际功耗随利用率、内存访问模式和时钟频率而变化:H100 的空闲功耗约为 50–80 W,运行推理工作负载时为 250–400 W,只有在张量核心占用率较高的持续训练期间才接近其 700 W TDP。使用 TDP 计算能耗会高估推理集群的碳排放(这类集群很少持续维持峰值功耗),也会低估较新硬件上持续训练的碳排放,因为其动态加速可能使功耗超过公布的上限。用于地理部署决策的碳排放与电力成本估算(节 1.2)应采用按工作负载类别测得的平均功耗,而非规格表中的 TDP。
陷阱:将 PUE 作为全面的环境指标。
数据中心运营方在可持续性披露中报告 PUE,工程师则将其视为概括效率的单一数字。PUE 仅衡量设施总功耗与 IT 功耗之比;它既不涉及水消耗,也不涉及制造环节的隐含碳,更不涉及设施所消耗电力的碳强度。一家 PUE 为 1.06、运行于以燃煤为主的电网(820 g CO2/kWh)的数据中心,其运行碳足迹远大于一家 PUE 为 1.40、运行于水电的(10 g CO2/kWh)数据中心——仅 PUE 就掩盖了约 60\(\times\) 倍的差异。要报告总环境影响,必须将 PUE、WUE、电网碳强度以及隐含碳分摊结合起来,没有任何单一指标是充分的。
谬误:效率提升会自动降低总环境影响。
工程师假定将推理成本减半就能使环境影响减半。杰文斯悖论警示,效率提升可能因推动使用量扩张而增加总消耗。在反弹场景中,将每 1,000 tokens 的 token 成本从 $0.06 to $0.002 降低(改善 30\(\times\) 倍),同时使查询量增长 100\(\times\) 倍,总排放反而增加,尽管每次查询的效率有所提升。任何降低每次查询能耗的实现改进,只要使用量以更大的倍数增长,都会推高总能耗。因此,缺乏使用量治理而只优化效率的团队,可能将可持续性成果转化为消耗增长,需要采用受 AI 工作负载中的 Jevons 悖论 中杰文斯分析启发的碳预算与用量上限。
陷阱:将碳抵消视为减少实际排放的替代方案。
组织购买碳抵消以中和排放,却未验证抵消项目的质量。事实上,对自愿碳市场的分析显示,60–90% 的碳信用因基线虚高、封存不永久,或项目本身无论如何都会发生,而未能实现所宣称的减排量。一家在燃煤电网(1000 g CO2/kWh)上训练模型并购买碳抵消的公司,比直接迁移到可再生能源区域(20–50 g CO2/kWh)多花费 2–3\(\times\),而环境结果却更差。抵消项目需要 5-20 年才能完成碳封存,而计算排放是即时的。优先抵消而非实际减排的团队,会错过 节 1.0.1 中确立的地理优势,并推迟带来永久性改善的可再生能源转型。
谬误:部件层面的优化保证全生命周期改善。
团队为提升可持续性而降低训练成本,却未分析部署规模。在生产环境中,训练与推理之间的权衡往往会使总排放反转。一个为节省训练能耗而修剪 40% 的模型,若服务超过 1 亿次查询,则其所需的 2\(\times\) 倍推理算力会使总生命周期排放增加;生产系统通常在三到六个月内达到这一交叉点。边缘部署可将数据中心能耗降低 60%,但需要制造 10,000 台专用设备,从而增加 1,500-2,000 kg 隐含碳(相当于云训练排放的 10\(\times\) 倍)。将 GPU 使用寿命从三年延长至五年可使分摊后的隐含碳降低 40%,但可能牺牲 15–25% 的运营效率;生命周期盈亏平衡取决于电网碳强度,在清洁电网下寿命延长占优,在脏煤电网下效率占优。有效的可持续性需要跨 节 1.2.1.2 进行整体分析,而非局部优化。
陷阱:在部件边界而非生命周期边界上评估可持续性。
一个为节省训练能耗而激进修剪的模型,却因精度损失而在推理阶段需要大量计算开销来补偿,这正体现了局部优化的危险。同样的错误也出现在硬件团队只报告加速器效率而不报告采购碳、平台团队只报告 PUE 而不报告电网强度、模型团队只报告训练排放而不报告预期服务量量的情况。避免这些系统性陷阱需要采用 节 1.2.1.2 中提出的生命周期边界:在将某项变更称为可持续之前,必须将训练、服务、隐含碳、区域电网组合、硬件寿命和需求增长放在一起评估。
Summary
生命周期边界将训练、服务、隐含碳、电网组合、硬件寿命和需求增长联系起来。可持续 AI 追问的是:在模型与基础设施经过优化之后,机器学习集群是否仍能在可用的能源、水资源和材料资源范围内运行。
生命周期碳足迹从 节 1.2.1.1 中量化的单台 H100 隐含碳,一直延伸到训练期间消耗的数千兆瓦时。在自回归解码过程中,加速器可能在等待内存时仍在耗电,这使得量化和面向内存优化的硬件只有在固定质量、延迟和可靠性条件下确实降低实测能耗时才相关。杰文斯反弹效应引入了需求约束,因为当使用量的增长速度超过每次查询消耗的下降速度时,效率提升并不会降低总影响。
碳预算、电力供应、冷却能力和水资源可用性对集群扩展施加了可量化的限制。测量契约通过固定有用工作量、系统边界、归因、时间和不确定性,使这些限制具有可比性。因此,可持续性除了部件层面的优化之外,还需要工作负载核算与需求治理。
生命周期核算涵盖训练、推理和隐含制造排放,而碳感知调度则将电网强度纳入选址决策。这些方法将可持续性转化为可测量的工程约束。当监管、采购或碳定价使环境影响成为运营边界的一部分时,核算的重要性便与容错或安全性同等。
Key Takeaways: 效率本身并不足够
- 电力是硬性上限:集群的计算量不能超过其站点所能提供的兆瓦数、冷却能力、水资源和电网容量。因此,可持续性是对模型规模的存续性约束,而非围绕一个本来已经完成的架构所加的宣传层。
- 需求可能跑赢效率:在 2012–2019 年的扩展窗口内,AI 计算需求年均增长约 6.2\(\times\),而硬件效率年曲线仅为 1.5\(\times\)。若无算法与治理层面的限制,即使每次操作的代价都在下降,电力墙依然会到来。
- 解码在结构上浪费能源:自回归服务会长时间处于带宽受限状态,加速器在等待内存时持续消耗静态功耗。可持续的服务需要量化、稀疏性、批处理纪律以及面向内存优化的硬件,因为单纯的 FLOP 效率会遗漏主要损失。
- 碳从开机之前就开始:硬件制造在首次查询运行之前就已产生排放,且其生命周期份额在清洁电网和低利用率条件下更高。当生命周期核算构成边界时,采购、硬件寿命、复用、隐含分摊规则以及电子废弃物政策都属于 MLOps 决策。
- 地点改变足迹:当灵活任务在不同电网之间迁移时,碳感知调度可依据本书所述的 8 到 40 倍区域代表性因子削减排放。效率必须与任务放置和需求治理相结合,否则杰文斯反弹会消耗掉这些收益(原则 19)。
本书的大部分篇幅中,效率都是使其他一切成为可能的杠杆,每一章都以更少的字节、更少的 FLOPs、更少的焦耳实现相同的结果。可持续性正是这一杠杆撞上它无法突破的墙的地方。数据中心拥有固定的电力边界,无论计算量、通信量还是协同量有多大,都无法让设施交付更多的能量;热力学极限是跨越这三者的唯一约束。效率无法突破这一上限,而杰文斯悖论表明它可能加速这一过程,因为更便宜的计算会以更大的数量被购买,直到收益被消耗殆尽。因此,始终低于这一限制需要依靠效率之外的东西:需要就消耗多少新获得的廉价容量作出有意识的决策。
What’s Next: 从可持续性到责任
机器学习集群的环境足迹是可量化且受约束的,这使得物理可行性成为系统设计问题的一部分。安全性、鲁棒性和可持续性共同构成生产 AI 的工程基础。然而,一个技术上可靠的系统仍可能对社会造成危害。责任人工智能 考察了确保集群服务于构建它所在社会价值的治理框架、公平性要求与伦理护栏,从而完成了从“如何构建机器”到“为谁构建机器”的转变。