算法基础
算法基础
性能剖析结果显示利用率低时,往往会被误诊为硬件限制,而实际原因可能在于算法:矩阵乘法的形状无法充分利用张量核心、布局破坏了连续性,或者为反向传播保留了激活内存。本附录汇总了本书性能相关章节所依赖的计算复杂度模型与内存占用推导,使读者能够在将代码部署到加速器之前评估算法权衡。本附录假定读者熟悉线性代数,以及本书前面介绍的机器学习系统铁律。
如何使用本附录
本附录旨在供读者查阅。当需要将性能剖析工具呈现的症状(“矩阵乘法缓慢”“形状不匹配”“训练期间内存不足”)对应到具体的计算或内存原因时,可以参考本附录。
这里采用的约定遵循全书统一的符号体系(例如,\(B\) 专用于表示批大小,\(\text{BW}\) 表示带宽)。
- 当通用矩阵乘法(GEMM)内核运行缓慢时:参阅 section 1.1.4,并将算术强度与硬件的拐点进行比较。
- 当训练中的内存占用急剧增加时:参阅 section 1.3.3 及训练内存的
- 当张量代码“本应可行”却无法运行时:参阅 section 1.2.2 和 section 1.2.3。
- 当有人提出用稀疏性解决问题时:参阅 section 1.1.5,检查密度与元数据开销。
- 当需要证明梯度计算的界限时:参阅 section 1.4,了解 Baur–Strassen 反向模式自动微分(AD)复杂度定理。
- 当分析序列长度瓶颈时:参阅 section 1.5,了解在线 softmax 递推关系,以及 FlashAttention 减少高带宽内存(HBM)I/O 的证明。
- 当在参数与词元之间分配计算量时:参阅 section 1.6,了解 Kaplan 与 Chinchilla 计算最优缩放定律的推导。
神经网络将线性代数转化为习得的行为:矩阵变换激活,张量布局决定数据如何在内存中移动,反向传播则沿由此形成的计算过程传递误差信号。这些基础支撑了 神经计算 中对深度学习的讨论、机器学习框架 中对框架内部机制的介绍,以及 模型训练 中的训练策略。架构会变化,但底层的数学机制保持不变。
线性代数
深度学习系统本质上是变换大规模矩阵的引擎。PyTorch 等框架封装了底层数学运算,但性能工程仍然依赖底层的线性代数。在 数值表示 介绍数值存储方式的基础上,本节重点讨论如何对这些数值进行运算。
Systems Perspective 1.1: 为何重要
张量运算与记法
本书始终使用爱因斯坦求和1记法来明确表达复杂运算(在 PyTorch 中实现为 torch.einsum,在 NumPy 中实现为 np.einsum)。矩阵乘法 \(\mathbf{C} = \mathbf{A}\mathbf{B}\) 可写为: \[ C_{ij} = \sum_k A_{ik} B_{kj} \]
在 einsum 记法中,这写作 ik,kj->ij。该记法可以自然地扩展到注意力机制中的多维运算。例如,批量多头注意力写作 bhid,bhjd->bhij(批 \(b\)、头 \(h\)、查询序列 \(i\)、键序列 \(j\) 和头维度 \(d\))。
内存布局与性能
数据在内存中的布局(行优先或列优先)会直接影响缓存效率。遍历矩阵时,访问连续内存位置的速度远高于跨步访问。
一种常见的优化模式是在重复运算之前,将转置张量一次性物化,以确保热点循环中的访问连续。一次性的复制成本可由后续大量运算摊销。
作为相似性度量的点积
点积 \(\mathbf{a} \cdot \mathbf{b} = \sum a_i b_i\) 在几何上等价于 \(\|\mathbf{a}\| \|\mathbf{b}\| \cos \phi\),因此天然适合度量两个向量的相似性:对于非零向量,点积的符号可以区分锐角、直角和钝角,而其大小还取决于两个向量的范数。
这一几何解释说明了为何点积在现代架构中无处不在。在注意力机制中,查询(\(Q\))向量与键(\(K\))向量通过点积计算相似性分数,以确定每个词元对其他各词元的关注程度。随后,利用所得的注意力权重对值(\(V\))向量进行加权组合。因此,点积构成了 Transformer 建模长距离依赖能力的基础。
通用矩阵乘法(GEMM)
GEMM2 是深度学习的核心计算操作。对于大小分别为 \(M{\times}K\) 和 \(K{\times}N\) 的矩阵,GEMM 执行 \(2MNK\) 次浮点运算(乘加计为两次运算)。
GEMM 的算术强度随矩阵维度线性增长。对于采用 FP16 的 \(n{\times}n\) 方阵(每个元素 2 字节),理想的 \(\beta=0\) 界限对应于读取 \(\mathbf{A}\) 和 \(\mathbf{B}\) 各一次,并写入 \(\mathbf{C}\) 一次: \[\text{Intensity} = \frac{O}{D_{\text{vol}}} = \frac{2n^3}{3n^2 \times 2} = \frac{n}{3}\text{ FLOP/byte}\]
当 \(\beta \ne 0\) 时,需要读取原有的 \(\mathbf{C}\),算术强度因此变为 \(n/4\) FLOP/byte。GEMM 的执行受以下三个系统层面的规律支配:
- 更大的批次可以提高效率:当批处理形成更大的 GEMM 或实现数据复用时,会增大有效矩阵维度;仅将独立的小型 GEMM 排入队列并不会提高算术强度。
- 维度对齐有助于提高性能:硬件张量核心针对特定精度和架构所要求的分块倍数进行了优化。与这些倍数对齐的维度可以避免填充开销并提高内核效率,但不必是 2 的幂。
- 小矩阵效率较低:当 \(n =\) 64 时,方阵 GEMM 的算术强度为 64/3 ≈ 21.3 FLOP/byte,远低于拐点(153.0 FLOP/byte)。其 Roofline 上限约为峰值的 13.9 percent;启动和分块开销还可能进一步降低实际吞吐量。
稀疏矩阵格式
当矩阵中的大多数元素为零时,专用存储格式可以避免为零元素浪费内存,并使计算能够完全跳过这些元素。压缩稀疏行(CSR)格式使用三个数组:
Values:按行顺序存储的非零元素Col_Idx:每个非零元素的列索引Row_Ptr:每行在Values中的起始位置(长度 = 行数 + 1)
CSR 适用于推荐流水线中的稀疏特征矩阵和剪枝后的模型权重。对于具有 \(N\) 个元素、\(R\) 行和 \(K\) 个非零元素的矩阵,CSR 的存储复杂度为 \(\mathcal{O}(K + R)\),而非 \(\mathcal{O}(N)\);当 \(K\) 相对于 \(R\) 较大时,通常简写为 \(\mathcal{O}(K)\)。
为具体说明这一权衡,考虑一个具有 100,000 行和 10,000 列的词表嵌入矩阵(1B 个参数):
- 稠密(FP32):1B 个参数 \(\times\) 每个参数 4 字节 = 4 GB。
- 稀疏(密度为 1 percent):CSR 存储约 10M 个条目 \(\times\)(4 字节的值 + 4 字节的列索引),再加上每行一个行指针和一个末尾指针,总计 ≈ 80.4 MB。
- 结果:内存占用按 50× 的缩减因子降低,使原本会发生 OOM(内存不足)的模型能够装入内存。
线性代数告诉我们计算什么;接下来的问题是如何用代码表达这些计算。张量编程原语——形状、步幅和广播——在数学记法与实际在硬件上执行的数组运算之间架起了桥梁。
张量编程原语
形状不匹配导致崩溃、广播结果悄然出错、非连续张量使内核仅以峰值性能的 5% 运行——这些常见的机器学习工程故障都可追溯到同一个抽象层。张量编程将线性代数的抽象数学转化为在硬件上运行的具体数组操作。
计算复杂度速查表
Table 1 为最常见的构建模块提供了定量参考。可以利用这些公式,在配置硬件之前粗略估算模型大小和计算需求。给定层维度和输入形状,这些公式可提供参数量与计算量的一阶估计。注意力一行给出了关键提醒:序列长度引入 \(S^2\) 项,而隐藏维度引入 \(d^2\) 的投影计算量,因此,长上下文模型即使不改变参数量,也可能使主导成本发生转移。
| 层类型 | 输出形状 | 参数量(\(P\)) | FLOPs(每次前向传播) |
|---|---|---|---|
| 线性层 | \((B, N_{\text{out}})\) | \(N_{\text{in}} \times N_{\text{out}} + N_{\text{out}}\),启用偏置时 | \(2 \times B \times N_{\text{in}} \times N_{\text{out}}\) |
| 二维卷积 | \((B, C_{\text{out}}, H', W')\) | \(K^2 \times C_{\text{in}} \times C_{\text{out}} + C_{\text{out}}\),启用偏置时 | \(2 \times B \times H' \times W' \times K^2 \times C_{\text{in}} \times C_{\text{out}}\) |
| 多头自注意力 | \((B, S, d_{\text{model}})\) | \(4 \times d_{\text{model}}^2\),若启用投影偏置,则再加 \(4 \times d_{\text{model}}\) | \(B \times (4 S^2 d_{\text{model}} + 8 S d_{\text{model}}^2)\) |
| 层归一化 | \((B, S, d_{\text{model}})\) | \(2 \times d_{\text{model}}\),启用仿射缩放与偏置时 | \(\mathcal{O}(B \times S \times d_{\text{model}})\) |
形状与步幅
张量是底层存储缓冲区上的一个视图,由形状、步幅、数据类型和偏移量等元数据描述。只有连续张量才会将其逻辑元素排列为一个相邻的内存块。
- 形状:张量的各维大小(例如
(3, 4))。 - 步幅:沿某一维移动到下一个元素时,在内存中需要跨过的元素数。
transpose() 或 view() 等操作通常只改变步幅,而不改变内存中的数据。这种操作很快(\(\mathcal{O}(1)\)),但可能产生非连续张量,导致其无法用于要求数据连续的内核。在这种情况下,调用 contiguous() 会强制执行一次 \(\mathcal{O}(N)\) 的内存复制;如果在循环内反复触发,这一操作可能主导运行时间。
广播
广播允许对不同形状的张量执行算术运算。从最后一维向第一维逐一比较。两个维度在以下情况下兼容:
- 二者相等。
- 其中一个为 1。
大小为 1 的维度会被“拉伸”以匹配另一个维度,如 figure 1 所示。这种拉伸是虚拟的:数据不会在内存中复制。实际做法是将该维度的步幅设为 0,使硬件能够反复读取同一个值,内存开销为 \(\mathcal{O}(1)\)。
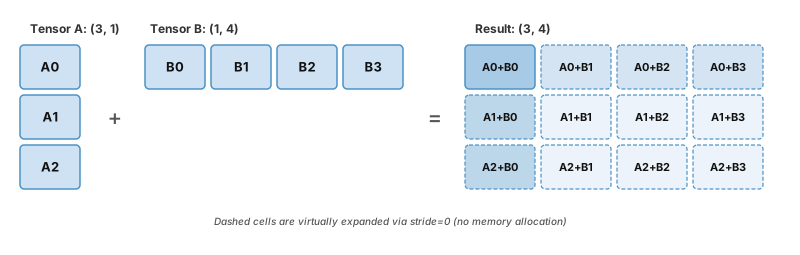
考虑一个具体示例:张量 A 的形状为 (32, 1, 64),张量 B 的形状为 (1, 128, 64)。从右向左比较维度,64 与 64 匹配,然后 1 扩展为 128,再将 1 扩展为 32,得到结果形状 (32, 128, 64)。将这一扩展过程可视化,有助于避免悄然发生的逻辑错误,以免意外分配大型张量(例如,分配了一个 (Batch, Batch) 矩阵,而非逐元素的 (Batch) 向量)。
形状、步幅和广播决定了张量如何流经模型的前向传播。训练还提出了第二个要求:从误差中学习。反向传播使这种学习成为可能,同时也带来了下文将推导的内存成本。
学习机制
正确的张量程序使训练循环得以运行。反向传播协调这些张量以计算梯度,将前向预测转化为反向的学习信号。
Systems Perspective 1.2: 为何重要
链式法则与自动微分
对于复合函数 \(y = f(g(x))\),其导数为 \(\frac{dy}{dx} = \frac{dy}{dg} \cdot \frac{dg}{dx}\)。在神经网络中,\(f\) 和 \(g\) 是层,复合关系可以深入许多层。对于三层网络 \(y = f_3(f_2(f_1(x)))\),链式法则可扩展为: \[ \frac{\partial y}{\partial x} = \frac{\partial f_3}{\partial f_2} \cdot \frac{\partial f_2}{\partial f_1} \cdot \frac{\partial f_1}{\partial x} \]
该乘积中的每个因子都是一个局部导数,仅使用某一层的输入和输出在该层计算得到。这种局部性使算法在计算上可行:不必将整个网络视为一个整体函数来求导。相反,每一层在反向传播期间计算自身的局部导数,并将其乘以靠近输出端的上层传来的梯度。
现代框架使用反向模式自动微分,通过一次反向传播计算全部 \(P\) 个参数的梯度。关键在于,从输出开始向后计算(反向模式)只需要一次遍历,与参数数量无关;而从每个输入开始向前计算(前向模式)则需要 \(P\) 次遍历,即每个参数一次。这就是为何一个训练步骤的成本只是推理成本的一个较小常数倍:对于稠密网络,通常约为一次前向传播的 2–3\(\times\),而非 \(P\) 次遍历。
反向传播算法
反向传播3通过两次遍历高效实现链式法则:前向传播计算输出,反向传播计算梯度。Figure 2 以一个简单的两层网络展示了这一过程,其中前向传播(灰色箭头)计算输出,反向传播(红色虚线箭头)传播梯度。
\begin{tikzpicture}[font=\small\sffamily, node distance=3cm, auto, >=stealth, thick]
  \tikzset{
    Node/.style={circle, draw=BlueLine, fill=BlueFill, line width=0.8pt, minimum size=0.9cm, text=TextBlack},
    Edge/.style={->, draw=GrayLine, line width=0.8pt},
    BackEdge/.style={->, dashed, draw=RedLine, line width=0.8pt, bend right=30},
    Label/.style={font=\footnotesize\sffamily, text=TextBlack}
  }
  \node[Node] (x) {x};
  \node[Node, right of=x] (h) {h};
  \node[Node, right of=h] (y) {y};
  \node[Node, right of=y, fill=RedLine!10, draw=RedLine] (L) {$\mathcal{L}$};
  \draw[Edge] (x) -- node[below, Label] {$W_1$} (h);
  \draw[Edge] (h) -- node[below, Label] {$W_2$} (y);
  \draw[Edge] (y) -- node[below, Label] {损失} (L);
  \draw[BackEdge,overlay] (L) to node[above, Label, text=RedLine] {$\frac{\partial \mathcal{L}}{\partial y}$} (y);
  \draw[BackEdge,overlay] (y) to node[above, Label, text=RedLine] {$\frac{\partial \mathcal{L}}{\partial h}$} (h);
  \draw[BackEdge,overlay] (h) to node[above, Label, text=RedLine] {$\frac{\partial \mathcal{L}}{\partial x}$} (x);
 \path[use as bounding box] (-0.5,-0.55) rectangle (9.5,1.21);
\end{tikzpicture}梯度边沿前向依赖关系反向回溯,因此每个反向步骤都需要使用相应前向运算中保留的值。
前向传播
采用行向量表示激活值,省略偏置,并保留中间激活值以供反向传播使用。从输入 \(x\) 开始,将其乘以 \(W_1\),得到隐藏层激活值 \(h\)。缓存 \(h\),因为稍后的反向传播需要使用它。将 \(h\) 乘以 \(W_2\),得到输出 \(y\)。缓存 \(y\)。将 \(y\) 与目标标签进行比较,计算损失 \(\mathcal{L}\)。
此时,损失已计算完成,内存中存有输入 \(x\)、缓存的激活值 \(h\)、缓存的输出 \(y\) 以及损失 \(\mathcal{L}\)。对于大型模型,这些缓存的激活值可能占据内存使用量的主要部分。
反向传播
现在从 \(\mathcal{L}\) 开始反向回溯。损失函数提供 \(\frac{\partial \mathcal{L}}{\partial y}\),即损失对预测值的梯度。误差信号由此进入网络。
由于 \(y = h \cdot W_2\),链式法则给出该层的两个梯度: \[ \frac{\partial \mathcal{L}}{\partial W_2} = h^T \cdot \frac{\partial \mathcal{L}}{\partial y} \qquad \text{(weight gradient—used to update } W_2\text{)} \] \[ \frac{\partial \mathcal{L}}{\partial h} = \frac{\partial \mathcal{L}}{\partial y} \cdot W_2^T \qquad \text{(input gradient—passed backward to the previous layer)} \]
计算 \(\frac{\partial \mathcal{L}}{\partial W_2}\) 需要前向传播中缓存的激活值 \(h\)。反向传播期间必须能够访问激活值,因为每一层的权重梯度都依赖于该层的输入。
现在继续反向传播到第一层。由于 \(h = x \cdot W_1\),采用相同模式可得: \[ \frac{\partial \mathcal{L}}{\partial W_1} = x^T \cdot \frac{\partial \mathcal{L}}{\partial h} \]
每个反向步骤都需要两项信息:从上层传入的梯度 \(\left(\frac{\partial \mathcal{L}}{\partial h}\right)\) 和该层的输入(\(x\));反向传播期间必须能够访问该输入。这就是反向传播的计算成本约为前向传播 2\(\times\) 的原因:反向传播在每一层执行两次矩阵乘法(一次用于权重梯度,一次用于输入梯度),而前向传播只执行一次。
训练内存的真实成本
一个常见错误是认为训练所需内存等于模型大小。这一假设会立即导致内存不足(OOM)错误,因为权重只是四个组成部分之一。训练内存由权重、梯度、优化器状态和保留的激活值组成: \[ M_{\text{total}} = M_{\text{weights}} + M_{\text{gradients}} + M_{\text{optimizer}} + M_{\text{activations}} \]
对于采用混合精度 (Micikevicius et al. 2017) 的标准自适应矩估计(Adam)优化器 (Kingma and Ba 2015):
- 权重:2 bytes(FP16/BF16)或 4 bytes(FP32)。
- 梯度:与权重大小相同。
- 优化器状态:Adam 的矩估计每个参数需要 8 字节;FP32 主副本额外增加 4 bytes,因此每个参数共需 8–12 字节。
- 激活值:隐藏的内存消耗大户。适用于重计算或分块注意力实现的估算按 \(\mathcal{O}(B \times S \times N_L \times d)\) 增长;完整且不进行重计算的注意力实现还会显式生成随 \(S^2\) 增长的注意力分数张量。
为了解这些组成部分在实践中如何相互影响,下面考察一个具体模型。
Napkin Math 1.1: 计算示例:GPT-2(15 亿参数)的训练内存
模型状态(每步固定):
- 权重(BF16):\(1.5 \times 10^{9}\) \(\times\) 2 字节 = 3 GB
- 梯度(BF16):\(1.5 \times 10^{9}\) \(\times\) 2 字节 = 3 GB
- 优化器(FP32 主副本 + 动量 + 方差):\(1.5 \times 10^{9}\) \(\times\) 12 字节 = 18 GB
- 模型状态总量:24 GB——可容纳于一块 80 GB 级别的 A100/H100(按十进制单位计为 85.9 GB)中,但仅剩 61.9 GB 可用于激活值。
激活值(随批量大小增长):
在这一快速估算中,每层保留的激活值约为 \(12 \times B \times S \times d\) 个 BF16 元素,即 \(12 \times B \times S \times d \times 2\) 字节,其中 \(B\) 为批量大小,\(S\) 为序列长度。系数 12 涵盖了为反向传播保留的主要中间张量:输入激活值、QKV 投影(\(3d\))、注意力输出、FFN 中间值(\(4d\))以及层归一化/dropout 掩码。该估算假设实现不保留完整的 \(B \times N_{\text{heads}} \times S^2\) 注意力分数张量,与适用于重计算或分块注意力实现的内存核算方式一致。当层数为 48、批量大小为 8、序列长度为 1024 时:
\[48 \times 12 \times 8 \times 1024 \times 1600 \times 2\text{ bytes } \approx 15.1 GB\]
系统层面的洞见:在这一激活值内存核算约定下,总内存为 ~39.1 GB,可容纳于一块容量为 85.9 GB 的加速器中。然而,将批量大小增至 64 后,激活值内存将增长至 ~120.8 GB,超过剩余容量。此时便必须采用梯度检查点或其他节省内存的方法;其内存节省量和重计算开销取决于检查点的放置位置与具体实现。
激活值内存激增
权重所占内存固定(\(\mathcal{O}(P)\)),而激活值内存随批量大小线性增长,并且至少随序列长度线性增长;显式生成注意力分数的实现还会增加一个 \(\mathcal{O}(S^2)\) 分量。如上述计算示例所示,激活值内存可能很快超过模型状态占用后剩余的空间。梯度检查点4 通过仅存储选定的激活值,并在反向传播期间重计算其余激活值,来缓解这一压力 (Chen et al. 2016);FlashAttention 等技术则通过分块计算注意力以减少内存往返访问,解决相关的注意力内存瓶颈 (Dao et al. 2022)。
同样的分解方法也可用于快速检查可行性:汇总每个参数对应的模型状态内存,加上由批量大小和序列长度决定的激活值内存项,再将总量与加速器容量进行比较。
计算图与优化
反向传播所揭示的依赖结构也为编译器提供了优化对象。机器学习编译器将模型表示为有向无环图(DAG),这种表示支持与硬件无关的变换。
静态单赋值
编译器将图转换为静态单赋值(SSA)形式,其中每个变量恰好被赋值一次。这使数据依赖关系显式化,从而支持安全的优化——其中最重要的是算子融合。
算子融合
如果不进行融合,MatMul → Add (bias) → ReLU 这类运算链中的每个运算都会生成一个中间张量,将其写入 HBM,然后在下一个运算中读回。对于 Add 和 ReLU 这样的逐元素运算,计算量很小(每个元素一次浮点运算),但内存流量并不小(读取张量,再将其写回)。因此,未融合的逐元素运算的算术强度接近于零,严重受限于内存访问。
融合将连续运算合并为一个内核,仅读取一次输入,在寄存器或共享内存中执行所有运算,并仅写入一次最终结果。对于大小为 \(N\) 字节的张量上的 \(k\) 个逐元素运算,融合将内存流量从 \(2kN\) 字节(每个运算都读写一次)降至 \(2N\) 字节(一次读取、一次写入),即内存流量的缩减倍数为 \(k\times\)。
FlashAttention 是一种 I/O 感知的分块注意力算法:它在 SRAM 块中计算分数、softmax 和与值相乘的各阶段,无须在 HBM 中显式生成完整的注意力矩阵,从而减少 HBM 流量,并将注意力辅助内存从 \(\mathcal{O}(S^2)\) 降至 \(\mathcal{O}(S)\)。原始研究报告,在其评估的工作负载上,实际运行时间最多可获得 3\(\times\) 的加速 (Dao et al. 2022);实际收益取决于张量形状和硬件(逐步推导见 section 1.5)。本附录介绍的线性代数基础、张量编程机制和训练内存模型共同构成了所有机器学习系统赖以建立的算法基础。
Baur–Strassen 反向模式自动微分复杂度定理
现代深度学习能够扩展至数千亿参数,是因为计算标量损失函数 \(f: \mathbb{R}^N \to \mathbb{R}\) 的完整梯度向量 \(\nabla f(x)\) 所需的计算量,与计算 \(f(x)\) 本身所需的计算量成正比,且常数因子上界与输入维度 \(N\) 无关。Baur 和 Strassen 于 1983 年证明了这一复杂度结果 (Baur and Strassen 1983)。
数学形式与定理陈述
设 \(f: \mathbb{R}^N \to \mathbb{R}\) 为多元标量值函数,由计算图 \(G = (V, E)\) 表示,该图包含 \(W(f)\) 次基本运算(加法、减法、乘法、除法,以及 \(\exp, \ln, \sin, \sqrt{\cdot}\) 等一元函数)。
Theorem 1.1: Baur–Strassen 复杂度定理
基于链式法则的伴随图传播逐步证明
设计算图 \(G = (V, E)\) 的节点按拓扑顺序排列为 \(v_{1-N}, \dots, v_0, v_1\),\(v_2, \dots, v_W\),其中输入变量为 \(x_i = v_{i-N}\),\(i \in \{1, \dots, N\}\),最终输出为 \(f(x) = v_W\)。每个中间节点 \(v_j\) 通过一个原语运算计算: \[ v_j = \phi_j\left( \{ v_k \mid k \in \text{Parents}(j) \} \right) \]
对每个节点 \(v_i\),将其伴随变量 \(\bar{v}_i\) 定义为标量输出 \(v_W\) 对 \(v_i\) 的偏导数: \[ \bar{v}_i \triangleq \frac{\partial f}{\partial v_i} = \frac{\partial v_W}{\partial v_i} \]
根据多元链式法则,伴随变量 \(\bar{v}_i\) 等于所有使用 \(v_i\) 的后继节点(子节点)传播而来的偏导数贡献之和: \[ \bar{v}_i = \sum_{j \in \text{Children}(i)} \bar{v}_j \cdot \frac{\partial v_j}{\partial v_i} \]
反向模式自动微分初始化 \(\bar{v}_W = 1\),并对所有 \(i < W\) 初始化 \(\bar{v}_i = 0\),然后按逆拓扑顺序从 \(v_W\) 遍历至 \(v_1\)。对于每个原语节点 \(v_j\),其已完成累加的伴随变量 \(\bar{v}_j\) 通过下式向父节点 \(v_k\)(\(k \in \text{Parents}(j)\))传播误差信号: \[ \bar{v}_k \gets \bar{v}_k + \bar{v}_j \cdot \frac{\partial v_j}{\partial v_k} \]
现在对所有原语节点逐项进行细粒度的运算成本核算,以确定反向计算工作量的上界:
- 加法/减法(\(v_j = v_i \pm v_k\)):
- 局部导数:\(\frac{\partial v_j}{\partial v_i} = 1\),\(\frac{\partial v_j}{\partial v_k} = \pm 1\)。
- 反向更新:\(\bar{v}_i \gets \bar{v}_i + \bar{v}_j\) 和 \(\bar{v}_k \gets \bar{v}_k \pm \bar{v}_j\)。
- 成本:每 1 次前向运算对应反向传播中的 2 次加法。工作量比:\(\text{Fwd}(1) + \text{Bwd}(2) = 3 \text{ OPs} \le 5 \cdot 1\)。
- 乘法(\(v_j = v_i \cdot v_k\)):
- 局部导数:\(\frac{\partial v_j}{\partial v_i} = v_k\),\(\frac{\partial v_j}{\partial v_k} = v_i\)。
- 反向更新:\(\bar{v}_i \gets \bar{v}_i + \bar{v}_j \cdot v_k\) 和 \(\bar{v}_k \gets \bar{v}_k + \bar{v}_j \cdot v_i\)。
- 成本:每 1 次前向运算对应反向传播中的 2 次乘法 + 2 次加法 = 4 次运算。工作量比:\(\text{Fwd}(1) + \text{Bwd}(4) = 5 \text{ OPs} \le 5 \cdot 1\)。
- 除法(\(v_j = v_i/v_k\)):
- 局部导数:\(\frac{\partial v_j}{\partial v_i} = \frac{1}{v_k}\),\(\frac{\partial v_j}{\partial v_k} = -\frac{v_i}{v_k^2} = -\frac{v_j}{v_k}\)。
- 反向更新:\(\bar{v}_i \gets \bar{v}_i + \frac{\bar{v}_j}{v_k}\) 和 \(\bar{v}_k \gets \bar{v}_k - \frac{\bar{v}_j \cdot v_j}{v_k}\)。
- 成本:每 1 次前向运算对应反向传播中的 2 次乘法/除法 + 2 次加法 = 4 次运算。工作量比:\(\text{Fwd}(1) + \text{Bwd}(4) = 5 \text{ OPs} \le 5 \cdot 1\)。
- 一元超越运算(\(v_j = \phi(v_i)\)):
- 局部导数:\(\frac{\partial v_j}{\partial v_i} = \phi'(v_i)\)。
- 反向更新:\(\bar{v}_i \gets \bar{v}_i + \bar{v}_j \cdot \phi'(v_i)\)。
- 对于 \(v_j = \exp(v_i)\),\(\phi'(v_i) = v_j\),需要 1 次乘法 + 1 次加法 = 2 次运算。
- 对于 \(v_j = \ln(v_i)\),\(\phi'(v_i) = 1/v_i\),需要 1 次除法 + 1 次加法 = 2 次运算。
对 \(G\) 中所有原语节点求和,每次前向运算至多产生 4 次反向运算: \[ \text{Work}_{\text{Backward}}(\nabla f) \le 4 \cdot W(f) \]
加上前向传播工作量 \(W(f)\),得到总工作量上界: \[ \text{Work}_{\text{Reverse}}(f, \nabla f) = W(f) + \text{Work}_{\text{Backward}}(\nabla f) \le 5 \cdot W(f) \qquad\blacksquare\]
Systems Perspective 1.3: 为何能够训练具有 1750 亿参数的大语言模型
- 前向传播:矩阵乘法 \(Y = X W\) 每个词元需要 \(2P\) 次浮点运算。
- 反向模式的反向传播:同时计算权重梯度 \(\frac{\partial \mathcal{L}}{\partial W} = X^T \frac{\partial \mathcal{L}}{\partial Y}\)(\(2P\) 次浮点运算)和输入激活值梯度 \(\frac{\partial \mathcal{L}}{\partial X} = \frac{\partial \mathcal{L}}{\partial Y} W^T\)(\(2P\) 次浮点运算),合计每个词元 \(4P\) 次浮点运算。
- 训练总工作量:每个词元 \(2P (\text{fwd}) + 4P (\text{bwd}) = 6P\) 次浮点运算。反向传播相对于前向传播的计算量因子恰为 \(\frac{4P}{2P} = 2\),完全处于 Baur–Strassen 理论上界 \(C \le 5\) 之内。
如果改用前向模式自动微分(AD)或有限差分来计算 \(\nabla f \in \mathbb{R}^P\),分别计算每个偏导数将需要 \(P\) 次前向传播:\(\text{Work}_{\text{ForwardMode}}(\nabla f) = \mathcal{O}(P \cdot W) = \mathcal{O}(P^2)\) FLOPs。当 \(P = 175 \times 10^9\) 时,该方法每个词元需要 \(2 \times (175 \times 10^9)^2 \approx 6.1 \times 10^{22}\) FLOPs,是前向传播计算量的 \(P\) 倍,因此在这一规模下成本高得难以承受。对于上述稠密层计算量核算,反向模式自动微分将这一 \(\mathcal{O}(P)\) 因子降为常数乘数 2。
FlashAttention 分块与在线 Softmax 递推证明
Transformer 中的标准自注意力需要在 HBM 中显式存储一个 \(N \times N\) 的注意力分数矩阵,从而形成 \(\mathcal{O}(N^2)\) 的内存带宽瓶颈。FlashAttention (Dao et al. 2022) 通过对查询、键和值矩阵进行分块,并使用在线 softmax 递推重新计算注意力,避免将中间分数显式存储到 HBM 中,从而消除这一瓶颈。
标准 softmax 的 HBM I/O 瓶颈
对于序列长度 \(N\) 和注意力头维度 \(d\),给定查询 \(\mathbf{Q} \in \mathbb{R}^{N \times d}\)、键 \(\mathbf{K} \in \mathbb{R}^{N \times d}\) 和值 \(\mathbf{V} \in \mathbb{R}^{N \times d}\),标准注意力计算如下: \[ \mathbf{S} = \mathbf{Q} \mathbf{K}^T \in \mathbb{R}^{N \times N}, \qquad \mathbf{A} = \text{softmax}(\mathbf{S}) \in \mathbb{R}^{N \times N}, \qquad \mathbf{O} = \mathbf{A} \mathbf{V} \in \mathbb{R}^{N \times d} \]
为防止数值溢出,逐行 softmax 会减去该行的最大值 \(m_i = \max_{1 \le j \le N} S_{ij}\): \[ A_{ij} = \frac{\exp(S_{ij} - m_i)}{\sum_{k=1}^N \exp(S_{ik} - m_i)} \]
标准 GPU 实现通过三次独立的内核启动执行这一过程:
- 在 SRAM 中计算 \(\mathbf{S} = \mathbf{Q}\mathbf{K}^T\),然后将 \(\mathbf{S} \in \mathbb{R}^{N \times N}\) 写入 HBM(\(\Theta(N^2)\) 次写入)。
- 从 HBM 读取 \(\mathbf{S}\),计算行最大值 \(m\) 和行求和项 \(d\),计算 \(\mathbf{A} = \text{softmax}(\mathbf{S})\),并将 \(\mathbf{A} \in \mathbb{R}^{N \times N}\) 写入 HBM(\(\Theta(N^2)\) 次读取与写入)。
- 从 HBM 读取 \(\mathbf{A}\) 和 \(\mathbf{V}\),计算 \(\mathbf{O} = \mathbf{A}\mathbf{V}\),并将 \(\mathbf{O} \in \mathbb{R}^{N \times d}\) 写入 HBM(\(\Theta(N^2 + Nd)\) 次读取与写入)。
HBM 的总内存流量为 \(\Theta(N^2 + Nd)\) 个元素。当 \(N = 8192\)、\(d = 128\) 且采用 FP16 时,每层每个注意力头的 \(\mathbf{S}\) 需要 \(8192^2 \times 2 \text{ B} = 134 \text{ MB}\)。由于现代 GPU 相对于 HBM 带宽具有极高的计算吞吐量,反复读写中间矩阵 \(\mathbf{S}\) 和 \(\mathbf{A}\) 会使 GPU 执行单元受限于内存访问。
在线 softmax 递推证明
对 softmax 进行分块较为困难,因为计算 \(d_i = \sum_{k=1}^N \exp(S_{ik} - m_i)\) 需要所有 \(N\) 个键对应分数的全局最大值 \(m_i\)。在线 softmax 递推通过在子块到达时增量更新归一化统计量来解决这一问题。
Theorem 1.2: 在线 softmax 递推定理
则合并后的最大值 \(m^{\text{new}}\)、归一化求和项 \(d^{\text{new}}\) 和累积输出向量 \(\mathbf{O}^{\text{new}}\) 满足以下精确递推关系: \[ m^{\text{new}} = \max\left(m^{(1)}, m^{(2)}\right) \] \[ d^{\text{new}} = d^{(1)} e^{m^{(1)} - m^{\text{new}}} + d^{(2)} e^{m^{(2)} - m^{\text{new}}} \] \[ \mathbf{O}^{\text{new}} = \frac{d^{(1)} e^{m^{(1)} - m^{\text{new}}}}{d^{\text{new}}} \mathbf{O}^{(1)} + \frac{e^{m^{(2)} - m^{\text{new}}}}{d^{\text{new}}} \sum_{j=1}^{N_2} e^{x_j^{(2)} - m^{(2)}} \mathbf{V}_j^{(2)} \] 其中,\(\mathbf{O}^{(1)} = \frac{1}{d^{(1)}} \sum_{j=1}^{N_1} e^{x_j^{(1)} - m^{(1)}} \mathbf{V}_j^{(1)}\) 是从块 1 累积得到的部分输出。
分母递推关系的推导
展开合并后的求和项 \(d^{\text{new}} = \sum_{j=1}^N e^{x_j - m^{\text{new}}}\): \[ \begin{aligned} d^{\text{new}} &= \sum_{j=1}^{N_1} e^{x_j^{(1)} - m^{\text{new}}} + \sum_{j=1}^{N_2} e^{x_j^{(2)} - m^{\text{new}}} \\ &= \sum_{j=1}^{N_1} e^{\left(x_j^{(1)} - m^{(1)}\right) + \left(m^{(1)} - m^{\text{new}}\right)} + \sum_{j=1}^{N_2} e^{\left(x_j^{(2)} - m^{(2)}\right) + \left(m^{(2)} - m^{\text{new}}\right)} \\ &= e^{m^{(1)} - m^{\text{new}}} \underbrace{\sum_{j=1}^{N_1} e^{x_j^{(1)} - m^{(1)}}}_{d^{(1)}} + e^{m^{(2)} - m^{\text{new}}} \underbrace{\sum_{j=1}^{N_2} e^{x_j^{(2)} - m^{(2)}}}_{d^{(2)}} \\ &= d^{(1)} e^{m^{(1)} - m^{\text{new}}} + d^{(2)} e^{m^{(2)} - m^{\text{new}}}. \quad \blacksquare \end{aligned} \]
输出重缩放递推关系的推导
拼接后的完整序列上的真实归一化输出为 \(\mathbf{O}^{\text{new}} = \frac{1}{d^{\text{new}}} \sum_{j=1}^N e^{x_j - m^{\text{new}}} \mathbf{V}_j\): \[ \begin{aligned} \mathbf{O}^{\text{new}} &= \frac{1}{d^{\text{new}}} \left[ \sum_{j=1}^{N_1} e^{x_j^{(1)} - m^{\text{new}}} \mathbf{V}_j^{(1)} + \sum_{j=1}^{N_2} e^{x_j^{(2)} - m^{\text{new}}} \mathbf{V}_j^{(2)} \right] \\ &= \frac{1}{d^{\text{new}}} \left[ e^{m^{(1)} - m^{\text{new}}} \sum_{j=1}^{N_1} e^{x_j^{(1)} - m^{(1)}} \mathbf{V}_j^{(1)} + e^{m^{(2)} - m^{\text{new}}} \sum_{j=1}^{N_2} e^{x_j^{(2)} - m^{(2)}} \mathbf{V}_j^{(2)} \right] \end{aligned} \]
注意到 \(d^{(1)} \mathbf{O}^{(1)} = \sum_{j=1}^{N_1} e^{x_j^{(1)} - m^{(1)}} \mathbf{V}_j^{(1)}\),将其直接代入可得: \[ \mathbf{O}^{\text{new}} = \frac{d^{(1)} e^{m^{(1)} - m^{\text{new}}}}{d^{\text{new}}} \mathbf{O}^{(1)} + \frac{e^{m^{(2)} - m^{\text{new}}}}{d^{\text{new}}} \sum_{j=1}^{N_2} e^{x_j^{(2)} - m^{(2)}} \mathbf{V}_j^{(2)}. \quad \blacksquare \]
HBM 访问复杂度的形式化证明
设 \(M\) 为高速 SRAM 的容量(以字为单位)。按照 Dao et al. (2022) 的算法 1,FlashAttention 设置 \(B_c = \lfloor M/(4d) \rfloor\) 和 \(B_r = \min(\lfloor M/(4d) \rfloor,d)\)。证明中略去常数因子并抽象缓冲区复用,使用 \(B_c=\Theta(M/d)\)、\(B_r=\Theta(\min(M/d,d))\),且片上工作集满足 \(B_rB_c=O(M)\)。
该算法执行两层嵌套循环:
- 将 \(\mathbf{Q}\) 划分为 \(T_r = \lceil N/B_r \rceil\) 个大小为 \(B_r \times d\) 的块。
- 将 \(\mathbf{K}, \mathbf{V}\) 划分为 \(T_c = \lceil N/B_c \rceil\) 个大小为 \(B_c \times d\) 的块。
- 外层循环遍历 \(j = 1, \dots, T_c\):将 \(\mathbf{K}_j\) 和 \(\mathbf{V}_j\) 加载到 SRAM。
- 内层循环遍历 \(i = 1, \dots, T_r\):加载 \(\mathbf{Q}_i\)、\(\mathbf{O}_i\) 及其 softmax 统计量;在 SRAM 中计算 \(\mathbf{S}_{ij} = \mathbf{Q}_i \mathbf{K}_j^T\);随后更新并写回 \(\mathbf{O}_i\) 和统计量,而不在 HBM 中显式存储 \(\mathbf{S}_{ij}\)。
这种循环顺序是 I/O 减少的根源。算法遍历所有查询块时,一个键值块始终驻留在 SRAM 中,因此 \(\mathbf{K}\) 和 \(\mathbf{V}\) 的每个元素仅跨越一次 HBM 边界。对于每个键值块,都必须重新访问查询块和输出块,但 \(B_r\times B_c\) 的分数块在片上使用后即被丢弃。相比之下,标准注意力会写入并重新读取完整的 \(N\times N\) 分数矩阵和概率矩阵。
总内存访问量核算
- 键和值的读取:\(\mathbf{K}\) 和 \(\mathbf{V}\) 的每个元素仅加载一次,共产生 \(2Nd\) 次访问。
- 查询、输出和统计量的遍历:\(T_c\) 个列块中的每一个都要读取整个 \(\mathbf{Q}\),读取并写入 \(\mathbf{O}\),并更新 \(O(N)\) 个 softmax 统计量。当注意力头维度 \(d\geq 1\) 时,矩阵访问量占主导,统计量访问量不改变其渐近阶,因此每轮遍历产生 \(\Theta(Nd)\) 次访问,所有遍历共产生 \(\Theta(NdT_c)\) 次访问。
由于 \(T_c=\lceil N/B_c\rceil=\Theta(Nd/M)\),总访问量为 \[ \text{HBM}_{\text{Flash}} = \Theta\left(Nd + NdT_c\right) = \Theta\left(Nd + \frac{N^2d^2}{M}\right) = \Theta\left(\frac{N^2d^2}{M}\right), \] 其中,最后一个等式在 \(d \leq M \leq Nd\) 时成立。
这一界限核算的是通信量而非算术运算量。FlashAttention 仍然计算相同的稠密分数块,并且可能在反向传播期间重新计算中间量;其优势来自避免将这些中间量存入 HBM。
I/O 缩减比
将标准注意力的 I/O 与 FlashAttention 的 I/O 进行比较: \[ \frac{\text{HBM}_{\text{Standard}}}{\text{HBM}_{\text{Flash}}} = \frac{\Theta(N^2 + Nd)}{\Theta\left(Nd + \frac{N^2 d^2}{M}\right)} = \Theta\left(\frac{M}{d^2}\right) \quad \text{for } N \gg \max\left(d,\frac{M}{d}\right) \]
Systems Perspective 1.4: A100 上的 I/O 缩减
- 标准注意力:HBM 读写量为 35.3 GB;运行时间为 35.1 ms。
- FlashAttention:HBM 读写量为 4.4 GB;运行时间为 11.7 ms。
这些测量结果展示了 I/O 界限在系统层面的影响:尽管 FlashAttention 执行了额外的重计算,HBM 流量的大幅减少仍伴随着运行时间的缩短。这并不意味着每种配置都会变为计算受限;分块大小、序列长度和内核实现共同决定实际运行时的瓶颈类型。
Kaplan 与 Chinchilla 计算最优缩放定律推导
对于给定的浮点运算预算 \(C\),确定模型参数量 \(N\) 与训练数据集词元数 \(D\) 之间的计算最优分配,是大语言模型系统设计中的核心决策。本节使用拉格朗日乘数法,严格推导计算最优缩放定律,并对比 Kaplan et al. (2020) 的原始发现与 Hoffmann et al. (2022) 对计算最优分配的修正。
参数化损失曲面的表述
对于具有 \(N\) 个非嵌入参数、在 \(D\) 个词元上训练的自回归 Transformer 语言模型,其交叉熵评估损失 \(\mathcal{L}(N, D)\) 可用以下幂律形式建模: \[ \mathcal{L}(N, D) = E + \frac{A}{N^\alpha} + \frac{B}{D^\beta} \] 其中:
- \(E\):不可约损失,表示自然语言数据的熵。
- \(\frac{A}{N^\alpha}\):有限模型参数量 \(N\) 导致的容量瓶颈损失。
- \(\frac{B}{D^\beta}\):有限训练词元数 \(D\) 导致的数据集规模瓶颈损失。
- \(A, B > 0\):经验缩放常数。
- \(\alpha, \beta > 0\):分别对应模型规模和数据集规模的幂律缩放指数。
使用拉格朗日乘数法进行约束优化
对具有 \(N\) 个非嵌入参数的 Transformer,在 \(D\) 个词元上进行训练所需的浮点运算总量为: \[ C = 6 N D \text{ FLOPs} \]
其中,\(2 N D\) 对应前向传播,\(4 N D\) 对应反向传播。
给定固定的训练计算预算 \(C_0\),我们构建以下约束优化问题,以最小化可约损失 \(\hat{\mathcal{L}}(N, D) = \frac{A}{N^\alpha} + \frac{B}{D^\beta}\): \[ \min_{N, D} \left( \frac{A}{N^\alpha} + \frac{B}{D^\beta} \right) \quad \text{subject to} \quad g(N, D) = 6 N D - C_0 = 0 \]
构建拉格朗日函数 \(\mathcal{L}_{\text{Lagrange}}(N, D, \lambda)\): \[ \mathcal{L}_{\text{Lagrange}}(N, D, \lambda) = \frac{A}{N^\alpha} + \frac{B}{D^\beta} + \lambda (6 N D - C_0) \]
分别对 \(N, D\) 和 \(\lambda\) 求偏导,并令其为零: \[ \frac{\partial \mathcal{L}_{\text{Lagrange}}}{\partial N} = -\alpha A N^{-\alpha - 1} + 6 \lambda D = 0 \implies \alpha A N^{-\alpha - 1} = 6 \lambda D \tag{1} \] \[ \frac{\partial \mathcal{L}_{\text{Lagrange}}}{\partial D} = -\beta B D^{-\beta - 1} + 6 \lambda N = 0 \implies \beta B D^{-\beta - 1} = 6 \lambda N \tag{2} \] \[ \frac{\partial \mathcal{L}_{\text{Lagrange}}}{\partial \lambda} = 6 N D - C_0 = 0 \tag{3} \]
将式 (1) 乘以 \(N\),式 (2) 乘以 \(D\): \[ \alpha A N^{-\alpha} = 6 \lambda N D \] \[ \beta B D^{-\beta} = 6 \lambda N D \]
令这两个表达式相等,可得基本的幂律最优性条件: \[ \alpha A N^{-\alpha} = \beta B D^{-\beta} \]
这一条件证明,在计算最优分配下,参数量每增加一个单位的相对比例所带来的边际损失下降,必须等于数据集词元数每增加一个单位的相对比例所带来的边际损失下降。
计算最优指数的解析推导
由 \(\alpha A N^{-\alpha} = \beta B D^{-\beta}\),可解出 \(D\) 关于 \(N\) 的表达式: \[ D^\beta = \left(\frac{\beta B}{\alpha A}\right) N^\alpha \implies D = \left(\frac{\beta B}{\alpha A}\right)^{1/\beta} N^{\alpha/\beta} \]
将 \(D\) 代入计算约束 \(C = 6 N D\): \[ C = 6 N \left(\frac{\beta B}{\alpha A}\right)^{1/\beta} N^{\alpha/\beta} = 6 \left(\frac{\beta B}{\alpha A}\right)^{1/\beta} N^{\frac{\alpha + \beta}{\beta}} \]
显式求解计算最优参数量 \(N^*(C)\): \[ N^*(C) = \left( \frac{\alpha A}{\beta B} \right)^{\frac{1}{\alpha + \beta}} \left( \frac{C}{6} \right)^{\frac{\beta}{\alpha + \beta}} \propto C^{\frac{\beta}{\alpha + \beta}} \]
根据对称性,求解计算最优词元数 \(D^*(C)\): \[ D^*(C) = \left( \frac{\beta B}{\alpha A} \right)^{\frac{1}{\alpha + \beta}} \left( \frac{C}{6} \right)^{\frac{\alpha}{\alpha + \beta}} \propto C^{\frac{\alpha}{\alpha + \beta}} \]
经验指数与 \(D/N \approx 20\) 规则
通过对 400 多次实验运行的结果拟合参数化损失曲面,Hoffmann et al. (2022) 估计得到 \(\alpha \approx 0.34\) 和 \(\beta \approx 0.28\)。代入这些数值,得到的指数接近论文中参数化模型的结果:
\[ \frac{\beta}{\alpha + \beta} \approx 0.45, \qquad \frac{\alpha}{\alpha + \beta} \approx 0.55 \]
因此,参数化模型预测: \[ N^*(C) \propto C^{0.45}, \qquad D^*(C) \propto C^{0.55} \]
论文中的两种直接经验方法报告了接近平衡的指数 \((0.50, 0.50)\) 和 \((0.49, 0.51)\),这构成了常见平方根近似说法的依据。然而,在参数化拟合下,\(D^*/N^*\) 会随计算量缓慢增长,而非严格保持不变。在所研究的范围内,每个参数约对应 20 个训练词元是一条实用的 Chinchilla 经验规则,而非普适不变量。
Systems Perspective 1.5: Kaplan 与 Chinchilla 缩放规律对比
Kaplan et al. (2020) 与 Hoffmann et al. (2022) 之间的差异凸显了经验基准测试中的超参数选择如何改变系统设计结论:
- Kaplan et al. (2020) 估计得到 \(\alpha \approx 0.057\) 和 \(\beta \approx 0.28\),预测 \(N \propto C^{0.73}\) 和 \(D \propto C^{0.27}\)。这促使该领域大幅扩大模型规模,同时保持相对较小的训练数据集规模(例如,GPT-3 175B 使用 300B 个词元训练,得到 \(D/N = 1.71\))。
- 方法差异:Kaplan et al. (2020) 对不同模型使用固定的词元预算和学习率调度。Hoffmann et al. (2022) 则使调度与各次训练的总长度相匹配,并发现先前的设置低估了使用更多数据训练较小模型的价值。
- Hoffmann et al. (2022) 发现参数量与词元数的缩放接近平衡:其三种方法报告的指数对分别为 \((0.50, 0.50)\)、\((0.49, 0.51)\) 和 \((0.46, 0.54)\),而非一个精确的普适比例。
- 实际影响:Chinchilla(70B 个参数,使用 1.4T 个词元训练,\(D/N = 20\))在各项下游基准测试中的表现优于 GPT-3(175B 个参数,使用 300B 个词元训练),同时推理计算量降至其 \(2.5\times\) 分之一,在相同精度下的权重内存占用也降至其 \(2.5\times\) 分之一 (Hoffmann et al. 2022)。
总结
算法通过其张量形状、运算图、数据依赖关系和数值表示,形成系统工作负载。线性代数原语、内存布局、广播和稀疏格式决定计算量、数据流量、局部性及可用并行性。自动微分与反向传播引入需要保存的激活值和反向计算;计算图进而揭示融合与重计算的机会。Baur–Strassen 结果给出了反向模式额外开销的界限,而 FlashAttention 则展示了分块和在线递推如何在不改变注意力语义的前提下减少 HBM 流量。
同样的核算方法也将内核与缩放决策联系起来。计算最优缩放将固定预算转化为模型与数据的分配方案,但拟合得到的指数仍然是经验性的,并不具有普适性。贯穿这些模型的可复用方法是:在选择优化方案之前,先明确运算、字节数、保存的状态、依赖关系和渐近约束。
Footnotes
爱因斯坦求和约定:乘积中重复出现的下标隐含求和,因此无需显式求和符号。机器学习框架采用这一约定,是因为它能够用一个字符串简洁地表达任意张量缩并。↩︎
通用矩阵乘法(GEMM):BLAS(基础线性代数子程序)系列始于 1979 年标准化的向量例程 (Lawson et al. 1979);GEMM 后来作为第 3 级例程实现标准化 (Dongarra et al. 1988)。前缀“GE”表示“通用”,以区别于对称或三角形式。GEMM 计算 \(\mathbf{C} = \alpha \mathbf{A}\mathbf{B} + \beta \mathbf{C}\),是深度学习中对性能至关重要的例程。矩阵运算 解释了 GEMM 形状如何决定训练吞吐量。↩︎
反向传播:“误差反向传播”的简称。该算法曾被多次独立发现——Werbos (1974) 和 Linnainmaa (1970) 将其用于反向模式微分,Rumelhart et al. (1986) 将其用于神经网络训练。其核心洞见是,计算所有参数的梯度只需对计算图进行一次反向遍历,而无须为每个参数分别遍历一次。Section 1.4 推导了计算工作量的常数因子上界,并给出了典型稠密层的计算成本。↩︎
梯度检查点:以计算换取内存。不存储所有激活值,而是仅保留其中一个子集(检查点),并在反向传播期间重新计算未保留的激活值。这将内存使用量从存储每一层激活值的规模降至大约与层数平方根成正比的规模,代价是计算量增加约 33% (Chen et al. 2016)。↩︎