模型训练
模型训练
目的
为什么训练一个模型的成本可能比一次推理高出数个数量级?
推理执行一次前向传播,数据流经网络并产生预测结果。训练则增加了反向传播和优化器更新步骤,需要保留中间状态,并在大量样本和优化步骤中重复这些工作。优化器还可能维护动量和方差估计,其存储量会超过模型权重。两者的成本比取决于模型、工作负载、训练时长和推理量,但一次训练运行的成本通常比一次推理高出数个数量级。能够在三天内完成训练的实验室,可以比需要一个月才能完成训练的实验室探索更多设计。如果单步加速延缓了收敛,就不意味着训练更快,因此吞吐量只有相对于达到目标质量所需的时间才有意义。在反复实验中,即使收敛速度或利用率只有小幅变化,也会累积成显著的工期和成本差异。核心系统挑战在于持续向加速器供给数据和有效的算术运算,同时避免耗尽内存或在同步上浪费时间。哪种干预措施有效,取决于起制约作用的是计算、内存、数据还是通信约束,因此必须先进行性能剖析,再开展扩展或优化。由此,批量大小、数值精度、检查点、数据加载和并行策略必须被视为相互耦合的决策,而非独立的调优旋钮。对于系统工程师而言,在训练环节,硬件和并行策略决定了一次运行能否满足内存、工期和预算限制,以及反复执行的优化循环是加速推进还是停滞不前。从数据—算法—机器的角度看,每一项精度和并行策略决策,都在优化的数学规律与执行的物理规律之间进行权衡。
学习目标
- 从前向传播、反向传播、优化器状态、数据和迭代成本解释训练成本的不对称性
- 计算神经网络训练的 FLOPs、激活内存、优化器状态和美元成本
- 从收敛行为、内存开销和计算成本比较 SGD、Adam 和 AdamW
- 使用 Roofline 分析和性能剖析证据,诊断受计算、内存和数据限制的训练瓶颈
- 应用混合精度、检查点、梯度累积和 FlashAttention,以满足加速器的内存与吞吐量限制
- 设计包含预取、重叠执行、批处理和系统性重复性能剖析的单机训练流水线
- 根据内存、时长、通信、能源和成本约束,评估何时应扩展到多台机器
训练系统基础
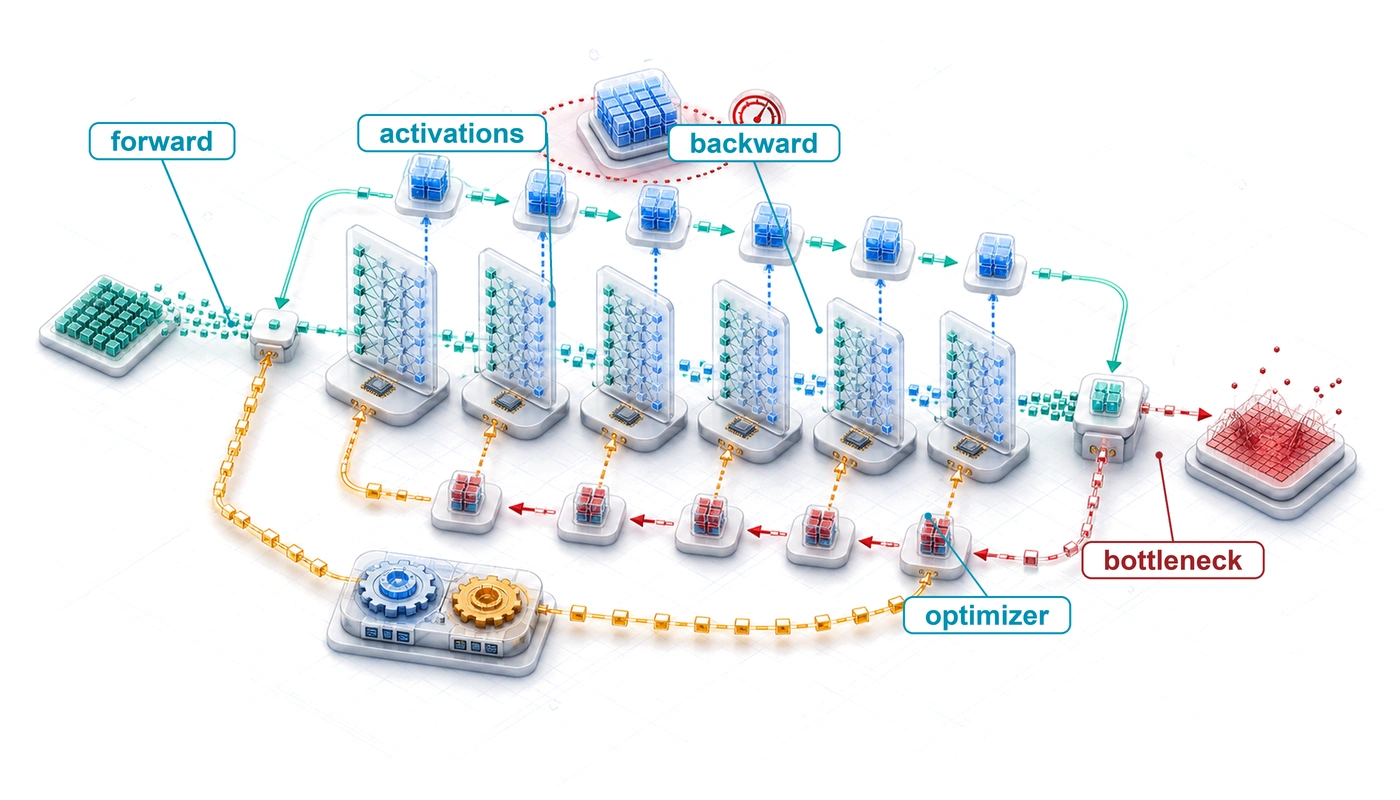
运行一次模型与从零开始训练模型,处于系统成本曲线的两端。框架提供执行基础:计算图调度运算,自动微分计算梯度,硬件抽象适配各类加速器。这些机制使单个训练步骤得以执行;训练系统则使其能够大规模重复执行。同一个前向传播、反向传播和更新循环可能运行数千乃至数百万次,同时还要保留激活值、向加速器供给数据,并满足实际的内存、时间和预算限制。
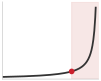
训练成本随规模增长起初保持平稳,越过大规模拐点后便急剧攀升。
本章采用外部给出的数量级估计:GPT-2 规模训练约需 $50,000,GPT-4 级别的一次训练运行则采用接近 $100M 的公开估计值。1 这两个数字均未作为经过审计的训练账单披露。这种训练成本不对称性,反映了针对特定请求评估已训练模型,与在训练语料上反复执行前向传播、反向传播和更新计算之间的差异。
对于 GPT-2,本章遵循与 GPT-2 技术报告中架构相对应的、基于参数量的核算方法,采用每个词元前向计算约 3.00 × 10⁹ 次浮点运算的估计 (Radford et al. 2019)。若将前向和反向工作的总量近似为前向成本的三倍,则 1.50 × 10²¹ FLOPs 的总预算对应约 167 十亿个词元位置。这一核算估计并不意味着 GPT-2 执行了如此多的完整推理请求。这样的规模使训练系统工程成为一门独立学科,也表明训练基础设施的可获得性如何限制参与 AI 开发的机会。
Definition 1.1: 训练系统
机器学习训练系统是执行迭代优化循环(前向传播、损失计算、反向传播和参数更新)的软硬件系统,其目标是最小化训练数据集上的损失函数。
- 重要性:在标准的混合精度自适应矩估计(Adam)配置中,每个参数的训练内存成本是推理内存成本的 8×:一个参数量为 7B 的模型,至少需要 14 GB(FP16 权重)+ 14 GB(FP16 梯度)+ 28 GB(FP32 主权重)+ 56 GB(以 FP32 存储的 Adam 一阶矩和二阶矩)= 112 GB,这还未计入激活值的存储。这个倍数是一个模型能够在单张 GPU 上运行推理,却需要多张 GPU 才能训练的主要原因之一。
- 区别:推理系统执行一次前向传播后便丢弃中间激活值,而标准反向传播会存储反向过程所需的张量,因此其内存占用随模型深度和批量大小增长。
- 常见误区:一种常见误解是认为训练失败属于计算问题。常见的失败情形是内存不足(OOM)错误,这属于内存管理问题:为反向传播保存的张量在前向传播期间不断累积,可能在计算第一个梯度之前就耗尽内存。
训练工作负载具有三个区别于通用计算的特征:
- 计算密集性:要在数天的实际耗时内完成 1.50 × 10²¹ FLOPs 的运算预算,需要硬件持续提供 PFLOP/s 级吞吐量,而硬件在大模型上的实际吞吐量往往远低于理论峰值 (Narayanan et al. 2021; Chowdhery et al. 2022)。
- 内存压力:以 FP32 存储 1.5B 个权重需要 6 GB;Adam 优化器为每个参数增加两个状态张量,额外消耗 12 GB。激活内存还会带来随工作负载变化的占用,其大小由架构、序列长度、批量大小、精度和检查点策略决定,而这些状态的总量可能超过单个加速器的容量。
- 数据依赖:每次梯度更新都依赖于前一次更新的结果,由此形成串行瓶颈,限制系统能够利用的并行程度。
每项挑战都指向不同类型的解决方法。计算密集性推动系统提高加速器利用率并采用更低精度的算术运算。内存压力则需要梯度检查点等技术,2 它是重物化(通过丢弃并重新计算中间值来节省内存,见 机器学习框架)的具体应用,以重新计算换取激活存储量的降低;同时还需要混合精度训练,3 以降低权重和激活值的内存占用。数据依赖促使系统采用将计算与数据移动重叠的流水线设计,直接利用 数据工程 中优化的数据加载吞吐量,使加速器不必因等待下一批数据而空闲。此处的分析建立了单机和单节点多 GPU 拓扑下的执行基线;跨越分布式网络边界的扩展会引入多节点通信互连和容错协议,这些内容将在高级分布式系统中讨论。
分阶段系统流水线:识别“加速器气泡”
训练系统并非单一循环,而是一条分阶段系统流水线。要实现较高的加速器利用率,需要将训练视作工厂车间来分析,其中四个不同阶段相互协调,使算术逻辑单元(ALU)持续工作:
- 数据加载与预处理(CPU/存储):从非易失性内存高速接口(NVMe)存储中读取原始数据,并在 CPU 核上进行解码和数据增强。
- 主机到设备传输(PCIe):通过直接内存访问,将处理后的批次经 PCIe 总线传入 GPU 内存。
- 前向/反向传播(加速器):在 GPU 上逐层传播激活值和梯度。
- 参数同步(互连):通过可用的互连结构在加速器之间交换梯度。在后文使用的 H100 配置中,NVLink 可提供高达 900 GB/s 的带宽,而其他系统可能使用 PCIe 或网络互连。
这些阶段之间任何吞吐量不匹配都会产生加速器气泡,即部分加速器资源在等待其他阶段时处于空闲或利用不足的时间区间。系统工程师通过异步预取和流水线重叠等技术减少这些气泡,目标是在当前步骤需要下一批数据之前,使其准备就绪。Section 1.5 将介绍用于测量和减少这些气泡的定量工具。
这条架构依赖链决定了系统的运行层级。训练性能铁律(机器学习系统铁律)将总运算量、峰值吞吐量和硬件利用率分开,为神经网络工作负载、优化器动态、反向传播机制和算术强度建立了核算框架。在执行流水线中,数据加载、前向传播、反向传播和参数更新构成串行依赖,每个阶段都会限制下游吞吐量。有针对性的缓解措施分别作用于该吞吐量方程中的具体项:混合精度算术、分块注意力内核、梯度累积、激活检查点和异步预取。当单个加速器的吞吐量达到饱和后,多设备扩展会使芯片间互连带宽成为主导约束。
这些物理约束在大规模执行中会产生叠加效应:一次未得到缓解的数值爆炸,就可能使数千加速器小时的工作作废。
War Story 1.1: PaLM 损失尖峰(2022 年)
背景:PaLM 的 5400 亿参数训练运行使用了 6,144 颗张量处理单元(TPU)v4 芯片,分布在两个各含 3,072 颗芯片的 Pod 中,通过 Google 的数据中心网络连接,并出现了小规模训练中未曾出现的严重训练不稳定尖峰 (Chowdhery et al. 2022)。
故障模式:尽管采用了梯度裁剪,训练损失仍出现了约 20 次尖峰。这些尖峰出现的间隔极不规律,有时发生在训练后期,从未在较小模型中出现,且尚未找到具有原理依据的缓解方法。
影响:每次恢复都会丢弃这次昂贵的 6,144 芯片训练运行中最近取得的进展,因此,可复现的检查点和可重复的数据顺序是重放的前提。
应对措施:工程师从每次尖峰发生前约 100 步处的未损坏检查点重新启动训练,并跳过故障时间窗口附近约 200–500 个数据批次。
系统启示:运行中的容错能力直接决定训练性能铁律(equation 1)中的利用率因子 \(\eta_{\text{hw}}\)。自动损失尖峰检测、检查点保存频率和批次跳过,是保障集群计算效率所必需的核心系统机制。
训练性能铁律
PaLM 的损失尖峰表明,在前沿规模下,同时将计算密集性、内存压力和数据依赖推至极限,会产生可预见的物理后果,即训练不稳定。这三个特征单独来看都可以管理,但它们的相互作用会产生仅靠运行恢复无法预防的故障模式。要诊断某次故障中哪个因素占主导地位,并量化各因素的成本,就需要将训练时间形式化地分解为其物理组成部分。
铁律恰好提供了这一组织框架:它分解训练时间,使每项优化技术都能映射到方程中的特定项。这是 机器学习系统铁律 中介绍的通用机器学习系统铁律的一项专门应用,重点在于最大化计算吞吐量。
Definition 1.2: 训练性能铁律
训练性能铁律通过工作负载的运算量及其实际达到的有效吞吐量来表示训练时间: \[T_{\text{train}} = \frac{O}{R_{\text{peak}} \times \eta_{\text{hw}}} \tag{1}\]
其中,\(\eta_{\text{hw}}\) 是有效的端到端利用率因子,即实际达到的模型运算速率除以相应的硬件峰值。数据停顿、通信、同步、启动开销以及低效内核都会降低这一因子。预取和重叠执行可以隐藏其中一部分成本,但不能保证消除这些成本。
- 意义:在数据—算法—机器分类体系中,这些项对应不同的优化手段:\(O\) 由数据(训练词元数量)和算法(模型架构或剪枝、知识蒸馏等压缩方法)决定,\(R_{\text{peak}}\) 由机器(在所选数值精度下的硬件执行单元)决定,而 \(\eta_{\text{hw}}\) 是系统的有效利用率因子,也是主要的工程优化目标(Narayanan et al. (2021) 测得,在 A100 集群上训练的各类 GPT 模型,其吞吐量达到理论峰值的 44% 至 52%)。模型压缩 定义了这些压缩技术;此处仅用它们说明这些方法如何纳入计算。
- 区别:一般形式的铁律将数据移动、计算和延迟分别呈现。这一训练形式将所有造成吞吐量损失的因素归入 \(\eta_{\text{hw}}\),因此适用于预算核算,但不足以诊断究竟是哪个底层项导致了问题。
- 常见误区:一种常见误解是认为 \(\eta_{\text{hw}}\) 由硬件固定决定。系统效率是流水线的属性:内存带宽饱和、内核启动开销和同步屏障都会独立降低 \(\eta_{\text{hw}}\),而判断哪个因素占主导地位需要进行性能剖析,不能仅靠查阅硬件规格。
Equation 1 揭示了三种改进手段:通过算法创新减少总运算量,通过硬件选择和精度格式提高峰值吞吐量,或通过流水线编排提高利用率。核心训练优化技术针对其中一种或多种手段,汇总见 table 1。
| 技术 | 受影响的项 | 机制 |
|---|---|---|
| 混合精度(FP16/BF16) | 峰值吞吐量 ↑ | 使用硬件支持的低精度执行路径 |
| 数据预取 | 利用率 ↑ | 减少加速器等待数据的空闲时间 |
| 梯度检查点 | 内存占用 ↓,运算量 ↑ | 通过重新计算选定的值来减少保存的激活值 |
| 梯度累积 | 内存占用 ↓,同步 ↓ | 通过串行执行的微批次构建有效批次 |
| 算子融合 | 内存流量 ↓,开销 ↓ | 避免中间数据传输并减少内核启动次数 |
| FlashAttention | 内存流量 ↓,利用率 ↑ | 渐近 FLOPs 相同,HBM I/O 大幅减少;反向传播中的重新计算可能增加 FLOPs |
铁律关注执行效率——硬件处理给定工作负载的速度。它不涵盖数据质量、数据集规模或课程设计等数据侧因素,而这些因素会影响达到目标准确率所需的总运算量 \(O\)。更干净的数据集或更合理的数据配比可以减少所需的训练轮数,从而在完全不改动硬件的情况下降低 \(O\)。在工作负载固定的条件下,问题在于如何尽可能快地执行它。
只要内核、数据供给或通信使资源处于空闲状态,实际训练吞吐量就会低于算术峰值。扩展到多个加速器会引入额外的通信开销,section 1.7 对这一权衡进行了量化。
Checkpoint 1.1: 训练的物理约束
训练速度取决于硬件峰值能力的利用程度。
利用率差距
铁律为分析训练性能提供了一个静态框架,但深度学习的发展历史揭示了:随着硬件与算法共同演进,起主导限制作用的约束也在不断变化。1986 年,Rumelhart 及其同事推广了用于多层神经网络的反向传播 (Rumelhart et al. 1986)。2012 年,AlexNet 在两块 GPU 上用五至六天训练出一个 ImageNet 分类器 (Krizhevsky et al. 2012),展示了神经网络的并行性与图形硬件的良好适配。到 2017 年,Transformer (Vaswani et al. 2017) 将关注点转向大规模序列建模和高吞吐量加速器内核。2020 年的 GPT-3 消耗了约 \(3.14 \times 10^{23}\) FLOPs (Brown et al. 2020),使利用率 \((\eta_{\text{hw}})\) 变得至关重要。到 2023 年,针对性的系统优化提高了训练效率:FlashAttention 在减少内存流量的同时提高 \(\eta_{\text{hw}}\);梯度检查点以增加 \(O\) 为代价换取内存容量;混合精度提高 \(R_{\text{peak}}\)。每项创新都针对一个特定的铁律瓶颈。
Vaswani, Ashish, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N. Gomez, Lukasz Kaiser, and Illia Polosukhin. 2017. “Attention Is All You Need.” Advances in Neural Information Processing Systems (NeurIPS) 30: 5998–6008.
贯穿示例:训练 GPT-2
在推理中,GPT-2 充当“带宽大户”灯塔模型。这里,它再次作为本章固定的工作负载,用于检验各项训练成本与优化措施。
Lighthouse 1.1: 灯塔示例:训练 GPT-2
背景: GPT-2(15 亿参数)是主要案例,因为它的规模足以暴露有实际意义的计算、激活值和优化器状态约束,同时又比前沿规模模型更易于分析。它是否需要分布式训练,取决于精度、优化器状态、激活值内存、硬件容量以及目标训练时间。Table 2 将每项模型属性映射到其产生的系统约束:
Table 2: GPT-2(15 亿参数)灯塔模型规格:参数数量、架构深度、数据集规模和总训练计算量与其系统影响之间的映射。每一行将一项模型属性与其产生的工程约束配对——权重的内存占用、流水线深度带来的激活值压力、I/O 吞吐量要求以及并行化需求。
| 属性 | 规格 | 对系统的影响 |
|---|---|---|
| 参数 | 1.5B (XL) | 仅权重就需要约 3 GB(FP16)或约 6 GB(FP32)。 |
| 架构 | 48 层,1600 维 | 深流水线带来较大的激活值内存压力。 |
| 数据集 | WebText(40 GB) | 预处理、打乱和数据供给必须持续满足所选训练配置的需求。 |
| 计算量 | ~ 1.50 × 10²¹ FLOPs | 训练时长取决于实际达到的吞吐量和加速器数量。 |
机制: 训练 GPT-2 同时涉及总运算量 \(O \approx 6 \cdot P \cdot D_{\text{tokens}}\),即 1.50 × 10²¹ FLOPs,以及严格的内存占用约束 \(M_{\text{state}} = M_{\text{weights}} + M_{\text{grads}} + M_{\text{opt}} + M_{\text{act}}\)。要平衡执行时间 \(T_{\text{train}} = \frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}}\),就需要在加速器高带宽内存(HBM)的容量范围内,统筹数据摄取、激活值内存和计算吞吐量。
并非所有训练工作负载都受计算限制。DLRM 等推荐模型主要受庞大的嵌入表 支配(100B 至 10T 个参数,大部分为嵌入参数),因此受内存带宽限制,而非受计算限制。对于此类工作负载,首要的扩展问题往往是容量:将嵌入表拆分到多个设备上,使模型至少能够被容纳。相比之下,以后文分析的 GPT-2 灯塔模型为代表的稠密、计算密集型训练,暴露的是计算与激活值内存方面的限制,而非容量分区问题。
在端到端机器学习生命周期中,训练系统从上游流水线(数据工程)摄取已准备好的数据,并生成供下游部署使用的模型检查点。数据质量直接决定训练稳定性,而训练吞吐量决定迭代速度。这种系统压力体现在三个不同的尺度上。在数据尺度上,大规模语料库需要高吞吐量 I/O 流水线和分布式存储,以免加速器因数据供给不足而空闲。在模型尺度上,数十亿参数的架构迫使系统在内存容量与通信之间进行权衡,选择在数据并行设备间复制权重4,或通过模型并行将各层划分到不同设备上。5 在基础设施尺度上,协调多个加速器会引入同步开销,甚至可能主导训练时间。这些物理权衡使 机器学习工作流 中的工作流契约在训练期间至关重要:编排决策同时决定迭代速度和硬件效率。
GPT-2 的 40 GB WebText 语料库处于这一数据规模范围的较低端。更大的语料库会使数据路径发生质的变化。
Systems Perspective 1.1: 从 10 GB 到 10 TB 的规模变化
在内存驻留模式下,语料库可能完全装入系统 RAM,并在缓存后避免重复读取存储,但预处理和传输成本仍然存在。在流式处理模式下,语料库超出本地内存容量,系统必须在整个训练过程中统筹存储读取、预处理、缓存和数据供给。合适的设计可能包括多个工作进程、预取、本地缓存或分布式存储,具体取决于哪个阶段限制了吞吐量。
因此,规模改变的不仅是数据量,还会改变系统的物理约束。
这些扩展约束转化为具体的工作流要求。训练工作流由相互依赖的阶段组成——数据预处理、前向与反向传播,以及参数更新——扩展了 神经计算 中的神经网络概念。系统约束决定了这些执行限制:现代加速器的算术强度很容易超出 HBM 带宽的供给能力,使受内存限制的内核无法获得足够的操作数 (Hennessy and Patterson 2017)。在多加速器配置中,跨设备同步会引入延迟代价,而互连带宽(PCIe、NVLink、InfiniBand)决定了通信与计算的比例。6
Hennessy, John L., and David A. Patterson. 2017. Computer Architecture: A Quantitative Approach. 6th ed. Morgan Kaufmann.
框架在 机器学习框架 中呈现的硬件与软件之间的边界,在此同样处于核心地位。混合精度训练源于对 Tensor Core 硬件能够加速低精度算术运算的认识。梯度检查点则源于内存容量约束。训练系统工程的工作,就是让这些算法选择与机器的物理极限相匹配。
每个训练瓶颈最终都可以追溯到特定数学运算的执行成本。稠密矩阵乘法受计算限制,由峰值算术吞吐量决定 (Goto and Geijn 2008);而逐元素激活函数和归一化层受内存带宽限制。与此同时,无论是否进行算术运算,优化器状态都会增加常驻内存占用。要设计能够高效执行这些运算的系统,首先需要分别核算每类成本。
Goto, Kazushige, and Robert A. van de Geijn. 2008. “Anatomy of High-Performance Matrix Multiplication.” ACM Transactions on Mathematical Software 34 (3): 1–25. https://doi.org/10.1145/1356052.1356053.
数学基础
线性代数将矩阵乘法简洁地表示为 \(\mathbf{C} = \mathbf{A}\mathbf{B}\)。在硬件上,训练 GPT-2 这样的模型需要对张量反复执行这一运算,而这些张量的规模远超片上 SRAM 可提供的数十兆字节容量,因此需要不断从高带宽内存(HBM)调入矩阵分块。稠密矩阵乘法具有较高的算术强度,使 Tensor Core 等专用执行单元能够实现较高的计算利用率。相比之下,周围的逐元素运算——如激活、归一化和残差相加——算术强度较低,仍受内存带宽限制,这为通过内核融合消除冗余内存流量提供了机会。神经计算 已经阐明神经网络运算计算的是什么,以及它们为什么能够支持学习;系统层面的问题则是,当这些运算大规模执行时,它们在 FLOPs、内存和带宽方面的成本是什么。
这一成本分析围绕四个维度展开:
- 主导稠密神经网络训练的矩阵运算的 FLOP 数。
- 同时存储激活值和优化器状态所需的内存。
- 决定运算受计算限制还是受内存限制的带宽需求。
- 指导优化策略选择的算术强度分类。
这些维度共同构成了分析 section 1.1 中所介绍的计算强度、内存压力和数据依赖关系的术语体系。
神经网络计算
神经网络训练由反复执行的矩阵运算和非线性变换组成。这些运算在概念上很简单,却带来了主导现代训练基础设施的系统级挑战。Rumelhart et al. (1986) 对反向传播7 的引入,以及基本线性代数子程序(BLAS)8 (Dongarra et al. 1988) 等高效矩阵计算库的发展,为现代训练架构奠定了基础。
神经网络中的数学运算
在最简单的情况下,前向传播 涉及两种运算:矩阵乘法和激活函数应用。矩阵乘法实现每一层的线性变换。在第 \(\ell\) 层,计算可以表示为(遵循 神经计算 中确立的行向量约定): \[ \mathbf{A}^{(\ell)} = f\left(\mathbf{A}^{(\ell-1)}\mathbf{W}^{(\ell)} + \mathbf{b}^{(\ell)}\right) \] 其中:
- \(\mathbf{A}^{(\ell-1)}\) 表示上一层的激活值(对于第一层,则为输入层),每一行对应批次中的一个样本,
- \(\mathbf{W}^{(\ell)} \in \mathbb{R}^{n_{\ell-1} \times n_\ell}\) 是第 \(\ell\) 层的权重矩阵,包含网络学习得到的参数,
- \(\mathbf{b}^{(\ell)}\) 是第 \(\ell\) 层的偏置向量,
- \(f(\cdot)\) 是逐元素应用的激活函数(例如 ReLU、sigmoid),用于引入非线性。
矩阵运算
矩阵乘法表述 已说明,前向传播可归结为一系列矩阵乘法;核心计算原语 则梳理了所有架构共有的计算原语——通用矩阵乘法、卷积和动态注意力。训练放大了这些模式:每种运算并非只执行一次,而是执行数十亿次,且每次前向传播都伴随一次反向传播,使计算成本大致翻倍。理解哪些矩阵运算占主导地位,以及它们的形状在前向和反向传播之间如何变化,就能揭示为什么训练会催生特定的系统设计和优化措施。
矩阵乘法的主导地位推动了算法与硬件两方面的创新。早期神经网络实现依赖标准的 CPU 线性代数库,但现代训练的规模要求专门的优化。Strassen 算法9将朴素算法的 \(\mathcal{O}(n^3)\) 复杂度降至约 \(\mathcal{O}(n^{2.807})\) (Strassen 1969),而 cuBLAS (NVIDIA 2024) 等当代硬件加速库仍在不断突破计算效率的极限。
Strassen, Volker. 1969. “Gaussian Elimination Is Not Optimal.” Numerische Mathematik 13 (4): 354–56. https://doi.org/10.1007/bf02165411.
NVIDIA. 2024. cuBLAS: CUDA Basic Linear Algebra Subprograms.
这种计算上的主导地位推动了系统级优化:能够跨多个单元并行执行的分块矩阵计算,以及针对前向传播和反向传播访问模式设计的内存层次结构。随着神经网络架构规模扩大,权重矩阵和激活矩阵都必须保持可访问,以供反向传播使用;硬件也随之演进,在不断增长的内存预算内支持这些稠密乘法模式。为了具体说明这些运算的规模,下面考察 GPT-2 灯塔模型中的注意力层计算。
单个 GPT-2 层即可具体展示这些计算的规模。
Napkin Math 1.1: GPT-2 注意力层计算
GPT-2 的每一层都执行注意力计算,体现了稠密矩阵乘法的计算需求。对于一个 GPT-2 Transformer 层(合并所有注意力头),设批大小 \(B\) = 32,序列长度 \(S\) = 1024,隐藏维度 \(d\) = 1600:
查询、键、值投影(生成注意力输入的三个线性变换——3 次独立的矩阵乘法): \[\begin{gather*} \text{FLOPs} = 2 \times 3 \times (B \times S \times d \times d) \\ = 2 \times 3 \times (32 \times 1024 \times 1600 \times 1600) \approx 503 \text{ billion FLOPs} \end{gather*}\] 注意力矩阵乘法(\(\mathbf{Q}\mathbf{K}^\top\) 和 \(\mathbf{A}_{\text{attn}}\mathbf{V}\)): \[\begin{gather*} \text{FLOPs}_{QK} = 2 \times B \times N_{\text{heads}} \times S \times S \times d_{\text{head}} = 107.4 \text{ billion FLOPs} \\ \text{FLOPs}_{\text{Attn}\times V} = \text{FLOPs}_{QK};\quad \text{pair total} \approx 214.8 \text{ billion FLOPs} \end{gather*}\] 输出投影(注意力输出 \(\rightarrow\) 隐藏表示): \[ \text{FLOPs} = 2 \times B \times S \times d \times d \approx 168 \text{ billion FLOPs} \] 前馈网络(两个线性变换,扩展因子为 4): \[ \text{FLOPs} \approx 16 \times B \times S \times d^2 \] 计算规模
- 每层前向计算总量(QKV 503 + 注意力 214.8 + 输出投影 168 + FFN):约 2228.01 GFLOP
- GPT-2 共 48 层:每个训练步约 320.8 TFLOP
- 在这一包含 50,000 steps 的示例场景中:总计约 16041.7 PFLOP
系统洞察:对于上述注意力加 FFN 的训练步估算模型,一块 V100 GPU(使用 Tensor Core 时峰值为 125 TFLOP/s,不使用时为 15.7 TFLOP/s)在利用率达到 100% 时需要 2.6 s(理论峰值;实际吞吐量会更低)。因此,将训练步时间缩短至 180 到 220 ms,即便仅考虑下界,也已经需要多个加速器:仅理想算术计算就需要约 12 到 15 块 V100,实际系统还需为利用率损失、通信和流水线开销预留额外余量。
这些 FLOP 计数并非纯粹的学术性记账。它们将机器学习系统铁律中的计算项具体化,并解释了为何训练成本是模型架构和序列长度的可预测函数,而非不可预测的涌现属性。
矩阵向量运算与批处理运算
神经网络中的运算并非都涉及大规模矩阵与矩阵乘法。归一化层、偏置加法以及某些循环计算涉及的是矩阵向量运算。尽管这些运算在计算上比矩阵与矩阵乘法更简单,却带来了独特的系统挑战:由于可并行化的潜力有限,它们的硬件利用率较低。单个向量所提供的工作量不足以让数千个加速器核心同时保持忙碌。这一特征既影响硬件设计,也影响模型架构决策,尤其是在处理序列输入或计算层统计量的网络中。
认识到矩阵向量运算的局限性后,批处理的引入改变了神经网络中的矩阵计算方式。通过同时处理多个输入,训练系统将矩阵向量运算转化为效率更高的矩阵与矩阵运算。这种方法提高了硬件利用率,但也增加了存储中间结果的内存需求。现代实现必须在批大小与可用内存之间取得平衡,由此产生了针对内存管理和计算调度的特定优化。
从矩阵向量运算到批量矩阵与矩阵运算的演进,有助于解释现代加速器的硬件设计选择。谷歌第一代 TPU 面向推理设计,配备了用于稠密运算的专用矩阵单元和内存层次结构 (Jouppi et al. 2017)。在另一种规模下,GPT-3 训练使用分布式加速器来执行大批量处理所呈现的矩阵与矩阵乘法模式 (Brown et al. 2020)。
Brown, Tom B., Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared Kaplan, Prafulla Dhariwal, Arvind Neelakantan, et al. 2020. “Language Models Are Few-Shot Learners.” Advances in Neural Information Processing Systems 33: 1877–901. https://doi.org/10.48550/arxiv.2005.14165.
Systems Perspective 1.2: GPU 为何主导训练
section 1.3.1.2 中描述的矩阵运算直接解释了数据中心训练硬件的架构。GPU 成为大规模训练的核心,原因有三:
- 矩阵乘法中各元素的独立计算可以很好地映射到数千个 GPU 核心上(NVIDIA A100 拥有 6,912 个 CUDA 核心)。
- Tensor Core 等专用硬件单元可为其支持的低精度矩阵运算提供显著更高的峰值吞吐量。
- 分块矩阵计算模式能够高效利用 GPU 内存层次结构(L1/L2 缓存、共享内存、全局内存)。
后文的一个 GPT-2 示例场景假设 V100 混合精度计算可获得 2.4\(\times\) 的加速,其中一个增益来源就是 Tensor Core 对符合条件的矩阵乘法的加速。实际实现的端到端加速比还取决于非矩阵运算、内存流量,以及输入和通信开销。
矩阵乘法主导了训练计算,但神经网络所需的不仅是线性变换。在各层的矩阵运算之间,激活函数引入了使网络能够学习复杂模式的非线性。与矩阵乘法相比,这些函数的计算看似微不足道,但其实现特征对训练效率的影响在大规模系统中不容忽视。
激活函数
sigmoid、tanh、ReLU 和 softmax 等激活函数引入了非线性,但其实现特征也影响着训练系统的性能。从系统角度看,激活函数的选择决定了反向传播过程中的计算成本、硬件利用率和内存访问模式。
对于机器学习系统工程师而言,关键问题并非这些函数在数学上做了什么,而是其成本在大规模条件下如何变化。下文的基准测试与权衡共同指向一个系统层面的论点:逐元素激活函数搬移的字节数远多于其执行的计算量,因此其内核往往受内存带宽而非算术计算限制,所以下述逐操作差异的重要性并没有其数值乍看之下那么大。
激活函数的成本会在大量元素和多层网络中累积,但其对端到端时间的贡献取决于张量形状、融合、实现、精度和硬件。Figure 1 保留了本章编写过程中一个用于示意的 Apple M2 计时快照。其基准测试配置未被记录,因此不应将这些数值视为可复现的证据,也不应将其推广到其他系统。在加速器上,激活函数内核通常受内存流量、融合边界和特殊函数吞吐量限制,而非标量 CPU 指令延迟。同一个激活函数可能作为独立内核运行,也可能与相邻算子融合,或使用编译器选定的近似。因此,图中所示的标量计时无法预测它在编译后的训练步内的成本。
\scalebox{0.9}{%
\begin{tikzpicture}[font=\small\sffamily]
% Standard color definitions
\definecolor{BlueLine}{HTML}{006395}
\definecolor{GreenLine}{HTML}{008F45}
\definecolor{RedLine}{HTML}{CB202D}
\definecolor{OrangeLine}{HTML}{CC5500}

\begin{axis}[
    ylabel={执行时间(秒)},
    ymin=0.40,
    width=100mm,
    height=57mm,
    axis lines=left,
    axis line style={thick,-latex},
    ytick={0.4,0.5,...,1.1},
    yticklabel style={font=\footnotesize\sffamily,
    /pgf/number format/.cd, fixed, fixed zerofill, precision=2},
    xticklabel style={font=\footnotesize\sffamily},
    ylabel style={font=\footnotesize\sffamily},
    ymax=1.15,
    enlarge x limits=0.2,
    tick style={draw=black,thin},
    tick align=outside,
    major tick length=1mm,
    xtick={1,2,3,4},
    xticklabels={Sigmoid,Tanh,ReLU,Softmax},
    every axis plot/.append style={
          ybar,
          bar width=0.55,
          bar shift=0pt,
          fill
        }]
      \addplot[RedLine] coordinates {(1,1.1)};
      \addplot[BlueLine] coordinates {(2,0.61)};
      \addplot[GreenLine] coordinates {(3,0.45)};
      \addplot[OrangeLine] coordinates {(4,0.91)};
\end{axis}
\end{tikzpicture}}现代加速器可以通过原生指令、多项式近似、查表方法或融合内核来实现这些函数。ReLU 只需简单的阈值操作,而 sigmoid、tanh 和精确的高斯误差线性单元(GELU)形式则需要更多算术运算或特殊函数支持。实际延迟差异仍取决于限制因素究竟是算术计算、内存流量还是启动开销。ReLU 可能产生可供后续系统利用的零值,但稀疏比例取决于激活值分布和训练后的模型。Softmax10则增加了沿选定轴执行的归约与归一化操作。这些依赖关系需要协调,但优化后的实现仍具有高度并行性。
Table 3 总结了这些行为如何转化为系统约束。
| 函数 | 主要优点 | 主要缺点 | 系统影响 |
|---|---|---|---|
| Sigmoid | 平滑;输出限定于 \((0, 1)\)。 | 输入绝对值较大时梯度趋于饱和;输出不以零为中心。 | 使用指数运算或近似内核,其成本取决于目标平台。 |
| Tanh | 平滑;输出以零为中心,范围为 \((-1, 1)\)。 | 输入绝对值较大时梯度趋于饱和。 | 使用与 sigmoid 结构相似的特殊函数或近似内核。 |
| ReLU | 简单的阈值操作;对正输入不饱和。 | 可能产生持续不活跃的单元。 | 通常成本低且可融合;稀疏性能否利用取决于下游支持。 |
| Softmax | 沿某个轴生成归一化分布。 | 需要归约和跨元素协调。 | 并行实现在最大值、求和与归一化阶段进行协调。 |
ReLU 因简单高效而仍被广泛使用;当模型必须将分数归一化为概率时,softmax 则不可或缺。GPT-2 通过采用高斯误差线性单元 GELU,展示了另一种选择。
Systems Perspective 1.3: GELU 激活函数的选择
除 神经计算 中介绍的基础激活函数(Sigmoid、Tanh、ReLU)外,现代架构越来越多地采用更平滑的替代方案。GPT-2 使用 GELU 激活函数 (Radford et al. 2019),即 Hendrycks and Gimpel (2016) 提出的高斯误差线性单元,通常采用该文给出的常见 tanh 近似形式来实现。其精确定义为: \[
\text{GELU}(x) = x \cdot \Phi(x) = x \cdot \frac{1}{2}\left[1 + \text{erf}\left(\frac{x}{\sqrt{2}}\right)\right]
\] 其中,\(\Phi(x)\) 是标准正态分布的累积分布函数。
GELU 施加平滑且依赖输入的缩放,而 ReLU 使用硬阈值。尽管 GELU 的形式以高斯累积分布为基础,它仍是确定性函数。与其他激活函数相比,它是否能提高模型质量,是取决于架构和训练方案的经验性结果,并非普遍保证。
精确 GELU 使用 erf,而常见实现采用基于 tanh 的近似,例如 listing 1。该近似改变了算术计算成本,并相较精确函数引入了微小的数值差异。端到端影响取决于融合、张量大小、精度、内核实现,以及激活函数内核所占的运行时间比例,因此不存在适用于所有系统的固定 GELU 与 ReLU 性能比率。
Hendrycks, Dan, and Kevin Gimpel. 2016. “Gaussian Error Linear Units (GELUs).” arXiv Preprint arXiv:1606.08415.
# Fast GELU approximation used in production systems
# Avoids expensive erf() computation while
# preserving activation properties
gelu_approx = (
    0.5 * x * (1 + tanh(sqrt(2 / pi) * (x + 0.044715 * x**3)))
)
GELU 近似揭示了一个更普遍的规律:计算成本并不总是首要考量。对于激活函数,真正的瓶颈往往是内存带宽,而非算术运算。计算受限与内存受限操作之间的这一区别直接影响优化优先级,并贯穿训练瓶颈的分析。
稠密矩阵乘法可以在大量乘加运算中复用操作数,而未融合的逐元素激活通常对每个读取和写入的值只执行少量计算。这种算术强度差异常常使独立的激活内核对内存性能较为敏感。融合可以消除中间结果的内存流量;对于算术运算开销未被完全隐藏的内核,特殊函数的吞吐量仍可能产生影响。因此,将一种激活函数替换为另一种,对实际运行时间的影响并不固定。
Systems Perspective 1.4: 内存带宽瓶颈
激活函数揭示了一项关键的系统原理:并非所有操作都受计算能力限制。矩阵乘法能够充分占用加速器的计算单元,而激活函数往往受内存带宽限制,原因有三:
- 逐元素操作每次内存访问仅执行少量计算;ReLU 每次加载执行一次操作。
- 简单操作的完成时间短于内存传输时间,限制了并行化带来的收益。
- 加速器计算能力的增长速度快于外部内存带宽,这使得在计算单元附近复用数据的需求更加迫切。
因此,仅凭标量运算次数无法预测激活内核的延迟。在判断内存带宽是否限制吞吐量时,前向传播既要考虑函数求值成本,也要考虑融合和激活值存储。
前向传播中的矩阵乘法占据了浮点运算的主要部分,而激活函数则给内存带宽带来压力。要将这些前向激活转化为模型收敛,就需要沿计算图反向传播误差梯度,以更新参数张量。这一优化步骤引入了状态存储、更新调度和数值稳定性约束,进而制约训练效率。
优化算法
优化算法将误差梯度转化为参数更新,引导模型走向收敛。尽管在数学上,优化器的每一步被表述为在抽象损失曲面上移动,但每一步都会给加速器执行带来具体的物理约束:占用高带宽内存(HBM)的持久状态张量、受内存带宽限制的逐元素更新,以及同步屏障。在数据—算法—机器分类体系中,优化算法的选择将数学轨迹(算法)与工作集占用空间及内存流量(机器)直接耦合起来。
基于梯度的优化方法
参数更新算法 将梯度下降作为基本优化算法进行了介绍:沿最速下降方向迭代调整参数。这一概念性表述假设网络规模适中,且运行于单个设备。在大规模硬件环境中,梯度下降及其变体会遭遇物理瓶颈:内存容量限制了可驻留的激活值和优化器状态数量,而内存带宽则限制了参数更新速度。
梯度下降
梯度下降是神经网络训练的数学基础,通过迭代调整参数来最小化损失函数。在训练系统中,这一数学操作体现为特定的计算模式。每次迭代,系统必须执行四项存在依赖关系的操作:
- 计算前向传播的激活值
- 计算损失值
- 通过反向传播计算梯度
- 使用梯度值更新参数
梯度下降的计算需求随模型规模和数据集规模共同增长。计算梯度需要在前向传播期间存储中间激活值,以供反向传播使用。这些激活值占用的内存与网络深度及所处理的样本数量成正比。
传统梯度下降在每次参数更新前都要处理整个数据集。对于包含一百万个样本的训练集,系统必须先计算所有样本的汇总梯度,才能执行一次更新。令 \(D\) 表示训练数据集中的样本数,\(B_{\text{micro}}\) 表示一次前向/反向传播中驻留的样本数,\(T_{\text{forward+backward per example}}\) 表示在所选微批次执行方式下,每个样本分摊的前向/反向传播时间。梯度累积将多个微批次组合成一个更大的有效批次。equation 2 中的峰值内存关系和 equation 3 中的单步时间关系刻画了这一实现层面的区别: \[ \text{Peak Activation Memory} \propto B_{\text{micro}} \times \text{Activation Memory per Example} \tag{2}\] \[ T_{\text{step}} \propto D \times T_{\text{forward+backward per example}} \tag{3}\]
训练内存的真实成本 通过推导包含优化器状态开销在内的完整训练内存方程,对这一分解进行了形式化描述。如果以流式方式或微批次方式处理数据集,全批量训练并不需要同时存储每个样本的激活值;峰值内存由同一时刻保留在内存中的样本决定。系统层面的问题依然严峻:每次更新前都要处理 \(D=1{,}000{,}000\) 个样本,意味着一次迭代需要耗费处理百万样本的时间,而在此期间参数保持不变,从而降低模型从数据中学习的速率。
对硬件友好的变体放宽了每次更新都必须获得精确全数据集梯度的要求。随机梯度下降(SGD)11使用采样样本或小批次而非整个数据集来估计梯度。这改变了更新频率和梯度方差,同时使每次更新都能在有界工作集上执行。
然而,逐个处理样本(\(B=1\))会使加速器效率急剧下降。现代加速器通过将大型通用矩阵乘法(GEMM)操作映射到脉动阵列和单指令多数据(SIMD)执行单元上来实现峰值吞吐量。当 \(B=1\) 时,层运算退化为矩阵向量乘法(GEMV),算术强度降至从设备内存传输的每字节仅对应 \(O(1)\) 次操作。计算单元在等待 DRAM 或 HBM 传输时无法获得足够数据。同时,单样本更新要求在每处理一个样本后,都从设备内存读取参数张量、应用梯度并写回更新后的权重,这会使内存带宽饱和,却无法在多个输入之间分摊参数访问开销。
小批次处理
小批量梯度下降是在全批量方法与随机方法之间形成的一种实用折中,也是一种算法与机器协同设计:对符合现代加速器架构特点的小批次样本计算梯度 (Dean et al. 2012)。批次大小 \(B\) 因而成为影响计算效率和内存需求的关键系统参数。
Dean, Jeffrey, Greg Corrado, Rajat Monga, Kai Chen, Matthieu Devin, Quoc V. Le, Mark Z. Mao, et al. 2012. “Large Scale Distributed Deep Networks.” In Advances in Neural Information Processing Systems (NeurIPS), edited by Peter L. Bartlett, Fernando C. N. Pereira, Christopher J. C. Burges, Léon Bottou, and Kilian Q. Weinberger, vol. 25. Curran Associates.
Definition 1.3: 批处理
批处理将多个训练样本聚合为张量运算,将每一步的固定开销分摊到 \(B\) 个样本上,并可提供更多可并行执行的工作。增大 \(B\) 可能提高硬件占用率和算术强度,但不能保证每项操作都会变为计算受限。
- 意义:吞吐量通常随批次大小增加而提高,直到目标硬件得到充分占用;而收敛所需更新的数量和质量则遵循另一条取决于工作负载的曲线。Goyal 等人使用线性学习率缩放和预热,展示了在 \(B=8{,}192\) 下训练 ResNet-50 的 ImageNet 训练方案 (Goyal et al. 2017)。这一结果是针对特定配置的展示,而非普适的临界批次大小。
- 区别:一次小批次更新会对 \(B\) 个样本的梯度求平均。在样本相互独立且分布相近的条件下,该均值的标准差近似按 \(1/\sqrt{B}\) 下降。与单样本更新相比,这种更新处理的数据更多,因此其总数据移动量和耗时取决于复用情况、实现方式,以及批次大小如何改变所需的更新次数。
- 常见误区:一个常见误解是,线性学习率缩放(将 \(\eta\) 乘以 \(B/B_0\))适用于任意批次大小。这是一种通常需要预热和实证验证的训练方案,其适用范围取决于模型、数据、优化器和目标准确率。
批次大小 \(B\) 的选择直接决定加速器的内存分配。equation 4 中的分解将固定的参数与梯度存储同依赖批次大小的激活工作集区分开来: \[ \text{Memory Required} = \text{Parameter Memory} + \text{Gradient Memory} + B \times \text{Activation Memory} \tag{4}\]
由于激活项随 \(B\) 增长,而参数和梯度内存保持不变,批次大小翻倍会使激活工作集翻倍。因此,一个在小批次下可以轻松装入内存的模型,可能在批次增大后耗尽高端训练加速器上 40–80 GB 的 HBM。Section 1.4.3.2 针对 逐层分析了这一内存预算。
增大批次大小会将受内存带宽限制的向量操作转化为计算受限的矩阵乘法。在稠密前馈投影和注意力投影中,从 HBM 加载到片上 SRAM 的参数权重会在批次中的全部 \(B\) 个样本间复用。算术强度随 \(B\) 成比例增加,使张量核心流水线充分饱和,并分摊参数读取开销。线性缩放规则允许学习率随批次大小一同增大,从而在经验确定的上限内保持收敛速率 (Goyal et al. 2017)。
由于激活内存随 \(B\) 线性增长,加速器 HBM 的容量限制了单次前向/反向传播可执行的最大批次大小。当实现较高硬件占用率或稳定收敛所需的批次大小超出设备内存容量时,系统通过梯度累积将执行批次大小与优化批次大小解耦。系统依次执行多个较小的微批次(\(B_{\text{micro}}\)),通过串行执行将峰值激活内存限制在 equation 2 所描述的范围内,就地累积所得梯度,并仅在完成整个累积有效批次后触发优化器更新。
自适应优化器与基于动量的优化器
基本 SGD 对每个参数张量应用相同的标量学习率;当各维度的损失曲率相差数个数量级时,这可能使训练停滞。动量利用历史梯度的方向信息平滑更新,RMSprop 利用梯度平方的大小调整各参数的步长,而 Adam 则将一阶矩跟踪与自适应二阶矩缩放相结合 (Kingma and Ba 2015)。这些算法改进虽然可能减少收敛所需的总优化步数,但也引入了持久辅助状态,直接增加加速器的内存压力和内存总线流量。
Kingma, Diederik P., and Jimmy Ba. 2015. “Adam: A Method for Stochastic Optimization.” 3rd International Conference on Learning Representations (ICLR).
基于动量的方法
动量方法12通过在迭代间累积速度向量来解决 SGD 的振荡问题,抑制沿陡峭谷地的高频振荡。在硬件上,这种平滑需要分配并维护一个持久速度张量,其形状和精度与模型参数完全一致。在尚未计入梯度和激活值之前,参数与这一辅助状态合计占用参数本身 \(2\times\) 的存储空间。
自适应学习率方法
动量虽然可以平滑梯度方向,却无法解决不同参数之间梯度尺度不同的问题。RMSprop13通过为每个参数维护梯度平方的移动平均来解决这一问题,自动减小历史梯度较大参数的步长。按参数调整步长需要维护梯度平方的移动平均 \(s_t\),使静态内存占用达到参数本身的 \(2\times\),与动量相当。此外,计算这一移动平均还会在每次参数更新中引入逐元素平方和平方根内核。
Adam 优化
Adam14结合了动量与 RMSprop 的优点:动量的梯度平滑机制应对含噪更新,而 RMSprop 的自适应缩放机制则处理各参数特有的步长。这一组合为每个参数维护两个移动平均。这里,\(m_t\) 和 \(v_t\) 分别是一阶矩和二阶矩缓冲区,\(\beta_1\) 和 \(\beta_2\) 是各自的衰减因子,\(\epsilon\) 是分母中用于保证数值稳定性的常数: \[\begin{gather*} m_t = \beta_1 m_{t-1} + (1-\beta_1)\nabla \mathcal{L}(\theta_t) \\[0.5ex] v_t = \beta_2 v_{t-1} + (1-\beta_2)\big(\nabla \mathcal{L}(\theta_t)\big)^2 \\[0.5ex] \hat{m}_t = \frac{m_t}{1-\beta_1^t}, \qquad \hat{v}_t = \frac{v_t}{1-\beta_2^t} \\[0.5ex] \theta_{t+1} = \theta_t - \eta \frac{\hat{m}_t}{\sqrt{\hat{v}_t} + \epsilon} \end{gather*}\]
维护两个矩缓冲区会使参数与优化器状态的总占用空间增至参数本身的三倍:训练系统必须在参数张量之外分配两个持久状态张量(\(m_t\) 和 \(v_t\))。对于一个具有 100M 参数的模型,仅这些辅助向量就在权重存储之外额外占用 800 MB。
优化算法对系统的影响
从 SGD(无辅助状态),到动量和 RMSprop(每个参数一个状态向量),再到 Adam(每个参数两个状态向量),辅助状态内存逐步增加,具体量化结果见 table 4。这些内存占用与收敛速率之间形成了根本性的权衡:15虽然 Adam 往往能够用更少的优化步骤达到目标损失,但其静态内存占用限制了加速器 HBM 所能容纳的批次大小,并增加了每次更新的内存总线流量。在 GPT-2 规模下,这一开销成为主要的内存约束。
| 属性 | SGD | 动量 | RMSprop | Adam |
|---|---|---|---|---|
| 内存开销 | 无 | 速度项 | 梯度平方 | 速度与梯度平方 |
| 参数 + 优化器状态 | 1\(\times\) | 2\(\times\) | 2\(\times\) | 3\(\times\) |
| 稠密状态访问 | 参数与梯度 | 增加速度 | 增加梯度平方状态 | 增加一阶矩和二阶矩状态 |
| 更新计算量 | 辅助计算量最少 | 增加动量更新 | 增加自适应缩放 | 增加矩更新和偏差校正 |
| 硬件效率 | 视情况而定 | 视情况而定 | 视情况而定 | 视情况而定 |
| 收敛行为 | 视情况而定 | 视情况而定 | 视情况而定 | 视情况而定 |
table 4 中量化的成本形成了一种设计上的权衡。Adam 的两个矩缓冲区可能改善特定工作负载的优化效果,但其内存占用可能减小加速器所能容纳的模型规模或批次大小。AdamW16 (Loshchilov and Hutter 2019) 将权重衰减与 Adam 的自适应梯度更新解耦,同时无需为每个参数再增加一个状态张量。
Napkin Math 1.2: GPT-2 优化器内存需求
一种具有代表性的 GPT-2 XL 训练配置采用 Adam 优化器,并设置以下五个超参数:
- β₁ = 0.9(动量衰减)
- β₂ = 0.999(二阶矩衰减)
- 学习率:在前 500 步中从 0 预热至 2.5e-4,随后进行余弦衰减
- 权重衰减:0.01
- 梯度裁剪:以 1.0 为阈值进行全局范数裁剪
计算:
对于 GPT-2 的 1.5B 个 FP32 参数(每个占 4 字节),内存占用分为四个部分:
- 参数:1.5B \(\times\) 4 字节 = 6 GB
- 梯度:1.5B \(\times\) 4 字节 = 6 GB
- Adam 状态(m, v):1.5B \(\times\) 8 字节 = 12 GB
- 静态内存总量:24 GB
这解释了为何尚未计入激活存储时,仅 GPT-2 的 24 GB 静态训练状态就已接近 V100 的 32 GB 容量。
优化器驱动的系统决策
- 混合精度训练(FP16)降低了运算精度,但需要保留 FP32 主权重,使静态内存占用维持在约 24 GB。
- 梯度累积(将有效批次拆分为更小的微批次)使系统能够在内存受限的情况下实现 \(B=512\) 的有效批大小。
系统洞见:这一示例配置展示了 Adam 的矩缓冲区如何约束容量。相较于 SGD 或动量法的任何收敛收益,都必须在模型、数据、调度、批大小和停止准则一致的条件下进行测量。
框架优化器接口与调度
量化优化器内存之后,框架接口就变得至关重要,因为它规定了这些状态在各训练步之间何时被读取、写入、清除和保留。训练循环将梯度计算与参数更新分离,使系统能够在不改变优化器方程的情况下累积梯度、同步梯度或推迟更新。Listing 2 展示了 Adam 优化在这一循环中的介入位置。
import torch
import torch.nn as nn
import torch.optim as optim

# Initialize Adam optimizer with model parameters and learning rate
optimizer = optim.Adam(
    model.parameters(), lr=0.001, betas=(0.9, 0.999)
)
loss_function = nn.CrossEntropyLoss()

# Standard training loop implementing the four-step optimization cycle
for epoch in range(num_epochs):
    for batch_idx, (data, targets) in enumerate(dataloader):
        # Step 1: Clear accumulated gradients from previous iteration
        optimizer.zero_grad()

        # Step 2: Forward pass - compute model predictions
        predictions = model(data)
        loss = loss_function(predictions, targets)

        # Step 3: Backward pass - compute gradients via autodiff
        loss.backward()

        # Step 4: Parameter update - apply Adam optimization equations
        optimizer.step()
optimizer.zero_grad() 调用标志着相邻两次更新之间的边界。梯度会在多次 backward() 调用之间累积,因此显式清零可防止旧梯度污染下一批次。同样的累积行为随后也有助于实现较大的有效批大小,但前提是训练循环有意识地管理这一边界。
optimizer.step() 方法是另一个边界:它使用当前梯度,并修改持久化的优化器状态。对于 Adam 优化,该调用执行动量估计、梯度平方跟踪、偏差校正和参数更新。Algorithm 1 将隐藏状态显式呈现出来,使内存成本保持可见,而非隐没于 API 调用之后。
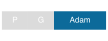
在这一简化的静态状态视图中,Adam 的两个矩缓冲区占用的存储空间是参数存储空间的两倍。
\begin{algorithm} \caption{Adam 参数更新(一个优化器步)} \begin{algorithmic} \Require 梯度 $g_t = \nabla\mathcal{L}(\theta_t)$;步数 $t$;学习率 $\eta$;衰减系数 $\beta_1,\beta_2$;常数 $\epsilon$ \Ensure 更新后的参数 $\theta_{t+1}$;传递至下一步的矩缓冲区 $m_t, v_t$ \State $m_t \gets \beta_1 m_{t-1} + (1-\beta_1)\, g_t$ \Comment{一阶矩(动量)} \State $v_t \gets \beta_2 v_{t-1} + (1-\beta_2)\, g_t^2$ \Comment{非中心二阶矩} \State $\hat{m}_t \gets m_t / (1-\beta_1^{t})$; $\hat{v}_t \gets v_t / (1-\beta_2^{t})$ \Comment{偏差校正} \State $\theta_{t+1} \gets \theta_t - \eta\, \hat{m}_t / (\sqrt{\hat{v}_t} + \epsilon)$ \Comment{参数更新} \end{algorithmic} \end{algorithm}
步骤 1 和 2 为每个参数保留两个持久化矩缓冲区,因此,尚未计入梯度、激活和 FP32 主权重时,参数加优化器状态的内存占用就已达到参数内存的约 3\(\times\)。除容量之外,优化器步还会造成严重的内存带宽瓶颈。从数学上看,更新由逐元素运算构成,其算术强度低于 \(1\text{ FLOP/byte}\):在 FP32 下,更新每个参数需要读取四个张量(\(g_t, \theta_t, m_{t-1}, v_{t-1}\))并写入三个张量(\(m_t, v_t, \theta_{t+1}\)),为完成约十余次算术运算,需要通过内存总线传输 28 字节。由于矩阵执行单元(如 Tensor Core)在这一受内存限制的阶段处于空闲状态,高性能训练系统采用融合优化器内核,将矩更新、偏差校正和权重写入合并为每个参数组的一次内核启动,从而尽量减少对设备内存的往返访问。
学习率调度集成
框架的学习率调度钩子无需增加逐参数状态,即可改变优化器的轨迹。它在训练期间调整学习率 \(\eta\),使系统能够塑造收敛行为,同时保持底层优化器方程不变。
余弦退火、指数衰减或阶梯式降低等调度方案,通过随时间改变步长来实现这一轨迹。调度器跟踪轻量级标量状态(当前步数、轮次、预热阶段);这些状态必须与优化器状态一起序列化到检查点中,以保证按位精确地恢复训练。机器学习框架 介绍了协调这些步骤的框架调度器接口。这种分离使系统工程师能够将基础优化算法(SGD、Adam)与调度策略(余弦退火、线性预热)组合,而无需修改底层张量更新规则。
参数更新规则定义了给定梯度向量时的轨迹,但假定这些梯度已经计算并存储。对于拥有数十亿参数的网络,梯度计算构成了训练循环中主要的计算和内存负担。决定训练内存预算和运行时间的是梯度生成机制,而非优化器步本身。
反向传播机制
反向传播按逆拓扑顺序遍历网络的计算图,以计算参数梯度。在前向推理中,加速器会在后续层使用某个激活张量后立即释放它。训练打破了这种短暂的生命周期:计算某一层参数的梯度,需要前一层在前向传播中产生的确切激活张量。因此,每个前向激活都必须驻留于 HBM 中,直到反向遍历返回对应层,这使激活存储成为大规模训练的关键内存约束。
梯度计算与反向传播 奠定了数学基础:链式法则将梯度计算分解为逐层的向量—雅可比积,将误差信号从标量损失反向传递至输入参数。在系统规模上,核心问题不是反向传播计算了什么,而是它在内存容量和算术吞吐量方面的成本。section 1.3.1.1 中的层运算产生了必须为反向传播保留的前向激活。计算 \(\frac{\partial \mathcal{L}}{\partial \mathbf{W}^{(\ell)}}\) 需要直接访问这些已存储的激活,由此形成了训练内存方程,后文的梯度检查点技术正是利用了这一特性。
从计算角度看,对线性层 \(\mathbf{Z} = \mathbf{A}\mathbf{W}\) 进行反向传播,需要执行两次与前向传播维度相同的独立矩阵乘法:一次计算激活梯度 \(\nabla_{\mathbf{A}}\mathcal{L} = (\nabla_{\mathbf{Z}}\mathcal{L})\mathbf{W}^\top\),以向上游传播误差信号;另一次计算参数梯度 \(\nabla_{\mathbf{W}}\mathcal{L} = \mathbf{A}^\top(\nabla_{\mathbf{Z}}\mathcal{L})\),以更新权重。由于每次前向矩阵乘法都对应反向传播中的两次相同维度的矩阵乘法,反向传播所需的算术工作量是前向传播的两倍。这确立了系统领域的标准惯例:一个完整训练步所需的 FLOPs 约为前向传播的三倍(\(1\times\) 前向 \(+ 2\times\) 反向)。
一个处理 MNIST 的简单三层网络只需千字节级的激活存储。相比之下,GPT-2 处理单个批次所需的激活存储超过 35.9 GB,超出了标准加速器的高带宽内存总容量。训练内存的真实成本 推导了反向传播如何造成这些内存成本,并形式化给出了完整的训练内存方程(\(M_{\text{total}} = M_{\text{weights}} + M_{\text{gradients}} + M_{\text{optimizer}} + M_{\text{activations}}\))。现代机器学习框架通过自动微分(机器学习框架)自动完成梯度计算,但管理由此产生的内存占用和算术运算调度,仍是系统工程不可回避的职责。
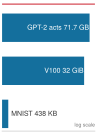
从 MNIST 玩具示例到 GPT 规模训练,激活内存需求跨越多个量级。
激活内存需求
训练内存分为四类不同的状态:
- 反向求导规则所需的已保存前向激活,
- 模型参数,
- 参数梯度,以及
- 优化器状态和任何更高精度的主权重。
考虑一批训练样本通过网络的过程。前向传播计算并存储: \[\begin{gather*} \mathbf{Z}^{(\ell)} = \mathbf{A}^{(\ell-1)}\mathbf{W}^{(\ell)} + \mathbf{b}^{(\ell)} \\ \mathbf{A}^{(\ell)} = f(\mathbf{Z}^{(\ell)}) \end{gather*}\]
为计算参数梯度 \(\nabla_{\mathbf{W}^{(\ell)}}\mathcal{L} = (\mathbf{A}^{(\ell-1)})^\top(\nabla_{\mathbf{Z}^{(\ell)}}\mathcal{L})\),反向传播规则必须读取该层的输入激活 \(\mathbf{A}^{(\ell-1)}\)。为通过 \(\nabla_{\mathbf{Z}^{(\ell)}}\mathcal{L} = (\nabla_{\mathbf{A}^{(\ell)}}\mathcal{L}) \odot f'(\mathbf{Z}^{(\ell)})\) 将误差信号经非线性激活函数传向上游,内核需要激活前张量 \(\mathbf{Z}^{(\ell)}\)(如 GELU),或激活后输出 \(\mathbf{A}^{(\ell)}\)(当 \(f'\) 可由输出计算时,如 sigmoid;对于 ReLU,则可通过 1 位布尔掩码计算)。融合内核和选择性重计算可以压缩这些已保存数据的内存占用。然而,由于激活随批大小 \(B\) 和序列长度 \(S\) 扩展,其存储需求随数据维度增长,而参数和优化器内存则由模型架构决定,保持固定。1.3 中的 GPT-2 计算将这一内存压力分解为注意力块、前馈子层和优化器状态的占用。
Napkin Math 1.3: GPT-2 激活内存分解
对于批大小 \(B\) = 4、序列长度 \(S\) = 1024、隐藏维度 \(d\) = 1600 且具有 48 layers 的 GPT-2:
计算:
- 注意力激活:\(B \times S \times d \times 4\)(Q、K、V、输出)= 4 \(\times\) 1024 \(\times\) 1600 \(\times\) \(4 \times 2\) 字节(FP16)= 52.4 MB
- FFN 激活:\(B \times S \times (4d)\)(中间维度扩展)= 4 \(\times\) 1024 \(\times\) 6400 \(\times\) 2 字节 = 52.4 MB
- 注意力分数:\(S{\times}S\) 分数矩阵、softmax 缓冲区和 dropout 缓冲区共需 \(5 \times N_{\text{heads}} \times S^2 \times B\) 字节。当头数为 25 时,这一项每层达到 524.3 MB——它是占主导地位的一项,随序列长度呈二次增长,也正是选择性重计算所丢弃的部分
- 层归一化状态:很少(每层约 10 MB)
- 每层总计:约 639.1 MB(注意力 + FFN + 注意力分数 + 层归一化状态)
结果:
- 激活内存总量(库估算值,包含上述分项之外的残差流缓冲区和框架缓冲区):35.9 GB
- 参数(FP16):3 GB
- 梯度:3 GB
- 主权重(FP32):6 GB
- Adam 矩状态(FP32):12 GB
- 训练期间的峰值内存:约 59.9 GB
这超出了单张 V100 的 32 GB 容量。
解决方案:
- 选择性激活重计算:丢弃注意力中间结果,在反向传播期间重新计算,使模型估算的这一激活内存项减少 70.2 percent,降至约 10.7 GB;额外计算量取决于具体实现
- 将激活卸载至 CPU:将部分激活存储在 CPU 内存中,在反向传播期间传输
- 混合精度:使用 FP16 激活(已采用),而非 FP32(后者将占用 71.7 GB)
- 减小微批次大小并累积梯度:通过多次内存容量允许的前向传播和反向传播,形成更大的有效批次
系统洞见:即使采用选择性重计算,模型估算的激活与静态状态总量仍约为 34.7 GB,在尚未计入工作空间和分配器开销时,就已略高于 V100 的原始容量 32 GB。因此,对于这里采用的表示方式,仍需使用完全重计算、分片、卸载或更小的微批次。
这一分解说明了加速器内存不足时所需的实际工程决策。存储激活、重计算与批次大小之间的同类权衡,也是下文内存与计算分析的核心。
Checkpoint 1.2: 内存与计算的权衡
内存与计算的权衡
训练系统必须在内存使用量与计算效率之间取得平衡。每次前向传播都会生成反向传播规则可能需要的值。对于一个具有 \(N_L\) 层的简化网络模型,令 \(s_\ell\) 表示第 \(\ell\) 层为每个样本保存的中间状态字节数,\(a_\ell\) 表示为每个样本保存的激活输出字节数。按照这种按样本计量的约定,其存储量随批次大小线性增长,可由 equation 5 近似表示:
\[ \text{Memory per batch} = B \times \sum_{\ell=1}^{N_L} (s_\ell + a_\ell) \tag{5}\]
这一内存需求还会与 section 1.3.2.3 中讨论的权重、梯度和优化器内存叠加。Equation 6 给出了训练状态的概念性分解: \[ \text{Total Memory} = \text{Memory}_{\text{weights}} + \text{Memory}_{\text{gradients}} + \text{Memory}_{\text{optimizer}} + \text{Memory per batch} \tag{6}\]
运行时峰值可能超过这一总和,因为临时工作空间、通信缓冲区、分配器行为以及框架记账信息也会占用内存。为了减少激活这一项,训练系统可以有策略地在反向传播期间重新计算中间值,而不是存储它们。这会增加计算量,但能够让内存受限的硬件支持更深的网络或更大的批次 (Chen et al. 2016)。Algorithm 2 明确展示了这一权衡:前向传播仅保留稀疏选取的一组检查点层的激活,反向传播则按需重新计算其余激活。
\begin{algorithm} \caption{梯度检查点(激活重计算)} \begin{algorithmic} \Require $N_L$ 层网络;检查点集合 $\mathcal{C} \subseteq \{1,\dots,N_L\}$(例如,每隔 $\sqrt{N_L}$ 层设置一个检查点) \Ensure 参数梯度,同时降低激活内存峰值 \For{$\ell = 1$ 到 $N_L$} \State 对第 $\ell$ 层执行前向传播;仅当 $\ell \in \mathcal{C}$ 时存储其激活 \Comment{丢弃其余激活} \EndFor \For{$\ell = N_L$ 递减至 $1$} \If{第 $\ell$ 层的激活已被丢弃} \State 从最近的已存储检查点开始,重新计算直至第 $\ell$ 层的前向传播片段 \EndIf \State 计算该层的梯度;释放激活 \EndFor \State \Return 累积的梯度 \end{algorithmic} \end{algorithm}
每隔 \(\sqrt{N_L}\) 层均匀设置检查点,可将激活内存峰值从 \(\mathcal{O}(N_L)\) 降至 \(\mathcal{O}(\sqrt{N_L})\),代价是每个训练步增加相当于一次前向传播的算术运算量 (Chen et al. 2016)。这会使每步总计算量从前向传播 FLOPs 的约 \(3\times\) 增至 \(4\times\),以额外的算术运算换取显著减少的激活内存占用,使其能够容纳在加速器的物理内存中。
Jouppi, Norman P., Cliff Young, Nishant Patil, David Patterson, Gaurav Agrawal, Raminder Bajwa, Sarah Bates, et al. 2017. “In-Datacenter Performance Analysis of a Tensor Processing Unit.” Proceedings of the 44th Annual International Symposium on Computer Architecture, ISCA ’17, 1–12. https://doi.org/10.1145/3079856.3080246.
Paszke, Adam, Sam Gross, Francisco Massa, Adam Lerer, James Bradbury, Gregory Chanan, Trevor Killeen, et al. 2019. “PyTorch: An Imperative Style, High-Performance Deep Learning Library.” Advances in Neural Information Processing Systems (NeurIPS) 32: 8024–35.
容量只是内存施加的两项物理约束之一;另一项是带宽。加速器提供了巨大的矩阵计算吞吐量,但在片外高带宽内存(HBM)与片上 SRAM 之间搬运中间激活张量时,内存总线往往会达到饱和 (Jouppi et al. 2017)。即使激活完全能够容纳在 HBM 中,其读写时间仍可能远超算术执行时间。为缓解这一内存总线压力,现代训练引擎会将逐元素运算直接融合到前序矩阵乘法中,并通过片上 SRAM 分块而非全局内存来组织梯度计算。在运行时层面,框架的缓存分配器会跟踪计算图中张量的生命周期,并在激活的最后一个反向传播使用方完成计算后立即回收内存块 (Paszke et al. 2019)。
前向传播、梯度计算和参数更新定义了训练系统必须计算的内容。然而,仅凭操作名称无法判断系统会在何处停滞。矩阵形状、算子融合、数值精度和内存层次结构共同决定了执行受限于算术吞吐量还是数据搬运。算术强度提供了量化这种平衡关系的分析工具。
算术强度
算术强度刻画了这一区别——它是计算量与数据搬运量之比,能够揭示操作受限于计算吞吐量还是内存带宽: \[ \text{Arithmetic Intensity} = \frac{\text{FLOPs}}{\text{bytes moved}} \]
算术强度高的操作受计算限制:其性能受限于处理器的计算吞吐量。算术强度低的操作受内存限制:它们花在数据搬运上的时间多于计算时间。Roofline 模型 给出了 Roofline 模型的形式化定义,并说明了如何计算硬件的脊点。17
Table 5 总结的是常见趋势,而非固定测量值。稠密矩阵乘法可以通过充分复用操作数来达到较高的算术强度,而独立的逐元素内核和归约内核通常每搬运一个字节所执行的计算更少。目标硬件的脊点决定了由此形成的受限类型。
| 操作 | 算术强度趋势 | 分类条件 |
|---|---|---|
| 稠密矩阵乘法(大型) | 当形状与分块能够提供充分的操作数复用时,算术强度较高 | 仅当算术强度超过脊点时才受计算限制 |
| 激活函数 | 作为独立的逐元素内核时,算术强度通常较低 | 除非通过融合消除数据流量,否则通常对内存敏感 |
| LayerNorm/BatchNorm | 包含归约和逐元素运算,需要多次遍历张量 | 取决于融合、形状和目标脊点 |
| 注意力 softmax | 沿注意力轴进行归约与归一化 | 取决于物化、分块和融合 |
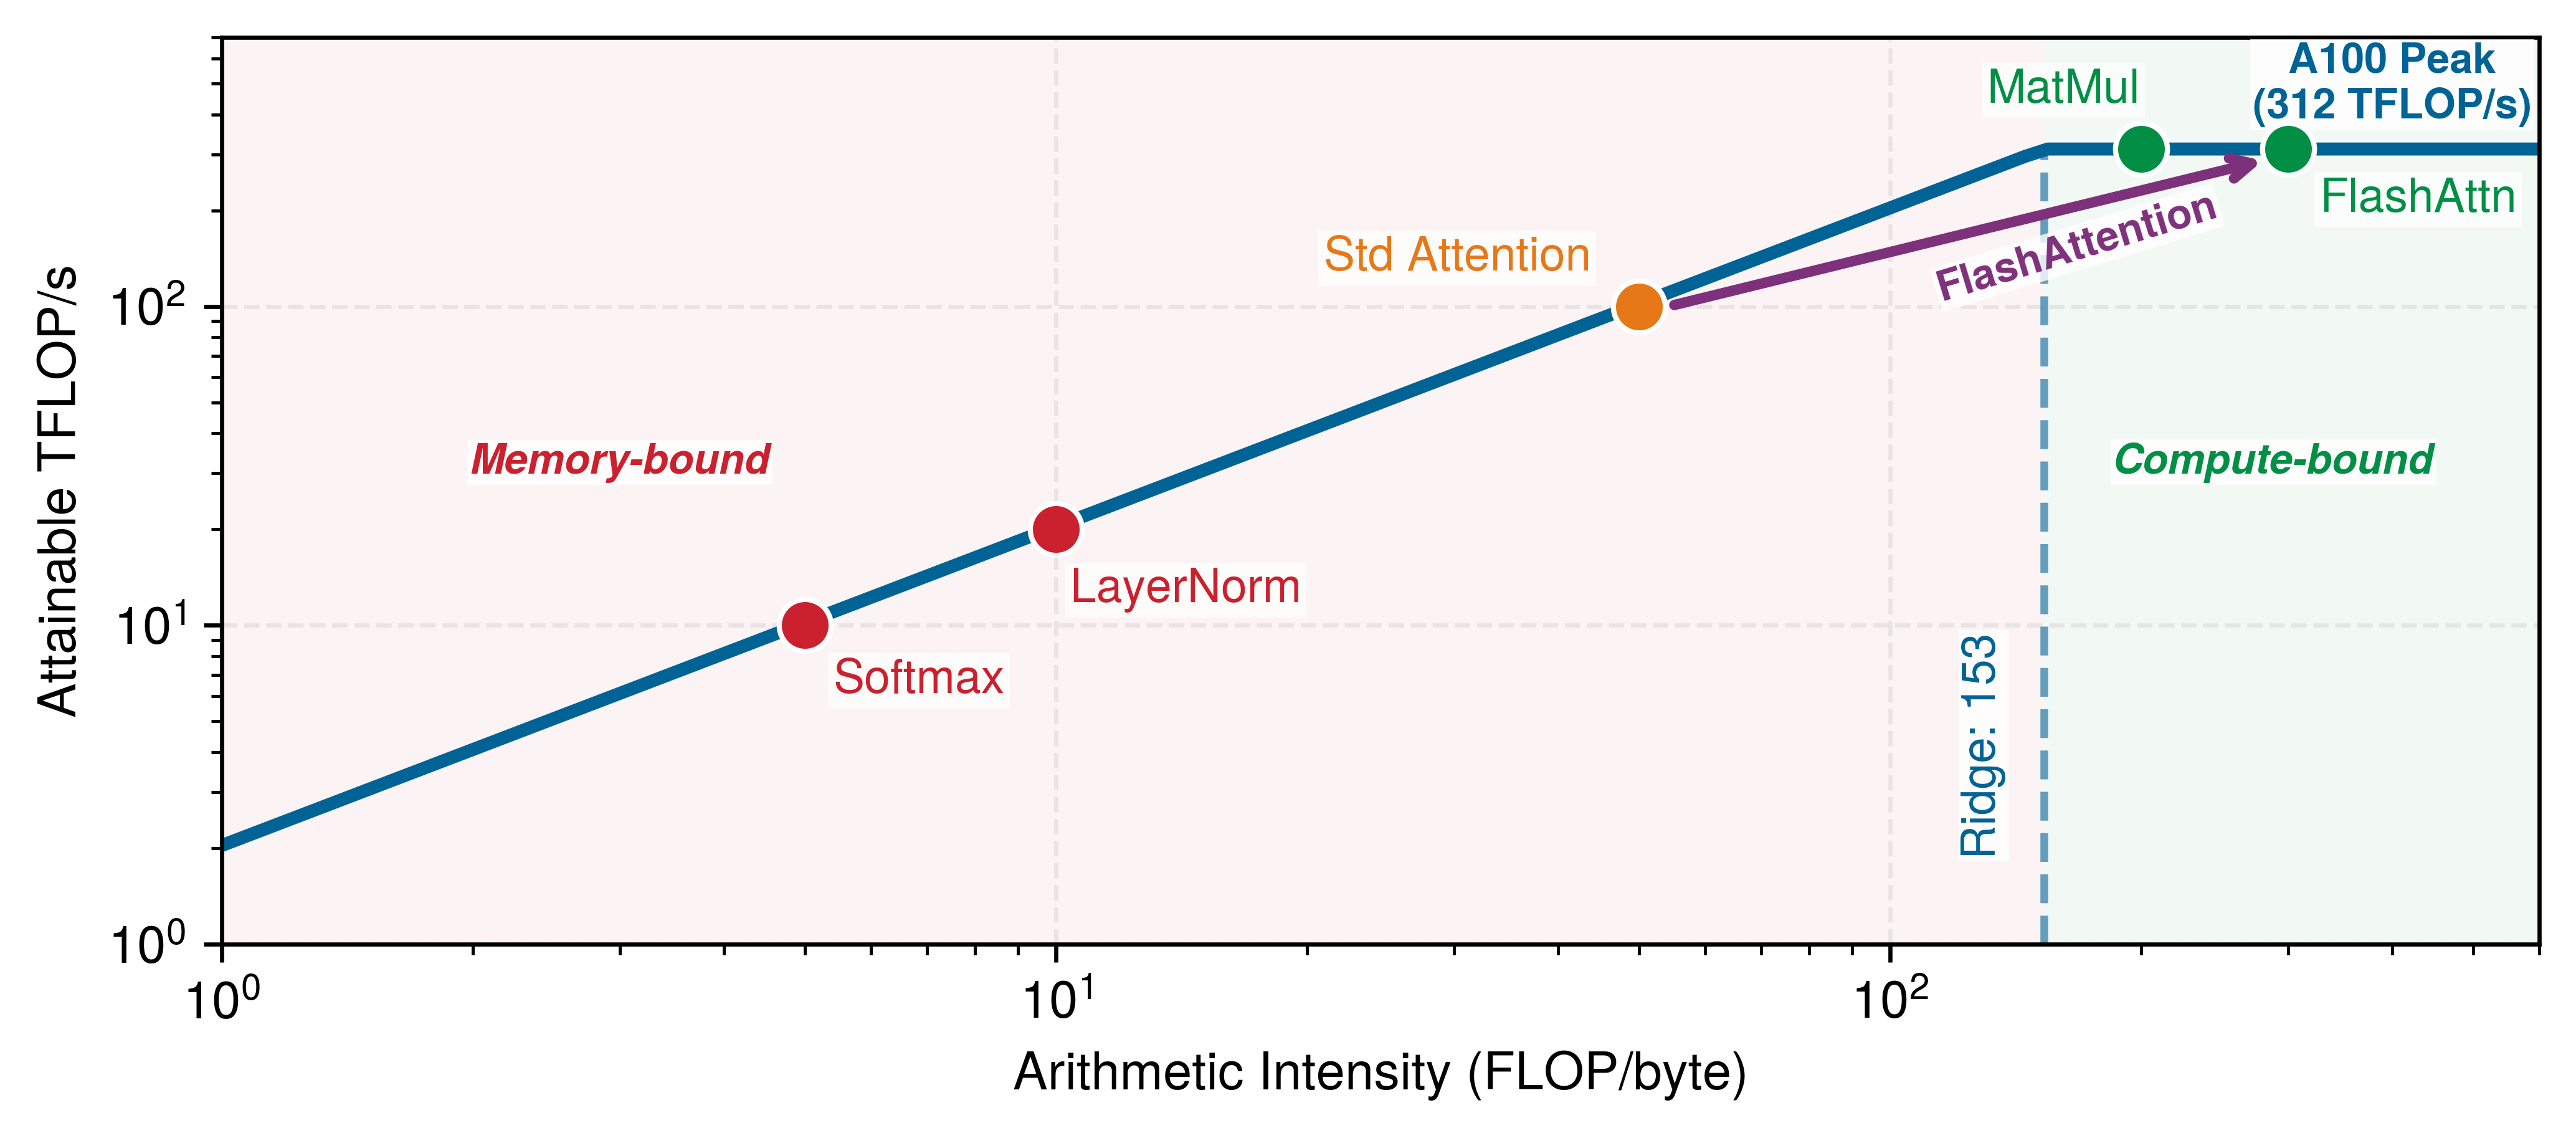
模型训练期间的硬件效率直接取决于内核的算术强度。沿着 figure 2 中的对数算术强度轴定位各操作点,比较位于倾斜上限处、受内存带宽限制的算子与位于水平峰值处、受计算限制的算子。
为直观理解这些关系,请研究 figure 2 中的 Roofline 图。脊点标记了倾斜的内存受限区域与水平的计算受限上限相接的“拐点”。在 Roofline 假设下,位于该点左侧的实现受带宽限制,位于右侧的实现则受计算限制。图中各操作点的位置用于示意如何解读该模型,并非实测的 GPT-2 坐标。
考虑一个将 \(S{\times}S\) 注意力分数矩阵物化的 GPT-2 注意力层。对于每个头,\(\mathbf{Q}\mathbf{K}^\top\) 乘积约需 \(2S^2d_{\text{head}}\) FLOPs,而写入 FP16 分数矩阵并将其读回,约需搬运 \(4S^2\) 字节。仅计算这一分数矩阵的数据流量,可得到近似值 \(d_{\text{head}}/2\)。对于 GPT-2 Small(\(d_{\text{model}}=\) 768,分布在 12 个头上,因此 \(d_{\text{head}}=\) 64),这种有限范围的核算得到 32 FLOP/byte。完整的内核分析还必须计入 Q 和 K 的数据流量、softmax 运算、额外读写、缓存复用以及融合。FlashAttention 所针对的仍是物化分数矩阵产生的 \(\mathcal{O}(S^2)\) 数据流量。
加速器具有特定的硬件脊点,操作在该处从受内存限制转变为受计算限制。典型数据中心加速器的脊点足够高,以至于即便大型矩阵乘法受计算限制,物化注意力 softmax 等低算术强度操作仍受内存限制。算术强度低于脊点的操作受内存限制,高于脊点的操作则受计算限制。
Systems Perspective 1.5: 峰值 FLOP/s 与持续性能
峰值 TFLOP/s 是算术运算的上限,并非对应用持续性能的预测。对于严格受带宽限制的实现,仅提高算术运算上限并不能改善 Roofline 性能界限。混合精度训练既能启用更快的算术执行路径,也能减少实际以较低精度存储和传输的张量所产生的数据流量。实际收益取决于内核支持、转换开销、数值要求以及构成瓶颈的资源。因此,基于 Roofline 的优化会先测量实现,再选择融合、精度调整或增加计算能力。
批次大小可通过改变矩阵形状以及内核可利用的复用量,影响算术强度和占用率。不存在以批次大小 32 为界、普遍区分内存受限与计算受限执行的边界;这一转变取决于操作、维度、实现、精度和硬件。
这一分析为优化策略的选择提供了指导。对于受内存限制的操作,通过算子融合、降低精度或采用 FlashAttention 等算法改进来减少数据搬运,可带来最大的收益。对于受计算限制的操作,通过 Tensor Core 和并行执行提高吞吐量更为重要。这一区别具有实际意义:前一种情况关注如何搬运更少的字节,后一种情况则关注如何让更多算术单元保持忙碌。
在 figure 2 中,FlashAttention18 体现了 I/O 感知算法设计的核心洞见。FlashAttention 不在 HBM 中物化完整的 \(S{\times}S\) 注意力矩阵,而是处理能够容纳在高速 SRAM 中的分块,从而将注意力辅助内存从 \(\mathcal{O}(S^2)\) 降至 \(\mathcal{O}(S)\),并大幅减少 HBM 数据流量。原始研究报告称,在所评估的工作负载上,加速比最高可达 3\(\times\) (Dao et al. 2022),具体收益取决于张量形状、硬件和基线。section 1.6.4 将详细讨论该算法及其适用条件。
算术强度分析用于确定某个具体实现受哪种物理资源制约。当张量形状能够提供充分的数据复用时,稠密矩阵乘法会进入计算受限区间,而独立的归一化和逐元素激活内核仍受内存带宽限制。FlashAttention 展示了分块如何减少片外数据搬移并提高有效算术强度,使受内存限制的注意力计算趋向计算资源饱和。
优化单个操作是必要的,但并不充分。如果加速器因等待下一批数据而闲置,那么即使矩阵乘法调优得再完善,也毫无作用。各个操作的独立成本——稠密矩阵乘法的 FLOPs、受内存限制的激活操作,以及优化器状态分配——会在执行循环中累积。要维持持续的吞吐量,就必须将这些离散操作协调为均衡的流水线,通过上游数据供给和下游参数更新,避免加速器因缺乏工作而闲置。
流水线架构
一个训练步骤并非单一操作,而是一系列具有依赖关系的阶段——必须先加载数据才能开始计算,必须先完成前向传播才能开始反向传播,必须先计算梯度才能更新参数。最慢阶段的速度决定了整个系统的速度。如果不采用流水线,这些阶段就会串行执行,在主机准备数据或通过总线传输批次时,加速器只能闲置。
模型执行图(机器学习框架)控制加速器上的算术运算,而持续训练则要求跨越物理机器边界,为这些内核供给数据。主机 CPU 从存储中读取原始记录,并在主机 DRAM 中执行预处理;加速器则在 HBM 中执行矩阵乘法。数据必须通过互连传输——通常是 PCIe 链路,其带宽比设备内存带宽低一个数量级。当上游数据准备或总线传输所需的时间超过前向传播和反向传播的持续时间时,加速器计算引擎就会因缺乏数据而闲置,从而降低训练性能铁律中的硬件利用率因子 \(\eta_{\text{hw}}\)。
对这些物理边界的管理将训练系统划分为三个相互连接的子系统,每个子系统对硬件资源都有不同的需求。数据流水线在主机上处理数据读取、转换和组批;训练循环在加速器上协调前向传播、反向传播和参数更新;评估流水线则定期使用留出数据评估模型质量。Figure 3 展示了这些子系统在整个训练生命周期中的交互方式。它们之间的接口构成了关键的同步边界,I/O 延迟、互连传输或同步验证暂停都可能在这些边界处限制加速器利用率。
\begin{tikzpicture}[line join=round,
    font=\small\sffamily,
    box/.style={
        draw=none,%BlueLine,
        fill=none,%BlueL,
        rounded corners=2pt,
        align=center,
        minimum height=1.4cm,
        minimum width=3.2cm,
        line width=0.75pt,
        font=\small\sffamily
    },
    arrow/.style={
        ->,
        color=GrayLine,
        line width=1.0pt,
        >=latex
    },
    label_text/.style={
        font=\footnotesize\sffamily,
        align=center,
        color=TextBlack
    },
    node distance=2.0cm,
satellite/.style = {circle, draw=none, semithick, fill=#1,
                    text width=26mm, inner sep=1pt, align=flush center,
                    minimum size=28mm,minimum height=12mm},
arr/.style = {-{Triangle[length=5mm,width=2mm]}, color=#1,
                    line width=1mm, shorten <=1mm, shorten >=1mm},
]

%graph style
\tikzset{
pics/graph/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=GRAPH,scale=1, every node/.append style={transform shape}]
\def\dx{\Width}
\def\dy{\Height}
\def\dz{\Depth}
% koordinata donjeg levog ugla (početak bara)
\def\x{0}
\def\y{0.15}
\def\z{0}
% boje
\draw[draw=\filllcirclecolor,line width=1pt](-0.2,0)--(1.3,0);
\draw[draw=\filllcirclecolor,line width=1pt](-0.2,0)--(-0.2,1.2);
\filldraw[fill=\filllcolor!10, draw=\drawcolor] (\x,\y+\dy,\z) -- (\x,\y+\dy,\z+\dz) -- (\x+\dx,\y+\dy,\z+\dz) -- (\x+\dx,\y+\dy,\z) -- cycle; % gornja strana
\filldraw[fill=\filllcolor!50, draw=\drawcolor] (\x+\dx,\y,\z) -- (\x+\dx,\y,\z+\dz) -- (\x+\dx,\y+\dy,\z+\dz) -- (\x+\dx,\y+\dy,\z) -- cycle; % desna strana
\filldraw[fill=\filllcolor!60, draw=\drawcolor] (\x,\y,\z+\dz) -- (\x+\dx,\y,\z+\dz) -- (\x+\dx,\y+\dy,\z+\dz) -- (\x,\y+\dy,\z+\dz) -- cycle; % prednja strana
\end{scope}
    }
  }
}
%brain
\tikzset{pics/brain/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=BRAIN,scale=\scalefac, every node/.append style={transform shape}]
\draw[fill=\filllcolor,line width=\Linewidth](-0.3,-0.10)to(0.08,0.60)
to[out=60,in=50,distance=3](-0.1,0.69)to[out=160,in=80](-0.26,0.59)to[out=170,in=90](-0.46,0.42)
to[out=170,in=110](-0.54,0.25)to[out=210,in=150](-0.54,0.04)
to[out=240,in=130](-0.52,-0.1)to[out=300,in=240]cycle;
\draw[fill=\filllcolor,line width=\Linewidth]
(-0.04,0.64)to[out=120,in=0](-0.1,0.69)(-0.19,0.52)to[out=120,in=330](-0.26,0.59)
(-0.4,0.33)to[out=150,in=280](-0.46,0.42)
%
(-0.44,-0.03)to[bend left=30](-0.34,-0.04)
(-0.33,0.08)to[bend left=40](-0.37,0.2) (-0.37,0.12)to[bend left=40](-0.45,0.14)
(-0.26,0.2)to[bend left=30](-0.24,0.13)
(-0.16,0.32)to[bend right=30](-0.27,0.3)to[bend right=30](-0.29,0.38)
(-0.13,0.49)to[bend left=30](-0.04,0.51);
\draw[rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcolor,length=7.5pt]},line width=\Linewidth](-0.23,0.03)--(-0.15,-0.03)--(-0.19,-0.18)--(-0.04,-0.28);
\draw[rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcolor,length=7.5pt]},line width=\Linewidth](-0.17,0.13)--(-0.04,0.05)--(-0.06,-0.06)--(0.14,-0.11);
\draw[rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcolor,length=7.5pt]},line width=\Linewidth](-0.12,0.23)--(0.31,0.0);
\draw[rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcolor,length=7.5pt]},line width=\Linewidth](-0.07,0.32)--(0.06,0.26)--(0.16,0.33)--(0.34,0.2);
\draw[rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcolor,length=7.5pt]},line width=\Linewidth](-0.01,0.43)--(0.06,0.39)--(0.18,0.51)--(0.31,0.4);
\coordinate(PO)at(-0.1,0.2);
\node[circle,draw=white,line width=1pt,fill=\filllcirclecolor,minimum size=5mm,inner sep=0pt](LV)at(PO){};
\node[draw=none,rotate=40,rounded corners=3pt,rectangle,minimum width=1.2mm,inner sep=1pt,
fill=\filllcirclecolor,minimum height=6mm,anchor=north]at(PO){};
\node[circle,draw=none,fill=white,minimum size=3.0mm,inner sep=0pt](LM)at(PO){};
\node[font=\tiny\bfseries]at(LM){...};
\end{scope}
     }
  }
}
%data
\tikzset{mycylinder/.style={cylinder, shape border rotate=90, aspect=1.3, draw, fill=white,
minimum width=25mm,minimum height=11mm,line width=\Linewidth,node distance=-0.15},
pics/data/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=STREAMING,scale=\scalefac, every node/.append style={transform shape}]
\node[mycylinder,fill=\filllcolor!50] (A) {};
\node[mycylinder, above=of A,fill=\filllcolor!30] (B) {};
\node[mycylinder, above=of B,fill=\filllcolor!10] (C) {};
 \end{scope}
     }
  }
}
%%%
\pgfkeys{
  /channel/.cd,
  Depth/.store in=\Depth,
  Height/.store in=\Height,
  Width/.store in=\Width,
  filllcirclecolor/.store in=\filllcirclecolor,
  filllcolor/.store in=\filllcolor,
  drawcolor/.store in=\drawcolor,
  drawcircle/.store in=\drawcircle,
  scalefac/.store in=\scalefac,
  Linewidth/.store in=\Linewidth,
  picname/.store in=\picname,
 tiecolor/.store in=\tiecolor,
  bodycolor/.store in=\bodycolor,
  stetcolor/.store in=\stetcolor,
  tiecolor=red,      % default tie color
  bodycolor=blue!30,  % default body color
  stetcolor=green,  % default stet color
  filllcolor=BrownLine,
  filllcirclecolor=violet!20,
  drawcolor=black,
  drawcircle=violet,
  scalefac=1,
  Linewidth=0.5pt,
  Depth=0.2,
  Height=0.5,
  Width=0.25,
  picname=C
}

%training Loop
\node (s1) [satellite=magenta!90!black!10] at (0,0) {};
\pic[shift={(0.2,-0.3)}] at  (s1){brain={scalefac=1.7,picname=1,
filllcolor=orange!30!, filllcirclecolor=cyan!55!black!60, Linewidth=1.5pt}};
\node[box, below=1pt of s1] (s1t) {训练循环\\
\footnotesize\sffamily 前向传播、损失、\\反向传播};
%Data pipeline
\node (s2) [satellite=brown!90!black!15] at (-6.65,0) {};
\pic[shift={(0.05,-0.55)}] at  (s2){data={scalefac=0.5,picname=1,filllcolor=BlueLine,
Linewidth=1.0pt}};
\node[box, below=1pt of s2] (data) {数据流水线\\
\footnotesize\sffamily 数据读取、预处理、\\组批};
%Evaluation
\node (s3) [satellite=cyan!20] at (6.65,0) {};
%graph
\begin{scope}[local bounding box=GRAPH1,shift={($(s3)+(-0.55,-0.6)$)},scale=1.2, every node/.append style={transform shape}]
\pic[shift={(0,0)}] at  (0,0){graph={filllcirclecolor=black!60,scalefac=0.5,picname=1,drawcolor=black,filllcolor=red,Height=0.5,Linewidth=1.25pt}};
\pic[shift={(0.33,0)}] at  (0,0){graph={filllcirclecolor=none,scalefac=0.5,picname=2,drawcolor=black,filllcolor=red,Height=1,Linewidth=1.25pt}};
\pic[shift={(0.66,0)}] at  (0,0){graph={filllcirclecolor=none,scalefac=0.5,picname=3,drawcolor=black,filllcolor=red,Height=0.25,Linewidth=1.25pt}};
\pic[shift={(0.99,0)}] at  (0,0){graph={filllcirclecolor=none,scalefac=0.5,picname=4,drawcolor=black,filllcolor=red,Height=0.75,Linewidth=1.25pt}};
\end{scope}
\node[box, below=1pt of s3] (eval) {评估流水线\\
\footnotesize\sffamily 验证与指标};

\draw[arr=cyan,shorten >=1pt] (s2) --coordinate[pos=0.45](AR1) (s1);
\draw[arr=cyan,shorten >=1pt] (s1.10) --coordinate[pos=0.45](AR2) (s3.170);
\draw[arr=green!70!black,shorten >=1pt] (s3.190) --coordinate[pos=0.45](AR3) (s1.350);
% Data -> Training (top arrow)
\node[label_text,above=5pt of AR1]{已处理的批次};
% Training -> Evaluation (top arrow, shifted up)
\node[label_text,above=5pt of AR2]{评估指标};
% Evaluation -> Training (bottom arrow, feedback)
\node[label_text,below=5pt of AR3]{反馈};
\end{tikzpicture}架构概览
端到端训练系统协调三个不同的子系统:用于准备输入批次的主机侧数据流水线、执行数学优化步骤的加速器执行循环,以及跟踪模型在验证数据上质量的周期性评估流水线。这些子系统在不同的硬件域中执行。数据流水线消耗主机 CPU 核心和存储带宽;执行循环占用加速器计算核心和设备内存;评估则定期抢占训练资源以验证泛化能力。这些组件之间的任何延迟失衡,都会直接转化为加速器的空闲周期。
在数据读取边界,数据流水线将原始记录从持久化存储暂存到主机内存中,应用数据增强和归一化等变换 (LeCun et al. 2012),并将张量打包成稠密批次。这些批次通过主机与加速器之间的互连(如 PCIe)传输到加速器内存中。在验证边界,评估流水线定期将留出数据送入模型执行,不计算梯度。由于验证占用的加速器核心也是训练所需的核心,因此其调用频率体现了监测精细程度与总体训练吞吐量之间的直接权衡。
LeCun, Yann, Leon Bottou, Genevieve B. Orr, and Klaus-Robert Müller. 2012. “Efficient BackProp.” In Neural Networks: Tricks of the Trade, vol. 7700. Lecture Notes in Computer Science. Springer Berlin Heidelberg. https://doi.org/10.1007/978-3-642-35289-8_3.
在加速器内部,训练迭代构成一个由严格的数据依赖和内存依赖约束的闭环反馈过程。figure 4 中的循环数据路径展示了这些顺序操作:前向传播、通过反向传播计算梯度,以及参数更新。
\begin{tikzpicture}[
    box/.style 2 args={
        draw=#2,
        fill=#1,
        rounded corners=0pt,
        align=center,
        minimum height=10mm,
        minimum width=22mm,
        line width=0.75pt,
        font=\footnotesize\sffamily
    },
    box_lg/.style 2 args={
        box={#1}{#2},
        minimum width=22mm
    },
    box_blue/.style ={
        box={BlueL}{BlueLine},
        minimum width=25mm
    },
    arrow/.style={
        ->,
        color=GrayLine,
        line width=1.2pt,
        >=latex
    },
    dash_arrow/.style={
        arrow,
        dashed
    },
    node distance=1.4cm and 1.9cm
]

% Row 1: Predict
\node[box={GreenL}{GreenLine}] (batch) {训练\\批次};
\node[box_blue, right=of batch] (forward) {前向传播\\(模型)};
\node[box={GreenL}{GreenLine}, right=of forward] (pred) {预测\\标签};
% Row 2: Gradients
\node[box_lg={RedL}{RedLine}, below=8mm of pred] (loss) {损失函数\\(误差计算)};
\node[box_blue, below=8mm of forward] (grads) {反向传播\\(链式法则)};
\node[box={GreenL}{GreenLine}, below=8mm of batch] (backward) {参数\\梯度};
%labels
\node[box={GreenL}{GreenLine}, right=of loss] (truth) {真实\\标签};
\node[above=0.1cm of truth, font=\footnotesize\sffamily\itshape, color=gray] {标签};
% Row 3: Update
\node[box_lg={OrangeL}{OrangeLine}, below=8mm of backward] (optim) {优化器\\(Adam/SGD)};
\node[box_blue, below=8mm of grads] (update) {更新\\参数};
% Connections
\draw[arrow] (batch) -- (forward);
\draw[arrow] (forward) -- (pred);
\draw[arrow] (pred) -- (loss);
\draw[dash_arrow] (truth) -- (loss);
\draw[arrow] (loss) -- (grads);
\draw[arrow] (grads) -- (backward);
\draw[arrow] (backward) -- (optim);
\draw[arrow] (optim) -- (update);
% Updated parameters feed the model, while each new batch remains a separate input.
\draw[dash_arrow] (update.east) -- ++(0.5,0) coordinate(a)
    -- (a |- optim.south) -- ++(0,-0.35) coordinate(b)
    node[right, font=\footnotesize\sffamily\itshape,
color=gray, pos=0] {下一次迭代}
    -- (b -| backward.west) -- ++(-0.8,0) coordinate(c)
    -- (c |- batch.south) -- ++(0,-0.10) coordinate(d)
    -- (d -| forward.south) -- (forward.south);
% Step labels
\node[above=1pt of forward, font=\small\sffamily\bfseries, color=TextBlack] {步骤 1:预测};
\node[above=1pt of grads, font=\small\sffamily\bfseries, color=TextBlack] {步骤 2:梯度};
\node[above=1pt of $(optim.north east)!0.5!(update.north west)$,
font=\small\sffamily\bfseries, color=TextBlack] {步骤 3:更新};
\end{tikzpicture}section 1.3 对这一循环中的数值算子进行了形式化描述,而物理硬件上的执行则由内存驻留要求和数据依赖决定。在前向传播期间,中间激活张量必须保持驻留在加速器 HBM 中,因为反向传播需要使用它们来计算链式法则中的导数。梯度计算完成后,优化器读取参数和累积梯度,应用更新规则,为下一次迭代生成新的权重。容纳激活、权重和优化器状态所需的内存容量,构成了整个训练步骤的内存需求下限。
这一执行循环在各个批次和训练轮次中不断重复,直到优化过程收敛。要最大化加速器的算术运算效率,就需要在系统层级之间重叠执行这些流水线阶段。当加速器执行批次 \(k\) 时,主机 CPU 线程预取批次 \(k+1\) 并将其暂存到页锁定内存中,从而将存储延迟和 PCIe 传输时间隐藏在矩阵乘法计算内核的执行期间。当这种并发机制失效时——无论是 I/O 受限的数据流水线无法为设备提供足够的输入张量,还是频繁评估导致更新循环停顿——加速器都会闲置,使有效吞吐量下降。
数据流水线
要使加速器的算术单元保持饱和,就必须以不低于模型消耗速率的速度,将训练样本从持久化存储流式传输到设备内存中。上游数据工程(数据工程)在存储介质上准备和划分数据集,而运行时数据流水线则在主机 CPU 上与模型计算并发执行。
数据流水线跨越机器边界,将原始存储与加速器执行连接起来。Figure 5 展示了数据在三个物理区域之间的流动。
\begin{tikzpicture}[font=\small\sffamily, >=stealth]
\tikzset{
Box/.style={align=center, inner xsep=2pt,draw=GreenLine, line width=1pt,fill=none,
minimum width=27mm, minimum height=25mm,node distance=1.0},
LineA/.style={violet!50,line width=4.0pt,{-{Triangle[width=1.5*6pt,length=2.0*5pt]}},shorten <=1pt,shorten >=1pt},
ALine/.style={black!50, line width=1.1pt,{{Triangle[width=0.9*6pt,length=1.2*6pt]}-}},
Larrow/.style={fill=violet!50, single arrow,  inner sep=2pt, single arrow head extend=3pt,
            single arrow head indent=0pt,minimum height=10mm, minimum width=3pt},
Text2/.style={font=\sffamily\bfseries\small,align=center}
}

%file_transfer
\tikzset{
pics/fileT/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\draw[fill=\filllcirclecolor,draw=\drawcolor,line width=\Linewidth](-0.53,0.8)--(-0.22,0.5)--(-0.22,-0.54)
arc[start angle=360, end angle=270, radius=1mm]
--(-1.18,-0.65)arc[start angle=270, end angle=180, radius=1mm]--  (-1.28,0.7)
 arc[start angle=180, end angle=90, radius=1mm]--(-0.53,0.8);
 \draw[draw=\drawcolor,line width=\Linewidth](-0.53,0.8)|-(-0.22,0.5);
%right
\draw[fill=\filllcolor,line width=\Linewidth,draw=\drawcolor](0.72,0.8)--(1.03,0.5)--(1.03,-0.54)
arc[start angle=360, end angle=270, radius=1mm]
--(0.07,-0.65)arc[start angle=270, end angle=180, radius=1mm]--  (-0.03,0.7)
 arc[start angle=180, end angle=90, radius=1mm]--(0.72,0.8);
 \draw[draw=\drawcolor,line width=\Linewidth](0.72,0.8)|-(1.03,0.5);
 %
 \fill[\filllcirclecolor,](-0.450,0)--(0.220,0)--(0.220,0.13)--(0.6220,-0.1)--(0.220,-0.33)--(0.220,-0.2)--(-0.32,-0.2);
\draw[draw=\drawcolor,line width=\Linewidth](-0.450,0)--(0.220,0)--(0.220,0.13)--(0.6220,-0.1)--(0.220,-0.33)--(0.220,-0.2)--(-0.32,-0.2);
\fill[\filllcolor](0.220,0)--(-0.450,0)--(-0.450,-0.13)--(-0.880,0.1)--(-0.450,0.33)--(-0.450,0.19)--(0.1,0.19);
\draw[draw=\drawcolor,line width=\Linewidth](0.220,0)--(-0.450,0)--(-0.450,-0.13)--(-0.880,0.1)--(-0.450,0.33)--(-0.450,0.19)--(0.1,0.19);
%
\end{scope}
    }
  }
}
%dataP
\tikzset{mycylinder/.style={cylinder, shape border rotate=90, aspect=1.3, draw, fill=white,
minimum width=25mm,minimum height=11mm,line width=\Linewidth,node distance=-0.15},
pics/dataP/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=DATA,scale=\scalefac, every node/.append style={transform shape}]
\node[mycylinder,fill=\filllcolor!50] (A) {};
\node[mycylinder, above=of A,fill=\filllcolor!50] (B) {};
\node[mycylinder, above=of B,fill=\filllcolor!10] (C) {};
\fill[\filllcolor!50!black]($(C.west)!0.12!(C.east)$)circle(3pt);
\fill[\filllcolor!50!black]($(B.west)!0.12!(B.east)$)circle(3pt);
\fill[\filllcolor!50!black]($(A.west)!0.12!(A.east)$)circle(3pt);
%
\draw[draw=\drawcolor,line width=2.5*\Linewidth](B.east)--++(17mm,0);
\node[draw=\drawcolor,line width=\Linewidth,minimum width=9mm,fill=white,minimum height=22mm](BD)at($(B.east)+(8mm,0)$){};
\node[draw=\drawcolor,line width=\Linewidth,minimum width=5mm,minimum height=8mm,fill=white](BDM)at($(BD.east)+(5mm,0)$){};
\node[circle,draw=orange,line width=\Linewidth,minimum size=5mm]at($(BD.north)!0.2!(BD.south)$){};
\node[rectangle,draw=blue,line width=\Linewidth,minimum size=5mm]at($(BD.north)!0.5!(BD.south)$){};
\node[circle,draw=green,line width=\Linewidth,minimum size=5mm]at($(BD.north)!0.8!(BD.south)$){};
\end{scope}
     }
  }
}
%gear
\tikzset{
  pics/gear/.style args={#1/#2/#3/#4/#5/#6/#7}{
   code={
           \pgfkeys{/channel/.cd, #7}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
    \pgfmathtruncatemacro{\N}{#1}%
    \def\rin{#2}\def\rout{#3}\def\aA{#4}\def\aOff{#5}\def\rcut{#6}%
    \path[draw=\drawcolor,fill=\filllcolor]
      (0:\rin)
      \foreach \i [evaluate=\i as \n using (\i-1)*360/\N] in {1,...,\N}{%
        arc (\n:\n+\aA:\rin)
        -- (\n+\aA+\aOff:\rout)
        arc (\n+\aA+\aOff:\n+360/\N-\aOff:\rout)
        -- (\n+360/\N:\rin)
      } -- cycle;
      \draw[draw=none,fill=white](0,0) circle[radius=\rcut];
\end{scope}
  }}
}
%square-block
\tikzset{
pics/squareB/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[line join=round,local bounding box=SQUARE,scale=\scalefac,every node/.append style={transform shape}]
% Right Face
\draw[fill=\filllcolor!70,line width=\Linewidth]
(\Depth,0,0)coordinate(\picname-ZDD)--(\Depth,\Width,0)--(\Depth,\Width,\Height)--(\Depth,0,\Height)--cycle;
% Front Face
\draw[fill=\filllcolor!40,line width=\Linewidth]
(0,0,\Height)coordinate(\picname-DL)--(0,\Width,\Height)coordinate(\picname-GL)--
(\Depth,\Width,\Height)coordinate(\picname-GD)--(\Depth,0,\Height)coordinate(\picname-DD)--(0,0,\Height);
% Top Face
\draw[fill=\filllcolor!20,line width=\Linewidth]
(0,\Width,0)coordinate(\picname-ZGL)--(0,\Width,\Height)coordinate(\picname-ZGL)--
(\Depth,\Width,\Height)--(\Depth,\Width,0)coordinate(\picname-ZGD)--cycle;
\end{scope}
    }
  }
}
%stackedS
\tikzset{%
 pics/stackedS/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=FUNNEL,scale=\scalefac, every node/.append style={transform shape}]
%plats

\draw[fill=\filllcolor,line width=\Linewidth,draw=\drawcolor](0,-0.2)--(-0.67,0.13)--(0,0.47)--(0.67,0.13)--cycle;
\draw[fill=\filllcirclecolor,line width=\Linewidth,draw=\drawcolor](0,0)--(-0.67,0.33)--(0,0.67)--(0.67,0.33)--cycle;
\draw[fill=\filllcolor,line width=\Linewidth,draw=\drawcolor](0,0.2)--(-0.67,0.53)--(0,0.87)--(0.67,0.53)--cycle;
\draw[fill=\filllcirclecolor,line width=\Linewidth,draw=\drawcolor](0,0.4)--(-0.67,0.73)--(0,1.07)--(0.67,0.73)--cycle;
\end{scope}
     }
  }
}
%CPU2
\tikzset{%
 pics/cpu2/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=CHIP,scale=\scalefac, every node/.append style={transform shape}]
\node[fill=\filllcolor,minimum width=15mm, minimum height=15mm,inner sep=0pt,
            rounded corners=2,outer sep=2pt] (C1) {};
\node[fill=white,minimum width=11mm, minimum height=11mm,inner sep=0pt,] (C2) {};
\node[fill=\filllcolor!40,minimum width=7mm, minimum height=7mm,inner sep=0pt,] (C3) {};
\foreach \x in {0.2,0.5,0.8}{
\draw[line width=2*\Linewidth,draw=\drawcolor,
-{Circle[fill=white,length=4.5pt]}]($(C1.north west)!\x!(C1.north east)$)--++(0,5mm);
}
\foreach \x in {0.2,0.5,0.8}{
\draw[line width=2*\Linewidth,draw=\drawcolor,
-{Circle[fill=white,length=4.5pt]}]($(C1.south west)!\x!(C1.south east)$)--++(0,-5mm);
}
\foreach \x in {0.2,0.5,0.8}{
\draw[line width=2*\Linewidth,draw=\drawcolor,
-{Circle[fill=white,length=4.5pt]}]($(C1.north west)!\x!(C1.south west)$)--++(-5mm,0);
}
\foreach \x in {0.2,0.5,0.8}{
\draw[line width=2*\Linewidth,draw=\drawcolor,
-{Circle[fill=white,length=4.5pt]}]($(C1.north east)!\x!(C1.south east)$)--++(5mm,0);
}
 \end{scope}
     }
  }
}
\pgfkeys{
  /channel/.cd,
  Depth/.store in=\Depth,
  Height/.store in=\Height,
  Width/.store in=\Width,
  filllcirclecolor/.store in=\filllcirclecolor,
  filllcolor/.store in=\filllcolor,
  drawcolor/.store in=\drawcolor,
  drawcircle/.store in=\drawcircle,
  scalefac/.store in=\scalefac,
  Linewidth/.store in=\Linewidth,
  picname/.store in=\picname,
  filllcolor=BrownLine,
  filllcirclecolor=cyan,
  drawcolor=black,
  drawcircle=violet,
  scalefac=1,
  Linewidth=0.5pt,
  Depth=1.3,
  Height=0.8,
  Width=1.1,
  picname=C
}

%Raw Data  (Disk/S3)
\node[Box](B1){};
%\fill[fill=none](B1.north west) rectangle ($(B1.north east)!0.6!(B1.south east)$)coordinate(B1DE);
\fill[green!20](B1.south east) rectangle ($(B1.north west)!0.6!(B1.south west)$)coordinate(B1LE);
\node[Box,draw=mygreen](){};
\node[Text2](T1)at($(B1.south east)!0.5!(B1LE)$){原始数据 \\(磁盘/S3)};
\coordinate(Q1)at($(B1.north east)!0.5!(B1LE)$);
\pic[shift={(-0.35,-0.45)}] at  (Q1){dataP={scalefac=0.4,filllcirclecolor=violet!20,filllcolor=BlueLine, Linewidth=0.7pt}};
%Format Conversion
\node[Box, right=of B1](B2){};
\fill[cyan!20](B2.south east) rectangle ($(B2.north west)!0.6!(B2.south west)$)coordinate(B2LE);
\node[Box, right=of B1,draw=myblue](B2){};
\node[Text2]at($(B2.south east)!0.5!(B2LE)$){格式\\ 转换};
\coordinate(Q2)at($(B2.north east)!0.5!(B2LE)$);
\pic[shift={(0.11,0)}] at  (Q2){fileT={scalefac=0.8,picname=1,drawcolor=black,
filllcolor=magenta!40,Linewidth=0.7pt, filllcirclecolor=white}};
%Preprocessing\\ (Augment)
\node[Box, right=of B2](B3){};
\fill[cyan!20](B3.south east) rectangle ($(B3.north west)!0.6!(B3.south west)$)coordinate(B3LE);
\node[Box, right=of B2,draw=myblue](B3){};
\node[Text2]at($(B3.south east)!0.5!(B3LE)$){预处理\\ (数据增强)};
\coordinate(Q3)at($(B3.north east)!0.5!(B3LE)$);
\pic[shift={(0,0)}] at (Q3) {gear={14/1.4/1.7/8/4/0.7/scalefac=0.35,drawcolor=mybrown,filllcolor=mybrown}};
%Batching
\node[Box, right=of B3](B4){};
\fill[cyan!20](B4.south east) rectangle ($(B4.north west)!0.6!(B4.south west)$)coordinate(B4LE);
\node[Box, right=of B3,draw=myblue](B4){};
\node[Text2]at($(B4.south east)!0.5!(B4LE)$){批次组装};
\coordinate(Q4)at($(B4.north east)!0.5!(B4LE)$);
%\pic[rotate=0,shift={(-0.55,-0.5)}] at  (Q4){squareB={scalefac=0.5,picname=1,filllcolor=myblue, Linewidth=0.5pt}};
%\pic[rotate=0,shift={(0.1,-0.5)}] at  (Q4){squareB={scalefac=0.5,filllcolor=myblue, Linewidth=0.5pt}};
%\pic[rotate=0,shift={(-0.23,0.05)}] at  (Q4){squareB={scalefac=0.5,filllcolor=myblue, Linewidth=0.5pt}};
\pic[shift={(0,-0.450)}] at  (Q4){stackedS={scalefac=1,picname=1,Linewidth=1.0pt,
 filllcolor=cyan!90!black!40!,drawcolor=black,filllcirclecolor=myorange}};
%GPU 1
\node[Box, right=1.65 of B4](B5){};
\fill[fill=white](B5.north west) rectangle ($(B5.north east)!0.6!(B5.south east)$);
\fill[black!15](B5.south east) rectangle ($(B5.north west)!0.6!(B5.south west)$)coordinate(B5LE);
\node[Box, right=1.65of B4,draw=black](B5){};
\node[Text2]at($(B5.south east)!0.5!(B5LE)$){GPU 1};
\coordinate(Q5)at($(B5.north east)!0.5!(B5LE)$);
\pic[shift={(0.,0)}] at  (Q5){cpu2={scalefac=0.5, drawcolor=BlueLine, filllcolor=BlueLine, Linewidth=0.5pt}};
%
\begin{scope}[on background layer]
\node[Box, below right=1.6 and 0.6 of B5.north west](B5B){};
\fill[black!15](B5B.south east) rectangle ($(B5B.north west)!0.6!(B5B.south west)$)coordinate(B5LEB);
\node[Text2]at($(B5B.south east)!0.5!(B5LEB)$){GPU 3};
\node[Box, below right=1.6 and 0.6 of B5.north west,draw=black]{};
%%
\node[Box, below right=0.8 and 0.3 of B5.north west](B5A){};
\fill[fill=white](B5A.north west) rectangle ($(B5A.north east)!0.6!(B5A.south east)$);
\fill[black!15](B5A.south east) rectangle ($(B5A.north west)!0.6!(B5A.south west)$)coordinate(B5LEA);
\node[Text2]at($(B5A.south east)!0.5!(B5LEA)$){GPU 2};
\node[Box, below right=0.8 and 0.3 of B5.north west,draw=black]{};
\end{scope}
%arrows
\foreach \i in {1,2,3,4}{
\pgfmathtruncatemacro{\x}{\i + 1} %
\draw[LineA](B\i)--coordinate[pos=0.47](SR\i)(B\x);
}
\node[above=2pt of SR4]{数据};
%
\node[draw=mygreen,thick,inner sep=2mm,dashed,fit=(B1)](BB1){};
\node[below=0pt of BB1,mygreen]{存储区};
\node[draw=myblue,thick,inner sep=2mm,dashed,fit=(B2)(B4)](BB2){};
\node[below=0pt of BB2,myblue]{CPU 预处理区};
%
\node[draw=black,thick,inner sep=2mm,dashed,fit=(B5)(B5A)(B5B)](BB3){};
\node[below=0pt of BB3,black]{GPU 训练区};
\end{tikzpicture}在存储区,原始记录存放于本地 NVMe 驱动器或网络存储系统中。在 CPU 预处理区,主机工作线程对原始字节进行解码,执行词元化或数据增强等变换,并将单条记录整理为稠密的小批量张量。在 GPU 训练区,加速器通过 PCIe 总线传输这些张量,并执行前向传播和反向传播。由于这三个区域构成严格的流水线,最慢的阶段决定了端到端训练吞吐量。
核心组件
数据流水线吞吐量源于存储子系统。数据工程 中的上游布局决策——例如采用列式格式或容器格式(Parquet、TFRecord、Arrow)进行顺序分块——决定了呈现给操作系统的物理 I/O 模式。
存储吞吐量受两个硬件约束中较慢者的限制,如 equation 7 所示: \[R_{\text{storage}} =\min(\text{BW}_{\text{disk}}, \text{BW}_{\text{network}}) \tag{7}\] 其中,\(\text{BW}_{\text{disk}}\) 是物理磁盘带宽,\(\text{BW}_{\text{network}}\) 表示分布式存储系统的网络带宽。实际训练工作负载很少能达到这一理论最大值,因为数据打乱可能将大规模顺序读取变为规模更小、效率更低的访问。有效存储吞吐量可建模为 \(R_{\text{storage,eff}} = R_{\text{storage}} \times F_{\text{access}}\),其中 \(F_{\text{access}}\) 取决于记录大小、文件布局、缓存和存储硬件。当无缓冲随机读取使 \(F_{\text{access}}\) 降低时,存储带宽会下降一个数量级,使一个在纸面上看似足够的 I/O 系统成为主要的训练瓶颈。
预处理
从存储中检索出的原始字节需要经 CPU 变换为可供模型使用的张量。静态特征提取可以离线执行(数据工程),而即时词元化和图像增强等动态变换则在训练期间执行。在工作线程彼此独立、可理想扩展的条件下,预处理吞吐量随工作线程数量增长,如 equation 8 所示: \[R_{\text{preprocessing}} = \frac{N_{\text{workers}}}{T_{\text{transform}}} \tag{8}\] 其中,\(N_{\text{workers}}\) 个并行处理线程各自执行耗时 \(T_{\text{transform}}\) 秒的变换。训练架构采用多个工作线程,以确保预处理速度能够跟上加速器的数据消耗速率——如果单线程执行图像增强时每批耗时 30 ms,就无法为前向传播计算仅需 10 ms 的加速器持续供给数据。
随后,预处理后的数据必须先传输至加速器,才能开始计算。因此,总体训练吞吐量受三个阶段中最慢者的限制,equation 9 明确表达了这一点: \[R_{\text{training}} =\min\left(R_{\text{preprocessing}}, \frac{\text{BW}_{\text{GPU transfer}}}{D_{\text{vol}}^{(\text{batch})}}, \frac{R_{\text{compute}}}{O_{\text{batch}}}\right) \tag{9}\] 其中,\(D_{\text{vol}}^{(\text{batch})}\) 为每批输入的字节数,\(O_{\text{batch}}\) 为每批前向传播和反向传播的计算量,以 FLOPs 为单位。因此,在取最小值之前,各项均以每秒批次数表示。
Example 1.1: GPT-2 语言模型数据流水线
场景:量化为使用 32 块 V100 GPU 训练 GPT-2 的集群供给数据时,涉及的存储访问、CPU 词元化以及通过 PCIe 从主机到设备的数据传输。
阶段追踪:
- 原始文本存储:WebText 语料库提供约 40 GB 的原始文本。从 NVMe SSD 存储进行顺序读取时,带宽可达 7 GB/s。在访问因子为 0.1 的文档采样场景下,随机访问存储带宽降至 0.70 GB/s,因此 \(T_{\text{read}} = D_{\text{vol}} / \text{BW}_{\text{storage}} \approx 0.1\text{ ms}\)。
- 词元化:BPE 词元化器(词表大小为 50,257)将文本转换为词元 ID。当批大小 \(B =\) \(B=32\)、序列长度 \(S =\) \(S=1024\)(共 32.8K tokens)时,处理速率为 500K tokens/s 的单个 CPU 核心处理每个批次需要 \(T_{\text{tokenize}} \approx\) 65.5 ms。
- 组批与填充:填充和打包生成形状为 32 sequences \(\times\) 1,024 tokens 的 int64 张量,每个批次产生 262.1 KB 的数据。
- PCIe 传输:通过 PCIe Gen3 x16 总线(带宽为 15.75 GB/s)传输该张量需要 \(T_{\text{transfer}} =\) 0.017 ms,因此总线传输开销可以忽略不计。
系统洞见:单核 CPU 数据准备(\(T_{\text{prep}} \approx\) 65.6 ms)消耗了加速器单步时间预算(\(T_{\text{step}} \approx\) 84.4 ms)的大部分,因此串行流水线在每一步都要承担这两项开销,\(\eta_{\text{hw}}\) 降至约 56 percent。如果准备过程再慢一些,加速器就会完全陷入数据饥饿状态。扩展到 8 个并行工作进程,可将词元化延迟降至 \(T_{\text{tokenize}} / N_{\text{worker}} \approx\) 8.2 ms;同时,预取使 \(T_{\text{prep}}\) 与 \(T_{\text{step}}\) 重叠,将硬件利用率恢复至 95 percent,使 32 块 V100 GPU 的全局样本吞吐量达到每秒 379。
这种三者取最小值的关系决定了训练流水线的设计,因为系统吞吐量等于瓶颈吞吐量。计算能力为 312 TFLOP/s 的加速器在等待数据时,无法完成任何有效工作。反过来,如果加速器的计算能力已经饱和,即使数据流水线得到完美优化,也不会带来收益。均衡的流水线设计使预处理能力、传输带宽和计算吞吐量相互匹配,从而避免任何单一阶段主导迭代时间。GPT-2 工作负载表明,除非通过并行工作进程和预取掩蔽主机端准备延迟,否则构成主要吞吐量障碍的是 CPU 词元化,而非存储读取或总线传输。
数据流水线吞吐量并不是唯一可能使加速器陷入饥饿状态的数据流。多 GPU 训练引入了第二类流量:每一步之后所需的梯度同步。一旦同步时间超过计算时间,通信就会成为限制因素。Section 1.7.2 量化了训练跨越节点边界时遇到的这一网络瓶颈。
对系统设计的影响
数据流水线与计算引擎构成一个耦合系统,其吞吐量等于两者中较慢一方的吞吐量,如 equation 10 所示: \[R_{\text{system}} =\min(R_{\text{pipeline}}, R_{\text{compute}}) \tag{10}\]
当 \(R_{\text{pipeline}} < R_{\text{compute}}\) 时,加速器会空闲等待数据,加速器利用率也会按比例下降,如 equation 11 所示: \[\text{Accelerator Utilization} = \min\left(1, \frac{R_{\text{pipeline}}}{R_{\text{compute}}}\right) \times 100\% \tag{11}\]
现代加速器硬件上的 ResNet-50 模型每秒可以处理 1,000 张图像,但如果数据流水线每秒仅提供 200 张图像,加速器利用率就会降至 20%——加速器有 80% 的时间处于空闲状态。在这种情况下,升级到更快的硬件也无济于事;在同一条流水线下,每秒能够处理 2,000 张图像的加速器只能达到 10% 的利用率。均衡的系统设计旨在持续向加速器供应数据,避免其等待上游阶段。
数据流
训练数据从磁盘传送到加速器的过程中会经过三个存储层级,这些层级之间跨越三个数量级的带宽差距,是数据流水线设计的核心挑战。数据通过这一层次结构的有效传输速率受其最慢环节限制,如 equation 12 所示: \[R_{\text{memory}} =\min(\text{BW}_{\text{storage}}, \text{BW}_{\text{system}}, \text{BW}_{\text{accelerator}}) \tag{12}\]
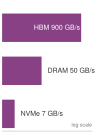
从存储到 DRAM 再到 HBM,带宽沿层次结构逐级提升。
本地 NVMe 存储提供 7 GB/s 的带宽,系统内存提供 50 GB/s 的带宽,而加速器 HBM 的带宽可达 900 GB/s 或更高。每一层的速度大约比其下一层高一个数量级,这意味着,在加速器内存中能够顺畅流动的数据,一旦必须从磁盘获取,就会造成严重瓶颈。这种逐级变化的带宽层次结构解释了为什么流水线组织良好的系统,其迭代时间由各组成部分延迟的最大值决定,而非它们的总和,如 equation 13 所示: \[T_{\text{iteration}} =\max(T_{\text{fetch}}, T_{\text{process}}, T_{\text{transfer}}) \tag{13}\]
当流水线各阶段正确重叠时(在预处理当前批次、将上一批次传输到加速器的同时,从存储中获取下一批次),迭代时间等于最慢阶段的持续时间,而非所有阶段时间的总和。预取所实现的正是这种重叠:将串行瓶颈转化为并行流水线,使各层级能够同时处理不同的批次。
实用架构
对于额定带宽为 7 GB/s 的 NVMe 设备,如果工作负载达到峰值带宽的一半,其持续带宽将为 3.50 GB/s。小规模随机读取和数据打乱可能进一步降低吞吐量;其损失程度取决于访问大小、队列深度、文件布局和缓存。
为在带宽降低的情况下仍能持续向加速器供应数据,流水线架构会同时维护多个数据缓冲区:预取缓冲区用于加载未来批次,处理缓冲区用于保存正在转换的数据,传输缓冲区则用于暂存即将供加速器使用的数据。所需的主机内存总量随每批次内存占用 \(M_{\text{batch}}\) 的变化关系如 equation 14 所示: \[M_{\text{required}} = (N_{\text{prefetch}} + N_{\text{processing}} + N_{\text{transfer}}) \times M_{\text{batch}} \tag{14}\]
为避免加速器陷入数据饥饿状态,每批次的平均预处理服务时间必须满足 equation 15: \[T_{\text{preprocessing}} \leq T_{\text{compute}} \tag{15}\]
如果一个工作进程预处理每批数据需要 40 ms,而加速器每 10 ms 就会消耗一个批次,那么在理想扩展条件下,至少需要四个工作进程。实际需求取决于存储、CPU 资源争用和数据转换开销;section 1.6.2 将探讨预取和并行工作进程。
前向传播
准备好的批次通过前向传播进入训练循环,输入数据在模型中逐层传播,生成预测结果。其概念流程遵循逐层变换 \(\mathbf{A}^{(\ell)} = f\left(\mathbf{A}^{(\ell-1)}\mathbf{W}^{(\ell)} + \mathbf{b}^{(\ell)}\right)\),但物理实现必须调度计算内核,使激活值流经存储层次结构,并保留中间张量以供反向传播使用。
计算操作
前向传播将神经网络层映射为 section 1.3.1.2 中分析的矩阵乘法内核。对于每个全连接层,加速器执行 \(N \times M \times B\) 次乘加运算。例如,维度为 \(512 \times 1024\) 的层处理包含 64 个样本的批次时,约执行 33.6 million MACs;按照每次 MAC 计为两次 FLOP 的约定,约为 67.1 MFLOP。
Systems Perspective 1.6: 执行波次量化与尾部效应
机器学习系统中的一个常见错误,是忽略 GPU 内核固定的执行粒度。GPU 执行被量化为若干工作波次,但相关单位取决于内核的线程映射或分块映射,并不一定是每个线程对应一个样本。
Table 6: 线程束尾部效应的计算示例:在每个线程对应一个工作项的映射下,工作项数略高于 32 线程边界时,会启动一个未完全填满的线程束,因此 33 个工作项使用两个线程束,而 64 个工作项恰好填满同样的两个线程束。实际训练内核以具体实现所决定的方式将张量映射到线程和分块,通常为每个样本分配多个线程,因此无法仅凭批大小推断这些数值。性能剖析必须确定内核的实际映射方式和波次边界。
NVIDIA GPU 以包含 32 个线程的线程束为单位执行任务。在一个独立工作项映射到一个线程的说明性特例中,32 个工作项恰好填满一个线程束,而 33 个工作项则需要第二个大部分为空的线程束。神经网络内核通常将每个样本映射到多个线程,因此仅凭批大小无法确定这种利用率。
在 NVIDIA H100 这类拥有 132 个流式多处理器(SM)的大型 GPU 上,每个 SM 都会调度多组线程束,硬件在一个波次中会处理数千个线程。如果总工作负载略微超过一个波次的边界(例如,1.01 个波次),硬件就必须将第二个几乎为空的波次执行完毕,才能开始下一个任务。
Table 6 量化了上述每个线程对应一个工作项的示例。它并不是通用的批大小性能模型。
| 独立工作项数 | 所需线程束数 | 通道利用率 | 相对时间 |
|---|---|---|---|
| 32 | 1 | 100% | 1\(\times\) |
| 33 | 2 | 51.6% | ~2× |
| 64 | 2 | 100% | 1\(\times\) |
| 65 | 3 | 67.7% | ~1.5× |
系统洞见:应使张量维度和分块维度与内核的硬件映射相匹配,然后对候选批大小进行基准测试。性能剖析可以揭示未完全填满的线程束或波次;仅凭批大小则无法做到这一点。
除稠密矩阵乘法外,不同的神经网络架构还引入了专门的计算模式。例如,卷积网络会在多通道输入张量上滑动空间滤波器。考虑一个维度为 \(64 \times 224 \times 224 \times 3\)(批大小 \(\times\) 高度 \(\times\) 宽度 \(\times\) 通道数)的输入张量,由 \(7 \times 7\) 的卷积核处理。每个位置需要 147 multiply-accumulate operations,当 64 个滤波器在 \(218 \times 218\) 的空间维度上运算时,每张图像的算术运算量可达数百万次乘加运算。加速器执行这些空间卷积时,要么通过列展开(im2col)将其转换为稠密 GEMM,要么采用 Winograd 最小滤波,以暂存存储空间换取片外内存流量的减少。
Transformer 架构引入了注意力机制(网络架构),用于计算序列各位置之间的相似度分数。注意力将批量矩阵乘法(\(QK^T\) 和 \(\text{Softmax}(...)V\))与逐行归约相结合。由于中间注意力分数矩阵的规模随序列长度呈二次增长,将这些激活值显式存储在全局内存中会造成内存带宽瓶颈,除非内核在片上 SRAM 中融合矩阵乘法与归一化操作。
在这些网络中,逐元素操作普遍具有较低的算术强度。ReLU 和 sigmoid 等激活函数的独立实现会分别变换各个张量元素,因此其性能受内存带宽限制,而非计算吞吐量限制(section 1.3.4)。批归一化需要跨批次维度和空间维度计算统计量,要求全局同步屏障,并对存储激活值的内存进行多轮读写扫描,从而进一步增加内存流量。
加速器通过将执行线程组织为固定大小的单元来执行这些并行工作负载:在 NVIDIA 架构上是包含 32 个线程的线程束19,在 AMD 架构上则是包含 64 个线程的波前。硬件执行效率取决于张量维度和分块形状是否与线程块的几何布局,以及 Tensor Core 等专用单元所要求的操作数矩阵维度相匹配。
cuDNN (Chetlur et al. 2014) 等优化算子库为每种层类型实现多种计算算法,并根据张量维度、暂存内存限制和硬件能力,在这些算法之间动态选择。例如,cuDNN 通过评估工作空间内存开销与算术运算量之间的权衡,在直接卷积、基于 GEMM 的展开、快速傅里叶变换(FFT)卷积和 Winograd 变换之间进行选择 (NVIDIA Corporation 2023)。这些硬件利用模式进一步印证了 section 1.3.2.1 中确立的批大小与硬件效率之间的耦合关系:较大的批大小能够使加速器计算单元充分饱和,并摊薄内存传输开销,但也会增加中间激活值的存储需求。
Chetlur, Sharan, Cliff Woolley, Philippe Vandermersch, Jonathan Cohen, John Tran, Bryan Catanzaro, and Evan Shelhamer. 2014. “cuDNN: Efficient Primitives for Deep Learning.” arXiv Preprint arXiv:1410.0759.
NVIDIA Corporation. 2023. NVIDIA cuDNN Developer Guide, Version 8.9.6.
内存管理
在前向传播过程中,内存管理成为制约因素,因为中间激活值必须保留在高带宽内存中,以供反向传播时计算梯度。为理解内存容量如何约束训练,考虑在容量为 24 GB 的加速器上训练一个具有 7B 个参数的模型时,权重、梯度、优化器状态和保留的激活值共同构成的内存占用。
Napkin Math 1.4: 估算显存需求
问题:一个具有 7B 个参数的模型,能否在显存为 24 GB 的 GPU 上进行训练?
已知:7B 个参数,FP16 权重和梯度,FP32 主权重和 Adam 状态,以及 24 GB 的 GPU 显存。
计算:
- 权重(FP16):7B \(\times\) 2 字节 = 14 GB。
- 梯度(FP16):与权重大小相同 = 14 GB。
- FP32 训练状态:主权重需要 28 GB;Adam 的动量和方差还需要 56 GB。
- 小计(不含激活值):14 GB + 14 GB + 28 GB + 56 GB = 112 GB,已经超过显存为 24 GB 的 GPU 的容量。
- 激活值:Transformer 激活值内存的一个简化估算式为:批大小 \(\times\) 序列长度 \(\times\) 隐藏维度 \(\times\) 层数 \(\times\) 字节数 \(\times\) 激活因子,该因子用于计入保留的注意力、多层感知机和归一化中间结果。当批大小 = 1、序列长度 = 2048、隐藏维度 = 4096、层数为 32 layers,且激活因子约为 57× 时,保留的激活值还会增加 30.6 GB 的内存占用。
系统层面的启示:全参数训练需要通过完全分片数据并行(FSDP)或 ZeRO 等系统对状态进行分片或卸载。量化的基础权重能够减少参数高效微调的内存需求,但并不等同于这里的全参数混合精度训练方案。
只有激活值内存随批大小近似线性增长(equation 5);模型参数和优化器状态的大小保持不变。实际的复杂性在于这些开销如何跨层相互作用。
考虑 ResNet-50 以 32 的批大小处理分辨率为 224 \(\times\) 224 的图像。初始卷积层产生的激活图维度为 112 \(\times\) 112 \(\times\) 64;采用单精度(4 字节)时,每张图像约需 3.2 MB。在 50 layers 中,中间激活值内存不断累积:完整前向传播的激活值总计约为 8 GB,反向传播还会增加 4 GB 的激活值工作集(经验工作内存,不同于存储的参数梯度),模型参数则占用 102.4 MB。单个批次的总内存占用为 12.1 GB,约占 A100 GPU 的 80 GB 显存容量的 15.1 percent。
将批大小加倍至 64,会使激活值存储量加倍:前向激活值达到 16 GB,反向激活值工作集达到 8 GB,使总内存占用增至 24.1 GB。在空间分辨率较高的视觉模型中,激活值占据内存的主要部分,而参数存储(102.4 MB)几乎可以忽略。对于大语言模型,这一关系则相反:GPT-3(175B 个参数)仅以 FP32 存储参数就需要约 700 GB(FP16 下为 350 GB),尚未分配任何激活值内存或优化器状态,就已超过单个加速器的容量。
由于加速器内存(当代硬件上为 40 GB–80 GB)必须同时容纳激活值、参数、梯度和优化器状态,因此,可行批大小的上限往往受内存容量而非计算吞吐量限制。两种系统级技术可以缓解这一容量瓶颈:激活检查点在前向传播时丢弃中间激活值,并在反向传播时重新计算,以冗余算术运算换取存储需求的降低;混合精度训练则通过采用 16 位浮点格式,将每个数值的内存流量和存储量减半。这两种技术将在 section 1.6 中详细分析。
在反向传播(section 1.3.3)期间,反向传播过程以相反顺序遍历网络,利用保留的前向激活值计算参数梯度和激活值梯度,其算术运算开销约为前向传播的两倍。各层的内存需求会动态变化。在 ResNet-50 中,网络中部层的滤波器数量从初始的 64 增至 256,而空间特征图尺寸的减小部分抵消了通道深度增加带来的影响。在 50 layers 中,尚未计入参数梯度和优化器状态时,反向传播的激活值工作集就已达到约 3.2 GB。峰值内存占用取决于保留的前向激活值、活跃的梯度缓冲区、临时工作空间和运行时分配调度,而不只是单个层的宽度。
参数更新与优化器
反向传播将梯度写入缓冲区后,系统执行优化器步骤,以更新模型参数。优化器的选择既决定了趋近损失最小值的数学轨迹,也决定了每次迭代所需的硬件资源。在标准深度学习框架中,这一阶段将梯度计算与参数更新相结合(listing 3):loss.backward() 反向遍历计算图,将梯度写入梯度张量,而 optimizer.step() 则对所有已注册参数应用更新规则。
loss.backward()  # Compute gradients
optimizer.step()  # Update parameters
尽管 optimizer.step() 表现为一次框架调用,它却会在加速器内存上启动一项受内存带宽限制的工作负载。在前向传播和反向传播中,GEMM 通过在寄存器和共享内存中反复复用分块数据来实现较高的算术强度;与之不同,优化器步骤由低算术强度的逐元素运算组成。对于每个参数,加速器都必须将权重、梯度和辅助优化器状态从 HBM 流式传入片上寄存器,计算更新规则,再将修改后的数值写回 HBM。由于每传输一个字节仅对应少量浮点运算,算术强度远低于每字节 1 FLOP,因此执行时间由内存带宽而非计算吞吐量决定。
训练循环中的优化器内存
这一内存带宽瓶颈与 table 4 中量化的辅助状态需求叠加。标准随机梯度下降除权重和梯度外,不需要持久保存其他状态,而自适应优化器则需要大量辅助存储。对于 Adam,维护一阶矩(动量)和二阶矩(未中心化方差)的运行估计值,需要为每个参数额外配置两个 FP32 状态张量。每次更新时,加速器都必须通过内存总线读写这些状态缓冲区,从而使内存流量成倍增加,并占用原本可用于容纳更大批次或更长序列的容量。
在十亿参数规模下,优化器状态占据内存预算的主要部分。正如 GPT-2 计算示例(section 1.3.2.3)所量化的那样,对于一个具有 1.5B 个参数的模型,除参数和梯度之外,仅 FP32 的 Adam 优化器状态就需要 12 GB,这还未计入激活值。这一挑战推动了节省内存的优化器变体的发展:Adafactor 对二阶矩状态进行因子分解 (Shazeer and Stern 2018),8 位优化器对优化器统计量进行量化 (Dettmers et al. 2022),GaLore 则在低秩空间中计算更新 (Zhao et al. 2024)。Figure 6 比较了一个 70 亿参数模型在四种优化器配置下的内存分配,展示了低秩投影如何将优化器状态缩减至其标准内存占用的一小部分。
Shazeer, Noam, and Mitchell Stern. 2018. “Adafactor: Adaptive Learning Rates with Sublinear Memory Cost.” International Conference on Machine Learning (ICML), Proceedings of machine learning research, vol. 80: 4596–604.
Dettmers, Tim, Mike Lewis, Sam Shleifer, and Luke Zettlemoyer. 2022. “8-Bit Optimizers via Block-Wise Quantization.” International Conference on Learning Representations (ICLR).
Zhao, Jiawei, Zhenyu Zhang, Beidi Chen, Zhangyang Wang, Anima Anandkumar, and Yuandong Tian. 2024. “GaLore: Memory-Efficient LLM Training by Gradient Low-Rank Projection.” arXiv Preprint.
\begin{tikzpicture}[font=\small\sffamily]
% Standard color definitions
\definecolor{BlueLine}{HTML}{006395}
\definecolor{BlueL}{HTML}{D1E6F3}
\definecolor{GreenLine}{HTML}{008F45}
\definecolor{GreenL}{HTML}{D4EFDF}
\definecolor{RedLine}{HTML}{CB202D}
\definecolor{RedL}{HTML}{F5D2D5}
\definecolor{OrangeLine}{HTML}{CC5500}
\definecolor{OrangeL}{HTML}{FFE5CC}
\definecolor{GrayLine}{HTML}{666666}
\definecolor{GrayL}{HTML}{E0E0E0}

\begin{axis}[
    xbar stacked,
    legend style={
        legend columns=1,
        at={(axis cs:65,2.2)},
        anchor=north west,
        cells={anchor=west},
        row sep=1pt,
        draw=none,
        font=\fontsize{7pt}{7}\sffamily
    },
    xmajorgrids=true,
    grid style=dashed,
    ytick=data,
    axis y line*=none,
    axis x line*=bottom,
    tick label style={font=\footnotesize\sffamily},
    label style={font=\footnotesize\sffamily},
    xtick={0,20,40,60,80},
    width=120mm,
   % height=90mm,
    bar width=7mm,
    xlabel={内存开销 (GB)},
    yticklabels={8 位 GaLore, 8 位 Adam, Adafactor, BF16},
    xmin=0,
    xmax=85,
    ymax=3.35,
    area legend,
    y=10mm,
    enlarge y limits={abs=0.55},
]
\addplot[GrayLine,fill=GrayL] coordinates {(1,0) (2,1) (3,2) (5,3)};
\addplot[OrangeLine,fill=OrangeL] coordinates {(4,0) (6,1) (8,2) (10,3)};
\addplot[GreenLine,fill=GreenL] coordinates {(6,0) (8,1) (10,2) (15,3)};
\addplot[BlueLine,fill=BlueL] coordinates {(12,0) (15,1) (20,2) (25,3)};
\addplot[violet!70,fill=violet!30] coordinates {(8,0) (10,1) (15,2) (20,3)};

\legend{其他, 权重梯度, 优化器状态, 激活值, 权重}
\draw[dashed,RedLine,ultra thick] (axis cs:24,-0.5) -- (axis cs:24,3.5)
node[above right=0pt, RedLine, font=\footnotesize\bfseries\sffamily,
fill=white, fill opacity=0.85, text opacity=1, inner sep=2pt, pos=1] {24 GB 上限 (RTX 4090)};
\end{axis}
\end{tikzpicture}BF16 Adam 超出单加速器 24 GB 预算线的幅度最大,而 Adafactor、8 位 Adam 和 8 位 GaLore 则逐步压缩辅助状态。然而,即使最紧凑的配置也超过了 24 GB,这表明,在将大型模型装入容量固定的加速器时,仅压缩优化器状态仍无法消除对激活值管理或模型分区的需求。
批大小与参数更新
增大批大小可提高矩阵乘法的算术强度,并降低同步频率,从而提高加速器利用率。然而,改变批大小也会改变优化动态。如果扩大批大小却不重新调整学习率调度,就可能损害收敛性,形成以模型质量为代价换取硬件效率的优化差距。Figure 7 展示了这一权衡:在扩大批大小的同时保持学习率不变,会减缓损失下降;而相应缩放学习率则可恢复收敛。
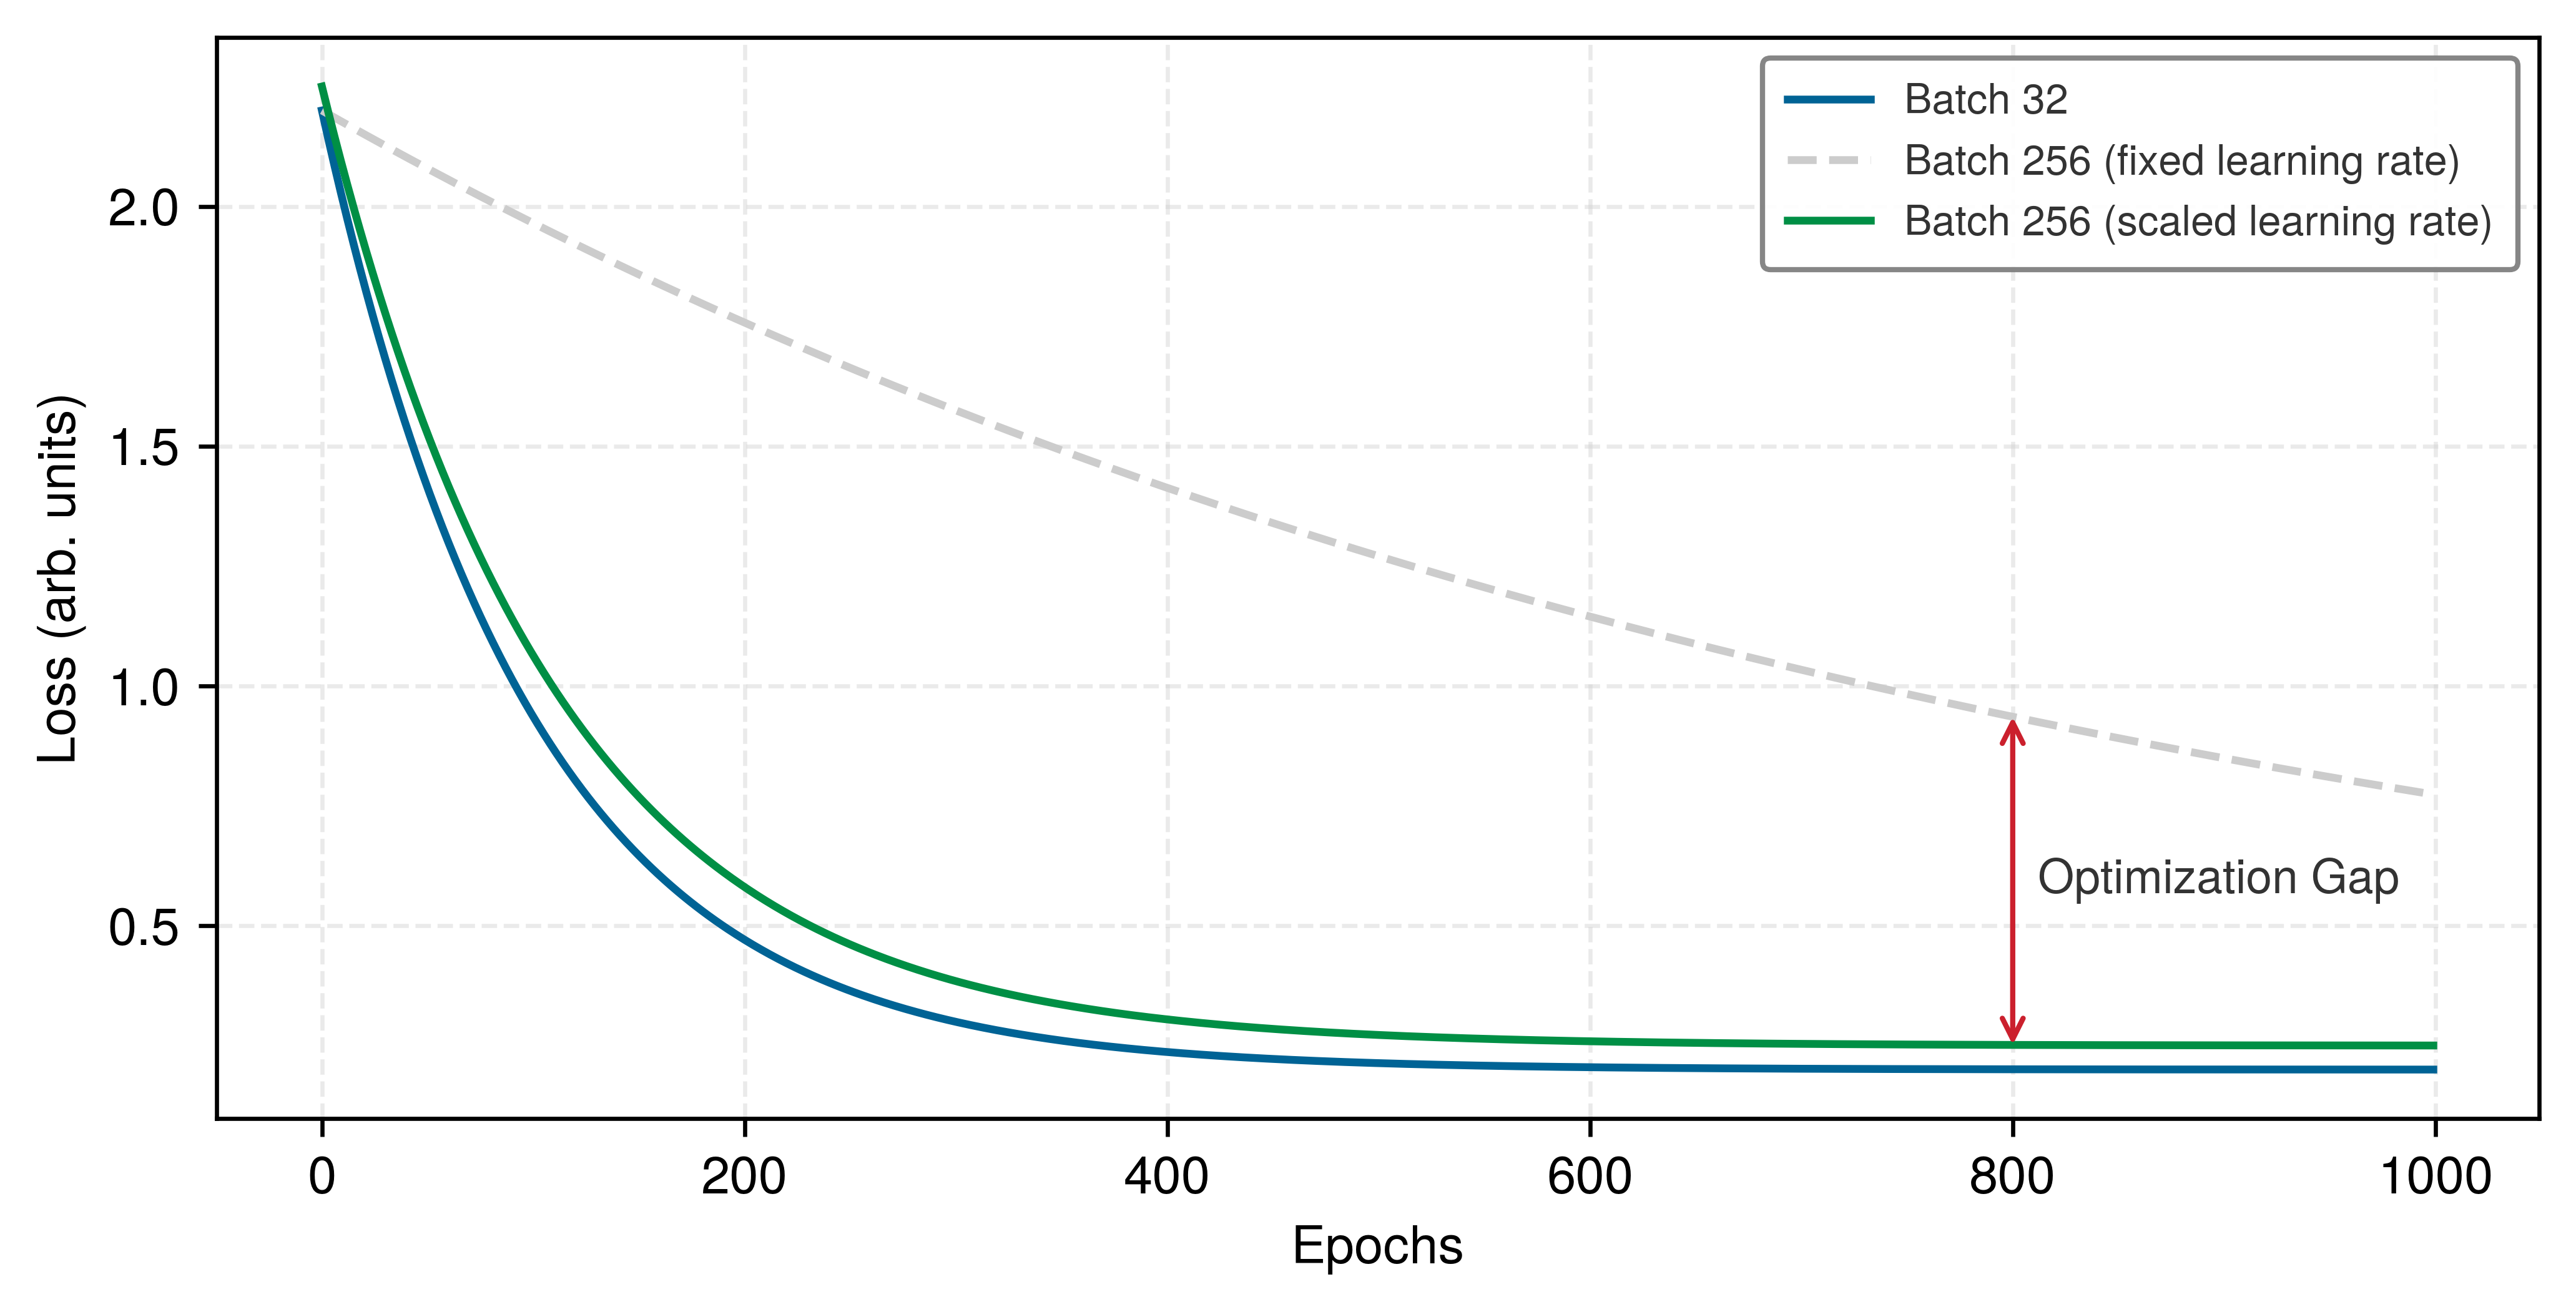
在词元预算固定的情况下,全局批大小翻倍会使每个训练轮次的参数更新次数减半。为了用更少的更新在参数空间中走过相近的距离,线性缩放规则 按批大小的比例缩放学习率(\(\eta_{\text{new}} = k \times \eta_{\text{base}}\))。尽管在适中的批大小范围内,结合学习率预热使用时效果良好,线性缩放仍不能保证等效的收敛性或泛化能力。超过某个临界批大小后,梯度噪声已基本消除,进一步扩大批大小所带来的每个训练样本的收益会递减,同时加剧内存压力。
除了影响收敛动态,批大小还决定分布式系统中的通信频率。更大的全局批会减少每个训练轮次的优化器步数和梯度同步次数。由于稠密全归约同步的通信数据量取决于参数数量,而非批大小,因此较大的批可将互连延迟分摊到更多计算 FLOPs 上。在分布式环境中,局部微批大小和全局批大小共同决定数据并行的最大规模。当内存容量限制局部微批大小时,梯度累积(section 1.6.5)可将有效批大小与每台设备的激活值内存占用解耦,在触发一次优化器更新前,跨多次前向和反向传播累积梯度。
训练中的每一项架构决策——批大小设定、精度、内存管理和同步频率——最终都旨在尽量缩短昂贵加速器集群上的实际运行时间。在前沿规模下,这些时间直接以资本计价。计算支出成为制约硬件采购和集群规模的刚性物理与经济约束。笔记本 1.5 将这些吞吐量计算转化为经济分析,比较在由 1,024 个加速器组成的集群上训练一个 700 亿参数语言模型时,租用与购买的成本。
Napkin Math 1.5: 算力账单
问题:在以下简化假设下,使用一个由 1,024 块 H100 组成的集群完成一次 Llama 2 700 亿参数模型训练,租用和购买哪种方式更便宜?
数学计算:
- 工作负载:Llama 2 70B 模型(70B 个参数,2T 个词元)。
- 所需计算量:\(6 \times 70 \times 10^9 \times 2 \times 10^{12} \approx 8.4 \times 10^{23}\) FLOPs。前面的系数 6 来自本章的核算方式:前向传播中,每个参数、每个词元约需 2 FLOPs(每次乘加运算计为两次浮点运算);计入计算成本约为前向传播两倍的反向传播后,总量变为三倍。
- 硬件:NVIDIA H100(峰值:989 TFLOP/s FP16)。假定利用率:50 percent(494.5 TFLOP/s)。
- 时间:\(8.4 \times 10^{23} / (494.5 \times 10^{12}) \approx 1.70 \times 10^{9}\) 秒 ≈ 53.8 years(在单块 GPU 上)。
- 集群:使用 1,024 GPUs → 19.2 days。
经济分析:
- 租用($3/hr):1,024 GPUs \(\times\) 24 小时 \(\times\) 19.2 days \(\times\) $3/hr ≈ $1.42M。
- 购买(每块 GPU 为 $30,000):1,024 GPUs \(\times\) $30,000 = $30.7M。
系统洞见:在这一简化的利用率与价格场景下,购买成本约等于租用运行 21.7 次的成本。真实的自有集群成本比较还必须计入集群网络、主机系统、基础设施、电力、人员、折旧、融资,以及两次运行之间实际达到的利用率。
分解训练流水线可以揭示数据加载、前向执行、反向传播和参数更新的结构机制,而 section 1.3 中的数学基础则量化了每个阶段所需的 FLOPs、内存占用和带宽。然而,了解各阶段如何执行,并不能揭示特定训练工作负载在哪个环节停滞。流水线的速度受其最慢阶段限制:如果数据加载需要 50 ms,计算需要 100 ms,将计算加速 20% 可节省 20 ms;但如果瓶颈转移到数据摄取,同样的优化工作就无法缩短实际运行时间。在应用优化技术之前,系统工程师必须对执行时间线进行性能剖析,以确定限制性能的是计算、内存带宽、存储 I/O,还是网络同步。
识别瓶颈
了解系统蓝图并不等于完成诊断。知道注意力运算消耗了 50% 的 FLOPs,数据加载占用了 25% 的实际运行时间,并不能说明应优先解决哪项约束;这取决于执行过程中实际饱和的是哪种资源。
将系统蓝图知识转化为可执行优化决策的诊断方法,始于一个有意义的训练效率度量。原始的加速器利用率百分比可能具有误导性,因为加速器在执行重计算、填充或其他未计入模型 FLOPs 核算的工作时,也可能保持活跃。模型 FLOPs 利用率(MFU)20 提供了这样的比较依据。
Definition 1.4: 模型 FLOPs 利用率(MFU)
模型 FLOPs 利用率(MFU) 是效率指标 \(\text{MFU} = O_{\text{model}} / (R_{\text{peak}} \cdot T_{\text{step}})\),其中,\(O_{\text{model}}\) 为每步有用的模型浮点运算次数(前向传播加反向传播,不包括重物化),\(T_{\text{step}}\) 为每个训练步骤的实测实际运行时间。该指标表示硬件峰值吞吐量中用于有用模型计算的比例。
- 意义:MFU 将机器学习系统铁律中的有效吞吐量项具体化。对于在一块 A100 上每步处理 1,024 tokens、具有 7B 个参数的 Transformer(FP16/BF16 Tensor Core 峰值为 312 TFLOP/s),若每步耗时为 1.2-second,则模型 FLOPs 除以可用的峰值速率 FLOP 预算约为 0.11(11.5 percent)。剩余的 88.5 percent 未计为模型 FLOPs,可能反映内存流量、通信、气泡、非模型运算或空闲时间。某个数值是否良好,取决于模型、硬件、精度和并行化策略;诊断需要性能剖析,而非通用阈值。
- 区别:硬件利用率报告设备引擎是否活跃,而 MFU 只计入其分子所采用的模型 FLOPs 解析估计值。因此,即使重计算和填充使设备保持忙碌,MFU 仍可将这些运算排除在外。跨加速器比较仍会受到所选峰值吞吐量规格和 FLOP 计数约定的影响。
- 常见误区:一种常见误解是将 100% 的 MFU 视为可持续达到的现实目标。内存流量、通信和非矩阵运算会使端到端运行低于峰值,但并不存在通用的 55–65% 上限。报告值取决于模型、精度、批次形状、硬件和 MFU 定义,并可通过 FlashAttention 和精细调优得到改善。
可以沿着与数据—算法—机器分类体系 对应的三个类别来排查训练瓶颈(数据、算法、机器;数据—算法—机器分类体系 提供了完整的诊断框架、故障排查矩阵和数据—算法—机器评分卡)。Table 7 将每个维度与一种常见训练瓶颈、其可观察症状及相关优化技术联系起来。这些对应关系是诊断的起点,并非排他性映射。
| 数据—算法—机器维度 | 瓶颈 | 症状 | 主要解决方案 |
|---|---|---|---|
| 算法 | 计算受限 | 算术单元活跃度高;增加带宽无法提高吞吐量;算术吞吐量构成限制 | 降低精度、更高效的算法、更快的计算硬件 |
| 机器 | 内存受限 | 相对于算术吞吐量,内存带宽使用率高;内核因数据搬移而停滞 | 算子融合、内存高效的注意力机制、低精度格式 |
| 数据 | 数据受限 | 加速器利用率周期性降至接近零;间隙期间 CPU 满负荷运行;流水线无法足够快地向 GPU 供给数据 | 预取、流水线重叠、更快的存储、DataLoader 并行化 |
在这三种状态中,数据受限导致的停滞最容易被误诊,因为它们在加速器上表现为空闲间隙,而非执行单元饱和。当主机侧的数据摄取、解码或预处理无法维持设备内存总线所需的吞吐量时,加速器就会因数据供给不足而等待。
Example 1.2: 被 GIL 锁住的 GPU
场景:某工程团队使用标准 Python
threading 构建 PyTorch 数据加载流水线,执行持有全局解释器锁(GIL)的 CPU 密集型图像预处理。
诊断:GIL 使这些 Python 层的预处理线程串行执行,导致主机准备时间(\(T_{\text{prep}} \approx 250 \text{ ms}\))远超 GPU 执行时间(\(T_{\text{step}} \approx 12 \text{ ms}\)),使硬件利用率骤降至 \(\eta_{\text{hw}} \approx 4.6\%\)。
系统启示:持有 GIL 的 Python CPU 工作可能使线程串行执行,并使 GPU 因缺少数据而空闲;原生操作则可能释放 GIL。进程工作者(num_workers > 0)可避免解释器层面的串行化,而 NVIDIA DALI 可将符合条件的工作从主机卸载出去。
性能剖析工具能够揭示给定工作负载中占主导地位的瓶颈。Figure 8 展示了上述提示框中受数据限制的异常表现:重复计算块之间的白色间隙标示出设备时间线上没有可见 GPU 内核的时段。
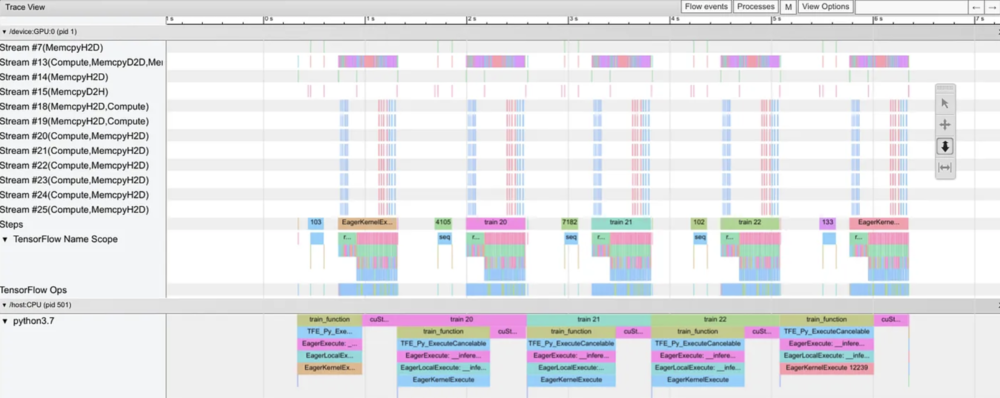
集成到机器学习框架中的四种工具可提供详细的瓶颈分析。Table 8 将框架级时间线工具与 GPU 级执行工具分开列出,因为它们各自揭示不同的失效特征。
| 工具 | 范围 | 最有价值的信号 |
|---|---|---|
PyTorch Profiler (torch.profiler) |
框架级操作轨迹 | 各操作耗时、内存分配模式和 GPU 内核执行情况 |
| TensorFlow Profiler | 框架级训练时间线 | 输入流水线瓶颈和设备放置情况 |
| NVIDIA Nsight Systems | 系统级 GPU 轨迹 | 内核执行、内存传输和同步点 |
| NVIDIA Nsight Compute | 内核级 GPU 分析 | 算术强度、内存吞吐量和占用率 |
严谨的性能剖析工作流从系统时间线到内核级性能计数器自顶向下展开,将可观测的性能剖析轨迹映射到 table 7 中的数据—算法—机器分类体系。首先,时间线可视化用于定位输入供给不足:内核调用之间的空闲时段表明,主机准备或 PCIe 传输延迟导致设备队列缺少待执行任务。消除这一数据限制需要采用异步预取、多进程工作者,或将预处理卸载到加速器,以使数据移动与计算重叠。其次,当内核连续执行且不存在主机引起的间隙时,可通过内存吞吐量相对于峰值带宽的水平,区分受内存限制与受计算限制的执行。如果 HBM 流量达到饱和,而算术单元处于空闲状态,则工作负载受内存限制;算子融合和内存高效注意力通过将中间张量保留在片上 SRAM 中,而非将其写回全局内存,来缓解这一限制。最后,如果张量核心接近理论能力运行,而内存总线仍有富余带宽,则工作负载受计算限制,此时需要采用 BF16 或 FP8 等更低的数值精度来提高峰值算术吞吐量,从而提升吞吐量。
流水线优化
性能剖析轨迹用于识别执行期间达到饱和的资源,而数据—算法—机器分类体系(数据—算法—机器分类体系)则用于定位起主导作用的物理约束:数据移动、算术吞吐量或内存容量。缩小实际吞吐量与理论吞吐量之间的差距,需要针对每种已识别的失效模式匹配相应的系统干预措施。
即使流水线架构设计良好,若不进行有针对性的优化,也很少能达到硬件峰值吞吐量。为说明这一差距的规模,将 30 percent 至 50 percent 的模型 FLOP 利用率应用于 A100 的峰值 312 TFLOP/s,可得模型 FLOP 吞吐量为 93.6 TFLOP/s–156 TFLOP/s。这些数值由假设场景推导得出,并非针对某个 A100 工作负载报告的测量结果。已发表的大模型系统研究报告了类似的峰值吞吐量与实际吞吐量差距 (Narayanan et al. 2021; Chowdhery et al. 2022)。SuperNeurons 等系统展示了这一问题的一种表现:除非运行时主动优化激活值的存储与传输,否则内存管理瓶颈可能阻碍较大网络的高效训练 (Wang et al. 2018)。Table 9 在 table 7 中基于数据—算法—机器的瓶颈分类基础上,将每种瓶颈映射到针对该瓶颈的具体优化技术。
Narayanan, Deepak, Mohammad Shoeybi, Jared Casper, Patrick LeGresley, Mostofa Patwary, Vijay Korthikanti, Dmitri Vainbrand, et al. 2021. “Efficient Large-Scale Language Model Training on GPU Clusters Using Megatron-LM.” Proceedings of the International Conference for High Performance Computing, Networking, Storage and Analysis, 1–15. https://doi.org/10.1145/3458817.3476209.
Wang, Linnan, Jinmian Ye, Yiyang Zhao, Wei Wu, Ang Li, Shuaiwen Leon Song, Zenglin Xu, and Tim Kraska. 2018. “SuperNeurons: Dynamic GPU Memory Management for Training Deep Neural Networks.” Proceedings of the 23rd ACM SIGPLAN Symposium on Principles and Practice of Parallel Programming, 41–53. https://doi.org/10.1145/3178487.3178491.
| 瓶颈 | 主要解决方案 |
|---|---|
| 数据移动延迟 | 预取与流水线重叠 |
| 计算吞吐量 | 混合精度训练 |
| 内存容量 | 梯度累积与激活检查点 |
| 内存带宽(注意力) | FlashAttention(IO 感知分块) |
尽管主导约束会随系统规模变化——100 GB 模型面临的容量和互连限制对于 1 GB 模型从不构成约束——但识别和缓解各类瓶颈仍遵循一致的物理原理。当主机存储 I/O 和 PCIe 传输无法以足够快的速度准备批次,使加速器计算单元保持饱和时,就会出现数据移动延迟问题。当操作以 FP32 执行而未使用更低精度的 Tensor Core,或未融合内核反复通过内存总线传输中间激活值时,计算吞吐量就会低于硬件峰值速率。内存容量之所以约束执行,是因为加速器 HBM 必须同时容纳模型参数、优化器状态、梯度和前向激活值。耗尽这部分内存会同时限制模型深度和每设备批次大小。
由于系统资源紧密耦合,缓解一种约束往往会暴露另一种约束,这体现了本书前文介绍的复杂性守恒启发式原则。例如,通过积极预取批次来消除主机 I/O 停顿,会为输入队列消耗额外的加速器内存。反过来,为满足 HBM 容量限制而缩小每设备批次大小,会降低矩阵乘法的算术强度,使执行从受计算限制的矩阵运算转为受内存带宽限制的停顿。考虑一个有代表性的 GPT-2 性能剖析结果:注意力占训练步耗时的 50 percent,数据加载占 25 percent,其他受计算限制的操作占 25 percent。这一耗时分布指导了优化顺序:IO 感知的注意力分块(FlashAttention)针对注意力中占主导地位的内存带宽瓶颈;异步预取通过与计算重叠来隐藏数据摄取耗时;混合精度则加速张量操作,同时将激活值的内存占用减半。优化的挑战在于,从执行性能剖析结果中诊断主导瓶颈,并实施有针对性的干预,同时避免在其他位置形成更严重的约束。
系统化优化框架
由于加速器计算引擎、内存子系统和主机互连之间存在紧密的物理耦合,缺乏实测遥测数据的优化可能转移关键路径,或将工程精力浪费在不构成约束的资源上。遵循原理的系统方法包括三个相互关联的阶段:通过性能剖析揭示起约束作用的物理限制,选择专门针对该资源限制设计的机制,以及组合干预措施以避免次生资源需求相互冲突。
性能剖析阶段使用 PyTorch Profiler、TensorFlow Profiler 或 NVIDIA Nsight Systems 等插桩工具,记录每次迭代中的时间戳和硬件计数器。轨迹捕获加速器执行单元上的内核执行时间、跨 PCIe 或 NVLink 总线的直接内存访问(DMA)传输,以及主机 CPU 线程调度情况。对耗时进行量化,可以定位决定关键路径的子系统。例如,若轨迹显示训练步耗时的 40 percent 用于数据加载,35 percent 用于计算,25 percent 用于内存操作,则可诊断出主机侧数据供给不足是主要约束。在这些条件下,解决数据供给流水线问题之前,加速矩阵乘法内核对实际运行时间的改善微乎其微。
选择阶段将已识别的瓶颈映射到针对相应物理约束的架构机制。当性能剖析显示执行受输入限制、加速器因等待批次而空闲时,基于 PCIe 的异步预取和双缓冲可使主机数据摄取与设备计算重叠。当内核运行时间受内存带宽限制,即主要耗时来自 HBM 往返访问而非算术运算时,算子融合和 FlashAttention 等分块算法可将中间激活值暂存于片上 SRAM。当内存容量限制模型时,激活检查点会丢弃激活值并在反向传播期间重新计算,梯度累积则将批次拆分到多个顺序执行的子步骤中,以限制峰值分配量。最后,当流式多处理器因密集矩阵运算而饱和时,FP16 或 BF16 等低精度数值格式可利用专用张量核心,将计算吞吐量翻倍,同时使内存流量减半。
组合阶段评估多项干预措施如何通过共享硬件资源相互作用。由于系统资源紧密耦合,缓解一种瓶颈的优化往往会在其他位置引入需求。异步预取通过与计算重叠来隐藏数据移动延迟,但维护双缓冲批次队列会消耗主机锁页内存和设备 HBM。相比之下,具有协同作用的组合能够叠加性能收益:将 16 位混合精度与激活检查点结合,可充分降低内存用量,从而允许使用更大的每设备批次大小,使利用不足的张量核心恢复较高的算术强度。因此,成功组合这些措施需要验证次生资源开销不会触发新的主导约束。
Figure 9 将这一框架落实为结构化决策树。各分支将性能剖析信号直接映射到候选干预措施,确保工程精力用于解决起约束作用的物理瓶颈,而非附带开销。
\begin{tikzpicture}[font=\small\sffamily, line width=0.8pt]
% Color palette aligned with chapter diagrams
\definecolor{BlueLine}{HTML}{006395}
\definecolor{BlueL}{HTML}{D1E6F3}
\definecolor{GreenLine}{HTML}{008F45}
\definecolor{GreenL}{HTML}{D4EFDF}
\definecolor{RedLine}{HTML}{CC0000}
\definecolor{RedL}{HTML}{F5D6D6}
\definecolor{VioletLine}{HTML}{702082}
\definecolor{VioletL}{HTML}{D8C2DE}

\tikzset{
  Flow/.style={->, >=latex, draw=black!65, line width=0.85pt},
  StartStop/.style={
    draw=VioletLine, fill=VioletL2, rounded corners=12pt,
    minimum width=3.9cm, minimum height=0.9cm, align=center, font=\small\sffamily
  },
  Decision/.style={
    draw=BlueLine, fill=cyan!10, diamond, aspect=2.2,inner sep= -1ex,
    minimum width=4.3cm, minimum height=2cm, align=center, font=\small\sffamily
  },
  Bottleneck/.style={
    draw=GreenLine, fill=GreenL!50,
    minimum width=3.5cm, minimum height=1.1cm, align=center, font=\small\sffamily
  },
  Action/.style={
    draw=RedLine, fill=magenta!10,
    minimum width=3.5cm, minimum height=1.1cm, align=center, font=\small\sffamily
  },
  BranchLabel/.style={font=\scriptsize\sffamily, fill=white, inner sep=1.2pt}
}

% Nodes
\node[StartStop] (profile) at (0,0) {对训练运行进行性能剖析};
\node[Decision,below =0.6 of profile] (util) {加速器\\利用率 $<70\%$?};
% Data Branch (Left)
\node[Bottleneck, left=2.5 of util] (data) {受数据限制};
\node[Action,below = 0.7 of data ] (prefetch)  {应用预取 \&\\流水线重叠};

% Memory Check (Center)
\node[Decision,below=1.6 of util] (memq)  {出现内存不足错误或\\内存使用率 $>90\%$?};

% Memory Branch (Left-Center)
\node[Bottleneck,left =2.50 of memq] (memb)  {受内存限制};
\node[Action,below =0.7 of memb] (memact)  {混合精度、\\激活检查点、\\梯度累积};
% Compute Branch (Right)
\node[Bottleneck,right= 2.50 of memq] (compb) {受计算限制};
\node[Action,below =0.7 of compb] (compact) {增大批次大小、\\优化内核};
% End Node
\node[StartStop,below =2.0 of memq] (reprofile) {重新进行性能剖析 \& 迭代};
% Main flow connections
\draw[Flow] (profile.south) -- (util.north);
\draw[Flow] (util) --node[above=1pt,pos=0.2, BranchLabel] {是}(data) ;
\draw[Flow] (util.south) -- (memq.north) node[pos=0.1, right=1pt,BranchLabel] {否};
\draw[Flow] (data.south) -- (prefetch.north);
\draw[Flow] (memq) -- node[above=1pt,pos=0.2, BranchLabel] {是}(memb);
\draw[Flow] (memq.east) --node[above=1pt,pos=0.2, BranchLabel] {否} (compb);
\draw[Flow] (memb.south) -- (memact.north);
\draw[Flow] (compb.south) -- (compact.north);
\draw[Flow] (memact.south)--++(0,-0.5)|-(reprofile);
\draw[Flow] (compact.south)--++(0,-0.5)|-(reprofile);
%
\draw[Flow] (prefetch.west)--++(-0.5,0)|-(reprofile);
\end{tikzpicture}由于消除一个瓶颈会暴露执行路径上的下一个约束,系统优化是一个受阿姆达尔定律支配的迭代过程。例如,通过异步预取消除输入供给不足,会提高加速器利用率,直到内存带宽或计算饱和开始限制训练步耗时。每次干预后都需要重新进行性能剖析,以识别新出现的关键路径,并持续迭代,直到加速器执行单元接近理论峰值吞吐量运行,或达到应用性能目标。
数据预取与重叠
预取与重叠技术通过协调数据传输与计算来解决数据移动延迟瓶颈,展示了系统化框架的实际应用。当性能剖析表明计算单元在等待数据传输完成期间保持空闲时,这种优化最为有效。
训练机器学习模型涉及存储、内存和计算单元之间的大量数据移动。数据流水线由一系列顺序传输组成:从磁盘存储到 CPU 内存,从 CPU 内存到 GPU 内存,再经过 GPU 处理单元。在机器学习训练中,“读取”操作很少只是简单地从磁盘获取数据:对于图像工作负载,它包括在张量准备好传输之前,在 CPU 核上执行的 JPEG 解码、随机裁剪和色彩抖动;对于语言工作负载,它包括分词、子词编码和序列填充。Figure 10 揭示了顺序数据传输的低效之处:GPU 在文件操作(打开 1、打开 2)期间保持空闲,训练步必须等待这些读取和预处理操作完成才能开始,导致昂贵的计算资源在每个训练轮次的相当一部分时间内利用不足。
预取通过在预定计算时间之前将数据加载到内存中,解决这些低效问题。在处理当前批次期间,tf.data 等框架数据流水线会加载并准备后续批次,持续供应就绪数据 (Murray et al. 2021)。
Murray, Derek G., Jiřı́ Šimša, Ana Klimovic, and Ihor Indyk. 2021. “Tf.data: A Machine Learning Data Processing Framework.” Proceedings of the VLDB Endowment 14 (12): 2945–58. https://doi.org/10.14778/3476311.3476374.
\begin{tikzpicture}[
  font=\small\sffamily,
  line width=0.75pt,
  execute at begin picture={
    %
    \def\W{128mm}   % total width of the diagram (time axis)
    \def\Tmax{95}   % total duration (units on x-axis)
    \def\rowH{9mm}  % row height
    %
    \pgfmathsetlengthmacro{\Xunit}{\W/\Tmax}
    \tikzset{x=\Xunit, y=\rowH}
  }
]
\tikzset{%
  box/.style={rounded corners=0pt, draw, line width=.5pt},
  open/.style ={box, fill=cOpen,  draw=gray!80},
  read/.style ={box, fill=cRead,  draw=BlueLine},
  train/.style={box, fill=cTrain, draw=GreenLine},
  epoch/.style={box, fill=cEpoch, draw=OrangeLine},
  tick/.style={draw=gray!50, line width=.25pt},
  gridline/.style={draw=gray!25, line width=.2pt},
}
% ---------------------------
% SETTINGS
% ---------------------------
% Standard color definitions
\definecolor{BlueLine}{HTML}{006395}
\definecolor{BlueL}{HTML}{D1E6F3}
\definecolor{GreenLine}{HTML}{008F45}
\definecolor{GreenL}{HTML}{D4EFDF}
\definecolor{OrangeLine}{HTML}{CC5500}
\definecolor{OrangeL}{HTML}{FFE5CC}
% Colors
\colorlet{cOpen}{gray!20}
\colorlet{cRead}{cyan!15}
\colorlet{cTrain}{GreenL!80}
\colorlet{cEpoch}{orange!10}
% ---------------------------
% COORDINATES OF ROWS (from top to bottom)
% ---------------------------
% y = 3: Open, 2: Read, 1: Train, 0: Epoch
\def\yOpen{3}
\def\yRead{2}
\def\yTrain{1}
\def\yEpoch{0}

% ---------------------------
%  BACKGROUND GRID (vertical lines)
% ---------------------------
% Every 5 min a thin line, every 15 min a little darker
\foreach \t in {0,5,...,\Tmax} {
  \draw[gridline] (\t, -0.4) -- (\t, 4.2);
}
\foreach \t in {0,15,...,\Tmax} {
  \draw[tick] (\t, -0.4) -- (\t, 4.2);
}

% ---------------------------
%LEFT LINE MARKS
% ---------------------------
\node[anchor=east] at (0,\yOpen+0.5)  {$\,$打开};
\node[anchor=east] at (0,\yRead+0.5)  {$\,$读取};
\node[anchor=east] at (0,\yTrain+0.5) {$\,$训练};
\node[anchor=east] at (0,\yEpoch+0.5) {$\,$训练轮次};

% ---------------------------
% LEVE OZNAKE REDOVA
% ---------------------------
% \bar{stil}{y}{start}{end}{tekst}
\renewcommand{\Bar}[5]{%
  \path (#3, #2+0.18) coordinate (A);
  \path (#4, #2+0.82) coordinate (B);
  \draw[#1] (A) rectangle (B);
  \node[font=\scriptsize\sffamily, anchor=center] at ($ (A)!0.5!(B) $) {#5};
}
% ---------------------------
% BARS
% ---------------------------
% Open
\Bar{open}{\yOpen}{0}{7.5}{打开 1}
\Bar{open}{\yOpen}{60}{67.5}{打开 2}
% Read
\Bar{read}{\yRead}{7.5}{20}{读取 1}
\Bar{read}{\yRead}{20}{30}{读取 2}
\Bar{read}{\yRead}{67.5}{80}{读取 3}
% Train
\Bar{train}{\yTrain}{30}{45}{训练 1}
\Bar{train}{\yTrain}{45}{60}{训练 2}
\Bar{train}{\yTrain}{80}{95}{训练 3}
% Epoch
\Bar{epoch}{\yEpoch}{0}{60}{训练轮次 1}
\Bar{epoch}{\yEpoch}{60}{95}{训练轮次 2}

% ---------------------------
% LOWER TIME AXIS (labels on 15 min)
% ---------------------------
\def\yAxis{-0.55}

\foreach \t/\lbl in {
  0/00:00,
  15/00:15,
  30/00:30,
  45/00:45,
  60/01:00,
  75/01:15,
  90/01:30,
  95/01:35
}{
  \node[font=\scriptsize\sffamily, anchor=north] at (\t,\yAxis+0.20) {\lbl};
}
\end{tikzpicture}重叠执行通过协调多个流水线阶段并发运行,扩展了预取机制。系统在处理当前批次的同时,通过数据加载和预处理操作准备后续批次。比较 figure 10 和 figure 11 中的示意调度。在图中假定的各阶段耗时下,重叠执行将完成时间从约 95 min 缩短至 65 min,降幅为 31.6 percent。实际收益取决于各阶段的均衡程度和可用的并发能力。
\begin{tikzpicture}[
  font=\small\sffamily,
  line width=0.75pt,
  execute at begin picture={
    %
    \def\W{140mm}   % total width of the diagram (time axis)
    \def\Tmax{65}   % total duration (units on x-axis)
    \def\rowH{9mm}  % row height
    %
    \pgfmathsetlengthmacro{\Xunit}{\W/\Tmax}
    \tikzset{x=\Xunit, y=\rowH}
  }
]
\tikzset{%
  box/.style={rounded corners=0pt, draw, line width=.5pt},
  open/.style ={box, fill=cOpen,  draw=gray!80},
  read/.style ={box, fill=cRead,  draw=BlueLine},
  train/.style={box, fill=cTrain, draw=GreenLine},
  epoch/.style={box, fill=cEpoch, draw=OrangeLine},
  tick/.style={draw=gray!50, line width=.25pt},
  gridline/.style={draw=gray!25, line width=.2pt},
}
% ---------------------------
% SETTINGS
% ---------------------------
% Standard color definitions
\definecolor{BlueLine}{HTML}{006395}
\definecolor{BlueL}{HTML}{D1E6F3}
\definecolor{GreenLine}{HTML}{008F45}
\definecolor{GreenL}{HTML}{D4EFDF}
\definecolor{OrangeLine}{HTML}{CC5500}
\definecolor{OrangeL}{HTML}{FFE5CC}
% Colors
\colorlet{cOpen}{gray!20}
\colorlet{cRead}{cyan!15}
\colorlet{cTrain}{GreenL!80}
\colorlet{cEpoch}{orange!10}
% ---------------------------
% COORDINATES OF ROWS (from top to bottom)
% ---------------------------
% y = 3: Open, 2: Read, 1: Train, 0: Epoch
\def\yOpen{3}
\def\yRead{2}
\def\yTrain{1}
\def\yEpoch{0}

% ---------------------------
%  BACKGROUND GRID (vertical lines)
% ---------------------------
% Every 5 min a thin line, every 15 min a little darker
\foreach \t in {0,5,...,\Tmax} {
  \draw[gridline] (\t, -0.4) -- (\t, 4.2);
}
\foreach \t in {0,15,...,\Tmax} {
  \draw[tick] (\t, -0.4) -- (\t, 4.2);
}
% ---------------------------
%LEFT LINE MARKS
% ---------------------------
\node[anchor=east] at (0,\yOpen+0.5)  {$\,$打开};
\node[anchor=east] at (0,\yRead+0.5)  {$\,$读取};
\node[anchor=east] at (0,\yTrain+0.5) {$\,$训练};
\node[anchor=east] at (0,\yEpoch+0.5) {$\,$训练轮次};

% ---------------------------
% LEVE OZNAKE REDOVA
% ---------------------------
% \bar{stil}{y}{start}{end}{tekst}
\renewcommand{\Bar}[5]{%
  \path (#3, #2+0.18) coordinate (A);
  \path (#4, #2+0.82) coordinate (B);
  \draw[#1] (A) rectangle (B);
  \node[font=\scriptsize\sffamily, anchor=center] at ($ (A)!0.5!(B) $) {#5};
}
% ---------------------------
% BARS
% ---------------------------
% Open
\Bar{open}{\yOpen}{0}{7.5}{打开 1}
\Bar{open}{\yOpen}{30}{37.5}{打开 2}
% Read
\Bar{read}{\yRead}{7.5}{20}{读取 1}
\Bar{read}{\yRead}{20}{30}{读取 2}
\Bar{read}{\yRead}{37.5}{50}{读取 3}
% Train
\Bar{train}{\yTrain}{20}{35}{训练 1}
\Bar{train}{\yTrain}{35}{50}{训练 2}
\Bar{train}{\yTrain}{50}{65}{训练 3}

% Epoch
\Bar{epoch}{\yEpoch}{0}{65}{训练轮次(重叠执行)}
% ---------------------------
% LOWER TIME AXIS (labels on 15 min)
% ---------------------------
\def\yAxis{-0.55}

\foreach \t/\lbl in {
  0/00:00,
  15/00:15,
  30/00:30,
  45/00:45,
  60/01:00,
  65/01:05
}{
  \node[font=\scriptsize\sffamily, anchor=north] at (\t,\yAxis+0.20) {\lbl};
}
\end{tikzpicture}预取机制
只有当性能剖析表明数据移动位于关键路径上时,预取才会带来收益。训练数据仍然需要经过检索、变换和模型执行;这项优化改变的是这些阶段的执行时机。未经优化的流水线将这些阶段串行化,导致 GPU 在数据获取和预处理期间处于空闲状态。数据加载器通过在当前批次训练时,使用独立的线程或进程准备下一批次,避免这种停顿。
重叠执行将同一思路扩展至整条流水线。当 GPU 处理一个批次时,下一批次开始预处理,再下一批次则开始获取数据。其目标是使各阶段持续运行,避免最慢的阶段使其他阶段一直等待。
机器学习框架(见 机器学习框架 中的介绍)提供了控制这一权衡的变量。Listing 4 展示了 PyTorch 的 DataLoader 配置,其中,num_workers = 4 设置预处理的并行度,prefetch_factor = 2 则维持一个包含 8 个批次的缓冲区,供加速器随时使用。
loader = DataLoader(
    dataset, batch_size=32, num_workers=4, prefetch_factor=2
)
参数 num_workers 和 prefetch_factor 并非通用的性能开关。它们决定 CPU 并行度和缓冲深度,这意味着它们将压力从加速器空闲时间转移到主机内存和 CPU 调度上。除了工作进程的并发度之外,要实现较高的主机到设备传输吞吐量,还需要使用固定(页锁定)的主机内存。标准虚拟内存可由操作系统换页,因此 GPU 驱动程序必须先通过主机端的中间暂存缓冲区暂存传输数据,再经由 PCIe 复制;在数据加载器中设置 pin_memory=True,会在页锁定的物理 RAM 中分配张量,使 GPU 能够发起异步 DMA 传输(tensor.to(device, non_blocking=True)),并与加速器执行直接重叠。
缓冲区管理是主要的权衡因素。缓冲区过小会导致 GPU 等待数据准备,重新引入预取原本旨在消除的空闲时间。缓冲区过大则会占用本可用于存储模型参数或更大批次的内存。合理的配置应协调 CPU 准备、存储 I/O 和 GPU 计算,使每种资源在能够执行任务时都有已准备就绪的任务。这些技术在存储访问缓慢、预处理复杂或数据集规模较大时收益最大。
实践注意事项
预取缓冲区和重叠深度均可调节,因此,同一套机制可以适应不同阶段的瓶颈,无论瓶颈来自缓慢的存储、有限的网络带宽,还是计算吞吐量。当预处理位于关键路径上、但能够与模型计算并发执行时,预取和重叠执行带来的收益最大。在一个示例图像流水线中,随机裁剪(10 ms)、颜色抖动(15 ms)和归一化(5 ms)每批次共耗时 30 ms。重叠执行最多可以隐藏与其并发的加速器计算时长所对应的预处理时间;超出的部分仍位于关键路径上。当词元化和子词处理原本会阻塞训练循环时,NLP 工作负载同样可以从中受益。
主要的权衡在于内存:预取缓冲区会消耗主机内存,若使用单独的设备端队列,则会消耗设备内存,其用量与缓冲深度和批次大小成正比。对于批次大小为 256 的高分辨率图像(\(1024\times 1024\) 像素),缓冲一个批次约需 3.2 GB。在 num_workers = 4 和 prefetch_factor = 2 的配置下,可容纳 8 个批次的预取窗口可占用约 25.8 GB。这些参数需要通过实测调优,因为工作进程过多会争用 CPU、存储和内存资源,而缓冲不足则会重新引入数据等待停顿。应从较少的工作进程开始,在测量吞吐量和内存用量的同时逐步增加进程数,并在新增工作进程不再减少加速器空闲时间时停止。当输入流水线的供给能力已经超过计算需求时,加深预取只会增加复杂性,而不会提高吞吐量。
混合精度训练
预取优化的是数据移动,而混合精度训练则同时应对计算吞吐量限制和内存容量约束。它在适当的位置使用较低精度格式,同时在选定的累加或更新操作中保留较高精度。数值表示 比较了 FP32、FP16、BF16、FP8 和 INT8 在精度与数值范围之间的权衡。训练方案通常将 FP32 与 FP16 或 BF16 中的一种结合使用;通常不会在同一执行路径中将 FP16 和 BF16 互换使用。由此产生的速度、内存和准确率影响取决于工作负载与硬件 (Micikevicius et al. 2017; Wang and Kanwar 2019; Kalamkar et al. 2019)。
神经网络存储的 FP32 权重每个参数需要 4 字节,而 FP16 和 BF16 权重需要 2 字节。对于具有 \(10^9\) 个参数的模型,权重张量从 4 GB 缩减至 2 GB。如果训练方案保留 FP32 主权重、优化器状态或部分激活值,则训练总内存的降幅会更小。
这些格式之间的数值差异决定了各自的适用场景。Table 10 表明,BF16 的 8 位指数使其具有与 FP32 大致相同的正规数指数范围,而 FP16 的 5 位指数使其最小正正规数约为 \(6.1 \times 10^{-5}\),最大有限值为 \(65{,}504\)。FP16 的次正规数可向下延伸至约 \(6 \times 10^{-8}\),但其处理方式取决于具体操作和硬件模式。FP32 提供约七位十进制有效数字,FP16 约三位,BF16 则约两到三位。因此,BF16 牺牲了尾数精度,以换取往往能简化深度学习训练的指数范围。
| 属性 | FP32 | FP16 | BF16 |
|---|---|---|---|
| 指数位数 | 8 | 5 | 8 |
| 尾数位数 | 23 | 10 | 7 |
| 最小正规数 | \(10^{-38}\) | \(6.1 \times 10^{-5}\) | \(10^{-38}\) |
| A100 峰值吞吐量比值 | 1\(\times\) | 16× | 16× |
格式的选择取决于模型特性和硬件支持。BF16 更宽的指数范围降低了上溢和下溢风险,而 FP16 提供更多尾数位,但通常需要损失缩放。框架的自动类型转换策略和融合内核会在必要时,为数值敏感的操作选择更高精度的累加;损失归约、softmax、归一化和优化器更新通常属于这类操作,但它们实际执行时使用的具体数据类型取决于实现。
Figure 12 展示了一种常规的 FP16 混合精度训练方案。FP32 主权重经类型转换后用于低精度计算,损失在反向传播前进行缩放,梯度则在 FP32 更新前还原缩放。现代框架实现可能以不同方式存储或累加特定张量,而 BF16 方案由于指数范围更宽,通常省略损失缩放。
\begin{tikzpicture}[font=\footnotesize\sffamily, line width=0.75pt, node distance=1.2cm]
% Standard color definitions
\definecolor{BlueLine}{HTML}{006395}
\definecolor{BlueL}{HTML}{D1E6F3}
\definecolor{GreenLine}{HTML}{008F45}
\definecolor{GreenL}{HTML}{D4EFDF}
\definecolor{RedLine}{HTML}{CB202D}
\definecolor{RedL}{HTML}{F5D2D5}
\definecolor{OrangeLine}{HTML}{CC5500}
\definecolor{OrangeL}{HTML}{FFE5CC}

\tikzset{
  Box/.style={
    rectangle, draw=black!50, line width=0.75pt,
    text width=25mm, align=center,
    minimum height=10mm
  },
  FP32Box/.style={
    Box, draw=BlueLine, fill=cyan!10
  },
  FP16Box/.style={
    Box, draw=GreenLine, fill=GreenL!60
  },
  ScaledBox/.style={
    Box, draw=RedLine, fill=magenta!10
  },
  Line/.style={
    draw=black!40, line width=1.0pt, ->,>=latex
  },
  StepLabel/.style={
    fill=white, inner sep=2pt, font=\scriptsize\bfseries\sffamily
  }
}

% Nodes
\node[FP32Box] (grad32) {FP32\\ 梯度};
\node[FP32Box, right=2.5 of grad32] (master) {FP32 主副本\\ 权重};
\node[FP16Box, below=0.85 of master] (weights16) {FP16\\ 权重};
\node[FP16Box, below=0.85 of weights16] (forward) {前向传播\\ (FP16 损失)};
\node[ScaledBox, left=2.5 of forward] (scaled) {缩放后的损失\\ (FP32)};
\node[ScaledBox, above=0.85 of scaled] (grad16) {缩放后的 FP16\\ 梯度};

% Cycle Connections
\draw[Line] (master) -- node[StepLabel,pos=0.42] {1. 类型转换} (weights16);
\draw[Line] (weights16) -- node[StepLabel,pos=0.42] {2. 前向传播} (forward);
\draw[Line] (forward) -- node[StepLabel] {3. 缩放} (scaled);
\draw[Line] (scaled) -- node[StepLabel,pos=0.42] {4. 反向传播} (grad16);
\draw[Line] (grad16) -- node[StepLabel,pos=0.42] {5. 复制 \& 还原缩放} (grad32);
\draw[Line, dashed] (grad32) -- node[StepLabel] {6. 更新} (master);

\end{tikzpicture}现代加速器架构将稠密矩阵执行单元与低精度数值格式相结合,以最大化算术吞吐量。NVIDIA 在 Volta 架构中引入了用于 FP16 运算的 Tensor Core (NVIDIA 2017),并在 Ampere 中增加了原生 BF16 执行能力 (NVIDIA Corporation 2020),与 Google 为张量处理单元开发的原生 BF16 支持相匹配 (Wang and Kanwar 2019)。这些专用功能单元执行低精度矩阵乘加运算的速率,是标准 32 位浮点 ALU 的四到十六倍。
NVIDIA. 2017. Training with Mixed Precision.
NVIDIA Corporation. 2020. NVIDIA A100 Tensor Core GPU Architecture. NVIDIA Whitepaper, V1.0.
混合精度训练将这些硬件能力转化为一种分工明确的数值精度约定。适用的矩阵乘法和卷积在张量单元上以 FP16 或 BF16 执行,而归约、累加和参数更新则保留更高精度。性能增益同时来自算术吞吐量和数据移动:低精度功能单元在每个时钟周期内可执行更密集的运算,而位宽更小的张量使缓存和高带宽内存之间的数据传输量减半。在大规模归约、微小参数更新或敏感的归一化操作可能累积舍入误差的环节,仍然需要更高精度。框架的自动类型转换策略动态实施这种分工,为计算密集型矩阵乘法选择低精度执行,同时为数值上易受误差影响的操作保留 FP32。
损失缩放
FP16 的 5 位指数限制了其可表示的动态范围,21因而在反向传播期间存在严重的下溢风险。在深层网络中计算梯度时,连续的链式法则乘法经常产生小于 FP16 最小正正规数值(\(2^{-14} \approx 6.1 \times 10^{-5}\))的梯度幅值。尽管 IEEE 754 FP16 定义了低至 \(\approx 6 \times 10^{-8}\) 的次正规数,硬件加速器仍经常将次正规输入和输出直接置零,以防止流水线停顿。当梯度下溢为零时,权重更新会停滞,训练无法收敛。
损失缩放利用微分的线性性质来应对下溢:\(\nabla_{\mathbf{w}} (S \cdot \mathcal{L}) = S \cdot \nabla_{\mathbf{w}} \mathcal{L}\)。在反向传播之前,将标量损失 \(\mathcal{L}\) 乘以一个较大的缩放因子 \(S\)(例如 \(2^{10}\) 或 \(2^{15}\)),会将梯度分布向右移动到 FP16 的正规数可表示范围内。反向传播完成后,在应用优化器更新之前,将累积的梯度除以 \(S\),以还原缩放。
深度学习框架通过动态损失缩放(GradScaler)自动完成这一过程。由于梯度范数会在训练期间波动,静态缩放因子可能导致下溢(\(S\) 过小时),也可能导致数值溢出,超出 FP16 的最大有限值 \(65{,}504\)(\(S\) 过大时)。执行参数更新之前,GradScaler 会在 FP32 中还原梯度缩放,并检查张量缓冲区中是否存在非有限值(inf 或 NaN)。如果检测到溢出,缩放器会跳过该优化器步骤,以保护 FP32 主副本权重免遭破坏,并减小缩放因子(通常将 \(S\) 减半)。如果训练在一个可配置的增长窗口内(例如连续 2,000 步)始终未发生溢出,缩放器就会将 \(S\) 加倍,使梯度保持在动态范围的上端附近而不发生饱和。
混合精度的收益
混合精度训练在三个相互作用的系统维度上带来收益:内存占用、算术吞吐量和通信量。操作数位宽减半可使权重存储量减少 50 percent,将一个十亿参数模型的权重存储量从 FP32 下的 4 GB 降至 FP16 或 BF16 下的 2 GB(不过,净节省量取决于优化器状态和主副本权重所保留的精度)。在计算方面,低精度使稠密矩阵乘法内核得以使用高吞吐量的 Tensor Core 流水线(section 1.6.3.3)。在分布式拓扑中,传输 16 位梯度而非 32 位梯度,可使互连上的 AllReduce 集合通信流量减半。这些效应相互叠加:释放出的内存空间允许使用更大的微批次,Tensor Core 加快内核执行,而位宽更小的张量则降低梯度交换延迟。以下案例研究以 GPT-2 XL 为对象,评估这些相互作用的内存节省效果,说明混合精度与选择性重计算如何使一个在 FP32 下超出设备内存容量的模型能够容纳于单个加速器中。
Napkin Math 1.6: GPT-2 混合精度的内存节省
问题:能否在单块 V100 GPU 上训练 GPT-2 XL(15 亿参数)?混合精度和梯度检查点技术能节省多少内存占用?
FP32 基线:
- 参数和梯度(FP32):12 GB(参数 6 GB + 梯度 6 GB)
- 激活值(批大小 = 4):约 71.7 GB
- 优化器状态(以 FP32 存储的 Adam m、v):12 GB
- 总计:约 95.7 GB(超出任何单块 GPU 的容量)
FP16 混合精度:
- 参数(FP16):1.5B 个参数,每个 2 字节 = 3 GB
- 激活值(FP16):约 35.9 GB
- 梯度(FP16):3 GB
- FP32 主副本权重:6 GB(用于精确的优化器更新)
- 优化器状态(以 FP32 存储的 Adam m、v):12 GB
- 总计:约 59.9 GB(仍然紧张,但经过优化后可以应对)
混合精度 + 示例性的激活值存储量降至四分之一:
- 通过选择性重计算,将激活值存储量降至约 9 GB
- 估算的张量总存储量:约 33 GB,相较之下 V100 容量为 32 GB;此处尚未计入临时工作区和分配器开销
系统洞见:在此方案中,混合精度使参数和梯度张量的存储量减半;检查点技术随后通过重计算来降低激活值存储量。当批大小为 4 时,简化的张量存储量估算已接近 V100 容量,因此实际运行在计入工作区和分配器行为后,可能仍需进一步减少内存占用。当批大小为 32 时,同样的估算需要约 95.7 GB,这促使我们采用多设备扩展技术。
仅节省内存并不能保证训练稳定。在 FP16 训练中,必须维护 FP32 主副本权重,因为参数更新 \(\Delta w = -\eta \cdot g\) 通常比权重值 \(w\) 小几个数量级。在 FP16 中,10 位尾数提供约三位十进制有效数字的精度;如果权重幅值超过所加更新幅值的 \(2^{11} \approx 2048\) 倍,就会发生算术淹没:更新量完全移出尾数位的表示范围,并被舍入为零。以 FP32 保留主副本权重,可以在数千个优化器步骤中保留这些增量更新,仅在为前向传播准备权重时才将其转换为 16 位。自动类型转换策略同样将大规模归约、层归一化和 softmax 层保留在 FP32 中执行,以防止灾难性消减。
数值稳定性得到保障后,低精度运算和内存流量的减少就会直接转化为实际运行时间的缩短与集群成本的降低。以下场景对一次分布式 GPT-2 XL 训练运行进行建模,展示这些相互叠加的吞吐量、工期和基础设施成本收益。
Napkin Math 1.7: GPT-2 混合精度的吞吐量与成本
问题:给定以下针对 GPT-2 XL 作业的示例性吞吐量和计费假设,采用 FP16 混合精度会带来怎样的速度和成本差异?
假设的 V100 吞吐量:
- FP32 吞吐量:约 90 samples/s
- FP16 吞吐量:约 220 samples/s
- 加速比:220 samples/s ÷ 90 samples/s ≈ 2.4× 的训练加速比
对由 32 GPUs 组成的集群的成本影响:
- 假设的 FP32 费用:运行 2 weeks,费用为 $50,000
- 假设的 FP16 费用:运行 1.2 weeks,费用为 $28,000
- 实际运行时间加速比:2 weeks ÷ 1.2 weeks ≈ 1.7×,低于 2.4× 的吞吐量加速比,因为假设的工期包含 FP16 内核无法加速的工作
- 节省时间:2 weeks − 1.2 weeks = 0.8 weeks(5.6 days)
- 节省成本:$50,000 − $28,000 = $22,000
质量门槛:只有受控验证运行表明 FP16 方案满足与 FP32 基线相同的验收标准时,成本比较才有效。该场景不假定任何特定的困惑度差异。
系统洞见:在这些假设下,同一个由 32 GPUs 组成的集群,其运行时间和费用从 2 weeks 和 $50,000 变为 1.2 weeks 和 $28,000。这是基于场景假设的算术计算,并非基准测试结论;实际决策需要针对目标工作负载测量吞吐量、核实计费并验证质量。
要实现这些加速效果,需要进行实测性能剖析,而不能假定加速会自动发生。对于小模型,或并非由大型矩阵乘法主导的内存受限工作负载,数据类型转换和内核启动开销可能抵消算术吞吐量优势。此外,加速器是支持原生 BF16,还是需要使用 FP16 损失缩放,取决于底层微架构。
混合精度的硬件支持
专用矩阵执行单元通过以数值精度和动态范围换取算术运算密度,实现混合精度在实际运行时间上的加速。22 加速器将这些低精度乘法单元与更高精度的累加寄存器配合使用,以维持稠密矩阵归约过程中的数值稳定性。
NVIDIA 在其 Volta 架构(2017 年)中引入了 Tensor Core,作为针对混合精度工作负载优化的专用矩阵乘法单元。标准 CUDA 核心处理标量或小向量运算,而 Tensor Core 可在单个时钟周期内执行 \(4{\times}4\) 矩阵乘加运算。对于 FP16 输入,单个 Tensor Core 执行: \[ \mathbf{D}_{\text{tc}} = \mathbf{A}_{\text{tc}} \times \mathbf{B}_{\text{tc}} + \mathbf{C}_{\text{acc}} \] 其中,\(\mathbf{A}_{\text{tc}}\) 和 \(\mathbf{B}_{\text{tc}}\) 为 FP16 输入,\(\mathbf{C}_{\text{acc}}\) 和 \(\mathbf{D}_{\text{tc}}\) 可采用 FP32 累加。更高精度的累加可减少舍入误差,但无法消除数值误差或相消。
硬件峰值规格定义了这种加速的理论上限。NVIDIA A100 GPU 的标准 CUDA 核心提供 19.5 TFLOP/s 的 FP32 吞吐量,Tensor Core 则提供 312 TFLOP/s 的 FP16 或 BF16 吞吐量,峰值比率为 16×。H100 级加速器 增加了 FP8 Tensor Core,在不使用稀疏性的情况下可提供 1,979 TFLOP/s 的吞吐量,约为 H100 FP16/BF16 Tensor Core 速率的 2×。这些数值代表硬件上限,并不保证端到端训练性能:矩阵乘法可直接映射到 Tensor Core,但数据搬移、非 Tensor Core 内核、通信、损失缩放和优化器更新仍然存在。虽然 Transformer 自注意力中的批量矩阵乘法 \(\mathbf{Q}\mathbf{K}^T\)(\(2 \times B \times N_{\text{heads}} \times S^2 \times d_{\text{head}}\) FLOPs)可直接映射到这些张量单元,但根据阿姆达尔定律,其余受内存带宽限制的逐元素运算、集合通信和优化器更新会限制实际实现的端到端加速比。
Brain Float 16(BF16) 保留了 FP32 的 8 位指数,同时将尾数缩减为 7 位。这一设计选择优先保留动态范围,而非精度;对于数值跨越多个数量级的基于梯度的学习,这一点尤为重要。Google 的 TPU 原生支持 BF16,而 NVIDIA 的 Ampere 架构(A100)及更新架构也提供完整的硬件支持。
当梯度或中间值超出 FP16 的正规数范围时,BF16 相对于 FP16 的范围优势便会显现。FP16 的最小正正规数为 \(6.1 \times 10^{-5}\),而其次正规数下限约为 \(6 \times 10^{-8}\)。23 BF16 的最小正正规数约为 \(10^{-38}\),其指数范围与 FP32 一致。因此,BF16 通常无需采用 FP16 所需的损失缩放,但累加精度和舍入仍然重要。
NVIDIA 的 Hopper 架构(H100)引入了对两种 FP8 格式的支持。E4M3 使用 4 位指数和 3 位尾数(优先保证前向传播权重和激活值的精度),而 E5M2 使用 5 位指数和 2 位尾数(优先保证反向传播梯度的动态范围)。
FP8 训练使 Tensor Core 吞吐量再次翻倍(在不使用稀疏性的情况下,H100 的 FP8 稠密运算吞吐量为 1.98 PFLOP/s,FP16 稠密运算吞吐量为 0.99 PFLOP/s)。然而,FP8 极其有限的精度要求为每个张量维护更高精度的缩放因子,从而增加了算法复杂性。Table 11 总结了各种精度的适用情形:
| 精度 | 适用情形 | 硬件要求 |
|---|---|---|
| FP8 | 面向吞吐量的训练,且缩放策略已通过验证 | 支持 FP8 的硬件 |
| BF16 | 需要宽指数范围,且无需 FP16 损失缩放 | 支持 BF16 的加速器 |
| FP16 | 需要更高尾数精度,并妥善管理损失缩放 | 支持 FP16 的加速器 |
| FP32 | 需要更高精度,或低精度路径不受支持 | GPU |
在这些格式之间进行选择,需要权衡算术吞吐量、实现复杂性和数值稳定性。
除加速计算受限的矩阵运算外,降低精度还可通过改变运算的算术强度来缓解内存带宽瓶颈。在现代加速器上,大型矩阵乘法处于 Roofline 模型的计算受限区域,而逐元素运算(如偏置加法、层归一化和残差连接)则明显处于内存带宽受限区域。NVIDIA A100 GPU 展示了算术计算能力与内存带宽之间的物理失衡:
- HBM2e 带宽:2,039 GB/s
- FP32 吞吐量(19.5 TFLOP/s):如果每次 FLOP 都需要新数据,最坏情况下的带宽需求为 78 TB/s
- 实际需求(存在数据复用时):低得多,但低算术强度运算仍受带宽限制
对于受内存带宽限制的内核,执行时间取决于通过内存总线传输的字节数,而非算术运算的时钟周期数。将 32 位操作数转换为 16 位 FP16 或 BF16,可使通过 HBM 总线传输的字节量减半,因此即使不使用 Tensor Core,也能使受内存带宽限制的运算的理论吞吐量翻倍。实际带宽收益取决于缓存命中率、内核融合和格式转换开销。
现代框架通过自动精度路由对这些微架构机制进行抽象(机器学习框架)。如 listing 5 所示,PyTorch 的自动混合精度(torch.amp)将模型执行封装在 autocast 上下文中,为符合条件的计算密集型内核分配低精度数据类型,同时将归约和归一化运算路由至 FP32。在 FP16 路径中,GradScaler 会介入损失计算和反向传播以防止下溢,而 BF16 路径则省略梯度缩放。
import torch

model = TransformerModel().cuda()
optimizer = torch.optim.Adam(model.parameters(), lr=1e-4)
amp_dtype = (
    torch.float16
)  # torch.bfloat16 usually does not need loss scaling
scaler = torch.amp.GradScaler(
    "cuda", enabled=(amp_dtype == torch.float16)
)

for inputs, targets in dataloader:
    optimizer.zero_grad()

    # Automatic precision selection per operation
    with torch.amp.autocast("cuda", dtype=amp_dtype):
        output = model(inputs)
        loss = criterion(output, targets)

    # Scale loss to prevent gradient underflow
    scaler.scale(loss).backward()

    # Unscale gradients before optimizer step
    scaler.step(optimizer)
scaler.update() # Adjust scaling factor dynamically由于加速器各代产品对低精度格式的硬件支持不断演进,最优混合精度方案取决于目标架构。Table 12 概述了三代 NVIDIA GPU 的精度权衡。
| 架构 | 推荐精度 | 关键考量 |
|---|---|---|
| V100 (Volta) | FP16 配合损失缩放 | 无原生 BF16 Tensor Core 路径;是否进行裁剪取决于训练方案 |
| A100 (Ampere) | BF16 或 FP16 | BF16 无需 FP16 损失缩放;TF32 可加速符合条件的 FP32 矩阵运算 |
| H100 (Hopper) | BF16、FP16 或经验证的 FP8 | FP8 需要适配 FP8 的训练方案;1,979 TFLOP/s 为峰值上限 |
一个示例性的单 GPU GPT-2 场景(1.5B)展示了架构执行单元与数值格式如何产生叠加效应:V100 FP32 的吞吐量为 18 samples/s,V100 FP16 为 45 samples/s,A100 BF16 为 165 samples/s,H100 FP8 为 380 samples/s。这些数值代表场景推算,而非隔离变量的基准测试,因为软件栈、内核实现和批次维度也随硬件代际演进。其系统原则十分明确:要最大化训练吞吐量,就需要将数值精度格式与加速器的原生矩阵执行流水线协同设计。
FlashAttention:I/O 感知的注意力优化
混合精度训练解决了两个瓶颈:计算吞吐量,因为 Tensor Core 在 FP16 上运行更快;以及内存容量,因为每个数值占用的字节数更少。然而,对于训练中的 Transformer 模型,第三个瓶颈往往占据主导地位:内存带宽。注意力机制中规模呈二次增长的中间矩阵,必须在前向传播过程中反复加载和存储,并在反向传播过程中再次访问。即使降低精度,庞大的内存流量仍可能使处理器在等待数据时让计算单元处于空闲状态。
FlashAttention24 (Dao et al. 2022) 通过优化数据在内存层次结构之间的流动方式来解决这一带宽瓶颈。按适合 SRAM 容量的分块处理注意力,可避免在 HBM 中显式生成完整的 \(S{\times}S\) 矩阵,并在不改变数学输出的前提下减少数据流量。原始研究报告,在所评估的工作负载上,加速比最高可达 3\(\times\);收益取决于张量形状、硬件和基线实现。
标准注意力的内存瓶颈
标准自注意力(网络架构)计算序列中所有位置之间的关系。对于长度为 \(S\) 的输入序列,该机制根据 equation 16 计算一个 \(S{\times}S\) 的注意力矩阵:
\[ \text{Attention}(\mathbf{Q}, \mathbf{K}, \mathbf{V}) = \text{softmax}\left(\frac{\mathbf{Q}\mathbf{K}^T}{\sqrt{d_k}}\right)\mathbf{V} \tag{16}\]
这里,\(\mathbf{Q}\)、\(\mathbf{K}\) 和 \(\mathbf{V}\) 分别为序列的查询矩阵、键矩阵和值矩阵,\(d_k\) 为键向量的维度,用于在 softmax 之前缩放点积。\(\mathbf{Q}\mathbf{K}^T\) 项产生了 \(S{\times}S\) 的分数矩阵,这也解释了为何即使算术运算本身能很好地映射到 Tensor Core,注意力仍会成为 I/O 问题。
内存瓶颈源于显式生成分数和概率所需的 \(S{\times}S\) 中间矩阵。对于序列长度为 4,096、嵌入维度为 64(单个注意力头的典型维度)的情况,仅注意力分数矩阵在 FP32 下就需要 \(4,096^2 \times 4\) 字节,即 67.1 MB。使用 16 heads 时,仅中间注意力矩阵的内存占用就增长至 1.1 GB,尚未计入键、查询、值或输出张量。
GPU 内存层次结构为 I/O 感知的注意力提供了优化机会。HBM 提供较大的片外容量,而容量小得多的片上 SRAM 具有显著更高的带宽和更低的延迟。在 HBM 中显式生成二次规模中间矩阵的注意力实现,必须先将其写入,并在后续反向传播期间读取。花费在这些传输上的时间占比取决于序列长度、注意力头维度、数据类型、硬件和内核实现,并非 GPT-2 规模模型的固定属性。
反向传播需要注意力概率所表示的信息,但实现上既可以保存这些中间结果,也可以重新计算它们。对于 \(\mathbf{A}_{\text{attn}} = \text{softmax}(\mathbf{Z}_{\text{attn}})\) 和 \(\mathbf{Z}_{\text{attn}} = \mathbf{Q}\mathbf{K}^T/\sqrt{d_k}\),其中一个梯度表达式为: \[ \frac{\partial \mathcal{L}}{\partial \mathbf{Q}} = \frac{1}{\sqrt{d_k}} \cdot \text{dsoftmax}\!\left(\frac{\partial \mathcal{L}}{\partial \mathbf{A}_{\text{attn}}},\, \mathbf{A}_{\text{attn}}\right) \cdot \mathbf{K} \] 其中,\(\text{dsoftmax}\) 表示 softmax 的雅可比矩阵与向量的乘积。常规实现可能会保存概率矩阵以进行这一计算;从数学上看,并不要求同时保存概率和原始分数。FlashAttention 则保存紧凑的归一化统计量,并在反向传播期间重新计算分块的分数和概率,从而避免在 HBM 中存放完整的二次规模中间矩阵。
通过分块实现 I/O 感知的注意力
FlashAttention 通过分块以增量方式计算注意力,无需在 HBM 中显式生成完整的 \(S{\times}S\) 注意力矩阵。该算法并非一次性计算整个注意力矩阵,而是将 \(\mathbf{Q}\)、\(\mathbf{K}\) 和 \(\mathbf{V}\) 划分为足够小、能够放入高速 SRAM 的分块,计算这些分块的注意力分数,并以增量方式累加结果。
其关键算法洞见依赖于 softmax 注意力的数学结构。标准注意力计算如下: \[ \text{Attention}(\mathbf{Q}, \mathbf{K}, \mathbf{V}) = \text{softmax}\left(\frac{\mathbf{Q}\mathbf{K}^T}{\sqrt{d_k}}\right)\mathbf{V} \]
Algorithm 3 将查询和键/值划分为足够小、能够放入 SRAM 的分块,以此分解上述计算,然后流式遍历键/值分块,同时维护构建各输出分块所需的运行中 softmax 统计量,整个过程始终不形成完整的分数矩阵。
FlashAttention 用小型 SRAM 分块替代完整的注意力矩阵。
完整的 \(S{\times}S\) 分数矩阵或概率矩阵都不会写入 HBM。例如,一个 \(128{\times}128\) 的 FP32 分数分块占用 65.5 KB,而一个 \(4096{\times}4096\) 的矩阵则占用 67.1 MB。其他输入、输出和运行统计量仍然存在,因此该分块不一定是整个内核中最大的张量。
\begin{algorithm} \caption{FlashAttention:采用在线 softmax 的分块注意力} \begin{algorithmic} \Require 长度为 $S$ 的序列的查询 $\mathbf{Q}$、键 $\mathbf{K}$、值 $\mathbf{V}$;分块大小 $b$ \Ensure 注意力输出 $\mathbf{Y}$,且不物化 $S\times S$ 分数矩阵 \For{每个查询分块 $\mathbf{Q}_i$} \State 在 SRAM 中:$\mathbf{Y}_i^{\text{acc}} \gets \mathbf{0}$, $m_i \gets -\infty$, $l_i \gets 0$ \For{每个键/值分块 $(\mathbf{K}_j, \mathbf{V}_j)$} \State 将 $\mathbf{Q}_i, \mathbf{K}_j, \mathbf{V}_j$ 加载到 SRAM;$\mathbf{Z}_{ij} \gets \mathbf{Q}_i \mathbf{K}_j^\top / \sqrt{d_k}$ \State $m_i' \gets \max(m_i,\operatorname{rowmax}(\mathbf{Z}_{ij}))$ \Comment{用于数值稳定的新最大值} \State $\mathbf{Y}_i^{\text{acc}} \gets \mathbf{Y}_i^{\text{acc}}\odot e^{m_i-m_i'} + e^{\mathbf{Z}_{ij}-m_i'}\mathbf{V}_j$ \State $l_i \gets l_i\odot e^{m_i-m_i'} + \operatorname{rowsum}(e^{\mathbf{Z}_{ij}-m_i'})$; $m_i \gets m_i'$ \State 丢弃 $\mathbf{Z}_{ij}$ \Comment{从不写入 HBM} \EndFor \State $\mathbf{Y}_i \gets \mathbf{Y}_i^{\text{acc}} / l_i$;将 $\mathbf{Y}_i$ 写入 HBM \EndFor \end{algorithmic} \end{algorithm}
在线 softmax 算法使这种分解成为可能。传统 softmax 需要先获知所有输入,才能计算任何输出:\(\text{softmax}(x)_i = e^{x_i} / \sum_j e^{x_j}\)。FlashAttention 使用增量形式,在新分块到来时更新 softmax 统计量:处理每个分块时,跟踪运行最大值 \(m\)(用于保证数值稳定性)和分母 \(l\),随后相应地重新缩放累积输出。
内存与 IO 复杂度分析
FlashAttention 同时改善了激活内存占用和内存 IO,二者都是受带宽限制的注意力计算中的制约性开销。标准注意力需要 \(\mathcal{O}(S^2)\) 内存,以存储覆盖所有序列位置的分数矩阵 \(\mathbf{Z}_{\text{attn}}\) 和注意力概率矩阵 \(\mathbf{A}_{\text{attn}}\)。FlashAttention 仅保留输入和输出张量 \((\mathbf{Q}, \mathbf{K}, \mathbf{V}, \mathbf{Y})\),并为当前分块配置一个小型 SRAM 缓冲区,从而将存储的激活内存占用降至 \(\mathcal{O}(S)\)。
当 \(S = 4096\)、\(d_{\text{head}} = 64\) 时:标准注意力每个头需要 \(4096^2 \times 4\) 字节 = 67.1 MB。FlashAttention 每个头仅需 \((3 \times 4096{\times}64) \times 4\) 字节 ≈ 3.1 MB,内存占用缩减至原来的 1/21.3×。
IO 模式也因同样的原因而改变。标准注意力从 HBM 读取 \(\mathbf{Q}\)、\(\mathbf{K}\) 和 \(\mathbf{V}\),在前向传播期间写入分数矩阵、概率矩阵和输出矩阵,随后在反向传播期间重新读取这些已存储的矩阵,再写入 \(d\mathbf{Q}\)、\(d\mathbf{K}\) 和 \(d\mathbf{V}\)。由此产生的 HBM 流量包含同一个 \(\mathcal{O}(S^2)\) 项,正是这一项导致激活内存占用过大。FlashAttention 在 SRAM 中生成分数分块和概率分块,从不将完整的 \(S \times S\) 张量写入 HBM。在反向传播中,它重新计算所需分块,而不读取已存储的完整矩阵。确切的 HBM IO 复杂度取决于分块大小和可用 SRAM,因为键分块和值分块需要针对不同查询分块反复流式传入,因此其复杂度界并非简单的 \(\mathcal{O}(S \cdot d)\)。
对于较长的序列,FlashAttention 通过避免写入和重新读取 \(S \times S\) 分数矩阵和概率矩阵来减少 HBM 流量。当 \(S = 4096\) 且 \(d_{\text{head}} = 64\) 时,激活内存占用从存储注意力矩阵所需的每个头数百 MB,降至分块输入和输出所需的几 MB,而确切的带宽需求降幅取决于硬件和内核分块方式。
对于稠密注意力,两种方法的渐近浮点运算量均为 \(\mathcal{O}(S^2 d)\)。FlashAttention 的反向传播根据保存的输入和归一化统计量,重新计算分块注意力中间结果,而不存储完整的分数矩阵和概率矩阵。由此减少的 HBM 流量可以使内核转向受计算限制的执行状态,并实现净加速,但最终瓶颈仍取决于张量形状和硬件。
实现与硬件利用率
FlashAttention 通过精细利用 GPU 内存层次结构来实现性能提升。现代框架可以根据硬件、输入和布局,为符合条件的注意力操作选择融合实现或回退实现;通过性能剖析,可以验证实际执行了哪条路径,以及它是否带来了收益。Listing 6 对比了标准注意力与优化注意力的实现。
import torch
import torch.nn.functional as F


# Standard attention (materializes n-by-n matrix)
def standard_attention(q, k, v):
    # q, k, v: [batch, heads, seq_len, head_dim]
    scores = torch.matmul(q, k.transpose(-2, -1)) / (
        q.size(-1) ** 0.5
    )
    attn = F.softmax(scores, dim=-1)  # n-by-n matrix in HBM
    output = torch.matmul(attn, v)
    return output


# FlashAttention (no n-by-n materialization)
def flash_attention(q, k, v):
    # Can use FlashAttention when inputs and hardware are eligible
    output = F.scaled_dot_product_attention(q, k, v)
    return output


# Explicit FlashAttention 2 (flash-attn library)
from flash_attn import flash_attn_func


def flash_attn_2(q, k, v):
    # q, k, v: [batch, seq_len, heads, head_dim]
    # Different layout for optimized memory access
    output = flash_attn_func(q, k, v)
    return output
基准测试结果
在真实硬件上进行测量,可以具体体现 FlashAttention 的收益。Dao et al. (2022) 报告了 GPT 风格训练的端到端加速效果,并提供了单独的注意力内核基准测试,表明 IO 感知注意力能够减少内存流量并缩短运行时间。Table 13 使用一个示例性的 A100 类场景展示相同的系统层面规律;其中的时间和内存数值是本章采用的代表性数值,并非 Dao et al. (2022) 中原样报告的数值。
| 序列长度 | 标准前向传播 | Flash 前向传播 | 标准反向传播 | Flash 反向传播 | 内存(标准) | 内存(Flash) |
|---|---|---|---|---|---|---|
| 512 | 12 ms | 8 ms | 35 ms | 18 ms | 4.2 GB | 2.8 GB |
| 2048 | 45 ms | 15 ms | 120 ms | 35 ms | 18 GB | 6 GB |
| 4096 | 内存不足 | 32 ms | 内存不足 | 85 ms | \(>40\) GB | 12 GB |
| 8192 | 内存不足 | 68 ms | 内存不足 | 180 ms | \(>80\) GB | 24 GB |
在这个示例性的 40 GB A100 类场景中,序列长度超过 2048 个词元时,标准注意力会耗尽内存,而 FlashAttention 可以容纳最长 8192 个词元的序列。即使在两者都能容纳的 2048 词元长度下,FlashAttention 的前向传播加速比也达到 3×,反向传播加速比达到 3.4×。
后续版本持续提升了性能:FlashAttention-2 (Dao 2023) 通过改善并行性和寄存器分配,实现了额外的 1.5–2\(\times\) 加速;FlashAttention-3 (Shah et al. 2024) 则利用 Hopper GPU 上的 FP8 张量核心和异步内存操作,据报告在 H100 上达到约 740 TFLOP/s,约为理论峰值的 75%。
Shah, Jay, Ganesh Bikshandi, Ying Zhang, Vijay Thakkar, Pradeep Ramani, and Tri Dao. 2024. “FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-Precision.” Advances in Neural Information Processing Systems 37 (NeurIPS), 68658–85. https://doi.org/10.52202/079017-2193.
何时使用 FlashAttention
对于长序列 Transformer 训练,FlashAttention 通常是首先应测试的注意力实现。一旦序列长度使标准注意力遭遇 HBM 容量或 HBM 带宽瓶颈,FlashAttention 往往就成为必需,尤其是在数千词元规模、\(S{\times}S\) 注意力矩阵主导内存占用的情况下。具有高速片上 SRAM 的 A100 和 H100 级 GPU 受益最大。对于分块开销得不偿失的短序列、缺乏相当 SRAM 带宽的较旧 GPU 架构,以及卷积神经网络和多层感知机等非注意力架构,其收益会减小。
实践中,深度学习框架承担了 FlashAttention 的大部分集成工作,但是否采用它仍取决于布局、精度和内存预算。当硬件、输入和后端约束允许时,PyTorch 的 scaled_dot_product_attention 可以分派到 FlashAttention;手写注意力实现必须使用符合条件的原语。以下三项实际检查可用于判断 FlashAttention 是否适用:
- 确保张量布局符合库的要求(内存连续、维度顺序正确)
- 使用 FP16 或 BF16 以获得最大加速效果(FlashAttention 针对混合精度进行了优化)
- 当需要进一步节省激活内存时,结合使用梯度检查点。
集成通常只需修改一行代码,即将手动注意力调用替换为 F.scaled_dot_product_attention(参见 listing 6)。工程决策仍遵循 Roofline 分析所确立的原则:当瓶颈在于 HBM 流量时,使用优化原语,并由库管理消除该瓶颈所需的分块和 SRAM 调度。
系统层面的影响与更广泛的原则
FlashAttention 体现了一项基本的系统工程原则:IO 感知算法设计。相对于内存带宽,许多加速器的计算能力较为充裕。对于受带宽限制的内核,即使浮点运算量不变,数据流量也可能决定运行时间。
这一原则并不限于注意力。在 IO 感知矩阵乘法中,CUTLASS 等库采用的分块算法 通过最大化高速缓存中的数据复用来最小化 DRAM 流量。朴素的 \(m{\times}m\) 矩阵乘法执行 \(\mathcal{O}(m^3)\) 次浮点运算,内存流量为 \(\mathcal{O}(m^2)\),而分块算法保持 \(\mathcal{O}(m^3)\) 的浮点运算量,同时通过局部性优化减少缓存未命中。
同样的字节搬移原则也出现在通信高效的分布式训练中:梯度压缩 用额外计算(压缩/解压缩)换取网络带宽消耗的减少。内存带宽有限的低功耗边缘设备能够从 IO 感知算法中获得更大收益。以增加 10% 的算术运算为代价,将内存流量减半,在数据搬移占据全部能耗预算的极限情况下,能耗可接近降至原来的一半,即实现 2\(\times\) 的能效提升;只要算术运算仍占有不可忽略的份额,就无法达到这一界限,因为将总和中的一个加法项减半,不可能使总和减少超过一半。本节确立了 IO 感知的启发式原则;分布式和边缘部署场景复用了相同的字节搬移逻辑。
消除 \(\mathcal{O}(S^2)\) 注意力矩阵的片外物化,可以释放加速器内存,并影响三个方面的架构权衡。首先,它使固定硬件能够支持更长的序列上下文,在所示 A100 配置中,将可处理的上下文边界从 2K 个词元推至 8K 个词元。其次,释放激活内存后可以采用更大的微批次,从而提高硬件算术单元的饱和度,前提是梯度动态保持稳定。第三,缩小的激活内存占用允许在给定内存预算内使用更深的 Transformer 堆栈,但数十亿参数模型的端到端可行性仍取决于参数分片、优化器状态和其余层的激活。
这项技术表明,除了单纯扩展硬件规模,系统级算法还可以利用内存层次结构,大幅减少激活内存占用,并获得取决于工作负载的加速。将内存带宽视为主要约束、将计算视为充裕资源,是机器学习性能优化中反复出现的模式。
FlashAttention 解决了计算过程中的内存带宽瓶颈,但还存在另一类内存约束:同时存储激活和优化器状态所需的庞大容量。当模型或批次大小超出 GPU 内存容量时,两种互补技术可以用计算换取内存。
梯度累积与检查点
训练大型模型需要大量内存来存储激活、梯度和参数。当内存限制批次大小或模型复杂度时,梯度累积25 通过顺序处理的微批次构成更大的有效批次,而检查点技术则丢弃并重新计算选定的激活。当内存成为约束性瓶颈时,这些技术便成为标准工具。
梯度累积与检查点的机制
梯度累积和激活检查点基于不同的原理,但二者都通过改变前向和反向计算的处理方式来优化训练期间的内存使用。梯度累积改变参与一次更新的样本数量;检查点技术改变在前向传播与反向传播之间常驻内存的激活。
梯度累积
为了在内存受限的加速器上执行大批次训练,系统将有效批次拆分为较小的微批次,并顺序处理。在 figure 13 中,可以观察微批次梯度向量 \(\delta_1, \delta_2, \delta_3\) 如何在触发优化器更新之前累积为单个统一的梯度张量。
\begin{tikzpicture}[  font=\small\sffamily]
\tikzset{Line/.style={line width=1.0pt,black!50,text=black
},
  Box/.style={inner xsep=2pt,
    draw=VioletLine2,
    line width=0.75pt,
    node distance=0.9,
    fill=VioletL2,
    align=flush center,
    text width=19mm,
    minimum width=19mm,
    minimum height=7.5mm
  },
}
\node[Box,fill=RedL,draw=RedLine](B2){批次 2};
\node[Box,right=of B2,fill=RedL,draw=RedLine](L2){$\mathcal{L}_2$};

\node[Box,node distance=2.8,right=of L2](D2){$\delta_2$};
\node[Box,node distance=1.9,right=of D2,
           fill=OrangeL,draw=OrangeLine](Z){$\delta_1+\delta_2+\delta_3$};
%
\node[Box,above=0.3 of B2,fill=GreenL,draw=GreenLine](B1){批次 1};
\node[Box,above=0.3 of L2,fill=GreenL,draw=GreenLine](L1){$\mathcal{L}_1$};
\node[Box,below=0.3 of B2,fill=BlueL,draw=BlueLine](B3){批次 3};
\node[Box,below=0.3 of L2,fill=BlueL,draw=BlueLine](L3){$\mathcal{L}_3$};
%
\node[Box,above=0.3 of D2](D1){$\delta_1$};
\node[Box,below=0.3 of D2](D3){$\delta_3$};
%

\scoped[on background layer]
\node[draw=BackLine,inner xsep=4mm,
line width=0.75pt,
inner ysep=4mm,
fill=BackColor,yshift=2mm,
fit=(B1)(L3)](BB1){};
\node[below=1pt of BB1.north,anchor=north]{损失};
%
\scoped[on background layer]
\node[draw=BackLine,inner xsep=4mm,
line width=0.75pt,
inner ysep=4mm,
fill=BackColor,yshift=2mm,
fit=(D1)(D3)](BB2){};
\node[below=1pt of BB2.north,anchor=north]{梯度};
%
\scoped[on background layer]
\node[dashed,draw=red,inner xsep=5mm,
line width=0.75pt,
inner ysep=5mm,
fill=white,yshift=1mm,xshift=-2mm,
fit=(Z)](BB3){};
\node[below right=1pt of BB3.north west,anchor=north west]{求和};
%
\foreach \x in {1,2,3} {
\draw[-latex,Line] (B\x) -- (L\x);
\draw[-latex,Line] (L\x)--node[above]{$\frac{\partial \mathcal{L}_\x}{\partial x}$} (D\x);
}
\draw[-latex,Line] (D2)--(Z);
\draw[-latex,Line] (D1)-|(Z);
\draw[-latex,Line] (D3)-|(Z);
\end{tikzpicture}在 PyTorch 中,梯度累积通常通过将每个微批次的损失除以累积步数,并且仅在处理完整个有效批次后才调用 optimizer.step() 来实现。在这种取平均的约定下,无需仅因采用梯度累积而调整学习率。实现过程分为五个步骤:
- 对一个微批次执行前向传播。
- 在反向传播期间计算梯度。
- 将梯度累积到缓冲区中,而不更新模型参数。
- 对有效批次中的所有微批次重复步骤 1–3。
- 在处理完所有微批次后,使用累积的梯度更新模型参数。
在受控假设下,梯度累积可以复现较大批次的梯度。对于有效批次大小 \(B = k \times b\),其中 \(k\) 为累积步数,\(b\) 为微批次大小,equation 17 证实,累积梯度等于真实的批次梯度: \[ \nabla \mathcal{L}_B = \frac{1}{B}\sum_{i=1}^{B} \nabla \mathcal{L}_i = \frac{1}{k}\sum_{j=1}^{k}\left(\frac{1}{b}\sum_{i \in \mathcal{B}_j} \nabla \mathcal{L}_i\right) \tag{17}\]
当每个样本的计算完全一致,且损失采用一致的平均方式时,这种等价关系成立。右侧表明,对 \(k\) 个微批次梯度(每个梯度均基于 \(b\) 个样本计算)取平均,与一次性对全部 \(B = kb\) 个样本计算梯度所得的结果相同。BatchNorm 等有状态层、dropout 和数据增强等随机操作、有限精度下的累积顺序,以及按步数索引的调度策略,都可能破坏严格等价性,因此大批次梯度累积仍需验证。
梯度累积以计算时间换取内存容量。Table 14 将内存收益与仍然存在的计算和调度成本区分开来。
| 维度 | 影响 |
|---|---|
| 内存 | 从 \(\mathcal{O}(B)\) 降至 \(\mathcal{O}(b)\),使激活内存缩减 \(k\times\) |
| 计算 | 总 FLOPs 不变,因为仍需处理全部 \(B\) 个样本 |
| 时间 | 每次优化器更新之前需执行 \(k\) 次微批次前向和反向传播;较小的微批次可能降低利用率并增加启动开销 |
梯度累积保持样本级算术运算总量不变,但可能改变执行效率,因为较小的微批次会以不同方式使用加速器,并更频繁地启动内核。使用分布式 no_sync() 累积时,梯度同步在 \(k\) 个本地微批次处理完毕后执行一次,而非在每个微批次之后执行。equation 18 中的模型给出了每次更新的时间: \[
T_{\text{effective}} = \sum_{j=1}^{k} T_{\text{micro},j} + T_{\text{sync}} + T_{\text{update}}
\tag{18}\]
这里,\(T_{\text{micro},j}\) 是微批次 \(j\) 的前向和反向传播实测时间,\(T_{\text{sync}}\) 是累积更新所需的同步时间,\(T_{\text{update}}\) 是优化器更新步骤的时间。在分布式数据并行训练中,标准框架封装会在每次反向传播期间自动触发异步梯度同步钩子。跨 \(k\) 个微批次累积梯度时,若保持这些钩子启用,就会在每个微批次上触发冗余的 AllReduce 操作;将前 \(k-1\) 个微批次包裹在 model.no_sync() 上下文中可以抑制这些通信,仅在最后的第 \(k\) 步执行一次 AllReduce 集合通信。
相对于一次性处理整个有效批次,实际耗时的增加取决于工作负载。必须通过测量确定,不能根据内存缩减倍数推断。
当梯度累积与跨多台机器的分布式数据并行结合使用时,还需考虑梯度同步时机以及整个集群的有效批次大小计算。高级分布式系统教材对这些模式有深入论述。
激活检查点
激活检查点通过丢弃激活值并选择性地重新计算,减少反向传播期间的内存使用。在标准训练中,前向传播产生的激活值会存储在内存中,以供反向传播期间计算梯度使用。然而,这些激活值可能占用数 GB 内存,在深层网络中尤其如此。
在反向传播期间,可以用额外的浮点运算换取内存带宽,从而减少激活内存。对比 figure 14 上排的前向传播与下排的反向传播,观察中间激活值如何被丢弃,以及如何根据绿色实心检查点张量按需重新计算。
\begin{tikzpicture}[line cap=round,line join=round,font=\small\sffamily]
% Standard color definitions
\definecolor{GreenLine}{HTML}{008F45}
\definecolor{GreenL}{HTML}{D4EFDF}
\definecolor{OrangeLine}{HTML}{CC5500}
\definecolor{OrangeL}{HTML}{FFE5CC}

\tikzset{
  Line/.style={line width=1.0pt, black!40, -latex},
  Node/.style={circle, draw=black!60, line width=0.75pt, minimum size=8mm},
  Checkpoint/.style={Node, fill=GreenL, draw=GreenLine},
  Discarded/.style={Node, dashed, fill=gray!10, draw=gray!40},
  Recomputed/.style={Node, fill=OrangeL, draw=OrangeLine},
  Label/.style={font=\footnotesize\bfseries\sffamily, anchor=east, xshift=-0.5cm}
}

% Forward Pass
\node[Label] at (0, 1.2) {前向传播};
\node[Checkpoint] (f1) at (1, 1.2) {};
\node[Discarded] (f2) at (3, 1.2) {};
\node[Discarded] (f3) at (5, 1.2) {};
\node[Checkpoint] (f4) at (7, 1.2) {};
\node[Discarded] (f5) at (9, 1.2) {};

\draw[Line] (f1) -- (f2);
\draw[Line] (f2) -- (f3);
\draw[Line] (f3) -- (f4);
\draw[Line] (f4) -- (f5);

% Backward Pass
\node[Label] at (0, 0) {反向传播};
\node[Checkpoint] (b1) at (1, 0) {};
\node[Recomputed] (b2) at (3, 0) {};
\node[Recomputed] (b3) at (5, 0) {};
\node[Checkpoint] (b4) at (7, 0) {};
\node[Recomputed] (b5) at (9, 0) {};

\draw[Line] (b5) -- (b4);
\draw[Line] (b4) -- (b3);
\draw[Line] (b3) -- (b2);
\draw[Line] (b2) -- (b1);

% Annotations
\node[below=0.2 of b1, font=\tiny\sffamily] {已存储};
\node[below=0.2 of b2, font=\tiny\sffamily] {重新计算};
\node[below=0.2 of b4, font=\tiny\sffamily] {已存储};

\end{tikzpicture}实现时,容量方面的权衡十分明确。系统将模型划分为多个段,在前向传播期间仅保留各段边界处的激活值,并在反向传播期间按需重新计算中间激活值。
PyTorch 等框架提供了 torch.utils.checkpoint 等工具来简化这一过程,但重新计算的成本依然存在。检查点技术对于具有数十层或数百层的深层架构最为有效,例如 Transformer 或大型卷积网络;在这些架构中,激活存储需求会在算术吞吐量耗尽之前就超过 GPU 容量。
梯度累积与检查点技术的协同作用,使更大、更复杂模型的训练成为可能。梯度累积应对与批次大小相关的内存约束,而检查点技术优化中间激活值的内存使用。二者结合,扩大了现有硬件上可训练模型的范围。
最优检查点放置策略
对于包含 \(N_L\) 层、每层存储 \(A\) 字节激活值的网络,table 15 量化了检查点数量及其放置位置如何决定内存与计算之间的权衡。次线性检查点策略可以将内存消耗从 \(\mathcal{O}(N_L)\) 降至 \(\mathcal{O}(\sqrt{N_L})\),而总计算时间仅增加一部分,从而使现有硬件能够训练深度大得多的模型。
| 策略 | 内存成本 | 重新计算成本 |
|---|---|---|
| 不使用检查点 | \(N_L \times A\) | 0 次前向运算 |
| 保留一个边界 | \(A\) | \((N_L-1)\) 次前向运算 |
| k 个检查点 | \(k\times A + (N_L/k)\times A\) | \((N_L-k)\) 次前向运算 |
令总内存成本 \((k \times A + (N_L/k) \times A)\) 关于 \(k\) 的导数为零,可得解析最优值 \(k_{\text{optimal}} = \sqrt{N_L}\)。在标准的 \(\sqrt{N_L}\) 检查点方案中,这会带来约三分之一的额外前向计算,以换取该解析模型下最小的激活内存占用。对于具有四十八个 Transformer 层的 GPT-2,实际运行差异十分显著:不使用检查点的训练需要 \(48 \times A\) 的完整激活存储,而均匀检查点方案(\(\sqrt{48} \approx 7\) 个检查点)需要 \(7 \times A + (48/7) \times A \approx 14 \times A\),以约 33% 的额外训练步总计算量为代价,节省 71% 的激活内存(在反向传播期间,对未设置检查点的层重新执行一次前向传播)。
并非所有操作的重新计算成本都相同,因此需要选择性检查点。Table 16 比较了哪些位置的激活内存足够大,值得付出重新计算的代价。
| 层类型 | 内存成本 | 重新计算成本 | 检查点策略 |
|---|---|---|---|
| 注意力块 | 取决于张量形状;显式存储的注意力可能引入按平方规模增长的中间结果 | 高,且取决于序列长度 | 当保留状态所节省的内存足以抵偿重新计算成本时,在块边界设置检查点 |
| 前馈块 | 通常由扩展后的隐藏激活值主导 | 高,且取决于宽度 | 当扩展后的激活值主导内存使用时设置检查点 |
| 归一化 | 单独输出占用较小 | 低 | 通常在设置了检查点的较大块内处理 |
实践原则是,将重新计算用于内存占用高的层,而不是用于那些激活值保留成本本就很低的操作。
内存与计算收益
梯度累积能够形成比常驻微批次更大的有效批次,而无需同时存储该有效批次的全部激活值。较大的有效批次可降低采样方差,但并不保证更快收敛或更好的泛化能力。当期望的有效批次无法一次性放入内存时,该技术尤为有用。
激活检查点显著减少了前向传播期间中间激活值的内存占用,使更深层模型的训练成为可能。通过按需丢弃和重新计算激活值,检查点技术为更大的模型、更多的层或更高分辨率的数据释放内存。这种权衡对于 Transformer 等需要大量内存来存储中间计算结果的架构至关重要。
这两种技术通过在增加硬件之前降低内存需求,提高了可扩展性。回到灯塔示例 1.1,在 V100 的内存约束下,梯度累积对于达到目标批次大小至关重要。
Napkin Math 1.8: GPT-2 梯度累积策略
这个 GPT-2 规模的示例场景使用假定的价格和时长来展示梯度累积;它并非对 GPT-2 历史训练账单的重建。
内存约束
- 按照本章简化的内存估算方法,具有 32 GB 内存的 V100 可容纳每 GPU 大小为 \(B=4\) 的微批次。
- 因此,要使大小为 \(B=512\) 的有效批次常驻内存,需要 512 ÷ 4 = 128 GPUs。
累积配置
- 使用 8 GPUs,并累积 16 个微批次,每个微批次包含 4 个样本。
- 每个加速器在每次更新中处理 4 \(\times\) 16 = 64 个样本,从而得到大小为 8 GPUs \(\times\) 64 = 512 的全局有效批次。
分布式 no_sync() 上下文可以将 AllReduce 推迟到最后一个微批次。
权衡分析
- 理想化实际耗时:延长至原来的 16×,因为更少的加速器执行相同的算术运算工作
- 内存开销:累积通常复用参数梯度缓冲区,但仍存在簿记和临时存储开销
- 通信:两种配置都在每次包含 512 个样本的更新中同步一次,但参与者数量和拓扑不同
- 等工作量成本:在计入利用率和通信影响之前,两种方式均为 $688K
为何有效:在上述等价条件下,求平均的逐样本梯度具有可加性。每个加速器首先对其 64 个样本累积局部梯度: \[ \frac{1}{16}\sum_{j=1}^{16} \left[\frac{1}{4}\sum_{k=1}^{4} \nabla \mathcal{L}(x_{jk})\right] \]
随后,AllReduce 在 8 GPUs 之间对这些局部梯度取平均,形成全局有效批次: \[ \frac{1}{8}\sum_{g=1}^{8} \nabla \mathcal{L}_{\text{local}}^{(g)}, \qquad B_{\text{global}} = 8 \times 64 = 512 \]
运行对比
常驻配置:
- 128 GPUs \(\times\) 4 个样本 = 每次更新有 512 个常驻样本
- 梯度同步覆盖 128 GPUs
- 每小时成本:128 GPUs \(\times\) $16/hour = $2,048/hour
累积配置:
- 8 GPUs \(\times\)(4 个样本 \(\times\) 16 个微批次)= 每次更新处理 512 个样本
- 每次更新在 8 GPUs 之间执行一次梯度同步
- 每小时成本:8 GPUs \(\times\) $16/hour = $128/hour
- 每小时成本降幅:$1,920/hour,即 93.8 percent
质量门槛
- 保持样本及其顺序、损失归一化、优化器状态与更新步调度,以及随机层行为一致。
- 在重复运行中比较留出集损失或困惑度以及优化轨迹,而非假定仅凭有效批次就能保证等价质量。
- 求和顺序的变化预计会带来微小的舍入差异;应要求在明确声明的容差内收敛,而非逐比特一致。此处不预设任何困惑度结果。
系统洞见:梯度累积减少了加速器数量和每小时支出,但在理想缩放条件下,加速器小时数保持不变;实际成本取决于利用率和通信。
Listing 7 将一次 AllReduce 安排在十六个本地微批次之后,明确了同步边界。
optimizer.zero_grad()
for step in range(16):  # Accumulation steps
    micro_batch = next(dataloader)  # 4 samples
    loss = model(micro_batch) / 16  # Average effective-batch loss
    loss.backward()  # Accumulate gradients
# Now gradients represent 64 local samples
all_reduce(gradients, op=SUM)  # Sum across 8 GPUs
gradients /= 8  # Convert the sum to the global mean
optimizer.step()  # Update with effective batch=512
实践注意事项
当最优批大小超出 GPU 内存容量时,梯度累积最具价值。Transformer 语言模型的有效批大小通常达到数十万至数百万词元;如果内存仅允许每台设备容纳较少的序列,梯度累积便可在无需额外硬件的情况下弥合这一差距。激活检查点通过支持更深的架构与之形成互补,常用于 Transformer 规模的训练,也用于生成对抗网络等激活量较大的双网络配置。
这两种技术都引入了明确的权衡。激活检查点在反向传播期间重新计算已丢弃的激活;采用普通的分段检查点时,每个被丢弃的激活通常只重建一次,而递归调度的行为可能有所不同。梯度累积降低了参数更新频率,因为每次更新都在完成 \(k\) 个微批次之后进行。当每个微批次的损失均除以 \(k\) 时,累积梯度遵循有效批次均值的约定。如果改为对损失求和,则必须在优化器执行更新步骤之前重新缩放梯度,或相应地调整学习率约定。不同框架和代码库采用的约定各异,因此归一化是细微错误的常见来源。
优化技术比较
每种训练优化都针对加速器内存与计算层次结构中的特定物理瓶颈。异步预取将经由 PCIe 总线的主机到设备传输与加速器执行组成流水线,防止计算引擎因输入数据供给不足而空闲。混合精度训练将权重和激活通过 HBM 总线传输的张量数据量减半,同时将矩阵运算交由专用的低精度张量单元执行。FlashAttention 通过解决自注意力中呈二次增长的内存带宽瓶颈,与这些系统级措施形成互补;它将查询、键和值分块放入片上 SRAM,将注意力辅助内存从 \(\mathcal{O}(S^2)\) 降至 \(\mathcal{O}(S)\),并报告在所评估工作负载上实现了最高 3\(\times\) 的加速。最后,激活检查点和梯度累积用于管理设备内存容量:检查点机制丢弃中间激活,并通过反向传播期间的重计算将其重建;梯度累积则将一个较大的逻辑批次拆分为按时间顺序处理的微批次,以限制峰值驻留内存。
由于训练吞吐量由系统中起约束作用的瓶颈决定,对非瓶颈子系统进行优化不会带来端到端加速。如果计算流水线仍因等待主机提供批次而停顿,那么使用更低精度或 FlashAttention 加速张量运算也无法缩短单步时间。反之,当执行受限于 HBM 容量或反向传播重计算时,扩大预取缓冲区也不会带来收益。因此,在选择优化措施之前,必须通过性能剖析确定工作负载究竟受限于 I/O 数据摄取、内存容量、内存带宽,还是算术吞吐量。
Table 17 从机制、硬件要求和运行权衡三个方面比较了其中三种基础策略,而 FlashAttention 则作为注意力内核内部的算法级补充。
| 方面 | 预取与重叠执行 | 混合精度训练 | 梯度累积与检查点 |
|---|---|---|---|
| 主要目标 | 尽量减少数据传输延迟并最大化加速器利用率 | 减少张量存储并加速适用的低精度运算 | 克服反向传播和参数更新期间的内存限制 |
| 关键机制 | 异步数据加载与并行处理 | 结合低精度与高精度计算 | 模拟更大的批大小并选择性存储激活 |
| 内存影响 | 预取缓冲区会增加内存使用量 | 可减少权重、激活和通信张量的内存占用 | 减少驻留激活;参数梯度的大小保持不变 |
| 计算速度 | 通过减少空闲时间提高速度 | 可在支持的硬件上加速适用的 FP16/BF16 运算 | 可能因检查点重计算而降低速度 |
| 可扩展性 | 可扩展性强,尤其适用于大型数据集 | 支持训练更大的模型 | 允许在有限硬件上训练更深的模型 |
| 硬件要求 | 受益于高速存储和多核 CPU | 需要受支持的低精度加速器执行路径 | 可在标准硬件上运行 |
| 实现复杂度 | 中等(需要调优预取参数) | 低至中等(有框架支持时) | 中等(需要谨慎分段与累积) |
| 主要收益 | 缩短训练时间,提高硬件利用率 | 加快训练,支持更大模型,减少内存使用量 | 支持更大的批大小和更深的模型 |
| 主要挑战 | 调优缓冲区大小,内存使用量增加 | 可能出现数值不稳定;FP16 可能需要损失缩放 | 计算开销增加,参数更新变慢 |
| 理想应用场景 | 大型数据集、复杂预处理 | 大规模模型,尤其是 NLP 和计算机视觉模型 | 批大小受内存限制或激活量较大的模型 |
该表分别比较了各项技术;GPT-2 演练则展示了当一个模型必须同时满足内存容量、运行速度和现实成本范围的要求时,这些技术如何组合使用。
GPT-2 优化演练
在单张 V100 GPU 上训练 GPT-2(15 亿参数)会暴露出支配大模型优化的物理边界:张量分配立即超出加速器内存容量,而朴素的输入流水线又使执行引擎缺乏数据。沿着这一单设备诊断过程逐步分析,可以在扩展至多加速器集群之前,先确保模型能够装入内存并使计算资源达到饱和。
Napkin Math 1.9: V100 上的 GPT-2 优化
步骤 1:确定基线内存占用。
Table 18: GPT-2 优化示例剖析结果:批大小为 4 时的内存数值由本演练计算得出;利用率、吞吐量和每轮时间是场景假设值,而非基准测试结果。Table 19 给出了批大小为 32 时的场景总量。
分析从 GPT-2 XL 开始:15 亿参数、批大小为 4、序列长度为 1024、全程使用 FP32 张量,并采用单线程同步数据加载器。这是一种刻意受限的配置:规模足够小,可以围绕单张 V100 展开讨论;同时又足够大,使首次失败立即发生且原因明确。本演练使用批大小 4,与混合精度提示框中的配置相同(粗略估算 1.6);table 19 给出了批大小为 32 时的对应值(FP32 基线为 597.8 GB,优化后为 95.7 GB),即使经过优化,这些值仍超出单张 GPU 的容量。在批大小为 4 时,FP32 基线需要 95.7 GB,因此在吞吐量成为问题之前,该训练就已无法满足容量为 32 GB 的 V100 的机器约束。
步骤 2:应用混合精度。
第一项措施旨在使模型能够装入内存,而非提高速度。自动混合精度(AMP)以 16 位精度执行前向和反向运算,将动态激活内存减半。由于数值稳定性要求保留 32 位主权重和 FP32 Adam 矩状态,静态参数与优化器存储仍保持为每个参数 16 字节。将激活占用减半后,峰值内存降至 59.9 GB,减少了 37.5 percent,但分配量仍超出容量为 32 GB 的加速器的物理容量。
步骤 3:加入梯度检查点。
由于在不改变优化器动态行为的前提下,静态状态无法进一步缩减,梯度检查点便针对剩余的激活占用进行优化。运行时不再为反向传播保留每一层的前向激活,而是丢弃中间状态,并在反向传播期间按需重新计算。每四层设置一个检查点,可使激活内存的缩减倍数达到 4×,使张量分配总量降至 33 GB,最终满足设备物理容量限制。在各层重计算量相等的模型下,这种内存缩减会带来约 33 percent 的额外前向算术运算;生产运行必须验证临时工作区分配和内存分配器碎片所需的空间仍处于可用余量之内。
步骤 4:检查示例吞吐量剖析结果。
将模型装入设备内存解决了容量问题,但并不保证高效执行。对现在能够执行的模型进行性能剖析,可以得到各子系统占用迭代时间的分布:
- 加速器利用率:45 percent
- 数据加载:占迭代时间的 40 percent
- 计算:占迭代时间的 35 percent
- 内存传输:占迭代时间的 25 percent
从数据—算法—机器的角度看,这些性能测量结果将诊断重点从机器内存容量(M)转向数据流水线(D)。由于迭代时间的 40 percent 用于等待主机准备的批次,在解决数据供给不足之前,进一步优化加速器内存也无法提高按实际耗时衡量的训练吞吐量。
步骤 5:应用预取和数据流水线优化。
解决输入供给不足需要使主机数据准备与加速器计算重叠进行。在此场景中,将数据加载器配置为使用八个工作进程,可并行执行 CPU 端的样本解码;页锁定(固定)主机内存支持通过 PCIe 总线进行异步 DMA 传输;预取因子设为 2,则在主机和设备队列中为后续批次提供双缓冲。将主机预处理和传输延迟隐藏在内核执行期间,可使加速器利用率从 45 percent 提高至 85 percent,将输入供给不足的工作负载转变为计算饱和的运行状态。
Table 18 对比了无法执行的朴素基线与优化后的单 GPU 配置。
| 指标 | 朴素配置 | 优化后 | 改进 |
|---|---|---|---|
| 内存 | 95.7 GB | 33 GB | 缩减倍数为 2.9× |
| 加速器利用率 | 不适用 | 85% | 可训练 |
| 吞吐量 | 不适用 | 1,200 词元/秒 | — |
| 每轮时间 | 不适用 | 8.3 小时 | — |
系统洞见:训练优化遵循严格的诊断依赖链:先解决模型能否装入内存的问题,再处理吞吐量;先消除数据供给不足,再调优内核。当容量和输入停顿不再制约执行后,应重新进行性能剖析,确定内核性能受限于内存带宽还是算术吞吐量,然后再改变批大小或模型架构。
本演练说明了训练优化为何是一门按顺序开展诊断的学科,而不是任意堆砌技术。每项措施都直接解决前一次测量所揭示的、起约束作用的物理限制:混合精度将激活存储减半;梯度检查点以增加 33 percent 的计算量为代价,使内存的缩减倍数达到 2.9×,从而满足设备物理容量限制;异步预取则在执行开始后消除 PCIe 传输停顿。在确保单加速器能够运行模型且计算达到饱和后,下一个任务是评估这些叠加的优化在扩展至多加速器集群时,对执行时间、能耗和总训练成本的影响。
优化影响总结
GPT-2 案例研究展示了有针对性的技术如何组合使用。其内存数值遵循本章的张量模型,而时间、功率、电价和电网碳排放输入则定义了一个示例运行场景,并非来自一次实测的 GPT-2 运行。
Table 19 汇总了这些集群级假设所推导出的结果。
| 指标 | FP32 基线 | 优化后 | 所用技术 |
|---|---|---|---|
| 参数 | 6 GB | 3 GB | 混合精度(FP16) |
| 梯度 | 6 GB | 3 GB | 混合精度(FP16) |
| 主权重 | 0 GB | 6 GB | AMP 开销 |
| 优化器状态(Adam) | 12 GB | 12 GB | 保持不变(FP32 矩) |
| 激活值(批大小=32) | 573.8 GB | 71.7 GB | 梯度检查点 + FP16 |
| 总内存 | 597.8 GB | 95.7 GB | — |
| 训练时间(32 块 V100) | 14 days | 8.4 days | 数据预取 + 利用率提升 |
| 能耗 | 3,914 kWh | 2,348 kWh | 假定集群功率在各自运行期间保持恒定 |
| 电费($0.10/kWh) | $391.4 | $234.8 | — |
| 碳足迹 | 1.7 t | 1.0 t | 区域电网平均值(0.43 kg/kWh) |
如 table 19 所示,在假定的输入条件下,优化前后内存之比为 6×,实际运行时间之比为 1.7×,且在建模功率恒定的情况下,能耗降低了 40 percent。在实践中,必须根据实测运行时间和功率计算能耗与成本,因为利用率提高可能改变集群的功耗。
单加速器优化相互叠加,使设备达到饱和:混合精度最大限度地提高 Tensor Core 吞吐量,FlashAttention 消除注意力中间结果的片外数据传输,梯度检查点缩减激活值的内存占用,异步预取则隐藏主机 I/O 延迟。然而,即使经过充分优化,计算预算达到数百 exaFLOP 的工作负载仍然受限于单个芯片的算术吞吐量。
要突破单设备的计算或内存容量限制,就必须将计算分布到多个加速器上。这种架构转变引入了设备间通信开销、集合操作同步屏障和容错约束,它们成为决定集群扩展效率的主要因素。
训练系统扩展
GPT-2 逐步示例通过建模展示了混合精度和检查点如何将批大小为 4 时的张量内存预算降至 33 GB;在尚未计入工作空间和内存分配器开销时,这已接近 V100 的 32 GB 容量。批大小为 32 时,建模得到的总量从 597.8 GB 降至 95.7 GB,但仍超出该 V100 的容量。内存更大的加速器可能改变这一边界。然而,一个拥有 700 亿参数的模型,仅 FP16 权重就需要约 140 GB,完整的全参数训练状态则需要多得多的内存,因此有必要采用分片、卸载或多设备方案。
对于某些模型,单 GPU 内存是首先遇到的限制。
当选定的工作负载仍然超出单设备的内存容量或时间安排时,将其分散到多个设备上可以汇集内存与计算能力。其他应对方法包括缩减模型、批大小、序列长度或训练范围,卸载状态,以及采用参数高效适配。超越单设备的扩展始于单机内的多 GPU 配置,并可进一步扩展到多个节点。主要的并行策略在通信方面有不同的权衡;分布式训练实现的完整论述超出了本章范围。
增加 GPU 并不会让所有工作负载同等受益。有效计算、通信、负载不均衡与同步之间的关系决定了扩展效率。Figure 15 使用类似阿姆达尔定律的形式对这种权衡进行建模,其中无法随规模扩展而缩减的开销构成了实际的吞吐量上限。理想线性加速与实际加速之间不断扩大的差距,直观展示了规模扩大时所付出的通信税。
红色曲线与理想虚线之间不断扩大的差距,直观体现了通信税;section 1.7.1 中介绍的分布式策略正是为了缩小这一差距。
单节点多 GPU 训练
单节点内的多 GPU 训练确立了分布式执行的基础架构模式。AlexNet26 (Krizhevsky et al. 2012) 将其卷积层拆分到两块 GTX 580 GPU 上,因为 3 GB 的设备内存上限使其无法在单个芯片上运行,从而使跨 GPU 连接立即成为架构约束。将多加速器拓扑限定在单节点互连(如 PCIe 或 NVLink)范围内,可以在引入跨机架网络互连结构之前,单独考察核心并行策略。
Krizhevsky, Alex, Ilya Sutskever, and Geoffrey E. Hinton. 2012. “ImageNet Classification with Deep Convolutional Neural Networks.” Advances in Neural Information Processing Systems (NeurIPS) 25.
两种基础策略——数据并行和模型并行——代表了根本不同的划分选择:数据并行复制模型并划分数据,而模型并行划分模型状态或计算。这一区别决定了内存需求、通信模式和扩展行为。
数据并行
数据并行在每块 GPU 上复制完整模型,各 GPU 处理不同的批次。在本地计算梯度后,各 GPU 通过梯度平均进行同步。Figure 16 展示了数据流:输入数据被划分为互不重叠的批次,每个加速器独立计算前向传播和反向传播,然后在更新共享模型之前聚合梯度。
\begin{tikzpicture}[font=\small\sffamily]
\tikzset{
 Box/.style={draw=none,minimum width=41mm, minimum height=20mm, node distance=20mm and -16mm},
 Arr/.style={-{Triangle[width=10pt,length=8pt]}, line width=5pt,cyan!40,shorten >=1pt, shorten <=2pt},
 Box2/.style={align=flush center, inner xsep=2pt,draw=none,
  font=\footnotesize\sffamily, line width=0.75pt, fill=OrangeL!30, text width=41mm,
    minimum width=36mm, minimum height=7mm},
  Box3/.style = {Box2,draw=none,fill=cyan!10},
  Box4/.style = {Box2,draw=none,fill=GreenFill!60},
  Box5/.style = {Box2,draw=none,fill=magenta!10},
  LineA/.style = {violet!60,{Circle[line width=1.0pt,fill=white,length=5.5pt]}-,line width=1.5pt,shorten <=-3pt},
  Arr/.style={-{Triangle[width=9pt,length=7pt]}, line width=3pt,black!40,shorten >=1pt, shorten <=2pt},
  Txt/.style = {font=\footnotesize\sffamily,black!80,align=center}
}

\tikzset{mycylinder/.style={cylinder, shape border rotate=90, aspect=1.3, draw, fill=white,
minimum width=25mm,minimum height=11mm,line width=\Linewidth,node distance=-0.15},
pics/dataP/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=STREAMING,scale=\scalefac, every node/.append style={transform shape}]
\node[mycylinder,fill=\filllcolor!50] (A) {};
\node[mycylinder, above=of A,fill=\filllcolor!50] (B) {};
\node[mycylinder, above=of B,fill=\filllcolor!10] (C) {};
\fill[\filllcolor!50!black]($(C.west)!0.12!(C.east)$)circle(3pt);
\fill[\filllcolor!50!black]($(B.west)!0.12!(B.east)$)circle(3pt);
\fill[\filllcolor!50!black]($(A.west)!0.12!(A.east)$)circle(3pt);
%
\draw[draw=\drawcolor,line width=2.5*\Linewidth](B.east)--++(17mm,0);
\node[draw=\drawcolor,line width=\Linewidth,minimum width=9mm,fill=white,minimum height=22mm](BD)at($(B.east)+(8mm,0)$){};
\node[draw=\drawcolor,line width=\Linewidth,minimum width=5mm,minimum height=8mm,fill=white](BDM)at($(BD.east)+(5mm,0)$){};
\node[circle,draw=orange,line width=\Linewidth,minimum size=5mm]at($(BD.north)!0.2!(BD.south)$){};
\node[rectangle,draw=blue,line width=\Linewidth,minimum size=5mm]at($(BD.north)!0.5!(BD.south)$){};
\node[circle,draw=green,line width=\Linewidth,minimum size=5mm]at($(BD.north)!0.8!(BD.south)$){};
\end{scope}
     }
  }
}
%CPU3
\tikzset{%
 pics/cpu3/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=CHIP,scale=\scalefac, every node/.append style={transform shape}]
\node[fill=\filllcolor,draw=\drawcolor,minimum width=8mm, minimum height=8mm,inner sep=0pt,
            rounded corners=1pt,line width=2*\Linewidth,outer sep=2pt] (C1) {};
\foreach \x in {0.2,0.5,0.8}{
\draw[line width=1.3*\Linewidth,draw=\drawcolor,
-{Circle[fill=white,length=4.5pt]}]($(C1.north west)!\x!(C1.south west)$)--++(-3mm,0);
}
\foreach \x in {0.2,0.5,0.8}{
\draw[line width=1.3*\Linewidth,draw=\drawcolor,
-{Circle[fill=white,length=4.5pt]}]($(C1.north east)!\x!(C1.south east)$)--++(3mm,0);
}
%dole
\foreach \x in {0.2,0.5,0.8}{
\draw[line width=1.3*\Linewidth,draw=\drawcolor,
-{Circle[fill=white,length=4.5pt]}]($(C1.south west)!\x!(C1.south east)$)--++(0,-3mm);
}
  \draw[draw=\drawcolor,,-{Triangle[width=3.5pt,length=4pt]}, shorten >=-1pt,line width=1.1*\Linewidth,]
  ($(C1.north)+(2mm,2.25mm)$)+(180:1.75mm) arc (180:490:1.75mm);
% \draw[draw=\drawcolor,-{Triangle[width=3.5pt,length=4pt]}, shorten >=-1pt,line width=1.1*\Linewidth,]
%($(C1.south)+(0mm,-2.5mm)$) +(90:1.75mm)arc (90:380:1.75mm);
 \end{scope}
     }
  }
}
%data folder with arrws
\tikzset{%
 pics/arrowD/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=DATAFOLDER,scale=\scalefac, every node/.append style={transform shape},
LinE/.style={\filllcirclecolor,line width=3.0pt,
{{Triangle[width=1.5*5pt,length=2.0*5pt]}-},shorten <=3pt,shorten >=1pt}
]
\node[fill=\filllcolor,circle,inner sep=1pt,minimum size=7mm](C1R){};
\draw[LinE](C1R.south)--++(270:2);
\draw[LinE](C1R.north)--++(270:-2);
\draw[LinE](C1R.west)--++(0:-2);
\draw[LinE](C1R.east)--++(0:2);
 \end{scope}
     }
  }
}
\tikzset{%
 pics/stackedA/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=FUNNEL,scale=\scalefac, every node/.append style={transform shape}]
%plats
\draw[fill=\filllcirclecolor,line width=\Linewidth,draw=\drawcolor](0,-0.4)--(-0.67,-0.07)--(0,0.27)--(0.67,-0.07)--cycle;
\draw[fill=\filllcolor,line width=\Linewidth,draw=\drawcolor](0,-0.2)--(-0.67,0.13)--(0,0.47)--(0.67,0.13)--cycle;
\draw[fill=\filllcirclecolor,line width=\Linewidth,draw=\drawcolor](0,0)--(-0.67,0.33)--(0,0.67)--(0.67,0.33)--cycle;
\draw[fill=\filllcolor,line width=\Linewidth,draw=\drawcolor](0,0.2)--(-0.67,0.53)--(0,0.87)--(0.67,0.53)--cycle;
\draw[fill=\filllcirclecolor,line width=\Linewidth,draw=\drawcolor](0,0.4)--(-0.67,0.73)--(0,1.07)--(0.67,0.73)--cycle;
\node[draw=none,circle,minimum size=20mm](SREDI)at(0,0.33){};
\def\Rad{10mm}
 \draw[draw=mygreen,-{Triangle[width=3.5pt,length=6pt]}, shorten >=-1pt,line width=1.25*\Linewidth,]
(SREDI)+(100:\Rad) arc (100:260:\Rad);
 \draw[draw=myorange,-{Triangle[width=3.5pt,length=6pt]}, shorten >=-1pt,line width=1.25*\Linewidth,]
(SREDI)+(280:\Rad)arc (280:440:\Rad);
\end{scope}
     }
  }
}
\pgfkeys{
  /channel/.cd,
   Depth/.store in=\Depth,
  Height/.store in=\Height,
  Width/.store in=\Width,
  filllcirclecolor/.store in=\filllcirclecolor,
  filllcolor/.store in=\filllcolor,
  drawcolor/.store in=\drawcolor,
  drawcircle/.store in=\drawcircle,
  scalefac/.store in=\scalefac,
  Linewidth/.store in=\Linewidth,
  picname/.store in=\picname,
  filllcolor=BrownLine,
  filllcirclecolor=violet!20,
  drawcolor=black,
  drawcircle=violet,
  scalefac=1,
  Linewidth=0.5pt,
  Depth=1.3,
  Height=0.8,
  Width=1.1,
  picname=C
}

%Input Data
\node[Box, fill=white](B1){};
\pic[shift={(-0.56,-0.6)}] at  (B1){dataP={scalefac=0.56,picname=1,filllcirclecolor=violet!20,filllcolor=BlueLine, Linewidth=0.7pt}};
\draw[mybrown,line width=1.5pt](B1.south west)--coordinate(1S1)(B1.south east);
\node[Box2,anchor=north,below= 0.2 of B1](T1){输入数据};
%%%%%%%%%%%%%%%%%%%%%
%second row
%%%%%%%%%%%%%%%%%%%%%
%Batch 2
\node[Box, fill=white,below left=1.7 and -1.7  of B1](2B2){};
\pic[shift={(0,0)}] at  (2B2){cpu3={scalefac=1.1,drawcolor=BlueLine, filllcolor=white, Linewidth=1pt}};
\draw[mybrown,line width=1.5pt](2B2.south west)--coordinate(2S2)(2B2.south east);
\node[Box3,anchor=north,below= 0.2 of 2B2](2T2){批次 2\\ GPU 2
前向传播 \& 反向传播};
%Batch 3
\node[Box, fill=white,below right=1.7 and -1.7  of B1](2B3){};
\pic[shift={(0,0)}] at  (2B3){cpu3={scalefac=1.1,drawcolor=BlueLine, filllcolor=white, Linewidth=1pt}};
\draw[mybrown,line width=1.5pt](2B3.south west)--coordinate(2S3)(2B3.south east);
\node[Box3,anchor=north,below= 0.2 of 2B3](2T3){批次 3\\ GPU 3
前向传播 \& 反向传播};
%Batch 4
\node[Box, fill=white, right=0.6 of 2B3](2B4){};
\pic[shift={(0,0)}] at  (2B4){cpu3={scalefac=1.1,drawcolor=BlueLine, filllcolor=white, Linewidth=1pt}};
\draw[mybrown,line width=1.5pt](2B4.south west)--coordinate(2S4)(2B4.south east);
\node[Box3,anchor=north,below= 0.2 of 2B4](2T4){批次 4\\ GPU 4
前向传播 \& 反向传播};
%Batch 1
\node[Box, fill=white, left=0.6 of 2B2](2B1){};
\pic[shift={(0,0)}] at  (2B1){cpu3={scalefac=1.1,drawcolor=BlueLine, filllcolor=white, Linewidth=1pt}};
\draw[mybrown,line width=1.5pt](2B1.south west)--coordinate(2S1)(2B1.south east);
\node[Box3,anchor=north,below= 0.2 of 2B1](2T1){批次 1\\ GPU 1
前向传播 \& 反向传播};
%%%%%%%%%%%%%%%%%%%%%
%third row
%%%%%%%%%%%%%%%%%%%%%
%Gradient Sync / All-Reduce
\node[Box, fill=white,below =5.7 of B1](3B1){};
\pic[shift={(0,0.1)},rotate=45] at  (3B1){arrowD={scalefac=0.45,picname=1,Linewidth=1.0pt,
 filllcolor=mygreen,drawcolor=BrownLine,filllcirclecolor=mypurple}};
\draw[mybrown,line width=1.5pt](3B1.south west)--coordinate(3S1)(3B1.south east);
\node[Box4,anchor=north,below= 0.2 of 3B1](3T1){梯度同步 / 全归约};
%%%%%%%%%%%%%%%%%%%%%
%fourth row
%%%%%%%%%%%%%%%%%%%%%
%Model Update
\node[Box, fill=white,below =1.6 of 3B1](4B1){};
\pic[shift={(0,-0.24)}] at  (4B1){stackedA={scalefac=0.9,Linewidth=1.0pt,
 filllcolor=cyan!90,drawcolor=none,filllcirclecolor=myred!35}};
\draw[mybrown,line width=1.5pt](4B1.south west)--coordinate(4S1)(4B1.south east);
\node[Box5,anchor=north,below= 0.2 of 4B1](4T1){模型更新};
%
%fitting
\begin{scope}[on background layer]
%\node[draw=brown,inner sep=3mm,dashed,line width=1pt,fit=(T1)(1S1)(B1)](F1){};
%\node[anchor=south east,font=\small\sffamily\bfseries]at(F1.north east){ML System Implementations};
%
\node[draw=myblue,inner sep=3mm,inner ysep=1mm,yshift=-0.25mm,
dashed,line width=1pt,fit=(2T1)(2T4)(2B3)](F2){};
%\node[anchor=south east,font=\small\sffamily\bfseries]at(F2.north east){Core System Principles};
%
%\node[draw=mygreen,inner sep=3mm,dashed,line width=1pt,fit=(3T1)(3B1)](F3){};
%\node[anchor=south east,font=\small\sffamily\bfseries]at(F3.north east){System Considerations};
%
\end{scope}
%arrows
\draw[Arr](T1)--(F2);
\draw[Arr](F2)--(3B1);
\draw[Arr](3T1)--(4B1);
\end{tikzpicture}当模型及其优化器状态能够轻松容纳于单设备内存时,数据并行是首要的扩展基线,因为本地前向与反向计算核能够以设备原生内存带宽运行,无需设备间同步。通信仅发生在梯度聚合期间。早期,框架使用 PyTorch 的 DataParallel(DP)等多线程封装器,支持单节点内的多 GPU 执行。然而,这种单进程设计存在两个严重的架构瓶颈:Python 运行时仍受全局解释器锁(GIL)限制;主协调设备(GPU 0)必须通过 PCIe 依次分发小批次并收集输出,耗尽主机与设备之间的互连带宽,并造成严重的计算与内存负载不均衡。现代系统采用 PyTorch 的 DistributedDataParallel(DDP)和 TensorFlow 的 MirroredStrategy 等多进程架构来取代这种设计。DDP 为每个加速器启动一个独立的 Python 进程,从而完全消除 GIL 争用;每个进程维护自己的模型副本和本地优化器,依靠去中心化的全归约(AllReduce)集合通信操作,将梯度分桶存入连续缓冲区,并使同步直接与反向传播计算重叠执行。
未分片的数据并行存在一项硬性约束:每个 GPU 都保存完整的模型副本,通常还保存其本地优化器状态。一个具有 70 亿参数的模型,仅 FP16 权重就需要 14 GB,尚未计入梯度、优化器状态或激活值。分片数据并行(例如零冗余优化器,即 ZeRO)将这些状态分布到多个设备上:ZeRO-1 对优化器状态进行分片,ZeRO-2 对梯度进行分片,ZeRO-3(或 FSDP)对模型参数进行分片;否则,超出本地内存容量的模型就需要进行流水线或张量划分。
模型并行
模型并行将模型本身划分到多个 GPU 上,当模型超出单 GPU 内存容量时,就有必要采用这种方式。AlexNet 采用了这一策略的早期形式:部分卷积层在 GPU 1 上执行,其他卷积层在 GPU 2 上执行,仅在层边界通过 PCIe 传递激活值。Figure 17 展示了前向与反向路径:数据流经不同设备上的模型分区,训练期间梯度沿反向流动。
\begin{tikzpicture}[line join=round,font=\sffamily\small]
\tikzset{%
  Box/.style={align=flush center,
    inner xsep=2pt,
    node distance=0.65,
    draw=VioletLine,
    line width=0.75pt,
    fill=VioletL2!13,
    %text width=35mm,
    minimum width=35mm, minimum height=15mm
  },
  Box2/.style={Box, draw=myblue, fill=myblue!03,
  },
  LineA/.style={mybrown!50,line width=1.5pt,{-{Triangle[width=1.0*5pt,length=1.0*8pt]}},
  shorten <=2pt,shorten >=2pt},
  LineAA/.style={myorange!50,line width=1.5pt,{-{Triangle[width=1.0*5pt,length=1.0*8pt]}},
  shorten <=2pt,shorten >=2pt},
  LineA2/.style={black!25,line width=1.25pt,{-{Triangle[width=1.0*5pt,length=1.0*8pt]}},
  shorten <=0pt,shorten >=0pt},
}

\tikzset {
pics/output/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=CLO,scale=\scalefac,, every node/.append style={transform shape}]
\node[draw=\drawcolor,line width=\Linewidth,rounded corners=2pt,
rectangle,minimum width=10mm,minimum height=13mm](REC){};
\node[rectangle,draw=none,fill=white,minimum width=10.5mm,minimum height=5mm,anchor=west]{};
\node[single arrow, draw=orange,fill=orange,inner sep=2pt,\filllcirclecolor,
      minimum width = 5mm, single arrow head extend=3pt,
      minimum height=10mm,anchor=west,
      rotate=0]at(0,0) {};
\end{scope}
}
}
}
 \tikzset{mycylinder/.style={cylinder, shape border rotate=90, aspect=1.3, draw, fill=white,
minimum width=25mm,minimum height=11mm,line width=\Linewidth,node distance=-0.15},
pics/data/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=STREAMING,scale=\scalefac, every node/.append style={transform shape}]
\node[mycylinder,fill=\filllcolor!50] (A) {};
\node[mycylinder, above=of A,fill=\filllcolor!30] (B) {};
\node[mycylinder, above=of B,fill=\filllcolor!10] (C) {};
\fill[\filllcolor!50!black]($(C.west)!0.12!(C.east)$)circle(3pt);
\fill[\filllcolor!50!black]($(B.west)!0.12!(B.east)$)circle(3pt);
\fill[\filllcolor!50!black]($(A.west)!0.12!(A.east)$)circle(3pt);
 \end{scope}
     }
  }
}
%CPU3
\tikzset{%
 pics/cpu3/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=CHIP,scale=\scalefac, every node/.append style={transform shape}]
\node[fill=\filllcolor,draw=\drawcolor,minimum width=10mm, minimum height=10mm,inner sep=0pt,
            rounded corners=1pt,line width=2*\Linewidth,outer sep=2pt] (C1) {};
\foreach \x in {0.2,0.5,0.8}{
\draw[line width=1.3*\Linewidth,draw=\drawcolor,
-{Circle[fill=white,length=3.5pt]}]($(C1.north west)!\x!(C1.south west)$)--++(-3mm,0);
}
\foreach \x in {0.2,0.5,0.8}{
\draw[line width=1.3*\Linewidth,draw=\drawcolor,
-{Circle[fill=white,length=3.5pt]}]($(C1.north east)!\x!(C1.south east)$)--++(3mm,0);
}
%dole
\foreach \x in {0.2,0.5,0.8}{
\draw[line width=1.3*\Linewidth,draw=\drawcolor,
-{Circle[fill=white,length=3.5pt]}]($(C1.south west)!\x!(C1.south east)$)--++(0,-3mm);
}
%gore
\foreach \x in {0.2,0.5,0.8}{
\draw[line width=1.3*\Linewidth,draw=\drawcolor,
-{Circle[fill=white,length=3.5pt]}]($(C1.north west)!\x!(C1.north east)$)--++(0,3mm);
}
 \end{scope}
     }
  }
}
\pgfkeys{
  /channel/.cd,
   Depth/.store in=\Depth,
  Height/.store in=\Height,
  Width/.store in=\Width,
  filllcirclecolor/.store in=\filllcirclecolor,
  filllcolor/.store in=\filllcolor,
  drawcolor/.store in=\drawcolor,
  drawcircle/.store in=\drawcircle,
  scalefac/.store in=\scalefac,
  Linewidth/.store in=\Linewidth,
  picname/.store in=\picname,
  filllcolor=BrownLine,
  filllcirclecolor=violet!20,
  drawcolor=red,
  drawcircle=violet,
  scalefac=1,
  Linewidth=0.5pt,
  Depth=0.2,
  Height=0.5,
  Width=0.25,
  picname=C
}

%Input Data
\node[Box](B1){};
\coordinate(GO1)at($(B1.north west)!0.38!(B1.north east)$);
\coordinate(T1)at($(GO1)!0.5!(B1.south east)$);
\coordinate(I1)at($(B1.west)!0.21!(B1.east)$);
\node[align=center]at(T1){输入数据};
\node[Box,fill=none]{};
\pic[shift={(0,-0.38)}] at  (I1){data={scalefac=0.35,picname=1,filllcolor=mygreen, Linewidth=0.6pt}};
%Device 1
\node[Box2,right=of B1](B2){};
\coordinate(GO2)at($(B2.north west)!0.38!(B2.north east)$);
\coordinate(T2)at($(GO2)!0.5!(B2.south east)$);
\coordinate(I2)at($(B2.west)!0.21!(B2.east)$);
\node[align=center]at(T2){设备 1 \\ 第 1-16 层};
\node[Box,fill=none]{};
\pic[shift={(0,0)}] at  (I2){cpu3={scalefac=0.67,drawcolor=BrownLine, filllcolor=white, Linewidth=0.75pt}};
%Device 2
\node[Box2,right=of B2](B3){};
\coordinate(GO3)at($(B3.north west)!0.38!(B3.north east)$);
\coordinate(T3)at($(GO3)!0.5!(B3.south east)$);
\coordinate(I3)at($(B3.west)!0.21!(B3.east)$);
\node[align=center]at(T3){设备 2\\ 第 17-32 层};
\node[Box,fill=none]{};
\pic[shift={(0,0)}] at  (I3){cpu3={scalefac=0.67,drawcolor=BrownLine, filllcolor=white, Linewidth=0.75pt}};
%Device 3
\node[Box2,right=of B3](B4){};
\coordinate(GO4)at($(B4.north west)!0.38!(B4.north east)$);
\coordinate(T4)at($(GO4)!0.5!(B4.south east)$);
\coordinate(I4)at($(B4.west)!0.21!(B4.east)$);
\node[align=center]at(T4){设备 3\\ 第 33-48 层};
\node[Box,fill=none]{};
\pic[shift={(0,0)}] at  (I4){cpu3={scalefac=0.67,drawcolor=BrownLine, filllcolor=white, Linewidth=0.75pt}};
%Output
\node[Box,right=of B4](B5){};
\coordinate(GO5)at($(B5.north west)!0.38!(B5.north east)$);
\coordinate(T5)at($(GO5)!0.5!(B5.south east)$);
\coordinate(I5)at($(B5.west)!0.21!(B5.east)$);
\node[align=center]at(T5){输出};
\node[Box,fill=none]{};
\pic[shift={(0,0)}] at  (I5){output={scalefac=0.7,filllcirclecolor=orange!80,drawcolor=BlueLine,
 filllcirclecolor=mygreen, Linewidth=5.0pt}};
%
\node[inner xsep=0pt,above=4mm of B1.north,anchor=south ](GT1){前向传播};
\node[inner xsep=0pt,above=4.3mm of B3.north,anchor=south](GT2){激活值};
\node[inner xsep=0pt,above=4mm of B5.north,anchor=south ](GT3){输出};
\draw[LineA](GT1)--(GT2);
\draw[LineA](GT2)--(GT3);
%
\node[inner xsep=0pt,rectangle,minimum height=4mm,draw=none,
below=4mm of B1.south,anchor=north](DT1){反向传播};
\node[inner xsep=0pt,rectangle,minimum height=4mm,draw=none,
below=4.3mm of B3.south,anchor=north](DT2){梯度};
\node[inner xsep=0pt,rectangle,minimum height=4mm,draw=none,
below=4mm of B5.south,anchor= north](DT3){损失梯度};
\draw[LineAA](DT3.west)--(DT2.east);
\draw[LineAA](DT2.west)--(DT1.east);
%
\foreach \i  in {1,2,3,4}{
\pgfmathtruncatemacro{\x}{\i + 1} %
\draw[LineA2](B\i)--(B\x);
}
\end{tikzpicture}Systems Perspective 1.7: 数据并行与模型并行
将选定的工作负载划分到 \(N_{\text{GPU}}\) 个设备上时,可以划分样本、模型状态、层或张量运算。对于参数量为 \(P\)、批大小为 \(B\) 的模型,数据并行与模型并行提供了两种基本思路。
数据并行(划分批次):在全局批大小固定的情况下,\(N_{\text{GPU}}\) 个工作进程中的每个进程处理约 \(1/N_{\text{GPU}}\) 的样本,但每个工作进程都保存一个模型副本,通常还保存其相关训练状态。每次更新的稠密梯度通信量与 \(P\) 成正比。随着本地批大小减小,或同步与输入开销增大,扩展效果会偏离理想情况。
模型并行(划分模型计算):每个加速器存储并计算模型的一部分。均匀划分时,每个工作进程的参数量可能接近 \(P/N_{\text{GPU}}\),但嵌入、缓冲区、负载不均衡和复制的状态都会改变这一估计。通信取决于划分方式:逐层流水线并行在阶段边界交换激活值,而张量并行则在被划分的层内部执行集合通信。
系统洞见:当每个工作进程都能容纳完整训练状态,且需要更高吞吐量时,数据并行是最简单的候选方案。无法容纳时,就有必要进行模型状态分片、流水线划分或张量划分,并且通常会与数据并行结合使用。
当模型超出单个加速器的内存容量时,可以沿深度方向将其划分到按顺序连接的多个设备上。Figure 18 展示了这种阶段分配方式,将连续的 Transformer 块组映射到执行链中的不同设备上。
\begin{tikzpicture}[font=\sffamily\small]

\tikzset{
  Box/.style={ inner xsep=2pt,
    node distance=1.4,
    draw=none,
    line width=0.5pt,,
    fill=none,
    minimum width=22mm, minimum height=10mm
  },
    LineA/.style={myblue!40,line width=3pt,{-{Triangle[width=1.0*6pt,length=1.0*8pt]}},shorten <=1pt,shorten >=1pt},
}
%CPU2
\tikzset{%
 pics/cpu3/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=CHIP,scale=\scalefac, every node/.append style={transform shape}]
\node[fill=\filllcolor,draw=\drawcolor,minimum width=8mm, minimum height=8mm,inner sep=0pt,
            rounded corners=1pt,line width=2.5*\Linewidth,outer sep=2pt] (C1) {};
\foreach \x in {0.2,0.5,0.8}{
\draw[line width=1.3*\Linewidth,draw=\drawcolor,
-{Circle[fill=white,length=3.2pt]}]($(C1.north west)!\x!(C1.south west)$)--++(-3mm,0);
}
\foreach \x in {0.2,0.5,0.8}{
\draw[line width=1.1*\Linewidth,draw=\drawcolor,
-{Circle[fill=white,length=3.2pt]}]($(C1.north east)!\x!(C1.south east)$)--++(3mm,0);
}
%dole
\foreach \x in {0.2,0.5,0.8}{
\draw[line width=1.1*\Linewidth,draw=\drawcolor,
-{Circle[fill=white,length=3.2pt]}]($(C1.south west)!\x!(C1.south east)$)--++(0,-3mm);
}
%gore
\foreach \x in {0.2,0.5,0.8}{
\draw[line width=1.1*\Linewidth,draw=\drawcolor,
-{Circle[fill=white,length=3.2pt]}]($(C1.north west)!\x!(C1.north east)$)--++(0,3mm);
}
 \end{scope}
     }
  }
}
\tikzset{%
 pics/stackedS/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=STACKED,scale=\scalefac, every node/.append style={transform shape}]
%plats

\draw[fill=\filllcolor,line width=\Linewidth,draw=\drawcolor](0,-0.2)--(-0.67,0.13)--(0,0.47)--(0.67,0.13)--cycle;
\draw[fill=\filllcirclecolor,line width=\Linewidth,draw=\drawcolor](0,0)--(-0.67,0.33)--(0,0.67)--(0.67,0.33)--cycle;
\draw[fill=\filllcolor,line width=\Linewidth,draw=\drawcolor](0,0.2)--(-0.67,0.53)--(0,0.87)--(0.67,0.53)--cycle;
\draw[fill=\filllcirclecolor,line width=\Linewidth,draw=\drawcolor](0,0.4)--(-0.67,0.73)--(0,1.07)--(0.67,0.73)--cycle;
\end{scope}
     }
  }
}
\pgfkeys{
  /channel/.cd,
   Depth/.store in=\Depth,
  Height/.store in=\Height,
  Width/.store in=\Width,
  filllcirclecolor/.store in=\filllcirclecolor,
  filllcolor/.store in=\filllcolor,
  drawcolor/.store in=\drawcolor,
  drawcircle/.store in=\drawcircle,
  scalefac/.store in=\scalefac,
  Linewidth/.store in=\Linewidth,
  picname/.store in=\picname,
  filllcolor=BrownLine,
  filllcirclecolor=cyan!40,
  drawcolor=black,
  drawcircle=violet,
  scalefac=1,
  Linewidth=0.5pt,
  Depth=1.3,
  Height=0.8,
  Width=1.1,
  picname=C
}
%device 1
\begin{scope}[local bounding box=D1,shift={($(0,0)+(0,0)$)}]
\node[Box](MM){};
\node[below=1pt of MM](T1){模块 1-6};
\pic[shift={(0,-0.35)}] at  (MM){stackedS={scalefac=0.8,Linewidth=1.0pt,
 filllcolor=cyan!90!black!40!,drawcolor=black,filllcirclecolor=orange}};
%
\node[below=3mm of T1,Box](DP){};
\node[below=1pt of DP](T2){GPU 1};
\pic[shift={(0,0)}] at  (DP){cpu3={scalefac=0.7, drawcolor=BlueLine, filllcolor=white, Linewidth=0.75pt}};

\scoped[on background layer]
\node[fit=(MM)(T1)(T2),draw=red,yshift=4mm,inner xsep=2mm,inner ysep=5mm,
fill=BackColor!10,draw=myolive](DD){};
\node[below=1pt of DD.north,font=\sffamily\bfseries\footnotesize]{设备 1};
\end{scope}
%device 2
\begin{scope}[local bounding box=D2,shift={($(0,0)+(4.5,0)$)}]
\node[Box](MM){};
\node[below=1pt of MM](T1){模块 7-12};
\pic[shift={(0,-0.35)}] at  (MM){stackedS={scalefac=0.8,Linewidth=1.0pt,
 filllcolor=cyan!90!black!40!,drawcolor=black,filllcirclecolor=orange}};
%
\node[below=3mm of T1,Box](DP){};
\node[below=1pt of DP](T2){GPU 2};
\pic[shift={(0,0)}] at  (DP){cpu3={scalefac=0.7, drawcolor=BlueLine, filllcolor=white, Linewidth=0.75pt}};

\scoped[on background layer]
\node[fit=(MM)(T1)(T2),draw=red,yshift=4mm,inner xsep=2mm,inner ysep=5mm,
fill=BackColor!10,draw=myolive](DD){};
\node[below=1pt of DD.north,font=\sffamily\bfseries\footnotesize]{设备 2};
\end{scope}
%device 3
\begin{scope}[local bounding box=D3,shift={($(0,0)+(9,0)$)}]
\node[Box](MM){};
\node[below=1pt of MM](T1){模块 13-18};
\pic[shift={(0,-0.35)}] at  (MM){stackedS={scalefac=0.8,Linewidth=1.0pt,
 filllcolor=cyan!90!black!40!,drawcolor=black,filllcirclecolor=orange}};
%
\node[below=3mm of T1,Box](DP){};
\node[below=1pt of DP](T2){GPU 3};
\pic[shift={(0,0)}] at  (DP){cpu3={scalefac=0.7, drawcolor=BlueLine, filllcolor=white, Linewidth=0.75pt}};

\scoped[on background layer]
\node[fit=(MM)(T1)(T2),draw=red,yshift=4mm,inner xsep=2mm,inner ysep=5mm,
fill=BackColor!10,draw=myolive](DD){};
\node[below=1pt of DD.north,font=\sffamily\bfseries\footnotesize]{设备 3};
\end{scope}
%device 4
\begin{scope}[local bounding box=D4,shift={($(0,0)+(13.5,0)$)}]
\node[Box](MM){};
\node[below=1pt of MM](T1){模块 19-24};
\pic[shift={(0,-0.35)}] at  (MM){stackedS={scalefac=0.8,Linewidth=1.0pt,
 filllcolor=cyan!90!black!40!,drawcolor=black,filllcirclecolor=orange}};
%
\node[below=3mm of T1,Box](DP){};
\node[below=1pt of DP](T2){GPU 4};
\pic[shift={(0,0)}] at  (DP){cpu3={scalefac=0.7, drawcolor=BlueLine, filllcolor=white, Linewidth=0.75pt}};

\scoped[on background layer]
\node[fit=(MM)(T1)(T2),draw=red,yshift=4mm,inner xsep=2mm,inner ysep=5mm,
fill=BackColor!10,draw=myolive](DD){};
\node[below=1pt of DD.north,font=\sffamily\bfseries\footnotesize]{设备 4};
\end{scope}

 \foreach \i [evaluate=\i as \t using int(\i+1)] in {1,2,3}{
\draw[LineA](D\i)--
node[above,pos=0.45,text=black!50,font=\sffamily
\fontsize{9pt}{7}\selectfont]{激活值}
(D\t);
}
\end{tikzpicture}朴素逐层划分的根本瓶颈在于设备串行执行。由于层计算严格按顺序进行,设备 1 计算第 1–6 层时,设备 2–4 处于空闲状态,等待前向激活值。在反向传播过程中,依赖关系反转:设备 4 首先计算,而上游设备等待回传的梯度。这段空闲时间构成了流水线气泡,在朴素顺序执行方式下,理论硬件利用率的上限为 \(1/N_{\text{GPU}}\)。减少这段空闲时间,需要将微批次以流水线方式调度到各个阶段,或者在层内沿张量维度进行划分,使所有设备能够同时计算。
在节点内部,GPU 可以通过 NVLink27 等高带宽链路通信(所示 H100 配置的双向聚合带宽最高为 900 GB/s)。有效集合通信带宽取决于拓扑和争用情况,低于原始聚合链路规格所标示的带宽。数据并行通过集合 AllReduce 操作传输梯度,而逐层模型并行在划分边界处以点对点方式传输激活值。选择策略时,需要根据节点拓扑的物理互连带宽,权衡这些通信模式及其内存占用。
扩展至多节点
当模型参数占用、优化器状态或训练时长超出一个配备 8 个加速器的节点所能承载的范围时,分布式训练便会扩展到多台机器。这一步引入了一种根本性的带宽层级:节点内的加速器通过 NVLink 等密集、高带宽的互连网络通信,而分布式工作进程必须通过以太网或 InfiniBand 等外部网络进行同步,后者的带宽显著更低、延迟更高,且存在交换机争用。由此产生的带宽差距,使同步数据并行中的梯度归约成为关键路径上反复出现的数据搬移瓶颈。
Systems Perspective 1.8: 同步的物理约束
回顾 数据工程 中的能量—搬移不变量:数据搬移消耗的能量和时间远高于就近执行算术运算。在分布式训练中,这种不对称性形成了通信开销。
在加速器之间同步梯度,意味着每个训练步都要通过互连传输数兆字节至数吉字节的数据。未被计算掩蔽的通信时间会直接降低硬件利用率,而收发器和交换机的功耗会增加集群的能源预算;这是两种不同的系统成本。混合精度执行(section 1.6.3)和梯度压缩通过更窄的数值格式、稀疏性、量化或差分编码减少传输量,从而缓解这两方面的约束。
在节点内部,高带宽互连允许梯度同步与反向计算重叠。然而,一旦跨越节点边界,通信就会转移到可用带宽低一至两个数量级的网络上。在同步数据并行中,AllReduce28 汇总各工作进程的梯度;当网络带宽无法匹配加速器的计算吞吐量时,未被计算掩蔽的通信时间就会主导训练步耗时,并使算术执行停滞。
Napkin Math 1.10: 网络墙
问题:某团队将训练扩展到 8 GPUs,每个节点配备一个 GPU,各节点通过 100 Gbps 网络连接。网络是否是瓶颈?
机制:对于一个具有 7B 个参数、采用 FP16 梯度的模型:
- 梯度大小(FP16):每步为 14 GB。
- AllReduce 成本:环形 AllReduce 沿逻辑环传递梯度分片,因此每个工作进程最终发送的数据量接近完整梯度的两倍:\(2(N_{\text{GPU}}-1)/N_{\text{GPU}}\),对于 8 GPUs,该值为 1.75×。因此,总量为 1.75 \(\times\) 14 GB = 24.5 GB。
- 仅考虑带宽的下界:在 100 Gbps 网络上,每个工作进程的带宽为 12.5 GB/s,同步延迟为 \(T_{\text{comm}} = D_{\text{comm}} / \text{BW}_{\text{net}} =\) 24.5 GB / 12.5 GB/s \(=\) 1.96 s。
- 计算对比:如果未与通信重叠的前向和反向计算耗时为 \(T_{\text{compute}} \approx\) 1 s,那么通信延迟 \(T_{\text{comm}} \approx\) 1.96 s 将占据主导地位。
系统洞见:当 \(T_{\text{comm}} > T_{\text{compute}}\) 时,网络便成为一道墙,导致加速器效率 \(\eta_{\text{hw}} = \frac{T_{\text{compute}}}{T_{\text{compute}} + T_{\text{comm}}}\) 骤降至约 33.8 percent。缓解措施包括梯度压缩(减少 \(D_{\text{comm}}\))、环形 AllReduce 原语 (Sergeev and Balso 2018),以及将高频传输限制在快速节点内链路上的分层拓扑(NVLink 带宽为 900 GB/s,而节点间带宽为 12.5 GB/s)。
Sergeev, Alexander, and Mike Del Balso. 2018. “Horovod: Fast and Easy Distributed Deep Learning in TensorFlow.” CoRR abs/1802.05799.
由于跨节点网络限制了频繁同步的速度,扩展训练需要将每种通信模式匹配到合适的带宽层级。流水线并行将模型层划分到顺序排列的设备上,并通过微批处理缓解朴素模型并行中的空闲流水线气泡。全局批次被划分为更小的微批次,依次流经流水线各阶段,而非将整个批次串行处理。当下游阶段对较早的微批次执行前向传播时,上游阶段同时处理后续微批次。流水线调度控制着这种并发:保留更多在途微批次可以减少加速器空闲时间,但要求每个阶段将激活值保存在内存中,直至相应的反向传播完成。GPipe29 先计算所有微批次的前向传播,再执行反向传播直至流水线排空;PipeDream 则将一次前向传播与一次反向传播交错执行(1F1B),以限制驻留激活值的内存占用 (Huang et al. 2019; Narayanan et al. 2019)。
张量并行的粒度更细:它将层内的单个矩阵运算分片到多个设备上,而非将完整的层分配给不同设备。(序列并行将这一原则扩展到长上下文 Transformer 训练中,沿序列维度对激活张量进行分片。)在 Transformer 前馈模块中,Megatron-LM 对第一个权重投影按列划分,对第二个投影按行划分 (Shoeybi et al. 2019)。每个加速器在隐藏维度的一个切片上执行计算,中间无需通信;仅需在模块末尾于张量并行组内执行一次 AllReduce,对部分输出求和。由于这种模式要求在每次前向和反向算子执行中进行集合同步,张量并行的通信频率极高,因此其部署被严格限制在 NVLink 等高带宽节点内链路上。
Shoeybi, Mohammad, Mostofa Patwary, Raul Puri, Patrick LeGresley, Jared Casper, and Bryan Catanzaro. 2019. “Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism.” arXiv Preprint arXiv:1909.08053.
混合策略结合张量并行、流水线并行和数据并行(三维并行),使大模型能够扩展到整个物理集群。Table 20 总结了由此形成的放置启发式原则:将频率最高的集合通信映射到带宽最高的物理链路,并将带宽较低的层级留给粒度更粗的同步边界。
| 策略 | 典型放置位置 | 通信模式 |
|---|---|---|
| 张量并行 | 节点内 | 利用 NVLink 高带宽进行频繁通信 |
| 流水线并行 | 机架内跨节点 | 在层边界进行适度通信 |
| 数据并行 | 跨机架 | 每次迭代同步一次梯度 |
将计算划分到整个集群,最终会使训练从纯粹的算术计算问题转变为多层级的数据搬移问题。尽管集合通信算法、参数服务器和容错调度使模型能够扩展到数千个加速器,其持续运行效率仍受计算吞吐量与网络传输时间之比的约束。要理解现代训练平台如何平衡这些约束,需要考察高性能科学计算与仓库级基础设施在历史上的融合,正是这种融合催生了当今的 AI 硬件互连网络。
训练基础设施的演进
section 1.7.1 和 section 1.7.2 中的并行策略体现了不同架构传统的融合。现代训练平台整合了四个计算时代发展出的范式,每个时代的范式都受到当时物理约束和主导工作负载的塑造。
神经网络训练同时结合了高性能计算(HPC)和仓库级系统的需求。训练从 HPC 继承了接近加速器计算极限运行的稠密矩阵乘法(GEMM)内核,这要求跨设备执行紧密同步的并行计算。从仓库级计算中,持续数日的训练作业继承了对集群级编排、异步数据摄取,以及在易发生故障的节点之间自动恢复的需求。标准同步数据并行训练在每个优化器步执行一次全局 AllReduce 集合操作。要使加速器持续执行算术运算而不因通信停滞,需要高带宽互连(如 NVLink 和 InfiniBand),以及绕过主机操作系统开销的直接内存访问运行时。Figure 19 按时间顺序展示了这些计算时代的演进过程。
\begin{tikzpicture}[font=\small\sf,node distance=0pt,xscale=2]
\tikzset{
  Box/.style={inner xsep=2pt, draw=black!80, line width=0.75pt,
    fill=black!10, anchor=south, rounded corners=2pt,
    font=\sf\footnotesize, align=center, minimum height=5mm},
}
\definecolor{col1}{RGB}{240,240,255}
\definecolor{col2}{RGB}{255, 255, 205}
\def\du{199mm}
\def\vi{15mm}
\node[fill=green!10,draw=none,minimum width=\du,
name path=G4,anchor=south west, minimum height=\vi](B1)at(-19.0mm,3mm){};
\node[right=2mm of B1.west,anchor=west,align=left]{AI 超级计算\\ 时代};
\node[fill=col2,draw=none,minimum width=\du,
name path=G3,anchor=south west, minimum height=\vi](Z)at(B1.north west){};
\node[right=2mm of Z.west,anchor=west,align=left]{仓库级\\ 计算};
\node[fill=red!10,draw=none,minimum width=\du,
anchor=south west, minimum height=\vi](B2)at (Z.north west){};
\node[right=2mm of B2.west,anchor=west,align=left]{高性能\\ 计算};
\node[fill=col1,draw=none,minimum width=\du,
name path=G1,anchor=south west, minimum height=\vi](V)at(B2.north west){};
\node[right=2mm of V.west,anchor=west,align=left]{大型机};
\def\hi{6.75}
\draw[thick,name path=V1](0mm,0)node[below]{1950}--++(90:\hi);
\draw[thick,name path=V2](10mm,0)node[below]{1960}--++(90:\hi);
\draw[thick,name path=V3](20mm,0)node[below]{1970}--++(90:\hi);
\draw[thick,name path=V4](30mm,0)node[below]{1980}--++(90:\hi);
\draw[thick,name path=V5](40mm,0)node[below]{1990}--++(90:\hi);
\draw[thick,name path=V6](50mm,0)node[below]{2000}--++(90:\hi);
\draw[thick,name path=V7](60mm,0)node[below]{2010}--++(90:\hi);
\draw[thick,name path=V8](70mm,0)node[below]{2020}--++(90:\hi);
\def\fa{2}
\path [name intersections={of=V1 and G1,by={A,B}}];
\node[Box, minimum width=20mm, anchor=south west, xshift=-\fa*5mm]at([yshift=1pt]B){ENIAC};
\path [name intersections={of=V3 and G1,by={C,D}}];
\node[Box, minimum width=20mm, anchor=north west, xshift=-\fa*6mm]at([yshift=-1pt]C){IBM\\ System/360};
\node[Box, minimum width=40mm, anchor=north west, xshift=-\fa*6mm]at([yshift=-1pt]D){CDC 6600};
\path [name intersections={of=V4 and G3,by={E,F}}];
\node[Box, minimum width=30mm, anchor=south west, xshift=-\fa*4mm]at([yshift=1pt]E){Cray-1};
\path [name intersections={of=V6 and G3,by={G,H}}];
\node[Box, minimum width=20mm, anchor=north west, xshift=0mm]at([yshift=-1pt]G){Google 数据\\ 中心};
\path [name intersections={of=V7 and G3,by={I,J}}];
\node[Box, minimum width=22mm, anchor=south west, xshift=-\fa*5mm]at([yshift=1pt]J){AWS};
\path [name intersections={of=V8 and G4,by={K,L}}];
\node[Box, minimum width=20mm, anchor=north west, xshift=-\fa*5mm]at([yshift=-1pt]K){NVIDIA GPU};
\node[Box, minimum width=20mm, anchor=south west, xshift=-\fa*5mm]at([yshift=1pt]L){Google TPU};
\end{tikzpicture}向 AI 超级计算的这一转变,反映了内存访问模式与同步语义在结构上的分化。科学高性能计算(HPC)仿真通常遍历规则的空间网格,每个自由度所需的工作状态较少;而仓库级服务通过商用以太网处理相互独立、松耦合的请求。相比之下,神经网络训练面临巨大的状态存储需求:加速器必须容纳模型权重、梯度、优化器状态(例如动量和方差缓冲区),以及为反向传播保留的中间激活值。当这些状态的总量超过单个设备的高带宽内存(HBM)容量时,就必须将模型划分到多个加速器上,以设备间通信开销为代价缓解本地内存压力。Table 21 对比了这四个架构时代的工作负载需求、内存层次结构和执行模型。
| 时代 | 主要工作负载 | 内存访问模式 | 处理模型 |
|---|---|---|---|
| 大型机 | 顺序批处理 | 简单的内存层次结构 | 单指令流 |
| HPC | 科学仿真 | 规则的数组访问 | 同步并行 |
| 仓库级计算 | 互联网服务 | 稀疏、不规则访问 | 独立的并行任务 |
| AI 超级计算 | 神经网络训练 | 参数密集、混合访问 | 混合并行、分布式 |
何时扩展:物理上限
知道如何将计算划分到多个设备上,与知道何时有必要采用分布式执行,是两个不同的问题。将状态分布到多个设备会引入通信开销、同步屏障和运行故障模式。首先充分挖掘单节点优化的潜力,有助于辨明瓶颈的根源究竟在于算法还是容量。基于性能剖析的调优应评估以下方法:在数值稳定性允许时采用较低精度的执行路径(section 1.6.3);通过梯度累积(section 1.6.5)实现目标批量大小,避免激活值占用激增;通过激活检查点(section 1.6.5.1)以冗余的前向计算换取内存余量;以及在主机端数据摄取限制关键路径时,采用与计算重叠的数据预取(section 1.6.2)。
Table 22 将这一推进过程组织为按资源瓶颈查找的决策表,依据是实测硬件瓶颈,而非任意设定的参数量阈值。
| 观测到的约束 | 候选方案 | 理由 |
|---|---|---|
| 训练状态可容纳于单个设备,且耗时可接受 | 单 GPU | 尽量减少通信和运维复杂度 |
| 状态容量或吞吐量需求超出单个设备,但未超出单个节点 | 单个多 GPU 节点 | 在跨网络通信之前,先利用高速本地互连 |
| 所需状态容量或进度要求超出单个节点的能力 | 多节点集群 | 以通信开销为代价增加总内存容量或算力 |
| 输入服务速率低于加速器需求 | 并行或分布式输入流水线 | 在性能剖析表明有需要的位置增加输入吞吐量 |
只有在性能剖析表明,经过上述优化后仍存在持续瓶颈时,才应考虑多设备方案。每个硬件设备都有物理上限:无论对加速器进行多么精细的调优,需要 \(10^{24}\) FLOPs 的工作负载都无法在实际可行的训练周期内由单个加速器完成。当触及以下三个硬性限制之一时,就有必要转向多设备训练:
- 内存耗尽:模型权重、梯度、优化器状态和激活值超出单个 GPU 的显存容量。一个 700 亿参数的模型,仅以 FP16 存储权重就需要约 140 GB,超过 A100 和 H100 SXM 加速器的 80 GB 配置;计入训练状态后,即使是 H100 NVL(94 GB)和 H200(141 GB)等容量更高的型号,也几乎没有或完全没有剩余容量。
- 训练墙钟时间:单个设备上的预计耗时超过项目的实际截止期限。在持续性能为 \(10^{15}\) FLOP/s 时,需要 \(10^{24}\) FLOPs 的工作负载将耗时约 32 年。
- 输入吞吐量:输入流水线无法持续满足所有加速器的总消耗速率。数据集大小本身并不决定这一限制;复用、压缩、局部性、变换成本和存储带宽都很重要。
这三个限制属于技术层面,但扩展所带来的代价并不限于复杂度和容量。增加设备会放大训练的能耗和环境影响,因此效率优化既是性能问题,也是环境问题。
Napkin Math 1.11: 训练的碳足迹
背景:训练大型模型需要大量能源和计算资源。物理上限体现在机器学习系统铁律的能耗推论中(\(E_{\text{total}} = P_{\text{fleet}} \cdot T_{\text{train}}\)),该推论量化了环境影响的规模:
- 工作负载:使用 1 trillion 个词元训练一个具有 7 billion 个参数的模型。
- 计算量:\(O \approx\) \(4.2 \times 10^{22}\)。
- 效率:A100 的持续性能为 156 TFLOP/s(热设计功耗为 400 W)。
- 执行时间:在 1,024 GPUs 上,\(T_{\text{train}} \approx\) 3.04 days。
- 能耗足迹:\(E_{\text{total}} = P_{\text{cluster}} \cdot T_{\text{train}} = (N_{\text{GPU}} \cdot P_{\text{GPU}} + N_{\text{host}} \cdot P_{\text{host}}) \cdot T_{\text{train}}\) 的计算结果为(1,024 GPUs \(\times\) 400 W + 128 hosts \(\times\) 200 W)\(\times\) 73 hours \(\approx\) 31,784.2 kWh。
影响:所消耗的能源相当于普通家庭 35.3 months 的平均用电量。
系统启示:在集群功率 \(P_{\text{cluster}}\) 保持不变的情况下,将硬件吞吐量 \(\eta_{\text{hw}}\) 提高一倍,会使执行时间 \(T_{\text{train}}\) 和总能耗 \(E_{\text{total}}\) 减半。在电网碳强度取平均值的条件下,将效率提高一倍可节省约 15,892.1 kWh 的电能,并避免 6.8 t 的排放。环境审计必须测量 \(E_{\text{total}} = \int P(t) dt\),而不能仅依赖 GPU 利用率指标。
扩展会改变起约束作用的瓶颈,而不会将其消除:数据并行换取吞吐量,模型并行换取内存容量,流水线并行换取利用率,张量并行使层级规模的计算变得可行,但每种方式都会增加通信和协调成本。多节点分布式训练的实现细节,包括集合通信原语、容错机制和弹性调度,都直接建立在本章所述的单机原理之上,并在高阶分布式系统教材中有深入论述。
Checkpoint 1.3: 扩展决策
扩展以通信瓶颈为代价缓解计算瓶颈。
误区与陷阱
从单 GPU 优化到多设备并行的演进表明,每种技术都会引入权衡和新的约束。本章逐步建立的方法通过机器学习系统铁律量化成本,通过性能剖析诊断瓶颈,实施有针对性的优化,并仅在必要时扩展规模。以下误区与陷阱概括了常见错误,这些错误会浪费计算资源、延缓研究进展,或导致生产环境中的训练失败。
误区:模型越大,性能就一定越好。
团队有时将规模视为能够单调提升性能的手段:如果一个 70 亿参数的模型表现良好,那么一个 200 亿参数的模型必然表现更好。在所述的混合精度 Adam 配置中,一个 20B 参数的模型需要约 320 GB 的非激活训练状态存储空间(40 GB 的 FP16 参数 + 40 GB 的 FP16 梯度 + 80 GB 的 FP32 主权重 + 160 GB 的 Adam 状态)。它是否优于一个 7B 参数的模型,取决于数据数量与质量、训练计算量、优化和评估。仅凭参数量,无法推导出通用的样本数量阈值或准确率损失。
陷阱:认为分布式训练会自动加快开发进程。
更多加速器并不能保证训练更快,因为通信、更小的本地批量、输入限制和负载不均衡都可能抵消收益。在一个用于说明的 8 GPUs 场景中,同步占据了单步时间的 30–50 percent,加速比仅达到 4–6×,而非理想的 8×。这些数值是假设值;决策需要依据实测的端到端时间和扩展效率。
误区:超参数可以从小规模实验直接迁移到大规模训练。
在批量大小为 512 时有效的学习率,未必适用于批量大小为 4,096 的情况。对于这一八倍的变化,线性缩放规则 (Goyal et al. 2017) 会将学习率从 0.1 提高到 0.8,通常还会配合学习率预热,但这是一种经验性配置,而非必要条件或收敛保证。大规模训练必须联合验证学习率、调度策略、优化器状态和有效批量大小。
Goyal, Priya, Piotr Dollár, Ross Girshick, Pieter Noordhuis, Lukasz Wesolowski, Aapo Kyrola, Andrew Tulloch, Yangqing Jia, and Kaiming He. 2017. “Accurate, Large Minibatch SGD: Training ImageNet in 1 Hour.” arXiv Preprint arXiv:1706.02677 abs/1706.02677.
陷阱:将混合精度训练视为无需验证的简单开关。
本章用于说明的 V100 输入数值意味着 2.4× 的加速比,但这些数值并非基准测试结果。FP16 通常需要损失缩放 (Micikevicius et al. 2017),而 BF16 通常不需要 (Wang and Kanwar 2019; Kalamkar et al. 2019)(参见 section 1.6.3)。两种配置都可能改变数值行为,因此必须在目标工作负载上验证吞吐量和收敛性。
Kalamkar, Dhiraj, Dheevatsa Mudigere, Naveen Mellempudi, Dipankar Das, Kunal Banerjee, Sasikanth Avancha, Dharma Teja Vooturi, et al. 2019. A Study of BFLOAT16 for Deep Learning Training.
误区:内存与计算可以独立优化。
内存与计算相互耦合:在这一用于说明的性能剖析结果中,加速器利用率从批量大小为 256 时的 90 percent,下降到批量大小为 16 时的 60–70 percent。梯度累积(有效批量大小为 512,物理批量大小为 64)以 5 percent 的效率损失,换取 8× 的内存缩减倍数。独立调整这些参数会使训练时间延长 20–40 percent(参见 section 1.6.5)。
陷阱:在估算训练内存预算时,认为其中只有模型权重。
仅根据权重估算训练内存,会遗漏梯度、优化器状态、使用时的主权重、激活值、临时工作空间以及内存分配器开销。在本章的混合精度 Adam 配置中,FP16 权重(2 字节)、FP16 梯度(2 字节)、FP32 主权重(4 字节)和两个 FP32 矩估计(8 字节),在不计激活值时合计为每个参数 16 字节。其他优化器和分片策略会改变这一预算。激活内存则取决于批量大小、序列长度、架构、内核和检查点策略;不存在通用的权重内存占用倍数关系。
误区:加速器始终是训练瓶颈。
数据加载经常造成空闲时间,但团队却优先优化计算。在这一用于说明的性能剖析结果中,通过流水线重叠进行预取,使数据加载与计算重叠,从而将实际经过时间缩短了 47.6 percent(从 105 min 降至 55 min)(参见 section 1.6.2)。在认定 GPU 是瓶颈之前,应先进行性能剖析。
陷阱:在剖析输入流水线之前优化内核。
内核级调优很有吸引力,因为 GPU 利用率易于查看,但供数不足的加速器看起来也可能像是执行效率低下的加速器。在改变精度、重写内核或增加 GPU 之前,应测量数据加载器吞吐量、主机预处理时间、存储等待时间,以及主机到设备传输的重叠程度。如果加速器正在等待批次,最快见效的优化是为其可靠地提供数据,而非让其内核仅仅快上一点。
总结
训练将算法、内存管理和硬件加速结合起来,把数据转化为模型参数。在大规模场景下,前向传播和反向传播需要在硬件与性能约束下协调矩阵运算、内存分配和梯度计算。
预取、混合精度、FlashAttention、梯度累积和检查点技术分别应对不同的吞吐量、内存和数值约束。应使技术与起决定作用的约束相匹配;当单机能力耗尽时,数据并行、模型并行、流水线并行和张量并行以更高的复杂性换取更大的规模。
这种协同设计塑造了大规模训练:矩阵运算模式推动了 GPU Tensor Core 的发展,框架通过混合精度 API 提供了对它们的访问,而 FP16 训练等技术又影响了后续硬件。随后,浮点运算量与内存核算为优化器比较、成本估算,以及判断增加硬件究竟有助于提升性能还是仅仅转移瓶颈提供依据。
要点回顾: 训练为何耗资数百万
- 训练成本是一项由机器学习系统铁律约束的预算:\(T_{\text{train}} = \frac{O}{R_{\text{peak}} \times \eta_{\text{hw}}}\) 使每项优化都有据可衡量:减少工作量、提高有效吞吐量,或提升利用率。未触及主导项的改动,只会在训练循环中转移成本。
- 内存决定能否容纳优化器:在所述表示方式下,不计激活值时,标准混合精度 Adam 使用的内存是 FP16 推理权重内存的 8\(\times\)。决定训练能否装入内存的是优化器状态和随批量大小变化的激活值,而非仅有权重。
- 性能剖析决定应对措施:剖析、诊断、修复,再次剖析。受计算限制的作业需要改进算术运算或算法;受内存限制的作业需要减少状态或数据流量;受数据和通信限制的作业需要调整流水线或并行方式。
- 精度和 IO 感知内核会转移瓶颈:采用 FP32 累加的 FP16 计算可以提高吞吐量并改善内存使用,而 FlashAttention 避免在 HBM 中显式存储完整的 \(S{\times}S\) 矩阵;实际收益取决于工作负载和硬件。
- 检查点技术以重计算换取内存:减少保存的激活值,并在反向传播期间重新计算它们,在本章演示中可将激活内存缩减 3–4\(\times\);当批量大小为 4 时,从 35.9 GB 降至 9 GB。当起约束作用的是内存而非计算时,应采用这一技术。
- 组合优化可以推迟横向扩展:对于批量大小为 4 的 GPT-2,在不计临时工作空间时,混合精度与检查点技术将内存需求从 95.7 GB 降至模型估算的 33 GB。在接受分布式通信和运维开销之前,应先采用适用的本地优化手段。
机器学习系统铁律将运行缓慢的作业归为受计算限制(改进算术运算或算法)、受内存限制(减少状态或数据流量)、受数据限制(修复输入流水线)或受通信限制(调整累积或并行方式)。仅在硬件未被充分占用时增大批量。遵循这一原则,可以避免通过增加硬件来处理表面症状,并在成本增长时保持迭代的可行性。
训练使机器学习系统铁律成为日常工具。混合精度改变有效吞吐量和内存流量;检查点技术以重计算换取内存;规模扩展则引入通信。工程任务在于识别主导项,并采用成本最低且能够改变该项的干预措施。
后续内容: 从训练到数据选择
训练通过在每个样本上投入计算来产生学习得到的参数;本章经过优化的运行仍需要 33 GB 的内存。一旦训练循环已实现高效运行,下一个问题便是每个样本是否都值得付出这一成本。重复或信息量较低的样本,与能够扩大覆盖范围或纠正薄弱环节的样本一样,都会消耗相同的前向传播、反向传播、优化器更新和通信资源。
因此,数据选择 将关注点从执行转向上游的工作负载构成。它考察冗余性、代表性、不确定性和类别覆盖如何决定哪些样本应纳入有限的训练预算。有用的子集必须减少工作量,同时避免丢失罕见案例或改变实际训练分布。当这一平衡得以保持时,经过精心选择的子集可以在接近完整数据集准确率的同时,降低每个训练轮次的成本,并使更多实验在成本上可行。优化目标不再仅仅是系统处理样本的效率,还包括系统究竟应当处理哪些样本。
Footnotes
训练成本增长:本章两个成本参考值之间约 2,000\(\times\) 的比值,说明参数量、训练词元预算、硬件代际和加速器集群规模如何产生叠加效应;它并非对已披露训练账单进行的受控比较。OpenAI 的 GPT-2 报告记录了模型和训练配置,但未披露训练成本 (Radford et al. 2019)。GPT-4 的确切训练细节同样未披露,因此,GPT-4 级别的成本数字被明确视为行业估计,其依据是公开报道和独立的基础设施分析 (Knight 2023; Patel and Wong 2023)。↩︎
梯度检查点(激活检查点):反向传播会保留各条反向计算规则所需的前向值。检查点策略保存选定的值,并在反向传播期间重新计算其他值,以额外工作量换取更低的激活内存占用。\(\sqrt{N_L}\) 检查点放置方式及其相应的重新计算成本,描述的是 Chen et al. (2016) 分析的经典调度方案,而非所有检查点实现。Section 1.6.5.2 将结合 GPT-2 的层数详细推演该调度方案。↩︎
混合精度训练:对选定的计算和存储使用较低精度,同时在累加或数值范围有要求的地方保留较高精度。一种常见的 FP16 方案维护 FP32 主权重,并使用损失缩放来减少梯度下溢 (Micikevicius et al. 2017)。BF16(“Brain Floating Point”,源自 Google Brain (Wang and Kanwar 2019))具有与 FP32 相同的 8 位指数范围,因此通常无需动态损失缩放,但具体的状态精度和累加精度取决于优化器及其实现。↩︎
数据并行:在每个设备上复制完整模型,仅拆分数据。每个设备独立计算梯度,再通过 AllReduce 操作同步梯度——这会在每一步增加与模型规模成正比的通信量。这种同步代价限制了扩展效率:一旦通信成为瓶颈,将加速器数量翻倍很少能使训练时间减半。↩︎
模型并行:当模型超出单设备内存容量时,将模型的各层划分到不同设备上。激活值必须在每个分区边界处跨设备传输,而朴素的分区方式会产生“流水线气泡”,使下游设备在等待时处于空闲状态。GPipe 和 PipeDream 中采用的微批次流水线执行能够挽回这部分效率损失中的大部分 (Huang et al. 2019; Narayanan et al. 2019)。↩︎
Transformer 训练对互连的敏感性:自注意力的内存与计算量按 \(\mathcal{O}(S^2)\) 缩放,使激活值规模随序列长度增加。在流水线并行中,激活值在模型分区边界处跨设备传输;而数据并行需要同步梯度,其数据量随参数数量增长。由此产生的通信成本取决于并行策略、拓扑、消息大小和重叠程度,因此互连选择是训练系统的一项首要决策。↩︎
反向传播的起源:Linnainmaa (1970) 为计算机程序的自动微分推导了该算法,Werbos (1974) 也在一篇关于经济建模的哈佛大学博士论文中独立推导了该算法——比 Rumelhart et al. (1986) 将其推广到神经网络早了十多年。从推导到广泛采用之间的这种时间差,在机器学习系统的发展史中反复出现:注意力机制比 Transformer 早了数十年,但 2017 年的 Transformer 表明,以注意力为主的模型能够在当时的 GPU 系统上高效训练;后来的 TPU 和 GPU 集群则支持了更大规模的部署。框架的反向传播过程按逆拓扑顺序遍历计算图,并应用链式法则;在这一遍历过程中,独立子图可能提供可并行执行的工作。↩︎
BLAS(基本线性代数子程序):最初的 BLAS 规范对可复用、可由 Fortran 调用的向量运算进行了标准化 (Lawson et al. 1979);后续 BLAS 扩展增加了矩阵向量和矩阵矩阵运算例程,形成了人们熟悉的 Level 1、Level 2 和 Level 3 层次结构 (Dongarra et al. 1988)。训练以 Level 3 运算为主,恰恰是因为其较高的算术强度——\(\mathcal{O}(n)\) FLOP/byte——能够维持较高的计算利用率。框架通常将稠密矩阵乘法交由 cuBLAS、oneDNN 等优化库或编译器生成的内核执行。↩︎
Strassen 算法:通过用加法替代八次子矩阵乘法中的一次,实现 \(\mathcal{O}(n^{2.807})\) 的复杂度,但训练系统很少能从中受益。递归会破坏 Tensor Core 所利用的规则内存访问模式,而数十亿次训练迭代中累积的舍入误差可能使收敛过程失稳。实践中,cuBLAS 等主流通用矩阵乘法库使用高度优化、硬件利用率更高的分块 \(\mathcal{O}(n^3)\) 内核来执行占主导地位的训练矩阵乘法,而非递归的 Strassen 变体。↩︎
Softmax:计算数值稳定的 softmax,需要沿选定轴执行最大值归约、指数运算、求和归约和归一化。并行内核通过协调的归约操作实现这些阶段。FlashAttention 重新组织了更大范围的注意力计算,使得在分块数据驻留于计算单元附近时,可以持续维护 softmax 统计量。↩︎
随机梯度下降:“随机”一词源于希腊语 stochastikos(“能够猜测的”);SGD 使用采样样本或小批次进行更新,无需等待精确的全数据集梯度。全批量方法和随机方法都可以通过有界微批次流式处理数据,因此其峰值激活内存由驻留的微批次决定,而非仅由数据集规模决定。两者的核心区别在于每次参数更新汇集了多少个采样梯度。↩︎
动量:借用自物理学,其中动量(质量 \(\times\) 速度)描述物体继续运动的趋势。这一比喻说明了该方法的设计原理:累积速度能够平滑含噪梯度,并可能减少收敛所需的迭代次数。其系统成本是每个参数额外存储一个速度值,而 Adam 则为每个参数维护两个矩值。↩︎
RMSprop:由 Geoffrey Hinton 在其 2012 年 Coursera 课程的第 6e 讲中提出,从未发表于同行评审论文,因此它可能是通过幻灯片传播的最具影响力的优化器。RMSprop 将学习率除以近期梯度大小的移动平均,从而按参数调整步长。Adam 将这种逐参数自适应机制继承为其二阶矩 \(v_t\),这直接构成了 section 1.3.2.3 中所述 Adam 的 3\(\times\) 内存开销的一部分。↩︎
Adam(自适应矩估计):这两个移动平均分别是梯度的一阶矩(动量)和二阶矩(未中心化方差),为每个模型参数分别存储。对于一个具有 7B 参数的模型,仅 Adam 的 FP32 矩张量就占用 56 GB;将 FP16 权重、FP16 梯度、FP32 主权重和 Adam 矩一并计入后,不含激活值的完整标准混合精度训练状态占用 112 GB。↩︎
收敛:当选定的训练或验证指标的改善程度已不足以支持继续投入计算时,一次训练便达到其停止准则。所需步数取决于模型、数据、优化器、调度策略、批次大小和目标质量。更少的步数可以降低实际运行时间和成本,但自适应优化器会增加状态,其内存占用和流量必须纳入系统预算。↩︎
AdamW(采用解耦权重衰减的 Adam):标准 \(L_2\) 正则化项进入梯度,因此会受到 Adam 自适应更新的重新缩放。AdamW 将权重衰减作为独立的参数更新执行,恢复了自适应梯度缩放与衰减之间原本应有的区分 (Loshchilov and Hutter 2019)。它采用与 Adam 相同的矩缓冲区结构,但其对模型质量的影响仍取决于工作负载。↩︎
脊点与精度:Roofline 脊点——区分受内存限制与受计算限制操作的算术强度阈值——会随数值精度变化。在同一加速器上,较低精度的 Tensor Core 执行路径能够在内存带宽大致相同的情况下提供高得多的算术吞吐量,从而显著提高脊点。因此,从 TF32 类执行切换到 BF16 混合精度,可能改变能够带来收益的优化技术,使精度选择与 Roofline 分析密不可分。↩︎
FlashAttention:其核心机制是将注意力计算划分为可容纳于加速器高速片上 SRAM 的小块进行处理,避免将完整的中间 \(S{\times}S\) 矩阵写入速度较慢的 HBM。确切的 HBM IO 界取决于分块大小和 SRAM 容量,但其实际效果是大幅减少内存流量和辅助激活存储。原始研究报告的加速比随工作负载而异,最高可达 3\(\times\)。↩︎
线程束(Warp):该词源于纺织业,其中“warp”指织机上保持绷紧的一组经线,梭子横穿其间进行编织。NVIDIA 采用这一术语,是因为线程束内的 GPU 线程以锁步方式执行同一条指令,类似于织机上平行的经线一同运动。一个 NVIDIA 线程束包含 32 个线程。↩︎
模型 FLOPs 利用率(MFU):PaLM 论文 (Chowdhery et al. 2022) 将 MFU 定义为实测吞吐量与峰值 FLOPs 下理论最大吞吐量之比。其 5,400 亿参数模型训练在 6,144 块 TPU v4 芯片上报告了 46.2% 的 MFU。余下部分未计入模型 FLOPs 分子,但仅凭 MFU 无法确定其中有多少来自内存流量、通信、流水线气泡、重计算或其他工作。↩︎
FP16(半精度浮点数):其正规数范围较窄,是因为指数仅使用 5 位,而 FP32 使用 8 位;最小正正规数值约为 \(6.1 \times 10^{-5}\),但次正规数值可延伸至约 \(6 \times 10^{-8}\)。下溢行为取决于具体运算和硬件模式。损失缩放可降低小梯度被舍入为零或直接置零的概率。↩︎
Tensor Core:一种专用矩阵乘加单元,支持低精度输入和更高精度累加。其支持的分块形状、对齐约束和峰值吞吐量比率因架构、数据类型、稀疏模式和库内核而异。↩︎
FP16 次正规数处理:IEEE FP16 可表示低于 \(6.1 \times 10^{-5}\)、最小约为 \(6 \times 10^{-8}\) 的次正规数,但某些加速器运算或模式会将次正规数输入或结果置零。必须针对目标硬件和内核检查这一行为。↩︎
FlashAttention:由 Dao et al. (2022) 提出,通过适合 SRAM 容量的分块减少 HBM 流量,同时保留精确注意力计算;其关键洞见是将注意力视为一个 I/O 问题:在保留稠密 \(\mathcal{O}(S^2)\) 分数计算的同时,避免在 HBM 中显式生成完整的 \(S{\times}S\) 分数矩阵。性能取决于形状、硬件和基线。FlashAttention-2 (Dao 2023) 进一步改进了并行性和工作划分,报告在 A100 上达到理论峰值的 50–73%。↩︎
梯度累积:在一次优化器更新之前,对 \(k\) 个微批次的梯度求和或取平均。相较于一次性处理同一有效批次,它减少了常驻激活内存,同时保持样本级算术运算总量不变。运行时间和数值等价性取决于微批次效率、同步、有状态层、随机操作、精度以及损失归一化。↩︎
AlexNet(2012):论文报告了 6000 万个参数和 3 GB 的单 GPU 容量上限,但并未将这一限制归因于某一个内存组成部分。其模型并行设计将约一半的卷积核放置在每块 GPU 上,并且仅允许特定层进行通信,明确地在内存容量与通信之间进行权衡。↩︎
NVLink:NVIDIA 的高带宽 GPU 互连技术。其拓扑和代际决定了特定一对 GPU 之间以及集合操作可用的带宽。只有当并行策略的通信和同步成本小于其节省的有效计算时间时,该策略才有益。↩︎
AllReduce:一种集合通信原语,对所有设备上的数据求和,并将结果分发回每个设备。环形 AllReduce 是一种常见实现:设备沿逻辑环传递梯度分片,使每个参与者收发大小受限的数据块,而非一次性收发每个梯度张量的完整副本。这一通信原语使大规模数据并行训练切实可行,但其详细成本模型应在分布式训练部分讨论。↩︎
GPipe(2019):GPipe 实现了上述微批处理策略,通过交错执行填补朴素模型并行中的空闲“气泡”,从而提高利用率 (Huang et al. 2019)。它所管理的关键权衡是:存储多个在途微批次的激活值会增加内存占用。它通过在权重更新前累积梯度,保持大批次训练的动态特性;论文报告,当微批次数量至少为划分数量的四倍时,Transformer 吞吐量几乎呈线性扩展。↩︎
Radford, Alec, Jeffrey Wu, Rewon Child, David Luan, Dario Amodei, and Ilya Sutskever. 2019. Language Models Are Unsupervised Multitask Learners. OpenAI.
Knight, Will. 2023. OpenAI’s CEO Says the Age of Giant AI Models Is Already over. WIRED.
Patel, Dylan, and Gerald Wong. 2023. GPT-4 Architecture, Infrastructure, Training Dataset, Costs, Vision, MoE. SemiAnalysis Blog.
Chen, Tianqi, Bing Xu, Chiyuan Zhang, and Carlos Guestrin. 2016. “Training Deep Nets with Sublinear Memory Cost.” arXiv Preprint arXiv:1604.06174.
Micikevicius, Paulius, Sharan Narang, Jonah Alben, Gregory Diamos, Erich Elsen, David Garcia, Boris Ginsburg, et al. 2017. “Mixed Precision Training.” arXiv Preprint arXiv:1710.03740.
Wang, Shibo, and Pankaj Kanwar. 2019. BFloat16: The Secret to High Performance on Cloud TPUs.
Huang, Y., Y. Cheng, A. Bapna, O. Firat, D. Chen, M. X. Chen, H. Lee, et al. 2019. “GPipe: Efficient Training of Giant Neural Networks Using Pipeline Parallelism.” Advances in Neural Information Processing Systems (NeurIPS) 32: 103–12.
Narayanan, Deepak, Aaron Harlap, Amar Phanishayee, Vivek Seshadri, Nikhil R. Devanur, Gregory R. Ganger, Phillip B. Gibbons, and Matei Zaharia. 2019. “PipeDream: Generalized Pipeline Parallelism for DNN Training.” Proceedings of the 27th ACM Symposium on Operating Systems Principles, 1–15. https://doi.org/10.1145/3341301.3359646.
Linnainmaa, Seppo. 1970. “The Representation of the Cumulative Rounding Error of an Algorithm as a Taylor Expansion of the Local Rounding Errors.” Master's thesis, University of Helsinki.
Werbos, Paul. 1974. “Beyond Regression: New Tools for Prediction and Analysis in the Behavioral Sciences.” PhD thesis, Harvard University.
Rumelhart, David E., Geoffrey E. Hinton, and Ronald J. Williams. 1986. “Learning Representations by Back-Propagating Errors.” Nature 323 (6088): 533–36. https://doi.org/10.1038/323533a0.
Lawson, Charles L., Richard J. Hanson, David R. Kincaid, and Fred T. Krogh. 1979. “Basic Linear Algebra Subprograms for Fortran Usage.” ACM Transactions on Mathematical Software 5 (3): 308–23. https://doi.org/10.1145/355841.355847.
Dongarra, Jack J., Jeremy Du Croz, Sven Hammarling, and Richard J. Hanson. 1988. “An Extended Set of FORTRAN Basic Linear Algebra Subprograms.” ACM Transactions on Mathematical Software 14 (1): 1–17. https://doi.org/10.1145/42288.42291.
Loshchilov, Ilya, and Frank Hutter. 2019. “Decoupled Weight Decay Regularization.” Proceedings of the International Conference on Learning Representations (ICLR).
Chowdhery, Aakanksha, Sharan Narang, Jacob Devlin, Maarten Bosma, Gaurav Mishra, Adam Roberts, Paul Barham, et al. 2022. “PaLM: Scaling Language Modeling with Pathways.” arXiv Preprint arXiv:2204.02311.
Dao, T., D. Y. Fu, S. Ermon, A. Rudra, and C. Ré. 2022. “FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness.” Advances in Neural Information Processing Systems (NeurIPS) 35: 16344–59. https://doi.org/10.52202/068431-1189.
Dao, Tri. 2023. “FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning.” arXiv Preprint arXiv:2307.08691.