硬件加速
硬件加速
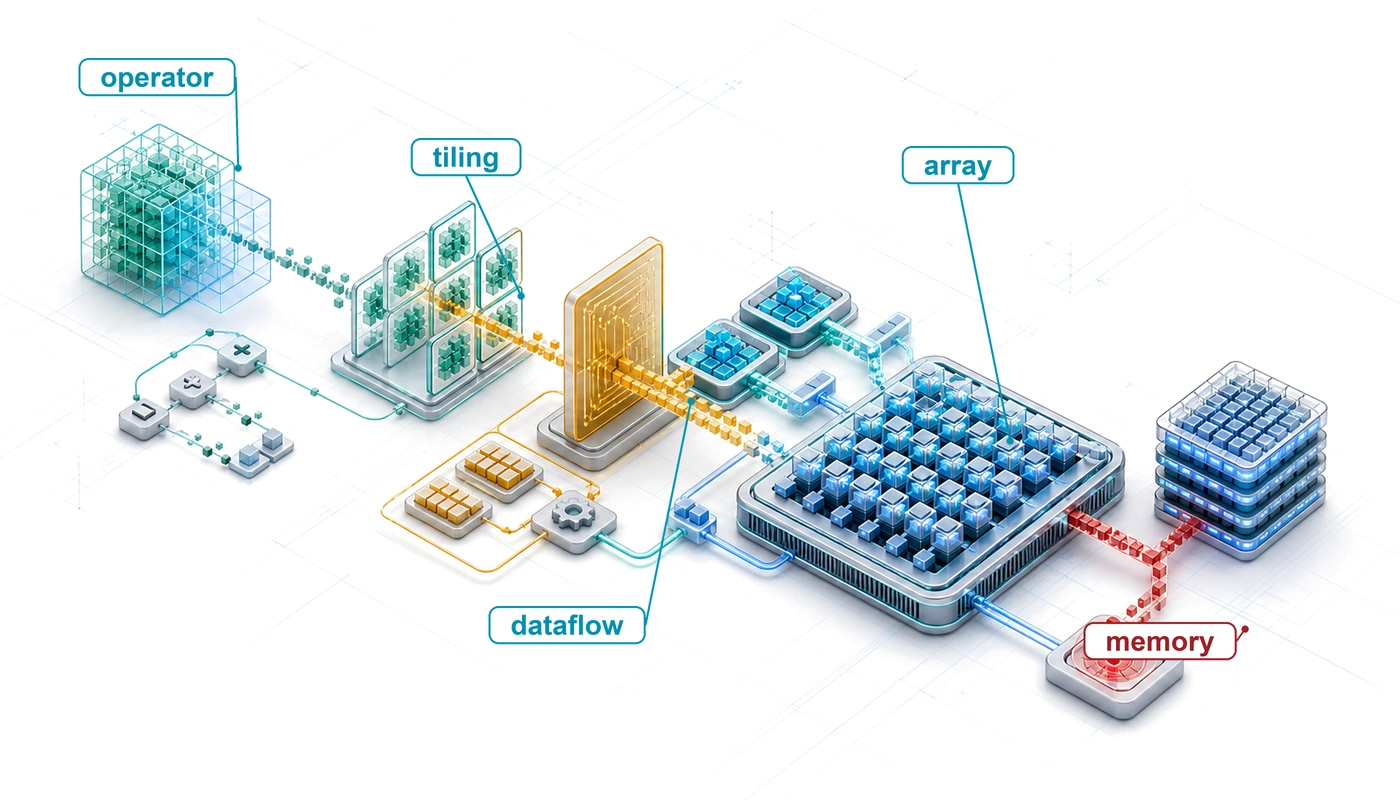
本章目的
为什么移动数据的成本高于对其进行计算的成本?
相较于许多内存访问操作,算术运算的成本很低。在从主存取回一个值所需的时间内,处理器可以执行大量计算。这种不平衡被称为“内存墙”,反映了数据在系统中移动所产生的延迟、带宽和能耗成本。这也解释了为什么专用加速器不仅在数学运算上更快,还通过深层内存层次结构、大规模并行和专用数据通路,在架构上隐藏、摊销并降低数据移动的成本。当仅靠通用处理器的性能扩展已不足以满足需求时,硬件加速使许多大型 AI 工作负载能够继续扩展。这也解释了为什么某些减少理论计算量的优化未能缩短运行时间。如果某个运算受内存限制,减少计算量可能无济于事,因为计算并非瓶颈。因此,硬件选择不能简化为比较峰值 FLOP/s。关键在于,工作负载的数据移动模式是否契合硬件的加速设计目标。具有大型嵌入表和不规则查找的模型,与对紧凑权重张量执行稠密矩阵乘法的模型,需要不同的加速器。软件必须显式呈现并调度可利用的数据复用;否则,专用单元就会在数据移动期间等待,标称吞吐量也只能停留在理论层面。工作负载与硬件的匹配程度,决定了执行性能是停留在理论峰值的一小部分,还是接近硬件的实际性能上限。用数据—算法—机器的视角来看,加速器使机器约束具体化,并决定了哪些算法在生产环境中仍然可行。
学习目标
- 将硬件加速解释为机器轴上针对张量工作负载、数据复用和每瓦性能的专门化
- 计算算术强度和 Roofline 性能上限,将内核归类为计算受限或内存受限
- 利用带宽、缓存层次结构、主机与设备之间的传输以及数据移动的能耗成本,诊断内存墙瓶颈
- 比较 Tensor Core、脉动阵列、SIMD/SIMT 单元和稀疏执行对机器学习计算原语的支持
- 选择数据流、分块和映射策略,在内存容量约束下最大限度地复用数据
- 分析用于融合内核、规划内存和调度加速器的编译器与运行时优化
- 在吞吐量、延迟、功耗、成本和部署场景约束下评估加速器选择
加速基础

硬件加速激活了机器轴。
只有当机器能够高效执行优化后的表示时,减少参数、降低精度或减少运算才有意义。数据选择减少了数据项,压缩减少了算法的工作量;硬件加速则追问机器实际上能提供怎样的性能。答案始于内存墙:相较于数据移动,算术运算通常成本很低。一次片外内存访问可能耗费许多个处理器周期,其能耗可能比一次低精度算术运算高出数个数量级,具体比值取决于设备和内存层级。专用硬件之所以重要,是因为它在提高计算吞吐量的同时,通过组织内存、数据流和并行执行,使这些算术单元能够持续获得所需数据。
Definition 1.1: 硬件加速
硬件加速 是指将原本由通用执行方式处理的工作,映射到针对更窄运算类别进行优化的专用处理器或功能单元上的实践。对于机器学习工作负载,这种专门化通常以牺牲部分可编程性为代价,换取规则张量运算能够利用的计算密度 \((R_{\text{peak}})\) 和每瓦性能提升。
- 意义:A100 GPU 的 FP16/BF16 矩阵乘法吞吐量可达 312 TFLOP/s;相对于本章用于说明的 1–2 TFLOP/s 参考 CPU 基线,其吞吐量为后者的 156–312×。它拥有 542 亿个晶体管,投入并行算术运算的硅面积远多于投入分支预测、乱序调度和大型缓存的硅面积 (NVIDIA Corporation 2020a; Choquette et al. 2021)。
- 区别:通用 CPU 的设计目标是灵活执行、低延迟控制以及适应多样化工作负载。加速器则将资源集中于更窄的运算类别,因此,只有当工作负载显式呈现受支持的运算,并提供足够多的并行工作以使算术单元保持忙碌时,才能实现性能收益。
- 常见误区:一种常见误解是,加速器宣传的峰值吞吐量就是工作负载能够获得的吞吐量。实际性能取决于计算上限与内存带宽所能供给的数据对应的性能上限,两者取较低值,这就是 Roofline 约束:无论芯片标称速度有多快,低算术强度内核的性能都可能只达到峰值 FLOP/s 的一小部分,因为它缺的是数据,而非算术能力。
这一定义界定了本章的核心工程权衡。通用处理器将硅面积分配给复杂控制逻辑、推测执行、分支预测和多级缓存层次结构,以处理任意控制流。加速器则将这些晶体管预算转向稠密算术阵列、专用寄存器文件,以及针对更窄工作负载类别定制的高带宽内存通路。当软件执行路径能够显式呈现足够的张量并行性时,这种专门化可使能效和每瓦吞吐量获得数量级的提升。
仅靠硬件无法实现这些收益。算法必须组织好运算,以显式呈现数据复用和规则内存访问;芯片架构则必须为算法实际执行的数学原语和数值精度分配物理单元。这种相互依存关系引出了一个互补原则:软硬件协同设计。
Definition 1.2: 软硬件协同设计
软硬件协同设计 是一种跨越传统抽象边界的机器学习加速器开发方法,使算法约束能够为芯片设计提供依据,并使硬件能力能够影响算法的构建方式。
- 意义:在受支持的 Tensor Core 执行路径上,8 位整数(INT8)量化可以带来数倍的吞吐量提升,因为相较于 FP32 路径,硬件能以更高密度执行低精度运算,并移动更少的字节;具体收益取决于架构和工作负载 (NVIDIA Corporation 2020a; Dally et al. 2021; Dally 2023)。
- 区别:与分层抽象不同,分层抽象中的软件调用硬件 API 而无需了解芯片细节,协同设计则将硬件约束直接暴露给算法和编译器开发者:数据对齐要求、精度格式和内存访问模式都成为跨层全局优化的显式输入。
- 常见误区:一种常见误解是,协同设计是一次性的硬件设计选择。实际上,受支持的功能会持续演进:NVIDIA Tensor Core 最初支持 FP16 矩阵乘法,后续几代增加了 TF32 和更广泛的整数支持,Ampere 则增加了对 2:4 结构化稀疏的加速 (NVIDIA 2017; NVIDIA Corporation 2020a)。
协同设计解释了为什么 模型压缩 中介绍的压缩技术能够带来实际加速。量化与精度 中的量化技术说明了为何将 FP32 转换为 INT8 能在受支持的硬件上加快执行:降低精度可减少内存流量,而专用算术单元每周期执行的低精度运算数量多于对应的 FP32 单元 (NVIDIA Corporation 2020a)。结构化剪枝 在生成更小的稠密形状或芯片能够识别的稀疏模式时,可以提升性能;而任意的非结构化稀疏会引入元数据处理和非合并内存访问,往往抵消理论收益。评估加速器性能,需要沿着从工作负载到芯片的路径逐层追踪:计算原语、内存层次结构、Roofline 诊断、映射与数据流,以及编译器调度。一个反复出现的问题是,为什么算法改进经常无法带来成比例的端到端加速。阿姆达尔定律给出了支配这一现象的限制。
Theorem 1.1: 加速的根本极限(阿姆达尔定律)
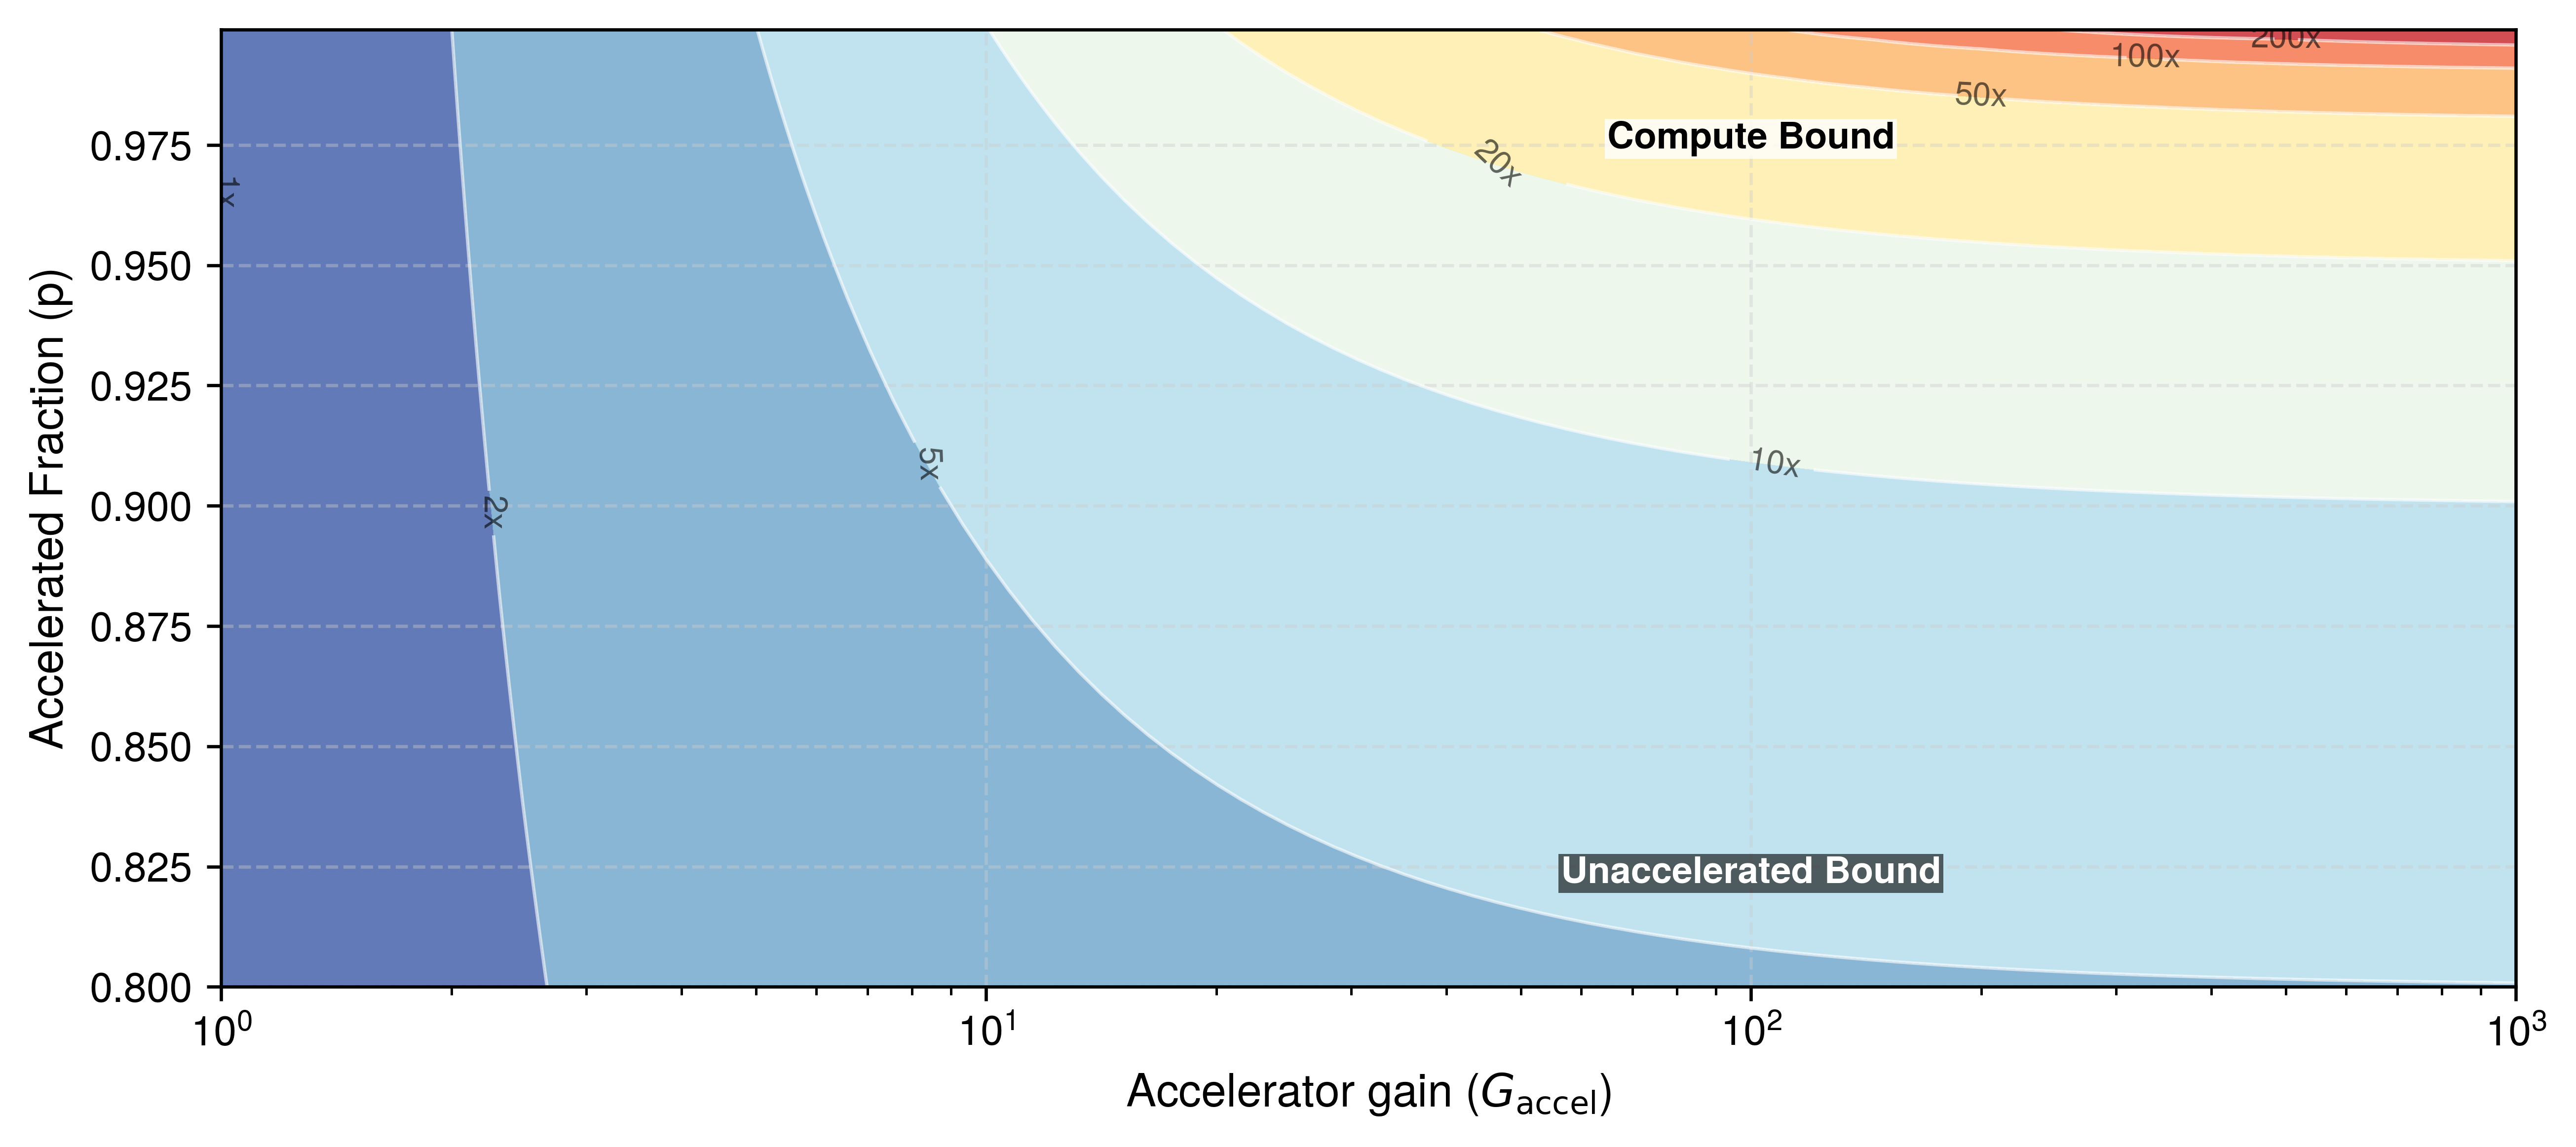
硬件加速不会使整个系统都加速;它只会加速基准执行时间中使用加速路径的那一部分。设这部分所占比例为 \(p\),路径加速倍数为 \(G_{\text{accel}}\),则 AI 的阿姆达尔定律 (Amdahl 1967) 给出的上界如 equation 1 所示。 \[ \text{Speedup} = \frac{1}{(1 - p) + \frac{p}{G_{\text{accel}}}} \tag{1}\]
- 被加速部分的占比(\(p\)):基准执行时间中获得所述加速收益的比例,通常对应矩阵乘法或其他受支持的内核。
- 加速器加速倍数(\(G_{\text{accel}}\)):对于工作负载中被加速的部分,GPU 或张量处理单元(TPU)相对于 CPU 的原始速度优势。
- 未加速部分的占比(\(1-p\)):所选路径之外的工作,例如数据加载、主机开销、不受支持的算子和内核启动延迟。
误区:未加速的工作限制了总加速比。 如果基准执行时间的 10% 不受影响(\(p=0.9\)),那么即使路径加速倍数无穷大(\(G_{\text{accel}}=\infty\)),总体加速比也最多为 10\(\times\)。一旦被加速的组件足够快,未受影响的工作就会占据主导地位。
Amdahl, Gene M. 1967. “Validity of the Single Processor Approach to Achieving Large Scale Computing Capabilities.” Proceedings of the April 18-20, 1967, Spring Joint Computer Conference on - AFIPS ’67 (Spring), AFIPS ’67 (spring), 483–85. https://doi.org/10.1145/1465482.1465560.
硬件加速针对机器学习系统铁律(机器学习系统铁律)中的特定项发挥作用,该定律将端到端时间分解为数据量项 \((D_{\text{vol}}/\text{BW})\)、计算项 \((O/(R_{\text{peak}} \cdot \eta_{\text{hw}}))\) 和固定延迟项 \((L_{\text{lat}})\)。数据选择减少总数据量,模型压缩减少每个样本的运算量 \(O\),而硬件加速则通过提高 \(R_{\text{peak}}\)、\(\eta_{\text{hw}}\) 和 \(\text{BW}\) 来提升执行速率。计算的物理基础 提供了用于诊断给定工作负载由哪一项主导的性能分析模型,其中包括确认铁律中每一项的量纲最终均为秒的量纲分析。然而,加速会遇到阿姆达尔定律确立的硬性上限。1
这一机制解释了为什么硬件升级经常无法带来成比例的端到端加速。Figure 1 展示了这道加速墙:只要未加速部分的占比 \(1-p\) 仍然存在,渐近上限 \(1/(1-p)\) 就会使路径加速倍数 \(G_{\text{accel}}\) 的收益急剧递减,除非 \(p\) 接近 1。
只有在未加速部分的占比降至最低之后,加速器的原始加速比才能转化为系统级吞吐量的提升。在相同硬件上运行的不同典型工作负载,其被加速部分占比 \(p\) 可能存在显著差异,这决定了加速器投资能否获得回报,还是会在非矩阵运算上陷入停滞。
Checkpoint 1.1: 并行性关卡
以下检查将阿姆达尔上界转化为硬件选型测试。
阿姆达尔定律揭示的现实
在真实硬件上,串行瓶颈会变得具体可见:同一个加速器在某种工作负载上可能接近其并行性能上限,却在另一种工作负载上陷入停滞。应知数值 汇总了各代加速器的参考 \(R_{\text{peak}}\) 数值和延迟层次,为这些硬件比较提供数量级依据。对比 NVIDIA H100 运行计算受限卷积和内存受限自回归解码时的表现,可以说明不同的未加速部分占比如何决定实际加速比。
Lighthouse 1.1: H100 上的阿姆达尔定律预算示例
NVIDIA H100 上的 ResNet-50 推理示例:
- 假设相对于不具备矩阵扩展指令的参考 CPU,H100 在矩阵乘法上提供的加速比为 \(G_{\text{accel}}\) = 247×(INT8 吞吐量为 1979 TOPS,而参考 CPU 约为 8 TOPS)(Choquette 2023)。
- 假设 \(p\) = 0.95:基准执行时间中的 95 percent 获得上述加速,而 5 percent 仍用于数据加载、预处理、后处理及其他工作。 \[ \text{$\text{Speedup} = \frac{1}{(1-0.95) + \frac{0.95}{247}} = \frac{1}{0.05 + 0.0038} \approx 18.6\times$} \] 该路径获得 247× 的加速比,却仅产生 18.6× 的端到端加速比,因为未受加速影响的 5 percent 部分决定了加速上限。
与 GPT-2(自回归)的对比:
- 对于 GPT-2 词元生成,假设 \(p\) = 0.80;其余 20 percent 包括主机端开销、采样,以及加速矩阵运算路径之外的解码工作。 \[ \text{$\text{Speedup} = \frac{1}{(1-0.80) + \frac{0.80}{247}} = \frac{1}{0.20 + 0.0032} \approx 4.9\times$} \] 词元生成时间中能够获得假定加速的比例较小,因此,即使该路径的加速比趋于无穷大,总加速比也最多为 \(1/(1-p)\) = 5×。模型服务优化以不同方式应对这一限制:批处理提高跨请求的资源利用率,而推测解码使用草稿模型来减少目标模型的顺序执行步数。
一个操作受限于计算速率还是数据移动,决定了硬件选择和软件优化的方向。如果数据供给是实际瓶颈,那么即使升级到峰值算力高出 \(10\times\) 的加速器,获得的加速也微乎其微。Roofline 模型为这种诊断提供了分析框架 (Williams et al. 2009);Roofline 模型 对其进行了正式介绍,section 1.6 则将其应用于 AI 工作负载。该模型将操作的算术强度2与硬件能力结合绘制,揭示性能究竟受计算能力还是带宽限制;算术强度定义为浮点运算次数与内存流量字节数之比(FLOP/byte)。高算术强度的稠密矩阵乘法可受益于更高的 TFLOP/s;低算术强度的 LayerNorm 则只能受益于更大的内存带宽。数据复用程度高的 ResNet-50 卷积处于计算受限区域,而小批量自回归注意力处于内存受限区域。因此,计算受限的工作负载需要采用使算术吞吐量和功能单元利用率最大化的策略,而内存受限的内核则需要通过算子融合和内存层次间的数据分阶段暂存,尽量减少片外流量。
架构设计始于迫使硬件走向专用化的物理约束:经典登纳德电压缩放规律的失效,以及跨内存层次移动数据的高昂能耗。当通用微架构遭遇这些散热和内存壁垒时,面向特定领域的硬件专用化便成为维持性能持续扩展的主要工程路径。
硬件专用化
当 Google 将其首款张量处理单元(TPUv1)与 NVIDIA K80 GPU 一同部署到生产数据中心时,两者的比较凸显了根本性的效率差距。通用处理器将大量芯片面积和功耗预算用于取指、分支预测和缓存一致性硬件,以支持任意代码。对于以规则、稠密线性代数运算为主的深度学习工作负载,这种控制开销导致算术运算密度偏低。当某种算法模式变得足够主导且具有明确结构时,专用硬件通过以专用算术阵列和软件管理的数据移动取代动态控制机制,能够超越通用平台。Google 的生产环境推理评估量化了这一效率差距(示例 1.1)。
Example 1.1: TPUv1 与 K80 的显著效率差距
场景:2015 年,Google 将其首款张量处理单元(TPUv1)部署到生产数据中心,并将其吞吐量和能效与通用 NVIDIA K80 GPU 进行比较 (Jouppi et al. 2017)。
诊断:K80 是一种可编程 GPU,旨在支持更广泛的图形与计算混合工作负载。TPUv1 的领域专用架构(DSA)则选择了更聚焦于推理的设计方向,将大型 8 位脉动矩阵单元与软件管理的内存及更简单的控制相结合。
系统层面的启示:在 TPU 论文所评估的六种 Google 推理工作负载及同期 CPU/GPU 基准系统上,针对主导矩阵运算定制芯片,实现了 15–30\(\times\) 的吞吐量和 30–80\(\times\) 的每瓦性能 (Jouppi et al. 2017)。这些比值描述的是所评估的系统,并不适用于所有工作负载。
从数据—算法—机器的角度看,这种效率提升源于根据算法结构定制机器资源。通过用软件管理的暂存缓冲区取代硬件缓存,并在脉动阵列中直接在相邻算术单元之间传送数据,专用架构能够最大化算术强度,并尽量减少片外内存流量。然而,这种专用化带来了架构上的权衡:固定的执行流水线牺牲了灵活性。当工作负载引入不规则内存访问、动态控制流或不受支持的数值精度时,固定功能数据通路便会停顿,使昂贵的芯片资源处于闲置状态。
现代机器学习加速器——包括 DianNao 类神经网络加速器 (Chen et al. 2014)、配备 Tensor Core 的 GPU、Google 的 TPU3以及 Apple 的神经网络引擎——体现了算术专用化与可编程灵活性之间持续的平衡。其设计源于一条跨越四个不同阶段的历史发展轨迹:专用计算的起源、并行图形处理、领域专用架构,以及机器学习专用硬件的兴起。每个阶段都针对当时制约扩展的特定资源瓶颈。
Chen, Tianshi, Zidong Du, Ninghui Sun, Jia Wang, Chengyong Wu, Yunji Chen, and Olivier Temam. 2014. “DianNao: A Small-Footprint High-Throughput Accelerator for Ubiquitous Machine-Learning.” Proceedings of the 19th International Conference on Architectural Support for Programming Languages and Operating Systems (ASPLOS ’14), 269–84. https://doi.org/10.1145/2541940.2541967.
专用计算
当特定计算模式成为系统的主要瓶颈,阻碍通用处理器高效扩展时,硬件专用化便随之出现。这段历史凸显了三种反复出现的限制:标量浮点运算实现缓慢、并行图形处理吞吐量不足,以及内存与并行计算的集成不佳。
第一阶段是精度瓶颈:科学和工程应用需要在仅具备整数算术逻辑单元的微处理器上执行浮点运算。20 世纪 70 年代末,CPU 通过多指令软件例程模拟浮点运算,这些例程拆解符号、指数和尾数字段,通过移位对齐二进制小数点,并对输出进行规格化。即便只执行一次乘法,这种软件模拟也会产生严重的标量指令开销,从而推动了第一波重要的硬件专用化浪潮:数学协处理器。
Intel 8087(1980 年)4通过在专用硬件流水线上直接执行浮点指令,解决了这一瓶颈 (Palmer 1980)。用硬连线算术逻辑取代多指令模拟例程,确立了一项核心系统原则:当某种特定操作主导内层循环时,专用芯片能够消除通用指令开销,并提高执行性能上限。
随着专用功能展现出实用价值,它们遵循一种反复出现的集成模式。Intel 486DX(1989 年)将 FPU 直接集成到 CPU 裸片上,消除了片外总线通信延迟,并使高精度数学运算成为标准功能,而不再依赖可选的协处理器 (Hennessy and Patterson 2017)。先通过专用化解决突出瓶颈,再进行架构集成,这一循环在不同硬件时代不断重现。
Figure 2 展示了横跨五个时代的这一演进过程,说明反复出现的计算瓶颈如何推动硬件从浮点协处理器和数字信号处理器,演进到可编程 GPU、流媒体编解码器以及深度学习张量加速器。现代机器学习工作负载直接依赖于这些时代确立的原则:将芯片资源专用于主导矩阵运算、在本地存储器中暂存操作数,以及尽量减少片外数据移动。
\begin{tikzpicture}[font=\sffamily\small]
\tikzset{
  Box/.style={inner xsep=1pt,
    font=\sffamily\footnotesize,
    draw=none,node distance=3mm,
    fill=#1,align=flush center,
    anchor=west,
    text width=35mm,
    minimum width=35mm, minimum height=10mm
  },
  Box/.default=red
}
\definecolor{col1}{RGB}{128, 179, 255}
\definecolor{col2}{RGB}{255, 255, 128}
\definecolor{col3}{RGB}{204, 255, 204}
\definecolor{col4}{RGB}{230, 179, 255}
\definecolor{col5}{RGB}{255, 153, 204}
\definecolor{col6}{RGB}{245, 82, 102}
\definecolor{col7}{RGB}{255, 102, 102}
\node[Box={col1}](B1){1980s};
\node[Box={col2},right=of B1](B2){1990s};
\node[Box={col3},right=of B2](B3){2000s};
\node[Box={col4},right=of B3](B4){2010s};
\node[Box={col5},right=of B4](B5){2020s};
\foreach \x in{1,2,...,5}
\draw[dashed,thick,-latex](B\x)--++(270:7.2);
\path[red]([yshift=-5mm]B1.south west)coordinate(P)-|coordinate(K)(B5.south east);
\draw[line width=2pt,-latex](P)--(K)--++(0:3mm);
%
\def\vi{1.1}
\node[Box={col1!50},below=\vi of B1](BB1){浮点运算 \&\\信号处理};
\node[Box={col1!50},below=of BB1](BB2){Intel 8087 FPU\\(1980)};
\node[Box={col1!50},below=of BB2](BB3){德州仪器\\TMS32010 DSP (1983)};
\node[Box={col1!50},below=of BB3](BB4){将 FPU 集成\\到 Intel 486DX\\(1989)};
%
\node[Box={col2!50},below=\vi of B2](2BB1){3D 图形 \&\\多媒体};
\node[Box={col2!50},below=of 2BB1](2BB2){早期 GPU\\问世};
\node[Box={col2!50},below=of 2BB2](2BB3){NVIDIA GeForce 256 --\\首款具备硬件\\T\&L 的 GPU (1999)};
\node[Box={col2!50},below=of 2BB3](2BB4){SIMD 处理\\单元的兴起};
%
\node[Box={col3!50},below=\vi of B3](3BB1){实时媒体\\编码 \&\\网络处理};
\node[Box={col3!50},below=of 3BB1](3BB2){媒体编解码器\\(H.264, MP3)};
\node[Box={col3!50},below=of 3BB2](3BB3){Intel IXP2800\\网络处理器};
\node[Box={col3!50},below=of 3BB3](3BB4){用于流式处理\\与编码的\\专用硬件};
%
\node[Box={col4!50},below=\vi of B4](4BB1){深度学习\\张量运算};
\node[Box={col4!50},below=of 4BB1](4BB2){用于机器学习推理的\\Google TPU v1 (2015)};
\node[Box={col4!50},below=of 4BB2](4BB3){用于深度学习加速的\\NVIDIA Tensor Core};
\node[Box={col4!50},below=of 4BB3](4BB4){面向 AI 的内存\\优化};
%
\node[Box={col5!50},below=\vi of B5](5BB1){应用专用\\加速};
\node[Box={col5!50},below=of 5BB1](5BB2){AI 引擎 \&\\SmartNIC};
\node[Box={col5!50},below=of 5BB2](5BB3){多芯片与\\晶圆级机器学习\\加速};
\node[Box={col5!50},below=of 5BB3](5BB4){针对专用硬件\\进行优化的\\机器学习框架};
\end{tikzpicture}并行计算与图形处理
通用 CPU 将大部分芯片资源预算分配给控制逻辑、分支预测和多级缓存,以尽量降低单条指令流的执行延迟。当工作负载呈现大规模、均匀的数据并行性,即对数百万个独立元素执行相同的算术运算时,这种面向延迟的架构会将芯片面积和散热预算消耗在无法提高计算吞吐量的控制结构上。专用加速器通过将芯片资源从缓存和控制重新分配给密集的算术逻辑单元(ALU)阵列来解决这种失衡,优先提高总体吞吐量,而非降低单线程延迟。
在整个 20 世纪 90 年代,实时 3D 图形推动了这种面向吞吐量的专用化。早期图形加速器卸载了位图传输和多边形填充等固定光栅化任务。1999 年,NVIDIA 的 GeForce 256集成了硬件加速的变换与光照(T&L),将坐标变换从主机 CPU 转移到专用片上电路。这些早期图形处理单元(GPU)虽然尚不可编程,但展示了专用流水线如何加速顶点变换和纹理映射等固定数学运算。然而,僵化的固定功能流水线造成了严重的负载失衡:复杂几何体使光栅化硬件闲置,而密集的片元着色则使顶点流水线得不到足够的工作。GeForce 3(2001 年)向可编程着色器的转变,以及 GeForce 8(2006 年)向统一着色器架构的转变,通过以相同的可编程计算核心阵列取代彼此分离的功能单元,解决了这种失衡。这种结构上的统一使硬件摆脱了固定图形阶段的束缚,并使 GPU 成为能够执行稠密矩阵运算的通用并行处理器。到 2004 年,高端 GPU 每秒可处理超过 1 亿个多边形 (Owens et al. 2008)。
Lyons, Richard G. 2011. Understanding Digital Signal Processing. 3rd ed. Prentice Hall.
与图形硬件并行发展的是数字信号处理(DSP)处理器,它们解决了另一种物理约束:在严格的能耗预算内实现确定性的低延迟执行。通用缓存层次在发生缓存未命中时会引入可变延迟,从而违反信号处理严格的实时截止期限。DSP 用软件管理的暂存存储器取代行为不可预测的缓存,并将专用乘加(MAC)单元与循环寻址缓冲区相结合,以连续执行滤波和傅里叶变换,避免内存停顿引起的抖动。德州仪器的 TMS32010(1983 年)展示了领域专用指令集和专用 MAC 数据通路如何在向量运算上超越通用微处理器 (Lyons 2011)。
网络处理面临着更严格的延迟期限:持续以线速检查数据包。当数据包每隔几纳秒就到达一次时,片外内存访问停顿便会导致丢包。Intel 的 IXP2800 网络处理器体现了这一硬约束带来的设计结果:满足线速数据包处理期限,不允许留下任何供缓存未命中消耗的余量,因此,该设计围绕分层片上存储器布置了多个并行核心,使数据紧邻计算单元。这种由数据包到达期限所迫而形成的计算靠近内存的组织方式,预示了现代机器学习加速器所采用的内存层次结构,后者用于持续向处理单元阵列供应张量分块。
这些领域因计算特征不同而采取了不同的实现方式。DSP 针对毫瓦级散热预算下的低延迟一维信号流进行优化,而网络处理器则针对以最少状态保留实现数据包路由进行优化。相比之下,深度学习工作负载主要由稠密矩阵乘法和多维卷积构成。这些操作具有高算术强度和大规模数据并行性。统一 GPU 提供了理想的机器匹配:宽内存总线支撑数千条并行 ALU 通道,并利用硬件管理的多线程机制,在稠密张量运算期间隐藏片外内存延迟。
这种架构适配的实际影响在 2012 年变得清晰可见:AlexNet5 (Krizhevsky et al. 2012) 以超过十个百分点的优势赢得了 ImageNet 竞赛。训练使用了两块消费级 NVIDIA GTX 580 显卡,每块仅配备 3 GB 显存。其底层算法——使用梯度下降训练的卷积网络——早已存在数十年,但 CPU 的计算吞吐量使大规模训练在计算上难以实现。通过将密集二维卷积直接映射到 GPU 执行单元,作者将需要数月的 CPU 计算压缩到了五至六天。从数据—算法—机器的角度看,此前机器约束决定了哪些算法可行;将卷积的并行结构与面向吞吐量的 GPU 硬件相适配,使得在大规模数据集上训练深度模型成为现实。
领域专用架构的兴起
这些多样化的加速模式汇聚成了一场更广泛的架构转变。领域专用架构(DSA)6 的兴起标志着计算机系统设计的一次转型,其驱动力来自传统缩放所带来的收益逐渐放缓 (Esmaeilzadeh et al. 2011),以及专用工作负载日益增长的计算需求。摩尔定律7 描述了晶体管密度长期持续增长的趋势 (Moore 1998)。登纳德缩放8 (Dennard et al. 1974) 使电压能够随着晶体管尺寸的缩小而降低;其失效使得在功率密度保持不变的情况下持续提高频率的途径不复存在。这些变化共同限制了通用计算的性能与效率。正如 Hennessy and Patterson (2019) 在 2017 年图灵讲座中所论述的,应对之道是进入一个针对重要工作负载进行优化的领域专用解决方案新时代。
Moore, G. E. 1998. “Cramming More Components onto Integrated Circuits.” Proceedings of the IEEE 86 (1): 82–85. https://doi.org/10.1109/jproc.1998.658762.
figure 3 清晰地展示了这一挑战的规模。该图以示例形式绘制了模型需求与硬件供给之间的系统差距,这一现象有时会以“黄氏定律”这一非正式名称加以讨论。9 这一归一化情景假设 GPU 供给每年增至约 1.7\(\times\),而模型需求每年增至约 6\(\times\),由此使差距每年扩大至约 3–4\(\times\)。已发表的计算量趋势为这种定性分化提供了依据,但图中的增长率是情景假设,而非预测 (Amodei and Hernandez 2018; Epoch AI 2024)。
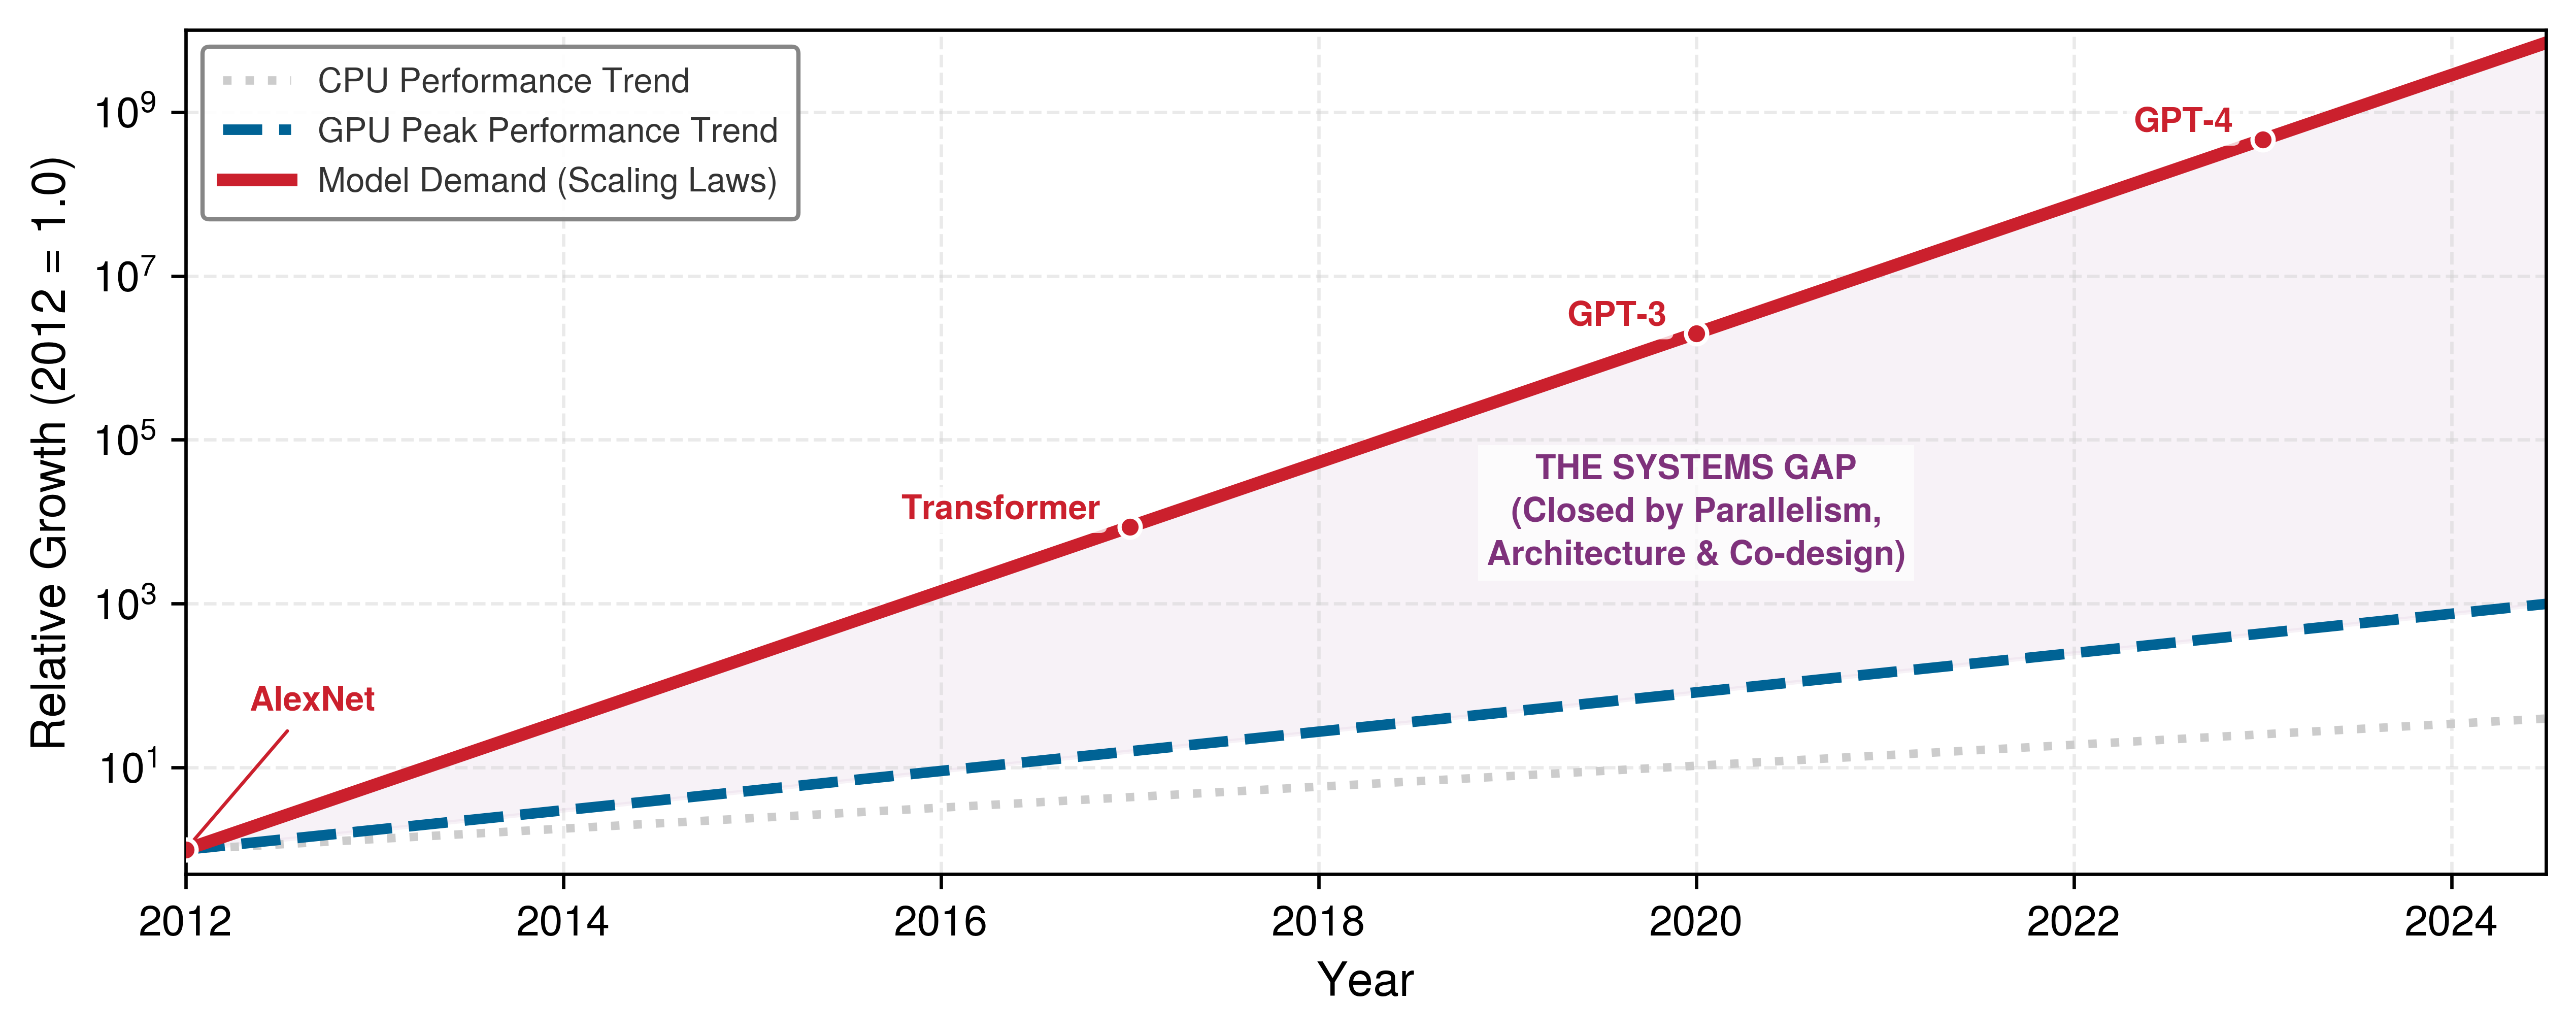
该图以 2012 年为基准进行归一化,以突出相对增长。紫色阴影区域强调了这种分化:仅靠工艺节点进步无法弥合系统差距,还需要架构创新、并行分布式执行以及软硬件协同设计。
技术 S 曲线:架构为何转变
许多计算技术的生命周期可分为酝酿期(初期进展缓慢)、起飞期(快速增长)和饱和期(接近物理或经济极限时收益递减)。Figure 4 使用两条概念性 S 曲线来表达这一模式:当一种设计方法带来的收益逐渐减小时,领域专用架构可以为计算结构稳定的工作负载开启一条新的效率曲线。
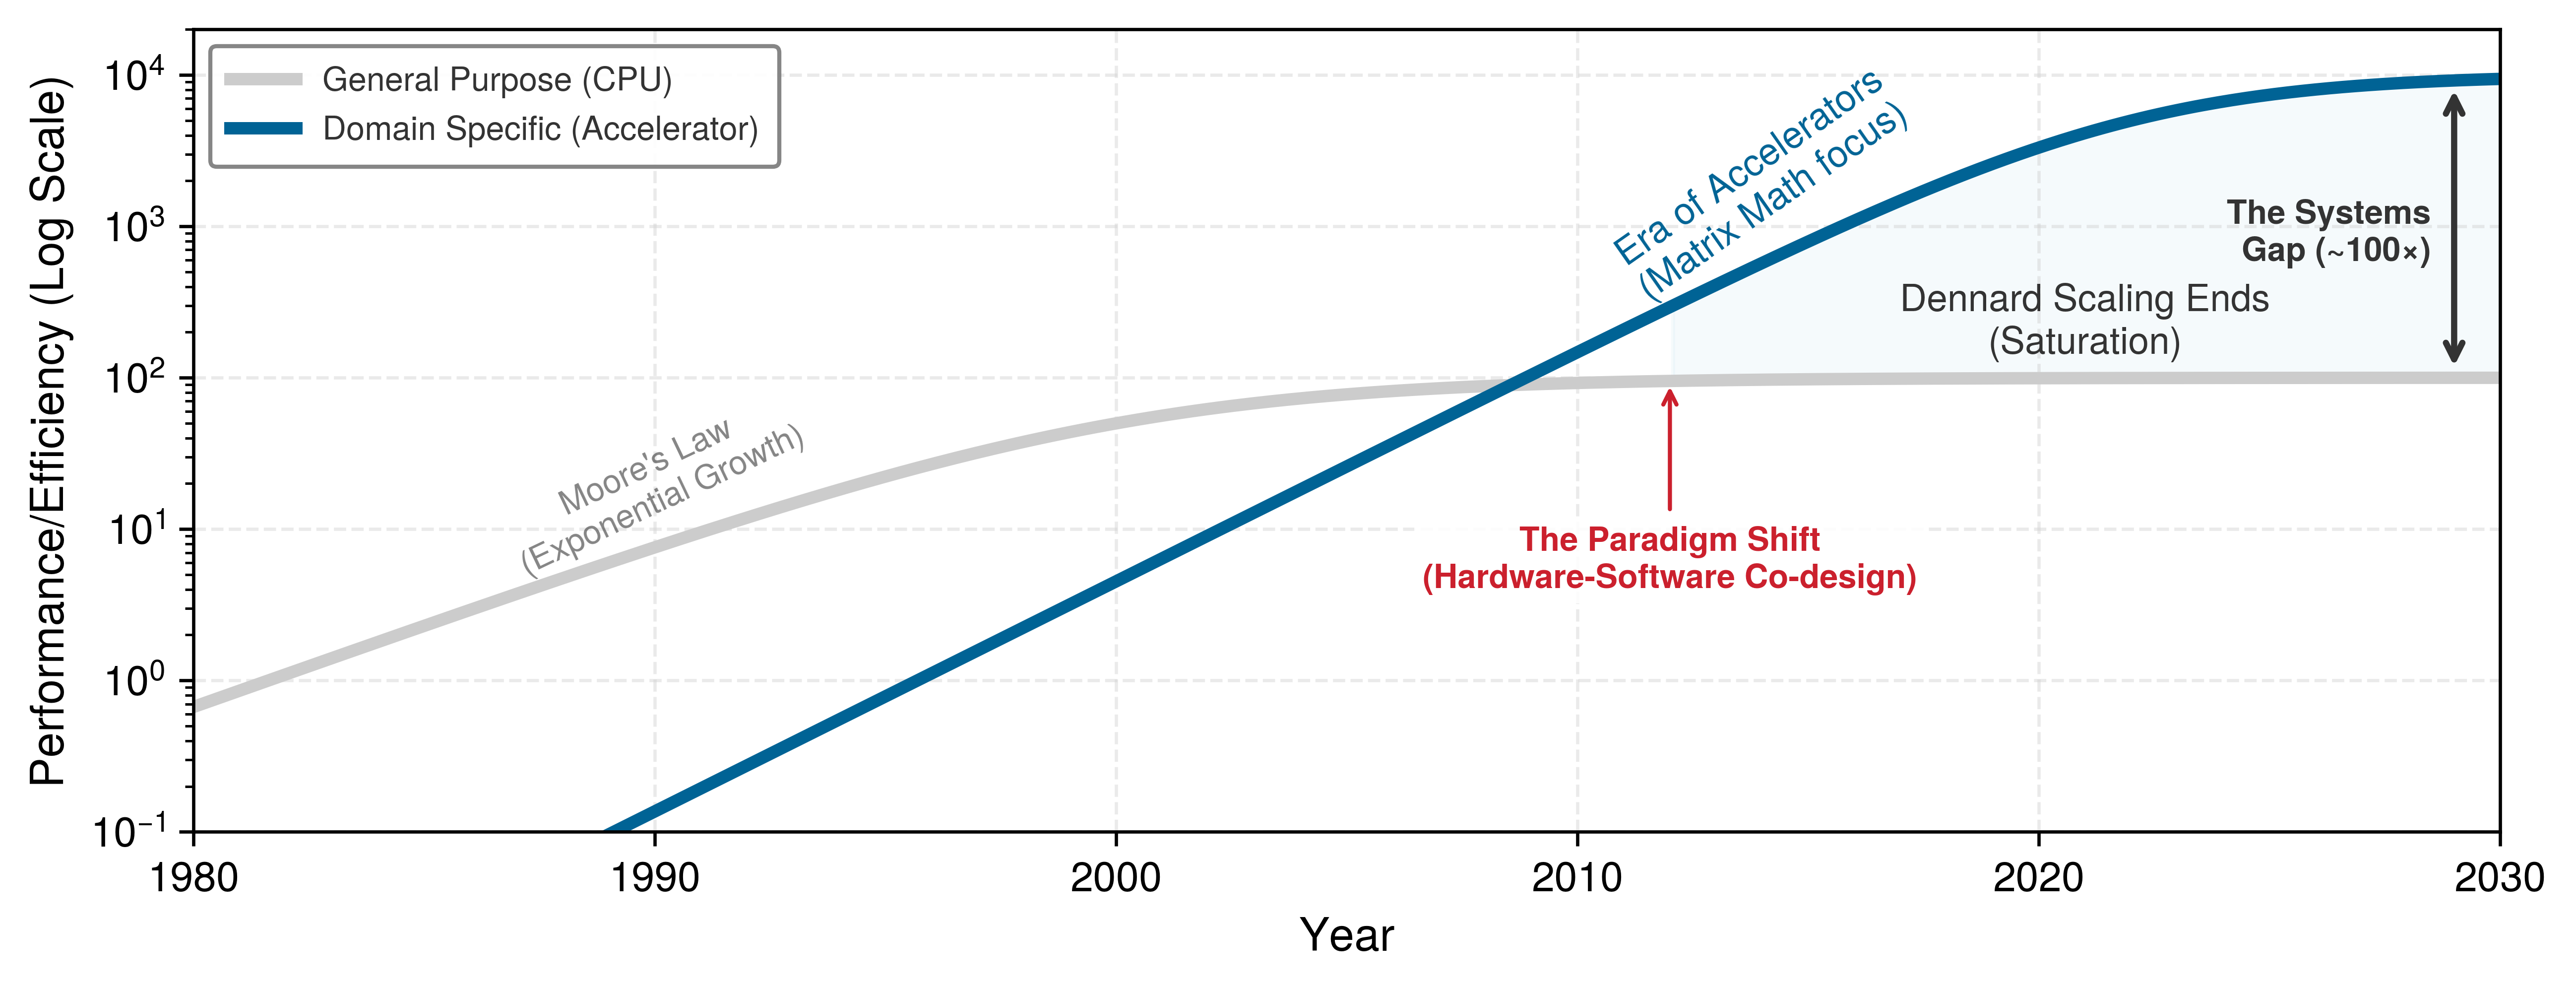
曾经伴随晶体管尺寸缩小而持续获得的收益已放缓,而 AI 模型计算需求的增长速度超过了通用硬件容量的增长速度。弥合这一差距不能依靠等待 CPU 工艺的持续微缩;它需要通过架构变革,重构工作负载利用硅面积、内存带宽和热预算的方式。
在通用计算 S 曲线的增长阶段,半导体缩放为现有软件带来了可预测的性能提升。在经典登纳德缩放规律下,晶体管尺寸缩小允许工作电压按比例降低,从而在提高时钟频率的同时保持功率密度不变。当登纳德缩放在 2000 年代中期失效时,亚阈值漏电流阻碍了电压进一步降低,迫使时钟频率在散热墙前停滞。架构师最初通过增加处理器核心来应对,但多核扩展遭遇了两项物理边界:阿姆达尔定律和暗硅——后者指的是只有芯片中一部分晶体管能够同时以全频率切换的热约束。此外,通用 CPU 将绝大部分能量预算用于控制开销——指令取出与译码、分支预测、推测性乱序执行以及缓存一致性——而非算术运算。对于规则的线性代数工作负载,在 CPU 核心上执行一条指令,可能需要消耗数百皮焦耳的控制能量,才能完成一次耗能 3 皮焦耳的浮点运算。
领域专用架构通过消除这种控制开销,并将硅资源用于与工作负载相匹配的数据通路,转向一条新的效率曲线。其主要架构创新是定制化数据通路:例如,AI 加速器中的矩阵乘法单元采用脉动阵列,即由处理单元组成的网格状网络,这些单元执行计算并将数据直接传递给相邻单元。脉动阵列不再持续将中间结果写回寄存器文件或缓存,而是使激活值和权重在相邻单元之间流动,从而让从片上内存中取出一次的数值,能够在整行或整列的乘加运算中复用。数据通路一旦确定,便可根据工作负载的复用模式直接定制内存层次结构,用软件管理的暂存存储器、预取逻辑以及针对确定性张量流设计的内存控制器,取代硬件管理的缓存。
领域专用指令集进一步强化了这种物理专用化。领域专用指令集不再逐一取出并译码标量操作,而是将粗粒度张量原语编码为单条宏指令,同时配置数千个算术单元,从而摊薄译码和分派开销。对于激活函数和归一化层等固定不变的操作,固定功能电路模块完全绕过软件执行。由此获得的效率源于各个层面统一的硬件专用化:数据移动、内存局部性、指令开销和电路实现都围绕同一组计算不变量进行适配。
移动片上系统(SoC)架构直接展示了这种效率权衡。尽管视频处理每秒需要数十亿次操作,现代智能手机仍能在毫瓦级热功耗范围内完成高分辨率视频解码。这种效率通过实现 H.264/AVC 和 H.265/HEVC 等行业标准的专用硬件视频编解码器10来实现 (Sullivan et al. 2012)。与在通用 CPU 核心上进行软件解码相比,这些专用电路能够带来数量级的每瓦性能提升,具体收益取决于编解码器配置档次、分辨率、工艺节点以及作为基准的 CPU。
Sullivan, Gary J., Jens-Rainer Ohm, Woo-Jin Han, and Thomas Wiegand. 2012. “Overview of the High Efficiency Video Coding (HEVC) Standard.” IEEE Transactions on Circuits and Systems for Video Technology 22 (12): 1649–68. https://doi.org/10.1109/tcsvt.2012.2221191.
Turakhia, Yatish, Gill Bejerano, and William J. Dally. 2018. “Darwin: A Genomics Co-Processor Provides up to 15,000X Acceleration on Long Read Assembly.” Proceedings of the Twenty-Third International Conference on Architectural Support for Programming Languages and Operating Systems (ASPLOS), 199–213. https://doi.org/10.1145/3173162.3173193.
Bedford Taylor, Michael. 2017. “The Evolution of Bitcoin Hardware.” Computer 50 (9): 58–66. https://doi.org/10.1109/mc.2017.3571056.
只要工作负载的计算内核趋于稳定,这种架构转变就会在各个数据密集型计算领域反复出现。基因组学处理采用定制加速器,是因为长读长组装包含固定的动态规划比对内核,专用硬件可直接在硅电路中将其实现为流水线 (Turakhia et al. 2018)。密码学工作负载也出于同样的原因催生了专用集成电路(ASIC)11:固定的哈希算法使专用硅电路流水线具有合理性,它以牺牲全部可编程灵活性为代价,换取最高能效 (Bedford Taylor 2017)。
这些转变凸显了现代系统工程的核心原则:依靠通用硬件缩放自动获得性能提升的时代已经结束。数十年来,软件开发者可以依靠摩尔定律,在不修改代码结构的情况下加速现有软件。随着登纳德缩放失效,计算瓶颈再也无法通过等待更快的通用核心来解决;必须设计与算法相匹配的机器。从数据—算法—机器的角度看,加速器使物理机器约束显性化。性能受软硬件协同设计支配:执行效率取决于算法的张量维度、内存访问模式和并行性能否有效映射到领域专用架构的专用物理结构上。
机器学习硬件专用化
许多重要的神经网络工作负载包含规则的张量运算、大量数据并行性,以及采用较低精度的机会。稠密矩阵乘法和卷积是其中的典型例子,因为它们的循环结构呈现出重复运算和可预测的数据复用。这些特征推动了专用硬件架构的发展:这些架构处理任意代码时可能效率不佳,但对于与之匹配的机器学习内核,可以带来显著收益。其他机器学习运算仍可能具有不规则、受带宽限制、顺序执行或规模过小而无法充分利用宽并行计算引擎等特点,因此,同一设备未必能加速模型的每个部分。为利用其中规则部分而构建的硬件,构成了一类称为机器学习加速器的设备;当其支持的工作负载在整个服务器集群规模上具有重要性,而非仅在基准测试中表现突出时,专用化的经济动因才会显现。
Example 1.2: TPU 容量悬崖
场景:Google 在 2013 年预测,如果用户采用语音搜索中的语音识别功能(每位用户每天使用 3 分钟),就需要将全球数据中心容量翻倍,才能运行基于 CPU 的神经网络推理 (Jouppi et al. 2017)。
诊断:从经济角度看,通用 CPU 服务器容量无法承接推理浮点运算量的指数级增长,可能形成基础设施资本投入瓶颈。
系统启示:当工作负载总量跨越整个服务器集群层面的经济阈值时,定制硬件加速就成为必需。总体算术强度和服务器总拥有成本决定了定制 ASIC 的部署决策。
机器学习的计算需求揭示了传统处理器的局限性。在一个示例场景中,假设参考 CPU 在神经网络工作负载上持续达到其峰值性能的 5 percent–10 percent,则在该范围的上限处,实际性能约为 0 GFLOP/s(每秒数十亿次浮点运算)。这种低效源于架构不匹配:CPU 针对单线程性能和不规则内存访问进行优化,而神经网络需要大规模并行性和可预测的数据流。内存带宽约束进一步加剧了这一问题:单个神经网络层可能需要访问数 GB 的参数,超出为较小工作集设计的 CPU 缓存层次结构的承载能力。
数据搬移的能耗经济性影响着加速器设计。就单次事件而言,从 DRAM 访问一个 32 位数值所消耗的能量,可能比执行一次 FP32 乘法高出约 \(10^2\times\) 的量级(具体数值随工艺节点和设计而变化),因此数据搬移成为首要优化目标 (Horowitz 2014; Sze et al. 2017)。这种差距有助于解释从改作他用的图形处理器向专门构建的神经网络加速器的演进。TPU 和其他定制加速器通过实现脉动阵列及其他架构,在最大限度复用数据的同时减少搬移,从而在稠密内核上维持高利用率。
IEEE Standards Association. 2019. IEEE 754-2019: Standard for Floating-Point Arithmetic. https://doi.org/10.1109/IEEESTD.2019.8766229.
训练与推理具有不同的计算特征,并由此影响加速器设计。训练需要计算梯度并更新权重:FP32 和 FP16 是标准化的二进制浮点格式 (IEEE Standards Association 2019),而混合精度训练在精度允许的情况下,使用较低精度的张量运算并以较高精度进行累加 (Micikevicius et al. 2017)。反向传播还需要保留或重新计算激活值(参见 激活内存需求),从而增加内存需求。推理只需要前向路径,并可在模型和内核支持时使用 INT8 或 INT4。交互式推理可能优先考虑尾延迟,而离线推理或批量推理可能优先考虑吞吐量、成本或能耗;加速器的选择取决于实际服务目标。这些特征通常有利于采用大容量、面向吞吐量的训练系统,以及节能的推理路径,但批大小和服务策略可能使这种表面上的偏好发生逆转。12
Definition 1.3: 机器学习加速器
机器学习加速器是主要为常见神经网络张量运算和数据流设计的处理器或专用单元。相较于通用执行路径,它们将更多资源投入算术运算和局部数据搬移,从而在匹配的工作负载上追求高 \(R_{\text{peak}}\) 和数据复用。
- 重要性:机器学习加速器的决定性特征并非仅仅是原始算术能力,而是一条能够供应操作数并将可复用数值保留在附近的均衡路径。A100 提供 2.04 TB/s 的设备内存带宽,约为此处采用的示例主机 DRAM 路径带宽 200 GB/s 的 10.2× (NVIDIA Corporation 2020a; Choquette et al. 2021)。这只是上限比较,并非性能保证:要接近其 312 TFLOP/s 的 FP16/BF16 峰值,仍需要足够的算术强度、并发性和数据复用。
- 区别:收益取决于运算支持、并行工作量、规则的数据访问,以及能够选择预期执行路径的软件栈。机器学习加速器在大规模稠密矩阵乘法上可能比参考 CPU 快几个数量级,但在规模小、不规则、同步密集或控制密集的工作负载上,可能失去大部分优势。即使加速后的内核本身很快,数据传输和不受支持的算子仍可能主导整体开销。
- 常见误区:一个常见误解是,机器学习加速器总能加速机器学习。要接近峰值吞吐量,需要兼容的精度、运算形状、布局和实现,以及足够的并行工作量来使相关单元保持忙碌。利用率还取决于内存和互连路径能否支撑这些工作。因此,批大小为 1 的自回归请求可能只能利用大型训练加速器算术容量的一小部分,尽管同一设备在批量预填充或训练时表现良好。
Choquette, Jack, Wishwesh Gandhi, Olivier Giroux, Nick Stam, and Ronny Krashinsky. 2021. “NVIDIA A100 Tensor Core GPU: Performance and Innovation.” IEEE Micro 41 (2): 29–35. https://doi.org/10.1109/mm.2021.3061394.
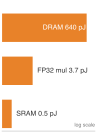
单次 DRAM 访问的能耗超过单次 FP32 乘法的 100\(\times\)。
部署环境通过确定起决定作用的约束来塑造架构选择。在数据中心中,这一约束通常是超大模型训练获得结果所需的时间。NVIDIA H100以数百瓦的功耗换取高吞吐量 (Choquette 2023);这种权衡能否降低总成本,取决于利用率、租赁价格、工作负载的扩展特性以及电价。Google 的 TPUv4采取了类似的架构权衡,通过脉动阵列和高带宽内存优先提升吞吐量 (Jouppi et al. 2023)。
Checkpoint 1.2: 加速器选用关卡
利用能耗层级判断专用化何时具有收益。
能耗倒挂
选择逻辑
在边缘端,优先事项往往转向单次推理能耗,以及严格的延迟或功率限制,不过对于连续的摄像头、音频或传感器数据流,吞吐量仍然重要。在几瓦功率预算内运行的智能手机摄像头或常开音频路径,无法直接采用数据中心加速器的高功耗内存系统。相反,边缘架构通过本地暂存存储器、紧密集成的加速器、动态电压和频率调节,以及在工作负载允许时采用事件驱动处理,来减少数据搬移。同样的内存墙原理适用于这两种场景:数据中心芯片投入资源提高高带宽内存(HBM)的容量和带宽,而边缘芯片则高度依赖数据邻近性和复用。
没有任何单一架构能够主导所有机器学习工作负载。边缘设备偏重能效和有界延迟,而云规模训练重视吞吐量、容量和互连性能。云端推理可能强调每次请求的成本或尾延迟,边缘设备也可能仍需为实时数据流提供持续吞吐量。因此,专用架构反映了各自的部署环境,但都受到数据搬移能耗和延迟成本的制约。
Table 1 总结了硬件专用化进程中的这些里程碑。浮点协处理器加速了此前由软件实现的算术运算,早期 GPU 提高了图形处理吞吐量,而媒体引擎则展示了稳定的处理流水线如何为固定功能模块提供合理依据。AI 加速器将稠密张量单元与内存层次结构和软件支持结合起来,使数据搬移与并行执行之间的集成成为核心挑战。
因此,现代 AI 加速已超出芯片本身的范畴。实用的加速器需要框架、编译器、库、驱动程序和运行时的支持,以实现图变换、内核选择、融合、内存调度,以及从数据中心到边缘设备等不同环境中的部署。不受支持的运算或外围数据传输可能抵消内核层面的收益。
| 时代 | 计算模式 | 架构示例 | 特征 |
|---|---|---|---|
| 20 世纪 80 年代 | 浮点与信号处理 | FPU、DSP | • 单一用途引擎 • 专用指令集 • 协处理器接口 |
| 20 世纪 90 年代 | 3D 图形与多媒体 | GPU、SIMD 单元 | • 大量相同的计算单元 • 规则的数据模式 • 宽内存接口 |
| 21 世纪 00 年代 | 实时媒体编解码 | 媒体编解码器、网络处理器 | • 固定功能流水线 • 高吞吐量处理 • 功耗与性能优化 |
| 21 世纪 10 年代 | 深度学习张量运算 | TPU、GPU Tensor Core | • 矩阵乘法单元 • 大规模并行性 • 内存带宽优化 |
| 21 世纪 20 年代 | 面向特定应用的加速 | 机器学习引擎、智能网卡、领域加速器 | • 面向特定工作负载的数据通路 • 定制内存层次结构 • 针对应用优化的设计 |
集成瓶颈
从 Intel 8087 数值协处理器到现代图形和 AI 加速器的演进,揭示了一个一贯的模式:硬件不断演进,以适应算法的主要瓶颈 (Palmer 1980; Goodfellow et al. 2016; Sze et al. 2017; Jouppi et al. 2017)。8087 卸载了科学计算中令通用 CPU 不堪重负的浮点运算,而现代 AI 加速器则针对稠密矩阵乘法和卷积。在这一领域,与向算术单元供应数据相比,配置原始算术单元相对容易。现代 AI 架构必须解决一个集成瓶颈:以足够快且高效的方式,将操作数和结果经由内存层次结构传送,从而支撑数千个并行计算单元持续运行。只有当工作负载的计算需求集中在与物理硬件数据通路相匹配的规则运算上时,专用芯片才能比通用处理器获得显著的单位功耗性能收益。
神经网络内核的三个特性使这一集成瓶颈变得可处理。首先,大规模矩阵乘法和卷积呈现出丰富的数据并行性,稠密处理单元阵列可以并发利用这种并行性。其次,静态或编译后的张量图具有可预测的数据流,使编译器能够进行分块,并将数据预先传输到本地暂存存储器中13,而非完全依赖硬件管理的缓存。这使软件能够显式控制规则工作集,同时保留硬件缓存以处理不规则访问。第三,许多张量运算在算法层面对较低精度具有容忍度,使受支持的 8 位或 4 位路径能够提高计算密度,并减少每个数值所占的字节数 (Dally et al. 2021; Dally 2023)。相反,以动态控制流、大型嵌入表、小张量、可变形状或严格精度要求为主的工作负载不满足这些假设,仍受内存延迟和不规则访问的限制。
一旦算术容量充足,核心工程挑战就变成了让数据保持在足够近的位置,以便使用这些算术资源。在 Horowitz (2014) 所分析的物理约束下,一次 DRAM 访问消耗的能量可能超过一次低精度算术运算的 100\(\times\)。这种陡峭的能耗层级决定了加速器架构为何将芯片面积和功率预算投入 HBM、片上 SRAM 和软件管理的暂存存储器,而非仅仅增加算术逻辑单元。14
硬件加速通过专用空间布局和分级存储层次结构解决集成瓶颈。如 figure 5 中的架构蓝图所示,高带宽内存向共享片上存储供给数据,后者再向执行单元网格周围的本地暂存存储器供给数据。
\begin{tikzpicture}[line cap=round,line join=round,font=\sffamily\small]
\tikzset{
  Box/.style={align=center,outer sep=0pt,
    inner xsep=2pt,
    node distance=0.45,
    draw=GreenLine,
    line width=0.75pt,
    fill=GreenL!60,
   % text width=32mm,
    minimum width=77mm, minimum height=11mm
  },
   Box2/.style={Box, minimum width=10mm, minimum height=6mm,fill=BrownL!60,draw=BrownLine},
   Box3/.style={Box,text width=20mm,  minimum width=20mm, minimum height=9mm,fill=RedL!60,draw=RedLine},
   Box4/.style={Box3, fill=BlueLine!20,draw=BlueLine},
   Box5/.style={Box3, fill=OrangeLine!20,draw=OrangeLine},
   Box6/.style={Box3, text width=27mm,  minimum width=27mm,  minimum height=13mm,fill=OrangeLine!20,draw=OrangeLine},
Line/.style={violet!50, line width=1.1pt,shorten <=1pt,shorten >=2pt},
LineA/.style={violet!50,line width=0.8pt,{-{Triangle[width=1.0*4pt,length=1.0*6pt]}},shorten <=1pt,shorten >=1pt},
ALine/.style={black!50, line width=1.1pt,{{Triangle[width=0.9*6pt,length=1.2*6pt]}-}},
Larrow/.style={fill=violet!50, double arrow,  inner sep=2pt, double arrow head extend=3pt,
            single arrow head indent=0pt,minimum height=17mm, minimum width=3pt}
}

\tikzset{
pics/dram/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\node[draw=\drawcolor,fill=\filllcolor!70,line width=1.5*\Linewidth,inner sep=0pt,outer sep=0pt,
minimum width=56mm,minimum height=14mm](DRAM\picname)at(0,0){};
\node[draw=\drawcolor,fill=\filllcolor!30,line width=1.5*\Linewidth,inner sep=0pt,outer sep=0pt,anchor=north,
minimum width=52mm,minimum height=6mm](MDRAM\picname)at(DRAM\picname.south){};
%
\pgfmathsetmacro{\spacing}{56/(6+1)}
\foreach \i in {1,...,6} {
  \pgfmathsetmacro{\x}{\i * \spacing}
  \node[draw=\drawcolor,fill=\filllcolor!20,line width=\Linewidth, inner sep=0pt, outer sep=0pt,
        minimum width=6mm, minimum height=8mm]
        at ([xshift=\x mm]DRAM\picname.west) {};
}
%
\foreach \i in {1,...,19} {
  \pgfmathsetmacro{\x}{\i*(52/20)}
  \draw[draw=\drawcolor, line width=3*\Linewidth]
    ([xshift=\x mm,yshift=1pt]MDRAM\picname.south west) -- ++(0,2mm);
}

\end{scope}
    }
  }
}
%CPU style
\tikzset{
pics/cpu/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box = CPU,scale=0.6, every node/.append style={transform shape}]
\node[fill=\filllcolor,minimum width=66, minimum height=66,
            rounded corners=2,outer sep=2pt] (C1) {};
\node[fill=white,minimum width=54, minimum height=54] (C2) {};
\node[fill=\filllcolor!50,minimum width=44, minimum height=44] (C3) {\large CPU};

\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=\filllcolor,minimum width=4, minimum height=15,
           inner sep=0pt,anchor=south](GO\y)at($(C1.north west)!\x!(C1.north east)$){};
}
\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=\filllcolor,minimum width=4, minimum height=15,
           inner sep=0pt,anchor=north](DO\y)at($(C1.south west)!\x!(C1.south east)$){};
}
\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=\filllcolor,minimum width=15, minimum height=4,
           inner sep=0pt,anchor=east](LE\y)at($(C1.north west)!\x!(C1.south west)$){};
}
\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=\filllcolor,minimum width=15, minimum height=4,
           inner sep=0pt,anchor=west](DE\y)at($(C1.north east)!\x!(C1.south east)$){};
}
\end{scope}
    }  }}
\pgfkeys{
  /channel/.cd,
   Depth/.store in=\Depth,
  Height/.store in=\Height,
  Width/.store in=\Width,
  filllcirclecolor/.store in=\filllcirclecolor,
  filllcolor/.store in=\filllcolor,
  drawcolor/.store in=\drawcolor,
  drawcircle/.store in=\drawcircle,
  scalefac/.store in=\scalefac,
  Linewidth/.store in=\Linewidth,
  picname/.store in=\picname,
  filllcolor=BrownLine,
  filllcirclecolor=BlueFill,
  drawcolor=black,
  drawcircle=violet,
  scalefac=1,
  Linewidth=0.5pt,
  Depth=1.3,
  Height=0.8,
  Width=1.1,
  picname=C
}

\node[Box](B1){L2 缓存(共享)};
\coordinate(PO1)at($(B1.north west)+(0.5,0.65)$);
\pgfmathsetmacro{\spacing}{47/(2+1)}
\foreach \i [count=\j] in {0,...,2} {
  \pgfmathsetmacro{\x}{\i * \spacing}
\node[Box2,anchor=south west](GPE\j)at([xshift=\x mm]PO1){PE};
}
\node[Box2,right=1.5 of GPE3](GPE4){PE};
\node[font=\tiny\sffamily]at($(GPE3)!0.5!(GPE4)$){$\bullet$ $\bullet$ $\bullet$};
%
\coordinate(PO2)at($(B1.south west)+(0.5,-0.65)$);
\pgfmathsetmacro{\spacing}{47/(2+1)}
\foreach \i [count=\j]in {0,...,2} {
  \pgfmathsetmacro{\x}{\i * \spacing}
\node[Box2,anchor=north west](DPE\j)at([xshift=\x mm]PO2){PE};
}
\node[Box2,right=1.5 of DPE3](DPE4){PE};
\node[font=\tiny\sffamily]at($(DPE3)!0.5!(DPE4)$){$\bullet$ $\bullet$ $\bullet$};
%arrows
\foreach \i  in {1,...,4} {
\draw[LineA](B1.south)--++(0,-0.25)
-|(DPE\i.north);
}
\foreach \i  in {1,...,4} {
\draw[LineA](B1.north)--++(0,0.25)-|(GPE\i.south);
}
\begin{scope}[shift={($(GPE1)+(0.3,2.8)$)}]
\node[Box3](L1){L1 缓存 / 暂存存储器};
\node[Box4,above right=-0.10 and 0.3 of L1](TC){张量核心};
\node[Box4,below right=0.1 and 0.3 of L1](VU){向量单元};
\node[Box5,below right=0 and 0.3 of TC](SFU){SFU};
\draw[LineA](L1)|-(TC);
\draw[LineA](L1)|-(VU);
\draw[LineA](TC)-|(SFU);
\draw[LineA](VU)-|(SFU);
%%fitting
\scoped[on background layer]
\node[draw=BackLine,fill=BackColor!20, inner ysep=4mm, inner xsep=2mm,yshift=2mm,
fit=(L1)(TC)(SFU)(VU),yshift=0mm](BB1){};
\node[below left=0 and 0 of BB1.north east]{处理单元};
\scoped[on background layer]
\fill[BrownLine!10](GPE3.north west)--(BB1.south west)--(BB1.south east)--(GPE3.north east)--cycle;
\draw[BrownLine](GPE3.north west)--(BB1.south west) (BB1.south east)--(GPE3.north east);
\end{scope}
%%fitting
\node[draw=red,dashed,fill=none, inner ysep=4mm, inner xsep=3mm,yshift=2mm,
fit=(BB1)(DPE1)(DPE4)(B1),yshift=0mm](BB2){};
\node[below =0pt of BB2.north]{AI 加速器芯片};
%CPU
\begin{scope}[local bounding box=CPU1,shift={($(B1)+(-8.1,0)$)}]
\pic[shift={(0,0)}] at (0,0) {cpu={scalefac=1,picname=1,drawcolor=BlueLine,filllcolor=BlueLine!80!,Linewidth=0.5pt}};
\end{scope}
\node[above=6pt of CPU1]{主机 CPU};
%%%%
\begin{scope}[local bounding box=DRAM1,shift={($(CPU1)+(0,-1.9)$)},scale=1, every node/.append style={transform shape}]
\pic[shift={(0,0)}] at  (0,0){dram={scalefac=0.45,picname=1,drawcolor=black,filllcolor=OrangeLine!50!,Linewidth=0.5pt}};
\end{scope}
\node[below=9pt of DRAM1]{主机 DRAM};
\node[Larrow](AR1)at($(CPU1.east)!0.45!(B1.west)$){};
\node[align=center,above=2pt of AR1,font=\sffamily\footnotesize]{主机接口\\ (PCIe/NVLink)};
\draw[LineA,dashed](DRAM1)--(CPU1);
%%
\node[Box6,right=2.5 of B1](B6){高带宽内存 (HBM)};
\node[Larrow](AR2)at($(B1.east)!0.55!(B6.west)$){};
\node[align=center,above=2pt of AR2,font=\sffamily\footnotesize]{内存\\ 接口};
\end{tikzpicture}在 figure 5 所示的通用设计中,处理单元阵列包含针对不同运算类别专门设计的单元:矩阵单元执行稠密矩阵乘法,向量单元执行逐元素算术运算,特殊函数单元则对指数运算及激活函数等超越函数运算进行近似计算。这些单元的数量、分组方式和厂商命名因架构而异,但其目标都是利用张量分块中的数据级并行性。有些设计将单元组织成显式的二维脉动阵列;另一些设计则将矩阵引擎分布在宽并行计算核心中。该示意图表示的是这些功能职责,而非某一家厂商的物理布局。
与执行单元相配合,存储层次结构通过多个层级摊销数据传输的延迟与能耗。高带宽内存提供片外容量和总吞吐量,而共享片上存储以及各处理单元的缓存或暂存存储器则减少片外流量。尽管具体实现各不相同——有些依赖硬件管理的缓存,有些提供软件管理的 SRAM,还有许多将两者结合使用——其物理原理始终相同:将张量分块移过封装边界所消耗的能量,比将其保留在芯片上高出数个数量级。编译器和运行时内核必须协调分块容量、复用、预取和双缓冲,使操作数始终预置于高速本地存储中。提高 HBM 带宽可以抬高片外吞吐量上限,但如果没有本地 SRAM 中的时间复用和空间复用,执行单元就会因等待操作数而停顿。机器基础附录汇集了包括 H100 和 TPU v5 在内的现代加速器的参考规格,并概述了延迟层次结构。
主机接口将加速器连接到主机 CPU 和更广泛的系统内存。主机 CPU 协调执行图、异步 I/O,以及因加速器不支持而回退执行的操作,加速器则执行派发给它的计算内核。这种分工并非绝对:现代加速器能够自主调度工作队列,CPU 也能够计算张量运算。在实践中,系统吞吐量取决于每个算子的执行位置,以及各算子之间的数据传输量、内核启动次数和同步屏障数量。直接内存访问引擎和硬件管理的队列能够使主机与设备间的传输与正在进行的执行重叠,但不受支持的算子会迫使系统付出高昂代价,往返于 CPU 与加速器之间。因此,主机内存与加速器存储之间的通信边界决定了实际可达到的加速范围;如果主机与设备间的传输主导了端到端延迟,内核执行时间就无关紧要。
处理单元、向量流水线和分层暂存存储器所体现的专门化,反映了神经网络的计算特征:模型反复调用一组规模较小的线性代数与逐元素运算原语。在数据—算法—机器框架中,只有当算法修改后的计算结构和内存访问模式能够直接映射到这些专用硬件原语时,才能缩短实际运行时间。若算法优化仅减少理论运算量,却未与硬件数据通路相匹配,就会使计算单元得不到充足的数据供给,令所宣称的收益停留在理论层面。
AI 计算原语
在全连接层、卷积层和注意力层中,学习得到的线性变换都可归结为反复执行的乘累加(MAC)运算。一个大型网络层可以发出数百万乃至数十亿次 MAC 运算,其规则的张量结构提供了并行计算和数据复用的机会,因此自然成为硬件专门化的目标。MAC 并不在所有模型或阶段中占据主导地位——归一化、路由、索引、通信和逐元素运算也可能成为限制因素——但现代机器学习加速器的峰值算术运算能力中,很大一部分用于 MAC 运算。它们是否主导实际耗时,仍取决于张量形状、数据移动和周围的算子。
利用这些模式的硬件单元称为 AI 计算原语:它们是专用功能模块,每个模块都针对某一类运算进行优化。其中有三类原语在加速器中尤为常见,分别面向神经网络中的不同计算模式。
在框架层面,一条声明式语句就封装了数千次数学运算(listing 1)。
# Framework abstracts compute-intensive operations
dense = Dense(512)(input_tensor)  # 256x512 MACs per sample
在这次 API 调用之下,自动微分或编译引擎会将该层降级为计算图。Listing 2 展示了这一分解过程:一次整体矩阵乘法、一次偏置广播和一次逐元素激活。
# Linear transformation work scales with input_dim x output_dim x
# batch.
output = (
    matmul(input, weights) + bias
)  # Matrix multiply dominates cost
output = activation(
    output
) # Element-wise: proportional to output_dim x batch尽管图表示将这些步骤组织为粗粒度张量算子,但在物理硬件上执行时,仍需要调度各个标量运算。将矩阵乘法降级为循环嵌套(listing 3),即可明确其执行结构:三层嵌套迭代遍历批次、输出特征和归约维度,由此确定其算术复杂度为 \(\mathcal{O}(B \times d_{\text{in}} \times d_{\text{out}})\)。
# Total operations: batch_size × output_size × input_size MACs
for n in range(batch_size):  # Batch dimension: parallelizable
    for m in range(output_size):  # Output neurons: parallelizable
        sum = bias[m]  # Initialize accumulator
        for k in range(input_size):  # Reduction dimension: sequential
            sum += input[n, k] * weights[k, m]  # MAC operation
        output[n, m] = activation(sum)  # Nonlinear transformation
# Example work scales as batch_size × output_size ×
# input_size multiply-accumulate operations
这些嵌套循环揭示了三种反复出现的计算模式:沿向量执行的逐元素运算、矩阵级乘累加归约,以及非线性变换。它们的普遍存在使专用硬件执行通路具有充分的合理性:向量流水线以流式方式处理独立元素和归约,矩阵引擎在空间分块上组织乘累加网格,特殊函数单元则对非线性数学运算进行近似计算。这些单元之间的界限源于架构,而非数学;优化编译器经常在一次内核调用中融合跨越这三条通路的运算,以消除中间结果的内存流量。
向量运算
向量运算通过以一条指令同时处理多个数据元素来加速计算。在 listing 3 的标量形式中,将一批 32 个样本送入输入维度为 256、输出维度为 512 的全连接层,需要执行 4.2M MACs。标量处理器为加载每一对输入与权重、执行乘法以及更新累加器分别发出指令,因此对每个元素都要承担完整的取指、译码和分支预测开销。向量流水线通过操作横跨多条并行执行通道的向量寄存器,消除了这类指令开销。
RISC-V15 是一种具有标准化向量扩展的开放指令集架构(ISA)(Waterman et al. 2013),为这种执行模型提供了具体载体。在 RISC-V 向量汇编中(listing 4),向量指令表达对长度在运行时配置的数组执行的操作,从而使软件与处理器的物理通道宽度解耦。
Waterman, Andrew, Yunsup Lee, Rimas Avizienis, Henry Cook, David Patterson, and Krste Asanovic. 2013. “The RISC-V Instruction Set.” 2013 IEEE Hot Chips 25 Symposium (HCS), 1–1. https://doi.org/10.1109/hotchips.2013.7478332.
fmv.w.x fa0, zero          # Scalar dot-product accumulator
fmv.w.x ft1, zero          # Zero seed for vector reduction
loop_feature:
    vsetvli t0, feature_cnt, e32, m1, ta, ma
    vle32.v v1, (in_ptr)
    vle32.v v2, (wt_ptr)
    vfmul.vv v3, v1, v2
    vfmv.v.f v0, ft1
    vfredusum.vs v4, v3, v0
    vfmv.f.s ft0, v4
    fadd.s fa0, fa0, ft0
    slli t1, t0, 2         # Four bytes per FP32 element
    add in_ptr, in_ptr, t1
    add wt_ptr, wt_ptr, t1
    sub feature_cnt, feature_cnt, t0
    bnez feature_cnt, loop_feature
listing 4 中的向量化归约循环依次经历五个硬件可见阶段:
- 向量长度配置:
vsetvli将向量单元配置为处理 32 位元素(e32),动态计算硬件向量寄存器(VLEN)能够容纳的元素数量(t0)。 - 向量初始化:清零用于保存累积点积结果的标量累加器。
- 向量加载:
vle32.v将连续的 32 位元素加载到向量寄存器v1和v2中,并通过内存接口发出宽内存请求。 - 向量乘法与归约:
vfmul.vv在各向量通道中并行地对元素对执行乘法,vfredusum.vs则将乘积归约为一个标量部分和。 - 指针运算与循环分支:推进基地址,将剩余元素数量减去已处理的分块大小
t0,并在仍有剩余元素时跳转。
在各次迭代中,向量乘法指令并发处理多个数据元素,而宽加载则摊销了指令译码和内存请求开销。由于运行时向量长度会动态适应该实现的硬件宽度(VLEN),同一二进制程序既能在窄嵌入式向量单元上正确执行,也能在宽数据中心流水线上正确执行。对于这一包含 256 个特征的工作负载,8 通道实现会将整个批次的归约划分为约 524,288 个向量分块。
除稠密内积外,深度学习工作负载还依赖更广泛的向量指令。Table 2 将这些基本向量运算映射到依赖它们的具体神经网络层。
| 向量运算 | 描述 | 神经网络应用 |
|---|---|---|
| 归约 | 合并向量中的元素(例如求和、求最大值) | 池化层、注意力分数计算 |
| 聚集 | 加载多个不连续的内存元素 | 嵌入查找、稀疏运算 |
| 散布 | 写入多个不连续的内存位置 | 嵌入的梯度更新 |
| 掩码运算 | 选择性地对向量元素执行运算 | 注意力掩码、填充处理 |
| 向量—标量广播 | 将标量应用于所有向量元素 | 偏置加法、缩放运算 |
其收益并不局限于指令数量。连续的向量加载能够高效利用内存接口,而控制开销则由多个数据元素分摊。聚集、散布、掩码操作以及较短的尾部数据可能只能利用较少的通道,或需要额外的内存事务,因此仅有向量宽度并不能保证成比例的加速。这种体系结构模式并非新事物。20 世纪 70 年代,Cray-116 就已使用向量寄存器和流水线功能单元进行科学计算 (Jordan 1982);现代机器学习处理器则以大得多的商业规模应用相关原理。
Jordan, T. L. 1982. “A Guide to Parallel Computation and Some Cray-1 Experiences.” In Parallel Computations. Elsevier. https://doi.org/10.1016/b978-0-12-592101-5.50006-3.
向量运算擅长处理激活函数等逐元素变换,其中每个输出仅依赖于其对应的输入。然而,神经网络还需要结构化计算,其中每个输出都依赖于所有输入,即定义层变换的加权求和。这些多对多运算自然可表示为矩阵乘法,也就是第二种计算原语。
矩阵运算
矩阵乘法在许多稠密神经网络中占据了大部分算术计算量,通过权重、激活值和梯度的结构化模式对高维数据进行变换 (Goodfellow et al. 2016)。向量运算独立处理元素或对其进行归约,而矩阵运算则跨多个维度组织计算。硬件和库对这些维度进行分块,使权重块和激活值块得以复用,同时在局部累加部分和。这种规则结构推动了重要的硬件策略,但规模较小或形状不规则的矩阵可能无法充分利用分块容量。
神经网络中的矩阵运算
神经网络计算可以分解为具有层次结构的矩阵运算。Listing 5 通过一个线性层展示了这一层次结构,该层将一个批次中的输入特征变换为输出神经元。
layer = nn.Linear(256, 512)  # Layer transforms 256 inputs to 512 outputs
output = layer(input_batch)  # Process a batch of 32 samples

# Framework Internal: Core operations (column-batch convention)
Z = matmul(weights, input)  # Matrix: transforms [256×32]
# input to [512×32] output
Z = Z + bias  # Vector: adds bias to each
# output independently
output = relu(Z)  # Vector: applies activation to
# each element independently
这一计算展示了神经网络中矩阵运算的规模。对于批次中的每个样本(共 32 个样本),每个输出神经元(共 512 个)都必须处理所有输入特征(共 256 个)。仅权重矩阵就包含 256 \(\times\) 512 = 131,072 parameters 个参数,用于定义这些变换,这说明了为何高效矩阵乘法在性能考量中占据主导地位。
除简单线性层之外,神经网络还在多种架构模式中使用矩阵运算。卷积运算可通过 im2col 技术转化为矩阵乘法,17从而在针对矩阵运算优化的硬件上高效执行。Listing 6 展示了这些应用。
hidden = matmul(weights, inputs)
# weights: [out_dim x in_dim], inputs: [in_dim x batch]
# Result combines all inputs for each output

# Attention Mechanisms - Multiple matrix operations
Q = matmul(Wq, inputs)
# Project inputs to query space [query_dim x batch]
K = matmul(Wk, inputs)
# Project inputs to key space [key_dim x batch]
attention = matmul(Q.T, K)
# Compare all query tokens with all key tokens [batch x batch]

# Convolutions - Matrix multiply after reshaping
patches = im2col(input)
# Convert [H x W x C] image to matrix of patches
output = matmul(kernel, patches)
# Apply kernels to all patches simultaneously
这些示例的张量形状和复用模式各不相同,这决定了每次乘法能以多高的效率利用矩阵单元。线性层在整个批次中复用同一个权重矩阵;注意力先形成投影,再形成词元之间的分数矩阵;卷积则在多个图像块上复用每个卷积核。将三者都表示为矩阵乘法,为硬件提供了共同的接口,但并不意味着它们的执行成本相同。批大小、序列长度、通道数和分块方式决定了操作数是在局部复用,还是从内存中反复读取。
矩阵运算的硬件加速
这种普遍存在的矩阵乘法模式对硬件设计具有直接影响:加速器需要能够大规模处理这些计算的专用单元。Listing 7 展示了一个具有代表性的专用矩阵单元,它一次处理一个完整的 \(16{\times}16\) 块,说明了为何矩阵指令和 Tensor Core 能够提供远高于标量或纯向量执行路径的吞吐量 (NVIDIA 2017; Intel Corporation 2021a)。
mload mr1, (weight_ptr)     # Load e.g., 16x16 block of
                            # weight matrix
mload mr2, (input_ptr)      # Load corresponding input block
matmul.mm mr3, mr1, mr2     # Multiply and accumulate entire
                            # blocks at once
mstore (output_ptr), mr3    # Store computed output block
示例中的单元以矩阵分块而非单个元素为操作对象。一次完整的 \(16{\times}16{\times}16\) 分块乘积包含 \(16^3=4{,}096\) 次乘加运算,但所需周期数取决于具体指令和体系结构。持续吞吐量还取决于矩阵单元数量、操作数精度、发射速率、流水线行为,以及内存能否持续为这些单元供给数据。矩阵单元通过加速结构化的多对多变换,对向量执行形成补充。
与向量处理一样,矩阵加速也有深厚的历史渊源:在 20 世纪 80 至 90 年代,DSP 和 GPU 就已针对图像处理、科学计算和 3D 渲染中的矩阵计算进行优化 (Owens et al. 2008; Hwu 2011)。神经网络使矩阵乘法在商业应用中占据主导地位,推动了将二维脉动阵列和矩阵执行引擎(如 NVIDIA Tensor Core 和 Google TPU)直接集成到处理器数据通路中。
Owens, John D., Mike Houston, David Luebke, Simon Green, John E. Stone, and James C. Phillips. 2008. “GPU Computing.” Proceedings of the IEEE 96 (5): 879–99. https://doi.org/10.1109/jproc.2008.917757.
Hwu, Wen-mei W. 2011. “Introduction.” In GPU Computing Gems Emerald Edition. Elsevier. https://doi.org/10.1016/b978-0-12-384988-5.00064-4.
线性代数仅构成神经网络执行流水线的一部分。在线性变换之间,神经网络引入了非线性激活函数和归一化层。ReLU 等分段线性函数可映射为简单的向量比较指令,而超越函数计算(如 softmax 和 GELU 中的指数运算,或归一化中的平方根倒数运算)若直接在乘加数据通路上执行,就会付出高昂的周期代价。Table 3 总结了三种主要计算原语的执行特征及其与神经网络运算的映射关系。
| 运算类型 | 最适合 | 示例 | 关键特征 |
|---|---|---|---|
| 矩阵运算 | 多对多变换 | 层变换、注意力、卷积 | 每个输出依赖于多个输入 |
| 向量运算 | 向量与归约计算 | 激活函数、层归一化、逐元素梯度 | 使用逐元素运算和向量归约 |
| 特殊函数路径 | 超越函数运算 | 指数、对数、平方根倒数 | 使用特定于体系结构的近似方法或专用逻辑 |
特殊函数单元
特殊函数单元(Special Function Units,SFU)或专用指令路径用于加速非线性函数及相关算术运算,补全了本章介绍的三类处理原语。这种需求并非新事物:浮点协处理器曾用于解决标量算术瓶颈 (Palmer 1980),数字信号处理器则为信号处理工作负载增加了专用算术功能 (Smith 1997)。具体实现可以采用独立单元、向量近似指令或库中的指令序列,在准确性、延迟和吞吐量之间进行权衡。在神经网络中,矩阵内核之间的激活、归一化和 softmax 运算可能成为重要环节,尤其是在反复遍历内存或超越函数限制吞吐量时。
Palmer, John F. 1980. “The Intel 8087 Numeric Data Processor.” Proceedings of the 1980 National Computer Conference (AFIPS), 887–93. https://doi.org/10.1145/1500518.1500674.
Smith, Steven W. 1997. “Digital Signal Processing.” In Digital Signal Processing Demystified. Elsevier. https://doi.org/10.1016/b978-187870716-1/50004-4.
非线性函数
一个常见的层序列展示了非矩阵算子如何进入执行流水线 (Goodfellow et al. 2016)。Listing 8 将线性变换、ReLU 激活和批归一化串联起来;这些运算在 Python 框架代码中看似简单,却对硬件施加了各不相同的算术和内存约束。
Goodfellow, Ian, Yoshua Bengio, and Aaron Courville. 2016. Deep Learning. MIT Press.
layer = nn.Sequential(
    nn.Linear(256, 512), nn.ReLU(), nn.BatchNorm1d(512)
)
output = layer(input_tensor)
Listing 9 将这一序列展开为算术原语,区分了 ReLU 的逐元素阈值处理,以及批归一化所需的跨批次样本归约和平方根倒数运算。
Z = matmul(weights, input) + bias  # Linear transformation
H = max(0, Z)  # ReLU activation
mean = reduce_mean(H, axis=0)  # BatchNorm statistics
var = reduce_mean((H - mean) ** 2)  # Variance computation
output = gamma * (H - mean) / sqrt(var + eps) + beta  # Normalization
非线性函数的硬件实现
将这些数学函数映射到芯片上,会显现出内存流量、指令数量和流水线利用率方面的显著差异。例如,批归一化 (Ioffe and Szegedy 2015) 需要通过多遍内存访问收集统计量、累加方差并计算平方根倒数,而 softmax 需要在整个归一化维度上计算指数。 尽管修正线性单元(ReLU)在数学上很简单,但朴素的标量实现会产生分支开销或冗余的内存往返访问,除非将其融合到相邻内核中。Listing 10 在未融合的循环模型中,对比了逐点激活与多遍归一化的内存开销和依赖开销。
Ioffe, Sergey, and Christian Szegedy. 2015. “Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift.” Proceedings of the 32nd International Conference on Machine Learning (ICML) 37: 448–56.
非线性这一标签掩盖了三种不同的执行约束。ReLU 等逐点函数保持元素之间的独立性,因此可以自然地映射到向量通道或并行线程。批归一化中的均值和方差等归约计算则引入了跨元素依赖:必须先合并部分结果,后续阶段才能继续执行。指数、对数和平方根倒数等超越函数还增加了数值方面的约束,因为其实现需要在延迟、精度和有效输入范围之间进行权衡。决定应采用向量算术、归约树还是专用近似路径的,是依赖模式,而不仅仅是数学分类。更快的特殊函数路径只能加速其所实现的运算;它无法消除周围的张量数据传输或同步。
Listing 10 有意显式呈现依赖关系,而非模拟优化后的内核。这些循环揭示了三种状态的生命周期:逐元素激活值、逐特征累加器,以及最终的归一化输出。在所需统计量就绪之前,无法应用归一化参数,因此实现必须保留中间激活值,或者重新计算它们。训练时从当前批次计算这些统计量,而推理时可以使用已存储的统计量,将归一化简化为逐元素仿射变换。编译器可以融合允许融合的阶段,但哪些变换能够保持计算不变,取决于数据依赖关系。因此,将该代码清单视为依赖图,可以揭示始终需要考虑的硬件问题:每个张量跨越内存接口的频率、哪些中间结果保留在局部,以及归约在哪些位置要求同步。
for batch in range(32):
    for feature in range(512):
        # ReLU: Naive scalar compare/select; optimized kernels
        # usually implement this branchlessly.
        z = matmul_output[batch, feature]
        h = max(0.0, z)  # Conditional operation

        # BatchNorm: Multiple passes over data
        mean_sum[feature] += h  # First pass for mean
        var_sum[feature] += h * h  # Additional pass for variance

        temp[batch, feature] = h  # Extra memory storage needed


# Normalization requires complex arithmetic
for feature in range(512):
    mean = mean_sum[feature] / batch_size
    var = (var_sum[feature] / batch_size) - mean * mean

    # Square root computation: Multiple iterations
    scale = gamma[feature] / sqrt(var + eps)  # Iterative
    # approximation
    shift = beta[feature] - mean * scale

    # Additional pass over data for final computation
    for batch in range(32):
        output[batch, feature] = temp[batch, feature] * scale + shift
listing 10 中的依赖结构揭示了朴素执行导致性能骤降的原因:算术强度急剧下降。逐点 ReLU 和归一化的缩放与平移操作,每进行一次四字节内存访问,仅执行一到两次算术运算,使工作负载深陷内存受限区间。此外,由于只有处理完所有样本后才能最终确定批次统计量,中间张量 temp 必须写回内存,并在后续遍历中重新读取,从而增加内存带宽消耗和缓存压力。同时,计算 \(1/\sqrt{\mathrm{var} + \epsilon}\) 需要迭代平方根和除法运算;如果在标准整数或浮点 ALU 上执行,可能使流水线执行停顿数十个周期。缓解这些开销需要两种互补策略:在硬件层面使用特殊函数单元,在个位数周期内近似计算超越函数;在编译器层面进行内核融合,将中间值保留在寄存器中,避免其溢出并通过内存总线传输。
SFU 的硬件实现
SFU 通过在专用功能单元中实现非线性运算和超越函数运算来解决算术瓶颈,而非使用包含多条指令的软件例程。加速器部署专用数据通路电路,例如二次多项式插值器和小型查找表(LUT),在少数几个流水线阶段内求出指数、平方根倒数和对数等函数的值。Listing 11 展示了指令集如何在提供向量内存访问的同时提供这些运算。
vld.v v1, (input_ptr)    # Load vector of values (pseudocode)
vrelu.v v2, v1           # Vector ReLU path
vsigm.v v3, v1           # Vector sigmoid path
vtanh.v v4, v1           # Vector tanh path
vrsqrt.v v5, v1          # Vector reciprocal-square-root path
专用函数路径需要在电路面积与数学精度之间取得平衡。ReLU 等分段线性激活函数只需要单周期的比较并选择(取最大值)数据通路逻辑,而超越函数则需要在查找表大小、多项式插值阶数与近似误差之间进行权衡。Table 4 总结了这些原语具有代表性的硬件机制及其定性延迟特征。
| 功能单元 | 运算 | 实现策略 | 示例性延迟特征 |
|---|---|---|---|
| 激活单元 | ReLU | 比较并选择或取最大值 | 较低;取决于体系结构 |
| 统计单元 | 均值、方差 | 并行归约树 | 随归约深度增加而增长 |
| 指数单元 | exp、log、sigmoid、tanh | 近似计算、查表和插值 | 取决于体系结构 |
| 根式/幂运算单元 | sqrt、rsqrt | 迭代或近似计算硬件 | 取决于体系结构 |
向量运算、矩阵运算和特殊函数路径构成了机器学习加速器的基础算术原语,但仅靠功能单元并不能决定持续吞吐量。这些原语决定芯片计算什么;执行模型和内存层次结构决定数据如何供给数据通路。如果内存带宽无法持续供给操作数、分块维度与寄存器分块不匹配,或线程同步使执行串行化,那么额定性能达数百 teraFLOP/s 的矩阵单元也会空闲。硬件峰值指标描述的是理想化操作数供给条件下的性能;体系结构的执行模型则决定了真实神经网络工作负载能够达到该峰值的多大比例。
计算单元与执行模型
对一个包含 512 个元素的向量应用 ReLU,可以说明执行模型为何重要:运算本身很简单,但吞吐量取决于硬件是将这 512 次比较视为标量指令、SIMD 通道、GPU 线程,还是张量程序片段。现代 AI 处理器将这三种计算原语组织到不同的执行单元中,包括单指令多数据(SIMD)单元、Tensor Core 和处理单元;这些单元定义了计算的组织方式及其向程序员呈现的方式。理解这种组织结构,能够揭示决定实际吞吐量的理论能力与实际性能特征。
将原语映射到执行单元
计算原语到执行单元的映射受到物理连线能耗和数据复用的制约。从寄存器文件读取操作数并通过片上连线传输所消耗的能量,是算术运算本身的数倍。硬件加速器通过配置与各类原语复用特征相匹配的专用执行单元,来应对这一物理约束:
- 向量运算 → SIMD 和单指令多线程(SIMT)单元。这些单元通过共享指令取指与译码逻辑的并行 ALU,执行加法、缩放和偏置等一维逐元素原语。由于向量运算对每个载入操作数的算术复用度为 \(O(1)\),其吞吐量仍受寄存器文件端口带宽和内存数据供给能力的限制。
- 矩阵运算 → Tensor Core18 和脉动阵列。这些单元将二维内积原语映射到由 MAC 电路构成的密集二维网格。矩阵单元通过局部连线在相邻处理单元之间直接传递激活值和权重,例如采用权重驻留或输出驻留数据流,从而在数据流动过程中实现复用。这种空间复用使算术吞吐量与主寄存器文件带宽解耦,在可控的热包络内维持峰值计算密度。
- 特殊函数 → 特殊函数单元(SFU)。这些单元利用分段多项式近似和查找表,将 \(\exp\)、\(\ln\) 和平方根倒数等超越函数及非线性原语映射到专用流水线。在通用 ALU 上计算超越函数需要使用耗费数十个时钟周期的迭代数值算法;专用 SFU 则在主执行路径之外以较低吞吐量计算这些函数,避免激活层阻塞向量流水线。
在数据—算法—机器分类体系中,这种划分定义了算法原语如何绑定到物理机器执行路径。将密集矩阵乘法交由标准向量流水线执行,会迅速耗尽寄存器文件读端口的带宽,使吞吐量降至加速器峰值能力的一小部分。反之,将低算术强度的逐元素运算或不规则激活运算交由矩阵阵列执行,则会使处理通道闲置。持续的系统性能取决于能否将每种计算原语匹配到数据流和存储层次结构与其算术强度相适应的执行单元。
从 SIMD 到 SIMT 架构的演进
在标量处理器架构中,对包含 512 个元素的激活向量执行逐元素运算,需要进行 512 次独立的循环迭代。每次迭代都要对一条指令进行取指、译码,并跟踪其在流水线中的执行过程,指令控制逻辑消耗的能量远高于算术逻辑单元(ALU)执行实际比较或加法所消耗的能量。在固定的热设计功耗(TDP)预算下,标量执行将芯片面积和功耗用于指令管理,而非提高算术吞吐量。Flynn 的 SIMD 执行模型通过向打包在宽向量寄存器中的多个数据元素发射一条已译码指令,摊薄这类前端开销 (Flynn 1966)。例如,一个 512 位 SIMD 寄存器可在单个时钟周期内同时处理十六个 32 位浮点值,将取指和译码流量降至原来的十六分之一。
Flynn, M. J. 1966. “Very High-Speed Computing Systems.” Proceedings of the IEEE 54 (12): 1901–9. https://doi.org/10.1109/proc.1966.5273.
传统的固定宽度 SIMD 架构将编译后的机器码绑定到特定的硬件寄存器宽度,例如 128 位、256 位或 512 位。当张量维度与固定向量宽度不对齐时,编译器必须生成标量收尾循环或插入内存填充,从而增大二进制体积和分支复杂度。Arm 可伸缩向量扩展(SVE)通过向量长度无关(VLA)执行和逐通道谓词控制,消除了这种僵化限制 (Stephens et al. 2017)。SVE 不在指令编码中硬编码物理寄存器宽度,而是依靠谓词寄存器动态配置活动通道,如 listing 12 中的向量算术指令序列所示。
ptrue p0.s              # Create predicate for vector length
ld1w z0.s, p0/z, [x0]   # Load vector of inputs
fmul z1.s, z0.s, z0.s   # Multiply elements
fadd z2.s, z1.s, z0.s   # Add elements
st1w z2.s, p0, [x1]     # Store results
ptrue 指令激活所有可用的谓词通道,而不编码固定的向量长度。这种向量长度无关的编程模型使同一个 SVE 二进制文件无需重新编译,即可在 128 位至 2048 位的实现上运行 (Stephens et al. 2017)。Intel 高级矩阵扩展(AMX)进一步推进了专用化:专用分块寄存器和矩阵乘法加速器直接处理二维数据块,而非一维向量 (Intel Corporation 2021a)。SVE 和 AMX 共同体现了 CPU 为适应机器学习工作负载所作的调整:可移植的向量执行与固定分块的矩阵流水线。
Stephens, Nigel, Stuart Biles, Matthias Boettcher, Jacob Eapen, Mbou Eyole, Giacomo Gabrielli, Matt Horsnell, et al. 2017. “The ARM Scalable Vector Extension.” IEEE Micro 37 (2): 26–39. https://doi.org/10.1109/mm.2017.35.
尽管具备向量长度灵活性,CPU SIMD 架构在扩展到大型神经网络工作负载时,仍面临根本性的物理限制。CPU 将大量芯片面积用于分支预测器、乱序执行逻辑和多级缓存层次结构,以尽量降低少量顺序线程的延迟。当以流式方式处理数 GB 的张量数据时,缓存未命中会迫使执行流水线等待数百个周期,以便从主存取回数据。在内存停顿期间,CPU 的指令重排序缓冲区会迅速填满,使宽 SIMD 流水线无工作可执行。此外,向量内部的条件分支需要在位掩码控制下计算两条路径,从而降低有效通道利用率。
单指令多线程(SIMT) 架构通过将逻辑编程抽象与物理硬件执行解耦,解决了这些瓶颈 (Lindholm et al. 2008; Nickolls et al. 2008)。SIMT 无需程序员将数据打包到显式向量寄存器中,而是提供由独立标量线程构成的执行模型。在 GPU 架构中,每个流式多处理器(SM)19 协调数千个并发线程。硬件线程束调度器将这些线程划分为线程束,20 即由 32 个线程组成的执行单元(在 AMD 架构中对应波前),在并行 ALU 上以锁步方式执行指令。GPU 通过大规模线程级并发隐藏延迟,而非依靠大型缓存降低内存延迟。SM 将片上寄存器文件静态划分给所有活动线程,从而消除上下文保存开销;当某个线程束因等待片外内存取数而停顿数百个周期时,线程束调度器会在紧接着的下一个周期选择另一个就绪线程束,并发射其指令。listing 13 中的基础矩阵乘法内核展示了这种标量线程模型如何映射到硬件。
Lindholm, Erik, John Nickolls, Stuart Oberman, and John Montrym. 2008. “NVIDIA Tesla: A Unified Graphics and Computing Architecture.” IEEE Micro 28 (2): 39–55. https://doi.org/10.1109/mm.2008.31.
Nickolls, John, Ian Buck, Michael Garland, and Kevin Skadron. 2008. “Scalable Parallel Programming with CUDA: Is CUDA the Parallel Programming Model That Application Developers Have Been Waiting For?” Queue 6 (2): 40–53. https://doi.org/10.1145/1365490.1365500.
__global__ void matrix_multiply(float* C, float* A, float*
                                B, int N) {  // CUDA kernel
    // Each thread processes one output element
    int row = blockIdx.y * blockDim.y + threadIdx.y;
    int col = blockIdx.x * blockDim.x + threadIdx.x;

    float sum = 0.0f;
    for (int k = 0; k < N; k++) {
        // Threads in a warp execute in parallel
        sum += A[row * N + k] * B[k * N + col];
    }
    C[row * N + col] = sum;
}
在 listing 13 中,CUDA21 内核为每个线程分配一个输出元素 \(C[\text{row}, \text{col}]\)。同一线程束中的相邻线程具有相同的行索引和连续的列索引(threadIdx.x)。当线程读取 \(B[k \cdot N + \text{col}]\) 时,其内存请求指向连续的 4 字节浮点数地址。内存控制器将这 32 次独立的 4 字节加载合并为一次 128 字节的合并内存事务,从而最大限度地提高 DRAM 总线效率。同时,线程束中的所有线程都读取同一个元素 \(A[\text{row} \cdot N + k]\),使硬件能够将单次取回的值广播到全部 32 个通道。然而,这个朴素内核揭示了机器学习系统铁律:算术强度限制实际可达吞吐量。由于内层循环的每次迭代仅执行两次浮点运算,同时反复从全局内存加载操作数,而不借助片上 SRAM 暂存,因此该内核仍严重受内存限制。此外,在标量 SIMT ALU 上执行密集矩阵乘法,每次乘加都需要一次指令取指、译码和发射周期,从而耗尽寄存器文件读端口的带宽。要克服这一机器瓶颈,就必须超越由标量组成的向量执行方式,转向专用的二维矩阵单元。
Tensor Core
考虑单个 Transformer 注意力头,为一个包含 2,048 个词元、嵌入维度为 64 的序列计算 \(\mathbf{Q} \times \mathbf{K}^T\) 乘积。该运算需要将一个 \(2048{\times}64\) 矩阵与一个 \(64{\times}2048\) 矩阵相乘:约需 268.4M MACs,若将乘法和加法分别计数,则约为 536.9 MFLOP。在时钟频率为 2 GHz、每周期执行一次浮点运算的标量处理器上,仅这一个注意力头就需要约 268.4 ms。GPU SIMT 执行可以将这些工作分配给大量线程,而 Tensor Core 更进一步,每条指令都处理完整的矩阵分块;在此处用于说明的假设下,分块执行路径可在 0.5 毫秒内完成相同运算,相对于标量执行,加速比约为 536.9×。这种加速并非来自更高的时钟频率,而是来自将分块级数据复用直接固化到执行数据通路中。
虽然 SIMD 和 SIMT 单元能够高效执行向量运算,但大型矩阵计算 更受益于围绕多维分块组织的单元。专用矩阵引擎通过在片上复用分块,将操作数加载开销摊分到大量乘加运算中。NVIDIA GPU 提供 Tensor Core,而 Google TPU 使用基于脉动阵列构建的矩阵单元。两者都执行分块矩阵乘法与累加。22 其收益取决于分块复用、形状、精度和内存行为。
NVIDIA 并行线程执行(PTX)通过线程束同步的矩阵指令暴露这一架构。23 在 listing 14 中,一个线程束中的全部 32 个线程共同执行 mma.sync,计算矩阵分块乘积 \(D = A \times B + C\)。
Tensor Core Operation (example GPU PTX):
mma.sync.aligned.m16n8k16.row.col.f32.f16.f16.f32
  {d0,d1,d2,d3},     // Destination registers
  {a0,a1,a2,a3},     // Source matrix A
  {b0,b1},           // Source matrix B
  {c0,c1,c2,c3};     // Accumulator
在这条指令中,线程束以混合精度执行一个 \(M=16, N=8, K=16\) 的矩阵乘法累加运算:输入 \(A\)(\(16{\times}16\))和 \(B\)(\(16{\times}8\))采用 FP16 格式,而累加器 \(C\) 和目标 \(D\)(\(16{\times}8\))采用 FP32。线程束调度器无需为每个线程调度 64 条独立的标量融合乘加(fma)指令,而是发射一条指令,通过 Tensor Core 数据通路完成 2,048 次乘加运算。将矩阵片段分布在线程寄存器中,并在专用加法树内累加中间结果,缓解了传统 SIMT 执行的两个关键硬件瓶颈:指令发射带宽和寄存器文件读端口争用。
设计优先级决定了矩阵引擎在不同处理器系列中的具体形态。GPU Tensor Core 在加速通用深度学习内核的同时保留可编程性。TPU 类设计采用以脉动阵列组织的大规模矩阵单元,以最大限度地提高密集张量内核的持续训练吞吐量。移动端 NPU24 将同一思路缩小为低功耗推理模块,而服务器 CPU 则增加矩阵指令扩展(AMX 类分块),用于推理和混合工作负载。每种实现都改变了同一个权衡:在减少密集矩阵运算周边数据移动的同时,硬件保留多少灵活性。
Figure 6 展示了专用化、更低精度和稀疏性支持如何改变标称峰值能力。从 K20X FP32 到支持结构化稀疏性的 H100 FP8,图示数值增长了约三个数量级 (NVIDIA Corporation 2017, 2020a, 2024; Choquette 2023)。这些数据点衡量的并非同一种量:它们混用了不同精度格式,并将 FLOP/s 与每秒 INT8 运算次数放在一起。因此,这条曲线比较的是各代产品最突出的标称执行路径,而非相同精度下的应用性能。加速器规格总矩阵 提供了相应的各精度规格、带宽和功率上限。
\begin{tikzpicture}[font=\sffamily\small]

\pgfplotsset{
  layers/axis lines on top/.define layer set={
    axis background,
    axis grid,
    axis ticks,
    axis tick labels,
    pre main,
    main,
    axis lines,
    axis descriptions,
    axis foreground,
  }{/pgfplots/layers/standard},
}

\begin{axis}[
   /pgf/number format/.cd,
   tick label style={/pgf/number format/assume math mode=true},
   ticklabel style={font=\footnotesize\sffamily},
   1000 sep={}, % uklanja zareze
  yticklabel style={
  /pgf/number format/.cd,
  sci,
  sci generic={mantissa e exponent},
  precision=1
},
    width=15cm,
    height=85mm,
    xmin=2010, xmax=2026,
    ymin=1e0, ymax=1e4,
    ymode=log,
    log basis y=10,
    xtick={2012,2014,2016,2017,2020,2022,2024},
    %ytick={1e9,1e10,1e11,1e12,1e13,1e14,1e15},
    yticklabels={1,10,100,{1,000},{10,000}},
    xlabel={年份},
    ylabel={峰值吞吐量(单位见标注)},
    title style={align=center},
    title={NVIDIA GPU 推理性能\\
    {\color{black!60}\footnotesize\sffamily\itshape 浮点运算以 TFLOP/s 计;INT8 运算以 TOPS 计,采用对数刻度}},
    axis lines*=left,
    axis line style={gray!70,line width=1pt},
 % axis on top=true,
  set layers=axis lines on top,
    tick style={black!90},
    tick label style={font=\sffamily\small},
    xlabel style={font=\sffamily\large},
    ylabel style={font=\sffamily\large},
    ylabel style={font=\small\sffamily,align=center,yshift=-1.2mm},
    xlabel style={font=\small\sffamily},
    grid=major,
    major grid style={black!22},
    %minor grid style={gray!6},
    clip=false,
   tick align=outside,
   major tick length=1.5mm,
]

%—shaded public text stock band ---

\addplot[
    draw=none,
    fill=magenta!03,opacity=0.7,
] coordinates {
    (2010,1e0)
    (2010,1e4)
    (2016,1e4)
    (2016,1e0)
}; %\closedcycle
\addplot[
    draw=none,
    fill=magenta!08,opacity=0.7,
] coordinates {
    (2016,1e0)
    (2016,1e4)
    (2026,1e4)
    (2026,1e0)
}; %\closedcycle

%—data points ---
\addplot[
    %only marks,
    mark=*,
    mark options={draw=white,fill=crimson, line width=0.95pt, mark size=3.25,
    },
    crimson,line width=1.75pt
] coordinates {
    (2012,5e0)   % K20X
    (2014,7e0)   % M40
    (2016,0.44e2)   % P40
    (2017,1.3e2)   % V100
    (2020,1.1e3)   % A100
    (2022,0.4e4)   % H100
    (2024,0.9e4)   % B200 (FP8 sparse ~9,000 TFLOP/s; mlsysim Hardware.Cloud.B200)
};
%—point labels ---
\node[anchor=north, align=center,text=black, font=\sffamily\fontsize{7pt}{8}\selectfont]
    at (axis cs:2012,4.4e0) {\textbf{K20X} \\ {\color{black!60}3.9 TFLOP/s FP32}};

\node[anchor=south, align=center,text=black, font=\sffamily\fontsize{7pt}{8}\selectfont]
    at (axis cs:2014,9.5e0) {\textbf{M40} \\ {\color{black!60}6.8 TFLOP/s FP32}};

\node[anchor=east, align=center,text=black, font=\sffamily\fontsize{7pt}{8}\selectfont]
    at (axis cs:2015.75,0.62e2) {\textbf{P40} \\ {\color{black!60}47 TOPS INT8}};

\node[anchor=west, align=center,text=black, font=\sffamily\fontsize{7pt}{8}\selectfont]
    at (axis cs:2017.25,1.05e2) {\textbf{V100} \\ {\color{black!60}125 TFLOP/s FP16}};

\node[anchor=north, align=center,text=black, font=\sffamily\fontsize{7pt}{8}\selectfont]
    at (axis cs:2020.4,1.0e3) {\textbf{A100} \\ {\color{black!60}1,248 TOPS INT8}};

\node[anchor=south east, align=center,text=black, font=\sffamily\fontsize{7pt}{8}\selectfont]
    at (axis cs:2021.8,0.45e4) {\textbf{H100} \\ {\color{black!60}4,000 TFLOP/s FP8}};

\node[anchor=west, align=center,text=black, font=\sffamily\fontsize{7pt}{8}\selectfont]
    at (axis cs:2024.3,0.9e4) {\textbf{B200} \\ {\color{black!60}9,000 TFLOP/s FP8}};
%
\coordinate(A)at(axis cs:2022.5,0.4e4);
\coordinate(B)at(axis cs:2012,5e0);
\coordinate(C)at(axis cs:2016,1e0);
\coordinate(D)at(axis cs:2016,1e4);
\end{axis}
%\scoped[on background layer]
\path[](A)|-coordinate(SR)(B);
\draw[myred,dashed,thick](C)--(D);
\draw[myred,dashed,thick](A)--node[right,font=\sffamily\fontsize{9pt}{9}\selectfont]{1,000$\times$}(SR);
\end{tikzpicture}处理单元
在执行层次结构的下一层,加速器将多个 Tensor Core 与局部存储器集成为模块化的处理单元(PE)。高吞吐量矩阵运算单元无法直接由全局存储器供数;片外 DRAM 和封装内 HBM 的带宽与延迟均无法满足每个周期向密集算术阵列连续输送操作数的要求。处理单元通过将异构计算流水线——用于矩阵乘法的 Tensor Core、用于逐元素运算的向量单元,以及用于非线性变换的特殊函数单元——与高带宽寄存器文件和暂存 SRAM 直接部署在一起,弥补这一带宽缺口。将操作数暂存在 PE 内部,可使数据始终靠近功能单元,并通过反复的算术复用摊薄外部存储器访问的延迟与能耗成本。
不同架构在计算密度、局部存储容量和互连距离之间选择不同的平衡,因此处理单元的设计也各不相同。Graphcore 的智能处理单元(IPU) 将计算分布在 1,472 个计算瓦片上,每个瓦片都包含一个由专用局部 SRAM 支撑的独立处理单元,从而在避免存储器争用的同时利用细粒度并行性 (Graphcore 2020)。Cerebras 在 CS-2 系统中进一步发展了这一局部存储原则,在晶圆级器件上集成约 850,000 个针对 AI 优化的核心,完全绕过片外存储器接口,转而采用片上 SRAM 网格 (Systems 2021)。特斯拉的 D1 处理器在处理单元内部为局部 SRAM 和高吞吐量路由接口分配了大量硅片面积,优先保障紧耦合计算阵列之间的低延迟数据交换 (Tesla, Inc. 2021)。
Graphcore. 2020. The Colossus MK2 IPU Processor.
Tesla, Inc. 2021. Tesla Dojo Technology: A Guide to Tesla’s Configurable Floating Point Formats & Arithmetic. Tesla AI Day, Whitepaper.
在这些设计中,起决定性作用的物理约束是计算密度与数据局部性之间的权衡:分配给算术单元的硅片面积无法同时用于容纳 SRAM 存储或路由连线。增加执行单元的数量可以提高理论峰值 FLOP/s,但如果内存带宽和路由通道无法及时提供操作数,这些单元就会闲置。因此,处理单元的实际效率既取决于其原始算术能力,也同样取决于其局部存储层次结构和互连策略。
这种对局部性的依赖同样决定了硬件实际上能够利用哪些算法优化。规则的处理单元网格只有在保留下来的非零值维持了该网格所依赖的可预测访问模式时,才能加速稀疏计算,而这正是 N:M 结构化稀疏性旨在满足的约束。
N:M 结构化稀疏性的机制
非结构化剪枝虽然减少了模型参数数量,却很少能转化为硬件加速,因为非零值的任意分布会破坏存储访问的局部性。硬件加速器通过 N:M 结构化稀疏性25 解决这一问题,将稀疏性限制在确定的细粒度模式内。记号“\(N{:}M\)”规定,沿归约维度的每个由 \(M\) 个连续值组成的块中,必须恰好有 \(N\) 个非零值。将非零值限制在固定的局部区间内,可确保各并行执行单元具有一致的存储器访问模式和可预测的索引方式。
并行架构要求结构规则性,其原因在于稀疏矩阵必须以特定方式编码并存储在存储器中。压缩稀疏行(CSR)和块压缩稀疏行(BSR)等经典格式依赖辅助索引数组来定位非零元素,稀疏矩阵格式 对此进行了形式化论述。当稀疏性为非结构化时,SIMT 线程束中的相邻线程会访问不连续的存储器地址,产生无法合并的存储器事务;这些事务取回的缓存行大部分为空,却占满了存储器总线。此外,各行非零元素数量不同会导致分支分歧,迫使线程串行执行。粗粒度块稀疏性虽然通过将非零值组织成较大的稠密瓦片来缓解分歧,但当必须剪除整个块时,会降低模型精度。Figure 7 比较了这些占用模式,并展示了对不规则非零元素或非零块进行索引所需的大量元数据。
\begin{tikzpicture}[ x=5mm,y=5mm,line join=round,font=\sffamily\small]
\tikzset{%
  cell/.style={draw=white, line width=0.6pt},
  gridline/.style={draw=black!70, line width=1.5pt},
  Arr/.style={->,>=Latex,line width=0.75pt},
}
  % dimensions
  \def\Rows{3}
  \def\Cols{9}

\definecolor{blue1}{RGB}{23,68,150}
\definecolor{blue2}{RGB}{84,131,217}
\definecolor{blue3}{RGB}{145,177,237}
  %—2) Macro: paint cell (r,c) with color ---
  \newcommand{\ColorCell}[3]{% #1=row, #2=col, #3=color
    \pgfmathtruncatemacro{\yy}{\Rows-#1}
    \fill[#3] (#2-1,\yy) rectangle ++(1,1);
    \draw[cell] (#2-1,\yy) rectangle ++(1,1);
  }
%Grid 9x3
\newcommand{\Gridd}{%
\foreach \r in {1,...,\Rows}{
  \foreach \c in {1,...,\Cols}{
    \pgfmathtruncatemacro{\yy}{\Rows-\r}

    % draw cell
    \fill[gray!25] (\c-1,\yy) rectangle ++(1,1);
    \draw[cell]    (\c-1,\yy) rectangle ++(1,1);

    % corners
    \coordinate (\br-cell-\r-\c-sw) at (\c-1,\yy);
    \coordinate (\br-cell-\r-\c-se) at (\c,\yy);
    \coordinate (\br-cell-\r-\c-nw) at (\c-1,\yy+1);
    \coordinate (\br-cell-\r-\c-ne) at (\c,\yy+1);
    \coordinate (\br-cell-\r-\c-n) at (\c-0.5,\yy+1);
    % center
    \coordinate (cell-\r-\c) at (\c-0.5,\yy+0.5);
  }
}
}
%%%%%%%%%%%%%
%Dense Matrix
%%%%%%%%%%%%%
\begin{scope}[local bounding box=BLOCK-A,shift={(0.0,0.0)}]
%—1) Base + all cell coordinates ---
\def\br{A}
\Gridd

  \ColorCell{1}{1}{blue2}
  \ColorCell{1}{2}{blue3}
  \ColorCell{1}{3}{blue2}
  \ColorCell{2}{1}{blue2}
  \ColorCell{2}{2}{blue1}
  \ColorCell{2}{3}{blue2}
  \ColorCell{3}{1}{blue2}
  \ColorCell{3}{2}{blue2}
  \ColorCell{3}{3}{blue2}
%Center
  \ColorCell{1}{4}{blue1}
  \ColorCell{1}{5}{blue2}
  \ColorCell{1}{6}{blue2}
  \ColorCell{2}{4}{blue3}
  \ColorCell{2}{5}{blue2}
  \ColorCell{2}{6}{blue1}
  \ColorCell{3}{4}{blue2}
  \ColorCell{3}{5}{blue1}
  \ColorCell{3}{6}{blue2}
%—4) Thick frame around the entire 9x3 grid ---
  \draw[gridline] (0,0) rectangle (\Cols,\Rows);

% (optional) thick vertical division after 3 and after 6 columns (as in the picture)
  \draw[gridline] (3,0) -- (3,\Rows);
  \draw[gridline] (6,0) -- (6,\Rows);
\end{scope}
%%%%%%%%%%%%%
%Sparse Matrix (CSR)
%%%%%%%%%%%%%
\begin{scope}[local bounding box=BLOCK-B,shift={(0.0,-6.7)}]
%—1) Base + all cell coordinates ---
\def\br{B}
\Gridd

  \ColorCell{1}{7}{blue1}
  \ColorCell{1}{8}{blue2}
  \ColorCell{1}{9}{blue2}
  \ColorCell{2}{7}{blue3}
  \ColorCell{2}{8}{blue2}
  \ColorCell{2}{9}{blue1}
  \ColorCell{3}{7}{blue2}
  \ColorCell{3}{8}{blue1}
  \ColorCell{3}{9}{blue2}

%—4) Thick frame around the entire 9x3 grid ---
  \draw[gridline] (0,0) rectangle (\Cols,\Rows);

% (optional) thick vertical division after 3 and after 6 columns (as in the picture)
  \draw[gridline] (3,0) -- (3,\Rows);
  \draw[gridline] (6,0) -- (6,\Rows);
\end{scope}
%%%%%%%%%%%%%
%Block Sparse Matrix
%%%%%%%%%%%%%
\begin{scope}[local bounding box=BLOCK-C,shift={(12,0,0)}]
%—1) Base + all cell coordinates ---
\def\br{C}
\Gridd
%LEFT
  \ColorCell{1}{1}{blue2}
  \ColorCell{1}{2}{blue3}
  \ColorCell{1}{3}{blue2}
  \ColorCell{2}{1}{blue2}
  \ColorCell{2}{2}{blue1}
  \ColorCell{2}{3}{blue2}
  \ColorCell{3}{1}{blue2}
  \ColorCell{3}{2}{blue2}
  \ColorCell{3}{3}{blue2}
%RIGHT
  \ColorCell{1}{7}{blue1}
  \ColorCell{1}{8}{blue2}
  \ColorCell{1}{9}{blue2}
  \ColorCell{2}{7}{blue3}
  \ColorCell{2}{8}{blue2}
  \ColorCell{2}{9}{blue1}
  \ColorCell{3}{7}{blue2}
  \ColorCell{3}{8}{blue1}
  \ColorCell{3}{9}{blue2}
%

  \draw[gridline] (0,0) rectangle (\Cols,\Rows);
  \draw[gridline] (3,0) -- (3,\Rows);
  \draw[gridline] (6,0) -- (6,\Rows);
\end{scope}
%%%%%%%%%%%%%
%Block Sparse (BSR)
%%%%%%%%%%%%%
\begin{scope}[local bounding box=BLOCK-D,shift={(12,-6.7)}]
%—1) Base + all cell coordinates ---
\def\br{D}
\Gridd
  \ColorCell{1}{4}{blue1}
  \ColorCell{1}{5}{blue2}
  \ColorCell{1}{6}{blue2}
  \ColorCell{2}{4}{blue3}
  \ColorCell{2}{5}{blue2}
  \ColorCell{2}{6}{blue1}
  \ColorCell{3}{4}{blue2}
  \ColorCell{3}{5}{blue1}
  \ColorCell{3}{6}{blue2}

  \draw[gridline] (0,0) rectangle (\Cols,\Rows);
 \draw[gridline] (3,0) -- (3,\Rows);
 \draw[gridline] (6,0) -- (6,\Rows);
\end{scope}
% =========================
% MINI GRID: 1-by-6
% =========================
\begin{scope}[local bounding box=MINI-G,shift={(27,2.1)},node distance=-0.95pt,
mCell/.style={draw=black!60,rectangle,minimum width=7.5mm,
minimum height=7.5mm,line width=0.75pt, fill=orange!15}]
\node[mCell](R1){1};
\node[mCell,below =of R1](R2){2};
\node[mCell,below =of R2](R3){4};
\node[mCell,below =of R3](R4){5};
\node[mCell,below =of R4](R5){7};
\node[mCell,below =of R5](R6){9};
\draw[black!70, line width=1pt] (R1.north west) rectangle (R6.south east);
\end{scope}
%%%%%%
\node[below=1pt of BLOCK-A]{稠密矩阵};
\node[below=1pt of BLOCK-B]{稀疏矩阵(CSR)};
\node[below=1pt of BLOCK-C]{块稀疏矩阵};
\node[below=1pt of BLOCK-D](BSS){块稀疏(BSR)};
\path[red](BSS)-|coordinate(SR1)(MINI-G);
\node[align=center]at(SR1){非零块索引};
%
%—Above   (R1,R2,R3 -> BLOCK-C) ---
\coordinate (busC) at ([xshift=-7mm]R1.west);
%
\coordinate (tapC1) at (busC |- R1.west);
\coordinate (tapC2) at (busC |- R2.west);
\coordinate (tapC3) at (busC |- R3.west);
% Arrows:
\draw[] (R1.west) -- (tapC1) ;
\draw[] (R2.west) -- (tapC2);
\draw[] (R3.west) -- (tapC3);
%
\draw[Arr] (tapC2)--++(-1.2,0)--++(0,3.5)-| (C-cell-1-1-n);
\draw[Arr] (tapC2)--++(-1.2,0)--++(0,3.5)-| (C-cell-1-3-n);
\draw[Arr] (tapC2)--++(-1.2,0)--++(0,3.5)-| (C-cell-1-9-n);
\draw[black!60,line width=4.0pt]
  ([yshift= 4mm]busC |- R1.west) -- ([yshift=-3mm]busC |- R3.west);
\fill[black!70] ($(tapC2)+(-3pt,0)$) circle (1.75pt);

% ---Below (R4,R5,R6 -> BLOCK-D) ---
\coordinate (busD) at ([xshift=-7mm]R4.west);

\coordinate (tapD4) at (busD |- R4.west);
\coordinate (tapD5) at (busD |- R5.west);
\coordinate (tapD6) at (busD |- R6.west);

\draw[] (R4.west) -- (tapD4);
\draw[] (R5.west) -- (tapD5);
\draw[] (R6.west) -- (tapD6);
  %
\draw[Arr] (tapD5)--++(-1.2,0)--++(0,1.2)-| (D-cell-1-4-n);
\draw[Arr] (tapD5)--++(-1.2,0)--++(0,1.2)-| (D-cell-1-7-n);
\draw[Arr] (tapD5)--++(-1.2,0)--++(0,1.2)-| (D-cell-1-9-n);
\draw[black!60,line width=4.0pt]
  ([yshift= 2mm]busD |- R4.west) -- ([yshift=-3mm]busD |- R6.west);
  \fill[black!70] ($(tapD5)+(-3pt,0)$) circle (1.75pt);
\end{tikzpicture}NVIDIA 的稀疏 Tensor Core 实现了细粒度结构化稀疏性的一种具体形式:2:4 约束,要求沿归约维度的每个连续四值块中,必须恰好有两个非零值 (NVIDIA Corporation 2020a; NVIDIA 2020a)。权重矩阵以压缩形式存储在存储器中:每个块仅保留两个非零值,并附带一个 4 位元数据标签(每个值 2 位),用于指示每个非零元素在原四元素向量中的位置。执行过程中,存储层次结构仅传输压缩权重及其元数据,使所需的权重内存带宽相较稠密执行减半。在稀疏 Tensor Core 数据通路内部,这 4 位元数据控制一个内部多路选择器网络,从未压缩的四元素激活向量中选出两个匹配的值。随后,选中的激活值和两个非零权重被送入规模减半的点积乘法器树。由于硬件仅对非零值执行计算,同时以流式方式传输压缩权重,这一设计使峰值算术指令吞吐量翻倍——当权重经过微调以满足该模式时,相较稠密运算可实现所宣称的 2\(\times\) 张量运算加速。
NVIDIA. 2020a. Accelerating Matrix Multiplication with Block Sparse Format and NVIDIA Tensor Cores.
2:4 模式进一步印证了内存墙的核心事实:硬件加速器通过完全消除零值的传输来提高效率,而非更快地对零值进行计算。将权重载荷减半可减少 HBM 与片上 SRAM 缓存的流量,使工作负载在 Roofline 曲线上移至更高的实际算术强度位置。
稀疏 Tensor Core 通过 SIMT 数据通路内的多路选择器筛选操作数,从而加速矩阵乘法;其他架构则通过改变数据在空间中的移动方式,绕过内存带宽限制。脉动阵列不再让激活值在执行单元与集中式寄存器文件之间反复往返,而是让中间值在物理网格中相邻的处理单元之间直接传递。
脉动阵列
Tensor Core 将矩阵运算封装为小型专用指令瓦片,而脉动阵列则将处理单元组织成大型二维网格,针对连续数据流和操作数复用进行优化。脉动架构使输入沿水平方向、部分和沿垂直方向以节拍方式流经阵列,从而最大限度地减少代价高昂的 DRAM 取数,使低精度量化权重能够实现最大的计算密度。脉动架构的核心动机源于驱动加速器设计的同一能耗约束:通过物理层面的操作数复用,尽量降低存储器访问的代价。对阵列执行过程进行简单的能耗比较,即可揭示这一架构为何已成为现代 AI 加速器的核心。
Napkin Math 1.1: 脉动数据传输的能耗优势
场景:脉动架构在计算任务按节拍流经阵列时,使操作数保持在局部,从而提高能效;“脉动”(心跳)这一比喻体现了局部复用操作数所带来的优势。下面的计算模型将脉动数据流与一种通过 DRAM 流式传输每个操作数的朴素实现进行比较:
- DRAM 流式处理基线:加载 \(\mathbf{A}\),加载 \(\mathbf{B}\),计算 \(\mathbf{A} \times \mathbf{B} + \mathbf{C}\),并写入 \(\mathbf{C}\),不通过缓存或寄存器复用数据。
- 数据搬移:3 次加载 + 1 次写入 = 每次运算 4 次 DRAM 访问。
- 能耗:≈ 4 \(\times\) 640 pJ + 1 pJ(计算)= 2561 pJ/op。
- 脉动阵列(规模为 128 \(\times\) 128):在边缘处各加载一次 A 和 B。数据以“脉动”方式流经 128 个处理单元。
- 数据搬移:每 128 次运算加载 2 次 = 每次运算 0.016 次 DRAM 访问。
- 能耗:≈ 0.016 \(\times\) 640 pJ + 1 pJ(计算)≈ 11 pJ/op。
系统洞见:在这一刻意简化的 DRAM 流式处理基线下,示例模型表明,脉动阵列的能效优势为 232.8×。这一比值衡量的是局部性,而非向量运算与脉动运算之间的固有差距。
- 具体而言,一个 \(128{\times}128\) 阵列通过让数据以脉动方式流经处理单元,而非反复从 DRAM 加载数据,可以持续达到 16,384 MACs/cycle,同时显著节省能耗 (Horowitz 2014; Jouppi et al. 2023)。
- 这种局部性使稠密阵列能够持续并行执行大量 MAC 运算,而无须为每次运算都付出一次 DRAM 访问的代价。
- 局限性:该比较假定基线中不存在有效复用,而阵列内部实现了充分复用。缓存、寄存器分块、阵列利用不足以及其他数据流都会显著改变这一比值。
脉动阵列将处理单元排列成网格,数据以同步、有节奏的方式在相邻单元之间流动,使每个操作数在阵列中传播时能够参与多次计算。这种结构化的数据搬移通过最大限度地利用局部数据复用,尽可能减少外部内存访问。单个权重值在流经处理单元时可以参与数十次运算,从而将执行过程的能耗特征从受内存制约转变为高计算能效。
Kung 和 Leiserson26 (Kung and Leiserson 1979) 最早提出了脉动阵列,系统确立了其在并行计算架构中实现高效矩阵运算的应用方式 (Kung 1982)。与通用执行单元不同,脉动阵列通过在操作数沿网格传播时复用它们,利用空间局部性和时间局部性。Google 的 TPU 是这种架构方法的典型实例:在 TPUv4 中,由乘加单元构成的 \(128{\times}128\) 脉动阵列通过以流水线方式让数据流经阵列来执行矩阵运算 (Jouppi et al. 2023)。Figure 8 展示了这些数据路径:控制单元向输入缓冲区提供数据,缓冲区将数据沿水平方向送入阵列;每个单元产生的部分和则沿垂直方向向下流入底部的累加器链,由其收集最终结果。每个处理单元在每个周期执行一次乘加运算,并将操作数传递给相邻单元,因此,一个值加载一次后便可在整行或整列中复用,无须重新从内存获取。
Kung, H. T. 1982. “Why Systolic Architectures?” Computer 15 (1): 37–46. https://doi.org/10.1109/mc.1982.1653825.
\resizebox{0.75\textwidth}{!}{%
\begin{tikzpicture}[font=\sffamily]
%
\tikzset{%
    Line/.style={line width=1.3pt,black!70,rounded corners}
}
\node[line width=0.75pt, draw=VioletLine,fill=VioletL!30, rectangle,
minimum width=200,minimum height=200](B){};
\foreach \x/\y in{0.08/1,0.33/2,0.58/3,0.95/4}
\draw[Line,line cap=round]($(B.south west)!\x!(B.south east)$)coordinate(G\y)
                --++(270:0.7)coordinate(D\y);
%
\foreach \a in{1,2,3,4}{
\begin{scope}[shift={(D\a)}, yshift=-33]
\node[line width=1.25pt, draw,fill=GreenL!30,
              minimum width=22, minimum height=32](MB\a){};
\foreach \x in{0.2,0.4,0.6,0.8}
\draw[line width=1.25pt]($(MB\a.north west)!\x!(MB\a.south west)$)--
            ($(MB\a.north east)!\x!(MB\a.south east)$);
\node[circle,line width=1.25pt,draw,minimum width=19,
           above=0.22 of MB\a,fill=white](C\a){};
\node[font=\bfseries\sffamily\bfseries]at(C\a){+};
\draw[Line](C\a)--(MB\a);
\draw[Line](MB\a.south)--++(270:0.3)--++(180:0.9)|-(C\a.west)coordinate(T\a);
\end{scope}
}

\draw[Line,-latex](MB1)--(MB2);
\draw[Line,-latex](MB2)--(MB3);
\node[font=\Huge](DL)at($(MB3.east)!0.44!(MB4.west)$){...};
\draw[Line,-latex](MB3)--(DL);
\draw[Line,-latex](DL)--(MB4);
\draw[Line,-latex](MB4)--++(0:1)node[right]{完成};

\foreach \x/\y in{0.08/1,0.31/2,0.55/3,0.95/4}
\draw[Line,line cap=round]($(B.north west)!\x!(B.south west)$)coordinate(GG\y)
                --++(180:0.7)coordinate(DD\y);

\foreach \a in{1,2,3,4}{
\begin{scope}[shift={(DD\a)}, xshift=-12,line cap=round]
\node[line width=1.25pt, draw=none,fill=GreenL!80,
              minimum width=32, minimum height=20](2MB\a){};
\foreach \x in{0,0.25,0.5,0.75}
\draw[line width=1.25pt]($(2MB\a.north west)!\x!(2MB\a.north east)$)--
            ($(2MB\a.south west)!\x!(2MB\a.south east)$);
\draw[line width=1.25pt,line cap=round,red](2MB\a.north west)
--++(180:2mm)coordinate(Z);
\draw[line width=1.25pt,line cap=round,red](2MB\a.south west)
--++(180:2mm)coordinate(DZ);
\draw[line width=1.25pt,line cap=round](Z)--(2MB\a.north east)|-(DZ);
\end{scope}
}
\draw[Line,-latex](2MB1)--(2MB2);
\draw[Line,-latex](2MB2)--(2MB3);
\node[font=\Huge,rotate=90](2DL)at($(2MB3.south)!0.52!(2MB4.north)$){...};
\draw[Line,-latex](2MB3)--(2DL);
\draw[Line,-latex](2DL)--(2MB4);
\draw[Line,-latex](2MB4)|-(MB1);
%
\node[line width=1.25pt, draw,fill=BlueL,
             % minimum width=22mm, minimum height=10mm,
             inner ysep=8,inner xsep=10,
              above left=0.25 and 1.2 of 2MB1](CO){控制};
\draw[Line,-latex](CO.350)-|(2MB1);
\draw[Line,-latex](CO.10)-|(B.north west);
%%
\def\di{0.5}
\def\du{1.0}
\draw[Line,-latex](GG1)++(\di,0)--++(0:\du)coordinate(H);
\draw[Line,-latex](H)++(\di,0)--++(0:\du)coordinate(H1);
\draw[Line,-latex](H1)++(\di,0)--++(0:\du)coordinate(H2)
node[right]{数据};
\draw[Line,-latex](GG2)++(\di,0)--++(0:\du)coordinate(2H);
\draw[Line,-latex](2H)++(\di,0)--++(0:\du)coordinate(2H1);
\draw[Line,-latex](GG3)++(\di,0)--++(0:\du)coordinate(3H);
%
\path[](H)-|coordinate(V1)(G4);
\draw[Line,-latex](V1)++(0,-5mm)--++(270:\du)coordinate(V2);
\draw[Line,-latex](V2)++(0,-5mm)--++(270:\du)coordinate(V3);
\draw[Line,-latex](V3)++(0,-5mm)--++(270:\du)coordinate(V4);
%
\path[](2H)-|coordinate(2V1)(G3);
\draw[Line,-latex](2V1)++(0,-0.8*\di)--++(270:0.8*\du)coordinate(2V2);
\draw[Line,-latex](2V2)++(0,-0.8*\di)--++(270:0.8*\du)coordinate(2V3);
\draw[Line,-latex](2V3)++(0,-0.8*\di)--++(270:0.8*\du)node[below]{部分和};
%
\path[](3H)-|coordinate(3V1)(G2);
\draw[Line,-latex](3V1)--++(270:0.8*\du)coordinate(3V2);
\draw[Line,-latex](3V2)++(0,-0.6*\di)--++(270:0.8*\du)coordinate(3V3);
\draw[Line,-latex](3V3)++(0,-0.6*\di)--++(270:0.8*\du)coordinate(3V4);
\end{tikzpicture}}分块原理:连接计算图与芯片
计算图(将运算视为一次 4,096 \(\times\) 4,096 矩阵乘法)与物理芯片(拥有固定规模为 128 \(\times\) 128 的脉动阵列)之间存在根本性的不匹配。弥合这一差距需要分块:将大型张量运算划分为能够恰好容纳于硬件快速本地存储器(SRAM 或暂存存储器)中的“块”。
要在宽度为 128 的脉动阵列上处理示例中宽度为 4,096 的层,编译器会将结果分解为 1,024 个输出块。每个输出块沿归约维度对 32 个块的计算结果进行累加,因此,完整的矩阵乘法会执行 32,768 次 \(\mathbf{A}\) 块与 \(\mathbf{B}\) 块的乘法。这种分解是存储层次容量限制所施加的物理要求:操作数块从大容量、高延迟的 HBM 中取出,暂存于快速 SRAM 中,再以脉动方式流经脉动阵列。
维度仅比块宽度多出一个,就会使利用率断崖式下降。
分块维度需要在片上容量与算术强度之间取得平衡。更大的块能够让每个加载的字节在更多乘加运算中复用,从而提高内核的算术强度,推动其进入 Roofline 模型中的计算受限区域;容量上限则由快速片上存储器能够同时容纳多少 \(\mathbf{A}\)、\(\mathbf{B}\) 和 \(\mathbf{C}\) 数据决定。分块通过确保从主存加载的每个字节都能在脉动网格内获得 128× 的复用,维持较高的硬件效率 \((\eta_{\text{hw}})\)。反之,不满足这种对齐要求就会违背芯片的约定:如果某层的维度不是块大小的整数倍(例如,在 128 宽的阵列上处理宽度为 129 的层),系统就会因芯片利用不足而付出边缘代价,即一个单元完成剩余块时,另有 127 个单元处于空闲状态。Algorithm 1 形式化描述了编译器为协调这种片上暂存与累加而生成的循环嵌套。
\begin{algorithm} \caption{分块矩阵乘法} \begin{algorithmic} \Require $\mathbf{A} \in \mathbb{R}^{M\times K}$, $\mathbf{B} \in \mathbb{R}^{K\times N}$;块大小 $T_M, T_N, T_K$ \Ensure $\mathbf{C} = \mathbf{A}\mathbf{B}$ \For{每个行块 $i_0$(大小为 $T_M$)} \For{每个列块 $j_0$(大小为 $T_N$)} \State 在片上将 $\mathbf{C}$ 块累加器初始化为零 \For{每个 $k_0$ 遍历 $K$,步长为 $T_K$} \State 将 $\mathbf{A}$ 块 $[i_0,k_0]$ 和 $\mathbf{B}$ 块 $[k_0,j_0]$ 加载到片上 \State 在片上累加块乘积 \Comment{每字节复用 $T_N$/$T_M$ 次} \EndFor \State 将 $\mathbf{C}$ 块写回内存 \EndFor \EndFor \end{algorithmic} \end{algorithm}
一旦操作数块驻留于快速本地 SRAM 中,硬件便可执行块乘法,而无须进一步产生片外内存流量。脉动阵列通过让操作数流经结构化的二维处理单元(PE)网格来实现高效计算;这些单元通过专用寄存器与相邻单元直接通信,避开共享内存总线争用。在权重驻留设计中——即 figure 8 所映射的典型 TPU 数据流——\(\mathbf{B}\) 块的权重被预先加载到各 PE 的本地寄存器中并保持驻留。来自 \(\mathbf{A}\) 块的输入激活值沿行从左向右水平流动,而部分和沿列垂直向下累加。在每个时钟周期,每个活跃 PE 将传入的激活值与其驻留权重相乘,把结果加到上方传入的部分和上,并将激活值向右传递给相邻单元,供下一周期使用。
由于操作数每个周期传播一跳,同步执行需要有意设置时间错位。考虑一个最小的 \(2{\times}2\) 块乘法,其中输出元素 \(C_{ij} = A_{i0}B_{0j} + A_{i1}B_{1j}\) 需要两次乘法和一次累加。权重矩阵 \(\mathbf{B}\) 驻留于四个 PE 中:\(\text{PE}_{00}\) 存储 \(B_{00}\),\(\text{PE}_{01}\) 存储 \(B_{01}\),\(\text{PE}_{10}\) 存储 \(B_{10}\),\(\text{PE}_{11}\) 存储 \(B_{11}\)。如果激活值 \(A_{00}\) 在周期 0 进入 \(\text{PE}_{00}\),其部分积 \(A_{00}B_{00}\) 会在周期 1 向下传递到 \(\text{PE}_{10}\)。为了与这个到达的部分和结合,激活值 \(A_{01}\) 必须延迟一个周期注入。沿各个后续行和列的输入在时间上错开,使在任意物理坐标处相遇的操作数对应相同的归约索引。局部复用摊薄了初始填充和排空的开销:每个加载的激活值会在包含 \(T_N\) 个处理单元的整行中复用,而每个驻留权重在被替换前会服务于一整串输入向量。然而,只要操作数补充速度跟不上阵列完成运算的速度,持续吞吐量仍会受到片外内存带宽的限制(section 1.5.1)。
一个规模为 128 \(\times\) 128、每周期能够执行 16,384 operations 的脉动阵列,需要持续的操作数流来维持利用率。片上缓冲区向阵列边缘提供激活值和权重,并根据需要从片外内存补充数据;阵列内部的复用避免了每个周期都从 HBM 获取每个操作数。TPU v4 的 1,200 GB/s HBM2 带宽有助于维持这一数据流,但对于工作集和复用模式所需存储空间超出片上容量的模型,片外带宽仍可能构成限制。
量化与精度 中的量化技术通过将 FP32 权重转换为 INT8 表示来减小模型的内存占用。将 32 位浮点权重转换为 8 位整数,可将权重传输量降至原来的四分之一,即缩减 4\(\times\);这是否会使内核从带宽受限转为计算受限,取决于该运算原本的算术强度、加速器的 INT8 屋脊点(其 INT8 计算能力达到饱和时的算术强度阈值),以及量化和反量化的开销。同样,结构化剪枝会移除权重矩阵的整行或整列,同时减少必须穿过存储层次的数据量和所需计算量。在数据—算法—机器分类体系中,这些算法优化之所以有价值,正是因为它们针对的是实际限制加速器性能的内存瓶颈。
Systems Perspective 1.1: 使架构与工作负载相匹配
挑战:脉动阵列必须选择将哪些数据保持驻留(在寄存器中),以尽可能减少数据搬移。这一选择将硬件对特定模型类型的偏好固化在架构中。Table 5 概述了三种操作数驻留策略及其各自偏好的工作负载;section 1.8 则将每种策略作为一种通用映射决策进行完整阐述。
Table 5: 脉动阵列数据流策略:脉动阵列的三种操作数驻留选择、各自最大化的复用模式,以及受益的工作负载类别,展示了固定的数据流选择如何将加速器对特定模型的适配倾向固化在架构中。
| 策略 | 驻留项 | 优化目标 | 示例工作负载 |
|---|---|---|---|
| 权重驻留 | 权重(\(\mathbf{W}\)) | 权重的高复用率 | CNN(Conv2D):滤波器较小,并在整幅图像上复用。 |
| 输出驻留 | 部分和(\(\mathbf{C}\)) | 累加器的高复用率 | 大批量矩阵乘法:针对大型权重矩阵,累加多个输入的计算结果。 |
| 输入驻留 | 输入(\(\mathbf{A}\)) | 激活值的高复用率 | Transformer:相同的激活值为不同注意力头中的多个权重矩阵提供输入。 |
没有一种加速器架构适合所有工作负载。针对权重驻留数据流优化的芯片(如早期 TPU)擅长处理 CNN,因为其滤波器权重较小,并可在许多图像块之间复用。同一架构在批大小为 1 的大语言模型(LLM)自回归推理中会陷入停顿,因为每生成一个词元,都必须从片外内存读取一次完整权重矩阵,且无法通过批处理实现任何复用,从而迫使架构转向输出驻留或混合数据流模式。
AI 加速中的数值计算
脉动阵列和 Tensor Core 通常支持低精度算术。相较于 FP32,FP16 将每个数值占用的字节数减半,而目标硬件也可能配备更多低精度乘加计算资源。2\(\times\) 的加速并不会自动实现:它需要受支持的内核、足够的并行工作量,且不存在其他瓶颈。在 模型压缩 的基础上,采用低精度是一项软硬件协同决策。输入格式与累加格式可能不同,从而影响精度、吞吐量、能耗和数据搬移。
精度权衡
降低精度并非没有代价。FP16 具有 5 位指数和 10 位显式存储的尾数小数位,因此其有效数精度高于 BF16,但动态范围远小于 FP32。其最小正规数约为 \(6.1\times10^{-5}\),最大有限值为 65,504;非正规数可将表示范围扩展到更小的数值,但精度会降低。BF16 保留了 FP32 的 8 位指数,并使用 7 位尾数小数位,以较低的精度保留了相近的动态范围。INT8 没有浮点指数,其数值表示取决于缩放因子、零点和截断策略。硬件和软件必须在这些特性与吞吐量及带宽之间取得平衡。
AI 硬件的演进体现了数值方法与硬件能力之间的协同设计。早期 GPU 即使在其他单元中支持多种格式,也不具备如今用于深度学习的专用混合精度矩阵执行路径。随着训练和推理方法证明,在选定的低精度运算中能够达到可接受的准确率,厂商开始加入原生 FP16、BF16 和整数张量执行路径。框架和库通过兼容的内核、自动类型转换、量化和校准来提供这些能力。只有当模型选择了高效的执行路径时,软件才能获得实际收益;仅改变存储格式可能减少字节数,却未必能带来所宣称的算术运算加速。
精度支持集成在执行单元和内存路径中。SIMD 和 SIMT 通道可以支持多种标量格式,而 Tensor Core(section 1.4.3)和脉动阵列单元(section 1.4.6)则提供特定于架构的输入与累加格式组合。降低精度可减少每个操作数所占的字节数,并可能增加每周期的运算次数。决定数据复用的是分块和数据流,而非精度本身;转换、缩放或回退开销则可能抵消部分收益。只有当内核和数值策略能够安全使用某种格式时,该格式才有价值。
尽管降低精度具有优势,深度学习模型并不总能完全依赖低位宽表示。为应对这一挑战,现代 AI 加速器实现了混合精度计算,在执行的不同阶段使用不同的数值格式。这些精度选择会影响数值可靠性:矩阵乘法可以采用 FP16 或 BF16,而累加则保持为 FP32,以防止精度损失。同样,推理引擎使用 INT8 算术运算,同时在必要时以更高精度保留关键激活值。
混合精度计算
现代 AI 加速器越来越多地支持混合精度执行,允许在计算的不同阶段使用不同的数值格式。训练工作负载通常使用 FP16 或 BF16 进行矩阵乘法,同时以 FP32 进行累加以保持精度 (Micikevicius et al. 2017; Mellempudi et al. 2019)。混合精度训练的软件实现,包括损失缩放技术和框架支持,将在 混合精度训练 中介绍。相比之下,推理工作负载针对 INT8 甚至 INT4 进行优化,在保持可接受准确率的同时实现高效率。
Micikevicius, Paulius, Sharan Narang, Jonah Alben, Gregory Diamos, Erich Elsen, David Garcia, Boris Ginsburg, et al. 2017. “Mixed Precision Training.” arXiv Preprint arXiv:1710.03740.
Mellempudi, Naveen, Sudarshan Srinivasan, Dipankar Das, and Bharat Kaul. 2019. “Mixed Precision Training with 8-Bit Floating Point.” arXiv Preprint arXiv:1905.12334.
NVIDIA. 2020b. TensorFloat-32 in the A100 GPU Accelerates AI Training, HPC up to 20x.
NVIDIA Corporation. 2018. NVIDIA Tesla T4 Tensor Core GPU. NVIDIA product documentation.
AI 硬件的演进清楚地体现了向精度多样化发展的趋势。NVIDIA Volta 等早期架构对 FP16 之外的低精度格式支持有限,而 Turing 和 Ampere 等后续架构则扩展了支持的格式范围。Table 6 展示了这一演进过程:Ampere GPU 引入了介于 FP32 和 FP16 之间的混合格式 TF32 (NVIDIA 2020b),同时更广泛地支持 BF16、INT8 和 INT4 (NVIDIA Corporation 2017, 2018, 2020a)。
| 架构 | 年份 | 支持的 Tensor Core 精度 | 支持的 CUDA Core 精度 |
|---|---|---|---|
| Volta | 2017 | FP16 | FP64, FP32, FP16 |
| Turing | 2018 | FP16, INT8, INT4, INT1 | FP64, FP32, FP16, INT8 |
| Ampere | 2020 | FP64, TF32, BF16, FP16, INT8, INT4 | FP64, FP32, FP16, BF16, INT8 |
较新的架构纳入了日益多样化的数值格式,因为不同工作负载在准确率、吞吐量和能耗之间的权衡中受到的约束各不相同。因此,精度支持也是工作负载匹配的一种形式,而非通用的功能清单。
硬件设计中使用的精度格式会对整个系统产生连锁影响。从 FP32 降至 FP16 会使内存流量减半,其意义远超表面所见:由于内存访问主导能耗,当数据移动成为瓶颈时,将内存流量减半可以显著降低单次推理的能耗 (Horowitz 2014)。与此同时,Tensor Core 和脉动阵列能够在相同的芯片面积内集成更多低精度乘加单元,从而提高峰值吞吐量 (Dally et al. 2021; Dally 2023)。代表性的工艺研究还表明,低精度整数算术运算的能耗低于 FP32 (Horowitz 2014),而面向推理的 TPUv1 则围绕 8 位乘法单元构建 (Jouppi et al. 2017)。从系统角度看,降低精度不仅仅是“节省位数”:它同时缓解内存带宽瓶颈,并 提高计算密度,同时改善 Roofline 模型中的带宽与计算两方面限制。
随着 AI 模型规模持续扩大,精度支持将计算原语的讨论重新与内存墙联系起来:低位宽格式的价值,在于减少移动的字节数,并持续为硬件矩阵引擎供给数据。剩下的架构问题是,如何将这些执行单元、精度格式和内存路径集成为完整的加速器系统。架构集成决定了计算原语能够以多高的效率转化为实际可用的加速器吞吐量。SIMD 通道、Tensor Core 和脉动阵列是基本构件,但它们在不同 AI 处理器中的全芯片组织方式差异显著;执行单元的选择、数值精度支持及其连接方式,共同决定了硬件针对深度学习工作负载的扩展效率。
节点内互连:扩展技术栈
掌握单机技术栈,需要理解比特如何在 GPU 与 CPU 之间移动。在 1–8 个 GPU 的规模下,系统通过 NVLink 等高速节点内互连,以及主机到设备的 PCIe 传输实现扩展,以缓解内存墙问题。这些链路构成了一个带宽逐级收窄的层次结构:从封装内 HBM,到 GPU 间的 NVLink 桥接,再到主机 PCIe 链路,距离计算单元每远一步,数据移动速度就降低一级。PCIe 这一层的速度远低于加速器本地内存和 GPU 间互连网络,因此,任何经过 CPU 的数据路径都可能成为性能隐患,这就是 NVLink 旨在规避的“PCIe 墙” (NVIDIA Corporation 2020b)。Section 1.5.5.1 将以主机与加速器之间的通信为关注重点,定量阐述这一层次结构。
Intel Corporation. 2021a. “Intel Advanced Matrix Extensions (Intel AMX).” Intel Architecture Instruction Set Extensions Programming Reference.
现代 AI 处理器会根据其目标应用进行不同的设计权衡,比较它们的配置可以揭示部署约束如何推动架构分化。NVIDIA A100 这类针对训练优化的加速器集成了大量流式多处理器,配备宽 SIMD 单元和 FP16 Tensor Core,因为训练吞吐量随总乘加能力的提升而增长 (NVIDIA Corporation 2020a)。Google 的 TPUv4 采取了截然不同的策略:每个芯片仅有两个核心,每个核心包含大规模 BF16 脉动阵列,这种设计以牺牲编程灵活性为代价,换取稠密矩阵乘法的执行效率 (Jouppi et al. 2023)。在推理领域,Intel 的 Sapphire Rapids 将高级矩阵扩展(AMX)分块引擎专用于 INT8 和 BF16,体现了 模型压缩 中关于推理模型能够容忍降低精度的认识 (Intel Corporation 2021a)。移动神经网络引擎更进一步,将矩阵引擎缩小为低功耗 SoC 模块,优先考虑每次运算的能效,而非峰值吞吐量。Table 7 比较了这些架构配置。
| 处理器 | 向量执行 | 矩阵引擎 | 处理单元 | 主要工作负载 |
|---|---|---|---|---|
| NVIDIA A100 | CUDA FP/INT 通道 | Tensor Core 指令分块 | 108 个 SM | 训练、HPC |
| Google TPUv4 | 向量单元 | \(128{\times}128\) BF16 脉动阵列 | 每芯片 2 个核心 | 训练 |
| Intel Sapphire | 512 位 AVX-512 | AMX 分块(最多 16 行,每行 64 字节) | 最多 60 个核心 | 推理 |
| 移动 NPU | CPU/GPU/DSP 向量单元 | 小型矩阵引擎 | 集成式 NPU 模块 | 移动端推理 |
这些配置呈现出一条一致的工程原则:每种设计都牺牲部分通用性,以针对目标工作负载中的主导运算和精度进行优化。训练芯片将芯片面积投入宽浮点数据通路;推理芯片以精度换取吞吐量;移动芯片以吞吐量换取能效。没有任何一种设计能在所有工作负载上占据优势,这正是硬件选择必须依赖工作负载分析,而非宣传中的关键规格的原因。
成本性能分析
架构规格定义了计算潜力,但部署决策需要成本性能分析。原始算力只是其中一个因素:实际性能可能受算术吞吐量、内存带宽、互连延迟、软件开销或较低的运行利用率限制。
section 1.2.5 中阐明的物理能耗差异——从片外 DRAM 移动操作数的能耗,比执行算术运算高出数个数量级——推动了加速器的专用化。由于内存访问成本远高于计算成本,加速器在受内存限制的内核上只能达到峰值吞吐量的一小部分。相反,最大限度复用数据的架构,例如执行稠密矩阵乘法的脉动阵列,通过将每次内存取数的成本分摊到多次算术运算中,能够维持显著更高的利用率。
考虑一个工程团队,需要在部署规模较大的旧款加速器集群和规模较小的新款加速器集群之间做出选择。当主导内核受内存带宽或通信限制时,峰值 FLOP/s 指标会产生误导。在大模型流水线中,稠密前馈层和注意力投影层可能仍受计算限制,而嵌入查找、层归一化、残差相加和自回归解码步骤则严格受内存限制。决定性的指标是,在现实的集群利用率、内存容量约束、可用内存带宽和横向扩展互连效率下,每美元所能获得的实际工作负载吞吐量。
这些架构和经济约束解释了为何尽管标称单价大幅上涨,业界仍迅速采用新一代加速器。对于受内存限制的工作负载,内存带宽和编译器代码生成的代际改进主导了端到端执行时间。云部署带来了额外的权衡:按小时计费的租用价格、动态变化的实例利用率和基础设施开销,持续改变着购买本地硬件与租用云端算力之间的经济盈亏平衡点。
Table 8 提供了一份常见加速器的示例成本测算表。标价因厂商、地区、合同条款和采购量而异。此外,各行的吞吐量对应不同的数值精度模式,因此,每单位峰值运算能力的价格指标仅在单行内部具有意义,不能作为跨设备比较的基准。该表建立了一个将经济假设明确化的框架,而非提供通用的硬件排名。
| 加速器 | 标价 | 代表性峰值吞吐量(标明精度) | 内存带宽 | 价格/性能 |
|---|---|---|---|---|
| NVIDIA V100 | ~$10,000 | 125 TFLOP/s | 900 GB/s | $80/(TFLOP/s) |
| NVIDIA A100 | ~$15,000 | 312 TFLOP/s | 2,039 GB/s | $48.1/(TFLOP/s) |
| NVIDIA H100 | ~$25,000–30,000 | 494 TFLOP/s (TF32) | 3,350 GB/s | ~$50.6/(TFLOP/s) |
| Google TPUv4 | ~$8,000* | 275 TFLOP/s (BF16) | 1,200 GB/s | ~$29.1/(TFLOP/s) |
| Intel Gaudi 2 | ~$12,000 | 865 TFLOP/s (FP8) | 2,450 GB/s | $13.9/(TFLOP/s) |
这份测算表说明了为何不能将加速器选择简化为单一的关键规格。对于受带宽限制的内核,H100 带宽为 3,350 GB/s 的内存子系统,比峰值算术性能的进一步提升更有帮助;而受计算限制的通用矩阵乘法(GEMM)则呈现相反的敏感性。设备内存容量决定了工作集能否在无需溢出或分区的情况下容纳于芯片上,而编译器和驱动程序的成熟度则决定了应用是否真正能够使用所宣称的数据通路。
软件框架的选择直接影响这些经济权衡:图编译器、算子融合优化过程和运行时分派器,决定了高层模型描述映射到物理执行单元的效率。具体的框架级优化策略将在 机器学习框架 中探讨,而实证测量和基准测试方法将在 基准测试 中阐述。
向量流水线、矩阵分块引擎和 Tensor Core 提供了强大的峰值算术运算能力。NVIDIA A100 宣称其 FP16 张量计算路径可达到 312 TFLOP/s,后续加速器设计则增加了低精度 FP8 执行模式 (NVIDIA Corporation 2020a; Kuzmin et al. 2022; Micikevicius et al. 2022)。NVIDIA 的 Blackwell(B200)架构通过 FP4 张量数据通路延续了这一发展趋势,其每芯片额定峰值吞吐量最高可达稠密计算 9 PFLOP/s 或稀疏计算 18 PFLOP/s (NVIDIA Corporation 2024)。要达到这些理论上限,数值表示、内核实现和稀疏模式必须与专用硬件路径精确匹配。位宽更窄的数值格式拓展了可用的设计空间,但数值稳定性和动态范围要求决定了工作负载能否安全地使用 FP4。
Kuzmin, Andrey, Mart Van Baalen, Yuwei Ren, Markus Nagel, Jorn Peters, and Tijmen Blankevoort. 2022. “FP8 Quantization: The Power of the Exponent.” Advances in Neural Information Processing Systems (NeurIPS), 14651–62. https://doi.org/10.52202/068431-1065.
Micikevicius, Paulius, Dusan Stosic, Neil Burgess, Marius Cornea, Pradeep Dubey, Richard Grisenthwaite, Sangwon Ha, et al. 2022. “FP8 Formats for Deep Learning.” arXiv Preprint arXiv:2209.05433.
将模型的总运算次数除以峰值算术吞吐量,得到的是执行时间的理想化下界,而非实际的推理延迟。在 A100 上,将 ResNet-50 的算术运算次数除以 312 TFLOP/s,得到的估计值处于微秒量级。然而,实际的 ResNet-50 推理需要毫秒量级的时间。这种相差数个数量级的差距揭示了机器学习系统的核心矛盾:算术吞吐量的增长已远远超过向执行单元供给数据所需的内存带宽的增长。从内存搬移数据所消耗的能量比算术运算高出数个数量级,而内存带宽的提升速度也慢于张量算术吞吐量。 这种物理层面的失衡决定了在给定工作负载下,标称的 312 TFLOP/s 能否转化为持续的高硬件利用率,还是大部分算力处于闲置状态 (Horowitz 2014; Gholami et al. 2024)。
要弥合这一性能差距,需要分析向计算单元供给数据的内存层次结构。内存子系统并非被动的支撑设施;它与算术强度和内核调度共同决定了算法能够利用机器峰值算力的比例。
AI 内存系统
ResNet-50 能够揭示加速器算术能力与内存供给能力之间的差距:卷积权重、激活值和中间结果仍然必须及时到位。现代加速器在特定低精度路径上可达到数百 TFLOP/s 甚至更高的吞吐量 (NVIDIA Corporation 2020a, 2024; Choquette 2023),但当内核所需的数据传输流量超过相应的内存带宽时,就无法利用这些算力。AI 内存墙 指的就是算术运算需求与为其供给数据的内存系统之间日益扩大的失配。
与传统工作负载不同,机器学习模型需要频繁访问大量参数、激活值和中间结果,因此对内存带宽提出了很高的要求。这一挑战与 数据工程 中介绍的数据管理策略密切相关。现代 AI 硬件通过先进的内存层次结构、高效的数据搬移技术以及有助于高效执行的压缩策略来应对这些需求。
理解 AI 内存墙
Definition 1.4: AI 内存墙
AI 内存墙 是指算术吞吐量 \((R_{\text{peak}})\) 的增长超过内存带宽 \((\text{BW})\) 的增长时,机器学习加速器所面临的性能约束。核心问题在于,内存系统能否足够快地供给操作数并接收结果,以维持 section 1.4 中介绍的专用原语的持续执行。
- 意义:当 \(\frac{D_{\text{vol}}}{\text{BW}}\) 项主导总运行时间,导致仅提高 FLOP/s 已无法缩短执行时间时,工作负载就达到了内存墙。
- 区别:通用内存墙影响所有计算,而 AI 内存墙则由深度学习所需的大量参数和中间激活张量驱动。
- 常见误区:一种常见误解是,增加内存就能“解决”内存墙。实际上,它体现的是带宽与延迟方面的差距:即使容量无限,内存与计算单元之间的数据搬移速度仍然是根本性的物理瓶颈。
数据访问可能主导内存密集型内核的能耗预算。27 Figure 9 比较了一项工艺研究中具有代表性的操作能耗,揭示了简单的本地算术运算与一次片外 DRAM 访问之间跨越多个数量级的差距。
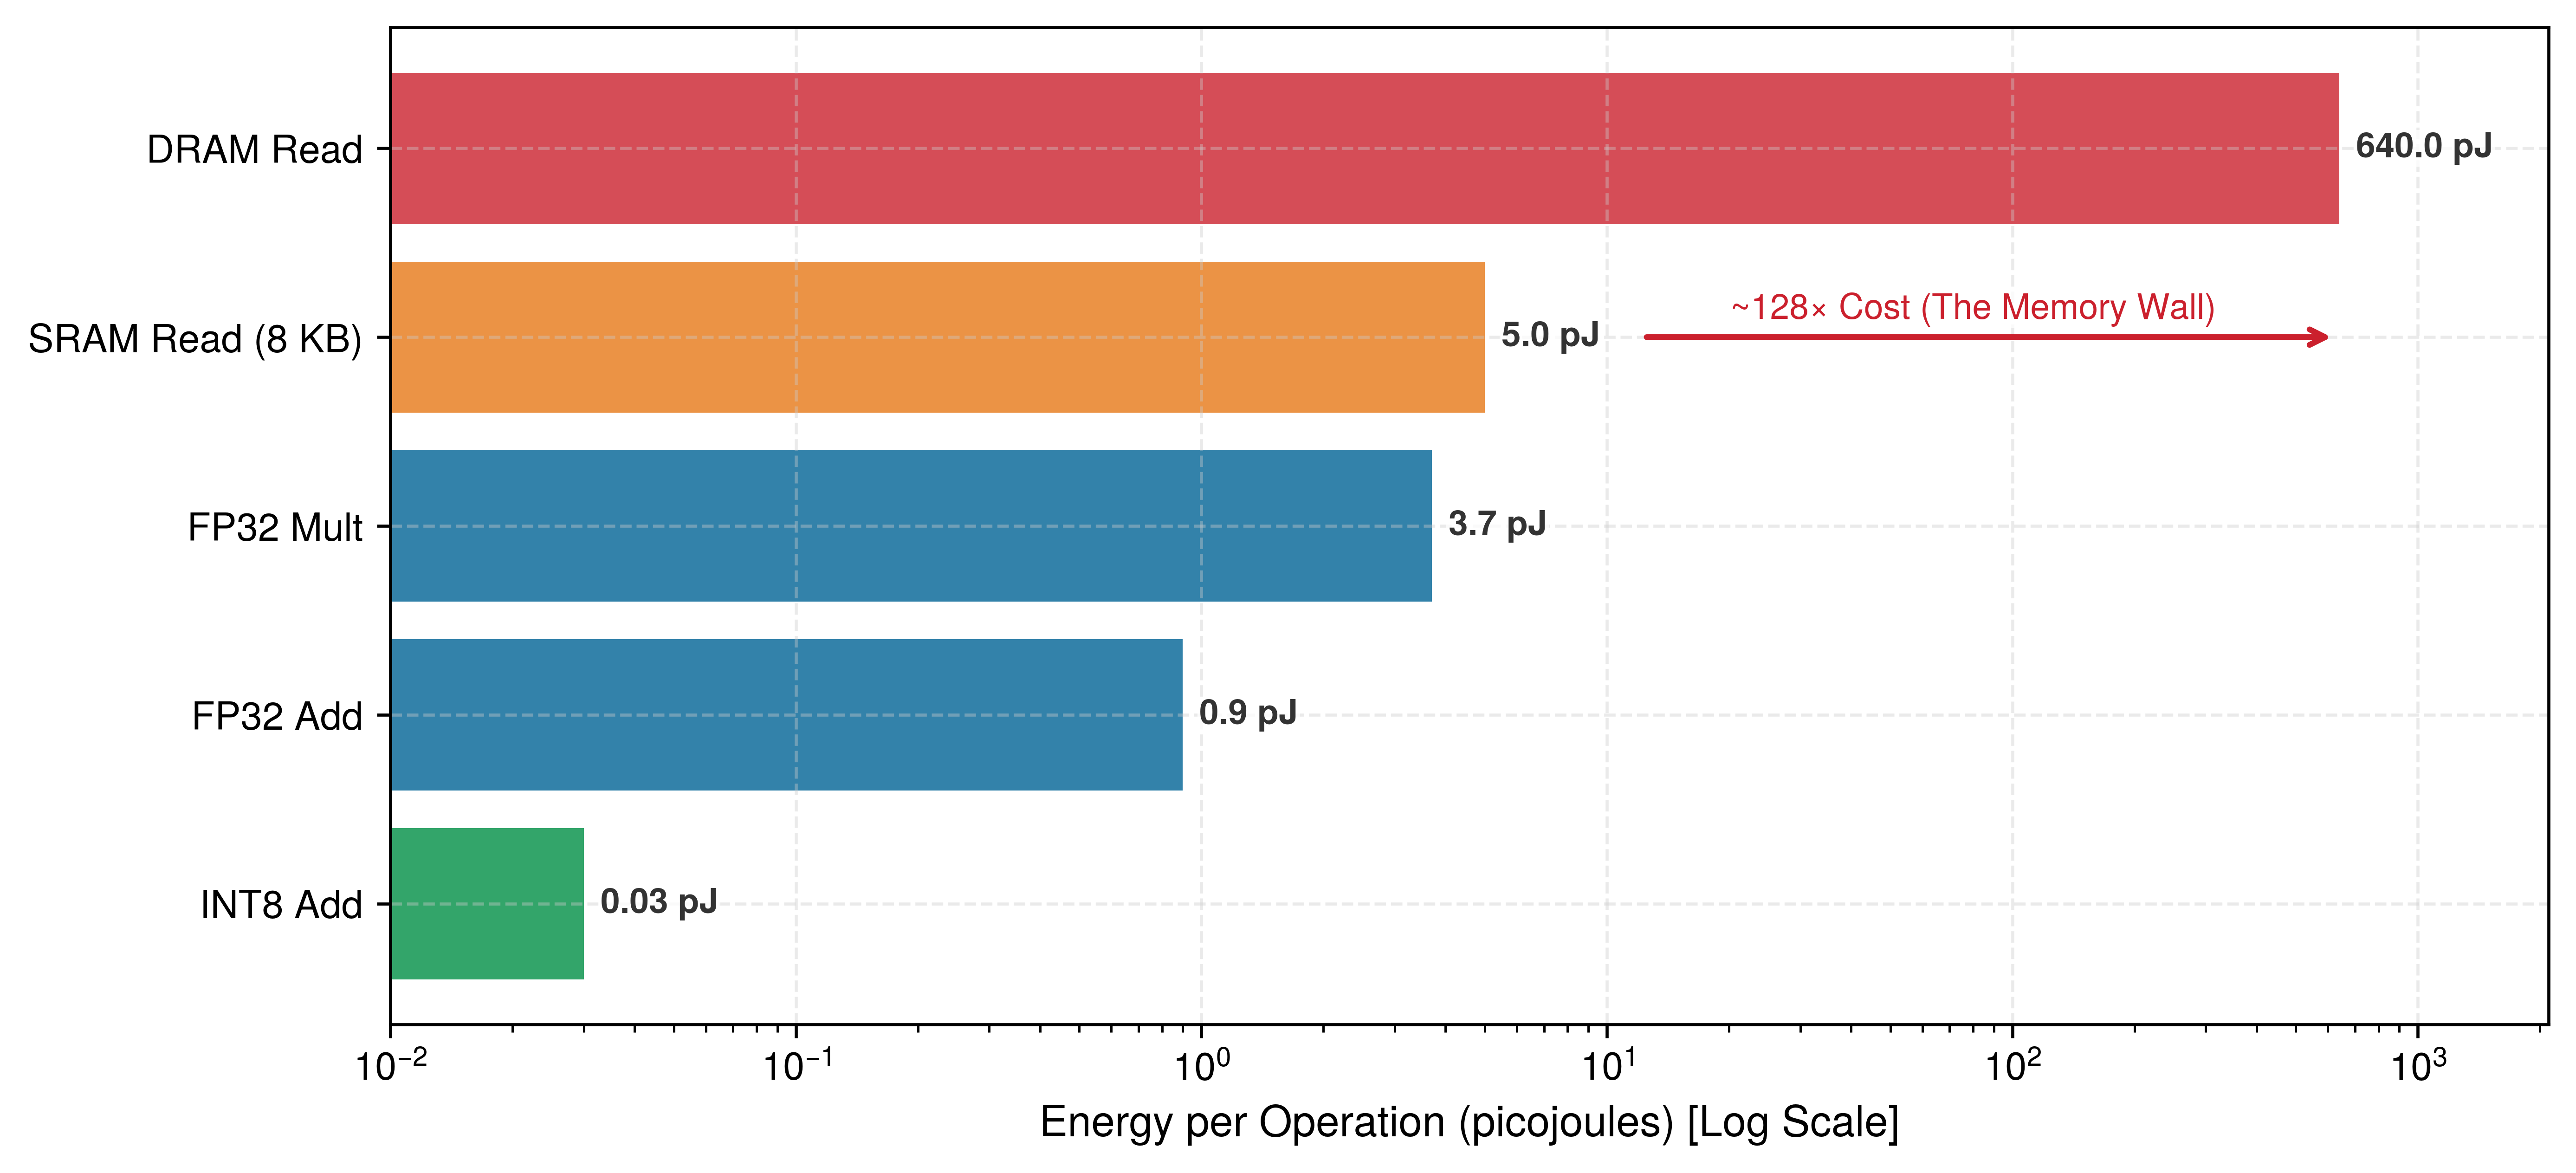
量化计算与内存之间的性能差距
figure 9 所呈现的能耗差距随着每一代硬件的发展而愈发显著。在过去二十年中,峰值计算能力的增长速度显著超过了 DRAM 带宽 (Gholami et al. 2024)。这种分化源于物理扩展约束:晶体管尺寸缩小和密集脉动阵列成倍提高了算术吞吐量,而内存带宽仍受限于引脚数量、封装基板布线密度和接口信号传输功耗。代表性的高端加速器能够提供 \(10^3\) TFLOP/s 量级的峰值张量吞吐量(例如,NVIDIA H100 的 FP16 吞吐量为 989 TFLOP/s,稠密 FP8 吞吐量接近 2,000 TFLOP/s),同时提供约 3.35 TB/s 的内存带宽 (Choquette 2023)。这意味着,要充分利用算力,每搬移一个字节就需要执行 \(10^2\) FLOP 量级的运算,这可能超过许多实际神经网络工作负载的算术强度。
Gholami, Amir, Zhewei Yao, Sehoon Kim, Coleman Hooper, Michael W. Mahoney, and Kurt Keutzer. 2024. “AI and Memory Wall.” IEEE Micro 44 (3): 33–39. https://doi.org/10.1109/mm.2024.3373763.
当工作负载的算术强度低于这一阈值时,执行时间预算完全转由数据传输项(\(\frac{D_{\text{vol}}}{\text{BW}}\))主导。加速器通过维持数千个并发执行线程,并在内存请求尚未完成时切换活跃线程束,来尝试容忍内存延迟;对于片外 DRAM,这种延迟通常达到数百个时钟周期。然而,当内存带宽饱和,或寄存器压力限制了占用率时,调度器便不再有可发射的独立指令。计算流水线随之停顿,使高吞吐量的张量核心在等待操作数时处于闲置状态。同时,通过具有电容负载的印制电路板走线和 PHY 接口驱动宽片外内存总线,会消耗芯片 TDP 的相当大一部分,直接限制可分配给算术逻辑的能耗预算 (Horowitz 2014; Sze et al. 2017)。
硬件平衡点(\(I_{\text{ridge}}\)):计算范式的分界
不同设备的计算与带宽分界对应不同的算术强度。硬件平衡点 \((I_{\text{ridge}})\) 是峰值算术吞吐量与峰值内存带宽的比值。在 Roofline 模型中,它就是计算上限与带宽上限相交的脊点: \[ I_{\text{ridge}} = \frac{R_{\text{peak}}}{\text{BW}} \]
这一比值确定了设备特有的分界。根据所选精度,H100 等高端加速器可能需要约 \(150\)–\(300\) FLOP/byte 才能达到其算术运算上限,而微控制器的脊点可能低得多。因此,同一个内核在算力密集型加速器上可能受带宽限制,在边缘处理器上却可能受计算限制。硬件平衡点并不意味着其中任何一种设备在所有情况下都高效;它表明了工作负载在该设备上需要多少数据复用。
在加速器的代际演进中,峰值计算能力的提升快于内存总线性能,而这种失配的程度决定了内核需要多少数据复用才能维持供给。Figure 10 分别展示了形成脊点的两种增长速率,并将两者均归一化到 V100 基准,因此可以直接观察它们之间不断扩大的距离。
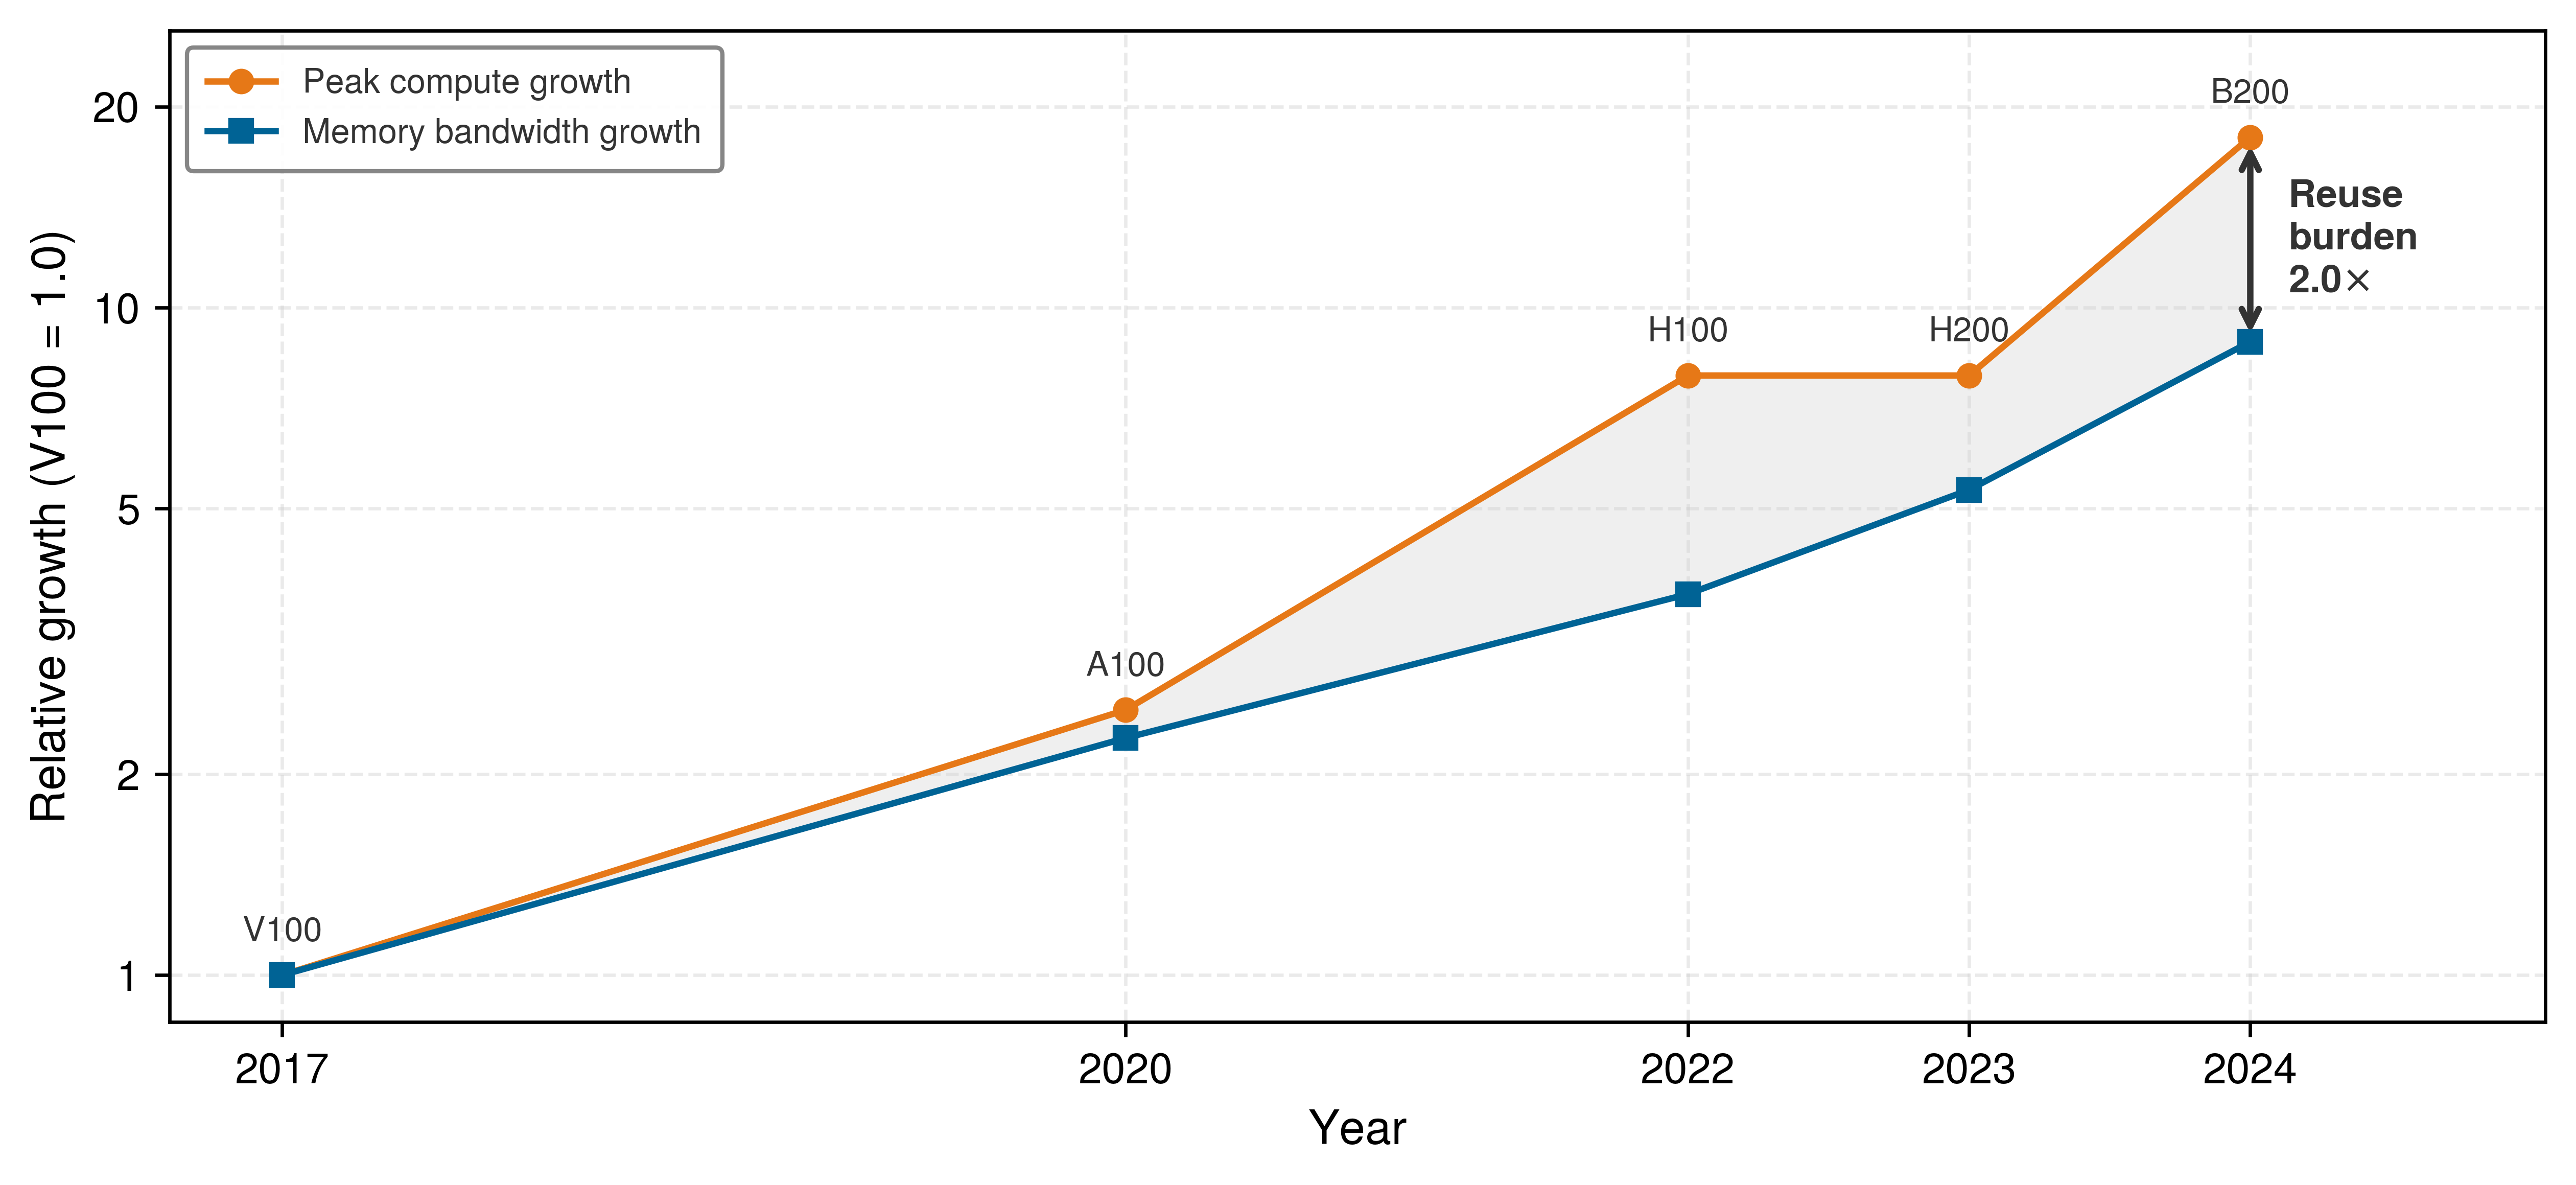
使内核转为受计算限制所需达到的阈值,已随着加速器硬件的代际演进而改变。在历代数据中心架构中(figure 11),硬件脊点从 V100 到 B200 总体攀升,使饱和峰值计算吞吐量所需的算术强度不断提高。
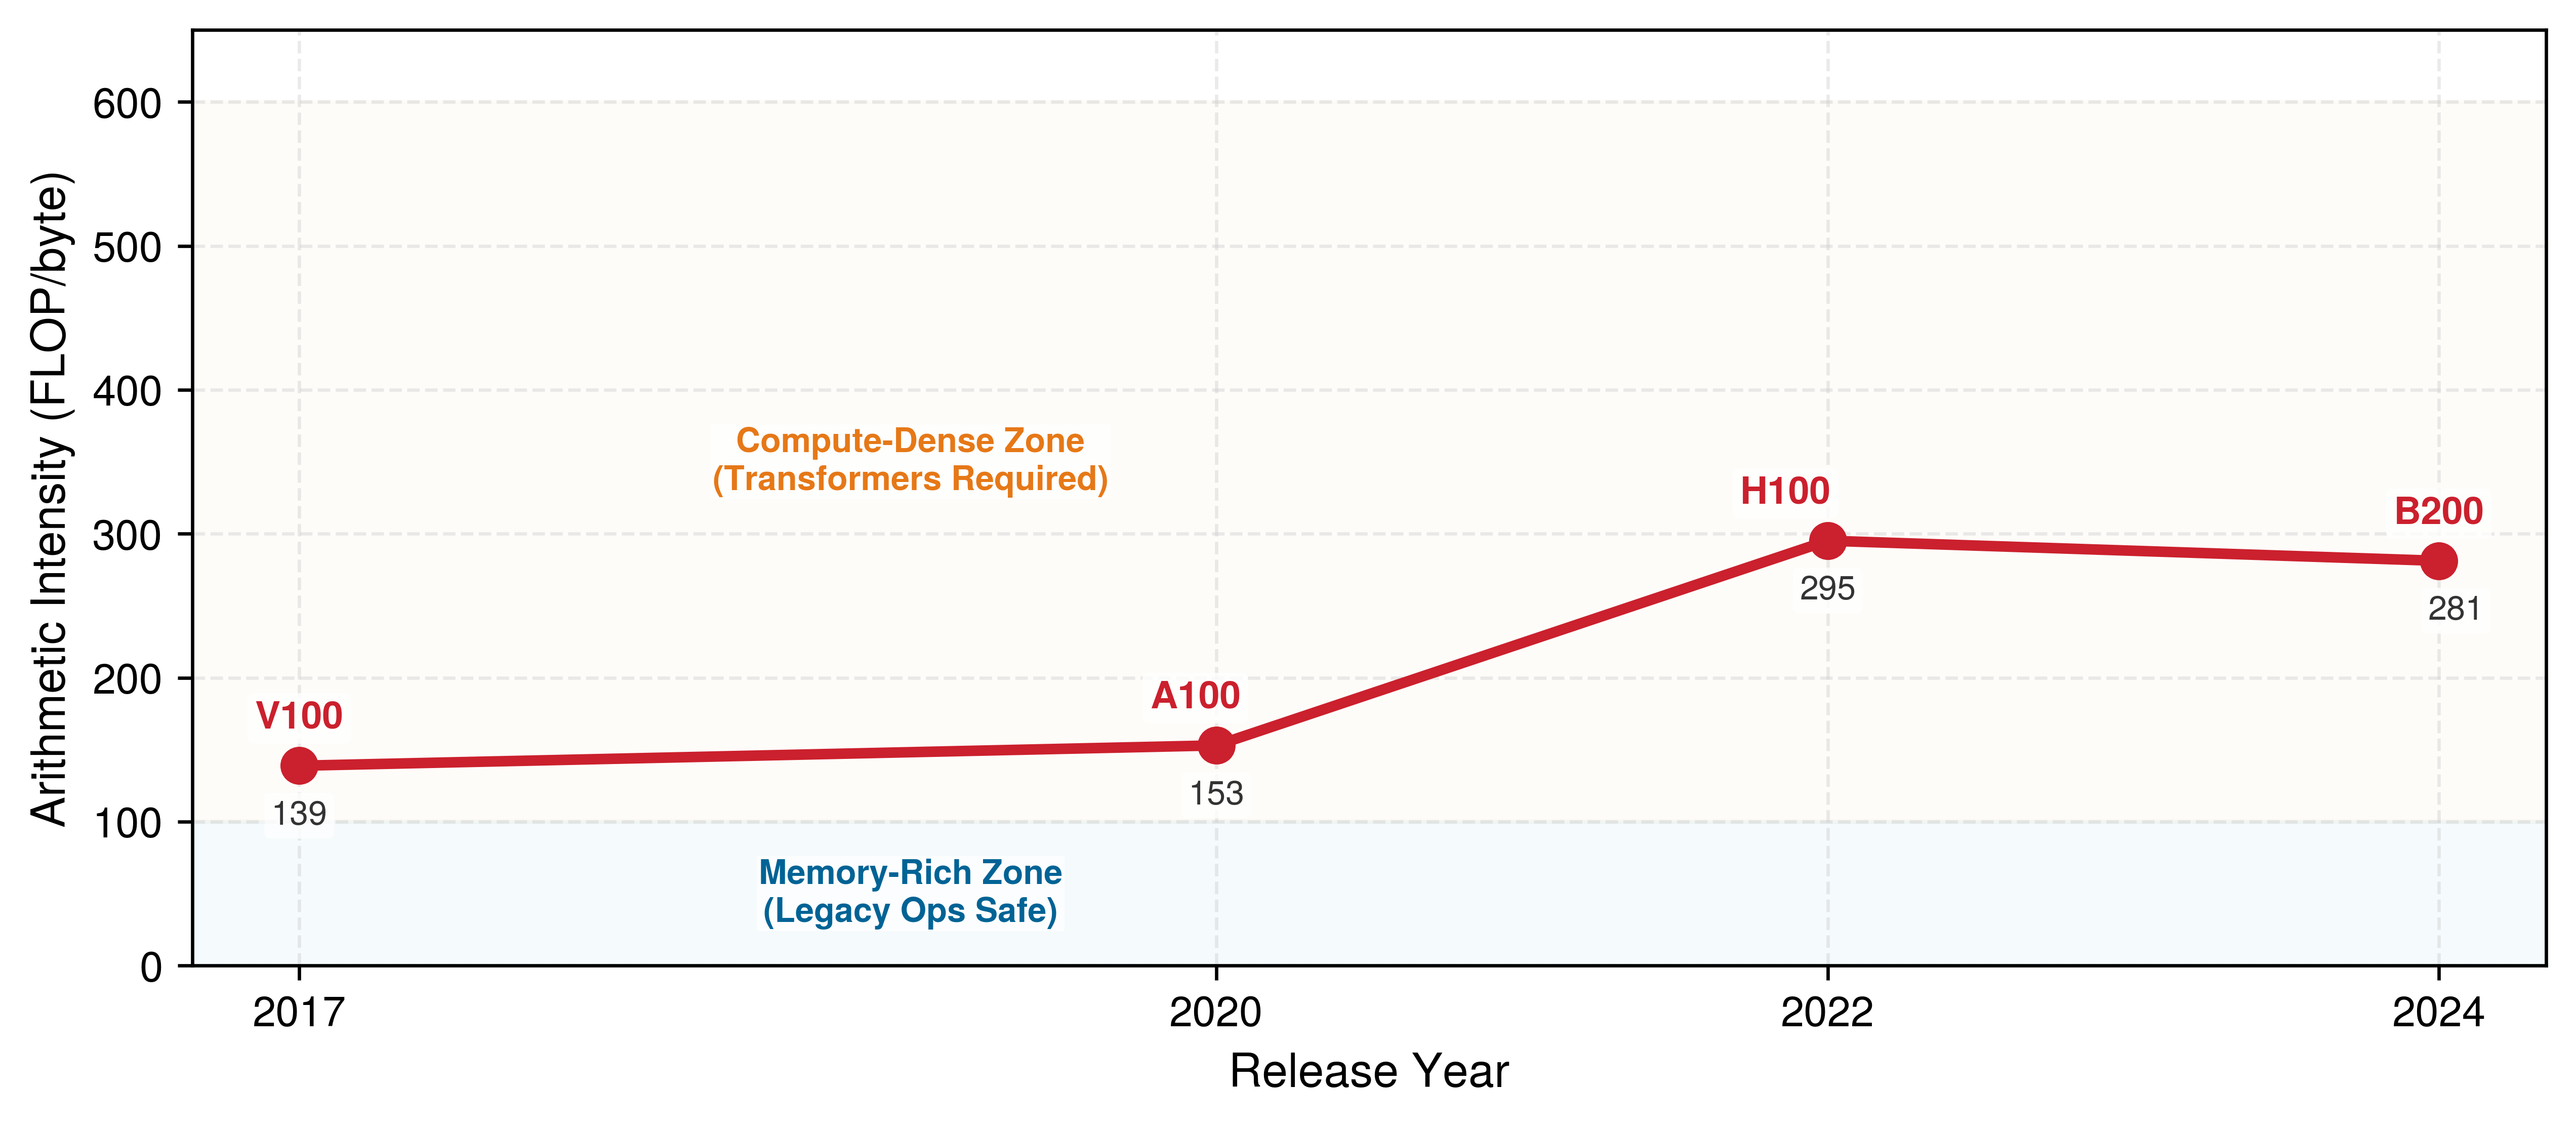
除了性能限制之外,内存访问还会带来高昂的能耗。从片外 DRAM 获取数据所消耗的能量,比在片上执行算术运算高出数个数量级 (Horowitz 2014)。算术单元通过硅片上微米尺度的导线传输信号,每次操作消耗数十飞焦耳;而从 DRAM 获取一个操作数需要驱动宏观尺度的 PCB 走线和封装互连,消耗数十皮焦耳。在数十亿个参数和激活值经由总线持续传输的机器学习模型中,数据搬移很快就会主导整体功耗。这种能耗差异推动了架构设计决策:Google 的 TPUv1 通过脉动阵列和大容量片上 SRAM 最大限度地减少片外数据搬移,在推理基准测试中的每瓦性能达到了同期 CPU 和 GPU 的 30–80\(\times\) (Jouppi et al. 2017)。这些设计选择表明,能耗预算与时钟周期预算同样决定了哪些架构能够在生产环境中运行。
机器学习工作负载中的内存访问模式
除了原始计算吞吐量之外,加速器的持续运行效率还取决于能否在不引起流水线停顿的情况下向执行单元供应操作数。深度神经网络对这种数据供应提出了三项并发需求。首先,模型参数(权重和偏置)可能达到数千亿个数值 (Brown et al. 2020)。在批大小为 1 的自回归生成中,每生成一个词元,都必须从内存流式读取全部参数,使算术强度降至约 1 FLOP/byte。其次,每一层产生的中间激活值都必须缓存在内存中,供后续操作使用;在训练期间,深层架构必须在整个前向传播过程中保留这些激活值,直到反向传播使用它们。第三,训练还会增加梯度和优化器的数据传输:反向传播为每个参数计算梯度,而自适应矩估计(Adam)等算法会读写占用多个机器字的动量状态,使每次参数更新的数据搬移量成倍增加 (Narayanan et al. 2021; Kwon and Rhu 2018)。
Kwon, Youngeun, and Minsoo Rhu. 2018. “TensorDIMM: A Practical Near-Memory Processing Architecture for Embeddings and Tensor Operations in Deep Learning.” Proceedings of the 52nd Annual IEEE/ACM International Symposium on Microarchitecture, 740–53. https://doi.org/10.1145/3352460.3358284.
这种数据搬移的物理成本取决于每个张量在内存层次结构中的存放位置。片上寄存器访问可以在单个时钟周期内完成,能耗低于一皮焦耳,而从片外 DRAM 获取数据会使执行停顿数百个周期,能耗也高出数个数量级。沿着一次推理过程中单个张量在各级内存间的流转路径进行追踪,可以具体呈现这种差异,示范案例 1.2 中的关键词检测(KWS)流水线便展示了这一点。
Lighthouse 1.2: 张量的生命周期:部署在 GPU 上的 KWS
回顾 五个灯塔模型 中概述的关键词检测示范案例。如果将同一个一秒音频片段纳入部署在 GPU 上的推理路径进行批处理,它在内存层次结构中的物理流转过程如下:
- DRAM(HBM):张量从这里出发。
- 大小:16,000 个采样点 \(\times\) 2 字节(FP16)= 32 KB。
- 延迟:从片外内存获取该张量需要约 300 ns(另加排队延迟)。
- 能耗:约为 20 pJ/bit。成本较高。
- L2 缓存:当所请求的缓存行驻留于此时,设备内存请求可以在这里得到响应。
- 延迟:约 4 ns。
- 访问:由多个流式多处理器(SM)共享。
- L1 缓存/共享内存:某个特定的 SM 使用硬件管理的缓存或显式暂存数据的共享内存,处理音频的一个分块。
- 延迟:约 1 ns。
- 局部性:如果 L1 请求未命中,在需要访问 HBM 之前,仍可能由 L2 响应该请求。
- 寄存器:Tensor Core 在这里执行运算。
- 延迟:通常为少量时钟周期,具体取决于指令和架构。
- 吞吐量:312 TFLOP/s。
- 能耗:约为 0.1 pJ/bit。
系统洞见:性能上限由峰值计算吞吐量与带宽乘以算术强度这两者中的较小值决定。相关带宽由哪一段内存链路提供,取决于工作集的驻留位置;HBM 到 L2 只是可能构成瓶颈的路径之一,并非 Roofline 模型性能上限的唯一决定因素。
内存受限执行与计算受限执行之间的边界,直接取决于数据传输时间与算术执行时间的相对大小。对于一个工作负载,若其需要通过可用内存带宽 \(\text{BW}\)(bytes/s)传输数据量 \(D_{\text{vol}}\)(bytes),并在峰值吞吐量为 \(R_{\text{peak}}\)(FLOP/s)、实际硬件利用率为 \(\eta_{\text{hw}}\) 的硬件上执行 \(O\) 次浮点运算,则两者各自的执行时间为: \[\begin{gather*} T_{\text{mem}} = \frac{D_{\text{vol}}}{\text{BW}} \\ T_{\text{compute}} = \frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}} \end{gather*}\]
在没有重叠的严格顺序模型中,\(T_{\text{mem}} > T_{\text{compute}}\) 表明执行受内存限制。当硬件使内存传输与计算重叠时,较大的一项决定了执行时间的理论下界。然而,在实践中,数据依赖、内存控制器排队以及流水线的部分重叠,决定了有多少算术硬件会在等待操作数时处于空闲状态。
模型内存占用与可用内存带宽之间不断扩大的结构性差距,使 \(T_{\text{mem}}\) 成为跨代演进中的主导约束。Figure 12 量化了公开的里程碑模型与加速器架构之间的这种差异 (Krizhevsky et al. 2012; Brown et al. 2020; Chowdhery et al. 2022; Dubey et al. 2024)。即使是 NVIDIA B200 和 AMD MI300X/MI325X 这样的高带宽加速器,也无法仅靠扩展带宽来弥合这种增长速率差距 (NVIDIA Corporation 2024; AMD 2023)。GPT-4 和 Gemini 等专有系统的参数数量尚未正式披露,因此未将其作为事实数据点绘制。
Chowdhery, Aakanksha, Sharan Narang, Jacob Devlin, Maarten Bosma, Gaurav Mishra, Adam Roberts, Paul Barham, et al. 2022. “PaLM: Scaling Language Modeling with Pathways.” arXiv Preprint arXiv:2204.02311.
Dubey, Abhimanyu, Abhinav Jauhri, Abhinav Pandey, Abhishek Kadian, et al. 2024. The Llama 3 Herd of Models. arXiv preprint arXiv:2407.21783.
NVIDIA Corporation. 2024. NVIDIA Blackwell Architecture. NVIDIA product documentation.
AMD. 2023. AMD Instinct MI300X Accelerators. AMD product documentation.
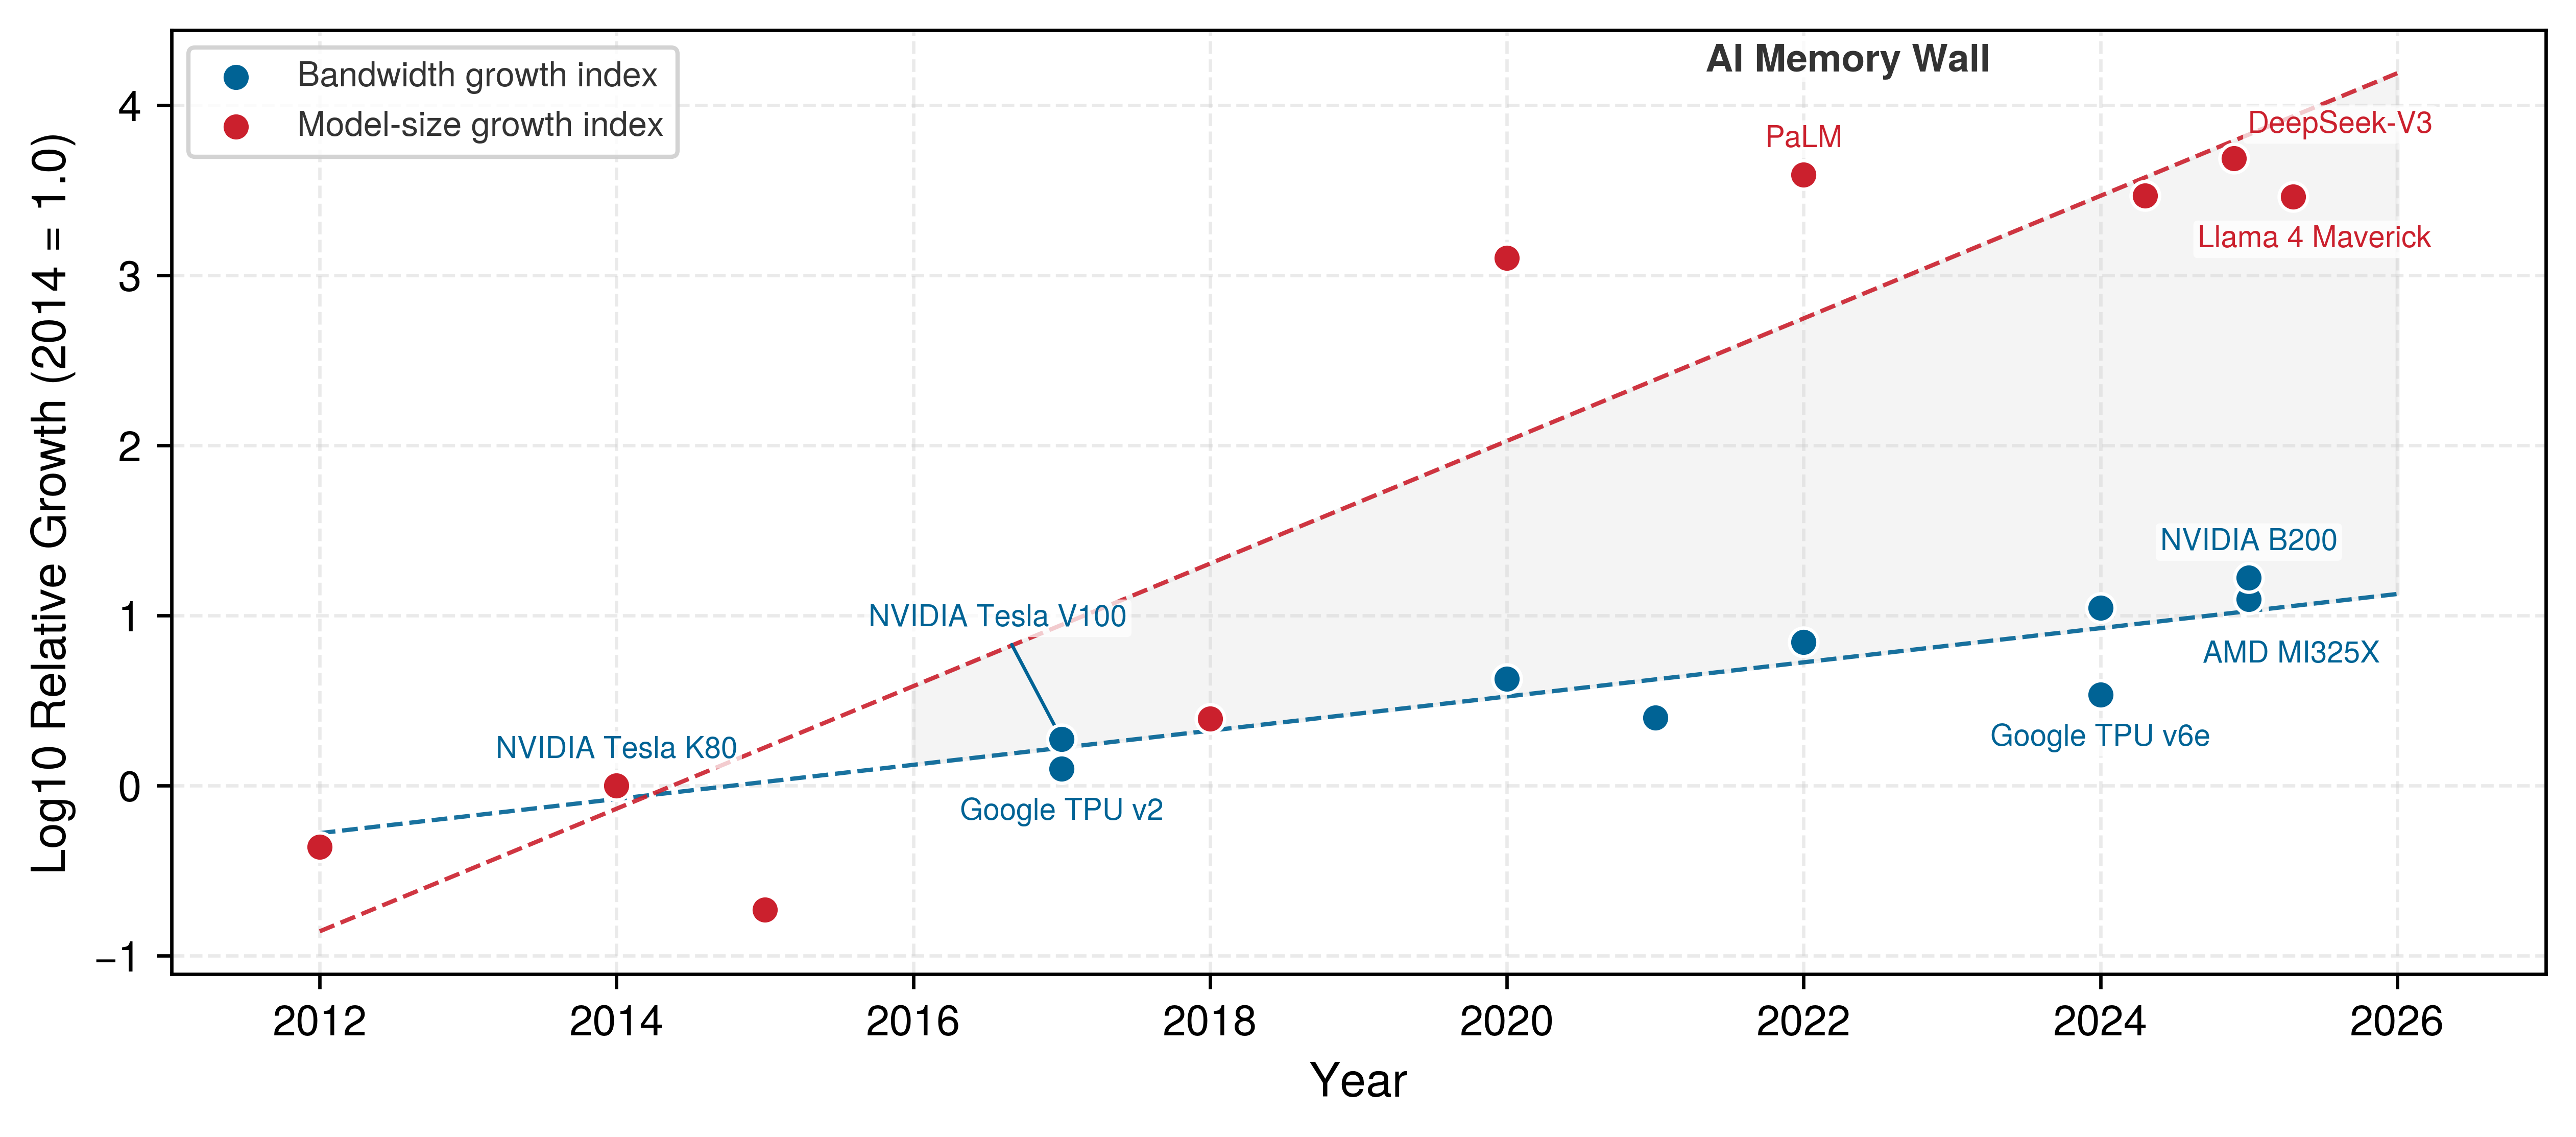
不规则内存访问
生产环境中的机器学习工作负载将规则的稠密矩阵内核与不规则内存访问模式相结合,后者会使传统缓存和预取硬件难以发挥作用。GEMM 和卷积等稠密运算以流式方式访问连续数据块,能够很好地映射到硬件缓存和脉动阵列,而不规则运算则依赖间接、稀疏或由输入决定的内存地址。Table 9 从访问几何特征、缓存局部性和硬件压力三个方面,对比了这两类内存访问模式。
| 特征 | 规则稠密内核 | 不规则机器学习组件 |
|---|---|---|
| 访问模式 | 连续或分块 | 间接、分散或由输入决定 |
| 缓存局部性 | 分块后通常较高 | 通常较低,且取决于工作负载 |
| 数据复用 | 在分块或批次之间具有结构化特征 | 稀疏或动态,取决于算子 |
| 依赖关系 | 静态循环嵌套 | 由输入决定的路由或可变形状 |
| 示例 | GEMM、卷积、稠密注意力 | 嵌入查找、非结构化稀疏性、MoE 路由 |
| 主要压力 | 计算或带宽,取决于算术强度 | 延迟、带宽、元数据和负载不均衡 |
| 能耗影响 | 取决于复用程度和内存层级 | 额外的数据搬移和元数据可能增加能耗 |
在单个神经网络内部,不同类型层的内存访问行为差异显著。卷积层中的小型权重卷积核在输入特征图上滑动,因此具有较高的空间局部性和寄存器复用率。全连接层和稠密注意力执行规则的矩阵乘法,但其大型参数矩阵或 KV 缓存可能超出片上 SRAM 的容量,并在运算中的数据复用程度较低时受到带宽限制。可变序列长度增加了内存缓冲区分配的复杂性,但每个序列内部的注意力运算仍然是规则、连续的矩阵乘法。
真正的内存访问不规则性源自三种不同的架构模式:非结构化稀疏性、28 嵌入查找和动态词元路由。在非结构化稀疏模式下,非零权重或激活值以压缩格式(如 CSR 或 COO)存储,需要通过指针间接寻址来解码操作数坐标。在嵌入表中,稀疏的类别 ID 从 DRAM 中规模达数十 GB 的表中选择任意行,将顺序内存传输转变为无法合并的分散读取。在混合专家(MoE)模型中,路由门控根据输入上下文将词元分配给不同的专家网络;虽然给定输入下的路由是确定的,但词元分配会随批次变化,从而扰乱预取流水线,并使并行核心之间的执行队列失衡。
不规则性通过不同机制降低性能,将它们视为同一种内存问题可能导致错误的优化方向。分散的地址可能将一次逻辑访问转化为多次内存事务,使得每条取回的缓存行只包含少量有效载荷字节。间接寻址还可能使地址生成串行化:系统必须先取回索引或指针,才能确定应请求哪一份有效载荷,因此即使总体带宽仍有余量,内存级并行性也会受到限制。输入相关的路由会造成第三种失效模式:部分处理单元的队列比其他单元更长;完成时间由最慢的队列决定,而相邻单元处于空闲状态。可变大小的内存分配可能造成容量碎片,但碎片化既不是不规则访问的必要条件,也不是充分条件。顺序数据流可以在访问规则的情况下耗尽带宽,而具有依赖关系的查找链则可能在远低于峰值带宽时就陷入停顿。
因此,诊断应从阻碍执行继续推进的机制入手。有效载荷字节数与传输字节数之比较低,表明空间利用率或访问合并效果不佳。长时间的内存停顿伴随未利用的带宽,表明存在具有依赖关系的缓存未命中,或并发请求数量不足以隐藏延迟。队列深度或各路由工作量不均衡,揭示的是负载失衡,而非缓存容量问题。仅凭缓存命中率无法区分这些情况,因为一次缓存未命中可能浪费带宽、暴露延迟,或同时造成两者。每种诊断都对应不同的解决方法:紧凑排列或分块可提高空间利用率,重排序和预取可增加可并发执行的请求,结构化稀疏格式可减少索引开销,而路由或分区可平衡工作量。内存层次结构决定剩余访问的成本,而数据流和张量布局的选择则决定软件在执行到达硬件之前能够消除多少不规则性。
优化顺序应遵循上述诊断。当数据格式由系统控制时,应首先优化表示方式,因为块结构稀疏格式或分组路由可以在计算内核执行之前消除间接寻址。其次是请求组织:同时发出的访问应指向相邻地址,并且必须保持足够多的独立请求处于在途状态,以隐藏不可避免的延迟。只有在性能剖析表明规则化后的请求流仍然耗尽某项资源时,增加缓存容量或带宽才有帮助。更高的带宽无法解除串行指针依赖,更大的容量也无法重新平衡倾斜的工作负载。目标是尽可能暴露规则结构,同时将不可避免的不规则性限制在尽可能小的执行范围内。
软件可以通过规则化张量布局、实施结构化稀疏性,以及将动态路由排序为统一批次来缓解不规则访问。然而,软件重构无法消除数据移动的物理代价:无论内存请求是连续的还是分散的,每个传输字节都必须经过受有限带宽、传播延迟和能量耗散约束的物理连线。要约束这些物理成本,就需要将存储组织为逐级衔接的硬件层级。加速器架构并不将内存视为统一的存储池,而是采用多级内存层次结构,在每一级权衡容量、延迟与能耗。
内存层次结构
没有任何单一存储技术能够同时满足稠密执行单元所需的每秒数 TB 带宽,以及存放现代模型参数所需的数十 GB 容量。加速器通过多级内存层次结构化解这一矛盾。机器并不将内存视为单一的地址空间,而是将存储组织为不同的物理层级,每一级都针对容量、访问延迟、带宽和能量耗散之间的特定平衡进行优化。
在层次结构顶端,寄存器文件和片上 SRAM 缓存以亚纳秒级延迟和个位数皮焦耳的能耗向算术单元提供操作数,但其容量受到硅片面积的严格限制。在底层,非易失性闪存存储保存数百 GB 的模型检查点和训练数据集,但访问需要毫秒或微秒级时间。在这两端之间,由软件管理的暂存存储器用于暂存活跃的张量块,而设备本地 DRAM(如 HBM 或 GDDR)则为参数和激活值提供主要工作内存。
这种组织方式在不同层级之间形成了反向变化关系:随着存储容量扩大、与算术单元之间的物理距离增加,带宽下降,延迟增加数个数量级,每比特能耗也随之上升。Table 10 从延迟、带宽、容量以及在深度学习工作负载中的功能角色等方面比较了这些层级。
| 内存层级 | 相对延迟 | 带宽 | 相对容量 | 在深度学习中的用途示例 |
|---|---|---|---|---|
| 寄存器 | 最低 | 最高 | 极小 | 存储供即时计算使用的操作数 |
| L1/L2 缓存(SRAM) | 很低 | 高 | 小 | 缓存频繁访问的激活值和小型权重块 |
| 暂存存储器 | 很低 | 高 | 小到中等 | 由软件管理、用于中间计算的存储空间 |
| 设备 DRAM(HBM、GDDR 或 LPDDR) | 高 | 中等–很高 | 大 | 存储片上无法容纳的模型参数和激活值 |
| 主机 DRAM(通常为 DDR) | 本地访问延迟高;传输会增加延迟 | 中等 | 大到很大 | 在加速器内存之外暂存或卸载数据 |
| 闪存存储(SSD/NVMe) | 很高 | 低 | 很大 | 存储预训练模型和检查点,以供后续加载 |
系统设计中反复出现的一个问题是:为什么加速器不能完全绕过片上 SRAM,直接从大容量片外 DRAM 流式读取所有操作数?阻止这种设计的物理约束,是芯片几何结构、电信号传播以及 DRAM 存储单元访问动态过程共同施加的延迟下限。
Napkin Math 1.2: 光速限制
问题:为什么必须使用片上 SRAM,而不能从 HBM 获取全部数据?
数学分析:
- 距离:在面积为 814 mm² 的 H100 级芯片上,信号传播距离约为 20 mm。
- 传播延迟:在硅中以 \(\approx 0.5c\) 的速度传播时,\(20\text{ mm}/(0.5c) \approx 130\text{ ps}\)。
- 时钟周期:在 2 GHz 下,\(1/(2\text{ GHz}) = 500\text{ ps}\)。
- DRAM:片外 HBM 位于封装内、距芯片数毫米处,但 DRAM 访问延迟加上协议开销 = 100 多个周期。
系统洞见:20 mm 传播距离对应的估计延迟约为 130 ps,小于一个 500 ps 的时钟周期,因此仅凭距离不足以证明单周期访问不可能实现。实际的 HBM 访问包括 DRAM 阵列延迟、串行化、协议遍历、互连延迟和排队,从而形成这条超过 100 个周期的访问路径。因此,必须使用本地寄存器和 SRAM,才能以 2 GHz 的频率向计算单元供给数据。对于 Transformer 模型,正是这条完整的访问路径,使得权重必须按块暂存于 SRAM,而不能按需从 HBM 读取;也正因如此,当内存流量无法被算术运算掩盖时,反复流式读取整个 KV 缓存会使推理吞吐量骤降。
片上内存
片上内存子系统将寄存器、静态随机存取存储器(SRAM)缓存以及由软件管理的暂存存储器直接集成在加速器芯片上。寄存器文件提供执行流水线所需的即时操作数和累加器存储空间。现代加速器在整个芯片上配置了可观的寄存器总容量,但会在并发线程或线程束之间动态划分这一资源池。增加每个线程的寄存器分配量,可以让单个线程保留更大的矩阵块,但会限制可并发调度的线程束总数,降低硬件隐藏内存延迟的能力。反之,寄存器分配不足会迫使编译器将值溢出到片外内存,将单周期寄存器访问转化为多周期停顿。高效的计算内核设计需要平衡寄存器分配,在使热点操作数常驻的同时维持最大占用率。
由硬件管理的 L1 和 L2 缓存通过自动标签检查和硬件淘汰策略,为频繁引用的数据提供快速缓冲。然而,自动缓存并不适合流式处理数 GB 规模的张量运算:遍历大型激活张量可能会在算术单元复用权重块之前,将这些可复用的权重块逐出缓存。此外,专用执行流水线对布局和数据类型施加了严格约束,而通用缓存无法自动满足这些约束。如示例 1.3 所示,硬件矩阵引擎要求特定的对齐方式和内存契约;违反这些要求会导致执行回退到未经加速的路径。
Example 1.3: Tensor Core 契约
场景:某工程团队将 Transformer 工作负载迁移到 NVIDIA A100 GPU,期望自动获得 Tensor Core 加速,但性能剖析显示 Tensor Core 始终处于空闲状态 (NVIDIA Corporation 2020a)。
诊断:该工作负载采用的形状和数据类型,使系统选择了效率较低的计算内核,而非预期的 Tensor Core 路径。
系统启示:专用路径对算子、精度、布局和形状都有要求。库通常可以通过填充或替代计算内核处理未对齐的维度,但要实现高利用率,必须验证实际选用了哪条路径。
为避免自动缓存的淘汰开销和不可预测性,AI 加速器引入了暂存存储器。与硬件缓存不同,暂存存储器是由软件管理的 SRAM 结构,直接映射到核心的地址空间中,不需要标签目录或硬件替换逻辑。编译器或程序员显式控制何时从外部 DRAM 加载张量块、它们在片上驻留多久,以及何时将更新后的值写回。在卷积模型中,暂存存储器在感受野窗口滑动过程中保留输入特征图和权重卷积核,从而消除冗余的 DRAM 读取 (Chen et al. 2017)。在 NVIDIA GPU 上,暂存存储器以共享内存的形式提供:它是一组快速、由程序员控制的 SRAM 存储体,由一个线程块内的所有线程共享。使用 CUDA 或 Triton 编写的自定义计算内核显式管理共享内存。FlashAttention 展示了这一机制的作用:计算内核不在片外 HBM 中物化完整的 \(S{\times}S\) 注意力分数矩阵,而是通过共享内存分块处理查询、键和值,并在线更新 softmax 统计量 (Dao et al. 2022)。加速完全源于消除了高延迟的 HBM 往返访问,而非减少了算术运算;事实上,该算法会在反向传播过程中重新计算中间注意力值,以避免将其存储到片外内存。
片外内存
当张量工作集超出片上 SRAM 容量时,操作数和参数驻留在设备本地 DRAM 中。高带宽内存(HBM)、图形 DDR(GDDR)和低功耗 DDR(LPDDR)并非依次排列的层级,而是针对不同成本、带宽和功耗范围设计的替代性内存架构。高性能加速器使用 HBM,通过硅通孔(TSV)将 DRAM 芯片垂直堆叠,并经由硅中介层以宽位宽接口(例如 1,024 至 8,192 位)与加速器芯片连接。相比传统 DRAM,这种宽总线能以更低的时钟频率和更低的每比特能耗提供每秒数 TB 的带宽,但需要复杂的 2.5D 封装。当硅中介层成本过高时,加速器采用 GDDR,通过标准电路板上以高引脚速率驱动的较窄总线(例如 256 至 384 位)传输数据。移动和嵌入式加速器使用 LPDDR,以牺牲原始带宽换取较低的工作电压和更低的待机功耗。
当参数和激活值的内存占用超出设备本地 DRAM 容量时,系统必须将状态卸载到主机 DRAM(通常为标准 DDR)。访问主机内存需要经过 PCIe 等 I/O 互连,或 NVLink、Compute Express Link(CXL)等一致性互连。由于 PCIe 带宽(每秒数十 GB)比加速器 DRAM 带宽低一到两个数量级,未经妥善管理的卸载会使算术执行停顿。高效的运行时通过将异步直接内存访问(DMA)复制与计算内核执行重叠来缓解这一代价,在当前层计算的同时预取后续层的参数。
在层次结构底层,非易失性闪存存储和固态硬盘(SSD)为数据集与训练检查点提供持久化的数 TB 容量 (Narayanan et al. 2021)。闪存设备的读取延迟为数十微秒,总线带宽上限为每秒个位数 GB,因此无法直接参与计算内核执行。检查点保存和数据加载流水线将闪存存储视为异步流式数据源,在计算开始之前,将批次数据经由主机 DRAM 暂存并传入加速器内存。
内存层次结构的各个物理层级确立了加速器的延迟下限和容量上限。应用能够多大程度接近硬件峰值,取决于软件能否在每个层级持续保持高利用率:标称内存带宽仅代表理论上限,而实际可达的吞吐量由访问规则性、张量布局和复用局部性决定。
内存带宽与架构权衡
标称内存带宽只是上限;实际可达带宽取决于访问模式、批处理、局部性,以及向加速器供给数据的主机接口。典型的数据中心加速器提供数 TB/s 量级的内存带宽,并配备数十 GB 的高带宽内存。峰值指标假设所有内存通道都持续执行步长为 1 的合并访问。实际神经网络工作负载与这一理想情况存在显著偏差:Transformer 注意力、卷积和全连接层能够达到的峰值带宽比例各不相同,因为它们的内存访问步长、分块维度和运算中的数据复用程度不同。只有当批大小足以摊薄权重矩阵加载成本时,全连接层才能接近峰值带宽——这与 section 1.6 中在 Roofline 模型下分析的批大小敏感性直接相关。当批大小较小时,执行受到内存延迟和通道利用不足的限制,使有效吞吐量远低于标称上限。
片上内存每次访问的能耗通常为个位数到数十皮焦耳,而外部 DRAM 每次访问的能耗可能达到数百皮焦耳量级——高出一个数量级(section 1.5.1)。由于驱动片外物理接口占据了散热和功耗预算的主要部分,加速器围绕空间数据复用来组织执行流水线。架构并不让张量反复往返于 DRAM,而是采用特定的驻留式数据流。在权重驻留设计中,模型参数固定保留在处理单元寄存器内,输入激活值流经这些处理单元,从而将参数加载成本摊薄到多个词元或空间位置。在输入驻留设计中,激活值在本地缓冲,权重则以流式方式传入,从而最大化不同卷积核之间的复用。在输出驻留设计中,部分和直接在本地累加器内累积,直到最终归约完成,从而消除尚未完成计算的特征图与外部 DRAM 之间的中间往返传输。
硅片和封装边界处的物理约束决定了不同类别加速器的内存带宽如何扩展。HBM 通过硅通孔垂直堆叠 DRAM 芯片,并经由硅中介层与处理器连接,实现每秒数 TB 的吞吐量。这种封装提供宽并行接口——在主流产品中达到约 1 TB/s,在高端系统中达到数 TB/s——代价是显著增加的封装成本和热密度。TPU 类设计将高带宽内存与大型片上缓冲区和二维脉动阵列配合使用,以牺牲通用内存灵活性为代价,换取稠密矩阵乘法中紧密的空间复用。在另一端,移动 SoC 设计的功耗预算仅为数瓦,无法承受基于中介层的堆叠方案所需的成本或散热负担。这些边缘处理器依赖统一的通用 LPDDR 架构,提供数百 GB/s 量级的共享带宽,必须在 CPU、GPU 和神经网络加速器核心之间进行严格调度,以防止内存总线争用和热降频。
带宽限制还超出了加速器封装,延伸到主机与设备之间的接口。当输入必须先经过一条 64 GB/s 的 PCIe 链路,才能使用配备 2 TB/s HBM 带宽的加速器时,HBM 带宽约为该接口带宽的 30\(\times\);带宽较低的该接口可能主导小规模、频繁传输的耗时 (NVIDIA Corporation 2020a, 2020b)。对于低延迟推理查询或细粒度计算内核卸载,主机总线上的传输串行化耗时很容易超过计算内核的计算时间。要缓解这一接口瓶颈,需要让模型参数和中间激活状态在多个执行步骤之间持续驻留于加速器内存,或者通过直接的点对点存储和网络数据路径完全绕过主机链路。
主机与加速器通信
在独立式加速器系统中,主机 CPU 和加速器作为两个独立的计算域运行,通过外设总线连接。主机管理存储 I/O、网络数据流和运行时编排,而加速器则利用高带宽设备内存执行密集数学计算内核。由于 CPU 内存(系统 DRAM)和加速器内存(HBM 或 GDDR)位于不同的物理地址空间,只有张量通过主机与加速器之间的互连传输后,计算才能开始。因此,主机与加速器之间的数据移动构成了一道运行边界:如果外设总线上的传输无法以线速向加速器计算核心供给数据,那么无论设备的峰值 FLOP/s 能力有多高,它都会处于空闲状态。
Figure 13 展示了支配这种主机与设备交互的四阶段执行顺序。计算开始之前,必须通过 DMA 将输入张量从主机 DRAM 经 PCIe 总线复制到加速器内存中(步骤 1)。29 随后,CPU 向加速器命令队列提交内核启动命令(步骤 2),使计算单元并行处理本地内存中的分块(步骤 3)。执行完成后,加速器将输出张量存入设备内存,并通过 PCIe 将结果复制回主机 DRAM(步骤 4)。在朴素的同步执行模型中,每个传输步骤都直接位于关键路径上,在每次内存事务完成之前,主机或加速器都必须停顿等待。
\begin{tikzpicture}[font=\sffamily\small]
\tikzset{%
    Line/.style={line width=1.0pt,black!50}
}
\tikzset{
  Box/.style={inner xsep=2pt,
    draw=GreenLine,
    line width=0.75pt,
    node distance=1.5,
    fill=GreenL!70,
    align=flush center,
    text width=26mm,
    minimum width=26mm,
    minimum height=10mm
  },
}

\begin{scope}
\node[Box](B1){主存};
\node[Box,right=of B1](B2){CPU};
\node[Box,right=of B2](B3){GPU 内存};
\node[Box,right=of B3](B4){GPU};
\end{scope}
%
\begin{scope}[shift={(0,-6)}]
\colorlet{GreenL}{OrangeL}
\colorlet{GreenLine}{OrangeLine}
\node[Box](2B1){主存};
\node[Box,right=of 2B1](2B2){CPU};
\node[Box,right=of 2B2](2B3){GPU 内存};
\node[Box,right=of 2B3](2B4){GPU};
%
\end{scope}
%
\foreach \x in {1,2,3,4} {
 \draw[Line] (B\x) -- (2B\x);
}
%
\draw[Line,-latex]($(B1)!0.2!(2B1)$)--
node[above,text=black,pos=0.26]{复制待处理数据 (1)}
($(B3)!0.2!(2B3)$);
\draw[Line,-latex]($(B2)!0.37!(2B2)$)--
node[above,text=black,pos=0.26]{发出处理指令 (2)}
($(B4)!0.37!(2B4)$);
%
\draw[Line,-latex]($(B4)!0.75!(2B4)$)--
node[above,text=black,pos=0.5]{存储结果}
($(B3)!0.75!(2B3)$);
\draw[Line,-latex]($(B3)!0.85!(2B3)$)--
node[above,text=black,pos=0.25]{复制结果 (4)}
($(B1)!0.85!(2B1)$);
%
\draw[Line,-latex]($(B4)!0.57!(2B4)$)
to [out=10,in=350,distance=42]
node[above,text=black,pos=0.1,fill=white]{各核心并行执行 (3)}
($(B4)!0.62!(2B4)$);
\end{tikzpicture}内核启动的端到端延迟可以分解为传输时间、队列分派开销和算术执行时间。当张量传输规模较小或较为频繁时,驱动提交和总线往返的固定开销会主导运行时间。当传输规模较大时,相对于封装内 HBM 而言较低的 PCIe 带宽会形成持续的 I/O 瓶颈。用数据—算法—机器的框架来表述,主机与加速器之间的机器边界迫使算法在张量到达设备后,最大限度地实现设备上的算术复用。
节点级互连拓扑
优化数据移动需要理解计算节点的物理拓扑。典型的 AI 服务器并不是由互联设备构成的扁平网格,而是一个带宽层次结构,数据距离芯片越远,可用带宽就越低。
数据距离加速器越远,带宽就越急剧地下降。
在多加速器服务器节点内,三个互连层级构成了这种逐级收窄的带宽结构:
- 设备间互连(NVLink/Infinity Fabric):现代多 GPU 节点使用 NVLink30 等专用高速桥接链路直接连接加速器,绕过主机 CPU。每个 GPU 的带宽范围为 600 GB/s 至 900 GB/s (NVIDIA Corporation 2020b; Choquette 2023)。只要张量需要在同一台服务器内的加速器之间移动,这种链路就很重要,包括模型划分、激活值交换以及训练期间的梯度同步。31 其架构原则在于边界:保持在加速器互连网络上的流量,其代价远低于回退到经由主机传输的流量。
- 主机与设备互连(PCIe):CPU 与加速器之间的链路。带宽范围为 32 至 64 GB/s(PCIe Gen4/Gen5)。经主机暂存的训练数据可能在此形成瓶颈,不过常驻数据、直接存储或网络 I/O,以及支持一致性的加速器链路可以使用其他路径。多 GPU 服务器也可能提供多条 PCIe 链路,而非一条共享的 64 GB/s 路径。
- 网络接口卡:主机通往外部的链路,用于连接其他节点。带宽范围为 25 至 50 GB/s(200 Gb/s 至 400 Gb/s 以太网/InfiniBand32)。这种互连是从单节点硬件分析迈向下一个前沿——规模扩展——的第一步。跨越网络会使流量进入系统中带宽最窄、延迟最高的路径。
这三个层级形成了典型的带宽递减关系:
\[\begin{aligned} \text{HBM (3350 GB/s)} &\gg \text{NVLink (900 GB/s)} \\ &\gg \text{PCIe (64 GB/s)} \gg \text{Network (50 GB/s)} \end{aligned}\]
系统效率取决于能否将张量保持在可用带宽最高的链路上。由于 PCIe 和网络链路的带宽比封装内内存低数个数量级,且延迟更高,因此,放置与调度必须尽量减少跨越这些边界的次数。
传输优化
两种互补策略可以缓解主机与加速器接口上的传输开销:异步数据移动和统一内存抽象。
在异步流水线中,软件分配固定(页锁定)的主机内存,并将非阻塞内存复制操作加入专用 DMA 引擎的队列。由于复制引擎独立于计算单元运行,加速器在本地内存中处理当前批次的同时,下一个输入批次可以通过 PCIe 并发传输。只要计算时间不小于传输时间(\(T_\text{compute} \ge T_\text{transfer}\)),这种双缓冲机制就能将传输延迟隐藏在算术运算时间之内。当计算持续时间过短,无法摊销传输开销时,执行仍受总线限制,计算单元不可避免地会停顿。
统一内存通过提供一个横跨主机 DRAM 和设备 HBM 的统一虚拟地址空间,形成了另一种抽象。它不再要求手动分配缓冲区和显式执行暂存复制,而是在任一处理器访问某个地址时,由运行时驱动通过硬件缺页异常按需迁移内存页。虽然这消除了用于暂存的样板代码,但按需迁移会给性能带来严重的不确定性。缺页异常会触发驱动中断,使执行流水线停顿,而分散的访问模式可能导致内存页在 PCIe 总线上来回颠簸。因此,高吞吐量生产工作负载依赖显式、流水线化的 DMA 传输来获得确定的性能,而将统一内存用于快速原型开发,或程序员生产力比持续硬件利用率更重要的应用。
这些互连与内存限制决定了神经网络架构如何映射到物理芯片。卷积具有高度的空间复用,可通过片上寄存器和 SRAM 分块摊销传输成本。稠密自注意力具有规则的矩阵结构,但其随序列长度呈二次增长的特性会给封装内内存容量和带宽带来巨大压力。稀疏嵌入、混合专家路由和自回归键值缓存则呈现出其他内存访问模式,使主导约束从算术吞吐量转向内存容量、总线延迟或互连带宽。
模型内存压力
模型架构决定了哪一项内存因素构成约束。多层感知机(MLP)、卷积神经网络(CNN)和 Transformer 呈现出根本不同的数据流特征:有些受权重容量限制,另一些则受中间激活值占用空间、设备内存带宽或主机互连吞吐量限制。因此,每种工作负载都需要不同的加速器内存层次结构和执行策略。
作为参考工作负载的灯塔模型 中介绍的标杆模型为本节分析提供了具体依据:ResNet-50 代表具有高度空间复用且激活值占用空间较大的 CNN 工作负载;GPT-2 和 Llama 体现了 Transformer 在参数容量和中间注意力状态两方面的内存压力;DLRM 展示了对随机访问内存带宽而非密集计算施加压力的稀疏嵌入查找;MobileNetV2 则展示了针对效率优化的架构,其逐通道卷积以降低算术强度为代价,减少参数占用空间。这些模型的内存特征揭示了计算图结构如何决定物理硬件的利用率。
多层感知机
MLP 层由一次稠密矩阵乘法以及可选的后续偏置、激活和归一化操作构成。其运算强度直接取决于批量大小:当批量大小为 \(B = 1\) 时,从片外内存加载的每个参数仅用于一次乘加操作,因而算术强度较低(通常为 \(\le 1\text{ FLOP/byte}\)),使 ALU 无法获得充足的数据供给,执行受内存带宽限制。增大批量大小后,每个已加载的权重矩阵都可被 \(B\) 个独立输入向量复用,算术强度随之提高,直到矩阵乘法达到加速器受计算能力限制的 Roofline 上限。
稠密权重矩阵通常会超过片上 SRAM 可提供的数十兆字节容量,因此参数需要存放在设备本地 DRAM(HBM 或 GDDR)中。只有在流式传输动态输入,或参数与激活值超出设备内存容量、需要卸载到主机时,主机互连(如 PCIe)才会进入关键路径。
由于 MLP 的内存访问模式规则且可预测,加速器会将矩阵操作划分为可容纳于片上 SRAM 和寄存器堆的分块。硬件双缓冲机制在对当前分块执行算术运算的同时,将后续的权重和激活值分块从 DRAM 预取到 SRAM。因此,实际吞吐量取决于批量大小能否提供足够的算术强度,以及矩阵维度能否与硬件分块边界良好对齐 (Chen et al. 2017)。
卷积神经网络
卷积层使用沿空间维度滑动的小型滤波器核处理输入特征图。这种局部滑动窗口结构通过三种不同的数据复用形式实现较高的算术强度:卷积复用(相邻空间窗口共享输入激活值)、滤波器复用(同一组卷积核权重用于计算每个空间位置)和通道复用(输入通道用于多个输出滤波器的计算)。与权重矩阵主导内存占用的 MLP 不同,CNN 的早期层具有紧凑的参数张量,却会生成庞大的中间激活图。
由于中间激活张量经常超过片上 SRAM 容量,未经优化的逐层执行会不断将特征图溢写到设备 DRAM,使流水线受限于内存带宽。加速器通过空间分块避免这些往返传输:将激活值和滤波器划分为大小适合片上 SRAM 缓冲区的分块 (Chen et al. 2017)。将重叠的边界像素直接暂存在本地内存中,可使相邻卷积使用这些激活值,而无需通过设备 DRAM 总线重新获取。
Chen, Yu-Hsin, Joel Emer, and Vivienne Sze. 2017. “Using Dataflow to Optimize Energy Efficiency of Deep Neural Network Accelerators.” IEEE Micro 37 (3): 12–21. https://doi.org/10.1109/mm.2017.54.
专用 CNN 加速器围绕这些复用模式配置硬件数据流。Eyeriss 架构引入了行固定数据流,将滤波器权重和激活值的一维行映射到处理引擎的寄存器,使滤波器行和累积的部分和固定保留在本地存储中,从而尽量减少高能耗的互连流量 (Chen et al. 2016)。在 section 1.8 更广泛的分类体系中,这种设计体现了一种混合数据流,利用寄存器、SRAM 缓冲区和执行单元之间的多维卷积复用。
Transformer 网络
Transformer:并行序列处理 中介绍的 Transformer 架构使用全局自注意力33和稠密前馈块替代局部滑动窗口,从而形成双重内存瓶颈:呈二次增长的中间注意力矩阵,以及庞大的参数占用空间。
全局词元交互在训练和推理期间产生了不同的内存挑战。在标准多头注意力中,对于长度为 \(S\) 的序列,计算词元两两之间的关联程度会生成一个 \(S \times S\) 分数矩阵。在 HBM 中显式存储这个中间矩阵,需要通过内存总线反复读写 \(O(S^2)\) 的数据,即使矩阵乘法算术单元尚未充分利用,也会使带宽饱和。FlashAttention (Dao et al. 2022) 等分块注意力算法通过将查询、键和值分块暂存在片上 SRAM 中,在本地计算在线 softmax 归约,并将输出直接流式写入 HBM,避免在设备 DRAM 中显式存储按二次规模增长的中间矩阵,从而解决这一瓶颈。
在自回归推理中,内存压力转移到键值(KV)缓存上(参见 内存与 KV 缓存)。每生成一个后续词元,都需要从 HBM 读取累积的历史 KV 状态,以执行一次向量与矩阵运算,其算术强度极低,因此生成速度直接受内存带宽约束。
在大语言模型的规模下 (Brown et al. 2020),参数数量所需的存储空间超过了任何单个加速器的物理 HBM 容量。将这些模型分布到多个加速器上,需要在 GPU 之间划分权重和激活值。在服务器节点内部,NVLink 等高带宽互连提供了张量并行和序列并行期间维持 all-reduce 与 all-gather 集合操作所需的互连吞吐量,而标准 PCIe 链路会限制执行速度。系统运行时通过调度异步传输,使这些跨加速器通信阶段与本地矩阵乘法运算重叠执行 (Narayanan et al. 2021)。
Narayanan, Deepak, Mohammad Shoeybi, Jared Casper, Patrick LeGresley, Mostofa Patwary, Vijay Korthikanti, Dmitri Vainbrand, et al. 2021. “Efficient Large-Scale Language Model Training on GPU Clusters Using Megatron-LM.” Proceedings of the International Conference for High Performance Computing, Networking, Storage and Analysis, 1–15. https://doi.org/10.1145/3458817.3476209.
对加速器设计的启示
面向特定工作负载的加速器设计取决于目标神经网络架构的内存与数据流需求。在数据—算法—机器分类体系中,算法形式直接塑造了物理内存层次结构中的数据移动模式,因此,单一且固定的硬件架构难以高效适应不同的模型类别。Table 11 比较了各基础模型家族由此形成的张量维度、复用特征、访问规律和主要硬件瓶颈。
| 模型类型 | 权重大小 | 激活值复用 | 内存访问模式 | 主要瓶颈 |
|---|---|---|---|---|
| MLP(稠密) | 大、稠密 | 低 | 规则、顺序(流式访问) | 带宽(片外) |
| CNN | 小、可复用 | 高 | 空间局部性 | 特征图搬移 |
| Transformer | 大,通常稠密;MoE 或剪枝变体中为稀疏 | 低至中等 | 主要为规则的 GEMM,加上 KV 缓存和注意力的数据流量 | 内存容量 + 带宽 |
每种模型架构对内存子系统的需求各不相同。在小批量多层感知机(MLP)推理中,矩阵—向量乘法(GEMV)主导执行过程;每个权重元素都从片外内存传输过来,与单个激活向量进行运算,算术强度接近每字节一次浮点运算,导致片外带宽饱和,而矩阵运算单元却处于空闲状态。增大批量大小会将该内核转变为矩阵—矩阵乘法(GEMM),使多个输入向量分摊权重加载成本。在 CNN 中,紧凑的滤波器核在空间特征图上滑动,实现较高的算术复用;加速器利用这种空间局部性,将特征分块暂存于片上静态 RAM(SRAM)或暂存存储器中,避免冗余的片外数据传输。Transformer 在不同执行阶段呈现出不同瓶颈:分布式训练受反向传播所需的激活值保留和加速器间通信制约,而自回归解码则受内存带宽限制,因为每生成一个词元,都需要从设备内存中流式读取全部参数以及不断扩大的键值(KV)缓存。
硬件架构师通过多级内存层次结构应对这些不同需求。片上 SRAM(缓存和暂存存储器)以低延迟提供每秒数十太字节的带宽,用于存放高复用率的激活值和分块矩阵。HBM 提供暂存大规模权重张量和动态序列状态所需的容量与吞吐量。当模型规模超过单个加速器的物理内存容量时,NVLink 等高速互连为分布式张量并行和流水线并行提供加速器间的点对点带宽,绕过带宽较窄的主机 PCIe 总线。
数据搬移也主导着硬件加速器的能耗预算。从片外动态 RAM(DRAM)传输操作数所消耗的能量,比在本地执行单元上执行一次算术运算大约高两个数量级。因此,硬件效率取决于能否最大化从外部存储获取的每字节数据所对应的计算量。要判断给定内核的执行受计算吞吐量还是内存带宽制约,需要一个分析边界。Roofline 模型通过比较运算强度与硬件性能上限来建立这种关系,确保优化针对真正的物理瓶颈。
Roofline 模型
低算术强度使工作负载受限于内存。
峰值 FLOP/s 表示操作数已位于片上时执行单元能够提供的性能,但加速器的持续吞吐量最终受内存层次结构提供数据的速率限制。Roofline 模型34 (Williams et al. 2009) 通过绘制可达性能与算术强度的关系,将这一关系形式化,从而确定某项运算是计算受限还是内存受限。该模型将硬件算术吞吐量与内存带宽相结合,而非孤立地评估计算能力,从而在工程师投入优化工作之前,揭示究竟是哪一项物理上限限制了执行性能。
性能受两个上限约束,equation 2 对此给出了形式化表达。这里,可达性能 \(R_{\text{attain}}\) 和峰值计算性能 \(R_{\text{peak}}\) 的单位为 FLOP/s(通常以 TFLOP/s 表示),峰值带宽 \(\text{BW}\) 的单位为 bytes/s(通常为 TB/s),算术强度 \(I\) 的单位为 FLOP/byte: \[R_{\text{attain}} = \min(R_{\text{peak}}, \text{BW} \times I) \tag{2}\]
Definition 1.5: 算术强度
算术强度是运算次数与通过所建模内存接口传输的字节数之比(\(\text{FLOP}/\text{byte}\))。它与该层级的带宽及相关峰值计算性能共同决定理想化 Roofline 模型中哪一个上限更低。
- 意义:两个上限之间的分界点是脊点 \(R_{\text{peak}} / \text{BW}\)。对于 A100(312 TFLOP/s FP16/BF16,2.04 TB/s),该值约为 153 FLOP/byte。在所述数据流量模型下,大规模、分块良好的 1024 \(\times\) 1024 矩阵乘法可达到约 341.3 FLOP/byte,而独立 ReLU 约为 0.125 FLOP/byte。因此,它们在同一硬件上会受到不同上限的约束。
- 区别:与总 FLOP 数(运算次数)不同,算术强度是一个比值,用于描述工作负载对硬件需求的特征。两个内核即使 FLOP 数相同,只要内存访问模式不同,其算术强度就会不同,并受到不同硬件资源的瓶颈制约。
- 常见误区:一种常见误解是认为算术强度是某项运算的固定属性。实际上,它取决于实现细节:朴素矩阵乘法在计算每个输出元素时都从 DRAM 重新加载操作数,因此算术强度较低;分块实现通过复用快速 SRAM 中的数据实现较高的算术强度——同一种数学运算,硬件效率却可能相差数个数量级。
令 \(O\) 为运算次数,\(D_{\text{vol}}\) 为以字节计的数据量,equation 3 给出了该定义的可计算形式。 \[I = \frac{O}{D_{\text{vol}}} \tag{3}\]
Roofline 可视化图以纵轴表示性能(TFLOP/s),横轴表示算术强度(FLOP/byte)。算术强度较低时,性能沿内存带宽斜线(\(\text{BW} \times I\))线性增长,此时执行受内存限制。超过脊点后,性能在峰值计算性能(\(R_{\text{peak}}\))处饱和,此时执行受计算限制。瓶颈诊断 将每个区域对应到有效的优化措施以及徒劳的优化措施,从而使工程师在将工作负载归类为内存受限或计算受限后,能够直接判断究竟是投资更快的加速器还是增加带宽才能解除当前约束。
硬件脊点
脊点,即 section 1.5.2 中确立的硬件平衡点 \(I_{\text{ridge}}\),是加速器从内存受限执行转变为计算受限执行的算术强度阈值。Table 12 量化了三代 NVIDIA 加速器的这一边界:
| NVIDIA 加速器 | FP16 峰值性能 | 带宽 | 脊点 |
|---|---|---|---|
| V100 (2017) | 125 TFLOP/s | 0.9 TB/s | 138.9 FLOP/byte |
| A100 (2020) | 312 TFLOP/s | 2.04 TB/s | 153 FLOP/byte |
| H100 (2022) | 989 TFLOP/s | 3.35 TB/s | 295.2 FLOP/byte |
由于代际演进中算术吞吐量的增长远快于内存带宽,硬件脊点逐渐向右移动。因此,工作负载必须具有显著更高的数据复用程度,才能充分利用较新的硬件;在较旧架构上计算受限的算法,在较新架构上很容易变为内存受限。
Napkin Math 1.3: 利用率差距
问题:为什么在 H100 上达到 100 percent 的利用率比在 V100 上更难?
指标:section 1.5.2 中的脊点 \(I_{\text{ridge}} = R_{\text{peak}} / \text{BW}\)(FLOP/byte):为使计算单元保持忙碌,硬件每加载一字节数据必须执行多少次数学运算。
演变:
- V100 (2017):125 TFLOP/s / 0.9 TB/s ≈ 138.9 FLOP/byte。
- A100 (2020):312 TFLOP/s / 2.04 TB/s ≈ 153 FLOP/byte。
- H100 (2022):989 TFLOP/s / 3.35 TB/s ≈ 295.2 FLOP/byte。
结果:达到张量运算峰值性能所需的算术强度已经提高。在这一简单的 HBM Roofline 模型下,\(I\) = 200 FLOP/byte 的内核,其算术强度高于 A100 的脊点,却低于 H100 的脊点。如果其算术强度和实现保持不变,那么其理想化性能提升倍数将更接近 1.6× 的带宽比,而非 3.2× 的峰值计算性能比。
系统洞见:在一次读取、一次写入的 FP32 数据流量模型下,独立 ReLU 每 8 字节约执行 1 次运算,远低于 H100 的张量运算脊点。分块良好的 1024 \(\times\) 1024 稠密矩阵乘法,在其理想化数据流量模型下可达到约 341.3 FLOP/byte。融合对低算术强度的运算链很有价值,因为它可以消除中间结果的往返传输;但它并非对每个内核都必然是最佳优化方式。
逐通道卷积、嵌入查找、LayerNorm 和 softmax 等运算可作为低算术强度的参考,因为其数据复用极少,导致执行时间主要由内存传输决定。 Table 13 将常见神经网络运算映射到 Roofline 模型。
| 运算 | 算术强度 | 分类 | 典型示例 |
|---|---|---|---|
| Conv2D(稠密) | 50–200 FLOP/byte | 跨越脊点;高复用情形下计算受限 | ResNet-50 |
| 稠密矩阵乘法(大批量、分块良好) | 64–256+ FLOP/byte | 大批量时通常计算受限 | GPT-2(批量投影) |
| 逐通道卷积 | 10–20 FLOP/byte | 内存受限 | MobileNet |
| 注意力 Softmax | 取决于计量约定 | 内存受限 | GPT-2(生成) |
| LayerNorm | 1–2 FLOP/byte | 内存受限 | GPT-2/Llama |
| 嵌入查找 | \(<1\) FLOP/byte | 内存受限 | DLRM |
Napkin Math 1.4: Transformer 层分析
对于隐藏维度 hidden_dim = 768、批量大小 batch = 32、序列长度 seq = 512 的 Transformer:
注意力 QKV 投影:
- 浮点运算量:2 \(\times\) 3 \(\times\) 32 \(\times\) 512 \(\times\) 768 \(\times\) 768 = 58 GFLOP
- 字节数:(输入 + 权重 + 输出)= (32 \(\times\) 512 \(\times\) 768 + 3 \(\times\) 768 \(\times\) 768 + 32 \(\times\) 512 \(\times\) 768 \(\times\) 3) \(\times\) 2 ≈ 104.2 MB
- 算术强度 AI = 58 GFLOP / 104.2 MB = 556.4 FLOP/byte,在 A100 上受计算限制(高于 153 FLOP/byte 的阈值)
Softmax:
- 浮点运算量:32 \(\times\) 12 \(\times\) 512 \(\times\) 512 \(\times\) 3 ≈ 302 MFLOP(指数运算、求和、除法)
- 字节数:32 \(\times\) 12 \(\times\) 512 \(\times\) 512 \(\times 2 \times 2\) = 402.7 MB
- 在这种简单的运算计数方式下,算术强度 AI = 302 MFLOP / 402.7 MB = 0.75 FLOP/byte,因此受内存限制。将指数运算和除法按多次运算计数,会得到数值更大的算术强度,但不会改变瓶颈分类。
系统洞察:这一分析解释了为什么 FlashAttention 着重减少注意力计算中的内存流量,而非减少浮点运算量。
Roofline 分类决定了哪个物理子系统限制性能,以及哪些优化能够缓解这一限制。对于受内存限制的运算,执行时间主要由通过片外内存总线的数据传输决定;ALU 流水线在等待操作数时会经历空闲周期。因此,优化必须着重节约内存带宽:融合相邻算子可将中间激活保留在片上寄存器或共享内存(SRAM)中,低精度数值格式可减少内存传输的物理字节数,而 FlashAttention 等算法重构则通过重新组织访问模式,在 SRAM 分块内完成计算。对于受计算限制的运算,片外带宽不再是瓶颈,因为较高的数据复用程度能够持续为执行单元提供数据。此时,性能取决于能否使算术执行流水线保持饱和:组织矩阵分块以维持 Tensor Core 吞吐量,通过软件流水隐藏指令延迟,以及增大批量大小以将工作分配到所有可用的流式多处理器上。
计算内存带宽界限
Roofline 模型中受内存限制的区域由加速器的片外内存带宽决定。对于算术强度为 \(I\)(FLOP/byte)的工作负载,要维持 \(R_{\text{ops}}\)(FLOP/s)的运算吞吐量,内存子系统必须以 equation 4 所定义的速率传输数据: \[\text{BW}_{\text{req}} = \frac{R_{\text{ops}}}{I} \text{ bytes/s} \tag{4}\]
当所需带宽超过硬件的峰值内存带宽 \(\text{BW}\) 时,内存传输会按照 equation 5 限制可达到的吞吐量: \[R_{\text{attain}} = \text{BW} \times I \tag{5}\]
将运算的算术强度与硬件的脊点进行比较,可以确定执行受内存带宽限制还是受算术吞吐量限制。当数据复用充分时,算术强度会超过脊点,使内核进入受计算限制的区域。二维卷积展示了这种行为。
Napkin Math 1.5: 卷积层分析
考虑 A100 GPU 上的一个 Conv2D 层,其输入形状为(批量大小 = 32,通道数 = 128,高度 = 56,宽度 = 56),输出通道数 = 256,卷积核大小为 \(3{\times}3\):
计算需求:
- 输出大小:\(32 \times 256 \times 56 \times 56\) = 25.7M 个元素
- 每个输出元素的浮点运算量:\(128 \times 3 \times 3 \times 2\) = 2,304(乘加运算)
- 总浮点运算量:25.7M \(\times\) 2,304 = 59.2 GFLOP
内存流量分析:
- 输入:\(32 \times 128 \times 56 \times 56 \times 2\) = 25.7 MB(FP16)
- 权重:\(256 \times 128 \times 3 \times 3 \times 2\) ≈ 0.6 MB(FP16)
- 输出:\(32 \times 256 \times 56 \times 56 \times 2\) = 51.4 MB(FP16)
- 总计:77.7 MB
算术强度: \(I\) = 59.2 GFLOP / 77.7 MB = 762.2 FLOP/byte
系统洞察:这一数值远高于 A100 的脊点 153 FLOP/byte,因此,简单的 Roofline 模型将该运算归入受计算限制的区域。由此,约 312 TFLOP/s 的峰值吞吐量(使用 Tensor Core 的 FP16 运算)构成其性能上限,但实际性能仍取决于分块、占用率、指令组合和库的效率。
卷积层的高算术强度源于权重的空间复用:同一个 \(3{\times}3\) 卷积核应用于特征图的每个空间位置,将从片外内存加载权重的开销分摊到数百万次乘累加运算中。由于中间值和卷积核权重保留在高速片上寄存器与共享内存中,算术流水线保持饱和时,片外内存总线仍处于空闲状态。
并非所有神经网络层都具有如此充分的数据复用。全连接(稠密)层——例如分类头、前馈网络以及 Transformer 注意力块中的线性投影——缺少空间维度。在小批量条件下评估时,其算术强度会显著下降,使执行转入受内存限制的区域:
Napkin Math 1.6: 稠密层分析
考虑同一 A100 上的一个全连接层:输入(批量大小 = 32,特征数 = 2048)→ 输出(批量大小 = 32,特征数 = 2048):
计算需求:
- 矩阵乘法:\((32 \times 2048) \times (2048 \times 2048)\)
- 总浮点运算量:\(2 \times 32 \times 2048 \times 2048\) = 268.4 MFLOP
内存流量分析:
- 输入:\(32 \times 2048 \times 2\) = 131.1 KB(FP16)
- 权重:\(2048 \times 2048 \times 2\) = 8.4 MB(FP16)
- 输出:\(32 \times 2048 \times 2\) = 131.1 KB(FP16)
- 总计:8.7 MB
算术强度: \(I\) = 268.4 MFLOP / 8.7 MB = 31 FLOP/byte
这一算术强度低于 A100 的脊点 153 FLOP/byte,因此该运算受内存限制。可达到的性能为: \(R_{\text{attain}}\) = 2,039 GB/s \(\times\) 31 FLOP/byte = 63.3 TFLOP/s
系统洞察:实际吞吐量仅达到峰值计算能力的 20.3 percent,体现了小批量条件下的内存墙效应。
稠密层较低的算术强度源于有限的参数复用。卷积核会在激活图的每个空间位置复用,而稠密权重矩阵仅沿批量维度复用。当批量大小为 32 时,从 HBM 传输的每个权重参数在被逐出之前仅参与 32 次乘法。由于片外内存总线无法足够快地传输操作数,以持续向 Tensor Core 提供数据,算术单元有超过 80% 的周期处于停顿状态,使吞吐量上限仅为峰值计算能力的 20.3 percent。这一结构性约束解释了为什么小批量下的 Transformer 推理主要受内存带宽而非算术能力限制。
小批量矩阵乘法受到参数复用有限的制约,而逐元素算子和归约算子的内存瓶颈则更为严重。层归一化、激活函数和残差加法等运算,对从内存加载的每个元素仅执行少量算术运算,使算术强度降至其物理下限:
Napkin Math 1.7: LayerNorm 分析
输入形状为(批大小 = 32,序列长度 = 512,隐藏维度 = 768)的 LayerNorm:
计算需求:
- 元素数:\(32 \times 512 \times 768\) = 12.6M
- 每个元素的近似运算次数:均值归约(1 次加法)、方差计算(2 次加法、1 次乘法)、归一化与仿射变换(2 次加法、2 次乘法)≈ 8;平方根倒数的计算开销在每个隐藏向量的各元素之间分摊
- 总 FLOPs:12.6M \(\times\) 8 = 100.7 MFLOP
内存流量:
- 输入:12.6M \(\times\) 2 = 25.2 MB
- 参数(缩放、偏置):\(768 \times 2 \times 2\) = 3.1 KB(可忽略不计)
- 输出:12.6M \(\times\) 2 = 25.2 MB
- 总计:50.3 MB
算术强度: \(I\) = 100.7 MFLOP / 50.3 MB = 2.0 FLOP/byte
这一算术强度远低于 A100 的脊点(脊点值是它的 77×)。性能上限为: \(R_{\text{attain}}\) = 2039 GB/s \(\times\) 2.0 FLOP/byte = 4.1 TFLOP/s
系统洞察:简单的 HBM Roofline 模型将这一独立 LayerNorm 的性能限制在 A100 张量计算峰值的约 1%。实际延迟还取决于融合、归约策略、启动开销,以及由哪一级存储提供数据。
正如 LayerNorm 分析所示,相对于其产生的内存流量,独立归一化操作执行的算术运算极少。在未融合的实现中,每个激活元素都从片外 HBM 经全局总线传输,参与归约计算,然后写回内存,算术强度约为 2 FLOP/byte,导致计算单元在 99% 的时间内处于空闲状态。在数据—算法—机器框架中,当机器约束表现为无法突破的内存带宽墙时,算法层面的应对方式就是算子融合:将线性投影、偏置加法、归一化和激活等相邻操作合并到单个内核中。融合使中间激活值驻留在高速片上 SRAM 或寄存器中,消除经内存总线往返传输的需要,将受带宽制约的工作负载转变为计算高效的执行过程。
按算术强度区间进行优化
Roofline 分析直接为优化优先级提供依据,汇总见 table 14。
| 强度区间 | 典型操作 | 优化优先级 | 常用技术 | 预期影响 |
|---|---|---|---|---|
| 高算术强度(\(>200\) FLOP/byte) | 大型卷积 | 最大化计算利用率。 | Tensor Core、线程块调优和高占用率。 | 当内核的算术强度已超过脊点时,提高持续计算利用率。 |
| 中等算术强度(20–200 FLOP/byte) | 中等规模的全连接层 | 平衡计算优化与内存优化。 | 增大批大小、寄存器分块,以及与相邻操作融合。 | 可使主导瓶颈在内存与计算之间转移。 |
| 低算术强度(\(<20\) FLOP/byte) | 小型全连接层和逐元素操作 | 减少内存流量。 | 积极进行算子融合、降低精度(FP16 → INT8)和算法调整。 | 在融合或布局变更符合约束时,减少外部存储流量。 |
| 极低算术强度(\(<2\) FLOP/byte) | 归一化层和激活函数 | 消除内存往返传输。 | 与相邻操作融合,并在符合约束时使用原地计算。 | 当相邻操作可以融合时,消除中间数据的往返传输。 |
对于低算术强度操作,算子融合 往往是决定性的优化手段:例如,LayerNorm 与高斯误差线性单元(GELU)可以合并为单个融合内核。批处理是使操作在 Roofline 图中向右上方移动的最易采用的手段之一。
Napkin Math 1.8: 批大小与算术强度
增大批大小 可通过分摊权重加载开销来提高矩阵运算的算术强度。Equation 6 针对理想化的 FP16/BF16 全连接层 \((B{\times}M){\times}(M{\times}N)\) 形式化描述了这一关系,计入输入和权重各读取一次、输出写入一次,其中 \(B\) 为批大小,\(M\) 和 \(N\) 分别为输入维度和输出维度: \[I = \frac{2BMN}{2BM + 2MN + 2BN} \approx \frac{2BMN}{2MN} = B \quad (\text{when } 2MN \gg 2B(M+N)) \tag{6}\]
示例:M=N=2048 的全连接层(FP16)
- 批大小 = 1:算术强度 ≈ 1 FLOP/byte(受内存限制)
- 批大小 = 32:算术强度 ≈ 31 FLOP/byte(受内存限制)
- 批大小 = 256:算术强度 ≈ 204.8 FLOP/byte(在 A100 上受计算限制)
系统洞察:这解释了为何批处理能够显著提高生产推理系统的吞吐量。基准测试 中介绍的标准化基准测试套件 MLPerf Inference 将大批量吞吐量测试与受延迟约束的服务测试分开进行,展示了这一点 (Reddi et al. 2019)。
Reddi, Vijay Janapa, Christine Cheng, David Kanter, Peter Mattson, Guenther Schmuelling, Carole-Jean Wu, Brian Anderson, et al. 2019. “MLPerf Inference Benchmark.” 2020 ACM/IEEE 47th Annual International Symposium on Computer Architecture (ISCA), 446–59. https://doi.org/10.1109/isca45697.2020.00045.
批大小分析揭示了推理服务系统围绕批处理进行设计的原因:批处理改变了受内存限制工作负载所处的算术强度区间。然而,批处理也带来了延迟方面的权衡,因为请求必须在队列中等待,直到形成一个批次。吞吐量(倾向于大批次)与延迟(倾向于小批次)之间的这种矛盾,是机器学习服务系统的核心挑战之一,动态批处理中的延迟与吞吐量权衡 对此进行了深入探讨。
当服务延迟限制批处理规模时,批大小为 1 或采用小批次的 LLM 解码通常仍具有较低的权重复用率和算术强度。接下来的计算模型将量化这一特定情形,而不是将所有 LLM 推理都视为相同的情况。
Napkin Math 1.9: 吞吐量上限
问题:批大小为 1 的 GPT-2 计算使这一带宽上限具体化:运行 GPT-2 推理(批大小为 1)时,NVIDIA A100 能达到的最大利用率是多少?
硬件约束(分母)
峰值计算性能:312 TFLOP/s(FP16 Tensor Core)。
峰值带宽:2.04 TB/s(HBM2e)。
脊点 \((R_{\text{peak}}/\text{BW})\):312 TFLOP/s / 2.04 TB/s = 153 FLOP/byte(针对 FP16 Tensor Core)。
解读:要在 FP16 精度下充分利用这块芯片,每加载一个字节就需要执行 153 FLOP/byte 所对应的运算量。脊点随精度而变化:FP32 运算(峰值为 19.5 TFLOP/s)的脊点仅约为 9.6 FLOP/byte。
工作负载特征(分子)
- 模型:GPT-2 XL(15 亿参数)。
- 操作:自回归生成(每次生成 1 个词元)。
- 数据搬移:每生成一个词元,都必须加载全部权重(FP16 下为 3 GB)。
- 计算:向量与矩阵相乘。2 \(\times\) 参数量 ≈ 3 GFLOP。
- 算术强度: 3 GFLOP / 3 GB = 1 FLOP/byte
预测(铁律)
由于实际算术强度(1)\(\ll\) 脊点(153 FLOP/byte),系统受带宽限制。
- 最大吞吐量:1 FLOP/byte \(\times\) 2.04 TB/s = 2.04 TFLOP/s。
- 利用率上限: 2.04 TFLOP/s(实际值)/ 312 TFLOP/s(峰值)≈ \(0.7\%\)
系统洞察: 在这一权重流式加载的解码模型中,如果不使用批处理,一块价格为 $15,000 的 GPU,其计算利用率将低于 1 percent。批处理和权重量化可缩小这一差距;键值缓存则用于避免重新计算先前的注意力状态。
通过上述推导,Roofline 模型提供了一个诊断框架,用于识别操作究竟受计算限制还是受内存限制。知道某个工作负载在利用率为 0.7 percent 时受内存限制,只是第一步;接下来的挑战是将这一诊断转化为能够充分利用加速器架构的高效执行计划。
硬件映射
考虑在加速器计算块上运行的一个 \(3{\times}3\) 卷积。数学运算是固定的,但执行计划并非如此。一种调度方式可以将滤波器保留在本地寄存器中,让多个输出像素的计算复用它;另一种方式则可能逐像素推进,并反复从较慢的存储层级重新加载相同的滤波器值。两种调度方式计算出的张量相同,但只有其中一种能将卷积中的复用转化为实际的带宽节省。
Definition 1.6: AI 加速中的映射
AI 加速中的映射 是加速器编译器将逻辑计算图绑定到物理硬件拓扑的过程,其中需要决定哪些操作在哪些处理单元上执行、哪些数据驻留在哪个存储层级,以及执行的时间顺序。
- 意义:在数据—算法—机器分类体系中,映射属于机器轴上的决策,有助于决定某个操作能够在多大程度上接近 Roofline 上限 \(\min(R_{\text{peak}},\; \text{BW} \times I)\)。不合理的分块选择会迫使系统进行不必要的 DRAM 访问,从而使有效算术强度下降到足以将一个名义上受计算限制的操作转变为受带宽限制的操作。
- 区别:传统编译通常强调通用处理器的指令选择、寄存器分配和调度。加速器映射则同样重视空间布局,以及数据流架构 中的显式数据搬移。其原因在于物理特性:在前文介绍的 45 nm 工艺比较中,片外 DRAM 访问消耗的能量约为一次本地整数乘加运算的 200\(\times\),不过这一比值取决于工艺和运算类型。
- 常见误区:一种常见误解是,框架会自动处理好映射。对于通用 GPU 工作负载,Accelerated Linear Algebra(XLA)等编译器可以为常见内核找到良好的映射;对于专用加速器(脉动阵列、定制 ASIC),编译器生成的映射仍可能落后于手工调优的调度方案,因为编译器的搜索空间受编译时间预算限制。
卷积示例揭示了加速器编译中反复出现的三项决策。放置将乘加工作分配给处理单元,使并行性不至于转化为空闲时间或互连拥塞。分配将权重、激活值和部分和保留在其下一次使用所在的存储层级中,避免复用过程退回到 DRAM。调度对循环和内核排序,使选定的放置与分配方案随时间推进始终保持有效。任何一个维度上的不合理选择,都可能使高算术强度操作重新退化为受带宽限制的执行过程。在实践中,这些选择耦合过于紧密,开发者难以在整个模型的规模上手工管理,因此 XLA、TVM 和 TensorRT 等系统会将高层模型逐步转换为低层表示,并在编译时间与硬件预算范围内搜索或选择执行计划。Section 1.9 将详细讨论这种编译器支持。
放置与分配
将模型的计算图转化为高效的硬件执行,需要解决两个紧密耦合的问题。计算放置决定哪些运算在哪些处理单元上运行,在并行性与通信成本之间取得平衡。内存分配决定数据驻留在内存层次结构的哪个位置,在容量与访问延迟之间进行权衡。这两类决策相互影响:将运算放置在相距较远的处理单元上,会增加在它们之间传输数据所需的内存带宽;而将数据分配到速度快但容量小的片上内存中,则会限制能够并发执行的运算。任何一项决策失误,都可能使数千个处理单元闲置或因缺少数据而无法工作。
计算放置
计算放置是将运算分配给加速器处理单元(PE)的过程,旨在发掘并行性、减少空闲时间,并减少不必要的数据移动。现代加速器包含大量此类资源:NVIDIA H100 拥有超过 16,000 个 CUDA 核心和超过 500 个 Tensor Core (Choquette 2023),TPU 将数千个乘加单元组织成脉动阵列 (Jouppi et al. 2017),而 Cerebras CS-2 等晶圆级处理器则集成了超过 850,000 个核心 (Systems 2021)。在这样的规模下,放置效率低下会产生可测量的影响,因为空闲核心和冗余传输都会浪费时间与能量。
放置的难度取决于工作负载的规则性。卷积网络和稠密 Transformer 运算具有规则的访问模式,可以按可预测的方式进行分块,不过 Transformer 架构混合了张量形状和复用特征各不相同的运算。图神经网络(GNN)带来的困难更大:稀疏且依赖输入的邻域聚合会导致处理单元之间的负载不均衡和非均匀通信。Table 15 总结了这些核心放置挑战及其对运行的影响。
| 挑战 | 对执行的影响 | 放置的关键考虑因素 |
|---|---|---|
| 工作负载不均衡 | 一些处理单元提前完成,而其他处理单元仍然过载,导致计算资源闲置。 | 均匀分配运算,以避免停顿并确保 PE 得到充分利用。 |
| 不规则计算模式 | 稀疏图、路由和可变形状可能产生非均匀的工作量,使静态放置复杂化。 | 当工作负载特征在运行时变化时,采用自适应放置。 |
| 过多的数据移动 | 频繁的内存传输会引入延迟并增加功耗。 | 将频繁使用的数据保留在计算单元附近,并尽量减少片外内存访问。 |
| 有限的互连带宽 | 运算放置不当可能造成拥塞,减慢 PE 之间的数据移动。 | 优化空间和时间放置,以减少通信开销。 |
| 模型特定的执行需求 | CNN、Transformer 和 GNN 需要不同的执行模式,因此单一放置策略难以奏效。 | 根据每种模型类型的计算结构定制放置策略。 |
对于形状和循环边界预先已知的规则稠密运算,静态空间映射足以满足需求。具有动态形状、稀疏性或混合专家路由的工作负载,则需要通过运行时调度来平衡各处理单元的执行。然而,即使计算放置最优,如果所需操作数未能及时就位,执行仍会停顿:计算单元的执行速度受限于操作数从内存层次结构到达的速度。
内存分配
计算放置决定运算在哪里执行,而内存分配则规定数据驻留在哪里,以及如何在层次结构中流动。其目标是在不超过更快层级容量的前提下,将可复用的数据保留在处理单元附近。GPU 提供全局内存、共享内存、缓存和寄存器,内核通过分块来协调这些资源 (NVIDIA Corporation 2020a)。TPU 使用片上缓冲区暂存激活值和权重,以供脉动阵列执行(figure 8)(Jouppi et al. 2017),而晶圆级处理器则通过划分内存和计算来控制互连流量 (Systems 2021)。通用处理器和加速器都使用内存层次结构,但许多加速器将更多放置决策交由编译器和内核处理。当分配未能利用局部性时,处理单元会因等待操作数而停顿,导致利用率下降,并在内存总线上消耗能量。
Systems, Cerebras. 2021. “Wafer-Scale Deep Learning Acceleration with the Cerebras CS-2.” Cerebras Technical Paper 2021.
这些代价的严重程度因工作负载而异。卷积网络依赖结构化、局部化的访问模式,并能从支持可预测复用的明确定义的内存布局中获益 (Chen et al. 2016)。Transformer 需要访问庞大的参数集和中间激活值,因此对容量和带宽敏感。图神经网络还引入了不规则的稀疏结构,使分配和预取更加复杂。
容量只是内存分配需要通过的第一项检验。即使一个张量能够放入加速器内存,如果每个内核都要从较远的层级重新读取它,它仍可能主导执行时间;反之,分块可以通过保留局部复用,使更大的工作集仍能高效处理。因此,评估分配是否合理应关注流量,而不只是容量:编译器必须跟踪数值跨越各内存边界的频率,并将复用程度高的张量保留在可行的最快层级中。系统将适用于已知形状的静态内存规划与形状变化时的动态缓冲区管理相结合,而设备容量则限制了哪些模型能够在无需分区或卸载的情况下容纳。Table 16 总结了整个层次结构中的这些分配挑战。
| 挑战 | 对执行的影响 | 分配的关键考虑因素 |
|---|---|---|
| 高内存延迟 | 缓慢的数据访问会延缓执行并降低吞吐量。 | 优先将频繁访问的数据放置在更快的内存位置。 |
| 有限的片上存储 | 容量较小的本地内存限制了计算单元附近可用的数据量。 | 高效分配存储,在不超过硬件限制的前提下最大限度地提高数据可用性。 |
| 高片外带宽需求 | 频繁访问外部内存会增加延迟和功耗。 | 通过精细管理数据移动的时机和方式,减少不必要的内存传输。 |
| 不规则内存访问模式 | 某些模型需要以不可预测的方式访问数据,导致内存使用效率低下。 | 根据访问模式组织内存布局,并尽量减少不必要的数据移动。 |
| 模型特定的内存需求 | 不同模型需要不同的分配策略来优化性能。 | 根据工作负载的结构和执行特征定制分配决策。 |
组合复杂性
小型卷积示例说明了硬件映射为何会成为一个组合搜索问题。将滤波器保留在本地存储中,只有在所分配的处理单元具备足够存储容量,且循环调度能在该滤波器被逐出之前再次访问它时,才能提高复用程度。同样,将计算并行分配到更多处理单元上,只能在同步开销和互连争用抵消收益之前提高吞吐量。由于改变一个决策会改变其他决策中可行且高效的选择,编译器必须联合评估放置、分配和调度,而不能独立评估。Table 17 总结了执行栈中反复出现的这些权衡。
| 维度 | 放置考虑因素 | 分配与调度考虑因素 |
|---|---|---|
| 计算粒度 | 细粒度放置可实现更高的并行性,但会增加同步开销。 | 粗粒度调度可减少同步开销,但可能限制灵活性。 |
| 空间映射与时间映射 | 空间放置可增强并行执行,但可能导致资源争用和内存拥塞。 | 时间调度可平衡资源共享,但可能降低总体吞吐量。 |
| 内存与数据局部性 | 将数据放置在更靠近计算单元的位置可尽量降低延迟,但可能减少总体可用内存。 | 将数据分配到多个内存层级可增加容量,但会引入更高的访问成本。 |
| 通信与同步 | 将计算单元集中放置可减少通信延迟,但可能引入争用。 | 对同步机制进行调度可缓解停顿,但可能引入额外开销。 |
| 数据流与执行顺序 | 静态放置可简化执行,但会限制对工作负载变化的适应能力。 | 动态调度可提高适应能力,但会增加调度复杂性。 |
评估这些权衡,需要探索一个由三类结构性决策决定的无约束搜索空间:循环执行顺序、跨处理单元的空间并行化,以及跨层次结构的内存分配。为了理解穷举搜索为何不切实际,可以分别考察每个维度的组合增长。
计算与执行的排序
机器学习工作负载通常表示为遍历张量维度的嵌套循环。例如,矩阵乘法内核会遍历批大小(\(B\))、输入特征(\(C_{\text{in}}\))和输出特征(\(C_{\text{out}}\))。循环执行顺序决定哪些张量元素在迭代之间保留在寄存器或 SRAM 中,从而直接决定数据局部性和复用程度。
忽略依赖关系和等价顺序,排列 \(n_{\text{loops}}\) 个循环的方式数量具有如下简化上界: \[ N_{\text{order}} = n_{\text{loops}}! \] 其增长十分迅速。典型的卷积层可能涉及多达七个循环维度,因此有: \[ 7! = 5,040 \text{ possible execution orders.} \]
随着循环维度增加,映射选择呈组合爆炸式增长。
如果每个内存层级都能独立选择顺序,相应的简化上界将扩展为: \[ (n_{\text{loops}}!)^{N_{\text{mem}}} \] 其中,\(N_{\text{mem}}\) 为内存层次结构的层级数。这种迅速扩张表明了执行顺序优化的重要性:次优的循环顺序会过早逐出数值,使 DRAM 流量成倍增加;而优化后的顺序则可最大限度地利用本地 SRAM 和缓存中的复用 (Sze et al. 2017)。
跨处理单元的并行化
现代 AI 加速器使用数千个处理单元并发执行循环迭代。然而,将内层归约循环并行化需要跨核心同步和集合通信,而将外层独立循环(例如批次或输出特征通道)并行化,则允许各核心独立执行,无需产生互连流量。确定哪些循环应进行空间映射,需要审慎划分。
在施加合法性和容量约束之前,选择循环进行并行执行的有序方式数量具有如下上界: \[ \mathcal{P}_{\text{parallel}} = \frac{n_{\text{loops}}!}{(n_{\text{loops}}-k_{\text{parallel}})!} \] 其中,\(n_{\text{loops}}\) 为循环数量,\(k_{\text{parallel}}\) 为选定用于并行执行的循环数量。对于一个包含六个循环、其中选取三个进行并行执行的计算,这一无约束计数为: \[ \frac{6!}{(6-3)!} = 120. \]
即使只有一层,在剔除无效或等价策略之前,候选数量也可达到数百个。每种候选调度对屏障同步、互连带宽和 PE 利用率都有不同的要求。
内存放置与数据移动
物理内存层次结构要求编译器确定,在执行的每个阶段,哪些张量驻留在寄存器、共享内存或全局 DRAM 中。从片外 DRAM 获取操作数所消耗的能量及产生的延迟,比从本地 SRAM 读取高出数个数量级,因此数据放置是实际达到的算术强度的首要决定因素。
如果每个计算维度在每个内存层级都有 \(n\) 个独立选择,则得到的简化上界为: \[ \mathcal{M}_{\text{placement}} = n^{N_{\text{comp}} \times N_{\text{mem}}} \] 其中:
- \(n\) = 每个层级的放置选择数量,
- \(N_{\text{comp}}\) = 计算维度数量,
- \(N_{\text{mem}}\) = 内存层次结构的层级数。
对于一个具有以下配置的模型:
- \(N_{\text{comp}} = 5\) 个计算维度,
- \(N_{\text{mem}} = 3\) 个内存层级,
- 每个层级有 \(n = 4\) 种可能的放置选择,
可能的内存分配数量为: \[ 4^{5 \times 3} = 4^{15} = 1,073,741,824. \]
映射搜索空间
这个无约束映射示例包含超过十亿种组合,尽管其中许多组合不合法、相互耦合或彼此等价。将这些简化计数相乘,可以得到映射搜索空间上界的示意表达: \[ \mathcal{S}_{\text{mapping}} = \left( n^{N_{\text{comp}}} \times n_{\text{loops}}! \times \frac{n_{\text{loops}}!}{(n_{\text{loops}}-k_{\text{parallel}})!} \right)^{N_{\text{mem}}} \] 其中:
- \(n^{N_{\text{comp}}}\) 表示内存放置选择,
- \(n_{\text{loops}}!\) 表示计算顺序选择,
- \(\frac{n_{\text{loops}}!}{(n_{\text{loops}}-k_{\text{parallel}})!}\) 表示并行化的可能方式,
- \(N_{\text{mem}}\) 为内存层次结构的层级数。
该方程并非合法调度数量的精确计数,因为各项选择会相互影响,而硬件约束也会裁剪搜索空间。它说明了候选空间为何迅速增长,以及穷举搜索为何变得不切实际。即使在一个小型层内,改变单个顺序决策也可能使内存流量产生数量级的差异。
Example 1.4: 小型卷积中的循环顺序
考虑一个卷积,将 16 个大小为 \(3{\times}3\) 的滤波器应用于一个 \(8{\times}8\) 的单通道输入。该计算可表示为五层嵌套循环,分别遍历输出行(\(H_{\text{out}}\))、输出列(\(W_{\text{out}}\))、滤波器数量(\(C_{\text{out}}\))、滤波器高度(\(F_h\))和滤波器宽度(\(F_w\))。\(5! = 120\) 种排列构成一个无约束上界:合法顺序保持数学结果不变,但浮点归约顺序可能改变舍入结果,而且不同顺序会产生不同的内存流量。
顺序 A(权重驻留):将滤波器循环(\(C_{\text{out}}\)、\(F_h\)、\(F_w\))置于最外层,将空间循环(\(H_{\text{out}}\)、\(W_{\text{out}}\))置于最内层。每个 \(3{\times}3\) 滤波器只加载到寄存器一次,随后应用于全部 36 个输出位置,再加载下一个滤波器。权重加载总量为 \(16 \times 9 = 144\) 个数值,每个数值恰好加载一次。
顺序 B(输出驻留):将空间循环置于最外层,将滤波器循环置于最内层。对于每个输出位置,都必须加载并应用全部 16 个滤波器,并累加相应的部分和,然后才能推进到下一个位置。如果寄存器文件无法同时容纳全部 16 个滤波器,就需要从缓存或 DRAM 反复获取滤波器。最坏情况下,36 个输出位置中的每一个都会重新加载全部 144 个滤波器权重,产生 \(36 \times 144 = 5{,}184\) 次权重读取。
系统洞见:在这两种极限假设下,顺序 A 的模型化权重读取次数为顺序 B 最坏情况的三十六分之一,即减少了 36\(\times\)。实际内核还会考虑激活值和部分和的流量、寄存器容量、缓存行为以及向量化。尽管如此,该示例仍说明了为什么两种数学上等价的循环顺序会对内存系统提出截然不同的要求。
这种组合爆炸提出了机器学习系统中的一个核心问题:如果无约束搜索空间包含数十亿个候选方案,编译器和内核开发者为何还能经常实现接近硬件峰值的效率?生产系统并不评估任意排列,而是将搜索限制在一小类典型数据流模式中,即为利用神经网络算子的特定复用属性而设计的空间与时间调度。
数据流优化
空间映射和时间映射(section 1.7)确定运算在哪里执行、操作数驻留在哪里,而数据流优化则控制数据在处理单元和内存层次结构中移动的精确路径与调度。在脉动阵列或分块向量单元中,权重、输入和部分和的时间调度与空间路由,决定了操作数必须从高能耗 DRAM 获取的频率,而非从本地寄存器或暂存存储器中复用。通过控制片外流量,数据流确定了内核的有效运算强度,进而决定执行能否达到 Roofline 模型中计算受限的平台区,还是停滞于内存受限区域。因此,优化编译器(section 1.9)和运行时系统(section 1.10)会定制数据流模式,使各层的复用特征与目标加速器的硬件约束相匹配。
三类反复出现的架构决策构成了这一设计空间:
- 局部性:驻留操作数的选择(权重驻留、输出驻留或输入驻留)决定哪个张量固定保留在本地寄存器或处理单元的暂存存储器中,在内存流量与寄存器压力之间进行权衡。
- 组织方式:物理张量布局(例如通道后置的
NHWC与通道前置的NCHW)决定内存访问是否与硬件内存控制器的突发传输大小和 SIMD 向量宽度匹配,从而避免无法合并的内存事务。 - 组合方式:内核融合和循环分块对迭代空间进行划分,并合并相邻运算,以消除中间张量往返片外内存的传输。
这些模式共同提供了一套精简的概念体系,用于探索数据流选择,而无需穷举数十亿种候选调度。
映射策略的基本构件
这三项决策可落实为四种基础技术:将特定操作数固定在算术单元附近的数据移动模式(权重驻留、输出驻留和输入驻留)、内存高效的张量布局(通道后置与通道前置)、在操作之间将中间激活保留在片上 SRAM 中的算子融合,以及将工作集大小限制在局部存储容量以内的循环分块。启发式编译器和自动调优框架将这些基本构件组合起来,为深度神经网络各层构建高效的执行计划,而无需从头重新探索调度方案。
数据移动模式
在现代加速器上,从片外 DRAM 访问一个操作数所消耗的能量,大约比执行一次算术运算或从局部寄存器文件中读取数据高两到三个数量级 (Chen et al. 2016)。无论工作负载执行的是超出片上缓存容量的稠密矩阵运算,还是不规则的稀疏查找,数据移动策略都决定着整体执行延迟和总功耗。如果无法按照处理单元算术吞吐量所要求的速率暂存并供应数据,执行单元就会因内存延迟而停顿,使理论计算能力闲置,并增加内存子系统的能耗。
为防止算术流水线停顿,数据移动策略必须利用局部低能耗存储,捕获张量运算在算法层面固有的数据复用。Listing 15 展示了矩阵乘法的经典三重嵌套循环实现,揭示了硬件映射必须在局部存储中实现的权重、输入和部分和复用。
## Matrix multiplication where:
## weights: [512x256] - model parameters
## input:   [256x32]  - batch of activations
## Z:       [512x32]  - output activations

## Computing each output element Z[i,j]:
for i in range(512):
    for j in range(32):
        for k in range(256):
            Z[i, j] += weights[i, k] * input[k, j]
这一计算过程揭示了几个关键的数据流挑战。第一个挑战是所需的内存访问次数。对于每个输出 \(Z_{ij}\),计算都必须从权重矩阵中读取一整行权重,并从输入矩阵中读取一整列激活。由于权重矩阵包含 512 行,输入矩阵包含 32 列,这会产生重复的内存访问,给内存带宽带来沉重负担。
第二个挑战来自权重复用。同一组权重会应用于多个输入,这意味着理想的映射策略应最大限度地提高权重的局部性,以避免冗余的内存读取。如果不能恰当地复用权重,加速器就会多次加载相同的权重,从而浪费带宽 (Chen et al. 2018)。
第三个挑战涉及中间结果的累加。由于 \(Z_{ij}\) 中的每个元素都需要累加 256 个不同权重与输入对的贡献,因此在计算出最终值之前,必须存储和读取部分和。如果这些中间值的存储方式效率低下,系统就需要频繁访问内存,进一步增加带宽需求。
缓解这些挑战的一种方法是采用 SIMD 和 SIMT 执行模型,它们允许并行读取多个值。然而,即使采用这些优化,数据移动仍然是瓶颈。主要瓶颈不仅在于读取速度,还在于传输频率以及数据在存储层次结构中的放置位置 (Han et al. 2016)。
Han, Song, Xingyu Liu, Huizi Mao, Jing Pu, Ardavan Pedram, Mark A. Horowitz, and William J. Dally. 2016. “EIE: Efficient Inference Engine on Compressed Deep Neural Network.” 2016 ACM/IEEE 43rd Annual International Symposium on Computer Architecture (ISCA), 243–54. https://doi.org/10.1109/isca.2016.30.
由于数据移动在 figure 9 所示的能耗预算中占据主导地位,因此加速器最重要的目标就是尽可能减少内存访问。数据流策略通过最大化数据复用来实现这一目标。核心决策是:将哪些数据保留在局部存储中最有价值。加速器通过确定哪些数据固定保留在存储中、哪些数据动态流动来作出这一决策:权重驻留将模型参数保留在局部存储中,输入驻留保留激活数据,输出驻留则保留中间结果。每种方法都在不同的内存访问模式之间进行权衡,以最大化数据复用,并尽可能减少构成人工智能加速主要瓶颈的高能耗传输。
权重驻留
权重驻留策略将权重固定在局部存储中,同时让输入激活和部分和以流式方式通过系统。对于 CNN 和矩阵乘法,同一组权重会应用于多个输入,因此权重驻留方法尤其有效。通过确保权重保持驻留,这种方法减少了冗余的内存读取,有助于缓解带宽瓶颈并提高能效。
权重驻留的一个关键优势是最大化权重复用,降低访问外部存储的频率。由于权重参数通常由多次计算共享,将其保留在局部存储中可以消除不必要的数据移动,降低计算的总体能耗。因此,对于权重构成主要存储开销的架构,例如脉动阵列和面向机器学习设计的定制加速器,这种方法尤其有效。Listing 16 展示了权重驻留执行如何将权重固定在局部存储中,同时流式传入输入并累加部分和。
## Weight Stationary Matrix Multiplication
## - Weights remain fixed in local memory
## - Input activations stream through
## - Partial sums accumulate for final output

for weight_block in weights:  # Load and keep weights stationary
    load_to_local(weight_block)  # Fixed in local storage
    for input_block in inputs:  # Stream inputs dynamically
        for output_block in outputs:  # Compute results
            output_block += compute(weight_block, input_block)
            # Reuse weights across inputs
在权重驻留执行中,权重只需加载到局部存储中一次,并在整个计算过程中保持固定,而输入则动态流入,从而减少冗余的内存访问。部分和得到高效累加,尽可能减少不必要的数据移动。由于每次新计算都无需重新加载权重,带宽需求显著降低,使这种数据流对于 CNN 和矩阵乘法等权重复用程度高的工作负载非常有效。
然而,尽管该策略减少了与权重相关的内存流量,却也引入了输入和输出移动方面的权衡。由于权重保持固定时,输入必须动态流入,因此这种方法的效率取决于能否将输入激活高效地送达计算单元而不引起停顿。代表中间结果的部分和也必须谨慎累加,以避免过多的内存流量。总体性能收益取决于可用片上存储的大小,因为对于拥有数百万或数十亿参数的模型,在局部存储中保存较大的权重矩阵可能成为制约因素。
权重驻留策略适用于权重复用程度高且内存带宽构成限制因素的工作负载。它通常用于 CNN、脉动阵列和矩阵乘法内核,在这些场景中,结构化的权重复用能够带来可测量的性能提升。然而,对于输入或输出复用更为关键的模型,输出驻留或输入驻留等其他数据流策略可能提供更好的权衡。
输出驻留
权重驻留将权重保留在局部存储中,并让输入以流式方式通过系统。然而,当瓶颈不是权重加载,而是部分和的频繁写入时,主导开销就会发生转移。在全连接层和 Transformer 注意力机制中,每个输出元素都要累加数百或数千个权重与输入对的贡献。如果每次累加后都将这些中间部分和写入外部存储,就会产生写带宽瓶颈,其严重程度远超权重驻留所解决的读取开销。输出驻留策略颠倒了优先级:它将部分和固定在局部存储中,同时让权重和输入激活以流式方式通过系统,使每个输出元素仅在所有贡献累加完成后才写入外部存储一次 (Chen et al. 2016)。
Chen, Yu-Hsin, Joel S. Emer, and Vivienne Sze. 2016. “Eyeriss: A Spatial Architecture for Energy-Efficient Dataflow for Convolutional Neural Networks.” 2016 ACM/IEEE 43rd Annual International Symposium on Computer Architecture (ISCA), 367–79. https://doi.org/10.1109/ISCA.2016.40.
Listing 17 展示了如何通过在局部累加部分和,尽可能减少内存写入并提高矩阵乘法的效率。在这一实现中,累加器缓冲区在整个内层循环期间都保留在局部寄存器或暂存存储器中;权重和输入流入后参与当前累加,随后被丢弃。每个输出元素的最终结果仅写出一次,从而消除了原本会占据带宽主导地位的重复写入流量。
这种方法与脉动阵列天然契合:计算在处理单元网格中推进,部分和可以沿一个轴流动而无需离开芯片。其代价是权重和激活现在都必须动态流入,因此系统必须同时为两条数据流维持高读取带宽。当多个处理单元(PE)共同计算同一个输出元素时,并行实现还需要谨慎同步。因此,输出驻留最适用于累加占主导地位的工作负载,例如全连接层和注意力机制;当输入复用是关键瓶颈时,其适用性则较低。
## - Partial sums remain in local memory
## - Weights and input activations stream through dynamically
## - Final outputs are written only once

for output_block in outputs:  # Keep partial sums stationary
    accumulator = 0  # Initialize accumulation buffer
    for weight_block, input_block in zip(weights, inputs):
        accumulator += compute(weight_block, input_block)
        # Accumulate partial sums
    store_output(accumulator)  # Single write to memory
输入驻留
前面讨论的两种策略分别将不同的操作数固定在局部存储中:权重驻留固定权重,以减少参数读取所需的带宽;输出驻留固定部分和,以减少累加所需的写入带宽。第三种策略通过固定剩余的操作数——输入激活——补全了这一体系。在一个 Transformer 层内部,一个激活可以供多个投影或注意力头使用;下一层接收的是新计算得到的表示,而不是同一个词元激活。当激活复用构成主要的内存开销时,将输入保持驻留并让权重以流式方式通过系统,可以降低能耗和带宽需求。Listing 18 展示了这种方法。
## - Input activations remain in local memory
## - Weights stream through dynamically
## - Partial sums accumulate and are written out

for input_block in inputs:  # Keep input activations stationary
    load_to_local(input_block)  # Fixed in local storage
    for weight_block in weights:  # Stream weights dynamically
        for output_block in outputs:  # Compute results
            output_block += compute(weight_block, input_block)
            # Reuse inputs across weights
这里,输入激活只加载一次,并固定保留在局部存储中,而权重则流式通过。部分和不断累加并最终写出,但与输出驻留数据流不同,局部性的主要受益者是输入激活,而非累加缓冲区。
其权衡与另外两种策略相似:权重动态流入,需要存储系统持续提供读取带宽;部分和则需要在写回之前进行缓冲。当一个激活分块在被逐出之前供多个投影、注意力头或门控计算使用时,输入驻留最为有效。
综合来看,这三种数据流策略提供的是一个决策框架,而非优劣排序。权重驻留尽可能减少参数读取流量,适合使用紧凑且高度复用的滤波器的卷积网络。输出驻留尽可能减少累加的写入流量,适合具有大扇入的全连接层。输入驻留尽可能减少激活读取流量,适合激活复用程度高的 Transformer 和大批量推理。没有哪一种策略在所有场景中占优;最优选择取决于相对于片上存储容量,哪个张量维度能够提供最高的复用率。硬件编译器根据工作负载维度和存储层次结构的限制,在这些策略中进行选择。针对卷积的专用设计还引入了第四种名称,即行驻留(如 Eyeriss 中所采用的策略),但它是一种混合策略:当将输入行和部分和保留在局部存储中的映射方式,比固定任一单独操作数能够获得更高复用率时,便采用这种方式(section 1.5.6.2)。
内存高效的张量布局
section 1.8.1.1 中的数据流策略决定哪些操作数保持在计算单元附近;张量布局则决定这些操作数到达后能否被高效访问。即使权重驻留调度选择得当,如果权重采用的布局导致跨步、无法合并的内存读取,执行仍会停顿。张量布局构成了内核的一项约定:多维数据在线性存储中的物理排列顺序必须与加速器执行单元预期的内存访问步长相匹配,否则处理器就会付出内存停顿、缓存利用不足和冗余总线事务的代价。
硬件加速器以固定大小的事务从设备内存中读取数据,每次事务通常传输 32 至 128 字节。当计算单元请求的地址不连续时,每次事务只会传送少量有效载荷,从而降低有效内存带宽。使张量布局与硬件执行模型对齐,可以确保并发线程或 SIMD 向量通道通过一次统一的事务访问连续的内存位置 (NVIDIA Corporation 2021)。
机器学习框架和编译器通常会自动管理布局选择。面向 NVIDIA GPU 的 cuDNN、面向 TensorFlow 和 JAX 的 XLA,以及基于 MLIR 的编译器栈等优化工具,会在将操作降低为后端专用内核时转换张量布局 (NVIDIA Corporation 2021; Google 2025; Lattner et al. 2020)。在高层框架中,布局转换通常是透明进行的,但编写自定义内核或面向 CUDA、Metal、OpenCL 等底层 API 的开发者必须直接管理张量格式。
例如,在 PyTorch 中,tensor.permute() 等视图操作只调整张量步长,而不移动内存中的数据;当下游内核要求连续存储时,需要显式调用 tensor.contiguous(),才能实际生成紧密排列的缓冲区 (PyTorch Contributors 2026)。相比之下,TensorFlow 对 NVIDIA GPU 上的卷积模型默认采用通道后置布局(NHWC),并警告 NCHW 输入在降低为 GPU 内核时会引入自动转置开销 (TensorFlow Developers 2024)。GPU 上的 cuDNN 和 CPU 上的 oneDNN 等硬件优化库实现了专门的内存格式,以最大化缓存行利用率和 SIMD 吞吐量。指导原则是将内存布局视为后端执行路径的固有属性:最快的张量格式,是能够尽可能减少布局转换开销,并使各硬件执行单元的内存访问连续的格式。
PyTorch Contributors. 2026. Tensor Views.
TensorFlow Developers. 2024. Optimize TensorFlow Performance Using the Profiler.
通道后置布局
在 NHWC 通道后置布局中,连续张量的通道索引变化最快,使每个空间坐标处的通道值在内存中相邻排列。NHWC 指定的是逻辑维度顺序,而非线性存储约定;NHWC 和 NCHW 张量都表示按各自维度顺序排列的线性存储序列。
考虑一个形状为 \((\text{Height}, \text{Width}, \text{Channels}) = (3, 3, 3)\) 的 RGB 图像张量。其元素在线性内存中的排列如下: \[\begin{gather*} I(0,0,0), I(0,0,1), I(0,0,2), I(0,1,0), I(0,1,1), \\ I(0,1,2), I(0,2,0), I(0,2,1), I(0,2,2), \ldots \end{gather*}\]
给定像素的所有通道值彼此相邻,内存地址先沿宽度方向推进,再沿高度方向向下推进。当计算内核同时处理多个通道时,这种布局支持向量化执行:CPU SIMD 寄存器和 GPU Tensor Core 可以直接加载连续的通道向量,无需在寄存器内部重排数据。
通道后置存储的优势取决于目标算子和硬件单元。TensorFlow 默认使用 NHWC,而 PyTorch 提供专用的通道后置内存格式,将逻辑维度顺序与物理存储解耦。cuDNN 中的现代 Tensor Core 内核倾向于采用 NHWC,因为矩阵乘法单元会将通道维度直接打包到累加器分块中。当内核要求输入在通道维度上连续时,传入不兼容的格式会迫使框架运行时插入显式内存转置,在计算开始前就产生内存带宽开销。
通道前置布局
在连续的 NCHW 通道前置布局中,空间宽度索引变化最快,整个通道的所有空间位置值都连续存储,随后才开始存储下一个通道。加速器在线程束或 SIMD 通道之间并行处理数据;当一个线程束中的连续线程访问连续内存地址时,内存控制器会将这些请求合并为一次内存事务(内存访问合并)。35
考虑同一个 RGB 图像张量,将其维度按通道前置顺序重新排列为 \((\text{Channels}, \text{Height}, \text{Width}) = (3, 3, 3)\)。保留 \(I(h,w,c)\) 作为语义坐标记法,数据按通道前置顺序存储如下: \[\begin{gather*} I(0,0,0), I(0,1,0), I(0,2,0), I(1,0,0), I(1,1,0), I(1,2,0), \ldots, \\ I(0,0,1), I(0,1,1), I(0,2,1), \ldots, I(0,0,2), I(0,1,2), I(0,2,2), \ldots \end{gather*}\]
在这种格式中,首先存储整幅图像的所有红色通道值,其次是所有绿色通道值,最后是所有蓝色通道值。这种排列使沿空间坐标 \((H, W)\) 并行化的内核能够沿图像行发起合并读取,适合早期的 GPU 卷积算法和 SIMD 执行流水线 (Chetlur et al. 2014)。
Chetlur, Sharan, Cliff Woolley, Philippe Vandermersch, Jonathan Cohen, John Tran, Bryan Catanzaro, and Evan Shelhamer. 2014. “cuDNN: Efficient Primitives for Deep Learning.” arXiv Preprint arXiv:1410.0759.
NCHW 相对于 NHWC 的优势取决于底层内核如何将计算映射到硬件线程。卷积层同时在空间维度和通道维度上计算滤波器。在经典的直接卷积或基于 FFT 的卷积中,通道前置顺序能够实现高效的空间滑动,而无需跨步跳转。然而,现代通过 GEMM 实现的卷积和 Tensor Core 流水线会将通道维度上的归约直接映射到矩阵乘法累加器,因此更适合通道后置结构。当模型采用 NCHW,却调用针对 Tensor Core 优化的后端时,运行时必须执行未经优化的回退内核,或动态地将张量转置为 NHWC,这两种情况都会消耗内存带宽。36
通道后置与通道前置布局的比较
通道后置(NHWC)和通道前置(NCHW)布局分别针对特定的硬件访问模式,其效率取决于内核是沿空间坐标并行化,还是沿通道维度向量化。布局选择直接决定缓存行利用率、内存总线事务数量和计算单元占用率。Table 18 对比了这两种方法在性能上的权衡以及与硬件的兼容性。
| 特性 | 通道后置(NHWC) | 通道前置(NCHW) |
|---|---|---|
| 内存存储顺序 | 像素逐行存储,通道数据交错排列 | 同一通道的所有值优先连续存储 |
| 最适用场景 | CPU 循环、逐元素运算、许多通道后置内核 | 许多传统 GPU 卷积执行路径和通道前置模型代码 |
| 缓存效率 | 对按行顺序或通道后置顺序访问具有较高的缓存局部性 | 可改善通道前置内核的合并访存 |
| 卷积性能 | 现代 Tensor Core 卷积与融合执行路径通常更倾向于采用此布局 | 对许多 cuDNN 和框架内核而言效率较高 |
| 内存取数 | 内核对相邻通道数据进行向量化处理时表现良好 | 内核处理以通道为主序的分块时表现良好 |
| 框架中的默认约定 | TensorFlow 的常见约定;PyTorch 提供通道后置选项 | PyTorch 常见的张量形状约定 |
尽管 XLA、TensorRT 和 PyTorch Inductor 等编译器会自动传播布局,并在有利时插入布局转换,但格式转换并非没有代价:转置张量需要从内存读取每个元素,再以不同顺序写回,这会消耗内存带宽,却不执行有用的算术运算。在生产部署中,使模型的内存布局与加速器的原生内核格式相匹配,可以完全消除这些布局转换。
即使张量布局与硬件完全匹配,将各项运算作为独立内核执行仍会引入另一种瓶颈:运算之间的中间值仍须往返于设备内存。解决这一瓶颈需要改变运算的调度方式,而非张量的布局方式。
内核融合
减少运算之间的中间数据搬移,是缓解内存墙的主要机制之一。内核融合37 将多个连续运算合并为一个可执行内核,从而消除中间数据的内存往返。
中间结果的内存写入
神经网络执行往往受限于内存带宽,而非算术吞吐量。当各项运算以独立内核执行时,每个中间结果都会写入设备内存(DRAM 或 HBM),随后由下游算子重新读回。这种往返会引入内存延迟,使计算单元停顿,并将总线带宽消耗在仅供紧邻的两个运算使用、除此之外毫无复用的数据上。
这一硬件现实为 算子融合 中介绍的算子融合技术提供了物理层面的动机。section 1.5.1 从运算强度较低的角度分析了带宽限制,而串联的逐元素运算会成倍增加全局内存事务,进一步加剧内存墙问题 (NVIDIA Corporation 2017)。
NVIDIA Corporation. 2017. NVIDIA Tesla V100 GPU Architecture. NVIDIA Whitepaper.
在朴素执行模型中,每项运算都作为独立的 GPU 内核执行,迫使中间张量往返于设备内存(listing 19)。在由三个运算组成的链中,例如 ReLU、批归一化和仿射缩放,中间输出 \(X_1\) 和 \(X_2\) 被写入 DRAM 后,随即又由后续内核重新读取。对于算术强度较低(\(I \ll 1\text{ FLOP/byte}\))的逐元素算子,经内存总线搬移数据所花费的时间超过了计算时间 (Jia et al. 2019)。此外,将这些未融合的中间缓冲区保留在内存中,会增大执行期间存活张量的内存占用(table 19)。
import torch
import torch.nn.functional as F

## Input tensor
X = torch.randn(1024, 1024).cuda()
running_mean = torch.zeros(1024, device=X.device)
running_var = torch.ones(1024, device=X.device)

## Step-by-step execution (naïve approach)
X1 = torch.relu(X)  # Intermediate tensor stored in memory
X2 = F.batch_norm(
    X1, running_mean, running_var, training=False
)  # Frozen inference BatchNorm
Y = 2.0 * X2 + 1.0  # Final result
提高内存效率的内核融合
这两个中间张量在保持存活时会占用内存容量,而独立内核将其物化时则会产生外部流量。内核融合 可以在单个内核内部通过寄存器或局部内存传递数值,从而消除这些中间写入和重新加载 (Jia et al. 2019)。
| 张量 | \(1024{\times}1024\) 张量的大小(MB) |
|---|---|
| X | 4.2 MB |
| X’ | 4.2 MB |
| X’’ | 4.2 MB |
| Y | 4.2 MB |
| 总内存占用 | 16.8 MB |
机器学习推理序列可能依次应用 ReLU、使用冻结统计量的批归一化,以及缩放系数为 \(\alpha\)、偏移量为 \(\beta\) 的仿射缩放。在朴素实现中,每个独立内核都会生成一个中间张量,将其写入内存,再由下一个内核读回: \[ \begin{aligned} \mathbf{X}' &= \text{ReLU}(\mathbf{X}) \\ \mathbf{X}'' &= \text{BatchNorm}(\mathbf{X}') \\ \mathbf{Y} &= \alpha \cdot \mathbf{X}'' + \beta \end{aligned} \]
通过内核融合,这些运算被合并为单个计算步骤,使整个变换无需生成不必要的中间张量即可完成: \[ \mathbf{Y} = \alpha \cdot \text{BatchNorm}\big(\text{ReLU}(\mathbf{X})\big) + \beta \]
Table 20 展示了运算融合对内存效率的影响。融合将中间结果保留在寄存器或局部内存中,无需写入主存,从而减少外部流量。对于三个独立的逐点推理内核,理想化的朴素执行路径中,每项运算都会读取并写入一个张量,而融合执行路径只读取一次输入并写入一次输出。
| 执行模型 | 外部张量有效载荷 | 流量(MB) |
|---|---|---|
| 朴素执行 | 3 次读取 + 3 次写入 | 25.2 MB |
| 融合执行 | 1 次读取 + 1 次写入 | 8.4 MB |
性能收益与约束
内核融合带来了若干关键优势,能够提高内存效率和计算吞吐量。通过减少内存访问,融合内核可使中间值保留在寄存器中,避免反复写入内存并从中读取。这显著降低了内存流量,而内存流量正是机器学习工作负载的主要瓶颈之一。GPU 和 TPU 尤其受益于内核融合,因为高带宽内存是一种稀缺资源,减少内存事务可以提高计算单元的利用率 (NVIDIA Corporation 2020a)。
然而,并非所有运算都可以任意融合。逐元素运算和使用冻结统计量的推理归一化是很适合融合的候选对象,因为它们的计算不需要在整个批次范围内进行归约。训练模式下的批归一化需要计算批次统计量,并非纯粹的逐元素运算。矩阵乘法和卷积涉及归约与大量数据搬移,因此对融合形成约束;它们通常可以与偏置或激活等逐元素尾部运算融合,但无法与不相关的全局运算自由融合。
另一个主要考量是寄存器压力。融合多项运算意味着所有临时值都必须保留在寄存器中,而非内存中。虽然这消除了冗余的内存写入,但也增加了寄存器需求。如果融合内核超出了每个线程可用的寄存器数量,编译器可能会将多余的值溢出到每线程局部内存;这种内存以设备内存为后备存储,并且可能被缓存,因此会引入额外延迟,甚至抵消融合的收益。在 GPU 上,线程占用率(可并行运行的线程数量)受到可用寄存器的限制,因此过度融合可能降低并行度,导致收益递减。
不同 AI 加速器和编译器处理融合的方式各不相同。例如,NVIDIA GPU 倾向于采用线程束级并行,在这种模式下,逐元素融合较为直接 (NVIDIA Corporation 2020a)。另一方面,TPU 优先采用脉动阵列执行稠密矩阵运算 (Jouppi et al. 2017)。TVM、XLA、TensorRT 和 MLIR 等编译器与推理软件栈通过图重写、降低抽象层级的编译遍或执行引擎构建启发式方法,在内存节省与执行约束之间进行权衡 (Chen et al. 2018; Google 2025; NVIDIA 2024b; Lattner et al. 2020)。
尽管具有这些优势,融合并非总能带来收益。一些 AI 框架允许开发者有选择地禁用融合,尤其是在调试性能问题或频繁修改模型时。决定是否融合运算时,必须权衡内存效率、寄存器使用量和硬件执行约束,确保融合带来切实的性能提升。
Checkpoint 1.3: 数据搬移与内核融合
至此,数据流的基本构件已经齐备:数据局部性、张量布局和内核融合。这些融合决策归根结底都与数据局部性有关,而数据局部性将本章的核心数据搬移策略联系起来:
高内存效率的分块策略
尽管现代 AI 加速器提供了很高的计算吞吐量,其性能通常仍受限于内存带宽,而非原始处理能力。如果数据无法足够快地供给处理单元,执行就会停顿,导致周期浪费和硬件利用率低下。
分块38 将计算重构为规模更小、对内存更友好的子问题,从而缓解这一问题。当无法直接增加内存带宽时,系统就必须减少对主存的访问。一次性处理整个矩阵或张量会产生过多的内存流量;分块则将计算划分为能够容纳于快速局部内存(例如缓存、共享内存或寄存器)的小块 (Lam et al. 1991)。
矩阵乘法广泛应用于 AI 模型,但朴素实现的内存访问效率较低。Listing 20 展示了在不采用分块时,对相同数据的反复内存访问如何导致不必要的带宽消耗。
for i in range(N):
    for j in range(N):
        for k in range(N):
            C[i, j] += A[i, k] * B[k, j]  # Repeatedly fetching
            # A[i, k] and B[k, j]
该循环反复访问 \(\mathbf{A}\) 和 \(\mathbf{B}\) 中的元素。一些访问可以命中缓存,但当矩阵较大且遍历顺序不利时,仍可能产生过多的较低存储层级流量。
分块通过将矩阵的较小部分加载到快速内存中、高效复用,并仅在必要时写回主存来解决这一问题。这项技术对于内存访问主导执行时间的 AI 加速器尤为重要。Figure 14 用三个维度标注乘积 \(\mathbf{C} = \mathbf{A}\mathbf{B}\):\(\mathbf{A}\) 有 \(M\) 行、\(K\) 列,\(\mathbf{B}\) 有 \(K\) 行、\(N\) 列,输出 \(\mathbf{C}\) 的尺寸为 \(M{\times}N\)。每个高亮分块表示某一时刻能够容纳于快速内存中的工作集:\(\mathbf{A}\) 中一个绿色的 \(M_{\text{tile}}{\times}K_{\text{tile}}\) 行带与 \(\mathbf{B}\) 中一个粉色的 \(K_{\text{tile}}{\times}N_{\text{tile}}\) 列带相乘,累加到 \(\mathbf{C}\) 中一个蓝色的 \(M_{\text{tile}}{\times}N_{\text{tile}}\) 输出块(\(\text{Block}_{m,n}\))。完成一个分块的所有计算后再转向下一个分块,可以避免反复付出 DRAM 访问代价。
\scalebox{0.65}{%
\begin{tikzpicture}[line join=round,font=\sffamily,x=1mm,y=1mm]
\tikzset{%
   Line/.style={draw,line width=1.25pt,black,text=black},
   LineT/.style={draw,line width=0.75pt,black,text=black},
  }
%Bmatrix
\node[Line,rectangle,anchor=south west,
minimum width=66mm,minimum height=60mm](BM)at(0,0){};
\scoped[on background layer]
\node[LineT,rectangle,anchor=south west,fill=RedFill,
minimum width=18mm,minimum height=60mm](BM1)at(18mm,0){};
\node[LineT,rectangle,anchor=south west,fill=RedFill,
minimum width=18mm,minimum height=9mm](BM2)at(18mm,30mm){};
%
\draw[thick,decorate,decoration={brace, amplitude=7pt}]([yshift=2mm]BM.north west)--
([yshift=2mm]BM.north east)node[midway,above=9pt]{N};
\draw[thick,decorate,decoration={brace, amplitude=7pt,mirror}]([xshift=-2mm]BM.north west)--
([xshift=-2mm]BM.south west)node[midway,left=9pt]{K};
\draw[thick,decorate,decoration={brace, amplitude=5pt}]([xshift=2mm]BM2.north east)--
([xshift=2mm]BM2.south east)node[midway,right=6pt]{Ktile};
\draw[thick,decorate,decoration={brace, amplitude=5pt,mirror}]([yshift=-2mm,xshift=1mm]BM2.south west)--
([yshift=-2mm,xshift=-1mm]BM2.south east)node[midway,below=6pt]{Ntile};
\node[below left=2 of BM.north east]{矩阵 B};
%Cmatrix
\node[Line,rectangle,anchor=north west,
minimum width=66mm,minimum height=48mm](CM)at(0,-10){};
\node[LineT,rectangle,anchor=north west,
minimum width=18mm,minimum height=48mm](CM1)at(18mm,-10){};
\node[LineT,rectangle,anchor=south west,
minimum width=66mm,minimum height=15mm](CM2)at(CM.south west){};
\node[LineT,rectangle,anchor=south west,fill=BlueL,
minimum width=18mm,minimum height=14.8mm](CM3)at(CM1.south west){};
%
\draw[thick,decorate,decoration={brace, amplitude=5pt}]([yshift=-1mm,xshift=2mm]CM3.north east)--
([yshift=1mm,xshift=2mm]CM3.south east)node[midway,right=6pt]{Mtile};
\draw[thick,decorate,decoration={brace, amplitude=5pt,mirror}]([yshift=-2mm,xshift=1mm]CM3.south west)--
([yshift=-2mm,xshift=-1mm]CM3.south east)node[midway,below=6pt]{Ntile};
\node[above right=2 of CM3.north east]{块 \textsubscript{m,n}};
%Amatrix
\node[Line,rectangle,anchor=north east,
minimum width=60mm,minimum height=48mm](AM)at(-10,-10){};
\node[LineT,rectangle,anchor=south west,fill=GreenL!40,
minimum width=60mm,minimum height=15mm](AM1)at(AM.south west){};
\node[LineT,rectangle,anchor=south west,fill=GreenL,
minimum width=9mm,minimum height=15mm](AM2)at($(AM.south west)+(21mm,0)$){};
\node[below left=2 of CM.north east]{矩阵 C};
\node[Line,rectangle,anchor=north east,
minimum width=60mm,minimum height=48mm](AM)at(-10,-10){};
%
\draw[thick,decorate,decoration={brace, amplitude=7pt}]([yshift=2mm]AM.north west)--
([yshift=2mm]AM.north east)node[midway,above=9pt]{K};
\draw[thick,decorate,decoration={brace, amplitude=7pt,mirror}]([xshift=-2mm]AM.north west)--
([xshift=-2mm]AM.south west)node[midway,left=9pt]{M};
\draw[thick,decorate,decoration={brace, amplitude=5pt}]([yshift=-1mm,xshift=2mm]AM2.north east)--
([yshift=1mm,xshift=2mm]AM2.south east)node[midway,right=6pt]{Mtile};
\draw[thick,decorate,decoration={brace, amplitude=5pt,mirror}]([yshift=-2mm,xshift=1mm]AM2.south west)--
([yshift=-2mm,xshift=-1mm]AM2.south east)node[midway,below=6pt]{Ktile};
\node[below left=2 of AM.north east]{矩阵 A};
\end{tikzpicture}}分块基础
分块将计算划分为能够容纳于可用快速存储器中的较小块,而不是一次性处理整个数据结构。这种结构能够最大限度地复用数据,减少冗余的内存访问并提高效率。
以矩阵乘法为例,这是机器学习工作负载中的关键运算。该运算计算 \(\mathbf{C} = \mathbf{A} \times \mathbf{B}\),其中每个元素为 \(C_{ij} = \sum_{k} A_{ik} \times B_{kj}\)。Listing 20 揭示了核心问题:最内层循环的每次迭代都会从内存中读取矩阵 \(\mathbf{A}\) 和 \(\mathbf{B}\) 的元素,执行乘法,并更新矩阵 \(\mathbf{C}\)。由于矩阵规模较大,处理器会反复从内存中重新加载相同的值,即使这些值刚刚在之前的计算中使用过。
这种数据移动开销代价高昂:DRAM 访问的延迟和能耗远高于片上缓存或寄存器访问 (Horowitz 2014; Sze et al. 2017)。解决方法就是分块。
分块的性能收益
分块每次处理一个子矩阵(块),将频繁使用的值保留在快速存储器中,而不是每次计算一个元素并不断在慢速存储器与处理器之间移动数据。其思路是将矩阵划分为能够容纳于处理器缓存或共享内存中的较小块,确保每个块加载后,在转向下一个块之前得到多次复用。Listing 21 展示了缓存友好的循环分块:循环边界将矩阵划分为多个块,当访问顺序具有局部性时,硬件缓存层次结构会将最近使用的块数据保留在计算单元附近。
TILE_SIZE = 32  # Choose a tile size based on hardware constraints

# Cache blocking: partition data via loop bounds.
# Loads are implicit through the hardware cache hierarchy.
for i in range(0, N, TILE_SIZE):
    for j in range(0, N, TILE_SIZE):
        for k in range(0, N, TILE_SIZE):
            # Each tile computed independently
            for ii in range(i, min(i + TILE_SIZE, N)):
                for jj in range(j, min(j + TILE_SIZE, N)):
                    for kk in range(k, min(k + TILE_SIZE, N)):
                        C[ii, jj] += A[ii, kk] * B[kk, jj]
这种重构通过三个相互促进的效应显著改善性能。首先,内存数据复用得到改善,因为该方法会在一个小块很可能仍驻留于缓存时反复访问它,然后再转向下一个块,而不是反复从慢速存储器中读取 \(\mathbf{A}\) 和 \(\mathbf{B}\) 的元素,从而最大限度地减少冗余内存访问。其次,内存带宽占用随之降低:由于每个块在被逐出前会使用多次,所需的大部分数据都可从 L1/L2 缓存或共享内存中获取,而无需访问 DRAM,因此数据流量减少,执行速度提高。计算效率也随之提升,因为处理器等待数据的时间减少,执行有效计算的时间增加;在 GPU 和 TPU 等数千个并行处理单元同时工作的架构中,分块使数据读取和处理保持有序,避免不必要的停顿。
这种技术在 AI 加速器中特别有效,因为机器学习工作负载包含大规模矩阵乘法和张量变换。如果不进行分块,这些工作负载很快就会受限于内存,也就是说,性能受数据读取速度约束,而不是受处理器的原始计算能力约束。
分块方法
分块的总体原则始终相同,即将大型计算划分为较小的子问题以改善内存数据复用,但根据计算结构和硬件约束,可以采用不同的分块方式。两种主要策略是空间分块和时间分块。这些策略分别优化计算和内存访问的不同方面,在实践中通常结合使用,以实现最佳性能。
空间分块将数据结构划分为能够容纳于快速存储器中的较小块。listing 21 中的分块矩阵乘法展示了缓存友好的循环分块:代码没有显式发出暂存存储器加载操作,但块状访问模式使硬件缓存能够在相邻数据被逐出之前复用它们。这种策略对超出快速存储器容量的大型张量尤其有益——通过将计算拆分为较小块,可以最大限度地减少存储层级之间的数据移动,使操作保持在缓存层次结构的局部范围内。
时间分块通过将数据显式暂存到共享内存或寄存器中,并围绕这些暂存数据重新组织计算顺序,对空间分块形成补充。许多机器学习工作负载会在多次迭代中反复访问相同数据——如果不进行时间分块,就会产生冗余的内存读取。时间分块重构计算过程,确保频繁使用的数据在下一轮计算开始前尽可能长时间地驻留于快速存储器中。
卷积运算是时间分块发挥作用的典型示例,其中同一组权重会应用于多个输入区域。如果不进行循环分块,每次计算都可能需要从内存中多次加载这些权重。采用时间分块后,计算顺序经过重新安排,使权重在处理多个输入期间始终保留在快速存储器中,从而减少不必要的内存读取并提高整体效率。Listing 22 展示了显式块暂存:代码将 \(\mathbf{A}\) 和 \(\mathbf{B}\) 的块加载到临时快速存储空间中,然后在多次内层循环操作中复用它们。
# Explicit tile staging: load data into fast
# temporary storage before the inner loops.
for i in range(0, N, TILE_SIZE):
    for j in range(0, N, TILE_SIZE):
        for k in range(0, N, TILE_SIZE):
            # Pseudocode: map these tile objects to fast memory
            A_tile = A[i : i + TILE_SIZE, k : k + TILE_SIZE]
            B_tile = B[k : k + TILE_SIZE, j : j + TILE_SIZE]

            # Reuse loaded tiles for all inner iterations
            for ii in range(A_tile.shape[0]):
                for jj in range(B_tile.shape[1]):
                    for kk in range(A_tile.shape[1]):
                        C[i + ii, j + jj] += (
                            A_tile[ii, kk] * B_tile[kk, jj]
                        )
当后端将临时块放入快速存储器,并在其被逐出之前进行复用时,显式块暂存能够提高性能。当 \(N\) 不能被 TILE_SIZE 整除时,该伪代码也涵盖了尺寸缩小的边界块。
这种技术特别适用于某些值会被反复使用的工作负载,例如卷积、循环神经网络(RNN)以及 Transformer 中的自注意力机制。通过采用循环分块,AI 加速器能够显著减少内存访问停顿,提高执行吞吐量。
分块的挑战与权衡
只有当块的大小与硬件可用于利用局部性的存储容量相匹配时,分块才能提高性能。如果块过小,数据复用过于有限,内存读取仍会主导执行时间。如果块过大,则会超出快速存储器容量,导致缓存颠簸或暂存存储器溢出。因此,选择合适的块大小直接决定了计算效率和内存带宽占用。
块的选择也决定负载均衡。在 GPU 和 TPU 等架构中,计算会在数千个处理单元上并行执行。如果块分配不均,一些单元会保持空闲,而另一些单元则负载过重,导致计算资源利用不充分。有效的块调度能够保持并行执行的均衡与高效。
即使进行分块后,数据移动仍然是限制性能的开销。虽然分块减少了慢速存储器访问次数,但在存储层级之间传输块仍会产生延迟和能耗,尤其是在数据从缓存或暂存存储器回落到 DRAM 时。高效的内存预取和调度策略能够最大限度地减少这些残余的数据移动,并确保在需要时数据已经就绪。
当单独采用空间或时间维度都无法充分利用工作负载的复用模式时,混合分块会结合这两种策略。一些 AI 加速器在矩阵乘法中使用空间分块,同时在卷积层中采用时间分块来复用权重,并根据实时执行条件动态调整块大小或重新安排计算顺序。
寄存器分块、双缓冲和分层分块将同一局部性原则扩展到更小和更大的存储层级。TensorFlow XLA、TVM 和 MLIR 等 AI 编译器及运行时系统会根据硬件约束自动选择这些分块策略,无需人工干预即可实现精细的性能优化。Table 21 对空间分块、时间分块和混合分块方法进行了比较,概述了各自的优势与权衡。
随着机器学习模型的规模和复杂度不断增加,分块仍是提高硬件效率的关键工具,可确保 AI 加速器接近其实际可达到的性能水平。虽然手动制定分块策略能够带来显著收益,但编译器和硬件感知优化技术可以针对给定工作负载自动选择有效的分块策略,进一步提升性能。
| 方面 | 空间分块(数据分块) | 时间分块(循环分块) | 混合分块 |
|---|---|---|---|
| 主要目标 | 通过让数据在快速存储器中保留更长时间来减少内存访问 | 提高跨循环迭代的数据复用 | 动态适应工作负载约束 |
| 优化重点 | 将数据结构划分为较小且有利于内存访问的块 | 重新安排计算顺序,最大限度地在数据被逐出前进行复用 | 平衡空间与时间复用策略 |
| 内存使用 | 改善缓存局部性并减少 DRAM 访问 | 将频繁使用的数据保留在快速存储器中,供多次迭代使用 | 在确保高复用率的同时最大限度地减少数据移动 |
| 常见用例 | 矩阵乘法、CNN、Transformer 中的自注意力 | 卷积、循环神经网络(RNN)、迭代计算 | 具有分层存储器的 AI 加速器、混合工作负载 |
| 性能收益 | 降低内存带宽需求,提高缓存利用率 | 降低内存读取延迟,改善数据局部性 | 最大限度地提高多种硬件上的效率 |
| 挑战 | 需要谨慎选择块大小,对空间复用极少的工作负载效率较低 | 可能增加寄存器压力,需要重构循环 | 动态调整块大小和执行顺序较为复杂 |
| 最适用情形 | 数据规模较大,需要划分后才能高效处理 | 在多次迭代中反复访问相同数据 | 数据划分和基于迭代的复用都很重要 |
将映射策略应用于神经网络
虽然这些基础映射技术具有广泛适用性,但其效果会随不同神经网络架构的计算结构、数据访问模式和并行化机会而变化。每种架构对数据移动、存储层次结构和计算调度都有不同的约束,因此需要有针对性的映射策略来优化性能。
将计算分配到 AI 加速器时,可选方案会出现组合爆炸,因此需要采用系统化的映射方法。无需将每个模型视为独立的优化问题,相同原则可以适用于不同架构;变化的只是这些原则随工作负载特征而调整的优先级。目标是系统地选择和应用映射策略,最大限度地提高不同类型机器学习模型的执行效率。
这些原则适用于三种具有代表性的 AI 工作负载,它们各自具有不同的计算需求。CNN 受益于空间数据复用,因此权重驻留执行和分块尤其有效。Transformer 的行为取决于执行阶段和张量形状:训练和预填充阶段的矩阵乘法可能受限于计算,而小批量解码通常取决于权重和 KV 缓存带宽。MLP 包含大量矩阵乘法,可受益于结构化分块、优化的权重布局和内存感知执行。
尽管存在差异,这些模型都遵循一组共同的映射原则,只是在优化优先级上有所不同。Table 22 总结了不同优化策略对 CNN、Transformer 和 MLP 的适用性。
卷积神经网络(ResNet-50)
对于 ResNet-50 和类似的 CNN,一个关键映射机会是空间权重复用。小型滤波器会应用于许多空间位置,因此其权重会参与大量乘加运算。权重驻留映射可以通过将滤波器块保留在本地来利用这种复用,而在其他架构上,行驻留或输出驻留映射可能更有利于平衡激活值和部分和的数据流量。有利的卷积形状能够实现较高的算术强度,因此非常适合矩阵运算和脉动阵列执行路径。模型类别本身并不能决定一种通用的数据流:层形状、批大小、本地存储容量以及目标硬件支持的内核,共同决定了哪种复用模式值得保留。
| 优化技术 | CNN | Transformer | MLP | 原因 |
|---|---|---|---|---|
| 数据流策略 | 权重驻留、行驻留或输出驻留 | 取决于阶段和内核 | 权重驻留或输出驻留 | CNN 具有滤波器复用和空间复用机会;Transformer 的注意力与 MLP 模块产生不同的数据流量;稠密 MLP 在一个批次内复用权重并累加输出。 |
| 内存感知张量布局 | 取决于后端(cuDNN 卷积通常采用 NCHW,Tensor Core 上采用通道后置布局) | 取决于后端(激活值通常采用行主序) | 通常采用行主序 | 布局选择取决于后端内核路径和精度模式(参见 section 1.8.1.2);表中列出的是常见默认选择,并非通用规则。 |
| 内核融合 | 卷积 + 激活 | 融合注意力 | GEMM 融合 | CNN 优化卷积与激活的融合;Transformer 融合注意力机制;MLP 受益于融合矩阵乘法。 |
| 提高内存效率的分块 | 空间分块 | 时间分块 | 块式分块 | CNN 沿空间维度分块;Transformer 使用循环分块来提高序列处理的内存效率;MLP 使用块式分块来处理大型矩阵乘法。 |
这种空间规则性也支持积极采用融合与分块。对于使用冻结 BatchNorm 统计量的推理,编译器可以折叠或融合卷积、归一化和激活,以避免不必要的中间结果写入。训练模式下的 BatchNorm 需要对批次统计量进行归约,因此不具备相同的逐元素融合条件。空间分块将特征图划分为能够容纳于片上 SRAM 中的子区域,使融合内核能够先在快速存储器中处理完每个块,再转向下一个块。
Transformer 架构(GPT-2/Llama)
CNN 的主要特征是权重复用,而 Transformer 的主要特征则是键值(KV)缓存带来的内存压力。在注意力计算过程中,每个查询向量都必须访问整个序列长度范围内存储的键值对。随着序列增长,完整的 KV 缓存通常存放在 HBM 或设备 DRAM 中,而注意力内核则通过 SRAM、寄存器或共享内存分块处理当前使用的数据。这种访问模式促使系统采用激活值驻留执行:将当前使用的 KV 块保留在计算单元附近,并以流式方式处理查询,避免在外部存储器中反复物化大型注意力中间结果。
标准注意力实现产生的内存流量解释了 FlashAttention (Dao et al. 2022) 等融合注意力内核为何能够带来显著的性能提升:这些实现将查询与键的点积、softmax 归一化以及对值向量的加权求和融合为单个沿序列维度分块的内核,从而避免在主存中物化完整的注意力矩阵。这种时间分块方法处理能够容纳于片上 SRAM 中的序列块,在保留 \(\mathcal{O}(S^2)\) 注意力计算量的同时,大幅减少 HBM 流量。Transformer 的映射取决于阶段和张量形状:训练和预填充阶段的 GEMM 可能受限于计算,而小批量自回归解码通常受权重和 KV 缓存带宽约束。
多层感知机与 DLRM
MLP 的映射问题最为直接,因为其计算主要可归结为稠密 GEMM。39 每个全连接层都将激活矩阵与权重矩阵相乘。权重矩阵在不同样本间保持不变,因此批处理能够将每个已加载的权重复用于更多激活值,从而提高算术强度。批大小为 1 时,跨样本的权重复用很少,通常无法充分利用宽矩阵运算引擎;较大的批次则可以使执行趋向计算受限状态。通用矩阵乘法(GEMM) 推导了决定这种敏感性的缩放关系。
由于 MLP 层之后通常紧接着激活函数和偏置加法,GEMM 融合会将这些步骤合并到单个内核中,避免中间结果的内存写入。块式分块将大型矩阵乘法划分为尺寸适合加速器共享内存的子块,确保整个计算过程中的高缓存利用率。MLP 映射以单一原语为主,访问模式可预测,正是这种简单性促使硬件厂商大力优化 GEMM 库:GEMM 性能的提升会直接转化为 MLP 吞吐量的提升。不过,DLRM 并非纯粹的 MLP 工作负载。其大型稀疏嵌入表和特征交互阶段可能主导存储容量需求和内存流量,因此这里描述的稠密映射适用于其底部和顶部 MLP 塔,而非整个模型 (Naumov et al. 2019)。
Naumov, Maxim, Dheevatsa Mudigere, Hao-Jun Michael Shi, Jianyu Huang, Narayanan Sundaraman, Jongsoo Park, Xiaodong Wang, et al. 2019. “Deep Learning Recommendation Model for Personalization and Recommendation Systems.” arXiv Preprint arXiv:1906.00091.
混合映射策略
前面的架构小节分别讨论了每种架构,但实际模型很少只包含一种层类型。例如,视觉 Transformer 结合了图像块嵌入阶段、自注意力层和 MLP 块 (Dosovitskiy et al. 2021)。这些层形成了不同的复用模式:嵌入阶段可受益于权重驻留映射,注意力侧重于激活值的数据移动与分块,而 MLP 块则需要分块 GEMM 的分块与融合。没有任何一种数据流策略能够在所有这些层上都达到最优,因此硬件映射需要采用混合策略,并针对各层分别设计。
Dosovitskiy, Alexey, Lucas Beyer, Alexander Kolesnikov, Dirk Weissenborn, Xiaohua Zhai, Thomas Unterthiner, Mostafa Dehghani, et al. 2021. “An Image Is Worth 16x16 Words: Transformers for Image Recognition at Scale.” International Conference on Learning Representations (ICLR).
混合映射允许加速器在层边界处切换策略,从而应对这种异构性。每一层在计算强度、数据复用和内存访问模式之间都有不同的权衡,最优映射也必须相应调整 (Sze et al. 2017)。混合方法不为整个模型固定采用一种数据流,而是为权重复用率高的层选择权重驻留执行,为具有大型 KV 缓存的注意力层选择激活驻留执行,并为最需要减少写入流量的层选择输出驻留执行。
现代加速器提供了在实践中实现混合映射所需的架构特性。TPU 风格的脉动阵列、NVIDIA GPU 和基于分块的加速器设计提供了本地内存、张量布局、融合与调度控制的不同组合,使编译器和运行时能够为各层选择相应策略,而不是为整个模型采用一种全局数据流 (Jouppi et al. 2023; NVIDIA Corporation 2020a; Chen et al. 2018)。这些实现需要可编程的内存层次结构、高效互连和专用执行流水线,进一步体现了软硬件协同设计原则。
然而,混合映射仍然是一种设计时优化。在生产工作负载中,输入大小、内存争用和硬件资源可用性的变化会导致执行条件动态变化。机器学习编译器和运行时系统通过引入动态调度、内存优化和自动调优,扩展这些静态映射选择,确保深度学习工作负载能够在多种加速器和部署环境中高效运行。
编译器支持
单个卷积可以通过数十种有效的分块策略、内核变体和内存布局来实现,其中大多数在给定目标硬件上的性能都不佳。机器学习编译器 通过将高层数据流表示转换为针对目标硬件的可执行代码,处理这种复杂性。将 ResNet-50 编译为用于 GPU 推理的代码,可以说明编译器的核心阶段:
- 图优化 将重复出现的 Conv2D-BatchNorm-ReLU 模式融合为单个复合内核,消除中间结果往返 HBM 的访问。
- 内核选择 为兼容的矩阵乘法选择专用 Tensor Core 实现,利用稠密卷积的高算术强度。
- 内存规划 确定激活值的生命周期,以安全地复用中间缓冲区分配,使其共享存储空间。
- 计算调度 在相互独立的硬件队列之间,将内存复制与执行组织成流水线,以隐藏数据传输延迟。
在这一场景中,推理延迟从 47 ms 降至 8 ms,实现了 5.9× 的加速,同时不改变模型的数学输出。这些数值体现了图重写、内核选择、内存规划和调度如何系统地应用内核融合(section 1.8.1.3)和内存高效的分块策略(section 1.8.1.4),将理论硬件 FLOP/s 转化为实际吞吐量 (Chen et al. 2018; NVIDIA 2024b)。
这一流水线体现了 section 1.1 中介绍的软硬件协同设计原则。机器学习编译器通过重构计算、选择针对硬件专门优化的内核,以及规划张量存储的生命周期,在高层模型描述与底层执行引擎之间架起桥梁 (Chen et al. 2018)。它们建立在经典编译器基础之上,同时引入张量级和图级变换。
机器学习编译器设计
机器学习编译器 针对以张量图和算子库表达的程序,对传统编译技术进行专门化。通用编译器优化标量控制流、向量指令、寄存器分配和缓存局部性;机器学习编译器栈则在更高的语义层次上运行,优化图拓扑、张量内存布局、形状特化、加速器内核分派,以及设备间执行规划 (Li et al. 2021)。
Li, Mingzhen, Yi Liu, Xiaoyan Liu, Qingxiao Sun, Xin You, Hailong Yang, Zhongzhi Luan, Lin Gan, Guangwen Yang, and Depei Qian. 2021. “The Deep Learning Compiler: A Comprehensive Survey.” IEEE Transactions on Parallel and Distributed Systems 32 (3): 708–27. https://doi.org/10.1109/tpds.2020.3030548.
Table 23 对比了这两个编译器层次的侧重点。两者的边界体现的是互补关系,而非彼此割裂:机器学习编译器栈将高层张量操作逐步降低为中间表示,再交由 LLVM、GPU 或厂商专用后端处理。
| 方面 | 传统编译器 | 机器学习编译器 |
|---|---|---|
| 输入表示 | 源程序或中间表示程序 | 张量图或张量级中间表示 |
| 执行模型 | 控制流、循环、线程、向量和任务 | 张量算子、内核、图和加速器流 |
| 优化重点 | 指令选择、循环变换、向量化、寄存器 | 图重写、融合、布局、形状和内核选择 |
| 内存管理 | 对象、栈/堆、缓存、局部性和预取 | 张量生命周期、缓冲区复用、布局、分块和设备传输 |
| 目标硬件 | CPU、GPU 和其他可编程目标硬件 | CPU、GPU、TPU 和定制加速器 |
| 编译输出 | 机器码或更低层的中间表示 | 内核以及针对特定硬件的图或执行计划 |
table 23 中的区别解释了为什么即使底层神经网络代码保持不变,编译器配置仍会决定实际性能。机器学习编译器负责高层张量操作与硬件执行单元之间的转换层;当这种映射未能优化数据复用或布局对齐时,内存总线会达到饱和,而算术单元则陷入停顿。
机器学习编译流水线
现代框架中定义的机器学习模型被表示为高层数据流图,用于描述对多维张量执行的操作。将这些表示降低为可在 CPU、GPU、TPU 或定制 ASIC 上执行的代码,需要机器学习编译流水线 (Chen et al. 2018; Google 2025; Lattner et al. 2020)。
标准编译流水线承担五项相互关联的职责:
- 图优化重构计算,以消除冗余工作并减少数据流量。
- 内核选择将数学运算映射到针对目标硬件优化的实现。
- 内存规划分配张量布局、静态缓冲区偏移和生命周期边界。
- 计算调度安排内核和内存传输的顺序,以最大化并行度并隐藏传输延迟。
- 代码生成输出针对目标硬件的机器指令、汇编或解释执行的字节码。
在这些阶段中,编译器应用了 section 1.8 中阐述的数据流策略:内核融合、内存分块和计算放置。只有当这些由编译器驱动的变换提供足够的算术强度,并使内存访问与硬件层次结构相适配时,硬件加速才能实现其理论吞吐量。
图优化
机器学习框架将模型表示为高层计算图,其中节点表示数学算子(如卷积、矩阵乘法和激活),有向边表示张量数据依赖关系。按照框架前端的定义逐节点执行该图,会产生严重的内存开销:每条边都需要一次内存分配和一次片外内存事务(先写入 DRAM 或 HBM,再读取),而每个节点都会产生内核启动与同步开销。在算术吞吐量比内存带宽高出一个数量级的加速器上,将不必要的中间张量实体化会占据总执行时间的主要部分。
图优化在硬件代码生成之前,将这一计算图转换为高效的执行计划 (Chen et al. 2018; Jia et al. 2019)。图优化过程主要在降低(section 1.9.6.2)之前、与目标硬件无关的中间表示(IR)层面开展,应用四种核心变换:
Jia, Zhihao, James Thomas, Todd Warszawski, Mingyu Gao, Matei Zaharia, and Alex Aiken. 2019. “Optimizing DNN Computation with Relaxed Graph Substitutions.” Proceedings of Machine Learning and Systems (MLSys).
算子融合将相邻操作合并为单个复合内核,以消除片外内存往返访问和启动开销。在卷积网络中,将 Conv2D、批归一化和 ReLU 融合为一个内核,可以使激活值在整个操作序列中始终保留在本地寄存器或共享 SRAM 中(section 1.8.1.3)。在 Transformer 架构中,模式匹配器将包含多个算子的自注意力子图(矩阵乘法、缩放、掩码、softmax 和投影)替换为整体式、面向 IO 优化的注意力内核,其分块计算完全在快速片上内存中进行 (Dao et al. 2022)。
冗余计算消除和常量折叠识别并移除不必要的操作。在推理编译期间,静态层中的参数(如批归一化的缩放和偏移向量)直接折叠到前置线性层或卷积层的权重和偏置中,从运行时执行中消除归一化算子。图优化过程还会剪除无用子图,并通过公共子表达式消除来合并相同的并行路径。
代数化简和布局调整在数学等价的前提下重排操作,以尽量减少数据移动。例如,可以将转置移过逐元素操作,或将其与逆置换相消,从而减少运行时的形状变换开销。
内存感知的节点重排会在图的不同拓扑排序中评估数据依赖关系,为独立操作安排执行顺序,以尽量减小活跃张量的峰值内存占用。节点重排确保中间激活值得到及时使用并释放,避免内存压力迫使数据溢出到主机内存。
XLA、TVM、TensorRT 和 MLIR 等编译器通过模式匹配规则和等式饱和执行这些重写。通过消除不必要的内存往返访问并暴露粗粒度并行性,图优化生成符合加速器带宽约束的执行图。当图被重构为优化后的复合操作后,编译器必须将每个节点绑定到具体的、针对特定硬件的执行例程。
内核选择
内核选择 将优化后图中的每个节点绑定到具体的硬件实现。对于单个张量操作,加速器提供了数十种有效的内核实现,每种实现都由分块尺寸、线程块配置、内存暂存模式和目标精度等参数决定。能否选择最优内核,决定了执行引擎是实现高计算利用率,还是因非合并内存访问和流水线气泡而停顿 (Chen et al. 2018; Zheng et al. 2020)。
在大多数生产流水线中,编译器从厂商优化的内核库中选择实现,而不是从头合成内核。NVIDIA 的 cuDNN 和 cuBLAS 为 GPU 提供手工调优的例程,Intel 的 oneDNN 面向 x86 架构,Arm Compute Library(ACL)面向 Arm 处理器,而 BLIS 提供优化的 CPU 矩阵基础运算。这些库编码了寄存器文件容量、缓存层次结构延迟和向量通道宽度等微架构细节,使编译器能够调用预先调优的实现。
AI 编译器主要采用三种策略,从候选内核中进行选择:
基于规则的选择依赖静态启发式规则40,根据张量形状、数据类型和目标硬件映射算子。例如,只要矩阵维度是 8 或 16 的倍数,且精度设置为 FP16 或 BF16,XLA 就会在 NVIDIA GPU 上选择支持 Tensor Core 的 GEMM 内核。启发式规则不会增加编译时间开销,但对于不规则张量形状,它们可能错过不易察觉的最优配置。
基于成本模型的选择利用硬件架构的解析模型,估算内核执行延迟和内存流量。MLIR 等框架提供成本模型基础设施,用于预测参数空间中的寄存器压力、缓存命中率和算术强度,无需在实际硬件上运行基准测试,即可剪除不具潜力的候选项 (Lattner et al. 2020)。
Lattner, Chris, Mehdi Amini, Uday Bondhugula, Albert Cohen, Andy Davis, Jacques Pienaar, River Riddle, Tatiana Shpeisman, Nicolas Vasilache, and Oleksandr Zinenko. 2020. “MLIR: Scaling Compiler Infrastructure for Domain Specific Computation.” 2021 IEEE/ACM International Symposium on Code Generation and Optimization (CGO), 2–14. https://doi.org/10.1109/cgo51591.2021.9370308.
基于性能剖析的选择在目标硬件上通过实测评估候选内核。TVM 的 AutoTVM 和 Ansor 系统直接在加速器上测量执行延迟,通过统计搜索探索分块大小、循环展开因子和线程配置,逐步收敛到最快的实现 (Chen et al. 2018; Zheng et al. 2020)。类似地,TensorRT 直接针对目标批大小和内存约束,对候选执行策略进行基准测试,从而构建针对特定硬件的执行引擎。
精度感知选择将数值要求纳入选择过程。训练需要 FP32 或 BF16,以维持梯度累积过程中的数值稳定性;推理流水线则利用 FP16 或 INT8,最大限度地提高算术吞吐量,并将内存流量减半。此处的选择错误既影响正确性,也影响速度:将未经校准的模型分派给 INT8 内核会降低模型准确率,而默认采用 FP32 则会导致 Tensor Core 引擎利用不足。
内核选定后,内存规划和计算调度将确定具体的缓冲区分配、启动顺序和流并发。
内存规划
内存规划 在加速器的内存层次结构中分配物理存储位置、缓冲区偏移和张量生命周期 (Roesch et al. 2018; Chen et al. 2018)。如果内存管理引入非合并内存事务、存储体冲突,或耗尽加速器内存的不必要分配,即使是高性能执行计划也会失效。
编译器协调三种核心内存管理机制:
张量布局优化确定张量各维度在内存中的物理排列方式。不同硬件架构和计算引擎要求特定的内存布局,才能实现合并的全局内存访问和向量化(section 1.8.1.2)。例如,对于 FP16 和 INT8 卷积,NVIDIA Tensor Core 在采用通道维度置于最后的 NHWC 布局时可达到峰值吞吐量,其中通道维度与 16 字节内存事务对齐;而传统 FP32 CUDA 核心过去更适合通道维度置于最前的 NCHW 布局 (NVIDIA Corporation 2021; Google 2025)。编译器在整个图上进行全局布局分配,以避免连续执行消耗内存带宽的布局变换内核。
Google. 2025. XLA: Optimizing Compiler for Machine Learning.
Roesch, Jared, Steven Lyubomirsky, Logan Weber, Josh Pollock, Marisa Kirisame, Tianqi Chen, and Zachary Tatlock. 2018. “Relay: A New IR for Machine Learning Frameworks.” Proceedings of the 2nd ACM SIGPLAN International Workshop on Machine Learning and Programming Languages, 58–68. https://doi.org/10.1145/3211346.3211348.
活跃性分析和缓冲区复用通过让生命周期不重叠的张量共享物理内存,防止内存不足错误。深度神经网络在前向传播期间会生成数十个中间激活张量。如果为每个张量分配独立的内存缓冲区,就会迅速超出设备内存容量(例如典型加速器 GPU 上的 16 至 80 GB)。编译器分析计算图,计算每个张量的活跃区间,即从该张量生成到最后一个使用它的操作完成之间的时间。通过将内存分配建模为区间图着色问题或二维装箱问题,编译器将多个活跃区间不重叠的中间张量分配到相同的物理内存偏移处 (Roesch et al. 2018)。这种静态复用将设备峰值内存需求降低至同时活跃张量的工作集大小,避免运行时分配开销和内存碎片。
内存层次放置优化外部内存(HBM 或 GDDR)与片上暂存存储器(SRAM 或共享内存)之间的数据暂存。外部内存带宽是一种稀缺资源;通过内存总线来回移动中间分块会造成受内存限制的停顿。编译器生成分块参数,确保中间块在所有本地计算操作完成之前始终驻留在片上 SRAM 中,尽量减少通过内存总线的往返流量。
当内存布局固定、缓冲区地址分配完成后,编译器便在硬件计算资源之间调度操作执行。
计算调度
计算调度 确定编译后图中各操作的执行时间线及其硬件资源绑定 (Zheng et al. 2020)。现代加速器具有深度硬件流水线、多个独立计算引擎和专用 DMA 复制引擎。有效的调度协调这些资源,以最大限度地提高硬件占用率、维持数据依赖关系,并防止流水线停顿 (Chen et al. 2018)。
AI 编译器中的实现
编译器在三个不同的架构维度上实现调度:
任务划分将计算子图映射到目标硬件的物理执行单元。在 GPU 上,计算被划分为线程块网格,分派到各个流式多处理器(SM)上。在 TPU 上,矩阵乘法被划分为与脉动阵列物理尺寸相匹配的分块序列(例如,\(128 \times 128\) 或 \(256 \times 256\) 个处理单元)(Norrie et al. 2021)。在 CPU 上,任务被分配到与物理核心相匹配的线程池中,并通过向量化充分利用 SIMD 寄存器。
Norrie, Thomas, Nishant Patil, Doe Hyun Yoon, George Kurian, Sheng Li, James Laudon, Cliff Young, Norman Jouppi, and David Patterson. 2021. “The Design Process for Google’s Training Chips: TPUv2 and TPUv3.” IEEE Micro 41 (2): 56–63. https://doi.org/10.1109/mm.2021.3058217.
执行顺序在解析依赖关系的同时,尽量降低存活数据带来的内存压力。依赖先前结果的操作必须等待生成这些结果的内核完成,但相互独立的分支(例如多头注意力投影或并行残差路径)可以并发或交错执行,以保持计算资源利用率的平稳。编译器分析依赖图,对操作进行排序,使计算流水线保持满载,同时缩短激活值的生命周期,防止缓冲区膨胀。
异步重叠通过让数据传输与计算内核并发执行来隐藏内存访问延迟。加速器配备了独立于算术流水线运行的专用 DMA 引擎。编译器利用这种架构上的分离,将内存传输(例如从主机到设备的权重传输或加速器之间的晕区交换)调度到独立的硬件队列或 CUDA 流中,使传输延迟与长时间运行的计算操作重叠 (Chen et al. 2018; NVIDIA 2024b)。当计算与传输完全重叠时,数据搬移开销就被隐藏在算术执行过程之中。
Chen, Tianqi, Thierry Moreau, Ziheng Jiang, Lianmin Zheng, Eddie Q. Yan, Haichen Shen, Meghan Cowan, et al. 2018. “TVM: An Automated End-to-End Optimizing Compiler for Deep Learning.” Proceedings of the 13th USENIX Symposium on Operating Systems Design and Implementation (OSDI ’18), 578–94.
NVIDIA. 2024b. NVIDIA TensorRT: Programmable Inference Accelerator.
Zheng, Lianmin, Chengfan Jia, Minmin Sun, Zhao Wu, Cody Hao Yu, Ameer Haj-Ali, Yida Wang, et al. 2020. “Ansor: Generating High-Performance Tensor Programs for Deep Learning.” Proceedings of the 14th USENIX Symposium on Operating Systems Design and Implementation (OSDI), 863–79.
不良调度会引入执行气泡,使算术单元空闲,等待内核分派或串行化的数据复制。通过编译器显式生成的事件和流调度来同步内核,可确保硬件持续执行,无需 CPU 驱动程序介入 (NVIDIA 2024b; Zheng et al. 2020)。
代码生成
调度完成后,编译的最后阶段将已调度的执行计划转换为针对目标硬件的机器指令。代码生成采用针对加速器架构定制的传统编译器后端处理流程,包括指令选择、寄存器分配、指令调度和窥孔优化。
关键在于,面向机器学习目标硬件的指令选择必须生成能够直接调用专用矩阵 ISA 扩展的指令。在 NVIDIA GPU 上,代码生成器会生成 mma.sync.aligned 等 PTX 指令,直接调用 Tensor Core,如 listing 14 所示。在具有高级矩阵扩展(AMX)的 Intel CPU 上,后端面向在二维寄存器分块上执行的分块矩阵乘法指令。在具有可伸缩矩阵扩展(SME)的 Arm 架构上,目标操作是在可伸缩向量分块上进行外积累加。如果后端生成通用浮点向量指令,而非这些矩阵扩展指令,就会使主要计算引擎闲置,令有效吞吐量降低一个数量级。
对于 CPU 和 GPU,编译器生成机器码或优化后的汇编代码;对于 TPU、现场可编程门阵列(FPGA)41和专有 NPU,输出通常是由专用硬件运行时执行的优化字节码或二进制执行包。
从编译到运行时
编译器将高层模型转换为针对目标硬件定制的执行计划,但该计划包含对运行时条件的静态假设:张量形状、工作空间分配限制、设备能力和执行并发度。提前编译(AOT)针对固定形状和已知硬件配置,优化图结构、融合边界和内存布局。虽然即时编译(JIT)可以在新形状到来时动态编译专用变体,但每个编译后的内核仍然执行固定的执行计划。
然而,生产环境中的 AI 服务受到的动态约束与编译器的静态假设并不相同。请求到达率会波动,批大小会动态变化,多个推理工作负载会争用共享的加速器内存,而热降频可能使时钟频率降至额定规格以下。服务运行时通过动态请求批处理、多流并发、准入控制和执行引擎选择来管理这些变化,而非即时重新生成内核融合或分块策略。模型服务章节将动态批处理、准入控制和服务级别目标作为系统层面的工程挑战加以讨论(模型服务);此处直接关注的系统问题是:当一个批次到达硬件后,加速器运行时如何高效分派编译后的执行计划。
运行时支持
AI 运行时在静态图编译与加速器执行的动态现实之间架起桥梁。编译器在固定结构假设下优化并降低计算图的抽象层级,但生产系统会遇到变化的批大小、波动的序列长度和受限的内存预算。运行时执行编译后的引擎,同时管理依赖输入的张量形状、暂存区分配、异步硬件流和预编译执行配置。在 NVIDIA TensorRT 等生产推理栈中,离线构建器优化网络并对候选策略进行基准测试,以构建执行引擎;运行时引擎则绑定输入缓冲区、选择有效的优化配置,并将内核分派到加速器 (NVIDIA Corporation 2026a, 2026b)。
NVIDIA Corporation. 2026a. How TensorRT Works.
NVIDIA Corporation. 2026b. Working with Dynamic Shapes.
Huang, Y., Y. Cheng, A. Bapna, O. Firat, D. Chen, M. X. Chen, H. Lee, et al. 2019. “GPipe: Efficient Training of Giant Neural Networks Using Pipeline Parallelism.” Advances in Neural Information Processing Systems (NeurIPS) 32: 103–12.
Mirhoseini, Azalia, Hieu Pham, Quoc V. Le, Benoit Steiner, Rasmus Larsen, Yuefeng Zhou, Naveen Kumar, Mohammad Norouzi, Samy Bengio, and Jeff Dean. 2017. “Device Placement Optimization with Reinforcement Learning.” International Conference on Machine Learning (ICML) 70: 2430–39.
这一执行生命周期涵盖三项核心职责。首先,运行时选择并分派与运行时张量维度和硬件能力匹配的预编译内核变体。其次,它通过内存区域分配器和静态缓冲区复用来管理设备内存,消除执行过程中代价高昂的主机—设备同步。第三,在分布式环境中,框架运行时协调跨设备执行边界,GPipe 等流水线并行框架 (Huang et al. 2019) 和自动设备放置系统 (Mirhoseini et al. 2017) 展示了这一点。服务调度器负责集群范围内的请求批处理和准入控制,而加速器运行时负责设备上的本地执行。
将 AI 运行时与传统软件执行环境进行比较,有助于理解机器学习工作负载为何需要专门的执行策略。
机器学习运行时架构
通用运行时在任意控制流路径上管理线程、抢占式任务、堆分配和异步 I/O。相比之下,AI 运行时处理的是由多维张量、预先调度的内核网格、设备内存区域和硬件命令队列组成的数据流图。
table 24 对比了传统软件运行时与 AI 执行环境之间的架构差异。
| 方面 | 传统运行时 | AI 运行时 |
|---|---|---|
| 执行模型 | 函数、线程、任务、事件和异步 I/O | 张量图、内核、流和设备事件 |
| 任务调度 | 跨处理器资源调度线程和任务 | 感知依赖关系的内核与传输分派 |
| 内存管理 | 对象、栈、堆、池和虚拟内存 | 张量缓冲区、工作空间、设备内存和缓冲区复用 |
| 优化重点 | 响应性、吞吐量、局部性和资源共享 | 形状兼容性、传输重叠、复用和利用率 |
| 适应性 | 在程序语义范围内动态调度和分配 | 在已编译的图和可用内核范围内进行运行时选择 |
| 目标硬件 | CPU 和异构设备 | CPU、GPU、TPU 和定制加速器 |
张量内存管理是一个主要的架构差异。在传统系统中,通用分配器利用运行时元数据管理大小不一的堆对象。在 AI 加速器上,通过设备驱动调用(例如 cudaMalloc)进行动态内存分配会触发主机驱动陷入,使加速器流水线停顿。AI 运行时通过结合离线生命周期分析和内存区域分配来消除这一开销。对于固定形状的图,编译器计算静态内存偏移,将生命周期不重叠的中间张量映射到共享的物理缓冲区。对于可变形状的张量,运行时从预分配的暂存区池中划分内存,无需运行时分配调用即可限制峰值内存占用。
硬件执行环境还受到物理运行边界的约束,这些边界不同于离线基准测试配置。
生产环境会引入不同于离线基准测试的物理约束。例如,NVIDIA A100 SXM 加速器的最大 TDP 为 400 W,而 A100 PCIe 版本受限于 300 W 的 TDP 范围。由于持续时钟频率随可用功率和散热能力而变化,针对 SXM 模块调优的编译内核在 PCIe 卡上可能遭遇热降频,或无法满足延迟上限。运行时无法为响应热约束而动态重新综合循环结构或改变线程块维度;它必须在预编译配置范围内执行,而由服务系统处理请求批处理和准入控制。
动态内核执行
静态编译可以为固定形状生成高性能机器码,但生产推理需要执行具有动态维度的请求。在语言模型中,输入序列长度 \(S\) 和批大小 \(B\) 随请求而变化。当出现预期之外的形状时,动态重新编译计算图并不现实:探索循环展开、共享内存分块和寄存器分配需要数秒或数分钟,而服务时限处于毫秒量级。
AI 运行时利用预编译的优化配置来解决这种不匹配。优化配置为动态张量轴设定有效的维度边界(最小、最优和最大形状)。在引擎构建期间,构建器按最大形状分配暂存工作空间,并选择在所定义运行范围内尽可能提高算术强度的内核策略。在执行时:
- 当传入的张量形状与某个活动配置匹配时,运行时将张量指针绑定到预分配缓冲区,并启动对应的预编译内核,无需承担 JIT 开销。
- 当输入维度落在所有已编译配置之外时,运行时无法即时综合新的分块策略;服务系统必须将输入填充到有效的维度边界、拆分批次,或将请求路由到较慢的通用回退内核。
动态请求处理也会给主机与加速器之间的互连带来压力。如果输入传输同步进行,加速器计算引擎在数据搬移期间就会闲置。为了让通信与计算重叠,运行时采用异步流和双缓冲。通过将输入张量暂存在页锁定(固定)主机内存中,专用 DMA 复制引擎可以经由 PCIe 或 NVLink 传输批次 \(n{+}1\),同时加速器核心执行批次 \(n\)。只要计算时长超过传输时长,这种流水线机制就能隐藏传输延迟;如果内存搬移占主导,加速器流水线就会停顿。
运行时内核选择
在选定的优化配置内,一个操作可以由多个预编译内核实现来执行,这些实现称为策略。运行时根据张量维度、算术强度和可用暂存内存选择最优策略。
实际运行的批大小直接决定最优执行策略。对于小批大小(自回归词元生成期间的 \(B=1\)),矩阵—向量乘法受内存带宽限制,算术强度较低。运行时选择针对全局内存读取吞吐量优化的内存流式内核(GEMV)。对于大规模提示处理批次(\(B \ge 64\)),工作负载转变为受计算限制的 GEMM。运行时分派针对 Tensor Core 脉动阵列设计的策略,利用二维寄存器分块和共享内存分块,最大限度地复用片上 SRAM 中的数据。
暂存工作空间的可用性进一步限制了策略选择。当 GEMM 的输出维度较小、但归约维度 \(K\) 较大时,标准分块无法充分利用加速器,因为启动的线程块太少,无法占满所有流式多处理器(SM)。在这种情况下,构建器提供 split-\(K\) 策略,将归约维度划分给不同线程块,使其在不同 SM 上并发运行。然而,split-\(K\) 执行需要设备内存(HBM)中的辅助工作空间缓冲区,在最终累加阶段之前存储部分归约和。如果并发请求使设备内存受限,运行时就必须拒绝 split-\(K\) 变体,转而分派非拆分内核,以牺牲并行占用率来满足内存上限。
运行时选择仍严格受限于编译期间确定的数值格式。在 Megatron-LM 等混合精度训练与推理系统中,在 Tensor Core 上以 FP16 或 BF16 执行矩阵乘法并以 FP32 累加,是部署前经过验证的架构不变量 (Shoeybi et al. 2019)。运行时不会监测损失值,也不会动态改变精度;它只会在实现指定数值精度且经过验证的策略之间进行选择。
Shoeybi, Mohammad, Mostofa Patwary, Raul Puri, Patrick LeGresley, Jared Casper, and Bryan Catanzaro. 2019. “Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism.” arXiv Preprint arXiv:1909.08053.
内核调度与利用率
内核分派是运行时执行的最后阶段,负责协调主机端任务队列与设备端执行。
软件运行时管理主机端命令队列(例如 CUDA 流或 TPU 命令环),并记录硬件事件或信号量,以异步方式强制满足数据流依赖关系。当独立操作(例如并行的多头注意力投影)彼此之间没有数据依赖时,运行时将其分派到不同流上,使其能够在加速器上并发执行。然而,一旦提交到设备队列,执行控制权就完全转交给硬件调度器。在 GPU 上,硬件线程束调度器和工作分发引擎根据寄存器文件的可用性、共享内存容量和最大线程束占用率,将线程块分配给 SM;软件运行时无法调度单个线程,也无法规定 L1/L2 缓存替换策略。类似地,TPU 运行时向片上命令队列提交宏指令,而硬件序列器向脉动矩阵单元和向量单元供给指令 (Jouppi et al. 2017)。
内存管理直接促进加速器利用率的提升。在请求执行期间调用设备驱动内存分配器(例如 cudaMalloc)会强制进行全设备同步,使执行流水线排空。AI 运行时通过维护预分配的内存区域并静态管理张量生命周期来消除这一延迟。中间激活值从暂存内存中分配,生命周期重叠的激活值被映射到相同的物理地址,从而确保推理热路径上的分配开销为零。
即使采用积极的内核融合、最优策略选择和零分配内存复用,单个加速器的执行能力仍受到硅片面积、散热极限和高带宽内存容量的物理限制。要突破这些物理边界进行扩展,就需要将计算分布到多个加速器上。
考虑训练 GPT-3 所需的估计 \(3.14 \times 10^{23}\) 次浮点运算 (Brown et al. 2020)。作为规模比较,将这一历史运算量除以后来推出的 H100 的 FP8 峰值速率 1.98 PFLOP/s。单设备上的算术时间下界约为 5 years,而在用于说明的 40–60% 利用率范围内,所需时间为 8.4–12.6 years (Choquette 2023)。这并不是对 GPT-3 训练过程的重建:这里的精度、硬件、通信和工作负载均为反事实设定。它只是说明,模型规模的计算量或服务规模的请求量为何可能超出单个加速器的有效容量。
Brown, Tom B., Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared Kaplan, Prafulla Dhariwal, Arvind Neelakantan, et al. 2020. “Language Models Are Few-Shot Learners.” Advances in Neural Information Processing Systems 33: 1877–901. https://doi.org/10.48550/arxiv.2005.14165.
多芯片扩展
单个 H100 具有很高的 FP8 峰值性能,但训练时间或吞吐量目标仍可能需要多个加速器。前面介绍的技术仍是多芯片扩展的基础;每个设备仍然需要高效的数据流。新的认识在于,通信会增加更多层级边界。数据依次经过片上存储、HBM、节点内链路和集群互连网络时,延迟和能耗通常会增加,因此扩展并不只是增加芯片数量的问题。
当单个加速器的容量不足时,设计问题就从如何为一块芯片持续供给数据,转变为选择工作负载能够承受哪一种通信边界。即使大部分优化工作仍在单个加速器内部进行,工程实践者也会在生产环境中遇到这些边界。
多芯片扩展方法
大型 AI 系统通过将通信边界向外推移,实现超越单个加速器的扩展,而每一道边界都会改变主导性的权衡。这一过程始于封装内部。基于芯粒的架构将大型设计划分为更小的模块化裸片,并在同一封装内互连,从而突破单片芯片的制造限制,同时保持相对较低的通信延迟。下一道边界是节点:多加速器服务器通过板级或服务器级互连连接多个芯片。每个加速器都拥有专用的内存和计算资源,因此工作负载可以通过数据并行(每个加速器处理不同批次)或模型并行进行拆分。模型并行包括流水线并行,即由不同加速器处理连续的网络层;也包括张量并行,即在高带宽互连域内,将单个矩阵乘法拆分到多个设备上执行。高带宽节点内互连可以实现高效的梯度同步,但实际性能取决于拓扑结构和集合通信效率。
在节点之外,边界进一步扩展到集群。专门构建的数据中心互连网络协调数百个加速器,使拓扑结构和集合通信算法成为扩展效率的核心决定因素;当通信开销得到控制时,某些工作负载可以实现近线性扩展。晶圆级集成则采取相反的路径:它将更多计算重新收拢到单个大型设备中,而不是继续将边界向外推移。Cerebras WSE 级系统等平台在单个设备上集成数量极其庞大的晶体管和核心,减少芯片间通信开销,同时也带来了散热、容错和制造良率方面的特有挑战。
为什么扩展会引入新的约束
从单芯片架构向多芯片架构的转变引入了通信开销及其他约束,从而改变了优化方式。通信、同步、负载均衡以及每台设备承担的并行工作量都可能限制扩展。阿姆达尔定律42为那些无法被隐藏、且不会随设备增加而缩减的工作提供了一个一阶模型。对于千亿参数模型,未经分片的完整梯度载荷每步可能占据数百 GB,而 AllReduce43 必须对其进行聚合;精度、分片、压缩以及集合通信算法都会改变每台设备传输的字节数。
首要考察的量是梯度载荷。对于具有 \(P\) 个参数的模型,在计入优化器状态、填充和协议开销之前,该载荷大致等于参数数量乘以每个梯度元素存储所需的字节数。因此,只有当节省的计算时间超过通过所选互连和集合通信算法传输这一载荷所需的时间时,扩展才能带来收益。
这种开销解释了为什么大量加速器可能呈现收益递减,除非系统减少交换的数据量、将通信与有效计算重叠,或选择更优的并行化模式。内存模型也随之改变:各加速器独立的内存通常需要显式管理,集合操作用于建立所需的同步,而不是在整个集群中呈现一个完全一致的内存映像。一些系统具备一致性链路,但其作用范围和成本取决于具体架构。
当计算跨越大量链路、芯片和内存堆栈时,可靠性与能耗也成为扩展问题的一部分。大规模系统必须妥善应对组件故障,因为至少发生一次故障的概率会随系统规模增大而上升。其架构原则具有根本性:分布式 TPU 系统必须能够在系统规模下容忍组件故障 (Jouppi et al. 2023),而 Cerebras 则利用冗余核心和互连链路替代制造过程中存在缺陷的核心,恢复晶圆的逻辑网格 (Lie 2021)。数据移动的成本也随距离增加而上升,使分布式训练成为计算并行性与通信效率之间需要精细权衡的问题。
Jouppi, Norm, George Kurian, Sheng Li, Peter Ma, Rahul Nagarajan, Lifeng Nai, Nishant Patil, et al. 2023. “TPU v4: An Optically Reconfigurable Supercomputer for Machine Learning with Hardware Support for Embeddings.” Proceedings of the 50th Annual International Symposium on Computer Architecture, 1–14. https://doi.org/10.1145/3579371.3589350.
Lie, Sean. 2021. Thinking Outside the Die: Architecting the ML Accelerator of the Future.
数据中心扩展与边缘部署处于部署谱系的两端,但它们遵循相同的核心原则。数据中心扩展需要协调大量高吞吐量加速器,而边缘扩展则要在受限的几瓦功率内实现有用的 AI 功能。两者都需要将工作负载特征与硬件能力相匹配,同时尽量减少数据移动。计算专用化、内存层次结构优化和工作负载映射的原则在两种规模下均适用;区别仅在于约束条件。数据中心在以兆瓦计的功率预算内优化总吞吐量;边缘设备则在严格的电池与热约束内优化响应能力。同一个在数据中心中运行自如的视觉模型,在智能手机或微控制器上可能需要截然不同的映射策略。
异构 SoC 设计
边缘、移动和汽车部署受到严格的物理约束:没有主动散热风扇的密封外壳将散热能力限制在几瓦,而电池容量则限制了总能耗。为了在这些边界内提供机器学习能力,异构 SoC 架构将通用 CPU 核心、GPU 着色器阵列、数字信号处理器(DSP)和专用神经处理单元(NPU)集成到同一块硅片上,共享统一的内存子系统。独立加速器所面临的工作负载映射问题依然存在,但其范围进一步扩展,涵盖硬件算子支持范围、跨引擎传输开销、实时截止时间以及动态热降频。
移动 SoC 架构的演进
移动片上系统架构通过片上网络,将多核 CPU、宽 SIMD GPU 着色器核心、定点 DSP 和专用神经处理单元(NPU)44等不同执行引擎连接到共享的低功耗 DRAM(LPDDR),从而实现异构计算。工作负载划分将传感与感知任务分配给最适合其算术结构的计算引擎:连续音频特征提取与关键词检测在低功耗 DSP 上运行,密集卷积层和矩阵乘法层在脉动阵列或张量阵列 NPU 上执行,并行图形处理与图像后处理映射到 GPU,而顺序控制流则在 CPU 上运行。要在不触发激进热降频的前提下满足实时帧截止时间,就必须在这些引擎之间调度执行,同时考虑它们不同的功耗特性。
Example 1.5: 异构微控制器
场景:嵌入式智能门铃必须在严格的内存、能耗和延迟预算内定期执行人员检测。
诊断:在某个受支持的部署中,通用 Cortex-M 执行路径未能达到实测能耗或延迟目标。Arm Ethos-U 等微型 NPU 可以卸载兼容的卷积算子,而 CPU 则保留控制流和不受支持的操作。
系统启示:微型 NPU 的专用化可以改善受支持算子的能耗和延迟,但必须针对整个流水线测量其可行性,包括回退执行和传感器处理。
现代移动 SoC 采用统一内存架构,所有处理单元共享 LPDDR 中的同一物理地址空间。与会产生显式 PCIe 传输延迟的独立加速器架构不同,统一内存允许图像信号处理器(ISP)、CPU、GPU 和 NPU 之间以零拷贝方式传递缓冲区。然而,共享物理 DRAM 并不保证软件开销为零。如果 NPU 引擎缺乏硬件缓存侦听能力,将中间张量从 CPU 传递给它时,就需要显式执行缓存刷写和失效操作。此外,专用 NPU 通常需要特定于硬件的张量布局,例如通道维在最后的布局(\(NHWC\)),并要求通道按 16 或 32 字节对齐,以向向量寄存器通道供给数据;因此,与采用通道维在最前的布局(\(NCHW\))的 CPU 层衔接时,必须执行受内存性能限制的转置。
SoC 架构师会根据特定领域的物理约束定制这些计算模块。高端智能手机 SoC 强调峰值突发性能和低空闲漏电,以支持实时计算摄影和端侧文本生成等交互任务。相比之下,嵌入式和汽车 SoC 更重视确定性内存访问、硬件故障检测以及有界的最坏情况延迟,以满足实时控制约束。
动态工作负载分配策略
在异构 SoC 核心之间划分神经网络工作负载,需要根据计算图中每个算子的算术强度和内存访问规律性,将其匹配到最适合执行它的微架构。考虑一个在集成 CPU、GPU 和 NPU 的移动 SoC 上执行的实时目标检测流水线。该流水线包含三个连续阶段:用于特征提取的 MobileNet 主干网络、用于对候选边界框进行后处理的非极大值抑制(NMS),以及将最终检测结果渲染到摄像头画面上的显示叠加。卷积主干网络具有规则、确定性的内存访问和密集算术运算,适合 NPU 的固定功能张量引擎,尽管深度可分离层的算术强度低于标准卷积。相比之下,NMS 依赖基于得分的排序,以及在变长候选列表上执行的条件性交并比循环。这种不规则且分支密集的控制流难以映射到 NPU 的空间阵列,却能在具备分支预测和硬件缓存的乱序 CPU 核心上高效执行。最后,显示叠加需要对高分辨率帧逐像素进行光栅化和 alpha 混合;这是一项易于并行、受内存带宽限制的任务,可直接映射到 GPU 的光栅化器和纹理单元。将流水线拆分到三个引擎上——NPU 负责特征提取、CPU 负责 NMS、GPU 负责显示合成——与在任一单独处理器上执行整个流水线相比,能够最大限度地降低端到端延迟和总能耗。
这种流水线划分反映了算法结构与机器架构之间更广泛的关系。规则的矩阵缩并和卷积可以自然地映射到脉动阵列或向量化 NPU 数据通路,而依赖数据的控制流则映射到 CPU 执行资源。Transformer 注意力层横跨这两种范式:投影 GEMM(\(Q, K, V, O\))和注意力分数缩并(\(Q K^T\) 和 \(A V\))可以在 NPU 矩阵单元上高效执行,但中间的 softmax 归约、因果掩码和层归一化涉及逐元素操作。如果 NPU 运行时无法将这些逐元素操作融合到片上 SRAM 暂存区中执行,中间张量就必须溢出到 LPDDR,从而削弱加速器的吞吐量优势。
最优处理器分配是动态的,而非静态的。随着设备热状况恶化或电池余量下降,运行时必须调整其调度策略。然而,在处理器后端之间迁移正在执行的模型会产生不可忽视的开销:权重必须在内存中重新绑定,中间缓冲区可能需要重新转换布局,设备驱动程序也会产生内核分发延迟。如果跨处理器同步状态的开销超过卸载计算所节省的时间,那么将执行保留在单个次优引擎上,可能比持续进行跨引擎迁移带来更低的总延迟和能耗。
共享内存子系统会在同时执行时引入跨引擎干扰。由于 CPU、GPU、NPU、摄像头 ISP 和显示引擎共享同一条 LPDDR 内存总线,SoC 内存控制器会实施服务质量(QoS)优先级,以满足实时硬件截止时间。显示引擎和摄像头 ISP 必须获得有保证的内存带宽和有界延迟,以防止显示闪烁和传感器 FIFO 溢出;因此,内存控制器会优先处理显示与摄像头事务,而后处理 NPU 和 GPU 流量。在内存密集阶段,例如自回归语言模型解码中每生成一个词元都必须从 DRAM 读取模型权重时,高优先级的 ISP 或显示流量会降低 NPU 的有效内存带宽,增加词元生成延迟。
功耗与热管理
无风扇移动设备受到严格的持续功率预算和热约束限制,通常整个机身持续耗散的功率不超过 3 至 5 瓦,否则触摸表面温度就会超过安全阈值。虽然瞬时突发功率可达 10 至 15 瓦,但持续推理会迅速耗尽设备热容所提供的缓冲空间,使硅片结温升高,因此需要在整个 SoC 上实施主动功耗管理。
异构 SoC 使用动态电压与频率调节(DVFS)来管理不同硅片分区的功耗。由于动态功率与供电电压的平方成正比,与工作频率成正比(\(P_{\text{dyn}} \propto V^2 f\)),降低时钟频率就可以降低核心电压,从而显著降低功耗。在异构 SoC 上,CPU 集群、GPU 着色器核心和 NPU 引擎分别处于独立的电源域和电压域。提高 NPU 的电压和频率以满足严格的延迟截止要求,会消耗原本可供 CPU 或 GPU 使用的电流与热余量。系统功耗调节器会根据工作负载队列、温度传感器读数和帧截止时间目标,持续调整这些工作点。
当持续计算产生的热量超过机身散热速率时,平台就会启动热降频。由于专用 NPU 在张量运算方面的能效(TOPS/W)高于通用核心,在触发热限制期间将矩阵工作负载卸载到 CPU 或 GPU,往往会增加总能量耗散,加剧热积累。因此,运行时会通过限制时钟频率、降低推理占空比(例如将感知模型从每秒 30 帧降至每秒 15 帧),或动态切换到更小的剪枝模型检查点来管理热限制。任务迁移则有选择地用于将非张量预处理移出芯片上的局部热点区域。
电池状态也会进一步影响运行时调度。当电池电量降至临界阈值以下,或设备进入低功耗模式时,系统调度器会通过将运算量化到更低位宽(例如从 16 位浮点精度转为 8 位整数精度)、提高执行稀疏性,或对异步推理请求进行批处理,以最大限度地延长核心处于深度低功耗休眠状态的时间,从而以推理保真度换取电池续航。
汽车异构 AI 系统
汽车计算平台承担双重要求:既要为多摄像头感知和传感器融合提供每秒数百 T 次运算(TOPS)的能力,又要满足严格的功能安全标准(如 ISO 26262)。在移动系统中,热降频可以使用户体验平缓退化;汽车系统则必须遵守硬实时截止时间,错过一帧的截止时间就可能危及车辆控制。然而,并非所有车载 AI 工作负载都要求最高的安全完整性;信息娱乐和驾驶舒适性模型会与安全关键感知流水线共享计算平台。
为了支持这种混合关键性执行,汽车 SoC 会确保安全关键工作负载(如自动紧急制动)与非关键应用(如自然语言座舱助手)之间互不干扰。硬件强制实施的虚拟化、输入输出内存管理单元(IOMMU)以及内存总线带宽预留,可对计算核心和 LPDDR 通道进行隔离。如果没有内存带宽预留,一个未经验证、从 DRAM 流式读取权重的便利功能模型就可能使内存通道饱和,延迟向具有经过认证的最坏情况执行时间(WCET)的紧急感知内核交付帧。实时操作系统使用时间触发式分发来调度关键神经网络流水线,而不是采用以平均吞吐量为依据的优先级队列。
汽车架构还需要处理分布式和集中式传感器拓扑下的端到端延迟。自动驾驶平台同时接收来自高分辨率摄像头、车载雷达和激光雷达的高带宽数据流。通过汽车以太网(如 10GBASE-T1)或串行器/解串器链路(SerDes)接收、分包和传输这些数据,会引入传输延迟与抖动。传感器融合算法要求数据流具有硬件时间戳,并通过 IEEE 802.1AS 同步到共享的微秒级时钟。只有当时间窗口内最慢的传感器帧到达后,加速器才能开始跨传感器融合,这意味着必须将传感器对齐、串行化开销和 DMA 接收延迟与神经网络推理时间一并纳入预算。
外部车联网(V2X)输入会引入非确定性的通信延迟和可变的数据包交付率。由于无线信号会受到丢包、多径衰落和对抗性欺骗的影响,安全关键感知算法不能将 V2X 输入视为同步传感器数据流。相应地,规划流水线将 V2X 载荷作为异步上下文提示纳入处理,并限制其影响,以确保车辆安全始终由车载确定性传感器保障。
软件栈面临的挑战
异构性使主要系统挑战从硅片设计转向软件协调。OpenCL 和 Vulkan 等标准编程模型提供了跨计算设备的可移植底层执行抽象,但并不能消除针对特定微架构调优内核的需求。机器学习推理运行时通过面向 CPU、GPU、DSP 和 NPU 的硬件专用委托或后端来划分计算图。当模型包含 NPU 委托不支持的算子,例如自定义激活函数、动态张量形状或非标准归约时,运行时会将计算图拆分为子图,并插入回退到 CPU 或 GPU 的执行路径。每次跨越边界都需要同步执行并转换数据表示,从而将算法计算图变为一系列碎片化的硬件分发操作。
共享内存子系统需要在非一致性执行域之间显式管理缓存和内存。CPU 通过硬件侦听协议维护其自身核心之间的缓存一致性,而移动 NPU 和 DSP 则经常作为非一致性 DMA 总线主设备与系统内存交互。当 CPU 通过缓存向 DRAM 写入输入张量,并将控制权交给 NPU 时,软件必须在 NPU 开始执行之前,显式地将 CPU 的脏缓存行刷写到 DRAM。同样,在 NPU 完成后,CPU 必须使自身缓存中对应目标内存范围的缓存行失效,以防止读取陈旧的缓存数据。如果不受支持的算子导致推理图在 CPU 与 NPU 之间反复切换,缓存维护和中间数据往返 DRAM 的延迟就可能超过算子本身的执行时间。
运行时利用提前编译、实测性能数据库和动态分发启发式方法来应对这种调度复杂性。设备遥测通过监测帧完成时间、核心温度和电池耗电情况,为运行时降低时钟频率或切换执行委托的决策提供依据。然而,动态适应不能替代延迟敏感应用所需的确定性计算图降级转换;部署时必须在目标物理芯片上,在最坏情况的热条件和内存争用条件下,验证编译并完成降级转换后的图分区。
异构加速表明,系统效率从根本上说是一个协调问题,而非专用执行模块的简单堆砌。在数据—算法—机器分类体系中,SoC 代表一个复合的机器层,其组件具有不同的内存层次结构、算术运算优势和热约束。机器学习系统铁律指出,总体运行时间和能耗由数据移动决定:当软件协调无法维持张量局部性,或引发频繁的跨引擎回退时,能量耗散将主要由互连和 DRAM 流量决定,而非算术运算。在异构 SoC 上实现最高性能,需要尽量减少跨域边界的数据移动,同时将每项算法操作匹配到专为加速该操作而设计的专用数据通路。
硬件可持续性
在大规模设备集群中,每次有效推理的能耗成为重要的硬件选型标准。运行阶段的排放取决于工作负载吞吐量、实测系统功率、利用率、冷却开销和电力结构;隐含排放则增加了另一项生命周期成本。因此,峰值每瓦性能是一项筛选指标,不能替代端到端的单次请求能耗。下面的场景展示了在比较通用 CPU 集群与专用加速器时,各项假设如何产生叠加影响。
Napkin Math 1.10: 运行能耗的示例性比较
问题:在给定的吞吐量等效假设下,用专用 NPU(神经网络处理单元)替换 CPU 集群后,运行能耗会如何变化?
假设:这一简化比较将所列峰值速率视为有效工作负载吞吐量,假设两个集群均以所列功率持续运行,并且不考虑主机功耗、冷却、隐含碳排放和利用率差异。这是一项敏感性计算,而非实测的采购结果。
- CPU 推理:以 100 W 的功率提供 1 TFLOP/s 的吞吐量(能效 = 0.01 TFLOP/s/W)。
- NPU 推理:以 5 W 的功率提供 10 TFLOP/s 的吞吐量(能效 = 2 TFLOP/s/W)。
- 假设的峰值能效差距:200×。
计算:
- 工作负载:每天执行 1 billion 次推理。
- CPU 集群能耗:1,000 台 CPU 服务器 \(\times\) 100 W \(\times\) 24 h \(\approx\) 2,400 kWh/天。
- NPU 集群能耗:100 枚 NPU 芯片 \(\times\) 5 W \(\times\) 24 h \(\approx\) 12 kWh/天。
- 碳减排量:在碳强度为 0.429 kg/kWh 时,改用 NPU 每年可减少约 373.9 t 的 CO2 排放。
系统洞见:当工作负载能够利用专用加速器的高效执行路径,且较少的设备即可提供所需的服务吞吐量时,专用加速器可以降低运行能耗。在将结果用于采购或碳核算之前,应以实测的每秒请求数和墙端功率替换这些假设。
可持续性视角进一步强化了一个核心主题:硬件选择并非仅由峰值速度决定。每个有效结果的能耗、碳强度、隐含环境影响和总拥有成本,都应与延迟、吞吐量及内存容量一并纳入考量。接下来需要识别那些导致团队选择错误硬件路线的误解。
谬误与陷阱
硬件加速呈现出一些反直觉的性能特征,因为醒目的规格参数往往掩盖了特定工作负载的瓶颈。此处的谬误与陷阱涵盖了选型、扩展和优化中的错误,这些错误会使昂贵的计算资源得不到充分利用。
谬误:专用程度更高的硬件总能提供比通用硬件更好的性能。
只有当工作负载的访问模式与底层执行数据通路相匹配时,专用加速器才能实现高效率:这正是算法与机器协同设计的核心原则。根据 Roofline 模型(section 1.6),运算的算术强度必须超过硬件的屋脊点,才会受到计算能力限制。A100 GPU 的屋脊点为 153 FLOP/byte,这意味着,无论该芯片的峰值算力达到 312 TFLOP/s,算术强度低于这一阈值的运算仍然受内存限制。算术强度 AI = 2 FLOP/byte–5 FLOP/byte 的 Transformer 注意力 softmax 在 A100 上仅能达到 4.1 TFLOP/s–10.2 TFLOP/s(利用率为 3.3 percent)。屋脊点约为 10 FLOP/byte–20 FLOP/byte 的 CPU 执行该内核时同样受内存限制,但相同的算术强度可利用 CPU 计算能力的 10 percent–50 percent。当工作负载存在不规则内存访问、极小批量或动态控制流时,大规模并行执行流水线会因内存延迟和线程分歧而停顿。在这些条件下,配备大容量缓存层次结构、乱序执行和分支预测器的通用 CPU 往往能提供更低的延迟和更高的资源效率。硬件选择要求将工作负载的算术强度和数据流规则性与架构的屋脊点相匹配,而不能假定专用化必然带来速度提升。
陷阱:选择加速策略时忽略内存带宽限制。
采购决策常常以峰值算术吞吐量为目标,却忽视内存接口的约束。片外数据移动会带来严重的性能和能耗代价:从 DRAM 获取一个操作数约消耗 640 pJ,而访问片上 L1 SRAM 则消耗 0.5 pJ(section 1.5.1)。考虑一款加速器,其算力为 300 TFLOP/s,内存带宽为 2 TB/s,因此屋脊点为 150 FLOP/byte。对于 LayerNorm 这类算术强度为 1.5 FLOP/byte 的归一化内核,只能达到 3 TFLOP/s(计算利用率为 1 percent)。由于 LayerNorm 需要将完整的激活张量流经内存,以计算简单的归约统计量,因此内存带宽严格限制了吞吐量。在不增加内存带宽的情况下增添计算单元,不会改变运行时间,只会浪费芯片面积。
谬误:硬件加速的收益会随加速器数量的增加而线性增长。
分布式训练在八个加速器上无法实现 \(8\times\) 的吞吐量,因为芯片间通信开销会降低并行效率。通过环形 AllReduce(section 1.11)在各 rank 之间同步梯度时,每个 rank 需要传输模型梯度数据量的 \(2(N-1)/N\) 倍:在八个设备上,每个 rank 的传输量为梯度载荷的 1.75×。对于 NVLink 这类提供 600 GB/s 双向带宽(每个方向为其一半)的互连,传输 1 GB 梯度载荷需要 5.83 ms。对于计算步骤耗时为 50 ms 的模型,即使尚未计入软件集合通信延迟,这一数据交换也会增加 11.7 percent 的通信开销。在没有计算与通信流水线重叠的情况下,八加速器节点只能实现 7.2× 的加速比(并行效率为 89.6 percent)。慢节点、屏障同步和集合通信协议开销会进一步拉大线性预期与实际集群扩展效果之间的差距。
陷阱:依据峰值 FLOP/s 规格规划加速器容量。
峰值 FLOP/s 衡量的是理想指令组合且操作数持续可用时算术单元的容量,而非实际实现的应用吞吐量。实际性能取决于内核算术强度、矩阵维度、内存访问合并情况以及运行时启动开销。Roofline 模型(section 1.6)界定了峰值计算性能与带宽受限执行性能之间的差距。在峰值为 312 TFLOP/s 的 A100 GPU 上,稠密 Transformer 训练可持续达到 120 TFLOP/s–180 TFLOP/s(模型 FLOPs 利用率为 40 percent–60 percent)。相比之下,稀疏推荐模型只能持续达到 10 TFLOP/s–30 TFLOP/s(利用率为 3.2 percent–9.6 percent),因为稀疏嵌入表查找会发出无法合并的内存读取请求,使张量执行单元因数据供给不足而闲置。依据峰值 FLOP/s 规划集群容量会导致严重的资源配置不足;容量规划必须依赖实测的持续吞吐量,或受 Roofline 上界约束的内核性能预测。
谬误:任何 FLOP/s 标称值都可用于估算低精度工作负载的性能。
加速器为不同精度配备了独立的数据通路,各通路的峰值吞吐量差异巨大。H100 在 FP16 张量运算中可达到约 989 TFLOP/s,但在 FP32 CUDA 核心运算中只能达到约 67 TFLOP/s:同一芯片内部的差距约为 15× (Choquette 2023)。当工作负载实际使用 BF16 时,若用 FP32 数值估算训练时间,就会得到看似严重下降、却没有物理原因支持的利用率数值;而与错误的 Roofline 上界进行比较,则会将内存受限的内核误判为计算受限,或反之。务必使峰值常数与工作负载实际执行的精度相匹配,并在报告模型 FLOPs 利用率时明确注明精度。
陷阱:将小批量推理工作负载部署到高算力加速器上。
小批量推理会严重浪费高算力加速器的计算能力,因为单样本执行缺乏参数复用。对于维度为 \(M=N=2048\) 的稠密线性投影,单个请求(\(B=1\))需要从设备内存流式读取整个权重张量,以执行矩阵—向量乘法,其算术强度仅为 1 FLOP/byte。当批量大小为 \(B=256\) 时,权重复用将内存传输开销分摊到各个词元,使算术强度提升至 204.8 FLOP/byte。在 \(B=1\) 时,内存带宽将 A100 的实际性能限制在 2.04 TFLOP/s,将 T4 的实际性能限制在 0.3 TFLOP/s。尽管 T4 的峰值较低,为 65 TFLOP/s,且脊点为 203.1 FLOP/byte,但它在 \(B=1\) 时的实际吞吐量与 A100 相差不到两倍,而购置成本和散热需求仅为后者的一小部分。将 A100 用于不进行批处理的实时推理,会使昂贵的计算单元闲置;系统架构师必须根据运行时的批量大小和延迟目标选择加速器。
谬误:厂商专属优化没有长期的可移植性成本。
仅针对单一厂商运行时进行优化,可以立即提高内核效率,但也会引入严重的架构锁定(section 1.9)。当更新、性价比更高的加速器出现时,充斥着专有设备内建函数、厂商专属汇编和非标准内存布局的代码库,需要投入数月的工程工作才能完成移植。这种技术债务会延误硬件迁移,并阻碍多厂商采购策略的实施。为保持灵活性,系统必须将针对厂商调优的微内核隔离在硬件抽象层 之后,或面向中间编译器表示(如 Triton 或 MLIR)进行开发。保留可移植的执行路径,使基础设施能够跟进硬件创新,同时保有专用执行单元带来的优化收益。
Checkpoint 1.4: 可行性评估:能否运行?
采购硬件之前,应验证每项物理约束。这些失效模式可转化为具体的可行性测试:
这份检查清单将架构原则转化为严谨的工程实践。系统评估需要养成严谨的诊断习惯:表征工作负载的算术强度,识别物理瓶颈指标,使执行与适当的数据通路相匹配,并计入互连、扩展和可移植性成本。
总结
硬件加速对计算引擎、内存层次结构、数值格式和数据流进行协同设计。对于选定的内存接口,机器学习系统铁律将计算时间 \(O/(R_{\text{peak}}\eta_{\text{hw}})\) 与数据搬移时间 \(D_{\text{vol}}/\text{BW}\) 进行比较;Roofline 模型则将这种竞争关系重新表述为 \(\min(R_{\text{peak}}, \text{BW}I)\)。端到端延迟还包括启动、同步、通信和固定开销。只有当受支持的执行路径能够在局部实现复用时,加速器才能提高效率。因此,硬件选择应从工作负载实测或建模得到的瓶颈出发,而非从厂商标称的峰值出发。
要点回顾: 搬移数据的成本高于计算数据
- Roofline 模型用于识别瓶颈:将内核实测的算术强度与目标硬件在特定精度下的脊点进行比较(此处为 153 FLOP/byte)。低于脊点时,应减少内存流量;高于脊点时,应提高计算利用率。
- 内存带宽制约性能:GPU 计算能力的增长速度快于内存带宽。许多推理阶段受内存限制,尤其是小批量解码和嵌入查找,而大批量 GEMM 仍可能受计算限制。
- 软硬件协同设计可叠加性能收益:使算法模式与架构能力相匹配,例如在脉动阵列或张量单元上执行稠密 GEMM,以及在稀疏执行路径上使用受支持的稀疏模式,可以带来显著改进。
- Tensor Core 需要兼容的执行路径:精度、维度、布局和库支持必须与架构相匹配。批量大小和形状会影响复用与利用率,但不存在能够保证峰值性能的单一批量阈值。
- 端到端加速受下一个瓶颈限制:加速某个内核不会改变启动、传输、同步、通信以及不受支持工作的开销。应使用阿姆达尔定律和性能剖析,判断增加硬件资源、改进映射或减少数据搬移,哪种方式能够改善整个工作负载的性能。
加速器并非在所有方面都更快的计算机;它为特定运算和数据流提供高效的执行路径。只有当工作负载、数值格式和软件路径能够利用分块、融合、层次结构感知调度和脉动执行时,这些技术才能减少所建模接口上的数据流量。
Roofline 模型利用算术强度和脊点缩小可能瓶颈的范围,从而提供初步诊断;随后通过性能剖析,将延迟、占用率、通信和实现开销纳入分析。所得结果是一个可检验的假设,而非预测。
Footnotes
阿姆达尔定律:只有在明确拟议变更之后,才能将其映射到铁律上。如果更快的张量单元减少了计算项 \((O/(R_{\text{peak}} \cdot \eta_{\text{hw}}))\),但数据传输和固定延迟保持不变,那么这些未受影响的项就会限制总加速比。另一种加速器或内存系统也可能同时提高带宽。因此,未加速部分的占比由具体干预措施决定,而不是由将各项永久归类为串行部分来决定。↩︎
算术强度:计算操作次数与跨越所建模内存接口传输的字节数之比(FLOP/byte)。算术强度高于该硬件层级转折点的工作负载,例如经过良好分块且具有大量数据复用的矩阵乘法,属于计算受限型,可受益于更高的 TFLOP/s。低算术强度操作,包括某些小批量注意力和解码内核,在该层级上受带宽限制,需要更大的带宽或更多的数据复用,而非仅仅提高计算吞吐量。↩︎
TPU(张量处理单元):首款 TPU 有意选择了较窄的设计范围,以单个用于 8 位矩阵乘法的 \(256{\times}256\) 脉动阵列为设计核心,并省去了通用核心所需的大部分控制机制 (Jouppi et al. 2017)。这种权衡以灵活性为代价,换取了稠密矩阵乘法上的高计算密度。不规则或分支密集的代码仍然难以适配,而编译器分块、填充和层维度则决定了阵列能够得到多充分的利用。↩︎
Intel 8087:该协处理器直接在芯片中实现浮点逻辑,避免了 CPU 为每次计算执行缓慢的多指令软件模拟。其收益取决于应用在受支持浮点运算上花费的时间比例,这说明,当被加速的工作主导执行过程时,专用化最为有效。↩︎
AlexNet:Krizhevsky、Sutskever 和 Hinton 提出的卷积神经网络(CNN)拥有 6000 万个参数,使用两块各仅配备 3 GB 显存的消费级 GTX 580 GPU,以超过十个百分点的优势赢得了 ImageNet 2012 竞赛。由于模型超出了单块 GPU 的显存容量,作者将网络划分到两块显卡上,并限制两者之间的通信。这是模型并行的一种早期形式,预示了后来系统化的张量并行和流水线并行。论文报告的这次训练耗时五至六天 (Krizhevsky et al. 2012)。↩︎
DSA(领域专用架构):针对某一应用领域优化的硬件,以牺牲部分通用可编程性换取效率。Google 的 TPUv1 以脉动阵列和软件管理的内存为设计核心,在 Google 推理工作负载上的评估中,其性能达到同期所评估 CPU 和 GPU 系统的 15–30\(\times\),每瓦性能达到这些系统的 30–80\(\times\) (Jouppi et al. 2017)。擅长密集矩阵乘法的 DSA 在图遍历等不规则工作负载上的表现可能不如 CPU,因此,其工作负载适用范围和效率收益必须足以证明软件、编译器及生态系统成本的合理性 (Hennessy and Patterson 2019, 2017)。↩︎
摩尔定律:在 figure 3 所采用的示例性假设中,模型计算需求每年增至约前一年的 6.1×,而加速器的峰值供给能力每年提升至约前一年的 1.7×,使模型中需求与供给的差距每年扩大至约前一年的 3.5×。已发表的计算量趋势为这种分化提供了依据,但图中的增长率是假设,而非预测。因此,该图展示的是系统差距对增长率持续存在差异的敏感程度,而非固定的未来轨迹。在这样的差距下,压缩、量化和稀疏化等提高算法效率的技术变得越来越有价值 (Amodei and Hernandez 2018; Epoch AI 2024)。↩︎
登纳德缩放:1974 年提出的缩放模型认为,工作电压可以随着晶体管尺寸的缩小而降低,从而使功率密度保持近似恒定 (Dennard et al. 1974)。该规律在约 2005 年后失效,限制了芯片在热设计功耗范围内进一步提高时钟频率;由此产生的暗硅研究文献估计,在所建模的先进工艺节点和设计假设下,热限制可能使相当大比例的可用晶体管无法同时工作。这一比例并非普适常数,但功耗约束长期存在:专用单元将有限的活跃硅资源用于高价值的操作类别,从而提高其利用价值 (Esmaeilzadeh et al. 2011)。↩︎
黄氏定律:这一观察指出,GPU 在 AI 工作负载上的性能提升既来自晶体管缩放,也来自 Tensor Core 等架构创新。该归一化图使用示意性的 GPU 供给曲线和模型需求曲线,展示不同增长率如何造成不断扩大的系统差距;它并不是对任一增长率的预测 (Amodei and Hernandez 2018; Epoch AI 2024; NVIDIA Corporation 2020a; Choquette 2023)。↩︎
编解码器(Codec):Codec 是“coder-decoder”(编码器—解码器)的混成词,体现了该硬件的双重功能。编码(压缩)需要搜索最优表示,因此属于计算密集型任务;解码(解压缩)需要从压缩流中重建全分辨率帧,因此属于带宽密集型任务。专用编解码芯片在固定功能硬件中实现这两条路径,因此两条路径都不会将晶体管浪费在无关的通用控制逻辑上。↩︎
ASIC(专用集成电路):这类电路通过直接在硅电路中实现单一算法来获得极高效率,其每瓦性能通常可达到原来的 \(10^3\times\) 至 \(10^5\times\)。示例包括区块链挖矿中的密码学哈希计算和基因组学中的序列比对。代价是完全缺乏灵活性:如果核心算法发生变化,ASIC 无法重新编程,因而会被淘汰;硬件设计被锁定在其最初所要解决的特定问题版本上。↩︎
加速器设计中的延迟与吞吐量:训练通常采用面向吞吐量的执行方式和较大的批次,以摊销工作开销,而延迟敏感的推理必须控制单请求延迟和尾延迟。这是服务目标的差异,并非训练与推理之间普遍存在的分界:批量推理也可以面向吞吐量,小规模或交互式训练循环也可能关注单步延迟。流水线深度、批处理等待时间、内核准备开销和排队,都可能使面向训练的路径不太适合交互式请求,即使其峰值 FLOP/s 更高也是如此。因此,设计必须匹配工作负载的实际到达模式、成批处理机会和目标。↩︎
暂存存储器:当编译器能够确定张量内核的访问模式时,就可以显式地将数据块预先放入由软件控制的高速本地存储器中。这可以省去部分标签、替换和一致性机制,但必须正确调度数据传输、同步、存储体访问和容量使用。暂存存储器是对缓存的补充,并不能普遍取代缓存,因为不规则数据或共享数据仍可能受益于硬件管理。例如,Google 的 TPU v1 使用了一个由软件管理的 24 MB 统一缓冲区来存储中间激活值,而权重和指令则使用其他路径 (Jouppi et al. 2017)。↩︎
HBM:A100 和 H100 两代产品通过堆叠内存和宽接口,提供 2.0–3.4 TB/s 的设备内存带宽,而此处采用的 GDDR6X 参考带宽为 760 GB/s (NVIDIA Corporation 2020a; Choquette 2023)。提高带宽上限可以使某些内核向 Roofline 模型中受计算限制的一侧移动,但前提是其访问模式和算术强度能够利用这些带宽。HBM 也会增加封装和系统成本,因此其价值取决于工作负载的带宽需求。↩︎
RISC-V(精简指令集计算机 V):这一开放 ISA 允许硬件团队在不改变基础 ISA 的情况下添加自定义机器学习指令,包括向量点积、激活函数和稀疏张量运算。其权衡在于软件生态系统的成熟度:自定义扩展需要相应的编译器、库和运行时支持,这可能限制可移植性并增加集成工作量。↩︎
Cray-1 的向量计算传承:Cray-1(1975 年)采用了包含 64 个元素的向量寄存器和流水线功能单元,使元素流能够依次通过算术运算,而无须为每个元素发出一条标量指令。现代加速器将宽寄存器、流水线执行和数据复用这些相同原理扩展到了向量和矩阵分块。↩︎
Im2col(图像转列):通过将感受野中的数值排列为列,将卷积转化为矩阵乘法。显式物化可能会重复存储重叠的数值;在尚未考虑边缘、步幅和通道影响时,存储量最多可扩展至原来的约卷积核面积倍。生产级库通常采用隐式 GEMM 或直接卷积内核,在不物化完整展开矩阵的情况下,实现适合矩阵硬件的执行方式。↩︎
低精度机器学习:将操作数位宽减半,会使每个存储元素的字节数减半,并可支持更高密度的算术计算,但实际吞吐量取决于可用的数据通路和内核 (Dally et al. 2021; Dally 2023)。NVIDIA 从 Pascal P100 的向量算术转向 Volta V100 的混合精度 Tensor Core,使标称峰值 FP16 吞吐量从约 21.2 提升至 125 TFLOP/s,这两款产品之间的提升约为 6\(\times\) (NVIDIA 2017)。精度选择必须保持数值行为,并使用受支持的高效执行路径;最小的数据格式并不一定是最佳选择。↩︎
SM(流式多处理器):通过线程束调度器协调大量并行线程、实现 SIMT 模型的物理硬件引擎。维持足够多的活动线程束有助于隐藏指令和内存延迟,但仅凭占用率无法识别瓶颈。低占用率可能源于寄存器使用量、共享内存使用量、线程块维度或并行工作量不足,而受内存限制的内核仍可能具有较高占用率。↩︎
线程束:在 NVIDIA GPU 上,线程束是由 32 个线程组成的硬件调度组,当这些线程的控制路径一致时,它们执行同一条指令。如果线程进入不同路径,硬件会在不同掩码下执行所需路径,从而降低有效通道利用率。性能损失取决于路径长度以及进入各条路径的通道数量,因此机器学习内核通常倾向于采用一致的控制流或谓词化控制流。↩︎
CUDA(统一计算设备架构):CUDA 由 NVIDIA 于 2006 年发布,使通用计算无需再伪装成图形操作,通过类 C 编程模型将 GPU 开放给科学计算和机器学习工作负载。由此建立的生态系统——cuBLAS、cuDNN、TensorRT——构成了一道软件护城河,可将机器学习训练栈锁定在 NVIDIA 硬件上:迁移到其他平台需要重写或替换数千个针对 GPU 优化的内核,其成本往往超过采用竞争平台所节省的硬件成本。这种软件锁定与芯片本身的性能共同解释了为何许多大型机器学习训练栈仍以 CUDA 为中心。↩︎
Tensor Core 维度对齐:当矩阵维度对齐到由精度和架构决定的特定倍数时,NVIDIA Tensor Core 的效率最高,例如常见 FP16/BF16/INT8 路径中的 8 或 16 的倍数。现代 cuBLAS 和 cuDNN 仍可对许多未对齐的维度使用 Tensor Core,但对齐不佳的形状可能触发效率较低的内核、需要填充,或降低有效吞吐量 (NVIDIA 2024a; NVIDIA Corporation 2021)。这就是模型架构设计者经常选择 512 而非 500 作为嵌入维度和通道维度的原因,也是批大小为 1 的推理可能无法达到峰值 Tensor Core 利用率的原因:对齐和算术强度共同决定硬件矩阵引擎能否保持满载。↩︎
Tensor Core:单条 Tensor Core 指令使用专用硬件模块,对一小块数据执行完整的矩阵乘法累加运算 (NVIDIA 2017; NVIDIA Corporation 2020a)。这种方式绕过了在通用 CUDA 核心上获取和调度数十条独立算术指令的开销。由于这些模块贡献了现代加速器标称张量吞吐量的很大一部分,未能使用它们可能使工作负载无法利用芯片理论峰值中的大部分能力。↩︎
NPU(神经网络处理单元):移动端 NPU 通过固定功能或可编程范围有限的硬件实现常见张量运算,而非将其作为完全通用的 GPU 内核执行,从而实现低功耗推理。这种架构选择可为受支持的内核带来显著的能效提升,但也使部署依赖于算子覆盖范围:不受支持的函数必须回退到 CPU 或 GPU 路径,而这些路径处理该工作负载时的效率可能低得多 (Sze et al. 2017)。↩︎
N:M 结构化稀疏性:NVIDIA Ampere 稀疏 Tensor Core 使用的 2:4 比例(密度为 50%)是一种适合硬件实现的折中方案:每组连续的四个值保留两个非零值,在维持规则索引的同时,将稠密数值载荷减半 (NVIDIA Corporation 2020a)。在 2:4 模式下,元数据开销足够小,可以与权重一同存储,而不会抵消存储器流量的节省;正是这一约束,使得当内核和模型权重满足该模式时,所宣称的 2\(\times\) 张量运算吞吐量路径具有可行性。↩︎
脉动阵列:源自希腊语 sustole(“收缩”),借用自心脏病学,用以体现有节奏的泵送。Kung 和 Leiserson 用这一术语描述数据按照固定时序在相邻处理单元间推进的阵列 (Kung and Leiserson 1979)。流水线填充允许多个波前并发推进并实现局部复用。其收益取决于驻留操作数、分块、缓冲区及利用率,并不保证固定幅度的 DRAM 访问节省。对于不规则工作负载和维度对齐不佳的形状,其适配性仍然较弱,因为填充、排空和空闲单元都会占用处理容量。↩︎
冯·诺依曼瓶颈:存储与计算的分离要求指令和数据跨越接口传输,而无法始终保留在本地寄存器中。在 Horowitz (2014) 给出的代表性 45 nm 估计值中,一次 DRAM 访问消耗的能量超过一次 INT8 加法的 20,000\(\times\)。具体比值会随工艺和操作而变化,但数据局部性始终是首要的设计考量。↩︎
稀疏性与内存访问不规则性:非结构化稀疏格式通常通过间接寻址收集非零元素,这可能削弱顺序访问特性,并使元数据开销变得显著。结构化稀疏性保留了对硬件友好的块结构,因此其访问行为不同于任意剪枝。在缺少合适的计算内核或硬件支持时,非结构化稀疏模型即使执行的算术运算更少,也可能比对应的稠密模型运行得更慢。↩︎
DMA(直接内存访问):一种专用硬件单元,无需 CPU 直接管理即可负责数据复制(步骤 1),从而使 CPU 能够立即发出计算命令(步骤 2)。这种并发至关重要:没有它,加速器可能在计算批次之间空闲,尤其是在主机到设备的数据移动位于关键路径上时。↩︎
NVLink(NVIDIA Link):这种 GPU 间直接互连的目的,是在张量必须于服务器内部移动时,使加速器之间的流量不经过 PCIe。其双向聚合带宽为 600–900 GB/s,在均衡的全双工流量下,每个方向约为 300–450 GB/s,是标准 PCIe 链路单向带宽的数倍,因此,需要频繁跨设备移动张量的工作负载可以保持在带宽层次结构中的高速部分 (NVIDIA Corporation 2020b; Choquette 2023)。决定有多少张量流量必须跨越此链路的训练算法将在后文展开;这里需要了解的硬件事实是带宽差距。 ↩︎
AllReduce:源自 MPI 的一种集合操作,先跨进程聚合数值(“reduce”),再将结果分发回每个进程(“all”)。这里使用该术语是为了说明加速器间带宽为何对分布式训练工作负载至关重要。在大规模场景中,算法、拓扑选择和运行时协议共同决定这种同步的代价。 ↩︎
InfiniBand:它支持多节点扩展的关键特性是 RDMA(远程直接内存访问)。借助 GPUDirect RDMA 等支持 GPU 的路径以及已注册的 GPU 内存,网络适配器可以在跨节点的 GPU 之间直接传输数据,无需经由主机内存暂存。这减少了主机参与和协议开销,因此,规模扩展更常受限于物理带宽、拓扑和集合操作的实现,而非由 CPU 管理的数据包处理。↩︎
注意力机制:Bahdanau、Cho 和 Bengio 为序列到序列模型引入了注意力机制;随后,Transformer 自注意力使每个词元都能够关注序列中的所有词元 (Bahdanau et al. 2015; Vaswani et al. 2017);对于长度为 \(S\) 的序列,显式存储完整注意力分数需要一个 \(S{\times}S\) 矩阵,从而产生二次增长的中间存储需求。FlashAttention 通过对计算进行分块,避免在 HBM 中显式存储该完整矩阵 (Dao et al. 2022)。推理中的 KV 缓存是另一回事:每层的 KV 缓存容量随序列长度线性增长,但每个解码步骤都需要读取不断增大的缓存(参见 内存与 KV 缓存)。↩︎
Roofline 模型:由加州大学伯克利分校的 Williams et al. (2009) 提出,建立在 20 世纪 80 年代已有的 I/O 复杂度研究基础之上。他们的具体贡献在于,使计算与带宽之间的权衡变得可视化且可指导行动:典型的 Roofline 图能够立即揭示内核是计算受限(达到水平上限)还是内存受限(达到倾斜的带宽线),并量化其与硬件极限之间的差距。一个仅达到其性能上限 50% 的内核,利用率仍有明确的 2\(\times\) 提升空间,这使其成为加速器优化的标准诊断工具。↩︎
内存访问合并:当线程束中的线程访问连续内存时,GPU 硬件会将这些线程的内存请求合并为一次事务。张量布局会影响访问合并,但其影响是正面还是负面取决于内核:对于某些卷积实现,NCHW 可以高效运行,而现代 Tensor Core 卷积和融合执行路径通常更倾向于 NHWC/通道后置。布局选择不当仍可能造成数倍的性能差距,但正确的解决方法是使布局与后端相匹配,而不是记住一种通用格式。↩︎
NHWC 与 NCHW:NHWC 的维度顺序为批次、高度、宽度、通道;NCHW 的维度顺序为批次、通道、高度、宽度。物理内存格式决定相邻线程是否读取相邻地址,因此其性能影响因后端而异。布局与硬件不匹配并非微小的优化问题;它可能造成数倍的性能差距,尤其是在转换导致无法使用 Tensor Core 卷积或融合执行路径时。↩︎
内核融合:独立的 GPU 内核通过设备内存传递中间结果,不过缓存可以承接其中一部分流量。融合内核可以将中间值保留在寄存器或局部存储中,避免相应的外部写入与读取周期。由此获得的加速取决于缓存行为、占用率、启动开销,以及内存流量是否构成瓶颈;加速幅度不一定与字节数的减少成正比。↩︎
分块(循环分块):这种重构将计算划分为大小适合快速局部存储层的块。朴素循环会反复访问相同元素;缓存可能承接其中一部分访问,而分块则有意在数据被逐出之前集中进行复用 (Lam et al. 1991)。较低存储层级流量的减少,是朴素矩阵乘法与优化 GEMM 例程之间性能差距的主要来源。↩︎
GEMM:运算 \(\mathbf{C} = \alpha \mathbf{A}\mathbf{B} + \beta \mathbf{C}\) 是许多深度学习层经底层转换后所采用的稠密线性代数原语。cuBLAS 和 oneDNN 等经过优化的 GEMM 库使用寄存器分块、向量化和分层分块,在有利的形状下逼近硬件极限 (NVIDIA 2024a; Intel Corporation 2021b)。现代 AI 加速器针对类 GEMM 块进行了高度专门化设计:Tensor Core、脉动阵列和矩阵扩展都用于加速这一原语,因此 GEMM 性能是预测不同架构端到端吞吐量的重要指标。↩︎
内核选择中的启发式规则:一种实用规则,无需对整个候选空间进行穷尽式基准测试,即可选择有潜力的实现。分块大小、布局、精度模式、融合选择和形状约束可以形成许多合法的 GEMM 变体。启发式规则降低了调优成本,但也可能错过更快的候选项,因此 AutoTVM 等自动调优器会在目标硬件上对选定方案进行性能剖析。↩︎
现场可编程门阵列:“现场可编程”意味着逻辑结构在制造完成后仍可配置,这与固定功能的 ASIC 不同。FPGA 可以通过实现与特定工作负载匹配的定制流水线,提升延迟敏感型数据中心服务的性能 (Putnam et al. 2014)。这种可重配置性使 FPGA 对快速演进的机器学习架构具有吸引力,因为为这类架构投入 ASIC 开发可能面临过时风险;但对硬件描述语言(Verilog/VHDL)的要求,以及以小时计的编译时间,构成了生产力障碍,使其应用局限于效率收益足以抵偿工程成本的部署场景。↩︎
阿姆达尔定律(扩展极限):Amdahl 定律与 Gustafson 定律 形式化描述了未加速部分占比固定时的性能上界。如果固定工作负载中有 5% 的工作始终无法被隐藏,且不受设备数量影响,那么该模型给出的加速比上限为 20\(\times\)。分布式训练更为复杂,因为通信可以与计算重叠,其成本本身也可能随规模变化,但这个例子说明了为什么必须减少或隐藏暴露在关键路径上的同步。↩︎
AllReduce:源自 MPI 的一种集合操作,先跨进程聚合数值(“reduce”),再将结果分发回每个进程(“all”)。这里使用该术语是为了说明加速器间带宽为何对分布式训练工作负载至关重要。在大规模场景中,算法、拓扑选择和运行时协议共同决定这种同步的代价。 ↩︎
NPU(神经处理单元):NPU 的专用矩阵引擎针对密集张量运算进行了优化,为上述工作负载分配提供了硬件基础。这种专用化给调度器带来了一项关键约束:任何未映射到 NPU 所支持数据通路的 AI 算子,都必须“回退”到 GPU 或 CPU 执行。这种回退可能抵消 NPU 的能效优势,使实时延迟预算更加复杂,并增加移动设备的散热压力。↩︎
Jouppi, Norman P., Cliff Young, Nishant Patil, David Patterson, Gaurav Agrawal, Raminder Bajwa, Sarah Bates, et al. 2017. “In-Datacenter Performance Analysis of a Tensor Processing Unit.” Proceedings of the 44th Annual International Symposium on Computer Architecture, ISCA ’17, 1–12. https://doi.org/10.1145/3079856.3080246.
Krizhevsky, Alex, Ilya Sutskever, and Geoffrey E. Hinton. 2012. “ImageNet Classification with Deep Convolutional Neural Networks.” Advances in Neural Information Processing Systems (NeurIPS) 25.
Hennessy, John L., and David A. Patterson. 2019. “A New Golden Age for Computer Architecture.” Communications of the ACM 62 (2): 48–60. https://doi.org/10.1145/3282307.
Hennessy, John L., and David A. Patterson. 2017. Computer Architecture: A Quantitative Approach. 6th ed. Morgan Kaufmann.
Amodei, Dario, and Danny Hernandez. 2018. “AI and Compute.” OpenAI Blog 2.
Epoch AI. 2024. Machine Learning Trends. Epoch AI Research Database.
Dennard, Robert H., Frank H. Gaensslen, Hwa-Nien Yu, Victor L. Rideout, Elias Bassous, and Antoine R. LeBlanc. 1974. “Design of Ion-Implanted MOSFET’s with Very Small Physical Dimensions.” IEEE J. Solid-State Circuits 9 (5): 256–68. https://doi.org/10.1109/jssc.1974.1050511.
Esmaeilzadeh, Hadi, Emily Blem, Renee St. Amant, Karthikeyan Sankaralingam, and Doug Burger. 2011. “Dark Silicon and the End of Multicore Scaling.” Proceedings of the 38th Annual International Symposium on Computer Architecture, 365–76. https://doi.org/10.1145/2000064.2000108.
NVIDIA Corporation. 2020a. NVIDIA A100 Tensor Core GPU Architecture. NVIDIA Whitepaper, V1.0.
Choquette, Jack. 2023. “NVIDIA Hopper H100 GPU: Scaling Performance.” IEEE Micro 43 (3): 9–17. https://doi.org/10.1109/mm.2023.3256796.
Dally, William J., Stephen W. Keckler, and David B. Kirk. 2021. “Evolution of the Graphics Processing Unit (GPU).” IEEE Micro 41 (6): 42–51. https://doi.org/10.1109/mm.2021.3113475.
Dally, Bill. 2023. “Hardware for Deep Learning.” 2023 IEEE Hot Chips 35 Symposium (HCS), 1–58. https://doi.org/10.1109/hcs59251.2023.10254716.
NVIDIA. 2017. Training with Mixed Precision.
NVIDIA. 2024a. cuBLAS: CUDA Basic Linear Algebra Subprograms.
NVIDIA Corporation. 2021. NVIDIA cuDNN Developer Guide.
Sze, Vivienne, Yu-Hsin Chen, Tien-Ju Yang, and Joel S. Emer. 2017. “Efficient Processing of Deep Neural Networks: A Tutorial and Survey.” Proceedings of the IEEE 105 (12): 2295–329. https://doi.org/10.1109/jproc.2017.2761740.
Kung, Hsiang Tsung, and Charles E Leiserson. 1979. “Systolic Arrays (for VLSI).” Sparse Matrix Proceedings 1978 1: 256–82.
Horowitz, Mark. 2014. “1.1 Computing’s Energy Problem (and What We Can Do about It).” 2014 IEEE International Solid-State Circuits Conference Digest of Technical Papers (ISSCC), 10–14. https://doi.org/10.1109/isscc.2014.6757323.
NVIDIA Corporation. 2020b. “NVLink: Scalable High-Performance Interconnect.” NVIDIA Technical Report 2020.
Bahdanau, Dzmitry, Kyunghyun Cho, and Yoshua Bengio. 2015. “Neural Machine Translation by Jointly Learning to Align and Translate.” International Conference on Learning Representations (ICLR).
Vaswani, Ashish, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N. Gomez, Lukasz Kaiser, and Illia Polosukhin. 2017. “Attention Is All You Need.” Advances in Neural Information Processing Systems (NeurIPS) 30: 5998–6008.
Dao, T., D. Y. Fu, S. Ermon, A. Rudra, and C. Ré. 2022. “FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness.” Advances in Neural Information Processing Systems (NeurIPS) 35: 16344–59. https://doi.org/10.52202/068431-1189.
Williams, Samuel, Andrew Waterman, and David Patterson. 2009. “Roofline: An Insightful Visual Performance Model for Multicore Architectures.” Communications of the ACM 52 (4): 65–76. https://doi.org/10.1145/1498765.1498785.
Lam, Monica D., Edward E. Rothberg, and Michael E. Wolf. 1991. “The Cache Performance and Optimizations of Blocked Algorithms.” Proceedings of the Fourth International Conference on Architectural Support for Programming Languages and Operating Systems - ASPLOS-IV, 63–74. https://doi.org/10.1145/106972.106981.
Intel Corporation. 2021b. oneDNN: Intel’s Deep Learning Neural Network Library.
Putnam, Andrew, Adrian M. Caulfield, Eric S. Chung, Derek Chiou, Kypros Constantinides, John Demme, Hadi Esmaeilzadeh, et al. 2014. “A Reconfigurable Fabric for Accelerating Large-Scale Datacenter Services.” ACM SIGARCH Computer Architecture News 42 (3): 13–24. https://doi.org/10.1145/2678373.2665678.