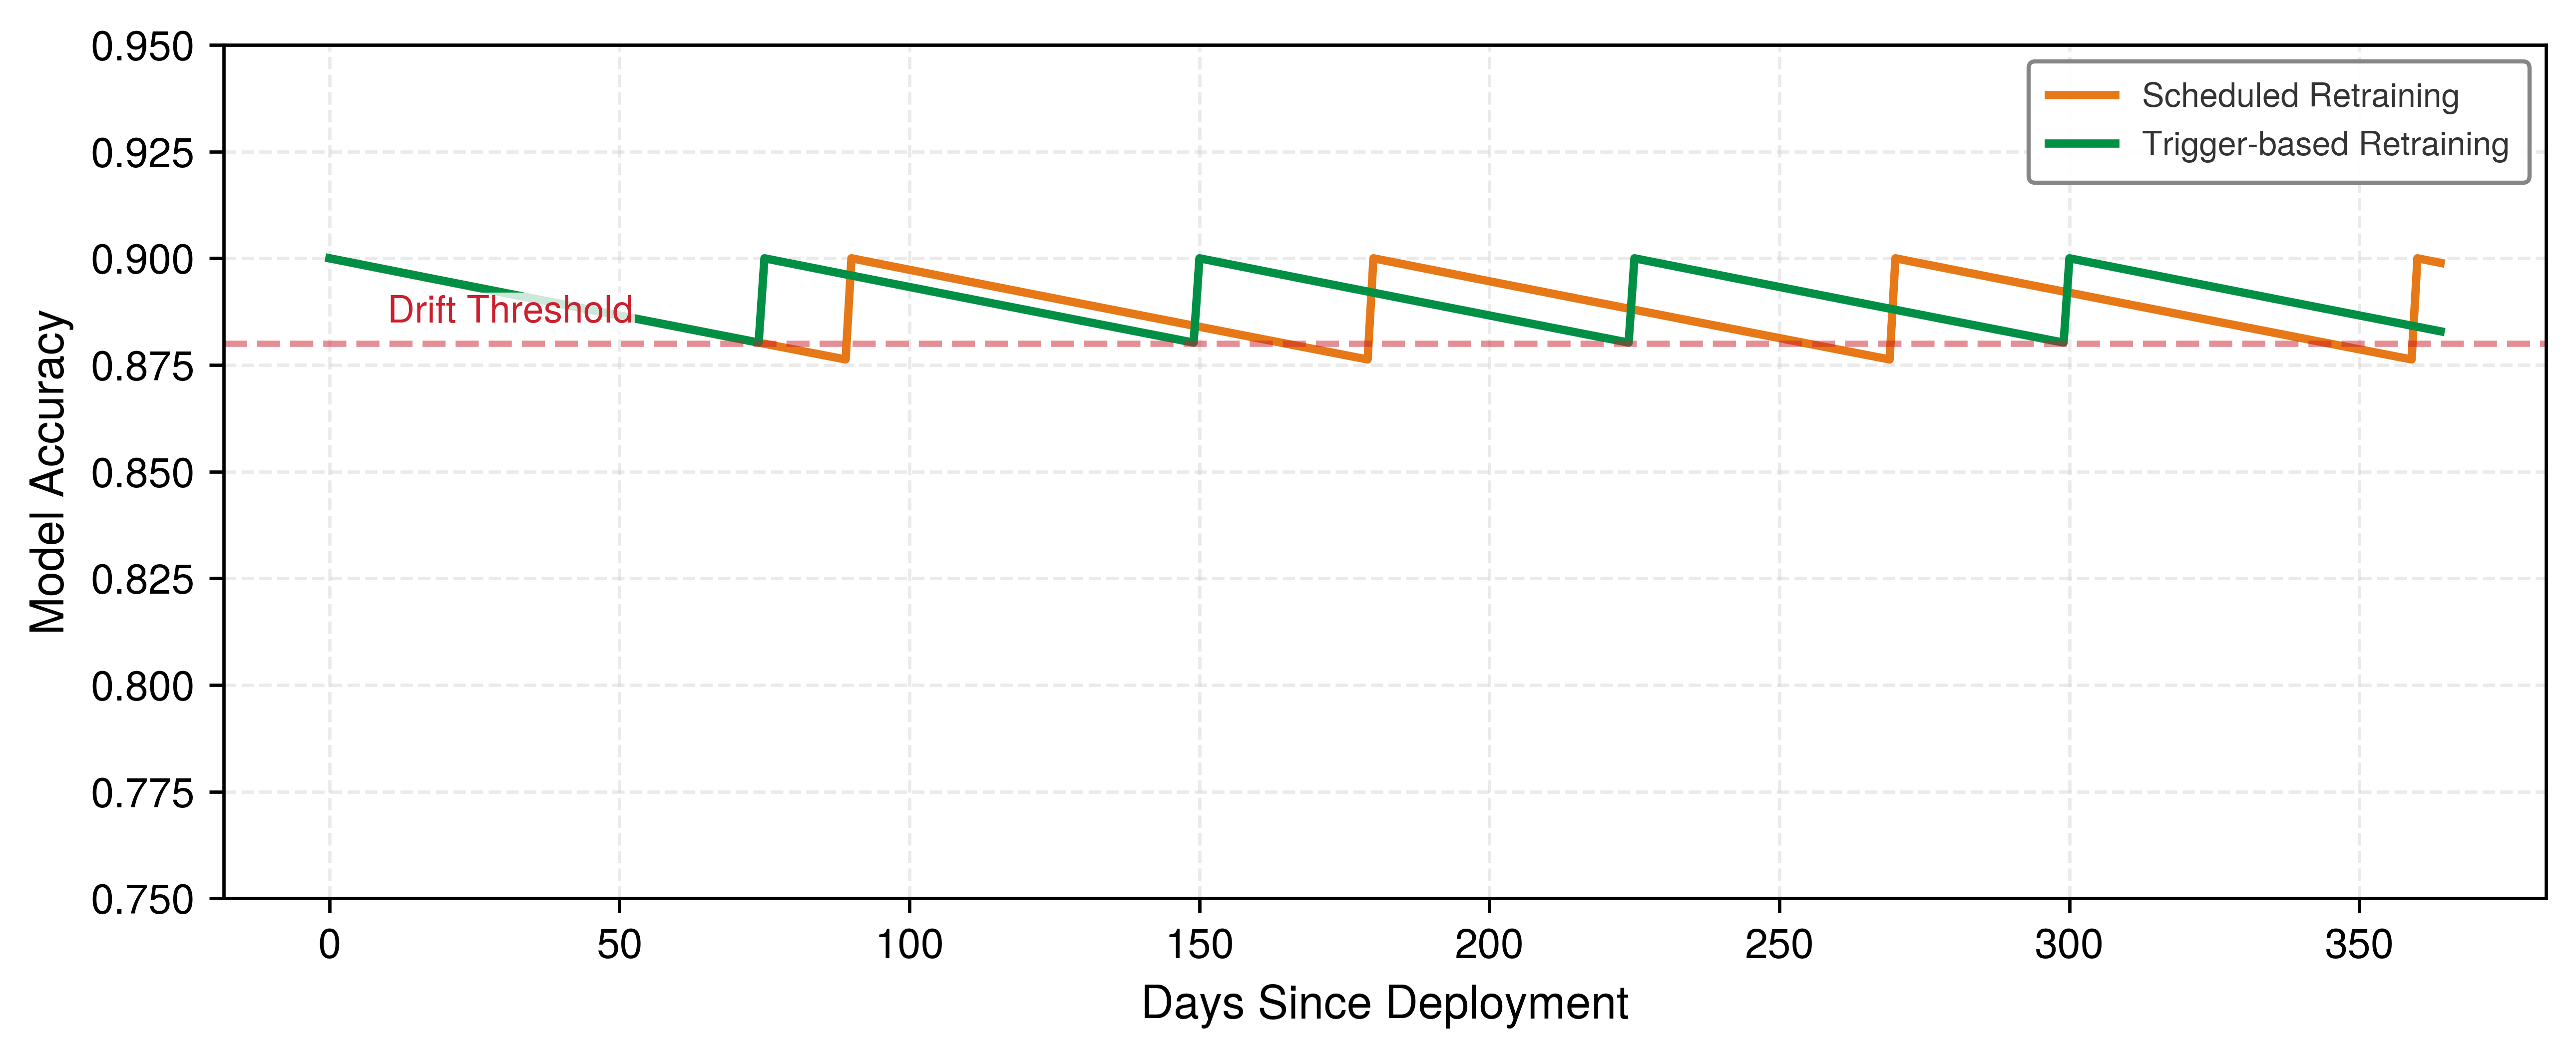
机器学习运维
机器学习运维
本章目的
为什么一个机器学习系统能够在完全可用的同时,给出完全错误的结果?
常规监控通常能迅速检测到崩溃、延迟恶化和可用性故障,但在任何软件系统中,语义错误都可能悄无声息地存在。机器学习系统又增加了一种静默故障模式。发生数据漂移的模型可能继续提供看似正常的预测,而准确率却不断下降;由于每项健康检查(延迟、吞吐量、正常运行时间)仍然显示正常,因此不会触发任何告警。服务基础设施负责将模型投入生产;运维则帮助模型在投入生产后保持正确。世界的变化可能导致模型质量下降。客户行为发生转变,新的产品类别不断出现,季节性模式持续演变,模型学习时所依据的分布逐渐偏离它当前面对的分布。漂移并非必然发生,但它是已部署模型持续面临的风险。与延迟或正常运行时间不同,正确性可能只有在标签或下游结果到来后才能被观测到,因此,检测质量下降往往需要借助不完美的信号并开展明确的调查,而不能仅依靠单一阈值。管理这一问题,需要在持续监控中同时跟踪预测质量和系统健康状况,利用漂移信号触发调查,在结果证据支持时重新训练,并采用部署策略,在全面发布之前利用生产流量验证新模型版本。开发与生产之间的差距并不是跨越一次便能消除的障碍,而是一种需要长期管理的状态。机器学习运维之所以存在,是因为即使系统持续正常运行,若不衡量准确率,仍可能大规模地给出错误答案。它使数据—算法—机器协同设计成为一个持续过程,因为在初次部署很久之后,数据环境仍可能不断变化。
学习目标
- 解释为什么在分布偏移下,机器学习系统仍可保持可用,而预测质量却悄然下降
- 诊断数据与模型、模型与基础设施、生产与监控接口边界上的技术债务
- 设计特征存储、注册中心和 CI/CD 流水线,以保持训练与服务的一致性,并支持可复现的回滚
- 应用重新训练陈旧度模型,选择兼顾成本的重新训练触发条件和时间间隔
- 实现分层监控,覆盖漂移、偏差、质量下降、业务指标和数据新鲜度
- 比较金丝雀、蓝绿、影子和回滚策略在生产模型发布风险方面的差异
- 根据模型关键程度、运维风险和组织准备程度,评估运维成熟度与投入
MLOps 概述
模型完成构建、优化、基准测试并提供服务之后,系统仍须保持正确。基准测试确定某一时点的性能;服务基础设施则在毫秒内响应请求。团队将模型部署到生产环境,第一周的表现非常出色。挑战从第二周开始。
数据分布发生偏移,用户行为发生变化,现实世界逐渐偏离模型训练时的条件。如果缺乏部署后的责任归属和监控,在开发阶段表现成功的机器学习模型可能无法在生产环境中得到持续使用。根本原因是运维要求不匹配:以可用性为中心的监控跟踪服务器正常运行时间、请求延迟和请求成功率,而机器学习监控还必须跟踪统计健康状况,包括准确率随时间的变化、输入分布偏移,以及各细分群体的预测质量。模型可能已经显著退化,却未抛出任何异常、未触发任何基础设施告警,并且始终保持完全正常运行。
使这些不可见故障变得可见的学科,就是机器学习运维(MLOps)。MLOps 将监控、自动化和治理融入生产架构,以检测质量下降、触发重新训练,并在模型的整个运行生命周期内维持系统健康。它继承了 DevOps 的自动化与运维传统 (Kreuzberger et al. 2023),但所应对的故障模式有所不同。常规服务通常可以针对确定性的代码路径进行测试,而机器学习系统则依赖训练数据分布、学习得到的参数,以及持续变化的环境条件。
一个示例部署场景可以具体说明第二周问题。考虑一个用于网约车服务的需求预测系统。初始测量结果显示,其准确率为 94%,p99 延迟为 15 ms,并且在各测试细分群体中表现良好。到第四周,准确率降至 88%,但基础设施指标没有显示任何异常。到第八周,一位产品经理注意到司机调度效率低下;调查发现,模型尚未适应竞争对手新促销活动引起的用户行为变化。模型在六周前就已需要重新训练,但没有任何系统在监测这种质量下降。MLOps 提供了相应框架,用于检测这类漂移、触发重新训练,并在用户受到影响之前验证新模型。
这种运维要求不匹配与本书的分析基础直接相关。如果说基准测试为系统提供了传感器,那么 MLOps 就是完整的控制系统。它通过持续针对变化的世界进行重新校准,弥合验证差距方程(equation)中的验证差距。当配对的漂移数据与结果数据表明分布变化能够预测准确率损失时,MLOps 可以将局部拟合的退化方程(equation)应用于运维;仅有分布差异并不能证明退化必然发生。它还通过持续重新训练、A/B 评估、分阶段发布,以及支持可复现性与可审计性的标准化制品跟踪,将传统上相互隔离的领域(数据科学、机器学习工程和系统运维 (Amershi et al. 2019))之间的接口与职责正式确立起来。
部署、监控和维护一个生产机器学习系统,定义了基本的运维单元:机器学习节点,即面向单个机器学习应用,由数据流水线、特征计算、模型训练、服务基础设施和监控组成的完整系统。更大规模的平台运维,包括管理数百个模型、模型间依赖、多区域协调,以及组织范围内的机器学习平台工程,属于建立在这些单模型基础之上的进阶主题。
管理生产机器学习节点,需要在每个接口上保持可观测性。当这些边界逐渐模糊时,技术债务就会累积;特征存储、CI/CD 流水线和实验跟踪则建立了隔离故障所需的可复现性。在具备可复现的数据和制品之后,持续监控、漂移检测和金丝雀部署能够保护预测质量,使其免受环境偏移的影响。
单模型运维挑战可以分解为三个不同的接口。数据与模型接口是数据基础设施与模型训练之间的交接点;其目标是特征一致性,使训练流水线与服务流水线以相同方式计算特征。模型与基础设施接口是从训练好的权重向可扩展服务的过渡;其挑战是环境一致性,因为在笔记本中正常工作的模型可能因版本、依赖或运行时不匹配而在生产环境中失效。生产与监控接口是实现自我纠正的反馈回路,将统计遥测数据1从生产环境返回训练环节,因为机器学习系统可能因漂移而退化,却并不崩溃。
这些接口决定了基础设施组件如何划分职责。特征存储在数据与模型边界上稳定特征计算。模型注册中心和部署流水线保障模型与基础设施之间的交接。漂移监控器、重新训练触发器和治理策略则闭合生产与监控回路,避免静默退化演变为业务故障。
运行这条反馈路径,需要区分 MLOps 与传统 DevOps,确立指导生产决策的基础原则,并识别这些边界失效时累积的技术债务模式。
原则与基础
一次生产机器学习发布所涉及的内容超出了代码差异:数据分布、学习得到的参数、评估切片和监控反馈回路,都成为会改变运行时行为的发布对象。MLOps 建立在 DevOps 的基础上,用于管理贯穿开发与部署过程的这些数据依赖需求 (Kreuzberger et al. 2023; Amershi et al. 2019)。传统 CI/CD 流水线验证确定性的源代码、配置、单元测试和基础设施清单,而机器学习运维必须治理各类制品,其统计有效性取决于生成它们的数据谱系和执行环境。
Amershi, Saleema, Andrew Begel, Christian Bird, Robert DeLine, Harald Gall, Ece Kamar, Nachiappan Nagappan, Besmira Nushi, and Thomas Zimmermann. 2019. “Software Engineering for Machine Learning: A Case Study.” 2019 IEEE/ACM 41st International Conference on Software Engineering: Software Engineering in Practice (ICSE-SEIP), 291–300. https://doi.org/10.1109/icse-seip.2019.00042.
DevOps 将确定性软件的集成与交付自动化。MLOps 则将这一实践扩展到具有统计性且依赖数据的工作流,涵盖数据采集、预处理、分布式训练、评估、部署和持续监控,并通过迭代闭环连接系统设计、模型开发与在线运维。
Definition 1.1: MLOps
机器学习运维(MLOps)是一种工程实践,通过 CI/CD、工作流编排、可复现性、版本管理、协作、持续训练与评估、监控以及反馈回路,将机器学习系统投入生产 (Kreuzberger et al. 2023)。
- 意义:未能闭合这一回路的代价,表现为预测陈旧、准确率静默下降和恢复时间延长。漂移阈值、重新训练触发条件和平均恢复时间(MTTR)目标,都是因部署而异的量,需要根据预测价值、标签延迟、验证风险和重新训练计算开销进行校准。核心工程实践在于闭环控制:测量分布偏移,估计陈旧成本,仅在预期准确率收益超过执行成本和发布风险时触发重新训练,并在提升替代模型为正式版本之前对其进行验证。
- 区别:DevOps 监控功能正确性、系统吞吐量和基础设施可用性。MLOps 则为预测正确性引入统计控制;即使服务器正常运行时间、请求延迟和 HTTP 状态码完全正常,预测正确性仍可能悄然下降。
- 常见误区:一种常见误解是,使用新数据重新训练会自动解决分布偏移。如果不诊断究竟是哪一种分布发生了偏移——输入特征(\(p(x)\))、标签条件分布(\(p(y \mid x)\)),还是两者都发生了偏移——就进行重新训练,便可能保留底层故障模式,或放大采集偏差。在协变量偏移且具有共同支撑集的条件下,样本重加权或分层重采样可恢复校准;概念漂移则需要新标签和模型适应。
Kreuzberger, Dominik, Niklas Kühl, and Sebastian Hirschl. 2023. “Machine Learning Operations (MLOps): Overview, Definition, and Architecture.” IEEE Access 11: 31866–79. https://doi.org/10.1109/access.2023.3262138.
沿着 figure 1 中的无穷循环结构,可以看到运维遥测如何将经验证据反馈到设计与工程中,形成这一学科持续运行的形态:
\scalebox{0.6}{%
\begin{tikzpicture}[line join=round,font=\sffamily,outer sep=0pt,  radius=2, start angle=-90]
\tikzset{
arr node/.style={sloped, allow upside down, single arrow,
single arrow head extend=+.12cm, thick, minimum height=+.6cm, fill=white},
arr/.style ={  edge node={node[arr node, pos={#1}]{}}},
arr'/.style={insert path={node[arr node, pos={#1}]{}}},
}
\begin{scope}[shift={(0,0)},scale=1.1, every node/.append style={transform shape}]
\draw[line width=7mm, sloped, text=white,GreenD!60]
 (0, 2) edge[preaction={line cap=butt, line width=10mm, draw=white, overlay},
              out=0, in=180, arr=.1, arr=.8] (5, -2)
(5,-2)to[out=0, in=180, arr=.2, arr=.9](10,2)
arc[start angle=90, delta angle=-180][arr'=.5]
(10,-2)edge[preaction={line cap=butt, line width=10mm, draw=white, overlay},out=180, in=0, arr=.1, arr=.8](5,2)
(5,2)to[out=180, in=0, arr=.2, arr=.9](0,-2)
arc[start angle=-90, delta angle=-180][arr'=.5] ;
\end{scope}
\node[align=center,blue!50!black]at(0,0){设计};
\node[align=center,BrownLine!50!black]at(5.5,0){模型\\ 开发};
\node[align=center,GreenD!80!black]at(11,0){运维};
%
\node[align=left,anchor=north,blue!50!black]at(0,-3){$\bullet$ 需求工程\\
$\bullet$ 机器学习用例优先级排序\\
$\bullet$ 数据可用性检查};
\node[align=left,anchor=north,BrownLine!50!black]at(5.75,-3){$\bullet$ 数据工程\\
$\bullet$ 机器学习模型工程\\
$\bullet$ 模型测试 \& 验证};
\node[align=left,anchor=north,GreenD!80!black]at(11.25,-3){$\bullet$ 机器学习模型部署\\
$\bullet$ CI/CD 流水线\\
$\bullet$ 监控 \& 触发};
\end{tikzpicture}}推荐服务清楚地揭示了在缺乏规范运维工具的情况下部署机器学习所带来的运维复杂性和财务风险。新部署的排序模型最初提高了转化率,但渐进的数据漂移持续削弱预测质量。由于常规监控跟踪的是服务器正常运行时间、请求延迟和 HTTP 成功率,而非推理准确率,因此这种损失一直未被察觉,直到数月后的汇总收入审查才被发现。MLOps 提供运维控制机制,在这些静默的统计故障累积成重大财务损失之前将其暴露出来。
基础原则
上述推荐系统故障说明了一种系统性模式:缺乏规范的运维控制时,即使准确的模型也会在生产环境中静默失效。调试此类事件,需要按结构化顺序执行运维检查。当收入下降时,首要任务是重建已部署模型的状态,这需要可复现性。接下来要确定数据流水线、训练作业、服务路径和监控服务是否保持清晰边界,以便隔离缺陷,这需要关注点分离。如果在线服务特征偏离离线训练特征,一致性就提供了防止偏差反复出现的不变量。如果漂移在用户投诉之前就已开始,可观测的退化就能将静默故障转化为可采取行动的告警。最后,当重新训练可行但计算开销较高时,成本感知自动化会评估干预是否值得付出相应的计算开销并承担运维发布风险。这些原则定义了工程团队为隔离和解决生产故障而执行的运维序列中的控制机制。
可复现性
可复现性要求对影响模型行为的每一项制品2进行版本管理,并确保其可追溯。这一原则超越了代码仓库的范围,还涵盖输入数据集、特征模式、超参数配置和执行环境。Equation 1 形式化地表达了这种依赖关系: \[\text{Model Output} = f(\text{Code}_v, \text{Data}_v, \text{Config}_v, \text{Environment}_v; \xi) \tag{1}\] 其中,\(v\) 标识不可变的版本哈希,\(\xi\) 表示执行过程中的非确定性。精确复现需要冻结全部四项版本化输入,同时固定随机种子、数据加载器的样本顺序、确定性 GPU 归约内核(防止异步原子加法因浮点运算不满足结合律而产生数值偏移),并使用相同的加速器硬件架构。
关注点分离
关注点分离将 MLOps 系统分解为能够独立演进的不同功能层,如 table 1 所示:
| 层 | 职责 | 稳定性 |
|---|---|---|
| 数据层 | 特征计算、存储、服务 | 随数据模式演进而变化 |
| 训练层 | 模型开发、超参数优化 | 随算法研究而变化 |
| 服务层 | 推理、扩缩容、延迟管理 | 随流量模式而变化 |
| 监控层 | 漂移检测、性能跟踪 | 随业务需求而变化 |
一致性要求
table 1 中的架构边界使团队能够在不重新训练模型的情况下升级服务运行时,在不重新部署的情况下调整告警阈值,并在保持接口契约的同时修改数据摄取流水线。只有当训练环境与服务环境以完全相同的方式处理特征时,这种架构独立性才是安全的,因此,训练与服务一致性是一项必要要求。equation 2 刻画了这种差异造成的财务后果: \[\text{Skew Cost} = \text{Rate}_{\text{skew}} \times Q \times C_{\text{error}} \tag{2}\] 其中,\(\text{Rate}_{\text{skew}}\) 是受训练与服务偏差影响的查询比例,\(Q\) 是每个核算周期的查询总量,\(C_{\text{error}}\) 是每次错误预测造成的平均业务成本。
对于一个以 1,000,000 queries/day 的速率提供服务的系统,如果偏差导致的错误占比为 1 percent,每次错误成本为 $0.10,那么年度偏差成本将达到 $365,000。这一量化结果说明,一致性机制是一项具有可衡量财务回报的投资。共享特征存储、在离线训练与在线服务中以相同方式调用的统一 C++ 或 Rust 特征提取库,以及自动化模式验证测试,都能在系统边界上直接确保这种一致性。
可观测的退化
可观测的退化要求机器学习系统通过持续测量,使静默故障变得可见。模型准确率沿连续的统计谱逐渐下降,而不是以离散的二元崩溃形式失效。观测到的故障在时间上的表现——无论是骤降、渐进漂移,还是局部群体的质量下降——同时决定了检测机制和运维响应。
成本感知自动化
成本感知自动化在计算成本与准确率提升之间进行权衡。令 \(\Delta\text{Accuracy}\) 表示以百分点计的预期准确率增益,\(\text{Value per Point}\) 表示在决策时间范围内每提升一个百分点的货币价值,\(\text{Training Cost}\) 表示一次重新训练运行的计算与人力成本,\(\text{Deployment Risk}\) 表示验证和上线失败的预期成本。Equation 3 对这一权衡进行建模: \[\text{Retrain if: } \Delta\text{Accuracy} \times \text{Value per Point} > \text{Training Cost} + \text{Deployment Risk} \tag{3}\]
该不等式充当运维决策关卡,而非不受约束的触发条件:只有当实证证据表明预期准确率增益超过执行成本与上线风险时,自动化流水线才应启动重新训练。这一经济权衡支配着重新训练的触发条件、验证阈值和上线关卡;section 1.4.2.2 将此模型形式化,以计算最优重新训练周期。
要检测何时应触发干预,需要为每种故障特征匹配适当的遥测数据与运维应对措施,如 table 2 所示:
| 退化类型 | 检测机制 | 应对策略 |
|---|---|---|
| 准确率骤降 | 阈值告警 | 诊断;若与发布有关则回滚 |
| 渐进漂移 | 趋势分析 | 先诊断,再根据需要重新训练 |
| 子群体退化 | 队列监控 | 定向数据采集 |
| 延迟增加 | 百分位数跟踪 | 基础设施扩容 |
每项基本原则只有落实到具体、可度量的指标上,才能付诸运维实践(table 3)——这些指标涵盖从制品哈希值到重新训练净价值的各个方面:
| 原则 | 核心洞见 | 关键指标 |
|---|---|---|
| 可复现性 | 对所有制品进行版本管理 | 完整制品哈希值 |
| 关注点分离 | 各层独立演进 | 层间耦合评分 |
| 一致性 | 训练与服务保持一致 | 特征偏差率 |
| 可观测退化 | 使故障可见 | 检测耗时 |
| 成本感知自动化 | 优化总成本 | 重新训练净价值 |
这些原则在实践中的体现方式取决于工作负载。推荐系统会随着用户偏好的变化而每日发生漂移;部署在嵌入式硬件上的 TinyML 模型则可能数月保持不变。监控策略必须与工作负载类型相匹配。
Lighthouse 1.1: 按典型工作负载制定监控策略
不同典型工作负载的主要故障模式和监控重点各不相同。Table 4 从漂移模式、监控指标和重新训练触发条件示例三个方面比较了四种代表性工作负载:
| 典型工作负载 | 主要漂移模式 | 主要监控指标 | 重新训练触发条件示例 |
|---|---|---|---|
| ResNet-50(计算巨兽) | 视觉分布偏移(光照、摄像头、新物体类别) | 留出集上的准确率(有真实标签可用) | 准确率相对于基线下降 > 2%(稳定领域约为每月一次,\(\sim\)) |
| GPT-2(带宽大户) | 词汇漂移、主题偏移、新实体出现 | 实时流量上的困惑度(无需真实标签) | 困惑度增加 > 10%;检测到新词汇(新闻领域约为每周一次,\(\sim\)) |
| DLRM(稀疏散布) | 用户行为偏移、商品目录更替、冷启动商品 | 相对于历史队列的 CTR/CVR 变化 | 参与度下降 > 5%;目录更新(电商领域约为每日一次,\(\sim\)) |
| DS-CNN(微型约束) | 声学环境变化(本底噪声偏移) | 占空比(唤醒次数/小时)+ 假阳性率 | 误唤醒率 > 1%;电池消耗超出规格要求(OTA 更新约为每季度一次,\(\sim\)) |
系统洞见:真实标签的可用性与物理瓶颈决定监控设计。受 \(O/(R_{\text{peak}} \cdot \eta_{\text{hw}})\) 限制的计算受限视觉模型(ResNet-50)跟踪留出集准确率;受 \(D_{\text{vol}}/\text{BW}\) 限制的内存密集型语言模型与推荐模型(GPT-2、DLRM)可能依赖困惑度或隐式点击;受严格延迟 \(L_{\text{lat}}\) 与能耗上限约束的微控制器模型(DS-CNN)则监控占空比与误唤醒率。重新训练周期受到标签延迟、部署访问条件、验证成本以及观测到的变化速率的制约。
这些原则旨在应对反复出现的运维故障:概念漂移、3数据质量缺陷 (Schelter et al. 2018),以及部署后的静默退化。这些因素促使 MLOps 与传统 DevOps 分化:系统健康状况不能仅以可用时间或延迟来衡量。规范的运维要求监控数据分布与模型输出的统计属性,将关注重点从基本的服务器可用性转向预测正确性。
Schelter, Sebastian, Matthias Boehm, Johannes Kirschnick, Kostas Tzoumas, and Gunnar Ratsch. 2018. “Automating Large-Scale Machine Learning Model Management.” Proceedings of the 2018 IEEE International Conference on Data Engineering (ICDE), 137–48.
MLOps 协调范围更广的利益相关方生态,并引入超出传统软件工程范畴的专门实践,例如数据版本管理、4模型版本管理和持续统计监控。这一扩展后的范围使模型运维成为持续的反馈循环,而非线性的发布流水线,table 5 从多个维度对此进行了比较:
| 方面 | DevOps | MLOps |
|---|---|---|
| 目标 | 简化软件开发与运维流程 | 优化机器学习模型的生命周期 |
| 方法 | 面向软件开发的持续集成与持续交付(CI/CD) | 与 CI/CD 类似,但侧重机器学习工作流 |
| 主要工具 | 版本控制(Git)、CI/CD 工具(Jenkins、Travis CI)、配置管理(Ansible、Puppet) | 数据版本管理工具、模型训练与部署工具、面向机器学习定制的 CI/CD 流水线 |
| 主要关注点 | 代码集成、测试、发布管理、自动化、基础设施即代码 | 数据管理、模型版本管理、实验跟踪、模型部署、机器学习工作流的可扩展性 |
| 典型成果 | 更快、更可靠的软件发布,以及开发团队与运维团队之间更好的协作 | 高效管理和部署机器学习模型,以及数据科学家与工程师之间更好的协作 |
Checkpoint 1.1: MLOps 循环
MLOps 是循环的,而非线性的。
反馈周期
制品
运维循环的每次迭代都可能引入标准软件测试无法发现的数据依赖、模型交互和配置漂移。这些不断累积的成本构成了技术债务:这一工程框架将静默的统计故障模式转化为可量化的负债。
传统 DevOps 处理部署吞吐量与服务扩展问题,而 MLOps 必须在技术债务破坏服务系统的稳定性之前将其隔离并处理。边界侵蚀说明了模块化流水线设计为何不可或缺;修正级联揭示了严格的制品版本管理与即时回滚为何至关重要;未声明的使用方则说明了强制执行特征模式与契约测试的必要性。这些债务模式提供了诊断术语和具体故障模式,也构成了本书后续各部分所讨论的专用 MLOps 基础设施的建设动因。
技术债务
生产环境中机器学习的静默故障模式具体表现为技术债务 (Sculley et al. 2015):上游分布偏移、反馈循环和未进行版本管理的流水线依赖会导致准确率退化,并随时间不断累积。这些故障跨越系统边界无形积累,要求运维架构在考虑传统软件契约的同时,也考虑统计行为与数据依赖。技术债务这一比喻最初于 20 世纪 90 年代在软件工程领域提出,5它将实现过程中的捷径类比为金融债务,即以持续的维护开销与系统性风险换取短期交付速度 (Cunningham 1992)。在机器学习系统中,这类债务超出了可执行代码的范围,还涵盖统计依赖与未经验证的数据流。ML Test Score (Breck et al. 2017) 等系统化评估标准提供了相应框架,用于量化这类债务,并评估数据、模型和基础设施各接口的生产就绪程度。
Definition 1.2: 机器学习中的技术债务
机器学习中的技术债务是机器学习系统中由隐式数据依赖、相互纠缠的特征以及未声明的使用方所产生并不断累积的维护与变更成本,由此形成的负债也可能表现为静默的准确率退化。
- 意义:Google 对生产环境机器学习系统的分析指出,模型代码仅占外围系统的一小部分;更广泛的运维范围包括数据采集、特征提取、配置、服务基础设施、监控和流程管理 (Sculley et al. 2015)。机器学习特有的债务驱动因素进一步加剧了这一问题:改变一个输入特征可能静默地改变其他所有特征的学习表示(纠缠);训练一个模型来修正另一个模型的错误,会形成脆弱的依赖链(修正级联);在没有显式契约的情况下使用模型输出的下游系统,会成为未声明的使用方,并在模型更新时发生静默故障。
- 区别:机器学习技术债务包含代码审查和普通的、以代码为中心的测试可能遗漏的系统级与数据级依赖。即使可用性指标仍然正常,它也可能拖慢开发并降低预测质量。
- 常见误区:一个常见误解是,“更好的代码”能够解决机器学习中的技术债务。实际上,这是一个系统架构问题:当训练分布的假设(特征取值范围、标签含义、数据新鲜度)未在系统边界被作为运行时契约强制执行时,债务就会累积。
盈亏平衡计算能够具体说明技术债务的成本动态。团队往往抵触自动化投入,因为在开发初期,手动流程看起来更快;但一旦反复进行的手动干预成本超过前期自动化成本,这一优势就会消失。
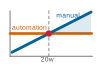
累计手动工作量在第 20 周附近超过一次性自动化投入。
手动运维很快就会触及容量上限,因为建模代码仅占真实部署的一小部分。如 figure 2 所示,更广泛的运维范围涵盖十个相互关联的组件,从数据验证到机器资源管理,每个组件都可能累积隐性负债。核心机器学习代码只占其中一个方框,其余九个都需要持续的运维维护。
\scalebox{0.73}{%
\begin{tikzpicture}[line join=round,font=\small\sffamily]
\tikzset{%
planet/.style = {circle, draw=none,
semithick, fill=blue!30,
                    font=\sffamily\bfseries, ball color=green!70!blue!70,shading angle=-15,
                    text width=27mm, inner sep=1mm,align=center},
satellite/.style = {circle, draw=#1, semithick, fill=#1!30,
                    text width=18mm, inner sep=1pt, align=flush center,minimum size=21mm},%<---
arr/.style = {-{Triangle[length=3mm,width=6mm]}, color=#1,
                    line width=3mm, shorten <=1mm, shorten >=1mm}
}
%planet
\node (p)   [planet]    {机器学习系统};
%satellites
\foreach \i/\j [count=\k] in {red/{机器资源管理},
cyan/{配置},
purple/{数据采集},
green/{数据验证},
orange/{服务基础设施},
yellow/{监控},
Siva/{特征提取},
magenta/{机器学习代码},
violet/{分析工具},
teal/{流程管理工具}
}
%connections
{
\node (s\k) [satellite=\i,font=\footnotesize\sffamily] at (\k*36:3.8) {\j};
\draw[arr=\i] (p) -- (s\k);
}
\end{tikzpicture}}Napkin Math 1.1: 手动运维的累积成本
问题:既然手动重新训练更快,为什么还要构建自动化流水线?
物理规律:手动工作会随时间累积。
- 手动重新训练:每周投入 4 hours 的工程工作。
- 流水线构建:一次性投入 80 个工程工时。
数学计算:
- 结果:80 个工程工时 \(\div\) 每周 4 hours = 20 weeks。
- 陷阱:这假设模型始终不变。
- 局限:新增特征可能增加手动工作量。
- 后果:经过 1 year 后,采用手动流程的团队仍需每周花费 4 hours 进行维护。在这一简化计算中,采用流水线的团队产生的持续性工时为 0。
背景:系统工程的一条核心规律是,系统全生命周期内的维护成本可能超过其构建成本。在机器学习中,技术债务尤其危险,因为它往往由数据驱动,而非由代码驱动:即使代码完美无缺,也可能因其处理的数据发生偏移而失效。度量构成管理的边界:没有遥测数据,团队就无法判断维护工作是在减少债务,还是仅仅将其掩盖起来。
系统洞见:自动化解决的是容量限制,而不仅仅是速度问题。采用手动流程的团队最终会达到这样一个临界点:维护现有模型使其无力部署新模型。MLOps 通过系统化的可观测性与自动化来应对这一问题。如果没有监控基础设施使静默故障变得可见,团队就会不断累积债务,并构建出一个越来越难以管理的系统。
自动化能够减少手动重新训练带来的持续运维开销,但无法阻止架构退化。已部署系统会通过系统性故障模式累积隐性复杂性,而这些故障模式源自统计耦合,而非确定性逻辑。Figure 3 展示了横跨数据、模型与基础设施的六种债务模式,明确了运维架构必须隔离的故障模式。
\scalebox{0.75}{%
\begin{tikzpicture}[line join=round,font=\small\sffamily]
\tikzset{%
planet/.style = {circle, draw=none,semithick, fill=RedLine!30,
                    font=\sffamily\bfseries,
                    text width=27mm, inner sep=1mm,align=flush center},
satellite/.style = {rectangle, draw=#1, semithick, fill=#1!20,
                    text width=18mm, inner sep=1pt, align=flush center,minimum size=21mm,minimum height=10mm},
satellite1/.style = {rectangle, draw=#1, semithick, fill=#1,anchor=east,
                   inner sep=1pt, align=flush center,minimum size=2.5mm,minimum height=10mm},
arr/.style = {-{Triangle[length=3mm,width=6mm]}, color=#1,
                    line width=3mm, shorten <=1mm, shorten >=1mm},
TxtL/.style = {font=\footnotesize\sffamily,text width=30mm,align=flush right},
TxtR/.style = {font=\footnotesize\sffamily,text width=30mm,align=flush left},
TxtC/.style = {font=\footnotesize\sffamily,text width=30mm,align=flush center}
}
%planet
\node (p)   [planet]    {隐性技术债务};
%satellites
\foreach \i/\j/\radius/\sho [count=\k] in {
  red/{配置债务}/3.1/7pt,
  cyan/{反馈循环}/3.1/7pt,
  Siva/{数据债务}/4.0/10pt,
  green!65!black/{流水线债务}/3.1/7pt,
  orange/{修正级联}/3.1/7pt,
  yellow!80!red/{边界侵蚀}/4.1/10pt
}
{
%Satelit
\node (s\k) [satellite=\i,font=\footnotesize\sffamily] at (\k*60:\radius) {\j};
%Decoration
\node[satellite1=\i](DE\k) at (s\k.west) {};
%Arrows
\draw[arr=\i,shorten >=\sho] (p) -- (s\k);
}
\node[TxtL,left=2pt of DE2]{\textbf{未声明的使用方:} 隐藏的模型依赖};
\node[TxtR,right=2pt of s1.east,anchor=west]{\textbf{参数蔓延:}\\ 临时设置与
硬编码值};
\node[TxtL,left=2pt of DE4]{\textbf{脆弱的工作流:} 紧密耦合};
\node[TxtR,text width=40mm,right=2pt of s5.east,anchor=west]{\textbf{顺序依赖:}
上游修复破坏下游系统};
\node[TxtL,left=10pt of s3]{\textbf{质量问题:} 格式
与分布不一致};
\node[TxtR,right=2pt of s6]{\textbf{CACE 原则:}
改变任何事物都会改变一切};
\end{tikzpicture}}边界侵蚀
系统边界的消解是统计软件的主要失效模式。在传统软件中,模块化封装提供了明确的隔离:组件通过带类型的 API 交互,使内部实现能够发生变化,同时保持系统行为的确定性。机器学习系统模糊了这些边界,因为组件行为取决于输入数据的经验分布,而非语法层面的接口定义。上游的格式修改或归一化变更可能通过所有单元测试,却在不被察觉的情况下改变特征分布,降低下游模型的准确率。这种通过数据流水线形成的隐式耦合,在特征工程、训练流水线和服务端点之间建立了未受监控的依赖关系。
这种侵蚀会产生纠缠,即特征与组件之间的依赖关系交织得如此紧密,以至于局部修改也需要全局协调。由此产生的失效模式体现了 CACE 原则:改变任何事物都会改变一切。当系统缺乏严格的分布边界时,调整单个特征编码或数据过滤阈值,就会改变整个模型中学得的权重。例如,改变连续特征的分箱策略会改变该特征的方差和协方差结构,导致此前已校准的模型性能下降,并迫使下游重新校准,其影响会波及各个依赖服务。
防范边界侵蚀需要在运行时强制落实架构的模块化。组件需要明确的数据契约,以约束统计不变量,包括允许的特征取值范围、空值容忍度和漂移阈值。将数据摄取、特征生成和推理逻辑分离,可以建立验证边界,在数据分布影响模型权重之前对其进行验证。由于边界侵蚀在最初的原型开发阶段不会显露,建立明确的模式契约和不变量检查,是防止统计耦合逐渐蔓延的唯一可靠防线。
修正级联
当边界侵蚀未得到处理时,工程干预往往会触发修正级联:通过辅助补丁修复某个模型缺陷,却在其他位置引入次生错误,进而需要更多补偿性修复,最终破坏整个流水线的稳定性。在机器学习系统中,这类级联尤为严重,因为变更通过统计依赖关系传播,而非通过确定性的代码分支传播。为纠正某一组假阳性而重新训练模型,可能降低此前表现稳定的群体中的准确率。添加辅助模型以覆盖边缘情形的预测,会引入未经校准的残差,进而干扰下游使用方。每个补丁都会触发后续修正,消耗的工程工作量很快就会超过使用干净数据重新训练的成本。
Figure 4 将级联结构呈现为一条相互依赖的模型链。每个模型都经过训练,用于纠正前一个模型的错误:模型 B 补偿模型 A 的残余错误,模型 C 补偿模型 B 的残余错误,依此沿模型链延续。只要上游模型不变,这种安排就能维持。当重新训练模型 A 以修复某种失效模式时,所有针对其先前行为调优的下游模型会同时失效,每个模型都必须重新修正。红色弧线描绘了这种传播,展示一个看似局部的修复如何影响整条模型链。靠近链首的变更会迫使团队进行最多的返工,而靠近链尾的变更几乎不产生额外成本。对于运维团队而言,一个变更请求就可能触发整条模型链的协同重训练。
\begin{tikzpicture}[font=\small\sffamily, >=stealth]
\tikzset{
Line/.style={line width=0.5pt,black!50,text=black},
LineA/.style={-{Triangle[width=7pt,length=11pt]},line width=1pt,black!50,text=black},
LineD/.style={-{Triangle[width=7pt,length=11pt]},crimson,line width=1.5pt,rounded corners=15pt,
dashed,dash pattern=on 7pt off 5pt},
Box/.style={align=center, inner xsep=2pt,draw=none, line width=1pt,fill=none,
minimum width=30mm, minimum height=25mm,node distance=1.0},
Box1/.style={align=center, inner sep=5pt,draw=none, line width=1pt,fill=crimson,text=white,
 minimum width=18mm, minimum height=7mm,font=\small\sffamily\bfseries,rounded corners=7pt},
Text2/.style={font=\sffamily\bfseries\small,align=center},
Text3/.style={font=\sffamily\bfseries\small,align=center,redd},
}
\definecolor{redd}{HTML}{A31F34}
\definecolor{blueeD}{HTML}{4A90C4}
\definecolor{blueeL}{HTML}{CFE2F3}

%model
\tikzset{%
 pics/model/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=MODEL,scale=\scalefac, every node/.append style={transform shape}]
\foreach \i in {1,...,3}{
  \pgfmathsetmacro{\y}{(-\i)*0.37}
  \node[circle,draw, minimum size=2.5mm,inner sep=0pt,fill=red](2K\i) at(0,\y){};
}
\foreach \i in {1,...,3}{
  \pgfmathsetmacro{\y}{(-\i)*0.37}
  \node[circle,draw, minimum size=2.5mm,inner sep=0pt,fill=brown](3K\i) at(0.6,\y){};
}
\foreach \i in {1,...,2}{
  \pgfmathsetmacro{\y}{-(3.5-\i)*0.37}
  \node[circle,draw, minimum size=2.5mm,inner sep=0pt,fill=cyan](1K\i) at(-0.6,\y){};
}
\foreach \i in {1}{
  \pgfmathsetmacro{\y}{-(3.0-\i)*0.37}
  \node[circle,draw, minimum size=2.5mm,inner sep=0pt,fill=green!40!black](4K\i) at(1.2,\y){};
}
\foreach \i in {1,...,2}{
  \foreach \j in {1,...,3}{
\draw[Line](1K\i)--(2K\j);
}}
\foreach \i in {1,...,3}{
  \foreach \j in {1,...,3}{
\draw[Line](2K\i)--(3K\j);
}}\foreach \i in {1,...,3}{
  \foreach \j in {1}{
\draw[Line](3K\i)--(4K\j);
}}
 \end{scope}
     }
  }
}
\pgfkeys{
  /channel/.cd,
  scalefac/.store in=\scalefac,
  scalefac=1,
}

\begin{scope}[local bounding box=mainfig]
%Models
\foreach \name/\x/\title/\subtitle/\picid in {
  B1/0/{模型 A}/{基础预测}/1,
  B2/6/{模型 B}/{纠正 A}/2,
  B3/12/{模型 C}/{纠正 B}/3,
  B4/18/{模型 D}/{纠正 C}/4
}{
  % osnovni box
  \node[Box] (\name) at (\x,0) {};

  % gornji i donji fill
  \fill[cyan!07] (\name.north west)
    rectangle ($( \name.north east)!0.6!(\name.south east)$)
    coordinate (\name DE);

  \fill[cyan!20] (\name.south east)
    rectangle ($( \name.north west)!0.6!(\name.south west)$)
    coordinate (\name LE);

  % spoljašnja linija / border
  \node[Box,draw=blueeD] at (\name.center) {};

  % tekst u box-u
  \node[Text2] at ($(\name.south west)!0.5!(\name DE)$)
    {\title\\
    \textcolor{black!70}{\sffamily\subtitle}};

  % koordinata za ikonicu / pic
  \coordinate (\name Q) at ($(\name.north west)!0.5!(\name DE)$);

  % pic
  \pic[shift={(-0.3,0.73)}] at (\name Q)
    {model={scalefac=1.0}};
}
%%%
\foreach \x in {2,3,4}{
\node[below=3pt of B\x.south,Text3]{必须重新修正};
}
%
\draw[LineD](B1.north)--++(0,17.8mm)-|(B4.north);
\draw[LineD](B1.north)--++(0,14.0mm)-|(B3.north);
\draw[LineD](B1.north)--++(0,10.5mm)-|(B2.north);
%
\node[Box1,above=5pt of B1.north]{变更};
\end{scope}

\draw[LineA](B1)--(B2);
\draw[LineA](B2)--(B3);
\draw[LineA](B3)--(B4);
%
\node[below =8mm of mainfig.south,font=\small\sffamily\itshape,
black!70]{对上游模型的一次修复,会迫使所有
下游修正重新进行。};

\coordinate(L1)at($(B2.south)+(-6mm,-11mm)$);

\begin{scope}[local bounding box=MC,shift={($(L1)+(0,0)$)}]
\node[](LT1) at(L1){修正依赖};
\draw[LineA](LT1.west)+(180:15mm)--(LT1.west);

\node[right=49mm of LT1](LT2) at(L1){变更向下游传播};
\draw[LineD](LT2.west)+(180:15mm)--(LT2.west);
\end{scope}
\end{tikzpicture}这种传播将局部模型修复转变为贯穿整个生命周期的工程依赖。顺序式模型开发是一个常见来源:微调或复用已有模型可以加快初始部署,但也会将下游系统锁定在源模型的潜在假设和表征偏差之中。随着时间推移,这些继承而来的属性会成为刚性的架构约束,使未来更新更加复杂。
例如,为新产品线微调现有的客户流失模型,会继承基础模型的特征编码和校准阈值。如果新产品表现出不同的用户参与模式,使用辅助后处理规则修补预测错误,就会形成脆弱的多阶段流水线。当准确率下降时,工程团队才发现,根本问题位于上游数层之前的原始标注约定中。
缓解修正级联需要在组件复用与重新设计之间取得平衡。微调虽然能降低初始计算和数据采集成本,但从头训练可以完全控制模型假设,并消除对上游错误的依赖。这一架构决策取决于任务相似度、协变量对齐程度,以及链式模型的持续维护成本。在无法避免模型依赖的情况下,系统必须通过固定版本的模型制品和冻结的中间表征来实现解耦。
接口与依赖挑战
边界侵蚀和修正级联都源于绕过正式软件契约的接口依赖。传统软件依赖通过导入语句、包管理器和 RPC 模式声明,使静态分析工具能够绘制依赖图。在机器学习系统中,依赖关系隐藏在数据流内部。当模型 A 的输出被记录到数据仓库,随后作为模型 B 的训练特征被摄取时,这种耦合仅存在于数据流水线中,静态代码分析无法发现。
隐藏耦合往往表现为未声明的使用方,即下游服务在未正式注册或未签订服务级别协议的情况下使用模型预测。当上游模型重新训练或其输出分布发生偏移时,这些未被追踪的使用方会静默失效。例如,自动化营销系统使用信用风险评分,可能改变申请人群体的构成,将偏移后的分布反馈到未来的训练运行中,并诱发失控的选择偏差。数据依赖债务 会进一步加剧这一脆弱性:当机器学习流水线摄取未进行版本管理的表、不稳定的上游特征或分布易变的信号时,这类债务就会不断累积。
消除接口债务需要由基础设施强制实施边界:对模型预测端点实行严格的身份验证和注册,为特征存储建立机器可读的模式契约,并通过自动化数据血缘追踪,在授予读取权限之前登记使用方。
系统演进挑战
即使机器学习系统设计良好、接口文档完备,也会遇到确定性软件中不存在的演进挑战。
这些动态机制中最隐蔽的是反馈循环,即已部署模型会影响用于训练后续模型的数据分布。推荐系统直接体现了这一模式:推荐内容决定用户参与行为,点击生成后续训练集,模型不断强化自身过去的选择,同时使未被选中的内容缺乏曝光。在生产环境中,这种失效模式通常表现为不同人口群体之间的性能差距不断扩大:代表性不足的群体得到次优预测,由此生成偏斜的参与日志,进一步削弱该群体在后续重训练中的代表性。检测反馈循环需要按群体分层监控,追踪不同用户群体的错误分布,而非依赖汇总验证指标。
经过反复部署,工作流会累积流水线与配置债务,逐渐演变为临时性胶水脚本和各不相同的超参数文件交织的丛林。当流水线缺乏模块化接口时,团队会复制现有脚本,而非重构脆弱的数据加载器,从而产生冗余流水线,以存在细微差异的方式处理相同的原始输入。快速原型开发还经常将业务逻辑直接嵌入特征准备脚本,进一步加剧这一问题。控制流水线演进需要工作流编排引擎,具备不可变的有向无环图(DAG)定义、严格的参数验证,以及与模型代码纳入同一源代码管理体系的配置版本管理。
代码与架构债务
除了统计耦合和数据流,机器学习系统还会累积代码层面的技术债务,使基础设施重构陷入停滞 (Sculley et al. 2015)。
在实现层面,胶水代码 往往占据生产代码仓库的主体。为了在通用机器学习框架、专用特征流水线和低延迟服务引擎之间传递张量与记录,团队会编写大量集成封装代码。在生产环境中,这类样板代码最多可占代码库的 95%,而核心机器学习逻辑仅占 5%。由此形成的对框架特定 API 的紧密耦合,会带来严重的维护负担:上游框架的小幅更新也会迫使团队大规模重写外围集成支撑代码。将第三方库隔离在稳定的内部接口之后,可以防止外部 API 的频繁变动传播到整个服务栈。
快速实验还会通过废弃的实验代码路径 为代码库增加负担。研究迭代会遗留旧分支、替代性特征变换和被弃用的评分逻辑。传统死代码会被静态分析器标记并由编译器裁剪,而实验性机器学习代码路径往往受动态配置开关控制,因此在运行时仍可执行。这些休眠分支会扩大测试矩阵,使回归验证更加复杂,并掩盖生产环境中实际运行的精确执行图。强制执行弃用时间表并清理已退役的功能开关,可以防止实验残留破坏服务运行时的稳定性。
这两种模式的根源都是抽象债务:传统软件工程依赖对象、接口和模块等成熟抽象,而机器学习工程对于特征、训练数据集切片或模型生命周期状态等概念,缺乏通用抽象。没有标准化的基本构件,团队往往会反复创建专用抽象,或彻底放弃封装。特征存储、模型注册中心和标准化预测服务等基础设施组件,通过为特征变换、制品血缘和推理路由提供统一抽象,缓解了这类债务。
除这些结构性模式之外,Sculley et al. (2015) 还指出了若干预示债务不断累积的系统异味:普通数据类型异味(传递未经验证的原始浮点数和字符串数组,而非具有不变量检查的领域类型)、多语言异味(跨越训练与服务边界拼接 Python、SQL、C++ 和 shell 脚本),以及原型异味(未经重新工程化,就将一次性研究笔记本直接用于生产服务)。将偿还债务视为日常运维纪律,而非紧急干预,可以防止这些代码异味降低集群效率。
实践中的技术债务
这些债务模式并非理论上的边缘情形;它们是大规模生产机器学习部署中的主要失效模式。当统计依赖关系和缺乏契约约束的数据流与真实运行环境相互作用时,未受管理的技术债务会直接转化为系统性故障和商业失败。
生产环境中的债务模式
第一组案例揭示了通过模型行为形成的耦合。YouTube 推荐系统 展示了大型推荐系统如何从含噪声的用户行为信号中学习,使排序目标、对每位用户赋予相同权重,以及在线 A/B 评估成为系统设计的一部分,而非仅仅是离线评估的细节 (Covington et al. 2016)。Zillow 的房屋估值与购买工作流 则在其 iBuying 业务中暴露了修正级联这一形式。6 估值和库存假设传播到购买决策中;后续修正又破坏了库存与定价决策的稳定性,迫使团队重新验证,并最终在公司于 2021 年关闭 iBuying 业务部门时全面回退。
Covington, Paul, Jay Adams, and Emre Sargin. 2016. “Deep Neural Networks for YouTube Recommendations.” Proceedings of the 10th ACM Conference on Recommender Systems, 191–98. https://doi.org/10.1145/2959100.2959190.
National Transportation Safety Board. 2017. Collision Between a Car Operating with Automated Vehicle Control Systems and a Tractor-Semitrailer Truck Near Williston, Florida, May 7, 2016. HAR-17/02. National Transportation Safety Board.
Engineering, M. 2016. Introducing FBLearner Flow: Facebook’s AI Backbone. Engineering at Meta Blog.
Mosseri, Adam. 2018. Bringing People Closer Together. Meta Newsroom.
第二组案例揭示了通过职责归属和配置形成的耦合。安全关键型驾驶自动化 从另一个角度体现了未声明使用方的风险:当自动控制输出、驾驶员预期和子系统职责没有得到足够清晰的规定时,运行故障可能跨越组件边界,而非局限于局部 (National Transportation Safety Board 2017)。Facebook 动态消息的迭代 则体现了同一治理问题在配置方面的表现。快速实验和排序变更需要可追溯的设置和明确的目标,否则部署后的行为变化将难以审计 (Engineering 2016; Mosseri 2018)。
这些事件是在缺乏使耦合可见的基础设施时部署概率决策系统所产生的可预见后果。YouTube、Zillow、安全关键型驾驶自动化和 Facebook 分别揭示了一种不同的债务模式:反馈循环、修正级联、未声明的使用方和配置蔓延。
这些控制措施并非彼此孤立的单点解决方案,而是结构性边界。缓解技术债务需要端到端的 MLOps 基础设施:强制执行运行时模式的特征注册中心、追踪模型与数据血缘的元数据存储、验证统计属性的自动化 CI/CD 流水线,以及在静默错误向下游传播之前检测分布偏移的可观测性平台。
开发基础设施
开发基础设施将前文诊断出的债务模式转化为可强制执行约束的控制点。上游发生漂移的特征模式无法仅靠仪表板修复;它需要共享契约、进行版本管理的制品,以及在不兼容变更进入生产环境之前将其拒绝的部署路径。Table 6 将每个组件直接映射到一项基础原则(section 1.2.1)和一种特定的失效模式。
| 基础设施组件 | 落实的原则 | 应对的债务模式 |
|---|---|---|
| 特征存储 | 一致性要求 | 数据依赖债务、训练与服务偏差 |
| 版本管理系统 | 通过版本管理实现可复现性 | 配置债务、修正级联 |
| CI/CD 流水线 | 成本感知自动化 | 流水线债务、边界侵蚀 |
| 监控系统 | 可观测的退化 | 反馈循环、静默失效 |
这些运维组件横跨高层算法抽象与底层机器执行之间的边界。如 figure 5 所示,系统栈将职责划分为五个层级:机器学习模型、框架、编排、基础设施和硬件。尽管模型和框架以数学形式表达张量计算,但它们并不感知集群状态、硬件故障或输入分布漂移。模型编排与基础设施弥合了这一缺口:编排负责管理数据血缘、特征计算和模型服务,而基础设施负责调度加速器资源、管理存储层级并收集运行时遥测数据,以落实 table 6 中确定的技术债务治理契约。
\begin{tikzpicture}[line width=0.75pt,font=\small\sffamily]
%
\tikzset{%
   Line/.style={line width=1.0pt,GrayLine},
   Box/.style={align=flush center,
    inner xsep=2pt,
    node distance=0.9,
    draw=BlueLine,
    line width=0.75pt,
    fill=BlueFill,
    text width=31mm,
    minimum width=31mm, minimum height=10mm
  },
  Box2/.style={Box,text width=40mm,minimum width=40mm,fill=OrangeFill,draw=OrangeLine
  },
Box3/.style={Box, fill=GreenFill,draw=GreenLine},
Box31/.style={Box3, node distance=0.5, minimum height=9mm},
Box4/.style={Box, fill=RedFill,draw=RedLine,text width=34mm, minimum width=34mm},
Box41/.style={Box4, node distance=0.5, minimum height=9mm},
}
%
\node[Box,text width=37mm, minimum width=37mm](B1){\textbf{机器学习模型/应用}(例如 BERT)};
\node[Box2,right=0.35 of B1](B2){\textbf{机器学习框架/平台}(例如 PyTorch)};
\node[Box3,right=of B2](B3){\textbf{模型编排}(例如 Ray)};
\node[Box4,right=0.4of B3](B4){\textbf{基础设施}\\(例如 Kubernetes)};
\node[Box,right=of B4,fill=VioletFill,draw=VioletLine](B5){\textbf{硬件}\\(例如 GPU 集群)};
%
\node[Box31,below=of B3](B31){数据管理};
\node[Box31,below=of B31](B32){CI/CD};
\node[Box31,below=of B32](B33){模型训练};
\node[Box31,below=of B33](B34){模型评估};
\node[Box31,below=of B34](B35){部署};
\node[Box31,below=of B35](B36){模型服务};
%
\node[Box41,below=of B4](B41){作业调度};
\node[Box41,below=of B41](B42){资源管理};
\node[Box41,below=of B42](B43){容量管理};
\node[Box41,below=of B43](B44){监控};
\node[Box41,draw=none,fill=none,below=of B44](B45){};
\scoped[on background layer]
\node[draw=BackLine,inner xsep=11,inner ysep=19,yshift=3mm,fill=BackColor!70,fit=(B3)(B44)(B36),line width=0.75pt](BB1){};
\node[below=3pt of BB1.north, anchor=north]{MLOps};
%
\foreach \y in{3,4}{
\foreach \x in{1,2,3,4}{
\pgfmathtruncatemacro{\newX}{\x + 1}
\draw[-latex,Line](B\y\x)--(B\y\newX);
}}
\foreach \y in{3,4}{
\draw[-latex,Line](B\y)--(B\y1);
}
\draw[-latex,Line](B35)--(B36);
\draw[-latex,Line](B44)--(B45)coordinate(T44);

\node[inner sep=0pt,below=0 of T44,rotate=90,align=center,font=\tiny\sffamily]{$\bullet$ $\bullet$ $\bullet$};
%
\foreach \y in{1,2,3,4}{
\pgfmathtruncatemacro{\newX}{\y + 1}
\draw[Line](B\y)--(B\newX);
}
\end{tikzpicture}数据基础设施与准备
在运行中的机器学习系统里,数据并非静态的编译输入,而是一种持续从外部摄取环节流向加速器执行环节的活跃物理依赖。从初始摄取到在线推理,数据基础设施必须在离线训练和实时服务过程中保证质量、数学一致性和端到端可追溯性。满足这些运维要求,需要系统在整个机器学习生命周期中将特征变换和制品版本管理规范化。
数据管理
机器学习技术债务很大程度上源于未受管理的数据边界:未纳入版本管理的数据集会侵蚀系统边界,不一致的特征计算会引发级联修正,而未记录的数据依赖会产生隐蔽的下游使用方。基于 数据工程 中的数据工程基础,数据收集、预处理和特征变换被规范为正式的运维契约。数据工程优化的是单条流水线的正确性和摄取吞吐量,而 MLOps 数据管理则治理跨流水线的一致性,确保离线训练与在线服务计算出的特征在数学上完全相同。数据管理超越了初始准备阶段,覆盖数据制品的持续生命周期治理。
应对这些根本原因的基础设施围绕三项原则组织:一致性、新鲜度和质量。每项原则都驱动具体工具的选择,而非反过来由工具决定原则。
首要要求是数据一致性:从原始数据集到经特征工程处理的特征,凡是影响模型行为的制品,都必须纳入版本管理且可复现。缺少版本管理,团队就无法追溯哪个模型由哪些数据产生,从而无法调试和回滚。其实现通常结合代码版本管理、数据集版本管理和持久化对象存储。DVC(数据版本控制) (Iterative 2024)、Git (Torvalds and Hamano 2024)、Amazon S3 (Amazon Web Services 2024a) 和 Google Cloud Storage (Google Cloud 2024b) 都是这一模式的实例,但关键在于不变量:原始制品和处理后的制品必须始终能够按版本寻址。Section 1.4.1.3 探讨了包括 Git 集成、元数据跟踪和血缘保留在内的实现细节。在特征层面,特征存储通过集中管理训练和服务流水线中的特征定义及服务路径,可以减少偏差,但两者是否等价仍需验证。Uber 的 Michelangelo 平台在大型生产机器学习平台中推广了这一模式,随后 Feast 以开源特征存储基础设施的形式提供了这一模式 (Hermann and Del Balso 2017; Gojek and Google 2019)。Section 1.4.1.2 详细介绍了实现训练与服务一致性的模式。
Amazon Web Services. 2024a. Amazon Simple Storage Service (S3).
Google Cloud. 2024b. Google Cloud Storage.
Apache Software Foundation. 2024. Apache Airflow.
dbt Labs. 2024. Dbt (Data Build Tool).
如果底层数据已经过时,仅有一致性仍然不够。数据新鲜度确保模型使用当前数据进行训练和服务,而非使用过时的快照。自动化数据流水线通过摄取、模式验证、去重、变换和加载等结构化阶段,持续将原始数据转换为可供分析的格式,从而维持数据新鲜度。Apache Airflow (Apache Software Foundation 2024) 和 Prefect (Prefect Technologies, Inc. 2024) 等工作流编排器与变换框架 dbt (dbt Labs 2024) 配合,使这些阶段能够以代码形式显式定义、调度和审查。一旦以这种方式管理流水线,数据流就可以随模型需求演进,同时保留版本管理、模块化和 CI/CD 集成能力。
第三项原则是数据质量,它决定了到达模型的输入是否保持准确、完整且标注一致。在监督学习系统中,无论模型容量如何,标注质量都决定了模型性能的上限。Label Studio (HumanSignal 2024) 等标注平台支持团队协作标注,并集成审计轨迹和版本历史,从而在标注本体发生演变或需要跨多个训练周期进行修正时,提供必要的核验支持。
HumanSignal. 2024. Label Studio: Open Source Data Labeling Platform.
在工业预测性维护系统中,这三项原则协同发挥作用。持续的遥测数据流通过 Airflow 管理的定时流水线完成摄取,并与历史维护日志关联(新鲜度)。生成的特征——滑动窗口均值和振动频率聚合值——存储在特征存储中,供离线重新训练和低延迟在线推理共同使用(一致性)。模式验证、传感器量程检查、缺失值测试和标签审计会在损坏的遥测记录进入训练集之前将其拒绝(质量),而数据集版本管理与模型注册中心集成则维持从原始传感器日志到已部署模型预测结果的可追溯性。围绕这三项原则构建的数据管理,为模型可复现性和生产可靠性奠定了运维基础。
特征存储
section 1.3 中分析的数据依赖债务和训练与服务偏差具有共同的根本原因:流水线各阶段的特征计算不一致。如果缺少统一的特征层,特征定义通常会被实现两次:数据科学家在 Python 中对历史日志进行批量聚合,计算 user_session_length,而系统工程师则用 Java 或 C++ 重新实现该计算,以满足实时服务的延迟要求。细微差异由此产生:一种实现使用原始事件之间的墙钟时间,另一种实现则跟踪服务器处理时间并过滤空闲超时。模型使用一种定义进行训练,却使用另一种定义提供服务,导致生产环境中准确率静默下降。特征存储7通过在数据工程与机器学习之间提供抽象层来解决这种分歧,以特征变换的单一事实来源落实一致性要求。在缺少这一抽象的流水线中,跨环境重复实现的特征逻辑会引入训练与服务偏差、时间数据泄漏和分布漂移。
特征存储通过在统一 API 背后维护两个同步的存储层,解决批处理吞吐量与在线延迟之间的根本性系统矛盾。离线训练需要对数 TB 或数 PB 的历史日志进行高吞吐量顺序读取,这适合使用托管在分布式对象存储或数据仓库上的列式存储格式(如 Parquet)。相比之下,在线推理需要以实体标识符(如 user_id)为键进行亚毫秒级点查询,并受到严格的尾延迟服务级别目标(SLO)约束。在线存储使用内存型或分布式键值存储(如 Redis 或 Cassandra)满足这一访问模式。尽管底层物理引擎为适配这些访问模式而有所不同,但二者均基于同一套纳入版本管理的变换逻辑读取数据。
历史特征检索必须严格保证时间点正确性(防止时间数据泄漏或时间穿越)。为发生于时间戳 \(t_{\text{event}}\) 的事件生成训练样本时,特征存储必须精确重建特征在 \(t_{\text{event}}\) 时的值,排除之后到达的任何更新。如果训练查询直接与最新特征快照进行简单关联,就会将未来状态引入历史特征。模型因而学到在实时在线推理中实际无法获取的虚假相关性,导致生产环境中的准确率崩塌。通过对带时间戳的事件日志自动执行时间点(as-of)关联,特征存储既能在训练集中强制遵循时间因果关系,又能使离线和在线环境中的特征定义保持统一。
除一致性之外,特征存储还支持版本管理、元数据管理以及跨模型的特征复用。欺诈检测模型和信用评分模型通常依赖部分相同的交易特征,这些特征可以集中维护、验证和共享。与数据流水线和模型注册中心集成可保留血缘:当上游特征定义被更新或弃用时,系统可以自动识别下游模型,并安排重新训练。
训练与服务偏差:诊断与预防
训练与服务偏差(其正式定义见 训练与服务偏差)在运维中表现为特征存储不一致和流水线分歧。Table 7 汇总了常见原因及其检测方法:
| 偏差类型 | 示例 | 检测方法 |
|---|---|---|
| 特征预处理 | 归一化使用不同的统计量 | 对特征分布进行统计比较 |
| 缺失数据处理 | 训练时用均值填充 NaN;服务时使用 0 | 显式处理空值的模式验证 |
| 时间相关特征 | 使用不同的时间截止点计算特征 | 特征流水线中的时间戳验证 |
| 库版本漂移 | NumPy 或 Pandas 版本不同 | 环境哈希比较 |
训练与服务偏差案例研究
一个生产推荐系统说明了特征分歧如何在部署中显现。上线一个月后,尽管模型代码和权重均未发生任何改动,模型准确率仍下降了 8%。比较特征分布发现,user_session_length 在训练集中的经验均值为 45 分钟,而在线推理中仅为 12 分钟。该故障可追溯至特征定义偏差:离线训练流水线计算的是会话中从初始事件到最终事件的墙钟时长,而在线服务路径在过滤空闲时段后,仅统计前台活跃时间。模型基于一种服务基础设施从未提供的特征分布学习了决策边界。
特征存储以 数据工程 中的数据流水线为基础,通过将特征逻辑集中到单一的版本化定义中来解决这一差异。Listing 1 展示了这一架构:训练以满足时间点正确性的方式物化历史特征,服务执行实时点查询,两条流水线均绑定到相同的版本化定义哈希,而非相互独立的代码路径。
feature_definitions = registry.load(version="2026-06-01")

training_features = feature_definitions.materialize_historical(
    entities=training_entities,
    at_event_time=True,
    names=["user.session_length", "user.purchase_history"],
)

serving_features = feature_definitions.lookup_online(
    entities=[{"user_id": 12345}],
    names=["user.session_length", "user.purchase_history"],
)

assert training_features.schema == serving_features.schema
assert (
    training_features.definition_hash
    == serving_features.definition_hash
)
通过集中管理 session_length 的定义,离线和在线流水线执行相同的变换逻辑,但仍须通过自动化集成测试验证数值等价性。集中式注册中心还会记录元数据和血缘,以便在特征定义演变时快速诊断问题 (Hermann and Del Balso 2017; Gojek and Google 2019)。
Gojek, and Google. 2019. Feast: An Open Source Feature Store for Machine Learning. Google Cloud Blog.
正如 section 1.2.1.3 中的一致性要求所量化的,在生产规模下,偏差引发的错误每年可能造成数十万美元的损失。集中式特征存储将这一基础设施的工程成本分摊至多个模型和服务,从而将架构一致性转化为可衡量的运维成本节省。
Example 1.1: Uber Michelangelo 特征存储
场景:Uber 的 Michelangelo 平台支持预计到达时间等生产模型,并在离线训练和在线预测之间使用共享的特征基础设施 (Hermann and Del Balso 2017)。对同一特征逻辑分别实现会产生训练与服务偏差。
诊断:共享特征契约可以降低批处理流水线与在线流水线对特征作出不同解释的可能性,但独立的离线和在线存储仍需进行时间点正确性和等价性验证。
系统启示:特征存储通过集中管理纳入版本管理的特征定义和访问路径,减少了训练与服务偏差的一项主要来源。它们并不能消除偏差:时间点正确性、新鲜度以及在线与离线等价性仍需通过显式测试验证。
CI/CD 中的偏差检测
持续集成流水线必须在部署前验证特征一致性。Listing 2 定义了一道门禁,使用双样本 Kolmogorov-Smirnov 检验比较离线训练分布与在线服务样本;如果任一特征的偏离超过预定义阈值,就阻止部署。双样本 Kolmogorov-Smirnov 检验衡量训练样本与服务样本的经验累积分布函数(eCDF)之间的最大垂直距离:\(D = \sup_x |F_{\text{train}}(x) - F_{\text{serve}}(x)|\)。将阈值设为 \(0.1\),意味着要求在特征支持集内的任意取值处,累积概率之差均不超过 10 个百分点;这为连续特征提供了一种无需经验分箱的无参数分布差异度量。这道验证门禁在生产发布之前,将分布差异转化为自动化测试失败。不过,阈值必须根据样本量和特征敏感性进行校准;通过分布检查可以验证统计上的一致性,却无法验证语义等价性或时间点正确性。
def validate_no_skew(
    training_features, serving_features, threshold=0.1
):
    """Reject deployment if feature distributions diverge."""
    for feature in training_features.columns:
        ks_stat = ks_2samp(
            training_features[feature], serving_features[feature]
        )
        if ks_stat.statistic > threshold:
            raise SkewDetectedError(
                f"{feature}: KS={ks_stat.statistic:.3f}"
            )
版本管理与血缘
血缘跟踪和版本管理落实了 section 1.2.1 中形式化阐述的可复现性原则。在传统软件工程中,二进制可执行文件由源代码和构建配置确定性地编译而成。在机器学习系统中,模型行为是代码、超参数配置和训练数据集快照共同作用的产物。改变其中任一依赖,都会生成一个完全不同的模型制品。MLOps 基础设施通过对每个流水线组件强制实施基于密码学的版本管理,来管理这一多维依赖空间。
数据版本管理通过为原始数据快照和中间特征表记录内容寻址哈希来应对数据集的可变性,确保能够精确重建任意历史训练运行。模型版本管理将训练后的权重注册为不可变制品,并一同记录训练超参数、评估指标和环境依赖清单。模型注册中心8管理这些制品的生命周期状态(如预发布、生产或已退役),并提供血缘图,追踪从摄取的原始记录到已部署预测端点的完整依赖链 (MLflow Project 2026; Google Cloud 2024d)。
MLflow Project. 2026. MLflow Model Registry.
这些机制构建了机器学习系统的血缘图。该图建立了诊断生产故障所需的审计轨迹:确定传入请求的分布是否偏离了训练基线、上游特征计算是否发生变化,或者模型服务环境是否加载了未经验证的权重检查点。通过将溯源正式确立为显式的架构契约,系统工程将事件排查从人工启发式判断转变为确定性的根因分析。
持续流水线与自动化
特征存储和版本管理系统从静态层面解决数据一致性问题:它们确保特征在某个时间点被正确计算。自动化使这些系统能够持续演进,将数据预处理、训练、评估和发布同步为集成工作流,以响应新数据、不断变化的目标和运维约束 (Orr et al. 2021; Google Cloud 2026b)。
Orr, Laurel, Atindriyo Sanyal, Xiao Ling, Karan Goel, and Megan Leszczynski. 2021. “Managing ML Pipelines: Feature Stores and the Coming Wave of Embedding Ecosystems.” Proceedings of the VLDB Endowment 14 (12): 3178–81. https://doi.org/10.14778/3476311.3476402.
CI/CD 流水线
特征存储和版本管理系统解决一致性的数据层面问题;CI/CD 流水线则解决流程层面问题,确保变更经过已验证的阶段,而非临时部署。机器学习 CI/CD 流水线必须处理传统软件中不存在的复杂性:数据依赖、模型训练工作流,以及将代码变更与统计行为变化关联起来的制品版本管理。
典型的机器学习 CI/CD 流水线由相互协调的阶段组成:检出更新后的代码、预处理输入数据、训练候选模型、验证性能、封装模型,以及部署到模型服务环境。在某些情况下,流水线还包含根据数据漂移或性能下降自动触发重新训练的机制。通过将这些步骤编码固化,CI/CD 流水线9减少了人工干预,强制执行质量检查,并支持已部署系统的持续改进。
面向机器学习的 CI/CD 采用两层工具,其原因在于:通用 CI/CD 编排器(Jenkins、CircleCI (2024) 或 GitHub Actions (GitHub, Inc. 2024b))负责管理版本控制事件和执行逻辑,但机器学习层还必须对数据进行版本管理、以模型指标作为准入条件,并触发重新训练。因此,团队会增加一个机器学习平台或工作流编排器(Kubeflow (Authors 2024)、Metaflow (Netflix 2024) 或 Prefect (Prefect Technologies, Inc. 2024)),为这些任务提供更高层次的抽象。
CircleCI. 2024. CircleCI: Continuous Integration and Delivery Platform.
GitHub, Inc. 2024b. GitHub Actions.
Authors, Kubeflow. 2024. Kubeflow.
Netflix. 2024. Metaflow.
Prefect Technologies, Inc. 2024. Prefect: Workflow Orchestration Framework for Python.
缺少这种自动化时,模型部署就会退化为人工操作且容易出错的过程:工程师在本地重新训练,将制品复制到预发布服务器,再将其发布到生产环境,而无法保证数据、代码或超参数与验证时一致。这类临时工作流的成本会随团队规模和部署频率的增加而累积,造成配置漂移和静默回归;这些问题往往要到模型已经输出错误预测后才会显现。
Figure 6 展示了一条具有代表性的持续训练流水线如何从数据集摄取和验证,依次进入转换、训练/调优、评估、模型验证和模型注册。重新训练触发器启动这一流程,而数据集、模型、元数据和制品存储库则保存血缘追踪所需的输入和输出。
\begin{tikzpicture}[line join=round,font=\small\sffamily]
\definecolor{Red}{RGB}{249,56,39}
\definecolor{Blue}{RGB}{0,97,168}
\definecolor{Violet}{RGB}{178,108,186}
\tikzset{%
helvetica/.style={align=flush center, font={\sffamily\small}},
cyl/.style={cylinder, draw=BrownLine,shape border rotate=90, aspect=1.8,inner ysep=0pt,
    minimum height=20mm,minimum width=21mm, cylinder uses custom fill,
 cylinder body fill=brown!10,cylinder end fill=brown!35},
Line/.style={line width=1.2pt,black!50},
LineB/.style={line width=1.5pt,BlueLine
   },
  Box/.style={align=flush center,
    inner xsep=2pt,
    node distance=0.9,
    draw=BlueLine,
    line width=0.75pt,
    fill=BlueL!80,
    text width=22mm,
    minimum width=22mm, minimum height=10mm
  },
Box2/.style={Box,fill=OrangeL,draw=OrangeLine},
Box3/.style={Box, fill=GreenL,draw=GreenLine},
Box4/.style={Box, fill=RedL,draw=RedLine},
}
\definecolor{CPU}{RGB}{0,120,176}

\node[Box](B1){数据验证};
\node[Box2,right=of B1](B2){数据转换};
\node[Box3,right=of B2](B3){模型验证};
\node[Box4,right=of B3](B4){模型注册};
\node[Box,above=0.75 of B1](B11){数据集摄取};
\node[Box2,above=0.75 of B2](B21){模型训练/调优};
\node[Box3,above=0.75 of B3](B31){模型评估};
%fitting
\scoped[on background layer]
\node[draw=BackLine,inner xsep=11,inner ysep=19,yshift=3mm,
           fill=BackColor!70,fit=(B11)(B4),line width=0.75pt](BB1){};
\node[below=3pt of  BB1.north,anchor=north,helvetica]{\textbf{持续训练流水线}};

\draw[-latex,Line](B11)--(B1);
\draw[-latex,Line](B1)--(B2);
\draw[-latex,Line](B2)--(B21);
\draw[-latex,Line](B21)--(B31);
\draw[-latex,Line](B31)--(B3);
\draw[-latex,Line](B3)--(B4);
%cylinder left
\begin{scope}[local bounding box = CYL1,shift={($(BB1.west)+(-3.85,0)$)}]
\node (CA1) [cyl] {};
\node[align=center]at (CA1){数据集 \&\\ 特征\\存储库};
\end{scope}
%cylinder right
\begin{scope}[local bounding box = CYL2,shift={($(BB1.east)+(3.85,0)$)}]
\node (CA1) [cyl] {};
\node[align=center]at (CA1){模型\\存储库};
\end{scope}
%cylinder top
\begin{scope}[local bounding box = CYL3,shift={($(BB1.north)+(0,2.4)$)}]
\node (CA1) [cyl] {};
\node[align=center]at (CA1){机器学习元数据\\\& 制品\\存储库};
\end{scope}
% connect cube and fitting
\draw[{Circle[length=4.5pt]}-latex,LineB](CYL1.east)coordinate(CC1)--(CYL1.east-|BB1.west)coordinate(CC2);
\draw[latex-{Circle[length=4.5pt]},LineB](CYL2.west)coordinate(CD1)--(CYL2.west-|BB1.east)coordinate(CD2);
\draw[latex-latex,LineB](CYL3.south)coordinate(CE1)--(CYL3.south|-BB1.north)coordinate(CE2);
%cube left
\begin{scope}[local bounding box=CU1,shift={($(CC1)!0.35!(CC2)+(0,0.6)$)},scale=0.8,every node/.append style={transform shape}]
%cube coordinates
\newcommand{\Depth}{1.5}
\newcommand{\Height}{1.1}
\newcommand{\Width}{1.5}
\coordinate (O2) at (0,0,0);
\coordinate (A2) at (0,\Width,0);
\coordinate (B2) at (0,\Width,\Height);
\coordinate (C2) at (0,0,\Height);
\coordinate (D2) at (\Depth,0,0);
\coordinate (E2) at (\Depth,\Width,0);
\coordinate (F2) at (\Depth,\Width,\Height);
\coordinate (G2) at (\Depth,0,\Height);

\draw[fill=OrangeLine!80] (D2) -- (E2) -- (F2) -- (G2) -- cycle;% Right Face
\draw[fill=OrangeLine!50] (C2) -- (B2) -- (F2) -- (G2) -- (C2);% Front Face
\draw[fill=OrangeLine!20] (A2) -- (B2) -- (F2) -- (E2) -- cycle;% Top Face
%
\node[align=center]at($(B2)!0.5!(G2)$){数据集\\ \textless$\backslash$\textgreater};
\end{scope}
%cube right
\begin{scope}[local bounding box=CU2,shift={($(CD1)!0.65!(CD2)+(0,0.6)$)}, scale=0.8,every node/.append style={transform shape}]
%cube coordinates
\newcommand{\Depth}{1.5}
\newcommand{\Height}{1.1}
\newcommand{\Width}{1.5}
\coordinate (O2) at (0,0,0);
\coordinate (A2) at (0,\Width,0);
\coordinate (B2) at (0,\Width,\Height);
\coordinate (C2) at (0,0,\Height);
\coordinate (D2) at (\Depth,0,0);
\coordinate (E2) at (\Depth,\Width,0);
\coordinate (F2) at (\Depth,\Width,\Height);
\coordinate (G2) at (\Depth,0,\Height);

\draw[fill=OrangeLine!80] (D2) -- (E2) -- (F2) -- (G2) -- cycle;% Right Face
\draw[fill=OrangeLine!50] (C2) -- (B2) -- (F2) -- (G2) -- (C2);% Front Face
\draw[fill=OrangeLine!20] (A2) -- (B2) -- (F2) -- (E2) -- cycle;% Top Face
%
\node[align=center]at($(B2)!0.5!(G2)$){已训练的\\模型\\ \textless$\backslash$\textgreater};
\end{scope}
%cube top
\begin{scope}[local bounding box=CU3,shift={($(CE1)!0.71!(CE2)+(0.7,0)$)},scale=0.7,every node/.append style={transform shape}]
%cube coordinates
\newcommand{\Depth}{4.2}
\newcommand{\Height}{1.1}
\newcommand{\Width}{1.4}
\coordinate (O2) at (0,0,0);
\coordinate (A2) at (0,\Width,0);
\coordinate (B2) at (0,\Width,\Height);
\coordinate (C2) at (0,0,\Height);
\coordinate (D2) at (\Depth,0,0);
\coordinate (E2) at (\Depth,\Width,0);
\coordinate (F2) at (\Depth,\Width,\Height);
\coordinate (G2) at (\Depth,0,\Height);

\draw[fill=OrangeLine!80] (D2) -- (E2) -- (F2) -- (G2) -- cycle;% Right Face
\draw[fill=OrangeLine!50] (C2) -- (B2) -- (F2) -- (G2) -- (C2);% Front Face
\draw[fill=OrangeLine!20] (A2) -- (B2) -- (F2) -- (E2) -- cycle;% Top Face
%
\node[align=center]at($(B2)!0.5!(G2)$){训练流水线的\\ 元数据  \& 制品 \textless$\backslash$\textgreater};
\end{scope}
%above fitting
\node[Box,above=of BB1.153,fill=OliveL,draw=OliveLine](RT){重新训练触发器};
\draw[{Circle[length=4.5pt]}-latex,LineB](RT)--(RT|-BB1.north);
%%%
%cubes below center
\begin{scope}[local bounding box=CUS,shift={($(BB1.south west)!0.45!(BB1.south east)+(0,-1.45)$)},scale=0.8,every node/.append style={transform shape}]
%cube coordinates
\newcommand{\Depth}{3}
\newcommand{\Height}{0.7}
\newcommand{\Width}{1.2}
\coordinate (O2) at (0,0,0);
\coordinate (A2) at (0,\Width,0);
\coordinate (B2) at (0,\Width,\Height);
\coordinate (C2) at (0,0,\Height);
\coordinate (D2) at (\Depth,0,0);
\coordinate (E2) at (\Depth,\Width,0);
\coordinate (F2) at (\Depth,\Width,\Height);
\coordinate (G2) at (\Depth,0,\Height);
\colorlet{OrangeLine}{Blue}
\draw[fill=OrangeLine!80] (D2) -- (E2) -- (F2) -- (G2) -- cycle;% Right Face
\draw[fill=OrangeLine!50] (C2) -- (B2) -- (F2) -- (G2) -- (C2);% Front Face
\draw[fill=OrangeLine!20] (A2) -- (B2) -- (F2) -- (E2) -- cycle;% Top Face
%
\node[align=center]at($(B2)!0.5!(G2)$){模型\\ 训练引擎};
\end{scope}
%left
\begin{scope}[local bounding box=CUL,shift={($(BB1.south west)!0.15!(BB1.south east)+(0,-1.45)$)},scale=0.8,every node/.append style={transform shape}]
%cube coordinates
\newcommand{\Depth}{3}
\newcommand{\Height}{0.7}
\newcommand{\Width}{1.2}
\coordinate (O2) at (0,0,0);
\coordinate (A2) at (0,\Width,0);
\coordinate (B2) at (0,\Width,\Height);
\coordinate (C2) at (0,0,\Height);
\coordinate (D2) at (\Depth,0,0);
\coordinate (E2) at (\Depth,\Width,0);
\coordinate (F2) at (\Depth,\Width,\Height);
\coordinate (G2) at (\Depth,0,\Height);
\colorlet{CubeColor}{VioletFill}
\draw[fill=CubeColor] (D2) -- (E2) -- (F2) -- (G2) -- cycle;% Right Face
\draw[fill=CubeColor!50] (C2) -- (B2) -- (F2) -- (G2) -- (C2);% Front Face
\draw[fill=CubeColor!20] (A2) -- (B2) -- (F2) -- (E2) -- cycle;% Top Face
%
\node[align=center]at($(B2)!0.5!(G2)$){模型处理\\ 引擎};
\end{scope}
%right
\begin{scope}[local bounding box=CUD,shift={($(BB1.south west)!0.75!(BB1.south east)+(0,-1.45)$)},scale=0.8,every node/.append style={transform shape}]
%cube coordinates
\newcommand{\Depth}{3}
\newcommand{\Height}{0.7}
\newcommand{\Width}{1.2}
\coordinate (O2) at (0,0,0);
\coordinate (A2) at (0,\Width,0);
\coordinate (B2) at (0,\Width,\Height);
\coordinate (C2) at (0,0,\Height);
\coordinate (D2) at (\Depth,0,0);
\coordinate (E2) at (\Depth,\Width,0);
\coordinate (F2) at (\Depth,\Width,\Height);
\coordinate (G2) at (\Depth,0,\Height);
\colorlet{OrangeLine}{Red}
\draw[fill=OrangeLine!80] (D2) -- (E2) -- (F2) -- (G2) -- cycle;% Right Face
\draw[fill=OrangeLine!50] (C2) -- (B2) -- (F2) -- (G2) -- (C2);% Front Face
\draw[fill=OrangeLine!20] (A2) -- (B2) -- (F2) -- (E2) -- cycle;% Top Face
%
\node[align=center]at($(B2)!0.5!(G2)$){模型评估\\ 引擎};
\end{scope}
%%
\draw[latex-,Line](CUL)--(CUL|-BB1.south);
\draw[latex-,Line](CUS)--(CUS|-BB1.south);
\draw[latex-,Line](CUD)--(CUD|-BB1.south);
\end{tikzpicture}
Google Cloud. 2026b. MLOps: Continuous Delivery and Automation Pipelines in Machine Learning.
考虑一个正在积极开发的图像分类模型。当开发者向 GitHub (GitHub, Inc. 2024a) 仓库提交代码变更时,Jenkins 流水线便会触发执行:拉取指定版本的数据集,进行特征预处理,并启动模型训练。实验通过 MLflow (Databricks 2024) 进行跟踪,由其记录损失曲线并注册模型制品。通过自动化离线验证后,模型被容器化,并部署到由 Kubernetes (Cloud Native Computing Foundation 2024a) 管理的预发布集群。如果候选模型满足预发布验证要求,流水线就会执行金丝雀发布(详见 section 1.4.2.3),在监控推理延迟和错误率的同时,逐步将生产查询流量转移到新模型。如果出现性能回归,流量会自动切回先前的模型检查点。
当系统反复发布模型,或承担显著的生产风险时,CI/CD 就成为基础设施,将临时实验转变为结构化、可重复的部署。要从单条流水线扩展到多条流水线,需要可复用组件和显式的制品契约。
Example 1.2: Google TFX 生产机器学习流水线
场景:Google 的生产实践推动了 TensorFlow Extended(TFX)的诞生,这是一套用于生产机器学习流水线的可复用组件 (Baylor et al. 2017)。随着流水线数量增加,临时性的交接方式使验证、血缘追踪和复现变得困难。
诊断:每个阶段都需要显式验证和元数据,以便将已部署模型追溯到生成它的数据、转换、代码和评估过程。
系统启示:仅靠有向无环图编排无法建立可复现性。标准化组件和 ML Metadata(MLMD)通过记录输入和转换来保留血缘信息。
Baylor, Denis, Eric Breck, Heng-Tze Cheng, Noah Fiedel, Chuan Yu Foo, Zakaria Haque, Salem Haykal, et al. 2017. “TFX: A TensorFlow-Based Production-Scale Machine Learning Platform.” Proceedings of the 23rd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, 1387–95. https://doi.org/10.1145/3097983.3098021.
训练流水线
CI/CD 流水线编排整体工作流,但训练本身需要专门的计算基础设施。模型训练建立在 模型训练 中介绍的分布式执行原语之上。在 MLOps 中,训练活动成为可复现流水线的组成部分,以支持持续实验和生产部署。
TensorFlow (Abadi et al. 2016)、PyTorch (Paszke et al. 2019) 和 Keras (Chollet et al. 2024) 等框架为模型架构和优化例程提供模块化组件,将 机器学习框架 中的框架选择标准延伸到生产环境。运维规范决定哪些探索性训练例程能够转化为经过版本管理和测试的重新训练作业,以及这些作业在何种执行条件下触发。
Abadi, Martı́n, Paul Barham, Jianmin Chen, Zhifeng Chen, Andy Davis, Jeffrey Dean, Matthieu Devin, et al. 2016. “TensorFlow: A System for Large-Scale Machine Learning.” Proceedings of the 12th USENIX Symposium on Operating Systems Design and Implementation (OSDI), 265–83.
Paszke, Adam, Sam Gross, Francisco Massa, Adam Lerer, James Bradbury, Gregory Chanan, Trevor Killeen, et al. 2019. “PyTorch: An Imperative Style, High-Performance Deep Learning Library.” Advances in Neural Information Processing Systems (NeurIPS) 32: 8024–35.
Chollet, François et al. 2024. Keras.
Torvalds, Linus, and Junio Hamano. 2024. Git.
GitHub, Inc. 2024a. GitHub.
Project Jupyter. 2024. Project Jupyter.
除了可扩展性,运维完整性还要求严格的可复现性。训练脚本和环境配置使用 Git (Torvalds and Hamano 2024) 等工具进行版本控制,并托管在 GitHub (GitHub, Inc. 2024a) 等平台上。Jupyter (Project Jupyter 2024) 笔记本等交互式环境将代码、内嵌可视化和执行状态结合在一起,能够加速初期原型开发,但将其原样运行于生产流水线中会带来严重的运维隐患。
生产环境中的笔记本
自动化 CI/CD 流水线假定代码执行具有确定性和可复现性,但 Jupyter 笔记本的持久化内核状态破坏了这一假设。在交互式会话中,单元格可以不按线性顺序执行,产生无法在解释器干净重启后复现的隐式内存依赖。一种常见的生产故障是:开发过程依赖于按 1-3-2 顺序执行的单元格,而按从上到下的顺序(1-2-3)执行的定时批处理运行器,会因变量未定义或中间张量发生变化而失败。
测试困难进一步加剧了这种状态脆弱性。标准单元测试框架和模拟框架难以与交互式笔记本文档顺畅集成。单元格级断言很少经过参数化或接入测试运行器,导致笔记本的测试充分程度显著低于模块化 Python 代码。
将笔记本投入运维需要专门工具的介入。Papermill支持笔记本参数化和无界面执行,能够注入运行时配置,并将笔记本作为独立流水线阶段,按从上到下的顺序执行单元格 (Papermill Project 2026)。类似地,nbconvert 将经过验证的笔记本转换为用于生产环境的静态可执行 Python 脚本 (Project Jupyter 2026),移除探索性草稿单元格,并使代码能够接受代码检查器和 CI 测试运行器的检查。
Papermill Project. 2026. Papermill Documentation.
Project Jupyter. 2026. nbconvert: Convert Notebooks to Other Formats.
Napkin Math 1.2: 静默故障的成本
问题:构建自动化漂移检测系统是否值得投入工程精力?
场景:考虑一个年收入为 $50M 的产品推荐引擎。 故障模式:一个部署缺陷导致训练与服务偏差,使推荐质量下降 5 percent。这会使转化率按相同比例下降。
成本分析:
- 人工运维(每月审查):
- 检测时间:约 4 weeks(28 days)。
- 收入损失:$50M \(\times\) 0.05 \(\times\) 28 days/365 days ≈ $191,780.8。
- 自动化 MLOps(每日检查):
- 检测时间:1 day。
- 收入损失:$50M \(\times\) 0.05 \(\times\) 1 day/365 days ≈ $6,849.3。
系统洞见:在没有 MLOps 的情况下,单次静默故障会多造成 $184,931.5 的损失。在该场景每年发生 4 incidents/year 的条件下,缩短检测耗时(TTD)每年可避免近 $739,726 的损失。
1.2 中的成本计算量化了这一工程权衡。虽然将笔记本中的代码提取为经过测试的模块会带来重构开销,但这能防止隐式状态假设在生产环境中造成训练与服务偏差。当每次静默故障造成的损失高达数十万美元时,规范地提取预处理和训练代码能够直接保护业务收入。
训练逻辑模块化后,自动化流水线便可在模型设计空间中执行系统化的搜索策略。工作流纳入分布式超参数优化 (Ranjit et al. 2019; Li et al. 2017)、神经架构搜索 (Elsken et al. 2019) 和特征选择 (scikit-learn developers 2024a),协调加速器资源池中的多次并行训练运行。
Ranjit, Mercy Prasanna, Gopinath Ganapathy, Kalaivani Sridhar, and Vikram Arumugham. 2019. “Efficient Deep Learning Hyperparameter Tuning Using Cloud Infrastructure: Intelligent Distributed Hyperparameter Tuning with Bayesian Optimization in the Cloud.” 2019 IEEE 12th International Conference on Cloud Computing (CLOUD), 520–22. https://doi.org/10.1109/cloud.2019.00097.
Li, Lisha, Kevin G. Jamieson, Giulia DeSalvo, Afshin Rostamizadeh, and Ameet Talwalkar. 2017. “Hyperband: A Novel Bandit-Based Approach to Hyperparameter Optimization.” Journal of Machine Learning Research 18: 185:1–52.
Elsken, Thomas, Jan Hendrik Metzen, and Frank Hutter. 2019. “Neural Architecture Search.” In The Springer Series on Challenges in Machine Learning, vol. 20. Springer International Publishing. https://doi.org/10.1007/978-3-030-05318-5_3.
scikit-learn developers. 2024a. Feature Selection — Scikit-Learn Documentation. Scikit-learn Documentation.
Gartner. 2024. Gartner Forecasts Worldwide Public Cloud End-User Spending to Total $679 Billion in 2024. Gartner, Inc.
Google Cloud. 2024c. Tune Models Overview.
Lehdonvirta, Vili, Boxi Wu, Zoe Jay Hawkins, Celine Caira, and Lucia Russo. 2025. Measuring Domestic Public Cloud Compute Availability for Artificial Intelligence. No. 49. OECD Artificial Intelligence Papers. OECD Publishing. https://doi.org/10.1787/8602a322-en.
扩展这些自动化工作负载需要大量计算能力,企业对云基础设施的需求反映了这一点 (Gartner 2024)。这与 机器学习工作流 中探讨的工作流编排模式相联系,这些模式用于协调跨分布式集群的多阶段作业。云平台按需提供高性能加速器实例,包括 GPU 和张量处理单元(TPU)节点。10 团队可以构建自定义编排图,也可以使用 Vertex AI Fine Tuning (Google Cloud 2024c) 等托管平台,使基础模型适应领域任务。此外,物理加速器的分配和区域互连带宽也限制了大规模训练流水线的执行位置 (Lehdonvirta et al. 2025)。
当训练流水线实现自动化且可复现后,就会出现一项工程权衡:执行频率。由于向多加速器集群分派作业会产生可观的计算成本,没有经济上的合理依据,就不能持续触发流水线运行。
再训练决策框架
自动化训练流水线引入了一项关键的运维决策:执行周期。决定何时再训练模型,需要在准确率下降与计算支出之间取得平衡。常见策略有三种,各自涉及不同的系统权衡。Table 8 给出了不同领域的示例周期,从针对快速变化的广告点击预测进行每日再训练,到针对稳定的医学影像应用进行季度更新:
| 领域 | 示例周期 | 依据 |
|---|---|---|
| 广告点击预测 | 每日 | 用户兴趣变化迅速 |
| 欺诈检测 | 每周 | 攻击模式持续演变 |
| 需求预测 | 每月 | 季节性模式变化缓慢 |
| 医学影像 | 每季度 | 疾病表现较为稳定 |
这些周期是起点,并非一成不变的规则。在定期再训练策略中,流水线按固定的日历周期执行,例如每日、每周或每月,而不考虑接收到的性能遥测数据。这种策略易于自动化,并能确保定期整合新积累的训练数据。然而,它会在平稳时期消耗加速器小时数,而且当分布偏移发生在两次计划执行之间时,响应较为迟缓。
触发式再训练策略在监控系统检测到统计漂移或性能下降超过预设阈值时启动流水线执行。这种方法仅在必要时进行训练,从而节省计算资源,但它高度依赖低延迟的标签流或准确的代理指标,以避免响应延迟或误报引发的再训练运行。
持续再训练策略使用流式微批处理或在线学习算法,在带标签记录到达时增量更新模型权重。虽然这种策略最大限度地缩短了模型陈旧的滞后时间,但也显著放大了验证风险:在自动化异常检测器或工程团队能够介入之前,损坏的、不具代表性的或对抗性数据就可能迅速污染模型参数。
在这些策略之间作出运维选择,取决于四项物理与运维约束:再训练计算成本、验证流水线延迟、自动回滚能力以及标签到达延迟。在多加速器节点上重新优化模型会产生实际的能源和集群成本;当真实标签到达存在较长延迟时,触发式策略需要统计上可靠的代理信号;而每条持续部署流水线都需要稳健的金丝雀发布和回滚机制。再训练策略是一项由运维权衡决定的工程优化,而不是任意设定的启发式规则。
在 listing 3 中,经济与验证约束被转化为可执行逻辑:只有当预计挽回的价值超过再训练成本、验证成本与发布风险之和,且验证数据足够新时,决策函数才会安排运行。
quality_loss = baseline_accuracy - current_accuracy
feature_drift = max(population_stability_index(features))
prediction_shift = distribution_distance(
    baseline_predictions, live_predictions
)

benefit = estimate_value_recovered(
    quality_loss=quality_loss,
    feature_drift=feature_drift,
    prediction_shift=prediction_shift,
)
risk = retraining_cost + validation_cost + rollout_risk

if benefit > risk and validation_data_is_fresh():
    schedule_retraining_run()
这一门控机制将漂移检测与再训练授权分离:漂移参与预期收益的估计,而足够新的验证数据和正的净价值决定自动化系统是否采取行动。对于接下来评估的完整示例场景,给定参数得到的最优间隔约为一天。
再训练经济性的量化分析
是否再训练模型,需要在准确率衰减的代价与再训练支出之间取得平衡。当结果数据支持局部指数拟合时,拟合得到的衰减率便提供了一个可测量的时间尺度。11 其半衰期12描述了拟合准确率何时降至初始值的一半,但并不决定经济最优的再训练间隔。equation 4 中的推导区分了拟合半衰期与经济最优再训练间隔。
Napkin Math 1.3: 最优再训练间隔
问题:团队应多久再训练一次模型,才能使利润最大化?
物理机制:由于数据漂移,模型准确率 \(\text{Accuracy}(t)\) 以速率 \(\gamma\) 衰减。
- \(Q\):每日查询量(流量)。
- \(V\):准确率比例值每变化一个单位时,每次查询对应的经济价值。按照这一定义,\(V = \$0.50\) 意味着准确率每变化 1 个百分点,每次查询对应的价值为 \(\$0.005\)。
- \(C\):单次再训练的固定成本,包括计算和运维开销。
公式:equation 4 中的近似式给出了使陈旧损失与训练成本之和最小的最优再训练间隔 \((T^*)\): \[ T^* \approx \sqrt{\frac{2 \cdot C}{Q \cdot V \cdot \text{Accuracy}_0 \cdot \gamma}} \tag{4}\] 计算:考虑一个作为标杆示例的欺诈检测模型(\(\text{Accuracy}_0\) = 0.95):
- 流量 \((Q)\):每天 1,000,000 笔交易。
- 效用 \((V)\):准确率变化一个单位时为 $0.50/query。
- 再训练成本 \((C)\):$5,000。
- 漂移率 \((\gamma)\):每天 2 percent。 \[ T^* \approx \sqrt{\frac{2 \times 5,000}{1,000,000 \times 0.50 \times 0.95 \times 0.02}} \approx \mathbf{1\text{ Day}} \]
系统层面的启示:如果流量很高,且准确率具有很高的价值,团队就承担不起等待的代价。流水线必须实现自动化。如果 \(T^*\) 小于团队手动部署所需的时间,系统就处于持续的技术债务状态。
要将这一优化形式化,需要从第一性原理推导总成本函数,将系统支出分解为陈旧损失和再训练开销。
陈旧成本函数
模型准确率可能随时间下降,从而产生陈旧成本。为进行经济规划,团队可以在稳定的局部状态下,将可观测到的影响拟合为指数衰减过程。这里,\(\gamma\) 是在假设测得的性能退化持续累积的前提下定义的时间衰减率;它并非仅由分布散度决定。指数模型是一种简化,使闭式经济分析成为可能。令 \(\text{Accuracy}(t)\) 表示距上次训练经过时间 \(t\) 时的准确率,\(\text{Accuracy}_0\) 表示初始准确率。Equation 5 描述了这一拟合场景,其中速率 \(\gamma\) 取决于领域波动性和观测结果: \[\text{Accuracy}(t) = \text{Accuracy}_0 \cdot e^{-\gamma t} \tag{5}\]
陈旧成本的累积取决于每个时间周期的查询量 \(Q\),以及准确率比例值变化一个单位所带来的价值影响 \(V\)。在再训练间隔 \(T\) 上对瞬时准确率损失 \((\text{Accuracy}_0 - \text{Accuracy}(t))\) 积分,可得 equation 6: \[ \begin{array}{>{\displaystyle}c} \text{Staleness Cost}(T) = \int_0^T Q \cdot V \cdot (\text{Accuracy}_0 - \text{Accuracy}(t)) \, dt = \\ Q \cdot V \cdot \text{Accuracy}_0 \cdot \left(T - \frac{1-e^{-\gamma T}}{\gamma}\right) \end{array} \tag{6}\]
该积分累积了时间 \(t\) 从 0 到 \(T\) 的成本,将 equation 5 代入 \(\text{Accuracy}(t)\) 即可得到其闭式表达式。
再训练成本函数
每次再训练都会产生固定成本,包括计算、验证和部署开销。Equation 7 将其分解为: \[\text{Retraining Cost} = C_{\text{compute}} + C_{\text{validation}} + C_{\text{deployment}} + C_{\text{risk}} \tag{7}\] 其中,\(C_{\text{compute}}\) 是训练运行本身的成本,\(C_{\text{validation}}\) 是发布前评估新模型的成本,\(C_{\text{deployment}}\) 是将其部署到生产环境的成本,\(C_{\text{risk}}\) 是新模型可能引发性能退化的预期成本。
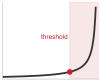
再训练间隔拉得过长,陈旧成本就会失控。
最优再训练间隔
最优再训练间隔 \(T^*\) 使单位时间的总成本最小,如 equation 8 所示: \[T^* = \operatorname{arg\,min}_T \frac{\text{Staleness Cost}(T) + \text{Retraining Cost}}{T} \tag{8}\]
在假设 \(\gamma T \ll 1\) 的条件下,对指数项进行泰勒展开,可以得到前面粗略计算中使用的平方根近似。具体而言,二阶泰勒近似 \(e^{-\gamma T} \approx 1 - \gamma T + \frac{1}{2}(\gamma T)^2\) 将括号中的陈旧项 \(\left(T - \frac{1-e^{-\gamma T}}{\gamma}\right)\) 化简为 \(\frac{1}{2}\gamma T^2\)。将总成本除以 \(T\),得到平均成本率 \(\frac{1}{2} Q V \text{Accuracy}_0 \gamma T + \frac{C}{T}\);对 \(T\) 求导并令导数为零,可使边际陈旧损失与摊销后的启动费用达到平衡,从而直接得到 equation 4 中的平方根形式经济最优间隔。使用 table 9 中的参数时,这一近似得到的经济最优值约为一天;要获得精确最优值,则需要在不进行展开的情况下最小化 equation 8。
| 参数 | 值 | 说明 |
|---|---|---|
| \(Q\) | 1,000,000 | 每日交易量 |
| \(V\) | $0.50/query | 准确率变化一个单位时,每次查询对应的价值 |
| \(\text{Accuracy}_0\) | 0.95 | 初始准确率 |
| \(\gamma\) | 0.02 | 每日衰减率(每天 2%) |
| 再训练成本 | $5,000 | 再训练总支出 |
敏感性分析
在平方根近似下,\(T^*\) 随这些参数的平方根变化。Table 10 表明,再训练成本、查询量或衰减率变为原来的四倍时,近似间隔会变为原来的两倍或一半。
| 变化 | 对 \(T^*\) 的影响 |
|---|---|
| 再训练成本变为 4\(\times\) | 间隔延长至 2\(\times\) |
| 查询量变为 4\(\times\) | 间隔缩短 2\(\times\),即减半 |
| 衰减率变为 4\(\times\) | 间隔缩短 2\(\times\),即减半 |
模型局限性
这一闭式框架为运维规划提供了一阶近似,但其实用性取决于若干简化假设。首先,指数衰减形式假设漂移以恒定速率 \(\gamma\) 渐进发生;突发的协变量偏移或严重的数据中断需要即时的统计变点检测,而非平滑衰减模型。其次,该形式假设准确率每变化一个百分点所对应的边际价值 \(V\) 恒定,而现实中的效用往往存在非线性阈值或不对称惩罚。第三,该模型将各次再训练视为相互独立的静态重启,未考虑再训练周期之间的迁移学习。最后,基础设施成本被建模为固定金额,而云端竞价定价、队列争用和弹性计算资源的可用性会引入动态变化。尽管存在这些边界,该推导仍将再训练周期建立在经济权衡之上,而非任意的日历计划之上。随着运维经验的积累,可通过历史遥测数据进行经验校准,改进参数。通过使成本收益权衡显式化并可量化,这一框架实现了成本感知自动化(section 1.2.1),使基础设施投资有据可依,并使监控阈值建立在可测量的业务影响之上。
模型验证
训练流水线生成候选模型;模型验证决定哪些候选模型值得部署到生产环境。在研究评估中,模型在静态测试集上超越基准就可能被视为成功;与之不同,生产验证必须在具有代表性的条件下评估模型是否具备运行条件,并建立分布变化后所需的监控和回滚控制机制。
评估过程首先在从与生产数据相同的分布中抽样得到的留出测试集上进行性能测试。计算准确率、曲线下面积(AUC)、精确率、召回率和 F1 分数等核心指标 (Rainio et al. 2024),并进行长期跟踪,以检测数据漂移引起的性能下降 (IBM 2024)。figure 7 中三个对齐的面板具体展示了这种下降模式。顶部面板展示了随时间到达的数据样本,并按类型用颜色区分。中间面板展示了一个相关变化:特征分布(sales_channel)逐渐从以线上交易为主转向以线下交易为主。底部面板显示,同一时间段内模型准确率持续下降。这一可视化揭示了模型验证的核心挑战:需要同时监控输入与输出,以理解性能变化的原因。
Rainio, Oona, Jarmo Teuho, and Riku Klén. 2024. “Evaluation Metrics and Statistical Tests for Machine Learning.” Scientific Reports 14 (1): 6086. https://doi.org/10.1038/s41598-024-56706-x.
IBM. 2024. IBM Watson OpenScale: Data Drift Detection.
\begin{tikzpicture}[line join=round,font=\sffamily,outer sep=0pt]
\tikzset{
  % Arrow style for connecting lines
  LineA/.style={line width=0.75pt,black,text=black,-{Triangle[width=0.7*6pt,length=1.5*6pt]}},
  % Style for green cells (default box style)
  styleBox/.style={draw=none, fill=green!60!black!40, minimum width=\cellsize,
                    minimum height=\cellheight, line width=0.5pt},
  % Style for orange cells (alternative box style)
  styleBox2/.style={styleBox, fill=orange},
}
% Define reusable dimensions
\def\cellsize{6mm}
\def\cellheight{8mm}
\def\columns{26}
\def\rows{1}
% Draw green cells at selected x positions
\foreach \x in {1,2,3,4,6,7,8,9,10,12,13,15,17,18,21,24}{
    \foreach \y in {1,...,\rows}{
        \node[styleBox] (C-\x-\y) at (\x*1.3*\cellsize,-\y*\cellheight) {};
    }
}
% Draw orange cells at other selected x positions
\foreach \x in {5,11,14,16,19,20,22,23,25,26}{
    \foreach \y in {1,...,\rows}{
        \node[styleBox2] (C-\x-\y) at (\x*1.3*\cellsize,-\y*\cellheight) {};
    }
}
% Add label above the first row of cells
\node[inner sep=0pt,above right=0.2 and 0of C-1-1.north west]{\textbf{流入数据}};
% Draw horizontal arrow below the row of cells with "Time" label
\draw[LineA]($(C-1-1.south west)+(0,-0.4)$)--($(C-\columns-1.south east)+(0,-0.4)$)
node[below left=0.2 and 0]{时间};
% === Feature distribution box ===
% Define corners of the rectangle
\coordinate(GL)at($(C-1-1.south west)+(0,-1.6)$);
\coordinate(DD)at($(C-\columns-1.south east)+(0,-3.9)$);
% Filled green rectangle representing "Feature distribution"
\path[fill=green!60!black!40](GL)rectangle(DD);
% Define auxiliary coordinates for corners
\path[](GL)|-coordinate(DL)(DD);
\path[](DD)|-coordinate(GD)(GL);
% Add title label above rectangle
\node[inner sep=0pt,above right=0.2 and 0of GL]{\textbf{特征分布:} sales\_channel};
% Draw orange triangular shape inside rectangle
\path[fill=orange](DL)--(DD)--($(DD)!0.6!(GD)$)coordinate(SR)--cycle;
% Add text labels inside the distribution area
\node[align=center] at (barycentric cs:DL=1,GL=1,SR=0.1,GD=0.1) {线上商店};
\node[align=center] at (barycentric cs:DL=0.2,DD=1,SR=1) {线下商店};
% === Accuracy graph area ===
% Define corners of the graph box
\coordinate(2GL)at($(C-1-1.south west)+(0,-5.0)$);
\coordinate(2DD)at($(C-\columns-1.south east)+(0,-7.1)$);
% Draw empty rectangle for graph
\path(2GL)rectangle(2DD);
% Define auxiliary coordinates for graph corners
\path(2GL)|-coordinate(2DL)(2DD);
\path(2DD)|-coordinate(2GD)(2GL);
% Add title label above graph
\node[inner sep=0pt,above right=0.2 and 0of 2GL]{\textbf{模型质量:} 准确率随时间的变化};
% Draw graph axes
\draw[line width=1pt](2GL)--(2DL)--(2DD);
% Draw accuracy curve (green line)
\draw[line width=2pt,green!50!black!80]($(2GL)!0.2!(2DL)$)to[out=0,in=170]($(2DD)!0.25!(2GD)$);
\end{tikzpicture}除静态评估外,生产流水线还采用受控部署策略,在限制影响范围的同时,将候选权重置于在线服务环境中。一种广泛采用的方法是金丝雀测试 (Fowler 2014),即让新模型接收少量生产流量。在这一有限发布阶段,遥测流水线监控推理延迟、系统稳定性和预测分布。例如,某电商平台将候选推荐模型部署到 5% 的在线查询流量上,对照基线模型监控点击率、p99 延迟和预测漂移。只有当候选模型表现出统计稳定性且未出现延迟退化时,才会将其提升为承接全部生产流量的模型。
Fowler, Martin. 2014. Canary Release. Martin Fowler’s Blog.
Weights & Biases, Inc. 2024. Weights & Biases: The AI Developer Platform.
在相同运行条件下评估候选模型,是做出可靠提升决策的前提;如果某个候选模型仅因评估所用的流量切片或时间窗口不同而表现出表面上的指标提升,就会将模型质量与数据变异混为一谈。云端机器学习平台通过请求重放、影子服务和合成负载测试来支持受控评估。Weights & Biases (Weights & Biases, Inc. 2024) 等平台会记录确切的训练产物、超参数配置和评估指标,使整个模型生命周期中的提升决策可复现、可审计。
虽然自动化验证门禁可以防止主要聚合指标退化,但生产验证还需要审查数据切片和长尾行为。自动化测试套件往往会掩盖代表性不足的子群体或安全关键边缘案例上的严重性能下降。生产架构将自动化门禁与政策审查相结合,对于部署在受监管领域的模型尤其如此。这种多阶段验证规范将离线评估与在线生产监控衔接起来,确保候选模型在接收不受限制的服务流量之前,满足准确率、延迟和安全性方面的不变条件。
基础设施集成
开发基础设施解决了三个关键系统接口中的两个。特征存储和数据版本控制通过集中管理并跟踪训练与服务过程中的特征访问,减少数据—模型接口处的不一致。CI/CD 流水线、模型注册表和验证门禁通过自动完成从训练后权重到具备回滚能力的容器化服务的转换,稳定模型—基础设施接口。
这些仅覆盖了运维挑战的三分之二。即使模型通过了所有验证门禁并顺利部署,仍可能随着输入分布变化而在生产环境中悄然失效。第三个关键接口,即生产—监控接口,需要采用着眼于持续保持预测正确性而非构建模型的实践。
生产运维
已部署的模型具有运行半衰期。 只要底层硬件的不变条件成立,传统软件二进制程序就能保持确定性的正确性;而机器学习模型则将确定性的矩阵运算与外部非平稳数据分布耦合在一起。当在线输入特征偏离训练流形时,预测会悄然退化,即使集群健康检查——从 HTTP 响应码到尾延迟(\(p_{99}\))——仍全部显示正常。生产运维实现生产—监控接口,使这种无声衰退变得可见,并能够采取行动。通过将渐进式流量路由与运行时漂移检测相结合,运维基础设施能够隔离失效的模型版本,并在错误推理结果传播至下游系统之前触发缓解措施。
模型部署与服务
模型经过训练和验证后,必须集成到能够大规模提供预测的生产环境中。部署将静态检查点转换为具有版本、可复现的执行产物;服务则分配加速器内存、准备输入批次并调度计算内核,以便在动态请求负载下满足延迟 SLO。这些系统共同使模型能够在生产软件生态系统中实际运行。
模型部署
考虑一个在开发环境中达到 99.2% 精确率的欺诈检测模型。工程师导出权重,将其复制到生产服务器,却发现模型将每笔交易都预测为合法交易:生产服务器运行的特征提取库版本不同,生成了模型从未见过的输入。这一情景说明,部署是一个系统工程问题,而非简单的文件传输。为实现可靠的生产部署,对机器学习模型进行打包、测试和跟踪,需要将模型权重、运行时依赖和预处理配置视为一个统一的可部署单元。将模型产物和服务运行时容器化13,可以把用户空间依赖、运行时库和环境变量打包到不可变镜像中,确保开发环境与集群节点之间的环境一致性。
生产部署需要能够处理模型打包、版本管理以及与服务基础设施集成的框架。MLflow 和模型注册表等工具管理这些部署产物 (Chen et al. 2020),而专用服务框架(详见 模型服务)则处理运行时优化和扩缩容需求。在全面发布之前,团队会将更新后的模型部署到预发布或 QA 环境14,以严格测试其性能。
Chen, Andrew, Andy Chow, Aaron Davidson, Arjun DCunha, Ali Ghodsi, Sue Ann Hong, Andy Konwinski, et al. 2020. “Developments in MLflow: A System to Accelerate the Machine Learning Lifecycle.” Proceedings of the Fourth International Workshop on Data Management for End-to-End Machine Learning, 1–4. https://doi.org/10.1145/3399579.3399867.
影子部署15 将在线生产流量异步复制给候选模型,但不向用户返回其推理结果,从而能够在不直接影响用户的情况下比较延迟和输出;准确率评估仍需要标签或其他真实值参照。金丝雀部署16 将少量用户流量路由至候选模型,并逐步提高比例,以检测在线负载下的退化。蓝绿部署17 维护并行环境,以支持路由层切换和快速回滚。每种策略都降低了不同的发布风险,但都不能替代经过测试的回滚流程和生产监控。
War Story 1.1: 骑士资本错误事件(2012 年)
背景:骑士资本集团是美国股票市场的一家主要做市商,处理纽约证券交易所超过 17% 的交易量。2012 年 8 月,一次运维部署更新了八台生产服务器中七台上的 SMARS 订单路由软件,却遗漏了第八台 (U.S. Securities and Exchange Commission 2013)。
机制:此次部署重新利用了一个二进制功能标志,该标志在未更新的第八台服务器上激活了遗留的 Power Peg 代码。这台未更新的服务器进入了一个不限速的循环,以 \(\sim 1,400\text{ orders/sec}\) 的速率发送母订单请求。
影响:在 45 分钟内,路由器执行了超过 400 万笔未经授权的交易,涉及超过 3.97 亿股股票,造成 $460 百万美元的损失。该公司仅靠数日后筹集的紧急救助融资才得以存续,并在数月内因被收购而失去独立地位。
应对:这一事件凸显了在所有生产节点上进行原子部署验证、对功能标志实施明确的生命周期控制,以及采用熔断器限制故障发布可能造成的损害的必要性。
系统启示:自动化部署是一个物理控制问题,异构节点之间的配置漂移会导致系统范围的服务故障。机器学习部署同样存在这一脆弱性:模型注册表版本不匹配、特征模式未同步或金丝雀路由仅部分生效,都可能在遥测告警触发之前,使损坏的推理请求大量涌入生产环境。
U.S. Securities and Exchange Commission. 2013. “Securities Exchange Act of 1934, Release No. 70694: Knight Capital Americas LLC.”
避免骑士资本式故障,是机器学习系统分阶段发布而不一次性切换流量的原因,但分阶段部署会暴露依赖负载的行为。当金丝雀部署在更高流量占比下暴露异常时——例如,内存耗尽、队列溢出,或在 5% 流量下无法检测、到 30% 流量时才出现的 p99 尾延迟上升——定位问题需要对整个技术栈进行系统化调试。有效诊断需要关联多种信号:基准测试 中的性能指标、用于检测漂移的数据分布分析,以及可能解释退化的特征重要性变化。团队维护的调试工具集包括 A/B 测试分析框架、特征归因工具和数据切片分析器,用于识别哪些子群体的性能正在下降。
这一诊断闭环必须直接连接到发布流水线。CI/CD 集成可以自动执行部署和回滚,但前提是将回滚设计为发布机制的一部分,而非将其视为应急脚本。
回滚策略与安全机制
回滚18能力是支持团队有信心地部署的安全网。缺乏可靠回滚时,团队会回避部署,迭代速度也会减慢。有效的回滚需要针对三种不同情景进行规划:
最快的一层是即时回滚,用于应对部署后立即发现的严重故障:服务错误、延迟突增或明显的预测失败。它要求上一模型版本保持已加载且已预热的状态,以便切换流量时不会产生冷启动延迟。快速回滚 处理部署后不久通过金丝雀指标检测到的性能退化,这需要与模型注册表集成,使先前版本只需极少的配置变更即可部署。延后回滚 处理全面部署后通过业务指标或用户反馈发现的细微问题,此时回滚必须考虑新模型运行期间积累的个性化状态或缓存嵌入等模型相关数据。
Table 11 总结了各类回滚的实现模式:
| 回滚类型 | 触发条件 | 实现方式 | 状态处理 |
|---|---|---|---|
| 即时 | 服务错误、崩溃 | 热备并即时切换 | 无状态——无需特殊处理 |
| 快速 | 金丝雀指标退化 | 基于注册表重新部署 | 清空缓存、重启会话 |
| 延后 | 业务指标下降 | 包含迁移的完整重新部署 | 迁移状态,必要时重放 |
回滚测试
从未测试过的回滚流程可能在需要时失效,而这类缺陷往往在事故处置过程中才被发现,此时认知负荷和时间压力都处于最高水平。失败可能源于配置依赖、状态不兼容或责任归属不清。定期开展回滚演练,可以在这些缺陷造成影响之前将其暴露。自动化回滚判据可以缩短反应时间,但阈值必须根据服务进行校准,并包含防止反复切换的保护措施。恢复后的模型还必须产生一致的行为,避免预测被陈旧缓存或不兼容的特征状态破坏。分步操作手册可以确保响应人员不必是部署方案的设计者。
有状态与无状态回滚
机器学习系统的状态性各不相同,这直接决定了回滚的复杂度。对于表格分类和静态回归等无状态工作负载,回滚只需替换模型权重或将流量路由回先前的容器,因为各次推理之间不共享执行上下文。相比之下,有状态模型——包括序列推荐模型、基于会话的搜索排序模型和对话系统——会积累临时用户状态。回退此类工作负载可能需要重置会话、为缓存的上下文向量提供模式兼容层,或显式迁移状态;在部署边界保存带版本的检查点可以缓解这一困难,但能否干净地恢复仍是一项架构属性,需要通过实证验证,而不能依赖假设。例如,双塔推荐和搜索服务通常会预先计算稠密的用户与物品嵌入,并将其存储在低延迟缓存中;如果模型 v2 旋转了潜在向量空间或改变了嵌入维度,那么这些缓存向量对于回滚后的模型 v1 就会在数学上失去意义。因此,有状态回滚必须在重新部署权重的同时,协调执行原子缓存失效或双版本命名空间切换,以防止使用不兼容的向量空间对查询进行评分。最复杂的故障模式出现在存在反馈循环的系统中:如果不良预测在性能退化期间污染了下游特征日志或点击流训练集,那么回退服务二进制程序后,重训练语料中仍会保留受污染数据;必须先删除或隔离这些数据,才能恢复先前的行为。
用于模型验证的 A/B 测试
A/B 测试 通过在受控条件下比较模型版本,为部署决策提供统计基础。金丝雀部署验证运行稳定性,而 A/B 测试则衡量新模型是否在具有统计置信度的情况下改善业务结果。
实验设置与决策规则
有效的 A/B 测试需要确立四项控制措施,以确保部署决策在统计上保持可靠:
首先,随机化单元 规定流量是按用户 ID 还是按单次请求划分。用户级哈希划分能够保持跨会话的一致性,代价是需要更大的样本量;请求级划分则能最大化样本吞吐量,但可能使同一用户交替接触不同的模型变体。
其次,统计功效范围决定了识别有实际意义的差异所需的流量。在方差相同的正态近似下,设 \(n\) 为每个实验组所需的用户数,\(\delta\) 为最小可检测效应,\(\sigma\) 为结果变量的标准差,\(z_{\alpha/2}\) 和 \(z_{\beta}\) 为所选双侧置信水平和统计功效对应的正标准正态临界值。本例采用 95 percent 的置信水平和 80 percent 的统计功效。Equation 9 将这些设计目标转换为实验上线前所需的流量。 \[n = \frac{2(z_{\alpha/2} + z_{\beta})^2 \sigma^2}{\delta^2} \tag{9}\] 对于基线转化率为 5 percent、相对提升为 2 percent(从 5 percent 提升至 5.1 percent)且统计功效为 80 percent 的情形,实验每组约需 745,644 名用户;如果每组只有 25,000 名用户,则检验只能检测到大得多的提升,即绝对提升约为 0.5 percentage points。
第三,护栏指标 定义了运行和行为方面的边界,即使主要指标有所改善,这些指标也不得恶化。如果推荐模型将点击率提高了 10%,却使 p99 响应延迟增加了 500 ms,就违反了系统护栏约束,并可能导致下游服务发生级联超时。
第四,固定的评估周期要求实验持续运行,直到达到预注册的样本量和最短持续时间,以涵盖周期性的周季节性变化。在首次出现统计显著性时立即停止实验,会因反复查看结果而抬高假阳性率;提前停止需要预先指定序贯设计,并校准 alpha 消耗边界。
这些控制措施确立了统计约束范围,但机器学习系统还存在普通 Web 实验可能掩盖的失效模式。转化事件可能在预测数天后才发生,从而产生延迟反馈:周一展示的推荐可能促成周五的购买,因此归因窗口必须纳入实验设计。新奇效应 也可能因用户积极响应新推荐而抬高早期表现,这也是成熟实验在正式测量前设置预热期的原因。
推荐和排序系统还存在干扰效应,因为向一个用户展示某个物品,可能影响另一个用户可获得或注意到的内容,从而违反标准 A/B 分析所依赖的独立性假设。群体异质性带来了第二个分析问题:总体上无明显变化的结果,可能掩盖对某一群体的显著正向效应以及对另一群体的负向效应。这些复杂因素并不会使 A/B 测试失效,但它们要求将护栏、分群分析和预注册的决策规则纳入实验本身,而非留待事后解释。
Table 12 将这些约束转化为部署决策:
| 主要指标 | 护栏 | 决策 |
|---|---|---|
| 显著改善 | 全部通过 | 发布新模型 |
| 显著改善 | 部分未通过 | 调查权衡关系,可能需要迭代模型 |
| 无显著变化 | 全部通过 | 证据尚无定论;保留当前模型,除非预先指定的等效性或非劣效性检验支持更换模型 |
| 显著恶化 | 不适用 | 不予发布;调查根本原因 |
只有在上线前预注册评估方法,决策矩阵才可靠。团队必须在观察生产流量之前,确定预期效应量、随机化单位、归因窗口、护栏阈值和最短运行时间。
中期评估也需要同等的严谨性。CUPED(利用实验前数据的受控实验)等方差缩减技术,利用实验前的协变量调整结果,降低指标方差,从而在不牺牲统计功效的情况下加快决策。自动化分析流水线可避免人工计算错误影响决策边界,而归档负面结果则能保留实证依据,避免重复采用无效的架构。
只有发布机制能够将受测的确切制品正式上线、暂缓发布或回滚时,A/B 决策才有实际意义。模型注册表(例如 Vertex AI 的模型注册表 (Google Cloud 2024d))充当集中式存储库,用于存储和管理训练完成的模型及其版本。模型目录承担不同的职责:注册表管理内部经过版本控制的部署制品,而 Vertex AI Model Garden (Google Cloud 2026a) 等目录则为外部模型和基础模型系列(例如 Llama 2 (Touvron et al. 2023))建立索引,以供评估、微调和初步选择。
Google Cloud. 2024d. Vertex AI Model Registry.
Google Cloud. 2026a. Explore Models in Model Garden.
推理端点将经过验证的模型提供给线上流量。轻量级服务通常通过 HTTP/1.1 上的 REST API 进行实时评分,而高吞吐量系统则采用 HTTP/2 上的 gRPC 等二进制 RPC 协议,以消除 JSON 序列化瓶颈并减少 CPU 解析开销。根据性能要求,模型服务系统会配置专用加速器实例(例如 GPU 或 TPU),或使用无服务器推理19,在空闲时将计算容量缩减至零。
为维护血缘关系和可审计性,团队使用 MLflow20 (Databricks 2024) 等工具跟踪模型制品,包括脚本、权重、日志和指标。注册表、端点、血缘跟踪以及 Ray21 等分布式编排框架,共同将 A/B 测试结果转化为受控的生产变更:受测模型可以正式上线、接受观测并回滚,同时保留其来源信息。
Databricks. 2024. MLflow: An Open Source Platform for the Machine Learning Lifecycle.
模型格式优化
未经优化的 PyTorch 模型在即时执行模式下,通过 Python 解释器将各算子作为独立的内核启动进行调度,使中间激活张量反复经由高带宽内存(HBM)往返传输,并产生内核启动开销,导致 p99 延迟远超严格的 SLO 要求。格式优化 将动态计算图编译为针对硬件调优的静态中间表示,融合相邻内核、折叠常量权重并消除死代码。虽然 推理运行时选择 和 服务中的精度选择 详细介绍了底层运行时和数值精度选择,但要将这些格式投入实际运行,还需要管理转换和验证工作流。
第一个运行边界是表示形式。开放神经网络交换格式(ONNX) 是广泛使用的模型互操作格式,支持模型可移植性,但运行时和执行提供程序 的选择决定了目标硬件、受支持的算子以及可用的优化。ONNX Runtime 强调跨多个后端的统一 API,而 TensorRT 则专门针对 NVIDIA GPU 优化执行;实际性能必须针对目标模型和硬件进行测量。典型工作流包括将 PyTorch 模型导出为 ONNX、执行计算图清理(常量折叠和死代码消除)、融合兼容算子、选择精度,并在每一步对照源模型验证数值行为和任务层面的表现。table 13 中的代表性选项在可移植性、硬件覆盖范围和优化机制方面各有不同。
| 框架 | 源格式 | 目标硬件 | 关键优化 |
|---|---|---|---|
| ONNX Runtime | PyTorch, TF, Keras, scikit | CPU, GPU, NPU | 计算图优化、算子融合、量化 |
| TensorRT | ONNX, TF, PyTorch | 仅 NVIDIA GPU | 内核自动调优、精度校准、层融合 |
| OpenVINO | ONNX, TensorFlow/TFLite, PyTorch, PaddlePaddle | Intel CPU, GPU, NPU | 模型压缩、异步执行、缓存 |
| TF-TRT | TensorFlow | NVIDIA GPU | 在 TensorFlow 计算图中集成 TensorRT |
| Core ML | TensorFlow, PyTorch | Apple Neural Engine, GPU, CPU | 面向 Apple 设备的统一格式、端侧推理 |
| TFLite | TensorFlow, Keras | 移动端 CPU、GPU、Edge TPU | 量化、委托支持、模型压缩 |
长期存在的架构权衡是可移植性与峰值性能之间的取舍:加速器吞吐量的每一分提升,都需要以依赖专用运行时和接受算子约束为代价。数值精度构成了第二个运行边界。通过量化 降低数值精度(例如从 FP32 或 FP16 降至 INT8 或 FP8),可使算术吞吐量翻倍,并缓解张量核心的内存带宽压力。从运行角度看,量化部署的主要障碍是验证 INT8 或 FP8 表示能否在实时、非平稳的生产流量分布中保持数值保真度,而不仅是在静态校准数据切片上保持保真度。训练后量化(PTQ)、量化感知训练(QAT)和混合精度的机制见 模型压缩,运行时精度选择见 服务中的精度选择。
因此,将优化后的模型部署到生产环境时,需要针对优化可能悄然引入的失效模式进行验证。设想某个团队仅验证了吞吐量提升,就部署了 INT8 量化模型:模型在罕见但高价值的边缘案例上的分类准确率下降,而由于汇总指标仍处于 SLO 范围内,这种退化数周都未被发现。第一层验证是数值等效性,即在具有代表性的测试集上,使用应用特定的偏差阈值,将优化后的输出与原始模型进行比较。这项检查必要但不充分,因为罕见输入、分布外样本以及特定子群体的案例,可能暴露出汇总测试指标所掩盖的量化伪差。
第二层是运行验证。必须在运行时资源利用率达到峰值时测量内存占用,包括推理期间的动态分配,因为某些优化以增加运行时内存占用为代价换取计算速度。预热行为因运行时而异:加速线性代数(XLA) 可能在初始执行期间即时编译内核,而 TensorRT 则在部署前选择执行策略并构建引擎;加载该引擎仍可能增加启动延迟。最后,运行时版本兼容性使验证形成闭环:部署配置需要显式锁定版本,因为即使运行时的细微变更也可能影响性能特征和数值正确性。
推理服务
磁盘上的序列化模型制品,只有与执行基础设施配合才能产生价值;这些基础设施负责接收网络请求、准备输入、调度加速器计算,并在严格的延迟限制内返回预测。在超大规模下运行服务基础设施——例如文献报告的跨计算集群架构每天数十万亿次推理 (Hazelwood et al. 2018)——除了满足 模型服务 中详述的正式 SLO 外,还需要持续的生命周期管理。
Hazelwood, Kim, Sarah Bird, David Brooks, Soumith Chintala, Utku Diril, Dmytro Dzhulgakov, Mohamed Fawzy, et al. 2018. “Applied Machine Learning at Facebook: A Datacenter Infrastructure Perspective.” 2018 IEEE International Symposium on High Performance Computer Architecture (HPCA), 620–29. https://doi.org/10.1109/hpca.2018.00059.
Olston, Christopher, Noah Fiedel, Kiril Gorovoy, Jeremiah Harmsen, Li Lao, Fangwei Li, Vinu Rajashekhar, Sukriti Ramesh, and Jordan Soyke. 2017. “TensorFlow-Serving: Flexible, High-Performance ML Serving.” CoRR abs/1712.06139. https://doi.org/10.48550/arXiv.1712.06139.
NVIDIA. 2024. NVIDIA Triton Inference Server.
KServe Community. 2024. KServe: Highly Scalable and Standards-Based Model Inference Platform on Kubernetes.
TensorFlow Serving (Olston et al. 2017)、NVIDIA Triton Inference Server (NVIDIA 2024) 和 KServe (KServe Community 2024) 等生产级模型服务框架,为模型部署、版本管理和扩缩容提供了标准化机制。从运行角度看,关键决策是哪种框架最适合部署环境:TensorFlow Serving 适用于 TensorFlow 原生工作流,Triton 适用于多框架 GPU 模型服务,而 KServe 适用于需要缩容至零的 Kubernetes 原生环境。
无论采用哪种服务范式(在线、离线或近在线,详见 模型服务架构谱系),模型推理通常只占端到端总延迟 的一部分。分解延迟预算,可以揭示运行瓶颈究竟位于模型中,还是请求路径的其他位置。
Systems Perspective 1.1: 延迟预算
某服务的 p99 SLO 为 100 ms,模型推理预算为 45 ms;剩余的 55 ms 必须覆盖请求路径中的所有其他阶段。Table 14 展示了请求生命周期各阶段的预算分配。
| 组成部分 | 预算占比 | p99 预算 | 优化手段 |
|---|---|---|---|
| 网络 RTT | 15% | 15 ms | 边缘部署、连接池 |
| 特征检索 | 25% | 25 ms | 特征缓存、预计算 |
| 请求解析 | 5% | 5 ms | 二进制协议(gRPC)、模式优化 |
| 模型推理 | 45% | 45 ms | 量化、批处理、模型蒸馏 |
| 后处理 | 5% | 5 ms | 异步处理、结果缓存 |
| 响应序列化 | 5% | 5 ms | 高效格式(Protobuf、MessagePack) |
系统洞见:仅优化模型通常只能覆盖不到 50% 的延迟优化空间。模型运行加速至原来的 2×,会使本例的延迟从 100 ms 降至 77.5 ms,端到端加速比仅为 1.3×,因为推理只占总延迟的 45 percent。
系统思维要求进行端到端分析。应用数据—算法—机器分类法,从数据(特征提取开销、序列化成本)、算法(层数过多、计算图未经优化)和机器(内存带宽饱和、过热降频)三个方面诊断根本原因。测量端到端性能,并优化起决定性约束作用的瓶颈。如果特征检索超出预算,无论如何优化模型,都无法达到 SLO。
除了确定延迟预算,将模型服务投入实际运行还需要针对预算所揭示的约束选择基础设施技术。Table 15 总结了机器学习即服务基础设施的代表性策略;其组织思路是判断瓶颈究竟位于排队延迟、容量、路由、编排开销还是延迟预测。
| 技术 | 描述 | 系统示例 |
|---|---|---|
| 请求调度与批处理 | 将推理请求分组,以提高吞吐量并减少开销 | Clipper (Crankshaw et al. 2017) |
| 实例选择与路由 | 根据约束将请求动态分配给不同的模型变体 | INFaaS (Romero et al. 2021) |
| 预测式自动扩缩容 | 在需求激增前增加容量,以满足延迟 SLO | MArk (Zhang et al. 2019) |
| 自动扩缩容 | 调整模型实例以匹配工作负载需求 | INFaaS |
| 模型编排 | 协调模型组件或流水线之间的执行 | AlpaServe (Li et al. 2023) |
| 执行时间预测 | 预测延迟,以优化请求调度 | Clockwork (Gujarati et al. 2020) |
Crankshaw, Daniel, Xin Wang, Guilio Zhou, Michael J. Franklin, Joseph E. Gonzalez, and Ion Stoica. 2017. “Clipper: A Low-Latency Online Prediction Serving System.” 14th USENIX Symposium on Networked Systems Design and Implementation (NSDI 17), 613–27.
Romero, Francisco, Qian Li, Neeraja J. Yadwadkar, and Christos Kozyrakis. 2021. “INFaaS: Automated Model-Less Inference Serving.” 2021 USENIX Annual Technical Conference (USENIX ATC 21), 397–411.
Zhang, Chengliang, Minchen Yu, Wei Wang, and Feng Yan. 2019. “MArk: Exploiting Cloud Services for Cost-Effective, SLO-Aware Machine Learning Inference Serving.” 2019 USENIX Annual Technical Conference (USENIX ATC 19), 1049–62.
Li, Zhuohan, Lianmin Zheng, Yinmin Zhong, Vincent Liu, Ying Sheng, Xin Jin, Yanping Huang, et al. 2023. “\(\{\)AlpaServe\(\}\): Statistical Multiplexing with Model Parallelism for Deep Learning Serving.” 17th USENIX Symposium on Operating Systems Design and Implementation (OSDI 23), 663–79.
Gujarati, Arpan, Reza Karimi, Safya Alzayat, Wei Hao, Antoine Kaufmann, Ymir Vigfusson, and Jonathan Mace. 2020. “Clockwork: Predictable and Scalable DNN Inference in the Cloud.” USENIX Symposium on Operating Systems Design and Implementation (OSDI), 443–62.
这些策略构成了云端模型服务的基础。边缘部署保留了相同的运行目标,但改变了约束条件:回滚、遥测和更新控制必须在电力、内存和连接能力有限的设备上正常工作。
边缘 AI 部署
考虑一个配备机器学习模型、用于区分烹饪烟雾与火灾烟雾的烟雾探测器。当这个模型性能退化时,工程师无法简单地通过 SSH 登录设备、回滚到先前版本并重启。设备安装在某个人家的天花板上,Wi-Fi 连接时断时续,依靠纽扣电池供电,且只有 256 KB 内存。云端 MLOps 中的每一项运行假设(即时回滚、集中式日志、实时监控)都必须重新审视。
边缘 AI 体现了这种转变:机器学习推理发生在数据源处或其附近,而非集中式云基础设施中 (Reddi et al. 2019)。受严格延迟期限、上行链路带宽限制、数据隐私保障或低于一瓦的功耗范围约束的工作负载,需要直接在边缘芯片上执行推理。这种运行范式引入了三个相互依赖的系统约束:资源限制、层级化分层执行,以及具备故障安全能力的空中更新机制。
Reddi, Vijay Janapa, Christine Cheng, David Kanter, Peter Mattson, Guenther Schmuelling, Carole-Jean Wu, Brian Anderson, et al. 2019. “MLPerf Inference Benchmark.” 2020 ACM/IEEE 47th Annual International Symposium on Computer Architecture (ISCA), 446–59. https://doi.org/10.1109/isca45697.2020.00045.
Warden, Pete, and Daniel Situnayake. 2020. TinyML: Machine Learning with TensorFlow Lite on Arduino and Ultra-Low-Power Microcontrollers. O’Reilly Media.
资源约束主导着边缘部署决策。边缘设备需要采用 模型压缩 中介绍的激进模型优化技术(量化、剪枝、知识蒸馏),以满足微控制器级部署的内存和功耗限制 (Warden and Situnayake 2020; David et al. 2021)。功耗预算跨越四个数量级,从物联网传感器的毫瓦级到汽车系统的数十瓦,因此需要功耗感知的推理调度和热管理。一些硬实时、安全关键型应用提出了确定性的时序目标,需要在包括热节流和内存争用在内的不利条件下进行最坏情况执行时间(WCET)分析。
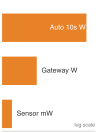
边缘功耗预算涵盖传感器、网关和车辆,跨越多个数量级。
这些约束自然形成了包含三个层级的部署体系。传感器级处理在功耗为 1–100 mW 的微控制器级设备上执行即时数据过滤和特征提取。边缘网关处理在功耗预算为 1–10 W 的应用处理器上执行中间层推理。云端协调负责模型分发、聚合学习,以及需要 GPU 级资源的复杂推理。这种层级体系支持系统范围的优化:计算开销大的操作向上层迁移,而对延迟敏感的决策保留在本地。
有两种部署场景值得特别关注。TinyML 面向在严格内存限制和毫瓦级功耗约束下基于微控制器执行的推理,需要 TensorFlow Lite Micro 和 CMSIS-NN 等专用引擎 (David et al. 2021; Lai et al. 2018)。模型架构必须与硬件约束协同设计,优先采用紧凑算子、量化和剪枝策略,其激进程度取决于设备和准确率目标。移动 AI 将边缘部署扩展到计算能力适中的智能手机,利用 NPU 和 GPU 计算着色器,通过功耗感知调度满足交互延迟和电池续航约束。
David, Robert, Jared Duke, Advait Jain, Vijay Janapa Reddi, Nat Jeffries, Jian Li, Nick Kreeger, et al. 2021. “TensorFlow Lite Micro: Embedded Machine Learning for TinyML Systems.” Proceedings of Machine Learning and Systems 3: 800–811.
Lai, Liangzhen, Naveen Suda, and Vikas Chandra. 2018. “CMSIS-NN: Efficient Neural Network Kernels for Arm Cortex-M CPUs.” ArXiv Preprint abs/1801.06601.
更新和监控补全了边缘运行体系。模型空中更新(OTA) 支持维护难以通过物理方式访问的系统。OTA 流水线需要安全的模型分发、制品验证和回滚机制;当设备无需接收完整模型制品时,增量或差分更新可以减少传输量。在微控制器和嵌入式目标设备上,具备故障安全能力的 OTA 回滚在物理层面依赖双区闪存:操作系统从 A 区启动,同时将候选模型和运行时写入 B 区。处于工作状态的硬件看门狗定时器会监控更新后的初始推理;如果新模型触发内存故障、挂起或违反延迟预算,引导加载程序就会自动恢复到 A 区执行,防止难以通过物理方式访问的设备变砖。更新调度必须考虑设备连接模式、可用电量和运行关键性。
监控需要适应资源受限的环境:轻量级遥测系统在尽量减少开销的同时,采集关键指标(推理延迟、功耗、准确率指示指标)。健康监控跟踪设备级状况(热状态、电池电量、连接质量),以预测维护需求。边云协调模式支持根据当前负载、网络状况和延迟要求,在不同层级之间进行自适应卸载。边缘网关上的特征缓存减少了冗余计算,而联邦学习使边缘设备能够贡献模型更新,而非原始训练记录。除非结合差分隐私或安全聚合协议,否则原始参数更新仍容易受到梯度反演和重构攻击。
平稳降级是边缘 AI 的标志性运行模式。当温度限制或电池耗尽约束硬件容量时,边缘运行时必须动态削减负载——降低输入采样率、绕过推测执行分支,或回退到浅层启发式模型——以保证持续安全运行。
将模型投入生产只是运行挑战的一半。成功部署的模型可能因分布偏移或上游特征损坏而发生性能退化,却不引发运行时错误——这是机器学习系统特有的静默失效模式。健全的监控、事件响应和值班实践使这一流程形成闭环。
资源管理与监控
部署和模型服务使模型进入生产环境。维持其健康运行需要两项互补的工作:资源管理(配置和扩缩计算、存储与网络资源)以及监控(观察系统行为,并在用户察觉之前检测到退化)。
基础设施管理
三个故障案例说明了这一问题。一个模型在预发布环境中工作正常,却因为有人手动配置了不同类型的 GPU 而在生产环境中失效。一个训练作业因同事的实验耗尽了所有可用内存而崩溃。一个推理服务无法扩容,因为其资源配额是在六个月前通过一条非正式消息设定的。这些故障有一个共同根源:通过手动流程而非代码管理基础设施。
可扩展且具有韧性的基础设施是将机器学习系统投入实际运行的基础,而基础设施即代码(IaC) 是使其可靠的实践。IaC 将基础设施配置视为软件(进行版本控制、审查、测试并自动执行),而非通过图形界面或命令行工具手动配置。这种方法将软件工程规范引入资源管理:变更可跟踪,配置可在部署前测试,环境可可靠地复现。
具体采用哪种基础设施工具,其重要性低于该工具所强制实施的契约。Terraform (HashiCorp 2014)、AWS CloudFormation (Amazon Web Services 2024d) 和 Ansible (Hatcher 2024) 代表了将基础设施定义与应用代码一同进行版本管理的常见方式。在 MLOps 场景中,正是这种经过版本管理的定义,使团队能够在 AWS (Amazon Web Services 2024b)、Google Cloud Platform (Google Cloud 2024a)、Microsoft Azure (Microsoft 2024) 或本地基础设施上,复现训练或服务环境所使用的 GPU 类型、网络策略、存储权限和扩缩容限制。
HashiCorp. 2014. Terraform: Infrastructure as Code. Software available from https://www.terraform.io/.
Amazon Web Services. 2024d. AWS CloudFormation.
Hatcher, Blake Douglas. 2024. “Automating Server Deployments with Ansible: Utilizing Automation in DevOps.” Journal of Computing Sciences in Colleges 40 (3): 42–43.
Amazon Web Services. 2024b. Amazon Web Services (AWS).
Google Cloud. 2024a. Google Cloud Platform Documentation. Https://cloud.google.com/docs.
Microsoft. 2024. Microsoft Azure.
基础设施管理贯穿机器学习的整个生命周期。在训练期间,IaC 脚本分配配备 GPU 或 TPU 加速器的计算实例、配置分布式存储并部署容器集群。由于基础设施定义以代码形式存储,因此可以审计、复用并集成到 CI/CD 流水线中,从而确保跨环境的一致性。
容器化 为运行时依赖提供了同样的可复现性边界。Docker (Merkel 2014) 将模型、库和服务代码打包为一个隔离单元,而 Kubernetes (Cloud Native Computing Foundation 2024a) 等编排系统则跨集群管理这些单元。其运行价值在于能够重复部署同一个制品,同时使资源分配、扩缩容和健康管理保持显式可控,而不在于容器的名称。
Cloud Native Computing Foundation. 2024a. Kubernetes: Production-Grade Container Orchestration.
为应对工作负载强度的变化,包括超参数调优期间的负载峰值和预测流量激增,团队依赖云弹性和自动扩缩容。22 云平台支持按需配置基础设施资源并进行水平扩展。自动扩缩容机制 (Amazon Web Services 2024c) 根据使用指标自动调整计算容量,使团队能够同时优化性能和成本效率。
MLOps 中的基础设施并不限于云端。许多部署根据延迟、隐私或监管约束,跨越本地、云端和边缘环境。健全的基础设施管理策略必须适应这种多样性,提供灵活的部署目标和跨环境一致的配置管理。
基础设施即代码解决了如何以可复现的方式配置资源的问题,但运维人员仍必须决定何时分配容量以及分配多少容量。机器学习工作负载打破了传统 Web 资源配置的假设。训练作业需要跨分布式加速器拓扑进行高并发突发计算,从而在集群利用效率与求解时间之间形成矛盾。推理服务需要持续的基线资源配额,并通过快速弹性横向扩展,在严格的尾延迟 SLO 下吸收请求峰值。
硬件利用率模式
配置加速器资源只是问题的前半部分;要高效使用这些资源,需要正确解读硬件指标,而非仅看其表面数值。标准 GPU 利用率指标 可能误导运维人员,因为报告的百分比反映的是时间占用率,而非实际执行情况。nvidia-smi 等工具报告的是至少有一个线程束在任意一个流式多处理器(SM)上处于活动状态的时间占比。一个内核即使因等待 HBM 数据读取或主机到设备的 PCIe 传输而停顿数百个时钟周期,仍会被记录为 100% 活跃,从而在看似健康的利用率数值背后,掩盖严重的内存带宽饱和或流水线供给不足。
要区分计算执行与内存或流水线停顿,需要结合内存带宽和 I/O 饱和度评估 SM 执行效率。Table 16 区分了这些利用率特征,并为每一种特征指出相应的优化策略:
| 模式 | GPU 利用率 | 内存带宽利用率 | 优化策略 |
|---|---|---|---|
| 计算受限 | >85% | <70% | 增大批大小,在节点内采用张量并行 |
| 内存受限 | 50–85% | >85% | 缩小模型、量化、优化内存访问 |
| I/O 受限 | <50% | <50% | 改进数据流水线、预取输入、使用 SSD |
| 批次供给不足 | 波动(呈尖峰状) | 波动 | 动态批处理、在单台服务器上对请求排队 |
不同工作负载的利用率目标
代表性的利用率目标随工作负载特征而变化,反映了不同运行模式在延迟容忍度和成本敏感性上的差异。对于批量训练,运维人员以持续超过 80% 的 GPU 利用率为目标;较低的数值通常表明存在数据预取瓶颈、非合并内存访问,或微批次过小的问题。相比之下,在线推理 以中位负载下 50–70% 的利用率为目标,有意预留 30–50% 的余量,以吸收不可预测的流量突发,同时不违反尾延迟 SLO;让推理硬件接近满容量运行,会使排队延迟级联累积并导致 p99 超时。对于批量推理,查询能够容忍较长时间的排队和离线调度,因此利用率目标提高到 85% 以上,以最大化吞吐量并摊薄加速器成本。
这些数值应作为诊断的起点,而非普适阈值:同一个利用率读数,在在线服务资源池中表示健康的余量,在批处理流水线中却可能意味着不可接受的闲置容量。
内存层次结构的影响
模型服务性能在很大程度上取决于 GPU 内存层次结构的利用情况。数据必须流经带宽差异巨大的多个内存层级(存储层次结构 展示了整个存储体系的完整延迟层次结构),table 17 对此进行了量化。L2 是由硬件管理、用于小规模活跃工作集的缓存,并非用于放置选定权重的存储层级。完整模型参数通常驻留在 HBM 中;更大的模型可能将参数或状态卸载到主机内存或存储设备,而传输延迟往往会主导推理时间。应知数值 列出了这些服务数据所依据的当前加速器规格和 HBM 带宽,因此 table 17 中的容量和接口带宽均可追溯至有文档记录的各代硬件数据,而片上 L2 缓存带宽则是一个近似值,厂商并未直接公布该数值:
| 内存层级 | 带宽 | 典型内容 |
|---|---|---|
| L2 缓存(A100 上为 40 MB) | ~3 TB/s | 缓存的工作集 |
| HBM2e GPU 内存(80 GB) | ~2 TB/s | 模型 |
| 连接 CPU 的 PCIe Gen4 x16 | ~32 GB/s | 激活值 |
| 系统 RAM(512 GB) | ~200 GB/s | 成批输入 |
| NVMe SSD | ~7 GB/s | 模型换入换出 |
对于在单个 GPU 或服务器上提供的大语言模型(LLM) 服务,KV 缓存(存储每个词元的注意力键和值)往往会成为内存瓶颈;vLLM 的 PagedAttention 设计正是由这种服务压力所推动的 (Kwon et al. 2023)。对于采用类似 Llama 2 700 亿参数模型架构的分组查询注意力模型 (Touvron et al. 2023),若其具有 80 层、8 个 KV 头、长度为 4,096 个词元的上下文,并采用 FP16 缓存条目,则每个活跃序列需存储约 1.3 GB 的 KV 缓存。因此,在尚未计入调度器预留空间、碎片化或激活值的情况下,八个并发序列就会消耗约 10.7 GB,从而限制单个节点能够一同批处理的请求数量。监控每个服务节点的 KV 缓存利用率有助于进行容量规划。接近内存上限时,调度器可能会将请求排队或拒绝请求、减小批大小,或缩短允许的上下文长度,而每种方式都会产生不同的延迟或服务质量代价。
Kwon, Woosuk, Zhuohan Li, Siyuan Zhuang, Ying Sheng, Lianmin Zheng, Cody Hao Yu, Joseph Gonzalez, Hao Zhang, and Ion Stoica. 2023. “Efficient Memory Management for Large Language Model Serving with PagedAttention.” Proceedings of the 29th Symposium on Operating Systems Principles, 611–26. https://doi.org/10.1145/3600006.3613165.
Touvron, Hugo, Louis Martin, Kevin Stone, Peter Albert, Amjad Almahairi, Yasmine Babaei, Nikolay Bashlykov, et al. 2023. “Llama 2: Open Foundation and Fine-Tuned Chat Models.” arXiv Preprint arXiv:2307.09288.
单次推理成本跟踪
设 \(\text{Hourly GPU cost}\) 为服务 GPU 一小时的计费成本,\(\text{Inferences per hour}\) 为其在同一时间区间内的持续吞吐量。Equation 10 将这些硬件指标转换为与业务相关的单次推理成本: \[\text{Cost per 1K inferences} = \frac{\text{Hourly GPU cost} \times 1000}{\text{Inferences per hour}} \tag{10}\]
以一块费用为 $3/hour、处理速率为 50,000 inferences/hour 的 GPU 为例,其成本为 $0.06/1K inferences。应持续跟踪这一指标;其变化可能反映定价、工作负载构成或效率的变化。
模型与基础设施监控
基础设施管理负责配置资源;监控则观察资源的行为。单元测试可以验证确定性组件,但仅凭单元测试无法确定模型在总体层面的预测性能,后者必须通过统计方法估计。监控将可观测的退化(section 1.2.1)落实为机制,把这一理论局限转化为运维实践。一旦监控暴露出某种症状——延迟未达到服务等级协议(SLA)要求、吞吐量低于目标或内存占用缓慢增长——瓶颈诊断 就会将该症状映射到数据—算法—机器中起主导作用的项,并告知运维人员哪些优化能够缓解当前起约束作用的瓶颈,哪些优化用于服务基础设施只会徒劳无功。如果没有持续监控及其所支持的更深入的可观测性(根据输出推断内部状态的能力),已部署的模型就如同一个逐渐失去实用性的黑箱。
有效的监控应同时覆盖基础设施健康状况和模型的统计行为。在基础设施方面,指标跟踪硬件饱和度、内存分配和延迟分布。在模型方面,团队会针对实时预测流跟踪准确率、精确率、召回率以及混淆矩阵变化等评估指标 (scikit-learn developers 2024b)。
scikit-learn developers. 2024b. Sklearn.metrics.confusion_matrix — Scikit-Learn Documentation. Scikit-learn Documentation.
统计监控中的一个基本约束是漂移检测延迟:统计检验能够多快确认预测质量已经下降。确认速度受样本到达速率和统计功效要求的制约。低流量服务可能需要等待数天或数周,才能积累足够的带标签结果,以区分真实的性能衰退与随机噪声。这一延迟缺口并非工具能够消除的工程缺陷;它是有限样本到达速率与假设检验功效要求相冲突的直接结果。因此,监控架构必须将输入分布偏移(可从无标签的推理请求载荷中即时检测)与决策边界偏移(只有在真实标签到达后才能检测)解耦。
漂移检测速度受样本到达速率的限制。
Napkin Math 1.4: 漂移检测延迟
问题:一个准确率为 95 percent 的模型,其准确率可能下降 5 percentage-point。监控策略设定的证据预算为 1,000 个带标签样本;确切需求取决于检验方法、统计功效、标签噪声和依赖性。收集这些样本需要多长时间?
计算:
- 证据预算:1,000 个带标签样本。
- 高速率情形:每秒到达 1 个带标签结果时,收集耗时为 1,000 seconds ≈ 16.7 minutes。
- 低速率情形:每天到达 100 个带标签结果时,收集耗时为 10 days。
系统启示:检测速度受带标签结果到达速率的限制,而这一速率可能远远落后于流量。业务量较低或标签延迟较大的领域可能需要数天或数周,因此高风险系统会通过主动模型审计来补充统计监控。
当遥测信号表明出现退化时,诊断根本原因并执行回滚,需要在模型注册库中进行严格的血缘追踪。在切实可行的情况下,每个注册的模型版本都必须关联训练代码、数据集快照、超参数和序列化权重制品的不可变摘要。尽管这条关联链能够支持以可复现的方式回滚到已知正常的检查点,但如果集群内各机器的驱动程序版本、CUDA 库或非确定性归约内核有所不同,就无法保证逐位可复现性。
退化本身沿着分布偏移的两个不同维度产生23,监控系统必须将两者解耦: 概念漂移发生在特征与目标之间的关系发生偏移时(\(p(y \mid x)\) 发生变化),即使输入特征看似正常,决策边界也会改变。数据漂移24指输入特征分布的偏移(\(p(x)\) 发生变化),例如自动驾驶中的季节性光照变化或传感器特性变化。
这两种漂移形式促使我们给出一个正式定义:
Definition 1.3: 数据漂移
数据漂移是输入分布 \(p(x)\) 的变化。协变量偏移是其中的特例,即 \(p(x)\) 发生变化,而 \(p(y \mid x)\) 保持稳定。数据漂移检测与响应 中更广泛的漂移分类还包括概念漂移,即 \(p(y \mid x)\) 发生变化;这两个维度的变化可以同时发生。
- 意义:它违反了同分布假设,并可能随着分布差异 \((\mathcal{D}(P_t \lVert P_0))\) 的增大而导致准确率下降。在协变量偏移和支撑集覆盖假设成立时,重要性加权或使用当前带标签数据进行重训练可能恢复性能。
- 区别:模型衰退描述的是随时间推移所观察到的质量下降;模型代码不一定发生变化。数据漂移是可能的外部原因之一,其他原因还包括概念漂移和周边流水线的变化。
- 常见陷阱:仅监控模型输出可能遗漏输入漂移,或将无害的输出变化误判为质量下降。由于真实标签反馈通常存在延迟,输入特征统计量(通过 PSI、KS 检验或 Wasserstein 距离/推土机距离(EMD)度量的 \(\mathcal{D}(P_t \lVert P_0)\))可以比带标签的性能指标更早发出预警。
由于漂移,已部署模型的行为更像是逐渐贬值的库存,而非静态软件。统计漂移风险将这一风险形式化:运维人员通过经验分布差异对准确率下降进行建模, \[\text{Accuracy}(t) \approx \text{Accuracy}_0 - \lambda \cdot \mathcal{D}(P_t \lVert P_0)\] 其中,\(\lambda\) 根据历史退化数据针对每个部署进行拟合。虽然这并非普适定律,但跟踪分布差异 \(\mathcal{D}(P_t \lVert P_0)\) 可以在准确率损失累积并影响业务之前,为退化提供运维层面的先行指标。
资产衰减曲线(figure 8)通过对比两种维护策略,说明了这一运维权衡。定期策略(橙色锯齿线)无论模型实际健康状况如何,都以固定的 90 天间隔进行重训练,因此会交替出现两种情况:性能仍然稳定时浪费计算资源,漂移在计划时间之前加速时则提供质量已退化的预测。相比之下,触发式策略(绿色线)仅在监控到的质量越过漂移阈值时启动重训练,在维持准确率下限的同时避免不必要的训练任务。
这两条曲线将漂移从抽象的统计问题转化为运维策略的选择。定期重训练易于规划,但可能过早或过晚进行;触发式重训练需要更强的遥测能力,但能够让干预时机与观测到的退化相匹配。
分层监控与漂移量化
分布差异可能伴随准确率衰减,但确定退化的方向和幅度需要真实标签,而这些标签往往存在显著的到达延迟。在生产环境中,服务故障涉及两种根本不同的物理机制:即时的硬件执行瓶颈和渐进的分布漂移。要区分两者,需要两个不同的遥测层:一层是基础设施指标,用于揭示服务系统本身是否受计算、内存或 I/O 限制;另一层是分布和结果指标,用于将数据移动与模型性能联系起来。
第一层是基础设施级监控,跟踪 CPU 和 GPU 利用率、内存带宽、磁盘占用、网络延迟和服务可用性等指标。仅测量 GPU 利用率并不充分;报告执行时间占比很高的加速器仍可能因等待 DRAM 或 PCIe 传输而停滞,而低利用率通常表明主机端存在预处理瓶颈。将内核执行时间与内存带宽利用率和输入流水线队列深度进行关联分析,可以区分受计算、内存和 I/O 限制的行为。
Systems Perspective 1.2: 生产监控中的铁律
这些利用率模式直接对应机器学习系统铁律(机器学习系统铁律)。监控能够揭示哪一项起主导作用:
- 计算受限(GPU 利用率高,内存带宽利用率低):受 \(O/(R_{\text{peak}} \cdot \eta_{\text{hw}})\) 限制。优化内核、使用 Tensor Core 或升级硬件。
- 内存受限(GPU 利用率中等,内存带宽利用率高):受 \(D_{\text{vol}}/\text{BW}\) 限制。通过量化、剪枝或批处理进行优化。
- I/O 受限(GPU 利用率低,内存带宽利用率低):受数据流水线延迟限制。应修复 DataLoader,而不是模型。
这条铁律同时也是生产系统的诊断框架。当延迟违反 SLO 时,监控仪表板会指明应调查哪一项。
能效指标(例如每焦耳推理次数或 FLOP/s/W,具体取决于工作负载)增加了按成本归一化的视角,从而支持混合工作负载调度。温度监控同样为运维调度提供依据,尤其是在持续高负载下,温控降频会迫使硬件时钟频率降低,引发违反 SLO 的尾延迟尖峰。MLOps 遥测流水线纳入温度裕量指标,以便在降频发生之前,将流量调度到可用的加速器上。Prometheus25 (Cloud Native Computing Foundation 2024b)、Grafana (Labs 2024) 和 Elastic (Elastic NV 2024) 等时序引擎可收集整个服务集群的这些运维指标,并将其可视化。
Cloud Native Computing Foundation. 2024b. Prometheus: Monitoring System and Time Series Database.
Labs, Grafana. 2024. Grafana.
Elastic NV. 2024. Elasticsearch: Distributed Search and Analytics Engine.
在生产规模下收集这些信号,会引入严峻的网络和存储约束:为每个请求采集未经压缩的遥测数据,可能使承载模型服务的网络互连本身达到饱和。这些开销迫使团队在监控粒度与基础设施运营费用之间作出审慎权衡。
Napkin Math 1.5: 可观测性的经济性
权衡:在大规模系统中,“测量一切”在物理上不可能实现。设 \(N_{\text{series}}\) 为展开后的序列数量,\(f_{\text{sample}}\) 为每个序列的采样频率,\(B_{\text{sample}}\) 为每个样本的字节数,\(T_{\text{retention}}\) 为保留时长;\(C_{\text{ingest/sample}}\) 和 \(C_{\text{storage/byte-time}}\) 分别为提供商特定的数据摄入和存储价格。Equation 11 将这些项组合为单位时间的运行成本: \[ \text{Cost rate} \approx N_{\text{series}} f_{\text{sample}} \left(C_{\text{ingest/sample}} + B_{\text{sample}} T_{\text{retention}} C_{\text{storage/byte-time}}\right) \tag{11}\]
Table 18: 追踪采样与可观测性成本:假设每个请求产生 1 KB 数据,在 1M req/s 的请求速率下,每 60 条请求追踪保留一条,可使数据量缩减 60×。这种缩减并非由批处理间隔造成。
该乘积表示单位时间的运行成本,而非一次性的部署成本。
两种数据量均可通过相同的两步计算得出。在完整保真度下,每个请求的遥测数据都会进入数据流:1M req/s \(\times\) 每个请求 1 KB = 1 GB/s。每 60 条请求追踪保留一条,可将平均摄入速率降至 16.7 MB/s;每隔 60 s 批量发送采样后的追踪,只会改变交付时序,不会改变平均字节速率。Table 18 并列展示了这两种策略及其成本影响。
| 采样 | 粒度 | 数据量(1M req/s) | 成本影响 |
|---|---|---|---|
| 全部追踪 | 微突发 | ~1 GB/s | 高(需要专用集群) |
| 每 60 条追踪保留一条 | 趋势 | ~16.7 MB/s | 较低(取决于策略) |
系统洞见:保留 1 percent 的成功请求和 100 percent 的错误请求。每隔 1 s 监测聚合计数器,每隔 60 s 监测高基数数据摘要;section 1.5.3.1 说明了如何规划基础设施预算。
告警机制将这些运行信号转化为主动干预,在静默退化向下游传播之前采取行动。模型准确率持续下降会触发漂移调查;基础设施告警则提示内存饱和、热降频或网络吞吐量下降。这些告警的延迟决定了故障未被发现的时间窗口。告警必须记录模型版本、受影响的输入子群体以及触发告警的聚合窗口,以便响应人员隔离并复现故障状态。
Example 1.3: 大规模推荐监控
场景:考虑一个高吞吐量的流式推荐服务,其延迟始终满足 SLO,但推荐质量随着用户行为变化而下降。
诊断:传统基础设施指标(CPU 利用率、HTTP 错误率)始终正常,而模型的点击率(CTR)却下降了,因为全局指标掩盖了局部子群体的退化。
系统经验:仅靠基础设施遥测无法检测模型在统计层面的失效。高吞吐量推荐系统需要按群组跟踪子群体并进行反事实评估,以检测局部准确率漂移。
数据质量监控
基础设施遥测跟踪系统可用性,但当输入数据损坏或发生偏移时,模型可能会静默失效。当下游业务指标出现退化时,上游数据损坏可能已经持续数天甚至数周。数据质量监控在推理发生前揭示这些输入缺陷,而输出与结果监控则确认分布偏移是否损害预测准确率。第一道输入防线是可执行的校验:listing 4 展示了在推理前拒绝格式错误批次的模式约束,将隐含的数据假设转化为可强制执行的软件契约。
schema.require_column("user_id")
schema.require_type("timestamp", "datetime")
schema.require_non_null("feature_a")

schema.require_range("age", min_value=0, max_value=120)
schema.require_mean_between(
    "purchase_amount", min_value=10, max_value=1000
)
输入数据校验
模式校验26在数据摄入时发现结构性缺陷。这些检查强制要求列存在、数据类型严格匹配、空值数量不超限以及数值边界不变量成立。
特征分布监控
模式校验能够发现结构性损坏(缺失列、错误类型、空值),但无法检测更隐蔽的失效模式:数据以正确格式到达,其分布却已发生偏移。表示用户年龄的特征可能通过所有模式检查,但随着营销活动吸引了年龄更大的人群,其均值在三个月内悄然从 32 变为 45。这种分布偏移早在任何结构异常出现之前,就会降低模型准确率。
长期渐进式退化尤其隐蔽,因为它能避开粗粒度的检测阈值:质量指标每日的微小变化可能在一年内累积成显著退化,却不触发月度告警。季节性模式使这一问题更加复杂;夏季训练的模型可能在整个秋季表现良好,却在从未见过的冬季条件下失效。检测这种渐进式退化需要多时间尺度监控:建立覆盖多个时间跨度(每日、每周、每季度)的性能基线,通过滑动窗口比较检测缓慢趋势,并建立考虑周期性变化的季节性特征剖面。
统计距离度量通过比较服务阶段的分布与训练基线,量化这种偏离。Table 19 给出了三种常见指标的代表性告警阈值,其中群体稳定性指数(PSI)适用于类别特征和分箱特征,Kolmogorov-Smirnov(KS)统计量适用于连续分布,Jensen-Shannon 散度则用于对概率分布进行对称、有界的比较。
| 指标 | 告警阈值 | 适用场景 |
|---|---|---|
| PSI | PSI > 0.25 | 类别特征和分箱特征 |
| Kolmogorov-Smirnov 统计量 | KS > 0.1 | 连续特征分布 |
| Jensen-Shannon 散度 | JS > 0.1 | 概率分布 |
PSI27通过比较固定分箱内的预期(训练)频率与实际(服务)频率,量化分布偏移(度量漂移(散度) 阐述了用于系统监控的 KL 散度、PSI 和信息论的数学基础)。此处,\(n\) 为固定分箱的数量,\(\text{expected}_i\) 和 \(\text{actual}_i\) 为相互对齐且严格为正的分箱占比,并且在各自分布内的总和均为一。Equation 12 给出了该指标的形式化定义: \[ \text{PSI} = \sum_{i=1}^{n} (\text{actual}_i - \text{expected}_i) \times \ln\left(\frac{\text{actual}_i}{\text{expected}_i}\right) \tag{12}\]
生产环境中的监控器需要采用有文档记录的空分箱处理策略,例如拉普拉斯平滑,因为分母中的任何空分箱都会导致对数无定义。监控器还必须在各比较时段之间保持固定的分箱边界;PSI 是漂移信号,而非自动触发重新训练的条件。
对于离散分布或分箱分布,KL 散度提供了另一种比较方式。设 \(p\) 为受监控的服务分布,\(q\) 为训练参考分布。Equation 13 定义了此处专用于 KL 散度的符号 \(\mathcal{D}_{\text{KL}}\);在本书其他部分,\(\mathcal{D}(P_t \lVert P_0)\) 表示退化方程中的一般统计散度: \[ \mathcal{D}_{\text{KL}}(p \lVert q) = \sum_{x} p(x) \log\left(\frac{p(x)}{q(x)}\right) \tag{13}\]
由于 KL 散度不对称,且当 \(q(x)=0\) 而 \(p(x)>0\) 时变为无穷大,运行监控器必须保持比较方向,并采用明确的支持集处理策略,例如对先前未出现的分箱进行平滑。从代数上看,PSI 等同于对称 Kullback-Leibler 散度(也称 Jeffreys 散度),其表达式为 \(\mathcal{D}_{\text{KL}}(\text{actual} \parallel \text{expected}) + \mathcal{D}_{\text{KL}}(\text{expected} \parallel \text{actual})\),这保证了任一方向的概率偏移都会产生正的漂移贡献。同样,Jensen-Shannon 散度通过计算各分布相对于平均分布 \(M = \frac{1}{2}(p + q)\) 的散度,避免了 KL 散度在不重叠分布上趋于无穷大的问题,从而得到一个平滑、对称且严格介于 0 和 1 之间的距离。在实践中,人口特征迁移在未经校准的直方图上可能并不明显,却会产生显著的漂移指标。在监控用户年龄的推荐系统中,用户向较高年龄群组偏移时,逐分箱的 PSI 分解如 table 20 所示:
| 年龄分箱 | 训练 | 服务 | 差值 | ln(服务/训练) | 贡献 |
|---|---|---|---|---|---|
| 18–25 | 15% | 12% | -0.03 | -0.223 | 0.0067 |
| 26–35 | 25% | 22% | -0.03 | -0.128 | 0.0038 |
| 36–45 | 20% | 18% | -0.02 | -0.105 | 0.0021 |
| 46–55 | 18% | 20% | +0.02 | +0.105 | 0.0021 |
| 56–65 | 12% | 15% | +0.03 | +0.223 | 0.0067 |
| 66+ | 10% | 13% | +0.03 | +0.262 | 0.0079 |
将六个分箱的贡献相加,得到总 PSI 为 0.029(稳定)。训练列和服务列以百分比显示,而差值列以比例值表示,因此 3 个百分点的偏移显示为 \(\pm 0.03\)。尽管特定分箱的占比变化了 3 个百分点,总体漂移仍远低于 0.1 的预警阈值。运行中是否采取行动取决于经过校准的阈值、样本量和业务成本。
数据新鲜度监控
特征存储和数据流水线中的数据可能变得陈旧,却不触发明显错误。数据新鲜度监控能够发现这种失效模式,listing 5 展示了一种配置,用于监控特征新鲜度,并在数据变得陈旧时触发回退行为。
user_purchase_history 特征是否陈旧,通过 PagerDuty 和 Slack 向运维团队发出告警,并在特征的数据年龄超过允许的最大值时回退至默认值。
# Example freshness alert configuration
feature: user_purchase_history
max_staleness: 6h
alert_channels: [pagerduty, slack]
on_stale:
  action: fallback_to_default
  default_value: []
新鲜度策略将数据陈旧从静默的数据缺陷转化为显式的回退行为;同样的检测与响应契约必须覆盖监控栈的每一层。
Checkpoint 1.2: 监控栈
机器学习监控是分层的,并非单一整体。本检查清单中的问题用于检验是否能将每种症状追溯到负责的层级。
同一套技术栈还必须监控向机器学习系统提供输入的上游依赖:数据库复制延迟、特征存储的摄取水位线以及流水线完成状态。在一次典型事件中,某推荐服务在两天内检测到其 user_lifetime_value 特征发生了显著变化,并将异常追溯到一次数据库迁移,该迁移在未发出提示的情况下改变了聚合窗口。如果缺少输入层的分布监控,这类上游数据损坏可能会使模型预测持续退化数周,直到真实结果指标暴露故障。
监控成本模型
可观测性基础设施的成本随监控粒度而变化。理解这些成本,有助于在监控深度与预算约束之间做出合理决策。
成本构成
监控成本可分为四类,如 equation 14 所示: \[\text{Monitoring Cost} = C_{\text{ingest}} + C_{\text{storage}} + C_{\text{compute}} + C_{\text{alert}} \tag{14}\]
这四个 \(C_*\) 项是在同一核算周期内的成本构成:数据摄取、留存存储、查询或仪表板计算,以及告警规则评估。将它们分开很重要,因为每一项都随不同的控制参数而变化。
Table 21 给出了各组成部分具有代表性的单位成本假设。将这些单位成本换算为具体的预算估计,可以明确即使只监控一个生产模型也会产生多少实际支出:
| 组成部分 | 示例单位成本 | 规模影响因素 |
|---|---|---|
| 指标摄取 | 每百万个数据点 $0.10–0.50 | \(\text{Number of metrics} \times \text{sample rate}\) |
| 日志存储 | 每 GB/月 $0.50–2.00 | \(\text{Log verbosity} \times \text{retention period}\) |
| 查询计算 | 每次查询 $0.01–0.05 | \(\text{Dashboard refresh rate} \times \text{users}\) |
| 告警评估 | 每次评估 $0.001–0.01 | \(\text{Number of alert rules} \times \text{check frequency}\) |
Napkin Math 1.6: 单模型监控预算
问题:在以下假设下,监控单个机器学习节点每月会产生多少摄取、存储和查询成本?
变量:
- 一个模型具有 3 种部署变体(生产、金丝雀、预发布),每种变体输出 50 项指标
- 每隔 15 seconds 对指标采样一次
- 保留要求:30 days
- 2 个仪表板(模型健康状况、基础设施),3 名团队成员,每五分钟刷新一次
指标摄取:
- 每月数据点数:3 \(\times\) 50 \(\times\) (4 samples/min \(\times\) 60 \(\times\) 24 \(\times\) 30 days) = 25.9M
- 按 $0.30/million 计费的成本:$7.8/month
存储:
- 压缩后每个数据点占 8 字节:25.9M \(\times\) 8 字节 = 0.2 GB
- 按 $1/GB 计费的成本:$0.21/month
查询计算:
- 每月查询数:2 个仪表板 \(\times\) 3 名用户 \(\times\) (12 queries/hour \(\times\) 8 hours/day \(\times\) 22 days) = 12,672 queries/month
- 按 $0.02/query 计费的成本:$253.4/month
合计:单个机器学习节点约为 $261.4/month。不包括告警评估和平台开销。
系统洞见:在这些假设下,成本随相同节点的数量线性增长;达到平台规模时,查询成本优化会变得愈发重要。
成本优化策略
equation 14 中的每个成本组成部分都对应一种不同的架构缓解措施。\(C_{\text{ingest}}\) 和 \(C_{\text{storage}}\) 的主要驱动因素是指标基数:user_id 或 request_id 等高基数标签会导致时间序列索引中的状态发生组合爆炸,其成本远超原始计算成本。在摄取之前丢弃高基数维度或对其进行哈希处理,可以立即节省存储和摄取成本。存储成本的第二个驱动因素是时间分辨率:将原始的 15 秒粒度指标保留 30 天,通常缺乏充分理由。分层保留策略(使用高分辨率遥测数据调试近期事件,使用降采样汇总数据分析历史趋势)可以在保持诊断保真度的同时,大幅减少留存数据量。对于 \(C_{\text{compute}}\),数十个无人操作的用户会话中的自动刷新循环,会不断累积仪表板查询开销;设置较长的刷新间隔,并自动暂停非活动会话,可以限制查询负载。最后,\(C_{\text{alert}}\) 随评估频率而变化:将重叠的阈值检查合并为多条件复合规则,可以在消除告警疲劳的同时,将规则引擎开销降至最低。
成本效益框架
使用 equation 15 中的监控效益成本比,结合事件成本论证监控投资的合理性: \[\text{Monitoring Benefit/Cost} = \frac{\text{Incidents Prevented} \times \text{Avg Incident Cost}}{\text{Annual Monitoring Cost}} \tag{15}\]
如果每起事件的平均成本为 $50,000(停机时间 + 工程时间 + 声誉损失),且每年以 $50,000 的监控成本预防了 5 起事件:
\[ \text{Benefit/Cost} = \frac{5 \times \$50,000}{\$50,000} = 5× \]
这一框架有助于论证监控投资的合理性,并确定哪些指标值得进行细粒度观测,哪些指标适合粗粒度采样。监控系统本身也需要进行韧性规划,以防止运维盲区。当主监控基础设施发生故障(Prometheus 停机或 Grafana 不可用)时,团队在关键时期可能面临失去可见性的风险。因此,生产级 MLOps 实现会维护冗余监控路径:在主系统故障期间启用的备用指标采集器、在集中式系统故障时仍持续记录的本地日志,以及用于检测监控系统中断的心跳检查。
稳健的生产部署会实施交叉监控,由外部看门狗基础设施监控遥测流水线本身,确保观测故障能够通过备用通知路径立即触发告警。这种纵深防御架构可以防止模型及其遥测系统同时失效却无人察觉的情况。熔断器28提供了进一步的保障:当某项服务的错误率超过阈值时,自动将流量从故障服务转移出去。在大量复制的服务之间协调这些保障措施,包括基于共识的告警和跨区域指标聚合,是模型跨区域复制后产生的集群规模问题,超出了此处单节点的讨论范围。
事件响应与运维实践
监控和漂移检测用于识别异常;事件响应、调试以及结构化的值班轮换则将这些统计信号转化为及时的工程行动,形成维持生产可靠性的运维反馈闭环。
机器学习系统的事件响应
凌晨 2:00,一名值班工程师收到告警:推荐点击率在过去一小时内下降了 12%。没有堆栈跟踪,没有错误日志,也没有崩溃的进程,只有一个表明某些情况发生变化的统计信号。响应人员必须区分四种可能的根因:上游数据流水线故障、模型漂移、季节性流量模式或统计噪声。这种模糊性在机器学习事件中很常见:症状可能表现为结果指标或预测质量指标退化,而非显式错误,因此事件响应必须考虑统计不确定性。
严重程度分类为在这种模糊情境下确定响应优先级提供了基础。Table 22 定义了四个优先级及其相应的响应时间,从要求在 15 分钟内响应的 P0 完全故障,到允许在 24 小时内调查的 P3 轻微异常。
确定严重程度后,事件响应过程会遵循一份结构化检查清单,按顺序逐步缩小排查范围:
- 检测环节确定是哪个监控信号触发了告警。
- 影响评估量化受影响流量的百分比。
- 响应人员审查近期变更,确定是否部署了任何模型、特征或数据流水线。
- 评估缓解方案,包括回滚、启用回退机制或减少流量。
- 根因分析确定问题源于模型、数据还是基础设施。
| 级别 | 判定标准 | 响应时间 | 示例 |
|---|---|---|---|
| P0 | 模型完全失效、服务错误 | 15 分钟 | 模型返回空预测 |
| P1 | 准确率显著下降(>10%) | 1 小时 | 推荐 CTR 下降 15% |
| P2 | 中等程度漂移、局部影响 | 4 小时 | 某一特征的 PSI > 0.3 |
| P3 | 轻微异常、无用户影响 | 24 小时 | 训练流水线延迟 |
对于 P0 和 P1 事件,必须编写事后复盘文档。这些复盘必须包括时间线、根因、用户影响和预防措施。机器学习特有的内容包括:识别是哪个监控缺口使问题进入生产环境,以及何种验证本可更早发现问题。
模型调试:从检测到诊断
事件响应负责分级处置与缓解;模型调试则负责识别根因。监控检测到某处出了问题;调试确定原因。除了常规软件缺陷,机器学习调试还必须考虑概率性故障和依赖数据的故障。错误预测不会抛出异常,也不会生成堆栈跟踪,因此系统化调试对于高效解决机器学习事件至关重要。
调试决策树
当模型性能退化时,请按顺序逐一回答以下诊断问题。生产环境故障排查 提供了一个系统化诊断矩阵,将症状映射到数据—算法—机器(D·A·M)的各个轴。

生产环境调试从数据—算法—机器的数据轴开始。
- 是数据问题吗? 检查上游数据流水线故障、模式变更、缺失值或分布变化。数据通常是首要排查对象,因为许多生产环境中的机器学习故障源于输入、标签或特征流水线的变化。
- 是训练与服务偏差吗? 对训练和服务中的匹配样本,比较其特征值或预处理输出。KS 或 PSI 可以用于筛查分布差异,但无法确定其成因。
- 是否涉及特定子群体? 按关键维度(地理位置、设备类型、用户群体)对性能进行切片分析。退化集中于某个切片,提示可能存在数据覆盖或标注问题。
- 是否与时间有关? 绘制性能随时间变化的曲线。突然下降时,应优先检查近期部署和数据故障;逐渐下降可能与漂移相符,但仅凭时间特征无法确定原因。
- 是模型问题吗? 排查数据和流水线方面的原因后,通过预测分析和特征归因检查模型行为。
切片分析
这一顺序使切片分析成为检测到全局退化后的首个深入分析步骤,因为它可以检验表面上的系统整体问题是否实际上集中于某个子群体。对所有流量聚合得到的性能指标,可能掩盖子群体中的严重问题:切片分析揭示了这种掩盖现象,table 23 展示了总体准确率如何隐藏特定细分群体中的严重退化。
| 用户群体 | 流量占比 | 准确率 | 影响 |
|---|---|---|---|
| 桌面端用户 | 45% | 94% | 正常 |
| 移动端(iOS) | 30% | 92% | 正常 |
| 移动端(Android) | 20% | 88% | 轻微下降 |
| 平板电脑用户 | 5% | 62% | 严重下降——需要调查 |
| 总体 | 100% | 91% | 掩盖了平板电脑端的问题 |
用于调试的特征归因
当切片分析识别出存在问题的群体时,特征归因技术有助于识别模型在错误预测中依赖了哪些特征。Listing 6 展示了一个使用 SHAP 值分析特定切片内错误预测的工作流。SHAP 值是一种特征归因分数,用于估计每个输入特征对单次预测的贡献程度。
# SHAP-based debugging workflow
import shap

# Select mispredicted examples from problematic slice
errors = predictions[
    (predictions.actual != predictions.predicted)
    & (predictions.device_type == "tablet")
]

# Compute SHAP values for error cases
explainer = shap.Explainer(model)
shap_values = explainer(errors[feature_columns])

# Plot feature attributions for the selected errors
shap.summary_plot(shap_values, errors[feature_columns])
归因图识别出模型在发生错误的切片中依赖的特征;它并不能确定这些特征是否导致了错误。诊断特征陈旧、覆盖不足或语义偏移,需要检查特征血缘和生产环境中的分布。
Systems Perspective 1.3: 僵尸特征
长期运行的生产模型往往会积累一些特征,而这些特征最初的负责人、语义或预期用途已经逐渐无人知晓。某个特征可能已在应用代码中弃用,却仍然流经特征存储、训练数据集或序列化模型输入契约。模型可能学会忽略它,将信号分散到一个重复特征上,或依赖某个已无人负责的预处理产物。因此,移除此类特征不再只是局部清理,而会成为一项可能影响重新训练、模型服务、监控和下游分析的兼容性变更。
机器学习系统中的特征不会仅仅因为代码负责人不再关注它们就自行消失。未使用的特征载荷体积 \(D_{\text{vol}}\) 会增加序列化开销并消耗内存带宽 \(\text{BW}\),却不提升准确率。如果没有明确的弃用策略和特征存储治理,模型就会积累“死代码”,使 \(D_{\text{vol}}/\text{BW}\) 所表征的开销恶化,并增加调试难度 (Sculley et al. 2015)。
僵尸特征表明,归因可以揭示模型不应再依赖哪些因素。对于单次错误预测,反事实分析提供了一个互补视角:使单次决策发生翻转所需的最小变化。
反事实分析
对于单次错误预测,反事实分析识别出使预测发生翻转所需的最小变化:如果 session_duration 是 45 秒而非 12 秒,模型就会预测为“活跃”而非“流失”。这揭示了哪些特征边界驱动决策,以及这些边界在语义上是否合理。要求不合理变化的反事实(例如“用户年龄需要为 -5 岁”)通常表明特征工程存在问题。
这些技术(决策树、切片分析、特征归因和反事实分析)共同构成了一套调试工具。为了始终如一地应用这些技术,团队会将流程规范化。
调试检查清单
系统化调试遵循包含六个阶段的检查清单:复现、隔离、二分定位、归因、验证和预防。这一顺序经过精心安排,因为每个阶段都会为下一阶段缩小搜索空间。复现排在首位,因为无法在留出数据上复现的机器学习故障往往依赖于特定数据;这一认识会将调查方向引向数据—算法—机器分类体系中的数据层。故障复现后,隔离阶段会识别触发故障的最小输入集,将笼统的“模型出错了”转化为具体、可测试的条件。
随后,二分定位利用版本历史:如果故障与近期部署相关,比较模型版本就能精确定位引入回归问题的变更。特征归因运用这些可解释性技术,识别驱动错误行为的输入因素。验证则通过确认修正假设的根因后确实解决了故障,闭合因果链,从而区分真正的修复与偶然的改善。
最后一个阶段是预防,即将每个已解决的事件转化为监控规则或验证检查,系统地弥合问题检测与再次发生之间的防护缺口。这种持续积累的加固能够随着时间推移减少重复出现的故障模式,因为每个事件都会强化可观测性基础设施。
调试机器学习系统既需要系统化的方法,也需要领域专业知识。最有效的调试往往来自既了解模型架构,又理解预测所处业务背景的工程师。
机器学习系统的值班实践
section 1.5.4.2 中的调试技术适用于工程师在工作时间主动调查问题的情形。然而,生产系统可能在周末凌晨 3:00 发生故障,而响应人员未必就是构建该模型的人。调试解决单个事件;值班实践则通过确保始终有具备适当专业知识、且做好响应准备的人员可用,长期维持运行健康。机器学习系统的轮值值班需要超出传统软件运维范畴的专门实践,因为机器学习事件往往表现为逐步退化,而非彻底失效。传统软件工程师响应告警时,通常能在几分钟内沿堆栈跟踪定位根因。面对准确率下降 3% 的机器学习工程师,则必须先判断这一变化究竟是统计噪声、合理的概念漂移,还是需要立即回滚的严重故障。这种区分需要统计背景信息,而非简单的日志分析。
影响显现的滞后性进一步加剧了这种模糊性。延迟突增会立即体现在仪表板上,而机器学习性能退化可能需要数小时或数天才会反映在业务指标中。一个从周一开始提供略差推荐结果的推荐模型,可能直到周五才产生可测量的收入影响;届时,易于诊断的时间窗口已经关闭。跨系统依赖进一步增加了响应的复杂性:机器学习问题往往源自其他团队负责的上游数据系统,因此事件响应需要跨组织边界协调。最深层的挑战在于,有效响应需要理解模型行为,而不仅是基础设施的健康状况。数据库管理员可以在不了解业务逻辑的情况下重启崩溃的服务,但机器学习工程师如果不了解模型的特征依赖和预期行为模式,就无法有效调试准确率下降问题。
这些挑战促使团队采用分层升级结构,使专业能力与事件复杂程度相匹配。Table 24 展示了一种可能的结构:一线响应人员使用标准化运行手册处理常规问题,升级路径则将事件转交给能够深入调查的专家。当根因位于上游数据系统时,并行设置的数据值班岗位可以缩短解决时间。
| 层级 | 响应人员 | 职责 |
|---|---|---|
| 第 1 层(一线) | 机器学习工程师 | 初步分诊、执行标准运行手册、决定是否升级 |
| 第 2 层(升级) | 高级机器学习工程师/数据科学家 | 复杂调试、跨系统调查、模型特有问题 |
| 第 3 层(重大事件) | 机器学习平台负责人 | 架构决策、重大事件、向供应商升级问题 |
| 数据值班(并行) | 数据工程师 | 数据流水线问题、特征存储问题、上游依赖 |
有效值班高度依赖运行手册的质量。每个生产机器学习模型都应具备文档,涵盖模型的用途、归属和业务关键程度,以及正常运行参数:用于界定健康行为的预期延迟、吞吐量和准确率范围。历史事件及其解决方案为常见故障模式提供参考,而诊断命令则支持快速评估健康状况,包括如何检查近期预测、特征分布和模型置信度分数。关键在于,运行手册必须明确升级标准(何时唤醒第 2 层人员,何时无需批准即可回滚),并提供包含逐步操作说明和预期恢复时间的回滚流程。在平稳时期编写的运行手册,能在凌晨 3:00 的事件中节省关键的几分钟。
即使监控设计良好,也可能产生过多告警,削弱值班的有效性。告警疲劳是指经历过多误报后倾向于忽视或直接略过告警的现象,它构成了显著的运行风险。团队通过合并相关告警来缓解疲劳,使多个特征同时漂移时只生成一条通知,而不是数十条。考虑每周和季节性模式的自适应阈值,可以避免可预测的波动触发不必要的呼叫。极少需要采取行动的告警应予以停用或重新校准。当必须暂时静默告警时,责任约束机制(例如要求在暂缓告警前创建后续跟进工单)可防止告警被永久忽视。
交接班是成熟运维的另一项关键实践。接班工程师需要了解当前事件及其状态、可能导致延迟显现问题的近期部署、即将进行的数据迁移或模型更新等计划变更,以及所有被抑制的告警和相应原因。如果缺乏结构化交接,背景信息就会在班次之间丢失,接班工程师会浪费时间重新发现前任已收集的信息。
可持续的值班实践还必须应对职业倦怠。机器学习值班因事件的模糊性而承受特殊压力:无法确定告警是否代表真实问题,要求值班人员始终保持警觉。组织可以通过限制连续值班天数、在高严重性事件后提供补休、定期审查轮值安排以平衡团队成员负担,以及投资自动化以减少重复性运维劳动,来缓解倦怠。目标是让轮值值班在多年的运行中保持可持续,而不是事后才临时安排人员。
仅有技术监控能力并不能确保运维成功。如果无人负责响应告警,再先进的仪表板也无济于事;如果团队结构不支持使用运行手册,再详尽的手册也会被束之高阁。生产机器学习运维需要与技术基础设施相配套的组织基础设施:清晰的治理、明确的角色,以及支持跨职能协调的沟通模式。
治理与团队协调
值班运行手册用于应对实时运行故障,但生产机器学习系统还需要主动治理,以强制落实行为与监管方面的不变条件。模型治理确立了模型在接收线上推理流量之前必须满足的验证标准。未经检查的模型可能产生带有偏差的推理结果或无法解释的决策,违反法律法规和组织政策。在运维流水线中,治理落实三个具体目标:通过可审计的训练数据血缘和可验证的模型权重实现透明性;通过将受保护用户子群体之间的性能差异限制在规定范围内实现公平性;通过遵守隐私、留存和可审计性要求实现合规性。负责任工程 详细介绍了这些属性所需的统计指标和可解释性算法,而 MLOps 则提供自动化验证基础设施,在整个部署生命周期中落实这些要求。
机器学习治理贯穿产物的整个生命周期。在开发阶段,自动化流水线记录特征模式、训练数据来源和超参数配置。部署前,预发布验证关卡评估分布外鲁棒性和人口统计均等性。进入生产环境后,监控系统必须在跟踪总体准确率下降的同时,跟踪公平性漂移,即人口统计子群体或租户子群体之间错误率随时间的变化。将这些治理策略直接编码进自动化 CI/CD 流水线,可以用程序化的发布断言取代临时性的人工审查。
具体而言,在模型从预发布环境晋级到生产环境之前,模型注册中心的晋级关卡要求具备已签署的特征契约、已记录的训练数据血缘哈希值、高于策略阈值的子群体指标、附带自动回滚标准的金丝雀发布 SLO,以及指定的产物负责人。该关卡使治理从组织层面的评审会议,转变为由部署模型的同一套 CI/CD 机制强制执行的发布不变条件。
治理策略定义发布标准,但运行可靠性取决于跨组织边界的执行。由于机器学习系统横跨数据工程、统计建模和分布式模型服务基础设施,角色之间的交接构成了运行生命周期中最容易出错的接口。版本化实验存储和集中式模型注册中心,为研究与生产工程之间可复现的转换提供了所需的共享基础。在数据接口处,正式的模式规范和血缘 DAG 确保数据科学家与平台工程师对特征语义、默认空值处理方式和标签到达延迟持有完全一致的假设。
不同组织的职位名称和边界各不相同,但一种常见划分采用 table 25 中的五种角色。该表将每种角色映射到一项主要职责,并不意味着每个组织都需要设置五个独立岗位:
| 角色 | 主要关注领域 | 关键交付物 | 协作衔接点 |
|---|---|---|---|
| 数据科学家 | 模型开发、实验、算法选择 | 训练完成的模型、实验结果、性能基准 | 向机器学习工程师交接,以实现生产化 |
| 机器学习工程师 | 生产机器学习系统、训练流水线、模型服务基础设施 | 已部署模型、训练流水线、模型服务系统 | 接收数据科学家的交付;与平台工程师协作建设基础设施 |
| 数据工程师 | 数据流水线、特征工程、数据质量 | 特征流水线、数据质量系统、特征存储 | 为数据科学家提供数据;为机器学习工程师维护特征存储 |
| 平台工程师 | MLOps 基础设施、工具、自动化 | CI/CD 流水线、监控系统、计算基础设施 | 为机器学习工程师提供支持;维护共享基础设施 |
| DevOps/SRE | 可靠性、事件响应、系统健康 | SLO/SLA、值班流程、运行手册 | 支持所有角色;负责生产环境健康 |
清晰的角色定义在交接点尤为重要,因为产物会在这些位置从一类专业人员转交给另一类。最容易出错的交接发生在数据科学家与机器学习工程师之间:探索性笔记本脚本常因未记录的数据预处理步骤、硬编码的本地文件路径、隐含的状态执行顺序或未锁定版本的库依赖而在生产环境中失败。同样,机器学习工程师向 SRE 的交接 (Beyer et al. 2016) 需要经过验证的监控仪表板、已启用的告警规则、有文档记录的运行手册,以及经过测试的回滚流程。数据工程师通过特征契约与模型构建人员对接。这些契约是对数据模式、新鲜度 SLO 和分布不变条件的正式规范,可防止上游流水线修改在数周后表现为下游无声的预测故障。团队通过要求所有产物在进入下一阶段前具备标准化容器镜像、封闭构建清单和自动化可复现性断言,消除这些接口风险。
Beyer, Betsy, Chris Jones, Jennifer Petoff, and Niall Richard Murphy. 2016. Site Reliability Engineering: How Google Runs Production Systems. O’Reilly Media.
利益相关者沟通
跨职能交接规范内部工程执行,而利益相关者沟通则在技术团队与组织决策者之间建立运行契约。与故障语义固定的确定性软件服务不同,机器学习系统具有概率性输出、复杂的延迟与准确率权衡,以及持续的分布漂移。当利益相关者按照传统软件的假设评估模型时,双方在预期可靠性、延迟预算和维护成本方面必然会产生认知偏差。
一种常见的沟通失误,是不加约束地要求“让模型更准确”。模型准确率无法独立于系统成本而提升:将验证准确率提高两个百分点,往往需要采用规模显著更大的模型架构,导致每个样本的浮点运算次数增加、内存带宽需求上升,并违反严格的推理延迟服务等级目标(SLO)。以帕累托前沿为依据讨论改进,能够迫使各方在模型准确率、推理延迟预算、训练计算成本和数据集获取费用之间作出明确取舍。
将统计指标转化为运营影响,需要把分类错误直接映射到经济或运营后果。准确率、ROC-AUC 或 F1 分数等传统评估指标从几何角度或以对称方式评价错误。然而,在生产环境中,分类错误造成的成本高度不对称:在自动化欺诈检测流水线中,假阳性会在结账过程中给用户带来阻碍,而假阴性则会导致直接且无法挽回的资金盗窃损失。
Figure 9 展示了这种不对称的经济现实。当假阴性的成本是假阳性的五倍时,最优决策边界会从对称的 0.50 分类阈值显著向左移动,通过接受更高的误报率来尽量减少灾难性的漏检。
运营事件需要结构化的沟通协议,以明确无歧义地传达技术问题的严重程度。当监控系统检测到分布漂移,或推理性能退化触发自动回滚时,工程状态报告必须直接陈述实证依据:统计散度指标、受影响的具体人口群体或租户群组、金丝雀发布的回滚目标,以及预计恢复时间。若未经统计假设检验就将异常输出分布视为暂时性噪声,便会使隐蔽的语义失效传播至生产决策中。
论证硬件资源分配的合理性,同样需要将硬件能力与开发速度和服务容量联系起来。申请增加加速器节点时,必须从吞吐量扩展和迭代速度的角度进行阐述:配置一个 8 GPU 节点,可使分布式数据并行训练在数小时而非数天内完成,直接加快模型迭代与验证周期。此外,工程进度安排必须反映真实的生产瓶颈:数据提取、特征工程和流水线验证通常比超参数优化消耗多得多的日历时间。
考虑一个正在评估模型升级提案的欺诈检测团队。当利益相关方要求提高捕获率时,工程团队将该计划表述为一项具体的系统权衡:将捕获的欺诈金额占比从 92 percent 提高至 94 percent,需要集成外部特征流水线、将训练时长延长两周,并接受基础设施成本增加 30 percent。作为回报,此次升级预计每年可避免 $2 million 的欺诈损失;同时,在另行假设假阳性减少 20 percent 的条件下,每月可减少 50,000 条假阳性告警。
围绕财务影响、延迟预算和计算支出来阐述模型改进,能够使运营治理立足于可验证的工程权衡。通过将自动化 CI/CD 发布不变量与错误成本的结构化沟通相结合,工程团队可确保生产部署在技术上稳健、在经济上合理。
机器学习测试评分
发布就绪性评估需要一份明确的结构性债务模式清单,以识别那些即使离线验证指标看似可接受,仍会使模型无法安全提供服务的问题。机器学习系统在生产环境中的失效,不仅源于算法性能退化,也源于接口的隐性劣化、未跟踪的使用方,以及未纳入版本管理的流水线依赖。Table 26 对这些主要债务模式及其根本原因、故障症状和缓解策略进行了分类,明确了生产就绪性评估准则必须检测并防范的失效模式。
| 债务模式 | 主要原因 | 关键症状 | 缓解策略 |
|---|---|---|---|
| 边界侵蚀 | 组件紧密耦合,接口不明确 | 变更以不可预测的方式级联传播,违反 CACE 原则 | 强制采用模块化接口,围绕封装进行设计 |
| 修正级联 | 顺序模型依赖,继承的假设 | 上游修复破坏下游系统,修订不断扩大 | 审慎权衡复用与重新设计,明确版本管理 |
| 未声明的使用方 | 非正式共享输出,依赖关系未被跟踪 | 模型更新引发隐性故障,隐藏的反馈环路 | 严格的访问控制,正式的接口契约,使用情况监控 |
| 数据依赖债务 | 不稳定或未充分利用的数据输入 | 数据变化导致模型失效,特征流水线脆弱 | 数据版本管理,血缘跟踪,留一分析 |
| 反馈环路 | 模型输出影响未来的训练数据 | 自我强化行为,隐蔽的性能退化 | 按群组监控,金丝雀部署,架构隔离 |
| 流水线债务 | 临时拼凑的工作流,缺乏标准接口 | 执行脆弱,重复建设,维护负担 | 模块化设计,工作流编排工具,共享库 |
| 配置债务 | 设置分散,版本管理不善 | 结果不可复现,隐性故障,调优过程不透明 | 版本控制,验证,结构化格式,自动化 |
| 原型债务 | 快速原型开发中的捷径,代码与逻辑紧密耦合 | 系统扩展时缺乏灵活性,团队协作困难 | 灵活的基础设计,有意识地跟踪债务,有计划地重构 |
对失效模式的定性认识无法防止运营中断;部署关卡需要一套正式的技术债务评估准则,将主观的就绪性争论转化为可量化的工程约束。机器学习测试评分 (Breck et al. 2017) 将这项评估划分为四个运营类别:数据测试、模型测试、基础设施测试和监控测试。该准则规定了 28 项二元或分级测试,每类七项,每项评分从 0(未测试)到 1(已自动化并受监控)。综合评分并不将这些评估取平均值以形成一个可相互补偿的总分,而是遵循最弱环节原则: \[\text{ML Test Score} = \min(S_{\text{data}}, S_{\text{model}}, S_{\text{infra}}, S_{\text{mon}})\] 其中,每个类别的得分为 \(S_{\text{cat}} \in [0, 7]\)。一个具备全面离线模型验证(\(S_{\text{model}} = 7\))但缺乏生产遥测(\(S_{\text{mon}} = 0\))的部署,其总体得分为 0。这个最小值运算符反映了机器学习系统的现实:无论离线基准准确率如何,未经监控的服务路径都可能悄无声息地输出损坏的预测结果。
该评估将生产风险划分到系统的数据、算法和机器三个层面。数据测试套件验证特征分布是否符合声明的模式、隐私边界是否保持完整,以及每个特征带来的收益是否足以抵偿其推理延迟和内存占用。模型测试套件确认架构和超参数配置是否纳入版本控制、是否强制执行模型陈旧程度的上限,以及离线基准改进是否转化为线上指标提升。基础设施测试套件检验在不同硬件与随机种子条件下训练的确定性可复现性、训练与推理流水线在服务路径上的一致性,以及自动回滚机制。监控测试套件验证模式变更、不变量违反、训练与服务偏差以及陈旧权重,是否会在退化预测影响下游系统之前触发可采取行动的告警。Table 27 汇总了各类别中的代表性测试:
| 类别 | 测试 | 实现示例 |
|---|---|---|
| 数据测试 | 特征预期已记录在模式中 | Great Expectations、TFX Data Validation |
| 所有特征均有益(没有未使用的特征) | 特征重要性分析、消融研究 | |
| 任何特征的成本均不超过其收益 | 延迟与准确率的权衡分析 | |
| 数据流水线具备适当的隐私控制 | 个人身份信息(PII)检测、访问日志记录 | |
| 模型测试 | 模型规格经过审查并纳入版本控制 | 由 Git 跟踪的模型配置 |
| 离线指标与线上指标相关 | 通过 A/B 测试验证离线改进 | |
| 所有超参数均经过调优 | 自动化超参数优化(HPO)及结果跟踪 | |
| 模型陈旧程度得到度量并受到限制 | 性能衰减监控 | |
| 基础设施测试 | 训练可复现 | 固定随机种子、版本化数据、锁定依赖 |
| 模型可回滚至先前版本 | 支持版本管理的模型注册表 | |
| 已测试训练与服务代码路径的一致性 | 特征存储集成测试 | |
| 模型质量在提供服务前得到验证 | CI/CD 中的自动化验证关卡 | |
| 监控测试 | 依赖变更会触发告警 | 数据模式监控 |
| 数据不变量在训练和服务阶段均成立 | 分布比较测试 | |
| 训练特征与服务特征之间不存在偏差 | 训练与服务偏差检测 | |
| 模型陈旧会触发重新训练 | 自动化重新训练流水线 |
由于综合评分受最低类别得分限制,可靠性审计必须优先关注限制系统评分的瓶颈子系统。当监控覆盖得分仍为 1 时,投入工程资源将模型测试套件得分从 5 提高到 6,对总体生产安全性的增益为零。定期依据该准则开展审计,可以系统地揭示可靠性风险究竟源于未经验证的输入流水线、离线与线上分布偏离,还是缺乏观测设施的服务路径,从而将重构工作引向直接威胁生产可用性的结构性债务。
设计与成熟度框架
部署首个机器学习模型的组织,可能依赖手动运行的 Jupyter 笔记本、定时 cron 任务和最低限度的监控。成熟企业则通过具备漂移检测、金丝雀部署和持续验证能力的自动化流水线运行数千个模型。两者都在实践“MLOps”,但它们在可靠性、成本效率和部署速度上的差距可达数个数量级。针对生产部署的实证调查显示,系统故障集中发生在数据依赖、流水线边界和监控盲区,而非核心模型架构 (Paleyes et al. 2022)。运营成熟度为评估这一演进过程提供了系统框架:组织从临时性的实验逐步发展到完全自动化的运营;与不加选择地采用工具相比,识别系统在这一连续谱上所处的位置,能够更有效地指导资源分配。
Paleyes, Andrei, Raoul-Gabriel Urma, and Neil D. Lawrence. 2022. “Challenges in Deploying Machine Learning: A Survey of Case Studies.” ACM Computing Surveys 55 (6): 1–29. https://doi.org/10.1145/3533378.
成熟度级别
机器学习测试评分评估单项技术实践,而运营成熟度 衡量这些实践在系统层面的整合程度。MLflow 等生命周期工具解决的是孤立的流水线阶段问题 (Zaharia et al. 2018),而成熟度反映的是数据、算法和执行硬件在训练与服务过程中衔接的紧密程度。尽管运营成熟度是连续变化的,将系统划分为不同的成熟度级别,仍有助于明确工作流如何从探索性原型转变为生产级基础设施。
Zaharia, Matei, Andrew Chen, Aaron Davidson, Ali Ghodsi, Sue Ann Hong, Andy Konwinski, Siddharth Murching, et al. 2018. “Accelerating the Machine Learning Lifecycle with MLflow.” IEEE Data Engineering Bulletin 41 (4): 39–45.
在最低级别,工作流是临时性的:训练在本地工作站上手动运行,特征提取嵌入短期使用的脚本中,部署依赖手动传输文件。随着成熟度提高,工作流变得可重复:团队引入受版本控制的流水线、集中式制品注册表以及定时批处理任务。在最高级别,系统具备可扩展性:声明式基础设施即代码、持续验证流水线和实时可观测性,使模型迭代与生产服务解耦。
Table 28 概述了从分散执行到统一生命周期管理的架构演进。
| 成熟度级别 | 系统特征 | 典型结果 |
|---|---|---|
| 临时性 | 手动处理数据、本地训练、无版本控制、职责归属不明确 | 工作流脆弱,难以复现或调试 |
| 可重复 | 自动化训练流水线、基础 CI/CD、集中式模型存储、一定程度的监控 | 可复现性提高,可扩展性有限 |
| 可扩展 | 完全自动化的工作流、集成式可观测性、基础设施即代码、治理 | 高可靠性、快速迭代、生产级机器学习 |
考虑欺诈检测系统如何在这些成熟度级别之间演进:
- 临时应对:数据科学家在 Jupyter notebook 中训练模型,将其导出为 pickle 文件,再交给工程师部署到单台服务器上。当准确率下降时,数据科学家使用新数据重新运行 notebook,手动重新训练模型。调试必须由原来的数据科学家参与,因为其他人都不了解预处理步骤。
- 可重复:训练脚本纳入版本控制,定时 Jenkins 作业每月重新训练一次。特征通过 SQL 脚本计算,该脚本由工程团队单独维护。模型通过容器部署,并进行基本的准确率监控。当特征 SQL 发生变化时,数据科学家必须手动验证模型是否仍能正常工作。
- 可扩展:训练和模型服务使用同一个特征存储,减少偏差。当 PSI 超过 0.2 时,CI/CD 流水线调查漂移,在证据支持时重新训练,将新模型与基线进行验证比较,并通过金丝雀发布部署。监控按商户跟踪准确率,当特定细分群体的表现退化时触发调查。从原始数据到生产预测的完整血缘链路均可审计。
成熟度级别之间的转变需要大量工程投入,但对于关键业务服务,由此带来的平均恢复时间(MTTR)缩短和静默故障减少足以证明这笔成本的合理性。依据这一成熟度谱系评估组织,可以识别具体的架构瓶颈,例如手动数据传输或未纳入版本控制的预处理逻辑,避免这些问题累积并演变为生产中断。
对系统设计的影响
组织成熟度决定了具体的架构约束。随着团队向更高成熟度级别迈进,底层系统从单体脚本转向模块化、解耦的服务。
在成熟度较低的环境中,系统高度耦合:数据转换直接嵌入模型训练脚本,配置以非正式方式管理,模型服务依赖具有隐式环境依赖关系的序列化产物。此类设计虽然便于快速开展探索性原型开发,但缺乏清晰的故障边界。在更高成熟度下,显式抽象使数据—算法—机器各组件解耦:特征流水线通过版本化模式独立计算数据转换,模型提供基于契约的推理 API,模型服务运行时在隔离的容器环境中执行,并具有可复现的硬件执行目标。闭合反馈回路使数据流、算法更新和计算资源能够在无须人工干预的情况下进行调整。
Figure 10 展示了支撑生产机器学习系统的结构性依赖层级。可见的服务正常运行时间仅代表运行健康状况的最上层。水线之下隐藏着一些静默故障模式,它们会降低推理质量,却不会触发传统的基础设施告警:协变量偏移、上游模式损坏以及局部细分群体的表现退化。稳健的运维框架必须并行监控三个领域:数据健康、模型健康和服务健康。
\scalebox{0.65}{%
\begin{tikzpicture}[line join=round,font=\sffamily\small]
\tikzset{Line/.style={line width=1.5pt,BlueD},
 mysnake/.style={postaction={line width=2.5pt,BlueD,draw,decorate,
 decoration={snake,amplitude=1.8pt,segment length=18pt}}},
pics/flag/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=FLAG,scale=\scalefac, every node/.append style={transform shape}]
\draw[draw=\drawchannelcolor,fill=\channelcolor](0.15,1.07)to[out=30,in=220](1.51,1.07)to(1.51,2.02)
           to[out=210,in=40](0.15,2.04)--cycle;
\draw[draw=none,fill=\channelcolor](0.05,0)rectangle (-0.05,2.1);
\fill[fill=\channelcolor](0,2.1)circle(3pt);
\end{scope}
     }
  }
}
\pgfkeys{
  /channel/.cd,
  channelcolor/.store in=\channelcolor,
  drawchannelcolor/.store in=\drawchannelcolor,
  scalefac/.store in=\scalefac,
  Linewidth/.store in=\Linewidth,
  picname/.store in=\picname,
  channelcolor=BrownLine,
  drawchannelcolor=BrownLine,
  scalefac=1,
  Linewidth=1.6pt,
  picname=C
}
\colorlet{BlueD}{GreenD}

\begin{scope}[local bounding box=FLAG1,shift={($(0,0)+(0,0)$)},
scale=1, every node/.append style={transform shape}]
\pic[shift={(0,0)}] at  (0,0){flag={scalefac=0.45,picname=1,drawchannelcolor=none,channelcolor=GreenD, Linewidth=1.0pt}};
 \end{scope}
%
\path[top color=GreenD!60,bottom color=GreenD](-1.69,-1.69)--(-2,-2)--(-2.5,-2.06)--(-3.1,-3.0)--(-4,-3.84)--(-3.72,-4.33) --(-3.95,-4.5)
 --(-2.85,-5.92)--(-3,-6.059)--(-1.84,-7.341)-- (1.9,-7.341)--(3.58,-5.45)--(3.35,-4.56)--(3.91,-3.5)--(3.5,-3.18)
 --(2.82,-2.11)--(2.25,-2.05)--(1.85,-1.69)--cycle;
  \draw[Line](-1.13,-1.14)--(-2,-2)--(-2.5,-2.06)--(-3.1,-3.0)--(-4,-3.84)--(-3.72,-4.33) --(-3.95,-4.5)
 --(-2.85,-5.92)--(-3,-6.059)--(-1.84,-7.341)-- (1.9,-7.341)--(3.58,-5.45)--(3.35,-4.56)--(3.91,-3.5)--(3.5,-3.18)
 --(2.82,-2.11)--(2.25,-2.05)--(1.2,-1.14);
 \node[draw=none,rectangle,minimum width=140mm,inner sep=0pt, minimum height=2mm](TA)at(0,-1.7){};
\path[mysnake](TA.west)--(TA.east);
\draw[Line](0,0)--(-0.6,-0.63);
\draw[Line](-0.45,-0.65)--(-0.84,-0.60)--(-1.26,-1.41);
\draw[Line](0,0)--(0.57,-0.55);
 \draw[Line](0.45,-0.61)--(0.84,-0.37)--(1.38,-1.51);
 %
\node[BlueD]at(0,-1.2){正常运行时间};
\node[white]at(1.2,-2.4){模型准确率};
\node[white]at(-1.34,-2.75){数据漂移};
\node[white]at(2.1,-3.35){概念漂移};
\node[white]at(-1.85,-3.75){流水线故障};
\node[white]at(-0.05,-4.5){模式变更};
\node[white]at(1.8,-5.2){模型偏差};
\node[white]at(-1.5,-5.4){数据中断};
\node[white,align=center]at(0.15,-6.4){表现不佳的\\ 细分群体};
%
\node[BlueD]at(-5,-2.65){数据健康};
\node[BlueD]at(5,-2.6){模型健康};
\node[BlueD]at(2.8,0.1){服务健康};
\end{tikzpicture}}这三个监控领域直接对应不同的系统故障机制:
- 数据健康 故障,例如模式漂移、空值激增和特征过时,在不改变模型服务二进制程序的情况下,违反训练期间所假定的分布不变量。
- 模型健康 故障,例如准确率下降、评分校准漂移和退化的反馈回路,会静默发生,因为推理引擎仍然以低延迟返回语法有效的张量。
- 服务健康 故障,例如内存碎片化、依赖漂移和容器编排故障,会威胁传统意义上的可用性和吞吐量。 由于数据和模型故障不会使标准 HTTP 健康检查和进程状态失去正常标记,仅监控可用性无法反映机器学习系统的真实运行状态。
设计模式与反模式
如果缺乏能够有效运作基础设施的组织模式,即使最先进的基础设施也会失效。如果无人负责特征定义,特征存储就无法防止训练与服务之间的偏差;如果告警被路由到错误的团队,自动化监控就无法捕获漂移。随着机器学习系统复杂度增加,组织模式也必须相应演进。
在成熟环境中,组织设计强调明确的责任归属和严格的接口规范。平台团队负责共享基础设施和 CI/CD 流水线,领域团队则专注于模型开发以及与业务需求的对齐。团队间的接口,包括特征定义、数据模式和部署目标,都经过正式规定并纳入版本控制。
一种有效模式是由集中式 MLOps 团队为多个模型开发团队提供共享服务。此类结构有助于保持一致性并减少重复劳动。另一种方式是,一些组织采用联邦式模式,将 MLOps 工程师嵌入产品团队,同时保留中央架构职能,负责整个系统的集成。
当职责分散时,反模式就会出现。工具优先的方法,即在定义流程和角色之前就采用基础设施工具,会导致流水线脆弱、交接责任不清。孤立式实验,即数据科学家与生产工程师彼此隔离地开展工作,会产生难以有效部署或重新训练的模型。
组织漂移构成了另一项挑战。随着团队规模扩大,未记录的工作流逐渐固化,协调成本随之上升。组织成熟度必须通过沟通渠道、角色定义和问责结构,与系统复杂度共同演进,以强化模块化和可观测性。
组织结构需要相应的技术架构来维持系统可靠性。传统分布式系统处理硬件正常或故障这类二元状态以及网络分区,而机器学习系统引入了对不断变化的数据分布和共享加速器资源的有状态依赖。
传统熔断器在 RPC 超时或 HTTP 5xx 错误率超过设定阈值时触发。在机器学习模型服务场景中,熔断器必须监控统计不变量:异常输入分布,例如特征取值边界或特征缺失率突然变化,或输出分布塌缩。触发后,熔断器绕过模型,使用确定性启发式回退方案、缓存查找表或更简单的基线模型提供预测,防止损坏的推理结果级联传播到下游事务系统。
类似地,舱壁模式29将候选模型或金丝雀模型与主要模型服务路径隔离。在多租户加速器硬件上,不受约束的实验模型如果发生内存不足导致的中止、内存泄漏或线程池耗尽,可能使共享模型服务运行时崩溃,或使 PCIe 总线停滞。通过容器化内存限制、隔离的工作队列和专用硬件分区实施舱壁隔离,可确保实验工作负载不会降低主要生产系统的吞吐量。普通模型预测错误属于语义故障,而非拜占庭故障;拜占庭容错30仅能为任意组件故障提供有限的类比。
共识算法在节点之间建立一致性;当真实标签延迟到达或不可用时,它们无法判断模型预测是否正确。在多个节点上复制模型,或在集成成员之间进行投票,可以针对崩溃故障提供冗余,但当所有副本具有相同的归纳偏置或训练分布盲区时,这些方法无法解决静默的语义错误。不过,在适用范围内使用这些可靠性模式所提供的保障,仍有助于区分稳健与脆弱的 MLOps 实现。
将 MLOps 置于具体情境中
标准运维模式必须适应物理约束和组织约束。每个机器学习系统都运行在影响其实现方式的特定情境中:物理约束,例如边缘计算和功耗预算;监管要求,例如医疗和金融领域的要求;或组织规模,例如团队规模和技能分布。在无法直接访问主机时,标准 CI/CD 流水线可能不可行;监控可能需要间接信号或设备端异常检测;数据收集可能受到隐私法规限制。这些适应体现了约束条件下的成熟度,而非对基础原则的偏离。
在最高运维成熟度级别,单模型实践成为更广泛的平台能力的构建模块。同时运行多个机器学习节点的组织会整合为平台架构,提供共享基础设施、集中治理和规模经济。从单个机器学习节点转向平台规模基础设施,会引入性质不同的挑战,包括跨模型资源分配、系统级可观测性以及相互依赖的流水线之间的容错,这些挑战超出了单节点运维的范围。健全的机器学习节点实践仍然是平台成功的前提,因为单模型监控、测试或部署中的缺口会在整个模型组合中成倍放大。
MLOps 投资经济性
只有当投资与模型的生产价值相匹配时,MLOps 的运维收益才具有说服力。对于单个机器学习节点,需要判断部署速度、事故减少和监控覆盖是否足以证明运维支出的合理性;对于模型组合,同样的经济效应会累积,形成平台投资的依据。
单模型 MLOps 投资
对于单个生产机器学习系统,首先需要考量的门槛是使该节点具备可观测、可部署和可恢复能力的年度成本。Table 29 汇总了主要成本类别:
| 组成部分 | 示例假设 | 理由 |
|---|---|---|
| CI/CD 流水线搭建 | $10–30K,一次性 | 将部署时间从数天缩短至数小时 |
| 监控与告警 | $2–10K/年 | 在影响用户之前发现性能退化 |
| 特征存储(基础版) | $5–20K/年 | 减少训练与服务偏差的一项来源 |
| 模型注册表 | $0–5K/年 | 支持回滚和审计追踪 |
| 工程时间 | 搭建需 1–2 个全职当量月 | 初始自动化与集成 |
单模型 ROI 计算
收益门槛随后取决于模型的关键程度:直接影响收入的模型可以支持更多运维支出,因为避免事故和缩短部署时间具有可衡量的价值。Equation 16 将这一单节点计算形式化: \[\text{Annual Benefit/Cost} = \frac{\text{Incidents Avoided} \times \text{Avg Incident Cost} + \text{Time Savings} \times \text{Hourly Cost}}{\text{Annual MLOps Investment}} \tag{16}\] 其中,避免的事故数是工具每年防止的生产故障数量,平均事故成本是每次故障造成的损失,因此两者的乘积就是避免事故所带来的价值;节省的时间是自动化每年节省的工程师工时,每小时成本是包含各项用工成本的小时费率,因此两者的乘积就是节省劳动时间所带来的价值;分母是工具本身的年度成本。该比率表示每投入一美元所获得的美元收益。
对于一个年收入为 $1M 的模型,假设:
- 每年避免 4 起事故(每起成本为 $25K)= 节省 $100K
- 每月节省 20 hours 的部署时间(按 $150/hr 计)= 节省 $36K
- MLOps 投资为 $30K/year
\[ \text{Benefit/Cost} = \frac{\$100K + \$36K}{\$30K} = 4.53× \]
何时增加投资
4.53× 的收益成本比意味着,这项投资的合理性并不来自工具设计的优雅,而是来自模型足够高的经济价值,使得避免事故和缩短部署时间的收益超过年度平台支出。随着团队增加更多模型,单模型 MLOps 实践的收益会累积。从运行多个独立的机器学习节点转向构建集中式平台,涉及完全不同的经济因素,包括共享基础设施摊销、平台团队开销和跨模型协调成本。
对于单模型运维,应根据模型的关键程度按比例投入 MLOps。一个带来 $10M 年收入的模型,比内部分析模型更有理由采用严格的运维措施。监控、血缘追踪和可重复部署通常是最先进行的投资。当共享特征定义以及线上与离线一致性成为实质性问题时,再引入特征存储;只有当证据支持触发条件,且验证回路能够控制不良更新的影响时,才自动化重新训练。
这些经济权衡和架构成熟度原则体现在各种真实部署中。在 section 1.7 中,生产案例研究展示了组织如何在可复现性、可观测性和自动化重新训练之间进行权衡,同时满足具体的延迟和吞吐量约束。
案例研究
机器学习系统的运维约束由模型服务硬件的物理能力边界以及应用故障的后果决定。电池供电的可穿戴设备受限于毫瓦级功耗预算、有限的设备端 SRAM,以及低功耗蓝牙上的狭窄遥测带宽。相比之下,临床软件必须满足法定可审计性要求、安全关键的误差界限,以及由 FDA 生命周期指南规定的监管变更控制要求 (U.S. Food and Drug Administration 2025)。这些差异显著的环境决定了工程团队如何在整个生命周期中管理数据流水线、模型产物和硬件执行。边缘架构将工程预算用于弥合高吞吐量云训练集群与微控制器之间的硬件不对称,而临床系统则将这笔预算用于来源追踪、队列监控和人在回路中的验证关卡。
U.S. Food and Drug Administration. 2025. Marketing Submission Recommendations for a Predetermined Change Control Plan for Artificial Intelligence-Enabled Device Software Functions. Guidance for Industry and Food and Drug Administration Staff. U.S. Department of Health; Human Services.
section 1.7.1 中受 Oura 启发的案例研究使用已发表的离线评估数据对这些边缘约束进行建模,其作用是开展架构研究,而非审计专有的生产环境无线更新流水线。在这一边缘工作流中,参考睡眠标签来源于多导睡眠监测(PSG),即实验室级多通道生理记录。尽管运行条件截然不同,边缘部署和临床部署都必须满足相同的核心 MLOps 规范。Table 30 将这些基础原则映射到两种环境中,展示物理硬件限制和监管要求如何改变实现机制,而不改变底层运维要求。
| 原则 | 受 Oura 启发的边缘设计 | ClinAIOps |
|---|---|---|
| 可复现性 | 对同步的可穿戴设备数据集和 PSG 数据集进行版本管理 | 审计追踪、决策溯源 |
| 关注点分离 | 独立的数据层、训练层和服务层,配备边缘设备专用部署流水线 | 分离临床验证与部署阶段,并隔离监管合规相关职责 |
| 一致性 | 训练与设备端推理均采用与 PSG 对齐的预处理 | 通过标准化临床数据流水线确保训练与服务一致 |
| 退化可观测性 | 设备端异常检测、有限的遥测 | 针对特定队列的监控、结局追踪 |
| 成本感知自动化 | 考虑电池电量的重训练触发机制,以及平衡准确率与资源成本的边缘 CI/CD | 通过人在回路的审批关卡实现模型自动更新,平衡更新成本与患者风险 |
受 Oura 启发的边缘设计
Oura Ring 为这一边缘 MLOps 案例研究提供了实证基础。已发表的临床研究验证了数据采集和多传感器睡眠分期评估 (Altini and Kinnunen 2021),而版本管理、遥测、空中部署和生命周期控制则属于假设架构,并非对 Oura 专有生产系统的实际描述。在可穿戴戒指的毫瓦级功耗范围和严格内存限制下运行,使每一项运维权衡都清晰可见,而这些权衡在云规模系统中往往被掩盖。
背景与动机
作为一种微型消费级可穿戴设备,该戒指持续采集生理信号:通过加速度测量感知运动,通过光学光电容积描记法(PPG)测量脉率和心率变异性,并通过负温度系数热敏电阻测量皮肤温度。嵌入式模型根据这些原始传感器数据流,将睡眠分为四个阶段——清醒、浅睡、深睡和快速眼动(REM)睡眠——以生成每日恢复评分。由于微型的 15–22 mAh 电池无法支持持续的低功耗蓝牙(BLE)流式传输,否则会在数小时内耗尽电量,因此该架构将计算划分为三个层级:戒指端特征提取、配套手机端模型推理,以及云规模历史数据聚合。
核心目标是提高睡眠分期准确率,使其与临床金标准多导睡眠监测(PSG)保持一致。31 仅使用加速度计的模型在四阶段睡眠分类中达到了 57 percent 的准确率,因为单靠运动信号无法区分安静清醒状态与浅睡或 REM 睡眠。人工 PSG 专家评分者之间的一致率约为 82 percent 至 83 percent,单模态运动感知与临床共识之间的性能差距揭示了加速度测量的物理局限。将自主神经系统信号(心率和心率变异性)与昼夜节律温度特征相结合,使分类准确率提高至 79 percent。由此获得的 22 percentage-point 提升,弥合了基线与人工评分一致率之间约 84.6–88 percent 的差距;不过,人工评分者之间的一致率反映的是标签歧义,并非相对于经裁定参考标准的严格理论上限。
构建这一多传感器流水线,需要通过一项涉及来自三个大洲的 106 participants 的研究,使可穿戴设备遥测数据与临床标准相衔接 (Altini and Kinnunen 2021)。每位参与者在佩戴 Oura Ring 的同时接受实验室 PSG 检查,最终获得了 440 nights 的数据和 3,444 hours 的时间同步记录,将可穿戴设备的原始传感器数据流与经过验证的睡眠标注对齐。数据采集的规模和人口统计学多样性,涵盖了不同年龄、性别和基础健康状况下的生理差异,以及对于向真实世界用户群体泛化至关重要的行为差异。
整合同步的加速度计、温度、光学 PPG 和临床睡眠记录,明确了时间对齐和特征工程规范。生产环境中的边缘工作流需要针对传感器硬件修订版本、采样率和数字滤波例程,实施严格的数据集版本管理与血缘追踪,以防止 Python 开发流水线与嵌入式 C 推理之间出现训练与服务偏差。
建立同步的临床数据后,离线模型探索量化了每一种新增感知模态的贡献。通过 5 折交叉验证评估四种特征配置,证实结合温度、心率变异性和昼夜周期性,可以将四阶段分类准确率从仅使用加速度计的基线水平 57 percent 提高至 79 percent (Altini and Kinnunen 2021)。这些离线改进展示了多传感器融合的价值,但将其部署到嵌入式设备上,会引入原始研究范围之外的运维要求:可复现的模型量化、数值转换验证,以及严格的运行时能耗预算。
离线验证完成后,主要系统挑战从统计准确率转向部署安全与运行时效率。边缘架构必须跨硬件边界划分执行任务:轻量级滤波和运动分类在微控制器 SRAM 中持续运行,而计算量更大的多阶段序列模型则在手机同步期间执行。为了在数千台物理设备上保持流水线完整性,MLOps 工具链需要自动化量化流水线(例如使用经过校准的缩放因子将 float32 权重转换为 int8)、经过密码学签名的模型制品,以及具备容错能力的 OTA32 分发机制。
边缘 MLOps 所受的物理约束不同于服务器端流水线:模型准确率必须与严格的电池续航要求、受限的无线电带宽、设备端存储容量限制,以及几乎完全缺失的实时真值标签进行协同设计。在 table 4 中的 DS-CNN(微型约束)原型中,健康状态监控依赖运维代理指标——传感器占空比、推理延迟异常和分类置信度分布——而非经过验证的结果。要在实际使用中维持从加速度计准确率 57 percent 到多传感器准确率 79 percent 的跃升,就必须对传感器固件版本、DSP 预处理例程和量化网络权重进行严格的配置管理。
这些物理约束直接对应于 table 30 中介绍的五项基础 MLOps 原则。经过版本管理的可穿戴设备和 PSG 数据集,将每个已部署模型制品与用于训练它的确切实验室记录及传感器固件校准配置关联起来,从而实现可复现性。分层软件架构通过将嵌入式传感器驱动程序与推理引擎、手机端聚合器隔离,实现关注点分离,使量化方案、模型拓扑和节能回退机制能够独立更新。共享的特征提取内核确保离线训练与设备端执行的一致性,消除因数值库或浮点舍入差异导致的训练与服务偏差。保护隐私的遥测通过传输聚合运维诊断信息——每日传感器占空比、电池耗电量、推理异常次数和分类熵——来保持退化可观测性,而无需将敏感的原始生物特征数据以流式方式传出用户设备。最后,空中部署界定了成本感知自动化的边界:每次更新都必须证明,其准确率收益超过无线电接收和闪存重写周期带来的电池成本,以及修改持续佩戴在用户身上并运行的可穿戴设备软件所带来的运维风险。
可穿戴边缘设备展示了物理资源限制——毫瓦、千字节和无线电带宽——如何决定 MLOps 设计。当机器学习从个人健康管理转向受监管的医疗保健时,主要工程约束便从硬件物理限制转向患者安全、临床验证和算法问责,这正是 ClinAIOps 的运维领域。
ClinAIOps 案例研究
在消费级可穿戴硬件上,工程设计空间受到毫瓦级功耗、内存占用和无线电带宽的限制。当机器学习从健身追踪转向受监管的医疗服务时,主导约束便从硬件物理限制转向患者安全和临床责任。在持续治疗监测(CTM)33 中,可穿戴传感器以流式方式传输生理遥测数据,为个性化医疗干预提供指导。通用 MLOps 框架提供生命周期自动化功能,包括编排流水线、追踪制品和监控可用性。然而,标准运维流水线假定,可以依据统计代理指标评估预测结果,并自主部署模型。在临床环境中,自动化预测直接影响人的健康,因此无监督的自动执行不可接受。
ClinAIOps (Chen et al. 2023) 通过明确规定算法推理与临床决策权之间的边界,使 MLOps 原则适应这些约束。ClinAIOps 将多方利益相关者的反馈回路直接集成到服务架构中,而不将人工监督视为外部阻碍。该框架将运维控制权分配给患者、临床医生和机器学习工程师三个参与方,各方在不同的时间尺度上运作,并设有明确的安全关卡。
反馈回路
三个相互衔接的反馈回路,使机器学习能够安全、自适应地融入临床实践。Figure 11 将这些回路描绘为三个利益相关方之间的循环流程。患者通过可穿戴传感器提供持续监测数据,并接收限定范围内的 AI 辅助指导。临床医生接收 AI 生成的摘要、警报和建议,然后通过制定治疗方案和审批限制来运用临床判断。AI 开发者持续接收患者和临床医生的反馈,利用真实世界的性能表现和工作流信号改进模型与部署流程。连接所有三个利益相关方的外层回路代表完整的治理周期。
\scalebox{0.85}{%
\begin{tikzpicture}[line join=round,font=\small\sffamily]
%radius
\def\ra{53mm}
\newcommand{\gear}[6]{%
  (0:#2)
  \foreach \i [evaluate=\i as \n using {(\i-1)*360/#1}] in {1,...,#1}{%
    arc (\n:\n+#4:#2) {[rounded corners=1.5pt] -- (\n+#4+#5:#3)
    arc (\n+#4+#5:\n+360/#1-#5:#3)} --  (\n+360/#1:#2)
  }%
  (0,0) circle[radius=#6];
  \scoped[on background layer]
}

\tikzset{
  man/.pic={
  \pgfkeys{/man/.cd, #1}
     % tie
    \draw[draw=\tiecolor,fill=\tiecolor] (0.0,-1.1)--(0.16,-0.87)--(0.09,-0.46)--(0.13,-0.37)--(0.0,-0.28)--(-0.13,-0.37)--(-0.09,-0.46)--(-0.16,-0.87)--cycle;
    % ears
    \draw[fill=black,draw=none] (0.74,0.95) to[out=20,in=80](0.86,0.80) to[out=250,in=330](0.65,0.65) to[out=70,in=260] cycle;
    \draw[fill=black,draw=none] (-0.76,0.96) to[out=170,in=110](-0.85,0.80) to[out=290,in=190](-0.65,0.65) to[out=110,in=290] cycle;

    % head
    \draw[fill=black,draw=none] (0,0) to[out=180,in=290](-0.72,0.84) to[out=110,in=190](-0.56,1.67)
               to[out=70,in=110](0.68,1.58) to[out=320,in=80](0.72,0.84) to[out=250,in=0] cycle;
    % face
    \draw[fill=white,draw=none] (0,0.11) to[out=175,in=290](-0.53,0.65) to[out=110,in=265](-0.61,1.22)
                      to[out=80,in=235](-0.50,1.45) to[out=340,in=215](0.50,1.47)
                      to[out=310,in=85](0.60,0.92) to[out=260,in=2] cycle;
    \draw[fill=black,draw=none] (-0.50,1.45) to[out=315,in=195](0.40,1.25) to[out=340,in=10](0.37,1.32)
                      to[out=190,in=310](-0.40,1.49) -- cycle;
    % neck
    \draw[line width=1.5pt] (-0.62,-0.2) to[out=50,in=290] (-0.5,0.42);
    \draw[line width=1.5pt] (0.62,-0.2) to[out=130,in=250] (0.5,0.42);
    % body
    \draw[draw=\bodycolor,fill=\bodycolor] (0.0,-1.0) to[out=150,in=290](-0.48,-0.14) to[out=200,in=50](-1.28,-0.44)
                   to[out=240,in=80](-1.55,-2.06) -- (1.55,-2.06)
                   to[out=100,in=300](1.28,-0.44) to[out=130,in=340](0.49,-0.14)
                   to[out=245,in=30] cycle;
    % right stet
    \draw[line width=2pt,\stetcolor] (0.8,-0.21) to[bend left=7](0.78,-0.64)
         to[out=350,in=80](0.98,-1.35) to[out=250,in=330](0.72,-1.60);
    \draw[line width=2pt,\stetcolor] (0.43,-1.53) to[out=180,in=240](0.3,-1.15)
         to[out=60,in=170](0.78,-0.64);
    % left stet
    \draw[line width=2pt,\stetcolor] (-0.75,-0.21) to[bend right=20](-0.65,-1.45);
    \node[fill=\stetcolor,circle,minimum size=5pt] at (-0.65,-1.45) {};
    % eyes
    \node[circle,fill=black,inner sep=2pt] at (0.28,0.94) {};
    \node[circle,fill=black,inner sep=2pt] at (-0.28,0.94) {};
     % mouth
    \draw[line width=1.0pt] (-0.25,0.5) to[bend right=40](0.25,0.5);
  },
}
\pgfkeys{
  /man/.cd,
  tiecolor/.store in=\tiecolor,
  bodycolor/.store in=\bodycolor,
  stetcolor/.store in=\stetcolor,
  tiecolor=red,      % default tie color
  bodycolor=blue!30, % default body color
  stetcolor=green    % default stet color
}

\begin{scope}[local bounding box=PAC,
shift={($(90: 0.5*\ra)+(0,0.3)$)},
scale=0.5, every node/.append style={transform shape}]
\pic[scale=1] {man={tiecolor=red!50!yellow, bodycolor=green!50!blue,stetcolor=green!50!blue}};
\end{scope}

\begin{scope}[local bounding box=DOC,
shift={($(210: 0.5*\ra)+(-0.4,0.1)$)},
scale=0.5, every node/.append style={transform shape}]
\pic at (0,0) {man={tiecolor=red, bodycolor=VioletLine2,stetcolor=yellow}};
\end{scope}

\begin{scope}[local bounding box=GEAR,
shift={($(330: 0.5*\ra)+(0.5,0)$)},
scale=0.7, every node/.append style={transform shape}]
\fill[draw=none,fill=green!50!red,even odd rule] \gear{14}{1.2}{1.4}{10}{2}{0.9}coordinate(2GER1);
\end{scope}

\definecolor{CPU}{RGB}{0,120,176}
\begin{scope}[local bounding box = CPU,scale=0.3, every node/.append style={transform shape},
shift={($(GEAR)+(0,0)$)}]
\node[fill=CPU,minimum width=66, minimum height=66,
            rounded corners=2,outer sep=2pt] (C1) {};
\node[fill=white,minimum width=54, minimum height=54] (C2) {};
\node[fill=CPU!40,minimum width=44, minimum height=44,align=center,inner sep=0pt] (C3) {\huge 人工智能};

\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=CPU,minimum width=3, minimum height=12,
           inner sep=0pt,anchor=south](GO\y)at($(C1.north west)!\x!(C1.north east)$){};
}
\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=CPU,minimum width=3, minimum height=12,
           inner sep=0pt,anchor=north](DO\y)at($(C1.south west)!\x!(C1.south east)$){};
}
\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=CPU,minimum width=12, minimum height=3,
           inner sep=0pt,anchor=east](LE\y)at($(C1.north west)!\x!(C1.south west)$){};
}
\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=CPU,minimum width=12, minimum height=3,
           inner sep=0pt,anchor=west](DE\y)at($(C1.north east)!\x!(C1.south east)$){};
}
\end{scope}
\draw[{Triangle[width=12pt,length=8pt]}-, line width=5pt,violet!80] (355:0.5*\ra)
                arc[radius=0.5*\ra, start angle=-5, end angle= 67]node[left,pos=0.3,
                align=center,font=\footnotesize\sffamily,text=black]{持续\\监测数据\\和健康报告};
\draw[{Triangle[width=12pt,length=8pt]}-, line width=5pt,CPU] (110:0.5*\ra)
arc[radius=0.5*\ra, start angle=110, end angle= 181]node[right=0.3,pos=0.66,
                align=center,font=\footnotesize\sffamily,text=black]{治疗\\方案};
\draw[{Triangle[width=12pt,length=8pt]}-, line width=5pt,red!70] (233:0.5*\ra)
arc[radius=0.5*\ra, start angle=233, end angle= 311]node[above=0.4,pos=0.5,
                align=center,font=\footnotesize\sffamily,text=black]{
治疗调整\\提醒与\\监测摘要};
%%bigger circle
%radius
\def\ra{68mm}
\draw[-{Triangle[width=12pt,length=8pt]}, line width=5pt,violet!40] (353:0.5*\ra)
                arc[radius=0.5*\ra, start angle=-7, end angle= 77]node[right=0.21,pos=0.5,
                align=center,font=\footnotesize\sffamily,text=black]{经临床医生\\批准的治疗\\
                更新提醒};
\draw[-{Triangle[width=12pt,length=8pt]}, line width=5pt,CPU!40] (105:0.5*\ra)
arc[radius=0.5*\ra, start angle=105, end angle= 185]node[left=0.2,pos=0.5,
                align=center,font=\footnotesize\sffamily,text=black]{健康问题\\与目标};
\draw[-{Triangle[width=12pt,length=8pt]}, line width=5pt,red!40] (232:0.5*\ra)
arc[radius=0.5*\ra, start angle=232, end angle= 305]node[below=0.11,pos=0.5,
                align=center,font=\footnotesize\sffamily,text=black]{
治疗方案的限制\\与批准};
%
\node[below=0.1of PAC]{\textbf{患者}};
\node[below=0.1of DOC]{\textbf{临床医生}};
\node[below=0.48of CPU]{\textbf{人工智能开发者}};
\end{tikzpicture}}每个反馈循环都在不同的时间尺度上运行,以平衡响应速度与临床验证。患者治疗循环 持续实时执行,采集传感器遥测数据,并为患者自我管理提供限定范围内的调整。临床医生监督循环 则以异步监督节奏审查汇总趋势、设定运行边界,并在实施干预之前验证治疗建议。最后,开发者反馈循环 将遥测数据和临床医生覆写系统决策的模式汇总反馈给工程团队,推动离线重新训练与界面校准。
患者治疗循环
患者治疗循环对可穿戴设备采集的高频生理数据流执行本地推理,这些设备包括连续血糖监测仪或光学脉搏传感器。边缘模型服务运行时结合电子健康记录中的患者近期病史,对传入的特征向量进行评估。
为保障患者安全,治疗建议遵循分级执行模式。严格处于临床医生所定义边界内的微小调整会直接呈现给患者。重大变更,或在模型不确定性超出可接受范围时生成的建议,则会被阻止自动下发,并提交临床医生处理。这种结构能够快速适应动态变化的生理状态,同时确保自主执行绝不超出临床医生授权的阈值。
临床医生监督循环
临床医生监督循环为自动化推理提供监督控制。批量聚合流水线将时间序列数据流提炼为纵向摘要,例如昼夜节律方差、多日趋势和信号质量指标,从而避免持续的原始传感器遥测数据给医务人员造成负担。
当系统生成治疗建议时,例如为血压读数持续偏低的患者调整降压药剂量,临床医生会结合可穿戴设备模型未观测到的诊断因素评估该方案。临床医生可以批准、修改或拒绝该建议。这一决策会写入经过审计的事件日志,在运行中发挥双重作用:既在诊疗现场落实临床责任,又为后续模型微调生成经过验证、由专家标注的监督数据。临床医生还会更新控制患者治疗循环的运行阈值,重新校准自动化指导与强制审查之间的边界。
开发者反馈与医患协同
开发者反馈循环将临床实践反馈至工程基础设施。通过将持续数据记录和基础趋势检测交由人工智能流水线承担,医患咨询的重点从常规测量数据采集转向有针对性的临床评估与目标设定。
这些交互过程中生成的运行遥测数据,使工程团队能够直接了解生产环境中的系统行为。覆写记录、拒绝频率以及上报的不良事件,有助于揭示特定人口群体子集中的协变量偏移,或不同硬件版本上的传感器性能退化。工程师利用这些反馈触发有针对性的重新训练流水线、完善数据验证模式,并消除导致临床人员警报疲劳的可用性故障模式。
高血压案例
高血压管理 展示了这三个运行循环如何在实践中协同开展诊疗。血压会随着体力活动、压力和昼夜节律持续波动,因此需要个体化的长期药物治疗调整,而持续的治疗监测有助于实施这些调整。
数据基础设施
研究系统利用心电图(ECG)、光电容积描记(PPG)、34脉搏传导时间和心率特征,间接估计收缩压 (Zhang et al. 2017)。在生产工作流中,还会加入用于识别运动伪影的加速度计数据流,以及患者自行报告的用药日志,以补充这些信号。准确性需要严格校准,相关应用还需获得监管授权;未经正式的前瞻性验证,不能假定消费级传感器所宣称的性能具有临床可靠性。在针对目标队列完成适当验证后,该多模态数据流会与电子健康记录合并,为推理提供特征上下文。
Zhang, Qingxue, Dian Zhou, and Xuan Zeng. 2017. “Highly Wearable Cuff-Less Blood Pressure and Heart Rate Monitoring with Single-Arm Electrocardiogram and Photoplethysmogram Signals.” BioMedical Engineering OnLine 16 (1): 23. https://doi.org/10.1186/s12938-017-0317-z.
循环实现
Figure 12 的上方展示了三个反馈循环中的两个,下方展示了医患协同。左上面板展示患者治疗循环:患者监测血压,并接收限定范围内的剂量滴定建议,人工智能系统可以在临床医生定义的安全阈值内发出这些建议;重大变更需要明确批准。右上面板展示临床医生监督循环:人工智能系统向临床医生提供纵向趋势摘要,临床医生设定审批限值,并接收持续性低血压或高血压危象等临床风险事件的警报。下方面板展示了常规数据采集转入人工智能循环后形成的医患协同:就诊重点转向对生活方式因素和共同决策的更高层次讨论。第三个循环(开发者反馈)未在图中绘出;section 1.7.2.1 将其描述为一个通道,通过该通道,来自患者和临床医生双方的真实工作流信号为模型与界面改进提供依据。
\begin{tikzpicture}[line join=round,font=\small\sffamily]
%radius
\newcommand{\gear}[6]{%
  (0:#2)
  \foreach \i [evaluate=\i as \n using {(\i-1)*360/#1}] in {1,...,#1}{%
    arc (\n:\n+#4:#2) {[rounded corners=1.5pt] -- (\n+#4+#5:#3)
    arc (\n+#4+#5:\n+360/#1-#5:#3)} --  (\n+360/#1:#2)
  }%
  (0,0) circle[radius=#6];
  \scoped[on background layer]
  %\pic (a) at (0,0.2) {pers={scalefac=1.3,headcolor=BlueLine,bodyycolor=BlueLine}};
}

\tikzset{
  helvetica/.style={align=flush center, font={\sffamily\small}},
  man/.pic={
  \pgfkeys{/man/.cd, #1}
     % tie
    \draw[draw=\tiecolor,fill=\tiecolor] (0.0,-1.1)--(0.16,-0.87)--(0.09,-0.46)--(0.13,-0.37)--(0.0,-0.28)--(-0.13,-0.37)--(-0.09,-0.46)--(-0.16,-0.87)--cycle;
    % ears
    \draw[fill=black,draw=none] (0.74,0.95) to[out=20,in=80](0.86,0.80) to[out=250,in=330](0.65,0.65) to[out=70,in=260] cycle;
    \draw[fill=black,draw=none] (-0.76,0.96) to[out=170,in=110](-0.85,0.80) to[out=290,in=190](-0.65,0.65) to[out=110,in=290] cycle;

    % head
    \draw[fill=black,draw=none] (0,0) to[out=180,in=290](-0.72,0.84) to[out=110,in=190](-0.56,1.67)
             to[out=70,in=110](0.68,1.58) to[out=320,in=80](0.72,0.84) to[out=250,in=0] cycle;
    % face
    \draw[fill=white,draw=none] (0,0.11) to[out=175,in=290](-0.53,0.65) to[out=110,in=265](-0.61,1.22)
                      to[out=80,in=235](-0.50,1.45) to[out=340,in=215](0.50,1.47)
                      to[out=310,in=85](0.60,0.92) to[out=260,in=2] cycle;
    \draw[fill=black,draw=none] (-0.50,1.45) to[out=315,in=195](0.40,1.25) to[out=340,in=10](0.37,1.32)to[out=190,in=310](-0.40,1.49) -- cycle;
    % neck
    \draw[line width=1.5pt] (-0.62,-0.2) to[out=50,in=290] (-0.5,0.42);
    \draw[line width=1.5pt] (0.62,-0.2) to[out=130,in=250] (0.5,0.42);
    % body
    \draw[draw=\bodycolor,fill=\bodycolor] (0.0,-1.0) to[out=150,in=290](-0.48,-0.14) to[out=200,in=50](-1.28,-0.44)
                   to[out=240,in=80](-1.55,-2.06) -- (1.55,-2.06)
                   to[out=100,in=300](1.28,-0.44) to[out=130,in=340](0.49,-0.14)
                   to[out=245,in=30] cycle;
    % right stet
    \draw[line width=2pt,\stetcolor] (0.8,-0.21) to[bend left=7](0.78,-0.64)
         to[out=350,in=80](0.98,-1.35) to[out=250,in=330](0.72,-1.60);
    \draw[line width=2pt,\stetcolor] (0.43,-1.53) to[out=180,in=240](0.3,-1.15)
         to[out=60,in=170](0.78,-0.64);
    % left stet
    \draw[line width=2pt,\stetcolor] (-0.75,-0.21) to[bend right=20](-0.65,-1.45);
    \node[fill=\stetcolor,circle,minimum size=5pt] at (-0.65,-1.45) {};
    % eyes
    \node[circle,fill=black,inner sep=2pt] at (0.28,0.94) {};
    \node[circle,fill=black,inner sep=2pt] at (-0.28,0.94) {};
     % mouth
    \draw[line width=1.0pt] (-0.25,0.5) to[bend right=40](0.25,0.5);
  },
}
\pgfkeys{
  /man/.cd,
  tiecolor/.store in=\tiecolor,
  bodycolor/.store in=\bodycolor,
  stetcolor/.store in=\stetcolor,
  tiecolor=red,      % default tie color
  bodycolor=blue!30, % default body color
  stetcolor=green    % default stet color
}
\definecolor{CPU}{RGB}{0,120,176}

%left patient-AI
\begin{scope}[local bounding box=PAC1,
%shift={($(90: 0.5*\ra)+(0,0.3)$)},
scale=0.5, every node/.append style={transform shape}]
\pic[scale=1] {man={tiecolor=red!50!yellow, bodycolor=green!50!blue,stetcolor=green!50!blue}};
\end{scope}
%%%%
%AI left
\begin{scope}[local bounding box=AI1,shift={($(PAC1)+(3.0,-0.1)$)}]
\begin{scope}[local bounding box=GEAR,
%shift={($(330: 0.5*\ra)+(0.5,0)$)},
scale=0.7, every node/.append style={transform shape}]
\fill[draw=none,fill=green!50!red,even odd rule] \gear{14}{1.2}{1.4}{10}{2}{0.9}coordinate(2GER1);
\end{scope}
\begin{scope}[local bounding box = CPU,scale=0.3, every node/.append style={transform shape},
shift={($(GEAR)+(0,0)$)}]
\node[fill=CPU,minimum width=66, minimum height=66,
            rounded corners=2,outer sep=2pt] (C1) {};
\node[fill=white,minimum width=54, minimum height=54] (C2) {};
\node[fill=CPU!40,minimum width=44, minimum height=44,align=center,inner sep=0pt] (C3) {\Huge 人工智能};

\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=CPU,minimum width=4, minimum height=12,
           inner sep=0pt,anchor=south](GO\y)at($(C1.north west)!\x!(C1.north east)$){};
}
\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=CPU,minimum width=4, minimum height=12,
           inner sep=0pt,anchor=north](DO\y)at($(C1.south west)!\x!(C1.south east)$){};
}
\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=CPU,minimum width=12, minimum height=4,
           inner sep=0pt,anchor=east](LE\y)at($(C1.north west)!\x!(C1.south west)$){};
}
\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=CPU,minimum width=12, minimum height=4,
           inner sep=0pt,anchor=west](DE\y)at($(C1.north east)!\x!(C1.south east)$){};
}
\end{scope}
\end{scope}
%circle1 left
\begin{scope}[local bounding box=CIRC1,
shift={($(PAC1)!0.45!(AI1)+(0,0.3)$)},
scale=0.5, every node/.append style={transform shape}]
\def\ra{15mm}
\draw[latex-, line width=1.25pt,red] (10:0.5*\ra) arc[radius=0.5*\ra, start angle=10, end angle= 170];
\draw[latex-, line width=1.25pt,CPU] (190:0.5*\ra)arc[radius=0.5*\ra, start angle=190, end angle= 350];
\end{scope}
%%%%%%%%%%%%%%%
%right Doctor-AI
%%%%%%%%%%%%%
\begin{scope}[local bounding box=DOC1,shift={($(PAC1)+(11.5,0)$)},
scale=0.5, every node/.append style={transform shape}]
\pic at (0,0) {man={tiecolor=red, bodycolor=VioletLine2,stetcolor=yellow}};
\end{scope}
%%%%
%AI left
\begin{scope}[local bounding box=AI2,shift={($(DOC1)+(3.0,-0.1)$)}]
\begin{scope}[local bounding box=GEAR,
%shift={($(330: 0.5*\ra)+(0.5,0)$)},
scale=0.7, every node/.append style={transform shape}]
\fill[draw=none,fill=green!50!red,even odd rule] \gear{14}{1.2}{1.4}{10}{2}{0.9}coordinate(2GER1);
\end{scope}
\begin{scope}[local bounding box = CPU,scale=0.3, every node/.append style={transform shape},
shift={($(GEAR)+(0,0)$)}]
\node[fill=CPU,minimum width=66, minimum height=66,
            rounded corners=2,outer sep=2pt] (C1) {};
\node[fill=white,minimum width=54, minimum height=54] (C2) {};
\node[fill=CPU!40,minimum width=44, minimum height=44,align=center,inner sep=0pt] (C3) {\Huge 人工智能};

\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=CPU,minimum width=4, minimum height=12,
           inner sep=0pt,anchor=south](GO\y)at($(C1.north west)!\x!(C1.north east)$){};
}
\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=CPU,minimum width=4, minimum height=12,
           inner sep=0pt,anchor=north](DO\y)at($(C1.south west)!\x!(C1.south east)$){};
}
\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=CPU,minimum width=12, minimum height=4,
           inner sep=0pt,anchor=east](LE\y)at($(C1.north west)!\x!(C1.south west)$){};
}
\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=CPU,minimum width=12, minimum height=4,
           inner sep=0pt,anchor=west](DE\y)at($(C1.north east)!\x!(C1.south east)$){};
}
\end{scope}
\end{scope}
%circle2 right
\begin{scope}[local bounding box=CIRC2,
shift={($(DOC1)!0.45!(AI2)+(0,0.3)$)},
scale=0.5, every node/.append style={transform shape}]
\def\ra{15mm}
\draw[latex-, line width=1.25pt,red] (10:0.5*\ra) arc[radius=0.5*\ra, start angle=10, end angle= 170];
\draw[latex-, line width=1.25pt,CPU] (190:0.5*\ra)arc[radius=0.5*\ra, start angle=190, end angle= 350];
\end{scope}
%%%%%%%%%%%%%%%
%below Patient-Doctor
%%%%%%%%%%%%%
\begin{scope}[local bounding box=PAC3,shift={($(PAC1)+(5.9,-3.3)$)},
scale=0.5, every node/.append style={transform shape}]
\pic[scale=1] {man={tiecolor=red!50!yellow, bodycolor=green!50!blue,stetcolor=green!50!blue}};
\end{scope}
%%%%
\begin{scope}[local bounding box=DOC2,shift={($(PAC3)+(3.0,-0)$)},
scale=0.5, every node/.append style={transform shape}]
\pic at (0,0) {man={tiecolor=red, bodycolor=VioletLine2,stetcolor=yellow}};
\end{scope}
%circle3 down
\begin{scope}[local bounding box=CIRC2,
shift={($(PAC3)!0.45!(DOC2)+(0,0.3)$)},
scale=0.5, every node/.append style={transform shape}]
\def\ra{15mm}
\draw[latex-, line width=1.25pt,red] (10:0.5*\ra) arc[radius=0.5*\ra, start angle=10, end angle= 170];
\draw[latex-, line width=1.25pt,CPU] (190:0.5*\ra)arc[radius=0.5*\ra, start angle=190, end angle= 350];
\end{scope}
%
%fitting
\scoped[on background layer]
\node[draw=BackLine,inner xsep=4,inner ysep=10,yshift=-2mm,
           fill=BackColor!50,fit=(PAC1)(AI1),line width=0.75pt](BB1){};
\node[above=0.5pt of  BB1.south,anchor=south,helvetica]{\textbf{患者—人工智能闭环}};
\scoped[on background layer]
\node[draw=BackLine,inner xsep=4,inner ysep=10,yshift=-2mm,
           fill=BackColor!50,fit=(DOC1)(AI2),line width=0.75pt](BB2){};
\node[above=0.5pt of  BB2.south,anchor=south,helvetica]{\textbf{临床—人工智能闭环}};
\scoped[on background layer]
\node[draw=BackLine,inner xsep=4,inner ysep=10,yshift=-2mm,
           fill=BackColor!50,fit=(DOC2)(PAC3),line width=0.75pt](BB3){};
\node[above=0.5pt of  BB3.south,anchor=south,helvetica]{\textbf{患者—临床闭环}};
%
\node[align=flush right,left=0.1 of BB1.west, text width=30mm]{患者佩戴被动式连续血压监测仪,并报告降压药的使用情况。};
 \node[align=flush left,right=0.1 of BB1.east, text width=28mm]{人工智能生成
                 降压药剂量滴定建议。};
\node[align=flush right,left=0.1 of BB2.west, text width=26mm]{临床医生设定并更新人工智能进行降压药剂量滴定的限值。};
 \node[align=flush left,right=0.1 of BB2.east, text width=30mm]{人工智能针对严重高血压或低血压发出警报,提示进行随访或寻求急救医疗服务。};
%
\node[align=flush right,left=0.1 of BB3.west, text width=38mm]{患者讨论人工智能生成的自身血压趋势摘要以及治疗的有效性。};
 \node[align=flush left,right=0.1 of BB3.east, text width=35mm]{临床医生检查有无不良事件,并识别患者特异性影响因素(如饮食和运动)。};
\end{tikzpicture}
Chen, Emma, Shvetank Prakash, Vijay Janapa Reddi, David Kim, and Pranav Rajpurkar. 2023. “A Framework for Integrating Artificial Intelligence for Clinical Care with Continuous Therapeutic Monitoring.” Nature Biomedical Engineering 9 (4): 445–54. https://doi.org/10.1038/s41551-023-01115-0.
这三个子图确立了临床自动化的工程边界:常规监测和小幅剂量滴定在临床医生定义的阈值范围内自动执行,而急性病情升级处置、不良事件处理以及治疗方案变更则需要人类明确授权。正是在这一边界上,常规 MLOps 实践需要引入下文概述的额外临床协调机制。
MLOps 与 ClinAIOps 的比较
高血压案例展示了标准软件流水线与医疗部署在运维方面的差异。通用 MLOps 提供技术生命周期控制,包括自动化测试、持续集成、模型注册中心和漂移监测。ClinAIOps 将这一基础扩展到受监管的社会技术环境中,在这些环境下,输出会直接影响医疗干预。Table 31 从八个运维维度比较了这两种方法。
| 通用 MLOps 的侧重点 | ClinAIOps 的扩展 | |
|---|---|---|
| 关注点 | 模型的技术生命周期 | 人类与人工智能的决策 |
| 利益相关方 | 机器学习、数据、平台和运维团队 | 增加患者、临床医生和临床治理参与方 |
| 反馈闭环 | 监测、再训练和发布 | 增加治疗、临床医生和开发者反馈 |
| 目标 | 可靠、受治理的机器学习运维 | 安全、有效且可问责的医疗支持 |
| 流程 | 自动化流水线和运维控制 | 整合临床工作流和人工审批关卡 |
| 数据考量 | 血缘、质量、新鲜度和访问控制 | 增加知情同意、临床数据来源追溯和受保护数据 |
| 模型验证 | 预测指标、运维指标和切片级指标 | 增加临床效用、安全性和队列结局 |
| 实施 | 技术集成和运维责任归属 | 增加临床问责和利益相关方激励机制 |
该表的核心区别在于,临床部署改变了风险责任的归属。统计准确率是先决条件,但当错误预测引发医疗干预时,它并不能免除法律责任。因此,ClinAIOps 框架将主导约束从设备效率转变为临床问责。模型参与医疗服务的提供,却无法承担临床决策责任。每一条建议及临床医生后续采取的行动,都必须能够追溯到其底层传感器输入、模型版本和推理元数据;否则,系统就无法支持监管审计或事后事件分析。关注点分离从架构偏好转变为安全不变量:传感器数据摄取、推理评分、临床诊断和参数更新必须通过明确的软件契约和人工审批关卡实现解耦。
同样的问责要求也改变了监测方式。标准化临床数据流水线支持训练与服务的一致性,但临床验证要求对照标准诊疗的结局以及队列特异性效果,评估模型建议。可观测的退化不再局限于统计损失和延迟,还延伸到临床指标:血压控制率、不良事件、临床医生否决模型建议的情况以及亚组间差异。在这种机制下,多层反馈闭环并非不必要的运维延迟;它们是有意设置的架构控制,用于在边缘端自动适应与法律及伦理问责之间取得平衡。成本感知自动化严格限定在这些关卡之内:只有当经过验证的临床收益超过验证成本和患者风险时,才更新模型;低置信度预测则触发确定性回退,转交人工临床审核。
案例研究综合分析
受 Oura 启发的设计案例与 ClinAIOps 案例,将稳定的 MLOps 原则与重塑其实施方式的部署约束区分开来。假设的戒指生命周期属于资源边界案例:当电池、遥测和薄弱的真实标签限制了设备端可测量及可更新的内容时,运维系统仍必须保持可复现性、一致性以及退化的可观测性。ClinAIOps 则属于问责边界案例:相同的原则依然适用,但由于模型会影响临床行动,验证、审计轨迹和人工审批关卡成为主导因素。
两者共同揭示的工程经验是,MLOps 的成熟度并不在于工具的堆积,而在于识别主导约束、选择与之匹配的运维控制,并在模型发生变化时保留证据的能力。当团队套用以代码为中心的运维直觉,却未考虑统计行为和不断变化的数据分布时,生产机器学习系统就会失效,暴露出常见的谬误与运维陷阱。
谬误与陷阱
基于传统软件假设来运行生产机器学习系统,会产生特有的失效模式。以下谬误与陷阱说明,面对已部署模型的统计现实,标准软件工程直觉会在哪些方面失效。
谬误:MLOps 只是将传统 DevOps 实践应用于机器学习模型。
工程师常常认为,标准 CI/CD 流水线可以直接迁移到机器学习中。传统 DevOps 在相同源代码产生相同二进制行为这一不变量的前提下,实现代码编译、单元测试和制品部署的自动化。在机器学习系统中,代码仅代表数据—算法—机器三元组中的一个维度。模型执行共同依赖于代码、持续演变的大规模数据集以及加速器计算预算。如 section 1.4.2.1 所详述,机器学习流水线引入了有状态的再训练、多指标验证关卡和不可变制品注册。标准 CI/CD 引擎无法原生跟踪数据血缘、编排特征存储或检测分布漂移。当团队应用 DevOps 却未针对机器学习进行适配时,他们最大化了服务集群的计算可用性,却未对统计行为进行监测。系统实现了高可用率和低延迟,但由于未经验证的数据变化以及训练与服务偏差,仍会在不被察觉的情况下提供质量退化的预测。
陷阱:将模型部署视为一次性事件,而非持续过程。
将部署视为终点里程碑,意味着假定已部署的权重会永久保持与生产输入分布一致。编译后的二进制程序具有固定的执行语义,而模型质量则会随着现实世界分布的变化而退化。监测 PSI 等统计指标(section 1.5.3.1)可以提供特征漂移的早期信号,区分无害波动与需要采取行动的分布变化。超过警告阈值时,需要进行运维诊断,而非未经验证就开展再训练。如 section 1.4.2.2 所确立,安排更新是一个经济权衡问题:最优再训练间隔 \(T^* \approx \sqrt{\frac{2C}{Q \cdot V \cdot \text{Accuracy}_0 \cdot \gamma}}\) 在固定的计算与工程成本 \(C\) 和由查询量 \(Q\)、单位准确率价值 \(V\) 及陈旧性衰减率 \(\gamma\) 所决定的累积业务损失之间进行权衡。运行生产模型要求将部署视为持续的控制闭环,在监测信号与再训练的经济性之间取得平衡。
谬误:自动再训练无需人工监督即可确保最优模型性能。
流水线执行的自动化并不能消除运维治理的必要性。闭环再训练流水线运行时不具备语义感知能力;如果上游数据摄取出现模式异常、标签损坏或传感器突发漂移,自动再训练就会将这些错误直接固化到更新后的模型权重中。此外,自动化验证关卡通常评估留出测试集上的总体损失,这很容易掩盖关键切片或低频边界案例上的严重性能退化。例如,使用周末流量再训练排序模型,可能导致其在延迟敏感的工作日工作负载上性能下降,因为此时用户查询分布有所不同。具有韧性的 MLOps 架构将流水线自动执行与模型自动晋级生产环境解耦,强制实施金丝雀部署、切片级回归检查关卡,并在验证指标偏离预期历史范围时要求人工签署批准。
陷阱:专注于技术基础设施,却忽视组织与流程的协同。
投入 MLOps 工具却不定义组织接口,会导致运维责任归属碎片化。机器学习系统连接着两种不同的工程文化:模型开发者优化离线准确率指标,而平台工程师管理主机级延迟、内存容量和吞吐量预算。当组织将部署视为孤立团队之间的交接时,生产事故中的根因排查就会陷入停滞。基础设施工程师检查容器健康状况和 GPU 利用率,却不了解模型预测分布;模型开发者检查离线训练曲线,却不了解运行时的服务约束。特征存储和注册中心等工具提供了技术支撑,但可靠性需要制度层面的协同:涵盖统计准确率与服务延迟的统一 SLO、联合值班运行手册,以及对生产性能退化的共同问责。
谬误:一旦建立流水线,训练与服务环境就会自动保持一致。
建立初始端到端流水线,并不能保证训练与服务永久一致。训练与服务偏差源于离线和在线执行路径之间的根本架构差异。训练通常以离线批处理工作流运行(例如分布式 SQL 查询或 Spark 流水线),针对历史日志的高吞吐量扫描进行优化;在线服务则在毫秒级延迟约束下,以低延迟微服务的形式运行。在这些环境中维护两套特征变换实现,不可避免地会引入数值差异、不同的缺失值语义,或历史数据关联中的前视偏差。如 section 1.4.1.2 所示,特征存储通过统一变换逻辑,并同步批处理存储与点查询存储,缓解了这种分歧。然而,仅靠软件流水线无法保证一致性;运维验证需要持续检查离线特征日志与在线推理输入之间的分布一致性,并执行模式断言,以便在偏差损害下游决策之前将其发现。
陷阱:假定全面监测能够防止所有生产事故。
仪表盘和告警阈值无法防止静默数据故障导致的生产中断。监测本质上是被动的;只有在损坏的状态传播到系统中之后,它才能检测到退化。此外,仅跟踪输出指标会在数据流水线中留下关键盲区。如 section 1.5.3.1 所示,测量服务延迟和预测分布无法检测特征陈旧等输入异常。推理服务可以维持正常的 \(p99\) 响应时间和预测范围,同时却在使用因上游数据库复制延迟或缓存淘汰失败而过时的用户嵌入。等到下游业务指标退化时,错误预测已经影响了用户。生产可靠性要求在被动可观测性之外设置防御性边界控制:严格执行输入模式约束、进行特征新鲜度断言,并在输入质量低于运维容忍范围时,通过熔断器回退到确定性启发式方法。
谬误:准确率是生产环境中首先应监测的信号。
团队常将准确率仪表板配置为首要的运维预警机制,认为性能退化会首先在其中显现。实际上,基于真实标签的准确率几乎总是滞后指标。在欺诈检测、广告转化或信贷审批等生产环境中,真实标签的获取存在显著延迟,往往需要数周或数月才能通过拒付记录或还款历史积累起来。仅依赖准确率仪表板,会使系统在整个标签延迟窗口内处于盲目运行状态。此外,即使关键子群体的输入分布发生偏离,整体准确率仍可能保持具有误导性的稳定。如 section 1.5.3.1 中所详述,使用 PSI 或 Kullback-Leibler(KL)散度等指标监控输入特征分布,可以提供即时且无需标签的先行指标。这些统计信号能够实时检测分布偏移,使工程团队在准确率退化影响业务结果之前开展诊断。
陷阱:将先行指标告警路由至与准确率告警不同的渠道。
将先行指标告警与主要事件响应渠道分离,会使其失去运维价值。当工程团队将分布漂移和数据新鲜度警告发送至仅供信息展示的仪表板或低优先级渠道,而仅在下游准确率下降时才呼叫值班人员,早期警告就会被忽视。漂移告警在无人察觉的情况下不断积累,直到准确率骤降,迫使团队启动应急响应。只有将先行指标接入实际运行、责任明确的响应流程,并配备经过校准的严重性分级和明确的诊断操作手册,它才具有运维价值。运维目标是利用先行统计信号触发根因诊断,核查特征流水线的完整性并验证输入模式,确保准确率指标用于确认运行健康状况,而非宣告一次失控故障。
生产机器学习中的可观测性远不止被动的仪表板遥测。它要求在整个数据—算法—机器架构中建立运维闭环:保障输入数据完整性和特征稳定性,通过自动化验证关卡约束模型行为,并在无声的统计退化损害生产系统之前,将先行指标直接发送给配有诊断操作手册、能够采取行动的工程师。
总结
MLOps 的存在,是因为机器学习系统引入了确定性软件中根本不存在的失效模式。服务器崩溃或网络超时会立即使可用性仪表板变红,提醒运维人员采取纠正措施。模型退化则引入了一种无声的统计失效模式:服务基础设施在延迟时限内返回 200 OK 响应,但预测准确率却在未被察觉的情况下持续下降。仅围绕服务器正常运行时间建立的运维实践无法观测这种统计衰退。机器学习运维通过将模型质量视为动态运行时变量,而非静态部署制品,弥合了这一缺口。
五项基本原则(section 1.2.1)提供了一个不受规模或领域限制的评估框架。通过版本管理实现可复现性,能够处理许多生产事故的根因:未被追踪的制品及其变化,包括数据版本、配置变更和环境漂移;它们会使调试无法进行,并使回滚不可靠。关注点分离能够在发生变更时控制影响范围,防止边界侵蚀和级联修正将局部修复演变为全系统回归。一致性要求针对的是训练与服务偏差,即离线训练流水线与在线服务系统之间的特征计算出现差异时,准确率在无声中下降的现象;特征存储集中管理特征定义和服务路径,但保持一致仍需要持续验证。通过分层监控跟踪数据新鲜度、特征分布、模型输出和业务指标,使退化可观测,能够将抽象的静默失效问题转化为可采取行动的告警。最后,成本感知自动化以拟合的陈旧性成本模型 \((T^* \approx \sqrt{\frac{2C}{Q \cdot V \cdot \text{Accuracy}_0 \cdot \gamma}})\) 取代任意设定的重训练计划,其实际应用取决于底层假设是否成立。
基础设施组件在三个关键运维边界上落实这些原则。特征存储和数据版本管理通过减少训练与服务之间的不一致,管理数据与模型之间的接口。CI/CD 流水线和模型注册中心通过强制保障可复现性并支持回滚,管理模型与基础设施之间的接口。监控系统、事件响应框架和值班实践通过使退化可观测且可采取行动,管理生产与监控之间的接口。重训练决策框架将测得的退化与经济阈值联系起来,从而支持成本感知自动化。领域约束会重塑这些原则的实现方式,但不会改变哪些原则重要:受 Oura 启发的设计,利用该研究中离线准确率从 57 percent 提升至 79 percent 的结果,说明资源感知验证和更新控制的必要性,而不据此声称存在未经验证的生产生命周期。同样,ClinAIOps 展示了高风险临床部署为何需要平稳降级和人工监督控制,其中三个反馈回路发挥的是架构模式的作用,而非构成运维负担。
要点回顾: 完全可用,却完全错误
- 缺少结果监控时,机器学习系统会无声失效:模型质量会随着分布差异 \(\mathcal{D}(P_t \lVert P_0)\) 的增大而退化,但分布差异本身并不能决定准确率损失。由于服务节点可以在预测失效时仍保持完全正常运行,因此必须跟踪真实结果,不能仅依赖服务器健康检查。
- 训练与服务偏差会在不引发崩溃的情况下损害推理:特征存储通过统一不同环境中的特征定义和变换来缓解偏差,但保持一致仍需要持续验证在线和离线数据流水线。
- 重训练是工程优化问题,而非凭空猜测:拟合的陈旧性成本模型 \((T^* \approx \sqrt{2C/(Q \cdot V \cdot \text{Accuracy}_0 \cdot \gamma)})\) 在重训练计算成本与预测质量衰退之间进行权衡,并在其所述假设下,将更新频率与定量经济分析联系起来。
- 通过渐进式发布进行部署,并预先测试回滚:金丝雀部署、蓝绿部署和影子部署将发布风险分散到不同部分的生产流量中,并由分级回滚流程提供保障;这些流程必须通过定期运维演练加以验证。
- 根据系统风险分阶段投入基础设施:监测机制和持续部署构成初始运维基线。后果严重的系统需要更严格的运维;应根据偏差和规模带来的需求,逐步引入特征存储和自动化重训练。
- 五项原则可跨领域应用:可复现性、关注点分离、一致性、退化可观测性和成本感知自动化在不同应用中始终成立;领域约束只会重塑其具体机制和工具实现。
- 运维成熟度既取决于组织,也取决于架构:管理单个模型与治理生产模型群存在本质差异。虽然核心原则可以随规模扩展,但运维复杂性会随着模型群规模增长,因此统一的激励机制和共同参与的值班轮换与工具同样不可或缺。
这种运维纪律将生产机器学习工程与开发实验区分开来。当已部署模型发生退化时,系统化监测使实践者能够定位失效模式:通过分布差异识别数据漂移,通过预处理一致性审计识别训练与服务偏差,通过制品来源追踪识别配置债务,并通过输出的时序跟踪识别反馈回路。将生产机器学习视为“部署后即可不管”的工作,会忽略这些不同的动态机制,使模型可能连续数月提供无效推理,而基础设施仪表板仍然保持绿色。
这一运维现实使机器学习工程扎根于数据—算法—机器分类框架。在传统软件中,代码在硅芯片上以确定性方式执行;而在机器学习系统中,即使模型代码和加速器硬件逐字节保持不变,其所依赖的数据维度仍在持续变化。模型与现实世界的匹配,并非部署时一次性达到的工程状态,而是一项需要通过遥测、验证关卡和依据成本校准的重训练持续支付的成本。因此,系统可靠性必须衡量预测结果,不能仅衡量服务器正常运行时间,因为生产环境中最危险的失效模式,是绿色仪表板掩盖了正在漂移的模型。
后续内容: 从可靠性到责任
机器学习系统即使高效、可扩展且可靠,仍可能因放大偏见或泄露数据而造成伤害。即使正常运行时间达到 99.9%,延迟低于 10 ms,也无法证明其决策是负责任的。负责任工程 探讨了最后一项约束:使技术优化与人类价值观保持一致,让部署后的系统服务于受其影响的人们。
Footnotes
遥测:一种反馈路径,能够在模型退化演变为业务故障之前使其可见;崩溃和错误码可以暴露某些软件故障,但语义错误在任何应用中都可能保持静默。机器学习系统又引入了分布偏移,如果没有特征分布、预测置信度和漂移指标等统计遥测数据,这种偏移可能无法被检测到。仅靠可用性指标无法暴露这种退化。↩︎
制品:模型权重是训练实际产生的输出;通常无法从参数推断出生成它们的输入和随机性。因此,仅对代码进行版本管理并不足够;即使对代码、数据、配置和环境都进行了版本管理,当内核或训练具有非确定性时,也未必能保证精确重放。↩︎
概念漂移:概念漂移与数据流研究将模型所预测的目标关系可能在部署后发生变化这一问题形式化 (Widmer and Kubat 1996; Gama et al. 2014)。在垃圾邮件、欺诈和滥用检测等对抗性领域中,数据分布可能主动适应模型的行为,因此持续监控与重新训练成为结构性要求,而非运维上的奢侈配置。↩︎
DVC(数据版本控制):DVC 为数据集与模型制品提供类似 Git 的版本管理能力 (Iterative 2024),解决了 equation 1 所形式化的制品缺口问题:没有数据版本管理,\(\text{Data}_v\) 项就无法恢复,任何代码提交的组合都无法重建已部署的模型。↩︎
技术债务:Ward Cunningham 在 1992 年的 WyCash 经验报告中引入了债务比喻,用以描述为了快速交付而编写代码并推迟整理的做法 (Cunningham 1992);在机器学习中,债务可以通过数据与模型依赖静默累积,而以代码为中心的单元测试和审查可能无法发现这些依赖。流水线可以保持不变,但其建模的世界却会变化。ML Test Score 评估标准 (Breck et al. 2017) 通过 28 项生产就绪测试将这类债务显式化,这些测试分为数据、模型、基础设施和监控四个部分。↩︎
Zillow iBuying 失败:Zillow 于 2021 年 11 月公布逐步关闭 Zillow Offers 的计划,其中包括第三季度库存减记和裁员 (Zillow Group 2021)。这次失败体现了大规模修正级联债务:定价错误、购买决策和库存反馈可能相互强化,形成任何单次重训练周期都无法打破的循环。↩︎
特征存储:Uber 的 Michelangelo 平台描述了一种集中式特征存储,用于在生产模型之间共享特征并提供特征服务 (Hermann and Del Balso 2017)。在这一规模下,一致性保证必须在在线延迟预算内成立:特征存储与共享特征代码库的区别在于,共享的特征路径还必须足够快速地提供新鲜特征,以支持实时推理。↩︎
模型注册中心:防止“绕过注册中心”,即由于预处理不同、序列化格式过时,或直接对服务端点应用手动热修复,导致未记录的生产模型偏离训练制品的故障模式。如果没有注册中心强制使用具备可查询元数据和状态的版本化不可变制品,回滚就需要在事故压力下,从临时搭建的制品存储中寻找正确的权重。↩︎
幂等性:这一性质确保重试某个流水线阶段不会产生重复的外部可见影响、相互冲突的注册记录或重复的部署操作。由相同输入生成完全相同的模型属于另一种性质——确定性与可复现性——而
training阶段可能因权重初始化等随机性而不满足这一性质。因此,生产系统将稳定的运行标识符和原子发布相结合以实现幂等性,同时采用固定随机种子、确定性内核、固定库版本和受控的数据顺序来实现可复现性。↩︎云端机器学习训练的经济性:按 V100 GPU 小时计价时,GPT-3 的训练成本估计达数百万美元 (Li 2020)。微调成本因模型规模、提供商、数据集和训练步数而异。竞价实例和 Spot VM 可以降低实例价格,但也带来了权衡:AWS Spot Instances 和 Google Cloud Spot VMs 可能被中断或抢占,因此,容错训练工作负载需要具备检查点保存与恢复基础设施 (Amazon Web Services 2026; Google Cloud 2026c)。↩︎
系统熵:拟合衰减率 \(\gamma\) 在不同部署中可能差异显著,必须根据结果数据进行估计。更短的衰减时间尺度要求监控更加及时,但这本身并不意味着必须持续训练;标签延迟、验证风险、再训练成本和回滚能力共同决定运维周期。↩︎
半衰期(源自核物理,用于衡量放射性样品中一半物质发生衰变所需的时间):在机器学习运维中,这一比喻是一种方便的近似,而非普适定律。对于 equation 5 中的指数拟合,半衰期为 \(\ln(2)/\gamma\)。再训练周期还取决于流量、价值、再训练成本和风险;季节性、突发性或对抗性变化需要更丰富的漂移过程来描述。↩︎
用于机器学习部署的容器化:Docker (Merkel 2014) 将代码及其依赖打包为可移植单元;Kubernetes (Burns et al. 2016) 则在集群中编排这些单元。容器化通过将用户空间依赖记录为带版本的产物,部分解决了 equation 1 中的 \(\text{Environment}_v\) 项;宿主机内核、驱动程序和硬件仍是外部依赖。↩︎
预发布验证:机器学习预发布验证在传统功能验证和运行验证的基础上,增加了概率意义上的充分性检查。模型可能通过单元测试,却仍在生产环境中失效,因为测试数据未能反映部署分布。因此,发布门禁必须将预测统计量、评估切片和业务护栏指标与经过校准的阈值进行比较,而不能仅依赖单元测试。↩︎
影子部署:当其预期减少的发布损失超过影子基础设施为重复推理且不提供结果而产生的成本时,影子部署在经济上才是合理的。↩︎
金丝雀部署:将少量在线流量路由至候选模型,将其用作生产健康状况的哨兵。机器学习特有的挑战在于,“故障”表现为统计退化,而非确定性崩溃:以高置信度检测微小的准确率差异可能需要数千次推理,这使决策速度与统计功效之间产生张力,并决定了金丝雀阶段的最短持续时间。↩︎
蓝绿部署:维护两个相当的生产环境,“蓝”环境承接当前流量,“绿”环境运行候选模型,然后在绿环境通过验证后,通过一次路由变更切换流量。由于回滚是流量切换,而非分阶段排空,对于无状态服务,其恢复速度可能快于渐进式金丝雀部署。代价是切换期间需要额外的基础设施,因此,当短暂的双份容量可以接受且分群统计验证成本较高时,蓝绿部署优于金丝雀部署。↩︎
回滚(源自数据库事务管理):在机器学习中,模型相关状态(例如缓存的嵌入)可能在不同模型版本之间不兼容,使部署的这一“撤销”操作变得复杂。这种不匹配可能延长恢复时间,并导致团队回避部署、迭代放缓。↩︎
无服务器机器学习推理:该方案的成本效益来自仅在收到请求时配置计算资源,并在空闲时缩容至零,从而消除持续运行端点的成本。这与性能目标形成了直接矛盾,因为空闲期后的首个请求需要将模型加载到内存中,因此会产生“冷启动”延迟。对于大型模型,这一延迟可能长到足以违反实时延迟预算,除非服务保留预热容量,或使用专为快速加载设计的运行时。↩︎
MLflow:一种开源 MLOps 框架,将制品存储(S3/GCS)与元数据数据库(PostgreSQL)结合,用于记录超参数实验运行、模型二进制文件的哈希值和部署阶段转换。其系统层面的权衡在于:集中管理血缘跟踪,但在大规模并行超参数搜索期间可能引发数据库连接瓶颈。↩︎
Ray:加州大学伯克利分校开发的分布式计算框架 (Moritz et al. 2018),提供统一的任务和 actor 接口,由分布式调度器和容错存储提供支持。更广泛的 MLOps 经验是,碎片化的基础设施会产生转换环节,预处理逻辑、归一化常量、分词器版本或制品格式可能在这些环节中悄然出现差异。共享的执行抽象可以减少这种碎片化,但训练与服务偏差仍需要针对数据、特征和服务代码进行显式的一致性检查。↩︎
机器学习自动扩缩容:自动扩缩容根据需求信号调整容量 (Amazon Web Services 2024c),但机器学习服务带来了无状态 Web 服务所没有的约束。除了 CPU 利用率,自动扩缩容决策还必须考虑模型加载时间(冷启动开销)、GPU 内存碎片化和批处理行为。扩容过慢会违反延迟 SLO;缩容过于激进则会迫使系统反复冷启动,导致 p99 延迟恶化。↩︎
漂移检测延迟:无需标签,只要有足够的输入样本,就可以估计 \(p(x)\) 的变化,但检测并非即时完成。\(p(y \mid x)\) 的变化通常需要带标签结果才能检测,而在高风险领域(医疗诊断、欺诈检测、法律决策),这些结果可能需要数天、数周或数月才能获得。预测置信度分布和输出熵等代理指标可以提供不完全可靠的早期预警,以误报率为代价换取检测速度。↩︎
协变量偏移:针对协变量偏移的重要性加权校正,假设训练分布的支撑集覆盖部署分布:每个部署时的输入都可能在训练中出现,只是概率不同。当部署环境包含真正的分布外输入(新的产品类别、新的人口群体、对抗性输入)时,校正可能失效,模型也可能在没有任何预警信号的情况下自信地输出错误结果。因此,支撑集覆盖是决定可能需要漂移校正还是完整重训练的隐含假设。↩︎
Prometheus:Prometheus 定期抓取目标的数据,并存储时间序列以供聚合。抓取间隔与规则评估间隔共同影响告警延迟,并可能遗漏短暂的异常波动。监控每个加速器的温度状况,可以以更高的数据成本实现精确的工作负载路由,而服务器级聚合指标可能掩盖组件级降频。↩︎
模式校验:listing 4 中的规则可防止数据契约被静默违反,例如特征列从整数类型变为浮点类型。缺少这道输入层防线,下游模型监控就无法区分数据质量错误与真正的性能退化,从而掩盖根本原因。关键特征的模式不匹配,可能使一个其他方面格式均正确的预测批次失效。↩︎
PSI(群体稳定性指数):PSI 广泛用于信用风险评分卡监控,以比较预期与观测到的分箱群体;Yurdakul 和 Naranjo 分析了其统计性质 (Yurdakul and Naranjo 2020)。常见的 0.1 和 0.25 分界值是实用的运行惯例,并非普适的统计定律。机器学习运维采用 PSI,是因为它适用于分箱后的类别特征或连续特征,并能提供便于非专业人员审查的可解释漂移分数。↩︎
熔断器模式:一种自动故障检测机制,当错误率超过配置的阈值时“断开”,将流量从故障服务转移出去。在机器学习系统中,该模式需要一项关键适配:预测准确率退化所需的阈值不同于服务可用性故障,因为模型返回看似合理但实际错误的预测时,不会触发任何错误信号,导致熔断器无法察觉这一最危险的故障模式。↩︎
舱壁模式:该模式对系统资源进行分区,将故障限制在隔离区域内。在机器学习模型服务中,舱壁为实验模型版本分配固定的加速器内存、主机 RAM 和工作线程池,防止金丝雀模型中的内存不足中止或内存泄漏终止共享模型服务进程。↩︎
拜占庭容错:经典拜占庭模型关注可能任意行动或发送相互冲突消息的节点。在同步、无身份认证的环境,即口头消息环境中,容忍 \(f\) 个拜占庭故障至少需要 \(3f+1\) 个参与者 (Lamport et al. 1982)。机器学习集成仅能作为类比,因为预测错误可能相关,而且达成一致并不能证明语义正确性。↩︎
多导睡眠监测(PSG):一种多参数睡眠检查,为这一分类任务提供临床真值数据。这种“真值”本身存在噪声;解读同一组 PSG 记录的人工专家评分者之间的一致率约为 82 percent–83 percent (Altini and Kinnunen 2021)。评分者间一致率表明标签存在不确定性,但并不构成相对于固定或经裁定参考标准的准确率上限。↩︎
空中(OTA)更新:一种无需物理接触即可将优化后的模型部署到已投入使用设备上的机制。通过量化和剪枝尽量减小制品体积,可直接降低蓝牙传输能耗和无线电传输时间。原子化更新暂存与回滚例程可确保无线传输中断或校验和不匹配不会损坏设备端闪存,也不会使设备陷入无法恢复的状态。↩︎
持续治疗监测(CTM):一种使用可穿戴传感器实时采集生理数据并进行个性化治疗调整的医疗保健方法。CTM 迫使 MLOps 面对典型部署中不存在的约束:对于安全关键决策,反馈回路必须包含人在回路的审批;重训练需要经过临床医生验证的标签,而非隐式信号;模型更新必须在部署前满足监管合规要求。这些约束重塑了每一项 MLOps 原则,使 CTM 成为检验运维成熟度的压力测试。↩︎
光电容积描记(PPG):一种光学技术,通过照射组织后检测到的光的变化,推断血容量变化。对于机器学习运维而言,PPG 带来了受控环境中不存在的数据质量挑战:手腕运动产生的运动伪影会破坏信号,形成一种数据漂移模式,即同一生理状态会因用户活动不同而产生不同的输入分布。模型必须在推理前过滤受损的时间窗口,或学习对运动噪声保持鲁棒性;监测系统还必须区分真实的生理变化与伪影引起的分布偏移。↩︎
Widmer, Gerhard, and Miroslav Kubat. 1996. “Learning in the Presence of Concept Drift and Hidden Contexts.” Machine Learning 23 (1): 69–101. https://doi.org/10.1023/a:1018046501280.
Gama, João, Indrė Žliobaitė, Albert Bifet, Mykola Pechenizkiy, and Abdelhamid Bouchachia. 2014. “A Survey on Concept Drift Adaptation.” ACM Computing Surveys 46 (4): 1–37. https://doi.org/10.1145/2523813.
Iterative. 2024. Data Version Control (DVC).
Cunningham, Ward. 1992. “The WyCash Portfolio Management System.” ACM SIGPLAN OOPS Messenger 4 (2): 29–30. https://doi.org/10.1145/157710.157715.
Breck, Eric, Shanqing Cai, Eric Nielsen, Michael Salib, and D. Sculley. 2017. “The ML Test Score: A Rubric for ML Production Readiness and Technical Debt Reduction.” Proceedings of the 2017 IEEE International Conference on Big Data (Big Data), 1123–32. https://doi.org/10.1109/bigdata.2017.8258038.
Zillow Group. 2021. Zillow Group Reports Third-Quarter 2021 Financial Results and Shares Plan to Wind down Zillow Offers Operations. Investor Relations Press Release.
Hermann, Jeremy, and Mike Del Balso. 2017. Meet Michelangelo: Uber’s Machine Learning Platform. Uber Engineering Blog.
Li, Chengwei. 2020. Estimating the Training Cost of GPT-3.
Amazon Web Services. 2026. Amazon EC2 Spot Instances.
Google Cloud. 2026c. Spot VMs.
Merkel, Dirk. 2014. “Docker: Lightweight Linux Containers for Consistent Development and Deployment.” Linux Journal 2014 (239).
Burns, Brendan, Brian Grant, David Oppenheimer, Eric Brewer, and John Wilkes. 2016. “Borg, Omega, and Kubernetes.” Communications of the ACM 59 (5): 50–57. https://doi.org/10.1145/2890784.
Moritz, Philipp, Robert Nishihara, Stephanie Wang, Alexey Tumanov, Richard Liaw, Eric Liang, Melih Elibol, et al. 2018. “Ray: A Distributed Framework for Emerging AI Applications.” Proceedings of the 13th USENIX Symposium on Operating Systems Design and Implementation (OSDI), 561–77.
Amazon Web Services. 2024c. AWS Auto Scaling.
Yurdakul, Bilal, and Joshua Naranjo. 2020. “Statistical Properties of the Population Stability Index.” The Journal of Risk Model Validation 52. https://doi.org/10.21314/jrmv.2020.227.
Lamport, Leslie, Robert Shostak, and Marshall Pease. 1982. “The Byzantine Generals Problem.” ACM Transactions on Programming Languages and Systems 4 (3): 382–401. https://doi.org/10.1145/357172.357176.
Altini, Marco, and Hannu Kinnunen. 2021. “The Promise of Sleep: A Multi-Sensor Approach for Accurate Sleep Stage Detection Using the Oura Ring.” Sensors 21 (13): 4302. https://doi.org/10.3390/s21134302.