神经计算
神经计算
目的
为什么理解神经网络的数学原理比阅读其代码更重要?
神经网络代码看似简单,却容易造成误导,因为寥寥几个张量操作就隐藏了系统各层必须执行的工作负载。矩阵维度决定算术运算量和数据移动量;中间值决定内存压力;数值范围和梯度决定学习过程能否保持稳定。某个操作单独看来开销很小,但在整个批次中反复执行,或必须为学习过程保留其输出时,就可能成为系统开销的主要来源,因此源代码长度几乎无法反映资源成本。同一模型的两种实现可能呈现截然不同的运行表现,因为批次形状、精度和目标机器会改变哪些内容能够容纳于内存、运行速度有多快,以及计算能否保持数值有效性。当训练停滞或部署耗尽内存时,仅阅读框架调用通常无法找出起决定性作用的约束。数值故障、内存瓶颈和低效实现可能表现出相似的高层症状,却需要不同的解决方法。因此,诊断和规划需要从底层操作出发,推导移动的字节数、保留的数值以及重复执行的工作。这种视角能够在代价高昂的训练运行或部署尝试之前揭示不匹配。这些基本操作提供了跨架构的稳定术语体系,使软件抽象能够被审查,将不透明的代码转化为可测量、可诊断且可映射到硬件的工作负载。用数据—算法—机器的术语来说,神经计算是算法结构转化为机器工作、物理限制反过来影响模型设计的接口。
学习目标
- 解释为什么在高维模式识别中,学习得到的算术运算取代了基于规则的逻辑
- 计算多层网络的参数数量、乘加运算量、激活值存储量和内存流量
- 从非线性、梯度行为和硬件执行成本三个方面比较激活函数
- 运用交叉熵损失和梯度更新分析监督学习动态
- 将前向传播和反向传播推导为面向批次的矩阵运算
- 基于计算、内存和部署约束分析训练与推理工作负载
- 评估从预处理到决策阈值和人工复核的端到端文档识别流水线
从逻辑到算术
经过前述工程阶段的数据集已经可以用于模型开发,但样本本身并不会学习。下一个系统边界是模型,数据在这里通过矩阵乘法、激活函数和梯度更新转化为学习得到的行为。一个模型在某台机器上运行正常、在另一台机器上运行失败,并不一定意味着硬件存在缺陷。其层维度可能产生超出可用内存容量的中间激活值,即训练时为反向传播保留的各层输出。这种故障源于模型工作负载与机器资源预算之间的不匹配。
硅片契约指出,每种模型架构都与运行它的硬件达成了一项计算约定。在算法轴上,架构的数学算子决定所需的工作量和状态。随后,精度、实现、数据复用、运行时和硬件共同决定实际的内存流量、延迟和能耗。要履行这一契约,系统工程师必须同时理解这些算子及其映射到机器的方式。
神经网络中的每个数学算子都规定了硬件上的一项具体计算工作负载。神经计算将执行方式从显式逻辑分支(if-then-else 控制流)转向以乘加运算为主的长序列连续数学变换。这种从 逻辑 到 算术 的转变产生了密集的张量工作负载,其执行吞吐量取决于算术强度、批次大小、缓存复用,以及由峰值算力和内存带宽确定的硬件 Roofline 包络。这类系统中的故障源于数值不稳定、梯度消失或激活函数进入饱和区间,而非语法错误。例如,在贯穿本章的 MNIST 网络示例中,识别一个手写数字需要执行 109,184 MACs,而前向传播过程中不执行任何逻辑分支。
没有分支的算术运算并不意味着没有风险。当中间值超出某种数值格式的动态范围时,硬件单元会触发异常,或静默地产生无穷值(Inf)和无效值(NaN),从而破坏下游张量。未处理的数值溢出所带来的危险并非机器学习所独有;安全关键系统也曾因数值不变量遭到破坏而发生灾难性故障。
War Story 1.1: 变成制导信息的溢出(1996 年)
背景:欧洲航天局的阿丽亚娜 5 号第 501 次飞行复用了阿丽亚娜 4 号的惯性基准软件,其中包括一些数值转换,其假设与旧型号运载火箭的飞行剖面相匹配 (European Space Agency 1996)。
机制:阿丽亚娜 5 号的飞行剖面导致一个 64 位浮点值在转换过程中超出有符号 16 位整数的范围,触发了未处理的操作数错误。
影响:飞行计算机在发射后 36 秒崩溃,导致运载火箭偏离航线、解体并自毁,价值 $370 百万美元的卫星载荷被毁。
应对:调查建议将软件功能限制为飞行期间所必需的功能,审查数值范围假设,并设计异常处理机制,使单次数值转换失败不至于导致冗余单元失效 (European Space Agency 1996)。
系统层面的教训:数值范围、异常处理和复用假设都是系统契约的一部分。一项计算即使在语法上正确,也仍可能不适用于其运行的物理工况。当数值格式的可表示范围与流经其中的数值量级不匹配时,机器学习系统就会遇到这一问题:低精度乘法发生溢出后产生的 Inf 或 NaN 会在其余计算中静默传播,因此,数值运行区间对于调试的重要性与控制流相当。
European Space Agency. 1996. Ariane 501: Presentation of Inquiry Board Report. European Space Agency press release.
Definition 1.1: 深度学习
深度学习 是一种计算范式,通过组合非线性变换,从数据中学习分层特征表示。对于适合的任务,这些学习得到的表示可以减少人工特征工程,同时增加计算量 \((O)\) 和状态量。
- 意义:对于适合的复合函数类,深度结构能够以比浅层网络少得多的参数来表示层次结构。每一层都会增加工作量和状态量,最终起决定性作用的约束可能位于数据轴、算法轴或机器轴,具体取决于工作负载。
- 区别:逻辑回归和支持向量机等浅层方法 在采用适当表示时可以取得良好效果。深度学习则使用多个非线性阶段,将表示学习与预测任务联合进行,从而减少人工特征设计,有时还能支持跨任务迁移。
- 常见误区:一个常见误解是,仅凭参数数量就能解释深度学习。宽度可以逼近广泛的函数类,但深度可以高效得多地编码某些复合函数。架构、数据、优化和规模共同决定实际结果。
深度学习体现为一种物理计算工作负载,其中数学算子组合成架构流水线,在数据—算法—机器分类体系的各个维度上,对加速器内存和执行单元提出不同要求。LeCun、Bengio 和 Hinton1 在其 2015 年发表于 《自然》 的综述中 (LeCun et al. 2015),对这一范式进行了系统总结。
经典机器学习通常需要专家为每个新问题设计特征提取器,这是一个劳动密集的过程,将领域知识编码为人工构造的表示。深度学习通过非线性变换的层次结构直接从数据中学习表示,从而减轻这一负担。Figure 1 从两个视角展示了这种关系:一个是主要里程碑的历史时间线,另一个是分类上的嵌套关系,其中深度学习属于机器学习,而机器学习又属于人工智能。
\begin{tikzpicture}[x=3.5mm,y=10mm,line cap=round,line join=round,font=\small\sffamily]
 \tikzset{
  Box/.style={draw=none,minimum width=30mm, minimum height=18mm, anchor=south},
  Arr/.style={-{Triangle[width=10pt,length=8pt]}, line width=5pt,cyan!40,shorten >=1pt, shorten <=2pt},
  Box2/.style={align=flush center, inner xsep=2pt,draw=none,
  font=\footnotesize\sffamily\bfseries, line width=0.75pt, fill=OrangeL!30, text width=38mm,
    minimum width=44mm, minimum height=7mm},
  Box3/.style = {Box2,draw=none,fill=cyan!10},
  Box4/.style = {Box2,draw=none,fill=GreenFill!60},
  LineA/.style = {violet!60,{Circle[line width=1.0pt,fill=white,length=5.5pt]}-,line width=1.5pt,shorten <=-3pt},
  Arr/.style={-{Triangle[width=5pt,length=10pt]}, line width=1.5pt,black},
  Txt1/.style = {font=\small\sffamily\itshape,black!80,align=left},
  Txt/.style = {font=\small\sffamily,black!80,align=center},
  Txt2/.style = {font=\footnotesize\sffamily,black!80,align=center}
}

%machine learning
\tikzset{
pics/machineL/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}, line cap=round,
    line join=round,x=11mm,y=11mm]
  % left data cards
  \draw[draw=\drawcolor,line width=\Linewidth, rounded corners=1pt] (0,0.55) rectangle (0.52,0.95);
  \draw[draw=\drawcolor,line width=\Linewidth] (0.08,0.87) -- (0.26,0.72) -- (0.44,0.87);

  \draw[draw=\drawcolor,line width=\Linewidth, rounded corners=1pt] (0,0.05) rectangle (0.52,0.45);
  \draw[draw=\drawcolor,line width=\Linewidth] (0.08,0.37) -- (0.26,0.22) -- (0.44,0.37);
  % arrows
  \draw[draw=\drawcolor,line width=\Linewidth,-{Latex[length=2mm]}] (0.62,0.75) -- (1.02,0.75);
  \draw[draw=\drawcolor,line width=\Linewidth,-{Latex[length=2mm]}] (0.62,0.25) -- (1.02,0.25);

  % model/filter
  \draw[draw=\drawcircle,line width=\Linewidth, rounded corners=1pt] (1.08,0.48) rectangle (1.42,0.98);
  \draw[draw=\drawcircle,line width=\Linewidth] (1.15,0.88) -- (1.35,0.88);
  \draw[draw=\drawcircle,line width=\Linewidth] (1.18,0.78) -- (1.32,0.78);
  \draw[draw=\drawcircle,line width=\Linewidth] (1.21,0.68) -- (1.29,0.68);

  % output arrow
  \draw[draw=\drawcolor,line width=\Linewidth,-{Latex[length=2mm]}] (0.62,0.25) -- (1.62,0.25);
%
\end{scope}
    }
  }
}

\tikzset{mycylinder/.style={cylinder, shape border rotate=90, aspect=1.3, draw, fill=white,
minimum width=25mm,minimum height=11mm,line width=\Linewidth,node distance=-0.15},
pics/dataP/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=STREAMING,scale=\scalefac, every node/.append style={transform shape},
x=10mm,y=10mm]
\node[mycylinder,fill=\filllcolor!50] (A) {};
\node[mycylinder, above=of A,fill=\filllcolor!50] (B) {};
\node[mycylinder, above=of B,fill=\filllcolor!10] (C) {};
\fill[\filllcolor!50!black]($(C.west)!0.12!(C.east)$)circle(3pt);
\fill[\filllcolor!50!black]($(B.west)!0.12!(B.east)$)circle(3pt);
\fill[\filllcolor!50!black]($(A.west)!0.12!(A.east)$)circle(3pt);
%
\draw[draw=\drawcolor,line width=2.5*\Linewidth](B.east)--++(17mm,0);
\node[draw=\drawcolor,line width=\Linewidth,minimum width=9mm,fill=white,minimum height=22mm](BD)at($(B.east)+(8mm,0)$){};
\node[draw=\drawcolor,line width=\Linewidth,minimum width=5mm,minimum height=8mm,fill=white](BDM)at($(BD.east)+(5mm,0)$){};
\node[circle,draw=orange,line width=\Linewidth,minimum size=5mm]at($(BD.north)!0.2!(BD.south)$){};
\node[rectangle,draw=blue,line width=\Linewidth,minimum size=5mm]at($(BD.north)!0.5!(BD.south)$){};
\node[circle,draw=green,line width=\Linewidth,minimum size=5mm]at($(BD.north)!0.8!(BD.south)$){};
% magnifier
  \draw[line width=4*\Linewidth,Brown] (0.1,0.4)--++ (310:1.2);
  \draw[line width=\Linewidth,fill=yellow!30] (0.1,0.4) circle (0.45);
 \draw[line width=1.5*\Linewidth] (-0.15,0.4) -- (0.35,0.4);
\end{scope}
     }
  }
}
\tikzset{
pics/gamme/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}, line cap=round,
    line join=round,x=15mm,y=13mm]
  % board
  \draw[draw=\drawcolor,line width=\Linewidth,fill=black!05] (0,0.6) -- (0.9,1.1) -- (1.8,0.6) -- (0.9,0.1) -- cycle;
  \draw[draw=\drawcolor,line width=\Linewidth] (0.45,0.35) -- (1.35,0.85);
  \draw[draw=\drawcolor,line width=\Linewidth] (0.45,0.85) -- (1.35,0.35);
 \coordinate(XC1)at($(0.45,0.35)!0.5!(0.45,0.85)$);
\coordinate(XC2)at($(0.45,0.35)!0.5!(1.35,0.35)$);
\coordinate(XC3)at($(1.35,0.35)!0.5!(1.35,0.85)$);
\coordinate(XX1)at($(0.9,1.1)!0.28!(0.9,0.6)$);
\coordinate(XX2)at($(0.9,1.1)!0.72!(0.9,0.6)$);
\coordinate(YY1)at($(0.45,0.85)!0.28!(1.35,0.85)$);
\coordinate(YY2)at($(0.45,0.85)!0.72!(1.35,0.85)$);
  % pieces
  \draw[draw=black,line width=1.25*\Linewidth, fill=mygreen!50,rotate=80] (XC1) ellipse(1.2mm and 1.95mm);
  \draw[draw=red!70!black,line width=1.25*\Linewidth, fill=white,rotate=80] (XC2) ellipse(1.2mm and 1.95mm);
  \draw[draw=black,line width=1.25*\Linewidth, fill=mygreen!50,rotate=80] (XC3) ellipse(1.2mm and 1.95mm);
  \draw[draw=red!70!black,line width=2.25*\Linewidth] (XX1)--(XX2);
    \draw[draw=red!70!black,line width=2.25*\Linewidth] (YY1)--(YY2);
%  \fill[red](YY1) circle(1pt);
\end{scope}
    }
  }
}
\pgfkeys{
  /channel/.cd,
   Dual/.store in=\Dual,
   Depth/.store in=\Depth,
  Height/.store in=\Height,
  Width/.store in=\Width,
  Smile/.store in=\Smile,
  Level/.store in=\Level,
  filllcirclecolor/.store in=\filllcirclecolor,
  filllcolor/.store in=\filllcolor,
  drawcolor/.store in=\drawcolor,
  drawcircle/.store in=\drawcircle,
  scalefac/.store in=\scalefac,
  Linewidth/.store in=\Linewidth,
  picname/.store in=\picname,
  filllcolor=BrownLine,
  filllcirclecolor=cyan,
  drawcolor=black,
  drawcircle=violet,
  scalefac=1,
  Dual=adual,
  Smile=smile,
  Level=0.52,
  Linewidth=0.5pt,
  Depth=1.3,
  Height=0.8,
  Width=1.1,
  picname=C
}

\newcommand{\yearx}[1]{{#1-1950}}

\draw[Arr] ({\yearx{1947}},0) coordinate(PO)-- coordinate(CEN)({\yearx{2022}},0)coordinate(KR);
\coordinate(KR1)at($(KR)+(0,5mm)$);

\foreach \Y in {1950,1960,1970,1980,1990,2000,2010} {
  \draw[thick] ({\yearx{\Y}},-0.1) -- ({\yearx{\Y}},0.1);
  \node[below=3pt] at ({\yearx{\Y}},0) {\Y s};
}
%1956
\draw[red,thick,dashed] ({\yearx{1956}},0) -- ++(0,2)
node[above,Txt]{1956\\ 达特茅斯\\ 研讨会};
\fill[red] ({\yearx{1956}},0) circle (3pt);
%1969
\draw[red,thick,dashed] ({\yearx{1969}},0) -- ++(0,1.5)
node[above,Txt]{1969\\ 感知机\\ 局限性};
\fill[red] ({\yearx{1969}},0) circle (3pt);
%1986
\draw[myblue,thick,dashed] ({\yearx{1986}},0) -- ++(0,3)
node[above,Txt]{1986\\ 反向传播\\ (Rumelhart)};
\fill[myblue] ({\yearx{1986}},0) circle (3pt);
%1997
\draw[myblue,thick,dashed] ({\yearx{1997}},0) -- ++(0,2.25)
node[above,Txt]{1997\\ LSTM};
\fill[myblue] ({\yearx{1997}},0) circle (3pt);
%2001
\draw[myblue,thick,dashed] ({\yearx{2001}},0) -- ++(0,1.5)
node[above,Txt]{2001\\ 支持向量机 \\ 集成方法};
\fill[myblue] ({\yearx{2001}},0) circle (3pt);
%2012
\draw[mygreen,thick,dashed] ({\yearx{2012}},0) -- ++(0,2.0)
node[above,Txt]{2012\\ AlexNet\\ ImageNet};
\fill[mygreen] ({\yearx{2012}},0) circle (3pt);
%2017
\draw[mygreen,thick,dashed] ({\yearx{2017}},0) -- ++(0,1.45)
node[above,Txt]{2017\\Transformer};
\fill[mygreen] ({\yearx{2017}},0) circle (3pt);
%
\begin{scope}[on background layer]
%\draw[magenta,thick,rounded corners=10,fill=magenta!05](KR1)rectangle (PO2);
%
\node[draw=magenta,thick,rounded corners=10,anchor=south east,fill=magenta!07,
minimum width=262mm,minimum height =95mm](RED)at(KR1){};
%
\node[draw=myblue,thick,rounded corners=10,anchor=south east,fill=myblue!07,
minimum width=140mm,minimum height =85mm](BLU)at(KR1){};
%
\node[draw=mygreen,thick,rounded corners=10,anchor=south east,fill=mygreen!05,
minimum width=60mm,minimum height =75mm](GRE)at(KR1){};
\end{scope}
\node[anchor=north west,text=myred,font=\Large\sffamily\bfseries](CT1)
at($(RED.north west)+(2mm,-3mm)$){人工智能};
\node[Txt1,below=-2pt of CT1.south west,anchor=north west]{符号推理 \& 专家系统};
\coordinate(RL)at($(RED.west)!0.22!(RED.east)$);
\node[Box](BS1)at(RL){};
\pic[shift={(-5.15,-1.0)}] at  (BS1){gamme={scalefac=1.3,filllcirclecolor=violet!20,filllcolor=BlueLine, Linewidth=1pt}};
\node[Txt2,below=0pt of BS1]{博弈\\ \& 专家系统};
%
\node[anchor=north west,text=myblue,font=\Large\sffamily\bfseries](CT2)
at($(BLU.north west)+(2mm,-3mm)$){机器学习};
\node[Txt1,below=-2pt of CT2.south west,anchor=north west]{从数据中进行统计学习};
\coordinate(BL)at($(BLU.178)!0.33!(BLU.2)$);
\node[Box](BS2)at(BL){};
\pic[shift={(-2.5,-0.8)}] at  (BS2){machineL={scalefac=1.4,picname=1,drawcolor=blue!70!,
drawcircle=red,filllcolor=BlueLine!90!,Linewidth=1pt, filllcirclecolor=blue!80!}};
\node[Txt2,below=-4pt of BS2]{垃圾邮件过滤\\ \& 分类};
%
\node[anchor=north west,text=mygreen,font=\Large\sffamily\bfseries](CT3)
at($(GRE.north west)+(2mm,-3mm)$){深度学习};
\node[Txt1,below=-2pt of CT3.south west,anchor=north west]{大规模神经网络};
\coordinate(GL)at($(GRE.182)!0.65!(GRE.358)$);
\node[Box](BS3)at(GL){};
\begin{scope}[scale=0.75, every node/.append style={transform shape}]
\pic[shift={(-1.1,-0.55)}] at  (BS3){dataP={scalefac=0.5,filllcirclecolor=violet!20,filllcolor=BlueLine, Linewidth=0.7pt}};
\node[Txt2,below=-3pt of BS3]{图像识别\\ \& 生成};
%
\node[anchor= south east, above left=0.4 and 1 of BLU.south west,rounded corners,
fill=magenta!20,opacity=0.6]{第一次人工智能寒冬};
\node[anchor= south west, above right=0.4 and 6 of BLU.south west,rounded corners,
fill=cyan!20,opacity=0.6]{第二次人工智能寒冬};
%
\node[Txt,anchor=north]at($(CEN)+(0,-9mm)$){每一轮后续浪潮(从符号人工智能到统计机器学习,再到深度学习)\\
都在收窄关注范围的同时,大幅拓展了实际能力。};
\end{scope}
\end{tikzpicture}这种范式转变带来了传统软件调试无法解决的工程问题。深度学习故障可能表现出细微的症状:阻碍学习的梯度不稳定性2、在多次迭代中破坏模型权重的数值精度误差,或张量运算中低效的内存访问模式3,导致加速器计算单元利用不足。解决这些故障需要推理张量代数在硬件上的实际执行过程,而不是逐步跟踪过程式控制流。
诊断和解决这些故障,需要理解算法的表达形式如何直接转化为物理硬件需求。系统的结构性要求从根本上取决于它如何表示模式——是通过手工编写的规则、人工设计的统计特征,还是端到端学习得到的表示。跟踪一个 \(28{\times}28\) 的 MNIST 数字在这三种范式中的处理过程,可以说明这一转变,展示每种表示策略如何重塑系统的算术强度、内存流量和运行特征。
利用模式进行计算
从逻辑到算术的转变,重塑了硬件处理现实世界模式的方式。跟踪同一个任务——对一个 \(28{\times}28\) 像素的 MNIST 数字进行分类——在三种范式中的实现,可以揭示表示策略如何从根本上改变计算特征。
从显式逻辑到学习得到的模式
基于规则的编程要求开发者明确指定将输入映射为输出的处理步骤。以《打砖块》(Breakout)这样的简单游戏为例。4 其模拟器使用显式的碰撞规则:当球击中砖块时,代码移除砖块并反转球的运动方向(figure 2)。这类通用规则适用于定义明确的游戏物理机制,但为杂乱、非结构化的现实世界数据中的每一种变化手工编写识别策略,则难以扩展。
\scalebox{0.8}{%
\begin{tikzpicture}[line join=round,font=\small\sffamily]
\definecolor{BlueGreen}{RGB}{20,188,188}
\definecolor{Cerulean}{RGB}{0,173,231}
\definecolor{Dandelion}{RGB}{255,185,76}
\definecolor{Goldenrod}{RGB}{255,219,87}
\definecolor{Lavender}{RGB}{253,160,204}
\definecolor{LimeGreen}{RGB}{136,201,70}
\definecolor{Maroon}{RGB}{186,49,50}
\definecolor{OrangeRed}{RGB}{255,46,88}
\definecolor{Peach}{RGB}{255,147,88}
\definecolor{Thistle}{RGB}{222,132,191}

\def\columns{5}
\def\rows{3}
\def\cellsize{25mm}
\def\cellheight{7mm}
\def\rowone{Peach,BlueGreen,OrangeRed,Thistle,Dandelion}
\def\rowtwo{brown!50,lime,teal,pink,lightgray}
\def\rowthree{Lavender,Goldenrod,Cerulean,Maroon,LimeGreen}
%
\foreach \x in {1,...,\columns}{
    \foreach \y in {1,...,\rows}{
        %
        \node[draw=black, fill=GreenFill, minimum width=\cellsize,
                    minimum height=\cellheight, line width=0.25pt] (cell-\x-\y) at (\x*\cellsize,-\y*\cellheight) {};
    }
}
\foreach \color [count=\x] in \rowone {
    \node[fill=\color,draw=black,line width=0.25pt, minimum size=\cellsize,
    minimum height=\cellheight] at (cell-\x-1) {};
}
%
\foreach \color [count=\x] in \rowtwo {
    \node[fill=\color,draw=black,line width=0.25pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-2) {};
}
%
\foreach \color [count=\x] in \rowthree {
    \node[fill=\color,draw=black,line width=0.25pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-3) {};
}
\begin{scope}[shift={($(cell-4-3)+(0,-1.7)$)}]
\node[align=left,font=\small\ttfamily]at(0,0){if (ball.collide(brick)) \{ \\
\qquad    removeBrick();\\
\qquad    ball.dx = 1.1 * (ball.dx);\\
\qquad    ball.dy = -1 * (ball.dy);\\
\}};
\end{scope}
\node[draw,rectangle,minimum width=40mm,minimum height=4mm,fill=Sepia!50!black!]
at($(cell-3-3.south west)+(0,-2.8)$)(R){};

\node[draw,circle,minimum size=5mm,fill=Sepia!50!black!,anchor=north]
at($(cell-1-3.south west)!0.8!(cell-1-3.south east)$)(C){};
\draw[thick,-latex,dash pattern={on 5pt off 2pt on 1pt off 3pt}](R)--(C)--++(225:2);
\end{tikzpicture}}figure 3 中的数据流明确展示了传统编程的关系:程序将指定的处理步骤应用于输入数据,从而产生输出。早期人工智能研究探索了手工编写的符号规则能否扩展到复杂的推理和识别任务。
\resizebox{.65\textwidth}{!}{
\begin{tikzpicture}[font=\small\sffamily]
%
\tikzset{%
Line/.style={line width=1.0pt,black!50,text=black},
  Box/.style={inner xsep=2pt,
    node distance=1,
    draw=GreenLine, line width=0.75pt,
    fill=GreenL,
    text width=22mm,align=flush center,
    minimum width=22mm, minimum height=8mm
  },
  Box1/.style={Box, draw=RedLine, fill=RedL,
    text width=36mm, minimum width=40mm
  },
}
%
 \node[Box1](B1){传统编程};
 \node[Box,right=of B1](B2){答案};
 \node[Box,above left=0.2 and 1 of B1](B3){规则};
 \node[Box, below left=0.2 and 1 of B1](B4){数据};
 \draw[-latex,Line](B1)--(B2);
 \draw[-latex,Line](B3)-|(B1);
 \draw[-latex,Line](B4)-|(B1);
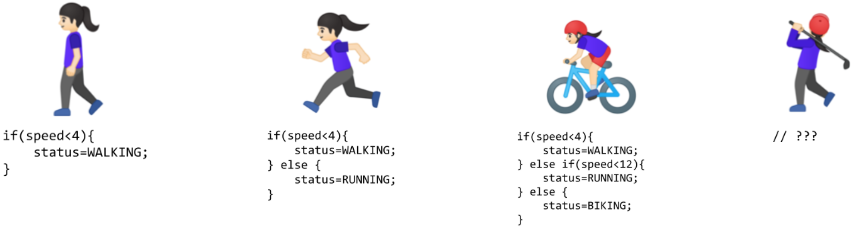
\end{tikzpicture}}基于规则的方法看似简单,但在复杂的现实世界任务中,其局限性很快就会显现。人体活动识别说明了这一挑战。将速度低于 4 km/h 的运动归类为步行,似乎很直接,直到遇到现实世界的复杂情况。速度变化、活动之间的转换,以及未预料到的情形,都需要额外的规则,如 figure 4 中依次展开的代码片段所示。计算机视觉任务进一步加剧了这些困难。检测猫需要有关耳朵、胡须和体形的规则,同时还要考虑视角、光照、遮挡和自然差异。早期系统只有在约束明确的受控环境中才取得了成功。
认识到这些局限性后,主导 20 世纪 70 年代和 80 年代人工智能研究的知识工程方法尝试将规则创建系统化。专家系统5将领域知识编码为显式规则,在参数定义明确的特定领域中展现出潜力,但在物体识别、语音理解和自然语言解读等人类能够自然完成的任务上却举步维艰。这些失败揭示了一个更深层的挑战:智能行为的许多方面依赖隐性知识,而这类知识难以用显式规则表示。
考虑一个用于 28 × 28 数字图像的示例性规则分类器:将像素强度与阈值进行比较,检查特定区域中的笔画模式,并根据结果进入不同分支。在这个玩具实现中,计算大致是在 784 bytes 的像素数据上执行 100 comparisons——规模小、行为可预测,并且适合普通 CPU 缓存。这一比较确立的是工作负载基线,而不是生产环境规则系统的准确率。
特征工程瓶颈
基于规则的系统的失败提示了另一条路径:让系统从数据中发现模式,而不是将人类知识编码为显式规则。机器学习提供了这一方向——研究者不再为每种情形编写规则,而是编写能够从示例中识别模式的程序。然而,这些方法能否成功,仍然在很大程度上依赖人类的洞察力来确定应寻找哪些模式,这一过程称为特征工程。
特征工程将原始数据转换为能够向学习算法显现模式的表示。方向梯度直方图(HOG)6 (Dalal and Triggs 2005) 方法是这一思路的典型例子:识别亮度急剧变化处的边缘,将图像划分为单元格,并测量每个单元格中的边缘方向(figure 5)。这一过程将原始像素转换为对光照变化和小幅位置变化具有鲁棒性的形状描述子。
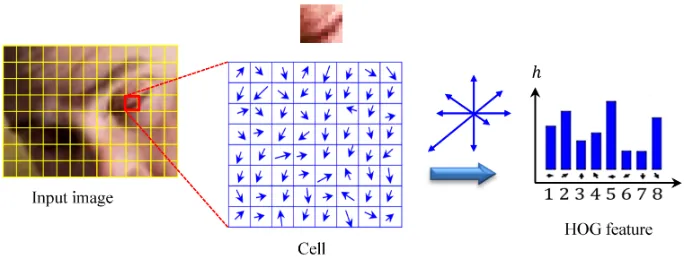
Bakheet, Samy, and Ayoub Al-Hamadi. 2021. “A Framework for Instantaneous Driver Drowsiness Detection Based on Improved HOG Features and Naïve Bayesian Classification.” Brain Sciences 11 (2): 240. https://doi.org/10.3390/brainsci11020240.
尺度不变特征变换(SIFT)7 (Lowe 1999) 和 Gabor 滤波器8等互补方法能够捕捉不同的视觉模式。SIFT 检测在尺度和方向变化下保持稳定的关键点,而 Gabor 滤波器识别纹理和频率。每种方法都编码了视觉模式识别领域的专业知识。
Lowe, David G. 1999. “Object Recognition from Local Scale-Invariant Features.” Proceedings of the Seventh IEEE International Conference on Computer Vision 2: 1150–1157 vol.2. https://doi.org/10.1109/iccv.1999.790410.
这些工程工作推动了 21 世纪头十年的计算机视觉进展。系统开始能够以一定的鲁棒性识别存在现实世界变化的物体,进而促成了人脸检测、行人检测和物体识别等应用。尽管取得了这些成功,这种方法仍有局限。专家需要为每个新问题精心设计特征提取器,而所得特征可能遗漏设计时未预料到的重要模式。瓶颈依然存在:人类专业知识无法扩展到足以应对现实世界视觉模式的复杂性和多样性。
回到同一个 28 × 28 数字图像。在这个示例实现中,HOG 将图像划分为 7 × 7 的网格,每个单元格大小为 4 × 4,计算梯度幅值和方向,将其归入每个单元格中包含 9 个方向区间的直方图,并生成一个包含 441 个元素的特征向量。随后,线性支持向量机(SVM)分类器对该向量执行十次点积。总计大约需要 8,000 operations 和约 2 KB 的工作内存——计算量约为玩具规则基线的 80×,但仍具有规整的结构,适合由采用单指令多数据(SIMD)的 CPU 向量单元高效处理。描述子大小、类别数量和具体实现都会改变这一成本。
自动发现模式
手工设计特征的局限性促使人们采用一种更彻底的方法:系统自行发现特征,而非由人工编码特征。神经网络恰好体现了这一转变——系统不再遵循显式规则或依赖人工设计的特征提取器,而是直接从原始数据中学习表示。
监督学习改变了传统的编程关系。工程师不再直接编码每一条决策规则,而是提供示例和目标答案,再通过优化得到学习出的模型。Figure 6 将学习出的规则呈现为输出而非输入,直观展示了这种关系。人类仍然通过数据、目标、架构和评估来塑造任务。
\resizebox{.65\textwidth}{!}{
\begin{tikzpicture}[font=\small\sffamily]
%
\tikzset{%
Line/.style={line width=1.0pt,black!50,text=black},
  Box/.style={inner xsep=2pt,
    node distance=1,
    draw=GreenLine, line width=0.75pt,
    fill=GreenL,
    text width=22mm,align=flush center,
    minimum width=22mm, minimum height=8mm
  },
  Box1/.style={Box,  draw=RedLine,
    fill=RedL, text width=36mm,
    minimum width=40mm
  },
}
%
 \node[Box1](B1){机器学习};
 \node[Box,right=of B1](B2){规则};
 \node[Box,above left=0.2 and 1 of B1](B3){答案};
 \node[Box, below left=0.2 and 1 of B1](B4){数据};
 \draw[-latex,Line](B1)--(B2);
 \draw[-latex,Line](B3)-|(B1);
 \draw[-latex,Line](B4)-|(B1);
\end{tikzpicture}}系统通过这一自动化过程从示例中发现模式。当接触到数百万张猫的图像时,它会学习识别越来越复杂的视觉模式,从简单的边缘,到构成类似猫的特征的组合。这与生物视觉系统的工作方式相似,都是从基本视觉元素逐步建立对复杂物体的理解。
模式的逐层构建揭示了神经网络深度为何重要。对于某些复合函数类,深层网络能够表示的函数,需要宽得多的浅层网络才能表示;section 1.3.1 对这一优势进行了形式化阐述。
深度学习通常表现出经验性的规模扩展规律:在给定范围内,有效利用更多数据、计算资源和模型容量可以改善性能,但收益取决于数据质量、优化、架构和评估条件。在 ImageNet 竞赛中,传统方法在 2011 年的 top-5 错误率约为 25.8%。AlexNet9 在 2012 年将其降至 15.3%。到 2015 年,ResNet 的 top-5 错误率达到 3.6%,低于该评估协议下已发表的约 5.1% 的人类基线错误率。
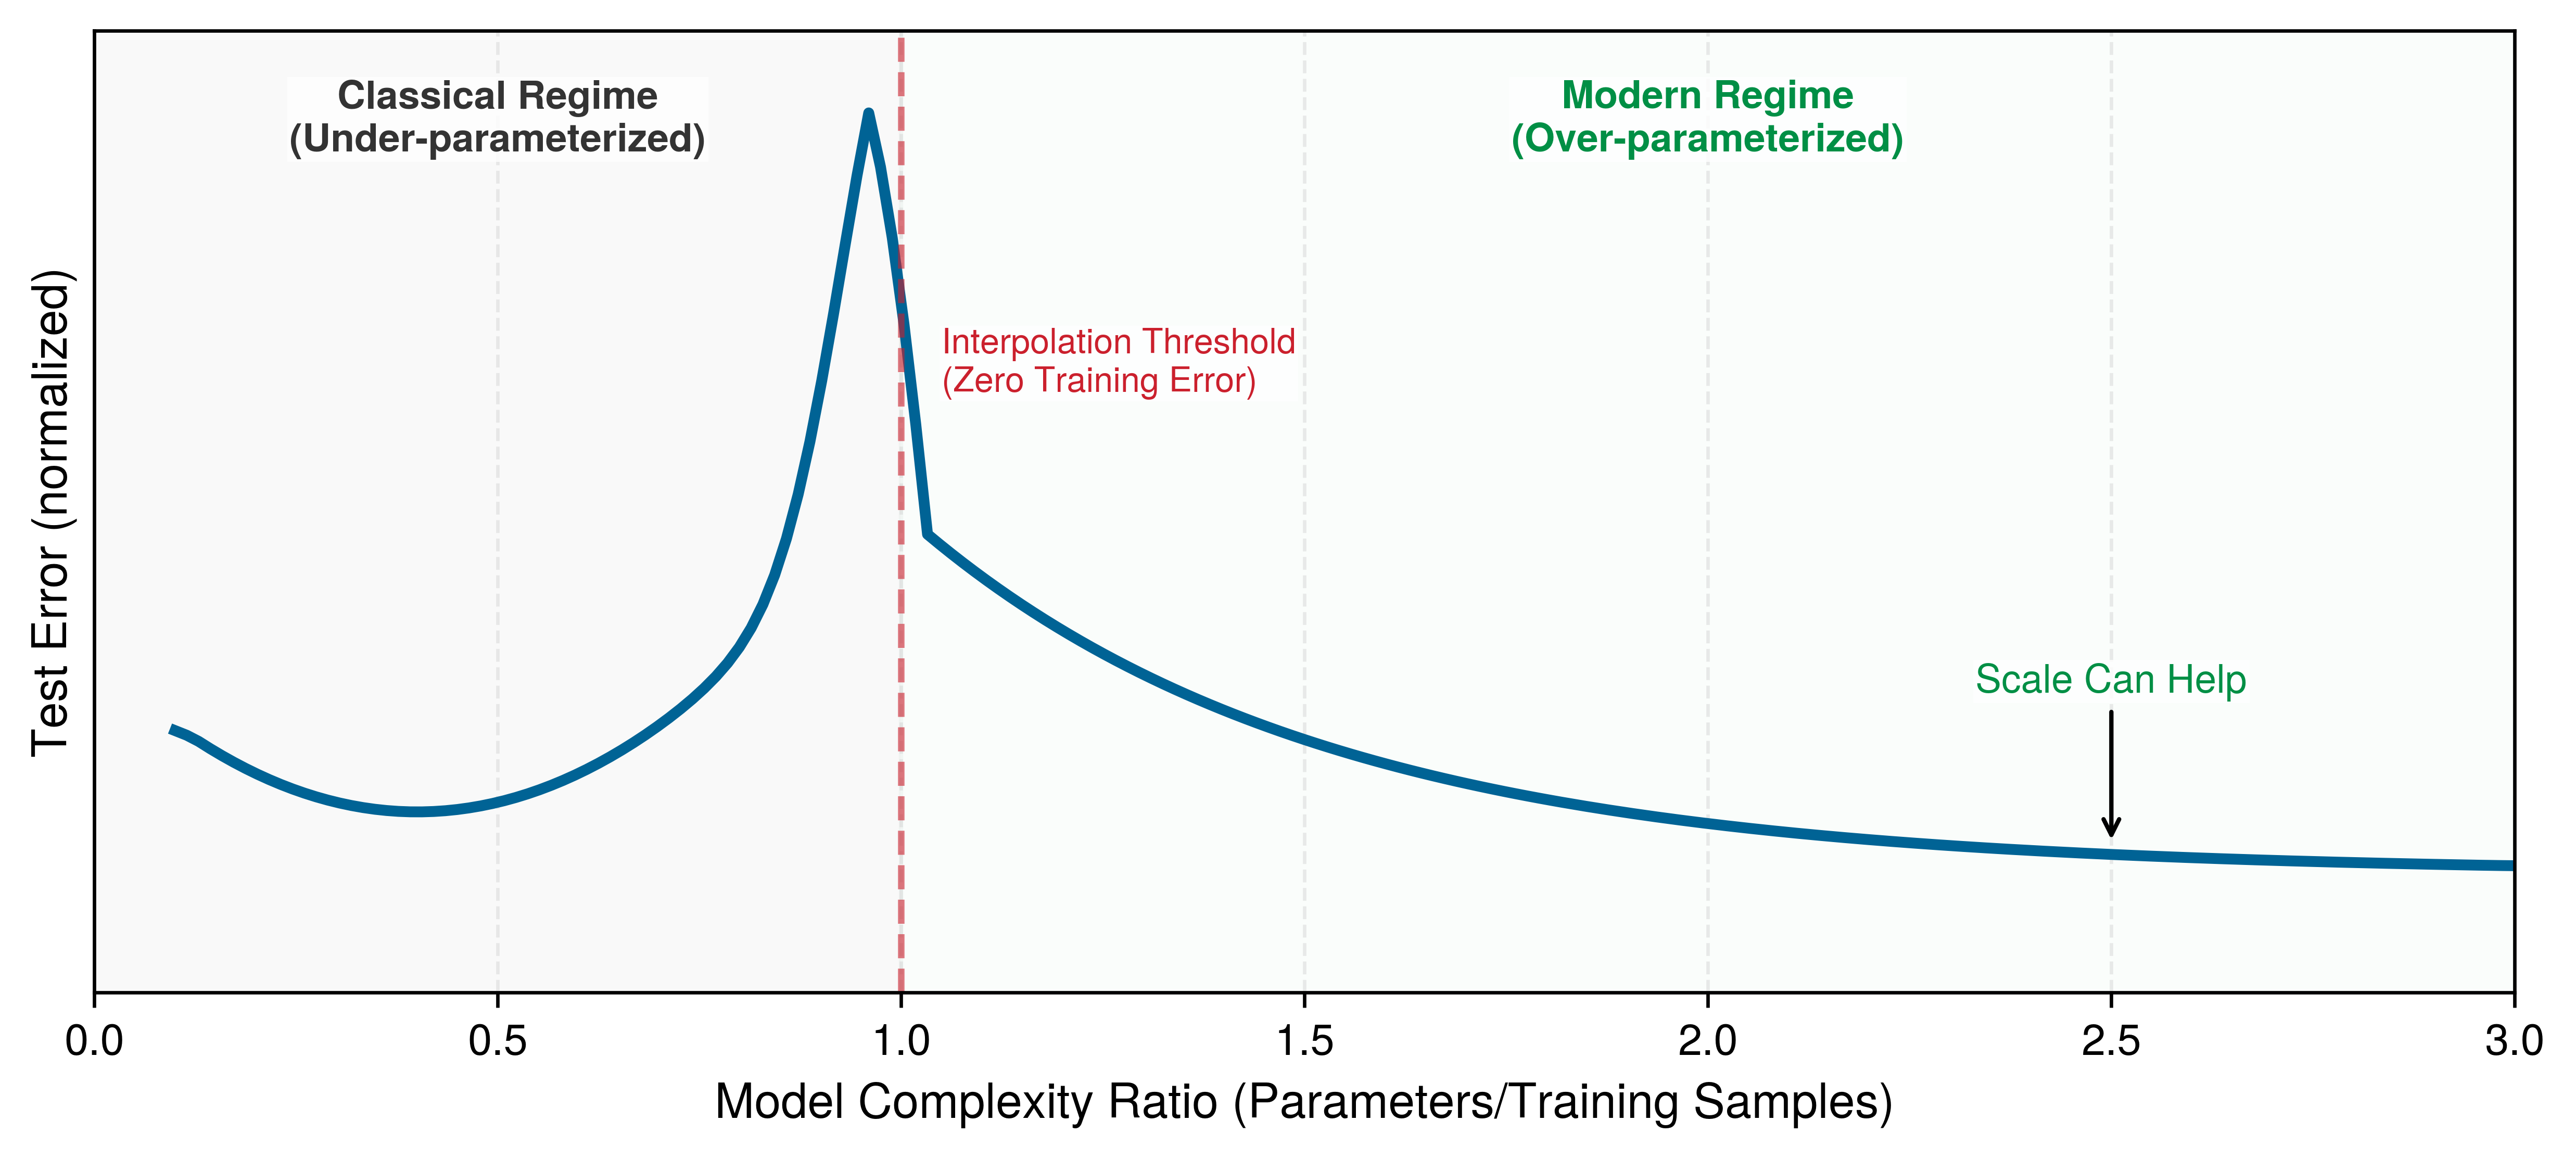
Figure 7 展示了不同模型复杂度区间中的双下降现象。在经典的欠参数化区间中,随着容量增加,测试误差呈现标准的 U 形曲线。在插值阈值处,即模型的参数恰好足以拟合训练样本时,测试误差出现尖锐的峰值。超过这一阈值后,在现代的过参数化区间中,测试误差可能再次下降。坐标轴经过归一化处理,以强调跨模型族的结构性曲线形态,而非某个数据集的具体结果。
这一反直觉的形态之所以重要,是因为测试误差,即在留出示例上而非模型直接接触的训练示例上的误差,最初遵循预期的 U 形曲线,随后在模型参数数量超过最简单理论的预期时再次下降。这种行为使经典理论对过参数化的解释变得更复杂。通常的偏差—方差权衡10认为,过小的模型会欠拟合,而容量过大的模型则存在拟合噪声的风险。双下降 (Belkin et al. 2019) 表明,超过插值阈值后,较大的模型有时能够比较小的模型获得更好的泛化能力。这种过参数化效应意味着,规模可以成为一种工程调节手段,但并不意味着扩大规模就必然安全:额外容量究竟带来帮助还是导致记忆,仍由数据分布、训练过程和正则化决定。section 1.4.4.8 详细讨论了过拟合及其控制所用的正则化技术。
Belkin, Mikhail, Daniel Hsu, Siyuan Ma, and Soumik Mandal. 2019. “Reconciling Modern Machine-Learning Practice and the Classical Bias–Variance Trade-Off.” Proceedings of the National Academy of Sciences 116 (32): 15849–54. https://doi.org/10.1073/pnas.1903070116.
神经网络性能遵循经验性的规模扩展关系,并对系统产生直接影响。一个长期成立的基本事实是,过去十年间,前沿模型的规模和训练计算预算增长了数个数量级(section 1.2.7 对这一发展轨迹进行了量化)。这种增长使算术吞吐量、内存带宽、存储容量和通信成为潜在瓶颈,其重要性取决于工作负载和机器。模型训练 阐述了定量的规模扩展公式,包括模型规模、数据和计算资源之间如何权衡;模型压缩 则探讨了实践中的应对方法。
这两种关系都不能使模型规模成为决策规则。双下降描述的是特定数据和训练条件下测得的泛化表现,而历史上的规模扩展描述的是一组选定系统的资源投入。选择模型仍需在有代表性的部署数据上比较候选模型,并比较训练、服务、监控和维护的完整成本。真正有用的问题不是扩大规模能否带来帮助,而是其实测收益是否足以抵偿这些系统成本。这种比较还应纳入收益和成本两方面的不确定性。
Systems Perspective 1.1: 何时使用神经网络
并非所有问题都能从深度学习中受益。当数据具有可由架构利用的空间、序列或层次结构,较简单的基线方法无法达到所需的任务质量,且实测收益足以抵偿完整的系统成本时,神经网络是有力的候选方案(table 1)。在标签有限、表格数据维度较低、关系近似线性、存在严格延迟限制或可审计性要求严格的情况下,经典方法可能以更少的训练、服务和维护投入,达到与神经网络相当的实用性能(table 2)。
| 条件 | 应寻找的证据 | 依据 |
|---|---|---|
| 有代表性的数据 | 训练和验证覆盖部署条件 | 容量无法弥补覆盖范围的缺失 |
| 可利用的结构 | 空间、序列或层次模式 | 架构能够编码有用的先验 |
| 基线差距 | 较简单的方法无法达到所需的任务质量目标 | 复杂性带来可测量的收益 |
| 运行适配性 | 在延迟、内存和成本限制下仍能保持收益 | 仅有离线准确率并不足够 |
| 维护优势 | 学习出的特征减少了反复进行的手工更新 | 整个系统的维护变得更简单 |
| 条件 | 应测试的基线 | 优先选择它的原因 |
|---|---|---|
| 标注数据有限 | 线性模型或树集成 | 方差更低,验证更容易 |
| 结构化表格输入 | 梯度提升或线性模型 | 无需学习特征即可获得较高准确率 |
| 近似线性的信号 | 线性或加性模型 | 执行过程透明且成本低廉 |
| 严格的资源上限 | 规则或紧凑的经典模型 | 延迟、内存使用量和能耗需求可预测 |
| 需要直接审计 | 受约束的树模型或线性模型 | 决策更容易检查 |
系统洞见:在构建神经网络之前,先建立一个简单的基线。比较候选方案时,既要考察关键的任务指标,也要考察训练、服务、监控和更新所需的资源。只有当神经网络方法的实测收益足以证明新增系统的合理性时,才保留该方法。section 1.6 中的文档识别发展历程说明,比较必须包括预处理、拒识策略以及人工复核的成本,而不能只考察模型准确率。
从数据中学习表示重塑了 AI 系统的构建方式。减少手工特征工程也带来了新的需求:处理大型数据集的基础设施、处理这些数据的高吞吐量硬件,以及高效执行数学计算的专用加速器。这些计算需求推动了针对神经网络运算进行优化的芯片的发展。如今,深度学习已成为计算机视觉、语音识别、游戏博弈和自然语言处理领域中重要系统的基础。
回到同一个 28 × 28 的数字图像,现在由本章的三层神经网络(784 → 128 → 64 → 10)处理。在所述实现下,前向传播需要 109,184 MACs,其工作量是简化规则基线的 1,091.8×。这些 109,386 parameters 采用 32 位单精度浮点(FP32)格式时占用 438 KB,超过大多数 L1 缓存的容量,并在推理期间产生缓存层级之间的数据流量。训练进一步成倍增加成本:每次更新前,每张图像都要经过前向和反向处理,按简化的稠密层算术计算,其运算量约为三次前向传播,并且需要对 60,000 图像重复多个训练轮次。稠密矩阵乘法此时主导了本示例的算术运算,并适合并行硬件,使工程挑战从控制流分支转向内存带宽、数据复用和硬件并行性。
计算基础设施需求
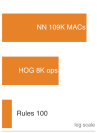
在这一 MNIST 比较中,学习特征所需的算术运算远多于其他方法。
贯穿全文的 MNIST 示例追踪了一组示意性实现:从约 100 comparisons(基于规则),经过约 8,000 operations(HOG),到 109,184 MACs(神经网络);在所述运算模型下,运算量增加至 1,091.8×,并相应地转向并行矩阵运算。Table 3 总结了这一比较揭示的趋势。
这一比较之所以重要,是因为每一步都会改变可能出现的瓶颈:从分支密集的 CPU 控制,到面向批处理的特征流水线,再到依赖内存供数的矩阵并行计算。CPU 对小型网络和延迟敏感型工作负载仍然有效,而大型稠密运算通常能够更高效地映射到加速器上。
向并行化转变也带来了新的瓶颈。核心挑战是内存墙:11计算吞吐量的增长快于片外内存带宽。矩阵运算受内存限制还是受计算限制,取决于其算术强度:规模较大且分块合理的矩阵—矩阵乘法可能受计算限制,而矩阵—向量运算、小型层、窄长层或复用程度较低的层通常受带宽限制。12理解 AI 内存墙 探讨了硬件层面的应对措施,存储层次结构 则详细介绍了内存层次结构。
| 系统方面 | 传统编程 | 采用特征的机器学习 | 深度学习 |
|---|---|---|---|
| 计算 | 通常以控制流为主 | 结构化并行运算 | 通常采用矩阵并行 |
| 内存访问 | 取决于工作负载 | 通常面向批处理 | 大型张量工作集 |
| 数据搬移 | 取决于程序和输入 | 特征流水线中的数据搬移 | 参数和激活值的搬移 |
| 硬件需求 | 通常以 CPU 为中心 | 通常为配备向量单元的 CPU | 通常适合加速器 |
| 资源扩展 | 取决于输入和程序 | 由描述子和数据驱动 | 由宽度、批量大小、状态和复用驱动 |
除速度之外,能耗也构成一项约束。将数据从主存搬移到处理单元所消耗的能量,可能远高于一次简单的算术运算 (Horowitz 2014)。这种能耗层次关系解释了神经网络加速器为何要尽可能提高数据复用程度:它们将频繁访问的数值保留在本地存储中,并通过调度运算来减少搬移。究竟是数据搬移还是算术运算占主导,取决于精度、复用程度、工作负载形态和硬件,但数据搬移的成本推动了从数据中心 GPU 到 TinyML 加速器的专用架构发展。
Horowitz, Mark. 2014. “1.1 Computing’s Energy Problem (and What We Can Do about It).” 2014 IEEE International Solid-State Circuits Conference Digest of Technical Papers (ISSCC), 10–14. https://doi.org/10.1109/isscc.2014.6757323.
内存与计算之间的权衡,在 机器学习系统 所介绍的从云端到边缘端的各类系统中表现不同。云服务器可能使用更多内存和功率来追求吞吐量,而移动设备则在更严格的功率预算内运行。大批量训练通常侧重吞吐量;延迟敏感或由电池供电的推理则可能侧重响应时间或每次预测的能耗。具体优先级取决于部署工作负载。
这些单机约束在扩展到多台机器时会叠加:稠密层的规模随相邻维度变化,批次大小会同时影响激活值存储规模和吞吐量需求,而训练还会引入反向传播、激活值和优化器状态所带来的倍增开销。模型压缩、硬件加速和训练系统技术都通过减少工作量、提高机器的有效处理速率或改变状态的存放位置来应对这种压力。
这些物理约束——硬件并行性、内存墙以及主导能耗的数据移动——直接源于神经计算的结构:训练过程中不断变化的权重、同时运行的大量简单单元、将低层特征组合成高层概念的层,以及尽量减少高能耗数据移动的数据复用。这些性质具体体现在神经计算的基本构件——人工神经元——之中。13 正如理解单个晶体管有助于揭示复杂处理器的工作原理,理解人工神经元也有助于揭示拥有数百万参数的网络的行为。
作为计算原语的人工神经元
神经计算的基本单元——人工神经元(或节点)——是对神经活动的简化数学抽象 (McCulloch and Pitts 1943)。后来的数字神经网络实现将这一抽象改造为标准化的处理单元。借助这一构件,简单组件可以协同工作,形成复杂网络。并排比较 figure 8 中的生物神经元与人工神经元,可以看出这一计算模型如何将生物系统的复杂性提炼为更简单的计算形式。
\begin{tikzpicture}[line join=round,font=\sffamily\footnotesize]
\tikzset{
  Box/.style={,
    inner xsep=2pt,
    node distance=1.4,
    draw=GreenLine,
    line width=0.75pt,
    rounded corners,
    fill=mygreen!07,
    minimum width=65mm, minimum height=57mm
  },
    Txt/.style={black!50,font=\sffamily\itshape\fontsize {8pt}{7}\selectfont},
  }

\ExplSyntaxOn

\fp_new:N  \l__ctp_angle_fp
\tl_new:N  \l__ctp_spec_tl
\tl_new:N  \l__ctp_name_tl
\int_new:N \g__ctp_shading_int

\keys_define:nn { colour_transition_path }
  {
    angle .fp_set:N  = \l__ctp_angle_fp,
    angle .initial:n = 0,
  }

% Razdvaja stavku:
%   orange      -> boja=orange, pozicija prazna
%   orange/12   -> boja=orange, pozicija=12
\cs_new_protected:Npn \__ctp_split_item:nNN #1#2#3
  {
    \seq_set_split:Nnn \l_tmpa_seq {/} {#1}
    \tl_set:Ne #2 { \tl_trim_spaces:n { \seq_item:Nn \l_tmpa_seq {1} } }
    \int_compare:nNnTF { \seq_count:N \l_tmpa_seq } > {1}
      {
        \tl_set:Ne #3 { \tl_trim_spaces:n { \seq_item:Nn \l_tmpa_seq {2} } }
      }
      {
        \tl_clear:N #3
      }
  }

% Gradi shading specifikaciju.
% Ako pozicija nije data, računa se ravnomerno.
\cs_new_protected:Npn \__ctp_build_shading:n #1
  {
    \tl_clear:N \l__ctp_spec_tl

    \int_step_inline:nn { \clist_count:n {#1} }
      {
        \__ctp_split_item:nNN
          { \clist_item:nn {#1}{##1} }
          \l_tmpa_tl
          \l_tmpb_tl

        \tl_if_blank:VTF \l_tmpb_tl
          {
            \tl_set:Nx \l_tmpb_tl
              { \fp_eval:n { 100*(##1-1)/(\clist_count:n {#1}-1) } }
          }
          { }

        \tl_put_right:Nx \l__ctp_spec_tl
          {
            color(\tl_use:N \l_tmpb_tl bp)=(\tl_use:N \l_tmpa_tl)
          }

        \int_compare:nNnF {##1} = { \clist_count:n {#1} }
          {
            \tl_put_right:Nn \l__ctp_spec_tl { ; }
          }
      }
  }

\cs_new_protected:Npn \__ctp_declare_shading:
  {
    \int_gincr:N \g__ctp_shading_int
    \tl_set:Nx \l__ctp_name_tl
      { colourtransitionpath\int_use:N \g__ctp_shading_int }

    \use:e
      {
        \exp_not:N \pgfdeclarehorizontalshading
          { \tl_use:N \l__ctp_name_tl }
          { 100bp }
          { \tl_use:N \l__ctp_spec_tl }
      }
  }

% #1 = opcije (ugao)
% #2 = lista boja
% #3 = zatvorena putanja, BEZ završnog ;
\NewDocumentCommand \ColourTransitionPath { O{} m m }
  {
    \group_begin:
      \keys_set:nn { colour_transition_path } {#1}
      \clist_set:Nn \l_tmpa_clist {#2}

      \int_compare:nNnTF { \clist_count:N \l_tmpa_clist } = {1}
        {
          % Samo jedna boja
          \__ctp_split_item:nNN
            { \clist_item:Nn \l_tmpa_clist {1} }
            \l_tmpa_tl
            \l_tmpb_tl

          \path[fill=\l_tmpa_tl] #3 ;
        }
        {
          \__ctp_build_shading:n {#2}
          \__ctp_declare_shading:

          \path[
            path~picture={
              \shade[
                shading=\tl_use:N \l__ctp_name_tl,
                shading~angle=\fp_eval:n { -\l__ctp_angle_fp }
              ]
              (path~picture~bounding~box.north~west)
                rectangle
              (path~picture~bounding~box.south~east);
            }
          ] #3 ;
        }
    \group_end:
  }

\ExplSyntaxOff

\draw[black,fill=myorange](-0.81,0)to[out=200,in=330](-1.02,0)
to[out=-210,in=275](-1.13,0.23)to[out=90,in=225](-1.06,0.33)to[out=40,in=255](-0.99,0.43)
to[out=70,in=220](-0.8,0.79)to[out=200,in=70](-1.03,0.49)to[out=250,in=50](-1.11,0.37)
to[out=230,in=270](-1.15,0.4)to[out=100,in=250](-1.16,0.64)to[out=70,in=290](-1.12,1.13)
to[out=270,in=70](-1.205,0.68)to[out=240,in=310](-1.275,0.72)to[out=120,in=280](-1.41,1.07)
to[out=270,in=125](-1.28,0.62)to[out=310,in=100](-1.21,0.32)to[out=270,in=45](-1.26,0.08)
to[out=220,in=5](-1.50,0.0)to[out=175,in=260](-1.55,0.14)to[out=80,in=300](-1.6,0.38)
to[out=120,in=280](-1.73,0.78)to[out=260,in=120](-1.64,0.35)to[out=300,in=85](-1.615,0.09)
to[out=260,in=325](-1.73,0.095)to[out=149,in=315](-2.01,0.3)to[out=115,in=255](-1.967,0.48)
to[out=65,in=295](-1.959,0.77)to[out=265,in=285](-2.1,0.42)to[out=105,in=275](-2.205,0.87)
to[out=260,in=115](-2.14,0.39)to[out=295,in=135](-1.971,0.19)to[out=305,in=00](-2.1,0.166)
to[out=175,in=50](-2.43,0.04)to[out=25,in=170](-2.09,0.11)to[out=345,in=188](-1.91,0.09)
to[out=10,in=150](-1.71,0.02)to[out=-30,in=120](-1.58,-0.1)to[out=285,in=90](-1.57,-0.25)
to[out=280,in=60](-1.57,-0.45)to[out=240,in=20](-1.75,-0.58)to[out=180,in=320](-1.88,-0.48)
to[out=140,in=0](-2.29,-0.37)to[out=340,in=130](-1.85,-0.59)to[out=320,in=20](-1.95,-0.70)
to[out=200,in=90](-2.25,-1.20)to[out=70,in=230](-2.09,-0.87)to[out=45,in=200](-1.73,-0.69)
to[out=25,in=60](-1.68,-0.72)to[out=245,in=70](-1.79,-0.92)to[out=245,in=90](-1.84,-1.18)
to[out=75,in=220](-1.64,-0.83)to[out=55,in=190](-1.49,-0.59)to[out=5,in=120](-1.26,-0.69)
to[out=300,in=60](-1.26,-0.89)to[out=240,in=85](-1.36,-1.19)to[out=270,in=70](-1.42,-1.53)
to[out=40,in=90](-1.32,-1.17)to[out=88,in=230](-1.22,-0.93)to[out=68,in=110](-1.17,-0.93)
to[out=290,in=130](-1.08,-1.16)to[out=298,in=95](-1.06,-1.61)to[out=58,in=95](-1.00,-1.27)
to[out=115,in=125](-0.97,-1.2)to[out=335,in=135](-0.7,-1.36)to[out=95,in=340](-0.97,-1.15)
to[out=150,in=300](-1.06,-1.05)to[out=110,in=280](-1.155,-0.69)to[out=100,in=150](-0.99,-0.54)
to[out=325,in=170](-0.8,-0.62)to[out=-5,in=110](-0.755,-0.72)to[out=280,in=150](-0.455,-1.16)
to[out=130,in=280](-0.71,-0.70)to[out=105,in=180](-0.61,-0.655)to[out=355,in=160](-0.31,-0.73)
to[out=335,in=180](0.07,-0.84)to[out=155,in=330](-0.25,-0.70)to[out=145,in=230](-0.255,-0.643)
to[out=40,in=185](0.13,-0.54)to[out=170,in=45](-0.28,-0.61)to[out=220,in=340](-0.44,-0.62)
to[out=160,in=290](-0.95,-0.36)
to[out=105,in=190](-0.75,-0.11)coordinate(PL1)
to[out=5,in=190](0.10,-0.2)to[out=10,in=200](1.10,0.13)to[out=20,in=170](1.50,0.15)
to[out=345,in=152](1.88,0.01)to[out=325,in=122](1.95,-0.11)to[out=290,in=95](1.985,-0.30)
to[out=270,in=100](2,-0.60)
arc[start angle=110, end angle=430, radius=0.065] %1
to[out=95,in=280](2.031,-0.40)to[out=95,in=130](2.06,-0.395)to[out=305,in=150](2.288,-0.565)
arc[start angle=180, end angle=500, radius=0.065] %2
to[out=145,in=310](2.088,-0.35)to[out=135,in=280](2.03,-0.15)to[out=95,in=300](2.00,-0.06)
to[out=95,in=170](2.10,-0.06)to[out=95,in=170](2.10,-0.06)to[out=345,in=190](2.26,-0.06)
to[out=355,in=150](2.46,-0.21)to[out=320,in=150](2.55,-0.27)
arc[start angle=170, end angle=490, radius=0.065] %3
to[out=160,in=310](2.395,-0.09)to[out=130,in=180](2.42,-0.04)to[out=0,in=170](2.73,-0.03)
arc[start angle=170, end angle=490, radius=0.075] %4
to[out=170,in=10](2.4,0.01)to[out=190,in=350](2.1,0.03)to[out=170,in=330](1.91,0.07)
to[out=170,in=210](1.91,0.12)to[out=30,in=210](2.01,0.17)to[out=20,in=170](2.21,0.21)
to[out=330,in=180](2.41,0.18)to[out=10,in=170](2.52,0.185)
arc[start angle=180, end angle=495, radius=0.07] %5
to[out=190,in=350](2.28,0.23)to[out=160,in=190](2.28,0.28)to[out=35,in=210](2.48,0.41)
to[out=35,in=190](2.55,0.43)
arc[start angle=200, end angle=520, radius=0.07] %6
to[out=195,in=40](2.25,0.32)to[out=215,in=10](2.1,0.25)to[out=195,in=260](2.05,0.30)
to[out=70,in=230](2.185,0.50)
arc[start angle=250, end angle=565, radius=0.055] %7
to[out=215,in=75](1.99,0.25)to[out=255,in=25](1.93,0.2)to[out=205,in=25](1.83,0.161)
to[out=200,in=345](1.73,0.161)to[out=160,in=325](1.57,0.23)to[out=120,in=225](1.62,0.3)
to[out=40,in=235](1.76,0.45)to[out=50,in=215](1.96,0.60)to[out=45,in=210](2.33,0.79)
to[out=30,in=170](2.43,0.8)to[out=335,in=180](2.76,0.74)
arc[start angle=210, end angle=525, radius=0.06] %8
to[out=180,in=340](2.45,0.839)to[out=150,in=220](2.48,0.9)to[out=50,in=210](2.66,1.07)
arc[start angle=220, end angle=545, radius=0.065] %9
to[out=205,in=40](2.4,0.9)to[out=215,in=20](2.1,0.79)to[out=200,in=30](1.97,0.715)
to[out=220,in=250](1.925,0.75)to[out=90,in=245](1.975,0.95)to[out=65,in=225](2.175,1.15)
to[out=50,in=265](2.285,1.37)
arc[start angle=280, end angle=590, radius=0.05] %10
to[out=260,in=45](2.17,1.23)to[out=230,in=55](2.08,1.13)to[out=260,in=275](2.04,1.13)
to[out=100,in=255](2.034,1.44)
arc[start angle=285, end angle=590, radius=0.055] %11
to[out=260,in=105](1.98,1.15)to[out=280,in=55](1.92,0.95)to[out=230,in=90](1.85,0.67)
to[out=250,in=60](1.74,0.55)to[out=230,in=290](1.68,0.55)to[out=100,in=270](1.677,0.78)
to[out=100,in=290](1.65,0.86)to[out=72,in=260](1.767,1.08)to[out=72,in=270](1.78,1.18)
arc[start angle=295, end angle=600, radius=0.05] %12
to[out=272,in=60](1.64,0.95)to[out=252,in=280](1.6,0.95)to[out=112,in=270](1.545,1.25)
arc[start angle=290, end angle=610, radius=0.07] %13
to[out=260,in=100](1.58,0.82)to[out=150,in=300](1.274,1.1)
arc[start angle=320, end angle=620, radius=0.05] %14
to[out=300,in=140](1.35,0.92)to[out=320,in=130](1.55,0.75)to[out=320,in=90](1.58,0.59)
to[out=290,in=50](1.58,0.394)to[out=230,in=0](1.34,0.27)to[out=180,in=20](1.0,0.23)
to[out=200,in=30](0.5,0.03)to[out=210,in=180](-0.05,-0.07)
to[out=180,in=340](-0.45,0.01)to[out=166,in=10]cycle;

\definecolor{col1}{RGB}{131,216,255}
\definecolor{col2}{RGB}{65,167,250}
\definecolor{col3}{RGB}{36,110,173}
\definecolor{col4}{RGB}{0,18,34}
\definecolor{col5}{RGB}{14,60,102}
\definecolor{col6}{RGB}{32,112,180}

\ColourTransitionPath[angle=100]
    {col5,col4,col5,col5,col1,col1,col1}
    {
      (-0.6,0.12)
      to[out=5,in=170](-0.17,0.04)
      to[out=290,in=70](-0.23,-0.29)
      to[out=180,in=330](-0.65,-0.17)
      to[out=90,in=240]cycle
    }

\draw[black](-0.6,0.12)coordinate(1X1)
to[out=5,in=170](-0.17,0.04)
to[out=290,in=70](-0.23,-0.29)coordinate(1X2)
to[out=180,in=330](-0.65,-0.17)
to[out=90,in=240]cycle;

\coordinate(1S1)at($(1X1)!0.5!(1X2)$);
\node[draw=none,ellipse,minimum width=2mm,minimum height=1.2mm,
inner sep=0pt,rotate=-10,fill=col3](EL1)at(1S1){};
\node[draw=none,ellipse,minimum width=1.75mm,minimum height=0.8mm,
inner sep=0pt,rotate=-10,fill=col2,anchor=south]at(EL1.south){};
\node[draw=none,ellipse,minimum width=1.5mm,minimum height=0.4mm,
inner sep=0pt,rotate=-10,fill=col1,anchor=south]at(EL1.south){};
\node[draw=black,ellipse,minimum width=2mm,minimum height=1.2mm,
inner sep=0pt,rotate=-10,fill=none](EL1)at(1S1){};

%the second
\ColourTransitionPath[angle=80]
    {col5,col4,col5,col5,col1,col1,col1}
    {
    (-0.09,0.04)
to[out=0,in=190](0.3,0.09)
to[out=300,in=85](0.39,-0.25)
to[out=200,in=350](-0.09,-0.29)
to[out=97,in=260]cycle;
    }

\draw[black](-0.09,0.04)coordinate(2X1)
to[out=0,in=190](0.3,0.09)
to[out=300,in=85](0.39,-0.25)coordinate(2X2)
to[out=200,in=350](-0.09,-0.29)
to[out=97,in=260]cycle;

\coordinate(2S1)at($(2X1)!0.5!(2X2)$);
\node[draw=none,ellipse,minimum width=2mm,minimum height=1.2mm,
inner sep=0pt,rotate=10,fill=col3](EL2)at(2S1){};
\node[draw=none,ellipse,minimum width=1.75mm,minimum height=0.8mm,
inner sep=0pt,rotate=10,fill=col2,anchor=south]at(EL2.south){};
\node[draw=none,ellipse,minimum width=1.5mm,minimum height=0.4mm,
inner sep=0pt,rotate=10,fill=col1,anchor=south]at(EL2.south){};
\node[draw=black,ellipse,minimum width=2mm,minimum height=1.2mm,
inner sep=0pt,rotate=10,fill=none]at(2S1){};

%The third
\ColourTransitionPath[angle=65]
    {col5,col4,col5,col5,col1,col1,col1}
    {
(0.38,0.1)
to[out=25,in=190](0.76,0.27)
to[out=298,in=95](0.86,-0.04)
to[out=210,in=5](0.48,-0.2)
to[out=117,in=280]cycle;
    }

\draw[black](0.38,0.1)coordinate(3X1)
to[out=25,in=190](0.76,0.27)
to[out=298,in=95](0.86,-0.04)coordinate(3X2)
to[out=210,in=5](0.48,-0.2)
to[out=117,in=280]cycle;

\coordinate(3S1)at($(3X1)!0.5!(3X2)$);
\node[draw=none,ellipse,minimum width=2mm,minimum height=1.2mm,
inner sep=0pt,rotate=25,fill=col3](EL3)at(3S1){};
\node[draw=none,ellipse,minimum width=1.75mm,minimum height=0.8mm,
inner sep=0pt,rotate=25,fill=col2,anchor=south]at(EL3.south){};
\node[draw=none,ellipse,minimum width=1.5mm,minimum height=0.4mm,
inner sep=0pt,rotate=25,fill=col1,anchor=south]at(EL3.south){};
\node[draw=black,ellipse,minimum width=2mm,minimum height=1.2mm,
inner sep=0pt,rotate=25,fill=none]at(3S1){};

%The fourth
\ColourTransitionPath[angle=65]
    {col5,col4,col5,col5,col1,col1,col1}
    {
(0.84,0.285)
to[out=25,in=190](1.26,0.39)
to[out=298,in=95](1.32,0.08)
to[out=185,in=5](0.93,-0.02)
to[out=117,in=280]cycle;
    }

\draw[black](0.84,0.285)coordinate(4X1)
to[out=25,in=190](1.26,0.39)
to[out=298,in=95](1.32,0.08)coordinate(4X2)
to[out=185,in=5](0.93,-0.02)
to[out=117,in=280]cycle;

\coordinate(4S1)at($(4X1)!0.5!(4X2)$);
\node[draw=none,ellipse,minimum width=2mm,minimum height=1.2mm,
inner sep=0pt,rotate=15,fill=col3](EL4)at(4S1){};
\node[draw=none,ellipse,minimum width=1.75mm,minimum height=0.8mm,
inner sep=0pt,rotate=15,fill=col2,anchor=south]at(EL4.south){};
\node[draw=none,ellipse,minimum width=1.5mm,minimum height=0.4mm,
inner sep=0pt,rotate=15,fill=col1,anchor=south]at(EL4.south){};
\node[draw=black,ellipse,minimum width=2mm,minimum height=1.2mm,
inner sep=0pt,rotate=15,fill=none]at(4S1){};

%left

\coordinate(0S1)at(-1.25,-0.26);
\node[draw=none,ellipse,minimum width=3.8mm,minimum height=2.8mm,
inner sep=0pt,rotate=0,fill=col3](EL0)at(0S1){};
\node[draw=none,ellipse,minimum width=3.5mm,minimum height=1.9mm,
inner sep=0pt,rotate=0,fill=col2,anchor=south]at(EL0.south){};
\node[draw=none,ellipse,minimum width=3.1mm,minimum height=1.2mm,
inner sep=0pt,rotate=0,fill=col1,anchor=south]at(EL0.south){};
\node[draw=black,ellipse,minimum width=3.8mm,minimum height=2.8mm,
inner sep=0pt,rotate=0,fill=none]at(0S1){};

\coordinate (P1) at (2.00,-0.60);
\coordinate (N1) at ($(P1)-({0.065*cos(110)},{0.065*sin(110)})$);

\coordinate (P2) at (2.288,-0.565);
\coordinate (N2) at ($(P2)-({0.065*cos(180)},{0.065*sin(180)})$);

\coordinate (P3) at (2.55,-0.27);
\coordinate (N3) at ($(P3)-({0.065*cos(170)},{0.065*sin(170)})$);

\coordinate (P4) at (2.73,-0.03);
\coordinate (N4) at ($(P4)-({0.075*cos(170)},{0.075*sin(170)})$);

\coordinate (P5) at (2.52,0.185);
\coordinate (N5) at ($(P5)-({0.07*cos(180)},{0.07*sin(180)})$);

\coordinate (P6) at(2.55,0.43);
\coordinate (N6) at ($(P6)-({0.07*cos(200)},{0.07*sin(200)})$);

\coordinate (P7) at(2.185,0.5);
\coordinate (N7) at ($(P7)-({0.055*cos(250)},{0.055*sin(250)})$);

\coordinate (P8) at(2.76,0.74);
\coordinate (N8) at ($(P8)-({0.06*cos(210)},{0.06*sin(210)})$);

\coordinate (P9) at(2.66,1.07);
\coordinate (N9) at ($(P9)-({0.065*cos(220)},{0.065*sin(220)})$);

\coordinate (P10) at(2.285,1.37);
\coordinate (N10) at ($(P10)-({0.05*cos(280)},{0.05*sin(280)})$);

\coordinate (P11) at(2.034,1.44);
\coordinate (N11) at ($(P11)-({0.055*cos(285)},{0.055*sin(285)})$);

\coordinate (P12) at(1.78,1.18);
\coordinate (N12) at ($(P12)-({0.05*cos(295)},{0.05*sin(295)})$);

\coordinate (P13) at(1.545,1.25);
\coordinate (N13) at ($(P13)-({0.07*cos(290)},{0.07*sin(290)})$);

\coordinate (P14) at(1.274,1.1);
\coordinate (N14) at ($(P14)-({0.05*cos(320)},{0.05*sin(320)})$);

\foreach \x / \v in {1/1.64pt,2/1.64pt,3/1.64pt,
4/1.94pt,5/1.85pt,6/1.85pt,7/1.4pt,8/1.5pt,9/1.65pt,
10/1.3pt,11/1.4pt,12/1.3pt,13/1.8pt,14/1.3pt
}{
\shade[ball color=cyan!50!blue] (N\x) circle (\v);
}
%Labeling
\draw[](0S1)--++(245:1.65)node[below]{细胞核};
\draw[](0S1)+(300:0.2)--++(306:1.65)node[below]{\textbf{细胞体}};
\node[]at(-0.15,0.99){\textbf{树突}};
\draw[red,<-,>=Latex](-2.1,0.9)--++(80:0.65)node[above=0pt,inner sep=0pt]{\textbf{输入}};
\node[]at(0.9,-0.4){\textbf{轴突}};
\draw[red,<-,>=Latex](N3)+(270:0.14)--++(256:1.15)node[below]{\textbf{输出}};

\begin{scope}[on background layer]
\node[Box](BB1)at(0.25,-0.1){};
\node[Box,right=2.5 of BB1](BB2){};
\end{scope}
\node[below=9pt of BB1.north,GreenLine]{\textbf{生物神经元}};
\node[below=9pt of BB2.north,GreenLine]{\textbf{人工神经元}};

\begin{scope}[shift={($(BB2)+(-2.15,1.4)$)}]
 \tikzset{%
  Line/.style={line width=1.0pt,black!50,text=black},
  Box2/.style={inner sep=2pt,
    node distance=0.23,circle,
    draw=VioletLine, line width=0.75pt,
    fill=VioletL2,
    align=flush center,
    minimum width=8mm,
  },
}
%
\node[Box2](B1){$x_{0}$};
\node[Box2,below=of B1](B2){$x_1$};
\node[Box2,below=of B2](B3){$x_2$};
\node[Box2,node distance=0.7,below=of B3](B4){$x_n$};
\node[rotate=90,font=\tiny\sffamily]at($(B3)!0.5!(B4)$){$\bullet$ $\bullet$ $\bullet$};

\node[above=0.1 of B1,font=\sffamily\small](WE){\textbf{输入}};
\node[Box2,minimum width=12mm,right=2of $(B1)!0.5!(B4)$,
            fill=VioletL2,draw=VioletLine](B5){};
\draw[VioletLine,dashed,thick](B5.north)--(B5.south);
\node[right=2pt of B5.west]{\textbf{z}};
\node[left=2pt of B5.east]{\textbf{f}};
%
\node[below left=0 and -0.5 of B5.south,align=left]{线性\\函数};
\node[below right=0 and 0.5 of B5.south,align=left]{激活\\函数};
\foreach \x in{1,...,4}{
\draw[Line](B\x)--coordinate[pos=0.4](S\x)(B5);
}
\node[right=0pt of B1]{$=1$};
\node[below=0pt of S1]{$b$};
\node[below=0pt of S2]{$w_1$};
\node[below=0pt of S3]{$w_2$};
\node[below=3pt of S4]{$w_n$};
%
\draw[Line,-latex](B5)--node[above,pos=0.8]{$y$}++(1.97,0)
node[below,pos=0.7]{\textbf{输出}};
\end{scope}
%%between
\coordinate(TG)at($(BB1.north east)!0.5!(BB2.north west)$);
\coordinate(TD)at($(BB1.south east)!0.5!(BB2.south west)$);

\draw[black!40,shorten >=4mm,shorten <=4mm](TG)--(TD);

\foreach \x[count =\a]  in {0.14,0.38,0.62,0.85}{
\fill[black!30]($(TG)!\x!(TD)$) circle(2pt)coordinate(Q\a);
}
\node[above=2pt of Q1,Txt]{树突};
\node[below=2pt of Q1,Txt]{= 输入};

\node[above=2pt of Q2,Txt]{突触};
\node[below=2pt of Q2,Txt]{= 权重};

\node[above=2pt of Q3,Txt]{胞体};
\node[below=2pt of Q3,Txt]{= 线性函数(z)};

\node[above=2pt of Q4,Txt]{轴突放电};
\node[below=2pt of Q4,Txt]{= 激活 (f)};

\end{tikzpicture}figure 8 的右侧面板展示了信号经过的四个阶段,每个阶段都将一种生物结构转化为一种数学运算:
- 输入接收(树突 → \(x_1, x_2, \dots, x_n\)):人工神经元接收输入特征向量 \(\mathbf{x}\)。在 MNIST 数字识别任务中,这些特征表示像素强度。树突类比体现了对多个信号的接收,但并不意味着二者在生物学上等同。
- 加权调制(突触 → \(w_1, w_2, \dots, w_n\)):每个输入都乘以一个可学习权重 \(w_i\),正如突触强度对生物信号进行调制一样。这些权重充当“增益”控制,决定每个特征对最终决策的影响程度。偏置项 \(b\)(在 figure 8 中表示为最上方的输入 \(x_0 = 1\))用于移动激活阈值。在整个网络中,学习到的行为分布在大量此类参数之中,而非存储于某一个权重中。
- 信号聚合(细胞体 → 线性函数 \(z\)):神经元整合加权信号,产生单个标量值 \(z = \sum (x_i \cdot w_i) + b\)。这对应于生物细胞体对传入的电化学信号进行求和,以判断神经元是否已接收到足够支持某种特定模式的证据。
- 非线性激活(轴突 → 激活函数 \(f\)):聚合后的信号通过激活函数 \(f(z)\),产生激活输出 \(a = f(z)\)(通常记作 \(y\))。这对应于轴突全或无的放电决策:非线性决定神经元是否向下一层“发放”信号。与生物神经元不同,\(f\) 可以产生连续变化的输出(例如,ReLU 让正值直接通过,将负值置零),但其原理相同——先进行阈值处理,再传播信号。Table 4 对这些对应关系作了形式化表述。
| 生物结构 | 人工组件 | 数学运算 | 工程作用 |
|---|---|---|---|
| 树突(接收信号) | 输入向量 | \(\mathbf{x} = [x_1, \dots, x_n]\) | 从传感器或前层摄取数据 |
| 突触(调制强度) | 权重向量 | \(\mathbf{w} = [w_1, \dots, w_n]\) | 编码重要性的可学习参数 |
| 细胞体(整合信号) | 线性函数 \(z\) | \(z = \sum (x_i \cdot w_i) + b\) | 对特征信号进行线性整合 |
| 轴突(发放输出) | 激活函数 \(f\) | \(a = f(z)\) | 非线性阈值处理与信号传播 |
从系统工程的角度看,这种转换揭示了神经网络为何会提出很高的计算要求。对单个神经元进行直接的标量求值需要执行 \(N\) 次乘加累积(MAC)14运算;在不进行复用的情况下,还需要加载 \(N\) 个输入、\(N\) 个权重和一个偏置,然后写入输出。批处理和分块内核在多次神经元求值之间复用输入和权重,从而减少每次 MAC 的数据流量。因此,在整个网络的尺度上,性能既取决于运算次数,也取决于实现对数据的复用效率。
从单个神经元过渡到集成系统,需要处理表征能力与计算成本之间的核心权衡。数字硬件能够快速执行算术运算,但深度网络中的运算量和数据移动量会造成单神经元视角无法揭示的瓶颈。
在硅芯片上复现智能行为面临三个相互关联的系统级约束。随着模型规模增大,参数和激活的移动可能比算术吞吐量更具限制性。并发性与依赖关系存在冲突:一层内部的许多运算可以并行执行,但第 \(\ell+1\) 层仍然依赖第 \(\ell\) 层,从而为端到端延迟设定了下界。精度也需要与内存、吞吐量和能耗进行权衡:位宽更大的表示会消耗更多存储空间并产生更多数据移动,而位宽更小的格式则需要证据证明任务质量仍然可以接受。模型压缩 将进一步讨论如何寻找最低可行精度。
应对这些约束需要两种互补策略。架构归纳偏置是关于数据的内置结构假设:卷积网络假设图像中相邻像素之间存在共同作用,而循环网络则假设序列中的顺序具有重要意义。将这些假设编码进架构,会使函数类受到约束,倾向于预期有用的结构 (Mitchell 1980)。计算规模扩展则提供额外的容量和优化投入。现代 AI 工程结合这两种方法,利用架构结构有效发挥现有规模的作用。
Mitchell, Tom M. 1980. The Need for Biases in Learning Generalizations. CBM-TR-117. Rutgers University, Department of Computer Science.
硬件与软件要求
将神经计算概念映射到硅芯片上需要付出物理成本。特征提取可以转化为加权线性求和后接非线性激活,而密集交互则转化为硬件必须高效执行的矩阵运算。然而,数学图并不规定执行方案。框架和编译器必须针对特定处理器选择内核、张量布局、融合边界和调度方案。因此,两种实现即使计算相同的函数、具有相同的标称算术运算次数,也可能在数据流量、临时存储和延迟方面存在显著差异。硬件提供算术单元、内存和通信链路;软件决定计算图如何使用这些资源。这一转换层决定了模型中可见的并行性能否转化为有效的机器利用率。
神经网络学得的行为分布在存储于普通内存地址中的参数之中。推理需要读取参数和激活;训练还需要保存中间结果、梯度和优化器状态,因此,存储容量和带宽都很重要。生物突触将存储与局部处理结合在一起,而数字加速器则通过内存层次结构移动数值。大脑消耗人体静息状态下约 20% 的氧气和热量 (Raichle and Gusnard 2002),但直接比较效率容易产生误导,因为生物系统和人工系统执行的任务不同,所受的准确率和延迟约束也不同。更具体的系统层面启示是:数据移动的影响足够大,因而推动了 硬件加速 中的专用硬件和 模型压缩 中的优化策略的发展。
Raichle, Marcus E., and Debra A. Gusnard. 2002. “Appraising the Brain’s Energy Budget.” Proceedings of the National Academy of Sciences 99 (16): 10237–39. https://doi.org/10.1073/pnas.172399499.
这些硬件需求并非一夜之间出现。从最早的感知机到如今的万亿参数模型,算法目标与可用芯片之间的矛盾塑造了神经网络研究的整个发展轨迹。
神经网络计算的演进
感知机15引入了一种用于学习和信息存储的概率神经元模型 (Rosenblatt 1958)。其简单的数学形式遇到了硬件约束:更大的网络需要多得多的处理能力和内存。深度学习正是在这种算法与芯片的协同演进中发展起来的;神经元抽象仍然保持着可辨识的形式,而能够执行它的硬件已发生巨大变化。这种协同演进构成了下文历史叙述的框架:进步既需要更好的方法,也需要更好的机器。
Rosenblatt, Frank. 1958. “The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain.” Psychological Review 65 (6): 386–408. https://doi.org/10.1037/h0042519.
Paul Werbos 在其 1974 年的博士论文中,将反向传播16算法应用于神经网络 (Werbos 1974),其基础是 Seppo Linnainmaa 于 1970 年开展的自动微分研究 (Linnainmaa 1970);此后,Rumelhart、Hinton 和 Williams 推动了该算法的普及 (Rumelhart et al. 1986)。他们发表的研究展示了该算法的实际有效性,并使其在机器学习界受到广泛关注,重新激发了人们对神经网络的兴趣。本章将在 section 1.4.4 中再次讨论该算法;反向传播机制 将进一步阐述其系统级实现。1986 年的演示表明,隐藏单元能够学得有用的内部特征,但并未解决扩大训练规模所面临的系统问题。更大的模型会成倍增加前向运算、保存的激活、梯度计算和参数更新。因此,实际应用依赖于整个技术栈的改进,而不仅仅依赖于学习规则本身。
这段历史反复揭示了一条系统层面的经验:只有当完整系统能够有效地训练和评估一个算法时,该算法才会变得有用。早期反向传播研究17与其广泛应用之间的时间差,反映了硬件、数据、初始化方法、非线性函数、优化方法、基准测试和软件基础设施逐步成熟的过程。因此,一个算法在原理上可行的时间,可能远早于其周边系统使它在实践中发挥作用的时间。深度学习源于这些因素的汇合,而非仅仅源于一项新的数学发现。
尽管这一术语在 2010 年代随着数据量和计算量的大幅增长而广为人知,其背后的规模扩展轨迹已延续七十年。Figure 9 以对数尺度绘制了近七十年来 AI 训练计算量的代表性估计值,呈现出两个拟合阶段:以浮点运算次数(FLOPs)衡量的总训练计算量在 2010 年之前沿着相对缓慢的趋势增长,而 2012 年之后的深度学习前沿则急剧加速。2015 年之后的大规模模型比 2010 年之前的趋势轨迹高出多个数量级,表明现代进步将硬件和算法带来的收益重新投入到规模大得多的训练运行中。
除了计算量本身,这种增长还带来了系统工程师无法忽视的能耗成本。在所述情景假设下,在工作站上进行一次为期三天的 LeNet-1 训练运行大约会消耗 54 kWh。采用外部的 GPT-4 GPU 天数估计值并计入数据中心开销系数后,得到的能耗约为 33,600 MWh,相当于大约 3,200 个代表性美国家庭的年用电量。18这些是数量级估计,并非实测用电记录,而且会随加速器利用率、设施开销和核算边界而变化。即便如此,这一规模也使每次运算的能耗和实际达到的利用率,与峰值 FLOP/s 一样成为设计时需要关注的问题。定量能耗分析见 硬件加速。
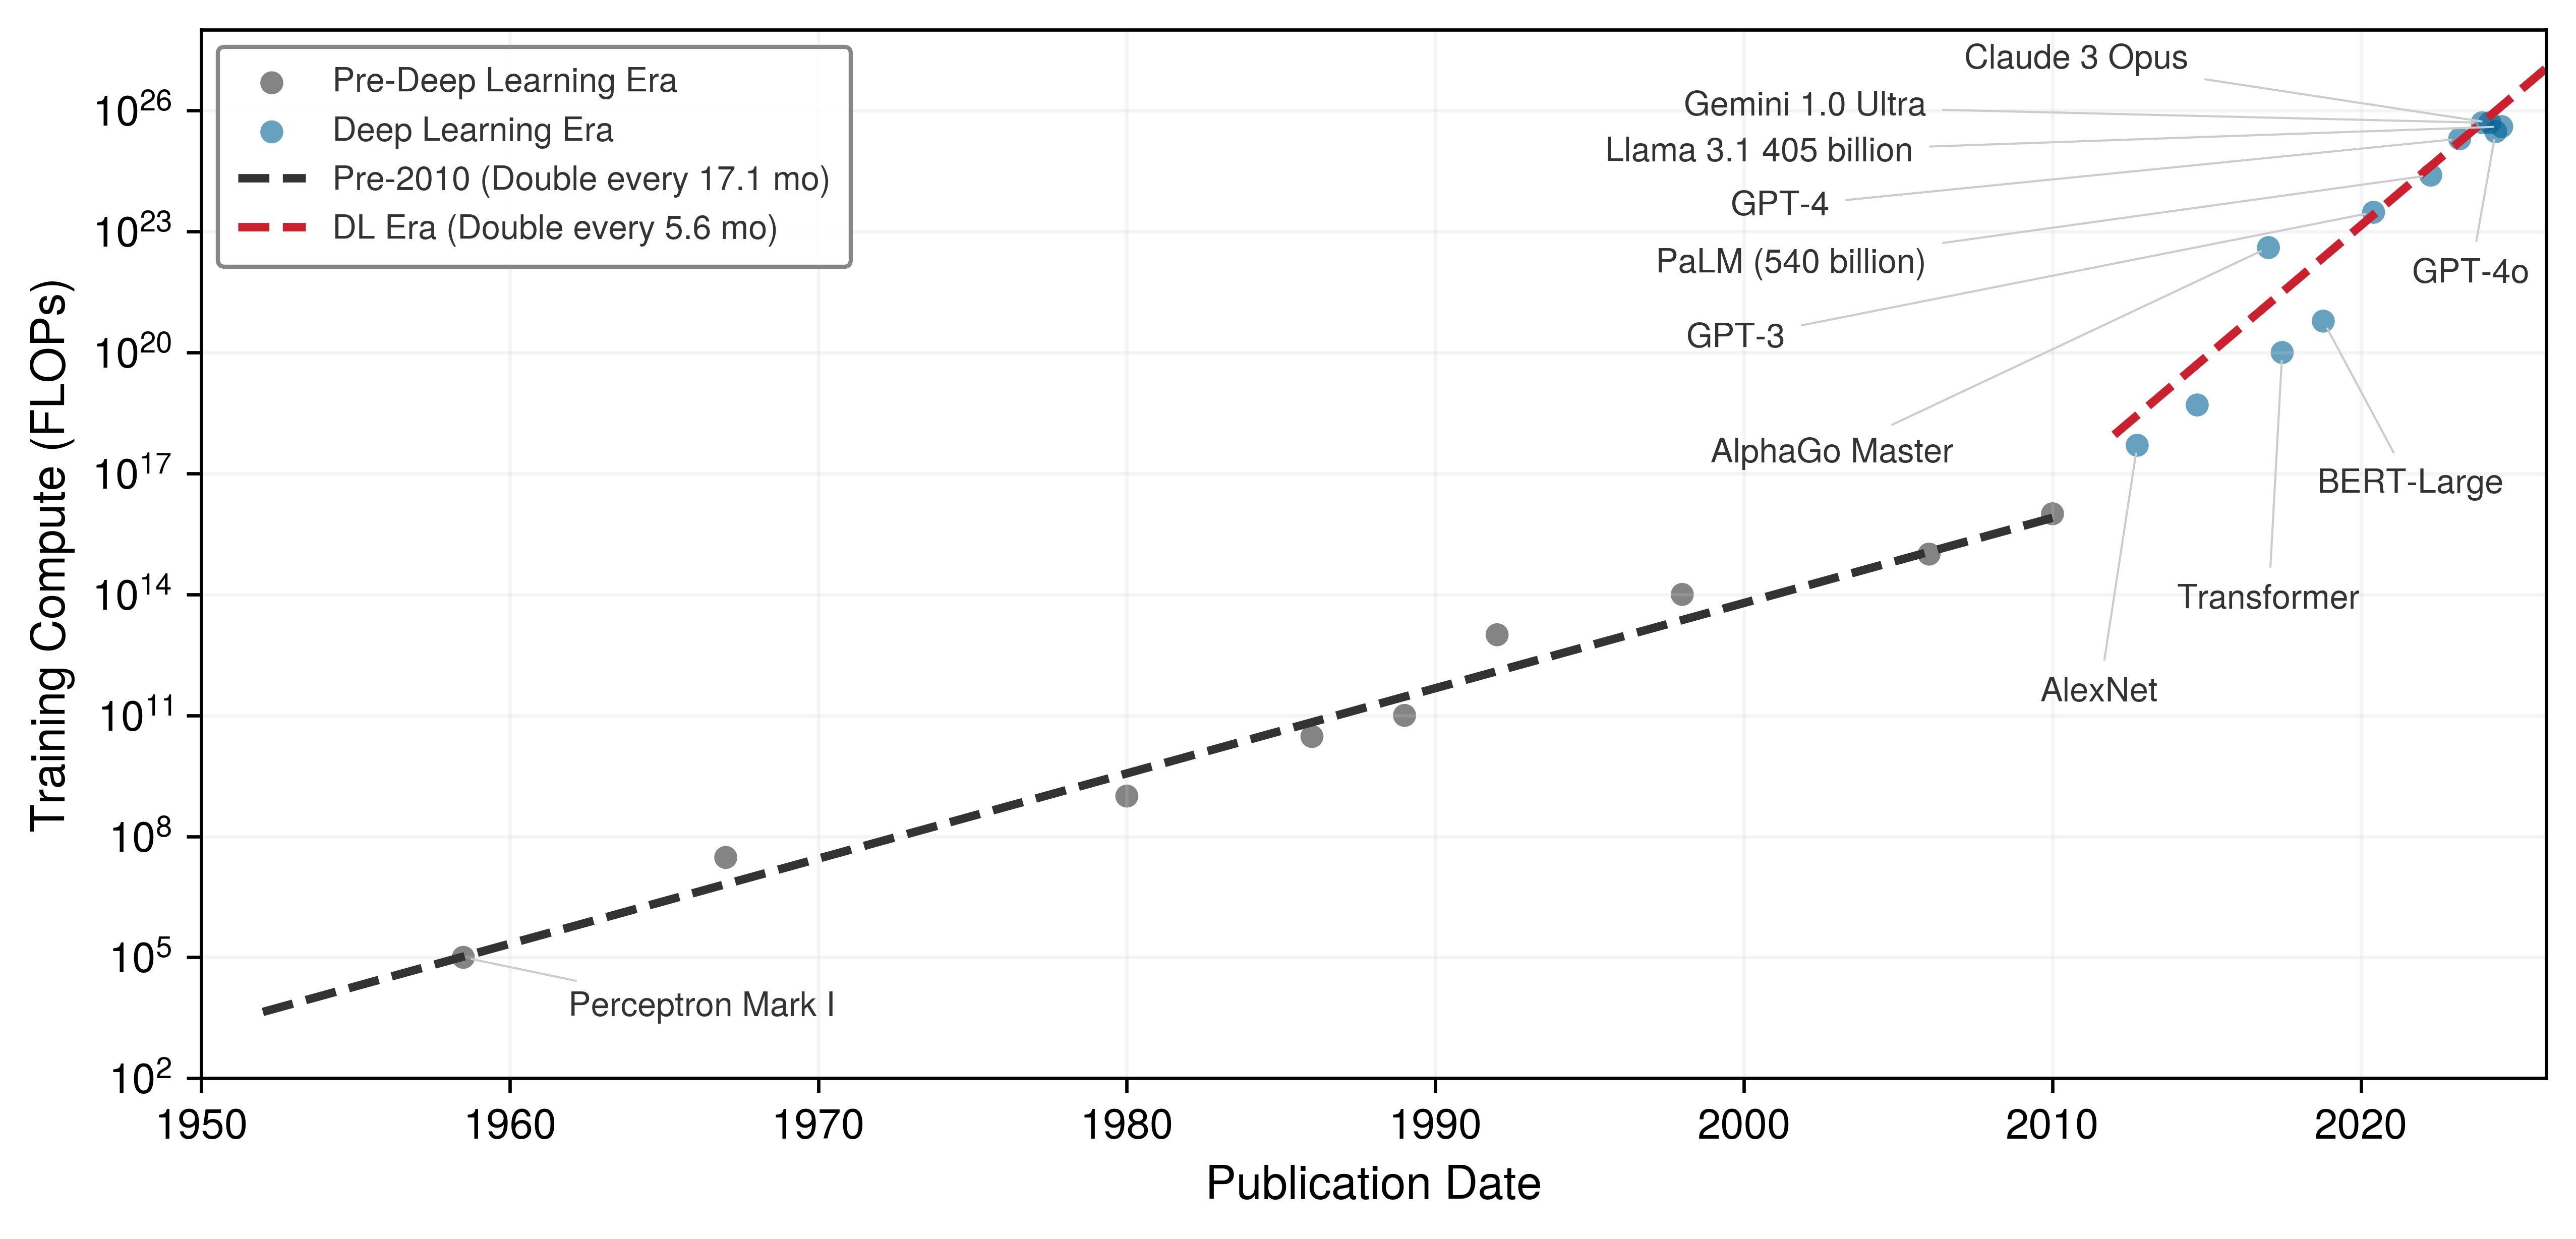
Table 5 以具有代表性的系统为这些趋势提供具体依据,展示了神经网络发展四十年间参数、计算量和硬件如何协同演进。有三种模式值得分别讨论。第一,图中所示的 2012 年后训练计算量前沿以月为时间尺度上升,但拟合速率取决于所选系统以及具有不确定性的估算。第二,在某些领域,算法和系统的进步降低了达到固定基准目标所需的计算量,因此,前沿计算量的趋势并不能描述能力保持不变时的效率。第三,硬件利用率、降低的数值精度、软件成熟度和采购条件会影响原始计算量与货币成本之间的关系;这些因素并不保证成本增长得更慢。对于系统工程师而言,这些区别会影响基础设施建设时间表、实验预算以及自建还是采购的决策。因此,规划需要实测效率、明确的比较目标和显式说明的不确定性,对于架构和训练配置未披露的闭源模型尤其如此。
| 年份 | 系统 | 参数量 | 训练 FLOPs | 硬件 | 训练时间 | 错误率/任务 |
|---|---|---|---|---|---|---|
| 1989 | LeNet-1 | ~10K | \(10^{11}\)–\(10^{12}\) | Sun-4/260 工作站 | 3 天 | 拒识率为 12.1% 时错误率为 1%(USPS 数字) |
| 1998 | LeNet-5 | \(60\text{K} \pm 1\text{K}\) | \(10^{14} \pm 1\text{ OoM}\) | SGI Origin 2000 (200 MHz) | 2–3 天 | 0.95%(MNIST) |
| 2012 | AlexNet | ~60M | \(5 \times 10^{17}\) | 2\(\times\) GTX 580 GPU | 5–6 天 | 15.3%(ImageNet) |
| 2015 | ResNet-152 | ~6000 万 | \(10^{19} \pm 0.5\text{ OoM}\) | 8\(\times\) Tesla K80 GPU | ~3 周 | 3.6%(ImageNet) |
| 2020 | GPT-3 | 175B(精确值) | \(3 \times 10^{23}\) | 未披露 | 未披露 | 不适用(语言) |
| 2023 | GPT-4 | 未披露 | \(10^{24}\)–\(10^{25}\)(外部估算) | 未披露 | 未披露 | 不适用(语言) |
数据可用性、算法创新和计算基础设施这三个维度的进步强化了这些趋势。沿着 figure 10 中的箭头可以看到它们之间的相互作用:更快的基础设施使更大规模的数据和模型成为现实,不断增长的数据集为算法带来了新的机遇和压力,而算法进步则改变了对计算系统的需求。这一循环提供了促成进步的条件,但并不会自动带来进步:一个维度的进展可能暴露另一个维度的瓶颈,而非立即带来收益。
\begin{tikzpicture}[font=\small\sffamily]

\tikzset{
    Box/.style={draw=none,minimum width=44mm, minimum height=25mm, node distance=16mm},
    Arr/.style={-{Triangle[width=10pt,length=8pt]}, line width=5pt,cyan!40,shorten >=1pt, shorten <=2pt},
 Box2/.style={align=flush center, inner xsep=2pt,draw=none,
  font=\footnotesize\sffamily\bfseries, line width=0.75pt, fill=OrangeL!30, text width=38mm,
    minimum width=44mm, minimum height=7mm},
  Box3/.style = {Box2,draw=none,fill=cyan!10},
  Box4/.style = {Box2,draw=none,fill=GreenFill!60},
LineA/.style = {violet!60,{Circle[line width=1.0pt,fill=white,length=5.5pt]}-,line width=1.5pt,shorten <=-3pt},
    Arr/.style={-{Triangle[width=9pt,length=11pt]}, line width=3pt,mybrown!30,shorten >=1pt, shorten <=2pt},
Txt/.style = {font=\footnotesize\sffamily,black!80,align=center}
}

%cloud ML
\tikzset {
pics/cloudA/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=CLO,scale=\scalefac, every node/.append style={transform shape}]
\node[draw=\drawcolor!90!red,line width=\Linewidth,minimum width=6mm,minimum height=12mm](VSK)at(0,0.5){};
\node[draw=\drawcolor!90!red,line width=\Linewidth,fill=white,minimum width=9mm,minimum height=4mm](VSKG)at(VSK.north){};
\node[draw=\drawcolor!90!red,line width=\Linewidth,fill=white,minimum width=9mm,minimum height=4mm](VSKC)at(VSK.center){};
\node[draw=\drawcolor!90!red,line width=\Linewidth,fill=white,minimum width=9mm,minimum height=4mm](VSKD)at(VSK.south){};
\draw[fill=\filllcolor,draw=\drawcolor!60,,line width=\Linewidth](0,0)to[out=170,in=180,distance=11](0.1,0.61)
to[out=90,in=105,distance=17](1.07,0.71)
to[out=20,in=75,distance=7](1.48,0.36)
to[out=350,in=0,distance=7](1.48,0)--(0,0);
\draw[draw=\drawcolor!60,,line width=\Linewidth](0.27,0.71)to[bend left=25](0.49,0.96);
\draw[draw=\drawcolor!60,,line width=\Linewidth](0.67,1.21)to[out=55,in=90,distance=13](1.5,0.96)
to[out=360,in=30,distance=9](1.68,0.42);
\node[single arrow, draw=orange,fill=orange,
      minimum width = 10pt, single arrow head extend=3pt,
      minimum height=10mm,
      rotate=270]at(1.05,0) {};
\end{scope}
}
}
}
    % #1 number of teeths
    % #2 radius intern
    % #3 radius extern
    % #4 angle from start to end of the first arc
    % #5 angle to decale the second arc from the first
    % #6 inner radius to cut off
    \tikzset{
      pics/gear/.style args={#1/#2/#3/#4/#5/#6/#7}{
       code={
               \pgfkeys{/channel/.cd, #7}
    \begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
        \pgfmathtruncatemacro{\N}{#1}%
        \def\rin{#2}\def\rout{#3}\def\aA{#4}\def\aOff{#5}\def\rcut{#6}%
        \path[rounded corners=1.5pt,draw=\drawcolor,fill=\filllcolor]
          (0:\rin)
          \foreach \i [evaluate=\i as \n using (\i-1)*360/\N] in {1,...,\N}{%
            arc (\n:\n+\aA:\rin)
            -- (\n+\aA+\aOff:\rout)
            arc (\n+\aA+\aOff:\n+360/\N-\aOff:\rout)
            -- (\n+360/\N:\rin)
          } -- cycle;
          \draw[draw=none,fill=white](0,0) circle[radius=\rcut];
    \end{scope}
      }}
    }

\tikzset {
pics/cloudML/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=CLO,scale=\scalefac, every node/.append style={transform shape}]
\draw[fill=\filllcolor,draw=\drawcolor!60,,line width=\Linewidth](0,0)to[out=170,in=180,distance=11](0.1,0.61)
to[out=90,in=105,distance=17](1.07,0.71)
to[out=20,in=75,distance=7](1.48,0.36)
to[out=350,in=0,distance=7](1.48,0)--(0,0);
\draw[draw=\drawcolor!60,,line width=\Linewidth](0.27,0.71)to[bend left=25](0.49,0.96);
 \draw[red,rounded corners,line width=\Linewidth,-{Circle[red,fill=yellow,length=6.5pt]}]
(0.3,0.1)--++(0,-8mm)--++(-5mm,0);
 \draw[violet,rounded corners,line width=\Linewidth,-{Circle[violet,fill=yellow,length=6.5pt]}]
(0.7,0.1)--++(0,-10mm);
 \draw[blue,rounded corners,line width=\Linewidth,-{Circle[blue,fill=yellow,length=6.5pt]}]
(1.1,0.1)--++(0,-8mm)--++(5mm,0);
\pic[shift={(0,0)}] at (0.65,0.1) {gear={12/1.5/1.9/8/4/0.8/scalefac=0.35,
drawcolor=mypurple,filllcolor=mypurple}};
\end{scope}
}
}
}
\tikzset {
pics/mobile/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=MOB,scale=\scalefac, every node/.append style={transform shape}]
\node[rectangle,draw=\drawcolor,minimum height=94,minimum width=47,
            rounded corners=4,thick,fill=white](R1){};
\node[rectangle,draw=\drawcolor,minimum height=67,minimum width=38,thick,fill=\filllcolor](R2){\Large 人工智能};
\node[circle,minimum size=8,below= 2pt of R2,inner sep=0pt,thick,fill=\filllcirclecolor]{};
\node[rectangle,fill=\filllcirclecolor,minimum height=1,minimum width=20,above= 4pt of R2,inner sep=0pt,thick]{};
%
 \end{scope}
     }
  }
}

\tikzset{mycylinder/.style={cylinder, shape border rotate=90, aspect=1.3, draw, fill=white,
minimum width=25mm,minimum height=11mm,line width=\Linewidth,node distance=-0.15},
pics/dataP/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=STREAMING,scale=\scalefac, every node/.append style={transform shape}]
\node[mycylinder,fill=\filllcolor!50] (A) {};
\node[mycylinder, above=of A,fill=\filllcolor!50] (B) {};
\node[mycylinder, above=of B,fill=\filllcolor!10] (C) {};
\fill[\filllcolor!50!black]($(C.west)!0.12!(C.east)$)circle(3pt);
\fill[\filllcolor!50!black]($(B.west)!0.12!(B.east)$)circle(3pt);
\fill[\filllcolor!50!black]($(A.west)!0.12!(A.east)$)circle(3pt);
%
\draw[draw=\drawcolor,line width=2.5*\Linewidth](B.east)--++(17mm,0);
\node[draw=\drawcolor,line width=\Linewidth,minimum width=9mm,fill=white,minimum height=22mm](BD)at($(B.east)+(8mm,0)$){};
\node[draw=\drawcolor,line width=\Linewidth,minimum width=5mm,minimum height=8mm,fill=white](BDM)at($(BD.east)+(5mm,0)$){};
\node[circle,draw=orange,line width=\Linewidth,minimum size=5mm]at($(BD.north)!0.2!(BD.south)$){};
\node[rectangle,draw=blue,line width=\Linewidth,minimum size=5mm]at($(BD.north)!0.5!(BD.south)$){};
\node[circle,draw=green,line width=\Linewidth,minimum size=5mm]at($(BD.north)!0.8!(BD.south)$){};
\end{scope}
     }
  }
}
%nodes
\tikzset{
pics/nodes/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[scale=\scalefac,every node/.append style={transform shape}]
\node[draw=white,fill=none,circle,minimum size=0.925*40mm,line width=1pt](CI){};
\draw[step=5mm,draw=white] (-2,-2) grid (2,2);
\foreach \x/\y[count=\a] in {-0.2/0.35,
0.7/0.6,-0.5/1.4,-1.20/-0.8,-0.1/-1.3,-0.4/-0.43,
0.61/-0.3,1/-0.85,0.45/1.2,-0.96/0.63}{
\node[circle,fill=myblue,draw=black,inner sep=0pt,minimum size=3mm](XB\a)at(\x,\y){};
}
\foreach \x/\y[count=\a] in {-2.0/0.1
}{
\node[circle,fill=myred,draw=black,inner sep=0pt,minimum size=3mm](XR\a)at(\x,\y){};
}
\foreach \x/\y[count=\a] in {1.87/0.1
}{
\node[circle,fill=mygreen,draw=black,inner sep=0pt,minimum size=3mm](XG\a)at(\x,\y){};
}
\foreach \x in {1,3,4,6,10}{
\draw[RedLine,line width=0.5pt](XR1) edge  (XB\x);
}
\foreach \x in {1,2,5,8,9}{
\draw[mygreen,line width=0.5pt](XG1) edge  (XB\x);
}
\foreach \x in {2,3,6,9,10}{
\draw[black,line width=0.5pt](XB1) edge  (XB\x);
}
\foreach \x in {4,5,7}{
\draw[black,line width=0.5pt](XB6) edge  (XB\x);
}
\draw[black,line width=0.5pt](XB4) edge  (XB5);
\draw[black,line width=0.5pt](XB3) edge  (XB9);
\foreach \x in {2,8}{
\draw[black,line width=0.5pt](XB7) edge  (XB\x);
}
\end{scope}
    }
  }
}
\tikzset {
pics/infras/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=CLO,scale=\scalefac, every node/.append style={transform shape}]
\draw[fill=\filllcolor,draw=\drawcolor!60,,line width=\Linewidth](0,0)to[out=170,in=180,distance=11](0.1,0.61)
to[out=90,in=105,distance=17](1.07,0.71)
to[out=20,in=75,distance=7](1.48,0.36)
to[out=350,in=0,distance=7](1.48,0)--(0,0);
\draw[draw=\drawcolor!60,,line width=\Linewidth](0.27,0.71)to[bend left=25](0.49,0.96);
%
\node[draw=black,fill=mygreen!30,line width=\Linewidth,minimum width=7mm,minimum height=6mm](VSK)at(0.7,0.1){};
\node[draw=black,fill=myblue!20,line width=\Linewidth,minimum width=4mm,minimum height=3mm](VSK0)at(0.7,0.1){};
\node[draw=black,fill=mypurple!30,line width=\Linewidth,minimum width=6mm,minimum height=5mm,
below=4.5mm of VSK](VSK1){};
\node[draw=black,fill=myorange!30,line width=\Linewidth,minimum width=6mm,minimum height=5mm,
right=3.0mm of VSK1](VSK2){};
\node[draw=black,fill=myred!40,line width=\Linewidth,minimum width=6mm,minimum height=5mm,
left=3.0mm of VSK1](VSK3){};
\draw[black,shorten >=-2pt,-{Circle[fill=white,length=5.5pt]},
line width=\Linewidth,rounded corners](VSK.240)--++(0,-2mm)-| (VSK3.center);
\draw[black,shorten >=-2pt,-{Circle[fill=white,length=5.5pt]},
line width=\Linewidth,rounded corners](VSK.300)--++(0,-2mm)-| (VSK2.center);
\draw[black,shorten >=-2pt,-{Circle[fill=white,length=5.5pt]},
line width=\Linewidth,rounded corners](VSK.270)-- (VSK1.center);
\end{scope}
}
}
}
\pgfkeys{
  /channel/.cd,
   Depth/.store in=\Depth,
  Height/.store in=\Height,
  Width/.store in=\Width,
  filllcirclecolor/.store in=\filllcirclecolor,
  filllcolor/.store in=\filllcolor,
  drawcolor/.store in=\drawcolor,
  drawcircle/.store in=\drawcircle,
  scalefac/.store in=\scalefac,
  Linewidth/.store in=\Linewidth,
  picname/.store in=\picname,
  filllcolor=BrownLine,
  filllcirclecolor=violet!20,
  drawcolor=black,
  drawcircle=violet,
  scalefac=1,
  Linewidth=0.5pt,
  Depth=1.3,
  Height=0.8,
  Width=1.1,
  picname=C
}
%Data Available
\node[Box, fill=white](B1){};
\pic[shift={(-0.56,-0.6)}] at  (B1){dataP={scalefac=0.56,picname=1,filllcirclecolor=violet!20,filllcolor=myorange, Linewidth=0.7pt}};
\draw[violet,line width=1.5pt](B1.south west)--coordinate(S1)(B1.south east);
\node[Box3,anchor=north,below= 0.2 of B1](T1){数据可用性};
%Algorithmic Innovations
\node[Box, right=of B1](B2){};
 \pic[shift={(0,0)}] at  (B2){nodes={scalefac=0.75,drawcolor=orange,filllcirclecolor=orange!20,filllcolor=orange}};
\draw[violet,line width=1.5pt](B2.south west)--coordinate(S2)(B2.south east);
\node[Box3,anchor=north,below= 0.2 of B2](T2){算法创新};
%Computing Infrastructure
\node[Box, right=of B2](B3){};
\pic[shift={(-0.70,0.1)}] at  (B3){infras={scalefac=1.0,filllcirclecolor=orange!80,drawcolor=BlueLine,
filllcolor=cyan!10,  Linewidth=1.0pt}};
\draw[violet,line width=1.5pt](B3.south west)--coordinate(S3)(B3.south east);
\node[Box3,anchor=north,below= 0.2 of B3](T3){计算基础设施};
%
\draw[Arr](T3)--++(0,-12mm)coordinate(DO)-|(T1);
\begin{scope}[on background layer]
\node[draw=myorange,inner sep=3mm,dashed,line width=1pt,fit=(T1)(B1)(B3)(DO)](F1){};
\node[myorange,anchor=south east,font=\small\sffamily\bfseries]at(F1.north east){关键突破};
\end{scope}
%
\draw[Arr](B1)--(B2);
\draw[Arr](B2)--(B3);
\end{tikzpicture}数据可用性提供了学习表示所需的大量样本。互联网和数字设备的兴起创造了丰富的新训练数据来源:图像分享平台提供了数百万张带标注的图像,数字文本集使大规模语言处理成为可能,传感器网络则持续生成源自现实世界的数据流。这些丰富的数据为神经网络有效学习复杂模式提供了所需的原材料。
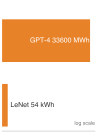
神经网络的发展史也是训练能耗规模爆炸式增长的历史。
算法创新将海量数据转化为可训练的系统。新的网络初始化方法和学习率控制方法使训练更加稳定。控制过拟合的技术改善了实测条件下的泛化能力。研究人员还记录了模型规模、计算量、数据量与性能之间的经验关系,推动了越来越宏大的架构设计,但有效的规模扩展区间仍取决于具体任务。
由此产生的工作负载催生了对更高吞吐量计算基础设施的需求,而计算基础设施也随之演进。在硬件方面,GPU 提供了高效执行神经网络计算所需的并行处理能力,张量处理单元(TPU)19 (Jouppi et al. 2023) 则进一步提升了性能。高带宽内存系统和高速互连应对了数据移动方面的挑战。软件的进步与硬件演进相互配合:框架和库简化了网络的构建与训练,分布式计算系统支持了大规模训练,模型部署优化工具则缩小了研究与生产之间的差距。
Jouppi, Norm, George Kurian, Sheng Li, Peter Ma, Rahul Nagarajan, Lifeng Nai, Nishant Patil, et al. 2023. “TPU v4: An Optically Reconfigurable Supercomputer for Machine Learning with Hardware Support for Embeddings.” Proceedings of the 50th Annual International Symposium on Computer Architecture, 1–14. https://doi.org/10.1145/3579371.3589350.
Checkpoint 1.1: 理解深度学习的兴起
在将这段历史与其对基础设施的影响联系起来之前,请检查自己是否理解深度学习兴起的原因:
如果其中任何概念仍不清楚,请先复习相关章节,再继续阅读。下文讨论的系统层面影响直接建立在这些概念基础之上。
数据可用性、算法创新与计算基础设施的汇聚,使神经网络从理论形式转变为占主导地位的生产工作负载。随着现代前沿模型不断逼近内存带宽、互连延迟和散热预算的限制,系统工程的关注点也从高层模型定义转向物理执行。要管理这些瓶颈,就需要考察在各个加速器上执行的具体数学原语与硬件数据流。
神经网络基础
现在的问题是,计算需求为什么会变得如此庞大。对于适合的神经网络工作负载,GPU 能够超越 CPU,是因为它为矩阵和张量运算提供了高并行吞吐量与数据复用能力,而不只是因为时钟频率。这些网络原语——神经元、层和非线性激活——的结构决定了数据如何流经硬件,以及训练和推理期间的内存需求如何扩展。理解这些运算,就能看清单个神经元上的简单算术如何累积为塑造现代人工智能的基础设施需求。
这里的概念适用于作为本章基础、并在许多更大型架构中反复出现的前馈神经网络。它们共有的基础是加权求和、非线性激活和基于梯度的学习。掌握这些运算及其计算特征,可以为分析更专门化的网络奠定基础;后续章节则会介绍这一简单模型未涵盖的算子与执行模式。
深度为何重要:层次化表示的力量
尝试对手写数字进行分类的单层网络,必须将原始像素直接映射到标签。当目标函数具有组合性时,更深的网络则可以利用层次结构。问题在于,深度为什么能提供这样的表示优势;这一问题的答案是后续所有数学推导的基础。
深度网络能够利用组合性:复杂模式可能分解为更简单的模式,而这些模式本身又可以进一步分解。在图像识别中,学到的表示可以从局部边缘和纹理逐步发展为部件和物体。这类层次化规律存在于许多数据集中,也为分层模型提供了依据,尽管训练后的网络未必会重现这一确切的序列。
以 MNIST 示例中对数字“7”的识别为例。单层网络将全部 784 个像素值直接映射为一个判定。当任务具有组合结构时,深度网络可以通过复用中间特征,以更高的参数效率计算这一判定:
- 第 1 层学习简单的边缘检测器:竖线、横线、斜向笔画
- 第 2 层将边缘组合为形状:“7”顶部的横向笔画、向下的斜向笔画
- 第 3 层将形状组合为完整的数字模式
每一层都建立在前一层的基础上,使后续计算能够复用先前的特征。当任务具有适当的组合结构时,这种层次结构的参数效率可以远高于浅层表示。为“7”学到的同一组边缘检测器,也能用于识别“1”“4”和其他数字。这种参数复用 有助于解释为什么深度是一种有效的设计选择,但并不意味着它对每个任务都具有固定的参数优势。不过,增加层数与加宽现有层这两种选择并不对称:深度和宽度通过不同机制增强表示能力。
生物视觉中的分层处理为层次模型提供了部分启发,但这并不意味着人工网络复现了相同的机制。网络架构 中研究的架构针对图像、序列和其他数据类型编码了不同的结构假设。深度解释了分层表示为何可能有用;其余机制则解释了如何实现这种层次结构。接下来的各节将阐述这些机制:神经元如何计算、层之间如何连接,以及信息如何从输入流向输出。
Systems Perspective 1.2: 深度与宽度的权衡
对于某些函数类,深度具有指数级的表示优势:具有 \(N_L\) 层的网络可以表示某些函数,而浅层网络要表示这些函数,则需要指数级更多的单元 (Telgarsky 2016)。这一适用范围有限的理论结果解释了非线性组合为何能够实现较高的参数效率;它并不是适用于所有任务的普遍保证。
然而,每增加一层,深度都会带来三项工程挑战:
- 增加顺序依赖(第 \(\ell+1\) 层等待第 \(\ell\) 层),限制并行性
- 增加梯度路径长度,带来梯度消失或梯度爆炸的风险
- 需要存储中间激活值以进行反向传播
现代架构会在深度与宽度之间取得平衡。一个具有十层、每层 100 个神经元的网络,与一个具有两层、每层 500 个神经元的网络,都拥有总计 1,000 个隐藏单元,但两者的参数量、函数类和执行图并不相同。两者在每层内部都提供并行性;更深的网络增加了顺序依赖,也可能更高效地表示某些具有组合性的函数。
Telgarsky, Matus. 2016. “Benefits of Depth in Neural Networks.” Proceedings of the 29th Annual Conference on Learning Theory, 1517–39.
网络架构基础
神经网络的架构决定了信息如何从输入流向输出。现代网络可以极其复杂,但它们都建立在少数几个组织原则之上,这些原则既影响实现方式,也决定其所需的计算基础设施。
手写数字识别为这些概念提供了具体示例,这里特指对 MNIST 数据集中的图像进行分类的任务 (LeCun et al. 1998)。这一看似简单的任务揭示了神经网络的所有核心原则,同时也为理解更复杂的应用提供了直觉。
从神经元的连接方式到层的组织方式,每一种架构选择都会形成特定的计算模式,而这些模式必须高效地映射到硬件上。网络架构与计算需求之间的这种映射,对于构建可扩展的机器学习系统至关重要。
Example 1.1: 贯穿示例:MNIST 数字识别
场景:部署一个基础的手写数字分类器,处理 \(28{\times}28\) 灰度图像,输出类别共 10 个。
诊断:本章贯穿使用的网络架构将 784 个原始像素特征依次映射到包含 128 和 64 个单元的隐藏层,最终得到 10 个输出,参数总量约为 10 万。
系统启示:在紧凑的数据集上检查输入向量维度和各层参数,可以在扩展到高维生产工作负载之前,确立计算和内存带宽需求的基线。
感知机的加权和
每个全连接层内部的计算机制都是一个感知机式人工神经元,其信号路径(输入、权重、偏置、聚合、激活)已在 section 1.2.5 中通过追溯其生物学起源加以介绍。接下来需要用数学形式描述这条路径,因为这一重复执行的运算将成为硬件执行的层级计算内核。在 MNIST 网络中,第一层的一个单元将全部 784 个像素强度组合为一个激活值,该激活值可能响应某种学得的模式,例如数字“1”和“7”共有的竖直边缘。从左到右观察 figure 11 :每个输入 \(x_i\) 与其对应的权重 \(w_{ij}\) 相乘,将这些乘积与偏置累加,再通过激活函数变换所得分数。不同神经元以不同的学习权重重复相同的结构,使一层能够针对同一个输入检测多种模式。
\scalebox{0.85}{
\begin{tikzpicture}[font=\sffamily]
\tikzset{%
  Line/.style={line width=1.0pt,black!50,text=black},
  Box/.style={inner xsep=3pt,
    node distance=0.4,
    circle,
    draw=GreenLine, line width=0.75pt,
    fill=GreenL,
    align=flush center,
    minimum width=8mm,
  },
}
%
\node[Box](B1){$w_{1j}$};
\node[Box,below=of B1](B2){$w_{2j}$};
\node[Box,below=of B2](B3){$w_{3j}$};
\node[Box,node distance=1.0,below=of B3](B4){$w_{ij}$};
\node[rotate=90,font=\tiny\sffamily]at($(B3)!0.5!(B4)$){$\bullet$ $\bullet$ $\bullet$};
\foreach \x in{1,...,3}{
\draw[Line,latex-](B\x)--++(180:2)node[left](X\x){$x_\x$};
}
\node[above=0.1 of B1,font=\sffamily\small](WE){权重};
\path[](WE)-|coordinate(IN)(X1);
\node[font=\sffamily\small]at(IN){输入};

\draw[Line,latex-](B4)--++(180:2)node[left](X4){$x_i$};
\node[rotate=90,font=\tiny\sffamily]at($(X3)!0.5!(X4)$){$\bullet$ $\bullet$ $\bullet$};
\node[Box,minimum width=12mm,right=2of $(B1)!0.5!(B4)$,
            fill=RedL,draw=RedLine](B5){$\sum$};
\foreach \x in{1,...,4}{
\draw[Line,-latex](B\x)--(B5);
}
%
\node[Box,node distance=1.3,rectangle, right=of B5,fill=BlueL,
            draw=BlueLine, minimum width=11mm, minimum height=11mm,
            font=\sffamily\huge](SI){$\sigma$};
\draw[Line,-latex](B5)--node[above]{$z$}(SI);
\draw[Line,latex-,font=\sffamily\small](B5)--
           node[right]{$b$}++(270:1.75)node[below,]{偏置};
\draw[Line,-latex](SI)--++(0:1.75)node[right](OU){$\hat{y}$};
\node[above=0.1 of OU,font=\sffamily\small]{输出};
\node[below=0.3 of SI,font=\sffamily\small,align=center]{激活\\ 函数};
\end{tikzpicture}}每个输入 \(x_i\) 都有一个对应的权重 \(w_{ij}\),感知机将各输入与对应权重相乘。中间输出 \(z\) 由输入的加权和计算得到,如 equation 1 所示: \[ z = \sum (x_i \cdot w_{ij}) \tag{1}\]
这里,当感知机组装成一层时,\(j\) 标识接收信号的神经元,求和遍历所有输入索引 \(i\)。简单来说,每个输入特征都按其重要性(即权重)进行缩放,再将结果汇总为一个分数。这就是两个向量的点积——硬件加速器旨在以最大吞吐量执行的基本运算,也是用每秒完成的 MAC 运算次数衡量神经网络性能的原因。
偏置项 \(b\) 将线性输出向上或向下平移,使模型能够更灵活地拟合数据。因此,感知机计算的、包含偏置的中间线性组合变为 equation 2 : \[ z = \sum (x_i \cdot w_{ij}) + b \tag{2}\]
得到这个加权和后,配合适当的输出激活函数和损失函数,就可以支持回归或分类。二元线性阈值分类器根据分数位于阈值哪一侧来选择两个类别之一;多分类网络则生成多个分数,通常使用 softmax 将其归一化。
按照前文确立的直接标量、无复用核算方式,一个神经元执行 \(N\) 次乘加运算,并搬运其输入、权重、偏置和输出。这一形式化描述进一步引入了层级视角。包含 \(M\) 个神经元的全连接层将加权求和重复 \(M\) 次,因此其算术成本为 \(M \times N\) 次 MAC——这恰好就是硬件必须执行的矩阵乘法 \(\mathbf{x}\mathbf{W}\),也是本章其余部分统计计算工作量所采用的形式。
非线性激活函数
激活函数是表达能力、梯度传播与硬件成本的交汇点。它们将线性加权和转换为非线性输出;如果没有激活函数,多个线性层会退化为单个线性变换,严重限制网络的表达能力。Figure 12 比较了三种常用的逐元素激活函数和一种向量级函数(softmax),它们各自的数学特性同时影响学习行为和执行成本。
\begin{tikzpicture}[line join=round,font=\sffamily\small]
\pgfplotsset{
    compat=1.15,
    MyStyle/.style={
        title style={yshift=-1mm},
        legend style={at={(0.17,0.88)}, anchor=south},
        legend cell align={left},
        axis x line=bottom,
        axis y line*=left,
        axis line style={thick},
        width=10cm,
        height=7cm,
        grid = major,
        major grid style={dashed},
        xlabel = {},
        tick style = {line width=1.0pt},
        tick align = inside,
        tick label style={/pgf/number format/assume math mode=true},
        ticklabel style={font=\footnotesize\sffamily,
},
   yticklabel style={ font=\footnotesize\sffamily,
  /pgf/number format/fixed,
  /pgf/number format/fixed zerofill,
  /pgf/number format/precision=2
},
    },
}

 \begin{scope}[local bounding box=GR1,shift={($(0,0)+(0,0)$)}]
 \begin{axis}[
        title = {Sigmoid 激活函数},
        MyStyle,
        ymin=-0.05, ymax=1.05,
        xmin=-10.5,xmax=10.75,
        xtick={-10.0,-7.5,-5,0,-2.5,0.0,2.5,5.0,7.5,10.0},]
        \addplot[
BlueLine,line width=2pt,
            domain = -10:10,
            samples = 100
        ]
            {1/(1+exp(-x))};
            \addlegendentry{Sigmoid}
    \end{axis}
    \end{scope}
 %
\begin{scope}[local bounding box=GR2,shift={($(0,0)+(10.5,0)$)}]
 \begin{axis}[
        title = {Tanh 激活函数},
        MyStyle,
        ymin=-1.1, ymax=1.1,
        xmin=-10.5,xmax=10.75,
        xtick={-10.0,-7.5,-5,0,-2.5,0.0,2.5,5.0,7.5,10.0},
        ytick={-1.00,-0.75,-0.5,-0.25,0.0,0.25,0.50,0.75,1.00},
    ]
        \addplot[
            OrangeLine,line width=2pt,
            domain = -10:10,
            samples = 100
        ]
           {tanh(x)};
           \addlegendentry{Tanh}
    \end{axis}
    \end{scope}
 %
 \begin{scope}[local bounding box=GR3,shift={($(0,0)+(0,-7)$)}]
 \begin{axis}[
        title = {ReLU 激活函数},
        MyStyle,
        ymin=-0.5, ymax=10.5,
        xmin=-10.5,xmax=10.75,
        xtick={-10.0,-7.5,-5,0,-2.5,0.0,2.5,5.0,7.5,10.0},
        ytick={0,2,4,6,8,10},
    ]
        \addplot[
            red,line width=2pt,
            domain = -10:10,
            samples = 100
        ]
          {max(0, x)};
          \addlegendentry{ReLU}
    \end{axis}
    \end{scope}
     %
 \begin{scope}[local bounding box=GR4,shift={($(0,0)+(10.5,-7)$)}]
 \begin{axis}[
        title = {Softmax 激活函数},
        MyStyle,
        ymin=-0.002, ymax=0.052,
        xmin=-10.5,xmax=10.75,
        xtick={-10.0,-7.5,-5,0,-2.5,0.0,2.5,5.0,7.5,10.0},
        ytick={0.000,0.005,0.010,0.015,0.020,0.025,0.030,0.035,0.040,0.045,0.050},
        scaled y ticks = false,
   yticklabel style={/pgf/number format/precision=3},
    ]
        \addplot[
            green!70!black,line width=2pt,
            domain = -10:10,
            samples = 100
        ]
           {exp(x)/(exp(13)+exp(0)+exp(x))};
           \addlegendentry{Softmax}
    \end{axis}
    \end{scope}
\end{tikzpicture}激活函数的选择同时影响学习与计算效率,体现了系统约束如何塑造算法设计。ReLU(\(\max(0, x)\))因计算成本低、对正输入的局部导数为一,以及能够产生稀疏激活,成为前馈网络中常用的隐藏层激活函数。早期的可微深度网络通常使用 sigmoid 或 tanh。它们平滑的 S 形曲线可能进入饱和区,导致梯度在跨越多层时逐渐缩小,阻碍靠前层的学习。这种差异并不意味着可以简单地给它们排序:sigmoid 仍适用于某些二元输出,tanh 在需要有界且以零为中心的激活值时仍然有用,而现代架构还使用其他激活函数族。相关的设计问题是:哪种函数能以可接受的执行成本,提供所需的输出语义和梯度行为。理解这些作用有助于解释 ReLU 为何得到广泛采用,而不必将其视为普遍适用的默认选择。
Sigmoid
逻辑 sigmoid 函数20将连续输入压缩到开区间 \((0,1)\) 内(equation 3): \[ \sigma(x) = \frac{1}{1 + e^{-x}} \tag{3}\]
这条 S 形曲线将 logit 映射到 \((0,1)\),因此 sigmoid 可以用于参数化二元事件的概率。对于较大的正输入,其输出趋近于一;对于绝对值较大的负输入,其输出趋近于零。尽管 sigmoid 处处平滑可微,但基于梯度的学习并不要求激活函数具备这一性质:ReLU 在零点使用指定的次梯度。
Sigmoid 有一个显著局限:当输入的绝对值较大(远离零)时,梯度会变得极小,这种现象称为梯度消失问题。21在反向传播过程中,这些小梯度在跨层传播时相乘,导致靠前层的梯度呈指数级缩小。由于权重更新变得微乎其微,这实际上会阻碍深度网络中的学习。
Sigmoid 的输出不以零为中心。当参与参数更新的输入也非负时,对应的权重梯度在符号上可能出现相关性,使优化轨迹更加曲折。完整梯度仍取决于上游误差,其符号并非总是相同。
Tanh
双曲正切函数22将输出激活值置于区间 \((-1,1)\) 内,并以零为中心(equation 4): \[ \tanh(x) = \frac{e^x - e^{-x}}{e^x + e^{-x}} \tag{4}\]
Tanh 产生一条与 sigmoid 类似但以零为中心的 S 形曲线:负输入映射为负输出,正输入映射为正输出。这种对称性使训练期间的梯度传播更加平衡,通常比 sigmoid 收敛更快。
与 sigmoid 一样,tanh 处处平滑可微,但在输入幅值较大时仍存在梯度消失问题。当函数饱和(趋近于 -1 或 1)时,梯度趋近于零。尽管存在这一局限,tanh 以零为中心的输出仍使其在许多架构的隐藏层中优于 sigmoid,尤其是在需要跨时间步保持激活值平衡的循环神经网络中。
Sigmoid 和 tanh 都有一个关键局限:在输入取极端值时出现梯度饱和。为寻找一种既能避免这一问题、又能保持计算效率的激活函数,研究者推动了深度学习中最重要的创新之一。
ReLU
ReLU23将负值置零,对正输入则保持线性恒等映射(equation 5): \[ \text{ReLU}(x) = \max(0, x) = \begin{cases} x & \text{if } x > 0 \\ 0 & \text{if } x \leq 0 \end{cases} \tag{5}\]
ReLU 的特征形状——正输入区间上的直线和负输入区间上的零输出——提供了三项优势。第一,对正输入的局部导数为一,避免了该分支上的激活饱和;完整网络的梯度仍可能因权重和其他运算而缩小或增大。第二,ReLU 通过将负值置零,引入确定性的激活稀疏性;这与 dropout 的随机掩蔽不同。24零值不会自动带来加速,因为普通的稠密计算内核仍会处理这些位置,除非实现能够利用稀疏性。第三,ReLU 使用比较与选择,即 output = (input > 0) ? input : 0,而非指数函数近似。这些都是算子的局部性质,而端到端性能取决于它如何与相邻计算融合。
ReLU 也存在缺点。ReLU 死亡问题是指神经元永久输出零并停止学习,当神经元陷入非激活状态时就会发生。如果训练过程中某个神经元的权重发生变化,使得预激活值 \(z = \mathbf{w}^T\mathbf{x} + b\) 对所有训练样本始终为负,那么该神经元对每个输入都输出零。由于 ReLU 对负输入的梯度也为零,反向传播时就没有梯度流经这个神经元:权重无法更新,神经元会一直处于死亡状态。当较大的学习率将权重推入不利区域时,就可能发生这种情况。从系统角度看,死亡神经元意味着容量浪费:这些参数在推理期间占用内存和计算资源,却对输出毫无贡献。精心初始化 (He et al. 2015)、适中的学习率以及带泄漏的 ReLU 变体有助于缓解 ReLU 死亡问题。批归一化25则通过稳定各层输入,使更高的学习率成为可能 (Ioffe and Szegedy 2015)。
Ioffe, Sergey, and Christian Szegedy. 2015. “Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift.” Proceedings of the 32nd International Conference on Machine Learning (ICML) 37: 448–56.
Softmax
与独立处理每个值的逐元素激活函数不同,softmax26是一种向量级函数:它同时考虑所有值,生成一个概率分布。在简单分类器中,softmax 通常用于输出层,而不是用作隐藏层的逐元素激活函数;在注意力架构中,它还用于对学习得到的重要性分数向量进行归一化。Softmax 函数定义见 equation 6 : \[ \text{softmax}(z_i) = \frac{e^{z_i}}{\sum_{j=1}^K e^{z_j}} \tag{6}\]
对于包含 \(K\) 个值(通常称为 logit27)的向量,softmax 将它们转换为 \(K\) 个总和为 1 的概率。figure 12 (右下角)展示了 softmax 输出的一个分量;实际使用中,softmax 处理整个向量,其中每个元素的输出都依赖于所有输入值。
在多类别分类器中,输出层通常使用 softmax。它将任意实数值的 logits 转换为归一化的预测概率,但这些值不一定是经过校准的置信度估计。概率最高的类别成为预测类别,而较大的 logits 会获得不成比例地更高的概率。
输入 logits 与输出概率之间的数学关系是可微的,因此在训练期间,梯度可以通过 softmax 反向传播。当与交叉熵损失(见 section 1.4.3)结合使用时,softmax 会产生特别简洁的梯度表达式,从而有效地引导学习。除数学性质外,激活函数的选择还会直接影响硬件效率。
Systems Perspective 1.3: 激活函数与硬件
ReLU 得到广泛采用,既源于其避免梯度消失的特性,也源于其硬件效率。计算 \(\max(0,x)\) 只需要一次比较操作,而 sigmoid 和 tanh 则需要计算指数函数,这类操作在时间和能耗方面的开销都高得多。section 1.3.2.3 中的晶体管税计算将这一差距建模为逻辑成本比,而 硬件加速 则讨论其对更广泛的基准测试和加速器实现的影响。
晶体管税:逻辑单元成本
激活函数的选择除了影响梯度行为,还涉及另一项成本:硅面积。在计算机体系结构中,逻辑单元成本 以晶体管数量和每次操作的能耗来衡量。
ReLU 数据通路可以通过比较和选择逻辑实现,而 sigmoid 或 tanh 则需要对超越函数进行近似,例如使用查找表或多项式求值。此处的示例假设为 ReLU 分配 50 个晶体管等效量,为高精度指数运算数据通路分配 2,500 个晶体管等效量。实际面积、延迟和能耗取决于精度、近似方法、共享方式、吞吐量目标以及硬件工艺。
这种示例中的差异就是晶体管税:在所述假设下,模型中 sigmoid 的硅面积“价格”为 ReLU 的 50×。这一具体比值并非硬件常数。具有长期意义的系统层面启示是:简单的分段线性激活函数通常比超越函数的实现成本更低,而 ReLU 的采用也反映了其优化行为和梯度流特性。
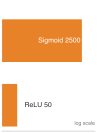
一个示例逻辑模型说明了为什么 ReLU 的实现成本通常更低。
这些变换将线性的输入加权和转换为非线性输出,得到 equation 7 中通用的人工神经元计算: \[ \hat{y} = f(z) = f\left(\sum (x_i \cdot w_{ij}) + b\right) \tag{7}\]
这种非线性扩展了多层网络的表示能力。如果没有非线性,无论实现时计算了多少个中间矩阵,堆叠的线性层在代数上都会退化为一次线性变换。在 figure 13 中,左图展示了一条无法分离各类别的线性边界,右图则展示了一条曲线边界,具有非线性激活函数和适当学习参数的多层网络能够表示这样的边界。该图说明的是表示上的可能性,并不保证训练一定会找到这条边界。优化、数据覆盖范围和架构仍然决定了学习所得参数最终产生的函数。
\scalebox{0.7}{
 \begin{tikzpicture}[line join=round,font=\sffamily]
\newcounter{point}
\tikzset{
  circ/.pic={
    \pgfkeys{/circ/.cd, #1}
%red
\foreach \x/\y in{0.4/0.77,0.39/1.46,0.39/2.02,0.37/2.52,0.37/2.95,0.47/3.35,
0.84/0.42,0.68/1.09,0.7/1.72,0.74/2.36,0.77/2.78,0.85/3.18,1.16/3.44,
1.37/0.36,1.14/0.82,1.08/1.47,1.02/1.97,1.45/2.10,1.16/2.39,1.26/2.9,1.56/3.3,
1.89/2.37,1.64/2.7,2.09/2.96,2.00/3.37,
2.57/2.33,3.08/2.2,3.42/2.42,3.25/3.06,2.96/2.75,2.48/2.73,2.71/3.13,
2.44/3.44,3.07/3.48
}{
 \stepcounter{point} % We increment the counter for each iteration
\fill[draw=none,fill=\bballcolor](\x,\y)circle[radius=5.5pt];
%\node[font=\tiny\sffamily,blue] at (\x,\y) {C\arabic{point}};
\coordinate(C\arabic{point})at(\x,\y);
}
%blue
\foreach \x/\y in {1.83/0.36,2.29/0.35,2.71/0.35,3.38/0.35,
3.4/0.8,3.39/1.35,3.41/1.90,3.07/1.62,2.59/1.82,2.19/1.98,
1.79/1.67,1.52/1.25,1.66/0.80,2.13/0.72,2.63/0.74,3.04/0.59,
3.02/0.99,2.72/1.28,2.29/1.48,1.95/1.15,2.36/1.07}
{
    \stepcounter{point} %We increment the counter for each iteration
\fill[draw=none,fill=\bballcolorr](\x,\y)circle[radius=5.5pt];
%\node[font=\tiny\sffamily,red] at (\x,\y) {P\arabic{point}};
\coordinate(P\arabic{point})at(\x,\y);
}
  } }

\pgfkeys{
  /circ/.cd,
  bballcolor/.store in=\bballcolor,
  bballcolorr/.store in=\bballcolorr,
  bballcolor=red,      % default ball1 color
  bballcolorr=blue,      % default ball2 color
}
%LEFT
\begin{scope}[local bounding box=CIRC1,shift={(0,0)}]
\pic at (0,0) {circ={bballcolor=Cerulean,bballcolorr=LimeGreen}};
%fitting
\node[draw=black,inner xsep=4mm,inner ysep=3mm,
fill=none,fit=(C6)(P38)(C34),line width=1.75pt](BB1){};
\draw[red,line width=2pt]($(BB1.south west)!0.18!(BB1.south east)$)--
             ($(BB1.north east)!0.12!(BB1.south east)$);
\node[align=center,below=0.1 of BB1]{不使用激活函数的神经网络};
\end{scope}
%RIGHT
\begin{scope}[local bounding box=CIRC2,shift={(6,0)}]
\pic at (0,0) {circ={bballcolor=Cerulean,bballcolorr=LimeGreen}};
%fitting
\node[draw=black,inner xsep=4mm,inner ysep=3mm,
yshift=0mm,fill=none,fit=(C61)(P93)(C89),line width=1.75pt](BB2){};
\draw[red,line width=2pt]($(BB2.south west)!0.4!(BB2.south east)$)
to[out=90,in=270]($(C69)!0.5!(P90)$)
to[out=90,in=280]($(C70)!0.5!(P102)$)
to[out=110,in=240]($(C71)!0.5!(P101)$)
to[out=70,in=220]($(C73)!0.5!(P100)$)
to[out=30,in=200]($(C77)!0.5!(P99)$)
to[out=30,in=160]($(C81)!0.5!(P98)$)
to[out=340,in=220]($(C82)!0.5!(P96)$)
to[out=60,in=210]($(C83)!0.5!(P96)$)
to($(BB2.north east)!0.4!(BB2.south east)$);
\node[align=center,below=0.1 of BB2]{使用激活函数的神经网络};
\end{scope}
\end{tikzpicture}}通用近似定理28 表明,具有适当激活函数且足够宽的网络,可以以任意高的精度近似广泛类别的函数。这一理论基础,结合 ReLU 和 sigmoid 等特定激活函数的计算与优化特性,解释了神经网络在复杂任务中的实际有效性。然而,该定理是在宽度不受限制的假设下给出的纯粹存在性结论;它并未涉及执行计算的加速器。物理机器学习系统对宽度与深度权衡的两个维度都施加了硬性限制:一个足够宽、能够近似复杂函数的单隐藏层,其参数存储和激活值内存需求可能耗尽加速器的全部显存;而网络过深、其激活值无法装入内存时,反向传播也会因同样的约束而停滞。因此,工程问题并不在于足够宽或足够深的网络是否存在,而在于它是否能满足目标硬件的内存容量和带宽约束。
层与连接
单个神经元计算加权和、加上偏置项,并将结果传入激活函数。然而,神经网络的能力来自将这些神经元组织为层,即针对共享输入并行执行的一组单元。输入层 接收原始特征张量;一个或多个隐藏层 通过连续的矩阵乘法和非线性激活来变换这些表示;输出层 则输出针对特定任务的预测或决策 logits。
在 figure 14 中,数据从输入层进入,经过多个逐步提取更抽象特征的隐藏层,最终在输出层形成预测。后续各层依次变换表示,构建越来越复杂的特征;这种层次化处理流水线赋予了深度神经网络学习复杂模式的能力。
\begin{tikzpicture}[line join=round,font=\sffamily\small]
\tikzset{%
Line/.style={line width=0.35pt,black!60,-latex}
}

\tikzset{
  box/.pic={
    \pgfkeys{/box/.cd, #1}
\foreach \x in {1,...,\columns}{
    \foreach \y in {1,...,\rows}{
        %
        \node[draw=black, fill=\ffill, minimum width=\cellsize,
                    minimum height=\cellheight, line width=\Linewidth] (cell-\x-\y\br) at (\x*\cellsize,-\y*\cellheight) {};
    }
}
 } }

\pgfkeys{
  /box/.cd,
  cellsize/.store in=\cellsize,
  linewidth/.store in=\Linewidth,
  cellheight/.store in=\cellheight,
  columns/.store in=\columns,
  br/.store in=\br,
  ffill/.store in=\ffill,
  rows/.store in=\rows,
  columns=1,
  rows=3,
  br=A,
  ffill=red,
  cellsize=5mm,
  cellheight=5mm,
  linewidth=0.75pt
}

\pic at (0,0) {box={columns=1,rows=4,br=A,ffill=Thistle!30,linewidth=1.5pt}};
\pic at (3.0,16mm) {box={columns=1,rows=10,br=B,ffill=Dandelion!40}};
\pic at (6,11mm) {box={columns=1,rows=8,br=C,ffill=red!20}};
\pic at (9.0,21mm) {box={columns=1,rows=12,br=D,ffill=Cerulean!40}};
\pic at (12,11mm) {box={columns=1,rows=8,br=E,ffill=green!30}};
\pic at (15,-4mm) {box={columns=1,rows=2,br=F,ffill=Thistle!30,linewidth=1.5pt}};

\foreach \x in {1,...,4}{
    \foreach \y in {1,...,10}{
\draw[Line](cell-1-\x A.east)--(cell-1-\y B.west);
}}

\foreach \x in {1,...,10}{
    \foreach \y in {1,...,8}{
\draw[Line](cell-1-\x B.east)--(cell-1-\y C.west);
}}

\foreach \x in {1,...,8}{
    \foreach \y in {1,...,12}{
\draw[Line](cell-1-\x C.east)--(cell-1-\y D.west);
}}

\foreach \x in {1,...,8}{
    \foreach \y in {1,...,2}{
\draw[Line](cell-1-\x E.east)--(cell-1-\y F.west);
}}

\node[font=\Large]at($(cell-1-6D.south east)!0.5!(cell-1-4E.south west)$){$\bullet$ $\bullet$ $\bullet$};
\path[](cell-1-1B.north west)--++(90:0.5)coordinate(L)-|coordinate(D)(cell-1-1E.north east);
\draw[thick,decoration={brace,amplitude=11pt},decorate](L)--node[above=9pt](HL){隐藏层}(D);

\path(HL)-|node[]{输入层}(cell-1-1A);
\path(HL)-|node[]{输出层}(cell-1-1F);
\end{tikzpicture}数据流经网络时,会在每一层发生变换,以提取有意义的模式。前面针对单个神经元介绍的加权求和与激活过程,在层级上得到扩展:每一层在其所有神经元上并行执行这些操作,一层的输出成为下一层的输入。由此形成一个层次化流水线,早期层检测到的简单特征在更深层组合为越来越复杂的模式,使神经网络能够从原始数据中学习复杂的表示。
参数与连接
神经网络的可学习参数29,即权重和偏置,决定了信息如何在网络中流动,以及如何对输入数据施加变换。它们的组织方式直接影响学习能力和计算需求。
权重矩阵
权重 决定输入对神经元输出的影响强度。在稠密层中,这些权重被组织为矩阵,能够高效地映射到线性代数计算内核。对于具有 \(n\) 个输入特征和 \(m\) 个神经元的层,权重构成矩阵 \(\mathbf{W} \in \mathbb{R}^{n \times m}\),其中每一列表示一个神经元的权重。矩阵与向量的乘积处理单个输入,而矩阵与矩阵的乘积处理一批输入,并能提供更多并行计算和数据复用的机会。
对于单个神经元,激活前值是标量点积 \(z = \sum_{i=1}^n (x_i \cdot w_{ij}) + b\)。对于包含 \(m\) 个神经元的层,独立计算各单元会浪费 SIMD 向量化和缓存复用的机会。将该层表述为矩阵乘法,就能通过一次稠密线性代数调用计算全部 \(m\) 个激活前值(equation 8): \[ \mathbf{z} = \mathbf{x}\mathbf{W} + \mathbf{b} \tag{8}\]
该方程计算单个输入对应的所有神经元的激活前值:向量 \(\mathbf{x}\) 与权重矩阵 \(\mathbf{W}\) 相乘,产生全部 \(m\) 个值,偏置向量 \(\mathbf{b}\) 则对每个值进行平移。对于一个批次,输入变为矩阵,同一层的计算也变为矩阵与矩阵的乘积。这些计算内核承担了稠密前馈网络中的大部分计算工作,但它们是否主导运行时间,以及它们受计算限制还是受内存限制,取决于其维度、批量大小、精度、实现方式和目标硬件。
这种矩阵组织方式不仅是数学上的便利,也反映了现代神经网络为实现高效率而采用的实现方式。每个权重 \(w_{ij}\) 表示输入特征 \(i\) 与该层神经元 \(j\) 之间的连接强度。
这里研究的典型情形将一层中的每个神经元与前一层的每个神经元相连,形成“稠密”或“全连接”层。这种模式使每个神经元都能使用前一层的全部特征。全连接层奠定了此处所需的数学原理,而其他连接模式(见 网络架构)则利用数据中的结构,可以减少计算工作量或提高统计效率。
Figure 15 展示了一个小型三层网络,并标注每条连接的权重,从而明确呈现稠密连接模式。每个输入都连接到每个隐藏神经元,每个隐藏神经元都连接到每个输出。每条带标签的边表示一个可学习权重,使参数数量和运算结构清晰可见。可以逐个观察目标神经元:其入边构成前一个权重矩阵的一列,而其偏置对所得加权和进行平移。将所有目标神经元一起观察,就能看出其中的矩阵运算。数值标签仅用于示意,并非一次完整的前向传播计算;关键关系在于矩阵形状。对于大小分别为 \((n_1, n_2, n_3)\) 的各层,权重矩阵为 \(\mathbf{W}^{(1)} \in \mathbb{R}^{n_1 \times n_2}\) 和 \(\mathbf{W}^{(2)} \in \mathbb{R}^{n_2 \times n_3}\),在不计偏置时需要 \(n_1n_2+n_2n_3\) 个权重。
\scalebox{0.78}{\begin{tikzpicture}[font=\small\sffamily]
\definecolor{Blue}{RGB}{0,195,240}
  \tikzstyle{neuron}=[rectangle,draw=none,fill=BlueFill,minimum size=10mm,inner sep=0pt]
  \tikzstyle{input neuron}=[neuron, fill=GreenFill];  \tikzstyle{output neuron}=[neuron, fill=red!50];
  \tikzstyle{hidden neuron}=[neuron, fill=Blue,node distance=0.9];
  \tikzstyle{annot} = [sloped,text centered,text=black,midway,fill=white,inner sep=2pt,
                    font=\fontsize{7pt}{7}\selectfont\sffamily]
  \tikzstyle{arrowR} = [line width=1.0pt,-latex,olive]
  \tikzstyle{arrowB} = [line width=1.0pt,-latex,RedLine]
  \tikzstyle{unutra} = [draw=yellow,regular polygon,line width=0.75pt, regular polygon sides=7,
                                     minimum size=10mm]
\tikzstyle{arrowC} = [line width=1.0pt,latex-,olive]
%
\node[hidden neuron] (H1) {.8337};
\node[hidden neuron,below=of H1] (H2) {.8764};
\node[hidden neuron,below=of H2] (H3) {.9087};
\node[hidden neuron,below=of H3] (H4) {.9329};
\node[input neuron,left=5 of $(H1)!0.25!(H2)$] (0H1) {1.0};
\node[input neuron,left=5 of $(H2)!0.5!(H3)$] (0H2) {5.0};
\node[input neuron,left=5 of $(H3)!0.75!(H4)$] (0H3) {9.0};

\node[output neuron,right=5 of $(H1)!0.5!(H2)$] (3H1) {.4886};
\node[output neuron,right=5 of $(H3)!0.5!(H4)$] (3H2) {.5114};
%
\draw[arrowR](0H1)--node[annot]{$w^{(1)}_{00}=0.01$} (H1);
\draw[arrowR](0H1)--node[annot,pos=0.15]{0.02}(H2);
\draw[arrowR](0H1)--node[annot,pos=0.15]{0.03}(H3);
\draw[arrowR](0H1)--node[annot,pos=0.1]{0.04}(H4);
%
\draw[arrowR](0H2)--node[annot,pos=0.12]{0.05}(H1);
\draw[arrowR](0H2)--node[annot,pos=0.15]{0.06}(H2);
\draw[arrowR](0H2)--node[annot,pos=0.15]{0.07}(H3);
\draw[arrowR](0H2)--node[annot,pos=0.12]{0.08}(H4);
%
\draw[arrowR](0H3)--node[annot,pos=0.12]{0.09}(H1);
\draw[arrowR](0H3)--node[annot,pos=0.12]{0.10}(H2);
\draw[arrowR](0H3)--node[annot,pos=0.12]{0.11}(H3);
\draw[arrowR](0H3)--node[annot,pos=0.5]{$w^{(1)}_{23}=0.12$}(H4);
%
\draw[arrowB](H1)--node[annot]{$w^{(2)}_{00}=0.17$} (3H1);
\draw[arrowB](H1)--node[annot,pos=0.12]{0.18} (3H2);
%
\draw[arrowB](H2)--node[annot,pos=0.12]{0.19} (3H1);
\draw[arrowB](H2)--node[annot,pos=0.12]{0.20} (3H2);
%
\draw[arrowB](H3)--node[annot,pos=0.12]{0.21} (3H1);
\draw[arrowB](H3)--node[annot,pos=0.12]{0.22} (3H2);
%
\draw[arrowB](H4)--node[annot,pos=0.12]{0.23} (3H1);
\draw[arrowB](H4)--node[annot,pos=0.5]{$w^{(2)}_{31}=0.24$} (3H2);
%%
\draw[arrowC](H1.150)--++(160:0.35)
   node[left,inner sep=1pt,text=black,
    font=\fontsize{7pt}{7}\selectfont\sffamily]{$b^{(1)}_0=0.13$};
\draw[arrowC](H2.80)--++(130:0.35)
   node[above,inner sep=1pt,text=black,
    font=\fontsize{7pt}{7}\selectfont\sffamily]{0.14};
\draw[arrowC](H3.80)--++(130:0.35)
    node[above,inner sep=1pt,text=black,
     font=\fontsize{7pt}{7}\selectfont\sffamily]{0.15};
\draw[arrowC](H4.210)--++(200:0.35)
    node[left,inner sep=1pt,text=black,
     font=\fontsize{7pt}{7}\selectfont\sffamily]{$b^{(1)}_3=0.16$};
%
\draw[arrowC,RedLine](3H1.70)--++(60:0.35)
              node[above,inner sep=1pt,text=black,
               font=\fontsize{7pt}{7}\selectfont\sffamily]{$b^{(2)}_0=0.25$};
\draw[arrowC,RedLine](3H2.70)--++(60:0.35)
              node[above,inner sep=1pt,text=black,
               font=\fontsize{7pt}{7}\selectfont\sffamily]{$b^{(2)}_1=0.26$};
%
\node[above=0.3 of H1,BlueLine](HL){隐藏层};
\path[red](HL)-|coordinate(OL)(3H1);
\path[red](HL)-|coordinate(IL)(0H1);
\node[green!40!black!90]at(IL){输入层};
\node[red]at(OL){输出层};
\end{tikzpicture}}偏置项
层中的每个神经元还具有一个对应的偏置项30。权重决定输入的相对重要性,而偏置使神经元能够平移其激活函数。这种平移对学习很重要,因为它赋予网络拟合更复杂模式的灵活性。
对于具有 \(m\) 个神经元的层,偏置项构成向量 \(\mathbf{b} \in \mathbb{R}^m\)。在该层执行期间,这个偏置向量被加到输入的加权和上(形式与 equation 8 相同),从而独立地平移每个神经元的激活阈值: \[ \mathbf{z} = \mathbf{x}\mathbf{W} + \mathbf{b} \]
前馈网络中权重和偏置的组织遵循系统性的模式。对于每个参数化仿射层 \(\ell\),其计算由三个组成部分定义;权重和偏置通过学习获得,而激活函数通常由设计者选择:
- 权重矩阵 \(\mathbf{W}^{(\ell)}\)
- 偏置向量 \(\mathbf{b}^{(\ell)}\)
- 激活函数 \(f^{(\ell)}\)
由此得到 equation 9 中完整的层计算: \[ \mathbf{a}^{(\ell)} = f^{(\ell)}(\mathbf{z}^{(\ell)}) = f^{(\ell)}(\mathbf{a}^{(\ell-1)}\mathbf{W}^{(\ell)} + \mathbf{b}^{(\ell)}) \tag{9}\]
这里,\(\mathbf{a}^{(\ell)}\)(对于批量数据写作 \(\mathbf{A}^{(\ell)}\))表示该层的激活输出。全文采用行向量约定:每个样本占一行,权重矩阵 \(\mathbf{W}^{(\ell)} \in \mathbb{R}^{n_{\ell-1} \times n_\ell}\) 将前一层的宽度映射到当前层的宽度。有了这个方程,核心架构概念已足够完整,可以继续讨论。
Checkpoint 1.2: 神经网络架构基础
在继续讨论网络拓扑和训练之前,请检查自己对基础概念的理解:
以 MNIST 架构 784 → 128 → 64 → 10 作为贯穿自检的示例。
如果其中任何一点仍不清楚,请先回顾前面关于神经网络基础、人工神经元和参数的章节,再继续阅读。接下来关于训练和优化的章节将直接建立在这些基础之上。
架构设计
架构设计决定各个神经元、激活函数和权重矩阵如何连接,以解决任何单层都无法处理的问题。这种设计会直接影响系统,因为每一种拓扑选择(增加一层、扩大隐藏维度、改变连接方式)都会改变参数量、内存占用和算术运算成本。
网络拓扑描述各个神经元如何组织成层,并通过连接构成完整的神经网络。建立直觉可以从一个在人工智能历史上广为人知的简单问题开始。31
异或示例说明了引入隐藏层的必要性,但实际网络还需要系统地考虑设计约束和计算规模。使用 MNIST (LeCun et al. 1998) 数据集识别手写数字,可以说明问题结构如何决定网络维度,同时隐藏层配置仍是一项重要的设计决策。
Example 1.2: 建立直觉:异或问题
考虑一个学习异或函数的网络,这是一个需要非线性的经典问题。输入 \(x_1\) 和 \(x_2\) 可以取 0 或 1;当输入不同时,异或输出 1,当输入相同时,输出 0。
设置:两个输入 → 两个隐藏神经元 → 一个输出
示例:对于输入 \((1, 0)\):
- 隐藏神经元一:\(h_1 = \text{ReLU}(1 \cdot w_{11} + 0 \cdot w_{12} + b_1)\)
- 隐藏神经元二:\(h_2 = \text{ReLU}(1 \cdot w_{21} + 0 \cdot w_{22} + b_2)\)
- 输出:\(y = \text{sigmoid}(h_1 \cdot w_{31} + h_2 \cdot w_{32} + b_3)\)
系统洞见:隐藏层不仅增加容量,还会改变系统能够表示的函数类别。异或这个简单示例表明,深度可以是一项结构性要求,而非仅用于点缀的设计选择 (Minsky and Papert 1969)。
Minsky, Marvin, and Seymour A. Papert. 1969. Perceptrons: An Introduction to Computational Geometry. The MIT Press.
前馈网络架构
将三层架构应用于 MNIST,可以揭示数据特征和任务要求如何约束网络设计。比较 figure 16 中的两个子图,可以从两种视角观察该架构:子图 (a) 示意性地展示了一幅 \(28{\times}28\) 像素的灰度图像如何连接到隐藏层和输出层,而子图 (b) 展示了将相同数值重塑为 784 维特征向量后的形式。矩阵乘法可以作用于多维数组,但这个全连接层为每一对输入特征与隐藏单元定义一个权重,因此其参数化形式并不保留图像的各个轴。相比之下,网络架构 中探讨的卷积架构会直接编码空间局部性。
输入层的宽度由数据格式直接决定。对于一幅 28 乘 28 像素的图像,每个像素成为一个输入特征,因此需要 784 个输入神经元。等价地,28 行和 28 列展平后得到 784 个数值。数据既可以表示为二维空间像素网格,也可以表示为展平后的一维向量,其中每个数值表示一个像素的强度。
输出层的结构由任务要求决定。对于 10 类数字识别,最后一层设置 10 个输出神经元,每个神经元对应一个可能的数字(0–9)。输入一幅图像后,网络会为每个输出神经元生成一个分数;随后可以通过 softmax 将这些 logits 转换为预测的类别概率。
在这些固定的输入层和输出层之间,隐藏层拓扑的设计具有灵活性。隐藏层结构的选择,包括使用多少层以及各层的宽度,是神经网络的关键设计决策之一。增加层数会增加网络深度,使其能够通过连续变换学习更抽象的特征。每层的宽度则为在各个抽象层次上学习不同特征提供容量。
将隐藏层从 100 个神经元扩宽到 1000 个,会使参数量从约 89.6K 增加到约 1.8M(采用 FP32 时,存储占用分别约为 358 KB 和 7 MB)。更宽的网络能否提高准确率,需要通过训练和评估确定;仅存储占用的增加就已对移动端部署的资源预算产生重要影响。
\begin{tikzpicture}[line join=round,font=\sffamily]
 \tikzset{%
   mycycleR/.style={circle, draw=none, fill=Red, minimum width=8mm,node distance=0.4},
   LineA/.style={line width=2pt,violet!30,text=black,{Triangle[width=1.1*6pt,length=2.0*6pt]}-{Triangle[width=1.1*6pt,length=2.0*6pt]}},
   Line/.style={line width=0.5pt,BrownLine!50}
}
%circles sty
\tikzset{
  circles/.pic={
    \pgfkeys{/channel/.cd, #1}
\node[circle,draw=\channelcolor,line width=1pt,fill=\channelcolor!10,
minimum size=3mm](\picname){};
        }
}

\tikzset{
  channel/.pic={
    \pgfkeys{/channel/.cd, #1}
\begin{scope}[yscale=\scalefac,xscale=\scalefac,every node/.append style={scale=\scalefac}]
\node[rectangle,draw=\drawchannelcolor,line width=1pt,fill=\channelcolor!10,
minimum width=46,minimum height=56](\picname){};
\end{scope}
        }
}

\pgfkeys{
  /channel/.cd,
  channelcolor/.store in=\channelcolor,
  drawchannelcolor/.store in=\drawchannelcolor,
  scalefac/.store in=\scalefac,
  picname/.store in=\picname,
  channelcolor=BrownLine,
  drawchannelcolor=BrownLine,
  scalefac=1,
  picname=C
}
  \def\data{
    % 28-by-28 = 784 pixel values (shown here as a 20-row excerpt)
       0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,
       0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,
       0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,
       0,0,0,0,0,0,255,255,255,255,255,255,255,255,255,255,255,255,255,255,255,255,0,0,0,0,0,0,0,
       0,0,0,0,0,0,255,255,255,255,255,255,255,255,255,255,255,255,255,255,255,255,0,0,0,0,0,0,0,
       0,0,0,0,0,0,255,255,0,0,0,0,0,0,0,0,0,0,255,255,255,255,0,0,0,0,0,0,0,
       0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,255,255,255,255,0,0,0,0,0,0,0,0,
       0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,255,255,255,255,0,0,0,0,0,0,0,0,0,
       0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,255,255,255,255,0,0,0,0,0,0,0,0,0,0,
       0,0,0,0,0,0,0,0,0,0,0,0,0,0,255,255,255,255,0,0,0,0,0,0,0,0,0,0,0,
       0,0,0,0,0,0,0,0,0,0,0,0,0,255,255,255,255,0,0,0,0,0,0,0,0,0,0,0,0,
       0,0,0,0,0,0,0,0,0,0,0,0,255,255,255,255,0,0,0,0,0,0,0,0,0,0,0,0,0,
       0,0,0,0,0,0,0,0,0,0,0,255,255,255,255,0,0,0,0,0,0,0,0,0,0,0,0,0,0,
       0,0,0,0,0,0,0,0,0,0,255,255,255,255,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,
       0,0,0,0,0,0,0,0,0,255,255,255,255,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,
       0,0,0,0,0,0,0,0,255,255,255,255,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,
       0,0,0,0,0,0,0,255,255,255,255,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,
       0,0,0,0,0,0,255,255,255,255,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,
       0,0,0,0,0,0,255,255,255,255,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,
       0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0
  }
%%%%
\begin{scope}[local bounding box=AFIG]
\begin{scope}[local bounding box=BIT,scale=7.5]
  \pgfmathsetmacro{\w}{29} % width
  \pgfmathsetmacro{\h}{20} % height
  \foreach \i [count=\n from 0] in \data {
    \pgfmathtruncatemacro{\x}{mod(\n,\w)}
    \pgfmathtruncatemacro{\y}{\h - 1 - int(\n/\w)}
    \pgfmathsetmacro{\percent}{100 - (\i / 255.0 * 100)} % skala u [0,100]
    %\fill[black!\percent!white] (\x,\y) rectangle ++(1,-1);
\def\px{0.01} % pixel width
\def\py{0.013} % pixel height

\fill[black!\percent!white] ({\x*\px},{\y*\py}) rectangle ++(\px,-\py)coordinate(P\n);
  }

\fill[green](P39)circle(0.1pt);
\end{scope}

\draw[LineA,shorten <=-3mm,shorten >=-3mm]([yshift=5mm]BIT.north west)--node[above]{28 像素}([yshift=5mm]BIT.north east);
\draw[LineA,shorten <=-3mm,shorten >=-3mm]([xshift=-5mm]BIT.north west)--node[left]{28 像素}([xshift=-5mm]BIT.south west);

\begin{scope}[local bounding box=CIRCLES1,shift={($(0,0)+(3.3,0.4)$)}]
\foreach \i in {1,...,20} {
  \pgfmathsetmacro{\y}{(11.5-\i)*0.5}
  \pic at (0,\y) {circles={channelcolor=VioletLine,picname=1CI\i,}};
}
\end{scope}

\begin{scope}[local bounding box=CIRCLES1,shift={($(0,0)+(6.5,0)$)}]
\foreach \i in {1,...,10} {
  \pgfmathsetmacro{\y}{(6.5-\i)*0.5}
  \pic at (0,\y) {circles={channelcolor=VioletLine,picname=2CI\i}};
}
\foreach \i in {1,...,7,9,10} {
 \node[right=1mm of 2CI\i]{0};
  \node[right=1mm of 2CI8]{1};
 }
\end{scope}

\foreach \i in {1,...,20} {
\foreach \j in {1,...,10} {\draw[Line](1CI\i)--(2CI\j);
}}
\end{scope}
\node[below=2mm of AFIG,font=\Large]{a)};
%%%%%%%%%%%
%RIGHT
%%%%%%%%%%%

\begin{scope}[local bounding box=BFIG,shift={($(AFIG)+(10.50,0)$)}]
 \begin{scope}[local bounding box=PIXG,shift={(0,5)}]
 \def\rows{18}
  \def\cols{0}
  \def\lastrows{18}  % number of rows in last column
  \def\xsize{0.55}
  \def\ysize{0.4}

  \foreach \j in {0,...,\cols} {
      \foreach \i in {0,...,\rows} {
        % Random blend: 30–60
        \pgfmathsetmacro\blend{rnd*99 + 0}
        %
          \draw[draw=black,fill=black!\blend!white] (\j*\xsize, -\i*\ysize) rectangle ++(\xsize, -\ysize);
    }
  }
 \coordinate (1topLeft) at (0, 0);
\pgfmathsetmacro\ycoord{-\rows*\ysize - \ysize}
\pgfmathsetmacro\xcoord{\cols*\xsize + \xsize}
\coordinate (1bottomLeft) at (0,{\ycoord});
\coordinate (1topRight) at ({\xcoord},0);
\coordinate (1bottomRight) at (\xcoord,\ycoord);
\end{scope}
 \begin{scope}[local bounding box=PIXD,shift={(0,-3.5)}]
 \def\rows{3}
  \def\cols{0}
  \def\lastrows{19}
  \def\xsize{0.55}
  \def\ysize{0.4}

  \foreach \j in {0,...,\cols} {
      \foreach \i in {0,...,\rows} {
        % Random blend: 0–99
        \pgfmathsetmacro\blend{rnd*99 + 0}
        %
          \draw[draw=black,fill=black!\blend!white] (\j*\xsize, -\i*\ysize) rectangle ++(\xsize, -\ysize);
    }
  }
\coordinate (2topLeft) at (0, 0);
\pgfmathsetmacro\ycoord{-\rows*\ysize - \ysize}
\pgfmathsetmacro\xcoord{\cols*\xsize + \xsize}
\coordinate (2bottomLeft) at (0,{\ycoord});
\coordinate (2topRight) at ({\xcoord},0);
\coordinate (2bottomRight) at (\xcoord,\ycoord);
\end{scope}

\draw[LineA,shorten <=-3mm,shorten >=-3mm]([yshift=3mm]1topLeft)--node[above]{}([yshift=3mm]1topRight);
\draw[LineA,shorten <=-3mm,shorten >=-3mm]([xshift=-5mm]1topLeft)--node[left]{784}([xshift=-5mm]2bottomLeft);
%%
\begin{scope}[local bounding box=CIRCLES2,shift={($(0,0)+(3.3,-0.55)$)}]
\foreach \i in {1,...,20} {
  \pgfmathsetmacro{\y}{(11.5-\i)*0.5}
  \pic at (0,\y) {circles={channelcolor=VioletLine,picname=1CI\i,}};
}
\end{scope}

\begin{scope}[local bounding box=CIRCLES22,shift={($(0,0)+(6.5,0)$)}]
\foreach \i in {1,...,10} {
  \pgfmathsetmacro{\y}{(6.5-\i)*0.5}
  \pic at (0,\y) {circles={channelcolor=VioletLine,picname=2CI\i}};
}
\foreach \i in {1,...,7,9,10} {
 \node[right=1mm of 2CI\i]{0};
  \node[right=1mm of 2CI8]{1};
 }
\end{scope}

\foreach \i in {1,...,20} {
\foreach \j in {1,...,10} {\draw[Line](1CI\i)--(2CI\j);
}}
\end{scope}
\node[below=0.6mm of BFIG,font=\Large]{b)};
\node[single arrow, draw=VioletLine, fill=VioletLine!50,
      minimum width = 10pt, single arrow head extend=3pt,
      minimum height=17mm]at([xshift=-15mm]CIRCLES2){};
\end{tikzpicture}层连接设计模式
section 1.3.3 中的全连接架构通过将每个神经元连接到下一层的每个神经元,实现最大的灵活性,但连接方式本身就是一项工程决策。稠密、稀疏和跳跃连接模式需要在学习灵活性与参数量、局部性及梯度流之间进行权衡。
稠密连接是标准的连接模式,其中每个神经元都连接到后一层的每个神经元。在 MNIST 示例中,将 784 维输入层连接到具有 128 个神经元的隐藏层,需要 100,352 个权重参数(\(784{\times}128\))。这种全连接方式使该层能够学习输入的任意线性组合;稠密层之间的非线性激活则将这些组合扩展到非线性关系。参数量随相邻层宽度的乘积增长,因此加宽其中一层会使参数量线性增长,而同时加宽两层则会使其呈二次增长。
稀疏连接模式有目的地限制层间神经元的连接方式。神经元只连接到相邻层中一部分神经元,而非维持所有可能的连接。这种方法受到生物神经系统的启发,在这类系统中,神经元通常只与有限数量的其他神经元建立连接。在 MNIST 示例这样的视觉处理任务中,神经元可能仅连接到表示邻近像素的输入,从而体现视觉特征的局部性。
随着网络加深,从输入到输出的路径变长,可能使学习过程更加复杂。跳跃连接通过在不相邻的层之间添加直接路径来解决这一问题。这些连接为信息流提供了替代路径,补充了标准的逐层传递方式。在数字识别流水线中,跳跃连接使后面的层能够直接参考高层模式和原始像素值。
这些连接模式既有理论影响,也会直接影响硬件执行。稠密连接最大限度地提高学习灵活性,并能在面向张量的硬件上高效映射到通用矩阵乘法(GEMM)内核。稀疏连接会减少理论参数量和浮点运算次数(FLOPs),但在标准硬件上,稀疏权重矩阵的执行速度并不会自动快于稠密矩阵——如果没有结构化稀疏支持(例如硬件可通过压缩索引格式利用的 2:4 模式),算术运算量的减少就无法转化为执行时间的同比例缩短。跳跃连接有助于在更深的网络中维持有效的信息流,同时保留使极深架构能够训练的梯度路径。
模型大小与计算复杂度
参数(权重和偏置)的配置方式同时决定了学习能力和计算成本——这是硅契约中模型一方的约定(机器学习系统铁律):参数数量、数值精度及其所需的运算,共同界定了模型与硬件之间的计算权衡。拓扑结构定义了网络的结构,而参数的初始化与组织方式则直接影响学习动态和最终性能。
计算示例:训练与推理的内存占用
对 784 → 128 → 64 → 10 网络执行一次前向传播,需要 109,184 MACs。训练期间的内存占用则呈现出不同的情况。在批量大小为 32、采用 32 位(4 字节)浮点精度时,评估参数、激活值、梯度和优化器状态的内存占用,可以揭示训练与推理需求之间的差距。
第一项是模型参数:table 6 逐层统计了权重和偏置,总计 109,386 parameters,每个参数占 4 字节,共占用 437.5 KB。
| 层 | 权重 | 偏置 | 参数总数 |
|---|---|---|---|
| 输入层 → 隐藏层1 | \(784{\times}128\) = 100,352 | 128 | 100,480 |
| 隐藏层1 → 隐藏层2 | \(128{\times}64\) = 8,192 | 64 | 8,256 |
| 隐藏层2 → 输出层 | \(64{\times}10\) = 640 | 10 | 650 |
| 总计 | 109,386 parameters |
下一项是激活值。Table 7 记录了批量大小为 32 时各层的激活张量及其内存开销。
| 层 | 激活张量形状 | 数值个数 | 内存 |
|---|---|---|---|
| 输入层 | \(32{\times}784\) | 25,088 | 100.4 KB |
| 隐藏层1 | \(32{\times}128\) | 4,096 | 16.4 KB |
| 隐藏层2 | \(32{\times}64\) | 2,048 | 8.2 KB |
| 输出层 | \(32{\times}10\) | 320 | 1.3 KB |
| 总计 | 31,552 | 126 KB |
训练还增加了推理完全不需要承担的两项内存开销。梯度占用的空间与其所更新的参数相同,此处为 437.5 KB;自适应矩估计(Adam)优化器存储动量和速度,需要参数大小两倍的空间,额外占用 875.1 KB。Table 8 汇总了训练与推理中各组成部分的内存占用。
| 组成部分 | 训练 | 推理 |
|---|---|---|
| 参数 | 437.5 KB | 437.5 KB |
| 激活值 | 126 KB | 117 KB |
| 梯度 | 437.5 KB | — |
| 优化器状态 | 875.1 KB | — |
| 总计 | ~1.9 MB | ~554 KB |
规模决定了这里的系统层面启示。在这份简化的内存明细中,批量大小为 32 时,训练所需内存是推理的 3.4×。绝对差距随参数和激活值存储量的增加而扩大;两者的比值取决于这两类存储量之间的比例,以及检查点技术、精度和工作区复用等实现选择。
Lighthouse 1.1: 从 MNIST 到 GPT-2 的内存规模扩展
贯穿全文的 MNIST 示例与 GPT-2 灯塔案例展示了模型规模如何改变机器学习系统铁律中的数据项 \((D_{\text{vol}})\)。
- MNIST(贯穿示例):109,386 个参数,每个占 4 字节,合计约占 438 KB。整个模型可以容纳在现代处理器的 L2 缓存中。
- GPT-2(灯塔案例):1,500,000,000 个参数,每个占 4 字节,在计入激活值和运行时工作区之前,约占 6 GB。这超出了缓存容量,除非降低精度,否则模型将进入依赖设备内存或多设备的运行范畴。
系统层面的启示:参数数量从约 109.4K 增长到 1.5B,相当于跃升至原来的 13,712.9×。这种增长意味着工程上的相变,而不仅仅是“参数更多”。MNIST 可以将权重保留在靠近处理器的位置;GPT-2 模型服务则必须管理大得多的内存工作集。某一特定层究竟受计算限制还是受内存限制,仍取决于批量大小、精度、复用程度和硬件的计算与内存性能平衡。
参数数量随网络宽度和深度的增加而增长。在 MNIST 网络中,784 维的输入层、分别包含 128 和 64 个神经元的隐藏层,以及包含 10 个神经元的输出层(784 → 128 → 64 → 10),共同决定了参数的存储规模。第一层需要 100,352 个权重和 128 个偏置,第二层需要 8,192 个权重和 64 个偏置,输出层需要 640 个权重和 10 个偏置,总计 109,386 parameters。每个参数都必须存储在内存中,并在学习过程中更新。
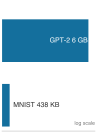
MNIST 属于缓存规模;GPT-2 属于显存规模。
table 8 中汇总的内存需求对于小型 MNIST 分类器而言似乎并不高。扩展到生产规模的模型时,这些需求会发生显著变化,使系统进入不同的硬件资源层级。
Napkin Math 1.1: 面向机器学习工程师的快速估算
设计文档离不开详细计算,但经验丰富的工程师也会培养快速心算估算的能力。这些“餐巾纸估算”捷径能够在投入详细分析之前,快速检查可行性。
内存估算:
- 参数量 → 字节数:对于 32 位单精度(FP32),乘以四;对于 16 位半精度(FP16)或脑浮点 16(BF16,后者具有类似 FP32 的指数范围),乘以二;对于 8 位整数(INT8),乘以一
- 全连接(FC)层参数量:输入维度 \(\times\) 输出维度(再加上输出维度个偏置,通常可以忽略)
- 训练状态:参数、梯度和优化器状态所需的内存可能约为仅存储权重参数时的 ~3–4\(\times\);激活值的峰值内存和工作空间还需额外计入
- Adam 优化器开销:参数内存的 2\(\times\)(动量 + 速度)
- 最大批大小:近似为(GPU 显存 \(-\) 持久状态 \(-\) 工作空间)/ 每个样本的激活值峰值内存
计算量估算:
- FC 层 FLOPs:\(2 \times d_{\text{in}} \times d_{\text{out}} \times B\)(乘加 = 2 次运算)
- MACs 转换为 FLOPs:乘以 2
- 计算利用率的近似指标:\(\text{achieved FLOP/s} / R_{\text{peak}}\)
示例:“我能在一块 16 GB 的 GPU 上训练一个具有 100M 个参数 的模型吗?”
心算:100M 个参数,每个参数占 4 字节,训练内存按 4 份计,则持久模型状态需要 1.6 GB。这样大约还剩 14.4 GB,可用于激活值、临时工作空间和框架开销。答案是:参数能够放下,但尚不能确认训练配置可行;完整训练步骤能否容纳,取决于批大小、激活值形状和内核工作空间。
系统洞见:粗略估算持久状态的内存需求,可以快速排除不可能实现的配置,但批大小仍取决于留给激活值和工作空间的余量。
除上述模型能否容纳的示例外,table 9 将三个常见的可行性问题提炼为单行公式,工程师可以在使用性能分析器之前应用这些公式。
| 问题 | 快速估算 |
|---|---|
| “这个模型能放进 GPU 显存吗?” | \(\text{persistent training state} + \text{peak activations} + \text{workspace} < \text{VRAM}\) |
| “在 MNIST 上每个训练轮次需要多长时间?” | \(60\text{K} \times \text{forward-backward FLOPs/image} / \text{achieved FLOP/s}\) |
| “这是受计算限制还是受内存限制?” | 将算术强度与 \(R_{\text{peak}}/\text{BW}\) 比较 |
table 8 中按组件列出的内存账目明确清晰,但经过了有意简化。在实践中,系统工程师会采用两种精细程度:用于设计文档的详细预算,以及用于早期可行性筛选的数量级估算。即使尚未计入运行时工作空间,这份账目也已确认,MNIST 可以轻松放入缓存,而 GPT-2 则需要容量大得多的内存层级。快速心算应当在几秒钟内得出相同结论,而不是花费数分钟,并在运行任何一行性能分析代码之前,标记出所有在物理容量上无法放入目标硬件的模型。
可行性计算告诉工程师模型是否放得下;它并不能说明模型是否学得会。后者取决于这些字节所存储的参数最初如何设置。参数初始化对网络行为至关重要。将所有参数都设为零,会使同一层中的神经元表现完全相同,从而无法学习多样化的特征。因此,权重通常采用随机初始化,且常使用 Xavier/Glorot 初始化32 (Glorot and Bengio 2010) 或 He 初始化 (He et al. 2015) 等特定策略,而偏置通常从较小的常数或零开始。这些初始值的尺度很重要:数值过大或过小都会导致不良的学习动态。
参数的分布影响信息在各层之间的流动。在数字识别中,如果权重过小,重要的输入细节可能无法传播到后续层。如果权重过大,网络可能会放大噪声。偏置有助于调整每个神经元的激活阈值,使网络能够学习最优决策边界。
不同架构对参数组织施加了特定约束。有些架构在网络的不同区域之间共享权重,以实现位置不变的模式识别;另一些则将某些权重限制为零,从而实现稀疏连接模式。
网络架构、神经元和参数现已就位,但一个核心问题仍未解决:这些随机初始化的参数通过何种机制变得有用。随机连接的网络产生的输出并不优于随机猜测。架构回答模型计算什么;训练回答模型如何学习。训练机制揭示了系统约束,因为训练增加了反向计算、需要保存的激活值、梯度和优化器状态。因此,批大小成为统计与硬件层面的共同选择:它会改变梯度噪声、激活值内存、数据复用和并行效率。学习过程协调这些成本,同时将 109,386 parameters 从随机数转变为能够正常工作的数字分类器。
学习过程
MNIST 网络目前持有随机初始化的 109,386 parameters——这些数值完全不包含任何知识。将这些随机值转变为准确率超过 95% 的数字分类器,依赖于反复执行数百万次的四项操作:前向传播计算预测,损失函数衡量误差,反向传播计算损失对每个参数的梯度,优化器利用这些梯度更新参数。
从带标签样本中进行监督学习
随机初始化的网络在数字分类上的表现,并不优于在十个类别中随机猜测(准确率约为 10%)。要将其转变为准确率为 95% 的分类器,需要进行监督学习:向网络展示带标签的样本,并根据它所犯的错误调整权重。以 MNIST 数字识别任务为例:数据集包含 60,000 张训练图像,每张都是一幅 \(28{\times}28\) 像素的灰度图像,并配有正确的数字标签。网络必须通过反复预测和调整权重,学习这些图像与其对应数字之间的关系。确保训练数据的质量与完整性,是模型成功的必要条件(数据工程)。
输入与输出之间的关系决定了训练方法。训练以循环方式运行,每次迭代处理训练样本的一个子集,称为批次。33对于每个批次,网络执行四项操作:通过网络各层的前向计算生成预测,损失函数评估预测准确性,根据预测误差计算权重调整量,以及更新网络权重以改进后续预测。
这种迭代方法可以用数学方式表达。给定输入图像 \(x\) 及其真实标签 \(y\),网络按照 equation 10 计算预测: \[ \hat{y} = f(x; \theta) \tag{10}\]
该方程概括了整个前向传播过程:网络 \(f\) 接收输入 \(x\)(例如一幅 \(28{\times}28\) 的数字图像),并利用当前参数 \(\theta\)(所有层的权重和偏置)产生预测 \(\hat{y}\)(一个包含十个概率的向量,每个概率对应一个数字)。分号记法 \(f(x; \theta)\) 将随每个样本变化的输入 \(x\),与在推理期间保持固定、但在训练期间不断演变的 \(\theta\) 区分开来。网络误差由损失函数34 \(\mathcal{L}\) 衡量(equation 11): \[ \text{loss} = \mathcal{L}(\hat{y}, y) \tag{11}\]
误差度量通过反向传播驱动网络参数调整,详见 section 1.4.4。在实践中,训练处理的是成批样本,而不是 输入。对于 MNIST 数据集,每次训练迭代可能同时处理 32、64 或 128 张图像,其原因将在 section 1.4.4.6 中展开。训练循环持续进行,直到网络达到足够的准确率,或达到预先设定的迭代次数。在整个过程中,损失函数起着引导作用,其最小化意味着性能改善。建立恰当的指标与评估规程,是评估训练有效性的必要条件(基准测试)。
前向传播计算
一张 MNIST 图像经过带权重的网络层和非线性激活后,转变为十个类别得分。这一计算过程就是前向传播:输入数据流经网络各层,生成预测。在训练期间,这些预测随后与真实值进行比较;由此产生的损失进入 figure 17 所示的反向传播与更新循环。前向传播本身是推理和训练的共同基础。
\scalebox{0.7}{\begin{tikzpicture}[font=\sffamily\small]
\definecolor{Red}{RGB}{227,48,103}
\definecolor{Green}{RGB}{102,187,120}
\tikzset{%
  mycycleR/.style={circle, draw=none, fill=Red, minimum width=8mm,node distance=0.4},
  mycycleB/.style={circle, draw=none, fill=Green, minimum width=8mm,node distance=0.4},
  mycycleD/.style={circle, draw=none, fill=BlueLine, minimum width=8mm,node distance=0.4},
  mylineD/.style={line width=0.75pt,draw=black!70,dashed},
  myelipse/.style={ellipse,draw = brown,fill = BlueFill,minimum width = 20mm,
minimum height = 10mm,node distance=0.4,align=center},
%
  Box/.style={
    inner xsep=2pt,
    draw=RedLine,
    line width=0.75pt,
    fill=RedL!20,
    align=flush center,
    text width=22mm,
    minimum width=22mm, minimum height=10mm
  },
%
Line/.style={line width=0.5pt,black!60,text=black},
Line2/.style={line width=0.85pt,black!60,text=black}
}

\begin{scope}[local bounding box = CIRC2]
\node[mycycleR] (2C1) {};
\node[mycycleR,below=of 2C1] (2C2) {};
\node[mycycleR,below=of 2C2] (2C3) {};
\node[mycycleR,below=of 2C3] (2C4) {};
%%
\node[mycycleD,left=1.6 of $(2C1)!0.5!(2C2)$] (1C1) {};
\node[mycycleD,left=1.6 of $(2C2)!0.5!(2C3)$] (1C2) {};
\node[mycycleD,left=1.6 of $(2C3)!0.5!(2C4)$] (1C3) {};
\foreach \x in {1,2,3} {
\draw[latex-,line width=0.75pt](1C\x)--++(180:1)node[left](X\x ){X\textsubscript{\x}};
}
\node[rotate=90,font=\Large\bfseries]at($(X2)!0.5!(X3)$){...};
\end{scope}
\begin{scope}[local bounding box = CIRC3,shift={(2.1,0)}]
\node[mycycleB] (3C1) {};
\node[mycycleB,below=of 3C1] (3C2) {};
\node[mycycleB,below=of 3C2] (3C3) {};
\node[mycycleB,below=of 3C3] (3C4) {};
\end{scope}
  \foreach \i in {1,2,3,4} {
        \foreach \j in {1,2,3,4} {
            \draw[Line,-latex] (2C\i) -- (3C\j);
        }
    }
      \foreach \i in {1,2,3} {
        \foreach \j in {1,2,3,4} {
            \draw[Line,-latex] (1C\i) --node(L\i\j){} (2C\j);
        }
    }
%
\node[mycycleD,fill=violet,right=1.5 of $(3C2)!0.5!(3C3)$] (4C1) {};
        \foreach \i in {1,2,3,4} {
            \draw[Line,-latex] (3C\i) --(4C1);
        }
\node[Box,right=1.95of 4C1](B1){预测值\\ $(\hat{y})$};
\node[Box,right=of B1,fill=VioletL2,draw=VioletLine2](B2){真实值\\ $(y)$};
\node[myelipse,below=1.5 of $(B1)!0.5!(B2)$,fill=BlueL,draw=BlueLine,
            ](B3){损失\\ 函数 $\mathcal{L}$};
\node[Box,below left=0.25 and 0.25 of B3,fill=BrownL,draw=BrownLine](B4){参数\\ 梯度};
\node[myelipse,left=0.8 of B4,fill=BlueL,draw=BlueLine](B5){优化器};
\node[Box,left=2.3 of B5,fill=BrownL,draw=BrownLine](B6){权重\\ \& 偏置};
%
\draw[Line2,-latex](4C1)--(B1);
\draw[Line2,-latex](B1)--(B3);
\draw[Line2,-latex](B2)--(B3);
\draw[Line2,-latex](B3)|-node[pos=0.55,below,font=\scriptsize\sffamily]{反向传播}(B4);
\draw[Line2,-latex](B4)--(B5);
\draw[Line2,-latex](B5)--node[above]{参数}node[below]{更新}(B6);
\draw[mylineD,-latex,shorten >=2pt](B6)--(L34.10);
\draw[mylineD,-latex,shorten >=2pt](B6)--(L33.180);
%%
\path[](1C1.west)--++(90:1.35)coordinate(A)-|coordinate(B)(4C1.east);
\path[](1C3.west)--++(270:2.9)coordinate(C)-|coordinate(D)(4C1.east);

\draw[RedLine, -{Triangle[width = 12pt, length = 5pt]}, line width = 5pt]
(A)--node[above,text=black]{前向传播}(B);
\draw[OrangeLine, -{Triangle[width = 12pt, length = 5pt]}, line width = 5pt]
(D)--node[below,text=black]{反向传播}(C);
\end{tikzpicture}}数据沿各层向前流动(figure 17 中的红色箭头),而梯度则反向流动以更新权重(橙色箭头)。该图揭示了一个重要的不对称性:前向传播产生模型输出,反向传播则计算参数的梯度。正是由于这种依赖关系,训练需要保留反向传播所需的、与具体运算相关的前向计算值。
当一张手写数字图像进入网络时,它会在各层中经历一系列变换。每次变换都将加权输入与学到的模式相结合,逐步提取相关特征。对于 784-128-64-10 数字分类器,一张 \(28{\times}28\) 像素的图像经过多个层处理,最终产生每个可能数字(0–9)的概率。
这一过程从输入层开始,每个像素的灰度值成为一个输入特征。对于 MNIST,这意味着共有 784 个输入值(\(28{\times}28\) = 784),每个值都归一化到 0 到 1 之间。随后,这些值通过隐藏层向前传播;每个神经元根据学到的权重组合其输入,并应用非线性激活函数。
MNIST 网络(784-128-64-10)的每次前向传播都需要大量矩阵运算。仅第一层,每个样本就需要执行 100,352 MACs。当一个批次中包含多个样本时,这些运算量会相应成倍增加,因此必须谨慎管理内存带宽和计算资源。GPU 等专用硬件通过并行处理高效执行这些运算。
单层处理
神经网络的前向计算按系统化的方式进行,每一层都将输入转换为越来越抽象的表示。数字分类器体现了这一点:其变换过程分为不同阶段。在每一层,计算包含两个关键步骤:先对输入进行线性变换,再进行非线性激活。线性变换采用与 equation 2 中定义相同的加权求和运算,但此处使用能够跟踪层索引的记法(equation 12): \[ \mathbf{Z}^{(\ell)} = \mathbf{A}^{(\ell-1)}\mathbf{W}^{(\ell)} + \mathbf{b}^{(\ell)} \tag{12}\]
这里,\(\mathbf{A}^{(\ell-1)}\) 包含前一层的激活值(应用激活函数后的输出),\(\mathbf{W}^{(\ell)} \in \mathbb{R}^{n_{\ell-1} \times n_\ell}\) 是第 \(\ell\) 层的权重矩阵,\(\mathbf{b}^{(\ell)}\) 是偏置向量(沿批次维度广播)。上标 \((\ell)\) 用于标识每个参数所属的层。这种行向量约定与 equation 2 中的单样本方程一致:\(\mathbf{A}\) 的每一行是一个样本,右乘 \(\mathbf{W}\) 将其转换为下一层的宽度。
在线性变换之后,每一层应用非线性激活函数 \(f\)(这里,\(f\) 或 \(f^{(\ell)}\) 表示第 \(\ell\) 层的通用激活函数;在 section 1.3.2.1 中,\(\sigma\) 特指 sigmoid 函数),如 equation 13 所示: \[ \mathbf{A}^{(\ell)} = f(\mathbf{Z}^{(\ell)}) \tag{13}\]
这一过程在每一层重复,形成一条变换链: \[ \text{Input} \rightarrow \text{Linear Transform} \rightarrow \text{Activation} \rightarrow \text{Linear Transform} \rightarrow \text{Activation} \rightarrow \cdots \rightarrow \text{Output} \]
回到数字识别,像素值首先通过第一个隐藏层的权重进行变换,将 784 维输入转换为中间表示。后续各层进一步变换这一表示,最终生成一个 10 维类别得分向量,每个分量对应一个可能的数字。
矩阵乘法表述
完整的前向传播过程可以表示为一组函数的复合,其中每个函数代表一个层的变换。下面基于 MNIST 示例,对这一过程进行数学形式化。
对于具有 \(N_L\) 层的网络,完整的前向计算可表示为 equation 14 中的复合形式: \[ \mathbf{A}^{(N_L)} = f^{(N_L)}\!\Big(\cdots f^{(2)}\!\Big(f^{(1)}(\mathbf{X}\mathbf{W}^{(1)} + \mathbf{b}^{(1)})\mathbf{W}^{(2)} + \mathbf{b}^{(2)}\Big)\cdots \mathbf{W}^{(N_L)} + \mathbf{b}^{(N_L)}\Big) \tag{14}\]

矩阵乘法占该稠密网络前向传播 FLOPs 的 90% 以上。
这一复合形式表明,前向传播的核心是一连串矩阵乘法,其间穿插着非线性激活。要理解矩阵乘法为何在 AI 计算中占据主导地位,需要考察每种运算的算术强度。
这一嵌套表达式逐层展开,每一步都以上一层的激活值作为输入:
第一层: \[\begin{gather*} \mathbf{Z}^{(1)} = \mathbf{X}\mathbf{W}^{(1)} + \mathbf{b}^{(1)} \\[0.2ex] \mathbf{A}^{(1)} = f^{(1)}(\mathbf{Z}^{(1)}) \end{gather*}\]
隐藏层 \((\ell = 2,\ldots, N_L-1)\): \[\begin{gather*} \mathbf{Z}^{(\ell)} = \mathbf{A}^{(\ell-1)}\mathbf{W}^{(\ell)} + \mathbf{b}^{(\ell)} \\[0.2ex] \mathbf{A}^{(\ell)} = f^{(\ell)}(\mathbf{Z}^{(\ell)}) \end{gather*}\]
输出层: \[\begin{gather*} \mathbf{Z}^{(N_L)} = \mathbf{A}^{(N_L-1)}\mathbf{W}^{(N_L)} + \mathbf{b}^{(N_L)} \\[0.2ex] \mathbf{A}^{(N_L)} = f^{(N_L)}(\mathbf{Z}^{(N_L)}) \end{gather*}\] 在 MNIST 示例中,对于包含 \(B\) 张图像的批次,各运算的维度如下:
- 输入 \(\mathbf{X}\):\(B{\times}784\)
- 第一层权重 \(\mathbf{W}^{(1)}\):\(784{\times}n_1\)
- 隐藏层权重 \(\mathbf{W}^{(\ell)}\):\(n_{\ell-1}{\times}n_\ell\)
- 输出层权重 \(\mathbf{W}^{(N_L)}\):\(n_{N_L-1}{\times}10\)
算术强度决定一个计算内核是受计算限制还是受内存限制。采用分块的稠密矩阵乘法会复用数值,而未融合的逐元素运算每传输一个字节仅完成少量计算。Table 10 比较了二者的理想化算术强度。
| 运算 | 运算次数 (\(O\)) | 最小数据搬移量 | 理想化算术强度 | 典型优化方式 |
|---|---|---|---|---|
| 矩阵乘法 \((N{\times}N)\) | \(2N^3\) | \(3N^2s\) 字节 | \(\approx 2N/(3s)\) | 在 CPU/GPU/TPU 上分块 |
| 逐元素运算(ReLU) | \(N^2\) | \(2N^2s\) 字节 | \(1/(2s)\) | 向量化与融合 |
Systems Perspective 1.4: 矩阵乘法为何在 AI 中占据主导地位
相对于片外内存带宽,现代加速器具有规模庞大的计算阵列。只有当运算具有足够的数据复用和可并行工作量时,它们才能接近峰值算术吞吐量。稠密层和卷积层能够很好地映射到优化内核;自定义的逐元素运算序列则通常通过融合,使其中间值保留在片上。
对于单个样本,表达式 \(\mathbf{x}\mathbf{W}\) 是一次通用矩阵—向量乘法(GEMV);将样本组成批次后,同一计算变为 \(\mathbf{X}\mathbf{W}\),即一次 GEMM。二维、三维卷积等多维运算可通过降层变换(如 im2col)映射到同一个 GEMM 核心。这些变换将相互重叠的滑动感受野展开为二维矩阵的列,使经过优化的厂商基础线性代数子程序(BLAS)库能够以硬件峰值效率执行这些运算。这种降层变换引入了明确的系统权衡:由于滑动感受野相互重叠,im2col 会在内存中复制输入元素,通常使临时张量的存储量扩大至 \(K_h \times K_w\) 倍(例如,\(3{\times}3\) 卷积会扩大至 \(9\times\))。系统编译器有意接受这一内存开销,以将带步长的空间内存访问转换为连续的矩阵乘法,从而充分利用加速器的脉动阵列。矩阵运算占本章稠密网络示例浮点运算量的 90% 以上,并在许多重要的神经网络工作负载中占据主导地位,不过其占比取决于网络架构和执行方式。为提升性能,工程师会采用分块与平铺等技术,提高缓存或片上内存的复用程度。这种围绕专用硬件能够高效执行的运算来设计模型架构的软硬件协同设计原则,是现代深度学习的核心。通用矩阵乘法(GEMM) 详细介绍了 GEMM 的算术强度、稀疏矩阵格式以及常见层类型的计算复杂度,这些内容是实际优化上述运算所必需的。
逐步计算序列
要理解这些数学运算如何转化为实际计算,需要考察一批 MNIST 图像的前向传播过程。这一过程展示了数据如何从原始像素值转化为数字预测结果。
考虑输入网络的一批 32 张图像。每张图像最初是一个由像素值构成的 \(28{\times}28\) 网格,展平后成为一个 784 维向量。对于整个批次,这会形成一个大小为 \(32{\times}784\) 的输入矩阵 \(\mathbf{X}\),其中每一行代表一张图像。通常会将这些值归一化到 0 到 1 之间。
各层的变换构成一个形状不断变化的序列;这些形状既决定内核的选择,也决定激活值的存储需求。网络首先接收输入矩阵 \(\mathbf{X}\)(\(32{\times}784\)),并使用第一层的权重进行变换。如果第一个隐藏层有 128 个神经元,则 \(\mathbf{W}^{(1)}\) 是一个 \(784{\times}128\) 矩阵,因此计算 \(\mathbf{X}\mathbf{W}^{(1)}\) 会生成一个 \(32{\times}128\) 矩阵。随后,该矩阵中的每个元素加上对应的偏置,再经过激活函数。例如,使用 ReLU 激活时,所有负值变为零,正值保持不变。这种非线性变换使网络能够学习数据中的复杂模式。最后一层将其输入变换为一个 \(32{\times}10\) 矩阵,其中每行包含 10 个类别得分。令 \(z_j\) 表示数字 \(j\) 的原始得分(logit),并令 \(z_k\) 遍历全部 10 个数字的得分。通常,这些得分通过 equation 6 中的 softmax 函数转换为概率: \[ p(\text{digit } j) = \frac{e^{z_j}}{\sum_{k=1}^{10} e^{z_k}} \]
对于批次中的每张图像,这会生成一个关于各个可能数字的概率分布。概率最高的数字即为网络的预测结果。
Napkin Math 1.2: 计算前向传播中的运算次数
问题:批量大小为 32 时,MNIST 网络(784 → 128 → 64 → 10)执行一次前向传播的算术运算总次数(\(O\))是多少?
背景:维度为 \((M{\times}K) \times (K{\times}N)\) 的矩阵乘法需要 \(2 \times M \times K \times N\) FLOPs(每个输出元素对 \(K\) 项求和,每项包含一次乘法和一次加法)。偏置相加增加 \(M \times N\) 次浮点加法。ReLU 激活增加 \(M \times N\) 次比较,因此表中激活运算各行报告的是等效运算总量,而非纯粹的 FLOPs。
解答:Table 11 逐层列出了运算次数。总计约为 7 MOp,即每张图像 7 MOp ÷ 32 = 约 219 KOp。
系统层面的启示:
- 第一层占主导地位:第一层处理的输入最大(784 维),因此占全部运算的 91.9 percent。这就是在前面几层进行降维影响如此显著的原因。
- 计算与内存:批量大小为 1 时,219 KOp 只能在一张图像的计算中摊销一次参数读取,因此在这一数据传输量模型下,算术强度约为 0.5 FLOP/byte。批量大小为 32 时,读取一次参数并遍历一次批次激活值至少需要搬移约 564 KB,使算术强度提升至约 12.4 FLOP/byte。额外的缓存未命中和中间数据传输可能使实际达到的数值降低。这一比较说明了批处理为何能够改善复用,但实际受内存限制还是受计算限制,仍取决于 Roofline 模型 中介绍的机器平衡。
- 扩展的直观认识:将隐藏层宽度加倍(784 → 256 → 128 → 10),会使运算次数增至原来的约 2.1×,达到约 15 MOp。这一结果来自对各层的重新计算:第一层和第三层增至两倍,第二层增至四倍,因此总量增至约 2.15×,而非四倍。
| 层 | 运算 | 维度 | 运算次数 |
|---|---|---|---|
| 第一层 | 矩阵乘法 | (\(32{\times}784\)) \(\times\) (\(784{\times}128\)) | \(2 \times 32 \times 784{\times}128\) = 6,422,528 |
| 第一层 | 偏置 + ReLU | \(32{\times}128\) | \(2{\times}4,096\) = 8,192 |
| 第二层 | 矩阵乘法 | (\(32{\times}128\)) \(\times\) (\(128{\times}64\)) | \(2 \times 32 \times 128{\times}64\) = 524,288 |
| 第二层 | 偏置 + ReLU | \(32{\times}64\) | \(2{\times}2,048\) = 4,096 |
| 第三层 | 矩阵乘法 | (\(32{\times}64\)) \(\times\) (\(64{\times}10\)) | \(2 \times 32 \times 64{\times}10\) = 40,960 |
| 第三层 | 偏置 + Softmax | \(32{\times}10\) | ~640(简化计算) |
| 总计 | ~7 MOp |
实现与优化考量
前向传播在数学上易于表述,但其实现受到激活值存储、批量大小、内存布局以及硬件适配程度的制约。内存管理在前向传播中起着核心作用,因为在训练期间,必须存储每一层的激活值,以供反向传播使用。对于批量大小为 32 的 MNIST 示例(784-128-64-10),激活值的存储需求如下:
- 输入层:\(32{\times}784\) = 25,088 个值
- 第一个隐藏层:\(32{\times}128\) = 4,096 个值
- 第二个隐藏层:\(32{\times}64\) = 2,048 个值
- 输出层:\(32{\times}10\) = 320 个值
因此,在训练期间,每个批次总共需要在内存中保留 31,552 个值,这与 section 1.3.4.3 中的计算示例一致。内存需求随批量大小线性增长,对于更大的网络会变得相当可观。
批处理引入了重要的权衡。更大的批次能够实现更高效的矩阵运算和更高的硬件利用率,但需要更多内存。例如,将批量大小加倍至 64,激活值的内存需求也会加倍。批量大小、内存用量与计算效率之间的这种关系,指导着实践中对批量大小的选择。
计算的组织方式也会影响性能。通过精心设计内存布局并使用专用库,可以优化矩阵运算。激活函数的选择既影响网络的学习能力,也影响计算效率,因为某些函数(如 ReLU)所需的计算量少于其他函数(如 tanh 或 sigmoid)。
神经网络的计算特征适合并行处理架构。虽然传统 CPU 能够执行这些运算,但对于大规模稠密矩阵运算,为并行计算设计的 GPU 可以快得多。专用 AI 加速器通过低精度算术、专用内存架构,以及针对神经网络计算模式的数据流优化,能够实现更高的效率。
不同硬件平台的单次推理能耗可能存在显著差异。CPU 提供灵活的执行能力,GPU 通过并行性提供高吞吐量,而专用边缘加速器则以通用性为代价,换取对特定算子的高效执行。仅凭功率无法确定能耗:相关的量是在相同工作负载和质量目标下,功率对执行时间的积分。内存层次结构和数据搬移往往能够解释其中很大一部分差异。这些考量将在后续章节中反复出现,尤其是在 网络架构 中,针对特定架构的优化会引入额外的权衡。
前向传播将输入转换为预测,但仅有预测本身并不足以进行学习。训练循环需要一种方法,以能够指导权重调整的形式衡量预测错得有多严重。损失函数承担了这一作用:它们将预测与实际之间的差距转换为一个可供优化过程最小化的标量。
损失函数
section 1.4.2 中描述的前向传播过程足以完成推理,即使用预训练模型进行预测。然而,要训练模型,就需要一种定量误差指标,衡量预测与真实标签的吻合程度。损失函数对这些误差进行量化,充当指导学习的反馈机制。它们将“做出良好预测”这一抽象目标转化为具体的优化问题。
继续以 MNIST 数字识别为例:当网络处理一幅手写数字图像时,它会输出十个类别分数,这些分数通常会转换为数字 0–9 的预测概率。损失函数将这些预测与目标进行比较。如果图像显示的是“七”,那么当模型赋予数字七的概率过低时,交叉熵就会对模型施加惩罚。损失越高,表示所选目标在该样本上的取值越差;但仅凭损失本身,无法诊断原因,也不能断定所有任务指标都变差了。
误差度量基础
损失函数在选定的目标下,为预测与目标值赋予一个标量代价。损失越低,表示该目标在所评估样本上的取值越好,但这并不等同于准确率越高:即使预测类别保持不变,置信度和校准程度也可能发生变化。在训练过程中,损失的梯度指导参数更新。在手写数字识别中,交叉熵会惩罚那些为正确数字赋予较低概率的预测。
从数学上讲,损失函数 \(\mathcal{L}\) 接收两个输入:网络的预测值 \(\hat{y}\) 和真实值 \(y\)。对于数字分类中的单个训练样本,损失衡量预测与真实值之间的差异。当使用批量数据训练时,系统会计算批次中所有样本的平均损失(equation 15): \[ \mathcal{L}_{\text{batch}} = \frac{1}{B}\sum_{i=1}^B \mathcal{L}(\hat{y}_i, y_i) \tag{15}\] 其中,\(B\) 是批大小,\((\hat{y}_i, y_i)\) 表示第 \(i\) 个样本的预测值与真实值。取平均使不同批大小下的损失和平均梯度尺度具有可比性,但最佳学习率仍可能随批大小和优化方式而变化。求和运算也能自然映射到并行硬件:每个样本的损失都可以独立计算,再通过归约操作将其合并。
损失函数的选择取决于任务类型。对于数字分类,损失函数必须能够处理多个类别上的概率分布,提供有意义的梯度以指导学习,根据错误预测的严重程度施加相应惩罚,并在批处理时高效扩展。交叉熵损失满足这四项要求。
交叉熵与分类损失函数
对于 MNIST 数字识别这类分类任务,交叉熵损失是比较预测概率分布与真实类别标签的常用方法。信息论中的熵概念可追溯至 Shannon (Shannon 1948);在监督分类中,交叉熵会惩罚赋予正确类别的低概率。
Shannon, Claude E. 1948. “A Mathematical Theory of Communication.” Bell System Technical Journal 27 (3): 379–423. https://doi.org/10.1002/j.1538-7305.1948.tb01338.x.
对数函数决定了交叉熵损失的优化行为,因为正确类别的概率越接近零,受到的惩罚就越大。这种函数形状会为高置信度的错误预测产生较强的梯度,并使正确类别的概率成为该目标的核心量。
对于单幅数字图像,网络输出一个覆盖 10 个可能数字的概率分布。真实标签表示为独热向量35,其中除正确数字所在位置为 1 外,其余元素均为 0。例如,如果真实数字是“七”,则标签为 \(y = \big[0, 0, 0, 0, 0, 0, 0, 1, 0, 0\big]\)。
该样本的交叉熵损失定义见 equation 16: \[ \mathcal{L}(\hat{y}, y) = -\sum_{j=1}^{10} y_j \log(\hat{y}_j) \tag{16}\] 其中,\(\hat{y}_j\) 表示网络对数字 \(j\) 的预测概率。由于 \(y\) 是独热向量,该式可简化为 equation 17: \[ \mathcal{L}(\hat{y}, y) = -\log(\hat{y}_c) \tag{17}\] 其中,\(c\) 是正确类别的索引。因此,损失仅取决于正确数字的预测概率;网络受到的惩罚取决于它对正确答案的置信程度。
例如,如果网络对一幅“七”的图像预测出以下概率:
预测概率: [0.1, 0.0, 0.0, 0.0, 0.0, 0.0, 0.0, 0.8, 0.0, 0.1]
真实标签: [0, 0, 0, 0, 0, 0, 0, 1, 0, 0]
损失为 \(-\log(0.8)\),约等于 0.223。如果网络更加确信,并为正确数字预测出 0.9 的概率,则损失会降至约 0.105。
批次损失计算方法
实际计算损失时,需要同时考虑数值稳定性与批处理。使用批量数据时,目标函数评估所有样本的平均损失。
对于包含 \(B\) 个样本的批次,交叉熵损失变为 equation 18: \[ \mathcal{L}_{\text{batch}} = -\frac{1}{B}\sum_{i=1}^B \sum_{j=1}^{10} y_{ij} \log(\hat{y}_{ij}) \tag{18}\]
这里,\(i\) 是批次中样本的索引,\(j\) 是十个输出类别的索引,\(y_{ij}\) 是样本 \(i\) 对类别 \(j\) 的独热目标指示值,\(\hat{y}_{ij}\) 是该类别的预测概率。对 \(B\) 个样本取平均,可使批大小变化时的损失尺度保持可比。
高效计算这一损失需要仔细考虑数值精度。危险情形并非普通的小概率,而是不稳定的 softmax 将概率舍入为零。如果正确类别的概率变为 0,则 \(\log(0)\) 变为 \(-\infty\),后续算术运算可能产生非数值(NaN)。
稳定的实现会避免先显式计算数值上不稳定的概率,再对其取对数:
- 在求指数之前平移 logits,这是 log-sum-exp 技巧(Logit 与数值稳定性)的核心,如 equation 19 所示: \[ \text{softmax}(z_i) = \frac{\exp\big(z_i - \max(z)\big)}{\sum_j \exp\big(z_j - \max(z)\big)} \tag{19}\]
从每个 logit 中减去相同的 \(\max(z)\) 不会改变 softmax 概率,因为分子和分母中的公共因子会相互抵消。其数值效果具有决定性:平移后最大的 logit 变为零,因此最大的指数值为 \(\exp(0)=1\),而不是一个可能溢出的值。
- 优先采用直接从 logits 计算的融合交叉熵。对于目标类别 \(c\) 和 \(m=\max(z)\),稳定的实现计算 \[ \mathcal{L} = -(z_c-m) + \log\!\sum_j \exp(z_j-m) \tag{20}\] Equation 20 在数学上等价于 \(-\log p_c\),但不会先将极小的 softmax 概率舍入为零。对概率设置截断下限或加上 \(\epsilon\) 可以作为防御性的后备措施,但这会改变目标函数,不应取代稳定的计算形式。
对学习动态的影响
当批大小为 32、输出类别数为 10 时,每个训练步骤会处理 32 组分数,每组包含 10 个分数,计算每个样本的损失,再取平均得到一个批次损失。在训练过程中,这个值具有两种作用。它的梯度提供更新方向,它的变化趋势则有助于诊断优化是在推进、停滞还是发散。任务准确率、校准程度和其他评估指标仍必须在留出数据上单独测量。
对于 MNIST 分类器,当类别概率接近均匀分布时,训练损失通常从 \(\log(10) \approx 2.3\) 附近开始,在优化初期快速下降,随后改善速度放缓。较低的训练损失表明模型对训练样本具有较高置信度,并不能证明其泛化能力。验证损失和任务指标用于判断学到的行为是否能迁移到留出数据。
损失函数相对于网络输出 logits 的梯度提供了驱动反向传播的初始误差信号。当 softmax 与交叉熵结合时,每个 logit 的梯度具有特别简单的形式:预测概率与目标概率之差,即 \(p-y\)。这一数学性质使交叉熵损失尤其适合分类任务,因为即使预测与目标相差很远,它也能提供较强的梯度。在系统运行时中,这种数学上的消去是将 softmax 与交叉熵融合为单个算子的主要动机。通过独立的 softmax 进行反向传播,需要计算完整的 \(K \times K\) 雅可比矩阵(中间存储和计算量均为 \(\mathcal{O}(K^2)\));将损失与输出激活函数融合后,整个反向步骤可简化为 \(\mathcal{O}(K)\) 的逐元素向量减法(\(p - y\)),从而消除输出层的一个主要内存与计算瓶颈。
损失函数的选择也会影响其他训练决策。梯度尺度与学习率相互作用,而对各批次损失取平均会影响梯度噪声,进而影响适用的批大小范围。曲率会影响优化器的行为,而判断是否收敛需要验证指标和停止规则,不能仅依赖训练损失的变化轨迹。
损失函数量化了预测误差,但仅有误差信号并不能告诉系统,损失对每个参数有多敏感。MNIST 网络中有 109,386 parameters 个参数,若通过独立扰动来估计每个导数,计算成本将难以承受。这就是贡献分配问题:将最终误差与能够改变它的参数及中间值联系起来。下一节介绍反向传播,它应用链式法则,高效计算所有这些局部敏感度。
梯度计算与反向传播
Definition 1.2: 反向传播
反向传播是训练系统用于将链式法则应用于计算图的梯度计算算法。它利用记录的运算以及保存或重新计算的前向传播值,在一次反向遍历中计算损失相对于每个参数的梯度。
- 意义:对于全连接层,反向传播的浮点运算次数通常约为前向传播的两倍,并且需要保留或重新计算链式法则所需的中间值。对于具有 \(N_L\) 层、批大小为 \(B\)、各层宽度为 \(n_1,\ldots,n_{N_L}\) 的模型,简化的激活值存储需求按 \(\mathcal{O}\!\left(B\sum_{\ell=1}^{N_L} n_\ell\right)\) 缩放。梯度和优化器状态还需要额外内存,因此,能够在单个加速器上进行推理的模型,训练时可能无法装入该加速器。
- 区别:数值微分需要对 \(P\) 个参数中的每一个进行扰动求值。反向模式自动微分在一次反向遍历中计算全部 \(P\) 个梯度,其成本与计算图规模成正比,避免了 \(P\) 次独立的前向传播。
- 常见误区:一种常见误解是将反向传播视为学习本身。它是一种梯度计算算法;梯度下降才执行实际的参数更新。混淆二者会掩盖系统层面的职责划分:反向传播决定内存需求(激活值存储),而优化器决定额外的状态需求(动量、方差缓冲区)。
汽车工厂为同样的贡献分配问题提供了一个具体例子。车辆依次经过四个工位:车架安装(A)、发动机安装(B)、车轮装配(C)和总装(D)。当检验人员发现一辆有缺陷的汽车时,他们必须确定问题由哪个工位引起。
解决过程沿反方向展开。检验人员从缺陷出发,逐个工位追溯责任:D 的装配操作造成了多少影响,从 C 接收的部件又带来了多少影响;C 的工作造成了多少影响,从 B 传来的部分又带来了多少影响。每个工位获得的调整反馈与其贡献程度成正比。如果 B 工位的发动机安装是主要原因,它就会收到最强的改进信号。
反向传播遵循类似的反向追踪过程,但它计算的是敏感度,而非因果责任。它从损失出发,评估每层输入的微小变化会如何改变损失,并将这些导数向后传播。随后,优化器将得到的参数梯度转换为实际更新。
在神经网络中,每一层都像装配线上的一个工位,而反向传播确定最终损失对每条连接的敏感度。将这种直观认识转化为数学表达,需要使用微积分中的链式法则。在工厂类比中,“D 工位的调整信号”对应输出层的梯度,局部敏感度对应偏导数,而“向后发送反馈”描述的是通过链式法则的乘法将梯度传播到整个网络。
这种敏感度是针对当前参数值、输入批次和损失的局部性质。它回答的是一个反事实问题——此处的无穷小变化会如何改变当前损失——而不是某个权重是否始终重要,或是否曾在历史上导致该预测。计算图使这个问题可以通过计算来求解。每个节点记录一个运算,其反向规则将传入的损失梯度映射为相对于各输入的梯度。反向遍历从标量损失开始,按依赖关系的逆序应用这些局部规则;当某个值通过多条下游路径影响损失时,则累加各条路径的贡献。正是这种累加,使反向传播不仅仅是沿一条链传递一个误差信号:运行时必须遵循图的依赖关系,并在梯度计算完成前合并所有相关路径的贡献。下面的算法将这一计算图层面的描述转化为逐层执行的过程。
反向传播算法步骤
前向传播计算预测值,而反向传播计算供优化器调整权重使用的梯度。继续考虑网络将“七”的图像预测为“三”的例子。反向传播系统地计算:在当前参数值下,每个权重发生微小变化时,损失会如何响应。
这一过程始于网络输出端,在此将预测的数字概率与真实标签进行比较。随后,得到的损失梯度沿网络向后流动,给出损失对每一层的值和权重的局部敏感度。该计算遵循微积分中的链式法则,将权重与损失之间的关系分解为易于处理的步骤。
反向传播的数学基础为神经网络训练提供了理论依据,但实际实现需要软件支持。Wengert 提出了无需解析导数表达式即可自动进行数值导数求值的方法 (Wengert 1964)。现代框架通过自动微分系统提供这一能力,自动处理梯度计算。链式法则与自动微分 正式推导了链式法则,并说明了为什么反向模式自动微分能够在一次反向传播中计算所有参数梯度;反向传播算法 则逐步讲解反向传播算法,并解释其浮点运算次数为何约为前向传播的两倍。后文的 自动微分的框架实现 将探讨这些框架的系统工程问题。algorithm 1 给出了核心实现约定:前向传播必须保存反向传播所需的值。
Wengert, Ralph E. 1964. “A Simple Automatic Derivative Evaluation Program.” Communications of the ACM 7 (8): 463–64. https://doi.org/10.1145/355586.364791.
\begin{algorithm} \caption{反向传播训练步骤} \begin{algorithmic} \Require 小批量输入 $\mathbf{X}$,标签 $\mathbf{y}$;具有参数 $\{\mathbf{W}^{(\ell)}, \mathbf{b}^{(\ell)}\}_{\ell=1}^{N_L}$ 的 $N_L$ 层网络;损失 $\mathcal{L}$ \Ensure 供优化器使用的参数梯度 $\{\nabla_{\mathbf{W}^{(\ell)}}\mathcal{L}, \nabla_{\mathbf{b}^{(\ell)}}\mathcal{L}\}$ \State $\mathbf{A}^{(0)} \gets \mathbf{X}$ \For{$\ell = 1$ 至 $N_L$} \Comment{前向传播} \State 计算 $\mathbf{Z}^{(\ell)}, \mathbf{A}^{(\ell)}$;保存求导所需的值 \EndFor \State 计算损失 $\mathcal{L}(\mathbf{A}^{(N_L)}, \mathbf{y})$;初始化输出梯度 $\nabla_{\mathbf{A}^{(N_L)}}\mathcal{L}$ \For{$\ell = N_L$ 递减至 $1$} \Comment{重复应用相同的局部规则} \State 使用保存的前向传播值计算 $\nabla_{\mathbf{W}^{(\ell)}}\mathcal{L}, \nabla_{\mathbf{b}^{(\ell)}}\mathcal{L}$ \State 将 $\nabla_{\mathbf{A}^{(\ell-1)}}\mathcal{L}$ 传播至前一层 \EndFor \State \Return 累加后的参数梯度 \end{algorithmic} \end{algorithm}
在 algorithm 1 的前向循环中保存激活值,是系统成本产生的环节:每个激活值都必须保留,直到反向传播到达其所在层,因此激活值内存随批大小、层数和激活宽度而增长。这就是即使参数数量不变,训练所需内存也可能超过推理的原因。
误差信号传播
梯度在神经网络中的流动路径与前向传播相反。梯度从输出层的损失开始向后传播,计算损失对每一层以及最终对每个权重的局部敏感度。
考虑数字分类器将“七”误分类为“三”时会发生什么。损失函数在输出层生成初始误差信号,本质上指示“七”的概率应当增大,而“三”的概率应当减小。随后,这一误差信号通过网络各层向后传播。
对于具有 \(N_L\) 层的网络,可以用数学形式表达梯度流。在每一层 \(\ell\),最终损失对该层输出的敏感度由链式法则36以及 equation 21 中的示意性雅可比记号描述: \[ \frac{\partial \mathcal{L}}{\partial \mathbf{A}^{(\ell)}} = \frac{\partial \mathcal{L}}{\partial \mathbf{A}^{(\ell+1)}} \frac{\partial \mathbf{A}^{(\ell+1)}}{\partial \mathbf{A}^{(\ell)}} \tag{21}\]
这一计算在网络中逐层向后传递,每一层的梯度都依赖于其后一层的梯度。得到的是局部敏感度,而非因果责任:等价的参数化方式可以表示相同的函数,却具有不同尺度的梯度。反向传播提供这些敏感度,而优化器在更新权重之前,可能会对它们进行归一化、累加或其他变换。
这一过程在深度网络中面临挑战。当梯度反向流经许多层时,可能会消失或爆炸。反复相乘可能使梯度以指数速度缩小,尤其是在 sigmoid 或 tanh 激活函数处于饱和区时。当数值格式和硬件保留次正规数时,低于最小正正规数(FP32 中为 \(1.18 \times 10^{-38}\),FP16 中为 \(6.10 \times 10^{-5}\))的值会进入次正规数范围;更小的值会下溢为零,而某些加速器模式会为提高速度而将次正规数直接置零。在另一个极端,超出可表示最大值的数值可能上溢为 Inf,并传播 NaN,导致训练不稳定。
导数计算过程
计算梯度需要在每一层计算若干偏导数:权重、偏置和激活值的变化如何影响最终损失。这些计算直接遵循微积分的链式法则,但必须高效实现,才能用于实际训练。
在每一层 \(\ell\),反向传播会计算三种不同的梯度分量,每种分量在优化中都承担特定作用:
首先,将传入的误差信号 \(\frac{\partial \mathcal{L}}{\partial \mathbf{A}^{(\ell)}}\) 与局部激活函数的导数逐元素相乘(\(\odot\)),将其转换为预激活梯度 \(\frac{\partial \mathcal{L}}{\partial \mathbf{Z}^{(\ell)}}\)(equation 22): \[ \frac{\partial \mathcal{L}}{\partial \mathbf{Z}^{(\ell)}} = \frac{\partial \mathcal{L}}{\partial \mathbf{A}^{(\ell)}} \odot f'(\mathbf{Z}^{(\ell)}) \tag{22}\] 对于 ReLU 激活函数,\(f'(\mathbf{Z}^{(\ell)})\) 起到二值掩码的作用,使梯度通过处于激活状态的神经元(\(z > 0\)),并将未激活神经元的梯度置零。
权重梯度衡量最终损失对每个权重的局部敏感性。优化器使用这些梯度确定参数更新(equation 23): \[ \frac{\partial \mathcal{L}}{\partial \mathbf{W}^{(\ell)}} = {\mathbf{A}^{(\ell-1)}}^T \frac{\partial \mathcal{L}}{\partial \mathbf{Z}^{(\ell)}} \tag{23}\]
偏置梯度衡量改变每个偏置项会如何影响损失。由于偏置会移动神经元的激活阈值,这些梯度指示神经元应该变得更容易还是更不容易被激活,如 equation 24 所示: \[ \frac{\partial \mathcal{L}}{\partial \mathbf{b}^{(\ell)}} = \mathbf{1}^T \frac{\partial \mathcal{L}}{\partial \mathbf{Z}^{(\ell)}} \tag{24}\]
这里,\(\mathbf{1}\in\mathbb{R}^{B}\) 是一个全一向量,因此左乘该向量的转置会对批次中各样本的偏置梯度求和。
输入梯度将误差信号反向传播到前一层。这些梯度并不直接更新参数,而是充当“调整信号”,使较早的层能够从最终预测误差中学习(equation 25): \[ \frac{\partial \mathcal{L}}{\partial \mathbf{A}^{(\ell-1)}} = \frac{\partial \mathcal{L}}{\partial \mathbf{Z}^{(\ell)}} {\mathbf{W}^{(\ell)}}^T \tag{25}\]
这些方程揭示了一条经典系统经验法则的物理根源:反向传播所需的算术运算量大约是前向传播的两倍(\(2\times\))。前向传播在每个全连接层执行一次矩阵乘法(\(\mathbf{A}^{(\ell-1)}\mathbf{W}^{(\ell)}\)),而反向传播必须计算两次不同的矩阵乘法,且二者的计算复杂度相同:一次用于计算权重梯度(\({\mathbf{A}^{(\ell-1)}}^T \frac{\partial \mathcal{L}}{\partial \mathbf{Z}^{(\ell)}}\)),另一次用于将梯度传播到前一层(\(\frac{\partial \mathcal{L}}{\partial \mathbf{Z}^{(\ell)}} {\mathbf{W}^{(\ell)}}^T\))。因此,一次完整训练迭代所需的 FLOPs 是前向传播的 \(1 + 2 = 3\times\)。
这三类梯度与一项实际系统约束相互关联:期望的有效批次可能大于加速器内存一次能够容纳的规模。工程师通过梯度累积应对这一问题:将完整批次拆分为能够分别装入内存的较小微批次,并在优化器执行更新步骤之前,采用适当的损失归一化来累积各微批次的梯度。从优化器的角度看,有效批次大小等于所有微批次大小之和;从硬件的角度看,每个微批次都是一次独立的前向与反向传播,其内存使用量保持在预算之内。对于各样本之间计算相互独立的情况,累积采用一致方式归一化的梯度,得到的就是同一个批次梯度之和或均值。但并非总能保证数值完全等价:浮点归约顺序、批归一化等依赖批次的操作、随机层以及依赖批次的损失,都可能使微批次执行与单次完整批次执行产生差异。
考虑网络输出数字概率的最后一层。如果网络对一张数字“七”的图像预测出 \([0.1, 0.2, 0.5,\ldots, 0.05]\),梯度将通过三个步骤反向流动:
- 从这些概率中的误差开始
- 计算权重调整将如何影响这一误差
- 将这些梯度反向传播,以帮助调整较早层的权重
Systems Perspective 1.5: 反向传播的内存成本
激活值保留是更广泛的训练状态内存预算的一部分。在不计临时工作空间和框架开销的简化单设备核算中,equation 26 概括了四项主要的字节数: \[ \text{Training Memory} \approx \text{Model Weights} + \text{Gradients} + \text{Optimizer States} + \text{Activations} \tag{26}\]
这些导数方程也是一份状态依赖清单:
- equation 23 中的权重梯度需要传入的激活值 \(\mathbf{A}^{(\ell-1)}\)。
- 激活函数的导数可能需要 \(\mathbf{Z}^{(\ell)}\),或记录哪些非线性单元处于激活状态的紧凑掩码。
- equation 25 中的输入梯度需要该层的权重 \(\mathbf{W}^{(\ell)}\)。
- 优化器使用计算完成的参数梯度,并可能在反向传播生成这些梯度之后添加动量、方差或其他状态。
训练系统可以保留这些值,以实现最快的反向传播;也可以重新计算选定的值来节省内存,或在不同内存层级或设备之间卸载和分片存储状态。这些选择都无法消除成本:重新计算会消耗额外的 FLOPs,而卸载和分片会引入数据移动与同步。对于批次较大、激活宽度较大或输入分辨率较高的深度网络,这种权衡可能成为决定加速器容量需求的主要因素。训练内存的真实成本 给出了完整的训练内存方程,以及对权重、梯度、优化器状态和激活值成本的分析示例。
通过在反向传播中追踪实际数值,一个极简网络可以让梯度运算变得具体可见。
Napkin Math 1.3: 追踪梯度:反向传播计算示例
设置:考虑一个网络,它有两个输入、一个包含两个神经元的隐藏层(采用 ReLU 激活函数),以及一个输出神经元(为简化起见,不使用激活函数)。假设当前权重和偏置为:
- 隐藏层:\(\mathbf{W}^{(1)} = \begin{bmatrix} 0.5 & -0.3 \\ 0.8 & 0.2 \end{bmatrix}\),\(\mathbf{b}^{(1)} = \begin{bmatrix} 0 \\ 0 \end{bmatrix}\)
- 输出层:\(\mathbf{W}^{(2)} = \begin{bmatrix} 0.6 \\ -0.4 \end{bmatrix}\),\(\mathbf{b}^{(2)} = 0\)
给定输入 \(\mathbf{x} = [1.0,\; 0.5]\) 和目标 \(y = 1.0\),采用均方误差:\(\mathcal{L} = \frac{1}{2}(\hat{y} - y)^2\)。
前向传播(确定反向传播所需的数值):
- 隐藏层预激活值: \[\mathbf{z}^{(1)} = \mathbf{x}\mathbf{W}^{(1)} + \mathbf{b}^{(1)} = [1.0 \cdot 0.5 + 0.5 \cdot 0.8,\; 1.0 \cdot (-0.3) + 0.5 \cdot 0.2] = [0.9,\; -0.2]\]
- 隐藏层激活值(ReLU):\(\mathbf{a}^{(1)} = [\max(0, 0.9),\; \max(0, -0.2)] = [0.9,\; 0.0]\)
- 输出:\(\hat{y} = \mathbf{a}^{(1)}\mathbf{W}^{(2)} + b^{(2)} = 0.9 \cdot 0.6 + 0.0 \cdot (-0.4) = 0.54\)
- 损失:\(\mathcal{L} = \frac{1}{2}(0.54 - 1.0)^2 = 0.1058\)
反向传播(逐层应用链式法则):
步骤 1:输出层梯度。损失对输出的梯度为 \[\frac{\partial \mathcal{L}}{\partial \hat{y}} = \hat{y} - y = 0.54 - 1.0 = -0.46.\] 步骤 2:输出层权重梯度(应用 equation 23)。由于输出层没有激活函数 \[\frac{\partial \mathcal{L}}{\partial z^{(2)}} = \frac{\partial \mathcal{L}}{\partial \hat{y}} = -0.46, \quad\text{and}\quad \frac{\partial \mathcal{L}}{\partial \mathbf{W}^{(2)}} = {\mathbf{a}^{(1)}}^T \frac{\partial \mathcal{L}}{\partial z^{(2)}} = \begin{bmatrix} 0.9 \\ 0.0 \end{bmatrix} \cdot (-0.46) = \begin{bmatrix} -0.414 \\ 0.0 \end{bmatrix}\] 步骤 3:传播到隐藏层(应用 equation 25)。反向传递的误差信号为: \[\frac{\partial \mathcal{L}}{\partial \mathbf{a}^{(1)}} = \frac{\partial \mathcal{L}}{\partial z^{(2)}} {\mathbf{W}^{(2)}}^T = (-0.46) \cdot [0.6,\; -0.4] = [-0.276,\; 0.184]\]
步骤 4:通过 ReLU。当 \(z > 0\) 时,ReLU 的导数为一,否则为 0,因此 \[\frac{\partial \mathcal{L}}{\partial \mathbf{z}^{(1)}} = [-0.276 \cdot 1,\; 0.184 \cdot 0] = [-0.276,\; 0.0].\] 第二个神经元的梯度被置零,因为 ReLU 阻断了它的前向信号。
步骤 5:隐藏层权重梯度(应用 equation 23): \[\frac{\partial \mathcal{L}}{\partial \mathbf{W}^{(1)}} = \mathbf{x}^T \cdot \frac{\partial \mathcal{L}}{\partial \mathbf{z}^{(1)}} = \begin{bmatrix} 1.0 \\ 0.5 \end{bmatrix} \cdot [-0.276,\; 0.0] = \begin{bmatrix} -0.276 & 0.0 \\ -0.138 & 0.0 \end{bmatrix}\]
权重更新(学习率为 \(\eta = 0.1\)):每个权重都沿其梯度的反方向移动。例如,\(W^{(1)}_{11}\) 从 \(0.5\) 更新为 \(0.5 - 0.1 \cdot (-0.276) = 0.5276\),使网络向正确输出略微靠近。对于这个样本,第二个隐藏神经元的权重更新量为零,因为 ReLU 阻断了它的激活;这说明了当这种情况在训练数据上持续发生时,可能导致神经元死亡的机制。
系统洞见:反向传播不仅是一个微积分过程,也是一张数据依赖图。训练系统必须保留此次反向传播所需的前向激活值,这就是激活值内存成为系统主要成本的原因。
虽然理解这些数学细节对于调试和优化至关重要,但现代从业者很少手动实现梯度计算。系统层面的突破在于框架如何自动实现这些计算。考虑矩阵乘法后接 ReLU 激活这样一个简单操作:output = relu(input @ weight)。数学上的梯度计算涉及求 ReLU 的导数(负输入为 0,正输入为 1),并对矩阵乘法应用链式法则。框架在前向传播期间将该操作记录到计算图中,存储梯度计算所需的 ReLU 之前的激活值,为每个操作关联反向计算规则,并调度反向遍历,以平衡正确性、内存使用量和硬件利用率。这种自动化将梯度计算从一个需要深厚数学知识、容易出错的手工过程,转变为支持快速实验和部署的可靠系统能力。
计算实现细节
激活值存储只是反向传播的第一项成本。随着模型规模扩大,训练还会增加梯度存储、优化器状态的数据传输量和调度压力,而这些都未包含在前向传播的内存估算中。
考虑 MNIST 网络的一个更大变体(784 → 512 → 256 → 10),批次大小为 32。每一层的激活值都必须保留,直到反向传播到达该层:
- 输入层:\(32{\times}784\) 个值(使用 32 位数值时约为 100 KB)
- 隐藏层 1:\(32{\times}512\) 个值(约 66 KB)
- 隐藏层 2:\(32{\times}256\) 个值(约 33 KB)
- 输出层:\(32{\times}10\) 个值(约 1 KB)
除激活值外,训练还会为参数梯度分配内存。对于这个约有 535,818 parameters 的较大网络,梯度存储需要数兆字节。Adam37 等高级优化器会为每个参数维护动量和速度项,使这部分内存需求大致增至三倍。
内存带宽和内存占用进一步加重了这些容量要求。一个训练步骤会读取参数、生成梯度,并保留或重新计算各层反向计算所需的前向传播数值。保存激活值所需的存储通常随批次大小和网络深度增长,因此对于相同模型和批次,训练的峰值内存需求会大于推理的内存占用。对于 MNIST 示例这样规模较小的网络,这些数据传输量仍可控制。随着模型增大,内存带宽和激活值存储可能成为限制性约束,从而推动高带宽内存、混合精度、分片和激活检查点技术的应用。
反向传播的计算模式遵循严格的顺序:计算当前层的梯度,更新已存储的梯度,将误差信号传播到前一层,然后重复这一过程,直到到达输入层。对于批处理,这些计算会同时针对批次中的所有样本执行,从而高效利用矩阵运算和并行处理能力。
现代框架通过复杂的 autograd38 引擎处理这些计算。动态计算图在操作执行时记录操作,而静态计算图则延迟执行,以暴露更多优化机会。当训练脚本请求计算梯度时,框架会自动管理整个计算图中的内存分配、操作调度和梯度累积。系统会追踪哪些张量需要梯度,并调度操作,使反向传播遵循前向传播期间建立的依赖关系。这种自动化管理使从业者能够专注于模型设计,而不必处理梯度计算实现中的复杂细节。
Checkpoint 1.3: 反向传播
贡献分配问题要回答的是:损失如何依赖网络各处的参数。反向传播通过链式法则计算这些梯度;请检查自己是否清楚这一机制:
机制
训练与推理
反向传播计算损失对每个权重的局部梯度;优化器将该信号转化为实际的参数更新。步长、方向修正以及跨迭代的动量均由优化器控制。不存在一种优化器能在所有可能的问题上普遍最优 (Wolpert and Macready 1997),因此,神经网络训练依赖于选择与模型、数据和硬件约束相匹配的更新规则与超参数。
Wolpert, D. H., and W. G. Macready. 1997. “No Free Lunch Theorems for Optimization.” IEEE Transactions on Evolutionary Computation 1 (1): 67–82. https://doi.org/10.1109/4235.585893.
参数更新算法
Definition 1.3: 梯度下降
梯度下降是一种迭代优化算法,它沿负梯度方向更新模型参数,\(\theta \leftarrow \theta - \eta \nabla_\theta \mathcal{L}\),以计算步骤 \((O)\) 换取损失降低。
- 重要性:优化器的选择会影响训练内存需求。在简化的 FP32 内存核算中,随机梯度下降(SGD)需要存储每个权重及其梯度(每个参数 8 字节),而 Adam 还会增加两个矩缓冲区,使这四个张量的总存储量达到每个参数 16 字节。混合精度训练可能保留部分 FP32 主副本值,同时以更低精度存储其他张量;模型训练 将详细说明完整的核算方法。优化器状态、保存的激活值、梯度、临时工作区和通信缓冲区共同决定训练需要多少个加速器。
- 区别:反向传播计算梯度(即“改变什么”的信号);优化器应用更新(即“执行改变”的动作)。反向传播过程决定哪些前向计算值必须保留,而优化器则引入自身的状态和更新计算。
- 常见误区:一种常见的误解是,梯度下降能够找到全局最小值。神经网络的损失景观是非凸的,包含许多局部最小值、鞍点和平坦区域。在实践中,SGD 及其变体会收敛到泛化性能良好的低损失区域,但其路径取决于学习率调度、批大小和初始化。
优化过程现在需要一条更新规则,将反向传播得到的梯度转化为参数变化。这一迭代过程利用损失对每个权重的局部敏感性来更新参数,力求在连续的步骤中降低损失。基本更新规则将反向传播的梯度计算与参数调整结合起来,如 equation 27 所定义: \[ \theta_{\text{new}} = \theta_{\text{old}} - \eta \nabla_{\theta}\mathcal{L} \tag{27}\] 其中,\(\theta\) 表示网络参数(权重和偏置)的集合,\(\eta\) 是学习率,\(\nabla_{\theta}\mathcal{L}\) 是通过反向传播计算得到的梯度。
对于数字分类器,这意味着调整权重以提高分类准确率。如果网络经常将“7”与“1”混淆,梯度下降就会修改权重,以更好地区分这些数字。学习率 \(\eta\)39 控制调整幅度:过大的值会导致更新越过最优参数,而过小的值则会导致收敛缓慢。
尽管神经网络的损失景观具有高度非凸性,但当模型、数据、初始化和优化设置相互匹配时,基于梯度的方法往往能够找到有用的解。其理论原因涉及彩票假设 (Frankle and Carbin 2019)、隐式偏置 (Neyshabur et al. 2017) 和过参数化的益处 (Nakkiran et al. 2019) 等概念,仍然是活跃的研究领域。对于实际的机器学习系统工程,关键认识来自经验:必须联合验证学习率、初始化、正则化和训练配置。
Frankle, Jonathan, and Michael Carbin. 2019. “The Lottery Ticket Hypothesis: Finding Sparse, Trainable Neural Networks.” International Conference on Learning Representations (ICLR).
Neyshabur, Behnam, Srinadh Bhojanapalli, David McAllester, and Nati Srebro. 2017. “Exploring Generalization in Deep Learning.” Advances in Neural Information Processing Systems 30.
Nakkiran, Preetum, Gal Kaplun, Yamini Bansal, Tristan Yang, Boaz Barak, and Ilya Sutskever. 2019. “Deep Double Descent: Where Bigger Models and More Data Hurt.” arXiv Preprint arXiv:1912.02292.
小批量梯度更新
神经网络在训练期间通常同时处理多个样本,这种方法称为小批量梯度下降。它并非在每张图像之后更新权重,而是在执行更新之前,先计算一批样本的平均梯度。
对于大小为 \(B\) 的批次,令 \(\mathcal{L}_i\) 表示样本 \(i\) 的损失;平均损失的梯度如 equation 28 所示: \[ \nabla_{\theta}\mathcal{L}_{\text{batch}} = \frac{1}{B}\sum_{i=1}^B \nabla_{\theta}\mathcal{L}_i \tag{28}\]
以典型的批大小 32 为例,系统对 32 张图像执行一次前向传播,计算 32 个逐样本损失,对其梯度取平均,然后执行一次权重更新。这种平均操作平滑了带噪声的逐样本梯度,但也意味着加速器必须保留该批次的激活值,直到反向传播使用它们。因此,批大小与模型形状、内核实现和硬件共同影响可用并行度与利用率。
迭代学习过程
完整的训练过程将前向传播、反向传播和权重更新结合为一个系统化的训练循环。这一循环不断重复,直到网络达到令人满意的性能,或达到预先设定的迭代次数。
对整个训练数据集完整遍历一次称为一个轮次(epoch)。40 对于 MNIST,训练图像数量为 60,000,批大小为 32,因此每个轮次包含 1,875 次批次迭代。Algorithm 2 展示了小批量 SGD 循环:每个轮次先打乱数据,然后逐个小批量执行前向传播和反向传播,并对每个批次执行一次参数更新。
\begin{algorithm} \caption{小批量随机梯度下降} \begin{algorithmic} \Require 训练集 $\{(x_i,y_i)\}_{i=1}^{D}$;学习率 $\eta$;批大小 $B$;轮次数 $E$;初始参数 $\theta_0$ \Ensure 训练后的参数 $\theta$ \State $\theta \gets \theta_0$ \For{$e = 1$ 到 $E$} \State 打乱训练集 \Comment{减少与顺序相关的模式} \For{每个小批量 $\mathcal{M}$,大小为 $B$} \State $\hat{y}_i \gets f_\theta(x_i)$,对所有 $(x_i,y_i) \in \mathcal{M}$ \State $\mathcal{L}_{\mathcal{M}} \gets \tfrac{1}{B}\sum_{(x_i,y_i)\in \mathcal{M}} \mathcal{L}(\hat{y}_i, y_i)$ \State $\theta \gets \theta - \eta\, \nabla_\theta \mathcal{L}_{\mathcal{M}}$ \Comment{先反向传播,再更新} \EndFor \State 在验证集上评估;若满足收敛准则则停止 \EndFor \State \Return $\theta$ \end{algorithmic} \end{algorithm}
小批量循环使批大小 \(B\) 成为硬件的工作单元:较大的 \(B\) 可以提高矩阵计算利用率和加速器占用率,但会增加激活值内存需求;并且,由于每个批次而非每个样本触发一次更新,\(B\) 也决定了梯度更新的频率。algorithm 2 中的内层循环就是硬件反复执行的单元。前向传播为当前小批量中的每个样本生成激活值,反向传播使用所需的已保存值来计算梯度,而优化器每个批次修改一次参数。训练损失跟踪最近批次上的优化目标,而验证准确率衡量模型在单独留出的验证集上的任务性能。测试集则保留用于模型和超参数选择确定之后的最终评估。
收敛与稳定性考量
如果网络在训练数据上达到 99.5% 的准确率,但在相关的未见数据上仅达到 85%,就表现出较大的泛化差距,这是过拟合的强烈迹象。模型可能既学到了有用的模式,又过度适应了训练样本。
Definition 1.4: 过拟合
过拟合是一种泛化失败现象,即模型在训练样本上的性能提高,但在相关的未见数据上的性能并未提高。
- 重要性:其诊断特征可以测量:训练损失持续下降,而验证损失上升,或相关验证指标进入平台期,从而形成不断扩大的泛化差距。参数数量本身并不能决定这一行为;数据覆盖范围、架构、优化、正则化,以及训练分布与部署分布之间的关系都会产生影响。
- 区别:欠拟合是指模型缺乏捕捉目标函数的能力,训练误差和验证误差均保持较高水平;与之不同,过拟合会产生较低的训练误差和较高的验证误差,表明模型已经过度适应训练样本,而未能学到其背后的分布。
- 常见误区:只有当更多数据能够代表系统需要泛化到的行为时,增加数据才有帮助。增加样本、数据增强、正则化和提前停止都是可能的干预措施,但每种措施都必须在来自相关运行条件的留出数据上进行评估。
学习率选择会显著影响训练动态。对于给定的优化器、批大小、归一化方式和调度策略,过大的学习率可能使损失振荡或发散;过小的学习率则可能浪费多个轮次,却几乎没有进展。不存在通用的“适中”值,因此工程师会在预期的训练配置中测试不同学习率,并同时监控优化稳定性和验证性能。
收敛监控在训练期间提供关键反馈,并延续到生产部署阶段,详见 机器学习运维。训练损失曲线趋于平坦表明优化速度正在放缓,但无法据此确定原因:训练可能正在接近一个有用的解,也可能遇到了优化瓶颈,或存在欠拟合。验证指标进入平台期同样只能提供诊断线索,不能据此得出定论。训练性能与验证性能之间的差距有助于区分过拟合与能够迁移到留出样本上的改进。为了在硬件约束内实现高效训练,需要仔细平衡批大小、可用内存和计算资源之间的相互影响,这与本节前面确立的内存—计算权衡相同。
Checkpoint 1.4: 神经网络学习过程
完整的训练周期提供了使神经网络能够从数据中学习的数学机制。在转向推理和部署之前,请检验对训练周期核心内容的理解:
使用 MNIST 网络(784 → 128 → 64 → 10)和批大小 32 作为贯穿以下检查的示例。
如果有任何概念尚不清楚,请在继续之前复习前面关于前向传播、损失函数、反向传播和学习的各节。这些机制构成了后文区分训练与推理的基础。
选择停止时点需要定期在验证集上评估模型,并将其权重保存到持久化存储中,这一做法称为检查点保存。对于 MNIST 网络这样的小模型,写入检查点所需的时间可以忽略不计。对于参数占用数十至数百 GB 的模型,同步写入检查点可能会使训练循环停顿,等待这些字节序列化并写入磁盘或对象存储;异步和分布式检查点保存可以缩短这一停顿,但仍然会消耗内存、网络带宽和存储带宽。验证本身需要对留出数据集执行一次完整的前向传播,在大规模场景下,这会占用原本可以用于训练的可观加速器时间。因此,检查点保存和验证并非没有代价的统计观测:它们会带来周期性的 I/O 和计算开销,必须在执行频率与故障恢复及模型选择需求之间取得平衡。保存频率过低,可能会在故障或后续性能退化后丢失有用的权重;保存过于频繁,则会增加存储带宽压力并引入额外开销。这就是为什么收敛监控虽然在概念上直观,却会在大规模场景下成为系统基础设施问题。
完整的训练流水线从前向传播开始,经过损失计算,最终执行基于梯度的权重更新。然而,训练只是准备工作,并非最终目标——参数优化完成后,将模型部署用于实时预测会彻底改变其资源需求特征。
推理流水线
训练将随机初始化的权重转化为编码了有用模式的参数,但部署阶段在完全不同的资源需求特征下使用这些参数执行计算。在推理期间,41相同的数学算子面对的是根本不同的运行条件:严格的延迟时限取代了大批量训练吞吐量要求,梯度和优化器状态从内存中消失,而目标执行环境则从毫瓦级边缘处理器延伸到配备多个加速器的云服务器。这一转变重塑了内存带宽、计算能力和流水线阶段对系统性能的制约方式。
生产部署与预测流水线
假设一个在测试集上达到 99% 准确率的模型,在部署三个月后开始产生毫无意义的输出,尽管代码没有任何变化。权重保持固定,推理流水线运行时也没有报错。一种可能的原因是,模型保持不变,而它所处的运行环境已经发生了变化。
从训练转向推理,限制了已部署的固定模型的适应方式。训练后的模型通过学到的统计模式泛化到未见输入,但其参数在常规推理期间不会改变。当运行数据偏离训练分布时,模型仍然继续应用这些已学到的模式。以自动驾驶汽车的感知系统为例:如果施工区域变得更加常见,或出现了新的车辆配置,其响应仍然反映训练时的证据。对于不在线更新参数的系统,适应变化需要通过受监控的数据采集、验证和重新训练来实现,这是一个有计划的工程过程,详见 模型训练。
运行阶段的差异
神经网络的运行分为两个不同阶段,其计算需求和状态生命周期存在显著差异。推理只执行前向传播,使用静态参数对输入进行计算,批大小由到达的流量决定。训练则将前向传播与用于梯度计算和参数更新的反向传播结合起来,并选择能够最大限度提高加速器占用率和梯度稳定性的批大小。关键在于,训练必须同时保留中间激活值、梯度和优化器状态,从而成倍增加工作内存需求。42 尽管底层网络权重相同,执行图却会发生变化:仅用于训练的正则化机制(如 dropout)会被移除,而相邻的矩阵运算和激活运算可以通过融合或量化转化为专用执行内核。Figure 18 展示了双向训练与仅前向推理之间的这种结构差异。
\scalebox{0.85}{%
\begin{tikzpicture}[line join=round,font=\sffamily]
\tikzset{
 Line/.style={line width=0.75pt,black!50,text=black},
 LineD/.style={line width=0.5pt,black!50,text=black},
 LineE/.style={line width=1.95pt,brown!50,text=black}
}
\makeatletter
\newif\ifboxdashed
\boxdashedfalse % default: not dashed

\tikzset{
  circles/.pic={
    \pgfkeys{/channel/.cd, #1}
\node[circle,draw=\channelcolor,line width=1pt,fill=\channelcolor!10,
minimum size=4.5mm,\ifboxdashed dashed\fi](\picname){};
        }
}

\tikzset{
  channel/.pic={
    \pgfkeys{/channel/.cd, #1}
\node[rectangle,draw=\drawchannelcolor,line width=1pt,fill=\channelcolor!10,
minimum height=13mm,minimum width=22mm,\ifboxdashed dashed\fi](\picname){};
        }
}

\pgfkeys{
  /channel/.cd,
  channelcolor/.store in=\channelcolor,
  drawchannelcolor/.store in=\drawchannelcolor,
  scalefac/.store in=\scalefac,
  picname/.store in=\picname,
  channelcolor=BrownLine,
  drawchannelcolor=BrownLine,
  scalefac=1,
  dashed/.code={\boxdashedtrue},
  picname=C
}
\makeatother
\tikzset{
  man/.pic={
  \pgfkeys{/man/.cd, #1}
     % tie
    \draw[draw=\tiecolor,fill=\tiecolor] (0.0,-1.1)--(0.16,-0.87)--(0.09,-0.46)--(0.13,-0.37)--(0.0,-0.28)
                   --(-0.13,-0.37)--(-0.09,-0.46)--(-0.16,-0.87)--cycle;
    % ears
    \draw[fill=black] (0.74,0.95) to[out=20,in=80](0.86,0.80) to[out=250,in=330](0.65,0.65) to[out=70,in=260] cycle;
    \draw[fill=black] (-0.76,0.96) to[out=170,in=110](-0.85,0.80) to[out=290,in=190](-0.65,0.65) to[out=110,in=290] cycle;

    % head
    \fill[fill=black] (0,0) to[out=180,in=290](-0.72,0.84) to[out=110,in=190](-0.56,1.67)
                      to[out=70,in=110](0.68,1.58) to[out=320,in=80](0.72,0.84) to[out=250,in=0] cycle;
    % face
    \fill[fill=white] (0,0.11) to[out=175,in=290](-0.53,0.65) to[out=110,in=265](-0.61,1.22)
                      to[out=80,in=235](-0.50,1.45) to[out=340,in=215](0.50,1.47)
                      to[out=310,in=85](0.60,0.92) to[out=260,in=2] cycle;
    \draw[fill=black] (-0.50,1.45) to[out=315,in=195](0.40,1.25) to[out=340,in=10](0.37,1.32)
                      to[out=190,in=310](-0.40,1.49) -- cycle;
    % neck
    \draw[line width=1.25pt] (-0.62,-0.2) to[out=50,in=290] (-0.5,0.42);
    \draw[line width=1.25pt] (0.62,-0.2) to[out=130,in=250] (0.5,0.42);
    % body
    \draw[draw=\bodycolor,fill=\bodycolor] (0.0,-1.0) to[out=150,in=290](-0.48,-0.14) to[out=200,in=50](-1.28,-0.44)
                   to[out=240,in=80](-1.55,-1.76) -- (1.55,-1.76)
                   to[out=100,in=300](1.28,-0.44) to[out=130,in=340](0.49,-0.14)
                   to[out=245,in=30] cycle;
    % right stet
    \draw[line width=2pt,\stetcolor] (0.8,-0.21) to[bend left=7](0.78,-0.64)
         to[out=350,in=80](0.98,-1.35) to[out=250,in=330](0.72,-1.60);
    \draw[line width=2pt,\stetcolor] (0.43,-1.53) to[out=180,in=240](0.3,-1.15)
         to[out=60,in=170](0.78,-0.64);
    % left stet
    \draw[line width=2pt,\stetcolor] (-0.75,-0.21) to[bend right=20](-0.65,-1.45);
    \node[fill=\stetcolor,circle,minimum size=5pt] at (-0.65,-1.45) {};
    % eyes
    \node[circle,fill=black,inner sep=2pt] at (0.28,0.94) {};
    \node[circle,fill=black,inner sep=2pt] at (-0.28,0.94) {};
     % mouth
    \draw[line width=1.0pt] (-0.25,0.5) to[bend right=\emotion](0.25,0.5);
  },
}
\pgfkeys{
  /man/.cd,
  tiecolor/.store in=\tiecolor,
  bodycolor/.store in=\bodycolor,
  stetcolor/.store in=\stetcolor,
  emotion/.store in=\emotion,
  emotion=40,
  tiecolor=red,      % default tie color
  bodycolor=blue!30,  % default body color
  stetcolor=green,  % default stet color
}
%%%%
\begin{scope}[local bounding box=DOWN,shift={(0,0)}]
\begin{scope}[local bounding box=CHANEL1,shift={(0,0)}]
\foreach \i/\clr/\da in {1/BrownLine/dashed,2/BrownLine/dashed,3/BrownLine/dashed,4/BrownLine/,5/green/} {
\pic at ({-\i*0.17}, {-0.17*\i}) {channel={picname=\i-CH1,channelcolor=\clr,\da}};
}
\end{scope}
\node[below=0.1 of 5-CH1]{\textbf{推理}};
\draw[Line,latex-latex]([xshift=3mm]5-CH1.south east)--node[pos=0.37, right=12pt, align=left] {较小且\ 大小可变的批次}
([xshift=3mm]1-CH1.south east);

\begin{scope}[local bounding box=MAN,shift={($(5-CH1.north west)!0.5!(5-CH1.south east)$)},scale=0.3, every node/.append style={transform shape}]
\pic at (0,0) {man={tiecolor=brown, bodycolor=BlueLine,stetcolor=BlueLine,emotion=50}};
\end{scope}

\begin{scope}[local bounding box=CIRCLE1,shift={($(CHANEL1)+(7.5,-0.3)$)}]
\foreach \i in {1,...,5} {
  \pgfmathsetmacro{\y}{(2-\i)*0.6+0.7}
  \pic at (0,\y) {circles={channelcolor=RedLine,picname=1CD\i}};
}
%middle -3 neurons
\foreach \j in {1,2,3} {
  \pgfmathsetmacro{\y}{(1-\j)*0.6 + 0.7}
  \pic at (1.5,\y) {circles={channelcolor=RedLine,picname=2CD\j}};
}
%right -3 neurons
\foreach \j in {1,2,3} {
  \pgfmathsetmacro{\y}{(1-\j)*0.6 + 0.7}
  \pic at (3.0,\y) {circles={channelcolor=RedLine,picname=3CD\j}};
}
\end{scope}
\coordinate(DL)at($(1CD3)+(-2,0)$);
\coordinate(DD)at($(3CD2)+(2.5,0)$);
\foreach \i in {1,2,3,4,5}{
  \foreach \j in {1,2,3}{\draw[LineD](1CD\i)--(2CD\j);
}}

\foreach \i in {1,2,3}{
  \foreach \j in {1,2,3}{\draw[LineD](2CD\i)--(3CD\j);
}}

\draw[LineE,-latex](DL)--(DD)node[above left]{前向传播}node[right]{"人"};
\end{scope}
%%%%%%%%%%
%ABOVE
%%%%%%%%%%
\begin{scope}[local bounding box=ABOVE,shift={(0,3.28)}]
\begin{scope}[local bounding box=CHANEL1,shift={(0.6,0)}]
\foreach \i/\clr/\da in {1/BrownLine/,2/BrownLine/,3/BrownLine/,4/BrownLine/,5/BrownLine/,6/BrownLine/,7/yellow!70!/} {
\pic at ({-\i*0.17}, {-0.17*\i}) {channel={picname=\i-CH1,channelcolor=\clr,\da}};
}
\end{scope}
\node[below=0.1 of 7-CH1]{\textbf{训练}};
\draw[Line,latex-latex]([xshift=3mm]7-CH1.south east)--node[pos=0.37, right=12pt, align=left] {大批次}
([xshift=3mm]1-CH1.south east);
%person
\begin{scope}[local bounding box=MAN,shift={($(7-CH1.north west)!0.5!(7-CH1.south east)$)},scale=0.3, every node/.append style={transform shape}]
\pic at (0,0) {man={tiecolor=GreenLine, bodycolor=VioletLine,stetcolor=VioletLine,emotion=-50}};
\end{scope}

\begin{scope}[local bounding box=CIRCLE1,shift={($(CHANEL1)+(7.0,-0.1)$)}]
\foreach \i in {1,...,5} {
  \pgfmathsetmacro{\y}{(2-\i)*0.6+0.7}
  \pic at (0,\y) {circles={channelcolor=RedLine,picname=1CD\i}};
}
%middle -3 neurons
\foreach \j in {1,2,3} {
  \pgfmathsetmacro{\y}{(1-\j)*0.6 + 0.7}
  \pic at (1.5,\y) {circles={channelcolor=RedLine,picname=2CD\j}};
}
%right -3 neurons
\foreach \j in {1,2,3} {
  \pgfmathsetmacro{\y}{(1-\j)*0.6 + 0.7}
  \pic at (3.0,\y) {circles={channelcolor=RedLine,picname=3CD\j}};
}
\end{scope}
\coordinate(DL)at($(1CD2)+(-2,0)$);
\coordinate(DD)at($(3CD1)+(2.5,0)$);
\coordinate(DL2)at($(1CD4)+(-2,0)$);
\coordinate(DD2)at($(3CD3)+(2.5,0)$);
\foreach \i in {1,2,3,4,5}{
  \foreach \j in {1,2,3}{\draw[LineD](1CD\i)--(2CD\j);
}}

\foreach \i in {1,2,3}{
  \foreach \j in {1,2,3}{\draw[LineD](2CD\i)--(3CD\j);
}}

\draw[LineE,-latex](DL)--(DD)node[above left]{前向传播}node(PE)[right]{"人"};
\draw[LineE,latex-](DL2)--(DD2)node[below left]{反向传播}node[right]{};
\draw[LineE,-latex,red](PE)|-node[fill=white,pos=0.2]{误差}(DD2);
\end{scope}
\end{tikzpicture}}这些计算差异直接体现于硬件选择和部署拓扑中。训练集群依赖高带宽、大内存的加速器,每个插槽需要数百瓦的供电,并配备专用的数据中心冷却基础设施。在受限硬件上的推理部署中,异构平台均优先考虑有界的尾延迟和能源效率:移动设备在低功耗神经处理单元上执行推理(通常为 2–4 W),边缘服务器采用专用推理加速器,43云实例则利用较低的数值精度,使张量核心达到饱和利用率。44在大规模场景下,生产环境中的模型服务会引入动态请求批处理、负载均衡和故障隔离等运维要求,而这些要求在独立的训练运行中并不存在。在内存层面,训练会保留所有前向激活值,直到反向传播使用它们;推理则随着计算图的执行推进,丢弃或覆盖中间缓冲区;table 12 总结了这一资源特征。
| 特征 | 训练前向传播 | 推理前向传播 |
|---|---|---|
| 激活值存储 | 保留反向传播所需的值 | 保留当前的输入和输出缓冲区 |
| 内存使用模式 | 保存或重新计算选定的中间状态 | 随着各层依次完成计算而复用缓冲区 |
| 计算流程 | 围绕梯度计算的准备工作组织 | 针对直接生成输出进行优化 |
| 资源特征 | 训练操作的内存需求较高 | 尽量减小内存占用,以实现高效执行 |
内存与计算资源
神经网络在推理期间消耗计算资源的方式与训练期间不同。推理有两类内存需求。第一类是持久性的:训练得到的权重和偏置必须始终可供每个请求使用。第二类是临时性的:每一层产生的激活缓冲区,只需保留到下一层使用完毕。这一区别解释了为何即使前向传播中的算术运算相同,推理的资源开销仍可远低于训练。
对于典型的 MNIST 网络(784 → 128 → 64 → 10),持久参数块包含 109,386 parameters,采用 32 位浮点精度时约占 438 KB。table 13 中逐层列出的计数说明了原因:每个全连接层都要为每个权重执行一次乘加运算,因此参数内存占用与算术运算量会同步增长。
| 层 | 权重 | 偏置 | 乘加运算次数 |
|---|---|---|---|
| 第 1 层 | \(784{\times}128\) = 100,352 | 128 | 100,352 |
| 第 2 层 | \(128{\times}64\) = 8,192 | 64 | 8,192 |
| 输出层 | \(64{\times}10\) = 640 | 10 | 640 |
| 总计 | 109,386 parameters | 已计入总数 | 109,184 |
这种持久存储加滚动缓冲区的模型也解释了后续的部署优化。批处理可以提高算术运算中的数据复用程度和硬件占用率,但会增加激活值存储需求。较低的数值精度可以缩小持久参数块和激活缓冲区,45但前提是采用更小的表示后,任务质量仍能保持。针对特定硬件的数据布局可以将工作数据保留在计算单元附近,从而提高缓存复用率。推理的参数固定,且许多激活值的生命周期较短,因此更容易规划这些优化。
性能提升技术
冻结参数并消除反向传播状态后,便会显现出训练期间无法利用的系统性优化机会。由于前向计算图是静态且确定的,运行时引擎可以针对目标处理器的物理极限,优化内存布局、算子调度和数值精度。
输入批处理在单个请求的延迟与硬件效率之间引入了根本性的矛盾。在对单个输入(\(B=1\))求值时,全连接层执行矩阵—向量乘法(GEMV)。处理器必须将每个权重参数从 DRAM 经内存总线流式传输到寄存器,而每个值仅参与两次浮点运算,因此算术强度的上限约为 \(1\text{ FLOP/byte}\)(16 位精度)或 \(0.5\text{ FLOP/byte}\)(32 位精度)。在这种情况下,执行受内存带宽限制:算术单元处于空闲状态,等待参数送达。将请求聚合为大小为 \(B > 1\) 的批次,会把工作负载转换为通用矩阵—矩阵乘法(GEMM)。此时,从内存加载的每个参数都会在全部 \(B\) 个输入之间并行复用,使算术强度随 \(B\) 成比例增长,直至机器达到其计算吞吐量上限。代价是激活值存储:对于 MNIST 网络,处理一张图像需要存储 202 个层输出激活值(包括输入缓冲区在内共 986 个值),而大小为 32 的批次则需要 6,464 个层输出激活值。处理交互式流量的生产系统必须动态权衡两者,仅在服务级别延迟预算允许的范围内累积输入。
推理期间的内存分配比训练期间精简得多,因为中间激活值具有严格互不重叠的生命周期。在训练中,每个激活张量都必须保留到反向传播到达其对应层时,因此内存消耗会沿整个网络深度累积(\(\sum_l A_l\))。在推理期间,一旦第 \(l+1\) 层执行完毕,第 \(l\) 层的激活缓冲区便不再存活,其分配的存储空间可以回收或覆盖。模型服务运行时通过静态内存规划或双缓冲(乒乓分配)利用这一生命周期特性,在数据逐层推进时交替使用两个物理内存块。在这种方案下,瞬态激活值的峰值内存需求从所有层的累计总量降至相邻层内存之和的最大值:\(\max_l (A_l + A_{l+1})\)。
针对特定硬件的编译通过消除片外内存流量进一步降低延迟。在 CPU 上,执行例程将矩阵分块,使其适配 L1 和 L2 缓存,避免高延迟的主存访问停顿,同时发出 SIMD 向量指令(如 AVX-512 或 ARM NEON),在每个指令周期内完成多次乘加运算。在加速器上,执行效率取决于算子融合。朴素的执行路径会为矩阵乘法、偏置加法和非线性激活分别启动内核,在每一步之后将中间张量写回高带宽内存(HBM),随后立即将其读回。内核融合将这些操作合并为单个内核,使中间值完全暂存于片上寄存器和共享 SRAM 中。这以局部寄存器访问替代了高延迟的全局内存往返访问,减少了内核启动开销和内存总线拥塞。
消除反向传播还使降低数值精度成为可能。训练需要较宽的动态范围和较高的精度(如 FP32 或 BF16),以便累积极小的梯度更新,同时避免下溢或灾难性消减。在推理期间,冻结的权重和激活值通常可以量化为较低位宽的表示,如 FP16 或 INT8,而对最终预测的影响可以忽略不计。较低精度直接缓解了内存带宽瓶颈:将 FP32 参数转换为 INT8,会使经内存总线传输的字节量降至四分之一,并使片上缓存的有效容量增至四倍。对于 MNIST 网络,将存储位宽减半会使参数和激活值占用的字节数减半;实际能够获得多少延迟加速,则取决于目标处理器是否提供专用的低精度算术流水线(如 Tensor Cores 或向量点积指令)。
尽管此处以一个前馈网络进行演示,但这些系统机制——通过批处理摊薄参数传输成本、通过缓冲区复用限制存活区间、通过算子融合消除内存往返访问,以及通过量化缓解总线带宽压力——构成了所有生产推理引擎的核心设计空间。专用网络结构还会引入额外的计算模式:卷积算子在空间维度上共享权重,以提高算术强度;循环架构通过具有迭代状态依赖的顺序步骤进行处理;基于 Transformer 的模型则需要动态管理键值缓存。这些架构结构及其压缩方法将在 网络架构 和 模型压缩 中介绍,而模型服务架构、动态批处理和生产运维将在 吞吐量优化 和 机器学习运维 中展开讨论。
输出解读与决策
只有将神经网络输出转换回常规系统能够据以采取行动的决策,输出才具有实际用途。预处理将现实世界的数据转换为张量形式;后处理则将神经网络输出映射为标签、决策阈值、验证逻辑、错误处理和下游消息。在贯穿本章的 MNIST 示例中,仅有原始 logits 并不足够:数字识别系统需要最可能的数字类别、校准情况经过评估的置信度分数,以及将模糊或低置信度预测交由人工复核或次级识别器处理的回退路径。
这些边界阶段的计算特征与前向传播完全不同。神经网络执行利用加速器上大规模并行的矩阵单元,而预处理(如图像解码和归一化)与后处理(如 argmax 归约、阈值检查和消息序列化)通常作为顺序标量代码在主机 CPU 上执行。根据阿姆达尔定律,随着加速器内核使前向传播执行时间趋近于零,这些未得到加速的 CPU 阶段及其相关的 PCIe 数据传输在端到端请求延迟中的占比会不断增大,最终占据主导地位。
从架构设计、训练到推理部署,完整的神经网络生命周期由一组资源成本可量化的数学运算组成。迄今为止,这些运算都处于 MNIST 示例的受控环境中:数据干净、延迟不受约束,硬件也未承受严苛考验。接下来的历史案例研究将把这些运算置于生产部署中检验,而上述条件在其中均不成立。
Checkpoint 1.5: 完整的神经网络系统
在考察这些概念如何整合到实际部署之前,请检验自己对完整神经网络生命周期的理解:
以 MNIST 分类器(784 → 128 → 64 → 10)作为贯穿分析的生产系统。
手写数字识别展示了架构选择、预处理、决策阈值和人工复核如何在实际运行的文档处理流水线中协同发挥作用。
手写数字识别
20 世纪 80 年代末,LeCun 及其同事使用 USPS 提供的图像,展示了基于反向传播的手写邮政编码数字识别 (LeCun et al. 1989)。相关的卷积文档识别研究后来为商业部署的银行支票读取系统提供了支持 (LeCun et al. 1998)。这些是不同的系统,但它们揭示了相同的工程模式:预处理将多变的手写输入规范化,神经网络推理产生候选数字,拒识阈值将不确定的预测交由人工复核,下游逻辑则将被接受的预测转换为业务决策。这一共同的流水线可作为端到端机器学习设计的系统案例,说明预处理、模型结构和拒识策略如何在物理吞吐量约束下相互作用。
文档识别的挑战
文档分拣的运行约束直接源于实体处理机械。邮件分拣机通过机械传送带,以固定速度将信封送过光学扫描仪,每件邮件仅有几十毫秒可用于采集图像、分离字符、运行模型并驱动物理分流闸门。信封错分或支票误读都会在人工重新处理或下游财务对账中造成高昂的运营成本。由于对不受控手写输入的原始识别准确率无法达到 100%,流水线必须将自动推理与明确的拒识机制结合起来,将模糊输入转交人工操作员。figure 19 中的手写地址样本展示了预处理和分类阶段必须在这些时间约束下处理的感知输入差异。
应对这种物理差异,需要将计算负担分配到流水线的多个阶段。上游图像采集和归一化限定了呈现给神经网络的输入分布,神经网络推理将像素模式映射为经过校准的类别分数,下游阈值逻辑则控制自动化吞吐量与错误之间的权衡。
工程流程与设计决策
识别干净且居中的数字并不困难。在背景、尺度、对齐方式和图像质量各不相同的情况下识别手写内容,则需要在从数据准备到部署的每个阶段作出工程决策。
必须区分这些数据集各自的历史。早期邮政编码研究使用了为该任务提供的邮政数字图像 (LeCun et al. 1989)。MNIST 则是后来基于美国国家标准与技术研究院(NIST)的手写数字数据库构建的,并被标准化为经过尺寸归一化的基准图像 (LeCun et al. 1998)。它并非通过采集颜色、纹理、光照和朝向各异的实际流转信封而形成。不过,这两个数据集所对应的工程要求相同:预处理必须减少无关差异,同时保留识别所需的笔画信息。
LeCun, Yann, Léon Bottou, Yoshua Bengio, and Patrick Haffner. 1998. “Gradient-Based Learning Applied to Document Recognition.” Proceedings of the IEEE 86 (11): 2278–324. https://doi.org/10.1109/5.726791.
架构设计需要平衡准确率、处理时间和内存成本。对于本章标准化的 \(28{\times}28\) 数字输入,核心问题是可用的延迟和硬件预算能够支持多大的模型容量。全连接层的规模随输入与输出维度的乘积增长,需要大量参数存储和内存带宽。卷积层在空间感受野之间复用权重,减少参数量,并使中间激活值保持紧凑。
训练必须覆盖手写差异,而不能仅针对经过筛选的测试集进行优化。预处理使尺寸和朝向规范化,而数据增强可以让模型接触更多合理的变化。随后,评估必须遵循 机器学习工作流 中介绍的系统性工作流程,衡量模型在相关书写风格和运行条件下的表现。
置信度阈值决定了自动化与人工复核之间的分工。较高的阈值会拒识更多项目,将其交由人工处理;较低的阈值则会接受更多模型错误。期望成本规则在满足吞吐量和延迟约束的前提下,选择阈值 \(t\),使 \(\text{manual\_rate}(t)C_{\text{manual}} + \text{error\_rate}(t)C_{\text{error}}\) 最小化。
共同的流水线架构
邮政编码研究与已部署的银行支票读取系统采用了不同的业务系统,但两者均符合 figure 20 中的模式。图像采集和常规预处理准备输入,神经网络推理产生数字分数,后处理则接受结果,或将不确定的项目转交复核。
\begin{tikzpicture}[font=\small\sffamily, >=stealth]
\tikzset{
Box/.style={align=center, inner xsep=2pt,draw=GreenLine, line width=1pt,fill=none,
minimum width=24mm, minimum height=25mm,node distance=1.0},
LineA/.style={BrownLine!70,line width=4.0pt,{-{Triangle[width=1.5*6pt,length=2.0*5pt]}},shorten <=1pt,shorten >=1pt},
ALine/.style={black!50, line width=1.1pt,{{Triangle[width=0.9*6pt,length=1.2*6pt]}-}},
Larrow/.style={fill=violet!50, single arrow,  inner sep=2pt, single arrow head extend=3pt,
            single arrow head indent=0pt,minimum height=10mm, minimum width=3pt}
}
%inbox
\tikzset{%
 pics/inbox/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=INBOX,scale=\scalefac, every node/.append style={transform shape}]
\node[line width=\Linewidth,draw=\drawcolor,fill=\filllcolor!50,
rectangle,rounded corners=3pt,minimum width=14mm,minimum height=10mm]at(0,0.3){};
\node[line width=\Linewidth,draw=\drawcolor,fill=\filllcolor,
rectangle,rounded corners=3pt,minimum width=15mm,minimum height=10mm]at(0,0.1){};
\node[line width=\Linewidth,draw=\drawcolor,fill=\filllcolor!50,
,rectangle,rounded corners=3pt,minimum width=17mm,minimum height=10mm]
at(0,-0.1){};
\draw[line width=\Linewidth,draw=\drawcolor,fill=\filllcirclecolor,,rounded corners=2pt](-0.92,0.05)--
(-0.92,-0.78)--(0.92,-0.78)--(0.92,0.05)--(0.40,0.05)--(0.32,-0.2)--(-0.29,-0.2)--(-0.40,0.05)--cycle;

\node[single arrow, line width=\Linewidth,draw=black,fill=cyan!90!black!30, rotate=270,
      minimum width = 15pt, single arrow head extend=6pt,
      minimum height=10mm]at(0,0.5) {}; % length of arrow
 \end{scope}
     }
  }
}
%brain
\tikzset{pics/brain/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=BRAIN,scale=\scalefac, every node/.append style={transform shape}]
\fill[fill=\filllcolor!50](0.1,-0.5)to[out=0,in=180](0.33,-0.5)
to[out=0,in=270](0.45,-0.38)to(0.45,-0.18)
to[out=40,in=240](0.57,-0.13)to[out=110,in=310](0.52,-0.05)
to[out=130,in=290](0.44,0.15)to[out=90,in=340,distance=8](0.08,0.69)
to[out=160,in=80](-0.42,-0.15)to (-0.48,-0.7)to(0.07,-0.7)to(0.1,-0.5)
(-0.10,-0.42)to[out=310,in=180](0.1,-0.5);
\draw[draw=\drawcolor,line width=\Linewidth](0.1,-0.5)to[out=0,in=180](0.33,-0.5)
to[out=0,in=270](0.45,-0.38)to(0.45,-0.18)
to[out=40,in=240](0.57,-0.13)to[out=110,in=310](0.52,-0.05)
to[out=130,in=290](0.44,0.15)to[out=90,in=340,distance=8](0.08,0.69)
(-0.42,-0.15)to (-0.48,-0.7)
(0.07,-0.7)to(0.1,-0.5)
(-0.10,-0.42)to[out=310,in=180](0.1,-0.5);
\draw[fill=\filllcolor,line width=\Linewidth](-0.3,-0.10)to(0.08,0.60)
to[out=60,in=50,distance=3](-0.1,0.69)to[out=160,in=80](-0.26,0.59)to[out=170,in=90](-0.46,0.42)
to[out=170,in=110](-0.54,0.25)to[out=210,in=150](-0.54,0.04)
to[out=240,in=130](-0.52,-0.1)to[out=300,in=240]cycle;
\draw[fill=\filllcolor,line width=\Linewidth]
(-0.04,0.64)to[out=120,in=0](-0.1,0.69)(-0.19,0.52)to[out=120,in=330](-0.26,0.59)
(-0.4,0.33)to[out=150,in=280](-0.46,0.42)
%
(-0.44,-0.03)to[bend left=30](-0.34,-0.04)
(-0.33,0.08)to[bend left=40](-0.37,0.2) (-0.37,0.12)to[bend left=40](-0.45,0.14)
(-0.26,0.2)to[bend left=30](-0.24,0.13)
(-0.16,0.32)to[bend right=30](-0.27,0.3)to[bend right=30](-0.29,0.38)
(-0.13,0.49)to[bend left=30](-0.04,0.51);

\draw[rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcirclecolor,length=2.5pt]}](-0.23,0.03)--(-0.15,-0.03)--(-0.19,-0.18)--(-0.04,-0.28);
\draw[rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcirclecolor,length=2.5pt]}](-0.17,0.13)--(-0.04,0.05)--(-0.06,-0.06)--(0.14,-0.11);
\draw[rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcirclecolor,length=2.5pt]}](-0.12,0.23)--(0.31,0.0);
\draw[rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcirclecolor,length=2.5pt]}](-0.07,0.32)--(0.06,0.26)--(0.16,0.33)--(0.34,0.2);
\draw[rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcirclecolor,length=2.5pt]}](-0.01,0.43)--(0.06,0.39)--(0.18,0.51)--(0.31,0.4);
\end{scope}
     }
  }
}
%llm
\tikzset{
pics/llm/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\node[circle,minimum size=12mm,draw=\drawcolor, fill=\filllcolor!70,line width=0.5*\Linewidth](C\picname) at (0,0){};
\def\startangle{90}
\def\radius{1.15}
\def\radiusI{1.1}
\foreach \i [evaluate=\i as \j using \i+1] [count =\k] in {0,2,4,6,8} {
\pgfmathsetmacro{\angle}{\startangle - \i * (360/8)}
\draw[draw=black,-{Circle[black ,fill=\filllcirclecolor,length=5.5pt,line width=0.5*\Linewidth]},line width=1.5*\Linewidth](C\picname)--++(\startangle - \i*45:\radius) ;
\node[circle,draw=black,fill=\filllcirclecolor!80!red!50,inner sep=3pt,line width=0.5*\Linewidth](2C\k)at(\startangle - \j*45:\radiusI) {};
}
\draw[line width=1.5*\Linewidth](2C1)--++(-0.5,0)|-(2C2);
\draw[line width=1.5*\Linewidth](2C3)--++(0.5,0)|-(2C4);
\node[circle,,minimum size=12mm,draw=\drawcolor, fill=\filllcolor!70,line width=0.5*\Linewidth]at (0,0){};
\node[draw,rectangle,rounded corners=1pt,minimum width=7mm,minimum height=4mm,fill=orange!10](R1)at(0.1,0.1){};
\draw[BrownLine,shorten <=2pt,shorten >=2pt ]($(R1.north west)!0.35!(R1.south west)$)--($(R1.north east)!0.35!(R1.south east)$);
\draw[BrownLine,shorten <=2pt,shorten >=2pt ]($(R1.north west)!0.7!(R1.south west)$)--($(R1.north east)!0.7!(R1.south east)$);
\node[draw,rectangle,rounded corners=1pt,minimum width=6mm,minimum height=4mm,fill=orange!10](R2)at(-0.05,-0.15){};
\draw[BrownLine,shorten <=2pt,shorten >=2pt ]($(R2.north west)!0.35!(R2.south west)$)--($(R2.north east)!0.35!(R2.south east)$);
\draw[BrownLine,shorten <=2pt,shorten >=2pt ]($(R2.north west)!0.7!(R2.south west)$)--($(R2.north east)!0.7!(R2.south east)$);
\end{scope}
    }
  }
}
%funnel
\tikzset{%
 pics/funnel/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=FUNNEL,scale=\scalefac, every node/.append style={transform shape}]
\draw[fill=\filllcolor,line width=\Linewidth,draw=\drawcolor](-0.12,-0.81)--(-0.19,-0.25)--(-0.7,0.41)--(0.7,0.41)--(0.19,-0.25)--(0.12,-0.81)--cycle;
\draw[fill=\filllcolor,line width=\Linewidth,draw=\drawcolor](-0.19,-0.25)--(0.08,-0.25);
\draw[fill=\filllcolor,line width=\Linewidth,draw=\drawcolor](0.16,-0.09)--(0.41,0.31);
%
\node[line width=\Linewidth,draw=\drawcolor,fill=\filllcolor,inner sep=1pt,
rectangle,rounded corners=2pt,minimum width=16mm,minimum height=5pt]at(0,0.5){};
%
\foreach \i in{-0.5,0,0.5}{
\node[single arrow, line width=0.8*\Linewidth,draw=black,fill=\filllcirclecolor, rotate=270,inner sep=1pt,
      minimum width =9pt, single arrow head extend=2pt,
      minimum height=5mm]at(\i,0.9) {}; % length of arrow
   }
\node[single arrow,line width=0.8*\Linewidth,draw=black,fill=\filllcirclecolor, rotate=270,inner sep=1pt,
      minimum width =11pt, single arrow head extend=2pt,
      minimum height=5mm]at(0,-1.1) {}; % length of arrow
 \end{scope}
     }
  }
}
\def\inset{2.0pt} %
\def\myshape{%
  (0,1.34) to[out=220,in=0] (-1.20,1.03) --
  (-1.20,-0.23) to[out=280,in=160] (0,-1.53) to[out=20,in=260] (1.20,-0.23) --
  (1.20,1.03)  to[out=180,in=320] cycle
}
\tikzset{
pics/stitC/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\fill[fill=\filllcolor!60] \myshape;
%
\begin{scope}
  \clip \myshape;
  \draw[draw=\filllcolor!60, line width=3*\inset,fill=white] \myshape; % Color and thickness as desired
\end{scope}
\draw[red,line width=3pt](-0.7,-0.35)--++(320:0.5)--++(50:1.5);
\end{scope}
    }
  }
}
%gear-arrow
% #1 number of teeths
% #2 radius intern
% #3 radius extern
% #4 angle from start to end of the first arc
% #5 angle to decale the second arc from the first
% #6 inner radius to cut off
\tikzset{
  pics/gearAR/.style args={#1/#2/#3/#4/#5/#6/#7}{
   code={
           \pgfkeys{/channel/.cd, #7}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape},
LinE/.style={\filllcirclecolor,line width=5.0pt,
{{Triangle[width=1.5*10pt,length=2.0*5pt]}-},shorten <=5pt,shorten >=1pt},
ELin/.style={\filllcirclecolor,line width=7.0pt,
{-{Triangle[width=1.15*10pt,length=2.0*5pt]}},shorten <=0pt,shorten >=0pt}]
    \pgfmathtruncatemacro{\N}{#1}%,
    \def\rin{#2}\def\rout{#3}\def\aA{#4}\def\aOff{#5}\def\rcut{#6}%
    \path[rounded corners=0.5pt,draw=\drawcolor,fill=\filllcolor]
      (0:\rin)
      \foreach \i [evaluate=\i as \n using (\i-1)*360/\N] in {1,...,\N}{%
        arc (\n:\n+\aA:\rin)
        -- (\n+\aA+\aOff:\rout)
        arc (\n+\aA+\aOff:\n+360/\N-\aOff:\rout)
        -- (\n+360/\N:\rin)
      } -- cycle;
      \draw[draw=none,fill=white](0,0) circle[radius=\rcut];
\draw[ELin](0,0)--++(0:2.5);
\end{scope}
  }}
}
%testing+pencil
\tikzset{
pics/testing/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=TESTING1,shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\newcommand{\tikzxmark}{%
\tikz[scale=0.18] {
    \draw[line width=0.7,line cap=round,RedLine] (0,0) to [bend left=6] (1,1);
    \draw[line width=0.7,line cap=round,RedLine] (0.2,0.95) to [bend right=3] (0.8,0.05);
}}
\newcommand{\tikzxcheck}{%
\tikz[scale=0.16] {
    \draw[line width=0.7,line cap=round,GreenLine] (0.5,0.75)--(0.85,-0.1) to [bend left=16] (1.5,1.55);

}}
 \node[draw, minimum width  =15mm, minimum height = 20mm, inner sep = 0pt,
        rounded corners,draw = \drawcolor, fill=\filllcolor!10, line width=\Linewidth](COM){};
\node[draw=GreenLine,inner sep=4pt,fill=white](CB1) at ($(COM.north west)!0.25!(COM.south west)+(0.3,0)$){};
\node[xshift=0pt]at(CB1){\tikzxcheck};
\node[draw=RedLine,inner sep=4pt,fill=white](CB2) at ($(COM.north west)!0.5!(COM.south west)+(0.3,0)$){};
\node[xshift=0pt]at(CB2){\tikzxmark};
\node[draw=RedLine,inner sep=4pt,fill=white](CB3) at ($(COM.north west)!0.75!(COM.south west)+(0.3,0)$){};
\node[xshift=0pt]at(CB3){\tikzxmark};
\draw[GreenLine,decoration={zigzag,segment length=4pt, amplitude=0.5pt},decorate]($(CB1)+(0.3,0.05)$)--++(0:0.8);
\draw[GreenLine,decoration={zigzag,segment length=4pt, amplitude=0.5pt},decorate]($(CB1)+(0.3,-0.12)$)--++(0:0.7);
\draw[RedLine,decoration={zigzag,segment length=4pt, amplitude=0.5pt},decorate]($(CB2)+(0.3,0.05)$)--++(0:0.8);
\draw[RedLine,decoration={zigzag,segment length=4pt, amplitude=0.5pt},decorate]($(CB2)+(0.3,-0.12)$)--++(0:0.6);
\draw[RedLine,decoration={zigzag,segment length=4pt, amplitude=0.5pt},decorate]($(CB3)+(0.3,0.05)$)--++(0:0.8);
\draw[RedLine,decoration={zigzag,segment length=4pt, amplitude=0.5pt},decorate]($(CB3)+(0.3,-0.12)$)--++(0:0.6);
\end{scope}
    }
  }
}
%pencil
\tikzset{
pics/pencil/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=TESTING1,shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape},rotate=340]
            \fill[fill=\filllcolor!70] (0,4) -- (0.4,4) -- (0.4,0) --(0.3,-0.15) -- (0.2,0) -- (0.1,-0.14) -- (0,0) -- cycle;
            \draw[color=white,thick] (0.2,4) -- (0.2,0);
            \fill[black] (0,3.5) -- (0.2,3.47) -- (0.4,3.5) -- (0.4,4) arc(30:150:0.23cm);
            \fill[fill=\filllcolor!40] (0,0) -- (0.2,-0.8)node[coordinate,pos=0.75](a){} -- (0.4,0)node[coordinate,pos=0.25](b){} -- (0.3,-0.15) -- (0.2,0) -- (0.1,-0.14) -- cycle;
            \fill[fill=\filllcolor] (a) -- (0.2,-0.8) -- (b) -- cycle;

\end{scope}
    }
  }
}
\pgfkeys{
  /channel/.cd,
   Depth/.store in=\Depth,
  Height/.store in=\Height,
  Width/.store in=\Width,
  filllcirclecolor/.store in=\filllcirclecolor,
  filllcolor/.store in=\filllcolor,
  drawcolor/.store in=\drawcolor,
  drawcircle/.store in=\drawcircle,
  scalefac/.store in=\scalefac,
  Linewidth/.store in=\Linewidth,
  picname/.store in=\picname,
  filllcolor=BrownLine,
  filllcirclecolor=violet!20,
  drawcolor=black,
  drawcircle=violet,
  scalefac=1,
  Linewidth=0.5pt,
  Depth=1.3,
  Height=0.8,
  Width=1.1,
  picname=C
}
%Raw Data
\node[Box](B1){};
\fill[cyan!07](B1.north west) rectangle ($(B1.north east)!0.6!(B1.south east)$)coordinate(B1DE);
\fill[cyan!20](B1.south east) rectangle ($(B1.north west)!0.6!(B1.south west)$)coordinate(B1LE);
\node[Box,draw=BlueD](){};
\tikzset{Text2/.style={font=\sffamily\bfseries\small,align=center}}
\node[Text2]at($(B1.south west)!0.5!(B1DE)$){原始数据};
\coordinate(Q1)at($(B1.north west)!0.5!(B1DE)$);
\pic[shift={(0,0)}] at  (Q1){inbox={scalefac=0.7,picname=1,Linewidth=1.0pt,
 filllcolor=BrownL,drawcolor=black,filllcirclecolor=orange!70!yellow!80}};
%Preprocessing
\node[Box, right=0.75 of B1](B2){};
\fill[cyan!07](B2.north west) rectangle ($(B2.north east)!0.6!(B2.south east)$)coordinate(B2DE);
\fill[cyan!20](B2.south east) rectangle ($(B2.north west)!0.6!(B2.south west)$)coordinate(B2LE);
\node[Box, right=0.75 of B1,draw=BlueD](B2){};
\node[Text2]at($(B2.south west)!0.5!(B2DE)$){预\\处理};
\coordinate(Q2)at($(B2.north west)!0.5!(B2DE)$);
\pic[shift={(0,0)}] at  (Q2){funnel={scalefac=0.53,picname=1,Linewidth=0.5pt,
 filllcolor=green!70!orange!70,drawcolor=black,filllcirclecolor=red!70!blue!80}};
%Neural Network
\node[Box, right=of B2](B3){};
\fill[green!07](B3.north west) rectangle ($(B3.north east)!0.6!(B3.south east)$)coordinate(B3DE);
\fill[green!20](B3.south east) rectangle ($(B3.north west)!0.6!(B3.south west)$)coordinate(B3LE);
\node[Box, right=of B2,draw=GreenD](B3){};
\node[Text2]at($(B3.south west)!0.5!(B3DE)$){神经\\ 网络};
\coordinate(Q3)at($(B3.north west)!0.5!(B3DE)$);
%\pic[shift={(0,0)}] at  (Q3){brain={scalefac=0.9,picname=1,filllcolor=orange!30!, Linewidth=0.95pt}};
\pic[shift={(0,0)}] at  (Q3){llm={scalefac=0.6,drawcolor=BlueLine,filllcolor=BlueLine!50!, Linewidth=1pt,filllcirclecolor=red}};
%Raw output
\node[Box, right=of B3](B4){};
\fill[violet!07](B4.north west) rectangle ($(B4.north east)!0.6!(B4.south east)$)coordinate(B4DE);
\fill[violet!20](B4.south east) rectangle ($(B4.north west)!0.6!(B4.south west)$)coordinate(B4LE);
\node[Box, right=of B3,draw=VioletLine](B4){};
\node[Text2]at($(B4.south west)!0.5!(B4DE)$){原始\\ 输出};
\coordinate(Q4)at($(B4.north west)!0.5!(B4DE)$);
 \pic[shift={(0,0)}] at (Q4) {gearAR={14/1.4/1.8/8/4/0.7/scalefac=0.35,drawcolor=BlueLine,filllcolor=BlueLine,filllcirclecolor=red}};
%Postprocessing
\node[Box, right=0.75of B4](B5){};
\fill[violet!05](B5.north west) rectangle ($(B5.north east)!0.6!(B5.south east)$)coordinate(B5DE);
\fill[violet!15](B5.south east) rectangle ($(B5.north west)!0.6!(B5.south west)$)coordinate(B5LE);
\node[Box, right=0.75of B4,draw=VioletLine](B5){};
\node[Text2]at($(B5.south west)!0.5!(B5DE)$){后\\处理};
\coordinate(Q5)at($(B5.north west)!0.5!(B5DE)$);
\pic[shift={(0,0)}] at  (Q5){testing={scalefac=0.65,picname=1,drawcolor=myblue,filllcolor=myblue, Linewidth=1.0pt}};
\pic[shift={(0,-0.5)},rotate=-15] at  (Q5){pencil={scalefac=0.30,picname=1,filllcolor=mygreen, Linewidth=1.0pt}};
%%%%%%
%Final output
\node[Box, right= 0.75of B5](B6){};
\fill[violet!05](B6.north west) rectangle ($(B6.north east)!0.6!(B6.south east)$)coordinate(B6DE);
\fill[violet!15](B6.south east) rectangle ($(B6.north west)!0.6!(B6.south west)$)coordinate(B6LE);
\node[Box, right=0.75of B5,draw=VioletLine]{};
\node[Text2]at($(B6.south west)!0.5!(B6DE)$){最终输出};
\coordinate(Q6)at($(B6.north west)!0.5!(B6DE)$);
\pic[shift={(0,0.05)}] at  (Q6){stitC={scalefac=0.45,drawcolor=orange,filllcolor=green!55!black}};
%arrows
\foreach \i in{1,2,3,4,5}{
\pgfmathtruncatemacro{\X}{\i + 1} %
\draw[LineA](B\i)--(B\X);
}
\node[draw=myblue,line width=0.75pt,fit=(B1)(B2),inner ysep=3mm,inner xsep=4mm,xshift=1mm](F1){};
\node[draw=none,fit=(B3),inner ysep=3mm,inner xsep=4mm](F2){};
\node[draw=mypurple,line width=0.75pt,fit=(B4)(B6),inner ysep=3mm,inner xsep=4mm,xshift=-1mm](F3){};
\node[below =0pt of F1,text=myblue]{预处理};
\node[below =0pt of F2,text=GreenD]{深度学习};
\node[below =0pt of F3,text=mypurple]{后处理};
\end{tikzpicture}流水线始于图像采集。在邮政研究中,输入是手写邮政编码区域的图像;已部署的支票识读系统同样以扫描得到的文档图像为起点。采集质量决定了后续预处理和识别阶段必须应对多大程度的变化。
预处理定位相关字段,分离或以其他方式确定其中的字符,并对所得图像进行归一化。阈值化、连通分量分析和尺寸归一化是具有代表性的传统技术。本章在 MNIST 相关计算中采用标准化的 \(28{\times}28\) 图像;这一尺寸在此是教学约定,并不意味着所有邮政或支票识读部署都采用这一尺寸。
随后,神经网络处理每幅归一化后的数字图像。1989 年的邮政编码研究系统采用了一个早期 LeNet 变体 (LeCun et al. 1989),约有 10,000 parameters,以单精度存储时约占 40 KB。这一参数规模比本章全连接 MNIST 网络的 109.4K 小一个数量级。在 20 世纪 80 年代末的工作站硬件上,将参数存储占用保持在 40 KB,使模型权重能够在推理期间驻留于高速缓存中,从而最大限度地减少片外内存访问流量,并保留在分拣时限内完成数字判别所需的计算带宽。
后处理将数字评分转换为应用决策。对于邮政编码任务,只要有一个数字存在不确定性,就可能需要将整个编码送交进一步处理或人工复核。已部署的文档识读系统采用相同的基本原则:接受置信度足够高的预测,拒绝不确定的样本,而不是强行给出答案。
已部署的文档识读系统必须满足端到端时序约束,涵盖采集、预处理、推理、后处理及下游操作。邮件应用与金融文档应用所使用的具体设备各不相同,但吞吐量取决于整条流水线,而不仅仅取决于神经网络的延迟。
性能结果与运行影响
1989 年的邮政编码研究将模型、识别、吞吐量和训练测量结果作为同一个实验系统的结果进行报告。Table 14 将这些测量结果汇集在一起,揭示了拒识策略和预处理如何影响对分类器原始速度的解读 (LeCun et al. 1989)。
LeCun, Yann, Bernhard Boser, John S. Denker, Donald Henderson, Richard E. Howard, Wayne Hubbard, and Lawrence D. Jackel. 1989. “Backpropagation Applied to Handwritten Zip Code Recognition.” Neural Computation 1 (4): 541–51. https://doi.org/10.1162/neco.1989.1.4.541.
| 指标 | 报告结果 |
|---|---|
| 错误与拒识 | 拒识 12.1% 的测试数字后,分类错误率为 1% |
| 吞吐量 | 包含采集时为 10–12 次分类/秒;归一化后超过 30 次/秒 |
| 模型参数量 | ~10,000 |
| 训练 | 23 轮;在 Sun-4/260 工作站上约需 3 天 |
这些测量结果凸显了贯穿流水线的三项系统权衡:
第一,端到端吞吐量受非神经网络阶段的限制。尽管神经网络每秒执行超过 30 次分类(每个数字耗时不足 33 ms),完整流水线每秒却只能处理 10 至 12 个项目(每个项目耗时 83 至 100 ms)。纸质文档处理、扫描、阈值化和分割消耗了总延迟预算的一半以上。当外围 I/O 和传统预处理占据主要执行时间时,仅加速神经网络推理所带来的收益会递减。
第二,运行可靠性依赖于明确的拒识路径。系统没有强制对每个数字进行自动分类,而是将歧义最大的 12.1% 测试输入排除在自动路由之外。拒识这些处于尾部的高不确定性预测后,其余自动处理数据流上的观测分类错误率降至 1%。拒识阈值使运行点沿帕累托前沿移动:自动化系统承担常规处理量,人工操作人员则处理存在歧义的尾部样本,以确保系统不超出运行错误预算。
第三,模型大小受训练主机的计算能力上限约束。在 Sun-4/260 工作站上训练 10,000 个参数,需要进行 23 轮遍历,耗时约三天。受部署年代的处理器时钟频率和内存带宽限制,扩展到更大的参数规模并不可行。
在生产环境中维护这些系统,还会产生模型训练之外的生命周期要求。扫描仪光学系统、墨水配方、信封纹理或地区书写风格的变化,会使输入分布随时间发生漂移。生产监控必须在跟踪原始分类延迟的同时,跟踪输入图像统计特征和拒识率,并在拒识率超出人工复核人员的处理能力时,触发数据采集和模型重新训练。
关键工程经验与设计原则
从邮政编码研究到已部署的支票识读系统,核心经验是:只有当外围流水线也满足相同的运行约束时,神经计算才能取得成功。预处理、推理、后处理、拒识和下游操作必须共同满足所需的吞吐量和错误预算。
将手写笔迹转化为可靠的业务决策,需要在网络架构、训练、预处理、置信度策略和下游处理方面作出协调一致的选择。这些历史系统确立了一些原则,至今仍是生产部署的基础:通过专门的预处理限定输入分布的范围,根据内存带宽限制确定架构规模,校准置信度阈值以支持有人参与的回退处理,以及围绕端到端延迟预算设计完整的数据路径。维持这些流水线运行所需的运维生命周期在 机器学习运维 中进行了形式化阐述。
现代边缘系统所处的功耗、延迟和部署约束有所不同,但其底层工程权衡仍然相同:预处理吸收现实环境中的变化,置信度阈值保障下游错误预算,而端到端硬件吞吐量决定了可行的模型容量。
Systems Perspective 1.6: 如何解读历史系统比较
早期 LeNet 类识别系统与本章的 MNIST 多层感知机体现了计算方式的延续性,并不构成受控的性能基准比较。它们的数据集、架构、软件栈、机器和运行目标各不相同。能够成立的比较在于结构:两者都将归一化像素转换为数字得分,都依赖学习得到的参数和预处理流水线,也都需要针对不确定输出制定明确的策略。
参数数量提供了一个具体的对比。1989 年的邮政编码网络约有 10,000 个参数,而本章的全连接网络有 109,386 个参数。这一差异描述的是模型状态;它本身并不能确定延迟、能耗、吞吐量或成本。这些结果需要固定的工作负载,以及明确硬件、数值精度、运行时、批量大小和端到端决策路径的测量。区分这些变量,可以避免在数据、模型、软件或运行策略也发生变化时,将部署速度的提升完全归因于芯片。
文档识别流水线展示了机器学习系统工程的基础性协同关系:高吞吐量的自动分类需要在数据分布、算法容量和底层机器约束之间持续协调。
数据—算法—机器分类体系
在文档识别的发展历程中,不同资源发挥了不同作用。USPS 提供的邮政编码图像为早期识别研究提供了基础,LeNet 提供了算法机制,后来的银行支票识别系统提供了有文献记录的部署场景,而 MNIST 提供了源自 NIST 数据的标准化基准。它们并不构成单一系统,但共同体现了数据—算法—机器分类体系的三方协同:数据是否涵盖任务分布,算法是否能够学习所需的变换,以及机器是否能够在物理延迟、内存和能耗预算内执行该计算。数据—算法—机器分类体系 进一步阐述了这些维度之间的交叉关系。
数据维度确定训练和评估样本是否忠实地反映实际运行分布。USPS 邮政编码图像、MNIST 数字和银行支票输入都具有数字语义,但来自不同的采集过程和噪声环境:扫描分辨率、阈值化伪影和文档版式使它们无法互换。预处理可以对尺度和方向的变化进行归一化,但无法合成数据中未涵盖的手写风格,也无法纠正与下游业务决策不一致的标注策略。数据还具有物理占用:输入分辨率、批量大小、张量布局和数值精度决定了必须穿过内存层级、进入加速器内存的字节量。
这些传入的字节构成算法维度的输入,而算法维度规定了学习或计算表示所需的数学运算。在本章贯穿使用的网络中,784 到 128 的全连接层既决定了初始表示容量,也构成了模型中最大的参数块。激活函数引入非线性,决定能够形成哪些决策边界,以及反向传播的梯度能否保持数值稳定;损失函数和优化器决定预测误差如何驱动参数更新。这些选择确定了系统必须执行的数学工作,但只有当统计假设与数据分布相符,且计算图能够容纳于硬件预算之内时,算法形式才具有可行性。
这一硬件预算由机器维度决定,该维度确定所需的线性代数运算能否在物理延迟、内存带宽、内存容量和热限制内执行。前向传播将参数权重和输入激活值以流式方式送入运算单元;反向传播则将这些前向激活值保留在内存中,计算梯度张量,更新优化器状态,并遍历反向计算图。增大批量大小可以通过提高算术强度来摊薄参数加载开销,但会使激活值存储需求按比例增加。将数值精度从 FP32 降至 16 位或 8 位格式可使内存流量减半,并启用专用矩阵执行单元,前提是缩小后的动态范围仍能保持数值稳定性和任务准确率。因此,物理机器不仅约束固定架构的执行速度,也约束哪些批量大小、参数数量和数值格式在物理上可以实现。
两两交叉关系解释了为何不能孤立地优化这些维度。数据与算法决定了系统能够从什么信息中学习;数据与机器决定了信息如何表示和移动;算法与机器决定了计算如何高效执行。在三者的交汇处,所有约束同时生效。扩充数据集可以提高统计覆盖度,却会增加存储流量;加宽网络层可以提高模型容量,却会超出加速器内存容量;降低运算精度可以提升执行吞吐量,却有任务层面性能下降的风险。
本章的定量分析将这一诊断框架转化为具体的工程实践。面对运行中的症状——准确率不足、违反延迟服务级别目标或内存不足故障——工程师需要围绕全部三个维度提出相互竞争的假设。区分这些假设,需要测量构成瓶颈的物理量或统计量:对于数据,是样本覆盖度和标签保真度;对于算法,是梯度动态和误差分布;对于机器,则是计算利用率、内存带宽饱和程度和容量占用。由于对一个维度的干预经常会将瓶颈约束转移到另一个维度,验证需要在预期的生产工作负载下对端到端性能进行剖析。数据—算法—机器分类体系 将这一初步诊断循环扩展为系统性参考,涵盖全书各部分所应用的交叉维度技术。
运用数据—算法—机器分类体系进行推理,可以避免将系统问题视为孤立的软件缺陷。然而在实践中,当团队依赖直觉假设时,工程决策往往会出现偏差——例如认定深度网络无法调试、深度总是优于宽度,或软件层面的准确率能够保证实际运行吞吐量。要识别这些启发式判断何时失效,就需要考察神经计算与物理硬件相遇时反复出现的陷阱。
谬误与陷阱
统计学习引入了一些仅靠逐行检查代码无法发现的失效模式。以下谬误与陷阱可能导致团队错误分配精力,或部署不合适的解决方案。
谬误:神经网络完全不透明,无法调试。
神经网络无法像传统代码那样提供逐行的因果轨迹,但并非无法诊断。激活值可视化可以揭示学到的模式,梯度分析可以衡量对输入的局部敏感性,消融研究则可以估计各组件的贡献。这些工具提供的是部分证据,而非完整解释:显著性可能不稳定,相关特征会使归因复杂化,而消融操作可能改变它原本要探查的行为。对于 section 1.3.2 中的 MNIST 分类器,第一层权重仍可用于有效检查模型学到了哪些模式。因此,调试统计系统需要将模型层面的探查与数据切片、受控干预和端到端评估结合起来。
陷阱:因为有深度模型可用,就抛弃领域专业知识。
团队以为自动特征学习消除了对领域知识的需求。成功的系统在每个阶段都需要领域专业知识:架构选择、训练目标设计、数据集整理和输出解释。section 1.6 中的文档识别发展历程说明,置信度阈值为何必须反映业务运行的经济性,并将不确定案例转交人工处理。缺乏领域知识时,团队可能部署在测试集上表现出色、却因阈值、回退路径或错误成本设置不当而在生产中失效的网络。
谬误:更深的网络总是比更宽的网络更准确。
工程师认为,既然深度能够支持分层特征提取,堆叠更多层就是提高准确率的主要途径。实践中,单纯增加深度会遭遇收益递减。ResNet 表明,非常深的残差网络可以有效训练,但其 ImageNet 结果也清楚表明,增加层数必须与额外的训练和推理成本相权衡 (He et al. 2016)。后来的 EfficientNet 证明,在给定资源预算下,联合缩放宽度、深度和输入分辨率可以优于仅缩放深度 (Tan and Le 2019)。由此得到的教训并非深度不好,而是团队应当剖析容量利用情况,并扩展能够带来最佳单位 FLOP 准确率的架构维度。
He, Kaiming, Xiangyu Zhang, Shaoqing Ren, and Jian Sun. 2016. “Deep Residual Learning for Image Recognition.” 2016 IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 770–78. https://doi.org/10.1109/cvpr.2016.90.
Tan, Mingxing, and Quoc V Le. 2019. “EfficientNet: Rethinking Model Scaling for Convolutional Neural Networks.” International Conference on Machine Learning (ICML), 6105–14.
陷阱:对可以用更简单方法解决的问题使用神经网络。
团队以为深度学习总能表现得更好。对于小型数据集或近似线性的关系,逻辑回归等更简单的模型可能达到甚至超过神经网络的表现,同时所需的训练、内存和维护成本更低。这种优势的大小取决于工作负载,因此团队应对简单基线进行基准测试,并通过测得的任务特定收益来证明增加复杂性的合理性。神经网络擅长发现分层模式(section 1.2.3),但也会带来额外开销。当其表示容量产生的收益足以抵偿实测的系统成本时,才应使用它们。
即使在大型 GPU 上,小型神经网络工作负载仍然受内存限制。
谬误:训练数据分布问题可以在模型设计完成后再解决。
团队将训练视为机械地把数据送入架构。在不平衡数据集上,网络可能表现出较差的少数类性能:对于类别不平衡比例为 99:1 的欺诈检测器,只要始终预测“非欺诈”,就能达到 99 percent 的准确率,却无法检出任何欺诈案例。如果采样、加权、损失设计和评估未能处理类别不平衡问题,采用无加权平均的经验风险目标就可能对罕见但关键的类别赋予过低权重。跳过探索性数据分析的团队,可能部署总体指标出色、但少数类性能不可接受的模型。
陷阱:未处理系统约束就将研究模型部署到生产环境。
生产环境增加了研究中不存在的约束:延迟预算(端到端 50–100 ms)、内存限制(边缘设备为 2–4 GB)以及并发负载(每秒 100–1,000 个请求(RPS))。完整流水线包括预处理、推理和后处理(section 1.5)。即使模型的推理延迟为 20 ms,当预处理增加 25 ms、后处理增加 10 ms 时(总计 55 ms),仍会超出其 50 ms 的预算。因此,将模型开发与系统设计割裂,会使团队在忽视部署可行性的同时,将精力耗费在准确率上。
谬误:更多算力自动意味着更快的训练。
团队购买昂贵的 GPU,期望获得成比例的加速,但实际限制性能的可能是内存流量或启动开销。算术强度可以识别构成瓶颈的资源。在一个将参数读取一次、将每个批次的各激活值移动一次的简单流量模型下,table 11 中的 MNIST 前向传播在批量大小为 32 时,算术强度约为 12.4 FLOP/byte,批量大小为 1 时则更低。这远低于许多高吞吐量加速器的转折点。处理器的转折点就是其机器平衡比,\(R_{\text{peak}}/\text{BW}\)(以 FLOP/s 为单位的峰值算力除以以 bytes/s 为单位的峰值内存带宽),它定义了使计算单元饱和所需的最低算术强度。对于 NVIDIA A100 或 H100 等现代服务器加速器,这一转折点位于 \(150\) 至 \(300+\) FLOP/byte 之间。由于 MNIST 的 12.4 FLOP/byte 比这一阈值低一个数量级以上,执行被限制在内存带宽斜线上,因此在批量大小或运算复用程度提高之前,增加峰值 FLOP/s 完全无用。Roofline 模型 中的 Roofline 模型解释了为何在工作负载每字节所提供的可复用计算工作量足够大之前,增加峰值 FLOP/s 无法带来帮助。缓存、融合、向量化和启动成本的影响,使实测加速比成为最终的检验标准。
陷阱:在不考虑收益递减的情况下外推准确率提升。
团队可能会将参数量从 10K 扩展到 100K 时获得的 5 个百分点提升,外推为扩展到 1M 时还能再提升 5 个百分点。实际观测到的改善却会随着规模扩大而递减,其规律取决于任务、指标、数据质量、模型家族和所处的缩放区间。在 table 5 中,ImageNet 各行显示,错误率从 AlexNet 的 15.3% 降至 ResNet-152 的 3.6%,而训练 FLOPs 从 \(5 \times 10^{17}\) 增至约 \(10^{19}\)。因此,团队必须在自身所处的条件下测量边际收益,而不能进行线性外推。
这些谬误与陷阱有一个共同根源:将统计行为视为仅由代码行为决定。及早识别它们,可以将注意力引向恰当的测量和诊断。
总结
神经计算将数学形式转化为物理机器上的执行。在线性代数和微积分的基础上,可依据机器学习系统铁律(\(T = \frac{D_{\text{vol}}}{\text{BW}} + \frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}} + L_{\text{lat}}\))确定运算成本。前向传播确定计算工作量 \(O\),通常由矩阵乘法主导;反向传播则保留选定的中间值,并增加梯度和优化器状态。由此产生的内存数据量 \(D_{\text{vol}}\) 取决于架构、批量大小、精度、优化器和重计算策略。这些机制使得在部署前估算内存占用、算术强度和延迟限制成为可能。
用从数据中学习得到的参数替代手工编写的决策规则,将特征工程转化为机器执行。加权求和、非线性激活和梯度更新的分层组合形成层次化表示,将原始输入转化为预测。训练通过迭代优化调整连接权重,而推理则将固定参数应用于传入数据。这两个阶段提出了不同的物理需求:按照本章的 FP32 内存核算,批量大小为 32 的训练步骤所需内存约为同样批量大小的推理的 3.4×,因为反向传播会保留保存的激活值,并分配梯度和优化器缓冲区。在生产环境中,正如文档识别案例研究所展示的那样,这些数学内核并非独立运行;预处理、神经网络推理、拒识和后处理必须共同满足统一的延迟和可靠性预算。
要点回顾: 模型背后的数学
- 每次范式转变都会改变表示的系统成本:在这个 \(28{\times}28\) 数字示例中,运算量从约 100 comparisons(基于规则),经由约 8,000 operations(经典机器学习),上升至 109,184 MACs(深度学习)——在这一场景中达到原来的 1,091.8×,从而重塑硬件需求。
- 神经网络从数据中学习表示:这些网络以从样例中学习得到的层次化表示,替代部分手工编码的特征。这种灵活性将负担转移到具有代表性的数据、训练计算资源和验证上。
- 训练与推理通常侧重不同的目标:训练通常注重多次迭代更新过程中的高效吞吐量,而在线推理通常注重单个请求的延迟;离线推理则可能更注重吞吐量。在这些运行模式下,批大小将利用率、内存、吞吐量、延迟和统计行为联系起来。
- 激活函数兼具数学与硬件属性:ReLU 的实现成本通常低于 sigmoid 或 tanh,且其在正输入处的梯度为 1,避免了该分支上的激活饱和。它的实际优势同时来自实现成本与优化行为。
- 前向传播通常以矩阵运算为核心:在本章的稠密网络示例中,稠密矩阵计算内核占浮点运算量的 90% 以上,并在许多重要的神经网络工作负载中占据主导地位,因此专用矩阵硬件在执行这些运算时能够显著优于通用执行硬件。
- 反向传播需要保留计算路径:解决贡献分配问题需要保留或重新计算反向传播所用的值,因此内存成本往往决定模型能否在给定设备上训练,也推动了减少、重新计算或划分训练状态的技术的发展。
- 完整的机器学习流水线决定端到端性能:预处理、神经网络计算和后处理都会影响延迟与可靠性。文档识别示例表明,生产环境中的成功取决于整条流水线能否在现实约束下运行,而不仅仅取决于模型在测试集上的准确率。
MNIST 工作负载直观地体现了跨计算范式的成本攀升:对单个 \(28{\times}28\) 数字进行分类,采用手工设计的规则时约需 100 comparisons,而采用一个规模不大的三层网络时则需 109,184 MACs——达到原来的 1,091.8×,改变了 table 3 中的每一个系统维度。这一比较为数据—算法—机器分类体系中的算法轴提供了具体依据,展示了算法选择如何直接转化为机器约束。
本章分析的多层感知机揭示了一条直接的资源规律:稠密连接使参数存储量和乘加运算次数都随相邻层维度的乘积而增长。仅在第一层,一幅 \(28{\times}28\) 的 MNIST 图像就提供了 784 个输入值,将每个输入连接到 128 个隐藏神经元需要 100,352 个权重。这种稠密连接并未显式引入空间局部性先验:模型必须从数据中学习哪些近距离和远距离像素关系具有重要性,同时为计算每一条连接付出内存带宽和存储成本。
阅读代码可以了解网络被要求做什么;阅读数学表达式则可以了解执行这些任务的成本。这些算术运算正是算法与机器的交汇点:权重必须存储和传输,稠密层映射到矩阵执行引擎,而保存的激活值占用加速器内存,决定了设备是否能够容纳训练所需的状态。在硅契约下,数学表达式预先约定了机器必须执行的运算。审查这一契约,使系统工程师能够从第一性原理出发,计算出起制约作用的瓶颈,再通过性能剖析确认执行在何处受阻。
后续内容: 从通用到专用
通用全连接网络将每一条输入到神经元的连接都转化为内存数据量 \(D_{\text{vol}}\) 和计算工作量 \(O\)。然而,现实世界的数据具有可利用的结构:图像具有空间局部性,文本包含序列依赖关系,音频信号则遵循时间模式。网络架构 将介绍卷积网络和 Transformer 等专用架构,它们将这些结构假设编码为归纳偏置。根据数据结构定制网络拓扑,可以减少冗余数据搬移并提高权重复用率,但也会在激活值存储、算术强度和加速器并行化方面引入新的权衡。
Footnotes
LeCun、Bengio 和 Hinton:2018 年 ACM 图灵奖获得者,他们在概念和工程方面的突破使深度神经网络成为计算的重要组成部分。他们的共同工作推动了表示学习、网络架构和训练方法的发展,为现代深度学习奠定了基础。↩︎
梯度不稳定性:在一条简化的、包含 20 层 sigmoid 的路径中,仅激活函数导数因子的乘积就以 \(0.25^{20}\),即 \(9.1 \times 10^{-13}\) 为上界。完整梯度还包含权重和其他运算,但反复出现的饱和区导数仍可能使早期层的更新小到可以忽略。平台期或 NaN 可以显现症状,却不能指出原因;整流线性单元(ReLU)激活函数、审慎的初始化、归一化、优化方法和残差连接,都有助于使深度网络能够训练,跳跃连接:解决深度问题 详细讨论了残差连接。↩︎
张量运算:张量的逻辑维度映射到一维的物理布局,而计算内核可能更适合另一种排列顺序。如果将典型的 ImageNet 输入(224×224×3,约 151 KB)从通道优先顺序改为通道末尾顺序时,需要实际执行数据重排,那么每张图像会产生约 301 KB 的读写总流量,却不会改变模型的数学结果。一些运行时通过视图、融合或兼容的计算内核来避免复制。如果重排仍无法消除,它就可能在模型的主要算术运算开始之前,消耗紧张的推理预算中的一部分。↩︎
《打砖块》(DQN——深度 Q 网络):Atari 于 1976 年推出的这款街机游戏,在 DeepMind 的 DQN 从像素中学习到游戏策略时(2015 年),成为人工智能发展的一个里程碑;该系统无需为每一种情形手工编写策略。环境、动作空间、奖励和预处理仍由程序设定。DQN 将帧缩放至 \(84{\times}84\),堆叠 4 帧作为输入,并每隔 4 帧选择一个新动作,说明学习得到的控制策略仍然依赖人工构建的实时推理循环。↩︎
专家系统:这类系统将人类专业知识转化为显式的
IF-THEN规则。对于物体识别等难以穷举相关变化的任务,这种知识工程方法的可扩展性较差。即使是 DEC 的 XCON 这样的成功系统,也积累了数千条手工编写的规则,使规则获取、一致性和维护成为主要工程成本。↩︎方向梯度直方图(HOG):深度学习兴起之前,一种在行人检测中颇具影响力的人工设计描述子 (Dalal and Triggs 2005)。一种常见配置是在 \(8{\times}8\) 像素的单元格中计算梯度方向,单元格大小和其他选项则针对任务进行调整。HOG 的固定计算图能够在 CPU 上高效运行,并提供可预测的延迟;学习得到的特征可以减少描述子的重新设计,但不会自动实现跨领域迁移,而且通常只有随着模型和批次规模增大,才能从加速器中获益。↩︎
尺度不变特征变换(SIFT):SIFT 将这类领域知识编码为一个四阶段算法,用于识别在尺度和旋转变化下保持稳定的关键点。检测到的关键点数量因图像而异,这使固定形状的批处理更加复杂。系统可以通过数量上限、填充、池化或固定编码,使表示规整化,但每种选择都会增加计算量或丢弃信息。↩︎
Gabor 滤波器:这类滤波器最初为局部时频分析而开发 (Gabor 1946),用于检测特定方向和频率上的边缘与纹理。典型的滤波器组包含许多覆盖不同方向和频率的人工设计滤波器。相比之下,深度卷积层从数据中学习小尺寸卷积核;卷积神经网络(CNN)的早期层滤波器往往会成为对边缘、颜色和纹理敏感的检测器,将特征设计从人工滤波器组转向数据驱动的优化 (Krizhevsky et al. 2012; LeCun et al. 2015)。↩︎
AlexNet 的内存拆分:Krizhevsky 团队将 AlexNet 拆分到两块 NVIDIA GTX 580 GPU 上,每块配备 3 GB 显存,使模型和训练状态能够共同容纳于这两块设备中。这一变通方案体现了一条系统层面的经验:训练配置可能超出单个设备的内存预算,迫使工程师在多个设备之间划分工作并安排通信。↩︎
偏差—方差权衡:在某些过参数化区间中,测试误差在插值阈值之后再次下降,因此经典的单一 U 形解释并不完整。其系统层面的影响是,不能将模型规模视为普遍单调递增的过拟合风险。只要实测的数据、优化和正则化条件能够支持相应收益,较大的模型就可以成为有用的工程选项。↩︎
内存墙:高速片上存储以纳秒级时间响应,而容量更大的片外内存在延迟和能耗方面高出数个数量级。神经网络权重通常超出最小缓存的容量,因此性能取决于分块、更大容量的缓存层级、片上静态随机存取存储器(SRAM)以及高带宽内存(HBM),以便在再次从片外取数之前复用数值。复用不足可能使计算单元闲置,即使峰值算术吞吐量很高也是如此。↩︎
内存受限的运算:矩阵乘法的算术强度(每加载一字节所执行的浮点运算次数,即 FLOP/byte)决定了一层受计算限制还是受内存限制。算术强度低于硬件 Roofline 交叉点的层,在下一块权重从内存到达之前就已完成算术运算。结果是:硬件的有效利用率可能急剧下降,而在内存带宽或数据复用得到改善之前,增加计算单元几乎无法带来加速。↩︎
神经元:McCulloch and Pitts (1943) 提出了神经活动的数学阈值模型:输入相互组合,并在达到阈值时触发全或无的输出。这种逻辑神经元是人工神经元抽象以及由大量简单单元构建的网络的起点。可学习权重、深层层级结构以及现代融合乘加(FMA)加速器数据通路都是后续的发展,它们将这一抽象转化为本章研究的以矩阵运算为主的工作负载。↩︎
MAC(乘加累积):全连接层和卷积层中的一种核心运算是 \(a \leftarrow a + (b \times c)\)。硬件数据表通常以 FLOPs 报告融合乘加的吞吐量,因为一次乘法和一次加法计为两次浮点运算。按照这一约定,当一次 MAC 计为一次乘加累积时,所报告的 FLOP/s 速率是 MAC/s 速率的两倍。层和批次的选择还会带来激活、通信和数据移动成本,因此,MAC 次数是系统预算的必要依据,但并不充分。↩︎
感知机:一种为执行学习算法而构建的机器,从一开始就将硬件与软件直接联系起来。无论增加多少输入硬件,单个线性阈值层都无法表示 XOR 等非线性可分函数。多层非线性网络扩展了可表示的函数类,但也引入了本章讨论的训练成本和系统成本。↩︎
反向传播:全称为“误差的反向传播”,该算法利用链式法则计算损失对数百万个权重的局部敏感程度。它并不能确定哪些权重在历史上导致了某个误差。Werbos 于 1974 年将其应用于神经网络 (Werbos 1974),而 Rumelhart、Hinton 和 Williams 于 1986 年发表的研究展示了其实际有效性 (Rumelhart et al. 1986)。其系统成本在于:反向传播需要存储前向传播的激活和额外的训练状态,从而使内存占用增加到数倍;本章稍后将对此进行量化。↩︎
算法与系统的应用时滞:到 1974 年,反向传播已可用于神经网络 (Werbos 1974),而 Rumelhart、Hinton 和 Williams 于 1986 年进行的演示使其受到更广泛的关注 (Rumelhart et al. 1986)。注意力机制于 2014 年出现在神经机器翻译中,Transformer 于 2017 年使其成为核心机制,随后 TPU 和 GPU 的规模化基础设施支持了规模大得多的部署。这些历史并不意味着每一种计算成本高昂的想法都会成功。它们表明,评估一种算法时,应同时考虑使其发挥作用所需的数据、优化方法、软件、硬件和任务条件。↩︎
训练能耗规模:该估计假设历史训练运行使用一台功率为 750 W 的工作站,并以 10.5 MWh/year 作为代表性美国家庭的用电预算。闭源模型情景将外部的 GPU 天数估计值视为 A100 等效加速器使用时间,并计入简单的数据中心开销。该结果用于说明规模,并不能确定训练 GPT-4 实际消耗的能量。↩︎
TPU(张量处理单元):Google 的定制加速器,于 2015 年首次在内部部署,专门针对神经网络工作负载中占主导地位的矩阵乘法进行了优化。TPU v1 在功耗为 75 W 时,实现了 92 TOPS 的推理吞吐量(厂商报告的 INT8 每秒万亿次运算),这一能效水平是当时的通用 GPU 无法企及的。“张量处理单元”这一名称体现了其设计取舍:牺牲通用灵活性,以便在神经网络最需要的运算上实现最大吞吐量。↩︎
Sigmoid:源自希腊语 sigma + eidos(“sigma 形”),指将输入映射到有界范围 (0, 1) 的 S 形曲线。该映射需要进行指数函数近似,通常通过专用指令、查找表或多项式方法实现。其成本一般高于 ReLU 的比较与选择操作,但实测差距取决于精度、向量化和硬件。ReLU 的广泛采用既源于其正值分支上更顺畅的梯度传播,也源于更低的执行成本。↩︎
梯度消失问题:链式法则会将各层的雅可比因子相乘,从而可能导致梯度缩小。Sigmoid 的导数至多为 0.25,因此沿一条简化的 10 层路径,仅激活函数导数因子的乘积就至多为 \(0.25^{10} \approx 10^{-6}\)。完整梯度还包含权重和其他运算的影响,但饱和激活函数的导数反复相乘,仍可能使靠前层的更新变得微乎其微。↩︎
Tanh(双曲正切):通过使输出范围以零为中心,
tanh可以减轻全正激活值所导致的相关更新行为。由于同样依赖指数函数近似,其计算成本与 sigmoid 相似;同时,其饱和特性仍可能导致梯度消失。↩︎ReLU(修正线性单元):与先前激活函数中成本高昂的指数运算不同,ReLU 的
max(0, x)运算可映射为简单的比较与选择。这种效率,加上正激活值下更顺畅的梯度传播,帮助 AlexNet 时代的深层架构在计算上变得可行 (Nair and Hinton 2010; Krizhevsky et al. 2012)。↩︎Dropout:在训练期间随机停用神经元,迫使网络学习冗余表示;这是一种正则化技术,曾用于 AlexNet 时代向深度视觉模型的转变 (Srivastava et al. 2014; Krizhevsky et al. 2012)。它使训练(随机)与推理(确定性)的计算图在系统层面产生差异。未能从训练计算图切换到推理计算图是一种常见错误,可能在没有明显征兆的情况下损害准确率。↩︎
批归一化的系统成本:BatchNorm 为每个特征增加两个可学习参数(缩放参数 \(\gamma\) 和平移参数 \(\beta\)),且在训练和推理期间具有不同行为:训练使用当前小批量的均值和方差,而推理使用冻结的运行统计量;通过使激活值分布保持更合适的尺度,它能够稳定训练,并可能允许使用更高的学习率,但也使该层依赖批统计量。小批量可能产生噪声较大的均值和方差估计,因此,一种数学上的稳定化手段会转变为涉及批大小、激活值内存占用以及训练与服务行为一致性的系统选择。后续架构和大规模训练场景进一步引入了围绕同一批统计量权衡的各种变体。↩︎
Softmax:这个名称体现了它作为
argmax的“软”版本或可微版本的作用,后者必须检查整个向量才能找到最大值。这种向量级运算并不能直接替代 ReLU 等逐元素非线性函数,但只要模型需要对分数向量进行归一化,它就发挥着核心作用,包括分类头和注意力层。直接求指数在 32 位浮点数中可能导致溢出。数值稳定的实现会在求指数前减去最大的 logit;这种平移不会改变任何 softmax 概率,同时使最大的指数运算结果等于一。↩︎Logit:在多分类神经分类器中,logit 是未经归一化的输出分数。分数之差对应于 softmax 之后的概率比的对数,而单个多分类 logit 本身并不是经过校准的对数几率。由于对 logit 执行
argmax和对 softmax 概率执行argmax会选择同一类别,因此在仅需要得分最高的类别时,推理可以跳过 softmax。↩︎通用近似定理:在激活函数、目标函数、紧致定义域和近似容差满足相应条件时,足够宽的单隐藏层网络可以以任意高的精度近似目标函数。这一存在性结论是非构造性的:它既不说明如何找到权重,也不说明实际训练需要多少个神经元。对于某些函数类别,深度相比浅层网络具有指数级的表示优势,但这种差异并非普遍存在。↩︎
参数内存成本:用参数数量衡量参数对内存的重要性可能产生误导;某些层会增加少量可学习的缩放或平移参数,这些参数几乎不影响以字节计的内存预算,但当训练选择发生变化时,却可能显著影响模型行为。另一方面,密集权重矩阵中的大量参数在训练期间需要额外状态:除了存储权重本身,还需要存储梯度和优化器的辅助状态。因此,一个在推理时能够装入内存的模型,训练时可能需要数倍的内存;后文将在训练内存预算中量化这一成本。↩︎
偏置项:每个神经元的偏置增加一个参数,而具有 \(n\) 个输入的神经元有 \(n\) 个权重,因此偏置占该层参数的 \(1/(n+1)\)。偏置在整个模型参数中所占的比例及其对准确率的影响取决于层宽、架构和归一化方式。一些现代架构会省略后接批量归一化的层中的偏置,因为归一化变换已包含一个可学习的平移项。↩︎
异或问题:异或是说明网络拓扑为何重要的经典示例。无论包含多少个单元,单个线性阈值层都无法表示这个非线性可分函数,而具有非线性隐藏层的小型网络则可以。所需单元的确切数量取决于激活函数和表示约定;其中始终成立的启示是,增加非线性深度会改变网络能够表达的函数类别。↩︎
Xavier/Glorot 初始化:对于具有 \(n_{\text{in}}\) 个输入和 \(n_{\text{out}}\) 个输出的层,一种常见的 Glorot 方案采用权重方差 \(2/(n_{\text{in}}+n_{\text{out}})\),以平衡前向激活值与反向梯度 (Glorot and Bengio 2010)。这种修正不增加任何 FLOPs;它仅涉及在启动时设置随机分布。↩︎
批处理:批处理具有双重作用。较大的批次通过在更多样本上取平均来降低梯度噪声,并可将矩阵—向量运算转变为更大规模的矩阵—矩阵内核,从而提高硬件利用率。它们也会执行更多的总计算工作,且通常会增加单个请求的延迟;吞吐量的提升取决于形状和硬件。批大小每翻一倍,激活值内存也大致翻一倍,因此批大小需要从优化与系统两个角度共同决策,而不能仅从统计或硬件角度选择。↩︎
损失函数:亚伯拉罕·瓦尔德在统计决策理论中将其形式化为错误决策的“代价”,\(\mathcal{L}\) 用于量化预测 \(\hat{y}\) 与真实值 \(y\) 之间的差距。损失函数的选择塑造了优化的几何结构:它决定了反向传播必须遍历的梯度景观。在错误预测附近具有平坦区域的损失函数会产生微弱梯度,使学习停滞;而在决策边界附近具有陡峭梯度的损失函数,则会在最关键的位置加速收敛——section 1.4.3 将探讨这一系统层面的影响。↩︎
独热编码:将 \(K\) 个类别表示为 \(K\) 维二进制向量,其中恰好有一个元素为 1;这种编码在构造上就是稀疏的:对于 MNIST 的 10 个类别,每个标签向量中有 90% 的元素为零。实现中通常存储整数类别索引,而不实际构造该向量。对于非常大的输出空间,采样 softmax 等方法还可以减少输出计算量。↩︎
链式法则:对于一个 \(n\) 层网络,微积分恒等式 \(\frac{\partial \mathcal{L}}{\partial w} = \frac{\partial \mathcal{L}}{\partial a_n} \cdot \frac{\partial a_n}{\partial a_{n-1}} \cdots \frac{\partial a_1}{\partial w}\) 会成为 \(n\) 项的乘积。如果每个偏导数都略小于一,乘积就会以指数速度趋于零;如果都略大于一,乘积就会爆炸。这种乘法结构解释了为什么深度是一项系统约束,而不仅仅是设计选择:它决定了保持训练稳定所需的数值精度要求和初始化策略 (Glorot and Bengio 2010; He et al. 2015)。↩︎
Adam(自适应矩估计):为每个参数维护一阶矩和二阶矩估计,在参数本身之外,还需要额外 2\(\times\) 的 FP32 内存 (Kingma and Ba 2015)。对于一个具有 100K 个参数的 MNIST 模型,这项开销可以忽略不计;但对于一个具有 7-billion 个参数的模型,它会增加约 56 GB,往往决定了模型能否装入单个 GPU,还是必须进行分片。Adam 被广泛使用,是因为它的自适应更新在许多任务中都表现稳健,但学习率、调度方案、正则化和内存策略仍需验证。↩︎
Autograd(自动微分):反向模式自动微分可追溯至 Linnainmaa 关于对计算机程序求导的研究 (1970)。现代 autograd 引擎将前向传播操作记录到有向无环图(DAG)中,然后利用链式法则反向遍历该图,自动计算梯度。其关键系统权衡在于:更灵活的执行方式能够精确记录每次迭代中实际发生的操作,而更固定的执行方式则能暴露更多提前优化的机会。机器学习框架 详细阐述了这一框架设计选择。↩︎
学习率:这一标量对训练基础设施有着格外显著的影响,因为扩大批大小可能需要重新调整优化调度。线性缩放规则在一种特定的 ImageNet 大批量训练设置中随批大小增大学习率 (Goyal et al. 2017),但最佳策略取决于模型、优化器、数据和规模。在其经过验证的适用范围之外应用缩放规则,可能导致从单 GPU 训练转向多 GPU 训练时发生发散。↩︎
轮次(Epoch):对训练数据集的一次完整遍历。遍历次数直接决定总工作量的倍数:一次包含 100 个轮次的 MNIST 训练所执行的前向传播和反向传播次数,是单个轮次的 100\(\times\)。大语言模型训练通常以词元预算而非简单的轮次数来规定,因为可能会混合多个数据源,并以不同的速率进行采样。同样的核算方式仍然适用:每增加一个训练词元,就会增加相应的前向和反向计算。↩︎
推理:源自拉丁语 inferre(“引入、得出结论”),借自逻辑学,在逻辑学中意为从前提推导结论。在机器学习中的用法标志着一条系统边界:训练执行前向传播和反向传播,并维护优化器状态,而常规推理则使用固定参数执行前向计算图。移除梯度、优化器状态和大部分保存的激活值,可以显著减少内存和计算需求,但减少的比例取决于架构、批大小、精度、运行时工作区和服务策略。↩︎
训练 GPU 功耗预算:“大内存”要求源于同时存储参数、梯度、优化器状态和激活值的需要。相应的功耗决定了对“大规模冷却基础设施”的需求,因为单个高端训练 GPU 的功耗为 400 W–700 W。即使与一颗 4 W 的移动推理芯片相比,其功耗预算也至少为后者的 100×。↩︎
边缘推理加速器:Edge TPU(Google Coral)属于移动/嵌入式功耗档位,以约 2 W 的功耗运行,通过 INT8 数据通路提供 4 TOPS 的算力。边缘服务器属于不同的档位:Jetson AGX Orin在 15 W–60 W 的功耗下达到 275 TOPS,吞吐量约为前者的 68.8×,但前提是采用有线供电。↩︎
量化:从 FP32 转为 INT8 可将参数存储需求缩小 4\(\times\),并可在具有高效 INT8 数据通路的硬件上提高吞吐量,但实际加速效果取决于算子内核支持、内存流量和工作负载形态。推理通常允许采用比训练更低的精度,因为它无需在反复的学习步骤中表示微小的梯度或优化器更新。这种权衡并非没有代价:激进的量化可能降低准确率,尤其是在罕见或代表性不足的输入上,因此必须通过校准和任务级评估,确定每种部署可安全采用的精度。模型压缩 详细介绍了量化技术。↩︎
FP32 与低精度格式:IEEE 754 binary32 格式使用 32 位(1 位符号位、8 位指数位、23 位小数位),而 16 位替代格式对指数位和小数位采用不同的分配方式:IEEE 754 FP16 分配 5 位指数位和 10 位小数位,提供较高的精度,但动态范围较窄(\(6.1 \times 10^{-5}\) 至 \(65,504\)),需要动态损失缩放;Brain Floating Point(BF16)则分配 8 位指数位,使其动态范围与 FP32 相同,以消除训练期间的下溢。INT8 将 32 位存储占用进一步缩减至四分之一,使用 8 位整数(-128 至 127),广泛用于经过校准或量化感知训练后的高吞吐量推理。形式化的数值比较见 数值表示。↩︎
Dalal, Navneet, and Bill Triggs. 2005. “Histograms of Oriented Gradients for Human Detection.” 2005 IEEE Computer Society Conference on Computer Vision and Pattern Recognition (CVPR’05) 1: 886–93. https://doi.org/10.1109/cvpr.2005.177.
Gabor, D. 1946. “Theory of Communication. Part 1: The Analysis of Information.” Journal of the Institution of Electrical Engineers - Part III: Radio and Communication Engineering 93 (26): 429–41. https://doi.org/10.1049/ji-3-2.1946.0074.
Krizhevsky, Alex, Ilya Sutskever, and Geoffrey E. Hinton. 2012. “ImageNet Classification with Deep Convolutional Neural Networks.” Advances in Neural Information Processing Systems (NeurIPS) 25.
LeCun, Yann, Yoshua Bengio, and Geoffrey Hinton. 2015. “Deep Learning.” Nature 521 (7553): 436–44. https://doi.org/10.1038/nature14539.
McCulloch, Warren S., and Walter Pitts. 1943. “A Logical Calculus of the Ideas Immanent in Nervous Activity.” The Bulletin of Mathematical Biophysics 5 (4): 115–33. https://doi.org/10.1007/bf02478259.
Werbos, Paul. 1974. “Beyond Regression: New Tools for Prediction and Analysis in the Behavioral Sciences.” PhD thesis, Harvard University.
Rumelhart, David E., Geoffrey E. Hinton, and Ronald J. Williams. 1986. “Learning Representations by Back-Propagating Errors.” Nature 323 (6088): 533–36. https://doi.org/10.1038/323533a0.
Nair, Vinod, and Geoffrey E. Hinton. 2010. “Rectified Linear Units Improve Restricted Boltzmann Machines.” Proceedings of the 27th International Conference on Machine Learning (ICML-10), 807–14.
Srivastava, Nitish, Geoffrey E. Hinton, Alex Krizhevsky, Ilya Sutskever, and Ruslan Salakhutdinov. 2014. “Dropout: A Simple Way to Prevent Neural Networks from Overfitting.” Journal of Machine Learning Research 15 (1): 1929–58.
Glorot, Xavier, and Yoshua Bengio. 2010. “Understanding the Difficulty of Training Deep Feedforward Neural Networks.” Proceedings of the Thirteenth International Conference on Artificial Intelligence and Statistics (AISTATS) 9: 249–56.
He, Kaiming, Xiangyu Zhang, Shaoqing Ren, and Jian Sun. 2015. “Delving Deep into Rectifiers: Surpassing Human-Level Performance on ImageNet Classification.” 2015 IEEE International Conference on Computer Vision (ICCV), 1026–34. https://doi.org/10.1109/iccv.2015.123.
Kingma, Diederik P., and Jimmy Ba. 2015. “Adam: A Method for Stochastic Optimization.” 3rd International Conference on Learning Representations (ICLR).
Linnainmaa, Seppo. 1970. “The Representation of the Cumulative Rounding Error of an Algorithm as a Taylor Expansion of the Local Rounding Errors.” Master's thesis, University of Helsinki.
Goyal, Priya, Piotr Dollár, Ross Girshick, Pieter Noordhuis, Lukasz Wesolowski, Aapo Kyrola, Andrew Tulloch, Yangqing Jia, and Kaiming He. 2017. “Accurate, Large Minibatch SGD: Training ImageNet in 1 Hour.” arXiv Preprint arXiv:1706.02677 abs/1706.02677.