基准测试
基准测试
目的
当硬件、模型、数据和部署相互影响时,如何公平地比较机器学习系统?
基准测试汇总了在数据选择、模型压缩和硬件加速过程中已经形成的决策,随后检验这些决策带来的收益能否在具有部署代表性的条件下保持。每项决策都针对一个维度(延迟、准确率、吞吐量或能耗),但机器学习系统是所有这些维度共同作用的结果。剪枝后的模型在一种加速器上运行更快,在另一种加速器上却可能更慢。增大批大小可以提高加速器利用率,但可能违反延迟服务等级协议。边缘设备可能宣传其峰值吞吐量,而热降频会使其在持续工作负载下的吞吐量大幅下降。挑战不在于某个局部指标是否改善,而在于组合后的系统能否在真正重要的条件下得到改善。基准测试使这类比较系统化,而不再依赖个别经验。它要求明确测量什么(准确率、延迟、吞吐量、能耗)、以何种粒度测量(单个内核、完整模型、端到端流水线),以及在什么条件下测量(批大小、输入分布、热状态、并发负载)。缺乏这种结构,团队就会比较测量条件根本不一致的数字,而那些在电子表格中看似合理的决策,在生产工作负载下便会失效。前面的章节优化了模型、选择了数据,并匹配了硬件。基准测试验证这些优化,将主张与证据对照,并量化承诺与实际交付之间的差距。用数据—算法—机器的视角来看,基准测试通过揭示数据、算法和机器究竟得到了匹配,还是仅仅被组装在一起,对协同设计进行检验。
学习目标
- 将基准测试解释为数据—算法—机器的验证过程,检验优化主张能否在具有代表性的条件下成立
- 使用吞吐量、延迟百分位数、能耗、准确率和工作负载范围比较训练与推理基准测试
- 根据所检验的工程决策,选择微观、宏观或端到端粒度
- 应用标准化的基准测试运行规则,统一数据集、指标、硬件配置和报告方式
- 设计能够控制功耗测量边界、输入分布、批大小和统计变异的基准测试规程
- 使用校准、鲁棒性、代表性和数据切片级指标评估模型与数据质量
- 诊断由漂移、热降频、动态负载和静默退化造成的基准测试与生产环境之间的差距
机器学习基准测试框架
量化为 INT8 的模型在合成工作负载上的基准测试速度可能提升至 2\(\times\),但在输入大小可变且存在并发请求的真实流量模式下,却可能毫无改善。剪枝后的模型可能在测试集上保持准确率,却无法处理基准测试从未覆盖的边界情况。数据选择承诺提高训练效率,模型压缩承诺使模型更小、更快,硬件加速承诺提高吞吐量。验证这些主张在生产环境中是否成立,本身就是一门工程学科。
Definition 1.1: 机器学习基准测试
机器学习基准测试 是在指定条件下对机器学习工作负载进行的实证测量,用具有代表性的证据检验关于组件、模型或端到端系统的主张,而非仅依据峰值规格。
- 意义:峰值性能与持续性能之间的差距可能很大。A100 GPU 的峰值性能为 312 TFLOP/s(BF16),但在这个模型 FLOPs 利用率(MFU)为 30 percent–50 percent 的示例场景中——该指标衡量理论架构计算量与硬件标称每秒计算能力之比——其持续性能为 93.6 TFLOP/s–156 TFLOP/s,由于内存停顿、流水线气泡和内核启动开销等因素,峰值性能约为持续性能的 2–3.3×。基准测试能够量化工作负载实际的 \(\eta_{\text{hw}}\) 差距;厂商规格表则不能。
- 区别:机器学习基准测试涵盖多个范围。微基准测试隔离矩阵乘法等操作,模型级基准测试评估完整的训练或推理工作负载,端到端基准测试则纳入数据加载、预处理、优化、检查点 I/O 或服务基础设施等外围工作。测试范围必须与工程主张相匹配。
- 常见陷阱:一种常见误解是将基准测试数字视为稳定的参考。工作负载(新的模型架构)和硬件(新一代 GPU)都在演进,因此,在某一版本基准测试中领先的结果,往往会成为后续版本的基线;只有保持基准测试版本不变,逐年比较才有意义。
基准测试让前面章节确立的物理定律接受实证现实的检验。基准测试与生产环境之间的差距 衡量建模预期与实际观测到的生产行为之间的差异。缩小这一差距,需要通过测量将理论主张转化为经过验证的工程知识。
机器学习基准测试涵盖三个相互依赖的维度,它们直接对应任何已部署系统的组成部分。系统基准测试 衡量硬件能否在真实工作负载下兑现承诺的性能,或者内存带宽饱和与软件分派开销是否侵蚀了收益。模型基准测试 衡量优化技术能否在完整的输入分布上保持模型质量,而非仅在精心整理的测试集上保持质量。数据基准测试 衡量模型能否泛化到包含各种噪声、偏差和分布偏移的真实世界数据。每个维度都能独立揭示其他维度无法发现的问题,而通过全部三个维度检验的系统,比仅沿任一单一维度评估的系统更能让人对其部署充满信心。
机器学习基准测试捕获的是工作负载和数据分布的一个快照,而非永久不变的规格。峰值性能与持续性能之间的差距也不是固定的;它会随着工作负载和硬件代际的演进而变化,因此,任何单次基准测试结果都具有时间属性,而非普遍适用。
Systems Perspective 1.1: 不断变化的基准测试目标
在传统系统中(例如 SPEC CPU),基准测试是一种刚性规格。只要排序算法能够将列表排好序,它就是正确的。正确性是绝对且不变的。在机器学习系统中,基准测试是一种柔性规格:正确性由有限的样本集(ImageNet)定义,而世界在不断变化。在 ImageNet 上得分很高的模型,面对基准测试创建多年后拍摄的用户照片时,仍可能表现不佳。
在计算机体系结构领域,工程师面向基准测试进行设计,因为基准测试代表工作负载。在机器学习工程中,仅围绕基准测试进行设计就是过拟合。鲁棒性源于承认基准测试只是不断变化的现实的一种代理。
MobileNetV2 部署验证 使这个三维框架变得具体。它作为贯穿本章的示例,是因为它覆盖了全部三个评估维度,展示了每个维度如何揭示其他维度无法发现的问题。
Lighthouse 1.1: MobileNetV2 部署验证
MobileNetV2(在 灯塔模型名录:模型小传 中介绍)作为验证完整优化流水线的灯塔示例。MobileNetV2 通过倒残差和线性瓶颈改进了 v1 的深度可分离设计,同时保持了相近的参数规模 (Sandler et al. 2018)。它体现了基准测试决定成败的部署挑战:压缩可以减小模型大小,硬件加速可以降低推理延迟,而只有基准测试才能确定这些收益能否在完整部署流水线中保持。
- 模型压缩(模型压缩):INT8 量化 将此 MobileNetV2 算例的模型大小从 14 MB 减小至 3.5 MB(压缩倍数为 4×)
- 硬件加速(硬件加速):示例 EdgeTPU 场景 采用的推理延迟为 2 ms,而 CPU 上为 15 ms
- 基准测试验证:验证流水线在实践中能否兑现预期效果
系统化评估将 EdgeTPU 延迟与预处理及数据传输开销分离,确认 INT8 量化能否在异常光照等边界情况下保持准确率,并验证吞吐量能否在真实世界的智能手机传感器数据流上保持,而非仅在精心整理的 ImageNet 测试集上保持。
严谨的评估始于一种能够区分有意义的证据与误导性指标的思维方式。有效的实践者遵循以下三个原则。
第一,基准测试是代理,而非真相。 每项基准测试都测量特定条件,而这些条件可能与目标部署环境不匹配。系统在 Offline 模式(所有输入均已就绪时的批量吞吐量)下可能实现很高的样本吞吐量,而在 Server 模式(随时间到达且受延迟约束的请求)下,每秒查询数(QPS)却可能低得多。关键问题始终是:基准测试没有测量什么。
第二,古德哈特定律无处不在。1 “当一个度量成为目标时,它就不再是一个好的度量。”围绕基准测试排名进行优化的团队,往往会构建出在评估中表现出色、在生产环境中却失败的系统。针对基准测试的特定优化经常会损害对部署至关重要的特性:鲁棒性、校准和效率。
第三,端到端指标优于组件指标。在这个示例流水线中,一个请求的总延迟为 50 ms,其中模型阶段的延迟为 10 ms;将该阶段的推理速度提升至 3×,只能带来约 1.2× 的端到端加速;如果优化增加了内存压力,效果还会更差。这些原则贯穿基准测试方法论,并将在 section 1.13 中深入讨论。
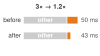
组件加速很少能等比例转化为端到端基准测试中的加速。
然而,知道测量什么只解决了一半问题。错误的测量方式(使用不恰当的工作负载、有偏的基线或未受控制的变量)会产生看似精确、却会误导决策的数字。计算基准测试的历史中,这类案例比比皆是:指标在技术上合理,应用它们的方法却存在缺陷,从通过编译器投机优化获得的 Whetstone 分数,到经过精挑细选、对持续工作负载毫无预测能力的 GPU 基准测试。理解测量方法如何演进以及曾在何处失效,对于设计能够区分真实改进与测量伪象的基准测试至关重要。
基准测试的历史基础2 之所以重要,是因为它揭示了机器学习中仍在反复出现的验证失效:经过优化后不再能够预测真实工作负载的指标、忽略持续运行状态的硬件数字,以及未能反映部署成本的模型分数。同样的验证顺序也支配着现代实践:首先验证硬件能否兑现承诺的性能,再验证构建于该硬件之上的模型和数据优化能否带来承诺的收益。
历史基础
1976 年,Whetstone 成为最早的标准化计算基准测试之一,厂商开始专门针对其合成浮点循环优化编译器,产生了无法预测真实应用性能的峰值执行数字。类似的指标操纵反复削弱了单指标评估和组件级评估的有效性。要理解现代机器学习评估为何需要数据—算法—机器分类体系(数据 · 算法 · 机器),就需要追溯计算史上测量方法的演进。每一代基准测试都诞生于既有指标无法揭示关键系统瓶颈之时,为机器学习评估提供了直接的先例。
在展开这段历史之前,有一个重要的边界条件:只有明确指出所验证主张所属的层次,基准测试才有用。
这种跨层作用解释了基准测试历史为何重要:每当实践者发现既有指标无法预测端到端行为时,性能测量就会向前发展。从早期合成测试到现代机器学习测试套件的演进,揭示了三种方法论转变:从孤立内核转向具有代表性的应用套件,从单指标吞吐量转向多目标能耗特征,以及从通用计算指标转向领域特定的执行约束。
性能基准测试
最早的计算基准测试揭示了实证评估中一个长期存在的弱点:基准测试投机优化。Whetstone (Curnow and Wichmann 1976) 使用一组合成的科学计算操作,而 LINPACK3 (Dongarra et al. 1979) 则测量稠密线性方程组的求解性能。由于这些工作负载依赖可预测的计算循环,编译器和硬件厂商可以专门针对基准测试内核进行优化——例如展开合成循环,或针对确切的矩阵维度定制缓存分块——却不改善一般应用的性能。SPEC CPU(1989 年)通过评估完整、可移植的软件套件来解决这一局限,这些套件对整数分支、不规则的内存层次结构和浮点流水线施加压力 (Dixit 1993)。这一演进对机器学习系统有直接启示:模型压缩 中的模型压缩主张不能依赖孤立的矩阵乘法内核,而需要在完整的软件运行时环境中,使用 ResNet-50 和 BERT 等具有代表性的任务进行验证。
Dixit, Kaivalya M. 1993. “Overview of the SPEC Benchmarks.” In The Benchmark Handbook for Database and Transaction Systems, 2nd ed., edited by Jim Gray. Morgan Kaufmann.
随着计算扩展到交互式和移动环境,单一指标评估被证明并不充分。图形基准测试将帧率与渲染质量结合起来,移动设备评估则将电池耗电与延迟视为同等重要的指标。这种多目标权衡也体现在机器学习模型服务中:孤立地优化延迟可能导致模型准确率或能效出现灾难性下降(引言)。
第三次转变发生在分布式计算表明组件级微基准测试无法预测集群级吞吐量之时。当网络互连延迟、序列化开销和集合通信主导实际运行时间时,孤立地评估 CPU 或加速器无法反映执行动态。类似地,分布式机器学习训练也依赖于加速器矩阵引擎(硬件加速)、主机到设备的 PCIe 带宽、输入数据预取流水线,以及跨网络互连架构的梯度同步之间的紧密配合。
为捕捉这些相互作用,DAWNBench (Coleman et al. 2019) 率先采用达到目标准确率所需时间的评估方法,将原始硬件吞吐量直接与算法收敛关联起来。如果数值不稳定或批大小选择不当导致模型无法达到目标验证准确率,那么最大化每秒处理的样本数就没有工程价值。这些经验最终促成了 MLPerf4(2018 年)的诞生,将全系统测量、多目标约束,以及涵盖视觉、语言和推荐系统的代表性工作负载制度化 (Mattson et al. 2020; Reddi et al. 2019)。
Coleman, Cody, Deepak Narayanan, Daniel Kang, Tian Zhao, Jian Zhang, Luigi Nardi, Peter Bailis, Kunle Olukotun, Christopher Ré, and Matei Zaharia. 2019. “Analysis of DAWNBench, a Time-to-Accuracy Machine Learning Performance Benchmark.” ACM SIGOPS Operating Systems Review 53 (1): 14–25. https://doi.org/10.1145/3352020.3352024.
能耗基准测试
随着计算从大型机扩展到电池受限的移动设备和兆瓦级数据中心,多目标评估范式也延伸到了能效。由于能耗直接决定边缘端的电池续航时间和仓库级集群的运营费用,能耗成为与性能并列的首要评估指标。这一转变催生了标准化的能耗基准测试,例如面向服务器的 SPEC Power5 和面向超级计算机的 Green5006。
评估机器学习工作负载的能耗会带来独特的物理测量挑战。加速器的动态功率会剧烈波动:在受内存限制的激活层与功率密度高的矩阵乘法单元之间交替执行,会产生快速的电流变化(\(\frac{dI}{dt}\)),简单的平均功率计无法分辨这些变化。此外,要将加速器能耗与主机 CPU 活动、PCIe 互连及冷却风扇的能耗区分开来,还需要严格界定测量边界。MLPerf Power (MLCommons 2024b) 将标准化工作负载与严格的物理测量方法及经过校准的外部功率分析仪相结合,以满足这些要求。
MLCommons. 2024b. MLPerf Power Measurement.
Howard, A. G., M. Zhu, B. Chen, D. Kalenichenko, W. Wang, T. Weyand, M. Andreetto, and H. Adam. 2017. “MobileNets: Efficient Convolutional Neural Networks for Mobile Vision Applications.” CoRR abs/1704.04861.
能耗基准测试不仅涉及硬件遥测,还评估算法效率。模型压缩技术(剪枝、量化、知识蒸馏)通过减少算术运算和片外内存流量来降低能耗,而非仅依赖低功耗芯片。例如,MobileNet 架构以深度可分离卷积替代标准卷积,相较于 ResNet 等标准卷积神经网络(CNN)基线,大幅减少了 DRAM 访问和算术运算 (Howard et al. 2017; Sandler et al. 2018; He et al. 2016)。正如 模型压缩 中所阐述、并在 能耗成本 中量化的那样,从片外 DRAM 读取一个操作数所消耗的能量,比执行一次算术运算高出数个数量级,因此,通过算法减少内存流量是实现高能效计算的主要手段。
领域专用基准测试
随着专用加速器出现以绕过通用 CPU 的瓶颈,通用基准测试已无法反映特定领域的执行约束。三个运行维度推动了这种专用化,并界定了如何在现实条件下评估系统。
部署约束根据物理限制决定核心指标的优先级。数据中心训练集群在机架和设施级功率限制内优化总吞吐量。相比之下,移动 AI 必须在严格的热节流阈值内运行(通常低于 5 瓦),而嵌入式微控制器系统的功率预算则处于毫瓦级。这些物理边界源于 引言 中的效率原则,决定了基准测试优先关注吞吐量(每秒样本数)还是能效(每次推理的焦耳数)。
应用需求施加了超出原始速度的功能约束。临床 AI 模型除分类准确率外,还要求严格的校准和可解释性;高频金融交易系统对尾延迟施加硬性上限,并要求确定性执行;自动驾驶车辆则要求最坏情况延迟有界,并通过正式的功能安全验证。这些要求将评估标准扩展到吞吐量之外;负责任工程 对安全、合规和公平性所对应的工程原则作了形式化阐述。
运行条件决定实际环境中的鲁棒性。边缘设备必须在环境温度波动和传感器数据流含噪的情况下仍能满足推理截止时间;数据中心模型服务基础设施必须承受突发查询高峰和网络丢包,同时不丢弃请求;工业物联网节点则必须在无人值守的情况下运行多年。硬件加速能力(硬件加速)只有在这些运行环境中能够持续保持,才能产生生产价值。
机器学习体现了这种领域专用化的分化。由于机器学习工作负载会引发张量执行单元、内存层次结构带宽和分布式通信互连之间的复杂相互作用,任何单一指标或工作负载都无法刻画一个系统。MLPerf 通过不同的部署套件将这种专用化规范化:MLPerf Training 在达到目标质量所需时间的要求下,评估多节点扩展能力和高带宽互连 (Mattson et al. 2020);MLPerf Inference 在服务等级协议(SLA)约束下,测量服务器和客户端系统的吞吐量与延迟百分位数 (Reddi et al. 2019);MLPerf Tiny 测试在严格内存约束下运行的超低功耗微控制器 (Banbury et al. 2021);而横跨各类环境的 MLPerf Power 测试类别则评估各环境中的能效。沿 table 1 的约束列向下阅读,可以看出指标如何适应物理限制:关注点从集群规模的互连带宽,转向边缘端的延迟百分位数,最终转向微控制器上严格受限的内存占用。
| MLPerf 变体 | 目标领域 | 关键约束 | 主要指标 |
|---|---|---|---|
| MLPerf Training | 数据中心 | 多节点扩展能力、高带宽互连 | 达到目标质量所需时间、吞吐量(样本/秒) |
| MLPerf Inference | 服务器/边缘端 | 延迟 SLA、吞吐量要求 | QPS、延迟百分位数、准确率保持 |
| MLPerf Tiny | MCU/IoT | 超低功耗推理、有限内存 | 延迟、准确率、每次推理能耗 |
| MLPerf Power | 跨领域 | 能耗预算、热约束 | 性能/W、每次查询能耗 |
在所有变体中,MLPerf Power 测量的都是每瓦完成的有效工作,而非仅测量原始吞吐量。领域专用套件确保架构优化能够转化为部署成效,而不是局限于孤立的合成基准测试。
机器学习基准测试套件在继承这些历史经验的同时,也必须应对机器学习工作负载带来的统计变异性和数据依赖性变异,这些变异并不存在于传统的确定性计算中。除操作系统中断、后台守护进程活动和热节流等常见系统噪声外,机器学习执行还表现出内在的非确定性。并行线程间的浮点归约不满足结合律,因此求和顺序变化会造成细微的数值差异;数据摄取流水线会应用伪随机数据增强;随机梯度下降则在对权重初始化敏感的非凸损失曲面上搜索。因此,严谨的机器学习评估需要明确的统计控制措施,包括使用多个随机种子重复实验、报告方差,以及采用确定性的数据加载规则。
标准化将这些经验转化为共同的工程方法。当一个团队测量推理延迟时计入主机预处理,而另一个团队只有在张量已驻留加速器设备内存后才开始计时,或者功率计围绕电源单元划定不同的物理测量边界时,所得数值就无法比较。标准化套件以经过审计的测试框架、统一的测量边界和可验证的提交规则替代临时性测试,使整个行业能够进行严谨的硬件采购评估和算法比较。Table 2 综合呈现了从早期合成循环到多维机器学习系统评估的历史演进。
| 基准测试 | 年份 | 主要关注点 | 关键指标 | 对机器学习基准测试的启示 |
|---|---|---|---|---|
| Whetstone | 1976 | 合成浮点运算 | MWIPS | 对合成测试投机取巧会损害评估的有效性 |
| LINPACK | 1979 | 线性代数(矩阵运算) | FLOP/s | 孤立运算无法反映系统级复杂性和瓶颈 |
| SPEC CPU | 1989 | 真实应用工作负载 | SPECrate、SPECspeed | 代表性工作负载揭示真实部署性能 |
| SPEC Power | 2007 | 服务器能效 | 各负载水平下的 ssj_ops/W | 能效需要多负载评估,不能只看峰值性能 |
| Green500 | 2007 | HPC 能效 | 每瓦 GFLOP/s | 能效排名补充原始性能排名 |
| MLPerf | 2018 | 机器学习系统(训练 + 推理) | 达到目标质量所需时间、QPS、延迟、准确率 | 综合全部经验:代表性工作负载 + 多目标 + 系统 |
系统基准测试套件
一个评估边缘部署硬件的团队,需要为智能摄像头产品比较五种不同的片上系统(SoC)设计。厂商 A 报告 INT8 下为 8 TOPS;厂商 B 报告 INT4 下为 15 TOPS;厂商 C 报告某个专有模型上的推理延迟;厂商 D 引用两代之前的 MLPerf 得分;厂商 E 仅提供最大批大小下的峰值吞吐量。这些数字都无法直接比较。团队无法作出有充分依据的采购决策,因为每家厂商都在各自特有的条件下单独呈现对自身有利的指标,掩盖了真实的运行权衡。基准测试套件通过强制采用统一的测量框架和标准化评估规则,解决这种碎片化问题。
基准测试历史中的三个经验——代表性工作负载、多目标评估和集成系统测量——汇聚为机器学习独有的一项要求:管理统计近似。在传统计算基准测试中,有效的系统优化必须保持算术结果逐比特一致。在机器学习系统中,底层工程选择则经常改变数值输出:激进的权重量化、内核剪枝或低精度累加器,以准确率换取执行速度和更低的内存带宽压力。因此,机器学习基准测试不能孤立地评估执行时间;输出准确率是一项不可违背的运行约束。现代基准测试套件将这些约束编码到标准化框架中,使严谨的跨平台比较成为可能。
因此,评估机器学习系统需要考察数据—算法—机器(D·A·M)协同设计空间中的耦合交互,而非测量原始计算吞吐量。早期基准测试主要关注孤立数据集上的算法准确率 (LeCun et al. 1998)。随着模型规模扩大,计算瓶颈推动基准测试扩展到硬件执行效率 (Jouppi et al. 2017),而部署失败则表明,数据流水线瓶颈和输入分布偏移决定了实际行为 (Gebru et al. 2021)。能耗直接贯穿这三个维度:算法结构决定算术强度和计算复杂度 (Hernandez and Brown 2020),机器微架构决定每次算术运算和内存访问的能耗,而数据摄取模式决定总线利用率。稳健的基准测试套件会同时测试这些维度,确保所声称的优化在生产约束下依然成立。
Jouppi, Norman P., Cliff Young, Nishant Patil, David Patterson, Gaurav Agrawal, Raminder Bajwa, Sarah Bates, et al. 2017. “In-Datacenter Performance Analysis of a Tensor Processing Unit.” Proceedings of the 44th Annual International Symposium on Computer Architecture, ISCA ’17, 1–12. https://doi.org/10.1145/3079856.3080246.
Gebru, Timnit, Jamie Morgenstern, Briana Vecchione, Jennifer Wortman Vaughan, Hanna Wallach, Hal Daumé III, and Kate Crawford. 2021. “Datasheets for Datasets.” Communications of the ACM 64 (12): 86–92. https://doi.org/10.1145/3458723.
Hernandez, Danny, and Tom B. Brown. 2020. “Measuring the Algorithmic Efficiency of Neural Networks.” arXiv Preprint arXiv:2005.04305, ahead of print. https://doi.org/10.48550/arxiv.2005.04305.
机器学习测量挑战
机器学习系统结合了多种测量变异来源,而经典软件基准测试在设计时并未考虑对它们进行联合评估。这些波动同时源于机器层和算法层。在机器侧,持续执行使加速器逼近热限制和功率限制,触发动态电压与频率调节(DVFS),从而在运行过程中降低处理器时钟频率。主机操作系统活动——包括线程调度抖动、内存分页,以及批数据准备期间的 PCIe 总线争用——进一步引入了不同运行之间的延迟变异。在算法侧,并行执行线程间非确定性的浮点归约顺序、小批量数据打乱和随机 dropout 掩码都会扰动数值轨迹。要将真正的系统优化与背景测量噪声区分开来,就必须分离这些相互叠加的方差来源。
为分离不同运行之间的变异,基准测试协议要求在受控伪随机种子下重复开展实验。运行次数必须满足明确的统计功效目标,而非随意采样。报告不能只给出 \(N\) 次运行中的单次最佳得分或孤立的算术平均值:报告样本方差、标准差或置信区间,可以量化稳定性,并确定观测到的加速是否超过背景系统抖动。缺少这些控制措施,基准测试就会得出误导性结论。在强化学习中,所报告的性能优势常常会淹没在随机权重初始化和环境动态产生的统计噪声中 (Henderson et al. 2018)。类似地,对生成对抗网络的非标准化评估会在不同随机种子下产生排名逆转,说明未被刻画的方差会削弱比较结论的可信度 (Lucic et al. 2018)。
Lucic, Mario, Karol Kurach, Marcin Michalski, Sylvain Gelly, and Olivier Bousquet. 2018. “Are GANs Created Equal? A Large-Scale Study.” Advances in Neural Information Processing Systems (NeurIPS) 31.
即使完全控制了不同运行之间的执行方差,基准测试仍会遇到评估数据集自身的结构性约束:测试集的测量能力。测试集相当于一种分辨率有限的测量仪器。由于有限样本上的准确率是一个二项比例,经验得分具有内在的抽样方差,其大小与样本量成反比。当某项优化使准确率改变一到两个百分点时,使用规模过小的测试集进行评估,无法确定这种变化反映的是真实的算法效应还是随机抽样波动。如页边的可检测性标记所示,并如配套笔记本所分析的那样,试图在仅有一千个样本的测试集上评估细微的准确率差异,会直接落入这一统计置信陷阱。

1K 测试集无法可靠地检测出一个百分点的准确率下降。
Napkin Math 1.1: 统计置信陷阱
问题:一个基线分类器在 1,000 张图像上的准确率为 95 percent,而压缩版本的准确率为 94 percent。这一个百分点的下降是否足以证明性能退化?
数学分析:
预期错误数:这两个准确率分别对应 50 errors 和 60 errors 个错误。在基线二项分布模型下,错误数的标准差约为 7 errors。
差值区间(95 percent):令 \(\hat p_1\) 和 \(\hat p_2\) 分别表示基线模型和压缩模型的准确率估计值,令 \(N\) 表示每个模型评估的图像数。将这两个估计值视为相互独立时,其差值的标准误为
\[ \operatorname{SE}(\hat p_1-\hat p_2) = \sqrt{\frac{\hat p_1(1-\hat p_1)}{N} + \frac{\hat p_2(1-\hat p_2)}{N}}. \]
观测到的 1 percentage point 差值对应的近似区间为 -1 percentage point 至 3 percentage points,其中包含零。
含义:由于该区间包含零,这一结果不足以证明存在一个百分点的性能退化。如果两个模型使用相同的图像进行评估,应保留二者预测不一致的计数,并使用 McNemar 检验等配对检验;仅有各自的准确率并不足够。针对单一比例、精度为 ±1 percentage point 的 1,825 样本量估计,不能保证此次比较具有足够的统计功效。
系统洞见:小规模基准测试会表现出一种可称为实验室谬误的现象。将测试集视为测量工具时,其规模必须与所要检测的变化精度相匹配。
除统计功效之外,基准测试的有效性还取决于工作负载的代表性。合成微基准测试直接在加速器的高带宽内存(HBM)中生成形状统一、大小静态固定的张量。微基准测试通过在隔离循环中连续执行受计算能力限制的通用矩阵乘法(GEMM)运算,测量理论峰值算术吞吐量。然而,它们掩盖了在生产部署中占主导地位的内存层次结构和调度瓶颈。合成工作负载绕过了主机到设备的 PCIe 数据传输、输入解码流水线、频繁的动态内存分配以及 GPU 缓存逐出。相比之下,基于轨迹的基准测试会回放从在线服务集群中记录的带时间戳的请求日志。生产轨迹能够捕获泊松分布和突发式请求到达分布、可变序列长度以及并发查询流。回放在线轨迹会迫使服务基础设施管理动态批处理、内存压力下的键值(KV)缓存分配以及排队延迟,从而在合成稳态循环所掩盖的实际运行条件下对系统进行压力测试。
即使工作负载具有代表性,如果评估指标未能反映部署约束,结果仍可能具有误导性。这种失效模式表明指标对齐出现了问题。当工程团队脱离系统服务级别目标(SLO),孤立地优化某一个算法性能指标,例如离线 BLEU 分数、Top-1 分类准确率或词元困惑度时,该指标便不再能够衡量真实的运行适用性。这种偏离体现了古德哈特定律:一旦某个算法代理指标成为唯一的优化目标,它作为整体系统健康状况衡量标准的有效性就会崩溃。下面的示例展示了神经机器翻译中的这一病态现象:离线准确率优化带来了灾难性的延迟代价。
Example 1.1: 古德哈特定律的实际表现
场景:一个工程团队以离线 BLEU 分数为目标优化神经机器翻译(NMT)模型,将束搜索宽度从 1 增加到 10。
诊断:更大的束搜索宽度在指标上带来了 0.5 分的 BLEU 提升,但使候选评估次数增至原来的 10×,推理延迟也从 50 ms 增加到 200 ms(延迟增至原来的 4×),超过了服务响应时限。
系统教训:在没有延迟约束的情况下优化离线准确率,容易引发古德哈特定律所描述的失效。生产基准测试必须强制执行严格的服务延迟 SLO(例如,延迟 < 100 ms)。
这一翻译任务中的权衡揭示了数据—算法—机器(D·A·M)协同设计空间中的根本张力:算法变更(将束宽扩大至十倍)使计算负载和内存流量成倍增加,仅换取了微小的数据质量提升,却违反了硬件延迟时限。除指标失配之外,在静态数据集上评估系统还引入了一个更深层的局限:固定基准测试评估的是不变输入分布下的执行情况,掩盖了系统在生产分布偏移下的性能退化。因此,公平地评估机器学习系统,需要将基础设施执行效率与模型架构及数据集变化分离。MLPerf 等标准化测试套件通过同时固定模型权重和输入数据集来建立这一基线,使不同平台之间的软硬件执行效率能够得到直接且可复现的测量。
系统基准测试
系统基准测试衡量支撑模型能力的计算基础,考察硬件架构、内存系统和互连如何影响整体性能。这种验证至关重要,因为硬件规格通常描述的是应用工作负载无法持续达到的理论峰值。这种差距十分普遍,以至于峰值性能声明往往并不完整。系统基准测试通过运行标准化的机器学习工作负载来揭示这些差距,而非仅依赖峰值算术运算速率。
Systems Perspective 1.3: 峰值性能谬误
Dave Patterson 经常将峰值性能称为“制造商保证你不会超过的性能”。对于机器学习系统,由于内存墙的存在,这一差距可能很大:无论算术运算单元运行得多快,受内存限制的模型都无法达到标称 FLOP/s 的很大一部分。MLPerf 等标准化基准测试要求系统运行指定的模型和数据,从而揭示有明确记录的运行条件下的持续性能,而不是给出适用于所有工作负载的通用速率。
对于受内存限制的工作负载,峰值性能与持续性能之间的差距源于内存墙;受计算能力限制的工作负载则可能接近峰值。这一区分将厂商评估从猜测转变为依据具体标准逐项核查的过程。
Checkpoint 1.1: 解读厂商的基准测试声明
根据厂商报告的基准测试评估硬件或软件时,应检查其声明是否明确说明了工作负载、测量边界和运行条件。
对于无法还原其工作负载边界、精度及排除成本的基准测试声明,工程师应予以拒绝。只有当工程师能够将醒目的吞吐量或延迟数值对应到实际模型、批次形状、数据移动、持续运行条件和功耗范围时,这些数值才有用。
底层硬件——CPU、GPU、张量处理单元(TPU)7以及专用集成电路(ASIC)8——决定了机器学习系统的速度、效率和规模。系统基准测试提供了标准化方法,可根据计算吞吐量、内存带宽、能效、算子覆盖率和扩展能力,对不同 AI 工作负载下的硬件进行比较 (Reddi et al. 2019; Mattson et al. 2020)。
Table 3 将常见的营销措辞转换为其背后的技术限定条件。
| 厂商声明 | 通常意味着什么 |
|---|---|
| “最高 10,000 张图像/秒” | 最大批大小、INT8 精度且不含预处理时的峰值吞吐量 |
| “亚毫秒级延迟” | 仅计加速器计算,不含数据传输 |
| “效率提高至 5\(\times\)” | 每次运算的效率,而非整个系统的效率 |
| “针对 AI 优化” | 可能仅加速特定运算或精度 |
系统基准测试具有两方面作用。对于实践者,它们通过提供不同配置的比较数据,帮助做出有依据的硬件选择。对于制造商,它们量化代际改进,并指导加速器开发。随着 GPU 应用日益普及,准确率也迅速提高,这说明硬件与算法的进步能够共同推动发展。
Definition 1.2: 机器学习系统基准测试
机器学习系统基准测试是标准化评估协议,在保持工作负载和质量目标不变的同时改变软硬件栈,通过测量 \(\eta_{\text{hw}} = R_{\text{sustained}} / R_{\text{peak}}\) 和 \(L_{\text{lat}}\),将基础设施效率与算法改进分离。
- 意义:同一个 ResNet-50 模型在不同硬件栈、精度格式、批大小和编译器配置下可能实现截然不同的吞吐量,却仍然报告相同的 ImageNet Top-1 准确率。系统基准测试能够捕获这种实现差距,而仅报告准确率的算法基准测试无法反映这一差距。
- 区别:算法基准测试通过改变模型架构和训练流程来提高收敛准确率,而系统基准测试保持算法固定,改变实现方式(内核库、量化格式、批大小和硬件代际),以测量软硬件栈执行铁律中 \(O/(R_{\text{peak}} \cdot \eta_{\text{hw}})\) 项的效率。
- 常见误区:一种常见误解是,系统基准测试结果可以推广到不同工作负载。在 ResNet-50(一种适合计算单元发挥性能的视觉工作负载)上达到高利用率的加速器,在推荐系统(一种受内存带宽限制的工作负载)上的利用率可能低得多。系统基准测试具有工作负载特异性;没有任何单一指标能够表征一个硬件平台。
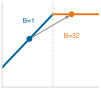
更大的批次推动 Transformer 推理从受内存限制转向受计算能力限制。
有效解读基准测试需要了解目标硬件的性能特征。确定某个 AI 工作负载是受计算能力限制还是受内存限制,能够为优化决策提供关键依据。以 FLOP/byte 衡量的计算强度9决定了性能上限。以 NVIDIA A100 GPU为例,其 FP16 Tensor Core 性能为 312 TFLOP/s(FP32 为 19.5 TFLOP/s),内存带宽为 2.04 TB/s(SXM 版本)。将峰值计算性能除以峰值带宽,可得算术强度阈值为 153 FLOP/byte。低于这一阈值的工作负载受内存带宽限制,高于这一阈值的工作负载则受计算能力限制。Roofline 模型 中的 Roofline 模型为解读这些基准测试结果提供了架构基础。Roofline 模型 从第一性原理推导了 Roofline 方程和脊点阈值,因此可以为任意加速器重新推导此处使用的算术强度界限。
工作负载在 Roofline 中的位置10取决于工作负载本身。在这个 A100 计算示例中,一个用于说明的高强度 ResNet-50大批次前向传播工作负载采用约 300 FLOP/byte 的算术强度,高于 A100 的脊点,因此代表受计算能力限制的内核 (He et al. 2016; Choquette et al. 2021)。较低强度的运算位于脊点以下,落入受内存限制的区域:批大小为 1 的 BERT 推理若仅计入权重加载流量,其算术强度约为 100 FLOP/byte,性能上限低于峰值。增大批大小会使同一个工作负载跨越脊点,从受内存限制转为受计算能力限制 (Pope et al. 2023)。具体示例:A100 分析 在 A100 上完整展示了从算术强度到利用率的计算过程,对比了受计算能力限制的矩阵乘法内核与受内存限制的逐元素内核,因此这些步骤可推广到任意模型与硬件组合。
Choquette, Jack, Wishwesh Gandhi, Olivier Giroux, Nick Stam, and Ronny Krashinsky. 2021. “NVIDIA A100 Tensor Core GPU: Performance and Innovation.” IEEE Micro 41 (2): 29–35. https://doi.org/10.1109/mm.2021.3061394.
Pope, Reiner, Sholto Douglas, Aakanksha Chowdhery, Jacob Devlin, James Bradbury, Jonathan Heek, Kefan Xiao, Shivani Agrawal, and Jeff Dean. 2023. “Efficiently Scaling Transformer Inference.” Proceedings of Machine Learning and Systems (MLSys) 5: 606–24.
一个 BERT 推理估算实例展示了如何将这些 Roofline 原理转化为具体的部署预测。
Napkin Math 1.2: BERT 推理的 Roofline 分析
问题:需要在 A100 GPU 上部署 BERT-Base 进行推理。管理层期望实现较高的 GPU 利用率。应预测其性能达到什么水平,又该如何改进?
步骤 1:硬件极限。
- 峰值算力:312 TFLOP/s(FP16 Tensor Core)
- 内存带宽:2.04 TB/s
- 转折点:312 TFLOP/s ÷ 2.04 TB/s = 153 FLOP/byte
算术强度低于 153 FLOP/byte 的任何工作负载均受内存限制;高于该值则受计算限制。
步骤 2:BERT-base 的特征。
- 参数量:110M = 220 MB(FP16)
- 每次推理的浮点运算量:约 22 GFLOP(序列长度为 \(S=128\) 的前向传播)
- 数据搬移量:约 220 MB(必须从内存加载全部权重)
- 算术强度:\((22 \times 10^{9}) \div (220 \times 10^{6})\) = 100 FLOP/byte(仅考虑权重的模型;参见正文中的说明)
步骤 3:性能预测。 由于 100 FLOP/byte < 153 FLOP/byte,批量大小 = 1 时的 BERT 受内存限制: \[\begin{gather*} \text{Achievable perf} = \text{100 FLOP/byte} \times \text{2.04 TB/s} = \text{203.9 TFLOP/s} \\ \text{GPU utilization} = \text{203.9 TFLOP/s} / \text{312 TFLOP/s} = \text{$65.4\%$} \end{gather*}\]
步骤 4:通过批处理进行优化。 将批量大小增加至 32:
- 权重仍为 220 MB,但计算量变为原来的 32×
- 新的浮点运算量:\(22 \times 10^{9} \times 32\) = 704 GFLOP
- 新的算术强度:\((704 \times 10^{9}) \div (220 \times 10^{6})\) = 3200 FLOP/byte
由于 3200 FLOP/byte > 153 FLOP/byte,批量大小 = 32 时受计算限制。假设此时实现能够持续达到峰值性能的 85 percent: \[\begin{gather*} \text{Achievable perf} \approx \text{$85\%$} \times \text{312 TFLOP/s} = \text{265.2 TFLOP/s} \\ \text{GPU utilization} \approx 85\% \end{gather*}\] 系统层面的洞见:增大批量大小可以提高算术强度,从而将受内存限制的推理转变为受计算限制的推理。这里显示的 85 percent 是对实现效率的假设,并非 Roofline 预测。批处理也会增加延迟,因为系统必须等待请求积累。这正是 MLPerf 场景所体现的基本吞吐量与延迟权衡:SingleStream(批量大小 = 1,针对延迟优化)与 Offline(最大批量,针对吞吐量优化)。
系统基准测试评估不同规模下的性能,范围从单芯片配置到大型分布式系统,涵盖训练和推理。Figure 1 将有来源依据的 ImageNet top-5 错误率 (Russakovsky et al. 2015; Krizhevsky et al. 2012) 与竞赛参赛方案中 GPU 使用增长情况的重建结果并列展示;后者根据 NVIDIA 为该竞赛绘制的参赛方案数量图读取并重建 (Gray 2015)。这两组序列展示的是同期趋势,并非对准确率提升中有多少来自硬件而非算法、数据或训练实践的因果估计。
\begin{tikzpicture}[font=\small\sffamily]

\pgfplotsset{myaxis/.style={
  axis line style={draw=none},
  /pgf/number format/.cd,
  1000 sep={},
   width=105mm,
   height=60mm,
   axis lines=left,
   axis line style={thick,-latex},
    tick label style={/pgf/number format/assume math mode=true},
    yticklabel style={font=\fontsize{7pt}{7}\selectfont\sffamily,
    /pgf/number format/.cd, fixed, fixed zerofill, precision=1},
    xticklabel style={font=\fontsize{7pt}{7}\selectfont\sffamily},
    ylabel style={font=\footnotesize\sffamily},
    xlabel style={font=\footnotesize\sffamily},
    y tick style={draw=none},
    x tick style={draw=none,thin},
    tick align=outside,
    major tick length=1mm,
    title style={yshift=-4pt,font=\footnotesize\sffamily},
    xmin=2009.5,xmax=2014.5,
    xtick={2010,2011,2012,2013,2014},
    }}
  %grid
\begin{axis}[myaxis,
    grid=both,
    major grid style={thin,black!60},
    minor tick num=1,
    ymin=0,    ymax=33,
    ytick={0,10,...,30},
    xticklabels={,,,,},
]
\end{axis}
%bar
\begin{axis}[myaxis,
    axis y line*=right,
    axis x line=none,
    ylabel={\color{green!60!black}使用 GPU 的参赛方案数量(\#)},
    xlabel={年份},
    ymin=0,    ymax=133,
    ytick={0,25,...,125},
    every axis plot/.append style={
          ybar,
          bar width=0.55,
          bar shift=0pt,
          fill
        }]
      \addplot[draw=none]coordinates {(2010,0)};
      \addplot[draw=none]coordinates {(2011,0)};
      \addplot[green!60!black]coordinates {(2012,4)};
      \addplot[green!60!black]coordinates{(2013,60)};
      \addplot[green!60!black]coordinates{(2014,110)};
      %
\end{axis}
  %line
\begin{axis}[myaxis,
    ylabel={\color{blue!50!black}Top-5 错误率 (\%)},
    xlabel={年份},
    ymin=0,    ymax=33,
    ytick={0,10,...,30},
    xticklabels={2010,2011,2012,2013,2014},
]
\addplot[
  mark=*,
  mark size=2pt,
  line width=1.5pt,
  draw=blue!50!black, %
  mark options={fill=red, draw=red} %
]
table[x=Year,y=Y, col sep=comma] {
Year,Y
  2010,28.2
  2011,25.8
  2012,16.4
  2013,11.7
  2014,7.3
};
\end{axis}
\end{tikzpicture}
Gray, Allison. 2015. NVIDIA and IBM Cloud Support ImageNet Large Scale Visual Recognition Challenge. NVIDIA Technical Blog.
ImageNet 示例将 GPU 采用情况与错误率下降并列呈现,并未单独识别二者各自的贡献;section 1.11.1 将通过各模型的架构里程碑重新审视这一演进过程。然而,有效的系统基准测试需要理解工作负载特征与硬件利用率之间的关系。由于计算模式、内存层次结构和系统架构之间的相互作用,现代 AI 系统很少能达到理论峰值性能。理论性能与实际性能之间的这一差距影响着有意义的系统基准测试的设计。
符合实际的硬件利用率模式对于设计具有实际指导价值的基准测试至关重要。如前面的 Roofline 分析所示,GPU 利用率随批量大小和模型架构而变化;受计算限制时的 85 percent 是一个假设值,而受内存限制时的单请求利用率为 65.4 percent。这些模式也延伸至内存带宽:参数量大的 Transformer 推理与激活量大的卷积工作负载会对内存层次结构的不同部分施加压力,直接影响不同精度下可达到的性能。
有效的系统基准测试必须测量实际利用率,而非理论峰值能力,这一要求也确立了若干范围边界。能耗是其中一个维度:不同平台的每瓦性能差异很大,利用不足的加速器相对于其产出会消耗不成比例的功率,从而同时增加运营成本和环境影响。分布式运行是另一个维度:多节点训练会引入通信瓶颈、网络拓扑效应和协调开销,这些因素无法由单节点基准测试捕捉,需要在本书范围之外专门讨论。在这里的单机范围内,多 GPU 基准测试则侧重于节点内通信、跨加速器的内存带宽利用率,以及通过 NVLink 或 PCIe 连接的不同加速器内存之间的梯度同步效率。对于所有这些维度,只有当基准测试的运行点与部署的运行点一致,而非与规格表上的运行点一致时,基准测试才有价值。
社区驱动的标准化
如果没有严格且共享的测量边界,硬件利用率指标就无法为系统间的比较评估提供有意义的依据。如果一个基准测试包含主机端数据预处理和 PCIe 传输,而另一个仅测量设备内核执行,那么得到的延迟数值反映的是不兼容的系统边界,而非架构效率。同样,仅在加速器供电轨处测量功耗,会遗漏主机处理器和机箱散热风扇消耗的大量能量。单个组织无法独自解决这一差异,因为各厂商都有商业动机,将测量边界调整为有利于自身硬件优势的形式。
可靠的基准测试标准需要多个组织达成广泛共识,以防止选择性报告。在成熟的工程领域,这种共识通过 IEEE 工作组 (IEEE Standards Association 2024) 和 ISO/IEC 技术委员会 (ISO 2024) 等机构形成正式规范;这些机构制定严格的测量规范,例如用于系统功耗建模的 IEEE 2416 (IEEE Standards Association 2019)。在硬件架构和模型结构快速演进的机器学习系统领域,MLCommons 等联盟提供了维护持续演进的基准测试套件所需的运行框架。通过提供开源参考实现并配套严格的合规验证规则,这些联盟确保不同实验室报告的性能数值代表相同的计算工作。
IEEE Standards Association. 2024. IEEE Standards Association: Working Groups for AI and ML.
ISO. 2024. ISO/IEC JTC 1/SC 42 Artificial Intelligence.
IEEE Standards Association. 2019. IEEE 2416-2019: Standard for Power Modeling to Enable System-Level Analysis.
系统基准测试的标准化需要将数据—算法—机器分类体系形式化,使评估能够单独考察机器,而不混入算法或数据变化的影响。MLPerf Training 基准测试通过测量训练达到指定质量目标所需的时间,而非原始浮点运算吞吐量或单个训练轮次的时长,来强制实现这种分离 (Mattson et al. 2020)。如果数值漂移导致模型收敛质量下降,或迫使模型增加训练轮次,那么硬件平台即使通过激进的低精度缩放实现了很高的 TFLOPS,也不会带来系统层面的收益。在其封闭组(Closed Division)中,标准同时锁定模型架构和数值超参数,确保观测到的性能提升来自互连带宽利用和内核融合等实质性的硬件与编译器效率提升,而非未经验证的算法折中。
MLPerf Inference 基准测试将这一原则应用于生产部署约束 (Reddi et al. 2019)。如果交互式服务要求保证响应速度,加速器就不能仅报告无限批处理条件下的峰值吞吐量。该基准测试为不同的实际运行状态定义了不同的评估场景。对于交互式环境,Server 模式按照泊松到达过程注入查询,并要求满足严格的第 99 百分位延迟服务级别协议(SLA);Single-Stream 模式则测量批量大小为 1 时的最低延迟。对于非交互式吞吐量,Offline 模式利用预加载的批次使计算单元饱和。通过标准化这些执行边界,社区基准测试将排队延迟和主机到设备的 PCIe 传输纳入考虑,防止厂商展示在生产流量下无法维持的吞吐量数值。
社区标准确立了可复现的测量边界,但并不规定评估发生的物理尺度。测量可以针对一个独立的矩阵乘法内核,也可以剖析一次端到端的多加速器训练运行,而每种范围所诊断的物理瓶颈各不相同。测量深度决定了能够单独识别哪些架构限制,由此确立了基准测试粒度的作用。
基准测试粒度
如果数据摄取流水线无法使设备内存带宽饱和,那么一个单独运行时速度提升至 3\(\times\) 的 GPU 内核,可能无法带来任何端到端加速。这种诊断上的不匹配,使评估粒度成为一项基本的系统设计选择。标准化规定了如何保持测量一致,而基准测试粒度规定了测量的物理边界是什么。系统验证跨越多个架构尺度,从单个张量操作到分布式生产流水线,每种粒度诊断的瓶颈各不相同:
- 微基准测试单独考察各个组件:内核执行时间、内存带宽利用率以及单层的数值行为。这类测试用于诊断底层硬件效率低下发生在何处。
- 宏基准测试评估由多个组件组成的模型子系统:完整模型训练的收敛情况、推理流水线吞吐量以及数据集上的准确率指标。这类测试揭示跨层组合存在哪些架构权衡。
- 端到端基准测试测量完整的运行流水线:包含预处理的客户端请求到响应延迟、包含存储 I/O 的训练达到目标准确率所需时间,以及模型在生产数据分布上的鲁棒性。这类测试表明组合后的系统是否满足现实中的服务级别目标。
优化技术作用于不同的粒度:内核融合针对微观层面的执行,结构化剪枝改变宏观层面的参数结构,而数据整理决定端到端泛化能力。系统验证必须与这些相应的边界保持一致。独立的微基准测试可能显示内核显著加速,但宏基准测试却可能揭示,激活内存占用的增加迫使系统采用更小的批量大小,进而降低整体吞吐量。同样,端到端基准测试能够暴露在加速器内核层面完全不可见的存储阻塞或主机反序列化停顿。
Figure 2 将评估划分为四个不同的物理范围,从而将这些粒度层级映射到机器学习技术栈上。每个范围都进一步扩展测量边界:微基准测试单独考察内核执行,宏基准测试评估由多个组件构成的模型拓扑,应用基准测试纳入主机数据管理和辅助运行时逻辑,而端到端基准测试涵盖完整的分布式部署。
\begin{tikzpicture}[font=\sffamily\small]
 \tikzset{%
 Box/.style={
 node distance=1.25,
    inner xsep=2pt,
    draw=RedLine,
    line width=0.75pt,
    fill=RedL!20,
    align=flush center,
    text width=30mm,
    minimum width=30mm, minimum height=10mm
  },
   Box2/.style={Box, draw=BlueLine,fill=BlueL!20},
   Box3/.style={Box, draw=GreenLine,fill=GreenL!40},
   Box4/.style={Box, draw=BrownLine,fill=BrownL!40,text width=24mm,},
 %
  Line/.style={line width=0.35pt,black!60,text=black},
  LineD/.style={line width=0.75pt,black!60,text=black,dashed,dash pattern=on 3pt off 2pt},
  Line2/.style={line width=0.85pt,black!60,text=black,-{Latex[length=6pt, width=4pt]}}
}

  \def\rows{3}
  \def\cols{4}
  \def\r{0.35}
  \def\xgap{0.15}
  \def\ygap{0.5}

\begin{scope}[local bounding box=CEN,shift={($(0,0)+(0,0)$)}]
  \foreach \i [count=\c] in {0,...,\numexpr\rows-1} {
    \foreach \j  in {0,...,\numexpr\cols-1} {
      \pgfmathtruncatemacro{\newX}{\j + 1} %
      % Circle position
      \pgfmathsetmacro\x{\j*(2*\r + \xgap)}
      \pgfmathsetmacro\y{-\i*(2*\r + \ygap)}
\definecolor{cellcol}{RGB}{253,226,240}
     \node[fill=VioletLine!60,circle,minimum size=\r](C\c\newX)at(\x,-\y){};
    }
  }
\foreach \a/\b in {C3/C2, C2/C1}{%
  \foreach \i in {1,2,3,4}{%
    \foreach \j in {1,2,3,4}{%
      \draw[Line] (\a\i) -- (\b\j);
    }%
  }%
}
\end{scope}
\scoped[on background layer]
\node[outer sep=0pt,draw=BackLine,inner xsep=3mm,inner ysep=2mm,yshift=0mm,
           fill=BackColor!20,fit=(C11)(C34),line width=0.75pt](BB1){};
\node[above=2pt of  BB1.north,anchor=south]{机器学习层};
%%%
\node[Box,below right =0.19 and 1.4 of BB1.north east](MA){模型 A};
\node[Box,above right =0.19 and 1.4 of BB1.south east](MB){模型 B};
\scoped[on background layer]
\node[outer sep=0pt,draw=BackLine,inner xsep=3mm,inner ysep=2mm,yshift=0mm,
           fill=BackColor!20,fit=(MA)(MB),line width=0.75pt](BB2){};
\node[above=2pt of  BB2.north,anchor=south]{机器学习模型};
%
\def\du{1.7}
\node[Box2,right =\du of MA](T1){AI 任务 1};
\node[Box2, right =\du  of MB](T2){支撑计算};
\scoped[on background layer]
\node[outer sep=0pt,draw=BackLine,inner xsep=3mm,inner ysep=2mm,yshift=0mm,
           fill=BackColor!20,fit=(T1)(T2),line width=0.75pt](BB3){};
\node[above=2pt of  BB3.north,anchor=south]{AI 任务};
%
\node[Box3,right =\du  of T1](CN1){AI 计算节点};
\node[Box4,right = 1.15 of CN1](NA1){非 AI 计算节点};
\node[Box3, right =\du  of T2](CN2){AI 计算节点};
\node[Box4,right = 1.15 of CN2](NA2){非 AI 计算节点};
\scoped[on background layer]
\node[outer sep=0pt,draw=BackLine,inner xsep=3mm,inner ysep=2mm,yshift=0mm,
           fill=BackColor!20,fit=(CN1)(NA2),line width=0.75pt](BB4){};
\node[above=2pt of  BB4.north,anchor=south]{端到端应用};
%
\draw[Line2](MA)--(MB);
\draw[Line2](T1)--(T2);
\draw[Line2](CN1)--(NA1);
\draw[Line2](CN2)--(NA2);
\draw[Line2](NA1)--++(0,-0.8)-|(CN2);
\draw[LineD](BB1.north east)--(MA.170);
\draw[LineD](BB1.south east)--(MA.190);
\draw[LineD](BB2.north east)--(T1.170);
\draw[LineD](BB2.south east)--(T1.190);
\draw[LineD](BB3.north east)--(CN1.170);
\draw[LineD](BB3.south east)--(CN2.190);
\end{tikzpicture}微基准测试
尽管端到端指标决定了服务级别协议的要求,但优化加速器流水线需要隔离出消耗执行时间和能量的具体数学运算。微基准测试通过独立评估各个张量运算,测量 硬件加速 中介绍的硬件原语,从而发挥这种诊断作用。在剖析运行缓慢的推理服务时,宏基准测试能够报告总体延迟是否违反要求,但只有微基准测试才能揭示执行时间主要消耗在矩阵乘法、自注意力投影、跨主机与加速器互连的内存复制,还是逐元素激活内核上。
张量运算是微基准测试的主要对象,因为矩阵乘法和卷积占据了深度神经网络算术运算量的主要部分。cuDNN11 (Chetlur et al. 2014) 等高度优化的运行时库,提供了针对特定微架构手工调优的内核实现。微基准测试还会在标准化输入形状下评估独立的激活函数(如 ReLU、Sigmoid 和 GELU)以及结构子模块(如多头注意力投影或 Transformer 前馈块)。百度的 DeepBench (Baidu Research 2016) 等基准测试套件通过在不同硬件平台上评估原始 GEMM、卷积和集合通信原语,将芯片层面的执行效率与更高层框架的调度开销分离,从而将这一方法体系化。
Chetlur, Sharan, Cliff Woolley, Philippe Vandermersch, Jonathan Cohen, John Tran, Bryan Catanzaro, and Evan Shelhamer. 2014. “cuDNN: Efficient Primitives for Deep Learning.” arXiv Preprint arXiv:1410.0759.
Baidu Research. 2016. DeepBench: Benchmarking Deep Learning Operations on Different Hardware.
测量独立内核需要严格的实验控制。如果缺乏严谨的测量规程,硬件动态调频、异步执行队列和缓存状态就会引入瞬态干扰,使内核运行时间的测量结果失真。
Systems Perspective 1.4: 微基准测试规则
为避免测量到硬件干扰效应而非内核性能,请遵循系统侦探规则:
- 预热规则:不要将冷启动迭代的测量结果作为稳态性能。现代硬件采用 DVFS(动态电压与频率调节)和动态频率提升;缓存、内核和时钟都需要预热,测量循环才能代表持续运行时的行为。
- 变异规则:报告变异系数(CV)\((\text{CV} = \sigma_{\text{run}} / \mu_{\text{run}})\),其中 \(\sigma_{\text{run}}\) 和 \(\mu_{\text{run}}\) 分别为多次重复运行结果的标准差和均值。当数值超过测量规程针对具体工作负载设定的容差时,应调查原因;常见原因包括操作系统后台抖动、热降频和内存争用,5% 并不是通用阈值。
- “光速”(SOL)检查:将实际达到的吞吐量与 Roofline 上限进行比较。如果某个内核在 H100 上仅达到 10 TFLOP/s(FP16 峰值约为 989 TFLOP/s,或稠密 FP8 峰值约为 1,979 TFLOP/s),则应先查明利用率偏低的原因(通常是过多小内核带来的内核启动延迟),再优化代码本身。
- 缓存状态规则:设置与所要验证的结论相匹配的缓存状态。测量冷缓存条件下的动态随机存取存储器(DRAM)带宽时,应清空 L2 缓存或使访问数据量超过其容量;测量稳态复用时,则应保留已预热的缓存。否则,名义上的 DRAM 测量结果可能反映的是缓存带宽(约 5 TB/s–10 TB/s),而非 DRAM 带宽(约 1 TB/s–2 TB/s)。
- 同步屏障规则:从主机 CPU 的角度看,加速器内核启动是异步的。使用 CPU 时钟对 GPU 操作计时,如果没有显式设备屏障(如
torch.cuda.synchronize()),测量到的将是主机入队延迟,而非内核执行时间;务必紧邻计时区域的前后放置同步屏障,或使用 GPU 端时间戳事件(cudaEventRecord)。
性能剖析器将内核执行时间分解为机器学习系统铁律的三个支配项:数据移动、计算吞吐量和延迟开销,从而将这些测量规则转化为物理层面的诊断(机器学习系统铁律)。
Systems Perspective 1.5: 测量铁律中的各项
从理论走向执行轨迹,意味着将 机器学习系统铁律 中的铁律方程映射到性能剖析器(如 Nsight Systems 或 PyTorch Profiler)的时间线上。
测量数据项 \(\left(\frac{D_{\text{vol}}}{\text{BW}}\right)\)
- 信号:查找“内存吞吐量”或“DRAM 带宽”曲线。
- 公式:\(\text{BW}_{\text{effective}} = \frac{D_{\text{vol}}}{T_{\text{kernel}}}\)。
- 诊断:如果 \(\text{BW}_{\text{effective}} \approx \text{BW}_{\text{peak}}\)(例如,接近 A100 的 2.04 TB/s 峰值),则该内核受内存限制。优化计算量(\(O\))不会产生任何效果。
测量实际达到的计算吞吐量 \((R_{\text{peak}} \cdot \eta_{\text{hw}})\)
- 信号:查找“SM 活跃度”或“计算吞吐量”。
- 公式:\(\text{Achieved TFLOP/s} = \frac{O}{10^{12}\,T_{\text{kernel}}}\)。
- 诊断:如果 \(\text{Achieved TFLOP/s} \ll \text{Peak TFLOP/s}\) 且 \(\text{BW}_{\text{effective}} \ll \text{BW}_{\text{peak}}\),则系统陷入了 “利用率陷阱”:很可能受延迟限制(内核过小)或受网格规模限制(线程不足)。
测量延迟项 \((L_{\text{lat}})\)
- 信号:查找时间线上彩色内核条带之间的间隙(空白区域)。
- 公式:\(\text{Overhead Ratio} = \frac{T_{\text{gap}}}{T_{\text{kernel}} + T_{\text{gap}}}\)。
- 诊断:“锯齿状”模式(计算、间隙、计算、间隙)表明软件开销较高。解决方案是 内核融合 中介绍的算子融合,或 CUDA Graphs;后者捕获重复的 GPU 启动序列,使运行时能够以更低的 CPU 调度开销重放该序列。
标准化基准测试测量总体吞吐量,而性能剖析器则揭示导致执行停顿的物理机制。系统诊断采用两个互补层次的监测工具:框架级性能剖析器和内核级性能剖析器。
框架级性能剖析器
PyTorch Profiler 等框架级性能剖析器会捕获一次训练或推理迭代的逻辑执行轨迹。它们跟踪主机 CPU 上的算子调度,确定主机准备工作是否与加速器执行异步重叠,并识别数据加载器流水线是否导致计算队列缺乏待执行工作。主要诊断指标是将单步耗时分解为数据加载、主机启动延迟、设备计算和设备间通信。这种分解可以在检查单个内核之前,确定哪个子系统限制了迭代延迟。
内核级性能剖析器
NVIDIA Nsight Systems 和 Nsight Compute 等内核级性能剖析器会捕获加速器芯片上的物理执行过程。Nsight Systems 构建涵盖 CPU 线程、CUDA API 调用、内存传输和内核持续时间的全局时间线,以揭示串行化造成的空闲间隙。Nsight Compute 对单次内核调用进行深入分析,测量流式多处理器(SM)的线程束占用率、指令发射停顿和内存合并访问效率,并与硬件 Roofline 上限进行对照。内核级性能剖析器直接从片上性能监控单元(PMU)提取这些诊断信息,采集 HBM 字节流量、L2 缓存命中率和流水线停顿原因等硬件计数器数据,避免软件插桩扭曲执行动态行为。
严谨的性能剖析流程采用自顶向下的方式。工程师首先使用框架级性能剖析器,在执行时间线中定位占主导地位的层(例如,发现某个多头注意力块占单步延迟的 65%)。随后,工程师使用内核级性能剖析器,将该层的分析深入到芯片层面(例如,验证 softmax 内核因 DRAM 访问未合并,只达到了峰值内存带宽的一小部分)。这种两阶段流程确保工程工作针对起限制作用的物理瓶颈,从而避免优化方向偏离。
这些细粒度测量能够支持精确的内核优化,但无法揭示组件组装成完整模型后如何相互作用。宏基准测试弥补了这一不足。
宏基准测试
微基准测试验证独立算子是否达到较高的计算效率或内存效率。宏基准测试则确定,当各层组合成完整模型时,这些收益是否仍然存在。层的组合会引入独立基准测试无法观察到的物理交互:中间激活张量增大峰值内存占用,顺序内核启动暴露出 CPU 驱动程序的调度开销,前序运算的内存访问流会在下游内核复用共享缓存行之前将其逐出。
宏基准测试服务于一个核心工程目标:在标准化工作负载下评估模型架构和运行时配置。模型级评估能够捕获层组合所产生的权衡:在未见过的验证数据上的泛化准确率、不同批量大小和上下文长度下的动态内存分配,以及不同请求到达模式下的总体吞吐量。这些维度直接相互影响:某种架构虽然能达到更高的准确率,但其激活内存占用可能迫使系统在设备内存约束下采用更小的批量大小,导致原本促使人们采用该架构的计算吞吐量优势大幅下降。
评估完整模型需要标准化数据集、固定的参考任务和可复现的指标定义。在计算机视觉领域,标准基准测试在 ImageNet (Deng et al. 2024) 上评估模型,在固定批量大小下同时测量 top-1 分类准确率和推理延迟。在自然语言处理领域,标准化任务评估序列到序列翻译和自回归生成,在规定的上下文长度下量化输出质量与词元生成速率之间的关系。
Ignatov, Andrey, and Radu Timofte. 2024. AI Benchmark.
多个行业标准套件为跨平台的模型级比较建立了可复现的规范。MLPerf 套件将数据中心、边缘设备、移动设备和微控制器的评估标准化,详见 section 1.8.4。对于资源受限的嵌入式目标设备,EEMBC 的 MLMark 在严格内存预算下量化推理吞吐量和能耗,而 AI-Benchmark (Ignatov and Timofte 2024) 套件则评估移动片上系统中各类异构计算单元的表现。
端到端基准测试
端到端基准测试覆盖整个生产流水线,捕获接收原始数据、生成模型预测并将结果交付下游客户端所需的每个阶段。微基准测试和宏基准测试聚焦于加速器执行,而实际模型服务流水线的主要瓶颈往往位于模型本身之外。
数据预处理构成流水线的初始阶段,将原始外部输入转换为可供模型使用的张量表示。在计算机视觉流水线中,图像接收需要对压缩文件格式进行解码(如 JPEG 解压缩)、缩放、裁剪和颜色归一化。在主机 CPU 上不使用硬件加速执行时,这些预处理步骤的耗时可能达到现代加速器上模型推理耗时的数倍,使高吞吐量的张量核心在等待主机内存传输时处于空闲状态。同样,在自然语言处理流水线中,主机 CPU 上的子词词元化和动态序列填充往往限制了模型服务吞吐量。后处理也会引入类似的延迟瓶颈:目标检测流水线需要进行非极大值抑制(NMS)和边界框坐标变换,如果未将这些操作高效集成到执行图中,就会造成顺序执行停顿。
分布式基础设施组件会在计算互连结构之外引入进一步的性能约束。读取大型多模态数据集时,远程存储系统会限制训练吞吐量,而分布式集群中网络接口卡(NIC)的饱和则会限制集合通信。端到端基准测试必须在真实的网络延迟、并发查询到达模式和实际存储 I/O 约束下测量流水线吞吐量,以确保能够将部署作为一个集成系统进行可复现的评估。
公开基准测试套件很少在单一统一规程中测量存储、网络和计算。虽然 MLPerf Training 和 Inference 相较于独立算子测试更接近端到端场景,但其封闭组有意将输入数据加载标准化,以将加速器性能与存储和网络的变化分离。因此,生产环境中的端到端基准测试仍主要属于内部工程实践,通过针对线上查询分布的分布式追踪和生产遥测进行评估。
粒度权衡与选择标准
Table 4 对比了三种基准测试粒度的诊断重点、范围和工程权衡。微基准测试隔离底层运算,以指导内核优化和硬件选择;宏基准测试评估完整模型,以指导架构选择;端到端基准测试测量完整流水线,以确保生产部署满足实际服务要求。
| 组成要素 | 微基准测试 | 宏基准测试 | 端到端基准测试 |
|---|---|---|---|
| 重点 | 单个运算 | 完整模型 | 完整系统流水线 |
| 范围 | 张量运算、层、激活函数 | 模型架构、训练、推理 | 提取、转换、加载;模型;基础设施 |
| 示例 | cuDNN 上的卷积层性能 | ImageNet 上的 ResNet-50 | 生产推荐系统 |
| 优势 | 精确识别瓶颈、组件优化 | 模型架构比较、标准化评估 | 真实的性能评估、系统整体洞察 |
| 挑战 | 可能遗漏交互效应 | 对基础设施的洞察有限 | 难以标准化,通常为内部专有 |
| 典型用途 | 硬件选择、运算优化 | 模型选择、研究比较 | 生产系统评估 |
仅选择一种粒度通常并不足够,因为基准测试在诊断隔离性与生产保真度之间存在内在权衡。Figure 3 展示了这一连续谱,将微基准测试置于高隔离性一端,将端到端基准测试置于高代表性一端。微基准测试能够精确定位内核的具体物理限制(如内存带宽饱和或线程束占用率低),但无法捕获层间内存压力或主机开销。相应地,端到端基准测试能够捕获线上流量分布下的真实生产延迟,但在尾延迟骤增时难以揭示根本原因。
\begin{tikzpicture}[font=\sffamily\small,x=8mm,y=8mm]
\tikzset{%
  axis/.style={-latex,thick,black},
  grid/.style={very thin,gray!40},
  point/.style={circle,fill,inner sep=1.75pt}
}
% Draw axes
\draw[axis] (0,0) -- node[pos=.5, sloped, above=17pt]{\footnotesize 隔离能力/诊断能力} (0,5.6);
\draw[axis] (0,0) --node[below=10pt] {\footnotesize 对真实场景的代表性} (8,0) ;
% Draw grid lines
\foreach \x in {1,2,3,4,5,6,7}
  \draw[grid] (\x,0) -- (\x,4.75);
\foreach \y in {1,2,3,4}
  \draw[grid] (0,\y) -- (7.25,\y);
% Add trend line (passes through all three points)
\draw[dashed,thick,gray!60] (1.5,4) -- (4.5,1);
% Draw benchmark points
\node[point,color=RedLine] (micro) at (1.5,4) {};
\node[point,color=BlueLine] (macro) at (3,2.5) {};
\node[point,color=GreenD] (endtoend) at (4.5,1) {};
% Add labels
\node[right=4pt ,color=RedLine] at (micro) {\footnotesize \textbf{微基准测试}};
\node[right=4pt ,color=BlueLine] at (macro) {\footnotesize \textbf{宏基准测试}};
\node[right=4pt ,color=GreenD] at (endtoend) {\footnotesize \textbf{端到端基准测试}};
% Add axis labels
\node[rotate=90] at (-0.3,4.5) {\footnotesize 高};
\node[rotate=90] at (-0.3,0.45) {\footnotesize 低};
\node[below] at (0.5,-0.0) {\footnotesize 低};
\node[below] at (7.5,-0.0) {\footnotesize 高};
\end{tikzpicture}这种权衡直接对应于数据—算法—机器分类体系。微基准测试评估机器(\(M\))执行基本算法(\(A\))时的物理能力。宏基准测试评估算法(\(A\))如何在机器(\(M\))上协调组合层之间的张量数据流。端到端基准测试评估在生产负载下,从外部存储和网络基础设施摄取原始数据(\(D\))的过程如何与算法和机器相互作用。系统化的性能工程需要评估全部三个层级,以确保局部内核优化能够转化为全局系统加速。
选择适当的粒度确定了测量的物理边界,但建立这一边界只是第一步。完整的基准测试还需要明确运行所需的各项要素:任务定义、具有代表性的数据集、目标模型和评估指标。缺少这些具体组成部分,任何粒度的测量都无法得出可指导工程实践的结论。
基准测试的组成部分
在微基准、宏基准和端到端粒度之间做出选择,决定了基准测试能够诊断什么;但每项基准测试都必须明确任务、数据、模型、指标、测试框架、系统环境和运行规则,才能使其结果具有可解释性。微基准测试使用合成张量运算,隔离并测定特定的硬件执行极限,例如流式内存带宽或张量核心吞吐量。宏基准测试在 ImageNet 等标准化数据集上评估完整计算图的执行。端到端基准测试涵盖完整流水线,包括数据摄取、主机到设备的传输、批次组装和推理执行。在这三种粒度下,基准测试的组成部分都不能孤立地选择:每个组成部分都会为下一个组成部分确定物理和算法边界条件。
这些组成部分相互连接,形成按数据—算法—机器分类体系组织的评估流水线。figure 4 中的工作流展示了工业音频异常检测基准测试的九个阶段,从最初的任务定义,经过量化,直到在 ARM 微控制器上进行嵌入式部署。每个阶段都会为下一阶段确定边界条件:问题定义规定声学采样率和输入表示(数据);数据集属性和任务目标决定可行的模型架构(算法);微控制器的硬件限制,例如 SRAM 容量、能耗限额和实时延迟期限,则决定必须采用 INT8 量化和内存高效的内核编译(机器)。异常检测直接体现了这种全栈耦合:仅测量分类准确率或仅测量原始推理延迟的基准测试,会遗漏跨阶段的相互作用,而任何阶段的工程决策都会缩小下游的可行设计空间。
\begin{tikzpicture}[line cap=round,line join=round,font=\sffamily]
\tikzset{
  Box/.style={align=center,outer sep=0pt ,
    inner xsep=2pt,
    node distance=0.45,
    draw=GreenLine,
    line width=0.75pt,
    fill=GreenL!60,
    text width=32mm,
    minimum width=17mm, minimum height=11mm
  },
   Box2/.style={Box, fill=BrownL!60,draw=BrownLine},
   Box3/.style={Box, fill=RedL!60,draw=RedLine},
   Box4/.style={Box, fill=GreenD,  text width=3mm,minimum width=3mm, minimum height=22mm,draw=none},
   Box5/.style={Box, fill=red,  text width=5mm,minimum width=5mm, minimum height=5mm,draw=none},
   Box6/.style={Box, fill=BrownL!70,text width=17mm,minimum width=17mm, minimum height=9mm,draw=none},
   Box7/.style={Box6, fill=magenta!20},
   Box8/.style={Box6, fill=magenta!20,minimum width=27mm, minimum height=18mm},
   Box9/.style={Box, node distance=0.2,fill=white,text width=22mm,minimum width=22mm,
                        minimum height=14mm,draw=none,font=\sffamily\small},
   Trap/.style={trapezium, trapezium stretches = true, fill=GreenD,draw=none,
   minimum width=15mm,minimum height=10mm, draw=none, thick,rotate=270},
Line/.style={violet!50, line width=1.1pt,shorten <=1pt,shorten >=2pt},
LineA/.style={violet!50,line width=1.0pt,{-{Triangle[width=1.1*4pt,length=1.5*6pt]}},shorten <=1pt,shorten >=1pt},
ALine/.style={black!50, line width=1.1pt,{{Triangle[width=0.9*6pt,length=1.2*6pt]}-}},
Larrow/.style={fill=violet!50, single arrow,  inner sep=2pt, single arrow head extend=3pt,
            single arrow head indent=0pt,minimum height=10mm, minimum width=3pt}
}

\tikzset{
channel/.pic={
\pgfkeys{/channel/.cd, #1}
\begin{scope}[yscale=\scalefac,xscale=\scalefac,every node/.append style={scale=\scalefac}]
\draw[draw=BrownLine,fill=BrownLine!10](0,0.20)coordinate(W1)--
(0.75,-0.20)coordinate(W2)coordinate(\picname-W2)--(1.75,0.4)coordinate(W3)--
(1.0,0.8)coordinate(W4)coordinate(\picname-W4)--cycle;
\draw[BrownLine,shorten <=4pt,shorten >=5pt]($(W4)!0.3!(W1)$)--($(W3)!0.3!(W2)$);
\draw[BrownLine,shorten <=4pt,shorten >=7pt]($(W4)!0.5!(W1)$)--($(W3)!0.5!(W2)$);
\draw[BrownLine,shorten <=4pt,shorten >=9pt]($(W4)!0.7!(W1)$)--($(W3)!0.7!(W2)$);
\end{scope}
        },
}
\pgfkeys{
  /channel/.cd,
  channelcolor/.store in=\channelcolor,
  drawchannelcolor/.store in=\drawchannelcolor,
  scalefac/.store in=\scalefac,
  picname/.store in=\picname,
  channelcolor=BrownLine,
  drawchannelcolor=BrownLine,
  scalefac=1,
  picname=C
}
%Graph1
\begin{scope}[local bounding box=GRAPH1,shift={($(0,0)+(0,0)$)},scale=1, every node/.append style={transform shape}]
\begin{axis}[axis lines=none,  ticks=none, clip=false, width=3cm, height=2cm,
  scale only axis, enlargelimits=false,samples=600]
\addplot[smooth, color=GreenD,  domain=2:7.9] (\x,{sin((22.9*(27*deg(x))) )*cos(((1*deg(x))) )});
\end{axis}
%%fitting
\scoped[on background layer]
\node[draw=OrangeLine,fill=OrangeL!20, inner ysep=1mm, inner xsep=1mm,
fit=(GRAPH1),yshift=0mm](BB1){};
\end{scope}
%
\node[Box,below=1.3 of GRAPH1](ASDS){异常声音检测系统};
\node[Box2, minimum height=7mm,below=1 .3of ASDS](NORM){正常};
\node[Box3, minimum height=7mm,below=0 of NORM](ANOM){异常};
\draw[LineA](GRAPH1)--(ASDS);
\draw[LineA](ASDS)--(NORM);
%Graph2
\begin{scope}[local bounding box=GRAPH2,shift={($(GRAPH1)+(5.5,-1.0)$)},scale=1, every node/.append style={transform shape}]
\begin{axis}[ axis x line=bottom,  axis y line=left,  axis line style={-latex},
ticklabel style={font=\tiny\sffamily},axis background/.style={fill=gray!10},
%clip=false,
width=4cm, height=2cm,ymax=0.99,xmax=16,
enlarge x limits=0.1,
 scale only axis, %enlargelimits=false,
 samples=600]
\addplot[smooth, color=cyan,  domain=2:14.9] (\x,{sin((3*(147*deg(x))) )*cos(((1*deg(x))) )}) ;
\end{axis}
\end{scope}
%Graph3
\begin{scope}[local bounding box=GRAPH3,shift={($(GRAPH2.south)+(-1.5,-2.3)$)},scale=1, every node/.append style={transform shape}]
\pgfdeclareverticalshading{rainbow}{100bp}
 {color(0bp)=(blue); color(25bp)=(blue); color(35bp)=(blue);
  color(45bp)=(green); color(55bp)=(cyan); color(65bp)=(blue);
  color(75bp)=(violet); color(100bp)=(violet)}
 \shade[shading=rainbow] (0.1,0.1) rectangle (3.6,2.1);
\draw[-latex](0,0)--(4,0);
\draw[-latex](0,0)--(0,2.5);
\end{scope}
%diagram
\begin{scope}[local bounding box=DIAGRAM1,shift={($(GRAPH3.south)+(-2.7,-1.5)$)}]
\node[Box4](T1){};
\node[Trap,right=1.7 of T1,anchor=north](T2){};
\node[Box5,right=2.3 of T1](T3){};
\node[Trap,right=0.65 of T3,anchor=north,yscale=-1,fill=cyan](T4){};
\node[Box4,right=2.3 of T3,fill=cyan](T5){};
\draw[LineA](T1)--(T2.south);
\draw[LineA](T2)--(T3.west);
\draw[LineA](T3)--(T4.north);
\draw[LineA](T4.south)--(T5);
\end{scope}
%%fitting2
\scoped[on background layer]
\node[draw=BackLine,fill=BackColor!40, inner ysep=2mm, inner xsep=3mm,
fit=(GRAPH2)(DIAGRAM1),yshift=0mm](BB2){};
\fill[BrownL!50](ASDS.north east)--(BB2.north west)--(BB2.south west)--(ASDS.south east)--cycle;
%%%right
\node[Box6,below right=0.9 and 1.9 of BB2.north east](FP){FP32};
\node[Box7,right=1.0  of FP](IN){INT8};
\node[Box8,right=1.1  of IN](ARM){{\large\textbf{ARM}}\\ mbed OS};
%%table
\coordinate(S) at ($(ARM.south)+(0,-1.3)$);
\begin{scope}[local bounding box=TAB2,shift={(S)},anchor=north]
\colorlet{col1}{BrownLine!35}
\colorlet{col2}{BrownLine!15}
\colorlet{col3}{BrownLine!5}
\matrix(T)[%nodes in empty cells,
  matrix of nodes,
  row sep =3\pgflinewidth,
  column sep = 3\pgflinewidth,
  nodes={text height=1.5ex,text depth=0.25ex, text width=2mm, draw=white,
  line width=0.25pt, font=\footnotesize\sffamily},
  row 1/.style={nodes={align=center,fill=col1}},
  column 1/.style = {nodes={text width=23mm,align=left}},
  column 2/.style = {nodes={text width=16mm,align=center}},
  ]
  {
\textbf{问题}&\textbf{AD}\\
|[fill=col3]| 模型 &|[fill=col3]| FC-AE\\
% NOTE: Values hardcoded because inline {python} doesn't work inside .tikz blocks.
% Source: ReferenceStats.AnomalyModel.{Latency,Auc,Energy}; keep synchronized with the Python cell below.
|[fill=col2]| 规模&|[fill=col2]| 270K 个参数\\
|[fill=col3]| 延迟 &|[fill=col3]| 10.4 ms/inf.\\
|[fill=col2]| 准确率 &|[fill=col2]| 0.86 AUC\\
|[fill=col3]| 能耗 &|[fill=col3]| 516 $\mu$J/inf.\\
  };
\end{scope}
%
\begin{scope}[local bounding box=F1,shift={($(FP)+(-0.1,-4.25)$)}]
\foreach \j in {1,2,3} {
\pic[shift={(0,0)}]  at ({\j*0.02}, {0.16*\j}) {channel={scalefac=1.5,picname=1\j}};
}
\node[below=3pt of 11-W2,align=center]{训练代码};
\end{scope}
%
\draw[LineA](FP)--(IN);
\draw[LineA](IN)--(ARM);
\draw[LineA](ARM.south)--(S);
\draw[LineA](13-W4)--++(0,0.8)-|(FP);
%above
\coordinate(AB)at($(GRAPH1.north)+(-0.2,1.7)$);
\node[Box9](B1)at(AB){问题\\ 定义};
\node[Box9,right=of B1](B2){数据集 \\ 选择 \\ (公有领域)};
\node[Box9,right=of B2](B3){模型 \\ 选择};
\node[Box9,right=of B3](B4){模型 \\ 训练代码};
\node[Box9,right=of B4](B5){生成“微型” \\ 版本:\\ 量化};
\node[Box9,right=of B5](B6){嵌入式\\ 实现};
\node[Box9,right=of B6](B7){基准测试 \\ 框架\\ 集成};
\node[Box9,right=of B7](B8){部署到 \\ 设备};
\node[Box9,right=of B8](B9){基准测试 \\ 运行\\ 示例};
%%fitting arrow
\node[draw=none,fill=none, inner ysep=4mm, inner xsep=6mm,fit=(B1)(B9),xshift=-3mm](A){};
\coordinate(AL)at($($(A.north west)!0.5!(A.south west)$)+(0.6,0)$);
\coordinate(AD)at($($(A.north east)!0.5!(A.south east)$)+(0.6,0)$);
\scoped[on background layer]
\draw[draw=none,fill=cyan!50](A.north west)--(A.north east)--(AD)--(A.south east)--(A.south west)--(AL)--cycle;
\end{tikzpicture}评估机器学习系统需要将任务的统计指标与物理效率指标结合起来。量化和剪枝能够减少参数占用空间和内存总线流量,但也会改变数值表示,并带来任务准确率下降的风险。只记录执行延迟而不记录统计准确性(例如 AUC 或分类错误率)的基准测试,会奖励那些产生无效输出的激进近似;反过来,只报告准确率而不报告延迟或内存消耗,则会掩盖模型是否满足目标系统的物理约束。解释这些结果时,需要使用 Roofline 模型,将工作负载的算术强度,即运算次数与从内存传输的字节数之比,与机器的平衡点联系起来,以判断某项优化缓解的是内存带宽瓶颈还是计算吞吐量瓶颈。
测量框架和运行规则提供了使这些评估可复现的实验控制条件。没有严格的执行规程,测得的运行时间反映的将是操作系统和硬件噪声,而非算法执行成本。严谨的基准测试框架会强制执行缓存预热迭代,以达到稳态内存行为;锁定处理器时钟频率,防止动态电压频率调整(DVFS)引入瞬态延迟波动;将主机内存分配锁定在物理内存中,以避免缺页开销;并在记录平均延迟的同时记录尾延迟分布(\(p95\)、\(p99\)),以揭示内存总线争用和排队延迟。这些运行层面的组成部分确保测量结果反映系统真实的物理极限,为逐一详细考察各个组成部分奠定基础,首先从问题定义开始。
问题定义
每项基准测试都始于确定工作负载的计算边界和运行边界。没有明确的任务规范,就无法在同等条件下评估硬件和软件优化:改变输入分辨率、数值数据类型或延迟期限,都会从根本上改变底层机器需要完成的物理工作量。如 figure 4 中的音频异常检测系统所示,应用将原始传感器信号转换为实际决策。无论是机器翻译、问答 (Hirschberg and Manning 2015) 和文本分类等自然语言处理任务,还是目标检测和图像分割 (Everingham et al. 2009; Lin et al. 2014) 等计算机视觉任务,完整的问题定义都需要确立三项具体规范:输入规范、输出规范和性能规范。
Hirschberg, Julia, and Christopher D. Manning. 2015. “Advances in Natural Language Processing.” Science 349 (6245): 261–66. https://doi.org/10.1126/science.aaa8685.
Everingham, Mark, Luc Van Gool, Christopher K. I. Williams, John Winn, and Andrew Zisserman. 2009. “The Pascal Visual Object Classes (VOC) Challenge.” International Journal of Computer Vision 88 (2): 303–38. https://doi.org/10.1007/s11263-009-0275-4.
输入和输出规范确立数据移动约定,并定义计时执行的确切范围。输入规范确定张量维度、批处理行为、数值表示(例如 FP16 或 INT8)和摄取速率。在音频异常检测流水线中,以固定的一秒窗口流式摄取 16 kHz 的单通道音频,会在特征提取开始之前就确定严格的摄取速率和内存缓冲区需求。相应地,输出规范定义计算的终止边界。基准测试经常只对加速器前向传播计时,却忽略将原始张量输出转换为可用决策所需的 CPU 后处理,从而引入测量偏差。完善的输出规范应明确系统输出的是原始 logits、中间嵌入还是最终的二元异常标志,并将消耗主机内存带宽的任何下游阈值处理或归约内核纳入考量。
性能规范定义决定优化是否可行的运行范围。如果统计准确性下降到可接受阈值以下,不受约束的吞吐量数值就毫无意义;如果系统违反延迟服务等级协议(SLA),再高的平均吞吐量也无济于事。对于实时异常检测,性能规范将目标质量指标(例如 ROC 曲线下面积)与硬件执行限制结合起来:确定性的尾延迟上限(例如第 99 百分位响应时间 \(p_{99} \le 10\text{ ms}\))、与数据到达速率相匹配的持续吞吐量,以及严格的驻留内存占用限制,以防止内存受限的加速器发生内存不足故障。通过预先定义这三类边界,基准测试能够确保后续各阶段,从数据集构建到测量框架配置,都依据部署的真实运行约束评估系统优化。
标准化数据集
任务定义的有效性取决于用于评估它的数据。标准化数据集确保所有模型在相同条件下接受测试,从而能够直接比较不同方法;没有标准化数据集,各团队都会使用私有数据进行评估,使跨实验室比较成为不可能。 在计算机视觉领域,ImageNet (Deng et al. 2024, 2009)、COCO (Lin et al. 2014) 和 CIFAR-10 (Krizhevsky 2009) 充当参考标准;在自然语言处理领域,SQuAD12 (Rajpurkar et al. 2016)、GLUE13 (Wang et al. 2018) 和 WikiText (Merity 2016; Merity et al. 2016) 发挥着类似作用,每个数据集都涵盖不同的复杂程度和边界情况。
Deng, Jia, Wei Dong, Richard Socher, Li-Jia Li, Kai Li, and Li Fei-Fei. 2024. ImageNet.
Lin, Tsung-Yi, Michael Maire, Serge Belongie, James Hays, Pietro Perona, Deva Ramanan, Piotr Dollár, and C. Lawrence Zitnick. 2014. “Microsoft COCO: Common Objects in Context.” In European Conference on Computer Vision (ECCV). Springer. https://doi.org/10.1007/978-3-319-10602-1_48.
Merity, Stephen. 2016. The WikiText Long Term Dependency Language Modeling Dataset.
Merity, Stephen, Caiming Xiong, James Bradbury, and Richard Socher. 2016. “Pointer Sentinel Mixture Models.” arXiv Preprint arXiv:1609.07843.
Warden, Pete. 2018. “Speech Commands: A Dataset for Limited-Vocabulary Speech Recognition.” arXiv Preprint arXiv:1804.03209, ahead of print. https://doi.org/10.48550/arXiv.1804.03209.
数据集选择是基准测试最早可能脱离实际部署情境的环节。在音频异常检测示例(figure 4)中,数据集必须既包含具有代表性的正常运行波形样本,也全面涵盖异常状况示例。领域专用数据集覆盖不同的音频任务:ToyADMOS14 (Koizumi et al. 2019) 支持受控条件下的异常检测研究,而 Google Speech Commands (Warden 2018) 支持关键词识别。有效的基准测试数据集必须平衡两项相互竞争的需求:准确反映现实世界的挑战,同时保持足够的复杂性,以区分模型性能。ToyADMOS 等简化数据集对方法开发很有价值,但可能无法涵盖生产环境的全部复杂性。
模型选择
任务和数据集确定后,基准测试必须明确模型架构及其基线实现。在系统基准测试中,模型定义执行工作负载:其计算图决定算术强度、内存占用和通信拓扑。基准模型的选择决定了测得的性能差异究竟反映架构效率、软件运行时优化,还是加速器的原始能力。如 网络架构 中所述,评估架构修改需要保持运行时和目标硬件不变。相应地,评估硬件平台或软件执行引擎,如 机器学习框架 中所讨论的情形,则需要统一采用固定且具有代表性的模型计算图,使吞吐量差异能够单独反映执行效率,而非工作负载在数学层面的变化。
基线模型为目标领域确立实证参考点。系统基准测试依赖的并非玩具算法,而是计算特征和内存访问模式已得到充分表征的典型工作负载。在语言处理领域,BERT15 是一种标准基线,因为其多头自注意力和稠密前馈模块既涉及计算受限的矩阵乘法,也涉及内存带宽受限的归约运算。然而,基线规范不能止步于数学计算图。同一架构在不同框架或运行时中的两种实现,往往表现出不同的执行特征。算子融合方面的差异,例如将归一化和激活函数直接融合到 GEMM 输出的尾处理阶段,以避免往返访问 HBM,以及内核启动开销和内存分配器行为方面的差异,对性能的影响可能超过细微的架构变化。因此,基准测试必须在统一数学模型的同时,统一运行时实现。
基准必须在两种不同的运行模式下评估模型,每种模式都受不同的物理瓶颈制约。在训练中,主要约束是内存容量和互连带宽:在多个加速器上存储前向激活、反向梯度和优化器状态,会限制批大小,并要求高带宽的集合通信。因此,训练基准衡量的是在固定收敛标准下达到目标准确率所需的时间,而非仅衡量原始迭代速度。在推理中,反向传播和优化器状态不再存在,瓶颈随之转向严格服务级别协议(SLA)下的尾延迟,或自回归解码期间的内存带宽。将模型投入生产通常需要降低精度,即将 FP32 或 BF16 权重和激活量化为 INT8 或 FP8。量化使内存流量减半、张量核心吞吐量翻倍,但需要校准,以确保数值误差不会降低验证质量。由于某种模型架构可能训练高效,却无法满足严格的延迟 SLA,因此基准必须使用专门的领域指标来评估这两种运行模式。
评估指标
评估指标16将模型的原始行为转化为可供比较、排序和工程决策使用的数值。难点在于选择恰当的数值:只反映准确率而忽略延迟的指标,可能会将速度过慢、无法用于生产的模型判为优胜者;奖励吞吐量却忽略能耗的指标,则可能针对实际并不存在的部署预算进行优化。
Table 5 根据各项评估度量所揭示的失效模式及其服务的部署场景,对其进行分类。
| 类别 | 指标 | 单位 | 主要应用场景 |
|---|---|---|---|
| 准确率 | Top-1/Top-5 准确率 | 百分比 | 分类 |
| mAP(平均精度均值) | 0–1 分值 | 目标检测 | |
| BLEU/ROUGE | 0–100 分值 | 自然语言生成 | |
| 困惑度 | 分值(越低越好) | 语言建模 | |
| 吞吐量 | 样本数/秒 | 样本/s | 批量推理 |
| 词元吞吐量 | 词元/s | 大语言模型推理 | |
| 训练耗时 | 小时/天 | 训练基准 | |
| 延迟 | p50 延迟 | 毫秒 | 响应时间中位数 |
| p99 延迟 | 毫秒 | 尾延迟(SLA) | |
| 首词元延迟 | 毫秒 | 大语言模型响应能力 | |
| 效率 | 样本数/秒/瓦 | 样本/s/W | 能源效率 |
| 准确率/FLOP | 百分比/PFLOP | 算法效率 | |
| 每次推理的总拥有成本(TCO) | $/推理 | 经济效率 |
table 5 中的指标揭示了由加速器架构决定的物理权衡。吞吐量衡量总体处理能力,而延迟衡量单个请求的完成时间。这两个目标在硬件边界处直接冲突。最大化吞吐量需要将请求聚合为更大的批次,以便在多个输入之间摊薄加载权重所需的内存带宽开销,从而提高张量单元上的算术强度。这种批处理机制会增加单个样本的延迟:单个请求在批次形成期间需要在到达队列中等待,而更大的矩阵运算也需要更长时间才能完成。此外,延迟的算术平均值会掩盖尾部行为。排队抖动、内存分配停顿和加速器热降频会导致执行时间出现差异;平均延迟为 10 ms 的系统,其第 99 百分位(p99)延迟可能达到 500 ms,从而违反服务级别协议。因此,基准必须报告分布的百分位数(p50、p95、p99),而非平均值。样本数/秒/瓦等复合指标将多个维度压缩为单个标量,便于进行总体比较,但也会掩盖瓶颈所在。在报告复合指标的同时报告原子指标(延迟分布、吞吐量和功率),有助于识别限制系统的具体物理约束。
任务特定指标评估算法维度,量化模型是否解决了相应的统计问题。分类工作负载评估准确率(预测正确的比例)、精确率、召回率和 F1 分数 (Sokolova and Lapalme 2009)。精确率和召回率区分了正确检出正例的情况与误报,这在类别分布不均衡时至关重要。连续值估计任务依赖均方误差(MSE)或平均绝对误差(MAE),而序列生成则使用 BLEU17 等专门的评分规则,衡量相对于人工参考译文的修正 n 元语法精确率 (Papineni et al. 2002)。
任务指标单独评估算法质量,但部署可行性取决于机器的物理约束。模型容量以参数数量和内存占用衡量,决定权重能否容纳于片上 SRAM 或加速器内存中,还是需要溢出并通过高延迟互连访问。单次推理的执行延迟决定系统能否满足实时截止期限,而每次推理的能耗(以焦耳或毫瓦衡量)则约束散热和电池续航。在不同生产环境中维持这些指标所面临的运维挑战,将在部署策略(机器学习运维)中探讨。
基准还必须考虑测量结果对不同软件运行时的敏感性。如 模型训练 所述,不同框架处理损失计算、算子融合和梯度累积的方式不同,会改变所报告的基准数值。细微的实现差异,例如评估模式下的批归一化使用总体统计量还是运行中的小批次矩统计量,或归约内核如何重排不满足结合律的浮点加法,都会使测得的准确率和延迟发生变化;当候选模型差距很小时,这些变化足以颠倒基准排名。
统计质量与硬件约束之间的这种相互依赖关系,在异常检测中尤为明显。在工业监控中,极端的类别不均衡会使原始准确率具有误导性:如果异常仅占运行样本的 0.1%,那么一个始终预测运行正常的简单模型,就能达到 99.9% 的准确率,却无法检测出任何故障。因此,基准必须报告 ROC 曲线下面积(AUC),以评估不同决策阈值下的区分能力,同时报告物理资源指标。
这种多指标评估方法指导异常检测流水线的设计,使其同时平衡四项约束:模型规模为 270K 个参数,能够容纳于嵌入式 SRAM 中;每次推理的处理延迟为 10.4 ms,以维持实时采样;检测准确性为 0.86 AUC;每次推理的能耗为 516 μJ,处于目标电池预算之内。沿全部四个维度进行评估,可以避免将某个模型判为更优,而其准确率提升实际上来自规模过大、无法装入内存的架构,或来自功耗过高、无法支持持续部署的架构。
基准测试框架
指标定义测量什么;基准测试框架决定如何测量。该框架由软件和测量设施组成,负责向被测系统提供输入、协调执行、收集计时和功率轨迹,并确保可复现性。在机器学习系统中,要深入硬件层面测量执行过程,就必须考虑主机 CPU 与加速器之间的异步执行边界。当主机软件发起一次推理或训练步骤时,框架运行时只是将命令加入加速器工作队列(例如 CUDA 流或硬件命令缓冲区),然后立即返回控制权。简单地用计时器包围主机层调用,测得的仅是这种亚微秒级的队列派发延迟,而非设备的实际执行时间。严谨的测试框架会插入硬件同步屏障,或读取设备上的时间戳事件,以确保记录的时间反映完整的内核执行以及跨总线的内存传输。
测试框架的架构必须与部署目标的运行模式相适应。在服务器环境中,测试框架使用开环负载生成器产生并发请求流量,通常用泊松分布对请求到达间隔进行参数化建模。18 开环测试框架按照独立的到达时间表发出请求,不受服务器响应能力影响。这种解耦能够在突发请求使可用计算资源饱和时,揭示排队延迟和尾延迟(例如 p99 响应时间)。相比之下,闭环测试框架会等待响应后再派发下一个请求,从而引入协调遗漏,人为调节流量节奏,并掩盖服务器性能下降期间的队列积压。离线批处理则完全不需要到达调度。测试框架预先将大批量输入放入内存,使加速器执行单元饱和,最大化内存带宽利用率,并测量可持续的峰值吞吐量。
在嵌入式和边缘部署中,工作负载既不是随机网络流,也不是不受约束的批处理队列。相反,输入由物理传感器(例如音频模数转换器或图像传感器)按固定的硬件采样时钟依次产生。测试框架必须通过直接内存访问(DMA)将这些传感器数据流注入容量有限的片上 SRAM 缓冲区,并验证每次推理都能在下一个样本到达之前完成,以防止缓冲区溢出。此外,边缘测试框架必须集成分流电阻或外部功率分析仪等物理测量设备,在活跃执行周期和低功耗睡眠状态期间采样电压与电流,以获取每次推理的实际能耗。
可复现性要求基准测试不受不同评估运行之间的运行时和环境波动影响。现代加速器和运行时框架存在显著的冷启动瞬态过程。最初的几次推理会触发按需内存分配、动态即时(JIT)编译、驱动程序初始化,以及从二级存储向加速器内存传输权重。可复现的测试框架必须先执行不计入测量的预热迭代,直到缓存填充完成、内存分配器稳定且芯片达到热稳态,之后再启动计时测量循环。为防止测量漂移,测试环境必须锁定加速器和 CPU 的时钟频率,禁用动态电压与频率调整(DVFS),并终止争用资源的后台进程。最后,遥测日志必须将执行时间戳和性能计数器记录到非阻塞、预分配的内存缓冲区中,以最大限度地减小探针效应。这可确保测量设施不会占用被测系统的内存带宽,也不会改变其流水线执行过程。
系统规格
测试框架控制执行条件,而系统规格作为补充,记录计算环境:构成系统机器(\(M\))边界的物理硬件和软件栈。如果没有完整的规格,就无法解释所报告的吞吐量或延迟测量结果。执行指标反映了算法的算术强度与机器物理极限之间的相互作用,这些极限包括峰值算术吞吐量、内存层次结构带宽和互连延迟。若报告吞吐量时不注明加速器型号、内存带宽或运行时钟频率,就会掩盖所观察到的加速究竟源于算法效率提升,还是芯片升级。
严谨的硬件规格应记录决定内核执行和数据移动的约束。在加速器层面,文档必须记录微架构、计算能力、活跃核心数、基础与加速时钟频率以及功率限制(热设计功耗(TDP)),同时记录设备的内存层次结构:HBM 容量、内存总线宽度和峰值内存带宽。对于从一个设备扩展到八个设备的多加速器配置,规格必须明确主机到设备的总线接口(例如 PCIe 通道),以及加速器间的互连网络,即通信是经过点对点链路(例如 NVLink),还是共享 PCIe 交换机。由于 all-reduce 等分布式集合操作受互连拓扑和对分带宽约束,省略互连规格会掩盖通信瓶颈的来源。
软件栈同样具有决定性作用,它决定数学运算如何映射到执行单元。规格必须记录操作系统内核、设备驱动程序、底层计算运行时(例如 CUDA 或 ROCm)以及厂商数学库(例如 cuBLAS 或 CUTLASS)。在框架层面,记录运行时版本(例如 PyTorch 或 JAX)、执行模式(即时解释执行与通过 torch.compile 进行图级编译)以及内核融合优化,有助于区分框架开销与模型性能。最后,规格必须量化运行功率和能耗指标,包括持续板卡功率、热降频事件,以及每个词元或样本的能耗。记录这些运行范围,可以确保测得的加速并非由不受限制的功率消耗或短暂的时钟加速所造成的隐蔽假象。
运行规则
系统规格描述基准在什么系统上运行;运行规则规定基准如何运行。这些程序性约束使结果可解释、可重复,而在机器学习领域,做到这一点比听起来更困难,因为随机过程(权重初始化、数据打乱和 dropout 掩码)意味着即使在相同硬件上运行两次,也可能产生不同的数值。在隔离系统影响时,协议可以固定随机种子和数据顺序;当随机变化是工作负载的一部分时,也可以要求重复运行并满足质量阈值。无论采用哪种方式,都必须明确随机种子策略和已知的非确定性来源。
超参数文档同样至关重要。学习率的变化会改变收敛过程和最终准确率,因此,可复现的结果需要记录所有可能影响结果的配置设置。同样,必须明确数据集版本、划分方式和预处理流程。当隐私或许可限制导致无法直接共享数据时,报告必须说明这一限制,并保留足够的数据来源和转换细节,以便判断结果是否具有可比性。
代码来源补全了可复现性链条。完善的基准协议会保留实现版本,不仅包括模型,还包括相关的预处理、训练和评估代码,并披露这些代码是否可以共享。参考测试套件可以分发封装了依赖项和配置的容器化环境,而实验日志则保留训练指标、检查点和运行过程中的所有调整。这些记录共同将一次性测量转化为其他团队可以审查,并在具备访问条件时复现的证据。
结果解读
生成原始基准数值只需要执行测试;解读这些数值则需要理解产生它们的条件、其背后的统计置信度,以及决定这些数值能否反映生产行为的运行边界。 单个报告指标,例如延迟或准确率,很少能揭示某项优化在部署中是否成功。在资源受限的设备上评估边缘视觉模型,可以说明吞吐量、内存占用和模型保真度如何在严格的硬件边界下相互作用。
Example 1.2: 面向边缘部署的视觉模型基准测试
场景:一个边缘 AI 团队在严格的延迟和模型大小限制下,评估用于 Raspberry Pi 4 野生动物自动触发相机的 MobileNetV2 (Sandler et al. 2018)。
诊断:FP32 执行的延迟为 120 ms(8.3 FPS),模型大小为 14 MB。INT8 量化使推理获得 3.4× 的加速比,将延迟降至 35 ms(28.6 FPS),并使模型大小按 4× 的缩减倍数缩小,代价是 Top-1 准确率下降 0.9 percentage points。
系统启示:边缘模型基准测试需要评估延迟、准确率和内存占用之间的多维权衡。当适度的准确率下降仍能满足产品要求时,量化可实现高吞吐量的边缘执行。
将基准测试数值转化为工程决策,需要进行两项方法论检查:架构一致性和统计严谨性。首先,比较必须严格保证架构一致性。将 ResNet-50 与 MobileNet 进行基准比较,会混淆卷积算子的效率与参数数量的影响。同样,比较 FP32 与 INT8 执行,会将算法的数值精度与内存流量、执行单元吞吐量的影响混为一谈:INT8 将 DRAM 传输量降至原来的四分之一(缩减倍数为 \(4\times\)),并在专用整数算术流水线上执行。有效的比较要求模型架构、数值格式、批大小、硬件 SKU 和软件运行时保持不变。其次,测量必须将稳态执行与初始化引入的干扰分离。单次运行会将冷启动开销——内核编译、缺页和缓存预热——与持续吞吐量混在一起。反过来,长时间的压力测试又可能引发热节流,使加速器时钟频率降至基础规格以下。要获得具有统计意义的结果,需要丢弃预热迭代,记录多次试验之间的方差,并报告置信区间或延迟百分位数,而非孤立的平均值。将这些标准应用于一项孤立的吞吐量声明,可以揭示被省略的执行参数如何掩盖真实的系统行为。
Systems Perspective 1.6: 解读基准测试声明
某供应商声称:“我们的系统在 ResNet-50 上达到 10,000 inferences/秒。”单凭这一数值无法支持部署规划,因为决定其含义的条件并未说明。
以下四项未说明的条件决定了该声明的含义:
- 批大小:大批次可摊薄权重传输开销,并最大限度地提高计算利用率,但会增加排队延迟;批大小为 1 可最大限度地降低延迟,却会使执行单元利用不足。
- 精度:INT8 执行利用吞吐量更高的整数流水线,并减少内存流量,但需要校准,而校准可能损害数值保真度。
- 测量边界:测量窗口必须说明,是仅测量纯加速器内核执行,还是也包括主机到设备的传输、JPEG 解码和张量格式转换。
- 准确率:声明必须说明,优化后的模型是保留了基线验证准确率(例如在 ImageNet 上达到 76.1% 的 Top-1 准确率),还是以任务质量换取纯粹的执行速度。
示例:“在 NVIDIA H100 上,以 700 W 的 TDP、32 的批大小、INT8 精度和 76 percent 的 Top-1 准确率运行 ResNet-50,包含 JPEG 解码,达到 10,000 inferences/秒。”
系统洞见:评估性能差异是否有意义,既需要统计严谨性,也需要结合具体情境进行验证。缺少批大小、精度、测量范围和准确率目标的吞吐量数值,只是营销指标,而非工程规格。
除供应商声明外,部署约束决定了哪些指标支配系统的可行性。在医学影像或自动驾驶等安全关键应用中,准确率提高 1% 足以证明大幅增加计算成本是合理的;在交互式搜索或语音转写中,严格服务等级协议约束下的尾延迟占主导地位,如果微小的准确率提升会突破延迟预算,这种提升便失去了意义。系统评估还必须防范基准测试过拟合,即优化针对标准化测试套件中特有的计算模式,却以牺牲生产工作负载的性能为代价。例如,专门针对基准测试框架中固定序列长度调优的激进内核融合或算子分块,在部署后面对动态、变长的用户请求时,可能降低吞吐量。要获得可靠的解读,需要在多样化的输入分布、经过扰动的批大小以及有代表性的运行占空比下验证性能。
基准测试示例
figure 4 中的异常检测流水线展示了这些基准测试组成部分如何在输出阶段相互作用。该基准测试产生三项互补的测量结果:模型大小为 270K 个参数,每次推理耗时 10.4 ms(计算资源);区分正常与异常音频模式的检测准确性为 0.86 AUC(任务有效性);每次推理的能耗为 516 μJ(运行效率)。
这些指标中哪一项决定可行性,完全取决于部署环境及其物理约束。每次推理的能耗决定了无外接电源的边缘设备的电池续航,并限定服务器机架的供电上限和散热成本。模型大小决定权重能否完全驻留在高速片上 SRAM 中,还是需要溢出至片外 DRAM;而在多租户云加速器中,参数量决定 HBM 能容纳多少个模型副本。推理延迟决定系统能否在流式音频处理中满足实时截止时间而不丢帧;批处理则通过在多个输入之间摊薄权重传输开销,以更高的单样本延迟换取更高的吞吐量。这些指标揭示了直接的工程权衡:将模型大小降至 270K 个参数以下,可减少内存流量并缩短执行时间,但可能损害 0.86 AUC 的检测准确性。这些测量结果是否构成通过基准测试,取决于运行约束范围;基准测试规范使评估协议标准化,但验收阈值由应用需求决定。
两类基准测试在优化流水线中反复出现,值得为其制定专门的检查清单:一类是压缩基准测试,剪枝或量化后的模型在部署前必须通过;另一类是移动与边缘基准测试,受到功率和热边界的严格约束。两者均由任务、数据、模型、指标、测试框架和运行规则组成,同时施加领域特定的限制。压缩验证需要采用多指标协议,平衡大小缩减、准确率与延迟(section 1.11.1.3),而边缘部署则需要在真实的热约束和占空比约束下测量持续运行功率(section 1.9)。
压缩基准测试
神经网络压缩(剪枝、量化、知识蒸馏和架构优化)需要专门的基准测试,因为压缩重塑了权衡格局:每节省一个字节或消除一次运算,都必须权衡潜在的准确率损失和硬件兼容性。最基本的压缩指标是原始大小的缩减,包括参数数量、以字节计的内存占用以及压缩存储需求。然而,仅看大小会产生误导。在 ImageNet 上,MobileNetV2 以 3.5M 个参数实现约 72 percent 的 top-1 准确率,而 ResNet-50 以 25.6M 个参数实现 76 percent 的准确率;在准确率相近的情况下,前者参数量的缩减倍数约为 7.3×,或者说,前者单位参数对应的准确率约为后者的 6.9× (Sandler et al. 2018; He et al. 2016)。
Li, Hao, Asim Kadav, Igor Durdanovic, Hanan Samet, and Hans Peter Graf. 2017. “Pruning Filters for Efficient ConvNets.” International Conference on Learning Representations (ICLR).
剪枝基准测试必须区分结构化与非结构化方法,因为它们在真实硬件上产生的结果存在本质差异。结构化剪枝移除整个神经元或滤波器,产生规模更小的稠密运算,常规内核能够利用这一特性 (Li et al. 2017)。非结构化剪枝消除单个权重,可以产生高度稀疏的模型,但要实现实际加速,需要专门的稀疏计算支持——这意味着基准测试协议必须明确硬件平台和软件实现 (Han et al. 2015; Gale et al. 2019)。
量化基准测试评估跨数据类型降低精度的效果。在示例性的 MobileNetV2 场景中,INT8 将原始权重存储量缩减至原来的四分之一,缩减倍数为 4\(\times\),假定的延迟值则给出了所显示的加速比;实际性能取决于硬件和实现。精度与准确率之间的权衡在 section 1.8.2 中分析,其能耗影响在 section 1.9.1 中分析 (Jacob et al. 2018)。混合精度方法通过为不同层应用不同精度进一步推进优化:关键层保留 FP16,而计算密集层使用 INT8 或 INT4,从而实现细粒度的效率优化。知识蒸馏增加了另一个维度:较小的学生模型可以在缩减大小和推理成本的同时,保留教师模型的大部分行为,但基准测试必须验证学生模型具有泛化能力,而非仅仅记住教师模型的输出 (Hinton et al. 2015)。
关键在于,加速倍数在不同硬件平台之间差异巨大:只有目标运行时具备能够利用稀疏模型、低精度模型和高效架构的内核、内存布局及加速器支持时,这些方法才能带来加速。MLPerf 等当前基准测试套件主要聚焦于标准化参考模型,而生产部署往往使用经过压缩或针对特定硬件的变体。基准测试所测量的对象与生产环境实际运行的对象之间存在差距,这仍是该领域影响最深远的盲点之一。
移动与边缘基准测试
数据中心具备千瓦级供电和主动冷却基础设施,与之不同,移动与边缘部署必须在严格的毫瓦至瓦级功率范围和被动散热限制内运行。对这些系统进行基准测试,需要处理功耗、推理延迟和模型准确率之间相互依赖的三角关系,优化其中任意两项通常都会使第三项恶化。Table 6 将这些运行约束与云环境进行了对比。
| 约束 | 对云端的影响 | 对边缘端的影响 |
|---|---|---|
| 功率 | 运行成本 | 设备能量预算 |
| 延迟 | 服务等级目标 | 本地响应截止时间 |
| 准确率 | 任务质量目标 | 与功率和延迟相权衡 |
考虑一台智能手机相机,在 3 W 至 5 W 的热设计功率范围内,以每秒 30 帧执行实时目标检测。在这一场景中,MobileNet 等高效架构是现实可行的基准测试目标,而规模更大的 ResNet 模型会超出热限制,尽管后者在云端评估中的准确率更高。因此,边缘基准测试必须结合持续运行功率和散热情况共同评估准确率。section 1.1 中确立的峰值与持续性能之间的差距,在边缘端变得尤为突出,其物理原因在数据中心并不存在:被动冷却设备无法无限期地通过机身导热散去连续推理产生的热量。随着结温升高,动态热管理(DTM)控制器会降低工作电压和时钟频率,导致持续吞吐量大幅低于突发模式下的峰值。正是这一热机制,而非测量不严谨,使边缘基准测试与服务器基准测试成为性质不同的工作。
Example 1.3: 边缘端基准测试
场景:一个边缘工程团队对智能门铃芯片进行基准测试,供应商宣称其功率规格为“1 W AI”。
诊断:初期的突发模式测试结果符合供应商声明,但连续执行推理循环会使结区热量积聚,触发热节流并降低稳态吞吐量。
系统启示:短时突发基准测试会掩盖长期运行中的热节流。对边缘机器学习工作负载进行基准测试,需要开展连续、持续的执行测试,以反映硬件真实的运行限制。
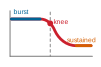
一旦发生热节流,突发基准测试的 FPS 便会骤降。
Systems Perspective 1.7: 边缘基准测试的现实核验
评估边缘硬件声明时,以下四个因素决定供应商给出的数值能否转化为实际性能:
- 峰值与持续性能:厂商可能宣称峰值吞吐量为 45 TOPS,而在持续运行的热稳态测试中,实际吞吐量更接近 20 TOPS。基准测试应始终采用持续时间超过 30 s 的持续工作负载。
- 空闲功耗与活动功耗:在此场景中,一台空闲功耗为 50 mW、活动功耗为 2 W 的设备,可能在营销中报告活动功耗;但如果应用仅在 1 percent 的时间内执行推理,则有效功耗为 ~69.5 mW,而非 2 W。
- 热设计约束:边缘设备通常在严格的 TDP 范围内运行。超出该范围会触发降频,因此,未说明热条件的基准测试报告是不完整的。
- 端到端测试与仅加速器测试:NPU 基准测试通常不计入数据传输开销。对于小模型,将图像数据从摄像头传输至 NPU 再传回所需的时间,可能超过推理时间。
由于被动散热限制了持续功耗的上限,移动 SoC 架构师无法依赖高频单体核心。相反,他们将执行任务分配给针对不同算术运算模式设计的专用计算模块。这种硬件专用化使边缘基准测试的重点从评估单个核心转向表征整个 SoC 上的多处理器协同。
异构处理器协同
现代移动 SoC 将 CPU、GPU、数字信号处理器(DSP)和神经网络处理单元(NPU)集成在同一块芯片上,共享系统内存和总热预算。每类处理单元面向不同的计算模式:CPU 处理不规则控制流、动态批处理和顺序后处理;GPU 执行并行浮点运算以及未量化的回退层;DSP 以低功耗执行流式向量运算,用于始终开启的感知任务;NPU 则通过专用脉动阵列或乘加引擎执行稠密的量化矩阵乘法,通常采用 INT8 或 INT4。
基准测试必须评估流水线编排,而非孤立的内核吞吐量。例如,在端到端语音助手中,超低功耗 DSP 持续监听麦克风音频以检测唤醒词;检测到唤醒词后,系统唤醒 NPU,执行声学特征提取和语音识别,再将词元序列传递给 CPU,以完成语言理解和对话逻辑处理。单处理器基准测试仅评估各阶段独立的计算时间,遗漏了三类主要系统开销:从深度休眠状态唤醒加速器的延迟、多个引擎同时访问共享 DRAM 时的总线争用,以及转置张量布局所消耗的内存带宽,例如将 CPU 使用的 NCHW 布局转换为 NPU 所需的分块 NHWC 格式。仅报告计算时间的基准测试会掩盖这些数据搬移和调度代价。
电池与热特性基准测试
电池电量消耗取决于一段时间内消耗的总能量,而非瞬时峰值功率。计算摄影在图像采集期间,会以突发方式在数百毫秒内消耗数瓦功率;而后台传感器处理必须维持在毫瓦级功耗预算内,才能实现持续数天的电池续航。要表征对电池的影响,需要在具有代表性的运行模式下测量总能耗 \(E = \int P(t)\,dt\)。
起主导作用的运行变量是工作负载占空比 \(\alpha\),定义为加速器主动执行推理的时间占比。对于活动功耗 \(P_{\text{active}}\) 和待机功耗 \(P_{\text{idle}}\),平均功耗为: \[P_{\text{avg}} = \alpha P_{\text{active}} + (1 - \alpha) P_{\text{idle}}\] 对于智能门铃摄像头这类间歇性工作负载(\(\alpha \ll 0.01\)),待机功耗 \(P_{\text{idle}}\) 和内存数据保持功耗决定了电池续航时间,因此活动推理的能效居于次要地位。对于视频分析这类连续流水线(\(\alpha \approx 1.0\)),活动推理能耗 \(E_{\text{inf}} = P_{\text{active}} \cdot t_{\text{inf}}\) 占主导地位。此外,工作温度升高会增大半导体漏电流,导致静态功耗随设备升温而增加。因此,要对电池影响进行基准测试,就必须在运行占空比所涵盖的活动和待机阶段分别测量功耗,同时在持续数分钟的长时间运行中监测结温。
边云协同
当边缘设备通过 5G 或 Wi-Fi 网络将计算卸载到远程服务器时,基准测试必须评估完整的边云流水线,而非孤立的本地执行。尽管 URLLC19 等蜂窝通信标准规定了严格的无线接口延迟目标,但现实中的蜂窝和 Wi-Fi 信道会引入分组抖动、尾延迟和短暂断连。因此,工作负载划分基准测试必须在模拟网络受损条件下评估四类系统行为:本地执行与远程执行的决策边界、传输中间激活值与原始传感器输入各自的往返传输开销、网络连接中断时的回退机制(例如降级为紧凑的端侧模型),以及限制原始数据外传的隐私策略。
在受汽车安全完整性等级(ASIL)标准约束的安全关键环境中,本地与远程计算之间的划分受到严格时限约束。对于控制环路时限为 10 ms 至 30 ms 的自动驾驶车辆感知栈而言,广域蜂窝上行链路数百毫秒级的尾延迟是不可接受的。安全关键推理必须完全在具备多传感器同步能力、可耐受严苛温度条件的本地车规级芯片上执行,边云上行链路则严格限于传输非时间关键的遥测数据和地图更新。
无论是云数据中心还是边缘设备,基准测试方法都围绕一条根本性的运行边界展开:系统执行的是训练还是推理。训练需要执行前向传播、将中间激活值存储在内存中、执行反向传播以计算梯度,并通过分布式互连更新模型权重。推理仅执行前向传播,因此运行时可以立即丢弃中间激活值、融合相邻算子内核,并将权重量化为低精度整数格式。由于训练与推理的内存访问模式、算术强度和计算依赖关系截然不同,二者各自需要不同的基准测试框架。
训练与推理
同一加速器可能在截然不同的运行状态下失效:训练运行可能因加速器间梯度同步占满互连带宽而停滞,而模型服务部署则可能因请求突发造成排队延迟而违反其 SLO。训练与推理的评估要求差异如此之大,以至于二者分别拥有独立的基准测试套件:MLPerf Training 和 MLPerf Inference (Mattson et al. 2020; Reddi et al. 2019)。理论峰值 TFLOP/s 对这两类工作负载都缺乏解释力。训练通过数十亿个样本迭代优化参数(模型训练),需要持续的高功率计算、用于存储优化器状态的大容量内存,以及加速器之间高效的集合通信。推理则在限定的响应时间内,使用固定参数处理传入查询(模型服务),要求尾延迟受控、冷启动初始化延迟尽可能低,并具备高能效;机器学习运维 将这些模型服务约束与生产部署和监控联系起来。
这种划分改变了内存分配和算术强度。在训练中,设备内存必须存储模型参数、梯度、优化器状态(例如动量和方差累加器),以及为反向传播保留的中间激活值。这些动态状态需求造成的内存压力,比仅存储权重所需的内存占用高出一个数量级,具体程度受激活检查点、数值精度和批次维度影响。训练依赖混合精度运算和梯度压缩来缓解容量与互连瓶颈。推理则完全舍弃反向计算图和优化器状态;其内存需求由静态权重和动态执行缓冲区决定,例如自回归模型中的键值缓存。因此,模型服务工作负载可以大幅降低精度(详见 section 1.8.2)、采用训练后量化,并进行权重剪枝。硬件利用率也体现了这种运行差异:训练工作负载通过大批量尽可能使加速器算术单元达到饱和,而推理引擎必须处理不可预测、并发度较低的请求到达分布,导致执行单元利用不足,section 1.3.2 中的 Roofline 分析对此进行了建模。
这两个阶段的能耗采用不同的核算方式。训练能耗是一项在模型运行生命周期内摊销的资本投入;大规模训练会消耗数千兆瓦时的电能(训练 GPT-3 约需 1,287 MWh)(Patterson et al. 2021)。推理能耗则随请求量持续累积,当查询量增至数百万次时,会主导整个生命周期的总成本。单次查询能耗遵循物理恒等式 \(E = P \times t\),其中 \(P\) 为平均运行功率,\(t\) 为服务延迟。例如,如果在推理时间窗口内测得的加速器平均功率为 300 W,则一次耗时 10 ms 的推理,其能耗计算为 \(300 W \times 0.01 s = 3 J\),约合 0.0008 Wh;当耗时为 100 ms 时,能耗约为 0.0083 Wh。加速器的 TDP 额定值表示散热能力上限,而非动态功耗,因此,实测运行时功耗对于准确的基准测试至关重要。
从数据—算法—机器的视角来看,这些不同的物理要求塑造了基准测试方法。训练基准测试评估的是:在持续摄入数据的情况下,将算法更新扩展至通过分布式互连连接的加速器后,能否高效收敛;其主要评价指标是达到目标准确率所需的实际经过时间。推理基准测试评估的是:在已配置的硬件上,面对突发查询流量,固定的算法产物能否满足延迟百分位数要求,例如 \(p95\) 和 \(p99\) 响应时间,以及吞吐量目标。由于训练过程中的算法收敛决定了模型准确率的上限,因此,在基准测试生命周期中,应先评估训练效率,再表征推理性能。
训练基准测试
一个说明性的采购失败案例是:某团队购买了更大的 GPU 集群,期望训练速度按比例提升,却发现通信开销和内存瓶颈限制了实际加速比。训练基准测试旨在采购前发现此类差距。它们分为三类:衡量学习进展的收敛指标、衡量计算效率的吞吐量指标,以及衡量分布式性能的可扩展性指标。
Definition 1.3: 机器学习训练基准测试
机器学习训练基准测试是一类机器学习系统基准测试,用于测量在固定数据集和模型上达到目标质量指标(例如指定的验证准确率或损失阈值)所需的时间,从而量化单位资源下的收敛速率。
- 意义:训练基准测试能够揭示硬件规格无法体现的巨大差距。在模型和质量目标保持不变的情况下,不同硬件与软件栈的收敛时间可能相差很大,因为训练性能取决于完整流水线:数据加载 \((D_{\text{vol}}/\text{BW})\)、计算利用率 \((\eta_{\text{hw}})\)、梯度同步 \((L_{\text{lat}})\) 和故障恢复开销。峰值 FLOP/s 规格表无法体现这些交互作用。
- 区别:推理基准测试衡量负载下的单次查询延迟和吞吐量,而训练基准测试衡量整个优化循环中达到目标准确率所需的时间,涵盖数据加载、前向传播、反向传播、梯度同步和优化器更新步骤。起决定作用的约束会从小规模下的计算能力 \((R_{\text{peak}})\) 转变为大规模下的通信能力 \((\text{BW})\)。
- 常见误区:一种常见误解是,训练基准测试衡量的是“GPU 运行得有多快”。在大规模条件下,相较于峰值 FLOP/s,梯度同步所需的互连带宽 \((\text{BW})\) 和容错开销(检查点 I/O、慢任务缓解)往往对基准测试结果具有更大的影响。
训练基准测试用于验证硬件加速是否兑现了承诺的训练吞吐量。硬件加速 中讨论的 GPU 集群、TPU pod 和分布式训练策略都宣称能实现显著加速,而训练基准测试能够揭示哪些宣称在真实工作负载下成立。它们评估硬件配置、数据加载机制和分布式训练策略在训练生产规模模型时的表现。这些基准测试至关重要,因为训练是机器学习系统中最大的资本支出;只有严格测量达到目标准确率所需的时间,才能判断这项资本投入是否带来了相称的价值,还是被低效扩展、内存瓶颈或通信开销所消耗。
例如,OpenAI 的 GPT-320 (Brown et al. 2020) 等大规模模型,具有 175B 个参数,使用约 570 GB 的过滤后 CommonCrawl 文本进行训练(这些文本来自约 45 TB 的原始数据集,并与其他来源的数据结合,形成 300B 个训练词元),凸显了现代训练对计算的巨大需求。标准化机器学习训练基准测试对底层系统进行系统性评估,以确保硬件和软件配置能够高效满足这些前所未有的需求。
训练基准测试的动机
MLPerf Training (Mattson et al. 2020; MLCommons 2024c) 为这类达到目标质量所需时间的测量提供了标准化框架。Figure 5 表明,在连续发布的基准测试版本中,性能提升超过了图中绘制的摩尔定律基线,其中一些工作负载在多年间实现了大幅加速 (Tschand et al. 2024)。这一比较体现了一项核心原则:能够被测量的方面,就会得到改进。标准化基准测试框架形成了竞争压力,推动整个机器学习计算栈快速优化。
\begin{tikzpicture}[font=\small\sffamily]
\makeatletter
\newcommand*\short[1]{\expandafter\@gobbletwo\number\numexpr#1\relax}
\makeatother

\begin{axis}[
   axis line style={draw=none},
  /pgf/number format/.cd,
  width=163mm,
  height=63mm,
  legend style={at={(0.16,0.98)}, anchor=north},
  legend cell align=left,
  legend style={fill=BrownL!40,draw=BrownLine,row sep=-1.1pt,
  font=\fontsize{7pt}{7}\selectfont\sffamily},
  date coordinates in=x,
  table/col sep=comma,
  xticklabel=\month/\short{\year},
  xtick={2018-12-01,2019-06-01,2019-12-01,
  2020-06-01,2020-12-01,2021-06-01,2021-12-01,2022-06-01,2022-12-01,
 2023-06-01,2023-12-01, 2024-06-01},
  x tick label style={rotate=0, anchor=north},
  xmin=2018-10-18,
  xmax=2024-07-30,
  ymin=0.95, ymax=64,
  ymode=log,
  log basis y=2,
  ytick={1,2,4,8,16,32,64},
  yticklabels={1,2,4,8,16,32,64},
  ylabel={},
  title={相对性能 -- 最佳结果 -- 封闭组、已上市、本地部署},
  grid=both,
  major grid style={black!60},
        tick label style={/pgf/number format/assume math mode=true},
        ticklabel style={font=\footnotesize\sffamily},
        xticklabel style={yshift=-3pt},
]
%green-ResNet
\addplot[green!70!black,mark=Mercedes star,
mark options={line width=1pt},
mark size=3pt,line width=1.15pt,
] table[x=Date, y=Y,  col sep=comma] {
Y,Date
1, 2018-12-15
4.87, 2019-07-15
8.2, 2020-07-15
15.5, 2021-06-15
17.85, 2021-12-15
32.5, 2022-06-15
32.5, 2022-11-15
33.8, 2023-06-15
33.8, 2023-11-15
33.8, 2024-06-15
};
\addlegendentry{ResNet}
%diamond-Mask R-CNN
\addplot[cyan!90!black,mark=diamond*,
mark size=2pt,line width=1.15pt,
] table[x=Date, y=Y,  col sep=comma] {
Y,Date
1, 2018-12-15
 3.95, 2019-07-15
6.95, 2020-07-15
18.25, 2021-06-15
22.15, 2021-12-15
32.5, 2022-06-15
32.5, 2022-11-15
48.8, 2023-06-15
48.8, 2023-11-15
};
\addlegendentry{Mask R-CNN}
%triangle RetinaNet
\addplot[OliveLine,
line width=1.15pt,
mark size=2pt,mark=triangle*,
mark options={line width=1pt}
] table[x=Date, y=Y,  col sep=comma] {
Y,Date
3.45, 2022-06-15
4.35, 2022-11-15
5.3, 2023-06-15
8.6, 2023-11-15
10.3, 2024-06-15
};
\addlegendentry{RetinaNet}
%red 3D-U-Net
\addplot[red,line width=1.15pt,
mark=square*,mark size=1.5pt,
] table[x=Date, y=Y,  col sep=comma] {
Y,Date
2.45, 2021-06-15
5.8, 2021-12-15
6.05, 2022-06-15
6.05, 2022-11-15
8.94, 2023-06-15
9.45, 2023-11-15
9.4, 2024-06-15
};
\addlegendentry{3D-U-Net}
%pentagon-Bert-large
\addplot[BlueLine,line width=1.15pt,
  mark=pentagon*,
  mark size=2pt,
] table[x=Date, y=Y,  col sep=comma] {
Y,Date
1.78, 2020-07-15
4.45, 2021-06-15
6.3, 2021-12-15
7.95, 2022-06-15
6.9, 2022-11-15
10.6, 2023-06-15
11.9, 2023-11-15
11.99, 2024-06-15
};
\addlegendentry{BERT-Large}
%violet GPT3
\addplot[pink!59!orange,line width=1.15pt,
mark=|,
  mark options={line width=1pt},
  mark size=2pt,
] table[x=Date, y=Y,  col sep=comma] {
Y,Date
4.8, 2023-06-15
13.45, 2023-11-15
15.39, 2024-06-15
};
\addlegendentry{GPT-3}
%red-DLRM
\addplot[RedLine,line width=1.15pt,
  mark=star,
  mark size=3pt,mark options={line width=1pt}
] table[x=Date, y=Y,  col sep=comma] {
Y,Date
1.78, 2020-07-15
5.95, 2021-06-15
9.3, 2021-12-15
10.0, 2022-06-15
10, 2022-11-15
};
\addlegendentry{DLRM}
%plus DLRM-dcnv2
\addplot[BrownLine,
line width=1.15pt,
mark size=2pt,mark=+,
mark options={line width=1pt}
] table[x=Date, y=Y,  col sep=comma] {
Y,Date
4.8, 2023-06-15
7.55, 2023-11-15
7.9, 2024-06-15
};
\addlegendentry{DLRM-DCNv2}
%violet-Stable diffusion v2
\addplot[VioletLine,
line width=1.25pt,
mark size=2pt,mark=x,
mark options={line width=1pt}
] table[x=Date, y=Y,  col sep=comma] {
Y,Date
5.5, 2023-11-15
9.8, 2024-06-15
};
\addlegendentry{Stable Diffusion v2}
%orange-Moore's Law Cumulative
\addplot[orange,line width=1.25pt,
mark size=2pt,mark=*,
] table[x=Date, y=Y,  col sep=comma] {
Y,Date
1, 2018-12-15
1.23, 2019-07-15
1.78, 2020-07-15
2.45, 2021-06-15
2.85, 2021-12-15
3.45, 2022-06-15
3.9, 2022-11-15
4.8, 2023-06-15
5.5, 2023-11-15
6.6, 2024-06-15
};
\addlegendentry{摩尔定律累计增长}
\end{axis}
\end{tikzpicture}训练基准测试不仅记录这些进展,还揭示了通过系统性评估才能显现的低效问题:数据加载缓慢、加速器利用不足、内存开销过大,以及削弱扩展效率的通信瓶颈。硬件加速 中确立的硬件理论能力(例如 GPU 的 TFLOP/s、TPU 的张量吞吐量),只有在基准测试于真实条件下加以验证后,才能转化为实际的训练加速。
训练基准测试具有四项相互关联的功能。首先,它们通过在标准化任务上对不同加速器架构和框架(TensorFlow、PyTorch)进行厂商中立的比较,支持硬件和软件优化,为数据中心和云环境的硬件选型提供指导。混合精度训练21和内存高效的数据加载等软件优化,也通过同样的方式加以量化。其次,它们评估可扩展性:增加 GPU 数量理应按比例缩短训练时间,但在实践中,通信开销、同步延迟和内存瓶颈会限制扩展效率。训练基准测试量化这些损失,揭示基础设施投入能否带来成比例的回报。第三,它们支持成本与能耗核算:大规模训练运行会消耗数千兆瓦时的电能,跟踪每次训练运行成本和单位训练进展功耗的基准测试,有助于组织在计算能力与可持续发展目标之间取得平衡。最后,标准化的评估标准、受控的随机性、提交规则和审计,使比较更具可复现性,并限制针对特定实现采取的取巧做法。
训练指标
从系统角度看,训练基准测试评估模型达到预定义准确率阈值的效率。吞吐量和可扩展性等指标,只有在模型达到目标准确率这一前提下才有意义;没有这一约束,优化原始速度可能产生误导。MLPerf Training 通过为每项任务定义具体的准确率目标,将这一原则明确化:训练速度很快却未达到目标的系统,其结果无效;准确收敛但速度过慢的系统,则不具备实用性。有效的基准测试需要平衡速度、效率与准确率收敛。
时间与吞吐量
评估训练效率的主要指标之一,是达到预定义准确率阈值所需的时间。训练时间 \((T_{\text{train}})\) 衡量模型收敛到可接受性能水平所需的时长,反映系统的整体计算效率。设 \(\text{Accuracy}(t)\) 为模型在训练时刻 \(t\) 的准确率,目标准确率为基准测试规定的阈值(例如,MLPerf 中 ResNet-50 在 ImageNet 上的 top-1 准确率为 75.9%)。Equation 1 对该指标给出了形式化定义,使基准测试聚焦于系统多快能够取得有意义的结果: \[T_{\text{train}} = \inf \big\{t \geq 0 : \text{Accuracy}(t) \geq \text{target accuracy} \big\} \tag{1}\]
从未达到目标的运行,其达到目标准确率所需的时间不存在有限值,从而避免仅凭原始训练速度奖励未能满足基准测试质量标准的系统。
吞吐量22通常表示为每秒处理的训练样本数,为系统性能提供了另一种度量。设 \(N_{\text{samples}}\) 为处理的训练样本总数,\(T_{\text{train}}\) 为 equation 1 中的训练时间。Equation 2 将处理的样本数除以训练时间,明确给出了这一速率: \[\text{Throughput} = \frac{N_{\text{samples}}}{T_{\text{train}}} \tag{2}\]
吞吐量本身并不能保证结果有意义,因为模型可能快速处理大量样本,却不一定达到期望的准确率。例如,MLPerf Training 针对不同工作负载规定了质量目标;ResNet-50 在 ImageNet 上的结果必须达到 75.9% 的 top-1 准确率目标才有效 (Mattson et al. 2020; MLCommons 2024c)。假设某个系统每秒处理大量图像,却无法达到目标,那么它的基准测试结果无效;而速度较慢但能够高效收敛的系统可能更可取。这说明,应结合达到目标准确率所需的时间来评估吞吐量,而不应将其视为独立的性能度量。
MLCommons. 2024c. MLPerf Training Benchmark.
可扩展性与并行性
可扩展性衡量增加资源时训练性能改善的有效程度。理想情况下,GPU 数量翻倍应使训练时间减半。实践中,通信开销、内存带宽限制和并行化低效,使扩展效果远低于线性水平。
Napkin Math 1.3: 扩展效率计算
问题:某团队在 ImageNet 上训练 ResNet-50。单 GPU 训练耗时 24 hours。使用 8 GPUs 时,训练耗时 4 hours。这样的扩展效果好吗?效率损失在哪里?
Table 7: 扩展效率损失来源:将损失的效率份额示例性地分解为可度量的开销类别,以及用于对各项损失进行归因的相应度量信号。实际百分比取决于模型、互连、存储、批量调度和框架实现。
步骤 1:定义扩展效率。 对于强扩展(问题规模固定,处理器数量增加),设 \(T(1)\) 为单 GPU 上的训练时间,\(T(N_{\text{GPU}})\) 为 \(N_{\text{GPU}}\) 个 GPU 上的训练时间,\(N_{\text{GPU}}\) 为 GPU 数量。Equation 3 定义了效率: \[\text{Eff}_{\text{scaling}} = \frac{T(1)}{N_{\text{GPU}} \times T(N_{\text{GPU}})} \times 100\% \tag{3}\]
步骤 2:计算效率。 \(\text{Eff}_{\text{scaling}}(8) = \frac{24\,\text{hours}}{8 \times 4\,\text{hours}} \times 100\%\) = 24/32 = 75 percent
在完美扩展的情况下,8 GPUs 应在 3 hours 内完成训练(24 hours/8 GPUs)。实际耗时 4 hours 对应的效率为 75 percent。
步骤 3:分析效率损失。Table 7 将“损失”的 25 percent 分解为可度量的开销类别,包括梯度同步、内存复制、负载不均衡和批量大小效应,每一类都可以通过不同的性能剖析信号加以度量。
| 来源 | 示例占比 | 度量方式 |
|---|---|---|
| 梯度同步 | 10–15% | 每步的 AllReduce 时间 |
| 内存复制(CPU\(\leftrightarrow\)GPU) | 3–5% | 数据传输性能剖析 |
| 负载不均衡 | 2–5% | 各 GPU 的单步时间方差 |
| 批量大小效应 | 2–5% | 更大批量的收敛行为不同 |
步骤 4:系统层面的认识。 随着 \(N_{\text{GPU}}\) 增大,扩展效率会下降,因为通信开销随 GPU 数量增加,而每个 GPU 的计算量则会减少。在本例中,八个 GPU 达到了 75% 的效率;在更大规模下,同样的计算清楚地说明了为何必须进行精细的通信优化和输入流水线优化。
MLPerf 报告原始性能,而扩展效率可以通过相互匹配的提交结果计算得出:一个以 50% 的效率实现 2\(\times\) 吞吐量的系统,可能不如以 90% 的效率实现 1.5\(\times\) 吞吐量的系统,具体取决于成本约束。
训练 GPT-3 等大规模模型时,OpenAI 在分布式训练配置中使用了由大量 NVIDIA V100 GPU 组成的集群 (Brown et al. 2020; Patterson et al. 2021)。Google 的 TPU v4 系统在数据中心规模上展示了同样的分布式系统经验:增加计算资源能够提供更多原始算力,但性能与韧性取决于网络通信、拓扑结构和运维管理 (Jouppi et al. 2023; Zu et al. 2024)。MLPerf 等基准测试量化系统在多个加速器上的扩展效果,帮助理解分布式训练中的低效问题出现在何处。
Brown, Tom B., Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared Kaplan, Prafulla Dhariwal, Arvind Neelakantan, et al. 2020. “Language Models Are Few-Shot Learners.” Advances in Neural Information Processing Systems 33: 1877–901. https://doi.org/10.48550/arxiv.2005.14165.
Zu, Y., A. Ghaffarkhah, H.-V. Dang, B. Towles, S. Hand, S. Huda, A. Bello, et al. 2024. “Resiliency at Scale: Managing Google’s TPUv4 Machine Learning Supercomputer.” 21st USENIX Symposium on Networked Systems Design and Implementation (NSDI 24), 761–74.
训练中的并行性分为数据并行、模型并行和流水线并行(参见 模型训练),每种方式都面临不同的挑战。数据并行是最常用的策略,它将训练数据集划分到多个计算节点上。这种方法的效率取决于同步机制和梯度通信开销。相比之下,模型并行划分的是神经网络本身,需要处理器之间高效协调。基准测试评估系统能否在不损害准确率收敛的情况下,有效管理这些并行策略。评估并行性的一项关键指标是扩展效率,它量化新增计算能力中有多少转化为了实际加速。强扩展评估在总工作负载固定时,增加处理器能否缩短训练时间;而弱扩展则按处理器数量成比例地增加问题规模,使每个设备的工作负载保持不变,以衡量集群能否在固定时间预算内训练更大的模型或处理更大的数据集,同时避免通信瓶颈占据主导地位。
资源利用率
机器学习训练的效率不仅取决于速度和可扩展性,还取决于可用硬件资源的利用程度。计算利用率衡量 GPU 或 TPU 等处理单元在训练期间积极参与计算的程度。在现代训练基准测试中,计算利用率通过模型 FLOPs 利用率(MFU)进行形式化量化,即理论模型运算量与相同时间内机器峰值计算能力之比。MFU 与硬件 FLOPs 利用率(HFU)不同,后者统计包括激活重计算在内的所有已执行运算;重计算激活会提高 HFU,而 MFU 保持不变,从而揭示额外的 FLOPs 究竟代表真实的学习进展,还是为绕过内存容量限制而付出的工作量。利用率较低可能表明数据移动、内存访问或低效的工作负载调度存在瓶颈。
例如,在 TPU 集群上训练 BERT 时,即使加速器具备很高的原始计算能力,输入流水线的低效仍可能限制整体吞吐量。如果存储读取或预处理跟不上,系统就无法让 TPU 始终满负荷工作。对资源利用率进行性能剖析可以识别瓶颈,而预取、缓存和提高输入处理并行度等优化能够改善持续性能。
内存带宽是另一个关键因素,因为深度学习模型在训练期间需要频繁访问大量数据。如果内存带宽成为限制因素,仅增加计算能力无法提高训练速度。基准测试评估模型利用可用内存的效果,确保存储、主存和处理单元之间的数据传输速率不会成为性能瓶颈。
I/O 性能也直接影响训练效率,尤其是在处理无法完全装入内存的大型数据集时。基准测试评估数据加载流水线的效率,包括预处理操作、缓存机制和存储读取速度。无论计算能力多强,未能优化数据加载的系统都可能出现严重的速度下降。
能源效率与成本
训练大规模机器学习模型需要大量计算资源,因而会产生可观的能源消耗和经济成本。能源效率指标量化训练工作负载的电力使用情况,帮助识别能够在优化计算效率的同时尽量减少能源浪费的系统。对可持续发展的日益关注,促使基准测试纳入能源相关指标,例如 MLPerf Training 中衡量每次训练运行电力消耗的指标。同样的电力核算也适用于推理,在推理中,精度成为影响能耗的主要调节手段;section 1.9 详细说明了 INT8 量化为何能够通过同时减少内存流量和算术运算成本,降低每次推理的能耗。
据估计,训练 GPT-3 消耗了 1,287 MWh 的电能 (Patterson et al. 2021)。如果系统能够通过更少的训练迭代达到相同准确率,就能直接减少能源消耗。考虑能耗的基准测试有助于指导硬件和训练策略的开发,使其在保持准确率目标的同时优化能源效率。
成本考量不仅涉及用电,还包括硬件支出、云计算费用和基础设施维护。训练基准测试通过结合资源支出来衡量训练时间,帮助了解不同软硬件配置的成本效益。组织可以利用这些基准测试,在选择训练基础设施时平衡性能与预算约束。
容错性与鲁棒性
训练工作负载通常会持续运行较长时间,有时长达数天或数周,因此容错是必须考虑的重要因素。具备韧性的系统必须能够应对意外故障(硬件故障、网络中断和内存错误),同时不影响模型收敛至目标准确率。
在大规模云端训练中,节点故障是运维中不可回避的现实。如果分布式集群中的某个 GPU 节点发生故障,训练必须能够继续进行,且不能损坏模型。生产系统通过检查点实现容错,定期保存进度,使故障不会导致训练从头开始。然而,对于大语言模型(LLM)训练,检查点保存本身就是一个系统瓶颈:单个检查点必须将模型权重和优化器状态写入网络存储,在千亿参数规模下,这可能意味着训练恢复前需要写入数百 GB 的数据。在写入期间,加速器可能停顿,延长有效迭代时间,从而增加达到目标准确率所需的时间。生产级 LLM 训练系统通过将检查点 I/O 与下一个训练步骤重叠执行(异步检查点保存),或使用高带宽并行文件系统来减少空闲时间,以应对这一问题。MLPerf Training 本身主要衡量标准化工作负载下达到目标质量所需的时间,并不直接对故障恢复进行基准测试,但检查点开销是任何实际持续吞吐量测量中的重要组成部分。
可复现性与标准化
可复现性研究反复表明,当随机种子、硬件、框架版本或实现细节发生变化时,基准测试中的小幅提升可能消失 (Henderson et al. 2018)。这种失效情形揭示了一个普遍问题:训练基准测试涉及随机过程(权重初始化、数据打乱、dropout 掩码),这些过程与硬件特定行为(浮点舍入、内存布局、编译器优化)相互作用,使结果在不同环境之间可能出现显著差异。
Henderson, Peter, Riashat Islam, Philip Bachman, Joelle Pineau, Doina Precup, and David Meger. 2018. “Deep Reinforcement Learning That Matters.” Proceedings of the AAAI Conference on Artificial Intelligence 32 (1): 3207–14. https://doi.org/10.1609/aaai.v32i1.11694.
更深一层的非确定性来自并行硬件本身。例如,在图神经网络等模型中,稀疏嵌入的梯度累积会使用并行原子加法;当并发更新指向同一内存位置时,这类操作在线程间的执行顺序是不确定的。由此产生的浮点求和顺序在不同运行中会发生变化,即使输入和随机种子完全相同,也会产生逐位不同的梯度。在这些情况下,要强制实现逐位精确的可复现性,就必须禁用并行累积路径,从而降低训练吞吐量。这是可复现性与性能之间的直接权衡,基准测试规程必须明确处理这一问题。如果不对所有这些变异来源进行显式控制,基准测试数值反映的就只是特定条件的共同作用,而非系统的真实能力。
MLPerf Training 通过标准化数据预处理、目标质量规则,以及多次符合验收条件的运行来刻画随机变异,从而应对这一问题 (Mattson et al. 2020)。其目的不仅是完成一次快速运行,还要证明所报告的性能反映的是系统能力,而非随机因素的有利组合。
因此,对于训练基准测试,可复现性涵盖完整的运行条件,而不仅仅是随机种子。可信的报告必须保留模型代码的提交版本、数据集校验和、预处理流水线、随机种子方案、框架与编译器版本、精度策略、批次调度方案、硬件拓扑、温度与功率限制,以及检查点行为。报告还必须给出符合验收条件的各次运行的分布,而不能只报告单次最佳运行。只有这样,基准测试才能将真正的系统改进与软件版本、硬件状态和随机训练路径之间的有利相互作用区分开来。
训练性能评估
全面的训练基准测试需要考察系统行为的多个维度,因为每个维度都揭示了硬件投入未能转化为收敛进展的一种不同原因。Table 8 总结了评估系统级训练性能时常用的核心类别及相关指标,为理解训练系统在不同工作负载和配置下的行为提供了框架。
| 类别 | 关键指标 | 基准测试用途示例 |
|---|---|---|
| 训练时间与吞吐量 | 达到目标准确率所需的时间(秒、分钟、小时);吞吐量(样本/秒) | 比较不同 GPU 架构的训练速度 |
| 可扩展性与并行性 | 扩展效率(理想加速比的百分比);通信开销(延迟、带宽) | 分析大模型的分布式训练性能 |
| 资源利用率 | 计算利用率(GPU/TPU 使用率百分比);内存带宽(GB/s);I/O 效率(数据加载速度) | 优化数据流水线以提高 GPU 利用率 |
| 能效与成本 | 每次运行的能耗(MWh、kWh);每瓦训练吞吐量(FLOP/s/W) | 评估高能效训练策略 |
| 容错与鲁棒性 | 检查点开销(每次保存耗时);恢复成功率(百分比) | 评估云端训练系统的故障恢复能力 |
| 可复现性与标准化 | 不同运行间的变异(准确率、训练时间的百分比差异);框架一致性(TensorFlow、PyTorch 与 JAX 的比较) | 确保不同硬件上的基准测试结果一致 |
这些维度之间的相互作用无法通过表格充分呈现。如果降低精度(例如使用 TF32)虽然提高了吞吐量,却增加了达到目标准确率所需的迭代次数,那么这种吞吐量提升就没有意义。因此,达到目标准确率所需的时间是纠正此类判断不可或缺的指标。扩展效率在节点数较少时可能接近线性,但随着梯度同步成本占据主导地位,其增长会逐渐放缓。资源利用率指标能够揭示其中的原因:GPU 利用率中等的 BERT 预训练任务,其瓶颈可能在于数据流水线,而非加速器。用于容错的检查点保存会引入自身的开销,因此需要在韧性与性能之间取得平衡。
在所有维度上,测量准确性都取决于对硬件变异性的控制。GPU 加速时钟23行为和热节流24可能使结果产生足以淹没所宣称的小幅增益的变化,因此,重复运行和统计严谨性(如前文所述)对于区分真实性能差异与噪声至关重要。
尽管已有定义明确的基准测试方法,但当团队将某一项训练指标视为整个优化闭环的替代时,仍会反复得出误导性结论。以下陷阱说明,基准测试必须在哪些方面将速度、收敛、扩展能力和可复现性紧密联系起来。
训练基准测试出现问题,通常始于将吞吐量视为目标,而非学习过程的一部分。系统可以通过使用较低数值精度、减少同步,甚至跳过某些计算来提高每秒处理的样本数,但这些改变只有在保持收敛性的前提下才有帮助。TF32 运行的单步速度可能快于 FP32,但如果数值不稳定性增加了达到目标准确率所需的迭代次数,其总体表现仍可能更差。因此,基准测试必须结合达到目标准确率所需的时间来报告吞吐量,确保速度优化不会以牺牲收敛效率为代价。
扩展带来了第二个陷阱:少量节点下的结果可能呈现线性扩展,直到通信和同步开始占据主导地位。前文的八 GPU 计算说明,一旦同步成为制约因素,就不能对少量节点下的结果进行线性外推。
正如 section 1.7.2.2 中的扩展效率计算所示(其中 8 GPUs 仅达到 75 percent 的效率),将单节点结果外推至集群是一种常见错误。Google 在包含 4,096 个节点的 TPU v4 集群上的经验表明,这种效应在极大规模下尤为明显,此时同步难题成为主导性能的因素。恰当的基准测试应显式测量扩展效率,而不是假设性能会线性提升。
同样的严谨原则也适用于故障和干扰。许多基准测试假设处于理想化条件下,不会发生硬件故障、网络不稳定和工作负载干扰,尽管这些事件在大规模系统中十分常见。有效的基准测试应考虑检查点开销、故障恢复效率和资源争用,而不是仅报告最佳情况下的性能。
可复现性构成另一种威胁。结果必须能够跨技术栈复现:使用加速线性代数优化的 TensorFlow 运行,与在 PyTorch 中使用自动混合精度(AMP)训练同一模型时,可能表现出不同的收敛行为,因为浮点运算、内存布局和优化策略都可能改变训练时间和准确率。
要避免这些陷阱,就需要结合准确率收敛来评估吞吐量,全面评估扩展效率,并考虑现实中的故障,而不是假设理想化条件。然而,即使模型训练得很高效,仍然需要验证其部署性能,这会使评估框架发生根本变化。
推理基准测试
训练基准测试衡量系统学习的速度;推理基准测试衡量系统提供服务的可靠程度。这一转变改变了评估的几乎所有方面。只要收敛持续推进,训练就能容忍迭代时间的波动;推理则需要稳定的延迟,因为用户会感受到每一次缓慢响应。训练优化的是数小时内的总体吞吐量;推理则必须应对不可预测的请求模式和特定场景的时限要求。大规模基准训练通常使用专用高性能硬件,而推理则覆盖从数据中心 GPU 到手机,再到微控制器的各种环境。
优化相关章节的内容在此汇合:硬件加速 中的加速硬件运行 模型压缩 中的压缩模型,以提供实时预测。推理基准测试揭示了这些理论加速能否在实际部署条件下转化为真实的延迟降低。
Definition 1.4: 机器学习推理基准测试
机器学习推理基准测试是一类机器学习系统基准测试,用于量化系统在指定吞吐量水平下满足延迟约束 \((L_{\text{lat}})\) 的能力,并在具有代表性的服务场景中测量由场景定义的延迟统计量、吞吐量(每秒查询数)和能效。
- 意义:推理基准测试揭示了在特定工作负载和系统下,无约束吞吐量与满足服务级别目标(SLO,例如 p99 延迟目标)时的吞吐量之间的差距。在高负载下,排队延迟可能使尾延迟超过目标;如果基准测试不在每个吞吐量水平上强制满足延迟目标,就无法发现这一差距。
- 区别:训练基准测试衡量在固定数据集上达到目标准确率所需的时间,而推理基准测试衡量真实负载模式下的逐查询响应时间,捕捉决定实际服务经济性的排队效应、批处理权衡和冷启动开销。
- 常见陷阱:一种常见误解是,平均延迟足以作为基准指标。平均延迟较低但 p99 尾部较长的系统,可能对最慢的 1% 请求违反基于百分位数的生产 SLO;当请求速率很高时,这一小部分比例就对应着大量受影响的用户。基准测试必须报告服务目标所指定的延迟统计量,而不能假设均值或 p99 在所有情况下都具有决定性。
推理基准测试的动机
大规模基准训练通常在专用数据中心硬件上运行,而推理覆盖差异极大的部署场景,从自动驾驶和对话式 AI 等实时应用,到移动设备、物联网系统和嵌入式处理器。这种多样性也体现在硬件上:GPU 和 TPU 主导大规模训练,而推理工作负载则经常使用 NPU、现场可编程门阵列,以及 Google Edge TPU 等专用推理芯片。25推理基准测试评估硬件选择、模型优化和数据流水线设计在这些部署环境中的协同效果。
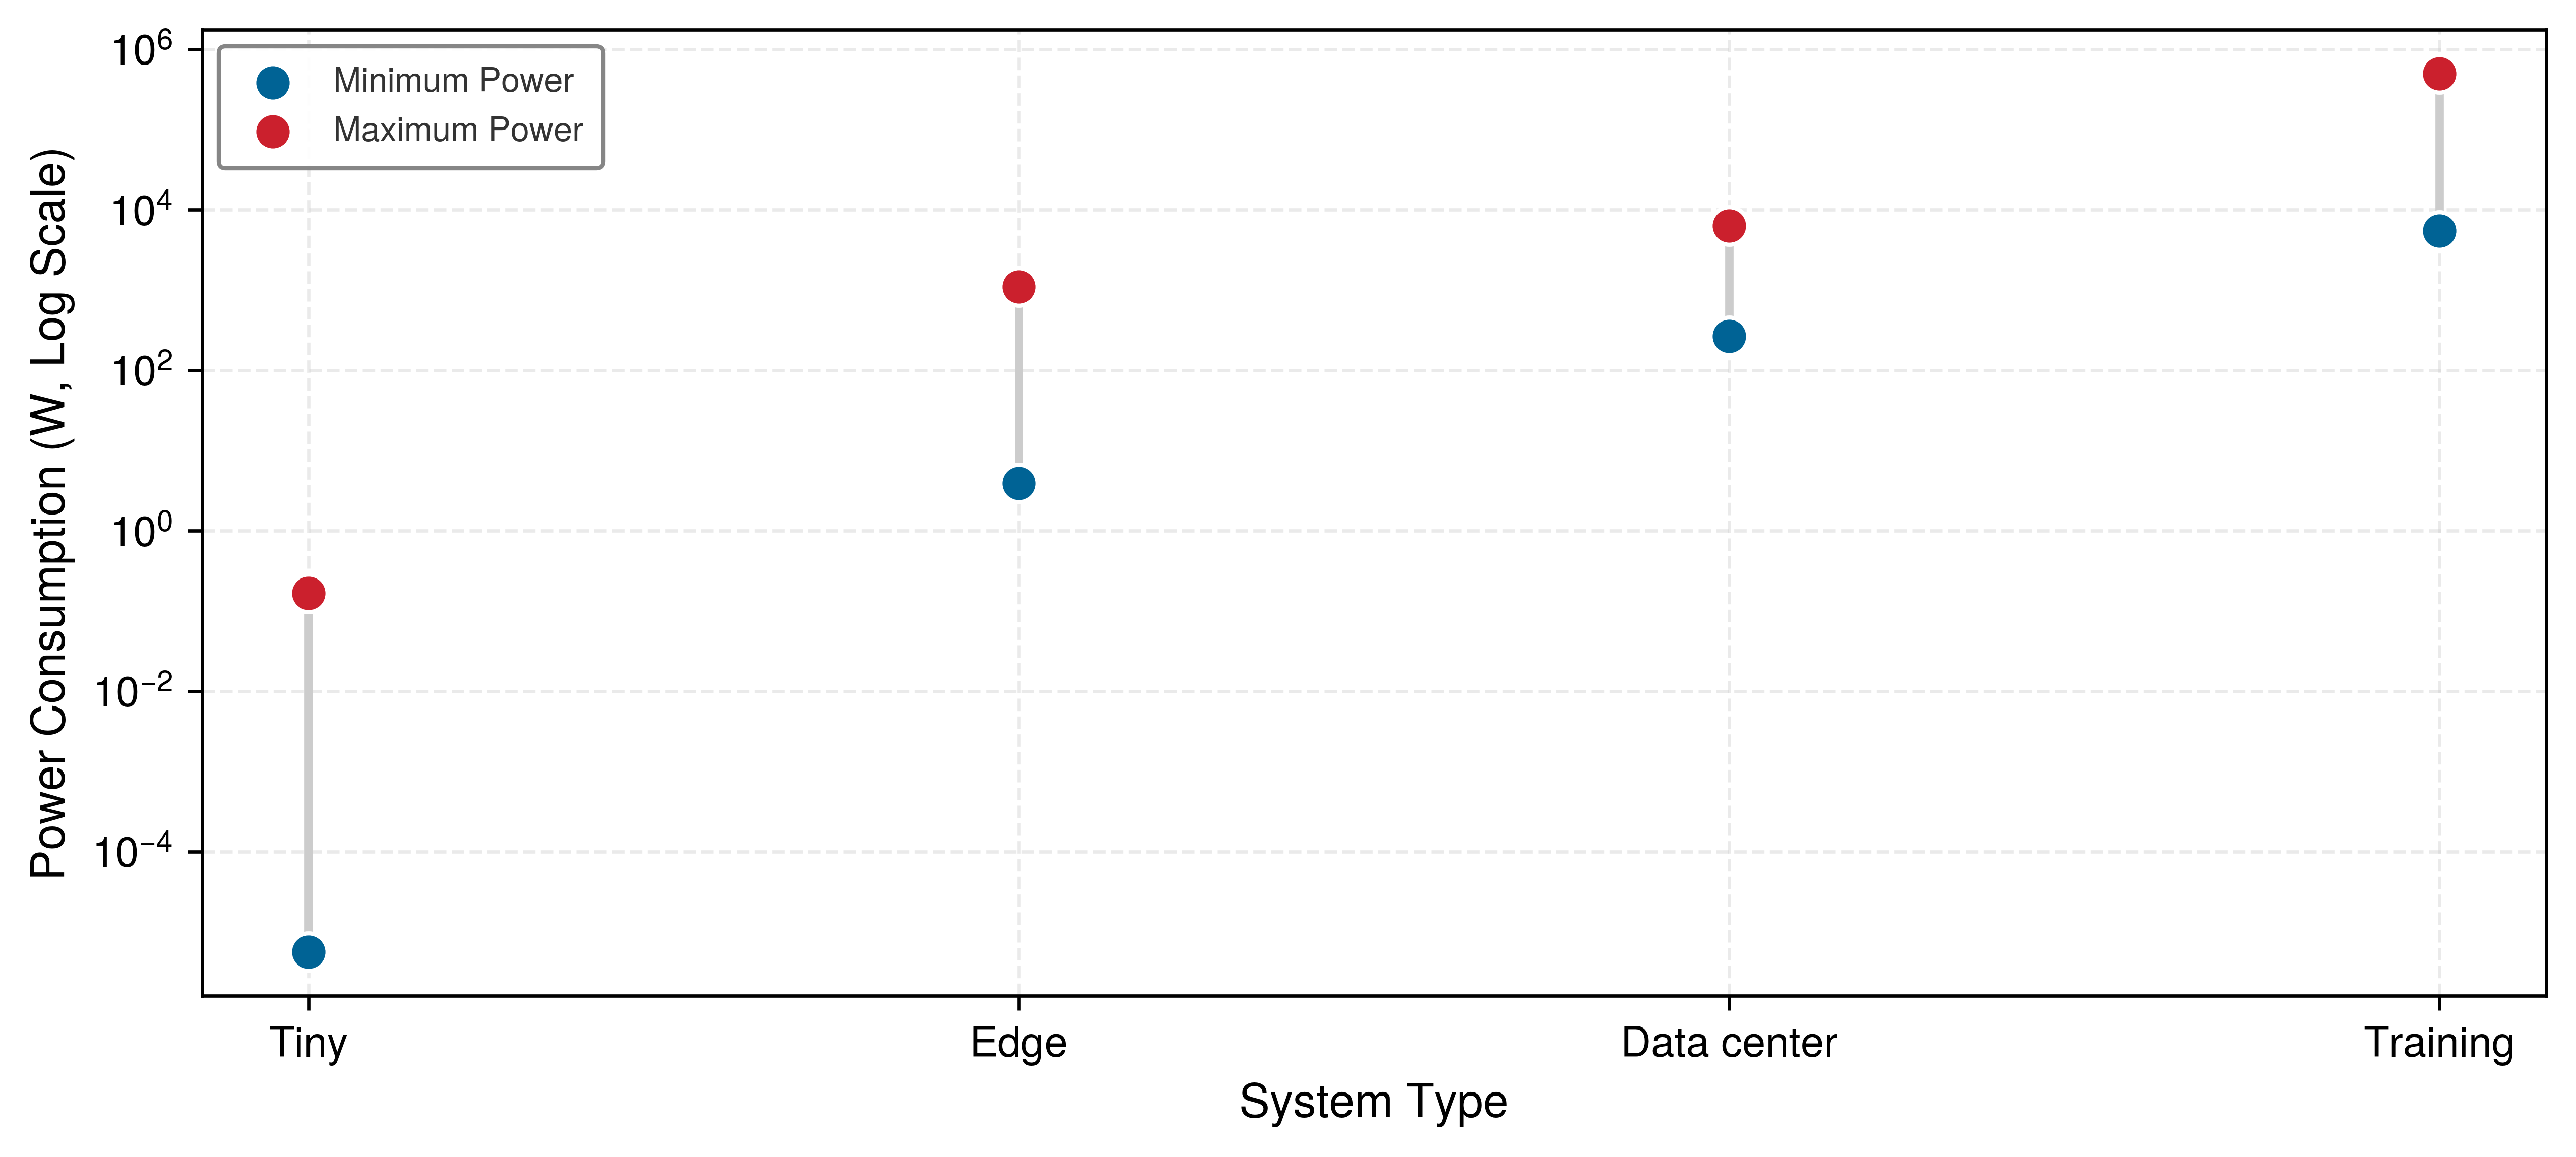
将推理工作负载扩展到云服务器、边缘平台、移动设备和 TinyML 系统,会引入额外的复杂性。Figure 6 揭示了这些系统之间巨大的功耗差异,从微型嵌入式设备的微瓦级,到数据中心训练集群的数百千瓦级,跨越十多个数量级。这些范围具有代表性,但并非穷尽所有情况。如此大的跨度解释了为什么不存在适用于所有部署场景的单一基准测试:对数据中心优化有意义的指标(每机架千瓦数),对于电池供电的边缘设备(每次推理毫瓦数)就不再适用。推理基准测试必须评估各个规模下延迟、成本与能效之间的权衡,以帮助组织作出有依据的部署决策。
这些部署差异构成了推理基准测试的实际动机:评估模型从开发转向生产服务时出现的瓶颈。其驱动因素与训练类似(硬件优化、可扩展性、成本、公平比较),但具体内容不同。软件优化框架采用算子融合(参见 模型压缩 和 硬件加速)、精度校准和内核调优等推理专用技术,必须在真实条件下测量这些技术对延迟、吞吐量和能效的影响,以确认它们能够在不降低准确率的前提下带来实际改进。自动调优编译器还引入了一个隐藏变量:针对每一组模型与硬件的组合,编译器本身可能需要数小时进行优化。这意味着基准测试结果既反映硬件能力,也反映调优预算,而比较不同提交结果时,需要对编译器优化时间进行归一化处理。
可扩展性方面的关注点也发生了变化。训练通过增加 GPU 数量来缩短固定工作负载达到目标准确率所需的时间,而推理必须根据波动的用户需求动态扩展,在不违反延迟保证的前提下处理流量突增。冷启动性能,即模型加载并开始处理查询所需的时间,成为推理特有的关注点,在训练中没有对应问题。按需加载模型的应用,例如无服务器 AI 部署,对这类开销尤其敏感。
推理的成本和能耗特征与训练存在显著差异。训练成本集中在一次次独立运行中,这些运行可能随着数据、目标或模型的变化而重复进行;推理成本则随着生产流量持续累积。大规模运行低效模型可能成倍增加云计算开支,而在电池供电设备上,过量计算会直接影响可用性。衡量每次推理请求成本和每瓦效率的基准测试,有助于组织在不同部署平台上同时优化性能与可持续性。
MLPerf Inference 将训练基准测试确立的标准化比较原则扩展至部署场景,为图像分类、目标检测和语音识别等任务定义跨硬件平台的评估标准。这确保推理性能比较具有意义且可复现,同时考虑延迟要求和能效等部署特定约束 (Reddi et al. 2019)。
推理指标
例如,语音助手必须足够迅速地响应,使用户感觉不到迟滞;推荐引擎则必须对足够多的候选项进行评分,以跟上用户滚动浏览的速度。这些约束(延迟和吞吐量)定义了所有服务优化必须遵守的性能边界。推理指标将这些现实需求形式化为可测量的量,它们与训练指标的差异是性质上的,而不仅仅是程度上的,因为优化目标从训练期间的收敛速率转向了服务期间延迟的可预测性。训练优化吞吐量和达到目标准确率所需的时间;推理则优化延迟一致性、资源效率和服务级别的可预测性,覆盖从处理数百万请求的云数据中心,到在严格功率约束下运行的边缘设备。
延迟与尾延迟
延迟(在 机器学习系统 中已介绍)衡量推理系统处理输入并生成预测所需的时间。平均延迟很有用,但它无法反映高需求场景下会降低可靠性的高百分位延迟。
为反映这一情况,基准测试通常会测量尾延迟,26它概括的是延迟分布中延迟较高的尾部,而非最坏情况。这些数值通常以第 95 百分位(p95)或第 99 百分位(p99)延迟报告,表示 95% 或 99% 的推理在给定时间内完成。对于具有硬截止时间的应用,除这些百分位数外,还需要显式分析截止时间违约或最坏情况。
这些测量构成了服务级别目标(SLO)和 SLA 的基础,二者将性能预期形式化。
Definition 1.5: SLO 与 SLA
SLO 与 SLA 是生产环境机器学习服务系统的性能承诺规范:服务级别目标(SLO)是服务级别指标的目标值或目标范围,而 SLA 则是规定服务目标及未达标后果的合同。
- 意义:延迟 SLO 通过为特定延迟指标设定目标,约束机器学习系统铁律中的 \(L_{\text{lat}}\) 项。典型的生产环境配置可能将内部 SLO 设得比外部 SLA 更严格,为瞬时峰值、维护窗口和级联故障预留运行余量。
- 区别:SLO 本身不产生合同约定的后果,而未达到 SLA 目标则会触发协议中规定的后果,其中可能包括服务抵扣或罚款。团队通常会将内部 SLO 设得比外部协议更严格,以预留运行余量,但这是一种实践惯例,而非定义上的要求。
- 常见误区:一种常见误解是,平均延迟达标就意味着满足尾延迟 SLO。SLO 可以使用平均值、百分位数、比率或其他指标;当目标定义在 p99 或 p99.9 时,优异的平均值并不能证明达标。
这一区别在实践中很重要:工程团队围绕 SLO 进行优化,而业务方则对 SLA 作出承诺。选错优化指标会浪费工程投入,或违反对客户的保障承诺。
可用的延迟目标还必须明确请求总体和测量时间窗口。否则,两个团队可能基于不同的流量构成报告相同的百分位阈值,却对是否达标得出互不相容的结论。
Checkpoint 1.2: 指标选择
指标决定优化方向。
在最终确定指标选择之前,应用以下三条规则:
在服务数百万用户的生产系统中,尾延迟与大规模用户体验之间的联系至关重要。即使 p99 延迟仅小幅恶化,也会在海量请求中产生累积影响:如果 1% 的请求延迟达到原来的 10\(\times\)(例如从 100 ms 增至 1000 ms),那么每百万次请求中就有 10,000 次受到影响,可能导致超时错误、用户体验下降和客户流失。搜索引擎和推荐系统体现了这种敏感性:Google 的搜索延迟实验发现,在服务端增加 100–400 ms 延迟后,每位用户的每日搜索次数出现了可测量的下降 (Brutlag 2009),这也是交互式服务通常将低于 100 ms 的响应时间视为实际设计目标的原因。
Brutlag, Jake. 2009. Speed Matters for Google Web Search. Google Research Blog.
因此,生产系统中的服务级别目标(SLO)侧重于尾延迟,而非平均延迟,以确保一致的用户体验。交互式服务通常定义基于百分位数的延迟目标,因为偶发的慢响应会对用户满意度产生不成比例的影响。当流量峰值和基础设施变化影响可靠性时,大规模系统可能会跟踪更深的尾部,例如 p99.9。
满足这些尾延迟目标的挑战在于,尾部的来源往往在于架构,而非算法。采用垃圾回收的运行时、共享内核驱动程序,或服务栈中的优先级反转缺陷,都可能引入任何模型优化都无法消除的延迟峰值。
War Story 1.1: Discord Read States 服务重写(2019)
背景:Discord 是一个支持数百万并发用户的实时聊天平台,最初使用 Go 实现 Read States 服务,用于跟踪每位用户已读的频道和消息 (Howarth 2020)。
机制:Go 的强制垃圾回收过程会扫描一个包含数千万条目的 LRU 缓存,无论如何调整内存配置,都会每隔两分钟引发一次周期性的“全局暂停”垃圾回收停顿。
影响:尾延迟(\(P_{99}\))每隔两分钟就会急剧升高,导致数百万活跃连接的用户体验下降。
修复:2019 年,Discord 使用 Rust 重写了 Read States 服务,消除了垃圾回收停顿,并将平均响应时间降至微秒级。
系统启示:当服务目标定义在延迟分布的尾部时,仅凭平均延迟无法描述用户体验。语言运行时的选择可能决定尾延迟的下限:为推荐模型提供实时嵌入的特征存储可能使用托管运行时,而垃圾回收停顿可能延迟所有等待检索结果的下游推理请求。当瓶颈位于检索路径时,模型优化无法弥补这一差距。Discord 事件记录了机器学习领域之外的这一底层机制,并说明了为何生产环境延迟基准测试必须涵盖完整的服务栈。
Howarth, Jesse. 2020. “Why Discord Is Switching from Go to Rust.”
端到端延迟与组件延迟
推理基准测试中的一个关键区别,是组件延迟(模型计算所花费的时间)与端到端延迟(从请求到达到响应交付的总时间)之间的区别。许多基准测试仅报告模型推理时间,掩盖了决定实际用户体验的其余开销。这些开销并非微不足道:序列化、网络跳转和排队等待时间可能占据请求总时间的主要部分,使仅针对模型的优化收益递减。
Example 1.4: JSON 序列化陷阱
场景:研究人员在评估低延迟模型服务系统 Clipper 时,将端到端请求延迟分解为网络、CPU 序列化和模型执行几个部分 (Crankshaw et al. 2017)。
诊断:对于轻量级模型,CPU 端的 JSON 反序列化和 IPC 数据复制所消耗的实际经过时间,比加速器执行神经网络所需的时间更多。
系统启示:单独报告模型推理延迟会遗漏端到端服务瓶颈。生产环境基准测试必须计入 CPU 数据解析、IPC 序列化和网络传输开销。
Crankshaw, Daniel, Xin Wang, Guilio Zhou, Michael J. Franklin, Joseph E. Gonzalez, and Ion Stoica. 2017. “Clipper: A Low-Latency Online Prediction Serving System.” 14th USENIX Symposium on Networked Systems Design and Implementation (NSDI 17), 613–27.
Table 9 给出了推理请求延迟分解的示例。厂商作为“基准测试”数值报告的模型推理阶段耗时为 5 至 100 ms,但该阶段之前的排队等待时间却从 0 到超过 1,000 ms 不等:在负载下,基准测试测量的单个组件耗时,远小于它从未观察到的另一个组件耗时,因此所报告的数值可能仅占用户实际体验的一小部分。
| 组件 | 示例范围 | 说明 |
|---|---|---|
| 网络往返 | 10–100 ms | 随区域而变化 |
| 请求解析 | 0.1–1 ms | JSON/protobuf |
| 输入预处理 | 1–50 ms | 分词、图像缩放 |
| 排队等待时间 | 0–1000+ ms | 取决于负载 |
| 模型推理 | 5–100 ms | 所谓的“基准测试” |
| 输出后处理 | 0.5–10 ms | 解码、格式化 |
| 响应序列化 | 0.1–1 ms | JSON/protobuf |
这些组件级贡献解释了为何优化任何单一阶段,对端到端性能的收益都会递减;这一优化上限由 Amdahl 定律形式化描述。
Napkin Math 1.4: Amdahl 定律:优化上限
问题:某视觉流水线在预处理(JPEG 解码、缩放、归一化)上花费 8 ms,在推理上花费 10 ms。如果仅将推理加速至原来的 5×,端到端延迟实际上能改善多少?
数学分析:将推理耗时从 10 ms 优化至 2 ms,总延迟只会从 18 ms 降至 10 ms,对应的加速比为 1.8×,而非 5×。Amdahl 定律将这一上限形式化:如果预处理占总延迟的比例为 \(f\),那么即使推理速度无限快,加速比也最多为 \(1/f\)。当预处理占总延迟的 44.4 percent 时,确定这一主导部分的占比 \(f\) = 0.444,即可得出最大可实现加速比 \(1/f\) 为 2.25×,无论如何优化模型都无法突破。
系统洞察:只要模型之外的部分占据主导地位,大幅优化模型所带来的端到端结果就会令人失望。任何单独报告的组件加速比,在将未改动阶段一并计入测量后都会缩水,而且这些阶段在流水线中所占比例越大,差距就越大。全面的基准测试必须将预处理纳入测量,或明确声明所报告的加速比仅适用于推理组件。
Amdahl 上限凸显了严谨基准测试方法的重要性。全面的延迟报告需要明确包含哪些组件,在真实负载条件下进行测量,并区分组件指标与端到端指标。在解读任何基准测试结果之前,应先验证测量方法本身是否可靠。
吞吐量和批处理效率衡量服务系统能否在不违反延迟约束的情况下利用可用硬件。吞吐量统计系统每秒处理的推理请求数,通常以每秒查询数(QPS)或每秒帧数(FPS)表示。单实例系统在每个输入到达时独立处理;批处理系统并行处理多个输入,利用硬件并行能力提高效率。
Checkpoint 1.3: 基准测试方法
不良的基准测试会导致优化方向错误。
以下三种实践可区分严谨的基准测试与具有误导性的基准测试:
例如,每秒处理数百万次查询的云服务可从批量推理中获益,即将大量输入集中处理,以最大限度地提高计算效率。相比之下,机器人、交互式 AI 和增强现实等应用需要低延迟的单实例推理,系统必须立即响应每个新输入。基准测试必须同时考虑单实例吞吐量和批处理吞吐量,才能全面理解不同部署场景下的推理性能。
仅有速度还不够,因为推理优化可能改变模型行为。降低数值精度可以加速计算,同时减少内存占用和能耗,MobileNetV2 的示例能耗估算便展示了这一点(table 17),但低精度计算可能导致准确率下降。因此,推理基准测试会评估模型在 FP32、FP16 和 INT8 等不同数值设置下的表现。27许多现代 AI 加速器支持混合精度推理,使系统能够根据工作负载需求选择数值表示。模型压缩技术28可进一步提高效率,但其对模型准确率的影响因任务和数据集而异。基准测试有助于确定这些优化是否适合部署,确保效率提升不会以不可接受的准确率损失为代价。
内存占用和模型加载时间决定了模型能否在部署约束范围内启动、保持驻留并作出响应。训练时模型可以分布在多个加速器上,而推理往往受到严格的内存预算限制。模型总大小决定存储需求,RAM 使用量反映执行期间的工作内存,而内存带宽可能成为处理单元之间数据传输的瓶颈。当模型按需加载,而非始终驻留内存时,冷启动性能就变得至关重要。在无服务器 AI 环境中,29资源会随传入请求动态伸缩,从空闲到开始实际执行所需的时间决定了用户能否获得可接受的响应时间。
模型加载时间是指将已训练模型加载到内存中、使其能够处理输入所需的时长。在某些情况下,尤其是在资源受限设备上,为了给其他应用释放内存,模型必须频繁重新加载。首个推理请求所花费的时间也是一项重要考量,因为它反映了用户与 AI 服务交互时经历的总延迟。基准测试有助于量化这些延迟,确保推理系统能够满足现实环境中的响应性要求。
部署规模层面的指标将同样的逻辑从单个请求扩展至整个工作负载。云服务必须高效处理数百万并发用户,随需求波动动态分配资源,同时不牺牲延迟表现;移动设备则必须管理多个同时运行的 AI 模型,避免系统过载。可扩展性衡量增加计算资源后推理性能改善的程度。在某些情况下,增加 GPU 或 TPU 可以使吞吐量按比例提升,但在其他场景中,内存带宽限制或网络延迟等瓶颈可能限制扩展效率。基准测试还会评估系统在实际部署中协调多个并发模型的能力;在这类部署中,不同的 AI 功能可能需要同时运行且互不干扰。
能耗补全了评估,因为推理工作负载会在生产环境中持续运行。移动设备和边缘设备面临的约束最为严峻,电池续航和散热限制会约束可用计算资源。即使在大规模云环境中,能效也会直接影响运营成本和可持续发展目标。单次推理所需能量通常以焦耳/次推理衡量,反映系统在尽量降低功率消耗的同时处理输入的效率。在云端推理中,效率通常以每瓦每秒查询数(QPS/W)表示,用于量化系统平衡性能与能耗的能力。对于移动 AI 应用,优化推理功耗可以延长电池续航,并使模型在资源受限设备上高效运行。减少能耗对于提高大规模 AI 系统的环境可持续性同样至关重要,可确保计算能力的进步与注重节能的部署策略相协调。
推理性能评估
在训练中,系统针对大规模离线批次优化总体吞吐量,将参数移动开销分摊到数百或数千个加速器节点上。推理的运行方式则相反:工作负载由需求驱动,从外部客户端异步到达,并受到严格的延迟服务级别协议(SLA)、设备内存容量和散热预算的约束。因此,评估推理系统需要在能够代表实际部署的请求到达模式下,衡量其平衡响应时间、处理量和物理资源消耗的有效程度。
Table 10 起到部署筛选器的作用:每项指标都量化了在特定模型服务环境中占主导地位的物理约束或运行约束。尾延迟约束面向用户的交互式服务中的慢请求,而安全关键系统则要求确定性的最坏情况界限,或有界的截止期限违约概率。相比之下,能效(每瓦每秒查询数)主导着受电池限制的边缘加速器,其持续计算能力受电池容量和被动散热能力约束,而非峰值算术吞吐量。
| 类别 | 关键指标 | 基准测试应用示例 |
|---|---|---|
| 延迟与尾延迟 | 平均延迟(ms/请求);尾延迟(p95、p99、p99.9) | 评估交互式性能和软实时性能 |
| 吞吐量与效率 | 每秒查询数(QPS);每秒帧数(FPS);批处理吞吐量 | 比较大规模云端推理系统 |
| 数值精度的影响 | 准确率下降(FP32 与 INT8 对比);降低精度带来的加速比 | 在优化推理时权衡准确率与效率 |
| 内存占用 | 模型大小(MB/GB);RAM 使用量(MB);内存带宽利用率 | 评估边缘和移动部署的可行性 |
| 冷启动与加载时间 | 模型加载时间(s);首次推理延迟(s) | 评估无服务器 AI 的响应能力 |
| 可扩展性 | 负载下的效率;多模型服务性能 | 衡量动态高需求系统的稳健性 |
| 功率与能效 | 功耗(W);每瓦性能(QPS/W) | 优化移动 AI 和可持续 AI 的能源使用 |
这些指标通过硬件的基本权衡相互影响。通过将请求聚合成大批次来最大化吞吐量,可以提高算术强度,将加载权重产生的内存流量分摊到多个输入上。然而,请求必须在队列中等待批次组建完成,这会增加单个请求的排队延迟,并突破实时延迟预算。同样,将数值精度从 FP32 降至 INT8,可使内存带宽需求最多减少 75%,并使张量核心上的峰值算术执行速率提高至原来的两倍或四倍,但如果量化噪声扰动了敏感层,就可能导致准确率下降。物理部署环境决定了哪些权衡可行:超大规模云服务器通过高批处理吞吐量和高内存利用率来优化单次查询成本,而边缘设备则受固定的 SRAM 和 DRAM 容量、电池续航时间及散热包络限制。
由于不同环境的物理约束不同,不存在适用于所有系统的统一指标优先级排序。基准测试需要直接依据部署契约建立优先级层次。Table 11 展示了五种运行场景中指标优先级的变化,将硬件约束和运行约束映射为优化目标。
| 部署场景 | 首要优先项 | 次要优先项 | 第三优先项 | 关键设计约束 |
|---|---|---|---|---|
| 实时应用 | 延迟 | 可靠性 | 内存占用 | 用户体验要求即时响应 |
| 云规模服务 | 吞吐量(QPS) | 成本效率 | 平均延迟 | 商业可行性要求大规模运行 |
| 边缘/移动设备 | 功耗 | 内存占用 | 延迟 | 电池续航时间和资源限制占主导地位 |
| 训练工作负载 | 训练时间 | GPU 利用率 | 内存效率 | 研究推进速度的提升使更快的实验迭代成为可能 |
| 科学/医疗 | 准确率 | 可靠性 | 可解释性 | 不能为性能牺牲正确性 |
在一种部署场景中决定架构成败的指标,在另一种场景中可能无关紧要。对于自主机器人系统,延迟位列首位,因为传感器处理流水线必须在严格的执行截止期限内完成,才能维持车辆稳定性;而云端批处理服务则可以接受更高的排队延迟,以换取更低的单次查询运行成本。同样,当电池容量或热节流构成主导约束时,部署在边缘的模型即使提高了吞吐量,只要消耗了额外电力,就会降低系统整体效用。相比之下,医疗诊断流水线可以合理地牺牲执行速度,以换取经过验证的更高准确率。吞吐量提高至 2\(\times\),在超大规模云集群中具有显著的经济价值,但对于电池供电的设备,其收益却很有限;在这类设备上,功耗降低 20% 能够延长运行时间。
基准测试失效,通常是因为它们测量的是稳态平均值,而非决定生产环境模型服务表现的瞬态行为或最坏情况行为。报告平均延迟会掩盖排队延迟尖峰、内存垃圾回收、线程调度抖动和尾部争用;生产环境的服务级别协议依赖尾部分位数(\(p95\)、\(p99\) 和 \(p99.9\))。即使模型服务系统的平均响应时间可以接受,只要其尾延迟违反 SLA,仍可能产生用户明显感知到的严重停顿。
即使基准测试捕获了稳定负载下的尾延迟,如果忽略初始化开销,也会错误地反映按需系统或无服务器系统的表现。在无服务器模型服务中,工作实例会在空闲期间缩容至零。冷启动延迟30 衡量配置硬件资源、将模型权重从存储加载到主机和加速器内存、初始化运行时上下文,以及执行首次推理请求所需的全部经过时间。仅对预热后的实例进行基准测试,会掩盖终端用户在空闲间隔后所经历的延迟惩罚。
除初始化延迟外,如果报告运行指标时没有进行功能验证,推理基准测试也会产生误导。
数值精度优化 在不同加速器平台之间引入了显著的可比性陷阱。加速器提供的 INT8 运算吞吐量31 远高于基准 FP32 浮点运算速率,但只有当基准测试验证了量化噪声下的准确率保持情况、确认硬件支持模型中的所有算子,并在不同架构之间采用等价的运算定义时,这些峰值数据才有意义。
硬件规模扩展会使训练和推理面临不同的瓶颈。分布式训练的扩展主要受节点间互连上的梯度同步限制,而推理扩展则会遇到词元生成期间的内存带宽饱和、张量并行集合通信延迟,以及在分布式服务副本间进行负载均衡请求路由的开销。在边缘设备和高密度加速器机箱中,持续的查询流会引发热节流,使运行时钟频率降至标称峰值速率以下(硬件加速)。仅针对云端峰值吞吐量优化的基准测试无法捕获这些散热约束和内存约束,这进一步说明,评估套件必须反映实际部署条件,而非理想化的硬件规格。
捕获这些运行现实需要严格的统计规程,而非孤立的执行循环。有效的推理基准测试要求足够长的持续运行时间、符合实际的查询到达分布,以及严格的延迟分位数统计。标准化基准测试联盟将这些要求形式化为不同的部署场景:例如,MLPerf Inference 针对 SingleStream 边缘任务报告第 90 百分位延迟,在 Server 场景中于最大化查询吞吐量的同时强制执行第 99 百分位延迟阈值,并在 Offline 模式下测量无延迟约束的批处理能力 (Reddi et al. 2019)。这些针对特定场景的规程提供了必要的结构化框架,可依据机器学习系统所受的主导物理约束对其进行评估。
MLPerf 推理基准测试
要避免这些陷阱,就必须将推理基准测试视为平衡多项优先目标(延迟、吞吐量、内存、能耗和准确率)的过程,而非孤立地优化某一项指标;MLPerf Inference 通过针对不同部署的场景,将这种平衡落实为可执行的评估方式。MLPerf Inference 之所以重要,是因为部署场景会改变结果的含义。该基准由 MLCommons 开发,32 为评估多种部署环境中的机器学习推理性能提供了标准化框架。MLPerf 于 2018 年从训练基准测试起步;随后加入了 MLPerf Inference,以标准化不同场景下的部署阶段评估。随着机器学习系统扩展到多种应用中,人们逐渐认识到,单一通用的推理基准测试并不足够。由此形成的 MLPerf 推理基准测试系列将每项基准映射到特定部署环境,使分数能够结合系统将面临的延迟、吞吐量、内存和功率约束进行解读。
MLPerf Inference
MLPerf Inference (Reddi et al. 2019) 作为基础推理基准,定义了用于数据中心和边缘环境部署阶段评估的标准化场景。提交分为两个组别:封闭组 严格要求模型结构和精度等价,以确保硬件之间能够直接进行同条件比较;开放组 则允许提交者修改模型架构、量化算法,或重新训练模型,以展示创新的算法协同设计。它评估图像分类、目标检测、自然语言处理和推荐系统等深度学习工作负载的性能。当提交规则和工作负载场景与预期部署环境匹配时,这一版本的 MLPerf 是比较 AI 加速器、GPU、TPU 和 CPU 的广泛使用的参考基准。
大型科技公司经常参考 MLPerf 结果来制定硬件采购决策。在评估推荐系统基础设施的硬件时,DLRM33 工作负载上的 MLPerf 基准分数可为不同代际加速器之间的选择提供依据。跨代际的基准测试结果通常显示出显著的吞吐量提升,但提升幅度取决于工作负载、软件栈和系统配置。这说明标准化基准测试如何转化为具有重大影响的基础设施决策。
这些标准化评估提供了极有价值的比较,但全面基准测试的成本限制了参与者范围以及系统评估的深入程度。
Systems Perspective 1.8: 全面基准测试的成本
向 MLPerf 提交结果,可能需要专门投入工程工作、获取硬件、进行调优和验证,并针对相关配置编制严谨的文档。成本在很大程度上取决于工作负载和测试范围,但其高昂程度足以使提交者主要集中于大型科技公司和硬件厂商,而较小的组织则依赖已公布的结果,而非自行开展全面评估。这一门槛促使人们寻求更轻量的内部基准测试实践,使组织无需承担全面标准化基准测试的费用,也能作出有依据的决策。
MLPerf 推理系列中的其他基准则依据部署场景进一步细化这一基础。MLPerf Mobile (MLCommons 2024a) 评估模型能否在智能手机的功率和内存限制内保持响应能力 (Janapa Reddi et al. 2022),测量图像分类、目标检测、图像分割和语言处理工作负载。MLPerf Client (MLCommons 2026b) 关注本地计算决策:消费级设备能否直接运行 AI 工作负载,而不依赖云端推理。它目前侧重本地生成式 AI 和 LLM 工作负载,因此 CPU、独立 GPU 和集成 NPU 都成为被测系统的一部分,而非仅仅充当配套的主机硬件。MLPerf Tiny (Banbury et al. 2021) 测试约束最为严苛的情况:嵌入式和超低功耗 AI 系统,例如物联网 设备、可穿戴设备和微控制器。这些变体保持相同的基准测试规范,同时将主导资源约束从数据中心吞吐量转变为客户端响应能力、移动设备功率或微控制器内存。
MLCommons. 2024a. MLPerf Mobile Benchmark.
Janapa Reddi, Vijay et al. 2022. “MLPerf Mobile V2. 0: An Industry-Standard Benchmark Suite for Mobile Machine Learning.” Proceedings of Machine Learning and Systems (MLSys) 4: 806–23.
MLPerf 执行场景
同一硬件可能因请求的到达方式不同而报告截然不同的基准数据——这一事实解释了为什么厂商宣称的指标往往无法预测生产性能。经典 MLPerf Inference 定义了四种执行场景,用以表征不同的流量模式,每种场景都需要不同的优化策略 (Reddi et al. 2019)。当前的客户端和生成式 AI 基准变体还包括针对延迟敏感型 LLM 工作负载的交互式测量,其中首词元时间和每个输出词元耗时等指标成为核心 (MLCommons 2026b)。
MLCommons. 2026b. MLPerf Client Benchmark.
SingleStream
SingleStream 每次处理一个请求,测量顺序推理的延迟。该场景模拟单个用户与设备交互的移动和嵌入式应用:智能手机相机应用进行图像分类、语音助手处理语音,或可穿戴设备检测手势。关键指标是单个请求的延迟;由于只有在前一个结果被使用后,下一个请求才会到达,因此批处理无法带来收益。优化重点是预处理效率和功耗,而非吞吐量。
MultiStream
MultiStream 同时处理多个同步输入流,模拟自动驾驶车辆等场景:车辆配备多个摄像头,必须一同处理其输入以进行空间融合。与 SingleStream 的顺序请求不同,MultiStream 要求在严格的视频帧率截止期限内处理所有传感器的帧。它与 Server 模式的关键区别在于,MultiStream 输入同步到达,而 Server 请求则独立且不可预测地到达。关键约束是同步:所有流都必须处理完成,规划模块才能采取行动。优化重点是处理抖动和满足硬截止期限,而非平均吞吐量。
Server
Server 按泊松分布生成请求,模拟请求独立且不可预测地到达的云端 API 流量。该场景模拟处理来自不同用户的数百万次查询的 Web 服务。与 SingleStream 保证顺序到达不同,Server 流量会形成多个请求争用资源的排队动态。关键指标是吞吐量(每秒查询数)和尾延迟(p99);动态批处理可将一个时间窗口内到达的请求分组,从而提高效率。优化需要在吞吐量与延迟服务级别目标(SLO)之间取得平衡。
Offline
离线(Offline)场景预先提供全部输入,测量移除延迟约束后的最大吞吐量。该场景模拟批处理流水线:夜间数据处理、科学计算或推荐结果预计算。在没有延迟要求的情况下,系统可以采用最大批量大小,使硬件利用率达到饱和。关键指标是纯吞吐量(每秒样本数),优化完全围绕硬件效率展开。
Table 12 将经典执行场景以及较新的面向 LLM 的交互式场景,映射到各自的部署环境和优化策略。
| 场景 | 环境 | 策略 | 重点 |
|---|---|---|---|
| 单流(SingleStream) | 移动应用、嵌入式设备 | 不进行批处理(批量大小 = 1) | 预处理、功耗效率 |
| 多流(MultiStream) | 自动驾驶、视频分析 | 同步传感器融合 | 抖动处理、截止时间保障 |
| 服务器(Server) | 云 API、Web 服务 | 带超时机制的动态批处理 | 吞吐量与延迟权衡的调优 |
| 离线(Offline) | 批处理、数据流水线 | 最大批量大小 | 吞吐量、硬件利用率 |
| 交互式(Interactive) | 聊天、智能体、本地生成式 AI | 词元流式输出、KV 缓存管理 | 首词元生成时间、每个输出词元的生成时间 |
每种场景都通过明确有效结果必须满足何种延迟或吞吐量要求,充当工作负载契约。
Lighthouse 1.2: EdgeTPU 上的 MobileNetV2
作为灯塔案例 1.1 的延伸,这里采用一个示例性的单流式边缘推理场景,评估 硬件加速 中的硬件加速论断 (Reddi et al. 2019; Banbury et al. 2021)。
Table 13: EdgeTPU 与 Cortex-M7 的 MobileNetV2 场景对比:示例性的单流式推理延迟、端到端延迟、功耗和能耗数值表明,预处理开销如何缩小加速器的标称加速比;这些数值并非受控测量结果。
硬件加速论断:在这个示例性的边缘加速器场景中,假设 INT8 MobileNetV2 在加速器上的推理耗时约为 2 ms,相对于 Cortex-M 级 CPU(约 15 ms)的加速比约为 7.5×。实际结果取决于算子覆盖范围、时钟频率、热状态和具体实现。
Table 13 列出了该示例性单流式场景的假设。
| 指标 | CPU(Cortex-M7) | EdgeTPU | 标称比率 | 系统级比率 |
|---|---|---|---|---|
| 推理延迟 | ~15 ms | ~2 ms | 加速比为 7.5× | — |
| 端到端延迟 | ~18 ms | ~6 ms | — | 加速比约为 3× |
| 功耗 | ~120 mW | ~500 mW | — | 约为 CPU 的 4.2× |
| 每次推理能耗 | ~1.8 mJ | ~1 mJ | — | 能效约为 CPU 的 1.8× |
由此揭示的结论:在这些假设下,由于两种情况下的预处理都在 CPU 上运行,推理阶段 7.5× 的加速比在端到端层面缩小至约 3×。EdgeTPU 的工作功耗更高,但完成推理更快,因此推理能耗更低;部署时仍需进行受控测量。
部署决策取决于工作负载。对于运行频率较低的电池供电设备,仅依据工作期间的推理能耗计算,EdgeTPU 更有优势,但对电池的总体影响还取决于休眠功耗、唤醒能耗、主机传输开销,以及系统等待期间加速器是否引入额外的空闲漏电。对于持续视频处理,EdgeTPU 每次推理工作能耗较低这一优势更有可能起主导作用。
单流场景的结果说明了为什么基准测试需要将 MLPerf 场景与部署环境相匹配:单流场景强调延迟,而离线基准测试针对吞吐量而非延迟进行优化,因此会得出不同的结论。
Banbury, Colby, Vijay Janapa Reddi, Peter Torelli, Jeremy Holleman, Nat Jeffries, Csaba Kiraly, Pietro Montino, et al. 2021. “MLPerf Tiny Benchmark.” arXiv Preprint.
这些场景解释了为什么同一硬件会报告差异显著的基准测试数值。在一个示例性对比中,某加速器虽然具有很高的离线吞吐量,但一旦施加 p99 延迟约束并计入排队开销,其能够持续维持的服务器模式吞吐量就可能低得多,因为服务器模式无法始终采用最大批量大小。在为特定应用评估硬件时,选择适当的场景可确保基准测试结果能够预测生产环境性能。因此,MobileNetV2 的结果表明,场景选择是部署的必要要求,而不只是结果报告方式的选择。
训练基准测试衡量学习速度;推理基准测试衡量服务速度。然而,这两类测量存在一个共同的关键盲点:它们都未说明系统为达到该速度消耗了多少能量。一个在消耗数千瓦功率的同时创下吞吐量纪录的系统,可能在经济上不可持续,或在物理上根本无法部署到边缘端。要完善评估体系,就需要进行功耗测量:测量获得性能所付出的能耗代价。
功耗测量技术
某芯片厂商宣称“在 0.5 W 功耗下达到 10 TOPS”,但在持续推理负载下,热节流使实际吞吐量降至 3 TOPS,功耗却为 2 W。如果没有标准化的功耗测量,数据手册与实际运行之间这一比值为 13.3× 的能效差距,直到部署时才会被发现。
这一能效维度至关重要,因为 硬件加速 已将 TOPS/W 与原始 TOPS 并列为主要设计目标。功耗基准测试验证以能效优化为目标的加速器是否实现了其承诺的节能效果。TOPS/W 尤其容易被操纵,恰恰是因为它是两个可以分别引用的峰值之比:厂商可以在使吞吐量最大化的批量大小和精度下读取分子(运算量),而在接近空闲的工作点读取分母(瓦数),因此宣传的能效描述的是芯片在真实负载下从未处于的状态。功耗基准测试通过固定工作负载和测量时间窗口,强制在同一工作点读取分子与分母,从而堵住这一漏洞。
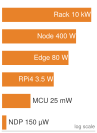
部署功耗从 µW 到 kW,跨越近八个数量级。
Henderson, Peter, Jieru Hu, Joshua Romoff, Emma Brunskill, Dan Jurafsky, and Joelle Pineau. 2020. “Towards the Systematic Reporting of the Energy and Carbon Footprints of Machine Learning.” CoRR abs/2002.05651 (248): 1–43. https://doi.org/10.48550/arxiv.2002.05651.
功耗测量与执行时间测量存在根本差异。延迟是单一时间间隔,而瞬时功率(\(P = V \cdot I\))会在微秒级执行阶段之间持续波动,并随着芯片升温、与温度相关的漏电流增大,在数分钟尺度上发生漂移。此外,机器学习部署的物理规模范围极广。如 table 14 所列,代表性系统从微瓦级唤醒词协处理器到千瓦级数据中心机架,功耗跨越近八个数量级 (Henderson et al. 2020)。
| 类别 | 设备类型 | 功耗 |
|---|---|---|
| 微型 | 神经决策处理器(NDP) | 150 µW |
| 微型 | M7 微控制器 | 25 mW |
| 移动端 | 树莓派 4 | 3.5 W |
| 移动端 | 智能手机 | 4 W |
| 边缘端 | 智能摄像头 | 10–15 W |
| 边缘端 | 边缘服务器 | 65–95 W |
| 云端 | 机器学习服务器节点 | 300–500 W |
| 云端 | 机器学习服务器机架 | 4–10 kW |
由于功耗范围从微瓦延伸至千瓦,没有任何一种仪器或测量规程能够适用于所有情况。对始终开启的神经传感器进行基准测试,需要在毫伏级供电轨上测量微安级电流;而对服务器机架进行基准测试,则需要在配电单元处测量高电压三相交流电。这种差异迫使基准测试标准确立精确的物理边界,明确哪些硬件计入能耗账目。
功耗测量边界
工程师划定的系统边界决定了能效判定所涵盖的范围。如果基准测试仅测量加速器核心,就会忽略驱动 PCIe 总线的主机 CPU、存储权重的片外 DRAM,以及散热风扇。Figure 7 展示了 MLPerf 如何在三个部署层级上定义测量边界:绿色实线框内的组件属于能耗核算边界,而红色虚线框标出的组件则明确排除在外 (Tschand et al. 2024)。
\begin{tikzpicture}[font=\footnotesize\sffamily]
\tikzset{%
Line/.style={line width=1.0pt,black!50,text=black,align=center},
BoxG/.style={inner xsep=4pt,
    node distance=0.3,
    draw=GreenLine,
    line width=0.5pt,
    fill=GreenL!60,
    align=flush center,
    rounded corners=2pt,
    minimum height=7.5mm
  },
BoxFill/.style={draw=BackLine,inner xsep=2mm,inner ysep=2mm,
yshift=0mm,fill=BackColor!60,line width=1pt},
BoxFill2/.style={draw=BackLine,inner sep=1pt,fill=BackColor!60,line width=1pt,align=flush center},
BoxDash2/.style={draw=RedLine,inner sep=1pt,fill=white,line width=1pt,dashed,align=flush center},
BoxDash/.style={draw=RedLine,inner xsep=2mm,inner ysep=2mm,
yshift=0mm,fill=white,line width=1pt,dashed,align=flush center},
BoxB/.style={BoxG,fill=cyan!10},
BoxR/.style={BoxG,fill=magenta!15},
BoxO/.style={BoxG,fill=orange!15},
BoxV/.style={BoxG,fill=violet!15}
}
%%%Tiny Example
\foreach \j in {1,2} {
\node[BoxG](1C\j) at({0}, {-0.15*\j}){计算单元};
}
\node[BoxB,below =0.4 of  1C2.south west,minimum height=11mm](1C3){基础\\ 交换器};
\node[BoxR,below =0.4 of 1C2.south east,minimum height=11mm](1C4){片上\\ SRAM};
\scoped[on background layer]
\node[BoxFill,inner xsep=5mm,fit=(1C1)(1C3)(1C4)](BB1){};
\node[above=4pt of  BB1.north,inner sep=0pt, anchor=south](THE){\textbf{微型示例}};
\node[below=4pt of  BB1.south,inner sep=0pt, anchor=north]{传统(超)低功耗 SoC};
%%%Diagam Key
\node[BoxFill,below =1.4 of BB1.219,minimum width=5mm](PMB){};
\node[right=1mm of PMB,yshift=-1pt](PMBT){功率测量边界};
\node[BoxDash,below =0.13of PMB,,minimum width=5mm](NIB){};
\node[right=1mm of NIB,yshift=-1pt](NIBT){边界之外};
\scoped[on background layer]
\node[BoxFill,fill=white,inner ysep=4mm,yshift=2mm,fit=(PMB)(PMBT)(NIB)](1BB1){};
\node[below left=4pt and -4ptof  1BB1.north west,inner sep=0pt, anchor=north west]{\textbf{图例}};
%%%Inference Example
%%Typical Inference SoC 1
\foreach \j in {1,2} {
\node[BoxG,minimum height=12mm,yshift=-8mm](2C\j) at({5.6}, {-0.15*\j}){计算\\ 单元};
}
\node[BoxB,below=of 2C2.south west,anchor=north west,minimum height=12mm](2C3){片上\\SRAM};
\node[BoxR,right=of 2C1.north east,anchor=north west,minimum height=10mm](2C4){交换式\\片上网络};
\coordinate(S1)at($(2C3.north east)+(1,-0.25)$);
\begin{scope}[local bounding box=CU2,shift={($(S1)+(0,0)$)}]
\foreach \j in {1,2} {
\node[BoxG,minimum height=10mm](22C\j) at({0.15*\j}, {0}){计算\\ 单元};
}
\end{scope}
\scoped[on background layer]
\node[BoxFill,fill=white,fit=(2C1)(2C3)(2C4)(CU2)](2BB1){};
\node[above left=2pt and -4pt of  2BB1.north west,inner sep=0pt, anchor=south west](TIS){典型推理 SoC 1};
\node[BoxO,xshift=2mm,below=0mm of 2BB1.east,rotate=90,minimum height=6mm](OCD1){片外 DRAM};
\node[BoxO,xshift=-2mm,above=0mm of 2BB1.west,rotate=90,minimum height=6mm](OCD2){片外 DRAM};
\node[BoxO,below =11mm of OCD2.west,minimum height=8mm,minimum width=6mm](OCD4){};
\node[BoxO,below =11mm of OCD1.west,minimum height=8mm,minimum width=6mm](OCD3){};
%
\path[red](OCD4)-|coordinate(S2)(2C3.south west);
\path[red](OCD3)-|coordinate(S3)(22C2.south east);
\node[BoxG,anchor=west,minimum height=6mm,minimum width=6mm](2B1)at(S2){};
\node[BoxR,anchor=east,minimum height=6mm,minimum width=6mm](2B4)at(S3){};
\node[BoxB,minimum height=6mm,minimum width=6mm](2B3)at($(2B1)!0.66!(2B4)$){};
\node[BoxO,minimum height=6mm,minimum width=6mm](2B2)at($(2B1)!0.33!(2B4)$){};
\scoped[on background layer]
\node[BoxFill,inner xsep=5mm,fit=(OCD3)(TIS)(OCD4)](BB2){};
\scoped[on background layer]
\node[BoxFill,fill=white,fit=(2B1)(2B4),inner ysep=1.5mm,](2BB2){};
\node[above left=2pt and -4pt of  2BB2.north west,inner sep=0pt, anchor=south west]{典型推理 SoC n};
\scoped[on background layer]
\node[BoxFill,fill=white,fit=(2C1)(2C3)(2C4)(CU2)](2BB1){};
%%%Typical Inference Node 1
\begin{scope}[local bounding box=CU3,shift={($(15,-0.45)+(0,0)$)}]
\foreach \j in {1,2} {
\node[BoxG,minimum height=17mm](3C\j) at({0}, {-0.2*\j}){加速器(一个或多个)+\\ 本地 RAM};
}
\node[BoxV,below=4mm of 3C2.south east,minimum width=15mm,minimum height=9mm,anchor=north east](3C3){主动\\ 散热};
\node[BoxR,below=4mm of 3C3.south east,minimum width=15mm,minimum height=11mm,anchor=north east](3C4){网卡};
\node[BoxR,left=4mm of 3C2.south west,minimum width=15mm,minimum height=9mm,anchor=south east](3C5){本地\\ 存储};
\node[BoxO,below=4mm of 3C2.south west,minimum width=15mm,minimum height=15mm,anchor=north east](3C6){主机\\ DRAM};
\coordinate(S4)at($(3C6.230)+(0,-0.75)$);
\begin{scope}[local bounding box=CU2,shift={($(S4)+(0,0)$)}]
\foreach \j in {1,2} {
\node[BoxG,minimum width=16mm,minimum height=9mm](33C\j) at({0.15*\j}, {0}){主机(一个或多个)};
}
\end{scope}
%
\scoped[on background layer]
\node[BoxFill,inner xsep=5mm,fit=(3C1)(3C4)(33C2)](BB4){};
\node[below=4pt of  BB4.south west,inner sep=0pt, anchor=north west]{传统推理节点 1};
\end{scope}
%%%Training Example
\def\ra{1.89mm}
\node[BoxFill2,right=24mm of 3C1.north east,minimum width=41mm,minimum height=6mm,anchor=north west](4C1){
计算节点 1(实测)};
\node[BoxFill2,below=\ra of 4C1.south,minimum width=41mm,minimum height=6mm,anchor=north](4C2){
计算节点 2(实测)};
\node[BoxFill2,below=\ra of 4C2.south,minimum width=41mm,minimum height=9mm,anchor=north](4C3){
网络交换机\\ (实测/估算)};
\node[BoxDash2,below=\ra of 4C3.south,minimum width=41mm,minimum height=6mm,anchor=north](4C4){
存储节点};
\node[BoxFill2,below=\ra of 4C4.south,minimum width=41mm,minimum height=6mm,anchor=north](4C5){
计算节点 n(实测)};
\node[BoxDash2,below=\ra of 4C5.south,minimum width=41mm,minimum height=6mm,anchor=north](4C6){
数据中心冷却组件};
%
\scoped[on background layer]
\node[BoxFill,inner xsep=5mm,fit=(4C1)(4C6),fill=white,draw=BrownLine,line width=0.75pt](BB6){};
\node[below=4pt of  BB6.south west,inner sep=0pt, anchor=north west]{训练机架 1};
%%%Right
\node[BoxFill2,right=22mm of 4C1.east,minimum width=7mm,minimum height=6mm,anchor=west](5C1){};
\node[BoxFill2,below=\ra of 5C1.south,minimum width=7mm,minimum height=6mm,anchor=north](5C2){};
\node[BoxFill2,below=\ra of 5C2.south,minimum width=7mm,minimum height=9mm,anchor=north](5C3){};
\node[BoxDash2,below=\ra of 5C3.south,minimum width=7mm,minimum height=6mm,anchor=north](5C4){};
\node[BoxFill2,below=\ra of 5C4.south,minimum width=7mm,minimum height=6mm,anchor=north](5C5){};
\node[BoxDash2,below=\ra of 5C5.south,minimum width=7mm,minimum height=6mm,anchor=north](5C6){};
%
\scoped[on background layer]
\node[BoxFill,inner xsep=4.5mm,fit=(5C1)(5C6),fill=white,draw=BrownLine,line width=0.75pt](BB7){};
\node[below=4pt of  BB7.south west,inner sep=0pt, anchor=north west]{训练机架 n};
%
\node[BoxDash2,rotate=90,minimum height=6mm,minimum width=46mm](RS1)at($(BB2.east)!0.5!(BB4.west)$){远程存储};
\node[BoxDash2,rotate=90,minimum height=6mm,minimum width=46mm](RS2)at($(BB4.east)!0.5!(BB6.west)$){远程存储};
\node[BoxFill2,rotate=90,minimum height=6mm,minimum width=46mm,
fill=OrangeL!40](RS3)at($(BB6.east)!0.5!(BB7.west)$){互连网络};
\path[red](THE)-|coordinate(S6)(RS1);
\path[red](THE)-|coordinate(S7)($(BB6.north west)!0.5!(BB7.north east)$);
\node[]at(S6){\textbf{推理示例}};
\node[]at(S7){\textbf{训练示例}};
\end{tikzpicture}figure 7 中的三个层级反映了不同的硬件接口。在 TinyML 部署中,整个低功耗 SoC——包括计算核心、内部 SRAM 和电源管理单元——均位于测量边界内,并在直流供电轨上直接测量。专用推理节点将这一范围扩展到主机 CPU、加速卡、PCIe 总线、本地存储和机箱内的主动散热风扇,但不包括远程存储网络。多机架训练部署测量计算节点和机架顶部的互连交换机,但不包括数据中心的集中式冷水机组、设施级配电单元(PDU)和解耦式存储集群。
测量边界决定哪些组件被纳入统计;工作负载的组成决定这些组件的能量消耗在何处。在运行 TensorFlow Mobile 的移动设备上,数据搬移占推理总能耗的 57.3% (Boroumand et al. 2018),这揭示了为何仅凭运算次数无法预测功耗。笔记本 1.5 中的计算示例对 MobileNetV2 的推理能耗进行了分解,展示了从 FP32 转向 INT8 如何同时缓解内存数据搬移瓶颈并降低算术运算的开关能耗。
Boroumand, Amirali, Saugata Ghose, Youngsok Kim, Rachata Ausavarungnirun, Eric Shiu, Rahul Thakur, Daehyun Kim, et al. 2018. “Google Workloads for Consumer Devices: Mitigating Data Movement Bottlenecks.” Proceedings of the Twenty-Third International Conference on Architectural Support for Programming Languages and Operating Systems, ASPLOS ’18, 316–31. https://doi.org/10.1145/3173162.3173177.
Napkin Math 1.5: INT8 为何能够节能
问题:在所述的 45 nm 组件能耗模型下,用 INT8 替代 FP32 能使 MobileNetV2 的权重读取能耗和算术运算能耗降低多少?
回顾 硬件加速 中的内容,搬移数据所消耗的能量远高于对其进行计算所消耗的能量(这一能量搬移不变量在 数据工程 中得到形式化表述,并由 Horowitz 的能耗估算 (Horowitz 2014) 加以量化)。要理解量化为何能够降低能耗,需要按物理来源分解能耗。决定推理能耗的两个主要因素是计算操作和内存访问。
位宽较小的数据类型通常每次运算所需的开关能耗和存储能耗更低,因此 table 15 显示,FP32 与 INT8 的乘法能耗相差 18×:
在这一 45 nm 组件模型中,8 位乘法器相较于 32 位浮点乘法器的能耗降低倍数约为 18×,因为位宽较小的算术运算减少了开关活动和存储操作 (Horowitz 2014)。应知数值 列出了这些比值所依据的单次运算能耗估算值;绝对值和比值会随电路设计和工艺技术而变化。
Table 16 将分析扩展到内存访问,列出了存储层次结构中各层级每字节的能耗:
内存访问占据主导地位:从 DRAM 读取一个字节的能耗是寄存器访问能耗的 1,600× 以上。
计算:组件能耗遵循 \(E_{\text{load}}=\text{model bytes}\times\text{DRAM energy per byte}\) 和 \(E_{\text{compute}}=\text{FLOPs}\times\text{operation energy}\)。FP32 各项之和为 2243 μJ + 2,220 μJ = 4,463 μJ;INT8 各项之和为 561 μJ + 120 μJ = 681 μJ。将两者的总能耗相除,可得这一简化模型下的能耗降低倍数为 6.6×。
Table 17 在一个刻意简化的 MobileNetV2 模型中综合了这两种效应。该模型对每个权重计入一次 DRAM 读取,并按所列的乘法器能耗计算每个已统计 FLOP 的能耗,但不计入激活值流量、缓存行为、作为独立成本的加法、控制开销和静态功耗:
| 组成部分 | FP32 (14 MB) | INT8 (3.5 MB) | 能耗降低倍数 |
|---|---|---|---|
| 从 DRAM 读取全部权重一次 | 2243 μJ | 561 μJ | 4× |
| 计算 (600 MFLOP) | 2,220 μJ | 120 μJ | 18.5× |
| 总计 | 4,463 μJ | 681 μJ | 6.6× |
系统洞见:在这一简化模型中,权重读取与算术运算贡献的 FP32 能耗相当(分别为 2243 μJ 和 2,220 μJ),而 INT8 同时降低了两者,使总能耗从 4,463 μJ 降至 681 μJ。这解释了潜在节能效果背后的物理机制,但关于电池续航或单次推理能耗的结论,需要通过受控的整机功率测量来验证。
Horowitz, Mark. 2014. “1.1 Computing’s Energy Problem (and What We Can Do about It).” 2014 IEEE International Solid-State Circuits Conference Digest of Technical Papers (ISSCC), 10–14. https://doi.org/10.1109/isscc.2014.6757323.
Barroso, Luiz André, Urs Hölzle, and Parthasarathy Ranganathan. 2019. The Datacenter as a Computer: Designing Warehouse-Scale Machines. Synthesis Lectures on Computer Architecture. Springer International Publishing. https://doi.org/10.1007/978-3-031-01761-2.
Kim, Wonyoung, Meeta S. Gupta, Gu-Yeon Wei, and David Brooks. 2008. “System Level Analysis of Fast, Per-Core DVFS Using on-Chip Switching Regulators.” IEEE International Symposium on High-Performance Computer Architecture (HPCA), HPCA ’08, 123–34. https://doi.org/10.1109/hpca.2008.4658633.
除单个服务器节点外,大规模部署还引入了共享基础设施,使边界定义更加复杂。在数据中心,冷却系统和供电系统占设施总用电量的 20% 至 30% (Barroso et al. 2019)。这一设施级开销由电能使用效率(PUE)表征: \[\text{PUE} = \frac{\text{Total Facility Energy}}{\text{IT Equipment Energy}}\] 采用芯片直接液冷的超大规模设施,其 PUE 约为 1.1;而依赖机房空调的传统设施,其 PUE 可超过 2.0 (Barroso et al. 2019)。如果评估仅报告服务器插座处的能耗,就未计入这一设施级放大系数。此外,动态电压与频率调节(DVFS)在执行期间持续调节处理器的功耗与散热量 (Kim et al. 2008),形成热反馈回路,进而改变冷却开销本身。
计算效率与功耗
互补金属氧化物半导体(CMOS)数字电路的总功率为动态开关功率与静态漏电功率之和: \[P = P_{\text{dynamic}} + P_{\text{leakage}} = \alpha C V^2 f + I_{\text{leak}} V\] 其中,\(\alpha\) 为门电路开关活动因子,\(C\) 为物理负载电容,\(V\) 为供电电压,\(f\) 为时钟频率,\(I_{\text{leak}}\) 为随温度变化的漏电流。从历史上看,每千瓦时可完成的计算次数大约每 1.5 年翻一番,这一长期能效提升趋势被称为库米定律 (Koomey et al. 2011)。然而,在任一硬件代际内,动态功率会限制吞吐量的扩展。提高时钟频率 \(f\) 时,需要近似线性地提高供电电压 \(V\),以维持晶体管的开关裕量,从而导致动态功耗呈立方增长: \[P_{\text{dynamic}} \propto f^3\] 将时钟频率提高一倍以使标量吞吐量翻倍,可能使动态功率增至八倍 (Le Sueur and Heiser 2010)。这种立方增长的代价解释了为什么现代机器学习加速器倾向于采用以适中频率运行的大规模简单执行单元并行阵列,而非以极高频率运行的窄流水线。
Koomey, Jonathan, Stephen Berard, Marla Sanchez, and Henry Wong. 2011. “Implications of Historical Trends in the Electrical Efficiency of Computing.” IEEE Annals of the History of Computing 33 (3): 46–54. https://doi.org/10.1109/mahc.2010.28.
Le Sueur, Etienne, and Gernot Heiser. 2010. “Dynamic Voltage and Frequency Scaling: The Laws of Diminishing Returns.” Proceedings of the 2010 International Conference on Power Aware Computing and Systems, 1–8.
Wu, Hao, Patrick Judd, Xiaojie Zhang, Mikhail Isaev, and Paulius Micikevicius. 2020. “Integer Quantization for Deep Learning Inference: Principles and Empirical Evaluation.” arXiv Preprint arXiv:2004.09602 abs/2004.09602.
Gholami, Amir, Sehoon Kim, Zhen Dong, Zhewei Yao, Michael W. Mahoney, and Kurt Keutzer. 2021. “A Survey of Quantization Methods for Efficient Neural Network Inference.” arXiv Preprint arXiv:2103.13630 abs/2103.13630.
由于频率扩展很快就会触及热设计功耗(TDP)上限,系统设计者会沿数据、算法和机器三个维度优化能效。在算法和数据层面,降低精度的整数运算(INT8 或 FP8)可直接减小算术逻辑单元(ALU)中的开关电容 \(C\),并压缩互连总线上的内存流量,在保持模型准确率的同时降低动态能耗 (Jacob et al. 2018; Wu et al. 2020; Gholami et al. 2021)。在机器层面,系统在能量延迟积(EDP)最小值附近运行,而非以峰值时钟频率运行。在电池受限的移动设备上,在这一最高能效点运行可延长电池续航时间;在数据中心中,则可最大化每兆瓦已配置供电容量所支持的吞吐量。
标准化功率测量
SPECpower_ssj2008 等通用功率基准测试使用稳态事务工作负载,测量服务器在阶梯式负载水平下的功率,负载范围为 0% 至 100%,每次递增 10 个百分点 (Lange 2009)。相比之下,机器学习工作负载在时间上表现出极强的波动性:瞬时功率会在计算受限的矩阵乘法阶段(脉动阵列或 Tensor Core 汲取峰值电流)与内存受限的停顿或词元传输阶段(执行单元停顿,等待从 DRAM 或互连获取数据)之间快速变化。
表征这些波动需要经过校准的物理测量仪器。虽然软件性能分析工具可以读取 Intel RAPL 或 NVIDIA NVML 等片上能量计数器,但这些接口存在两个缺陷:采样查询会消耗主机处理周期,干扰执行过程;其内部模型也很少能溯源至经过校准的实验室标准。因此,MLPerf Power 等标准化基准测试要求使用经过校准的外部物理功率分析仪(例如横河或吉时利分析仪),通过串联电流分流器或霍尔效应传感器连接至交流市电或直流供电轨 (Tschand et al. 2024)。
为避免微秒级内核边界处的瞬态尖峰发生混叠,功率分析仪必须以千赫兹级频率采样电流和电压,并对瞬时功率积分以得到总能量: \[E = \int_{t_{\text{start}}}^{t_{\text{end}}} P(t) \, dt\] 为防止冷启动伪影扭曲结果,基准测试框架强制执行三个协议阶段:
- 预热阶段运行不计入测量的推理,直至指令缓存、权重缓冲区和芯片结温达到稳态热平衡。
- 持续测量窗口在数分钟内重复执行推理,以平均微架构阶段变化和热漂移的影响。
- 硬件与软件同步,将分析仪的功率时间戳与负载生成器的查询派发时间戳配对。
工作负载结构会进一步改变功率曲线。在 Transformer 中,自回归解码阶段受内存带宽限制,平均功率较低,而提示词预填充阶段会执行大规模矩阵乘法,产生尖锐的功率峰值。DLRM 等推荐模型主要执行跨 DRAM 的稀疏嵌入表查找,消耗在内存总线传输上的能量多于算术逻辑运算。批大小还带来另一种权衡:较大的批次将参数读取开销分摊到更多输入上,降低每次推理的能耗,但会使瞬时功率升高并接近加速器的热极限。在边缘端,占空比决定了最终结果:对于占空比为 1% 的间歇式唤醒词检测器,基线休眠和漏电功耗消耗的电量超过电池容量的 90%,因此,相较于低功耗休眠状态管理,活跃推理阶段的能效处于次要地位。
MLPerf Power 案例研究
MLPerf Power (Tschand et al. 2024) 将原始电气测量结果转换为标准化能效指标:在严格定义的系统边界内,每瓦功率每秒完成的推理次数。该协议在数据中心、边缘和微型推理场景中采用统一的测量原则;在这些场景之间,起决定作用的约束从机架散热与运行成本转变为电池续航时间与微瓦级能量采集。
标准化系统边界可防止不同架构类别之间出现误导性比较。通过要求使用外部功率分析仪、经过校准的日志记录以及固定的延迟阈值,MLPerf Power 确保报告的能效数值反映持续执行状态,而非无法持续实现的突发状态。
在 2021 年至 2024 年连续多轮基准测试提交中,标准化测量记录了架构改进、编译器优化和低精度运算如何转化为生产环境中的能效提升。figure 8 中的数据中心结果展示了不同机器学习工作负载的这些归一化能效变化轨迹。
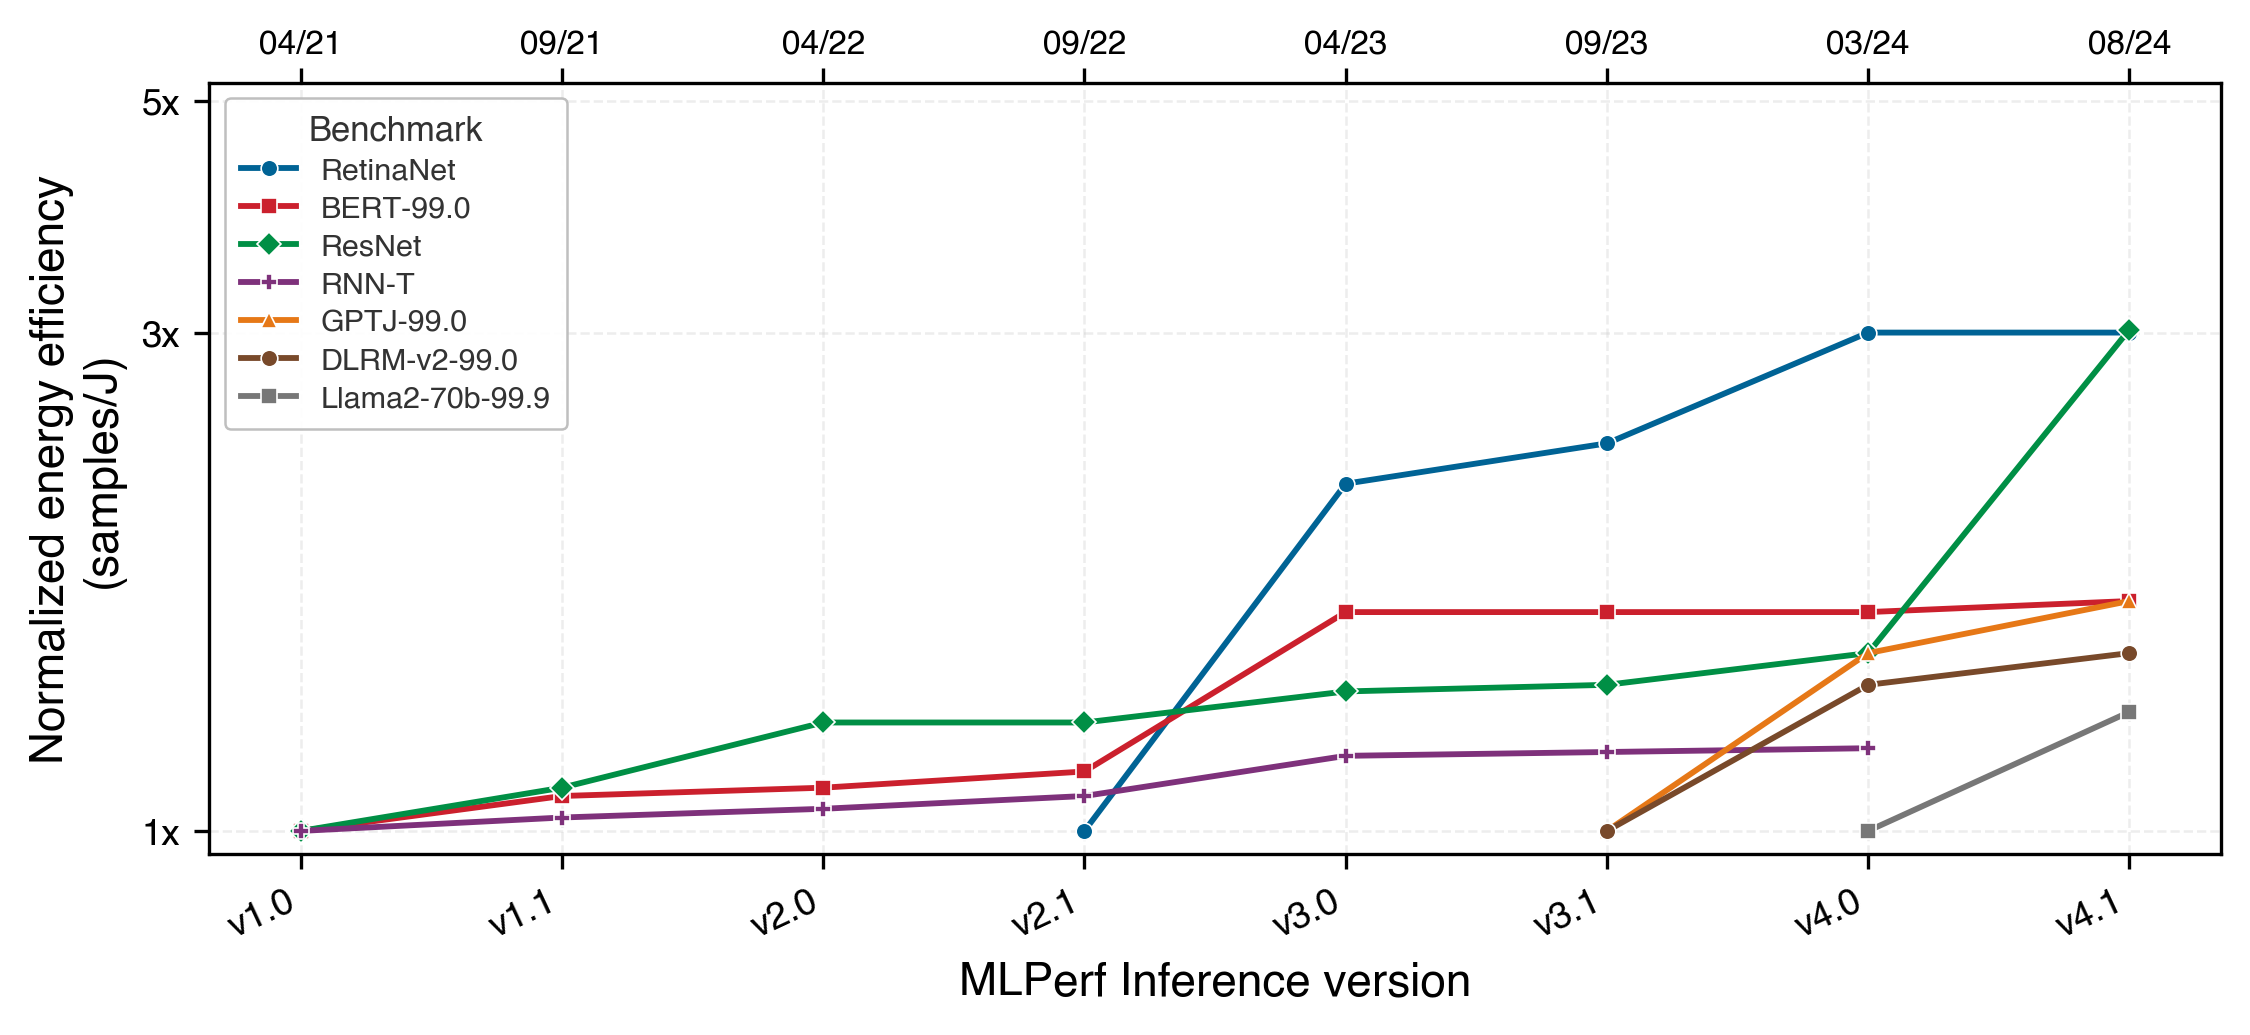
Tschand, Arya, Arun Tejusve Raghunath Rajan, Sachin Idgunji, Anirban Ghosh, Jeremy Holleman, Csaba Kiraly, Pawan Ambalkar, et al. 2024. “MLPerf Power: Benchmarking the Energy Efficiency of Machine Learning Systems from \(\mu\)Watts to MWatts for Sustainable AI.” 2025 IEEE International Symposium on High Performance Computer Architecture (HPCA), 1201–16. https://doi.org/10.1109/hpca61900.2025.00092.
图中 RetinaNet 和 ResNet 的提升最大,均达到初始归一化能效的 3\(\times\)。BERT 和 GPT-J 达到约 1.9\(\times\),DLRM-v2 达到约 1.7\(\times\),Llama 2 约为 1.5\(\times\),RNN-T 约为 1.3\(\times\)。这些差异反映了各工作负载底层算术强度的差异。具有静态形状和高运算强度的卷积网络(RetinaNet 和 ResNet)直接受益于成熟的 INT8 Tensor Core 执行和内核融合。相比之下,大语言模型(GPT-J 和 Llama 2)与推荐模型(DLRM-v2)在自回归解码和稀疏嵌入查找期间仍受内存带宽限制,此时能效提升依赖于内存子系统创新,而非单纯扩展计算能力。
计时协议和功率测量仪器为基准测试提供了原始数据。然而,仅有原始数据并不能保证得出可靠结论。要将测量结果转化为有意义的比较,就必须理解误差、偏差和失配的系统性来源;即使基准测试数据经过精心采集,这些因素仍可能使其具有误导性。
基准测试最佳实践
即使推理栈通过了实验室中的稳态运行测试,当生产流量突发到达,或输入构成转向处理成本较高的样本时,它仍可能无法达到延迟目标。训练吞吐量、推理延迟和功率效率各自都有经过 MLPerf 验证的成熟测量协议,但仅知道测量什么还不够,还必须理解基准测试无法涵盖哪些因素,以及这些缺口为何会导致生产部署违反服务级别目标。
基准测试采用简化假设,以实现标准化比较,但这些假设与生产实际存在差异。训练测试套件固定数据集并严格规定随机性,而生产数据和重新训练条件持续演变。推理测试套件强调规定的稳态场景,而生产流量具有突发式到达分布和可变序列长度。功率基准测试控制热环境,而部署中的加速器面临变化的环境温度和持续的热负载。统计、部署、系统设计和组织四类局限,决定了基准测试结果能否转化为成功的部署。
统计与方法问题
基准测试结果的可靠性取决于生成结果的统计体系。三个核心方法问题经常削弱这种可靠性。
问题覆盖不完整是指基准测试仅考察系统的狭窄运行点。CIFAR-10 (Krizhevsky 2009) 等受控数据集将输入限制为尺寸一致的低分辨率图像(\(32 \times 32\) 像素),这些图像可完全容纳于片上缓存(L2/L3)中。这个较小的工作集掩盖了 HBM 带宽瓶颈,并消除了在生产视觉流水线中占主导地位的动态内存分配、内核启动开销和非合并内存事务。在尺寸统一、经过降采样的基准测试上获得高准确率和高吞吐量的模型,在部署后面对可变图像分辨率、任意宽高比以及传感器噪声时,可能因频繁触发内核重新编译或回退执行路径而出现停顿。
Krizhevsky, Alex. 2009. Learning Multiple Layers of Features from Tiny Images. University of Toronto.
当评估依赖的试验次数过少,无法区分算法改进与测量噪声时,就会出现统计上不显著的问题,尤其是在评估媒介本身会引入方差的情况下。大语言模型评估体现了这一脆弱性:无论是通过人类偏好评分,还是通过以大语言模型为评判者的协议,对候选生成结果相对于参考结果进行评分,分数都会随提示词措辞、评判模型的对齐方式和回答顺序而显著变化。报告中领先两分的优势,可能在换用另一种提示词模板或评判配置后消失。严格的评估需要对数百组独立提示词配对进行配对假设检验,并计算自助法置信区间。省略这些置信界限,会掩盖报告中的差距究竟反映了真正的架构进步,还是随机评估噪声。
跨不同软件环境的可复现性始终是一项系统层面的障碍。编译器、数值运行时或数学库的细微版本变化,都可能使基准测量结果显著波动。例如,用自动调优的内核编译器替换厂商提供的基础线性代数子程序(BLAS)库,会改变线程块分块尺寸、寄存器分配和共享内存 bank 冲突。此外,浮点运算的非结合性会使跨线程块的并行归约因线程调度不同而产生位级不一致的输出。MLPerf 通过提供参考实现、固定随机种子以及经过审计的提交规则来解决可复现性问题。即使在严格规则下,要跟踪不同加速器架构上的性能,仍需固定库依赖、编译器标志和执行运行时,以防止配置在不知不觉中发生漂移。
从实验室到部署的性能差距
统计严谨性确保基准测量具有精确性,但对错误运行状态进行精确测量,仍会导致生产失败。基准测试套件必须与部署的物理约束相匹配。
当基准测试孤立地考察单一标量指标,而生产环境需要在多目标帕累托前沿上进行权衡时,就会出现与现实目标不一致的问题。标准推理基准测试通常在闭环负载下,使用静态批次使加速器饱和,以评估离线吞吐量。相比之下,生产服务器作为开放排队系统运行,受到突发式泊松或帕累托到达模式的影响。随着加速器利用率接近饱和,排队延迟会非线性增长,导致尾延迟(\(p99\) 和 \(p99.9\))违反严格的服务级别协议,即使平均延迟看起来仍可接受。此外,离线基准测试评估的是独占加速器 HBM 的孤立模型。在生产环境中,多租户模型服务引擎、自回归解码所需的动态键值(KV)缓存分配,以及经 PCIe 进行的主机与设备间数据传输,会争用相同的内存容量和总线带宽,使实际运行吞吐量低于实验室预测值。
系统设计挑战
统计方法和部署匹配程度决定了如何测量性能以及如何设定性能目标。第三类局限直接源于执行工作负载的物理硬件。加速器行为会随热条件、操作系统资源争用和底层微架构拓扑而波动。
环境与运行条件通过物理硬件机制改变基准测试结果。加速器受严格的 TDP 功耗包络和芯片结温上限约束。当持续计算产生热量的速度超过散热方案排出热量的速度时,板载控制器会启用动态电压与频率调整(DVFS),降低计算引擎的频率,从而降低时钟频率和算术吞吐量。在空闲、低温加速器上进行的短时基准测试捕捉到的是瞬态加速频率,而连续生产执行则在较低的稳态频率下运行,导致吞吐量降低 15% 至 25%。同样,未受管理的操作系统后台线程、主机 CPU 中断和 PCIe 总线争用会引入延迟抖动;除非执行环境强制实施 CPU 核绑定和专用内存分配,否则这些抖动会扭曲尾延迟测量结果。
硬件彩票34 (Hooker 2021) 将算法的可行性与专用硬件支持绑定,进一步加剧了这种物理差异。现代加速器将绝大部分芯片面积分配给稠密矩阵乘法单元(例如 Tensor Core 或脉动阵列),并以宽向量单元和高带宽内存层次结构提供支持。稠密 Transformer 等算法架构通过在批量词元之间复用权重来实现高算术强度,从而利用峰值理论 FLOP/s 的较大比例。相反,依赖动态控制流、细粒度稀疏性或图消息传递的架构会受到非合并内存事务和线程分歧的影响,无法充分利用可用计算电路。算法在基准测试中的性能,往往反映的是模型计算图与主流加速器执行单元的天然适配程度,而非其内在的数学优越性。
在异构执行目标上评估模型时,对硬件兼容性的依赖会引入系统性偏差。针对 GPU 执行优化的架构,在向量宽度、缓存层次结构和量化支持不同的嵌入式 CPU、DSP 或定制边缘加速器上,可能表现不佳。Figure 9 通过比较不同平台上的模型性能,具体展示了这种硬件依赖性。在 CPU uint8 和 GPU 配置上,多硬件模型与“MobileNetV3 Large min”基线的表现接近:前者的 ImageNet top-1 准确率约为 77%,而基线约为 75%。在 EdgeTPU 和 DSP 硬件上,同样的多硬件模型以显著更低的延迟维持了 77% 的准确率,而仅针对 CPU 调优的模型则无法获得这些收益。这表明,“最佳”模型完全取决于部署目标,而这一结论无法从单平台基准测试中得出。
\begin{tikzpicture}[font=\small\sffamily]
\pgfplotsset{myaxis/.style={
  /pgf/number format/.cd,
  1000 sep={},
   legend style={at={(1.85,0.97)}, anchor=north},
   legend cell align=left,
   legend style={fill=BrownL!30,draw=BrownLine,row sep=1.1pt,
   font=\fontsize{6pt}{6}\selectfont\sffamily},
   width=58mm,
   height=50mm,
   axis line style={thick,-latex},
   tick label style={/pgf/number format/assume math mode=true},
   yticklabel style={xshift=0mm,font=\fontsize{7pt}{7}\selectfont\sffamily,
   /pgf/number format/.cd, fixed, fixed zerofill, precision=2},
   xticklabel style={font=\fontsize{7pt}{7}\selectfont\sffamily},
   ylabel style={font=\fontsize{7pt}{7}\selectfont\sffamily,align=center,yshift=-1mm},
   xlabel style={font=\fontsize{7pt}{7}\selectfont\sffamily},
   tick style={draw=black!60,thin},
   tick align=outside,
   tick pos=bottom,
   major tick length=1mm,
   title style={yshift=-4pt},
   grid=none,
   major grid style={black!60},
   x tick label style={rotate=0, anchor=north,yshift=2pt},
   ylabel={ImageNet Top-1 准确率},
   cycle list={
     {myblue,mark=*,mark size=1.5pt,line width=1pt},
     {myolive,mark=*,mark size=1.5pt,line width=1pt},
     {mygreen,mark=*,mark size=1.5pt,line width=1pt},
     {myred,mark=*,mark size=1.5pt,line width=1pt},
     {mypurple,mark=*,mark size=1.5pt,line width=1pt},
     {myorange,mark=*,mark size=1.5pt,line width=1pt},
     {black,mark=triangle*,mark size=2.5pt,line width=1pt},
     {mybrown,mark=triangle*,mark size=2.5pt,line width=1pt}
  }
    }}

%LEFT
 \begin{scope}[local bounding box=GR1,shift={(0,0)}]
\begin{axis}[myaxis,
  xmin=7,
  xmax=115,
  xtick={25,50,75,100},
  ymin=0.6912, ymax=0.783,
  ytick={0.70,0.72,...,0.78},
  xlabel={Pixel 4 CPU 浮点运算延迟},
]
%blue
\addplot+[] coordinates {(24.2,0.711)(37.1,0.736)(55,0.752)};
%olive
\addplot+[] coordinates {(18,0.703)(25.3,0.733)(39,0.753)};
%green
\addplot+[] coordinates {(14,0.731)(20.3,0.754)(30.5,0.766)};
%red
\addplot+[] coordinates {(12,0.695)(17.3,0.725)(27,0.748)};
%purple
\addplot+[] coordinates {(48,0.743)(60,0.762)(109.5,0.779)};
%orange
\addplot+[] coordinates {(20.5,0.7245)(28,0.75)(41.5,0.765)};
%black
\addplot+[] coordinates {(20.5,0.7345)(25,0.748)(35.5,0.758)};
%brown
\addplot+[] coordinates {(26,0.748)(31,0.759)(45.5,0.769)};
\coordinate(X)at(axis cs: 20.3,0.754);
\end{axis}
\end{scope}
%above center
\begin{scope}[local bounding box=GR2,shift={(5.7,0)}]
\begin{axis}[myaxis,
  xmin=5.4,
  xmax=34.4,
  xtick={10,20,30},
  ymin=0.691, ymax=0.782,
  ytick={0.70,0.72,...,0.78},
  xlabel={Pixel 4 CPU uint8 运算延迟}
]
%blue
\addplot+[] coordinates {(9.0,0.711)(12.8,0.736)(18.2,0.751)};
%olive
\addplot+[] coordinates {(8.5,0.703)(11.5,0.733)(16.6,0.753)};
%green
\addplot+[] coordinates {(9.5,0.731)(13.3,0.753)(17.9,0.7655)};
%red
\addplot+[] coordinates {(6.8,0.695)(8.7,0.726)(12.6,0.749)};
%purple
\addplot+[] coordinates {(16.1,0.743)(19.5,0.762)(33.0,0.7785)};
%orange
\addplot+[] coordinates {(11.3,0.7245)(14.8,0.749)(20.2,0.765)};
%black
\addplot+[] coordinates {(10.2,0.7345)(11.5,0.749)(14.8,0.758)};
%brown
\addplot+[] coordinates {(12.3,0.748)(13.9,0.758)(18.4,0.769)};
\end{axis}
\end{scope}

%above right
\begin{scope}[local bounding box=GR3,shift={(11.4,0)}]
\begin{axis}[myaxis,
  xticklabel style={xshift=0mm,font=\fontsize{7pt}{7}\selectfont\sffamily,
  /pgf/number format/.cd, fixed, fixed zerofill, precision=1},
  xmin=2.2,
  xmax=12.9,
  xtick={2.5,5.0,7.5,10.0,12.5},
  ymin=0.691, ymax=0.782,
  ytick={0.70,0.72,...,0.78},
  xlabel={Pixel 4 GPU Adreno 640 延迟}
]
%blue
\addplot+[] coordinates {(3.7,0.711)(4.8,0.7355)(7.1,0.751)};
%olive
\addplot+[] coordinates {(3.4,0.703)(4.4,0.7323)(5.7,0.7525)};
%green
\addplot+[] coordinates {(4.75,0.731)(5.62,0.753)(7.29,0.7655)};
%red
\addplot+[] coordinates {(2.7,0.695)(3.37,0.725)(4.6,0.748)};
%purple
\addplot+[] coordinates {(6.1,0.7427)(7.5,0.7615)(12.4,0.7781)};
%orange
\addplot+[] coordinates {(4.86,0.7245)(5.9,0.749)(7.82,0.764)};
%black
\addplot+[] coordinates {(3.92,0.7345)(4.4,0.748)(5.58,0.758)};
%brown
\addplot+[] coordinates {(4.73,0.747)(5.39,0.758)(6.64,0.768)};
\end{axis}
\end{scope}
%below left
\begin{scope}[local bounding box=GR4,shift={(0,-5)}]
\begin{axis}[myaxis,
  xticklabel style={xshift=0mm,font=\fontsize{7pt}{7}\selectfont\sffamily,
  /pgf/number format/.cd, fixed, fixed zerofill, precision=1},
  xmin=1.85,
  xmax=3.59,
  xtick={2.0,2.5,3.0,3.5},
  ymin=0.691, ymax=0.782,
  ytick={0.70,0.72,...,0.78},
  xlabel={Pixel 4 EdgeTPU 延迟}
]
%blue
\addplot+[] coordinates {(1.92,0.711)(2.38,0.7359)(2.845,0.7514)};
%olive
\addplot+[] coordinates {(2.03,0.703)(2.3,0.7325)(2.93,0.7525)};
%green
\addplot+[] coordinates {(1.942,0.6947)(2.105,0.7253)(2.58,0.749)};
%red
\addplot+[] coordinates {(1.942,0.6947)(2.105,0.7253)(2.58,0.749)};
%purple
\addplot+[] coordinates {(2.34,0.7425)(2.67,0.7615)(3.495,0.77844)};
%orange
\addplot+[] coordinates {(2.6,0.7245)(3.09,0.7484)(3.42,0.764)};
%black
\addplot+[] coordinates {(2.08,0.734)(2.21,0.748)(2.44,0.7577)};
%brown
\addplot+[] coordinates {(2.315,0.747)(2.4,0.7575)(2.9,0.7676)};
\end{axis}
\end{scope}
%below right
\begin{scope}[local bounding box=GR5,shift={(5.7,-5)}]
\begin{axis}[myaxis,
  xmin=2.35,
  xmax=6.35,
  xtick={3,4,5,6},
  ymin=0.691, ymax=0.782,
  ytick={0.70,0.72,...,0.78},
  xlabel={Pixel 4 DSP 高通骁龙 855 延迟}
]
%blue
\addplot+[] coordinates {(2.52,0.711)(3.05,0.736)(3.72,0.751)};
\addlegendentry{MobileNet V1}
%olive
\addplot+[] coordinates {(3.3,0.703)(3.84,0.733)(4.97,0.7525)};
\addlegendentry{MobileNet V2}
%green
\addplot+[] coordinates {(3.95,0.731)(4.5,0.753)(5.15,0.7652)};
\addlegendentry{MobileNet V3 Large}
%red
\addplot+[] coordinates {(2.92,0.6945)(3.29,0.725)(3.81,0.7488)};
\addlegendentry{MobileNet V3 Large min}
%purple
\addplot+[] coordinates {(3.82,0.7425)(4.29,0.7615)(6.14,0.7781)};
\addlegendentry{MobileNet-EdgeTPU}
%orange
\addplot+[] coordinates {(3.54,0.7245)(3.885,0.7485)(5.06,0.764)};
\addlegendentry{ProxylessNAS-Mobile}
%black
\addplot+[] coordinates {(3.08,0.7341)(3.377,0.748)(4.05,0.762)};
\addlegendentry{Multi-MAX}
%brown
\addplot+[] coordinates {(3.6,0.747)(3.84,0.759)(4.52,0.7675)};
\addlegendentry{Multi-AVG}
\coordinate(Y)at(axis cs: 4.5,0.753);
\end{axis}
\end{scope}
\draw[VioletLine!60,-{Triangle[width=8pt,length=13pt]}, line width=3pt,
shorten <=2pt](X)--(Y);
\end{tikzpicture}
Chu, Grace, Okan Arikan, Gabriel Bender, Weijun Wang, Achille Brighton, Pieter-Jan Kindermans, Hanxiao Liu, Berkin Akin, Suyog Gupta, and Andrew Howard. 2021. “Discovering Multi-Hardware Mobile Models via Architecture Search.” 2021 IEEE/CVF Conference on Computer Vision and Pattern Recognition Workshops (CVPRW), 3016–25. https://doi.org/10.1109/cvprw53098.2021.00337.
如果不在异构硬件配置上开展基准测试,系统设计者就可能仅仅因为某些架构契合现有加速器的存储层次结构和指令集而选择它们。在多种执行引擎上评估模型,可以确保架构决策反映根本性的计算效率,而非特定平台协同设计所产生的偶然优势。
组织与战略问题
统计噪声、与部署场景不一致、环境差异以及硬件兼容性等技术局限,涉及的是测量机制。另一类截然不同的失效源于人的激励机制。商业采购和学术排行榜的激励机制,使基准测试的执行与报告方式产生系统性偏差。缓解这些组织层面的影响,需要正式的治理机制和社区审计标准,以维护基准测试的完整性。
基准工程化
硬件彩票是硬件专用化的非预期后果,而基准工程化则是有意调整模型或系统,以利用特定基准测试框架独有特征的做法。这种做法会产生虚高的性能指标,而这些指标在生产条件下便无法维持。
当开发者专门调整超参数、预处理流水线或执行路径,以最大化基准测试分数而非可泛化的性能时,就出现了基准工程化。合理的系统优化与基准工程化之间的界限,在于调优是否损害分布外鲁棒性。例如,推理流水线可能将输入张量维度硬编码,并专门对批次进行填充,以匹配加速器 GEMM 分块配置的内存步长,从而在固定的基准测试形状上实现峰值吞吐量,却在面对任意生产输入时触发代价高昂的内核回退和内存重新分配。同样,为匹配自动评估模型的格式偏好而精细调整评估流水线,会获得较高的排行榜名次,但在与非结构化的人类对话交互时却表现失效。
采购合同和营销宣传形成了直接针对公开基准进行优化的强烈激励。当基准排名决定商业采用时,工程资源便会集中于针对测试框架进行优化,并以牺牲通用效用为代价——这正是 section 1.1 中引入、并在 section 1.3.1 中通过 BLEU 分数示例说明的古德哈特定律失效模式。
偏差与过度优化
系统工程师在评估基准测试结果时,必须区分合理的架构收益与基准工程化。有几种技术实践可以揭示二者之间的差异。透明性构成第一道防线:提交结果时公开完整的编译器标志、内核配置和执行轨迹,使独立评估者能够区分具有泛化能力的效率提升与针对测试框架的特定调优。成对报告受控基准测试与未经筛选的生产轨迹中的指标,可以揭示延迟分布和内存利用率的差异。此外,在多个独立维护的基准测试套件上开展评估,可以提高过拟合的门槛,因为针对某个测试框架中人为构造的特殊模式所做的优化,通常难以迁移到多样化的测试套件中。
标准化和第三方验证强化了问责机制。独立审计会验证所报告的加速效果能否在相同硬件环境中复现,MLPerf 对参考实现与提交实现的验证便展示了这一点(section 1.10.5)。面向特定应用的压力测试会评估静态基准测试所遗漏的运行失效模式,例如将视觉模型置于不利环境条件下,或让推理引擎承受分布偏斜的请求流量。最后,跨硬件基准测试可以验证性能优势究竟源于真正的算法优越性,还是仅仅源于与单一加速器存储层次结构的狭窄适配。
基准的演进
基准并非静态标准;它们必须随模型架构和硬件能力共同演进。当模型达到其准确率上限,或硬件创新改变了系统的主要瓶颈时,曾经能够在某一代架构中有效区分系统能力的基准就会过时。陈旧的基准会激励人们对旧有计算内核进行过度优化,而不是推动系统效率提升。
这一演进周期贯穿机器学习基准的发展史。早期深度学习基准评估的是卷积网络上的图像分类和目标检测。随着神经网络架构扩展到大语言模型、推荐系统和生成式 AI,静态视觉基准无法涵盖长上下文注意力、自回归解码和稀疏专家路由。为此,社区基准逐步演进,以衡量语言理解能力 (Wang et al. 2018, 2019) 和基础模型能力 (Liang et al. 2022)。
Wang, Alex, Yada Pruksachatkun, Nikita Nangia, Amanpreet Singh, Julian Michael, Felix Hill, Omer Levy, and Samuel R. Bowman. 2019. “SuperGLUE: A Stickier Benchmark for General-Purpose Language Understanding Systems.” arXiv Preprint arXiv:1905.00537.
基准的演进还扩展了测量维度。早期基准侧重吞吐量和准确率,而当代系统需要在资源约束下,对能效、内存占用和尾延迟进行多目标评估。Figure 10 通过将科学应用映射到数据速率和计算时间两个维度,使这些差异显著的需求变得具体。具体而言,大型强子对撞机的传感器必须以接近每秒 \(10^{14}\) 字节的速率处理数据,且计算时间为纳秒量级;而移动应用的数据速率为每秒 \(10^{4}\) 字节,允许更长的计算时间窗口——数据速率的跨度约为十个数量级,计算时间的跨度约为六至七个数量级。这种广泛的需求范围要求采用专门的基准。例如,边缘 AI 应用可受益于 MLPerf 这类在资源约束下评估性能的基准,而科学应用领域则需要自身的“面向科学的快速机器学习”基准 (Duarte et al. 2022)。
\scalebox{0.77}{%
\begin{tikzpicture}[font=\small\sffamily]
\pgfplotsset{
  errorplot/.style n args={1}{
    scatter,
    line width=0.75pt,
    only marks,
    mark=none,
    error bars/.cd,
      x dir=both, x explicit,
      y dir=both, y explicit relative,
    error bar style={#1, line width=0.75pt, solid},
    error mark options={line width=0.75pt, mark size=3pt, rotate=90}
  }
}
\begin{axis}[
  ymin=2, ymax=14.3,
  ytick={2,4,6,8,10,12,14},
  yticklabels={10\textsuperscript{2},10\textsuperscript{4},10\textsuperscript{6},
  10\textsuperscript{8},10\textsuperscript{10},10\textsuperscript{12},10\textsuperscript{14}},
  xmin=2, xmax=9.0,
  xtick={2,3,4,5,6,7,8,9},
  xticklabels={10\textsuperscript{-9},10\textsuperscript{-7},10\textsuperscript{-5},
  10\textsuperscript{-3},10\textsuperscript{-1},10\textsuperscript{1},10\textsuperscript{3},10\textsuperscript{5}},
   xlabel={计算时间 [s]},
   ylabel={数据速率 [字节/s]},
   width=120mm, height=120mm,
   legend style={at={(0.7,0.3)},anchor=south west},
   grid=both
]
%LHC sensor
\addplot+[errorplot={RedLine}]
  coordinates {(2.6,13.72) +- (0.1,0.022)
}node[RedLine,pos=1,right=8pt,anchor=west]{LHC 传感器};
%X-ray diffraction
\addplot+[errorplot={VioletLine}]
  coordinates {(3.82,7.52) +- (0.33,0.069)
 } node[VioletLine,pos=1,right=22pt,anchor=west]{X 射线衍射};
%Internet-of-things
\addplot+[errorplot={OliveLine}]
   coordinates {(5.49,5.50) +- (0.5,0.18)
} node[OliveLine,pos=1,right=22pt,anchor=west]{物联网};
%Mobile devices
\addplot+[errorplot={cyan!90!black}]
   coordinates {( 5.87,4.23) +- (0.1,0.044)
}node[cyan!90!black,pos=1,right=7pt,anchor=west]{移动设备};
%Plasma control
\addplot+[errorplot={green!70!black}]
  coordinates { (4.0,9.51) +- (0.15,0.) [meta=a]
}node[green!70!black,pos=1,above right=12pt,anchor=north west]{等离子体控制};
%LHC trigger
\addplot+[errorplot={BrownLine}]
  coordinates { (3.42,9.11) +- (0.42,0.) }
node[BrownLine,pos=1, right=17pt,anchor= west]{LHC 触发器};
%Beam control
\addplot+[errorplot={OrangeLine}]
  coordinates { (4.92,4.69) +- (0.42,0.) [meta=c]
}node[OrangeLine,pos=0.1,below=2pt,anchor=north east]{束流控制};
%
\addplot+[line width=1.15pt,
  scatter,
  only marks,mark size=3.25pt,
  scatter src=explicit symbolic,
  scatter/classes={
   a={mark=+,blue}, b={mark=+,red}, c={mark=+,purple},
   d={mark=+,orange!70!black},e={mark=+,violet!60!black},f={mark=+,GreenD}
  }
]
table[meta=label, row sep=crcr]{
  x    y    label \\
  3.49 8.90 a     \\
  3.34 9.89 b     \\
  2.99 9.97 c     \\
  5.00 6.72 d     \\
  4.330 8.73 f\\
  4.50 6.50 e\\
};
\node[blue,below left=2pt and -11pt]at(axis cs:3.49,8.93){DUNE 读出};
\node[red,below left=0.5pt and 0pt]at(axis cs:3.34,9.89){EIC 触发器};
\node[purple,above right=2.5pt and -19pt]at(axis cs:2.99,9.97){量子比特读出};
\node[orange!70!black,above right=1.5pt and 1pt]at(axis cs:5.00,6.72){神经科学};
\node[violet!60!black,below left=0.5pt and 0pt]at(axis cs:4.50,6.50 ){磁体失超};
\node[GreenD,below right=0.5pt and 0pt]at(axis cs:4.330,8.78){电子显微成像};
%
\coordinate(A)at(axis cs:2,14.3);
\coordinate(B)at(axis cs:5.33,14.3);
\coordinate(C)at(axis cs:5.33,4.69);
\coordinate(D)at(axis cs:2,4.69);
\scoped[on background layer]
\filldraw[cyan!5](A)--(B)--(C)--(D)--cycle;
\node[align=center]at(axis description cs: 0.8,0.92){\textbf{面向科学的快速机器学习}\\基准任务};
\end{axis}
\end{tikzpicture}}
Duarte, Javier, Nhan Tran, Ben Hawks, Christian Herwig, Jules Muhizi, Shvetank Prakash, and Vijay Janapa Reddi. 2022. “FastML Science Benchmarks: Accelerating Real-Time Scientific Edge Machine Learning.” arXiv Preprint arXiv:2207.07958.
管理基准的演进,会在长期稳定性与架构相关性之间引入根本性的权衡。基准必须保持固定足够长的时间,才能支持严谨的跨代硬件和软件比较。如果基准变化过于频繁,就无法追踪历史进展。反之,无限期冻结基准会导致指标停滞和过度专用化。现代基准测试联盟通过采用固定的发布周期来平衡这一权衡,在引入新的代表性工作负载的同时,逐步淘汰过时的测试套件。
MLPerf 综合与基准投机
当编译器、运行时或硬件栈专门针对基准测试框架,而非其所代表的一般工作负载进行优化时,就出现了基准投机。在 Hennessy 与 Patterson 的定量系统架构传统中,基准是主动优化的目标,而非被动的测量工具。section 1.1 中引入的古德哈特效应直接适用于此:当基准分数影响采购合同或营销宣传时,工程投入就会转向利用评估框架的独有特征。MLPerf 将参考实现、严格的提交审计、封闭组精度规则以及定期淘汰工作负载相结合,以对抗基准投机并防止停滞。
在定量计算机体系结构领域,运行规则必须禁止以下三类具体的基准投机行为:
- 未披露的精度截断:编译器悄然降低数值精度(例如,使用 FP8 或 INT8 而非 BF16 执行中间激活计算)以虚增算术吞吐量,却不披露动态范围的缩减,也不验证较低精度是否会损害生产工作负载的数值稳定性。
- 工作裁剪与算子消除:执行引擎利用固定的基准测试集,跳过一般生产输入所需的操作,例如绕过动态填充移除、越界词元掩码处理或输入边界校验。
- 基准指纹识别:运行时检查输入张量维度、数据集哈希指纹或内存布局模式,以识别基准测试套件,并执行硬编码、预先调优的执行图和定制内核配置,而任意用户工作负载无法使用这些执行图和配置。
MLPerf 通过对提交进行结构化分组、验证与参考实现的等价性,以及开展代码同行审计,来消除这些捷径。在封闭组中,预处理、后处理和模型架构必须与参考实现严格等价,且提交必须达到严格的质量目标(例如,准确率保持不低于 FP32 参考准确率的 99%)。虽然鼓励提交者在执行运行时、内存布局(例如将 NCHW 转换为 NHWC)和内核融合方面创新,但运行规则严格禁止输入指纹识别和不具备泛化能力的捷径。修改模型图或重新训练方案的提交会被划入开放组,其中的修改会被明确标注并接受审计。
即使最严格的系统基准,也只能验证部署就绪程度的一个维度。在 MLPerf 工作负载上实现创纪录的吞吐量和能效,能够证实硬件与运行时栈可以提供较高的计算效率,但无法判断部署后的模型能否泛化到真实世界的数据分布,也无法判断底层数据集是否代表实际运行所面向的总体。在数据—算法—机器分类体系中,硬件吞吐量(机器)是必要基础,但算法保真性(算法)和数据集完整性(数据)必须同时成立。要构建完整的验证体系,就必须覆盖数据—算法—机器分类体系的全部三个维度,确保数据质量、模型能力和硬件效率在生产约束下协调一致。
模型与数据评估
即使压缩模型运行在加速硬件上,如果训练数据存在偏差,它仍可能失效。系统基准可以确认硬件是否实现了承诺的训练吞吐量、推理延迟和功率效率,但仅凭硬件验证无法确保部署成功。第三部分的优化流水线还包括模型压缩(模型压缩)和数据选择(数据选择),二者都需要各自的验证。该框架余下的两个维度弥补了这一缺口:模型基准验证压缩是否保留了准确率和关键模型属性,而数据基准验证训练数据是否支持鲁棒泛化。
模型基准测试
模型基准验证 模型压缩 中的压缩技术是否保留了对部署至关重要的属性。这种评估不限于总体准确率。剪枝后的模型可能保持 ImageNet 准确率,却失去对对抗性输入的鲁棒性。量化模型可能保留平均情况下的性能,却在罕见但关键的边界案例上表现退化。蒸馏模型可能达到教师模型的准确率,却丧失校准能力。历史上,基准几乎只关注准确率,但压缩使多维度评估成为必要。
ImageNet 将模型基准测试与 figure 1 中的硬件发展历程联系起来:随着 GPU 支持的架构变得切实可行,错误率不断下降。Figure 11 展示了这一演进过程:在 ImageNet 大规模视觉识别挑战赛中,错误率从 2010 年的 28.2% 降至 3.57% (Russakovsky et al. 2015)。AlexNet35 的引入使错误率从 25.8% 降至 16.4%。此后的 ZFNet、VGGNet、GoogLeNet 和 ResNet36 等模型延续了这一趋势,其中 ResNet 达到了 3.57% 的错误率 (He et al. 2016)。这一演进过程确立了评估模型压缩技术的基线:经过剪枝的 ResNet 必须说明,为获得给定的效率提升,它牺牲了多少准确率。
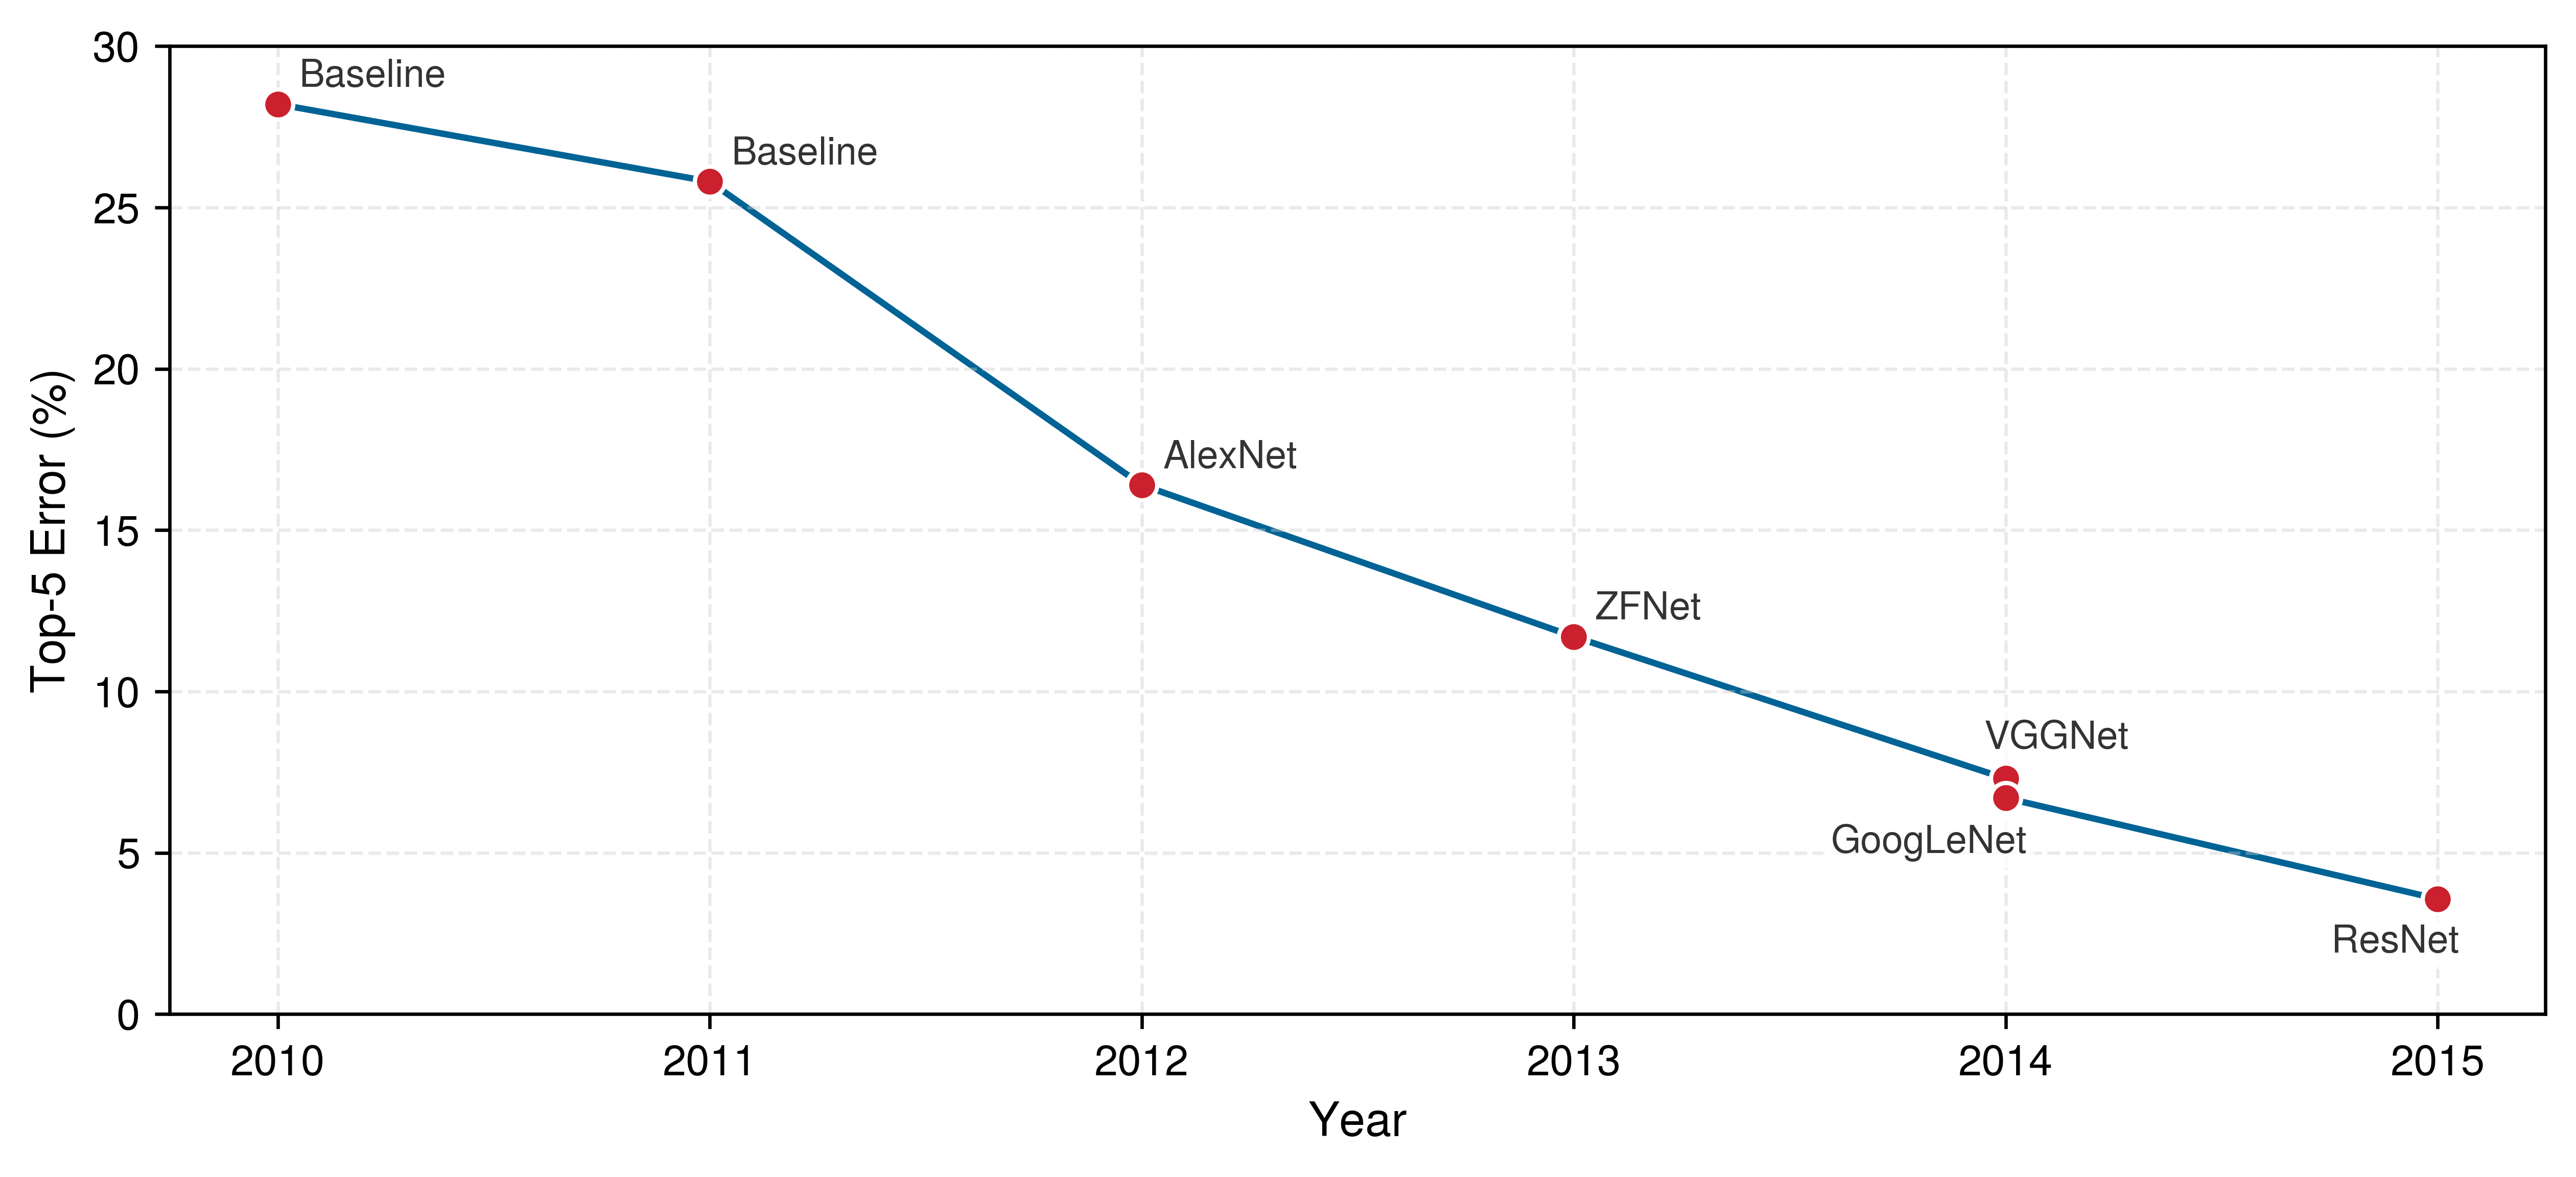
准确率指标及其盲点
最常见的模型指标(准确率、精确率、召回率、F1)各自揭示了模型行为的不同方面,同时也掩盖了其他方面;理解这些指标的盲点对压缩验证至关重要。Top-\(k\) 准确率衡量正确标签是否出现在模型的前 \(k\) 个预测中。Top-1 准确率要求严格;top-5 则较为宽松。两者之间的差距揭示了模型的不确定性:一个 top-1 准确率为 75%、top-5 准确率为 95% 的模型,“知道”答案位于少数几个候选项之中,却难以确定最终选择。对于部署而言,可接受的差距取决于下游系统能否使用排序后的预测,还是必须获得单一答案。
当类别不均衡或错误代价不对称时,精确率和召回率尤为重要 (Sokolova and Lapalme 2009)。一个准确率为 99% 的欺诈检测模型,对实际欺诈的召回率可能只有 10%(每 10 笔欺诈交易仅识别出 1 笔);尽管准确率很高,这样的结果仍不可接受。精确率(预测为正例的样本中预测正确的比例)和召回率(实际正例中被识别出的比例)揭示了总体准确率所掩盖的失效情况。
Sokolova, Marina, and Guy Lapalme. 2009. “A Systematic Analysis of Performance Measures for Classification Tasks.” Information Processing &Amp; Management 45 (4): 427–37. https://doi.org/10.1016/j.ipm.2009.03.002.
Buolamwini, Joy, and Timnit Gebru. 2018. “Gender Shades: Intersectional Accuracy Disparities in Commercial Gender Classification.” Conference on Fairness, Accountability and Transparency, 77–91.
总体指标还会掩盖子群体上的失效。一个总体准确率达到 95% 的模型,在某个关键人口统计子群体上的准确率可能只有 60%。Gender Shades 项目 (Buolamwini and Gebru 2018) 揭示,用于面部分析的商业性别分类系统在深肤色女性上的表现显著差于浅肤色男性,而总体基准测试无法显示这种差异。必须针对与部署相关的各个子群体开展分组评估;负责任工程 系统地探讨了公平性评估。
校准:何时置信度分数至关重要
在许多部署场景中,模型有多大把握与它预测什么同样重要。经过良好校准37的模型,其置信度分数与实际正确概率相对应:当它表示“置信度为 90%”时,其预测应有 90% 的概率是正确的。
即使保持了准确率,压缩也可能改变校准状况;在验证 量化与精度 中的量化技术时,这是一个关键问题。量化模型可能保持总体准确率,却对预测错误的样本变得过度自信。这一点很重要,因为只有明确测量校准状况,温度缩放等事后校准技术才能纠正这一问题 (Guo et al. 2017)。
校准失效会给下游带来问题。过度自信的模型会自动执行本应交由其他机制处理的错误决策(预测置信度为 95%,但有 30% 的情况是错误的)。置信度不足的模型则会将过多正确预测送交审核,而未能自动处理其本可胜任的决策(预测置信度为 70%,但有 95% 的情况是正确的)。期望校准误差(ECE) 衡量各置信度分箱中置信度与准确率之间的差距;可靠性图则将这种对应关系可视化。
压缩验证:效率与质量的前沿
模型压缩(模型压缩)以模型容量换取效率。验证必须确定,压缩是否实现了可接受的权衡,还是损害了重要能力。
帕累托前沿38评估用于确定压缩模型是否实现了良好的权衡。绘制准确率与目标效率指标(延迟、模型大小、能耗)的关系图,可以揭示权衡前沿。位于帕累托前沿上的模型无法在不降低另一项指标的情况下改善某项指标;位于前沿下方的模型则被更优的替代方案所支配。

被支配模型在帕累托前沿的两个坐标轴上均处于劣势。
Han, Song, Jeff Pool, John Tran, and William J. Dally. 2015. “Learning Both Weights and Connections for Efficient Neural Networks.” Advances in Neural Information Processing Systems 28 (NeurIPS 2015), 1135–43.
Gale, Trevor, Erich Elsen, and Sara Hooker. 2019. “The State of Sparsity in Deep Neural Networks.” arXiv Preprint arXiv:1902.09574.
Hinton, Geoffrey, Oriol Vinyals, and Jeff Dean. 2015. “Distilling the Knowledge in a Neural Network.” arXiv Preprint.
不同压缩技术在效率与质量之间作出不同权衡。量化降低数值精度,同时通常能够保持总体准确率 (Jacob et al. 2018)。剪枝引入稀疏性,同时以不同程度保留测试性能 (Han et al. 2015; Gale et al. 2019)。知识蒸馏将较大的教师模型或集成模型的知识迁移到较小的模型中 (Hinton et al. 2015)。由于这些总体结果无法证明校准状况或尾部行为得到保留,验证必须直接评估这些属性 (Guo et al. 2017)。
在压缩过程中评估校准状况需要标准化协议。期望校准误差(ECE)比较预测置信度与经验准确率,但它没有通用阈值。该指标取决于分箱方案、分箱数量、样本量和预测分布。因此,基准测试协议必须固定估计方法,并在固定的任务容忍度下,评估相对于未压缩基线的退化程度。
帕累托最优性可以识别非支配方案,但不能证明其中任何方案都达到了部署所要求的绝对质量下限。可接受的退化取决于部署背景:对于用户能够容忍不完美建议的推荐系统,准确率下降 2% 可能是可接受的;但对于每个假阴性都会造成严重后果的医疗诊断,这可能不可接受。生产验收关卡必须在压缩前定义绝对准确率阈值,同时评估总体准确率、校准稳定性以及对部署至关重要的数据切片。MobileNetV2 灯塔案例将这一多维验证协议具体化。
Lighthouse 1.3: MobileNetV2 INT8 压缩
回到灯塔案例 1.1,考虑一个基于 MobileNetV2 架构 (Sandler et al. 2018) 和训练后量化实践 (Jacob et al. 2018) 的 INT8 量化示例验证协议。table 18 中的数值均为假设值:
压缩前基线:MobileNetV2 的参数量为 3.5M(FP32 大小为 14 MB),在 ImageNet 上达到 71.8 percent 的 top-1 准确率。
在 table 18 中,INT8 量化将模型大小降至 3.5 MB 后,总体准确率几乎没有变化,但校准误差和边缘情形准确率揭示了显著退化。INT8 模型的 ECE 从 0.031 升至 0.089;这一增幅是否可以接受,取决于固定 ECE 协议下针对具体任务设定的容忍度。
| 指标 | FP32 | INT8 | 是否可接受? |
|---|---|---|---|
| Top-1 准确率 | 71.8% | 70.9% | ✓(下降 0.9 pp;低于 1 个百分点的阈值) |
| Top-5 准确率 | 91% | 90.4% | ✓ |
| 校准 ECE | 0.031 | 0.089 | 否(发生退化) |
| 边缘情形准确率 | 68.2% | 61.4% | 否(下降 6.8 pp) |
边缘情形定义:遮挡比例 \(>\) 50 percent、照度 \(<\) 100 lux,或相对于训练分布的旋转角度 \(>\) 30° 的图像(约占真实世界输入的 5 percent)。
这揭示了什么:在这些假设下,平均情形准确率看似可以接受(下降 0.9 percentage-point),但校准状况退化,且边缘情形准确率下降 6.8 percentage points。如果部署使用置信度阈值(例如,“仅在置信度 > 85 percent 时采取行动”),或遇到大量边缘情形(异常光照、局部遮挡),那么即使通过了总体基准测试,INT8 MobileNetV2 仍可能失效。
修正方法:事后应用温度缩放,以改善校准状况 (Guo et al. 2017)。温度缩放学习一个标量 \(T_{\text{cal}}\),在 softmax 之前用它对 logits 作除法:\(\text{softmax}(z_i/T_{\text{cal}})\)。同时,将边缘情形样本加入测试集,持续监测这一特定失效模式。
Jacob, Benoit, Skirmantas Kligys, Bo Chen, Menglong Zhu, Matthew Tang, Andrew Howard, Hartwig Adam, and Dmitry Kalenichenko. 2018. “Quantization and Training of Neural Networks for Efficient Integer-Arithmetic-Only Inference.” 2018 IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2704–13. https://doi.org/10.1109/cvpr.2018.00286.
Sandler, Mark, Andrew Howard, Menglong Zhu, Andrey Zhmoginov, and Liang-Chieh Chen. 2018. “MobileNetV2: Inverted Residuals and Linear Bottlenecks.” 2018 IEEE/CVF Conference on Computer Vision and Pattern Recognition, 4510–20. https://doi.org/10.1109/cvpr.2018.00474.
Frankle, Jonathan, and Michael Carbin. 2019. “The Lottery Ticket Hypothesis: Finding Sparse, Trainable Neural Networks.” International Conference on Learning Representations (ICLR).
彩票假说(彩票假说)提供了具体的基准测试数据,说明满足帕累托效率的压缩是什么样的。通过迭代剪枝,Frankle and Carbin (2019) 在全连接网络和卷积网络中找到了稀疏子网络(“中奖彩票”),这些子网络在独立训练时能够达到原始网络的测试准确率。这些实证发现展示了压缩权衡的非线性形态:在达到某个临界稀疏度阈值之前,大幅剪枝仍能保持准确率;超过该阈值后,质量会急剧下降。因此,压缩验证必须针对每个具体模型和架构建立经验权衡曲线,确定模型在帕累托前沿上的位置,并判断进一步剪枝究竟能带来硬件效率提升,还是仅会降低准确率。
大语言模型基准测试
当任务具有稳定标签时,例如分类准确率、检测 mAP 或分割 IoU,压缩评估框架可以直接适用。大语言模型打破了这一模式。团队可能因为某个模型在公开基准测试中得分很高而选择它,随后却在部署时发现:模型能够识别多项选择题中的事实,却无法生成有依据的回答;响应速度过慢,无法满足交互式产品的要求;或者会自信地生成基准测试从未重点检验过的不安全文本。因此,LLM 基准测试首先要明确:某个分数旨在排除哪一种部署失效。
table 19 中的指标分类围绕这些失效模式组织评估,而非围绕排行榜名次。其中各行以大规模多任务语言理解(MMLU)、39HELM(语言模型整体评估)40和困惑度41为例,说明不同分数分别回答哪些部署问题:
| 需要排除的部署失效 | 指标或基准测试类别 | 分数揭示的内容 | 分数无法证明的内容 |
|---|---|---|---|
| 模型对事实的识别能力较差 | MMLU(大规模多任务语言理解) | 涵盖五十七个学科的广泛事实知识与学科知识,其分数可相对于随机猜测的多项选择题表现进行解读 | 模型能否生成有依据的开放式回答,而非仅从多项选择中选出答案 |
| 模型能力较强,但不安全 | HELM(语言模型整体评估) | 准确率,以及校准、鲁棒性、公平性、偏见、毒性和效率 | 单一汇总分数能否涵盖部署风险;模型可能准确率很高,但在校准、安全性、成本或提示稳定性方面表现较差 |
| 模型能很好地预测其语料库 | 困惑度 | 在同一语料库的留出数据上进行下一词元预测的表现;困惑度为 10 表示模型平均处于“在 10 个选项间难以确定”的状态 | 生成的回答在该语料库之外是否有用、安全或有依据 |
| 模型在使用中显得缓慢 | 首词元延迟、词元间延迟和词元吞吐量 | 生成开始前的提示处理延迟,以及生成开始后的解码速度 | 单一吞吐量数值是否掩盖了较差的交互响应性,尤其是在批处理提高吞吐量却加剧首词元延迟时 |
响应性一行需要具体的计时参照,因为 LLM 基准测试经常只报告单一的汇总吞吐量数值,而用户实际经历的生成过程具有不同阶段。即使模型实现了很高的每秒词元汇总吞吐量,如果首个词元迟迟未到,用户仍会感到迟缓;模型也可能将首词元延迟降至最低,却因后续文本生成过慢而无法满足交互式阅读需求。
词元吞吐量将这些生成速率转化为用户感知的实际经过时间:对于长度为 750 tokens 的回答,生成速率为 25 tokens/s 时需要 30 seconds,而以 100 tokens/s 的速率生成则在 7.5 seconds 内完成。因此,必须同时报告首词元时间和词元间延迟:前者反映初始响应性,后者反映持续输出速度。这种延迟划分体现了两种截然不同的计算模式:首词元时间由提示预填充决定,该过程并行处理词元,通常受计算能力限制;词元间延迟则由自回归解码决定,在此过程中,每生成一个词元,都需要从高带宽内存重新加载全部模型权重和 KV 缓存张量,使吞吐量严格受限于内存带宽。
最后一种失效模式是,基准测试分数可能反映的是对训练数据的记忆,而非通用能力。基准测试污染是 LLM 特有的风险,因为在网络规模语料库上训练的模型可能在预训练期间接触过基准测试题目,从而凭借记忆而非能力抬高分数 (Xu et al. 2024)。泄漏检测将这一风险转化为基准测试设计者能够检验的问题,而非仅仅怀疑的对象。时间留出方法使用训练截止日期之后发布的内容,动态基准测试持续生成新实例,污染测试则检查模型是否记住了基准测试的原文表述。这些技术使基准测试始终与部署问题保持一致,而不是奖励模型在预训练期间接触过评估集。
Xu, Ruijie, Zengzhi Wang, Run-Ze Fan, and Pengfei Liu. 2024. “Benchmarking Benchmark Leakage in Large Language Models.” arXiv Preprint arXiv:2404.18824.
数据基准测试
模型基准测试验证压缩是否保留了模型质量。然而,模型质量完全取决于用于训练和评估的数据,而这种依赖关系造成了机器学习部署中最隐蔽的失效模式。即使模型得到完美保留,只要其训练数据存在偏见或缺乏代表性,它仍会在生产环境中失效。数据基准测试验证 数据选择 中的效率策略(主动学习、课程设计、数据增强和合成数据生成)所产生的训练集能否支持可靠部署。这通常是最后才暴露问题、也最难诊断的一项验证:模型在留出测试数据上准确率极高,却可能在训练数据从未充分代表的生产输入上表现崩溃。
在数据—算法—机器分类体系中,优化算法和机器无法弥补数据的结构性缺陷:当训练分布存在缺陷时,即使加速器集群以峰值算术强度运行,也只是更快地计算出错误表征。因此,数据基准测试始于操作规程,而非汇总分数。该规程定义模型必须服务的部署细分场景,预留能够抵御泄漏的留出集,验证不同数据划分之间的重复样本与近重复样本已相互隔离,设定稀有类别和子群体的最低覆盖要求,审计标签质量,并确立漂移阈值,以判断基准测试何时不再代表生产环境。只有明确这些准入条件之后,汇总指标才具有可解释性。
覆盖度指标
数据基准测试必须回答的第一个问题是,训练分布是否覆盖模型在生产环境中将遇到的实际运行域。模型无法泛化到训练分布中不存在的输入情形,而训练覆盖失效的机制往往十分隐蔽。
类别平衡是最明显的失效模式。在一个合法交易占 99%、欺诈交易占 1% 的欺诈检测数据集中,无条件预测多数类的退化模型可以达到 99% 的准确率,却无法实现其实际运行目的。缓解严重的类别不平衡需要采用损失重加权、定向过采样或决策阈值校准。更隐蔽的是类别内部的子群体不平衡:数据集在总体上可能呈现正负类别平衡,却从某个特定人口群体或地理区域抽取了比例过高的负样本。总体准确率指标会掩盖这些系统性的局部失效。当系统与人群交互时,必须审计各人口统计维度(例如年龄、地理位置或方言)的代表性,不过人口统计元数据的缺失或噪声常常使检测变得复杂。
特征覆盖度超越离散类别标签,延伸至实际运行变化所构成的连续空间。类别平衡可以直接通过标签统计来验证,而特征覆盖度则需要梳理部署环境的物理参数。仅使用白天采集数据训练的视觉流水线,会在低照度传感器噪声下失效;使用干净录音室信号训练的语音处理流水线,会在声学混响和环境噪声下性能下降。这些环境变化——不同的传感器硬件、光照条件以及罕见的运行边界情形——超出了离散标签分布的范围。因此,对特征覆盖度进行基准测试,需要先与领域专家共同明确输入空间的具体边界,再评估模型性能。
质量指标
即使训练数据集覆盖了实际运行域,标注错误仍会破坏监督信号。普遍存在的标签错误——在包括 ImageNet 在内的经典基准数据集中,测得的错误率一直处于 3% 至 6% 之间 (Northcutt et al. 2021)——并非无害噪声。监督优化会将错误标签视为真值。当评估集包含错误标签时,学到真实底层分布的模型会受到惩罚,而记住标注伪迹的模型却会获得虚高分数。
Northcutt, Curtis G., Anish Athalye, and Jonas Mueller. 2021. “Pervasive Label Errors in Test Sets Destabilize Machine Learning Benchmarks.” arXiv Preprint arXiv:2103.14749 34: 19075–90. https://doi.org/10.48550/arxiv.2103.14749.
对于小规模语料库,对分层随机样本进行人工审计可以提供基线错误率估计。在大规模场景下,置信学习利用样本外预测概率估计噪声标注与真实潜在标签的联合分布,从而以算法方式识别标签错误。当模型持续对某个与指定标签冲突的类别赋予高置信度时,这种差异就能将候选标注错误与通常的优化不确定性区分开来。标记这些候选样本后,便可进行有针对性的重新标注或过滤,避免全面人工审查所需的高昂成本。
标注者间一致性衡量模型训练之前不同标注者之间的一致程度。用于两名评定者的 Cohen’s kappa 和用于多名评定者的 Fleiss’ kappa,量化了超出随机预期的一致程度 (Cohen 1960; Fleiss 1971)。在具有客观真值的任务中,如果一致性指标低于既定阈值,这种失效就表明标注分类体系含糊、评定者疲劳或指南不一致。尽管 Landis 和 Koch 对 kappa 的定性分级提供了历史参考 (Landis and Koch 1977),生产流水线仍需要根据具体应用的风险容忍度直接校准一致性阈值。
Cohen, Jacob. 1960. “A Coefficient of Agreement for Nominal Scales.” Educational and Psychological Measurement 20 (1): 37–46. https://doi.org/10.1177/001316446002000104.
Fleiss, Joseph L. 1971. “Measuring Nominal Scale Agreement Among Many Raters.” Psychological Bulletin 76 (5): 378–82. https://doi.org/10.1037/h0031619.
Landis, J. Richard, and Gary G. Koch. 1977. “The Measurement of Observer Agreement for Categorical Data.” Biometrics 33 (1): 159–74. https://doi.org/10.2307/2529310.
标签噪声的结构形式决定其下游影响。随机标签噪声会稀释各类别的梯度信号,增加样本复杂度,但很少使模型学到连贯的错误表征。相比之下,系统性错误——例如持续错误标注代表性不足的子类,或将标签与环境伪迹绑定——会向模型权重中注入结构性偏差。如果以雪地为背景拍摄的狼的图像被持续标注为狗,模型就会学会将雪与目标类别关联起来。在存在系统性标签错误时,按照相同标注规程收集更多训练数据并不能纠正偏差;这只会以更高的参数确定性强化这种虚假关联。
分布对齐
数据基准测试最终必须评估模型能否从训练条件泛化到部署环境。标准评估规程假设训练集、验证集和测试集相互独立且同分布(i.i.d.)。在生产系统中,这一假设经常失效:时间漂移改变消费者行为,传感器退化改变硬件特性,地域扩展引入未建模的子群体。当独立同分布假设不成立时,留出验证准确率便无法继续预测实际运行性能,并会持续对模型可靠性给出过于乐观的评估。
WILDS42 基准测试 (Koh et al. 2021) 系统性地量化了这种训练到生产的对齐差距,它评估模型在医院系统、野生动物相机布设位置和卫星过境等场景中的分布偏移表现。在 Camelyon17-WILDS 上,所报告的 ERM 基线在分布内的平均准确率为 93.2%,而在未见过的临床站点上的分布外平均准确率为 70.3%。这一性能下降发生在架构、超参数和训练计算量均保持不变的情况下,证实部署性能退化直接源于分布偏移,而非模型容量不足。
Koh, Pang Wei, Shiori Sagawa, Henrik Marklund, Sang Michael Xie, Marvin Zhang, Akshay Balsubramani, Weihua Hu, et al. 2021. “WILDS: A Benchmark of in-the-Wild Distribution Shifts.” In Proceedings of the 38th International Conference on Machine Learning, ICML 2021, 18-24 July 2021, Virtual Event, edited by Marina Meila and Tong Zhang, vol. 139. Proceedings of Machine Learning Research. PMLR.
Berger, Vance W., and YanYan Zhou. 2014. “Kolmogorov–Smirnov Test: Overview.” In Wiley StatsRef: Statistics Reference Online. Wiley. https://doi.org/10.1002/9781118445112.stat06558.
Gretton, Arthur, Karsten M. Borgwardt, Malte J. Rasch, Bernhard Schölkopf, and Alexander Smola. 2012. “A Kernel Two-Sample Test.” Journal of Machine Learning Research 13 (25): 723–73.
为防止分布偏移导致服务级别协议违约,模型服务流水线会对传入的推理流部署统计偏移检测。双样本假设检验,例如用于单变量特征的 Kolmogorov-Smirnov 检验 (Berger and Zhou 2014),以及用于多变量嵌入的最大均值差异 (Gretton et al. 2012),可以检测协变量偏移——即使条件目标分布 \(P(Y \mid X)\) 仍未被观测,也能检测边缘输入分布 \(P(X)\) 的变化。跟踪预测熵和置信度分布,还能进一步识别输入何时落在训练分布支持集之外,使系统能够在服务质量下降之前,将异常查询路由至备用模型或人工审核。
分布对齐的挑战凸显了机器学习开发中两种范式之间持续存在的张力:固定数据并迭代模型,或固定模型并迭代数据。Figure 12 将这两种范式并列展示,准确揭示了反馈回路的差异所在。在以模型为中心的示意图中,迭代循环针对架构,而数据保持不变;在以数据为中心的示意图中,架构保持固定,而循环针对数据质量。这两种方法相互补充,并不构成关于改进来源的普遍优先排序。
\begin{tikzpicture}[font=\sffamily]
\tikzset{Line/.style={line width=1.25pt,black!50,-{Latex[length=3mm,width=2mm]}}
}
%CPU
\tikzset{%
 pics/cpu/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=CPU\picname,scale=\scalefac, every node/.append style={transform shape}]
\node[fill=\filllcolor,minimum width=66, minimum height=66,
            rounded corners=2,outer sep=2pt] (C1) {};
\node[fill=white,minimum width=54, minimum height=54] (C2) {};
\node[fill=\filllcolor!40,minimum width=44, minimum height=44] (C3) {\large CPU};

\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=\filllcolor,minimum width=3, minimum height=15,
           inner sep=0pt,anchor=south](GO\y)at($(C1.north west)!\x!(C1.north east)$){};
}
\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=\filllcolor,minimum width=3, minimum height=15,
           inner sep=0pt,anchor=north](DO\y)at($(C1.south west)!\x!(C1.south east)$){};
}
\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=\filllcolor,minimum width=15, minimum height=3,
           inner sep=0pt,anchor=east](LE\y)at($(C1.north west)!\x!(C1.south west)$){};
}
\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=\filllcolor,minimum width=15, minimum height=3,
           inner sep=0pt,anchor=west](DE\y)at($(C1.north east)!\x!(C1.south east)$){};
}
 \end{scope}
     }
  }
}
%CPU
\tikzset{mycylinder/.style={cylinder, shape border rotate=90, aspect=1.3, draw, fill=white,
minimum width=25mm,minimum height=11mm,line width=\Linewidth,node distance=-0.15},
pics/data/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=DATA\picname,scale=\scalefac, every node/.append style={transform shape}]
\node[mycylinder,fill=\filllcolor!50] (A) {};
\node[mycylinder, above=of A,fill=\filllcolor!30] (B) {};
\node[mycylinder, above=of B,fill=\filllcolor!10] (C) {};
\fill[\filllcolor!50!black]($(C.west)!0.12!(C.east)$)circle(3pt);
\fill[\filllcolor!50!black]($(B.west)!0.12!(B.east)$)circle(3pt);
\fill[\filllcolor!50!black]($(A.west)!0.12!(A.east)$)circle(3pt);
 \end{scope}
     }
  }
}
%lokot
\tikzset{
pics/lokot/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\fill[fill=\filllcolor](0,0)--(2.7,0)--++(270:1.6)to[out=270,in=0](1.85,-2.45)
--++(180:1.1)to[out=180,in=270](0,-1.3)--cycle;
\fill[fill=white](1.32,-0.9)+(230:0.3)
arc[start angle=230, end angle=-50, radius=0.3]--++(280:0.75)--++(180:0.62)--cycle;
\path[](0.27,0)circle(1pt)coordinate(K1);
\path[](0.57,0)circle(1pt)coordinate(K2);
\path[](2.10,0)circle(1pt)coordinate(K3);
\path[](2.4,0)circle(1pt)coordinate(K4);
%
\path[](K1)--++(90:0.6)coordinate(KK1);
\path[](K2)--++(90:0.5)coordinate(KK2);
\path[](K4)--++(90:0.6)coordinate(KK4);
\path[](K3)--++(90:0.5)coordinate(KK3);
\fill[fill=\filllcolor](K1)--(KK1)to[out=90,in=90,distance=37](KK4)--(K4)
--(K3)--(KK3)to[out=90,in=90,distance=29](KK2)--(K2)--cycle;
\end{scope}
    }
  }
}
\pgfkeys{
  /channel/.cd,
   Depth/.store in=\Depth,
  Height/.store in=\Height,
  Width/.store in=\Width,
  filllcirclecolor/.store in=\filllcirclecolor,
  filllcolor/.store in=\filllcolor,
  drawcolor/.store in=\drawcolor,
  drawcircle/.store in=\drawcircle,
  scalefac/.store in=\scalefac,
  Linewidth/.store in=\Linewidth,
  picname/.store in=\picname,
  filllcolor=BrownLine,
  filllcirclecolor=violet!20,
  drawcolor=black,
  drawcircle=violet,
  scalefac=1,
  Linewidth=0.5pt,
  Depth=1.3,
  Height=0.8,
  Width=1.1,
  picname=C
}

%Data
\pic[shift={(0,0)}] at  (0,0){data={scalefac=0.75,picname=1,filllcolor=RedLine, Linewidth=1.0pt}};
%padlock
\pic[shift={(0,0)}] at  (0.5,2){lokot={scalefac=0.22,picname=1,drawcolor=OrangeLine!70!,
filllcolor=black!,Linewidth=0.7pt, filllcirclecolor=black}};
%CPU
\pic[shift={(0,-0.2)}] at  (4.5,1){cpu={scalefac=0.6,picname=1,filllcolor=BlueLine, Linewidth=0.7pt}};
\node[below=0.15 of DO3](MO){模型};
\path[red](MO)-|coordinate(D)(A);
\node[]at(D){数据};
\draw[Line,shorten <=4pt,shorten >=11pt](B.east)--++(0:25mm);
\draw[Line,shorten <=8pt,shorten >=8pt,]($(DE3)!0.5!(DE4)$)--++(0:1)--++(90:1.8)-|
node[above,text=black](TXT){系统性地改进模型}($(GO3)!0.5!(GO4)$);
%
\scoped[on background layer]
\node[draw=BackLine,inner xsep=5mm,inner ysep=5mm,
yshift=2mm,
fill=BackColor,fit=(D)(DATA1)(CPU1)(TXT),line width=0.75pt](BB){};
\node[below=4pt of  BB.north,inner sep=0pt,xshift=3,
anchor=north,fill=BackColor]{\textbf{以模型为中心的 AI}};
%%%%%%%%%%%%%%%%%
%right
%%%%%%%%%%%%%%%%%%%%
\begin{scope}[node distance=-0.15,shift={(13.5,0)},local bounding box = 2DATA]
\pic[shift={(0,0)}] at  (0,0){data={scalefac=0.75,picname=2,filllcolor=RedLine, Linewidth=1.0pt}};
\pic[shift={(0,-0.2)}] at  (4.5,1){cpu={scalefac=0.6,picname=2,filllcolor=BlueLine, Linewidth=0.7pt}};
\pic[shift={(0,0)}] at  (4.75,1.69){lokot={scalefac=0.22,picname=2,drawcolor=OrangeLine!70!,
filllcolor=black!,Linewidth=0.7pt, filllcirclecolor=black}};
%
\draw[Line,shorten <=4pt,shorten >=11pt](B)--($(LE3)!0.5!(LE4)$);

\node[below=0.15of CPU2](2MO){模型};
\path[red](2MO)-|coordinate(2D)(DATA2);
\node[]at(2D){数据};

\draw[Line](CPU2.east)--++(0:1)coordinate(DE)--++(90:1.8)-|
           node[above,text=black,pos=0.25](2TXT){系统性地改进数据}(DATA2);
%
\scoped[on background layer]
\node[draw=GreenLine,inner xsep=5mm,inner ysep=5mm,
           yshift=2mm, fill=GreenL!50,fit=(2D)(DATA2)(CPU2)(2TXT)(DE),line width=0.75pt](2BB){};
\node[below=4pt of  2BB.north,inner sep=0pt,xshift=3,
           anchor=north]{\textbf{以数据为中心的 AI}};
\end{scope}
%%%%
\node[double arrow, fill=red!80!black!90,
           minimum width = 10pt, double arrow head extend=4pt,
           minimum height=35mm](DA) at($(BB.east)!0.5!(2BB.west)$){};
\node[below=0.2of DA]{相互补充};
\end{tikzpicture}以数据为中心的 AI 体现了一种重要的认识转变,挑战了“数据越多越好”的假设:数据集的构成与规模同样重要。DataPerf (Mazumder et al. 2023) 和 DataComp43 等项目相继出现,旨在系统评估数据集构建方式如何影响模型性能。在 DataComp 控制计算量的设置下,采用基于 CLIP 的过滤方法、保留候选池中排名前 30% 样本的基线,在下游综合评估中优于使用未过滤候选池的基线 (Gadre et al. 2023)。这一结果确立了数据筛选整理在该实验规程下的价值,并不意味着存在普遍适用的最优保留比例。
Mazumder, Mark, Colby Banbury, Xiaozhe Yao, Bojan Karlaš, et al. 2023. “DataPerf: Benchmarks for Data-Centric AI Development.” Advances in Neural Information Processing Systems 36.
Gadre, Samir Yitzhak, Gabriel Ilharco, Alex Fang, Jonathan Hayase, Georgios Smyrnis, Thao Nguyen, Ryan Marten, et al. 2023. “DataComp: In Search of the Next Generation of Multimodal Datasets.” Advances in Neural Information Processing Systems (NeurIPS) 36: 27092–112. https://doi.org/10.52202/075280-1179.
数据集饱和与动态基准
即使满足了覆盖度、质量和分布对齐方面的规程要求,静态基准仍会遇到数据集饱和 问题。当模型在固定测试集上的表现接近经验上限时,排行榜上的差距不断缩小,难以区分真正的能力进步与针对基准特有伪特征的过度优化。如 figure 13 中的时间线所示,受到广泛关注的 AI 基准已多次超过所报告的人类基线,逐渐耗尽其作为区分工具的剩余空间 (Maslej et al. 2024)。
\begin{tikzpicture}[font=\small\sffamily]
%\node[anchor=south west]at(-0.93,-0.76){%
%\includegraphics[scale=0.7]{1}};

\begin{axis}[clip=false,
   axis line style={draw=none},
  /pgf/number format/.cd,
 1000 sep={},
  width=155mm,%155.9mm,
  height=80mm,%58.0mm,
  axis x line*=bottom,
  legend style={at={(0.16,0.98)}, anchor=north},
  legend cell align=left,
  title style={yshift=-2pt,font=\fontsize{9pt}{9}\selectfont\sffamily},
  ylabel style={align=center,font=\footnotesize\sffamily},
  xmin=1997,
  xmax=2022,
  xtick={2000,2005,2010,2015,2020},
   x tick label style={rotate=0, anchor=north},
  ymin=-100, ymax=24,
  ytick={-100,-80,...,20},
  yticklabels={$-$100,$-$80,$-$60,$-$40,$-$20,0,+20},
  ylabel={AI 相对于人类表现的\\测试得分},
  title={AI 系统的语言与图像识别能力已迅速提升},
  grid=both,
  major grid style={black!60},
  minor grid style={draw=none},
  minor x tick num=4,
  minor x tick  style={thin,black!60},
  tick label style={/pgf/number format/assume math mode=true},
  ticklabel style={font=\footnotesize\sffamily},
  xticklabel style={yshift=-3pt},
]
%Handwriting recognition
\addplot[OrangeLine,mark=*,
mark size=2pt,line width=1.5pt,
]
coordinates{
(1998,-100)(1998,-80)(2002,-48)(2003,-27)(2006,-25)(2010,-20)(2012,-5)(2013,-1)(2018,2)
}node[pos=0.67,above=3mm]{手写识别};
%Speech recognition
\addplot[RedLine,mark=*,
mark size=2.0pt,line width=1.5pt,
] coordinates{
(1998,-100)(2011,-66)(2013,-53)(2014,-28)(2015,-26)(2015,-9)(2016,-5)(2016,-1.2)(2017,0.5)(2018,2)
}node[pos=0.17,above=3mm]{语音识别};
%Image recognition
\addplot[GreenD,mark=*,
mark size=2.0pt,line width=1.5pt,
] coordinates{
(2009,-100)(2012,-44)(2014,-11.5)(2014,-7)(2015,1)(2016,6)(2018,11.5)(2019,9)(2020,16)
}node[pos=0.13,left=2mm,anchor=north east]{图像识别};
%Reading comprehension
\addplot[cyan!90!black,mark=*,
mark size=2.0pt,line width=1.5pt,
] coordinates{
(2016,-100)(2016,-34)(2017,-30)(2017,-9)(2018,6)(2019,18)(2020,19)
}node[pos=0.23,left=2mm,anchor=north east,align=right]{阅读\\理解};
%Language understanding
\addplot[red,mark=*,
mark size=2.0pt,line width=1.5pt,
] coordinates{
(2018,-100)(2018,-68)(2019,-64)(2019,-25)(2019,0)(2019,4)(2020,8)(2020,12)
}node[pos=0.23,right=2mm,anchor=north west,align=left]{语言\\理解};
%
\draw[font=\fontsize{7pt}{9}\selectfont\sffamily,latex-](axis cs:1996.5,-104)to[bend right=25]++(320:9mm)
node[align=left,below right=2mm and 1mm,anchor=west]{每个 AI 系统的能力均归一化,\\
初始表现设为 $-$100};
\draw[font=\fontsize{7pt}{9}\selectfont\sffamily,latex-](axis cs:1996.8,2)to[bend left=25]++(30:6mm)
node[align=left, right=1mm,anchor=west]{作为基准的人类表现设为零};
%
\draw[red,line width=2pt,{Triangle[width=6pt,length=5pt]}-{Triangle[width=5pt,length=6pt]}](axis cs:2021,-1)--
node[font=\fontsize{7pt}{9}\selectfont\sffamily,right,text=black]{AI 系统表现较差}
(axis cs:2021,-19);
\draw[red,line width=2pt,{Triangle[width=6pt,length=5pt]}-{Triangle[width=5pt,length=6pt]}](axis cs:2021,1)--
node[align=left,font=\fontsize{7pt}{9}\selectfont\sffamily,right,text=black]{AI 系统的表现优于\\
参加这些测试的人类}
(axis cs:2021,19);
\coordinate(A)at(axis cs:1994,-100);
\coordinate(B)at(axis cs:2027.5,-100);
\coordinate(C)at(axis cs:2027.5,0);
\coordinate(C1)at(axis cs:2027.5,25);
\coordinate(D)at(axis cs:1994,0);
\coordinate(D1)at(axis cs:1994,25);
\scoped[on background layer]
\fill[fill=magenta!5](A)--(B)--(C)--(D)--cycle;
\scoped[on background layer]
\fill[fill=green!5](D)--(C)--(C1)--(D1)--cycle;
\end{axis}
\end{tikzpicture}
Maslej, Nestor, Loredana Fattorini, C. Raymond Perrault, Vanessa Parli, Anka Reuel, Erik Brynjolfsson, John Etchemendy, et al. 2024. “Artificial Intelligence Index Report 2024.” In CoRR, abs/2405.19522. https://doi.org/10.48550/ARXIV.2405.19522.
一旦静态基准饱和,排行榜上的高准确率就可能掩盖脆弱的启发式策略。MNIST 数字识别 (LeCun et al. 1998) 很早便表明,模型可能利用数据集特有的采集伪特征,而非不变特征;这一担忧最终促使研究者提出“ImageNet 的研究已经完成了吗?”这一问题 (Beyer et al. 2020)。当评估分布保持不变时,反复进行模型选择可能导致模型过拟合测试集中特有的伪特征,而非提升可泛化的任务能力。
LeCun, Yann, Léon Bottou, Yoshua Bengio, and Patrick Haffner. 1998. “Gradient-Based Learning Applied to Document Recognition.” Proceedings of the IEEE 86 (11): 2278–324. https://doi.org/10.1109/5.726791.
Beyer, Lucas, Olivier J. Hénaff, Alexander Kolesnikov, Xiaohua Zhai, and Aäron van den Oord. 2020. “Are We Done with ImageNet?” arXiv Preprint arXiv:2006.07159.
Kiela, Douwe, Max Bartolo, Yixin Nie, Divyansh Kaushik, Atticus Geiger, Zhengxuan Wu, Bertie Vidgen, et al. 2021. “Dynabench: Rethinking Benchmarking in NLP.” Proceedings of the 2021 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies 9: 4110–24. https://doi.org/10.18653/v1/2021.naacl-main.324.
Dynabench44 (Kiela et al. 2021) 等动态基准框架通过持续更新评估数据来应对饱和问题。在这一范式中,人工标注者针对当前表现最佳模型的失效模式构造对抗性输入,确保基准持续检验表征能力的极限。然而,动态基准引入了一项根本性的系统权衡:由于评估分布随迭代而变化,不同代际模型之间的纵向比较变得难以校准。因此,静态基准与动态基准发挥着互补作用:静态测试集确保标准化任务上的纵向可复现性,动态基准则识别新出现的错误边界。
系统—模型—数据的整体评估
分别通过系统、模型和数据基准测试并不足够。系统基准可以验证硬件性能,模型基准可以验证压缩后是否保留了质量,数据基准可以评估训练集的代表性,但部署后的系统仍可能失效,因为这三个维度会相互作用。现实中的 AI 性能产生于这种相互作用,而优化某一维度可能暴露另一维度的薄弱环节。
考虑一个具体的级联失效案例:工程团队在专用加速器上部署了一个经过 INT8 量化的视觉模型,并在 MLPerf Inference 上达到了目标吞吐量。系统基准测试通过。然而,由于量化缩放因子和零点严格依据 ImageNet 验证样本进行校准,将模型部署到工厂车间后,准确率出现严重下降。工厂照明带来的动态范围超出了校准时的裁剪阈值,导致特征激活被截断。针对不同曝光水平开展的模型质量基准测试本可暴露这种数值敏感性。向上游追溯失效原因发现,训练流水线中没有任何工业图像——这种数据分布缺口,无论进行多少加速器优化或运行时内核调优,都无法解决。
跨维度耦合意味着,某个领域通过的基准测试,可能因另一个领域中未被测量的失效而失去效力:
- 系统成功 + 模型失败:硬件提供了承诺的吞吐量,但激进压缩使准确率降至部署阈值以下。
- 系统成功 + 数据失败:在基准输入上能够快速执行推理,但训练数据偏差导致不同人口子群体之间出现严重的准确率差异。
- 模型成功 + 系统失败:模型能够生成准确预测,但并发负载下尾延迟的波动违反了服务级别协议。
- 模型成功 + 数据失败:在留出测试集上验证得到很高的准确率,但生产环境中的分布偏移导致静默退化。
这些失效模式可直接对应到 引言(数据—算法—机器交叉全景)中引入的数据—算法—机器分类体系,不过,基准评估的视角与这三个物理轴并非一一对应。数据基准评估提供给学习过程的输入分布和质量;模型基准评估学习得到的算法表征及其数值稳健性;系统基准则揭示硬件执行、内核效率以及内存与互连流量的情况。整体评估验证这些轴相交之处。贯穿第三部分流水线(数据选择 → 模型压缩 → 硬件加速)的优化,会引入孤立测量所掩盖的跨轴依赖关系。
数据—算法—机器分类体系 提供了一个诊断框架,用于系统地识别限制性能的轴。诊断概览 将每个轴映射到其起约束作用的物理限制及相应的优化路径,为基准测试揭示利用率不足时提供首个诊断步骤。Table 20 将每个数据—算法—机器轴与三类基本瓶颈交叉组合,使这一方法形式化;数据—算法—机器分类体系 提供了完整的诊断指南,包括性能剖析工具和效率筛查指标。
| 组成部分 | 计算受限 | 内存受限 | I/O 受限 |
|---|---|---|---|
| 数据 | 预处理过慢(数据增强、词元化) | 数据集超出 RAM 容量(溢写到磁盘) | 存储无法及时向 GPU 供给数据(磁盘吞吐量受限) |
| 算法 | 模型规模超出硬件处理能力(FLOPs 超出计算容量) | 激活值超出内存容量(批大小受限) | 梯度同步慢于计算(分布式训练) |
| 机器 | GPU 利用率已饱和(需要更快的加速器) | 内存带宽已饱和(需要更高的 HBM 带宽) | 网络/PCIe 带宽已饱和(需要更快的链路) |
当系统遥测结果偏离硬件理论峰值时,应用这一矩阵可以定位根因。如果加速器在训练期间的 GPU 利用率仅为 30%,工程师可能过早地归咎于模型架构(算法行),并尝试修改模型结构。然而,性能剖析往往会发现,实际原因是主机端数据工作进程在图像增强或词元化过程中占满了 CPU 核,无法以足够快的速度通过 PCIe 供给批次(数据行,计算受限列:“预处理过慢”)。加速器停顿并非源于算法效率低下,而是输入流水线供给不足。沿矩阵排查可以直接指向起约束作用的物理子系统,避免工程干预方向错误。
受控实验室条件下的验证不同于生产环境中的验证。在实验室中,数据分布保持固定,请求模式保持均匀,系统独立运行。在生产环境中,这三个假设可能同时失效:数据发生漂移,流量不可预测地激增,并发工作负载争夺共享硬件资源。基准测试的最后一个维度要回答的是:实验室结果在实际运行条件下是否仍然成立。
生产环境考量
通过全部三类基准测试的系统仍可能在生产环境中失效。三维框架在受控条件下验证了硬件性能、模型质量和数据代表性,但实际部署会持续打破这些条件。验证机器学习系统,需要测量其在动态工作负载、不断演变的数据分布以及硬件资源争用条件下的行为。
从实验室到生产环境
实验室基准测试确定系统在理想条件下具备什么能力。生产环境验证则确定该系统此刻在真实条件下是否正常运行。
这种差距之所以存在,是因为生产工作负载打破了实验室评估中内置的静态假设:
静默退化之所以发生,是因为模型会生成看似合理的输出,却不会触发硬件异常或软件错误码。传统软件在状态无效时会崩溃、触发 panic,或返回 HTTP 500 状态码。相比之下,即使预测质量下降或失去校准,机器学习模型仍会完成矩阵乘法并返回有效的浮点张量。推荐服务即使返回次优排序,也不会提供任何硬件层面的信号来表明其预测准确率已经崩塌。
动态工作负载会引入稳态基准测试所掩盖的排队和内存瓶颈。一个在稳定 1,000 QPS 下完成基准测试的模型服务栈,可能在突发流量事件使请求速率激增至 10,000 QPS 时崩溃,因为闭环实验室测试假设请求均匀到达,且队列积压极少。当生产环境中的到达速率超过瞬时服务能力时,排队延迟会非线性攀升。动态批处理调度器试图通过累积更大的请求批次来吸收流量激增,但更大的批大小需要额外的加速器内存来存储激活张量和键值(KV)缓存。如果内存容量耗尽,引擎就会因内存不足错误而崩溃;即使内存足够,队列等待时间也会推动尾延迟(\(p99\))超出运行服务级别协议的要求。
随着生产数据逐渐偏离训练和验证分布,数据分布偏移进一步加剧了这些运行挑战。一个在精心筛选整理的基准图像上评估的视觉模型,在实时推理中处理带有镜头伪影、压缩失真和不同光照条件的智能手机上传图像时,表现会下降;其准确率不断受损,而硬件吞吐量和延迟指标看起来却完全不受影响。
生产环境约束还会将实验室基准中独立评估的维度耦合起来。在实验室中,准确率、延迟、成本和资源利用率沿各自独立的帕累托曲线进行优化。在部署环境中,这些约束会在硬件上直接发生冲突:要在流量激增期间严格满足尾延迟 SLA,就必须限制批大小或丢弃部分负载,这会降低硬件算术强度、降低加速器利用率,并提高每次查询的模型服务成本。
从基准测试衔接到部署
部署前,应在具有生产环境代表性的条件下验证基准测试结论。Table 21 列出了基准测试假设、打破这些假设的生产环境现实,以及弥合差距所需的验证步骤;随后给出的检查点将这些表格行转化为发布就绪行动。
| 基准测试假设 | 生产环境实际情况 | 验证方法 |
|---|---|---|
| 请求均匀到达 | 突发流量模式 | 回放生产环境流量轨迹进行负载测试 |
| 输入干净且已预处理 | 输入质量参差不齐 | 使用生产数据样本进行评估 |
| 系统处于预热状态 | 冷启动、缓存未命中 | 测量冷启动性能 |
| 隔离执行 | 资源争用 | 在真实系统负载下进行基准测试 |
| 模型版本固定 | A/B 测试、逐步发布 | 建立比较基线 |
Checkpoint 1.4: 部署前基准测试检查清单
基于基准测试结果部署模型之前:
将生产监控作为持续基准测试
生产监控将基准测试从一次性的准入关卡扩展为持续过程。相同的原则仍然适用,包括标准化指标、可复现的测量和统计严谨性,但目标从离线资格验证转向持续的运行验证。
模型上线后,基准测试就成为与刚刚建立的基线进行滚动比较的过程。需要即时检查的问题依然具体:输入分布是否仍接近基准测试分布,延迟和吞吐量是否保持在测得的范围内,以及模型质量是否偏离预期范围。回答这些问题需要与离线基准测试相同的测量规范,但此时测量是在真实流量下持续进行的。
实际的模型服务环境将这一测量循环转化为发布与恢复机制(机器学习运维):分阶段发布、影子评估(让新模型与生产模型并行运行,但不向用户提供其输出)、持续验证和自动回滚。基准测试定义性能基线范围与失效阈值;生产监控则持续检验实时遥测数据是否处于这些界限之内。
基准测试条件与生产环境实际情况之间的差距,解释了为何团队会不断落入可预见的陷阱。一组反复出现的谬误说明,即使指标本身合理,误用它们也会得出具有误导性的结论。
谬误与陷阱
当标准化测量掩盖了部署的实际情况时,基准测试就会带来虚假的信心。团队假定受控评估能够预测生产性能,但真实系统面临着基准测试无法涵盖的可变性、资源约束和多目标权衡,导致工程投入被浪费在针对评估而非部署进行优化的系统上。
谬误:基准测试性能可以直接转化为实际应用性能。
基准测试排名看似清晰,使团队在选择系统时误以为排行榜位置能够预测生产环境中的表现。实际情况很少如此。如 section 1.3.1 所示,机器学习系统因数据质量问题、分布偏移以及受控评估中不存在的资源约束而表现出内在可变性。在一个具有代表性的失效场景中,某语言模型在基准测试中的准确率达到 92 percent,但在生产环境中处理包含拼写错误、非正式语言和领域专用术语的用户生成文本时,准确率降至 78–82 percent。某推理系统在 MLPerf 上的平均延迟为 15 ms,但由于并发负载、垃圾回收暂停和网络波动,其生产环境 p99 延迟达到 150–200 ms(延迟增至基准值的 10–13.3×)。仅依赖基准测试排名的团队会系统性地低估部署复杂性,导致上线失败和代价高昂的重新设计。
基准测试平均延迟将生产环境尾延迟低估了一个数量级。
陷阱:仅针对基准测试指标进行优化,而不考虑更广泛的系统要求。
基准测试排行榜激励激进优化,但能够提升排名的优化往往会损害生产环境所要求的特性。这体现了古德哈特定律(section 1.10.4):当基准测试分数成为优化目标时,它们就不再是衡量系统质量的有效指标。在一个示例场景中,某团队通过激进量化,将推理延迟从 12 ms 降至 8 ms,使 MLPerf 排名提升了 15 位,却损害了校准质量,导致预测置信度分数无法可靠地用于下游决策。另一个团队通过大量超参数调优,将 ImageNet 准确率提高了 2.1 percent,但优化后的模型能耗增加了 40 percent,且在来自生产环境摄像头的分布外图像上,性能下降了 25 percent。将基准测试排名置于部署成功之上的组织,会系统性地产出在评估中表现优异、却在生产环境中失效的系统。
谬误:单一指标评估足以揭示系统性能。
用单个数字描述性能看起来简洁而有吸引力(“准确率为 94%”或“速度达到 1,200 QPS”)。但生产环境中的成功需要平衡多个相互竞争的目标,而任何单一指标都会掩盖这些目标。现代推理系统需要从准确率、延迟、吞吐量、能耗和鲁棒性等维度进行评估(section 1.8.2)。在一个展示权衡关系的示例中,某推荐模型的准确率达到 94 percent,p99 延迟为 180 ms;尽管准确率出色,它仍无法满足要求 p99 < 100 ms 的服务级别目标。另一方面,某系统经优化后达到 1,200 QPS 的吞吐量,但功耗为 4.2 W;一个速度略低、吞吐量为 1,000 QPS 的系统,功耗则为 1.8 W(前者功耗是后者的 2.3×)。对于电池供电的边缘设备,牺牲 17 percent 的吞吐量,可使运行时间延长至原来的 2.3×。不同利益相关方对指标的优先级不同:机器学习工程师关注准确率,基础设施团队关注吞吐量和成本,产品经理关注延迟百分位数。单一指标优化会系统性地产出在某一维度表现优异、却在其他维度无法满足部署要求的系统。
陷阱:使用已经无法反映部署挑战与要求的过时基准测试。
基准测试具有惯性:即使结果已无法提供有用的区分,团队仍会继续报告既有基准测试的成绩。当多种方法达到几乎相同的性能、无法再进行有效比较时,基准测试便趋于饱和。ImageNet 的 top-5 分类错误率从 2010 年的 28.2 percent (Russakovsky et al. 2015) 降至 2015 年的 3.57 percent (He et al. 2016),大幅压缩了该指标所衡量的提升空间。随着差距缩小,section 1.10.1 中讨论的统计置信区间,以及结果与部署的相关性,比排行榜名次更加重要。部署情境的变化进一步加剧了这一问题:当边缘设备的内存容量和功率预算分别按 10× 和 100× 的倍数缩减时,为服务器硬件设计的基准测试就会产生误导。有效的基准测试要求淘汰已饱和的基准测试,并建立符合目标部署实际情况的评估框架。
谬误:研究基准测试能够预测真实流量下的生产行为。
研究基准测试旨在受控条件下比较算法;生产系统则旨在可变条件下服务用户。将前者视为对生产环境的预测,往往会得出过于乐观的结果,因为研究基准测试可能忽略资源争用、输入质量变化和运行故障模式。不当的执行方法还会引入另一类误差:省略预热运行,可能将一次性初始化、即时编译、缓存填充和内存分配混入稳态延迟;不明确缓存状态,可能使名义上的内存基准测试测量到热缓存复用或冷内存访问中的任意一种;允许动态电压与频率调节(DVFS)发生变化却不予报告,则会使细微差异难以复现。生产系统面临并发用户负载、输入质量变化、网络延迟和系统故障,这些因素都会降低性能(section 1.10.2)。某系统在隔离基准测试中可达到 800 QPS 的吞吐量,但在生产负载下、利用率为 90 percent 时,由于队列争用和垃圾回收暂停,只能维持 400–500 QPS 的吞吐量(下降 37.5–50 percent)。研究基准测试报告模型推理时间(5–10 ms),而生产环境的端到端延迟还包括预处理、排队和后处理开销,总计为 50–100 ms。生产系统要求达到 99.9 percent 的可用性(每月停机时间为 43 minutes),并能在故障时优雅降级,而研究基准测试往往忽略这些特性。有效的生产评估需要运行指标:负载下的持续吞吐量、故障恢复时间,以及完整的延迟分解。
陷阱:将研究基准测试用作生产发布准入条件。
团队有时会因为模型通过研究基准测试而将其推向生产,却直到上线后才发现,基准测试从未覆盖实际运行路径。模型服务系统的发布准入条件必须包括负载测试、尾延迟测量、数据质量检查、故障演练和回滚标准。研究基准测试仍可用于比较算法,但生产发布准入测试必须在已部署系统实际将面对的流量、硬件和故障条件下进行测量。
总结
基准测试通过验证数据选择(数据选择)、模型压缩(模型压缩)和硬件加速(硬件加速)带来的效率提升能否在实践中兑现,完成了第三部分的优化流程。三个基准测试视角分别考察系统执行、模型行为和数据代表性,然后检验完整系统在部署条件下运行时,这些视角所依赖的假设是否仍然成立。
这些视角揭示了不同的失效模式。系统基准测试暴露吞吐量未达预期、尾延迟和热行为方面的问题。模型基准测试检验准确率、校准、鲁棒性,以及优化可能改变的其他属性。数据基准测试考察覆盖范围、标签质量、数据泄漏以及与部署环境的一致性。MLPerf Training 和 Inference 等标准化套件提供可比较的系统证据;模型和数据评估规程则提供硬件测试结果无法确立的质量与代表性证据。
为优化主张提供依据,需要测量实际的物理执行过程,而非依赖分析性代理指标。实际运行时间能够反映 FLOP 计数所忽略的 DRAM 带宽饱和、内核启动串行化以及主机与设备之间的数据传输开销。并发负载下的百分位性能剖析能够揭示算术平均值所掩盖的排队延迟和热降频。使用能够代表生产环境的数据评估工作负载,可以揭示均匀合成输入永远不会触发的动态形状变化和频繁的内存分配与释放。
要点回顾: 测量真正重要的指标
- 基准测试验证协同设计:系统、模型和数据基准测试能够揭示硬件性能未达预期、压缩导致的质量损失以及分布不匹配。仅在一个维度上通过测试的系统,在生产负载下同时面对数据、算法和机器的约束时,仍然可能失败。
- 代理指标需要明确适用边界:标准化的运行规则使比较公允,但固定工作负载仍然只是代理。批大小、热状态、输入分布、并发度和服务截止时间窗口,共同决定实验室结果能否跨越基准测试与生产环境之间的鸿沟。
- 测量粒度决定诊断能力与真实性之间的权衡:微基准测试隔离内核,宏基准测试揭示模型层面的成本,端到端基准测试则捕捉用户可感知的行为。有效的测量体系应结合这三者,使团队既能看到症状,也能定位导致症状的层级。
- 尾延迟才是衡量标准:交互式系统往往在平均值发生变化之前,就已在 p95 和 p99 处失效。在代表性负载下报告百分位延迟,可以避免基准测试认可这样的系统:其平均值达标,但得到最差服务的请求却违反了 SLO。
- 阿姆达尔定律为每项优化主张设定上限:更快的模型无法突破流水线其余部分的限制;如果预处理占延迟的 50%,那么即使模型速度无限快,系统也只能获得 2\(\times\) 的加速。在庆祝内核加速之前,应先对完整请求路径进行基准测试。
- 效率提升仍需质量证据:INT8 可将原始权重存储量压缩 4\(\times\);简化的组件模型估计,能耗可降低至原来的约 1/6.6×,但压缩后的模型能否部署,取决于整机测量、校准、子群体鲁棒性以及边界情形下的行为。
本部分的每一章都承诺减少 FLOP 数量、缩小模型或提高吞吐量。基准测试在完整系统中检验这些承诺。宣称的改进与实测改进之间的差距,揭示了数据、算法和机器在哪些环节只是被拼装在一起,而未得到相互适配。阿姆达尔定律说明,即使模型速度无限快,流水线为何仍会受模型之外所有环节的制约;尾延迟则说明,为何即使得到最差服务的请求已经失败,平均值仍然可以达标。这就是对协同设计成效的检验。机器学习系统是工程实践的产物,而非口头断言的结果;只有在真实工作负载上进行测量,才能区分二者。
后续内容: 从实验室走向线上
在受控环境中通过所有基准测试的系统,在实际部署中仍可能失败。静态基准测试无法充分捕捉线上工作负载下的流量突发、数据漂移或级联故障。第四部分将从受控的基准测试环境转向生产环境,首先讨论 模型服务 中的模型服务。
Footnotes
古德哈特定律:Goodhart (1984) 阐述了 1975 年英国央行关于货币政策的最初观察;Strathern (1997) 将其概括为上文引用的形式。其原始背景是宏观经济学:一旦某个货币总量成为官方政策目标,银行便会改变行为以操纵该指标,从而破坏其预测价值。在机器学习中,相同的失效模式在结构上反复出现:BLEU 奖励 n 元语法重叠 (Papineni et al. 2002),ImageNet 奖励在固定视觉分布上的性能 (Deng et al. 2009; Recht et al. 2019),而基准测试排行榜可能激励针对特定测试集进行调优。↩︎
基准:源自测量学,其中“bench mark”指石头上的水平刻痕,用作固定的高程参考。这个术语于 20 世纪 70 年代进入计算领域,用于描述标准化的比较参照点,但这一测量学隐喻也蕴含着一条系统层面的启示:正如缺少经校准的参考就无法赋予高程测量意义一样,若没有受控的工作负载、热状态和精度设置,机器学习吞吐量数字也毫无意义。↩︎
Whetstone 与 LINPACK:Whetstone (Curnow and Wichmann 1976) 得名于英国莱斯特郡惠特斯通的英国电气公司设施,最初的 ALGOL 编译器正是在那里构建的;LINPACK (Dongarra et al. 1979) 是用于稠密线性方程组的软件包和基准测试,后来被 Top500 榜单采用。Whetstone 固定的合成程序组合与 LINPACK 对稠密线性代数的专注,使二者各具实用价值,但覆盖范围都比多样化的应用套件更窄。机器学习基准测试继承了同样的弱点:针对特定模型的内核调优可能过拟合单一工作负载,因此 MLPerf 使用了涵盖视觉、语言和推荐的多种工作负载 (Mattson et al. 2020; Reddi et al. 2019)。↩︎
MLPerf:MLPerf 由产业界和学术机构组成的联盟于 2018 年发起,其名称由“ML”和“Perf”(性能)组合而成,呼应了 SPEC 的基准测试传统。MLPerf 的设计原则——代表性工作负载、全系统测量和开放提交——直接针对困扰 Whetstone 和 LINPACK 的投机取巧行为:以往可以在精心挑选的问题规模上报告内核峰值吞吐量的厂商,如今必须报告标准化任务上的端到端系统性能 (Mattson et al. 2020; Reddi et al. 2019)。↩︎
SPEC Power:SPEC Power 于 2007 年推出,测量从空闲(0%)到 100%、以 10% 为增量的 11 个负载水平下的每瓦性能 (Lange 2009)。这种细粒度测量对机器学习模型服务很重要:推理工作负载很少持续处于 100% 负载,而峰值负载下高效、部分负载下却浪费能源的服务器,会抬高实际部署的能耗成本。↩︎
Green500:Green500 于 2007 年启动,作为 Top500 的对应榜单,按每瓦 FLOP/s 而非原始性能对系统排名 (Feng and Cameron 2007)。它对机器学习系统的方法论启示是:最具成本效益的训练集群不一定是最快的,而是在所关注的工作负载和测量边界下,每瓦能够完成最多有效工作的系统。↩︎
TPU(张量处理单元):Google 为神经网络工作负载定制的 ASIC(架构细节见 硬件加速)。一个 TPU v4 pod(4,096 个芯片)可提供 1.1 exaFLOP/s 的 BF16 峰值性能 (Jouppi et al. 2023),但对 TPU 进行基准测试时需要谨慎:其脉动阵列架构更适合规则的张量运算,因此峰值 FLOP/s 会高估稀疏注意力或动态控制流等不规则工作负载的性能。↩︎
ASIC(专用集成电路):ASIC 的峰值 TOPS 数值仅适用于其设计所针对的特定算子。只要有一层不受支持,就会迫使执行回退到通用处理器,可能抵消全部效率优势。因此,算子覆盖率是任何 ASIC 基准测试中首先要考察的问题:峰值吞吐量与实际吞吐量之间的差距并非硬件限制,而是工作负载兼容性限制。↩︎
FLOP/s(每秒浮点运算次数):标称峰值 FLOP/s 与实际达到的 FLOP/s 之间的差距,是硬件基准测试中的核心矛盾。A100 标称的 FP16 Tensor Core 性能为 312 TFLOP/s,但真实工作负载所能达到的峰值比例各不相同,取决于算术强度、内存访问模式、精度和运行时开销。脱离利用率背景报告峰值 FLOP/s,是最常见的基准测试失真。↩︎
Roofline 模型:Williams et al. (2009) 提出了这一伯克利模型,其名称源于性能上限的视觉形状。其脊点(峰值 FLOP/s 除以峰值带宽)将受内存限制与受计算能力限制的工作负载分开,表明优化应着眼于数据移动还是算术运算。↩︎
cuDNN(CUDA 深度神经网络库):cuDNN 由 NVIDIA 于 2014 年发布,为卷积、池化和归一化提供手工调优的内核实现。对基准测试而言,这意味着所报告的推理延迟高度依赖于所用的 cuDNN 版本和算法自动调优器设置,因此,任何可复现的基准测试规范都必须明确 cuDNN 版本。↩︎
SQuAD(斯坦福问答数据集):于 2016 年推出,包含来自维基百科的超过 100,000 个问答对 (Rajpurkar et al. 2016)。到 2018 年,AI 系统已超过 SQuAD 1.1 上 F1 为 91.2% 的人类基线 (Devlin et al. 2019),但这一“超越人类”的结果体现了基准测试的一种失效模式:该任务的抽取式形式(答案是篇章中的文本片段)使其比开放式问答更容易,从而高估了相对于生产环境 NLP 系统的能力。↩︎
GLUE(通用语言理解评估):于 2018 年作为一项覆盖广泛的语言理解基准推出 (Wang et al. 2018),但很快就被 BERT 等系统推至饱和 (Devlin et al. 2019)。这正是古德哈特定律的体现:一旦 GLUE 成为优化目标,针对排行榜的优化就削弱了它的区分能力。这一现象推动了 SuperGLUE 和 BIG-bench 等更具挑战性的后续评估的出现。↩︎
ToyADMOS:由 NTT Communications 于 2019 年为声学异常检测开发,包含玩具汽车、玩具输送机及相关微型机器运行声音的音频录音 (Koizumi et al. 2019)。“Toy”这一前缀是有意为之:受控环境能够支持可复现的基准测试,但当模型迁移到噪声更大、机器、传感器、振动和背景声音均不同的工业环境时,可能产生领域差异。↩︎
BERT(基于 Transformer 的双向编码器表示):BERT-Large(340M 个参数)是 MLPerf Inference 中的一项语言处理工作负载。该基准固定任务、数据、质量目标和适用的执行场景,使不同系统能够在相同工作负载下进行比较。BERT 的延迟仍取决于序列长度、批处理方式和实现。↩︎
指标(Metric):在数学中,度量是满足包括三角不等式在内的严格公理的距离函数。机器学习较为宽泛地借用这一术语,指代 BLEU 和困惑度等定量测量值;这些是评分规则,而非数学意义上的度量。当评估协议、数据集切片或指标权重发生变化时,排行榜排名也可能改变,因此,指标选择是一项决定哪个系统胜出的工程决策,而不仅仅关乎如何衡量性能。↩︎
BLEU(双语评估替身):BLEU 由 IBM 于 2002 年提出,通过相对于参考译文的修正 n 元语法精确率,并结合长度惩罚,来衡量翻译质量 (Papineni et al. 2002)。BLEU 是机器学习中古德哈特定律的典型例子:针对 n 元语法匹配进行优化,可能会奖励表层的词语重合,即使译文的含义、流畅度或部署实用性已经偏离目标。↩︎
泊松分布:以西莫恩·德尼·泊松命名,他于 1837 年在对法国法院的错误定罪率建模时,对该分布进行了形式化描述。该分布描述以恒定平均速率 \((\lambda_{\text{arr}})\) 发生的独立事件,是服务器请求到达过程的常用基线。真实的机器学习服务流量往往具有突发性、相关性和随时间变化的速率,因而不满足这些假设。因此,除非轨迹或压力测试用例覆盖了这些生产流量模式,否则采用泊松分布的测试框架可能会错误估计尾延迟。↩︎
URLLC(超可靠低延迟通信):ITU-R 规定了 1 ms 的无线接口用户面延迟目标,并要求在指定测试条件下,32 字节分组在 1 ms 内成功交付的概率达到 99.999%。这些无线接口目标并不构成低于 1 ms 的端到端应用延迟保证。边缘推理基准测试应分别报告无线或网络延迟与计算延迟,并报告二者的合计值,同时报告模型质量。↩︎
GPT-3(生成式预训练 Transformer 3):OpenAI 于 2020 年推出的语言模型(175B 个参数、300B 个训练词元),在 10,000 块 V100 GPU 上消耗了估计 3,640 petaFLOP-days 的计算量 (Patterson et al. 2021)。这一规模说明,在投入计算资源之前,训练基准测试对于预测计划中的训练运行在实际运行层面是否可行至关重要。↩︎
混合精度训练:大多数算术运算采用较低精度,同时在需要时保留较高精度的累加 (Micikevicius et al. 2017)。这对基准测试的影响是:混合精度与全精度运行不能直接比较,因为减少的内存流量和可行的更大批量可能改变收敛动态。MLPerf 通过固定准确率目标来解决这一问题,使达到目标准确率所需的时间成为可比较的量,而不受精度策略影响。↩︎
吞吐量:该术语源于制造业,用于衡量单位时间内生产的产品数量,并在 20 世纪 60 年代的批处理时代进入计算领域。这一制造业渊源蕴含着一条系统层面的经验:吞吐量与延迟存在内在矛盾,因为批处理以单个对象的等待时间为代价,提高了吞吐量(每小时处理更多对象)。在机器学习模型服务中,这表现为批量大小的权衡:更大的批量可以提高 GPU 利用率,但会增加单个请求的延迟。↩︎
GPU 加速时钟:当温度和功率余量允许时,动态频率调节会将时钟频率提升至基础频率以上。基准测试中的陷阱在于:短时间的基准测试可能捕捉到加速时钟下的性能,但持续的机器学习训练可能随着结温升高而稳定在较低的稳态频率。报告突发阶段的结果会高估生产工作负载能够持续维持的吞吐量。↩︎
热节流:结温超过安全限值时触发的降频。对于没有主动散热的边缘设备,持续推理过程中就可能开始出现热节流,这意味着短时间基准测试得到的峰值吞吐量可能无法准确反映稳态性能。↩︎
Edge TPU(张量处理单元):Google 的固定功能边缘 AI 加速器。它说明了固定功能加速器特有的一项基准测试约束:其标称吞吐量仅适用于使用受支持算子类型的量化 TensorFlow Lite 模型,因此,需要不受支持算子的模型会回退到主机 CPU 执行,或者需要先重写计算图,加速器上的结果才有意义。↩︎
尾延迟:只有当服务级别目标(SLO)或服务级别协议(SLA)明确规定了百分位数时,p95 或 p99 等高百分位响应时间才能决定生产环境是否满足该目标或协议。Dean and Barroso (2013) 表明,在扇出架构中(推荐系统中很常见),即使只有 1% 的慢响应,其影响也会叠加:一个访问 100 个后端分片的请求,至少有一个分片落入其 1% 慢响应尾部的概率约为 63%。仅报告平均延迟的基准测试会掩盖这种失效模式。↩︎
INT8(8 位整数):INT8 位于精度层级中较为激进的一端(以 FP32 为基准,FP16 将原始权重存储量减半,INT8 将其减至四分之一),每降低一级精度,都需要更加谨慎地保持准确率。训练后 INT8 量化通常使用具有代表性的校准数据集;准确率取决于模型、算子覆盖范围、量化方法,以及校准数据对部署输入的代表程度。INT8 基准测试必须说明使用的是训练后量化还是量化感知训练,并记录所有校准过程。↩︎
模型压缩基准测试:必须同时从四个维度衡量压缩的影响:准确率下降、推理加速、内存减少和能耗节省。某项技术即使将模型大小压缩 10\(\times\),并仅造成 1% 的准确率损失,如果延迟未按比例改善,仍可能不适用;例如,非结构化剪枝虽然减少了参数数量,却很少能在稠密计算硬件上改善延迟,因为大多数 GPU 对稀疏运算缺乏高效的硬件支持。↩︎
无服务器 AI:一种模型按需从零实例开始扩容的部署范式。冷启动时间随模型、运行时、存储路径、硬件分配和提供商而变化。针对间歇性工作负载的基准测试必须报告是否包含初始化和模型加载,因为仅报告已预热实例的延迟可能低估用户感知的延迟。↩︎
冷启动延迟:从空闲状态开始的初始化时间包括存储读取、主机到加速器的传输,以及框架设置。对于参数量为 7B、采用 FP16 格式(约 14 GB)且已驻留在主机内存中的模型,仅通过有效带宽为 25 GB/s 的 PCIe 4.0 进行传输,就需要约 560 ms;存储读取和初始化还会增加耗时。这一物理下界使冷启动缓解措施(模型缓存、推测性加载)成为系统设计的必要要求。↩︎
TOPS(每秒万亿次运算):衡量原始计算吞吐量的指标(每秒万亿次运算)。H100 的 INT8 吞吐量为 1979 TOPS,Apple M2 神经网络引擎为 15.8 TOPS,Edge TPU 为 4 TOPS,但这些数字混合了不同的运算类型——乘加、累加和激活。只有在运算定义、精度和稀疏性假设相同时,跨厂商的 TOPS 比较才有意义,而厂商规格很少满足这些条件。↩︎
MLCommons:MLCommons 于 2020 年成立,是由 2018 年的 MLPerf 项目发展而来的非营利联盟,成员涵盖产业界和学术界 (MLCommons 2026a)。要求公开系统规格有助于提高结果的可比性,但并不能阻止提交者自行选择参测的系统或工作负载。已公布的结果显示,不同厂商在相同工作负载上的性能存在巨大差异,这使 MLCommons 成为该领域最接近 SPEC 式同条件硬件比较的评估体系。↩︎
DLRM(深度学习推荐模型):Facebook 于 2019 年提出的推荐架构,将用于类别特征的嵌入表与用于连续特征的多层感知机相结合 (Naumov et al. 2019)。DLRM 对基准测试系统施加的压力不同于视觉或语言模型:其嵌入表可能大到使内存容量和带宽成为主导因素,而非计算吞吐量。因此,DLRM 是 MLPerf 式推理评估中一种有用的内存受限推荐工作负载,能够揭示计算受限基准测试无法显现的硬件局限 (Reddi et al. 2019)。↩︎
硬件彩票:由 Hooker (2021) 提出,用于描述算法的成功如何依赖于其与现有硬件和软件的适配程度。Transformer 工作负载受益于能够高效映射到现代加速器的稠密矩阵运算,而当现有芯片和软件栈偏重稠密内核时,图神经网络和稀疏混合专家模型可能更难评估。因此,针对特定硬件的排行榜会偏向与受测平台相适配的架构,并可能掩盖在其他硬件假设下表现不同的替代方案。↩︎
AlexNet:这一八层 CNN(6000 万个参数)在 2012 年将 ImageNet 的 top-5 错误率从 25.8% 降至 16.4%,训练使用了两块 GTX 580 GPU,每块配备 3 GB 显存 (Krizhevsky et al. 2012)。AlexNet 确立了一种至今仍影响视觉评估的基准测试范式:以固定数据集上的准确率为主要指标,将硬件配置作为次要规格说明。后续的 ImageNet 结果沿用了这种基线比较结构。↩︎
ResNet(残差网络):由 He et al. (2016) 提出,跳跃连接使构建 152 层及更深的网络成为可能,并实现了 3.57% 的 ImageNet top-5 错误率(集成模型),优于 ImageNet 挑战赛背景下报告的估计人类错误率 (Russakovsky et al. 2015)。ResNet-50 成为常见的 MLPerf Training 参考工作负载,是因为它的规模适中(25.6M 个参数),且计算特征明确(每张图像 8.2 GFLOP),因此无需多节点配置,就能对硬件和软件优化均表现出敏感性 (Mattson et al. 2020)。↩︎
校准:源自阿拉伯语 qalib(用于铸造金属的模具),经由拉丁语 calibrare 演变而来,最初描述依据已知标准调整测量仪器的过程。在机器学习中,校准确保预测概率与经验频率相匹配;Guo et al. (2017) 针对现代神经网络形式化描述了这一问题,并表明温度缩放是一种简单有效的事后校正方法。这一词源十分贴切:正如未经校准的仪器会产生精密但不准确的测量结果,未经校准的模型也会产生自信却不可靠的预测,导致依据置信度分数设置阈值的下游系统作出系统性错误决策。↩︎
帕累托前沿:以经济学家 Pareto (1896) 命名,该前沿包含所有改善一个目标就必须降低另一个目标的解。在压缩基准测试中,前沿的形状具有诊断意义:陡峭区域意味着只需较小代价即可获得效率提升(应在此处剪枝),而平坦区域则意味着进一步压缩会付出不成比例的准确率代价(应在此处停止)。前沿下方的点受到严格支配,表明容量被浪费。↩︎
MMLU(大规模多任务语言理解):由 Hendrycks et al. (2020) 提出,包含覆盖五十七个学科的 15,908 道多项选择题。MMLU 作为基准测试的局限在于其形式:多项选择识别与开放式生成并非同一任务,因此不应将 MMLU 分数直接视为模型能够在生产环境中生成有依据的自由形式回答的证据。↩︎
HELM(语言模型整体评估):斯坦福大学于 2022 年提出的评估框架,从七个维度(准确率、校准、鲁棒性、公平性、偏见、毒性、效率)测试了广泛的模型 (Liang et al. 2022)。HELM 的贡献在于方法论:通过评估准确率得分相近、但校准或毒性表现不同的模型,它表明单一指标排行榜会系统性地掩盖对生产部署至关重要的失效模式。↩︎
困惑度:源自拉丁语 perplexus(纠缠的);在信息论中为 \(2^{H(p)}\),其中 \(H\) 为熵。困惑度为 10 表示模型平均处于“在 10 个选项间难以确定”的状态。其系统层面的意义在于如何解读,而非直接核算内存:困惑度衡量在语料库留出数据上的下一词元预测表现,而模型服务的内存压力由上下文长度、批大小、模型形状和解码状态决定;KV 缓存管理是一个独立的模型服务问题 (Kwon et al. 2023)。↩︎
WILDS:斯坦福大学于 2021 年提出的基准测试,包含十个具有真实世界分布偏移的数据集:医院变化(Camelyon17)、野生动物相机位置偏移(iWildCam)和卫星影像时间漂移(PovertyMap)。对于所报告的 Camelyon17-WILDS ERM 基线,平均准确率从分布内的 93.2% 降至分布外的 70.3%,表明当独立同分布假设失效时,标准留出评估可能高估性能。↩︎
DataComp:DataComp 于 2023 年推出,固定模型族、训练代码和计算预算,同时允许参与者改变数据集构建方式。其过滤赛道单独考察从同一候选池中选择样本的影响,使数据筛选整理策略具有可比性,避免将每一项提升都归因于额外的训练计算量。↩︎
Dynabench:Facebook AI Research 于 2021 年推出的动态基准生成平台,由人类构造能够欺骗当前最佳模型的对抗性输入。Dynabench 旨在解决基准饱和问题,即静态基准上的极高准确率可能反映的是对测试集的熟悉程度,而非稳健能力;但它也引入了自身的权衡:由于评估集不断变化,动态基准更难进行跨时间比较。静态基准与动态基准发挥着互补的诊断作用。↩︎
Goodhart, Charles A. E. 1984. “Problems of Monetary Management: The UK Experience.” In Monetary Theory and Practice. Palgrave. https://doi.org/10.1007/978-1-349-17295-5_4.
Strathern, Marilyn. 1997. “‘Improving Ratings’: Audit in the British University System.” European Review 5 (3): 305–21. https://doi.org/10.1002/(SICI)1234-981X(199707)5:3<305::AID-EURO184>3.0.CO;2-4.
Papineni, Kishore, Salim Roukos, Todd Ward, and Wei-Jing Zhu. 2002. “Bleu: A Method for Automatic Evaluation of Machine Translation.” Proceedings of the 40th Annual Meeting on Association for Computational Linguistics - ACL ’02, 311–18. https://doi.org/10.3115/1073083.1073135.
Deng, Jia, Wei Dong, Richard Socher, Li-Jia Li, Kai Li, and Li Fei-Fei. 2009. “ImageNet: A Large-Scale Hierarchical Image Database.” 2009 IEEE Conference on Computer Vision and Pattern Recognition, 248–55. https://doi.org/10.1109/cvpr.2009.5206848.
Recht, Benjamin, Rebecca Roelofs, Ludwig Schmidt, and Vaishaal Shankar. 2019. “Do ImageNet Classifiers Generalize to ImageNet?” Proceedings of the 36th International Conference on Machine Learning (ICML), 5389–400.
Curnow, H. J., and B. A. Wichmann. 1976. “A Synthetic Benchmark.” The Computer Journal 19 (1): 43–49. https://doi.org/10.1093/comjnl/19.1.43.
Dongarra, J. J., J. R. Bunch, C. B. Moler, and G. W. Stewart. 1979. LINPACK Users’ Guide. SIAM. https://doi.org/10.1137/1.9781611971811.
Mattson, Peter, Christine Cheng, Cody Coleman, Greg Diamos, Paulius Micikevicius, David Patterson, Hanlin Tang, et al. 2020. “MLPerf Training Benchmark.” Proceedings of Machine Learning and Systems (MLSys) 2: 336–49.
Reddi, Vijay Janapa, Christine Cheng, David Kanter, Peter Mattson, Guenther Schmuelling, Carole-Jean Wu, Brian Anderson, et al. 2019. “MLPerf Inference Benchmark.” 2020 ACM/IEEE 47th Annual International Symposium on Computer Architecture (ISCA), 446–59. https://doi.org/10.1109/isca45697.2020.00045.
Lange, Klaus-Dieter. 2009. “Identifying Shades of Green: The SPECpower Benchmarks.” IEEE Computer 42 (3): 95–97. https://doi.org/10.1109/mc.2009.84.
Feng, Wu-chun, and Kirk W. Cameron. 2007. “The Green500 List: Encouraging Sustainable Supercomputing.” Computer 40 (12): 50–55. https://doi.org/10.1109/MC.2007.445.
Jouppi, Norm, George Kurian, Sheng Li, Peter Ma, Rahul Nagarajan, Lifeng Nai, Nishant Patil, et al. 2023. “TPU v4: An Optically Reconfigurable Supercomputer for Machine Learning with Hardware Support for Embeddings.” Proceedings of the 50th Annual International Symposium on Computer Architecture, 1–14. https://doi.org/10.1145/3579371.3589350.
Williams, Samuel, Andrew Waterman, and David Patterson. 2009. “Roofline: An Insightful Visual Performance Model for Multicore Architectures.” Communications of the ACM 52 (4): 65–76. https://doi.org/10.1145/1498765.1498785.
Rajpurkar, Pranav, Jian Zhang, Konstantin Lopyrev, and Percy Liang. 2016. “SQuAD: 100,000+ Questions for Machine Comprehension of Text.” Proceedings of the 2016 Conference on Empirical Methods in Natural Language Processing, 2383–92. https://doi.org/10.18653/v1/d16-1264.
Devlin, Jacob, Ming-Wei Chang, Kenton Lee, and Kristina Toutanova. 2019. “BERT: Pre-Training of Deep Bidirectional Transformers for Language Understanding.” Proceedings of the 2019 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies, 4171–86. https://doi.org/10.18653/v1/n19-1423.
Wang, Alex, Amanpreet Singh, Julian Michael, Felix Hill, Omer Levy, and Samuel R. Bowman. 2018. “GLUE: A Multi-Task Benchmark and Analysis Platform for Natural Language Understanding.” Proceedings of the 2018 EMNLP Workshop BlackboxNLP: Analyzing and Interpreting Neural Networks for NLP, 353–55. https://doi.org/10.18653/v1/w18-5446.
Koizumi, Yuma, Shoichiro Saito, Hisashi Uematsu, Noboru Harada, and Keisuke Imoto. 2019. “ToyADMOS: A Dataset of Miniature-Machine Operating Sounds for Anomalous Sound Detection.” 2019 IEEE Workshop on Applications of Signal Processing to Audio and Acoustics (WASPAA), 313–17. https://doi.org/10.1109/waspaa.2019.8937164.
Patterson, David, Joseph Gonzalez, Quoc Le, Chen Liang, Lluis-Miquel Munguia, Daniel Rothchild, David So, Maud Texier, and Jeff Dean. 2021. “Carbon Emissions and Large Neural Network Training.” arXiv Preprint arXiv:2104.10350.
Micikevicius, Paulius, Sharan Narang, Jonah Alben, Gregory Diamos, Erich Elsen, David Garcia, Boris Ginsburg, et al. 2017. “Mixed Precision Training.” arXiv Preprint arXiv:1710.03740.
Dean, Jeffrey, and Luiz André Barroso. 2013. “The Tail at Scale.” Communications of the ACM 56 (2): 74–80. https://doi.org/10.1145/2408776.2408794.
MLCommons. 2026a. MLCommons: About Us.
Naumov, Maxim, Dheevatsa Mudigere, Hao-Jun Michael Shi, Jianyu Huang, Narayanan Sundaraman, Jongsoo Park, Xiaodong Wang, et al. 2019. “Deep Learning Recommendation Model for Personalization and Recommendation Systems.” arXiv Preprint arXiv:1906.00091.
Hooker, Sara. 2021. “The Hardware Lottery.” Communications of the ACM 64 (12): 58–65. https://doi.org/10.1145/3467017.
Krizhevsky, Alex, Ilya Sutskever, and Geoffrey E. Hinton. 2012. “ImageNet Classification with Deep Convolutional Neural Networks.” Advances in Neural Information Processing Systems (NeurIPS) 25.
He, Kaiming, Xiangyu Zhang, Shaoqing Ren, and Jian Sun. 2016. “Deep Residual Learning for Image Recognition.” 2016 IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 770–78. https://doi.org/10.1109/cvpr.2016.90.
Russakovsky, Olga, Jia Deng, Hao Su, Jonathan Krause, Sanjeev Satheesh, Sean Ma, Zhiheng Huang, et al. 2015. “ImageNet Large Scale Visual Recognition Challenge.” International Journal of Computer Vision 115 (3): 211–52. https://doi.org/10.1007/s11263-015-0816-y.
Guo, Chuan, Geoff Pleiss, Yu Sun, and Kilian Q. Weinberger. 2017. “On Calibration of Modern Neural Networks.” International Conference on Machine Learning (ICML) 70: 1321–30.
Pareto, Vilfredo. 1896. Cours d’économie Politique. F. Rouge.
Hendrycks, Dan, Collin Burns, Steven Basart, Andy Zou, Mantas Mazeika, Dawn Song, and Jacob Steinhardt. 2020. “Measuring Massive Multitask Language Understanding.” arXiv Preprint.
Liang, Percy, Rishi Bommasani, Tony Lee, Dimitris Tsipras, Dilara Soylu, Michihiro Yasunaga, Yian Zhang, et al. 2022. “Holistic Evaluation of Language Models.” arXiv Preprint arXiv:2211.09110.
Kwon, Woosuk, Zhuohan Li, Siyuan Zhuang, Ying Sheng, Lianmin Zheng, Cody Hao Yu, Joseph Gonzalez, Hao Zhang, and Ion Stoica. 2023. “Efficient Memory Management for Large Language Model Serving with PagedAttention.” Proceedings of the 29th Symposium on Operating Systems Principles, 611–26. https://doi.org/10.1145/3600006.3613165.