数据选择
数据选择
目的
如何通过精心选择的子集保留一个大得多的数据集的大部分价值?
训练需要为样本的获取、标注、评分、移动和处理付出成本,尽管这些样本的学习价值各不相同。大型数据集中包含冗余、含噪或与目标不匹配的样本,而数据稀缺区域可能缺少模型所需的样例。数据选择将这种异质性转化为系统优化问题。它可以在训练前消除可避免的工作,在学习过程中将标注资源和训练步数投入信息量较大的样例,或者在稀缺性成为制约因素时创建缺失的样本。当可复用表征学习的成本能够在下游任务之间摊销时,数据选择也可以为此进行一次性投入。因此,目标并非获得最小的数据集,而是在不丢失罕见样例、代表性不足的群体或与部署相关的覆盖范围的前提下,以最低的端到端成本达到目标质量。每种策略都会引入自身的开销:样本需要评分、生成、打乱、存储或验证,这些成本可能抵消其承诺的节省。必须从端到端角度作出判断,因为标注或训练环节的收益可能被选择延迟、存储访问或分布式协调所抵消。只有当一种方法所保留或创造的学习价值超过应用该方法所需的工作量时,它才值得采用。这一区别在重复实验中尤为重要,因为有效的缩减会产生累积收益;在适应过程中也同样重要,因为样本的价值会随模型和目标分布而变化。数据工程确立了数据是机器学习系统源代码的观点;数据选择则追问哪些证据在当前有用,以及还缺少哪些证据。用数据—算法—机器的术语来说,这就是数据与算法的协同设计:塑造训练信号,使每单位机器工作都能换取更多有用的学习。
学习目标
- 将数据选择解释为在训练开始前减少总运算量的数据与算法协同设计
- 计算信息—计算比,以判断增加样本能否提高每 FLOP 的学习收益
- 比较去重、核心集选择和质量剪枝在减少冗余预训练数据方面的作用
- 设计课程学习、主动学习或合成数据策略,以应对训练过程中不断变化的数据价值
- 应用选择不等式,检验选择开销是否低于使用完整数据集训练的成本
- 根据存储局部性、一致性和 GPU 利用率约束评估分布式选择流水线
- 使用投资回报率、摊销和计算最优前沿诊断来选择数据选择方面的投入
数据选择基础
训练处理每个样本都要付出机器学习系统铁律所描述的成本,但并非每个样本所提供的学习信号都值得这一成本。数据选择 为干净且经过良好工程化处理的数据集赋予了一个系统目标:保留单位计算量能够贡献最多学习收益的样本。数据工程通过正确的标签、一致的模式以及受治理的记录来确保数据集可靠。数据选择则通过以最少的样本提取最多的学习收益来优化数据集的价值,直接缩减机器学习系统铁律 中的总运算量 \((O)\) 项(原理 原则(英文原版))。这一区别很重要:质量关注数据是否正确,而价值关注正确的数据是否值得为处理它而投入计算资源。

计算供给的增长可能超过高质量数据供给的增长。
长期以来,增加训练数据量一直是改进模型的标准方法。缩放定律1 (Kaplan et al. 2020; Hoffmann et al. 2022) 量化了模型性能如何随数据集规模增大而改善,各团队也因此不断收集和生成更多样本。然而,加速器集群所能提供的可用计算量,其增长速度可能快于新颖、高质量的人类生成文本和图像的供给增长速度。易于获取的公共网络内容已有很大一部分被纳入大型训练语料库,而专家标注能力增长缓慢。这种不对称性就是数据墙,2 它使关注点从收集更多数据转向从现有数据中提取更多价值。后续各节将阐述作出这一选择所需的选择方法和成本模型。
Table 1 使用了一个示例性增长情景,其中 GPU 计算能力每 3 years 增至原来的 10×,而可获取的高质量数据增长较慢。这些是情景输入,并非测得的普适增长率。
| 资源 | 增长率 | 含义 |
|---|---|---|
| GPU 计算能力 | ~10× / 3 years | 在特定时期内,硬件吞吐量可以快速增长 |
| 训练数据(网络) | ~2× / 5 years | 高质量网络文本有限,其中很大一部分已被抓取 |
| 已标注数据 | ~1.5× / 5 years | 人工标注的吞吐量存在内在上限 |
| 合成数据 | 潜在规模很大 | 受生成器质量限制(使用模型生成数据训练的模型可能退化) |
扩大数据集规模最终会触及高质量人类语音和文本存量有限这一边界。沿着 figure 1 中的对数尺度轨迹,观察基础模型的训练需求如何逐渐接近可用公共数据的估计上限。
因此,计算能力所能处理的工作量与可获取的高质量数据所能支撑的工作量之间的差距,是一个系统变量,而非固定定律。在 table 1 所示的情景中,计算供给的增长快于可获取的高质量数据的增长,因此加速器预算可能超出语料库所能支撑的水平,使系统计算资源充裕却受制于数据。要使模型持续适应现实,需要随着世界的变化反复更新训练语料库;当数据质量而非加速器时间成为制约因素时,智能数据选择就变得至关重要。
\begin{tikzpicture}[font=\sffamily\small]

\pgfplotsset{
  layers/axis lines on top/.define layer set={
    axis background,
    axis grid,
    axis ticks,
    axis tick labels,
    pre main,
    main,
    axis lines,
    axis descriptions,
    axis foreground,
  }{/pgfplots/layers/standard},
}

\begin{axis}[
   /pgf/number format/.cd,
   tick label style={/pgf/number format/assume math mode=true},
   ticklabel style={font=\footnotesize\sffamily},
   1000 sep={}, % uklanja zareze
  yticklabel style={
  /pgf/number format/.cd,
  sci,
  sci generic={mantissa e exponent},
  precision=1
},
    width=15cm,
    height=75mm,
    xmin=2012, xmax=2028.5,
    ymin=1e8, ymax=1.4e15,
    ymode=log,
    log basis y=10,
    xtick={2012,2014,2016,2018,2020,2022,2024,2026,2028},
    ytick={1e8,1e9,1e10,1e11,1e12,1e13,1e14,1e15},
    yticklabels={10\textsuperscript{8},10\textsuperscript{9},
    10\textsuperscript{10},10\textsuperscript{11},
    10\textsuperscript{12},10\textsuperscript{13},
    10\textsuperscript{14},10\textsuperscript{15}},
    xlabel={年份},
    ylabel={数据集规模(词元)},
    axis lines*=left,
    axis line style={gray!70,line width=1pt},
 % axis on top=true,
    set layers=axis lines on top,
    tick style={gray!70},
    tick label style={font=\sffamily\footnotesize},
    ylabel style={font=\small\sffamily,align=center,yshift=-1.2mm},
    xlabel style={font=\small\sffamily},
    grid=both,
    major grid style={gray!12},
    minor grid style={gray!6},
    clip=false,
    major tick style={thin,black},
   tick align=outside,
   major tick length=4pt,
]

%—shaded public text stock band ---
\addplot[
    draw=none,
    fill=myorange!07
] coordinates {
    (2012,1e14)
    (2028,1e14)
    (2028,1e15)
    (2012,1e15)
}; %\closedcycle

\node[
    anchor=center,
    align=center,
    text=myorange!75!black,
    font=\footnotesize\sffamily
] at (axis cs:2015.5,3e14)
{高质量公共文本存量\\(书籍、论文、代码、网络)};

%—scaling line ---
\addplot[
    BlueLine,
    line width=1.5pt,
] coordinates {
    (2017.15,1e9)
    (2026.60,1e15)
};

%—data points ---
\addplot[
    only marks,
    mark=*,
    mark size=2.5,
    BlueLine,
    draw=white,line width=0.95pt
] coordinates {
    (2019.0,1.4e10)   % unlabeled low point
    (2020.0,3.0e11)   % GPT-3
    (2022.0,1.4e12)   % Chinchilla
    (2023.0,2.0e12)   % Llama 2
    (2024.0,1.5e13)   % Llama 3
};

%—point labels ---
\node[anchor=west, text=BlueLine, font=\sffamily\footnotesize]
    at (axis cs:2018.5,3.0e11) {GPT-3};

\node[anchor=west, text=BlueLine, font=\sffamily\footnotesize]
    at (axis cs:2022.0,9.0e11) {Chinchilla};

\node[anchor=west, text=BlueLine, font=\sffamily\footnotesize]
    at (axis cs:2023.1,2.0e12) {Llama 2};

\node[anchor=west, text=BlueLine, font=\sffamily\footnotesize]
    at (axis cs:2024.15,1.5e13) {Llama 3};

%—red curved arrow and label ---
\node[
    anchor=west,
    text=myred,
    font=\sffamily\footnotesize
](PD) at (axis cs:2015.4,1.2e12)
{预计数据上限};
\coordinate(PO)at(axis cs:2025.05,1.05e14);
\end{axis}
\draw[myred,line width=0.75pt, <-,>=latex]
(PO)
to[bend right=15]
(PD);
\end{tikzpicture}计算与数据之间的不对称性可能颠倒优化的优先级。当数据充裕而计算资源稀缺时,算法效率可以从有限的 GPU 计算周期中获得更高的准确率。当计算资源充裕而高质量数据稀缺时,数据选择则可以从每个样本中提取更多学习收益。数据选择位于模型优化和机器优化的上游。通过剔除冗余并选择高价值样本,工作负载在进入模型或到达硬件之前就已减少,直接缩减机器学习系统铁律中的总运算量 \((O)\) 项。因此,从系统视角来看,选择属于上游工作负载缩减,而非建模启发式方法。对于加速器预算超出其精选语料库所能支撑水平的团队,瓶颈会从 GPU 的可获取性转向训练数据的质量、合法性和多样性。
智能数据选择的工程工具集遵循一种经过审慎安排的优化顺序:首先判断一个样本是否值得处理,然后再考虑如何高效处理剩余工作负载。数据选择通过在简化或加速剩余工作之前寻找可避免的工作,将“最大回报优先”原则付诸实践。静态剪枝 在计算任何梯度之前就移除低价值样本。动态选择 通过课程学习和主动学习,在训练过程中调整数据供给。合成生成 则在真实数据不足时,通过数据增强、仿真或教师模型生成的样例来创建高价值样本。
当实测质量收益足以证明其开销合理时,每个阶段都能提高到达模型的数据的信息密度;这些阶段共同构成一套互补的工具:剪枝减少流水线中包含什么,选择聚焦流水线如何使用这些数据,而合成则扩展流水线能够获取什么。比较这些技术,需要从系统角度定义数据选择,并以可度量的方式描述其有效性。
定义数据选择
这一三阶段流水线需要一个量,使工程师能够在投入加速器时间之前比较样本。一张重复图像、一条错误标注的记录和一个罕见的边界样例,可能都需要成本相同的前向与反向传播,但它们贡献的学习信号并不相同。因此,数据选择首先要明确样本相对于计算成本的价值。信息—计算比以单位训练计算量所获得的学习信号来度量这一价值,其形式化定义见 section 1.1.3。
Definition 1.1: 数据选择
数据选择 是使训练数据集的信息—计算比(ICR)最大化的过程。
- 意义:它识别针对目标任务值得保留、优先使用或生成的数据;当能够在不损失必要覆盖范围的前提下排除冗余或含噪样本时,它可以减少总运算量 \((O)\)。
- 区别:数据工程关注数据的清洁性和一致性,而数据选择关注样本的信息量和多样性。
- 常见误区:一种常见的误解是数据越多总是越好。新增低质量数据所带来的改进可能不及一个小得多但经过精心选择的数据集,因此必须将保留的数据量与覆盖范围和目标质量结合起来评估。
为使这一概念具体化,考虑训练一个属于 灯塔模型名录:模型小传 中 GPT-2/Llama 灯塔模型家族的自回归语言模型。该情景使用一个拥有 700 亿参数的模型,以呈现大规模场景下计算与数据之间的差距。
计算预算(10,000 块 H100 GPU,运行 3 months)按本章采用的云端训练价格基准计算,约为 $86.4M;在持续模型 FLOPs 利用率为 40 percent 时,可处理约 73.2T 个词元。经质量和重复程度调整后,公开的人类生成文本估计约有 300T 个词元,远大于单个经过整理的网络语料库。实际瓶颈的范围更窄:这些存量文本中,有多少可以获取、可以合法使用、质量高、经过了去重,并且对目标分布有用。如果团队仅有一个包含 5T 个词元的已过滤语料库可供使用,那么现有计算预算已足以将其处理约 14.6×。此时,集群的计算能力已超过可用独特信号所能支撑的需求。工程团队可以对同一语料库重复训练多个轮次,但对已见过的词元进行梯度更新,所带来的损失下降会逐渐递减。团队也可以降低质量门槛,纳入未经整理的网络文本,但含噪且与目标不匹配的词元会降低下游评估表现。另一种选择是投入数据选择——改进质量过滤器、构建难度课程,并合成缺失的边界案例——以提高每 FLOP 的学习收益。当计算能力的增长超过高信号数据的供给时,相比增配加速器,数据选择能带来更高的资本回报。
这一机会适用于不同的模型架构,但各类架构的瓶颈和可安全削减的幅度有所不同。与受计算限制的 ResNet-50 标杆案例不同,GPT-2/Llama 模型在推理时可能受内存带宽限制,而在训练时受计算限制。当经过验证的选择方法能够移除样本或词元,且不增加补偿性步骤时,样本越少,训练所需的 FLOPs 就越少。因此,适当的分析框架应着眼于系统整体,而非仅关注统计层面。
系统视角
数据墙规定了扩展未经整理的数据集的物理极限;系统视角则决定如何在整个硬件栈中管理这一约束。传统的机器学习框架通过统计样本复杂度和泛化理论来评估数据选择,关注达到给定测试误差需要多少样本。这种表述将每个样本视为零成本的数学抽象,忽略了数据摄取、传输和执行所消耗的物理资源。
数据选择的系统框架 则关注如何在整个机器学习生命周期中,将达到目标准确率所需的总资源成本降至最低。该框架将关注点从理论样本效率转向具体的资源消耗,如 table 2 所示。
| 机器学习框架 | 系统框架 |
|---|---|
| “以更少样本达到相同准确率” | “以更少 FLOPs 达到相同准确率” |
| “更好的泛化能力” | “更低的训练成本(时间、资金、能源)” |
| “样本复杂度界” | “端到端资源效率” |
| “学习理论” | “成本工程” |
这一框架揭示了整个执行栈中的优化着力点。在数据—算法—机器分类体系中,数据选择作用于数据层,在算法和硬件优化执行相关工作之前将其消除;机器学习系统铁律对这一点作了形式化描述(机器学习系统铁律)。
Systems Perspective 1.1: 数据选择与铁律
在机器学习系统铁律 \((T = \frac{D_{\text{vol}}}{\text{BW}} + \frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}} + L_{\text{lat}})\) 中,数据选择减少了进入工作负载的样本或词元数量。后续的模型级优化减少每次前向传播和反向传播的运算量,机器级优化则提高 \(R_{\text{peak}}\)(峰值吞吐量)和 \(\eta_{\text{hw}}\)(利用率)。数据选择在这些下游优化执行相关工作之前,就将其消除了。
这使数据选择在铁律中具有乘法叠加的价值:当三个优化层均作用于同一瓶颈时,数据集规模的缩减倍数为 2×,每个样本运算量的缩减倍数为 2×,有效吞吐量提高至原来的 2×,则总成本的缩减倍数为 8×,而非 6×。
在训练轮数、批大小和每个样本的工作量保持不变的情况下,数据集规模减少 50 percent,会直接使所需的前向传播、反向传播和梯度更新次数减半。对于训练成本为 $100M 的场景,只要训练计划不通过增加优化步骤进行补偿,这一削减就能直接节省 $50M 的计算成本。
这些计算节省会传导至整个硬件层次结构。通过减少总数据量(\(D_{\text{vol}}\)),去重 和核心集选择可缓解存储带宽需求、网络互连入口流量以及主机到加速器的 PCIe 传输压力,否则这些压力会使张量核心停滞于 I/O 等待状态。在上游,主动学习 将人工标注专门用于高熵或高梯度样本,从而控制标注预算。
然而,选择并非没有成本:每种选择策略都会产生自身的运行时开销,用于对样本进行评分、过滤、打乱或协调。如果选择开销超过随后减少的训练时间,那么通过额外前向传播来评估样本难度的在线选择算法,很容易消耗比其节省的更多的加速器周期。只有当过滤加上在整理后的子集上训练的端到端成本,严格低于在未经整理的完整数据集上训练的成本时,数据选择流水线才有采用的价值。
信息—计算比
section 1.1.2 中建立的系统框架需要一个定量指标。数据选择需要在准确率与成本之间的效率前沿上进行权衡:保留每个样本可以维持覆盖范围,却会将计算资源耗费在冗余信号上;而过度激进的剪枝虽然节省 FLOPs,却会牺牲稀有数据切片的召回率。要驾驭这一权衡,就必须量化每个样本在单位硬件执行量下产生的边际学习信号。这一指标就是信息—计算比(ICR)。
Figure 2 将数据—算法—机器分类体系重新表述为优化图谱,其中数据选择承担输入优化的角色:在工作负载进入模型或硬件之前,先减少其总量。模型侧关注每个样本需要多少数学运算。机器侧关注硬件执行这些运算的速度。数据侧则关注这个样本究竟是否应该被处理。三角形的三条边体现了主要瓶颈:受计算限制描述受算术吞吐量限制的系统,受 I/O 限制描述受数据搬移限制的系统,而样本效率则描述受训练数据信息含量限制的系统。
\scalebox{0.8}{%
\begin{tikzpicture}[line join=round,font=\sffamily\footnotesize]
\tikzset{%
Box2/.style={align=flush center, inner sep=0pt,draw=none,fill=none,minimum height=8mm },
planet/.style = {circle, draw=none,semithick, fill=yellow!10,line width=1.5pt,
                    font=\sffamily\bfseries,
                    minimum size=27mm, inner sep=1mm,align=flush center},
satellite/.style = {circle, draw=#1, dashed, thick, fill=none,%#1!10,
                    text width=26mm, inner sep=1pt, align=flush center,minimum size=28mm,minimum height=12mm},
TxtC/.style = {font=\footnotesize\sffamily,text width=50mm,align=flush center},
LineA/.style = {violet!60,{Kite[line width=1.1pt,fill=white,round,length=9pt,width=7pt]}-,line width=1.5pt,shorten <=-3pt},
ALineA/.style={{Triangle[width=14pt,length=10pt]}-{Triangle[width=14pt,length=10pt]}, line width=7pt,cyan!40}
}

\tikzset{mycylinder/.style={cylinder, shape border rotate=90, aspect=1.3, draw, fill=white,
minimum width=25mm,minimum height=11mm,line width=\Linewidth,node distance=-0.15},
pics/data/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=STREAMING,scale=\scalefac, every node/.append style={transform shape}]
\node[mycylinder,fill=\filllcolor!50] (A) {};
\node[mycylinder, above=of A,fill=\filllcolor!30] (B) {};
\node[mycylinder, above=of B,fill=\filllcolor!10] (C) {};
\fill[\filllcolor!50!black]($(C.west)!0.12!(C.east)$)circle(3pt);
\fill[\filllcolor!50!black]($(B.west)!0.12!(B.east)$)circle(3pt);
\fill[\filllcolor!50!black]($(A.west)!0.12!(A.east)$)circle(3pt);
 \end{scope}
     }
  }
}

%funnel
\tikzset{%
 pics/funnel/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=FUNNEL,scale=\scalefac, every node/.append style={transform shape}]
\draw[fill=\filllcolor!50,line width=\Linewidth,draw=\drawcolor](-0.12,-0.81)--(-0.19,-0.25)--(-0.7,0.41)--(0.7,0.41)--(0.19,-0.25)--(0.12,-0.81)--cycle;
\draw[fill=\filllcolor!50,line width=\Linewidth,draw=\drawcolor](-0.19,-0.25)--(0.08,-0.25);
\draw[fill=\filllcolor!50,line width=\Linewidth,draw=\drawcolor](0.16,-0.09)--(0.41,0.31);
%
\node[line width=\Linewidth,draw=\drawcolor,fill=\filllcolor!50,inner sep=1pt,
rectangle,rounded corners=0.5pt,minimum width=16mm,minimum height=5pt]at(0,0.5){};
%
\foreach \i in{-0.5,0,0.5}{
\node[single arrow, line width=0.8*\Linewidth,draw=black,fill=\filllcirclecolor, rotate=270,inner sep=1pt,
      minimum width =9pt, single arrow head extend=2pt,
      minimum height=5mm]at(\i,0.9) {}; % length of arrow
   }
\node[single arrow,line width=0.8*\Linewidth,draw=black,fill=\filllcirclecolor, rotate=270,inner sep=1pt,
      minimum width =11pt, single arrow head extend=2pt,
      minimum height=5mm]at(0,-1.1) {}; % length of arrow
 \end{scope}
     }
  }
}
%CPU
\tikzset{%
 pics/cpu/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=FUNNEL,scale=\scalefac, every node/.append style={transform shape}]
\node[fill=\filllcolor,minimum width=66, minimum height=66,
            rounded corners=2,outer sep=2pt] (C1) {};
\node[fill=white,minimum width=54, minimum height=54] (C2) {};
\node[fill=\filllcolor!40,minimum width=44, minimum height=44] (C3) {\large CPU};

\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=\filllcolor,minimum width=3, minimum height=15,
           inner sep=0pt,anchor=south](GO\y)at($(C1.north west)!\x!(C1.north east)$){};
}
\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=\filllcolor,minimum width=3, minimum height=15,
           inner sep=0pt,anchor=north](DO\y)at($(C1.south west)!\x!(C1.south east)$){};
}
\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=\filllcolor,minimum width=15, minimum height=3,
           inner sep=0pt,anchor=east](LE\y)at($(C1.north west)!\x!(C1.south west)$){};
}
\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=\filllcolor,minimum width=15, minimum height=3,
           inner sep=0pt,anchor=west](DE\y)at($(C1.north east)!\x!(C1.south east)$){};
}
 \end{scope}
     }
  }
}
\tikzset{
pics/algorithm/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\node[fill=\filllcolor!60,draw=\drawcolor,line width=\Linewidth,rectangle,minimum size=2.5mm,
rounded corners=1pt,inner sep=1pt](B2)at(0,-0.47){};
\node[fill=\filllcolor!30,draw=\drawcolor,line width=\Linewidth,rectangle,minimum size=2.5mm,
rounded corners=1pt,inner sep=1pt](B3)at(-0.6,-0.47){};
\node[fill=\filllcolor!30,draw=\drawcolor,line width=\Linewidth,rectangle,minimum size=2.5mm,
rounded corners=1pt,inner sep=1pt](B1)at(0.6,-0.47){};
%
\node[fill=\filllcolor!99!violet!80,draw=\drawcolor,line width=\Linewidth,rectangle,
minimum width=8.5mm,minimum height=3mm,
rounded corners=2pt,inner sep=1pt](B0)at(0,0.53){};
\draw[draw=\drawcolor,shorten >=4pt,shorten <=4pt,line width=1.5*\Linewidth]
($(B0.north west)!0.33!(B0.south west)$)--($(B0.north east)!0.33!(B0.south east)$);
\draw[draw=\drawcolor,shorten >=4pt,shorten <=4pt,line width=1.5*\Linewidth]
($(B0.north west)!0.66!(B0.south west)$)--($(B0.north east)!0.66!(B0.south east)$);
\draw[draw=\drawcolor,rounded corners](B1)|-(B0);
\draw[draw=\drawcolor,rounded corners](B3)|-(B0);
\draw[draw=\drawcolor,rounded corners](B2)--(B0);
\node[fill=\filllcirclecolor!60,draw=\drawcolor,line width=\Linewidth,rectangle,minimum size=2.5mm,
rounded corners=1pt,inner sep=1pt,rotate=45](R2){};
\node[fill=\filllcirclecolor!30,draw=\drawcolor,line width=\Linewidth,rectangle,minimum size=2.5mm,
rounded corners=1pt,inner sep=1pt,rotate=45](R1) at (-0.6,0){};
\node[fill=\filllcirclecolor!30,draw=\drawcolor,line width=\Linewidth,rectangle,minimum size=2.5mm,
rounded corners=1pt,inner sep=1pt,rotate=45](R3) at (0.6,0){};
\end{scope}
    }
  }
}
%vaga
\tikzset{
pics/vaga/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\node[rectangle,minimum width=2mm,minimum height=22mm,
draw=none, fill=\filllcolor,line width=\Linewidth](1R) at (0,-0.95){};
\fill[fill=\filllcolor!60!black](230:2.8)arc(230:310:2.8)--cycle;%circle(2.9);
%LT
\node [semicircle, shape border rotate=180,  anchor=chord center,
      minimum size=11mm, draw=none, fill=\filllcirclecolor](LT) at (-2,-0.5) {};
\node [circle,  minimum size=4mm, draw=none, fill=\filllcirclecolor](T1) at (-2,1.25) {};
\draw[draw=\drawcolor,,line width=1.2*\Linewidth,shorten <=3pt,shorten >=3pt](T1)--(LT);
\draw[draw=\drawcolor,,line width=1.2*\Linewidth,shorten <=3pt,shorten >=3pt](T1)--(LT.30);
\draw[draw=\drawcolor,,line width=1.2*\Linewidth,shorten <=3pt,shorten >=3pt](T1)--(LT.150);
%DT
\node [semicircle, shape border rotate=180,  anchor=chord center,
      minimum size=11mm, draw=none, fill=\filllcirclecolor!70!black](DT) at (2,-0.5) {};
\node [circle,  minimum size=4mm, draw=none, fill=\filllcirclecolor!70!black](T2) at (2,1.25) {};
\draw[draw=\drawcolor,line width=1.2*\Linewidth,shorten <=3pt,shorten >=3pt](T2)--(DT);
\draw[draw=\drawcolor,,line width=1.2*\Linewidth,shorten <=3pt,shorten >=3pt](T2)--(DT.30);
\draw[draw=\drawcolor,,line width=1.2*\Linewidth,shorten <=3pt,shorten >=3pt](T2)--(DT.150);
%
\node[draw=none,rectangle,minimum width=32mm,minimum height=1.5mm,inner sep=0pt,
fill=\filllcolor!60!black]at(0,1.25){};
\node[draw=white,fill=\filllcolor,line width=2*\Linewidth,ellipse,minimum width=9mm,  minimum height=15mm](EL)at(0,0.85){};
\node[draw=white,fill=\filllcolor!60!black,line width=2*\Linewidth,,circle,minimum size=10mm](2C)at(0,2.05){};
\end{scope}
    }
  }
}
\pgfkeys{
  /channel/.cd,
   Depth/.store in=\Depth,
  Height/.store in=\Height,
  Width/.store in=\Width,
  filllcirclecolor/.store in=\filllcirclecolor,
  filllcolor/.store in=\filllcolor,
  drawcolor/.store in=\drawcolor,
  drawcircle/.store in=\drawcircle,
  scalefac/.store in=\scalefac,
  Linewidth/.store in=\Linewidth,
  picname/.store in=\picname,
  filllcolor=BrownLine,
  filllcirclecolor=violet!20,
  drawcolor=black,
  drawcircle=violet,
  scalefac=1,
  Linewidth=0.5pt,
  Depth=1.3,
  Height=0.8,
  Width=1.1,
  picname=C
}
\definecolor{Siva}{RGB}{161,152,130}
\def\radius{3.15}
%planet
\node (p)   [planet]    {};
\node[TxtC,below=0pt of p]{机器学习\\ 性能};
%satellites

\foreach \i/\j/\sho [count=\k from 0] in {
magenta!70!/{算法(模型)}/105pt,
Siva/{数据选择}/105pt,
cyan/{机器(硬件)}/105pt
%violet!75!/{\textbf{Embodiment}\\{\footnotesize No grounding}}/11pt%,
%orange/\textbf{Alignment}\\ {\footnotesize Value loading}/11pt
}
{
\def\startangle{90}
%Satelit
\pgfmathsetmacro{\angle}{\startangle - \k * (360/3)}
\node (s\k) [satellite=\i, font=\footnotesize\sffamily] at (\angle:\radius+\sho) {};
\node[TxtC,below=0pt of s\k]{\j};
%Arrows
%\draw[arr=\i,shorten >=\sho] (p) --coordinate[pos=0.35](AR\k) (s\k);
}

 \pic[shift={(0,0)}] at  (0,0){vaga={scalefac=0.35,picname=1,filllcolor=BlueLine,  Linewidth=1.0pt,filllcirclecolor=orange}};
 %algorithm
 \pic[shift={(0,0)}] at  (s0){algorithm={scalefac=1.2,picname=1,
drawcolor=black,filllcolor=orange!80!, Linewidth=0.75pt,filllcirclecolor=green}};
%data
\begin{scope}[local bounding box=DATA1,shift={($(0,-0.66)+(s1)$)},
scale=0.6, every node/.append style={transform shape}]
\pic[shift={(0,0)}] at  (0,0){data={scalefac=1,picname=1,filllcolor=BlueLine, Linewidth=0.7pt}};
\node[draw=black!70,line width=1pt,yshift=-3mm,fill=white,circle,minimum size=18mm](CIR)at(A.north east){};
\pic[shift={(0,0)}] at  (CIR){funnel={scalefac=0.6,picname=1,Linewidth=0.5pt,
 filllcolor=BrownL,drawcolor=black,filllcirclecolor=green}};
 \end{scope}
  %machine - CPU
 \pic[shift={(0,0)}] at  (s2){cpu={scalefac=0.55,picname=1,filllcolor=BrownLine, Linewidth=0.7pt}};
 %Arrows
 \draw[ALineA] (60:\radius) arc[radius=\radius, start angle=60, end angle= 0];
\coordinate (AR1) at (30:\radius);

\draw[ALineA] (300:\radius) arc[radius=\radius, start angle=300, end angle= 240];
\coordinate (AR2) at (270:\radius);

\draw[ALineA] (180:\radius) arc[radius=\radius, start angle=180, end angle= 120];
\coordinate (AR3) at (150:\radius);
%%%%%%%%%
 \path[LineA](AR1)--++(0:1.0)coordinate(MA);
 \node[Box2,anchor=west](T1)at(MA){样本效率};
 \draw[violet!50,line width=2pt](T1.north west)to[bend right=25]coordinate(AR11)(T1.south west);
 \draw[LineA](AR1)--(AR11);

 \path[LineA](AR2)--++(270:0.65)coordinate(MA2);
 \node[Box2,anchor=west,rotate=90](T2)at(MA2){};%Sample Efficiency
  \node[anchor=north](T222)at(MA2){受 I/O 限制};
 \draw[violet!50,line width=2pt](T2.north west)to[bend left=25]coordinate(AR22)(T2.south west);
 \draw[LineA](AR2)--(AR22);

 \path[LineA](AR3)--++(0:-1.0)coordinate(MA1);
 \node[Box2,anchor=east,align=right](T3)at(MA1){受计算限制};
 \draw[violet!50,line width=2pt](T3.north east)to[bend left=25]coordinate(AR33)(T3.south east);
 \draw[LineA](AR3)--(AR33);
\end{tikzpicture}}形式上,该比值将边际信息含量与边际计算量联系起来: \[\text{ICR} = \frac{\Delta I}{\Delta \text{FLOPs}}\]
ICR 越高,表明每 FLOP 的训练计算能换取更多学习信号。由于在生产运行中无法直接观测分子,系统流水线依赖可操作的代理指标:单位计算量带来的验证表现提升、学习曲线下面积、留出评估中的损失下降、基于不确定性或梯度的样本评分,以及对部署至关重要的数据切片的覆盖指标。这些代理指标在训练运行耗尽计算预算之前,将抽象的信息论目标转化为具体的选择信号。
ICR 前沿:当数据成为负担时
越过前沿,数据便成为负担:计算量攀升,学习停滞。
信息—计算比并非常数,而是遵循边际收益递减规律。ICR 前沿 是指新增数据带来的边际学习信号趋近于零的临界点。
为说明边际收益递减,设 \(I(D)\) 为规模为 \(D\) 的数据集所包含的信息量,并假设 \(I(D) \propto \log D\)。这是一个简化的分析模型,而非普适定律。如果计算成本随每个样本的操作数 \(O_{\text{sample}}\) 线性增长,则 \(C(D) = O_{\text{sample}} \cdot D\),由此得到的 ICR 遵循 equation 1: \[\text{ICR}(D) = \frac{\frac{d}{dD} I(D)}{\frac{d}{dD} C(D)} \approx \frac{1/D}{O_{\text{sample}}} = \frac{1}{O_{\text{sample}} \cdot D} \tag{1}\]
在这一示意模型下,\(1/(O_{\text{sample}} \cdot D)\) 的衰减形成了数据墙。越过一个取决于工作负载的前沿后,新增数据可能几乎无法带来学习收益,却仍会增加计算量。在这一阶段,数据成为一种数据税,使机器学习系统铁律中的 \(O\) 项增大,却未使 RoC(计算回报,参见 以计算回报率(RoC)作为经济分析视角)的准确率分子获得相称的提升。拐点体现的是目标性能与边际成本之间的实际权衡,而不是该模型中 ICR 的数学最大值。
数据选择将机器学习系统铁律中的总操作数 \((O)\) 项从固定常数转变为变量。实测 ICR 提升至原来的 2\(\times\),意味着达到相同实测增益所需的 FLOPs 减半。只有当工作负载受计算限制,且节省的工作位于关键路径上时,这才会产生与吞吐量提升至原来的 2\(\times\) 相同的理想时间缩减。ICR 专门关注计算;section 1.8 中的成本建模框架将相同的推理扩展到采集、标注和存储成本。
当随机抽取的一批原始数据包含冗余、噪声或模型已经掌握的样本时,其 ICR 可能很低。高效数据流水线(figure 3)可通过三个阶段改善 ICR:训练前的静态剪枝、训练期间的动态选择,以及按需合成生成。为说明这一点,考虑在一项具体的核心集选择任务中计算 ICR:核心集是经过有意选择、旨在保留完整数据集学习信号的子集。Section 1.2.2 定义了用于构建此类子集的 EL2N 和 GraNd 评分方法,section 1.11 则提供了评估这些效率增益的完整测量框架,其中包括一种计算最优前沿诊断方法,可用于判断训练是否受数据限制或受计算限制。
\begin{tikzpicture}[font=\small\sffamily, >=stealth]
\tikzset{
Box/.style={align=center, inner xsep=2pt,draw=GreenLine, line width=1pt,fill=none,
minimum width=24mm, minimum height=25mm,node distance=1.5},
LineA/.style={violet!50,line width=4.0pt,{-{Triangle[width=1.5*6pt,length=2.0*5pt]}},shorten <=1pt,shorten >=1pt},
ALine/.style={black!50, line width=1.1pt,{{Triangle[width=0.9*6pt,length=1.2*6pt]}-}},
Larrow/.style={fill=violet!50, single arrow,  inner sep=2pt, single arrow head extend=3pt,
            single arrow head indent=0pt,minimum height=10mm, minimum width=3pt}
}
\tikzset{%
 pics/inbox/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=INBOX,scale=\scalefac, every node/.append style={transform shape}]
\node[line width=\Linewidth,draw=\drawcolor,fill=\filllcolor!50,
rectangle,rounded corners=3pt,minimum width=14mm,minimum height=10mm]at(0,0.3){};
\node[line width=\Linewidth,draw=\drawcolor,fill=\filllcolor,
rectangle,rounded corners=3pt,minimum width=15mm,minimum height=10mm]at(0,0.1){};
\node[line width=\Linewidth,draw=\drawcolor,fill=\filllcolor!50,
,rectangle,rounded corners=3pt,minimum width=17mm,minimum height=10mm]
at(0,-0.1){};
\draw[line width=\Linewidth,draw=\drawcolor,fill=\filllcirclecolor,,rounded corners=2pt](-0.92,0.05)--
(-0.92,-0.78)--(0.92,-0.78)--(0.92,0.05)--(0.40,0.05)--(0.32,-0.2)--(-0.29,-0.2)--(-0.40,0.05)--cycle;

\node[single arrow, line width=\Linewidth,draw=black,fill=cyan!90!black!30, rotate=270,
      minimum width = 15pt, single arrow head extend=6pt,
      minimum height=10mm]at(0,0.5) {}; % length of arrow
 \end{scope}
     }
  }
}
%target
\tikzset{
pics/target/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\definecolor{col1}{RGB}{62,100,125}
\definecolor{col2}{RGB}{219,253,166}
\colorlet{col1}{\filllcolor}
\colorlet{col2}{\filllcirclecolor}
\foreach\i/\col [count=\k]in {22mm/col1,17mm/col2,12mm/col1,7mm/col2,2.5mm/col1}{
\node[circle,inner sep=0pt,draw=\drawcolor,fill=\col,minimum size=\i,line width=\Linewidth](C\k){};
}
\draw[thick,fill=brown,xscale=-1](0,0)--++(111:0.13)--++(135:1)--++(225:0.1)--++(315:1)--cycle;
\path[green,xscale=-1](0,0)--(135:0.85)coordinate(XS1);
\draw[thick,fill=yellow,xscale=-1](XS1)--++(80:0.2)--++(135:0.37)--++(260:0.2)--++(190:0.2)--++(315:0.37)--cycle;
\end{scope}
    }
  }
}
%brain
\tikzset{pics/brain/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=BRAIN,scale=\scalefac, every node/.append style={transform shape}]
\fill[fill=\filllcolor!50](0.1,-0.5)to[out=0,in=180](0.33,-0.5)
to[out=0,in=270](0.45,-0.38)to(0.45,-0.18)
to[out=40,in=240](0.57,-0.13)to[out=110,in=310](0.52,-0.05)
to[out=130,in=290](0.44,0.15)to[out=90,in=340,distance=8](0.08,0.69)
to[out=160,in=80](-0.42,-0.15)to (-0.48,-0.7)to(0.07,-0.7)to(0.1,-0.5)
(-0.10,-0.42)to[out=310,in=180](0.1,-0.5);
\draw[draw=\drawcolor,line width=\Linewidth](0.1,-0.5)to[out=0,in=180](0.33,-0.5)
to[out=0,in=270](0.45,-0.38)to(0.45,-0.18)
to[out=40,in=240](0.57,-0.13)to[out=110,in=310](0.52,-0.05)
to[out=130,in=290](0.44,0.15)to[out=90,in=340,distance=8](0.08,0.69)
(-0.42,-0.15)to (-0.48,-0.7)
(0.07,-0.7)to(0.1,-0.5)
(-0.10,-0.42)to[out=310,in=180](0.1,-0.5);
\draw[fill=\filllcolor,line width=\Linewidth](-0.3,-0.10)to(0.08,0.60)
to[out=60,in=50,distance=3](-0.1,0.69)to[out=160,in=80](-0.26,0.59)to[out=170,in=90](-0.46,0.42)
to[out=170,in=110](-0.54,0.25)to[out=210,in=150](-0.54,0.04)
to[out=240,in=130](-0.52,-0.1)to[out=300,in=240]cycle;
\draw[fill=\filllcolor,line width=\Linewidth]
(-0.04,0.64)to[out=120,in=0](-0.1,0.69)(-0.19,0.52)to[out=120,in=330](-0.26,0.59)
(-0.4,0.33)to[out=150,in=280](-0.46,0.42)
%
(-0.44,-0.03)to[bend left=30](-0.34,-0.04)
(-0.33,0.08)to[bend left=40](-0.37,0.2) (-0.37,0.12)to[bend left=40](-0.45,0.14)
(-0.26,0.2)to[bend left=30](-0.24,0.13)
(-0.16,0.32)to[bend right=30](-0.27,0.3)to[bend right=30](-0.29,0.38)
(-0.13,0.49)to[bend left=30](-0.04,0.51);

\draw[rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcirclecolor,length=2.5pt]}](-0.23,0.03)--(-0.15,-0.03)--(-0.19,-0.18)--(-0.04,-0.28);
\draw[rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcirclecolor,length=2.5pt]}](-0.17,0.13)--(-0.04,0.05)--(-0.06,-0.06)--(0.14,-0.11);
\draw[rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcirclecolor,length=2.5pt]}](-0.12,0.23)--(0.31,0.0);
\draw[rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcirclecolor,length=2.5pt]}](-0.07,0.32)--(0.06,0.26)--(0.16,0.33)--(0.34,0.2);
\draw[rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcirclecolor,length=2.5pt]}](-0.01,0.43)--(0.06,0.39)--(0.18,0.51)--(0.31,0.4);
\end{scope}
     }
  }
}
%starS
\tikzset{
 mystar/.style={shape=star,star points=4,inner sep=1pt,
 minimum size=#1,star point ratio=2.1,rounded corners=#1/20},
pics/starS/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\node[fill=\filllcolor,mystar={13mm}] at (0,0) {};
\node[fill=\filllcolor,mystar={8mm}] at (-0.75,0.6) {};
\node[fill=\filllcolor,mystar={4mm}] at (-0.2,1.0) {};
\node[fill=\filllcolor,mystar={5mm}] at (-0.8,-0.3) {};
\end{scope}
    }
  }
}
%funnel
\tikzset{%
 pics/funnel/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=FUNNEL,scale=\scalefac, every node/.append style={transform shape}]
\draw[fill=\filllcolor,line width=\Linewidth,draw=\drawcolor](-0.12,-0.81)--(-0.19,-0.25)--(-0.7,0.41)--(0.7,0.41)--(0.19,-0.25)--(0.12,-0.81)--cycle;
\draw[fill=\filllcolor,line width=\Linewidth,draw=\drawcolor](-0.19,-0.25)--(0.08,-0.25);
\draw[fill=\filllcolor,line width=\Linewidth,draw=\drawcolor](0.16,-0.09)--(0.41,0.31);
%
\node[line width=\Linewidth,draw=\drawcolor,fill=\filllcolor,inner sep=1pt,
rectangle,rounded corners=2pt,minimum width=16mm,minimum height=5pt]at(0,0.5){};
%
\foreach \i in{-0.5,0,0.5}{
\node[single arrow, line width=0.8*\Linewidth,draw=black,fill=\filllcirclecolor, rotate=270,inner sep=1pt,
      minimum width =9pt, single arrow head extend=2pt,
      minimum height=5mm]at(\i,0.9) {}; % length of arrow
   }
\node[single arrow,line width=0.8*\Linewidth,draw=black,fill=\filllcirclecolor, rotate=270,inner sep=1pt,
      minimum width =11pt, single arrow head extend=2pt,
      minimum height=5mm]at(0,-1.1) {}; % length of arrow
 \end{scope}
     }
  }
}
\pgfkeys{
  /channel/.cd,
   Depth/.store in=\Depth,
  Height/.store in=\Height,
  Width/.store in=\Width,
  filllcirclecolor/.store in=\filllcirclecolor,
  filllcolor/.store in=\filllcolor,
  drawcolor/.store in=\drawcolor,
  drawcircle/.store in=\drawcircle,
  scalefac/.store in=\scalefac,
  Linewidth/.store in=\Linewidth,
  picname/.store in=\picname,
  filllcolor=BrownLine,
  filllcirclecolor=violet!20,
  drawcolor=black,
  drawcircle=violet,
  scalefac=1,
  Linewidth=0.5pt,
  Depth=1.3,
  Height=0.8,
  Width=1.1,
  picname=C
}
%Raw Data
\node[Box](B1){};
\fill[green!07](B1.north west) rectangle ($(B1.north east)!0.6!(B1.south east)$)coordinate(B1DE);
\fill[green!20](B1.south east) rectangle ($(B1.north west)!0.6!(B1.south west)$)coordinate(B1LE);
\node[Box](){};
\tikzset{Text2/.style={font=\sffamily\bfseries\small,align=center}}
\node[Text2]at($(B1.south west)!0.5!(B1DE)$){原始数据};
\coordinate(Q1)at($(B1.north west)!0.5!(B1DE)$);
\pic[shift={(0,0)}] at  (Q1){inbox={scalefac=0.7,picname=1,Linewidth=1.0pt,
 filllcolor=BrownL,drawcolor=black,filllcirclecolor=orange!70!yellow!80}};
%Static Pruning
\node[Box, right=of B1](B2){};
\fill[cyan!07](B2.north west) rectangle ($(B2.north east)!0.6!(B2.south east)$)coordinate(B2DE);
\fill[cyan!20](B2.south east) rectangle ($(B2.north west)!0.6!(B2.south west)$)coordinate(B2LE);
\node[Box, right=of B1,draw=BlueD](B2){};
\node[Text2]at($(B2.south west)!0.5!(B2DE)$){1. 静态\\ 剪枝};
\coordinate(Q2)at($(B2.north west)!0.5!(B2DE)$);
\pic[shift={(0,0)}] at  (Q2){funnel={scalefac=0.53,picname=1,Linewidth=0.5pt,
 filllcolor=green!70!orange!70,drawcolor=black,filllcirclecolor=red!70!blue!80}};
%%Dynamic Selection
\node[Box, right=of B2](B3){};
\fill[violet!07](B3.north west) rectangle ($(B3.north east)!0.6!(B3.south east)$)coordinate(B3DE);
\fill[violet!20](B3.south east) rectangle ($(B3.north west)!0.6!(B3.south west)$)coordinate(B3LE);
\node[Box, right=of B2,draw=violet](B3){};
\node[Text2]at($(B3.south west)!0.5!(B3DE)$){2. 动态\\ 选择};
\coordinate(Q3)at($(B3.north west)!0.5!(B3DE)$);
 \pic[shift={(0,0)}] at  (Q3){target={scalefac=0.55,picname=1,drawcolor=BlueD,
filllcolor=cyan!90!,Linewidth=0.7pt, filllcirclecolor=cyan!20}};
%Synthetic Gen
\node[Box, right=of B3](B4){};
\fill[orange!07](B4.north west) rectangle ($(B4.north east)!0.6!(B4.south east)$)coordinate(B4DE);
\fill[orange!20](B4.south east) rectangle ($(B4.north west)!0.6!(B4.south west)$)coordinate(B4LE);
\node[Box, right=of B3,draw=OrangeLine](B4){};
\node[Text2]at($(B4.south west)!0.5!(B4DE)$){3. 合成\\ 生成};
\coordinate(Q4)at($(B4.north west)!0.5!(B4DE)$);
\pic[shift={(0.15,-0.23)}] at  (Q4){starS={scalefac=0.7,picname=1,filllcolor=violet!90!}};
%Model
\node[Box, right=1.95 of B4](B5){};
\fill[black!05](B5.north west) rectangle ($(B5.north east)!0.6!(B5.south east)$)coordinate(B5DE);
\fill[black!15](B5.south east) rectangle ($(B5.north west)!0.6!(B5.south west)$)coordinate(B5LE);
\node[Box, right=1.95 of B4,draw=black](B5){};
\node[Text2]at($(B5.south west)!0.5!(B5DE)$){模型};
\coordinate(Q5)at($(B5.north west)!0.5!(B5DE)$);
\pic[shift={(0,0)}] at  (Q5){brain={scalefac=0.9,picname=1,filllcolor=orange!30!, Linewidth=0.95pt}};
%arrows
\foreach \i in{1,2,3}{
\pgfmathtruncatemacro{\X}{\i + 1} %
\draw[LineA](B\i)--(B\X);
}
\draw[LineA,font=\footnotesize\sffamily,text=black!70](B4)--node[above]{高 ICR}(B5);
\node[below =2pt of B2,text=black!70]{训练前};
\node[below =2pt of B3,text=black!70]{训练期间};
\node[below =2pt of B4,text=black!70]{按需};
\end{tikzpicture}Checkpoint 1.1: 数据选择效率
数据选择的目标是最大化 ICR。
指标检查:
流水线检查:
实际问题在于,当数据集规模、模型成本和选择策略与具体的 FLOP 预算相互作用时,效率差距可能有多大。下面的 ImageNet 规模 ResNet-50 场景使用假设的准确率增益来说明计算过程;它并非已报告的 EL2N 结果。
Napkin Math 1.1: 计算 ICR:核心集
问题:在 ImageNet 上将 灯塔模型名录:模型小传 中的 ResNet-50 灯塔模型训练一个轮次,需要 3.15 × 10¹⁶ FLOPs 的计算量。在该场景假设的准确率增益下,保留 50 percent 的数据会如何改变信息—计算比?该计算保持每个样本的工作量不变,且不计入选择开销。
设置:
- 数据集:ImageNet(1.28M)
- 模型:ResNet-50 灯塔模型(每次前向传播约需 8.2 GFLOP,一次包含前向传播和反向传播的训练步骤约需 24.6 GFLOP,具体取决于实现)
- 一个轮次:1.28M \(\times\) 24.6 GFLOP = 3.15 × 10¹⁶ FLOPs
- 假设每个轮次的准确率提升(训练早期):5 percentage points
随机选择(基线):
- 均匀处理全部 1.28M 个样本
- 准确率增益:5 percentage points
- \(\text{ICR}_{\text{random}}\) = 5 percentage points / (3.15 × 10¹⁶ FLOPs) = 每 FLOP \(1.6 \times 10^{-16}\)
EL2N 核心集(误差 L2 范数,一种在 section 1.2.2 中阐述的训练动态评分;包含 50 percent 的数据):
- 处理 640.6K 个选定样本
- 假设的准确率增益:4.5 percentage points(全量数据增益的 90 percent)
- 计算量:640.6K \(\times\) 24.6 GFLOP = 1.6 × 10¹⁶ FLOPs
- \(\text{ICR}_{\text{coreset}}\) = 4.5 percentage points / (1.6 × 10¹⁶ FLOPs) = 每 FLOP \(2.9 \times 10^{-16}\)
系统洞见:在这些假设下,选定子集的 ICR 达到基线的 1.8×,而准确率增益减少了 0.5 percentage points。实际决策需要依据实测增益、选择开销和覆盖度检查。
提高信息—计算比遵循分阶段的优化顺序:预先剪除静态浪费,在执行期间引导动态批次选择,并按需合成数据以弥补覆盖缺口。第一种手段完全作用于模型开始执行之前。
静态剪枝
静态剪枝 与训练前过滤在训练循环的上游剔除不含有效信息的样本。通过在计算任何梯度之前清除冗余和损坏的记录,静态过滤无需修改模型架构或执行内核,即可减少操作数 \((O)\)。
支持使用更小数据集的依据
实证规模扩展研究表明,数据集体量本身并不决定模型准确率:大规模语料中存在大量冗余。在许多情形下,相当一部分训练样本贡献的梯度信号微乎其微,却消耗了完整的前向与反向传播计算量。
在 CIFAR-10 上,Paul et al. (2021) 报告称,EL2N 剪枝移除了一半的训练数据,而未降低准确率。在 ImageNet-1K 上,Sorscher et al. (2022) 报告称,一种自监督原型度量方法舍弃了 20% 的数据,而未牺牲性能。这一模式也延伸到语言建模领域:The Pile3 和 C44 等网络抓取语料包含足够多的重复内容和模板化内容,使去重成为一个系统问题。在 Lee et al. (2022) 研究的数据集中,近似重复内容移除涉及 C4 的 3.04% 和 RealNews 的 13.63%,且使用去重后的数据进行训练减少了记忆现象,同时保持或改善了困惑度。
Sorscher, Ben, Robert Geirhos, Shashank Shekhar, Surya Ganguli, and Ari S. Morcos. 2022. “Beyond Neural Scaling Laws: Beating Power Law Scaling via Data Pruning.” Advances in Neural Information Processing Systems (NeurIPS) 35: 19523–36. https://doi.org/10.52202/068431-1419.
所报告的增益具有基准特异性。剪枝的有效性取决于数据集内在的冗余程度、选择算法和目标模型容量;生产部署在采用激进过滤之前,需要针对具体任务进行验证。
各个数据点对训练的价值不必相同。这种异质性部分源于分类器学习决策边界的方式。许多样本远离边界:一旦模型学会了狗的主要特征,一张光照良好的狗的图片就可能变得容易识别,而模糊不清和代表性不足的样本仍可能具有信息价值。标签质量也会影响数据需求。在简化的二元对称噪声模型中,标签翻转率 \(\rho\) 会将有效样本量因子降低至 \((1 - 2\rho)^2\);当 \(\rho = 10\%\) 时,要达到与干净数据相同的界,所需样本量约为其 \(1/(1-2\rho)^2 \approx 1.56\times\)。配套笔记本使用另一个玩具学习曲线模型来说明另一种数据质量乘数;这两种乘数都不具有普适性。
Napkin Math 1.2: 数据质量乘数
问题:要达到与干净数据相同的目标误差,需要多少额外的含噪数据?
数学原理:在这个示例模型中,干净数据的误差按 \(\mathcal{O}(1/D)\) 缩放,因此 \(D_{\text{clean}} \propto 1/\epsilon\)。含噪数据的误差按 \(\mathcal{O}(1/\sqrt{D})\) 缩放,因此 \(D_{\text{noisy}} \propto 1/\epsilon^2\)。当目标误差 \(\epsilon\) = 0.01(1 percent)时:
- \(D_{\text{clean}}\) ≈ 100
- \(D_{\text{noisy}}\) ≈ 10,000
结果:在这些假设下,要达到目标误差,含噪数据所需的样本量为干净数据的 100×。
系统启示:在这里,数据清洗相当于一个 100× 的计算加速器;实际乘数取决于工作负载。
核心集选择算法
确定应保留哪些样本,需要系统化的选择标准。核心集选择5将静态剪枝决策转化为覆盖问题:保留能够维持整个数据集统计性质的最小子集。
系统层面的决策在于将选择预算投入何处:是投入成本较低、能够保留分布结构的覆盖度指标,还是投入成本更高、能够更好地针对决策边界的训练动态评分。在应用任何评分之前,这一决策还需要设置约束:对于部署时重要的类别、人口群体、时间窗口和罕见失效模式,必须保证最低代表性,因为平均 ICR 最高的子集仍可能删除那些决定生产环境风险的样本。
基于几何的方法选择能够覆盖某种选定表示的样本,而无须训练目标模型。\(k\)-Center 算法6采用一种设施选址式目标,在选定的嵌入和度量下,选择能够减小任意点到其最近已选中心的最大距离的样本。
Herding采用另一种方法。Welling 最初提出的过程以迭代方式构造具有代表性的伪样本,使其特征统计量近似观测到的矩 (Welling 2009)。相关的矩匹配目标可以指导从固定样本池中选择子集。这些方法在特征表示上运行,因此计算成本具有吸引力,但其评分本身并不感知标签信息。
Welling, Max. 2009. “Herding Dynamical Weights to Learn.” Proceedings of the 26th Annual International Conference on Machine Learning, 1121–28. https://doi.org/10.1145/1553374.1553517.
基于训练动态的方法使用代理模型识别可能重要的样本。GraNd(Gradient Normed,梯度范数)和 EL2N(误差 L2 范数)7根据训练早期的梯度大小或预测误差对样本评分 (Paul et al. 2021)。从理论上讲,样本价值评估可以通过影响函数来表述,利用经验 Hessian 矩阵的逆(\(H^{-1} \nabla_\theta \mathcal{L}\))衡量移除一个样本会如何改变验证损失;然而,对于现代模型的参数量 \(P\),计算 \(H^{-1}\) 在计算上难以承受(\(\mathcal{O}(P^2)\) 至 \(\mathcal{O}(P^3)\))。GraNd 通过使用期望梯度范数(\(\|\nabla_\theta \mathcal{L}\|_2\))对样本评分来绕过这一问题,而 EL2N 则利用如下观察:在训练早期,相对于线性层参数的梯度范数与输出预测误差(\(\|p(x) - y\|_2\))高度相关。这使实践者能够仅通过一次前向传播识别高不确定性的边界样本,无须计算反向传播梯度。高分表示代理模型认为这些样本较难,但高分也可能对应噪声或不具代表性的样本,因此需要进行覆盖度和质量检查。同一研究报告了评分在多种架构之间的有效迁移,这使成本更低的代理模型选择方法成为可能。遗忘事件(Forgetting Events)8跟踪训练过程中样本被正确分类后又被错误分类的次数 (Toneva et al. 2019)。
table 3 中的每种算法都在前期评分计算与后续训练计算的减少之间进行权衡。由于基于几何的方法和基于训练动态的方法优化的是不同的代理目标,它们的相对排名取决于数据集规模、特征表示、目标模型容量和评分预算;只有当下游训练节省的成本超过评估开销时,评分才具有计算成本上的合理性。
| 方法 | 计算成本 | 是否需要训练 | 最适用场景 | 局限性 |
|---|---|---|---|---|
| k-Center | \(\mathcal{O}(D^2)\) 或 \(\mathcal{O}(DK)\) | 否 | 覆盖、探索 | 忽略标签信息 |
| Herding | \(\mathcal{O}(DK)\) | 否 | 分布匹配 | 假设分布近似高斯分布 |
| GraNd | \(\mathcal{O}(\text{epochs} \times D)\) | 是(少量轮次) | 决策边界 | 需要训练代理模型 |
| 遗忘事件 | \(\mathcal{O}(\text{full training})\) | 是(完整训练) | 困难样本 | 计算成本高昂 |
| EL2N | \(\mathcal{O}(\text{epochs} \times D)\) | 是(少量轮次) | 不确定性采样 | 配合代理模型效果最佳 |
基于几何的方法优先考虑在特征表示空间中的均匀覆盖,而基于训练动态的方法则将容量集中于模糊的边界样本。Figure 4 将一种基于不确定性的策略与均匀随机采样并列展示:随机选择使样本分散在整个特征空间中,而不确定性采样则将选择预算集中在模型预测尚不确定的边界区域。
\scalebox{0.9}{%
\begin{tikzpicture}[font=\small\sffamily,x=9mm,y=8mm]
% Left plot: Random Sampling
\begin{scope}
    \node[font=\small\sffamily] at (2.15, 5.0) {随机采样};

    % Decision boundary
    \draw[thick, dashed, gray] (0, 0) -- (5, 5);

    % Class A points (below line) - circles
    \foreach \x/\y in {0.5/0.2, 1.0/0.5, 0.8/1.2, 1.5/0.8, 2.0/1.0,
                       2.5/1.5, 1.2/0.3, 0.3/0.8, 1.8/1.5, 2.2/0.5,
                       3.0/2.0, 3.5/2.5, 2.8/1.8, 3.2/1.2, 4.0/2.8} {
        \fill[blue!60] (\x, \y) circle (2pt);
    }

    % Class B points (above line) - triangles
    \foreach \x/\y in {0.5/1.5, 1.0/2.0, 0.3/2.5, 1.5/2.5, 2.0/3.0,
                       2.5/3.5, 1.2/3.2, 0.8/3.8, 1.8/3.5, 2.2/4.0,
                       3.0/4.0, 3.5/4.5, 2.8/3.8, 3.2/4.2, 4.0/4.5} {
        \fill[red!60] (\x, \y) circle (2pt);
    }

    % Randomly selected (circled) - some easy, some hard
    \foreach \x/\y in {0.5/0.2, 1.5/2.5, 3.0/2.0, 0.8/3.8, 2.2/0.5} {
        \draw[thick, orange] (\x, \y) circle (5pt);
    }

    % Axis
    \draw[->,>=Latex,thick] (0, 0) -- (5.2, 0) node[right, font=\footnotesize\sffamily] {$x_1$};
    \draw[->,>=Latex,thick] (0, 0) -- (0, 5.2) node[above, font=\footnotesize\sffamily] {$x_2$};

    % Label
    \node[font=\footnotesize\sffamily, orange] at (2.5, -0.5) {已选样本(随机)};
\end{scope}

% Right plot: Coreset Selection
\begin{scope}[xshift=7cm]
    \node[font=\small\sffamily] at (2.15, 5.0) {核心集选择};

    % Decision boundary
    \draw[thick, dashed, gray] (0, 0) -- (5, 5);

    % Uncertainty band near boundary
    \fill[yellow!20] (0, 0) -- (0, 1) -- (4, 5) -- (5, 5) -- (5, 4) -- (1, 0) -- cycle;
        \node[font=\fontsize{7pt}{8}\sffamily, fill=white, inner sep=1pt] at (3.5, 3.25) {高不确定性};

    % Class A points (below line) - circles
    \foreach \x/\y in {0.5/0.2, 1.0/0.5, 0.8/1.2, 1.5/0.8, 2.0/1.0,
                       2.5/1.5, 1.2/0.3, 0.3/0.8, 1.8/1.5, 2.2/0.5,
                       3.0/2.0, 3.5/2.5, 2.8/1.8, 3.2/1.2, 4.0/2.8} {
        \fill[blue!60] (\x, \y) circle (2pt);
    }

    % Class B points (above line) - triangles
    \foreach \x/\y in {0.5/1.5, 1.0/2.0, 0.3/2.5, 1.5/2.5, 2.0/3.0,
                       2.5/3.5, 1.2/3.2, 0.8/3.8, 1.8/3.5, 2.2/4.0,
                       3.0/4.0, 3.5/4.5, 2.8/3.8, 3.2/4.2, 4.0/4.5} {
        \fill[red!60] (\x, \y) circle (2pt);
    }

    % Coreset selected (near boundary) - circled
    \foreach \x/\y in {0.8/1.2, 2.5/1.5, 3.0/2.0, 1.0/2.0, 2.0/3.0} {
        \draw[thick, green!60!black] (\x, \y) circle (5pt);
    }

    % Axis
    \draw[->,>=Latex,thick] (0, 0) -- (5.2, 0) node[right, font=\footnotesize\sffamily] {$x_1$};
    \draw[->,>=Latex,thick] (0, 0) -- (0, 5.2) node[above, font=\footnotesize\sffamily] {$x_2$};

    % Label
    \node[font=\footnotesize\sffamily, green!60!black] at (2.5, -0.5) {已选样本(边界)};
\end{scope}
\end{tikzpicture}}将 EL2N 与小型代理模型结合,是在评分成本和选择质量之间取得实用平衡的一种方式。该方法先训练轻量级模型若干轮次,再计算 EL2N 评分,并在满足覆盖度和质量检查要求的条件下选择子集。代理模型必须提供能够迁移到目标模型的排序,而且只有当下游训练节省的成本超过选择开销时,这项投入才有回报。下面的具体场景说明了这一工作流程,但并不声称其中占比 10% 的子集能够保持准确率。
Example 1.1: 核心集选择实践
场景:某工程团队计划从 1 million 张训练图像中选择包含 100,000 张图像的核心集(10 percent),以加快模型迭代。
诊断:朴素的随机子采样会丢失稀有类别和边界样本。将轻量级代理模型训练 5 个轮次后,计算 EL2N 误差评分,保留决策边界附近的高不确定性样本。
系统经验:基于代理模型的核心集选择用有针对性的评分计算替代部分全量数据遍历。只有当代理模型的排序能够迁移,且覆盖度检查能够保留稀有类别和边缘情况时,它才能加速完整模型的训练。
Listing 1 演示了如何使用轻量级代理模型计算 EL2N 评分并选择核心集。该机制投入少量探测计算,以识别决策边界附近的高不确定性样本,随后在保留的子集上训练完整模型,避免将训练计算用于冗余的简单样本。此示例要求数据加载器不打乱样本顺序,以便每个评分的位置始终与其数据集索引对应。
代理模型评分将不确定性转化为可复用的已选样本索引:compute_el2n_scores 衡量哪些样本仍会使经过短暂训练的模型感到困惑,select_coreset 则保留这些高信息量样本,用于完整训练。
compute_el2n_scores 函数先训练代理模型若干轮次,再通过预测结果与独热标签之间的 L2 距离衡量预测误差。高分表示代理模型认为这些样本较难,其中可能包括含噪样本。select_coreset 函数演示了按该评分排序的过程;在生产环境中使用时,还需要验证覆盖度、噪声和目标质量。
def compute_el2n_scores(model, dataloader, num_epochs=5):
    """Compute EL2N scores.

    Returns L2 norm of (prediction - one_hot_label).
    """
    # Train proxy model for a few epochs to get meaningful predictions
    train_proxy(model, dataloader, num_epochs)

    scores = []
    model.eval()
    for x, y in dataloader:
        logits = model(x)
        probs = softmax(logits, dim=1)
        # One-hot encode labels
        one_hot = zeros_like(probs).scatter_(1, y.unsqueeze(1), 1)
        # EL2N score = L2 distance from confident prediction
        el2n = (probs - one_hot).norm(dim=1)  # High = uncertain
        scores.extend(el2n.tolist())
    return scores


def select_coreset(scores, dataset, fraction=0.1):
    """Select top-k highest-scoring (most uncertain) samples."""
    k = int(len(dataset) * fraction)
    # Sort by score descending (highest uncertainty first)
    indices = argsort(scores, descending=True)[:k]
    return Subset(dataset, indices)


# Illustrative 10% subset; validate accuracy and coverage before use
scores = compute_el2n_scores(proxy_model, full_loader)
coreset = select_coreset(scores, full_dataset, fraction=0.1)
train_full_model(model, coreset)
数据去重
核心集选择根据信息量确定应保留哪些样本,而一种互补方法则针对那些增加计算量却不增加学习信号的重复样本。去重能够立即带来效率提升,尤其适用于完全重复和近重复样本,而且无须训练模型。这使其成为数据选择中最容易实施的优化手段之一,但必须验证近重复阈值,以免流水线移除有用的分布信号。
最简单的去重形式(在 系统化数据处理 中作为数据工程流水线的一个阶段介绍,此处则将其提升为一种优化手段)使用基于哈希的方法进行精确匹配。通过为每个样本计算密码学哈希值(MD5 或 SHA-256),并移除哈希值相同的样本,实践者可以消除大规模网络抓取语料库中不可避免地积累的逐字节完全重复数据。该过程计算成本低,随数据集大小线性扩展,而且很容易并行化。
近重复检测针对的是在字节层面有所不同,但仍具有大量词元或字符片段重叠的内容。对于文本,MinHash9结合局部敏感哈希10(LSH)可以高效地近似 Jaccard 相似度11。在实践中,流水线将每篇文档转换为一组相互重叠的字符或词级 \(k\) 元片段,将这些集合压缩为固定长度的 MinHash 签名,其哈希碰撞概率等于 Jaccard 相似度,然后使用 LSH 将签名划分为 \(b\) 个带,每个带包含 \(r\) 行。只要文档在任意一个带的所有行上均匹配,就会落入同一个桶,从而将昂贵的相似度验证限制在可能匹配的候选文档之间,避免对数十亿篇网络文档进行难以实现的 \(\mathcal{O}(N^2)\) 全对比较。它能够检测出经过轻微编辑且重叠度较高的内容,但不能确定语义改写的等价性。
对于图像,感知哈希生成的签名对缩放和压缩等轻微变换具有鲁棒性,能够识别以不同格式存储、但视觉上相似的候选图像。基于嵌入的相似度可以通过计算稠密表示来检索语义近邻候选(图像使用 CLIP12 (Radford et al. 2021),文本使用句子 Transformer),但距离接近本身并不能证明重复,而且这种方法会带来更高的计算开销。
去重可以减少对重复内容的记忆,并避免将 FLOPs 花费在完全重复或近似重复的样本上。它也可能改变语料有意设置的经验权重,因此必须验证阈值和下游质量,而不能假定每个重复样本都有害。
当输入样本用于索引持久化模型状态,而非流经无状态计算层时,去重对系统的影响会发生变化。
Lighthouse 1.1: DLRM 与嵌入去重
灯塔模型名录:模型小传 中的 DLRM 灯塔模型受内存容量限制,其嵌入表为数十亿个用户/物品 ID 占用了数 TB 的存储空间。其中很大一部分容量浪费在了冷嵌入上,即训练数据中很少出现的 ID 所对应的嵌入。
DLRM 的数据选择可以包括交互去重,以及针对冷 ID 的嵌入剪枝。移除重复交互会减少训练样本,但只有当 ID 消失,或分配、哈希或共享策略发生变化时,嵌入表才会缩小。
基于质量的数据剪枝
去重移除了冗余样本,但仍然存在第三类有问题的数据:会主动损害学习的样本。基于质量的剪枝会剔除无法提供有意义信号的样本,或引入矛盾信息、干扰优化过程的样本。
标签错误检测可以是一种成效显著的质量剪枝方式。Cleanlab 等工具根据训练过程中模型置信度的变化模式,识别所赋标签可能有误的样本。对于模型始终预测为 A 类、但标记为 B 类的样本,其原因可能是困难的边界情况、分布偏移、模型盲区,也可能是标注错误。评分应触发审核,而非自动删除;随后可以纠正或移除已确认的错误。
离群值移除处理的是另一类问题:在特征空间中远离任何聚类中心的样本。这些点可能意味着噪声、标注错误或数据损坏,但也可能是决定部署风险的罕见边缘案例。关键在于区分有信息价值的离群点和无效样本,并在移除前采用保守阈值,按数据切片进行审核。
低信息量过滤采用领域特定的启发式方法,移除缺乏足够学习信号的样本。对于文本语料,这通常意味着移除高困惑度的乱码文本(困惑度是语言模型衡量文本出乎其预期程度的指标,因此高值可用于标记不连贯的字符串),而在某些流水线中,也会移除低困惑度的模板化或重复文本。对于图像数据集,过滤的目标是模糊、损坏或近乎均匀、只能提供少量视觉信息的样本。
除启发式方法和困惑度外,工业级预训练流水线还大量依赖基于分类器的过滤:使用经过整理的高质量参考文本(如维基百科、书籍和科学论文)作为正样本,未经整理的网页转储数据作为负样本,训练轻量、高吞吐量的线性分类器(如 fastText)。该分类器为每篇抓取的文档赋予连续的质量分数,使流水线能够以每秒 GB 级的摄取速度过滤数百万个低质量网页,而无需承担运行完整神经语言模型进行评估的高昂计算负担。
这三种静态剪枝技术——核心集选择、去重和质量过滤——共同作用,可以在训练前减少工作量。在训练轮数、批大小和单样本工作量固定的条件下,数据集缩减 50% 意味着前向传播、反向传播和梯度更新次数均减少 50%。如果训练计划增加轮数或步数作为补偿,这一节省幅度就会降低。
静态剪枝回答了保留哪些数据的问题,但它将答案视为固定不变。一旦剪枝后的数据集确定,每轮训练都会使用同一个子集。然而,样本的效用可能随着模型学习而变化:对训练不足的模型构成挑战的样本,在经过足够多次梯度更新后可能变得容易。动态选择技术根据模型已经掌握的内容,在每个阶段调整训练数据,从而解决这一局限。
动态选择
样本提供的边际学习信号在训练过程中是非平稳的。在优化初期,广泛的覆盖范围能够提供稳定的梯度,建立通用特征表示。随着参数收敛,已掌握样本的梯度范数逐渐衰减至零。对这些样本执行前向和反向传播,仍会消耗加速器执行周期和高带宽内存(HBM)传输资源,却只能产生微乎其微的参数更新,使其有效 ICR 趋近于零。动态选择通过根据模型当前状态调整批次组成来缓解这种浪费。这使数据选择从离线预处理步骤转移到实际执行循环中,在运行时改变操作次数(\(O\)),同时要求数据加载器在评分开销与加速器吞吐量(\(T\))之间取得平衡。
课程学习:由易到难
第一种动态选择技术是课程学习13 (Bengio et al. 2009; Soviany et al. 2022),它对数据呈现给模型的顺序进行组织。它从较简单的样本开始,逐步引入更复杂的样本,而不是随机打乱数据,类似于人类先掌握基础、再学习更难内容的过程。
Bengio, Yoshua, Jérôme Louradour, Ronan Collobert, and Jason Weston. 2009. “Curriculum Learning.” Proceedings of the 26th Annual International Conference on Machine Learning, 41–48. https://doi.org/10.1145/1553374.1553380.
Soviany, Petru, Radu Tudor Ionescu, Paolo Rota, and Nicu Sebe. 2022. “Curriculum Learning: A Survey.” International Journal of Computer Vision 130 (6): 1526–65. https://doi.org/10.1007/s11263-022-01611-x.
课程学习可以通过控制每个阶段由哪些梯度主导来改变优化轨迹。简单样本可能提供稳定的早期信号,而被评为困难的样本则可能包含有用的边界信息、标签噪声或离群值。由易到难的训练计划可以使某些工作负载的训练更加平稳,但其收益取决于难度评分、节奏规则、模型和数据;因此,table 5 将节省幅度视为示例,而非保证。
实施课程学习需要两个组件:对样本排序的难度评分器,以及控制引入困难样本速度的节奏函数。一种常见选择是线性节奏: \[ \text{samples}_{n_{\text{epoch}}} = \texttt{sort\_by\_difficulty}[:N_{\text{samples}} \cdot \min(1, n_{\text{epoch}}/N_{\text{warmup}})] \] 其中,\(n_{\text{epoch}}\) 是当前训练轮次,\(N_{\text{samples}}\) 是数据集的总样本数,\(N_{\text{warmup}}\) 是完整数据集可用之前的预热轮数。早期轮次使用最容易的 \(N_{\text{samples}} \cdot (n_{\text{epoch}}/N_{\text{warmup}})\) 部分样本进行训练;预热结束后,训练使用完整数据集。从系统角度看,每轮动态重排数 TB 的数据集会破坏顺序 I/O 预读,并使加速器因存储延迟而停顿。生产环境中的数据加载器通过离线预排序,将数据组织为按难度分层的离散分片或桶,以实现课程学习。训练期间,工作进程从存储中顺序流式读取分片,同时在每个难度层内维护本地混洗缓冲区,在保持高顺序存储带宽的同时,维持批次多样性和梯度稳定性。
难度评分器是一项系统层面的选择,因为它需要在探测计算开销与排序质量之间权衡,如 table 4 所示。损失评分和置信度评分通过额外推理换取更好的排序,启发式方法避免了计算但需要领域知识,而自步评分则将自适应调整移入训练循环本身。
| 策略 | 难度评分 | 最适用的场景 |
|---|---|---|
| 基于损失 | 探测模型的损失(低 = 容易) | 通用;需要训练探测模型 |
| 基于置信度 | 教师模型的置信度(高 = 容易) | 已有教师模型时;蒸馏场景 |
| 领域启发式 | 句子长度、图像复杂度 | 无额外计算;需要领域知识 |
| 自步 | 当前模型的损失(每轮更新) | 自适应;无需探测模型 |
Table 5 使用假设的训练轮数,说明如何计算不同工作负载中课程学习带来的节省。这些数值并非所引用课程学习研究中的测量结果。
| 数据集 | 模型 | 节奏策略 | 达到目标准确率所需的轮数 | 训练轮数减少幅度 |
|---|---|---|---|---|
| CIFAR-10 | ResNet-18 | 线性预热 | 115,基线为 150 | 训练轮数减少 23.3% |
| CIFAR-100 | ResNet-32 | 自步 | 180,基线为 220 | 训练轮数减少 18.2% |
| ImageNet | ResNet-50 | 基于损失 | 80,基线为 90 | 训练轮数减少 11.1% |
| ImageNet | ResNet-50 | 学习得到(含噪标签) | 70,基线为 90 | 训练轮数减少 22.2% |
这一情景说明,课程学习的有效收益必须在固定目标指标下衡量。样本排序取决于任务:反课程学习先呈现困难样本,而自步学习则使用模型当前的损失调整难度。两种排序方式都不具有普遍优势。
主动学习:人在回路中
课程学习优化样本呈现的顺序,但假定所有样本都已标注。在标注需要大量专业知识、时间或资金的专业领域,这一假设不再成立。主动学习14 (Settles 2012; Ren et al. 2021) 无需预先标注所有数据,而是将优化目标从选择用哪些已标注样本进行训练,转变为选择哪些未标注样本值得标注。
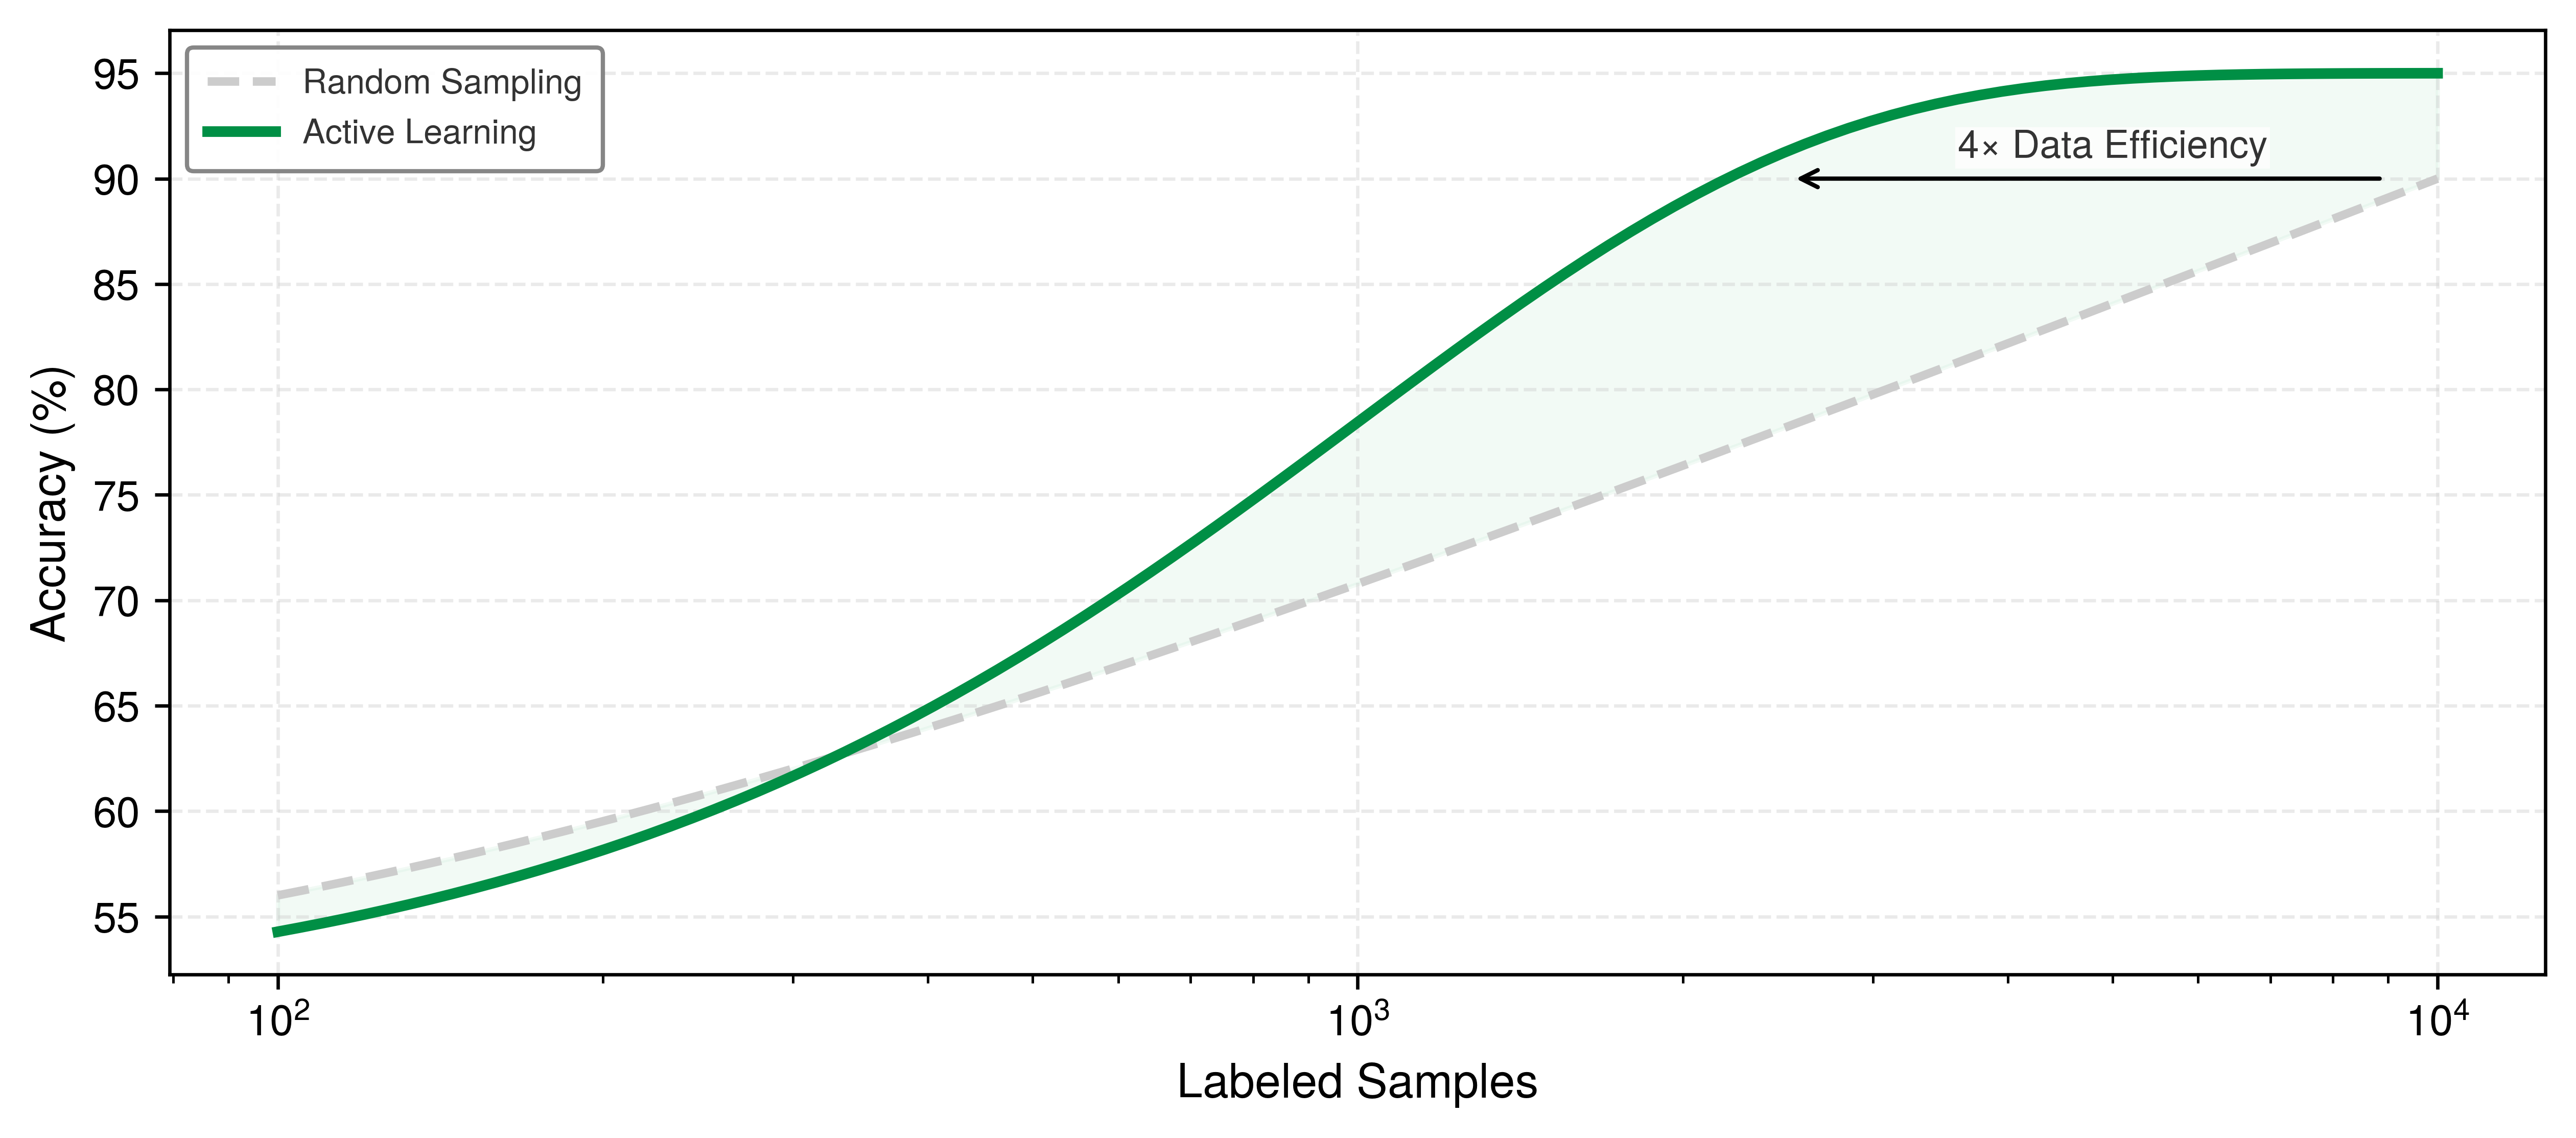
主动学习将数据获取从静态收集转变为迭代查询过程。沿着 figure 5 中的环形流程,观察模型不确定性指标如何为专家标注选出高价值的未标注样本。
主动学习的有效性在很大程度上取决于用于选择待标注样本的查询策略 (Settles 2009, 2012; Ren et al. 2021)。最简单的方法是不确定性采样,它选择模型最不自信的样本,例如二分类中预测概率接近 0.5 的样本。使用单个模型进行评分的成本较低,但可能使查询过度集中于某一个模糊区域。委员会查询通过训练多个模型并选择它们分歧最大的样本来扩展这一思路,从而捕捉单个模型可能遗漏的认知不确定性。
Settles, Burr. 2009. Active Learning Literature Survey. Computer Sciences Technical Report 1648. University of Wisconsin-Madison.
Settles, Burr. 2012. Active Learning. Synthesis Lectures on Artificial Intelligence and Machine Learning. Springer Cham. https://doi.org/10.1007/978-3-031-01560-1.
Ren, Pengzhen, Yun Xiao, Xiaojun Chang, Po-Yao Huang, Zhihui Li, Brij B. Gupta, Xiaojiang Chen, and Xin Wang. 2021. “A Survey of Deep Active Learning.” ACM Computing Surveys 54 (9): 1–40. https://doi.org/10.1145/3472291.
对于愿意投入更多计算资源的实践者,预期模型变化方法选择一旦获得标注就会引起最大梯度更新的样本。这种方法提供了一种有理论依据但成本高昂的替代方案。多样性采样通过选择与当前已标注数据不相似的样本,补充基于不确定性的方法,改善覆盖范围,避免所有查询都聚集在同一个模糊区域附近。
主动学习在标注需要专业知识的领域尤其有价值。例如,在医学影像中,通过 X 光片诊断疾病的 AI 系统可能对常见病症较为自信,但对较罕见的病例存在不确定性。通过将人工标注集中于这些模糊病例,主动学习可以优化昂贵专家时间的使用,同时加快模型改进。
\scalebox{0.9}{\begin{tikzpicture}[font=\small\sffamily]
\tikzset{
Box2/.style={align=flush center, inner sep=2pt,draw=none,fill=black!70,
font=\fontsize{8pt}{8}\sffamily\bfseries,text=white,minimum width=20mm, minimum height=5mm },
Box/.style={align=center, inner xsep=2pt,draw=black!70, line width=1pt,node distance=12mm,
fill=none, minimum width=25mm, minimum height=20mm},
Circle1/.style={circle,  minimum size=33mm, draw=none, fill=BrownLine!20},
LineD/.style={BrownLine!60!black!20,line width=4.0pt,dashed,dash pattern=on 5pt off 2pt,
{-{Triangle[width=1.5*6pt,length=2.0*5pt]}},shorten <=5pt,shorten >=1pt},
LineA/.style={BrownLine!80!black!40,line width=4.0pt,
{-{Triangle[width=1.5*6pt,length=2.0*5pt]}},shorten <=5pt,shorten >=1pt},
ALineA/.style={violet!60,{Circle[line width=1.1pt,fill=white,round,length=5pt,width=5pt]}-,
line width=1.5pt,shorten <=-3pt,shorten >=-6pt}
}

%dataS
\tikzset{%
 pics/dataS/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=FUNNEL,scale=\scalefac, every node/.append style={transform shape}]
%plats
\draw[fill=\filllcolor,line width=\Linewidth,draw=\drawcolor](0,-0.3)--(-0.67,0.03)--(0,0.37)--(0.67,0.03)--cycle;
\draw[fill=\filllcirclecolor,line width=\Linewidth,draw=\drawcolor](0,0)--(-0.67,0.33)--(0,0.67)--(0.67,0.33)--cycle;
\draw[fill=\filllcolor,line width=\Linewidth,draw=\drawcolor](0,0.3)--(-0.67,0.63)--(0,0.97)--(0.67,0.63)--cycle;
%left
\draw[line width=\Linewidth,draw=\drawcolor](-0.39,1.21)--++(210:0.55)--++(270:1.22)--(-0.39,-0.56);
\fill[line width=\Linewidth,fill=\filllcirclecolor!60!violet!,draw=green,draw=\drawcolor](-0.39,1.21)circle(3pt);
\fill[line width=\Linewidth,fill=\filllcolor,draw=green,draw=\drawcolor](-0.39,-0.56)circle(3pt);
%right
\draw[line width=\Linewidth,draw=\drawcolor](0.39,1.21)--++(330:0.55)--++(270:1.22)--(0.39,-0.56);
\fill[line width=\Linewidth,fill=\filllcirclecolor!60!violet!,draw=green,draw=\drawcolor](0.39,1.21)circle(3pt);
\fill[line width=\Linewidth,fill=\filllcolor,draw=green,draw=\drawcolor](0.39,-0.56)circle(3pt);
\end{scope}
     }
  }
}
%graph style
\tikzset{
pics/graph/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=GRAPH,line join=round,scale=1, every node/.append style={transform shape}]
\def\dx{\Width}
\def\dy{\Height}
\def\dz{\Depth}
%
\def\x{0}
\def\y{0.15}
\def\z{0}
% colors
\draw[draw=\filllcirclecolor,line width=1pt](-0.2,0)--(1.3,0);
\draw[draw=\filllcirclecolor,line width=1pt](-0.2,0)--(-0.2,1.2);
\filldraw[fill=\filllcolor!10, draw=\drawcolor] (\x,\y+\dy,\z) -- (\x,\y+\dy,\z+\dz) -- (\x+\dx,\y+\dy,\z+\dz) -- (\x+\dx,\y+\dy,\z) -- cycle; % gornja strana
\filldraw[fill=\filllcolor!50, draw=\drawcolor] (\x+\dx,\y,\z) -- (\x+\dx,\y,\z+\dz) -- (\x+\dx,\y+\dy,\z+\dz) -- (\x+\dx,\y+\dy,\z) -- cycle; % desna strana
\filldraw[fill=\filllcolor!60, draw=\drawcolor] (\x,\y,\z+\dz) -- (\x+\dx,\y,\z+\dz) -- (\x+\dx,\y+\dy,\z+\dz) -- (\x,\y+\dy,\z+\dz) -- cycle; % prednja strana
\end{scope}
    }
  }
}
 %person style
 \tikzset{
 pics/man/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=PERSON,scale=\scalefac, every node/.append style={transform shape}]
     % tie
    \draw[draw=\tiecolor,fill=\tiecolor] (0.0,-1.1)--(0.16,-0.87)--(0.09,-0.46)--(0.13,-0.37)--(0.0,-0.28)
                   --(-0.13,-0.37)--(-0.09,-0.46)--(-0.16,-0.87)--cycle;
    % ears
    \draw[fill=black] (0.74,0.95) to[out=20,in=80](0.86,0.80) to[out=250,in=330](0.65,0.65) to[out=70,in=260] cycle;
    \draw[fill=black] (-0.76,0.96) to[out=170,in=110](-0.85,0.80) to[out=290,in=190](-0.65,0.65) to[out=110,in=290] cycle;

    % head
    \draw[fill=black] (0,0) to[out=180,in=290](-0.72,0.84) to[out=110,in=190](-0.56,1.67)
                      to[out=70,in=110](0.68,1.58) to[out=320,in=80](0.72,0.84) to[out=250,in=0] cycle;
    % face
    \draw[fill=white] (0,0.11) to[out=175,in=290](-0.53,0.65) to[out=110,in=265](-0.61,1.22)
                      to[out=80,in=235](-0.50,1.45) to[out=340,in=215](0.50,1.47)
                      to[out=310,in=85](0.60,0.92) to[out=260,in=2] cycle;
    \draw[fill=black] (-0.50,1.45) to[out=315,in=195](0.40,1.25) to[out=340,in=10](0.37,1.32)
                      to[out=190,in=310](-0.40,1.49) -- cycle;
    % neck
    \draw[line width=1.0pt] (-0.62,-0.2) to[out=50,in=290] (-0.5,0.42);
    \draw[line width=1.0pt] (0.62,-0.2) to[out=130,in=250] (0.5,0.42);
    % body
    \draw[draw=\bodycolor,fill=\bodycolor,line width=\Linewidth] (0.0,-1.0) to[out=150,in=290](-0.48,-0.14) to[out=200,in=50](-1.28,-0.44)
                   to[out=240,in=80](-1.55,-2.06) -- (1.55,-2.06)
                   to[out=100,in=300](1.28,-0.44) to[out=130,in=340](0.49,-0.14)
                   to[out=245,in=30] cycle;
    % right stet
    \draw[line width=3pt,\stetcolor] (0.8,-0.32) to[bend left=7](0.78,-0.64)
         to[out=350,in=80](0.98,-1.35) to[out=250,in=330](0.72,-1.60);
    \draw[line width=3pt,\stetcolor] (0.43,-1.53) to[out=180,in=240](0.3,-1.15)
         to[out=60,in=170](0.78,-0.64);
    % left stet
    \draw[line width=3pt,\stetcolor] (-0.75,-0.31) to[bend right=20](-0.65,-1.45);
    \node[fill=\stetcolor,circle,minimum size=5pt] at (-0.65,-1.45) {};
    % eyes
    \node[circle,fill=black,inner sep=2pt] at (0.28,0.94) {};
    \node[circle,fill=black,inner sep=2pt] at (-0.28,0.94) {};
     % mouth
    \draw[line width=1.1pt] (-0.25,0.5) to[bend right=40](0.25,0.5);
 \end{scope}
     }
  }
}
%target
\tikzset{
pics/target/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\definecolor{col1}{RGB}{62,100,125}
\definecolor{col2}{RGB}{219,253,166}
\colorlet{col1}{\filllcolor}
\colorlet{col2}{\filllcirclecolor}
\foreach\i/\col [count=\k]in {22mm/col1,17mm/col2,12mm/col1,7mm/col2,2.5mm/col1}{
\node[circle,inner sep=0pt,draw=\drawcolor,fill=\col,minimum size=\i,line width=\Linewidth](C\k){};
}
\draw[thick,fill=brown,xscale=-1](0,0)--++(111:0.13)--++(135:1)--++(225:0.1)--++(315:1)--cycle;
\path[green,xscale=-1](0,0)--(135:0.85)coordinate(XS1);
\draw[thick,fill=yellow,xscale=-1](XS1)--++(80:0.2)--++(135:0.37)--++(260:0.2)--++(190:0.2)--++(315:0.37)--cycle;
\end{scope}
    }
  }
}
%AI style
\tikzset{
pics/llm/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\node[circle,minimum size=12mm,draw=\drawcolor, fill=\filllcolor!70,line width=1.25*\Linewidth](C\picname) at (0,0){};
\def\startangle{90}
\def\radius{1.15}
\def\radiusI{1.1}
\foreach \i [evaluate=\i as \j using \i+1] [count =\k] in {0,2,4,6,8} {
\pgfmathsetmacro{\angle}{\startangle - \i * (360/8)}
\draw[draw=black,-{Circle[black ,fill=\filllcirclecolor,length=5.5pt,line width=0.5*\Linewidth]},line width=1.5*\Linewidth](C\picname)--++(\startangle - \i*45:\radius) ;
\node[circle,draw=black,fill=\filllcirclecolor!80!red!50,inner sep=3pt,line width=0.5*\Linewidth](2C\k)at(\startangle - \j*45:\radiusI) {};
}
\draw[line width=1.5*\Linewidth](2C1)--++(-0.5,0)|-(2C2);
\draw[line width=1.5*\Linewidth](2C3)--++(0.5,0)|-(2C4);
\node[circle,,minimum size=12mm,draw=\drawcolor, fill=\filllcolor!70,line width=0.5*\Linewidth]at (0,0){};
\end{scope}
    }
  }
}
%brain
\tikzset{pics/brain/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=BRAIN,scale=\scalefac, every node/.append style={transform shape}]
\draw[fill=\filllcolor,line width=\Linewidth](-0.3,-0.10)to(0.08,0.60)
to[out=60,in=50,distance=3](-0.1,0.69)to[out=160,in=80](-0.26,0.59)to[out=170,in=90](-0.46,0.42)
to[out=170,in=110](-0.54,0.25)to[out=210,in=150](-0.54,0.04)
to[out=240,in=130](-0.52,-0.1)to[out=300,in=240]cycle;
\draw[fill=\filllcolor,line width=\Linewidth]
(-0.04,0.64)to[out=120,in=0](-0.1,0.69)(-0.19,0.52)to[out=120,in=330](-0.26,0.59)
(-0.4,0.33)to[out=150,in=280](-0.46,0.42)
%
(-0.44,-0.03)to[bend left=30](-0.34,-0.04)
(-0.33,0.08)to[bend left=40](-0.37,0.2) (-0.37,0.12)to[bend left=40](-0.45,0.14)
(-0.26,0.2)to[bend left=30](-0.24,0.13)
(-0.16,0.32)to[bend right=30](-0.27,0.3)to[bend right=30](-0.29,0.38)
(-0.13,0.49)to[bend left=30](-0.04,0.51);
\draw[thick,rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcolor,length=2.5pt]}](-0.23,0.03)--(-0.15,-0.03)--(-0.19,-0.18)--(-0.04,-0.28);
\draw[thick,rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcolor,length=2.5pt]}](-0.17,0.13)--(-0.04,0.05)--(-0.06,-0.06)--(0.14,-0.11);
\draw[thick,rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcolor,length=2.5pt]}](-0.12,0.23)--(0.31,0.0);
\draw[thick,rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcolor,length=2.5pt]}](-0.07,0.32)--(0.06,0.26)--(0.16,0.33)--(0.34,0.2);
\draw[thick,rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcolor,length=2.5pt]}](-0.01,0.43)--(0.06,0.39)--(0.18,0.51)--(0.31,0.4);
\end{scope}
     }
  }
}
\pgfkeys{
  /channel/.cd,
   Depth/.store in=\Depth,
  Height/.store in=\Height,
  Width/.store in=\Width,
  filllcirclecolor/.store in=\filllcirclecolor,
  filllcolor/.store in=\filllcolor,
  drawcolor/.store in=\drawcolor,
  drawcircle/.store in=\drawcircle,
  scalefac/.store in=\scalefac,
  Linewidth/.store in=\Linewidth,
  picname/.store in=\picname,
  tiecolor/.store in=\tiecolor,
  bodycolor/.store in=\bodycolor,
  stetcolor/.store in=\stetcolor,
  tiecolor=red,      % default tie color
  bodycolor=blue!30,  % default body color
  stetcolor=green,  % default stet color
  filllcolor=BrownLine,
  filllcirclecolor=violet!20,
  drawcolor=black,
  drawcircle=violet,
  scalefac=1,
  Linewidth=0.5pt,
  Depth=0.2,
  Height=0.5,
  Width=0.25,
  picname=C
}
%Unlabeled Pool
\node[Box,dashed](B1){};
\pic[shift={(0,-0.28)}] at  (B1){dataS={scalefac=0.9,picname=1,Linewidth=1.0pt,
 filllcolor=cyan!90!black!40!,drawcolor=black,filllcirclecolor=orange}};
 \draw[ALineA,draw=black!70](B1.south west)--++(200:0.45)
 node[below=1pt,Box2]{未标注样本池};
%Selection Strategy
\node[Box,right=3 of B1,draw=BlueLine](B2){};
 \pic[shift={(0,0)}] at  (B2){target={scalefac=0.7,picname=1,
 drawcolor=BlueD,filllcolor=green!90!black,Linewidth=0.7pt, filllcirclecolor=green!20}};
\draw[ALineA,draw=BlueLine](B2.south west)--++(200:0.45)
 node[below=1pt,Box2,fill=BlueLine]{选择策略};
%Oracle (Human)
\node[Box,below=of B2,draw=OrangeLine](B3){};
 %persons 1
\begin{scope}[local bounding box=PERSON1,shift={($(B3)+(-0.5,-0.17)$)},scale=1, every node/.append style={transform shape}]
\pic at (1.0,0) {man={scalefac=0.32,tiecolor=green, bodycolor=RedLine,stetcolor=RedLine, Linewidth=0.5pt}};
\pic at (0.25,0.16) {man={scalefac=0.4,tiecolor=orange, bodycolor=BlueLine,stetcolor=BlueLine, Linewidth=0.5pt}};
\end{scope}
\draw[ALineA,draw=OrangeLine](B3.south west)--++(200:0.45)
 node[below=1pt,Box2,fill=OrangeLine]{预言机(人工)};
%Training Set
\node[Box,below=of B3,draw=GreenD](B4){};
\begin{scope}[local bounding box=GRAPH1,shift={($(B4)+(-0.67,-0.75)$)},
scale=1.3, every node/.append style={transform shape}]
\pic[shift={(0,0)}] at  (0,0){graph={filllcirclecolor=black!60,scalefac=0.5,picname=1,drawcolor=black,filllcolor=red,Height=0.5,Linewidth=1.25pt}};
\pic[shift={(0.33,0)}] at  (0,0){graph={filllcirclecolor=none,scalefac=0.5,picname=2,drawcolor=black,filllcolor=violet,Height=1,Linewidth=1.25pt}};
\pic[shift={(0.66,0)}] at  (0,0){graph={filllcirclecolor=none,scalefac=0.5,picname=3,drawcolor=black,filllcolor=green!60!black,Height=0.25,Linewidth=1.25pt}};
\pic[shift={(0.99,0)}] at  (0,0){graph={filllcirclecolor=none,scalefac=0.5,picname=4,drawcolor=black,filllcolor=cyan,Height=0.75,Linewidth=1.25pt}};
\end{scope}
\draw[ALineA,draw=GreenD](B4.south west)--++(200:0.45)
 node[below=1pt,Box2,fill=GreenD]{训练集};
%Model
\node[Box,left=3 of B4,draw=RedLine](B5){};
%AI
\pic[shift={(0,0)}] at  (B5){llm={scalefac=0.8,picname=1,drawcolor=GreenD,filllcolor=GreenD!20!, Linewidth=1pt,filllcirclecolor=red}};
%brain
\pic[shift={(0.12,-0.18)}] at  (C1){brain={scalefac=0.81,picname=2,filllcolor=orange!30!, filllcirclecolor=cyan!55!black!60, Linewidth=0.75pt}};
\draw[ALineA,draw=RedLine](B5.south west)--++(200:0.45)
 node[below=1pt,Box2,fill=RedLine]{模型};
%arrows
\draw[LineA,BrownLine!80!black!70](B1)--node[above,font=\footnotesize\sffamily,text=black!70]{查询}(B2);
\draw[LineA](B2)--node[right,font=\footnotesize\sffamily,text=black!70]{不确定性}(B3);
\draw[LineA](B3)--node[right,font=\footnotesize\sffamily,text=black!70]{标签}(B4);
\draw[LineA](B4)--node[above,font=\footnotesize\sffamily,text=black!70]{训练}(B5);
\draw[LineD](B5)--node[left,font=\footnotesize\sffamily,text=black!70]{更新}(B1);
\end{tikzpicture}}在专业领域中,其经济影响可能相当显著,因为标注成本和周转时间可能远超候选样本评分所需的计算成本与时间。这些查询策略驱动着 figure 5 中主动学习循环的每次迭代,而一个简单的预算比较展示了主动学习如何在给定假设下降低标注成本和训练工作量。
Napkin Math 1.3: 主动学习的投资回报
问题:某医院团队拥有 1 Million 份未标注扫描影像,专家标注成本为 $5/label,预算为 $500,000,期限为 1 month。相对于预算匹配的随机基线,不确定性采样会如何改变标注成本和每轮训练工作量?
场景 A:朴素标注
- 成本:标注全部 1 Million 份扫描影像将花费 $5,000,000(为预算的 10×)。
- 预算匹配的基线:随机选择的扫描影像数量为 \(\$500,000 \div \$5/\text{label} = 100,000\)。
- 朴素标注的结果:随机选择无法保证覆盖罕见病变。
场景 B:主动学习
- 策略:不确定性采样选择 50,000 份扫描影像,由专家标注。
- 成本:\(50,000 \times \$5/\text{label} = \$250,000\)(比预算低 50 percent)。
- 训练工作量:每轮使用的样本数为预算匹配随机基线的一半(样本数之比:\(100,000 \div 50,000 = 2×\))。
- 主动学习的结果:能否达到随机选择 100,000 份扫描影像的效果,需要通过实证验证。
系统洞见:相对于预算匹配的随机基线,样本选择节省了 \(\$500,000 - \$250,000 = \$250,000\);准确率仍需通过实证验证。
有针对性的样本选择可以减少达到目标指标所需的标注量。比较 figure 6 中两条示意性的准确率变化曲线,并注意随着样本数量增加,主动不确定性采样与基线随机选择之间的水平差距。
该图考察的维度与粗略估算 1.3 中的计算不同。它展示的是标签效率,而提示框则在另一组假设下计算标注费用。主动学习还会产生评分、样本获取和反复重新训练的成本,因此端到端节省幅度可能小于标签数量上的差距。
主动学习不仅可以节省标注成本:适当的查询规则还可以将审核工作集中于不确定性高、多样性强或与失效相关的样本。
Example 1.2: 智能门铃中的困难负样本挖掘
场景:智能门铃的视觉检测器持续接收视频流,其中主要是空背景(简单负样本)和常见的行人姿态。
诊断:随机帧采样可能遗漏雕像、成堆衣物和人形阴影等罕见误报。主动学习将不确定的预测(“行人:51%”)和从生产环境中采样得到的错误交由人工审核人员进行针对性标注。
系统启示:困难负样本挖掘通过将审核精力用于疑似误报和其他困难负样本,可以提高标注效率。查询样本流仍需接受多样性和覆盖范围检查,以免排除那些置信度高但存在系统性错误的案例。
半监督学习:利用未标注数据
考虑一个用于说明的医学影像场景:共有 50,000 张胸部 X 光片,其中 500 张已由放射科医师审阅并标注15,标注比例为 1 percent。该种子集是否足够,取决于任务和数据分布。当未标注数据池与目标分布一致,且所用方法已在有标签数据上得到验证时,半监督学习可以利用剩余的 49,500 张图像。
主动学习优化的是选择哪些样本进行标注,但每个选中的样本仍需人工标注。半监督学习将工程权衡从人工标注转向加速器计算:它利用一个小规模有标签子集,为更大规模未标注数据池上的优化提供锚点,直接从未标注输入中提取监督信号。在未标注数据池反映目标分布的前提下,这使模型能够以显著更少的人工标签,达到接近全监督学习的准确率。
半监督学习背后的核心认识是:未标注数据虽然无法直接传授从输入到输出的映射,但包含关于输入分布 \(p(x)\) 的结构信息,能够约束假设空间。在平滑性假设和聚类假设下,穿过高密度区域的决策边界会为彼此邻近的输入分配不同标签,因此不如位于低密度区域的决策边界合理。半监督方法利用这些假设,而这些假设必须结合目标任务加以检验。
三种技术实现了这一利用数据分布进行正则化的思想。伪标签法16先在有标签子集上训练模型,再对未标注数据池生成模型预测,并将置信度超过阈值的样本作为合成真实标签数据,纳入后续重新训练。置信度阈值决定了一项关键的系统权衡:设置过低会引入标签噪声,损害学习效果;设置过高则会丢弃信息丰富的样本,浪费未标注数据池。
一致性正则化17要求模型对同一输入的不同扰动版本产生不变的预测。由于类别语义在裁剪、旋转或颜色偏移等符合实际的变换下保持不变,损失函数会惩罚未标注样本的两个随机视图之间的预测差异。FixMatch18 等混合方法将这两种机制结合起来:当预测置信度超过阈值时,在弱增强视图上生成伪标签,然后训练模型,使其在同一输入的强增强版本上预测出该标签。
标签传播将半监督学习表述为图扩散过程:它基于样本表示构建亲和图,并将标签从有标签节点传播到相邻的未标注节点。当表示形成分离良好的簇时,这种方法效果较好,但在大规模数据集上构建和查询相似度图会引入显著的内存开销和近邻搜索开销。
Example 1.3: CIFAR-10 上的 FixMatch
场景:一个半监督图像分类流水线在 CIFAR-10 上进行训练,仅使用 250 个有标签样本(每类 25 个),并同时利用未标注数据 (Sohn et al. 2020)。
诊断:完整标注的 CIFAR-10 训练集包含 50K 个标签。FixMatch 在经过弱增强的未标注图像上生成高置信度伪标签(阈值 >0.95),并在强增强版本上施加一致性约束,在所引用的实验中达到了 94.9 percent 的准确率。
系统启示:半监督学习以额外的训练计算换取更少的人工标签。在本章的标注成本假设下,FixMatch 场景将数据集准备费用降至原来的 1/8.1×;端到端节省的成本取决于未标注数据成本和计算成本。
半监督学习中的系统权衡,是以额外处理有标签和未标注样本的计算来换取标注工作量的减少。它能够以更少的标签达到接近全监督学习的准确率,但标签减少幅度和计算增加幅度都不具有普遍性。CIFAR-10 上的比较具体展示了这样一种权衡(table 6)。
| 标签预算 | 方法 | 准确率 | 标签效率 |
|---|---|---|---|
| 50,000 (100%) | 完整训练集 | — | 标签数量参照 |
| 4,000 (8%) | FixMatch | 95.7% | 效率为参照的 12.5× |
| 250 (0.5%) | FixMatch | 94.9% | 效率为参照的 200× |
| 40 (0.08%) | FixMatch | 88.6% | 效率为参照的 1250× |
这些效率收益依赖于有利的数据分布假设。半监督学习假定未标注数据与有标签数据来自相同分布;当未标注数据包含分布外样本时(模型会以高置信度为其分配错误标签)、类别不平衡严重时(伪标签会放大对多数类的偏向),或者有标签集未覆盖所有类别时(导致标签无法传播到未见类别),其效果会受到限制。应始终在具有真实标签的留出集上进行验证,以发现分布不匹配问题。
尽管存在这些局限,半监督学习仍能在适合的任务上减少标签需求,同时保持准确率。综观这些技术,核心集选择和去重在训练前剔除低价值样本;课程学习改变样本的呈现顺序;主动学习选择哪些样本接受人工标注;半监督学习则从未标注数据池中提取额外信号。每种技术都能减少对任务特定标签的依赖,但都无法消除对有标签评估的需求。这一演进引出了一个相关的可能性:预训练可能不需要任务特定标签。数据本身的结构——例如猫的图像与其他猫的图像相似,连贯的句子遵循语法模式——可能提供监督信号,而下游质量仍需通过与任务相匹配的验证来确认。
自监督学习
GPT 的训练目标是预测序列中的下一个词元。BERT 的训练目标是填补被掩码的词元。这两种预训练目标都不需要任务特定的人工标签。自监督学习19(SSL)推广了这一认识:通过设计从数据结构中获取监督信号的前置任务,模型可以从大规模未标注数据中学习可复用的表示。主动学习和半监督学习减少了对标签的需求,而 SSL 则通过将未标注数据的结构用作预训练信号,改变了成本核算方式。在三阶段框架中,这意味着 SSL 与其说是第四个选择阶段,不如说是对可用数据池的扩展:问题从选择哪些有标签样本用于训练,转变为未标注样本如何支持预训练。它通过拓宽训练信号的范围,回应了 section 1.1.4 中数据墙的一个方面,同时并未改变对语料库质量、许可、覆盖范围以及有标签评估的要求。
标签是监督的一种形式;前置任务也可以从数据结构中提取学习信号,如 table 7 所概述。
| 模态 | 自监督任务 | 监督信号 |
|---|---|---|
| 文本 | 掩码语言建模 | 根据上下文预测 [MASK] |
| 文本 | 下一词元预测 | 预测序列中的下一个词元 |
| 图像 | 对比学习 | 同一图像(经增强)与不同图像的对比 |
| 图像 | 掩码自编码 | 重建被掩码的图像块 |
| 多模态 | CLIP 式对齐 | 匹配图像—文本对 |
前置任务自动生成监督信号。掩码词元目标可以促使模型学习语法和语义结构;下一词元预测使模型学习续写结构;图像对比目标则促使模型学习对选定变换保持不变的视觉特征。这些方法建立在 网络架构 中的卷积神经网络和 Transformer 架构族之上,但仍需从系统层面核算成本:自监督消除的是预训练启动前对任务专用标注的依赖,而非数据成本。预训练可以直接在无标签语料库上开始,无须等待样本级标签,但数据收集、过滤、许可获取、存储和处理仍然不可或缺。当表征能够跨任务迁移时,将预训练与下游标注分离会重构机器学习的经济性;任务专用适配和评估仍各自具有数据需求。
摊销的经济性
自监督学习在基础模型工作流中的核心地位直接源于成本摊销。基础模型是经过广泛预训练、可重复使用的底座模型,通过微调适配下游任务。这种架构将成本划分为两个阶段:首先,在无标签数据上进行一次成本高昂的前期预训练投资;随后,进行轻量级的任务专用适配,并在众多应用中复用(table 8)。
| 方法 | 每项任务的标签量 | 每项任务的计算量 | 数据获取 |
|---|---|---|---|
| 从头训练 | 100K–1M 个标签 | 完整训练的 100% | 针对任务专门收集 |
| 微调基础模型 | 100–1K 个标签 | 完整训练的 1–5% | 复用预训练语料库 |
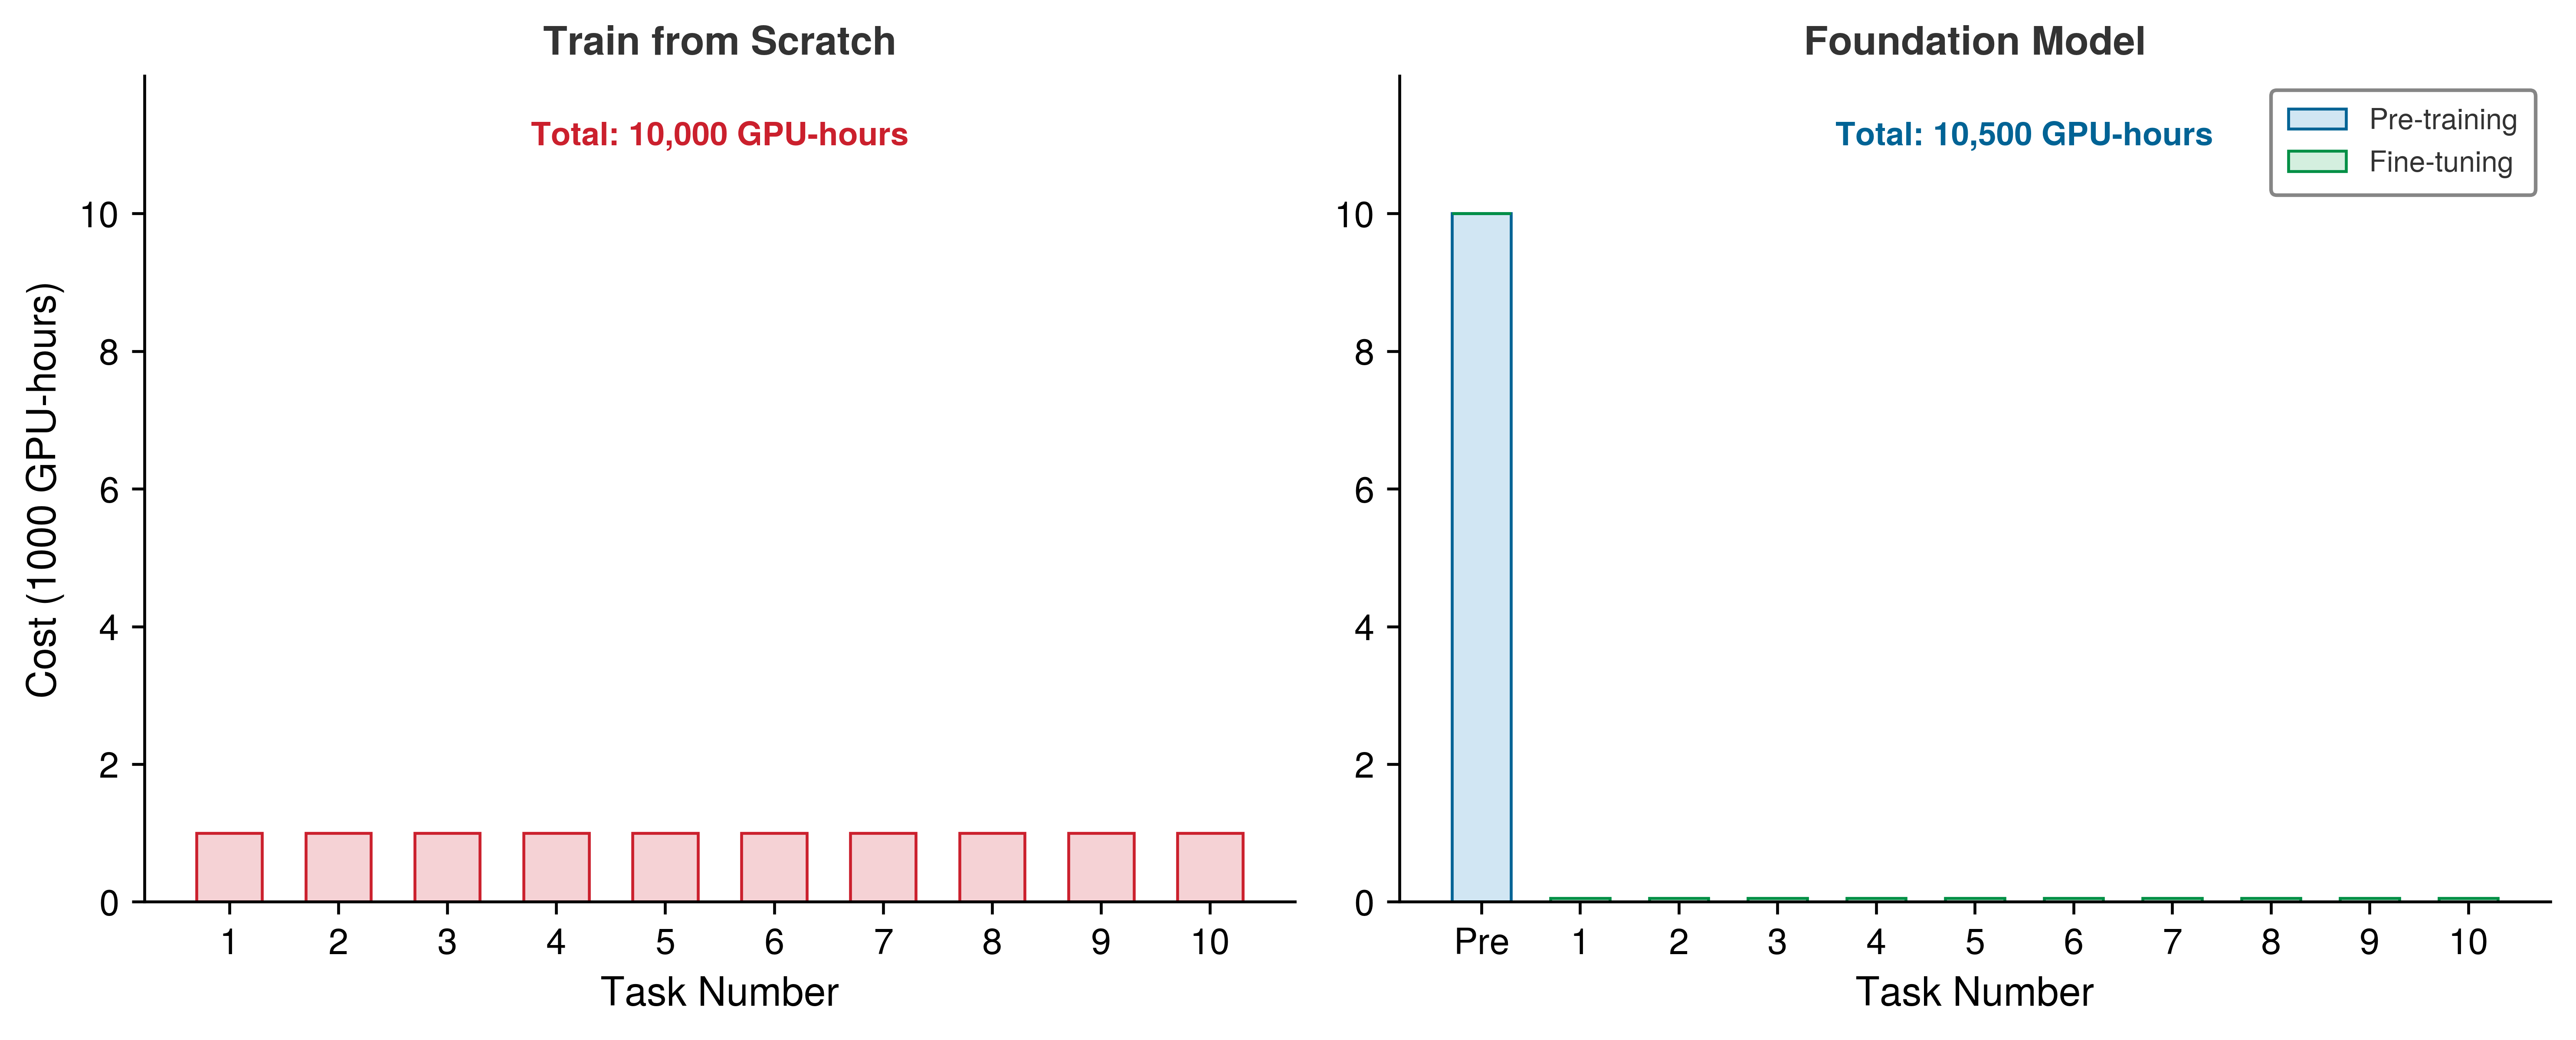
为说明这种经济性转变,考虑一家正在构建 10 个专用分类器的公司。在该场景假设下,每项从头训练的任务需要 100,000 个标签,每个标签的成本为 $1,所有任务的标签总成本为 $1M。模型估算的计算开销为 10,000 GPU-hours。
微调场景先一次性投入 10,000 GPU-hours,然后为每项任务分配 1,000 个标签和 50 GPU-hours 的计算量。对于全部 10 项任务,模型估算的微调标签总成本为 $10K。
在这些输入条件下,标注成本的缩减倍数为 100×,每项任务边际计算量的缩减倍数为 20×。这些结果由所选场景数值决定,而只有当足够多的下游任务摊销了预训练成本之后,总计算量才会体现出优势。
当表征能够有效迁移,且下游任务数量超过盈亏平衡阈值时,微调才具有经济性。figure 7 中的并列成本比较,将左侧重复进行的从头训练与右侧先预训练、再进行低成本微调的方式进行对照。
基础模型范式
不同自监督方法的摊销经济性各不相同,因为每种目标都会在成本效率前沿上触及不同的硬件瓶颈。对比学习需要大规模负样本池来防止表征坍塌。SimCLR (Chen et al. 2020) 直接从同一小批量中同时出现的样本获取负样本,所需批量大小可达 4,096;将这些样本分布到多个加速器上,会导致中间激活值占用大量内存,并通过设备间互连频繁执行 all-gather 通信。MoCo (He et al. 2020) 将表征缓存在动态队列中,并通过动量平均编码器更新该队列,从而将负样本池与小批量大小解耦,使适度规模的加速器配置也能支持大规模负样本集,而不会使内存或互连带宽饱和。掩码建模则沿不同维度改变内存需求和算术强度:掩码自编码器(MAE)在编码器处理之前丢弃多达 75% 的视觉图像块,大幅降低自注意力机制的二次方级内存开销;而掩码语言建模则使用双向注意力处理完整词元序列。自回归生成式预训练以计算量换取广泛的任务迁移能力,遵循词元量、参数量和计算量之间的经验幂律缩放关系。这些方法建立在 网络架构 中的架构之上;对于数据选择,自监督预训练通过直接从原始数据结构中提取可复用表征,成倍提升稀缺标注数据的效用。
Chen, Ting, Simon Kornblith, Mohammad Norouzi, and Geoffrey Hinton. 2020. “A Simple Framework for Contrastive Learning of Visual Representations.” Proceedings of the 37th International Conference on Machine Learning, ICML’20, vol. 119: 1597–607.
He, Kaiming, Haoqi Fan, Yuxin Wu, Saining Xie, and Ross Girshick. 2020. “Momentum Contrast for Unsupervised Visual Representation Learning.” 2020 IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 9726–35. https://doi.org/10.1109/cvpr42600.2020.00975.
Bommasani, Rishi, Drew A. Hudson, Ehsan Adeli, Russ Altman, Simran Arora, Sydney von Arx, Michael S. Bernstein, et al. 2021. “On the Opportunities and Risks of Foundation Models.” arXiv Preprint arXiv:2108.07258.
当预训练成本能够在多个任务之间摊销时,SSL 便支持了基础模型范式20 (Bommasani et al. 2021)。核心数据选择原则——核心集选择、课程学习和主动学习——在这一范式中仍然至关重要。预训练语料库整理在网络规模上执行去重和质量过滤,而下游选择则决定哪些微调样本能够最大限度地促进任务专用迁移。

预训练语料库中的一个缺陷会传播到众多下游任务。
自监督学习通过从数据结构而非人工标注中学习来缓解标签瓶颈,但它无法解决数据稀缺本身。稀有类别可能只有极少的样本,边缘案例可能从未在真实环境中出现,隐私约束也可能阻止真实样本的收集。数据选择流水线的第三阶段通过按需创建新数据,而非选择或整理现有数据,来弥补这一缺口。
合成数据生成
真实世界的数据收集面临物理和法律边界:自动驾驶车队无法在确保安全的前提下通过撞毁车辆来获取灾难性碰撞轨迹,医疗系统无法跨机构防火墙传输受保护的患者遥测数据,而边缘设备早在实体产品大规模部署之前就会面临各种声学环境。当目标分布中的数据极度稀缺或完全没有经验样本覆盖时,无论是静态过滤还是动态样本优先级排序,都无法从源语料库中提取本不存在的信号。合成数据生成通过直接构造训练分布来解决这一根本瓶颈。工程策略从整理——过滤和加权现有记录——转向创建,即生成新输入、领域扰动或监督目标,以满足统计覆盖约束。
数据增强:基于变换的合成
数据增强是开销最低的合成生成形式:它在数据摄取过程中动态变换现有样本,以扩展有效训练分布。由于保持标签不变的变换能够生成新输入,而不增加持久化存储量,因此数据增强能够以零额外数据获取成本成倍增加数据集的多样性。然而,在基于加速器的训练流水线中,数据增强会使计算瓶颈在主机 CPU 与加速器之间转移。当增强操作在主机 CPU 工作线程上执行时,密集的解码和空间变换可能使主机核心饱和,导致通过 PCIe 总线接收数据的加速器因供给不足而空等。将变换直接卸载到加速器内核可以消除主机到设备传输中的空隙,但会消耗原本可用于梯度更新的高带宽内存(HBM)和计算周期。
对于图像数据,变换流水线会施加部署时所需的归纳不变性 (Shorten and Khoshgoftaar 2019)。几何操作(旋转、水平翻转、随机裁剪和缩放)施加视角不变性,而光度调整(亮度、对比度和颜色抖动)则模拟传感器噪声及光照变化。更激进的策略会直接改变输入拓扑:Cutout21施加随机矩形零值掩码,防止模型依赖局部特征;MixUp (Zhang et al. 2018) 通过对图像对及其独热标签进行线性组合来构造虚拟样本(\(\tilde{x} = \lambda x_i + (1 - \lambda) x_j\));CutMix22则将一幅图像中的矩形图像块粘贴到另一幅图像中,并按图像块面积比例混合标签。由于 CutMix 和 MixUp 直接在设备内存中通过张量线性组合和内存块复制进行操作,因此它们能够以可忽略的 FLOP 开销提供强有力的数据空间正则化。
Shorten, Connor, and Taghi M. Khoshgoftaar. 2019. “A Survey on Image Data Augmentation for Deep Learning.” Journal of Big Data 6 (1): 1–48. https://doi.org/10.1186/s40537-019-0197-0.
Zhang, Hongyi, Moustapha Cisse, Yann N. Dauphin, and David Lopez-Paz. 2018. mixup: Beyond Empirical Risk Minimization. OpenReview.net.
文本增强面临不同的约束,因为离散词元词表不具备平滑的几何流形。回译23通过中间模型处理目标语言单语语料库,生成合成源语言配对数据,从而为序列到序列任务提供语义改写。更简单的启发式变换——例如通过 WordNet 替换同义词、随机插入或删除词元——会引入局部扰动,但如果未经任务专用验证就应用,则可能破坏语义标签。
自动化策略搜索直接优化增强组合,无须手动调整变换方案。AutoAugment24在离散操作空间中使用强化学习,但计算开销极高。RandAugment25仅用两个值来参数化策略,从而消除这一搜索成本:变换数量 \(N\) 和全局失真幅度 \(M\)。
Lighthouse 1.2: MobileNetV2 与强数据增强
灯塔模型名录:模型小传 中的 MobileNetV2 灯塔模型展示了数据增强如何与资源受限的架构形成互补。其深度可分离卷积以逐通道空间滤波器和随后的 \(1 \times 1\) 逐点投影替代标准空间卷积,大幅减少了参数量并降低了算术强度。
由于紧凑架构的表示能力有限,强数据增强可以对特征表示施加正则化,而不增加推理时的参数内存占用或延迟预算。然而,必须谨慎平衡增强幅度:过度失真可能超出紧凑网络的容量,导致其对底层任务分布欠拟合。
生成式合成:创建新样本
数据增强在现有训练点的局部邻域内对其进行扰动。生成式合成则通过从参数化生成模型或物理仿真引擎中采样,构造全新的坐标元组 \((x, y)\)。不同生成范式的系统权衡横跨一个成本与保真度的连续谱:
- 生成对抗网络(GAN)通过生成器与判别器的对抗来训练。训练完成后,前馈生成器的推理只需一次前向传播,因此具有低延迟和高样本吞吐量。然而,GAN 训练容易发生模式坍塌,从而抑制稳健覆盖边缘情况所需的长尾多样性。
- 扩散模型将合成表述为沿参数化马尔可夫链或连续的基于得分的过程进行迭代去噪。Stable Diffusion26 等潜在扩散系统在压缩潜在空间中运行,同时支持通过文本提示进行精确的语义条件控制。然而,生成每个批次都需要展开大型骨干网络的 20 至 50 次顺序前向传播,带来很高的算术强度和内存带宽开销,使其无法在正在进行的训练循环中即时生成数据。
- 物理仿真引擎(例如用于自动驾驶的 CARLA,或用于机器人的 Isaac Sim 和 Unity)将数据生成与神经网络推理完全解耦,执行刚体物理、运动学和图形渲染流水线。仿真器根据内部状态生成精确的真值标注(包括三维边界框、深度图和速度向量),无需人工标注成本。系统瓶颈转移到主机 CPU 的物理计算以及 GPU 的图形光栅化或光线追踪吞吐量。
无论采用何种生成引擎,合成样本都不可避免地偏离真实部署环境的统计分布。这种偏离定义了域差距。
弥合域差距
域差距27表示合成训练分布与生产部署数据之间的统计差异。当模型仅针对合成分布进行优化时,其决策边界会适应仿真器或生成模型的伪影,而非物理现实。如 figure 8 所示,在发生偏移的合成分布上训练的分类器,其合成训练误差可以接近于零,却在真实世界的数据簇上评估时悄然失效。
\begin{tikzpicture}[font=\small\sffamily]
\begin{axis}[
    width=11cm, height=50mm,
    xlabel={特征空间},
    ylabel={密度},
    xmin=-3, xmax=7.25,
    ymin=0, ymax=0.7,
    axis lines=left,
    axis line style={thick,-latex},
    axis on top,
    xtick=\empty,
    ytick=\empty,
    ylabel style={font=\footnotesize\sffamily},
    xlabel style={font=\footnotesize\sffamily},
   % legend style={at={(0.98,0.98)}, anchor=north east, font=\footnotesize\sffamily, draw=none},
legend style={at={(0.85,0.92)}, anchor=north},
  legend cell align=left,
  legend style={fill=BrownL!30,draw=BrownLine,row sep=1.15pt,
  font=\fontsize{7pt}{7}\selectfont\sffamily},
    clip=false
]
    % Synthetic data distribution (centered at 0)
    \addplot[line width=1.25pt, blue, domain=-3:4, samples=100, fill=blue!20, fill opacity=0.5]
        {0.4*exp(-0.5*(x)^2)};
    \addlegendentry{合成数据}

    % Real data distribution (centered at 3, slightly different shape)
    \addplot[line width=1.25pt, orange, domain=0:7, samples=100, fill=orange!20, fill opacity=0.5]
        {0.35*exp(-0.4*(x-3)^2)};
    \addlegendentry{真实数据}

    % Decision boundary learned from synthetic
    \draw[thick, dashed, red] (axis cs: 1.5, 0) -- (axis cs: 1.5, 0.6)
    node[red, font=\footnotesize\sffamily, fill=white,above=0pt,inner sep=1pt] {合成数据边界};

    % Ideal boundary for real data
    \draw[thick, dotted, green!60!black] (axis cs: 3, 0) -- (axis cs: 3, 0.50);
 %   \draw[thick, dotted, green!60!black] (axis cs: 0, 0) -- (axis cs: 0, 0.50);

    % Domain gap annotation
    \draw[latex-latex, thick, purple] (axis cs: 0, 0.48) --
    node[purple, font=\footnotesize\sffamily, fill=white, inner sep=1pt]{域差距} (axis cs: 3, 0.48);

\end{axis}
\end{tikzpicture}两种互补策略可以应对这种分布不匹配。域随机化28采用较为激进的方式:它不试图精确匹配真实世界,而是在生成过程中随机化光照、纹理、背景和相机参数,使用多样化的合成数据进行训练。
其目的是使部署条件落在训练期间见过的变化范围内,但仅靠随机化始终无法保证覆盖。当仿真器涵盖相关的物理和视觉因素,并且结果经过真实数据验证时,该方法可以在机器人和自动驾驶场景中发挥作用。
域适应采取相反的方式,显式对齐合成分布与真实分布。特征对齐方法在合成数据上训练的同时,最小化合成特征分布与真实特征分布之间的距离,通常使用对抗训练来学习域不变表示。微调提供了一条更简单的路径:先在丰富的合成数据上预训练以学习通用特征,再在小规模真实数据集上微调以适应部署条件。自训练则结合了这些思路:使用在合成数据上训练的模型为未标注的真实数据生成伪标签,然后在合并后的标注数据集上重新训练。
在实践中,混合合成数据与真实数据可以在保留部分合成数据覆盖范围的同时,提供真实数据锚点,但最佳比例取决于工作负载。Table 9 总结了不同混合比例下的权衡。
| 合成数据占比 | 代表性结果 |
|---|---|
| 100% 合成数据 | 缺少真实数据锚点;需验证域差距 |
| 80% 合成数据 + 20% 真实数据 | 降低真实数据需求;需在部署数据上验证 |
| 50% 合成数据 + 50% 真实数据 | 更多真实数据锚定;采集成本更高 |
| 100% 真实数据 | 不存在从合成到真实的域差距;采集成本最高 |
Example 1.4: KWS 数据选择
场景:一个嵌入式关键词检测(KWS)系统计划部署在 SRAM 为 256 KB 的微控制器上,需要 10,000+ 个音频样本。
诊断:在不同说话人和声学环境下人工录制 10,000 条真实语音,成本为 $20K–50K。构建五阶段流水线(种子录音 \(\to\) 数据增强 \(\to\) 噪声注入 \(\to\) 难负样本挖掘 \(\to\) TTS 仿真),可从 500 个种子样本扩展数据集规模。
系统启示:分层数据策略可以降低资源受限的边缘机器学习部署中的数据获取成本。在此场景中,数据增强和噪声注入将实际采集成本降至全部录制估算成本的 5 percent;目标准确率和声学覆盖范围仍需验证。
关键词检测场景说明,数据增强、噪声注入和仿真能够扩展小规模种子集,但当样本来自学习得到的生成器时,同样的数据创建策略会带来更大风险。在递归训练中,模型坍塌29可能逐代放大误差并降低多样性。因此,合成数据需要来源追踪、混合比例控制以及基于真实部署数据的验证,不能未经验证便假定生成更多样本就会有所帮助。
知识蒸馏:压缩信息
数据增强(section 1.5.1)和生成式合成(section 1.5.2)合成新的输入样本,而知识蒸馏30 (Hinton et al. 2015; Gou et al. 2021) 合成监督目标。紧凑的学生网络并非仅使用稀疏真值标签(例如独热向量 \([1, 0, 0]\))训练,而是以更大的教师模型生成的连续概率分布(例如 \([0.70, 0.20, 0.10]\))为目标进行训练。经过温度参数 \(\tau\) 缩放的软目标分布揭示了类别间的相关性,即暗知识,反映了教师模型在其表示空间中学到的度量相似性。
Hinton, Geoffrey, Oriol Vinyals, and Jeff Dean. 2015. “Distilling the Knowledge in a Neural Network.” arXiv Preprint.
Gou, Jianping, Baosheng Yu, Stephen J. Maybank, and Dacheng Tao. 2021. “Knowledge Distillation: A Survey.” International Journal of Computer Vision 129 (6): 1789–819. https://doi.org/10.1007/s11263-021-01453-z.
蒸馏揭示了加速器高带宽内存(HBM)容量与辅助存储 I/O 带宽之间的一项基本系统权衡:
- 在在线蒸馏中,训练期间教师模型与学生模型直接共驻于加速器内存中。系统在执行学生模型的同时,并发计算教师模型的前向传播,从而消除了软目标的持久化存储开销。然而,共驻的过参数化教师模型会消耗加速器内存和张量核心吞吐量,限制学生模型在每个加速器上的最大批次大小,并增加训练步延迟。
- 在离线蒸馏中,教师模型在离线预计算阶段为整个语料库生成预测,将稠密 logit 向量存储到磁盘。这使加速器内存可以完全用于学生模型训练,但会大幅增加数据集存储量和输入流水线带宽需求。对于包含 \(V\) 个类别的分类词表,存储未压缩的 float32 logit 会使每个样本的标签占用从单个整数索引(\(\lceil \log_2 V \rceil\) 位)增加到 \(4V\) 字节——对于大词表,这意味着存储量扩大至千倍。
基于变换的数据增强(section 1.5.1)、生成式合成(section 1.5.2)和监督知识蒸馏共同构成了数据选择的第三阶段。静态过滤消除冗余输入样本,动态选择优化训练期间的样本顺序,而当实际采集受到物理、法律或经济约束时,合成生成则用于构造缺失的信号。要在数据、算法和机器三个维度上协调这些技术,就需要在统一的系统预算内平衡数据存储占用、流水线预处理吞吐量和加速器利用率。
决策框架
当标注预算、冗余、稀有类别、隐私和收敛速度同时重要时,实践者首先必须识别哪一项约束构成实际瓶颈。当测得的质量收益足以证明其开销合理时,每个阶段都可以提高信息与计算之比:剪枝在训练前移除低价值样本,动态选择在训练期间将计算集中于高价值样本,而合成则按需创建新的高价值样本(table 10)。
| 阶段 | 应用时机 | 技术 | 示例结果 |
|---|---|---|---|
| 静态剪枝 | 训练前 | 核心集选择、去重、质量过滤 | 数据集缩减 30–50% |
| 动态选择 | 训练期间 | 课程学习、主动学习、半监督学习 | 课程学习加快 10–30%;标签需求减少至原来的 1/2–1/100(2–100\(\times\)) |
| 合成生成 | 按需 | 数据增强、生成模型、知识蒸馏 | 有效数据扩展至 2–10\(\times\) |
确定主导约束后,table 11 比较了哪些技术能够改变该约束及其原因。
| 约束 | 候选技术 | 原因 |
|---|---|---|
| 标注预算有限 | 主动学习 | 通过选择信息量大的样本,最大化标注投资回报 |
| 数据冗余度高 | 去重 + 核心集 | 在训练开始前消除浪费 |
| 稀有类别或边缘情况 | 合成生成 | 创建原始数据中不存在的样本 |
| 收敛缓慢 | 课程学习 | 改善训练早期的梯度质量 |
| 隐私要求 | 经隐私审计的合成 | 减少对真实记录的直接使用;验证是否存在泄露 |
| 大模型、小数据集 | 知识蒸馏 | 将教师模型的知识用作“数据” |
Table 11 将单个约束映射到相应技术,但实际项目会同时面临多项约束。figure 9 中的决策树以层次结构组织选择过程:首先识别主要瓶颈,再沿分支逐步缩小候选范围。
\begin{tikzpicture}[font=\small\sffamily]
  \tikzset{
     Decision/.style={draw=BlueD,fill=cyan!10, trapezium,aspect=2,inner sep=-1.2ex,
     text width=30mm,line width=1pt,
                        diamond, minimum width=32mm, minimum height=20mm, align= flush center,
                        node distance=15mm and 25mm},
    Leaf/.style={
      rectangle,
      draw=GreenLine,
      fill=green!90!black!10,
      align=center,
      line width=1pt,minimum width=23mm,
      minimum height=1cm,
      font=\footnotesize\sffamily
    },
    Arrow/.style={->, >=Latex,line width=1pt, color=black!70}
  }
\def\be{8mm}
% Root
\node[Decision] (D1) {主要\\瓶颈?};
% Left
\node[Decision, below left= 17mm and 31mm of D1] (D2) {标注\\成本};
\node[Decision, below = \be of D2] (D3) {是否有\\标注者?};
\node[Leaf, left=14mm of D2] (B1){自监督\\学习};
\node[Leaf, below=7mm of D3] (B2){主动\\学习};
\node[Leaf, left=14mm of D3] (B3){半监督\\学习};
%right
\node[Decision, below right=17mm and 31mm  of D1] (D4) {数据\\稀缺};
\node[Decision, below = \be of D4] (D5) {是否有\\模拟器?};
\node[Leaf, right=14mm of D4] (B6){知识\\蒸馏};
\node[Leaf, right=14mm of D5] (B7){数据\\增强};
\node[Leaf, below=7mm of D5] (B8){合成数据\\生成};
%center
\node[Decision, below = 7mm of D1] (D6) {计算\\成本};
\node[Decision, below = \be of D6] (D7) {数据是否\\冗余?};
\node[Leaf, below=7mm of $(D3.south)!0.6!(D7.south)$] (B4){去重 +\\核心集};
\node[Leaf, below=7mm of $(D7.south)!0.4!(D5.south)$] (B5){课程\\学习};
%%arrows
\draw[Arrow](D1)-|node[above, pos=0.25, font=\scriptsize\sffamily] {标注 $\$\$\$$}(D2);
\draw[Arrow](D1)-|node[above, pos=0.25, font=\scriptsize\sffamily] {数据不足}(D4);
\draw[Arrow](D1)--node[right, pos=0.25, font=\scriptsize\sffamily] {计算 $\$\$\$$}(D6);
\draw[Arrow] (D2) -- node[above, pos=0.45, font=\scriptsize\sffamily] {大规模候选池} (B1);
\draw[Arrow](D2)--(D3);
\draw[Arrow](D3)--node[right, pos=0.25, font=\scriptsize\sffamily] {是}(B2);
\draw[Arrow](D3)--node[above, pos=0.25, font=\scriptsize\sffamily] {否}(B3);
%
\draw[Arrow](D7.west)-|node[above, pos=0.25, font=\scriptsize\sffamily] {高}(B4.120);
\draw[Arrow](D7.east)-|node[above, pos=0.25, font=\scriptsize\sffamily] {低}(B5.65);
%
\draw[Arrow](D5)--node[right, pos=0.25, font=\scriptsize\sffamily] {是}(B8);
\draw[Arrow](D5)--node[above, pos=0.25, font=\scriptsize\sffamily] {否}(B7);

\draw[Arrow] (D4) -- node[above, pos=0.45, font=\scriptsize\sffamily] {教师模型} (B6);

\draw[Arrow](D4)--node[right, pos=0.25, font=\scriptsize\sffamily] {领域}(D5);

\draw[Arrow](D6)--(D7);
\end{tikzpicture}决策过程
每条路径都需要结构化评估,因为相同的数据集症状可能指向不同的瓶颈。技术选择首先要明确起决定性作用的约束,然后检查所选方法所需的数据、标签和基础设施是否具备。
步骤 1:评估瓶颈
确定哪种资源约束对训练流水线的限制最为严重:
- 标注成本:主动学习、半监督学习和自监督学习等提高标签利用效率的技术,能够最大限度地挖掘每次人工标注的价值。
- 计算成本:核心集选择和去重可以减少处理的样本数,而经过验证的课程安排可能减少达到目标指标所需的步数。
- 数据稀缺:通过增强、合成和蒸馏创建数据,可使有效训练集超出原始采集所能提供的范围。
这一诊断步骤使技术选择始终围绕起决定性作用的资源约束,而非最熟悉的算法。
步骤 2:检查前提条件
确定瓶颈后,验证在现有基础设施和数据条件下,相应技术是否可行。每种方法都有特定要求,只有满足这些要求才能开始实施(table 12)。
| 技术 | 前提条件 |
|---|---|
| 主动学习 | 可访问标注者、未标注数据池、重新训练基础设施 |
| 核心集选择 | 代理模型或嵌入提取器、可访问完整数据集 |
| 课程学习 | 难度评分方法、进度调度方案 |
| 半监督学习 | 部分已标注数据、来自同一分布的未标注数据 |
| 自监督学习 | 大规模未标注语料库、预训练计算预算 |
| 数据增强 | 关于不变性的领域知识、数据增强库 |
| 合成数据生成 | 生成模型或模拟器、领域差距缓解措施 |
步骤 3:估算投资回报率
在投入工程资源之前,估算每种候选技术的投资回报率: \[ \text{ROI} = \frac{\text{(Baseline Cost)} - \text{(Technique Cost + Implementation Cost)}}{\text{Technique Cost + Implementation Cost}} \]
理论收益高但实施成本也高的技术,其投资回报率可能低于更简单的方法。精确去重通常是成本较低的首选候选方案,因为哈希计算简单,重复字节也容易识别,但下游收益仍取决于语料库的冗余程度以及有意设置的样本权重。主动学习需要访问标注者、具备重新训练基础设施并开发选择算法,因此其投资回报率在很大程度上取决于有多少轮标注能够分摊这笔投入。
步骤 4:组合技术
数据选择技术并不互斥,但组合使用并不保证收益能够相加。一种典型工作流是先对原始语料库去重,再应用考虑覆盖度的核心集过滤器,通过经实证验证的课程安排对保留的批次排序,并在批次整理时应用运行时数据增强。预训练表示会进一步改变基线轨迹。每增加一个阶段,都必须证明其计算开销合理,因为级联过滤器经常会丢弃相互重叠的子集,而各自的评分延迟却会累积。
当各阶段的作用互不重叠且开销保持较小时,效率收益可以累积放大;组合后节省的资源必须通过测量确定,不能凭空假定。
只有当选择开销受到严格约束时,算法过滤才能转化为系统加速。如果一次核心集选择需要花费十小时进行探测推理,只为缩减原本两小时的训练任务,那么无论是实际耗时还是云服务支出都会产生净损失。同样,如果自适应课程在每个训练轮次都扫描整个语料库来进行难度评分,就可能因主机 CPU 瓶颈而使加速器停滞。在生产环境中实现数据效率收益,要求工程设计充分体察物理技术栈的约束:分摊评分遍历的成本、以流式方式加载非顺序批次且不破坏预取引擎的作用,以及同步分布式选择状态而不引发序列化停顿。
选择工程
如果一个朴素的主动学习循环在每个训练轮次都扫描整个数据集以选择“最佳”样本,就可能将受计算限制的训练任务变成受 I/O 限制的瓶颈。选择工程从决策框架结束之处开始:确定要应用哪些算法之后,工程实现必须确保这些算法能够在真实硬件和真实数据流水线上兑现其承诺的加速效果。要将算法过滤转化为实际吞吐量,需要采用能够限制评分延迟、保持存储顺序访问并防止加速器因缺少数据而空转的架构模式。
选择瓶颈
动态数据选择引入了一个新的瓶颈:选择延迟。传统数据加载器遵循预先确定的采样计划,而主动学习或自适应课程可能需要先在大型候选池上计算选择函数 \(f(x)\),再构建后续批次。具体而言,使用大型模型对规模为 1M 的数据集进行评分,可能需要 2.8 hours;如果不采用更小的代理模型,这一开销可能抵消使用占比为 10 percent 的核心集所带来的节省。这种系统权衡要求选择成本低于该子集节省的训练工作量;否则,样本数虽然下降,端到端成本却会上升。
在目标指标固定的情况下,选择与子集训练的总成本必须低于全量数据训练的成本。设 \(T_{\text{selection}}\) 为对候选池评分所花费的实际时间,\(T_{\text{train}}(D)\) 为在大小为 \(D\) 的数据集上训练的实际时间,\(D_{\text{subset}}\) 和 \(D_{\text{total}}\) 分别为保留的样本数和完整样本数。Equation 2 表达了这一盈亏平衡条件,即选择不等式。 \[ T_{\text{selection}} + T_{\text{train}}(D_{\text{subset}}) < T_{\text{train}}(D_{\text{total}}) \tag{2}\]
等价地,将允许的选择开销单独列出,可得 \(T_{\text{selection}} < T_{\text{train}}(D_{\text{total}}) - T_{\text{train}}(D_{\text{subset}})\)。选择延迟的上限严格取决于子集减少了多少训练执行工作量;不存在适用于所有工作负载的任意固定开销比例。当 \(f(x)\) 使用主模型架构反复评估候选池时,重复评分和分布式协调可能耗尽节省的训练周期,使数据选择反而造成吞吐量的净下降。
Example 1.5: 选择不等式的实践应用
场景:一个计算机视觉团队从 1M 张图像中选择包含 100K 张图像的核心集(占比为 10 percent),以减少在加速器集群上的训练时间。
诊断:使用完整模型评分(方案 A:目标模型 ResNet-50)会增加 2.8 h 的选择开销,使净节省时间降至 247.2 h。使用代理模型评分(方案 B:ResNet-18)可将选择开销降至 0.6 h,总计节省 249.4 h 的实际耗时。
系统启示:只有当选择开销小于减少全量数据集训练所节省的时间时,核心集选择才能降低训练延迟。代理评分使样本评分开销远低于完整模型前向传播的成本,从而保留浮点运算量的净节省。
端到端实际耗时由选择开销和子集训练时间两部分组成。在 figure 10 中,堆叠时间条形图将全量数据集训练基线与高效选择和高成本选择两种情形进行了比较。
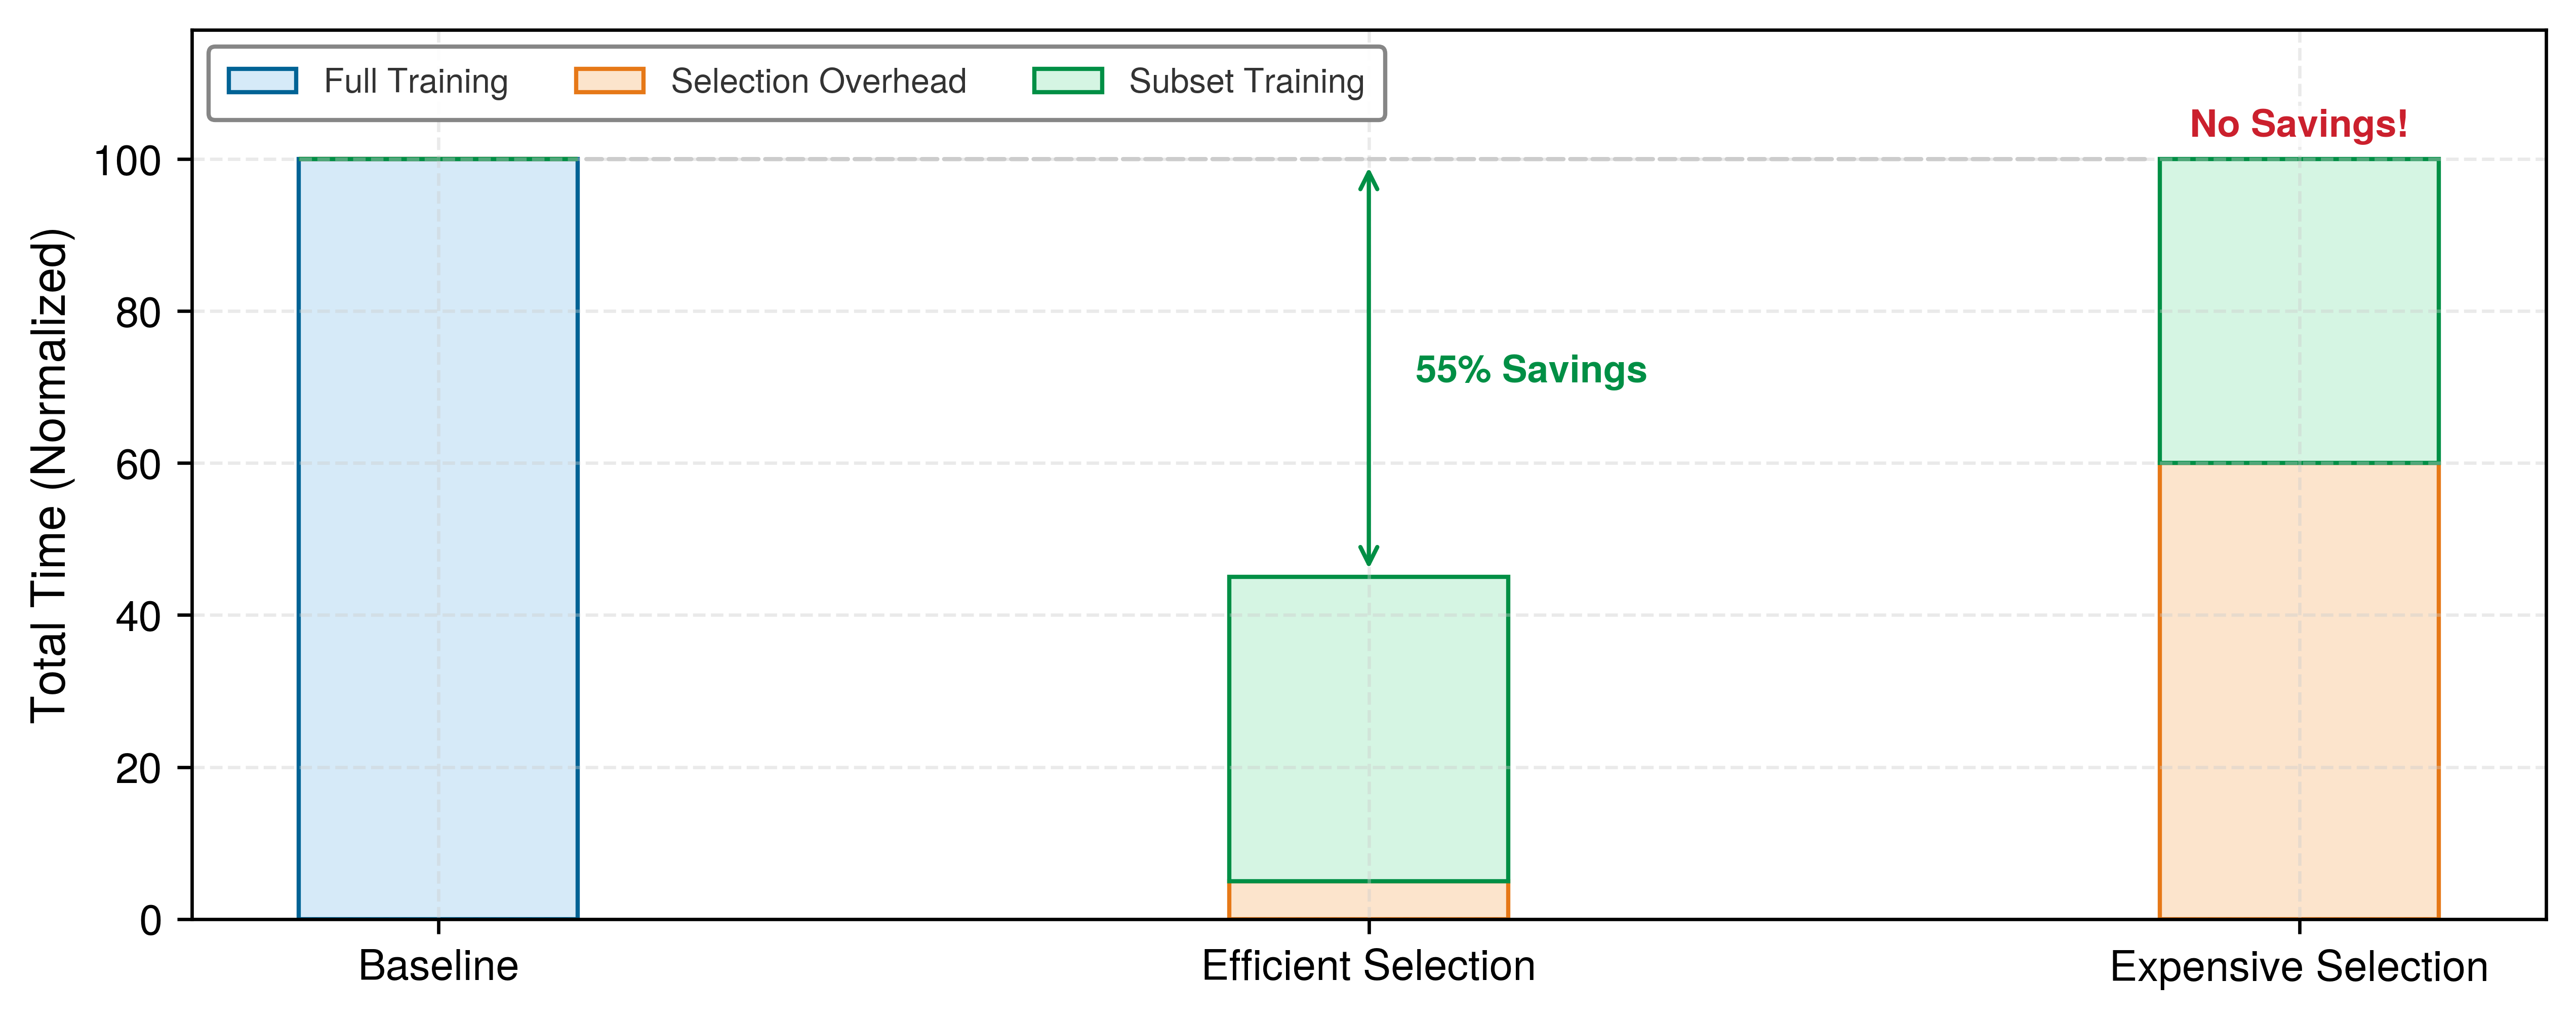
当选择在多个训练轮次中动态运行,而非仅离线执行一次时,这种开销会不断累积。如果每轮重新评分的成本接近通过裁剪子集所节省的训练工作量,系统层面的净优势就会消失。
工程流水线通过代理模型、缓存嵌入和索引检索来管理选择开销。只要较小代理模型给出的样本排序能够准确迁移到目标架构,就能缩短评分延迟。在排序保真度允许的情况下,以较低数值精度执行评分遍历,可进一步减少算术运算工作量和内存流量。对于基于相似性或多样性的选择,FAISS31 等向量索引通过在预计算嵌入上执行近似最近邻检索,替代成本高昂的全语料库扫描。这些技术将选择评估与主模型训练解耦,约束 \(T_{\text{selection}}\),从而使不等式成立。
硬件同理心:随机访问的代价
选择不等式考虑了计算开销,但选择算法也会重塑物理 I/O 模式。索引驱动的采样将大型分片的顺序传输变为分散的非顺序读取,因而失去硬件预读、操作系统页缓存和控制器批量预取带来的吞吐量优势。由于磁盘磁头必须进行物理寻道,而闪存控制器必须执行随机块查找,大小相同的子集可能因访问局部性不同而产生截然不同的训练实际耗时。Table 13 量化了不同存储层级在 4 KB 传输下的这种小块读取代价。
| 存储层级 | 顺序吞吐量 | 随机 I/O(IOPS) | 随机吞吐量(近似值) | 随机访问代价 |
|---|---|---|---|---|
| HDD (7.2k) | ~150 MB/s | ~100 IOPS | ~0.4 MB/s | 375× |
| SATA SSD | ~550 MB/s | ~10K IOPS | ~40 MB/s | 13.8× |
| NVMe SSD | ~3,500 MB/s | ~500K IOPS | ~2,000 MB/s | 1.75× |
| 云存储(S3) | 取决于配置 | 无法用 IOPS 直接比较 | 取决于配置 | 可能极高 |
数据加载器通过数据与机器的协同设计解决这一冲突。WebDataset 和 FFCV 等分片数据集格式将数千个独立样本打包为连续、可顺序读取的归档块。加载器将大型顺序分片流式读入主机内存,并填充一个混洗缓冲区,而不是从磁盘获取分散的单个样本。训练循环从这个内存缓冲区中进行伪随机采样,在保持存储峰值读取带宽的同时,满足小批量随机化的统计要求。在跨多个加速器的分布式训练中,每个工作进程针对互不重叠的分片维护独立的混洗缓冲区。由于随机化仅发生在各工作进程的内存缓冲区内,而非整个语料库范围内,除非在分发前对数据集进行分层并均衡各分片,否则集中于特定分片中的稀有类别或边界案例在各工作进程中的出现频率将不均衡。
Checkpoint 1.2: 选择不等式
数据选择并非没有代价。它为机器学习系统铁律引入了一个新项,也带来了新的 I/O 成本。
公式检查:
系统影响:
数据回响:摊销 I/O 成本
即使保住了存储带宽,动态选择流水线也往往会将系统瓶颈向上游转移至主机 CPU 计算。3D 旋转、MixUp、JPEG 解码或即时生成式合成等繁重的数据变换,需要对每个样本进行大量主机端处理。当主机流水线生成批次的速度低于加速器执行前向和反向传播的速度时,GPU 计算核心会因输入供给不足而空闲。由此造成的加速器利用率骤降会延长训练实际耗时,抵消裁剪数据集所带来的效率收益。
数据回响32 (Choi et al. 2019) 在获取新样本之前多次复用数据,当输入流水线慢于训练时,以数据新鲜度换取加速器利用率。在随机增强之前进行回响,可以在每次重复时生成不同的变换后输入,而在流水线较后的位置进行回响,则可能重复相同的张量。
最优回响因子取决于上游处理时间与下游训练时间的比值 \(R\): \[ R = \frac{T_{\text{data pipeline}}}{T_{\text{GPU training}}} \]
当 \(R > 1\) 时,数据流水线成为训练瓶颈:回响因子 \(e < R\) 可以部分利用原本闲置的 GPU 周期,而在重复样本仍具有统计价值的前提下,\(e \ge R\) 可使加速器算力得到充分利用。将 \(e\) 增大至超过 \(R\) 不会进一步提高利用率,还可能降低梯度多样性。反之,当 \(R < 1\) 时,加速器已经受计算能力限制,数据回响不会带来收益。
流水线利用率在比值阈值附近达到饱和;统计价值仍取决于工作负载。
Napkin Math 1.4: 计算示例:数据回响的投资回报率
场景:使用强数据增强(RandAugment + MixUp)在 ImageNet 上训练 ResNet-50。
测量结果:
- 数据流水线吞吐量:300 images/s(在 CPU 上读取、解码和增强)
- GPU 训练吞吐量:800 images/s(前向 + 反向传播)
- 比值 \(R = T_{\text{pipeline}} / T_{\text{GPU}}\) = (1/300 images/s) / (1/800 images/s) = 800 images/s/300 images/s ≈ 2.67(GPU 有 62.5 percent 的时间在等待)
不使用回响:
- 有效吞吐量:300 images/s(受数据流水线限制)
- 训练 90 轮的时间:\(90 \times 1.28\text{M}\) / 300 images/s = 384,350 seconds(106.8 hours)
- GPU 利用率:37.5 percent
使用回响因子:\(e\) = 2。
- 每个批次使用不同的增强处理两次
- 有效吞吐量:600 images/s(仍低于 GPU 处理能力)
- 每秒不同图像数:300 images/s(不变)
- 训练时间:若回响数据具有同等价值,则为 \(90 \times 1.28\text{M}\) / 600 images/s = 192,175 seconds(53.4 hours)
权衡:无法保证重复样本与新样本同样有用;数据回响论文评估了回响因子、插入位置和混洗方式,因为这些选择决定了数据复用能否保持预测性能。在一种通过网络供给数据的 ResNet-50/ImageNet 配置中,Choi et al. (2019) 报告,达到目标指标所需的实际耗时缩短至原来的 1/3.25,即加速 3.25\(\times\)。
系统洞察:当输入流水线成为瓶颈时,数据回响可以用样本多样性换取加速器利用率。有效的回响因子必须针对具体工作负载进行测量,因为它取决于批量大小、插入位置、增强方式、混洗方式和目标指标。
当同一样本出现在同一批次内或相邻批次之间时,回响可能引入相关性,因此实现时必须保持充分的混洗,并验证目标指标。Choi et al. (2019) 在其 ResNet-50 或单次多框检测器(SSD)实验中没有观察到与批归一化的负面相互作用,但这一结果并不能保证所有工作负载都会表现相同。
这些实现模式决定了数据选择能否带来系统吞吐量的净收益。当评分排序能够迁移至目标架构时,代理选择可减少探测计算。分片文件格式和混洗缓冲区使伪随机批次生成与硬件层面的顺序流式读取相协调,而当数据摄取吞吐量限制训练循环时,数据回响则可以利用原本因等待而闲置的加速器周期。
然而,运行上的可行性并不保证经济上的可行性。一个需要花费 $50K 进行工程开发、却在整个训练计划中仅节省 $10K 的去重基础设施会造成净亏损。部署选择技术需要对资本、计算和人工标注预算进行严格的财务核算。
成本建模
系统化的成本建模指导着数据选择投资。工程团队面临具体的资本配置权衡:是购买额外的 100,000 条人工标注,还是预留更多 GPU 集群;主动学习流水线何时达到盈亏平衡;以及需要多少次训练运行才能摊销定制数据整理工具的成本。
量化数据成本与投资回报率
训练数据的总成本涵盖获取、标注、存储保留和加速器计算,远不止对象存储账单: \[ C_{\text{total}} = C_{\text{acquire}} + C_{\text{label}} + C_{\text{store}} + C_{\text{process}} \] 标注(\(C_{\text{label}}\))是数据选择最直接针对的支出,而存储(\(C_{\text{store}}\))和处理(\(C_{\text{process}}\))成本则分别随保留的字节量和加速器处理遍数按相应关系增长。Table 14 逐项列出了这四个成本组成部分及其运营驱动因素。
| 组成部分 | 公式 | 示例范围 |
|---|---|---|
| \(C_{\text{acquire}}\) | \(D \times c_{\text{sample}}\) | $0.001–$10/样本(网页抓取与授权获取) |
| \(C_{\text{label}}\) | \(D_{\text{labeled}} \times c_{\text{label}}\) | $0.01–$200/样本(众包与专家标注) |
| \(C_{\text{store}}\) | \(D_{\text{vol,store}} \times c_{\text{storage}} \times T_{\text{months}}\) | $0.02–$0.10/GB/月 |
| \(C_{\text{process}}\) | \(D \times N_{\text{epochs}} \times O_{\text{sample}} \times c_{\text{FLOP}}\) | 与训练浮点运算次数成正比 |
在评估一次 ImageNet 规模的视觉模型训练运行时,这四个成本项之间的相互作用就会具体显现出来。
Napkin Math 1.5: 成本明细:ImageNet 规模训练
Table 15 逐项列出了一个 ImageNet 规模的获取、标注、存储和计算示例场景。所得比例取决于所述的许可、标注、存储、运行时间和计算成本假设;它并非所有监督学习工作负载的典型比例。
Table 15: ImageNet 规模成本明细示例:在所述场景假设下,逐项列出获取、标注、存储和计算成本。每项金额均根据其旁列出的费率计算,采用本书公布的众包标注、对象存储和云 GPU 费率。在这一特定计算中,数据成本占主导地位,因为其中包含许可和标注费用,而单次训练运行本身耗时较短。
| 成本组成 | 计算方式 | 金额 |
|---|---|---|
| 原始数据(1.2M 张图像) | 获得许可的数据集,一次性固定费用 | $50,000 |
| 标签(众包标注) | 1.2M \(\times\) $0.05/label | $60,000 |
| 存储(云对象存储) | 150 GB \(\times\) $0.02/GB/month \(\times\) 12 months | $36 |
| 完整训练实验(30 runs,每次使用 8 A100s,在 24 h 内完成 100 epochs) | 5,760 GPU-hours \(\times\) $4/GPU-hour | $23,040 |
| 合计 | $133,076 | |
| 数据与计算成本占比 | 数据 82.7%,计算 17.3% |
系统洞见:在监督式视觉工作负载中,获取和标注成本可能远超计算成本,本例假设下的情况便是如此。计算费用涵盖完整训练实验,而非单次运行:发布的模型是经过参数扫描、重启和消融实验后最终保留下来的结果,仅核算一次运行会使计算成本被低估至实际值的大约三十分之一。即便如此,获取和标注仍占更大份额。运行次数与其他条件一样,也是一项假设,因此,完整的投资回报率计算必须明确说明该假设,并核算这两类成本,而不能预先假定哪一类占主导地位。
数据选择技术的投资回报率框架
数据选择技术在训练流水线中引入算法过滤,以降低下游成本。然而,评估样本重要性并非没有成本:评分会消耗加速器计算周期,产生主机与设备之间的内存流量,或需要投入工程工作来构建定制的流水线阶段。评估某种选择策略在经济上是否合理,需要通过投资回报率(ROI)来权衡这些前期额外开销与下游节省: \[ \text{ROI} = \frac{\text{Savings} - \text{Investment}}{\text{Investment}} \times 100\% \]
投入与节省之间的权衡因选择策略而异。Table 16 列出了四种常见技术的主要成本驱动因素和收益机制;其净回报取决于语料规模、模型规模和现有流水线基础设施。
| 技术 | 投入(成本) | 节省(收益) |
|---|---|---|
| 去重 | 哈希计算的一次性计算成本 + 基础设施 | 减少存储和对重复样本的处理 |
| 核心集选择 | 代理模型训练 + 选择计算 | 在保持目标质量和覆盖度的前提下,减少保留样本数 |
| 主动学习 | 对未标注样本池进行推理 + 人在回路中的延迟 | 当查询选择策略能够迁移时,降低标注需求 |
| 数据增强 | 执行变换所需的 CPU/GPU 计算周期 | 无需获取新数据即可增大有效数据集规模 |
盈亏平衡分析
选择算法通过付出计算开销和流水线延迟,减少下游标注或训练工作。盈亏平衡点 标志着一个运行边界:省略样本所节省的费用恰好等于选择这些样本所产生的计算和运营开销。如果候选样本评分的计算量很大,或者候选样本池极其庞大,选择策略消耗的资源很容易超过其节省的资源。
假设标注成本为 $10/sample,主动学习从 1,000 个已标注样本(成本为 $10,000)开始,每轮发出 100 queries,推理成本为 $50,而随机标注基线需要 5,000 个样本才能达到目标准确率。如果主动学习仅用 2,000 个已标注样本即可达到目标准确率,则可通过比较标注和计算成本求得投资回报率。 \[\begin{gather*} \text{Random labeling cost} = \text{5,000} \times \text{\$10/sample} = \text{\$50,000} \\ \text{Active learning cost} = \text{2,000} \times \text{\$10/sample} + \text{10 rounds} \times \text{\$50} = \text{\$20,500} \\ \text{ROI} = \frac{\text{\$50,000} - \text{\$20,500}}{\text{\$20,500}}= \text{$143.9\%$} \end{gather*}\]
当节省的标注成本等于选择开销时,即达到盈亏平衡。如果对候选样本评分和重新训练代理模型需要耗费大量加速器小时,即使标注量减少 20%,投资回报率仍可能为负。
跨训练运行的成本摊销
静态数据选择技术将数据集整理与模型训练循环解耦。MinHash 去重、精确 \(n\) 元语法索引或嵌入聚类等计算过滤方法,需要大量前期工程投入和预处理计算。然而,生产模型开发本质上是迭代式的:超参数搜索、神经架构搜索、消融研究和随机种子扫描会反复使用同一份整理后的语料进行训练。仅基于一次孤立运行来评估这些技术,会歪曲其经济效益。摊销投资回报率(ROI) 考虑了前期数据整理投入如何分摊到完整训练实验中: \[ \text{Amortized ROI} = \frac{N_{\text{runs}} \times \text{Per-Run Savings} - \text{One-Time Investment}}{\text{One-Time Investment}} \times 100\% \]
Table 17 逐项列出了一个 MinHash 去重流水线示例的前期资本与计算支出,以及每次运行的节省。
| 组成项 | 成本 |
|---|---|
| 构建去重流水线 | $50,000(工程工时) |
| 计算 MinHash 签名(一次性) | $5,000 |
| 每次运行的节省 | $10,000/run |
由于初始基础设施和签名生成成本是固定的,此后每次训练运行都会进一步累积净财务回报。数据整理基础设施能否达到盈亏平衡,取决于三个运营因素:
- 重复训练运行:超参数搜索、模型迭代和定期重新训练会多次复用同一套选择基础设施。
- 共享数据集:清洗或去重后的语料可以支持多个团队或多种模型架构。
- 具有广泛复用性的技术:去重等方法可跨模型迁移,而面向特定任务的核心集则未必如此。
Table 18 展示了在这些成本参数下,摊销回报如何随完整训练实验中的运行次数变化。
| 运行次数 | 摊销投资回报率 |
|---|---|
| 1 次运行 | -81.8%(净亏损) |
| 5 次运行 | -9.1%(接近盈亏平衡) |
| 10 次运行 | +81.8%(正回报) |
| 50 次运行 | +809.1%(高盈利) |
去重具有较高的投资杠杆效应,因为消除冗余序列能够减少主机存储占用,并避免每一种下游架构中的无效梯度更新。相反,基于代理模型梯度或不确定性得分的样本选择方法难以在差异较大的架构之间迁移,因此其摊销范围仅限于固定模型族内的小范围参数扫描。对于探索性或一次性的训练运行,均匀随机采样或基础数据增强等低开销方法无需承担大量基础设施投入,因而能获得更高的投资回报率。
标准成本模型假设采用集中式数据流水线,由单个主机进程在统一数据集上评估重要性指标。扩展至高吞吐量的多加速器训练时,数据集会被分片到独立存储卷和分布式工作进程上,由此产生的通信与同步瓶颈可能使这些理想化的单节点经济性不复存在。
分布式选择
数据分片打破了单进程抽象。在集中式流水线中,核心集算法对单一的全局排名进行排序,课程学习执行统一的样本顺序,主动学习循环则评估共享候选池。分布式执行将存储分片到独立节点上,基于不同步的模型检查点计算得分,并限制各工作进程的可见范围。将数据选择扩展到集群会引入两项物理约束:从彼此隔离的分片视角合成具有全局代表性的子集,以及在工作进程状态发生分歧时维持一致的样本排名。
分布式选择能否忠实反映全局数据集,还是退化为局部分片启发式方法,取决于每种技术所需的跨工作进程协调量,以及可用于支撑这些协调的带宽。因此,必须在统计价值与分片及局部性相交的边界上评估选择问题。
这两项要求彼此独立。核心集可能仍具有代表性,但协调成本过高;而成本低廉的分片局部方法虽然能够扩展,却可能系统性地遗漏只有从全局语料库中才能识别的稀有群体。因此,分布式设计需要通过两项验收检验:将所选数据的质量与集中式或其他可审计的参照结果进行比较,以及将选择开销与其节省的端到端训练时间进行比较。仅通过其中一项检验是不够的。
分布式选择策略
在基本的数据并行布局中,每个工作进程处理不同的分片,模型同步则单独处理。数据选择可能在这些分片之间引入依赖关系(table 19)。
针对这些选择依赖关系,可以采用多种架构方案,每种方案在一致性与可扩展性的权衡空间中处于不同位置。最直接的方法是将选择集中处理,同时将训练分布式执行。协调节点在完整数据集上执行选择,然后将所选索引分发给工作进程。这保留了选择质量,但也引入了单一瓶颈:
Coordinator: score_all_samples() → selected_indices
Broadcast: selected_indices → all workers
Workers: train on subset(local_shard, selected_indices)| 技术 | 单节点假设 | 分布式挑战 |
|---|---|---|
| 核心集选择 | 具有数据集的全局视图 | 每个工作进程只能看到自己的分片 |
| 主动学习 | 集中式不确定性评分 | 评分需要模型同步 |
| 课程学习 | 全局难度排序 | 不同工作进程的“最难”样本可能不同 |
| 去重 | 哈希表可容纳于内存 | 分布式哈希表会增加延迟 |
其语义仍然清晰,但协调节点会成为单点故障源,也可能成为带宽瓶颈。这种开销是否可以接受,取决于选择结果的传输量、刷新频率、网络路径和集群规模。
分层选择通过将选择计算本身分布式执行来缓解这一可扩展性限制。每个工作进程在自己的分片上执行局部选择,然后由协调节点合并结果:
Workers: local_selected = select_top_k(local_shard)
Coordinator: global_selected = merge_and_rerank(all local_selected)
Broadcast: final_indices → all workers
分片局部选择降低了协调节点的负载,但也引入了质量权衡:局部配额和得分分布可能无法保留全局排名,也可能无法保留在各分片间分布不均的稀有群体。因此,合并步骤需要进行归一化、施加覆盖约束,或再执行一轮全局处理。
当分层方法的成本仍然过高时,近似全局选择提供了一种备选方案。这些方法通过分布式近似算法,以精确性换取可扩展性。分布式 MinHash让各工作进程独立计算 MinHash 签名,再汇总签名以识别跨分片的近重复项,从而实现去重,而无需任何单个节点查看全部数据。类似地,分布式不确定性采样允许工作进程计算局部不确定性得分,并根据得分分布统计量而非精确排名确定全局阈值。
主动学习中的一致性挑战
上述近似选择策略假设选择标准保持静态,但主动学习引入了额外的复杂性:模型在选择过程中会发生变化。考虑这样一种情况:工作进程 A 使用第 \(t\) 步的模型对样本评分,而工作进程 B 同时将模型更新至第 \(t+1\) 步。此时,工作进程 A 的得分已经过时,可能选择出在更新后的模型中排名不同的样本。
因此,评分调度决定的不仅是查询的成本,还包括查询的含义。可复现的系统会将模型检查点、候选池快照、评分规则和所选索引一并进行版本管理。随后,系统可以衡量排名一致程度随检查点陈旧程度的增加而衰减的幅度,并依据这些证据选择刷新间隔,而非任意指定步数。
有几种策略可以缓解这一陈旧性问题,各自具有不同的开销特征:
- 同步评分:所有工作进程暂停训练并同时评分,以保证一致性,但会显著损失 GPU 利用率。
- 定期刷新得分:工作进程每隔 \(k\) 个轮次重新评分,而非每个批次都重新评分,以得分的新鲜度换取更低的开销。
- 对检查点变化具有鲁棒性的选择:系统选择在多个模型检查点下均表现出高不确定性的样本,使选择决策在模型演化过程中保持有效。
下面以一个示例性的 8 节点 GPU 集群场景,展示这些刷新策略如何与存储带宽和计算效率相互作用。
Example 1.6: 分布式核心集选择
场景:一个由 8 个节点组成的 A100 GPU 集群,通过分布式工作进程,从 ImageNet(1.3M 张图像)中选择占比为 10 percent 的核心集。
诊断:在单个节点上进行集中式核心集评分会造成内存和计算瓶颈。分布式流水线分阶段处理(分片局部嵌入 \(\to\) 并行去重 \(\to\) 局部 EL2N 评分 \(\to\) 集中式 top-\(k\) 合并),可在 67 minutes 内完成数据集选择。
系统启示:分布式核心集选择可以消除单节点内存对评分的限制,如 figure 11 所示。对嵌入和评分进行分片,可将工作分散到整个集群,而集中式合并仍然是一项协调成本,必须满足选择不等式。
\scalebox{0.85}{%
\begin{tikzpicture}[font=\small\sffamily]
\tikzset{
  ScoreLine/.style={-{Triangle[width=6pt,length=6pt]}, line width=1.2pt,BrownLine!70,text=black},
  IndexLine/.style={-{Triangle[width=6pt,length=6pt]}, line width=1.2pt,BlueLine!75,text=black},
  Box/.style={inner xsep=2pt, draw=BlueD, line width=0.75pt,fill=BlueL!70,
    text width=70mm,align=left,minimum width=110mm, minimum height=18mm},
   Box2/.style={Box, draw=GreenLine,fill=green!80!black!10,align= flush center,
   text width=23mm,minimum width=23mm, minimum height=16mm},
   Text/.style={right,fill=none,text=black!70,font=\footnotesize\sffamily,align=left},
}

% Coordinator node
\node[Box] (B0) {};
\node[draw=none,fill=BlueD,text=white,below=0pt of B0.north] (BB0) {\textbf{协调节点}};
\node[draw=none,align=left,anchor=south]at($(B0.south)+(0,2pt)$){%
    \textbullet\ 维护全局嵌入索引(FAISS)\\
    \textbullet\ 合并局部选择结果\\
    \textbullet\ 广播最终核心集索引};

% Worker 1
\node[Box2,below=of B0.south] (W0){};
\node[Box2,below=0pt of W0.north,minimum height=6mm,
fill=GreenLine,text=white] (WW0){\textbf{工作进程 1}};
\node[align=center]at($(WW0.south)!0.5!(W0.south)$){150K 张图像\\
    局部 EL2N};
% Worker 0
\node[Box2,below=of B0.194] (W1){};
\node[Box2,below=0pt of W1.north,minimum height=6mm,
fill=GreenLine,text=white] (WW1){\textbf{工作进程 0}};
\node[align=center]at($(WW1.south)!0.5!(W1.south)$){150K 张图像\\
    局部 EL2N};
% Worker N
\node[Box2,below=of B0.346] (W2){};
\node[Box2,below=0pt of W2.north,minimum height=6mm,
fill=GreenLine,text=white] (WW2){\textbf{工作进程 N}};
\node[align=center]at($(WW2.south)!0.5!(W2.south)$){150K 张图像\\
    局部 EL2N};
% Bidirectional coordination: local scores flow up; final coreset indices flow down.
\foreach \i in{0,1,2}{
\draw[ScoreLine] ([xshift=-1.7mm]W\i.north) -- ([xshift=-1.7mm]W\i.north |- B0.south);
\draw[IndexLine] ([xshift=1.7mm]W\i.north |- B0.south) -- ([xshift=1.7mm]W\i.north);
}
\node at ($(W1)!0.5!(W0)$) {\Large$\cdots$};
\node at ($(W2)!0.5!(W0)$) {\Large$\cdots$};
\end{tikzpicture}}当工作进程在训练期间频繁协调时,正的投资回报率可能迅速下降。分布式选择会引入协调税,其大小取决于同步的内容及频率。这项协调税必须小于节省的训练时间;如果接近这一上限,就应简化策略或增大刷新间隔。
集群网络拓扑还会带来进一步约束。梯度同步可能通过专用链路使用加速器集合通信,而嵌入向量、得分数组和核心集索引则可能经由主机或存储路径传输。实际路径取决于系统架构。因此,选择流量可能暴露出仅分析训练性能时无法发现的 CPU、网络接口卡、存储或集合通信网络瓶颈。
真实的机器学习系统会同时结合数据选择、模型级效率优化、机器级吞吐量优化和分布式训练。这些优化之间的相互作用既可能放大收益,也可能相互削弱,理解这些相互作用对于设计高效的端到端流水线至关重要。
跨层相互作用
在数据—算法—机器分类体系中,数据选择作用于数据维度,在计算开始之前削减训练工作负载。然而,根据机器学习系统铁律,执行时间取决于输入削减如何改变算法(模型表征、损失景观和可压缩性)以及机器(内存带宽、内核算术强度和加速器间通信)。这些跨层相互作用可以放大整个技术栈中的效率收益,也可能引入意外瓶颈,抵消上游节省的开销。系统效率要求将数据整理与模型压缩、硬件调度协同设计,而非孤立地优化各个组件。
模型级效率
模型级效率通过剪枝、低精度表示和知识蒸馏等技术,减少训练后模型的参数量和算术运算成本。训练语料库的构成塑造了内部表征,从而改变最终网络对训练后压缩的适应程度。然而,仅统计被消除的运算会忽视物理执行平台对稀疏结构的响应方式(1.2)。模型压缩 和 硬件加速 详细探讨了模型压缩与硬件加速的架构基础。
Systems Perspective 1.2: 稀疏性延迟陷阱
背景:数据选择带来的可压缩性优势以算术运算量来衡量,但模型压缩研究反复表明,剪枝降低运算量比降低实际运行延迟更容易。
失效模式:FLOPs 可能大幅下降,而推理延迟保持不变甚至增加。稠密矩阵乘法硬件受益于规整的布局和复用,而稀疏矩阵需要不规则的内存访问、元数据检查和地址跳转。除非稀疏模式与执行平台相匹配,否则管理稀疏性的开销可能超过算术运算减少所带来的收益。
系统洞见:FLOPs 并不等同于延迟。如果剩余运算受内存限制或缓存效率低下,即使运算量减少 99%,耗时的降幅也可能为 0%。优化必须针对硬件中实际起限制作用的瓶颈,而不能只着眼于抽象指标 (Hoefler et al. 2021)。
Hoefler, Torsten, Dan Alistarh, Tal Ben-Nun, Nikoli Dryden, and Alexandra Peste. 2021. “Sparsity in Deep Learning: Pruning and Growth for Efficient Inference and Training in Neural Networks.” Journal of Machine Learning Research 22 (241): 1–124.
数据选择与模型压缩之间的这种相互作用,可以追溯到网络在训练过程中编码表征的方式。在重复数据上训练的模型,往往会将容量分配给冗余特征,而这些特征随后又会被训练后剪枝丢弃,从而浪费了用于学习它们的训练计算。相反,在经过整理、信息丰富且多样化的样本语料库上训练的模型,通常从一开始就能获得更紧凑的表征。这种初始效率可能简化后续的剪枝或量化,但这仍是有待测量的经验假设,而非每个所选数据集都具备的不变属性。数据选择和模型压缩是数据—算法—机器分类体系中互补的优化手段;必须通过端到端模型服务延迟和任务准确率的基准测试,联合评估二者的相互作用,而不能假设上游数据集缩减会自动保证下游可压缩性。
机器级吞吐量
模型级效率决定训练完成后剩余的计算工作量,而机器级吞吐量决定硬件执行训练循环本身的效率。根据机器学习系统铁律,训练运行时间取决于执行受限于输入数据传输(\(D_{\text{vol}}/\text{BW}\))、算术执行(\(O/(R_{\text{peak}} \cdot \eta_{\text{hw}})\))还是调度延迟(\(L_{\text{lat}}\))。削减样本会减少浮点运算总量,但非均匀采样和动态过滤会改变数据加载器的访问模式,并暴露新的硬件限制。Table 20 概述了选择策略如何改变主导系统瓶颈。
| 观测到的状况 | 可能的瓶颈 | 候选应对措施 |
|---|---|---|
| 输入速率低于加速器需求 | 存储、解码或主机链路 | 分片、预取、并行解码 |
| 低算术强度的训练内核 | 加速器内存带宽 | 融合、减少数据传输、降低精度 |
| 动态评分主导迭代耗时 | 选择计算或索引 I/O | 代理模型、缓存得分或嵌入 |
因此,数据选择可能改变硬件执行所处的状态。一项将样本数量减少 80% 的技术,可能缓解张量核心的计算压力,却使随机访问存储延迟、主机到设备的 PCIe 带宽或评分开销成为新的关键路径。缓解这一后续瓶颈,需要使工程应对措施与当前约束相匹配:缓存选择得分、融合受内存限制的运算,或在向加速器派发任务之前,将连续分片预先加载到主机内存中。在大幅削减数据之前,工程师必须对完整流水线进行性能分析,以确认究竟是哪一瓶颈限制了执行。
分布式训练
section 1.10.2 中的硬件瓶颈分析侧重于单个加速器上的执行。当扩展至多加速器训练时,例如在配备两到八个设备的单节点上训练,数据选择会同时改变通信量和内存同步。
在跨加速器的数据并行训练中,每个设备先在局部微批次上计算前向和反向传播,再通过 all-reduce 集合通信同步参数梯度。在每设备批次大小和训练轮次数保持不变的条件下,削减训练语料库会减少一次运行中的参数更新总次数,直接消除通过 PCIe 或 NVLink 互连进行的集合通信轮次。此外,较小的工作进程分片可以提高数据集中可容纳于本地主机 RAM 或加速器缓存的比例,减少反复从存储中流式读取数据的需求。
这些通信节省必须与 section 1.9 中分析的协调开销相权衡。梯度同步利用专用高带宽互连,而动态样本评分和索引交换通常经由主机内存和 CPU 调度线程。某项选择策略在单个加速器上可能具有良好的扩展效率,但在划分给八个并行工作进程后,可能引入串行化瓶颈或分片工作负载不均衡,使设备在同步屏障处停顿,侵蚀通过削减样本节省的计算时间。
优化技术栈
两两交互揭示了局部瓶颈,但生产部署会将这些优化作为一条集成流水线执行。如完整优化栈(figure 12)所示,从数据摄取到硬件执行,每个阶段都会放大或削弱下游效率。
\begin{tikzpicture}[font=\small\sffamily]
\tikzset{
Box/.style={align=center, inner xsep=2pt,draw=GreenLine, line width=1pt,
node distance=10mm,fill=none, minimum width=28mm, minimum height=20mm},
Box1/.style={Box,draw=OrangeLine,fill=none},
BoxD/.style={Box,font=\footnotesize\sffamily\bfseries,anchor=south,draw=none,text=white,fill=GreenLine,minimum height=5mm},
BoxD1/.style={Box,font=\footnotesize\sffamily\bfseries,anchor=south,draw=none,text=white,fill=OrangeLine,minimum height=5mm},
Circle1/.style={circle,  minimum size=33mm, draw=none, fill=BrownLine!20},
LineD/.style={BrownLine!60!black!20,line width=4.0pt,dashed,dash pattern=on 5pt off 2pt,
{-{Triangle[width=1.5*6pt,length=2.0*5pt]}},shorten <=5pt,shorten >=1pt},
LineA/.style={BrownLine!80!black!40,line width=4.0pt,
{-{Triangle[width=1.5*6pt,length=2.0*5pt]}},shorten <=1pt,shorten >=1pt},
ALineA/.style={violet!60,{Circle[line width=1.1pt,fill=white,round,length=5pt,width=5pt]}-,
line width=1.5pt,shorten <=-3pt,shorten >=-6pt}
}

%dataS
\tikzset{%
 pics/dataS/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=FUNNEL,scale=\scalefac, every node/.append style={transform shape}]
%plats
\draw[fill=\filllcolor,line width=\Linewidth,draw=\drawcolor](0,-0.3)--(-0.67,0.03)--(0,0.37)--(0.67,0.03)--cycle;
\draw[fill=\filllcirclecolor,line width=\Linewidth,draw=\drawcolor](0,0)--(-0.67,0.33)--(0,0.67)--(0.67,0.33)--cycle;
\draw[fill=\filllcolor,line width=\Linewidth,draw=\drawcolor](0,0.3)--(-0.67,0.63)--(0,0.97)--(0.67,0.63)--cycle;
%left
\draw[line width=\Linewidth,draw=\drawcolor](-0.39,1.21)--++(210:0.55)--++(270:1.22)--(-0.39,-0.56);
\fill[line width=\Linewidth,fill=\filllcirclecolor!60!violet!,draw=green,draw=\drawcolor](-0.39,1.21)circle(3pt);
\fill[line width=\Linewidth,fill=\filllcolor,draw=green,draw=\drawcolor](-0.39,-0.56)circle(3pt);
\draw[line width=\Linewidth,draw=\drawcolor](0.39,1.21)--++(330:0.55)--++(270:1.22)--(0.39,-0.56);
\fill[line width=\Linewidth,fill=\filllcirclecolor!60!violet!,draw=green,draw=\drawcolor](0.39,1.21)circle(3pt);
\fill[line width=\Linewidth,fill=\filllcolor,draw=green,draw=\drawcolor](0.39,-0.56)circle(3pt);
\end{scope}
     }
  }
}
%AI style
\tikzset{
pics/llm/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\node[circle,minimum size=12mm,draw=\drawcolor, fill=\filllcolor!70,line width=1.25*\Linewidth](C\picname) at (0,0){};
\def\startangle{90}
\def\radius{1.15}
\def\radiusI{1.1}
\foreach \i [evaluate=\i as \j using \i+1] [count =\k] in {0,2,4,6,8} {
\pgfmathsetmacro{\angle}{\startangle - \i * (360/8)}
\draw[draw=black,-{Circle[black ,fill=\filllcirclecolor,length=5.5pt,line width=0.5*\Linewidth]},line width=1.5*\Linewidth](C\picname)--++(\startangle - \i*45:\radius) ;
\node[circle,draw=black,fill=\filllcirclecolor!80!red!50,inner sep=3pt,line width=0.5*\Linewidth](2C\k)at(\startangle - \j*45:\radiusI) {};
}
\draw[line width=1.5*\Linewidth](2C1)--++(-0.5,0)|-(2C2);
\draw[line width=1.5*\Linewidth](2C3)--++(0.5,0)|-(2C4);
\node[circle,,minimum size=12mm,draw=\drawcolor, fill=\filllcolor!70,line width=0.5*\Linewidth]at (0,0){};
\end{scope}
    }
  }
}
%brain
\tikzset{pics/brain/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=BRAIN,scale=\scalefac, every node/.append style={transform shape}]
\draw[fill=\filllcolor,line width=\Linewidth](-0.3,-0.10)to(0.08,0.60)
to[out=60,in=50,distance=3](-0.1,0.69)to[out=160,in=80](-0.26,0.59)to[out=170,in=90](-0.46,0.42)
to[out=170,in=110](-0.54,0.25)to[out=210,in=150](-0.54,0.04)
to[out=240,in=130](-0.52,-0.1)to[out=300,in=240]cycle;
\draw[fill=\filllcolor,line width=\Linewidth]
(-0.04,0.64)to[out=120,in=0](-0.1,0.69)(-0.19,0.52)to[out=120,in=330](-0.26,0.59)
(-0.4,0.33)to[out=150,in=280](-0.46,0.42)
%
(-0.44,-0.03)to[bend left=30](-0.34,-0.04)
(-0.33,0.08)to[bend left=40](-0.37,0.2) (-0.37,0.12)to[bend left=40](-0.45,0.14)
(-0.26,0.2)to[bend left=30](-0.24,0.13)
(-0.16,0.32)to[bend right=30](-0.27,0.3)to[bend right=30](-0.29,0.38)
(-0.13,0.49)to[bend left=30](-0.04,0.51);
\draw[thick,line width=\Linewidth,rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcolor,length=2.5pt]}](-0.23,0.03)--(-0.15,-0.03)--(-0.19,-0.18)--(-0.04,-0.28);
\draw[thick,line width=\Linewidth,rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcolor,length=2.5pt]}](-0.17,0.13)--(-0.04,0.05)--(-0.06,-0.06)--(0.14,-0.11);
\draw[thick,line width=\Linewidth,rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcolor,length=2.5pt]}](-0.12,0.23)--(0.31,0.0);
\draw[thick,line width=\Linewidth,rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcolor,length=2.5pt]}](-0.07,0.32)--(0.06,0.26)--(0.16,0.33)--(0.34,0.2);
\draw[thick,line width=\Linewidth,rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcolor,length=2.5pt]}](-0.01,0.43)--(0.06,0.39)--(0.18,0.51)--(0.31,0.4);
\end{scope}
     }
  }
}
%funnel
\tikzset{%
 pics/funnel/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=FUNNEL,scale=\scalefac, every node/.append style={transform shape}]
\draw[fill=\filllcolor!50,line width=\Linewidth,draw=\drawcolor](-0.12,-0.81)--(-0.19,-0.25)--(-0.7,0.41)--(0.7,0.41)--(0.19,-0.25)--(0.12,-0.81)--cycle;
\draw[fill=\filllcolor!50,line width=\Linewidth,draw=\drawcolor](-0.19,-0.25)--(0.08,-0.25);
\draw[fill=\filllcolor!50,line width=\Linewidth,draw=\drawcolor](0.16,-0.09)--(0.41,0.31);
%
\node[line width=\Linewidth,draw=\drawcolor,fill=\filllcolor!50,inner sep=1pt,
rectangle,rounded corners=2pt,minimum width=16mm,minimum height=5pt]at(0,0.5){};
%
\foreach \i in{-0.5,0,0.5}{
\node[single arrow, line width=0.8*\Linewidth,draw=black,fill=cyan!90!black!30, rotate=270,inner sep=1pt,
      minimum width =9pt, single arrow head extend=2pt,
      minimum height=5mm]at(\i,0.9) {}; % length of arrow
   }
\node[single arrow,line width=0.8*\Linewidth,draw=black,fill=cyan!90!black!30, rotate=270,inner sep=1pt,
      minimum width =11pt, single arrow head extend=2pt,
      minimum height=5mm]at(0,-1.1) {}; % length of arrow
 \end{scope}
     }
  }
}
\tikzset{
pics/algorithm/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\node[fill=\filllcolor!60,draw=\drawcolor,line width=\Linewidth,rectangle,minimum size=2.5mm,
rounded corners=1pt,inner sep=1pt](\picname-B2)at(0,-0.47){};
\node[fill=\filllcolor!30,draw=\drawcolor,line width=\Linewidth,rectangle,minimum size=2.5mm,
rounded corners=1pt,inner sep=1pt](\picname-B3)at(-0.6,-0.47){};
\node[fill=\filllcolor!30,draw=\drawcolor,line width=\Linewidth,rectangle,minimum size=2.5mm,
rounded corners=1pt,inner sep=1pt](\picname-B1)at(0.6,-0.47){};
%
\node[fill=\filllcolor!99!violet!80,draw=\drawcolor,line width=\Linewidth,rectangle,
minimum width=8.5mm,minimum height=3mm,
rounded corners=2pt,inner sep=1pt](\picname-B0)at(0,0.53){};
\draw[draw=\drawcolor,shorten >=4pt,shorten <=4pt,line width=1.5*\Linewidth]
($(\picname-B0.north west)!0.33!(\picname-B0.south west)$)--($(\picname-B0.north east)!0.33!(\picname-B0.south east)$);
\draw[draw=\drawcolor,shorten >=4pt,shorten <=4pt,line width=1.5*\Linewidth]
($(\picname-B0.north west)!0.66!(\picname-B0.south west)$)--($(\picname-B0.north east)!0.66!(\picname-B0.south east)$);
\draw[draw=\drawcolor,rounded corners](\picname-B1)|-(\picname-B0);
\draw[draw=\drawcolor,rounded corners](\picname-B3)|-(\picname-B0);
\draw[draw=\drawcolor,rounded corners](\picname-B2)--(\picname-B0);
\node[fill=\filllcirclecolor!60,draw=\drawcolor,line width=\Linewidth,rectangle,minimum size=2.5mm,
rounded corners=1pt,inner sep=1pt,rotate=45](R2){};
\node[fill=\filllcirclecolor!30,draw=\drawcolor,line width=\Linewidth,rectangle,minimum size=2.5mm,
rounded corners=1pt,inner sep=1pt,rotate=45](R1) at (-0.6,0){};
\node[fill=\filllcirclecolor!30,draw=\drawcolor,line width=\Linewidth,rectangle,minimum size=2.5mm,
rounded corners=1pt,inner sep=1pt,rotate=45](R3) at (0.6,0){};
\end{scope}
    }
  }
}
%CPU
\tikzset{%
 pics/cpu/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=FUNNEL,scale=\scalefac, every node/.append style={transform shape}]
\node[fill=\filllcolor,minimum width=66, minimum height=66,
            rounded corners=2,outer sep=2pt] (C1) {};
\node[fill=white,minimum width=54, minimum height=54] (C2) {};
\node[fill=\filllcolor!40,minimum width=44, minimum height=44] (C3) {\large CPU};

\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=\filllcolor,minimum width=3, minimum height=15,
           inner sep=0pt,anchor=south](GO\y)at($(C1.north west)!\x!(C1.north east)$){};
}
\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=\filllcolor,minimum width=3, minimum height=15,
           inner sep=0pt,anchor=north](DO\y)at($(C1.south west)!\x!(C1.south east)$){};
}
\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=\filllcolor,minimum width=15, minimum height=3,
           inner sep=0pt,anchor=east](LE\y)at($(C1.north west)!\x!(C1.south west)$){};
}
\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=\filllcolor,minimum width=15, minimum height=3,
           inner sep=0pt,anchor=west](DE\y)at($(C1.north east)!\x!(C1.south east)$){};
}
 \end{scope}
     }
  }
}
\tikzset{
pics/llm1/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\node[circle,minimum size=13mm,draw=\drawcolor, fill=\filllcolor!70,line width=\Linewidth](C\picname) at (0,0){\bfseries 大语言模型};
\def\startangle{110}
\def\radius{1.75}
\def\radiusI{1.4}
\foreach \i [evaluate=\i as \j using \i+1] in {0,2,4,6,8} {
\pgfmathsetmacro{\angle}{\startangle - \i * (360/10)}
\draw[draw=\drawcolor,line width=0.7*\Linewidth,-{Circle[\drawcolor,fill=\filllcirclecolor,length=7.0pt]}](C\picname)--++(\startangle - \i*36:\radius) ;
\draw[draw=\drawcolor,line width=0.7*\Linewidth,-{Circle[\drawcolor,fill=\filllcirclecolor!80!red!50,length=4.5pt]}](C\picname)--++(\startangle - \j*36:\radiusI) ;
}
\end{scope}
    }
  }
}
\tikzset{
pics/rocket/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
%vrh
\draw[fill=\filllcolor,draw=\drawcolor,line width=\Linewidth](-0.26,0.5)to[bend right=12](0.26,0.5)to[bend right=7] (0,0.85)to[bend right=7] cycle;
%krila
\draw[fill=\filllcolor!70!red,,draw=\drawcolor,line width=\Linewidth,rounded corners=1pt](-0.2,-0.7)--(-0.45,-0.9)--(-0.567,-0.4)--(-0.3,-0.17)--cycle;
\draw[fill=\filllcolor!70!red,draw=\drawcolor,line width=\Linewidth,rounded corners=1pt](0.2,-0.7)--(0.45,-0.9)--(0.567,-0.4)--(0.3,-0.17)--cycle;
%rep
\draw[fill=\filllcolor,draw=\drawcolor,line width=\Linewidth](0.16,-0.76)--(0.22,-0.9)--(-0.2,-0.9)--(-0.15,-0.76)--cycle;
%body
\draw[fill=\filllcolor,draw=\drawcolor,line width=\Linewidth](-0.2,-0.7)--(0.2,-0.7)to[out=75,in=320](0,0.85)to[out=220,in=105] cycle;
%krug
\node[circle,draw=\drawcolor,minimum size=4mm,fill=\filllcirclecolor,line width=\Linewidth]{};
\draw[draw=\drawcolor](0,-0.99)--(0,-1.3);
\draw[draw=\drawcolor](-0.11,-0.99)--(-0.11,-1.2);
\draw[draw=\drawcolor](0.11,-0.99)--(0.11,-1.2);
\end{scope}
    }
  }
}
\tikzset{mycylinder/.style={cylinder, shape border rotate=90, aspect=1.3, draw, fill=white,
minimum width=25mm,minimum height=11mm,line width=\Linewidth,node distance=-0.15},
pics/data/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=STREAMING,scale=\scalefac, every node/.append style={transform shape}]
\node[mycylinder,fill=\filllcolor!50] (A) {};
\node[mycylinder, above=of A,fill=\filllcolor!30] (B) {};
\node[mycylinder, above=of B,fill=\filllcolor!10] (C) {};
\fill[\filllcolor!50!black]($(C.west)!0.12!(C.east)$)circle(3pt);
\fill[\filllcolor!50!black]($(B.west)!0.12!(B.east)$)circle(3pt);
\fill[\filllcolor!50!black]($(A.west)!0.12!(A.east)$)circle(3pt);
 \end{scope}
     }
  }
}
\tikzset{%
 pics/dataFolderS/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=DATAFOLDER,scale=\scalefac, every node/.append style={transform shape},
LinE/.style={\filllcirclecolor,line width=2.0pt,
{{Triangle[width=1.5*3pt,length=2.0*3pt]}-},shorten <=1pt,shorten >=1pt},
ELin/.style={\filllcirclecolor,line width=2.0pt,
{-{Triangle[width=1.5*3pt,length=2.0*3pt]}},shorten <=1pt,shorten >=1pt},]
\draw[line width=\Linewidth,draw=\drawcolor,rounded corners=0.1pt,fill=\filllcolor!20] (0,0) -- (-0.20,2.45)coordinate(\picname-GL)--
(0.4,2.45)to[out=360,in=180](0.9,2.1)-- (2.5,2.1)--(2.5,0)--cycle ;
\draw[line width=\Linewidth,draw=\drawcolor,rounded corners=2pt,
fill=\filllcolor!50] (0,0)coordinate(\picname-DL) -- (2.8,0)
coordinate(\picname-DD)-- (3,1.8) -- (0.2,1.8) -- cycle;
\draw[LinE](\picname-DD)--++(330:2.0);
\draw[LinE](-0.3,1.8)--++(150:2.0);
\draw[LinE](3,1.8)--++(30:2.0);
\draw[LinE](\picname-DL)--++(210:2.0);
 \end{scope}
     }
  }
}
\pgfkeys{
  /channel/.cd,
   Depth/.store in=\Depth,
  Height/.store in=\Height,
  Width/.store in=\Width,
  filllcirclecolor/.store in=\filllcirclecolor,
  filllcolor/.store in=\filllcolor,
  drawcolor/.store in=\drawcolor,
  drawcircle/.store in=\drawcircle,
  scalefac/.store in=\scalefac,
  Linewidth/.store in=\Linewidth,
  picname/.store in=\picname,
  tiecolor/.store in=\tiecolor,
  bodycolor/.store in=\bodycolor,
  stetcolor/.store in=\stetcolor,
  tiecolor=red,      % default tie color
  bodycolor=blue!30,  % default body color
  stetcolor=green,  % default stet color
  filllcolor=BrownLine,
  filllcirclecolor=violet!20,
  drawcolor=black,
  drawcircle=violet,
  scalefac=1,
  Linewidth=0.5pt,
  Depth=0.2,
  Height=0.5,
  Width=0.25,
  picname=C
}
%Unlabeled Pool
\node[Box](B1){};
\node[BoxD](BB1)at(B1.south){原始数据};
\coordinate(S1)at($(B1.north)!0.5!(BB1.north)$);
\pic[shift={(0,-0.22)}] at  (S1){dataS={scalefac=0.6,picname=1,Linewidth=1.0pt,
 filllcolor=red!90!black!40!,drawcolor=black,filllcirclecolor=cyan}};
 % Data Selection
 \node[Box1,right=of B1](B2){};
\node[BoxD1](BB2)at(B2.south){数据选择};
\coordinate(S2)at($(B2.north)!0.5!(BB2.north)$);
\pic[shift={(0,0.05)}] at  (S2){funnel={scalefac=0.53,picname=1,Linewidth=0.5pt,
 filllcolor=BrownL,drawcolor=black,filllcirclecolor=orange!70!yellow!80}};

 % Curated Data
 \node[Box,right=of B2](B3){};
\node[BoxD](BB3)at(B3.south){精选数据};
\coordinate(S3)at($(B3.north)!0.5!(BB3.north)$);
\pic[shift={(0,-0.45)}] at  (S3){data={scalefac=0.4,picname=1,filllcolor=magenta, Linewidth=0.7pt}};
% Training
 \node[Box1,right=of B3](B4){};
\node[BoxD1](BB4)at(B4.south){训练};
\coordinate(S4)at($(B4.north)!0.5!(BB4.north)$);
\pic[shift={(0,-0.04)}] at  (S4){algorithm={scalefac=0.9,picname=1,
drawcolor=black,filllcolor=cyan!50!, Linewidth=0.75pt,filllcirclecolor=green}};

 % Model
 \node[Box,below right=0 and 1 of B4](B5){};
\node[BoxD](BB5)at(B5.south){模型};
\coordinate(S5)at($(B5.north)!0.5!(BB5.north)$);
%AI
\pic[shift={(0,0)}] at  (S5){llm={scalefac=0.6,picname=1,drawcolor=GreenD,
filllcolor=GreenD!20!, Linewidth=0.7pt,filllcirclecolor=red}};
%brain
\pic[shift={(0.09,-0.13)}] at  (C1){brain={scalefac=0.6,picname=2,filllcolor=orange!30!,
filllcirclecolor=cyan!55!black!60, Linewidth=0.5pt}};
% Compression
 \node[Box1,below left=0 and 1 of B5](B6){};
\node[BoxD1](BB6)at(B6.south){压缩};
\coordinate(S6)at($(B6.north)!0.5!(BB6.north)$);
\pic[shift={(-0.32,-0.27)}] at  (S6){dataFolderS={scalefac=0.29,picname=1,Linewidth=0.5pt,
 filllcolor=BrownLine,drawcolor=BrownLine,filllcirclecolor=RedLine}};
% Compact Model
 \node[Box,left=of B6](B7){};
\node[BoxD](BB7)at(B7.south){紧凑模型};
\coordinate(S7)at($(B7.north)!0.5!(BB7.north)$);
\pic[shift={(0,0)}] at  (S7){llm1={scalefac=0.38,drawcolor=black,filllcolor=orange!50!, Linewidth=1.0pt,filllcirclecolor=violet!70!}};
% Hardware
 \node[Box1, left=of B7](B8){};
\node[BoxD1](BB8)at(B8.south){硬件};
\coordinate(S8)at($(B8.north)!0.5!(BB8.north)$);
\pic[shift={(0,0)}] at  (S8){cpu={scalefac=0.35,picname=1,filllcolor=BlueLine, Linewidth=0.7pt}};
% Deployed System
 \node[Box, left=of B8](B9){};
\node[BoxD](BB9)at(B9.south){已部署系统};
\coordinate(S9)at($(B9.north)!0.5!(BB9.north)$);
\pic[shift={(0,0.1)}] at  (S9){rocket={scalefac=0.6,picname=1,
drawcolor=black,filllcolor=cyan!10!, Linewidth=0.75pt,filllcirclecolor=red}};
%arrows
\foreach \i in {1,2,3,6,7,8}{
\pgfmathtruncatemacro{\x}{\i + 1} %
\draw[LineA](B\i)--(B\x);
}
\draw[LineA](B4)-|(B5);
\draw[LineA](B5)|-(B6);
\end{tikzpicture}figure 12 中的流水线揭示了数据选择为何在优化栈的起点占据战略地位。在训练计划保持不变的情况下,将数据集规模减半,可以使样本级训练工作量减半。然而,数据集剪枝本身并不会缩小参数的存储占用、增加量化余地或放宽模型服务的延迟约束。每个下游层级都会同时承接上游带来的计算节省和上游造成的任何表征缺陷;激进的过滤策略若丢弃了罕见但关键的边缘案例,就可能迫使下游工程师延长训练时间,或放弃激进量化,以保持任务准确率。
要量化这些复合权衡,就需要确定名义上的样本减少能否转化为真正的端到端效率提升,同时不在不知不觉中损害泛化能力。回答这一问题需要严谨的度量框架:通过定量指标,在整条流水线上权衡算术运算节省、数据移动开销和实测任务质量。
度量框架
跨层优化栈使度量框架成为必需:每种数据选择技术都声称能够提高效率,但只有严格的度量才能区分真正的节省、成本转移和隐蔽的质量损失。section 1.11.1 中的核心指标将样本减少与准确率、成本及部署覆盖范围联系起来,从而依据较小数据集保留了什么来评价它,而非仅依据它移除了什么。
核心指标
核心指标将样本减少与模型质量联系起来,而非仅报告准确率。它们度量每个样本带来的准确率增益(单位数据性能)、跨数据集规模的累积学习效率(学习曲线下面积),以及达到目标准确率时的数据集缩减程度(数据压缩比)。
单位数据性能
最直接的指标是单位数据性能(PPD),它度量每个样本带来的准确率增益: \[ \text{PPD}(n) = \frac{\text{Accuracy}(n) - \text{Accuracy}(0)}{n} \] 其中,\(n\) 是训练样本数。PPD 越高,表示在给定区间内每个样本带来的平均提升越大。其曲线形态必须通过度量确定,因为收益递减及其开始出现的时点取决于工作负载。
学习曲线下面积
学习曲线下面积(AULC)并非仅在单个点上进行比较,而是对所有数据集规模下的性能进行积分: \[ \text{AULC} = \int_0^D \text{Accuracy}(n) \, dn \] 其中,\(n\) 是数据集规模,\(D\) 是完整数据集的规模。
在指标和积分区间相同的情况下,AULC 越高,意味着该策略能以更少的样本获得更好的性能。比较时必须使用相同的上限 \(D\),或对积分进行归一化。
数据压缩比
对于核心集方法,数据压缩比(DCR)度量在达到目标准确率时实现的数据缩减程度: \[ \text{DCR} = \frac{D_{\text{full}}}{D_{\text{coreset}}} \text{ at } \text{Accuracy}_{\text{target}} \]
DCR 为 5\(\times\),意味着核心集仅用 20% 的数据即可达到目标准确率。
计算最优前沿
虽然 section 1.11.1 中的核心指标可以度量单项技术,但仍需要更高层次的诊断方法,以检验整体训练策略究竟受限于数据还是计算。神经网络缩放定律实验 (Kaplan et al. 2020; Hoffmann et al. 2022) 在特定模型族、数据集和计算量范围内拟合幂律关系。受控的参数扫描实验可以利用这些拟合关系比较模型与数据的资源分配,但不存在能够诊断所有训练运行的单一比率。
Chinchilla 研究33 (Hoffmann et al. 2022) 在其实验范围内,拟合出了模型规模与训练数据之间的计算最优平衡。偏离这一拟合平衡的两侧分配方案,对该研究计算预算的利用效率都较低。
最优平衡定义了一条计算最优前沿:当数据与模型规模得到适当平衡时,每个计算预算下所能达到的最佳性能。Figure 13 将这一诊断概念绘制为概念性前沿,而非 Chinchilla 的拟合结果。
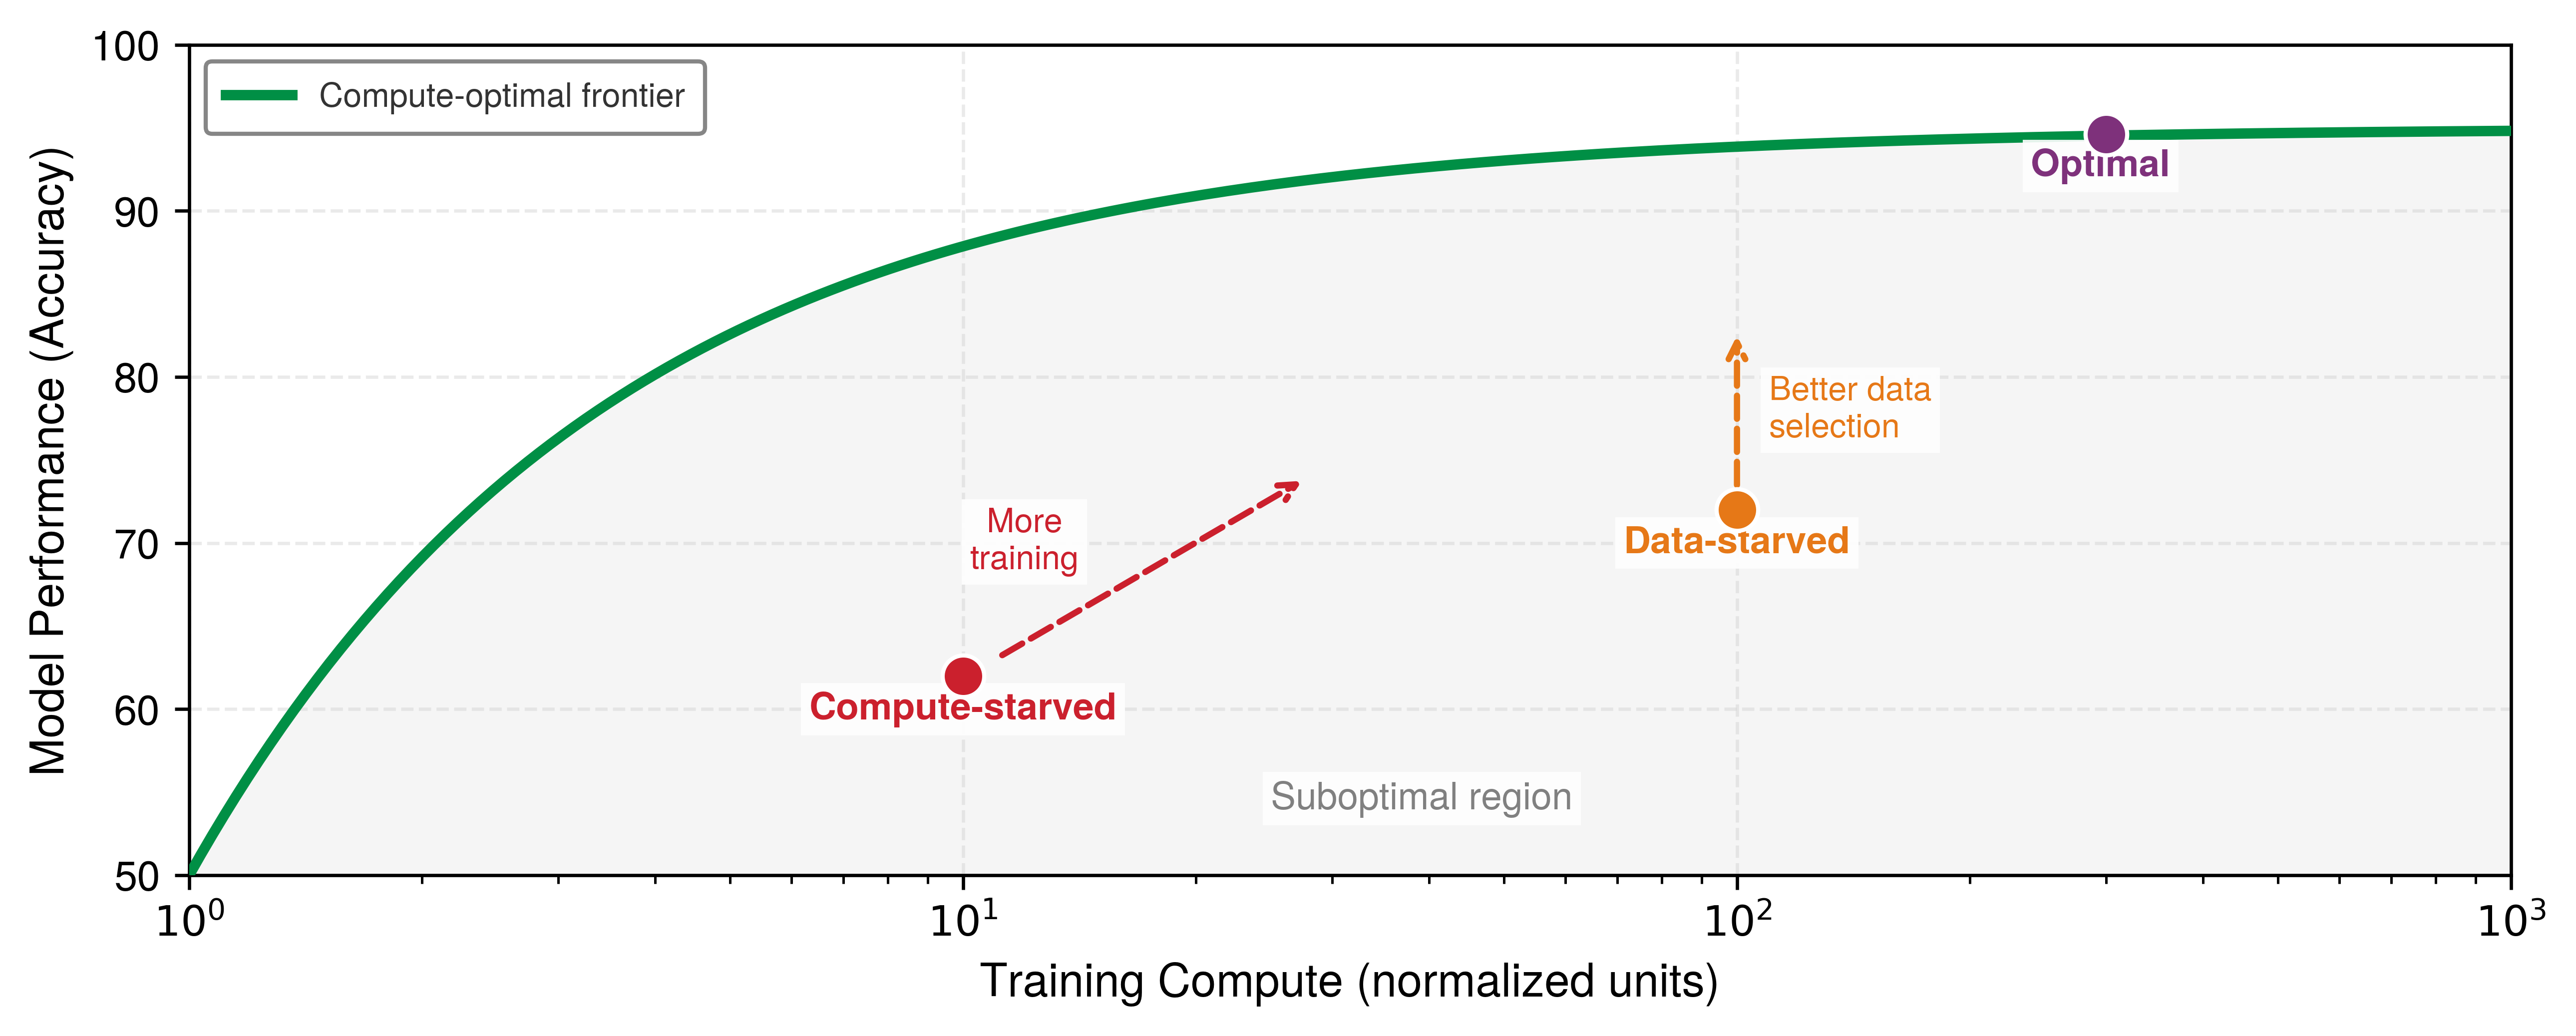
相对于通过受控扫描实验拟合得到的前沿,一个点的位置可以提示下一步实验的方向。受数据限制的资源分配方案提示应测试语料质量、覆盖范围或选择策略;受计算限制的资源分配方案则提示应测试有效吞吐量、训练时长或模型规模。figure 13 中的概念性示意点本身无法诊断真实的训练运行,而拟合前沿附近的点仍然仅适用于估计该前沿时所使用的模型族、数据、目标和计算量范围。
解读 Chinchilla 结果
在 Chinchilla 拟合所涵盖的范围内,计算最优的模型参数量与训练词元数以大致相同的速率增长。34 具体而言,训练一个稠密 Transformer 大约需要 \(6ND\) FLOPs(前向传播需要 \(2ND\),采用激活重计算的反向传播需要 \(4ND\),其中 \(N\) 为参数量,\(D\) 为词元数)。在参数量与词元数按比例增长(\(N \propto D\))的等比例扩展条件下,总计算量呈二次增长(\(C \approx 6 D^2\)),由此直接可知,最优词元数与计算预算的平方根成正比(\(D_{\text{opt}} \propto \sqrt{C}\))。因此,在这些假设下,计算量翻倍对应于词元数增加约 \(\sqrt{2} - 1\),即 41.4 percent。通常引用的每个参数对应 20 个词元,是该研究提供的一个有用参考点,而非普遍适用的最优值。
应用诊断方法
如果一次训练的表现低于预期,延长该次训练可以揭示额外的优化步骤是否仍有帮助,但仅凭性能进入平台期,无法判定数据不足。学习率调度、优化局限、模型容量和数据质量都可能导致平台期。可靠的诊断需要在保持评估协议不变的同时,比较改变模型规模、词元数和计算资源分配的受控训练实验。
在 figure 14 中,两条曲线出现分离:数据利用效率较高的选择策略(蓝色)以比随机采样(灰色)更少的样本达到性能平台期。水平差距表示样本量的减少;当每个样本的计算工作量和训练计划保持不变时,这种减少可以转化为计算节省;红色箭头标出的垂直差距则表示在固定数据集规模下获得的性能提升。
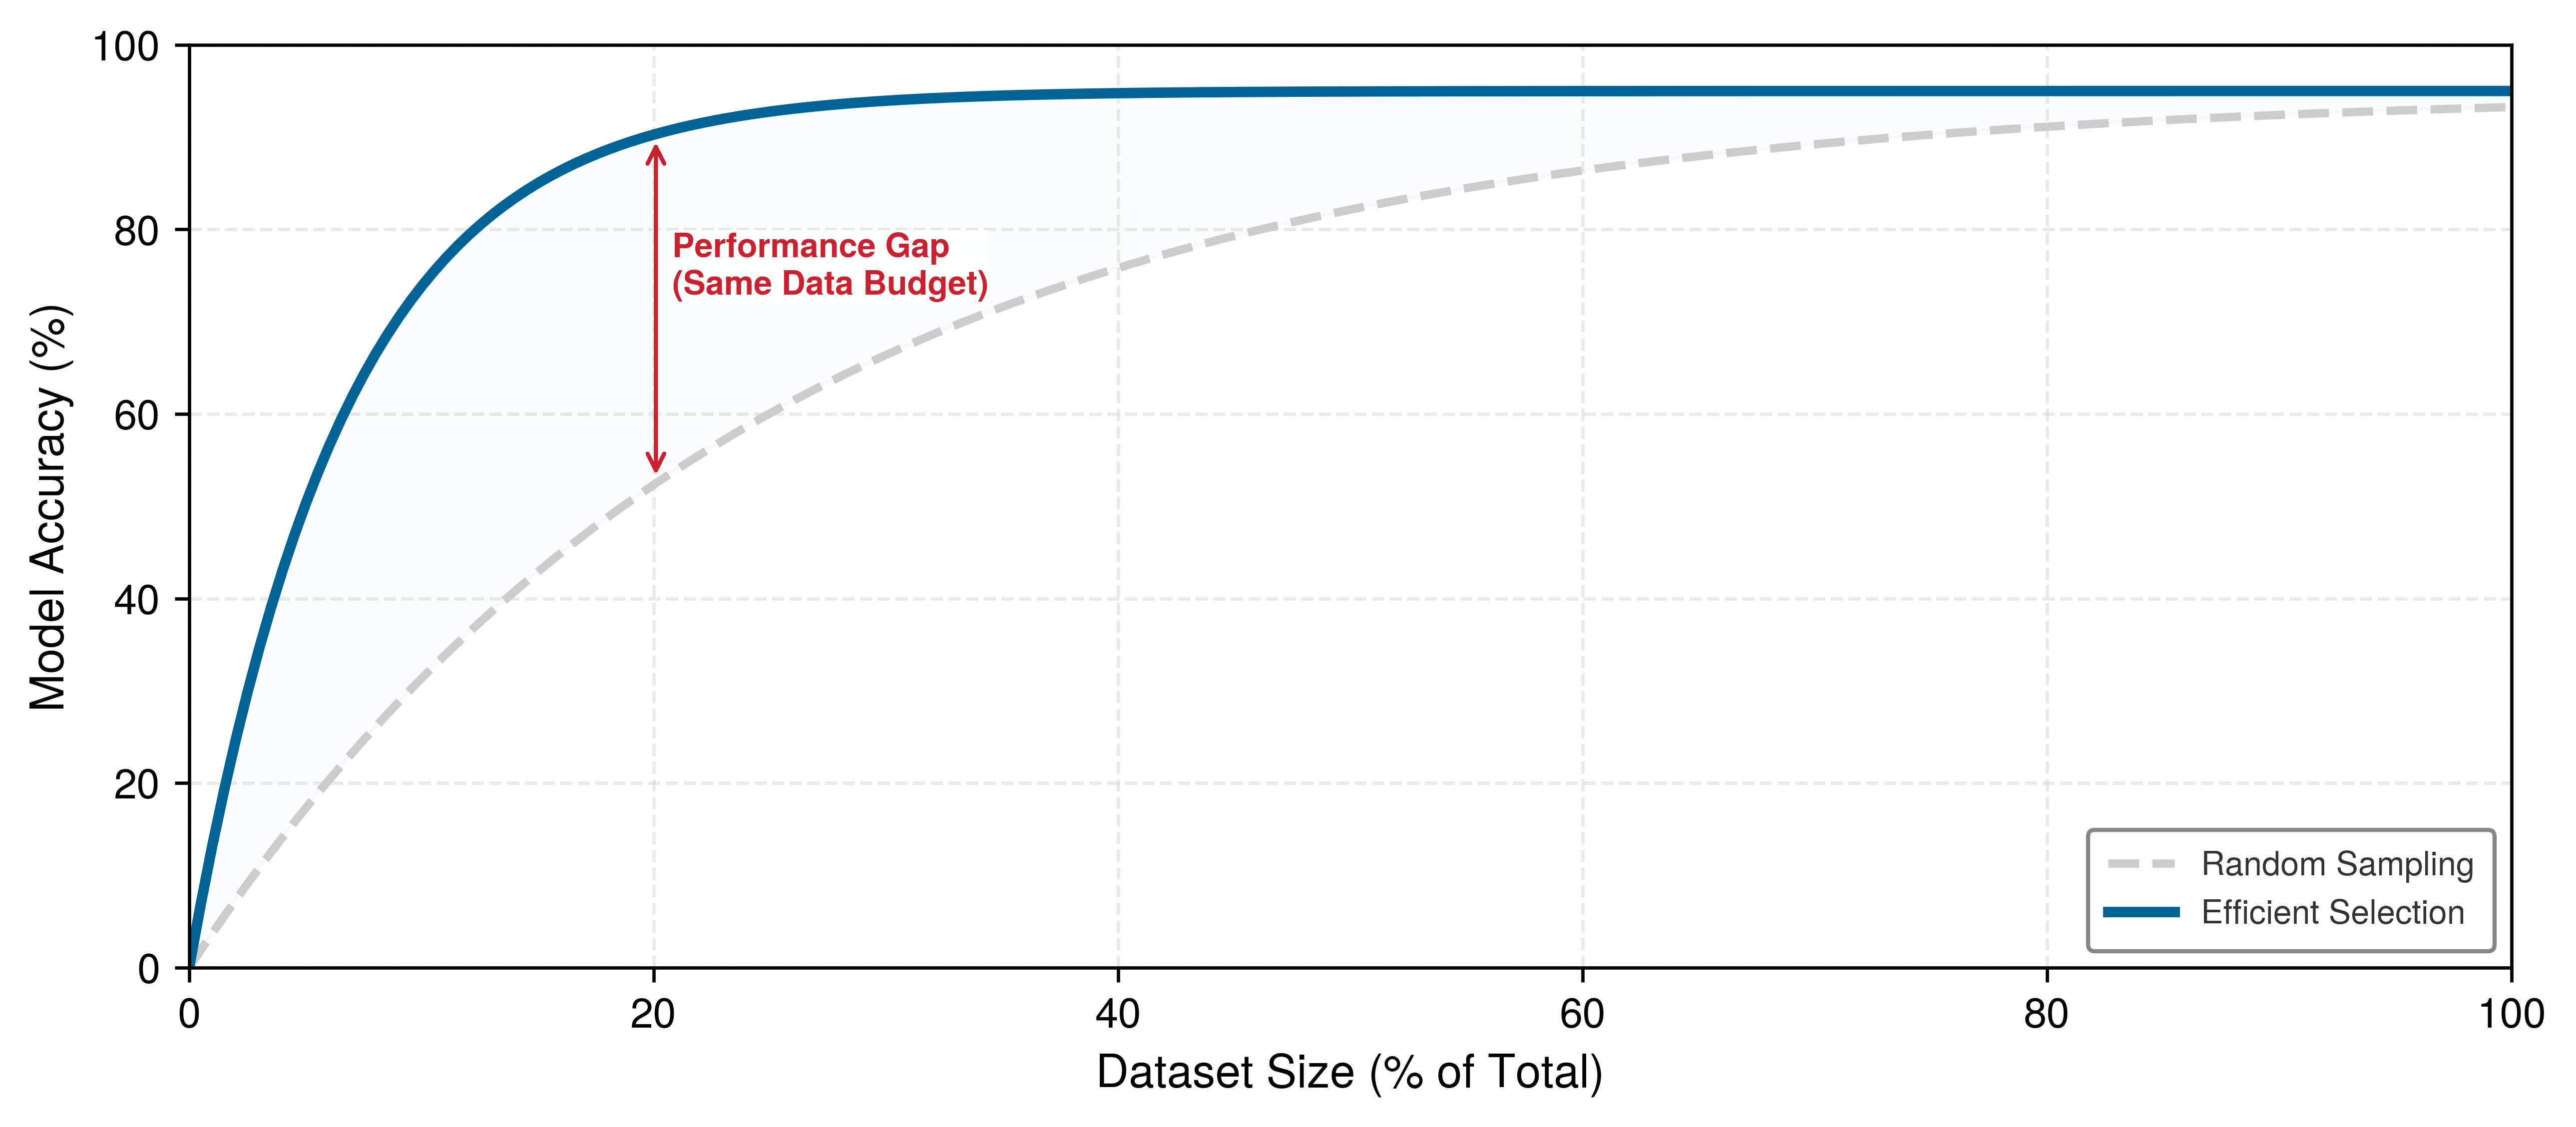
这些评估指标决定了从无差别数据收集转向定向数据整理的转折点,识别出新增样本何时只会浪费训练计算资源,而无法改善泛化能力。然而,算法效率并不能保证缩减后的数据集在实际运行中的边缘情形下仍能保持模型质量。
数据选择技术隐含地对样本价值进行排序,而验证整理后的数据集是否保持了模型质量,需要从三个维度开展系统性的基准测试。覆盖度指标用于验证核心集选择是否保留了各类别和人口统计群体的代表性。分布对齐指标(例如 KL 散度和群体稳定性指数,其定义见 度量漂移(散度) )用于检测整理后的训练集是否偏离部署分布。标签质量指标(标注者间一致性、置信学习)用于验证主动学习是否引入了系统性的标注错误。只有当基准测试确认模型保持了目标准确率、校准性和鲁棒性时,数据集缩减 50% 才有价值。基准测试 将在后文把这些思想推广为更广泛的模型与数据评估协议;此处的论点更为具体:必须针对任务分布验证整理后的数据集,而不能只看其缩减比例。
验证目标本身也可能不可靠。当测试集未能涵盖实际运行中的分布偏移时,基准准确率可能高估泛化能力,因此必须像审查整理后的训练集一样审查评估基准。
Example 1.7: 基准复现差距
场景:在新收集的测试集上评估分类器时,CIFAR-10 上的准确率下降了 3 至 15 个百分点,ImageNet 上下降了 11 至 14 个百分点 (Recht et al. 2019)。
诊断:复现数据收集过程得到的图像比原始测试集中的图像略难。该研究发现,基准适应性并不能解释这一差距,尽管反复使用固定测试集仍然是一项普遍的评估风险。
系统层面的启示:评估集的构建会影响测得的泛化能力。数据选择流水线应在独立收集且与部署场景相关的测试集上验证整理后的子集,而不能仅信赖一个长期重复使用的基准。
Recht, Benjamin, Rebecca Roelofs, Ludwig Schmidt, and Vaishaal Shankar. 2019. “Do ImageNet Classifiers Generalize to ImageNet?” Proceedings of the 36th International Conference on Machine Learning (ICML), 5389–400.
在单一基准上测得的效率收益,可能在分布偏移下消失;只有整理后的子集在多个留出分布上展现出一致的质量,其报告的缩减比例才值得信赖。
Lighthouse 1.3: 灯塔模型的数据选择
数据选择原则适用于全部五个灯塔模型,但主导约束决定了所采用的技术。Table 21 为每种工作负载对应了一项优先策略:例如,受计算限制的 ResNet-50 可受益于核心集选择,受内存限制的 GPT-2/Llama 可受益于去重,而微型 KWS 模型则可受益于数据增强与合成。
Table 21: 各灯塔模型的数据选择优先策略:每种灯塔工作负载的主要瓶颈与候选数据选择优先策略。这种对应关系提出了有待检验的假设;仅凭主导资源约束,并不能保证某项技术会带来收益。
| 灯塔模型 | 主要瓶颈 | 数据选择优先策略 |
|---|---|---|
| ResNet-50 | 计算 | 核心集选择直接减少训练 FLOPs |
| GPT-2/Llama | 内存带宽 | 去重缩减语料规模;课程学习提高词元利用效率 |
| MobileNetV2 | 延迟/功耗 | 针对目标模型和部署所需的不变性验证数据增强 |
| DLRM | 内存容量 | 交互记录去重与嵌入剪枝缩减表规模 |
| 关键词检测 | 极端约束 | 数据增强与合成从极少量种子样本生成数据集 |
在这些工作负载中,数据选择是一种系统优化手段,旨在有针对性地缓解制约流水线的物理资源瓶颈。
在整个优化技术栈中,严谨的指标能够区分真正的计算节省与被推迟的计算债务。只有当在目标质量下实现的下游训练与模型服务节省,超过为样本评分、筛选和暂存所产生的算术运算及数据搬移开销时,选择策略才算成功。
谬误与陷阱
数据选择涉及反直觉的收益递减现象,与传统机器学习中“越多越好”的直觉相矛盾。以下错误分为三类:对数据选择能力的概念性误解、正确策略遇到工程现实后产生的实施陷阱,以及将基准结果不加审视地应用于新领域时发生的迁移错误。
谬误:数据是新的石油,因此总是越多越好。
更多数据并不意味着准确率会成比例提升,因为学习曲线呈现幂律形式的收益递减。测试损失随样本量的增加以次线性方式下降(\(L(N) \propto N^{-\alpha}\)),这意味着每进一步降低误差,都需要规模呈指数级增长的语料。在 table 1 建模的场景中,将数据集从 1M 个样本扩展十倍至 10M 个样本,准确率仅提升了 4 percentage points。从系统角度看,这种 \(10\times\) 的数据量扩张要求存储 I/O、主机到设备的数据传输以及加速器 FLOPs 均增加十倍,消耗大量集群能源来处理冗余、低梯度的样本,而这些样本对参数更新提供的信息微乎其微。工程团队必须测量具体工作负载的经验学习曲线和边际计算成本,而不能假定未经整理的数据扩展会带来成比例的价值。
陷阱:用纯合成训练数据取代真实数据验证。
工程师往往假定,生成模型能够以零边际获取成本提供取之不尽的合成样本,从而替代实证数据收集。纯合成数据训练主要存在两种失效模式。首先,如 section 1.5.3 和 table 9 中所探讨的,生成分布存在域差距:合成数据可能偏离实际部署环境的流形,使 figure 8 中学得的决策边界产生偏差,并导致模型在真实世界输入上发生灾难性的分类失败。其次,使用模型生成的数据进行递归训练会引发模型坍塌 (Shumailov et al. 2024)。如页边图所示,将合成输出反馈到后续训练周期中,会逐步侵蚀分布尾部:在此场景中,经过五代递归训练,评估准确率从 95 percent 降至 78 percent,出现了 17 percentage-point 的骤降。尽管在示意性的 50–80 percent 混合比例下,合成数据增强能够提供有用的覆盖,但合成数据混合方案始终必须以整理后的真实世界分布为基准进行验证和锚定。

递归式合成数据训练使准确率随代数增加而下降。
谬误:数据选择仅仅是数据清洗。
工程师常常将数据质量(修复格式错误的模式、损坏的标签和含噪词元)与特定训练过程下的数据价值混为一谈。一个数据集可以完全干净、标注正确且语法无可挑剔,却在数学上存在冗余:如果模型已经将某个特征簇上的损失降至最小,处理更多相同样本所产生的梯度信号为零,却仍会消耗内存带宽和加速器 FLOPs。数据清洗解决数据的内在缺陷,而数据选择则主动最大化每单位 FLOP 开销带来的学习收益。正如 figure 4 中的不确定性采样边界和 section 1.2.2 中的几何目标所示,针对信息丰富的边界样本进行选择可以提高 ICR——在我们的核心集算例中,ICR 提高至原来的 1.8×。清洗确保数据正确性;选择优化训练计算效率。
陷阱:将数据选择视为仅用于应对预算限制的策略。
实践者常常认为,数据选择是一种专供资源受限的边缘部署或预算有限的团队使用的技术,并假定前沿基础模型只需扩大集群规模,就能依靠算力强行实现收敛。实际上,大规模训练从根本上受到数据墙的制约(figure 1),即可用加速器容量的增长超过了可获取的、高质量且与任务相关的人类数据的供给。此外,数据选择的经济回报随集群支出的增加而扩大:在我们的基准假设下,对于一次成本为 $100M 的前沿模型训练,效率提高 10 percent 可节省 $10M。当选择基础设施、预先计算的重要性分数和缓存嵌入的成本分摊到多次训练及下游适配中时(section 1.8.4),智能筛选便成为大规模工程系统中一项基础性的经济杠杆。
谬误:选择开销太小,不足以改变训练的经济性。
只有当评分和筛选的计算成本严格低于其节省的训练计算成本时,数据选择策略才可行。正如 equation 2 中的选择不等式所形式化的那样,端到端可行性要求 \(T_{\text{selection}} + T_{\text{train}}(\text{subset}) < T_{\text{train}}(\text{full})\)。考虑一次耗时 8 hours 的基准训练,其中在优化后的核心集上训练需要 2-hour。如果某种复杂的选择算法需要 10 hours 来计算样本重要性,那么仅选择步骤的耗时就是加速后训练耗时的 5×,甚至超过完整训练本身的基准耗时,从而造成计算资源的净损失。为满足 equation 2,生产流水线通过使用缓存嵌入或轻量级代理网络,将评分与主模型解耦。在我们的示例比较中,基于代理模型的 EL2N 评分在 30 minutes 内完成,仅占完整训练基准耗时的 6.2 percent,因而满足该不等式,并带来切实的实际耗时节省。
陷阱:将稀有类别剪除殆尽。
标准选择目标最小化总体经验损失,使长尾切片对全局采样概率的影响微乎其微。在一个包含 1M 个样本的数据集中,若稀有类别占数据的 0.1 percent(即 1,000 个样本),则未经分层、规模为原数据集 10 percent 的核心集在期望上仅保留 100 个稀有类别样本,远低于学习稳定特征表示所需的 150 个样本阈值。虽然重要性采样 理论上可以通过按选择概率的倒数对损失贡献加权来补偿,但极端的采样权重会增大梯度方差。这种梯度方差会使优化器的动量轨迹不稳定,迫使训练采用更小的学习率,从而减缓集群上的训练收敛。正如 section 1.2.2 中所建议的,生产环境中的核心集流水线必须先为每个类别或对部署至关重要的切片强制设定分层保留数量的硬性下限,再优化剩余的选择预算。
谬误:对训练数据去重就足以使评估可靠。
工程师常常认为,消除训练分区中的重复序列就能防止记忆并确保评估不受污染。然而,网络规模的数据摄取流水线会从共同的网络爬取数据中获取训练集、验证集和基准测试集,从而引入隐蔽的跨划分数据泄漏。当评估集包含训练文档的重复或近重复内容时,验证指标衡量的是记忆能力,而非分布外泛化能力。一项全面的去重研究表明,在标准语言建模基准中,训练集与测试集之间的重叠影响了超过 4% 的验证样本 (Lee et al. 2022)。仅对训练数据单独去重,无法消除这种评估污染。严格的流水线数据治理要求使用 \(n\)-gram 匹配或 MinHash LSH 进行跨分区去重(section 1.2.3),并校准近重复相似度阈值,以同时清除所有划分中泄漏的序列。
Lee, Katherine, Daphne Ippolito, Andrew Nystrom, Chiyuan Zhang, Douglas Eck, Chris Callison-Burch, and Nicholas Carlini. 2022. “Deduplicating Training Data Makes Language Models Better.” Proceedings of the 60th Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), 8424–45. https://doi.org/10.18653/v1/2022.acl-long.577.
陷阱:开展主动学习时不考虑标注延迟。
主动学习的理论表述假定存在一个零延迟的预言机,能够即时标注被查询的样本,使模型在选择下一批查询样本之前立即利用新的梯度。在生产系统中,人工标注队列会引入显著的周转延迟——例如,样本发出到标签返回之间可能存在 14-day 的延迟。这种延迟通过两种方式破坏主动学习反馈回路。如果加速器集群在等待标签期间停止训练,昂贵的硬件就会闲置,严重损害集群计算利用率。反之,如果在等待标注期间继续利用后台数据异步训练,模型权重就会随训练步骤发生漂移;等到标签返回时,最初作为查询这些样本依据的不确定性分数已经过时。此外,为分摊标注周转开销而发送超大批次的样本,会导致查询批次内部出现信息冗余,除非施加多样性惩罚。主动学习的投资回报不仅受标注价格限制,还受标注周转延迟与模型重训练周期之比的限制。
谬误:如果一种技术在 ImageNet 上有效,它在我的数据集上也会有效。
从标准视觉基准得出的数据选择剪枝比例,不能盲目迁移到特定领域的工作负载。CIFAR-10 和 ImageNet 等基准数据集在典型对象类别中具有较高的语义冗余,因此可以进行大幅度的核心集剪枝(通常为 30% 至 50%),而不会出现可测量的准确率下降。相比之下,组织病理学、卫星遥感或工业缺陷检测等专业领域具有重尾特征分布,其中与安全至关重要的模式只出现在少数稀有样本中。依据 ImageNet 启发式规则丢弃 50% 的样本,可能会消除区分细微病理差异的唯一边界样本,引发灾难性的领域性能退化。此外,几何核心集算法依赖嵌入空间:如果特征提取器是在自然图像上预训练的,其表示就缺乏辨别领域内细粒度差异所需的归纳偏置。工程团队必须先衡量自身数据的冗余程度,针对目标下游任务评估表示,并在与安全至关重要的切片上验证保留比例,然后才能应用剪枝。
陷阱:优化数据选择指标,而非部署指标。
选择算法优化的是替代性数学目标,例如总体损失下降、学习曲线下面积(AULC)或每美元进展(PPD,section 1.11.1),这些目标在验证语料上被评估为一个汇总标量。保留 10 percent 核心集的选择策略,可以优先选择常见且易于学习的样本所形成的密集簇,以加速平均收敛,同时丢弃模糊的边界情况和稀有切片,从而获得更高的总体 PPD。然而,在生产环境中,系统故障发生在长尾切片、边界情况和受保护子群体上,而不是发生在数据集的平均水平上。在缺乏子群体约束的情况下最大化总体选择效率,会产生能够通过全局验证门槛、却在部署中灾难性失效的模型。按照 section 1.11 中测量框架的要求,必须使用分层的切片级基准来评估选择策略,确保覆盖不同人口群体、稀有类别和运行中的边界情况,即使这样做会略微降低平均 PPD。
总结
数据选择将训练数据量视为一个工程变量,而非不可改变的约束。传统机器学习关注达到目标准确率需要多少样本,系统工程则优化计算、存储、标注、能源和实际耗时的总成本。经过筛选整理的数据集能够达到甚至超越大规模未经筛选语料的效果,因为不同原始样本的边际学习信号可能相差数个数量级。在优化顺序中,选择解决的是首要问题:在模型训练开始前消除不必要的工作。
三种定量工具使这一系统视角能够付诸实践:ICR、选择不等式和数据总成本模型。信息—计算比量化每次浮点运算带来的学习收益,据此判断一个样本是否值得为其执行一次训练处理。选择不等式要求,对候选样本评分所产生的计算开销和实际耗时开销,必须严格小于在保留子集上训练所节省的时间。这些形式化表述与投资回报及盈亏平衡分析共同决定了所提议的选择机制究竟是在节省资源,还是仅仅在不同阶段之间转移支出。
三阶段优化流水线分别处理这一成本方程中的不同阶段:静态剪枝在训练前通过核心集选择和去重消除冗余;动态选择在训练期间通过课程学习和主动学习优先处理信息丰富的样本;合成生成则通过增强、仿真和蒸馏,在缺乏数据之处创建数据。这些策略共同应对“数据墙”,即快速增长的计算能力与缓慢增长的高质量数据之间的结构性不对称。
自监督学习代表了数据选择谱系中的一个极端。预训练将大部分表示学习转移到无需标注的上游阶段,使下游任务能够以少几个数量级的任务专用标签达到目标质量。当预训练成本分摊到数十次或数百次专业化适配中时,这种前期投入便具有显著的经济吸引力。
将这些选择策略应用于生产环境,需要解决具体的系统瓶颈。equation 2 中的选择不等式为每种技术设定了准入条件:任何评分过程,只要其耗时超过训练所节省的实际耗时,就会造成净损失。代理模型和基于分片的加载器使动态选择能够适应存储的顺序访问带宽,避免随机样本访问导致加速器执行停滞。当输入流水线仍是吞吐量瓶颈时,数据回显通过复用批次来利用闲置的 GPU 周期。最后,诊断指标——每美元点数(PPD)、学习曲线下面积(AULC)和数据—计算比(DCR)——能够揭示模型受限于数据还是计算,从而引导投入流向构成约束的资源。
要点回顾: 精选,而非堆积
- 选择优化系统成本:目标是最小化计算、存储、标注和能源的总成本,而不仅仅是减少样本数量。信息—计算比以每单位 FLOP 开销带来的学习收益来量化这一权衡,只有在计算受限的条件下,这种收益才会转化为实际耗时的缩短。
- 从去重开始:精确去重通常是风险最低的首选技术,因为它无需经过学习型评分过程,就能移除重复字节。只有在根据下游质量指标验证阈值之后,才应应用近重复去重和语义去重。
- 选择不等式为每种技术设定准入条件:下游训练节省必须严格超过选择开销:\(T_{\text{selection}} + T_{\text{train}}(\text{subset}) < T_{\text{train}}(\text{full})\)。轻量级代理模型和缓存嵌入可使 \(T_{\text{selection}}\) 保持较低水平,而未经优化的选择算法可能耗尽其节省的全部计算资源。
- 动态选择调整数据供给:课程学习改变样本的呈现顺序,主动学习则改变哪些样本获得标注。在评分规则、覆盖范围和更新开销得到验证时,两者都能提高效率。
- 自监督预训练可以分摊适配成本:一次预训练、多次微调,可将预训练成本分摊到多个下游任务中。算例假设标签需求降至原来的 1/100(100\(\times\)),边际计算量降至原来的 1/20(20\(\times\));实际节省取决于迁移质量和复用程度。
- 合成数据是补充,而非替代:50%–80% 的合成数据混合比例仅为示例,取决于工作负载,并非普适的最优值。纯合成数据训练存在模型坍塌和领域差距导致性能退化的风险。
- 经验证的工作负载削减会在下游累积收益:当选择能够安全地消除样本或词元,且无需增加补偿步骤时,这些工作就不会进入后续的模型或机器优化阶段。动态评分和合成会引入自身成本,因此必须测量组合后的节省,而不能想当然。
数据选择所遵循的核心不变量是:对于每传输一个字节和每执行一次 FLOP,不同训练样本提供的边际学习信号存在巨大差异。在数据—算法—机器分类体系中,选择位于系统的最前端:每安全消除一个冗余样本或无信息量词元,都会直接减少机器学习系统铁律(原理 原则(英文原版))中的数据量(\(D_{\text{vol}}\))和运算次数(\(O\))。只要选择开销始终严格满足选择不等式的约束,这种上游削减就会在下游算法压缩或硬件加速开始之前,永久消除相应工作。
后续内容: 从数据到算法
数据选择改变的是系统从什么数据中学习;即使是最好的数据,也无法让低效模型在受限硬件上快速运行。模型压缩 将关注点转向系统如何表示其学到的内容,通过剪枝、量化和知识蒸馏来降低模型产物本身的计算成本。
Footnotes
缩放定律:约翰斯·霍普金斯大学和 OpenAI 的 Jared Kaplan 及其同事于 2020 年通过实证研究表明,在其研究的范围内,语言模型损失与模型规模、数据集规模和计算预算之间呈幂律关系 (Kaplan et al. 2020)。在 \(\mathcal{L} \propto D^{-\alpha}\) 中,他们拟合得到的数据指数约为 \(\alpha = 0.095\)。这一数值并不具有普适性,但收益递减的曲线形态使我们能够推断选择何时比收集更具成本效益。↩︎
数据墙:与计算能力(随资本支出扩展)或算法(通过研究改进)不同,高质量人类生成文本的存量增长缓慢;Epoch AI 更新后的预测估计,在该论文所建模的数据消耗假设下,模型可能会在 2026 年至 2032 年之间使用规模大致等于公开人类生成文本存量的数据集 (Villalobos et al. 2022)。对于系统设计而言,重点并非某个固定的日历期限,而是数据可能成为供给约束,而不仅仅是经济约束。这一约束直接影响总运算量 \((O)\) 项:当高质量数据变得稀缺时,无论硬件吞吐量如何,增加计算量都会带来递减的收益。↩︎
The Pile:一个约 886 GB 的英语文本语料库(来源报告的大小为 825 GiB),汇集了二十二个子数据集,包括 PubMed、ArXiv、GitHub、Project Gutenberg、Common Crawl、Stack Exchange、Wikipedia 和 USPTO 专利 (Gao et al. 2020)。其多源设计使其成为说明数据多样性的有用示例:每类来源在重复程度、质量和领域覆盖方面均有不同特征,因此选择流水线必须在移除冗余文本的同时保留覆盖度。↩︎
C4(超大规模干净网络抓取语料库):C4 对 Common Crawl 数据进行过滤,包括语言检测、对重复的三句连续文本片段进行去重,以及移除未通过启发式质量检查的页面,最终生成约 750 GB 的清洗后英语文本 (Raffel et al. 2020)。过滤本身具有计算成本,也可能移除有用材料,因此必须测量其投资回报率和质量影响,而不能仅根据语料规模加以推断。↩︎
核心集(core set):在计算几何中,一个小子集可以在受控的误差因子内近似某个指定的几何目标 (Agarwal et al. 2005)。机器学习将这一思想用作选择原则,但针对某种嵌入和距离目标的保证,本身并不能保证神经网络的准确率。仍须在目标任务上验证所保留的子集。↩︎
k-center 算法:其贪心策略在选定的嵌入和度量下,迭代选择距离现有中心最远的点。Sener 和 Savarese 将这一核心集框架用于卷积神经网络的主动学习 (Sener and Savarese 2018)。由此得到的覆盖界适用于该几何目标,并不直接适用于下游准确率或稀有类别的保留。↩︎
EL2N(误差 L2 范数)和 GraNd(梯度范数):这些方法根据训练早期的误差或梯度范数对样本评分,识别模型认为最难的样本。这种方法的实用性依赖于可迁移性,即小型代理模型产生的评分能够指导规模大得多的目标模型的数据选择。例如,一个训练了五个轮次的代理模型可以生成评分,用于筛选数据集,供完整的 90 轮次生产训练使用 (Paul et al. 2021)。↩︎
遗忘事件:该方法通过跟踪模型何时“遗忘”样本来识别有价值的样本,即样本在训练过程中从分类正确转为分类错误的时刻。核心权衡在于,这种分析成本高昂,需要完成一次完整训练。然而,由此得到的重要性评分能够可靠地从小型代理模型迁移到大型目标模型(例如,从 ResNet-18 迁移到 ResNet-50),这正是“低成本代理模型选择”策略可行的原因 (Toneva et al. 2019)。↩︎
MinHash:该算法由 Broder (1997) 提出,用于为 AltaVista 检测重复网页。它使用随机哈希函数创建紧凑签名,使相似文档以高概率产生相似签名。每个签名将文档压缩为固定大小的摘要;对于大小为 \(s\) 的摘要,可以在 \(\mathcal{O}(s)\) 时间内估计两两相似度。↩︎
局部敏感哈希(LSH):LSH 将 MinHash 签名哈希到桶中,使相似签名更有可能发生碰撞。候选生成避免了穷尽式的全样本两两比较,而运行时间和内存开销取决于签名宽度、分带方式、桶大小以及需要验证的候选数量。↩︎
Jaccard 相似度:定义为 \(|A \cap B| / |A \cup B|\),取值范围从 0(不相交)到 1(完全相同)。在去重中,该指标比较不同长度文档的片段集合。阈值必须根据片段定义、语料库和下游质量进行校准,因为不存在能够区分重复文档与合理相关文档的通用阈值。↩︎
CLIP(对比式语言—图像预训练):CLIP 在 4 亿个图文对上进行预训练,将语义相关的图像和文本映射到共享嵌入空间 (Radford et al. 2021)。嵌入可以检索供审核的候选样本,但语义接近并不能证明两个样本重复。生成嵌入的成本也显著高于计算感知哈希,具体比值取决于模型和硬件。↩︎
课程学习:源自拉丁语 currere(“奔跑”),最初意为“要跑的路线”——这一比喻与该技术直接对应:将训练数据视为一条按刻意安排的顺序跑过的路线,先跑容易的路段。课程学习可以作为非凸优化的一种延拓方法,由较容易的样本塑造早期优化轨迹,随后再引入较难的样本。从系统角度看,样本的 ICR 可能在训练期间发生变化,这为随时间改变样本组合提供了依据。↩︎
主动学习:“主动”的主体是学习算法本身,由它选择接下来应由人类专家标注哪些未标注样本。这将问题从计算优化(在给定数据上训练)重新表述为经济优化:使专家标注上每花费一美元所带来的模型改进最大化。与随机采样相比,查询信息量最大的样本可以显著减少标注需求,但具体倍数取决于任务、模型和标注者。↩︎
临床标注经济性的示例分析:审阅速率和每小时费用的范围是场景假设,而非实测结果。在这些输入条件下,标注 500 张影像需要 7–10 hours,成本为 $1,000–3,000;标注全部 50,000 张影像的成本为 $94,000–300,000。这些计算说明了为什么在专家标注成本高昂时,半监督学习可能具有吸引力,但实际审阅时间、争议裁决、患病率以及验证要求仍须测定。↩︎
伪标签法:将已训练模型自身的高置信度预测作为未标注数据的真实标签;该技术的有效性依赖于一个良性循环:对简单未标注样本的准确预测扩充了训练集,进而改进模型,使其能够对更难的样本做出准确预测。其失效模式同样具有自我强化特征:错误的伪标签通过确认偏误强化错误,导致模型不断强化自身的误分类。↩︎
一致性正则化:源于平滑性假设:如果两个输入 \(x_1\) 和 \(x_2\) 在输入空间中彼此接近,其标签也应接近;训练目标是最小化模型对某个输入及其增强版本的预测之间的差异。这在概念上不同于数据增强(后者用于创建更多训练样本),因为它明确将预测一致性作为损失项加以约束,即使对于“正确”标签未知的未标注数据也是如此。其系统层面的代价是,需要额外计算来生成并比较多种扰动下的预测;这种权衡可能有利于计算资源充足而标签匮乏的场景。↩︎
FixMatch:它利用弱增强图像生成伪标签,然后训练模型,使其对该图像的强增强版本预测出相同标签。这种一致性训练由置信度阈值控制;只有当模型对弱增强图像的预测具有很高置信度(例如 >0.95)时,才使用相应伪标签 (Sohn et al. 2020)。这体现了额外训练计算与更少人工标签之间的直接系统权衡;其幅度取决于基线和成本模型。↩︎
自监督学习:前置任务(例如下一词元预测或掩码词元预测)提供源自数据本身的监督信号。这减少了对任务特定人工标签的依赖,但可能需要大量预训练计算。成本能否摊薄,取决于所得模型被复用的广泛程度。↩︎
基础模型:这一名称强调这些模型是众多下游任务的共享底座,但这也形成了单点故障。基础模型预训练数据中的缺陷(偏差、事实错误、被记忆的隐私内容)会传播到基于该模型构建的每个应用。从系统角度看,这种同质化风险意味着,预训练阶段数据选择质量的影响范围异常广泛:在从头训练范式中只会影响一项任务的数据整理错误,如今会影响数千个下游部署。↩︎
Cutout:在训练期间随机遮蔽输入图像的正方形区域,迫使模型根据局部信息识别对象,而非依赖任何单一的判别性区域 (DeVries and Taylor 2017)。与在特征空间中将神经元置零的 dropout 不同,Cutout 在输入空间中操作。最初的 Cutout 实验在 CIFAR-10/100 和 SVHN 上取得了 0.3–2.0 个百分点的提升,计算开销可忽略不计。因此,当遮挡式不变性与任务相匹配时,它是一种高 ICR 的增强技术:以接近零的流水线额外成本,提高每个样本所提供的信息量。↩︎
CutMix:将 Cutout 中被置零的区域替换为另一幅训练图像中的图像块,并按图像块面积比例混合标签(图像 A 中 30% 的面积被图像 B 替换时,标签按 70/30 划分)(Yun et al. 2019)。这解决了 Cutout 的一个弱点:置零区域浪费了本可承载学习信号的像素信息。CutMix 论文报告,在 ImageNet 上,ResNet-50 和 ResNet-101 的 top-1 准确率分别提升了 2.28 个百分点和 1.70 个百分点,同时定位表现也有所改善。该方法只需很少的额外数据流水线成本,就能提供比单独使用 Cutout 或 MixUp 更强的正则化。↩︎
回译:在 Sennrich et al. (2016) 描述的方法中,目标语言单语文本被翻译成源语言,再将合成的源语言文本与保持不变的目标语言文本配对,用于机器翻译训练。系统层面的权衡在于延迟,因为每个合成源语言样本都需要进行翻译模型推理。流水线可以离线预先计算这些样本,而非在数据加载器中生成。↩︎
AutoAugment:将增强策略设计视为强化学习搜索问题:控制器选择操作(旋转、平移、剪切、直方图均衡化)、操作幅度和应用概率,以最大化验证准确率 (Cubuk et al. 2019)。最初的 ImageNet 搜索使用了约 15,000 GPU 小时,促使后续方法缩小搜索空间。↩︎
RandAugment:将 AutoAugment 的策略搜索简化为两个超参数:变换次数 \(N\) 和共享幅度 \(M\) (Cubuk et al. 2020)。在所报告的基准测试中,这个小型搜索空间以低得多的搜索成本达到或超过了 AutoAugment 的表现,因此,当投入 15,000 GPU 小时进行策略搜索难以证明合理时,该方法具有实用价值。↩︎
Stable Diffusion:在压缩潜在空间中执行迭代去噪,能够生成具有针对性的文生图样本 (Rombach et al. 2022)。其迭代生成所需的计算远多于几何变换,因此适用于新颖性比单样本吞吐量更重要的场景。↩︎
域差距:合成数据分布与真实数据分布之间的统计差异,可使用最大均值差异(MMD)或弗雷歇 Inception 距离(FID)等指标衡量。对于机器学习系统,这种差距表现为训练与服务偏差:在仿真器数据上训练的模型可能在合成数据上取得良好的验证结果,却在真实部署数据上悄然失效。↩︎
域随机化:通过随机化纹理、颜色、光照和物理属性,有意增加合成数据的变化。目标并非照片级真实感,而是提供足够的变化以改善对部署条件的覆盖,从而将成本瓶颈从渲染保真度转移到覆盖范围。↩︎
模型坍塌:Shumailov et al. (2024) 对这一现象进行了形式化分析,其成因在于生成模型系统性地低估了尾部分布——即训练数据中出现频率较低、但十分重要的罕见模式。当第 \(n+1\) 代模型使用第 \(n\) 代模型的输出进行训练时,后续每一代都会进一步压缩分布尾部,产生越来越同质化的数据。在递归训练场景中,这种退化可能非常迅速,因此,在缺少真实数据锚定的合成输出上训练,存在尾部多样性灾难性坍塌的风险。↩︎
知识蒸馏:教师模型的软概率揭示了独热编码所忽略的类别间结构相似性。温度参数调节 logit 的平滑程度(\(\tau > 1\));过度平滑会抹去判别信号,而 \(\tau \to 1\) 则退化回 argmax 预测。蒸馏会引入教师模型的推理成本,必须通过学生模型样本效率或准确率的提升来证明其合理性。↩︎
FAISS(Facebook AI 相似性搜索):通过精确、近似和压缩域索引设计,提供 GPU 加速的相似性搜索 (Johnson et al. 2019);Johnson、Douze 和 Jegou 报告了在多个 GPU 上构建十亿向量规模图的工作,说明了向量索引基础设施为何对互联网规模的数据选择至关重要。对于数据选择流水线,FAISS 式索引支持用于核心集选择的 \(k\) 近邻检索、基于嵌入的去重,以及用于均衡采样的分层聚类。缺少这类基础设施时,基于嵌入的选择往往只能退回到代价高昂的全语料库扫描。↩︎
数据回响:关键的微妙之处在于将回响点插入流水线的什么位置。在增强之前进行回响(上游回响),可以对每次重复应用不同的随机增强,而在增强之后进行回响,则会向加速器提供相同的张量。有效的回响因子和实际加速比取决于工作负载、批量大小、插入位置和混洗策略 (Choi et al. 2019)。↩︎
Chinchilla:Chinchilla 是一个具有 700 亿参数、使用 1.4 万亿词元训练的语言模型。在 Hoffmann et al. (2022) 报告的实验中,在相近的训练计算预算下,它在大多数评估任务上优于规模更大的 GPT-3。在该研究的实验范围内,拟合得到的计算最优分配使参数量和词元数以大致相同的速率增长;它并非适用于所有架构、数据集或训练方案的通用准则。↩︎
每个参数对应的词元数:比值 \(D/P\) 比较训练词元数与模型参数量;GPT-3 每个参数使用了约 1.7 个词元 (Brown et al. 2020),而 Llama 2 70B 约为 28.6 个 (Touvron et al. 2023)。这些描述性比值无法确定,在不同的架构、语料、目标或硬件预算下,这两次训练中的任何一次是否达到了计算最优。要作出这一诊断,需要对模型规模和词元数进行受控扫描实验。↩︎
Kaplan, J., S. McCandlish, T. Henighan, T. B. Brown, B. Chess, R. Child, S. Gray, A. Radford, J. Wu, and D. Amodei. 2020. “Scaling Laws for Neural Language Models.” ArXiv Preprint abs/2001.08361.
Villalobos, Pablo, Anson Ho, Jaime Sevilla, Tamay Besiroglu, Lennart Heim, and Marius Hobbhahn. 2022. “Will We Run Out of Data? Limits of LLM Scaling Based on Human-Generated Data.” arXiv Preprint arXiv:2211.04325.
Gao, Leo, Stella Biderman, Sid Black, Laurence Golding, Travis Hoppe, Charles Foster, Jason Phang, et al. 2020. “The Pile: An 800GB Dataset of Diverse Text for Language Modeling.” arXiv Preprint arXiv:2101.00027.
Raffel, C., N. Shazeer, A. Roberts, K. Lee, S. Narang, M. Matena, Y. Zhou, W. Li, and P. J. Liu. 2020. “Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer.” Journal of Machine Learning Research 21 (140): 1–67.
Agarwal, Pankaj K., Sariel Har-Peled, and Kasturi R. Varadarajan. 2005. “Geometric Approximation via Coresets.” In Combinatorial and Computational Geometry, edited by Jacob E. Goodman, János Pach, and Emo Welzl, vol. 52. MSRI Publications. Cambridge University Press. https://doi.org/10.1017/9781009701259.002.
Sener, Ozan, and Silvio Savarese. 2018. “Active Learning for Convolutional Neural Networks: A Core-Set Approach.” International Conference on Learning Representations (ICLR).
Paul, Mansheej, Surya Ganguli, and Gintare Karolina Dziugaite. 2021. “Deep Learning on a Data Diet: Finding Important Examples Early in Training.” Advances in Neural Information Processing Systems (NeurIPS) 34: 20596–607.
Toneva, Mariya, Alessandro Sordoni, Remi Tachet des Combes, Adam Trischler, Yoshua Bengio, and Geoffrey J Gordon. 2019. “An Empirical Study of Example Forgetting During Deep Neural Network Learning.” International Conference on Learning Representations (ICLR).
Broder, A. Z. 1997. “On the Resemblance and Containment of Documents.” Proceedings. Compression and Complexity of SEQUENCES 1997 (Cat. No.97TB100171), 21–29. https://doi.org/10.1109/sequen.1997.666900.
Radford, Alec, Jong Wook Kim, Chris Hallacy, Aditya Ramesh, Gabriel Goh, Sandhini Agarwal, Girish Sastry, et al. 2021. “Learning Transferable Visual Models from Natural Language Supervision.” International Conference on Machine Learning (ICML), 8748–63.
Sohn, Kihyuk, David Berthelot, Nicholas Carlini, Zizhao Zhang, Han Zhang, Colin A Raffel, Ekin Dogus Cubuk, Alexey Kurakin, and Chun-Liang Li. 2020. “FixMatch: Simplifying Semi-Supervised Learning with Consistency and Confidence.” Advances in Neural Information Processing Systems (NeurIPS) 33: 596–608.
DeVries, Terrance, and Graham W. Taylor. 2017. “Improved Regularization of Convolutional Neural Networks with Cutout.” arXiv Preprint arXiv:1708.04552.
Yun, Sangdoo, Dongyoon Han, Seong Joon Oh, Sanghyuk Chun, Junsuk Choe, and Youngjoon Yoo. 2019. “CutMix: Regularization Strategy to Train Strong Classifiers with Localizable Features.” 2019 IEEE/CVF International Conference on Computer Vision (ICCV), 6023–32. https://doi.org/10.1109/ICCV.2019.00612.
Sennrich, Rico, Barry Haddow, and Alexandra Birch. 2016. “Improving Neural Machine Translation Models with Monolingual Data.” Proceedings of the 54th Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), 86–96. https://doi.org/10.18653/v1/P16-1009.
Cubuk, Ekin D., Barret Zoph, Dandelion Mané, Vijay Vasudevan, and Quoc V. Le. 2019. “AutoAugment: Learning Augmentation Strategies from Data.” 2019 IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 113–23. https://doi.org/10.1109/cvpr.2019.00020.
Cubuk, Ekin D., Barret Zoph, Jonathon Shlens, and Quoc V. Le. 2020. “Randaugment: Practical Automated Data Augmentation with a Reduced Search Space.” 2020 IEEE/CVF Conference on Computer Vision and Pattern Recognition Workshops (CVPRW), 3008–17. https://doi.org/10.1109/cvprw50498.2020.00359.
Rombach, Robin, Andreas Blattmann, Dominik Lorenz, Patrick Esser, and Bjorn Ommer. 2022. “High-Resolution Image Synthesis with Latent Diffusion Models.” 2022 IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 10674–85. https://doi.org/10.1109/cvpr52688.2022.01042.
Shumailov, Ilia, Zakhar Shumaylov, Yiren Zhao, Nicolas Papernot, Ross Anderson, and Yarin Gal. 2024. “AI Models Collapse When Trained on Recursively Generated Data.” Nature 631 (8022): 755–59. https://doi.org/10.1038/s41586-024-07566-y.
Johnson, Jeff, Matthijs Douze, and Hervé Jégou. 2019. “Billion-Scale Similarity Search with GPUs.” IEEE Transactions on Big Data 7 (3): 535–47. https://doi.org/10.1109/tbdata.2019.2921572.
Choi, Dami, Alexandre Passos, Christopher J. Shallue, and George E. Dahl. 2019. “Faster Neural Network Training with Data Echoing.” arXiv Preprint, ahead of print. https://doi.org/10.48550/arXiv.1907.05550.
Hoffmann, Jordan, Sebastian Borgeaud, Arthur Mensch, Elena Buchatskaya, Trevor Cai, Eliza Rutherford, Diego de Las Casas, et al. 2022. “Training Compute-Optimal Large Language Models.” Advances in Neural Information Processing Systems (NeurIPS) 35: 30016–30. https://doi.org/10.52202/068431-2176.
Brown, Tom B., Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared Kaplan, Prafulla Dhariwal, Arvind Neelakantan, et al. 2020. “Language Models Are Few-Shot Learners.” Advances in Neural Information Processing Systems 33: 1877–901. https://doi.org/10.48550/arxiv.2005.14165.
Touvron, Hugo, Louis Martin, Kevin Stone, Peter Albert, Amjad Almahairi, Yasmine Babaei, Nikolay Bashlykov, et al. 2023. “Llama 2: Open Foundation and Fine-Tuned Chat Models.” arXiv Preprint arXiv:2307.09288.