模型压缩
模型压缩
目的
为什么在基准测试中胜出的模型,很少成为在生产环境中运行的模型?
训练得到了能力出色的模型,但仅有能力并不能保证可部署性。云端、边缘端、移动端和 TinyML 都施加了研究基准测试所忽略的约束,包括以兆字节而非吉字节计量的内存预算、以毫秒而非秒计量的延迟目标,以及以毫瓦而非千瓦计量的功率包络。研究优化的是留出测试集上的准确率;生产环境优化的是每美元、每瓦和每毫秒所能获得的准确率。在基准测试中胜出的模型,其规模、速度和资源消耗往往超出了生产约束所允许的范围。弥合这一差距需要一套系统性的压缩方法,用部署场景不需要的能力换取对不可违反的约束的满足。许多训练后的模型具有超出部署场景需求的精度、连接数或容量,其中一部分冗余可以在保留所需行为的同时移除。然而,更小的表示并不自动意味着更快的执行。硬件和软件栈必须能够利用新的精度或结构;否则,名义上的缩减可能只是转移了瓶颈,而延迟保持不变。运用得当时,压缩可以显著减小模型规模,将只能在数据中心运行的研究产物转变为可用于手机、传感器或微控制器的生产资产。这一方法不仅关乎缩小模型,更关乎使适合其物理环境的模型成为可能。用数据—算法—机器的视角来看,压缩是在模型本身上实施算法与机器的协同设计,通过重写模型的数学结构,使其适应机器的物理约束。
学习目标
- 将压缩解释为算法与机器的协同设计,以冗余容量换取对内存、延迟和能耗约束的满足
- 按照各自缓解的资源约束,比较剪枝、蒸馏、量化和架构搜索
- 计算参数内存、精度和稀疏化带来的缩减,估计最佳情况下的压缩收益
- 在准确率和硬件约束下应用训练后量化、量化感知训练和仅权重量化策略
- 选择能够映射到现有加速器内核的结构化剪枝方式和算子
- 设计压缩流水线,安排剪枝、蒸馏和量化的顺序,以保持部署准确率
- 在目标硬件上评估实测延迟、能耗和准确率,而非依赖 FLOP 计数
优化框架
前沿模型的权重规模远超手机和微控制器的内存容量;压缩弥合了这一差距。
一个拥有 7 十亿参数的语言模型,仅以 FP16 存储权重就需要 14 GB。预期部署目标是一部智能手机,其 8 GB RAM 由操作系统、后台应用和用户界面共享。即使操作系统将整个内存池都分配给单个进程,14 GB 仍然超过设备的物理容量。此外,自回归词元生成受内存带宽限制:每生成一个词元,都需要将所有参数从 DRAM 读入处理器寄存器。在带宽约为 50 GB/s 的移动低功耗 DDR(LPDDR)总线上,流式读取 14 GB 的权重,每个词元需要近 300 ms,并消耗数焦耳能量,这会迅速耗尽电池电量,并超出设备 3 至 5 W 的持续散热功率包络。模型占用与边缘硬件容量之间的这种物理不匹配,界定了模型压缩的核心工程任务。
根据硅契约(原则 原则(英文原版)),每个机器学习模型都会与其硬件达成一项物理性能权衡:计算吞吐量、内存带宽、内存容量和固定启动开销决定了哪种物理资源最先成为瓶颈。在训练期间,这项权衡朝着更高的资源供给方向展开:服务器级加速器集群提供支持宽层、高数值精度和大量辅助状态所需的总内存容量与浮点吞吐量。训练必须在各次反向传播过程中维护梯度、优化器矩缓冲区和激活缓存。推理部署则彻底改变了这些需求:执行仅包含前向传播,中间激活可以立即被覆盖,优化器状态也不再存在。混合精度方法通过选择性采用 FP16 或 BF16 来提高训练吞吐量(混合精度训练),而在目标执行单元支持的情况下,部署允许将精度进一步降低至 INT8、INT4 或专用微格式。用数据—算法—机器的视角来看,训练通过数据与算法的协同设计最大化表示容量;压缩则通过算法与机器的协同设计,重塑数学结构以满足部署硬件的物理限制。模型压缩 是针对受限执行环境重新协商硅契约的系统性过程,在保持任务准确率的同时,减少参数占用、内存流量或算术运算。
不同部署环境之间的物理差异跨越六个数量级:一个拥有 175 十亿参数的前沿模型,仅 FP16 表示就占用超过 350 GB,而嵌入式微控制器仅提供 512 KB 的片上 SRAM。弥合这一差距需要一个物理权衡可预测的工程框架。每种压缩技术都会从模型中移除特定结构——不必要的权重、多余的数值位或冗余的算子子图。设计生产部署方案时,需要识别目标平台上最先成为瓶颈的资源,并分析连续的近似处理如何在整个内存层次结构中产生累积效应。
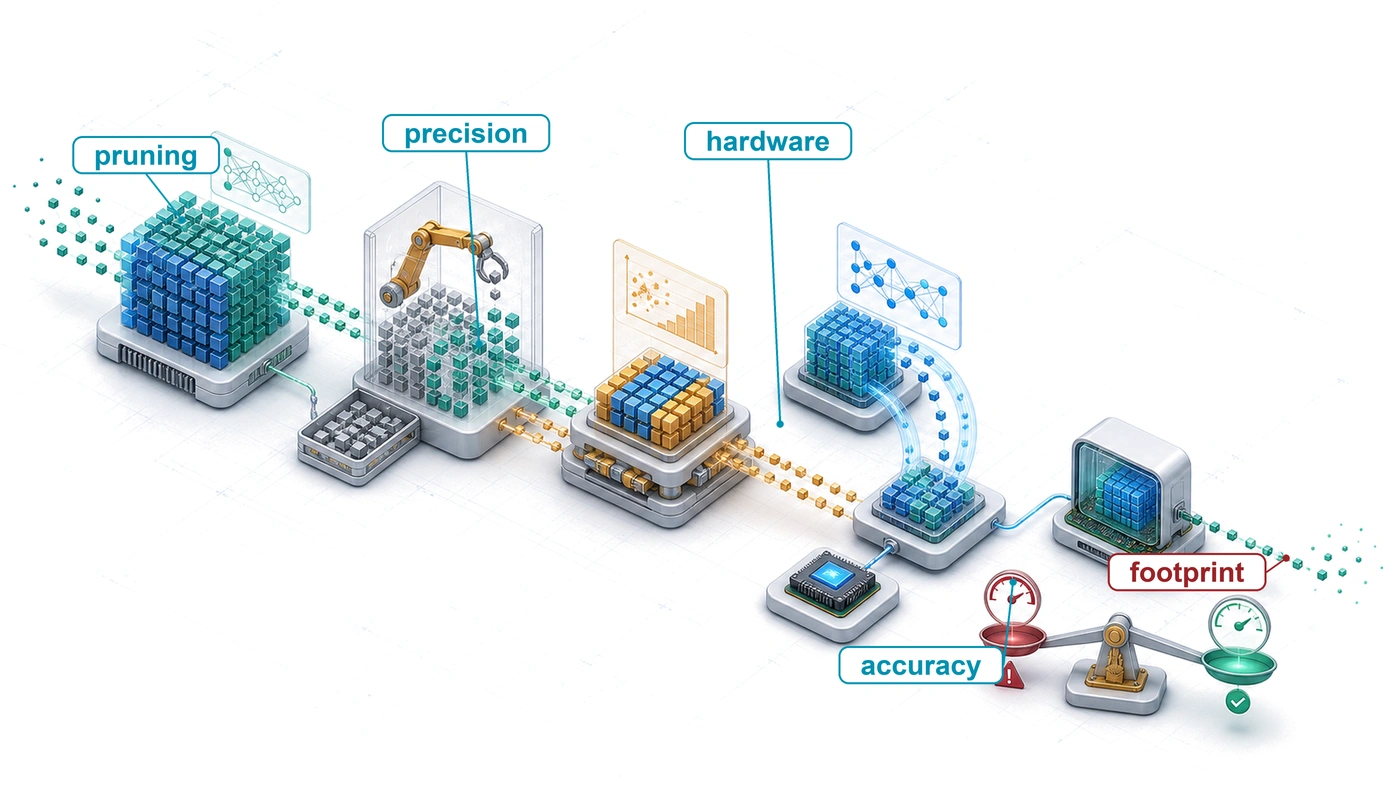
压缩沿三个互补维度展开。结构优化从模型图本身移除冗余:剪枝 消除影响较小的参数,知识蒸馏将行为迁移到更小的架构中,神经架构搜索则发现针对指定目标定制的设计。精度优化降低权重和激活的位宽;例如,从 FP32 转换为 INT8,可将每个表示值的原始字节数降至四分之一。受支持的低精度矩阵单元还可以加速算术运算。硬件级优化通过算子融合和硬件支持的稀疏性,将变换后的图映射到目标处理器。这些维度构成一个优化栈:结构变化改变了存在哪些运算,精度变化改变了每个值的字节数,而硬件级映射决定了这些理论节省能否转化为受支持的执行路径。在卷积网络中,将批归一化融合到前置权重中,可以在推理期间完全消除单独的内存往返和算术运算。只有当各项变换缓解了不同的瓶颈,且运行时支持所得到的图时,收益才会叠加。Tensor Core 解释了低精度执行路径背后的加速器机制。
具体的基准工作负载使这些权衡在不同运行情境下有了实证依据:用于视觉任务的 ResNet-50 和 MobileNetV2(灯塔模型名录:模型小传 中的灯塔模型)、用于自回归序列的基于 Transformer 的语言模型、用于考察推荐系统内存容量需求的 DLRM (Naumov et al. 2019),以及用于 TinyML 关键词检测的深度可分离卷积神经网络(DS-CNN)(Y. Zhang et al. 2017)。从参数占主导的嵌入表到计算密集的矩阵乘法,每种工作负载都会对机器学习系统铁律中的不同项施加压力。在这些参考工作负载上评估压缩,可以揭示在相同运行时条件下,参数和精度的缩减如何转化为实际的延迟与能耗节省。
Definition 1.1: 模型压缩
模型压缩 是一类技术,通过消除冗余参数(剪枝)、降低数值精度(量化),或将学习到的行为迁移到更小的架构中(蒸馏),降低已训练模型的计算成本和内存占用,同时尽可能保留预测准确率。
- 意义:压缩直接减小机器学习系统铁律中的数据搬移项和计算项。对一个拥有 175 十亿参数的 LLM 进行 INT8 量化,可将权重内存从 350 GB(FP16)降至 175 GB,使 \(D_{\text{vol}}\) 按 2× 的倍数缩减;当内核和布局采用受支持的 INT8 路径时,专用低精度矩阵单元还可以提高计算吞吐量。将非结构化剪枝的稀疏度设为 50%,可使非零元素数量减半,但只有运行时能够通过受支持的稀疏格式或内核跳过这些零值时,实际执行的运算量才会下降。
- 区别:与剪枝和量化等训练后压缩方法不同,神经架构搜索通过探索设计空间,从零开始发现高效架构。这里将 NAS 视为一种相关的结构优化技术:它在训练前改变表示,而不是在模型完成后对其进行事后压缩。
- 常见陷阱:压缩技术在组合时会相互干扰。剪枝改变权重分布和运算模式;量化引入校准和内核约束。如果缺少联合验证,两者的组合可能导致准确率损失,或无法实现加速。
这三个优化维度构成了一个抽象层次逐步降低的层级体系,从算法表达逐步深入到物理硅芯片。优化首先确定模型执行哪些运算(表示),然后确定每个操作数用多少位编码(数值),最后确定如何将执行调度到加速器的内存结构和功能单元上(实现)。Figure 1 展示了这一从软件表示走向硬件执行的过程。
\resizebox{.5\textwidth}{!}{
\begin{tikzpicture}[font=\small\sffamily]
\tikzset{
  Box/.style={inner xsep=2pt,
  draw=black!90,
  line width=0.75pt,
  anchor=west,
  text width=54mm,align=flush center,
  minimum width=54mm, minimum height=8mm
  },
}
\node[Box,fill=red!30,anchor=south west](B1)at (0.33,0.5){高效硬件实现};
\node[Box,fill=red!20,node distance=0.15,above=of B1](B2){高效数值表示};
\node[Box,fill=red!10,node distance=0.15,above=of B2](B3){高效模型表示};
\draw[latex-latex,line width=0.75pt](0,0.20)--(0,3.7);

\node[left=1.4 of B1,rotate=90,anchor=north,align=center,font=\footnotesize\sffamily]{更偏向\\ 硬件};
\node[left=1.4 of B3,rotate=90,anchor=north,align=center,font=\footnotesize\sffamily]{更偏向 \\软件};
\end{tikzpicture}}顶层的高效模型表示消除计算图内部的结构冗余。剪枝、知识蒸馏和神经架构搜索(NAS)1 等技术直接修改参数数量和算子拓扑。剪枝移除对模型准确率贡献可忽略的权重或整个通道。知识蒸馏训练一个紧凑的学生模型,使其匹配过参数化教师模型的输出分布或中间表示。硬件感知 NAS 将这一探索过程自动化,通过评估候选层拓扑、扩展比和卷积核尺寸,在明确的延迟或内存界限下发现帕累托最优的图。
中间层的高效数值表示优化用于编码每个张量值的位宽。量化 将连续的高精度浮点值映射为低位宽表示,例如 8 位或 4 位整数,从而将权重内存占用和 DRAM 总线流量(\(D_{\text{vol}}\))缩减至原来的二分之一到四分之一。除了减少内存占用,整数运算还能缓解计算瓶颈:低精度矩阵单元执行整数乘累加运算所需的硅面积和能量,仅为 32 位浮点 ALU 的一小部分,因此能够在相同散热功率包络内实现更高的峰值吞吐量。
底层的高效硬件实现使剩余运算与加速器的物理架构相匹配。如果数据搬移使计算核心停顿,或者非合并内存访问使 DRAM 通道串行化,那么运算量减少并不能保证执行更快。算子融合将相邻层合并,例如将卷积、偏置加法和激活函数折叠到单个内核中,使中间激活驻留在快速的片上 SRAM 或寄存器中,而不必往返于高延迟的片外 DRAM。同样,硬件支持的稀疏引擎,例如支持结构化 2:4 稀疏性的 Tensor Core,只有在非零元素符合硬件执行流水线的对齐和取数约束时,才能带来实际加速。
这三个层次跨越编译与执行边界,彼此紧密耦合。剪枝改变权重分布和激活特征,从而改变后续量化校准所需的动态范围。量化减少内存总线上的数据搬移量,使原先受内存限制的工作负载转向受计算限制的执行,此时内核融合和分块调度成为主导因素。要实现性能收益的叠加,需要对三个层次的变换进行协同设计,而不是孤立地应用它们;section 1.6.2 对这种组合策略进行了形式化阐述。
优化栈中哪一层能带来最高收益,完全取决于承载工作负载的物理机器。配备多个高带宽内存加速器的数据中心服务器能够容纳数吉字节的模型,但要求在并发条件下实现高词元吞吐量。智能手机或嵌入式微控制器则受到内存容量、总线带宽和毫瓦级散热能力的严格物理上限约束。确定这些不同物理层级的硬件包络,并识别每种环境中最先成为瓶颈的资源,是任何压缩策略必不可少的起点。
部署环境
配备 80 GB 高带宽内存(HBM)的数据中心 GPU,与使用共享 RAM 的智能手机或仅有数百千字节 SRAM 的微控制器,面临的主导约束存在根本差异。实际部署目标决定了哪种资源最先成为瓶颈(table 1)。
| 场景 | 内存 | 延迟 | 功率 | 主要目标 |
|---|---|---|---|---|
| 云端 | 数十 GB | 100–500 ms | 灵活 | 吞吐量、成本 |
| 移动端/边缘端 | 数百 MB 至 GB 级 | 5–100 ms | W 级 | 大小、延迟 |
| TinyML | KB–MB | 1–10 ms | mW | 大小、能耗 |
部署场景
云端推理以吞吐量(每美元每秒处理的请求数)为核心;在这一场景中,受支持的整数量化执行路径可提高服务密度,算子融合则可减少每个请求的内核启动开销 (Choudhary et al. 2020; Dean et al. 2018)。移动端和边缘端部署必须在严格的物理内存限制内运行,同时满足确定性的实时截止时间要求。以每秒 30 帧处理图像的摄像头流水线,每帧的延迟预算为 33 ms;超出该预算会导致丢帧,并违反实时性保证。
Choudhary, Tejalal, Vipul Mishra, Anurag Goswami, and Jagannathan Sarangapani. 2020. “A Comprehensive Survey on Model Compression and Acceleration.” Artificial Intelligence Review 53 (7): 5113–55. https://doi.org/10.1007/s10462-020-09816-7.
Dean, Jeff, David Patterson, and Cliff Young. 2018. “A New Golden Age in Computer Architecture: Empowering the Machine-Learning Revolution.” IEEE Micro 38 (2): 21–29. https://doi.org/10.1109/mm.2018.112130030.
Banbury, Colby R., Vijay Janapa Reddi, Max Lam, William Fu, Amin Fazel, Jeremy Holleman, Xinyuan Huang, et al. 2020. “Benchmarking TinyML Systems: Challenges and Direction.” arXiv Preprint arXiv:2003.04821.
对于 TinyML,压缩是部署的绝对必要条件。只有几百 KB SRAM 的微控制器,无法运行一个 100 MB 的模型,无论其预测准确率有多高 (Banbury et al. 2020)。由于没有虚拟内存或分页硬件,模型权重和峰值激活缓冲区必须完全驻留在物理 SRAM 中;如果工作集超出物理容量,程序就会立即因内存不足故障而失败。
自深度学习诞生以来,物理内存容量上限就一直构成约束。赢得 2012 年 ImageNet 挑战赛的 AlexNet 在训练期间遭遇了内存墙,其架构体现了由此产生的双 GPU 设计选择。
Example 1.1: AlexNet 的双 GPU 拆分(2012 年)
背景:2012 年,Alex Krizhevsky、Ilya Sutskever 和 Geoffrey Hinton 计划在 ImageNet 上训练一个包含 6000 万参数的视觉模型 (Krizhevsky et al. 2012)。
机制:一块 NVIDIA GTX 580 仅提供 3 GB GDDR5 显存,不足以同时存储 240 MB 的模型权重,以及单 GPU 训练所需的 FP32 激活值(\(M_{\text{act}}\))和优化器状态(\(M_{\text{state}}\))。
影响:该模型根本无法在单个设备上训练,因此,内存上限的影响向上传递到了网络设计本身,而不再只是硬件采购问题。
解决方法:他们将模型划分到两块配备 3 GB 显存的 GTX 580 GPU 上,并限制跨 GPU 连接,使工作集能够容纳在每个设备的内存上限内(\(M_{\text{peak}} \le 3\text{ GB}\))。由此形成的双塔架构以 15.3% 的 top-5 错误率获胜,领先幅度为 10.8 个百分点。
系统启示:自深度学习诞生以来,内存容量上限就一直构成约束。模型部署策略(剪枝、量化)所应对的物理限制,与当年迫使 AlexNet 拆分模型的限制相同。
Krizhevsky, Alex, Ilya Sutskever, and Geoffrey E. Hinton. 2012. “ImageNet Classification with Deep Convolutional Neural Networks.” Advances in Neural Information Processing Systems (NeurIPS) 25.
塑造 AlexNet 训练架构的内存约束,同样决定了模型在普通移动硬件上部署的可行性。
Example 1.2: MobileNet 优化成效示例
场景:在中端 Android 智能手机上,以 30 FPS 部署用于实时背景虚化的视频分割模型。
诊断:未经压缩的 FP32 MobileNetV3 模型只能达到 8 FPS,超出了设备的延迟和热功率限制。将权重量化为 INT8 后,即可利用移动端 NPU/DSP 执行整数矩阵运算。
系统启示:在此例中,INT8 将原始参数载荷缩减至原来的四分之一,即缩减 4\(\times\);受支持的整数执行路径将推理速度从 8 FPS 提升至 35 FPS。速度和功率仍需在设备上实测。
平衡各项权衡
Table 2 针对 灯塔模型名录:模型小传 中的标杆模型,量化了这一部署差距。即使采用 INT8 精度,MobileNetV2 所需的内存仍约为 TinyML 设备内存的 6.7×,这表明物理内存范围如何约束模型的可部署性:
| 模型 | 运行时权重内存 | 模型制品权重存储 | 云端(~107 GB) | 移动端(8 GB) | TinyML(~512 KB) |
|---|---|---|---|---|---|
| DLRM | 100 GB | 100 GB | 可容纳 | 无法容纳(11.6×) | 无法容纳(190734.9×) |
| GPT-2 XL | 6 GB | 6 GB | 可容纳 | 可容纳 | 无法容纳(11444.1×) |
| ResNet-50 | 102.4 MB | 102.4 MB | 可容纳 | 可容纳 | 无法容纳(195.3×) |
| MobileNetV2 | 14 MB | 14 MB | 可容纳 | 可容纳 | 无法容纳(26.7×) |
| MobileNetV2(INT8) | 3.5 MB | 3.5 MB | 可容纳 | 可容纳 | 无法容纳(6.7×) |
| DS-CNN(KWS,INT8) | 200 KB | 200 KB | 可容纳 | 可容纳 | 可容纳 |
这种不匹配使得准确率与效率的权衡 不可避免。增加模型容量通常会提高预测准确率,但也需要更大的权重载荷、更大的激活工作集,以及推理期间更高的内存带宽。在内存或功率限制严格的硬件上,这些需求迫使工程师沿帕累托前沿作出选择。
Systems Perspective 1.1: 压缩与准确率的权衡曲线
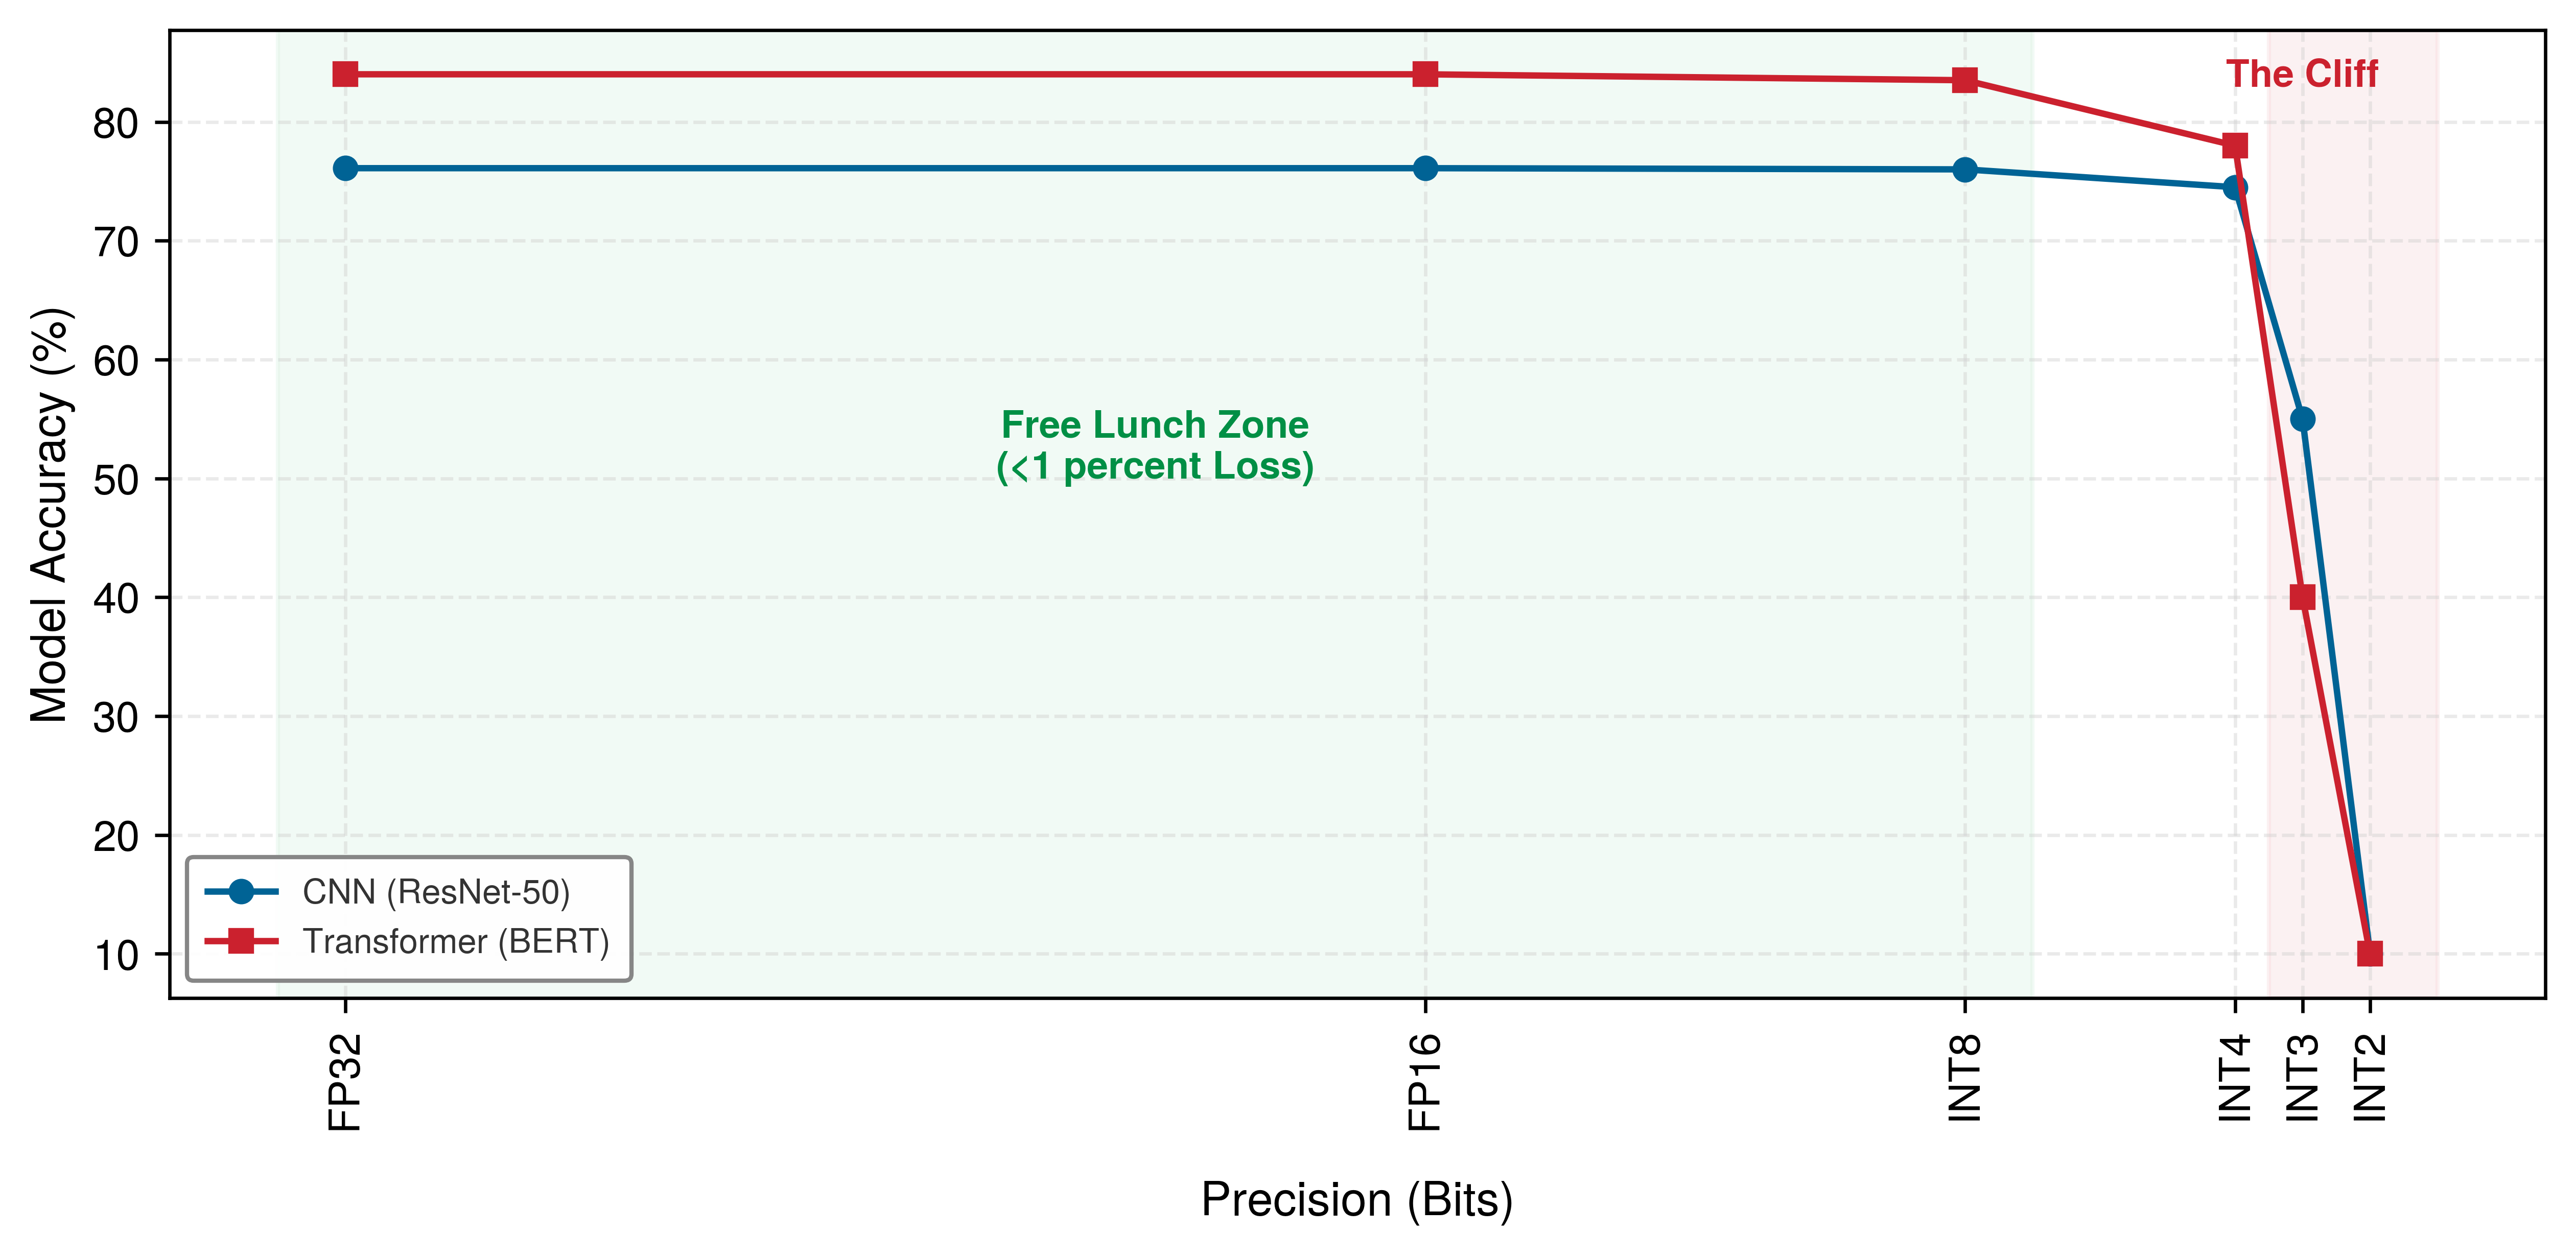
这一前沿并不均匀:保持结构的技术位于顶部附近,以很少的准确率损失甚至零损失换取实际加速;激进的结构改造则位于底部,每增加一分收益,都要付出愈加高昂的准确率代价。
工程决策在于何时停止。压缩应止于曲线的“拐点”,即准确率的边际损失首次超过效率的边际收益之处。越过这一拐点后,模型性能退化的速度会快于其加速的速度。
Table 3 汇总了这些区域中的主要压缩技术,将其系统收益与机器学习代价进行对应。
| 技术 | 系统收益 | 机器学习代价 | 典型影响 | 区域 |
|---|---|---|---|---|
| 算子融合 | 延迟降低 10–30% | 无 | 无准确率损失 | 1 |
| FP32 → BF16 | 内存占用缩减 2\(\times\),吞吐量约提升至 2\(\times\) | 极小 | 准确率下降 \(<0.1\%\) | 1 |
| FP16 → INT8 | 内存占用缩减 2\(\times\),吞吐量提升至 2–4\(\times\) | 量化误差 | 准确率下降 0.5–1% | 2 |
| 50% 剪枝 | 模型大小约缩减 2\(\times\) | 容量损失 | 准确率下降 0.5–1% | 2 |
| 知识蒸馏 | 学生模型大小缩减 2–10\(\times\) | 能力上限 | 准确率下降 1–3% | 2 |
| 4 位量化 | 内存占用缩减 4\(\times\) | 显著误差 | 准确率下降 2–5% | 2–3 |
| 90% 剪枝 | 模型大小约缩减 10\(\times\) | 严重容量损失 | 准确率下降 5–15% | 3 |
| ↑ 批大小(8\(\times\)) | 更高的吞吐量、更高的 GPU 利用率 | 泛化差距 | 需要缩放学习率 | — |
保持模型结构的技术,如内核融合和适度降低精度(FP32 转为 BF16),可在准确率损失可忽略的情况下带来延迟和内存收益。相比之下,剪枝和蒸馏等改变网络结构的技术,能够更大幅度地减少内存占用和运算量,但如果不进行谨慎的重新训练,就可能导致显著的质量下降。优化首先要识别起决定作用的硬件约束:移动设备的内存容量、交互式流水线的帧延迟,或电池供电传感器每次推理的能耗。随后,压缩策略直接针对该瓶颈:结构方法减少参数量和运算次数,量化减少内存流量并提高算术强度,编译器层面的融合则消除中间结果的内存往返传输。
Checkpoint 1.1: 效率前沿
优化的本质是用一种资源换取另一种资源。
权衡
结构优化
现代神经网络的参数量往往超过部署所需。2 未使用的容量仍会消耗内存、计算和能量。结构优化通过改变模型计算的内容,解决优化框架的第一个维度,即高效的模型表示。尽管额外容量有助于训练期间的优化,但不能改善部署后模型表现的参数,仍然会带来部署成本。
本章中的每项技术都遵循同一条工程启发式原则:复杂性守恒。压缩很少会彻底消除成本,而是将成本在数据、算法和机器三个轴之间转移。剪枝可能减少参数,却要求运行时利用稀疏结构;蒸馏可能降低推理成本,却增加教师—学生训练阶段;量化可能减少数据移动,却要付出数值精度的代价。工程师的任务是,在给定部署约束下,将复杂性转移到成本最低的位置。
系统层面的挑战在于,在不损害任务关键表征的前提下,去除多余容量。沿着这一帕累托前沿3 进行优化,需要决定复杂性应存在于何处:训练时的结构发现、运行时的稀疏索引,还是学生模型的容量中。
这些技术通过互补机制应对这一挑战。剪枝从现有网络中消除冗余参数;知识蒸馏将已学习的表征迁移至独立设计的紧凑拓扑结构中;神经架构搜索则从零开始,将结构发现过程自动化 (Hutter et al. 2019)。在生产流水线中,这些技术经常组合使用:由 NAS 发现的架构,在蒸馏教师模型的监督下训练,并在最终量化之前进行剪枝。本节分析首先讨论剪枝,因为它最直接地揭示了物理瓶颈:只有当剪枝后的结构能够映射到受支持的硬件内核时,减少参数量才能加快执行速度。
Hutter, Frank, Lars Kotthoff, and Joaquin Vanschoren. 2019. Automated Machine Learning: Methods, Systems, Challenges. In Automated Machine Learning. The Springer Series on Challenges in Machine Learning. Springer International Publishing. https://doi.org/10.1007/978-3-030-05318-5.
剪枝
考虑一个经过训练、用于可穿戴健康监测设备图像分类的 MobileNet。训练后的模型占用 14 MB,但目标微控制器仅提供 2 MB 的闪存。从头重新训练一个更小的架构需要数周的数据采集与验证,而产品进度不允许投入这些时间。假设性能剖析表明,模型中约有 85.7 percent 的权重接近零,且在验证集上的贡献很小。移除这些权重,并对其余权重微调几个训练轮次,即可得到一个占用 2 MB、准确率损失可接受的模型。这些数值旨在为工程权衡提供具体依据,而非报告通用的 MobileNet 基准测试结果。
剪枝4通过消除对部署目标贡献很小的参数或结构,直接应对内存效率约束。许多训练后的网络都包含可移除的容量,但能够安全移除的比例取决于架构、任务、剪枝模式和恢复过程。核心问题包括:剪枝的对象是什么(单个权重还是整个结构),如何估计哪些部分可以舍弃(依据幅值、梯度或激活值),以及何时剪枝(训练后、训练中,甚至初始化时)。尽管 N:M 结构化稀疏性的机制 分析了稀疏操作数在微架构层面的执行机制,但基本的系统规则始终不变:只有当底层硬件和运行时执行路径能够跳过零值权重的加载或计算时,这些权重才能节省物理资源。
Definition 1.2: 剪枝
剪枝是一种模型压缩技术,通过移除对损失景观贡献的信息极少的权重,使参数空间稀疏化。
- 意义:当稀疏表示、元数据和恢复过程能够保持可接受的质量时,剪枝可将稠密矩阵转换为稀疏结构,减少内存占用和总数据量 \((D_{\text{vol}})\)。
- 区别:量化降低每个权重的精度,而剪枝通过识别并消除冗余来减少权重数量。
- 常见误区:一种常见误解是,剪枝会“自动”加速执行。实际上,如果没有专门的稀疏执行支持,由于内存访问模式不规则,生成的稀疏矩阵甚至可能比稠密矩阵运行得更慢;仅有更高的 \(R_{\text{peak}}\) 并不能使不规则的稀疏布局高效执行。
形式化的剪枝目标是在参数预算 \(k\) 的约束下,寻找使经验损失最小化的稀疏参数张量 \(\hat{\mathbf{W}}\): \[ \min_{\hat{\mathbf{W}}} \mathcal{L}(\hat{\mathbf{W}}) \quad \text{subject to} \quad \|\hat{\mathbf{W}}\|_0 \leq k \] 其中,\(\|\hat{\mathbf{W}}\|_0\) 是 L0 范数(非零参数的数量)。求解这种带基数约束的优化问题属于组合优化,因此实际方法采用基于幅值的剪枝等启发式方法5。Listing 1 展示了这一方法,通过移除绝对值较小的权重,将稠密权重矩阵转换为 figure 2 中所示的稀疏表示。
import torch

# Original dense weight matrix
weights = torch.tensor(
    [[0.8, 0.1, -0.7], [0.05, -0.9, 0.03], [-0.6, 0.02, 0.4]]
)

# Simple magnitude-based pruning: keep only the 4 largest weights
threshold = 0.5
mask = torch.abs(weights) >= threshold
pruned_weights = weights * mask

print("Original:", weights)
print("Pruned (4 nonzeros):", pruned_weights)\begin{tikzpicture}[line join=round,font=\sffamily\footnotesize]
\tikzset{%
cell/.style={draw=black!80,line width=0.5pt, minimum size=\cellsize,
minimum height=\cellheight}
}
\definecolor{Blue1}{RGB}{84,131,217}
\definecolor{Blue2}{RGB}{145,177,237}
\definecolor{Blue3}{RGB}{201,217,247}
\definecolor{Blue4}{RGB}{227,235,250}
\colorlet{Blue1}{RedFill}
\colorlet{Blue2}{RedFill}
\colorlet{Blue3}{RedFill}
\colorlet{Blue4}{RedFill}
\def\columns{3}
\def\rows{3}
\def\cellsize{8mm}
\def\cellheight{8mm}
%%LEFT
\begin{scope}[local bounding box=M1,shift={(0,0)}]
\def\columns{11}
\def\rows{11}
\def\br{M1}
\foreach \x in {1,...,\columns}{
\foreach \y in {1,...,\rows}{
%
\node[draw=black!80, fill=Blue4, minimum width=\cellsize,
minimum height=\cellheight, line width=0.5pt] (cell-\x-\y\br) at (\x*\cellsize,-\y*\cellheight) {0.01};
}
}
%1
\foreach \c/\n/\f in {3/-1.9/Blue3,5/1.76/Blue3,8/3.75/Blue2,2/0.02/Blue4,4/0.02/Blue4,9/0.02/Blue4}{
\node[cell,fill=\f]at(cell-\c-1M1){\n};
}
%2
\foreach \c/\n/\f in {1/7.93/Blue1,4/0.68/Blue3,7/-1.1/Blue3,2/0.02/Blue4,5/0.02/Blue4,9/0.02/Blue4}{
\node[cell,fill=\f]at(cell-\c-2M1){\n};
}
%3
\foreach \c/\n/\f in {3/5.2/Blue2,4/0.2/Blue3,9/-6.2/Blue2,1/0.02/Blue4,5/0.02/Blue4,8/0.02/Blue4,10/0.02/Blue4}{
\node[cell,fill=\f]at(cell-\c-3M1){\n};
}
%4
\foreach \c/\n/\f in {9/-2.5/Blue3,2/0.02/Blue4,7/0.02/Blue4}{
\node[cell,fill=\f]at(cell-\c-4M1){\n};
}
%5
\foreach \c/\n/\f in {1/0.32/Blue3,3/-3.5/Blue3,5/0.88/Blue3,7/0.02/Blue4,9/0.02/Blue4,11/0.02/Blue4}{
\node[cell,fill=\f]at(cell-\c-5M1){\n};
}
%6
\foreach \c/\n/\f in {4/2.4/Blue3,6/-3.1/Blue2,11/8.26/Blue1,2/0.02/Blue4,3/0.02/Blue4,5/0.02/Blue4,9/0.02/Blue4}{
\node[cell,fill=\f]at(cell-\c-6M1){\n};
}
%7
\foreach \c/\n/\f in {1/0.96/Blue2,2/9.77/Blue1,3/0.92/Blue3,7/8.5/Blue1,8/6.6/Blue2}{
\node[cell,fill=\f]at(cell-\c-7M1){\n};
}
%8
\foreach \c/\n/\f in {2/0.8/Blue2,1/0.03/Blue4,4/0.03/Blue4,7/0.03/Blue4,6/0.02/Blue4,8/0.02/Blue4,9/0.02/Blue4,11/0.02/Blue4}{
\node[cell,fill=\f]at(cell-\c-8M1){\n};
}
%9
\foreach \c/\n/\f in {8/0.7/Blue3,9/14.8/Blue1,11/0.91/Blue3,2/0.02/Blue4,4/0.02/Blue4,7/0.03/Blue4}{
\node[cell,fill=\f]at(cell-\c-9M1){\n};
}
%10
\foreach \c/\n/\f in {7/-0.38/Blue2,11/10.1/Blue1,1/0.02/Blue4,2/0.02/Blue4,5/0.02/Blue4,10/0.03/Blue4}{
\node[cell,fill=\f,inner sep=0pt]at(cell-\c-10M1){\n};
}
%11
\foreach \c/\n/\f in {3/16.3/Blue1,6/2.9/Blue2,10/-5.4/Blue2,2/0.03/Blue4,4/0.03/Blue4,9/0.02/Blue4}{
\node[cell,fill=\f,inner sep=0pt]at(cell-\c-11M1){\n};
}
\end{scope}
%%RIGHT
\begin{scope}[local bounding box=M2,shift={(11,0)}]
\def\columns{11}
\def\rows{11}
\def\br{M2}
\foreach \x in {1,...,\columns}{
\foreach \y in {1,...,\rows}{
%
\node[draw=black!80, fill=white, minimum width=\cellsize,
minimum height=\cellheight, line width=0.5pt] (cell-\x-\y\br) at (\x*\cellsize,-\y*\cellheight) {0};
}
}
\node[cell,fill=Blue3]at(cell-3-1M2){-1.9};
\node[cell,fill=Blue3]at(cell-5-1M2){1.76};
\node[cell,fill=Blue2]at(cell-8-1M2){3.75};
%2
\node[cell,fill=Blue1]at(cell-1-2M2){7.93};
\node[cell,fill=Blue3]at(cell-4-2M2){0.68};
\node[cell,fill=Blue3]at(cell-7-2M2){-1.1};
%3
\node[cell,fill=Blue2]at(cell-3-3M2){5.2};
\node[cell,fill=Blue3]at(cell-4-3M2){0.2};
\node[cell,fill=Blue2]at(cell-9-3M2){-6.2};
%4
\node[cell,fill=Blue3]at(cell-9-4M2){-2.5};
%5
\node[cell,fill=Blue3]at(cell-1-5M2){0.32};
\node[cell,fill=Blue3]at(cell-3-5M2){-3.5};
\node[cell,fill=Blue3]at(cell-5-5M2){0.88};
%6
\node[cell,fill=Blue3]at(cell-4-6M2){2.4};
\node[cell,fill=Blue2]at(cell-6-6M2){-3.1};
\node[cell,fill=Blue1]at(cell-11-6M2){8.26};
%7
\node[cell,fill=Blue2]at(cell-1-7M2){0.96};
\node[cell,fill=Blue1]at(cell-2-7M2){9.77};
\node[cell,fill=Blue3]at(cell-3-7M2){0.92};
\node[cell,fill=Blue1]at(cell-7-7M2){8.5};
\node[cell,fill=Blue2]at(cell-8-7M2){6.6};
%8
\node[cell,fill=Blue2]at(cell-2-8M2){0.8};
%9
\node[cell,fill=Blue3]at(cell-8-9M2){0.7};
\node[cell,fill=Blue1]at(cell-9-9M2){14.8};
\node[cell,fill=Blue3]at(cell-11-9M2){0.91};
%10
\node[cell,fill=Blue2]at(cell-7-10M2){-0.38};
\node[cell,fill=Blue1]at(cell-11-10M2){10.1};
%11
\node[cell,fill=Blue1]at(cell-3-11M2){16.3};
\node[cell,fill=Blue2]at(cell-6-11M2){2.9};
\node[cell,fill=Blue2]at(cell-10-11M2){-5.4};
\end{scope}
\node[above=0.2 of M1,align=center,
font=\sffamily\normalsize]{权重矩阵 \\ (剪枝前)};
\node[above=0.2 of M2,align=center,
font=\sffamily\normalsize]{权重矩阵 \\ (剪枝后——非常稀疏)};
\path[draw=OrangeLine, line width=2mm, -{Triangle[length=4mm, bend]},
shorten >=1.1mm, shorten <=1.15mm](cell-11-1M1.north east) to [bend left] (cell-1-1M2.north west);
\end{tikzpicture}得到的稀疏矩阵仅保留大幅值元素(彩色单元格),而接近零的权重则变为精确的零值。对于适合剪枝的模型,移除小幅值权重后,大部分表示能力仍得以保留,因此幅值阈值法成为一种有效的基线启发式方法。
为使剪枝在基于梯度的训练中具有计算可行性,实际方法通常使用连续惩罚项来松弛组合性的 \(\ell_0\) 约束,例如 \(\ell_1\) 正则化 \((\lambda_{\text{L1}} \| \mathbf{W} \|_1)\),其中 \(\lambda_{\text{L1}}\) 用于缩放施加于权重张量 \(\mathbf{W}\) 的稀疏性惩罚。对权重幅值施加惩罚,会推动非必要参数趋近于零,便于后续进行阈值处理。实践中通常将这一方法与迭代剪枝结合,分多次逐步移除参数,并在其间穿插微调周期,以恢复损失的准确率 (Gale et al. 2019; Blalock et al. 2020)。
目标结构
选择剪枝对象取决于部署目标的硬件约束,以及哪种资源构成实际的限制性瓶颈。当内存容量是首要约束时,对于全连接层主导参数存储的模型,神经元剪枝可以直接缓解这一约束:移除整个神经元及其关联的权重和偏置,会减小层宽度并减少参数数量。必须首先通过性能剖析确认,这些层才是真正的瓶颈,而非嵌入、激活值或其他组件。
当通用加速器上的卷积推理延迟成为瓶颈时,通道剪枝(也称滤波器剪枝)是一种有力的候选方案。消除整个通道或滤波器,会减小特征图深度,并减少后续层中的乘加运算次数。得到的子网络仍保持稠密且规则的结构,因此可以映射到常规的 GPU 和张量处理单元(TPU)内核,而无须采用非结构化稀疏格式。实际延迟仍取决于剪枝后的维度、内核和内存流量。
当模型中存在可移除的阶段时,层剪枝会从网络中移除整个层。每次移除都会消除该阶段的全部计算,但也会降低表示深度,并可能改变张量形状、残差路径或下游接口。其余层必须承担被移除部分的功能,通常需要通过微调或再训练实现。因此,名义上的运算量节省并不保证延迟按比例降低:执行仍受图重写、内核形状和内存流量支配。层剪枝需要仔细开展任务验证和端到端性能剖析。figure 3 中的并排对比说明了通道剪枝与层剪枝为何具有不同的实现成本。
\begin{tikzpicture}[line join=round,font=\small\sffamily]
\colorlet{PrunedGreen}{green!30!red}
\tikzset{
 Line/.style={line width=0.5pt,black!50,dashed},
 cubes/.pic={
\pgfkeys{/cubes/.cd, #1}
\begin{scope}[scale=\scalefac,every node/.style={scale=1*\scalefac}]
\pgfmathsetmacro{\cubex}{0.1}
\pgfmathsetmacro{\cubey}{1.5}
\pgfmathsetmacro{\cubez}{1.3}
\coordinate (\picname-tl) at (-\cubex,0,0); % top-left point
\coordinate (\picname-tr) at (0,0,0); % top-right point
\coordinate (\picname-br) at (0,-\cubey,0); % bottom-right point
\coordinate (\picname-bl) at (-\cubex,-\cubey,0); % bottom-left point
\coordinate (\picname-ztl) at (-\cubex,0,-\cubez); % ztop-left point
\coordinate (\picname-ztr) at (0,0,-\cubez); % ztop-right point
\coordinate (\picname-zbr) at (0,-\cubey,-\cubez); % zbottom-right point
\coordinate (\picname-zbl) at (-\cubex,-\cubey,-\cubez); %z bottom-left point
%front
\draw[draw=\drawcubecolor,fill=\cubecolor!15, \ifboxdashed dashed\fi] (0,0,0) -- ++(-\cubex,0,0) -- ++(0,-\cubey,0) -- ++(\cubex,0,0) -- cycle;
%right
\draw[draw=\drawcubecolor,fill=\cubecolor!30, \ifboxdashed dashed\fi] (0,0,0) -- ++(0,0,-\cubez) -- ++(0,-\cubey,0) -- ++(0,0,\cubez) -- cycle;
%top
\draw[draw=\drawcubecolor,fill=\cubecolor!20, \ifboxdashed dashed\fi] (0,0,0) -- ++(-\cubex,0,0) -- ++(0,0,-\cubez) -- ++(\cubex,0,0) -- cycle;
            \end{scope}
        }
}
\makeatletter
\newif\ifboxdashed
\boxdashedfalse % default: not dashed
\makeatother

\pgfkeys{
  /cubes/.cd,
  cubecolor/.store in=\cubecolor,
  drawcubecolor/.store in=\drawcubecolor,
  scalefac/.store in=\scalefac,
  picname/.store in=\picname, % ← nova linija
  cubecolor=red,
  drawcubecolor=BrownLine,
  scalefac=1,
  dashed/.is if=boxdashed,
  dashed/.default=true,
  picname=C
}
\newcommand{\Desno}[1]{
\foreach \i /\da in {1,...,9} {
   \pic at ({\i*0.22}, {-0.022*\i}) {cubes={cubecolor=BrownLine,picname=\i-cube#1}};
}
}
\newcommand{\Levo}[1]{
\foreach \i /\da in {1,2,3} {
\pic at ({\i*0.25}, {-0.025*\i}) {cubes={scalefac=1.65,cubecolor=BrownLine,picname=\i-cube#1}};
}
}
\newcommand{\Sredina}[2]{
\foreach \i /\clr/\dclr/\da in {#2} {
\pic at ({\i*0.22}, {-0.022*\i}) {cubes={scalefac=1.35, drawcubecolor=\dclr,
cubecolor=\clr,picname=\i-cube#1,\da}};
}
}
%%%%%%%%%%%%%%%%%%%%%%
\begin{scope}[local bounding box=ROW1,shift={(0,0)}]
\begin{scope}[local bounding box=G1,shift={(0,0)}]
 \Desno{1}
\end{scope}
\begin{scope}[local bounding box=G2,shift={(-4,0.5)}]
\Sredina{2}{1/BrownLine/BrownLine/,
2/red/red/,
3/BrownLine/BrownLine/,
4/BrownLine/BrownLine/,
5/BrownLine/BrownLine/,
6/BrownLine/BrownLine/,
7/BrownLine/BrownLine/,
8/BrownLine/BrownLine/,
9/BrownLine/BrownLine/}
\end{scope}
\begin{scope}[local bounding box=G3,shift={(-7,0.8)}]
\Levo{3}
\end{scope}
\draw[Line] (1-cube1-bl) -- (9-cube2-br);
 \draw[Line] (1-cube1-tl) -- (9-cube2-tr);
 \scoped[on background layer]
\draw[Line] (1-cube1-zbl) -- (9-cube2-zbr);
 \draw[Line] (1-cube1-ztl) -- (9-cube2-ztr);
 %
 \draw[Line] (1-cube2-bl) -- (3-cube3-br);
 \draw[Line] (1-cube2-tl) -- (3-cube3-tr);
 \scoped[on background layer]
\draw[Line] (1-cube2-zbl) -- (3-cube3-zbr);
 \draw[Line] (1-cube2-ztl) -- (3-cube3-ztr);
\end{scope}
%%%%%%%%%%%%%%%%
\begin{scope}[local bounding box=ROW2,shift={(0,-4.5)}]
\begin{scope}[local bounding box=G1,shift={(0,0)}]
 \Desno{1}
\end{scope}
\begin{scope}[local bounding box=G2,shift={(-4,0.5)}]
\Sredina{2}{1/BrownLine/BrownLine/,
2/PrunedGreen/red/dashed,
3/BrownLine/BrownLine/,
4/BrownLine/BrownLine/,
5/BrownLine/BrownLine/,
6/BrownLine/BrownLine/,
7/BrownLine/BrownLine/,
8/BrownLine/BrownLine/,
9/BrownLine/BrownLine/}
\end{scope}
\begin{scope}[local bounding box=G3,shift={(-7,0.8)}]
\Levo{3}
\end{scope}
\draw[Line] (1-cube1-bl) -- (9-cube2-br);
 \draw[Line] (1-cube1-tl) -- (9-cube2-tr);
 \scoped[on background layer]
\draw[Line] (1-cube1-zbl) -- (9-cube2-zbr);
 \draw[Line] (1-cube1-ztl) -- (9-cube2-ztr);
 %
 \draw[Line] (1-cube2-bl) -- (3-cube3-br);
 \draw[Line] (1-cube2-tl) -- (3-cube3-tr);
 \scoped[on background layer]
\draw[Line] (1-cube2-zbl) -- (3-cube3-zbr);
 \draw[Line] (1-cube2-ztl) -- (3-cube3-ztr);
\end{scope}
%%%%%%%%%%%%%%%%
\begin{scope}[local bounding box=ROW3,shift={(0,-9)}]
\begin{scope}[local bounding box=G1,shift={(0,0)}]
 \Desno{1}
\end{scope}
\begin{scope}[local bounding box=G2,shift={(-4,0.5)}]
\Sredina{2}{1/BrownLine/BrownLine/,
2/BrownLine/BrownLine/,
3/BrownLine/BrownLine/,
4/BrownLine/BrownLine/,
5/BrownLine/BrownLine/,
6/BrownLine/BrownLine/,
7/BrownLine/BrownLine/,
8/BrownLine/BrownLine/}
\end{scope}
\begin{scope}[local bounding box=G3,shift={(-7,0.8)}]
\Levo{3}
\end{scope}
\draw[Line] (1-cube1-bl) -- (8-cube2-br);
 \draw[Line] (1-cube1-tl) -- (8-cube2-tr);
 \scoped[on background layer]
\draw[Line] (1-cube1-zbl) -- (8-cube2-zbr);
 \draw[Line] (1-cube1-ztl) -- (8-cube2-ztr);
 %
 \draw[Line] (1-cube2-bl) -- (3-cube3-br);
 \draw[Line] (1-cube2-tl) -- (3-cube3-tr);
 \scoped[on background layer]
\draw[Line] (1-cube2-zbl) -- (3-cube3-zbr);
 \draw[Line] (1-cube2-ztl) -- (3-cube3-ztr);
\end{scope}
\node[draw,
      single arrow, draw=red, fill=red,rotate=-90,
      minimum width=8pt, single arrow head extend=3pt,
      minimum height=13mm, line width=1pt] (ST1)
      at($(ROW1.south)!0.75!(ROW2.north)$){};
\node[below right=1pt and 12pt of ST1.south,align=center,anchor=west]{剪除选定的\\ 通道(红色)};
\node[draw,
      single arrow, draw=green!90!black, fill=green!90!black,rotate=-90,
      minimum width=8pt, single arrow head extend=3pt,
      minimum height=13mm, line width=1pt] (ST2)
      at($(ROW2.south)!0.75!(ROW3.north)$){};
\node[below right=1pt and 12pt of ST2.south,align=center,anchor=west]{重新配置模型的\\
架构以适应 \\ 这些变化};
\node[above=2pt of ROW1]{\textbf{通道/滤波器剪枝}};
%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%
%RIGHT
\begin{scope}[local bounding box=RROW1,shift={(11,0)}]
\begin{scope}[local bounding box=G1,shift={(0,0)}]
 \Desno{1}
\end{scope}
\begin{scope}[local bounding box=G2,shift={(-4,0.5)}]
\Sredina{2}{1/red/red/,
2/red/red/,
3/red/red/,
4/red/red/,
5/red/red/,
6/red/red/,
7/red/red/,
8/red/red/,
9/red/red/}
\end{scope}
\begin{scope}[local bounding box=G3,shift={(-7,0.8)}]
\Levo{3}
\end{scope}
\draw[Line] (1-cube1-bl) -- (9-cube2-br);
 \draw[Line] (1-cube1-tl) -- (9-cube2-tr);
 \scoped[on background layer]
\draw[Line] (1-cube1-zbl) -- (9-cube2-zbr);
 \draw[Line] (1-cube1-ztl) -- (9-cube2-ztr);
 %
 \draw[Line] (1-cube2-bl) -- (3-cube3-br);
 \draw[Line] (1-cube2-tl) -- (3-cube3-tr);
 \scoped[on background layer]
\draw[Line] (1-cube2-zbl) -- (3-cube3-zbr);
 \draw[Line] (1-cube2-ztl) -- (3-cube3-ztr);
\end{scope}
%%%%%%%%%%%%%%%%
\begin{scope}[local bounding box=RROW2,shift={(11,-4.5)}]
\begin{scope}[local bounding box=RG1,shift={(0,0)}]
 \Desno{1}
\end{scope}
\begin{scope}[local bounding box=RG2,shift={(-4,0.5)}]
\Sredina{2}{1/PrunedGreen/red/dashed,
2/PrunedGreen/red/dashed,
3/PrunedGreen/red/dashed,
4/PrunedGreen/red/dashed,
5/PrunedGreen/red/dashed,
6/PrunedGreen/red/dashed,
7/PrunedGreen/red/dashed,
8/PrunedGreen/red/dashed,
9/PrunedGreen/red/dashed}
\end{scope}
\begin{scope}[local bounding box=RG3,shift={(-7,0.8)}]
\Levo{3}
\end{scope}
\draw[Line] (1-cube1-bl) -- (9-cube2-br);
 \draw[Line] (1-cube1-tl) -- (9-cube2-tr);
 \scoped[on background layer]
\draw[Line] (1-cube1-zbl) -- (9-cube2-zbr);
 \draw[Line] (1-cube1-ztl) -- (9-cube2-ztr);
 %
 \draw[Line] (1-cube2-bl) -- (3-cube3-br);
 \draw[Line] (1-cube2-tl) -- (3-cube3-tr);
 \scoped[on background layer]
\draw[Line] (1-cube2-zbl) -- (3-cube3-zbr);
 \draw[Line] (1-cube2-ztl) -- (3-cube3-ztr);
\end{scope}
%%%%%%%%%%%%%%%%
\begin{scope}[local bounding box=RROW3,shift={(11,-9)}]
\begin{scope}[local bounding box=RG1,shift={(-2,0)}]
 \Desno{1}
\end{scope}
\begin{scope}[local bounding box=RG3,shift={(-5.5,0.8)}]
\Levo{3}
\end{scope}
\draw[Line] (1-cube1-bl) -- (3-cube3-br);
 \draw[Line] (1-cube1-tl) -- (3-cube3-tr);
 \scoped[on background layer]
\draw[Line] (1-cube1-zbl) -- (3-cube3-zbr);
 \draw[Line] (1-cube1-ztl) -- (3-cube3-ztr);
 %
\end{scope}
 \node[draw,
      single arrow, draw=red, fill=red,rotate=-90,
      minimum width=8pt, single arrow head extend=3pt,
      minimum height=13mm, line width=1pt] (RST1)
      at($(RROW1.south)!0.75!(RROW2.north)$){};
\node[below right=1pt and 12pt of RST1.south,align=center,anchor=west]{剪除整个层\\
(所有红色通道)};
\node[draw,
      single arrow, draw=green!90!black, fill=green!90!black,rotate=-90,
      minimum width=8pt, single arrow head extend=3pt,
      minimum height=13mm, line width=1pt] (RST2)
      at($(RROW2.south)!0.75!(RROW3.north)$){};
\node[below right=1pt and 12pt of RST2.south,align=center,anchor=west]{重新配置模型的\\
架构以适应 \\ 这些变化};
\node[above=2pt of RROW1]{\textbf{层剪枝}};
\draw[violet!30,line width=2pt]($(ROW1.north east)!0.5!(RROW1.north west)$)--
($(ROW3.south east)!0.26!(RROW3.south west)$);
\end{tikzpicture}figure 3 中展示的结构变化机制说明了为何这些剪枝粒度会带来不同的硬件权衡。通道剪枝会缩减稠密通用矩阵乘法(GEMM)运算的内部维度:移除第 \(l\) 层的输出通道,会减小第 \(l+1\) 层的输入通道维度。虽然张量仍然稠密,避免了稀疏指针查找,但剪枝后的维度必须保持与硬件分块边界对齐(对于单指令多数据(SIMD)向量单元和 Tensor Core,通常为 8、16 或 32 个元素的整数倍),以防止非合并内存访问和计算通道闲置。层剪枝通过移除完整的计算阶段,完全绕过了维度对齐问题。这消除了内核启动延迟、中间激活值的内存流量以及残差同步操作,但需要重新连接残差跳跃连接,并接受表示能力更大幅度的下降。
非结构化剪枝
非结构化剪枝 在保留整体网络架构的同时移除单个权重。有些连接在训练过程中变得冗余,对最终输出的贡献很小。剪除这些弱连接能够减少非零元素数量,并且在恢复后可以保留大部分任务质量。
为形式化描述这一过程,令 \(\mathbf{W} \in \mathbb{R}^{m \times n}\) 表示给定层中的权重矩阵。剪枝通过应用二值掩码 \(\mathbf{M} \in \{0,1\}^{m \times n}\) 移除一部分权重,得到剪枝后的权重矩阵: \[ \hat{\mathbf{W}} = \mathbf{M} \odot \mathbf{W} \] 其中,\(\odot\) 表示逐元素的 Hadamard 积。掩码 \(\mathbf{M}\) 根据剪枝准则构建,通常依据权重幅值。一种常见方法是基于幅值的剪枝,通过定义阈值 \(\delta_{\text{prune}}\),移除幅值最小、占比为 \(\rho_{\text{sparse}}\) 的权重: \[ M_{i,j} = \begin{cases} 1, & \text{if } |W_{i,j}| > \delta_{\text{prune}} \\ 0, & \text{otherwise} \end{cases} \] 其中,选择 \(\delta_{\text{prune}}\) 以确保仅保留幅值最大的 \((1 - \rho_{\text{sparse}})\) 比例的权重。这种方法假设幅值较大的权重对网络功能的贡献更大,因此更应优先保留。
非结构化剪枝减少了非零参数的数量,但要将这种减少转化为物理存储空间节省,需要采用带索引的稀疏编码,例如压缩稀疏行(CSR)或坐标列表(COO)。由于这些格式必须在存储非零值的同时存储列索引和行指针等位置元数据,因此在稀疏度较低时,元数据开销会抵消节省的空间。例如,将一个 16 位浮点权重与一个 16 位列索引一同存储,会使每个元素占用的字节数翻倍,因而稀疏度必须超过 50%,才能在模型产物大小(\(D_{\text{vol}}\))上达到收支平衡。以稠密张量形式存储已置零的元素,不会节省任何内存。
非结构化稀疏性也不会直接转化为现代硬件上的推理加速。通用加速器通过稠密脉动阵列和宽 SIMD 执行单元实现峰值吞吐量(\(R_{\text{peak}}\)),这些单元要求锁步执行,并要求对相邻内存地址的内存事务进行合并。任意的零值分布迫使稀疏矩阵与稠密矩阵乘法(SpMM)内核执行间接内存寻址和指针追踪。这种不规则的内存访问会导致线程束分歧、非合并的全局内存事务以及严重的缓存行利用不足。除非网络达到极高的稀疏度(通常超过 80% 至 90%),并使用专门的稀疏内核执行,否则非结构化剪枝得到的模型虽然磁盘占用更小,运行时执行却更慢。
结构化剪枝
非结构化剪枝移除单个权重,而结构化剪枝 (Li et al. 2017) 则移除整个计算单元:神经元、滤波器、通道或层。这种方法生成更小的稠密张量,可在标准加速器内核上执行。因此,相比任意的非结构化稀疏性,它更容易转化为延迟降低,不过仍需仔细剖析张量形状、内存对齐和任务质量。
Li, Hao, Asim Kadav, Igor Durdanovic, Hanan Samet, and Hans Peter Graf. 2017. “Pruning Filters for Efficient ConvNets.” International Conference on Learning Representations (ICLR).
神经元、滤波器和层对模型预测的贡献可能存在显著差异。有些单元可能承载冗余或影响较小的信息,但只有验证表明剩余结构保留了所需行为时,移除才是安全的。识别这些结构仍然是核心挑战。
硬件感知剪枝策略,例如 N:M 结构化稀疏性,6 会强制采用特定模式(例如,确保每 4 个权重中有 2 个为零),以适配专用加速器的能力。本章使用 2:4 模式作为压缩示例;后文的 N:M 结构化稀疏性的机制 将说明稀疏 Tensor Core 如何利用该模式。
剪枝方法需要在参数减少量与硬件执行的规整性之间进行权衡。比较 figure 4 中的三个子图,可以看到左侧的不规则权重移除与中间、右侧的结构化神经元和通道移除之间的差异。
\begin{tikzpicture}[line join=round,font=\small\sffamily]
\tikzset{
 Line/.style={line width=0.5pt,black!50,text=black},
  LineD/.style={line width=0.5pt,black!50,text=black,dashed},
}
\makeatletter
\newif\ifboxdashed
\boxdashedfalse % default: not dashed
\makeatother

\tikzset{
channel/.pic={
\pgfkeys{/channel/.cd, #1}
\node[rectangle,draw=\channelcolor,line width=1pt,fill=\channelcolor!10,
minimum size=56,\ifboxdashed dashed\fi](\picname){};
\node[rectangle,draw=BrownLine,line width=0.5pt,fill=white,
minimum size=18](\smallpicname){};
        }
}

\tikzset{
circles/.pic={
\pgfkeys{/channel/.cd, #1}
\node[circle,draw=\channelcolor,line width=1pt,fill=\channelcolor!10,
minimum size=9mm,\ifboxdashed dashed\fi](\picname){};
        }
}

\tikzset{
channelw/.pic={
\pgfkeys{/channel/.cd, #1}
\node[rectangle,draw=\channelcolor,line width=1pt,fill=\channelcolor!10,
minimum size=56,\ifboxdashed dashed\fi](\picname){};
        }
}

\pgfkeys{
  /channel/.cd,
  channelcolor/.store in=\channelcolor,
  scalefac/.store in=\scalefac,
  picname/.store in=\picname,
  smallpicname/.store in=\smallpicname,
  channelcolor=BrownLine,
  scalefac=1,
  dashed/.is if=boxdashed,
  dashed/.default=true,
  picname=C
}

\begin{scope}[local bounding box=CHANEL1,shift={(0,0)}]
\foreach \i/\da in {1/dashed,2/,3/dashed,4/} {
\pic at ({-\i*0.8}, {-0.8*\i}) {channel={picname=\i-CH1,smallpicname=\i-SCH1,\da}};
}
\end{scope}

\begin{scope}[local bounding box=CHANEL2,shift={(4.5,0)}]
\foreach \i/\da in {2/dashed,3/} {
\pic at ({-\i*0.8}, {-0.8*\i}) {channelw={picname=\i-CH2,smallpicname=\i-SCH2,\da}};
}
\end{scope}
\node[below =5pt of CHANEL2,align=center]{卷积\\ 神经网络};
\draw[Line](4-SCH1.center)--++(120:3.2)coordinate(CE1);
\draw[Line](2-SCH1.north)--(CE1);
\draw[Line](1-SCH1.north)--(CE1)node[above,align=center,text=black]{卷积\\ 核};
%%
\coordinate(CE2)at ($(3-CH2.north west)!0.35!(3-CH2.south east)$);
\coordinate(CE3)at ($(3-CH2.north east)!0.2!(3-CH2.south west)$);
\coordinate(CE4)at ($(1-CH1.north east)!0.15!(1-CH1.south west)$);

\draw[Line](4-SCH1.north east)--(CE2);
\draw[Line](4-SCH1.south east)--(CE2);
\foreach \i in {1,2,3}{
\draw[Line](\i-SCH1.east)--(CE2);
}
\draw[Line](CE3)--++(80:1.8)node[above]{通道}--(CE4);
%%
\begin{scope}[local bounding box=CIRCLE1,shift={($(CHANEL1)+(-5.6,0)$)}]
\foreach \i/\da in {1/,2/dashed,3/} {
  \pgfmathsetmacro{\y}{(2-\i)*1.5}
  \pic at (0,\y) {circles={channelcolor=OrangeLine,picname=1CL\i,\da}};
}
%right -2 neurons
\foreach \j/\da in {1/dashed,2/} {
  \pgfmathsetmacro{\y}{(1-\j)*1.5 + 0.6}
  \pic at (1.8,\y) {circles={channelcolor=OrangeLine,picname=1CR\j,\da}};
}
\end{scope}

\draw[Line](1CL3)--(1CR2);
\draw[Line](1CL1)--(1CR2);
\foreach \i in {1,2,3}{
  \foreach \j in {1,2}{
\draw[LineD](1CL\i)--(1CR\j);
}}

\scoped[on background layer]
\node[draw=BlueLine,inner xsep=8,inner ysep=9,yshift=-2mm,
minimum height=57mm,
           fill=BlueL!20,fit=(CIRCLE1)(CHANEL1)(CHANEL2),line width=1.0pt](BB1){};
\node[above=2pt of BB1.south,anchor=south]{结构化剪枝};
%%
\begin{scope}[local bounding box=CIRCLE2,shift={($(CIRCLE1)+(-4.6,0)$)}]
\foreach \i/\da in {1/,2/,3/} {
  \pgfmathsetmacro{\y}{(2-\i)*1.5}
  \pic at (0,\y) {circles={channelcolor=OrangeLine,picname=2CL\i,\da}};
}
%right -2 neurons
\foreach \j/\da in {1/,2/} {
  \pgfmathsetmacro{\y}{(1-\j)*1.5 + 0.6}
  \pic at (1.8,\y) {circles={channelcolor=OrangeLine,picname=2CR\j,\da}};
}
\draw[Line](2CL3)--(2CR1);
\draw[Line](2CL1)--(2CR2);
\draw[Line](2CL2)--(2CR2);

\foreach \i in {1,2,3}{
  \foreach \j in {1,2}{
\draw[LineD](2CL\i)--(2CR\j);
}}
\end{scope}
\scoped[on background layer]
\node[draw=OliveLine,inner xsep=10,inner ysep=9,yshift=-2mm,
minimum height=57mm,
           fill=yellow!10,fit=(CIRCLE2),line width=1.0pt](BB1){};
\node[above=2pt of BB1.south,anchor=south]{非结构化剪枝};
\end{tikzpicture}
Qi, Chen, Shibo Shen, Rongpeng Li, Zhifeng Zhao, Qing Liu, Jing Liang, and Honggang Zhang. 2021. “An Efficient Pruning Scheme of Deep Neural Networks for Internet of Things Applications.” EURASIP Journal on Advances in Signal Processing 2021 (1): 31. https://doi.org/10.1186/s13634-021-00744-4.
结构化剪枝通过将底层矩阵缩减为更小、连续的稠密张量,消除了非结构化稀疏性带来的稀疏元数据开销和内存访问分歧代价(figure 4)。在全连接层(中)中,剪除神经元会移除相邻权重矩阵中对应的行和列。在卷积层(右)中,剪除通道会移除完整的三维滤波器切片。由于所得子网络完全由稠密运算组成,因此可以直接在标准基本线性代数子程序(BLAS)和卷积引擎上执行,无需专门的稀疏库。系统层面的首要要求是保持维度对齐:当张量维度保持为硬件缓存行大小和线程束分块大小(例如 32、64 或 128 个元素)的整数倍时,现代加速器内核能够实现峰值内存吞吐量。
结构化剪枝的一种常见方法是根据关联权重的幅值,对整个神经元或滤波器进行排序。较小的组范数是一种计算成本较低的重要性代理指标,并不能证明该单元可以被移除。评分可以采用与每个单元关联的权重的 \(\ell_1\) 范数或 \(\ell_2\) 范数;低于选定阈值的组会成为剪枝候选。逐层排序很重要,因为不同层的原始尺度可能存在差异。这种方法无需使用代表性数据进行一次前向计算,但计算评分、选择阈值、实际构建更小的计算图,以及验证或微调结果,仍会产生工程和计算成本。
另一种策略是基于激活的剪枝,它在数据集上评估神经元或滤波器的激活值。在代表性输入上始终保持较弱激活的单元会成为移除候选,但仍需通过消融或微调检查。这种方法捕捉依赖于输入的行为,而非仅依靠静态权重。其排序仍可能遗漏罕见但重要的输入,受到激活值缩放的影响,或在上游单元移除后发生变化。因此,基于激活的剪枝需要代表性的剖析数据,并在选定结构移除后进行验证。
基于梯度的剪枝 使用损失函数的导数来估计移除某个神经元或滤波器会如何改变目标函数。较小的一阶评分表明,在当前检查点和所采样的数据上,该单元可以作为候选;它并不能证明该单元永久无关紧要,也无法捕捉单元之间的所有交互。基于梯度的准则可以结合单元的值及其梯度,按照预期的局部损失变化进行排序。在数学上,该准则通过一阶泰勒展开来近似将参数 \(w_i\) 置零时的损失变化 \(\Delta \mathcal{L}\):\(\Delta \mathcal{L} \approx |w_i \cdot \frac{\partial \mathcal{L}}{\partial w_i}|\)。接近零或梯度可忽略的权重对目标函数的影响极小,因此是优先移除的候选。与仅依据权重幅值的准则不同,这类方法需要反向计算,通常集成到训练或微调过程中。由于评分只是局部近似,剪枝结果仍需进行任务层面的验证。
这些准则需要在测量成本与对模型行为的忠实程度之间进行权衡。幅值评分计算成本较低,可提供有用的基线,但忽略了输入分布。激活评分纳入了代表性输入,能够揭示在该工作负载上激活较弱的单元;基于梯度的评分还纳入了局部损失曲面的信息,但会增加训练成本。没有一种方法在所有模型上都占优,也没有一种能够证明移除操作无害。合理的比较应剪枝至相同的结构目标,采用相同的恢复预算,并测量移除后的任务质量。随后还应对导出的计算图进行性能剖析,因为更好的重要性评分可能保留任务质量,却未必产生目标运行时能够高效执行的形状。因此,具体选择取决于可用的数据和计算资源、待移除的结构,以及部署所允许的质量余量。
动态剪枝
传统剪枝方法,无论是非结构化剪枝还是结构化剪枝,都会生成一个在部署期间保持固定的静态剪枝掩码或子网络,即使该掩码是在训练过程中逐步学习得到的。相比之下,动态剪枝根据输入数据或训练动态调整激活哪些计算,因此实际执行的子网络可以随时间变化。
动态剪枝可以采用运行时稀疏化技术,由模型根据输入特征选择参数或结构。例如,以激活为条件的剪枝会针对特定输入停用神经元或通道 (Hu et al. 2023)。由此产生的输入依赖稀疏性,只有在控制器和运行时跳过相关计算的成本低于稠密路径执行这些计算的成本时,才能减少实际执行的工作量。
Hu, Jie, Peng Lin, Huajun Zhang, Zining Lan, Wenxin Chen, Kailiang Xie, Siyun Chen, Hao Wang, and Sheng Chang. 2023. “A Dynamic Pruning Method on Multiple Sparse Structures in Deep Neural Networks.” IEEE Access 11: 38448–57. https://doi.org/10.1109/access.2023.3267469.
例如,考虑一个处理复杂度各异的图像的卷积神经网络。在对主要包含均匀区域的简单图像进行推理时,某些卷积滤波器可能产生可忽略的激活。动态策略可以识别候选滤波器,并暂时将其排除在计算之外。这种排除减少了名义工作量,但控制器、不规则执行以及任何质量变化仍然是结果的一部分。只有当输入之间的差异足够大,能够抵偿这些成本时,该方法才对延迟敏感的应用有用。如 基准测试 所详述,评估此类效率收益需要在同一目标工作负载上,针对完整的输入分布同时测量延迟和准确率。
另一类动态剪枝在训练期间运行,在整个优化过程中逐步引入并调整稀疏性。渐进式幅值剪枝从稠密网络开始,在微调保留权重的同时,逐步提高被剪除参数的比例。动态稀疏训练的变体还允许重新生长在训练后期被证明重要的连接,从而使网络能够从剪枝导致的容量损失中恢复。
动态剪枝可以为不同输入分配不同的计算量,并重新激活静态部署掩码会永久移除的容量。这些性质创造了机会,但并不保证效率或准确率收益。控制器位于关键路径上,依赖输入的路由使批次执行在 SIMD 向量通道之间碎片化,而扩大的行为空间需要更多验证。训练可能还需要路由损失或正则化,以确保策略确实使用成本更低的路径。生产部署必须按路由监控路由频率、尾延迟和质量;后文的 机器学习运维 将进一步阐述这些监控与回滚实践。因此,只有当输入复杂度的变化足以抵偿控制器和批处理开销时,动态剪枝才值得考虑,而不应将其作为静态剪枝的默认替代方案。
剪枝的权衡
这三种剪枝方法在规则性与粒度的权衡中各有侧重。非结构化剪枝可以移除单个权重,因此能够表达细粒度稀疏性,但加速器需要匹配的稀疏格式和计算内核才能跳过这些零值。结构化剪枝移除通道、滤波器或层,可以产生传统硬件已经支持的、更小的稠密运算。动态剪枝使实际执行的结构依赖于输入,通过增加控制和批处理开销来实现条件式分配。Table 4 总结了这些部署差异。
这些类别描述的是部署后的执行方式,而非互斥的训练算法。结构化子网络可以通过动态调度学习得到,然后固定下来用于模型服务;应根据其运行时实际执行的内容对该产物进行分类。
| 方面 | 非结构化剪枝 | 结构化剪枝 | 动态剪枝 |
|---|---|---|---|
| 移除什么? | 模型中的单个权重 | 整个神经元、通道、滤波器或层 | 根据运行时条件调整剪枝 |
| 模型结构 | 稀疏权重矩阵;原始架构保持不变 | 模型架构发生改变;被剪除的层完全移除 | 结构动态适应 |
| 对内存的影响 | 减少非零元素数量;只有采用适当的稀疏表示时,存储占用才会下降 | 通过移除整个组件来减少模型存储占用 | 随实时剪枝情况而变化 |
| 对计算的影响 | 除非受支持的稀疏路径跳过零值,否则仍需执行稠密计算 | 减少名义 FLOPs;延迟取决于最终的张量形状和计算内核 | 随路由策略和控制器开销而变化 |
| 硬件兼容性 | 需要稀疏格式及匹配的执行支持 | 生成稠密子网络,但不理想的张量形状仍可能导致硬件利用率不足 | 需要自适应推理引擎 |
| 是否需要微调? | 通常用于恢复剪枝后的准确率 | 通常在结构修改后使用 | 取决于路由策略和子网络的训练方式 |
| 应用场景 | 用于云端部署的内存高效模型压缩 | 实时推理优化、移动端/边缘 AI 和高效训练 | 自适应 AI 应用、实时系统 |
剪枝策略
执行调度决定了网络能否消化容量损失,还是会发生不可逆的性能退化。权重移除主要由两种调度策略控制:迭代剪枝和一次性剪枝。
迭代剪枝
迭代剪枝通过交替进行结构参数移除与重新训练,缓解准确率的灾难性下降(figure 5)。
\begin{tikzpicture}[line join=round,font=\sffamily]
\tikzset{
 Line/.style={line width=0.5pt,black!50,dashed},
 cubes/.pic={
\pgfkeys{/cubes/.cd, #1}
\begin{scope}[scale=\scalefac,every node/.style={scale=1*\scalefac}]
\pgfmathsetmacro{\cubex}{0.08}
\pgfmathsetmacro{\cubey}{1.6}
\pgfmathsetmacro{\cubez}{1.6}
%front
\coordinate (\picname-tl) at (-\cubex,0,0); % top-left point
\coordinate (\picname-tr) at (0,0,0); % top-right point
\coordinate (\picname-br) at (0,-\cubey,0); % bottom-right point
\coordinate (\picname-bl) at (-\cubex,-\cubey,0); % bottom-left point
\coordinate (\picname-ztl) at (-\cubex,0,-\cubez); % ztop-left point
\coordinate (\picname-ztr) at (0,0,-\cubez); % ztop-right point
\coordinate (\picname-zbr) at (0,-\cubey,-\cubez); % zbottom-right point
\coordinate (\picname-zbl) at (-\cubex,-\cubey,-\cubez); %z bottom-left point
\draw[draw=\cubecolor,fill=\cubecolor!15, \ifboxdashed dashed\fi] (0,0,0) -- ++(-\cubex,0,0) -- ++(0,-\cubey,0) -- ++(\cubex,0,0) -- cycle;
%right
\draw[draw=\cubecolor,fill=\cubecolor!30, \ifboxdashed dashed\fi] (0,0,0) -- ++(0,0,-\cubez) -- ++(0,-\cubey,0) -- ++(0,0,\cubez) -- cycle;
%top
\draw[draw=\cubecolor,fill=\cubecolor!20, \ifboxdashed dashed\fi] (0,0,0) -- ++(-\cubex,0,0) -- ++(0,0,-\cubez) -- ++(\cubex,0,0) -- cycle;
            \end{scope}
        }
}
\makeatletter
\newif\ifboxdashed
\boxdashedfalse % default: not dashed
\makeatother

\pgfkeys{
  /cubes/.cd,
  cubecolor/.store in=\cubecolor,
  scalefac/.store in=\scalefac,
  picname/.store in=\picname, % ← nova linija
  cubecolor=red,
  scalefac=1,
  dashed/.is if=boxdashed,
  dashed/.default=true,
  picname=C
}
\newcommand{\Iteration}[8]{%
\begin{scope}[local bounding box=G1,shift={(0,0)}]
\foreach \i in {#1} {
  \pgfmathsetmacro\colorname{%
    ifthenelse(\i==#2 || \i==#3 ,
      "red", "BrownLine")}
\pic at ({\i*0.15}, {-0.02*\i}) {cubes={cubecolor=\colorname,picname=\i-cube1}};
}
\end{scope}

\begin{scope}[local bounding box=G2,shift={(-2.75,0.4)}]
\foreach \i in {#5} {
  \pgfmathsetmacro\colorname{%
    ifthenelse(\i==#6 || \i==#7,
      "red", "BrownLine")}
\pic at ({\i*0.18}, {-0.02*\i}) {cubes={scalefac=1.35,cubecolor=\colorname,picname=\i-cube2}};
}
\end{scope}

\begin{scope}[local bounding box=G3,shift={(-5.5,0.6)}]
\foreach \i in {1,2,3} {
  \pgfmathsetmacro\colorname{%
    ifthenelse(\i==13 || \i==14,"red", "BrownLine")}
\pic at ({\i*0.30}, {-0.02*\i}) {cubes={scalefac=1.5,cubecolor=\colorname,picname=\i-cube3}};
}
\end{scope}

\begin{scope}[local bounding box=G4,shift={(-7.75,1.0)}]
\foreach \i in {1} {
  \pgfmathsetmacro\colorname{%
    ifthenelse(\i==13 || \i==14,"red", "BrownLine")}
\pic at ({\i*0.25}, {-0.02*\i}) {cubes={scalefac=1.8,cubecolor=\colorname,picname=\i-cube4}};
}
\end{scope}
\draw[Line] (1-cube1-bl) -- (6-cube2-br);
 \draw[Line] (1-cube1-tl) -- (6-cube2-tr);
 \scoped[on background layer]
\draw[Line] (1-cube1-zbl) -- (6-cube2-zbr);
 \draw[Line] (1-cube1-ztl) -- (6-cube2-ztr);
 %
 \draw[Line] (1-cube2-bl) -- (3-cube3-br);
 \draw[Line] (1-cube2-tl) -- (3-cube3-tr);
 \scoped[on background layer]
\draw[Line] (1-cube2-zbl) -- (3-cube3-zbr);
 \draw[Line] (1-cube2-ztl) -- (3-cube3-ztr);
 %
  \draw[Line] (1-cube3-bl) -- (1-cube4-br);
 \draw[Line] (1-cube3-tl) -- (1-cube4-tr);
 \scoped[on background layer]
\draw[Line] (1-cube3-zbl) -- (1-cube4-zbr);
 \draw[Line] (1-cube3-ztl) -- (1-cube4-ztr);

\scoped[on background layer]
\node[draw=BlueLine,inner xsep=8,inner ysep=14,yshift=0mm,
           fill=BlueL!10,fit=(G1)(G4),line width=1.0pt](BB1){};
\node[fill=BlueL,below left=5.5pt and 11pt of  BB1.north east,anchor=north east,align=center]{
初始准确率:\\ \textbf{#4}};
\node[above=1pt of  BB1.north west,anchor=south west,align=left]{\large #8};
}

%%%%%%
% #1 number of teeth
% #2 radius intern
% #3 radius extern
% #4 angle from start to end of the first arc
% #5 angle to decale the second arc from the first
% #6 inner radius to cut off
\newcommand{\gear}[6]{%
  (0:#2)
  \foreach \i [evaluate=\i as \n using {\i-1)*360/#1}] in {1,...,#1}{%
    arc (\n:\n+#4:#2) {[rounded corners=1.5pt] -- (\n+#4+#5:#3)
    arc (\n+#4+#5:\n+360/#1-#5:#3)} --  (\n+360/#1:#2)
  }%
  (0,0) circle[radius=#6];
}
\newcommand{\Test}[2]{%
\begin{scope}[local bounding box=GEAR,shift={($(BB1.east)+(8,0)$)},
scale=1.0, every node/.append style={transform shape}]
\def\ra{20mm}
\tikzset{%
 Arrow/.style={-{Triangle[width=15pt,length=8pt]}, line width=7pt,}
}
\draw[Arrow,violet!60] (-80:0.5*\ra)
arc[radius=0.5*\ra, start angle=-80, end angle= 80]coordinate(K1);
\draw[Arrow,orange!80!black!90] (100:0.5*\ra)
arc[radius=0.5*\ra, start angle=100, end angle= 260]coordinate(K2);
\node[circle,minimum size=\ra](KR){};

\fill[draw=none,fill=black,even odd rule,xshift=-2mm]\gear{10}{0.23}{0.28}{10}{2}{0.1};
\fill[draw=none,fill=black,even odd rule,xshift=3mm,yshift=2mm]\gear{10}{0.18}{0.22}{10}{2}{0.08};

\scoped[on background layer]
\node[draw=BlueLine,minimum width=27mm,minimum height=29mm,
           fill=BlueL!20,fit=(K1)(K2)(KR),line width=1.0pt](BB3){};
\end{scope}
%
\begin{scope}[local bounding box=TA1,shift={($(BB1.east)+(3.25,0)$)},
scale=1.0, every node/.append style={transform shape}]
\node[draw=BrownLine,
minimum width=27mm,minimum height=29mm,
           fill=brown!10,line width=1.0pt](BB2){};
\node[below=0.2 of BB2.north](TTA1){\textbf{测试准确率:}};
\node[below right= 0.7 and -0.6 of TTA1, draw,
      single arrow, draw=red, fill=red, rotate=-90,
      minimum width=8pt, single arrow head extend=3pt,
      minimum height=9mm, line width=1pt] (ST1) {};
\node[left=0.3 of ST1,anchor=north east](BR1){\large\textbf{#1}};
\end{scope}
%%
\begin{scope}[local bounding box=TA2,shift={($(BB3.east)+(2.5,0)$)},
scale=1.0, every node/.append style={transform shape}]
\node[draw=GreenLine,
minimum width=27mm,minimum height=29mm,
           fill=yellow!10,line width=1.0pt](BB4){};
\node[below=0.2 of BB4.north](TTA1){\textbf{测试准确率:}};
\node[below right= 1.1 and -0.9 of TTA1, draw,
      single arrow, draw=GreenLine, fill=GreenL!90!black, rotate=90,
      minimum width=8pt, single arrow head extend=3pt,
      minimum height=9mm, line width=1pt] (ST1) {};

\node[left=0.3 of ST1,anchor=south east](BR1){\large\textbf{#2}};
\end{scope}
     \node[draw,
      single arrow, draw=red, fill=red,
      minimum width=8pt, single arrow head extend=3pt,
      minimum height=16mm, line width=1pt] (ST1)
      at($(BB1.east)!0.5!(BB2.west)$){};
      \node[draw,
      single arrow, draw=VioletLine, fill=VioletL,
      minimum width=8pt, single arrow head extend=3pt,
      minimum height=16mm, line width=1pt] (ST2)
      at($(BB2.east)!0.5!(BB3.west)$){};
      \node[draw,
      single arrow, draw=GreenLine, fill=GreenL!90!black,
      minimum width=8pt, single arrow head extend=3pt,
      minimum height=9mm, line width=1pt] (ST3)
      at($(BB3.east)!0.5!(BB4.west)$){};
\node[align=center,above=3pt of ST1]{剪除\\ 选定的\\ 通道};
\node[align=center,above=3pt of ST2]{在新\\ 结构上\\ 微调};
}

%%%%%%%%%%%%%%%%%%%%
%#1 number of plants - first group
%#2 and #3 red plants - first group
%#4 starting accuracy - first group
%#5 number of plants - second group
%#6 and #7 red plants - second group
%#8 iteration name
%\Iteration{#1}{#1}{#2}{#3}{#4}{#5}{#6}{#7}{#8}
%%%%%%%%%%%%%%%%%%%%%%%
\begin{scope}[local bounding box=ROW1,shift={(0,0)}]
\Iteration{1,...,12}{3}{4}{0.995}{1,...,6}{5}{6}{第 1 次迭代}\Test{0.971}{0.992};
\end{scope}
\begin{scope}[local bounding box=ROW2,shift={(0,-6)}]
\Iteration{1,2,5,6,...,12}{3}{4}{0.992}{1,...,6}{3}{4}{第 2 次迭代}\Test{0.956}{0.993};
\end{scope}
\begin{scope}[local bounding box=ROW3,shift={(0,-12)}]
\Iteration{1,2,5,6,...,12}{9}{10}{0.993}{1,2,5,6}{3}{4}{第 3 次迭代}\Test{0.967}{0.991};
\end{scope}
\end{tikzpicture}figure 5 中的三行工作流程展示了卷积网络在剪除六个通道时的这种渐进适应过程。该流程并非一次移除全部六个通道,而是在三次迭代中每个周期移除两个通道,并在每次剪除后微调剩余参数。首次剪除使准确率从 0.995 降至 0.971,但短暂微调便将其恢复至 0.992。随后两个剪枝与微调周期得到的最终模型准确率为 0.991——尽管通道数减少了 27%,准确率却仅下降了可忽略的 0.4%。将结构调整分散到多个重新训练阶段,使保留的权重能够沿损失景观调整其表示。
一次性剪枝
一次性剪枝在单个步骤中移除多个架构组件,随后进行充分微调,以恢复模型准确率。这种激进方法能够快速压缩模型,但由于网络必须同时适应显著的结构变化,存在准确率下降更大的风险。
对同一网络应用一次性剪枝,说明了激进结构截减的风险。一次性剪枝不分阶段移除通道,而是同时剪除全部六个通道(figure 6)。在单个步骤中移除 27% 的网络容量,使准确率从 0.995 降至 0.914。后续微调仅恢复至 0.943——相较基线永久下降了 5%。尽管迭代剪枝和一次性剪枝最终得到的张量几何形状完全相同,但表示容量的骤然损失使一次性剪枝后的微调陷入较差的局部极小值。
\begin{tikzpicture}[line join=round,font=\sffamily]
\tikzset{
    Line/.style={line width=0.5pt,black!50,dashed},
 cubes/.pic={
   \pgfkeys{/cubes/.cd, #1}
\begin{scope}[scale=\scalefac,every node/.style={scale=1*\scalefac}]
\pgfmathsetmacro{\cubex}{0.08}
\pgfmathsetmacro{\cubey}{1.6}
\pgfmathsetmacro{\cubez}{1.6}
%front
\coordinate (\picname-tl) at (-\cubex,0,0); % top-left point
\coordinate (\picname-tr) at (0,0,0); % top-right point
\coordinate (\picname-br) at (0,-\cubey,0); % bottom-right point
\coordinate (\picname-bl) at (-\cubex,-\cubey,0); % bottom-left point
\coordinate (\picname-ztl) at (-\cubex,0,-\cubez); % ztop-left point
\coordinate (\picname-ztr) at (0,0,-\cubez); % ztop-right point
\coordinate (\picname-zbr) at (0,-\cubey,-\cubez); % zbottom-right point
\coordinate (\picname-zbl) at (-\cubex,-\cubey,-\cubez); %z bottom-left point
\draw[draw=\cubecolor,fill=\cubecolor!15, \ifboxdashed dashed\fi] (0,0,0) -- ++(-\cubex,0,0) -- ++(0,-\cubey,0) -- ++(\cubex,0,0) -- cycle;
%right
\draw[draw=\cubecolor,fill=\cubecolor!30, \ifboxdashed dashed\fi] (0,0,0) -- ++(0,0,-\cubez) -- ++(0,-\cubey,0) -- ++(0,0,\cubez) -- cycle;
%top
\draw[draw=\cubecolor,fill=\cubecolor!20, \ifboxdashed dashed\fi] (0,0,0) -- ++(-\cubex,0,0) -- ++(0,0,-\cubez) -- ++(\cubex,0,0) -- cycle;
            \end{scope}
        }
}
\makeatletter
\newif\ifboxdashed
\boxdashedfalse % default: not dashed
\makeatother

\pgfkeys{
  /cubes/.cd,
  cubecolor/.store in=\cubecolor,
  scalefac/.store in=\scalefac,
  picname/.store in=\picname, % ← nova linija
  cubecolor=red,
  scalefac=1,
  dashed/.is if=boxdashed,
  dashed/.default=true,
  picname=C
}
\begin{scope}[local bounding box=G1,shift={(0,0)}]
\foreach \i in {1,...,12} {
  \pgfmathsetmacro\colorname{%
    ifthenelse(\i==3 || \i==4 || \i==9 || \i==10,
      "red", "BrownLine")}
\pic at ({\i*0.15}, {-0.02*\i}) {cubes={cubecolor=\colorname,picname=\i-cube1}};
}
\end{scope}

\begin{scope}[local bounding box=G2,shift={(-2.75,0.4)}]
\foreach \i in {1,...,6} {
  \pgfmathsetmacro\colorname{%
    ifthenelse(\i==3 || \i==4,
      "red", "BrownLine")}
\pic at ({\i*0.18}, {-0.02*\i}) {cubes={scalefac=1.35,cubecolor=\colorname,picname=\i-cube2}};
}
\end{scope}

\begin{scope}[local bounding box=G3,shift={(-5.5,0.6)}]
\foreach \i in {1,2,3} {
  \pgfmathsetmacro\colorname{%
    ifthenelse(\i==13 || \i==14,"red", "BrownLine")}
\pic at ({\i*0.30}, {-0.02*\i}) {cubes={scalefac=1.5,cubecolor=\colorname,picname=\i-cube3}};
}
\end{scope}

\begin{scope}[local bounding box=G4,shift={(-7.75,1.0)}]
\foreach \i in {1} {
  \pgfmathsetmacro\colorname{%
    ifthenelse(\i==13 || \i==14,"red", "BrownLine")}
\pic at ({\i*0.25}, {-0.02*\i}) {cubes={scalefac=1.8,cubecolor=\colorname,picname=\i-cube4}};
}
\end{scope}
\draw[Line] (1-cube1-bl) -- (6-cube2-br);
 \draw[Line] (1-cube1-tl) -- (6-cube2-tr);
 \scoped[on background layer]
\draw[Line] (1-cube1-zbl) -- (6-cube2-zbr);
 \draw[Line] (1-cube1-ztl) -- (6-cube2-ztr);
 %
 \draw[Line] (1-cube2-bl) -- (3-cube3-br);
 \draw[Line] (1-cube2-tl) -- (3-cube3-tr);
 \scoped[on background layer]
\draw[Line] (1-cube2-zbl) -- (3-cube3-zbr);
 \draw[Line] (1-cube2-ztl) -- (3-cube3-ztr);
 %
  \draw[Line] (1-cube3-bl) -- (1-cube4-br);
 \draw[Line] (1-cube3-tl) -- (1-cube4-tr);
 \scoped[on background layer]
\draw[Line] (1-cube3-zbl) -- (1-cube4-zbr);
 \draw[Line] (1-cube3-ztl) -- (1-cube4-ztr);

\scoped[on background layer]
\node[draw=BlueLine,inner xsep=8,inner ysep=14,yshift=0mm,
           fill=BlueL!10,fit=(G1)(G4),line width=1.0pt](BB1){};
\node[fill=BlueL,below left=5.5pt and 11pt of  BB1.north east,anchor=north east,align=center]{
初始准确率:\\ \textbf{0.995}};
\node[above=1pt of  BB1.north west,anchor=south west,align=left]{\large 一次性剪枝(单次迭代)};

\begin{scope}[local bounding box=GEAR,
shift={($(BB1.east)+(8,0)$)},
scale=1.0, every node/.append style={transform shape}]
\def\ra{20mm}
\tikzset{%
 Arrow/.style={-{Triangle[width=15pt,length=8pt]}, line width=7pt,}
}
\draw[Arrow,violet!60] (-80:0.5*\ra)
arc[radius=0.5*\ra, start angle=-80, end angle= 80]coordinate(K1);
\draw[Arrow,orange!80!black!90] (100:0.5*\ra)
arc[radius=0.5*\ra, start angle=100, end angle= 260]coordinate(K2);
\node[circle,minimum size=\ra](KR){};

% #1 number of teeth
% #2 radius intern
% #3 radius extern
% #4 angle from start to end of the first arc
% #5 angle to decale the second arc from the first
% #6 inner radius to cut off
\newcommand{\gear}[6]{%
  (0:#2)
  \foreach \i [evaluate=\i as \n using {\i-1)*360/#1}] in {1,...,#1}{%
    arc (\n:\n+#4:#2) {[rounded corners=1.5pt] -- (\n+#4+#5:#3)
    arc (\n+#4+#5:\n+360/#1-#5:#3)} --  (\n+360/#1:#2)
  }%
  (0,0) circle[radius=#6];
}

\fill[draw=none,fill=black,even odd rule,xshift=-2mm]\gear{10}{0.23}{0.28}{10}{2}{0.1};
\fill[draw=none,fill=black,even odd rule,xshift=3mm,yshift=2mm]\gear{10}{0.18}{0.22}{10}{2}{0.08};

\scoped[on background layer]
\node[draw=BlueLine,%inner xsep=8,inner ysep=8,yshift=0mm,
minimum width=27mm,minimum height=29mm,
           fill=BlueL!20,fit=(K1)(K2)(KR),line width=1.0pt](BB3){};
\end{scope}

%%
\begin{scope}[local bounding box=TA1,
shift={($(BB1.east)+(3.25,0)$)},
scale=1.0, every node/.append style={transform shape}]
\node[draw=BrownLine,
minimum width=27mm,minimum height=29mm,
           fill=brown!10,line width=1.0pt](BB2){};
\node[below=0.2 of BB2.north](TTA1){\textbf{测试准确率:}};
\node[below right= 0.7 and -0.9 of TTA1, draw,
      single arrow, draw=red, fill=red, rotate=-90,
      minimum width=8pt, single arrow head extend=3pt,
      minimum height=9mm, line width=1pt] (ST1) {};

\node[below right= 0.7 and -0.9 of TTA1, draw, xshift=6mm,
      single arrow, draw=red, fill=red, rotate=-90,
      minimum width=8pt, single arrow head extend=3pt,
      minimum height=9mm, line width=1pt] (ST2) {};
\node[left=0.3 of ST1,anchor=north east](BR1){\large\textbf{0.914}};
\end{scope}
%%
\begin{scope}[local bounding box=TA2,
shift={($(BB3.east)+(2.5,0)$)},
scale=1.0, every node/.append style={transform shape}]
\node[draw=GreenLine,
minimum width=27mm,minimum height=29mm,
           fill=yellow!10,line width=1.0pt](BB4){};
\node[below=0.2 of BB4.north](TTA1){\textbf{测试准确率:}};
\node[below right= 1.1 and -0.9 of TTA1, draw,
      single arrow, draw=GreenLine, fill=GreenL!90!black, rotate=90,
      minimum width=8pt, single arrow head extend=3pt,
      minimum height=9mm, line width=1pt] (ST1) {};

\node[left=0.3 of ST1,anchor=south east](BR1){\large\textbf{0.943}};
\end{scope}

\node[draw,
      single arrow, draw=red, fill=red,
      minimum width=8pt, single arrow head extend=3pt,
      minimum height=16mm, line width=1pt] (ST1)
      at($(BB1.east)!0.5!(BB2.west)$){};
      \node[draw,
      single arrow, draw=VioletLine, fill=VioletL,
      minimum width=8pt, single arrow head extend=3pt,
      minimum height=16mm, line width=1pt] (ST2)
      at($(BB2.east)!0.5!(BB3.west)$){};
      \node[draw,
      single arrow, draw=GreenLine, fill=GreenL!90!black,
      minimum width=8pt, single arrow head extend=3pt,
      minimum height=9mm, line width=1pt] (ST3)
      at($(BB3.east)!0.5!(BB4.west)$){};
\node[align=center,above=3pt of ST1]{剪除\\ 选定的\\ 通道};
\node[align=center,above=3pt of ST2]{在新\\ 结构上\\ 微调};
\end{tikzpicture}调度策略的选择受三项操作约束支配。较高的目标稀疏度要求采用迭代循环,以防止表征能力严重损失。相反,优化过程中的严格计算预算或紧迫的部署期限更有利于采用一次性剪枝,以接受轻微的准确率下降为代价,避免多轮代价高昂的重新训练。最后,目标加速器架构决定了所形成的稀疏模式是否值得投入迭代成本。
彩票假说
标准剪枝流程假定先获得一个训练完成的稠密模型,再从中移除权重。然而,网络结构与优化动态之间的关系更为深刻:剪枝可以揭示初始随机参数化中内嵌的、本身就高效且易于训练的子网络。
这一视角引出了彩票假说7(LTH)。该假说挑战了传统剪枝流程,提出大型神经网络内部存在规模较小、初始化良好的子网络(“中奖彩票”),这些子网络在独立训练时能够达到与完整模型相当的准确率。LTH 并非将剪枝视为训练后的压缩步骤,而是认为剪枝可以充当一种发现机制,在训练早期识别这些高效子网络 (Rachwan et al. 2022)。
最初的 LTH 方法通过迭代幅值剪枝和权重回溯来识别这些子网络(figure 7)。先将网络训练至收敛,再剪除幅值较小的权重,并将保留下来的参数重置为其初始值 \(\boldsymbol{\theta}_0\),而非重新随机初始化。重复这一循环可以分离出一个稀疏子网络,在所报告的实验设置下,该子网络经过训练能够达到与原始网络相当的准确率 (Frankle and Carbin 2019)。同一方法能否成功,取决于架构、规模、优化器和训练预算。
\begin{tikzpicture}[line join=round,font=\small\sffamily]
\tikzset{
Line/.style={line width=0.5pt,black!50,text=black},
LineD/.style={-{Triangle[width=7pt,length=8pt]},red,line width=1.25pt},
}

\begin{scope}[local bounding box=CIRCLES,shift={($(0,0)+(-5.6,0)$)}]
\tikzset{
circles/.pic={
\pgfkeys{/channel/.cd, #1}
\node[circle,draw=\channelcolor,line width=\linewidth,fill=\channelcolor!10,
minimum size=9mm](\picname){};
        }
}
\pgfkeys{
  /channel/.cd,
  linewidth/.store in=\linewidth,
  channelcolor/.store in=\channelcolor,
  scalefac/.store in=\scalefac,
  picname/.store in=\picname,
  channelcolor=BlueLine,
  scalefac=1,
  linewidth=0.3pt,
  picname=C
}

\def\vi{1.75}
\foreach \i in {1,...,7} {
  \pgfmathsetmacro{\y}{(7-\i)*\vi}
  \pic at (0,\y) {circles={channelcolor=VioletLine2!70!,picname=2CI\i}};
}
 %
\foreach \i in {2,4,6} {
  \pgfmathsetmacro{\y}{(7-\i)*\vi}
  \pic at (0,\y) {circles={channelcolor=red,linewidth=1pt}};
}
\foreach \i in {1,...,7} {
  \pgfmathsetmacro{\y}{(7-\i)*\vi}
  \pic at (3.5,\y) {circles={channelcolor=VioletLine2!70!,,picname=3CI\i}};
}
\foreach \i in {2,5} {
  \pgfmathsetmacro{\y}{(7-\i)*\vi}
  \pic at (3.5,\y) {circles={channelcolor=red,linewidth=1pt}};
}
%right -2 neurons
\foreach \j in {1,...,2} {
  \pgfmathsetmacro{\y}{(4-\j)*\vi + 0.6}
  \pic at (6,\y) {circles={channelcolor=red,linewidth=1pt,picname=4CI\j}};
}
%left -4 neurons
\foreach \j in {1,...,4} {
  \pgfmathsetmacro{\y}{(5-\j)*\vi + 0.6}
  \pic at (-2.85,\y) {circles={channelcolor=red,linewidth=1pt,picname=1CI\j}};
}
\foreach \i in {1,...,4} {
  \foreach \j in {1,...,7} {
\draw[VioletLine2!70!,](1CI\i )--(2CI\j);
}}
\foreach \i in {1,...,7} {
  \foreach \j in {1,...,7} {
\draw[VioletLine2!70!,](2CI\i )--(3CI\j);
}}
\foreach \i in {1,...,7} {
  \foreach \j in {1,...,2} {
\draw[VioletLine2!70!,](3CI\i )--(4CI\j);
}}
\draw[LineD](1CI1)--(2CI2);
\draw[LineD](1CI1)--(2CI4);
\draw[LineD](1CI2)--(2CI4);
\draw[LineD](1CI3)--(2CI6);
\draw[LineD](1CI4)--(2CI6);
\draw[LineD](1CI4)--(2CI2);
\draw[LineD](2CI2)--(3CI2);
\draw[LineD](2CI4)--(3CI5);
\draw[LineD](2CI6)--(3CI5);
\draw[LineD](2CI6)--(3CI2);
\draw[LineD](3CI2)--(4CI1);
\draw[LineD](3CI2)--(4CI2);
\draw[LineD](3CI5)--(4CI1);
\draw[LineD](3CI5)--(4CI2);
\end{scope}
%%%%%%%%%%%%%%
%left figure
\begin{scope}[local bounding box=krug,shift={($(CIRCLES)+(-11.2,-2.1)$)}]
\def\ra{65mm}
\draw[{Triangle[width=18pt,length=8pt]}-, line width=10pt,violet!60] (1:0.5*\ra)
arc[radius=0.5*\ra, start angle=1, end angle= 57];
\draw[{Triangle[width=18pt,length=8pt]}-, line width=10pt,cyan!80!black!90] (123:0.5*\ra)
arc[radius=0.5*\ra, start angle=123, end angle= 180];
\draw[{Triangle[width=18pt,length=8pt]}-, line width=10pt,orange!70] (245:0.53*\ra)
arc[radius=0.53*\ra, start angle=245, end angle= 290];
\node[]at(0,0){\large 迭代};
%%top
\begin{scope}[local bounding box=GEAR,shift={($(90: 0.5*\ra)+(0,-0.75)$)},
scale=1.0, every node/.append style={transform shape}]
% #1 number of teeth
% #2 radius intern
% #3 radius extern
% #4 angle from start to end of the first arc
% #5 angle to decale the second arc from the first
% #6 inner radius to cut off
\newcommand{\gear}[6]{%
  (0:#2)
  \foreach \i [evaluate=\i as \n using {\i-1)*360/#1}] in {1,...,#1}{%
    arc (\n:\n+#4:#2) {[rounded corners=1.5pt] -- (\n+#4+#5:#3)
    arc (\n+#4+#5:\n+360/#1-#5:#3)} --  (\n+360/#1:#2)
  }%
  (0,0) circle[radius=#6];
}
\fill[draw=none,fill=green!40!black,even odd rule,xshift=-2mm]\gear{12}{0.4}{0.33}{10}{2}{0.1};
\fill[draw=none,fill=green!40!black,even odd rule,xshift=4mm,yshift=4mm]\gear{10}{0.22}{0.28}{10}{2}{0.08};
\node[align=center](TTN) at (0,1.25){训练网络\\ 直至收敛};
\node[align=center](TTN1) at (0,-0.5){};

\scoped[on background layer]
\node[draw=BlueLine,minimum width=27mm,minimum height=27mm,
           fill=BlueL!20,fit=(TTN1)(TTN),line width=1.0pt](5BB3){};
\end{scope}
%%right
\begin{scope}[local bounding box=PRUNE,shift={($(330: 0.5*\ra)+(0,-0.5)$)},
scale=1.0, every node/.append style={transform shape}]
\node[align=center](TTN) at (0,1.25){剪除一定\\比例的\\ 最小权重};
\node[align=center](TTN1) at (0,-0.5){};

\begin{scope}[local bounding box=MC,shift={($(TTN)+(-0.2,-0.5)$)},
scale=1.0, every node/.append style={transform shape}]

\foreach \i in {1,...,3}{
  \pgfmathsetmacro{\y}{(-\i)*0.37}
  \node[circle,draw, minimum size=2.5mm,inner sep=0pt,fill=red](2K\i) at(0,\y){};
}
\foreach \i in {1,...,3}{
  \pgfmathsetmacro{\y}{(-\i)*0.37}
  \node[circle,draw, minimum size=2.5mm,inner sep=0pt,fill=brown](3K\i) at(0.6,\y){};
}
\foreach \i in {1,...,2}{
  \pgfmathsetmacro{\y}{-(3.5-\i)*0.37}
  \node[circle,draw, minimum size=2.5mm,inner sep=0pt,fill=cyan](1K\i) at(-0.6,\y){};
}
\foreach \i in {1}{
  \pgfmathsetmacro{\y}{-(3.0-\i)*0.37}
  \node[circle,draw, minimum size=2.5mm,inner sep=0pt,fill=green!40!black](4K\i) at(1.2,\y){};
}
\foreach \i in {1,...,2}{
  \foreach \j in {1,...,3}{
\draw[Line](1K\i)--(2K\j);
}}
\foreach \i in {1,...,3}{
  \foreach \j in {1,...,3}{
\draw[Line](2K\i)--(3K\j);
}}\foreach \i in {1,...,3}{
  \foreach \j in {1}{
\draw[Line](3K\i)--(4K\j);
}}
\end{scope}
\scoped[on background layer]
\node[draw=BlueLine,minimum width=30mm,minimum height=27mm,
           fill=BlueL!20,fit=(TTN1)(TTN),line width=1.0pt](6BB3){};
\end{scope}
%%left
\begin{scope}[local bounding box=PUMPE,shift={($(210: 0.5*\ra)+(0,-0.3)$)},
scale=1.0, every node/.append style={transform shape}]
\node[align=center](TTN) at (0,1.25){将权重重置\\ 为初始值};
\node[align=center](TTN1) at (0,-0.5){};
\scoped[on background layer]
\node[draw=BlueLine,yshift=-1mm,
minimum width=30mm,minimum height=27mm,
           fill=BlueL!20,fit=(TTN1)(TTN),line width=1.0pt](BB3){};
%
\begin{scope}[local bounding box=RESETA,shift={($(TTN)+(0.25,-1.2)$)}]
\def\ra{12mm}
\tikzset{%
 Arrow/.style={{Triangle[width=15pt,length=8pt]}-, line width=7pt,}
}
\draw[Arrow,violet!60] (-80:0.5*\ra)
arc[radius=0.5*\ra, start angle=-80, end angle= 80]coordinate(K1);
\node[circle,minimum size=\ra](KR){};
\end{scope}
\node[]at(-0.50,0){$\left[\begin{array}{c} 0.5\\ 0.08\\ 0.45\\ 0.98\end{array}\right]$};
\end{scope}
\end{scope}
%%%%TOP
\begin{scope}[local bounding box=KOCKICE,shift={($(GEAR)+(0,3.2)$)},
scale=1.0, every node/.append style={transform shape}]
\node[align=center](TTN) at (0,1.25){随机\\ 初始化\\ 权重};
\node[align=center](TTN1) at (0,-0.5){};
\scoped[on background layer]
\node[draw=RedLine,yshift=-1mm,
minimum width=30mm,minimum height=27mm,
           fill=RedL!20,fit=(TTN1)(TTN),line width=1.0pt](2BB3){};
%
\begin{scope}[local bounding box=VK,shift={($(TTN)+(0.2,-1.0)$)},
scale=0.15, every node/.append style={transform shape}]
\pgfmathsetmacro{\cubex}{4}
\pgfmathsetmacro{\cubey}{4}
\pgfmathsetmacro{\cubez}{3}
\draw[fill=yellow!10] (0,0,0) -- ++(-\cubex,0,0) -- ++(0,-\cubey,0) -- ++(\cubex,0,0) -- cycle;
\draw[fill=yellow!60] (0,0,0) -- ++(0,0,-\cubez) -- ++(0,-\cubey,0) -- ++(0,0,\cubez) -- cycle;
\draw[fill=yellow!30] (0,0,0) -- ++(-\cubex,0,0) -- ++(0,0,-\cubez) -- ++(\cubex,0,0) -- cycle;
 \node[circle,draw, minimum size=5mm,inner sep=0pt,fill=green!40!black]
at($(0,0,0)!0.5!(-\cubex,-\cubey,0)$){};
 \node[circle,draw, minimum size=5mm,inner sep=0pt,fill=green!40!black]
at($(0,0,0)!0.22!(-\cubex,-\cubey,0)$){};
 \node[circle,draw, minimum size=5mm,inner sep=0pt,fill=green!40!black]
at($(0,0,0)!0.78!(-\cubex,-\cubey,0)$){};
 \node[circle,draw, minimum size=5mm,inner sep=0pt,fill=green!40!black]
at($(-\cubex,0,0)!0.78!(0,-\cubey,0)$){};
 \node[circle,draw, minimum size=5mm,inner sep=0pt,fill=green!40!black]
at($(-\cubex,0,0)!0.22!(0,-\cubey,0)$){};
%
 \node[ellipse,draw, minimum width=6mm,minimum height=3mm,inner sep=0pt,fill=green!40!black]
at($(0,0,0)!0.5!(-\cubex,0,-\cubez)$){};
 \node[ellipse,draw, minimum width=3mm,minimum height=6mm,inner sep=0pt,fill=green!40!black]
at($(0,0,0)!0.3!(0,-\cubey,-\cubez)$){};
 \node[ellipse,draw, minimum width=3mm,minimum height=6mm,inner sep=0pt,fill=green!40!black]
at($(0,0,0)!0.7!(0,-\cubey,-\cubez)$){};
\end{scope}
\end{scope}
\path[red](2BB3.north east)--++(0:3.9)coordinate(GO)|-coordinate(DO)(6BB3.south east);
\draw[brown!60,line width=2pt,dash pattern={on 10pt off 8pt}](GO)--(DO);
\node[draw,
      single arrow, draw=VioletLine, fill=VioletL,rotate=270,
      minimum width=8pt, single arrow head extend=3pt,
      minimum height=8mm, line width=1pt] (1ST2)
      at($(KOCKICE.south)!0.45!(GEAR.north)$){};
%
      \node[draw, align=left,anchor=south west,
      single arrow, draw=BlueLine, fill=BlueL,
      minimum width=8pt, single arrow head extend=10pt,
      minimum height=8mm, line width=1pt] (2ST2)
      at($(KOCKICE.east)+(2.26,-0.5)$){剩余结构\\构成中奖彩票\\
      子网络};
\end{tikzpicture}彩票假说表明,过参数化初始化中可能存在紧凑且可训练的子网络。这一观察推动了直接稀疏训练研究,但标准的发现方法并未消除稠密训练成本:它首先需要付出一次或多次稠密或部分稠密训练的成本,才能找到中奖彩票子网络。因此,这一结果强调了初始化的作用,同时留下了一个实际的系统问题:能否在原始训练预算的大部分被消耗之前识别出该子网络。
迭代方法还区分了一次性剪枝所混合的两种效应:哪些权重得以保留,以及每次剪除后进行多少恢复训练。在某些场景中,较小的剪枝步幅给予网络更多恢复机会;在另一些场景中,额外循环的收益不足以抵偿其成本。因此,部署比较必须同时衡量最终质量、搜索或重新训练成本,以及实际实现的运行时节省。
在实践中,应将 LTH 式流程与从头训练较小的稠密模型、配合恢复训练的一次性剪枝,以及直接稀疏训练方法进行比较。成本核算必须涵盖每一次稠密或部分稠密的发现训练、检查点回溯、剪枝循环和恢复阶段,而不能仅考虑最终子网络。中奖彩票是一个训练结果;只有当加速器总用时、最终产物大小、目标延迟和任务质量优于这些替代方案时,它才能转化为系统层面的收益。
剪枝实践
彩票假说有助于理解优化景观,但实际模型服务系统只关心可执行产物。框架层面的剪枝只有在转化为具体的硬件资源节省时才有用:更小的稠密张量、与硬件相适配的结构化稀疏矩阵,或与相应运行时内核配套的索引式稀疏布局。训练时剪枝通常从应用掩码开始:原始张量仍驻留在内存中,而二值掩码在前向传播期间将选定权重置零。这一机制在恢复训练期间引导梯度流,但其本身既不能减少内存占用,也不能改善延迟。只有将掩码所定义的结构导出为推理引擎加载的实际产物后,才会出现可测量的效率收益。
这一产物边界区分了不同的剪枝策略。非结构化剪枝移除单个权重,需要稀疏内核和适当的存储格式,才能将零值转化为速度提升。结构化剪枝移除整个通道、注意力头、神经元或块,从而可以将张量重构为更小的稠密运算,而普通加速器已经能够高效执行这类运算。微调期间的渐进式剪枝还引入了训练调度:稀疏度随时间增加,使剩余权重能够在容量被移除的过程中恢复准确率。因此,系统审查需要落实到具体事项:确定剪除了什么,确定运行时格式,并验证目标硬件是否具备能使这种稀疏性产生实际收益的内核。
考察实际部署时,这些权衡会变得具体。一些模型家族通过架构设计而非事后剪枝来降低部署成本:MobileNet 使用深度可分离卷积,面向移动和嵌入式视觉任务 (Howard et al. 2017);EfficientNet 则使用复合缩放,改善资源约束下准确率与效率之间的权衡 (Tan and Le 2019)。剪枝仍是一种独立的优化手段。BERT 式 Transformer8 已通过移除冗余注意力头或中间维度实现剪枝;而 DistilBERT 和 TinyBERT 等独立的蒸馏方法则训练规模更小的稠密学生模型,保留 BERT 的大部分性能 (Sanh et al. 2019; Jiao et al. 2020)。
Jiao, Xiaoqi, Yichun Yin, Lifeng Shang, Xin Jiang, Xiao Chen, Linlin Li, Fang Wang, and Qun Liu. 2020. “TinyBERT: Distilling BERT for Natural Language Understanding.” Findings of the Association for Computational Linguistics: EMNLP 2020, 4163–74. https://doi.org/10.18653/v1/2020.findings-emnlp.372.
剪枝存在固有局限:它从现有架构出发,逐步移除其中的部分组件。剪枝后的模型继承原模型的结构——层类型相同、连接模式相同,只是参数更少。原始架构本身可能并不适合高效部署。实践者可能需要一个结构完全不同的模型,例如用六层 Transformer 替代 12 层 Transformer,同时仍能保有原模型的能力。
当部署限制要求采用完全不同的拓扑结构时,压缩目标便从删减权重转向利用原模型的输出监督较小模型。知识蒸馏通过将过参数化网络视为教师,而非部署产物,来满足这一需求。
知识蒸馏
假设一个医疗问答模型超出了医院单 GPU 服务器的内存和延迟预算。即使将其现有权重稀疏化,也仍可能得到不受支持的表示形式,或相对于目标硬件而言过大的架构,因此部署可能需要一个规模显著缩小的模型。知识蒸馏通过训练紧凑的“学生”来复现更大“教师”的行为,解决这类问题,通常能够以更低的推理成本保留教师在任务上的大部分性能 (Hinton et al. 2015; Sanh et al. 2019)。蒸馏一词借自化学,指从较大的混合物中提取浓缩精华的过程,9但其系统层面的洞见是明确的:教师的预测能够携带原始训练标签之外的信息。
Definition 1.3: 知识蒸馏
知识蒸馏 是一种模型压缩技术,通过训练较小的学生模型,使其行为与较大的预训练教师模型相匹配。
- 意义:蒸馏将反复推理的成本转移到额外的训练阶段。学生的规模可以显著小于教师,同时保留有用的任务性能;例如,DistilBERT 报告其参数数量减少了 40%,推理速度提升了 60%,并保留了 BERT 语言理解性能的 97% (Sanh et al. 2019)。当学生训练成本能够分摊到大量部署后的查询中时,这种权衡具有价值。
- 区别:剪枝从现有架构中移除参数,量化降低数值精度,而蒸馏则训练一个新的稠密架构。学生从教师的输出分布或中间表示中继承行为,而不继承教师的全部参数规模或层结构。
- 常见误区:一种常见误解是将蒸馏视为无损压缩。实际上,学生受限于自身容量、教师质量,以及蒸馏数据与部署分布的匹配程度;学生既可能忠实复现教师的知识,也可能忠实复现教师的错误。
教师模型通过分配给所有类别的相对概率传递语义知识。独热真实标签将正确类别的概率设为一,将其他所有类别的概率设为零;相比之下,figure 8 中的教师输出分布捕捉了类别间的结构关系——揭示出被分类为猫的输入与狗共享的语义特征多于与狐狸共享的语义特征。
\begin{tikzpicture}[font=\small\sffamily]
\definecolor{Softmax}{HTML}{FDAE61}
\definecolor{ReLU}{HTML}{ABDDA4}
\definecolor{Tanh}{HTML}{2B83BA}
\begin{axis}[
  width=85mm,
  height=53mm,
   axis line style={draw=none},
    ylabel={概率},
    xlabel={动物},
    ymin=0,
    axis lines=left,
   axis line style={thick,-latex},
 ytick={0,20,40,60,80,100},
  yticklabels={0\%,20\%,40\%,60\%,80\%,100\%},
    tick label style={/pgf/number format/assume math mode=true},
    yticklabel style={font=\fontsize{7pt}{7}\selectfont\sffamily,
    /pgf/number format/.cd, fixed, fixed zerofill, precision=2},
    xticklabel style={font=\fontsize{7pt}{7}\selectfont\sffamily},
    ylabel style={font=\footnotesize\sffamily},
    xlabel style={font=\footnotesize\sffamily},
    ymax=101,
    enlarge x limits=0.3,
   y tick style={draw=none},
    x tick style={draw=black,thin},
    tick align=outside,
    major tick length=1mm,
    bar width=30pt,
     grid=both,
    major grid style={thin,black!60},
    minor tick num=1,
    xtick={1,2,3},
    xticklabels={猫,狗,狐狸},
nodes near coords={\pgfmathprintnumber{\pgfplotspointmeta}\%},
    every node near coord/.append style={yshift=0pt,
  font=\scriptsize\sffamily, anchor=south,black,
  /pgf/number format/assume math mode=true,fill=white,
   /pgf/number format/.cd, fixed, fixed zerofill, precision=2,zerofill=false},
    every axis plot/.append style={
          ybar,
          bar width=0.55,
          bar shift=0pt,
          fill
        }]
      \addplot[red]coordinates {(1,85)};
      \addplot[Tanh]coordinates{(2,10)};
      \addplot[ReLU]coordinates{(3,5)};
\end{axis}
\end{tikzpicture}训练学生模型需要在模仿教师与基于真实标签的任务监督之间取得平衡。在操作层面,训练开始前需要做出四项决策:选择具有期望行为的教师,设计稠密架构以满足目标加速器内存和计算预算的学生,在训练语料上生成软目标,以及选择控制优化过程的温度和损失权重。Figure 9 展示了这种双路径训练流程,其中每个输入样本都经过两个网络,通过软损失与硬损失函数的组合驱动学生参数更新。
\begin{tikzpicture}[font=\small\sffamily]
\tikzset{%
helvetica/.style={align=flush center,font=\small\sffamily},
Line/.style={line width=1.0pt,black!50},
Box/.style={inner xsep=2pt,
    node distance=0.7,
    draw=GreenLine,
    line width=0.75pt,
    fill=GreenL,
    align=flush center,
    minimum width=15mm, minimum height=10mm
  },
Box2/.style={Box, minimum width=25mm, minimum height=10mm}
}

\node[Box,fill=BrownL,draw=BrownLine](B1){第 1 层};
\node[Box,right=of B1,fill=BrownL,draw=BrownLine](B2){第 2 层};
\node[, node distance=0.7,right=of B2,fill=none,draw=none,
           font=\Large\bfseries](B0){$\cdots$};
\node[Box,right=of B0,fill=BrownL,draw=BrownLine](B3){第 $N_{L,\text{student}}$ 层};
\draw[Line,-latex](B1)--(B2);
\draw[Line,-latex](B2)--(B0);
\draw[Line,-latex](B0)--(B3);
\scoped[on background layer]
\node[draw=BrownLine,inner xsep=4mm,inner ysep=5mm,
yshift=2.5mm,fill=none,fit=(B1)(B3),line width=0.75pt](BB2){};
\node[below=4pt of  BB2.north,inner sep=0pt,
anchor=north]{学生(蒸馏后)模型};
%%
\node[Box,above=1.95 of B1,fill=RedL,draw=RedLine](GB1){第 1 层};
\node[Box,right=of GB1,fill=RedL,draw=RedLine](GB2){第 2 层};
\node[, node distance=0.7,right=of GB2,fill=none,draw=none,
           font=\Large\bfseries](GB0){$\cdots$};
\node[Box,right=of GB0,fill=RedL,draw=RedLine](GB3){第 $N_{L,\text{teacher}}$ 层};
\draw[Line,-latex](GB1)--(GB2);
\draw[Line,-latex](GB2)--(GB0);
\draw[Line,-latex](GB0)--(GB3);
\scoped[on background layer]
\node[draw=red,inner xsep=4mm,inner ysep=5mm,
yshift=2.5mm,fill=none,fit=(GB1)(GB3),line width=0.75pt](GBB2){};
\node[below=4pt of  GBB2.north,inner sep=0pt,
anchor=north]{教师模型};
%%
\node[Box, rounded corners=7pt, left=2of $(GB1)!0.5!(B1)$](IN){输入 x};
\draw[Line,-latex](IN.east)--++(0:0.4)|-(GB1);
\draw[Line,-latex](IN.east)--++(0:0.4)|-(B1);
%%
\node[Box2, right= 1.3of GB3,fill=OliveL,draw=OliveLine](S1){Softmax ($T_{\text{distill}}=t$)};
\node[Box2,above right=0 and 1.3 of B3,fill=OliveL,draw=OliveLine](S2){Softmax ($T_{\text{distill}}=t$)};
\node[Box2,below right=0 and 1.3 of B3,fill=OliveL,draw=OliveLine](S3){Softmax ($T_{\text{distill}}=1$)};
%
\node[Box2, right= 0.65of S1,fill=BlueL,draw=BlueLine](SL1){软标签};
\node[Box2, right= 0.65of S2,fill=BlueL,draw=BlueLine](SL2){软预测};
\node[Box2, right= 0.65of S3,fill=BlueL,draw=BlueLine](SL3){硬预测};
\node[Box, rounded corners=7pt, below =1.0of SL3.250](HL){硬\\ 标签 y};
%
\node[Box,right=1.5of $(SL1)!0.5!(SL2)$,fill=OliveL,draw=OliveLine](L1){损失函数};
\node[Box,below right=0.2 and 0.2of SL3,fill=OliveL,draw=OliveLine](L2){损失函数};
%%
\node[left=2pt of L1,align=right,violet]{蒸馏\\ 损失};
\node[left=2pt of L2,align=right,violet]{学生\\ 损失};
\node[below=2pt of HL,align=center]{(真实标签)};
%
\draw[Line,-latex](GB3)--(S1);
\draw[Line,-latex](S1)--(SL1);
\draw[Line,-latex](SL1)-|(L1);
\draw[Line,-latex](SL2)-|(L1);
%
\draw[Line,-latex](B3.east)--++(0:0.74)|-(S2);
\draw[Line,-latex](B3.east)--++(0:0.74)|-(S3);
\draw[Line,-latex](S2)--(SL2);
\draw[Line,-latex](S3)--(SL3);
\draw[Line,-latex](SL3)-|(L2);
\draw[Line,-latex](L2)|-(HL);
%
\end{tikzpicture}部署蒸馏后的学生模型时,需要验证的内容不止 top-1 准确率。由于学生既容易继承教师的有用表示,也容易继承其系统性偏差和校准失准,因此验证必须测量校准误差、子群体表现,以及在目标硬件上实际执行的延迟。
蒸馏的数学原理
标准 softmax 归一化(非线性激活函数)将模型的原始 logits \(z_i\) 转换为概率。引入温度参数10 \(T_{\text{distill}}\),可使输出类别上的概率分布更加平缓: \[ p_i^{(T_{\text{distill}})} = \frac{\exp(z_i/T_{\text{distill}})}{\sum_j \exp(z_j/T_{\text{distill}})} \]
较高的 \(T_{\text{distill}}\) 会使 softmax 分布更加平坦,并显露暗知识:即相对类别概率中包含的潜在信息,例如教师在对猫的图像进行分类时,为狗分配一个较小但非零的概率,而为卡车分配接近零的概率。总蒸馏损失 \(\mathcal{L}_{\text{distill}}\) 在标准交叉熵与相对于教师软化分布的 Kullback-Leibler(KL)散度之间取得平衡:11
\[ \mathcal{L}_{\text{distill}} = (1 - \gamma_{\text{KD}}) \mathcal{L}_{\text{CE}}(\mathbf{p}_{\text{student}}, y) + \gamma_{\text{KD}} T_{\text{distill}}^2 \mathcal{D}_{\text{KL}}(\mathbf{p}_{\text{teacher}}^{(T_{\text{distill}})} \lVert \mathbf{p}_{\text{student}}^{(T_{\text{distill}})}) \]
其中,\(\mathbf{p}_{\text{teacher}}^{(T_{\text{distill}})}\) 和 \(\mathbf{p}_{\text{student}}^{(T_{\text{distill}})}\) 是在温度 \(T_{\text{distill}}\) 下计算的概率向量,\(y\) 是独热真实标签,\(\gamma_{\text{KD}} \in [0,1]\) 用于平衡硬标签目标与软目标。缩放因子 \(T_{\text{distill}}^2\) 确保蒸馏损失的梯度量级与硬标签交叉熵损失保持相当:将 logits 除以 \(T_{\text{distill}}\) 会使 softmax 概率的导数按 \(1/T_{\text{distill}}\) 缩放,而在高温极限下,KL 散度相对于学生 logits 的梯度按 \(1/T_{\text{distill}}^2\) 缩放。乘以 \(T_{\text{distill}}^2\) 可防止随着 \(T_{\text{distill}}\) 增大,教师的监督梯度相对于硬标签损失趋于消失。这一形式定义了基于响应的蒸馏,即匹配最终输出分布。现代流程还采用基于特征的蒸馏,训练学生的中间层直接匹配教师的隐藏表示或注意力图,并使用均方误差或余弦距离来指导深层骨干网络中的梯度更新。
效率收益与权衡
相较于非结构化剪枝,蒸馏在部署方面的主要优势在于能够生成更小的稠密模型。标准加速器在连续矩阵乘法上可达到峰值算术强度;非结构化稀疏模型会产生不规则内存访问和索引解码开销,除非稀疏程度极高,否则这些开销往往会抵消理论上的 FLOP 减少。紧凑的稠密学生模型可保持合并内存访问,并执行厂商优化的稠密 GEMM 内核。然而,仅减少参数并不能保证更低的延迟:运算强度、层深度、注意力序列长度和内存带宽限制仍然决定运行时间。例如,DistilBERT 主要通过移除 BERT 一半的 Transformer 层,实现了 60% 的延迟降低,这使内存流量和顺序层依赖均减半,同时保留了 BERT 语言理解性能的 97% (Sanh et al. 2019)。12 MobileNet 等紧凑视觉架构在教师监督下训练时,也应用了相同原理 (Howard et al. 2017; Hinton et al. 2015)。
Gordon, Mitchell, Kevin Duh, and Nicholas Andrews. 2020. “Compressing BERT: Studying the Effects of Weight Pruning on Transfer Learning.” Proceedings of the 5th Workshop on Representation Learning for NLP, 143–55. https://doi.org/10.18653/v1/2020.repl4nlp-1.18.
蒸馏可以自然地与剪枝和量化组合,构成多阶段压缩流程。例如,实践者可以将大型教师蒸馏到紧凑的学生架构中,从该学生中剪除冗余的注意力头或通道,再将保留的权重从 FP16 量化为 INT8 以用于部署。Gordon et al. (2020) 表明,BERT 可以在预训练期间进行剪枝并迁移到下游任务,说明结构压缩与蒸馏可以同时进行。
这些运行收益以大量训练开销换取推理效率。蒸馏需要运行教师模型推理以生成软目标,并在数百万个词元上通过学生反向传播损失。对于大型模型,这一辅助训练阶段会消耗大量加速器 FLOP 和内存带宽,而训练后量化方法在校准子集上仅需数分钟即可完成。压缩效果还受限于学生容量和教师保真度:规模过小的学生缺乏吸收教师分布的容量,而不准确或未经校准的教师会将自身的系统性错误传递给学生。如 基准测试 中所述,选择优化策略需要综合评估任务准确率、参数占用空间、服务延迟和总训练成本。
Table 5 从准确率保留、训练成本、推理速度、硬件兼容性和实现复杂度等方面,对比了知识蒸馏与剪枝的关键权衡。DistilBERT 和 MobileBERT 展示了架构重新设计与蒸馏的结合;剪枝可以在其他优化流程中与蒸馏结合,但应主要将这两个模型理解为稠密学生模型的示例。
| 评判标准 | 知识蒸馏 | 剪枝 |
|---|---|---|
| 准确率保留 | 取决于模型和学生;教师能力强时通常表现良好 | 取决于模型和稀疏程度 |
| 训练成本 | 较高 – 需要教师推理和学生训练 | 通常较低 – 需要剪枝,且通常需要微调 |
| 推理速度 | 对于较小的稠密学生通常较有利 | 视情况而定 – 结构化剪枝效率高,非结构化剪枝需要特殊支持 |
| 硬件兼容性 | 高 – 可在标准加速器上运行 | 有限 – 稀疏模型可能需要专门的执行支持 |
| 实现工作量 | 更为复杂:教师推理、学生目标函数和训练 | 各有不同:选择准则、剪枝、微调和导出 |
剪枝修改现有参数化形式,而蒸馏将行为迁移到选定的学生架构中。两者都不直接通过低秩因子来表示稠密权重张量。以一个 \(4096{\times}4096\) 矩阵为例,秩为 128 的分解所存储的标量参数数量仅为稠密矩阵的 6.25%;这一近似是否准确,取决于矩阵的奇异值谱。结构化近似方法利用的正是这种数学冗余。
结构化近似
与剪枝或蒸馏相比,结构化近似处理的是另一类部署约束:当某层的权重张量存在数学冗余时,直接对这种冗余进行表示,比从 DRAM 中读取稠密张量所需的存储容量和内存带宽更少。结构化方法并非消除单个权重或将行为迁移到独立架构,而是将大型权重矩阵和张量分解为紧凑的低维因子。低秩矩阵分解与张量分解为实现这种压缩提供了互补的代数策略。
低秩分解
低秩矩阵分解(LRMF)使用低秩表示来近似权重矩阵。给定权重矩阵 \(\mathbf{A} \in \mathbb{R}^{m \times n}\),LRMF 寻找因子矩阵 \(\mathbf{U} \in \mathbb{R}^{m \times k}\) 和 \(\mathbf{V} \in \mathbb{R}^{n \times k}\),使得: \[ \mathbf{A} \approx \mathbf{U}\mathbf{V}^T \] 其中,近似秩 \(k \ll \min(m, n)\)。这种分解通常通过奇异值分解(SVD)计算,13仅保留最大的 \(k\) 个奇异值,并将其大小吸收到因子中。在推理过程中,将层输出计算为 \(\mathbf{y} = \mathbf{U}(\mathbf{V}^T \mathbf{x})\),即可用两次顺序执行的较小乘法替代一次大型矩阵—向量乘法。系统层面的首要问题是:参数存储占用和算术运算量的减少,能否抵消暂存中间激活值和额外调度一个内核所带来的开销。
Systems Perspective 1.2: 带宽与计算的权衡
当保留的秩较小时,低秩分解可以同时降低算术运算需求和带宽需求,但也会增加一次因子运算,并可能引入内核启动开销。存储一个 4096 行、4096 列的矩阵需要 67.1 MB(采用 FP32)。为单次推理读取该矩阵会产生大量内存流量,尤其是在执行受物理内存带宽限制时。
以秩 \(k =\) 128 分解该矩阵,需要存储两个较小矩阵(4096 行、128 列,以及 128 行、4096 列),总计仅需 4.2 MB——存储数值的数量缩减为原来的 1/16×。当推理直接使用这两个因子时,对于较小的 \(k\),矩阵—向量运算量也会从 \(\mathcal{O}(mn)\) 降至 \(\mathcal{O}(k(m+n))\)。只有当两次因子运算及其中间数据流量的成本低于原始稠密内核时,部署后的执行才会加速。显式构造 \(\mathbf{U}\mathbf{V}^T\) 将增加 \(\mathcal{O}(mkn)\) 的计算量,从而违背分解的初衷。
这种带宽与计算的权衡体现了算子层面的内存墙:当批量较小时,执行瓶颈在于从 DRAM 读取权重字节所需的时间,而非执行乘加运算所需的时间。理解 AI 内存墙 从硬件架构视角考察了这一内存墙。在生产环境的服务引擎中,使用分解后的表示进行计算,可以完全避免显式构造满秩矩阵。Figure 10 展示了这种分解,说明原始矩阵 \(\mathbf{M}\) 如何拆分为紧凑的秩 \(k\) 因子 \(\mathbf{L}_k\) 和 \(\mathbf{R}_k^T\)。
\begin{tikzpicture}[font=\small\sffamily]
\tikzset{
  Box/.style={inner xsep=2pt,
  draw=black!90,node distance=0.8,
  line width=0.65pt,
  anchor=west,
  align=flush center,
  minimum width=12mm,
  minimum height=17mm
  },
}
\node[Box,fill=red!30](B1)at (0.33,0.5){\textit{M}};
\node[Box,fill=Brown!20,minimum width=8mm,
             right=of B1](B2){\textit{L\textsubscript{k}}};
\node[Box,fill=BlueL!90,minimum width=12mm,   minimum height=8mm,
             right=of B2](B3){\textit{R\textsubscript{k}\kern-3pt\textsuperscript{T}}};
\node[]at($(B1)!0.53!(B2)$){$\boldsymbol{\approx}$};
\node[]at($(B2)!0.47!(B3)$){$\boldsymbol{\times}$};
\node[below=2pt of B1]{\textit{m $\boldsymbol{\times}$ n}};
\node[below=2pt of B2]{\textit{m $\boldsymbol{\times}$ k}};
\node[below=2pt of B3]{\textit{k $\boldsymbol{\times}$ n}};
\end{tikzpicture}LRMF 可直接应用于全连接投影层以及展平后的卷积权重张量。对分解后的层进行计算时,两次串联的乘法取代一次稠密矩阵—向量乘法,使参数存储量和算术运算量从 \(\mathcal{O}(mn)\) 降至 \(\mathcal{O}(k(m+n))\)。然而,在现代加速器上,这种拆分会引入具体的系统权衡:中间激活向量 \(\mathbf{z} = \mathbf{V}^T \mathbf{x}\) 必须暂存在片上 SRAM 中,或经由内存完成一次往返传输;除非将运算融合,否则调度两个独立内核会产生启动延迟。此外,如果近似秩 \(k\) 较小,或未与硬件分块尺寸(例如 \(16{\times}16\) 脉动阵列)对齐,硬件计算单元的实际吞吐量就会远低于峰值。因此,选择秩 \(k\) 时,需要在降低内存占用和带宽需求与近似误差、内核调度开销及硬件分块利用率之间取得平衡。
张量分解
张量分解将低秩近似扩展到多维数组,例如四维卷积核(\(C_{\text{out}} \times C_{\text{in}} \times K_h \times K_w\))和多头注意力权重。将这些参数展开为二维矩阵会丢失空间相关性和跨通道相关性,导致在给定秩预算下的近似精度较差。张量分解通过低维因子的多线性乘积表示张量,从而保留其多维结构。Figure 11 展示了三维张量的典范多元分解,说明如何沿秩 \(R\) 维度组合因子向量的外积,以重构各个张量元素。
\scalebox{0.75}{%
\begin{tikzpicture}[line width=0.35pt,line join=round]

\begin{scope}
\newcommand{\Depth}{3}
\newcommand{\Height}{3}
\newcommand{\Width}{3}
\coordinate (O) at (0,0,0);
\coordinate (A) at (0,\Width,0);
\coordinate (B) at (0,\Width,\Height);
\coordinate (C) at (0,0,\Height);
\coordinate (D) at (\Depth,0,0);
\coordinate (E) at (\Depth,\Width,0);
\coordinate (F) at (\Depth,\Width,\Height);
\coordinate (G) at (\Depth,0,\Height);

\draw[GreenLine,fill=GreenFill] (O) -- (C) -- (G) -- (D) -- cycle;% Bottom Face
\draw[GreenLine,fill=GreenFill] (O) -- (A) -- (E) -- (D) -- cycle;% Back Face
\draw[GreenLine,fill=GreenFill] (O) -- (A) -- (B) -- (C) -- cycle;% Left Face
\draw[GreenLine,fill=none] (D) -- (E) -- (F) -- (G) -- cycle;% Right Face
\draw[GreenLine,fill=none] (C) -- (B) -- (F) -- (G) -- (C);% Front Face
\draw[GreenLine,fill=none] (A) -- (B) -- (F) -- (E) -- cycle;% Top Face
%
\draw[GreenLine,line width=0.75pt](B)--(C)--(G)--(F)--(B)
(A)--(E)--(D)--(G)
(B)--(A) (F)--(E);
\path [every edge/.append style={line width=0.75pt,draw=blue, |-|}](C)+(0,-7pt)coordinate (C2)
edge [auto, text=blue, "$N$"']  (C2 -|G)
(G) +(4.5pt,-4.5pt) coordinate (G2) edge [text=blue,"$T$"'] ([xshift=4.5pt,yshift=-4.5pt]D)
(C) +(-7pt,0) coordinate (C1) edge [blue,"$M$"] (C1 |- B);
\end{scope}

\begin{scope}[shift={(0.75,0.75)},line width=0.5pt]
\newcommand{\Depth}{0.4}
\newcommand{\Height}{0.4}
\newcommand{\Width}{0.4}
\coordinate (MO) at (0,0,0);
\coordinate (MA) at (0,\Width,0);
\coordinate (MB) at (0,\Width,\Height);
\coordinate (MC) at (0,0,\Height);
\coordinate (MD) at (\Depth,0,0);
\coordinate (ME) at (\Depth,\Width,0);
\coordinate (MF) at (\Depth,\Width,\Height);
\coordinate (MG) at (\Depth,0,\Height);

\draw[RedLine,fill=RedFill] (MO) -- (MC) -- (MG) -- (MD) -- cycle;% Bottom Face
\draw[RedLine,fill=RedFill] (MO) -- (MA) -- (ME) -- (MD) -- cycle;% Back Face
\draw[RedLine,fill=RedFill] (MO) -- (MA) -- (MB) -- (MC) -- cycle;% Left Face
\draw[RedLine,fill=none] (MD) -- (ME) -- (MF) -- (MG) -- cycle;% Right Face
\draw[RedLine,fill=none] (MC) -- (MB) -- (MF) -- (MG) -- cycle;% Front Face
\draw[RedLine,fill=none] (MA) -- (MB) -- (MF) -- (ME) -- cycle;% Top Face
\draw[latex-]($(MC)!0.5!(MG)$)--++(260:0.81)node[below,text=black]{第 $(i,j,t)$ 个};
\node[RedLine,below right=0pt and 0pt of MG]{$\boldsymbol{y_{ijt}}$};
%
\draw[RedLine,line width=0.75pt](MB)--(MC)--(MG)--(MF)--(MB)
(MA)--(ME)--(MD)--(MG)
(MB)--(MA) (MF)--(ME);
%
\node[below=0.8of $(C)!0.5!(G)$]{$y\in\mathbb{R}^{M\times N\times T}$};
\end{scope}

%the second
\begin{scope}[shift={(5,-0.50)}]
\newcommand{\Depth}{1}
\newcommand{\Height}{0.5}
\newcommand{\Width}{3}
\coordinate (O2) at (0,0,0);
\coordinate (A2) at (0,\Width,0);
\coordinate (B2) at (0,\Width,\Height);
\coordinate (C2) at (0,0,\Height);
\coordinate (D2) at (\Depth,0,0);
\coordinate (E2) at (\Depth,\Width,0);
\coordinate (F2) at (\Depth,\Width,\Height);
\coordinate (G2) at (\Depth,0,\Height);

\draw[BrownLine,fill=brown!07] (O2) -- (C2) -- (G2) -- (D2) -- cycle;% Bottom Face
\draw[BrownLine,fill=brown!07] (O2) -- (A2) -- (E2) -- (D2) -- cycle;% Back Face
\draw[BrownLine,fill=brown!07] (O2) -- (A2) -- (B2) -- (C2) -- cycle;% Left Face
\draw[BrownLine,fill=none] (D2) -- (E2) -- (F2) -- (G2) -- cycle;% Right Face
\draw[BrownLine,fill=none] (C2) -- (B2) -- (F2) -- (G2) -- cycle;% Front Face
\draw[BrownLine,fill=none] (A2) -- (B2) -- (F2) -- (E2) -- cycle;% Top Face
\draw[BrownLine,line width=0.75pt](B2)--(C2)--(G2)--(F2)--(B2)
(A2)--(E2)--(D2)--(G2)
(B2)--(A2) (F2)--(E2);
%
\node[below=0.3 of $(C2)!0.5!(G2)$]{$U\in\mathbb{R}^{M\times R}$};
\end{scope}

%the second small
\begin{scope}[shift={(5,0.950)},line width=0.5pt]
\newcommand{\Depth}{1}
\newcommand{\Height}{0.5}
\newcommand{\Width}{0.4}
\coordinate (MO2) at (0,0,0);
\coordinate (MA2) at (0,\Width,0);
\coordinate (MB2) at (0,\Width,\Height);
\coordinate (MC2) at (0,0,\Height);
\coordinate (MD2) at (\Depth,0,0);
\coordinate (ME2) at (\Depth,\Width,0);
\coordinate (MF2) at (\Depth,\Width,\Height);
\coordinate (MG2) at (\Depth,0,\Height);

\draw[RedLine,fill=magenta!10] (MO2) -- (MC2) -- (MG2) -- (MD2) -- cycle;% Bottom Face
\draw[RedLine,fill=magenta!10] (MO2) -- (MA2) -- (ME2) -- (MD2) -- cycle;% Back Face
\draw[RedLine,fill=magenta!10] (MO2) -- (MA2) -- (MB2) -- (MC2) -- cycle;% Left Face
\draw[RedLine,fill=none] (MD2) -- (ME2) -- (MF2) -- (MG2) -- cycle;% Right Face
\draw[RedLine,fill=none] (MC2) -- (MB2) -- (MF2) -- (MG2) -- cycle;% Front Face
\draw[RedLine,fill=none] (MA2) -- (MB2) -- (MF2) -- (ME2) -- cycle;% Top Face
\draw[BrownLine,fill=none,line width=0.75pt] (F2) -- (G2) -- cycle;% Right Face
\draw[RedLine,line width=0.75pt](MB2)--(MC2)--(MG2)--(MF2)--(MB2)
(MA2)--(ME2)--(MD2)--(MG2)
(MB2)--(MA2) (MF2)--(ME2);
%
\node[RedLine,left=1pt of $(MB2)!0.5!(MC2)$](UI){$\boldsymbol{u_i}$};
\node[left=0.17 of UI,font=\Large]{$\boldsymbol{\approx}$};
\end{scope}

%%%%%%%%
%the threed
\begin{scope}[shift={(7,4)}]
\newcommand{\Depth}{1}
\newcommand{\Height}{3}
\newcommand{\Width}{0.5}
\coordinate (O3) at (0,0,0);
\coordinate (A3) at (0,\Width,0);
\coordinate (B3) at (0,\Width,\Height);
\coordinate (C3) at (0,0,\Height);
\coordinate (D3) at (\Depth,0,0);
\coordinate (E3) at (\Depth,\Width,0);
\coordinate (F3) at (\Depth,\Width,\Height);
\coordinate (G3) at (\Depth,0,\Height);

\draw[BlueLine,fill=BlueFill] (O3) -- (C3) -- (G3) -- (D3) -- cycle;% Bottom Face
\draw[BlueLine,fill=BlueFill] (O3) -- (A3) -- (E3) -- (D3) -- cycle;% Back Face
\draw[BlueLine,fill=BlueFill] (O3) -- (A3) -- (B3) -- (C3) -- cycle;% Left Face
\draw[BlueLine,fill=none] (D3) -- (E3) -- (F3) -- (G3) -- cycle;% Right Face
\draw[BlueLine,fill=none] (C3) -- (B3) -- (F3) -- (G3) -- cycle;% Front Face
\draw[BlueLine,fill=none] (A3) -- (B3) -- (F3) -- (E3) -- cycle;% Top Face
\draw[BlueLine,line width=0.75pt](B3)--(C3)--(G3)--(F3)--(B3)
(A3)--(E3)--(D3)--(G3)
(B3)--(A3) (F3)--(E3);
%
\node[right=0.3 of $(G3)!0.5!(D3)$]{$X\in\mathbb{R}^{T\times R}$};
\end{scope}

%the threed small
\begin{scope}[shift={(6.55,3.55)}]
\newcommand{\Depth}{1}
\newcommand{\Height}{0.4}
\newcommand{\Width}{0.5}
\coordinate (MO3) at (0,0,0);
\coordinate (MA3) at (0,\Width,0);
\coordinate (MB3) at (0,\Width,\Height);
\coordinate (MC3) at (0,0,\Height);
\coordinate (MD3) at (\Depth,0,0);
\coordinate (ME3) at (\Depth,\Width,0);
\coordinate (MF3) at (\Depth,\Width,\Height);
\coordinate (MG3) at (\Depth,0,\Height);

\draw[RedLine,fill=magenta!10] (MO3) -- (MC3) -- (MG3) -- (MD3) -- cycle;% Bottom Face
\draw[RedLine,fill=magenta!10] (MO3) -- (MA3) -- (ME3) -- (MD3) -- cycle;% Back Face
\draw[RedLine,fill=magenta!10] (MO3) -- (MA3) -- (MB3) -- (MC3) -- cycle;% Left Face
\draw[RedLine,fill=none] (MD3) -- (ME3) -- (MF3) -- (MG3) -- cycle;% Right Face
\draw[RedLine,fill=none] (MC3) -- (MB3) -- (MF3) -- (MG3) -- cycle;% Front Face
\draw[RedLine,fill=none] (MA3) -- (MB3) -- (MF3) -- (ME3) -- cycle;% Top Face
\draw[RedLine,line width=0.75pt](MB3)--(MC3)--(MG3)--(MF3)--(MB3)
(MA3)--(ME3)--(MD3)--(MG3)
(MB3)--(MA3) (MF3)--(ME3);
%
\draw[BlueLine,fill=none,line width=0.75pt] (F3) -- (E3) -- cycle;% Right Face
%
\node[right=0.3 of $(G3)!0.5!(D3)$]{$X\in\mathbb{R}^{T\times R}$};
\node[RedLine,left=2pt of $(MB3)!0.9!(MA3)$](UI){$\boldsymbol{x_t}$};
\end{scope}

%%%%%%%%%%%%%%%%%%%%%
%%%%%%%%
%the fourth
\begin{scope}[shift={(7,1)}]
\newcommand{\Depth}{3}
\newcommand{\Height}{0.4}
\newcommand{\Width}{1}
\coordinate (O4) at (0,0,0);
\coordinate (A4) at (0,\Width,0);
\coordinate (B4) at (0,\Width,\Height);
\coordinate (C4) at (0,0,\Height);
\coordinate (D4) at (\Depth,0,0);
\coordinate (E4) at (\Depth,\Width,0);
\coordinate (F4) at (\Depth,\Width,\Height);
\coordinate (G4) at (\Depth,0,\Height);

\draw[OliveLine,fill=yellow!10] (O4) -- (C4) -- (G4) -- (D4) -- cycle;% Bottom Face
\draw[OliveLine,fill=yellow!10] (O4) -- (A4) -- (E4) -- (D4) -- cycle;% Back Face
\draw[OliveLine,fill=yellow!10] (O4) -- (A4) -- (B4) -- (C4) -- cycle;% Left Face
\draw[OliveLine,fill=none] (D4) -- (E4) -- (F4) -- (G4) -- cycle;% Right Face
\draw[OliveLine,fill=none] (C4) -- (B4) -- (F4) -- (G4) -- cycle;% Front Face
\draw[OliveLine,fill=none] (A4) -- (B4) -- (F4) -- (E4) -- cycle;% Top Face
\draw[OliveLine,line width=0.75pt](B4)--(C4)--(G4)--(F4)--(B4)
(A4)--(E4)--(D4)--(G4)
(B4)--(A4)  (F4)--(E4);
%
\node[below=0.6 of $(C4)!0.5!(G4)$]{$V^{\mathsf T}\in\mathbb{R}^{R\times N}$};
\end{scope}
%
%the fourth small
\begin{scope}[shift={(8.8,1)}]
\newcommand{\Depth}{0.4}
\newcommand{\Height}{0.4}
\newcommand{\Width}{1}
\coordinate (MO4) at (0,0,0);
\coordinate (MA4) at (0,\Width,0);
\coordinate (MB4) at (0,\Width,\Height);
\coordinate (MC4) at (0,0,\Height);
\coordinate (MD4) at (\Depth,0,0);
\coordinate (ME4) at (\Depth,\Width,0);
\coordinate (MF4) at (\Depth,\Width,\Height);
\coordinate (MG4) at (\Depth,0,\Height);

\draw[RedLine,fill=magenta!10] (MO4) -- (MC4) -- (MG4) -- (MD4) -- cycle;% Bottom Face
\draw[RedLine,fill=magenta!10] (MO4) -- (MA4) -- (ME4) -- (MD4) -- cycle;% Back Face
\draw[RedLine,fill=magenta!10] (MO4) -- (MA4) -- (MB4) -- (MC4) -- cycle;% Left Face
\draw[RedLine,fill=none] (MD4) -- (ME4) -- (MF4) -- (MG4) -- cycle;% Right Face
\draw[RedLine,fill=none] (MC4) -- (MB4) -- (MF4) -- (MG4) -- cycle;% Front Face
\draw[RedLine,fill=none] (MA4) -- (MB4) -- (MF4) -- (ME4) -- cycle;% Top Face
\draw[RedLine,line width=0.75pt](MB4)--(MC4)--(MG4)--(MF4)--(MB4)
(MA4)--(ME4)--(MD4)--(MG4)
(MB4)--(MA4)  (MF4)--(ME4);
\node[RedLine,below=2pt of $(MC4)!0.5!(MG4)$](UI){$\boldsymbol{v_j}$};
%
\draw[OliveLine,fill=none,line width=0.75pt] (B4) -- (F4) -- cycle;% Right Face
\end{scope}
\end{tikzpicture}}不同分解形式在参数缩减程度与张量缩并复杂度之间进行权衡。CP 分解将张量表示为秩一分量之和,\(\mathcal{X} \approx \sum_{r=1}^{k} \mathbf{u}_r \otimes \mathbf{v}_r \otimes \mathbf{w}_r\) (Lebedev et al. 2015),能够最大程度地减少参数,但在秩优化过程中往往存在数值不稳定问题。Tucker 分解通过保留一个小型稠密核心张量,并沿各模态乘以正交因子矩阵来放宽这一约束,\(\mathcal{X} \approx \mathcal{G} \times _1 \mathbf{U} \times _2 \mathbf{V} \times _3 \mathbf{W}\)。张量列车(TT)分解将高阶张量分解为由三阶核心张量组成的线性链,沿共享的辅助索引进行缩并,从而避免了限制 Tucker 核心张量的、随张量阶数呈指数增长的问题。
Lebedev, Vadim, Yaroslav Ganin, Maksim Rakhuba, Ivan Oseledets, and Victor Lempitsky. 2015. “Speeding up Convolutional Neural Networks Using Fine-Tuned CP-Decomposition.” 3rd International Conference on Learning Representations (ICLR).
在深度学习系统中,张量分解用于压缩四维卷积滤波器、多头注意力投影和大型词元嵌入表。然而,在生产环境的加速器上执行张量缩并面临严重的系统障碍:现代硬件架构高度专门化于稠密二维矩阵乘法(GEMM)。对分解后的张量进行缩并时,要么需要通过显式转置内核重新排列内存布局,要么需要发起多次小规模缩并,且其内存访问模式无法合并。除非有专门的融合缩并内核支持,否则分解运算所产生的数据搬移和内核调度延迟,很容易抵消理论上的算术运算节省。Table 6 从数据结构、压缩机制和执行权衡等方面比较了 LRMF 与张量分解。
| 特征 | 低秩矩阵分解(LRMF) | 张量分解 |
|---|---|---|
| 适用数据结构 | 二维矩阵 | 多维张量 |
| 压缩机制 | 将矩阵分解为两个或多个低秩矩阵 | 将张量分解为多个低秩分量 |
| 常用方法 | 奇异值分解(SVD)、交替最小二乘法(ALS) | CP 分解、Tucker 分解、张量列车(TT)分解 |
| 计算成本 | 取决于分解方法、所选秩和内核 | 取决于分解形式、所选的各个秩、优化过程和张量缩并内核 |
| 存储量缩减 | 将存储量从 \(\mathcal{O}(mn)\) 降至 \(\mathcal{O}(mk + kn)\) | 取决于分解形式和所选的各个秩;需要存储因子矩阵,部分方法还需存储核心张量 |
| 推理执行 | 用两次因子运算替代一次稠密运算 | 引入张量缩并,其延迟取决于可用内核 |
| 主要应用场景 | 全连接层、嵌入、推荐系统 | 卷积滤波器、注意力机制、多模态学习 |
| 实现复杂度 | 较易实现,通常采用直接分解方法 | 更复杂,需要迭代优化和秩选择 |
在生产流水线中,实践者经常组合使用这些结构化近似方法:对大型线性投影和嵌入表应用 LRMF,对多维卷积层采用张量分解。在数据—算法—机器分类框架下,结构化近似通过改变算法,缓解机器的内存容量和带宽瓶颈。当服务延迟严格受内存限制时——例如批量大小为一的自回归词元生成——从 DRAM 传输的权重字节数减少,会直接转化为延迟降低。当服务受计算限制时,多次因子运算和碎片化内存访问的开销可能抵消这些收益。
剪枝和分解会修改现有模型的参数化形式,而知识蒸馏则将行为迁移到独立训练的学生模型中。神经架构搜索采用了一条根本不同的路径:发现从结构设计上就具备效率优势的架构。
神经架构搜索
剪枝、知识蒸馏和分解都以一个凭借人类直觉设计的现有拓扑为前提。选择具有竞争力的配置可能需要大量实验,而人工探索可能遗漏高效的候选架构 (Elsken et al. 2019)。神经架构搜索(NAS)通过探索指定的架构空间和目标,自动完成这一过程的一部分。早期基于强化学习的 NAS 以验证准确率为优化目标 (Zoph and Le 2016),权重共享方法降低了候选架构的评估成本 (Pham et al. 2018),而硬件感知 NAS 则将设备延迟或平台效率纳入目标 (Tan et al. 2019)。
Elsken, Thomas, Jan Hendrik Metzen, and Frank Hutter. 2019. “Neural Architecture Search.” In The Springer Series on Challenges in Machine Learning, vol. 20. Springer International Publishing. https://doi.org/10.1007/978-3-030-05318-5_3.
figure 12 中的优化循环将搜索过程形式化。NAS14 定义由架构组件和约束构成的搜索空间,采用强化学习 (Zoph and Le 2016)、进化搜索或基于梯度的优化等策略,并根据准确率和效率目标评估候选架构。每次评估都会将性能指标反馈给搜索控制器,引导后续候选架构的提出,使搜索逐步转向任务准确率与物理资源预算相平衡的区域。
\begin{tikzpicture}[line join=round,font=\sffamily\small]
\tikzset{%
    Line/.style={line width=1.0pt,black!50,text=black},
Box/.style={align=center,
    inner xsep=2pt,
    node distance=2.7,
    draw=BlueLine,
    line width=0.75pt,
    fill=BlueL,
    text width=32mm,
    minimum width=32mm, minimum height=10mm
  },
Box2/.style={Box,fill=VioletL2,draw=VioletLine},
Circ/.style={draw=none,fill=none,circle,minimum size=30mm},
Arr/.style={-{Triangle[width=10pt,length=6pt]}, line width=5pt,violet!40,
shorten <=-8pt,shorten >=-8pt},
 }

%griddot
\tikzset{
pics/griddot/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[shift={($(0,0)+(0,0)$)},line cap=round,scale=\scalefac,every node/.append style={transform shape}]
\node[draw=\drawcolor,line width=0.4*\Linewidth,fill=\filllcolor,rectangle,minimum height=20mm,
minimum width=20mm](RE){};

\draw[draw=\drawcolor,line width =\Linewidth,shorten >=5pt,shorten <=5pt]
(RE.150)--coordinate[pos=0.66](D1)(RE.30);
\node[draw=\drawcolor,fill=cyan,line width=\Linewidth,circle,minimum size=13,inner sep=2pt]at(D1){};);
\draw[draw=\drawcolor,line width =\Linewidth,shorten >=5pt,shorten <=5pt]
(RE.180)--coordinate[pos=0.33](D2)(RE.0);
\node[draw=\drawcolor,fill=violet!50,line width=\Linewidth,circle,minimum size=13,inner sep=2pt]at(D2){};);
\draw[draw=\drawcolor,line width =\Linewidth,shorten >=5pt,shorten <=5pt]
(RE.210)--coordinate[pos=0.66](D1)(RE.330);
\node[draw=\drawcolor,fill=red,line width=\Linewidth,circle,minimum size=13,inner sep=2pt]at(D1){};);
\end{scope}
    }
  }
}
%patharrow
\tikzset{
pics/patharrow/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\node[draw=\drawcolor,line width=1.5pt,fill=\filllcolor,rectangle,
minimum width=20mm,minimum height=20mm](RE){};
\node[draw=\drawcolor,fill=\filllcirclecolor,line width=3pt,circle,minimum size=18,inner sep=2pt,]
at($(RE.south east)!0.75)!(RE.north west)$){};
\node [font=\bfseries\fontsize{32pt}{32}\selectfont,text=\drawcolor,
rotate=45,line width=3pt]at($(RE.south east)!0.23)!(RE.north west)$){+};
%
\draw[draw=black,
-{Latex[length=6mm,width=6mm,round,open,fill=\filllcirclecolor,line width=2.5pt]},
line width=3pt,shorten <=4pt](RE.240)--++(0,0.58)
arc[start angle=180, end angle=90, radius=3mm]
--++(0.43,0)
arc[start angle=270, end angle=360, radius=3mm]
--++(0,0.7);
\end{scope}
    }
  }
}
%graph
\tikzset{pics/graph/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=GRAPH,scale=\scalefac, every node/.append style={transform shape}]
\draw[line width=2*\Linewidth,draw = \drawcolor](-0.20,0)--(2,0);
\draw[line width=2*\Linewidth,draw = \drawcolor](-0.20,0)--(-0.20,2);
\foreach \i/\vi[count=\k] in {0/5,0.5/8,1/11,1.5/15}{
\node[draw, minimum width  =4mm, minimum height = \vi mm, inner sep = 0pt,
      draw = \filllcolor, fill=\filllcolor!20, line width=\Linewidth,anchor=south west](COM\k)at(\i,0.2){};
}
\draw[line width=2*\Linewidth,draw =\filllcolor!70!black!80,->,>=Latex]
($(COM1.north west)+(0,0.15)$)--($(COM2.north west)+(0,0.5)$)
--++(0,-0.35)--($(COM3.north west)+(0,0.5)$)
--++(0,-0.35)--($(COM4.north west)+(0,0.4)$)
;
 \end{scope}
     }
  }
}
\pgfkeys{
  /channel/.cd,
   Dual/.store in=\Dual,
   Depth/.store in=\Depth,
  Height/.store in=\Height,
  Width/.store in=\Width,
  Smile/.store in=\Smile,
  Level/.store in=\Level,
  filllcirclecolor/.store in=\filllcirclecolor,
  filllcolor/.store in=\filllcolor,
  drawcolor/.store in=\drawcolor,
  drawcircle/.store in=\drawcircle,
  scalefac/.store in=\scalefac,
  Linewidth/.store in=\Linewidth,
  picname/.store in=\picname,
  filllcolor=BrownLine,
  filllcirclecolor=cyan,
  drawcolor=black,
  drawcircle=violet,
  scalefac=1,
  Dual=adual,
  Smile=smile,
  Level=0.52,
  Linewidth=0.5pt,
  Depth=1.3,
  Height=0.8,
  Width=1.1,
  picname=C
}

\node[Circ](C1){};
\pic[shift={(0,0)}] at  (C1){patharrow={scalefac=1.0,picname=1,drawcolor=orange,
filllcolor=orange!05!,Linewidth=0.7pt, filllcirclecolor=green!60}};
\node[below =-7pt of C1](B1){搜索空间  $\mathcal{A}$};

\node[Circ,right=4 of C1](C2){};
\pic[shift={(0,0)}] at  (C2){griddot={scalefac=1,picname=1,drawcolor=BlueD,
filllcolor=green!10!,Linewidth=2.75pt, filllcirclecolor=cyan!20}};
\node[below =-7pt of C2](B2){搜索策略};

\node[Circ,right=4 of C2](C3){};
\pic[shift={(-0.80,-0.9)}] at  (C3){graph={scalefac=1,picname=1,filllcolor=BlueLine, Linewidth=1.0pt}};
\node[below =-7pt of C3,align=center](B3){性能估计策略};
 \scoped[on background layer]
\node[draw=BackLine,inner xsep=5mm,inner ysep=5mm,minimum height=37mm,
yshift=5.5mm,fill=BackColor!10,fit=(C2)(C3)(B3),line width=1pt](BB1){};
\node[below=4pt of BB1.north,inner sep=0pt,
anchor=north,align=center]{单次训练方法:\\
联合学习模型架构参数与权重};
\draw[Arr](C1)--(C2);
\draw[Arr](C2.15)--node[text=black,above=2pt,align=center]{架构  $A\in\mathcal{A}$}(C3.165);
\draw[Arr](C3.195)--node[text=black,below,align=center]{$A$ 的性能\ 估计}(C2.345);
\end{tikzpicture}NAS 优化问题
NAS 的有效性取决于三个设计决策:搜索哪些架构(搜索空间)、如何高效探索该空间(搜索策略),以及如何评估每个候选架构的部署适用性。该优化问题首先面临一个相互依赖的约束:只有训练之后才能知道架构的表现如何,但训练成本高昂。这形成了两个嵌套决策:选择包含哪些操作(架构),以及寻找这些操作的最优参数(权重)。架构定义优化的对象;权重决定该架构能够达到的性能水平。
因此,NAS 是一个双层优化问题。15 外层循环搜索架构空间 \(\mathcal{A}\),内层循环则训练候选架构以评估性能。形式上,我们要寻找在约束 \(C\)(延迟、内存)下使验证损失 \(\mathcal{L}_{\text{val}}\) 最小的最优架构 \(\alpha^*\): \[ \alpha^* = \operatorname{arg\,min}_{\alpha \in \mathcal{A}} \mathcal{L}_{\text{val}}(\theta^*(\alpha), \alpha) \quad \text{subject to} \quad C(\alpha) \leq C_{\text{max}} \] 其中,\(\theta^*(\alpha)\) 表示架构 \(\alpha\) 的最优模型参数,通过最小化训练损失获得: \[ \theta^*(\alpha) = \operatorname{arg\,min}_{\theta} \mathcal{L}_{\text{train}}(\theta, \alpha) \]
计算瓶颈就在这个内层循环。如果评估每个候选架构都需要独立地从头训练,那么即使搜索空间规模不大,仅在 20 层中每层提供 10 种操作选择,也会产生 \(10^{20}\) 种可能的架构,使穷举变得不可能。实用的 NAS 方法通过三种机制克服这种组合爆炸:将搜索空间限制为可复用单元,通过权重共享分摊评估成本,或将离散选择松弛为连续、可微的形式。
搜索空间设计
搜索空间定义了 NAS 能够发现哪些架构。设计良好的搜索空间融入领域知识,使搜索聚焦于有潜力的区域,同时保留足够的灵活性以发现新模式。
许多 NAS 系统并不搜索整个网络架构,而是搜索可复用的计算模块,即单元,再通过堆叠单元构成完整网络。卷积单元可以从 \(3{\times}3\) 卷积、\(5{\times}5\) 卷积、深度可分离卷积、最大池化或恒等连接等操作中进行选择。一个包含四个节点、每条边有两种操作可选的简化单元,大约可产生 10,000 种单元设计,比搜索完整架构容易处理得多。NASNet 是这种方法的典型实例:它发现了可复用的常规单元和降采样单元,通过堆叠这些单元,可以构建不同模型规模的完整网络。
搜索空间还会直接编码物理硬件约束。硬件感知搜索空间并不允许任意拓扑图,而是将候选操作限制为在目标平台上具有高效向量化内核实现的原语。例如,移动端搜索空间优先采用深度可分离卷积,并限制卷积核大小和通道对齐方式,以适配片上缓存行并尽量减少内存总线事务 (Zhang et al. 2020)。MobileNetV3 将这种结构化的块级搜索空间与 NetAdapt 相结合,根据实测移动 CPU 延迟剪除层中的通道 (Howard et al. 2019)。
Zhang, Li Lyna, Yuqing Yang, Yuhang Jiang, Wenwu Zhu, and Yunxin Liu. 2020. “Fast Hardware-Aware Neural Architecture Search.” 2020 IEEE/CVF Conference on Computer Vision and Pattern Recognition Workshops (CVPRW). https://doi.org/10.1109/cvprw50498.2020.00354.
搜索策略
搜索策略决定如何在不进行穷举的情况下高效探索架构空间。Table 7 比较了各类方法在搜索成本、架构多样性和最优性保证之间的权衡。
| 策略 | 搜索效率 | 适用情形 | 主要挑战 |
|---|---|---|---|
| 强化学习 | 22,400 GPU 天 | 新领域、无约束搜索 | 计算成本高昂 |
| 进化算法 | 3,150 GPU 天 | 具备并行基础设施 | 需要大规模种群 |
| 基于梯度的方法(DARTS) | 1–4 GPU 天 | 计算预算有限 | 可能收敛至次优局部极小值 |
基于强化学习的 NAS 将架构搜索视为一个序贯决策过程:控制器生成架构,并获得准确率奖励。控制器通常是长短期记忆网络,通过策略梯度优化学习提出更好的架构。这种方法发现了 NASNet 等高性能架构,但其内层循环成本高昂,因为每次获得奖励都需要训练一个候选架构;Zoph and Le (2016) 评估了约 12,800 个架构,总计消耗 22,400 GPU 天。这种成本推动实用 NAS 转向权重共享和成本更低的性能预测器。
Real, Esteban, Alok Aggarwal, Yanping Huang, and Quoc V. Le. 2019. “Regularized Evolution for Image Classifier Architecture Search.” Proceedings of the AAAI Conference on Artificial Intelligence 33 (01): 4780–89. https://doi.org/10.1609/aaai.v33i01.33014780.
进化算法维护一个候选架构种群,并迭代应用变异(改变操作、添加连接)和交叉(组合父代架构)来生成后代。基于适应度的选择将高性能架构保留到下一代,因此跳跃连接或深度可分离卷积等有用组件可以重新组合,而无须从头重新发现。AmoebaNet 通过进化,在消耗 3,150 GPU 天后实现了可与顶尖人工设计模型媲美的 ImageNet 准确率 (Real et al. 2019),既展示了种群搜索的价值,也表明仍需借助代理任务、权重共享或大规模并行来控制搜索成本。
DARTS(可微架构搜索)(Liu et al. 2019) 等基于梯度的方法将搜索空间表示为连续松弛形式,其中所有可能的操作以加权组合的形式表示。DARTS 不进行离散采样,而是使用梯度下降联合优化架构权重和模型权重。通过使搜索可微,DARTS 将搜索成本从数百 GPU 天降至一至四 GPU 天,不过连续松弛可能遗漏离散搜索方法能够发现的离散架构模式。
Liu, Hanxiao, Karen Simonyan, and Yiming Yang. 2019. “DARTS: Differentiable Architecture Search.” International Conference on Learning Representations (ICLR).
硬件感知 NAS 超越了理论 FLOP 计数,直接针对目标芯片上的执行指标进行优化。当内存带宽、缓存驻留或内核启动开销占主导地位时,FLOP 计数与运行时延迟的相关性较弱:FLOPs 较低但算术强度也较低的操作会因等待内存事务而停顿,其运行速度反而低于 FLOPs 较高、却能达到 Roofline 计算饱和状态的操作。MnasNet 通过引入延迟预测模型来应对这种差异,该模型基于在手机上测得的数千组架构与延迟配对数据进行训练。搜索目标通过加权乘积将准确率与延迟结合起来: \[ \text{Reward}(\alpha) = \text{Accuracy}(\alpha) \times \left(\frac{L_{\text{lat,target}}}{L_{\text{lat}}(\alpha)}\right)^\beta \] 其中,\(L_{\text{lat}}(\alpha)\) 是实测延迟,\(L_{\text{lat,target}}\) 是延迟约束,\(\beta\) 控制准确率与延迟之间的权衡。该形式惩罚超出延迟目标的架构,同时奖励在预算内实现高准确率的架构。在所报告的 MnasNet 搜索空间中,相比采用统一扩展比例,改变倒残差模块的扩展比例能够实现更好的准确率与延迟权衡,说明搜索能够揭示范围较窄的人工扫描可能不会测试的非均匀设计。
何时使用 NAS
神经架构搜索能够发现优于人工设计方案的架构,但其计算成本要求仔细考虑何时值得投入。对于约束特殊的新型硬件平台,例如新的加速器架构或资源高度受限的边缘设备,如果现有架构的优化不足,NAS 可能值得采用。当部署规模足够大,微小的效率提升就能抵偿前期搜索成本时,或者面向云端、边缘端和移动端部署的架构族能够将一次搜索的成本分摊到多个变体上时,采用 NAS 也可能合理。
反之,当标准部署约束已有充分优化的架构族可用时,定制 NAS 就很难证明其合理性。如果计算预算只有几 GPU 天,大规模强化学习搜索或进化搜索并不现实;DARTS 等可微方法或权重共享方法可能仍然可行,但依然需要从部署规模和验证成本角度论证其合理性。快速变化的需求也会削弱采用 NAS 的理由,因为在搜索和验证完成之前,目标就可能已经改变。
对于大多数从业者,在投入资源从头搜索之前,EfficientNet (Tan and Le 2019)、MobileNetV3 (Howard et al. 2019) 和 MnasNet (Tan et al. 2019) 等现有的 NAS 发现或 NAS 辅助设计的架构能够提供强有力的基线。它们的迁移效果仍取决于任务和硬件。应将定制 NAS 留给约束特殊的场景,或部署规模足以分摊搜索与验证投入的场景。
架构示例
NAS 研究在各自的搜索空间中发现了可复用的设计模式。EfficientNet 利用复合系数联合缩放深度、宽度和分辨率,并报告其模型族实现了更好的准确率与效率权衡 (Tan and Le 2019)。MobileNetV3 将硬件感知搜索与 NetAdapt 相结合,以满足手机延迟目标 (Howard et al. 2019),而 FBNet 则将设备特定的延迟纳入移动 CPU 搜索目标 (B. Wu et al. 2019)。这些结果展示了搜索在特定空间、目标和测量条件下的发现;它们并不能证明自动搜索普遍优于精心的人工设计。
Wu, Bichen, Kurt Keutzer, Xiaoliang Dai, Peizhao Zhang, Yanghan Wang, Fei Sun, Yiming Wu, Yuandong Tian, Peter Vajda, and Yangqing Jia. 2019. “FBNet: Hardware-Aware Efficient ConvNet Design via Differentiable Neural Architecture Search.” 2019 IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 10726–34. https://doi.org/10.1109/cvpr.2019.01099.
除卷积网络之外,NAS 也已应用于 Transformer 架构,包括在计算或内存约束下搜索紧凑的语言模型和视觉模型。其共同的系统层面启示,比“搜索总能胜过人工设计”这一论断更为有限:当延迟、内存或能耗被纳入目标,并在目标平台上进行测量时,搜索就会依据部署实际受限的资源来评估候选架构。结果仍取决于搜索空间、代理评估质量、优化预算和最终重新训练。
到目前为止介绍的结构性技术(剪枝、蒸馏、分解和 NAS)都在优化模型执行哪些计算,包括存在哪些参数、保留哪些连接,以及如何组织架构。这些技术能够大幅减少参数量和理论 FLOPs。无论结构效率如何,每个保留下来的权重和激活值仍然必须以某种数值精度存储和处理。
Checkpoint 1.2: 选择结构性方法
结构性方法以不同方式转移部署成本。
保留下来的操作仍必须在物理内存带宽和寄存器容量限制内执行。优化框架的第二个维度控制这些操作的数值精度。结构性方法减少参数量和标称 FLOPs;精度优化则改变每个剩余数值带来的内存流量和算术运算成本。一个 32 位浮点数占用 4 字节,而一个 8 位整数在计入缩放或打包元数据之前占用 1 字节。对于受内存带宽限制的推理,当运行时将算子映射到受支持的整数执行单元时,这种更小的表示会直接减少内存流量。虽然经过良好校准的 INT8 工作负载往往能够保持基线准确率,但任务质量仍对模型族、层敏感性和硬件实现敏感 (Jacob et al. 2018; Gholami et al. 2022)。
量化通常很适合作为首次部署实验,因为它保持架构完整,并且可以在训练后应用。当权重或激活值的传输构成瓶颈,且目标平台提供高效的低精度内核时,量化的作用最大;否则,它可能只会缩小模型产物,而无法加快请求处理。
量化与精度
决定压缩需求的物理差距由内存约束所支配:一个拥有 7 十亿参数的语言模型采用 FP16 时,仅权重就需要 14 GB,而目标智能手机仅提供 8 GB 的共享 RAM。结构化剪枝可以移除层或注意力头,但对于以稠密形式存储的部署产物,若不引入专用格式的开销,非结构化的零值并不会使其缩小 (Han et al. 2016)。一种互补手段是减少表示每个参数的位宽:确定在准确率崩溃之前精度能够降低到何种程度,就能界定量化的实际可用范围。
Definition 1.4: 量化
量化 是一种模型压缩技术,通过将高精度连续值映射到低精度离散集合来降低信息保真度。
- 意义:从 FP32 转换为 INT8 可将每个量化值的原始有效载荷缩减至原来的四分之一(4\(\times\))。实际产物大小、流量和延迟还取决于缩放因子、元数据、紧凑打包、算子覆盖率以及目标内核。
- 区别:剪枝减少参数数量,而量化降低选定权重和/或激活值的位深度。
- 常见误区:一种常见误解是,量化只是“舍入”。实际上,量化是一种有损映射,需要仔细估计数值范围,并且往往需要采用量化感知训练(QAT),以尽量减小其对准确率的影响。
量化16涉及以某种数值精度存储的每个神经网络权重和激活值:FP32(32 位)、FP16(16 位)、INT8(8 位)或更低精度。因此,位宽成为关键的系统参数。它限制原始有效载荷大小和缓存占用,在数值保持紧凑打包时影响带宽需求,并决定专用矩阵引擎在面积与吞吐量之间的权衡(AI 加速中的数值计算)。
三个系统属性可能发生变化。从 FP32 转为 INT8 后,在计入缩放因子和打包元数据之前,原始权重有效载荷缩减至原来的四分之一(4\(\times\))。当数值在整个内存路径中保持紧凑打包时,权重流量也可按类似比例下降,从而加速受内存带宽限制的推理,例如某些小批量大语言模型(LLM)解码。当目标平台提供高效的 INT8 内核时,计算成本也可能降低;不受支持的算子、格式转换或回退路径可能抵消部分收益 (Gupta et al. 2015; Wang et al. 2019)。
Gupta, Suyog, Ankur Agrawal, Kailash Gopalakrishnan, and Pritish Narayanan. 2015. “Deep Learning with Limited Numerical Precision.” International Conference on Machine Learning (ICML), 1737–46.
Wang, Yu Emma, Gu-Yeon Wei, and David Brooks. 2019. “Benchmarking TPU, GPU, and CPU Platforms for Deep Learning.” arXiv Preprint arXiv:1907.10701.
准确率代价因模型、任务、量化器、校准数据和位宽而异。许多卷积神经网络(CNN)推理模型对 INT8 具有良好的容忍度;Transformer、语音模型和含有大量离群值的层可能需要采用不同的量化粒度、混合精度或考虑训练的方法。主要方法包括训练后量化(PTQ)、量化感知训练(QAT),以及面向更低位宽部署的极端量化。这些方法在训练成本和控制能力上有所不同,但其准确率并不存在有保证的优劣排序。
每种方法的可行性取决于特定模型在质量恶化之前能够降低多少精度。Figure 13 展示了一种常见的定性模式:适度降低精度时,测得的影响很小,形成平台区;随后出现因模型而异的断崖式下降。这两个边界对应的位宽并不具有普适性。
精度与能耗
精度是一项关乎能耗的决策,因为物理数据移动主导着现代计算系统的散热与功率包络。在硅芯片中,能量耗散与导线电容成正比(\(E \propto C V^2\)),这意味着沿长内存总线传输比特所消耗的焦耳数,比算术逻辑单元内部逻辑门翻转所需的能量高出数个数量级。将一个 32 位浮点操作数从片外 DRAM 移至本地寄存器所消耗的能量,显著高于执行乘加运算本身所需的能量。降低数值精度会直接减少穿越内存层次结构的字节量(\(D_{\text{vol}}\)),并降低每次 ALU 运算的开关能耗(\(E_{\text{compute}}\)),从而缓解整个硬件栈中的内存带宽与散热瓶颈。
Systems Perspective 1.3: 量化的物理原理
数据移动能耗不变量 \((E_{\text{move}} \gg E_{\text{compute}})\) 意味着,从硅芯片的物理机制来看,每个被读取的比特都带有能耗成本 (Horowitz 2014)。应知数值 汇集了参考能耗比,而 数值表示 比较了不同数值格式之间的权衡。
根据机器学习系统铁律 \((T = \frac{D_{\text{vol}}}{\text{BW}} + \frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}} + L_{\text{lat}})\),降低位宽只有通过使用新表示的执行路径,才会改变数据移动项和计算项。针对紧凑打包数值的一阶模型给出了两项有用的比较:
- 内存数据移动 \((D_{\text{vol}} \times E_{\text{move}})\):紧凑打包的 INT8 数据流所承载的原始数值比特数为 FP32 的四分之一。相应的能耗估计假设,完整事务的成本可由多个打包数值分摊;缓存、元数据、对齐方式和事务大小都会影响实际成本。
- 计算工作 \((O \times E_{\text{compute}})\):一次 32 位乘法的能耗约为 3.7 pJ/op。一次 INT8 乘法的能耗约为 0.2 pJ/op。
Table 8 以一次 8 位整数加法为基准,对这些成本进行归一化,以揭示算术运算与 DRAM 访问之间四个数量级的差距。
对于推理工作负载,从 FP32 转为 INT8 后,原始数值存储量的缩减倍数为 4×,而上述两种乘法成本给出的理想化乘法能耗缩减倍数为 18.5×。端到端能耗还包括内存、控制、传感器和空闲功耗。Roofline 模型 对这一关系进行了形式化描述:每字节算术运算量较小的工作负载受内存限制,因此减少数据移动起主导作用;每字节算术运算量较大的工作负载受计算限制,因此节省算术运算能耗更为重要。仅凭算术运算能耗比无法预测设备的电池续航时间。
相同的物理原理也适用于数据中心规模:分布式训练系统使用较低精度来减少梯度通信开销,混合精度训练 讨论了这一主题。硬件加速 将再次探讨利用这些能耗差异的硅芯片机制。
硅芯片层面的能耗测量解释了系统为何采用量化,但仅凭硬件效率无法决定部署可行性。量化的可运行范围取决于跨越数据—算法—机器边界的两个相互作用的约束:算法在任务准确率下降之前对数值扰动的容忍程度,以及机器将更窄位宽转化为更低能耗和实际运行时间加速的能力。要量化这一权衡中的硬件因素,需要测量内存与执行层次结构中各层级消耗的物理能量。
能耗成本
Table 8 总结了算术运算与数据移动之间的典型差距,以一次 8 位整数加法为基准对操作成本进行归一化。跨内存接口移动数据所付出的能耗代价,比执行片上算术运算高四个数量级,这构成了降低位宽的主要物理动因。
| 操作 | 位宽 | 相对能耗 |
|---|---|---|
| 整数加法 | 8 位 | 1\(\times\) |
| 浮点加法 | 32 位 | 30× |
| DRAM 读取 | 32 位 | 21,333.3× |
Figure 14 将这一基准扩展到不同数值精度和片上 SRAM 层次结构。在参考的 45 nm 工艺模型中,一次 32 位整数加法的能耗为 0.1 pJ/op,而一次 8 位整数加法消耗 0.03 pJ/op。浮点算术也遵循相同趋势:一次 32 位浮点加法消耗约 0.9 pJ/op,而一次 16 位浮点加法需要 0.4 pJ/op。相对于能耗为 0.03 pJ 的 INT8 加法,片上 SRAM 读取的能耗范围为 5 至 50 pJ,即其 167 至 1,667\(\times\),表明操作数在缓存层次结构中的位置与算术格式本身一样,对能耗具有重大影响。片外 DRAM 访问的成本还要更高。在大规模系统中,这些单次操作的差异会在数十亿个参数和操作上累积。对于受内存限制的工作负载,通过高电容 DRAM 总线移动未经量化的参数会使带宽饱和,并主导加速器功耗 (Patterson et al. 2021);而在能量受限的边缘设备上,冗余位宽会直接耗尽电池储备,并导致超出热约束。
Patterson, David, Joseph Gonzalez, Quoc Le, Chen Liang, Lluis-Miquel Munguia, Daniel Rothchild, David So, Maud Texier, and Jeff Dean. 2021. “Carbon Emissions and Large Neural Network Training.” arXiv Preprint arXiv:2104.10350.
\begin{tikzpicture}[font=\small\sffamily]
\definecolor{Softmax}{HTML}{FDAE61}
\definecolor{ReLU}{HTML}{ABDDA4}
\definecolor{Tanh}{HTML}{2B83BA}
%RIGHT
 \begin{scope}[local bounding box=RR2,shift={(7,0)}]
\begin{axis}[
    axis line style={draw=none},
    width=105mm,
    height=75mm,
    xlabel={操作},
    ylabel={能耗 (pJ)},
    title={典型 45 nm 工艺的单次操作能耗},
    title style={yshift=-4pt},
    ymin=-1.1,ymax=53,
    ytick={0,10,...,50},
    tick label style={/pgf/number format/assume math mode=true},
    yticklabel style={font=\footnotesize\sffamily,
    /pgf/number format/.cd, fixed, fixed zerofill, precision=1},
    xticklabel style={font=\fontsize{7pt}{7}\selectfont\sffamily,rotate=25,anchor=north east},
    ylabel style={font=\footnotesize\sffamily},
    enlarge x limits=0.1,
    grid=both,
    minor tick num=1,
    major grid style={black!60},
    tick style={draw=none},
    nodes near coords,
    every node near coord/.append style={yshift=2pt,
  font=\scriptsize\sffamily, anchor=south,black,
  /pgf/number format/assume math mode=true,fill=white,
   /pgf/number format/.cd, fixed, fixed zerofill, precision=2,zerofill=false,},
    major tick length=1mm,
    xtick={1,2,3,4,5,6,7,8},
    xticklabels={整数加法 (8b), 整数加法 (16b), 整数加法 (32b),
                整数乘法 (8b), 整数乘法 (32b),
                8 KB SRAM 读取 (32b), 32 KB SRAM 读取 (32b), 1 MB SRAM 读取 (32b) },
    every axis plot/.append style={
          ybar,
          bar width=9mm,
          bar shift=0pt,
          fill
        }]
      \addplot[VioletLine]coordinates {(1,0.03)};
      \addplot[BrownLine]coordinates{(2,0.05)};
      \addplot[BlueLine]coordinates{(3,0.1)};
      \addplot[Softmax]coordinates{(4,0.2)};
      \addplot[Softmax]coordinates {(5,3.1)};
      \addplot[Tanh]coordinates{(6,5)};
      \addplot[ReLU]coordinates{(7,10)};
      \addplot[RedLine]coordinates{(8,50)};
%
\coordinate(L)at(axis cs:1,0.03);
\coordinate(D)at(axis cs:6,5);
\coordinate(S1)at(axis cs:0,27);
\coordinate(S2)at(axis cs:2,30);
\end{axis}
\node[fill=white,text=red,font=\bfseries\large\sffamily] at (S2) {$\approx 167\times$};
\draw[red,-latex,line width=2pt](L)--(D);
\end{scope}
%LEFT
\path[red](S1)--++(180:5)coordinate(S);
%%
\begin{scope}[local bounding box=RR1,shift={(S)}]
\colorlet{col1}{BrownLine!35}
\colorlet{col2}{BrownLine!15}
\colorlet{col3}{BrownLine!5}
\matrix(T)[%nodes in empty cells,
  matrix of nodes,
  row sep =3\pgflinewidth,
  column sep = 3\pgflinewidth,
  nodes={text height=1.5ex,text depth=0.25ex, text width=2mm, draw=white,
  line width=0.25pt, font=\footnotesize\sffamily},
  row 1/.style={nodes={align=center,fill=col1}},
  column 2/.style = {nodes={text width=40mm,align=left}},
  column 3/.style = {nodes={text width=20mm,align=center}},
  ]
  {
&\textbf{操作}&\textbf{能耗 (pJ)}\\
1&|[fill=col3]| 整数加法 (8b) &|[fill=col3]| 0.03\\
2&|[fill=col2]| 整数加法 (16b)&|[fill=col2]| 0.05\\
3&|[fill=col3]| 整数加法 (32b)&|[fill=col3]| 0.10\\
4&|[fill=col2]| 整数乘法 (8b)&|[fill=col2]| 0.20\\
5&|[fill=col3]| 整数乘法 (32b)&|[fill=col3]|3.10\\
6&|[fill=col2]| 8 KB SRAM 读取 (32b)&|[fill=col2]|5.00\\
7&|[fill=col3]| 32 KB SRAM 读取 (32b)&|[fill=col3]|10.00\\
8&|[fill=col2]| 1 MB SRAM 读取 (32b)&|[fill=col2]|50.00\\
  };
\end{scope}
\end{tikzpicture}能耗红利:INT8 与 FP32
减少内存占用通常是量化的首要动机,但低精度算术运算也能带来能耗红利。从 FP32 转为 INT8,原始数值的数据量恰好缩减为原来的 1/4,即缩减 4\(\times\);运算层面的能耗比可能更大,而端到端能耗仍取决于工作负载和设备。
硬件能耗层次揭示了这种运算上的不对称性。在此处采用的参考工艺模型中,一次 FP32 加法消耗 0.9 pJ/op,而一次 INT8 加法消耗 0.03 pJ/op,运算层面的能耗比为 30×。这一比值并非对设备电池续航时间的预测:内存访问、累加精度、控制、传感器和空闲功耗等开销仍然存在。不过,它确实解释了为什么许多加速器会增加专用低精度单元,以及为什么当算术运算或内存能耗构成约束时,量化可能成为必要手段。

只有当机器轴具备合适的整数运算单元时,量化才能产生收益。
当起决定作用的物理约束是内存容量而非计算吞吐量时,这些能耗收益的实现方式会发生根本变化。推荐模型将能耗问题转化为放置问题:量化必须将占据主要空间的内存结构压缩到足以放入宿主机器物理内存的程度。
Lighthouse 1.1: DLRM 与嵌入量化
DLRM 灯塔案例(稀疏架构:推荐系统)展示了一类压缩挑战,其中起决定作用的约束是内存容量,而非计算吞吐量或内存带宽 (Naumov et al. 2019)。其嵌入表的规模可达数 TB,远超 GPU 内存容量。
对于 DLRM,量化的目标是存储密度,而非算术吞吐量。将嵌入表精度从 FP32 降至 INT8(或更低),可使内存占用缩减 4–8\(\times\);当精度要求和查找内核允许采用较低精度时,这使得更大的表能够放入更少的 GPU。压缩查找表可确保设备的物理内存能够容纳算法模型。
Naumov, Maxim, Dheevatsa Mudigere, Hao-Jun Michael Shi, Jianyu Huang, Narayanan Sundaraman, Jongsoo Park, Xiaodong Wang, et al. 2019. “Deep Learning Recommendation Model for Personalization and Recommendation Systems.” arXiv Preprint arXiv:1906.00091.
除了直接节省计算能耗,降低数值精度还能减少内存能耗,而后者往往在系统总功耗中占主导地位。访问内存,尤其是片外 DRAM,所需的能耗远高于执行算术逻辑运算:本章采用的代表性 32 位 DRAM 读取消耗 640 pJ,相比之下,缓存和算术运算的能耗处于皮焦耳量级。因此,一条指令的总能耗主要由内存流量决定,而非 ALU 计算。17
DLRM 与 TinyML 灯塔案例(1.2)共同展示了这种内存约束在实际运行中的两个极端。DLRM 利用较低精度将 TB 级嵌入表放入宿主内存;TinyML 则利用较低精度,将每次推理限制在极小的能耗预算和仅数百 KB 的片上 SRAM 范围内。
Lighthouse 1.2: TinyML 量化的必要性
关键词检测(KWS)灯塔案例 DS-CNN 与 DLRM 处于机器学习系统铁律所描述范围的两个相反极端 (Y. Zhang et al. 2017)。典型的 TinyML SRAM 预算约为 512 KB,即使是专门设计的 DS-CNN 关键词检测模型,在 FP32 下也会超出这一预算:其权重占用 800 KB。量化至 INT8 后,同一网络缩小至 200 KB,能够放入内存,并为运行时缓冲区留出空间。对于约束更严格、仅配备 256 KB SRAM 的智能门铃微控制器,扣除运行时缓冲区、音频窗口和特征提取状态后,留给模型权重的空间接近 100 KB,因此需要采用更激进的 INT4 或二值压缩。
采用 FP32 时,即使是紧凑的 DS-CNN 架构,其搬移的原始权重字节数也是 INT8 下的 4\(\times\);在配备高效整数单元的硬件上,算术运算路径的能耗也可能更高。对于由纽扣电池供电、始终开启的设备,这种缩减有助于延长电池续航,但传感器、唤醒、特征提取和空闲功耗可能占据主导地位。在此,量化降低了模型的数据搬移项,并且在支持整数运算路径时,可以改善其计算项 \((O / (R_{\text{peak}} \cdot \eta_{\text{hw}}))\)。
Zhang, Yundong, Naveen Suda, Liangzhen Lai, and Vikas Chandra. 2017. Hello Edge: Keyword Spotting on Microcontrollers.
因此,降低数值精度从两个不同方面削减了物理执行成本:ALU 中的算术运算延迟,以及跨内存总线的字节流量。这些缩减如何转化为实际运行时间的加速,直接取决于工作负载受限于计算吞吐量还是内存带宽。
性能增益
Figure 15 比较了示例性的 FP32 与 INT8 方案。成对柱形并非同一平台上的延迟测量结果;存储面板展示了从 32 位降至 8 位所带来的精确 4\(\times\) 缩减。
\begin{tikzpicture}[font=\small\sffamily]
\definecolor{other}{HTML}{D7191C}
\definecolor{WeightGradient}{HTML}{FDAE61}
\definecolor{Optimization}{HTML}{ABDDA4}
\definecolor{Activation}{HTML}{2B83BA}

\pgfplotsset{
  mybarstyle/.style={
   /pgf/number format/.cd,
   1000 sep={},
    width=75mm,
    height=62mm,
    axis line style={draw=none},
    ybar=1pt, ymin=0,
    bar width=8mm,
    title style={font=\fontsize{8pt}{8}\selectfont\sffamily,yshift=-4pt},
    symbolic x coords={Inception\_v3,MobileNet\_v1, ResNet\_v2},
    xtick=data,
    xticklabels={Inception v3,MobileNet v1,ResNet v2},
   legend style={at={(0.85,0.9)}, anchor=north},
   legend cell align=left,
   legend style={fill=BrownL!40,draw=BrownLine,row sep=1.85pt,
   font=\fontsize{7pt}{7}\selectfont\sffamily},
    enlarge x limits=0.2,
    tick label style={/pgf/number format/assume math mode=true},
    ticklabel style={font=\footnotesize\sffamily},
    grid=major,
    major grid style={black!60},
   every node near coord/.append style={yshift=2pt,
   /pgf/number format/assume math mode=true,
    font=\fontsize{6pt}{6}\selectfont\sffamily, anchor=south},
    %
    yticklabel style={font=\fontsize{7pt}{8}\selectfont\sffamily},
    xticklabel style={font=\fontsize{7pt}{8}\selectfont\sffamily,yshift=-3pt},
    ylabel style={font=\footnotesize\sffamily},
    xlabel style={font=\footnotesize\sffamily},
 }
}
\begin{scope}[local bounding box=RR,shift={(0,0)}]
\begin{axis}[mybarstyle,
    ymin=0,
    ytick={0,250,500,750,1000,1250},
    ylabel={推理时间 (ms)},
    title={推理时间},
   nodes near coords={\pgfmathprintnumber{\pgfplotspointmeta}~ms},
    ]
    \addplot [fill=WeightGradient!80,draw=none] coordinates {
        ({Inception\_v3},800)
        ({MobileNet\_v1},700)
        ({ResNet\_v2},300)};
    \addplot [fill=Activation!90,draw=none] coordinates {
        ({Inception\_v3},500)
        ({MobileNet\_v1},30)
        ({ResNet\_v2},70)};
\end{axis}
 \end{scope}
 %%%%RIGHT
 \begin{scope}[local bounding box=RR2,shift={(7.5,0)}]
\begin{axis}[mybarstyle,
  ymin=0,
  ymax=150,
  ytick={0,25,50,75,100,125,150},
  ylabel={权重存储量 (MB)},
  title={权重存储量},
  nodes near coords={\pgfmathprintnumber{\pgfplotspointmeta}~MB},
    ]
    \addplot [fill=WeightGradient!80,draw=none] coordinates {
        ({Inception\_v3},135)
        ({MobileNet\_v1},45)
        ({ResNet\_v2},24)};
    \addplot [fill=Activation!90,draw=none] coordinates {
        ({Inception\_v3},33.75)
        ({MobileNet\_v1},11.25)
        ({ResNet\_v2},6)};

\legend{FP32,INT8}
\coordinate (legend) at (axis description cs:0.85,0.9);
\end{axis}
\node[fill=white,above=1pt of legend,anchor=south,
 font=\fontsize{8pt}{8}\selectfont\sffamily]{精度};
 \end{scope}
 \node[draw=none,inner sep=0pt,fit=(RR)(RR2)](BB){};
 \node[above=-1pt of BB]{量化对推理时间和模型大小的影响};
  \node[below=-2pt of BB]{模型};
\end{tikzpicture}大语言模型展示了权重精度如何决定大规模部署时物理内存容量是否足够。
Napkin Math 1.1: 量化带来的存储节省
问题:部署 Llama 3 8B 需要在设备上存储 8B 个参数。模型在 FP16 和 INT4 下分别占用多少内存?量化能否将其压缩到足以放入单块消费级 GPU 的程度?
FP16
- 原始权重大小:8 \(\times 10^9 \times\) 2 字节(16 位)= 16 GB
- 运行时预算:16 GB 没有留下任何余量;24 GB 级设备较为实用。
INT4
- 原始权重大小:8 \(\times 10^9 \times\) 0.5 字节(INT4)= 4 GB
- 运行时预算:4 GB 在 8 GB 设备上留下约 4 GB 空间,可用于元数据、缓存、激活值和工作空间。
除了节省存储,量化还通过硬件寄存器中的数据级并行加速算术运算。当每个操作数占用的位数更少时,定宽向量执行单元(SIMD)和脉动阵列每个周期可以处理更多操作数。
Napkin Math 1.2: SIMD 倍增效应
问题:一个受计算限制的层在同一处理器上以 INT8 替代 FP32 运行。加速从何而来?
机制:SIMD 执行。CPU 或 GPU 核心在定宽向量寄存器中处理数据(例如,AVX-512 的宽度为 512 位)。
计算:
- 寄存器宽度:512 位。
- FP32 容量:512/32 = 每条向量指令处理 16 个元素。
- INT8 容量:512/8 = 每条向量指令处理 64 个元素。
结果:切换至 INT8 后,同一寄存器可容纳的元素数量变为原来的 4×。 \(\text{Throughput Gain} = \text{INT8 elements/inst} / \text{FP32 elements/inst}\) = 64/16 = 4×
系统洞察:在 INT8 向量指令吞吐量与 FP32 相当的硬件上,即使尚未考虑内存带宽的节省,仅凭向量打包,量化就能为受计算限制的层带来最高 4× 的加速。
然而,降低数值精度也会带来权衡。低精度格式可能引发数值不稳定和量化噪声,从而可能影响模型准确率。Figure 16 展示了一个示例性残差分布,它由具有不同尺度且可能经过截断的数值汇总而成。对于理想的均匀量化器,范围内的舍入误差则被限制在 \([-\Delta/2, \Delta/2]\) 内;超出该区间的误差源于截断或不同步长误差的汇总。某些架构,例如基于 Transformer 的大型 NLP 模型,对量化具有较好的容忍度,而其他架构则可能出现显著的性能退化。因此,选择合适的数值精度需要在准确率约束、硬件支持和效率增益之间取得平衡。
\begin{tikzpicture}[font=\small\sffamily]
\definecolor{barfill}{cmyk}{0.7, 0.4, 0, 0}
\begin{axis}[
  width=16cm,
  height=82mm,
  xmin=-3, xmax=3,
  ymin=0, ymax=1.06,
  axis lines=left,
  xtick={-3,-2,-1,0,1,2,3},
  xticklabels={$-$3,$-$2,$-$1,0,+1,+2,+3},
  ytick={0,0.25,0.5,0.75,1.0},
  ymajorgrids=true,
  grid style={draw=black!10},
  tick align=outside,
  tick style={black},
  tick label style={/pgf/number format/assume math mode=true},
  xlabel={\bfseries 量化误差},
  ylabel={\bfseries\sffamily 相对密度},
  title={\bfseries 量化误差分布},
  title style={yshift=1pt},
  clip=false
]

% ------------------------------------------------------------
% 1) Histogram bars (approx. values, symmetric)
%    x = bin center, y = bar height
% ------------------------------------------------------------
\addplot[ybar, line width=0.7pt,bar width=12.5pt, draw=BlueD, fill=barfill!80]
table[row sep=\\]{
x    y\\
-2.2 0.10\\
-2.0 0.16\\
-1.8 0.23\\
-1.6 0.31\\
-1.4 0.43\\
-1.2 0.56\\
-1.0 0.7\\
-0.8 0.80\\
-0.6 0.9\\
-0.4 0.97\\
-0.2 0.99\\
 0.0 1.0\\
 0.2 0.99\\
 0.4 0.95\\
 0.6 0.87\\
 0.8 0.75\\
 1.0 0.64\\
 1.2 0.52\\
 1.4 0.40\\
 1.6 0.3\\
 1.8 0.22\\
 2.0 0.15\\
 2.2 0.10\\
};

% ------------------------------------------------------------
% 2) Red tail overlays (bars in tails)
%    left tail: x <= -2.2, right tail: x >= 2.0
% ------------------------------------------------------------
\addplot[ybar, bar width=12.5pt, draw=red!70!black, fill=red!35, fill opacity=0.65]
table[row sep=\\]{
x    y\\
-2.8 0.03\\
-2.6 0.04\\
-2.4 0.06\\
};

\addplot[ybar, bar width=12.5pt, draw=red!70!black, fill=red!35, fill opacity=0.65]
table[row sep=\\]{
x    y\\
 2.4 0.06\\
 2.6 0.04\\
 2.8 0.03\\
};

% ------------------------------------------------------------
% 3) Smooth curve (normal-like) in dark red
% ------------------------------------------------------------
\addplot[line width=2pt, red!70!black, smooth, domain=-3:3, samples=200]
{exp(-0.5*x^2)}; % scaled to peak ~1

% ------------------------------------------------------------
% 4) Center dashed line around 0 (slightly to the right like the figure)
% ------------------------------------------------------------
\addplot[black!35, dashed, white,line width=1pt]
coordinates {(0.0,0) (0.0,1.0)};
% ------------------------------------------------------------
% 5) Annotations (Tail errors) with dashed arrows
% ------------------------------------------------------------
\draw[red!70!black, dashed, <-, >=Latex,line width=1pt]
(axis cs:-2.55,0.08) --  (axis cs:-2.4,0.27)
node[above=2pt,anchor=south,align=center,
text=red!70!black, font=\sffamily\bfseries]{尾部误差};
%
\draw[red!70!black, dashed, <-, >=Latex,line width=1pt]
(axis cs:2.55,0.08) --  (axis cs:2.35,0.27)
node[above=40pt,anchor=north,align=center,text=red!70!black, font=\sffamily\bfseries]{尾部误差}
node[above=27pt,anchor=north,align=center,text=black!50, font=\footnotesize\sffamily\itshape]{影响模型\\
准确率};

\node[font=\itshape\small\sffamily\itshape,text=black!70] at (rel axis cs:0.5,1.01)
{汇总残差密度示意};

\node[font=\itshape\footnotesize\sffamily\itshape,text=black!70] at (rel axis cs:0.5,.-0.21)
{大多数量化误差接近零;尾部误差会引入累积噪声};
\end{axis}
\end{tikzpicture}控制量化噪声能够保持算法准确率,而降低精度在系统层面的目标则是缩短实际运行时间。这种加速的幅度及其物理来源,直接取决于执行过程是受计算限制还是受内存限制。
Napkin Math 1.3: 量化带来的加速(受计算限制)
问题:一个受计算限制的矩阵乘法运算(例如 Transformer 多层感知机模块中的矩阵乘法)从 FP16 切换为 INT8。预期加速比是多少?
计算:在配备专用 INT8 单元的现代硬件上:
- 整数吞吐量路径:参考 A100 级加速器的专用 INT8 矩阵单元额定吞吐量为 624 TOPS,而 FP16 路径为 312 TFLOP/s (NVIDIA Corporation 2020; Choquette et al. 2021)。峰值吞吐量的提升倍数就是这两个规格值之比:624 TOPS ÷ 312 TFLOP/s ≈ 2×。
- 内存带宽:INT8 权重的大小减半,因此从内存加载这些权重所需的时间也减半。
- 综合效果:对于受计算限制的运算,加速主要来自计算吞吐量的提升:加速比约为 2×。
系统洞见:量化带来的加速取决于瓶颈。受计算限制的运算(大批量、高算术强度 \(I\))通过更快的 INT8 单元获得约 2× 的加速,其收益来自整数矩阵运算路径,而非内存流量的减少。受带宽限制的情形则相反:将传输字节数减半(从 FP16 转为 INT8)可获得最高 2× 的加速,更大幅度地降低位宽还能进一步扩大收益,下一个计算示例将对此展开分析。
当运算受带宽限制时,加速比取决于每个词元传输字节数的减少幅度,而非峰值算术吞吐量。在小批量的自回归词元生成中,内存总线流量是延迟的主要决定因素。
Napkin Math 1.4: 量化带来的加速
问题:某部署场景要求在配备 16 GB RAM 的设备上运行一个参数量为 7B 的大语言模型。权重采用 FP16 格式(2 字节)。
计算:
- 模型大小:7 \(\times 10^9 \times\) 2 字节 = 14 GB。
- KV 缓存:包含 4,096 个词元的 FP16 KV 缓存使用两个张量(键和值),涵盖 32 层、32 个 KV 头,每个头有 128 个维度,每个数值占 2 字节,所需空间约为 2.1 GB。
- 总内存:14 GB + 2.1 GB = 16.1 GB。尚未计入操作系统和工作区内存,这就已经超出了设备容量。
- 带宽开销:在这一简化的全缓存流量模型中,以 50 GB/s 的带宽加载权重和 KV 缓存,每个词元需要 323 ms。对应的吞吐量为 3.1 tokens/s,对于聊天应用而言过慢。
改进方案(INT4):
- 量化:将权重转换为 INT4(0.5 字节)。
- 新的大小:7 \(\times 10^9 \times\) 0.5 字节 = 3.5 GB 的权重;计入保持不变的 FP16 KV 缓存后,总大小为 5.6 GB。
- 新的速度:加载上述全部数据需要 113 ms。速度提升至 9 tokens/s。
系统洞见:权重量化使这一配置能够容纳于设备内存中,并在所述流量模型下获得 2.9× 的加速比。由于 FP16 KV 缓存的流量保持不变,加速比低于 4\(\times\)。
量化带来的加速取决于瓶颈是内存带宽还是计算吞吐量。
数值格式比较
量化能否加速执行,直接取决于算子受内存带宽限制还是受计算限制。对于受内存限制的内核,缩减位宽会减少通过内存总线传输的字节数,从而直接提高有效吞吐量。对于受计算限制的内核,要实现加速,就需要专用算术单元能够在每个时钟周期内完成更多低精度运算。因此,选择数值格式需要在动态范围、硬件执行支持与内存流量之间进行权衡,而非盲目追求最小位宽。Table 9 比较了各类加速器架构中常用的精度格式,以标准 32 位浮点数(FP32)为基准,列出了原始存储占用、算术吞吐量增益及目标硬件。
| 精度格式 | 位宽 | 存储缩减(相较于 FP32) | 计算速度(相较于 FP32) | 功耗影响 | 应用场景 |
|---|---|---|---|---|---|
| FP32 | 32 位 | 基准(1\(\times\)) | 基准(1\(\times\)) | 基准 | 训练与推理(通用) |
| FP16 | 16 位 | 缩小 2\(\times\) | 在部分支持该格式的硬件上,峰值最高为 2\(\times\) | 取决于硬件和工作负载 | 加速训练、推理(NVIDIA Tensor Core、TPU) |
| BF16(Brain 浮点数) | 16 位 | 缩小 2\(\times\) | 取决于硬件和工作负载 | 取决于硬件和工作负载 | TPU 上的训练、基于 Transformer 的模型 |
| TF32(TensorFloat-32) | 19 位 | 无(以 FP32 存储) | 在 NVIDIA Ampere Tensor Core 上,峰值最高为 8\(\times\) | 取决于硬件和工作负载 | NVIDIA GPU 上的训练 |
| FP8(8 位浮点数) | 8 位 | 缩小 4\(\times\) | 取决于硬件和工作负载 | 取决于硬件和工作负载 | 高效训练与推理(H100、AI 加速器) |
| INT8(8 位整数) | 8 位 | 缩小 4\(\times\) | 取决于硬件和工作负载 | 取决于硬件和工作负载 | 量化推理(边缘 AI、移动 AI、NPU) |
| INT4(4 位整数) | 4 位 | 缩小 8\(\times\) | 取决于硬件和工作负载 | 取决于硬件和工作负载 | 超低功耗 AI、实验性量化 |
| 二值/三值(1 位/2 位) | 1–2 位 | 缩小 16–32\(\times\) | 取决于硬件和工作负载 | 取决于硬件和工作负载 | 极致效率(二值/三值神经网络) |
在 16 位精度下,FP16 和 BF16 相较于 FP32 将内存存储需求减半,同时面向 NVIDIA Tensor Core 和 Google TPU 等专用矩阵执行单元,以提高算术吞吐量。然而,两者内部的位分配对数值范围与有效数精度作出了不同的权衡。BF16 保留了 FP32 的 8 位指数,使动态范围仍大致覆盖 \(10^{-38}\) 至 \(10^{38}\),同时将小数部分截短至 7 位。相比之下,FP16 为指数分配 5 位,为小数部分分配 10 位,提供了更高精度,但其可表示的最大有限值上限为 65,504,正规数在低于约 \(6.1\times10^{-5}\) 时发生下溢(非正规数则可低至 \(6.0\times10^{-8}\))。因此,FP16 训练通常需要损失缩放和 FP32 累加器寄存器来防止梯度下溢与溢出,而 BF16 较宽的指数范围无需缩放便可适应标准训练过程中的数值变化。TensorFloat-32(TF32)采用了一种混合折中方案:保留 FP32 的 8 位指数和 FP16 的 10 位小数部分,在 Tensor Core 上执行以加速矩阵乘法,同时以标准 32 位格式在内存中存储数值。比较 FP32、FP16 和 BF16 的位布局,可以看出各格式如何划分符号、指数和小数部分字段,以平衡动态范围与精度(figure 17)。
\begin{tikzpicture}[font=\small\sffamily]
\definecolor{col1}{RGB}{239,230,197}
\definecolor{col2}{RGB}{245,208,122}
\definecolor{col3}{RGB}{242,162,57}
\colorlet{col1}{VioletL}
\colorlet{col2}{RedL}
\colorlet{col3}{RedLine!50}
\tikzset{
  Box/.style={inner xsep=2pt,
  %rounded corners,
  node distance=0,
  draw=black!90,
    line width=0.75pt,
    anchor=west,
    align=flush center,
    minimum width=54mm, minimum height=11mm
  },
}

\node[Box,fill=col1,anchor=south west,minimum width=30
](B1){\textbf{1 位}\\符号};
\node[Box,fill=col2,right=of B1,minimum width=160
](B2){\textbf{8 位} 指数};
 \node[Box,fill=col3,right=of B2,minimum width=470,name path=GG,
](B3){\textbf{23 位} 尾数};
\node[left=2mmof B1]{\textbf{FP32}};

\begin{scope}[shift={(0,-1.7)}]
\node[Box,fill=col1,anchor=south west,minimum width=30
](BB1){\textbf{1 位}\\符号};
\node[Box,fill=col2,right=of BB1,minimum width=100
](BB2){\textbf{5 位} 指数};
 \node[Box,fill=col3,right=of BB2,minimum width=200
](BB3){\textbf{10 位} 尾数};
\node[left=2mmof BB1]{\textbf{FP16}};
\end{scope}

\begin{scope}[shift={(0,-3.4)}]
\node[Box,fill=col1,anchor=south west,minimum width=30
](DB1){\textbf{1 位}\\符号};
\node[Box,fill=col2,right=of DB1,minimum width=160
](DB2){\textbf{8 位} 指数};
 \node[Box,fill=col3,right=of DB2,minimum width=140
](DB3){\textbf{7 位} 尾数};
\node[left=2mmof DB1]{\textbf{BF16}};
\end{scope}

\draw[dashed,line width=0.75pt](DB3.south east)--++(270:0.5);
\draw[dashed,line width=0.75pt,name path=D](DB3.south east)--++(90:6);
%\node[Box,fill=cyan!10,minimum width=640](B13){S};

\path [name intersections={of=D and GG,by={X,Y}}];

\draw[align=center,
text width=62mm,
decoration={brace,amplitude=13pt},
decorate,thick] ([yshift=5mm,xshift=0mm]B1.north west) -- ([yshift=5mm]X)
node [midway,above=5mm] {\textbf{16 位}};

\draw[align=center,
text width=62mm,
decoration={brace,amplitude=13pt},
decorate,thick] ([yshift=5mm,xshift=0mm]X) -- ([yshift=5mm]B3.north east)
node [midway,above=5mm] {\textbf{16 位}};
\end{tikzpicture}对于推理工作负载,INT8 精度可将原始存储需求降至 FP32 的四分之一,同时保持可接受的预测准确率。推理无需执行梯度反向传播,因此消除了训练过程中那些幅值小、动态范围大且会导致下溢的更新。因此,激活值和权重可以通过均匀仿射量化或对称量化的缩放因子,直接映射为有符号 8 位整数(\([-128, 127]\))。在受带宽限制的推理场景中,例如自回归语言模型的词元生成,这种 \(4\times\) 的存储占用缩减通过减少 DRAM 和缓存流量,缓解了内存总线争用。对于受计算限制的算子,专用 INT8 向量单元和张量单元在每个时钟周期、每单位硅面积上提供的算术运算密度均高于同等浮点单元。
二值和三值网络代表了精度降低的理论极限,将权重和激活值限制为单比特取值(\(\{-1, +1\}\))或三值集合(\(\{-1, 0, +1\}\)),以按位 XNOR 和置位计数(popcount)逻辑替代浮点乘法器。然而,由于标准内存架构按字节而非单个比特寻址,亚字节表示需要将数值打包到 8 位或 32 位字中,除非定制硬件数据通路直接支持此类表示,否则会引入按位移位和掩码操作的开销。强烈的离散化还会限制训练期间的梯度传播,使任务准确率对替代梯度的构造方式和训练稳定化措施敏感。关键词检测标杆案例(高效架构:关键词检测)展示了一种运行场景:必须进行极端压缩,才能满足严格的 ~512 KB SRAM 预算。INT8 提供了基准目标;INT4、二值或三值表示则通过进一步牺牲数值动态范围,满足更严格的内存和功耗限制。
算术运算的能耗差异补全了量化的物理层面论证。低精度表示通过两条不同的物理路径降低能耗:减少经总线传输的内存数据量,以及降低每次算术运算所需的开关能量。例如,对应 FP32 运算的能耗约为一次完整 INT8 乘加运算能耗的 20×。配备原生低精度单元的加速器,例如 NVIDIA Tensor Core、Google TPU 或移动端 NPU,可在节省算术运算能耗的同时减少内存流量,从而叠加收益。相比之下,缺少原生低精度执行流水线的通用处理器,会因比特解包、格式转换和标量回退的运行时开销而损失大部分收益。因此,精度是模型与硬件的联合决策,而非一个软件配置开关。
精度降低策略
降低数值位宽可以减少内存流量和算术运算能耗,但简单截断会引入量化噪声,降低模型准确率。部署低精度表示需要系统化的策略,以控制计算图中位宽变化的位置与方式。
三种方法构成了复杂度阶梯。训练后量化(PTQ)在训练完成后降低精度,无需重新训练,工程投入也最少。量化感知训练(QAT)将量化效应纳入训练循环,使模型能够适应较低精度并保留更高的准确率。混合精度方法为不同层分配不同位宽,使数值精度与各算子的敏感程度相匹配。Figure 18 根据实现复杂度、资源需求和目标使用场景,将量化技术划分为三个递进层级。
\begin{tikzpicture}[line join=round,font=\sffamily]
\tikzset{
Box/.style={align=flush center,
    inner xsep=2pt,
    node distance=1.4,
    draw=OrangeLine,
    line width=0.75pt,
    rounded corners,
    fill=OrangeL!40,
    text width=61mm,
    minimum width=58mm, minimum height=22mm
  }
  }

\tikzset{%
planet/.style = {circle, draw=yellow!50!red!90,semithick, fill=yellow!30,line width=1.5pt,
                    font=\sffamily\bfseries,
                    minimum size=24mm, inner sep=1mm,align=flush center},
satelliteI/.style = {circle, draw=none, semithick, node distance=5,%fill=#1!10,
                    text width=35mm, inner sep=1pt, align=flush center,minimum size=20mm,minimum height=12mm},
satellite/.style = {circle, draw=none, semithick, fill=#1!10,
                    text width=26mm, inner sep=1pt, align=flush center,minimum size=20mm,minimum height=12mm},
TxtC/.style = {font=\sffamily,text width=44mm,align=flush center},
arr/.style = {-{Triangle[length=3mm,width=6mm]}, color=#1!60,
                    line width=3mm, shorten <=1mm, shorten >=1mm},
Line/.style = {},
LineA/.style = {violet!60,{Circle[line width=1.5pt,fill=white,length=7.5pt]}-,line width=2.0pt,shorten <=-4pt},
LineAA/.style={violet!30,dashed, line width=1.0pt,{-{Triangle[width=1.0*6pt,length=1.6*6pt]}},shorten <=3pt,shorten >=2pt}
}

\tikzset{pics/brain/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=BRAIN,scale=\scalefac, every node/.append style={transform shape}]
\draw[fill=\filllcolor,line width=\Linewidth](-0.3,-0.10)to(0.08,0.60)
to[out=60,in=50,distance=3](-0.1,0.69)to[out=160,in=80](-0.26,0.59)to[out=170,in=90](-0.46,0.42)
to[out=170,in=110](-0.54,0.25)to[out=210,in=150](-0.54,0.04)
to[out=240,in=130](-0.52,-0.1)to[out=300,in=240]cycle;
\draw[fill=\filllcolor,line width=\Linewidth]
(-0.04,0.64)to[out=120,in=0](-0.1,0.69)(-0.19,0.52)to[out=120,in=330](-0.26,0.59)
(-0.4,0.33)to[out=150,in=280](-0.46,0.42)
%
(-0.44,-0.03)to[bend left=30](-0.34,-0.04)
(-0.33,0.08)to[bend left=40](-0.37,0.2) (-0.37,0.12)to[bend left=40](-0.45,0.14)
(-0.26,0.2)to[bend left=30](-0.24,0.13)
(-0.16,0.32)to[bend right=30](-0.27,0.3)to[bend right=30](-0.29,0.38)
(-0.13,0.49)to[bend left=30](-0.04,0.51);
\draw[rounded corners=0.8pt,line width=2*\Linewidth,\drawcircle,-{Circle[fill=\filllcolor,length=5.5pt]}](-0.23,0.03)--(-0.15,-0.03)--(-0.19,-0.18)--(-0.04,-0.28);
\draw[rounded corners=0.8pt,line width=2*\Linewidth,\drawcircle,-{Circle[fill=\filllcolor,length=5.5pt]}](-0.17,0.13)--(-0.04,0.05)--(-0.06,-0.06)--(0.14,-0.11);
\draw[rounded corners=0.8pt,line width=2*\Linewidth,\drawcircle,-{Circle[fill=\filllcolor,length=5.5pt]}](-0.12,0.23)--(0.31,0.0);
\draw[rounded corners=0.8pt,line width=2*\Linewidth,\drawcircle,-{Circle[fill=\filllcolor,length=5.5pt]}](-0.07,0.32)--(0.06,0.26)--(0.16,0.33)--(0.34,0.2);
\draw[rounded corners=0.8pt,line width=2*\Linewidth,\drawcircle,-{Circle[fill=\filllcolor,length=5.5pt]}](-0.01,0.43)--(0.06,0.39)--(0.18,0.51)--(0.31,0.4);
\coordinate(PO)at(-0.1,0.2);
\node[circle,draw=white,line width=1pt,fill=\filllcirclecolor,minimum size=5mm,inner sep=0pt](LV)at(PO){};
\node[draw=none,rotate=40,rounded corners=2pt,rectangle,minimum width=1.2mm,inner sep=1pt,
fill=\filllcirclecolor,minimum height=6mm,anchor=north]at(PO){};
\node[circle,draw=none,fill=white,minimum size=3.0mm,inner sep=0pt](LM)at(PO){};
\node[font=\tiny\bfseries]at(LM){...};
\end{scope}
     }
  }
}
\tikzset{pics/factory/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=FACTORY,scale=\scalefac, every node/.append style={transform shape}]
\node[rectangle,draw=\drawcolor,fill=\filllcolor!50,minimum height=15,minimum width=23,,line width=\Linewidth](R1){};
\draw[fill=\filllcolor!50,line width=1.0pt]($(R1.40)+(0,-0.01)$)--++(110:0.2)--++(180:0.12)|-($(R1.40)+(0,-0.01)$);
\draw[,line width=\Linewidth,fill=green](-0.68,-0.27)--++(88:1.10)--++(0:0.15)--(-0.48,-0.27)--cycle;
\draw[line width=2.5pt](-0.8,-0.27)--(0.55,-0.27);

\foreach \x in{0.25,0.45,0.65}{
\node[rectangle,fill=black,minimum height=2,minimum width=5,thick,inner sep=0pt]
at ($(R1.north)!\x!(R1.south)$){};
}
\foreach \x in{0.25,0.45,0.65}{
\node[rectangle,fill=black,minimum height=2,minimum width=5,thick,inner sep=0pt]
at ($(R1.130)!\x!(R1.230)$){};
}
\foreach \x in{0.25,0.45,0.65}{
\node[rectangle,fill=black,minimum height=2,minimum width=5,thick,inner sep=0pt]
at ($(R1.50)!\x!(R1.310)$){};
}
\end{scope}
     }
  }
}
%brick
\tikzset{
  cigla/.style={ inner sep=0pt,anchor=west,
    node distance=1.4pt,
    draw=none,
    line width=0.1pt,
    rounded corners=1pt,
    fill=\filllcolor,
    minimum width=4mm, minimum height=2mm
  },
    cigla1/.style={cigla,fill=\filllcirclecolor},
pics/brick/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\path[clip] (-1.05,-0.52)rectangle (0.71,0.45);
\node[cigla](C1) at (-1.03,-0.4){};
\node[cigla1,right= of C1](C2){};
\node[cigla,right= of C2](C3){};
\node[cigla1,right= of C3](C4){};
%
\node[cigla,above right= of C1,anchor=south](C11){};
\node[cigla1,right= of C11](C12){};
\node[cigla,right= of C12](C13){};
\node[cigla1,right= of C13](C14){};
%
\node[cigla,above right= of C11,anchor=south](C21){};
\node[cigla1,right= of C21](C22){};
\node[cigla,right= of C22](C23){};
%
\node[cigla,above right= of C21,anchor=south](C31){};
\node[cigla1,right= of C31](C32){};
\node[cigla,right= of C32](C33){};
\end{scope}
    }
  }
}
\pgfkeys{
  /channel/.cd,
   Depth/.store in=\Depth,
  Height/.store in=\Height,
  Width/.store in=\Width,
  filllcirclecolor/.store in=\filllcirclecolor,
  filllcolor/.store in=\filllcolor,
  drawcolor/.store in=\drawcolor,
  drawcircle/.store in=\drawcircle,
  scalefac/.store in=\scalefac,
  Linewidth/.store in=\Linewidth,
  picname/.store in=\picname,
  filllcolor=BrownLine,
  filllcirclecolor=violet!20,
  drawcolor=black,
  drawcircle=violet,
  scalefac=1,
  Linewidth=0.5pt,
  Depth=1.3,
  Height=0.8,
  Width=1.1,
  picname=C
}

\def\radius{3.2}
\def\startangle{90}

\node[satelliteI,fill=green!79!black!10](S1){};
\node[satelliteI,fill=red!10,right=of S1](S2){};
\node[satelliteI,fill=gray!10,right=of S2](S3){};
%logos
\pic[shift={(0.15,-0.5)}] at  (S3){brain={scalefac=2.3,picname=1,filllcolor=orange!30!, filllcirclecolor=cyan!55!black!60, Linewidth=0.5pt}};
\pic[shift={(0.2,-0.40)}] at  (S2){factory={scalefac=1.8,picname=1,filllcolor=brown!, Linewidth=0.5pt}};
\pic[shift={(0.15,0.15)}] at  (S1) {brick={scalefac=1.5,picname=1,filllcolor=red!70!black!80, Linewidth=1.0pt,filllcirclecolor=red!90!black!50}};
 \def\ra{26mm}
\foreach \i [count=\k from 1] in{180,180,180}{
\pgfmathtruncatemacro{\newX}{\i + 90} %
\draw[Line,line width=2.6pt,violet]
   (S\k)+(\i:0.7*\ra) arc[start angle=\i, end angle=\newX, radius=0.7*\ra];
}
\draw[LineA](S1.240)--++(200:2.15)coordinate(MA);
 \node[Box,anchor=north](FO)at(MA){\textbf{基础层}\\ 训练后量化
FP32/FP16/INT8 基本校准};
 \draw[LineA](S2.240)--++(200:2.15)coordinate(ST);
 \node[Box,anchor=north](PR)at(ST){\textbf{生产层}\\ 量化感知训练
混合精度 逐通道量化};
 \draw[LineA](S3.240)--++(200:2.15)coordinate(ST1);
 \node[Box,anchor=north](RE)at(ST1){\textbf{研究前沿}\\ INT4/INT2
二值/三值网络 极端量化};
%
\node[TxtC,below=5pt of FO]{快速部署\\ 训练成本极低\\ 准确率损失 0.5-2\%};
\node[TxtC,below=5pt of PR]{生产系统\\ 需要重新训练\\ 准确率损失 0.2-1\%};
\node[TxtC,below=5pt of RE]{极端约束\\ 架构变更 \\ 准确率损失 2-10\%};
%
\draw[-{Triangle[width=18pt,length=8pt]}, line width=10pt,cyan!40,shorten >=5pt, shorten <=5pt]
(S1)--node[above,text=black]{逐步增加的}(S2);
\draw[-{Triangle[width=18pt,length=8pt]}, line width=10pt,cyan!40,shorten >=5pt, shorten <=5pt]
(S2)--node[above,text=black]{复杂度}(S3);
\end{tikzpicture}这一路线图用于安排部署顺序,而非对数值格式进行分类。PTQ 排在首位,是因为它以极低的训练成本改变表示形式;QAT 和混合精度进入生产层,是因为它们需要训练循环或内核支持;INT4、二值和三值方法位于前沿层,是因为其准确率与硬件假设开始依赖具体架构。
训练后量化
训练后量化(PTQ)在训练完成后降低数值精度,将选定的权重或激活值从 FP32 转换为 INT8 等低精度表示,而无需完整地重新训练 (Choukroun et al. 2019)。它能够可靠地减少原始数值的有效载荷;只有当导出的计算图映射到高效的低精度内核时,延迟和能耗才会改善 (Wu et al. 2020)。
PTQ 的主要优势在于计算成本低:它无需重新训练,通常也不需要带标签的训练集,不过激活值校准通常需要一个具有代表性的小型校准数据集。然而,降低精度会引入量化误差,可能降低准确率,尤其是对于需要精细数值精度的任务。TensorFlow Lite、开放神经网络交换格式运行时(ONNX Runtime)和 PyTorch 等机器学习框架均提供内置的 PTQ 支持。
PTQ 的核心机制是均匀量化,即使用一致的缩放因子,将浮点值映射到离散的整数级别。由于相邻量化值之间的间隔恒定,均匀量化简化了实现,并支持高效的硬件执行。对于此处所示的对称形式,\(s\) 根据最大绝对值选取,使得到的整数保持在目标范围内。量化值 \(q\) 的计算方式为: \[ q = \text{round} \left(\frac{x}{s} \right) \] 其中:
- \(q\) 是量化后的整数表示,
- \(x\) 是原始浮点值,
- \(s\) 是将浮点范围映射到可用整数范围的缩放因子。
Listing 2 演示了从 FP32 到 INT8 的均匀量化,在测量所产生量化误差的同时,将每个权重的原始数值有效载荷从 32 位降至 8 位;不计缩放元数据和打包开销。模型完成量化后,运行时可在支持的情况下使用整数算术 (Gholami et al. 2022)。
import torch

# Original FP32 weights
weights_fp32 = torch.tensor(
    [0.127, -0.084, 0.392, -0.203], dtype=torch.float32
)
print(f"Original FP32: {weights_fp32}")
print(f"Memory per weight: 32 bits")

# Simple uniform quantization to INT8 (-128 to 127)
# Step 1: Find scale factor
max_val = weights_fp32.abs().max()
scale = max_val / 127  # 127 is max positive INT8 value

# Step 2: Quantize using our formula q = round(x/s)
weights_int8 = torch.round(weights_fp32 / scale).to(torch.int8)
print(f"Quantized INT8: {weights_int8}")
print(f"Memory per weight: 8 bits (reduced from 32)")

# Step 3: Dequantize to verify
weights_dequantized = weights_int8.float() * scale
print(f"Dequantized: {weights_dequantized}")
print(
    f"Quantization error: "
    f"{(weights_fp32 - weights_dequantized).abs().mean():.6f}"
)
另一种方法是非均匀量化,它为数值分布更密集的区间分配更精细的精度,这有助于保持权重分布集中在特定数值附近的模型的准确率。非均匀方案需要更复杂的校准,在生产环境中较少使用,但对于对精度变化特别敏感的模型可能有效。
对于许多视觉、语言和语音模型,PTQ 是一种有用的初步实验,但其敏感程度因架构、层和分布而异。当均匀 PTQ 配置未能达到质量目标时,后续选项包括更细粒度的量化、混合精度、仅权重量化方法、更好的校准或 QAT。
校准
量化校准为每个张量估计实值裁剪范围 \([\alpha, \beta]\)。不合适的范围要么会因裁剪而使关键数值饱和,要么会将可用的整数级别浪费在稀疏离群值上。校准针对采样分布最小化表示误差,但并不保证分布外部署输入的误差界限。
由于激活张量随输入数据变化,分析时需要让无标签校准数据集经过前向传播,以捕获动态范围。Figure 19 概述了这一离线转换工作流,而 algorithm 1 则形式化描述了逐层校准过程,其中激活值观测器记录数值分布,以计算缩放因子和零点元数据。
\begin{algorithm} \caption{训练后量化校准} \begin{algorithmic} \Require 预训练模型 $f_\theta$;具有代表性的校准集 $C$;位宽 $b$;粒度(层/组/通道);方法(最大值、熵、百分位数) \Ensure 量化权重和逐组范围元数据 $\{(\alpha_g, \beta_g, s_g, z_g)\}$ \State 按选定粒度,为权重和选定的激活张量附加观测器 \For{$C$ 中的每个批次} \Comment{校准遍历} \State 运行 $f_\theta$ 进行推理;记录各组的数值分布 \EndFor \For{每个量化组 $g$} \State 按选定方法选择裁剪范围 $[\alpha_g, \beta_g]$ \State 推导缩放因子 $s_g$ 和零点 $z_g$,将 $[\alpha_g, \beta_g]$ 映射到 $b$ 位整数范围 \EndFor \State 量化静态权重;导出用于推理的激活值范围元数据 \State 如果准确率低于生产阈值,则扩大范围、改变粒度或转用 QAT \end{algorithmic} \end{algorithm}
\begin{tikzpicture}[font=\footnotesize\sffamily]
\tikzset{
  Box/.style={inner xsep=2pt,
   node distance=0.4,
    draw=black!90,
    line width=0.75pt,
    anchor=west,
    align=flush center,
    minimum width=64mm,
    minimum height=6.25mm
  },
Line/.style={line width=1.0pt,black!50,-latex}
}

\node[Box,fill=GreenL](B1){量化模型};
\node[Box,fill=BlueL,above=of B1](B2){量化};
\node[Box,fill=BlueL,above=of B2](B3){校准};
\node[Box,fill=GreenL,above=of B3.north west,minimum width=30mm,
anchor= south west](B4){预训练模型};
\node[Box,fill=BrownL,above=of B3.north east,minimum width=30mm,
anchor= south east](B5){校准数据};
\draw[Line](B2)--(B1);
\draw[Line](B3)--(B2);
\draw[Line](B4)--(B4|-B3.north);
\draw[Line](B5)--(B5|-B3.north);
\end{tikzpicture}对 \(C\) 进行一次校准遍历即可避免重新训练,而在计入缩放因子、零点和打包元数据之前,FP32 到 INT8 的权重量化可将原始权重数值的存储量缩减至原来的 1/4(4\(\times\) 压缩)。其代价是,当校准数据未能覆盖部署分布的尾部时,循环中固定的静态激活值范围可能导致饱和或整数级别浪费。随后的量化步骤将模型参数转换为较低精度格式,生成最终的量化模型。
将不必要地宽泛的实值区间映射到 8 位整数的 256 个离散分箱,会在没有数值分布的范围内浪费数值分辨率,而过于激进的裁剪则会截断信号。三种校准方法用于平衡裁剪与分辨率之间的权衡:最大值法将边界设为绝对极值(保留极端值,代价是容易受离群值影响),熵法通过最小化原始分布与量化分布之间的 Kullback–Leibler(KL)散度来选择边界,百分位数法则裁剪固定比例的尾部数据(例如 99.9%)。Figure 20 展示了离群值处理为何至关重要:在 ResNet-50 的激活值中,长尾拉大了动态范围,使零附近的密集簇缺少可用的离散级别。
\begin{tikzpicture}[font=\small\sffamily]
\definecolor{barfill}{cmyk}{0.7, 0.4, 0, 0}
\begin{axis}[
  width=16cm,
  height=62mm,
  xmin=0, xmax=2.5,
  ymin=0, ymax=1.06,
  axis lines=left,
  xtick={0,0.5,1,1.5,2,2.5},
  xticklabels={0.0,0.5,1.0,1.5,2.0,2.5},
  ytick={0,0.25,0.5,0.75,1.0},
  ymajorgrids=true,
  grid style={draw=black!10},
  tick align=outside,
  tick style={black},
  tick label style={/pgf/number format/assume math mode=true},
  xlabel={\bfseries 激活值},
  ylabel={\bfseries\sffamily 频率},
  title={\bfseries ResNet-50 层激活值分布},
  title style={yshift=1pt},
  clip=false,   %enlarge x limits=0.02,
]

% ------------------------------------------------------------
% 1) Histogram bars (approx. values, symmetric)
%    x = bin center, y = bar height
% ------------------------------------------------------------
\addplot[ybar, line width=0.7pt,bar width=15pt, draw=BlueD, fill=barfill!80]
table[row sep=\\]{
x    y\\
0.05 1\\
0.15 0.95\\
0.25 0.91\\
0.35 0.84\\
0.45 0.74\\
0.55 0.6\\
0.65 0.47\\
0.75 0.36\\
0.85 0.28\\
0.95 0.21\\
1.05 0.16\\
1.15 0.12\\
};
% ------------------------------------------------------------
% 2) Red tail overlays (bars in tails)
%    left tail: x <= -2.2, right tail: x >= 2.0
% ------------------------------------------------------------
\addplot[ybar, bar width=15pt, draw=red!70!black, fill=red!35, fill opacity=0.65]
table[row sep=\\]{
x    y\\
1.25 0.09\\
1.35 0.06\\
1.45 0.04\\
1.55 0.035\\
1.65 0.03\\
1.75 0.025\\
1.85 0.02\\
1.95 0.015\\
2.05 0.01\\
};

\node[font=\itshape\small\sffamily\itshape,text=black!70] at (rel axis cs:0.5,1.01)
{具有长尾的右偏分布给量化范围选择带来挑战};

\node[font=\itshape\footnotesize\sffamily\itshape,text=black!70] at (rel axis cs:0.5,.-0.27)
{大多数值集中在零附近;长尾要求谨慎选择校准范围};
% ------------------------------------------------------------
% 3) Center dashed line around 0 (slightly to the right like the figure)
% ------------------------------------------------------------
\addplot[black!35, dashed, GreenD,line width=1pt]
coordinates {(1.1,0) (1.1,1.0)};
% ------------------------------------------------------------
% 4) Annotations (Tail errors) with dashed arrows
% ------------------------------------------------------------
\node[align=left,text=GreenD, font=\small\sffamily\bfseries,
anchor=north west]at (axis cs:1.15,0.96){第 99 百分位数\\
{\sffamily\itshape 在此处裁剪}};
%
\draw[red!70!black, dashed, <-, >=Latex,line width=1pt]
(axis cs:1.15,0.13) --  (axis cs:1.6,0.4)
node[right=5pt,align=left,text=red!70!black,
font=\small\sffamily\bfseries]{离群值尾部\\
{\color{black!70}\footnotesize\sffamily\itshape 若不裁剪}\\[-2pt]
{\color{black!70}\footnotesize\sffamily\itshape 会使量化范围偏移}};
\end{axis}
\end{tikzpicture}校准范围可以是对称的(以零为中心的范围,零点通常为零),也可以是非对称的(使用一个缩放因子和一个通常非零的零点,适用于偏斜分布)。方法和范围的选择会显著影响量化模型的准确率。
调整量化范围
校准确定裁剪边界 \([\alpha, \beta]\) 后,必须将该范围映射到整数端点。Figure 21 对比了两种主要的映射策略:对称校准将实数零约束为映射到整数零,而非对称校准引入显式的零点偏移,以适应偏斜分布。
\begin{tikzpicture}[line join=round,font=\large\sffamily]
\tikzset{
Line/.style={line width=1.0pt,red,text=black},
LineT/.style={black,line width=0.5pt,-latex,shorten >=2pt},
LineD/.style={dashed,black,line width=0.75pt},
}
%\node[]at(-0.7,1.7){ \includegraphics[scale=1.0]{1}};
\def\go{2.8}
\begin{scope}[local bounding box=RIGHT,shift={($(10.5,0)+(0,0)$)}]

\coordinate(RD1)at(0,0);
\coordinate(RD2)at(2.3,0);
\coordinate(RD3)at(4.42,0);
\coordinate(RD4)at(5.67,0);
\coordinate(RD5)at(8.79,0);
\coordinate(RG1)at(0.33,\go);
\coordinate(RGG1)at($(RG1)+(-0.5,0)$);
\coordinate(RG2)at(1.81,\go);
\coordinate(RG3)at(3.15,\go);
\coordinate(RG4)at(4.43,\go);
\coordinate(RG5)at(5.09,\go);
\coordinate(RG6)at(6.87,\go);
\coordinate(RG7)at(8.23,\go);
\coordinate(RGG7)at($(RG7)+(0.5,0)$);
\draw[LineD,latex-latex](RGG1)--(RGG7)node[right,text=black]{$r$};
\draw[Line](RD1)--(RD5)node[right=3pt,text=black]{$Q$};
\draw[Line](RG2)node[above=2pt]{$\alpha=-0.5$}--(RG6);
\draw[LineT](RG2)--(RD1)node[below=2pt]{$-128$};
\draw[LineT](RG1)--(RD1);
\draw[LineT](RG3)node[above=2pt]{$0$}--(RD2)node[below=2pt]{$-z$};
\draw[LineT](RG4)node[above=2pt]{$s z$}--(RD3)node[below=2pt]{$0$};
\draw[LineT](RG5)--(RD4);
\draw[LineT](RG6)node[above=2pt]{$\beta=1.5$}--(RD5);
\draw[LineT](RG7)--(RD5)node[below=2pt]{$127$};
\foreach \i/\cl in {1/red,2/red,3/green!70!black,4/red,5/red,6/red,7/red} {
\fill[\cl](RG\i)circle(2.5pt);
}
\foreach \i/\cl in {1/red,2/red,3/green!70!black,4/red,5/red} {
\fill[\cl](RD\i)circle(2.5pt);
}\end{scope}

\begin{scope}[local bounding box=LEFT,shift={($(0,0)+(0,0)$)}]
\coordinate(D1)at(0,0);
\coordinate(D2)at(2.3,0);
\coordinate(D3)at(4.42,0);
\coordinate(D4)at(5.67,0);
\coordinate(D5)at(8.79,0);
\coordinate(G1)at(0.33,\go);
\coordinate(GG1)at($(G1)+(-0.5,0)$);
\coordinate(G2)at(1.81,\go);
\coordinate(G3)at(3.15,\go);
\coordinate(G4)at(4.43,\go);
\coordinate(G5)at(5.09,\go);
\coordinate(G6)at(6.87,\go);
\coordinate(G7)at(8.23,\go);
\coordinate(GG7)at($(G7)+(0.5,0)$);
\draw[LineD,latex-latex](GG1)--(GG7)node[right,text=black]{$r$};
\draw[Line](D1)--(D5)node[right=3pt,text=black]{$Q$};
\draw[Line](G2)node[above=2pt]{$\alpha=-1$}--(G6);
\draw[LineT](G2)--(D1)node[below=2pt]{$-127$};
\draw[LineT](G1)--(D1);
\draw[LineT](G3)--(D2);
\draw[LineT](G4)node[above=2pt]{$0$}--(D3)node[below=2pt]{$0$};
\draw[LineT](G5)--(D4);
\draw[LineT](G6)node[above=2pt]{$\beta=1$}--(D5);
\draw[LineT](G7)--(D5)node[below=2pt]{$127$};
\foreach \i/\cl in {1/red,2/red,3/red,4/green!70!black,5/red,6/red,7/red} {
\fill[\cl](G\i)circle(2.5pt);
}
\foreach \i/\cl in {1/red,2/red,3/green!70!black,4/red,5/red} {
\fill[\cl](D\i)circle(2.5pt);
}
\end{scope}
\end{tikzpicture}对称量化的零点为零(\(z = 0\)),因此可省去硬件累加过程中的交叉项加法,从而简化整数矩阵乘法内核。然而,对于服从非对称分布的激活值(例如所有值均非负的 ReLU 后特征图),对称量化会将大约一半的整数动态范围浪费在未使用的负值上。非对称量化通过将 \([\alpha, \beta]\) 映射到 \([0, 2^b - 1]\) 来回收这部分动态范围,但要求硬件在运行时的乘加运算中计算偏移校正项(\(z \sum W\))。
粒度
量化粒度决定了缩放因子和零点在张量内的共享范围,需要在表示分辨率、元数据开销与执行复杂度之间进行权衡。在卷积滤波器或 Transformer 投影矩阵中,各通道的权重幅值通常差异很大。整个张量共享一个缩放因子,可能使小幅值通道的动态范围塌缩为零;相反,逐通道分配缩放因子能够保留局部方差,代价是在矩阵乘法过程中需要跟踪额外的缩放向量。
Napkin Math 1.5: 计算缩放因子和零点
仿射量化公式:仿射映射通过以下构造,将包含零的浮点数范围 \([\alpha, \beta]\) 映射到整数范围 \([0, 2^b-1]\)(例如 UINT8)。
分析: 仿射量化建立线性映射 \(x \approx s(x_q - z)\),其中 \(s\) 是缩放因子(步长),\(z\) 是零点(与实数零对应的整数值)。该映射包含三个计算步骤:
计算缩放因子 \((s)\):使用 equation 1,将实数范围除以整数范围。 \[s = \frac{\beta - \alpha}{2^b - 1} \tag{1}\]
计算零点 \((z)\):使用 equation 2 平移范围,使实数零映射到一个整数。 \[z = \text{round}\left(\frac{-\alpha}{s}\right) \tag{2}\]
使用 equation 3 进行量化 \((x \to x_q)\): \[x_q = \text{clamp}\left(\text{round}\left(\frac{x}{s} + z\right), 0, 2^b - 1\right) \tag{3}\]
场景: 假设激活值范围从 \(\alpha = -1\) 到 \(\beta = 3\),目标精度为 UINT8 \((b=8)\)。
- 范围:\(\beta - \alpha = 4\)。
- 步数:\(2^8 - 1\) = 255。
- 缩放因子:\(s = \frac{4}{255} \approx 0.0157\)。
- 零点:\(z = \text{round}(-(\alpha)/s) = \text{round}\!\left(-(-1)/\frac{4}{255}\right) = \text{round}(63.75) = 64\)。
系统洞见:实数值 \(0.0\) 由整数 64 表示,这确保了零填充(在 CNN 中很常见)能够被精确表示,防止填充引入非零噪声而造成“量化漂移”。
当权重通道的标准差存在明显差异时,在整个层中共享单一裁剪阈值,要么会使小幅值通道塌缩,要么会裁剪分布较宽的通道。Figure 22 将卷积层中这种滤波器之间的差异可视化,对比了层内共享边界与独立的逐通道阈值。
\resizebox{.8\textwidth}{!}{%
\begin{tikzpicture}[line join=round,font=\sffamily]
\tikzset{%
helvetica/.style={align=flush center,font=\small\sffamily},
Line/.style={line width=1.0pt,black!50,text=black},
Box/.style={inner xsep=2pt,
    node distance=1.2,
    draw=VioletLine2,
    line width=0.75pt,
    fill=VioletL2,
    text width=27mm,align=flush center,
    minimum width=27mm, minimum height=10mm
  },
}
\pgfmathdeclarefunction{agausss}{2}{%
  \pgfmathparse{1/(#2*sqrt(2*pi))*exp(-((x-#1)^2)/(2*#2^2))}%
}
\pgfmathdeclarefunction{gauss}{3}{%
\pgfmathparse{1/(#3*sqrt(2*pi))*exp(-((#1-#2)^2)/(2*#3^2))}%
}
%first row
\begin{scope}
\begin{scope}[local bounding box=F1,line width=0.5pt]
\newcommand{\Depth}{1.3}
\newcommand{\Height}{1.3}
\newcommand{\Width}{1.3}
\coordinate (O2) at (0,0,0);
\coordinate (A2) at (0,\Width,0);
\coordinate (B2) at (0,\Width,\Height);
\coordinate (C2) at (0,0,\Height);
\coordinate (D2) at (\Depth,0,0);
\coordinate (E2) at (\Depth,\Width,0);
\coordinate (F2) at (\Depth,\Width,\Height);
\coordinate (G2) at (\Depth,0,\Height);

\draw[fill=GreenL] (D2) -- (E2) -- (F2) -- (G2) -- cycle;% Right Face
\draw[fill=GreenL] (C2) -- (B2) -- (F2) -- (G2) -- (C2);% Front Face
\draw[fill=GreenL] (A2) -- (B2) -- (F2) -- (E2) -- cycle;% Top Face
%
\draw($(C2)!0.33!(G2)$)--($(B2)!0.33!(F2)$)--($(A2)!0.33!(E2)$);
\draw($(C2)!0.66!(G2)$)--($(B2)!0.66!(F2)$)--($(A2)!0.66!(E2)$);
\draw($(B2)!0.33!(C2)$)--($(F2)!0.33!(G2)$)--($(E2)!0.33!(D2)$);
\draw($(B2)!0.66!(C2)$)--($(F2)!0.66!(G2)$)--($(E2)!0.66!(D2)$);
\draw($(B2)!0.33!(A2)$)--($(F2)!0.33!(E2)$)--($(G2)!0.33!(D2)$);
\draw($(B2)!0.66!(A2)$)--($(F2)!0.66!(E2)$)--($(G2)!0.66!(D2)$);
\node[below=0.1of $(C2)!0.5!(G2)$]{滤波器 1};
\end{scope}

\begin{scope}[line width=0.5pt,shift={(4.5,-1)},scale=0.7]
\draw[line width=2pt] plot[domain=-3.9:3.9,samples=51,
            smooth,xscale=0.5,yscale=2.0] (\x,{2*exp(-\x*\x/3});
\draw[red,dashed](3.2,0)--(3.2,4);
\draw[red,dashed](-3.2,0)--(-3.2,4);
\end{scope}

\begin{scope}[line width=0.5pt,shift={(10,-1)},scale=0.7]
\draw[line width=2pt] plot[domain=-3.9:3.9,samples=51,
             smooth,xscale=0.5,yscale=2.0] (\x,{2*exp(-\x*\x/3});
\draw[blue,dashed](1.95,0)--(1.95,4);
\draw[blue,dashed](-1.95,0)--(-1.95,4);
\end{scope}
\end{scope}
%%%%%%%%%%%%%%%%%%%%%%%%%%
%second row
\begin{scope}[shift={(0,-2.75)}]
\begin{scope}[line width=0.5pt]
\newcommand{\Depth}{1.3}
\newcommand{\Height}{1.3}
\newcommand{\Width}{1.3}
\coordinate (O2) at (0,0,0);
\coordinate (A2) at (0,\Width,0);
\coordinate (B2) at (0,\Width,\Height);
\coordinate (C2) at (0,0,\Height);
\coordinate (D2) at (\Depth,0,0);
\coordinate (E2) at (\Depth,\Width,0);
\coordinate (F2) at (\Depth,\Width,\Height);
\coordinate (G2) at (\Depth,0,\Height);

\draw[fill=white] (D2) -- (E2) -- (F2) -- (G2) -- cycle;% Right Face
\draw[fill=white] (C2) -- (B2) -- (F2) -- (G2) -- (C2);% Front Face
\draw[fill=white] (A2) -- (B2) -- (F2) -- (E2) -- cycle;% Top Face
%
\draw($(C2)!0.33!(G2)$)--($(B2)!0.33!(F2)$)--($(A2)!0.33!(E2)$);
\draw($(C2)!0.66!(G2)$)--($(B2)!0.66!(F2)$)--($(A2)!0.66!(E2)$);
\draw($(B2)!0.33!(C2)$)--($(F2)!0.33!(G2)$)--($(E2)!0.33!(D2)$);
\draw($(B2)!0.66!(C2)$)--($(F2)!0.66!(G2)$)--($(E2)!0.66!(D2)$);
\draw($(B2)!0.33!(A2)$)--($(F2)!0.33!(E2)$)--($(G2)!0.33!(D2)$);
\draw($(B2)!0.66!(A2)$)--($(F2)!0.66!(E2)$)--($(G2)!0.66!(D2)$);
\node[below=0.1of $(C2)!0.5!(G2)$]{滤波器 2};
\end{scope}

\begin{scope}[line width=0.5pt,shift={(4.5,-1)},scale=0.7]
\draw[line width=2pt] plot[domain=-3:3,samples=51,
            smooth,xscale=0.8,yscale=1.5] (\x,{2*exp(-\x*\x/3});
\draw[red,dashed](3.2,0)--(3.2,3.5);
\draw[red,dashed](-3.2,0)--(-3.2,3.5);
\end{scope}

\begin{scope}[line width=0.5pt,shift={(10,-1)},scale=0.7]
\draw[line width=2pt] plot[domain=-3:3,samples=51,
             smooth,xscale=0.8,yscale=1.5] (\x,{2*exp(-\x*\x/3});
\draw[blue,dashed](2.4,0)--(2.4,3.5);
\draw[blue,dashed](-2.4,0)--(-2.4,3.5);
\end{scope}
\end{scope}
%%%%%%%%%%%%%%%%%%%%%%%%%
%third row
\begin{scope}[shift={(0,-5.5)}]
\begin{scope}[local bounding box=SF3,line width=0.5pt]
\newcommand{\Depth}{1.3}
\newcommand{\Height}{1.3}
\newcommand{\Width}{1.3}
\coordinate (O2) at (0,0,0);
\coordinate (A2) at (0,\Width,0);
\coordinate (B2) at (0,\Width,\Height);
\coordinate (C2) at (0,0,\Height);
\coordinate (D2) at (\Depth,0,0);
\coordinate (E2) at (\Depth,\Width,0);
\coordinate (F2) at (\Depth,\Width,\Height);
\coordinate (G2) at (\Depth,0,\Height);

\draw[fill=white] (D2) -- (E2) -- (F2) -- (G2) -- cycle;% Right Face
\draw[fill=white] (C2) -- (B2) -- (F2) -- (G2) -- (C2);% Front Face
\draw[fill=white] (A2) -- (B2) -- (F2) -- (E2) -- cycle;% Top Face
%
\draw($(C2)!0.33!(G2)$)--($(B2)!0.33!(F2)$)--($(A2)!0.33!(E2)$);
\draw($(C2)!0.66!(G2)$)--($(B2)!0.66!(F2)$)--($(A2)!0.66!(E2)$);
\draw($(B2)!0.33!(C2)$)--($(F2)!0.33!(G2)$)--($(E2)!0.33!(D2)$);
\draw($(B2)!0.66!(C2)$)--($(F2)!0.66!(G2)$)--($(E2)!0.66!(D2)$);
\draw($(B2)!0.33!(A2)$)--($(F2)!0.33!(E2)$)--($(G2)!0.33!(D2)$);
\draw($(B2)!0.66!(A2)$)--($(F2)!0.66!(E2)$)--($(G2)!0.66!(D2)$);
\node[below=0.1of $(C2)!0.5!(G2)$](F3){滤波器 3};
\end{scope}

\begin{scope}[local bounding box=S1,line width=0.5pt,shift={(4.5,-0.5)},scale=0.7]
\draw[line width=2pt] plot[domain=-4:4,samples=51,
             smooth,xscale=0.8] (\x,{1.7*exp(-\x*\x/3});
\draw[red,dashed](3.2,0)--(3.2,2);
\draw[red,dashed](-3.2,0)--(-3.2,2);
\end{scope}

\begin{scope}[local bounding box=S2,line width=0.5pt,shift={(10,-0.5)},scale=0.7]
\draw[line width=2pt] plot[domain=-4:4,samples=51,
            smooth,xscale=0.8] (\x,{1.7*exp(-\x*\x/3});
\draw[blue,dashed](3.2,0)--(3.2,2);
\draw[blue,dashed](-3.2,0)--(-3.2,2);
\end{scope}
\end{scope}
%%%%%%%%%%%%%%%%%%%%%%%%%%
%fourth row
\begin{scope}[shift={(0,-8.65)}]
\begin{scope}[local bounding box=SFC,line width=0.5pt]
\newcommand{\Depth}{1.3}
\newcommand{\Height}{1.3}
\newcommand{\Width}{1.3}
\coordinate (CO2) at (0,0,0);
\coordinate (CA2) at (0,\Width,0);
\coordinate (CB2) at (0,\Width,\Height);
\coordinate (CC2) at (0,0,\Height);
\coordinate (CD2) at (\Depth,0,0);
\coordinate (CE2) at (\Depth,\Width,0);
\coordinate (CF2) at (\Depth,\Width,\Height);
\coordinate (CG2) at (\Depth,0,\Height);

\draw[fill=white] (CD2) -- (CE2) -- (CF2) -- (CG2) -- cycle;% Right Face
\draw[fill=white] (CC2) -- (CB2) -- (CF2) -- (CG2) -- (CC2);% Front Face
\draw[fill=white] (CA2) -- (CB2) -- (CF2) -- (CE2) -- cycle;% Top Face
%
\draw($(CC2)!0.33!(CG2)$)--($(CB2)!0.33!(CF2)$)--($(CA2)!0.33!(CE2)$);
\draw($(CC2)!0.66!(CG2)$)--($(CB2)!0.66!(CF2)$)--($(CA2)!0.66!(CE2)$);
\draw($(CB2)!0.33!(CC2)$)--($(CF2)!0.33!(CG2)$)--($(CE2)!0.33!(CD2)$);
\draw($(CB2)!0.66!(CC2)$)--($(CF2)!0.66!(CG2)$)--($(CE2)!0.66!(CD2)$);
\draw($(CB2)!0.33!(CA2)$)--($(CF2)!0.33!(CE2)$)--($(CG2)!0.33!(CD2)$);
\draw($(CB2)!0.66!(CA2)$)--($(CF2)!0.66!(CE2)$)--($(CG2)!0.66!(CD2)$);
\node[below=0.1of $(CC2)!0.5!(CG2)$](FC){滤波器 C};
\end{scope}

\begin{scope}[local bounding box=S3,line width=0.5pt,shift={(4.5,-1)},scale=0.7]
\draw[line width=2pt] plot[domain=-3:3,samples=51,
             smooth,xscale=0.8,yscale=1.5] (\x,{2*exp(-\x*\x/3});
\draw[red,dashed](3.2,0)coordinate(X2)--(3.2,3.5);
\draw[red,dashed](-3.2,0)coordinate(X1)--(-3.2,3.5);
\node[below=0.35of $(X1)!0.5!(X2)$,align=center]{逐层\\ 量化};
\end{scope}

\begin{scope}[local bounding box=S4,line width=0.5pt,shift={(10,-1)},scale=0.7]
\draw[line width=2pt] plot[domain=-3:3,samples=51,
            smooth,xscale=0.8,yscale=1.5] (\x,{2*exp(-\x*\x/3});
\draw[blue,dashed](2.4,0)coordinate(D2)--(2.4,3.5);
\draw[blue,dashed](-2.4,0)coordinate(D1)--(-2.4,3.5);
\node[below=0.35of $(D1)!0.5!(D2)$,align=center]{逐通道\\ 量化};
\end{scope}
\node[rotate=90,font=\Large\bfseries]at($(S1)!0.42!(S3)$){...};
\node[rotate=90,font=\Large\bfseries]at($(S2)!0.42!(S4)$){...};
\node[rotate=90,font=\Large\bfseries]at($(SF3)!0.48!(SFC)$){...};
\end{scope}
%%%%
%diagram
\begin{scope}[local bounding box=DI,line width=0.5pt,shift={(-5,-1)}]
\node[Box](B1){第 $N_L$ 层};
\node[Box,below=of B1](B2){第 $N_L-1$ 层};
\node[Box,node distance=2.2,,below=of B2](B3){第 2 层};
\node[Box,below=of B3,fill=RedL,draw=RedLine](B4){第 1 层};
\node[rotate=90,font=\Large\bfseries](B0)at($(B2)!0.5!(B3)$){...};
\draw[Line,-latex](B4)--(B3);
\draw[Line,-latex](B3)--(B0);
\draw[Line,-latex](B0)--(B2);
\draw[Line,-latex](B2)--(B1);
\draw[Line,-latex](B1)--++(90:1.3)node[above]{输出:$\hat{y}$};
\draw[Line,latex-](B4)--++(270:1.3)node[below]{输入:$x$};
\end{scope}
\draw[dashed,red,thick](B4.north east)--(F1.north west);
\draw[dashed,red,thick](B4.south east)--(FC.south west);
\end{tikzpicture}}量化粒度需要在校准与元数据开销和表示误差之间进行权衡。当通道存在差异时,更局部的范围能够保留信息,但并不会自动提高准确率,而且可能缺乏高效的内核执行路径。每增加一个缩放因子,还必须按照后端支持的粒度对其进行存储、加载和应用。Table 10 总结了四种常见级别,从整层共享一个范围到滤波器内部的局部范围。
| 层级 | 范围共享方式 | 权衡 |
|---|---|---|
| 逐层 | 每层使用一个范围 | 简单,但当滤波器范围差异较大时并非最优 |
| 逐组 | 将滤波器分组,组内共享范围 | Q-BERT (Shen et al. 2020) 将其用于 Transformer 注意力层 |
| 逐通道 | 每个滤波器使用一个范围 | 常见的默认选择;在量化误差与缩放元数据及实现开销之间取得平衡 |
| 子通道级 | 在每个滤波器内部设置多个范围 | 更局部的范围可以降低量化误差,但会增加元数据和实现开销 |
当各通道的动态范围不同时,相比逐层量化,逐通道量化能更好地保持精度,代价是需要存储额外的缩放向量,并在内核流水线中执行逐通道重缩放。除缩放粒度外,执行效率还取决于静态权重与动态激活之间的区别,两者对部署系统施加的内存与延迟约束存在根本差异。
权重与激活
执行低精度推理需要在内核执行前转换浮点输入,并对中间累加器输出进行重新量化。在整数矩阵乘法中,两个 8 位整数相乘会产生一个 16 位乘积。沿长度为 \(K\) 的内维度对这些乘积求和会导致位宽增长,很快就会超出 8 位寄存器的表示范围;因此,硬件使用 32 位整数寄存器(INT32)进行累加。在将结果送入后续层之前,重新量化会使用该层的有效缩放因子(\(s_{\text{eff}} = \frac{s_W \cdot s_X}{s_Y}\))对 32 位累加和进行重缩放,并将数值钳位回 8 位整数范围。Figure 23 展示了这一端到端执行流水线:浮点输入先经过 INT8 量化,再执行整数 SIMD 或 Tensor Core 矩阵乘法,在 32 位寄存器中累加,并在非线性激活前重新量化为 INT8。
\begin{tikzpicture}[font=\small\sffamily]
\tikzset{%
helvetica/.style={align=flush center,font=\small\sffamily},
Line/.style={line width=1.0pt,black!50,text=black},
Box/.style={inner xsep=2pt,
    node distance=0.5,
    draw=BlueLine,
    line width=0.75pt,
    fill=BlueL,
    text width=19mm,align=flush center,
    minimum width=19mm, minimum height=9mm
  },
}

\node[Box](B1){矩阵\\ 乘法};
\node[Box,right=of B1,fill=RedL,draw=RedLine](B2){INT32\\ 输出};
\node[Box,right=of B2,fill=GreenL,draw=GreenLine](B3){重新量化};
\node[Box,node distance=1.4,right=of B3,fill=BrownL,draw=BrownLine](B4){激活};
\node[Box,right=of B4,fill=RedL,draw=RedLine](B5){INT8\\ 输出};
\node[Box,above left=0.2 and 0 of B1,fill=VioletL2,draw=VioletLine2](GB2){量化};
\node[Box,left=of GB2,fill=VioletL2,draw=VioletLine2](GB1){浮点输入};
\node[Box,below left=0.2 and 0 of B1,fill=VioletL2,draw=VioletLine2](DB2){量化};
\node[Box,left=of DB2,fill=VioletL2,draw=VioletLine2](DB1){浮点输入};
%%%
\begin{scope}[font=\fontsize{7pt}{7}\selectfont\sffamily,scale=0.75,shift={($(B4)+(0,-3.25)$)}]
\draw[line width=0.5pt, -{Latex[length=6pt,width=4pt]}] (-3,0)--(3,0)node[below, xshift=-0.12cm]{$x$};
\draw[line width=0.5pt, -{Latex[length=6pt,width=4pt]}] (0,-1.8)--(0,2.2)node[left, yshift=-0.15cm]{$y$};
\draw[xscale=1, yscale=1, line width=1.25pt, domain=-2.9:2.9,smooth,
            variable=\x, BlueLine] plot ({\x},{rad(atan(\x))});
\draw[line width=0.5pt] (0,1.4)--(2.95,1.4);
\draw[line width=0.5pt] (0,-1.4)--(-2.95,-1.4);
\draw[line width=0.5pt] (-0.1,1.4)node[left]{1}--(0,1.4);
\draw[line width=0.5pt] (-0.1,0.7)node[left]{0.5}--(0.1,0.7);
\draw[line width=0.5pt] (-0.1,-0.7)--(0.1,-0.7)node[right]{–0.5};
\draw[line width=0.5pt] (-0.1,-1.4)--(0,-1.4)node[right]{–1};
%
\draw[red, line width=1.0pt](-2.9,0.1)to[out=0,in=180](2.9,1.3);
\draw[green!90!red!90, line width=1.0pt](0,0)--++(190:3);
\draw[VioletLine,line width=1.0pt](0,0)--++(45:3);
\end{scope}
%%
\draw[Line,-latex](GB1)--(GB2);
\draw[Line,-latex](GB2)-|node[above,pos=0.3]{INT8}(B1);
\draw[Line,-latex](DB1)--(DB2);
\draw[Line,-latex](DB2)-|node[below,pos=0.3]{INT8}(B1);
\draw[Line,-latex](B1)--(B2);
\draw[Line,-latex](B2)--(B3);
\draw[Line,-latex](B3)--node[above]{INT8}(B4);
\draw[Line,-latex](B4)--(B5);
\end{tikzpicture}激活量化在推理期间将层输出映射为低精度表示。它能减少中间数据量,并且可能在具有高效整数执行路径的硬件上降低算术运算成本,但也会在层间引入误差。例如,CNN 可以在后续卷积之前将 FP32 特征图转换为 INT8。当连续算子始终沿整数路径执行时,收益最大;孤立的量化算子可能承担转换成本,却未能减少足够的工作量。因此,激活量化能否改善延迟,取决于所支持的内核、缩放处理方式、张量生命周期,以及导出图中仍然存在的量化或反量化边界。
激活感知权重量化(AWQ)18 等激活感知方法旨在减少 LLM 推理中的权重数据传输量。当解码受限于模型权重加载时,这种方法适用于 GPT-2/Llama 灯塔案例。AWQ 根据激活幅值保护少量重要权重通道,从而在控制任务性能下降的同时支持 INT4 级权重量化。当运行时提供匹配的内核时,打包的低位宽权重可以减少词元生成期间所需的内存数据传输量 (Lin et al. 2024)。
静态量化与动态量化
除了裁剪范围的形态与粒度,系统设计还决定了何时计算激活范围。激活量化分为两种主要执行模型:静态量化和动态量化。
在静态量化中,裁剪范围在离线校准期间预先计算,并在推理期间保持固定。这种方法不会引入任何运行时范围估计开销:输入按固定因子缩放后,直接送入整数执行单元。然而,一旦生产输入偏离校准分布,静态范围就可能导致饱和或下溢 (Jacob et al. 2018; Yao et al. 2021)。
Yao, Zhewei, Amir Gholami, Sheng Shen, Kurt Keutzer, and Michael W. Mahoney. 2021. “HAWQ-V3: Dyadic Neural Network Quantization.” Proceedings of the 38th International Conference on Machine Learning (ICML), 11875–86.
相比之下,动态量化根据运行时激活张量动态计算缩放因子和零点。使裁剪窗口适应每个具体输入,可以消除分布偏移导致的饱和。其代价是运行时内存与延迟开销:在整数运算开始之前,硬件必须遍历中间激活张量执行归约,以提取最小值和最大值。对于受内存带宽限制的算子,这一归约遍历可能削弱低精度带来的执行优势。
这些时机与粒度决策,会与更广泛的量化方法选择相互影响。Table 11 比较了训练后量化、量化感知训练和动态量化,它们针对不同部署场景各有优势与权衡。
| 方法 | 工程投入 | 精度保持能力 | 输入适应性 | 适用情形 |
|---|---|---|---|---|
| 训练后量化(PTQ) | 低:无需重新训练 | 取决于模型;参数不会调整 | 固定校准范围 | 校准后的模型满足实测精度与性能目标 |
| 量化感知训练(QAT) | 高:需要加入量化模拟的额外训练 | 当 PTQ 效果不足时,通常更强 | 固定校准范围 | PTQ 未达到精度目标,且训练预算允许 |
| 动态量化 | 中等:运行时重新计算范围 | 取决于模型;范围适配每个输入 | 逐输入范围 | 不同输入的激活范围差异较大,且运行时开销可接受 |
PTQ 是投入较低的基线方案;当 PTQ 降低任务精度时,QAT 通过投入训练计算来弥补,而动态量化则消耗运行时内存数据传输量与计算资源,以跟踪随输入变化的动态范围。
Checkpoint 1.3: 校准与范围选择
只有范围策略与部署数据及运行时约束相匹配,量化才能成功。
范围设计
系统估算
PTQ 实践
训练后量化在部署周转速度与精度控制之间取得平衡。PTQ 不需要梯度反向传播或重新训练,因此成为部署优化流水线的标准起始步骤。离线校准是否足够,取决于架构、校准数据分布、数值量化器设计和目标硬件约束。
其主要局限是 PTQ 会冻结模型参数,无法通过调整参数来补偿精度损失。当量化模型的表现低于生产阈值时,可采取的缓解措施包括重新校准、细化缩放粒度、采用混合精度,或升级为量化感知训练。QAT 使用直通估计器(STE),让梯度穿过不可微的舍入算子,从而将精度约束直接整合到训练图中。这使权重能够在重新训练期间适应低位宽表示,以完整的训练计算量(\(O_{\text{train}}\))和超参数调优为代价恢复精度。
量化感知训练
量化感知训练将数值舍入噪声直接纳入优化图中。Figure 24 展示了这一训练流程:伪量化节点在前向传播期间模拟低精度裁剪与舍入误差,而直通估计器在反向传播期间将梯度传回浮点主权重。
\begin{tikzpicture}[font=\footnotesize\sffamily]
\tikzset{
  Box/.style={inner xsep=2pt,
   node distance=0.5,
    draw=black!90,
    line width=0.75pt,
    anchor=west,
    align=flush center,
    minimum width=64mm,
    minimum height=7.5mm
  },
Line/.style={line width=1.0pt,black!50,-latex}
}
\node[Box,fill=GreenL](B1){量化模型};
\node[Box,fill=BlueL,above=of B1](B2){重新训练/微调};
\node[Box,fill=BlueL,above=of B2.north west,minimum width=30mm,
anchor= south west](B3){量化};
\node[Box,fill=GreenL,above=of B3.north east,minimum width=30mm,
anchor= south east](B4){预训练模型};
\node[Box,fill=none,above=of B2.north east,minimum width=30mm,
draw=none,anchor= south east](B5){};
\draw[Line](B2)--(B1);
\draw[Line](B4)--(B4|-B3.north);
\draw[Line](B3)--(B3|-B2.north);
\path[red](B2.north east)|-coordinate(A)(B4.north east);
\path[blue](A)-|(B5.south west)coordinate(B);
\draw[line width=0.75pt, draw=black!90, fill=OrangeL]
(A) rectangle (B) node[pos=0.5] {训练数据};
\coordinate(S)at($(B)!0.5!(B5.south east)$);
\draw[Line](S)--(S|-B2.north);
\end{tikzpicture}生产工作流通常使用初始 PTQ 校准阶段得到的缩放因子来初始化 QAT,而不是从头训练或对缩放参数进行冷启动。Figure 25 展示了这一两阶段过程:离线校准先建立基准范围元数据,再通过微调调整主权重,以补偿量化噪声。
\scalebox{0.8}{
\begin{tikzpicture}[font=\small\sffamily]

\tikzset{%
helvetica/.style={align=flush center,font=\small\sffamily},
Line/.style={line width=1.0pt,black!50},
Box/.style={inner xsep=2pt,
    node distance=0.6,
    draw=GreenLine,
    line width=0.75pt,
    fill=GreenL,
    text width=27mm,align=flush center,
    minimum width=27mm, minimum height=9mm
  },
}

\node[Box](B1){预训练模型};
\node[Box,below=of B1,fill=RedL,draw=RedLine](B2){量化模型};
\node[Box,below=of B2,fill=RedL,draw=RedLine](B3){校准模型};
\node[Box,below=of B3](B4){PTQ 模型};
\node[Box,below=of B4,fill=RedL,draw=RedLine](B5){微调模型};
\node[Box,below=of B5](B6){QAT 模型};
%
\node[Box,node distance=1.6,left=of B3,fill=BlueL,draw=BlueLine](B7){校准数据};
\node[Box,node distance=1.6,left=of B5,fill=BlueL,draw=BlueLine](B8){训练数据};

\foreach \x in{1,...,5}{
\pgfmathtruncatemacro{\newX}{\x + 1}
\draw[Line,-latex](B\x)--(B\newX);
}
\draw[Line,-latex](B7)--(B3);
\draw[Line,-latex](B8)--(B5);
\scoped[on background layer]
\node[draw=BackLine,inner xsep=5mm,inner ysep=3mm,
yshift=0mm,
fill=BackColor,fit=(B2)(B3)(B7),line width=0.75pt](BB1){};
\node[below=4pt of  BB1.north,inner sep=0pt,
anchor=north,fill=BackColor]{PTQ};

\scoped[on background layer]
\node[draw=BackLine,inner xsep=5mm,inner ysep=3mm,
yshift=0mm,
fill=OliveL!30,fit=(B5)(B8),line width=0.75pt](BB2){};
\node[below=4pt of  BB2.north,inner sep=0pt,
anchor=north,fill=BackColor]{QAT};
\end{tikzpicture}}训练的数学原理
在前向传播期间,对权重和激活进行量化与反量化,以模拟精度降低。设 \(x\) 为全精度值,\(s\) 为将浮点值映射到低精度范围的缩放因子,\(q\) 为模拟量化值。该过程通常表示为: \[ q = \text{round} \left(\frac{x}{s} \right) \times s \] 其中,\(q\) 表示模拟量化值,\(x\) 表示全精度权重或激活,\(s\) 是将浮点值映射为低精度整数的缩放因子。
尽管前向传播使用模拟量化执行,但计算梯度需要通过舍入算子 \(\text{round}(\cdot)\) 进行反向传播。由于舍入是分段常数阶梯函数,其数学导数几乎处处为零,并且在阶跃位置未定义,这会使梯度归零并阻断梯度下降。直通估计器(STE)通过在反向传播期间用恒等函数替代舍入算子,解决了这一瓶颈 (Bengio et al. 2013):19
Krishnamoorthi, Raghuraman. 2018. “Quantizing Deep Convolutional Networks for Efficient Inference: A Whitepaper.” arXiv Preprint arXiv:1806.08342 abs/1806.08342.
在训练期间纳入量化效应,使模型能够调整权重和激活范围,以适应模拟的低精度误差。QAT 可以恢复训练后量化路径损失的质量,尤其是在位宽较低时,但其优势取决于模型、量化器、校准和训练过程 (Krishnamoorthi 2018)。
伪量化节点与实现
QAT 的实现依赖伪量化操作,这些操作在前向传播期间模拟量化,同时保持全精度以计算梯度。这些操作在计算图中插入量化—反量化对,在训练期间模拟推理时的行为。
伪量化节点必须保留推理运行时会遇到的相同误差,因此,其三项操作在训练期间对部署路径进行建模:
- 量化:将浮点值映射到离散量化级别
- 裁剪:根据位宽施加范围约束
- 反量化:转换回浮点值,以供后续操作使用
在数学上,对于位宽为 \(b\) 的对称量化,给定浮点输入值 \(x\): \[ \begin{aligned} q_{\text{level}} &= \text{clip}\left(\text{round}\left(\frac{x}{s}\right), -2^{b-1}, 2^{b-1} - 1\right) \\ x_{\text{fake}} &= q_{\text{level}} \times s \end{aligned} \] 其中,\(s = \frac{\max(|x|)}{2^{b-1} - 1}\) 是根据输入分布计算的缩放因子,\(x_{\text{fake}}\) 表示模拟 INT8 数值但仍保持浮点格式的伪量化输出。
对于支持无符号整数的非对称量化,假设已将观测范围扩展至包含零: \[ \begin{aligned} s &= \frac{\max(x) - \min(x)}{2^b - 1} \\ z &= \text{round}\left(-\frac{\min(x)}{s}\right) \\ q_{\text{level}} &= \text{clip}\left(\text{round}\left(\frac{x}{s} + z\right), 0, 2^b - 1\right) \\ x_{\text{fake}} &= (q_{\text{level}} - z) \times s \end{aligned} \] 其中,\(z\) 是用于实现非对称范围表示的零点偏移。
Listing 3 展示了 QAT 的前向路径:在卷积之前对输入和权重施加伪量化,在模拟 INT8 数值行为的同时,保留浮点张量用于训练。
# Forward pass with fake quantization
def qat_conv_forward(x, weight):
    # Fake quantize input activations
    x_scale = compute_scale(x, bits=8, symmetric=False)
    x_zero = compute_zero_point(x, x_scale, bits=8)
    x_quant = fake_quantize(x, x_scale, x_zero, bits=8)

    # Fake quantize weights (typically symmetric)
    w_scale = compute_scale(weight, bits=8, symmetric=True)
    w_quant = fake_quantize(weight, w_scale, zero=0, bits=8)

    # Convolution with fake-quantized values
    output = conv2d(x_quant, w_quant)
    return output
在反向传播期间,伪量化节点通过考虑裁剪范围的直通估计器近似梯度: \[ \frac{\partial x_{\text{fake}}}{\partial x} = \begin{cases} 1 & \text{if } x \in [x_{\text{min}}, x_{\text{max}}] \\ 0 & \text{otherwise} \end{cases} \] 在裁剪范围 \([x_{\text{min}}, x_{\text{max}}]\) 内,估计器将量化视为恒等映射,将上游梯度 \(\frac{\partial \mathcal{L}}{\partial x_{\text{fake}}}\) 原样传递给主权重 \(x\)。超出裁剪边界时,导数取零,从而阻断饱和异常值的梯度;否则,这些梯度可能使优化器更新变得不稳定。
在实践中,PyTorch 和 TensorFlow 等框架将伪量化实现为自定义自动微分算子,其前向传播执行量化—反量化往返过程,反向传播则应用 STE。缩放因子的处理取决于具体方法:观测器可以跟踪分布并在之后冻结,缩放因子也可以通过学习得到。批归一化同样需要采用与部署一致的处理方式:相关流程将批归一化折叠到前一层卷积的权重中(\(W_{\text{fused}} = \frac{\gamma}{\sigma} W\)),并在量化导出之前冻结其运行统计量,从而确保训练时的伪量化缩放因子与推理期间执行的静态融合内核参数相匹配。
QAT 的权衡
QAT20 的主要优势在于能够在低精度下进一步控制质量。通过在训练或微调期间引入模拟量化噪声,模型可以适应部署时的数值计算路径。当导出的算子受支持时,配备专用整数单元的处理器便可利用 INT8 算术实现更快或能耗更低的推理 (Wu et al. 2020; Gholami et al. 2022)。必须针对相同模型和目标平台,将其收益与 PTQ 进行比较,评估范围包括额外的训练成本,以及校准、计算图覆盖范围或内核选择方面的任何差异。
Wu, Hao, Patrick Judd, Xiaojie Zhang, Mikhail Isaev, and Paulius Micikevicius. 2020. “Integer Quantization for Deep Learning Inference: Principles and Empirical Evaluation.” arXiv Preprint arXiv:2004.09602 abs/2004.09602.
Choukroun, Yoni, Eli Kravchik, Fan Yang, and Pavel Kisilev. 2019. “Low-Bit Quantization of Neural Networks for Efficient Inference.” 2019 IEEE/CVF International Conference on Computer Vision Workshop (ICCVW), 3009–18. https://doi.org/10.1109/iccvw.2019.00363.
代价是额外的工程复杂性。QAT 将模拟量化插入训练过程,因此团队必须在目标模型上验证量化方案、缩放因子行为和精度恢复情况。当训练预算已经受限时,这些额外开销可能使 QAT 对超大模型而言不够实用。训练后量化方法提供了一条互补路径,可在训练预算受限时消除这部分重新训练开销 (Choukroun et al. 2019)。
在实践中,PTQ 与 QAT 之间的选择遵循一条简单的决策规则。先从 PTQ 开始,并在验证集上测量精度。如果精度达到生产阈值,就没有理由承担 QAT 的工程成本。如果 PTQ 未达到要求,则投入 QAT 以弥补差距。一种混合方法是先进行 PTQ 校准,再仅对精度关键层实施 QAT 微调,这通常能够取得有效的平衡。
PTQ 和 QAT 通常以 8 位或 4 位精度为目标,但能够保留多少精度取决于模型、任务和量化方法。然而,一些部署场景需要更激进的压缩,将数值精度推向神经网络所能承受的极限。
极端量化
对于即使使用 INT8 或 INT4 也无法满足内存或能耗预算的部署环境,极端量化将数值精度降至每个值 1 位或 2 位 (Courbariaux et al. 2015; Zhu et al. 2017)。二值化将权重和激活值限制为两个值,通常编码为 \(\{-1, +1\}\)。在数字逻辑中,将 \(-1\) 映射为二进制 \(0\),将 \(+1\) 映射为二进制 \(1\),可使标量乘法与按位 XNOR 运算同构。因此,代价高昂的浮点或整数乘加(MAC)单元可由按位逻辑和置位计数(popcount)运算替代 (Rastegari et al. 2016)。一个 64 位寄存器可以打包存储 64 个二值。单条 XNOR 指令可在一个时钟周期内并行执行 64 次乘法,随后由一条硬件 popcount 指令统计匹配位的数量,以累加得到点积(\(2 \times \text{popcount}(\mathbf{w} \text{ XNOR } \mathbf{a}) - 64\))。这完全消除了对硬件乘法器的需求。然而,1 位表示会严重限制模型的表达能力,导致复杂感知任务和语言任务上的精度大幅下降 (Hubara et al. 2018)。
Courbariaux, Matthieu, Yoshua Bengio, and Jean-Pierre David. 2015. “BinaryConnect: Training Deep Neural Networks with Binary Weights During Propagations.” Advances in Neural Information Processing Systems (NeurIPS) 28: 3123–31.
三值化通过允许三个值 \(\{-1, 0, +1\}\) 来缓解这种容量损失 (Zhu et al. 2017)。零状态引入了稀疏性,并简化了算术运算:将激活值乘以 \(+1\) 需要一次加法,乘以 \(-1\) 需要一次减法,而乘以 \(0\) 则可完全跳过。这消除了对通用乘法器的需求,将算术单元简化为带条件加减功能的累加器。然而,三值无法按每个值一位进行打包。在标准的字节对齐内存中,每个权重至少需要两位(浪费四种可能的 2 位状态中的一种),或者采用会引入运行时解码开销的多三进制位编码(例如,将五个三进制位打包到一个字节中,因为 \(3^5 = 243 < 256\))。
二值量化和三值量化都会引入几乎处处导数为零的阶跃函数(当 \(x \neq 0\) 时,\(\frac{d}{dx}\text{sign}(x) = 0\)),导致反向传播梯度消失。为了训练这些表示,量化感知训练使用梯度近似方法,主要是直通估计器(STE)(Bengio et al. 2013; Choi et al. 2018)。STE 在反向传播期间用恒等算子或裁剪算子替代不可微的量化器,将梯度直接传播到全精度潜在权重;这些权重累积优化器的小步更新,直至跨过量化阈值。
Choi, Jungwook, Zhuo Wang, Swagath Venkataramani, Pierce I-Jen Chuang, Vijayalakshmi Srinivasan, and Kailash Gopalakrishnan. 2018. “PACT: Parameterized Clipping Activation for Quantized Neural Networks.” arXiv Preprint.
挑战与局限
将低于字节的精度转化为实际墙钟时间上的加速,受到标准处理器架构的制约。通用 CPU 和 GPU 的 ALU 与张量流水线针对 8 位、16 位和 32 位寄存器设计,缺乏原生的单比特或两比特矩阵乘法指令。在这些通用架构上执行低于字节的操作数运算,需要进行位移、掩码和解包操作。这些位操作的指令开销往往会抵消内存带宽节省带来的收益,除非工作负载运行在定制的位串行加速器、现场可编程门阵列(FPGA),或配备原生按位执行单元的专用硬件上 (Umuroglu et al. 2017)。
Umuroglu, Yaman, Nicholas J. Fraser, Giulio Gambardella, Michaela Blott, Philip Leong, Magnus Jahre, and Kees Vissers. 2017. “Finn: A Framework for Fast, Scalable Binarized Neural Network Inference.” Proceedings of the 2017 ACM/SIGDA International Symposium on Field-Programmable Gate Arrays, 65–74. https://doi.org/10.1145/3020078.3021744.
Rastegari, Mohammad, Vicente Ordonez, Joseph Redmon, and Ali Farhadi. 2016. “XNOR-Net: ImageNet Classification Using Binary Convolutional Neural Networks.” In European Conference on Computer Vision (ECCV). Springer. https://doi.org/10.1007/978-3-319-46493-0_32.
Hubara, Itay, Matthieu Courbariaux, Daniel Soudry, Ran El-Yaniv, and Yoshua Bengio. 2018. “Quantized Neural Networks: Training Neural Networks with Low Precision Weights and Activations.” Journal of Machine Learning Research 18 (187): 1–30.
Zhu, Chenzhuo, Song Han, Huizi Mao, and William J. Dally. 2017. “Trained Ternary Quantization.” International Conference on Learning Representations (ICLR) 4 (4): 1–16.
模型质量构成了同样严峻的障碍。极端量化会大幅压缩网络的表示能力。受微控制器 SRAM 预算约束的关键词识别(KWS)等低熵工作负载或许能够容忍二值或三值权重,但复杂的感知模型和生成模型会遭遇严重的精度下降。只有当 INT8 或 INT4 等更高精度的替代方案无法满足物理内存或能耗预算,并且部署硬件能够原生执行位打包运算时,二值量化和三值量化才会成为可行的候选方案 (Rastegari et al. 2016; Hubara et al. 2018; Zhu et al. 2017; Umuroglu et al. 2017)。生产部署要求在相同工作负载上,将二值和三值基线与 INT8、INT4、结构化剪枝以及紧凑架构重新设计方案进行比较,并在目标硬件上测量二进制产物总大小、端到端延迟、每次推理的能耗和任务精度。
核心工程检查在于:位宽、硬件算术路径以及校准或训练选择,是否直接满足物理部署约束。
Checkpoint 1.4: 量化与精度检查点
量化设计评审标准:
前两个优化维度回答的是不同的问题:结构优化(剪枝、知识蒸馏、NAS)决定计算什么,精度优化(量化)决定以多高的精度表示和执行这些计算。在将缩减幅度换算为延迟或能耗之前,必须先用其实际改变的资源——非零元素数量、FLOPs 或原始字节数——来表述这些纸面节省。
在生产环境中,理论预测与实测运行时加速之间始终存在差距。这个示例场景将 50% 的剪枝比例与 INT8 位宽缩减相结合,粗略估算出 8× 的目标加速比,然后假设实际仅实现了 1.5× 的加速比。这约为纸面目标的 18.8 percent。该场景说明了为什么理论压缩并不意味着成比例的加速。优化必须超越模型计算图,延伸到运算在物理内存层次结构中的执行方式。
这种差距源于多种架构与运行时之间的不匹配。以稠密格式存储的稀疏矩阵会因传输零值而浪费内存带宽——硬件无法跳过未通过索引标识的零值。当调度或运行时依赖关系阻止执行重叠时,本可并发执行的运算会因串行执行而发生停顿。统一的执行图为每个输入分配相同的计算深度,而不考虑其难度。弥合纸面缩减与实测硬件加速之间的鸿沟,是第三个优化维度——架构效率——所关注的问题。该维度评估的是:当计算图与物理执行单元交互时,结构优化和精度优化能否转化为实际的执行收益。
架构效率
架构效率从执行轨迹出发。上一节量化了纸面加速比与实测加速比之间的差距;性能分析器则解释了收益损失在何处:稀疏张量可能仍通过稠密内核运算,低精度算子可能需要进行硬件无法隐藏其开销的转换,小型层在启动内核和移动中间结果上花费的时间可能比算术运算更多。模型在纸面上已经变小,但执行轨迹仍要求机器执行低效的内存访问与运算序列。
表示优化决定执行什么计算,精度优化决定以多高的精度执行计算,而架构效率决定这些计算如何适配机器。实测瓶颈决定了哪种架构应对措施有效。硬件感知设计在训练前改变模型,使其各层符合部署约束范围。稀疏性利用使已移除的权重能够被可跳过它们的内核识别。动态计算让简单输入提前退出,避免承担最坏情况下的计算成本。算子融合则在相邻运算原本需要写入并重新读取相同张量时,减少内存流量。
硬件感知设计
硬件感知设计始于压缩之前。如果目标设备无法持续为卷积内核供给数据,无法在不发生溢写的情况下存储激活值,或无法在选定的输入分辨率下满足功耗预算,那么剪枝和量化只能治标。架构本身必须暴露出硬件能够高效执行的工作类型。这意味着在选择层形状、缩放规则和算子模式时,将内存带宽、并行性和能耗视为首要约束,而不是事后的部署检查项。
高效设计原则
设计的第一步是识别执行轨迹所揭示的限制性资源。模型可能因为每一层都代价过高、某一类卷积主导算术运算、激活值或参数无法容纳于内存层次结构中,或候选架构未采用平台优选的算子而无法达到目标。Table 12 按照所应对的瓶颈,而非模型家族,组织了常见的应对措施。
| 观测到的瓶颈 | 架构应对措施 | 示例网络 |
|---|---|---|
| 模型缩放超出预算 | 协同调整深度、宽度和分辨率,使模型保持在延迟、内存和功耗约束范围内。 | EfficientNet, RegNet |
| 冗余计算 | 用因子分解运算或分组运算替代代价高昂的稠密运算,以更低的算术成本保留有效的通道混合。 | MobileNet, ResNeXt |
| 内存压力 | 减少参数和激活值的存储量,或复用特征,使工作集能够容纳于可用的缓存、SRAM 或设备内存中。 | DenseNet, SqueezeNet |
| 平台不匹配 | 在架构搜索或设计循环中纳入实测设备延迟、算子支持情况和功耗行为,而非仅优化 FLOPs。 | MobileNetV3, MnasNet |
这些应对措施会相互影响。使用深度可分离卷积21 减少卷积 FLOPs,只有在目标运行时为所得算子提供高效内核时才有帮助。通过参数缩减层来缩小模型,只有在激活值存储或内存流量属于实测问题的一部分时才有帮助。因此,硬件感知设计并不替代性能分析;它将性能分析信息前移,融入架构本身。
缩放优化
第一种架构应对措施是全局性的:当性能分析中的每个阶段都超出预算时,问题并非某一个层设计不佳,而是模型缩放不适合部署约束范围。此时,设计任务是在深度、宽度和输入分辨率之间分配容量,而不是选定一个参数总量。深度增加串行工作量和激活值存储量。宽度提供更多可并行的工作,但也增加内存使用量。分辨率改善空间细节,同时增加每次卷积必须处理的位置数量。适当的平衡取决于机器:高度并行的加速器通常能够利用宽度,而小型边缘设备则可能主要受内存容量和每次访问能耗的限制。
从数学上看,卷积模型的总 FLOPs 可近似表示为: \[ \text{FLOPs} \propto N_L \cdot w^2 \cdot r^2, \] 其中,\(N_L\) 为深度(层数),\(w\) 为宽度,\(r\) 为输入分辨率。该表达式说明了朴素缩放为何会失败:同时增加宽度和分辨率会使工作量迅速倍增,即使参数数量看似合理,所得模型也可能超出内存带宽或功耗预算。
复合缩放将这种平衡转化为受控的设计规则。复合缩放并不独立调整深度、宽度和分辨率,而是相对于基准模型,按固定比例 \((\alpha, \beta, \gamma)\) 增长这三个维度: \[ N_L = \alpha^\phi N_{L,0}, \quad w = \beta^\phi w_0, \quad r = \gamma^\phi r_0 \] 这里,\(\phi\) 为缩放系数,\(\alpha\)、\(\beta\) 和 \(\gamma\) 为根据精度与效率的经验测量结果确定的缩放因子。这条规则的意义在于,防止某一个维度在其他维度尚未对精度作出有效贡献之前就耗尽预算。
EfficientNet(section 1.3.4)通过搜索找到基准架构,再使用均衡的深度、宽度和分辨率系数对其进行缩放,从而验证了这一原则 (Tan and Le 2019)。这并不意味着所有部署都应使用 EfficientNet。从系统角度得到的启示是,缩放是一项资源分配决策:对于相同的精度目标,目标平台上的稀缺资源不同,所需的深度—宽度—分辨率权衡也可能不同。后续的基准测试内容将形式化说明如何测量这些权衡;此处的设计原则是,根据起约束作用的资源来缩放各个维度。
同样的逻辑也适用于卷积模型之外的模型。Transformer 层数、注意力头数、序列长度和嵌入宽度发挥着类似于深度、宽度和分辨率的作用:每个维度都会增加容量,但各自对计算、内存带宽或激活值存储施加的压力不同。硬件感知缩放使这些维度始终与实测瓶颈关联,而不是将模型大小视为单一标量。
计算量缩减
如果性能分析表明少量卷积算子主导了算术运算,那么均匀缩减整个模型会造成浪费。更好的应对方式是改变代价高昂的算子。现代高效架构通过将稠密计算分解为成本更低的组成部分来实现这一点,同时保留保证精度所需的表示。
由 MobileNet 推广的深度可分离卷积体现了这一方法:它将标准卷积分解为两个阶段,即逐通道卷积(对每个输入通道独立应用不同的滤波器)和逐点卷积(通过 \(1{\times}1\) 卷积混合各通道的输出)。对于批大小为一、步幅为一、填充后保持 \(h{\times}w\) 空间尺寸且使用宽度为 \(k\) 的方形卷积核的情况,具有 \(C_{\text{in}}\) 个输入通道和 \(C_{\text{out}}\) 个输出通道的标准卷积,其计算复杂度为: \[ \mathcal{O}(h w C_{\text{in}} C_{\text{out}} k^2) \] 其中,\(k\) 为卷积核大小。深度可分离卷积将其降至: \[ \mathcal{O}(h w C_{\text{in}} k^2) + \mathcal{O}(h w C_{\text{in}} C_{\text{out}}) \] 这从通道混合运算中消除了 \(k^2\) 因子,通常可实现 5–10\(\times\) 的 FLOPs 缩减。墙钟时间上的收益取决于内核支持和内存行为:具有优化逐通道卷积内核的移动端运行时,可以将大部分算术运算缩减转化为延迟节省,而支持不佳的后端则可能将分解后的运算呈现为许多受内存限制的小型内核。
其他分解模式也在应对同样的诊断结果。ResNeXt 使用的分组卷积先将特征图划分为独立的组,再进行合并,从而减少冗余的跨通道工作。ResNet 使用的瓶颈层在代价高昂的运算之前,应用 \(1{\times}1\) 卷积来降低特征维度。SqueezeNet 使用相同的 \(1{\times}1\) 思路减少参数。当这些技术减少了执行轨迹中真正占主导地位的运算时,它们能够提高效率;当内存流量、启动开销或不受支持的内核成为新的瓶颈时,其收益则小得多。
减少算术运算只是可能的应对方式之一。如果性能分析识别出的目标设备限制性资源是内存容量或数据移动,那么架构必须直接解决这一内存瓶颈。
内存优化
当性能分析指向内存而非算术运算时,架构必须缩小工作集,或减少代价高昂的内存访问次数。即使 FLOPs 处于可接受范围,激活值、特征图和参数的存储需求仍可能超出缓存、SRAM、加速器内存或边缘设备存储容量。因此,内存高效架构力求在存储或移动更少数据的同时保留有用信息。
DenseNet 展示了通过特征复用应对这一问题的方法 (Huang et al. 2017)。在传统卷积网络中,每一层都会计算一组新的特征图,随着网络加深,激活值的内存占用随之增加。DenseNet 通过连接各层,使后续计算能够复用先前的特征图,而无需重新学习相似的表示。在具有 \(N_L\) 层的标准卷积网络中,如果每层生成 \(g\) 个新特征图,则特征图总数呈线性增长: \[ \mathcal{O}(N_L g) \]
Huang, Gao, Zhuang Liu, Laurens Van Der Maaten, and Kilian Q. Weinberger. 2017. “Densely Connected Convolutional Networks.” 2017 IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 2261–69. https://doi.org/10.1109/cvpr.2017.243.
DenseNet 通过特征复用减少参数冗余,但拼接保留的特征可能增加激活值存储量和内存流量。由此产生的工作集大小和运行时间必须在目标硬件上测量。
激活检查点通过在训练期间以计算换取内存,与特征复用形成互补。对于 \(N_L\) 个规模相近、每层激活值内存占用为 \(A_{\text{layer}}\) 的层,等间隔设置检查点可将保存激活值的存储项从 \(\mathcal{O}(N_L A_{\text{layer}})\) 降至 \(\mathcal{O}(\sqrt{N_L}\,A_{\text{layer}})\),同时在反向传播期间重新计算未保存的激活值。在模型压缩场景下,检查点机制支持在固定内存预算内训练更大的模型,从而为后续剪枝或知识蒸馏提供更多可利用的模型容量。
参数缩减将相同的思路应用于存储。SqueezeNet 在应用标准卷积之前,使用 \(1{\times}1\) 卷积减少输入通道数,使计算开销较大的层能够在更小的表示上运行 (Iandola et al. 2016)。标准卷积层的参数数量为: \[ \mathcal{O}(C_{\text{in}} C_{\text{out}} k^2) \]
Iandola, Forrest N., Song Han, Matthew W. Moskewicz, Khalid Ashraf, William J. Dally, and Kurt Keutzer. 2016. “SqueezeNet: AlexNet-Level Accuracy with 50x Fewer Parameters and <0.5MB Model Size.” ArXiv Preprint abs/1602.07360.
通过使用 \(1{\times}1\) 卷积减小 \(C_{\text{in}}\),SqueezeNet 减少了参数数量,以远少于 AlexNet 的参数实现了论文所设定的 AlexNet 级别准确率目标。当部署约束是闪存存储容量、模型下载大小或参数传输带宽时,这种权衡很有吸引力;当激活值内存占用或算子开销占主导时,其决定性则较弱。
因此,特征复用、激活检查点和参数缩减并不是可以互换的方案。它们各自改变了内存问题的不同部分。特征复用减少冗余表示,检查点机制减少训练期间的激活值存储,而 \(1{\times}1\) 瓶颈结构减少参数搬移。正确的选择取决于性能剖析显示哪一项内存因素构成了实际约束。
除了尽量减少存储的张量体积,重构内存访问调度也能显著提高执行效率。将相邻操作合并为复合执行内核,可以消除中间特征图在片外 DRAM 与芯片之间的往返传输。
算子融合
考虑一个典型的神经网络层:卷积之后接批归一化,再接修正线性单元(ReLU)。在未融合时,每个操作都将输出写入 GPU 全局内存,然后由下一个操作将该输出读回。本可完全在高速片上寄存器中完成的计算,却发生了三次内存往返传输。通过将这些操作融合为单个内核,编译器和推理引擎能够消除冗余内存事务,从而改善受内存带宽限制的工作负载的吞吐量和延迟 (Chen et al. 2018; NVIDIA 2024)。
Chen, Tianqi, Thierry Moreau, Ziheng Jiang, Lianmin Zheng, Eddie Q. Yan, Haichen Shen, Meghan Cowan, et al. 2018. “TVM: An Automated End-to-End Optimizing Compiler for Deep Learning.” Proceedings of the 13th USENIX Symposium on Operating Systems Design and Implementation (OSDI ’18), 578–94.
NVIDIA. 2024. NVIDIA TensorRT: Programmable Inference Accelerator.
Definition 1.5: 算子融合
算子融合 是一种编译器和运行时优化,将相邻的张量操作合并为单个融合内核,使中间值保留在寄存器或片上内存中,而无需写入加速器全局内存后再读回。
- 意义:对于在同一个 \(M\) 字节张量上执行的、由 \(N\) 个逐元素操作组成的理想操作链,独立内核的数据搬移量约为 \(2NM\),而融合内核通过将中间值保留在片上,可使搬移量接近 \(2M\)。实际流量还包括权重、缓存、对齐和寄存器溢出带来的影响,因此必须通过性能剖析确认流量是否减少。
- 区别:与剪枝、量化或知识蒸馏不同,算子融合不会改变模型的参数、精度或架构。它改变的是数学等价操作的执行调度,在保持模型输出的同时,改善受内存带宽限制的工作负载的延迟和吞吐量。
- 常见误区:一种常见误解是融合越多越好。融合受到数据依赖、张量形状、寄存器压力和缓存容量的约束;过度融合可能降低占用率,或迫使寄存器中的值溢出回内存,从而抵消收益。
现代神经网络由卷积、批归一化、激活函数和逐元素操作等操作序列组成。独立执行时,每个操作都需要四个步骤:
- 从全局内存加载输入张量
- 执行计算
- 将输出张量写回全局内存
- 启动下一个内核
对于算术强度(FLOP/字节)较低的操作,读—计算—写循环会造成内存带宽瓶颈。对于在同一个 \(M\) 字节中间张量上执行的、由 \(N\) 个操作组成的理想序列,未融合时的流量为: \[ D_{\text{vol,unfused}} = 2NM \] 其中,每个操作都会对中间张量读写各一次。如果该序列满足融合条件,且中间值保持在片上,则流量可接近: \[ D_{\text{vol,fused}} = 2M \] 这是通过仅读取一次中间输入、仅写入一次最终输出实现的。权重、辅助输入、缓存效应和寄存器溢出不包含在这一简单界限中。尽管如此,若干推理模式仍足够接近这一界限,使融合具有实际意义。
卷积—批归一化—ReLU 融合
当编译器能够在满足合法性约束的前提下折叠批归一化并合并激活操作时,listing 4 中常见的 Conv-BN-ReLU 模式便可用一条融合执行路径替代三次内核启动及中间数据的往返传输。
# Pseudocode: runtime APIs and fusion legality are
# implementation-dependent.
# === UNFUSED: 3 kernel launches, 6 memory transfers ===
conv_out = conv2d(input, weight)
bn_out = batch_norm(conv_out, ...)
relu_out = relu(bn_out)


# === FUSED: 1 kernel launch, 2 memory transfers ===
def conv_bn_relu_fused(input, weight, gamma, beta, mean, var):
    # Read input and weight once
    conv = conv2d(input, weight)

    # Apply batch norm in registers (no memory write)
    bn = gamma * (conv - mean) / sqrt(var + eps) + beta

    # Apply ReLU in registers (no memory write)
    output = relu(bn)

    # Write final result once
    return output
算子融合将内存传输次数从六次降至两次。
算术运算保持完全一致,但内存流量从 6 次传输降至 2 次传输(流量缩减倍数为 3×)。对于通道数为 256、空间尺寸为 \(28{\times}28\) 的 ResNet-50 层,这会使每层减少 \(4 \times 256 \times 28 \times 28 \times 4 \text{ bytes} \approx \text{3.2 MB}\) 的中间数据内存流量。
同一原理也适用于 CNN 之外的网络。GEMM 偏置—激活融合在每个矩阵乘法输出元素计算完成后,立即在寄存器中执行逐元素操作,从而消除 Transformer 线性层中的中间结果写入。FlashAttention 中采用的注意力分块技术22,通过以适配 SRAM 容量的块处理注意力,避免显式生成完整的 \(S{\times}S\) 注意力矩阵,从而减少 HBM 流量,详见 FlashAttention:I/O 感知的注意力优化。
内存带宽分析能够具体量化这些融合收益。考虑一个作用于 \(28{\times}28{\times}256\) 特征图(802.8 KB)的 Conv-BN-ReLU 序列。在未融合时,每个操作都执行各自的内存往返传输:Conv 读取输入(802.8 KB)和权重(2.4 MB),并写入输出(802.8 KB),总计 4 MB。随后,BN 读取该输出,额外读取其参数(2 KB),然后再次写入,产生 1.6 MB 的流量。ReLU 重复这一模式,再产生 1.6 MB 的流量。未融合时的总内存流量为 7.2 MB。融合后,整个序列仅需读取一次输入和权重,并写入一次最终输出,仅产生 4 MB 的流量——带宽需求减少了 44.5 percent。
在建模采用的 900 GB/s HBM 带宽下,这些流量对应的理想时间下界在融合前为 8 microseconds,融合后为 4.5 microseconds,仅流量这一分量的时间比值为 1.80×。这些数值并非完整的层延迟,因为还必须计入卷积计算、缓存效应和内核启动开销。
如 table 13 所示,融合收益因工作负载而异。受内存带宽限制的操作获益最多,而受计算限制的操作改善很小。
| 工作负载 | 相对融合收益 | 原因 |
|---|---|---|
| 逐元素操作 | 高 | 高度受内存带宽限制,算术强度低 |
| Conv-BN-Act 模式 | 中等 | 兼具内存与计算特征 |
| 基于 GEMM 的操作 | 低 | 受计算限制;融合减少受内存带宽限制的尾部操作开销 |
| 注意力机制 | 高 | 长序列放大了避免传输注意力中间结果所节省的流量 |
融合还会减少内核启动开销。每次 CUDA 内核启动都会产生微秒级延迟。在一个假设包含五十三组符合融合条件的 Conv-BN-ReLU 三元组的计算图中,未融合执行会启动 159 个内核,而融合执行仅启动 53 个内核,因此除了减少内存流量,还节省了重复启动的开销。ResNet-50 并不包含五十三组直接相连的三元组,因为残差加法会打断许多此类模式。
融合的实现贯穿整个软件栈,从框架层面的模式匹配,到借助加速线性代数(XLA)、TVM 和 TensorRT 等进行编译器优化,再到根据输入形状和硬件特征进行调整的运行时融合。当框架能够将相关计算导出或追踪为计算图时,这一过程便易于处理:图中的节点是张量操作,边记录数据依赖关系。随后,编译器可以匹配 Conv→BN→ReLU 等满足合法性约束的模式,并在检查形状、别名关系和数值约束的同时,将其改写为融合操作。动态控制流、原地修改或不受支持的操作可能阻碍这种计算图改写,因此必须检查导出的执行计划,而不能想当然地认为融合已经完成。内核融合 详细探讨了融合在编译器和硬件方面的因素,包括寄存器压力、图匹配,以及 GPU、TPU 和边缘加速器各平台特有的权衡。
算子融合尽量减少静态流水线阶段之间的数据搬移,而自适应计算则挑战了每个输入都需要执行计算图全部深度或宽度这一假设。通过根据输入难度或运行时预算调整活跃子网络,系统以放弃确定性执行调度为代价,降低摊销延迟和能耗。
自适应计算方法
硬件感知架构设计和算子融合优化固定的执行图,确保在不存在依赖输入的控制逻辑时,每个输入都遵循相同的调度路径。在静态图上,算法向机器施加不变的计算工作负载:无论面对的是明显易于分类的样本,还是含糊难辨的样本,24 层 Transformer 都执行相同的 MAC 运算,并从 HBM 或片外 DRAM 流式读取全部参数。自适应推理 将这一开环流水线替换为依赖输入的控制环:中间表示或运行时预算为动态决策提供依据,以终止执行或将激活值路由至专门的子网络。尽管动态路径可以减少平均算术运算量和内存流量,但也会在路由逻辑、批次管理、置信度校准和延迟方差方面引入运行时开销。
动态方案
由于输入数据的语义复杂度并不均匀,分配固定不变的计算预算会在简单样本上浪费内存带宽和执行周期。动态方案通过调整执行路径来降低摊销计算量,同时保留深层网络以处理最坏情况的输入。这种架构灵活性涵盖四个主要控制变量:网络深度(提前退出)、结构路由(条件层跳过)、专家子网络(混合专家)以及连续计算分配。
为控制执行深度,提前退出 架构在中间层附加辅助分类头,当中间表示能够产生具有足够置信度的预测时便终止执行 (Teerapittayanon et al. 2017)。BranchyNet 通过浅层退出分支在卷积骨干网络中实现这一机制,而多出口视觉 Transformer 则在 Transformer 块之间附加线性探针和熵估计器 (Xin et al. 2021)。当输入满足退出准则时,例如 softmax 预测熵降至预先调优的阈值以下,运行时便停止求值并返回中间预测结果。要获得净运行收益,后续层中避免的算术运算和内存传输所节省的开销,必须超过中间分类器求值及门控阈值判断带来的计算开销。
Teerapittayanon, Surat, Bradley McDanel, and H. T. Kung. 2017. “BranchyNet: Fast Inference via Early Exiting from Deep Neural Networks.” 2016 23rd International Conference on Pattern Recognition (ICPR), 2464–69. https://doi.org/10.1109/icpr.2016.7900006.
Hu, Ting-Kuei, Tianlong Chen, Haotao Wang, and Zhangyang Wang. 2020. “Triple Wins: Boosting Accuracy, Robustness and Efficiency Together by Enabling Input-Adaptive Inference.” International Conference on Learning Representations (ICLR).
Chen, Yanxi, Xuchen Pan, Yaliang Li, Bolin Ding, and Jingren Zhou. 2024. “EE-LLM: Large-Scale Training and Inference of Early-Exit Large Language Models with 3D Parallelism.” Proceedings of the 41st International Conference on Machine Learning (ICML).
不同硬件部署目标上的系统权衡差异显著。在处理单样本的边缘处理器上(批大小 \(B=1\),常见于微控制器和移动端 NPU),提前退出会立即终止执行线程 (Hu et al. 2020)。跳过剩余层既消除了算术运算,也消除了将后续层权重加载到片上 SRAM 缓存所需的片外 DRAM 事务。相反,在处理批量工作负载(\(B > 1\))的并行吞吐型加速器(GPU 和 TPU)上,提前退出会导致严重的批次碎片化 (Chen et al. 2024)。如果一个批次中只有部分样本达到退出阈值,其余样本仍须继续经过更深的层。除非运行时执行动态批次压紧,即通过内存复制和内核同步,将尚未确定结果的激活张量收集到连续内存缓冲区中,否则非活跃样本仍会占用已分配的内存,或者加速器必须屏蔽非活跃的 SIMD 或单指令多线程(SIMT)通道。因此,批次的尾延迟仍由经过层数最多的样本决定。Figure 26 展示了这一决策流水线,其中每个中间块都会先计算置信度估计器,再将尚未确定结果的表示路由至后续层。
\begin{tikzpicture}[font=\small\sffamily]
\tikzset{%
Line/.style={line width=1.0pt,black!50,text=black},
Box/.style={inner xsep=2pt,
    node distance=1.7,
    draw=GreenLine,
    line width=0.75pt,
    fill=GreenL,
    text width=25mm,align=flush center,
    minimum width=25mm, minimum height=8mm
  },
}

\node[Box, ellipse,text width=14mm,minimum width=12mm,inner ysep=-1pt,
             minimum height=10mm, fill=RedL,draw=RedLine](B1){输入};
\node[Box,right=of B1](B2){Transformer 1};
\node[Box,right=of B2](B3){Transformer 2};
\node[Box, node distance=2.5,right=of B3](B4){Transformer $n$};
\node[font=\tiny\sffamily](B0)at($(B3)!0.5!(B4)$){$\bullet$ $\bullet$ $\bullet$};
%
\def\di{0.45}
\node[Box,node distance=\di,below=of B2,fill=VioletL2,draw=VioletLine](C1){分类器 1};
\node[Box,node distance=\di,below=of C1,fill=BlueL,draw=BlueLine](C2){置信度/LTE};
\node[Box,node distance=\di,below=of C2,ellipse,text width=14mm,minimum width=12mm,
             minimum height=10mm, fill=RedL,draw=RedLine](C3){退出};
%
\node[Box,node distance=\di,below=of B3,fill=VioletL2,draw=VioletLine](2C1){分类器 2};
\node[Box,node distance=\di,below=of 2C1,fill=BlueL,draw=BlueLine](2C2){置信度/LTE};
\node[Box,node distance=\di,below=of 2C2,ellipse,text width=14mm,minimum width=12mm,
             minimum height=10mm, fill=RedL,draw=RedLine](2C3){退出};
%
\node[Box,node distance=\di,below=of B4,fill=VioletL2,draw=VioletLine](3C1){分类器 $n$};
\node[Box,node distance=\di,below=of 3C1,fill=BlueL,draw=BlueLine](3C2){置信度/LTE};
\node[Box,node distance=\di,below=of 3C2,ellipse,text width=14mm,minimum width=12mm,
             minimum height=10mm, fill=RedL,draw=RedLine](3C3){退出};
%
\node[font=\tiny\sffamily](2B0)at($(2C1)!0.5!(3C1)$){$\bullet$ $\bullet$ $\bullet$};
\node[font=\tiny\sffamily](3B0)at($(2C2)!0.5!(3C2)$){$\bullet$ $\bullet$ $\bullet$};
\draw[Line,-latex](B1)--(B2);
\draw[Line,-latex](B2)--(B3);
\draw[Line,-latex](B3)--(B0);
\draw[Line,-latex](B0)--(B4);
%
\draw[Line,-latex](B2)--(C1);
\draw[Line,-latex](C1)--(C2);
\draw[Line,-latex](C2)--(C3);
%
\draw[Line,-latex](B3)--(2C1);
\draw[Line,-latex](2C1)--(2C2);
\draw[Line,-latex](2C2)--(2C3);
%
\draw[Line,-latex](B4)--(3C1);
\draw[Line,-latex](3C1)--(3C2);
\draw[Line,-latex](3C2)--(3C3);
%
\draw[Line,-latex](C2)-|node[left=6pt,pos=0.8,rotate=90]{继续}($(B2)!0.5!(B3)$);
\draw[Line,-latex](2C2.east)-|node[right=9pt,pos=0.35,rotate=90]{继续}($(B3)!0.68!(B0)$);
\end{tikzpicture}
Xin, Ji, Raphael Tang, Yaoliang Yu, and Jimmy Lin. 2021. “BERxiT: Early Exiting for BERT with Better Fine-Tuning and Extension to Regression.” In Proceedings of the 16th Conference of the European Chapter of the Association for Computational Linguistics: Main Volume, edited by Paola Merlo, Jorg Tiedemann, and Reut Tsarfaty. Association for Computational Linguistics. https://doi.org/10.18653/v1/2021.eacl-main.8.
除了沿单一线性流水线截断执行深度之外,条件计算 还会动态调节激活值在网络图中的拓扑路由 (Bengio et al. 2015)。门控函数对激活张量进行评估,以绕过残差层、改变算子内核或选择专门的功能块,而非按预定义顺序执行所有模块。这将静态有向无环图(DAG)转变为依赖输入的动态图。
Bengio, Emmanuel, Pierre-Luc Bacon, Joelle Pineau, and Doina Precup. 2015. “Conditional Computation in Neural Networks for Faster Models.” arXiv Preprint arXiv:1511.06297.
Wang, Xin, Fisher Yu, Zi-Yi Dou, Trevor Darrell, and Joseph E. Gonzalez. 2018. “SkipNet: Learning Dynamic Routing in Convolutional Networks.” In European Conference on Computer Vision (ECCV). Springer. https://doi.org/10.1007/978-3-030-01261-8_25.
Jia, Xu, Bert De Brabandere, Tinne Tuytelaars, and Luc Van Gool. 2016. “Dynamic Filter Networks.” Advances in Neural Information Processing Systems (NeurIPS) 29.
Sabour, Sara, Nicholas Frosst, and Geoffrey E Hinton. 2017. “Dynamic Routing Between Capsules.” Advances in Neural Information Processing Systems (NeurIPS) 30.
不同架构实现针对不同的结构粒度。SkipNet 使用轻量级循环或前馈门控控制器,有条件地绕过卷积网络中的残差块,仅对计算难度较高的输入保留完整的网络深度 (Wang et al. 2018)。动态滤波器网络根据输入动态生成样本专属的卷积滤波器权重,直接修改特征提取模式,而非跳过静态权重 (Jia et al. 2016)。胶囊网络利用迭代式一致性路由,将低层特征向量引导至与之兼容的高层胶囊 (Sabour et al. 2017)。从硬件系统的角度来看,只有当绕过算子所节省的周期超过评估门控网络、执行主机与设备之间的控制同步以及管理非合并内存访问所产生的延迟时,条件路由才能实现实际运行时间上的加速。
扩展稠密 Transformer 模型会将参数容量与每词元浮点运算量直接耦合:增大模型容量会迫使每个词元都与所有参数权重矩阵进行计算,从而同时提高算术运算需求和内存带宽需求。混合专家(MoE) 架构将稠密前馈网络(FFN)层替换为一组由参数化路由器协调的并行专家子网络,从而将参数容量与每词元计算量解耦 (Shazeer et al. 2017)。Google 的 Switch Transformer23 将每个词元引导至单个专家(\(k=1\)),以此扩展这一稀疏路由原理,相较于 top-\(k\) 路由大幅降低了通信开销 (Fedus et al. 2022)。
这种稀疏激活在加速器硬件上形成了内存带宽与容量之间的基本权衡。虽然一个词元仅对全部专家参数的 \(1/E\) 执行算术运算,但所有 \(E\) 个专家矩阵都必须常驻设备内存(HBM 或 SRAM)。在运行批量较小的情况下,例如单流自回归生成,将路由分歧的词元分配给不同专家会把矩阵—矩阵乘法(\(GEMM\))拆散为算术强度较低的矩阵—向量运算(\(GEMV\)),导致内存带宽饱和。此外,词元分布不均会造成计算热点:过载的专家会丢弃超出其容量因子所允许容量的词元,而分配到的词元不足的专家则会使张量核心流水线闲置。
稀疏混合专家架构以动态路由的子网络替代单体前馈网络(FFN)。比较 figure 27 左侧的 Transformer 模块结构与右侧展开的门控路由器,可以观察到每个输入词元如何仅激活一个专家 FFN 模块。
\begin{tikzpicture}[line join=round,font=\small\sffamily]
\tikzset{%
Line/.style={line width=1.0pt,black!50,text=black},
Box/.style={inner xsep=2pt,
    node distance=0.8,
    draw=GreenLine,
    line width=0.75pt,
    fill=GreenL,
    text width=75mm,align=flush center,
    minimum width=75mm, minimum height=8mm
  },
Box2/.style={inner xsep=2pt,
    node distance=0.15,
    draw=VioletLine,
    line width=0.75pt,
    fill=VioletL2,
    text width=10mm,align=flush center,
    minimum width=10mm, minimum height=7mm
  },
Box3/.style={inner xsep=2pt,
    node distance=0.8,
    draw=VioletLine,
    line width=0.75pt,
    fill=VioletL2,
    text width=33mm,align=flush center,
    minimum width=33mm, minimum height=8mm
  },
do path picture/.style={%
    path picture={%
      \pgfpointdiff{\pgfpointanchor{path picture bounding box}{south west}}%
        {\pgfpointanchor{path picture bounding box}{north east}}%
      \pgfgetlastxy\x\y%
      \tikzset{x=\x/2,y=\y/2}%
      #1
    }
  },
  cross/.style={do path picture={
    \draw [line cap=round] (-1,-1) -- (1,1) (-1,1) -- (1,-1);
  }},
plus/.style={do path picture={
    \draw [line cap=round] (-3/4,0) -- (3/4,0) (0,-3/4) -- (0,3/4);
  }}
}

\node[Box,fill=RedL,draw=RedLine](P1){自注意力};
\node[Box,above=0.4 of P1,fill=BrownL,draw=BrownLine](P2){相加 + 归一化};
\node[Box,node distance=6.5,above=of P2,fill=BrownL,draw=BrownLine](P3){相加 + 归一化};
\draw[Line,-latex](P2.172)coordinate(DPR1)--++(90:1)coordinate(PR1);
\draw[Line,-latex](P2.8)coordinate(DPR2)--++(90:1)coordinate(PR2);
\draw[Line,-latex](P3.172)coordinate(DAN1)--++(90:0.5)coordinate(AN1);
\draw[Line,-latex](P3.8)coordinate(DAN2)--++(90:0.5)coordinate(AN2);
\draw[Line,-latex](P1.172)--(P1.172|-P2.south);
\draw[Line,-latex](P1.8)--(P1.8|-P2.south);
%%%Router-1
\begin{scope}[local bounding box=R1,line width=0.5pt,shift={($(PR1)+(-0.4,0.2)$)}]
\newcommand{\Depth}{1.3}
\newcommand{\Height}{0.7}
\newcommand{\Width}{0.4}
\coordinate (O2) at (0,0,0);
\coordinate (A2) at (0,\Width,0);
\coordinate (B2) at (0,\Width,\Height);
\coordinate (C2) at (0,0,\Height);
\coordinate (D2) at (\Depth,0,0);
\coordinate (E2) at (\Depth,\Width,0);
\coordinate (F2) at (\Depth,\Width,\Height);
\coordinate (G2) at (\Depth,0,\Height);

\draw[fill=GreenL] (D2) -- (E2) -- (F2) -- (G2) -- cycle;% Right Face
\draw[fill=GreenL] (C2) -- (B2) -- (F2) -- (G2) -- (C2);% Front Face
\draw[fill=GreenL] (A2) -- (B2) -- (F2) -- (E2) -- cycle;% Top Face
%
\node[]at($(B2)!0.5!(G2)$){路由器};

\begin{scope}[local bounding box=BB1,line width=0.5pt,inner sep=3.6pt]
\def\dx{0.25}
\def\dy{0.5}
\def\dz{0.2}
% bottom-left corner coordinate (bar origin)
\def\x{0}
\def\y{0.21}
\def\z{0}

% boje
%\filldraw[fill=blue!30, draw=black] (\x,\y,\z) -- (\x,\y,\z+\dz) -- (\x,\y+\dy,\z+\dz) -- (\x,\y+\dy,\z) -- cycle; % leva strana
\filldraw[fill=red!10, draw=black] (\x,\y+\dy,\z) -- (\x,\y+\dy,\z+\dz) -- (\x+\dx,\y+\dy,\z+\dz) -- (\x+\dx,\y+\dy,\z) -- cycle; % gornja strana
%\filldraw[fill=blue!20, draw=black] (\x,\y,\z) -- (\x,\y,\z+\dz) -- (\x+\dx,\y,\z+\dz) -- (\x+\dx,\y,\z) -- cycle; % donja strana
%\filldraw[fill=blue!40, draw=black] (\x,\y,\z) -- (\x+\dx,\y,\z) -- (\x+\dx,\y+\dy,\z) -- (\x,\y+\dy,\z) -- cycle; % zadnja strana
\filldraw[fill=red!50, draw=black] (\x+\dx,\y,\z) -- (\x+\dx,\y,\z+\dz) -- (\x+\dx,\y+\dy,\z+\dz) -- (\x+\dx,\y+\dy,\z) -- cycle; % desna strana
\filldraw[fill=red!60, draw=black] (\x,\y,\z+\dz) -- (\x+\dx,\y,\z+\dz) -- (\x+\dx,\y+\dy,\z+\dz) -- (\x,\y+\dy,\z+\dz) -- cycle; % prednja strana
\end{scope}

\begin{scope}[local bounding box=BB1,shift={(0.25,0)}]
\def\dx{0.25}
\def\dy{1.0}
\def\dz{0.2}
%
\def\x{0}
\def\y{0.21}
\def\z{0}
\filldraw[fill=red!10, draw=black] (\x,\y+\dy,\z)coordinate(NB1) -- (\x,\y+\dy,\z+\dz) -- (\x+\dx,\y+\dy,\z+\dz) -- (\x+\dx,\y+\dy,\z) -- cycle; % gornja strana
\filldraw[fill=red!50, draw=black] (\x+\dx,\y,\z) -- (\x+\dx,\y,\z+\dz) -- (\x+\dx,\y+\dy,\z+\dz) -- (\x+\dx,\y+\dy,\z) -- cycle; % desna strana
\filldraw[fill=red!60, draw=black] (\x,\y,\z+\dz) -- (\x+\dx,\y,\z+\dz) -- (\x+\dx,\y+\dy,\z+\dz) -- (\x,\y+\dy,\z+\dz) -- cycle; % prednja strana
\end{scope}
\begin{scope}[local bounding box=BB1,shift={(0.5,0)}]
\def\dx{0.25}
\def\dy{0.2}
\def\dz{0.2}
%
\def\x{0}
\def\y{0.21}
\def\z{0}
%
\filldraw[fill=red!10, draw=black] (\x,\y+\dy,\z) -- (\x,\y+\dy,\z+\dz) -- (\x+\dx,\y+\dy,\z+\dz) -- (\x+\dx,\y+\dy,\z) -- cycle; % gornja strana
\filldraw[fill=red!50, draw=black] (\x+\dx,\y,\z) -- (\x+\dx,\y,\z+\dz) -- (\x+\dx,\y+\dy,\z+\dz) -- (\x+\dx,\y+\dy,\z) -- cycle; % desna strana
\filldraw[fill=red!60, draw=black] (\x,\y,\z+\dz) -- (\x+\dx,\y,\z+\dz) -- (\x+\dx,\y+\dy,\z+\dz) -- (\x,\y+\dy,\z+\dz) -- cycle; % prednja strana
\end{scope}
\begin{scope}[local bounding box=BB1,shift={(0.75,0)}]
\def\dx{0.25}
\def\dy{0.6}
\def\dz{0.2}
%
\def\x{0}
\def\y{0.21}
\def\z{0}
%
\filldraw[fill=red!10, draw=black] (\x,\y+\dy,\z) -- (\x,\y+\dy,\z+\dz) -- (\x+\dx,\y+\dy,\z+\dz) -- (\x+\dx,\y+\dy,\z) -- cycle; % gornja strana
\filldraw[fill=red!50, draw=black] (\x+\dx,\y,\z) -- (\x+\dx,\y,\z+\dz) -- (\x+\dx,\y+\dy,\z+\dz) -- (\x+\dx,\y+\dy,\z) -- cycle; % desna strana
\filldraw[fill=red!60, draw=black] (\x,\y,\z+\dz) -- (\x+\dx,\y,\z+\dz) -- (\x+\dx,\y+\dy,\z+\dz) -- (\x,\y+\dy,\z+\dz) -- cycle; % prednja strana
\end{scope}
\end{scope}
%%%%%%%%%%%%%%%%%%
%%%Router-2
\begin{scope}[local bounding box=R1,line width=0.5pt,shift={($(PR2)+(-0.4,0.2)$)}]
\newcommand{\Depth}{1.3}
\newcommand{\Height}{0.7}
\newcommand{\Width}{0.4}
\coordinate (O2) at (0,0,0);
\coordinate (A2) at (0,\Width,0);
\coordinate (B2) at (0,\Width,\Height);
\coordinate (C2) at (0,0,\Height);
\coordinate (D2) at (\Depth,0,0);
\coordinate (E2) at (\Depth,\Width,0);
\coordinate (F2) at (\Depth,\Width,\Height);
\coordinate (G2) at (\Depth,0,\Height);

\draw[fill=GreenL] (D2) -- (E2) -- (F2) -- (G2) -- cycle;% Right Face
\draw[fill=GreenL] (C2) -- (B2) -- (F2) -- (G2) -- (C2);% Front Face
\draw[fill=GreenL] (A2) -- (B2) -- (F2) -- (E2) -- cycle;% Top Face
%
\node[]at($(B2)!0.5!(G2)$){路由器};

\begin{scope}[local bounding box=BB1,line width=0.5pt,inner sep=3.6pt]
\def\dx{0.25}
\def\dy{1.1}
\def\dz{0.2}
%
\def\x{0}
\def\y{0.21}
\def\z{0}

%
\filldraw[fill=red!10, draw=black] (\x,\y+\dy,\z) coordinate(NB2)-- (\x,\y+\dy,\z+\dz) -- (\x+\dx,\y+\dy,\z+\dz) -- (\x+\dx,\y+\dy,\z) -- cycle; % gornja strana
\filldraw[fill=red!50, draw=black] (\x+\dx,\y,\z) -- (\x+\dx,\y,\z+\dz) -- (\x+\dx,\y+\dy,\z+\dz) -- (\x+\dx,\y+\dy,\z) -- cycle; % desna strana
\filldraw[fill=red!60, draw=black] (\x,\y,\z+\dz) -- (\x+\dx,\y,\z+\dz) -- (\x+\dx,\y+\dy,\z+\dz) -- (\x,\y+\dy,\z+\dz) -- cycle; % prednja strana
\end{scope}

\begin{scope}[local bounding box=BB1,shift={(0.25,0)}]
\def\dx{0.25}
\def\dy{0.6}
\def\dz{0.2}
%
\def\x{0}
\def\y{0.21}
\def\z{0}
\filldraw[fill=red!10, draw=black] (\x,\y+\dy,\z) -- (\x,\y+\dy,\z+\dz) -- (\x+\dx,\y+\dy,\z+\dz) -- (\x+\dx,\y+\dy,\z) -- cycle; % gornja strana
\filldraw[fill=red!50, draw=black] (\x+\dx,\y,\z) -- (\x+\dx,\y,\z+\dz) -- (\x+\dx,\y+\dy,\z+\dz) -- (\x+\dx,\y+\dy,\z) -- cycle; % desna strana
\filldraw[fill=red!60, draw=black] (\x,\y,\z+\dz) -- (\x+\dx,\y,\z+\dz) -- (\x+\dx,\y+\dy,\z+\dz) -- (\x,\y+\dy,\z+\dz) -- cycle; % prednja strana
\end{scope}
\begin{scope}[local bounding box=BB1,shift={(0.5,0)}]
\def\dx{0.25}
\def\dy{0.3}
\def\dz{0.2}
%
\def\x{0}
\def\y{0.21}
\def\z{0}
%
\filldraw[fill=red!10, draw=black] (\x,\y+\dy,\z) -- (\x,\y+\dy,\z+\dz) -- (\x+\dx,\y+\dy,\z+\dz) -- (\x+\dx,\y+\dy,\z) -- cycle; % gornja strana
\filldraw[fill=red!50, draw=black] (\x+\dx,\y,\z) -- (\x+\dx,\y,\z+\dz) -- (\x+\dx,\y+\dy,\z+\dz) -- (\x+\dx,\y+\dy,\z) -- cycle; % desna strana
\filldraw[fill=red!60, draw=black] (\x,\y,\z+\dz) -- (\x+\dx,\y,\z+\dz) -- (\x+\dx,\y+\dy,\z+\dz) -- (\x,\y+\dy,\z+\dz) -- cycle; % prednja strana
\end{scope}
\begin{scope}[local bounding box=BB1,shift={(0.75,0)}]
\def\dx{0.25}
\def\dy{0.15}
\def\dz{0.2}
%
\def\x{0}
\def\y{0.21}
\def\z{0}
%
\filldraw[fill=red!10, draw=black] (\x,\y+\dy,\z) -- (\x,\y+\dy,\z+\dz) -- (\x+\dx,\y+\dy,\z+\dz) -- (\x+\dx,\y+\dy,\z) -- cycle; % gornja strana
\filldraw[fill=red!50, draw=black] (\x+\dx,\y,\z) -- (\x+\dx,\y,\z+\dz) -- (\x+\dx,\y+\dy,\z+\dz) -- (\x+\dx,\y+\dy,\z) -- cycle; % desna strana
\filldraw[fill=red!60, draw=black] (\x,\y,\z+\dz) -- (\x+\dx,\y,\z+\dz) -- (\x+\dx,\y+\dy,\z+\dz) -- (\x,\y+\dy,\z+\dz) -- cycle; % prednja strana
\end{scope}
\end{scope}
%%%%%%%%%%%%%%%%%
%FFN left
\begin{scope}[local bounding box=SFFN1,line width=0.5pt,shift={($(NB1)+(-1.85,1.55)$)}]
\node[Box2](FFN1){FFN1};
\node[Box2,right=of FFN1,line width=1.5pt](FFN2){FFN2};
\node[Box2,right=of FFN2](FFN3){FFN3};
\node[Box2,right=of FFN3](FFN4){FFN4};
\end{scope}
%FFN right
\begin{scope}[local bounding box=SFFN2,line width=0.5pt,shift={($(SFFN1)+(3.9,0)$)}]
\node[Box2,line width=1.5pt](2FFN1){FFN1};
\node[Box2,right=of 2FFN1](2FFN2){FFN2};
\node[Box2,right=of 2FFN2](2FFN3){FFN3};
\node[Box2,right=of 2FFN3](2FFN4){FFN4};
\end{scope}
\node[draw,circle,line width=0.75pt, above=1.2 of $(FFN2)!0.5!(FFN3)$,cross,minimum width=6mm](CI1){};
\node[draw,circle,line width=0.75pt, above=1.2 of $(2FFN2)!0.5!(2FFN3)$,cross,minimum width=6mm](CI2){};
%
\draw[Line,-latex](NB1)--++(90:0.5)-|(FFN2);
\draw[Line,-latex](NB2)--++(90:0.5)-|(2FFN1);
\draw[Line,-latex,dashed,rounded corners=8pt](NB1)--
node[below,pos=0.5]{$p = 0.65$}++(180:2.7)|-(CI1.west);
\draw[Line,-latex,dashed,rounded corners=8pt](NB2)--
node[below,pos=0.5]{$p = 0.8$}++(0:3.2)|-(CI2.east);
\draw[Line,-latex](CI1)--(CI1|-P3.south);
\draw[Line,-latex](CI2)--(CI2|-P3.south);
\draw[Line,-latex](FFN2)--++(90:0.7)-|(CI1);
\draw[Line,-latex](2FFN1)--++(90:0.7)-|(CI2);
%%%
%fitting
\scoped[on background layer]
\node[draw=BackLine,inner xsep=7mm,inner ysep=3mm,
yshift=0mm,fill=BackColor!70,fit=(FFN1)(2FFN4)(CI2)(R1),line width=0.75pt](GBB2){};
%%below Router to Add +Normalize
\draw[Line,-latex]($(DPR1)!0.25!(PR1)$)--++(180:3.8)|-(P3);
\draw[Line,-latex]($(DPR2)!0.25!(PR2)$)--++(0:3.8)|-(P3);
%%%Above Add + Normalize
\begin{scope}[local bounding box=Y1,line width=0.5pt,shift={($(AN1)+(-1.2,0)$)}]
\def\side{0.4}
\foreach \i/\col in {0/white,1/green!40,2/white,3/green!40,4/white,5/green!40}{
    \draw[fill=\col,thick] (\i*\side,0) rectangle ++(\side,\side);
}
\end{scope}
\node[left=2pt of Y1]{$y_1$};
\begin{scope}[local bounding box=Y2,line width=0.5pt,shift={($(AN2)+(-1.2,0)$)}]
\def\side{0.4}
\foreach \i/\col in {0/white,1/green!40,2/white,3/green!40,4/white,5/green!40}{
    \draw[fill=\col,thick] (\i*\side,0) rectangle ++(\side,\side);
}
\end{scope}
\node[left=2pt of Y2]{$y_2$};
%%below Self-Attention
\draw[Line,latex-](P1.188)coordinate(GSA1)--++(270:0.7)coordinate(SA1);
\node[draw,circle,line width=0.75pt, below=0 of SA1,cross,minimum width=6mm](CI3){};
\draw[Line,latex-](P1.352)coordinate(GSA2)--++(270:0.7)coordinate(SA2);
\node[draw,circle,line width=0.75pt, below=0 of SA2,cross,minimum width=6mm](CI4){};
\draw[Line,latex-](CI3.south)coordinate(GDCI3)--++(270:0.7)coordinate(DCI3);
\draw[Line,latex-](CI4.south)coordinate(GDCI4)--++(270:0.7)coordinate(DCI4);%
%
\node[left=2pt of CI3,align=center]{位置\\ 嵌入};
\node[left=2pt of CI4,align=center]{位置\\ 嵌入};
%
\begin{scope}[local bounding box=X1,line width=0.5pt,shift={($(DCI3)+(-1.2,-0.14)$)}]
\def\side{0.4}
\foreach \i/\col in {0/white,1/green!40,2/white,3/green!40,4/white,5/green!40}{
    \draw[fill=\col,thick] (\i*\side,0) rectangle ++(\side,\side);
}
\end{scope}
\node[left=2pt of X1]{$x_1$};
\node[below=2pt of X1]{更多};
\begin{scope}[local bounding box=X2,line width=0.5pt,shift={($(DCI4)+(-1.2,-0.14)$)}]
\def\side{0.4}
\foreach \i/\col in {0/white,1/green!40,2/white,3/green!40,4/white,5/green!40}{
    \draw[fill=\col,thick] (\i*\side,0) rectangle ++(\side,\side);
}
\end{scope}
\node[left=2pt of X2]{$x_2$};
\node[below=2pt of X2]{参数};
%
\draw[Line,-latex]($(GSA1)!0.5!(SA1)$)--++(180:3.8)|-(P2);
\draw[Line,-latex]($(GSA2)!0.5!(SA2)$)--++(0:3.8)|-(P2);
%%%%%%%%%%%%
%left diagram
\begin{scope}[local bounding box=LD,line width=0.5pt,shift={(-13,1.8)}]
\node[Box3,fill=RedL,draw=RedLine](2P1){自注意力};
\node[Box3,above=of 2P1,fill=BrownL,draw=BrownLine](2P2){相加 + 归一化};
\node[Box3,above=of 2P2,fill=BackColor,draw=BackLine](2P3){切换式 FFN 层};
\node[Box3,above=of 2P3,fill=BrownL,draw=BrownLine](2P4){相加 + 归一化};
%
\draw[Line,-latex](2P1)--(2P2);
\draw[Line,-latex](2P2)--(2P3);
\draw[Line,-latex](2P3)--(2P4);
\draw[Line,-latex](2P4)--++(90:1)node[above]{$y$};
\draw[Line,latex-](2P1)--++(270:1)node[below]{$x$};
\draw[blue,dashed,thick]($(2P1.south east)+(0.2,-0.2)$)--++(310:5);
\draw[blue,dashed,thick]($(2P4.north east)+(0.2,-0.2)$)--++(40:5);
\end{scope}
\end{tikzpicture}由于路由器位于关键执行路径上,加速器运行时必须在专家模块之间动态分派和收集激活值,同时避免触发主机与设备同步引起的停顿。在 GPU 和 TPU 等 SIMD 与 SIMT 架构上,高效执行稀疏专家层需要进行词元重排:将分配给同一专家的词元收集到连续的内存分块中,以在后续矩阵乘法期间维持较高的张量核心利用率 (Lepikhin et al. 2021)。如果路由分布高度偏斜,热门专家的词元缓冲区就会超出为其分配的固定容量,迫使系统丢弃部分词元(导致表征退化),或触发不规则内核启动,使并行向量通道闲置。
Lepikhin, Dmitry, HyoukJoong Lee, Yuanzhong Xu, Dehao Chen, Orhan Firat, Yanping Huang, Maxim Krikun, Noam Shazeer, and Zhifeng Chen. 2021. “GShard: Scaling Giant Models with Conditional Computation and Automatic Sharding.” International Conference on Learning Representations (ICLR).
Yang, Le, Yizeng Han, Xi Chen, Shiji Song, Jifeng Dai, and Gao Huang. 2020. “Resolution Adaptive Networks for Efficient Inference.” 2020 IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2366–75. https://doi.org/10.1109/cvpr42600.2020.00244.
Wu, Jian, Hao Cheng, and Yifan Zhang. 2019. “Fast Neural Networks: Efficient and Adaptive Computation for Inference.” Advances in Neural Information Processing Systems (NeurIPS).
提前退出和 MoE 路由进行的是离散分支选择,而自适应推理也可以根据实时任务难度,逐步调节深度或迭代次数,以连续方式运行 (Yang et al. 2020)。快速神经网络根据运行时复杂度估计器动态调整活跃层数 (J. Wu et al. 2019),动态层缩放则逐步分配计算资源,直到输出不确定性降至经过校准的阈值以下。以处理传感器流的嵌入式视觉系统为例:道路几何形态清晰的高对比度帧,仅需经过特征提取层的最短前缀即可完成处理,而包含被遮挡障碍物的劣化帧则会触发更深的循环处理模块。只有当控制评估的计算开销保持轻量,并且运行时将执行深度相匹配的帧并发调度以维持较高的硬件利用率时,才能在实际系统中获得收益。
实现挑战
要实现自适应计算带来的效率收益,需要克服模型训练、运行时编排和硬件适配方面的关键挑战。在训练期间,离散路由决策(例如不可微的 \(\mathrm{argmax}\) 选择)会中断标准反向传播。实践中必须采用 Gumbel-Softmax 估计器等连续松弛方法、强化学习策略梯度或辅助负载均衡损失,以防止路由崩塌,即路由器将过多输入分配给单个专家或退出点 (Shazeer et al. 2017)。
Shazeer, Noam, Azalia Mirhoseini, Krzysztof Maziarz, Andy Davis, Quoc Le, Geoffrey Hinton, and Jeff Dean. 2017. “Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer.” International Conference on Learning Representations (ICLR).
在运行时,控制流分支与现代加速器的大规模同步并行执行模型存在根本冲突。当 GPU 线程束中的并行线程遇到不同的执行分支时,硬件会串行执行各分支,并屏蔽非活跃线程,使理论上的浮点运算量缩减无法转化为收益。此外,评估门控网络会引入控制依赖,阻碍算子融合,引入主机与设备之间的同步屏障,并要求为词元重排执行中间内存复制。如果这些分派开销超过跳过层所节省的计算时间,动态模型的端到端延迟就会高于稠密基线模型。动态内核执行 探讨了为管理这些执行模式而设计的硬件感知运行时策略,包括不规则批处理和动态内核启动队列。
除了系统效率之外,动态控制还会引入严重的质量与安全失效模式。由于门控策略基于统计启发式方法对输入进行路由,校准不佳的门控会系统性地为分布尾部的罕见输入分配不足的计算量,恰恰降低安全关键边缘案例上的预测准确率。此外,依赖输入的计算还会暴露攻击面:对抗扰动可以蓄意操纵路由门控,触发质量拒绝攻击(强制将输入送入经截断、会产生错误结果的提前退出路径)或拒绝服务攻击(强制将所有输入送入深度最大或负载不均衡的路径,使加速器队列饱和)。因此,评估自适应模型不能仅依赖平均浮点运算次数。严格的系统性能剖析必须报告路径分布直方图、尾延迟(P99)、按输入难度分层统计的准确率,以及动态批处理下的吞吐量稳定性。动态计算决定是否执行某些操作,而稀疏性利用则回答一个互补的问题:当许多操作数为零时,如何加速计算。
稀疏性利用
回顾 section 1.3.1 中介绍的剪枝,它会在权重矩阵中引入零值。稀疏性利用研究的是存在这些零值时如何加速计算。剪枝会产生零值或移除结构;稀疏格式可以减少存储需求,与之匹配的计算内核则可以减少计算量。机器学习中的稀疏性24是指张量(如权重矩阵或激活张量)中相当一部分元素为零或接近零的状态。
更形式化地,对于稀疏权重矩阵 \(\mathbf{W}_{\text{sparse}} \in \mathbb{R}^{m \times n}\),稀疏率 \(\rho_{\text{sparse}}\) 可表示为: \[ \rho_{\text{sparse}} = \frac{\Vert \mathbf{1}_{\{(\mathbf{W}_{\text{sparse}})_{ij} = 0\}} \Vert_0}{m \times n} \] 其中,\(\mathbf{1}_{\{(\mathbf{W}_{\text{sparse}})_{ij} = 0\}}\) 是指示函数,当元素 \((i,j)\) 为零时取值为 1,否则为 0;\(\Vert \cdot \Vert_0\) 表示 L0 范数,用于统计非零元素的数量。浮点数可以表示精确的零值,但当剪枝方法将幅值较小的值视为可移除元素时,基于阈值的定义也会将这些值归入其中。基于阈值的稀疏率变为: \[ \rho_{\text{sparse},\epsilon} = \frac{\Vert \mathbf{1}_{\{|(\mathbf{W}_{\text{sparse}})_{ij}| < \epsilon\}} \Vert_0}{m \times n} \] 其中,\(\epsilon\) 是一个较小的阈值。
精确稀疏性可以在训练过程中通过正则化产生,也可以通过剪枝有意引入,即将选定元素强制置零。只有当存储格式和执行路径跳过这些零值所产生的开销小于稠密执行的开销时,稀疏性才能节省内存、计算或能耗。这一限定条件对于资源受限设备尤为重要,因为索引元数据和不规则访问也会消耗同样稀缺的带宽和电力。
稀疏性类型
硬件决策首先取决于零值的分布模式。神经网络中的稀疏性大体分为两类:非结构化稀疏性和结构化稀疏性。
非结构化稀疏性是指不遵循任何特定模式,将单个权重置零,通常通过基于幅值的剪枝实现。虽然灵活性很高,但由于缺乏可预测的结构,非结构化稀疏性在硬件上的执行效率较低。25利用这种稀疏性需要专用硬件或软件优化。
结构化稀疏性会移除具有规则结构的元素组,例如滤波器、神经元、通道、块,或组内固定模式。规则性使存储和执行更具可预测性,但能否加速仍取决于目标硬件是否支持该结构,以及由此得到的形状能否高效利用其计算单元。因此,当部署要求资源使用可预测时,它是一种候选方案,而非必然的首选。
稀疏性利用方法
对于一个将 90% 权重置零的稀疏模型,如果硬件并非针对不规则内存访问而设计,其运行时仍可能承担接近完整的计算成本。关键问题在于如何将理论上的零值转化为实际加速。除非处理器知道操作数为零,否则它无法跳过乘法运算——而要获知这一点,首先就需要从内存中加载该操作数。弥合这一差距,需要专门的利用方法和能够高效跳过零值计算的硬件支持 (Hoefler et al. 2021)。Han 等人的剪枝工作 (2015) 是通过移除不重要连接将稠密网络转化为稀疏网络的经典示例,但加速器能否实现加速,取决于所得稀疏模式是否与硬件支持的格式相匹配。
Han, Song, Jeff Pool, John Tran, and William J. Dally. 2015. “Learning Both Weights and Connections for Efficient Neural Networks.” Advances in Neural Information Processing Systems 28 (NeurIPS 2015), 1135–43.
最简单的利用方法是稀疏矩阵运算:存储非零值,并利用其索引跳过针对零值的算术运算。考虑以下差异:一个稠密的 \(4{\times}4\) 矩阵与向量相乘通常需要 16 次乘法,而支持稀疏性的实现除了处理稀疏元数据外,只需计算六个非零乘积: \[ \begin{bmatrix} 2 & 0 & 0 & 1 \\ 0 & 3 & 0 & 0 \\ 4 & 0 & 5 & 0 \\ 0 & 0 & 0 & 6 \end{bmatrix} \begin{bmatrix} x_1 \\ x_2 \\ x_3 \\ x_4 \end{bmatrix} = \begin{bmatrix} 2x_1 + x_4 \\ 3x_2 \\ 4x_1 + 5x_3 \\ 6x_4 \end{bmatrix} \]
因此,部署选择并非笼统地追求更少的参数,而是在运行时能够高效执行的表示形式之间作出选择。前文 section 1.3.3.1 中介绍的低秩近似将一个稠密矩阵替换为更小的稠密因子,而稀疏性利用则跳过值确实为零的权重。稀疏性感知训练和稀疏梯度下降可以帮助模型学习或维持零值模式,但只有部署时采用能够跳过零值的格式和计算内核,才能获得运行时加速。因此,下一个设计问题不仅是矩阵有多稀疏,还包括零值具有怎样的结构。
结构化模式
要通过稀疏性实现实际加速,需要能够高效跳过零值计算的硬件。不同处理器架构处理稀疏模式的效果各不相同——例如,Ampere 稀疏张量核心利用细粒度的 2:4 结构化模式,而脉动阵列则要求稠密块结构,相关硬件机制详见 N:M 结构化稀疏性的机制。cuSPARSE 等软件库可以将稀疏计算重新表述为当前硬件能够高效处理的模式,从而帮助弥合这一差距。例如,MegaBlocks (Gale et al. 2022) 将稀疏混合专家训练重新表述为块稀疏运算,将路由后的专家与词元计算任务分组为稠密分块,使专门的计算内核即使面对不规则的稀疏模式,也能维持较高的加速器利用率。
Gale, Trevor, Deepak Narayanan, Cliff Young, and Matei Zaharia. 2022. “MegaBlocks: Efficient Sparse Training with Mixture-of-Experts.” arXiv Preprint.
Dao, Tri, Beidi Chen, Nimit Sohoni, Arjun Desai, Michael Poli, Jessica Grogan, Alexander Liu, Aniruddh Rao, Atri Rudra, and Christopher Ré. 2022. “Monarch: Expressive Structured Matrices for Efficient and Accurate Training.” arXiv Preprint.
只有当稀疏模式足够规则,能够被计算内核预测时,它才能带来硬件加速。两种主要格式明确体现了这种规则性:块稀疏矩阵和 N:M 稀疏模式。块稀疏矩阵将全零子矩阵块与非零稠密子矩阵块分离,使对大型稀疏矩阵的运算可以重新表述为对子矩阵执行较少次数的稠密运算。这种结构既能更高效地存储稠密子矩阵,又能保持矩阵或向量乘积所需的形状兼容性。例如,figure 28 展示了 NVIDIA 的 cuSPARSE (NVIDIA 2020) 库如何支持稀疏块矩阵的运算与存储。Monarch 矩阵 (Tri Dao et al. 2022) 等其他多项工作也以这种块稀疏方法为基础,在矩阵表达能力与计算及内存效率之间取得了更好的平衡。
\scalebox{0.6}{\begin{tikzpicture}[line join=round,font=\sffamily]
\tikzset{%
helvetica/.style={align=flush center,font=\small\sffamily},
Line/.style={line width=1.0pt,black!50,text=black},
}
\definecolor{Blue1}{RGB}{23,68,150}
\definecolor{Blue2}{RGB}{84,131,217}
\definecolor{Blue3}{RGB}{145,177,237}
\def\columns{3}
\def\rows{3}
\def\cellsize{5mm}
\def\cellheight{5mm}

\begin{scope}[local bounding box=BL1]
\begin{scope}[local bounding box=matrica1]
\def\rowone{Blue2,Blue3,Blue2}
\def\rowtwo{Blue2,Blue1,Blue2}
\def\rowthree{Blue2,Blue2,Blue2}
\def\br{A}
%
\foreach \x in {1,...,\columns}{
    \foreach \y in {1,...,\rows}{
        %
        \node[draw=white, line width=1pt,fill=black!10, minimum width=\cellsize,
                    minimum height=\cellheight, line width=0.5pt] (cell-\x-\y\br) at (\x*\cellsize,-\y*\cellheight) {};
    }
}

%
\foreach \color [count=\x] in \rowone {
    \node[fill=\color,draw=white,line width=1pt, minimum size=\cellsize,
    minimum height=\cellheight] at (cell-\x-1\br) {};
}
\foreach \color [count=\x] in \rowtwo {
    \node[fill=\color,draw=white,line width=1pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-2\br) {};
}
\foreach \color [count=\x] in \rowthree {
    \node[fill=\color,draw=white,line width=1pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-3\br) {};
}

%countur line
\draw[line width=2pt,black!80]
    (0.5*\cellsize,-0.5*\cellheight) rectangle
    (\columns*\cellsize+0.5*\cellsize,-\rows*\cellheight-0.5*\cellheight);
\end{scope}
%%%%%%
\begin{scope}[shift={(1.5,0)}]
\def\rowone{Blue1,Blue2,Blue2}
\def\rowtwo{Blue3,Blue2,Blue1}
\def\rowthree{Blue2,Blue1,Blue2}
\def\br{B}
%
\foreach \x in {1,...,\columns}{
    \foreach \y in {1,...,\rows}{
        %
        \node[draw=white, line width=1pt,fill=black!10, minimum width=\cellsize,
                    minimum height=\cellheight, line width=0.5pt] (cell-\x-\y\br) at (\x*\cellsize,-\y*\cellheight) {};
    }
}

%
\foreach \color [count=\x] in \rowone {
    \node[fill=\color,draw=white,line width=1pt, minimum size=\cellsize,
    minimum height=\cellheight] at (cell-\x-1\br) {};
}
\foreach \color [count=\x] in \rowtwo {
    \node[fill=\color,draw=white,line width=1pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-2\br) {};
}
\foreach \color [count=\x] in \rowthree {
    \node[fill=\color,draw=white,line width=1pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-3\br) {};
}

%countur line
\draw[line width=2pt,black!80]
    (0.5*\cellsize,-0.5*\cellheight) rectangle
    (\columns*\cellsize+0.5*\cellsize,-\rows*\cellheight-0.5*\cellheight);
\end{scope}
%%%%%%
\begin{scope}[shift={(3.0,0)}]
\def\br{C}
%
\foreach \x in {1,...,\columns}{
    \foreach \y in {1,...,\rows}{
        %
        \node[draw=white, line width=1pt,fill=black!10, minimum width=\cellsize,
                    minimum height=\cellheight, line width=0.5pt] (cell-\x-\y\br) at (\x*\cellsize,-\y*\cellheight) {};
    }
}
%countur line
\draw[line width=2pt,black!80]
    (0.5*\cellsize,-0.5*\cellheight) rectangle
    (\columns*\cellsize+0.5*\cellsize,-\rows*\cellheight-0.5*\cellheight);
\end{scope}
%%%%%%%%
%second row
\begin{scope}[shift={(0,-1.5)}]
\def\rowone{Blue1,Blue3,Blue3}
\def\rowtwo{Blue1,Blue2,Blue2}
\def\rowthree{Blue2,Blue1,Blue2}
\def\br{D}
%
\foreach \x in {1,...,\columns}{
    \foreach \y in {1,...,\rows}{
        %
        \node[draw=white, line width=1pt,fill=black!10, minimum width=\cellsize,
                    minimum height=\cellheight, line width=0.5pt] (cell-\x-\y\br) at (\x*\cellsize,-\y*\cellheight) {};
    }
}

%
\foreach \color [count=\x] in \rowone {
    \node[fill=\color,draw=white,line width=1pt, minimum size=\cellsize,
    minimum height=\cellheight] at (cell-\x-1\br) {};
}
\foreach \color [count=\x] in \rowtwo {
    \node[fill=\color,draw=white,line width=1pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-2\br) {};
}
\foreach \color [count=\x] in \rowthree {
    \node[fill=\color,draw=white,line width=1pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-3\br) {};
}

%countur line
\draw[line width=2pt,black!80]
    (0.5*\cellsize,-0.5*\cellheight) rectangle
    (\columns*\cellsize+0.5*\cellsize,-\rows*\cellheight-0.5*\cellheight);
\end{scope}
\begin{scope}[shift={(1.5,-1.5)}]
\def\br{E}
%
\foreach \x in {1,...,\columns}{
    \foreach \y in {1,...,\rows}{
        %
        \node[draw=white, line width=1pt,fill=black!10, minimum width=\cellsize,
                    minimum height=\cellheight, line width=0.5pt] (cell-\x-\y\br) at (\x*\cellsize,-\y*\cellheight) {};
    }
}

%countur line
\draw[line width=2pt,black!80]
    (0.5*\cellsize,-0.5*\cellheight) rectangle
    (\columns*\cellsize+0.5*\cellsize,-\rows*\cellheight-0.5*\cellheight);
\end{scope}
\begin{scope}[shift={(3,-1.5)}]
\def\rowone{Blue1,Blue2,Blue2}
\def\rowtwo{Blue2,Blue1,Blue2}
\def\rowthree{Blue2,Blue2,Blue1}
\def\br{E}
%
\foreach \x in {1,...,\columns}{
    \foreach \y in {1,...,\rows}{
        %
        \node[draw=white, line width=1pt,fill=black!10, minimum width=\cellsize,
                    minimum height=\cellheight, line width=0.5pt] (cell-\x-\y\br) at (\x*\cellsize,-\y*\cellheight) {};
    }
}

%
\foreach \color [count=\x] in \rowone {
    \node[fill=\color,draw=white,line width=1pt, minimum size=\cellsize,
    minimum height=\cellheight] at (cell-\x-1\br) {};
}
\foreach \color [count=\x] in \rowtwo {
    \node[fill=\color,draw=white,line width=1pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-2\br) {};
}
\foreach \color [count=\x] in \rowthree {
    \node[fill=\color,draw=white,line width=1pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-3\br) {};
}

%countur line
\draw[line width=2pt,black!80]
    (0.5*\cellsize,-0.5*\cellheight) rectangle
    (\columns*\cellsize+0.5*\cellsize,-\rows*\cellheight-0.5*\cellheight);
\end{scope}
%%third row
\begin{scope}[shift={(0,-3)}]
\def\br{H}
%
\foreach \x in {1,...,\columns}{
    \foreach \y in {1,...,\rows}{
        %
        \node[draw=white, line width=1pt,fill=black!10, minimum width=\cellsize,
                    minimum height=\cellheight, line width=0.5pt] (cell-\x-\y\br) at (\x*\cellsize,-\y*\cellheight) {};
    }
}

%countur line
\draw[line width=2pt,black!80]
    (0.5*\cellsize,-0.5*\cellheight) rectangle
    (\columns*\cellsize+0.5*\cellsize,-\rows*\cellheight-0.5*\cellheight);
\end{scope}
\begin{scope}[shift={(1.5,-3)}]
\def\rowone{Blue2,Blue1,Blue3}
\def\rowtwo{Blue2,Blue2,Blue1}
\def\rowthree{Blue1,Blue2,Blue2}
\def\br{E}
%
\foreach \x in {1,...,\columns}{
    \foreach \y in {1,...,\rows}{
        %
        \node[draw=white, line width=1pt,fill=black!10, minimum width=\cellsize,
                    minimum height=\cellheight, line width=0.5pt] (cell-\x-\y\br) at (\x*\cellsize,-\y*\cellheight) {};
    }
}

%
\foreach \color [count=\x] in \rowone {
    \node[fill=\color,draw=white,line width=1pt, minimum size=\cellsize,
    minimum height=\cellheight] at (cell-\x-1\br) {};
}
\foreach \color [count=\x] in \rowtwo {
    \node[fill=\color,draw=white,line width=1pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-2\br) {};
}
\foreach \color [count=\x] in \rowthree {
    \node[fill=\color,draw=white,line width=1pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-3\br) {};
}

%countur line
\draw[line width=2pt,black!80]
    (0.5*\cellsize,-0.5*\cellheight) rectangle
    (\columns*\cellsize+0.5*\cellsize,-\rows*\cellheight-0.5*\cellheight);
\end{scope}
\begin{scope}[shift={(3,-3)}]
\def\rowone{Blue2,Blue3,Blue2}
\def\rowtwo{Blue3,Blue1,Blue1}
\def\rowthree{Blue2,Blue3,Blue2}
\def\br{E}
%
\foreach \x in {1,...,\columns}{
    \foreach \y in {1,...,\rows}{
        %
        \node[draw=white, line width=1pt,fill=black!10, minimum width=\cellsize,
                    minimum height=\cellheight, line width=0.5pt] (cell-\x-\y\br) at (\x*\cellsize,-\y*\cellheight) {};
    }
}

%
\foreach \color [count=\x] in \rowone {
    \node[fill=\color,draw=white,line width=1pt, minimum size=\cellsize,
    minimum height=\cellheight] at (cell-\x-1\br) {};
}
\foreach \color [count=\x] in \rowtwo {
    \node[fill=\color,draw=white,line width=1pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-2\br) {};
}
\foreach \color [count=\x] in \rowthree {
    \node[fill=\color,draw=white,line width=1pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-3\br) {};
}

%countur line
\draw[line width=2pt,black!80]
    (0.5*\cellsize,-0.5*\cellheight) rectangle
    (\columns*\cellsize+0.5*\cellsize,-\rows*\cellheight-0.5*\cellheight);
\end{scope}
\end{scope}
\node[below=0.2 of BL1,align=center]{块稀疏\\ 权重};
\newcommand{\zeroentry}{%
    \tikz[baseline=0.8ex]{
\node[draw=black, line width=1.2pt,fill=black!10, minimum width=0.8*\cellsize,
                    minimum height=0.8*\cellheight] (cell-G)  {};
}}
\node[above=0.2 of BL1,align=center]{\zeroentry ~~= 零元素};

%%%%%%%%%%%%
%%right matrix
\begin{scope}[local bounding box=BL2,shift={(6,0)}]
\begin{scope}
\def\rowone{Blue2,Blue3,Blue2}
\def\rowtwo{Blue2,Blue1,Blue2}
\def\rowthree{Blue2,Blue2,Blue2}
\def\br{A2}
%
\foreach \x in {1,...,\columns}{
    \foreach \y in {1,...,\rows}{
        %
        \node[draw=white, line width=1pt,fill=black!10, minimum width=\cellsize,
                    minimum height=\cellheight, line width=0.5pt] (cell-\x-\y\br) at (\x*\cellsize,-\y*\cellheight) {};
    }
}
%
\foreach \color [count=\x] in \rowone {
    \node[fill=\color,draw=white,line width=1pt, minimum size=\cellsize,
    minimum height=\cellheight] at (cell-\x-1\br) {};
}
\foreach \color [count=\x] in \rowtwo {
    \node[fill=\color,draw=white,line width=1pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-2\br) {};
}
\foreach \color [count=\x] in \rowthree {
    \node[fill=\color,draw=white,line width=1pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-3\br) {};
}

%countur line
\draw[line width=2pt,black!80]
    (0.5*\cellsize,-0.5*\cellheight) rectangle
    (\columns*\cellsize+0.5*\cellsize,-\rows*\cellheight-0.5*\cellheight);
\end{scope}
%%%%%%
\begin{scope}[shift={(1.5,0)}]
\def\rowone{Blue1,Blue2,Blue2}
\def\rowtwo{Blue3,Blue2,Blue1}
\def\rowthree{Blue2,Blue1,Blue2}
\def\br{B2}
%
\foreach \x in {1,...,\columns}{
    \foreach \y in {1,...,\rows}{
        %
        \node[draw=white, line width=1pt,fill=black!10, minimum width=\cellsize,
                    minimum height=\cellheight, line width=0.5pt] (cell-\x-\y\br) at (\x*\cellsize,-\y*\cellheight) {};
    }
}

%
\foreach \color [count=\x] in \rowone {
    \node[fill=\color,draw=white,line width=1pt, minimum size=\cellsize,
    minimum height=\cellheight] at (cell-\x-1\br) {};
}
\foreach \color [count=\x] in \rowtwo {
    \node[fill=\color,draw=white,line width=1pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-2\br) {};
}
\foreach \color [count=\x] in \rowthree {
    \node[fill=\color,draw=white,line width=1pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-3\br) {};
}

%countur line
\draw[line width=2pt,black!80]
    (0.5*\cellsize,-0.5*\cellheight) rectangle
    (\columns*\cellsize+0.5*\cellsize,-\rows*\cellheight-0.5*\cellheight);
\end{scope}
%%%%%%
%second row
\begin{scope}[shift={(0,-1.5)}]
\def\rowone{Blue1,Blue3,Blue3}
\def\rowtwo{Blue1,Blue2,Blue2}
\def\rowthree{Blue2,Blue1,Blue2}
\def\br{C2}
%
\foreach \x in {1,...,\columns}{
    \foreach \y in {1,...,\rows}{
        %
        \node[draw=white, line width=1pt,fill=black!10, minimum width=\cellsize,
                    minimum height=\cellheight, line width=0.5pt] (cell-\x-\y\br) at (\x*\cellsize,-\y*\cellheight) {};
    }
}

%
\foreach \color [count=\x] in \rowone {
    \node[fill=\color,draw=white,line width=1pt, minimum size=\cellsize,
    minimum height=\cellheight] at (cell-\x-1\br) {};
}
\foreach \color [count=\x] in \rowtwo {
    \node[fill=\color,draw=white,line width=1pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-2\br) {};
}
\foreach \color [count=\x] in \rowthree {
    \node[fill=\color,draw=white,line width=1pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-3\br) {};
}

%countur line
\draw[line width=2pt,black!80]
    (0.5*\cellsize,-0.5*\cellheight) rectangle
    (\columns*\cellsize+0.5*\cellsize,-\rows*\cellheight-0.5*\cellheight);
\end{scope}
\begin{scope}[shift={(1.5,-1.5)}]
\def\rowone{Blue1,Blue2,Blue2}
\def\rowtwo{Blue2,Blue1,Blue2}
\def\rowthree{Blue2,Blue2,Blue1}
\def\br{D2}
%
\foreach \x in {1,...,\columns}{
    \foreach \y in {1,...,\rows}{
        %
        \node[draw=white, line width=1pt,fill=black!10, minimum width=\cellsize,
                    minimum height=\cellheight, line width=0.5pt] (cell-\x-\y\br) at (\x*\cellsize,-\y*\cellheight) {};
    }
}

%
\foreach \color [count=\x] in \rowone {
    \node[fill=\color,draw=white,line width=1pt, minimum size=\cellsize,
    minimum height=\cellheight] at (cell-\x-1\br) {};
}
\foreach \color [count=\x] in \rowtwo {
    \node[fill=\color,draw=white,line width=1pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-2\br) {};
}
\foreach \color [count=\x] in \rowthree {
    \node[fill=\color,draw=white,line width=1pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-3\br) {};
}

%countur line
\draw[line width=2pt,black!80]
    (0.5*\cellsize,-0.5*\cellheight) rectangle
    (\columns*\cellsize+0.5*\cellsize,-\rows*\cellheight-0.5*\cellheight);
\end{scope}
%%third row
\begin{scope}[shift={(0,-3)}]
\def\rowone{Blue2,Blue1,Blue3}
\def\rowtwo{Blue2,Blue2,Blue1}
\def\rowthree{Blue1,Blue2,Blue2}
\def\br{E2}
%
\foreach \x in {1,...,\columns}{
    \foreach \y in {1,...,\rows}{
        %
        \node[draw=white, line width=1pt,fill=black!10, minimum width=\cellsize,
                    minimum height=\cellheight, line width=0.5pt] (cell-\x-\y\br) at (\x*\cellsize,-\y*\cellheight) {};
    }
}

%
\foreach \color [count=\x] in \rowone {
    \node[fill=\color,draw=white,line width=1pt, minimum size=\cellsize,
    minimum height=\cellheight] at (cell-\x-1\br) {};
}
\foreach \color [count=\x] in \rowtwo {
    \node[fill=\color,draw=white,line width=1pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-2\br) {};
}
\foreach \color [count=\x] in \rowthree {
    \node[fill=\color,draw=white,line width=1pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-3\br) {};
}

%countur line
\draw[line width=2pt,black!80]
    (0.5*\cellsize,-0.5*\cellheight) rectangle
    (\columns*\cellsize+0.5*\cellsize,-\rows*\cellheight-0.5*\cellheight);
\end{scope}
\begin{scope}[shift={(1.5,-3)}]
\def\rowone{Blue2,Blue3,Blue2}
\def\rowtwo{Blue3,Blue1,Blue1}
\def\rowthree{Blue2,Blue3,Blue2}
\def\br{F2}
%
\foreach \x in {1,...,\columns}{
    \foreach \y in {1,...,\rows}{
        %
        \node[draw=white, line width=1pt,fill=black!10, minimum width=\cellsize,
                    minimum height=\cellheight, line width=0.5pt] (cell-\x-\y\br) at (\x*\cellsize,-\y*\cellheight) {};
    }
}

%
\foreach \color [count=\x] in \rowone {
    \node[fill=\color,draw=white,line width=1pt, minimum size=\cellsize,
    minimum height=\cellheight] at (cell-\x-1\br) {};
}
\foreach \color [count=\x] in \rowtwo {
    \node[fill=\color,draw=white,line width=1pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-2\br) {};
}
\foreach \color [count=\x] in \rowthree {
    \node[fill=\color,draw=white,line width=1pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-3\br) {};
}

%countur line
\draw[line width=2pt,black!80]
    (0.5*\cellsize,-0.5*\cellheight) rectangle
    (\columns*\cellsize+0.5*\cellsize,-\rows*\cellheight-0.5*\cellheight);
\end{scope}
\end{scope}

%%%%%%%%%%%
%%third matrix-other color
\begin{scope}[local bounding box=BL3,shift={(9.5,0.5)}]
\def\columns{2}
\def\rows{1}
\def\cellsize{5mm}
\def\cellheight{15mm}
\begin{scope}
\def\rowone{OrangeL,OrangeL}
\def\br{A3}
%
\foreach \x in {1,...,\columns}{
    \foreach \y in {1,...,\rows}{
        %
        \node[draw=white, line width=1pt,fill=white, minimum width=\cellsize,
                    minimum height=\cellheight, line width=0.5pt] (cell-\x-\y\br) at (\x*\cellsize,-\y*\cellheight) {};
    }
}
\foreach \color [count=\x] in \rowone {
    \node[fill=\color,draw=black!80,line width=2pt, minimum size=\cellsize,
    minimum height=\cellheight] at (cell-\x-1\br) {};
}
%countur line
\draw[line width=2pt,black!80]
    (0.5*\cellsize,-0.5*\cellheight) rectangle
    (\columns*\cellsize+0.5*\cellsize,-\rows*\cellheight-0.5*\cellheight);
\end{scope}
\begin{scope}[shift={(0,-1.5)}]
\def\rowone{OrangeL,OrangeL}
\def\br{B3}
%
\foreach \x in {1,...,\columns}{
    \foreach \y in {1,...,\rows}{
        %
        \node[draw=white, line width=1pt,fill=white, minimum width=\cellsize,
                    minimum height=\cellheight, line width=0.5pt] (cell-\x-\y\br) at (\x*\cellsize,-\y*\cellheight) {};
    }
}
\foreach \color [count=\x] in \rowone {
    \node[fill=\color,draw=black!80,line width=2pt, minimum size=\cellsize,
    minimum height=\cellheight] at (cell-\x-1\br) {};
}
%countur line
\draw[line width=2pt,black!80]
    (0.5*\cellsize,-0.5*\cellheight) rectangle
    (\columns*\cellsize+0.5*\cellsize,-\rows*\cellheight-0.5*\cellheight);
\end{scope}
\begin{scope}[shift={(0,-3)}]
\def\rowone{OrangeL,OrangeL}
\def\br{C3}
%
\foreach \x in {1,...,\columns}{
    \foreach \y in {1,...,\rows}{
        %
        \node[draw=white, line width=1pt,fill=white, minimum width=\cellsize,
                    minimum height=\cellheight, line width=0.5pt] (cell-\x-\y\br) at (\x*\cellsize,-\y*\cellheight) {};
    }
}
\foreach \color [count=\x] in \rowone {
    \node[fill=\color,draw=black!80,line width=2pt, minimum size=\cellsize,
    minimum height=\cellheight] at (cell-\x-1\br) {};
}
%countur line
\draw[line width=2pt,black!80]
    (0.5*\cellsize,-0.5*\cellheight) rectangle
    (\columns*\cellsize+0.5*\cellsize,-\rows*\cellheight-0.5*\cellheight);
\end{scope}
\end{scope}
\node[below=0.2 of BL2,align=center](NZ){非零\\ 数据值};
\node[below=0.2 of BL3,align=center](BI){块\\ 索引};
\scoped[on background layer]
\node[draw=none,inner xsep=0mm,inner ysep=0mm,
yshift=0mm,fill=none,fit=(NZ)(BI),line width=0.75pt](BB1){};
\node[below=2pt of BB1](IR){内部表示};

\coordinate(XA)at($(cell-1-1A2.north west)+(0.5,0.5)$);
\coordinate(XA1)at($(cell-1-3E2.south west)+(0.5,-1.5)$);
\coordinate(XB)at($(cell-1-1A3.north east)+(0,0.5)$);
\coordinate(XB1)at($(cell-1-1C3.south east)+(0.5,-1.5)$);
%\fill[red](cell-1-1A2.north west)circle(2pt);
\draw[line width=3.5pt,violet!30,rounded corners=20pt](XA)--++(180:1.3)|-(XA1);
\draw[line width=3.5pt,violet!30,rounded corners=20pt](XB)--++(0:1.3)|-(XB1);
%
\coordinate(T1)at($(cell-1-1A2.north west)+(-0.2,0.2)$);
\coordinate(T2)at($(cell-2-1A3.north east)+(0.2,0.2)$);
\coordinate(T3)at($(cell-2-1A3.south east)+(0.2,-0.2)$);
\coordinate(T4)at($(cell-1-1A3.south west)+(-0.2,-0.2)$);
\coordinate(T5)at($(cell-1-1A2.south west)+(-0.2,-0.2)$);
\draw[line width=3.5pt,red](T1)-|(T3)--(T4)|-(T5)--(T1);
%\fill[blue](T5)circle(2pt);

%%%%%%%%%%%
%%third matrix-other color
\begin{scope}[local bounding box=BL4,shift={(13,0)}]
\def\columns{4}
\def\rows{9}
\begin{scope}
\def\br{A4}
%
\foreach \x in {1,...,\columns}{
    \foreach \y in {1,...,\rows}{
        %
        \node[line width=2pt,draw=black!80, fill=GreenL, minimum width=\cellsize,
                    minimum height=\cellheight] (cell-\x-\y\br) at (\x*\cellsize,-\y*\cellheight) {};
    }
}
\end{scope}
\end{scope}
%%%%%%%%%%%
%%above matrix
\begin{scope}[local bounding box=BL5,shift={(13,6)}]
\def\columns{4}
\def\rows{9}
\begin{scope}
\def\br{A5}
%
\foreach \x in {1,...,\columns}{
    \foreach \y in {1,...,\rows}{
        %
        \node[line width=2pt,draw=black!80, fill=BrownL, minimum width=\cellsize,
                    minimum height=\cellheight] (cell-\x-\y\br) at (\x*\cellsize,-\y*\cellheight) {};
    }
}
\end{scope}
\end{scope}
\node[below=0.2 of BL4,align=center](OA){输出\\ 激活值};

\node[draw=red,inner xsep=1.5mm,inner ysep=1.5mm,outer sep=0pt,
yshift=0mm,fill=none,fit=(cell-1-1A4),line width=3.5pt](BB2){};
\draw[red,line width=1.5pt](BB2)--++(135:2)node[above left]{点积};
\node[draw=red,inner xsep=1.5mm,inner ysep=1.5mm,outer sep=0pt,
yshift=0mm,fill=none,fit=(cell-1-1A5)(cell-1-9A5),line width=3.5pt](BB3){};
%
\node[single arrow, draw=black,thick, fill=VioletL,
      minimum width = 20pt, single arrow head extend=3pt,
      minimum height=10mm]at($(BL3)!0.52!(BL4)$) {};
\node[single arrow, draw=black,thick, fill=VioletL,
      minimum width = 20pt, single arrow head extend=3pt,
      minimum height=9mm,rotate=270]at($(BL5)!0.5!(BL4)$) {};
\node[left=2mm of BB3,align=center,red]{输入\\激活值};
\end{tikzpicture}}
NVIDIA. 2020. Accelerating Matrix Multiplication with Block Sparse Format and NVIDIA Tensor Cores.
类似地,\(N\):\(M\) 稀疏性在每组 \(M\) 个连续元素中最多保留 \(N\) 个非零元素;面向硬件的剪枝通常强制恰好保留 \(N\) 个值,使每组具有相同的表示形式 (Zhou et al. 2021)。这种确定性格式使支持该格式的内核能够预知数值和元数据的布局,同时比移除整个通道或块保留更多的模型容量。这种规则性在任意掩码与稠密计算之间提供了一种可执行的折中方案,但仅适用于具有相应执行路径的目标硬件。由于每个由四个连续元素构成的块中恰好选出两个非零值,因此每个存储值只需一个 2 位索引(\(00_2\) 至 \(11_2\))来记录其在块内的原始坐标。这种紧凑的元数据对每个包含 16 个元素的行片段仅引入 16 位开销,远低于通用 CSR 或 COO 格式所需的多字节指针数组,从而使 Tensor Core 能够以流式方式处理压缩操作数,而不会造成内存带宽需求膨胀。Figure 29 比较了稠密矩阵乘法与 2:4 矩阵乘法,而 STEP 则研究如何学习更一般的 \(N\):\(M\) 掩码以用于推理 (Lu et al. 2023)。
Zhou, Aojun, Yukun Ma, Junnan Zhu, Jianbo Liu, Zhijie Zhang, Kun Yuan, Wenxiu Sun, and Hongsheng Li. 2021. “Learning n:m Fine-Grained Structured Sparse Neural Networks from Scratch.” arXiv Preprint.
Lu, Yucheng, Shivani Agrawal, Suvinay Subramanian, Oleg Rybakov, Christopher De Sa, and Amir Yazdanbakhsh. 2023. “STEP: Learning n:m Structured Sparsity Masks from Scratch with Precondition.” arXiv Preprint.
在加速器层面,同样适用这一依赖具体模式的规则:硬件支持是稀疏格式与执行路径之间的契约。
\begin{tikzpicture}[line join=round,font=\sffamily]
\tikzset{%
 mysnake/.style={postaction={draw,decorate,decoration={snake,amplitude=3pt,segment length=19pt}}},
helvetica/.style={align=flush center,font=\small\sffamily},
Line/.style={line width=1.0pt,black!50,text=black},
Box/.style={inner sep=5pt,
    node distance=0.8,
    draw=VioletLine,
    line width=0.75pt,
    fill=VioletL2,
    text width=43mm,align=flush center,
    minimum width=43mm, minimum height=7mm
  },
do path picture/.style={%
    path picture={%
      \pgfpointdiff{\pgfpointanchor{path picture bounding box}{south west}}%
        {\pgfpointanchor{path picture bounding box}{north east}}%
      \pgfgetlastxy\x\y%
      \tikzset{x=\x/2,y=\y/2}%
      #1
    }
  },
  cross/.style={do path picture={
    \draw [line cap=round] (-1,-1) -- (1,1) (-1,1) -- (1,-1);
  }},
}
\definecolor{Blue1}{RGB}{23,68,150}
\definecolor{Blue2}{RGB}{84,131,217}
\definecolor{Blue3}{RGB}{145,177,237}
\def\columns{3}
\def\rows{3}
\def\cellsize{5mm}
\def\cellheight{5mm}

\begin{scope}[local bounding box=LEFT]
\node[draw,circle,line width=0.75pt,cross,minimum width=6mm](CI1){};
\node[draw=black, line width=1.2pt,fill=GreenL, minimum width=0.9*\cellsize,
                    minimum height=0.9*\cellheight,below=0.5 of CI1](AR) {};
\node[right=1mm of AR](AR1){累加器(结果)};

\begin{scope}[local bounding box=M3,shift={(-0.2,1.5)}]
\def\columns{8}
\def\rows{1}
\def\br{M3}
%
\foreach \x in {1,...,\columns}{
    \foreach \y in {1,...,\rows}{
        %
        \node[draw=black!80, fill=BrownL, minimum width=\cellsize,
                    minimum height=\cellheight, line width=2pt] (cell-\x-\y\br) at (\x*\cellsize,-\y*\cellheight) {};
    }
}
\end{scope}
\begin{scope}[local bounding box=M1,shift={(-4.5,1.5)}]
\def\columns{8}
\def\rows{1}
\def\br{M1}
\def\rowone{Blue1,Blue2,Blue3,Blue1,Blue3,Blue1,Blue2,Blue3}
%
\foreach \x in {1,...,\columns}{
    \foreach \y in {1,...,\rows}{
        %
        \node[draw=black!80, fill=BrownL, minimum width=\cellsize,
                    minimum height=\cellheight, line width=1pt] (cell-\x-\y\br) at (\x*\cellsize,-\y*\cellheight) {};
    }
}
\foreach \color [count=\x] in \rowone {
    \node[fill=\color,draw=black!80,line width=2pt, minimum size=\cellsize,
    minimum height=\cellheight] at (cell-\x-1\br) {};
}
\end{scope}

\draw[Line,-latex](CI1)--(AR);
\draw[Line,-latex](M3)|-(CI1);
\draw[Line,-latex](M1)|-(CI1);
%%fitting
\scoped[on background layer]
\node[draw=BackLine,inner xsep=3mm,inner ysep=11mm,
yshift=8mm,fill=BackColor!50,fit=(AR1)(M1)(M3),line width=0.75pt](BB1){};
\node[anchor=north west,align=center]at(BB1.north west){Tensor Core 上的\\稠密运算};

%%below matrix Blue
\begin{scope}[local bounding box=DM1,shift={(0.2,-2.5)}]
\def\columns{8}
\def\rows{8}
\def\br{DM1}
\def\rowone{Blue1,Blue2,Blue3,Blue1,Blue3,Blue1,Blue2,Blue3}
\def\rowtwo{Blue3,Blue2,Blue3,Blue2,Blue3,Blue3,Blue1,Blue1}
\def\rowthree{Blue2,Blue1,Blue2,Blue3,Blue3,Blue2,Blue2,Blue1}
\def\rowfour{Blue2,Blue3,Blue2,Blue3,Blue1,Blue2,Blue3,Blue3}
\def\rowfive{Blue2,Blue2,Blue3,Blue1,Blue3,Blue1,Blue2,Blue3}
\def\rowsix{Blue2,Blue3,Blue1,Blue3,Blue1,Blue3,Blue2,Blue2}
\def\rowseven{Blue3,Blue3,Blue2,Blue1,Blue2,Blue2,Blue3,Blue3}
\def\rowosam{Blue3,Blue2,Blue3,Blue2,Blue3,Blue1,Blue2,Blue1}

\foreach \x in {1,...,\columns}{
    \foreach \y in {1,...,\rows}{
        %
        \node[draw=black!80, fill=BrownL, minimum width=\cellsize,
                    minimum height=\cellheight, line width=2pt] (cell-\x-\y\br) at (\x*\cellsize,-\y*\cellheight) {};
    }
}

%
\foreach \color [count=\x] in \rowone {
    \node[fill=\color,draw=black!80,line width=2pt, minimum size=\cellsize,
    minimum height=\cellheight] at (cell-\x-1\br) {};
}
\foreach \color [count=\x] in \rowtwo {
    \node[fill=\color,draw=black!80,line width=2pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-2\br) {};
}
\foreach \color [count=\x] in \rowthree {
    \node[fill=\color,draw=black!80,line width=2pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-3\br) {};
}
\foreach \color [count=\x] in \rowfour {
    \node[fill=\color,draw=black!80,line width=2pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-4\br) {};
}
\foreach \color [count=\x] in \rowfive {
    \node[fill=\color,draw=black!80,line width=2pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-5\br) {};
}
\foreach \color [count=\x] in \rowsix {
    \node[fill=\color,draw=black!80,line width=2pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-6\br) {};
}
\foreach \color [count=\x] in \rowseven {
    \node[fill=\color,draw=black!80,line width=2pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-7\br) {};
}
\foreach \color [count=\x] in \rowosam {
    \node[fill=\color,draw=black!80,line width=2pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-8\br) {};
}
\end{scope}

%
\draw[|-|,thick]([yshift=-5.5]cell-1-8DM1.south west)--node[below=0pt,
                       font=\sffamily\small]{K}([yshift=-5.5]cell-8-8DM1.south east);
\node[left=1mm of DM1.west,rotate=90,anchor=south]{A 矩阵(稠密)};
\draw[|-|,thick]([xshift=7.5]cell-8-8DM1.south east)--node[right=0pt,
                       font=\sffamily\small]{M}([xshift=7.5]cell-8-1DM1.north east);
%

\node[below=22pt of DM1](SP){\textbf{稠密 $M\times N\times K$ GEMM}};
%%%last matrix Green
\begin{scope}[local bounding box=DM3,shift={(6,-2.5)}]
\def\columns{4}
\def\rows{8}
\def\br{DM3}

\foreach \x in {1,...,\columns}{
    \foreach \y in {1,...,\rows}{
        %
        \node[draw=black!80, fill=GreenL, minimum width=\cellsize,
                    minimum height=\cellheight, line width=2pt] (cell-\x-\y\br) at (\x*\cellsize,-\y*\cellheight) {};
    }
}
\end{scope}
%
%
\node[below=0.35 of DM3,align=center](CM){C 矩阵\\(稠密)};
\draw[|-|,thick]([yshift=9.5]cell-1-1DM3.north west)--node[above=0pt,
                       font=\sffamily\small]{N}([yshift=9.5]cell-4-1DM3.north east);
\draw[|-|,thick]([xshift=7.5]cell-4-8DM3.south east)--node[right=0pt,
                       font=\sffamily\small]{M}([xshift=7.5]cell-4-1DM3.north east);
%

%
%fitting
\node[draw=red,inner xsep=1.2mm,inner ysep=1.2mm,outer sep=0pt,
yshift=0mm,fill=none,fit=(cell-1-1DM1)(cell-8-1DM1),line width=3.5pt](BB3){};
\draw[red,line width=1.5pt](BB3)--(BB1.south);
\node[draw=red,inner xsep=1.0mm,inner ysep=1.0mm,outer sep=0pt,
yshift=0mm,fill=none,fit=(cell-1-1DM3),line width=3.5pt](BB3){};
\draw[red,line width=1.5pt](BB3)--(BB1.south east);
%%%last upper matrix brown
\begin{scope}[local bounding box=DM4,shift={(6,3.5)}]
\def\columns{4}
\def\rows{8}
\def\br{DM4}

\foreach \x in {1,...,\columns}{
    \foreach \y in {1,...,\rows}{
        %
        \node[draw=black!80, fill=BrownL, minimum width=\cellsize,
                    minimum height=\cellheight, line width=2pt] (cell-\x-\y\br) at (\x*\cellsize,-\y*\cellheight) {};
    }
}
\end{scope}
%
\node[above=0.2 of DM4,align=center](BM){右侧矩阵\\(稠密)};
\draw[|-|,thick]([xshift=7.5]cell-4-8DM4.south east)--node[right=0pt,
                       font=\sffamily\small]{K}([xshift=7.5]cell-4-1DM4.north east);
%fitting
\node[draw=red,inner xsep=1.2mm,inner ysep=1.2mm,outer sep=0pt,
yshift=0mm,fill=none,fit=(cell-1-1DM4)(cell-1-8DM4),line width=3.5pt](BB4){};
\draw[red,line width=1.5pt](BB4)--(BB1.east);
\node[draw=red,inner xsep=1.0mm,inner ysep=1.0mm,outer sep=0pt,
yshift=0mm,fill=none,fit=(cell-1-1DM3),line width=3.5pt](BB3){};
\draw[red,line width=1.5pt](BB3)--(BB1.south east);
\end{scope}
%%%%%%%%%%
%right part
%%%%%%%%%%%%
\begin{scope}[local bounding box=RIGHT,shift={(15.15,0)}]
\node[draw,circle,line width=0.75pt,cross,minimum width=6mm](CI1){};
\node[draw=black, line width=1.2pt,fill=GreenL, minimum width=0.9*\cellsize,
                    minimum height=0.9*\cellheight,below=0.5 of CI1](AR) {};
\node[right=1mm of AR](AR1){累加器(结果)};

\begin{scope}[local bounding box=M3,shift={(1,1.5)}]
\def\columns{4}
\def\rows{1}
\def\br{M3}
%
\foreach \x in {1,...,\columns}{
    \foreach \y in {1,...,\rows}{
        %
        \node[draw=black!80, fill=BrownL, minimum width=\cellsize,
                    minimum height=\cellheight, line width=2pt] (cell-\x-\y\br) at (\x*\cellsize,-\y*\cellheight) {};
    }
}
\end{scope}

\begin{scope}[local bounding box=M2,shift={(-1.3,1.5)}]
\def\columns{4}
\def\rows{1}
\def\br{M2}
\def\cellsize{2.5mm}
%
\foreach \x in {1,...,\columns}{
    \foreach \y in {1,...,\rows}{
        %
        \node[draw=black!80, fill=OrangeL, minimum width=\cellsize,
                    minimum height=\cellheight, line width=2pt] (cell-\x-\y\br) at (\x*\cellsize,-\y*\cellheight) {};
    }
}
\end{scope}
\begin{scope}[local bounding box=M1,shift={(-3.8,1.5)}]
\def\columns{4}
\def\rows{1}
\def\br{M1}
\def\rowone{Blue2,Blue3,Blue1,Blue3}
%
\foreach \x in {1,...,\columns}{
    \foreach \y in {1,...,\rows}{
        %
        \node[draw=black!80, fill=BrownL, minimum width=\cellsize,
                    minimum height=\cellheight, line width=1pt] (cell-\x-\y\br) at (\x*\cellsize,-\y*\cellheight) {};
    }
}
\foreach \color [count=\x] in \rowone {
    \node[fill=\color,draw=black!80,line width=2pt, minimum size=\cellsize,
    minimum height=\cellheight] at (cell-\x-1\br) {};
}
\end{scope}
\node[Box,above=of M3)](CM){从 K 个元素中选择匹配的 K/2 个元素};
%%
\begin{scope}[local bounding box=M4,shift={($(CM.north)+(-2.3,1.5)$)}]
\def\columns{8}
\def\rows{1}
\def\br{M4}
\def\rowone{BrownL,BrownL!20,BrownL!20,BrownL,BrownL!20,BrownL,BrownL,BrownL!20}
%
\foreach \x in {1,...,\columns}{
    \foreach \y in {1,...,\rows}{
        %
        \node[draw=black!80, fill=BrownL, minimum width=\cellsize,
                    minimum height=\cellheight, line width=1pt] (cell-\x-\y\br) at (\x*\cellsize,-\y*\cellheight) {};
    }
}
\foreach \color [count=\x] in \rowone {
    \node[fill=\color,draw=black!80,line width=2pt, minimum size=\cellsize,
    minimum height=\cellheight] at (cell-\x-1\br) {};
}
\end{scope}
%\fill[red](cell-8-1M4)circle(2pt);
\foreach \x in{1,...,8}{
\draw[Line,-latex](cell-\x-1M4)--(cell-\x-1M4|-CM.north);
}
\foreach \x in{1,...,4}{
\draw[Line,latex-](cell-\x-1M3)--(cell-\x-1M3|-CM.south);
}
\draw[Line,-latex](CI1)--(AR);
\draw[Line,-latex](M3)|-(CI1);
\draw[Line,-latex](M1)|-(CI1);
\draw[Line,-latex](M2)|-node[left,pos=0.3]{选择}(CM);
%%fitting
\scoped[on background layer]
\node[draw=BackLine,inner xsep=3mm,inner ysep=3mm,
yshift=0mm,fill=BackColor!50,fit=(AR1)(M1)(M4)(CM),line width=0.75pt](BB1){};
\node[anchor=north west,align=center]at(BB1.north west){Tensor Core 上的\\稀疏运算};

%%below matrix Blue
\begin{scope}[local bounding box=DM1,shift={(0.2,-2.5)}]
\def\columns{4}
\def\rows{8}
\def\br{DM1}
\def\rowone{Blue2,Blue3,Blue1,Blue3}
\def\rowtwo{Blue2,Blue3,Blue1,Blue2}
\def\rowthree{Blue2,Blue1,Blue3,Blue2}
\def\rowfour{Blue2,Blue3,Blue1,Blue3}
\def\rowfive{Blue3,Blue1,Blue1,Blue2}
\def\rowsix{Blue2,Blue2,Blue1,Blue3}
\def\rowseven{Blue3,Blue1,Blue2,Blue3}
\def\rowosam{Blue3,Blue2,Blue1,Blue2}

\foreach \x in {1,...,\columns}{
    \foreach \y in {1,...,\rows}{
        %
        \node[draw=black!80, fill=BrownL, minimum width=\cellsize,
                    minimum height=\cellheight, line width=2pt] (cell-\x-\y\br) at (\x*\cellsize,-\y*\cellheight) {};
    }
}

%
\foreach \color [count=\x] in \rowone {
    \node[fill=\color,draw=black!80,line width=2pt, minimum size=\cellsize,
    minimum height=\cellheight] at (cell-\x-1\br) {};
}
\foreach \color [count=\x] in \rowtwo {
    \node[fill=\color,draw=black!80,line width=2pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-2\br) {};
}
\foreach \color [count=\x] in \rowthree {
    \node[fill=\color,draw=black!80,line width=2pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-3\br) {};
}
\foreach \color [count=\x] in \rowfour {
    \node[fill=\color,draw=black!80,line width=2pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-4\br) {};
}
\foreach \color [count=\x] in \rowfive {
    \node[fill=\color,draw=black!80,line width=2pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-5\br) {};
}
\foreach \color [count=\x] in \rowsix {
    \node[fill=\color,draw=black!80,line width=2pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-6\br) {};
}
\foreach \color [count=\x] in \rowseven {
    \node[fill=\color,draw=black!80,line width=2pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-7\br) {};
}
\foreach \color [count=\x] in \rowosam {
    \node[fill=\color,draw=black!80,line width=2pt, minimum size=\cellsize,
               minimum height=\cellheight] at (cell-\x-8\br) {};
}
\end{scope}
\node[below=0.7 of DM1,align=center](NZ){非零数据\\值};
\draw[|-|,thick]([yshift=-5.5]cell-1-8DM1.south west)--node[below=0pt,
                       font=\sffamily\small]{K/2}([yshift=-5.5]cell-4-8DM1.south east);
\node[left=1mm of DM1.west,rotate=90,anchor=south]{A 矩阵(稀疏)};
\begin{scope}[local bounding box=DM2,shift={(3.4,-2.5)}]
\def\columns{4}
\def\rows{8}
\def\br{DM2}
\def\cellsize{2.5mm}

\foreach \x in {1,...,\columns}{
    \foreach \y in {1,...,\rows}{
        %
        \node[draw=black!80, fill=OrangeL, minimum width=\cellsize,
                    minimum height=\cellheight, line width=2pt] (cell-\x-\y\br) at (\x*\cellsize,-\y*\cellheight) {};
    }
}
\end{scope}
%
\node[below=0.7 of DM2,align=center](2B){2 位\\索引};
\draw[|-|,thick]([yshift=-5.5]cell-1-8DM2.south west)--node[below=0pt,
                       font=\sffamily\small]{K/2}([yshift=-5.5]cell-4-8DM2.south east);
\draw[|-|,thick]([xshift=9.5]cell-4-8DM2.south east)--node[right=0pt,
                       font=\sffamily\small]{M}([xshift=9.5]cell-4-1DM2.north east);
%
\node[draw=none,inner xsep=0mm,inner ysep=0mm,
yshift=0mm,fill=none,fit=(NZ)(2B),line width=0.75pt](BB2){};
\node[below=2pt of BB2](SP){\textbf{稀疏 $M\times N\times K$ GEMM}};
%%%last matrix Green
\begin{scope}[local bounding box=DM3,shift={(6,-2.5)}]
\def\columns{4}
\def\rows{8}
\def\br{DM3}

\foreach \x in {1,...,\columns}{
    \foreach \y in {1,...,\rows}{
        %
        \node[draw=black!80, fill=GreenL, minimum width=\cellsize,
                    minimum height=\cellheight, line width=2pt] (cell-\x-\y\br) at (\x*\cellsize,-\y*\cellheight) {};
    }
}
\end{scope}
%
%
\node[below=0.7 of DM3,align=center](CM){C 矩阵\\(稠密)};
\draw[|-|,thick]([yshift=9.5]cell-1-1DM3.north west)--node[above=0pt,
                       font=\sffamily\small]{N}([yshift=9.5]cell-4-1DM3.north east);
\draw[|-|,thick]([xshift=7.5]cell-4-8DM3.south east)--node[right=0pt,
                       font=\sffamily\small]{M}([xshift=7.5]cell-4-1DM3.north east);
%
%fitting
\node[draw=red,inner xsep=1.2mm,inner ysep=1.2mm,outer sep=0pt,
yshift=0mm,fill=none,fit=(cell-1-1DM1)(cell-4-1DM2),line width=3.5pt](BB3){};
\draw[red,line width=1.5pt](BB3)--(BB1.south);
\node[draw=red,inner xsep=1.0mm,inner ysep=1.0mm,outer sep=0pt,
yshift=0mm,fill=none,fit=(cell-1-1DM3),line width=3.5pt](BB3){};
\draw[red,line width=1.5pt](BB3)--(BB1.south east);
%%%last upper matrix brown
\begin{scope}[local bounding box=DM4,shift={(6,3.5)}]
\def\columns{4}
\def\rows{8}
\def\br{DM4}

\foreach \x in {1,...,\columns}{
    \foreach \y in {1,...,\rows}{
        %
        \node[draw=black!80, fill=BrownL, minimum width=\cellsize,
                    minimum height=\cellheight, line width=2pt] (cell-\x-\y\br) at (\x*\cellsize,-\y*\cellheight) {};
    }
}
\end{scope}
%
\node[above=0.2 of DM4,align=center](BM){右侧矩阵\\(稠密)};
\draw[|-|,thick]([xshift=7.5]cell-4-8DM4.south east)--node[right=0pt,
                       font=\sffamily\small]{K}([xshift=7.5]cell-4-1DM4.north east);
\node[left=1mm of DM1.west,rotate=90,anchor=south]{A 矩阵(稀疏)};
%fitting
\node[draw=red,inner xsep=1.2mm,inner ysep=1.2mm,outer sep=0pt,
yshift=0mm,fill=none,fit=(cell-1-1DM4)(cell-1-8DM4),line width=3.5pt](BB4){};
\draw[red,line width=1.5pt](BB4)--(BB1.east);
\node[draw=red,inner xsep=1.0mm,inner ysep=1.0mm,outer sep=0pt,
yshift=0mm,fill=none,fit=(cell-1-1DM3),line width=3.5pt](BB3){};
\draw[red,line width=1.5pt](BB3)--(BB1.south east);
\end{scope}
\path[]($(RIGHT)!0.5!(LEFT)$)--++(90:6)coordinate(GO);
\path[]($(RIGHT)!0.5!(LEFT)$)--++(270:6)coordinate(DO);
\path[VioletLine!60,mysnake,line width=1pt](GO)--(DO);
\end{tikzpicture}
PyTorch. 2022. Accelerating Neural Network Training with Sparse Tensors.
NVIDIA Ampere 及后续架构上受支持的稀疏 Tensor Core 执行路径,可以通过跳过规定位置的零值并携带紧凑元数据来加速 2:4 稀疏计算,理想情况下,稀疏算术运算速率最高可提升至 \(2\times\) (NVIDIA Corporation 2020)。相反,非结构化剪枝 将任意单个权重置零。这些不规则的位置可能破坏内存访问合并和执行通道利用率,而压缩稀疏行(CSR)或坐标(COO)格式的元数据会增加存储开销和非单位步长访问。因此,当元数据和利用率不足带来的开销超过跳过算术运算所节省的成本时,非结构化稀疏模型可能比对应的稠密模型运行得更慢。TPU 为稠密脉动阵列加速提供了有用的对照案例 (Jouppi et al. 2021),但稀疏加速仍然依赖特定的硬件和软件执行路径,而非支持任意掩码。现场可编程门阵列可以实现面向特定应用的稀疏格式,但其效率取决于所选的数据流和资源预算;可编程性并不意味着普遍保证稀疏加速。
Jouppi, Norman P., Doe Hyun Yoon, Matthew Ashcraft, Mark Gottscho, Thomas B. Jablin, George Kurian, James Laudon, et al. 2021. “Ten Lessons from Three Generations Shaped Google’s TPUv4i: Industrial Product.” 2021 ACM/IEEE 48th Annual International Symposium on Computer Architecture (ISCA), 1–14. https://doi.org/10.1109/isca52012.2021.00010.
在所有平台上,当稀疏表示和内核实际跳过数据搬运而不只是跳过算术运算时,稀疏运算可以降低内存带宽需求和能耗。这一收益可以与量化叠加:当格式开销足够小时,稀疏 INT8 模型所需的内存流量可以低于单独采用任一技术时的内存流量 (Hoefler et al. 2021; Gale et al. 2020)。
挑战与局限性

非结构化稀疏只有越过特定于硬件和内核的盈亏平衡点后,才能带来收益。
同样的格式与硬件之间的契约,也解释了为什么稀疏性在实践中往往令人失望。核心挑战在于理论加速与实际加速之间的差距。非结构化剪枝根据重要性移除单个权重,形成常见稠密加速器执行路径无法利用的不规则模式;要跳过这些零值,需要稀疏表示和兼容的内核。剪枝本身会增加训练或分析成本,因为识别可移除的权重可能需要对大型模型进行复杂的重要性估计。即使已经实现稀疏性,存储格式仍会引入索引,其开销可能抵消减少数值存储和算术运算带来的节省。稀疏矩阵格式 详细介绍了压缩稀疏行布局,并量化了其每个非零元素的元数据如何使内存收益取决于密度。性能盈亏平衡点随张量形状、稀疏格式、内核、批大小和硬件而变化;不存在通用的稀疏度阈值。
准确率与效率之间的权衡需要在多个候选稀疏度水平上进行测量。模型可能在某一稀疏度下表现出很小的可测影响,却在进一步进行相对小幅度的剪枝后急剧退化。实际工作点应是任务质量和部署性能均满足各自阈值时,具有实际收益的最高稀疏度。
能效提升并无保证。虽然稀疏运算减少了算术运算次数,但在未针对稀疏模式优化的硬件上,稀疏索引和不规则内存访问的开销可能增加功耗。在功率预算严格的边缘设备上,这些开销可能超过收益。
最后,稀疏性的收益因层、模型和执行目标而异。如果工作负载中的有效张量仍然稠密,或者目标平台缺乏匹配的稀疏执行路径,则可能没有任何改善,而且在计入元数据和不规则访问成本后,性能还可能下降。
组合优化
剪枝、量化、算子融合、动态计算和稀疏执行共享权重、表示和物理资源。当单一技术无法满足所有约束时,部署方案可以将这些技术组合使用,但组合结果并不保证优于最佳的单项技术。每次变换都可能改变后续变换所依赖的准确率、形状、分布和瓶颈,因此,组合优化需要联合测量质量与性能,而不能承诺某个压缩比 (Hoefler et al. 2021)。
Elsen, Erich, Marat Dukhan, Trevor Gale, and Karen Simonyan. 2020. “Fast Sparse ConvNets.” 2020 IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 14617–26. https://doi.org/10.1109/cvpr42600.2020.01464.
稀疏性与剪枝之间的交互最为直接:剪枝产生稀疏性,但其模式决定了硬件效率。移除整个滤波器或层可以产生更小的稠密形状,而固定的组内模式可以映射到受支持的稀疏内核。非结构化剪枝产生不规则模式,需要专门的格式和内核才能实现加速 (Elsen et al. 2020; Gale et al. 2019)。
将稀疏性与量化结合,可以使原始数值载荷的缩减倍数相乘,但部署时的表示同时携带稀疏元数据和量化元数据。配备专用稀疏张量核心的 GPU 可以加速受支持的结构化模式,而 CPU 上的效果取决于所选格式、低精度稀疏内核、张量形状和索引开销 (NVIDIA Corporation 2020; Hoefler et al. 2021; Gale et al. 2020)。
Gale, Trevor, Matei Zaharia, Cliff Young, and Erich Elsen. 2020. “Sparse GPU Kernels for Deep Learning.” SC20: International Conference for High Performance Computing, Networking, Storage and Analysis 2020: 8955–67. https://doi.org/10.1109/sc41405.2020.00021.
所有组合中反复出现的主题都是与硬件相匹配。深度可分离卷积 (Howard et al. 2017) 等高效模型设计、动态计算和稀疏性,只有在目标硬件支持其产生的运算模式时才有帮助 (Hoefler et al. 2021)。选择技术组合需要了解目标平台的能力,硬件加速 对此进行了探讨。
将稀疏性与其他技术结合时固有的协调挑战,揭示了一条更广泛的原则:优化技术很少能孤立地取得成功,其有效性取决于执行顺序的决策以及与硬件的匹配程度。
Systems Perspective 1.4: 优化组合问题
优化技术通过共享的表示和物理资源相互作用,而不是像独立函数一样进行组合。剪枝会改变保留值的分布、张量形状或稀疏格式;量化会引入缩放因子并改变可用内核;融合会改变哪些中间结果需要物化,并可能改变支持先前选择的性能特征。因此,有效的优化应将模型、运行时与硬件的组合视为一个耦合系统,在每次变换后进行测量,并在出现新瓶颈时重新审视执行顺序。这使得压缩既是机器学习问题,也是系统工程问题。
技术选择
为生产部署选择压缩技术,需要识别目标执行环境中起决定性作用的物理约束。考虑一个 Transformer 部署场景:模型参数所需内存是设备内存容量的 3\(\times\),推理延迟是服务级别目标的 4\(\times\),且热设计约束将持续散热功率限制为不超过 2 W。决定采用量化、剪枝、蒸馏为紧凑架构,还是组合多种方法,取决于哪个硬件边界已达到饱和、允许的任务准确率损失,以及可用的训练预算。
三种主要优化手段针对系统栈的不同层级。蒸馏通过训练紧凑的稠密学生模型来模仿更大的教师模型,从而改变算法架构,使其无需专门的运行时支持即可在标准硬件上高效执行。剪枝修改张量拓扑和运算模式,但只有当所得稀疏性与硬件执行单元相匹配时,例如 \(2:4\) 结构化稀疏矩阵核心或按通道对齐的子矩阵,才能缩短实际运行时间。量化通过降低数值位宽来改变数据表示,直接减少内存总线流量和缓存占用,同时利用吞吐量更高的整数数据通路。Table 14 总结了这些技术在质量风险、训练成本和硬件依赖方面的一阶权衡。
| 技术 | 主要目标 | 质量风险 | 训练成本 | 硬件依赖 | 候选适用场景 |
|---|---|---|---|---|---|
| 剪枝 | 减少 FLOPs/模型大小 | 取决于稀疏模式 | 通常包括微调 | 稀疏加速高度依赖硬件 | 存在可移除的结构/权重 |
| 量化 | 减少字节数/降低精度 | 取决于位宽 | PTQ 较低;QAT 较高 | 运行时加速高度依赖硬件 | 受内存容量或带宽限制的执行路径 |
| 蒸馏 | 训练更小的模型 | 取决于学生模型 | 运行教师模型和学生模型 | 稠密执行对硬件依赖较低 | 可以开展新一轮训练 |
将约束映射到技术
起决定性作用的硬件约束决定必须首先采用哪一类优化。按照数据—算法—机器分类体系,压缩方法会在算法(网络拓扑和结构化剪枝)、数据(数值精度和校准集)以及机器(执行单元和内存层次结构)之间重新分配资源需求。Table 15 将每种系统约束映射到能够缓解该约束的主要优化维度。
| 系统约束 | 模型表示 | 数值精度 | 架构效率 |
|---|---|---|---|
| 计算成本 | ✓ | \(\triangle\) | ✓ |
| 内存与存储 | ✓ | ✓ | \(\triangle\) |
| 延迟与吞吐量 | ✓ | \(\triangle\) | ✓ |
| 能效 | ✓ | ✓ | ✓ |
| 可扩展性 | ✓ | \(\triangle\) | ✓ |
这些维度通过机器学习系统铁律相互作用,这意味着单项优化往往会同时改变多个物理瓶颈。例如,将权重从 FP32 量化为 INT8 会直接缓解设备端存储容量压力。然而,它对推理延迟的影响取决于运算强度:对于受内存带宽限制的算子,减少传输字节数会使延迟按比例降低;对于受计算限制的算子,只有当底层处理器提供更高的 INT8 算术峰值吞吐量,且运行时避免反量化开销时,延迟才会改善。相反,非结构化剪枝虽然消除了算术 FLOPs,却无法降低标准加速器上的延迟,因为稀疏索引开销和未合并的内存事务会降低内存带宽利用效率。
决策框架
当持久化存储或设备内存容量成为部署的制约因素时,例如空中下载软件包的大小限制或微芯片闪存预算,量化能够最直接地减小载荷。相对于 FP32 存储,INT8 训练后量化(PTQ)将原始权重存储量缩减为原来的 1/4,即缩减 4\(\times\),且无需重新训练。INT4 将原始载荷缩减为原来的 1/8,即缩减 8\(\times\),但大幅降低位宽会增加准确率下降的风险。如果统一的低位宽量化导致敏感层出现不可接受的准确率损失,则先将知识蒸馏到更小的稠密架构中,再进行适度量化,可以在满足存储预算的同时保持保真度。
当延迟受计算限制时,工作负载的算术强度高于加速器的脊点,执行单元达到饱和。缓解这一瓶颈需要减少实际执行的运算,或提高算术吞吐量。结构化剪枝移除通道、注意力头或整个层,生成可通过标准库执行的更小稠密矩阵,无需承担稀疏运行时开销;但是,如果剪枝后的维度与硬件线程束或分块大小不对齐,例如通道数不能被 8 或 16 整除,就会降低张量核心效率,限制实际运行时间的改善。如果目标平台提供专用整数执行单元,INT8 量化会提高指令吞吐率,直接加速受计算限制的内核。提前退出架构提供了另一条算法路径:对较简单的输入动态终止推理,前提是路由和流水线同步开销不会扰乱批处理。
小批量 Transformer 生成会引入一种截然不同的瓶颈:自回归解码受内存带宽而非计算限制。生成每个词元都需要从 HBM 或片外 DRAM 加载大型参数矩阵,以执行矩阵—向量运算,其运算强度约为每字节一次 FLOP。由于算术单元在等待内存传输时处于空闲状态,仅权重量化(例如 INT4 或 INT8 权重配合 FP16 激活值)带来的延迟加速倍数,大致与所读取权重字节数的缩减倍数成正比。这种带宽优势会持续存在,直到 KV 缓存流量、寄存器中的反量化内核开销,或更大的并发批量使运算强度重新进入计算受限区间。
当能耗或散热成为制约因素时,量化会带来显著收益,因为经片外内存总线移动数据时,每比特消耗的能量比片上算术运算或本地 SRAM 访问高出数个数量级。降低操作数位宽会直接减少总线电容充电能量,而整数 ALU 消耗的开关能量低于浮点数据通路。结构化剪枝通过完全消除部分运算和内存事务,进一步叠加这些节能收益。全系统功耗审计仍须测量外围组件,包括内存刷新、主机总线通信和静态空闲漏电,以确保内核级节能能够转化为更长的运行时间。
选择还取决于可用于优化的工程预算和计算预算。训练后量化可作为初始基线,因为经校准的 PTQ 仅需要一个小型代表性数据集,计算开销也可忽略不计。如果 PTQ 未达到准确率阈值,且具备微调资源,则量化感知训练(QAT)会在反向传播过程中对量化误差建模,以恢复损失的准确率。知识蒸馏的计算成本更高,需要教师模型前向传播和大量训练迭代来优化更小的学生模型。硬件感知 NAS 处于成本最高的层级,只有大规模部署能够摊销探索架构搜索空间所需的大量计算成本时,采用它才合理。
验证所选技术是否达到性能目标,需要在目标芯片上进行系统性的性能剖析和测量(section 1.8)。实际部署很少仅依靠单项优化:组合剪枝、量化和蒸馏会引入跨层交互,因此必须严格规定执行顺序。
优化策略
生产部署约束通常不允许仅依靠单项优化。要使一个拥有 1.1 亿参数的语言模型满足移动端内存和热设计预算,需要组合结构化剪枝、知识蒸馏和精度量化。在这一建模的移动端流水线中,分阶段优化将 BERT-Base 的占用空间从 440 MB 降至 28 MB,实现 16× 的原始占用空间缩减。每个阶段分别解决数据—算法—机器层次体系中的不同瓶颈:结构化剪枝消除冗余矩阵乘法以减少算术运算,知识蒸馏对紧凑的学生模型进行监督以恢复表示能力,量化则将权重和激活值打包为低位宽整数,以缓解内存带宽压力。
Example 1.3: BERT-Base 移动端部署流水线
场景:一个建模的部署方案旨在资源受限的移动硬件上执行拥有 1.1 亿参数的 BERT-Base 语言模型 (Sanh et al. 2019)。
诊断:以任意顺序应用压缩技术会降低表示质量。如果先进行 INT8 量化再剪枝,后续的权重移除会破坏已校准的缩放因子和零点,使准确率损失增加至 2.1 percent。将结构化剪枝和蒸馏安排在量化之前,可以稳定权重分布。
系统经验:在这一建模的流水线中,按顺序进行结构缩减、蒸馏和量化感知训练,可实现 16× 的占用空间缩减(从 440 MB 降至 28 MB),同时将任务准确率损失限制在 0.6 percent。由于张量分布和硬件内核效率随架构而异,必须在目标运行时上对每个中间产物进行性能剖析。
执行顺序之所以重要,是因为这些变换通过共享参数和激活值分布相互作用。结构化剪枝会移除通道或注意力头,改变保留下来的权重张量的动态范围和方差。如果先量化模型,后续权重剪枝会将原本用于确定校准缩放因子和零点的值置零,从而扭曲离散网格。此外,在微调期间为量化整数权重计算梯度更新,会引入严重的离散化误差。先以浮点形式进行结构化剪枝,可使网络调整其剩余参数。随后,蒸馏将表示从稠密教师模型迁移到学生模型,在量化感知训练(QAT)将最终参数锁定到离散区间之前,恢复损失的准确率。Figure 30 展示了在计算机视觉基准上评估的各类压缩技术之间的这些权衡 (Han et al. 2016)。尽管单独采用奇异值分解(SVD)或剪枝会在较高缩减倍数下出现急剧的准确率下降,但将剪枝与量化结合,可以在准确率接近基线时实现最高压缩比。这些收益的排序和幅度仍取决于具体模型与运行时,因此工程师需要独立验证每个变换阶段。
\begin{tikzpicture}[font=\small\sffamily]
\definecolor{other}{HTML}{D7191C}
\definecolor{WeightGradient}{HTML}{FDAE61}
\definecolor{Optimization}{HTML}{ABDDA4}
\definecolor{Activation}{HTML}{2B83BA}
\begin{axis}[name=boundary,
 axis line style={draw=none},
  width=14cm,
  height=7cm,
  xlabel={压缩后的模型大小比例},
  ylabel={准确率变化},
  xmin=2, xmax=20,
  ymin=-4.5, ymax=0.5,
  xtick={2,5,8,11,14,17,20},
  xticklabel={\pgfmathprintnumber{\tick}\%},
  ytick={-4.5,-4,-3.5,-3,...,0.5},
  yticklabel={\pgfmathprintnumber{\tick}\%},
    legend style={
    at={(0.5,1.05)},
    anchor=south,
    legend columns=4,
    font=\footnotesize\sffamily,
    /tikz/every even column/.append style={column sep=0.5cm}
  },
  axis line style={black},
  tick align=outside,
  tick label style={/pgf/number format/assume math mode=true},
  ticklabel style={font=\footnotesize\sffamily},
  grid=both,
  grid style={line width=.4pt, draw=gray!80},
  %major grid style={line width=.4pt,draw=gray!50},
  clip=false,
  enlargelimits=false,
  legend style={fill=BrownL!40,draw=none,row sep=1.85pt,
 font=\fontsize{7pt}{7}\selectfont\sffamily},
  forget plot,
]

% Pruning + Quantization (red, circle)
    \addplot+[
      scatter,
      scatter src=explicit symbolic,
      line width=1.5pt,
      draw= Activation,
      smooth,
      mark size=2.5pt,
      %
      mark options={fill=white,draw= Activation},
      scatter/classes={
        a={mark=none},
        b={mark=*}
      },
    ]
    table[row sep=crcr, meta=class] {
  x      y        class\\
  2.74   -4.7     a\\
  2.71   -1.82    b\\
  2.75   -1.25    b\\
  2.90   -0.60    b\\
  3.11   -0.24    b\\
  3.32   -0.10    b\\
  3.69   -0.01    b\\
  4.25    0.010   b\\
  5.00    0.02    b\\
  5.70    0.02    b\\
  6.39    0.02    b\\
  7.37    0.02    b\\
    };
      \addlegendimage{
      Activation,
      line width=1.25pt,
      mark=*,
      mark options={fill=white,draw=Activation},
      mark size=2.5pt
    }
\addlegendentry{剪枝 + 量化}

% Pruning Only (purple, triangle)
    \addplot+[
      scatter,
      scatter src=explicit symbolic,
      line width=1.5pt,
      draw= green!70!black,
      smooth,
      mark size=3.5pt,
      %
      mark options={fill=white,draw= green!70!black,},
      scatter/classes={
        a={mark=none},
        b={mark=triangle*}
      },
    ]
    table[row sep=crcr, meta=class] {
  x      y        class\\
  4.05   -4.7     a\\
  4.25   -4.2     b\\
  5.29   -1.99    b\\
  6.25   -1.04    b\\
  7.15   -0.6     b\\
  8.35   -0.28    b\\
  10.01  -0.073   b\\
  11.15   0.005   b\\
  12.55   0.05    b\\
    };
      \addlegendimage{
      green!70!black,
      line width=1.25pt,
      mark=triangle*,
      mark options={fill=white,draw=green!70!black},
      mark size=3.5pt
    }
     \addlegendentry{仅剪枝}
% Quantization Only
    \addplot+[
      scatter,
      scatter src=explicit symbolic,
      line width=1.5pt,
      draw=orange,
      smooth,
      mark size=2.5pt,
      %
      mark options={fill=white,draw=orange},
      scatter/classes={
        a={mark=none},
        b={mark=square*}
      },
    ]
    table[row sep=crcr, meta=class] {
      x      y        class\\
      6.45   -4.7     a\\
      6.48   -3.66    b\\
      6.65   -2.21    b\\
      7.19   -1.06    b\\
      8.07   -0.58    b\\
      9.9    -0.3      b\\
      13.03  -0.13    b\\
      16.07  -0.05    b\\
      19.3    0.01    b\\
      20.4    0.02    a\\
    };
%
    \addlegendimage{
      orange,
      line width=1.25pt,
      mark=square*,
      mark options={fill=white,draw=orange},
      mark size=2.5pt
    }
\addlegendentry{仅量化}
% SVD
    \addplot+[
      scatter,
      scatter src=explicit symbolic,
      line width=1.5pt,
      draw=RedLine,
      smooth,
      mark size=3.5pt,
      %
      mark options={fill=white,draw=RedLine},
      scatter/classes={
        a={mark=none},
        b={mark=diamond*}
      },
    ]
    table[row sep=crcr, meta=class] {
      x      y       class\\
      14.19  -4.7    a\\
      15.09  -2.58   b\\
      15.7   -1.86   a\\
      16.9   -1.35   a\\
      19.62  -0.83   b\\
      20.4   -0.73   a\\
    };
    % Legend
    \addlegendimage{
      RedLine,
      line width=1.25pt,
      mark=diamond*,
      mark options={fill=white,draw=RedLine},
      mark size=3.5pt
    }
    \addlegendentry{SVD}
\end{axis}
\end{tikzpicture}
Han, Song, Huizi Mao, and William J. Dally. 2016. “Deep Compression: Compressing Deep Neural Networks with Pruning, Trained Quantization and Huffman Coding.” arXiv Preprint.
理论上叠加的占用空间缩减并不保证硬件执行速度会按比例提升。剪枝后的维度可能与 SIMD 向量宽度不对齐,而量化张量需要受支持的硬件内核才能避免反量化开销。验证多阶段优化流水线是否达到延迟、内存和能耗目标,需要在目标芯片上进行系统性的性能剖析和测量(section 1.8)。
效率测量
Section 1.5 探讨了理论压缩比与模型实际加速比之间的差距。这一差距意味着必须开展实证测量。虽然相对于 FP32,INT8 将原始张量载荷缩减为原来的四分之一,即缩减 \(4\times\),但延迟加速比并不会按比例增长。实际吞吐量取决于内存层次结构约束、算术强度和目标内核实现,这些因素无法通过名义压缩比预测。要将理论压缩转化为实际加速,需要识别支配各模型组件的物理瓶颈,在目标硬件上建立多维基线,并单独分析算术运算减少与系统级开销之间的相互作用。
性能剖析与优化机会分析
性能剖析沿着加速器的物理边界分解模型执行过程:内存容量(SRAM、DRAM/HBM)、内存总线带宽和算术吞吐量。内存分配分为静态占用(权重张量和持久缓冲区)与动态分配(前向传播期间的激活张量和 KV 缓存)。静态占用决定模型参数能否容纳于高速片上内存或设备 DRAM 中,而无需溢出并经由 PCIe 等高延迟主机—加速器互连传输。动态分配决定峰值内存驻留量,从而限制最大批大小和服务并发度。在算子层面,性能剖析同时测量理论运算量(FLOPs)和实际执行时间。由于不同算子的算术强度(\(I = \text{FLOPs} / \text{byte}\))可相差多个数量级,其执行瓶颈也有所不同:计算密集的矩阵乘法会使执行单元饱和,而受内存限制的算子(例如层归一化和逐元素激活)在内存与执行单元之间流式传输张量时会导致执行单元停顿,其实际耗时与 FLOP 数量不成比例。
对边缘加速器上视觉 Transformer(ViT)的性能剖析展示了这种运行特征的异质性。注意力投影层占总 FLOPs 的 65%,层归一化虽然仅贡献 2% 的 FLOPs,却消耗了 8% 的实际延迟,而最终分类头仅占 1% 的计算量,却占用 15% 的参数内存。性能剖析能够识别各组件的主导物理瓶颈,从而指导有针对性的优化,而非统一压缩:结构化剪枝可缓解受计算限制的注意力投影的压力,算子融合可消除受内存限制的归一化层对全局内存的中间往返访问,而 INT8 量化可缩小参数密集的分类头的静态占用。
一旦非模型工作主导流水线,压缩就会触及端到端加速的上限。
将层级性能剖析指标转化为端到端系统加速比,需要考虑完整的服务流水线。在生产服务系统中,模型执行通常仅占总延迟的一部分,其余时间消耗在图像解码、词元化、RPC 反序列化或网络传输上。如页边图所示,只要非模型阶段在延迟预算中占主导地位,单独优化模型就会遇到阿姆达尔上限。
Systems Perspective 1.5: FLOPs 减少并不意味着成比例的加速
将模型的 FLOPs 减少 50 percent,并不能保证延迟减少 50 percent。受内存限制的运算几乎无法从算术运算量的减少中获益,因为决定其耗时的是数据移动,而非乘法。关键在于,阿姆达尔定律适用于系统层面(Amdahl 定律与 Gustafson 定律 推导了其强扩展形式):如果模型推理仅占端到端延迟的 20 percent(其余 80 percent 用于数据加载、预处理和后处理),那么即使对模型进行了完美优化,整体加速比也至多为 1.25×。在语言模型服务中,词元化和网络传输可能占据非模型部分;在视觉流水线中,图像解码、缩放和归一化也可能如此。在估计优化收益之前,应在目标硬件上对完整路径进行性能剖析。
作为延迟和吞吐量剖析的补充,逐层敏感性分析量化了各层对扰动的容忍程度。在深度网络中,不同层的参数分布对精度降低或权重移除表现出不同的鲁棒性。通过系统地逐次扰动单个层,评估量化噪声或权重移除的影响,并剖析准确率下降情况,可以识别哪些组件需要高精度表示,以及哪些组件能够承受激进的 4 位量化或结构化剪枝而不损害任务准确率。
衡量优化效果
评估压缩需要沿数据—算法—机器(D·A·M)各轴,权衡统计质量与物理执行成本。单一标量指标(例如 top-1 准确率或参数量)无法反映部署可行性。质量基线必须涵盖总体准确率、置信度校准(验证预测概率是否反映经验正确率),以及在代表性不足的输入子集上的表现。同时,效率基线必须记录峰值内存驻留量、延迟分布(包括尾延迟 \(p99\))、内存总线饱和度和每次推理的能耗。

示例性的 INT8 性能剖析必须同时验证大小和准确率。
将 ResNet-50 从 FP32 量化为 INT8,展示了压缩决策如何影响物理维度和统计维度。table 16 从计算、内存、能耗和统计校准等方面给出了通过建模得到的部署剖析,而非通过单独的准确率指标评估 INT8 转换。如页边图所示,验证压缩需要确认模型产物的压缩不会引发不可接受的质量下降。
| 指标 | FP32 基线 | INT8 结果 | 部署解读 |
|---|---|---|---|
| Top-1 准确率 | 76.1% | 75.8%(下降 0.3 pp) | 总体准确率基本保持,但仍需检查各子群体。 |
| 建模得到的 V100 延迟 | 1.56 ms | 0.39 ms | 当运行时将 INT8 映射到快速内核时,GPU 延迟会降低。 |
| 模型大小 | 102.4 MB | 25.6 MB(4×) | 模型产物更易于缓存、传输和部署到边缘设备。 |
| 每次推理能耗 | 0.25 J | 0.06 J(4×) | 较低精度同时减少算术运算能耗和内存数据移动能耗。 |
| 校准误差 | 2.1% | 3.4% | 即使准确率看似可接受,置信度校准也可能发生漂移。 |
建模剖析表明,将权重和激活转换为 INT8,可按 4× 的压缩比缩小模型占用(从 102.4 MB 减至 25.6 MB),减少 DRAM 流量,并降低每次推理能耗,改善倍数为 4×。建模得到的 V100 执行延迟从 1.56 ms 降至 0.39 ms,前提是运行时将 INT8 运算映射到原生 Tensor Core 内核,而非调用运行时反量化。关键在于,虽然总体 top-1 准确率仅下降 0.3 percentage points(从 76.1 percent 降至 75.8 percent),但校准误差从 2.1 percent 增至 3.4 percent。量化后的概率分布会发生漂移,即使 top-1 分类准确率看似得以保持,也可能破坏安全关键场景中的置信度阈值的可靠性。由于这些数值代表的是建模场景,生产部署决策需要在目标硬件上进行相应的实证测量。
在生产中实现这些收益,需要评估多种压缩技术之间的相互作用。依次应用剪枝、量化和知识蒸馏,可能产生不可加的收益或叠加的质量退化;例如,对经过激进剪枝的稀疏矩阵进行未经校准的权重量化,可能导致准确率灾难性崩溃。评估这些复合权衡,需要将模型映射到效率—质量帕累托前沿,详见 压缩验证:效率与质量的前沿。执行这一系统性的性能剖析与多阶段变换流水线,又依赖于能够协调编译、内核生成和硬件基准测试的自动化软件工具。
实现工具
手动量化一个拥有 1750 亿参数的模型,需要修改数千个算子调用点,以插入缩放因子并跟踪动态激活范围。若没有自动化框架工具,即使是统一的 INT8 训练后量化,也需要在整个计算图中手动拦截张量生命周期,而剪枝则需要在维护权重矩阵的同时维护稀疏掩码。在大规模场景下,手动操作计算图无法保证重新训练期间自动微分的一致性,也无法强制满足加速器硬件所要求的内存对齐约束。
工具的选择取决于软件栈中负责该变换的层级。框架 API 在训练和校准期间操作高层计算图,此时执行引擎能够查看权重、激活和自动微分状态。在这一阶段,量化通常通过模拟实现:伪量化节点在浮点寄存器内对数值进行限幅和舍入,在保持可微性的同时模拟数值精度损失。然而,框架工具本身无法实现物理执行层面的加速。计算图导出后,编译器和运行时引擎接手,将模拟运算降级转换为加速器原生执行计划。运行时编译器将缩放因子运算直接融合到矩阵乘法计算分块中,并将稀疏权重打包为硬件专用的元数据布局(例如 2:4 结构化稀疏格式)。这种降级转换消除了与 HBM 之间的往返内存事务,否则这些事务会抵消降低精度所带来的收益。软件基础设施通过记录生成可部署二进制文件时所使用的校准数据、剪枝调度和算子融合来确保这一边界得到落实,而非依赖未被跟踪的脚本修改。
在这一多阶段流水线中,运行层面的核心要求是可复现性。压缩模型会改变数据—算法—机器分类体系中算法层和机器层的数值表示。未记录的校准输入或不匹配的舍入模式,可能在不引发运行时错误的情况下悄然降低准确率。机器学习运维 将在后文把这一规范扩展到模型版本管理、监控、产物管理和回滚流程;此处的基本要求是,每个已部署产物都必须能够从源训练检查点,经由编译后的硬件执行图,进行确定性的追溯。
模型优化 API 与工具
在模型开发层,压缩算法需要访问下游部署编译器会丢弃的运行时状态:梯度历史、优化器状态变量和动态激活分布。当训练后量化或一次性剪枝导致准确率下降并超出可接受的运行阈值时,需要通过重新训练或迭代微调来恢复准确率。PyTorch 和 TensorFlow 等框架提供了专门的优化 API,以管理这一计算图变换边界。这些 API 注入量化节点,使用稀疏掩码重新参数化权重张量,并将校准元数据与训练后的参数一同保存。机器学习框架 全面讨论了框架执行引擎,而模型压缩则依赖这些专门的计算图修改,将算法损失函数与机器层面的执行约束衔接起来。
量化感知训练展示了这种计算图层面的干预。将连续浮点权重量化为离散整数,会引入一个几乎处处导数为零的不连续阶梯函数(\(d\lfloor x \rceil / dx = 0\)),从而使标准梯度下降停滞。优化 API 通过向计算图中插入伪量化算子来克服这一数学障碍。在前向传播期间,这些算子将数值限幅到目标动态范围内,并将其舍入为离散整数,使下游激活受到低精度截断噪声的影响。在反向传播期间,算子实现直通估计器:将舍入步骤视为恒等函数,使梯度无阻碍地传递到底层 32 位主权重。Listing 5 详细列出了生成可部署低精度产物所需的计算图变换和元数据跟踪步骤。
选择目标精度和校准策略
在选定张量周围插入量化/反量化边界
使用模拟的低精度数值进行训练,同时保持梯度流畅通
记录缩放因子、零点、累加器精度和不受支持的运算
将校准后的计算图和元数据导出为一个可复现的产物
框架 API 中的剪枝采用类似的计算图修改策略。物理硬件无法在训练期间加速任意的参数移除:动态删除不连续的权重会使内存分配碎片化,并破坏 SIMD 执行通道间的合并内存访问。因此,框架剪枝 API 在微调期间不会缩小张量维度,而是通过保留原始稠密权重张量 \(W\),并分配形状相同的辅助二值掩码张量 \(M\),对该层进行重新参数化,通过逐元素乘法执行前向传播(\(W_{\text{pruned}} = W \odot M\))。这种设计在优化期间保留了稠密张量的内存布局和梯度更新。只有在训练结束后,导出阶段才会完成变换:对于结构化剪枝,实际切除不需要的通道;或者将非零元素编码为与硬件加速器兼容的稀疏容器格式。Listing 6 展示了参数评分、掩码应用和导出的生命周期。
选择剪枝粒度:单个权重、通道、块或注意力头
根据幅值、敏感度或对验证损失的影响,为候选参数评分
按照与硬件兼容的规则移除或掩蔽选定结构
以原始验证目标为依据,对压缩后的模型进行微调
将权重、掩码、稀疏模式和校准证据一并导出
这些 API 的工程价值主要体现在数据—算法—机器层级上的实验可复现性。实践者使用内置优化模块作为标准化控制点,而非实施临时性的计算图操作。工程师可以在保持底层执行流水线不变的情况下,系统地遍历稀疏率、量化缩放方案、校准数据集和学习率调度方案。将生成的缩放因子、零点、掩码和架构修改打包为统一的导出制品,可确保下游推理运行时复现训练期间验证过的精确数值语义。
硬件专用优化库
从训练框架导出优化后的模型,得到的是中间计算图表示,而非可执行二进制文件。TensorRT、XLA、OpenVINO 和 TVM 等编译器及运行时引擎负责最终转换步骤:将经过剪枝、量化或融合的计算图编译为针对目标加速器定制的机器指令。尽管 硬件加速 详细介绍了这些工具面向的微架构结构,但其主导性系统原则植根于数据—算法—机器层级:只有当计算图映射到能够实际利用目标机器内存层次结构和执行单元的内核时,算法压缩才能从理论走向实际。
编译过程检验名义上的压缩是否带来了实际加速。剪枝会从计算图中移除零值权重,但除非硬件提供支持稀疏性的内存布局和执行路径(例如对 2:4 结构化稀疏性的支持),否则矩阵引擎对零值与非零值执行相同的流式读取和乘法运算,因而不会减少内存流量或延迟。量化降低了位宽,但如果加速器缺少原生 INT8 或 INT4 计算流水线,运行时就必须在执行算术运算之前,将操作数解包到浮点寄存器中,使内存瓶颈转变为指令开销。此外,低精度内核需要专用的张量布局,例如分块布局或内存通道交错布局,以确保合并加载到共享内存或寄存器文件中。算子融合将中间激活直接暂存于片上 SRAM 或寄存器空间,从而消除中间结果与片外 DRAM 之间的往返传输。当不受支持的算子序列阻碍融合时,内存带宽瓶颈依然存在。框架层面的优化仅仅暴露了优化机会;硬件专用编译器决定这些机会能否在转换后落实为高效的机器执行方案。
诊断可视化
工具链边界划分了各方职责:框架 API 创建并校准压缩后的模型,硬件优化库将该模型转换为适用于底层执行平台的表示,而诊断检查则验证数值完整性。尽管系统级验证和制品监控属于下游部署基础设施的职责,但当前诊断工作的首要任务是验证量化裁剪、剪枝掩码或稀疏模式对内部特征分布的扰动是否超出了可接受的任务误差容限。
量化误差直方图显示误差是广泛分布,还是集中于离群值。激活可视化有助于检测裁剪、溢出和饱和。Figure 31 按视觉模式对第一层卷积核进行了示意性分组。接近零的卷积核,或激活始终可忽略的滤波器,才是剪枝候选对象,而不能仅凭滤波器外观均匀就将其列为候选对象,因此诊断必须将权重可视化与实测激活行为结合起来。框架观测器和调试器可以呈现量化范围与张量误差,而编译器或运行时检查工具则可以显示导出模型实际执行的计算图和内核。
\begin{tikzpicture}[x=13mm,y=13mm,line join=round,font=\sffamily\footnotesize]

\definecolor{cBlue1}{RGB}{83,130,180}
\definecolor{cBlue11}{RGB}{96,128,160}
\definecolor{cBlue2}{RGB}{111,148,185}
\definecolor{cBlue3}{RGB}{155,182,205}
\definecolor{cBlue4}{RGB}{70,98,135}
\definecolor{cBlue44}{RGB}{80,104,112}
\definecolor{cBlue5}{RGB}{120,150,185}
\definecolor{cBlue55}{RGB}{128,160,160}

\definecolor{cOrange1}{RGB}{202,114,61}
\definecolor{cOrange2}{RGB}{214,164,95}
\definecolor{cOrange3}{RGB}{227,150,77}
\definecolor{cOrange33}{RGB}{224,144,80}
\definecolor{cOrange4}{RGB}{193,153,94}

\definecolor{cGreen1}{RGB}{88,154,86}
\definecolor{green11}{RGB}{192,224,192}
\definecolor{cGreen2}{RGB}{139,170,93}
\definecolor{cGreen3}{RGB}{148,182,145}
\definecolor{cGreen4}{RGB}{110,161,109}
\definecolor{cGreen5}{RGB}{162,185,162}

\definecolor{cPurple1}{RGB}{128,100,164}
\definecolor{cPurple2}{RGB}{150,133,184}
\definecolor{cPurple3}{RGB}{174,124,160}
\definecolor{cPurple4}{RGB}{199,173,193}
\definecolor{cPurple44}{RGB}{192,176,208}

\definecolor{cBrown1}{RGB}{173,146,121}
\definecolor{cBrown11}{RGB}{144,112,96}
\definecolor{cBrown2}{RGB}{201,176,145}
\definecolor{cBrown22}{RGB}{160,128,96}
\definecolor{cBrown3}{RGB}{168,141,120}
\definecolor{cBrown4}{RGB}{175,160,142}
\definecolor{cBrown44}{RGB}{160,144,128}
\definecolor{cBrown5}{RGB}{209,189,171}

\definecolor{cGray1}{RGB}{190,190,190}
\definecolor{cGray2}{RGB}{170,170,170}
\definecolor{cGray3}{RGB}{155,155,155}
\definecolor{cGray4}{RGB}{145,145,145}
\definecolor{cGray5}{RGB}{180,180,180}

\definecolor{khaki}{RGB}{208,192,160}
\definecolor{khaki1}{RGB}{208,208,176}
\definecolor{olive1}{RGB}{160,176,96}
\definecolor{rose}{RGB}{180,180,180}
\definecolor{blue1}{RGB}{80,144,192}
\definecolor{siva1}{RGB}{208,208,208}
\definecolor{rose1}{RGB}{192,160,160}
\definecolor{rose2}{RGB}{224,192,192}
%------------------------------------------------
% Dimensions
%------------------------------------------------
\def\T{1.00} % of tile page
\def\S{1.25} % step between tiles
\def\RC{3pt} % corner rounding radius

%------------------------------------------------
% Basic single tile macro
% #1,#2 = position
% #3 = base color
% #4 = content inside the tile
%------------------------------------------------
\newcommand{\Tile}[4]{%
  \begin{scope}[shift={(#1,#2)}]
    \clip[rounded corners=\RC] (0,0) rectangle (\T,\T);
    \fill[#3] (0,0) rectangle (\T,\T);
    #4
    \draw[rounded corners=\RC,draw=black!15,line width=0.3pt]
      (0,0) rectangle (\T,\T);
  \end{scope}
}

%------------------------------------------------
% Auxiliary forms
%------------------------------------------------
\newcommand{\HalfH}[2]{%
  \fill[#1] (0,0.5*\T) rectangle (\T,\T);
  \fill[#2] (0,0) rectangle (\T,0.5*\T);
}

\newcommand{\HalfHI}[2]{%
  \fill[#1] (0,0.5*\T) rectangle (\T,\T);
  \fill[#2] (0,0) rectangle (\T,0.25*\T);
  \fill[#2] (0,0.75*\T) rectangle (\T,1*\T);
}

\newcommand{\HalfV}[2]{%
  \fill[#1] (0,0) rectangle (0.5*\T,\T);
  \fill[#2] (0.5*\T,0) rectangle (\T,\T);
}

\newcommand{\DiagLR}[2]{% diagonal /
  \fill[#1] (0,0) rectangle (\T,\T);
  \fill[#2] (0,0) -- (\T,0) -- (\T,\T) -- cycle;
}

\newcommand{\DiagRL}[2]{% diagonal \
  \fill[#1] (0,0) rectangle (\T,\T);
  \fill[#2] (0,\T) -- (\T,\T) -- (\T,0) -- cycle;
}

\newcommand{\StripeH}[2]{%
  \fill[#1] (0,0) rectangle (\T,\T);
  \fill[#2] (0,0.25*\T) rectangle (\T,0.5*\T);
  \fill[#2] (0,0.75*\T) rectangle (\T,1*\T);
}

\newcommand{\StripeHI}[2]{%
  \fill[#1] (0,0) rectangle (\T,\T);
  \fill[#2] (0,0.33*\T) rectangle (\T,0.66*\T);
%  \fill[#2] (0,0.75*\T) rectangle (\T,1*\T);
}

\newcommand{\StripeHII}[2]{%
  \fill[#1] (0,0) rectangle (\T,\T);
  \fill[#2] (0,0.3*\T) rectangle (\T,0.7*\T);
}

\newcommand{\StripeHIII}[2]{%
  \fill[#1] (0,0) rectangle (\T,\T);
  \fill[#2] (0,0.25*\T) rectangle (\T,0.75*\T);
}

\newcommand{\StripeHV}[2]{%
  \fill[#1] (0,0) rectangle (\T,\T);
  \fill[#2] (0,0*\T) rectangle (0.25*\T,\T);
  \fill[#2] (0.5,0*\T) rectangle (0.75*\T,\T);
}

\newcommand{\StripeV}[2]{%
  \fill[#1] (0,0) rectangle (\T,\T);
  \fill[#2] (0.33*\T,0) rectangle (0.67*\T,\T);
}

\newcommand{\StripeVtwo}[2]{%
  \fill[#1] (0,0) rectangle (\T,\T);
  \fill[#2] (0.22*\T,0) rectangle (0.34*\T,\T);
  \fill[#2] (0.66*\T,0) rectangle (0.78*\T,\T);
}

\newcommand{\StripeVtwoI}[2]{%
  \fill[#1] (0,0) rectangle (\T,\T);
  \fill[#2] (0*\T,0) rectangle (0.25*\T,\T);
  \fill[#2] (0.75*\T,0) rectangle (1*\T,\T);
}

\newcommand{\StripeHtwo}[2]{%
  \fill[#1] (0,0) rectangle (\T,\T);
  \fill[#2] (0,0.18*\T) rectangle (\T,0.30*\T);
  \fill[#2] (0,0.70*\T) rectangle (\T,0.82*\T);
}

\newcommand{\StripeHtwoI}[2]{%
  \fill[#1] (0,0) rectangle (\T,\T);
  %\fill[#2] (0,0.18*\T) rectangle (\T,0.30*\T);
  \fill[#2] (0,0.0*\T) rectangle (\T,0.05*\T);
  \fill[#2] (0,0.25*\T) rectangle (\T,0.4*\T);
  \fill[#2] (0,0.60*\T) rectangle (\T,0.75*\T);
  \fill[#2] (0,0.95*\T) rectangle (\T,1*\T);
}

\newcommand{\CircleC}[2]{%
  \fill[#2] (0.5*\T,0.5*\T) circle[radius=0.28*\T];
}

\newcommand{\CircleCC}[2]{%
  \fill[#2] (0.5*\T,0.5*\T) circle[radius=0.33*\T];
}

\newcommand{\CircleCCC}[2]{%
  \fill[#2] (0.5*\T,0.5*\T) circle[radius=0.4*\T];
}

\newcommand{\DonutC}[3]{%
  \fill[#2] (0.5*\T,0.5*\T) circle[radius=0.34*\T];
  \fill[#3] (0.5*\T,0.5*\T) circle[radius=0.14*\T];
}

\newcommand{\SquareC}[2]{%
  \fill[#2,rounded corners=2pt] (0.26*\T,0.26*\T) rectangle (0.74*\T,0.74*\T);
}

\newcommand{\TriDown}[2]{%
  \fill[#1] (0,0) rectangle (\T,\T);
  \fill[#2] (0,\T) -- (\T,\T) -- (0.5*\T,0) -- cycle;
}

\newcommand{\TriUp}[2]{%
  \fill[#1] (0,0) rectangle (\T,\T);
  \fill[#2] (0,0) -- (\T,0) -- (0.5*\T,\T) -- cycle;
}

\newcommand{\FourQ}[2]{%
  \fill[#1] (0,0) rectangle (\T,\T);
  \fill[#2] (0,0.5*\T) rectangle (0.5*\T,\T);
  \fill[#2] (0.5*\T,0) rectangle (\T,0.5*\T);
}

%------------------------------------------------
% Row 1
%------------------------------------------------
\Tile{0*\S}{4*\S}{white}{\HalfH{cBlue1}{cOrange1}}
\Tile{1*\S}{4*\S}{white}{\HalfV{cGreen1}{red!65!black}}
\Tile{2*\S}{4*\S}{white}{\DiagLR{cBlue2}{cOrange2}}
\Tile{3*\S}{4*\S}{white}{\DiagRL{cPurple3}{cGreen2}}
\Tile{4*\S}{4*\S}{cBlue2}{\SquareC{cBlue2}{yellow!60!red!40}}
\Tile{5*\S}{4*\S}{cBlue4!90}{\StripeHtwoI{cBlue4!90}{siva1}}
\Tile{6*\S}{4*\S}{cOrange1}{\CircleCC{cOrange1}{cOrange33}}
\Tile{7*\S}{4*\S}{cBlue4}{\CircleCC{cBlue4}{blue1}}

%------------------------------------------------
% Row 2
%------------------------------------------------
\Tile{0*\S}{3*\S}{cGray1}{\StripeH{cGray1}{cPurple1}}
\Tile{1*\S}{3*\S}{cBrown2}{\StripeHV{brown!40!white}{cBrown22}}
\Tile{2*\S}{3*\S}{cGreen3}{\TriDown{cGreen3}{green11}}
\Tile{3*\S}{3*\S}{cBrown4}{\DonutC{cBrown4}{khaki!50!white}{cBrown11}}
\Tile{4*\S}{3*\S}{cBlue5!70!gray}{\StripeVtwoI{cBlue55}{cBlue44}}
\Tile{5*\S}{3*\S}{cBrown3}{\DiagLR{cBrown5}{cBrown3}}
\Tile{6*\S}{3*\S}{cBlue3}{\StripeHII{cBlue3}{cBlue1}}
\Tile{7*\S}{3*\S}{khaki!45}{\CircleCC{khaki1}{olive1}}

%------------------------------------------------
% Row 3
%------------------------------------------------
\Tile{0*\S}{2*\S}{cBrown2}{\HalfHI{cBrown2}{cBrown3}}
\Tile{1*\S}{2*\S}{cBlue4}{\TriDown{cBlue4}{cBlue3}}
\Tile{2*\S}{2*\S}{rose1}{\CircleC{rose1}{rose2}}
\Tile{3*\S}{2*\S}{cGreen3}{\FourQ{cGreen3}{cGreen4}}
\Tile{4*\S}{2*\S}{cPurple2}{\StripeHI{cPurple2}{cPurple44}}
\Tile{5*\S}{2*\S}{cBlue5}{\CircleCCC{cBlue5}{cBlue3}}
\Tile{6*\S}{2*\S}{cOrange2!75}{\DiagRL{cOrange2!75}{cOrange4}}
\Tile{7*\S}{2*\S}{cBrown5}{\StripeV{cBrown5}{cBrown44}}

%------------------------------------------------
% Row 4
%------------------------------------------------
\Tile{0*\S}{1*\S}{cBrown4!55}{\SquareC{cBrown4!55}{cBrown4}}
\Tile{1*\S}{1*\S}{cBlue1}{\DiagRL{cBlue11}{cBlue2!50}}
\Tile{2*\S}{1*\S}{cGreen2!55!gray}{\HalfH{cGreen2!55!gray}{cGreen2!35}}
\Tile{3*\S}{1*\S}{cBlue3!80}{\CircleC{cBlue3!80}{cBlue4!70}}
\Tile{4*\S}{1*\S}{cBrown5!80}{\TriUp{cBrown5!80}{cBrown3}}
\Tile{5*\S}{1*\S}{cGreen5}{\HalfV{cGreen1}{cGreen5}}
\Tile{6*\S}{1*\S}{cPurple4}{\StripeVtwoI{cPurple4}{cPurple3}}
\Tile{7*\S}{1*\S}{cBlue3}{\StripeHIII{cBlue3}{cBlue1}}
%------------------------------------------------
% Red 5 (gray row)
%------------------------------------------------
\Tile{0*\S}{0*\S}{cGray1}{\SquareC{cGray1}{cGray3}}
\Tile{1*\S}{0*\S}{cGray4}{}
\Tile{2*\S}{0*\S}{cGray5}{}
\Tile{3*\S}{0*\S}{cGray2}{}
\Tile{4*\S}{0*\S}{cGray3}{}
\Tile{5*\S}{0*\S}{cGray5}{}
\Tile{6*\S}{0*\S}{cGray2}{}
\Tile{7*\S}{0*\S}{cGray5}{}
%------------------------------------------------
%Labeling
%------------------------------------------------
\node[align=left,anchor=west]at(8*\S,4.4*\S){\textbf{\color{crimson}定向边缘}\\
\textit{\color{black!50}类 Gabor 滤波器}};
\node[align=left,anchor=west]at(8*\S,3.4*\S){\textbf{\color{crimson}色斑}\\
\textit{\color{black!50}色彩特征}};
\node[align=left,anchor=west]at(8*\S,2.4*\S){\textbf{\color{crimson}频率}\\
\textit{\color{black!50}纹理模式}};
\node[align=left,anchor=west]at(8*\S,1.4*\S){\textbf{\color{crimson}混合特征}\\
\textit{\color{black!50}中心—周边}};
\node[align=left,anchor=west]at(8*\S,0.4*\S){\textbf{\color{crimson}外观均匀}\\
\textit{\color{black!50}检查激活}};
%
\node[align=center,anchor=north]at(3.86*\S,-0.3*\S){
\textit{\color{black!50}第一层卷积滤波器($8{\times}5$ 网格);通过活跃程度测量确定剪枝候选对象}};

\node[align=center,anchor=south]at(3.86*\S,5.0*\S){\textbf{卷积核权重}\\
\textit{\color{black!50}第一层滤波器学习定向边缘、色斑和频率模式}};

\end{tikzpicture}稀疏性诊断回答了一个部署问题:哪些层实际达到了运行时能够利用的稀疏程度?Figure 32 展示了按层和块组织的热力图如何揭示稀疏性集中的位置,而趋势图则跟踪剪枝迭代过程中稀疏性的变化。仍需通过内核性能剖析确定这种模式是否带来了加速。TensorBoard、Netron 和 SparseML 提供了这些工具。
\begin{tikzpicture}[x=13mm,y=13mm,line join=round,font=\sffamily\footnotesize]

%====================================================
% PRECISELY DEFINED COLORS
%====================================================
%row1
\definecolor{col11}{RGB}{220,230,240}
\definecolor{col12}{RGB}{200,215,230}
\definecolor{col13}{RGB}{215,225,235}
\definecolor{col14}{RGB}{225,232,240}
\definecolor{col15}{RGB}{210,222,234}
\definecolor{col16}{RGB}{220,228,238}
\definecolor{col17}{RGB}{205,218,232}
\definecolor{col18}{RGB}{218,226,236}
%row2
\definecolor{col21}{RGB}{180,200,220}
\definecolor{col22}{RGB}{170,191,215}
\definecolor{col23}{RGB}{190,201,222}
\definecolor{col24}{RGB}{175,198,218}
\definecolor{col25}{RGB}{185,202,220}
\definecolor{col26}{RGB}{165,190,212}
\definecolor{col27}{RGB}{178,196,216}
\definecolor{col28}{RGB}{172,194,214}
%row3
\definecolor{col31}{RGB}{140,170,200}
\definecolor{col32}{RGB}{120,155,185}
\definecolor{col33}{RGB}{150,178,205}
\definecolor{col34}{RGB}{130,162,192}
\definecolor{col35}{RGB}{145,175,202}
\definecolor{col36}{RGB}{125,158,190}
\definecolor{col37}{RGB}{135,165,195}
\definecolor{col38}{RGB}{142,172,200}
%row4
\definecolor{col41}{RGB}{100,140,175}
\definecolor{col42}{RGB}{110,148,182}
\definecolor{col43}{RGB}{90,132,168}
\definecolor{col44}{RGB}{105,142,178}
\definecolor{col45}{RGB}{95,135,170}
\definecolor{col46}{RGB}{85,128,165}
\definecolor{col47}{RGB}{108,145,180}
\definecolor{col48}{RGB}{98,138,172}
%row5
\definecolor{col51}{RGB}{70,115,155}
\definecolor{col52}{RGB}{60,105,145}
\definecolor{col53}{RGB}{80,122,160}
\definecolor{col54}{RGB}{55,100,140}
\definecolor{col55}{RGB}{65,110,150}
\definecolor{col56}{RGB}{50,95,135}
\definecolor{col57}{RGB}{75,118,158}
\definecolor{col58}{RGB}{58,102,142}
%row6
\definecolor{col61}{RGB}{40,80,120}
\definecolor{col62}{RGB}{30,70,108}
\definecolor{col63}{RGB}{35,75,115}
\definecolor{col64}{RGB}{25,65,105}
\definecolor{col65}{RGB}{38,78,118}
\definecolor{col66}{RGB}{22,62,100}
\definecolor{col67}{RGB}{32,72,110}
\definecolor{col68}{RGB}{28,68,106}
%row7
\definecolor{col71}{RGB}{20,55,90}
\definecolor{col72}{RGB}{15,48,82}
\definecolor{col73}{RGB}{22,58,92}
\definecolor{col74}{RGB}{12,45,78}
\definecolor{col75}{RGB}{18,52,86}
\definecolor{col76}{RGB}{10,42,75}
\definecolor{col77}{RGB}{16,50,84}
\definecolor{col78}{RGB}{14,46,80}
%row8
\definecolor{col81}{RGB}{8,38,70}
\definecolor{col82}{RGB}{12,42,75}
\definecolor{col83}{RGB}{6,35,66}
\definecolor{col84}{RGB}{10,40,72}
\definecolor{col85}{RGB}{5,33,64}
\definecolor{col86}{RGB}{8,36,68}
\definecolor{col87}{RGB}{14,44,76}
\definecolor{col88}{RGB}{7,34,65}
%row9
\definecolor{col91}{RGB}{60,105,145}
\definecolor{col92}{RGB}{80,122,160}
\definecolor{col93}{RGB}{40,85,125}
\definecolor{col94}{RGB}{70,115,155}
\definecolor{col95}{RGB}{50,95,135}
\definecolor{col96}{RGB}{65,110,150}
\definecolor{col97}{RGB}{55,100,140}
\definecolor{col98}{RGB}{75,118,158}
%row10
\definecolor{col101}{RGB}{130,165,195}
\definecolor{col102}{RGB}{140,172,200}
\definecolor{col103}{RGB}{120,158,188}
\definecolor{col104}{RGB}{135,168,198}
\definecolor{col105}{RGB}{125,162,192}
\definecolor{col106}{RGB}{118,155,185}
\definecolor{col107}{RGB}{132,166,196}
\definecolor{col108}{RGB}{128,163,193}
%row11
\definecolor{col111}{RGB}{55,100,140}
\definecolor{col112}{RGB}{45,90,130}
\definecolor{col113}{RGB}{65,108,148}
\definecolor{col114}{RGB}{40,85,125}
\definecolor{col115}{RGB}{50,95,135}
\definecolor{col116}{RGB}{35,80,120}
\definecolor{col117}{RGB}{60,105,145}
\definecolor{col118}{RGB}{42,88,128}
%row12
\definecolor{col121}{RGB}{50, 95,135}
\definecolor{col122}{RGB}{40,85,125}
\definecolor{col123}{RGB}{60,105,145}
\definecolor{col124}{RGB}{35,80,120}
\definecolor{col125}{RGB}{45,90,130}
\definecolor{col126}{RGB}{30,75,115}
\definecolor{col127}{RGB}{55,100,140}
\definecolor{col128}{RGB}{38,82,133}
%legend
\definecolor{leg1}{RGB}{220,230,240}
\definecolor{leg2}{RGB}{160,190,215}
\definecolor{leg3}{RGB}{90,135,170}
\definecolor{leg4}{RGB}{40,80,120}
\definecolor{leg5}{RGB}{8,38,70}

%====================================================
% GEOMETRY
%====================================================
\def\BoxW{1.13}
\def\BoxH{0.52}
\def\GapX{0.20}
\def\GapY{0.2}
\def\StartY{0.10}

\pgfmathsetmacro{\RI}{\StartY}
\pgfmathsetmacro{\RII}{\StartY-(\BoxH+\GapY)}
\pgfmathsetmacro{\RIII}{\StartY-2*(\BoxH+\GapY)}
\pgfmathsetmacro{\RIV}{\StartY-3*(\BoxH+\GapY)}
\pgfmathsetmacro{\RV}{\StartY-4*(\BoxH+\GapY)}
\pgfmathsetmacro{\RVI}{\StartY-5*(\BoxH+\GapY)}
\pgfmathsetmacro{\RVII}{\StartY-6*(\BoxH+\GapY)}
\pgfmathsetmacro{\RVIII}{\StartY-7*(\BoxH+\GapY)}
\pgfmathsetmacro{\RIX}{\StartY-8*(\BoxH+\GapY)}
\pgfmathsetmacro{\RX}{\StartY-9*(\BoxH+\GapY)}
\pgfmathsetmacro{\RXI}{\StartY-10*(\BoxH+\GapY)}
\pgfmathsetmacro{\RXII}{\StartY-11*(\BoxH+\GapY)}
\pgfmathsetmacro{\GridW}{8*\BoxW + 7*\GapX}
\pgfmathsetmacro{\CenterX}{0.5*\GridW}

%====================================================
% JEDAN BOKS
% #1=x, #2=y, #3=color name
%====================================================
\newcommand{\OneBoxColor}[3]{%
  \path[
    rounded corners=2.8pt,
    fill=#3,
    draw=none
  ] (#1,#2) rectangle ++(\BoxW,\BoxH);
}

%====================================================
% ENTIRE ROW
% #1=y
% #2=label
% #3=list of 8 colors
\newcommand{\DrawRowColors}[3]{%
  \node[
    anchor=east,
    font=\sffamily\bfseries\small,
    text=black!85
  ] at (-0.25,#1+0.5*\BoxH) {#2};

  \foreach \clr [count=\i from 0] in {#3}{%
    \pgfmathsetmacro{\xx}{\i*(\BoxW+\GapX)}
    \OneBoxColor{\xx}{#1}{\clr}
  }%
}

%====================================================
% TITLE
%====================================================
\node[
  font=\sffamily\bfseries\normalsize,
  text=black!80
] at (\CenterX,1.85)
{各层的权重稀疏度分布};

\node[
  font=\sffamily\itshape\normalsize,
  text=black!55
] at (\CenterX,1.45)
{颜色越深,稀疏度越高(剪除的权重越多)};

\node[
  font=\sffamily\itshape\small,
  text=black!55
] at (\CenterX,-9.51)
{稀疏度因层类型而异:早期卷积层保留特征;全连接层可承受激进剪枝};

%====================================================
% COLUMN TITLE
%====================================================
\foreach \txt [count=\i from 0] in {块 1,块 2,块 3,块 4,块 5,块 6,块 7,块 8}{
  \pgfmathsetmacro{\xc}{\i*(\BoxW+\GapX)+0.5*\BoxW}
  \node[
    font=\sffamily\small,
    text=black!75
  ] at (\xc,0.9) {\txt};
}

%====================================================
% LINES
% Here is the KEY:
% each position gets a SPECIFIC COLOR NAME
%====================================================
\DrawRowColors{ \RI}{卷积层1}    {col11,col12,col13,col14,col15,col16,col17,col18}
\DrawRowColors{\RII}{卷积层2}    {col21,col22,col23,col24,col25,col26,col27,col28}
\DrawRowColors{\RIII}{卷积层3}     {col31,col32,col33,col34,col35,col36,col37,col38}
\DrawRowColors{\RIV}{卷积层4}    {col41,col42,col43,col44,col45,col46,col47,col48}
\DrawRowColors{\RV}{卷积层5}   {col51,col52,col53,col54,col55,col56,col57,col58}

\DrawRowColors{\RVI}{全连接层1}       {col61,col62,col63,col64,col65,col66,col67,col68}
\DrawRowColors{\RVII}{全连接层2}     {col71,col72,col73,col74,col75,col76,col77,col78}

\DrawRowColors{\RVIII}{全连接层3}     {col81,col82,col83,col84,col85,col86,col87,col88}
\DrawRowColors{\RIX}{注意力 Q/K} {col91,col92,col93,col94,col95,col96,col97,col98}
\DrawRowColors{\RX}{注意力 V/O} {col101,col102,col103,col104,col105,col106,col107,col108}

\DrawRowColors{\RXI}{MLP 上投影}   {col111,col112,col113,col114,col115,col116,col117,col118}
\DrawRowColors{\RXII}{MLP 下投影} {col121,col122,col123,col124,col125,col126,col127,col128}

%====================================================
% LEGEND
%====================================================
\node[
  anchor=east,
    font=\sffamily\normalsize,
  text=black!75
] at (1.30,-8.5) {稀疏度:};

\foreach \clr/\lab [count=\i from 0] in {
  leg1/{0\%},
  leg2/{25\%},
  leg3/{50\%},
  leg4/{75\%},
  leg5/{90\%+}
}{
  \pgfmathsetmacro{\xx}{1.75 + \i*1.65}
  \path[
    rounded corners=2.8pt,
    fill=\clr,
    draw=none
  ] (\xx,-8.8) rectangle ++(1.15,0.56);

  \node[
    font=\sffamily\small,
    text=black!75
  ] at (\xx+0.575,-9.04) {\lab};
}
%
\draw[black!70,thick](106*\StartY,0.35)--++(0.5,0)
node[align=left,anchor=west]{\textit{\color{black!50}低稀疏度}\\
\textit{\color{black!50}(保留早期层)}};
%
\draw[black!70,thick](106*\StartY,-3.25)--++(0.5,0)
node[align=left,anchor=west]{\textbf{\color{crimson}高稀疏度}\\
\textit{\color{black!50}全连接层:大多数}\\
\textit{\color{black!50}参数被剪除}
};
%
\draw[black!70,thick](106*\StartY,-6.85)--++(0.5,0)
node[align=left,anchor=west]{\textit{\color{black!50}Transformer 层:}\\
\textit{\color{black!50}(稀疏度可变)}};
\end{tikzpicture}诊断价值在于分布的不均匀性,而非某个单元格的确切色深。如果后期层的稀疏度远高于早期特征提取层,说明剪枝策略将压缩集中在表征冗余度更高的位置;如果早期层率先变深,则该策略可能在模型尚无足够深度进行补偿之前,就破坏了底层特征。
实现工具使压缩过程可重复,但并不会消除其中的权衡。量化可以在分阶段流水线中接续剪枝或蒸馏:剪枝改变模型结构或参数数量,量化改变数值表示,而蒸馏可以依据教师模型的行为训练更小的模型产物。这些变换可以叠加,进一步减少原始存储占用,但不存在可跨模型和部署场景通用的固定压缩比或质量结果;每个阶段都必须根据任务目标进行评估,并在目标执行路径上进行性能剖析。
谬误与陷阱
模型压缩中最有启发性的经验往往来自失败,而非成功。以下场景展示了常见的失效模式;具体结果取决于模型、压缩方法、工作负载和目标硬件。
模型优化涉及看似独立的技术之间违反直觉的相互作用。工程师常常假定各种策略可以线性组合,且理论指标能够预测部署性能;这些假设会浪费优化投入、降低准确率,或使团队即使投入大量资源也无法满足部署要求。
谬误:优化技术可以独立应用,无须考虑它们之间的相互作用。
工程师假定优化策略的收益可以相加:50% 的剪枝加上存储缩减倍数为 4× 的量化,就能获得组合收益。实际上,各种技术之间存在非线性相互作用,损失也会叠加。在一个具有代表性的 BERT 类模型压缩场景中,剪枝至 70 percent 的稀疏度可能保留大部分任务性能,但随后应用 INT8 量化,相较于在剪枝后的模型上进行 QAT,可能造成更大的准确率损失。从经过重度剪枝的教师模型进行知识蒸馏,还可能传递退化的注意力模式,使学生模型的准确率低于从稠密教师模型蒸馏所得的结果。正如 section 1.7 所示,成功的优化需要协调应用各种技术,统筹安排其先后顺序。若组织在未测量相互作用的情况下采用激进的技术组合,就可能耗费数周来恢复损失的准确率。
陷阱:针对理论指标进行优化,而非针对实际部署性能进行优化。
团队即使大幅减少 FLOPs,也未必能获得成比例的延迟改善。在一个假设的执行轨迹中,剪枝后的模型参数数量减少了 40%,但由于不规则稀疏性妨碍高效执行,延迟仅降低了 12%。另一个场景将 Transformer 模型从 440 MB 缩减至 110 MB,但在缺乏快速低精度执行路径的硬件上,转换开销侵蚀了延迟收益。这些数值旨在说明失效模式,并非 ARM 或 GPU 的测量结果。内存带宽、缓存行为、内核和指令级并行性决定实际性能,因此生产部署需要在目标硬件上测量实际运行时间。
谬误:激进量化能够以极小的准确率损失维持模型性能。
工程师假定量化误差随位宽均匀变化。实际上,降低精度可能呈现阈值效应,而阈值取决于模型、层、量化器、校准和训练方法。本章中的 ResNet 和 BERT 数值仅用于说明,并非普遍适用的性能退化区间。即使是 LayerNorm 和 Softmax 这样的运算,也可以通过整数近似实现,因此它们并非一律需要 FP16;低精度实现能否保留任务质量,必须通过测量确定。正如 section 1.4.4 所示,在统一量化失效的地方,混合精度方法可以保留更高精度。
陷阱:为规避量化风险,默认在所有位置使用 FP32。
FP32 的原始存储占用和带宽需求均为 BF16 的两倍,但低精度执行并不自动保证收敛性或准确率。混合精度训练通常保留 FP32 累加器或主权重,并且可能需要损失缩放;推理精度则必须针对每个模型和算子进行验证。正确的问题是:能够在评估分布上保留质量,并高效映射到目标硬件的最低精度是什么。
谬误:训练后优化总是足够的。
团队通常从训练后量化(PTQ)入手,因为它无须重新训练。如果所得模型产物满足任务和部署阈值,这条简单路径可能就已足够。如果未能满足,量化感知训练(QAT)可以通过使模型适应模拟的低精度行为,弥补部分质量差距。同样,在激进的稀疏度或位宽设置下,训练后剪枝和事后蒸馏也可能不如将压缩纳入训练过程的方案。如 section 1.4.4 所详述,决策依据应是生产要求的阈值,而非预先认定某条路径在所有情况下都更优。
陷阱:假定压缩比会直接转化为成比例的部署收益。
团队可能通过 INT8 量化,使原始权重载荷按 4× 的倍数缩减,并期望获得同等程度的部署收益。实际上,缩放因子、元数据、不受支持的算子、转换和稀疏索引都会侵蚀收益。本章中端到端改善为 18.8 percent、而纸面目标为 8× 的情况,是一个假设的执行轨迹,并非 BERT 基准测试。生产工作流必须在目标硬件上剖析部署后的延迟,而不能根据压缩比进行外推。
谬误:稀疏矩阵总能节省内存。
稀疏格式会增加索引数组元数据,在中等密度下侵蚀存储节省。采用 FP32 数值和 INT32 索引时,若不计行指针开销,CSR 格式在密度接近 50% 时达到存储盈亏平衡;COO 需要存储额外坐标,因此在更低密度下才达到这一平衡。性能方面不存在通用的稀疏度阈值,因为张量形状、格式、内核、批大小和硬件共同决定稀疏执行是否快于稠密执行。NVIDIA 的 2:4 稀疏性等专用格式能够减少元数据,并提供受支持的执行路径,而任意的非结构化稀疏性在通用硬件上可能既不节省内存,也不降低延迟(见 section 1.8.1)。
陷阱:尚未检查密度阈值就选择稀疏存储。
团队有时一看到剪枝产生了明显的零值,就将张量转换为稀疏格式。如果元数据、聚集/散射开销以及较差的缓存局部性超过了省去数值存储带来的收益,这种转换反而会使系统更慢、占用更大。生产环境中的压缩流程应测量实际密度,只有在越过盈亏平衡点后才选择稀疏格式;当目标硬件具有能够利用结构化稀疏性的内核时,应优先采用结构化稀疏性。
总结
模型压缩是一门建立在三个互补维度之上的工程学科:结构优化决定模型计算什么,精度优化决定计算的精确程度,架构优化决定这些计算在物理硬件上执行的效率。这些维度的收益可以叠加,但并不会自动相乘。剪枝、蒸馏和量化共同使示例流水线的存储占用从 440 MB 降至 28 MB,缩减倍数为 16×;元数据、不受支持的算子和硬件映射决定实际部署收益。只有当受影响的工作位于关键路径上,且运行时能够利用新的表示形式时,参数缩减幅度才可能接近延迟降低幅度。应在目标硬件上进行性能剖析,而非依赖纸面指标。
结合 数据选择 中的数据选择技术,这些以模型为中心的优化构成了完整的模型侧效率工具集:数据选择最大限度地利用现有样本进行学习,而模型压缩最大限度地减少部署所需的资源。这些节省能否转化为实际加速,仍取决于执行压缩模型的硬件和运行时。
要点回顾: 从基准测试优胜者到生产模型
- 压缩消耗富余容量:生产模型以未充分利用的参数、精度和容量为代价,满足部署不可违反的延迟、内存、功率或成本限制。目标是在部署约束下,得到能够保留所需任务行为的最小模型产物。
- 只有相互适配,节省收益才能相乘:结构剪枝、蒸馏、量化和架构变更可以叠加,进一步减少原始存储占用,所建模的 BERT 移动端流水线中 16× 的缩减倍数便说明了这一点。只有任务质量得到保持,且所得算子与目标运行时和加速器相匹配,这些收益才能真正实现。
- 精度是一项部署契约:在目标运行时支持的情况下,INT8 训练后量化是一个值得首先尝试的实验,因为它无须重新训练,就能将原始 FP32 权重载荷缩减至四分之一,即实现 4\(\times\) 的缩减倍数。当校准或层敏感性暴露出不可接受的误差时,可以考虑 QAT、蒸馏或混合精度。
- 硬件决定交换比率:除非内核和内存布局能够利用非结构化稀疏性以及理论上的 FLOP 缩减,否则它们并不意味着延迟收益。本章中纸面目标为 8\(\times\)、实际结果为 1.5\(\times\) 的假设场景,说明了为何必须在目标硬件上进行性能剖析。
- 端到端延迟限制模型优化收益:压缩只有作用于关键路径才有价值。当推理占请求总延迟的 20% 时,根据阿姆达尔定律,即使模型加速达到理想极限,整体加速比也至多为 1.25\(\times\),因此预处理、调度和数据移动可能才是真正的优化目标。
本章中的技术几乎在所有细节上都各不相同,但它们都遵循同一条规则。每种技术都通过消耗其他东西,换取更小、更快或发热更少的模型:剪枝消耗容量,量化消耗数值精度,蒸馏消耗训练计算资源。当模型没有可供消耗的富余资源时,代价可能由任务质量承担。压缩并不会使工作消失;它将成本或风险从系统的一个部分转移到另一个部分,而硬件决定交换比率。因此,一种在手机上有效的技术,在数据中心 GPU 上可能毫无价值。这就是复杂性守恒启发式在单个模型层面的体现。生产级模型产物的结构、表示和执行路径经过协同设计,使各项权衡在决定部署条件的芯片与应用约束下达到平衡。
后续内容: 从数学到物理
这些优化技术压缩了模型的逻辑,减少了算法要求机器执行的工作量。然而,逻辑最终必须在物理硅芯片上运行。硬件加速 探讨 GPU、TPU 和 NPU 如何利用其脉动阵列、稀疏张量核心以及分层 SRAM/HBM 存储体系,将受支持的压缩表示映射到硬件可提供的吞吐量和数据搬移能力上。
Footnotes
神经架构搜索(NAS):Google Brain 的 Zoph and Le (2016) 使用强化学习来学习架构本身,代价为 22,400 GPU-days(使用 800 GPUs,持续 28 days),相当于 537,600 GPU-hours。此后,高效神经架构搜索(ENAS)等权重共享方法通过在候选架构之间共享参数,使搜索成本降低了约 1,000× (Pham et al. 2018)。随后,硬件感知 NAS 和缩放方法使搜索结果能够实际用于 EfficientNet 和 MobileNetV3 等可部署架构族 (Tan and Le 2019; Howard et al. 2019)。↩︎
过参数化:C. Zhang et al. (2017) 表明,足以拟合 ImageNet 的网络也能够记忆完全随机的标签,这说明训练容量可以超过自然标签所需的结构。随后,剪枝研究揭示了这对部署的影响:经过训练的模型通常包含大量参数,在谨慎执行剪枝和微调的情况下,可以移除这些参数或使其稀疏化,而任务性能损失较小 (Gale et al. 2019; Blalock et al. 2020)。冗余程度并不是普遍适用的 10\(\times\) 常数;它取决于架构、数据集、稀疏模式和运行时支持。↩︎
帕累托前沿:以意大利经济学家维尔弗雷多·帕累托(1848–1923)的名字命名,他观察到意大利 80% 的土地由 20% 的人口拥有。在多目标优化中,帕累托前沿是这样一组解:改善一个目标(例如速度)必然要牺牲另一个目标(例如准确率)。EfficientNet 具体勾勒了这一前沿:从 B0(准确率 77.1%,3.9 亿 FLOPs)到 B7(84.4%,370 亿 FLOPs),计算量增至 95\(\times\),换来 7.3 个百分点的准确率提升,量化了前沿边缘处权衡关系的陡峭程度 (Tan and Le 2019)。↩︎
最优脑损伤:该方法由 LeCun et al. (1989) 提出,通过对二阶导数(Hessian)信息进行对角近似,估计移除每个权重所引起的损失增量,在手写识别器中实现了 4\(\times\) 的参数量压缩,并按相同比例节省内存。对于 \(n\) 个参数,完整的 Hessian 矩阵包含 \(\mathcal{O}(n^2)\) 个元素,但最优脑损伤通过近似其对角线,避免存储整个矩阵。现代大规模剪枝仍倾向于使用幅值等成本更低的准则,因为即使仅估计对角曲率也会增加训练成本。↩︎
启发式:源自希腊语 heuriskein(发现),与阿基米德的“eureka”同源。在剪枝中,主流的启发式准则——幅值越大,重要性越高——在经验上效果良好,但会造成一个系统层面的陷阱:全局应用基于幅值的剪枝,可能会移除过度参数化层中的大部分参数,却让关键瓶颈层基本保持不变,从而呈现出大幅压缩的表象,同时保留了关键层中的大部分计算和内存成本 (Blalock et al. 2020)。这就是为什么采用逐层预算、迭代执行剪枝与再训练,通常比朴素的全局幅值剪枝更稳妥:每个周期都让网络有机会在下一次剪枝前重新分配重要性。↩︎
N:M 结构化稀疏性:2:4 模式随 NVIDIA 的 A100 GPU(2020 年)首次实现商业化,之所以选择这一模式,是因为它在将乘累加运算量减半的同时,能够使位置元数据保持足够小,以适用于稀疏 Tensor Core 执行路径 (NVIDIA Corporation 2020; Choquette et al. 2021)。这一固定比例是硬件约束,而非数学上的最优值:A100 稀疏 Tensor Core 执行路径可加速 2:4 稀疏操作数,当内核和布局满足约束时,相比稠密执行,数学运算吞吐量最高可提升至 2\(\times\)。这一特定硬件路径不会加速其他比例,这说明芯片设计限制了哪些稀疏模式能够转化为实际加速。↩︎
彩票假说:这一名称源于如下直觉:训练大型网络就像购买许多张彩票——大多数未中奖,但少数“中奖彩票”(具有有利初始化的稀疏子网络)能够通过独立训练达到相当的准确率。Frankle and Carbin (2019) 在较小的视觉网络和全连接网络上确立了这一假说;后续研究对这一思想进行了综述,并将其扩展到更大规模的场景 (Rachwan et al. 2022)。其系统层面的含义是,训练稠密网络所消耗的部分内存和计算资源可能属于可通过发现子网络而避免的开销,但实际收益取决于能否在付出原始训练成本的大部分之前找到中奖彩票子网络。↩︎
BERT 剪枝:BERT 每层的 12 个注意力头可能存在大量冗余——Michel et al. (2019) 在 MultiNLI 上发现,移除许多注意力头并不会引起统计上显著的性能变化。可移除的比例取决于层和任务,因此部署剪枝必须同时衡量任务质量,以及所得结构是否减少了运行时工作量。↩︎
蒸馏:这一名称借自分离混合物的化学过程。在模型压缩中,学生从教师经过软化的输出分布或内部表示中学习,而不是复制其参数。软目标能够编码类别间的关系,但学生只能学到其目标函数和训练数据所呈现的内容。这一比喻有用,但不能按字面理解:温度参数源于 softmax 缩放,而规模与质量之间的权衡取决于学生、数据、目标函数和训练过程 (Hinton et al. 2015)。部署资源的节省来自学生架构,而非比喻本身。↩︎
温度(softmax):这一术语源于统计力学中的玻尔兹曼分布。将 logits 除以大于一的温度会产生更平缓的分布,并能够显露非目标类别之间的相对概率。当 \(T_{\text{distill}}{=}1\) 时,该表达式即为标准 softmax;提高温度会缩小 logit 差距,但并不保证显露出的概率有助于学生学习。有效的软化程度取决于 logit 尺度、教师校准情况、学生容量、损失权重,以及相伴的 \(T_{\text{distill}}^2\) 因子。因此,温度通过实验选择,而不是固定在某个通用范围内。↩︎
KL 散度:由 Solomon Kullback 和 Richard Leibler 于 1951 年提出,\(\mathcal{D}_{\text{KL}}(p \lVert q)\) 量化了使用针对 \(q\) 优化的编码来编码来自分布 \(p\) 的样本所需的额外比特数。其非对称性的关键影响是:当学生为教师认为具有概率的输出分配零概率时,\(\mathcal{D}_{\text{KL}}(\text{teacher} \lVert \text{student})\) 会对学生施加严厉惩罚,迫使学生广泛覆盖教师的分布,包括携带教师所学不确定性的低概率“软标签”。蒸馏可能影响校准情况,因此必须单独评估校准情况。↩︎
DistilBERT:报告中的模型具有 6600 万个参数,而 BERT-Base 为 1.1 亿个;其规模缩小了 40%,速度提升了 60%,并保留了 BERT-Base 语言理解性能的 97%。绝对内存用量和延迟仍取决于数值格式、批大小、序列长度、运行时和硬件 (Sanh et al. 2019)。↩︎
奇异值分解(SVD):Eckart-Young 定理(1936)证明,保留最大的 \(k\) 个奇异值,可以得到 Frobenius 范数和谱范数意义下的最优秩 \(k\) 近似。系统层面的关键权衡在于:这种分解较高的一次性计算成本——\(\mathcal{O}(mn \cdot \min(m,n))\)——能否通过在重复推理调用中使用较小模型所节省的内存和带宽来摊销。↩︎
硬件感知 NAS:优化实测延迟,而非 FLOPs;当内存访问或算子支持成为主导因素时,两者所反映的性能可能相差 3–5\(\times\)。Tan et al. (2019) 将设备延迟纳入搜索,发现了速度为 MobileNetV2 的 1.8\(\times\) 且准确率更高的架构。↩︎
双层优化:一种将一个优化问题嵌套在另一个优化问题之中的形式。在 NAS 中,外层选择架构,内层训练该候选架构的权重,因此早期方法每评估一个架构都要付出一次完整训练的成本。这种嵌套正是早期 NAS 需要 22,400 GPU 天的原因;权重共享方法将一次训练的成本分摊到多个候选架构上,使搜索成本降低约 1,000\(\times\)。↩︎
量化:其根源是香农关于用离散值表示连续信号的理论 (Shannon 1948),将 FP32 降为 INT8 会使可表示的数值从超过 40 亿个缩减为仅 256 个。神经网络通常能够容忍这种变化,因为训练后的权重将信息集中在相对大小而非绝对精度上:通过适当校准或量化感知训练,INT8 推理的表现可以接近全精度基线,而 INT4 及更低位宽方法的表现则更依赖具体架构和方法 (Jacob et al. 2018; Gholami et al. 2022; Shen et al. 2020; Lin et al. 2024)。其系统层面的含义是,必须针对每个模型和任务验证量化的可行性,不能根据汇总基准测试结果直接作出假设。↩︎
INT8 对能耗的影响:内存访问在能耗上的主导程度极高:采用此处使用的 Horowitz 常数,一次 32 位 DRAM 读取的能耗约为一次 INT8 乘加运算的 2,782.6× (Horowitz 2014)。从 FP32 量化至 INT8 从两个方面缓解这一差距——搬移的字节数缩减 4\(\times\),同时每次算术运算的能耗也更低——但实际节能效果取决于内存层次结构、内核和工作负载。↩︎
激活感知权重量化(AWQ):重要性由激活幅值而非权重幅值决定;这一区别至关重要,因为小权重与大激活相乘也会对输出产生较大贡献。AWQ 通过激活感知缩放保护约 1% 的重要权重通道,同时将大多数权重量化为低位宽格式,因此,一组原本约占 14 GB 的 70 亿参数 FP16 权重,在不计元数据、缩放因子和内核特定打包开销的情况下,其权重存储占用可接近约 3.5 GB 的 INT4 级水平 (Lin et al. 2024)。↩︎
直通估计器(STE):由 Bengio et al. (2013) 提出,STE 用恒等函数替代舍入运算的真实梯度;由于舍入是分段常数函数,其真实梯度几乎处处为零。常见的恒等 STE 将上游梯度原样传过量化器。它是一种有偏的启发式方法,而非真实导数。↩︎
量化感知训练(QAT):QAT 在训练或微调期间模拟低精度行为,使权重更新能够适应裁剪和舍入误差。BERT 相关研究报告称,在其评估设置中,训练感知或 Hessian 感知方法的结果可以比更简单的训练后量化方法更接近全精度的通用语言理解评估(GLUE)基线 (Zafrir et al. 2019; Shen et al. 2020)。具体差距取决于模型、任务、量化器、位宽、训练预算和评估分布;更接近基线的基准测试结果为尝试 QAT 提供了依据,但并不保证其额外训练成本或导出后的运行时性能能够满足生产目标。↩︎
深度可分离卷积:该技术将标准卷积分解为独立的逐通道卷积和逐点 \((1{\times}1)\) 运算,以减少计算量。MobileNet 架构利用这种分解,在模型容量和精度与更低的运算次数之间进行权衡,以服务于设备端视觉任务 (Howard et al. 2017; Sandler et al. 2018)。↩︎
FlashAttention:通过将计算划分为适配 SRAM 的块,避免显式生成完整的注意力矩阵,并报告了在长序列上实现数倍加速的结果,展示了融合对于受内存带宽限制的注意力计算的作用 (T. Dao et al. 2022)。这说明了算子融合如何改变受内存带宽限制的瓶颈:算术运算在数学上等价,但内存访问模式发生了变化,使原本无法承担完整中间矩阵存储开销的硬件也能执行更长上下文的注意力计算。↩︎
Switch Transformer:Fedus et al. (2022) 将总参数量扩展至约 1.6 万亿,同时将每个词元路由至一个专家;在计算量匹配的实验中,具有 64 个专家的 Switch-Base 达到 T5-Base 的质量目标所需的训练时间约为后者的七分之一;万亿参数规模的比较报告了相对于 T5-XXL 约 4\(\times\) 的加速。与 top-\(k\) 路由相比,将每个词元路由至一个专家可减少通信,但负载不均衡需要通过辅助损失和容量因子来处理。这种权衡——以较低的每词元计算成本获得庞大的参数容量,同时需要复杂的系统工程来实现负载均衡——界定了 MoE 的设计空间。↩︎
稀疏性:源自拉丁语 sparsus(散布的),它是 spargere(散布)的过去分词;在机器学习中,lasso 等 L1 正则化方法可以使元素精确为零,而不只是取较小的值 (Tibshirani 1996)。软件可以表示任意稀疏模式,但高效的硬件执行通常需要受支持的格式或结构化模式(例如 NVIDIA 的 2:4 稀疏性)。可表示的稀疏性与可执行的稀疏性之间的差距,将理论压缩效果与实际加速效果区分开来。↩︎
非结构化稀疏性与 SIMD 浪费:现代 CPU 和 GPU 以向量组或张量组的形式处理数据;非结构化稀疏性使非零元素不规则地散布在内存中,因此一次向量加载可能取回的大部分都是零值,却仍需承担完整的内存访问成本。处理器必须先知道非零元素的位置,才能跳过零值元素,而提供这些位置信息所需的元数据也会消耗带宽。因此,相比任意的非结构化稀疏性,结构化稀疏性能够在较低的稀疏程度下实现加速;非结构化稀疏性通常需要极高的零值比例和专门的计算内核,节省的算术运算成本才能超过索引处理和通道利用率方面的开销 (Hoefler et al. 2021)。↩︎
Zoph, Barret, and Quoc V. Le. 2016. “Neural Architecture Search with Reinforcement Learning.” International Conference on Learning Representations 3.
Pham, Hieu, Melody Y. Guan, Barret Zoph, Quoc V. Le, and Jeff Dean. 2018. “Efficient Neural Architecture Search via Parameter Sharing.” Proceedings of the 35th International Conference on Machine Learning (ICML), Proceedings of machine learning research, vol. 80: 4095–104.
Tan, Mingxing, and Quoc V Le. 2019. “EfficientNet: Rethinking Model Scaling for Convolutional Neural Networks.” International Conference on Machine Learning (ICML), 6105–14.
Howard, Andrew, Mark Sandler, Bo Chen, Weijun Wang, Liang-Chieh Chen, Mingxing Tan, Grace Chu, et al. 2019. “Searching for MobileNetV3.” 2019 IEEE/CVF International Conference on Computer Vision (ICCV), 1314–24. https://doi.org/10.1109/iccv.2019.00140.
Zhang, Chiyuan, Samy Bengio, Moritz Hardt, Benjamin Recht, and Oriol Vinyals. 2017. “Understanding Deep Learning Requires Rethinking Generalization.” International Conference on Learning Representations (ICLR).
Gale, Trevor, Erich Elsen, and Sara Hooker. 2019. “The State of Sparsity in Deep Neural Networks.” arXiv Preprint arXiv:1902.09574.
Blalock, Davis, Jose Javier Gonzalez Ortiz, Jonathan Frankle, and John Guttag. 2020. “What Is the State of Neural Network Pruning?” Proceedings of Machine Learning and Systems (MLSys) 2: 129–46.
LeCun, Yann, John S. Denker, and Sara A. Solla. 1989. “Optimal Brain Damage.” Advances in Neural Information Processing Systems 2 (NIPS 1989), 598–605.
NVIDIA Corporation. 2020. NVIDIA A100 Tensor Core GPU Architecture. NVIDIA Whitepaper, V1.0.
Choquette, Jack, Wishwesh Gandhi, Olivier Giroux, Nick Stam, and Ronny Krashinsky. 2021. “NVIDIA A100 Tensor Core GPU: Performance and Innovation.” IEEE Micro 41 (2): 29–35. https://doi.org/10.1109/mm.2021.3061394.
Frankle, Jonathan, and Michael Carbin. 2019. “The Lottery Ticket Hypothesis: Finding Sparse, Trainable Neural Networks.” International Conference on Learning Representations (ICLR).
Rachwan, John, Daniel Zügner, Bertrand Charpentier, Simon Geisler, Morgane Ayle, and Stephan Günnemann. 2022. “Winning the Lottery Ahead of Time: Efficient Early Network Pruning.” International Conference on Machine Learning (ICML), 18293–309.
Michel, Paul, Omer Levy, and Graham Neumann. 2019. “Are Sixteen Heads Really Better Than One?” Advances in Neural Information Processing Systems (NeurIPS).
Hinton, Geoffrey, Oriol Vinyals, and Jeff Dean. 2015. “Distilling the Knowledge in a Neural Network.” arXiv Preprint.
Sanh, Victor, Lysandre Debut, Julien Chaumond, and Thomas Wolf. 2019. “DistilBERT, a Distilled Version of BERT: Smaller, Faster, Cheaper and Lighter.” arXiv Preprint arXiv:1910.01108, ahead of print. https://doi.org/10.48550/arXiv.1910.01108.
Tan, Mingxing, Bo Chen, Ruoming Pang, Vijay Vasudevan, Mark Sandler, Andrew Howard, and Quoc V. Le. 2019. “MnasNet: Platform-Aware Neural Architecture Search for Mobile.” 2019 IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2815–23. https://doi.org/10.1109/cvpr.2019.00293.
Shannon, Claude E. 1948. “A Mathematical Theory of Communication.” Bell System Technical Journal 27 (3): 379–423. https://doi.org/10.1002/j.1538-7305.1948.tb01338.x.
Jacob, Benoit, Skirmantas Kligys, Bo Chen, Menglong Zhu, Matthew Tang, Andrew Howard, Hartwig Adam, and Dmitry Kalenichenko. 2018. “Quantization and Training of Neural Networks for Efficient Integer-Arithmetic-Only Inference.” 2018 IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2704–13. https://doi.org/10.1109/cvpr.2018.00286.
Gholami, Amir, Sehoon Kim, Zhen Dong, Zhewei Yao, Michael W. Mahoney, and Kurt Keutzer. 2022. “A Survey of Quantization Methods for Efficient Neural Network Inference.” In Low-Power Computer Vision: Improve the Efficiency of Artificial Intelligence. Chapman; Hall/CRC. https://doi.org/10.1201/9781003162810-13.
Shen, Sheng, Zhen Dong, Jiayu Ye, Linjian Ma, Zhewei Yao, Amir Gholami, Michael W. Mahoney, and Kurt Keutzer. 2020. “Q-BERT: Hessian Based Ultra Low Precision Quantization of BERT.” Proceedings of the AAAI Conference on Artificial Intelligence 34 (05): 8815–21. https://doi.org/10.1609/aaai.v34i05.6409.
Lin, Ji, Jiaming Tang, Haotian Tang, Shang Yang, Wei-Ming Chen, Wei-Chen Wang, Guangxuan Xiao, Xingyu Dang, Chuang Gan, and Song Han. 2024. “AWQ: Activation-Aware Weight Quantization for on-Device LLM Compression and Acceleration.” Proceedings of Machine Learning and Systems 6: 87–100.
Horowitz, Mark. 2014. “1.1 Computing’s Energy Problem (and What We Can Do about It).” 2014 IEEE International Solid-State Circuits Conference Digest of Technical Papers (ISSCC), 10–14. https://doi.org/10.1109/isscc.2014.6757323.
Bengio, Yoshua, Nicholas Léonard, and Aaron Courville. 2013. “Estimating or Propagating Gradients Through Stochastic Neurons for Conditional Computation.” arXiv Preprint arXiv:1308.3432.
Zafrir, Ofir, Guy Boudoukh, Peter Izsak, and Moshe Wasserblat. 2019. “Q8BERT: Quantized 8Bit BERT.” 2019 Fifth Workshop on Energy Efficient Machine Learning and Cognitive Computing - NeurIPS Edition (EMC2-NIPS), 36–39. https://doi.org/10.1109/emc2-nips53020.2019.00016.
Howard, A. G., M. Zhu, B. Chen, D. Kalenichenko, W. Wang, T. Weyand, M. Andreetto, and H. Adam. 2017. “MobileNets: Efficient Convolutional Neural Networks for Mobile Vision Applications.” CoRR abs/1704.04861.
Sandler, Mark, Andrew Howard, Menglong Zhu, Andrey Zhmoginov, and Liang-Chieh Chen. 2018. “MobileNetV2: Inverted Residuals and Linear Bottlenecks.” 2018 IEEE/CVF Conference on Computer Vision and Pattern Recognition, 4510–20. https://doi.org/10.1109/cvpr.2018.00474.
Dao, T., D. Y. Fu, S. Ermon, A. Rudra, and C. Ré. 2022. “FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness.” Advances in Neural Information Processing Systems (NeurIPS) 35: 16344–59. https://doi.org/10.52202/068431-1189.
Fedus, William, Barret Zoph, and Noam Shazeer. 2022. “Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity.” Journal of Machine Learning Research 23 (120): 1–39.
Tibshirani, Robert. 1996. “Regression Shrinkage and Selection via the Lasso.” Journal of the Royal Statistical Society: Series B (Methodological) 58 (1): 267–88. https://doi.org/10.1111/j.2517-6161.1996.tb02080.x.
Hoefler, Torsten, Dan Alistarh, Tal Ben-Nun, Nikoli Dryden, and Alexandra Peste. 2021. “Sparsity in Deep Learning: Pruning and Growth for Efficient Inference and Training in Neural Networks.” Journal of Machine Learning Research 22 (241): 1–124.