机器学习框架
机器学习框架
目的
为什么框架会在无形中约束此后的每一项决策?
模型方程不会自行执行。框架将架构转换为硬件能够运行的工作,而这种转换并非中立。它决定操作何时执行、训练保留哪些中间状态、如何分配内存,以及哪些部署目标能够使用生成的产物。这些选择影响的不只是速度:它们决定哪些内容可以直接调试、编译器能够优化什么,以及同一个模型能否顺利从研究环境迁移到生产运行时。因此,使实验变得便捷的抽象也会形成长期约束。一旦项目围绕某个框架积累了检查点、模块、数据加载器、服务格式和团队经验,更换框架就成为系统迁移,而非库的替换。适合快速探索的框架可能暴露的结构信息过少,无法支持高效部署;而受限的执行路径又可能牺牲探索阶段所需的灵活性。由于执行、微分和抽象汇聚于同一软件层,局部的便利可能成为下游性能或可移植性的约束。工程上的问题不是哪个框架普遍最优,而是工作负载、团队和目标机器能够承受将哪些权衡固定下来。因此,理解框架的关键在于推演这些系统选择,而不是学习短暂流行的 API 语法。用数据—算法—机器的术语来说,框架通过在机器约束下将算法意图和数据表示转换为可执行工作,协调算法与机器的协同设计。
学习目标
- 解释框架如何通过执行、微分和硬件抽象协调算法与机器的协同设计
- 根据分派开销、编译成本和部署约束比较执行策略
- 分析自动微分和激活值存储,以选择重计算或检查点策略
- 实现用于参数发现、模式行为、序列化和钩子的模块抽象模式
- 计算训练步骤的 FLOPs、内存流量和分派开销,以识别融合与布局瓶颈
- 根据模型、硬件、团队和部署需求选择 TensorFlow、PyTorch、JAX 或边缘运行时
框架的三个问题
架构是一张由各项既定选择构成的图:Transformer 使系统必须承担注意力、矩阵乘法、激活状态和内存流量。框架是将这张图转换为机器可执行工作的层。logits = model(tokens)、loss = criterion(logits, targets) 和 loss.backward() 这样的少量调用,隐藏了跨越内存层次结构的数十亿次浮点运算、通过自动微分计算的数百万个参数的梯度、数千次 GPU 内核启动,以及数 GB 的中间状态。API 看起来简单,是因为框架正在充当面向芯片契约的编译器。
架构规定神经网络执行哪些计算,但知道计算什么与知道如何高效计算完全不同。Transformer 的注意力机制需要按照特定模式,协调跨内存层次结构和加速器核心的计算;在这些模式下,由于非合并内存访问以及反复往返高带宽内存(HBM),朴素实现的运行速度可能比优化实现慢 100\(\times\)。如果每个模型都要从头实现这些操作,深度学习在经济上将不可行。机器学习框架的存在就是为了弥合这一差距:将抽象模型图逐级降低为与硬件相适配的执行流水线,在最大限度提高计算单元利用率的同时,尽可能减少片外内存流量。
框架之于机器学习,正如编译器之于传统编程。C 编译器将人类可读的代码转换为经过优化的机器指令,管理寄存器分配、指令调度和内存布局。机器学习框架将高层模型定义转换为面向特定硬件的执行计划,管理算子融合、内存复用和设备放置。这种对应关系体现在实际运作中,而不只是比喻:现代框架集成了优化编译器(例如加速线性代数编译器 XLA 或 TorchInductor),可将图表示直接降低为目标机器代码。
每个机器学习框架,无论采用何种 API 或设计理念,都必须解决三个核心问题。第一个是执行问题:决定计算何时以及如何运行。框架可以按代码编写的顺序立即执行操作(即时执行1),也可以构建计算图2——一种表示操作及数据依赖关系的结构化中间表示——在启动设备内核之前进行优化(图执行)。这一选择决定了交互式调试与全程序编译器优化之间的根本权衡。
确定执行策略后,框架必须解决微分问题:自动计算梯度。由于基于梯度的训练需要计算标量损失相对于数百万乃至数十亿个参数的导数(神经计算),大规模手工求导不可能实现。框架通过为受支持的算子组合注册求导规则来实现自动微分,以链式方式计算向量—雅可比积,同时管理数值精度,以及为反向传播保留的中间激活值所带来的内存开销。
第三个问题是硬件抽象:通过统一接口支持多种硬件。同一个模型定义应能够在 CPU、GPU、张量处理单元(TPU)和移动加速器上表达,即使各目标的内存层次结构、指令集和互连带宽各不相同。在 GPU 领域,框架生态系统越来越多地提供 Triton (Tillet et al. 2019) 等自定义内核语言,使开发者无需手工编写底层 CUDA 或设备汇编,即可编写高性能的块级内核。
Tillet, Philippe, H. T. Kung, and David Cox. 2019. “Triton: An Intermediate Language and Compiler for Tiled Neural Network Computations.” Proceedings of the 3rd ACM SIGPLAN International Workshop on Machine Learning and Programming Languages, 10–19. https://doi.org/10.1145/3315508.3329973.
这三个问题紧密耦合:执行模型规定何时记录微分所需的数据结构,而硬件抽象层决定哪些图变换可以降低为芯片上的执行。在物理机器约束下统一执行、微分和硬件抽象,需要依据支配机器学习性能的方程来评估框架。
Systems Perspective 1.1: 机器学习编译器
在机器学习系统铁律(机器学习系统铁律)的语境下,框架是面向芯片契约的编译器。
“源代码”是模型架构(\(O\) 项)。框架的任务是接收这一高层数学规范,并将其编译为一系列针对特定硬件的内核启动,以实现以下目标:
- 通过内核融合等技术,尽可能减少数据移动 \((D_{\text{vol}})\)。
- 通过将操作匹配到 Tensor Core 等专用硬件单元,最大限度提高利用率 \((\eta_{\text{hw}})\)。
- 通过高效的异步分派和图捕获,尽可能降低开销 \((L_{\text{lat}})\)。
选择框架,就是选择决定硬件效率的编译器。这里需要精确定义:涵盖这三项职责的定义,才能将真正的框架与仅解决其中一项问题的数值库区分开来。
Definition 1.1: 机器学习框架
机器学习框架是一类软件系统,通过管理计算图、自动微分、内核分派,以及硬件层次结构中的内存分配,将高层数学模型定义转换为针对硬件优化的执行计划。
- 意义:框架直接决定机器学习系统铁律中的系统效率 \((\eta_{\text{hw}})\) 项。例如,由编译器支持的算子融合可以消除兼容操作之间中间值的写入及后续读取。将矩阵乘法、偏置加法和修正线性单元(ReLU)融合,会改变同一数学计算映射到硬件的方式,而不改变模型。
- 区别:NumPy 等数值库通常在每个操作被调用时就对其求值,而机器学习框架可以捕获或推迟执行,以分析更大的计算图,并应用跨操作优化:算子融合、内存布局变换和并行调度。这些优化需要超越单独分派操作的可见范围。
- 常见误区:一种常见误解是,框架只是可以互换的 API 封装。框架选择决定了可用的编译器路径。PyTorch 可以通过
torch.compile()从即时执行代码中恢复图级优化,而 TensorFlow 和 JAX 通常依赖由 XLA 支持的编译路径,将操作降低到目标硬件。从即时执行切换到编译器路径,可能显著改变吞吐量,但收益取决于模型结构、形状、算子支持情况和硬件。
机器学习框架在机器学习系统铁律的约束下,将逻辑意图转换为物理执行,决定如何在内存层次结构之间划分计算、何时以数值精度换取吞吐量,以及如何调度操作,使主导项——数据移动(\(D_{\text{vol}}\))、算术计算或启动延迟(\(L_{\text{lat}}\))——最小化。贯穿本书所阐述的支配性物理规律,正是在框架中转化为可执行代码。
深入 API 表面之下,便能看清这种转换的规模。一次 loss.backward() 调用就会触发操作记录、梯度内存分配、逆序图遍历和针对硬件优化的内核分派——即使对于三层网络,这套机制也需要大量手工记录与管理。对于当代语言模型,框架还要组织跨加速器的数十亿次浮点运算,协调内存层次结构、数值精度,以及在系统扩展到多个设备时所需的通信库。对大多数组织而言,从头构建这些机制的经济成本难以承受,因此,机器学习框架的发展史,就是逐步自动化这些层次的历史。
执行、微分和抽象这三个问题并非同时出现。每个问题的提出,都是为了应对上一代工具在扩展规模时遇到的限制,由此形成了从底层线性代数例程到编译式图运行时的抽象演进历程。
抽象的阶梯
1979 年,要用 Fortran 编写能够高效利用硬件的矩阵乘法,需要深入了解缓存行、寄存器调度和向量单元。到 2016 年,一行 Python 代码(torch.matmul(A, W))就能分派到高度优化的实现,而程序员无需了解芯片细节。这种工程投入的压缩并非一步完成,而是经过四十年的抽象积累而来;每一层都解决了一个使上一代工具难以实际扩展规模的瓶颈。最终形成了一架抽象的阶梯,每一级都将下一级暴露出来的工作自动化。
第一级建立了可复用的硬件原语(1979–1992 年)。最初的基本线性代数子程序(BLAS)3将底层线性代数操作标准化 (Lawson et al. 1979),而 LAPACK4 (Bai et al. 2006) 则在这一基础之上构建了更高层的数值分解和特征值求解器。朴素的嵌套循环无法充分利用内存层次结构:如果没有缓存分块和寄存器分块,内存带宽会在算术单元达到峰值吞吐量之前很久就饱和。BLAS 和 LAPACK 通过建立稳定接口解决了这一硬件原语瓶颈,使数值软件能够将矩阵乘法(C = A @ B)5等计算密集型操作委托给厂商库;这些库针对特定缓存行大小、单指令多数据(SIMD)宽度和寄存器文件进行了调优,无需为每种目标架构手工编写汇编代码。
Lawson, Charles L., Richard J. Hanson, David R. Kincaid, and Fred T. Krogh. 1979. “Basic Linear Algebra Subprograms for Fortran Usage.” ACM Transactions on Mathematical Software 5 (3): 308–23. https://doi.org/10.1145/355841.355847.
Bai, Zhaojun, James Demmel, Jack Dongarra, Julien Langou, and Jenny Wang. 2006. “LAPACK.” In Handbook of Linear Algebra. Chapman; Hall/CRC. https://doi.org/10.1201/9781420010572-75.
Harris, Charles R., K. Jarrod Millman, Stéfan J. van der Walt, Ralf Gommers, Pauli Virtanen, David Cournapeau, Eric Wieser, et al. 2020. “Array Programming with NumPy.” Nature 585 (7825): 357–62. https://doi.org/10.1038/s41586-020-2649-2.
第二级引入了统一的数组抽象,以提高开发效率(2005–2006 年)。NumPy6用高层 Python 封装 BLAS 和 LAPACK,解决了低层语言带来的生产力障碍 (Harris et al. 2020)。在 NumPy 的跨步数组模型中,Python 管理控制流和张量元数据(形状、步长和数据类型),而底层 C 运行时则在连续内存缓冲区上分派向量和矩阵循环。这种向量化契约——用解释型语言组织高层算法意图,同时将内层循环委托给已编译的原生例程——成为科学计算和数值计算的架构模板。
第三级将梯度计算自动化(2007 年至今)。Theano、7 TensorFlow (Abadi et al. 2016) 和 PyTorch (Paszke et al. 2019) 等深度学习框架解决了手工微分在规模扩展方面的限制。数值软件包要求实践者手工推导并实现反向传播的解析梯度,这一过程容易出错,而且对于深层网络难以管理;现代框架则将计算图上的自动微分转变为核心运行时原语。这些框架在前向传播期间以有向无环图捕获操作,自动构建反向图以计算向量—雅可比积,将链式法则的微积分运算转化为自动化的反向模式执行。
这一演进历程勾勒了数值计算抽象四十年的发展,从汇编调优的子程序逐步走向编译式图执行引擎(figure 1)。
\begin{tikzpicture}[node distance=1mm,outer sep=0pt,font=\small\sffamily]
\tikzset{%
    Line/.style={line width=1.0pt,black!50
},
  Box/.style={inner xsep=1pt,
    draw=none,
    fill=#1,
    anchor=west,
    text width=27mm,align=flush center,
    minimum width=28mm, minimum height=13mm
  },
  Box/.default=red
}
\definecolor{col1}{RGB}{128, 179, 255}
\definecolor{col2}{RGB}{255, 255, 128}
\definecolor{col3}{RGB}{204, 255, 204}
\definecolor{col4}{RGB}{230, 179, 255}
\definecolor{col5}{RGB}{255, 153, 204}
\definecolor{col6}{RGB}{245, 82, 102}
\definecolor{col7}{RGB}{255, 102, 102}

\node[Box={col1}](B1){1979};
\node[Box={col2!},right=of B1](B2){1992};
\node[Box={col3},right=of B2](B3){2006};
\node[Box={col4},right=of B3](B4){2007};
\node[Box={col5},right=of B4](B5){2015};
\node[Box={col6},right=of B5](B6){2016};
\node[Box={col7},right=of B6](B7){2018};
%%
\foreach \x in{1,2,...,7}
\draw[dashed,thick,-latex](B\x)--++(270:4.1);

\path[red]([yshift=-7mm]B1.south west)coordinate(P)-|coordinate(K)(B7.south east);

\draw[line width=2pt,-latex](P)--(K)--++(0:3mm);

\def\vi{1.4}
\node[Box={col1!50},below=\vi of B1](BB1){BLAS 问世};
\node[Box={col2!50},below=\vi of B2](BB2){LAPACK 扩展 BLAS};
\node[Box={col3!50},below=\vi of B3](BB3){NumPy 成为 Python 数值计算的支柱};
\node[Box={col4!50},below=\vi of B4](BB4){Theano 引入计算图};
\node[Box={col5!50},below=\vi of B5](BB5){TensorFlow 普及静态图};
\node[Box={col6!50},below=\vi of B6](BB6){PyTorch 引入动态图};
\node[Box={col7!50},below=\vi of B7](BB7){JAX 引入函数式范式};
\end{tikzpicture}每一代都将上一代耗费工程精力的细节抽象掉,但每种抽象也引入了新的权衡。BLAS 隐藏了汇编级优化,却固定了接口。NumPy 隐藏了内存管理,却要求手工微分。现代框架隐藏了梯度计算,却引入了执行模型的选择。更深层的规律是,每种抽象都通过维持关于形状、数据类型、设备,有时还包括单位的契约来隐藏细节;一旦这种契约变成隐含约定,即使各组件本身正确,组合起来仍可能构成错误的系统。
War Story 1.1: 忘记单位的接口(1999 年)
背景:NASA 的火星气候轨道器依赖地面软件、航天器软件、导航团队和承包商接口,对交换数值的物理含义达成一致 (Mars Climate Orbiter Mishap Investigation Board 1999)。
机制:洛克希德·马丁公司提供的地面软件以英制单位(磅力秒)计算推进器冲量,而 JPL 导航软件在使用这些数值时假定其单位为国际单位制单位(牛顿秒)——形成了隐含的 4.45\(\times\) 单位失配。
影响:1999 年 9 月 23 日,航天器在进入掩星阶段后失联。修正后的近火点高度为 57 km,而非计划的 226 km,被判定为过低,无法使航天器存活。
应对措施:调查委员会建议开展单位一致性检查、对传输数据进行规格审计,并加强地面软件的端到端验证。
系统层面的经验:框架抽象之所以有价值,是因为它们承载着契约:形状、数据类型、设备放置和物理单位。如果这些契约是隐式的,两段各自正确的代码组合起来,仍可能构成一个错误的系统。当流水线各阶段的张量内存布局(如 NCHW 与 NHWC)、量化缩放因子或物理特征单位不一致时,机器学习框架就会遇到这一问题:产生看似合理的输出,却悄然破坏下游推理。
Mars Climate Orbiter Mishap Investigation Board. 1999. Mars Climate Orbiter Mishap Investigation Board Phase i Report. National Aeronautics; Space Administration.
考虑到这种契约风险,现代框架围绕三个核心问题逐渐趋同:如何执行计算、如何对计算求导,以及如何跨硬件进行抽象。执行问题居于首位,因为其解决方式决定了另外两个问题能够利用哪些优化。
执行问题
设想两位工程师正在编写同一个神经网络。第一位以交互方式调试,在每次运算后打印张量形状、检查中间值,并使用 pdb 逐步执行代码。第二位等待 30 秒完成编译,随后看到模型以 3\(\times\) 的速度运行,却失去了对中间状态直接、逐行的观察能力。两者都没有错;他们只是对执行问题做出了不同选择,即运算应当按代码所写立即执行,还是先记录下来供稍后执行。这一选择引发了一系列工程权衡,影响框架行为的方方面面,从调试工作流、部署选项,到硬件峰值利用率。
执行策略为何重要:内存墙
机器学习框架的执行策略,从根本上受到计算能力与内存带宽之间不断扩大差距的制约,内存墙方程(equation)量化了这一差距。处理器算术运算能力的增长远快于内存带宽,由此形成了内存墙。现代加速器执行算术运算的速度远高于获取数据的速度。ReLU 等逐元素运算只能利用峰值计算能力的极小一部分,并非因为硬件速度慢,而是因为它们几乎把全部时间都花在等待数据上。Roofline 模型 对这一权衡进行了形式化描述,明确展示了运算何时受内存限制、何时受计算限制。
内存墙将运算划分为计算受限(受算术吞吐量限制)或内存受限(受数据移动限制)两类。大多数单个神经网络运算类型(激活、归一化、逐元素运算)都受内存限制,而在总计算时间中占主导地位的大规模矩阵乘法则可能受计算限制。
针对内存受限运算的关键优化是内核融合,即将多个运算合并为一个 GPU 函数(称为内核)8,以避免中间内存数据传输。将一系列归一化、dropout 和激活运算融合到一个内核中,可以通过消除运算之间的中间结果写入而大幅加速。注意力内核9在更大规模上采用了相同原理:融合实现无需在 HBM 中显式存储完整的注意力矩阵,而是可以将分块保留在靠近计算单元的位置,将 HBM 访问次数最多缩减 9\(\times\),并根据具体工作负载获得从提速 15% 到达到 3\(\times\) 运行速度的加速效果 (Dao et al. 2022)。
框架只能融合能够同时观察到的运算。单独分派的即时执行运算会掩盖跨运算优化机会,而图捕获可以将这些机会暴露出来。延迟执行图使框架能够优化捕获的计算。因此,执行策略决定了哪些优化可以实现,以及这些优化的作用范围。
计算图
为了向编译器暴露涉及多个运算的优化机会,框架将程序表示为计算图:一种有向无环图(DAG),其中节点表示运算,边表示数据依赖关系。该图是框架内部对计算的模型。
通过图表示,可以将数学运算与物理执行解耦。计算图(figure 2)使这一抽象具体化:张量变量映射为数据节点,运算则映射为变换节点。
\begin{tikzpicture}[font=\sffamily\small]
%
\tikzset{%
    Line/.style={line width=1.0pt,black!50,rounded corners
},
  Box/.style={align=flush center,
   shape=circle,
    inner xsep=1pt,
    node distance=1.4,
    draw=BlueLine,
    line width=0.75pt,
    fill=BlueL,
    minimum width=8mm,
  },
}
\node[Box,fill=GreenFill,draw=GreenLine,minimum width=15mm, ](B1){$f(x,y)$};
\node[Box,right=of B1,fill=GreenFill,draw=GreenLine](B2){$z$};
\node[Box,above left=-0.10 and 2 of B1,fill=GreenFill,draw=GreenLine](B3){$x$};
\node[Box,below left=-0.10 and 2 of B1,fill=GreenFill,draw=GreenLine](B4){y};
\draw[-latex,Line](B1)--(B2);
\draw[-latex,Line](B3)to[bend left=25](B1);
\draw[-latex,Line](B4)to[bend right=25](B1);
\end{tikzpicture}实际的机器学习模型需要复杂得多的图结构。Figure 3 扩展了这一表示,展示神经网络计算图以及对其进行分析的系统组件。左侧面板描绘了数据在有向无环图的六个运算节点之间流动,每个节点的输出成为下一个节点的输入。右侧面板展示了运行时如何与该图交互:查询张量生命周期以规划内存复用,并根据数据依赖关系而非程序顺序,将运算分配到加速器流。关键认识在于,图独立于执行而存在,使框架能够在任何算术运算发生之前进行优化。
\scalebox{0.9}{%
\begin{tikzpicture}[font=\sffamily\small]

\tikzset{
  Box/.style={ inner xsep=2pt,
    node distance=1.4,
    draw=none,
    line width=0.5pt,,
    fill=none,
    minimum width=27mm, minimum height=15mm
  },
    LineA/.style={violet!40,line width=5pt,{-{Triangle[width=1.0*11pt,length=1.0*8pt]}},shorten <=1pt,shorten >=1pt},
    graphpanel/.style={
        draw=olive!60!black,
        fill=olive!02,
        line width=0.9pt,
        rounded corners=4pt,
        inner sep=14pt,yshift=9pt
    },
    syspanel/.style={
        draw=orange!70!black,
        fill=orange!03,
        line width=0.9pt,
        rounded corners=4pt,
        inner sep=10pt
    },
    opnode/.style={
        circle,node distance=6mm,
        draw=BlueLine,,
        fill=cyan!15,
        minimum size=5mm,
        line width=0.9pt
    },
    compbox/.style={
        draw=orange!80!black,
        fill=orange!12,
        rounded corners=2pt,
        minimum width=2.7cm,
        minimum height=0.9cm,
        align=center,
        line width=0.8pt
    },
    flow/.style={
        -{Latex[length=2.2mm]},
        draw=BrownLine!75,
        line width=0.9pt
    },
}
%CPU style
\tikzset{
pics/cpu/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box = CPU,shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\node[fill=\filllcolor,minimum width=66, minimum height=66,
            rounded corners=2,outer sep=2pt] (C1) {};
\node[fill=white,minimum width=54, minimum height=54] (C2) {};
\node[fill=\filllcolor!50,minimum width=44, minimum height=44] (C3) {\Large\bfseries GPU};

\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=\filllcolor,minimum width=4, minimum height=15,
           inner sep=0pt,anchor=south](GO\y)at($(C1.north west)!\x!(C1.north east)$){};
}
\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=\filllcolor,minimum width=4, minimum height=15,
           inner sep=0pt,anchor=north](DO\y)at($(C1.south west)!\x!(C1.south east)$){};
}
\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=\filllcolor,minimum width=15, minimum height=4,
           inner sep=0pt,anchor=east](LE\y)at($(C1.north west)!\x!(C1.south west)$){};
}
\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=\filllcolor,minimum width=15, minimum height=4,
           inner sep=0pt,anchor=west](DE\y)at($(C1.north east)!\x!(C1.south east)$){};
}
\end{scope}
    }
  }
}
\tikzset{
pics/dram/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\node[draw=\drawcolor,fill=\filllcolor!70,line width=1.5*\Linewidth,inner sep=0pt,outer sep=0pt,
minimum width=56mm,minimum height=14mm](DRAM\picname)at(0,0){};
\node[draw=\drawcolor,fill=\filllcolor!30,line width=1.5*\Linewidth,inner sep=0pt,outer sep=0pt,anchor=north,
minimum width=52mm,minimum height=6mm](MDRAM\picname)at(DRAM\picname.south){};
%
\pgfmathsetmacro{\spacing}{56/(6+1)}
\foreach \i in {1,...,6} {
  \pgfmathsetmacro{\x}{\i * \spacing}
  \node[draw=\drawcolor,fill=\filllcolor!20,line width=\Linewidth, inner sep=0pt, outer sep=0pt,
        minimum width=6mm, minimum height=8mm]
        at ([xshift=\x mm]DRAM\picname.west) {};
}
%
\foreach \i in {1,...,19} {
  \pgfmathsetmacro{\x}{\i*(52/20)}
  \draw[draw=\drawcolor, line width=3*\Linewidth]
    ([xshift=\x mm,yshift=1pt]MDRAM\picname.south west) -- ++(0,2mm);
}
\end{scope}
    }
  }
}
\pgfkeys{
  /channel/.cd,
   Depth/.store in=\Depth,
  Height/.store in=\Height,
  Width/.store in=\Width,
  filllcirclecolor/.store in=\filllcirclecolor,
  filllcolor/.store in=\filllcolor,
  drawcolor/.store in=\drawcolor,
  drawcircle/.store in=\drawcircle,
  scalefac/.store in=\scalefac,
  Linewidth/.store in=\Linewidth,
  picname/.store in=\picname,
  filllcolor=BrownLine,
  filllcirclecolor=cyan!40,
  drawcolor=black,
  drawcircle=violet,
  scalefac=1,
  Linewidth=0.5pt,
  Depth=1.3,
  Height=0.8,
  Width=1.1,
  picname=C
}

    % graph nodes
    \node[opnode] (a)  {};
    \node[opnode,below left=of a] (b) {};
    \node[opnode,below right =of a] (c) {};
    \node[opnode,below=of b] (d)  {};
    \node[opnode,below =of c] (e) {};
    \node[opnode,below right=of d] (f) {};
    % edges
    \draw[flow] (a) -- (b);
    \draw[flow] (a) -- (c);
    \draw[flow] (b) -- (d);
    \draw[flow] (c) -- (e);
    \draw[flow] (d) -- (f);
    \draw[flow] (e) -- (f);
    % optional cross-edge
    \draw[flow] (b) -- (e);

    \node[opnode,minimum size=3mm,below left= 0.33 and 1.65of f] (l) {};
    \node[right=0pt of l,font=\sffamily\footnotesize](O){运算};
    \draw[flow]($(O.east)+(1mm,0)$)--++(0:7mm)coordinate(A);
    \node[right=0pt of A,font=\sffamily\footnotesize](AA){数据流};
    \scoped[on background layer]
    \node[graphpanel,fit=(a)(l)(O)(AA),inner xsep=6pt](FF){};
    \node[below=1pt of FF.north,font=\sffamily\bfseries\footnotesize]{计算图};
%
   \node[right=29mm of FF.27,Box](MM){};
   \node[below=-6pt of MM](T1){内存管理};
   \pic[shift={(0,0.1)}] at  (MM){dram={scalefac=0.43,picname=1,
   drawcolor=black,filllcolor=OrangeLine!50!,Linewidth=0.5pt}};
   \node[right=29mm of FF.338,Box](DP){};
      \node[below=1pt of DP](T2){设备放置};
   \pic[shift={(0,0)}] at (DP) {cpu={scalefac=0.45,picname=1,
   drawcolor=RedLine,filllcolor=BlueLine!80!,Linewidth=0.5pt}};

   \scoped[on background layer]
   \node[fit=(MM)(T1)(T2),syspanel,yshift=1.0mm,inner xsep=6pt](DD){};
   \node[below=1pt of DD.north,font=\sffamily\bfseries\footnotesize]{系统组件};

\draw[LineA](FF)--
node[above,pos=0.45,text=black!70,font=\sffamily\footnotesize]{与之交互}
(DD);
\end{tikzpicture}}这种图表示不仅是一种可视化方式,更是实现高效执行和自动微分的数据结构。图的构建时机迫使系统在调试、优化、部署和灵活性之间做出根本性权衡。交互式调试要求立即执行,以便开发者使用标准工具检查中间值并逐步跟踪逻辑。全局优化要求同时观察较长的算子序列,以融合内核并规划内存复用。独立部署倾向于采用无需宿主解释器即可运行的图,而动态架构则需要根据计算出的张量值进行分支的控制流。
没有一种执行模型能够在所有这些维度上都达到最优。框架必须在这一权衡空间中选择自己的位置,而实践者必须理解这些权衡,才能选择合适的工具并编写高效代码。接下来的三类执行方式,是对同一个系统问题的不同回答:为了获得即时执行和调试能力,框架应当牺牲多少对图的可见性?
三种执行策略
计算图支持全局优化,但仍留下一个关键设计选择:运行时何时构建图。考虑 y = x * 2 这样一个基本表达式。立即计算乘法,会在 y 中得到一个具体的张量。这种命令式流程直观且可以直接调试,但运行时每次只能看到一个运算。延迟执行则将运算以符号形式记录到依赖图中,仅在收到请求时才执行该图。这种分阶段处理将计算意图与求值分离,为编译器提供算子融合和内存规划所需的端到端可见性。
两种方式都不具备绝对优势;它们各自体现了灵活性与优化潜力之间的不同权衡。现代框架探索了三种主要执行策略:采用动态图的即时执行、静态计算图,以及将即时(JIT)编译与即时执行开发模式结合的混合方式。每种策略都对系统具有不同的影响。
采用动态图的即时执行
即时执行在程序调用每个运算时立即对其求值,并在运行时动态构建计算图。下面的并列比较展示了它与基于图的执行在代码层面的区别。
Example 1.1: 即时执行与图执行的代码比较
PyTorch(即时执行):
import torch

x = torch.tensor([1.0, 2.0])
y = x * 2
print(f"Intermediate value: {y}")  # Works immediately
z = y.sum()
TensorFlow 1.x(静态图):
import tensorflow as tf

x = tf.placeholder(tf.float32)
y = x * 2
# print(y) -> Prints Tensor("mul:0"...), not value!
z = tf.reduce_sum(y)

with tf.Session() as sess:
result = sess.run(z, feed_dict={x: [1.0, 2.0]})系统层面的认识:即时执行将中间值作为普通运行时状态暴露出来,使调试更加直接。静态图在执行前先构建计算,从而支持全图优化,但也改变了调试模型。
在这种运行时定义模型中,当宿主代码对 y = x * 2 求值时,运行时会立即将乘法内核分派到设备命令队列,并使结果张量随即可供后续运算使用。
这提供了常规编程的灵活性:开发者可以打印中间值、使用基于计算结果的条件语句,并通过标准工具进行调试。框架在运算发生时对其进行记录,构建出反映实际执行路径的动态图。
为了计算梯度,框架会将运算历史记录在称为自动求导记录带的结构中,10这是一种在执行期间构建的临时数据结构。每个张量运算都会创建一个节点,记录所执行的运算、对输入张量的引用,以及梯度计算方式。这些节点形成一个 DAG,记录前向传播执行期间实际经过的路径,而非预先固定的图。Listing 1 展示了 PyTorch 如何在默认即时执行模式下,随运算执行而记录运算。
import torch

x = torch.tensor([1.0], requires_grad=True)
y = x * 2  # Executes immediately; records MulBackward node
z = y + 1  # Executes immediately; records AddBackward node
# The autograd tape exists NOW, built during execution
这两个运算完成后,框架已构建出包含两个节点的自动求导记录带:一个对应乘法,另一个对应加法。记录带记载了 z 依赖于 y,而 y 依赖于 x。
调用 z.backward() 会按逆拓扑顺序遍历此记录带,并在每个节点应用链式法则:
- 计算 \(\frac{\partial z}{\partial z} = 1\)(种子梯度)
- 调用
AddBackward0.backward()\(\rightarrow \frac{\partial z}{\partial y} = 1\) - 调用
MulBackward0.backward()\(\rightarrow \frac{\partial z}{\partial x} = 2\) - 将梯度累加到
x.grad中
backward() 完成后,自动求导图通常会被释放。下一次前向传播会构建新的图。梯度计算所需的值在前向传播期间保存,并一直保持存活,直到反向传播使用它们,因此其内存开销跨越两个阶段,而非仅在反向传播期间出现。
Example 1.2: 原地运算可能破坏梯度计算
场景:一位工程师在自定义 PyTorch 激活函数中执行原地修改(
x += 1),以减少内存分配。
诊断:原地运算覆盖了张量内存中的前向传播激活值,而自动求导记录带需要这些激活值来计算反向传播梯度,因此触发了运行时版本计数器错误 (PyTorch Contributors 2026a)。PyTorch 通过为每个张量维护一个整数版本计数器来强制保证这一安全不变量,该计数器在每次原地写入时递增;如果执行反向传播时,已保存张量的版本与前向传播期间记录的版本不同,自动求导就会抛出错误,因为求导规则所需的激活值已被原地修改。
系统层面的经验:框架的自动微分依赖于不可变的前向传播激活值记录。未经检查的原地内存修改会破坏自动求导记录带中的依赖关系,迫使框架在运行时中止执行。
PyTorch Contributors. 2026a. PyTorch Autograd Mechanics.
在即时执行框架中,宿主代码遇到运算时,就以命令式方式对其求值。Figure 4 跟踪了这一执行循环,展示了将各个运算直接发送到设备流队列的定义与分派序列。
\begin{tikzpicture}[line join=round,font=\sffamily\small]
\tikzset{%
  Line/.style={line width=0.75pt,black!50,text=black},
  Box/.style={align=flush center,
    inner xsep=2pt,
    node distance=0.75,
    draw=BlueLine,
    line width=0.75pt,
    fill=BlueL!30,
    %text width=35mm,
    minimum width=35mm, minimum height=11mm
  },
 decision/.style = {Box,diamond,text width=35mm,aspect=1.95, inner xsep=7pt,inner ysep=-2ex, fill=VioletL2!70,
 draw=VioletLine},
  startstop/.style = {Box,minimum width=25mm,  rounded corners=10pt, fill=red!10, draw=RedLine},
  LineA/.style={black!50,line width=1.5pt,{-{Triangle[width=1.0*5pt,length=1.0*5pt]}},shorten <=0pt,shorten >=0pt},
}

\tikzset{
pics/repeat/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\def\w{4cm}
\def\h{15mm}
\def\r{6mm} % radius
\def\gap{4mm} % break lengths
\draw[\filllcirclecolor, -{Latex[length=10pt,width=15pt]},line width=\Linewidth]
  (\w,\h-\r) -- (\w,\r)
  arc[start angle=0, end angle=-90, radius=\r]
  -- (\gap,0);
%
  \draw[\filllcolor, -{Latex[length=10pt,width=15pt]},line width=\Linewidth]
  (0,\r) -- (0,\h-\r)
  arc[start angle=180, end angle=90, radius=\r]
  -- ({\w-\gap},\h);
\end{scope}
    }
  }
}
\tikzset{
pics/interpreter/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\def\ra{}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\node[red,font=\Large\bfseries]at(-0.75,0.6){\textless\,/\,\textgreater};
\draw[line cap=round,line join=round,yellow,line width=\Linewidth](-1.15,-0.1)--(-0.95,-0.1);
\draw[line cap=round,line join=round,red,line width=\Linewidth](-0.7,-0.1)--(0.1,-0.1);

\draw[line cap=round,line join=round,yellow,line width=\Linewidth](-1.15,-0.5)--(0,-0.5);

\draw[line cap=round,line join=round,yellow,line width=\Linewidth](-1.15,-0.9)--(-0.75,-0.9);
\draw[line cap=round,line join=round,red,line width=\Linewidth](-0.45,-0.9)--(0.45,-0.9);
\draw[line cap=round,line join=round,cyan,line width=\Linewidth](0.75,-0.9)--(1.1,-0.9);

\draw[line cap=round,line join=round,yellow,line width=\Linewidth](-1.15,-1.3)--(-1,-1.3);
\draw[line cap=round,line join=round,red,line width=\Linewidth](-0.65,-1.3)--(-0.10,-1.3);
\draw[line cap=round,line join=round,cyan,line width=\Linewidth](0.2,-1.3)--(1.1,-1.3);
\end{scope}
    }
  }
}
%CPU
\tikzset{%
 pics/cpu/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=FUNNEL,scale=\scalefac, every node/.append style={transform shape}]
\node[fill=\filllcolor,minimum width=66, minimum height=66,
            rounded corners=2,outer sep=2pt] (C1) {};
\node[fill=white,minimum width=54, minimum height=54] (C2) {};
\node[fill=\filllcolor!40,minimum width=44, minimum height=44] (C3) {\Large\bfseries GPU};

\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=\filllcolor,minimum width=3, minimum height=15,
           inner sep=0pt,anchor=south](GO\y)at($(C1.north west)!\x!(C1.north east)$){};
}
\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=\filllcolor,minimum width=3, minimum height=15,
           inner sep=0pt,anchor=north](DO\y)at($(C1.south west)!\x!(C1.south east)$){};
}
\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=\filllcolor,minimum width=15, minimum height=3,
           inner sep=0pt,anchor=east](LE\y)at($(C1.north west)!\x!(C1.south west)$){};
}
\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=\filllcolor,minimum width=15, minimum height=3,
           inner sep=0pt,anchor=west](DE\y)at($(C1.north east)!\x!(C1.south east)$){};
}
 \end{scope}
     }
  }
}
%start
\tikzset{%
 pics/start/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=START,scale=\scalefac, every node/.append style={transform shape}]
\node[fill=\filllcolor,minimum width=6mm, minimum height=6mm,
            outer sep=2pt] (C1) {};
\node[isosceles triangle,isosceles triangle apex angle=45,xshift=-2.5pt,
    inner sep=1pt, fill=white,minimum size =3.5mm] (T1)at (C1){};
 \end{scope}
     }
  }
}
%check
\tikzset{pics/.cd,
checkmark/.style={code={
        \pgfkeys{/channel/.cd, #1}
\pgfgettransformentries{\tmpxx}{\tmp}{\tmp}{\tmp}{\tmp}{\tmp}
\draw[line width=\tmpxx*1pt,draw=none,fill=\filllcirclecolor,line join=bevel] (0,.35) -- (.25,0) to[bend left=5] (0.8,.6) to[bend
right=5] (.25,.18) -- cycle;}}}
\tikzset{%
 pics/checkI/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=CHECK,scale=\scalefac, every node/.append style={transform shape}]
\node[fill=\filllcolor,minimum width=6mm, minimum height=6mm,
            outer sep=2pt] (C1) {};
\pic[shift={(-0.27,-0.19)},scale=0.7]{checkmark};
 \end{scope}
     }
  }
}
\pgfkeys{
  /channel/.cd,
   Depth/.store in=\Depth,
  Height/.store in=\Height,
  Width/.store in=\Width,
  filllcirclecolor/.store in=\filllcirclecolor,
  filllcolor/.store in=\filllcolor,
  drawcolor/.store in=\drawcolor,
  drawcircle/.store in=\drawcircle,
  scalefac/.store in=\scalefac,
  Linewidth/.store in=\Linewidth,
  picname/.store in=\picname,
  filllcolor=BrownLine,
  filllcirclecolor=violet!20,
  drawcolor=red,
  drawcircle=violet,
  scalefac=1,
  Linewidth=0.5pt,
  Depth=1.3,
  Height=0.8,
  Width=1.1,
  picname=C
}

\node[startstop](B1){};
\coordinate(GO1)at($(B1.north west)!0.33!(B1.north east)$);
\coordinate(T1)at($(GO1)!0.5!(B1.south east)$);
\node[align=center]at(T1){开始};
\begin{scope}
\coordinate(I1)at($(GO1)!0.5!(B1.south west)$);
\clip (B1.south west) rectangle (GO1);
%\fill[RedLine!30,rounded corners=10pt] (B1.south west) rectangle (B1.north east);
\end{scope}
\draw[dashed,RedLine,  line width=0.75pt,](GO1)--(GO1|-B1.south west);
\node[startstop,fill=none]{};
\pic[shift={(0,0)}] at  (I1){start={scalefac=1,picname=1,filllcolor=GreenLine, Linewidth=0.7pt}};
%Define
\node[Box,right=of B1](B2){};
\node[above=1pt of B2,text=black!70]{Python 分发};
\coordinate(GO2)at($(B2.north west)!0.3!(B2.north east)$);
%\fill[fill=BlueL!90](B2.south west)rectangle(GO2);
\coordinate(T2)at($(GO2)!0.5!(B2.south east)$);
\coordinate(I2)at($(GO2)!0.5!(B2.south west)$);
\node[align=center]at(T2){定义\\操作};
\draw[dashed,BlueLine,  line width=0.75pt,](GO2)--(GO2|-B2.south west);
\node[Box,right=of B1,fill=none]{};
\pic[shift={(0.05,0.11)}] at  (I2){interpreter={scalefac=0.35,picname=1,
filllcolor=cyan!30!, Linewidth=1.5pt,filllcirclecolor=orange}};
 %Execute
\node[Box,right=of B2](B3){};
\node[above=1pt of B3,text=black!70]{GPU 内核};
\coordinate(GO3)at($(B3.north west)!0.3!(B3.north east)$);
%\fill[fill=BlueL!90](B3.south west)rectangle(GO3);
\coordinate(T3)at($(GO3)!0.5!(B3.south east)$);
\coordinate(I3)at($(GO3)!0.5!(B3.south west)$);
\node[align=center]at(T3){执行\\操作};
\draw[dashed,BlueLine,  line width=0.75pt,](GO3)--(GO3|-B3.south west);
\node[Box,right=of B2,fill=none](B3){};
\pic[shift={(0,0)}] at  (I3){cpu={scalefac=0.23,picname=1,filllcolor=BrownLine, Linewidth=0.7pt}};
%More operations
\node[decision,right=of B3](B4){是否还有\\操作?};
\path[red](B4.west)|-coordinate(SR4)(B4.south);
\pic[shift={(-0.30,-0.14)}] at  (SR4){repeat={scalefac=0.3,picname=1,filllcolor=RedLine,
Linewidth=4pt,filllcirclecolor=GreenLine}};
%End
\node[startstop,right=of B4](B5){};
\coordinate(GO5)at($(B5.north west)!0.33!(B5.north east)$);
\coordinate(T5)at($(GO5)!0.5!(B5.south east)$);
\coordinate(I5)at($(GO5)!0.5!(B5.south west)$);
\node[align=center]at(T5){结束};
\begin{scope}
\clip (B5.south west) rectangle (GO5);
%\fill[RedLine!30,rounded corners=10pt] (B5.south west) rectangle (B5.north east);
\end{scope}
\draw[dashed,RedLine,  line width=0.75pt,](GO5)--(GO5|-B5.south west);
\node[startstop,right=of B4,fill=none](B5){};
\pic[shift={(0,0)}] at  (I5){checkI={scalefac=1,picname=1,filllcolor=GreenLine, filllcirclecolor=white,Linewidth=0.7pt}};
%arrows
\foreach \i in {1,2,3,4}{
\pgfmathtruncatemacro{\x}{\i + 1}
\draw[LineA](B\i)--coordinate[pos=0.3](SR\i)(B\x);
}
\node[above=0pt of SR4]{否};
\draw[LineA](B4.south)--node[right,pos=0.5]{是}++(270:0.55)-|(B2);
\end{tikzpicture}系统层面的影响:灵活性
动态自动微分记录带直接在宿主语言中表达依赖数据的行为。条件分支和循环可以依赖执行期间计算出的张量值,从而支持束搜索、动态长度循环模型,以及根据中间激活值调整执行过程的自适应计算路径等算法。静态图也可以通过图操作表示依赖数据的控制流和动态维度,但即时执行使这些模式能够在 Python 中自然地编写和调试。由于操作会立即发出,开发者可以打印张量、检查数值,并使用标准调试器(pdb、断点)诊断错误,其方式与调试其他 Python 程序十分相似。
系统层面的影响:开销
这种灵活性带来的延迟成本可直接映射到机器学习系统铁律(机器学习系统铁律)。每个训练步都会动态构建自动微分记录带,将主机端 Python 分发延迟和记录带分配开销计入 \(L_{\text{lat}}\)。由于每个操作在设备内核启动前都要经过框架分发器,当单个内核的执行时间只有个位数微秒时,主机端开销很快就会占据主导地位。即时执行还缺乏全图视野,使框架无法将逐元素操作链融合为一次 GPU 内核启动,也无法为中间激活预先分配静态内存区(\(D_{\text{vol}}\))。自动微分记录带必须保留已注册的反向传播规则所需的每个张量,在反向传播使用这些张量之前持续占用内存。这些成本共同为细粒度工作负载设定了吞吐量上限;在此类负载中,分发延迟的影响超过了设备算术运算。
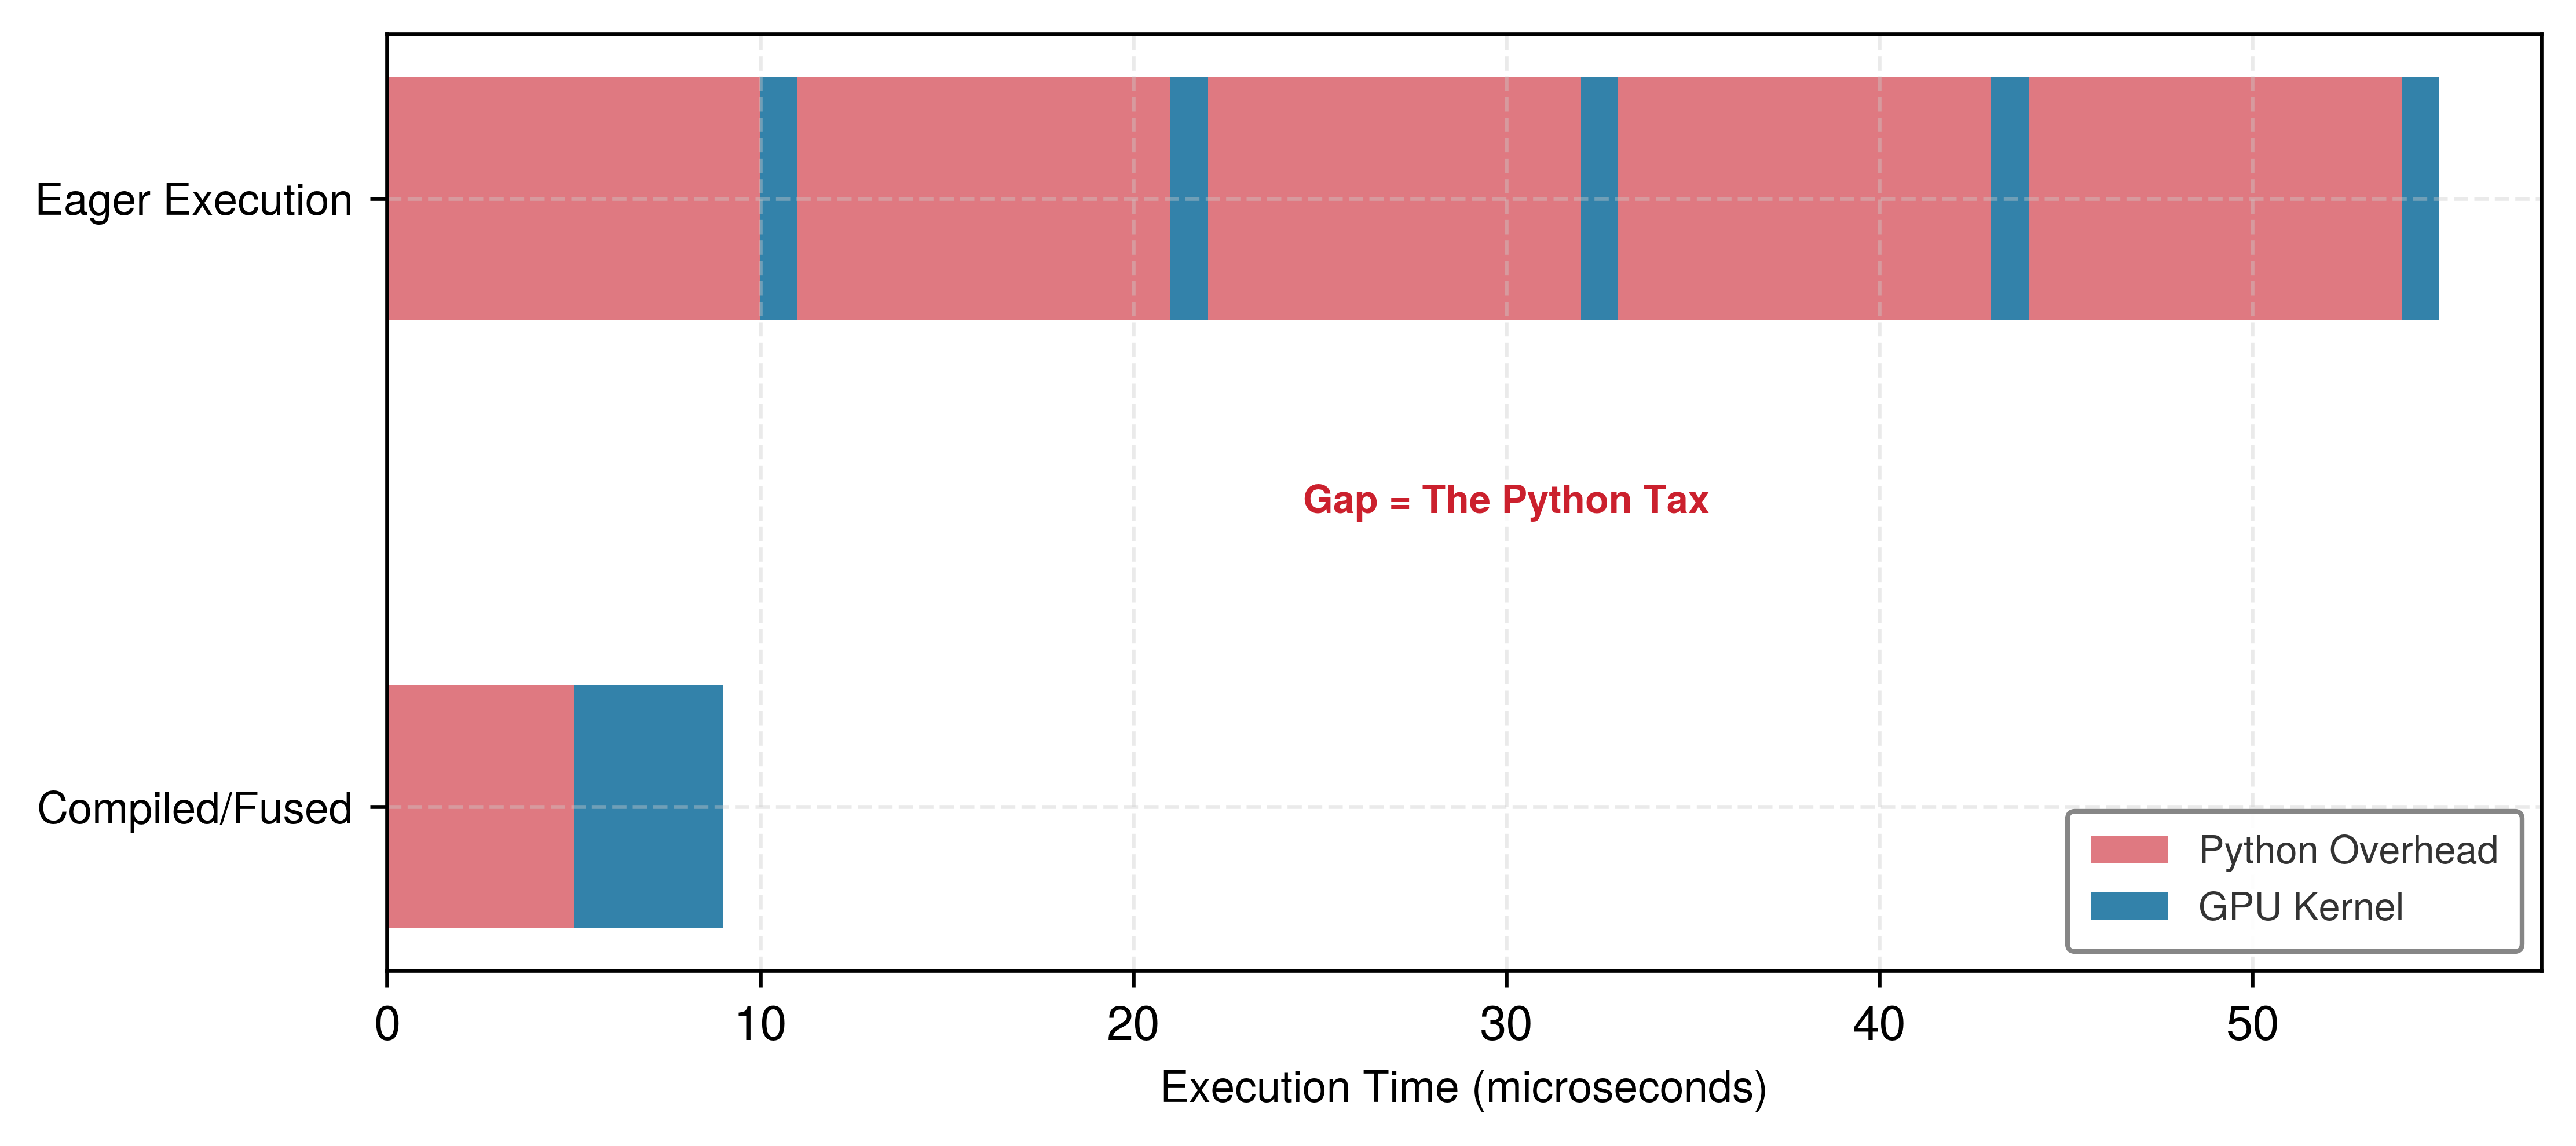
分发税:Python 开销与 GPU 实际执行
即时执行的性能上限源于一种根本性的系统不匹配:主机端解释器的速度与设备端芯片的速度不匹配。分发税定义为主机端编排(Python)所耗时间在其与实际设备执行(GPU)的总耗时中所占的比例,用于量化这种不匹配。
随着工作量增加,有效计算的增长超过固定分发成本;分发税随之降低。
在此处用于说明的即时执行模型中,每个操作都要为主机端分发、类型检查和内核启动支付约 15 \(\mu\)s 的固定“税费”。实际开销因框架、后端和硬件而异,但其相对占比仍取决于操作规模。对于在小向量上执行 ReLU 之类的小型操作,内核可能仅需 1 \(\mu\)s 即可执行完毕,因此模型中的分发税达到 94 percent,GPU 的大部分时间都在等待下一条命令。对于大型矩阵乘法之类的大型操作,内核执行时间为 100 \(\mu\)s,模型中的分发税降至 13 percent,系统转为受计算限制。
分发税解释了为何包含大量小型层的模型,其运行速度会明显低于仅根据 FLOP 数量预测的速度。瓶颈诊断 将这一现象纳入瓶颈分类体系,将分发占主导地位的工作负载归类为受延迟限制而非受计算限制,并说明哪些优化能够切实改善这种瓶颈。为了接近高效执行,框架必须从逐内核分发转向图级执行,使整个图只支付一次分发税,而非每个操作都支付一次。section 1.3.3.3 中的混合 JIT 与编译策略正是为解决这一开销而设计的。
即时执行的开销促使人们采用相反的设计:在执行任何计算之前,先捕获整个计算过程。这正是静态计算图所提供的能力。
静态计算图
静态图执行首先以符号表示定义完整的计算图,然后单独执行它。这种“先定义、后运行”的执行模型意味着,在任何计算发生之前,图就已经存在,从而能够进行积极的提前优化。在启动设备内核之前看到完整计算过程,使框架能够从全局分析、变换和优化计算图;除非编译器捕获了彼此独立的即时执行调用,否则无法获得跨越这些调用的全局视野。算子融合 详细推导了这种能力所支持的典型全局变换:对于 \(N\) 个元素,每个元素占 \(b\) 字节,将包含 \(k\) 个逐元素操作的操作链融合为单个内核,可将理想化的读写流量从 \(2kNb\) 字节降至 \(2Nb\) 字节。
两阶段执行
静态图将图构建与执行明确分离。Listing 2 使用 TensorFlow 1.x 展示这两个阶段,该版本是这种方法的典型代表。此处特意运行与 listing 1 中即时执行示例相同的计算,即先执行 x * 2,再执行 + 1,保持算术运算不变,使唯一变化的是执行时机:符号定义创建占位符和操作,但不进行计算;显式执行则触发实际的算术运算。
# Phase 1: Graph Construction (symbolic, no computation)
import tensorflow.compat.v1 as tf

tf.disable_v2_behavior()

# Define graph symbolically
x = tf.placeholder(tf.float32, shape=[1])  # Just a placeholder
y = x * 2  # Not executed, just recorded
z = y + 1  # Still no execution
# At this point, nothing has been computed

# Phase 2: Graph Execution (actual computation)
with tf.Session() as sess:
    result = sess.run(z, feed_dict={x: [1.0]})
# Now computation happens: result = [3.0]静态图编译将图构建与张量执行分离。figure 5 中的生命周期展示了这种阶段划分:左侧的符号图定义先于右侧的提前优化和运行时执行。
\begin{tikzpicture}[line join=round,font=\sffamily\small]
\tikzset{%
  Box/.style={align=flush center,
    inner xsep=2pt,
    node distance=0.65,
    draw=BlueLine,
    line width=0.75pt,
    fill=BlueL!30,
    %text width=35mm,
    minimum width=27mm, minimum height=14mm
  },
  Box2/.style={Box, draw=BrownLine, fill=BrownL!30,
  },
  LineA/.style={black!40,line width=6.5pt,{-{Triangle[width=1.0*12pt,length=1.0*5pt]}},shorten <=0pt,shorten >=0pt},
}

\tikzset{
pics/interpreter/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\def\ra{}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\node[red,font=\Large\bfseries]at(-0.75,0.6){\textless\,/\,\textgreater};
\draw[line cap=round,line join=round,violet,line width=\Linewidth](-1.15,-0.1)--(-0.95,-0.1);
\draw[line cap=round,line join=round,red,line width=\Linewidth](-0.7,-0.1)--(0.1,-0.1);

\draw[line cap=round,line join=round,violet,line width=\Linewidth](-1.15,-0.5)--(0,-0.5);

\draw[line cap=round,line join=round,violet,line width=\Linewidth](-1.15,-0.9)--(-0.75,-0.9);
\draw[line cap=round,line join=round,red,line width=\Linewidth](-0.45,-0.9)--(0.45,-0.9);
\draw[line cap=round,line join=round,cyan,line width=\Linewidth](0.75,-0.9)--(1.1,-0.9);

\draw[line cap=round,line join=round,violet,line width=\Linewidth](-1.15,-1.3)--(-1,-1.3);
\draw[line cap=round,line join=round,red,line width=\Linewidth](-0.65,-1.3)--(-0.10,-1.3);
\draw[line cap=round,line join=round,cyan,line width=\Linewidth](0.2,-1.3)--(1.1,-1.3);
\end{scope}
    }
  }
}
%CPU
\tikzset{%
 pics/cpu/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=FUNNEL,scale=\scalefac, every node/.append style={transform shape}]
\node[fill=\filllcolor,minimum width=66, minimum height=66,
            rounded corners=2,outer sep=2pt] (C1) {};
\node[fill=white,minimum width=54, minimum height=54] (C2) {};
\node[fill=\filllcolor!40,minimum width=44, minimum height=44] (C3) {\Large\bfseries GPU};

\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=\filllcolor,minimum width=3, minimum height=15,
           inner sep=0pt,anchor=south](GO\y)at($(C1.north west)!\x!(C1.north east)$){};
}
\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=\filllcolor,minimum width=3, minimum height=15,
           inner sep=0pt,anchor=north](DO\y)at($(C1.south west)!\x!(C1.south east)$){};
}
\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=\filllcolor,minimum width=15, minimum height=3,
           inner sep=0pt,anchor=east](LE\y)at($(C1.north west)!\x!(C1.south west)$){};
}
\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=\filllcolor,minimum width=15, minimum height=3,
           inner sep=0pt,anchor=west](DE\y)at($(C1.north east)!\x!(C1.south east)$){};
}
 \end{scope}
     }
  }
}
%graph style
\tikzset{
pics/graph3D/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=GRAPH,scale=1, every node/.append style={transform shape}]
\def\dx{\Width}
\def\dy{\Height}
\def\dz{\Depth}
% koordinata donjeg levog ugla (početak bara)
\def\x{0}
\def\y{0.15}
\def\z{0}
% boje
\draw[draw=\filllcirclecolor,line width=1pt](-0.2,0)--(1.3,0);
\draw[draw=\filllcirclecolor,line width=1pt](-0.2,0)--(-0.2,1.2);
\filldraw[fill=\filllcolor!10, draw=\drawcolor] (\x,\y+\dy,\z) -- (\x,\y+\dy,\z+\dz) -- (\x+\dx,\y+\dy,\z+\dz) -- (\x+\dx,\y+\dy,\z) -- cycle; % gornja strana
\filldraw[fill=\filllcolor!50, draw=\drawcolor] (\x+\dx,\y,\z) -- (\x+\dx,\y,\z+\dz) -- (\x+\dx,\y+\dy,\z+\dz) -- (\x+\dx,\y+\dy,\z) -- cycle; % desna strana
\filldraw[fill=\filllcolor!60, draw=\drawcolor] (\x,\y,\z+\dz) -- (\x+\dx,\y,\z+\dz) -- (\x+\dx,\y+\dy,\z+\dz) -- (\x,\y+\dy,\z+\dz) -- cycle; % prednja strana
\end{scope}
    }
  }
}
\tikzset{mycylinder/.style={cylinder, shape border rotate=90, aspect=1.3, draw, fill=white,
minimum width=25mm,minimum height=11mm,line width=\Linewidth,node distance=-0.15},
pics/data/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=STREAMING,scale=\scalefac, every node/.append style={transform shape}]
\node[mycylinder,fill=\filllcolor!50] (A) {};
\node[mycylinder, above=of A,fill=\filllcolor!30] (B) {};
\node[mycylinder, above=of B,fill=\filllcolor!10] (C) {};
\fill[\filllcolor!50!black]($(C.west)!0.12!(C.east)$)circle(3pt);
\fill[\filllcolor!50!black]($(B.west)!0.12!(B.east)$)circle(3pt);
\fill[\filllcolor!50!black]($(A.west)!0.12!(A.east)$)circle(3pt);
 \end{scope}
     }
  }
}
\tikzset{pics/brain/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=BRAIN,scale=\scalefac, every node/.append style={transform shape}]
\fill[fill=\filllcolor!50](0.1,-0.5)to[out=0,in=180](0.33,-0.5)
to[out=0,in=270](0.45,-0.38)to(0.45,-0.18)
to[out=40,in=240](0.57,-0.13)to[out=110,in=310](0.52,-0.05)
to[out=130,in=290](0.44,0.15)to[out=90,in=340,distance=8](0.08,0.69)
to[out=160,in=80](-0.42,-0.15)to (-0.48,-0.7)to(0.07,-0.7)to(0.1,-0.5)
(-0.10,-0.42)to[out=310,in=180](0.1,-0.5);
\draw[draw=\drawcolor,line width=\Linewidth](0.1,-0.5)to[out=0,in=180](0.33,-0.5)
to[out=0,in=270](0.45,-0.38)to(0.45,-0.18)
to[out=40,in=240](0.57,-0.13)to[out=110,in=310](0.52,-0.05)
to[out=130,in=290](0.44,0.15)to[out=90,in=340,distance=8](0.08,0.69)
(-0.42,-0.15)to (-0.48,-0.7)
(0.07,-0.7)to(0.1,-0.5)
(-0.10,-0.42)to[out=310,in=180](0.1,-0.5);
\draw[fill=\filllcolor,line width=\Linewidth](-0.3,-0.10)to(0.08,0.60)
to[out=60,in=50,distance=3](-0.1,0.69)to[out=160,in=80](-0.26,0.59)to[out=170,in=90](-0.46,0.42)
to[out=170,in=110](-0.54,0.25)to[out=210,in=150](-0.54,0.04)
to[out=240,in=130](-0.52,-0.1)to[out=300,in=240]cycle;
\draw[fill=\filllcolor,line width=\Linewidth]
(-0.04,0.64)to[out=120,in=0](-0.1,0.69)(-0.19,0.52)to[out=120,in=330](-0.26,0.59)
(-0.4,0.33)to[out=150,in=280](-0.46,0.42)
%
(-0.44,-0.03)to[bend left=30](-0.34,-0.04)
(-0.33,0.08)to[bend left=40](-0.37,0.2) (-0.37,0.12)to[bend left=40](-0.45,0.14)
(-0.26,0.2)to[bend left=30](-0.24,0.13)
(-0.16,0.32)to[bend right=30](-0.27,0.3)to[bend right=30](-0.29,0.38)
(-0.13,0.49)to[bend left=30](-0.04,0.51);

\draw[rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcirclecolor,length=2.5pt]}](-0.23,0.03)--(-0.15,-0.03)--(-0.19,-0.18)--(-0.04,-0.28);
\draw[rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcirclecolor,length=2.5pt]}](-0.17,0.13)--(-0.04,0.05)--(-0.06,-0.06)--(0.14,-0.11);
\draw[rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcirclecolor,length=2.5pt]}](-0.12,0.23)--(0.31,0.0);
\draw[rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcirclecolor,length=2.5pt]}](-0.07,0.32)--(0.06,0.26)--(0.16,0.33)--(0.34,0.2);
\draw[rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcirclecolor,length=2.5pt]}](-0.01,0.43)--(0.06,0.39)--(0.18,0.51)--(0.31,0.4);
\end{scope}
     }
  }
}
\tikzset{pics/brainMEM/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=BRAIN,scale=\scalefac, every node/.append style={transform shape}]
\fill[fill=\filllcolor!50](0.1,-0.5)to[out=0,in=180](0.33,-0.5)%
to[out=0,in=270](0.45,-0.38)to(0.45,-0.18)
to[out=40,in=240](0.57,-0.13)to[out=110,in=310](0.52,-0.05)
to[out=130,in=290](0.44,0.15)to[out=90,in=340,distance=8](0.08,0.69)
to[out=160,in=80](-0.42,-0.15)to (-0.48,-0.7)to(0.07,-0.7)to(0.1,-0.5)
(-0.10,-0.42)to[out=310,in=180](0.1,-0.5);
\draw[draw=\drawcolor,line width=\Linewidth](0.1,-0.5)to[out=0,in=180](0.33,-0.5)
to[out=0,in=270](0.45,-0.38)to(0.45,-0.18)
to[out=40,in=240](0.57,-0.13)to[out=110,in=310](0.52,-0.05)
to[out=130,in=290](0.44,0.15)to[out=90,in=340,distance=8](0.08,0.69)
(-0.42,-0.15)to (-0.48,-0.7)
(0.07,-0.7)to(0.1,-0.5)
(-0.10,-0.42)to[out=310,in=180](0.1,-0.5);
%
\node[draw=\drawcolor,fill=\filllcirclecolor,line width=\Linewidth,rounded corners=3pt,minimum size=8mm](MR)at(-0.350,0.31){};
\node[draw=\drawcolor,fill=white,line width=1.5*\Linewidth,circle,inner sep=1pt,minimum size=2mm]
at($(MR.south)+(0,0.25)$){};
\node[fill=\filllcolor!50!blue!50,draw=\drawcolor,line width=\Linewidth,rectangle,anchor=north,
minimum width=5mm](MMR)at(MR.north){};
\draw[draw=\drawcolor,line width=\Linewidth](MMR.120)--(MMR.240);
\node[fill=black,minimum size=0.9mm,inner sep=1pt]at($(MMR.west)!0.75!(MMR.east)$){};
\end{scope}
     }
  }
}
\pgfkeys{
  /channel/.cd,
   Depth/.store in=\Depth,
  Height/.store in=\Height,
  Width/.store in=\Width,
  filllcirclecolor/.store in=\filllcirclecolor,
  filllcolor/.store in=\filllcolor,
  drawcolor/.store in=\drawcolor,
  drawcircle/.store in=\drawcircle,
  scalefac/.store in=\scalefac,
  Linewidth/.store in=\Linewidth,
  picname/.store in=\picname,
  filllcolor=BrownLine,
  filllcirclecolor=violet!20,
  drawcolor=red,
  drawcircle=violet,
  scalefac=1,
  Linewidth=0.5pt,
  Depth=0.2,
  Height=0.5,
  Width=0.25,
  picname=C
}

\node[Box,minimum width=30mm,](B1){};
\coordinate(GO1)at($(B1.north west)!0.38!(B1.north east)$);
\coordinate(T1)at($(GO1)!0.5!(B1.south east)$);
\coordinate(I1)at($(B1.west)!0.21!(B1.east)$);
\node[align=center,minimum width=30mm,]at(T1){定义\\ 运算};
%\draw[dashed,RedLine,  line width=0.75pt,](GO1)--(GO1|-B1.south west);
\node[Box,fill=none,minimum width=30mm,]{};
\pic[shift={(0.05,0.11)}] at  (I1){interpreter={scalefac=0.38,picname=1,
filllcolor=cyan!30!, Linewidth=1.5pt,filllcirclecolor=orange}};
%Declare Variables
\node[Box,right=of B1](B2){};
\coordinate(GO2)at($(B2.north west)!0.4!(B2.north east)$);
%\fill[fill=BlueL!90](B2.south west)rectangle(GO2);
\coordinate(T2)at($(GO2)!0.5!(B2.south east)$);
\coordinate(I2)at($(B2.west)!0.24!(B2.east)$);
\node[align=center]at(T2){声明\\ 变量};
%\draw[dashed,BlueLine,  line width=0.75pt,](GO2)--(GO2|-B2.south west);
\node[Box,right=of B1,fill=none]{};
\pic[shift={(0,0)}] at  (I2){brainMEM={scalefac=0.68,drawcolor=black,
filllcirclecolor=green!70!black!30,picname=1,filllcolor=orange!30!, Linewidth=0.75pt}};
 %Build Graph
\node[Box,right=of B2](B3){};
\coordinate(GO3)at($(B3.north west)!0.4!(B3.north east)$);
%\fill[fill=BlueL!90](B3.south west)rectangle(GO3);
\coordinate(T3)at($(GO3)!0.5!(B3.south east)$);
\coordinate(I3)at($(B3.west)!0.22!(B3.east)$);
\node[align=center]at(T3){构建\\ 计算图};
%\draw[dashed,BlueLine,  line width=0.75pt,](GO3)--(GO3|-B3.south west);
\node[Box,right=of B2,fill=none](B3){};
\pic[shift={(0,0)}] at  (I3){brain={scalefac=0.65,picname=1,drawcolor=black,filllcolor=orange!30!, Linewidth=0.65pt}};
%Load Data
\node[Box2,right=1.25 of B3](B4){};
\coordinate(GO4)at($(B4.north west)!0.34!(B4.north east)$);
%\fill[fill=BlueL!90](B3.south west)rectangle(GO3);
\coordinate(T4)at($(GO4)!0.5!(B4.south east)$);
\coordinate(I4)at($(B4.west)!0.22!(B4.east)$);
\node[align=center]at(T4){加载\\ 数据};
%\draw[dashed,BlueLine,  line width=0.75pt,](GO4)--(GO4|-B4.south west);
\node[Box2,right=1.25 of B3,fill=none](B4){};
\pic[shift={(0,-0.33)}] at  (I4){data={scalefac=0.3,picname=1,filllcolor=red, Linewidth=0.6pt}};
%Run Graph
\node[Box2,right=of B4](B5){};
\coordinate(GO5)at($(B5.north west)!0.34!(B5.north east)$);
\coordinate(T5)at($(GO5)!0.5!(B5.south east)$);
\coordinate(I5)at($(B5.west)!0.24!(B5.east)$);
\node[align=center]at(T5){执行\\ 计算图};
%\draw[dashed,RedLine,  line width=0.75pt,](GO5)--(GO5|-B5.south west);
\node[Box2,right=of B4,fill=none](B5){};
\pic[shift={(0,0)}] at  (I5){cpu={scalefac=0.3,picname=1,filllcolor=VioletLine, Linewidth=0.7pt}};
%Get Results
\node[Box2,right=of B5,minimum width=28mm](B6){};
\coordinate(GO6)at($(B6.north west)!0.4!(B6.north east)$);
\coordinate(T6)at($(GO6)!0.5!(B6.south east)$);
\coordinate(I6)at($(B6.west)!0.22!(B6.east)$);
\node[align=center,minimum width=28mm]at(T6){获取\\ 结果};
%\draw[dashed,RedLine,  line width=0.75pt,](GO6)--(GO6|-B6.south west);
\node[Box2,right=of B5,fill=none,minimum width=28mm](B6){};
\begin{scope}[shift={($(I6)+(-0.25,-0.4)$)},scale=0.7, every node/.append style={transform shape}]
\pic[shift={(0,0)}] at  (0,0){graph3D={filllcirclecolor=black!60,scalefac=0.5,picname=1,drawcolor=black,filllcolor=red,Height=0.5,Linewidth=1.25pt}};
\pic[shift={(0.33,0)}] at  (0,0){graph3D={filllcirclecolor=none,scalefac=0.5,picname=2,drawcolor=black,filllcolor=blue,Height=1,Linewidth=1.25pt}};
\pic[shift={(0.66,0)}] at  (0,0){graph3D={filllcirclecolor=none,scalefac=0.5,picname=3,drawcolor=black,filllcolor=green,Height=0.25,Linewidth=1.25pt}};
\pic[shift={(0.99,0)}] at  (0,0){graph3D={filllcirclecolor=none,scalefac=0.5,picname=4,drawcolor=black,filllcolor=orange,Height=0.75,Linewidth=1.25pt}};
\end{scope}

%arrows
\foreach \i in {1,2,3,4,5}{
\pgfmathtruncatemacro{\x}{\i + 1}
\draw[LineA](B\i)--coordinate[pos=0.3](SR\i)(B\x);
}
\begin{scope}[on background layer]
\node[draw=orange,fit=(B1)(B3),inner xsep=3mm,inner ysep=7mm,yshift=3mm,
fill=orange!05](F1){};
\node[font=\sffamily\bfseries\small,below=1pt of F1.north]{定义阶段};
\node[draw=GreenLine,fit=(B4)(B6),inner xsep=3mm,inner ysep=7mm,yshift=3mm,
fill=green!03](F2){};
\node[font=\sffamily\bfseries\small,below=1pt of F2.north]{执行阶段};
\end{scope}
\end{tikzpicture}与即时执行的关键区别在于,在构建期间,x、y 和 z 并非包含数值的张量,而是图中的符号节点。* 和 + 等运算符会向图定义中追加变换节点,而不发起算术运算。调用 print(y) 可以直观地体现这一区别:它打印的是符号张量的元数据,而非数值。只有当主机调用 sess.run() 时,运行时系统才会分析、优化所捕获的图,并在设备缓冲区上执行它。
提前优化
由于框架在执行前已掌握完整的图,因此可以进行提前优化,而这种优化无法跨越未被捕获的即时执行调用进行。section 1.3.1 中介绍的内核融合机会在这里可以付诸实施:由于框架能够同时看到图中的 y = x * 2 和 z = y + 1,因此可以将二者融合为 z = x * 2 + 1,消除中间变量 y,并将理想情况下的内存流量减半。当张量的形状和生命周期已知时,编译器可以在执行前规划内存,并复用生命周期不重叠的缓冲区;动态维度则可能需要设定边界或在运行时分配内存。张量布局也可以进行全局变换(例如从 NCHW 转为 NHWC),以适应硬件偏好,但物理布局转换仍可能需要复制。死代码消除(DCE)11会移除结果未被使用的运算,而常量折叠则会在输入已知时,预先计算作用于常量值的运算。这些优化直接对应于铁律中的各项:内核融合可以通过避免中间结果的内存写入来减少 \(D_{\text{vol}}\),常量折叠可以减少重复工作,预先规划分配可以降低运行时开销,而在存在未使用的计算时,死代码消除可以移除这些计算及其相关的数据移动。
XLA12 (Google 2025) 等编译器进一步扩展了这一方法,将捕获的子图编译为针对目标硬件特化的融合机器代码。
系统层面的影响
静态图可以通过提前优化实现高性能。当中间结果流量构成瓶颈时,内核融合可以降低内存带宽需求;当形状、算子和布局与高效的后端执行路径相匹配时,针对特定硬件的编译可以达到较高的利用率。
这种性能的代价是灵活性降低。在静态图中,标准 Python 控制流(if、for)不能依赖计算得到的张量值。TensorFlow 提供了支持数据相关条件的图级控制流原语(tf.cond 和 tf.while_loop),但这些原语需要使用不同于标准 Python 的特殊语法,使代码更难编写和推理。调试也很困难,因为堆栈跟踪指向的是图构建代码,而非执行代码。错误消息通常引用符号节点名称,而非实际失败的运算。
混合方法:JIT 编译
JIT 编译通过在运行时捕获计算,力求同时获得即时执行的调试便利性和图优化能力。其核心权衡是保真度与通用性。追踪会捕获样例运行期间实际经过的执行路径,对该路径具有较高的保真度,但会遗漏未经过的分支。源代码级编译(脚本化)会分析受支持的程序结构,保留受支持的控制流,但要求使用受限的语言子集。两种方法都会生成中间表示(IR)13,从而支持算子融合、常量折叠、死代码消除和缓冲区复用等图优化。
即时执行与编译执行之间的权衡对铁律有直接影响。JIT 编译将 \(L_{\text{lat}}\)(分派开销)分摊到整个编译区域。编译区域越长,每个运算所分摊的开销就越低,这也解释了为什么图中断对性能至关重要:每次中断都会迫使执行返回即时分派,使开销分摊重新开始。
从历史上看,PyTorch 的 TorchScript体现了这两种策略 (PyTorch Contributors 2026c)。如今,TorchScript 已被弃用,转而采用 torch.export 等较新的捕获与导出路径 (PyTorch Contributors 2026c, 2026b);这里仍用它来具体说明追踪和源代码级脚本化。追踪使用示例输入执行函数,并记录在该路径上观察到的张量运算。Listing 3 展示了如何将追踪得到的模块序列化,并使其独立于 Python 解释器执行。
import torch


def forward(x):
    y = x * 2
    z = y + 1
    return z


# Trace the function by running it once
x_example = torch.tensor([1.0])
traced = torch.jit.trace(forward, x_example)

# traced is now a compiled TorchScript module
# Can serialize: torch.jit.save(traced, "model.pt")
# Can optimize: fusion, constant folding
# Can run without Python interpreter
追踪的关键局限具体揭示了保真度与通用性之间的权衡。追踪记录的是某条已观测路径中的运算,而不会保留任意 Python 控制流。Listing 4 展示了由此产生的正确性风险。
TracerWarning,因为生成的追踪结果可能无法泛化。
def conditional_forward(x):
    if x.sum() > 0:  # Data-dependent condition
        return x * 2
    else:
        return x * 3


traced = torch.jit.trace(conditional_forward, torch.tensor([1.0]))
# Tracing captures ONLY the x.sum() > 0 branch
# If input later has sum <= 0, traced version
# still executes x * 2 branch
追踪记录的是示例输入实际执行的分支。在此示例中,将张量条件转换为 Python 布尔值通常会产生 TracerWarning;对于后续本应执行另一分支的输入,生成的追踪结果仍可能沿着已捕获的分支执行。因此,在存在数据相关的 Python 控制流时,必须将追踪警告视为正确性失败。
TorchScript 历史上提供的另一种方式是脚本化,它直接分析受支持的 Python 源代码,并将其编译为 TorchScript IR,而无须追踪样例路径 (PyTorch Contributors 2026c)。脚本化编译器会保留受支持的分支结构,但只接受受限的 Python 子集。对于新建的部署流水线,当前项目应遵循受支持的 torch.export 和目标运行时的相关指南,而不应在 TorchScript 追踪与脚本化之间进行选择 (PyTorch Contributors 2026b)。在历史上的 TorchScript 工作流中,追踪适用于在受支持输入下张量路径保持稳定的前馈模型,而脚本化则能够在不依赖 Python 解释器的情况下处理受支持的数据相关控制流。脚本化的关键优势在于能够在 IR 中保留受支持的条件分支,如 listing 5 所示。
PyTorch Contributors. 2026c. TorchScript.
PyTorch Contributors. 2026b. torch.export.
@torch.jit.script
def conditional_forward(x: torch.Tensor) -> torch.Tensor:
    if x.sum() > 0:
        return x * 2
    else:
        return x * 3


# Both branches preserved in IR
# Correct branch executes based on runtime input values
脚本化会施加一些约束,因为 TorchScript 必须分析通常由 Python 动态解释执行的代码。函数签名和变量有时需要类型注解,而不受支持的 Python 对象、库调用或元编程可能导致编译失败。Table 1 总结的是这一历史设计权衡,而非当前的部署指南。
| 方面 | 追踪 | 脚本化 |
|---|---|---|
| 输入要求 | 需要示例输入 | 无需输入 |
| 控制流 | 无法处理依赖数据的控制流 | 支持依赖数据的控制流 |
| 转换难易程度 | 较简单(只需运行函数) | 较困难(受限的 Python) |
| 类型注解 | 不需要 | 类型推断失败时需要 |
| 错误检测 | 运行时(结果错误) | 编译时(语法错误) |
| 最适用场景 | 前馈模型 | 含条件分支的模型 |
为理解编译器生成的内容,listing 6 直接检查生成的中间表示,其中单个 Python 表达式已被降低为显式、带类型的原语操作,运行时无需解释器即可执行这些操作。TorchScript IR 使用 aten 命名空间表示核心张量操作,使用 prim 命名空间表示原语和控制流,为每个值指定静态类型,并采用静态单赋值(SSA)形式,即每个变量恰好赋值一次,以简化编译器分析。这种 IR 支持独立于 Python 的优化:算子融合将相邻操作合并为单个内核,常量折叠在编译时计算常量表达式,死代码消除移除未使用的操作,内存优化则在可能时复用缓冲区。
@torch.jit.script
def example(x: torch.Tensor) -> torch.Tensor:
    return x * 2 + 1


# Inspect generated IR:
print(example.graph)
# graph(%x : Tensor):
#   %1 : int = prim::Constant[value=2]()
#   %2 : Tensor = aten::mul(%x, %1)
#   %3 : int = prim::Constant[value=1]()
#   %4 : Tensor = aten::add(%2, %3, %3)
#   return (%4)
现代编译:图捕获 JIT
前述方法迫使开发者在灵活的即时执行与编译器可见的计算图之间做出选择。现代 JIT 编译通过自动将即时执行代码中的区域捕获为优化后的计算图,以有限的开发者干预缓解了这一权衡。
各框架中的图捕获 JIT 系统遵循相同的架构模式。首次执行时,系统观察张量操作,记录一个由形状、数据类型、布局和控制流等假设所约束的图区域,将该区域降低为中间表示,应用融合与布局优化,并缓存可执行代码,供后续满足相同守卫条件的调用使用。不受支持的 Python 代码并不会消失;它会形成图边界,执行在此返回即时执行运行时。PyTorch 2.0 的 torch.compile (Ansel et al. 2024) 是这一模式的具体实例,但其系统思想比该 API 更为普遍:只有当捕获区域足够长且足够稳定,能够摊销捕获、降低、代码生成和缓存管理的成本时,编译才有收益。
Ansel, Jason, Edward Yang, Horace He, Natalia Gimelshein, Animesh Jain, Michael Voznesensky, Bin Bao, et al. 2024. “PyTorch 2: Faster Machine Learning Through Dynamic Python Bytecode Transformation and Graph Compilation.” Proceedings of the 29th ACM International Conference on Architectural Support for Programming Languages and Operating Systems, Volume 2, 929–47. https://doi.org/10.1145/3620665.3640366.
这解释了编译在何种情况下能够提供帮助。对于单个操作而言看似微不足道的调度成本——每次内核启动几微秒——会在一次前向传播的数千个操作中累积。1.1 中的软件开销物理机制对这种调度与内存流量进行了建模。
Napkin Math 1.1: 软件开销的物理机制
与铁律的联系: 铁律中的延迟项 \((L_{\text{lat}})\) 主要由软件开销决定:将指令从 Python 调度到 GPU。每个操作都需要支付约 10 μs 的 Python 调度成本,以及约 5 μs 的内核启动成本,两者共同构成下述场景中每次启动的开销。
场景一:即时执行模式(“微小操作”陷阱) 考虑一个简单的激活模块 y = relu(x + bias),其中每个张量包含 \(N\) 个元素,每个元素占 \(b\) 字节。
- 操作:两个(Add、ReLU)。
- 执行过程:
- 启动
Add内核:开销为 15 μs。 - 读写内存:\(2Nb\) 字节。
- 启动
ReLU内核:开销为 15 μs。 - 读写内存:\(2Nb\) 字节。
- 启动
- 总开销:30 μs。
- 总内存流量:\(4Nb\) 字节。
场景二:编译模式(融合) 编译器将其融合为一个内核:FusedAddRelu。
- 执行过程:
- 启动
Fused内核:开销为 15 μs。 - 读写内存:\(2Nb\) 字节(中间结果保留在芯片上)。
- 启动
- 总开销:15 μs(加速比为 2×)。
- 总内存流量:\(2Nb\) 字节(带宽效率为原来的 2×)。
系统洞见: 融合同时从两个方面获益。在这一场景中,将两次启动合并为一次,使每个操作的调度开销减半;将中间结果保留在芯片上,则使理想化的内存流量从 \(4Nb\) 字节降至 \(2Nb\) 字节。对于小规模逐元素操作,避免往返外部内存的收益可能比算术计算本身更重要。
Figure 6 直观展示了调度代价:即时执行会产生空隙,在 Python 调度下一个内核时,GPU 处于空闲状态。蓝色计算区域很短,而红色调度区域相对较长。编译将这些操作融合为一次内核启动,用一个调度块和一个融合计算块替代多个调度空隙。
自动完成这种融合,正是 PyTorch 2.0 的 torch.compile 等图捕获编译器的设计目标。14 它们捕获即时执行中的张量计算区域,并将其编译为融合内核,无需工程师编写自定义 CUDA 代码。15
因此,核心工程问题是概念层面的,而非某个 API 特有的问题。捕获编译器需要一个前端来识别即时执行程序中的图区域,需要一种中间表示将捕获的计算与 Python 分离,还需要一个后端将该区域降低为针对特定硬件的代码。它还需要一个守卫系统:只有当关于张量秩、数据类型、布局和控制流路径的假设仍然成立时,编译产物才有效。当守卫条件不成立时,运行时必须重新编译或回退到即时执行。
图中断标志着编译不再适用的边界。依赖数据的 Python 控制流、不受支持的库调用、I/O、自定义 Python 对象以及高度可变的形状,都会缩短编译区域。每次中断都会重新引入调度开销,并且可能要求张量在编译代码与即时执行运行时之间传递。从机制上看,图中断迫使捕获引擎将程序拆分为互不相连的编译子图,子图之间由标准 Python 执行过程隔开。在每个边界处,中间设备张量必须被解包为 Python 运行时对象,在进入下一个编译子图之前付出内存物化与解释器调度的开销。因此,图中断分析属于性能工程的范畴:相关指标并非是否启用了编译,而是热点路径中有多少部分仍处于长且稳定的编译区域内。
不同后端在灵活性与性能之间的连续谱上占据不同位置。即时(JIT)编译器在运行时追踪模型执行,动态生成优化内核,因此会在首次执行期间产生初始预热延迟。提前(AOT)编译器则在部署前编译捕获的计算,将编译移出热点路径,并在导出目标支持的情况下提供独立运行时。通用 JIT 后端以适中的编译成本优化常规训练与模型服务工作负载;当部署目标固定时,专用推理后端可以应用更深入的融合、降低数值精度以及自动调优;提前编译的移动端或嵌入式运行时则进一步牺牲灵活性,以减小资源占用并提高可预测性。所有后端都遵循同一规律:目标范围越窄、计算图越稳定,编译器就能安全地执行越多优化。
由此形成的工作流程是一项系统决策。快速原型开发倾向于采用即时执行,因为架构变化和守卫条件失效会使重新编译的成本变得明显。长时间训练和大规模推理则可以通过大量执行来摊销编译成本,前提是模型形状稳定且图中断有限。调试通常从即时执行模式开始,因为错误能够直接对应到源代码;在模型行为正确且性能瓶颈可测量之后,再重新引入编译。
执行模型比较
Table 2 从六个维度对比了三种执行模型,展示混合 JIT 编译如何在捕获区域内重新获得图级优化,同时在区域之外保留即时执行回退机制。
| 方面 | 即时执行 + 自动微分记录带 (PyTorch 默认) | 静态图 (TensorFlow 1.x) | JIT 编译 (torch.compile) |
|---|---|---|---|
| 执行模型 | 立即执行 | 延迟执行 | 混合执行 |
| 图构建 | 前向传播期间 | 执行之前 | 首次执行时(缓存) |
| 优化 | 每个操作使用独立内核 | 提前优化 | JIT 编译 |
| 动态控制流 | Python 控制流 | 图控制流 | 捕获区域或图中断 |
| 调试 | 容易(标准 Python) | 困难(符号式) | 中等(混合) |
| 性能 | 基准水平 | 高(经过优化) | 高(编译区域内) |
即时执行模式的主要价值体现在 机器学习生命周期 中量化的迭代循环中:它允许使用标准 Python 调试器(如 pdb)在执行过程中检查变量,而图模式调试通常需要专门的框架工具。这种即时反馈加快了机器学习生命周期中的原型开发阶段。
除这些核心执行权衡之外,table 3 还重点展示了静态方法与动态方法在系统层面的其他差异。
| 方面 | 静态图 | 动态图 |
|---|---|---|
| 内存管理 | 精确规划分配,优化内存使用 | 灵活,但效率可能较低 |
| 硬件利用 | 能生成针对特定硬件高度优化的代码 | 可能牺牲针对特定硬件的优化 |
| 研究推进速度 | 由于要求先定义后运行,迭代较慢 | 原型开发和模型实验更快 |
| 与遗留代码集成 | 定义与执行之间的分离程度更高 | 与命令式代码自然集成 |
这些权衡并非非此即彼的选择。现代框架提供了一系列连续的执行选项,由此引出了一个定量问题:给定项目应当位于这一连续谱的哪个位置。
执行的定量原理
这些执行模型构成一个连续谱,而两条定量原理使实际选择变得可度量。编译连续谱原理通过比较生产执行次数与开发迭代次数,判断编译收益在何时足以抵偿开发成本。调度开销定律则说明了为何即时执行在调度小规模操作上花费的时间可能超过实际计算时间。
编译连续谱原理
执行问题需要一条定量原理,以判断项目应在何时采用编译。执行模型构成了从最大灵活性到最大优化程度的连续谱。Equation 1 列出了这一轴上的四个位置,每个带标签的箭头都标明了推动项目向右、向硬件迈进一步的机制。
\[ \text{Eager} \xrightarrow{\text{capture}} \text{Graph JIT} \xrightarrow{\text{export}} \text{AOT Runtime} \xrightarrow{\text{specialize}} \text{Hardware} \tag{1}\]
每向右迈进一步,都会牺牲灵活性来换取性能。实际问题在于,给定项目应被置于这一连续谱的何处。最优编译策略取决于生产执行次数、开发期间的重新编译次数及其各自的时间成本,equation 2 将这些因素结合起来:
\[ \text{Compilation Benefit} = \frac{N_{\text{prod}} \cdot (T_{\text{eager}} - T_{\text{compiled}})}{T_{\text{compile}} + N_{\text{dev}} \cdot T_{\text{compile}}} \tag{2}\]
其中:
- \(N_{\text{prod}}\) = 生产执行次数(无量纲计数:推理请求数、训练步数)
- \(N_{\text{dev}}\) = 需要重新编译的开发迭代次数(无量纲计数)
- \(T_{\text{eager}}\) = 即时执行模式下每次执行的时间(秒)
- \(T_{\text{compiled}}\) = 编译模式下每次执行的时间(秒)
- \(T_{\text{compile}}\) = 每次编译或重新编译的时间(秒;假定为常数)
该模型假设编译产物在两次开发变更之间保持有效,且初始编译与每次重新编译的成本相同;在这些假设下,决策规则是在 \(\text{Compilation Benefit} > 1\) 时采用编译。该比值无量纲。
Table 4 展示了不同执行模式和模型架构下的一个假设吞吐量场景:
| 模型 | 即时执行 (样本/秒) | torch.compile (样本/秒) | TensorRT (样本/秒) | 编译时间 (秒) |
|---|---|---|---|---|
| ResNet-50 | 1,450 | 2,150 | 3,800 | 15–30 |
| BERT-Base | 380 | 520 | 890 | 30–60 |
| ViT-B/16 | 620 | 950 | 1,650 | 25–45 |
| GPT-2 (124M) | 180 | 260 | 420 | 45–90 |
不同执行模式之间的这些吞吐量差异引出了一个实际问题:哪种框架执行策略最适合各类工作负载。合适的策略取决于工作负载、后端以及铁律中的主导项,table 5 将每种反复出现的典型工作负载映射到一种候选执行策略。
| 典型工作负载 | 铁律中的主导项 | 候选框架策略 | 理由 |
|---|---|---|---|
| ResNet-50(计算密集型) | \(\frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}}\)(计算) | 编译后的稠密内核 | 规则的稠密内核受益于布局选择、精度降低和后端特化;融合对其周边受内存或启动开销限制的区域帮助最大 |
| GPT-2(带宽消耗型) | \(\frac{D_{\text{vol}}}{\text{BW}}\)(内存带宽) | 融合注意力 + 图编译 | 融合注意力和编译可减少 HBM 往返访问,并提高缓存复用率 |
| DLRM(稀疏散布型) | \(\frac{D_{\text{vol}}}{\text{BW}_{\text{random}}}+L_{\text{lat, network}}\) | 采用专用内核的即时执行 | 嵌入查找本身具有不规则性和动态性;编译收益较小 |
| DS-CNN(微型受限型) | \(L_{\text{lat}}\)(开销) | 提前编译的微控制器运行时 | 推理时间低于毫秒量级;每一微秒的 Python 开销都不可接受 |
这一原则对三种情形具有具体意义。在研究原型开发中(\(N_{\text{dev}} \gg N_{\text{prod}}\)),团队应继续采用即时执行。如果架构每隔几分钟就发生变化,编译开销可能占主导地位。在该场景编译耗时 30 秒的假设下,每小时编译十次会消耗五分钟。
对于长时间训练任务(\(N_{\text{prod}} \gg N_{\text{dev}}\)),编译可能带来净收益,因为其一次性成本可分摊到众多步骤中。在 table 4 的假设 ResNet-50 场景中,torch.compile 的吞吐量提高了 48.3 percent(2,150 img/s,相比之下即时执行为 1,450 img/s)。采用该场景中 30 s 的编译成本时,执行量超过 equation 3 中的盈亏平衡点后即可获得净收益:
\[ N_{\text{breakeven}} = \frac{T_{\text{compile}}}{T_{\text{eager}} - T_{\text{compiled}}} \tag{3}\]
将假设的 ResNet-50 数值代入 equation 3,得到约 134,000 images,任何具有实际训练时长的单次训练任务都足以达到这一数量。
对于生产推理(\(N_{\text{dev}} \approx 0\),\(N_{\text{prod}} \rightarrow \infty\)),团队应最大限度地利用编译。在没有开发迭代且请求量可能达到数百万次的情况下,每项优化都很重要。即使编译耗时长得多,积极的自动调优也可能值得采用,因为成本会分摊到整个部署生命周期中。
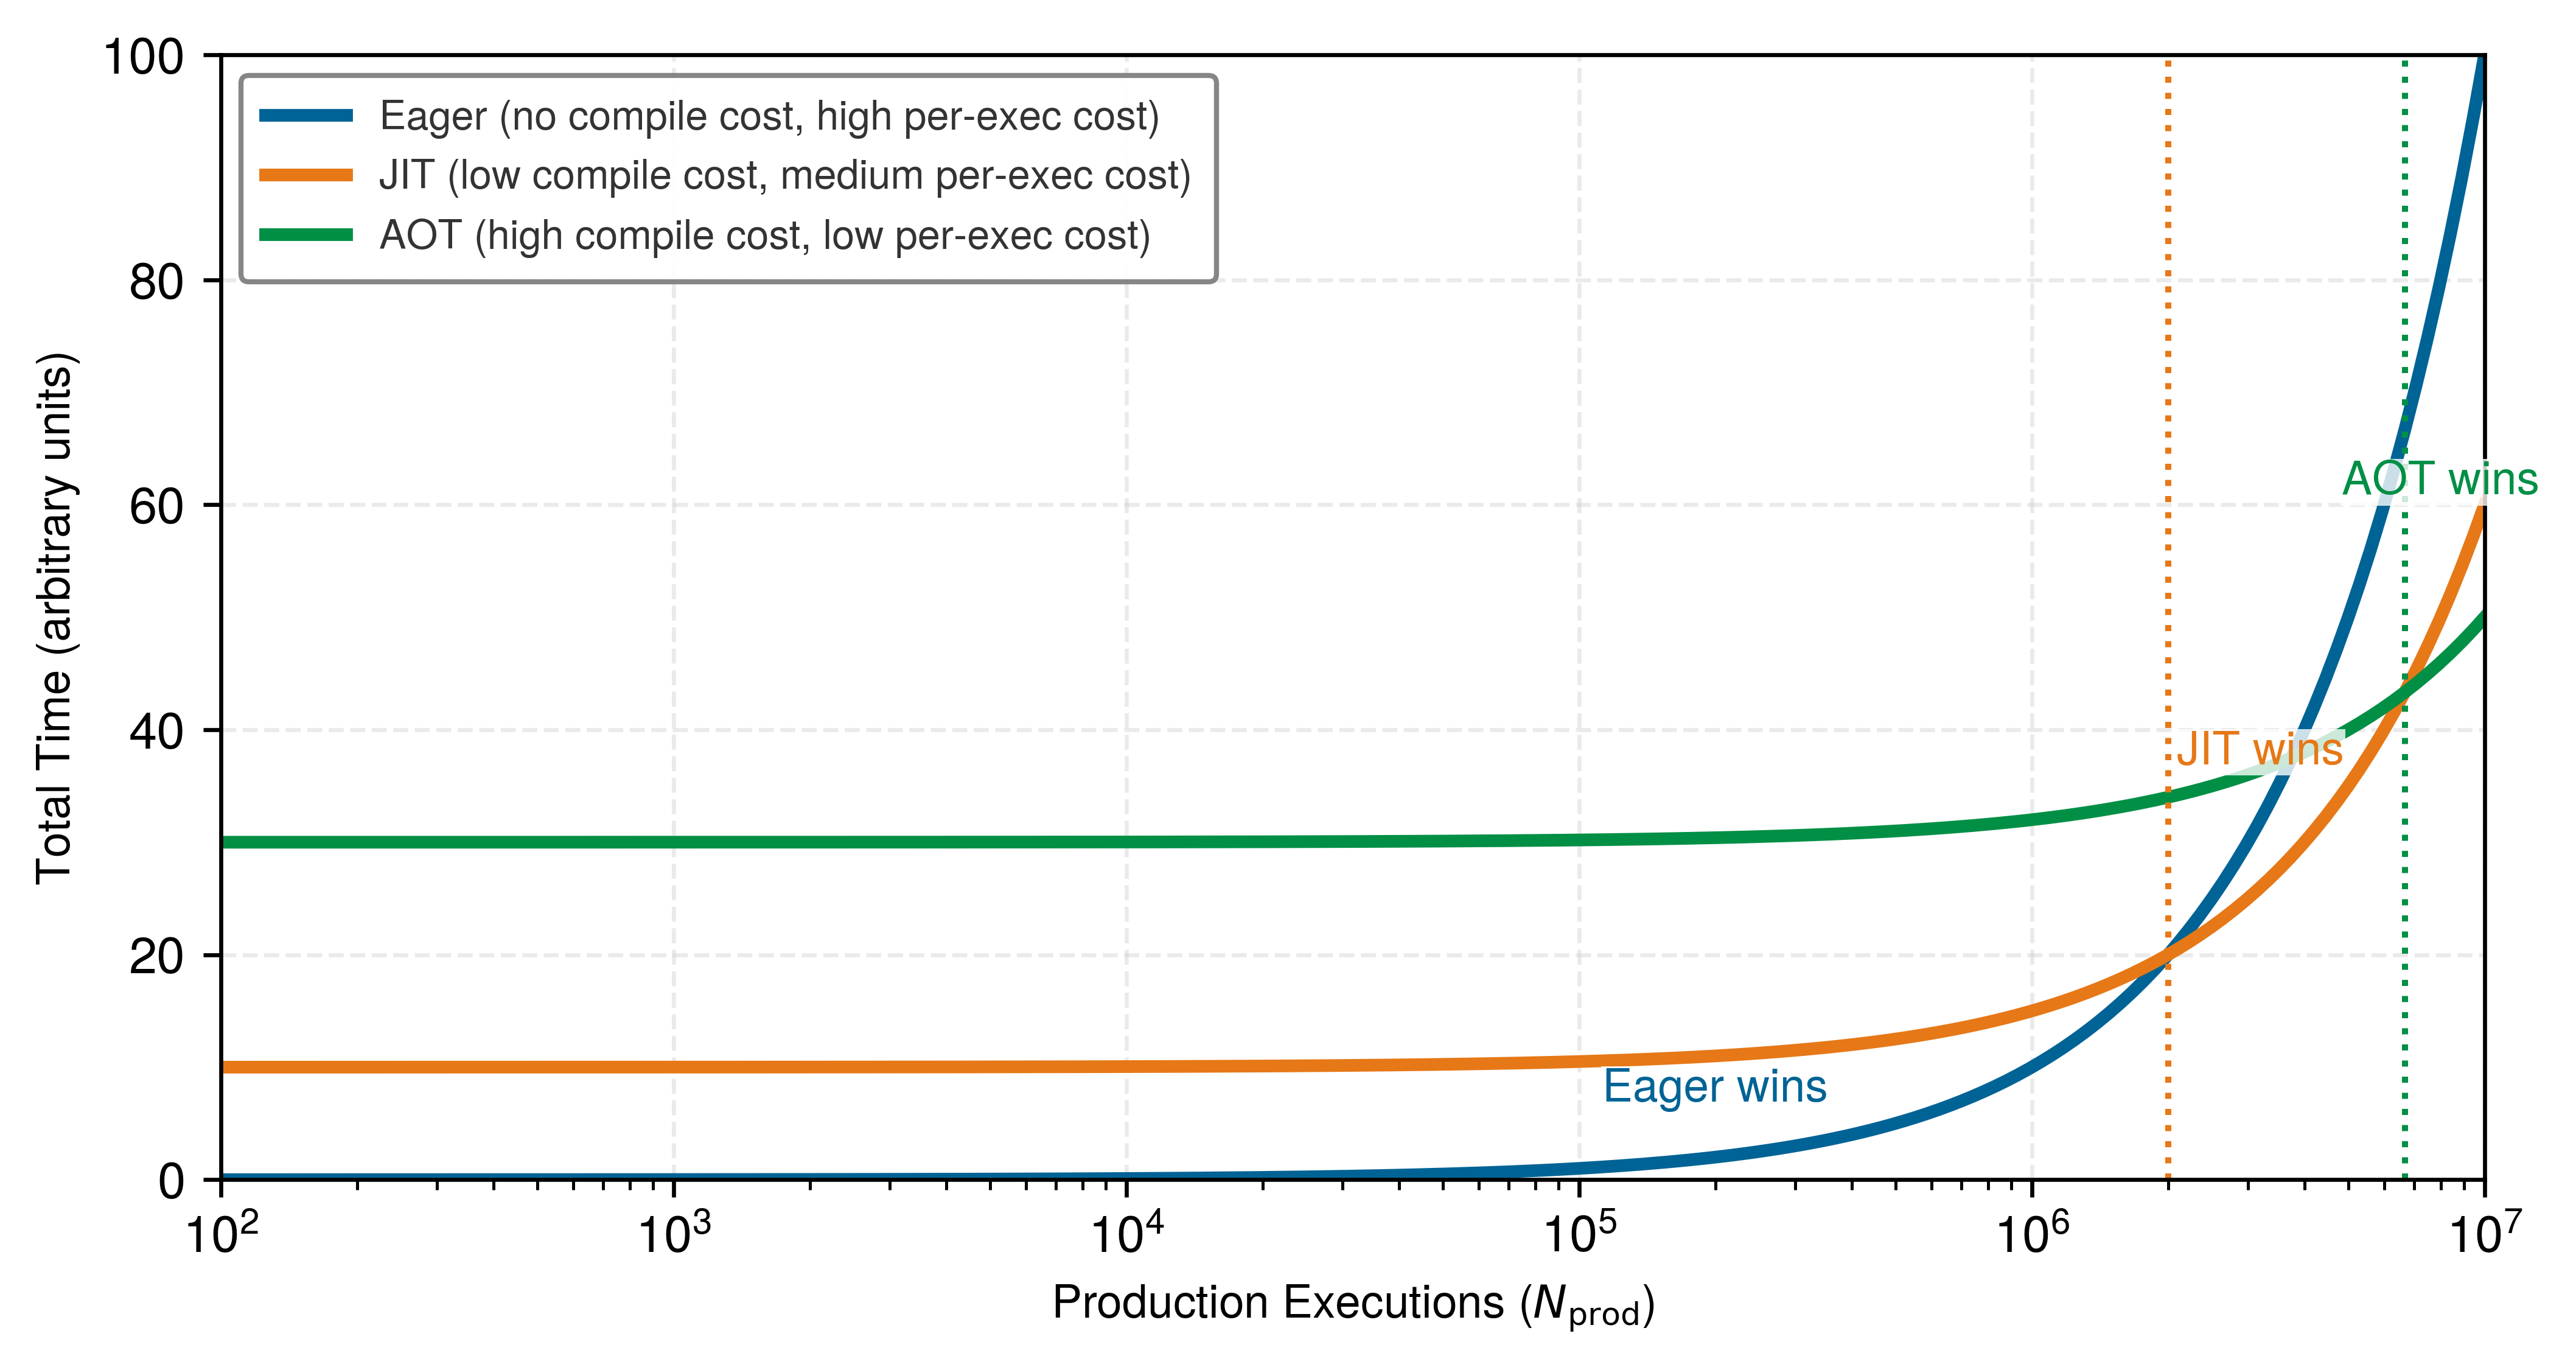
这三种情形在编译决策空间中形成了不同区域。Figure 7 描绘了这些区域,帮助工程师判断各策略在哪些条件下占优。交叉点标示了各策略成为最优选择的位置:陡峭的即时执行曲线(单次执行成本最高)被斜率适中的 JIT 曲线超越,而平缓的编译执行曲线(单次执行成本最低,但前期投入最大)在执行量较高时占据优势。斜率反映单次执行成本;纵轴截距反映编译开销。项目的执行量和实测成本共同决定哪种策略能够使总时间最短。
调度开销定律
第二条原则,即调度开销定律,源自 equation 4,该式刻画了框架开销而非计算或内存访问主导执行时间的情形。令 \(N_{\text{ops}}\) 表示操作数量(计数),\(t_{\text{dispatch}}\) 表示每次操作的调度开销(秒),\(T_{\text{compute}}\) 和 \(T_{\text{memory}}\) 分别表示总计算时间和总内存访问时间(秒)。该比率采用可加且无重叠的近似 \(T_{\text{hw}} \approx T_{\text{compute}} + T_{\text{memory}}\);当执行过程中这些成本存在重叠时,应以实测硬件时间替代二者之和。当操作本身的执行时间相对于调度成本很小时,框架开销占据主导地位:
\[ \text{Overhead Ratio} = \frac{N_{\text{ops}} \cdot t_{\text{dispatch}}}{T_{\text{compute}} + T_{\text{memory}}} \tag{4}\]
当开销比率 \(> 1\) 时,模型受开销限制。编译可以为受开销限制的工作负载带来最大的收益,因为融合减少了调度次数。section 1.10 中的训练步骤执行轨迹将端到端地分析这一效应,以下数值则先行展示其影响。
对 \(N_{\text{ops}}\) 次操作求和后,每次操作的调度成本 \(t_{\text{dispatch}}\) 会累积为执行过程中按调用收取的“税”。这种“税”是否占主导地位,取决于硬件执行时间 \(T_{\text{hw}}\) 与软件开销 \(T_{\text{sw}}\) 的相对大小(二者均以秒计),而不同模型规模下的情形存在显著差异。当调度主导执行时间时,由小操作组成的工作负载会从编译中获得格外显著的收益;仅凭模型参数量无法确定收益大小。笔记本 1.2 对比了一个小型多层感知机与一个大型 Transformer 层,以量化系统何时受主机开销或设备算术运算限制。
Napkin Math 1.2: 调度税
问题:Python 开销何时会严重损害性能?
场景一:小型多层感知机(MLP)(受开销限制)
- 计算:由小型矩阵运算和逐元素运算构成,共 6 ops。
- 硬件时间:\(T_{\text{hw}} \approx\) 2.6 μs(主要为内存访问延迟)。
- 软件开销:\(T_{\text{sw}} \approx\) 6 ops \(\times\) 15 μs/op = 90 μs。
- 比率:90 μs/2.6 μs ≈ 34.6。
- 小模型结果:系统将 97 percent 的时间用于主机端调度和内核启动开销。若消除模型中计入的全部调度开销,加速比上限为 35.6×。
场景二:GPT-3 层(受计算限制)
- 计算:大规模矩阵乘法。
- 硬件时间:\(T_{\text{hw}} \approx\) 100 ms = 100000 μs。
- 软件开销:\(T_{\text{sw}} \approx 50 \, \mu s\)。
- 比率:50 μs/100000 μs ≈ 0.0005。
- 大模型结果:模型中计入的 Python 开销可以忽略不计。编译仍可能改善融合、布局或后端特化;消除调度带来的贡献很小。
系统洞见:调度开销的影响取决于所处情形。对于由小操作组成的工作负载,编译可以将操作融合为更少的内核启动,从而降低主机端开销;而大型模型主要受益于融合内核和数据搬移的减少。
调度税分析表明,当调度延迟超过设备执行时间时,小操作就会受开销限制。这一系统约束在部署范围的边缘端达到极致:Python 运行时的内存占用和延迟开销超出了目标硬件的物理承载能力。
边缘端框架:TinyML 与微型运行时
编译连续谱在最边缘端达到极致。PyTorch 和 TensorFlow 2.x 等云端框架通过即时执行优先保障灵活性,而运行在仅有数千字节内存的微控制器(MCU)上的 TinyML16 系统无法承受 Python 解释器或完全动态运行时的开销。
Lighthouse 1.2: 灯塔示例:TinyML 上的关键词检测
场景:将智能门铃的关键词检测(KWS)模型,即 DS-CNN 微型约束灯塔案例,部署到具有 256 KB RAM 和 1 MB Flash 的 ARM Cortex-M4 上。
约束:完整的 PyTorch 和 Python 运行时所需内存比设备的内存预算高出数个数量级。
框架解决方案: TensorFlow Lite Micro(TFLM) (David et al. 2021) 等微型框架通过采用固定内存管理规则的微型解释器运行时解决这一问题:
- 固定内存区:应用程序提供一个连续的张量内存区,框架从该内存区中规划并复用缓冲区,而不依赖推理期间的动态分配。
- 内核选择:只需将模型使用的特定内核(例如 Conv2D、DepthwiseConv)链接到运行时或在运行时中注册。
- 紧凑的解释器执行:MCU 使用小型 C/C++ 解释器执行扁平化的模型表示,模型与内存区在初始化时绑定,而非在运行时动态组装。
芯片契约:在 TinyML 设备上,这一契约受到严格的内存约束。框架的首要任务是确保模型的中间激活(即“工作集”)能够容纳在 MCU 极小的 SRAM 中。
David, Robert, Jared Duke, Advait Jain, Vijay Janapa Reddi, Nat Jeffries, Jian Li, Nick Kreeger, et al. 2021. “TensorFlow Lite Micro: Embedded Machine Learning for TinyML Systems.” Proceedings of Machine Learning and Systems 3: 800–811.
这些微型运行时牺牲动态灵活性,以缩减占用空间并使内存使用可预测。结合紧凑模型、低功耗硬件和占空比控制,这种约束机制能够实现毫瓦级推理,且数据移动主要发生在片上。
从动态即时执行到静态图编译,再到专用微型运行时,不同执行策略要求开发者作出审慎权衡。以下关键执行模式决策概括了这些架构选择:
Checkpoint 1.1: 执行模型
执行模式的选择同时决定开发效率和模型性能。
可调试性与速度的权衡
现代折中方案
执行问题决定计算何时发生,以及可以进行哪些优化。然而,神经网络训练需要一种无论调度多么巧妙都无法提供的能力:自动计算梯度的能力。
考虑训练实际需要完成什么:对于数百万个参数中的每一个,计算其微小变化会如何影响损失。即使是简单的三层网络,手动完成这一任务也需要推导并实现数十个偏导数。对于具有数十亿个参数的现代 Transformer,手动求导在成本上不可行。一个执行高效但无法求导的框架可以进行推理,却无法学习。
求导问题
求导问题是自动计算梯度17的任务。神经网络训练需要求标量损失 \(\mathcal{L}\) 对数百万或数十亿个参数的导数。在执行前向传播时,运行时记录执行轨迹,并保存中间激活缓冲区,以供后续导数计算使用。由于单个标量损失依赖于大量参数,反向模式自动微分(AD)18具有较高效率:一次反向遍历即可计算所有请求的参数梯度,而使用前向模式求得同一个完整梯度时,每个参数都需要一个切向方向。因此,主流机器学习框架在常规标量损失训练中采用反向模式 AD (Baydin et al. 2018)。
Baydin, Atilim Gunes, Barak A. Pearlmutter, Alexey Andreyevich Radul, and Jeffrey Mark Siskind. 2018. “Automatic Differentiation in Machine Learning: A Survey.” Journal of Machine Learning Research 18 (153): 1–43.
在 神经计算 中介绍的反向传播算法基础上,求导的系统工程关注框架如何表示计算图、管理中间值的内存,以及跨加速器高效编排反向传播。框架将链式法则机械化为大规模系统状态管理:跟踪算子依赖关系、安排激活缓冲区,并为 模型训练 中详述的训练算法调度反向内核。Listing 7 使用一个包含三个操作的简单函数说明其核心思想。
def f(x):
    a = x * x  # Square
    b = sin(x)  # Sine
    c = a * b  # Product
    return c
框架将该函数分解为基本操作,每个操作都有已知的局部导数,然后通过链式法则组合这些局部导数,对所支持的操作组合计算梯度。系统层面的挑战是在物理硬件约束下执行这一变换:框架必须在前向执行期间记录计算图,将必要的中间张量保留在设备内存中,并在不耗尽加速器 HBM 的前提下调度反向内核。生产运行时通过结构化图记录、缓存分配器和反向模式遍历来应对这些挑战。
前向与反向模式微分
自动微分具有两种不同的遍历方向:前向模式和反向模式。两者之间的选择决定梯度计算成本随输入维数还是输出维数增长。由于深度学习目标需要计算单个标量损失对数百万或数十亿个参数的导数,这种数学上的不对称性决定了底层框架的内存占用和执行调度。
前向模式
前向模式自动微分在计算原值的同时计算方向导数。对于每个中间变量 \(v_i\),运行时同时计算原值 \(v_i\) 及其方向导数(切向量)\(\dot{v}_i = \sum_j \frac{\partial v_i}{\partial x_j} \dot{x}_j\)。由于切向量与原值一起向下游流动,前向模式不需要执行轨迹,也从不为后续反向传播保留前向激活。
为了具体说明其机制,考虑同时计算 \(f(x) = x^2 \sin(x)\) 的函数值和导数。Listing 8 展示了前向模式如何在执行每个基本操作的同时计算局部导数规则,并在每一步应用链式法则和乘积法则:
def f(x):  # Computing both value and derivative
    # Step 1: x -> x²
    a = x * x  # Value: x²
    da = 2 * x  # Derivative: 2x

    # Step 2: x -> sin(x)
    b = sin(x)  # Value: sin(x)
    db = cos(x)  # Derivative: cos(x)

    # Step 3: Combine using product rule
    result = a * b  # Value: x² * sin(x)
    dresult = a * db + b * da  # Derivative: x²*cos(x) + sin(x)*2x

    return result, dresult
前向模式通过对偶数将这种成对跟踪机械化;对偶数具有 \(v + \dot{v}\epsilon\) 的形式,其中 \(\epsilon^2 = 0\)。在对偶数上计算算术算子或基本函数,会自动得到更新后的原值和切向量,而无需保留计算图。Listing 9 展示了在 \(x = 2.0\)、种子 \(\dot{x} = 1.0\) 下的这一计算轨迹:
x, dx = 2.0, 1.0  # seed: track the derivative with respect to x

a = x * x  # value:      4.0
da = 2 * x  # derivative: 4.0
b = sin(x)  # value:      0.9093
db = cos(x)  # derivative: -0.4161
c = a * b  # value:      3.637
dc = a * db + b * da  # derivative: 1.973
一次以切向量 \(\dot{\mathbf{x}}\) 为种子的前向传播会计算雅可比矩阵与向量的乘积(JVP)\(J\mathbf{v}\),其中 \(J \in \mathbb{R}^{M \times P}\) 是雅可比矩阵。当目标函数将 \(P\) 个参数输入映射为单个标量损失(\(M = 1\))时,求得完整梯度 \(\nabla f \in \mathbb{R}^P\) 需要依次将 \(\dot{\mathbf{x}}\) 设置为 \(P\) 个标准基向量中的每一个。因此,使用前向模式求得梯度需要进行 \(P\) 次不同的前向计算(或传播宽度为 \(P\) 的切向量束),计算量和内存流量随参数数量按 \(\mathcal{O}(P)\) 增长。对于具有数百万或数十亿个参数的网络,这种增长使前向模式梯度计算难以实现;不过,当输入维数较小时,或在计算方向导数及海森矩阵与向量的乘积时,前向 JVP 仍然非常有效。
反向模式
反向模式自动微分通过颠倒遍历顺序,利用神经网络训练的多对一几何结构。反向模式并非从输入向下游传播切向量,而是从标量损失 \(\mathcal{L}\) 向上游所有参数传播伴随量 \(\bar{v}_i = \partial \mathcal{L} / \partial v_i\)。从数学上看,前向模式计算雅可比矩阵与向量的乘积(\(J\mathbf{v}\)),而反向模式计算向量与雅可比矩阵的乘积(VJP)\(\mathbf{u}^T J\)。以 \(\bar{\mathcal{L}} = 1\) 为反向扫描的种子,无论模型包含十个参数还是一百亿个参数,都能在一次反向传播中得到完整的参数梯度向量 \(\nabla_{\boldsymbol{\theta}}\mathcal{L}\)。
反向模式作用于 listing 7 中相同的三操作函数 \(f(x) = x^2\sin(x)\),其中 \(x\) 通过两条不同的计算路径到达输出:平方路径和正弦路径。Algorithm 1 先定义有向无环图上的反向模式遍历算法,再跟踪这一具体计算过程。
\begin{algorithm} \caption{反向模式自动微分} \begin{algorithmic} \Require 具有标量输出 $y$ 的有向无环图;按拓扑顺序排列的节点 $v_1,\dots,v_n$;每个节点的局部导数规则 \Ensure 所请求的输入节点或参数节点的伴随量 $\bar{v}_i = \partial y / \partial v_i$ \For{$i = 1$ 到 $n$} \State 计算 $v_i$,记录依赖关系,并保存其导数规则所需的值 \Comment{前向传播} \EndFor \State 对所有 $i$ 设置 $\bar{v}_i \gets 0$;$\bar{y} \gets 1$ \For{$i = n$ 递减到 $1$} \For{每个父节点 $u$,其对应子节点为 $v_i$} \State $\bar{u} \gets \bar{u} + \bar{v}_i \, \partial v_i / \partial u$ \Comment{通过链式法则累加} \EndFor \State 当所有需要某些已存储值的规则均已执行后,释放这些值 \EndFor \State \Return 所请求节点的伴随量 \end{algorithmic} \end{algorithm}
algorithm 1 的算法结构揭示了其系统成本。前向传播记录算子依赖关系,并缓存反向导数规则所需的中间值,直到反向扫描使用它们。反向模式以激活存储和计算图状态管理为代价,换取相对于参数数量为常数 \(\mathcal{O}(1)\) 的梯度传播次数。
对于 listing 7 中的具体函数,在 \(x=2.0\) 处求值时,前向传播记录 \(a=x^2=4.0\)、\(b=\sin(x)\approx0.9093\) 和 \(c=ab\approx3.637\)。以 \(\bar{c}=1.0\) 为种子,乘积法则给出伴随量 \(\bar{a}=0.9093\) 和 \(\bar{b}=4.0\)。平方分支对 \(\bar{x}\) 的贡献为 \(0.9093\cdot4.0\approx3.6372\),正弦分支的贡献为 \(4.0\cos(2.0)\approx-1.6646\)。累加两条路径即可得到精确导数 \(\partial c/\partial x = \bar{x} \approx 1.973\)。
无论有多少条扇出路径将 \(x\) 连接到 \(c\),这一次反向遍历都能计算出 \(\partial c/\partial x\)。在深度神经网络中,每个权重张量都通过跨越连续层的数千条分岔路径影响标量损失;反向模式在一次反向扫描中汇总所有传入的伴随量。这种效率使 GPT-3 这样具有 175B 个参数的模型在计算上能够训练:相对于参数数量,反向模式需要的反向传播次数为 \(\mathcal{O}(1)\)。
在硬件上执行这一遍历会暴露出一个物理约束:在反向传播期间计算局部导数,需要使用前向执行所确定的求值点。因此,框架必须确定哪些前向张量需要持久保存在设备内存中、何时分配它们,以及何时释放它们。现代框架通过动态计算图和梯度累积管理这一生命周期。19
Listing 10 使用一个两层网络说明这些要求,展示前向传播如何存储中间激活,以及反向传播如何使用它们计算参数梯度。
def simple_network(x, w1, w2):
    hidden = x * w1  # First layer
    activated = max(0, hidden)  # ReLU activation
    output = activated * w2  # Second layer
    return output


# --- Forward pass stores intermediates ---
x, w1, w2 = 1.0, 2.0, 3.0
hidden = x * w1
activated = max(0, hidden)
output = activated * w2

# --- Backward pass consumes them ---
d_output = 1.0  # Seed gradient
d_w2 = activated  # = 2.0
d_activated = w2  # = 3.0
d_hidden = d_activated * (1 if hidden > 0 else 0)  # ReLU gate: 3.0
d_w1 = x * d_hidden  # = 3.0
d_x = w1 * d_hidden # = 6.0从这一示例可以得出三项实现要求。首先,框架必须跟踪操作之间的依赖关系,以确定正确的反向遍历顺序。其次,中间值(hidden、activated)必须保留在设备内存中,直到反向传播使用它们。从数学上看,这种保留是必要的,因为链式法则在前向求值点处计算局部导数;例如,计算 \(\frac{\partial}{\partial z}\text{ReLU}(z) = \mathbb{I}(z > 0)\) 需要激活前的值 \(z\),而计算全连接层的权重梯度 \(\frac{\partial \mathcal{L}}{\partial W} = X^T \delta\) 需要前向输入激活张量 \(X\)。第三,每个操作都需要前向实现和对应的反向规则。这些要求界定了自动微分的工程实现范围,其中激活内存的持续保留构成了主要的扩展瓶颈。
内存管理策略
一个具有 175B 个参数的 FP16 模型,仅权重就需要 350 GB,超出任何单个加速器的物理内存容量。反向模式 AD 为反向导数规则保留依赖于具体操作的前向激活,进一步加剧了这种内存压力。以一个采用批次大小 64 进行训练的 100 层网络为例,除了权重、梯度和优化器状态之外,保存的激活还会额外占用 8–12 GB。决定训练可行性边界的因素往往是内存容量,而非原始浮点吞吐量。
这些保存的激活所占用的内存会随连续层逐步累积。Listing 11 展示了每个前向层如何增加一个激活张量,而该张量必须一直保留到反向扫描回溯至该层。
def deep_network(x, w1, w2, w3):
    # Forward pass - must store intermediates
    hidden1 = x * w1
    activated1 = max(0, hidden1)  # Store for backward
    hidden2 = activated1 * w2
    activated2 = max(0, hidden2)  # Store for backward
    output = activated2 * w3
return output框架通过两种主要的架构策略缓解这一内存墙。第一种是激活检查点(或梯度检查点):运行时不缓存每个中间激活,而是仅存储选定的分段边界张量,并在反向传播期间按需重新计算未保留的中间量。其关键系统机制是运行时契约:框架将边界激活标记为持久保留,并在反向执行到达相应分段时重新生成中间值;梯度累积与检查点的机制 详细介绍了用于划分网络的检查点放置策略。Listing 12 展示了这一契约:前向传播只保留分段边界,反向传播则重新执行前向分段以重新生成激活,而非从全局内存加载它们。
# Standard backward: every forward activation stays resident
h1 = layer1(x)  # kept for backward
h2 = layer2(h1)  # kept for backward
out = layer3(h2)  # kept for backward

# Checkpointed: keep only the boundary h1 and drop h2. The
# backward pass re-runs the wrapped segment to regenerate
# h2 on demand instead of holding it in memory.
h1 = layer1(x)  # boundary: kept
out = checkpoint(
    lambda a: layer3(layer2(a)), h1
) # h2 recomputed in backward第二种策略是算子融合。20 编译器将兼容的算子融合到单个内核中,通过寄存器或片上共享内存传递中间值,而不是将矩阵乘法、偏置加法和激活函数作为独立内核执行,并将中间张量序列化写入加速器全局内存(HBM)。
反向传播本身依赖于针对硬件优化的专用内核。框架不会通过朴素的基本运算组合出反向传播,而是调用经过调优的反向传播内核(例如 cuDNN 原语),以优化加速器硬件上的内存访问步长和寄存器使用 (Chetlur et al. 2014)。结合检查点、内核融合和专用反向传播内核,大型架构能够在加速器的物理内存限制内完成训练,而不触发内存不足故障。
Chetlur, Sharan, Cliff Woolley, Philippe Vandermersch, Jonathan Cohen, John Tran, Bryan Catanzaro, and Evan Shelhamer. 2014. “cuDNN: Efficient Primitives for Deep Learning.” arXiv Preprint arXiv:1410.0759.
自动微分的框架实现
检查点、融合和专用内核解决了自动微分的物理瓶颈,而生产级框架将这些机制封装在高层训练循环之下。一个标准的 PyTorch 训练步骤——optimizer.zero_grad()、前向传播、loss.backward() 和 optimizer.step()——看起来只是四次顺序调用。在这一接口背后,运行时会构建和遍历动态计算图,分配和释放中间缓冲区,在 CUDA 流之间调度反向传播内核,并管理数值精度。同一套图机制还通过嵌套的 torch.autograd.grad 调用支持二阶导数,并通过 autocast 支持自动混合精度;后者在保留 FP32 主权重的同时调度低精度内核。
PyTorch autograd 内部机制
autograd 系统 是解决 section 1.1 中所引入微分问题的引擎。其设计遵循三项系统原则:支持高效梯度计算的数据结构、维护该数据结构的内存成本,以及生产工作流所需的控制机制。分析这些原则,可以阐明为何相同架构的训练内存显著高于推理内存,以及框架如何管理这部分开销。
反向链接的图结构
在前向传播期间,autograd 动态构建由 Node(或 Function)对象组成的有向无环图。每个节点封装一个算子的反向微分逻辑,并保留对计算其向量—雅可比积所需张量的引用。由于边从输出反向指向输入,引擎一旦收到标量损失的伴随量,就会立即开始拓扑遍历。
由可微运算产生的每个张量都包含一个 grad_fn 属性,该属性引用计算出该张量的 Function。每个 Function 通过其 next_functions 列表链接到前驱节点,从而形成一条从标量损失回溯到叶参数张量的链。Listing 13 检查了一个简单复合计算中的这条指针链:
grad_fn 都链接到创建它的 Function,形成从输出到叶参数的反向链,从而支持 \(\mathcal{O}(1)\) 的反向传播。
import torch

x = torch.tensor([2.0], requires_grad=True)
y = x * 3
z = y.pow(2)


# Traverse the reverse-linked graph
print(z.grad_fn)  # PowBackward0
print(z.grad_fn.next_functions)  # -> MulBackward0
print(
    z.grad_fn.next_functions[0][0].next_functions
) # -> AccumulateGrad (leaf)检查结果揭示了遍历路径:PowBackward0(来自 z = y.pow(2))链接到 MulBackward0(来自 y = x * 3),最终终止于叶参数张量 x 上的 AccumulateGrad。叶张量是图的汇点,累积梯度在此直接写入 .grad 缓冲区,不再继续传播。元组格式 (Function, index) 用于跟踪多输出运算中的特定输出索引。
这种反向链接的图带来了一项基本内存约束:在反向遍历执行相应节点之前,图拓扑及其引用的所有前向张量都必须驻留在设备内存中。尽管图元数据(指针和节点描述符)占用的内存很少,但它所引用的张量缓冲区可能消耗数 GB 的加速器内存容量,并随模型深度和批量大小直接增长。
内存与计算的权衡
为反向传播保存的每个前向激活值都会一直保留在设备内存中,直到执行其对应的求导规则。这些保留的激活值是训练内存开销的主要来源之一,进一步增加了权重、梯度和优化器状态的内存占用。由于不同运算需要不同的前向张量——例如,矩阵乘法需要输入激活值,而逐元素 ReLU 只需要激活前数值的符号位——具体的内存使用情况取决于算子语义。
示例中的训练峰值内存远高于单独的权重存储量。
考虑一个示例性的 ResNet-50 训练场景:参数量为 25.6M(FP32 权重约占 102.4 MB),批量大小为 64,图像尺寸为 \(224{\times}224\)。保存的激活值占用 8 GB–12 GB,梯度额外占用约 102.4 MB,自适应矩估计(Adam)的两个 FP32 矩缓冲区额外占用约 204.8 MB。将这四部分相加,该训练场景的内存占用为 8.4 GB–12.4 GB,约为单独 FP32 权重存储量的 82.1–121.2×。该指标反映的是训练峰值内存,有别于推理内存;推理无需优化器状态、梯度或反向传播激活值缓冲区。
这一差异说明,不能仅凭参数量推断加速器的训练容量。训练总内存遵循四部分公式(\(M_{\text{total}} = M_{\text{weights}} + M_{\text{gradients}} + M_{\text{optimizer}} + M_{\text{activations}}\)),再加上分配器开销,具体推导见 训练内存的真实成本。
框架提供三种图级控制机制来管理这一权衡。梯度检查点 (Chen et al. 2016) 改变图所保留的内容:引擎只存储粗粒度分段的边界,并在反向传播期间重新生成中间激活值。用机器学习系统铁律来表述,检查点通过增加算术运算次数(\(O\)),来减少内存占用和传输量(\(D_{\text{vol}}\))。张量分离提供了一种互补优化:调用 .detach() 会将张量从 autograd 跟踪中移除,防止引擎沿上游图路径保留激活值。这对于冻结的特征提取器无需计算梯度的迁移学习至关重要,能够消除不必要的激活值存储(\(D_{\text{vol}}\))。混合精度训练提供了第三种手段:以 16 位格式表示激活值和权重,可直接将张量数据量(\(D_{\text{vol}}\))减半,同时提高 Tensor Core 上的算术吞吐量(\(R_{\text{peak}}\))。模型训练 将这些图机制形式化为集群规模规划决策。
Chen, Tianqi, Bing Xu, Chiyuan Zhang, and Carlos Guestrin. 2016. “Training Deep Nets with Sublinear Memory Cost.” arXiv Preprint arXiv:1604.06174.
可扩展性与控制
生产训练系统需要对梯度传播进行细粒度控制,超出标准反向遍历的能力范围。在实践中,工作负载需要三项核心能力:通过 requires_grad=False 或 .detach() 在迁移学习期间冻结层的选择性梯度计算;通过运行时钩子检查和修改梯度,以进行裁剪、调试或记录中间伴随量;以及针对专用 CUDA 内核或新型激活函数等非标准运算的自定义微分规则。
这些扩展点通过在图构建和反向遍历期间调用的回调函数发挥作用,同时保持核心引擎的执行路径。在 PyTorch 中,这些能力对应于具体的运行时机制:保留的图、梯度累积缓冲区、自定义 autograd.Function 实现、张量钩子和分离边界。Table 6 汇总了这些机制、它们的系统功能,以及它们在内存或正确性方面的权衡。
| 机制 | 控制内容 | 成本或风险 |
|---|---|---|
retain_graph=True |
保留已保存的图状态,以供再次进行反向遍历 | 保留原本会被释放的内存;具体内存量取决于图及保存的值 |
| 梯度累积 | 连续的反向传播将梯度累加到 .grad 中,直到 zero_grad() 将其重置,从而支持较大的有效批量 |
忘记重置会在无提示的情况下混合不同优化步骤的梯度 |
自定义 autograd.Function |
为内置库之外的运算定义前向和反向规则 | 将微分契约(保存什么、如何求导)的责任转交给实现者 |
| 梯度钩子 | 在遍历过程中检查或修改梯度(裁剪、日志记录、调试) | 每次反向传播都会为每个已注册的张量运行任意 Python 代码 |
.detach() |
在选定边界处截断梯度流(冻结层、推理输出) | 旧式 .data 属性会绕过 autograd,并在无提示的情况下破坏梯度;进行原地修改前应先克隆 |
自定义 autograd 函数 将状态保留的责任从引擎转移给程序员,从而直接暴露微分契约:实现代码在 ctx.save_for_backward() 中显式定义需要保留哪些前向张量,并在 backward() 中计算相应的向量—雅可比积。Listing 14 通过一个自定义乘加运算演示了这一接口:
class MultiplyAdd(torch.autograd.Function):
    @staticmethod
    def forward(ctx, x, y, z):
        # Save tensors needed for backward
        ctx.save_for_backward(x, y)
        return x * y + z

    @staticmethod
    def backward(ctx, grad_output):
        # Retrieve saved tensors
        x, y = ctx.saved_tensors

        # Compute gradients using chain rule
        grad_x = grad_output * y  # dL/dx = dL/dout * dout/dx
        grad_y = grad_output * x  # dL/dy = dL/dout * dout/dy
        grad_z = grad_output  # dL/dz = dL/dout * 1

        return grad_x, grad_y, grad_z


# Usage
x = torch.tensor([2.0], requires_grad=True)
y = torch.tensor([3.0], requires_grad=True)
z = torch.tensor([1.0], requires_grad=True)

output = MultiplyAdd.apply(x, y, z)
output.backward()

print(
    x.grad, y.grad, z.grad
)  # tensor([3.]), tensor([2.]), tensor([1.])
这些 autograd 机制与芯片契约直接相关。反向链接的图定义了设备必须执行的反向传播内核序列(\(O\) 项)。内存与计算的权衡决定中间张量的驻留情况,以及通过内存层次结构的内存流量(\(D_{\text{vol}}\) 项)。可扩展性钩子使工程师能够裁剪不必要的图路径并拦截数据流。图保留与内存带宽之间的相互作用直接引出了混合精度训练,它在减少内存占用的同时提高硬件执行效率。
混合精度训练支持
混合精度 利用硬件专门化同时改善机器学习系统铁律中的两个项:Tensor Core 执行 16 位矩阵乘法的吞吐量高于 FP32 算术单元(提高 \(R_{\text{peak}}\) 并降低 \(O/(R_{\text{peak}} \cdot \eta_{\text{hw}})\)),而 16 位激活值将全局内存流量减半(降低 \(D_{\text{vol}}\))。同时改善这两个项并不常见;多数系统优化以增加内存占用为代价提高计算效率,或反之。
自动混合精度 API 根据算子的数值敏感性和硬件能力动态分配数值精度。卷积和线性投影等计算密集型运算以 FP16 或 BF16 执行,而 softmax、归约和损失计算等对数值敏感的运算以 FP32 执行。由于 FP16 的动态范围较窄(指数为 5 位,正规数的下界为 \(\approx 6.10 \times 10^{-5}\)),梯度值在反向传播期间可能下溢为零。损失缩放 通过以下方式抵御下溢:在反向遍历之前将标量损失乘以缩放因子 \(S\),使梯度进入 FP16 的可表示范围,并在优化器更新之前将参数梯度除以 \(S\)。
框架支持三种主要的低精度格式:IEEE FP16、BF16、21 以及 TF32(一种 NVIDIA Ampere 及更新架构采用的内部格式,在矩阵乘法中将 FP32 的 8 位指数与 FP16 的 10 位尾数结合使用)。BF16 以牺牲尾数精度(7 位)为代价,保持了 FP32 的 8 位指数所提供的动态范围,从而防止梯度下溢,并使大多数工作负载无需动态损失缩放。混合精度训练 详细介绍了这些格式的数值稳定性和内存特性。Listing 15 演示了 PyTorch 的混合精度 API,将 autocast 上下文管理器与 GradScaler 配合使用以防止下溢。
import torch
from torch.amp import autocast, GradScaler

model = MyModel().cuda()
optimizer = torch.optim.Adam(model.parameters())
scaler = GradScaler("cuda")

for inputs, targets in dataloader:
    inputs, targets = inputs.cuda(), targets.cuda()
    optimizer.zero_grad()

    # Framework automatically selects precision per operation
    with autocast(device_type="cuda", dtype=torch.float16):
        outputs = model(inputs)
        loss = criterion(outputs, targets)

    # GradScaler handles gradient scaling for numerical stability
    scaler.scale(loss).backward()
    scaler.step(optimizer)
    scaler.update()
BF16 训练完全无需这套损失缩放机制。将 listing 16 与 listing 15 对比可见,移除 GradScaler 简化了训练循环:BF16 的动态范围消除了下溢风险,允许直接执行反向传播。
# BF16 training typically does not require loss scaling
with torch.autocast(device_type="cuda", dtype=torch.bfloat16):
    outputs = model(inputs)
    loss = criterion(outputs, targets)
loss.backward()  # No GradScaler needed
optimizer.step()
优化器状态与检查点
在抢占或硬件故障后恢复训练,需要同步恢复模型权重和优化器状态:一阶矩向量、二阶矩方差估计以及步数计数器。对于 Adam,为每个参数存储两个 FP32 状态所增加的内存是 FP16 模型权重内存的 \(4\times\),使总内存占用达到权重基准的 \(5\times\)。对于一个拥有 70 亿参数的模型,权重和优化器状态总共约需 70 GB(权重占 14 GB,优化器状态占 56 GB)。检查点的数据量直接决定了跨分布式存储恢复时的延迟,将容错能力与机器学习系统铁律中的 \(D_{\text{vol}}\) 项联系起来。
模型训练 分析了分布式训练中的优化器内存优化策略。在框架层面,优化器通过 state_dict() 暴露内部状态字典,以便进行序列化。Listing 17 演示了如何访问优化器状态字典,listing 18 则展示了如何保存和恢复模型参数与优化器状态,以保持训练轨迹的连续性。
import torch
import torch.nn as nn
import torch.optim as optim

model = nn.Linear(10, 5)
optimizer = optim.Adam(model.parameters(), lr=0.001)

# After training steps, optimizer accumulates state
loss = model(torch.randn(3, 10)).sum()
loss.backward()
optimizer.step()

# Access state for checkpointing
state = optimizer.state_dict()
# Contains: {'state': {...}, 'param_groups': [{'lr': 0.001, ...}]}# Saving checkpoint
checkpoint = {
"epoch": epoch,
"model_state_dict": model.state_dict(),
"optimizer_state_dict": optimizer.state_dict(),
}
torch.save(checkpoint, "checkpoint.pt")
# Resuming training
checkpoint = torch.load("checkpoint.pt")
model.load_state_dict(checkpoint["model_state_dict"])
optimizer.load_state_dict(checkpoint["optimizer_state_dict"])自动微分的数学基础比深度学习复兴早了数十年;工程上的挑战在于将这些原理机械化为高性能软件基础设施。即便只为单个层手动推导和编写反向计算内核,也需要跟踪中间变量、实现局部链式法则,并管理设备缓冲区的生命周期。对于在数百层中包含多头自注意力、层归一化和残差投影的现代 Transformer 架构,跨越数千个张量依赖关系进行手动微分是不可行的。自动微分引擎将这一推导过程机械化,适用于任意拓扑、精度模式和加速器后端,将难以处理的解析问题转化为自动化的图执行。
梯度计算中的内存管理
section 1.4.1.3 中考察的内存管理策略(检查点、梯度累积)之所以存在,是因为反向模式自动微分(AD)需要保留计算历史。如 listing 11 所示,每个前向层都会增加一个激活张量,该张量必须一直保留,直到反向遍历使用它。这形成了一波内存占用:在反向传播开始时达到峰值,随后随着梯度累积和中间缓冲区释放而回落。现代运行时会跟踪张量的引用计数,在使用相应激活的反向操作执行完毕时立即释放这些激活。
除了张量生命周期之外,框架还面临一个更底层的系统瓶颈:驱动层的分配延迟。调用同步设备内存分配操作(例如 cudaMalloc)会带来显著的操作系统和驱动开销,并强制进行主机与设备同步,使加速器命令队列被排空。为了消除这种延迟,现代框架使用缓存分配器 拦截分配请求,在训练迭代之间维护由预先保留的设备内存块组成的内存池。从这些内存池中进行子分配,可以摊薄设备分配成本并降低内核启动延迟,但张量生命周期的差异仍可能引发内存碎片。
Systems Perspective 1.2: 缓存分配器与利用率
缓存分配器主要用于减少分配开销并提高内存块复用率。仍需考虑两个方面:
- 分配延迟:复用缓存块可以避免反复调用设备内存分配操作,其成本和同步行为取决于分配器与运行时。
- 碎片:按大小分类和拆分内存块有助于提高复用率,但也可能使空闲容量分散在无法满足请求的内存块中。由于张量需要连续的物理地址,当不同的张量生命周期在内存池中留下较小且不连续的空闲块时,就会出现外部碎片;即使所有内存块的空闲内存总量超过请求的大小,一次大块分配仍可能触发内存不足(OOM)错误。
内存不足错误可能源于仍在使用的分配、分配器保留的内存块、碎片或其他进程。nvidia-smi 报告的是设备级使用情况,仅凭它不足以诊断框架分配器;还需要分配器专用的内存统计信息。
生产系统集成挑战
生产环境中的一次训练迭代可能比隔离性能剖析中的运行更慢,因为完整的训练步骤需要与内存分配器、设备管理器、操作调度器、数据流水线和优化器协调。完整系统的成本包含算子微基准测试或隔离内核性能剖析未测量的工作。梯度计算会启动加速器内核,并可能根据计算图和实现方式执行分配、同步或数据移动。这些交互可能主导由小规模操作构成的工作负载的开销,而且在大规模运行时仍可测量到其影响。程序员编写的内容(五行训练循环)与系统执行的内容(分配、内核启动和同步点)之间的差距,是 AD 系统设计的核心矛盾。
这种开销的严重程度取决于一个更深层的架构选择:AD 系统最初如何记录和重放计算。在运行时构建动态轨迹的框架,每次前向传播都要为每个操作付出簿记开销,其缓存分配器也必须适应可能随执行而变化的分配模式。相比之下,捕获稳定计算的框架可能预先规划缓冲区,并在前向图和反向图之间复用存储,因为它可以在执行之前分析生命周期。收益取决于捕获范围、张量生命周期、形状和后端支持。
Systems Perspective 1.3: 基于磁带与基于变换的自动微分
PyTorch(基于磁带):在前向传播期间将操作记录到动态“磁带”上。这种方式灵活且易于调试,但使编译器难以一次性看到整个计算图并进行全局优化。
JAX(基于变换):将自动微分视为一种高层函数变换(grad(f))。JAX 针对抽象输入签名追踪纯函数,使 jit(grad(f)) 或 vmap(grad(f)) 等兼容变换能够在降低为底层表示之前进行组合。这会向加速器编译器暴露更大范围的变换后程序,但并不保证生成单个内核,也不保证在所有情况下都有速度优势。
AD 系统会跟踪依赖关系,以便按有效顺序遍历相互独立的图分支,并正确累积梯度。虽然独立的主机线程或显式 CUDA 流可以提供设备并发机会,但除非显式指定,否则默认的自动微分调度会在主计算流上串行执行节点。并发程度受流依赖关系和硬件调度限制的约束。
不同框架如何实现 AD
section 1.3 中分析的执行模型——即时执行、静态图和混合执行——直接决定了框架如何实现自动微分。PyTorch (Paszke et al. 2019) 在前向执行期间动态构建自动微分磁带。其 grad_fn 链机制已在 section 1.4.2.1 中考察,该机制支持不受约束的 Python 控制流和透明的断点调试,但也迫使引擎保留磁带元数据和已保存的张量,直到反向遍历完成。相反,早期 TensorFlow (Abadi et al. 2016) 在构建计算图时提前执行符号微分,生成不可变的反向子图,使其能够在执行前进行全图死代码消除和内存复用。现代 TensorFlow 2.x 采用即时执行作为默认接口,同时提供 tf.function,在吞吐量有要求时编译静态微分图 (TensorFlow Developers 2024)。JAX22 (Frostig et al. 2018) 完全摒弃磁带跟踪,将微分视为纯函数变换:jax.grad() 接受一个函数并生成导数函数,从而能够与向量化(jax.vmap())和 XLA 编译(jax.jit())无缝进行代数组合。尽管这种函数式范式要求严格的引用透明性,但它可以向编译器暴露清晰的全程序中间表示(IR),而不带有命令式磁带的有状态副作用。
Paszke, Adam, Sam Gross, Francisco Massa, Adam Lerer, James Bradbury, Gregory Chanan, Trevor Killeen, et al. 2019. “PyTorch: An Imperative Style, High-Performance Deep Learning Library.” Advances in Neural Information Processing Systems (NeurIPS) 32: 8024–35.
Abadi, Martı́n, Paul Barham, Jianmin Chen, Zhifeng Chen, Andy Davis, Jeffrey Dean, Matthieu Devin, et al. 2016. “TensorFlow: A System for Large-Scale Machine Learning.” Proceedings of the 12th USENIX Symposium on Operating Systems Design and Implementation (OSDI), 265–83.
Frostig, Roy, Matthew James Johnson, and Chris Leary. 2018. “Compiling Machine Learning Programs via High-Level Tracing.” Systems for Machine Learning.
自动微分实现上的差异决定了团队可以从各个框架中获得多大程度的调试可见性、编译器优化能力和部署可移植性。每一个 AD 设计决策都贯穿着同一种矛盾:数学正确性要求存储计算历史,而硬件施加了严格的内存限制。各个框架以不同方式化解这种矛盾,选择为哪些激活设置检查点、融合哪些操作,以及在多大程度上用重计算换取内存。这些选择决定了哪些模型能够在哪些硬件上训练,使 AD 系统设计成为框架中影响最深远的工程决策之一。
Checkpoint 1.2: 梯度的系统成本
由于自动微分,训练在本质上比推理成本更高。
计算层面的实际情况
优化机制
执行问题和微分问题共同支撑了训练循环:执行模型决定计算何时发生,而自动微分计算驱动学习的梯度。然而,这两个问题都隐含了一个不能想当然的假设:相同代码能够在多种硬件上运行。在 NVIDIA A100 上训练的模型,必须能够在手机的 ARM CPU、Google TPU 或仅有数千字节内存的微控制器上执行推理。同一个 torch.matmul 调用必须能够在一种设备上分派给 cuBLAS,在另一种设备上分派给手工调优的 ARM NEON 内核。这种硬件多样性带来了第三个问题。
抽象问题
这种硬件多样性 是架构层面的基本事实。GPU 提供了丰富的面向吞吐量的并行能力,但其内存和执行语义与 CPU 不同。TPU 更适合规则的张量程序以及编译器可见的形状。微控制器的内存以千字节计,而服务器则以吉字节计。因此,抽象问题 要求框架将这种复杂性隐藏在统一的编程接口之后,同时仍能高效利用每种目标硬件的独特能力。
这一问题可以分解为两个相互作用的维度。第一个是数据表示:框架如何将张量、参数和计算状态编码为能够跨硬件使用的形式。第二个是执行映射:高层操作如何转化为特定硬件的实现。这两个维度并非彼此独立。数据的表示方式(内存布局、精度、设备放置)直接影响哪些执行策略可行。存储在 GPU 上的行主序张量,与存储在 CPU 上的列主序张量,需要不同的内核。量化为 INT8 的模型能够采用与 FP32 完全不同的执行路径。
解决抽象问题需要复杂的软件基础设施:同时编码数学语义和硬件约束的张量表示、支持针对特定硬件编译的中间表示,以及管理数据在内存层次结构中移动的运行时系统。为了使这一过程具体化,可以追踪程序员写下 model(input) 后必须发生的事情。框架必须快速依次完成五项决策:数据表示(张量形状、内存布局、数值精度)、设备放置(连接 CPU、GPU 和加速器内存的带宽层次结构)、输入供给(持续提供数百 MB/s 数据以满足加速器需求的数据流水线)、模型组织(必须共同移动的参数、缓冲区和子模块),以及内核执行(分派、调度和资源优化)。这些决策从数据容器逐步构建到硬件执行层。分布式放置预先展示了同样的抽象边界:框架暴露放置作用域,使系统组件能够管理设备边界,而 模型训练 则分析了使这些作用域高效运行的扩展算法和通信成本。
数据结构与张量抽象
ResNet-50 的一次前向传播会访问 25.6M 个参数,在每一层生成中间激活,并且必须协调 CPU 和 GPU 地址空间中的内存。框架通过依次解决四个问题来组织所有这些数据,使单个 model(input) 调用能够执行数百万次操作,而无需程序员管理任何指针:定义通用数据容器(张量)、将其放置在正确的设备上(内存管理)、以足够快的速度供给数据(数据流水线),以及分派到正确的硬件内核(核心操作)。这一路径从数据表示延伸至硬件执行。
计算图规定了操作的逻辑流程,而数据结构决定了这些操作如何访问和操作物理内存中的数据。这一区别很重要,因为同一个数学操作的吞吐量可能相差一个数量级,具体取决于数据是在缓存中连续存放、为直接内存访问(DMA)传输而锁页,还是分散在不同内存页中。
第一步是数据容器本身。框架数据结构必须维持高内存带宽(现代 GPU 上可达数百 GB/s),适应从一维序列到五维视频张量的各种架构,并将设备管理隐藏在简洁的 API 之后。张量是通用的解决方案。
张量
每个框架的数据表示都建立在同一个抽象之上:张量,即一种 n 维数组,将数值与解释和放置这些数值所需的信息结合起来。
神经网络中的每项计算都作用于张量。23 训练批次、激活图、参数梯度和优化器状态都是张量。这种统一表示使框架能够针对硬件优化单一数据结构,而无需为每种用途管理单独的容器。
Definition 1.2: 张量
张量 是具有形状、数据类型、步幅和设备元数据的 \(n\) 维数组。框架运行时利用这些信息选择兼容的操作和硬件内核。
- 意义:形状为 \([1024, 1024]\) 的连续 FP32 张量占用 \(1024{\times}1024{\times}4 = 4{,}194{,}304\) 字节(约 4.2 MB)。支持跨步访问的内核可以直接接受非连续视图;但当某项操作要求受支持的连续布局时,可能需要将该视图物化。
- 区别:NumPy 数组也携带形状、数据类型和步幅元数据。框架张量还集成了设备放置、自动微分和加速器调度。
- 常见陷阱:张量操作可能返回新分配的存储、共享现有存储的视图,或执行原地更新,具体取决于操作及其 API 变体。内存核算必须区分这些情况。
张量抽象消耗的内存远超仅根据模型权重推测的大小。工程师如果仅根据参数数量估算内存并据此分配资源,就会遇到看似难以解释的内存不足错误。简单的内存核算即可揭示这些隐性成本:每个权重张量都伴随着梯度、优化器动量和保存的激活值。
Napkin Math 1.3: 管理税
section 1.4.2.1 中用于说明的 ResNet-50 内存构成所需内存约为仅存储 FP32 权重所需内存的 82.1–121.2×。以下场景将核算扩展至十亿参数规模下的梯度、优化器状态和保存的激活值。
问题:在这一十亿参数场景中,训练状态在 FP16 权重之外增加了多少内存占用?
计算:
- 模型权重:2 GB。
- 梯度:2 GB(与权重大小相同)。
- 优化器状态(Adam):8 GB(以 FP32 存储的动量和速度占用 FP16 权重内存的 \(4 \times\))。
- 激活值:对于批量大小为 32、层数为 100 的网络,反向模式自动微分会保留导数规则所需的、取决于具体操作的值;激活检查点技术可以省略选定的值,并在反向传播过程中重新计算这些值。 \[ \text{Activations} \approx B \times N_L \times S \times d_{\text{model}} \times n_{\text{saved}} \times 2 \text{ bytes} \] 对于长度为 1024 个词元的序列、宽度为 1024 的隐藏状态,以及每层保存的 1 个张量:\(32 \times 100 \times 1024 \times 1024 \times 1 \times 2 \approx \mathbf{6.7 GB}\)。物化的注意力项可能额外增加一个 \(B \times N_{\text{heads}} \times S^2\) 分量,这正是内存高效的注意力内核至关重要的原因。
系统洞见:权重大小为 2 GB 的模型在处理第一个批次之前,就已携带持久的训练状态(2 GB 的梯度 + 8 GB 的优化器状态)。在一个训练步骤中,依赖批次的激活值又增加了 6.7 GB,使权重之外的峰值“管理税”达到约 16.7 GB。训练期间的数据搬运包括保存和读取这些激活值。
张量结构与维度
张量通过在线性内存布局上添加组织轴来组织数值数据。在 figure 8 中从左到右观察阶数的扩展,了解 0 阶标量如何演变为 3 阶体张量。
\scalebox{0.9}{%
\begin{tikzpicture}[font=\small\sffamily]
\begin{scope}
\pgfmathsetmacro{\cubex}{2.5}
\pgfmathsetmacro{\cubey}{2.5}
\pgfmathsetmacro{\cubez}{2.5}
\draw[BrownLine,fill=BrownL!40] (0,0,0) -- ++(-\cubex,0,0) -- ++(0,-\cubey,0) -- ++(\cubex,0,0) -- cycle;
\draw[BrownLine,fill=BrownL] (0,0,0) -- ++(0,0,-\cubez)coordinate(G) -- ++(0,-\cubey,0) -- ++(0,0,\cubez) -- cycle;
\draw[BrownLine,fill=BrownL!70] (0,0,0) -- ++(-\cubex,0,0) -- ++(0,0,-\cubez) -- ++(\cubex,0,0) -- cycle;
\path[red] (-\cubex,-\cubey,0)coordinate(A) -- (0,-\cubey,0)coordinate(B);
\node[below=0.3of $(A)!0.5!(B)$]{3 阶};
\end{scope}

\begin{scope}[shift={(-5.5,-0.77)}]
\node[draw=BrownLine,fill=BrownL!40,rectangle,%anchor=north west,
minimum width=98,minimum height=98](R){};
\node[right=2pt of $(R.north west)!0.1!(R.south west)$]{1 \ldots ~2};
\node[right=2pt of $(R.north west)!0.24!(R.south west)$]{3 \ldots  ~5};
\node[right=2pt of $(R.north west)!0.39!(R.south west)$]{5 \ldots ~3};
\node[right=2pt of $(R.north west)!0.58!(R.south west)$]{$\vdots$ \phantom{\ldots~} $\vdots$};
\node[right=2pt of $(R.north west)!0.9!(R.south west)$]{3 \ldots ~3};
\node[below=0.3of $(R.south west)!0.5!(R.south east)$]{2 阶};
\end{scope}

\begin{scope}[shift={(-8.75,-0.77)}]
\node[draw=BrownLine,fill=BrownL!40,rectangle,%anchor=north west,
minimum width=18,minimum height=98](R){};
\node[right=2pt of $(R.north west)!0.1!(R.south west)$]{1};
\node[right=2pt of $(R.north west)!0.24!(R.south west)$]{3};
\node[right=2pt of $(R.north west)!0.39!(R.south west)$]{5};
\node[right=2pt of $(R.north west)!0.58!(R.south west)$]{$\vdots$};
\node[right=2pt of $(R.north west)!0.9!(R.south west)$]{3};
\node[below=0.3of $(R.south west)!0.5!(R.south east)$](R1){1 阶};
\end{scope}

\begin{scope}[shift={(-10.5,-0.77)}]
\node[draw=BrownLine,fill=BrownL!40,rectangle,%anchor=north west,
minimum width=18,minimum height=18](3R){0};
\end{scope}
\path[red](R1)-|coordinate(P)(3R);
\node[]at(P){0 阶};
\end{tikzpicture}}在视觉应用中,原始图像输入直接映射到多维张量布局。观察 figure 9 中的 3 阶张量结构,了解红、绿、蓝颜色通道如何沿通道维度堆叠。
\scalebox{0.75}{%
\begin{tikzpicture}[font=\sffamily\Large]
%
\tikzset{
    Line/.style={line width=1.0pt,black!70,font=\sffamily\footnotesize
},
  Box/.style={align=flush center,
    inner xsep=4pt,
    node distance=0,
    draw=white,
    line width=0.75pt,
    fill=red!80,
    minimum width=10mm,
    minimum height=10mm
  },
}
\node[Box](B1){\textbf{6}};
\node[Box,right=of B1](B2){\textbf{2}};
\node[Box,right=of B2](B3){\textbf{5}};
\node[Box,below=of B1](B4){\textbf{32}};
\node[Box,right=of B4](B5){\textbf{15}};
\node[Box,right=of B5](B6){\textbf{4}};
\node[Box,below=of B4](B7){\textbf{1}};
\node[Box,right=of B7](B8){\textbf{8}};
\node[Box,right=of B8](B9){\textbf{3}};
%%
\node[Box,fill= GreenLine!80, draw= white,above=of B2](2B1){\textbf{8}};
\node[Box,fill= GreenLine!80, draw= white,right=of 2B1](2B2){\textbf{7}};
\node[Box,fill= GreenLine!80, draw= white,right=of 2B2](2B3){\textbf{5}};
\node[Box,fill= GreenLine!80, draw= white,below=of 2B3](2B4){\textbf{1}};
\node[Box,fill= GreenLine!80, draw= white,below=of 2B4](2B5){\textbf{2}};
%%
\node[Box,fill= BlueLine!80, draw= white,above=of 2B2](3B1){\textbf{2}};
\node[Box,fill= BlueLine!80, draw= white,right=of 3B1](3B2){\textbf{1}};
\node[Box,fill= BlueLine!80, draw= white,right=of 3B2](3B3){\textbf{9}};
\node[Box,fill= BlueLine!80, draw= white,below=of 3B3](3B4){\textbf{4}};
\node[Box,fill= BlueLine!80, draw= white,below=of 3B4](3B5){\textbf{3}};
%
\draw[dashed,Line,latex-latex]([yshift=-3mm]B7.south west)--
            node[below=1mm]{宽度:3 像素}([yshift=-3mm]B9.south east);
\draw[dashed,Line,latex-latex]([xshift=-4mm]B7.south west)--
            node[left]{高度:3 像素}([xshift=-4mm]B1.north west);
\draw[dashed,Line,latex-latex,shorten <=2mm]([xshift=-4mm]B1.north west)--
            node[left=3mm,pos=0.6]{3 个颜色通道}([xshift=-4mm]3B1.north west);
\end{tikzpicture}}框架张量携带的不只是原始数值。每个张量都存储张量元数据,即用于验证操作和选择快速执行路径的运行时信息:形状元组(例如,图像批次的形状为 [64, 3, 224, 224])、数据类型(框架中的字面量,如 float32、float16 或 int8),以及设备标签(CPU、cuda:0)。例如,矩阵乘法会在调度时检查形状兼容性,并根据数据类型选择正确的硬件内核,可以是标准 FP32 GEMM,也可以是 Tensor Core FP16 路径。
内存布局的实现给张量设计带来了独特的挑战。尽管张量提供了多维数据的抽象,但计算机的物理内存仍然是线性的。步幅模式通过建立多维张量索引与线性内存地址之间的映射来弥合这一差异。这些模式决定了张量操作期间的内存访问模式,因此会显著影响计算性能。Figure 10 以一个 \(2{\times}3\) 张量具体说明了这一点:观察相同的六个值如何映射到两种不同的线性排列——行优先和列优先——并注意步幅值如何相应变化。
\begin{tikzpicture}[font=\footnotesize\sffamily]
% Define colors
\definecolor{col1}{RGB}{135, 206, 250}
\definecolor{col2}{RGB}{255, 182, 193}
\definecolor{col3}{RGB}{152, 251, 152}
% 2x3 tensor visualization (LEFT SIDE)
\foreach \row in {0,1} {
  \foreach \col in {0,1,2} {
    \pgfmathsetmacro{\val}{\row * 3 + \col + 1}
    \node[draw, minimum width=15mm, minimum height=10mm,
          fill=col1!50](B\row\col) at (\col*1.7, 1-\row*1.2) {\val};
  }
}
\node[above=2pt of B01]{\textbf{二维张量 ($2{\times}3$)}};
\path[red](B02.north east)--++(3.5,0)coordinate(CR);
\path[red](B12.340)--++(3.5,0)coordinate(ZE);
% Row-major memory layout (RIGHT SIDE)
\foreach \i in {0,1,2,3,4,5} {
  \pgfmathsetmacro{\val}{\i + 1}
  \node[draw, minimum width=11mm, minimum height=8mm,
        anchor=north west,fill=col2!50](CB\i) at ($(CR)+(\i*1.1, 0)$) {\val};
  \node[below=0pt of CB\i, font=\tiny\sffamily]  {[\i]};
}
\node[above=2pt of CB2.north east]{\textbf{行优先布局}};
% Column-major memory layout (RIGHT SIDE)
\foreach \i in {0,1,2,3,4,5} {
  \pgfmathtruncatemacro{\val}{mod(\i,2)*3 + int(\i/2) + 1}
  \node[draw, minimum width=11mm, minimum height=8mm,
         anchor=north west,fill=col3!50](ZE\i) at ($(ZE)+(\i*1.1, 0)$) {\val};
  \node[below=0pt of ZE\i, font=\tiny\sffamily] {[\i]};
}
\node[above=2pt of ZE2.north east]{\textbf{列优先布局}};
% Strides explanation (BOTTOM)
\node[anchor=north west,align=left,inner sep=0pt,font=\fontsize{9pt}{12}\selectfont\sffamily]
at ($(B10.south west)+(0,-0.3)$) {%
\textbf{步幅计算:}\\
行优先步幅: [3, 1]\\
列优先步幅: [1, 2]\\
元素 [i,j] 的偏移量 = i$\times$ stride[0] + j$\times$ stride[1]
};
\end{tikzpicture}步幅的选择也就是性能的选择。行优先布局(NumPy、PyTorch 使用)逐行存储元素,使按行执行的操作更有利于缓存。列优先布局(某些 BLAS 库使用)逐列存储元素,优化按列访问的模式。步幅值编码了这些布局信息:对于采用行优先布局的 \(2{\times}3\) 张量,移动到下一行需要跳过三个元素(stride[0] = 3),而移动到下一列需要跳过一个元素(stride[1] = 1)。
这些内存布局细节直接影响性能,但没有哪种排列顺序在所有情况下都更优。访问效率取决于操作遍历哪个维度、内核支持的布局、向量化方式,以及目标内存层次结构。不匹配的布局可能需要跨步访问或布局转换,而专门针对该布局设计的内核则可以高效访问它。关键在于,.transpose() 等几何操作是零拷贝的:它们仅交换步幅元数据,就能在现有内存上创建一个非连续的“视图”。当后续操作(例如 .view())要求元素在内存中按顺序排列时,调用 .contiguous() 会强制运行时分配一个新缓冲区,并实际复制元素,使其按顺序排列。
数据类型是在张量层面权衡数值范围与数据搬运的调节手段。机器学习中的标准选择一直是 FP32 精度,框架通过 float32 等数据类型字面量提供这一精度,在精度与效率之间取得平衡。现代框架在此基础上提供了多种数值类型,以满足不同需求。整数类型支持索引和嵌入操作。FP16 等低精度类型支持高效的移动端部署。INT8 精度支持在专用硬件上进行快速推理。数值类型的选择同时影响模型行为和计算效率:神经网络训练通常需要在关键的累加运算中使用 FP32 精度,以保持梯度计算的稳定性;而推理任务通常可以采用更低的精度(框架数据类型字面量如 int8,甚至 int4,分别对应 INT8 和 INT4),从而减少内存占用并提高处理速度。混合精度训练方法结合了这些优势:关键累加运算使用 FP32,而大多数计算采用较低精度。
类型转换是抽象与物理约束相遇的另一个环节。对不同类型的张量执行操作需要明确的转换规则,以保证数值正确性。这些转换会引入计算成本,并带来精度损失的风险。框架提供类型转换能力,但依赖开发者在各项操作之间维持数值精度。
张量将形状、布局和精度编码到单一抽象中,解决了数据表示问题。然而,即使张量形状完全符合要求,如果它位于错误的设备上,或者必须跨越 PCIe 与 HBM 之间的带宽鸿沟才能到达 GPU,也可能抵消所有布局优化的收益。接下来的问题是放置:数据位于何处,以及如何移动。
设备与内存管理
张量及其内存布局决定了框架用于计算的数据形式。这些数据在物理上位于何处,以及如何在不同位置之间移动,决定了计算是全速运行还是缓慢进行。
框架作为操作系统接口
高层 API 关注数学运算,而框架后端则充当单机技术栈的操作系统。它管理单个节点的两类关键资源:计算调度和数据移动。
CUDA Runtime 充当这一操作系统层,提供启动内核和管理设备内存的底层原语。框架与该运行时协同,在 PCIe 总线上实现 DMA。主机(CPU)与设备(GPU)之间的带宽差距是主要的“数据加载瓶颈”:带宽与延迟 对这一传输过程进行建模,将两个约束分离出来,\(T = L_{\text{lat}} + D_{\text{vol}}/\text{BW}\),它们决定了给定的数据加载策略是受限于单次传输延迟,还是受限于持续带宽。框架通过固定内存(页锁定的主机内存)来缓解这一问题,使 DMA 传输无需经过可分页内存的暂存步骤。这一“硬件/操作系统”接口使单机上的高吞吐量训练循环成为可能。
每个张量都位于特定设备上,跨设备操作会产生传输开销,而且这种开销可能主导执行时间。PCIe 4.0 在 CPU 与 GPU 之间提供 32 GB/s 的带宽,而 HBM2e 在 GPU 内部提供 2.04 TB/s 的带宽。这种 63.7× 的带宽差距意味着,一次因张量放置不当而发生的传输就可能抵消 GPU 加速带来的全部收益。
互连带宽跨度约为 64\(\times\):HBM 远高于 NVLink,NVLink 远高于 PCIe。
设备放置对框架设计至关重要,因为框架必须跟踪每个张量的位置,并强制要求操作只能组合位于同一设备上的张量。当数据必须移动时,框架必须决定是阻塞执行,还是将传输与其他工作重叠。这些对大多数用户不可见的决策,可以使训练循环摆脱传输受限的执行状态,显著提高硬件利用率。
有效的设备与内存管理受三项系统原则支配:理解约束数据移动的带宽层次结构;通过计算与通信重叠来隐藏传输延迟;采用细粒度同步,在不牺牲并发性的情况下保持正确性。这些原则以基于铁律中数据移动项的定量分析为支撑。带宽层次结构给出了第一个约束。
设备间数据移动的成本会因互连方式而相差数个数量级。24 Table 7 展示了一个 \(1000{\times}1000\) float32 张量(4 MB)的传输时间,其大小大致相当于中等规模模型中的典型激活张量。这些数值揭示了为何不慎的设备放置会抵消 GPU 加速带来的任何收益。
| 互连 | 带宽 | 传输时间 | 路径 |
|---|---|---|---|
| PCIe 3.0 x16 | 15.8 GB/s | 0.254 ms | 主机到设备 |
| PCIe 4.0 x16 | 32 GB/s | 0.125 ms | 主机到设备 |
| NVLink 3.0 | 每个方向 300 GB/s(双向 600 GB/s) | 0.013 ms | GPU 到 GPU |
| GPU 内存 | 2039 GB/s | 0.002 ms | 设备内部 |
这些数值与性能铁律直接相关。每次跨设备传输都会对 \((D_{\text{vol}}/\text{BW})\) 作出贡献,而其带宽仅为设备内部带宽的一小部分。将 1 GB 除以上述 PCIe 4.0 峰值带宽,得到 31.2 ms;这是一个仅考虑带宽的下界,未计入协议、启动、同步、拓扑和资源争用开销。传输可能主导轻量级或小批量工作负载,因此部署环境中的延迟必须通过测量获得,不能仅凭峰值带宽推断。
严格的设备放置规范可以避免意外的 PCIe 流量破坏带宽层次结构带来的优势。每个张量都带有设备属性,框架强制执行一项严格的不变量:操作只能组合位于同一设备上的张量。混用 cuda:0 和 cuda:1 上的张量会触发 RuntimeError,从而防止静默的跨设备传输。
移动机制是显式的。当张量的数据类型和设备已符合请求时,对其调用 .to() 会返回原张量;否则会返回转换后的副本,除非 copy=True 强制进行复制。相比之下,nn.Module.to() 会就地修改已注册的参数和缓冲区,并返回该模块。
这一带宽差距直接导出了相应的性能实践:从一开始就在目标设备上分配张量,而不是先在主机上创建再传输;跨迭代复用 GPU 内存,而不是重新分配;将输入、标签和模型参数放置在同一设备上,以消除隐式传输。在 32 GB/s 的带宽下,违反其中任何一项原则都会在关键路径中引入 PCIe 传输,其开销可能主导原本以 2.04 TB/s 的设备内部带宽运行的训练迭代。
计算与通信重叠
当传输不可避免时,下一步优化就是让传输与计算并发执行,从而隐藏传输延迟。现代 GPU 包含独立的计算硬件单元(SM 集群)和数据传输硬件单元(复制引擎),能够实现真正的同时执行。框架通过 CUDA 流这一抽象暴露这种硬件并行性:流是一个独立的执行队列,同一流内的操作按顺序执行,不同流之间的操作则可并发执行。
如果没有显式的并发控制,GPU 会在单一默认流上串行执行所有操作,在等待数据传输完成时使执行单元闲置。将数据传输放在一个流上、计算放在另一个流上,可使有效延迟接近理论最小值 \(\max(\text{compute\_time}, \text{transfer\_time})\),而不是两者之和。当计算耗时更长时,基于流的重叠可以有效隐藏 \(D_{\text{vol}}/\text{BW}\) 带来的开销(参见 listing 19)。

复制与计算重叠后的耗时为 max(复制, 计算),而非两者之和。
当后端支持时,non_blocking=True 标志请求相对于主机异步执行复制。对于主机到设备的复制,通常需要固定内存,才能使传输与其他设备工作重叠;可分页内存可能在内部经过暂存,而该调用是否阻塞主机取决于具体实现。正确的重叠还需要兼容的硬件、独立的执行资源和显式的依赖管理。
当模型阶段在不同微批次之间重叠执行时,也会出现相同的同步模式。Listing 20 展示了每个阶段在各自的流上运行,并通过事件仅强制执行保证正确性所需的生产者—消费者依赖关系。
compute_stream = torch.cuda.Stream()
transfer_stream = torch.cuda.Stream()

# Transfer next batch while computing
# current batch
with torch.cuda.stream(transfer_stream):
    next_batch = next_batch_cpu.to("cuda", non_blocking=True)

with torch.cuda.stream(compute_stream):
    output = model(current_batch)
    loss = criterion(output, labels)

# Pinned host memory can enable transfer overlap
x_pinned = torch.randn(1000, 1000).pin_memory()
x_gpu = x_pinned.to("cuda", non_blocking=True)  # Asynchronous

# A pageable source may require staging and
# should not be assumed to overlap
y_regular = torch.randn(1000, 1000)
y_gpu = y_regular.to("cuda", non_blocking=True)# Pipeline parallelism: place stages on separate GPUs
devices = [torch.device(f"cuda:{i}") for i in range(3)]
stages = [
Stage1().to(devices[0]),
Stage2().to(devices[1]),
Stage3().to(devices[2]),
]
streams = [torch.cuda.Stream(device=device) for device in devices]
events = [
[torch.cuda.Event() for _ in range(num_microbatches)]
for _ in stages
]
outputs = [[None] * num_microbatches for _ in stages]
for mb in range(num_microbatches):
for stage_idx, (stage, stream, device) in enumerate(
zip(stages, streams, devices)
):
with torch.cuda.device(device), torch.cuda.stream(stream):
if stage_idx > 0:
# Wait for previous stage to complete
# this microbatch
events[stage_idx - 1][mb].wait()
stage_input = outputs[stage_idx - 1][mb].to(
device, non_blocking=True
)
else:
stage_input = inputs[mb].to(device, non_blocking=True)
outputs[stage_idx][mb] = stage(stage_input)
events[stage_idx][mb].record()这种重叠原则可以自然地扩展到单个节点内的模型阶段重叠。位于不同 GPU 上的模型阶段可以并发处理不同的微批次,使每个阶段的计算与下一阶段的数据接收重叠(参见 listing 20)。后文的 模型训练 将对基于这种调度模式构建的分布式训练策略进行命名和分析;在这里,单节点实现已足以揭示在更大规模下仍然适用的同步原则。一旦计算与通信实现重叠,剩下的挑战就是在操作乱序完成时确保正确性。
同步与正确性
并发执行会引入顺序约束。当一个流的输出成为另一个流的输入时,系统必须强制建立先发生关系,同时避免不必要地串行化独立工作。有两种同步机制,其性能影响截然不同。
全设备同步(torch.cuda.synchronize())会阻塞所有流和 CPU,直到所有已排队的操作完成。这会创建一个全局串行化点,消除重叠带来的全部收益。CUDA 事件提供了另一种方案:细粒度同步仅阻塞存在依赖的流,允许其他流和 CPU 继续执行(参见 listing 21)。
# Create streams and event
stream1 = torch.cuda.Stream()
stream2 = torch.cuda.Stream()
event = torch.cuda.Event()

# Stream 1: producer
with torch.cuda.stream(stream1):
    result1 = expensive_computation(data1)
    event.record()  # Mark completion point

# Stream 2: consumer (waits only for stream1's event)
with torch.cuda.stream(stream2):
    event.wait()  # Block stream2 until event is recorded
    result2 = dependent_computation(result1)  # Safe to use result1
这两种方法的性能差异是本质性的。在每次操作后进行全设备同步,会将并发流水线变为顺序流水线,完全抵消流所暴露的硬件并行性。基于事件的同步在保留并发执行模型的同时,仅强制执行正确性所要求的依赖关系。
这种同步实践存在一个操作层面的陷阱:调试代码常常将 torch.cuda.synchronize() 留在热路径中,使原本重叠执行的流水线变成串行流水线。当重叠效果仍然不佳时,性能剖析必须区分调度停顿与内核低效。NVIDIA Nsight Systems(nsys profile)在同一时间线上展示 CPU 活动、GPU 内核和内存传输。随后,NVIDIA Nsight Compute(ncu)通过硬件计数器解释内核行为。
Table 8 为第二步提供了诊断指南。SM 指流式多处理器,即调度线程组的 GPU 硬件模块;线程束是一个被调度的线程组。
| 指标 | 含义 | 优化目标 |
|---|---|---|
| SM 占用率 | 活跃线程束数/最大线程束数 | 若偏低,则提高并行度 |
| 内存吞吐量 | 实际带宽/峰值带宽 | 优化内存访问模式 |
| 计算吞吐量 | 实际 FLOP/s/峰值 FLOP/s | 减少内存瓶颈 |
| Tensor Core 活跃时间 | 执行 Tensor Core 操作的时间 | 验证混合精度利用情况 |
数据流水线与加载

每个 DataLoader 调节参数都用于缓解特定的输入瓶颈。
流和事件通过使传输与计算重叠来处理放置与移动问题,使 GPU 很少因单个张量而停顿。然而,如果数据一开始就到达得过慢,仅靠调度也无济于事。下一个约束是输入供给:数据必须足够快地到达,才能维持吞吐量。核心系统原则很直接:数据流水线必须持续满足加速器的消耗速率。对于以每秒 1,000 张的速度处理分辨率为 224 × 224 的图像的 GPU,需要约 150.5 MB/s 的持续原始 uint8 图像吞吐量。如果流水线无法维持这一速率,加速器就会闲置,铁律中的有效利用率项便会降至 1 以下。
框架通过三种机制满足这一吞吐量要求。第一种是并行工作进程:DataLoader 启动多个 CPU 进程,每个进程独立加载和预处理样本。当存储访问、解码、数据增强或归一化导致单个加载进程过慢、无法满足加速器需求时,多个工作进程可以使 I/O 等待与预处理重叠。一旦输入流水线已满足需求,增加工作进程带来的便是额外开销,而非吞吐量提升。当 num_workers > 0 时,DataLoader 通过共享队列将样本索引分发给各工作进程,工作进程再将处理完成的样本推入数据队列,由主进程组装成批次。
第二种机制是预取。启用多进程后,prefetch_factor 控制每个工作进程提前准备的批次数。四个工作进程配合 prefetch_factor=2,最多可以维持八个已预取批次,从而增加输入处理与加速器计算重叠的机会。预取无法保证加速器永不停顿;存储、解码、数据增强和资源争用仍可能使生产速度低于消耗速度。其代价是额外占用与排队数据量成正比的主机内存。
第三种机制是用于 DMA 传输的固定内存。pin_memory=True 选项将批次放置在页锁定的主机内存中,从而可以避免可分页内存的暂存步骤,并使主机到设备的复制与设备工作重叠。对于一个包含 64 张 FP32 图像、每张尺寸为 \(224{\times}224{\times}3\) 的批次(38.5 MB),将其大小除以上述 PCIe 4.0 x16 峰值带宽,得到 1.2 ms;这是仅考虑带宽的下界,而不是实测的固定内存传输延迟。相对于可分页内存的实际收益取决于平台、批大小、流水线和重叠情况。固定页面也会减少系统中可分页的内存。
只有将每个参数与具体瓶颈关联起来,DataLoader 配置才有意义。在这一配置中,num_workers 启用并行加载,prefetch_factor 控制流水线深度,pin_memory 启用 DMA 传输。工作进程数量体现了吞吐量与内存之间的权衡,并非通用常数。一个实用的起点是将 num_workers 设置为可用 CPU 核数,然后根据加载过程是受 I/O 限制还是受 CPU 限制进行调整。对于从网络存储读取图像等受 I/O 限制的工作负载,更多工作进程可以通过重叠磁盘访问延迟来提高吞吐量。对于涉及大量数据增强的 CPU 受限工作负载,一旦所有核心均被使用,收益便趋于饱和。过多的工作进程会浪费内存,因为每个进程都维护着 Dataset 对象的一份副本。
一旦吞吐量足够高,工作进程管理就成为正确性约束。PyTorch 为每个工作进程分配不同的 PyTorch 随机种子。当数据集或数据增强代码还使用 NumPy 或 Python 的 random 模块时,worker_init_fn 仍然有用,如 listing 22 所示。共享 Python 状态通常仅限于进程本地,因此一个工作进程中的修改不会自动传播到其他工作进程或主进程;当工作进程必须共享可变状态时,需要使用显式共享存储或内存映射存储。
Dataset 的选择也是一项吞吐量决策,因为它决定了样本的调度方式。PyTorch 支持两种数据集范式。映射式 数据集实现 __len__ 和 __getitem__,支持通过索引随机访问样本——这种模式适用于可装入内存或支持高效磁盘随机访问的数据集。可迭代式 数据集则实现 __iter__,按顺序生成样本,适用于难以进行随机访问的流式数据源。映射式数据集支持基于采样器的随机打乱,而可迭代数据集必须在迭代器或数据源内部实现任何排序或缓冲式随机打乱。
num_workers 在多个 CPU 核心上并行执行 I/O 和预处理,prefetch_factor 控制流水线深度,pin_memory 则支持向 GPU 进行 DMA 传输。
import random

import numpy as np
import torch
from torch.utils.data import DataLoader


def seed_worker(worker_id):
    worker_seed = torch.initial_seed() % 2**32
    np.random.seed(worker_seed)
    random.seed(worker_seed)


loader = DataLoader(
    dataset,
    batch_size=64,
    shuffle=True,
    num_workers=4,  # Parallel worker processes (mechanism 1)
    prefetch_factor=2,  # Batches prepared ahead per worker (mechanism 2)
    pin_memory=True,  # Page-locked memory for DMA (mechanism 3)
    worker_init_fn=seed_worker,  # Reproducible augmentation per worker
)

# Pipeline effect: while GPU processes batch N,
# 4 workers load batches N+1..N+8 into pinned memory,
# ready for DMA transfer when the GPU finishes.
批次组装 是表示方式选择影响吞吐量的最后一个阶段。collate_fn 参数决定如何将单个样本组合成批次。默认的组装方式沿一个新的批次维度堆叠张量,适用于所有样本形状相同的情况。对于文本序列等变长数据,自定义组装函数负责填充、按长度排序或创建注意力掩码——这些操作直接影响内存使用量和训练吞吐量。
DataLoader、Dataset 和组装函数通过并行、预取和 DMA,持续提供与加速器处理速率相匹配的吞吐量,从而解决输入供给问题。然而,这些结构只处理短暂存在的数据:样本在每个训练轮次中流经流水线一次,随后便被丢弃。框架的下一项职责是管理持久状态,尤其是在模型自身的权重超出任一单设备内存容量时管理这些权重。
参数结构
GPT-3 规模的模型存储 175B 个参数,以 FP16 格式存储时占用 350 GB。跨设备管理这些参数、保持梯度同步以及维护优化器状态(正如管理开销笔记本所示,仅 Adam 状态就可能额外占用约为 FP16 权重内存 4\(\times\) 的空间),是框架的核心职责。由于参数在整个训练和推理过程中持续存在,框架会将其组织为紧凑的结构,在尽量减少内存占用的同时支持快速读写。在多 GPU 训练中,框架可以在多个设备上复制参数以进行并行计算,同时保留一份同步的主副本;参数服务器系统是一种通信高效的设计,使工作进程能够读写全局共享参数 (Li et al. 2014)。同步数十亿参数规模的模型可能需要在每一步传输数十 GB 的梯度,因此框架会提供能够高效同步张量的通信后端。后文的 模型训练 将介绍具体的集合操作和扩展策略。
Li, Mu, David G. Andersen, Jun Woo Park, Alexander J. Smola, Amr Ahmed, Vanja Josifovski, James Long, Eugene J. Shekita, and Bor-Yiing Su. 2014. “Communication Efficient Distributed Machine Learning with the Parameter Server.” Advances in Neural Information Processing Systems (NeurIPS) 27: 19–27.
参数结构还必须适应不同的精度要求。训练通常使用 FP32 来保证梯度稳定性,但推理和大规模训练越来越多地采用 FP16 或 INT8。框架通过类型转换和混合精度管理,在不损害数值准确性的前提下实现这些优化。
分布式执行上下文
计算图定义了计算什么,而计算在跨设备环境中何处、如何运行,则由执行上下文 负责。在单个节点上,执行上下文管理 CUDA 流和事件(已在 section 1.5.1.3 中介绍),使多个 GPU 上的计算与数据传输相互重叠。
当训练扩展到单机之外时,这些抽象也随之扩展到具名设备组。框架使用 ProcessGroup(PyTorch)或 Mesh(JAX)等构造来描述哪些张量和操作属于同一组,并依赖 NCCL 等通信库执行集合通信原语——例如,用于梯度聚合的环形 AllReduce 和用于参数收集的 AllGather。运行时管理这些原语,以最大限度地提高互连利用率:节点内的 NVLink 链路可为每个 GPU 提供高达 \(900\text{ GB/s}\) 的双向带宽,而节点间的 InfiniBand 或以太网带宽则降至 \(50\text{--}400\text{ Gbps}\)(\(6.25\text{--}50\text{ GB/s}\)),因此集合通信效率成为分布式训练扩展的主要瓶颈。这里关键的框架理念是抽象边界:用户代码指定放置关系,框架则在底层硬件路径发生变化时仍保持这些关系。
此处引入这些概念,是因为即使本书尚未要求读者分析分布式训练算法,它们也已经影响了框架 API 的设计。后文将基于这些基础,进一步讨论梯度同步、通信拓扑和容错的细节。目前只需理解放置方式的表达能力:当模型超出单设备内存容量时,框架必须为训练系统提供多种工作放置方式。例如,GPT-3 规模的模型无法装入单个 GPU——仅其 175B 个参数以 FP16 格式存储就需要 350 GB,远超任何 GPU 的内存容量。Figure 11 预先展示了框架的放置理念,无需读者此时就掌握完整的分布式训练机制:系统可以跨层组、跨复制批次,或在超大张量内部划分工作。后文的 训练系统扩展 将把这些维度形式化为训练策略,并分析其通信成本。
\resizebox{0.6\textwidth}{!}{
\begin{tikzpicture}[line cap=round,line join=round,font=\small\sffamily]
\tikzset{
pics/square/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=SQUARE,scale=\scalefac,every node/.append style={transform shape}]
% Right Face
\draw[fill=\channelcolor!70,line width=\Linewidth]
(\Depth,0,0)coordinate(\picname-ZDD)--(\Depth,\Width,0)--(\Depth,\Width,\Height)--(\Depth,0,\Height)--cycle;
% Front Face
\draw[fill=\channelcolor!40,line width=\Linewidth]
(0,0,\Height)coordinate(\picname-DL)--(0,\Width,\Height)coordinate(\picname-GL)--
(\Depth,\Width,\Height)coordinate(\picname-GD)--(\Depth,0,\Height)coordinate(\picname-DD)--(0,0,\Height);
% Top Face
\draw[fill=\channelcolor!20,line width=\Linewidth]
(0,\Width,0)coordinate(\picname-ZGL)--(0,\Width,\Height)coordinate(\picname-ZGL)--
(\Depth,\Width,\Height)--(\Depth,\Width,0)coordinate(\picname-ZGD)--cycle;
\end{scope}
    }
  }
}
\pgfkeys{
  /channel/.cd,
  Depth/.store in=\Depth,
  Height/.store in=\Height,
  Width/.store in=\Width,
  channelcolor/.store in=\channelcolor,
  drawchannelcolor/.store in=\drawchannelcolor,
  scalefac/.store in=\scalefac,
  Linewidth/.store in=\Linewidth,
  picname/.store in=\picname,
  Depth=1.6,
  Height=1.1,
  Width=1.4,
  channelcolor=BrownLine,
  drawchannelcolor=BrownLine,
  scalefac=1,
  Linewidth=1.0pt,
  picname=C
}
\def\ras{0.95}
\def\dis{2.2}
\begin{scope}[local bounding box=BELOW,shift={($(0,0)+(0,0)$)},scale=1,every node/.append style={transform shape}]
\begin{scope}[local bounding box=GPU0,shift={($(0,0)+(0,0)$)},scale=1,every node/.append style={transform shape}]
 \foreach \i in {1,...,4} {
 \pic[shift={(0,0)}] at  ({-\i*\ras}, {-\ras*\i}) {square={scalefac=1,picname=4,channelcolor=BlueLine,Linewidth=0.7pt}};
  }
\end{scope}
\begin{scope}[local bounding box=GPU8,shift={($(0,0)+(\dis,0)$)},scale=1,every node/.append style={transform shape}]
 \foreach \i in {1,...,4} {
 \pic[shift={(0,0)}] at  ({-\i*\ras}, {-\ras*\i}) {square={scalefac=1,picname=12,channelcolor=RedLine,Linewidth=0.7pt}};
  }
\end{scope}
\begin{scope}[local bounding box=GPU16,shift={($(0,0)+(2*\dis,0)$)},scale=1,every node/.append style={transform shape}]
 \foreach \i in {1,...,4} {
 \pic[shift={(0,0)}] at  ({-\i*\ras}, {-\ras*\i}) {square={scalefac=1,picname=20,channelcolor=GreenLine,Linewidth=0.7pt}};
  }
\end{scope}
\begin{scope}[local bounding box=GPU16,shift={($(0,0)+(3*\dis,0)$)},scale=1,every node/.append style={transform shape}]
 \foreach \i in {1,...,4} {
 \pic[shift={(0,0)}] at  ({-\i*\ras}, {-\ras*\i}) {square={scalefac=1,picname=28-\i,channelcolor=OrangeLine,Linewidth=0.7pt}};
  }
\end{scope}
\end{scope}
%%%%ABOVE
\begin{scope}[local bounding box=ABOVE,shift={($(0,0)+(0,2.2)$)},scale=1,every node/.append style={transform shape}]
\begin{scope}[local bounding box=GPU0,shift={($(0,0)+(0,0)$)},scale=1,every node/.append style={transform shape}]
 \foreach \i in {1,...,4} {
 \pic[shift={(0,0)}] at  ({-\i*\ras}, {-\ras*\i}) {square={scalefac=1,picname=0,channelcolor=OliveLine,Linewidth=0.7pt}};
  }
\end{scope}
\begin{scope}[local bounding box=GPU8,shift={($(0,0)+(1*\dis,0)$)},scale=1,every node/.append style={transform shape}]
 \foreach \i in {1,...,4} {
 \pic[shift={(0,0)}] at  ({-\i*\ras}, {-\ras*\i}) {square={scalefac=1,picname=8,channelcolor=pink,Linewidth=0.7pt}};
  }
\end{scope}
\begin{scope}[local bounding box=GPU16,shift={($(0,0)+(2*\dis,0)$)},scale=1,every node/.append style={transform shape}]
 \foreach \i in {1,...,4} {
 \pic[shift={(0,0)}] at  ({-\i*\ras}, {-\ras*\i}) {square={scalefac=1,picname=16,channelcolor=green!70!,Linewidth=0.7pt}};
  }
\end{scope}
\begin{scope}[local bounding box=GPU16,shift={($(0,0)+(3*\dis,0)$)},scale=1,every node/.append style={transform shape}]
 \foreach \i in {1,...,4} {
 \pic[shift={(0,0)}] at  ({-\i*\ras}, {-\ras*\i}) {square={scalefac=1,picname=24,channelcolor=red,Linewidth=0.7pt}};
  }
\end{scope}
\end{scope}
\node[]at($(28-4-GL)!0.5!(28-4-DD)$){GPU 28};
%
\foreach \i in {0,8,16,24,4,12,20} {
\node[]at($(\i-GL)!0.5!(\i-DD)$){GPU \i};
}
\draw[thick,decoration={brace,amplitude=5pt,mirror},decorate]([yshift=-2mm]4-DL)--
([yshift=-2mm]28-4-DD) node [midway,below=2mm] {跨层组};
\draw[thick,decoration={brace,amplitude=5pt},decorate]([xshift=-2mm]4-DL)--
([xshift=-2mm]0-GL) node [midway,above=5mm, sloped,pos=0.9,anchor=east] {跨副本};
\draw[thick,decoration={brace,amplitude=5pt,mirror},decorate]([xshift=2mm]28-4-DD)--
([xshift=2mm]28-1-ZDD)node[midway, below=4mm, anchor=west, sloped,pos=0.25] {张量内部};
\end{tikzpicture}}迄今考察的数据结构——张量、设备管理器、数据流水线、参数结构和分布式执行上下文——定义了框架管理什么数据,以及数据位于何处。剩下的抽象问题是执行:究竟有哪些操作在硬件上运行。
核心操作
当工程师编写 y = torch.matmul(x, w) 时,Python 语法与芯片上的实际执行之间存在相当大的距离。要将一次高层调用衔接到数千个并行 GPU 线程,需要三个层次的操作 协同工作。Figure 12 展示了这一操作栈:硬件抽象操作管理平台特定的内核分派和内存传输,基本数值操作执行数学例程,系统级操作则在整个计算图中协调调度、内存生命周期和加速器资源。以下讨论将从硬件特定的内核执行路径出发,逐层深入到系统编排。
\begin{tikzpicture}[font=\sffamily\small]
%
\tikzset{Line/.style={line width=1.0pt,black!50
},
  Box/.style={align=flush center,
    inner xsep=2pt,
    node distance=0.15,
    draw=BlueLine,
    line width=0.75pt,
    fill=BlueL,
    text width=38mm,
    minimum width=30mm,
    minimum height=8.0mm
  },
  Box2/.style={Box,
    draw=OrangeLine,
    fill=OrangeL,
    text width=46mm,
    minimum width=30mm,
  },
}
\begin{scope}[local bounding box=box1]
\node[Box,](B1){调度};
\node[Box,below=of B1](B2){内存管理};
\node[Box,below=of B2](B3){资源优化};
%
\scoped[on background layer]
\node[draw=BackLine,inner xsep=4mm,inner ysep=5mm,yshift=3mm,
           fill=BackColor,fit=(B1)(B2)(B3),line width=0.75pt](BB1){};
\node[below=2pt of  BB1.north,anchor=north]{系统级操作};
\end{scope}

\begin{scope}[local bounding box=box2,shift={(5.3,0)}]
\node[Box,fill=BrownL,draw=BrownLine,](B1){GEMM 操作};
\node[Box,fill=BrownL,draw=BrownLine,below=of B1](B2){BLAS 操作};
\node[Box,fill=BrownL,draw=BrownLine,below=of B2](B3){逐元素操作};
%
\scoped[on background layer]
\node[draw=BackLine,inner xsep=4mm,inner ysep=5mm,yshift=3mm,
           fill=BackColor,fit=(B1)(B2)(B3),line width=0.75pt](BB2){};
\node[below=2pt of  BB2.north,anchor=north]{基本数值操作};
\end{scope}

\begin{scope}[local bounding box=box3,shift={(11,0)}]
\node[Box2,fill=OrangeL,draw=OrangeLine,](B1){计算内核管理};
\node[Box2,fill=OrangeL,draw=OrangeLine,below=of B1](B2){内存抽象};
\node[Box2,fill=OrangeL,draw=OrangeLine,below=of B2](B3){执行控制};
%
\scoped[on background layer]
\node[draw=BackLine,inner xsep=4mm,inner ysep=5mm,yshift=3mm,
           fill=BackColor,fit=(B1)(B2)(B3),line width=0.75pt](BB3){};
\node[below=2pt of  BB3.north,anchor=north]{硬件操作};
\end{scope}

\foreach \x/\y in{1/2,2/3}
\draw[-latex,Line](box\x)--(box\y);
\end{tikzpicture}硬件抽象操作
硬件抽象层将框架代码与平台特定细节隔离开来。它解决三个具体问题:选择合适的计算内核、在内存层次结构中移动数据,以及协调各处理单元的执行。
计算内核管理
内核管理器将每个受支持的操作分派 给当前后端的相应实现。对于矩阵乘法,这可能是 Intel oneMKL 或 OpenBLAS 等 CPU BLAS 后端 (Intel Corporation 2026; OpenBLAS Project 2026)、NVIDIA GPU 上的 cuBLAS (NVIDIA 2024a),或加速器专用的张量指令。选择取决于维度、数据类型、布局、后端和库的启发式规则。在 A100 上执行 \(4096{\times}4096\) 的 FP16 GEMM 时,可能采用 Tensor Core 路径,其公开峰值在此表示为 312 TFLOP/s (Choquette et al. 2021; NVIDIA Corporation 2020)。如果后端没有某个算子的实现,执行可能回退、被分区执行或失败,具体取决于框架和运行时。
NVIDIA Corporation. 2020. NVIDIA A100 Tensor Core GPU Architecture. NVIDIA Whitepaper, V1.0.
内存系统抽象
内存抽象层在可分页或页锁定的主机内存、设备内存和统一内存之间移动张量,并转换数据布局以适应硬件偏好。例如,卷积层在 NVIDIA GPU 上可能以 NCHW 格式(批次、通道、高度、宽度)存储激活值,但在 Apple 的 Metal 后端上则转换为 NHWC。对齐要求从 CPU 上的 4 字节到某些加速器上的 128 字节不等,而未对齐访问可能使有效内存带宽减半。当多个执行单元访问同一张量时,运行时还会保持依赖顺序,防止并发操作中的竞态。
执行控制
执行控制器协调多个处理单元和内存空间中的工作。在现代 GPU 上,当依赖分析确认独立内核已就绪,且这些内核留有足够的未使用资源以支持并发运行时,图运行时或显式使用流可以使其执行相互重叠。而即时执行模式下的默认流执行通常会将这些工作串行化。控制器在数据依赖要求的位置插入同步屏障,跟踪事件完成情况以触发依赖操作,并将硬件错误(ECC 故障、看门狗超时)传递到框架的错误处理路径。
基本数值操作
硬件抽象负责管理平台特定的细节,框架则在其上构建数学运算层。GEMM 在机器学习计算中占据主导地位。通用矩阵乘法(GEMM) 推导了 GEMM 算术强度 如何随矩阵维度变化,从而能够在运行任何性能分析器之前,预测给定层是受计算限制还是受内存限制。运算 \(\mathbf{C} = \alpha \mathbf{A}\mathbf{W} + \beta \mathbf{C}\) 占据了神经网络中绝大多数的算术运算:ResNet-50 的一次前向传播执行约 8.2 GFLOP 的运算,其中几乎全部都可归结为 GEMM。框架通过面向缓存的分块(将矩阵拆分为可容纳于 L1/L2 缓存的块)、用于指令级并行的循环展开以及针对特定形状的内核来优化 GEMM。全连接层使用标准的稠密 GEMM,而卷积层使用 im2col 变换,将输入图像块重排为矩阵的列,从而将卷积转换为 GEMM。
除 GEMM 外,框架还实现 BLAS 运算(用于向量加法的 AXPY、用于矩阵与向量乘积的 GEMV)和逐元素运算(激活函数、归一化)。受内存带宽影响,逐元素运算单独执行时开销较低,但累积开销较高。每个运算都会读写整个张量,因此,在一个 100 MB 的张量上依次执行五个逐元素运算,会搬移 1 GB 的数据。将这五个运算融合为单个内核,可将内存流量降至 200 MB,使带宽需求降低至原来的五分之一,即节省 5\(\times\),并直接转化为更快的执行速度。
数值精度增加了另一个维度。使用 FP32 训练时,每个参数占用 4 字节;量化为 INT8 后,每个参数仅占用 1 字节,使内存占用降低至原来的四分之一,即缩减 4\(\times\),并可在支持 INT8 加速的硬件上实现 2–4\(\times\) 的吞吐量提升。训练通常以较高精度执行对数值误差敏感的累加运算,而推理通常可以采用 FP16 或 INT8 执行许多运算,且质量损失很小。框架为每种精度格式维护独立的内核实现,并处理在单次前向传播中不同层采用不同位宽的工作流。
系统级操作
硬件抽象和数值运算提供基本构件;系统级操作负责协调这些构件。系统层将调度、内存管理和资源优化整合为一个协调一致的执行引擎。
运算调度器利用图中的依赖关系识别合法的执行顺序和可能的并发。静态捕获可以在执行前暴露更多依赖结构,而即时执行运行时则逐步发现待执行的工作。但无论哪种可见性,都不能保证最优调度或同时执行:能否重叠执行取决于流、编译器和运行时的决策、资源可用性以及运算本身。
内存管理器在计算图的整个生命周期内分配和回收 GPU 内存。模型参数(一个含 70 亿参数的模型采用 FP16 时约占用 14 GB)会在整个训练过程中持续存在,而激活张量仅存活到反向传播使用完它们为止。PyTorch 的缓存分配器维护一个内存池,对已释放的块进行细分和复用,而不将其归还给 CUDA,从而避免重复调用 cudaMalloc;此类调用可能耗费数十微秒,若引发设备同步,开销还可能更高。对于超出 GPU 内存容量的模型,管理器可以采用检查点技术,在前向传播期间丢弃选定的激活值,并在反向传播期间重新计算。保留哪些激活值、容许多少重计算,属于训练流水线的策略问题;框架抽象则使该策略能够被执行。
Checkpoint 1.3: 硬件抽象
抽象问题连接着可移植代码与高效执行。
资源优化器将调度和内存决策与后端内核选择结合起来。矩阵乘法库根据形状、数据类型、布局、工作空间和硬件,在多种分块 GEMM 实现中进行选择。Winograd 则是一种卷积专用变换,而 Strassen 并不是主流机器学习 GEMM 分派机制常规选择的替代方案。不佳的调度可能导致资源闲置,而内存池碎片或过多的存活状态可能导致内存不足错误,即使设备总容量看起来足够。
张量、流和内核分派以单个缓冲区和运算为粒度发挥作用。尽管这些原语能够确保硬件上的高执行效率,但要扩大模型开发的规模,还需要一种组织层面的抽象:将数千个底层运算组合为可复用、可嵌套的构件,称为模块。
nn.Module 抽象
面向硬件的机制——张量、内核、流和内存管理器——确保各个运算在芯片上高效执行。然而,像 ResNet-50 这样在五十层中包含 25.6M 个参数的网络,需要大量协调工作:向优化器注册权重、跟踪设备放置位置、切换训练和评估模式,以及序列化检查点。手动管理这些工作会使模型开发陷入容易出错的张量衔接细节之中。框架的组织层通过层次化组合 解决了这一问题。
所有主流框架都通过模块抽象来实现这一点,将参数张量、前向计算和生命周期钩子绑定到统一的接口中。PyTorch 的 nn.Module25 是一个具有启发性的案例,因为其设计模式在各框架中反复出现:Keras 使用类似的层抽象 (Chollet 2018),JAX 的 Flax 采用类似的模块结构,而 TensorFlow 的函数式 API 在概念上也有相通之处。无论语法或编程范式如何,以下三个经久适用的设计原则都会反复出现。
Chollet, François. 2018. Deep Learning with Python. Manning Publications.
自动参数发现
现代神经网络可能包含分布在数十层中的数百万个可训练参数。如果没有自动化,程序员就需要枚举每个参数张量,并手动将其传递给优化器;这一过程容易出错,而且难以随模型复杂度的增加而扩展。框架通过自动参数发现 解决这一问题:系统遍历模块树,收集每个参数张量,使优化器能够通过一次调用更新它们。
这本质上是一个树遍历问题。PyTorch 的 Module.__setattr__ 会将通过赋值添加的 nn.Parameter 或子 nn.Module 注册到模块的内部映射中。调用 .parameters() 会递归遍历已注册的子模块,并依次产出已注册的参数。其他框架也提供类似的参数树或参数集合,但其机制有所不同。
这对系统具有重要影响。自动参数发现为优化器提供完整的参数集合或参数组,使其能够在框架和后端支持时采用分组、foreach 或融合更新路径。最直接的收益是正确性和可组合性:新附加的子模块无需单独的手动注册表,即可参与设备迁移、序列化和优化器构建。它还允许优化后的更新路径直接操作参数集合,无需用户为每个参数编写代码。Listing 23 展示了这一核心机制:属性赋值触发注册,.parameters() 返回所有发现的张量。
参数与缓冲区的区别体现了参数发现机制中的一个细节。已注册的参数无论可训练还是被冻结,都会出现在 .parameters() 中;requires_grad 则单独控制自动微分是否为其累积梯度。已注册的缓冲区 会随模块一起迁移,也可以出现在模块的状态字典中,但不会包含在 .parameters() 中,也不会被常规优化器发现机制发现。批归一化的运行统计量是缓冲区的一种常见用途。
import torch
import torch.nn as nn


class CustomLayer(nn.Module):
    def __init__(self, input_size, output_size):
        super().__init__()
        self.weight = nn.Parameter(
            torch.randn(output_size, input_size)
        )
        self.bias = nn.Parameter(torch.randn(output_size))
        self.register_buffer("running_mean", torch.zeros(output_size))

    def forward(self, x):
        return torch.matmul(x, self.weight.t()) + self.bias


layer = CustomLayer(10, 20)
# Framework discovers both parameters automatically:
for name, param in layer.named_parameters():
    print(f"{name}: shape {param.shape}")
Table 9 展示了同一原则在不同框架中的不同表现形式。尽管语法不同,所有框架都在解决同一个问题:让优化器能够发现并更新可训练参数,同时在多次前向传播之间保留不可训练状态。
| 框架 | 参数访问 | 不可训练状态 |
|---|---|---|
| PyTorch | model.parameters() |
register_buffer() |
| Keras | layer.trainable_weights |
layer.non_trainable_weights |
| JAX/Flax | 执行 variables = model.init(key, x) 后访问 variables["params"] |
独立的变量集合(例如 batch_stats) |
| TensorFlow | module.trainable_variables |
module.non_trainable_variables |
依赖模式的行为
训练和推理要求同一个模型图具有不同的计算行为。训练期间,dropout 层 以概率 \(p_{\text{drop}} = \Pr(\text{drop})\) 随机将元素置零,以对网络进行正则化;而在推理期间,这些层必须执行恒等映射,以产生确定性的输出。批归一化 在训练期间使用每个批次的统计量,而在推理期间则切换为累积的运行统计量。如果将这些行为变化交由程序员管理,遗漏任何一次模式切换都会在生产环境中产生无明显报错的错误预测。
框架通过一个沿模块层次结构传播的状态标志解决这一问题。只需在根模块上调用一次 .eval(),就会递归地在每个后代模块上设置 self.training = False,各层再查询这一标志以选择相应行为。这体现了一个更广泛的系统原则:同一个计算图必须根据上下文产生不同的执行行为。当同一份源代码需要生成调试构建版本(包含边界检查和符号表)或发布构建版本(采用激进优化)时,编译器也面临相同的挑战。标志传播模式将模式决策集中在根节点,从而确保正确性,无需逐层协调。
这一原则也扩展到迁移学习中的参数冻结。设置 requires_grad=False 会阻止自动微分为这些参数累积梯度,并消除其梯度存储需求。但这并不一定会消除该层的反向计算,因为梯度可能仍需经过该层的运算,才能传递到可训练的输入或更早的参数。因此,节省的开销取决于冻结区域的位置,以及哪些张量需要梯度。
层次化组合与序列化
复杂模型由可复用的子模块 组合而成,形成树状结构。ResNet 并非实现为一个单体运算块,而是实现为一个层次结构:根模块包含一系列残差块,每个残差块包含卷积层和归一化层,每一层又包含参数张量。这种层次化组合必须支持两项关键操作,listing 24 给出了具体实现:用于训练的递归参数收集,以及用于检查点保存和部署的状态序列化。
import torch
import torch.nn as nn


class ResidualBlock(nn.Module):
    def __init__(self, channels):
        super().__init__()
        self.conv1 = nn.Conv2d(channels, channels, 3, padding=1)
        self.bn1 = nn.BatchNorm2d(channels)
        self.conv2 = nn.Conv2d(channels, channels, 3, padding=1)
        self.bn2 = nn.BatchNorm2d(channels)

    def forward(self, x):
        residual = x
        x = torch.relu(self.bn1(self.conv1(x)))
        x = self.bn2(self.conv2(x))
        return torch.relu(x + residual)


class ResNet(nn.Module):
    def __init__(self, num_blocks, channels=64):
        super().__init__()
        self.conv_in = nn.Conv2d(3, channels, 7, padding=3)
        self.blocks = nn.ModuleList(
            [ResidualBlock(channels) for _ in range(num_blocks)]
        )
        self.fc = nn.Linear(channels, 10)

    def forward(self, x):
        x = self.conv_in(x)
        for block in self.blocks:
            x = block(x)
        x = x.mean(dim=[2, 3])  # Global average pooling
        return self.fc(x)


model = ResNet(num_blocks=4)
total = sum(p.numel() for p in model.parameters())
print(f"Total parameters: {total}")
# state_dict() flattens the tree: 'blocks.0.conv1.weight', etc.
print(list(model.state_dict().keys())[:4])
层次化组合以一种与系统密切相关的方式呼应了硬件存储层次结构:每个子模块的参数都可以独立加载,从而支持跨设备放置。当模型过大、无法容纳于单个 GPU 时,框架可以将模块层次结构的不同子树分配到不同设备上,树结构为此提供了自然的划分边界。
state_dict() 方法生成一个有序映射,其中以点分隔的键(例如 blocks.0.conv1.weight)编码了模块层次结构中的位置。对于 70 亿个 FP16 参数,在不计元数据或额外状态时,检查点包含约 14 GB 的权重载荷,但这些字节如何序列化取决于文件格式和存储路径。load_state_dict() 将匹配的参数值和缓冲区值复制到已构建的模块中,并根据严格性设置报告缺失或意外的键;它不会重建模块层次结构。跨框架交换除了需要权重,还需要兼容的图和算子表示。
层次结构还支持模块级遍历,以执行系统化操作。诸如 .named_modules() 的方法会遍历整棵树,支持将所有 BatchNorm 层替换为 GroupNorm,或对每个 Linear 层应用 Xavier 初始化等批量变换。这些遍历操作依赖于实现参数发现的同一树结构,说明单一设计决策如何使多个用例受益。
这三个原则——自动参数发现、依赖模式的行为,以及支持序列化的层次化组合——并非 PyTorch 独有。每个框架都必须解决这些问题。Keras 层、JAX 的 Flax 模块,乃至函数式方法,都在处理相同的参数管理、状态跟踪和组合式设计问题。它们的差异不在于解决什么问题,而在于如何在相互竞争的解决方案之间确定优先级。两种实用模式展示了这些原则如何转化为系统控制手段:选择性参数冻结减少迁移学习中不必要的梯度计算(listing 25),而模块钩子则提供非侵入式检查能力(listing 26)。
from torchvision.models import ResNet18_Weights, resnet18

# Freeze all parameters in a pretrained
# model
pretrained_model = resnet18(weights=ResNet18_Weights.DEFAULT)

for param in pretrained_model.parameters():
    param.requires_grad = False

# Replace final layer with trainable parameters
pretrained_model.fc = nn.Linear(512, 10)  # New layer is trainable

# Only fc.parameters() will receive
# gradients during training
optimizer = torch.optim.Adam(
    filter(lambda p: p.requires_grad, pretrained_model.parameters()),
    lr=0.001,
)模块钩子是与参数冻结相对应的检查机制:它们在不修改模型代码的情况下拦截中间计算,从而支持梯度流诊断和激活监测。Listing 26 展示了这两类钩子。
这些模式——参数发现、冻结和钩子——共同展示了如何将三项原则落实为实用的 API。这些 nn.Module 模式体现了 PyTorch 解决抽象问题的方式。然而,PyTorch 只是几个主要框架之一,其选择(可变状态、类继承、默认即时执行)并非唯一合理的设计方案。TensorFlow 以不同的方式集中管理状态,而 JAX 则完全避免可变状态。这些并非表面的 API 差异,而是反映了对本章开篇三个问题的截然不同的回答。
import torch
import torch.nn as nn

model = nn.Sequential(nn.Linear(10, 20), nn.ReLU(), nn.Linear(20, 5))


# Forward hook to inspect activations
def forward_hook(module, input, output):
    print(
        f"Layer: {module.__class__.__name__}, "
        f"Output shape: {output.shape}, "
        f"mean={output.mean():.3f}, "
        f"std={output.std():.3f}"
    )


# Backward hook to inspect gradients
def backward_hook(module, grad_input, grad_output):
    print(f"Gradient norm: {grad_output[0].norm():.3f}")


# Register hooks on specific layer
handle_fwd = model[0].register_forward_hook(forward_hook)
handle_bwd = model[0].register_full_backward_hook(backward_hook)

# Execute forward and backward pass
x = torch.randn(32, 10)
y = model(x)
loss = y.sum()
loss.backward()

# Remove hooks when done
handle_fwd.remove()
handle_bwd.remove()
框架平台分析
一个团队若能快速构建原型,却无法部署所得到的模型;或者能够可靠部署,却无法调试训练故障,那么它遇到的是框架设计上的权衡,而非缺少某个 API 调用。每个主要框架都解决了三个核心问题,但各自侧重于不同的解决路径。TensorFlow 将即时开发与图捕获及广泛的部署生态相结合;PyTorch 从即时执行出发,逐步加入捕获、编译和导出路径;JAX 则将微分、向量化和编译组织为可组合的函数变换。这些是架构上的侧重点,而非各自独有的能力,其价值取决于工作负载和部署目标。

每个框架都针对不同的系统瓶颈进行优化。
TensorFlow:即时开发与计算图部署
TensorFlow 的架构涵盖即时开发和基于图的优化,支持从云端 TPU 到微控制器的各类硬件。TensorFlow 2 默认采用即时执行。性能敏感的函数可以通过 tf.function 捕获,部署格式则将捕获的计算传递给服务器、移动端和浏览器运行时。这种双路径方式保留了从 TensorFlow 1.x 继承的生产环境计算图能力,同时无需每个 TensorFlow 2 程序在运行前都构建完整的图。
在捕获的 tf.function 内,TensorFlow 可以应用常量折叠、算子融合和布局规划等图优化。Figure 13 展示了更完整的训练到部署流水线,涵盖从数据预处理和分布式训练,到 SavedModel 导出、TensorFlow Serving、TensorFlow Lite、TensorFlow.js 以及语言绑定的全过程。
\begin{tikzpicture}[font=\sffamily\small]
%
\tikzset{Line/.style={line width=1.0pt,black!50
},
  Box/.style={align=flush center,
    inner xsep=4pt,
    node distance=0.6,
    draw=BlueLine,
    line width=0.75pt,
    fill=BlueL,,
    minimum height=10mm
  },
}

\node[Box,text width=70mm,fill= BrownL,
            draw= BrownLine](B1){\textbf{读取 \& 预处理数据}\\ tf.data, 特征列};
\node[Box,fill= BrownL,draw= BrownLine,below=of B1.south west,minimum width=20mm,
             anchor=north west](B2){\textbf{tf.keras}};
\node[Box,fill= BrownL,draw= BrownLine,below=of B1.south east,,minimum width=20mm,
             anchor=north east](B3){\textbf{预制}\\\textbf{Estimator}};
\node[Box,fill= BrownL,draw= BrownLine,
              minimum width=20mm](B4)at($(B2.east)!0.5!(B3.west)$){\textbf{TensorFlow}\\\textbf{Hub}};
%
\node[Box,text width=70mm,fill= BrownL,below=of B4,
            draw= BrownLine](B5){\textbf{分布式策略}};
\node[Box,fill= BrownL,draw= BrownLine,below=of B5.south west,minimum width=18mm,
             anchor=north west](B6){\textbf{CPU}};
\node[Box,fill= BrownL,draw= BrownLine,below=of B5.south east,minimum width=18mm,
             anchor=north east](B7){\textbf{TPU}};
\node[Box,fill= BrownL,draw= BrownLine,minimum width=18mm](B8)at($(B6.east)!0.5!(B7.west)$){\textbf{GPU}};
%
\node[Box,fill= BlueL,draw= BlueLine,right=1.0 of $(B1.east)!0.5!(B7.east)$](B9){\textbf{SavedModel}};
%
\def\di{4.35}
\node[Box,text width=50mm,fill= RedL,right=\di of B1,
            draw= RedLine](L1){\textbf{TensorFlow Serving}\\ 云端、本地部署};
\node[Box,text width=50mm,fill= RedL,right=\di of B3,
            draw= RedLine](L2){\textbf{TensorFlow Lite}\\ Android, iOS, Raspberry Pi};
\node[Box,text width=50mm,fill= RedL,right=\di of B5,
            draw= RedLine](L3){\textbf{TensorFlow.js}\\ 浏览器和 Node 服务器};
\node[Box,text width=50mm,fill= RedL,right=\di of B7,
            draw= RedLine](L4){\textbf{其他语言绑定}\\ C, Java, Go, C\#, Rust, R,\ldots};
%
\node[above=2mm of B1]{\textbf{训练}};
\node[above=2mm of L1]{\textbf{部署}};
%
\draw[latex-,Line](B2)--(B1.south-|B2);
\draw[latex-,Line](B3)--(B1.south-|B3);
\draw[-latex,Line](B4)--(B2);
\draw[-latex,Line](B4)--(B3);
\draw[-latex,Line](B2)--(B5.north-|B2);
\draw[-latex,Line](B3)--(B5.north-|B3);
\draw[latex-,Line](B6)--(B5.south-|B6);
\draw[latex-,Line](B7)--(B5.south-|B7);
\draw[latex-,Line](B8)--(B5.south-|B8);
\draw[Line](B6)--++(270:0.8)-|(B7);
\draw[-latex,Line](B8)-++(270:1.1)-|(B9);
\foreach \x in {1,2,3,4}
\draw[-latex,Line](B9.east)--(L\x.west);
\end{tikzpicture}尽管 TensorFlow 2.0 引入即时执行以弥合研究与生产之间的鸿沟,TensorFlow 2.x 仍提供 tf.function,作为性能敏感代码的图转换路径 (TensorFlow Developers 2024)。其核心优势仍然是从研究通向全球规模部署的稳健编译路径。后文的 模型训练 和 模型服务 将探讨使用这些导出路径的扩展机制和生产基础设施。
TensorFlow Developers. 2024. Better Performance with tf.function.
PyTorch:采用即时执行的研究标准框架
TensorFlow 的图优先方式侧重于生产优化,而 PyTorch 则做出了相反的权衡:它优先考虑开发者体验。PyTorch 的架构基于动态图(或称“运行时定义”),对执行问题给出了截然不同的回答。PyTorch 不会在执行前构建蓝图,而是在代码运行时即时构建计算图。Facebook AI Research(FAIR)采用这种设计,是因为研究人员在试验新架构时需要即时反馈;静态图先定义后运行的周期引入了编译延迟,拖慢了研究工作流所必需的快速原型开发。
PyTorch 的方式适合探索性研究,原因也在于此:它将深度学习视为标准的 Python 编程。开发者可以直接在模型的前向传播中使用 Python 循环、条件语句和调试器(如 pdb),无需特殊语法,无需单独的编译步骤,也无需等待即可检验代码是否能正常工作。即时执行支持快速迭代和直观的模型设计,这在架构和训练目标仍不断变化时至关重要。
PyTorch 对微分问题的回答是基于操作记录带的自动微分(section 1.4.2.1):灵活且便于调试,但由于每次迭代都要重建记录带,因此更难进行全局优化。它对抽象问题的回答更偏向务实,而非全面覆盖:通过 cuBLAS 和 cuDNN 提供强大的 GPU 支持,同时提供包括 torch.export、面向边缘设备的 ExecuTorch、开放神经网络交换格式(ONNX)以及专用运行时在内的部署路径。
因此,其代价是部署路径更加分散。由于图是动态的,框架难以在执行前进行全局优化。一个在开发环境中运行完全正常的模型,在生产环境中可能因调度开销主导小规模操作而遭遇性能瓶颈。为弥合研究与生产之间的这一鸿沟,PyTorch 引入了图捕获和编译路径,从早期的 TorchScript 到 torch.compile 和导出工作流,使开发者能够捕获动态模型,并将其转换为适合部署的优化表示。这一演进展示了即时执行框架如何在保留最初促成其设计的交互体验的同时,沿编译连续谱向生产端移动。
JAX:函数式变换引擎
PyTorch 的即时执行和 TensorFlow 的图编译代表了同一谱系上的两个位置,但两者都继承了命令式编程传统,即计算以一系列有状态操作的形式进行。JAX 采用了截然不同的用户编程方式,其基础是函数式编程原则和可组合的程序变换,而非对象级操作记录带或用户编写的图 API (Bradbury et al. 2018)。JAX 由 Google Research 开发,尤其适用于需要自定义微分、高级优化研究和大规模分布式训练的工作。
Bradbury, James, Roy Frostig, Peter Hawkins, Matthew James Johnson, Chris Leary, Dougal Maclaurin, George Necula, et al. 2018. JAX: Composable Transformations of Python+NumPy Programs.
JAX 的架构将微分、向量化和编译视为对函数的变换。jax.grad 函数返回一个计算梯度的函数,当接口兼容时,还可以进一步对其进行变换。例如,vmap(grad(f)) 可以计算逐样本梯度,而 jit(vmap(grad(f))) 可以编译这一批量计算。变换顺序具有语义意义,不能任意排列。
JAX 的函数式范式将编程模型从“通过对象跟踪状态”转变为“变换纯函数”。PyTorch 和 TensorFlow 主要通过动态操作记录带或图编译路径提供自动微分,而 JAX 要求用户编写纯 Python 函数,再对这些函数应用变换。自动微分、向量化和 JIT 编译都是可以组合的程序变换。Listing 27 展示了这种方式。
import jax
import jax.numpy as jnp


def loss_fn(params, x, y):
    pred = jnp.dot(x, params["w"]) + params["b"]
    return jnp.mean((pred - y) ** 2)


# Transform: compute gradients
grad_fn = jax.grad(loss_fn)

# Transform: vectorize over batch dimension
batched_grad = jax.vmap(grad_fn, in_axes=(None, 0, 0))

# Transform: compile to XLA
fast_batched_grad = jax.jit(batched_grad)

# Compose all three: fast, batched gradient computation这种函数式方式要求使用纯函数(无副作用)和不可变数据(数组不能原地修改)。对于习惯 PyTorch 可变对象模型的开发者而言,这些约束可能显得苛刻,但它们能够提供形式化保证:由于函数输出仅取决于输入,编译器可以安全地对操作进行重排、融合和并行化。限制本身就是其特性;纯性使变换组合成为可能。
JAX 的能力源于组合。jax.grad 返回梯度函数;jax.vmap 可以沿映射轴对兼容函数进行向量化;jax.jit 则可以针对特定参数签名,对稳定的变换后函数进行追踪和编译。迭代式 Python 循环按顺序发出各项操作,反复产生调度开销;与之不同,jax.vmap 将批次维度直接传递给底层原语,将逐样本的矩阵—向量运算转换为批量矩阵—矩阵乘法(GEMM),通过一次并行内核启动执行。jax.pmap 将函数映射到多个设备上,但同步或梯度聚合必须使用 lax.psum 或 lax.pmean 等集合通信操作来表达。这些变换依据各自的类型和语义进行组合,不同的顺序可能计算出不同的量。
这一极简核心将神经网络抽象交由配套库(Flax、Haiku、Equinox)提供,将优化交由 Optax 负责。这种分离体现了函数式理念:核心提供变换,库则在其上构建常规抽象。其代价是,能否用于生产环境不仅取决于变换模型,还取决于目标环境中配套库、导出路径和运维工具的成熟度。
JAX 施加的函数式约束在特定领域中会转化为优势。自定义微分——高阶梯度、自定义向量—雅可比积(VJP)和雅可比—向量积(JVP)规则——能够自然组合,因为纯函数使微分规则的行为可预测。优化算法研究受益于这些变换,研究人员能够像操作数据一样自然地操作梯度计算。当程序能够以这种函数式风格表达时,以编译为重的加速器工作负载可以使用 XLA 提高利用率。需要自动微分的科学计算也受益于函数纯性,因为它支持对代码进行数学推理。JAX 比 PyTorch 需要更多的前期投入:函数式范式存在学习曲线,状态管理需要显式模式,而调试编译后的代码也比调试即时执行代码更困难。团队应在 JAX 的优势与项目需求相契合时选择它,而不应将其作为默认选择。
基于测量的框架权衡
前几节从定性角度描述了各框架的设计理念:图优先与即时执行优先、有状态与函数式。有价值的比较并不是抽象地判断哪个框架最快,因为答案会随模型形状、批大小、硬件后端和编译器配置而变化。有价值的比较在于,每种设计使系统能够看到什么、优化什么。因此,Table 10 将 TensorFlow、PyTorch 和 JAX 重新映射到框架的三个问题:执行可见性、微分模型和硬件抽象路径。
| 方面 | TensorFlow | PyTorch | JAX |
|---|---|---|---|
| 图类型 | 源于静态图,2.x 采用动态前端 | 动态图 | 函数式变换 |
| 编程模型 | 命令式前端,提供图捕获路径 | 命令式 | 函数式 |
| 核心数据结构 | 状态由框架管理的张量 | 状态由框架管理的张量 | 不可变数组 |
| 执行模式 | 默认即时执行,使用图进行优化 | 默认即时执行 | 追踪与即时编译 |
| 自动微分 | 对捕获的计算执行反向模式微分 | 基于即时执行记录带的反向模式微分 | 前向与反向变换 |
| 硬件抽象 | 广泛的部署运行时与 XLA 路径 | 原生 GPU 路径及导出/编译运行时 | 以 XLA 为核心的加速器编译 |
| 优化风险 | 图捕获与算子覆盖 | 即时执行开发后的图中断 | 纯性、形状稳定性与追踪 |
对测量的启示很直接:针对每个框架最容易显现的约束进行性能剖析。在 PyTorch 中,检查即时执行的调度开销或图中断是否占主导。在 TensorFlow 中,检查捕获的图是否覆盖所需算子,并支持部署目标。在 JAX 中,检查形状和纯性是否允许 XLA 编译实际执行的程序。框架层面的比较或排行榜可以为决策提供方向,但不能替代对目标硬件上特定工作负载的性能剖析。
同一个简单网络能够揭示每种设计理念如何影响代码。Listing 28 在三个框架中实现了同一个神经网络:用单个线性层将十个输入映射为一个输出。
这三种实现解决了同一个数学问题,却揭示了对三个问题的不同回答。这些差异并非表面形式,而是会影响调试工作流、部署选项和优化潜力。
PyTorch 通过类继承(nn.Module)将状态与计算绑定在一起,并通过即时求值解决执行问题:图随 Python 运行而构建,使标准调试器和控制流能够自然地工作。如果没有图捕获,优化器就无法在执行开始前看到完整计算。
TensorFlow/Keras 在 TensorFlow 2 中也默认采用即时执行,同时可以通过 tf.function 捕获结构化模型,并将其导出到受支持的部署运行时。可移植性仍取决于各个目标的算子覆盖和转换能力。
JAX 将模型视为纯函数26,使用不可变数据,且不包含内部状态。在这一模型中,grad、vmap(自动向量化)和 jit(即时编译27)是作用于无状态函数的可组合变换,而非附属于可变对象系统的方法。其代价是需要显式管理参数,而且对于来自有状态框架的工程师而言,这种编程模型可能较为陌生。
# PyTorch - Dynamic, Pythonic
import torch.nn as nn


class SimpleNet(nn.Module):
    def __init__(self):
        super().__init__()
        self.fc = nn.Linear(10, 1)

    def forward(self, x):
        return self.fc(x)


# TensorFlow/Keras - High-level API
import tensorflow as tf

model = tf.keras.Sequential(
    [tf.keras.layers.Dense(1, input_shape=(10,))]
)

# JAX - Functional approach
import jax.numpy as jnp
from jax import random


def simple_net(params, x):
    return jnp.dot(x, params["w"]) + params["b"]


key = random.PRNGKey(0)
key_w, key_b = random.split(key)
params = {
    "w": random.normal(key_w, (10, 1)),
    "b": random.normal(key_b, (1,)),
}
没有哪个框架能够同时最大限度地实现这三个目标,而这个十行程序让权衡直接体现在源代码中,而非隐藏在编译器内部:状态位于何处、图何时存在,以及允许编译器看到什么。根本上的权衡是编译器可见性与人工迭代延迟。图捕获和提前编译可以减少运行时开销及中间数据移动;即时求值缩短了人工迭代周期,这一周期位于铁律的运行时方程之外,其代价是在使用图捕获路径之前,编译器的可见性受到限制;函数纯性则赋予 XLA 更大的自由度,以变换稳定的已追踪程序。每种理念也会影响代码语法、团队工作流、调试实践和部署流水线,因此,迁移成本会随着项目特定集成和假设的增多而增加。
运行时约束图谱
同一原则也适用于这三个通用框架之外的系统。各类运行时之所以不同,是因为它们放弃了不同程度的灵活性,以换取编译器可见性、更小的二进制文件或针对特定硬件的执行方式。因此,Table 11 是一张约束图谱:每一行都展示了运行时放弃了什么、由此启用了什么优化路径,以及在决定采用之前应测试哪种故障模式。
| 运行时类别 | 适用场景 | 约束基准 | 优化路径 | 待检验的约束 |
|---|---|---|---|---|
| PyTorch 即时执行 | 研究与迭代 | 基准延迟;完整的 Python/运行时资源占用 | 动态图、即时执行调试 | 分派开销与缺乏全图视野 |
| 编译型 PyTorch/TensorFlow | 服务器训练与服务 | 图捕获顺利完成时,收益取决于工作负载 | 图捕获、融合、布局规划 | 算子覆盖范围与图中断 |
| TensorFlow Lite/Core ML | 移动端与边缘推理 | 特定目标平台的移动端延迟与软件包大小预算 | 量化、静态图、NPU 委托 | 特定目标平台的转换约束 |
| TF Lite Micro/microTVM | 微控制器推理 | 特定目标微控制器的 RAM 与闪存预算 | 静态分配、INT8 内核 | 所选算子与受限内存 |
| ONNX Runtime | 跨框架服务 | 取决于后端;对于受支持的图,可达到原生运行时的水平 | 标准图格式、执行提供程序 | 导出支持缺口与自定义算子回退 |
| TensorRT/TVM | 面向特定硬件的推理 | 相对于未经调优的即时执行基准,收益取决于目标平台 | 内核融合、降低精度、自动调优 | 更窄的目标范围与转换假设 |
这张映射表揭示的是一种系统模式,而非产品排名。每向范围更窄的运行时迈进一步,都是以灵活性换取更可预测的执行计划。当模型能够顺利转换且部署目标已知时,TensorRT 和 Apache TVM 等专用推理运行时可显著降低延迟。移动端和微控制器运行时通过移除训练机制,并依赖静态图、量化、平台委托或固定内存区来减少资源占用。委托是一种运行时插件,它将受支持的算子路由到目标加速器,并在算子不受支持时回退。工程上始终需要追问:为了实现优化,移除了什么?因为不受支持的算子、动态形状或图中断都可能使预期优势消失。
离开服务器机房后,这些效率差距就会成为硬约束。在云端 GPU 上,即时执行与专用推理引擎之间数倍的延迟差距意味着优化机会。在微控制器上,超出设备内存容量的框架根本无法运行。选择标准因而从单纯的延迟转变为框架能否满足内存与运行时的限制。
部署目标
在从云端到边缘端的整个谱系中,框架选择会根据硬件边界重新调整三个核心问题的权重。section 1.7.4 中测得的性能差距决定了数据中心的训练吞吐量与运营成本,而部署到边缘环境时,运行时效率则成为非可即否的可行性检验。执行问题从在可调试性与图优化之间权衡,转变为使计算严格满足延迟与内存限制。对于纯推理工作负载,求导问题不复存在,从而消除了激活值暂存与反向图的存储开销。与此同时,随着软件面向异构计算引擎,抽象问题变得更加突出:这些引擎包括服务器 x86 和 ARM CPU、移动端 NPU、边缘 TPU,以及仅有数十千字节 SRAM 的裸机微控制器。
Table 12 映射了从云端到边缘端各类运行时假设,详细列出了界定各硬件层级的优化手段与起决定作用的物理约束。
| 环境 | 通常适用的运行时假设 | 优化手段 | 决定性约束 |
|---|---|---|---|
| 云端/服务器 | 完整的训练/服务框架 | 图编译、批处理、较低精度 | 吞吐量、成本 |
| 边缘端 | 静态图或可移植的服务运行时 | 静态图、较低精度内核 | 特定工作负载的延迟与内存 |
| 移动端 | 集成到应用中且支持委托的运行时 | 加速器委托、紧凑模型格式 | 电池、散热、应用大小限制 |
| 微控制器(TinyML) | 采用固定分配的微型运行时 | 静态分配、小型整数内核 | 严格的 RAM 限制、无动态内存 |
这些边界说明,目标平台选择是框架架构的硬性筛选条件,而非后期的软件打包细节。例如,section 1.3.5 中的智能门铃关键词识别(KWS)模型就是微控制器层级的典型案例。要在千字节级内存中运行,就需要运行时采用固定、预分配的内存区,并具备紧凑的 C/C++ 资源占用,从而完全消除动态内存分配与 Python 运行时开销。这一物理限制迫使工程实践分离为两个阶段:工程团队在云端 GPU 上使用表达能力强的动态环境训练模型,却必须将模型部署到执行假设受到严格限制的运行时中。
ONNX28 格式通过标准化跨运行时的模型交换来应对这种碎片化 (ONNX Contributors 2019)。流水线可以在 PyTorch 中训练一种架构,将计算图导出为 ONNX 中间表示,然后在 ONNX Runtime 中执行序列化后的图,或将其编译到目标加速器。相比之下,TensorFlow Lite 依赖自己的转换路径,将 TensorFlow SavedModel 转换为 FlatBuffer,而不经过 ONNX。尽管标准交换格式减少了开发环境与生产环境之间的手动模型转换工作,但它们并不能消除兼容性测试、算子覆盖缺口或自定义内核回退开销。模型压缩 和 模型服务 中分析的模型压缩与服务策略,正是直接建立在这一导出边界之上的。
Figure 14 展示了这种中心辐射式互操作拓扑。训练框架将计算图导出为统一的中间表示,下游运行时与硬件后端则读取该表示,以便在异构目标平台上执行。
交换格式缓解了框架碎片化,但导出边界无法挽救违反目标平台物理限制的架构。在开发完成后将图转换为 ONNX 或嵌入式运行时,并不能解决内存占用过大、硬件算子缺失或动态控制流不受支持的问题。将部署视为事后才考虑的事项,必然导致代价高昂的重写,因此,在编写第一行模型代码之前,必须系统评估硬件与运行时之间的权衡。
框架选择
框架选择是一个约束优化问题,涉及本章确立的执行、求导与硬件抽象三个维度。问题不在于哪个框架“最好”,而在于哪种执行模型、求导系统与抽象路径能够满足项目约束。
框架选择的权衡空间
框架选择涉及三组相互关联的矛盾。第一组是开发速度与生产性能之间的矛盾:即时执行优先考虑迭代速度,而图编译优先考虑运行时优化。每天需要测试十种架构变体的研究团队,无法承受实验之间数分钟的编译等待;将单个模型部署数月的生产团队,也无法承受即时执行分派带来的吞吐量损失。随着项目生命周期的推进,最优平衡点会发生变化。
这种速度与性能之间的矛盾直接引出第二组矛盾:灵活性与优化深度之间的矛盾。即时执行使宿主语言的控制流能够自然使用,但在捕获更大的代码区域之前,编译器的优化范围受到限制。静态图可以通过专门的图算子表示依赖数据的控制流,暴露更大的子图,以便进行算子间内核融合,消除中间数据往返 HBM 的过程,并将中间激活值保留在片上 SRAM 中。如 table 3 所示,这一权衡会连锁影响内存管理、硬件利用率与调试工作流。它是一项支配整个执行流水线的架构约束。
灵活性与优化之间的矛盾又进一步揭示了第三组矛盾:生态系统广度与专用化之间的矛盾。通用框架覆盖广泛的算子集合,但对于专用运行时能够深度优化的工作负载,其性能往往不及这些专用运行时。TensorRT 和 TVM 等系统通过积极的内核融合、精度选择以及面向特定硬件的内存布局调度,针对范围更窄的部署目标进行优化 (NVIDIA 2024b; Chen et al. 2018)。尽管 ONNX 等交换格式弥合了部分差距 (ONNX Contributors 2019),运行时专用化也引入了自身的失效模式:当导出的模型遇到不受支持的算子时,执行必须回退到未经优化的内核,或触发开销高昂的主机与设备同步。
NVIDIA. 2024b. NVIDIA TensorRT: Programmable Inference Accelerator.
Chen, Tianqi, Thierry Moreau, Ziheng Jiang, Lianmin Zheng, Eddie Q. Yan, Haichen Shen, Meghan Cowan, et al. 2018. “TVM: An Automated End-to-End Optimizing Compiler for Deep Learning.” Proceedings of the 13th USENIX Symposium on Operating Systems Design and Implementation (OSDI ’18), 578–94.
ONNX Contributors. 2019. ONNX: Open Neural Network Exchange.
Systems Perspective 1.4: 框架选择约束
有效的框架选择应首先排除无法满足硬约束的候选项,而不是寻找“最好”的框架。这些硬约束包括部署目标、所需操作、编译器路径与团队专业能力。只有在此之后,才应根据性能、开发速度与生态系统等软性偏好,对剩余候选项排序。
TensorFlow 生态系统具体说明了这些维度如何相互作用。其三个变体(TensorFlow、TensorFlow Lite 和 TensorFlow Lite Micro)在逐步收紧的物理约束下,体现了同一种设计理念。Table 13 展示了由此产生的模型表达能力权衡。
| TensorFlow | TensorFlow Lite | 面向微控制器的 TensorFlow Lite | |
|---|---|---|---|
| 训练 | 支持 | 有限支持 | 不支持 |
| 推理 | 支持 | 支持 | 支持 |
| 算子覆盖范围 | 广泛 | 侧重推理 | 由模型选择的子集 |
| 原生较低精度工具支持 | 支持 | 支持 | 支持 |
这一演进过程表明,运行时效率是通过舍弃通用性换来的:支持更少的操作,可以实现更小的二进制文件、确定性的内存布局,以及更积极的较低精度优化。
框架选择标准
系统性框架评估由三个维度构成:模型需要什么(受支持的操作与图语义),软件环境提供什么(操作系统服务、内存分配器与加速器委托),以及硬件在物理上允许什么(计算吞吐量、内存容量与热功耗限制)。每个维度都起筛选作用:硬约束排除不可行的候选项,软性偏好则对剩余候选项排序。
模型需求
首要约束是框架能否表达模型所需的操作与执行语义。如 table 13 所示,算子覆盖范围从通用 TensorFlow 的广泛集合,收窄到 TensorFlow Lite 中侧重推理的集合,最后缩减为链接到 TensorFlow Lite Micro 中、由模型选择的最小子集。每次缩减都会剥离动态算子与训练机制,使编译器资源集中于静态内核。其底层系统原理是,算法表达能力与机器效率之间存在直接权衡:限制受支持的算子集合,使编译器能够裁剪死代码、生成紧凑且数据驻留于寄存器的内层循环,并消除动态分派开销。除算子覆盖范围外,模型需求还决定图语义:计算必须动态执行,还是可以提前捕获。
Systems Perspective 1.5: 动态计算图与静态计算图
静态图与动态图的区别(详见 section 1.3)直接影响模型需求分析。静态图要求以图运行时能够理解的形式表示控制流与动态行为,从而支持面向部署的提前优化。即时执行直接遵循普通的 Python 控制流,而
torch.compile 和 tf.function 等图捕获路径在能够表示已执行程序时,可以重新获得优化机会。
软件依赖
确认模型表达能力之后,框架还必须与目标软件环境集成。Table 14 概述了操作系统依赖、模型加载机制与加速器委托如何随部署层级而变化。
| TensorFlow | TensorFlow Lite | 面向微控制器的 TensorFlow Lite | |
|---|---|---|---|
| 需要操作系统 | 是 | 是 | 否 |
| 模型访问 | 文件系统或服务 | 平台特定的存储映射 | 平台特定的编译内置或映射存储 |
| 加速器支持 | 支持 | 委托 | 优化内核与集成 |
这些区别说明,消除软件抽象如何扩展部署范围。标准 TensorFlow 依赖完整的 POSIX 操作系统服务、动态共享库与虚拟内存分配器。TensorFlow Lite 针对移动平台放宽了这些要求,通过内存映射文件访问模型,并通过厂商运行时 API 将操作委托给硬件加速器。TensorFlow Lite Micro 则完全移除了操作系统依赖,使其能够在没有 POSIX 文件系统或动态堆分配器的微控制器上裸机执行(但它也可以与 FreeRTOS 或 Zephyr 等 RTOS 一同运行)。模型 FlatBuffer 被直接编译为驻留在只读闪存中的常量字节数组,硬件加速则依赖静态链接的 CMSIS-NN 或 DSP 汇编内核,而非动态驱动委托。每剥离一项软件依赖,就能使部署扩展到物理约束更严格的硬件层级。
硬件约束
仅有软件兼容性并不能保证执行;框架运行时必须满足内存容量、存储与计算带宽的物理限制。如 table 15 所概述,目标处理器架构随着部署层级变化,从数据中心的服务器级 x86 CPU、GPU 和 TPU,经由移动边缘端的 Arm Cortex-A 应用处理器,向下延伸至资源受限的 Arm Cortex-M 微控制器与 DSP。
| TensorFlow | TensorFlow Lite | 面向微控制器的 TensorFlow Lite | |
|---|---|---|---|
| 基础二进制大小 | 取决于构建与软件包 | 取决于构建与委托 | 取决于模型与算子选择 |
| 基础内存占用 | 取决于模型、运行时与分配器 | 取决于模型、委托与分配器 | 固定内存区加运行时状态 |
| 优化目标架构 | x86、TPU、GPU | Arm Cortex-A、x86 | Arm Cortex-M、DSP、MCU |
这些硬件边界反映了基本物理约束——光速屏障、功耗墙与内存墙——它们将部署谱系划分为不同的运行区间(物理约束:范式为何存在)。在数据中心,与数吉字节的高带宽设备内存相比,数兆字节的运行时二进制文件与动态内存管理开销可以忽略不计。在仅有 256 KB SRAM 和 1 MB 闪存的微控制器上,通用运行时甚至无法加载。框架必须用单个预分配内存区取代动态堆分配器,并提前确定其大小,以容纳张量激活值与暂存缓冲区。
生产就绪评估因素
满足模型需求、软件依赖与硬件约束,可以确立技术可行性,但生产可行性还要求评估持续服务工作负载下的运行可靠性。依赖动态内存分配或宿主语言解释器的运行时,会因垃圾回收暂停与堆碎片化而引入尾延迟(p99)波动。相比之下,面向生产的运行时强制采用静态张量内存区与将计算图预先转换为低层表示,以确保确定性的执行时间。
精度优化是一项核心运行调节手段。将数值精度从 FP32 降至 FP8 或 INT8,可使内存带宽消耗减半,并提高加速器张量核心上的算术吞吐量,但这需要原生量化工具支持。生产框架必须同时支持使用代表性校准数据集的训练后量化(PTQ),以及用于在部署前恢复精度余量的量化感知训练(QAT)。除单设备执行外,生产可行性还取决于工具链稳定性:模型检查点能否在运行时更新后保持向后兼容,框架是否提供用于剖析内核执行的遥测钩子,以及服务基础设施能否在不停机的情况下部署更新后的图定义。
开发支持与长期可行性评估
框架在多年生产生命周期中的可行性,取决于周边生态系统能否使所选的执行、求导与抽象路径保持可维护。社区构成直接影响工程优先级:以研究为导向的生态系统优先考虑实验速度、交互式调试与快速模型原型开发;以生产为导向的生态系统投入于服务运行时、向后兼容性与硬件厂商集成;以编译器为核心的生态系统则推动面向新兴加速器的数学变换与代码生成。
框架的运行成本往往更多地取决于周边生态系统的基础设施,而非核心张量 API。与模型注册中心、模型服务系统、集群编排器和加速器性能剖析工具集成能够加快部署,但每一层都会引入一个上游依赖。一旦组织将其流水线标准化,自定义 C++ 或 CUDA 内核实现、专用序列化格式以及厂商特定的编译阶段就会使框架迁移的成本高得难以承受。要保留架构上的退出路径,就需要有意识地进行解耦:通过 ONNX 等开放格式统一中间表示,将数据摄取流水线与框架特定的张量类隔离,并保持模块化的算子边界。
前面的章节将执行、微分和硬件抽象作为不同的架构选择进行了评估。然而,在模型执行过程中,这三个系统同时运行。单个训练步骤正是三者交汇之处:即时分派或图调度决定工作何时到达芯片,反向模式自动微分在保留中间激活值的同时生成反向传播过程,而硬件抽象则协调张量布局和内核启动。从输入批次到参数更新,追踪一个完整的训练步骤,可以揭示这些机制如何在物理机器约束下协同运作。
训练步骤剖析
在模型训练期间,执行、微分和硬件抽象同时运作。在 listing 29 中,一个最简的两层多层感知机通过八条可执行语句展示了这种协同。沿运行时栈追踪每条语句,可以将 section 1.1 中建立的定量原理与物理执行联系起来:张量分配、内核分派、动态图记录、梯度计算和参数更新。
# Single training step for a 2-layer MLP
x = torch.randn(32, 784, device="cuda")  # Input batch
y = torch.randint(0, 10, (32,), device="cuda")  # Labels

# Forward pass
optimizer.zero_grad()
h = torch.relu(x @ W1 + b1)  # Hidden layer
logits = h @ W2 + b2  # Output layer
loss = F.cross_entropy(logits, y)

# Backward pass
loss.backward()

# Parameter update
optimizer.step()
阶段 1:前向传播(解决执行问题)
在前向传播期间,执行 h = torch.relu(x @ W1 + b1) 会触发以下即时执行序列:
- Python 分派:Python 解释器调用
torch.matmul,该调用经由 PyTorch 的 C++ 分派器选择 CUDA 后端,在向设备提交工作之前产生数微秒的主机 CPU 开销。 - 内核选择:cuBLAS 选择一个针对维度 32 \(\times\) 784 \(\times\) 256 配置的 GEMM 内核,将计算划分为线程块,其大小适配流式多处理器的共享内存和 L2 缓存分块。
- 内核启动:主机线程将启动描述符加入 GPU 命令流队列,产生驱动程序启动延迟;与此同时,异步执行允许主机继续运行,而无需阻塞等待执行完成。
- GPU 执行:流式多处理器将
W1从 HBM29 经由 L2 缓存流式载入寄存器和 Tensor Core,计算矩阵乘积,并将输出激活值写回 HBM。 - 自动微分记录:与此同时,在主机上,PyTorch 的自动微分引擎在动态记录带上实例化一个
MmBackward节点,保存对设备内存中输入张量x和W1的引用,以供反向模式微分使用。
后续的偏置加法(+ b1)和激活(torch.relu)遵循相同的即时执行路径,每个运算都分派一个独立内核,与 HBM 进行往返数据传输,并向记录带追加一个节点。
阶段 2:反向传播(解决微分问题)
调用 loss.backward() 会分四个阶段执行反向模式自动微分:
- 记录带遍历:自动微分引擎从标量损失节点出发,按逆拓扑顺序遍历已记录的计算图。
- 梯度计算:引擎执行为每个节点注册的反向内核。在反向遍历过程中,
CrossEntropyBackward使用 softmax 的导数计算 \(\frac{\partial \mathcal{L}}{\partial \text{logits}}\);对应 \(W_2\) 的MmBackward计算 \(\frac{\partial \mathcal{L}}{\partial W_2} = h^T \cdot \frac{\partial \mathcal{L}}{\partial \text{logits}}\) 和 \(\frac{\partial \mathcal{L}}{\partial h}\);ReluBackward计算激活掩码,将前向激活值满足 \(h \leq 0\) 的位置上的梯度置零;对应 \(W_1\) 的MmBackward计算 \(\frac{\partial \mathcal{L}}{\partial W_1} = x^T \cdot \frac{\partial \mathcal{L}}{\partial z_1}\)。由于输入批次x未设置requires_grad=True,遍历会终止,而不计算 \(\frac{\partial \mathcal{L}}{\partial x}\)。 - 梯度累积:计算得到的参数梯度原地累积到叶张量(\(W_1\)、\(b_1\)、\(W_2\)、\(b_2\))的
.grad字段中。 - 内存释放:每个反向节点执行完成后,框架会释放其保存的前向激活值(如 \(h\) 和 \(x\)),使缓存分配器能够在后续运算中复用这些内存区域。
阶段 3:内存流量分析(物理约束的作用)
将 equation 4 应用于此步骤,table 16 详细列出了每个运算的 FLOPs、内存流量和算术强度:
| 组件 | 建模计算量 | 内存流量 | 算术强度 |
|---|---|---|---|
| 矩阵乘法 (x @ W1) | \(2 \times 32 \times 784{\times}256\) = 12.8 MFLOP | 0.9 MB | 13.7 FLOP/byte |
| ReLU | \(32{\times}256\) = 8.2 KFLOP | 65.5 KB | 0.125 FLOP/byte |
| 矩阵乘法 (h @ W2) | \(2 \times 32 \times 256{\times}10\) = 163.8 KFLOP | 44.3 KB | 3.7 FLOP/byte |
| 交叉熵(简化) | ~0.96 KFLOP | 2.6 KB | 0.4 FLOP/byte |
| 反向传播(假设为前向传播的 2\(\times\)) | ~26 MFLOP | 3.1 MB | 8.3 FLOP/byte |
算术强度一列揭示了每层的运行区间。矩阵乘法通过操作数复用使算术强度趋近计算性能上限。相比之下,逐元素 ReLU 和交叉熵中的归约在每传输一个字节时执行的计算量极小(\(0.125\) 至 \(0.375\text{ FLOP/byte}\)),始终严格受限于内存带宽和启动延迟。在未融合的即时执行中,每个逐元素运算都会产生一次独立的内核分派,并使中间张量经由 HBM 往返传输,而无法充分利用计算单元。
该解析模型得到的总算术计算量约为 39.1 MFLOP,内存流量约为 4.2 MB。将这些量除以 A100 的硬件峰值速率,即可确定理想化的下界:
- \(T_{\text{compute}} \approx\) 39.1 MFLOP/19.5 TFLOP/s FP32 ≈ 2.0 μs
- \(T_{\text{memory}} \approx\) 4.2 MB/2.04 TB/s ≈ 2.1 μs
- 假设有 12 ops 次内核启动,\(T_{\text{overhead}} \approx\) 12 ops \(\times\) 15 μs ≈ 180 μs
由于 \(T_{\text{overhead}}\) 比 \(T_{\text{compute}}\) 和 \(T_{\text{memory}}\) 高出一个数量级以上,该步骤受开销限制。当主机 CPU 串行执行分派时,加速器执行单元因缺少工作而闲置。在这种运行区间内,系统工程的优化目标是启动开销,而非算术效率:
- 内核融合(
torch.compile):将连续的受内存限制的运算融合为单个内核,可以避免中间数据与 HBM 之间的往返传输,并合并内核启动边界。 - 批大小扩展:增大批大小会使算术计算量线性增长,同时保持分派开销不变,从而将固定的启动延迟分摊到更多计算运算上。
- 图捕获:静态编译或 CUDA Graphs 仅捕获一次依赖关系 DAG,随后通过一次驱动程序调用重放执行,从而完全消除主机解释器开销。
阶段 4:硬件抽象(解决抽象问题)
通过后端抽象层,同一份 Python 脚本能够在异构硬件架构上执行,如 table 17 所概述。
每个后端都将通用张量语义映射到芯片特定的原语。一次 loss.backward() 调用会根据设备放置情况路由到不同的执行流水线。浮点求和顺序、归约树和非确定性原子操作的差异会在不同后端之间引入数值差异,因此需要依据明确的数值容差验证等价性,而不是要求逐位一致。
| 硬件 | 后端库 | 执行机制 |
|---|---|---|
| CUDA GPU | cuBLAS (NVIDIA 2024a; Choquette et al. 2021) | 通过 GEMM 内核和 CUDA 流实现异步执行 |
| CPU | Intel oneMKL 或 OpenBLAS (Intel Corporation 2026; OpenBLAS Project 2026) | 围绕优化内核实现线程级并行 |
| TPU | XLA (Google 2025) | 编译为 TPU 专用的高层优化器(HLO)操作 |
| Apple Silicon | Metal Performance Shaders | MPS 后端 |
Choquette, Jack, Wishwesh Gandhi, Olivier Giroux, Nick Stam, and Ronny Krashinsky. 2021. “NVIDIA A100 Tensor Core GPU: Performance and Innovation.” IEEE Micro 41 (2): 29–35. https://doi.org/10.1109/mm.2021.3061394.
Intel Corporation. 2026. Intel oneAPI Math Kernel Library.
OpenBLAS Project. 2026. OpenBLAS: An Optimized BLAS Library.
Google. 2025. XLA: Optimizing Compiler for Machine Learning.
设备放置、批大小、编译模式等实现决策,会同时在执行、微分和抽象层中引发连锁影响。当系统将框架视为不透明的数学解释器,而非具备硬件感知能力的调度器时,这些交互就会导致内核启动供给不足、内存碎片化和吞吐量骤降。
Systems Perspective 1.6: 三个问题的实际体现
从数据—算法—机器的角度看,单个训练步骤揭示了框架如何平衡算法与机器:
- 执行(机器调度):即时执行模式保留了命令式逐行调试能力,代价是每个内核都存在启动和分派延迟。
- 微分(算法图):反向模式自动微分将前向传播的中间激活保留在 HBM 中,以便按逆拓扑顺序计算精确的向量—雅可比乘积。
- 抽象(硬件可移植性):统一的张量 API 将模型代码与异构芯片解耦,将相同的操作分派给 cuBLAS、oneMKL 或 XLA HLO 内核。
要化解这些维度之间的摩擦,需要使算子粒度与硬件的 Roofline 性能上限相匹配:融合操作以消除内存往返访问,扩大批大小以摊薄启动延迟,并组织张量布局以充分利用加速器执行流水线。
谬误与陷阱
框架选择涉及微妙的权衡,传统软件工程的直觉在此可能失效。内存墙、内核融合约束以及部署目标的多样性,会形成浪费工程投入并导致生产系统无法达到延迟目标的陷阱。
谬误:“对于相同的模型架构,所有框架都能提供等同的性能。”
工程师认为,既然数学计算相同,ResNet-50 在不同框架中的性能就应完全一致,却忽略了性能是算法与机器协同设计所涌现出的属性。在生产环境中,实现方式至关重要。编译执行可以改善受支持的即时执行工作负载;在模型转换顺利的情况下,TensorRT 或 TVM 等针对硬件专门优化的推理引擎,相较于未经调优的即时执行基线,可以降低延迟。这些差异源于不同框架在内核融合深度、图优化策略、内存访问模式、精度支持和后端库方面的不同。假定各框架性能等同的组织,可能无法满足延迟服务级别协议,并被迫在最后关头进行成本高昂的框架迁移。
陷阱:依据流行程度而非项目需求选择框架。
工程师认为,最流行的框架适用于任何项目。实际上,部署约束起着主导作用。ExecuTorch 或 TensorFlow Lite 等移动端运行时,与 TensorFlow Lite Micro 等微控制器运行时,在内存分配、算子覆盖范围和硬件委托机制方面具有不同的假设;前者面向拥有 GB 级内存的手机,而后者通常面向仅有数百 KB RAM 的设备,在小型 TinyML 部署中,RAM 通常低于 256 KB。如果团队在开发边缘应用原型时未检查最终运行时,就可能面临内存膨胀超出设备容量的问题,或在开发完成后才进行框架迁移。在选择训练框架之前,应按照 section 1.8 评估部署目标。
谬误:“框架抽象消除了掌握系统知识的必要性。”
工程师认为,高层 API 会自动完成所有优化。Roofline 模型(Roofline 模型)表明,事实并非如此。ReLU 等逐元素操作每移动一个字节所执行的算术运算很少,因此即使加速器拥有充裕的计算能力,内存流量和启动开销仍可能占据主导地位。Section 1.3.1 解释了这种不平衡如何导致计算资源闲置。工程师必须先确定受限资源,再选择融合、批处理、布局或精度优化。
陷阱:忽视框架专用格式造成的供应商锁定。
工程师认为,模型“只是数学”,因此框架迁移很简单。将 TensorFlow SavedModel 转换为 PyTorch,可能需要重写自定义操作、通过大型测试套件验证数值等价性,并在操作缺乏精确等价实现时重新训练。ONNX(section 1.8)改善了可移植性,但自定义算子、动态形状以及后端专用优化仍可能需要人工处理。如果组织在最初选择框架时忽视这一点,那么当部署需求变化或更好的框架出现时,就会面临成本高昂的迁移。
谬误:训练框架的选择与生产基础设施无关。
工程师认为,训练框架的选择独立于部署基础设施。实际上,框架与基础设施不匹配可能带来大量运维开销。一些模型服务栈支持原子化模型切换,而另一些则需要重启进程或容器,除非部署架构在其外围增加了版本路由。一些框架和运行时直接提供监控钩子,另一些则需要自定义插桩。这些是 模型服务 和 机器学习运维 将详细讨论的模型服务层与运维层所带来影响的预览;这里的要点是,在选择框架时,应评估完整的部署栈,包括模型服务基础设施、监控和运维工具。
陷阱:未对激活内存建模就增大批大小。
工程师认为,只要内存可用,更大的批次就总能提高吞吐量。更大的小批次可以摊薄固定的分派开销,但也会增加训练期间必须保持存活的激活所占用的内存。一个采用 FP16 的 70 亿参数模型占用 14 GB,在尚未计入其他训练状态时,一块具有 80 GB 内存的 A100 上仅剩 71.9 GB。将批大小从 8 增加到 32,会使依赖批大小的激活内存占用增至四倍;Transformer 注意力还会引入一个随序列长度增长的较大 \(\mathcal{O}(S^2)\) 项,使每个样本的开销都很高。由此产生的内存压力可能触发重计算策略,其额外工作会使吞吐量下降,即使批次更大也是如此。盲目追求最大批大小的团队,其吞吐量可能低于采用较小批次、从而避免这些内存管理路径的方案;基于梯度的优化方法 对吞吐量目标进行了形式化描述。
谬误:编译开销可以忽略不计。
工程师认为,编译开销是一次性成本,能够很快收回。table 4 中的假设值为 ResNet-50 设定了更高的编译执行吞吐量,以及每次图变化后 15 s 至 30 s 的编译时间范围。在这些假设下,一个包含 10,000 张图像、经历 10 次代码变更的实验,在即时执行模式下耗时 6.9 s,在编译模式下则耗时 304.7 s,其中包括重新编译开销。因此,在这一用于说明的快速原型开发场景中,编译工作流的耗时约为即时执行工作流的 44.2×。在快速原型开发期间启用编译的团队,可能将时间浪费在等待重新编译上,从而抵消吞吐量收益。
陷阱:在探索阶段和生产阶段采用同一种执行策略。
合适的框架模式取决于所处的工作循环。在探索阶段,即时执行和小规模测试通过避免重复捕获计算图和重新编译来缩短反馈周期。在生产模型服务或长时间训练中,编译可以将准备成本分摊到大量请求或样本上。决定因素是工作负载的持续时间和稳定性:当图结构和形状反复出现时,编译能够带来收益;而控制流或输入形状的变化则可能使缓存产物失效,导致成本摊销重新开始。团队应根据实测的迭代延迟和稳态吞吐量选择策略。两个阶段共用一种策略,要么会拖慢研究迭代,要么会使生产环境的吞吐量潜力未得到发挥。
总结
机器学习框架解决了三个核心系统挑战,使深度学习能够在现代硬件上切实运行。第一个是执行:决定操作何时以及如何运行。框架在便于交互式调试的即时求值与支持全程序编译的图执行之间进行权衡,而 torch.compile 等现代混合方法能够动态捕获计算图,同时保留 Python 控制循环。第二个是微分:自动计算梯度。框架实现反向模式自动微分,对操作的复合应用链式法则,构建自动求导记录带或由向量—雅可比乘积组成的反向图,同时将中间激活保留在内存中。这一原语使得通过一次 loss.backward() 调用训练大型模型成为可能。第三个是抽象:通过统一接口面向异构硬件。框架提供多维张量抽象、中间表示和运行时分派系统,将高层模型定义连接到 CPU、GPU、TPU 和定制加速器上的优化设备内核。
这些挑战通过机器学习系统铁律(机器学习系统铁律)相互关联:执行策略决定分派延迟 \((L_{\text{lat}})\),微分决定内存流量 \((D_{\text{vol}})\),抽象决定硬件利用效率 \((\eta_{\text{hw}})\)。由于加速器计算吞吐量的增长远快于内存带宽,执行过程经常受内存带宽限制(\(D_{\text{vol}}/\text{BW}\)),而非受计算限制。框架通过编译器优化缓解这一内存墙问题:内核融合将相邻的逐元素操作合并,使中间结果保留在寄存器或片上 SRAM 中,而不必往返访问全局内存;选择性重计算则以冗余浮点运算 \((O)\) 为代价,缓解激活内存的峰值压力。
要点回顾: 数学与硬件之间的层
- 每个框架都解决三个问题:执行决定运行时分派,微分计算梯度,抽象面向异构硬件。TensorFlow、PyTorch 和 JAX 在这些维度上作出了不同的基础设施选择,从静态图捕获到动态追踪和函数式变换,形成了比 API 语法更为持久的架构约束。
- 内存墙驱动优化:数十年来,加速器计算能力的增长一直快于内存带宽,使片外数据移动成为执行的主要瓶颈。内核融合、选择性重计算和低精度数据布局直接针对机器学习系统铁律中的内存流量项(\(D_{\text{vol}}/\text{BW}\)),而非减少原始运算次数。
- 编译必须摊薄准备成本:equation 2 中的编译连续谱原理量化了运行时加速何时能够抵消编译开销。动态工作负载更适合即时执行,而反复执行的图则能从 JIT 或提前编译中受益;分派开销定律(equation 4)表明,一旦消除主机启动开销(\(L_{\text{lat}}\)),小操作就能获得格外显著的收益。
- 模块抽象使状态管理自动化:自动参数注册、依赖模式的执行(训练或推理)以及分层状态序列化,使数十亿参数模型能够跨多种硬件后端,在单个优化器步骤中完成更新。
- 部署约束应主导选择:专用运行时在算子覆盖范围、静态内存分配和编译延迟之间进行权衡,以适应严格的硬件资源预算。服务器级加速器内存与微控制器 SRAM 之间的差距,要求在确定开发框架之前评估下游部署目标。
框架以易用的编程接口呈现自身,但其真正作用是将数学图转换为物理硬件操作。这种转换从未消除硬件成本;它只是将开销在机器学习系统铁律(原理 原则(英文原版))的各项之间转移。即时执行以主机分派延迟(\(L_{\text{lat}}\))为代价,优先保障开发者的迭代效率;图编译付出前期优化时间,通过融合内核消除全局内存流量(\(D_{\text{vol}}/\text{BW}\));自动微分则在激活内存(\(D_{\text{vol}}\))与重计算的算术运算(\(O\))之间进行权衡。因此,看似只是 API 使用上的便利,实际上意味着持续的系统层面取舍:框架无法减轻铁律所规定的基本物理负担,只能决定由哪一项承担这一负担。
后续内容: 从控制室到发电厂
框架是将抽象架构转换为可执行内核的软件基础。计算图、自动求导记录带和内核分派流水线就像控制室中的仪表:它们使工程师能够观察并控制训练过程。机器已经建成,但它所揭示的每一项资源预算决策仍有待作出:内存不足时应对哪些激活采用检查点机制,硬件允许多大的批次,以及何时单个设备开始不敷使用。模型训练 将直面这些成本,把框架的执行、微分和内存管理机制扩展为能够大规模训练模型的分布式系统。
Footnotes
即时执行:这种模式会立即执行每个操作,因此可以使用标准工具直接调试,但也失去了图级优化所需的全局视图。如果不捕获更大范围的计算,即时运行时就无法在该范围内实施融合,也无法预先规划内存,从而将取决于工作负载的优化机会留给
torch.compile等编译器。↩︎计算图:引出本脚注的句子中,“先优化再执行”这一区别是关键设计选择。将程序捕获为数据结构,使框架能够在执行前将兼容操作融合为更少的 GPU 内核,从而减少启动开销和中间内存流量。获得这种可见性的工程代价是,实际执行的程序与源代码不同,因而调试更加困难;每个基于图的框架都必须证明,性能收益足以抵偿这一代价。↩︎
BLAS(基本线性代数子程序):1979 年的 API 规范构成了此处所述阶梯的最底一级;它将一组固定的、可从 Fortran 调用的向量操作标准化,把公开例程名称与底层针对特定机器的实现决策分离开来。其上的每个框架都继承了这一约定的扩展形式:从任意语言调用标准线性代数原语,让经过调优的厂商库负责适配芯片。对于 NVIDIA GPU 上的现代通用矩阵乘法(GEMM),这一经过调优的路径是 cuBLAS,而不是 1979 年的 BLAS 规范本身 (NVIDIA 2024a)。↩︎
LAPACK(线性代数软件包):通过为更高层例程(SVD、特征分解、最小二乘)提供标准 API 来扩展 BLAS;厂商以针对芯片的代码实现这些例程,并将其构建在快速 GEMM 内核之上。这种分层设计是每个机器学习框架都继承的架构模式:高层操作向下委托给手工调优的原语,因此,经过厂商优化的 LAPACK 调用,其执行速度可以比朴素实现快 10\(\times\) 以上,而框架作者无需编写任何针对特定硬件的代码。↩︎
GEMM:
C = A @ B背后的矩阵—矩阵运算原语。硬件厂商会针对自身的特定芯片手工调优 GEMM,因为全连接层、注意力投影和卷积的降低实现都依赖矩阵乘法,使这一例程成为阶梯上方许多框架的性能基础。GEMM 的高算术强度使其成为最有可能接近峰值计算吞吐量的操作,而形状较小或未对齐时,利用率往往会降至低得多的水平。↩︎NumPy(数值 Python):2005 年,Travis Oliphant 将两个相互竞争的 Python 数组库(Numeric 和 Numarray)整合为一个软件包,在科学计算社区需要扩大规模之际,为其提供了一个由 BLAS 支持的统一数组标准。由此形成的“向量化”契约(用 Python 编写逻辑,通过 BLAS 在 C/Fortran 中执行循环)成为此后每个机器学习框架的设计模板:PyTorch 张量和 TensorFlow 数组都是其直接后继,将同样的 \(n\) 维数组抽象扩展到了 GPU。Python 在机器学习基础设施中所扮演的角色,很大程度上承袭了这次整合决策所塑造的形式。↩︎
Theano:Theano 于 2007 年起在 Yoshua Bengio 的领导下,由蒙特利尔学习算法研究所(MILA)开发,是一个早期且具有重要影响力的 Python 框架,通过计算图将符号数学表达式编译为经过优化的 CPU 和 GPU 代码 (Bergstra et al. 2010; Team et al. 2016)。它证明了,用 Python 定义的计算图可以被编译为在 GPU 上执行的程序,而无需研究人员编写 CUDA 代码。Mila 于 2017 年停止了 Theano 的活跃开发 (Mila 2026)。↩︎
内核(GPU):在 GPU 编程中,内核是被分派到数千个线程上并行执行的函数。每次内核启动都会因参数组装和 GPU 信号通知而产生 5–20 \(\mu\)s 的 CPU 端开销,这意味着小型、未融合运算花在启动开销 \((L_{\text{lat}})\) 上的时间多于有效算术运算。因此,通过融合减少内核数量,就是直接降低机器学习系统铁律中的开销项。↩︎
融合注意力内核:融合注意力内核将 \(\mathbf{Q}\mathbf{K}^T\) 乘积、softmax 和对值向量加权得到的输出整合为一种分块实现,将中间值保存在片上内存中,而非在 HBM 中显式存储完整的注意力矩阵。FlashAttention 是 网络架构 中介绍的典型具名实例,其报告的 HBM 访问次数最多缩减 9\(\times\),并根据具体工作负载获得从提速 15% 到达到 3\(\times\) 运行速度的加速效果 (Dao et al. 2022)。对框架而言,这一经验超越了具体算法本身:融合通过减少对外部内存的往返访问,可以使运算在 Roofline 模型中的位置从带宽受限向吞吐量受限的执行区域移动。↩︎
自动求导记录带:一种在前向执行期间构建的临时数据结构,其节点记录运算、依赖关系以及用于按链式法则求值的反向函数。随着保存的激活值不断累积,其内存占用会随模型深度和序列长度增长,直至这些激活值在反向传播期间被释放。对于深层模型,框架会保留选定的激活值,并通过激活检查点机制重新计算其余激活值,以防止内存不足(OOM)故障。↩︎
死代码消除(DCE):移除其结果不影响可观测输出或副作用的图节点。在机器学习计算图中,死代码来自未使用的分支或变换后的残留产物;副作用分析可确保安全移除这些节点,从而避免执行无用运算,并减少内核启动开销。↩︎
XLA(加速线性代数):所注释句子中的“优化后的机器代码”是指,XLA 可以融合子图、特化布局,并将高层运算降低为后端专用代码;融合同时针对启动开销 \((L_{\text{lat}})\) 和中间结果的内存写入 \((D_{\text{vol}})\) 进行优化,但实际加速效果取决于图中是否包含足够多可融合且受内存限制的工作,供编译器消除。以大型 GEMM 为主的区域可能已经受计算限制,而由小型逐元素运算构成的链条可能获益更多,因为融合消除了反复访问外部内存的过程。其收益并非固定倍数:当 XLA 能够融合运算、特化布局和形状,以及降低启动或内存开销时,它才能发挥作用,因此收益取决于图结构、后端支持和输入形状的稳定性。↩︎
中间表示(IR):“中间”体现了这种格式在架构中的作用:它是一个与语言无关的层,将前端(Python 捕获)与后端(硬件代码生成)解耦,正如 LLVM IR 将 C/Rust/Swift 前端与 x86/ARM 后端解耦一样。机器学习框架采用这一编译器模式,是因为它将支持 \(M\) 个前端和 \(N\) 个后端的成本从 \(\mathcal{O}(M \times N)\) 降低到了 \(\mathcal{O}(M + N)\):单一的图捕获机制(TorchDynamo、tf2xla)即可面向多个硬件后端,而无须重写捕获逻辑。↩︎
torch.compile:这是 PyTorch 在 2020 年代实现的图捕获 JIT 编译机制:通过字节码拦截从即时执行程序中提取张量计算区域,通过中间表示将这些区域传递给编译器后端,并在守卫条件持续成立时复用缓存的生成代码。↩︎CUDA(统一计算设备架构):NVIDIA 于 2007 年推出的并行计算平台,是高层 Python 操作与 GPU 芯片之间的基础层;当 PyTorch 执行
torch.matmul(A, W)时,该调用经过框架的调度器,选择一个 cuBLAS 内核,并在 GPU 上启动它。每次启动都会产生 5–20 \(\mu\)s 的 CPU 端开销。对于小规模操作,这种调度开销 \((L_{\text{lat}})\) 超过了有效计算时间,因此编译(将 \(N_{\text{ops}}\) 个操作融合为一次内核启动)所带来的加速与启动次数的减少成正比,而非与算术运算量的减少成正比。↩︎TinyML:面向 MCU 设计的系统无法承担 Python 解释器的开销。微型运行时转而采用小型 C/C++ 运行时、固定内存规划和模型专用算子。TensorFlow Lite Micro 仍基于解释器:应用程序提供一个张量内存区,其中的缓冲区经过规划并被重复使用,初始化后不再进行堆分配。内存使用必须可预测,因为超出设备的 256 KB 预算可能导致初始化或推理无法进行。↩︎
自动微分(AD):正文对应句中的“自动”是关键词:AD 将链式法则机械化为图遍历,消除了手动计算导数的需要;正是这种手动计算使得网络难以扩展到玩具规模之外。使这一过程可行的系统权衡是选择反向模式,它利用训练的多对一拓扑结构(多个参数、一个标量损失),在一次反向传播中计算所有梯度。前向模式则需要为每个参数执行一次传播,使数十亿参数规模的训练在计算上不可行。↩︎
反向模式 AD:反向模式中 \(\mathcal{O}(1)\) 与 \(\mathcal{O}(P)\) 的不对称性有其具体代价:反向模式会保留反向遍历期间导数规则所需的、依赖于具体操作的数值。激活检查点通过不保存某些选定值,并在反向传播期间重新计算它们,改变所保存的值集合。↩︎
梯度累积:框架将一个较大的逻辑批次拆分为较小的微批次处理,在每个微批次的反向传播后释放其保存的激活,同时累积与参数规模相当的梯度。当激活内存随批次大小线性增长时,以每个微批次 64 个样本的方式处理 4,096 个样本,可将依赖批次大小的激活峰值内存最多降低至原来的 1/64,即最多降低 64\(\times\);权重、梯度、优化器状态及其他固定成本不会缩小。其代价是每次优化器更新前需要执行更多顺序工作。↩︎
算子融合:当兼容的算子作为独立内核执行时,中间结果可能会写入 HBM,再由下一个内核读回。融合可以将这些值保留在片上,避免相应的数据传输。实际收益取决于算子、形状、编译器和硬件。↩︎
BF16 的设计原理:BF16 由 Google Brain 于 2018 年前后专门为 TPU 训练稳定性而开发,在将内存占用减半的同时保留了 FP32 的 8 位指数范围——这是一种以尾数精度(7 位,而 FP16 为 10 位)换取动态范围的明确权衡。FP16 的最小正正规数约为 \(6.10 \times 10^{-5}\),而次正规数可延伸至约 \(5.96 \times 10^{-8}\);在将这些次正规数冲刷为零的硬件或运行模式下,损失缩放尤其重要。BF16 与 FP32 相同的指数范围在很大程度上避免了这类梯度下溢,使大多数工作负载无需损失缩放,这也是 BF16 与 FP16 不能互换的原因:当训练稳定性更重要时,优先选择 BF16;当数值精度比梯度稳定性更重要时,优先选择 FP16。↩︎
JAX:JAX 将
grad、jit和vmap暴露为函数上的变换;当它们的输入和输出契约相匹配时,就可以进行组合,但顺序很重要:对梯度进行向量化,通常并不等同于对向量值结果求导。编译可能生成融合区域、库调用和多个内核,而非一个通用内核。变换后的函数应当是纯函数;Python 副作用可能在追踪期间发生,但不会体现在编译后的程序中,而受支持的回调可以表达有意执行的运行时副作用。↩︎张量:在数学中,张量遵循坐标变换法则;机器学习框架则更广泛地使用这一术语,指携带形状、数据类型、步幅、设备放置信息,且通常还携带自动微分元数据的多维数组。转置通常会创建带步幅的视图,而形状重塑可能返回视图或副本,具体取决于布局。这些存储语义使布局与内核选择和数据移动密切相关。↩︎
NVLink:NVIDIA 的高带宽 GPU 间互连(参见 硬件加速),提供 600 GB/s 的双向带宽(A100 上的 NVLink 3.0),而 PCIe 4.0 x16 的双向带宽为 64 GB/s。这种约 10\(\times\) 的带宽优势决定了,对于给定模型规模,将一个大型张量计算拆分到多个 GPU 上的张量并行是否可行:仅通过 PCIe 连接的 GPU 可能使 \(D_{\text{vol}}/\text{BW}\) 通信项主导总训练时间,抵消增加计算资源带来的收益。↩︎
nn.Module:“设计模式反复出现”这一论断成立,是因为
nn.Module解决了一个普遍的组织问题:它会自动将通过赋值添加的子模块或参数注册到层次树中,使得一次.to('cuda')调用就能递归地将数百万个参数放置到 GPU 上。Keras 层、JAX Flax 模块和 TensorFlow 的tf.Module都实现了相同的树遍历模式。如果没有这一机制,管理模型状态就需要手动维护记录,其工作量随架构深度线性增长;对于具有数百层的模型,这一成本将高到难以承受。↩︎纯函数:返回由其输入决定的输出,不依赖未被跟踪的副作用;JAX 变换是为纯函数设计的。普通 Python 副作用可能在追踪期间执行,但不会体现在编译后的计算中,不纯代码可能失败或表现异常。运行时打印或外部副作用需要使用
jax.debug.print或回调等受支持的机制;随机抽样则需要显式管理随机键。↩︎即时(JIT)编译:针对某个参数签名追踪函数,并将其转换为后端专用的可执行代码;首次调用承担追踪和编译成本;后续兼容的调用可以复用缓存的可执行程序。新的形状、数据类型、设备或静态参数可能触发再次编译。编译时间和使用缓存的调用开销都取决于程序、后端和硬件。↩︎
ONNX:ONNX 所应对的“碎片化”是指,用于模型开发的框架可能与最适合部署目标的运行时不一致。ONNX 定义了一种与硬件无关的图表示,将两者解耦,从而减少每次部署目标变化时原本需要投入的、以工程师月计的手动模型转换工作。为此接受的权衡是,ONNX 导出可能丢失框架特有的优化或自定义算子,因而需要回退实现。↩︎
HBM(高带宽内存):在现代 GPU 上提供 2–3 TB/s 的带宽,是最直接为加速器算术运算供给数据的内存层级;HBM 带宽决定运算受内存限制还是受计算限制,而 A100 上 80 GB 的 HBM 容量则为同时存活的训练状态总量设定了硬性上限。执行期间,权重、激活值、梯度、优化器状态和临时工作区必须能够容纳于其中。如果无法容纳,框架就必须采用卸载、选择性重计算或跨设备放置等手段,每种手段都会增加程序员眼中一次
loss.backward()调用的复杂性。↩︎
NVIDIA. 2024a. cuBLAS: CUDA Basic Linear Algebra Subprograms.
Bergstra, James, Olivier Breuleux, Frédéric Bastien, Pascal Lamblin, Razvan Pascanu, Guillaume Desjardins, Joseph Turian, David Warde-Farley, and Yoshua Bengio. 2010. “Theano: A CPU and GPU Math Compiler in Python.” Proceedings of the Python in Science Conference 4: 18–24. https://doi.org/10.25080/majora-92bf1922-003.
Team, The Theano Development, Rami Al-Rfou, Guillaume Alain, Amjad Almahairi, Christof Angermueller, Dzmitry Bahdanau, Nicolas Ballas, et al. 2016. “Theano: A Python Framework for Fast Computation of Mathematical Expressions.” arXiv Preprint.
Mila. 2026. Open Source Software.
Dao, T., D. Y. Fu, S. Ermon, A. Rudra, and C. Ré. 2022. “FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness.” Advances in Neural Information Processing Systems (NeurIPS) 35: 16344–59. https://doi.org/10.52202/068431-1189.