引言
引言
本章目的
为什么构建机器学习系统所需的工程原则,与支配传统计算系统的工程原则如此不同?
机器学习系统有其自身的物理规律。数据在受带宽约束的内存层次结构中流动,算术运算在受功耗约束的硅芯片上执行,而预测结果必须在规定的延迟时间窗口内返回。这些约束并非实现细节;它们影响着从模型架构到部署目标的各项决策。机器学习系统与传统计算系统的另一项区别在于,其行为由数据定义,而不仅由显式逻辑或硬件状态定义。当传统程序出现异常行为时,工程师通常可以追踪源代码或检查硬件状态;而当机器学习系统出现异常行为时,代码可能执行无误,但学习得到的行为却因数据不完整、有偏差、过时或不再具有代表性而失效。因此,机器学习工程师必须同时管理统计不确定性和物理执行约束。一个能在数据中心运行的模型,在手机上可能毫无用处;一条在某种加速器上一周即可收敛的训练流水线,在另一种加速器上可能需要一个月;一个使用去年数据训练的高准确率模型,可能悄然退化。测试、模块化、版本控制和性能分析等传统实践仍然必不可少,但仅有这些还不够。在系统规模下,某一层的优化可能将瓶颈转移到另一层,因此不能独立设计正确性、效率和可部署性。首要任务因而是诊断,因为当其他约束起决定作用时,改进最显眼的组件可能并不会改变端到端行为。本书构建了一门以计算的物理极限为基础的学科。算法选择会沿技术栈向下影响机器,而硬件约束也会向上传导至模型设计。
学习目标
- 解释为何数据定义的行为和物理约束使机器学习系统区别于传统软件
- 运用数据—算法—机器视角,诊断数据移动、算术运算和机器限制中的瓶颈
- 通过苦涩的教训,分析人工智能从符号规则向深度学习的转变
- 计算铁律中的性能项,以推理吞吐量、延迟和计算投入回报
- 综合生命周期、部署、退化和五大支柱视角,形成机器学习系统工程判断
AI 系统的时代契机
人工智能已不再局限于研究演示。向智能手机提出一个问题,几秒之内,经过学习的组件就会将语音转换为文本、理解意图、检索信息并生成回答。搜索引擎对结果进行排序,推荐系统决定人们看到什么,贷款机构使用模型评估风险,驾驶辅助系统检测危险。在每一种情形中,预测都参与了一项更大范围的决策,而这项决策可能影响注意力、金钱、获取机会或安全。因此,看似一次智能行为,实际上是一个在现实世界中运行的端到端系统。
当三股力量汇合时,现代人工智能浪潮才具备了落地条件:数字服务产生的样例数量超出了工程师能够编码为规则的范围,学习算法从这些样例中提取出具有预测能力的结构,而并行硬件使相应计算成为可能。然而,影响最为深远的变化发生在观念层面。数据不再仅仅是软件的输入;它成为定义程序行为的机制。工程师不再手工编写决策逻辑,而是构建一条优化流水线,让实证样例塑造系统执行的规则。
这种融合带来了双重要求。每个机器学习系统都必须证明,其学习得到的行为值得信赖,并且机器能够在可用的时间、内存、能源和成本范围内产生这种行为。准确但过慢的模型无法使用;在缺乏代表性的数据上训练出的快速模型,则会以机器的速度犯错。这一区别在失效边界处最为清晰。代码缺陷可能导致显而易见的崩溃,而数据缺陷却可能让每条指令都正确执行,同时预测质量悄然恶化。在大规模运行时,这两项责任都贯穿整个技术栈。对话服务在管理内存、网络和热量的同时,还要协调 GPU 资源池1。驾驶辅助系统必须在毫秒级时间内融合传感器数据流。Google 每天在严格的延迟目标下处理 8.5B 次搜索。只有将学习行为与物理执行作为整体进行工程设计,这些系统才能成功。这种协同设计始于从代码定义的逻辑向数据定义的行为的转变。
以数据为中心的范式转变
这一转变改变了软件的构建方式。工程师不再直接编写行为,而是构建一个从数据中学习行为的过程。当传统程序失效时,工程师通常可以追踪分支、检查栈帧并修复相应代码路径。当机器学习系统在代码未变的情况下准确率下降时,原因可能是数据分布发生偏移、标签生成过程发生变化,或模型已无法表征生产环境中的行为。Andrej Karpathy2 将这一变化描述为从 软件 1.0 向 软件 2.0 的转变 (Karpathy 2017)。如 table 1 所示,软件 1.0 将运行逻辑编码在指令中,而软件 2.0 则从样例中学习这些逻辑。因此,其失效可能一直悄无声息,直到评估或监控揭示行为已经改变。
Karpathy, Andrej. 2017. Software 2.0. Medium.
软件 2.0 并未消除代码。工程师仍然需要构建数据流水线、训练循环、评估工具和模型服务基础设施。变化在于应用行为存在于何处。其中一部分行为存在于由数据塑造的学习权重中,因此仅靠代码审查无法解释系统会做什么。
| 特征 | 软件 1.0(传统软件) | 软件 2.0(机器学习) |
|---|---|---|
| 源代码 | C++、Python、Java | 训练数据 + 标签 |
| 编译器 | GCC、LLVM | 训练循环(随机梯度下降) |
| 逻辑 | 显式(手工编码) | 隐式(学习得到) |
| 失效模式 | 显性(崩溃、异常) | 隐性(指标退化) |
| 调试 | 追踪执行路径 | 检查数据分布 |
以数据为中心的工作流程改变了工程师必须构建和维护的内容。在一项针对 Google 生产系统的研究中,Sculley 及其同事发现,模型代码仅占工程工作范围的一小部分 (Sculley et al. 2015)。其外围系统——数据采集、验证、特征提取、资源管理、模型服务和监控——规模更大,存续时间也更长。

生产环境中的机器学习工作大多集中于外围系统,而非仅仅是模型代码。
这种不平衡会产生隐性技术债务。每个外围组件都编码了各种假设:如何采样一个样例、标签意味着什么、何时计算特征、哪个版本进入模型服务,以及如何检测退化。这些假设都不会出现在生成预测的矩阵乘法中,但其中任何一项都可能改变结果。仅仅改进模型,无法修复过时的代理指标、损坏的特征流水线或缺失的反馈信号。
因此,生产数据并不是被动的输入。它是通过特定产品采集、并由持续变化的流水线转换而成的对现实世界的测量。如果这种测量不再能够代表预期目标,模型可能在数值上仍然健康,而系统却已经出错。Google 流感趋势提供了一个很有启发性的例子。它拥有规模庞大、时效性强的搜索数据流,但在模型运行期间,这些数据的含义发生了变化。
War Story 1.1: 当搜索日志将关注度误判为疾病发生情况时(2014 年)
背景:Google 流感趋势(GFT)根据聚合搜索查询中的模式估计流感活动情况 (Ginsberg et al. 2009; Lazer et al. 2014)。它的吸引力在于,相较于临床报告,搜索数据到达的速度更快、规模更大。如果人们在患病时搜索流感症状,那么查询量看起来就能提供一个及时反映感染情况的代理指标。
失效模式:这一代理指标并不稳定。新闻报道改变了人们搜索的内容,自动补全功能改变了他们表达这些搜索的方式。查询量开始同时衡量公众关注度、产品行为和疾病发生情况。在 2012–2013 年流感季,GFT 估计的流感样疾病就诊比例约为 CDC 报告值的两倍,并且在 108 周中的 100 周出现了高估。
系统层面的教训:补救措施并不只是扩大搜索数据集或进一步调优模型。研究人员将搜索信号与 CDC 哨点临床数据相结合,并随时间推移重新校准二者的关系。数据量并不等于真实情况:行为代理指标需要一个连接可信测量的反馈回路,并且需要持续的证据,证明该代理指标仍能代表系统声称要估计的量。
Lazer, David, Ryan Kennedy, Gary King, and Alessandro Vespignani. 2014. “The Parable of Google Flu: Traps in Big Data Analysis.” Science 343 (6176): 1203–5. https://doi.org/10.1126/science.1248506.
Ginsberg, Jeremy, Matthew H. Mohebbi, Rajan S. Patel, Lynnette Brammer, Mark S. Smolinski, and Larry Brilliant. 2009. “Detecting Influenza Epidemics Using Search Engine Query Data.” Nature 457 (7232): 1012–14. https://doi.org/10.1038/nature07634.
Google 流感趋势在没有传统软件缺陷的情况下失效了。代码没有变化,但实际生效的程序发生了变化,因为输入分布以及代理指标与目标之间的关系已经改变。根据数据即代码原则,训练数据不仅仅是进入一个固定程序;它还参与决定模型实现的运行逻辑。工程师仍然编写优化过程,但样例通过随机梯度下降3及相关方法塑造模型权重4。因此,改变数据集与改变源代码一样,确实能够改变系统行为。
从机器学习开发的角度看,这代表了从以模型为中心向以数据为中心的人工智能的转变 (Ng 2021)。在以模型为中心的方法中,团队保持数据不变,专注于改进模型代码。在以数据为中心的方法中,团队保持代码相对固定,并系统性地改进数据,使数据整理成为对模型行为进行编程的核心环节。这一转变也改变了测试能够证明什么,因为任何有限的数据集都无法代表学习系统可能遇到的所有输入。
Ng, Andrew. 2021. MLOps: From Model-Centric to Data-Centric AI. DeepLearning.AI.
软件 1.0 的逻辑通常可以划分为执行路径和边界条件。相比之下,学习系统运行于一个高维输入空间中;该空间在严格意义上是有限的,但实际上无法穷举。2012 年 ImageNet 挑战赛使这一问题变得具体。AlexNet 的决定性胜利5推动了深度学习时代的到来,然而,该基准只能评估模型可能遇到的输入中微乎其微的一部分。每个输入都是一幅 \(224{\times}224\) 的 RGB 图像,具有 \(256^{150{,}528}\) 种可能的像素配置,这个数有 362,508 位数字。ImageNet 大规模视觉识别挑战赛(ILSVRC)的验证集仅包含 50,000 幅图像 (Krizhevsky et al. 2012; Russakovsky et al. 2015)。令总输入空间表示可能输入的数量,测试集覆盖量表示测试套件实际评估的输入数量。两者的悬殊差异形成了验证鸿沟(equation 1):
\[ \text{Verification Gap} = \text{Total Input Space} - \text{Test Set Coverage} \approx \text{Total Input Space} \tag{1}\]
这一鸿沟并不会使测试徒劳无功;它改变了测试能够证明的内容。部署前评估针对采样输入提供统计证据,而生产监控则检验实际运行中的总体及观测结果是否仍然支持这些证据。统计可靠性取代了对穷尽证明的任何期待。
测试覆盖的输入仅占输入空间中微乎其微的一部分。
验证鸿沟标志着工程师能够作出的论断发生了更深层次的变化。传统断言通常描述某一次特定执行:给定的输入和状态使程序沿着某条特定路径运行。机器学习性能论断则描述系统在某个总体上的行为。一个固定模型对相同输入可能返回相同输出,但其测得的准确率会随着总体变化而变化。数据提供了系统学习所依据的模式,但其中的噪声、漂移和遗漏也会带来不确定性。因此,鲁棒性不能意味着抵御一切变化。它要求使变化可被观测,并在证据不再支持系统假设时进行适应,这是一种概率工程。
其工程层面的影响超出了测试本身。调试机器学习系统需要调试数据,而不仅仅是 Python 脚本。版本控制必须跟踪数据集,而不仅仅是 git 提交。评估必须考察分布和结果,而不仅仅是代码路径。这些实践共同使学习到的行为具备可复现性和可追溯性,但无法将统计抽样转化为形式化验证。
Checkpoint 1.1: 范式转变
在回顾 AI 的历史之前,请检验自己是否理解软件构建方式的范式转变:
事后看来,从数据中学习行为似乎是必然的,但这实际上是严峻的规模扩展极限所迫使的一次工程转向。早期 AI 范式试图通过人工设计的符号和规则直接编程实现智能。回顾这些失败,可以看出起主导制约作用的约束如何在四个不同的时代间迁移——从逻辑到知识,再到特征,最终转向物理基础设施。
AI 瓶颈的演变
人工智能的每个主要时代,都在其算法思想尚未穷尽之前很久,就遇到了难以逾越的系统极限。当艾伦·图灵6 提出根据机器的实际输出而非内在本质来评估机器智能时 (Turing 1950),计算设备既缺乏存储现实世界知识所需的内存容量,也缺乏评估复杂模型所需的内存带宽。早期系统沿着一条根本性的分界线分成两类:弗兰克·罗森布拉特的感知机(1958 年)(Rosenblatt 1958) 尝试从感官输入中学习权重,而约瑟夫·魏岑鲍姆的 ELIZA7 (Weizenbaum 1966) 则执行人工编码的模式替换。两类系统都受制于物理现实而停滞不前:单层感知机缺乏多层训练机制和非线性表示,而基于规则的脚本则在用户输入偏离预先编写的模板时失效。随后的时代遭遇了知识获取瓶颈,因为人工录入知识无法规模化。现代系统面临的则是计算吞吐量这一不同的约束。
figure 1 中的时间线展示了已出版书籍提及人工智能的频率,它是关注度的代理指标,而非研究产出的直接度量。它揭示了一种反复出现的模式:强烈的乐观情绪之后,往往随着系统局限暴露出雄心与现有能力之间的差距,资金骤减,进而进入“AI 寒冬”8。每次复兴都将算法进步与新数据及工程基础设施结合起来。每次复兴都消解了一个瓶颈,同时暴露出下一个瓶颈。
\begin{tikzpicture}[line join=round,font=\sffamily\small]
\definecolor{bluegraph}{RGB}{0,102,204}
    \pgfmathsetlengthmacro\MajorTickLength{
      \pgfkeysvalueof{/pgfplots/major tick length} * 1.5
    }
\tikzset{%
   textt/.style={line width=0.5pt,draw=bluegraph,text width=26mm,align=flush center,
                        font=\sffamily\footnotesize,fill=cyan!7},
   Line/.style={line width=0.85pt,draw=bluegraph,dash pattern=on 3pt off 2pt,
   {Circle[bluegraph,length=4.5pt]}-   }
}

\begin{axis}[clip=false,
  axis line style={thick},
  axis lines*=left,
  axis on top,
  width=230mm,
  height=200mm,
  xmin=1950,
  xmax=2023,
  ymin=0.000000,
  ymax=0.00032,
  xtick={1950,1960,1970,1980,1990,2000,2010,2020},
  extra x ticks={1955,1965,1975,1985,1995,2005,2015},
  extra x tick labels={},
  xticklabels={1950,1960,1970,1980,1990,2000,2010,2020},
  ytick={0.0000,0.00005, 0.00010, 0.00015, 0.00020, 0.00025, 0.00030},
  yticklabels={0.0000,0.00005, 0.00010, 0.00015, 0.00020, 0.00025, 0.00030},
  grid=none,
    tick label style={/pgf/number format/assume math mode=true},
    xticklabel style={font=\footnotesize\sffamily,
},
   yticklabel style={
  font=\footnotesize\sffamily,
  /pgf/number format/fixed,
  /pgf/number format/fixed zerofill,
  /pgf/number format/precision=5
},
scaled y ticks=false,
 tick style = {line width=1.0pt},
 tick align = outside,
 major tick length=\MajorTickLength,
]
\fill[fill=BrownL!70](axis cs:1974,0)rectangle(axis cs:1980,0.00031)
        node[above,align=center,xshift=-7mm]{第一次 AI \ 寒冬};
\fill[fill=BrownL!70](axis cs:1987,0)rectangle(axis cs:1993,0.00031)
        node[above,align=center,xshift=-7mm]{第二次 AI \ 寒冬};
\addplot[line width=2pt,color=RedLine,smooth,samples=100] coordinates {
(1950,0.0000006281)
(1951,0.0000000683)
(1952,0.0000003056)
(1953,0.0000002927)
(1954,0.0000004296)
(1955,0.0000004593)
(1956,0.0000016705)
(1957,0.0000006570)
(1958,0.0000021902)
(1959,0.0000032832)
(1960,0.0000126863)
(1961,0.0000063721)
(1962,0.0000240680)
(1963,0.0000141502)
(1964,0.0000111442)
(1965,0.0000143832)
(1966,0.0000147726)
(1967,0.0000169539)
(1968,0.0000167880)
(1969,0.0000175559)
(1970,0.0000155680)
(1971,0.0000206809)
(1972,0.0000223804)
(1973,0.0000218203)
(1974,0.0000256138)
(1975,0.0000282924)
(1976,0.0000247784)
(1977,0.0000404966)
(1978,0.0000358032)
(1979,0.0000436903)
(1980,0.0000472788)
(1981,0.0000561471)
(1982,0.0000767864)
(1983,0.0001064465)
(1984,0.0001592212)
(1985,0.0002133700)
(1986,0.0002559067)
(1987,0.0002608470)
(1988,0.0002623321)
(1989,0.0002358150)
(1990,0.0002301105)
(1991,0.0002051343)
(1992,0.0001789229)
(1993,0.0001560935)
(1994,0.0001508219)
(1995,0.0001401406)
(1996,0.0001169577)
(1997,0.0001150365)
(1998,0.0001051385)
(1999,0.0000981740)
(2000,0.0001010236)
(2001,0.0000976966)
(2002,0.0001038084)
(2003,0.0000980004)
(2004,0.0000989412)
(2005,0.0000977251)
(2006,0.0000899964)
(2007,0.0000864005)
(2008,0.0000911872)
(2009,0.0000852932)
(2010,0.0000822649)
(2011,0.0000913442)
(2012,0.0001104912)
(2013,0.0001023061)
(2014,0.0001022477)
(2015,0.0000919719)
(2016,0.0001134797)
(2017,0.0001384348)
(2018,0.0002057324)
(2019,0.0002328642)
}
;

\node[textt,text width=20mm](1950)at(axis cs:1957,0.00014){\textcolor{red}{1950}\\
艾伦·图灵在期刊 \textit{Mind} 上发表\textit{《计算机器与智能》}。};
\node[red,align=center,above=2mm of 1950]{AI\ 里程碑};
\draw[Line] (axis cs:1950,0) -- (1950.235);
%
\node[textt,text width=19mm](1956)at(axis cs:1958,0.00007){\textcolor{red}{1956 年夏}\\
\textbf{达特茅斯研讨会} 由 AI 先驱约翰·麦卡锡组织的一次奠基性会议。};
\draw[Line] (axis cs:1956,0) -- (1956.255);
%
\node[textt](1957)at(axis cs:1969,0.00022){\textcolor{red}{1958}\\
\textbf{康奈尔大学心理学家弗兰克·罗森布拉特发明感知机},为
现代神经网络奠定基础。};
\draw[Line] (axis cs:1957,0) -- ++(0mm,17mm)-|(1957.248);
%
\node[textt,text width=21mm](1966)at(axis cs:1972,0.00012){\textcolor{red}{1966}\\
\textbf{ELIZA 聊天机器人} 由
MIT 教授约瑟夫·魏岑鲍姆创建,是自然语言编程的早期实例。};
\draw[Line] (axis cs:1966,0) -- ++(0mm,17mm)-|(1966);
%
\node[textt,text width=20mm](1979)at(axis cs:1985,0.00012){\textcolor{red}{1979}\\
汉斯·莫拉维克建造了\textbf{斯坦福小车},这是最早的自动驾驶车辆之一。};
\draw[Line] (axis cs:1979,0) -- ++(0mm,17mm)-|(1979.245);
%
\node[textt,text width=21mm](1981)at(axis cs:1990,0.00006){\textcolor{red}{1981}\\
日本\textbf{第五代计算机系统}项目启动。
研究资金的注入有助于结束第一次“AI 寒冬”。};
\draw[Line] (axis cs:1981,0) -- ++(0mm,10mm)-|(1981);
%
\node[textt,text width=15mm](1997)at(axis cs:2001,0.00007){\textcolor{red}{1997}\\
\textbf{IBM 的深蓝}击败世界国际象棋冠军加里·卡斯帕罗夫};
\draw[Line] (axis cs:1997,0) -- ++(0mm,10mm)-|(1997);
%
\node[textt,text width=15mm](2011)at(axis cs:2014,0.00003){\textcolor{red}{2011}\\
\textbf{IBM 的 Watson} 在 Jeopardy! 节目中获胜};
\draw[Line] (axis cs:2011,0) -- (2011);
%
\node[textt,text width=19mm](2005)at(axis cs:2012,0.00009){\textcolor{red}{2005}\\
\textbf{DARPA 大挑战赛} 斯坦福团队在未经预演的路线上行驶 212 千米,赢得该机构举办的第二届无人驾驶汽车
比赛};
\draw[Line] (axis cs:2005,0) -- (2005);
%
\node[textt,text width=30mm](2020)at(axis cs:2010,0.00017){\textcolor{red}{2020}\\
\textbf{OpenAI 推出 GPT-3}。这一拥有 1750 亿参数的模型展示了少样本上下文学习能力,开启了基础模型算力规模扩展的时代。};
\draw[Line] (axis cs:2020,0) |- (2020);
%
\draw[Line,solid,-] (axis cs:1991,0.0002) --++(50:35mm)
node[bluegraph,above,align=center,text width=30mm]{Google 数据库收录的美国出版书籍中
提及人工智能的书籍所占百分比};
\end{axis}
\end{tikzpicture}
Michel, Jean-Baptiste, Yuan Kui Shen, Aviva Presser Aiden, Adrian Veres, Matthew K. Gray, William Brockman, Joseph P. Pickett, et al. 2011. “Quantitative Analysis of Culture Using Millions of Digitized Books.” Science 331 (6014): 176–82. https://doi.org/10.1126/science.1199644.
Turing, Alan M. 1950. “I.—Computing Machinery and Intelligence.” Mind LIX (236): 433–60. https://doi.org/10.1093/mind/lix.236.433.
Rosenblatt, Frank. 1958. “The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain.” Psychological Review 65 (6): 386–408. https://doi.org/10.1037/h0042519.
Weizenbaum, Joseph. 1966. “ELIZA–a Computer Program for the Study of Natural Language Communication Between Man and Machine.” Communications of the ACM 9 (1): 36–45. https://doi.org/10.1145/365153.365168.
学习出现之前的时代:逻辑与知识瓶颈
在机器学习成为一门学科之前,工程师曾先后尝试通过两种范式构建智能系统,而两者都遇到了根本性的规模扩展障碍。符号 AI 将智能编码为逻辑规则,当这些规则无法涵盖现实世界的歧义时,就遭遇了逻辑瓶颈。专家系统将智能编码为领域知识,当获取和维护这些知识的成本超过系统本身的价值时,就遭遇了知识瓶颈。这两次失败暴露出同一个架构死胡同:人工设计的表示无法规模化。
符号 AI 时代与逻辑瓶颈
AI 工程的第一个时代(20 世纪 50 年代至 70 年代)试图将智能归结为符号 AI 操作,这一方法后来凝练为物理符号系统假说 (Newell and Simon 1976)。1956 年达特茅斯会议9 (McCarthy et al. 1955) 的研究人员提出,智能的某些方面可以被精确描述,并由机器模拟。即便在当时,IBM 的阿瑟·塞缪尔 也于 1959 年展示了另一条路径:一个西洋跳棋程序通过自我对弈实现了改进。他的工作创造了“机器学习”这一术语 (Samuel 1959),尽管当时的主导范式仍是符号方法。丹尼尔·鲍勃罗 的 STUDENT10 系统是这一方法的典型代表 (Bobrow 1964)。
Newell, Allen, and Herbert A. Simon. 1976. “Computer Science as Empirical Inquiry: Symbols and Search.” Communications of the ACM 19 (3): 113–26. https://doi.org/10.1145/360018.360022.
Samuel, A. L. 1959. “Some Studies in Machine Learning Using the Game of Checkers.” IBM Journal of Research and Development 3 (3): 210–29. https://doi.org/10.1147/rd.33.0210.
这些系统能够给出令人印象深刻的演示,但在实际运行中十分脆弱。它们的成功依赖于人工编码的规则,这些规则将每一种可接受的输入形式映射为符号表示。STUDENT 一旦将英语转换为方程,就能解出代数题,但措辞上的细微变化就可能使这一转换无法完成。这种困难并不限于语言。汉斯·莫拉维克11 在斯坦福开展的自主导航研究表明,人类认为轻而易举的任务(看、行走、抓取),在工程实现上远比国际象棋或代数这类人类认为困难的任务更难。
Example 1.1: STUDENT(1964 年)
STUDENT 将语言理解与代数求解分离:
language  "Two numbers sum to 30; one is twice the other."
parse     x + y = 30, x = 2y
solve     x = 20, y = 10
一旦表示正确,求解就是常规操作。瓶颈在于转换:每一种陌生的措辞都需要另一条人工编写的规则,因此语言覆盖范围只能随着规则库的扩展而增长。
专家系统时代与知识瓶颈
在专家系统时代,工程师缩小了问题的范围。他们不再构建通用推理系统,而是对特定领域的深厚知识进行编码。为诊断血液感染而设计的 MYCIN,使医学知识能够以产生式规则表达 (Shortliffe et al. 1975)。
Shortliffe, Edward H., Randall Davis, Stanton G. Axline, Bruce G. Buchanan, C.Cordell Green, and Stanley N. Cohen. 1975. “Computer-Based Consultations in Clinical Therapeutics: Explanation and Rule Acquisition Capabilities of the MYCIN System.” Computers and Biomedical Research 8 (4): 303–20. https://doi.org/10.1016/0010-4809(75)90009-9.
Example 1.2: MYCIN(1976 年)
MYCIN 将其推理过程显式呈现出来。患者事实触发可读的产生式规则:
facts  stain=gram-positive, shape=coccus, arrangement=clumps
rule   IF facts match THEN organism=staphylococcus (certainty=0.7)
cycle  match facts -> fire rule -> update certainty -> repeat
推理引擎在数百条规则间重复这一循环,并传播确定性因子,逐步形成诊断。医生可以检查每一步,但覆盖范围仍然只能逐条规则地增长:每个例外都必须经过知识获取、编码,并与现有规则库协调一致。
MYCIN 在特定测试中表现良好,但它的成功暴露了知识获取瓶颈。12 问题已不再是规则能否表达专业知识,而是隐性判断如何进入系统,以及如何在规则库不断扩展时保持一致性。
更快的机器可以评估更多规则,却无法更快地提取人类判断。可扩展的 AI 需要一种方法,能够从示例中推导出有用的决策边界,而不是要求工程师事先枚举这些边界。
这一变化并未消除人工设计,而是改变了工程师设计的对象。他们不再对每个决策进行编码,而是选择可用于学习决策的示例、表示、目标和度量。因此,下一个时代将知识获取瓶颈换成了一个新问题:应该让学习器看到哪些证据?
统计学习时代与特征工程瓶颈
20 世纪 90 年代标志着向统计学习 和概率系统的转变。系统不再依赖硬编码逻辑,而是从数据中估计概率(\(p(y \mid x)\))。这一转变由数字数据的可获得性以及大规模数据集“出乎意料的有效性”13 所推动。
垃圾邮件过滤体现了这一转变。统计过滤器不再维护禁用词列表,而是基于数百万个示例,学习某个词意味着垃圾邮件的概率。
Example 1.3: 早期垃圾邮件检测系统
统计过滤器将决策依据从人工编写的规则转向由标注邮件估计得到的概率:
rules: if "free" or "winner" appears -> spam
learn: labeled email -> word likelihoods -> P(spam | email)
维护工作并未消失,而是从编辑关键词列表转向整理有代表性的示例,并检查学习到的概率是否仍然符合当前邮件的实际情况。
从数据中学习决策边界消除了一个瓶颈,却暴露出另一个瓶颈。支持向量机(SVM)等统计算法,只有在人类将原始输入转换为结构化特征之后,才能稳健地学习。例如,在计算机视觉中,工程师花费多年时间设计 SIFT(尺度不变特征变换)和 HOG(方向梯度直方图)等人工数学变换,先提取边缘、角点和纹理摘要,再将其输入分类器。学习器调整边界;工程师决定它能看到哪些证据。扩展到新问题往往意味着重建预处理流程,从而使表面上的算法局限转化为特征工程瓶颈。传统流水线清楚地展现了这部分人工工作,因为在任何学习开始之前,都要先经过多个手工设计的阶段。
这种混合方法将人工设计的特征与统计学习结合起来。Viola-Jones 算法14 (Viola and Jones 2001) 是这一时代的典型代表,它利用简单的矩形特征和级联分类器实现了实时正面人脸检测。它表明,精心设计的特征可以支持实用的低延迟应用,但仅限于专家能够手工设计出合适表示的狭窄领域。
Example 1.4: 传统计算机视觉流水线
传统视觉系统将表示与分类分离:
image -> resize -> HOG/SIFT features -> SVM -> label只有最终的决策边界是学习得到的。从人脸转向行人或其他领域,意味着需要重新设计特征提取器,而且往往还要重新设计整个预处理流程。
深度学习时代与基础设施瓶颈
深度学习改变了系统中承担学习任务的部分。神经网络不再接收人工设计的特征,而是直接从像素、音频波形等原始输入中学习表示。此时,训练过程能够同时塑造表示与决策边界,从而实现“端到端”学习。
这一突破并非仅源于算法。卷积神经网络(CNN)早已存在 (LeCun et al. 1998, 2015);AlexNet 将架构和训练与系统协同设计相结合,统筹选择模型、训练过程和硬件映射方案 (Krizhevsky et al. 2012)。其并行矩阵运算与 GPU 的能力相契合。AlexNet 将 60 million 个参数分布在两块 GTX 580 GPU上,实现了 15.3 percent 的 top-5 错误率,相较于当年的第二名,错误率相对降低了 41.6 percent。figure 2 中的处理阶段展示了模型如何逐步学习更丰富的图像表示,最终输出 1,000 个类别中的一个。
LeCun, Yann, Yoshua Bengio, and Geoffrey Hinton. 2015. “Deep Learning.” Nature 521 (7553): 436–44. https://doi.org/10.1038/nature14539.
\begin{tikzpicture}[line join=round,font=\sffamily\small]
\clip (-11.2,-2) rectangle (15.5,5.45);
%\draw[red](-11.2,-1.7) rectangle (15.5,5.45);
\tikzset{%
 LineD/.style={line width=0.7pt,black!50,dashed,dash pattern=on 3pt off 2pt},
  LineG/.style={line width=0.75pt,GreenLine},
  LineR/.style={line width=0.75pt,RedLine},
  LineA/.style={line width=0.75pt,BrownLine,-latex,text=black}
}
\newcommand\FillCube[4]{
\def\depth{#2}
\def\width{#3}
\def\height{#4}
\def\nc{#1}
% Lower front left corner
\coordinate (A\nc) at (0, 0);
% Donji prednji desni
\coordinate (B\nc) at (\width, 0);
% Upper front right
\coordinate (C\nc) at (\width, \height);
% Upper front left
\coordinate (D\nc) at (0, \height);
% Pomak u "dubinu"
\coordinate (shift) at (-0.7*\depth, \depth);
% Last points (moved)
\coordinate (E\nc) at ($(A\nc) + (shift)$);
\coordinate (F\nc) at ($(B\nc) + (shift)$);
\coordinate (G\nc) at ($(C\nc) + (shift)$);
\coordinate (H\nc) at ($(D\nc) + (shift)$);
% Front side
\draw[GreenLine,fill=green!08,line width=0.5pt] (A\nc) -- (B\nc) -- (C\nc) --(D\nc) -- cycle;
% Top side
\draw[GreenLine,fill=green!20,line width=0.5pt] (D\nc) -- (H\nc) -- (G\nc) -- (C\nc);
% Left
\draw[GreenLine,fill=green!15] (A\nc) -- (E\nc) -- (H\nc)--(D\nc)--cycle;
\draw[] (E\nc) -- (H\nc);
\draw[GreenLine,line width=0.75pt](A\nc)--(B\nc)--(C\nc)--(D\nc)--(A\nc)
(A\nc)--(E\nc)--(H\nc)--(G\nc)--(C\nc)
(D\nc)--(H\nc);
}
%%%
\newcommand\SmallCube[4]{
\def\nc{#1}
\def\depth{#2}
\def\width{#3}
\def\height{#4}
\coordinate (A\nc) at (0, 0);
\coordinate (B\nc) at (\width, 0);
\coordinate (C\nc) at (\width, \height);
\coordinate (D\nc) at (0, \height);
\coordinate (shift) at (-0.7*\depth, \depth);
\coordinate (E\nc) at ($(A\nc) + (shift)$);
\coordinate (F\nc) at ($(B\nc) + (shift)$);
\coordinate (G\nc) at ($(C\nc) + (shift)$);
\coordinate (H\nc) at ($(D\nc) + (shift)$);
\draw[RedLine,fill=red!08,line width=0.5pt,fill opacity=0.7] (A\nc) -- (B\nc) -- (C\nc) -- (D\nc) -- cycle;
\draw[RedLine,fill=red!20,line width=0.5pt,fill opacity=0.7] (D\nc) -- (H\nc) -- (G\nc) -- (C\nc);
\draw[RedLine,fill=red!15,fill opacity=0.7] (A\nc) -- (E\nc) -- (H\nc)--(D\nc)--cycle;
\draw[] (E\nc) -- (H\nc);
}
%%%%%%%%%%%%%%%%%%%%%
%%4 column
%%%%%%%%%%%%%%%%%%%%
\begin{scope}
%big cube
\begin{scope}
\FillCube{4VD}{0.8}{3}{2}
\end{scope}
%%small cube
\begin{scope}[shift={(-0.10,0.4)},line width=0.5pt]
\SmallCube{4MD}{0.4}{3}{0.6}
%%
\draw[LineR](A\nc)-- (B\nc)--node[left,text=black]{3}
(C\nc)--(D\nc)-- (A\nc)
(A\nc)--(E\nc)--(H\nc)--(G\nc)--node[left,text=black]{3}(C\nc)
(D\nc)-- (H\nc);
%
\def\nc{4VD}
\draw[LineG](A\nc)--node[below,text=black]{192} (B\nc)--
(C\nc)--(D\nc)--node[right,text=black,text opacity=1]{13} (A\nc)
(A\nc)--(E\nc)--(H\nc)--(G\nc)--(C\nc)
(D\nc)--node[right,text=black,text opacity=1]{13} (H\nc);
\end{scope}
\end{scope}
%%Above
\begin{scope}[shift={(0,3.5)}]
%big cube
\begin{scope}
\FillCube{4VG}{0.8}{3}{2}
\end{scope}
%%small cube
\begin{scope}[shift={(-0.18,0.55)}]
\SmallCube{4MG}{0.4}{3}{0.6}
%%
\draw[LineR](A\nc)-- (B\nc)--node[left,text=black]{3}
(C\nc)--(D\nc)-- (A\nc)
(A\nc)--(E\nc)--(H\nc)--(G\nc)--node[left,text=black]{3}(C\nc)
(D\nc)-- (H\nc);
\def\nc{4VG}
\draw[LineG](A\nc)--node[below,text=black]{192} (B\nc)--
(C\nc)--(D\nc)--node[right,text=black,text opacity=1]{} (A\nc)
(A\nc)--(E\nc)--(H\nc)--(G\nc)--(C\nc)
(D\nc)--node[right,text=black,text opacity=1]{} (H\nc);
\end{scope}
\end{scope}
%%%%%
%%5 column
%%%%
%%small cube
\begin{scope}[shift={(4.15,0)}]
%big cube
\begin{scope}
\FillCube{5VD}{0.8}{3}{2}
\end{scope}
%%small cube
\begin{scope}[shift={(-0.10,1.25)}]
\SmallCube{5MD}{0.4}{3}{0.6}
%%
\draw[LineR](A\nc)-- (B\nc)--node[left,text=black]{3}
(C\nc)--(D\nc)-- (A\nc)
(A\nc)--(E\nc)--(H\nc)--(G\nc)--node[left,text=black]{3}(C\nc)
(D\nc)-- (H\nc);
%
\def\nc{5VD}
\draw[LineG](A\nc)--node[below,text=black]{192} (B\nc)--
(C\nc)--(D\nc)--node[right,text=black,text opacity=1]{13} (A\nc)
(A\nc)--(E\nc)--(H\nc)--(G\nc)--(C\nc)
(D\nc)--node[right,text=black,text opacity=1]{13} (H\nc);
\end{scope}
\end{scope}
%%Above
\begin{scope}[shift={(4.15,3.5)}]
%big cube
\begin{scope}
\FillCube{5VG}{0.8}{3}{2}
\end{scope}
%%small cube
\begin{scope}[shift={(-0.08,0.28)}]
\SmallCube{5MG}{0.4}{3}{0.6}
%%
\draw[LineR](A\nc)-- (B\nc)--node[left,text=black]{3}
(C\nc)--(D\nc)-- (A\nc)
(A\nc)--(E\nc)--(H\nc)--(G\nc)--node[left,text=black]{3}(C\nc)
(D\nc)-- (H\nc);
%
\def\nc{5VG}
\draw[LineG](A\nc)--node[below,text=black]{192} (B\nc)--
(C\nc)--(D\nc)--node[right,text=black,text opacity=1]{} (A\nc)
(A\nc)--(E\nc)--(H\nc)--(G\nc)--(C\nc)
(D\nc)--node[right,text=black,text opacity=1]{} (H\nc);
\end{scope}
\end{scope}
%%%%%%%%%%%%%%%%%%%%%%%
%%3 column
%%%%%%%%%%%%%%%%%%%%%%%
\begin{scope}[shift={(-3.75,-0.5)}]
%big cube
\begin{scope}
\FillCube{3VD}{1.5}{2.33}{3}
\end{scope}
%%small cube-down
\begin{scope}[shift={(-0.10,0.45)}]
\SmallCube{3MDI}{0.4}{2.33}{0.6}
%%
\draw[LineR](A\nc)-- (B\nc)--node[left,text=black]{3}
(C\nc)--(D\nc)-- (A\nc)
(A\nc)--(E\nc)--(H\nc)--(G\nc)--node[left,text=black]{3}(C\nc)
(D\nc)-- (H\nc);
%
\end{scope}
%%small cube - up
\begin{scope}[shift={(-0.12,2.23)}]
\SmallCube{3MDII}{0.4}{2.33}{0.6}
%%
\draw[LineR](A\nc)-- (B\nc)--node[left,text=black]{3}
(C\nc)--(D\nc)-- (A\nc)
(A\nc)--(E\nc)--(H\nc)--(G\nc)--node[left,text=black]{3}(C\nc)
(D\nc)-- (H\nc);
%
\def\nc{3VD}
\draw[LineG](A\nc)--node[below,text=black]{128} (B\nc)--
(C\nc)--(D\nc)--node[right,text=black,text opacity=1,pos=0.4]{27} (A\nc)
(A\nc)--(E\nc)--(H\nc)--(G\nc)--(C\nc)
(D\nc)--node[right,text=black,text opacity=1]{27} (H\nc);
\end{scope}
\end{scope}
%%Above
\begin{scope}[shift={(-3.75,3.5)}]
%big cube
\begin{scope}
\FillCube{3VG}{1.5}{2.33}{3}
\end{scope}
%%small cube-down
\begin{scope}[shift={(-0.42,0.75)}]
\SmallCube{3MGI}{0.4}{2.33}{0.6}
%%
\draw[LineR](A\nc)-- (B\nc)--node[left,text=black]{}
(C\nc)--(D\nc)-- (A\nc)
(A\nc)--(E\nc)--(H\nc)--(G\nc)--node[left,text=black]{3}(C\nc)
(D\nc)-- (H\nc);
%
\def\nc{3VG}
\draw[GreenLine,line width=0.75pt](A\nc)--node[below,text=black]{128} (B\nc)--
(C\nc)--(D\nc)--node[right,text=black,text opacity=1]{} (A\nc)
(A\nc)--(E\nc)--(H\nc)--(G\nc)--(C\nc)
(D\nc)--node[right,text=black,text opacity=1]{} (H\nc);
\end{scope}
%%small cube-up
\begin{scope}[shift={(-0.06,0.18)}]
\SmallCube{3MGII}{0.4}{2.33}{0.6}
%%
\draw[LineR](A\nc)-- (B\nc)--node[left,text=black]{3}
(C\nc)--(D\nc)-- (A\nc)
(A\nc)--(E\nc)--(H\nc)--(G\nc)--node[left,text=black]{3}(C\nc)
(D\nc)-- (H\nc);
%
\def\nc{3VG}
\draw[LineG](A\nc)--node[below,text=black]{128} (B\nc)--
(C\nc)--(D\nc)--node[right,text=black,text opacity=1]{} (A\nc)
(A\nc)--(E\nc)--(H\nc)--(G\nc)--(C\nc)
(D\nc)--node[right,text=black,text opacity=1]{} (H\nc);
\end{scope}
\end{scope}
%%%%%%%%%%%%%%%%%%%%%%%
%%2 column
%%%%%%%%%%%%%%%%%%%%%%%
\begin{scope}[shift={(-6.8,-1)}]
%big cube
\begin{scope}
\FillCube{2VD}{2}{1.3}{3.8}
\end{scope}
%%small cube
\begin{scope}[shift={(-0.2,2.5)}]
\SmallCube{2MD}{0.4}{1.3}{1}
%%
\draw[LineR](A\nc)-- (B\nc)--node[left,text=black]{5}
(C\nc)--(D\nc)-- (A\nc)
(A\nc)--(E\nc)--(H\nc)--(G\nc)--node[left,text=black]{5}(C\nc)
(D\nc)-- (H\nc);
%
\def\nc{2VD}
\draw[LineG](A\nc)--node[below,text=black]{48} (B\nc)--
(C\nc)--(D\nc)--node[pos=0.6,right,text=black,text opacity=1]{55} (A\nc)
(A\nc)--(E\nc)--(H\nc)--(G\nc)--(C\nc)
(D\nc)--node[pos=0.26,right,text=black,text opacity=1]{55} (H\nc);
\end{scope}
\end{scope}
%%Above
\begin{scope}[shift={(-6.8,3.5)}]
%big cube
\begin{scope}
\FillCube{2VG}{2}{1.3}{3.8}
\end{scope}
%%small cube
\begin{scope}[shift={(-0.1,0.5)}]
\SmallCube{2MG}{0.4}{1.3}{1}
%%
\draw[LineR](A\nc)-- (B\nc)--node[left,text=black]{5}
(C\nc)--(D\nc)-- (A\nc)
(A\nc)--(E\nc)--(H\nc)--(G\nc)--node[left,text=black]{5}(C\nc)
(D\nc)-- (H\nc);
%
\def\nc{2VG}
\draw[LineG](A\nc)--node[above,text=black]{48} (B\nc)--
(C\nc)--(D\nc)--node[right,text=black,text opacity=1]{} (A\nc)
(A\nc)--(E\nc)--(H\nc)--(G\nc)--(C\nc)
(D\nc)--node[right,text=black,text opacity=1]{} (H\nc);
\end{scope}
\end{scope}
%%%%%%%%%%%%%%%%%%%%%%%
%%1 column
%%%%%%%%%%%%%%%%%%%%%%%
\begin{scope}[shift={(-9.0,-1.2)}]
%big cube
\begin{scope}
\FillCube{1VD}{2}{0.2}{4.55}
\end{scope}
%%small cube=down
\begin{scope}[shift={(-0.25,0.5)}]
\SmallCube{1MDI}{0.8}{0.15}{1.7}
%%
\draw[LineR](A\nc)-- (B\nc)--
(C\nc)--(D\nc)-- node[left=-2pt,text=black,pos=0.4]{11}(A\nc)
(A\nc)--(E\nc)--(H\nc)--(G\nc)--node[left=3pt,text=black,pos=0.9]{11}(C\nc)
(D\nc)-- (H\nc);
%
\def\nc{1VD}
\draw[LineG](A\nc)--node[below,text=black]{3} (B\nc)--
(C\nc)--(D\nc)--node[right,text=black,text opacity=1]{} (A\nc)
(A\nc)--node[below left,text=black]{224}(E\nc)--
node[left,text=black,text opacity=1]{224}(H\nc)--(G\nc)--(C\nc)
(D\nc)-- (H\nc);
\end{scope}
%%small cube=up
\begin{scope}[shift={(-0.75,3.4)}]
\SmallCube{1MDII}{0.8}{0.15}{1.7}
%%
\draw[LineR](A\nc)-- (B\nc)--
(C\nc)--(D\nc)-- node[left=-2pt,text=black,pos=0.4]{11}(A\nc)
(A\nc)--(E\nc)--(H\nc)--(G\nc)--node[left=3pt,text=black,pos=0.9]{11}(C\nc)
(D\nc)-- (H\nc);
%
\def\nc{1VD}
\draw[LineG](A\nc)--node[below,text=black]{3} (B\nc)--
(C\nc)--(D\nc)--node[right,text=black,text opacity=1]{} (A\nc)
(A\nc)--node[below left,text=black]{224}(E\nc)--
node[left,text=black,text opacity=1]{224}(H\nc)--(G\nc)--(C\nc)
(D\nc)-- (H\nc);
\end{scope}
\end{scope}
%%%%
\begin{scope}[shift={(8.15,0)}]
\begin{scope}
\FillCube{6VD}{0.8}{2.0}{2}
\path(A6VD)--node[below]{128}(B6VD);
\path(A6VD)--node[right]{13}(D6VD);
\path(D6VD)--node[right]{13}(H6VD);
\end{scope}
%up
\begin{scope}[shift={(0,3.5)}]
\FillCube{6VG}{0.8}{2.0}{2}
\path(A6VG)--node[below]{128}(B6VG);
\end{scope}
\end{scope}

\newcommand\Boxx[3]{\node[draw,LineG,fill=green!10,rectangle,minimum width=7mm,minimum height=#2](#1){};
\node[below=2pt of #1]{#3};
}
\begin{scope}[shift={(11.7,1.0)}]
 \Boxx{B1D}{35mm}{2048}
\end{scope}
\begin{scope}[shift={(11.7,5.25)}]
 \Boxx{B1G}{35mm}{2048}
\end{scope}
\begin{scope}[shift={(13.5,1.0)}]
 \Boxx{B2D}{35mm}{2048}
\end{scope}
\begin{scope}[shift={(13.5,5.25)}]
 \Boxx{B2G}{35mm}{2048}
\end{scope}
\begin{scope}[shift={(15.0,1.0)}]
 \Boxx{B3}{19mm}{1000}
\end{scope}
%%%
\node[right=3pt of B1VD,align=center]{步幅为 4};
\node[right=3pt of B2VD,align=center]{最大池化};
\node[right=3pt of B3VD,align=center]{最大池化};
\node[align=right,anchor= east]at(B1D.south west){最大池化};
%
\coordinate(1C2)at($(A2VD)!0.4!(D2VD)$);
\foreach\i in{B,C,G}{
\draw[LineD](\i 1MDI)--(1C2);
}
\coordinate(2C2)at($(E2VG)!0.2!(H2VG)$);
\foreach\i in{B,C,G}{
\draw[LineD](\i 1MDII)--(2C2);
}
%3
\coordinate(1C3)at($(A3VD)!0.55!(H3VD)$);
\foreach\i in{B,C,G}{
\draw[LineD](\i 2MD)--(1C3);
}
\coordinate(2C3)at($(A3MGI)!0.35!(D3MGI)$);
\foreach\i in{B,C,G}{
\draw[LineD](\i 2MG)--(2C3);
}
%4
\coordinate(1C4)at($(A4VG)!0.15!(D4VG)$);
\foreach\i in{B,C,G}{
\draw[LineD](\i 3MGI)--(1C4);
}
\coordinate(2C4)at($(G4MD)!0.15!(H4MD)$);
\foreach\i in{B,C,G}{
\draw[LineD](\i 3MGII)--(2C4);
}
\coordinate(3C4)at($(A4MG)!0.5!(C4MG)$);
\foreach\i in{B,C,G}{
\draw[LineD](\i 3MDII)--(3C4);
}
\coordinate(3C4)at($(A4VD)!0.12!(D4VD)$);
\foreach\i in{B,C,G}{
\draw[LineD](\i 3MDI)--(3C4);
}
%5
\coordinate(1C5)at($(A5MG)!0.82!(H5MG)$);
\foreach\i in{B,C,G}{
\draw[LineD](\i 4MG)--(1C5);
}
\coordinate(2C5)at($(A5VD)!0.52!(C5VD)$);
\foreach\i in{B,C,G}{
\draw[LineD](\i 4MD)--(2C5);
}
%6
\coordinate(1C6)at($(A6VG)!0.52!(C6VG)$);
\foreach\i in{B,C,G}{
\draw[LineD](\i 5MG)--(1C6);
}
\coordinate(1C6)at($(D6VD)!0.3!(B6VD)$);
\foreach\i in{B,C,G}{
\draw[LineD](\i 5MD)--(1C6);
}
%
\draw[LineA]($(B6VD)!0.52!(C6VD)$)coordinate(X1)--
node[below]{全连接}(X1-|B1D.north west);
\draw[LineA](B1D)--node[below]{全连接}(B2D);
\draw[LineA](B2D)--(B3);
%
\draw[LineA]($(B6VG)!0.52!(C6VG)$)coordinate(X1)--(X1-|B1G.north west);
\draw[LineA]($(B6VG)!0.52!(C6VG)$)--(B1D);
\draw[LineA]($(B6VD)!0.52!(C6VD)$)--(B1G);
\draw[LineA](B1D)--(B2G);
\draw[LineA](B1G)--(B2D);
\draw[LineA](B2G)--node[right]{全连接}(B3);
\draw[LineA]($(B1G.north east)!0.7!(B1G.south east)$)--($(B2G.north west)!0.7!(B2G.south west)$);
\end{tikzpicture}硬件仍然决定着模型能够学习什么。由于每块 GTX 580 的视频随机存取存储器(VRAM)仅有 3 GB,AlexNet 将卷积层和全连接层分配到两条 GPU 流中。这种早期的模型并行设计预示了现代多 GPU 训练的发展方向。深度学习减少了对人工设计特征的需求,但也将主要制约因素转移到了存储数据、传输参数和协调计算所需的基础设施上。
深度学习实际上将特征工程瓶颈换成了新的计算瓶颈。GPT-3(拥有 175 billion 个参数)等模型体现了这一新挑战的规模。Brown et al. (2020) 报告称,其训练使用了约 300 billion 个词元,来源包括经过筛选的网页文本、书籍和维基百科。根据本书的稠密模型训练近似公式(\(C \approx 6 \times N \times D\),其中前向传播每个参数计 2 FLOPs,反向传播每个参数计 4 FLOPs,推导见 模型训练),这一参数量与词元量规模意味着约需 314 zettaFLOPs 的计算量(\(1\text{ zettaFLOP} = 10^{21}\text{ FLOPs}\))。词元数据集本身约占 420 GB。由于原始论文未说明确切的硬件集群配置,将这一计算预算折算为硬件运行时间,大致相当于当时的云端 GPU(例如 NVIDIA V100)运行 350 至 400 个加速器年;这是用于说明问题的系统估算,而非实测基准结果。首要工程挑战已从描述猫耳朵的特征,转变为协调大规模分布式训练并确保其不发生故障。
人工智能历史上的每一次重大转变,都可追溯到物理约束的变化,而非仅仅源于算法创新。Table 2 从核心推理优势、主要系统瓶颈和运行所需数据三个方面,对比了四个主要时代。
| 方面 | 符号主义人工智能 | 专家系统 | 统计学习 | 深度学习 |
|---|---|---|---|---|
| 核心优势 | 逻辑推理 | 领域专业知识 | 通用性 | 模式识别 |
| 瓶颈 | 脆弱性(规则失效) | 知识录入(专家稀缺) | 特征工程(人工预处理) | 计算与数据规模(基础设施成本) |
| 数据处理 | 仅需极少数据 | 基于领域知识 | 需要适量数据 | 海量数据处理 |
苦涩的教训
专家系统将工程精力投入领域知识的编码;深度学习系统则将这些精力投入吸收更多数据和计算资源。苦涩的教训 概括了这样一种历史规律:利用不断增长的计算资源的通用方法,持续优于对人类专业知识进行编码的方法。Richard Sutton15 在其 2019 年的文章《苦涩的教训》 (Sutton 2019) 中凝练了这一洞见。Sutton 写道:“从 70 年人工智能研究中可以得出的最大教训是,利用计算的通用方法最终最为有效,而且优势极为显著。”
Sutton, Richard S. 2019. “The Bitter Lesson.” Incompleteideas.net 43.
Table 3 将具有代表性的基准测试里程碑与其硬件基础对应起来。最后一列展示了从单线程 CPU 规则求值到数千个加速器组成的集群的演进,并以 2.5 million reference GPU-days 作为前沿模型训练规模的示例性参考值 (Patel and Wong 2023)。
| 时代 | 方法 | 代表性任务 | 性能 | 计算资源 |
|---|---|---|---|---|
| 专家系统(20 世纪 80 年代) | 人工编写规则 | 国际象棋(Elo 等级分) | 因系统而异 | 极少(规则求值) |
| 统计机器学习(20 世纪 90 年代至 21 世纪 00 年代) | 特征工程 + 学习 | 手写数字识别 | 在 MNIST 时代的基准测试上约为 98–99% (LeCun et al. 1998) | CPU 时代的特征流水线;资源随实现而异 |
| 深度学习(2012 年) | 端到端神经网络 | ImageNet top-5 准确率 | 84.7%(AlexNet) | 在 2 块 GPU 上运行 6 天 |
| 现代深度学习(2020 年起) | 大规模 Transformer | ImageNet top-1 准确率 | 88.55%(ViT-H/14)(Dosovitskiy et al. 2021) | 大规模张量处理单元(TPU)预训练 |
| 现代深度学习(2023 年) | 基础模型 | MMLU 基准测试 | 86.4%(GPT-4)(OpenAI et al. 2023) | 估计约为 2.5 million reference GPU-days(数量级相当于 25,000 块参考 GPU 运行 90 days)(Patel and Wong 2023) |
LeCun, Yann, Léon Bottou, Yoshua Bengio, and Patrick Haffner. 1998. “Gradient-Based Learning Applied to Document Recognition.” Proceedings of the IEEE 86 (11): 2278–324. https://doi.org/10.1109/5.726791.
OpenAI, Josh Achiam, Steven Adler, Sandhini Agarwal, Lama Ahmad, Ilge Akkaya, Florencia Leoni Aleman, et al. 2023. “GPT-4 Technical Report.” arXiv Preprint arXiv:2303.08774, ahead of print. https://doi.org/10.48550/arXiv.2303.08774.
Patel, Dylan, and Gerald Wong. 2023. GPT-4 Architecture, Infrastructure, Training Dataset, Costs, Vision, MoE. SemiAnalysis Blog.
ImageNet top-5 准确率和大规模多任务语言理解(MMLU)(基准测试)衡量的是不同能力,但具有共同的系统演进轨迹。硬件规模从单节点 CPU 执行扩展到数兆瓦级集群,印证了 Sutton 的观察:为利用原始算力而设计的方法,持续超越人工调优的表示。
自动博弈的早期里程碑也呈现出同样由硬件驱动的演进。在国际象棋领域,IBM 的深蓝(Deep Blue) 于 1997 年击败了世界冠军 Garry Kasparov16,其方法结合了定制国际象棋硬件、大规模搜索以及国际象棋专用评估知识。其评估函数编码了人类的国际象棋启发式知识,但定制芯片所支持的搜索规模,是将这些知识转化为冠军级棋力的关键。在围棋领域,DeepMind 的 AlphaGo17 (Silver et al. 2016) 将基于专家棋谱的监督学习、通过自我对弈进行的强化学习以及神经网络引导的树搜索相结合,实现了超越人类的表现,而非依赖人工编码的围棋策略。
Silver, David, Aja Huang, Chris J. Maddison, Arthur Guez, Laurent Sifre, George van den Driessche, Julian Schrittwieser, et al. 2016. “Mastering the Game of Go with Deep Neural Networks and Tree Search.” Nature 529 (7587): 484–89. https://doi.org/10.1038/nature16961.
这一教训之所以“苦涩”,是因为我们的直觉误导了我们。我们自然而然地认为,对人类专业知识进行编码应当是通向人工智能的道路。然而,只要规模足够,利用计算从数据中学习的系统就一再优于依赖人类知识的系统。这一规律贯穿了符号人工智能、统计学习和深度学习时代。
GPT-4 等现代语言模型以及 DALL-E 等图像生成系统直接体现了这一原理。它们的能力并非源于人类编码的语言学或艺术理论,而是源于利用大量计算资源,在海量数据上训练通用神经网络。对 GPT-3 规模模型的估算表明,其能耗约为 1.3 GWh18 (Patterson et al. 2021);而向数百万用户提供这些模型的服务,则使推理成为一个持续的数据中心供电、冷却和容量规划问题。
在实践中落实苦涩的教训,需要一门远超算法设计范畴的工程学科。当模型能力随原始算力扩展时,起制约作用的限制便转向内存带宽、19 互连延迟、散热能力和数据流水线吞吐量(硬件加速)。
计算规模的扩展使机器学习模型成为一种物理系统产物:它受功率范围、内存层次结构和通信开销的支配。构建这些系统,需要将数据移动、算术执行和运行可靠性视为一个统一问题。这一更广泛的职责就是人工智能工程,section 1.9 将对其作出正式阐述。要为这门学科奠定基础,需要结合具体生产服务的实际运行情况来定义其核心对象。
定义机器学习系统
回到统计学习历史中介绍的垃圾邮件过滤器。在生产规模下,这个看似简单的分类器面对的是全球每天数千亿封收发邮件的流量 (Statista Research Department 2024),大型服务提供商必须在毫秒内判断哪些邮件值得关注,哪些应被隔离。
Statista Research Department. 2024. Number of Sent and Received e-Mails Per Day Worldwide from 2017 to 2027. Statista.
这一看似简单的任务揭示了机器学习系统与传统软件的区别究竟是什么。挑战始于数据。过滤器利用数百万个有标签样本进行训练,并且必须随着垃圾邮件发送者策略的演变而持续适应,而非依赖程序员手动编码每一种垃圾邮件模式。随后,这又成为算法问题,因为模型必须从这些样本泛化到从未见过的邮件,同时平衡精确率与召回率,以免正常邮件被隐藏。最后,同一个决策又成为基础设施问题。服务提供商必须每天处理数十亿封邮件,随垃圾邮件的演变存储和更新模型,并在水平扩展的数据中心中以低于 100 ms 的延迟提供预测。因此,分类器只是一个持续演变的数据、软件与硬件系统中的组成部分。
当新的网络钓鱼模板出现时,数据层必须捕获具有代表性的邮件,算法必须区分攻击邮件与正常邮件,机器则必须在邮件投递前分发更新后的参数。任何一层都可能在其他层继续工作的同时发生故障,因此,从测量、学习到执行的完整链路才是恰当的分析单元。
Definition 1.1: 机器学习系统
机器学习系统 是一类软件系统,其核心行为由从数据中学习得到的参数决定,而非由显式编写的规则决定,因此其性能同时取决于数据质量、算法选择和硬件容量。
- 意义:需求贯穿端到端。只有当训练数据能够代表当前攻击、模型能够区分恶意邮件与正常邮件,且服务路径能够在投递时间预算内完成每封邮件的分类时,垃圾邮件过滤器才有用。任何一层的失败都会改变用户可见的结果。
- 区别:与传统软件不同,即使代码和权重不变,机器学习系统的准确率也可能随外部世界的变化而改变。生产环境中的输入分布可能相对于模型学习时的分布发生偏移,在不产生错误或异常的情况下悄然改变性能。
- 常见误区:模型并不等于系统。数据流水线、特征变换、服务基础设施、监控和反馈回路围绕着学习得到的参数,并且往往占据工程负担的主要部分 (Sculley et al. 2015)。
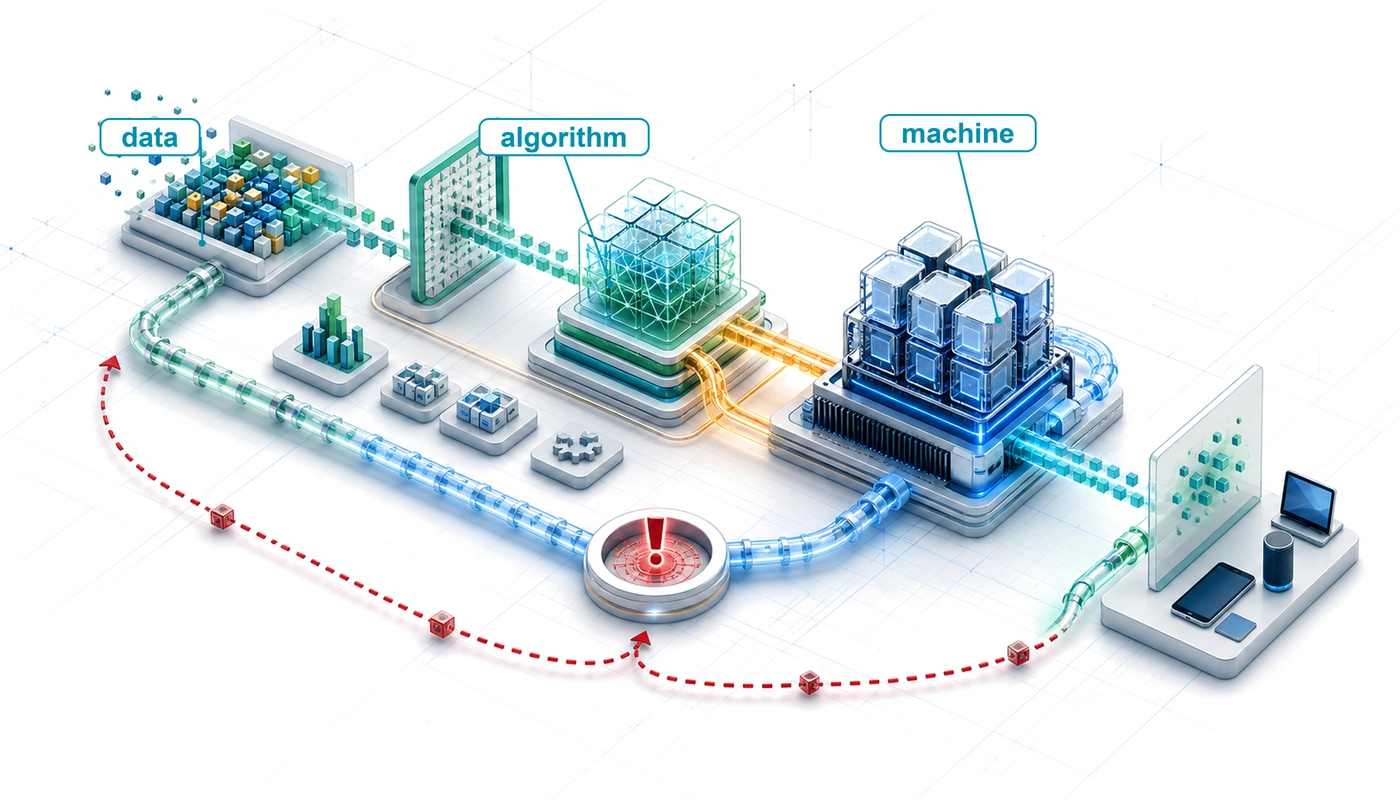
这一定义揭示了三个诊断轴:描述任务的数据、将这些样本转化为行为的算法,以及在运行预算内执行该行为的机器。数据—算法—机器分类体系为这些轴提供了一种可复用的形式。
同一种用户可见的症状可能源于三个轴中的任何一个。漏检一封网络钓鱼邮件,可能意味着缺少代表性样本、学习得到的决策边界不足以区分它,也可能意味着服务路径未能满足延迟预算。将每次漏检都视为模型问题,可能导致改进了错误的组件。有用的系统分类体系必须区分这些原因,同时承认它们并非彼此独立。
每一种解释都需要不同的证据。数据假设引导工程师检查覆盖度、标签和分布偏移。算法假设引导工程师检查错误切片、模型容量和学习目标。机器假设引导工程师检查延迟、吞吐量、内存和利用率。这些调查不能相互替代。更快的硬件无法提供从未采集过的样本,而更大的数据集也无法修复因内存饱和而错过截止时间的服务路径。
真正相关的约束,是放宽后能够改善端到端结果的那个约束。起制约作用的约束这一概念,可以防止团队去优化最显眼的组件,而非决定结果的组件。因此,数据—算法—机器的目的在于指导实际运行:识别下一个需要检验的假设,以及能够改变系统行为的干预类别。诊断是暂定的。一旦某项干预放宽了一项限制,就必须重新测量系统,因为此时可能由另一个轴起制约作用。数据—算法—机器是一个循环,而非一次性的标签。
Definition 1.2: 数据—算法—机器分类体系
数据—算法—机器分类体系 是一个诊断框架,沿三个轴对任何机器学习系统的性能瓶颈进行分类。数据 决定系统必须处理哪些样本和字节,算法决定模型结构以及学习或预测所需的工作量,机器决定可用于执行这些工作的硬件容量。其目标是识别哪个轴构成起制约作用的约束。
- 意义:即使尚未涉及详细的硬件计算,其诊断能力也已十分具体。如果垃圾邮件过滤器因训练集从未包含某种新网络钓鱼手法而漏检了一轮攻击,起制约作用的轴就是数据。如果训练样本充足,但模型无法表达该模式,起制约作用的轴就是算法。如果两者都足够,但服务在流量突增期间无法足够快速地对邮件进行分类,起制约作用的轴就是机器。定量诊断始于询问哪个轴正在限制系统。
- 区别:传统软件性能分析将代码和数据视为彼此分离的关注点,而数据—算法—机器分类体系认识到,算法选择直接决定了所需训练数据集的规模(Transformer 为实现泛化所需的数据量比线性模型高出数个数量级),也决定了运行该算法所需的机器。
- 常见误区:一个常见误解是认为这三个轴彼此独立。从简单分类器改为更大的模型,可能需要更多内存、不同的服务基础设施和覆盖范围更广的数据分布。这些轴会联动变化。
Figure 3 将这三个轴映射为一个相互依赖的诊断三元结构,其中沿任意一条边改变需求,都会直接调节另外两个轴所受的约束。
\scalebox{0.85}{
\begin{tikzpicture}[line join=round,font=\sffamily\small]
\tikzset{
 Line/.style={line width=0.35pt,black!50,text=black},
 ALineA/.style={violet!80!black!50,line width=3pt,shorten <=2pt,shorten >=2pt,
  {Triangle[width=1.1*6pt,length=0.8*6pt]}-{Triangle[width=1.1*6pt,length=0.8*6pt]}},
LineD/.style={line width=0.75pt,black!50,text=black,dashed,dash pattern=on 5pt off 3pt},
Circle/.style={inner xsep=2pt,
  circle,
    draw=BrownLine,
    line width=0.75pt,
    fill=BrownL!40,
    minimum size=16mm
  },
 circles/.pic={
\pgfkeys{/channel/.cd, #1}
\node[circle,draw=\channelcolor,line width=\Linewidth,fill=\channelcolor!10,
minimum size=2.5mm](\picname){};
        }
}
\tikzset {
pics/cloud/.style = {
        code = {\colorlet{red}{RedLine}
\begin{scope}[local bounding box=CLO,scale=0.5, every node/.append style={transform shape}]
\draw[red,fill=white,line width=0.9pt](0.67,1.21)to[out=55,in=90,distance=13](1.5,0.96)
to[out=360,in=30,distance=9](1.68,0.42);
\draw[red,fill=white,line width=0.9pt](0,0)to[out=170,in=180,distance=11](0.1,0.61)
to[out=90,in=105,distance=17](1.07,0.71)
to[out=20,in=75,distance=7](1.48,0.36)
to[out=350,in=0,distance=7](1.48,0)--(0,0);
\draw[red,fill=white,line width=0.9pt](0.27,0.71)to[bend left=25](0.49,0.96);

\end{scope}
    }
  }
}
%streaming
\tikzset{%
 LineST/.style={-{Circle[\channelcolor,fill=RedLine,length=4pt]},draw=\channelcolor,line width=\Linewidth,rounded corners},
 ellipseST/.style={fill=\channelcolor,ellipse,minimum width = 2.5mm, inner sep=2pt, minimum height =1.5mm},
 BoxST/.style={line width=\Linewidth,fill=white,draw=\channelcolor,rectangle,minimum width=56,
 minimum height=16,rounded corners=1.2pt},
 pics/streaming/.style = {
        code = {\pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=STREAMING,scale=\scalefac, every node/.append style={transform shape}]
\node[BoxST,minimum width=44,minimum height=48](\picname-RE1){};
\foreach \i/\j in{1/north,2/center,3/south}{
\node[BoxST](\picname-GR\i)at(\picname-RE1.\j){};
\node[ellipseST]at($(\picname-GR\i.west)!0.2!(\picname-GR\i.east)$){};
\node[ellipseST]at($(\picname-GR\i.west)!0.4!(\picname-GR\i.east)$){};
}
\draw[LineST](\picname-GR3)--++(2,0)coordinate(\picname-C4);
\draw[LineST](\picname-GR3.320)--++(0,-0.7)--++(0.8,0)coordinate(\picname-C5);
\draw[LineST](\picname-GR3.220)--++(0,-0.7)--++(-0.8,0)coordinate(\picname-C6);
\draw[LineST](\picname-GR3)--++(-2,0)coordinate(\picname-C7);
 \end{scope}
     }
  }
}
%data
\tikzset{mycylinder/.style={cylinder, shape border rotate=90, aspect=1.3, draw, fill=white,
minimum width=25mm,minimum height=11mm,line width=\Linewidth,node distance=-0.15},
pics/data/.style = {
        code = {\pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=STREAMING,scale=\scalefac, every node/.append style={transform shape}]
\node[mycylinder,fill=\channelcolor!50] (A) {};
\node[mycylinder, above=of A,fill=\channelcolor!30] (B) {};
\node[mycylinder, above=of B,fill=\channelcolor!10] (C) {};
 \end{scope}
     }
  }
}
\pgfkeys{
  /channel/.cd,
  channelcolor/.store in=\channelcolor,
  drawchannelcolor/.store in=\drawchannelcolor,
  scalefac/.store in=\scalefac,
  Linewidth/.store in=\Linewidth,
  picname/.store in=\picname,
  channelcolor=BrownLine,
  drawchannelcolor=BrownLine,
  scalefac=1,
  Linewidth=0.5pt,
  picname=C
}
\node[Circle](MO){};
\node[Circle,below right=0.85 and 2.5 of MO,draw=GreenLine,fill=GreenL!40,](IN){};
\node[Circle,below left=0.85 and 2.5 of MO,draw=OrangeLine,fill=OrangeL!40,](DA){};
\draw[ALineA](MO)--(IN);
\draw[ALineA](MO)--(DA);
\draw[ALineA](DA)--(IN);
\node[below=2pt of MO]{算法};
\node[below=2pt of IN]{机器};
\node[below=2pt of DA]{数据};
%%
\begin{scope}[local bounding box=CIRCLE1,shift={($(MO)+(0.04,-0.24)$)},
scale=0.55, every node/.append style={transform shape}]
%1 column
\foreach \j in {1,2,3} {
  \pgfmathsetmacro{\y}{(1.5-\j)*0.43 + 0.7}
  \pic at (-0.8,\y) {circles={channelcolor=RedLine,picname=1CD\j}};
}
%2 column
\foreach \i in {1,...,4} {
  \pgfmathsetmacro{\y}{(2-\i)*0.43+0.7}
  \pic at (0,\y) {circles={channelcolor=RedLine, picname=2CD\i}};
}
%3 column
\foreach \j in {1,2} {
  \pgfmathsetmacro{\y}{(1-\j)*0.43 + 0.7}
  \pic at (0.8,\y) {circles={channelcolor=RedLine,picname=3CD\j}};
}
\foreach \i in {1,2,3}{
  \foreach \j in {1,2,3,4}{
\draw[Line](1CD\i)--(2CD\j);
}}
\foreach \i in {1,2,3,4}{
  \foreach \j in {1,2}{
\draw[Line](2CD\i)--(3CD\j);
}}
\end{scope}
%
\pic[shift={(-0.4,-0.08)}] at (IN) {cloud};
%
\pic[shift={(-0.05,-0.13)}] at  (IN){streaming={scalefac=0.25,picname=2,channelcolor=RedLine, Linewidth=0.65pt}};
%
\pic[shift={(0,-0.3)}] at  (DA){data={scalefac=0.3,picname=1,channelcolor=green!70!black, Linewidth=0.4pt}};
\end{tikzpicture}}这一三元组为根因分析提供了操作规程。它将端到端症状(如准确率下降、尾延迟超限或成本超支)转化为三条系统性的测量路径:检查输入证据(数据)、刻画数学工作负载(算法),以及剖析物理硬件的执行情况(机器)。只有在放宽所识别的约束确实改善了整个系统的表现时,诊断才具有可信度。
figure 3 中的双向连线强调,对某一顶点的干预往往会将起决定作用的约束转移到另一顶点。升级为更快的加速器(机器)后,如果存储 I/O 无法足够快地以流式方式提供输入批次(数据),执行单元仍可能处于空闲状态。扩大数据集规模(数据)可能暴露出模型架构的表达能力不足,无法吸收新的模式(算法)。扩大模型容量以弥补这一差距(算法),又可能超出加速器的内存容量,引发非合并的内存溢出访问或内存不足故障(机器)。机器学习系统工程既需要识别当前起决定作用的约束,也需要预判该约束放宽后瓶颈将迁移到何处。
尽管这一三元组将三个轴分开以简化初步诊断,实际系统却运行于它们的交界处。数据格式支配内存流量,模型架构决定硬件功能单元的利用率,而部署预算则同时重塑数据表示和算法设计。Figure 4 展示了这些两两交界区域及其共同的中心。
\begin{tikzpicture}[line join=round,outer sep=0pt,inner sep=3pt]
\tikzset{%
  TxtC/.style={font=\sffamily\bfseries\small,text=datacol,align=center},
  TxtIT/.style={font=\sffamily\itshape\fontsize{8}{11}\selectfont,text=black!70,align=center},
  TxtSM/.style={font=\fontsize{7}{9}\selectfont\sffamily,text=black,align=center},
  TxtJM/.style={font=\fontsize{6}{8}\selectfont\sffamily\itshape,text=black!70,align=center},
   TxtCOL/.style={font=\fontsize{8}{11}\selectfont\sffamily,text=violet!70!black,align=center},
  LineA/.style={black!50,line width=1.0pt,{Circle[black!70,length=3.5pt]}-},
    Box/.style={align=flush center,
    inner xsep=3pt,
    node distance=0.54,
    draw=mybrown,
    line width=0.75pt,
    fill=mybrown!05,
    font=\fontsize{7}{9}\selectfont\sffamily,
    text width=41mm,
    minimum width=41mm, %minimum height=28mm
  },
}
%------------------------------------------------
% Colors
%------------------------------------------------
\definecolor{datacol}{RGB}{173,32,52}      % tamno crvena
\definecolor{algocol}{RGB}{0,82,170}       % plava
\definecolor{machcol}{RGB}{36,145,85}      % zelena
\definecolor{mutecol}{RGB}{90,90,90}       % siva za sitan tekst
\definecolor{lightdat}{RGB}{244,226,229}
\definecolor{lightalg}{RGB}{225,234,245}
\definecolor{lightmach}{RGB}{226,242,232}
%------------------------------------------------
% Centri krugova
%------------------------------------------------
\coordinate (D) at (0,2.6);
\coordinate (A) at (-2.02,-0.55);
\coordinate (M) at (2.02,-0.55);

\def\R{3.35}

%------------------------------------------------
% Circles
%------------------------------------------------
\fill[lightdat,opacity=0.55] (D) circle (\R);
\fill[lightalg,opacity=0.55] (A) circle (\R);
\fill[lightmach,opacity=0.55] (M) circle (\R);

\draw[datacol,line width=0.9pt] (D) circle (\R);
\draw[algocol,line width=0.9pt] (A) circle (\R);
\draw[machcol,line width=0.9pt] (M) circle (\R);
%------------------------------------------------
% Gornji krug: Data
%------------------------------------------------
\node[TxtC,text=datacol](DA) at (0,5.15) {数据};
\node[TxtIT,below=0pt of DA](TFI) {燃料 --- 信息};
\node[TxtSM,below=0pt of TFI](STO) {存储格式、数据质量\\分布特性、标注};
\node[TxtJM,below=0pt of STO](CH1) {章节:数据工程};
%------------------------------------------------
% Levi krug: Algorithm
%------------------------------------------------
\node[TxtC,text=algocol](AL) at (-3.2,-0.8) {算法};
\node[TxtIT,below=0pt of AL](TFI1) {蓝图 --- 逻辑};
\node[TxtSM,below=0pt of TFI1](STO1) {损失函数、架构\\优化数学、梯度};
\node[TxtJM,below=0pt of STO1](CH2) {章节:深度学习入门、深度神经网络架构};
%------------------------------------------------
% Desni krug: Machine
%------------------------------------------------
\node[TxtC,text=machcol] at (3.1,-0.8)(MA) {机器};
\node[TxtIT,below=0pt of MA](TFI2) {引擎 --- 物理};
\node[TxtSM,below=0pt of TFI2](STO2) {硅芯片、内存层次结构\\峰值 FLOP/s、功耗范围};
\node[TxtJM,below=0pt of STO2](CH3) {章节:硬件加速};
%------------------------------------------------
% Levi presek D ∩ A
%------------------------------------------------
\node[TxtC,text=black!75](PDA) at (-2.17,2.2) {D $\cap$ A};
\node[TxtCOL,below=0pt of PDA](WLF) {从什么中\\学习};
\draw[LineA](WLF.150)--++(150:3.85)coordinate(TXT1);
\node[Box,anchor = south]at(TXT1){数据选择、课程学习\\
主动学习、数据增强\\计算最优扩展
\\[1ex]{\sffamily\itshape\fontsize{6}{8}\selectfont \textcolor{black!80}{章节:数据选择、训练}}};
%------------------------------------------------
% Desni presek D ∩ M
%------------------------------------------------
\node[TxtC,text=black!75] at (1.95,2.45)(PDM) {D $\cap$ M};
\node[TxtCOL,below=0pt of PDM](HMI) {如何移动\\信息};
\draw[LineA](HMI.20)--++(30:3.85)coordinate(TXT1);
\node[Box,anchor = south]at(TXT1){I/O 带宽、预取\\
内存层次结构、数据格式\\数据引力、数据搬移能耗
\\[1ex]{\sffamily\itshape\fontsize{6}{8}\selectfont \textcolor{black!80}{章节:数据工程、硬件加速}}};
%------------------------------------------------
% Donji presek A ∩ M
%------------------------------------------------
\node[TxtC,text=black!75](PAM) at (0,-1.2) {A $\cap$ M};
\node[TxtCOL,below=0pt of PAM](HEE) {如何高效\\执行};
\draw[LineA](HEE.260)--++(270:1.9)coordinate(TXT1);
\node[Box,anchor = north]at(TXT1){量化、剪枝、内核融合\\
计算图、混合精度\\算子调度、张量核心
\\[1ex]{\sffamily\itshape\fontsize{6}{8}\selectfont \textcolor{black!80}{章节:框架、模型压缩}}};
%------------------------------------------------
% Centralni presek D ∩ A ∩ M
%------------------------------------------------
\node[TxtC,text=datacol] at (0,0.8) (DAM){D $\cap$ A $\cap$ M};
\node[TxtCOL,below=0pt of DAM,text=datacol](MLS) {机器学习系统\\工程};
\draw[LineA]([yshift=-1mm]MLS.260)--++(170:6.2)coordinate(TXT1);
\node[Box,anchor = east,    text width=25mm,
    minimum width=25mm,]at(TXT1){机器学习系统铁律 - Roofline 模型\\训练 - 模型服务};
%------------------------------------------------
% Donja linija i fusnota
%------------------------------------------------
\draw[gray!55,line width=0.5pt] (-6.3,-5.85) -- (6.3,-5.85);

\node[align=center,font=\sffamily \fontsize{7}{10}\selectfont,text=black!70] at (0,-6.125)
  {中心 --- 数据、算法和机器汇聚之处 --- 就是机器学习系统工程本身。};
\end{tikzpicture}维恩图由外部边界向内组织这些关系:数据与算法决定系统能从什么中学习;数据与机器决定信息如何移动;算法与机器决定计算如何高效执行。在中心,必须同时回答这三个问题。这一交叉区域定义了机器学习系统工程。
这些交叉关系反映了支配实现过程的物理权衡。数据选择和训练动态通过确定收敛所需的经验信号量,解决数据与算法交界处的问题。数据工程和硬件加速支配数据与机器之间的接口;在此,总线宽度、PCIe 通道数和存储带宽决定张量到达执行单元的速度。框架、编译和内核调度解决算法与机器交界处的问题,将稠密线性代数映射到执行单元,同时尽量减少内存访问停顿。
任何设计选择都不会孤立存在。对模型进行剪枝(算法)会改变其内存占用和缓存驻留情况(机器),而以流式方式传输压缩特征则会改变数据流水线的吞吐量以及主机到设备的传输延迟(数据)。在生产环境的机器学习中,忽略这些交叉关系的局部优化只会使瓶颈跨越边界发生转移。
数据—算法—机器全景提供了诊断框架,但构建真实系统还需要一个纵向层次结构,将硅芯片的物理极限与端到端应用任务联系起来。
从硅芯片到任务的四层结构
本书分析的每个机器学习系统都由四个层次构成,以确保能够追溯硅芯片层面的决策对最终任务的影响。
- 硬件(硅芯片)。 物理基础(引擎)定义峰值计算吞吐量 \((R_{\text{peak}})\)、内存带宽 \((\text{BW})\) 和内存容量。当部署场景需要数值约束时,具体的硬件孪生体为这些量提供实例值。
- 系统(平台)。 集成部署单元(汽车)通过其功耗预算、散热限制和节点级互连定义运行范围。例如训练集群节点或亚瓦级传感器节点。
- 工作负载(模型)。 算法需求(路线)包括运算次数 \((O)\)、搬移的数据量 \((D_{\text{vol}})\) 和数据布局。特定场景的工作负载,如 GPT-4 和 Wake Vision(规模适配微控制器的视觉唤醒词数据集),为特定任务提供这些需求的实例值。
- 任务(场景)。 应用背景(目的地)位于整个层次结构的顶端,系统在这一背景下部署以解决特定问题。任务会引入电池续航、安全延迟或云成本上限等要求,从而决定其下各层的配置。
这一层次结构确保系统优化始终立足于整体架构。矩阵内核中的微优化,只有在能够拓展部署平台的运行范围,或满足关键任务的延迟期限时,才有意义。section 1.9.1 中的生命周期分析将每类反复出现的任务与其工作负载及起决定作用的约束相配对,将硅芯片吞吐量直接关联到运行目标。
Systems Perspective 1.1: 机器学习系统全景:四种部署范式
机器学习系统在计算能力上的跨度约为 \(10^{6}\) 倍,在内存容量上的跨度约为 \(10^{5}\) 倍。Table 4 对比了四种部署范式的内存、计算和功耗范围;这些范式定义了后续各章所面对的约束。
Table 4: 四种部署范式:云端、边缘、移动和 TinyML 系统的代表性内存、计算和功耗范围,揭示了使模型无法在各层级之间简单复用的多个数量级跨度。具体的硬件孪生体和峰值速率计算见硬件相关章节。
| 范式 | 代表性系统 | 内存范围 | 计算能力范围 | 功耗范围 |
|---|---|---|---|---|
| 云端 | 数据中心加速器节点 | 大容量设备内存加存储(\(\approx 10^{11}\,\text{B}\)) | 吞吐量最高的层级(\(\approx 10^{15}\,\text{ops/s}\)) | 由设施统一管理的供电 |
| 边缘 | 机器人或工业网关 | 受部署限制的本地内存(\(\approx 10^{11}\,\text{B}\)) | 本地加速器或 CPU 预算(\(\approx 10^{14}\,\text{ops/s}\)) | 市电、车载或现场供电 |
| 移动 | 智能手机或可穿戴设备级 SoC | 共享应用内存(\(\approx 10^{10}\,\text{B}\)) | 手机级神经网络、GPU 和 CPU 引擎(\(\approx 10^{13}\,\text{ops/s}\)) | 电池与散热上限 |
| TinyML | 微控制器节点 | 千字节级内存(\(\approx 10^{6}\,\text{B}\)) | 始终开启的传感器计算(\(\approx 10^{9}\,\text{ops/s}\)) | 毫瓦级电池功耗预算 |
沿内存和计算列从云端读到 TinyML,可以看到两端的内存相差 \(10^{5}\) 倍,计算能力相差 \(10^{6}\) 倍。正是这种差异,使工程师无法仅通过缩小云端模型就让它在边缘运行;每个层级都需要从根本上重新设计数据—算法—机器这三个轴。
这四种部署范式之间跨越多个数量级的差异,会直接转化为财务成本和运营成本。一个能够轻松容纳于数据中心加速器内存中的架构,无法原封不动地在微控制器级设备上执行。要弥合这种物理差异,就必须在一项统领全局的经济约束下,权衡数据质量、算法复杂度与硬件能力:每美元完成的有效工作量。
Systems Perspective 1.2: 每美元完成的有效工作
研究人员通常以准确率为优化目标,而系统工程师必须以每美元完成的有效工作为优化目标。令 \(O_{\text{total}}\) 表示所有样本呈现过程中执行的总运算量,并将成本效率定义为每美元提供的有效运算量。Equation 2 给出了一个量纲一致的一阶成本模型: \[ \text{Compute Cost} \approx \frac{O_{\text{total}}}{\text{Useful Operations per Dollar}} \tag{2}\]
数据—算法—机器的每个维度都以不同方式改善这一比值。更好的数据可以减少达到目标质量所需的样本呈现次数。更高效的算法可以减少处理每个样本所需的运算量,而成本效率更高的硬件则可以增加每美元提供的有效运算量。
系统工程需要权衡这些取舍。在预算相同的情况下,成本效率提高 10% 可以支持约 10% 的额外有效运算,但应将这些运算分配给更多数据、更多训练轮次,还是容量更大的模型,取决于该工作负载的学习曲线弹性。如果误差随数据集大小 \(D\) 按 \(D^{-\alpha}\) 缩放,那么数据集扩大 10% 所带来的经验收益由 \(\alpha \log(1.1)\) 决定,而非任意固定百分比。系统工程师必须估计目标工作负载的这一弹性,才能确定将资源分配到何处可获得最高的边际回报。
这些相互作用不仅决定运营支出,也决定系统如何失效。数据流水线损坏、未建模的分布偏移或硬件带宽饱和,都可能在不触发操作系统崩溃或运行时异常的情况下,悄然导致生产环境中的模型行为退化。
机器学习与传统软件
按照数据—算法—机器分类体系,机器学习系统整合了定义行为的数据、提取统计模式的算法,以及执行训练和推理的机器。20 要理解这些系统的工程实践与传统软件有何不同,首先需要了解它们在生产环境中如何失效。
传统软件缺陷通常会产生显式的失效模式:应用程序崩溃、未处理的异常向上传播、进程以非零退出码终止,以及健康检查端点报告 HTTP 错误状态。尽管传统软件也可能产生静默的数值错误或逻辑缺陷,但机器学习使静默退化 成为一种主要的运行失效模式。运行时执行指令没有出错,内存分配成功,推理服务器返回预测结果所需的时间远低于延迟服务等级协议(SLA)的上限,但输出的统计有效性却持续恶化。
例如,在汽车驾驶辅助系统中,传统控制软件通过诊断故障码和硬件看门狗定时器暴露硬件或通信故障。基于机器学习的感知流水线则引入了一种这些看门狗无法察觉的失效模式。随着季节变化带来训练分布中代表性不足的冬季低角度阳光、强降水或厚重衣物,其行人检测准确率可能在数月内从 95% 降至 85%。嵌入式加速器仍以全帧率调度视觉内核,且不报告任何硬件故障,但车辆运行的安全风险已经升高,而标准操作系统遥测无法捕捉这一风险。
在安全关键场景中,这种退化的影响十分严重。以 10 Hz 运行的感知模型每小时评估 36,000 帧。虽然 0.1% 的假阴性率仅适用于包含真实行人的帧,但漏检的绝对次数取决于遇到行人的频率、时间滤波、传感器融合启发式方法,以及运行设计域的约束。准确率从 95% 降至 85%,即下降 10 个百分点,会直接成倍增加下游控制逻辑在检测原本就处于临界状态的边缘情形中面临的风险暴露率。
这种失效模式同时涉及数据—算法—机器的全部三个维度。在数据维度上,随着环境条件、用户行为或物理传感器校准偏离训练基线,输入分布发生漂移 (Gama et al. 2014; Quiñonero-Candela et al. 2009)。在算法维度上,模型将固定的参数权重应用于不符合原始分布假设的输入,产生质量下降的概率输出,却不触发 NaN 或无穷大等数值异常。在机器维度上,加速器以最大吞吐量执行内核调度,并使张量流经内存层次结构,在数百万次推理中规模化地产生退化输出,却不触发任何硬件中断。
由于这种失效模式不会产生操作系统异常或硬件故障,因此检测它需要能够度量分布差异的定量信号。正如硬件执行时间可以分解为物理延迟分量,模型退化也可以近似表示为分布偏移的函数。令 \(\text{Accuracy}_0\) 表示部署时的基线准确率,\(\mathcal{D}(P_t \lVert P_0)\) 表示当前生产分布 \(P_t\) 与训练分布 \(P_0\) 之间的统计散度,\(\lambda\) 表示通过局部拟合得到的、对该偏移度量的敏感度。这一关系在 equation 3 中形式化表示,并在页边图中示意,称为退化方程: \[ \text{Accuracy}(t) \approx \text{Accuracy}_0 - \lambda \cdot \mathcal{D}(P_t \lVert P_0) \tag{3}\]
准确率可能随着分布漂移而悄然下降。
当带标签的真实值验证了这一经验关系时,这种一阶线性化可以刻画局部趋势。当 \(P_t\) 不同于 \(P_0\) 时,就会发生数据漂移,即使模型二进制文件和执行环境逐字节完全一致,推理质量仍会下降。在严重的分布坍缩下,这一近似不再成立,而散度度量 \(\mathcal{D}(\cdot \lVert \cdot)\) 则有意保持一般形式——通常通过 Kullback-Leibler(KL)散度、全变差距离或 Wasserstein 距离来计算。由于缺少标签反馈时,仅凭统计散度无法确定准确率变化的方向或下降的严重程度,因此这一诊断框架提供了三种具体的工程调控手段:
- 提高初始准确率 \((\text{Accuracy}_0)\)。扩大训练数据规模、改进目标函数,以及采用容量更大的架构,可以提高基线性能,使截距上移,而不改变对漂移的敏感度。
- 降低对分布的敏感度 \((\lambda)\)。数据增强、领域自适应和正则化表征可以使退化曲线更平缓,在更广泛的输入分布下保持性能。
- 监测漂移及其结果(\(\mathcal{D}(P_t \lVert P_0)\))。跟踪输入特征流的统计散度可以提供预警信号,而延迟获得的真实标签则用于验证观测到的漂移是否已经引发功能退化。
在实践中,知道何时重新评估与知道如何训练同样重要。 自动化模型服务系统可以在分布散度越过运行阈值 \(\mathcal{D}(P_t \lVert P_0) > \tau\) 时发出告警,并在真实标签确认性能退化后触发重训练流水线。如果没有自动化漂移监测,推理系统就无法感知输入的变化。机器学习运维 将详细阐述实现这一原则的监测基础设施与告警策略。
静默退化并非仅源于外部环境变化。它也经常源于被称为训练与服务偏差 的内部架构缺陷。在生产机器学习系统中,特征工程通常跨两个不同的软件栈实现:一个是离线批处理流水线(例如 Spark 或 SQL),用于从历史数据湖生成训练数据集;另一个是在线微服务(使用 C++、Go 或 Rust 编写),用于在实时推理期间,在毫秒级延迟约束下计算特征。如果在线特征提取逻辑与离线实现之间存在哪怕细微的差异——例如计算滑动窗口平均值而非滚动窗口分桶、采用不同的时区归一化方式,或使用相互冲突的默认值处理缺失值——模型接收到的特征表征就会违背其训练假设。模型二进制文件正常执行,内存缓冲区保持有效,服务延迟也处于正常范围,但预测准确率在部署时骤降。训练与服务偏差本质上是一种分布式系统同步缺陷,却表现为算法失效。
这些失效模式重塑了整个工程生命周期。传统软件监测跟踪主机健康状况:CPU 利用率、内存驻留量、网络 I/O 和 HTTP 状态码。机器学习运维必须在跟踪这些基础设施指标的同时,跟踪数据质量、特征分布和预测准确率。由于机器学习系统可能在基础设施指标看似正常时静默失效,系统设计必须将持续评估贯穿于从数据摄取到推理服务的全过程。
应对静默退化,是机器学习系统双重使命的前半部分:确保学到的行为在非平稳世界中保持统计可靠性。使命的后半部分涉及物理执行:确保机器能够在严格的延迟、内存、能源和资金预算内评估并更新这种行为。随着计算规模持续决定机器学习的能力,系统工程需要对从物理上制约这种规模的内存带宽、算术吞吐量和通信开销进行定量推理。
机器学习系统铁律
计算规模的物理成本在两种常见的失效情形中变得具体可见。存储无法向加速器及时提供数据时,训练任务会停滞;模型状态在内存中或跨网络移动过慢时,推理路径会错过截止时间。两者的表现不同,但都通过数据移动、计算和固定开销消耗同一份有限的时间预算。机器学习系统铁律 将总执行时间 \(T\)(秒)分解为这三类物理成本,从而明确揭示这一共同结构(equation 4): \[T = \underbrace{\frac{D_{\text{vol}}}{\text{BW}}}_{\text{The Data Term}} + \underbrace{\frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}}}_{\text{The Compute Term}} + \underbrace{L_{\text{lat}}}_{\text{The Latency Term}} \tag{4}\]
这一方程是本书的数学主干。 无论是耗时数周的模型训练,还是毫秒级的推理服务,它都将任何机器学习任务所需的总时间分解为三项,直接对应于 section 1.1 中所介绍的双重使命所面临的物理约束:
- 数据项 \((D_{\text{vol}}/\text{BW})\) 表示移动比特的物理成本。\(D_{\text{vol}}\) 是移动的数据量(字节),\(\text{BW}\) 是内存或网络带宽(字节/秒)。无论是从云存储加载数 TB 的数据,还是从高带宽内存获取权重,性能往往受限于 I/O 的物理约束。第一部分将阐述这一基础。
- 计算项 \((O/(R_{\text{peak}} \cdot \eta_{\text{hw}}))\) 表示算术运算的成本。\(O\) 是浮点运算次数(FLOPs),\(R_{\text{peak}}\) 是硬件的理论峰值吞吐量(FLOP/s),\(\eta_{\text{hw}}\) 是无量纲的实际硬件利用率 \((0 \le \eta_{\text{hw}} \le 1)\)。第二部分和第三部分将阐述这一项。
- 延迟项 \((L_{\text{lat}})\) 表示系统编排、网络通信和序列化所带来的不可消除的“税负”(秒)。在实时部署中,这种固定延迟占主导地位。第四部分将阐述这一项。
Systems Perspective 1.3: 铁律的类比
“铁律”这一名称沿用了 Patterson 和 Hennessy 的处理器性能铁律 (Hennessy and Patterson 2017)。P&H 的铁律是一种乘法分解(通过因式分解 CPU 时间得到的恒等式),而这里的方程则是一种一阶加法模型,在简化假设下近似描述性能。
加法形式假设顺序执行。当数据移动与计算重叠时,我们以二者的关键路径下界替代求和,如 equation 5 所示: \[T_{\text{pipelined}} \ge \max\left(\frac{D_{\text{vol}}}{\text{BW}}, \frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}}\right) + L_{\text{lat}} \tag{5}\] 这种基于最大值的表述,在系统层面等价于使异步直接内存访问(DMA)数据传输与正在进行的算术逻辑单元(ALU)计算重叠,其中较慢流水线阶段的执行时间掩盖了较快阶段的延迟。等号成立要求理想的重叠,并假设 \(L_{\text{lat}}\) 始终位于重叠阶段之外。
即使采用加法形式,铁律依然有用,因为它与 Amdahl 定律 (Amdahl 1967) 一样,价值在于优化之前识别占主导地位的物理约束。数据—算法—机器协同:从求和到取最大值 给出了更精细的论述,包括如何通过流水线和重叠技术,将加法模型转化为实践中使用的基于最大值的表述。
Amdahl, Gene M. 1967. “Validity of the Single Processor Approach to Achieving Large Scale Computing Capabilities.” Proceedings of the April 18-20, 1967, Spring Joint Computer Conference on - AFIPS ’67 (Spring), AFIPS ’67 (spring), 483–85. https://doi.org/10.1145/1465482.1465560.
Hennessy, John L., and David A. Patterson. 2017. Computer Architecture: A Quantitative Approach. 6th ed. Morgan Kaufmann.
只有当工程师能够诊断出关键路径上哪一项占主导地位时,分解执行时间才有意义。Roofline 模型通过脊点 界定了数据移动与计算之间的边界:在脊点以下,数据移动占主导地位;在脊点以上,算术吞吐量占主导地位(Roofline 模型 将给出形式化推导)。本书阐述的每一种优化技术,都是通过减少数据移动量(\(D_{\text{vol}}\))、减少执行的运算量(\(O\))、更有效地利用硬件(\(\eta_{\text{hw}}\)),或掩盖编排延迟(\(L_{\text{lat}}\)),来调整这些变量之一。下面对 GPT-3 级别模型训练的估算展示了效率变化如何通过铁律传导,从而使这种调整变得具体可见。
Napkin Math 1.1: 训练 GPT-3
问题:在配备 1,024 accelerators 的参考集群上,训练一个 GPT-3 级别的模型需要多长时间?
已知条件:
- 运算量 \((O)\):\(\approx 3.14 \times 10^{23}\ \text{FLOPs}\)
- 峰值吞吐量 \((R_{\text{peak}})\):312 TFLOP/s
- 效率 \((\eta_{\text{hw}})\):≈ 45 percent(大规模分布式训练的典型值)
- 规模 \((N_{\text{accel}})\):1,024 accelerators
计算:
由于大规模语言模型预训练具有较高的算术强度,并通过流水线使数据加载异步进行、隐藏在矩阵乘法之后,因此计算项主导关键路径。单独考察 \(N_{\text{accel}}\) 个并行加速器上的这一项,可得:
- \(T_{\text{train}} \approx \frac{O}{N_{\text{accel}} \cdot R_{\text{peak}} \cdot \eta_{\text{hw}}}\) \(\approx \frac{3.14 \times 10^{23}}{1024 \times 312 \times 10^{12} \times 0.45}\) \(\approx 25\ \text{days}\)
结果: 25 days。
系统启示:如果通过更好的调度和更高效的执行,将硬件利用率 \((\eta_{\text{hw}})\) 从 45 percent 提高到 60 percent,训练时间就会降至 19 days,从而节省 6 days 的昂贵计算时间。
该方程在量纲上是一致的,因为每一项最终都以秒为单位。正如不能将米与千克相加一样,也不能将 FLOPs 与字节相加;铁律将时间、时间和时间相加。量纲分析 中的形式化论述验证了这种一致性,并展示了单位跟踪如何防止常见的建模错误。
铁律决定执行时间,但时间并非唯一的物理约束。无论是电池供电的边缘设备,还是仓库规模的加速器集群,能量耗散和散热限制往往会在吞吐量达到上限之前就约束系统。在内存层次结构中移动比特会产生一种能耗税,与数据项中的延迟相对应。
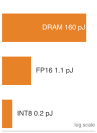
移动一个字节的能耗约为一次 FP16 运算的 145 倍,这就是数据移动税。
令 \(D_{\text{vol}}\) 为移动的总数据量(字节),\(E_{\text{move}}\) 为每移动一个字节消耗的能量,\(O\) 为总运算次数,\(E_{\text{compute}}\) 为每次运算消耗的能量。根据数据移动能耗可能高于算术运算能耗这一硬件能耗观察 (Horowitz 2014),Equation 6 将这一关系形式化: \[ E_{\text{total}} \approx \underbrace{ D_{\text{vol}} \times E_{\text{move}} }_{\text{Movement Term}} + \underbrace{ O \times E_{\text{compute}} }_{\text{Compute Term}} \tag{6}\]
就单次访问而言,数据移动的能耗可能远高于算术运算,因此 \(E_{\text{move}} \gg E_{\text{compute}}\)。根据本书采用的能耗常数,从片外动态随机存取存储器(DRAM)移动一个字节所消耗的能量,约为一次 FP16 乘法能耗的 145.5×,以及一次 INT8(8 位整数)乘法能耗的 800× (Horowitz 2014)。数据移动是否主导整个工作负载的能耗,还取决于相对于运算次数而言的数据传输次数和每次传输的宽度。单次访问能耗存在差距的物理原因在于,数据移动需要对较长距离的连线进行充放电,而算术运算则在处理单元的局部电路内完成。因此,尽量减少可避免的数据移动 \((D_{\text{vol}})\),能够同时提高速度和能效。
Checkpoint 1.2: 铁律
铁律 \((T \approx \frac{D_{\text{vol}}}{\text{BW}} + \frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}} + L_{\text{lat}})\) 是本书的分析主线。继续阅读之前,请确认你能够运用其中各项进行分析:
决定时间和能耗的物理项同样决定成本:每移动一个字节、执行一次运算,以及每一毫秒的延迟,都会消耗基础设施预算。因此,接下来需要进行经济性检验,评估增加计算投入所带来的模型改进是否足以证明这笔支出合理。
以计算回报率(RoC)作为经济分析视角
沿袭 Hennessy 和 Patterson 的定量推理传统,计算回报率(RoC) 衡量每增加一美元基础设施投入所带来的准确率增益。当准确率采用固定尺度衡量时,RoC 的单位为准确率点数/美元。 \[ \text{RoC} = \frac{\Delta \text{Accuracy}}{\Delta \text{Compute Cost}} \]
这一比值揭示了一条经济边界。如果准确率提高 1 个百分点需要将 \(O\)(总运算次数)增加至 10\(\times\),就可能无法通过 RoC 检验。后续章节中的每项优化都针对分子(从相同数据中提取更多信号)或分母(降低执行数学运算的成本)。如果 RoC 为负或微乎其微,那么无论技术多么精巧,系统都存在过度工程化。这一经济分析视角将“准确率”从研究目标转变为工程预算。
计算规模在扩展模型能力的同时,也不断推高硬件支出。苦涩的教训告诉我们,规模扩展有效;而铁律则决定了如何负担得起这种扩展。规模扩展与物理极限之间的这种张力,塑造了接下来的工程原则。
灯塔模型将铁律付诸实践
铁律组织起了本课程的核心工程要求。数据项要求构建稳健的数据摄取、验证和特征流水线(数据工程)。计算项要求在各类专用加速器架构上最大限度地提高算术强度和硬件利用率(第三部分)。延迟项则要求严格控制串行化延迟、通信开销和服务抖动(模型服务、机器学习运维)。这些项共同将抽象的系统需求转化为可据以采取行动的物理约束。
具体工作负载使抽象方程变得直观。本书反复使用五种灯塔模型,作为诊断铁律的探针。这些典型工作负载在各章中反复出现,用于检验物理约束如何影响不同的架构模式。
每种灯塔模型都针对铁律的一种不同压力情形。ResNet-50 用于探查算法反复复用已学习参数时的计算吞吐量,而 GPT-2/Llama 用于探查自回归生成过程中的内存带宽限制。对于语言模型,自回归解码每次生成一个词元;KV(键值)缓存存储先前词元的注意力状态(网络架构 将完整介绍注意力机制),而预填充则是在生成开始前处理提示的初始计算过程。运行情形决定主导瓶颈:小批量解码需要足够快速地流式读取权重和 KV 缓存状态,从而暴露出内存带宽瓶颈;预填充和大批量服务则会使瓶颈转向算术吞吐量或通信。
铁律使这些差异得到精确的数学描述。ResNet-50 在许多空间位置上应用相同的权重滤波器,并在采用批处理时跨多个输入样本复用这些滤波器;这种算术复用使 \(O/(R_{\text{peak}} \cdot \eta_{\text{hw}})\) 成为主导项,因为处理器必须维持较高的算术吞吐量,而数据占用仍可紧凑地容纳于缓存中。相比之下,GPT-2 每生成一个词元都要加载数十亿个不同的权重参数,每个权重仅使用一次便继续获取下一个;其 \(D_{\text{vol}}/\text{BW}\) 项占主导地位,因为起限制作用的约束是内存带宽,而非算术吞吐量。将同一个方程应用于两种工作负载,会得出相反的优化策略:当复用提高了每移动一个字节所执行的运算次数后,将 \(R_{\text{peak}}\) 提高一倍能够加速批处理 ResNet-50,却几乎不会改变 GPT-2 的解码速度;将内存带宽 \(\text{BW}\) 提高一倍能够加速受带宽限制的解码,却不会改变计算已饱和的卷积速度。其余灯塔模型分别针对铁律的其他物理边界:DLRM 对内存容量施加压力,因为映射数百万个用户和物品 ID 的多 GB 嵌入表超出了单个加速器的内存容量,需要进行分布式横向扩展;MobileNetV2 和关键词检测则用于评估电池供电的边缘设备和微控制器上的延迟(\(L_{\text{lat}}\))与能耗方程,在这些设备上,推理必须在毫瓦级功率预算内满足毫秒级截止时间要求。Table 5 概述了每种灯塔模型为何能够作为诊断特定瓶颈的工具。
| 灯塔模型 | 系统瓶颈 | 揭示的问题 | 关键工程问题 |
|---|---|---|---|
| ResNet-50 | 复用条件下的计算吞吐量 | GPU 利用率、批处理 | 硬件是在执行数学运算,还是在等待数据? |
| GPT-2/Llama | 内存带宽 | 权重与序列状态的移动 | 模型状态能以多快的速度送达计算单元? |
| 深度学习推荐模型(DLRM) | 内存容量 | 嵌入表、横向扩展 | 如何将 TB 级模型容纳于内存中? |
| MobileNetV2 | 延迟和功率 | 高效算子设计 | 系统能否在电池供电条件下满足实时约束? |
| 关键词检测 | 功率包络 | 极小的内存和能耗预算 | 系统能否以毫瓦级功率持续运行推理? |
GPT-2 解码受带宽限制,因为数据项占主导地位。
通过追踪这些工作负载从数据摄取到边缘部署的全过程,各章展示了架构选择如何使物理约束和经济约束传导至整个系统。每种灯塔模型都在数据—算法—机器各轴上体现出不同的约束,确保工程原则在多样的系统运行情形中得到检验。本书中反复出现的示例有着明确的分工:四种部署范式界定系统必须在其中运行的包络,五种灯塔模型提供对其施加压力的工作负载,而四项工程任务和三个生产案例研究(section 1.9.3 中的 Waymo、FarmBeats 和 AlphaFold)则在现实约束下将包络与工作负载结合起来。
同样的诊断性解读也适用于回顾开启深度学习时代的那次突破。AlexNet 系统将卷积架构与 2012 年 ImageNet 挑战赛训练集中的 1.3M 张标注图像相结合;该架构的并行矩阵运算与 GPU 能力相匹配21 (Deng et al. 2009)。因此,其错误率的降低体现了数据—算法—机器各轴之间的协同,而非孤立的算法创新。
沿数据—算法—机器各轴开展协同设计,意味着优化一个组成部分往往会将压力转移到另一个组成部分。AlexNet 的协同设计以 2012 年可负担的成本取得了成功(两块消费级 GPU 运行一周),但现代基础模型所需的训练计算量比它高出约 7 个数量级。如果说铁律决定系统运行得有多快,那么仍然需要一个工程框架来分析系统使用这些资源的效率有多高。
机器学习效率的三个维度
这一效率问题揭示了 section 1.4 中由苦涩的教训首次引出的张力。规模推动 AI 进步,但不断扩大的数据集和计算预算,使参与者逐渐局限于资源最充裕的组织。即使这些组织最终也会遭遇数据中心供电、内存带宽方面的物理极限,以及增加参数所带来的收益递减。
常见的公开估算认为,GPT-4 级模型训练的计算预算约为 2.5 million accelerator-days,意味着数百万美元的计算成本和显著的环境影响。许多研究机构和公司无力通过粗放的规模扩展参与竞争。这些成本与资源可及性约束,使高效利用现有计算资源成为推动进步的一条互补路径。
效率优化首先是瓶颈诊断,而非某一项单独的技术。数据—算法—机器全景图(figure 4)现在成为行动地图。数据选择改善系统可从哪些数据中学习,算法效率降低学习或预测所需的工作量,而计算效率使这些工作与机器相匹配。余下的交汇问题——信息如何移动——贯穿全部三个维度,因为每项改进都必须经受内存与通信路径的检验。
算法效率 是最早的探索前沿,它通过改进模型设计和训练流程来降低计算需求。其目标是使每次运算产生更多有用行为,从而在无需同步扩展每种资源的情况下提升能力。随着算法对计算量的需求不断增加,计算效率 成为第二个关键维度。它通过使算法逻辑与机器的物理特性相匹配,最大限度地提高硬件利用率,将处理器的理论能力转化为有效工作。最近,数据选择 成为第三个维度,通过从有限样本中提取更多学习信号,降低铁律中的总运算次数项 \(O\)。figure 5 中的时间线并列展示了这三个维度,后续章节则按照构建顺序介绍它们。这三个维度共同提供了工程工具,用于突破单纯扩大规模无法解决的数据、算法和机器壁垒。
\begin{tikzpicture}[font=\small\sffamily,node distance=2mm]
\tikzset{
  Box/.style={inner xsep=1pt,
    draw=none,
    fill=#1,
    anchor=west,
    text width=27mm,align=center,
    minimum width=27mm, minimum height=10mm
  },
  Box/.default=red
}
\definecolor{col1}{RGB}{128, 179, 255}
\definecolor{col2}{RGB}{255, 255, 128}
\definecolor{col3}{RGB}{204, 255, 204}
\definecolor{col4}{RGB}{230, 179, 255}
\definecolor{col5}{RGB}{255, 153, 204}
\definecolor{col6}{RGB}{245, 82, 102}
\definecolor{col7}{RGB}{255, 102, 102}

\node[Box={col1}](B1){手工设计 \&\\ 统计时代};
\node[Box={col1},right=of B1](B2){深度\\ 学习时代};
\node[Box={col1},right=of B2](B3){现代\\ 效率优化};
\node[Box={col2},right=of B3](B4){通用\\ 计算};
\node[Box={col2},right=of B4](B5){加速\\ 计算};
\node[Box={col2},right=of B5](B6){可持续计算};
\node[Box={col3},right=of B6](B7){数据\\ 稀缺};
\node[Box={col3},right=of B7](B8){大\\ 数据时代};
\node[Box={col3},right=of B8](B9){ 以数据为中心的 AI};
%%%%
\node[Box={col1},above=of B2,minimum width=87mm,
 text width=85mm](GB1){算法效率};
\node[Box={col2},above=of B5,minimum width=87mm,
text width=85mm](GB5){计算效率};
\node[Box={col3},above=of B8,minimum width=87mm,
text width=85mm](GB8){数据选择};
%%
\foreach \x in{1,2,...,9}
\draw[dashed,thick,-latex](B\x)--++(270:5.5);

\path[red]([yshift=-8mm]B1.south west)coordinate(P)-|coordinate(K)(B9.south east);
\draw[line width=2pt,-latex](P)--(K)--++(0:3mm);

\node[Box={col1!50},below=2 of B1](BB1){1980};
\node[Box={col1!50},below=2 of B2](BB2){2010};
\node[Box={col1!50},below=2 of B3](BB3){2023};
\node[Box={col2!70},below=2 of B4](BB4){1980};
\node[Box={col2!70},below=2 of B5](BB5){2010};
\node[Box={col2!70},below=2 of B6](BB6){2023};
\node[Box={col3!70},below=2 of B7](BB7){1980};
\node[Box={col3!50},below=2 of B8](BB8){2010};
\node[Box={col3!50},below=2 of B9](BB9){2023};
%%%%%
\node[Box={col4!50},below= of BB1](BBB1){2010};
\node[Box={col4!50},below= of BB2](BBB2){2022};
\node[Box={col4!50},below= of BB3](BBB3){未来};
%
\node[Box={col5!50},below= of BB4](BBB4){2010};
\node[Box={col5!50},below= of BB5](BBB5){2022};
\node[Box={col5!50},below= of BB6](BBB6){未来};
%
\node[Box={col7!50},below= of BB7](BBB7){2010};
\node[Box={col7!50},below= of BB8](BBB8){2022};
\node[Box={col7!50},below= of BB9](BBB9){未来};
\end{tikzpicture}这三个维度在不同的历史时期逐步展开,但系统工程按相反的顺序处理它们。在实践中,首先进行数据选择:在模型训练之前,剪除冗余训练样本,以减少总训练步数。随后进行模型压缩,减少参数占用空间和算术运算量。最后进行硬件加速,将剩余运算高效映射到加速器的物理内存层次结构和计算单元上。先优化上游,再优化下游,可确保昂贵的硬件资源仅执行必要的计算。
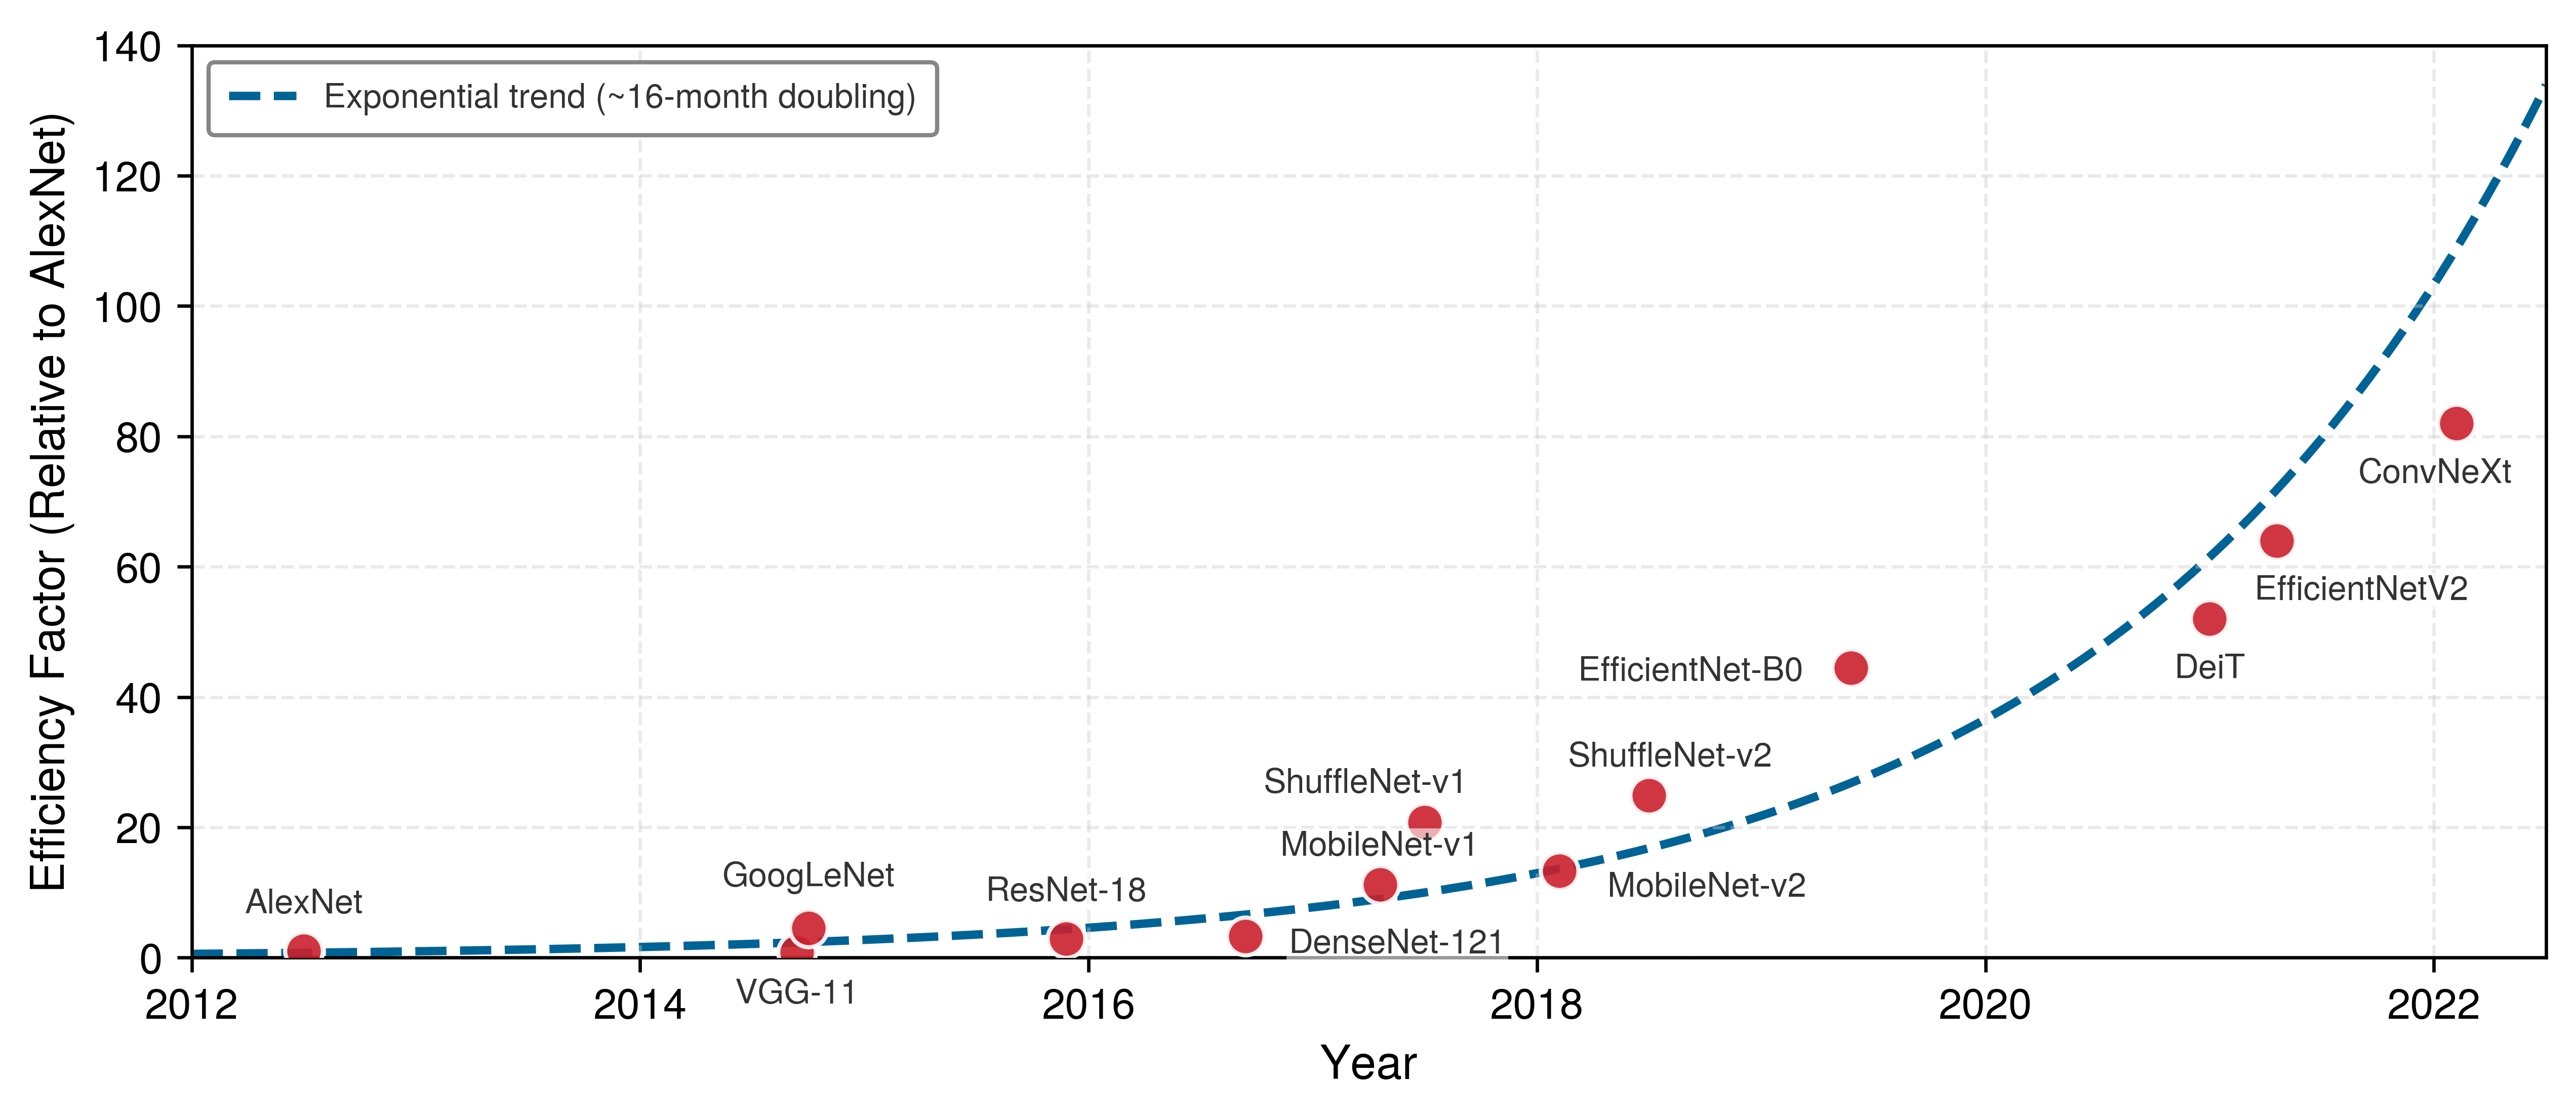
模型架构随时间的演进轨迹说明了这些维度如何发展。Figure 6 逐一展示了各模型的算法效率提升效果,说明随着架构改进,达到相同准确率目标所需的计算量逐步减少。
效率提升的幅度是可以测量的。将神经网络训练至在 ImageNet 分类任务上达到 AlexNet 水平,2012 年所需的计算资源约为 2019 年的 44.5× (Hernandez and Brown 2020)。所需计算资源约每 15 months 减半,这一改进速度超过了摩尔定律所预测的硬件效率提升速度,22 表明算法创新与硬件进步同样是推动效率提升的重要力量。
Hernandez, Danny, and Tom B. Brown. 2020. “Measuring the Algorithmic Efficiency of Neural Networks.” arXiv Preprint arXiv:2005.04305, ahead of print. https://doi.org/10.48550/arxiv.2005.04305.
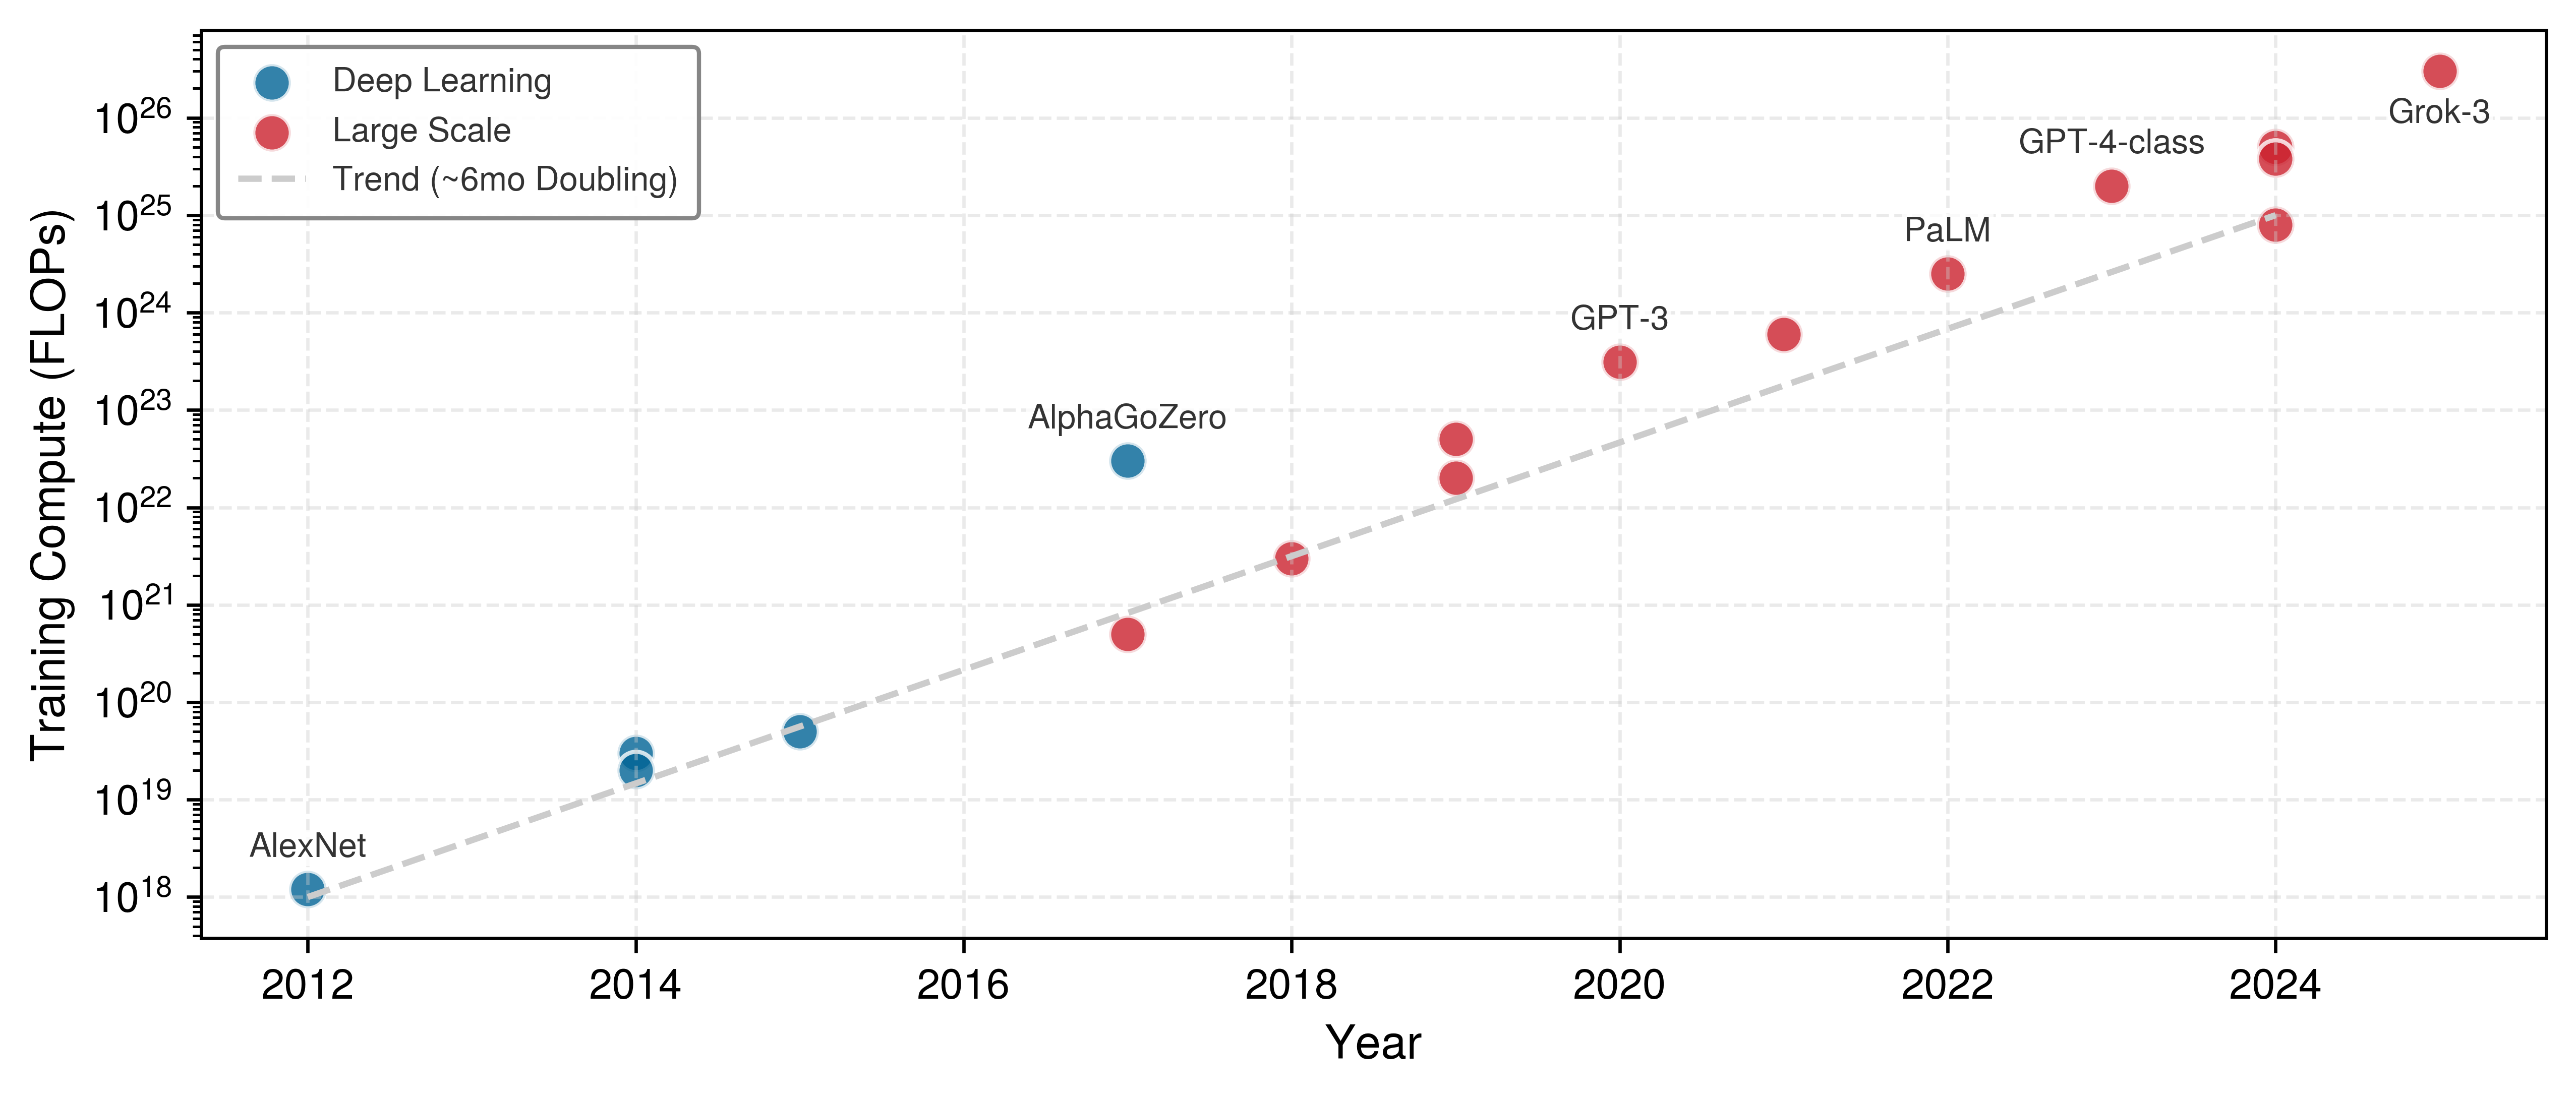
与此同时,已发表的前沿训练运行所使用的总体训练计算量,其增长节奏远快于摩尔定律,拟合得到的翻倍时间约为 3.4 个月 (Amodei and Hernandez 2018)。这一基于已发表结果的总体趋势,与两个里程碑模型之间的端点比值并非同一个量,但它解释了效率优化为何不可或缺。如果没有效率优化,就只有资源最充裕的组织能够参与 AI 开发。
这些测量结果来自一种实证研究方法,该方法追踪了数百个已发表模型的训练计算量(基准测试)。需求每 3.4 个月翻一番,而晶体管密度大约每两年翻一番,两者之间的分化界定了系统层面的差距。仅靠硅芯片的进步无法跟上这一需求;要跟上需求,就必须在算法、软件运行时和硬件架构各个层面持续累积效率改进(硬件加速)。
逐个架构取得的改进只揭示了一半情况。算法改进无法抵消总体训练计算量的上升。Figure 7 比较了示例性的 AlexNet 时代端点与 GPT-4 级别端点,这与总体上每 3.4 个月翻倍的趋势不同,并说明了为何技术栈的每个层级都需要效率优化。
Amodei, Dario, and Danny Hernandez. 2018. “AI and Compute.” OpenAI Blog 6.
Sevilla, Jaime, Lennart Heim, Anson Ho, Tamay Besiroglu, Marius Hobbhahn, and Pablo Villalobos. 2022. “Compute Trends Across Three Eras of Machine Learning.” 2022 International Joint Conference on Neural Networks (IJCNN), 1–8. https://doi.org/10.1109/ijcnn55064.2022.9891914.
综合来看,这两幅图揭示了一个看似矛盾的现象,它决定了现代 AI 开发的经济运行机制。Figure 6 显示效率提升至原来的 44.5×,而 figure 7 显示计算需求上升了约 7 个数量级。然而,两幅图保持不变的量并不相同。第一幅图考察达到一个大致固定的能力目标需要多少计算,而第二幅图允许目标不断扩展,并记录由此产生的训练预算。效率降低了实现给定能力的成本;规模则决定了如何使用那些因成本下降而变得可负担的计算。因此,这一表面矛盾反映的是经济反馈,而非测量结果之间的分歧。
Systems Perspective 1.4: 效率悖论
这种动态机制是杰文斯悖论在机器学习系统中的对应体现。在资源经济学中,提高资源利用效率往往会增加而非减少总消耗量。在 AI 领域,效率提升所节省的资源被用于支持更大的模型和更广泛的数据集,而非缩减计算预算。如果达到相同准确率时,AlexNet 所需的计算量为 EfficientNet 的 44.5×,组织就可以将节省下来的资源投入更大的模型和更广泛的数据。正因如此,尽管每 FLOP 的效率有所提升,GPT-3 所需的计算量仍比 AlexNet 高出多个数量级。效率使规模扩张成为可能,而规模扩张又要求更高效率,这一反馈循环塑造了现代 AI 工程的格局。
这一经济反馈循环说明了为何不能将效率问题视为彼此孤立的优化。数据选择(数据选择)、模型压缩(模型压缩)和硬件加速(硬件加速)必须结合具体部署约束进行权衡。统筹管理统计性能与物理执行要求,需要一门统一的系统学科。
AI 工程:一门学科
云服务可能以优化吞吐量为目标,而边缘设备则必须严格遵守功耗限制。因此,同一个模型可能在某种环境中效率很高,却在另一种环境中无法使用。仅凭模型准确率无法定义一个可用的系统。随着数据变化,学习得到的行为必须保持可信,而机器必须在其运行预算内实现这种行为。
退化方程、机器学习系统铁律和效率框架为这一双重使命提供了定量工具。它们共同涵盖统计行为、计算和部署约束。应用这些工具需要跨越学科边界。计算机科学研究算法,电气工程研究硬件,但任何一门学科都无法独自涵盖这一综合问题:如何构建在生产环境中持续保持可靠、高效且可扩展的系统。解决这一问题的学科就是 AI 工程。
Definition 1.3: AI 工程
AI 工程是一门设计、部署和维护机器学习系统的学科,旨在使通过统计方法评估的行为达到确定性的可靠性目标,同时满足数据—算法—机器三个轴上的生产约束:数据质量、算法正确性和机器效率。
- 重要性:机器学习研究通常只优化算法轴(\(O\) 和收敛性)。AI 工程则联合优化这三个维度:通过数据治理要求约束 \(D_{\text{vol}}\),通过生产环境的延迟要求约束 \(O/(R_{\text{peak}} \cdot \eta_{\text{hw}})\),并通过能源与成本预算约束总功耗。一个系统即使在研究中达到 95% 的准确率,只要在生产环境中违反了 100 ms 的延迟要求,就是一个失败的系统,无论其算法得分如何。
- 区别:机器学习研究在静态数据集上追求单一目标(验证损失),而 AI 工程则针对部署后持续变化的分布,面向多目标约束面进行优化(延迟、吞吐量、准确率、成本、公平性和鲁棒性)。
- 常见误区:一种常见的误解是,AI 工程只是“面向机器学习的软件工程”。实际上,其系统规约具有概率性。机器学习系统的输出,是相对于不断变化的分布在统计意义上有效或无效,而非相对于固定的确定性契约正确或错误。因此,持续监控是一项结构性要求,而非运维上的可选项。
“具有确定性可靠性的随机系统”这一表述,将 AI 工程与历史上一次学科融合联系起来。20 世纪 60 年代末至 70 年代初,计算系统变得过于复杂,电气工程或计算机科学都无法独自应对,计算机工程由此兴起23,将两者统一到一个综合性问题之下:如何用不可靠的物理组件构建可靠的计算机。AI 工程在数据、算法和基础设施的交界处面临着相同的挑战。在这一分类体系中,AI 工程指更广泛的学术学科,而机器学习系统工程则界定了在生产约束下设计、部署和维护这些系统的实践工作。
贯穿机器学习生命周期的工程实践
算法上的进步需要高效的数据摄取与预处理、跨数百或数千个加速器的分布式计算、满足严格延迟窗口的可靠服务基础设施,以及基于真实环境性能的持续遥测。这些职责构成了一个反复循环的生命周期,而非一条以部署为终点的流程。工程对象不再仅仅是代码,而是共同演进的代码、数据、模型行为、部署环境和监控证据。生产环境的反馈可能迫使已部署的系统重新进入数据收集和训练阶段,使人们熟悉的线性过程转变为循环。
这种结构性差异首先体现在工具链上。数十年积累的成熟实践,通过保留精确历史记录的版本控制、自动执行测试的持续集成流水线,以及衡量质量的静态分析工具,为由代码定义的行为提供支持。从数据中学习得到的行为却难以被这些工具覆盖,因为发生变化的产物不再是开发者编写的代码差异。机器学习工作流 将详细阐述应对这些挑战所需的专门工作流。
更深层的差异在于持续反馈所占据的突出地位。figure 8 中的循环展示了其中的原因。当监控检测到性能退化时,系统所需的不只是代码补丁。它可能需要重新经历数据收集、准备、训练和评估,然后再次部署,使迭代成为运行架构的一部分,而不仅仅是开发过程的一部分。
\begin{tikzpicture}[line join=round,font=\sffamily\small]
\tikzset{%
  Box/.style={align=flush center,
    inner xsep=2pt,
    node distance=1.1,
    draw=none,
    line width=0.75pt,
    fill=none,
    minimum width=23mm, minimum height=28mm
  },
  BBox/.style={Box,
    draw=none,
    line width=0.75pt,
    fill=mybrown!06,
    minimum width=23mm, minimum height=11mm
  },
  Box2/.style={Box, draw=BrownLine, fill=BrownL!30,
  },
  Txt/.style={font=\sffamily\footnotesize,text=black!90,align=center
  },
  LineA/.style={black!50,line width=1.2pt,{-{Triangle[width=1.0*5pt,length=9pt]}},shorten <=-9pt,shorten >=-9pt},
  LineAD/.style={black!30,line width=1.5pt,dashed,{-{Triangle[width=1.0*5pt,length=9pt]}},shorten <=-2pt,shorten >=-2pt},
}

%funnel
\tikzset{%
 pics/funnel/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=FUNNEL,scale=\scalefac, every node/.append style={transform shape}]
\draw[fill=\filllcolor!50,line width=\Linewidth,draw=\drawcolor](-0.12,-0.81)--(-0.19,-0.25)--(-0.7,0.41)--(0.7,0.41)--(0.19,-0.25)--(0.12,-0.81)--cycle;
\draw[fill=\filllcolor!50,line width=\Linewidth,draw=\drawcolor](-0.19,-0.25)--(0.08,-0.25);
\draw[fill=\filllcolor!50,line width=\Linewidth,draw=\drawcolor](0.16,-0.09)--(0.41,0.31);
%
\node[line width=\Linewidth,draw=\drawcolor,fill=\filllcolor!50,inner sep=1pt,
rectangle,rounded corners=2pt,minimum width=16mm,minimum height=5pt]at(0,0.5){};
%
\foreach \i in{-0.5,0,0.5}{
\node[single arrow, line width=0.8*\Linewidth,draw=\filllcirclecolor,fill=\filllcirclecolor, rotate=270,inner sep=1pt,
      minimum width =9pt, single arrow head extend=2pt,
      minimum height=5mm]at(\i,0.9) {}; % length of arrow
   }
\node[single arrow,line width=0.8*\Linewidth,draw=\filllcirclecolor,fill=\filllcirclecolor, rotate=270,inner sep=1pt,
      minimum width =11pt, single arrow head extend=2pt,
      minimum height=5mm]at(0,-1.1) {}; % length of arrow
 \end{scope}
     }
  }
}
%nodes
\tikzset{
pics/nodes/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\foreach \x/\y[count=\a] in {-0.2/0.35,
0.7/0.6,-0.5/1.4,-1.20/-0.8,-0.1/-1.3,-0.4/-0.43,
0.61/-0.3,1/-0.85,0.45/1.2,-0.96/0.63}{
\node[circle,fill=myblue,draw=black,inner sep=0pt,minimum size=3mm](XB\a)at(\x,\y){};
}
\foreach \x/\y[count=\a] in {-2.0/0.1
}{
\node[circle,fill=myred,draw=black,inner sep=0pt,minimum size=3mm](XR\a)at(\x,\y){};
}

\foreach \x/\y[count=\a] in {1.87/0.1
}{
\node[circle,fill=mygreen,draw=black,inner sep=0pt,minimum size=3mm](XG\a)at(\x,\y){};
}

\foreach \x in {1,3,4,6,10}{
\draw[RedLine,line width=0.5pt](XR1) edge  (XB\x);
}
\foreach \x in {1,2,5,8,9}{
\draw[mygreen,line width=0.5pt](XG1) edge  (XB\x);
}
\foreach \x in {2,3,6,9,10}{
\draw[black,line width=0.5pt](XB1) edge  (XB\x);
}
\foreach \x in {4,5,7}{
\draw[black,line width=0.5pt](XB6) edge  (XB\x);
}
\draw[black,line width=0.5pt](XB4) edge  (XB5);
\draw[black,line width=0.5pt](XB3) edge  (XB9);
\foreach \x in {2,8}{
\draw[black,line width=0.5pt](XB7) edge  (XB\x);
}
\end{scope}
    }
  }
}
%testing
\tikzset{
pics/testing/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=TESTING1,shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\newcommand{\tikzxmark}{%
\tikz[scale=0.18] {
    \draw[line width=0.7,line cap=round,RedLine] (0,0) to [bend left=6] (1,1);
    \draw[line width=0.7,line cap=round,RedLine] (0.2,0.95) to [bend right=3] (0.8,0.05);
}}
\newcommand{\tikzxcheck}{%
\tikz[scale=0.16] {
    \draw[line width=0.7,line cap=round,GreenLine] (0.5,0.75)--(0.85,-0.1) to [bend left=16] (1.5,1.55);

}}
 \node[minimum width  =15mm, minimum height = 20mm, inner sep = 0pt,
        rounded corners=2pt,draw = \drawcolor, fill=\filllcolor!10, line width=\Linewidth](COM){};
 \node[minimum width  =8mm, minimum height = 2mm, inner sep = 0pt,anchor=north,
        rounded corners=1.5pt,draw =white, fill=\drawcolor!70, line width=0.7*\Linewidth]at
        ($(COM.north)+(0,0.75mm)$)(GOR){};
 \node[minimum size = 2.5mm, inner sep = 0pt,circle,%anchor=north,
        rounded corners=0.5pt,draw =white, fill=\drawcolor!70, line width=0.7*\Linewidth]at(GOR.north)(GOR1){};
\node[draw=GreenLine,inner sep=4pt,fill=white](CB1) at ($(COM.north west)!0.25!(COM.south west)+(0.3,0)$){};
\node[xshift=0pt]at(CB1){\tikzxcheck};
\node[draw=RedLine,inner sep=4pt,fill=white](CB2) at ($(COM.north west)!0.5!(COM.south west)+(0.3,0)$){};
\node[xshift=0pt]at(CB2){\tikzxmark};
\node[draw=RedLine,inner sep=4pt,fill=white](CB3) at ($(COM.north west)!0.75!(COM.south west)+(0.3,0)$){};
\node[xshift=0pt]at(CB3){\tikzxmark};
\draw[GreenLine,decoration={zigzag,segment length=4pt, amplitude=0.5pt},decorate]($(CB1)+(0.3,0.05)$)--++(0:0.8);
\draw[GreenLine,decoration={zigzag,segment length=4pt, amplitude=0.5pt},decorate]($(CB1)+(0.3,-0.12)$)--++(0:0.7);
\draw[RedLine,decoration={zigzag,segment length=4pt, amplitude=0.5pt},decorate]($(CB2)+(0.3,0.05)$)--++(0:0.8);
\draw[RedLine,decoration={zigzag,segment length=4pt, amplitude=0.5pt},decorate]($(CB2)+(0.3,-0.12)$)--++(0:0.6);
\draw[RedLine,decoration={zigzag,segment length=4pt, amplitude=0.5pt},decorate]($(CB3)+(0.3,0.05)$)--++(0:0.8);
\draw[RedLine,decoration={zigzag,segment length=4pt, amplitude=0.5pt},decorate]($(CB3)+(0.3,-0.12)$)--++(0:0.6);
\end{scope}
    }
  }
}
%check mark
\tikzset{pics/.cd,
checkmark/.style={code={
        \pgfkeys{/channel/.cd, #1}
\pgfgettransformentries{\tmpxx}{\tmp}{\tmp}{\tmp}{\tmp}{\tmp}
\draw[line width=\tmpxx*1pt,draw=none,fill=\filllcirclecolor,line join=bevel] (0,.35) -- (.25,0) to[bend left=5] (0.8,.6) to[bend
right=5] (.25,.18) -- cycle;}}}
\tikzset{%
 pics/checkI/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=CHECK,scale=\scalefac, every node/.append style={transform shape}]
\node[fill=\filllcolor,minimum width=6mm, minimum height=6mm,
            outer sep=2pt] (C1) {};
\pic[shift={(-0.27,-0.19)},scale=0.7]{checkmark};
 \end{scope}
     }
  }
}
%cloud
\tikzset {
pics/cloudA/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=CLO,scale=\scalefac,, every node/.append style={transform shape}]
\node[draw=\drawcolor!90!red,line width=\Linewidth,minimum width=6mm,minimum height=12mm](VSK)at(0,0.5){};
\node[draw=\drawcolor!90!red,line width=\Linewidth,fill=white,minimum width=9mm,minimum height=4mm](VSKG)at(VSK.north){};
\node[draw=\drawcolor!90!red,line width=\Linewidth,fill=white,minimum width=9mm,minimum height=4mm](VSKC)at(VSK.center){};
\node[draw=\drawcolor!90!red,line width=\Linewidth,fill=white,minimum width=9mm,minimum height=4mm](VSKD)at(VSK.south){};
\draw[fill=\filllcolor,draw=\drawcolor!60,,line width=\Linewidth](0,0)to[out=170,in=180,distance=11](0.1,0.61)
to[out=90,in=105,distance=17](1.07,0.71)
to[out=20,in=75,distance=7](1.48,0.36)
to[out=350,in=0,distance=7](1.48,0)--(0,0);
\draw[draw=\drawcolor!60,,line width=\Linewidth](0.27,0.71)to[bend left=25](0.49,0.96);
\draw[draw=\drawcolor!60,,line width=\Linewidth](0.67,1.21)to[out=55,in=90,distance=13](1.5,0.96)
to[out=360,in=30,distance=9](1.68,0.42);
\node[single arrow, draw=orange,fill=orange,
      minimum width = 10pt, single arrow head extend=3pt,
      minimum height=10mm,
      rotate=270]at(1.05,0) {};
\end{scope}
}
}
}
%data
\tikzset{mycylinder/.style={cylinder, shape border rotate=90, aspect=1.3, draw, fill=white,
minimum width=25mm,minimum height=11mm,line width=\Linewidth,node distance=-0.15},
pics/data/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=STREAMING,scale=\scalefac, every node/.append style={transform shape}]
\node[mycylinder,fill=\filllcolor!50] (A) {};
\node[mycylinder, above=of A,fill=\filllcolor!30] (B) {};
\node[mycylinder, above=of B,fill=\filllcolor!10] (C) {};
\fill[\filllcolor!50!black]($(C.west)!0.12!(C.east)$)circle(3pt);
\fill[\filllcolor!50!black]($(B.west)!0.12!(B.east)$)circle(3pt);
\fill[\filllcolor!50!black]($(A.west)!0.12!(A.east)$)circle(3pt);
 \end{scope}
     }
  }
}
%display
\tikzset{%
    comp/.style = {draw,
        minimum width  =18mm,
        minimum height = 15mm,
        inner sep      = 0pt,
        rounded corners=3pt,
       draw = \drawcolor,
       fill=\filllcolor!10,
       line width=2.0pt
    },
 pics/displayK/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=COMPUTER1,scale=\scalefac, every node/.append style={transform shape}]
\node[comp](\picname-COM){};
\draw[draw = \drawcolor,line width=\Linewidth]($(\picname-COM.south west)!0.4!(\picname-COM.south east)$)--++(270:0.2)coordinate(DL);
\draw[draw = \drawcolor,line width=\Linewidth]($(\picname-COM.south west)!0.6!(\picname-COM.south east)$)--++(270:0.2)coordinate(DD);
\draw[draw = \drawcolor,line width=3*\Linewidth,shorten <=-3mm,shorten >=-3mm](DL)--(DD);
 \draw[
  line width=1pt,
  draw=red,
  line cap=round,
  line join=round
](-0.70,0) --(-0.40,0) --(-0.30,0.13) --(-0.2,-0.18) --(-0.05,0.32) --(0.05,-0.15) --
(0.15,0.23) --(0.38,-0.15) --(0.40,0.0) --(0.70,0.0);
\end{scope}
   }
  }
}

\pgfkeys{
  /channel/.cd,
   Depth/.store in=\Depth,
  Height/.store in=\Height,
  Width/.store in=\Width,
  filllcirclecolor/.store in=\filllcirclecolor,
  filllcolor/.store in=\filllcolor,
  drawcolor/.store in=\drawcolor,
  drawcircle/.store in=\drawcircle,
  scalefac/.store in=\scalefac,
  Linewidth/.store in=\Linewidth,
  picname/.store in=\picname,
  filllcolor=BrownLine,
  filllcirclecolor=violet!20,
  drawcolor=red,
  drawcircle=violet,
  scalefac=1,
  Linewidth=0.5pt,
  Depth=0.2,
  Height=0.5,
  Width=0.25,
  picname=C
}
%Data Collection
\node[Box](B0){};
\node[BBox,anchor=south](BB0)at(B0.south){数据\\ 收集};
\coordinate(I0)at($(B0.north)!0.5!(BB0.north)$);
\pic[shift={(0,-0.5)}] at  (I0){data={scalefac=0.45,filllcolor=red, Linewidth=0.6pt}};
%Data Preparation
\node[Box,right=of B0](B1){};
\node[BBox,anchor=south](BB1)at(B1.south){数据\\ 准备};
\coordinate(I1)at($(B1.north)!0.5!(BB1.north)$);
\pic[shift={(0,0.08)}] at  (I1){funnel={scalefac=0.6,Linewidth=0.5pt,
filllcolor=mypurple,drawcolor=black,filllcirclecolor=red}};
%Model Training
\node[Box,right=of B1](B2){};
\node[BBox,anchor=south](BB2)at(B2.south){模型\\ 训练};
\coordinate(I2)at($(B2.north)!0.5!(BB2.north)$);
\pic[shift={(0,0)}] at  (I2){nodes={scalefac=0.4,drawcolor=orange,filllcirclecolor=orange!20,filllcolor=orange}};
%Model Evaluation
\node[Box,right=of B2](B3){};
\node[BBox,anchor=south](BB3)at(B3.south){模型\\ 评估};
\coordinate(I3)at($(B3.north)!0.5!(BB3.north)$);
\pic[shift={(-0.1,-0.02)}] at  (I3){testing={scalefac=0.6,drawcolor=mypurple,filllcolor=gray, Linewidth=1.0pt}};
\pic[shift={(0.3,-0.46)}] at  (I3){checkI={scalefac=0.7,filllcolor=GreenLine, filllcirclecolor=white,Linewidth=0.7pt}};
%Model Deployment
\node[Box,right=2.25 of B3](B4){};
\node[BBox,anchor=south](BB4)at(B4.south){模型\\ 部署};
\coordinate(I4)at($(B4.north)!0.5!(BB4.north)$);
\pic[shift={(-0.36,-0.30)}] at  (I4){cloudA={scalefac=0.65,filllcirclecolor=orange!80,drawcolor=BlueLine,
filllcolor=cyan!10,  Linewidth=1.0pt}};
% Model\\ Training
\node[Box,right=of B4](B5){};
\node[BBox,anchor=south](BB5)at(B5.south){模型\\ 监控};
\coordinate(I5)at($(B5.north)!0.5!(BB5.north)$);
\pic[shift={(-0.02,0.06)}] at  (I5){displayK={scalefac=0.65,
filllcolor=myblue, drawcolor=myblue,Linewidth=0.7pt}};
\foreach \x in {0,1,2,3,4,5}{
\draw[line width =2.5pt,mybrown,shorten <=0pt,shorten >=0pt](BB\x.north west)--(BB\x.north east);
}
%arrows
\draw[LineA](B0.20)--(B1.160);
\draw[LineA](B1.20)--(B2.160);
\draw[LineA](B2.20)--(B3.160);
\draw[LineAD](B3.south)--++(0,-8mm)-|node[Txt,above=0pt,pos=0.25]{需要改进}(B1);
\draw[LineA](B3.20)--node[Txt,above=0pt,pos=0.5]{满足}
node[Txt,below=0pt,pos=0.5]{要求}(B4.160);
\draw[LineAD](B5.south)--++(0,-12mm)-|node[Txt,above=0pt,pos=0.1]{性能退化}(B0);
\draw[LineA](B4.20)--(B5.160);
\end{tikzpicture}由于机器学习模型直接从训练数据中编译出行为,而非由显式的源代码逻辑定义行为,真实环境中的分布偏移即使不修改任何一行代码,也会改变执行结果。这种差异打破了标准的软件工作流:Git 和基于文本的版本控制无法管理数 TB 规模的数据集谱系,而单元测试断言也无法针对不断变化的分布验证随机输出。应对这些运维挑战需要专门的基础设施。数据工程 将详细阐述数据集版本管理和来源追踪,机器学习运维 则介绍针对分布偏移的运行时监控。然而,各生命周期阶段的要求并不相同;起决定作用的物理约束取决于系统必须服务的实际任务。
Systems Perspective 1.5: 从范式到任务
这一层次结构的顶层将抽象系统转化为具体的工程任务。每项任务都继承了 section 1.5.1 中介绍的四种部署范式之一,并为其配上特定场景的工作负载。table 6 中的四项任务,就是贯穿全书及其配套实验的应用场景。它们充当工程决策的端到端测试。内存带宽提高 2\(\times\),只有被证明能够延长智能门铃的电池续航时间,或实现自主感知所需的安全关键延迟要求,才不再仅仅是一项学术成果。
每项任务都持续运行这一生命周期,其中,一个训练步表示对一个微批次数据执行一次前向传播、反向传播和权重更新。高质量数据能够改进模型,进而改进产品及其生成的遥测数据;任何阶段的薄弱环节都会沿整个技术栈向下游传播。Table 6 定义了这四项反复出现的任务,以及决定其执行方式的关键物理约束。
| 任务 | 部署范式 | 场景工作负载 | 关键约束 |
|---|---|---|---|
| 前沿模型训练 | 云集群 | GPT-4 | 目标:500 ms/step |
| 自主感知 | 边缘机器人系统 | YOLOv8-nano | SLA(服务级别协议):延迟为 10 ms |
| 移动助手 | 智能手机 | 针对移动端优化的小型 LLM(大语言模型) | RAM:\(< 2\text{ GB}\) / 热功耗:\(< 3\text{ W}\) |
| 智能门铃 | TinyML(MCU[微控制器]) | Wake Vision | 功耗:100 mW |
部署环境塑造生命周期
部署环境决定了哪些生命周期压力占据主导地位。各类机器学习系统都经历相同的阶段,但兆瓦级数据中心与毫瓦级嵌入式设备在数据收集、模型更新、监控和服务方面面临不同的瓶颈。
在这一谱系的一端,基于云的机器学习系统训练大型模型并为数百万用户提供服务,在获得充裕计算资源的同时,也面临容量限制、运维复杂性和高昂成本。机器学习系统 将探讨其架构模式,硬件加速 则详细阐述使这一规模在经济上可行的硬件基础。
在另一端,TinyML 系统运行于微控制器24和嵌入式设备。其千字节级内存和毫瓦级功耗预算使可行性优先于模型质量:智能家居设备必须以低于 LED 灯泡的功耗识别指令,而传感器可能需要依靠一块电池持续数年检测异常。section 1.8 中的效率框架提供了指导原则,而 模型压缩 则阐述了使此类部署成为可能的技术。
在这两个极端之间,部署位置的选择成为一个约束分配问题。边缘机器学习系统将计算移向数据源,以降低延迟25和带宽需求。移动机器学习系统与所有其他应用共享内存、热裕量和电池电量,以原始运行速度换取本地性和隐私。混合系统将工作分配到不同层级,以平衡延迟、隐私、带宽和更新控制。
这一部署谱系中的每个位置都会产生不同的瓶颈,决定哪些效率维度最为重要,如 table 7 所示:
| 环境 | 主要约束 | 效率重点 |
|---|---|---|
| 云端训练 | 成本、吞吐量 | 分布式效率、硬件利用率 |
| 云端推理 | 延迟、单次查询成本 | 批处理、模型服务优化 |
| 边缘设备 | 内存、功耗 | 更小的模型和更少的数据搬移 |
| 移动端 | 电池、散热 | 高能效推理 |
| TinyML | 千字节级内存、毫瓦级功耗 | 极致压缩、专用架构 |
部署谱系所代表的不只是不同的硬件配置。每种部署环境都会重塑机器学习生命周期的各个阶段,从最初的数据采集到持续运行与演进,形成传统软件很少遇到的约束交互。
考虑一个部署决策如何对整个系统产生连锁影响。自动驾驶汽车或实时欺诈检测等延迟敏感型应用,即便受到资源限制,也需要采用边缘或嵌入式架构,而大语言模型则自然倾向于集中式云基础设施。然而,这一最初的架构选择所决定的远不止计算发生在哪里。云端系统必须优化规模化运行的成本效率,平衡昂贵的 GPU 集群、存储和网络带宽,而这又会影响模型重新训练的频率、保留哪些历史数据,以及如何分配推理负载。边缘和移动系统面临固定的资源上限,这些上限约束了模型复杂度和更新频率,迫使系统采用激进的模型压缩26和精细的调度。最严格的约束出现在嵌入式和 TinyML 环境中,在这些环境里,每一字节内存和每一毫瓦功耗都至关重要。
随着系统的分布程度提高,运维复杂度也随之增加。集中式云架构受益于成熟的部署工具和托管服务,而边缘和混合系统则必须协调连接状况各异的传感器的数据采集,跟踪部署在数千台设备上的模型,处理具备回滚能力的分阶段发布,并汇聚来自地理上分散的端点的监测信号(机器学习运维)。数据方面的考量带来了相互竞争的压力。隐私要求或数据主权法规可能推动计算向边缘端迁移,而对大规模训练数据的需求又推动数据向集中式云端汇聚。模型更新在这一谱系中也呈现出不同特征。云架构通过集中式流量控制实现快速迭代,而边缘部署则需要进行远程更新,并精细管理带宽、提供回滚能力。
在实践中,部署选择很少遵循简单的二元划分。生产环境中的机器学习架构往往跨越多个层级,以协调相互冲突的物理需求和统计需求。系统可能将计算分配到边缘设备,以满足亚毫秒级响应时间窗口和数据隐私法规的要求,同时将采样后的遥测数据路由至集中式云集群,用于持续训练和模型重新评估。选择嵌入式或边缘端作为部署目标,所约束的远不止参数占用空间。它还决定了上游数据采集、量化感知训练、硬件在环评估、空中下载部署协议以及远程遥测数据汇聚方式。一个层级上的物理执行限制,必然会重塑工程生命周期的每个阶段。
生产系统揭示共同挑战
当部署案例能够揭示设计背后起决定作用的约束时,它就成为一种工程工具。Waymo、FarmBeats 和 AlphaFold 这三个生产系统横跨部署谱系的不同极端,揭示了相同的数据—算法—机器权衡如何迫使工程师采用截然不同的解决方案:
- 自动驾驶27受安全关键型延迟和数据新鲜度约束。Waymo 开放数据集提供了在多种驾驶环境中采集的摄像头和激光雷达数据 (Sun et al. 2020),展示了感知技术栈必须处理的多模态输入和地理覆盖范围。更广泛的案例采用了一种具有代表性的高风险混合模式:通过车载推理实现低延迟,并利用云基础设施进行训练和评估。
- FarmBeats28 (Vasisht et al. 2017) 受网络连接能力和数据新鲜度约束。微软的精准农业平台将田间传感器连接到本地网关 PC,以进行边缘处理。电视白频谱网络负责在农场内部传输数据,而较弱的农场到云端互联网链路则限制了同步。
- AlphaFold (Jumper et al. 2021) 受计算密集型训练和经整理的科学数据约束。DeepMind 的蛋白质结构预测系统以接近实验的准确度,解决了计算蛋白质结构预测这一延续 50 年的挑战。AlphaFold 代表了计算密集型云端部署模式。其初始训练使用了 128 个 TPUv3 核心,持续约一周,随后进行了约四天的微调,并使用了蛋白质数据库中通过实验测定的结构。
Jumper, John, Richard Evans, Alexander Pritzel, Tim Green, Michael Figurnov, Olaf Ronneberger, Kathryn Tunyasuvunakool, et al. 2021. “Highly Accurate Protein Structure Prediction with AlphaFold.” Nature 596 (7873): 583–89. https://doi.org/10.1038/s41586-021-03819-2.
这些系统补充了标杆模型,展示了相同的核心挑战(数据质量、模型复杂度和基础设施规模)如何在截然不同的约束下表现出来。我们通过数据—算法—机器分类体系的视角分析这些系统,而不是孤立地考察每个系统。同一种数据漂移现象,既会影响天气变化时 Waymo 的感知模型,也会影响跨生长季的 FarmBeats 作物病害检测,不过,工程应对方式会因机器约束而异。
数据—算法—机器各轴之间的相互依赖,在数据、算法和基础设施层面形成了具体的工程瓶颈。考察部署谱系的极端情况,可以揭示这些约束最严苛的形态。
现实世界的数据天然具有噪声和异步性。自动驾驶汽车处理来自激光雷达29和摄像头的大规模多模态传感器数据流 (Sun et al. 2020),需要通过硬件同步采集,并进行过滤,以应对雨、雾或镜头眩光造成的传感器性能下降。当数据通过带宽受限的链路传输时,规模会进一步加剧这些质量问题:FarmBeats 必须先在本地边缘网关上过滤和汇总农业传感器遥测数据,再通过间歇性连接的农场到云端链路进行同步;而 AlphaFold 在训练期间,则需要以高吞吐量访问蛋白质数据库中经过整理、由实验测定的结构。
Sun, Pei, Henrik Kretzschmar, Xerxes Dotiwalla, Aurelien Chouard, Vijaysai Patnaik, Paul Tsui, James Guo, et al. 2020. “Scalability in Perception for Autonomous Driving: Waymo Open Dataset.” Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2446–54. https://doi.org/10.1109/CVPR42600.2020.00252.
Gama, João, Indrė Žliobaitė, Albert Bifet, Mykola Pechenizkiy, and Abdelhamid Bouchachia. 2014. “A Survey on Concept Drift Adaptation.” ACM Computing Surveys 46 (4): 1–37. https://doi.org/10.1145/2523813.
Quiñonero-Candela, Joaquin, Masashi Sugiyama, Anton Schwaighofer, and Neil D. Lawrence, eds. 2009. Dataset Shift in Machine Learning. Neural Information Processing Series. The MIT Press.
Koh, Pang Wei, Shiori Sagawa, Henrik Marklund, Sang Michael Xie, Marvin Zhang, Akshay Balsubramani, Weihua Hu, et al. 2021. “WILDS: A Benchmark of in-the-Wild Distribution Shifts.” In Proceedings of the 38th International Conference on Machine Learning, ICML 2021, 18-24 July 2021, Virtual Event, edited by Marina Meila and Tong Zhang, vol. 139. Proceedings of Machine Learning Research. PMLR.
数据漂移在质量和规模问题之上,又增加了持续的运维负担。输入数据的统计性质会随时间变化,模型的可靠程度取决于它与当前分布的匹配程度 (Gama et al. 2014; Quiñonero-Candela et al. 2009; Koh et al. 2021)。Waymo 开放数据集报告了旧金山、凤凰城和山景城之间显著的域差异 (Sun et al. 2020);30要在此类区域性偏移表现为系统故障之前发现它们,就必须持续监测输入统计量。
在算法与基础设施的边界上,计算密集程度决定了能力的上限。GPT-3 规模的基础模型(section 1.3.3)需要 zettaFLOPs 级计算量,即使像 AlphaFold 这样较小的科学模型,也需要在专用加速器上训练数周。系统工程师必须优化“每瓦 FLOP/s”,才能使这些模型在经济和环境层面具备可行性。然而,仅有规模还不够。 泛化差距仍然是核心算法风险,因为模型在基准测试上可能达到 99% 的准确率,在现实世界中却只有 75%。对于 Waymo 的安全关键型自动驾驶系统,尽可能缩小这一差距是关乎生死的要求,需要能够覆盖长尾边缘情况的鲁棒性方法。
在生产部署中, 训练与服务鸿沟描述了模型诞生时所处的灵活环境与运行时所处的刚性环境之间的差距。延迟与吞吐量之间的权衡决定了系统架构。Waymo 式感知系统需要在边缘端以低延迟作出安全决策,而 AlphaFold 在云端运行,其推理时间取决于蛋白质长度和配置。分层协同进一步增加了复杂度:语音助手在微控制器(TinyML)上执行轻量级关键词检测,以确保在严格的毫瓦级预算内即时唤醒,同时将复杂的自然语言查询卸载到云端 GPU 集群。
最后,随着系统规模扩大,其社会影响成为贯穿数据—算法—机器三个轴的首要工程关切。必须主动管理公平性和偏见,因为模型可能无意间学习到训练数据中存在的社会偏见。负责任的工程实践要求系统性地审计不同人口子群体中的性能,以确保结果公平。透明度和隐私要求进一步约束了设计。许多深度网络如同“黑箱”一般运作,但在医疗或金融等领域,利益相关方需要可解释性。系统还必须能够抵御推断攻击31,这类攻击试图从模型预测中提取敏感训练数据。
由于生产环境中的故障会在数据、算法和物理机器之间产生连锁影响,任何单一专业领域都无法独自隔离或解决这些瓶颈。管理这些相互依赖关系,需要一个明确的运作框架。
五支柱框架
生产环境中的机器学习系统需要一个运作框架,在不割裂物理耦合关系的前提下,明确数据流水线、数学形式化、硬件执行和治理各方面的责任 (Paleyes et al. 2022)。传统软件工程通过模块化接口隔离组件;而在机器学习系统中,抽象会发生泄漏,因为错误会跨统计分布和物理硬件状态传播。系统故障不仅可能源于软件缺陷,也可能源于无声的分布漂移、内存带宽耗尽或热节流。
如 figure 9 所示,这些责任被组织为五个相互关联的专业领域,共同建立在同一技术基础之上。每个支柱划定一个运作边界,而其下方的基础则确立了支配执行的物理与经济限制,包括计算吞吐量、内存容量、互连带宽和功耗预算。
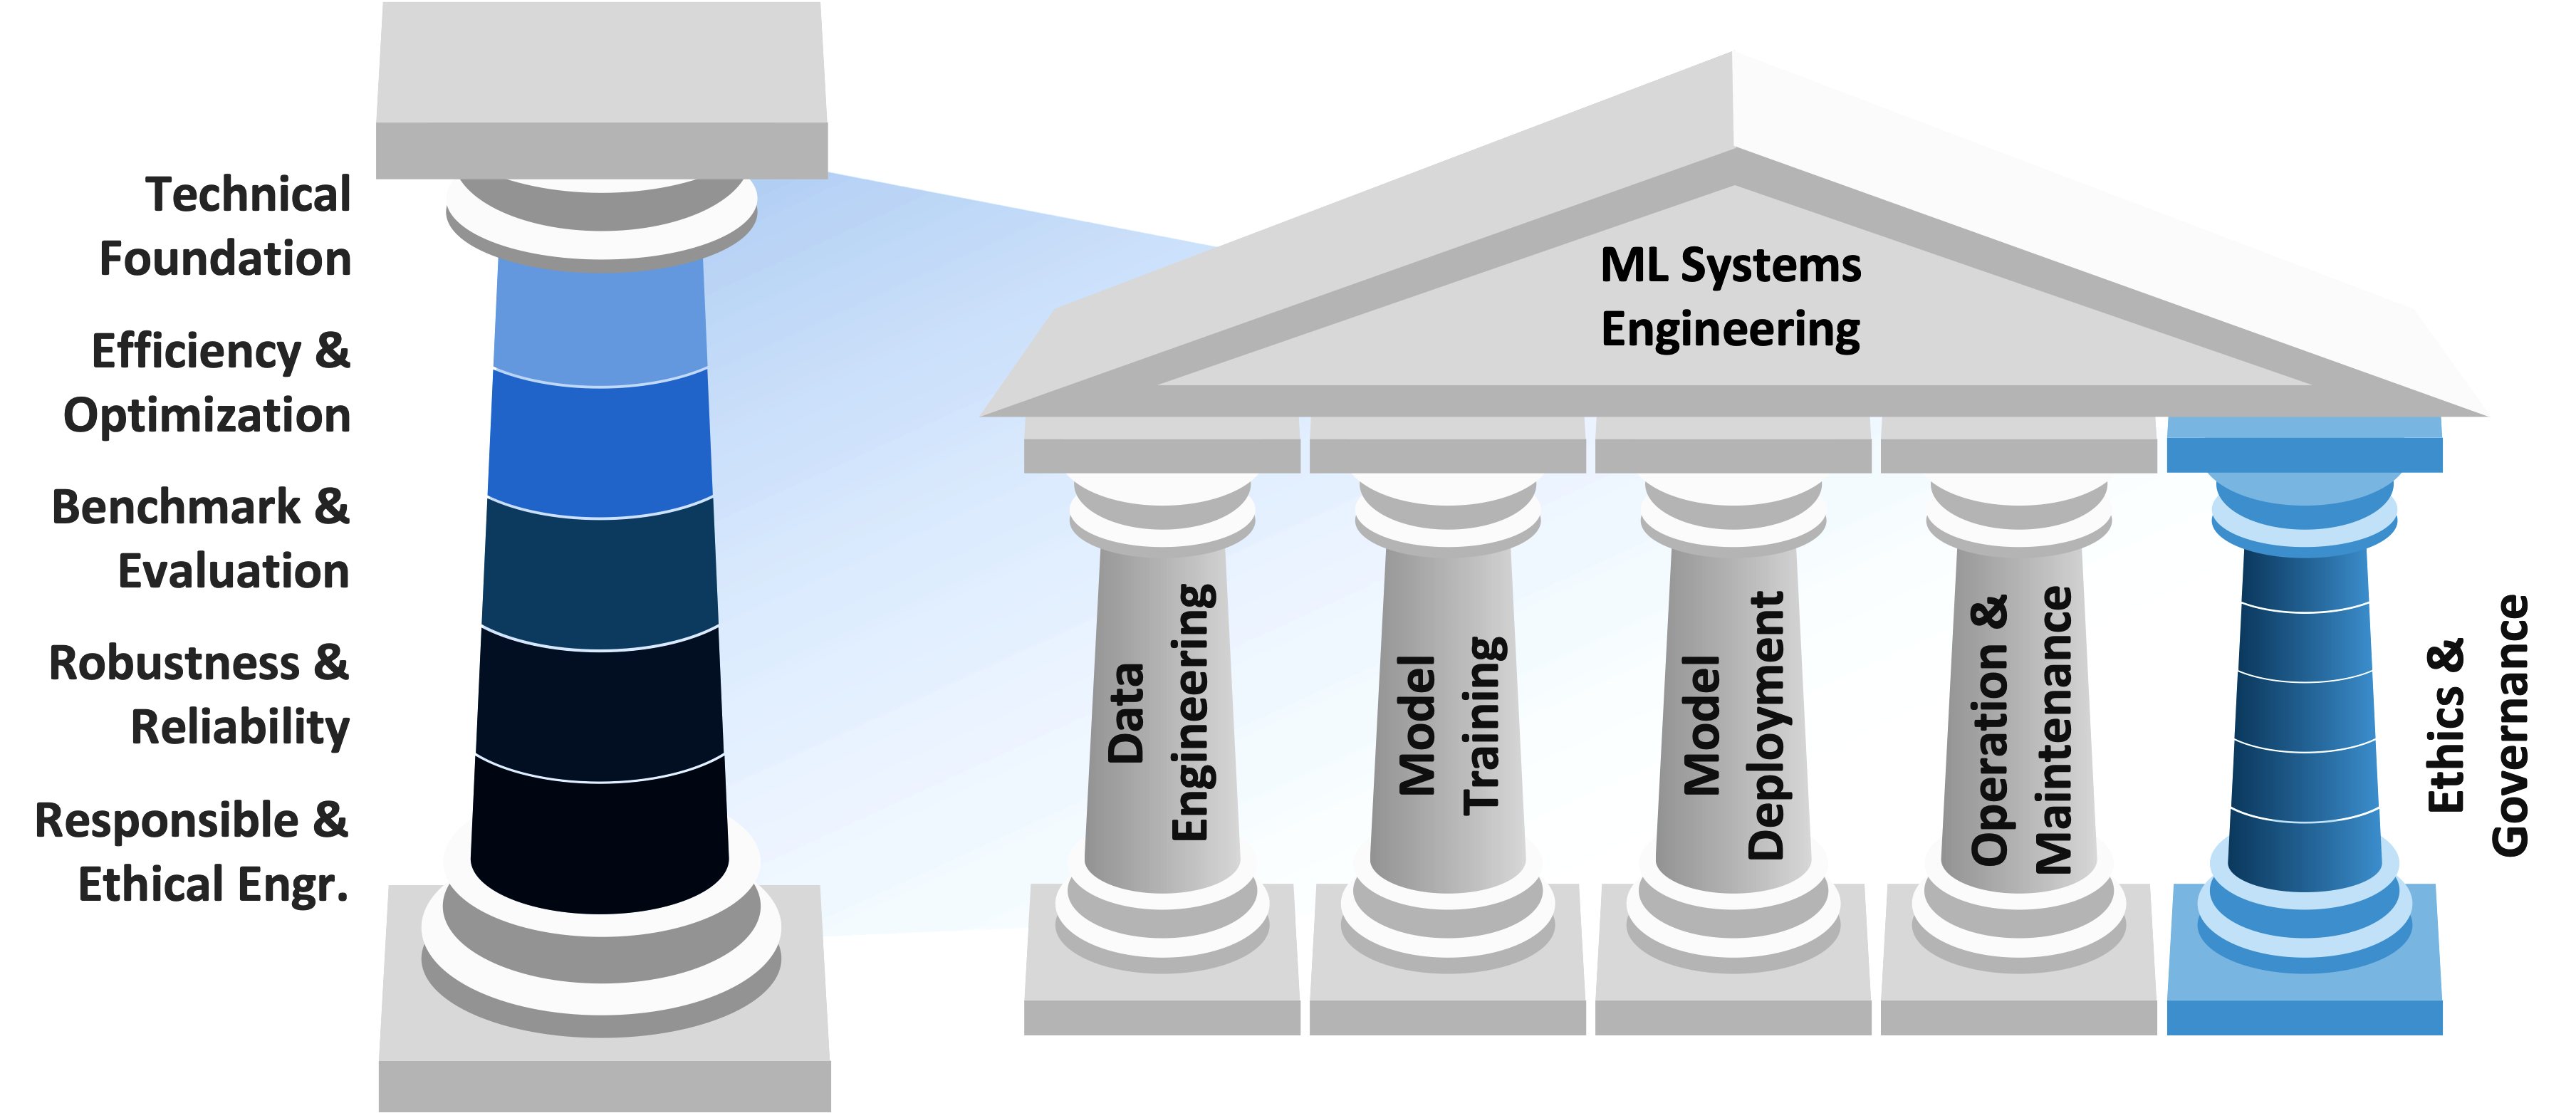
追踪一次具体故障,可以展示这些边界如何划分运作责任。假设模型更新后,端侧唤醒词检测器无法被处于混响房间中的用户触发。故障诊断从输入流水线开始:数据摄取过程是否过滤掉了具有混响特征的声学样本,预处理过程中标签是否遭到破坏,流水线血缘信息能否追溯此次更新所用的确切训练数据分区? 数据工程支柱(数据工程)负责数据摄取、验证、版本管理和血缘系统,这些系统决定了算法在数学上能够提取什么。
如果数据集包含具有代表性的声学样本,那么故障可能源于收敛缺陷或执行扩展问题。 训练系统支柱(模型训练)管理算法设计与物理计算之间的边界:协调分布式加速器集群,优化互连拓扑上的通信,在硬件故障期间安排检查点恢复,并在数值精度与计算成本之间取得平衡。
收敛后的检查点是数学产物,并非可运行的系统。 部署基础设施支柱负责弥合训练与服务鸿沟。训练着重优化批量矩阵乘法单元上的总体吞吐量,而推理则受严格的尾延迟服务级别目标(SLO)、片上内存容量和固定热设计范围的约束。这一领域负责运行时量化、算子融合、受内存带宽限制的执行,以及面向从边缘微控制器到数据中心推理加速器等目标设备的跨平台编译。
部署完成后,主要故障模式转为随时间演变的问题。 运行与监测支柱负责系统上线后的健康状况管理:生产数据分布会漂移,声学环境会变化,推理准确率会悄然下降,而 CPU 利用率、内存余量和网络吞吐量等标准基础设施指标却仍显示正常。这一领域将遥测、金丝雀发布、自动回退机制和持续评估流水线相结合,以便在模型的无声退化影响用户之前将其发现。
最后,故障特征可能表现出跨人口群体的系统性偏差,例如特定口音或音高区间的错误率较高,而持续采集音频又带来了严格的隐私和监管义务。 伦理与治理支柱(负责任工程)将规范性要求转化为可验证的工程防护措施,在整个系统生命周期中确立数据来源追溯、隐私保护聚合、公平性审计、安全限值和监管问责机制。
其他分类体系往往严格按软件组件或线性生命周期阶段来组织这些问题。五支柱结构则映射了生产工程团队的运作边界,同时保留它们之间的物理耦合。上游数据流水线决定收敛极限;分布式训练选择决定服务阶段的内存占用和延迟特征;部署运行时决定运维能够提取哪些遥测信息;治理政策则对其余四个支柱施加不可妥协的约束。将伦理与治理独立列为首要工程支柱,可以防止安全、隐私和公平性在进度压力下被当作可有可无的事后检查。
这些支柱共同将数据—算法—机器分类体系的概念轴(section 1.5.1)与按时间顺序划分的生命周期阶段(section 1.9.1)转化为明确的工程职责归属。数据工程锚定数据轴;训练系统和部署基础设施负责协调算法复杂度与机器硬件约束之间的权衡;运行与监测跟踪三个轴随时间的稳定性;伦理与治理则确立系统执行必须遵守的运作边界。这一分类体系反映了机器学习从孤立的算法实验向严谨的系统工程的根本转变——其首要目标是在物理硬件上持续实现可预测、高效且可靠的执行。
这一递进关系决定了本书的结构。理解机器学习系统,需要首先分析物理硬件不变量和数据流水线,其次在加速器集群上扩展分布式训练算法,随后在严格的延迟和能耗限制下优化编译与运行时服务。
本书结构
五个支柱定义了机器学习系统工程师需要协调的内容;本书的四个部分则定义了掌握这些内容的教学顺序。其组织原则是背景先于理论:物理硬件限制和数据摄取瓶颈决定算法选择,而非反过来。读者首先建立运作边界和术语体系(第一部分),然后构建模型(第二部分)、优化计算效率(第三部分),最后在生产环境服务级别协议的约束下部署系统(第四部分)。Table 8 概述了这四个部分的递进关系。
第一部分在模型机制登场之前,先确立物理与架构层面的基本术语。开篇这一章将 AI 系统工程界定为一门受物理约束支配的学科,介绍数据—算法—机器分类体系、效率维度和五支柱模型。机器学习系统 描绘了从云数据中心到毫瓦级 TinyML 微控制器的部署谱系,阐明热设计功耗、内存层次结构深度和延迟预算如何支配各个层级。机器学习工作流 追踪从问题定义到生产环境模型服务的端到端生命周期,指出反馈循环与技术债务在何处累积。数据工程 分析存储 I/O 瓶颈、抽取、转换、加载(ETL)流水线和特征存储,说明数据摄取吞吐量如何决定下游模型执行的运行上限。
第二部分将这些环境约束转化为模型构建技能。神经计算 推导矩阵乘法、卷积和注意力机制等基本计算内核,并分析其计算图。网络架构 将这些基本构件连接成完整的网络拓扑。这两章均以 section 1.7.2 中介绍的五个灯塔模型(ResNet-50、GPT-2/Llama、MobileNetV2、DLRM 和关键词检测)为参照,将计算需求落实到标准化工作负载上。机器学习框架 剖析 PyTorch 和 TensorFlow 中的计算图、自动微分和运行时执行引擎。模型训练 阐述加速器内存限制下的分布式执行、梯度同步、优化器内存占用管理和检查点保存。
第三部分通过改变铁律中的各项因素,在不牺牲准确率的前提下最大化效率。数据选择 通过过滤冗余样本、精选高信息量子集并缩短收敛时间,减少训练 FLOPs。模型压缩 通过训练后量化、权重剪枝和知识蒸馏,缓解内存带宽压力并缩小参数占用,使模型能够容纳于加速器严格的 SRAM 和 HBM 容量预算之内。硬件加速 分析 GPU 和专用集成电路(ASIC)的微架构机制,说明脉动阵列、Tensor Core 和高带宽内存层次结构如何实现高算术强度。基准测试 建立严谨的规程,用于测量持续计算吞吐量、尾延迟和能效,将真正的硬件瓶颈与测量伪影区分开来。
第四部分将这些优化后的产物部署到生产环境中;在这里,运行时动态、静默数据漂移和运行约束起主导作用。模型服务 设计推理引擎,在严格的延迟服务级别协议下管理动态请求批处理、KV 缓存内存分配和内核调度。机器学习运维 构建持续遥测流水线,以监控预测质量状况、检测分布漂移,并在模型的静默退化影响用户之前执行金丝雀发布。负责任工程 将安全验证、偏差审计和差分隐私约束直接嵌入系统生命周期。结论 综合完整的方法体系,帮助读者做好准备,从熟练掌握单节点系统迈向分布式集群编排。
本书涵盖的是单节点范畴,即一台主机配备一到八个加速器,每个加速器通常使用本地设备内存,并通过 PCIe 或 NVLink 等节点内互连进行通信。起决定作用的约束取决于工作负载,可能是设备内存容量、内存带宽、计算吞吐量或互连通信。在大规模集群中,数千个节点通过网络互连结构协同工作,瓶颈则转向二分带宽,即横跨集群网络某一二分割面的总容量。有关阅读路径、学习成果、先修知识以及如何充分利用本教材的详细指导,请参阅前言。
section 1.8 和 section 1.10 中介绍的分析框架,只有在工程师同时摒弃从相邻领域沿袭而来的假设时才能发挥作用。每一门成熟学科都会积累一些直觉,它们在本领域内有效,但应用于其他领域时却会失效。机器学习系统工程位于软件工程、统计学与硬件设计的交汇处,因此尤其容易受到此类外来假设的影响。传统软件假定执行是确定性的;经典统计学假定数据分布平稳且计算成本为零;硬件设计则假定指令流固定。若不正视这些视角之间的矛盾就将其混合,会直接导致系统脆弱和计算资源浪费。
误区与陷阱
在传统软件、学术研究或纯数学中成立的假设,应用于行为由数据涌现而来的系统时便会失效。这些误区与陷阱概括了那些浪费工程投入、延误部署并导致生产环境静默故障的错误。
误区:更好的算法会自动产生更好的系统。
工程师常常认为,算法的精巧程度决定系统性能,但这忽略了铁律(section 1.7)。视觉 Transformer 表明,架构与大规模预训练能够取得出色的图像识别效果 (Dosovitskiy et al. 2021),但生产环境中的效用仍取决于计算、内存数据搬移和延迟预算。在生产环境中,一个准确率提高了 1% 却违反延迟要求的模型,其效用实际上为零。因此,生产模型选择是一个约束优化问题:在延迟、内存、能耗、成本和可靠性预算约束下,最大化任务质量。生产模型周围隐藏的技术债务说明,模型代码只是一个庞大得多的系统中可见的核心部分。采用更简单模型但工程设计完善的系统,可能优于缺乏稳健基础设施的复杂架构。
Dosovitskiy, Alexey, Lucas Beyer, Alexander Kolesnikov, Dirk Weissenborn, Xiaohua Zhai, Thomas Unterthiner, Mostafa Dehghani, et al. 2021. “An Image Is Worth 16x16 Words: Transformers for Image Recognition at Scale.” International Conference on Learning Representations (ICLR).
陷阱:将机器学习系统视为恰好包含了一个模型的传统软件。
工程师将传统测试和部署实践应用于机器学习系统,但这些系统的失效方式存在本质差异(section 1.6)。传统缺陷往往会立即引发异常或崩溃;机器学习系统则可能在数周或数月内悄然退化,之后才被察觉。传统软件中的 A/B 测试可能很快呈现明确信号,而机器学习方案的比较可能需要更长的观察窗口,才能检测出不同子群体中的微小准确率差异。单元测试验证确定性执行路径;机器学习系统则需要监控基础设施,以发现不可靠的预测、数据漂移和校准失效。仅依靠持续集成与持续部署(CI/CD)流水线部署机器学习的团队,面临静默故障风险:测试套件和健康检查均显示正常,面向用户的预测质量却在下降。
误区:在基准数据集上取得高准确率,就意味着已具备生产部署条件。
基准准确率反映的是静态、经过整理的测试分布,而非实际运行状况(section 1.9.2)。一个在经过整理的测试数据上表现良好的情感分析模型,可能因用户使用基准中未包含的俚语、表情符号和语境,而在生产环境中表现大幅下滑。此外,实际部署环境会引入基准排行榜中不存在的硬性权衡。移动端加速器对数值精度和内存容量的限制,使那些提高基准分数的多模型策略无法采用,而网络往返又会增加显著的延迟开销。生产系统需要针对不同人口统计子群体开展失效模式分析,通过持续监控检测漂移,并采用与实际运行条件相匹配的验证规程,而非依赖理想化测试集。
陷阱:优化单个组件,却不考虑系统内的相互作用。
工程师孤立地优化推理延迟,但端到端性能受阿姆达尔定律支配。某个团队将模型推理时间从 45 ms 缩短至 15 ms,期望获得同比例的改善。然而,预处理耗时 60 ms,后处理又增加 25 ms,因此总延迟仅从 130 ms 降至 100 ms。这意味着改善幅度为 23 percent,而非预期的 67 percent。数据—算法—机器全景图(figure 4)表明,数据、算法和机器三个轴构成一个相互依赖的系统,优化其中一个组件会转移瓶颈,而不是消除瓶颈。组件层面的收益并不能决定端到端的改善幅度;结果取决于被优化组件在完整路径中所占的比例。
仅优化推理,端到端延迟基本不变。
误区:机器学习系统只需部署一次,便可无限期运行。
已部署的机器学习系统,其性能不会随时间保持不变:即使底层执行代码完全未变,环境分布的变化也会使冻结模型退化。在这个示例场景中,随着购买模式发生变化,一个部署时准确率为 85 percent 的推荐系统,在 6 months 内降至 80.2 percent,在没有任何代码变更的情况下下降了 4.8 percentage points。因此,机器学习生命周期(section 1.9.1)将结果监控和基于证据的重新训练视为运行要求。欺诈检测和自然语言处理系统也面临同样的风险:用户行为演变、对抗模式出现、词汇发生漂移,而提供服务的二进制程序仍保持不变。若缺乏持续监控,系统看似健康,预测质量却会悄然下降。将部署视为一次性交接的组织,往往只有在客户投诉或业务指标恶化迫使其开展紧急审计后,才发现故障。
陷阱:认为仅凭机器学习专业知识就足以胜任机器学习系统工程。
组织聘用机器学习研究人员,并期望他们交付可用于生产的系统,但五支柱框架(section 1.10)要求融合算法、软件、系统和运维等领域的专业知识。机器学习能力强但系统经验有限的团队,可能无法达到吞吐量目标,因为 API 设计、存储布局和模型服务基础设施都会影响实际性能。反过来,在缺乏机器学习认知的情况下构建的软件基础设施,可能引入预处理或特征缺陷,导致模型行为退化,却不出现明显的系统故障。部署案例研究表明,生产环境中的机器学习需要协调关注数据、模型、基础设施和组织工作流程,而不能仅依赖算法质量 (Paleyes et al. 2022)。高效团队将机器学习研究人员、软件工程师和运维专家整合起来,而非期望某一种角色掌握所有技能。生产故障通常源于学习得到的权重、物理执行硬件和运行工作流程之间衔接处的断裂。
Paleyes, Andrei, Raoul-Gabriel Urma, and Neil D. Lawrence. 2022. “Challenges in Deploying Machine Learning: A Survey of Case Studies.” ACM Computing Surveys 55 (6): 1–29. https://doi.org/10.1145/3533378.
总结
机器学习系统必须同时履行两项义务:学习得到的行为必须保持可信,机器也必须在物理与经济限制之内实现这种行为。软件 2.0 的转变解释了为何从数据中学习得到的行为会随着分布变化而静默失效。AI 的范式演进史与苦涩的教训解释了为何进步反复来自能够利用更多计算的系统,而非手工编码的专业知识。数据—算法—机器分类体系用于定位起决定作用的约束,而退化方程、铁律以及能耗与效率框架则将这些约束转化为定量诊断。
随后,生命周期、部署谱系和生产案例研究进一步说明了为何持续迭代与结合场景的设计不可或缺。五个灯塔模型(ResNet-50、GPT-2/Llama、MobileNetV2、DLRM 和关键词检测,详见 网络架构)贯穿全书,将这些原则落实到真实工作负载中。
回到本章开头的智能手机交互。看似一次智能操作,实则依赖具有代表性的数据、学习得到的模型、在运行预算内工作的机器,以及能够揭示行为变化的反馈。这条链路回答了开篇提出的问题。由于机器学习的行为既来自学习,也来自编码,因此它可能在没有显式故障的情况下退化,必须跨数据、算法、软件和硬件进行协同设计。AI 工程要求这种随机性行为达到确定性的可靠性目标。
要点回顾: 约束驱动架构
- 数据—算法—机器的瓶颈会迁移,而不会消失。 数据、算法与机器的约束相互作用,因此,改善一个维度往往会暴露另一个维度的瓶颈。系统工程的思维习惯是先判断当前哪个维度构成制约,再选择能够缓解该约束、同时不会在下游引发更大故障的干预措施。
- 习得行为可能悄然退化。 传统软件通常在代码或其运行环境发生变化时失效;机器学习系统则可能在代码和基础设施保持不变的情况下性能下降,因为现实世界相对于训练分布发生了变化。漂移指标将这种变化转化为触发调查的信号,避免准确率意外下降。
- 机器学习系统铁律使延迟具有诊断价值。 数据移动、计算和开销都消耗同一份时间预算。当预处理(60 ms)和后处理(25 ms)占主导地位时,将推理时间从 45 ms 缩短至 15 ms,只能带来 23 percent 的提升,因此应优化制约端到端表现的那一项。
- 规模扩展在物理极限之内奏效。 苦涩的教训解释了为何使用更多计算资源的通用方法取代了人工精心设计的系统,但只有当数据、架构和机器能够提供支撑时,规模扩展才有帮助。44.5× 的效率提升与计算量约 7 个数量级的增长同时存在。
- AI 工程是持续的协同设计。 部署情境、全生命周期监控和五大工程支柱并非后期附加项;从云端训练到 TinyML 运行,它们始终是使具有随机性的习得行为满足确定性可靠性目标的手段。
本章介绍的所有内容都支持一个论断:机器学习系统受物理规律支配,而非受意图支配。其行为反映了数据、算术运算和硬件所允许的范围。苦涩的教训、机器学习系统铁律、退化方程以及数据—算法—机器分类体系共同构成了一套统一的术语体系,用于推理那些通过学习获得、而非完全预先规定,且若不加维护便可能退化的行为。将这些约束视为真正的规格要求,才能使一组技术成为一门学科。
后续内容: 从愿景到架构
选择机器学习模型的运行位置受物理定律支配。光速使远端云服务器无法满足紧急制动的需求。热力学使数据中心级模型无法在移动设备上运行。存储器的物理特性形成了更快的芯片也无法突破的带宽上限。四种部署范式正是这些定律的具体体现。机器学习系统 从物理规律出发推导各范式的运行边界,并构建在需求相互冲突时用于选择部署范式的决策框架。
Footnotes
GPU(图形处理器):最初用于渲染电子游戏图形,这类工作负载需要执行数千次简单、并行的像素计算。事实证明,这种硬件与算法的契合对神经网络具有决定性意义:同样的大规模并行算术结构可以直接映射到矩阵乘法,使 GPU 成为支撑现代训练规模的主要物理基础之一。↩︎
Andrej Karpathy:OpenAI 创始成员之一、特斯拉前人工智能总监,率先推动了深度学习在自动驾驶车队中的应用。他于 2017 年提出的“软件 2.0”论述明确了一项洞见:神经网络权重是新的“源代码”。这带来了一种新的工程现实:工程师必须整理定义程序行为的数据,并对其进行版本管理,而不再只是调试显式逻辑,因为拥有数百万参数的模型无法被直接修补,也难以直接推理其行为。↩︎
随机梯度下降(SGD):该算法通过处理随机采样的小组样例(“批次”)来学习模型参数,而不是一次处理整个数据集。这是以统计噪声换取计算速度。批次大小也会影响机器执行,因为过小的批次可能无法充分利用加速器的并行处理器,浪费其大部分潜在计算能力。↩︎
模型权重:神经网络学习得到的数值参数。一个 GPT-3(生成式预训练 Transformer 3)规模的模型存储 175B 个这样的数值,在 FP16 精度下占用 350 GB;FP16 是一种 16 位浮点格式,每个数值占用两个字节 (Brown et al. 2020)。参数数量决定权重的存储占用,并对模型服务的内存流量和成本产生显著影响(参见 神经计算)。↩︎
AlexNet:Alex Krizhevsky、Ilya Sutskever 和 Geoffrey Hinton 使用两块 GPU 训练了这一卷积神经网络。在 ILSVRC 2012 中,其 top-5 错误率为 15.3%,即正确类别未出现在得分最高的五个预测之中的比例,显著优于第二名系统的 26.2% (Krizhevsky et al. 2012)。Section 1.3.3 将再次讨论其架构与系统协同设计。↩︎
艾伦·图灵:他在 1950 年提出的“模仿游戏”将智能重新界定为一个输出测量问题:根据系统做什么,而非它是什么来判断系统。这种工程优先的立场延续至今,体现在我们使用的每一项机器学习系统指标中:准确率、延迟、吞吐量以及每瓦 FLOP/s 都是对输出的测量。正因如此,机器学习系统铁律(section 1.7)将性能分解为可观测、可测量的项,而非内部架构属性。↩︎
ELIZA:1966 年开发的一种自然语言程序,使用模式匹配规则,而非学习得到的参数。它的脚本能够存储和检索选定的输入,但这种有限的人工编写的记忆机制并不能提供通过学习获得的对话状态。每一种新的输入变体都需要增加一条规则,使维护成本的增长快于能力的增长,也预示了后来制约专家系统的知识瓶颈。↩︎
作为系统性失败的 AI 寒冬:第一次 AI 寒冬(1974–1980 年)发生在资金削减的背景下;1973 年的《莱特希尔报告》批评了 AI 承诺与实际成果之间的差距 (Lighthill 1973)。第二次寒冬(1987–1993 年)涉及专家系统和专用 Lisp 机器市场及资金的崩溃,通用工作站削弱了它们的经济优势 (Hendler 2008)。从本书的系统视角来看,这两次事件都表明,算法的雄心超出了现有基础设施、市场支持和工程成熟度所能承载的范围,而不只是缺少巧妙的算法。↩︎
达特茅斯会议(1956 年):这次研讨会围绕“人工智能”这一术语展开,该术语已出现在 1955 年的会议提案中 (McCarthy et al. 1955)。与会者从语言、抽象、问题求解和自我改进的角度界定智能,却很少关注后来成为核心问题的存储与计算的物理约束。这种不考虑计算约束的假设——更好的算法总能克服硬件限制——正是本书要纠正的观念:后续每一章都将论证,系统约束是首要的设计变量,而非事后才考虑的因素。↩︎
STUDENT:丹尼尔·鲍勃罗于 1964 年在 MIT 开发的程序,能够解析受限的英语应用题,以符号形式表示其中的关系,并将所得方程传递给代数求解器。这是将语言理解与形式推理分离的早期实例:一旦表示正确,求解就很直接;覆盖范围则取决于人工编写的转换规则 (Bobrow 1964)。↩︎
莫拉维克悖论:卡内基梅隆大学机器人学家汉斯·莫拉维克观察到,高层推理(国际象棋)所需的计算量很少,而低层感知(行走)则需要大规模并行处理 (Moravec 1988)。这一悖论解释了机器学习系统工程中的一个核心事实:在人类看来“简单”的任务(视觉、语音、运动控制),恰恰需要最高的 FLOP/s、内存带宽和专用硬件,由此推动了塑造现代机器学习基础设施的加速器革命。↩︎
知识获取瓶颈:费根鲍姆的知识工程工作以提取、表示和维护专家知识的实际困难为核心来界定应用 AI (Feigenbaum 1984)。用系统术语来说,这一瓶颈是一个吞吐量问题:知识获取与规则维护受限于人类专家的串行带宽。计算瓶颈可以通过更快的硬件缓解,而这一瓶颈则是 AI 最初的“无法规模化”约束,也是随后转向数据驱动范式的直接动因。↩︎
数据出乎意料的有效性:这一观察指出,使用海量数据的简单统计模型,可能优于使用较少数据的更复杂模型 (Halevy et al. 2009)。Halevy 及其同事通过大规模网络语料库展示了这一效应,而非提出一个普遍适用的错误率变化倍数;收益取决于任务、模型、数据质量和起点。这一结果支持了从脆弱的人工设计系统向概率模型的转变,并使数据收集、存储、预处理和分布式训练成为核心工程问题。↩︎
Viola-Jones 算法:该算法的实时速度来自级联分类器,它使用简单的人工设计矩形特征,立即排除非人脸区域。该方法针对正面人脸检测进行设计和评估,体现了那个时代的权衡:专家设计的特征可以快速且有效,但表示具有任务专用性。仅前两层就能排除超过 80% 的负样本子窗口,而在总计 6,000 多个特征中仅使用了 12 个 (Viola and Jones 2001)。↩︎
Richard Sutton:强化学习先驱,其 2019 年的文章凝练了 section 1.3 中梳理的规律:从符号人工智能、专家系统到深度学习,利用计算的通用方法持续优于人工构建的专业知识。这一教训之所以“苦涩”,是因为它意味着领域专用逻辑是一种不断贬值的资产,而持久优势属于能够吸收自 20 世纪 70 年代以来原始算力十亿倍增长的系统工程。↩︎
深蓝:IBM 的国际象棋系统 (Campbell et al. 2002) 于 1997 年通过系统层面的组合击败了世界冠军 Garry Kasparov:在 480 个定制国际象棋处理器上以每秒约 2 亿个局面的速度进行搜索,并结合国际象棋专用评估与知识。深蓝是早期向公众展示专用芯片能够增强搜索和已编码领域知识作用的实例,预示了如今定义现代机器学习硬件的领域专用加速器策略。↩︎
AlphaGo:AlphaGo 首先从人类专家棋谱中学习,然后通过自我对弈的强化学习改进,以能够在庞大计算规模下探索问题空间的数据与计算流水线,取代人工编码的围棋策略。经过三天的自我对弈训练,AlphaGo Zero 超越了最初的 AlphaGo,以 100 比 0 的战绩获胜 (Silver et al. 2017)。↩︎
GPT-3(生成式预训练 Transformer 3)训练能耗:Patterson et al. (2021) 估算,GPT-3 单次训练运行消耗约 1,287 MWh,并排放 552 吨 CO2 当量;以 10.7 MWh/household-year 为基准,其用电量大致相当于 120 个美国普通家庭的年用电量。数据在内存层次结构中的移动占这一能耗的相当大一部分,因为跨内存层级移动操作数所消耗的能量,比本地算术运算高出数个数量级 (Horowitz 2014)。↩︎
内存带宽:数据在片外存储器(例如高带宽内存(HBM))与片上处理器寄存器或 SRAM 之间传输的速率。大批量训练可以将参数传输开销分摊到数千个词元上,从而实现较高的算术强度,而自回归推理每生成一个词元,都必须从片外内存重新加载数十亿个权重。由于片外内存传输的能耗和延迟均比片上计算高出数个数量级,因此决定执行延迟和数据中心功耗的往往是内存带宽,而非峰值算术吞吐量。↩︎
推理:源自拉丁语 inferre(“带入”或“得出结论”)。在机器学习工程中,推理指部署阶段,即训练好的模型将学到的模式应用于新输入的阶段。这一区别对系统设计至关重要,因为训练以吞吐量为优化目标(最大化每秒处理的样本数),而推理以延迟为优化目标(最小化每次预测所需的毫秒数)。这些相反的目标要求采用根本不同的硬件配置和软件栈(参见 模型服务)。↩︎
ImageNet:2009 年的论文报告了覆盖 5,247 个同义词集的 320 万张图像;此后,完整数据集增长到覆盖 21,841 个同义词集的约 1,420 万张图像。AlexNet 使用的 2012 年挑战赛训练集包含约 1.3M 张标注图像 (Deng et al. 2009; Russakovsky et al. 2015)(参见 数据工程)。↩︎
摩尔定律:戈登·摩尔于 1965 年提出的观察描述了能够以经济可行的方式集成到芯片上的元件数量的快速增长 (Moore 1998);后来的行业概述通常将这一节奏表述为大约每两年翻一番。↩︎
计算机工程:1971 年,凯斯西储大学开设了首个获得认证的计算机工程专业,标志着计算机工程正式成为一门学术学科。这体现了一个认识:无论是电气工程还是计算机科学,都无法独自解决用不可靠组件构建可靠计算机的问题。机器学习系统工程重现了这一融合过程:起决定作用的约束并不单独来自算法或硬件,而是来自如何在延迟、功耗和数据质量预算下整合二者,而这并非任何一门学科的课程体系所涵盖的内容。↩︎
微控制器:具有千字节级内存和毫瓦级功耗预算的单芯片计算机。对于 TinyML,内存和能耗先于模型质量决定系统的可行性。↩︎
延迟:源自拉丁语 latere(“隐藏”),延迟在导致故障之前往往不可见。以 30 m/s 的速度行驶时,每增加一毫秒延迟,车辆在开始制动前就会多行驶 3 cm,因此 \(L_{\text{lat}}\) 成为边缘端的关键约束。↩︎
模型压缩:一类用于减少模型存储或计算需求的技术,包括量化、剪枝和知识蒸馏。它们对模型大小和准确率的影响取决于模型、方法、工作负载和目标硬件。↩︎
自动驾驶混合工作流:这一具有代表性的工作流带来了纯云端或纯边缘系统中不存在的同步挑战。车载模型在部署前必须经过管控和回归测试,而云基础设施可以利用新采集的驾驶数据训练和评估改进版本。这使已部署模型与新训练模型之间产生了版本管理差距,因此,在向安全关键型车辆推送任何远程模型更新之前,都必须进行严格验证。↩︎
FarmBeats:该系统使用电视白频谱链路,作为从传感器到网关 PC 的农场内部高带宽回传通道,通过本地处理降低对较弱的云端互联网连接的依赖。由此产生的约束是能否通过农场到云端链路及时同步数据,而不是能否传输某一特定大小的模型 (Vasisht et al. 2017)。↩︎
激光雷达(光探测与测距):这种传感器是车辆成为“移动数据中心”的主要原因之一,因为其脉冲激光会生成环境的稠密三维点云。单台设备的原始数据流可能超过每秒 100 兆字节,既带来了前述太字节级数据量挑战,也带来了质量挑战,因为雨或雾造成的传感器干扰很容易使信号劣化。↩︎
数据漂移:训练数据分布(\(P_0\))与生产环境分布(\(P_t\))之间的偏离。即使代码没有变化,漂移也可能改变性能,但仅凭分布偏离并不能判定准确率是否下降;需要监测结果才能确认性能退化(参见 机器学习运维)。↩︎
推断攻击:一种安全威胁,攻击者通过查询模型来推断训练集中的敏感信息。这类攻击利用了过参数化模型倾向于记忆训练数据中特有模式的特点,使模型容量与隐私风险之间形成直接权衡,从而推动差分隐私和输出扰动等防御技术的发展。↩︎
Brown, Tom B., Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared Kaplan, Prafulla Dhariwal, Arvind Neelakantan, et al. 2020. “Language Models Are Few-Shot Learners.” Advances in Neural Information Processing Systems 33: 1877–901. https://doi.org/10.48550/arxiv.2005.14165.
Krizhevsky, Alex, Ilya Sutskever, and Geoffrey E. Hinton. 2012. “ImageNet Classification with Deep Convolutional Neural Networks.” Advances in Neural Information Processing Systems (NeurIPS) 25.
Lighthill, James. 1973. “Artificial Intelligence: A General Survey.” In Artificial Intelligence: A Paper Symposium. Science Research Council.
Hendler, James A. 2008. “Avoiding Another AI Winter.” IEEE Intelligent Systems 23 (2): 2–4. https://doi.org/10.1109/MIS.2008.20.
McCarthy, John, Marvin L. Minsky, Nathaniel Rochester, and Claude E. Shannon. 1955. A Proposal for the Dartmouth Summer Research Project on Artificial Intelligence, August 31, 1955. No. 4. Vol. 27. Dartmouth College. https://doi.org/10.1609/aimag.v27i4.1904.
Bobrow, Daniel G. 1964. “Natural Language Input for a Computer Problem Solving System.” PhD thesis, Massachusetts Institute of Technology.
Moravec, Hans. 1988. Mind Children: The Future of Robot and Human Intelligence. Harvard University Press.
Feigenbaum, Edward A. 1984. “Knowledge Engineering: The Applied Side of Artificial Intelligence.” Annals of the New York Academy of Sciences 426: 91–107. https://doi.org/10.1111/j.1749-6632.1984.tb16513.x.
Halevy, Alon, Peter Norvig, and Fernando Pereira. 2009. “The Unreasonable Effectiveness of Data.” IEEE Intelligent Systems 24 (2): 8–12. https://doi.org/10.1109/mis.2009.36.
Viola, Paul, and Michael J. Jones. 2001. “Rapid Object Detection Using a Boosted Cascade of Simple Features.” Proceedings of the 2001 IEEE Computer Society Conference on Computer Vision and Pattern Recognition. CVPR 2001 1: I-511-I-518. https://doi.org/10.1109/cvpr.2001.990517.
Campbell, Murray, Jr. Hoane A.Joseph, and Feng-hsiung Hsu. 2002. “Deep Blue.” Artificial Intelligence 134 (1-2): 57–83. https://doi.org/10.1016/s0004-3702(01)00129-1.
Silver, David, Julian Schrittwieser, Karen Simonyan, Ioannis Antonoglou, Aja Huang, Arthur Guez, Thomas Hubert, et al. 2017. “Mastering the Game of Go Without Human Knowledge.” Nature 550 (7676): 354–59. https://doi.org/10.1038/nature24270.
Patterson, David, Joseph Gonzalez, Quoc Le, Chen Liang, Lluis-Miquel Munguia, Daniel Rothchild, David So, Maud Texier, and Jeff Dean. 2021. “Carbon Emissions and Large Neural Network Training.” arXiv Preprint arXiv:2104.10350.
Horowitz, Mark. 2014. “1.1 Computing’s Energy Problem (and What We Can Do about It).” 2014 IEEE International Solid-State Circuits Conference Digest of Technical Papers (ISSCC), 10–14. https://doi.org/10.1109/isscc.2014.6757323.
Deng, Jia, Wei Dong, Richard Socher, Li-Jia Li, Kai Li, and Li Fei-Fei. 2009. “ImageNet: A Large-Scale Hierarchical Image Database.” 2009 IEEE Conference on Computer Vision and Pattern Recognition, 248–55. https://doi.org/10.1109/cvpr.2009.5206848.
Russakovsky, Olga, Jia Deng, Hao Su, Jonathan Krause, Sanjeev Satheesh, Sean Ma, Zhiheng Huang, et al. 2015. “ImageNet Large Scale Visual Recognition Challenge.” International Journal of Computer Vision 115 (3): 211–52. https://doi.org/10.1007/s11263-015-0816-y.
Moore, G. E. 1998. “Cramming More Components onto Integrated Circuits.” Proceedings of the IEEE 86 (1): 82–85. https://doi.org/10.1109/jproc.1998.658762.
Vasisht, Deepak, Zerina Kapetanovic, Jongho Won, Xinxin Jin, Ranveer Chandra, Sudipta N. Sinha, Ashish Kapoor, Madhusudhan Sudarshan, and Sean Stratman. 2017. “FarmBeats: An IoT Platform for Data-Driven Agriculture.” 14th USENIX Symposium on Networked Systems Design and Implementation (NSDI 17), 515–29.