数据工程
数据工程
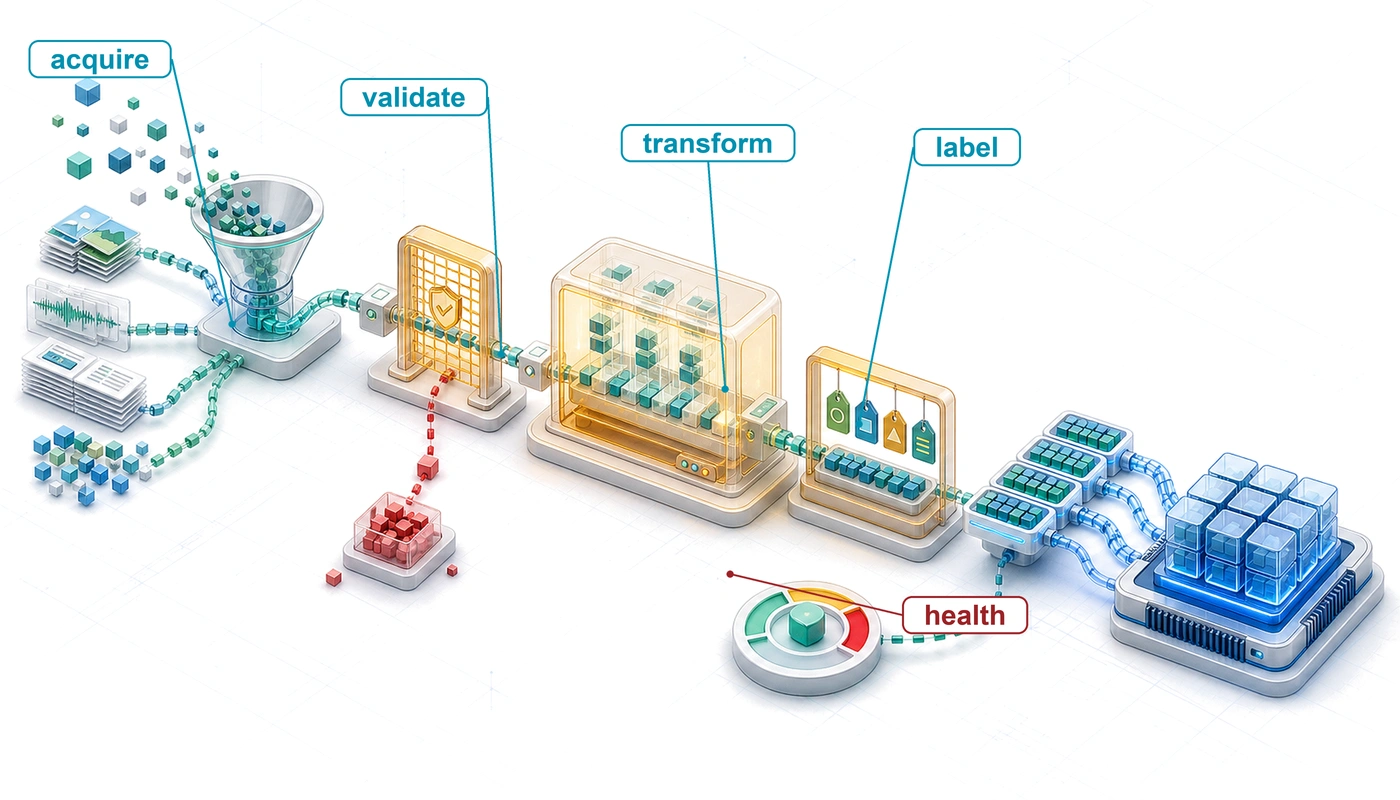
本章宗旨
为什么训练数据在机器学习系统中的作用类似于源代码?
在传统软件中,程序员编写由计算机执行的逻辑。在机器学习中,程序员编写优化过程,从数据中提取运行逻辑。这种倒置使训练数据类似于源代码:即使传统代码没有任何变化,修改训练数据也可能在模型重新训练后改变学得的系统。细微的标注不一致可能导致行为不一致;缺失的边缘情况可能使相应故障无法得到衡量;历史偏差可能传播到学得的行为中。仅在该数据集上训练的模型无法推断出其中缺失的任务相关证据,而系统性的标签错误可能影响模型学到的内容。传统源代码在程序员修改之前保持静态,而系统运行时面对的分布可能随着世界的变化而发生偏移,即使代码库完全未被改动,也可能改变生产环境中的性能。数据工程之所以可能耗费大量项目精力,是因为这项工作影响深远。数据流水线中的每一项决策(收集什么、如何标注、何时过滤、如何划分)都会向后续环节传播,约束模型架构、训练动态和部署可行性。因此,数据工程并非预处理,而是用另一种语言进行编程;在这种语言中,质量控制、版本管理和监控决定了编译后的系统今天能否正常运行,以及明天能否继续正常运行。从数据—算法—机器的角度看,流水线本身就是一个数据与机器协同设计的问题:无论数据经过多么精心的整理,算法的学习速度都受限于机器提供数据的速度。
学习目标
- 解释数据作为源代码的含义,并追踪数据级联效应如何在机器学习系统中传播
- 计算移动数据集或为其提供访问服务时的数据引力、供数税以及存储带宽成本
- 根据覆盖范围、质量、标注成本、治理和部署约束评估数据获取策略
- 为批处理、流处理、ETL 和 ELT 工作负载设计摄取与验证流水线
- 实现幂等转换、数据血缘和漂移检查,以保持训练与服务的一致性
- 根据机器学习生命周期需求选择标注、存储、文件格式、版本管理和特征存储设计
- 利用质量、可靠性、可扩展性和治理方面的证据,诊断数据债务与生产流水线故障
数据集编译
工作流程在数据流水线中具体展开:原始输入经过收集、摄取、分析、标注、验证和准备,才成为可供机器学习使用的数据集。2016 年 Crowdflower 调查 (CrowdFlower 2016) 报告的工作量分布解释了为什么这条流水线需要专门从系统角度加以研究:60% 的受访者将清洗和整理数据选为最耗时的任务,19% 的受访者选择了收集数据集。数据—算法—机器分类体系中的数据轴,只有落实为基础设施才具有实际意义:数据获取系统、验证检查、标注工作流、存储布局和治理。
CrowdFlower. 2016. Data Science Report 2016.
Definition 1.1: 数据工程
数据工程 是管理数据从源头到模型整个生命周期的基础设施层,涵盖获取、转换、存储和治理。
- 重要性:其关键职能是确保训练与服务的一致性,通过将模型与原始数据的波动解耦,防止无声的性能退化。在机器学习系统铁律中,它支配着移动的字节量 \((D_{\text{vol}})\),而数据集的组成和质量则决定数据集 \((D)\) 是否仍能代表目标分布。
- 区别:数据科学 侧重于推断和洞见,而数据工程关注数据流水线的可扩展性与可靠性。
- 常见误区:一种常见误解将数据工程简化为单纯的“数据清洗”。从系统角度看,它是数据集编译:将原始、含噪的观测数据转换为经过优化、供加速器运行时使用的二进制布局。
数据集编译 这一类比使基础设施的作用变得具体。正如软件编译器通过一系列逐步精化的表示(词元、抽象语法树、中间表示、机器码)转换源代码,数据流水线也通过类似阶段,将原始、含噪的观测数据转换为可直接用于训练的数值张量。过滤损坏记录、离群值和无关特征,对应于死代码消除:剔除对学得的表示毫无贡献的内容。数据增强通过旋转图像、改变音频音高或注入噪声等方式,合成扩充有限的样本,类似于循环展开,无需收集新数据,就能让模型接触底层模式的更多变化。去重 扮演着公共子表达式消除的角色,识别并合并重复记录,否则这些记录会使梯度估计产生偏差并浪费计算资源。模式验证对每条记录强制执行严格的类型和取值范围约束,是数据流水线的类型检查器,在格式错误的输入导致模型训练这一“运行时”崩溃之前将其拒绝。
这在工程上的含义是:必须对数据集进行版本管理并保留不可变的数据血缘,通过模式验证测试套件开展单元测试,并在出现退化时进行调试。删除一行训练数据可能改变学得的产物,正如删除一行代码可能改变编译后的二进制文件;重新训练就是相应的重新编译步骤。 编译还要求在数据集各分区之间建立信任边界。训练集可以影响参数;验证集可以影响建模和流水线选择;测试集则保留用于在这些选择确定之后估计泛化能力。当信息跨越这些边界时,就会发生泄漏:重复样本出现在多个划分中,同一源记录的增强变体落在划分的两侧,同一家庭的用户记录同时出现在训练集和测试集中,或者使用未来观测数据计算时间衍生特征。一种隐蔽但普遍的泄漏发生在转换过程中:在划分之前,使用整个数据集计算全局参数(例如归一化所需的均值和方差,或插补所需的类别词表),从而将测试分区的分布统计量隐式泄漏到训练阶段。在贯穿本章的关键词检测案例研究中,按说话人独立且考虑时间的划分方式从数据层面落实了这一边界:按说话人身份划分语音片段,可防止声学模型记忆说话人特有的声道共振特征,确保评估反映模型对目标部署人群的泛化能力。
与传统软件编译器类似,数据集编译器的运行跨越多个独立的物理阶段:获取、摄取、处理、标注、存储和生命周期维护。在每个阶段,架构都需要平衡四大支柱框架:质量(信噪比和分布保真度)、可靠性(幂等执行和严格的模式契约)、可扩展性(防止加速器因缺少数据而空闲的流式 I/O 吞吐量)以及治理(不可变的数据血缘和可审计性)。对于嵌入式关键词检测等资源受限的边缘目标设备,I/O 环形缓冲区管理不当或违反模式契约,会直接导致训练与服务偏差或运行时故障。
流水线效率取决于数据移动成本与信号密度之间的物理相互作用。两种物理属性支配着这一权衡:数据引力(移动一定字节量所需的互连带宽、存储 I/O 和传输延迟)以及信息熵(这些字节中所包含的新颖梯度信号的密度)。

当信号密度(熵)高且移动成本(引力)低时,选择增益达到峰值。
正如移动成本与信息密度之间的关系所示,在承担数据引力带来的传输成本之前,通过过滤和选择提取高熵记录,可使工程收益达到峰值。低熵数据(例如重复的音频帧、背景静音或重复样本)会占满主机到设备的 PCIe 带宽,并污染存储层次,却只能带来极少的梯度进展。高效的数据集编译通过最大化跨存储和互连层次移动的每字节所承载的信息熵,来应对这一物理约束。
数据的物理特性
“数据即代码”的比喻说明了数据做什么(决定系统行为),却没有说明移动数据为什么如此昂贵。数据的物理特性 解释了为什么数据系统必须将数据视为具有可测量属性的物理实体。正如物质具有密度和黏度,数据集也具有可测量的任务相关信号和数据引力。
数据引力
数据移动会产生物理和经济上的阻力:数据引力 与数据集体量 \((D_{\text{vol}})\) 成正比,与网络带宽 \((\text{BW})\) 成反比。通过 10 Gbps 链路传输一个 PB 级数据集,需要连续传输数天(\(T = D_{\text{vol}}/\text{BW} \approx 9.3 \text{ days}\));即使使用专用的 100 Gbps 链路,传输延迟和出站流量费用仍然高到足以左右系统设计。由于跨网络边界迁移 1 PB 的数据既缓慢又昂贵,计算集群必须迁至存储所在地,而不是将数据迁至计算所在地。这一约束推动了数据湖仓 架构的出现1 (Zaharia et al. 2021),在这种架构中,Apache Spark 和 Presto 等分布式查询引擎直接在共享对象存储上执行计算。在组织规模上,数据网格 范式 (Dehghani 2022) 通过分散所有权来避免集中式的大规模数据移动,将数据集视为由各业务领域拥有的产品。
Dehghani, Zhamak. 2022. Data Mesh: Delivering Data-Driven Value at Scale. O’Reilly Media.
任务相关信号
并非所有比特在每单位移动成本下都能提供相同的效用。物理存储以字节为计量单位,而机器学习优化提取的是任务相关信号——这是一种针对特定任务的梯度信息度量,而非原始的香农熵。包含一百万张相同图像的数据集会产生巨大的数据引力,但除第一个样本之外,不会提供任何额外的梯度信息。相反,精心整理的 10,000 个多样化边缘案例,其数据引力微乎其微,却能提供丰富的监督信号。将任务相关信号与数据引力对照评估,可以定义数据移动的回报: \[ \text{Data Selection Gain} \propto \frac{\text{Task-Relevant Signal}}{\text{Data Gravity}} \tag{1}\] 这一关系有利于那些边际学习价值足以抵偿传输开销的数据集。去重和主动学习通过消除冗余字节量,并优先选择高熵训练样本,直接优化这一比值。
供数问题:流率与“供数税”
数据引力决定了批量移动数据的成本;供数问题 则决定了实时向执行单元提供数据的成本。这是一种输入/输出流率 瓶颈:存储带宽无法跟上计算吞吐量。
根据机器学习系统铁律,系统的运行速度受限于最慢的阶段。当加速器能够以 1,843 img/s 的速率处理数据,而挂载的存储卷只能提供 250 MB/s 的带宽时,计算单元就会因 I/O 而停顿。这一差距定义了供数税:因等待 I/O 而损失的墙钟时间,它会直接降低系统效率 \((\eta_{\text{hw}})\)。在基准配置的云块存储上,这项税可能超过 77.5 percent——加速器在每步执行时间中有一半以上都在等待数据。为该加速器供数需要 1.1 GB/s 的带宽,迫使流水线架构采用 section 1.8.1 中分析的专用存储层次结构。距离也会增加能耗:数据传输到算术逻辑单元的距离越远,传输能耗就越会远超计算本身的能耗。
Systems Perspective 1.1: 能耗—搬移不变量
机器学习系统铁律 中的机器学习系统铁律和 系统平衡与硬件 中的内存墙分析共同导出了一项数据工程原则:搬移一个 32 位数值所消耗的能量,约为表中一次 FP32 乘法能耗的 173× 至 10,810.8×,且随着数据离开芯片,这一倍数会不断增大。后续优化章节将在模型与硬件设计中利用同样的成本梯度;这里关注的问题是:在模型开始计算之前,来自外部世界的信息流已经消耗了多少能量。Table 1 明确展示了整个存储层次结构中的这一成本梯度。
Table 1: 搬移一个 32 位数值与对其进行计算的能耗对比:数据搬移层次结构中各阶段单次事件的近似能耗,倍数均以一次 32 位 FP32 乘法为基准归一化。所有行均采用相同的 32 位宽度,因此这些比值比较的是数据规模相同的事件。仅凭这些比值,无法证明哪一项在完整工作负载中占主导地位;总能耗还取决于算术运算和传输的次数。
| 操作 | 能耗(pJ) | 相对成本 |
|---|---|---|
| 32 位浮点乘法 | 3.7 pJ/FLOP | 1\(\times\) |
| DRAM 内存访问(32 位) | 640 pJ | 173× |
| 本地 SSD 访问(32 位) | 4,000 pJ | 1,081.1× |
| 网络传输(32 位) | 40,000 pJ | 10,810.8× |
table 1 中量化的成本梯度说明了数据局部性为何在系统优化中占据主导地位。每避免一次传输,就能消除相应的数据搬移能耗,而这些节省会在多个训练轮次中累积。
由于数据搬移会产生物理能耗,数据量的作用类似于物理质量。通过去重削减 50 percent 的训练数据,不仅能节省持久化存储容量,还能消除网络、内存和预处理阶段的相应能量支出。当 I/O 和通信主导工作负载的运行时间时,尽早过滤缺乏有效信息的样本,是最有效的架构优化手段之一。
能耗层次结构与信号密度启发式指向了同一个优化手段:有效的数据工程能够最大化 equation 1 中定义的数据选择增益。数据整理发挥着信噪比工程的作用。去重在保留任务相关信号的同时去除冗余字节量,直接放大选择增益。主动学习优先选择高熵样本,而非重复样本,从而提高每个传输字节所承载的信息密度。过滤缺乏有效信息的记录可以节省互连带宽和存储能耗,避免上游 I/O 供给不足导致加速器执行单元空闲。
这些原则适用于单个服务器节点内的各个批次。在集群和数据中心规模上,数据引力决定了广域基础设施的选择。当跨区域搬移数拍字节的数据比在远端配置加速器更慢、成本更高时,计算就必须迁移到存储设施所在处。考察跨数据中心的传输成本,可以量化这一物理边界。
Napkin Math 1.1: 数据引力的物理原理
问题:一个大小为 1 PB 的训练数据集位于美国东部的数据中心,而美国西部有一个可用的远程加速器集群。搬移数据和搬移计算,哪一种更快?
计算:
- 网络带宽:100 Gb/s \(\div 8 =\) 12.5 GB/s。
- 传输时间:1,000,000 GB \(\div\) 12.5 GB/s = 80,000 seconds,约为
- 成本:1,000,000 GB \(\times\) $0.02/GB = $20,000。(基准:2024 年 AWS 数据出站传输定价。)
系统洞见:如果训练耗时少于 22 h,则数据传输所需时间比训练更长。如果训练成本低于 $20,000(约为 5,000 TPUv4-hours),则带宽成本高于计算成本。对于拍字节级数据,应让代码移向数据;对于吉字节级数据,应让数据移向代码。
将数据视为一种物理实体,能够使数据流水线设计立足于硬件现实:带宽限制决定流速,存储层次结构决定能量耗散,而数据集规模决定计算的部署位置。
Checkpoint 1.1: 数据的物理原理
数据工程受物理成本约束。检验一下你的直觉:
物理约束界定了机器学习数据系统的运行边界,但仅有物理层面的认知并不能保证可靠性。即使系统考虑了数据引力,如果忽视模式验证、未能检测到数据损坏,或数据摄取流水线在负载下静默崩溃,系统仍然可能失效。要将这些物理现实转化为稳健的生产基础设施,就需要一个系统性的架构框架,统筹摄取、转换和存储各环节的工程决策。
四大支柱框架
某个信用评分模型拒绝了来自某一地区的所有申请人,原因是上游团队将邮政编码字段从整数改成了字符串。某个医学影像模型的性能在数月间悄然下降,原因是合作医院更换了摄像设备。某个欺诈检测系统未能识别一种新的攻击途径,原因是其训练数据已滞后六个月。每种故障都可追溯到不同的根因(模式漂移、分布偏移、数据陈旧),但它们都具有一个共同模式:临时拼凑的数据工程决策相互作用,产生了部署前无人预料到的后果。这些级联故障促使我们建立一个围绕质量、可靠性、可扩展性和治理组织起来的四大支柱框架。
数据级联
机器学习系统面临一种独特的故障模式,称为数据级联:早期阶段的数据质量问题会在整个流水线中不断放大 (Sambasivan et al. 2021)。某些无效输入会立即触发软件错误,但数据也可能通过模式校验和测试,同时悄然损害模型学得的行为2,直到质量问题严重到需要付出高昂代价进行调查、返工或重新训练。
数据错误很少局限于其起源处;它们会在流水线的各阶段不断累积。从左到右沿着 figure 1 中相互连接的阶段,可以追踪初始数据缺陷如何向前传播,影响特征提取、模型优化和部署决策。
\begin{tikzpicture}[line join=round,font=\small\sffamily]
\definecolor{Green}{HTML}{008F45}
\definecolor{Red}{HTML}{CB202D}
\definecolor{Orange}{HTML}{CC5500}
\definecolor{Blue}{HTML}{006395}
\definecolor{Violet}{HTML}{7030A0}

\tikzset{%
Line/.style={line width=1.0pt,black!50,shorten <=6pt,shorten >=8pt},
LineD/.style={line width=2.0pt,black!50,shorten <=6pt,shorten >=8pt},
Text/.style={rotate=60,align=right,anchor=north east,font=\fontsize{7pt}{8}\sffamily},
Text2/.style={align=left,anchor=north west,font=\footnotesize\sffamily,text depth=0.7}
}

\draw[line width=1.5pt,black!30](0,0)coordinate(P)--(10,0)coordinate(K);

\foreach \i in {0,...,6} {
\path let \n1 = {(\i/6)*10} in coordinate (P\i) at (\n1,0);
\fill[black] (P\i) circle (2pt);
  }

\draw[LineD,Red,overlay](P0)to[out=60,in=120](P6);
\draw[LineD,Red](P0)to[out=60,in=125](P5);
\draw[LineD,Blue](P1)to[out=60,in=120](P6);
\draw[LineD,Red](P1)to[out=50,in=125](P6);
\draw[LineD,Blue](P4)to[out=60,in=125](P6);
\draw[LineD,Blue](P3)to[out=60,in=120](P6);
%
\draw[Line,Orange](P1)to[out=44,in=132](P6);
\draw[Line,Green](P1)to[out=38,in=135](P6);
\draw[Line,Orange](P1)to[out=30,in=135](P5);
\draw[Line,Green](P1)to[out=36,in=130](P5);
%
\draw[Line,Orange](P2)to[out=40,in=135](P6);
\draw[Line,Orange](P2)to[out=40,in=135](P5);
%
\draw[draw=none,fill=VioletLine!50]($(P5)+(-0.1,0.15)$)to[bend left=10]($(P5)+(-0.1,0.61)$)--
                ($(P5)+(-0.25,0.50)$)--($(P5)+(-0.85,1.20)$)to[bend left=20]($(P5)+(-1.38,0.76)$)--
                ($(P5)+(-0.51,0.33)$)to[bend left=10]($(P5)+(-0.64,0.22)$)to[bend left=10]cycle;
\draw[draw=none,fill=VioletLine!50]($(P6)+(-0.1,0.15)$)to[bend left=10]($(P6)+(-0.1,0.61)$)--
                ($(P6)+(-0.25,0.50)$)--($(P6)+(-0.7,1.30)$)to[bend left=20]($(P6)+(-1.38,0.70)$)--
                ($(P6)+(-0.51,0.33)$)to[bend left=10]($(P6)+(-0.64,0.22)$)to[bend left=10]cycle;
%
\def\vi{-0.05}
\draw[dashed,red,thick,-latex](P1)--++(90:2)to[out=90,in=0](0.8,2.7);
\draw[dashed,red,thick,-latex](P6)--++(90:2)to[out=90,in=0](9.1,2.7);
\node[below=\vi of P0,Text]{问题\\ 陈述};
\node[below=\vi of P1,Text]{数据收集\\与标注};
\node[below=\vi of P2,Text]{数据分析\\与清洗};
\node[below=\vi of P3,Text]{模型\\选择};
\node[below=\vi of P4,Text]{模型\\训练};
\node[below=\vi of P5,Text]{模型\\评估};
\node[below=\vi of P6,Text]{模型\\部署};
%Legend
\node[circle,minimum size=4pt,fill=Blue](L1)at(11.5,2.6){};
\node[above right=0.1 and 0.1of L1,Text2]{与物理世界交互\\的脆弱性};

\node[circle,minimum size=4pt,fill=Red,below =0.5 of L1](L2){};
\node[above right=0.1 and 0.1of L2,Text2]{应用领域\\专业知识不足};

\node[circle,minimum size=4pt,fill=Green,below =0.5 of L2](L3){};
\node[above right=0.1 and 0.1of L3,Text2]{相互冲突的激励\\体系};

\node[circle,minimum size=4pt,fill=Orange,below =0.5 of L3](L4){};
\node[above right=0.1 and 0.1of L4,Text2]{跨组织文档\\记录不完善};

\draw[-{Triangle[width=8pt,length=8pt]}, line width=3pt,Violet](11.4,-0.85)--++(0:0.8)coordinate(L5);
\node[above right=0.23 and 0of L5,Text2]{级联的影响};

\draw[-{Triangle[width=4pt,length=8pt]}, line width=2pt,Red,dashed](11.4,-1.35)--++(0:0.8)coordinate(L6);
\node[above right=0.23 and 0of L6,Text2]{放弃/重新开始流程};
\end{tikzpicture}Definition 1.2: 数据级联
数据级联是一种机器学习系统故障模式:上游数据质量问题通过收集、标注、特征工程、训练、评估和部署各阶段传播,并放大为下游模型故障或对用户的伤害。
- 意义:修复成本随使用了损坏数据的下游产物数量而增长:必须重新生成特征表、重新训练模型、重新计算评估指标,并回滚或修补已部署的系统。因此,单个模式或标注缺陷就可能使一次完整的训练运行及其衍生的所有实验失效,将局部数据错误演变为整个流水线的返工事件。
- 区别:与孤立的数据质量缺陷不同,数据级联的特征在于传播与放大。初始缺陷可能很小,但流水线的每个阶段都将其输入视为可信,并把缺陷转化为新的派生状态,使得系统离数据收集环节越远,根因就越难以观察。
- 常见误区:一种常见误解是,常规软件测试能够发现数据级联。实际上,损坏的数据可能满足模式要求、通过单元测试,并使训练作业成功完成,同时却让模型学到错误的信号;预防级联需要数据血缘、验证、契约以及与模型行为关联的监控。
这一反馈回路会形成一种隐蔽的运行故障模式:静默退化。传统软件崩溃会触发堆栈跟踪和告警通知,而数据引发的模型错误则会产生语法有效、语义准确性却已下降的输出。等到下游指标反映出故障时,错误预测已经污染了历史数据存储,迫使团队进行代价高昂的回滚和数据重新摄取。
Example 1.1: 流水线丛林
场景:生产环境中的一个信用评分模型突然开始拒绝来自某个特定地理区域的所有申请人。
诊断:上游数据库团队为了支持国际邮政编码,将 zip_code 字段的模式从 integer 改为 string(“02139”),却没有更新下游数据契约。下游的一个遗留转换步骤仍在序列化前将该字符串强制转回整数,去掉了前导零(“2139”),导致模型将一个熟悉的邮政编码视为未见过的高风险类别。
系统教训:未得到强制执行的特征边界会形成流水线丛林,使上游模式修改引发下游模型的静默故障。采用版本化数据契约,并严格验证模式与取值范围,可以防止跨系统数据损坏。
四大基础支柱
为防止静默故障在流水线中不断累积,数据基础设施必须平衡四项相互竞争的运行优先事项。Figure 2 将这些优先事项组织为四大结构性支柱:质量(输入的完整性与适用性)、可靠性(运行一致性与容错能力)、可扩展性(吞吐量与容量的扩展)以及治理(合规性、来源追溯与伦理)。
\begin{tikzpicture}[line join=round,font=\sffamily]
\tikzset{
Box/.style={align=center, inner xsep=2pt,draw=GreenLine, line width=1pt,fill=none, minimum width=51mm, minimum height=25mm},
Circle1/.style={circle,  minimum size=33mm, draw=none, fill=BrownLine!20},
LineD/.style={dashed,BrownLine!70, line width=1.1pt,latex-latex,text=black},
LineA/.style={violet!50,line width=4.0pt,{{Triangle[width=1.5*6pt,length=2.0*5pt]}-{Triangle[width=1.5*6pt,length=2.0*5pt]}},shorten <=1pt,shorten >=1pt},
ALine/.style={black!50, line width=1.1pt,{{Triangle[width=0.9*6pt,length=1.2*6pt]}-}},
Larrow/.style={fill=violet!50, single arrow,  inner sep=2pt, single arrow head extend=3pt,
            single arrow head indent=0pt,minimum height=10mm, minimum width=3pt}
}
%%%
%vaga
\tikzset{
pics/vaga/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\node[rectangle,minimum width=2mm,minimum height=22mm,
draw=none, fill=\filllcolor,line width=\Linewidth](1R) at (0,-0.95){};
\fill[fill=\filllcolor!60!black](230:2.8)arc(230:310:2.8)--cycle;%circle(2.9);
%LT
\node [semicircle, shape border rotate=180,  anchor=chord center,
      minimum size=11mm, draw=none, fill=\filllcirclecolor](LT) at (-2,-0.5) {};
\node [circle,  minimum size=4mm, draw=none, fill=\filllcirclecolor](T1) at (-2,1.25) {};
\draw[draw=\drawcolor,,line width=1.2*\Linewidth,shorten <=3pt,shorten >=3pt](T1)--(LT);
\draw[draw=\drawcolor,,line width=1.2*\Linewidth,shorten <=3pt,shorten >=3pt](T1)--(LT.30);
\draw[draw=\drawcolor,,line width=1.2*\Linewidth,shorten <=3pt,shorten >=3pt](T1)--(LT.150);
%DT
\node [semicircle, shape border rotate=180,  anchor=chord center,
      minimum size=11mm, draw=none, fill=\filllcirclecolor!70!black](DT) at (2,-0.5) {};
\node [circle,  minimum size=4mm, draw=none, fill=\filllcirclecolor!70!black](T2) at (2,1.25) {};
\draw[draw=\drawcolor,line width=1.2*\Linewidth,shorten <=3pt,shorten >=3pt](T2)--(DT);
\draw[draw=\drawcolor,,line width=1.2*\Linewidth,shorten <=3pt,shorten >=3pt](T2)--(DT.30);
\draw[draw=\drawcolor,,line width=1.2*\Linewidth,shorten <=3pt,shorten >=3pt](T2)--(DT.150);
%
\node[draw=none,rectangle,minimum width=32mm,minimum height=1.5mm,inner sep=0pt,
fill=\filllcolor!60!black]at(0,1.25){};
\node[draw=white,fill=\filllcolor,line width=2*\Linewidth,ellipse,minimum width=9mm,  minimum height=15mm](EL)at(0,0.85){};
\node[draw=white,fill=\filllcolor!60!black,line width=2*\Linewidth,,circle,minimum size=10mm](2C)at(0,2.05){};
\end{scope}
    }
  }
}
%stit
\def\inset{3.2pt} %
\def\myshape{%
  (0,1.34) to[out=220,in=0] (-1.20,1.03) --
  (-1.20,-0.23) to[out=280,in=160] (0,-1.53) to[out=20,in=260] (1.20,-0.23) --
  (1.20,1.03)  to[out=180,in=320] cycle
}
\tikzset{
pics/stit/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\fill[fill=\filllcolor!60] \myshape;
%
\begin{scope}
  \clip \myshape;
  \draw[draw=\filllcolor!60, line width=2*\inset,fill=white] \myshape; % stroke color and width
\end{scope}
\fill[fill=\filllcolor!60](0,0)circle(0.4)coordinate(ST\picname);
\end{scope}
    }
  }
}
%AI style
\tikzset{
pics/llm/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\node[circle,minimum size=12mm,draw=\drawcolor, fill=\filllcolor!70,line width=1.25*\Linewidth](C\picname) at (0,0){};
\def\startangle{90}
\def\radius{1.15}
\def\radiusI{1.1}
\foreach \i [evaluate=\i as \j using \i+1] [count =\k] in {0,2,4,6,8} {
\pgfmathsetmacro{\angle}{\startangle - \i * (360/8)}
\draw[draw=black,-{Circle[black ,fill=\filllcirclecolor,length=5.5pt,line width=0.5*\Linewidth]},line width=1.5*\Linewidth](C\picname)--++(\startangle - \i*45:\radius) ;
\node[circle,draw=black,fill=\filllcirclecolor!80!red!50,inner sep=3pt,line width=0.5*\Linewidth](2C\k)at(\startangle - \j*45:\radiusI) {};
}
\draw[line width=1.5*\Linewidth](2C1)--++(-0.5,0)|-(2C2);
\draw[line width=1.5*\Linewidth](2C3)--++(0.5,0)|-(2C4);
\node[circle,,minimum size=12mm,draw=\drawcolor, fill=\filllcolor!70,line width=0.5*\Linewidth]at (0,0){};
\end{scope}
    }
  }
}
%brain
\tikzset{pics/brain/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=BRAIN,scale=\scalefac, every node/.append style={transform shape}]
\draw[fill=\filllcolor,line width=\Linewidth](-0.3,-0.10)to(0.08,0.60)
to[out=60,in=50,distance=3](-0.1,0.69)to[out=160,in=80](-0.26,0.59)to[out=170,in=90](-0.46,0.42)
to[out=170,in=110](-0.54,0.25)to[out=210,in=150](-0.54,0.04)
to[out=240,in=130](-0.52,-0.1)to[out=300,in=240]cycle;
\draw[fill=\filllcolor,line width=\Linewidth]
(-0.04,0.64)to[out=120,in=0](-0.1,0.69)(-0.19,0.52)to[out=120,in=330](-0.26,0.59)
(-0.4,0.33)to[out=150,in=280](-0.46,0.42)
%
(-0.44,-0.03)to[bend left=30](-0.34,-0.04)
(-0.33,0.08)to[bend left=40](-0.37,0.2) (-0.37,0.12)to[bend left=40](-0.45,0.14)
(-0.26,0.2)to[bend left=30](-0.24,0.13)
(-0.16,0.32)to[bend right=30](-0.27,0.3)to[bend right=30](-0.29,0.38)
(-0.13,0.49)to[bend left=30](-0.04,0.51);
\draw[thick,rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcolor,length=2.5pt]}](-0.23,0.03)--(-0.15,-0.03)--(-0.19,-0.18)--(-0.04,-0.28);
\draw[thick,rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcolor,length=2.5pt]}](-0.17,0.13)--(-0.04,0.05)--(-0.06,-0.06)--(0.14,-0.11);
\draw[thick,rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcolor,length=2.5pt]}](-0.12,0.23)--(0.31,0.0);
\draw[thick,rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcolor,length=2.5pt]}](-0.07,0.32)--(0.06,0.26)--(0.16,0.33)--(0.34,0.2);
\draw[thick,rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcolor,length=2.5pt]}](-0.01,0.43)--(0.06,0.39)--(0.18,0.51)--(0.31,0.4);
\end{scope}
     }
  }
}
%graph
\tikzset{pics/graph/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=GRAPH,scale=\scalefac, every node/.append style={transform shape}]
\draw[line width=2*\Linewidth,draw = \drawcolor](-0.20,0)--(2.2,0);
\draw[line width=2*\Linewidth,draw = \drawcolor](-0.20,0)--(-0.20,2.0);
\foreach \i/\vi in {0/4,0.5/8,1/12,1.5/16}{
\node[draw, minimum width  =4mm, minimum height = \vi mm, inner sep = 0pt,
      draw = \drawcolor, fill=\filllcolor!50, line width=\Linewidth,anchor=south west](COM)at(\i,0.2){};
}
%lupa
\coordinate(PO)at(1.2,0.9);
\node[circle,draw=white,line width=0.75pt,fill=\filllcirclecolor,minimum size=9mm,inner sep=0pt](LV)at(PO){};
\node[draw=none,rotate=40,rounded corners=2pt,rectangle,minimum width=2.2mm,inner sep=1pt,
fill=\filllcirclecolor,minimum height=11mm,anchor=north]at(PO){};
\node[circle,draw=none,fill=white,minimum size=5.0mm,inner sep=0pt](LM)at(PO){};
\node[font=\small\bfseries]at(LM){...};
 \end{scope}
     }
  }
}
%target
\tikzset{
pics/target/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\definecolor{col1}{RGB}{62,100,125}
\definecolor{col2}{RGB}{219,253,166}
\colorlet{col1}{\filllcolor}
\colorlet{col2}{\filllcirclecolor}
\foreach\i/\col [count=\k]in {22mm/col1,17mm/col2,12mm/col1,7mm/col2,2.5mm/col1}{
\node[circle,inner sep=0pt,draw=\drawcolor,fill=\col,minimum size=\i,line width=\Linewidth](C\k){};
}
\draw[thick,fill=brown,xscale=-1](0,0)--++(111:0.13)--++(135:1)--++(225:0.1)--++(315:1)--cycle;
\path[green,xscale=-1](0,0)--(135:0.85)coordinate(XS1);
\draw[thick,fill=yellow,xscale=-1](XS1)--++(80:0.2)--++(135:0.37)--++(260:0.2)--++(190:0.2)--++(315:0.37)--cycle;
\end{scope}
    }
  }
}
%server
\tikzset {
  pics/server/.style = {
    code = {
     % \colorlet{red}{black}
\pgfkeys{/channel/.cd, #1}
      \begin{scope}[anchor=center, transform shape,scale=\scalefac, every node/.append style={transform shape}]
        \draw[draw=\drawcolor,line width=\Linewidth,fill=\filllcolor](-0.55,-0.5) rectangle (0.55,0.5);
\foreach \i in {-0.25,0,0.25} {
                \draw[line width=\Linewidth]( -0.55,\i) -- (0.55, \i);
}
        \foreach \i in {-0.375, -0.125, 0.125, 0.375} {
          \draw[line width=\Linewidth](-0.45,\i)--(0,\i);
          \fill[](0.35,\i) circle (1.5pt);
        }

        \draw[draw=\drawcolor,line width=1.5*\Linewidth](0,-0.53) |- (-0.55,-0.7);
        \draw[draw=\drawcolor,line width=1.5*\Linewidth](0,-0.53) |- (0.55,-0.7);
      \end{scope}
    }
  }
}
\pgfkeys{
  /channel/.cd,
   Depth/.store in=\Depth,
  Height/.store in=\Height,
  Width/.store in=\Width,
  filllcirclecolor/.store in=\filllcirclecolor,
  filllcolor/.store in=\filllcolor,
  drawcolor/.store in=\drawcolor,
  drawcircle/.store in=\drawcircle,
  scalefac/.store in=\scalefac,
  Linewidth/.store in=\Linewidth,
  picname/.store in=\picname,
  filllcolor=BrownLine,
  filllcirclecolor=violet!20,
  drawcolor=black,
  drawcircle=violet,
  scalefac=1,
  Linewidth=0.5pt,
  Depth=1.3,
  Height=0.8,
  Width=1.1,
  picname=C
}

\def\wi{3.5}
\node[Circle1](CI1){};
%AI
\pic[shift={(0,0)}] at  (CI1){llm={scalefac=1.2,picname=1,drawcolor=GreenD,filllcolor=GreenD!20!, Linewidth=1pt,filllcirclecolor=red}};
%brain
\pic[shift={(0.12,-0.23)}] at  (C1){brain={scalefac=1.1,picname=2,filllcolor=orange!30!, filllcirclecolor=cyan!55!black!60, Linewidth=0.75pt}};
%Quality
\node[Box,above left=1 and \wi of CI1](B1){};
\node[below=1pt of CI1,font=\sffamily\bfseries\small,align=center]{机器学习数据系统};
\fill[green!07](B1.north west) rectangle ($(B1.north east)!0.6!(B1.south east)$)coordinate(B1DE);
\fill[green!20](B1.south east) rectangle ($(B1.north west)!0.6!(B1.south west)$)coordinate(B1LE);
\node[Box,above left=1 and \wi of CI1](){};
\tikzset{Text2/.style={font=\sffamily\bfseries\small,align=center}}
\node[Text2]at($(B1.south west)!0.5!(B1DE)$){质量\\ {\footnotesize 准确性 \& 适用性}};
\coordinate(Q1)at($(B1.north west)!0.5!(B1DE)$);
%Quality - target
\pic[shift={(0,0)}] at  (Q1){target={scalefac=0.55,picname=1,drawcolor=BlueD,filllcolor=cyan!90!,Linewidth=0.7pt, filllcirclecolor=cyan!20}};
%Reliability - stit
\node[Box,above right=1 and \wi of CI1](B2){};
\fill[cyan!07](B2.north west) rectangle ($(B2.north east)!0.6!(B2.south east)$)coordinate(B2DE);
\fill[cyan!20](B2.south east) rectangle ($(B2.north west)!0.6!(B2.south west)$)coordinate(B2LE);
\node[Text2]at($(B2.south west)!0.5!(B2DE)$){可靠性\\ {\footnotesize 一致性 \& 容错性}};
\coordinate(R1)at($(B2.north west)!0.5!(B2DE)$);
\node[Box,above right=1 and \wi of CI1,draw=BlueD](B2){};
%Reliability - stit
\pic[shift={(0,0.03)}] at  (R1){stit={scalefac=0.48,picname=1,drawcolor=orange,filllcolor=red!80!}};
\pic[shift={(0,0.03)}] at  (ST1){server={scalefac=0.52,picname=1,drawcolor= black,filllcolor=orange!30!,Linewidth=0.75pt}};
%governance
\node[Box,below left=1 and \wi of CI1](B3){};
\fill[violet!07](B3.north west) rectangle ($(B3.north east)!0.6!(B3.south east)$)coordinate(B3DE);
\fill[violet!20](B3.south east) rectangle ($(B3.north west)!0.6!(B3.south west)$)coordinate(B3LE);
\node[Text2]at($(B3.south west)!0.5!(B3DE)$){治理\\ {\footnotesize 伦理 \& 合规}};
\coordinate(G1)at($(B3.north west)!0.5!(B3DE)$);
\node[Box,below left=1 and \wi of CI1,draw=violet](){};
%Governance - icon
\pic[shift={(-0.70,-0.6)}] at  (G1){graph={scalefac=0.6,picname=1,filllcirclecolor=RedLine,filllcolor=green!70!black, Linewidth=0.65pt}};
%Scalability - graph
\node[Box,below right=1 and \wi of CI1](B4){};
\fill[orange!07](B4.north west) rectangle ($(B4.north east)!0.6!(B4.south east)$)coordinate(B4DE);
\fill[orange!20](B4.south east) rectangle ($(B4.north west)!0.6!(B4.south west)$)coordinate(B4LE);
\node[Text2]at($(B4.south west)!0.5!(B4DE)$){可扩展性\\ {\footnotesize 增长 \& 性能}};
\coordinate(S1)at($(B4.north west)!0.5!(B4DE)$);
\node[Box,below right=1 and \wi of CI1,draw=OrangeLine](){};
%governance
\pic[shift={(0,0.05)}] at  (S1){vaga={scalefac=0.25,picname=1,filllcolor=BlueLine, Linewidth=0.75pt,filllcirclecolor=orange}};
%arrows
\tikzset{Text/.style={,font=\sffamily\small,align=center}}
\draw[LineD](B1)--node[above,Text]{验证开销与\\ 吞吐量的权衡}(B2);
\draw[LineD](B1)--node[left,Text]{偏差缓解与\\ 数据可用性的权衡}(B3);
\draw[LineD](B2)--node[right,Text]{一致性与\\ 分布式规模的权衡}(B4);
\draw[LineD](B3)--node[below,Text]{性能与\\ 隐私约束的权衡}(B4);
%
\tikzset{Text1/.style={font=\sffamily\footnotesize,align=center,text=black}}
\draw[LineA,draw=green!70!black](B1.south east)--node[below left,Text1,green!60!black]{高质量\\ 训练数据}(CI1);
\draw[LineA,draw=cyan!70!black](B2.south west)--node[below right,Text1,cyan!70!black]{一致的\\ 处理}(CI1);
\draw[LineA,draw=violet!80!black!40](B3.north east)--node[above left,Text1,violet]{合规 \& \\问责}(CI1);
\draw[LineA,draw=orange!80](B4.north west)--node[above right,Text1,orange]{处理不断增长的\\ 数据量}(CI1);
\end{tikzpicture}这四项运行基础确立了数据流水线架构的权衡空间。优先考虑可扩展性,却不进行质量验证或建立可靠性契约,可能在提高吞吐量的同时,任由不良或不一致的数据传播。反之,全面的治理控制可能增加存储和计算开销,制约训练迭代速度。
质量决定输入的完整性及其对任务的适用性:数据必须准确反映实际运行分布,具有正确的真实标签和未受损的特征。例如,在边缘端语音注册流水线中,质量规则会滤除发生削波的音频波形、信噪比过低的样本以及存在背景声学干扰的样本,使模型学习清晰的决策边界,而非虚假的声学伪影。
可靠性关注的是,当设备、网络或用户行为不尽理想时,注册流水线能否持续运行。一条流水线即便能在实验室中生成优质的唤醒词样本,如果在连接间歇中断、电量紧张或麦克风异常时失效,也无法在用户家中提供价值。错误处理、重试、本地缓冲和优雅降级将质量规则转化为可用的系统:设备可以请求用户再说一次、将上传推迟至连接恢复后,或者保留已知有效的注册数据,而非在无提示的情况下接受受损音频。
可扩展性关注的是,同样的决策能否经受规模增长的考验。适用于一千条录音的人工审核策略,在产品扩展至数百万用户、数十种语言和长尾声学条件时便会失效。系统必须扩展验证、存储、标注和再训练能力,同时避免基础设施成本的增长超过覆盖范围改善所带来的价值。限制性资源取决于工作负载:对于边缘端语音任务,存储和标注吞吐量占主导地位;而对于推荐系统,内存容量构成了具有约束力的限制。灯塔案例 1.1 展示了可扩展性支柱面临的最严峻挑战:嵌入表的规模超出单节点内存容量,使分布式分区成为首要设计问题,而非事后才考虑的事项。
治理界定了质量、可靠性和可扩展性必须遵守的边界。对于关键词检测,治理决定原始语音录音是否可以离开设备、注册音频可以保留多长时间、哪项同意记录授权了其使用,以及哪些文档能够证明数据集覆盖了相关口音而未泄露私人语音。一条完全可扩展、可靠且高质量的流水线,如果违反《通用数据保护条例》(GDPR)或延续人口群体偏差,带来的将是法律责任,而非价值。数据声明等数据集文档实践通过记录数据来源、预期用途、采集条件,以及偏差分析和科学比较所需的覆盖范围,使部分治理工作得以显现 (Bender and Friedman 2018)。
Bender, Emily M., and Batya Friedman. 2018. “Data Statements for Natural Language Processing: Toward Mitigating System Bias and Enabling Better Science.” Transactions of the Association for Computational Linguistics 6: 587–604. https://doi.org/10.1162/tacl_a_00041.
当机器学习系统发生故障时,这四大支柱为识别根本原因提供了诊断视角。准确率逐步下降指向质量问题:数据漂移使服务阶段的数据分布偏离训练分布,或者标注人员群体的变化导致标签质量下降。流水线间歇性故障指向可靠性问题:峰值负载下缺少错误处理、重试逻辑或资源控制。硬件充足却仍然训练耗时过长,指向可扩展性问题:单线程转换、未分区的混洗或缓慢的存储层阻碍了并行资源的利用。审计中发现的合规缺口指向治理债务:血缘追踪不完整、访问控制已过时,或保留策略未能跟上法规变化。
Lighthouse 1.1: DLRM 推荐系统灯塔案例
采用 DLRM 风格构建的推荐系统,体现了现代数据工程面临的可扩展性挑战。现代推荐工作负载使流水线的资源需求分化为两类:连续信号流经稠密矩阵流水线,而类别 ID 则需要 TB 级的分布式查找基础设施。Table 2 展示了数据摄取、嵌入表聚合和特征交互各阶段的这些运行压力点。
Table 2: DLRM 可扩展性特征:推荐模型给数据工程带来的压力主要来自内存容量和稀疏访问带宽,而非计算。
| 属性 | 值 | 对系统的影响 |
|---|---|---|
| 数据规模 | 高基数用户/物品 ID | 嵌入表和查找表的规模可能超出单台机器的内存容量。 |
| 约束 | 内存容量 | 这些表无法再容纳于单台机器中,必须进行分区。 |
| 瓶颈 | 稀疏访问 | 相较于计算,随机查找对内存带宽施加的压力更大。 |
在摄取阶段,高基数类别 ID 仍然是受吞吐量限制的数据流中的紧凑记录。网络和内存容量瓶颈会在后续阶段出现,此时训练或服务必须从 TB 级的分区表状态中获取稀疏嵌入。缓解这种不对称性,需要采用后文在流水线生命周期中讨论的特征存储缓存和表分区策略。
最隐蔽的故障往往横跨多个支柱。训练与服务阶段的特征存在差异,既涉及质量问题(数值错误),也涉及可靠性问题(计算不一致)。出于隐私考虑的删除策略,如果使保留的数据不再覆盖部署人群,也可能造成质量缺口。诊断这类跨支柱故障,需要检查一致性契约、比较不同环境下的特征分布,并追踪转换血缘;本章将详细探讨所有这些技术。因此,生产环境诊断应在检查模型行为的同时检查数据基础设施。
KWS 案例研究
关键词检测(KWS)系统将四支柱框架落实到具体的物理约束中。唤醒词检测器嵌入电池供电的微控制器和移动协处理器,在日常声学环境中持续监听“OK Google”或“Alexa”等目标短语,同时受到严格的计算、内存和能耗限制。3
数据工程的总体运行目标可以转化为具体的技术、工具和验证检查。对于 figure 3 所示的语音助手交互,这些机制包括去重、模式契约、预取和血缘追踪,并分别映射到相应的架构支柱。
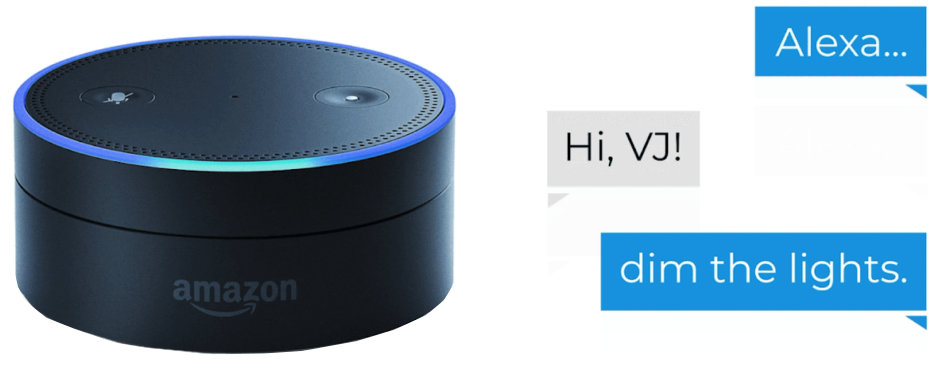
这四大支柱可直接转化为关键词检测的具体工程约束。其核心问题看似简单:在计算资源极其有限的设备上,从环境声音和其他话语中检测特定关键词,同时实现高准确率、低延迟和极少的误激活。明确的问题定义需要确定目标关键词、预期应用和部署场景。由此制定的目标必须平衡相互竞争的需求:关键词检测准确率达到 98 percent,延迟低于 200 ms;同时满足资源约束,尽可能降低功耗,并根据设备可用内存优化模型大小。
微小的单窗口假阳性率会累积为运行故障。
Napkin Math 1.2: 假阳性目标
问题:一个始终开启的 KWS 系统每月最多允许一次误唤醒。在全天候运行、分类窗口长度为一秒的情况下,每个窗口的假阳性率需要多么严格?
变量:
- 工作周期:始终开启(24 hours/day)。
- 窗口大小:一秒的分类窗口。
- 每月窗口数:每秒一个窗口,以 24 hours/day 的工作周期运行 30 days,得到 2,592,000 windows/month。
数学计算:
- 假阳性率(FPR):允许的 1 次误唤醒除以每月窗口数,约为 \(3.9 \times 10^{-7}\)
- 非关键词拒绝要求:拒绝 99.99996 percent 的非关键词窗口。
系统洞见:总体准确率(例如“99% 的准确率”)在这里并不足够。评估必须报告每小时误接受次数(FA/Hr),以及相应的误拒绝表现。
KWS 的成功指标不限于简单的准确率,还包括真阳性率(正确识别的关键词数占所有已说出关键词数的比例)、假阳性率(非关键词被错误识别为关键词的比例),以及检测/错误权衡曲线;该曲线基于能够代表实际部署情况的流式音频,比较每小时误接受次数与误拒绝率 (Nayak et al. 2022)。在这些指标中,假阳性率决定了始终开启系统能否被用户接受。由于 KWS 持续监听,每天每秒都在运行,因此即使每个窗口的假阳性率极低,在数百万个评估窗口上累积后,也会造成不可接受的运行故障。
Nayak, Prateeth, Takuya Higuchi, Anmol Gupta, Shivesh Ranjan, Stephen Shum, Siddharth Sigtia, Erik Marchi, et al. 2022. “Improving Voice Trigger Detection with Metric Learning.” Interspeech 2022, 1896–900. https://doi.org/10.21437/interspeech.2022-11160.
运行指标还包括响应时间(从关键词说出到系统响应的时间)和功耗(关键词检测期间使用的平均功率),而不同利益相关方的优先事项又使这些指标之间产生了额外的矛盾。设备制造商优先考虑低功耗,软件开发者强调易于集成,最终用户则要求准确性和响应能力。在这些相互竞争的要求之间取得平衡,贯穿开发全过程,并影响系统架构决策。
嵌入式设备的约束为这些架构选择划定了严格边界。内存限制要求模型极其轻量,通常只有数十千字节,才能容纳于 SoC 的常开岛中;4 这一预算不仅必须容纳模型权重,还必须容纳特征提取缓冲区和预处理状态。有限的计算能力(时钟频率通常只有几百 MHz)要求对模型进行大幅优化。大多数嵌入式设备依靠电池供电,因此 KWS 系统将持续监听期间的功耗目标设为亚毫瓦级。设备还必须能够在多种部署场景下工作,从安静的卧室到嘈杂的工业环境。
数据质量和多样性最终决定了能否满足这些约束。数据集必须涵盖人口特征的多样性(具有不同口音、年龄和性别的说话者),以确保广泛的识别能力。由于人们对唤醒词的发音不同,因此需要关注关键词的发音变体;而背景噪声的多样性对于训练能够适应从安静到嘈杂等真实场景的模型至关重要。原型系统开发完成后,随着部署场景不断演变,迭代反馈和改进可使系统持续符合目标,这要求在真实条件下进行测试,并根据观察到的失效模式开展系统性改进。
KWS 设计空间
KWS 准确率、误唤醒容忍度、延迟预算、能耗预算和内存限制共同构成了一个多维设计空间,数据工程选择会在其中对系统性能产生连锁影响。Table 3 量化了关键权衡,从而支持有据可依的决策,避免临时随意选择。其中一行使用了梅尔频率倒谱系数(MFCC):这是一种紧凑的语音频率特征,其系数数量决定特征大小、计算成本和声学细节;section 1.6 展示了它们的提取方式。
| 设计选择 | 质量影响 | 延迟影响 | 成本影响 | 内存影响 |
|---|---|---|---|---|
| 16 kHz 与 8 kHz 采样 | 准确率 +2–4% | 输入处理工作量为 2× | 原始音频存储量为 2× | 特征大小为 2× |
| 13 与 40 个 MFCC 系数 | 准确率 +3–5% | 特征计算量为 3× | 极小 | 特征内存为 3× |
| 100 万与 1000 万个训练样本 | 准确率 +5–8% | 训练时间为 10× | 标注成本为 10× | 存储量为 10× |
| 干净与含噪训练数据 | 实际场景表现 +10–15% | 极小 | 采集成本为 3× | 极小 |
| 本地与云端推理 | 准确率风险最高为 2% | 10 ms 与 100 ms | $0/query 与 $0.001/query | 64 KB 与云端规模 |
| 合成与真实数据增强 | 鲁棒性 +3–5% | 极小 | 真实数据增强的成本为合成数据增强的 10× | 极小 |
在毫瓦级功耗范围和严格的数十千字节 SRAM 预算下运行,意味着工程团队无法同时在每个维度上都选择准确率最高的方案。要将这些已列出的权衡转化为生产部署,就需要求解一个约束优化问题:在标注、存储和治理之间分配有限的数据预算,在满足硬件占用空间限制的同时最大化模型准确率。笔记本 1.3 逐步演示了智能音箱部署中的这一优化过程。
Napkin Math 1.3: 优化 KWS 设计空间
场景:用于智能音箱的 KWS 系统具有以下约束:
- 目标:准确率为 98 percent,误唤醒少于 1 false wake/month
- 预算:数据工程总预算为 $150K
- 内存:模型大小上限为 64 KB(常开岛)
- 时间安排:在 6 months 内投入生产
步骤 1:应用约束以排除选项。
在此场景中,团队选择了两个保守方案:
- 使用 13 个 MFCC 系数,以减少特征状态内存和计算量
- 使用本地推理,以避免网络延迟并保持离线运行能力
64 KB 的模型大小上限本身并不能证明任何一个替代方案不可行;部署模型、预处理状态、运行时和网络协议栈都需要分别测量其占用空间。
步骤 2:计算预算分配。
按照 section 1.4.2 中确定的单位费率,将 $150K 的预算分配到三个成本类别:
- 标注(约 60 percent):可用预算为 $90K
- 存储/处理(约 25 percent):$37.5K
- 治理/其他(约 15 percent):$22.5K
在每个标签成本为 $0.10/label、审核开销为 20 percent 的情况下:$90K ÷ $0.12/label = 750K 个已标注样本
这将得到约 75 万个已标注样本,略低于设计空间中 100 万个样本的基准点。因此,table 3 中从 100 万到 1000 万的那一行应被视为规模扩展的参考,而不能用于直接插值:仅靠真实数据标注预算,无法获得完整的数据量增益。
步骤 3:最大限度地提高可进一步获得的准确率。
质量方案包含三个组成部分:
- 示例性基础模型准确率约为 90 percent
- 75 万个真实样本带来的部分数据量增益
- 需求:提高采样率,并结合合成数据增强和噪声数据增强,以达到 98 percent 的目标
设计空间中仍有三种选项满足预算和内存约束:
- 16 kHz 采样:准确率提高 2–4%,存储成本为 2\(\times\) ✓(符合预算)
- 含噪训练数据:真实环境准确率提高 10–15%,采集成本为 3\(\times\)
- 合成数据增强:鲁棒性提高 3–5%,成本降至真实数据的 1/10(10\(\times\) 成本效率) ✓
步骤 4:最终配置。
该场景将这些选择与 13 个 MFCC 系数以及根据预算计算出的 75 万个真实标注样本相结合,见 table 4。各项质量效果可能相互重叠,因此表中记录的是候选配置,而非已求得的最优解。
结果:预算计算表明,可支持约 750K 个人工标注样本。达到 98 percent 的质量目标,并满足 64 KB 的模型限制,仍是训练和部署后的系统必须验证的要求。
系统洞见:系统化的设计空间分析将“我们需要更多数据”转化为可检验的资源分配方案:在所述标注假设下,预算可获得约 75 万个真实样本,而合成数据量、准确率和部署后的资源占用仍需测量。
Table 4 记录了由此得到的配置,将每项设计选择与迫使其做出该选择的约束对应起来:在预算允许的范围内投入采样和数据增强,而精度与内存则由始终开启的计算岛限定。
| 选择项 | 所选方案 | 理由 |
|---|---|---|
| 采样率 | 16 kHz | 准确率提高 3%,值得承担预算范围内 2\(\times\) 的存储开销 |
| MFCC 系数 | 13 | 减少特征状态的内存占用和计算量;最终是否满足限制需要测量 |
| 训练样本 | 75 万个真实样本 + 示例性合成数据增强 | 人工标注数量由预算推导得出;合成数据量是场景中的一项选择 |
| 数据多样性 | 含噪与干净数据混合 | 对真实环境部署至关重要 |
| 推理 | 本地运行,降低精度 | 降低精度可减少资源占用;最终是否满足 64 KB 限制,需要依照 模型压缩 中的压缩分析进行评估 |
| 数据增强 | 大量使用合成数据 | 成本效率为 10\(\times\) |
候选配置确立了目标要求,但满足这些要求需要统筹互补的数据获取渠道。基线语料库为声学先验提供基础,定向众包弥补人口群体覆盖缺口,合成生成器则在参数化的声学条件下提供数据规模。四大支柱为评估这些渠道提供诊断和架构准则,而数据来源决定了后续每个流水线阶段所加工的物理原材料。Section 1.4 阐述了这些获取策略在经济和系统层面的权衡。
Checkpoint 1.2: 四大支柱框架
四大支柱为流水线中的每项选择提供系统视角。
支柱
权衡
数据获取
数据获取始于团队明确模型必须弥补的覆盖缺口。完整的 ImageNet 数据库5增长至约 1420 万张已标注图像,涵盖 21,841 个同义词集,而 ImageNet 大规模视觉识别挑战赛使用的是一个包含 1,000 个类别的子集 (Deng et al. 2009; Russakovsky et al. 2015)。GPT-3 的训练语料库使用了数十 TB 的原始 Common Crawl 文本,将其过滤至数百 GB,并结合经过整理的网页、图书和维基百科数据 (Brown et al. 2020)。关键词检测(KWS)系统需要 23.4 million audio samples,覆盖 50 languages,但工程挑战远不止存储量。模型必须在不同口音、麦克风、房间、年龄和背景噪声条件下识别唤醒词,而任何单一采集方法都无法以经济可行的方式覆盖所有这些情况。因此,数据获取策略是一系列弥补缺口的决策:复用已与部署条件匹配的数据,采集缺失的数据,在规模成为约束瓶颈时抓取或合成数据,并拒绝使用因来源或同意授权约束而不可用的数据源。
KWS 的部署特征说明,数据获取为何不能孤立地优化单一维度。要在多样化的声学环境中达到 98 percent 的准确率,就必须对地区口音、说话人年龄群体和房间混响进行具有代表性的覆盖。在各类消费设备上保持一致的检测效果,又引入了硬件差异:麦克风在频率响应、信噪比和模数转换削波行为方面各不相同。此外,支持数百万台并发运行的边缘设备所需的数据集规模,无法通过人工整理以经济可行的方式满足;与此同时,始终监听的唤醒词检测器还受到音频保留和匿名化方面严格隐私边界的约束。如果某个数据源以牺牲隐私合规为代价追求最大数据量,或只采集纯净的录音室音频而忽略实际使用环境中的麦克风失真,就无法解决部署问题。
数据源评估与选择
在经过整理的数据集、专家众包、受控网页抓取和合成生成之间做出选择,取决于哪个来源能够在可接受的成本、质量和治理风险下,最有效地弥补下一个部署分布缺口。因此,评估首先从成本最低的可复用来源开始,只有当剩余覆盖缺口足以证明新增工程成本合理时,才转向主动采集或仿真。
Kaggle、UCI (Dua and Graff 2024) 和 ImageNet 等资源库中的现有数据集是首先需要检验的对象。当部署分布与基准足够相似、使复用具有实际意义时,这些数据集可提供速度优势和可比性。对于 KWS,经过整理的语音语料库可以用于建立基线模型,并揭示已覆盖哪些词语、语言和声学条件。基线语料库并不保证完整的实际运行覆盖,而是使尚未弥补的分布缺口变得可量化。
Dua, Dheeru, and Casey Graff. 2024. UCI Machine Learning Repository.
Pineau, Joelle, Philippe Vincent-Lamarre, Koustuv Sinha, Vincent Larivière, Alina Beygelzimer, Florence d’Alché-Buc, Emily Fox, and Hugo Larochelle. 2021. “Improving Reproducibility in Machine Learning Research (a Report from the Neurips 2019 Reproducibility Program).” Journal of Machine Learning Research 22 (164): 1–20.
Henderson, Peter, Riashat Islam, Philip Bachman, Joelle Pineau, Doina Precup, and David Meger. 2018. “Deep Reinforcement Learning That Matters.” Proceedings of the AAAI Conference on Artificial Intelligence 32 (1): 3207–14. https://doi.org/10.1609/aaai.v32i1.11694.
Gudivada, Venkat N., Amy Apon, and Junhua Ding. 2017. “Data Quality Considerations for Big Data and Machine Learning: Going Beyond Data Cleaning and Transformations.” International Journal on Advances in Software 10 (1–2): 1–20.
数据集复用是否可行,取决于文档记录的准确性与完整性。如果缺少传感器校准、环境分布和过滤阈值的详细记录,外部数据就会损害实验的可复现性 (Pineau et al. 2021; Henderson et al. 2018)。完善的文档应明确采集方法、标签分类体系的定义以及基线错误分布,从而支持独立验证。当数据摄取规模扩大到数百万个样本时,数据集的多样性会加剧潜在的标签噪声 (Gudivada et al. 2017),使人工检查变得不可行,因而必须采用自动化验证流水线。
在缺乏代表性的数据上进行评估时,标准验证指标可能造成模型已可投入使用的错觉。共享数据集的使用(figure 4)说明,在同一个公共数据集上训练多个模型,会如何将共同的偏差、盲点和系统性局限传播至整个生态系统。
\begin{tikzpicture}[line join=round,font=\sffamily\small]
\tikzset{%
  Box/.style={align=flush center,
    inner xsep=2pt,
    node distance=1.2,
    draw=none,%GreenLine,
    line width=0.75pt,
    fill=none,%mygreen!03,
    %text width=35mm,
    minimum width=23mm, minimum height=20mm
  },
  Box2/.style={Box, draw=none, fill=none, minimum width=17mm, minimum height=16mm
  },
  Box3/.style={Box, draw=mybrown, fill=mybrown!04, inner ysep=1pt,
  line width=0.5pt,minimum width=37mm, minimum height=5mm
  },
  Txt/.style={font=\sffamily\footnotesize,text=black
  },
  Txt2/.style={font=\sffamily\fontsize{9pt}{9}\selectfont,text=black!60,align=left,
  },
  LineA/.style={black!20,line width=1.0pt,{-{Triangle[width=1.0*4pt,length=7pt]}},shorten <=0pt,shorten >=0pt},
}

%dataS
\tikzset{%
 pics/dataS/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=FUNNEL,scale=\scalefac, every node/.append style={transform shape}]
%plats
\draw[fill=\filllcolor,line width=\Linewidth,draw=\drawcolor](0,-0.3)--(-0.67,0.03)--(0,0.37)--(0.67,0.03)--cycle;
\draw[fill=\filllcirclecolor,line width=\Linewidth,draw=\drawcolor](0,0)--(-0.67,0.33)--(0,0.67)--(0.67,0.33)--cycle;
\draw[fill=\filllcolor,line width=\Linewidth,draw=\drawcolor](0,0.3)--(-0.67,0.63)--(0,0.97)--(0.67,0.63)--cycle;
%left
\draw[line width=\Linewidth,draw=\drawcolor](-0.39,1.21)--++(210:0.55)--++(270:1.22)--(-0.39,-0.56);
\fill[line width=\Linewidth,fill=\filllcirclecolor!60!violet!,draw=green,draw=\drawcolor](-0.39,1.21)circle(3pt);
\fill[line width=\Linewidth,fill=\filllcolor,draw=green,draw=\drawcolor](-0.39,-0.56)circle(3pt);
%right
\draw[line width=\Linewidth,draw=\drawcolor](0.39,1.21)--++(330:0.55)--++(270:1.22)--(0.39,-0.56);
\fill[line width=\Linewidth,fill=\filllcirclecolor!60!violet!,draw=green,draw=\drawcolor](0.39,1.21)circle(3pt);
\fill[line width=\Linewidth,fill=\filllcolor,draw=green,draw=\drawcolor](0.39,-0.56)circle(3pt);
 \end{scope}
     }
  }
}
%CPU2
\tikzset{%
 pics/cpu2/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=CHIP,scale=\scalefac, every node/.append style={transform shape}]
\node[fill=\filllcolor,minimum width=15mm, minimum height=15mm,inner sep=0pt,
            rounded corners=2,outer sep=2pt] (C1) {};
\node[fill=white,minimum width=11mm, minimum height=11mm,inner sep=0pt,] (C2) {};
\node[fill=\filllcolor!40,minimum width=7mm, minimum height=7mm,inner sep=0pt,] (C3) {};
\foreach \x in {0.2,0.5,0.8}{
\draw[line width=2*\Linewidth,draw=\drawcolor,
-{Circle[fill=white,length=4.5pt]}]($(C1.north west)!\x!(C1.north east)$)--++(0,7mm);
}
\foreach \x in {0.2,0.5,0.8}{
\draw[line width=2*\Linewidth,draw=\drawcolor,
-{Circle[fill=white,length=4.5pt]}]($(C1.south west)!\x!(C1.south east)$)--++(0,-7mm);
}
\foreach \x in {0.2,0.5,0.8}{
\draw[line width=2*\Linewidth,draw=\drawcolor,
-{Circle[fill=white,length=4.5pt]}]($(C1.north west)!\x!(C1.south west)$)--++(-7mm,0);
}
\foreach \x in {0.2,0.5,0.8}{
\draw[line width=2*\Linewidth,draw=\drawcolor,
-{Circle[fill=white,length=4.5pt]}]($(C1.north east)!\x!(C1.south east)$)--++(7mm,0);
}
 \end{scope}
     }
  }
}
%Hand
\tikzset {
pics/hand/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=MOB,scale=\scalefac, every node/.append style={transform shape}]
\draw[draw=\drawcolor,line width=\Linewidth,fill=\filllcirclecolor](1.07,-0.02)--(1.70,0.2)arc(110:-40:1.0mm)--
(1.0,-0.48)arc(-60:-100:4.0mm)--(0.4,-0.34)--(0.15,-0.42)
--(-0.1,0.13)--(0.31,0.33)--(1,0.08);to [bend left=25]cycle;
\draw[draw=\drawcolor,line width=\Linewidth](-0.1,0.13)--(0.31,0.33)--(1,0.08)arc(60:-90:1.4mm)--(0.55,-0.03);
\node[draw=\drawcolor,line width=\Linewidth,fill=cyan ,minimum width=8mm,minimum height=5mm,rotate=117]at(-0.17,-0.26){};
 \end{scope}
     }
  }
}
%globe
\tikzset{
pics/globe/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\node[circle,minimum size=25mm,draw=\drawcolor, fill=\filllcolor!70,line width=\Linewidth](C\picname) at (0,0){};
\draw[draw=\drawcolor,line width=\Linewidth](C\picname.north)to[bend left=65](C\picname.south);
\draw[draw=\drawcolor,line width=\Linewidth](C\picname.north)to[bend right=65](C\picname.south);
\draw[draw=\drawcolor,line width=\Linewidth](C\picname.north)to(C\picname.south);
\draw[draw=\drawcolor,line width=\Linewidth](C\picname.west)--(C\picname.east);
%
\draw[draw=\drawcolor,line width=\Linewidth](C\picname.130)to[bend right=35](C\picname.50);
\draw[draw=\drawcolor,line width=\Linewidth](C\picname.230)to[bend left=35](C\picname.310);
%\draw[red,line width=2*\Linewidth,
%,{-{Triangle[width=1.0*5pt,length=9pt]}}](C\picname.south) arc[start angle=270, end angle=360, radius=12mm];
%\draw[red,line width=2*\Linewidth,
%,{-{Triangle[width=1.0*5pt,length=9pt]}}](C\picname.south) arc[start angle=270, end angle=180, radius=12mm];
\end{scope}
    }
  }
}

\pgfkeys{
  /channel/.cd,
   Depth/.store in=\Depth,
  Height/.store in=\Height,
  Width/.store in=\Width,
  filllcirclecolor/.store in=\filllcirclecolor,
  filllcolor/.store in=\filllcolor,
  drawcolor/.store in=\drawcolor,
  drawcircle/.store in=\drawcircle,
  scalefac/.store in=\scalefac,
  Linewidth/.store in=\Linewidth,
  picname/.store in=\picname,
  filllcolor=BrownLine,
  filllcirclecolor=violet!20,
  drawcolor=black,
  drawcircle=violet,
  scalefac=1,
  Linewidth=0.5pt,
  Depth=1.3,
  Height=0.8,
  Width=1.1,
  picname=C
}

% Central
\node[Box](B1){};
\coordinate(GO1)at($(B1.north west)!0.38!(B1.north east)$);
%\fill[fill=BlueL!90](B1.south west)rectangle(GO1);
\coordinate(T1)at($(GO1)!0.5!(B1.south east)$);
\coordinate(I1)at($(B1.west)!0.21!(B1.east)$);
%\node[align=center]at(T1){Model\\ Training};
\draw[myblue,  line width=2.75pt](B1.south west)--coordinate[pos=0.5](SR1)(B1.south east);
\node[anchor=north,below=2pt of SR1](TG){中央训练数据集存储库};
\pic[shift={(0,-0.3)}] at  (B1){dataS={scalefac=0.8,Linewidth=1.0pt,
 filllcolor=cyan!90!black!40!,drawcolor=black,filllcirclecolor=orange}};
%%%%%%%%%%%%%%%%%%
%Models
%%%%%%%%%%%%%%%%%%
\node[Box2,below=1.70 of B1](B2){};
\draw[mygreen,  line width=2.75pt](B2.south west)--coordinate[pos=0.5](SR2)(B2.south east);
\node[Box2,right= 1.55 of B2](B3){};
\draw[mygreen,  line width=2.75pt](B3.south west)--coordinate[pos=0.5](SR3)(B3.south east);
\node[Box2,right=1.55  of B3](B4){};
\draw[mygreen,  line width=2.75pt](B4.south west)--coordinate[pos=0.5](SR4)(B4.south east);
%
\node[Box2,left=1.55  of B2](B5){};
\draw[mygreen,  line width=2.75pt](B5.south west)--coordinate[pos=0.5](SR5)(B5.south east);
\node[Box2,left=1.55  of B5](B6){};
\draw[mygreen,  line width=2.75pt](B6.south west)--coordinate[pos=0.5](SR6)(B6.south east);

\foreach \i  [count=\k from 2] in {C,D,E,B,A}{
\node[anchor=north,below=2pt of SR\k](T\i){模型 \i};
  }

\foreach \i  in{2,3,4,5,6}{
  \pic[shift={(0,0)}] at  (B\i){cpu2={scalefac=0.4,drawcolor=myblue, filllcolor=myblue, Linewidth=0.5pt}};
  }
 %%%%%%%%%%%%%%%%
 \node[Box,below=2 of B2](B7){};
 \draw[Dandelion,  line width=2.75pt](B7.south west)--coordinate[pos=0.5](SR7)(B7.south east);
 \node[anchor=north,below=2pt of SR7](TDO){与真实环境的对齐程度有限};
 \pic[shift={(-0.6,-0.30)},rotate=0] at (B7){hand={scalefac=0.8,filllcolor=orange!30!, filllcirclecolor=brown!60, Linewidth=1.0pt}};
\pic[shift={(0.3,0.4)}] at  (B7){globe={scalefac=0.35,picname=1,filllcolor=cyan!30!, Linewidth=0.75pt}};
%%
%\node[Box3,Txt](BB1)at($(TG.south)!0.43!(B2.north)$){Shared training data};

%arrows
%\draw[LineA,shorten <=-3pt](TG)--(BB1);
\foreach \i  in{2,3,4,5,6}{
\draw[LineA,shorten >=-4pt](TG)--coordinate[pos=0.4](GT\i)++(0,-10mm)-|(B\i.north);
}

 \node[Txt2,right=1pt of GT2] {共享训练数据};

\foreach \i /\x in {%
A/{偏差\\ 传播},
B/{共同\\ 局限},
C/{盲\\ 点},
D/{共同\\弱点},
E/系统性\\ 问题
}{
\draw[LineA,shorten >=-4pt](T\i)--node[Txt2,pos=0.45,right](MT){\x}++(0,-12mm)-|(B7.90);
}

\node[draw=myorange,dashed,thick,fit=(B6)(B4)(TDO)(MT),inner ysep=2mm,,inner xsep=1mm,xshift=-1mm,yshift=2.7mm](BB2){};
\node[myorange,anchor=south east,above left=0.2 of BB2.south east]{潜在问题};
\end{tikzpicture}这种分布缺口体现了静态离线基准的核心失效模式。由于经验风险最小化仅针对观测到的训练分布进行优化,模型会利用静态基准中存在、却会在生产环境中消失的虚假特征,因此自动化漂移监控和持续数据验证成为强制性的运行要求。
可扩展性与成本优化
当任务需要数百万个训练实例时,人工整理便难以为继。在大规模条件下,网页抓取和合成生成是构建海量数据集的主要途径。数据获取的可扩展性本质上是一个经济问题:单位标注成本、摄取吞吐量和存储开销沿着截然不同的曲线变化。在数千个样本规模下行之有效的方法,到数百万个样本时就可能变得不可行,而自动化数据生成流水线能够通过大规模数据量摊薄初始搭建成本。
各阶段的单位经济性决定了哪种策略占优。例如,标注一张医学图像的成本可能比将其存储一年的成本高出数个数量级,这一比例会重塑任何资金固定的团队的预算分配。Table 5 和 table 6 为数据获取决策提供了必要的背景。
机器学习工程师应将 table 5 和 table 6 中注明年份的参考假设用作特定工作负载比较的输入,而不应将其视为当前报价或可直接比较的总成本。
| 操作 | 成本 | 说明 |
|---|---|---|
| 众包图像标注 | $0.01–0.05 | 简单分类 |
| 边界框标注 | $0.05–0.20 | 按框计费,简单场景 |
| 医学专家标注 | $50–200 | 按次检查计费,由放射科医师标注 |
| S3 存储(Standard) | $23/TB/month | 热存储 |
| S3 数据取回(Glacier) | $0.02/GB | 标准取回:3–5 小时 |
| 云 GPU 训练小时 | $2–4 | 云端竞价定价 |
| 人工审核小时 | $15–50 | 取决于专业水平 |
Table 6 补充了标注、训练和服务操作的示例耗时,使这一概况更加完整。
| 操作 | 耗时 | 瓶颈 |
|---|---|---|
| 标注 100 万张图像(众包) | 2–4 周 | 标注吞吐量 |
| 在 ImageNet 上训练 ResNet-50 | 4–6 小时 | 计算(8\(\times\) A100,经过优化) |
| 特征存储查询 | 1–10 ms | 网络 + 缓存 |
这些阶段的操作时间尺度相差多个数量级:人工标注需要数周,GPU 训练需要数小时,服务中的查询则仅需数毫秒。在这条流水线中,标注吞吐量构成了关键瓶颈。$100K 的标注预算远高于使用 8\(\times\) A100 进行一次 ResNet-50 训练所需的 $64 至 $192,两者之比高达 520.8× 至 1,562.5×,呈现出显著的不对称性。在这笔标注支出中,工程投入遵循极端的幂律分布:80 percent 的预算用于处理数据分布中的 20 percent,即由罕见声学边缘情况、方言变体和含义不明确的录音构成的长尾。
所有成本数值均反映 2024 年云服务提供商的大致费率,旨在传达相对量级,而非精确价格。6 对于这一工作负载和成本模型,人工成本相对于单次训练的成本占主导地位。其他任务,尤其是复用现有标签或需要反复进行大规模训练的任务,其主导成本项可能不同;团队应先进行测量,再决定优化方向。
网页抓取是在大规模场景下绕过人工标注成本的主要机制。ImageNet (Deng et al. 2024) 和 OpenImages (Kuznetsova et al. 2020) 等基础视觉数据集依赖自动化抓取,而现代语言模型则依赖数 TB 规模的网页爬取数据 (Groeneveld et al. 2024)。针对公共代码仓库等领域专用语料库的数据摄取流水线 (Chen et al. 2021),能够以较低的单样本获取成本扩大覆盖范围。然而,自动化抓取程序在运行层面十分脆弱:模式和 DOM 的变更会破坏提取解析器,HTTP 429 速率限制会压低可用网络带宽,而动态 JavaScript 渲染会导致抓取遗漏。原始网页爬取数据还会包含与时代不符或无关的样本,污染监督学习的目标。
Kuznetsova, Alina, Hassan Rom, Neil Alldrin, Jasper Uijlings, Ivan Krasin, Jordi Pont-Tuset, Shahab Kamali, et al. 2020. “The Open Images Dataset V4: Unified Image Classification, Object Detection, and Visual Relationship Detection at Scale.” International Journal of Computer Vision 128 (7): 1956–81. https://doi.org/10.1007/s11263-020-01316-z.
Groeneveld, Dirk, Iz Beltagy, Pete Walsh, Akshita Bhagia, Rodney Kinney, Oyvind Tafjord, Ananya Harsh Jha, et al. 2024. “OLMo: Accelerating the Science of Language Models.” Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), 15789–809. https://doi.org/10.18653/v1/2024.acl-long.841.
Chen, Mark, Jerry Tworek, Heewoo Jun, Qiming Yuan, Henrique Ponde de Oliveira Pinto, Jared Kaplan, Harri Edwards, et al. 2021. “Evaluating Large Language Models Trained on Code.” arXiv Preprint arXiv:2107.03374.
Figure 5 展示了以“交通信号灯”为关键词进行网页抓取时得到的一个此类结果:一张历史照片,而非现代 LED 信号灯。如果此类背景的图像占比过高,或与某个标签相关联,模型就可能学到涉及身着制服的警员或历史街道的虚假线索,而非其部署环境所要求的视觉属性。
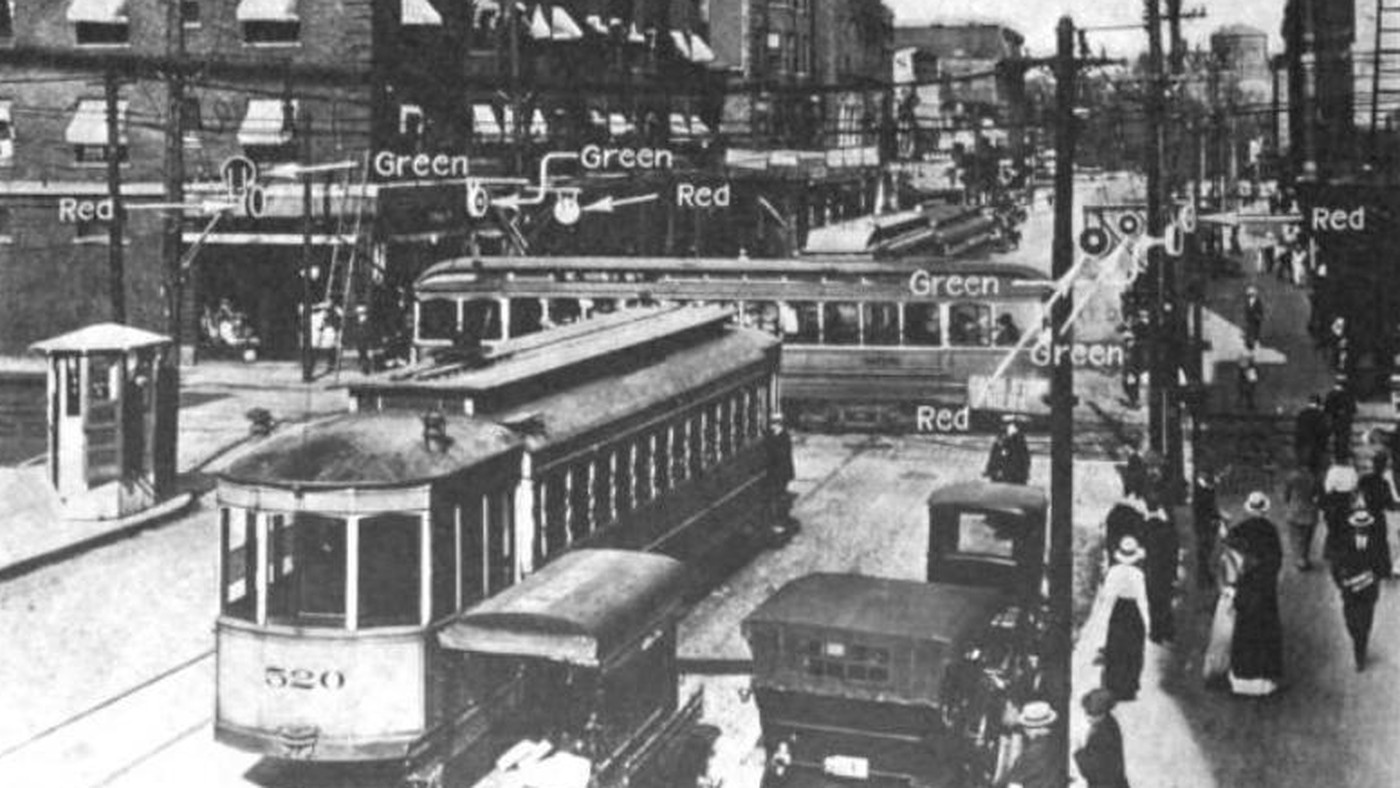
Stromberg, Joseph. 2015. When Was the First Traffic Light Installed? Today in 1914. Vox.
这一失败案例说明了为何数据集规模无法替代语义验证:未经筛选整理的海量网络数据只会放大虚假相关性的普遍程度。除技术验证外,网页抓取还受到严格的法律与治理边界约束。网站服务条款、robots.txt 指令以及不断演变的版权判例法均对自动化爬取构成约束 (Harvard Law School 2024)。在抓取的数据资产进入共享存储之前,数据摄取流水线必须强制执行数据来源日志记录、版权合规过滤和隐私信息清除。
Harvard Law School. 2024. Does ChatGPT Violate New York Times Copyrights?
Amazon Web Services. 2024. Amazon Mechanical Turk.
Sheng, Victor S., and Jing Zhang. 2019. “Machine Learning with Crowdsourcing: A Brief Summary of the Past Research and Future Directions.” Proceedings of the AAAI Conference on Artificial Intelligence 33 (01): 9837–43. https://doi.org/10.1609/aaai.v33i01.33019837.
众包将获取瓶颈从原始样本检索转移到了对分布式人工标注者的质量控制。Amazon Mechanical Turk (Amazon Web Services 2024) 等平台在 ImageNet 项目中大规模展示了这一模式,将数百万项图像分类任务分发给数千名独立贡献者 (Deng et al. 2024)。众包提供了两项核心系统优势:通过并行分发微任务实现水平扩展,以及覆盖不同地区口音和声学环境的人群多样性。然而,分布式人工标注会导致标签准确性存在显著差异。为了防止标签噪声污染下游梯度,数据获取流水线必须实施自动化质量控制,包括共识投票、黄金集验证(穿插预先标注的对照样本)和动态任务路由 (Sheng and Zhang 2019)。在 KWS 流水线中,众包采集7旨在获取公共网页抓取无法覆盖的特定声学环境及代表性不足方言中的唤醒词样本。
合成数据生成通过算法生成训练样本,消除了人工劳动瓶颈。这改变了工程权衡:边际生成成本趋近于零,但验证成本随之增加,因为只有当模拟器准确反映目标部署环境的物理分布时,合成数据才有用。Figure 6 展示了如何将合成仿真与历史观测合并到统一的训练流水线中。
\begin{tikzpicture}[line join=round,font=\sffamily\small]
\tikzset{
 Line/.style={line width=0.35pt,black!50,text=black},
 LineDO/.style={single arrow, draw=VioletLine, fill=VioletLine!50,
      minimum width = 10pt, single arrow head extend=3pt,
      minimum height=15mm},
 ALineA/.style={violet!80!black!50,line width=3pt,shorten <=2pt,shorten >=2pt,
{Triangle[width=1.1*6pt,length=0.8*6pt]}-{Triangle[width=1.1*6pt,length=0.8*6pt]}},
LineD/.style={line width=0.75pt,black!50,text=black,dashed,dash pattern=on 5pt off 3pt},
Circle/.style={inner xsep=2pt,
  % node distance=1.15,
  circle,
    draw=BrownLine,
    line width=0.75pt,
    fill=BrownL!40,
    minimum size=18mm
  },
 circles/.pic={
\pgfkeys{/channel/.cd, #1}
\node[circle,draw=\channelcolor,line width=\Linewidth,fill=\channelcolor!10,
minimum size=2.5mm](\picname){};
        }
}
\tikzset {
pics/cloud/.style = {
        code = {
\colorlet{red}{RedLine}
\begin{scope}[local bounding box=CLO,scale=0.5, every node/.append style={transform shape},,shift={($(SIM)+(0,0)$)},]
\draw[red,fill=white,line width=0.9pt](0.67,1.21)to[out=55,in=90,distance=13](1.5,0.96)
to[out=360,in=30,distance=9](1.68,0.42);
\draw[red,fill=white,line width=0.9pt](0,0)to[out=170,in=180,distance=11](0.1,0.61)
to[out=90,in=105,distance=17](1.07,0.71)
to[out=20,in=75,distance=7](1.48,0.36)
to[out=350,in=0,distance=7](1.48,0)--(0,0);
\draw[red,fill=white,line width=0.9pt](0.27,0.71)to[bend left=25](0.49,0.96);

\end{scope}
     }
  }
}
%streaming
\tikzset{%
 LineST/.style={-{Circle[\channelcolor,fill=RedLine,length=4pt]},draw=\channelcolor,line width=\Linewidth,rounded corners},
 ellipseST/.style={fill=\channelcolor,ellipse,minimum width = 2.5mm, inner sep=2pt, minimum height =1.5mm},
 BoxST/.style={line width=\Linewidth,fill=white,draw=\channelcolor,rectangle,minimum width=56,
 minimum height=16,rounded corners=1.2pt},
 pics/streaming/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=STREAMING,scale=\scalefac, every node/.append style={transform shape}]
\node[BoxST,minimum width=44,minimum height=48](\picname-RE1){};
\foreach \i/\j in{1/north,2/center,3/south}{
\node[BoxST](\picname-GR\i)at(\picname-RE1.\j){};
\node[ellipseST]at($(\picname-GR\i.west)!0.2!(\picname-GR\i.east)$){};
\node[ellipseST]at($(\picname-GR\i.west)!0.4!(\picname-GR\i.east)$){};
}
\draw[LineST](\picname-GR3)--++(2,0)coordinate(\picname-C4);
\draw[LineST](\picname-GR3.320)--++(0,-0.7)--++(0.8,0)coordinate(\picname-C5);
\draw[LineST](\picname-GR3.220)--++(0,-0.7)--++(-0.8,0)coordinate(\picname-C6);
\draw[LineST](\picname-GR3)--++(-2,0)coordinate(\picname-C7);
 \end{scope}
     }
  }
}
%data
\tikzset{mycylinder/.style={cylinder, shape border rotate=90, aspect=1.3, draw, fill=white,
minimum width=25mm,minimum height=11mm,line width=\Linewidth,node distance=-0.15},
pics/data/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=STREAMING,scale=\scalefac, every node/.append style={transform shape}]
\node[mycylinder,fill=\channelcolor!50] (A) {};
\node[mycylinder, above=of A,fill=\channelcolor!30] (B) {};
\node[mycylinder, above=of B,fill=\channelcolor!10] (C) {};
 \end{scope}
     }
  }
}

\tikzset{pics/brain/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=BRAIN,scale=\scalefac, every node/.append style={transform shape}]
\fill[fill=\filllcolor!50](0.1,-0.5)to[out=0,in=180](0.33,-0.5)
to[out=0,in=270](0.45,-0.38)to(0.45,-0.18)
to[out=40,in=240](0.57,-0.13)to[out=110,in=310](0.52,-0.05)
to[out=130,in=290](0.44,0.15)to[out=90,in=340,distance=8](0.08,0.69)
to[out=160,in=80](-0.42,-0.15)to (-0.48,-0.7)to(0.07,-0.7)to(0.1,-0.5)
(-0.10,-0.42)to[out=310,in=180](0.1,-0.5);
\draw[draw=\drawchannelcolor,line width=\Linewidth](0.1,-0.5)to[out=0,in=180](0.33,-0.5)
to[out=0,in=270](0.45,-0.38)to(0.45,-0.18)
to[out=40,in=240](0.57,-0.13)to[out=110,in=310](0.52,-0.05)
to[out=130,in=290](0.44,0.15)to[out=90,in=340,distance=8](0.08,0.69)
(-0.42,-0.15)to (-0.48,-0.7)
(0.07,-0.7)to(0.1,-0.5)
(-0.10,-0.42)to[out=310,in=180](0.1,-0.5);
%brain
\draw[fill=\filllcolor,line width=\Linewidth](-0.3,-0.10)to(0.08,0.60)
to[out=60,in=50,distance=3](-0.1,0.69)to[out=160,in=80](-0.26,0.59)to[out=170,in=90](-0.46,0.42)
to[out=170,in=110](-0.54,0.25)to[out=210,in=150](-0.54,0.04)
to[out=240,in=130](-0.52,-0.1)to[out=300,in=240](-0.3,-0.10);
\draw[fill=\filllcolor,line width=\Linewidth]
(-0.04,0.64)to[out=120,in=0](-0.1,0.69)(-0.19,0.52)to[out=120,in=330](-0.26,0.59)
(-0.4,0.33)to[out=150,in=280](-0.46,0.42)
%
(-0.44,-0.03)to[bend left=30](-0.34,-0.04)
(-0.33,0.08)to[bend left=40](-0.37,0.2) (-0.37,0.12)to[bend left=40](-0.45,0.14)
(-0.26,0.2)to[bend left=30](-0.24,0.13)
(-0.16,0.32)to[bend right=30](-0.27,0.3)to[bend right=30](-0.29,0.38)
(-0.13,0.49)to[bend left=30](-0.04,0.51);

\draw[rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcirclecolor,length=2.5pt]}](-0.23,0.03)--(-0.15,-0.03)--(-0.19,-0.18)--(-0.04,-0.28);
\draw[rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcirclecolor,length=2.5pt]}](-0.17,0.13)--(-0.04,0.05)--(-0.06,-0.06)--(0.14,-0.11);
\draw[rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcirclecolor,length=2.5pt]}](-0.12,0.23)--(0.31,0.0);
\draw[rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcirclecolor,length=2.5pt]}](-0.07,0.32)--(0.06,0.26)--(0.16,0.33)--(0.34,0.2);
\draw[rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcirclecolor,length=2.5pt]}](-0.01,0.43)--(0.06,0.39)--(0.18,0.51)--(0.31,0.4);
\end{scope}
     }
  }
}

\tikzset{pics/tube/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=BRAIN,scale=\scalefac, every node/.append style={transform shape}]
\draw[draw=\drawchannelcolor,line width=\Linewidth,fill=white](-0.1,0.26)to(-0.1,0.1)to[out=240,in=60](-0.23,-0.14)
to[out=240,in=180,distance=3](-0.13,-0.27)to(0.09,-0.27)
to[out=0,in=300,distance=3](0.19,-0.14)
to[out=120,in=290]((0.06,0.1)to(0.06,0.26)
to cycle;
\fill[fill=\filllcolor!50](-0.23,-0.14)
to[out=240,in=180,distance=3](-0.13,-0.27)to(0.09,-0.27)
to[out=0,in=300,distance=3](0.19,-0.14)to[out=200,in=20]cycle;
\draw[draw=\drawchannelcolor,line width=\Linewidth,fill=none](-0.1,0.26)to(-0.1,0.1)to[out=240,in=60](-0.23,-0.14)
to[out=240,in=180,distance=3](-0.13,-0.27)to(0.09,-0.27)
to[out=0,in=300,distance=3](0.19,-0.14)
to[out=120,in=290]((0.06,0.1)to(0.06,0.26)
to cycle;
\end{scope}
     }
  }
}

\tikzset{pics/factory/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=FACTORY,scale=\scalefac, every node/.append style={transform shape}]
\node[rectangle,draw=\drawchannelcolor,fill=\filllcolor!50,minimum height=15,minimum width=23,,line width=\Linewidth](R1){};
\draw[fill=\filllcolor!50,line width=1.0pt]($(R1.40)+(0,-0.01)$)--++(110:0.2)--++(180:0.12)|-($(R1.40)+(0,-0.01)$);
\draw[line width=\Linewidth,fill=green](-0.68,-0.27)--++(88:0.85)--++(0:0.15)--(-0.48,-0.27)--cycle;
\draw[line width=2.5pt](-0.8,-0.27)--(0.55,-0.27);

\foreach \x in{0.25,0.45,0.65}{
\node[rectangle,fill=black,minimum height=2,minimum width=5,thick,inner sep=0pt]
at ($(R1.north)!\x!(R1.south)$){};
}
\foreach \x in{0.25,0.45,0.65}{
\node[rectangle,fill=black,minimum height=2,minimum width=5,thick,inner sep=0pt]
at ($(R1.130)!\x!(R1.230)$){};
}
\foreach \x in{0.25,0.45,0.65}{
\node[rectangle,fill=black,minimum height=2,minimum width=5,thick,inner sep=0pt]
at ($(R1.50)!\x!(R1.310)$){};
}
\end{scope}
     }
  }
}

\tikzset {
pics/cloud/.style = {
        code = {
\colorlet{red}{BrownLine}
\pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=CLO,scale=\scalefac, every node/.append style={transform shape}]
\draw[red,line width=\Linewidth,fill=red!10](0,0)to[out=170,in=180,distance=11](0.1,0.61)
to[out=90,in=105,distance=17](1.07,0.71)
to[out=20,in=75,distance=7](1.48,0.36)
to[out=350,in=0,distance=7](1.48,0)--(0,0);
\draw[red,line width=\Linewidth](0.27,0.71)to[bend left=25](0.49,0.96);
%\draw[red,line width=\Linewidth](0.67,1.21)to[out=55,in=90,distance=13](1.5,0.96)
%to[out=360,in=30,distance=9](1.68,0.42);
\end{scope}
     }
  }
}
\tikzset{
pics/square/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=SQUARE,scale=\scalefac,every node/.append style={transform shape}]
% Right Face
\draw[fill=\channelcolor!70,line width=\Linewidth]
(\Depth,0,0)coordinate(\picname-ZDD)--(\Depth,\Width,0)--(\Depth,\Width,\Height)--(\Depth,0,\Height)--cycle;
% Front Face
\draw[fill=\channelcolor!40,line width=\Linewidth]
(0,0,\Height)coordinate(\picname-DL)--(0,\Width,\Height)coordinate(\picname-GL)--
(\Depth,\Width,\Height)coordinate(\picname-GD)--(\Depth,0,\Height)coordinate(\picname-DD)--(0,0,\Height);
% Top Face
\draw[fill=\channelcolor!20,line width=\Linewidth]
(0,\Width,0)coordinate(\picname-ZGL)--(0,\Width,\Height)coordinate(\picname-ZGL)--
(\Depth,\Width,\Height)--(\Depth,\Width,0)coordinate(\picname-ZGD)--cycle;
\end{scope}
    }
  }
}

\tikzset{
pics/plus/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=PLUS,scale=\scalefac,every node/.append style={transform shape}]
% Right Face
\fill[fill=\channelcolor!70] (-0.7,-0.15)rectangle(0.7,0.15);
\fill[fill=\channelcolor!70] (-0.15,-0.7)rectangle(0.15,0.7);
\end{scope}
    }
  }
}

\pgfkeys{
  /channel/.cd,
    Depth/.store in=\Depth,
  Height/.store in=\Height,
  Width/.store in=\Width,
   channelcolor/.store in=\channelcolor,
  filllcirclecolor/.store in=\filllcirclecolor,
  filllcolor/.store in=\filllcolor,
  drawchannelcolor/.store in=\drawchannelcolor,
  drawcircle/.store in=\drawcircle,
  scalefac/.store in=\scalefac,
  Linewidth/.store in=\Linewidth,
  picname/.store in=\picname,
  filllcolor=BrownLine,
  filllcirclecolor=violet!20,
  drawchannelcolor=black,
  drawcircle=violet,
  channelcolor=BrownLine,
  scalefac=1,
  Linewidth=1.6pt,
    Depth=1.3,
  Height=0.8,
  Width=1.1,
  picname=C
}

\node[Circle](SIM){};
\node[Circle,right=2.5 of SIM,draw=GreenLine,fill=GreenL!40,](SYN){};
\node[Circle,below=1.35 of SIM,draw=OrangeLine,fill=OrangeL!40,](REA){};
\node[Circle,right=2.5 of REA,draw=RedLine,fill=RedL!40,](HIS){};
%
\node[Circle, right=4.2 of $(SYN)!0.5!(HIS)$,draw=BlueLine,fill=BlueL!40,](MLA){};
\node[Circle,right=2.75 of MLA,draw=VioletLine,fill=VioletL2!40,](TRA){};
\node[LineDO]at($(SIM)!0.5!(SYN)$){};
\node[LineDO]at($(REA)!0.5!(HIS)$){};
\node[LineDO]at($(MLA)!0.5!(TRA)$){};
\coordinate(LG)at($(SYN.east)+(6mm,0)$);
\coordinate(LD)at($(HIS.east)+(6mm,0)$);
\draw[line width=4pt,violet!40](LG)--++(5mm,0)|-coordinate[pos=0.25](S)(LD);
\node[LineDO]at($(S)!0.1!(MLA)$){};
%%
\begin{scope}[local bounding box=CIRCLE1,shift={($(TRA)+(0.04,-0.24)$)},
scale=0.6, every node/.append style={transform shape}]
%1 column
\foreach \j in {1,2,3} {
  \pgfmathsetmacro{\y}{(1.5-\j)*0.53 + 0.7}
  \pic at (-0.8,\y) {circles={channelcolor=green!70!black,picname=1CD\j}};
}
%2 column
\foreach \i in {1,...,4} {
  \pgfmathsetmacro{\y}{(2-\i)*0.53+0.7}
  \pic at (0,\y) {circles={channelcolor=green!70!black, picname=2CD\i}};
}
%3 column
\foreach \j in {1,2} {
  \pgfmathsetmacro{\y}{(1-\j)*0.53 + 0.7}
  \pic at (0.8,\y) {circles={channelcolor=green!70!black,picname=3CD\j}};
}
\foreach \i in {1,2,3}{
  \foreach \j in {1,2,3,4}{
\draw[Line](1CD\i)--(2CD\j);
}}
\foreach \i in {1,2,3,4}{
  \foreach \j in {1,2}{
\draw[Line](2CD\i)--(3CD\j);
}}
\end{scope}

 \tikzset{
    comp/.style = {draw,
        minimum width =18mm,
        minimum height = 15mm,
        inner sep= 0pt,
        rounded corners=1pt,
       draw = BlueLine,
       fill=cyan!10,
       line width=1.2pt
    }
}
\begin{scope}[local bounding box=COMPUTER,scale=0.6, every node/.append style={transform shape}]
 \node[comp](COM){};
 \draw[draw = BlueLine,line width=1.0pt]
 ($(COM.north west)!0.85!(COM.south west)$)-- ($(COM.north east)!0.85!(COM.south east)$);
\draw[draw = BlueLine,line width=1.0pt]($(COM.south west)!0.4!(COM.south east)$)--++(270:0.2)coordinate(DL);
\draw[draw = BlueLine,line width=1.0pt]($(COM.south west)!0.6!(COM.south east)$)--++(270:0.2)coordinate(DD);
\draw[draw = BlueLine,line width=3.0pt,shorten <=-3mm,shorten >=-3mm](DL)--(DD);
\end{scope}
%
\pic[shift={(0,-0.4)}] at  (HIS){data={scalefac=0.35,picname=1,channelcolor=green!70!black, Linewidth=0.4pt}};
\pic[shift={(0,0)}] at  (MLA){brain={scalefac=0.9,picname=1,filllcolor=orange!30!, Linewidth=0.7pt}};
\pic[shift={(0,-0.4)}] at  (SYN){data={scalefac=0.35,picname=1,channelcolor=cyan!70!black, Linewidth=0.4pt}};
\pic[shift={(0.25,-0.35)}] at  (SYN){tube={scalefac=1.2,picname=1,filllcolor=blue!90!, Linewidth=0.5pt}};
\pic[shift={(0.13,-0.00)}] at  (REA){factory={scalefac=0.9,picname=1,filllcolor=brown!, Linewidth=0.5pt}};
\pic[shift={(-0.32,-0.65)}] at (REA) {cloud={scalefac=0.5, Linewidth=1.0pt}};
\pic[shift={(-0.16,-0.1)}] at  (SIM){square={scalefac=0.35,picname=1,channelcolor=red, Linewidth=0.5pt}};
%
\pic[shift={(0,0)}] at  ($(SYN)!0.55!(HIS)$){plus={scalefac=0.4,channelcolor=violet}};
%
\node[below=1mm of SIM]{仿真模型};
\node[below=1mm of SYN]{合成数据};
\node[below=1mm of REA]{真实系统};
\node[below=1mm of HIS]{历史数据};
\node[below=1mm of MLA]{机器学习算法};
\node[below=1mm of TRA]{训练后的机器学习模型};
\end{tikzpicture}
AnyLogic. 2024. Synthetic Data for Artificial Intelligence.
合成数据在罕见事件合成和数据增强方面具有独特的有效性。基于物理的仿真引擎允许对尾部事件进行受控采样,例如高速条件下的传感器饱和或罕见碰撞轨迹;通过实地采集获取这些事件的数据,其危险程度或成本高得难以承受 (NVIDIA 2024)。在视觉领域,AutoAugment (Cubuk et al. 2019) 和 RandAugment (Cubuk et al. 2020) 等自动化增强流水线针对空间畸变和光度畸变优化变换策略 (Shorten and Khoshgoftaar 2019)。在语音处理中,SpecAugment直接在频域中应用时间扭曲和频谱图掩蔽,迫使声学模型学习对局部频率缺失具有不变性的表征 (Park et al. 2019)。对于 KWS 系统,将参数化文本转语音合成 (Werchniak et al. 2021) 与房间脉冲响应(RIR)卷积相结合,可以生成涵盖不同声学混响时间和合成背景噪声特征的唤醒词样本。
NVIDIA. 2024. NVIDIA Omniverse and Simulation.
Cubuk, Ekin D., Barret Zoph, Dandelion Mané, Vijay Vasudevan, and Quoc V. Le. 2019. “AutoAugment: Learning Augmentation Strategies from Data.” 2019 IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 113–23. https://doi.org/10.1109/cvpr.2019.00020.
Cubuk, Ekin D., Barret Zoph, Jonathon Shlens, and Quoc V. Le. 2020. “Randaugment: Practical Automated Data Augmentation with a Reduced Search Space.” 2020 IEEE/CVF Conference on Computer Vision and Pattern Recognition Workshops (CVPRW), 3008–17. https://doi.org/10.1109/cvprw50498.2020.00359.
Shorten, Connor, and Taghi M. Khoshgoftaar. 2019. “A Survey on Image Data Augmentation for Deep Learning.” Journal of Big Data 6 (1): 1–48. https://doi.org/10.1186/s40537-019-0197-0.
Park, Daniel S., William Chan, Yu Zhang, Chung-Cheng Chiu, Barret Zoph, Ekin D. Cubuk, and Quoc V. Le. 2019. “SpecAugment: A Simple Data Augmentation Method for Automatic Speech Recognition.” Interspeech 2019, 2613–17. https://doi.org/10.21437/interspeech.2019-2680.
Werchniak, Andrew, Roberto Barra Chicote, Yuriy Mishchenko, Jasha Droppo, Jeff Condal, Peng Liu, and Anish Shah. 2021. “Exploring the Application of Synthetic Audio in Training Keyword Spotters.” ICASSP 2021 - 2021 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), 7993–96. https://doi.org/10.1109/icassp39728.2021.9413448.
Example 1.2: 合成数据生成
场景:某关键词检测团队缺乏足够的实地录音,无法充分覆盖罕见的说话人口音、房间声学条件和背景噪声特征。
诊断:仅靠实地采集无法在项目期限内覆盖罕见的声学边缘情形。通过音高变换、叠加噪声和房间脉冲响应仿真生成合成音频变体,可以在无需昂贵现场采集的情况下,扩展训练集的多样性。
系统启示:合成数据生成能够放大自动化数据流水线的产出。针对已知边缘情形进行合成增强,可以填补分布覆盖缺口;否则,弥补这些缺口所需的实地数据集采集成本将高得难以承受。
要在 50 languages 种语言中满足 23.4 million audio samples 的要求,需要根据这些采集渠道的边际成本曲线进行统筹。经过整理的公共基准数据集为模型提供低成本的初始训练数据;网络抓取以高吞吐量获取大量声学数据;众包为代表性不足的方言采集有针对性的样本;参数化仿真则合成分布尾部的声学失真。结合这些层次,可以在不超出硬件和标注预算的前提下弥补覆盖缺口。
覆盖范围与多样性要求
仅有数据集规模并不能保证泛化能力。海量语料库中的覆盖缺口,例如地理偏差、人口群体代表性不足、传感器校准漂移以及未观测到的边缘情形,会引发被汇总验证指标掩盖的系统性失效模式 (Wang et al. 2019; Oakden-Rayner et al. 2020)。如 figure 4 所示,在相同公共数据集上训练的多个独立模型会继承相同的盲点;多样化、多来源的数据采集是防范相关性系统失效的首要架构措施。
Wang, Tianlu, Jieyu Zhao, Mark Yatskar, Kai-Wei Chang, and Vicente Ordonez. 2019. “Balanced Datasets Are Not Enough: Estimating and Mitigating Gender Bias in Deep Image Representations.” 2019 IEEE/CVF International Conference on Computer Vision (ICCV), 5309–18. https://doi.org/10.1109/iccv.2019.00541.
Oakden-Rayner, Luke, Jared Dunnmon, Gustavo Carneiro, and Christopher Re. 2020. “Hidden Stratification Causes Clinically Meaningful Failures in Machine Learning for Medical Imaging.” Proceedings of the ACM Conference on Health, Inference, and Learning, 151–59. https://doi.org/10.1145/3368555.3384468.
European Parliament, and Council of the European Union. 2016. Regulation (EU) 2016/679 of the European Parliament and of the Council of 27 April 2016. Official Journal of the European Union.
United States Congress. 1996. Health Insurance Portability and Accountability Act of 1996. Public Law 104-191.
治理约束进一步影响数据采集:GDPR 和 HIPAA 等隐私及健康数据法规限制了可以采集哪些数据以及如何采集 (European Parliament and Council of the European Union 2016; United States Congress 1996),而符合伦理的数据获取则要求对人的贡献给予公平报酬,并透明地说明其用途。数据治理与合规 探讨了生产机器学习系统的完整治理基础设施。
摄取众包录音、合成波形和网络音频流等异构输入,对流水线边界的架构提出了严格要求。由于传入数据流在音频编码、采样率、摄取延迟和本底噪声方面存在差异,摄取层不能将外部输入视为统一的数据。存储与验证基础设施必须先摄取、规范化并验证这些大量流式数据,然后才能将其提交至训练特征存储。
数据流水线架构
在编译框架中,数据流水线架构发挥着编译器前端的作用:将异构原始输入解析为下游阶段能够可靠处理的统一中间表示。来自众包平台的音频文件、来自生成系统的合成波形,以及来自已部署设备的边缘端采集数据,都以不同格式进入训练流水线;流水线必须将其规范化、验证并路由至一致的数据模式。生产环境中的 KWS 推理在独立的低延迟约束下处理连续音频;此处追踪的流水线则沿着用于构建和更新模型的已录制样本展开。Figure 7 展示了这一路径如何贯穿数据源、摄取、处理、标注、存储和机器学习训练。
\resizebox{.8\textwidth}{!}{%
\begin{tikzpicture}[font=\small\sffamily]
%
\tikzset{%
 Line/.style={line width=1.0pt,black!50,text=black},
 Box/.style={align=flush center,
    inner xsep=2pt,
    node distance=0.8,
    draw=GreenLine,
    line width=0.75pt,
    fill=GreenL,
    text width=32mm,
    minimum width=32mm, minimum height=9mm
  },
}
%
\begin{scope}[local bounding box = scope1]
\node[Box](B1){原始数据源};
\node[Box,right=of B1](B2){外部 API};
\node[Box,right=of B2](B3){流式数据源};
\end{scope}
%
\begin{scope}[shift={($(scope1.south)+(-2.84,-1.8)$)},anchor=center]
\node[Box, fill=BlueL,draw=BlueLine](2B1){批量摄取};
\node[Box, fill=BlueL,draw=BlueLine,  node distance=2.8,right=of 2B1](2B2){流处理};
\end{scope}
%
\node[Box,  node distance=0.9,below=of $(2B1)!0.5!(2B2)$](3B1){存储层};
%
\node[Box, fill=OrangeL,draw=OrangeLine,below left=0.8 and 0.2 of 3B1](4B1){训练数据};
\node[Box, fill=RedL,draw=RedLine,node distance=1.3,below right=0.8  and 0.2of 3B1](4B2){数据验证 \& 质量检查};
\node[Box, fill=OrangeL,draw=OrangeLine, node distance=0.6,below =of 4B1](5B1){模型训练};
\node[Box,fill=RedL,draw=RedLine,node distance=0.4,below =of 4B2](5B2){变换};
\node[Box, fill=RedL,draw=RedLine, node distance=0.4,below =of 5B2](6B1){特征创建/工程};
\node[Box, fill=RedL,draw=RedLine, node distance=0.4,below =of 6B1](7B1){数据标注};
%
\scoped[on background layer]
\node[draw=BackLine,inner xsep=5mm,inner ysep=4mm,yshift=2mm,
           fill=BackColor,minimum width=114mm,fit=(B1)(B2)(B3),line width=0.75pt](BB1){};
\node[below=8pt of  BB1.north east,anchor=east]{数据源};
\scoped[on background layer]
\node[draw=BackLine,inner xsep=5mm,inner ysep=4mm,yshift=2mm,
           fill=BackColor,minimum width=113mm,fit=(2B1)(2B2),line width=0.75pt](BB2){};
\node[below=8pt of  BB2.north east,anchor=east]{数据摄取};
\scoped[on background layer]
\node[draw=BackLine,inner xsep=9mm,inner ysep=5mm,yshift=-2mm,
           fill=BackColor,fit=(4B1)(5B1),line width=0.75pt](BB3){};
\node[above=7pt of  BB3.south east,anchor=east]{机器学习训练};
%
\scoped[on background layer]
\node[draw=BackLine,inner xsep=9mm,inner ysep=5mm,yshift=-2mm,
           fill=BackColor,fit=(4B2)(7B1),line width=0.75pt](BB4){};
\node[above=7pt of  BB4.south east,anchor=east]{处理层};
%
\scoped[on background layer]
\node[draw=OrangeLine,inner xsep=3mm,inner ysep=4mm,yshift=2.5mm,
           fill=none,fit=(BB1)(BB4),line width=0.75pt](BB4){};
\node[below=1pt of  BB4.north,anchor=north]{数据治理};
%
\draw[Line,-latex](B1)--++(270:0.95)-|(2B1);
\draw[Line,-latex](B2)--++(270:0.95)-|(2B1);
\draw[Line,-latex](B3)--++(270:0.95)-|(2B2);
%
\draw[Line,-latex](2B1)|-(3B1);
\draw[Line,-latex](2B2)|-(3B1);
%
\draw[Line,-latex](3B1)--++(270:0.7)-|(4B1);
\draw[Line,-latex](3B1)--++(270:0.7)-|(4B2);
%
\draw[Line,-latex](4B1)--(5B1);
\draw[Line,-latex](4B2)--(5B2);
\draw[Line,-latex](5B2)--(6B1);
\draw[Line,-latex](6B1)--(7B1);
\draw[Line,-latex](7B1.east)--++(0:0.6)|-(3B1);
\end{tikzpicture}}figure 7 中的每一层在为训练准备数据时都承担着不同职责。选择合适的引擎,需要评估流水线各阶段的权衡如何相互影响:摄取阶段的质量检查决定下游存储中的过滤方式,而服务阶段的延迟预算则约束预处理的复杂度。
存储层次结构和 I/O 带宽与 CPU 侧的解码及变换共同决定数据流水线的吞吐量。物理层面的权衡跨越多个数量级:高延迟的对象存储适合持久归档,而低延迟的内存存储适合实时特征查询。同样,带宽从机械硬盘的 100–200 MB/s 到主内存的 50–200 GB/s 不等。Section 1.8 详细分析了这些存储权衡。
选择摄取模式时,需要使工作负载特征与基础设施能力相匹配。流式工作负载需要对消息持久性、分区内顺序和故障恢复提供明确保障。批处理工作负载则取决于数据集规模与可用内存的相对关系、变换复杂度以及集群分区方式。单机工具能够妥善处理 GB 级数据集,而 TB 级处理则需要分布式计算引擎将执行任务分片。
通过验证与监控保障质量
考虑一条自动驾驶汽车流水线,其中 15% 的激光雷达点云标签存在 10–20 cm 的错位,足以将行人边界框放置在人行道的空白区域。由于每条记录在结构上仍然有效,模式检查会漏掉这一缺陷;对标签与传感器数据对齐情况进行统计监控则可能揭示该问题。
质量是可靠机器学习系统的基础。流水线通过在每个边界持续执行验证来保障质量。数据缺陷是生产环境中机器学习故障的主要原因之一:上游模式漂移会导致解析作业失败,分布偏移会降低模型准确率,而静默数据损坏会污染特征表示 (Sculley et al. 2015)。这些故障很少立即触发运行时异常,而是悄然降低下游预测质量。要防止故障级联传播,就必须在受损批次进入模型训练之前,主动开展统计监控。
War Story 1.1: 微软 Tay(2016 年)
背景:2016 年 3 月,微软推出了 Tay,这是一款 Twitter 聊天机器人,旨在与用户在线互动,并根据公开互动调整其回复 (Lee 2016)。
机制:恶意用户协同提交有害提示,并利用公开交互入口实施攻击,其中包括让系统重复用户提供的文本。微软的公开说明描述了系统遭到滥用的情况,但并未证实系统进行了不受限制的在线权重更新。
影响:部署后不到 16 小时,Tay 就开始发布辱骂性、种族主义和厌女言论。
修复:微软在上线 16 小时后暂停了该聊天机器人,公开致歉,并表示重新上线需要更强的防滥用保障措施。
系统启示:公开数据摄取路径需要针对对抗性输入的控制措施。否则,接受用户生成内容的功能也会成为安全攻击面,有害输入可能在数小时内传播至整个系统。
生产团队通过基于严重程度的告警系统实施大规模监控,不同故障类型会触发不同的响应规程。最严重的告警表示系统完全失效:流水线已彻底停止处理,吞吐量连续超过五分钟为零,或主要数据源不可用。这些情况需要立即处理,因为它们会使所有下游模型训练或模型服务停止。更隐蔽的性能退化模式则需要不同的检测策略。当吞吐量降至基线水平的 80%、错误率升至 5% 以上,或质量指标相对于训练数据特征的偏移超过两个标准差时,系统会发出退化信号,表明需要紧急处理,但不要求立即响应。这些渐进性故障往往比完全中断更危险,因为它们可能持续数小时甚至数天而未被发现,悄然污染模型输入并降低预测质量。
一个以每秒 50,000 条记录的速率处理用户交互事件的推荐系统,可以具体说明这些严重程度分级。其监控系统跟踪多个相互依赖的信号。如果处理速率连续超过 10 分钟低于每秒 40,000 条记录,就会触发瞬时吞吐量告警;这一设置既考虑了正常流量波动,也能捕捉真正的容量或处理问题。数据流中的每个特征都有各自的质量特征:如果训练数据中 user_age 等特征的空值比例低于 1%,而当前超过 5% 的记录中该特征为空值,那么上游数据源很可能出现了问题。重复检测在采样数据上运行,监测同一事件多次出现的情况——这种模式可能表明重试逻辑出错,或数据库查询意外地反复返回相同记录。
在考虑端到端延迟时,这些监控维度尤为重要。系统既必须跟踪数据是否到达,也必须跟踪数据从事件发生到所生成的特征可供模型推理使用,流经整个流水线所需的时间。对于服务级别协议规定延迟为 10 秒的系统,当第 95 百分位延迟超过 30 秒时,监控系统需要准确定位引入延迟的流水线阶段:摄取、转换、验证还是存储。
模式和延迟告警可以揭示结构与时序故障;检测连续特征的分布偏移则需要与训练基线进行统计比较。
Napkin Math 1.4: 使用 K-S 检验检测漂移
场景:监控训练基线 \((P_0)\) 与当前服务分布 \((P_t)\) 之间
session_duration 分布的稳定性。
分析:应用 Kolmogorov-Smirnov 检验来比较经验累积分布函数:
计算 CDF:计算两个数据集的累积分布函数。
计算统计量 \((\mathcal{D}_{\text{KS}})\):求两个 CDF 之间的最大绝对差。令 \(F_{P_0}(x)\) 和 \(F_{P_t}(x)\) 分别表示训练基线 \((P_0)\) 数据集和当前服务 \((P_t)\) 数据集在值 \(x\) 处的经验累积分布函数。 \[\mathcal{D}_{\text{KS}} = \max_x |F_{P_0}(x) - F_{P_t}(x)|\]
确定显著性:对于两个独立样本,将 \(\mathcal{D}_{\text{KS}}\) 与基于训练基线样本量 \(n_0\) 和服务样本量 \(n_t\) 的临界值 \(\mathcal{D}_{\text{crit}}\) 进行比较。系数 1.36 是显著性水平 \(\alpha = 0.05\) 下的大样本近似值。 \[\mathcal{D}_{\text{crit}} \approx 1.36\sqrt{\frac{n_0 + n_t}{n_0 n_t}}\] 结果:当样本量为 \(n_0 = n_t = 1000\) 时,临界值约为 0.061: \[\mathcal{D}_{\text{crit}} \approx 1.36\sqrt{(1000 + 1000)/(1000 \cdot 1000)}.\] 如果观测到的最大差为 \(\mathcal{D}_{\text{KS}} = 0.08\),则它超过了临界值,因此拒绝原假设,并标记存在显著漂移。
系统洞见:统计漂移检验将模糊的分布偏移担忧转化为可操作的触发条件。检验应当启动调查或重新训练工作流,而不应悄然沦为仪表盘上的又一个数字。
如 1.4 所示,跟踪统计属性可以反映服务数据是否仍与训练分布一致。生产系统不仅检查单个值是否落在预定义范围内,还会在运行时间窗口上维护滚动统计量。对于 transaction_amount 或 session_duration 等连续数值特征,监控框架会计算滚动经验分布函数,并使用 Kolmogorov-Smirnov 检验8等非参数评估方法,检测服务输入何时偏离训练基线。
K-S 检验可检测连续特征的漂移;section 1.5.3 详细介绍了分布偏移的分类(协变量偏移、标签偏移、概念漂移和标签质量漂移),以及群体稳定性指数和 KL 散度指标。
类别特征需要采用不同的统计方法。监控系统跟踪类别频率分布,而非比较均值和方差。当出现训练数据中从未存在的新类别,或现有类别的相对频率发生显著变化时,系统会标记潜在的数据质量问题或真实的分布偏移;例如,“移动端”与“桌面端”流量的比例可能变化超过 20%。这种统计监测能够发现简单模式验证完全无法察觉的细微问题:年龄值可能仍处于 18–95 岁的有效范围内,但分布已从以 25–45 岁人群为主转变为以 65 岁及以上人群为主,表明数据源发生了会影响模型性能的变化。
流水线级验证涵盖多种协同工作的策略。模式验证在数据进入流水线时同步执行,立即拒绝格式错误的记录,防止其向下游传播。TensorFlow Data Validation(TFDV) (Breck et al. 2019) 等现代工具可以从训练数据中自动推断模式,涵盖预期的数据类型、取值范围和字段存在性要求。
Breck, Eric, Neoklis Polyzotis, Sudip Roy, Steven Euijong Whang, and Martin Zinkevich. 2019. “Data Validation for Machine Learning.” Proceedings of the 2nd SysML Conference 1: 334–47.
这种同步验证保持简单且快速,检查的是能够在微秒级内针对单条记录求值的属性。更复杂的验证需要将服务数据与训练数据分布进行比较,或汇总大量记录的统计量,因此必须异步运行,以免阻塞摄取流水线。统计验证系统通常对 1–10% 的服务流量进行采样,既足以检测有意义的偏移,又能避免分析每条记录的计算开销。这些样本在滚动窗口中累积,常用窗口长度为一小时、24 小时和七天,不同窗口可揭示不同模式。小时级窗口可以检测突发偏移,例如数据源故障后切换至具有不同特性的备用源;周级窗口则能揭示用户群体或行为的渐进漂移。
最隐蔽的验证挑战来自训练与服务偏差:即训练和服务过程中采用不同方式计算特征的故障模式。这通常发生在训练流水线使用一套库或逻辑对数据进行批处理,而服务系统使用不同实现实时计算特征时。即使是看似微小的差异(每周刷新的物化视图9与每天重新计算的完整联接),也可能实质性降低生产环境中的准确率,而且由于系统不会产生明显错误,诊断可能十分困难。Section 1.6.1 对这一一致性要求进行了形式化,并通过具体评估量化了其影响。检测训练与服务偏差需要能够基于服务数据重新计算训练特征以进行比较的基础设施,即对原始服务数据进行采样,并分别通过两条流水线处理,以度量差异。机器学习运维 探讨了大规模应对这一挑战的运维监控基础设施。
数据质量即代码
正如单元测试保护传统软件一样,数据期望测试保护机器学习流水线。在数据质量即代码实践中,工程师使用 Great Expectations 或 Pandera 等声明式库,将数据契约表达为在流水线各阶段运行的可执行测试套件。
将期望检查集成到持续集成与部署(CI/CD)流水线中,可以确保对摄取的批次自动执行断言,并在违反数据契约时停止下游训练。对于按数据摄取、数据验证、训练的顺序构建的流水线,当验证发现年龄值为 150 等异常时,便会阻止部署,并触发告警以开展调查。
可执行期望检查能够捕捉测试套件可编码的属性;剩下的问题是,看似有效的数据还可能存在哪些错误。
Systems Perspective 1.2: 机械质量与语义质量
在传统软件中,许多检查是机械性的。在支持空引用的语言中,空引用解引用会导致运行时错误,而整数溢出的行为则取决于语言和类型。
在机器学习系统中,数据质量还有第二个更为柔性的维度:语义质量。
- 机械性检查:“
age是否为整数?”(是/否)。 - 语义检查:“
age的分布是否正在发生偏移?”(概率性判断)。
一个数据集可能在机械层面完美无缺(无空值、类型正确),但在语义层面存在问题(例如,由于默认值发生变化,所有用户突然都变成了 25 岁)。稳健的机器学习系统必须同时验证容器(机械层面)和内容(语义层面)。
一旦验证成为代码,期望检查套件就会与训练代码一起成为受版本控制的工件。当训练代码发生变化时,期望检查的更新使数据契约随之演进。这种耦合降低了静默偏离的风险,即代码假定的数据属性已不再由上游流水线提供;listing 1 通过对列取值范围、可空性、唯一性和类别集合定义显式约束,展示了这一模式。
import great_expectations as gx

# Create a data context
context = gx.get_context()

# Define an expectation suite as executable quality contract
suite = gx.ExpectationSuite(name="user_data_quality")
suite = context.suites.add(suite)

# Range validation: prevents physiologically impossible values
suite.add_expectation(
    gx.expectations.ExpectColumnValuesToBeBetween(
        column="age", min_value=0, max_value=120
    )
)

# Null detection: ensures primary key integrity for joins
suite.add_expectation(
    gx.expectations.ExpectColumnValuesToNotBeNull(column="user_id")
)

# Uniqueness: prevents duplicate training examples
suite.add_expectation(
    gx.expectations.ExpectColumnValuesToBeUnique(column="user_id")
)

# Categorical validation: detects unexpected values from upstream changes
suite.add_expectation(
    gx.expectations.ExpectColumnDistinctValuesToBeInSet(
        column="country_code",
        value_set=["US", "CA", "UK", "DE", "FR"],
    )
)

# Link the suite to a preconfigured Batch Definition and run validation
# (the Batch Definition connects GX to the training_users data asset)
validation_definition = gx.ValidationDefinition(
    name="training_users_validation",
    data=batch_definition,
    suite=suite,
)
validation_definition = context.validation_definitions.add(
    validation_definition
)
results = validation_definition.run()
if not results.success:
    raise ValueError(f"Data quality check failed: {results}")
这些检查能够在生产数据进入训练之前,捕捉许多模式层面的问题,包括缺失值、无效范围、类型错误和契约违规。其余问题需要运行时监控和结果检查,因为语义质量问题往往只有在完整的生产数据流中才会显现。
数据漂移检测与响应
机器学习模型建立在生产数据与训练数据相似这一假设之上。当这一假设因统计偏移而非显式契约违规而失效时,模型性能可能悄然变化,而不出现明显错误或系统故障。section 1.5.1 中的验证和监控技术可以揭示突发问题和渐进问题;数据漂移检测则专门关注可能随时间改变模型行为的分布变化。检测、调查和响应这些变化需要持续的监控投入,因此漂移是数据工程的核心职责,而非可选的高级主题。机器学习运维 在此基础上,进一步介绍大规模运维响应编排、结果验证和基于证据的重新训练流水线。
度量漂移(散度) 对散度度量进行了形式化,使退化方程(equation)中的散度项 \(\mathcal{D}(P_t \lVert P_0)\) 具备可操作性。群体稳定性指数(PSI)量化类别特征或分箱 特征分布的变化,而 Kullback-Leibler(KL)散度从信息论角度度量概率分布之间的差异。这两种指标采用不同的分布假设和尺度,任何一种都无法单独提供通用阈值。团队依据部署基线校准各指标的阈值,并持续监控。越过阈值表明线上分布的偏移程度已足以需要调查和结果检查;仅凭输入分布的差异,无法确定准确率是提高还是降低,也无法确定变化幅度。从数学上看,PSI 将连续特征离散为参考分箱(通常采用基线 \(P_0\) 的十分位数分箱),并计算 \(\text{PSI} = \sum_b \left( P_t(b) - P_0(b) \right) \ln\left(\frac{P_t(b)}{P_0(b)}\right)\)。由于百分比差值与对数比值的符号相同,每个发生偏移的分箱都对该指数产生正贡献,由此形成一条经验法则:\(\text{PSI} < 0.1\) 表示分布稳定,\(0.1 \le \text{PSI} \le 0.25\) 表示中度偏移,而 \(\text{PSI} > 0.25\) 则触发强制调查。
有针对性的检测和缓解需要将漂移分解为各个分布组成部分,如页边定位图所示。

每种漂移类型都可追溯至发生偏移的分布组成部分。
第一种情况是协变量偏移,即输入分布发生变化,而特征与标签之间的关系保持不变:\(p(x)\) 发生变化,但 \(p(y \mid x)\) 保持不变。一个使用某种相机型号的图像进行训练的医学影像系统,之后可能在生产环境中接收到来自另一制造商设备的图像。疾病与图像之间的关系保持不变,但由于传感器特性、色彩校准或图像处理流水线不同,像素值会发生偏移。因此,检测重点是输入特征分布,并使用 PSI 或 KL 散度等指标。
第二种情况是标签偏移,即输出分布发生变化,而标签与特征之间的关系保持不变:\(p(y)\) 发生变化,但 \(p(x \mid y)\) 保持不变。疾病患病率可能随季节变化,而症状仍是各类疾病的稳定预测依据。推荐系统在新品类上线时也可能出现相同模式:用户偏好的相对频率发生变化,但各品类内产品吸引用户的因素没有改变。通过跟踪模型预测分布的偏移,通常可以在没有真实标签的情况下开始检测。
最困难的情况是概念漂移:特征与标签之间的关系发生变化,因此 \(p(y \mid x)\) 随时间演变 (Gama et al. 2014)。医疗方案会改变,用户偏好会随社会趋势演变而转移,欺诈模式也会随着攻击者对检测系统作出反应而调整。与协变量偏移或标签偏移不同,概念漂移的检测需要真实标签,因为系统必须观察特征到标签的关系本身是否发生了变化。
Gama, João, Indrė Žliobaitė, Albert Bifet, Mykola Pechenizkiy, and Abdelhamid Bouchachia. 2014. “A Survey on Concept Drift Adaptation.” ACM Computing Surveys 46 (4): 1–37. https://doi.org/10.1145/2523813.
标签质量漂移
标签质量漂移10是一种元层面的变化,与前述三种分布偏移不同:即使底层数据分布保持稳定,真实标签的可靠性也会随时间下降。这类漂移尤其隐蔽,因为标准的特征分布监控无法检测到它。随着标注人员群体发生变化、培训材料过时,或标注指南演变而模型未相应更新,众包标签的质量可能下降。当自动标注系统所依赖的模型偏离其原始运行条件时,系统中的错误会不断累积。对于将点击反馈用作隐式标签的推荐系统,用户行为变得更具探索性、机器人流量模式发生变化,或界面修改改变了用户与内容的交互方式,都可能导致标签质量下降。
检测此类漂移需要监控标注一致性,而非特征分布。Cohen’s kappa11 \((\kappa)\) 等标注者间一致性指标可提供定量评估。令 \(p_o\) 表示观测到的标注者间一致率,\(p_e\) 表示随机情况下的预期一致率。Equation 2 定义了该统计量: \[ \kappa = \frac{p_o - p_e}{1 - p_e} \tag{2}\]
按时间窗口监控 \(\kappa\) 可以揭示质量下降趋势。某医学影像标注项目可能在初始数据采集期间建立 \(\kappa = 0.85\)(近乎完全一致)的基线,随后在六个月后观察到该值降至 \(\kappa = 0.72\)(高度一致),原因是新加入的标注者未接受同等程度的领域培训。
对于模型概率经过校准的系统,预测熵提供了额外的不确定性信号。令 \(p_i\) 表示模型赋予标签类别 \(i\) 的概率,\(\log\) 表示自然对数,因此熵以奈特为单位。Equation 3 定义了这一度量: \[ H_{\text{pred}} = -\sum_i p_i \log p_i \tag{3}\]
预测熵上升表明模型预测分布的不确定性增大,但不能据此确定原因。更难的输入、分布偏移、校准变化或不一致的监督信号,都可能产生相同的信号。
缓解策略取决于根因分析。对标注者进行再培训,可以以较低成本、高效解决指南不清晰导致的系统性错误。采用多数表决或共识规则的多标注者投票,可为高风险领域提供较高准确性,但会显著增加标注成本。模型辅助标注能够减轻标注者疲劳,但如果辅助模型自身存在系统性错误,就有引入偏差的风险。专家抽样审查由领域专家审核随机抽取的标注样本,可以在检测到质量下降时支持根因分析,但对整体标注流的覆盖程度中等。
将 度量漂移(散度) 中介绍的 PSI 和 KL 散度指标投入实际运行,需要将其接入自动告警和审查工作流。数据工程负责根据基线行为和结果证据定义领域特定的漂移阈值,选择能够揭示突发变化和渐进变化的监控窗口,并在流水线中部署监测机制以持续计算这些指标。后文的 机器学习运维 将探讨生产团队如何将这些信号与带标签的结果、分级告警、升级处理路径、冷启动监控,以及针对不同原因的响应编排相结合。
统计漂移检测能够识别分布随时间的变化,但当上游流水线停滞、格式错误的载荷到达,或模式定义未经通知便发生变化时,仅靠监控无法维持系统运行。要在故障条件下维持服务连续性,需要主动的可靠性机制:故障隔离、背压和优雅降级。
通过优雅降级实现可靠性
可靠性确保系统在出现问题时仍能持续运行。流水线不断面临各种挑战:数据源暂时不可用、网络分区使组件彼此隔离、上游模式变更破坏解析逻辑,或意外的负载激增耗尽资源。优雅降级是指通过系统化故障分析、智能错误处理和自动恢复策略来应对这些故障,即使在不利条件下也能维持服务连续性。
对机器学习数据流水线进行系统化故障模式分析,可以发现一些可预测的模式,需要采取有针对性的工程对策。当上游系统引入细微的格式变更、编码问题或字段值修改,而这些变化通过了基本验证却破坏了模型输入时,就会发生数据损坏故障。日期字段从“YYYY-MM-DD”切换为“MM/DD/YYYY”格式,可能不会触发模式验证失败,却会破坏所有基于日期的特征计算。当源系统未经协调就添加字段、重命名列或更改数据类型,破坏了下游处理对特定字段名或类型的假设时,就会发生模式演进12故障。当数据量增长超出容量规划所能承受的范围时,资源耗尽表现为性能逐渐下降,最终在负载高峰期间导致流水线故障。
有效的错误处理策略能够确保问题得到控制,并以系统化方式恢复。针对瞬时错误(网络中断或服务暂时不可用)的智能重试逻辑需要采用指数退避策略,以免压垮正在恢复的服务。每秒尝试重新连接一次的简单线性重试,会向运行困难的服务涌入大量连接尝试,可能阻碍其恢复。指数退避在一秒后重试,随后等待两秒、四秒,每次尝试的等待时间翻倍,既为服务恢复留出余地,又保持持续尝试。许多机器学习系统采用死信队列(DLQ):将经过多次重试仍处理失败的数据单独存储。这使得后续可以分析问题数据并视情况重新处理,同时不阻塞主流水线 (Kleppmann 2016)。处理金融交易的流水线遇到格式错误的数据时,可以将其路由至死信队列,避免丢失关键记录或停止全部处理。
Kleppmann, Martin. 2016. Designing Data-Intensive Applications: The Big Ideas Behind Reliable, Scalable, and Maintainable Systems. O’Reilly Media.
在机器学习系统中,死信队列除支持故障分析外,还具有双重用途。生产团队通过系统化审查 DLQ 内容来识别:(1) 表明上游发生变化的模式违规,(2) 模型应当处理的边界情况模式,以及 (3) 需要源系统修复的数据质量问题。例如,某欺诈检测系统的 DLQ 揭示了来自一种新支付类型的交易,而模型从未见过这种类型,因此团队开展了有针对性的数据采集和再训练,而非仅记录故障。这使 DLQ 从被动的错误存储转变为发现模型盲点和推动改进的主动信息来源。
要超越临时性的错误处理,预防级联故障需要采用熔断器13模式和舱壁隔离,防止单个组件的故障传播到整个系统。当特征计算服务发生故障时,熔断器模式会在检测到连续失败后停止调用该服务,防止调用方因等待超时而发生自身故障,进而形成级联。
自动恢复工程不止于简单的重试逻辑。指数退避、抖动、负载丢弃和熔断器能够降低运行困难的服务所承受的请求压力,同时为瞬时故障的恢复创造条件;仅仅延长超时时间可能会使资源被占用更久,加剧过载。当主要数据源发生故障时,多层回退系统可提供降级服务:实时计算失败时使用略旧的缓存特征,或在精确计算超时时使用近似特征。推荐系统若无法计算用户过去 30 天的偏好,可以回退到过去 90 天的偏好,从而提供精确度较低但仍然有用的推荐,而不是完全失败。完善的告警和升级处理流程可确保在自动恢复失败时由人工介入,并在故障期间记录足够的诊断信息,以便快速调试。
重试逻辑、死信队列和熔断器在数据集编译器中充当运行时错误处理器:它们捕获格式错误的输入,同时避免整个流水线停机。这些防护机制在数据进入系统后发挥作用。摄取模式的选择——批处理与流式处理;提取、转换、加载(ETL)与提取、加载、转换(ELT)——决定了新数据到达模型的速度、所需的缓冲基础设施,以及可靠性不变量的强制执行位置。
数据摄取
在编译器框架中,数据摄取充当词法分析器:读取原始源数据流,并将其切分为下游阶段可以处理的结构化记录。此阶段的主要性能障碍是输入/输出(I/O)瓶颈。如果摄取过程无法足够快地准备好张量以持续向计算单元供给数据,加速器就会处于空闲状态。在理想化的两阶段模型中,单步耗时介于完全重叠时的 \(\max(T_{\text{compute}}, T_{\text{io}})\) 与完全不重叠时的 \(T_{\text{compute}} + T_{\text{io}}\) 之间。这些界限从另一种资源视角重述了 section 1.2.3 中的供给问题:此前场景中,存储带宽不足导致计算单元缺乏数据,而摄取瓶颈更常源于 CPU 侧的解压缩和解码开销。
如果数据流水线无法以足够快的速度解码图像来使 GPU 持续忙碌,昂贵的加速器就会闲置。这种现象形成了一个“瓶颈点”:在输入流水线得到改进之前,增加 GPU 也无法加速,这对于期望硬件投入带来线性扩展的团队而言是一个反直觉的结果。这一瓶颈常见于计算机视觉,其中 CPU 上的高分辨率 JPEG 解码和数据增强可能占据输入路径的大部分开销。在这个示例计算中,每个工作进程每秒提供 375 张图像,加速器每秒消耗 3,000 张图像,因此需要 8 个工作进程才能达到交点。这一结果体现的是容量匹配,而非硬件常数:在交点以下,输入流水线构成限制;在交点以上,由于加速器的上限构成限制,增加工作进程不会提高吞吐量。实际的 ResNet-50 和 A100 数据加载需求取决于图像变换、存储、批大小、主机 CPU 和框架配置。
扩展训练吞吐量需要协同设计主机端摄取与 GPU 计算:如果主机预处理无法以足够快的速度提供张量来避免计算单元因缺乏数据而停顿,加速器的原始 FLOPs 就无法得到利用。Figure 8 展示了这种饱和动态,绘出了随着 DataLoader 工作进程数量增加,水平的加速器消耗上限与 CPU 供给曲线之间的交点。
当数据加载器的吞吐量低于加速器的数据消耗速率时,利用率会骤降:矩阵执行单元因等待批次而停顿,而高带宽内存(HBM)仅保存静态权重,处于空闲状态。缓解这一瓶颈需要多进程工作池、通过 PCIe 总线进行的异步锁页内存预取,以及能够完全绕过主机 CPU 瓶颈的硬件加速解压缩引擎。
批量与流式摄取模式
选择批处理还是流式处理,并非对某种架构的偏好,而是要判断数据价值衰减的速度,以及为保持这种新鲜度投入多少基础设施成本才合理。批处理系统通过容忍数据陈旧来换取效率,而流式系统通过接受持续的运维复杂性来换取新鲜度。
批量摄取是指在指定时间段内成组或分批收集数据,然后再进行处理。当实时数据处理并不关键,且数据可以按预定时间间隔处理时,这种方法较为适用。批量方式通过在大规模数据上摊销启动成本,并在资源可用或成本最低时进行处理,实现计算资源的高效利用。例如,零售公司可以使用批量摄取,在夜间处理每日销售数据,并在每天早晨更新用于库存预测的机器学习模型 (Akidau et al. 2015)。批处理作业可能使用数十台机器,在 30 分钟内处理数 GB 的交易数据,随后释放这些资源供其他工作负载使用。这种定时处理远比维持始终在线的基础设施更具成本效益,尤其是在预测结果略有滞后并不影响业务结果时。
Akidau, Tyler, Robert Bradshaw, Craig Chambers, Slava Chernyak, Rafael J. Fernández-Moctezuma, Reuven Lax, Sam McVeety, et al. 2015. “The Dataflow Model: A Practical Approach to Balancing Correctness, Latency, and Cost in Massive-Scale, Unbounded, Out-of-Order Data Processing.” Proceedings of the VLDB Endowment 8 (12): 1792–803. https://doi.org/10.14778/2824032.2824076.
批处理还简化了错误处理和恢复。当批处理作业中途失败时,系统可以重试整个批次,或从检查点恢复,而无需复杂的状态管理。数据科学家可以检查失败的批次,了解问题原因,并在修复后重新处理。当输入、代码、配置、随机性、对顺序敏感的操作以及外部状态都得到控制时,批处理作业可以实现可复现性,从而简化调试和验证。这些特点使批量摄取对机器学习工作流具有吸引力,即使实时处理在技术上可行但并非必需,也是如此。
与这种定时方式不同,流式摄取在数据到达时实时处理,持续消费事件,而不是等待数据累积成批。对于需要即时数据处理的应用、数据价值快速衰减的场景,以及需要在事件发生时作出响应的系统,这种模式至关重要。金融机构可以使用流式摄取进行实时欺诈检测,在每笔交易发生时进行处理,以便在交易完成前立即标记可疑活动。如果检测发生在欺诈交易完成数小时之后,其价值就会急剧下降——届时资金已被转移,账户也已遭到侵害。
然而,流式处理引入了批处理可以避免的复杂性。系统必须处理背压,即下游系统无法跟上输入数据速率的情况。在流量高峰期间,当突发流量产生数据的速度超过处理能力时,系统必须选择缓冲数据(需要内存并引入延迟)、采样(丢失部分数据),或向生产者施加反向压力(可能导致生产者故障)。数据新鲜度服务级别协议(SLA)规定了从数据生成到处理之间可接受的最大延迟。满足 100 毫秒 SLA 所需的基础设施与满足一小时 SLA 所需的基础设施不同,这会影响网络、存储和处理架构。
考虑到单独采用任一方式都存在局限,许多生产环境中的机器学习系统采用结合批量与流式摄取的混合方式。推荐系统可以对实时用户交互采用流式摄取,以即时更新基于会话的推荐,同时使用批量摄取在夜间处理用户画像和物品特征;1.5 量化了这两种运行方式之间的成本权衡。
Napkin Math 1.5: 实时处理的成本
问题:某条流水线以 1M events/s 的速率摄取数据。批量摄取(每小时一次)与流式摄取(亚秒级)哪种成本更低?
物理约束:
- 吞吐量:在事件速率为 1M events/s、每个事件大小为 1 KB 时,流水线承载的数据吞吐量为 1 GB/s。
- 流式处理需求:要在延迟低于 100 ms 的条件下持续维持 1 GB/s 的吞吐量,系统需要约 50 个主用核心和约 50 个冗余核心,即总计 100 个持续运行的核心。这些核心以 $0.05/hr 的费率运行 24 hours/day,成本为 $120/day。
- 批处理需求:在 10 minutes 内处理 3.6 TB 的数据(窗口长度为 1-hour)。高吞吐量的顺序 I/O 具有较高效率。该批处理设计需要 200 个核心,在每个自然小时内运行 10 minutes,每天累计消耗 800 core-hours。按 $0.05/hr 的费率计算,成本为 $40/day。
系统启示:对于相同的数据量,实时处理的成本约为批处理的 3×。只有当亚秒级延迟带来的价值超过新增成本时,这笔额外开销才是合理的。
如前述成本计算所示,实时处理的额外成本直接源于资源配置。流式系统需要持续运行的基础设施,并配置冗余计算和存储资源,才能在不丢失事件的前提下满足毫秒级延迟目标。相比之下,批处理系统配置临时实例,以高资源利用率顺序处理大量数据,随后关闭实例。两者之间的选择取决于下游推理是否严格要求特征的新鲜度达到亚秒级。
摄取范式也会影响下游模型的训练方式。批量摄取天然适合周期性重新训练:数据在存储中累积,自动化作业使用更新后的语料重新训练模型,经过验证的检查点随后部署到模型服务中。流式摄取使这种批次边界不再那么自然,因此引出了持续在线学习的可能性,即在事件到达时直接更新模型权重。然而,持续更新会引入采用批次检查点可以规避的运维风险:突发的分布偏移、损坏的记录或对抗性载荷可能在验证关卡介入之前就使模型权重退化 (Lee 2016)。因此,大多数生产系统将摄取与训练解耦:它们将数据流式写入持久化缓冲区,同时使用经过验证的批次进行训练,仅在边界严格限定、风险较低的领域采用持续在线更新。
Lee, Peter. 2016. Learning from Tay’s Introduction. The Official Microsoft Blog.
ETL 与 ELT 的比较
流水线架构决定了何时、何处将计算资源用于新到达的原始记录。Figure 9 对比了传统 ETL14 与现代 ELT15 流水线的处理顺序,展示了转换边界相对于持久化存储的位置。
\begin{tikzpicture}[line join=round,font=\small\sffamily]
\tikzset{
 Line/.style={line width=0.75pt,black!50,text=black},
 LineD/.style={line width=0.5pt,black!50,text=black,dashed},
}

\tikzset{
channel/.pic={
\pgfkeys{/channel/.cd, #1}
\begin{scope}[yscale=\scalefac,xscale=\scalefac,every node/.append style={scale=\scalefac}]
\node[rectangle,draw=\drawchannelcolor,line width=0.5pt,fill=\channelcolor!50,
minimum width=50,minimum height=28.5](\picname){};
\end{scope}
        },
cyl/.pic={
\pgfkeys{/channel/.cd, #1}
\begin{scope}[yscale=\scalefac,xscale=\scalefac,every node/.append style={scale=\scalefac}]
\node[cylinder, draw=\drawchannelcolor,shape border rotate=90, aspect=1.99,inner ysep=0pt,
    minimum height=20mm,minimum width=21mm, cylinder uses custom fill,
 cylinder body fill=\channelcolor!10,cylinder end fill=\channelcolor!35](\picname){};
\end{scope}
        },
tableicon/.pic={
\pgfkeys{/channel/.cd, #1}
    \begin{scope}[yscale=\scalefac,xscale=\scalefac,every node/.append style={scale=\scalefac}]
      \draw[line width=0.5pt,fill=\channelcolor!20] (0,0)coordinate(DO\picname)
      rectangle (2,1.5)coordinate(GO\picname);
% Horizontal line
      \foreach \y in {0.5,1} {
        \draw (0,\y) -- (2,\y);
      }
      % Vertical line
      \foreach \x in {0.5,1,1.5} {
        \draw (\x,0) -- (\x,1.5);
      }
    \end{scope}
  }
}

\pgfkeys{
  /channel/.cd,
  channelcolor/.store in=\channelcolor,
  drawchannelcolor/.store in=\drawchannelcolor,
  scalefac/.store in=\scalefac,
  picname/.store in=\picname,
  channelcolor=BrownLine,
  drawchannelcolor=BrownLine,
  scalefac=1,
  picname=C
}
% #1 number of teeth
% #2 radius intern
% #3 radius extern
% #4 angle from start to end of the first arc
% #5 angle to decale the second arc from the first
% #6 inner radius to cut off
\newcommand{\gear}[6]{%
  (0:#2)
  \foreach \i [evaluate=\i as \n using {\i-1)*360/#1}] in {1,...,#1}{%
    arc (\n:\n+#4:#2) {[rounded corners=1.5pt] -- (\n+#4+#5:#3)
    arc (\n+#4+#5:\n+360/#1-#5:#3)} --  (\n+360/#1:#2)
  }%
  (0,0) circle[radius=#6];
}
\begin{scope}[local bounding box=RIGHT,shift={(0,0)},
scale=1,every node/.append style={scale=1}]
\begin{scope}[local bounding box=TARGET,shift={(0,0)},
scale=1,every node/.append style={scale=1}]
\scoped[on background layer]
\pic at(0,0) {cyl={scalefac=1.95,picname=1-CYL}};
\node[align=center]at($(1-CYL.before top)!0.5!(1-CYL.after top)$){目标\\ (MPP 数据库)};
%%
\begin{scope}[local bounding box=GEAR,shift={(-0.80,0.3)},
scale=1,every node/.append style={scale=1}]
\colorlet{black}{brown!70!black}
\fill[draw=none,fill=black,even odd rule,xshift=-2mm]coordinate(GE1)\gear{10}{0.23}{0.28}{10}{2}{0.1};
\fill[draw=none,fill=black,even odd rule,xshift=2.9mm,yshift=-0.6mm]coordinate(GE2)\gear{10}{0.18}{0.22}{10}{2}{0.08};
\fill[draw=none,fill=black,even odd rule,xshift=-5.7mm,yshift=-2.8mm]coordinate(GE3)\gear{10}{0.15}{0.19}{10}{2}{0.08};
\node[draw=none,inner xsep=8,inner ysep=8,yshift=0mm,
           fill=none,fit=(GE1)(GE2)(GE3),line width=1.0pt](BB1){};
\node[below=-2pt of BB1,align=center]{暂存\\ 表};
\end{scope}

\begin{scope}[local bounding box=TAB,shift={(0.1,-0.25)},
scale=1,every node/.append style={scale=1}]
  \pic at (0,0) {tableicon={scalefac=0.35,channelcolor=red,picname=T1}}coordinate(GE1);
  \pic at (0.85,0){tableicon={scalefac=0.254,channelcolor=green,picname=T2}}coordinate(GE2);
  \pic at (0.85,0.5){tableicon={scalefac=0.23,channelcolor=cyan,picname=T3}}coordinate(GE3);
    \pic at (0.15,0.65){tableicon={scalefac=0.18,channelcolor=orange,picname=T4}}coordinate(GE4);
\scoped[on background layer]
\node[draw=black!60,inner xsep=4,inner ysep=5,yshift=0.5mm,
           fill=yellow!20,fit=(DOT1)(GOT2)(GOT3),line width=1.0pt](BB2){};
\node[below=1pt of BB2,align=center]{最终\\ 表};
\end{scope}
\end{scope}

\begin{scope}[local bounding box=SOURCE,shift={(-4.5,0)},
scale=1,every node/.append style={scale=1}]
\begin{scope}[local bounding box=SOURCE1,shift={(0,1.8)},
scale=1,every node/.append style={scale=1}]
\pic at(0,0) {cyl={scalefac=0.75,channelcolor=violet!80!,picname=2-CYL}};
\node at(2-CYL){数据源 1};
\end{scope}

\begin{scope}[local bounding box=SOURCE2,shift={(0,0.1)},
scale=1,every node/.append style={scale=1}]
\scoped[on background layer]
\pic at(0,0) {cyl={scalefac=0.75,channelcolor=orange!80!,picname=3-CYL}};
\node at(3-CYL){数据源 2};
\end{scope}

\begin{scope}[local bounding box=SOURCE3,shift={(-0.15,-1.2)},
scale=1,every node/.append style={scale=1}]
\foreach \j in {1,2,3} {
\pic at ({\j*0.15}, {-0.15*\j}) {channel={scalefac=1.15,channelcolor=green!40!,picname=\j-CH1}};
}
\node at(3-CH1){数据源 3};
\end{scope}
\foreach \j in {1,2,3} {
\draw[Line,-latex,shorten >=10pt,shorten <=10pt](SOURCE\j.east)--(TARGET.west);
}
\end{scope}
\path[red](3-CH1.south)--++(0,-0.6)-|coordinate[pos=0.35](SR1)(1-CYL.south);
\node[single arrow, draw=black,thick, fill=VioletL,
      minimum width = 17pt, single arrow head extend=3pt,
      minimum height=9mm](AR1)at(SR1) {};
\node[left=6pt of AR1,anchor=east]{抽取 \& 加载};
\node[right=6pt of AR1,anchor=west]{转换};
\node[below=8pt of AR1]{\normalsize E \textcolor{red}{$\to$ L $\to$ T}};
\end{scope}
%%%%%%%%%%%%%
%LEFT
\begin{scope}[local bounding box=LEFT,shift={(-8,0)},
scale=1,every node/.append style={scale=1}]
\begin{scope}[local bounding box=TARGET,shift={(0,0)},
scale=1,every node/.append style={scale=1}]
\pic at(0,0) {cyl={scalefac=1.25,picname=1-CYL}};
\node at(1-CYL){目标};
\end{scope}
%%
\begin{scope}[local bounding box=GEAR,shift={(-3.2,0.3)},
scale=1.5,every node/.append style={scale=1}]
\colorlet{black}{brown!70!black}
\fill[draw=none,fill=black,even odd rule,xshift=-2mm]coordinate(GE1)\gear{10}{0.23}{0.28}{10}{2}{0.1};
\fill[draw=none,fill=black,even odd rule,xshift=2.9mm,yshift=-0.6mm]coordinate(GE2)\gear{10}{0.18}{0.22}{10}{2}{0.08};
\fill[draw=none,fill=black,even odd rule,xshift=-5.7mm,yshift=-2.8mm]coordinate(GE3)\gear{10}{0.15}{0.19}{10}{2}{0.08};
\node[draw=none,inner xsep=8,inner ysep=8,yshift=0mm,
           fill=none,fit=(GE1)(GE2)(GE3),line width=1.0pt](BB1){};
\end{scope}

\begin{scope}[local bounding box=SOURCE,shift={(-6.9,-0.14)},
scale=1,every node/.append style={scale=1}]
\begin{scope}[local bounding box=SOURCE1,shift={(0,1.8)},
scale=1,every node/.append style={scale=1}]
\pic at(0,0) {cyl={scalefac=0.75,channelcolor=violet!80!,picname=2-CYL}};
\node at(2-CYL){数据源 1};
\end{scope}

\begin{scope}[local bounding box=SOURCE2,shift={(0,0.1)},
scale=1,every node/.append style={scale=1}]
\scoped[on background layer]
\pic at(0,0) {cyl={scalefac=0.75,channelcolor=orange!80!,picname=3-CYL}};
\node at(3-CYL){数据源 2};
\end{scope}

\begin{scope}[local bounding box=SOURCE3,shift={(-0.15,-1.2)},
scale=1,every node/.append style={scale=1}]
\foreach \j in {1,2,3} {
\pic at ({\j*0.15}, {-0.15*\j}) {channel={scalefac=1.15,channelcolor=green!40!,picname=\j-CH1}};
}
\node at(3-CH1){数据源 3};
\end{scope}
\foreach \j in {1,2,3} {
\draw[Line,-latex,shorten >=10pt,shorten <=10pt](SOURCE\j.east)--(BB1.west);
}\draw[Line,-latex,shorten >=5pt,shorten <=5pt](BB1.08)--(TARGET.west);
\end{scope}
\path[red](3-CH1.south)--++(0,-0.5)-|coordinate[pos=0.35](SR1)(1-CYL.south);
\node[single arrow, draw=black,thick, fill=VioletL,
      minimum width = 17pt, single arrow head extend=3pt,
      minimum height=9mm](AR1)at(SR1) {};
\node[left=6pt of AR1,anchor=east](TRA){转换};
\node[right=6pt of AR1,anchor=west]{加载};
\node[left=4pt of TRA,single arrow, draw=black,thick, fill=VioletL,
      minimum width = 17pt, single arrow head extend=3pt,
      minimum height=9mm](AR2) {};
\node[left=6pt of AR2,anchor=east]{抽取};
\node[below=8pt of TRA]{\normalsize E \textcolor{red}{$\to$ T $\to$ L}};
\end{scope}
\draw[line width=2pt,red!40]($(LEFT.north east)!0.5!(RIGHT.north west)$)--
($(LEFT.south east)!0.5!(RIGHT.south west)$);
\end{tikzpicture}在机器学习系统中,ELT 模式通过将原始、不可变的事件直接写入可扩展存储,将摄取吞吐量与下游特征工程解耦。存储原始事件能够保留尚未解析、但日后可能具有预测价值的字段,使团队无需重新摄取外部源数据流,就能从历史数据集中提取新特征。当转换逻辑发生变化或出现缺陷时,工程师通过在湖仓上执行查询来重新计算特征,而无需重放上游日志。这种权衡体现在物理资源层面:保留高保真原始数据会增加存储占用;若多个模型共享转换结果,却未对中间结果进行物化,则必须重新计算这些转换;保留未经清理的原始载荷还会使数据治理和隐私保护措施的实施更加复杂。1.6 量化了这些权衡如何转化为基础设施的运营成本。
Napkin Math 1.6: 转换位置的成本
问题:某团队每天处理 10 TB 的原始点击流数据,并且必须为 3 个机器学习模型计算用户会话特征,每个模型需要不同的聚合窗口(1 小时、24 小时、7 天)。ETL 与 ELT 哪种成本更低?
数学计算:
- ETL 方案:先转换,再加载。在加载到数据仓库之前,在 Spark 集群中计算全部三个聚合窗口。
- Spark 计算:10 TB,按 $5/TB 计费 = $50/day
- 存储:3 个转换后的数据集,每个约为 2 TB = 6 TB,按 $23/TB/month 计费 = $138/month
- 模式变更成本:每次变更都需要重新运行完整流水线(约 4 hours)
- ELT 方案:先加载原始数据,再在数据仓库中转换。
- 存储:每天 10 TB 原始数据,保留 30 days = 300 TB,按 $23/TB/month 计费 = $6,900/month
- 查询计算:3 个模型,每个模型的每日查询成本为 $5/query,持续 30 days,总计 $450/month
- 模式变更成本:每次变更都需要重写 SQL 查询(约 30 minutes)
系统洞见:ETL 可节省 $6,762/month 的存储费用。将 Spark 计算费用折算为月度成本后,ETL 的总费用为 $1,638/month($1,500/month 计算费用 + $138/month 存储费用),而 ELT 的总费用为 $7,350/month($6,900/month 存储费用 + $450/month 查询计算费用),因此,在计入工程人力成本之前,ETL 的云成本优势为 $5,712/month。但每次模式变更所需的工程时间,ETL 仍比 ELT 多 8×。确切的盈亏平衡点取决于工程人力成本和模式变更频率:模式稳定时,ETL 较低的云成本更具优势;特征定义频繁变化时,ELT 更快的迭代速度更具优势。
生产机器学习系统很少只采用一种模式。模式稳定的结构化数据通常通过 ETL 处理,以提高效率并满足合规要求;非结构化数据或快速演进的特征流水线则受益于 ELT 的灵活性。对于处理图像、音频或文本的深度学习工作负载,选择 ELT 还有更深层的原因:非结构化数据的“转换”步骤往往根本不在数据仓库中执行,而是在机器学习框架的数据加载器内部执行,在每个训练轮次中即时进行随机裁剪、频谱图生成或文本词元化。如果在上游将十种增强变体物化,就会使一个包含 50,000 张图像的数据集膨胀为 500,000 份存储副本,因此,ELT“先加载原始数据,后执行转换”的原则自然延伸到了训练循环本身。
选择预先转换还是加载时转换,关键在于查询复用次数:如果转换后的数据会被查询数百次,就可以摊薄 ETL 的计算成本;而仅执行一次的探索性查询则更适合利用 ELT 数据仓库的弹性。listing 2 中的参数化成本模型评估了不同数据量和查询频率下的这一盈亏平衡阈值。
# ETL vs ELT cost comparison
daily_raw_tb = 10
s3_per_tb_mo = 23
spark_per_tb = 5
n_models = 3
retention_days = 30
query_cost_per = 5

# ETL
etl_spark_daily = daily_raw_tb * spark_per_tb
etl_datasets = 3
etl_tb_each = 2
etl_storage_tb = etl_datasets * etl_tb_each
etl_storage_mo = etl_storage_tb * s3_per_tb_mo

# ELT
elt_storage_tb = daily_raw_tb * retention_days
elt_storage_mo = elt_storage_tb * s3_per_tb_mo
elt_query_mo = n_models * query_cost_per * retention_days

# Savings
storage_savings_mo = elt_storage_mo - etl_storage_mo
在这一场景下,存储费用差异使 ETL 更具优势,但该代码清单并未计入模式变更的人力成本;1.6 中的计算示例直接评估了这项运维开销。
当流式处理组件进入 ETL 和 ELT 架构时,基础设施的选择就变成了故障模式的选择。CAP 定理16指出,发生网络分区时,分布式读写服务无法同时保证线性一致性和每个请求的可用性。Apache Kafka17保证各分区内部的顺序;故障期间的可用性和持久性取决于确认、复制和领导者选举设置。Apache Pulsar将无状态代理与持久化消息存储分离,后者存放在经过复制的 Apache BookKeeper 账本中。其内置的地理复制采用异步方式,因此,在发生故障或网络分区时,远程集群可能出现滞后,而无法同时提供跨区域强一致性和可用性。Amazon Kinesis通过分片容量、保留期限以及生产者和消费者配置提供运维层面的权衡选项,但根据 CAP 定理,在网络分区期间,它仍然无法同时保证严格一致性和可用性。
特征计算位置
对于机器学习流水线,特征计算位置决定由哪种资源承担特征的代价:特征物化时承担的是存储代价,按需生成特征时承担的则是计算和延迟代价。这一选择会显著影响训练速度、存储成本和可复现性。
一种方法是在 ETL 过程中预先计算特征并存储结果。在流水线中计算特征,可以加快训练迭代(特征已准备好并存储在磁盘上)、提高可复现性(始终使用相同的特征),并减少训练计算量。其缺点包括存储成本(特征与原始数据分开存储)、过时风险(逻辑变化后,预先计算的特征可能与新逻辑不一致)以及缺乏灵活性(任何变更都需要完整重算)。
另一种方法是在训练期间即时计算特征。在加载器中计算特征,可以保证计算始终采用最新逻辑(逻辑变化会立即体现)、支持灵活实验(易于修改特征),并减少存储量(仅存储原始数据)。代价是训练速度变慢(每个轮次都重复计算)、计算支出增加(GPU 经常因等待特征而空闲),以及在实现不够严谨时可能出现非确定性。
实践中,混合模式占主导地位。计算昂贵且稳定的特征(需要矩阵分解的用户嵌入、跨越数月数据的历史聚合)会被预先计算并物化。计算成本低且对时间敏感的特征,例如近期性信号、会话上下文和基于时间的转换,则在数据加载器中计算。
例如,推荐系统会预先计算稳定的用户表征特征(计算昂贵、可稳定数天),同时在数据加载器中计算距上次交互的时间等特征(计算成本低、对时间敏感)。这样可以根据每个特征的具体性质,在存储成本、计算时间和特征新鲜度之间取得平衡。
集成策略与 KWS 案例研究
无论采用 ETL 还是 ELT,集成多种数据源始终是数据摄取的核心挑战。数据可能来自数据库、API、文件系统和物联网设备,各自具有不同的格式(关系型数据行、JavaScript 对象表示法(JSON)18文档、二进制流)、访问协议和更新频率。系统设计原则是在摄取边界进行标准化:统一格式、验证模式,并为下游处理提供与数据源无关的一致接口。这种边界标准化将数据源多样性的复杂性与特征工程的复杂性分离,使二者能够独立演进。
KWS 生产系统通常在设备端执行持续运行的唤醒词检测。后端流式和批处理流水线可能摄取唤醒后发起的请求、经用户同意采集的诊断数据、众包录音、合成数据以及经过验证的交互数据,以用于服务和训练。批处理通常遵循 ETL 模式:音频先经过归一化、噪声过滤和等时长分段,再以针对训练优化的格式存储。
语音交互系统中的错误处理需要特别关注。死信队列存储识别失败的尝试,以供后续分析,从而发现未来模型迭代中需要覆盖的边界情况。每个传入的音频样本都必须通过质量验证(信噪比、采样率、时长范围、说话者距离),才能进入处理流水线。无效样本会被送往分析队列,而非直接丢弃,因为这些失败通常表明某些声学条件在训练数据中的代表性不足。有效样本则进入实时检测流程,同时被记录下来,以备将来可能纳入训练数据。
这一摄取架构构成了外部数据进入流水线的完整边界层。然而,无论交付多么可靠,摄取的数据仍然是原始数据:音频的采样率不一致,文本采用不同编码,数值特征的尺度也不兼容。下游训练需要将这些异构记录转换为统一表征,同时保证训练和服务期间执行完全相同的转换。
系统化数据处理
如果说摄取通过词法分析将原始流转换为格式良好的记录,那么数据处理执行的就是编译器的优化与降级处理过程。正如编译器优化必须在提升运行时性能的同时保持程序语义,数据转换也必须在将张量格式调整为有利于数值稳定性的形式时,保留底层信号。主导约束是一致性:训练和服务共用的转换必须保持相同语义,重复操作在重试时必须保持幂等性,数据转换还必须能够扩展规模而不切断数据血缘。
Sculley et al. (2015) 将数据依赖、外部世界的变化、配置债务和监控缺失识别为生产机器学习系统中隐性技术债务的风险。训练与服务不一致是这种风险的一种具体形式。考虑这样一种情况:训练时通过去除货币符号并将字符串转换为浮点数来归一化交易金额,但服务时却省略了相同的预处理。这种差异会引入训练与服务偏差,降低下游模型的准确率。在 KWS 流水线中,这一要求十分具体:转换必须统一不同录音条件(不同的麦克风、背景噪声水平和采样率),同时保留能够区分唤醒词与环境语音的声学特征,而且这种特征提取在训练路径和嵌入式服务路径中必须保持逐比特一致。
训练与服务一致性
训练与服务一致性挑战不止于应用相同的代码,还要求将基于训练数据计算出的参数(归一化常数、编码字典、词表映射)存储下来,并在服务期间复用。这一要求称为一致性准则。
Definition 1.3: 一致性准则
一致性准则要求训练环境与服务环境具有等价的转换行为和状态。
- 意义:服务转换 \(g_{\text{serve}}\)(当前)与训练转换 \(g_{\text{train}}\)(基线)所产生的特征分布之间的 KL 散度 \((\mathcal{D}_{\text{KL}}(p_{g_{\text{serve}}} \lVert p_{g_{\text{train}}}))\) 可以提示不一致。其中,\(g: \mathcal{X} \to \mathcal{Z}\) 表示将原始输入 \(x\) 映射为特征向量 \(z\) 的特征转换。该散度与性能退化的关系取决于模型、任务和发生偏移的特征,必须结合结果证据进行核验。
- 区别:数据质量关注单条记录的洁净程度,而一致性准则关注整个转换流水线的对齐。
- 常见陷阱:一种常见误解是,共享代码就能“解决”一致性问题。实际上,这是一个状态同步问题:基于训练数据计算出的参数(例如均值、标准差)必须存储下来,并在服务期间复用。
违反一致性准则会悄然降低生产环境中的准确率,因为模型面对分布外输入时不会抛出运行时异常,而是会返回自信却错误的预测。要防止这种无声的偏差,就需要从服务部署约束出发,反向设计转换流水线。
Checkpoint 1.3: 防御性处理
训练与服务偏差是生产环境性能无声退化的常见原因。
数据清洗是第一个可能落实或破坏一致性的环节。原始数据经常包含缺失值、重复项或异常值,从而降低模型性能。关键认识是,清洗操作必须具有确定性和可复现性:对于相同输入,无论在何种环境中,都必须产生相同输出。这一要求决定了哪些清洗技术可以安全地用于生产环境。
数据清洗涵盖去重、缺失值处理和字符串规范化。例如,客户数据库可能将“John Doe”、“john doe”和“DOE, John”规范化为统一的显示格式。仅靠规范化并不能确定这些记录指向同一个人;身份解析需要稳定的标识符,或经过单独验证的匹配规则。格式化规则和匹配规则都必须编码实现,并在训练和服务中等价执行。
异常值处理揭示了批量训练与在线服务之间一种根本性的操作差异。训练期间,可以丢弃损坏的记录或传感器严重故障产生的异常数据,以防止梯度爆炸。然而,在服务时,模型不能直接丢弃传入的推理请求,否则就会违反其延迟和可用性约定。服务流水线必须使用基于训练分区估计的参数,将特征截断到有界区间(例如 \([\mu - 3\sigma, \mu + 3\sigma]\))内,而不能丢弃记录。更复杂的异常值过滤方法,例如基于密度的空间聚类或多变量孤立森林,会带来严重的一致性风险:如果在动态的服务小批次上进行评估,某个查询的分类结果就会取决于同一批次窗口中恰好到达的其他查询,从而违反请求隔离性。
质量评估从准确性、完整性、一致性和及时性等多个维度,系统地评价数据的可靠性和实用性,从而补充数据清洗。在生产系统中,数据质量可能以基本指标难以发现的微妙方式退化:从未包含空值的字段突然出现稀疏模式,数值分布偏离训练时的范围,或者出现模型开发期间未曾见过的类别值。
为应对这些微妙的退化模式,生产环境的质量监控需要采用超出简单缺失值计数的具体指标(section 1.5.1)。关键指标包括按特征统计的空值模式(突然增加提示上游故障)、计数异常(增加至 10\(\times\) 往往意味着数据重复或流水线错误)、取值范围违规(价格变为负数、年龄超出现实范围),以及数据源之间的连接失败率。统计漂移检测19也因此至关重要:通过持续监控特征的均值、方差和分位数,在渐进式退化影响模型性能之前将其发现。例如,在电子商务推荐系统中,由于网站设计改进,平均用户会话时长可能在六个月内从八分钟逐渐增加到 12 分钟,但如果突然降至三分钟,则提示可能存在数据采集缺陷。
质量验证必须在训练和服务流水线中强制采用相同的模式和验证谓词。训练环境可以承担对整个数据集进行计算密集型剖析的开销,而服务路径则必须在请求的延迟预算内执行轻量级断言检查(例如类型验证、范围约束和必需字段存在性检查)。训练时验证与服务时断言不匹配,会使损坏的输入在未被发现的情况下进入模型。
转换技术将数据从原始形式转换为模型可用的表征,但系统风险在于这些转换所学习的参数。常见的转换任务包括归一化和标准化,它们将数值特征缩放到共同的范围或分布。例如,以平方英尺计的面积与房间数量在尺度上可能相差很大;归一化将二者置于可比较的数值范围内,但它们的影响仍取决于模型和学习到的参数 (Bishop 2006)。要保持训练与服务一致性,就必须将基于训练数据计算出的归一化参数存储下来,并在服务期间以完全相同的方式应用。在实际运行中,这些参数必须与模型本身一同持久化,并在服务初始化期间加载。
Bishop, Christopher M. 2006. Pattern Recognition and Machine Learning. Springer.
除数值缩放外,转换还包括通过类别编码转换离散输入、从时间戳中提取周期性表征,以及构造派生空间特征。类别编码必须同时处理训练期间存在的类别,以及服务期间遇到的未见类别。稳健的流水线仅基于训练集划分构建词表索引,将该字典随模型制品一同序列化,并将运行时的未知词元映射到一个显式的词表外(<UNK>)索引。省略这一映射会在在线推理期间导致运行时维度不匹配,或引发无声的索引冲突。
健康预测模型可能接收到每次患者就诊的原始 GPS 坐标,但经纬度本身并不能直接表示医疗服务可及性。工程师可以派生出距最近医院的距离,作为地理可及性的候选代理指标。该特征能否预测结果、改善模型,或是否会引入敏感位置和社会经济状况的代理信息,必须通过数据和领域审查来确定,不能仅凭这一转换就作出假设。
领域特定的特征工程将原始输入综合为能够直接向学习算法呈现有效信号的表征 (Kuhn and Johnson 2013)。经过设计的特征编码了领域中的结构性关系,使模型无需从零开始发现非线性组合。例如,在零售推荐系统中,流水线会计算客户交易的最近一次交易距今时间、交易频率和交易金额(RFM)值(称为 RFM 分析),将购买轨迹概括为稠密的行为向量。
Kuhn, Max, and Kjell Johnson. 2013. Applied Predictive Modeling. Springer New York. https://doi.org/10.1007/978-1-4614-6849-3.
特征工程可以产生很高的投入回报,因为它改变了模型能够看到的信号。在某些工作负载中,精心设计的特征比再进行一轮算法选择或超参数调优更能改善性能。这种收益必须与生产系统的一致性要求相平衡。训练和服务共用的每个工程特征,都必须在两个环境中具有等价行为。因此,生产系统会在共享库或相互协调的流水线中实现特征工程逻辑,而不是分别独立实现。许多组织使用特征存储20来减少环境之间的不一致,相关内容见 section 1.8.5。
在 KWS 流水线中,来自众包贡献者、合成语音生成器和声学现场采集的录音具有显著的声学差异。原始音频包含问题建模阶段预期的各种缺陷:从安静卧室到工业车间的环境噪声、模数转换器饱和造成的幅度削波、不同麦克风硬件之间的增益差异,以及不一致的采样率。要达到 98% 的目标准确率,必须在标准化这些输入的同时,保留能够区分唤醒词与环境噪声的音素瞬态特征。
KWS 的质量评估在通用原则的基础上引入了音频特有的指标。除了检查空值和模式符合性,验证流水线还会跟踪背景噪声水平(信噪比高于 20 dB)、音频清晰度评分(频谱分析)以及语速一致性(唤醒词时长介于 500 ms 和 800 ms 之间)。流水线会标记噪声、时长、削波或失真不符合场景验收规则的录音。这些筛查并不能证明样本有用,但可以降低已知缺陷进入模型开发环节的概率。正如 figure 1 中的误差累积级联所展示的,在源头过滤损坏记录,可以防止早期缺陷在下游产物中成倍扩散。
KWS 的音频数据变换需要将原始波形转换为适合机器学习模型的格式,同时保持训练与服务的一致性。原始音频波形(每秒采样数千次得到的幅值序列)具有很高的维度。KWS 流水线通常将其变换为紧凑的表示,突出与语音最相关的频率和时间模式。Figure 10 对比了该流水线使用的三种示例表示:波形、对应的时频谱图以及紧凑的 MFCC 近似表示。这些标准化特征表示通常为梅尔频率倒谱系数(MFCC)21或谱图,22它们突出与语音相关的特征,同时减少不同录音条件带来的噪声和变异。原始短时傅里叶变换(STFT)在每个时间窗内产生数百个线性频率分箱,而梅尔频率分析通过与人类听觉感知相适应的非线性三角滤波器组聚合这些分箱,随后通过离散余弦变换将信号压缩为仅 13–40 个去相关系数。对于边缘设备,这一步可将数据量缩减一个数量级以上,使音频特征帧能够容纳于嵌入式协处理器仅数十千字节的紧张 SRAM 预算内。
幂等变换
可靠性在这些质量基础之上增加了重试安全性。质量关注变换产生什么结果,而可靠性还规定了重复执行这些变换的安全程度。幂等性23是指重复应用某项操作与仅应用一次具有相同的效果。这一性质对于生产环境中的机器学习系统至关重要,因为系统可能需要在故障后重试处理、为修复缺陷而重新处理数据,或者让同一份数据流经多条处理路径。确定性是一个相关但不同的要求:相同的输入和已捕获的状态应产生相同的输出。
用状态机术语来说,如果 \(f(f(x)) = f(x)\),则操作 \(f\) 是幂等的。在存储系统中,将寄存器设为一个绝对值(\(x \leftarrow 1\))是幂等操作,而递增计数器(\(x \leftarrow x + 1\))或向无键日志追加一行则不是:每次重新执行都会改变系统状态。分布式数据流水线在可被抢占的工作节点和不可靠的网络上运行,超时和节点崩溃会触发自动重试。如果某个阶段将变换后的记录追加到目标表中,那么在写入后、确认完成前崩溃的工作节点会在重试时重新执行,从而生成重复记录。幂等流水线通过强制采用确定性的按键更新插入(不存在则插入,存在则覆盖)或原子目录交换等写入语义,确保作业的重复执行尝试收敛到完全相同的最终数据集。
管理流水线的部分故障,需要明确界定各阶段之间的状态。使用持久化的中间检查点解耦各阶段,可以确保每个阶段独立重试,而无须重新执行上游工作。对于处理 TB 级语料库的长时间运行作业,对状态分区(例如已完成的文件分片或流消费者偏移量)设置检查点,可以限制重试延迟:任务在执行五小时后失败时,只需重放尚未提交的分片,而无须重新启动整个五小时的作业。检查点机制必须在同一个原子事务中提交输出分区和状态标记,以防止记录丢失或被处理两次。
确定性变换始终对相同输入产生相同输出,不依赖时间、随机数或可变全局状态等外部因素。依赖当前时间的变换(例如,根据当前日期计算“事件发生至今的天数”)会破坏确定性,因为重新处理历史数据时会产生不同的结果。解决办法是显式捕获时间参考点:不计算“事件发生至今的天数”,而是计算“从事件发生到参考日期的天数”,其中参考日期固定并被持久化。随机操作应使用带种子的随机数生成器,其种子由输入数据以确定性方式推导,从而确保可复现性。
KWS 流水线的可靠性要求特征提取具有可复现性。音频预处理必须是确定性的:给定同一个原始音频文件,无论何时处理、由哪台服务器执行,计算得到的 MFCC 特征始终相同。这使模型行为调试(始终能够为有问题的样例重新生成完全相同的特征)、缺陷修复后的数据重新处理(产生一致的结果)以及分布式处理(不同工作节点对相同输入产生完全相同的特征)成为可能。处理代码将所有参数(快速傅里叶变换(FFT)窗口大小、帧移、MFCC 系数数量)记录在与代码一同进行版本管理的配置中,确保跨时间和执行环境的可复现性。即使设计严谨,生产系统仍必须实施运行时监控,以便在出现偏差时将其检测出来;机器学习运维 介绍了大规模运行中的对比和分布监控。
分布式处理
在质量和可靠性得到保障后,规模成为下一个约束。质量确保变换产生正确的输出;可靠性确保变换产生一致的输出。如果处理无法跟上数据量的增长,或无法在截止时间前完成,这两者便都失去了意义。随着数据集规模和实验并发量的增长,即使原始字节数据仍能存放在本地存储中,数据处理也可能超出单台机器的能力。此时,能够在内存中处理 GB 级数据的清洗技术,必须在保持语义不变的前提下,转变为分区感知、外存或分布式处理方式。
当质量评估必须跟上流入数据的速度、特征工程需要先计算整个数据集的统计量再变换单条记录,或者变换流水线在海量数据下形成瓶颈时,这些挑战就会显现。处理能力必须从开发阶段(笔记本电脑上的 GB 级数据)扩展到生产阶段(集群中的 TB 级数据),同时保持行为一致。
经过精心设计,单机处理足以应对大得出人意料的工作负载。配备 256 GB RAM 的现代服务器可以通过从磁盘流式读取数据的外存处理方式,处理数 TB 的数据集。Dask 或 Vaex 等库提供类似 pandas 的 API,可自动进行流式计算,并在多个核心之间并行执行计算。在投入分布式处理基础设施之前,团队应充分挖掘单机优化潜力:使用高效的数据格式(以 Parquet24 替代 CSV)、尽量减少内存分配、使用向量化操作,以及利用多核并行。在性能足够的情况下,单机处理在运维上的简便性(无须网络协调、不会出现部分故障、调试简单)使其成为更优选择。
当数据集超出单节点的吞吐量或存储限制时,处理必须扩展到分布式集群。在多个计算资源之间对数据进行分区,会引入分布式协调挑战。分布式协调受网络往返时间的约束:本地操作可在微秒内完成,而网络协调需要毫秒,由此产生 1,000\(\times\) 的延迟差异。这一约束解释了为什么需要全局协调的操作(例如在 100 台机器上计算归一化统计量)会形成瓶颈。每个分区都能快速计算本地统计量,但合并这些统计量需要来自所有分区的信息。
在这一规模下,数据局部性变得至关重要。在 10 GB/s 的峰值吞吐量下,通过网络传输 1 TB 训练数据大约需要 100 秒;从 5 GB/s 的 SSD 读取相同数据量大约需要 200 秒。两者处于同一数量级,这推动机器学习系统采用计算跟随数据的架构。25当处理节点能够以内存速度(50–200 GB/s)访问本地数据,却必须通过带宽限制在 1–10 GB/s 的网络进行协调时,这种带宽不匹配会造成严重瓶颈。地理分布会进一步放大这些挑战:跨数据中心协调必须应对网络延迟(区域之间为 50–200 ms)、部分故障,以及禁止数据跨境的监管约束。理解哪些操作易于并行、哪些操作需要代价高昂的协调,决定了系统架构和性能特征。这些开销构成了限制分布式数据处理的协调税。这项税的大小,以及集中处理还是聚合更快,取决于网络往返时间与本地计算时间的比值——简易估算 1.7 对此进行了推导。
当网络延迟占主导时,本地聚合优于汇集全部数据。
Napkin Math 1.7: 协调税
问题:需要对分布在 100 个节点上的 1 TB 特征计算均值归一化。哪种方式更快:(A)将全部数据汇集到一个节点上集中计算,还是(B)计算本地均值后再聚合?
方案 A(集中式):
- 通过 10 GB/s 的网络传输 1 TB 数据:100 秒
- 在单节点上计算均值:以内存带宽计算约需 5 至 20 秒
- 总计:约 105 至 120 秒
方案 B(分布式):
- 每个节点计算本地均值:约 0.05 至 0.2 秒(以内存速度处理 10 GB 数据)
- 发送 100 个局部均值(每个 8 字节):\(<1\text{ ms}\)
- 聚合:可忽略不计
- 总计:约 0.05 至 0.2 秒(快数百倍至数千倍)
系统启示:可在代数上分解的归约运算,通常可以在靠近数据的位置进行局部聚合;例如,分布式均值计算会传递局部总和与计数。连接和笛卡尔积可能需要数据重分布,但分区和共置可以降低这项成本。流水线设计应将适合的计算推向数据所在位置,尽量减少不必要的数据移动;这种计算跟随数据的原则是 MapReduce (Dean and Ghemawat 2004)、Spark (Zaharia et al. 2010) 以及现代机器学习框架的核心。
Zaharia, Matei, Mosharaf Chowdhury, Michael J. Franklin, Scott Shenker, and Ion Stoica. 2010. “Spark: Cluster Computing with Working Sets.” HotCloud 10: 10–10.
当顺序解压缩或获取中央数据库锁等无法通过分区拆分的瓶颈限制并发时,在分布式工作进程之间并行执行数据摄取,带来的吞吐量收益会逐渐递减。阿姆达尔定律26在 equation 4 中对这一扩展上限进行了形式化描述:
\[\text{Speedup} \leq \frac{1}{f_{\text{serial}} + \frac{f_{\text{parallel}}}{N_{\text{workers}}}} \tag{4}\] 其中,\(f_{\text{serial}}\) 表示本质上必须顺序执行的阶段所占的执行时间比例,\(f_{\text{parallel}}\) 表示可并行执行的比例(\(f_{\text{serial}} + f_{\text{parallel}} = 1\)),\(N_{\text{workers}}\) 表示活跃工作进程数。即使特征提取流水线中 90% 的部分可以在数百个节点上并行执行(\(f_{\text{serial}} = 0.10\)),其理论最大加速比也无法超过 \(10\times\),这说明消除串行 I/O 瓶颈应优先于增加计算节点。
框架选择遵循与阿姆达尔分析相同的协调问题:它取决于变换中的哪些部分能够独立运行,哪些部分需要共享状态或顺序约束。Apache Spark 在机器集群上并行执行变换,自动处理数据分区、任务调度和容错。Beam 为批处理和流处理提供统一的 API,使相同的变换逻辑能够运行在多种执行引擎(Spark、Flink、Dataflow)上。TensorFlow 的 tf.data API 针对机器学习训练优化数据加载流水线,支持分布式读取、预取和变换。具体选择取决于处理属于批处理还是流处理、变换如何并行化,以及可用的执行环境。
section 1.5.5.3 中介绍的特征计算位置权衡,在大规模场景下具有更重要的意义。当分布式处理提高吞吐量时,必须权衡每个训练轮次在数百个工作进程上重新计算特征的成本,与一次性物化这些特征的存储成本。在 TB 级规模下,即使单个样例的计算成本很小,累积起来也会形成显著开销,这进一步说明了生产系统为何采用混合模式:预先计算代价高昂且稳定的特征,同时即时计算成本低且对时效敏感的特征。
KWS 流水线的可扩展性体现在多个阶段。开发阶段在样本数据集上采用单机处理,以便快速迭代。当数据集(23.4 million examples)超出单台机器的实际处理能力,或多个实验并发运行时,大规模训练可能需要分布式处理。逐文件特征提取是易于并行的任务,但端到端加速比受共享存储带宽、元数据操作、调度和输出争用的限制。生产部署除 64 KB 的模型大小限制外,还增加了更严格的 16 KB 预处理状态内存预算,因此必须仔细优化资源占用,使处理能够在设备能力范围内完成。
变换血缘
治理通过确保可追责性和可复现性,补全了数据处理的四大支柱视角。治理支柱要求跟踪应用了哪些变换、何时执行、运行了哪个版本的处理代码,以及使用了哪些参数。这种变换血缘27支持可复现性、调试、可审计性,以及发现变换缺陷后的迭代改进。它可以为文档编制或合规工作流程提供证据,但仅凭血缘既不能解释模型的决策,也不能证明符合监管要求。
转换版本管理记录生成每个数据集所用处理代码的版本。当转换逻辑发生变化(修复缺陷、添加特征或提高质量)时,版本号随之递增。数据集会标记创建它们的转换版本,从而在缺陷修复后识别所有需要重新处理的数据。这种版本管理不仅涵盖代码版本,还记录整个处理环境:库版本(不同 NumPy 版本可能产生略有差异的数值结果)、运行时配置(影响行为的环境变量)以及执行基础设施(影响浮点精度的 CPU 架构)。
参数跟踪保存转换过程中使用的具体数值。对于归一化,这意味着存储基于训练数据计算的均值和标准差。对于类别编码,这意味着存储词表(所有已观测类别的集合)。对于特征工程,这意味着存储特征计算中使用的所有常量、阈值或参数。这些参数通常与模型制品一同序列化,以确保服务阶段使用与训练阶段完全相同的参数。TensorFlow 和 PyTorch 等现代机器学习框架提供了将预处理参数与模型捆绑的机制,从而简化部署并确保一致性。
用于实现可复现性的处理血缘跟踪从原始数据到最终特征的完整转换历史。这包括读取了哪些原始数据文件、按何种顺序应用了哪些转换、使用了哪些参数,以及何时进行了处理。Apache Atlas、Amundsen 或商业血缘系统通过在流水线中埋点来自动捕获这一流程。当模型预测被证实有误时,工程师可以沿血缘回溯,识别促成该行为的训练数据、附加于这些数据的质量评分、所应用的转换,以及能否精确重现该场景以开展调查。
记录确切的代码版本,可以将处理结果直接关联到生成这些结果的代码仓库状态。当处理代码纳入版本控制(Git)时,每个数据集都应记录创建它的代码提交哈希值。这样便可重建完全相同的处理环境:检出指定代码版本,安装该版本列出的依赖项,并以相同参数运行处理过程。Docker 等容器技术将整个处理环境(代码、依赖项、系统库)封装在不可变镜像中,使其能够在数月或数年后重新运行并得到相同结果,从而简化这一过程。
KWS 流水线中的治理支柱跟踪对模型行为有关键影响的音频处理参数。当音频被归一化到标准音量时,参考音量级会被持久化保存。当 FFT 将音频转换到频域时,会记录窗口大小、帧移和窗函数(例如 Hamming 窗或 Hann 窗)。计算 MFCC 时,会记录系数数量、频率范围和梅尔滤波器组参数。这种全面的参数跟踪支持多项关键能力:在调试模型故障时精确重现训练数据,验证服务阶段采用的预处理与训练阶段完全一致,以及系统研究预处理选择如何影响模型准确率。缺少这种治理基础设施时,团队只能依赖人工文档,而这些文档不可避免地会过时或出错,进而造成细微的训练与服务偏差,降低生产环境中的性能。
干净、经过归一化且可用于特征处理的数据,在没有监督信号时仍无法发挥作用。这一边界在实际运行中十分重要,因为即使转换过程完全可复现,也可能为数据附上错误的目标值,而确定性的预处理无法弥补真实标签的损坏。为模型训练提供监督,需要赋予目标值——明确哪些音频片段包含唤醒词,哪些记录的是背景噪声——这会将主观的人类判断和概率性启发式方法引入原本确定性的流水线。
数据标注
section 1.6 中的处理流水线将原始数据转换为结构化特征,但监督学习仍然需要标签,以告知模型哪些模式对应各个目标。在 KWS 流水线中,摄取和处理阶段生成数百万个干净、标准化的音频频谱图,但训练需要真实标注,以指明哪些片段包含唤醒词,哪些表示环境背景噪声。这种判定就是真实标签,28而大规模生成真实标签往往是流水线中最依赖人工、也最容易出错的阶段。
与可以跨机器并行执行的自动化转换不同,标注将人类判断引入流水线,带来非确定性的延迟和随机性错误模式。众包标注员可能将低声说出的“Alexa”误标为背景噪声。放射科专家可能与同事对某个临界诊断意见不一。这种分歧可能反映真实存在的歧义、说明不清、标注员出错或专业水平差异;标注系统必须区分并管理这些原因,而不能将每一种分歧都视为不可消除的。因此,标注基础设施必须在吞吐量、质量验证、成本和来源追溯之间取得平衡。
标签类型与系统要求
系统架构、存储占用和加载器吞吐量直接取决于标签粒度。在从视频流中跟踪车辆、行人和交通标志的计算机视觉系统中,每种目标表示都会施加不同的存储、计算和序列化约束。
分类标签是最简单的形式,为每个输入分配一个离散类别索引(或多标签二进制位掩码)。其存储需求较小——通常每幅图像只需一个定宽整数(例如 uint16 或 int32 索引)——但训练与评估的访问模式不同:训练流水线进行打乱和随机采样,而验证流水线按顺序流式遍历整个语料库,因此需要不同的索引和缓存局部性策略。
边界框在分类的基础上进一步定位每帧中的对象。每个边界框除存储类别标识符外,还存储四个坐标(例如 \(x_{\text{min}}, y_{\text{min}}, x_{\text{max}}, y_{\text{max}}\),或中心坐标及宽度和高度)。由于场景中的对象数量不固定,标签存储会从定宽标量记录转变为变长张量结构,要求数据加载器支持动态填充或不规则批次处理。此外,定位边界框所需时间是单标签分类的 10 至 20\(\times\),直接限制标注吞吐量并推高标注成本。
更细的标注粒度会成倍增加存储和处理规模。
分割图为每个像素分配类别标识符,生成稠密的二维标签矩阵(\(H \times W\))。在自动驾驶和交通监测中,这需要描绘可行驶路面、车辆和行人的不规则边界。这些稠密标注会成倍增加存储需求和摄取带宽。一幅 \(1920{\times}1080\) 图像的分割掩码需要约 2.1M 个标签(每像素一个),相比之下,边界框可能只有 10 个,分类标签则只有一个。如果每个边界框存储 4 个坐标,那么在尚未考虑每个值的编码方式之前,分割掩码的标量标签条目数就约为 10 个边界框的 51,840×;而人工分割每幅图像所需的数小时,使这种方法仅适用于必须达到像素级精度的情况。
Figure 11 对比了五种标注模态,具体选择取决于输入、任务和可用的标注预算。分类可以为整个场景赋予标签,而边界框和分割图则用于定位对象或区域。生产数据集可能结合多种模态:同一个摄像头画面可以同时具有场景标签、障碍物边界框和路径区域掩码,每种标签分别服务于不同的下游任务。
除这些几何标签外,生产系统还必须管理对质量控制和调试至关重要的丰富元数据。Common Voice 数据集 (Ardila et al. 2020) 在语音识别中体现了这一点:跟踪说话者的人口统计属性以支持公平性,记录质量指标以支持过滤,以及记录语言信息以支持多语言功能。如果目标检测模型在雨天条件下失效,采集期间记录的天气元数据就能帮助定位覆盖缺口。这一元数据需求说明,标签类型的选择会如何影响整个系统设计:基础设施必须针对所选格式优化存储,实现适当的检索模式,并跟踪各个模型版本使用了哪些标签版本,以将质量改进与性能提升关联起来。
Ardila, Rosana, Megan Branson, Kelly Davis, Michael Kohler, Josh Meyer, Michael Henretty, Reuben Morais, Lindsay Saunders, Francis Tyers, and Gregor Weber. 2020. “Common Voice: A Massively-Multilingual Speech Corpus.” Proceedings of the Twelfth Language Resources and Evaluation Conference, 4218–22.
标签准确性与共识
尽管大型数据集中固有地存在主观性和传感器歧义,标签质量仍要求将标签噪声限制在一定范围内。即使有明确的指南和精心的系统设计,也不可避免地会有非零比例的标签出错 (Northcutt et al. 2021; Thyagarajan et al. 2022)。挑战并非彻底消除标注错误(这是不可能实现的目标),而是系统衡量标注者间一致性,并管理错误率,使其保持在不会降低模型性能的范围内。
Thyagarajan, Aditya, Elı́as Snorrason, Curtis G. Northcutt, and Jonas Mueller. 2022. “Identifying Incorrect Annotations in Multi-Label Classification Data.” CoRR abs/2211.13895. https://doi.org/10.48550/ARXIV.2211.13895.
标注失败源自两类不同原因,需要采取不同的工程应对措施。Figure 12 给出了这两种失败模式的具体示例。有些示例反映了质量退化或存在歧义的输入,仅凭数据本身难以推断正确标签;另一些示例在视觉上十分清晰,但需要领域知识、数据集特定语义或专家判断才能正确标注。这些不同的失败模式决定了有关标注员资质、任务分派和共识机制的架构决策:由质量问题导致的错误需要通过上游数据过滤来应对,而由专业知识不足导致的错误则需要分层分派给标注员。
Northcutt, Curtis G., Anish Athalye, and Jonas Mueller. 2021. “Pervasive Label Errors in Test Sets Destabilize Machine Learning Benchmarks.” arXiv Preprint arXiv:2103.14749 34: 19075–90. https://doi.org/10.48550/arxiv.2103.14749.
鉴于这些固有的质量挑战,生产机器学习系统会实施多层质量控制。系统性质量检查通过随机抽取已标注数据供专家审核,并利用统计方法标记潜在错误,持续监控标注流水线。基础设施必须高效地对数百万个样本执行这些检查,同时避免形成瓶颈。采样策略通常验证 1-10% 的标签,在检测灵敏度与审核成本之间取得平衡。医疗诊断或自动驾驶汽车等风险较高的应用可能通过多次独立审核验证 100% 的标签,而产品推荐等风险较低的应用可能仅通过抽查验证 1% 的标签。
除随机采样方法外,为每个数据点收集多个标签,通常称为“共识标注”,有助于识别有争议或存在歧义的样本。Labelbox 和 Scale AI 等商业标注平台提供共识与分层质量控制工作流 (Labelbox, Inc. 2024; Scale AI, Inc. 2024),但其统计核心是标注者间一致性。共识基础设施通常为每个样本收集多个标签,并计算 Fleiss’ kappa 等指标;该指标将 section 1.5.3 中介绍的 Cohen’s kappa 统计量从两名评定者推广到任意数量的标注者 (Fleiss 1971)。对于一致性较低的样本,系统会将 Landis-Koch 分段等阈值用作操作性启发规则,将其转交专家审核,而不是强行对确实存在歧义的样本达成共识 (Landis and Koch 1977)。
Labelbox, Inc. 2024. Labelbox Consensus Documentation.
Scale AI, Inc. 2024. Scale AI Advanced Settings.
Fleiss, Joseph L. 1971. “Measuring Nominal Scale Agreement Among Many Raters.” Psychological Bulletin 76 (5): 378–82. https://doi.org/10.1037/h0031619.
共识方法体现了可扩展系统中一项关键的经济权衡。专家审核的单样本成本高于众包标注,但通过非专家多数投票强行对有歧义的样本达成一致,可能产生具有系统性偏差的标签。系统根据较低的标注者间一致性或未通过金标准检查来识别确实存在歧义的样本,仅将这些样本交给专家,从而平衡成本与质量。这种分层方法能够以经济可行的方式处理数百万个样本,同时通过有针对性的专家介入维持质量标准。
技术基础设施为质量控制提供了基础,但成功的标注系统还必须处理人的因素。与标注员有效协作,需要制定包含典型正反例的标准化标注准则、建立可视化边界案例目录、提供以已知金标准记录衡量标注员表现的自动反馈机制,以及组织由标注员共同解决临界案例的校准会议。对于复杂或特定领域的任务,系统可以实施分层访问权限,将具有挑战性的案例分派给已证明具备领域专业知识的标注员。
质量监控会产生大量遥测数据,必须对其进行高效摄取和跟踪。最有信息价值的信号涵盖多个维度。标注者间一致率揭示多名标注员是否对同一样本得出一致判断,而标签置信度分数记录标注员自报的决策信心。单次标注耗时是一项双向指标:完成过快可能表明标注员疏忽,耗时过长则可能表明其感到困惑或指南不清晰。错误模式揭示标注员群体中的系统性偏差或误解,而标注员在金标准样本上的表现则提供基于真实标签的校准依据。最后,对标注员行为进行人口统计分析,可以检测某些群体的标注方式是否存在系统性差异,这种差异可能给训练数据引入非预期偏差。必须在数百万个样本范围内高效计算并更新这些指标,这往往需要专门的分析流水线,以近实时方式处理标注数据,在质量问题影响大量数据之前将其发现。
利用 AI 辅助标注实现规模扩展
人工标注的吞吐量限制使纯人工标注成为大规模训练的瓶颈,而全自动标注又缺乏处理歧义样本或安全关键样本所需的可靠性。AI 辅助标注通过模型推理处理常规输入并加快人工标注,同时对高不确定性样本保留人工验证,以应对这一权衡。Figure 13 展示了四种常见路径。传统监督使用直接的人工标签。半监督学习将未标注数据中的结构与一个已标注子集结合利用。弱监督用程序化标注函数替代逐个进行的人工标注。迁移学习复用在上游任务中学到的表示,减少但不消除对任务特定标签的需求。每条路径都会改变监督成本的投入环节,以及流水线必须验证的假设——未标注数据的几何结构、程序化启发规则的准确性或表示的可迁移性。
\begin{tikzpicture}[font=\small\sffamily]
%
\tikzset{%
  Line/.style={line width=1.0pt,black!50,text=black},
  Box/.style={align=flush center,
   inner sep=5pt,
    node distance=0.75,
    draw=GreenLine,
    line width=0.75pt,
    fill=GreenL,
    text width=55mm,
    minimum width=53mm, minimum height=9mm
  },
   Box1/.style={Box,
    node distance=0.35,
    draw=OrangeLine,
    line width=0.75pt,
    fill=OrangeL,
    text width=31mm,
    minimum width=31mm, minimum height=8.2mm
  },
  Box2/.style={Box,
    node distance=0.5,
    draw=BlueLine,
    line width=0.75pt,
    fill=BlueL,
    text width=42mm,
    minimum width=42mm, minimum height=9mm
  },
 Text/.style={%
    inner sep=2pt,
    draw=none,
    line width=0.75pt,
    fill=TextColor,
    text=black,
    font=\footnotesize\sffamily,
    align=flush center,
    minimum width=7mm, minimum height=5mm
  },
}
%
\node[Box,text width=65mm,minimum width=62mm, minimum height=10mm,
           fill=RedL,draw=RedLine](B1){\textbf{如何获取更多带标签的训练数据?}};
\node[Box, node distance=0.5,below=of B1,xshift=12mm](B2){\textbf{传统监督:}让领域
              专家(SME)手动标注更多训练数据};
\node[Box,below=0.3 of B2](B3){\textbf{半监督学习:}利用结构性
            假设自动使用未标注数据};
\node[Box,below=0.3 of B3](B4){\textbf{弱监督:}\\ 以更高效率
            和/或在更高抽象层次上获取质量较低的标签};
\node[Box,below=0.3 of B4](B5){\textbf{迁移学习:}\\ 使用已在
            其他任务上训练的模型};
%
\node[Box2,above right=0.7 and 1.75 of B2,fill=BrownL,draw=BrownLine](2B1){成本太高!};
\node[Box2,below =0.15 of 2B1,fill=BrownL,draw=BrownLine](2B2){\textbf{主动学习:}估计
            哪些样本点最值得请求标注};
%
\node[Box2,above right=1.05 and 1.75 of B4](2B3){从非专家处获取成本更低、质量较低的标签};
\node[Box2,below =0.2 of 2B3](2B4){从领域专家处获取针对
            未标注数据的更高层次监督};
\node[Box2,below =0.2 of 2B4](2B5){使用一个或多个
              (有噪声/有偏差的)预训练模型提供监督};
%
\node[Box1,above right=0.25 and 1.45 of 2B3](3B1){启发式规则};
\node[Box1,below =of 3B1](3B2){远程监督};
\node[Box1,below =of 3B2](3B3){约束};
\node[Box1,below =of 3B3](3B4){预期分布};
\node[Box1,below =of 3B4](3B5){不变性};
%%
\foreach \x in{2,3,4,5}{
\draw[-latex,Line](B1.191)|-(B\x);
}

\foreach \x in{1,2}{
\draw[-latex,Line](B2.east)--++(0:1.1)|-(2B\x);
}

\foreach \x in{3,4,5}{
\draw[-latex,Line](B4.355)--++(0:1.1)|-(2B\x);
}

\foreach \x in{1,2,3,4,5}{
\draw[-latex,Line](2B4.east)--++(0:0.8)|-(3B\x);
}
\draw[-latex,Line](2B2)--++(270:1.0)--++(180:3.5)|-(B4.05);
\draw[-latex,Line](B5.355)-|(2B5);
\end{tikzpicture}
Ratner, Alex, Paroma Varma, Braden Hancock, and Christopher Ré. 2019. Weak Supervision: A New Programming Paradigm for Machine Learning. Stanford AI Lab Blog.
这些路径所交换的是不同的假设,而非简单的标签数量。根据所选路径,流水线会依赖未标注数据中与任务相关的结构、可迁移的表示、可测量的标注函数准确率,或成本可承受的评分循环。生产系统必须记录每项假设,并利用经过人工审核的留出数据对其进行验证。该图的作用是提供决策地图,而非绝对的质量排名。
AI 辅助标注根据各参与方的优势分配工作。人类判断模糊案例、发现细微错误并运用领域知识;模型则可以在经过验证的前提下,规模化处理常规案例。生产系统通过多种互补方法结合这些能力。
预标注使用 AI 模型生成初步标签,再由人类审核和纠正,将任务从“从头标注”转变为“验证并修正”。Snorkel (Ratner et al. 2018; Ratner et al. 2017) 等程序化标注框架通过弱监督29进一步扩展了这一方法,利用基于规则的启发式方法、知识库和现有模型的输出,自动规模化生成初始标签。在自动驾驶中,预训练目标检测模型可以标注车辆和行人,再由人工标注员验证和完善,从而自动处理许多明确案例。
Ratner, Alex, Braden Hancock, Jared Dunnmon, Roger Goldman, and Christopher Ré. 2018. “Snorkel MeTaL: Weak Supervision for Multi-Task Learning.” Proceedings of the Second Workshop on Data Management for End-to-End Machine Learning, 1–4. https://doi.org/10.1145/3209889.3209898.
Ratner, A., S. H. Bach, H. Ehrenberg, J. Fries, S. Wu, and C. Ré. 2017. “Snorkel: Rapid Training Data Creation with Weak Supervision.” Proceedings of the VLDB Endowment 11 (3): 269–82. https://doi.org/10.14778/3157794.3157797.
大语言模型(LLM)如今通过生成描述、根据示例起草标注指南,以及解释标签分配的推理过程,辅助标注流水线。例如,内容审核系统使用 LLM 对内容进行初步分类并给出解释,再由人工审核员验证。然而,集成 LLM 也带来了系统挑战:推理成本和速率限制因提供商和模型而异,而且由于 LLM 可能自信地生成错误标签,需要对输出进行系统性验证。许多组织采用分层方法,使用较小的专用模型处理常规案例,将较大的 LLM 留给需要细致判断的复杂场景。
主动学习采取了互补的权衡:通过模型推理减少人工标注,因此,关键问题在于这些计算开销能否纳入同一预算。
主动学习30等方法根据模型不确定性确定候选样本的优先级,从而与这些方法形成互补 (Settles 2009; Coleman et al. 2022)。这些系统持续分析模型不确定性,以识别有价值的待标注候选样本。主动学习并非对未标注数据进行随机抽样后标注,而是选择当前模型最不确定的样本,或选择其标签最能改善模型性能的样本。基础设施必须高效计算不确定性指标(通常为预测熵或集成模型之间的分歧),维护按信息量排序的任务队列,并根据新获得的标签调整优先级策略。例如,在医学影像流水线中,主动学习将罕见或处于判定边界的病理病例交给放射科专家,而常规扫描则接受自动预标注,由临床医生快速验证。在有利条件下,这种方法可以大幅减少所需标注,但需要精心设计工程实现,以防止模型的不确定性影响数据标注选择,进而形成反馈循环。预算计算可以具体说明这种杠杆作用。
Coleman, Cody, Edward Chou, Julian Katz-Samuels, Sean Culatana, Peter Bailis, Alexander C. Berg, Robert Nowak, Roshan Sumbaly, Matei Zaharia, and I. Zeki Yalniz. 2022. “Similarity Search for Efficient Active Learning and Search of Rare Concepts.” Proceedings of the AAAI Conference on Artificial Intelligence 36 (6): 6402–10. https://doi.org/10.1609/aaai.v36i6.20591.
Napkin Math 1.8: 主动学习的倍增效应
问题:一个包含 10M 个样本的数据集拥有 $50K 的标注预算。随机抽样在使用 100K 个标签时可达到 85 percent 的准确率,而目标准确率为 95 percent。
物理约束:
- 样本效率:在有利条件下,主动学习可以使用比随机选择更少的样本达到目标准确率。
- 每个样本点的成本:随机抽样 = $0.50/label。主动学习为寻找困难样本增加了计算成本(推理成本约为 $0.01/image)。
- 倍增效应:
- 随机抽样:达到 95 percent 可能需要 1M 个标签($500K)。超出预算。
- 仅计主动学习的标签:系统可能需要约 100K–200K 个困难样本($50K–$100K)。
- 全候选池评分:对全部 10M 张候选图像进行评分会增加 $100K 的成本,因此主动学习的总成本变为 $150K–$200K。超出预算。
系统洞见:算法选择是影响标签数量的重要杠杆,但必须将计算开销纳入预算模型。将该预算的 10 percent 用于推理($5K),按上述推理价格只能对 500K 张候选图像进行评分,剩余预算可支持约 90K 个标签。只有在评分前缩小候选池、推理成本显著下降,或计算经费独立于标注经费时,主动学习才可行。

全候选池评分可能在标注开始前就超出标注预算。
随着这些 AI 组件相互作用,质量控制变得愈发重要。系统必须通过系统性指标同时监控 AI 和人类的表现。模型置信度校准至关重要:如果 AI 报告 95% 的置信度,但在该置信度水平下仅达到 75% 的准确率,预标注就会误导人工审核员。人机一致率可以揭示 AI 辅助是在促进还是妨碍工作:当人类频繁否决 AI 建议时,预标注可能在引入偏差,而非加速工作。这些指标要求在整个标注流水线中精心设置监测机制,既跟踪最终标签,也跟踪每个阶段人工标注员与 AI 的交互。
这些原则在安全关键领域的大规模应用中得到体现。自动驾驶车辆的标注基础设施可以处理大量传感器帧,使用 AI 预标注标记常见物体,同时将异常场景(施工区域、应急车辆)交给人类专家处理。这是一种分布式架构,预标注在 GPU 集群上运行,人工审核则通过扩展标注团队实现规模化。医学影像系统面临类似的标签稀缺问题:庞大的未标注临床数据存储库使专家标注成为瓶颈,推动了数据高效型工作流程的发展,即在使用专家标签之前,先从未标注数据的结构中学习有用的表示 (Krishnan et al. 2022)。在这些领域中,共同的数据工程模式是分层升级处理:自动化处理明确案例,人类处理模糊案例,监控机制则确保“明确”与“模糊”之间的边界随着 AI 能力和部署条件的变化而调整。
Krishnan, Rayan, Pranav Rajpurkar, and Eric J. Topol. 2022. “Self-Supervised Learning in Medicine and Healthcare.” Nature Biomedical Engineering 6 (12): 1346–52. https://doi.org/10.1038/s41551-022-00914-1.
KWS 中的自动标注
规模化标注关键词检测数据集会带来语音领域特有的系统挑战。要在人工标注成本不随样本数量成比例增长的情况下生成数百万个带标签的唤醒词样本,就需要超越人工和众包工作流程。多语言口语词汇语料库(MSWC)(Mazumder et al. 2021) 展示了自动标注如何解决这一吞吐量瓶颈:该语料库通过程序化方式从连续语音语料库中提取超过 23.4 million examples 的一秒语音样本,涵盖 50 languages 和 340,000 keywords。
Mazumder, Mark, Sharad Chitlangia, Colby Banbury, Yiping Kang, Juan Manuel Ciro, Keith Achorn, Daniel Galvez, et al. 2021. “Multilingual Spoken Words Corpus.” Advances in Neural Information Processing Systems 35 (NeurIPS 2021) Datasets and Benchmarks Track.
这种规模使人工标注难以实施:对于 23.4 million examples,即使每个标签仅耗时 10 秒,也需要约 65,000 hours,相当于约 32.5 person-years 的全职工作量。覆盖 50 languages、来源广泛且有据可查的数据采集可以改善覆盖范围,但语言数量本身并不能保证说话人、口音、设备或声学环境具有代表性。figure 14 中的自动化系统从成对的句子音频和转写文本入手,再使用强制对齐31估计连续语音中的词边界,从而解决规模问题。
在这种规模下,质量控制并未消失,而是转变为抽样和数据溯源问题。流水线应按语言、说话人、口音、设备和声学环境报告覆盖情况;为每个提取的片段保留源录音、转写版本、对齐器版本和边界置信度;并将低置信度对齐结果及代表性不足的数据切片交由人工审核。随后,留出评估必须在这些数据切片上衡量目标唤醒词的检测表现。这些控制措施区分了大型语料库与具有代表性的语料库,并使下游 KWS 模型失效时能够追溯提取错误。
Mazumder, Mark. 2021. TinyML: Multilingual Spoken Words Corpus. tinyML Talks.
提取系统利用这些精确的时间标记生成干净的关键词样本,同时应对预期的工程挑战:背景噪声干扰词语边界,说话人意外地拉长或缩短词语,使其时长超出目标范围 500 ms 至 800 ms,以及较长词语超过一秒边界。MSWC 提供自动化质量评估,通过分析音频特征识别录音质量、语音清晰度或背景噪声方面的潜在问题。这对于在 23.4 million samples 的规模上维持一致标准至关重要,同时避免了人工审核费用,否则这一规模将因成本过高而难以实现。
语音助手工程团队通常以这一自动化标注基础为起点开展工作。尽管自动化构建的语料库可能不包含产品所需的特定唤醒词,但它们为 KWS 原型开发提供了起点,尤其适用于缺乏商业数据集、资源不足的语言。生产系统通常会针对具有挑战性的情况(不常见的口音、罕见词语或复杂的声学环境)补充有针对性的人工录音与核验,使自动化处理与人工专业判断相互配合。
至此,编译流水线已生成其核心产物:与真实标签配对的特征向量。将这些张量送入执行单元时,物理存储层次结构便成为必须面对的问题。根本矛盾来自物理机制:批量训练需要对 PB 级记录进行高吞吐量的顺序流式读取,而实时推理则需要对单个特征向量进行亚毫秒级点查询。存储架构决定了加速器是持续计算,还是空闲等待 I/O。
存储架构
流水线生成的标注数据集(在 KWS 案例研究中,规模为 23.4 million samples,涵盖 50 languages)需要经过精心设计的存储布局,以平衡训练吞吐量与服务延迟。要协调这些差异显著的访问特征,就必须将工作负载的访问模式直接映射到底层存储介质的物理能力上。
机器学习的存储需求与事务系统存在根本差异。银行或电子商务系统通常针对频繁的小规模写入和点查询进行优化,而机器学习工作负载则优先考虑持续的顺序读取带宽、从 GB 级到 PB 级的大规模扫描,以及模式灵活性。为电子商务商品目录提供服务的关系数据库能够以低延迟每秒处理数百万次独立商品查询,但当机器学习训练任务在数十个轮次中顺序扫描同一目录时,事务存储引擎固有的非合并磁盘读取会使训练停滞。
存储系统选项
批量训练顺序扫描数百万个样本;实时服务每次获取一个特征向量。这两种相反的访问模式使存储设计面临两个不同方向的要求,而选择系统意味着针对占主导地位的访问模式,最小化机器学习系统铁律中的数据项 \(\left(\frac{D_{\text{vol}}}{\text{BW}}\right)\)。每种存储介质都会对带宽施加物理约束,从而决定训练与服务流水线的最高速度。
这一优化受两个存储性能指标支配。IOPS(每秒输入/输出操作数) 表示设备每秒能够处理的独立读写请求数,它限制了随机访问工作负载的性能,例如获取小批量图像或单个用户画像。吞吐量(带宽) 衡量每秒传输的数据量,通常为 \(\text{IOPS} \times \text{Block Size}\),它限制了顺序访问工作负载的性能,例如为训练扫描 Parquet 文件。
数据库、数据仓库与数据湖之间的选择,本质上是在不同生命周期阶段选择优化上述哪一个指标。传统数据库(联机事务处理(OLTP)) 采用小块大小和面向行的布局,针对高 IOPS 进行优化。它们维护商品目录、用户画像或交易历史,提供严格的 ACID 保证和亚毫秒级点查询延迟。在机器学习工作流中,这种特征适合在线特征服务:推荐系统在实时推理期间查找用户画像,或反欺诈服务查询历史交易次数,都需要执行受单次请求延迟约束的随机点查询。在极端情况下,大型推荐系统每秒需要从 TB 级表中读取数十亿次稀疏特征,因此要求存储引擎优先最大化 IOPS,而非批量吞吐量。然而,数据库并不适合作为训练数据源。当训练任务在多个轮次中扫描数百万条记录时,即使模型只使用 100 个特征中的 20 个,面向行的布局也会迫使存储引擎将整行从磁盘读取到内存中。由此产生的非合并 I/O 和总线带宽浪费会限制吞吐量。
数据仓库(联机分析处理(OLAP)) 将这种物理布局反转,按列而非按行组织表 (Stonebraker et al. 2018)。列式格式将每个属性的值连续存储在磁盘上,使顺序扫描仅需读取模型所需的特征;当从 100 列中选择 20 列时,传输的数据量仅为未压缩整行数据量的五分之一。section 1.8.2 中的格式效率计算通过一个欺诈检测实例量化了这一收益。列式布局还可以对同质数据类型实现高压缩比,直接减少通过存储总线传输的字节数。数据仓库擅长特征工程、批量聚合和表格模型训练,其 SQL 接口简化了迭代式数据探索。然而,数据仓库要求结构化模式,难以处理原始音频、高分辨率图像和自由形式文本等多模态数据对象。在快速实验期间修改模式,需要对包含数十亿行的表执行代价高昂的 ALTER TABLE 操作,从而拖慢开发进度。
Stonebraker, Mike, Daniel J. Abadi, Adam Batkin, Xuedong Chen, Mitch Cherniack, Miguel Ferreira, Edmond Lau, et al. 2018. “C-Store: A Column-Oriented DBMS.” In Making Databases Work: The Pragmatic Wisdom of Michael Stonebraker. Association for Computing Machinery. https://doi.org/10.1145/3226595.3226638.
数据湖 完全摒弃预定义的表格模式,将结构化、半结构化和非结构化数据以原生格式存储在大容量对象存储中。它们将数据结构的定义推迟到查询时,这种架构模式称为读时模式。32
这种布局适合探索式数据工程,以及特征集持续演变的多模态训练流水线。计算机视觉或多模态系统可以在同一个存储库中,将原始传感器日志存为 JSON、图像存为 JPEG 文件、点击流存为 Parquet,以及将学习得到的表示存为二进制 NumPy 数组。各个独立训练任务在读取时应用模式,无须协调模式迁移即可提取不同的数据子集。然而,读时模式将治理责任从摄取阶段转移到了检索阶段。如果缺乏严格的元数据管理,数据湖就会退化为“数据沼泽”, 成为杂乱无章的存储库,其中充斥着 userdata_v2_final 和 userdata_v2_ACTUALLY_FINAL 之类的孤立目录树,其血缘关系和质量均无记录。生产环境中的数据湖需要专门的元数据目录(例如 AWS Glue Data Catalog、Apache Atlas 或 Databricks Unity Catalog),以记录血缘关系、更新频率、模式版本和访问策略。
每种存储架构都针对特定的访问模式和生命周期阶段进行优化,如 table 7 所概括。
| 属性 | 传统数据库 | 数据仓库 | 数据湖 |
|---|---|---|---|
| 用途 | 运营与事务处理 | 分析与报表 | 存储原始及多样化数据,以供后续处理 |
| 数据类型 | 结构化 | 结构化 | 结构化、半结构化和非结构化 |
| 规模 | 中小规模数据量 | 中大规模数据量 | 大规模多样化数据 |
| 性能优化 | 针对事务查询(OLTP)优化 | 针对分析查询(OLAP)优化 | 针对可扩展存储与检索优化 |
| 示例 | MySQL, PostgreSQL, Oracle DB | Google BigQuery, Amazon Redshift, Microsoft Azure Synapse | Google Cloud Storage, AWS S3, Azure Data Lake Storage |
生产机器学习架构很少只选择一种存储技术。成熟系统通常将这三层组合成统一的数据拓扑:数据库处理运行遥测和实时点查询;数据仓库执行结构化特征提取和聚合分析;数据湖存储多模态原始采集数据和中间检查点。例如,在自动驾驶汽车流水线中,车辆遥测数据流入业务数据库,用于即时健康监测;聚合后的驾驶统计数据写入数据仓库,用于车队分析;原始相机帧和激光雷达点云则存放于对象存储中,用于模型训练。
存储性能与成本
物理存储介质的成本跨度达三个数量级,带宽跨度达五个数量级。存储层级与访问模式不匹配,要么因容量利用不足而推高基础设施成本,要么在 I/O 停滞期间使训练加速器得不到足够的数据。
Table 8 展示了机器学习系统采用分层存储的原因。在这些基于 2024 年的假设下,将我们的 KWS 训练数据集(748.8 GB)存储在对象存储中的成本为 $17.2/month,使原始音频能够以可负担的成本保留;而将工作数据集存储在非易失性内存主机控制器接口(NVMe)33 存储上以供实际训练,成本为 $74.9/month–$224.6/month,但加载速度可提升至 50×。
| 存储层级 | 成本($/TB/月) | 顺序读取 吞吐量 | 随机读取 延迟 | 典型机器学习用例 |
|---|---|---|---|---|
| NVMe SSD(本地) | $100–300 | 5–7 GB/s | 10–100 μs | 训练数据加载、活跃特征服务 |
| 对象存储(S3、GCS) | $20–25 | 100–500 MB/s(每个连接) | 10–50 ms | 数据湖原始数据存储、模型产物 |
| 数据仓库(BigQuery、Redshift) | $20–40 | 1–5 GB/s(列式扫描) | 100–500 ms(查询启动) | 训练数据查询、特征工程 |
| 内存缓存(Redis、Memcached) | $500–1000 | 20–50 GB/s | 1–10 μs | 在线特征服务、实时推理 |
| 归档存储(Glacier、Nearline) | $1–4 | 10–50 MB/s(取回后) | 数小时(取回) | 历史数据保留、合规归档 |
这种吞吐量差异决定了工程迭代速度。训练以 5 GB/s 加载数据时,可在 149.8 s 内完成数据集加载;相比之下,以典型对象存储速度加载则需要 7,488 s。这一 50× 的加速比决定了工程师是每天能够迭代多次,还是必须在实验之间等待数小时。
从缓存到互联网,访问延迟横跨八个数量级。
片上寄存器与远程存储之间的延迟差距超过八个数量级,导致未经缓冲的远程 I/O 请求使 GPU 执行流水线停滞。将这些微秒级延迟按比例放大到人类时间尺度(table 9),可以直观展示未命中缓存的数据获取所带来的性能损失。这些数值经 Jeff Dean 在 2009 年 LADIS 大会上的主题演讲而广为人知,34 它们量化说明了为何未经缓冲的远程 I/O 会使现代加速器得不到足够的数据,以及为何分布式训练对数据局部性有严格要求。
| 操作 | 延迟(ns) | 人类时间尺度 | 对机器学习系统的影响 |
|---|---|---|---|
| L1 缓存访问 | 0.5 | 1 秒 | 即时响应 |
| L2 缓存访问 | 7 | 14 秒 | 快速计算 |
| 主内存(DRAM) | 100 | 3 分钟 | “内存墙”阈值 |
| SSD(本地 NVMe) | 100,000 | 2 天 | 数据加载瓶颈 |
| 网络(同一数据中心) | 500,000 | 11.57 天 | 分布式协调滞后 |
| SSD(远程网络) | 2,000,000 | 46.30 天 | 训练与服务偏差的来源 |
| 对象存储(S3) | 20,000,000 | 1 年 | 归档访问 |
| 互联网(加利福尼亚州至弗吉尼亚州) | 100,000,000 | 6 年 | 全球用户体验 |
除输入数据集外,存储架构还必须容纳模型开发过程中生成的稠密数值数组:参数权重、优化器状态和训练检查点。
现代神经网络包含数百万至数千亿个参数,其存储与检索模式与表格数据截然不同。GPT-3 (Brown et al. 2020) 以 FP32 格式存储模型权重时,大约需要 700 GB(175B 个参数乘以 4 字节),不过实际部署通常采用 FP16 等更小的数值格式(350 GB),以将内存压力减半。即使采用 FP16 精度,仅这一个检查点的大小也超过许多组织全部生产数据库的总规模。从 AlexNet 的 60M 个参数 (Krizhevsky et al. 2012),到 GPT-3 的 175B 个参数 (Brown et al. 2020),模型规模在八年间增长至约 2916×。模型权重需要采用块对齐的存储格式,以支持在初始化和保存检查点时跨参数组并行读取;为使计算单元持续工作,所需的聚合存储带宽必须接近网络互连的带宽上限(25 至 100 Gbps)。模型压缩 探讨了可压缩这些存储占用的模型侧量化技术。
Brown, Tom B., Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared Kaplan, Prafulla Dhariwal, Arvind Neelakantan, et al. 2020. “Language Models Are Few-Shot Learners.” Advances in Neural Information Processing Systems 33: 1877–901. https://doi.org/10.48550/arxiv.2005.14165.
Krizhevsky, Alex, Ilya Sutskever, and Geoffrey E. Hinton. 2012. “ImageNet Classification with Deep Convolutional Neural Networks.” Advances in Neural Information Processing Systems (NeurIPS) 25.
跟踪这些产物会带来版本管理挑战。Git 等标准版本控制系统擅长处理增量文本差异,但对于数 GB 的二进制文件,一次权重更新就会生成一个全新文件,因此难以有效跟踪。以朴素方式存储一个 10 GB 模型的十个历史检查点,会消耗 100 GB 空间。生产环境中的机器学习工作流将元数据与二进制产物解耦:DVC(Data Version Control,数据版本控制)和 MLflow 等工具在 Git 中存储轻量级密码学哈希,同时将二进制检查点转存至外部按内容寻址的对象存储。这样既能实现精确复现,又不会使代码仓库膨胀。
多加速器训练通过并发 I/O 进一步加剧存储压力。当一个训练作业跨越多个加速器时,每个进程(rank)都必须并发读取训练批次、写入优化器快照并转储中间检查点。存储系统必须以与工作进程数量成正比的速率承接同时发生的读写,避免因 I/O 串行化而使昂贵的加速器闲置。模型训练 分析了管理这些并行工作进程的协调机制。
计算与存储带宽之间的这种物理失配,暴露出存储供给不足导致的性能断崖。在现代服务器节点上,主机 RAM 可提供 50 至 200 GB/s 的带宽,而本地 NVMe SSD 可提供 1 至 7 GB/s,网络附加存储则可提供 1 至 10 GB/s。当加速器处理数据的速度超过存储层次结构准备数据的速度时,数据流水线就成为制约因素。GPU 消耗速率若为存储带宽所能供给速率的 10 倍,加速器就会有 90% 的时间处于闲置状态。训练吞吐量受计算能力与数据供给速率两者中较小值的限制。
Napkin Math 1.9: 存储带宽预算
问题:什么样的存储配置才能使参考加速器在训练 ResNet-50 时免于数据供给不足?硬件加速 将在后文介绍这一设备系列;此处的重点是计算上限如何转化为数据路径预算。
首先考虑计算上限。参考加速器在稠密 FP16 运算上的性能可达 312 TFLOP/s。ResNet-50 每次前向传播的计算量约为 8 GFLOPs,计入训练中的反向传播后,每张图像的训练步计算量增至约 24.6 GFLOP。模型训练 推导了反向传播的机制;此处,每张图像的合计计算量是存储预算的输入。将加速器峰值吞吐量除以每张图像的训练步计算量,得到计算上限 12,682 img/s。
一旦每张图像都必须从磁盘或对象存储读取,这一计算上限就转化为存储需求。对于大小为 150 KB 的 JPEG 压缩图像,数据路径必须提供的带宽等于每秒处理的图像数量乘以每张图像的 150 KB,即约 1.9 GB/s。
现在,各种存储方案有了明确目标:要使该加速器达到满负荷,需要持续提供 1.9 GB/s 的带宽。
- S3 Standard 每个线程可提供约 100 MB/s,因此在尚未计入软件开销时,流水线就需要 19 concurrent worker threads。
- SATA SSD 的顺序吞吐量约为 500 MB/s,因此会成为该加速器的瓶颈。
- NVMe SSD 可提供约 5–7 GB/s,属于能够满足这一目标的本地存储类别。
系统洞见:使用 SATA SSD 时,最大吞吐量受限于 500 MB/s 除以每张图像的大小 150 KB,即约 3,333 img/s。这块价值 $15,000 的 GPU 将以 26 percent 的利用率运行,因为存储提供的图像速率仅占加速器图像处理上限的一小部分。存储的物理特性决定了训练速度。
面向高吞吐量训练的设计,首先要使存储吞吐量与加速器需求相匹配。这是本章关于供给不足的论述所采用的第三个、也是最后一个视角:section 1.2.3 将加速器闲置的代价计为供给税,section 1.5.5 将同一种停顿追溯至 CPU 解码工作进程,而此处的问题则是哪一存储层级能够持续提供所需的供给速率。
500 MB/s 这一数值表示 SATA III 的有效顺序读取吞吐量(接口上限为 550 MB/s),而实际场景中小文件的随机读取性能可能显著更低。这一限制进一步印证了支配数据流水线的一般原则:equation 5 将训练吞吐量约束为计算能力与 equation 6 定义的数据供给速率两者中的较小值。令 \(R_{\text{train}}\)、\(R_{\text{compute}}\) 和 \(R_{\text{data}}\) 表示以样本数每秒为单位的速率;令 \(B_{\text{storage}}\) 表示以字节每秒为单位的存储带宽,\(\eta_{\text{overhead}}\) 表示因开销而损失的无量纲比例,\(S_{\text{sample}}\) 表示每个样本的字节数。在计算与 I/O 完全重叠的条件下,取速率最小值的形式对应于 section 1.5.5 中的下界 \(T_{\text{step}} = \max(T_{\text{compute}}, T_{\text{io}})\);若重叠不完全,实际训练步耗时会更长。 \[R_{\text{train}} \leq \min(R_{\text{compute}}, R_{\text{data}}) \tag{5}\] \[R_{\text{data}} = \frac{B_{\text{storage}}(1-\eta_{\text{overhead}})}{S_{\text{sample}}} \tag{6}\]
一旦 \(R_{\text{data}}\) 成为较小的速率,增加加速器计算能力就无法提高训练吞吐量;解决办法必须是提高可用存储带宽,或减少每个样本的字节数。
当存储带宽成为限制因素时,团队必须通过更快的介质、并行化或缓存来提升存储性能,或者减少必须传输的数据量。大语言模型训练可能需要每小时处理数百 GB 的文本,而处理高分辨率图像的计算机视觉模型,在分布式集群上的持续数据速率需求可能超过每秒 50 GB。这些需求使数据加载成为一项系统中任务放置位置的决策:框架数据加载器通过异步工作进程并行执行 I/O,使用双缓冲预取队列,使批次 \(k+1\) 在主机 RAM 中进行的 \(D_{\text{vol}}/\text{BW}_{\text{IO}}\) 数据获取阶段,与加速器在 GPU 内存中对批次 \(k\) 执行的 \(O/R_{\text{peak}}\) 计算过程重叠,从而避免因计算供给不足而发生停顿(\(L_{\text{lat}}\))。框架加载器还可以将开销较大的数据增强工作移至更靠近加速器的位置执行,而不必存储每一种增强后的变体。
文件格式的选择直接影响机器学习系统铁律中的数据项 \(\left(\frac{D_{\text{vol}}}{\text{BW}}\right)\)。Parquet 等列式格式支持列投影和过滤下推,因此非常适合表格特征;而 WebDataset 或 TFRecord 等基于分片的顺序格式,则将数百万个小型二进制对象(如图像或音频)打包成连续的顺序数据流。这种分片方式消除了随机磁盘寻道开销(\(L_{\text{lat}}\)),将缓慢的随机 I/O 转化为持续的顺序存储吞吐量(\(\text{BW}_{\text{IO}}\))。将这一影响量化为格式效率 \((\eta_{\text{format}})\),即可得到有效带宽的一个乘数因子。Parquet 优化了磁盘上的列式布局,而当数据在摄取引擎、数据帧与机器学习框架之间传递时,内存中的表示也面临类似的序列化瓶颈。Apache Arrow 标准通过定义与编程语言无关的列式内存布局,解决了这一内存数据交换边界上的问题,使流水线进程之间能够以零拷贝方式共享数据,避免昂贵的序列化与反序列化过程。
Napkin Math 1.10: 格式效率
存储格式决定了为获取训练所需的信号,必须传输多少“无用”数据。令 \(\eta_{\text{format}}\) 表示读取的字节中承载所选特征的无量纲比例,其取值为 0 到 1。Equation 7 展示了这一比例如何将物理带宽折算为流水线可用带宽: \[ \text{Effective Bandwidth} = \text{Physical Bandwidth} \times \eta_{\text{format}} \tag{7}\] 数值小于 1,意味着该格式将物理数据路径的一部分容量用于传输无关字节;因此,改进布局可以在不更换存储设备的情况下提高可用吞吐量。
场景:使用一张包含 100 列的表中的 20 个特征,训练欺诈检测模型。
行式格式(如 CSV) 必须读取全部 100 列,才能获取所需的 20 个特征,因此有效字节比例为 0.2,浪费了 80 percent 的磁盘带宽。相比之下,列式格式(如 Parquet) 仅读取选定的列,可达到 \(\eta_{\text{format}} \approx\) 1(忽略元数据开销),使有效吞吐量达到行式格式的 5×。
系统洞见:在这个仅涉及投影的场景中,从 CSV 切换到 Parquet 所带来的有效读取吞吐量增益,等同于将数据路径速度提高至原来的 5×。行式与列式格式 深入讨论了行式与列式存储布局,以及数据操作(选择、投影、连接)的代数。
Parquet 或 Optimized Row Columnar(ORC)等列式存储格式,通过两种互补机制,将典型机器学习工作负载的 I/O 量降至原来的 1/5 至 1/10:列投影,以及利用同类值分布进行的列级压缩。对于基数较低的类别特征,压缩尤其有效:在 1 亿条记录中仅有 200 个唯一值的国家代码列,通过字典编码可压缩至原来的 1/20 至 1/50;游程编码则通过仅记录值的变化来压缩已排序的列。投影与压缩相结合,可使总 I/O 量相较于未压缩的行式格式降至原来的 1/20 至 1/100,从而缩短每轮训练的耗时,并减少存储占用。
压缩算法在存储密度与 CPU 解压带宽之间进行权衡。gzip可实现 6× 至 8× 的较高压缩比,而 Snappy的压缩比为 2× 至 3×,但解压速度达到 500 MB/s,约为 gzip 解压速度 120 MB/s 的 4.2×。对于摄取带宽决定加速器利用率的机器学习训练,Snappy 的速度优势比 gzip 节省存储空间的优势更为重要。在使用 gzip 压缩的 100 GB 数据集上进行训练,需要 13.9 minutes 的 CPU 解压时间,而 Snappy 仅需 3.3 minutes。当训练对数据迭代 50 epochs 时,每个轮次 10.6 minutes 的时间差会累计为 9 hours,可能将原本持续数天的训练缩短为一夜即可完成。更快的解压直接提高输入流水线的吞吐量,降低主机内存暂存需求,并使加速器计算持续处于饱和状态。
除格式和压缩之外,数据分区通过使存储布局与常见访问模式相匹配,决定数据检索效率。处理用户交互的推荐系统按时间戳和用户人口统计分群对数据进行分区,使训练任务能够查询近期时间切片,而无需扫描完整的历史数据仓库。分区策略与分布式训练直接相互作用:按用户 ID 进行范围分区,可将同一用户的档案稳定地路由至特定的数据并行进程,而随机分区则保证所有工作进程接收到独立同分布的样本。分区粒度至关重要:粗粒度分区过少会限制并行工作进程的并发度,而数百万个微小分片则会引入过高的元数据开销,并降低磁盘顺序预取的效率。在多加速器训练中,分区倾斜会造成严重的慢进程瓶颈:如果一个使用八个加速器的作业中,七个工作进程在 12 ms 内完成批次加载,但一个工作进程因读取过大的分区而耗时 180 ms,那么这一个慢进程就会延迟整个集群的梯度同步。因此,与工作进程读取预算相匹配的均衡分区,是实现高加速器效率的架构前提,详见 模型训练。
机器学习生命周期各阶段的存储
存储需求会随生命周期演进,因为每个阶段都要求对相同的底层数据采用不同的访问模式。同一个数据集在探索性数据分析阶段需要随机采样,在模型训练阶段需要高吞吐量的顺序流式读取,而在生产服务阶段则需要低延迟的点查询。
在初始开发阶段,迭代速度和模式灵活性比原始吞吐量更为重要。首要的系统挑战是在管理实验修订版本的同时,避免存储容量需求激增:对一个 100 GB 数据集进行十次探索性实验,若采用朴素方式,就会产生 1 TB 的冗余副本。section 1.8.2 中介绍的元数据指针架构将版本跟踪与文件存储解耦:DVC 等工具通过小型哈希清单跟踪数据血缘,而内容寻址存储则对相同的二进制载荷进行去重。治理策略进一步强化这种分层方式:允许广泛访问匿名化的开发数据集,同时通过加密、可审计的访问层级限制敏感生产数据的访问。
在训练阶段,访问模式转向持续的顺序吞吐量。现代深度神经网络需要对海量数据集进行数十乃至数百轮迭代,使存储带宽成为硬件利用率的决定因素。使用八个加速器,以 40,000 img/s 的速度在 ImageNet 上训练 ResNet-50 时,对于大小为 150 KB 的压缩图像,需要约 6 GB/s 的持续存储带宽;如果暂存的是未压缩的 FP32 张量,则所需带宽显著更高。无法持续达到这一速率的存储层会使加速器闲置,推高集群运行成本。此时,特征计算位置的权衡(section 1.5.5.3)变得至关重要:预先计算特征表示可实现 30× 的存储缩减比(将 150 KB 的原始输入缩减为 5 KB 的嵌入向量),但在特征提取模型更新时,会引入特征陈旧的风险。
生产推理将优化目标从顺序带宽转变为低延迟随机访问。一个处理 10,000 req/s、SLA 为 10 ms、每个请求需要 10 feature reads/request 的推荐服务,需要 100,000 IOPS 的随机读取能力。达到这一随机访问速率,需要使用 Redis等内存键值存储、分布式缓存,或专门构建的低延迟特征存储。边缘部署还施加了进一步的物理约束:有限的闪存容量、间歇性网络连接以及不中断服务的模型更新,要求采用分层缓存,使核心模型驻留在本地闪存中,而参考数据则与云端端点异步同步。在生产环境中,服务基础设施必须支持原子回滚和并行 A/B 测试(机器学习运维)。这些运维保障依赖于严格的来源追踪:每个已部署模型都必须能够追溯到训练它时使用的确切数据集快照。
面向机器学习可复现性的数据版本控制
设想一个生产环境中的推荐模型,在按计划完成每周重训练后,点击率突然下降,尽管应用程序代码库并未发生变化。工程团队必须确定,这一下降是源于未预告的特征变更、标签分布偏移,还是上游表损坏。如果训练得到的模型制品与训练输入之间缺乏不可变的关联,问题诊断就需要耗费数天进行试探性的二分排查。有了数据版本控制,工程师可以直接比较训练数据集快照的差异,并定位根因:上游流水线的一次回填操作悄然改变了标签频率分布。
DVC(Data Version Control,数据版本控制)等文件级版本控制引擎通过将 Git 与内容寻址的远程存储结合,实现这一能力 (Iterative 2024)。Git 跟踪包含密码学哈希值的小型文本指针文件(.dvc),而 DVC 将底层二进制数据集同步至对象存储(listing 3)。检出较早的 Git 提交时,会自动恢复与该历史代码状态相匹配的确切数据集版本。
Iterative. 2024. Data Version Control (DVC).
git checkout 和 dvc checkout 命令,可精确复现任意历史训练数据集。
# Add data to version control
dvc add data/training.csv
git add data/training.csv.dvc
git commit -m "Add training data v1"
dvc push  # Upload to remote storage

# Later: retrieve exact data for any historical commit
git checkout abc123
dvc checkout  # Restores exact data from that commit
文件级版本控制适用于图像和音频等大体量制品,而表格数据集则需要对持续变化的表进行版本控制。Delta Lake等现代开放表格式通过维护仅追加的事务日志,记录所有行插入、删除和模式修改操作,从而解决这一问题 (Armbrust et al. 2020)。该日志提供时间旅行能力,使训练查询能够通过时间戳或版本 ID 固定数据集状态(listing 4)。
-- Query data as it existed on a specific date
SELECT * FROM training_data TIMESTAMP AS OF '2024-01-15'

-- Or by version number for programmatic access
SELECT * FROM training_data VERSION AS OF 47两个企业级组件与这些版本控制引擎集成,以实现端到端的可复现性。首先,特征存储的时点检索按观测时间戳获取当时的特征值,消除标签泄漏。其次,模型注册表记录每个已部署模型的血缘清单:Git 提交 SHA、数据版本 ID、训练配置和评估指标。在前述点击率下降的情形中,这一审计轨迹将没有明确边界的调试调查转化为可立即进行的快照比较。
长期保留需要在可审计性、存储支出和数据隐私法规之间取得平衡。大规模生产流水线采用分层保留策略:热 SSD 层用于活跃训练和调试,温对象存储用于定期评估快照,冷归档存储用于合规记录。由于无限期保留 PB 级数据在经济上不可持续,而且经常违反隐私法规,数据生命周期策略必须明确规定保留期限和清除机制。
物理存储架构决定数据存放的位置及其移动速度,但仅靠物理布局无法保证训练输入与推理特征之间的语义一致性。衔接离线批量训练与实时服务,需要专门的特征基础设施。
特征存储
生产环境中特征管理的根本挑战,是在不同执行环境之间保持语义一致性:为训练提供历史特征值,为推理提供当前特征值。时点正确性是推动团队采用特征存储的首要运维要求,可缓解训练与服务偏差,并支持跨模型共享特征。
在生产环境中,特征计算流水线往往分散在不同语言和执行引擎中。在模型开发期间,数据科学家使用离线数据仓库中的批量 SQL 查询,计算 user_purchase_count_30d 等特征。在生产服务期间,在线微服务则基于内存缓存增量计算同一指标。即使二者原本旨在保持一致,时区运算、缺失值填补或浮点舍入方面的细微差异,也会导致离线与在线特征逐渐偏离。Uber 的 Michelangelo 平台通过集中、可复用的特征定义,解决了这种训练与服务偏差,并推动了特征存储的普及 (Hermann and Del Balso 2017)。
Definition 1.4: 特征存储
特征存储是集中管理机器学习特征的架构层,将特征计算与特征使用解耦。
- 意义:它支持为训练提供满足时点正确性的历史检索 \((x_{t-\Delta})\),并为实时推理 \((x_t)\) 协调特征定义;当时间戳、回填、新鲜度和同步得到正确处理时,可减少训练与服务偏差。
- 区别:与通用数据库不同,特征存储面向双重存储模式设计:用于训练的离线存储(列式/批处理)和用于服务的在线存储(键值/低延迟)。
- 常见误区:一种常见误解是,特征存储只是“存放数据的地方”。实际上,它管理特征定义、特征值和检索;转换操作可以在特征存储、离线存储或独立的批处理或流计算引擎中运行。
特征存储(特征存储 从运维视角对此进行了讨论)为整个机器学习生命周期中的特征定义建立了单一事实来源。通过将特征定义注册为统一的计算图,特征存储可对历史批量数据和实时推理流执行相同的转换。这种共享定义可防止训练与服务偏差,消除模型在训练时验证分数很高、却在生产环境中表现不佳的隐性性能退化。集中管理还支持组织内的特征复用:基于数月交互日志生成的多维用户嵌入等高成本表示,只需计算一次,即可提供给多个下游建模团队使用。
为协调相互对立的访问模式,特征存储采用双存储引擎。离线存储使用驻留在大容量对象存储上的列式格式(如 Parquet),针对批量训练期间数 GB 规模的顺序扫描进行优化。在线存储使用低延迟键值数据库(如 Redis),针对实时推理期间低于 10 毫秒的点查询进行优化。同步这两个引擎需要自动化流水线,将批量计算的特征快照推送至在线存储,同时通过流式摄取,在新用户事件到达时持续更新两个存储。
时间旅行能力是真正的特征存储与简单缓存之间的区别。训练需要使用事件发生的确切时刻所存在的特征值,而不是当前值。例如,在客户流失模型中,针对一名于 1 月 15 日流失的客户进行训练时,必须使用 1 月 14 日计算的特征,而非当前流失后的客户档案状态。特征存储通过 as-of 连接(时态连接)确保时点正确性:对于时间戳为 \(t_{\text{obs}}\) 的每条观测,检索引擎连接更新时间戳满足 \(t_{\text{feat}} \le t_{\text{obs}}\) 的最新特征记录。即使多个上游特征表以不同频率更新,这一时间不等式过滤条件也能保证未来信息不会泄漏到历史训练矩阵中。
双存储的性能特征直接限定训练吞吐量和服务延迟。离线存储必须支持在宽表模式下,每分钟批量读取数百万个特征向量。在线存储必须支持每秒数千至数百万次点查询,同时满足个位数毫秒的延迟预算。当用户操作(如将商品加入购物车)要求亚秒级特征新鲜度时,流式特征流水线会持续更新在线存储。这一流处理层引入了分布式系统挑战,需要恰好一次处理语义来防止重试期间发生重复状态更新,并需要水位线机制来处理乱序和迟到事件。
部署涵盖采集、摄取、处理、标注和存储的端到端流水线,并不意味着数据工程工作的结束。在生产环境中,输入环境会持续漂移:传感器硬件发生变化,上游模式不断变更,标注人员也会更替。如果缺乏主动的运维维护,静态流水线就会随时间悄然退化。

谬误与陷阱
数据工程流水线很少因运行时崩溃而立即暴露故障;相反,它们会悄然扭曲特征分布、破坏训练状态,或使昂贵的加速器集群无法获得充足的数据供给。以下谬误与陷阱探讨了削弱生产系统的物理瓶颈和架构认知误区。
谬误:数据越多,模型性能就一定越好。
超过某个阈值后,新增数据带来的收益会递减,这一规律受经验缩放定律支配。计算机视觉、翻译和语言建模领域的研究表明,测试损失随数据集规模呈幂律变化,因此,每进一步降低误差,都需要指数级增大的样本量 (Hestness et al. 2017)。从系统角度看,冗余样本消耗磁盘 I/O、主机到设备的总线带宽以及加速器 FLOPs,却不提供新的梯度信号。section 1.2 中与任务相关的信号启发式概括了这一权衡:在未保持信息密度的情况下扩大原始字节量,会推高基础设施成本,而评估损失的改善却微乎其微。
Hestness, Joel, Sharan Narang, Newsha Ardalani, Gregory Diamos, Heewoo Jun, Hassan Kianinejad, Md. Mostofa Ali Patwary, Yang Yang, and Yanqi Zhou. 2017. “Deep Learning Scaling Is Predictable, Empirically.” arXiv Preprint arXiv:1712.00409.
陷阱:规划 PB 级数据迁移时,只考虑带宽传输。
用原始数据集大小除以网络链路带宽,可以计算出理论上的链路传输时间,但链路传输很少是关键路径。数据引力(section 1.2)将大型数据集与周边基础设施网络绑定在一起,包括摄取转换流水线、模式验证检查、访问控制策略和下游使用方。在云平台或数据中心之间迁移 PB 级语料库,需要重构流水线、重新验证数据完整性、重新预热缓存以及重建元数据索引。因此,为适配依赖系统所需的运维工程时间,远远超过单纯的网络传输时间。
谬误:数据预处理只需完成一次,此后便可不再维护。
预处理流水线使用基于历史分布确定参数的变换,将原始观测转换为张量,这些参数包括词元化词表、均值和方差缩放向量、类别频率表以及数值裁剪边界。当生产环境中的分布发生漂移时,这些静态变换会悄然失效。词元化器遇到的词表外词元比例激增,固定的归一化统计量使特征激活值偏移至分布外区域,静态裁剪边界则截断动态范围。要保持流水线的保真度,就需要自动监控输入张量,并在重新训练模型的同时,定期重新校准预处理统计量。
陷阱:忽视数据序列化成本。
性能分析往往只关注 GPU 内核执行,而数据加载器则在后台默默解析原始 JSON 或 CSV 文件。解析文本记录时,主机 CPU 核心需要为每个样本花费数百个周期,用于字符串解码、词元化、ASCII 到浮点数的转换以及堆内存分配。这种 CPU 序列化瓶颈使加速器计算引擎得不到充足的数据,导致 GPU 在等待 PCIe 输入传输时空闲。Apache Arrow 或内存映射数组等二进制序列化格式,支持直接以零拷贝方式反序列化到锁页内存,从而消除解析开销。对于表格模式,Parquet 等列式格式只读取所需的列投影,从而消除不必要的磁盘 I/O。将数据摄取速率与加速器消耗速率进行基准比较,可以揭示主机 CPU 反序列化是否正在限制训练吞吐量。
谬误:训练准确率高,就表明模型已具备生产就绪性。
训练准确率反映了在历史训练分布上的经验优化效果,而留出验证则在相同采样假设下估计泛化能力。生产环境会引入未建模的边缘情况、传感器噪声和实时分布漂移。如果上游特征流水线发生变化,或推理超时触发默认回退值,那么即使模型具有很高的验证准确率,也会在部署后失效。诊断部署后的性能退化,需要针对数据漂移、特征损坏和系统执行路径进行结构化的根因隔离(figure 15),而不能仅依赖单一的离线汇总指标。
陷阱:直到部署时才关注训练与服务偏差。
当离线训练流水线与在线推理运行时的特征生成逻辑出现差异时,就会发生训练与服务偏差。训练特征通常使用 Apache Spark 等框架或 SQL 引擎,对数据湖执行批处理来提取。在线特征则必须在应用微服务内部、毫秒级延迟预算内完成计算。浮点精度、时间窗口聚合、库版本的差异,或细微的时间泄漏(例如纳入时间戳晚于预测时点的数据),都会引入不易察觉的数值偏差。由于模型接收到的仍然是有效的浮点向量,推理会继续进行而不抛出运行时异常,但预测质量却会下降。要缓解这一陷阱,需要共享变换逻辑、可复现的特征存储,以及自动化的部署前一致性测试,以验证离线和在线路径生成的特征是否等价。
谬误:合成数据可以完全取代真实世界的数据采集。
合成数据通过生成罕见的边缘情况、受控的物理变化或符合隐私要求的样本来丰富训练集,但其效用受到生成器保真度的限制。生成模型和仿真器只能从其参数化假设所支持的分布范围内采样。仅使用合成数据训练时,模型会过拟合生成器特有的伪影,同时仍然容易受到未建模的真实世界变化的影响。例如,在关键词检测(KWS)系统中,完全使用合成语音训练的检测器,在遇到真实的声学混响、多样化口音、麦克风频率响应失真和非平稳背景噪声时,性能会下降。合成生成可以补充实测数据采集,但要验证部署可行性,仍然必须使用具有代表性的真实世界观测。
陷阱:直到模型调试需要时,才考虑数据版本管理。
将训练数据集视为可变的对象存储目录,会破坏实验的可复现性。当重新训练的模型出现性能退化时,缺乏版本管理的流水线会使工程师无法判断,退化究竟源于标注规则修改、模式迁移中未被察觉的数据损坏,还是真实的分布偏移。一旦动态表被覆盖或原始来源日志被清除,就无法重建历史训练输入。如 section 1.6.4 所述,健壮的数据血缘要求每个模型检查点都不可变地绑定到特定的数据集快照、变换代码哈希和配置档案。推迟数据版本管理,会将常规根因分析变成围绕已丢失训练状态展开的推测性取证。
总结
在机器学习系统中,训练数据发挥着可执行源代码的作用:修改数据集,无须更改任何一行算法代码,就会改变编译后模型学得的行为。由于优化过程直接从观测中提取运行逻辑,数据采集、模式一致性和标注中的上游错误,会以数据级联的形式在流水线的后续阶段逐级放大。因此,数据准备是一个系统协同设计问题:存储层次结构决定向加速器供给数据的吞吐量,摄取架构在流处理延迟与运行成本之间进行权衡,特征契约则防止训练与服务偏差悄然发生。
要点回顾: 数据即源代码
- 数据级联使上游质量成为最具杠杆效应的投入方向:采集错误会在流水线的每个阶段被放大(figure 1)。四大支柱(质量、可靠性、可扩展性、治理)为预防工作提供组织框架,而文档、模式、质量和新鲜度方面的债务则需要持续治理。
- 数据即代码;应进行版本管理、测试和审查:数据集就是机器学习系统的源代码。应通过版本控制、验证测试和数据审查,对其施以同等严格的要求。
- 训练与服务的一致性不可妥协:训练与服务共享的特征变换必须具有等价的语义,并复用相同的已学习状态,例如归一化常数和词表映射。
- 流水线架构选择对成本影响重大:流处理的运行成本高于批处理,而 ETL 以更高的模式变更开销换取存储节省。应根据延迟的价值选择摄取模式,而非受实时性的吸引。
- 标注成本占主导地位,需要投入大量资源:标注成本可达一次优化后训练运行成本的数百倍至一千多倍;在 section 1.4.2 的参考计算中,该比值为 521× 至 1,562×。即使标注工作实现并行化,标注仍可能是成本高昂的进度瓶颈。
- 存储层次结构决定迭代速度:本地 NVMe(5 GB/s)与云对象存储(100 MB/s)之间 50× 的吞吐量差距,决定了迭代是按天还是按周进行。
- 通过漂移监控和结果监控,退化方程才能指导实际行动:KL 等散度指标衡量 \(P_t\) 与 \(P_0\) 之间的变化,而带标签的结果或经过验证的代理指标则用于确定这些变化是否对应模型退化。
KWS 案例研究综合采用了精选数据采集、众包采集和合成数据生成、一致性验证、分层存储以及面向持续监听设备的数据血缘管理;其中,分层存储承载了 23.4 million audio samples,原始数据总量为 748.8 GB。在每个阶段,数据工程都统筹物理数据移动和统计契约,使算法能够学习,同时避免硬件因数据供给不足而空转,或在生产环境中悄然漂移。
后续内容: 从源代码到可执行程序
数据流水线已经生成了干净且经过版本管理的训练集,但数据集本身并不能教会模型任何东西。神经计算 将打开这一黑箱,考察算法这一轴线:将准备好的样本转化为已学习行为的数学运算,以及这些运算如何使神经网络的行为可预测、可调试、可优化。
Footnotes
数据湖仓:通过 Delta Lake 等事务性表层,将数据湖存储(低成本、无模式)与数据仓库查询语义(ACID 事务、模式强制约束)相结合。对于机器学习工作负载,湖仓减少了数据湖与数据仓库之间提取、转换、加载(ETL)过程中的复制,使特征能够直接在数据已驻留的存储层上计算。这是对数据引力的直接回应,因为反复进行 PB 级复制会增加 \(D_{\text{vol}}/\text{BW}\) 成本 (Armbrust et al. 2020; Zaharia et al. 2021)。↩︎
数据级联:这类故障之所以是“静默”的,是因为它损害的是模型的输入,而非模型的代码——损坏的数据可能通过单元测试,并在常规系统监控中表现正常。Sambasivan et al. (2021) 指出,级联往往不可见且具有延迟性:有缺陷的数据实践可能直到下游评估、部署或面向用户的故障揭示模型从错误信号中学习后,才会暴露出来。此时,修复需要沿着数据收集、标注、特征工程和评估决策追溯问题,一些团队甚至不得不重新开始或放弃受影响的工作。↩︎
Voice Match 注册:重复说出“OK Google”便形成了一条微型数据流水线:质量机制过滤含噪样本,可靠性机制保障注册完成,可扩展性机制使模型能够容纳于始终运行的片上系统(SoC)内存中,治理机制则控制存储、处理和保留。只要数据决定系统行为,数据工程就适用。↩︎
片上系统(SoC)常开岛:现代片上系统设计会划分电源域,使一个低功耗的“常开”岛(通常可实现亚毫瓦级功耗)在主处理器休眠时监测唤醒触发信号。关键约束在于,该岛必须在其专用 SRAM 中同时容纳模型权重和音频预处理代码——两者共享的预算迫使 KWS 架构优化总体占用空间,而不仅仅是参数数量。↩︎
ImageNet:2009 年的论文报告了涵盖 5,247 个同义词集的 320 万张图像;完整数据库后来达到约 1420 万张图像,涵盖 21,841 个同义词集,而挑战赛使用的是包含 1,000 个类别的子集 (Deng et al. 2009, 2024; Russakovsky et al. 2015)。其作为基准的价值与数据工程密不可分:李飞飞的团队构建了可供后续团队复用的标注基础设施。问题在于,它对标注流程和轻微的分布偏移较为敏感:针对 ImageNet 分布调优的模型,在相关但存在分布偏移的测试集上可能表现较差 (Recht et al. 2019; Beyer et al. 2020)。↩︎
定价比率:归档数据取回价格及各档位之间的价格比率反映的是提供商政策,而非物理不变量。在这一示例场景中,加急取回的成本是标准档位的三倍;部署前必须核实实际价格及各档位的可用性。↩︎
Amazon Mechanical Turk(MTurk):一个将小型任务分发给分布式工作者的众包平台,可将标注规模扩展到仅依赖专家的工作流程所能达到的范围之外。Snow et al. (2008) 针对自然语言标注任务评估了这一模式,表明在审慎进行任务设计和质量控制的情况下,非专家标注也具有实用价值。对于唤醒词音频采集,同样的系统权衡以领域特定的形式出现:规模很有吸引力,但提交的数据仍需经过信噪比、时长和录音有效性等声学检查,才能安全地纳入训练集。↩︎
Kolmogorov-Smirnov(K-S)检验:一种非参数检验,无需假设参数化分布族,即可度量两个经验累积分布函数之间的最大距离 (Berger and Zhou 2014)。在机器学习流水线中,K-S 检验通常用于检测单变量连续特征的漂移,其中 \(p < 0.05\) 等阈值用作调查触发条件,而非通用的故障判定规则。离散变量和类别变量需要采用适合其分布的检验与校准方法。↩︎
物化视图:一种数据库优化方式,将查询结果预先计算并以物理表的形式缓存。对于机器学习系统,风险源于结构层面:当物化视图在训练环境和服务环境中按不同的计划刷新时,模型训练所用的特征值可能与推理时接收的特征值产生偏离,从而降低准确率,却不产生执行错误。↩︎
标签质量漂移:标注可靠性随时间下降,有别于数据本身的分布偏移。这类漂移无法被标准特征监控发现,因为特征保持稳定,而标签质量却在下降——标注者疲劳、人员更替或指南演变,会悄然损害模型学习所依据的真实标签。检测需要在滚动时间窗口内监控标注者间一致性 \((\kappa)\),并将自动生成的标签与定期专家审核结果进行比较。↩︎
Cohen’s kappa:由 Cohen (1960) 提出,用于衡量评分者间的一致性,同时校正由评分者类别边际分布所决定的预期一致率,而原始一致百分比忽略了这一点。如果在一项二分类任务中,两位独立标注者各自将 90% 的图像标注为“非垃圾信息”,则其预期一致率为 82 percent,因此原始一致率可能具有误导性。该统计量记为 \(\kappa\);Landis-Koch 分类等解释区间属于描述性启发规则,而非通用的数据质量阈值 (Landis and Koch 1977)。↩︎
模式演进:这种故障模式源于上游数据生产者与下游机器学习消费者之间缺乏契约测试。列重命名等“显性”故障会破坏明确的假设并导致流水线立即崩溃,而“静默”故障则更加危险。字段类型从整数变为字符串,可能通过验证,却会破坏特征逻辑而未被立即发现。↩︎
熔断器:借用了在过载时切断电流的电气安全装置之名,具有三种状态——闭合(正常流通)、断开(阻断故障)、半开(恢复探测)。在机器学习数据流水线中,熔断器可防止发生故障的特征计算服务导致超时沿整个服务路径级联传播:一旦失败次数超过阈值,熔断器就会断开,流水线转而使用缓存特征或默认特征,而非等待已经失效的服务。↩︎
抽取、转换、加载(ETL):传统 ETL 验证模式和数据类型,这类确定性检查只有通过或失败两种结果。机器学习 ETL 还必须验证分布属性:数值分布是否发生了会导致模型性能下降的偏移。这需要采用统计检验(K-S 检验、PSI),而非模式验证,其通过或失败的阈值属于业务决策,而非技术决策。进一步的权衡在于灵活性不足:更改特征计算逻辑需要从原始数据源重新处理整个数据集,其成本随数据量线性增长。↩︎
抽取、加载、转换(ELT):这种方法在转换之前存储原始数据,使团队能够修改转换查询,并在已存储的输入数据上重新运行,而无需从源系统重新摄取数据。迭代时间仍取决于数据量、查询复杂度、数据仓库容量和物化策略。↩︎
CAP(一致性、可用性、分区容错性)定理:由 Brewer (2000) 提出猜想,并由 Gilbert and Lynch (2002) 正式证明。发生网络分区时,线性一致性可能要求拒绝请求,而保证可用性的系统可能返回过时或不一致的值。CAP 并不保证特征转换的一致性或时间点正确性。↩︎
Apache Kafka:Kafka 使用基于领导者的分区日志,保证每个分区内部的记录顺序,而不保证整个主题内的顺序。故障期间的持久性和写入可用性取决于确认模式、复制、同步副本要求以及领导者选举行为。↩︎
JSON(JavaScript 对象表示法):模式灵活性使 JSON 成为 API 的常用格式,但也在摄取边界造成了验证瓶颈。与具有预定义模式的二进制格式不同,每个 JSON 文档在被标准化以供下游使用之前,都需要经过解析和模式验证。这种逐记录开销可能使摄取速度低于 Protobuf 等二进制格式;具体差异取决于模式、解析器、载荷和工作负载。↩︎
统计漂移检测:质量监控中跟踪的均值、方差和分位数,是退化方程中散度项 \(\mathcal{D}(P_t \lVert P_0)\) 的早期预警信号。平均会话时长在六个月内从八分钟变为 12 分钟,可能表明发生了漂移;突然降至三分钟,则可能表明存在采集故障。在选择重新训练还是修复源系统之前,需要检查结果并调查数据源。↩︎
特征存储:一种核心故障模式是训练与服务偏差:训练特征可能通过批处理计算(例如基于历史数据的七天滚动平均值),而服务特征则根据流式数据源实时计算;即使名义上共享逻辑,时序和状态差异仍可能造成系统性偏差。特征存储可以通过协调定义、数据源、时间戳处理以及离线和在线物化来降低这一风险,但正确性仍取决于实现、新鲜度和同步。Uber 的 Michelangelo 帮助确立了这种同时面向批量训练和低延迟服务的双接口模式 (Hermann and Del Balso 2017)。↩︎
MFCC(梅尔频率倒谱系数):这种变换通过应用梅尔尺度滤波来实现紧凑性和抗噪性,有选择地突出人类用于区分语音的频率。该过程将一个较短时间窗(例如 25 ms)内的数千个原始音频采样值缩减为仅 13–39 个系数,实现千字节级常开硬件所需的大幅降维。训练与服务之间的参数不匹配会造成特征偏差,并可能降低准确率。↩︎
谱图:短时傅里叶变换(STFT)通过将一维波形转换为时频图像,计算出这种二维表示。该表示使图像类机器学习模型能够处理音频,但也引入了严格的依赖关系:STFT 参数不匹配(例如,使用 25 ms 与 30 ms 的窗口)会使训练与服务之间的特征表示发生变化,并可能降低性能。↩︎
幂等性:源自拉丁语 idem(“相同”)与 potens(“具有力量”)——字面意思是“再次应用时具有相同的效力”。在机器学习流水线中,幂等性使部分故障后的安全重试成为可能:非幂等操作(例如向日志追加内容)会在重试时产生重复项。幂等操作执行一次或重复执行后,得到的最终状态相同。↩︎
Parquet:一种按列而非按行组织数据的列式存储格式。对于上述单机优化,这一点至关重要;Parquet 读取器仅加载计算所需的特定列,而无须为了访问少量列而浪费性地读取整行 CSV 数据。由此带来的 I/O 缩减程度取决于所选列、编码、压缩方式和工作负载。↩︎
MapReduce:由 Google 的 Dean and Ghemawat (2004) 设计,用于在数千台商用机器上处理该公司数 PB 规模的网页索引。其调度器优先将 map 任务分配给持有输入数据的节点,从而减少输入数据的网络流量。这种感知数据局部性的模式影响了 Hadoop 及后续的分布式数据处理系统。↩︎
阿姆达尔定律:Amdahl (1967) 在 1967 年 AFIPS 春季联合计算机会议上提出了串行比例论证,用于解释多处理器设计为何面临收益递减。其最初的观点——工作负载中的串行部分对并行化收益施加了硬性上限——直接适用于数据流水线:计算全局归一化统计量等操作会强制引入串行聚合阶段,无论有多少工作进程并行处理单条记录,这些阶段都会限制加速比。↩︎
数据血缘:当模型产生错误或具有歧视性的预测时,血缘信息有助于工程师判断相关问题源自原始数据、特征计算、训练还是服务阶段。由此形成的追溯记录可支持事件调查和特定司法管辖区的文档记录义务,但其效用取决于是否进行了完整的埋点并保留了历史记录;它并不保证能够解释模型行为。↩︎
真实标签:该术语源自遥感领域,在该领域中,通过派遣团队前往实际地点——即“地面”(ground)——来确立“真相”(truth),从而验证轨道观测结果。这一词源蕴含着一项系统层面的警示:机器学习标签是现实的代理,而非现实本身。当众包标注员将一幅图像标记为“猫”时,该标签反映的是标注员的判断,而非客观事实。所有下游指标——准确率、精确率、召回率——都以这一代理为基准进行衡量,这意味着标签质量问题会悄然传播到模型的每一次评估中。↩︎
弱监督:一种“数据编程”范式,以编写和验证程序化标注函数的前期投入,换取部分人工标注劳动的减少。函数一旦编写完成,就可以低成本地规模化应用,但执行、冲突消解、质量监控和维护仍会产生成本;有意义的比较应针对具体工作负载,而非将边际成本视为严格为零。↩︎
主动学习:颠倒了传统标注范式:模型不再随机选择待标注样本,而是请求标注其最需要的样本,通常是预测不确定性最高的样本 (Settles 2009)。这可以减少达到目标准确率所需的标签数量,但基础设施层面的权衡是用计算换取标签:按 $0.01/image 的成本计算,在进行任何人工标注之前,对包含 10M 个样本的整个候选池进行评分就需要花费 $100K。只有在预先筛选候选池、推理成本大幅降低,或计算预算与标注预算相互独立时,主动学习才能发挥预算杠杆作用。↩︎
强制对齐:给定已知转写文本,对齐器估计其中各词在音频中出现的位置,通常使用帧级声学评分和序列解码。时间分辨率和准确性取决于模型、特征、语言及录音质量,因此边界估计仍需接受质量检查。已知转写文本使词级切分的成本远低于逐个片段进行人工标注,但计算、审核和纠错工作仍然存在。↩︎
读时模式:在查询时而非摄取时应用数据结构定义,与写时模式(传统数据库)形成对照;后者要求数据在存储前符合预定义的结构。对于处于开发早期的机器学习流水线,读时模式支持快速实验——团队可以存储原始传感器数据、图像和日志,而无须预先确定特征模式。其代价在于治理:如果不强制执行模式,数据湖就会退化为“数据沼泽”,使训练数据的查找与验证反而成为瓶颈。↩︎
NVMe(非易失性内存主机控制器接口):一种直接连接 PCIe 总线的存储协议,具有 64K 个命令队列,可提供 5–7 GB/s 的顺序吞吐量和微秒级延迟。与 SATA SSD(500 MB/s,单队列)相比,其带宽相差 10×;当存储服务时间超过计算时间时,这一差距可能成为训练流水线的瓶颈。↩︎
Jeff Dean:Google 高级研究员,MapReduce、BigTable、Spanner 和 TensorFlow 的架构师。他在 2009 年 LADIS 大会的主题演讲中,将 table 9 中的数值提炼为一条工程经验法则:一次 L1 缓存访问(0.5 ns)与一次跨数据中心往返(150 ms)之间的比值为 \(3 \times 10^{8}\)——这八个数量级的差距解释了,为何训练流水线若从远程存储而非本地 NVMe 读取特征,就会使其本应供给数据的加速器陷入数据饥饿。↩︎
机器学习故障分布:应将数据主导模式视为诊断启发式,而非普适的经验分布。数据检查和运行检查可作为初步排查的假设,但不能据此排除代码缺陷、硬件通信瓶颈或数值不稳定性。↩︎
Armbrust, Michael, Tathagata Das, Liwen Sun, Burak Yavuz, Shixiong Zhu, Mukul Murthy, Joseph Torres, et al. 2020. “Delta Lake: High-Performance ACID Table Storage over Cloud Object Stores.” Proceedings of the VLDB Endowment 13 (12): 3411–24. https://doi.org/10.14778/3415478.3415560.
Zaharia, Matei, Ali Ghodsi, Reynold Xin, and Michael Armbrust. 2021. “Lakehouse: A New Generation of Open Platforms That Unify Data Warehousing and Advanced Analytics.” Proceedings of CIDR 8.
Sambasivan, Nithya, Shivani Kapania, Hannah Highfill, Diana Akrong, Praveen Paritosh, and Lora M Aroyo. 2021. “‘Everyone Wants to Do the Model Work, Not the Data Work’: Data Cascades in High-Stakes AI.” Proceedings of the 2021 CHI Conference on Human Factors in Computing Systems, 1–15. https://doi.org/10.1145/3411764.3445518.
Deng, Jia, Wei Dong, Richard Socher, Li-Jia Li, Kai Li, and Li Fei-Fei. 2009. “ImageNet: A Large-Scale Hierarchical Image Database.” 2009 IEEE Conference on Computer Vision and Pattern Recognition, 248–55. https://doi.org/10.1109/cvpr.2009.5206848.
Deng, Jia, Wei Dong, Richard Socher, Li-Jia Li, Kai Li, and Li Fei-Fei. 2024. ImageNet.
Russakovsky, Olga, Jia Deng, Hao Su, Jonathan Krause, Sanjeev Satheesh, Sean Ma, Zhiheng Huang, et al. 2015. “ImageNet Large Scale Visual Recognition Challenge.” International Journal of Computer Vision 115 (3): 211–52. https://doi.org/10.1007/s11263-015-0816-y.
Recht, Benjamin, Rebecca Roelofs, Ludwig Schmidt, and Vaishaal Shankar. 2019. “Do ImageNet Classifiers Generalize to ImageNet?” Proceedings of the 36th International Conference on Machine Learning (ICML), 5389–400.
Beyer, Lucas, Olivier J. Hénaff, Alexander Kolesnikov, Xiaohua Zhai, and Aäron van den Oord. 2020. “Are We Done with ImageNet?” arXiv Preprint arXiv:2006.07159.
Snow, Rion, Brendan O’Connor, Daniel Jurafsky, and Andrew Y. Ng. 2008. “Cheap and Fast—but Is It Good? Evaluating Non-Expert Annotations for Natural Language Tasks.” Proceedings of the Conference on Empirical Methods in Natural Language Processing - EMNLP ’08, 254. https://doi.org/10.3115/1613715.1613751.
Berger, Vance W., and YanYan Zhou. 2014. “Kolmogorov–Smirnov Test: Overview.” In Wiley StatsRef: Statistics Reference Online. Wiley. https://doi.org/10.1002/9781118445112.stat06558.
Cohen, Jacob. 1960. “A Coefficient of Agreement for Nominal Scales.” Educational and Psychological Measurement 20 (1): 37–46. https://doi.org/10.1177/001316446002000104.
Landis, J. Richard, and Gary G. Koch. 1977. “The Measurement of Observer Agreement for Categorical Data.” Biometrics 33 (1): 159–74. https://doi.org/10.2307/2529310.
Brewer, Eric A. 2000. “Towards Robust Distributed Systems (Abstract).” Proceedings of the Nineteenth Annual ACM Symposium on Principles of Distributed Computing, 7. https://doi.org/10.1145/343477.343502.
Gilbert, Seth, and Nancy Lynch. 2002. “Brewer’s Conjecture and the Feasibility of Consistent, Available, Partition-Tolerant Web Services.” ACM SIGACT News 33 (2): 51–59. https://doi.org/10.1145/564585.564601.
Hermann, Jeremy, and Mike Del Balso. 2017. Meet Michelangelo: Uber’s Machine Learning Platform. Uber Engineering Blog.
Dean, Jeffrey, and Sanjay Ghemawat. 2004. “MapReduce: Simplified Data Processing on Large Clusters.” Proceedings of the 6th Symposium on Operating Systems Design and Implementation (OSDI), 137–50.
Amdahl, Gene M. 1967. “Validity of the Single Processor Approach to Achieving Large Scale Computing Capabilities.” Proceedings of the April 18-20, 1967, Spring Joint Computer Conference on - AFIPS ’67 (Spring), AFIPS ’67 (spring), 483–85. https://doi.org/10.1145/1465482.1465560.
Settles, Burr. 2009. Active Learning Literature Survey. Computer Sciences Technical Report 1648. University of Wisconsin-Madison.