模型服务
模型服务
本章目的
为什么模型服务会改变那些曾使训练取得成功的优化优先级?
训练与模型服务侧重于不同的运行目标。训练通常在大批次、长时间运行中最大化吞吐量,而模型服务必须在延迟目标内响应每个请求。训练将硬件成本分摊到大量样本上;模型服务则为每个请求付出额外开销,微小的低效会在此过程中累积为运维负担。这种转变解释了为什么训练效率高的模型在提供服务时仍可能表现不佳。在线系统受到端到端延迟预算的约束,因此排队、预处理、网络传输和后处理可能抵消仅针对模型本身的优化效果。为充分利用加速器而设计的依赖大批次的架构和内存密集型优化,可能并不适合具有突发性、对延迟要求严格且对成本敏感的生产流量。然而,模型服务所面临的不仅是延迟问题。服务系统必须应对峰谷之间变化的流量,为故障预留余量,在过载时丢弃部分负载或平稳降级,并在请求构成和需求随时间变化时保持可预测性。在训练中证明了价值、并通过压缩和基准测试的模型,最终会进入模型服务层,也就是机器学习生命周期中的部署与集成阶段。此时,问题从模型能否工作,转变为它能否在生产条件下可靠地大规模运行。模型服务基础设施是机器学习系统与用户交互的场所,而维持这种交互所需的工程方法与创建模型时不同。训练完成的算法也正是在这里,在机器的延迟预算内处理实时数据,使数据—算法—机器这三方面的约束汇聚于每个请求。
学习目标
- 解释模型服务如何从训练吞吐量转向每请求延迟、容量余量和尾部行为
- 将请求延迟分解为序列化、预处理、推理、排队、后处理和网络开销
- 应用排队定律和简单队列模型,根据延迟百分位目标规划容量
- 根据预处理、模型加载或缓存行为的不匹配,诊断训练与服务偏差以及冷启动问题
- 根据流量模式和延迟预算选择批处理、负载丢弃、自动扩缩容和运行时策略
- 结合词元延迟、KV 缓存内存和连续批处理约束,评估大语言模型服务的瓶颈
- 根据精度、硬件利用率、副本数量和运行时吞吐量,计算每次推理的成本
模型服务范式
模型服务始于基准测试结束之处。在合成测试框架条件下完成评估的模型,现在必须在真实生产流量下生成预测。在离线训练中,系统通过组织大批次来分摊从高带宽内存(HBM)传输权重的开销,并使矩阵运算单元充分运转,从而最大化总体吞吐量。在在线模型服务中,请求由相互独立的客户端随机发出,且必须在严格的服务级别目标(SLO)内返回结果。因此,工程工作的首要目标从长期吞吐量反转为每请求延迟。这种模型服务目标反转重塑了机器学习系统铁律(\(T = \frac{D_{\text{vol}}}{\text{BW}} + \frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}} + L_{\text{lat}}\))中各项之间的平衡。当应用无法延后请求以组成大批次时,就必须处理小批次或单个输入(\(B=1\))。小批次执行会使算术强度骤降,将受计算能力限制的矩阵乘法转变为受内存带宽限制的数据传输(\(D_{\text{vol}}/\text{BW}\))。与此同时,延迟项 \(L_{\text{lat}}\) 的范围不再局限于微秒级的加速器内核启动,还包括网络传输、请求序列化和主机端编排,并且往往成为端到端响应时间的主要制约因素。
数据—算法—机器分类框架阐明了这种反转如何重塑系统的各个层次。在数据层,约束从数据集总体规模转向实时查询的到达率、载荷新鲜度以及可变的序列维度。在算法层,执行严格限定为前向计算:反向传播状态和优化器内存不再占用加速器,但动态输入形状会给原本静态的算子图引入运行时执行的变化。在机器层,运行目标从最大化硬件利用率转向保留容量余量。离线训练将闲置加速器视为资本浪费,而在线模型服务则将接近饱和的运行状态视为运维风险。由于请求到达服从随机分布,当利用率接近 100% 时,队列长度和等待时间会以非线性方式趋于发散。保持充足的余量,可以保留吸收短时流量峰值所需的备用容量,避免违反尾延迟百分位目标。因此,模型服务优化的是在严格延迟期限内完成的请求量,而非稳态下的硬件占用率。
满足这一延迟期限,决定了工程团队如何划分端到端模型服务栈。一个请求的延迟预算涵盖三个依次执行的阶段:主机端接入与预处理(网络连接终止、载荷反序列化,以及词元化或特征变换)、加速器内核执行,以及下游后处理。未经优化的特征检索或排队延迟每消耗一毫秒,都会直接压缩分配给神经网络本身的执行时间。因此,模型服务的核心工程任务是确定哪些操作必须保留在同步请求路径上,哪些任务可以卸载到异步后台流水线,以及在负载导致尾延迟保证失效之前,系统必须预留多少余量。
模型服务的负载、延迟与架构
Example 1.1: “黑色星期五”流量激增
场景:某电商推荐服务系统在黑色星期五促销活动期间,流量激增至平时的 10×(10,000 QPS)。
诊断:当服务器利用率接近 100 percent 时,队列长度呈非线性爆炸式增长,使延迟升至 10 s,并导致客户端请求超时。
系统启示:较高的平均吞吐量并不能防止流量激增时发生排队崩溃。根据服务的具体情况,为维持尾延迟目标,可能需要在利用率达到该工作负载的排队拐点之前,采取负载丢弃、平稳降级或自动扩缩容措施。
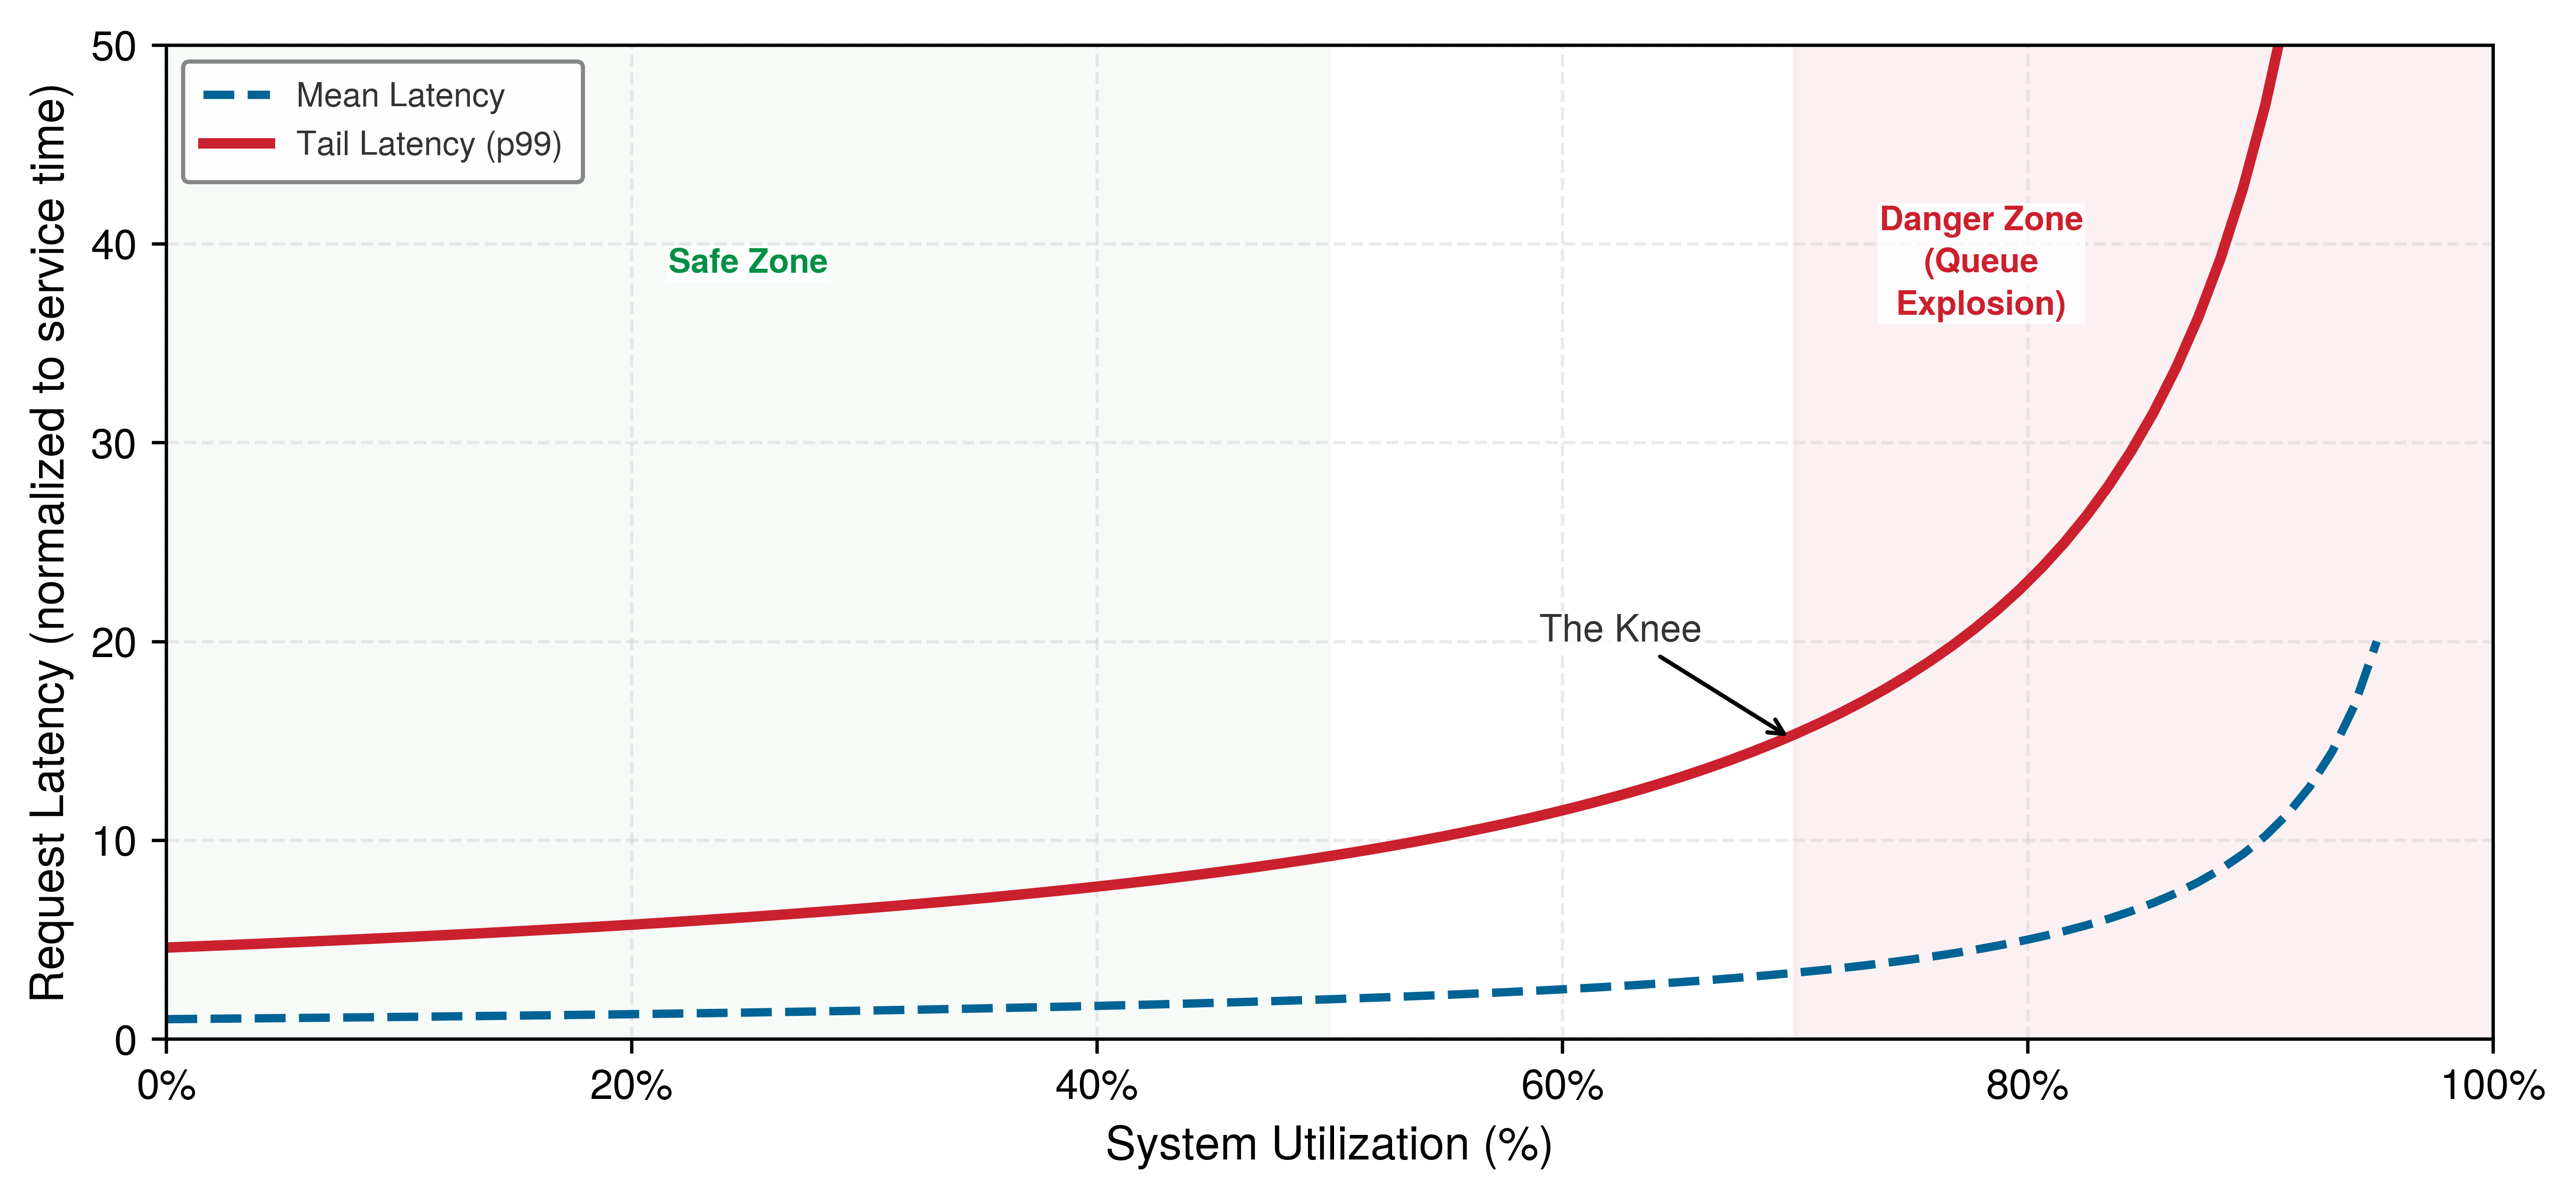
在线模型服务系统处理变化的、未经批处理的请求流,同时受到严格延迟期限的约束。当突发到达的请求耗尽系统预留的余量时,性能会以非线性方式恶化。
Figure 1 表明,在中等利用率下,延迟仍处于可控范围内,而当系统接近饱和时,延迟便会迅速上升;这正是延迟敏感型系统需要预留余量,而不能按加速器持续饱和的状态来规划容量的原因。分布与长尾 从数学角度讨论了长尾分布,并解释了当 SLO 涵盖最慢请求时,高百分位延迟为何重要。该曲线采用简单的排队近似,旨在建立直觉,而非描述某个特定工作负载。
除延迟方面的技术限制外,模型服务的经济性也在迅速变化。随着模型效率提高、硬件更加专用化,每次推理的成本持续下降。1 Facebook 在大规模服务器集群上的实践,展示了模型服务成本问题的规模。
Example 1.2: Facebook 的推理开销
场景:Meta 的生产机器学习服务系统,每天在面向全球用户的各项服务中执行数十万亿次推理 (Hazelwood et al. 2018)。
诊断:持续发生的推理服务计算与能源成本,远远超过最初离线模型训练的支出。实时请求的到达模式和严格的延迟上限限制了 GPU 批处理。
系统启示:训练成本低的模型架构,在大规模服务器集群上提供服务时可能并不可行。生产模型服务基础设施需要软硬件协同设计,以平衡尾延迟、批大小以及持续运维的总拥有成本。
Hazelwood, Kim, Sarah Bird, David Brooks, Soumith Chintala, Utku Diril, Dmytro Dzhulgakov, Mohamed Fawzy, et al. 2018. “Applied Machine Learning at Facebook: A Datacenter Infrastructure Perspective.” 2018 IEEE International Symposium on High Performance Computer Architecture (HPCA), 620–29. https://doi.org/10.1109/hpca.2018.00059.
OpenAI. 2023b. Introducing ChatGPT and Whisper APIs.
OpenAI. 2023a. GPT-4.
OpenAI. 2024. GPT-4o Mini: Advancing Cost-Efficient Intelligence.
OpenAI Developer Community. 2024. Announcing GPT-4o in the API.
Anthropic. 2024. Introducing the Next Generation of Claude.
Google Developers Blog. 2024. Gemini 1.5 Flash Price Drop with Tuning Rollout Complete, and More.
DeepSeek. 2024. Introducing DeepSeek-V3.
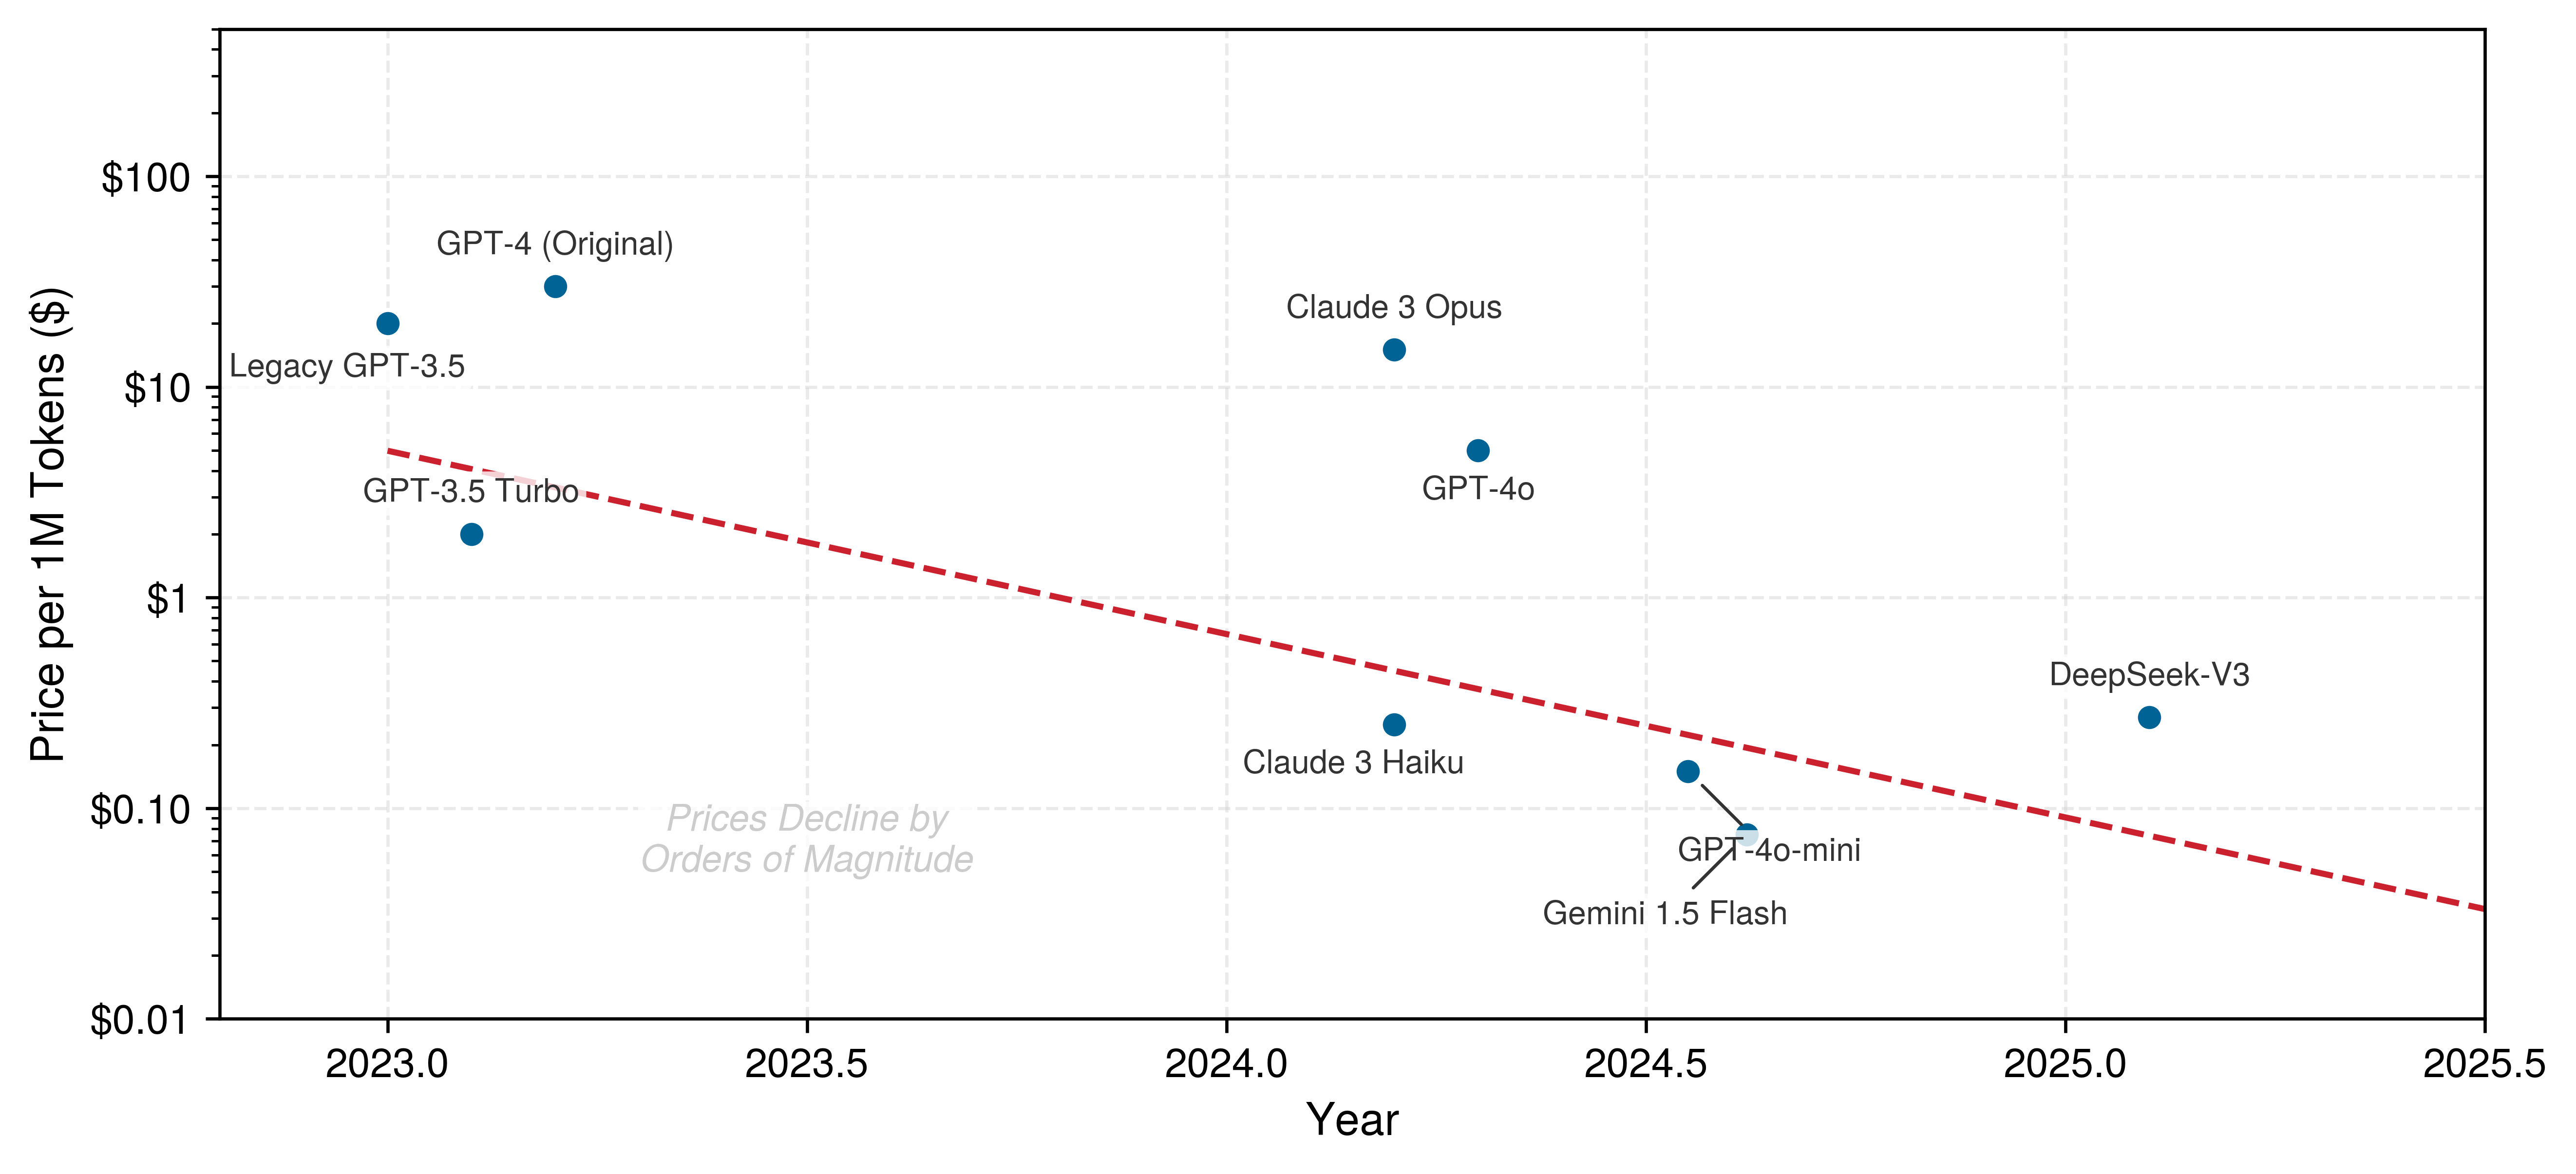
公开 API 价格也反映了同样的模型服务经济压力。figure 2 中采用对数尺度的价格轨迹,将具有代表性的公开 API 标价快照作为市场代理指标,展现了成本骤降的速度。供应商价格频繁变化,因此应将这些数据点视为该趋势的历史依据,而非当前采购建议 (OpenAI 2023b, 2023a, 2024; OpenAI Developer Community 2024; Anthropic 2024; Google Developers Blog 2024; DeepSeek 2024)。价格每下降一个数量级,都会改变哪些应用具备可行性。
如今,两种压力共同界定了模型服务问题:一旦利用率越过排队拐点,尾延迟就会爆炸式增长;与此同时,随着效率提高,每次推理的成本又会下降多个数量级。二者共同要求我们以延迟而非吞吐量为核心,对模型服务作出形式化定义。
Definition 1.1: 模型服务
模型服务 是在延迟、吞吐量、可用性和成本约束下,向最终用户或下游系统提供模型预测的运行阶段。
- 重要性:在线服务将训练中对吞吐量的优先追求(\(\eta_{\text{hw}}\))转变为请求延迟约束 \((L_{\text{lat}})\),要求围绕其 SLO 指定的百分位数设计整个技术栈。
- 区别:模型训练通常处理按计划调度的批次,而模型服务可能需要处理随机到达的在线请求、同步数据流或离线批次。
- 常见误区:一种常见误解是,模型服务“只是前向传播”。实际上,这是一个系统问题:模型执行只是整个技术栈的一个组成部分,该技术栈还可能包括请求路由、负载均衡和数据转换。
SLO2 定义了延迟目标,影响服务栈中的每一项架构决策,并确立了所有请求处理必须完成的严格时间预算。当推理服务器收到请求时,模型执行仅占端到端流水线的一部分:网络接入、载荷反序列化、特征转换、队列调度和输出序列化都会在加速器运行前后消耗时间。Figure 3 展示了原始输入如何依次经过预处理(传统计算)、神经网络推理(深度学习)和后处理(传统计算),最终生成输出。其中任何一个阶段都可能成为延迟瓶颈。Section 1.4.1 精确量化了各环节的耗时,揭示了关于哪些阶段占主导地位的一个反直觉结果。
\begin{tikzpicture}[font=\small\sffamily, >=stealth]
\tikzset{
Box/.style={align=center, inner xsep=2pt,draw=GreenLine, line width=1pt,fill=none,
minimum width=24mm, minimum height=25mm,node distance=1.0},
LineA/.style={BrownLine!70,line width=4.0pt,{-{Triangle[width=1.5*6pt,length=2.0*5pt]}},shorten <=1pt,shorten >=1pt},
ALine/.style={black!50, line width=1.1pt,{{Triangle[width=0.9*6pt,length=1.2*6pt]}-}},
Larrow/.style={fill=violet!50, single arrow,  inner sep=2pt, single arrow head extend=3pt,
            single arrow head indent=0pt,minimum height=10mm, minimum width=3pt}
}
%inbox
\tikzset{%
 pics/inbox/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=INBOX,scale=\scalefac, every node/.append style={transform shape}]
\node[line width=\Linewidth,draw=\drawcolor,fill=\filllcolor!50,
rectangle,rounded corners=3pt,minimum width=14mm,minimum height=10mm]at(0,0.3){};
\node[line width=\Linewidth,draw=\drawcolor,fill=\filllcolor,
rectangle,rounded corners=3pt,minimum width=15mm,minimum height=10mm]at(0,0.1){};
\node[line width=\Linewidth,draw=\drawcolor,fill=\filllcolor!50,
,rectangle,rounded corners=3pt,minimum width=17mm,minimum height=10mm]
at(0,-0.1){};
\draw[line width=\Linewidth,draw=\drawcolor,fill=\filllcirclecolor,,rounded corners=2pt](-0.92,0.05)--
(-0.92,-0.78)--(0.92,-0.78)--(0.92,0.05)--(0.40,0.05)--(0.32,-0.2)--(-0.29,-0.2)--(-0.40,0.05)--cycle;

\node[single arrow, line width=\Linewidth,draw=black,fill=cyan!90!black!30, rotate=270,
      minimum width = 15pt, single arrow head extend=6pt,
      minimum height=10mm]at(0,0.5) {}; % length of arrow
 \end{scope}
     }
  }
}
%brain
\tikzset{pics/brain/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=BRAIN,scale=\scalefac, every node/.append style={transform shape}]
\fill[fill=\filllcolor!50](0.1,-0.5)to[out=0,in=180](0.33,-0.5)
to[out=0,in=270](0.45,-0.38)to(0.45,-0.18)
to[out=40,in=240](0.57,-0.13)to[out=110,in=310](0.52,-0.05)
to[out=130,in=290](0.44,0.15)to[out=90,in=340,distance=8](0.08,0.69)
to[out=160,in=80](-0.42,-0.15)to (-0.48,-0.7)to(0.07,-0.7)to(0.1,-0.5)
(-0.10,-0.42)to[out=310,in=180](0.1,-0.5);
\draw[draw=\drawcolor,line width=\Linewidth](0.1,-0.5)to[out=0,in=180](0.33,-0.5)
to[out=0,in=270](0.45,-0.38)to(0.45,-0.18)
to[out=40,in=240](0.57,-0.13)to[out=110,in=310](0.52,-0.05)
to[out=130,in=290](0.44,0.15)to[out=90,in=340,distance=8](0.08,0.69)
(-0.42,-0.15)to (-0.48,-0.7)
(0.07,-0.7)to(0.1,-0.5)
(-0.10,-0.42)to[out=310,in=180](0.1,-0.5);
\draw[fill=\filllcolor,line width=\Linewidth](-0.3,-0.10)to(0.08,0.60)
to[out=60,in=50,distance=3](-0.1,0.69)to[out=160,in=80](-0.26,0.59)to[out=170,in=90](-0.46,0.42)
to[out=170,in=110](-0.54,0.25)to[out=210,in=150](-0.54,0.04)
to[out=240,in=130](-0.52,-0.1)to[out=300,in=240]cycle;
\draw[fill=\filllcolor,line width=\Linewidth]
(-0.04,0.64)to[out=120,in=0](-0.1,0.69)(-0.19,0.52)to[out=120,in=330](-0.26,0.59)
(-0.4,0.33)to[out=150,in=280](-0.46,0.42)
%
(-0.44,-0.03)to[bend left=30](-0.34,-0.04)
(-0.33,0.08)to[bend left=40](-0.37,0.2) (-0.37,0.12)to[bend left=40](-0.45,0.14)
(-0.26,0.2)to[bend left=30](-0.24,0.13)
(-0.16,0.32)to[bend right=30](-0.27,0.3)to[bend right=30](-0.29,0.38)
(-0.13,0.49)to[bend left=30](-0.04,0.51);

\draw[rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcirclecolor,length=2.5pt]}](-0.23,0.03)--(-0.15,-0.03)--(-0.19,-0.18)--(-0.04,-0.28);
\draw[rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcirclecolor,length=2.5pt]}](-0.17,0.13)--(-0.04,0.05)--(-0.06,-0.06)--(0.14,-0.11);
\draw[rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcirclecolor,length=2.5pt]}](-0.12,0.23)--(0.31,0.0);
\draw[rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcirclecolor,length=2.5pt]}](-0.07,0.32)--(0.06,0.26)--(0.16,0.33)--(0.34,0.2);
\draw[rounded corners=0.8pt,\drawcircle,-{Circle[fill=\filllcirclecolor,length=2.5pt]}](-0.01,0.43)--(0.06,0.39)--(0.18,0.51)--(0.31,0.4);
\end{scope}
     }
  }
}
%llm
\tikzset{
pics/llm/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\node[circle,minimum size=12mm,draw=\drawcolor, fill=\filllcolor!70,line width=0.5*\Linewidth](C\picname) at (0,0){};
\def\startangle{90}
\def\radius{1.15}
\def\radiusI{1.1}
\foreach \i [evaluate=\i as \j using \i+1] [count =\k] in {0,2,4,6,8} {
\pgfmathsetmacro{\angle}{\startangle - \i * (360/8)}
\draw[draw=black,-{Circle[black ,fill=\filllcirclecolor,length=5.5pt,line width=0.5*\Linewidth]},line width=1.5*\Linewidth](C\picname)--++(\startangle - \i*45:\radius) ;
\node[circle,draw=black,fill=\filllcirclecolor!80!red!50,inner sep=3pt,line width=0.5*\Linewidth](2C\k)at(\startangle - \j*45:\radiusI) {};
}
\draw[line width=1.5*\Linewidth](2C1)--++(-0.5,0)|-(2C2);
\draw[line width=1.5*\Linewidth](2C3)--++(0.5,0)|-(2C4);
\node[circle,,minimum size=12mm,draw=\drawcolor, fill=\filllcolor!70,line width=0.5*\Linewidth]at (0,0){};
\node[draw,rectangle,rounded corners=1pt,minimum width=7mm,minimum height=4mm,fill=orange!10](R1)at(0.1,0.1){};
\draw[BrownLine,shorten <=2pt,shorten >=2pt ]($(R1.north west)!0.35!(R1.south west)$)--($(R1.north east)!0.35!(R1.south east)$);
\draw[BrownLine,shorten <=2pt,shorten >=2pt ]($(R1.north west)!0.7!(R1.south west)$)--($(R1.north east)!0.7!(R1.south east)$);
\node[draw,rectangle,rounded corners=1pt,minimum width=6mm,minimum height=4mm,fill=orange!10](R2)at(-0.05,-0.15){};
\draw[BrownLine,shorten <=2pt,shorten >=2pt ]($(R2.north west)!0.35!(R2.south west)$)--($(R2.north east)!0.35!(R2.south east)$);
\draw[BrownLine,shorten <=2pt,shorten >=2pt ]($(R2.north west)!0.7!(R2.south west)$)--($(R2.north east)!0.7!(R2.south east)$);
\end{scope}
    }
  }
}
%funnel
\tikzset{%
 pics/funnel/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=FUNNEL,scale=\scalefac, every node/.append style={transform shape}]
\draw[fill=\filllcolor,line width=\Linewidth,draw=\drawcolor](-0.12,-0.81)--(-0.19,-0.25)--(-0.7,0.41)--(0.7,0.41)--(0.19,-0.25)--(0.12,-0.81)--cycle;
\draw[fill=\filllcolor,line width=\Linewidth,draw=\drawcolor](-0.19,-0.25)--(0.08,-0.25);
\draw[fill=\filllcolor,line width=\Linewidth,draw=\drawcolor](0.16,-0.09)--(0.41,0.31);
%
\node[line width=\Linewidth,draw=\drawcolor,fill=\filllcolor,inner sep=1pt,
rectangle,rounded corners=2pt,minimum width=16mm,minimum height=5pt]at(0,0.5){};
%
\foreach \i in{-0.5,0,0.5}{
\node[single arrow, line width=0.8*\Linewidth,draw=black,fill=\filllcirclecolor, rotate=270,inner sep=1pt,
      minimum width =9pt, single arrow head extend=2pt,
      minimum height=5mm]at(\i,0.9) {}; % length of arrow
   }
\node[single arrow,line width=0.8*\Linewidth,draw=black,fill=\filllcirclecolor, rotate=270,inner sep=1pt,
      minimum width =11pt, single arrow head extend=2pt,
      minimum height=5mm]at(0,-1.1) {}; % length of arrow
 \end{scope}
     }
  }
}
\def\inset{2.0pt} %
\def\myshape{%
  (0,1.34) to[out=220,in=0] (-1.20,1.03) --
  (-1.20,-0.23) to[out=280,in=160] (0,-1.53) to[out=20,in=260] (1.20,-0.23) --
  (1.20,1.03)  to[out=180,in=320] cycle
}
\tikzset{
pics/stitC/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\fill[fill=\filllcolor!60] \myshape;
%
\begin{scope}
  \clip \myshape;
  \draw[draw=\filllcolor!60, line width=3*\inset,fill=white] \myshape; % Color and thickness as desired
\end{scope}
\draw[red,line width=3pt](-0.7,-0.35)--++(320:0.5)--++(50:1.5);
\end{scope}
    }
  }
}
%gear-arrow
% #1 number of teeths
% #2 radius intern
% #3 radius extern
% #4 angle from start to end of the first arc
% #5 angle to decale the second arc from the first
% #6 inner radius to cut off
\tikzset{
  pics/gearAR/.style args={#1/#2/#3/#4/#5/#6/#7}{
   code={
           \pgfkeys{/channel/.cd, #7}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape},
LinE/.style={\filllcirclecolor,line width=5.0pt,
{{Triangle[width=1.5*10pt,length=2.0*5pt]}-},shorten <=5pt,shorten >=1pt},
ELin/.style={\filllcirclecolor,line width=7.0pt,
{-{Triangle[width=1.15*10pt,length=2.0*5pt]}},shorten <=0pt,shorten >=0pt}]
    \pgfmathtruncatemacro{\N}{#1}%,
    \def\rin{#2}\def\rout{#3}\def\aA{#4}\def\aOff{#5}\def\rcut{#6}%
    \path[rounded corners=0.5pt,draw=\drawcolor,fill=\filllcolor]
      (0:\rin)
      \foreach \i [evaluate=\i as \n using (\i-1)*360/\N] in {1,...,\N}{%
        arc (\n:\n+\aA:\rin)
        -- (\n+\aA+\aOff:\rout)
        arc (\n+\aA+\aOff:\n+360/\N-\aOff:\rout)
        -- (\n+360/\N:\rin)
      } -- cycle;
      \draw[draw=none,fill=white](0,0) circle[radius=\rcut];
\draw[ELin](0,0)--++(0:2.5);
\end{scope}
  }}
}
%testing+pencil
\tikzset{
pics/testing/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=TESTING1,shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\newcommand{\tikzxmark}{%
\tikz[scale=0.18] {
    \draw[line width=0.7,line cap=round,RedLine] (0,0) to [bend left=6] (1,1);
    \draw[line width=0.7,line cap=round,RedLine] (0.2,0.95) to [bend right=3] (0.8,0.05);
}}
\newcommand{\tikzxcheck}{%
\tikz[scale=0.16] {
    \draw[line width=0.7,line cap=round,GreenLine] (0.5,0.75)--(0.85,-0.1) to [bend left=16] (1.5,1.55);

}}
 \node[draw, minimum width  =15mm, minimum height = 20mm, inner sep = 0pt,
        rounded corners,draw = \drawcolor, fill=\filllcolor!10, line width=\Linewidth](COM){};
\node[draw=GreenLine,inner sep=4pt,fill=white](CB1) at ($(COM.north west)!0.25!(COM.south west)+(0.3,0)$){};
\node[xshift=0pt]at(CB1){\tikzxcheck};
\node[draw=RedLine,inner sep=4pt,fill=white](CB2) at ($(COM.north west)!0.5!(COM.south west)+(0.3,0)$){};
\node[xshift=0pt]at(CB2){\tikzxmark};
\node[draw=RedLine,inner sep=4pt,fill=white](CB3) at ($(COM.north west)!0.75!(COM.south west)+(0.3,0)$){};
\node[xshift=0pt]at(CB3){\tikzxmark};
\draw[GreenLine,decoration={zigzag,segment length=4pt, amplitude=0.5pt},decorate]($(CB1)+(0.3,0.05)$)--++(0:0.8);
\draw[GreenLine,decoration={zigzag,segment length=4pt, amplitude=0.5pt},decorate]($(CB1)+(0.3,-0.12)$)--++(0:0.7);
\draw[RedLine,decoration={zigzag,segment length=4pt, amplitude=0.5pt},decorate]($(CB2)+(0.3,0.05)$)--++(0:0.8);
\draw[RedLine,decoration={zigzag,segment length=4pt, amplitude=0.5pt},decorate]($(CB2)+(0.3,-0.12)$)--++(0:0.6);
\draw[RedLine,decoration={zigzag,segment length=4pt, amplitude=0.5pt},decorate]($(CB3)+(0.3,0.05)$)--++(0:0.8);
\draw[RedLine,decoration={zigzag,segment length=4pt, amplitude=0.5pt},decorate]($(CB3)+(0.3,-0.12)$)--++(0:0.6);
\end{scope}
    }
  }
}
%pencil
\tikzset{
pics/pencil/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=TESTING1,shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape},rotate=340]
            \fill[fill=\filllcolor!70] (0,4) -- (0.4,4) -- (0.4,0) --(0.3,-0.15) -- (0.2,0) -- (0.1,-0.14) -- (0,0) -- cycle;
            \draw[color=white,thick] (0.2,4) -- (0.2,0);
            \fill[black] (0,3.5) -- (0.2,3.47) -- (0.4,3.5) -- (0.4,4) arc(30:150:0.23cm);
            \fill[fill=\filllcolor!40] (0,0) -- (0.2,-0.8)node[coordinate,pos=0.75](a){} -- (0.4,0)node[coordinate,pos=0.25](b){} -- (0.3,-0.15) -- (0.2,0) -- (0.1,-0.14) -- cycle;
            \fill[fill=\filllcolor] (a) -- (0.2,-0.8) -- (b) -- cycle;

\end{scope}
    }
  }
}
\pgfkeys{
  /channel/.cd,
   Depth/.store in=\Depth,
  Height/.store in=\Height,
  Width/.store in=\Width,
  filllcirclecolor/.store in=\filllcirclecolor,
  filllcolor/.store in=\filllcolor,
  drawcolor/.store in=\drawcolor,
  drawcircle/.store in=\drawcircle,
  scalefac/.store in=\scalefac,
  Linewidth/.store in=\Linewidth,
  picname/.store in=\picname,
  filllcolor=BrownLine,
  filllcirclecolor=violet!20,
  drawcolor=black,
  drawcircle=violet,
  scalefac=1,
  Linewidth=0.5pt,
  Depth=1.3,
  Height=0.8,
  Width=1.1,
  picname=C
}
%Raw Data
\node[Box](B1){};
\fill[cyan!07](B1.north west) rectangle ($(B1.north east)!0.6!(B1.south east)$)coordinate(B1DE);
\fill[cyan!20](B1.south east) rectangle ($(B1.north west)!0.6!(B1.south west)$)coordinate(B1LE);
\node[Box,draw=BlueD](){};
\tikzset{Text2/.style={font=\sffamily\bfseries\small,align=center}}
\node[Text2]at($(B1.south west)!0.5!(B1DE)$){原始数据};
\coordinate(Q1)at($(B1.north west)!0.5!(B1DE)$);
\pic[shift={(0,0)}] at  (Q1){inbox={scalefac=0.7,picname=1,Linewidth=1.0pt,
 filllcolor=BrownL,drawcolor=black,filllcirclecolor=orange!70!yellow!80}};
%Pre-processing
\node[Box, right=0.75 of B1](B2){};
\fill[cyan!07](B2.north west) rectangle ($(B2.north east)!0.6!(B2.south east)$)coordinate(B2DE);
\fill[cyan!20](B2.south east) rectangle ($(B2.north west)!0.6!(B2.south west)$)coordinate(B2LE);
\node[Box, right=0.75 of B1,draw=BlueD](B2){};
\node[Text2]at($(B2.south west)!0.5!(B2DE)$){预\\处理};
\coordinate(Q2)at($(B2.north west)!0.5!(B2DE)$);
\pic[shift={(0,0)}] at  (Q2){funnel={scalefac=0.53,picname=1,Linewidth=0.5pt,
 filllcolor=green!70!orange!70,drawcolor=black,filllcirclecolor=red!70!blue!80}};
%Neural Network
\node[Box, right=of B2](B3){};
\fill[green!07](B3.north west) rectangle ($(B3.north east)!0.6!(B3.south east)$)coordinate(B3DE);
\fill[green!20](B3.south east) rectangle ($(B3.north west)!0.6!(B3.south west)$)coordinate(B3LE);
\node[Box, right=of B2,draw=GreenD](B3){};
\node[Text2]at($(B3.south west)!0.5!(B3DE)$){神经\\ 网络};
\coordinate(Q3)at($(B3.north west)!0.5!(B3DE)$);
%\pic[shift={(0,0)}] at  (Q3){brain={scalefac=0.9,picname=1,filllcolor=orange!30!, Linewidth=0.95pt}};
\pic[shift={(0,0)}] at  (Q3){llm={scalefac=0.6,drawcolor=BlueLine,filllcolor=BlueLine!50!, Linewidth=1pt,filllcirclecolor=red}};
%Raw output
\node[Box, right=of B3](B4){};
\fill[violet!07](B4.north west) rectangle ($(B4.north east)!0.6!(B4.south east)$)coordinate(B4DE);
\fill[violet!20](B4.south east) rectangle ($(B4.north west)!0.6!(B4.south west)$)coordinate(B4LE);
\node[Box, right=of B3,draw=VioletLine](B4){};
\node[Text2]at($(B4.south west)!0.5!(B4DE)$){原始\\ 输出};
\coordinate(Q4)at($(B4.north west)!0.5!(B4DE)$);
 \pic[shift={(0,0)}] at (Q4) {gearAR={14/1.4/1.8/8/4/0.7/scalefac=0.35,drawcolor=BlueLine,filllcolor=BlueLine,filllcirclecolor=red}};
%Post-processing
\node[Box, right=0.75 of B4](B5){};
\fill[violet!05](B5.north west) rectangle ($(B5.north east)!0.6!(B5.south east)$)coordinate(B5DE);
\fill[violet!15](B5.south east) rectangle ($(B5.north west)!0.6!(B5.south west)$)coordinate(B5LE);
\node[Box, right=0.75 of B4,draw=VioletLine](B5){};
\node[Text2]at($(B5.south west)!0.5!(B5DE)$){后\\处理};
\coordinate(Q5)at($(B5.north west)!0.5!(B5DE)$);
\pic[shift={(0,0)}] at  (Q5){testing={scalefac=0.65,picname=1,drawcolor=myblue,filllcolor=myblue, Linewidth=1.0pt}};
\pic[shift={(0,-0.5)},rotate=-15] at  (Q5){pencil={scalefac=0.30,picname=1,filllcolor=mygreen, Linewidth=1.0pt}};
%%%%%%
%Final output
\node[Box, right=0.75 of B5](B6){};
\fill[violet!05](B6.north west) rectangle ($(B6.north east)!0.6!(B6.south east)$)coordinate(B6DE);
\fill[violet!15](B6.south east) rectangle ($(B6.north west)!0.6!(B6.south west)$)coordinate(B6LE);
\node[Box, right=0.75 of B5,draw=VioletLine]{};
\node[Text2]at($(B6.south west)!0.5!(B6DE)$){最终输出};
\coordinate(Q6)at($(B6.north west)!0.5!(B6DE)$);
\pic[shift={(0,0.05)}] at  (Q6){stitC={scalefac=0.45,drawcolor=orange,filllcolor=green!55!black}};
%arrows
\foreach \i in{1,2,3,4,5}{
\pgfmathtruncatemacro{\X}{\i + 1} %
\draw[LineA](B\i)--(B\X);
}
\node[draw=myblue,line width=0.75pt,fit=(B1)(B2),inner ysep=3mm,inner xsep=4mm,xshift=1mm](F1){};
\node[draw=none,fit=(B3),inner ysep=3mm,inner xsep=4mm](F2){};
\node[draw=mypurple,line width=0.75pt,fit=(B4)(B6),inner ysep=3mm,inner xsep=4mm,xshift=-1mm](F3){};
\node[below =0pt of F1,text=myblue]{预处理};
\node[below =0pt of F2,text=GreenD]{深度学习};
\node[below =0pt of F3,text=mypurple]{后处理};

\end{tikzpicture}这条流水线使模型服务成为一个编排问题:由于每个阶段都消耗同一份延迟预算,如果数据转换或排队延迟占主导地位,优化加速器内核执行所带来的收益就会递减。在优化任何单个阶段之前,系统必须先决定预测是提前计算还是按需计算。
静态推理与动态推理
决定在用户请求之前还是在请求期间生成预测,就确立了离线硬件效率与在线运行敏捷性之间的基本权衡 (Google 2024)。这一选择决定了加速器是在不受延迟约束的吞吐量模式下运行,还是在交互式服务循环中受到严格尾延迟期限的约束。
Google. 2024. Static Vs. Dynamic Inference. Google Machine Learning Crash Course.
静态推理
静态推理(也称为离线推理或批量推理)针对预期输入预先计算预测,并将其保存在可供检索的存储系统中。将模型执行完全移出用户请求路径,会改变底层硬件约束:由于批处理作业没有毫秒级的完成期限,加速器可以采用最大批量大小(\(B \gg 1\))运行。大批量通过将从 HBM 传输权重的开销分摊到数千个样本上,最大化算术强度,使计算核心保持饱和。当客户端发出请求时——例如,用户请求每夜生成的推荐排序——服务系统执行低延迟的键值查找,而无需在加速器上执行前向传播。主要运行约束由加速器延迟转向存储容量和数据新鲜度:针对整个输入域预先计算预测,其规模会随输入组合数增长(在推荐系统中为 \(O(|U| \times |I|)\)),而过时的预测会一直保留到下一次批量刷新。
动态推理
动态推理(也称为在线推理或实时推理)在请求到达时按需对输入进行计算。按需执行能够处理符合模型输入模式的任意先前未见输入,并立即反映新部署的模型权重,无需预先计算。然而,直接在用户请求路径中执行模型,会使推理受到严格的端到端延迟预算(即服务级别目标,简称 SLO)约束。由于用户请求随机到达,服务运行时无法无限期推迟执行来积累大批量。逐个处理请求或采用小批量(\(B=1\) 到 \(B=4\))会降低算术强度,使加速器受限于内存带宽:内存总线必须将完整的层权重从内存传输到寄存器,而这些计算仅能利用硬件计算能力的一小部分,直接推高了每次查询的成本。交互式响应时间与硬件效率之间的这种矛盾,使动态服务的每次查询成本显著高于离线批处理(示例 1.3)。
Example 1.3: 延迟的成本
延迟约束直接决定基础设施成本。考虑一台租金为 $4/hour 的 GPU 服务器。
场景 A(低延迟):批大小为 1。
- 延迟:5 ms。
- 吞吐量:200 req/s。
- 每百万次查询的成本:$5.56。
场景 B(高吞吐量):批大小为 8。
- 延迟:10 ms(由于批处理开销而增至两倍)。
- 吞吐量:800 req/s(由于并行效率而增至四倍)。
- 每百万次查询的成本:$1.39。
系统洞察:将延迟从 10 ms 降至 5 ms,会使硬件费用增加 300 percent。工程师必须量化评估,这种加速是否产生了足够的业务价值,足以支撑成本增至原来的 4×。
考虑 ResNet-50 图像分类器的两种部署场景。静态方式适用于照片整理应用,可在夜间对用户图库中的所有图像预先分类。当图库包含 10,000 photos,且每张照片的推理耗时为 5 ms 时,批处理总耗时约为 50 s,用户浏览时即可即时获得分类结果。动态方式适用于内容审核 API,它必须实时分类用户上传的图像,每张图像都需要经过完整的预处理→推理→后处理流水线,延迟预算为 100 ms。生产环境中的图像分类系统可以结合这两种方式:对热门商品或已知网络迷因等频繁请求的图像预先分类并缓存,而新上传的图像则触发动态推理。
因此,这两种模式针对截然不同的运行条件进行优化。静态推理在离线批处理期间最大化加速器吞吐量并摊薄执行成本,以存储容量换取请求期间的零推理延迟。动态推理则在随机并发负载下最小化尾延迟,以较低的加速器利用率和较高的单次查询成本,换取处理任意实时输入的能力。生产架构通常将这两种范式融合为分层设计:通过静态预计算缓存常见或高概率查询,并由动态回退路径处理新颖或个性化请求。
静态和动态成本模型传统上都假定前向传播是固定的:每次请求执行一次静态计算图。新兴推理模型则通过有意为每次查询投入可变的计算量来提升回答质量,从而改变了这种经济权衡。
Systems Perspective 1.1: 展望:为每次查询投入更多计算
传统模型服务以最小化延迟为优化目标 \((L_{\text{lat}} \to 0)\)。在这里,优化目标扩展为同时涵盖回答质量。一些推理时计算系统会有意投入更多计算周期,以提升回答质量。在小批量下,词元生成通常受内存带宽限制,但更大的批量或更长的上下文可能使瓶颈转向计算或 KV 缓存数据传输。这些系统每次请求可能生成多得多的词元,包括中间推理词元或搜索词元,从而增加每次查询的总计算量和能耗。
无论系统执行的是一次确定性前向传播,还是一条延长的推理轨迹,决定何时计算预测结果,都只解决了模型服务的时间维度问题。同样具有约束力的是空间维度——模型实际在何处执行——因为物理部署位置决定了内存层次结构的限制、网络边界,以及模型服务栈可用的硬件预算。
模型服务架构谱系
尽管“模型服务”通常意味着由联网服务器处理 API 请求,但其架构模式随部署环境而变化。部署范式框架 介绍了四种部署范式(云端、边缘端、移动端和 TinyML),以及促成这些范式的物理约束(光速屏障、功耗墙和内存墙)。从架构上看,模型服务形成了一条连续谱系:从集中式联网微服务(汇聚加速器以优化吞吐量和单次查询成本,代价是网络往返开销和冷启动延迟),到嵌入应用的边缘模型服务(通过直接函数调用在客户端进程内运行模型,消除网络延迟并保护隐私,代价是受到严格的设备内存和功耗约束),再延伸到微控制器上的裸机固件执行。这些约束不会在模型服务阶段消失;模型服务在硬件限制之上又叠加了延迟 SLO 和成本压力,而训练阶段尚可通过延长等待时间来容忍这些硬件限制。同一个模型可能因执行位置不同而需要不同的服务策略。
联网模型服务(云端/数据中心)
在联网模型服务中,模型作为独立服务(微服务)运行,对应于 云端机器学习:计算能力 所描述的云部署范式,即以延迟为代价换取更大规模的汇聚算力。其主要接口是采用 HTTP 或 gRPC 等协议的网络,因此,除模型执行外,网络传输和序列化也可能成为关键约束。NVIDIA GPU(V100、A100、H100)、Google 张量处理单元(TPU)和 AWS Inferentia 等数据中心硬件支持高吞吐量的批处理与并发,但冷启动仍可能持续数秒至数分钟,因为容器启动、模型加载和预热都处于稳态推理路径之外。
嵌入应用的模型服务(移动端/边缘端)
在嵌入应用的模型服务中,模型在用户应用进程内运行(例如使用 CoreML 或 TensorFlow Lite 的智能手机应用),遵循 边缘机器学习:延迟与隐私 和 移动机器学习:离线智能 所分析的嵌入式范式,发挥其在延迟、隐私和离线运行方面的优势。这里没有“服务器”。接口是函数调用,因此优化重点是能耗和响应能力(SingleStream),而非共享服务器的吞吐量。
嵌入式执行支持零拷贝推理:当数据在系统中流动时,每次复制都会消耗 CPU 周期和内存带宽。在云端模型服务中,彼此独立的物理内存空间迫使数据反复传输:相机帧从网络套接字缓冲区传到用户空间,经预处理缓冲区进入页锁定的主机 DRAM,再通过 PCIe 传入加速器内存。当移动端流水线中的相机、图像信号处理器(ISP)、CPU 和 NPU 在统一系统内存中交换共享缓冲区描述符时,就可以消除这些中间复制。在统一内存的片上系统(SoC)架构中,例如 Apple A 系列和 M 系列处理器或 Qualcomm Snapdragon,所有计算引擎共享同一个物理 DRAM 池。当软件传递缓冲区句柄而非复制字节时,推理延迟会降低,内存总线功耗也会下降,但格式转换仍可能需要 CPU 或 ISP 介入。
典型硬件包括移动端 NPU(Apple Neural Engine、Qualcomm Hexagon)和嵌入式 GPU(NVIDIA Jetson)。当模型已驻留内存且完成编译时,启动时间可按毫秒计;如果首次推理触发冷页缺页异常或即时编译,则耗时更长。移动设备的功耗与散热范围受到被动散热能力的严格限制(1–10 W);持续的高吞吐量推理会耗尽设备机身的蓄热容量,迫使操作系统的温控调节器降低时钟频率,导致推理延迟增大。
裸机模型服务(TinyML)
在 TinyML 模型服务中,模型直接编译进微控制器固件,处于部署谱系的极端一端,即 TinyML:泛在感知 所介绍的在微瓦级功耗预算下实现泛在感知。许多部署没有通用操作系统或动态内存分配器;模型服务以紧凑的裸机循环执行,采样传感器并调用静态解释器。由于静态随机存取存储器(SRAM)容量仅为数百千字节,优化重点是在非易失性闪存中就地使用模型权重进行执行,同时将动态激活缓冲区容纳在预先分配的 Tensor Arena 中。对于单流传感器数据输入,请求批处理不可行。典型硬件包括 ARM Cortex-M 系列、ESP32 和专用 TinyML 加速器。当权重保留在内存映射闪存中,且执行缓冲区以静态方式预先分配时,启动延迟以微秒计;系统在微瓦至毫瓦级功耗范围内运行,使电池续航达到数月乃至数年。
各部署层级首先在运行条件范围上有所不同。Table 1 比较了各环境所带来的延迟、批量、内存、功耗、更新、故障和监控约束。
| 特征 | 云端/数据中心 | 移动端/边缘端 | TinyML |
|---|---|---|---|
| 延迟目标 | 10–100 ms | 20–50 ms | 1–100 ms |
| 批大小 | 1–128(动态) | 1(固定) | 1(固定) |
| 内存 | 16–80 GB 显存 | 2–8 GB 共享内存 | 256 KB–2 MB SRAM |
| 功耗 | 300–700 W | 1–10 W | 1–100 mW |
| 更新机制 | 容器部署 | 应用商店更新 | 固件空中更新(OTA) |
| 故障模式 | 重试/故障转移 | 优雅降级 | 静默故障或复位 |
| 监控 | 完整遥测 | 有限的分析能力 | 仅心跳检测 |
Systems Perspective 1.2: ResNet-50 在模型服务谱系中的部署
系统洞察:“同一个模型”的说法具有误导性:云端和移动端层级共享 ResNet-50 计算图,但采用不同的精度和运行时,而 TinyML 层级无法运行 ResNet-50,必须替换为针对其约束设计的架构。将它们视为同一个模型,会掩盖使各类部署成为可能的工程工作。
将这些运行条件范围应用于同一项图像分类工作负载,table 2 展示了为何云端和移动端能够适配 ResNet-50,而 TinyML 必须改用 MobileNetV2。
| 维度 | Cloud | Mobile | TinyML |
|---|---|---|---|
| 模型格式 | TensorRT FP16 引擎 | TensorFlow Lite INT8 | 不可行(25.6 MB);替代方案:MobileNetV2 INT8(3.5 MB) |
| 推理(批大小为 1) | 1.4 ms(批大小为 16:14 ms) | 12 ms(NPU),45 ms(CPU) | 120 ms |
| 吞吐量 | 1,143 img/s(批处理) | ~80 img/s(单流) | ~8 img/s |
| 内存 | 2 GB 显存(批大小为 32) | 峰值为 150 MB(与应用共享) | 320 KB 内存池(可容纳于 512 KB SRAM 中) |
| 单次推理能耗 | — | 0.8 mJ(NPU),4.2 mJ(CPU) | 12 mJ |
负载均衡器层
当流量超出单台机器的处理能力时,运行同一模型多个副本的云端和数据中心部署就需要一个额外的基础设施层:负载均衡器。生产服务系统将负载均衡器置于客户端与模型服务器之间,为服务基础设施提供三项基本功能。
服务负载均衡器承担三项核心职责。首先,请求分发使用轮询或最少连接等算法,将传入流量路由至可用的模型副本;避开缓慢或饱和的副本可以直接抑制尾延迟。其次,健康监测通过检查进程存活状态和模型初始化状态来验证副本是否就绪,确认权重已加载且预热运行已完成后,才允许流量进入。第三,部署支持通过在模型版本之间逐步转移流量来实现渐进式发布,避免突然切换。模型部署 将这些流量转移机制进一步扩展为完整的验证策略。
对于包含多个模型实例的单机服务,例如运行多个开放神经网络交换格式(ONNX)Runtime 会话,请求排队由框架和操作系统处理。当扩展至多台机器服务同一模型的分布式推理系统时,才需要引入完整而复杂的负载均衡机制。请求分发算法和多副本架构的实现细节属于这一分布式场景。
在单机容量规划中,服务单元对应于物理节点的模型吞吐量。section 1.5 中分析的排队动态决定了这一基线行为,并确立了必须进行水平扩展的利用率边界。
负载均衡器负责在副本之间分发请求,而要实现可预测的延迟,还需要控制每台机器内部的运行行为。操作系统环境本身也会引入变异来源。
确定性延迟与资源隔离

一个噪声邻居就会扰动共享该节点的所有工作负载。
推理服务器并非在专用且不受干扰的环境中执行。在单台主机上,操作系统在后台遥测守护进程、日志代理和内核工作线程之间复用硬件。当这些未经隔离的进程争用执行资源时,它们会间歇性地抢占推理流水线。这些噪声邻居是延迟抖动的主要来源,使执行相同前向传播所需的实际时间发生不可预测的波动。即使平均硬件利用率仍然较低,这种争用也会推高第 99 百分位(p99)尾延迟。因此,资源争用通过服务时间方差增大尾延迟;这种物理层面的性能退化不同于 figure 1 中分析的排队延迟累积。
实现确定性性能需要消除操作系统默认分时启发式策略带来的干扰。Clockwork 等服务系统表明,一旦系统性地消除硬件争用,深度神经网络(DNN)推理执行时间本身就具有可预测性,其误差可控制在亚毫秒范围内 (Gujarati et al. 2020)。CPU 亲和性(线程绑定)通过将推理工作线程绑定到指定物理核心,确立基本的计算资源边界。若不进行绑定,操作系统调度器会周期性地将线程迁移到不同核心,使私有 L1 和 L2 缓存失效,并迫使执行停顿,等待从共享 L3 缓存或 DRAM 重新取回缓存行。在多插槽架构中,跨非统一内存访问(NUMA)边界的线程迁移代价更高:指令必须通过插槽间互连访问内存,每次事务会增加数十纳秒的延迟。将线程绑定到特定核心,并将其内存分配绑定到本地 NUMA 节点,可以保持数据驻留于缓存,并消除跨插槽总线流量。
即使 CPU 核心已绑定,内存访问延迟仍可能受到虚拟内存子系统的影响。在主机内存压力下,内核可能将不活跃的地址范围换出到磁盘。当 CPU 或 PCIe 直接内存访问(DMA)引擎访问已换出的地址时,执行会停顿数毫秒,等待存储控制器通过缺页处理将物理页重新载入 DRAM。内存锁定(mlock)指示内核将指定虚拟地址范围固定在主机物理 RAM 中,禁止页面换出,从而保证能够立即访问驻留于主机的权重、输入暂存缓冲区以及卸载至主机的键值(KV)缓存块。这种保证以牺牲主机物理内存分配的灵活性来换取确定性,因为被锁定的页面无法由其他进程回收。由于 mlock 严格作用于主机页表,因此不适用于由加速器驱动程序直接分配的加速器 HBM。
除被调度的进程之外,异步硬件中断也是亚毫秒级抢占的另一来源。当网络接口卡(NIC)接收到突发数据包时,会触发硬件中断请求(IRQ),迫使处理中断的 CPU 核心立即暂停用户空间执行,转而运行内核中断处理程序。如果操作系统将这些中断路由到运行推理引擎提交循环的核心,CPU 就会暂停向加速器派发命令。由于 GPU 以微秒级时间处理较短的推理层,即使短暂的 CPU 提交停顿也会耗尽加速器硬件命令环形缓冲区中的待执行命令,造成流水线气泡,使计算单元空闲等待下一个内核描述符。中断屏蔽将 IRQ 亲和性限制在专用的系统维护核心上,防止传入网络流量和磁盘活动抢占 GPU 派发流。
隔离物理核心、锁定主机内存以及屏蔽中断线路可以消除操作系统噪声,将不稳定的执行路径转化为可预测、具有确定性的前向传播。然而,在单个节点上建立服务时间的确定性,只解决了模型服务挑战的一半。虽然硬件隔离可以保证加速器内核在不受主机侧干扰的情况下执行,但按顺序逐个运行请求会使庞大的张量计算流水线利用率严重不足。为了在延迟期限内实现高吞吐量,服务引擎的内部软件架构必须将不规则的异步请求流组织成结构化批次,使硬件达到饱和。
服务系统架构
虽然主机隔离确保了单个内核执行的确定性,但生产服务在系统边界处面临供需特征不匹配的问题。用户请求随机到达——可能在几毫秒内突发到达,随后数秒没有请求——而加速器计算引擎需要持续接收形状一致的稠密批次流,才能充分利用内存带宽和功能单元。弥合这一差距需要专门的服务架构,将网络接入与执行调度解耦,吸收突发到达的请求,并在不违反延迟 SLO 的前提下,将不规则输入打包为稠密批次。
内部架构与请求流
推理服务器3(例如 NVIDIA Triton 或 TensorFlow Serving)充当专用的运行时调度器,负责管理并发、设备内存,以及主机 CPU 与加速器设备之间的数据移动。服务器不会在请求到达时同步调用模型执行,而是让传入请求以流水线方式经过专用子系统,将客户端网络处理与加速器计算隔离开来。每个请求都会经过一个多阶段流水线,该流水线旨在最大化硬件吞吐量,同时限制排队延迟。Figure 4 将六个阶段分别展示,明确各组件在吸收流量、排队、批处理和加速器执行中的作用。
\begin{tikzpicture}[font=\small\sffamily]
  \tikzset{
    Box/.style={draw=none,minimum width=20mm, minimum height=15mm, node distance=18mm},
    Arr/.style={-{Triangle[width=10pt,length=8pt]}, line width=5pt,cyan!40,shorten >=1pt, shorten <=2pt},
 Box2/.style={align=flush center, inner xsep=2pt,draw=OrangeLine,
  font=\fontsize{7pt}{9}\sffamily,
    line width=0.75pt, rounded corners,fill=OrangeL!30, text width=16mm,
    minimum width=16mm, minimum height=9mm},
LineA/.style = {violet!60,{Circle[line width=1.0pt,fill=white,length=5.5pt]}-,line width=1.5pt,shorten <=-3pt}
}
%laptop
\tikzset{
pics/laptop/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\node[rounded corners=2pt,rectangle,minimum width=60,minimum height=37,
fill=\filllcolor!60,line width=\Linewidth,draw=black](EKV)at(0,0.53){};
%
\node[draw=black,rounded corners=2pt,rectangle,minimum width=53,minimum height=30,
fill=\filllcolor!10,line width=\Linewidth,](EK)at(0,0.53){};
\coordinate(SM1)at($(EK.south west)+(0.15,0.5)$);
\coordinate(SM2)at($(EK.south east)+(-1.1,0.5)$);
\coordinate(OK1)at($(EK.220)+(0,0.7)$);
\coordinate(OK2)at($(EK.240)+(0,0.7)$);
\node[fill=black,inner sep=0pt,ellipse,minimum width=2pt,minimum height=3pt](OKO1)at(OK1){};
\node[fill=black,inner sep=0pt,ellipse,minimum width=2pt,minimum height=3pt](OKO2)at(OK2){};
\draw[line width=1.4pt](SM1)to [bend right=45](SM2);
%%
\coordinate(4BL)at($(EK.south west)+(0.95,0.3)$);
    \def\n{5}          % broj boksova
    \def\w{0.12}        % širina boksa (mm)
    \def\h{0.5}       % visina boksa (mm)
    \def\gap{0.05}      % razmak između boksova (mm)
    % niz boksova
    \foreach \i in {0,...,4} {
      \pgfmathsetmacro{\x}{\i*(\w+\gap)}
      % popuna (klipujemo unutar ivica)
      \begin{scope}
        \clip[] ($(4BL)+(\x,0)$) rectangle ++(\w,\h);
        \fill[gray!10]($(4BL)+(\x,0)$) rectangle ++(\w,\h*1);
        \fill[fill=\filllcirclecolor]($(4BL)+(\x,0)$) rectangle ++(\w,\h*\Level);
      \end{scope}
      % kontura preko
      \draw[line width=0.6pt,draw=black]($(4BL)+(\x,0)$)  rectangle ++(\w,\h);
    }
%
\draw[fill=\filllcolor!60!black!30,line width=\Linewidth](-1.00,-0.1)--(1.0,-0.1)--(1.28,-0.6)--(-1.28,-0.6)--cycle;
\draw[fill=\filllcolor!60!black!30,line width=\Linewidth](1.28,-0.6)--(-1.28,-0.6)arc[start angle=180, end angle=270, radius=4pt]--(1.14,-0.73)
arc[start angle=270, end angle=355, radius=4pt]--cycle;
\draw[fill=\filllcolor!30!black!10,line width=\Linewidth](-0.95,-0.17)--(0.95,-0.17)--(1.03,-0.34)--(-1.03,-0.34)--cycle;
\draw[fill=\filllcolor!30!black!20,line width=\Linewidth](-0.16,-0.52)--(0.16,-0.52)--(0.14,-0.42)--(-0.14,-0.42)--cycle;
\end{scope}
    }
  }
}

\tikzset {
pics/gatewey/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=GAT,scale=\scalefac, every node/.append style={transform shape}]
\def\rI{4mm}
\def\rII{2.8mm}
\def\rIII{1.6mm}
\draw[draw=\drawcolor,line width=0.8*\Linewidth](0,0)--(0,0.38)--(1.2,0.38)--(1.2,0)--cycle;
\draw[draw=\drawcolor,line width=\Linewidth](0.6,0.4)--(0.6,0.9);

 \draw[draw=\drawcolor, line width=\Linewidth] (0.6,0.9)+(60:\rI) arc[start angle=60, end angle=-60, radius=\rI];
\draw[draw=\drawcolor, line width=\Linewidth] (0.6,0.9)+(50:\rII) arc[start angle=50, end angle=-50, radius=\rII];
\draw[draw=\drawcolor, line width=\Linewidth] (0.6,0.9)+(30:\rIII) arc[start angle=30, end angle=-30, radius=\rIII];
%
 \draw[draw=\drawcolor, line width=\Linewidth] (0.6,0.9)+(120:\rI) arc[start angle=120, end angle=240, radius=\rI];
\draw[draw=\drawcolor, line width=\Linewidth] (0.6,0.9)+(130:\rII) arc[start angle=130, end angle=230, radius=\rII];
\draw[draw=\drawcolor, line width=\Linewidth] (0.6,0.9)+(150:\rIII) arc[start angle=150, end angle=210, radius=\rIII];
\fill[fill=\filllcolor](0.6,0.9)circle (1.5pt);

\foreach\i in{0.15,0.3,0.45,0.6}{
\fill[fill=\filllcolor](\i,0.19)circle (1.5pt);
}

\fill[fill=\filllcolor](1,0.19)circle (2pt);
\end{scope}
}
}
}
\tikzset {
pics/cpu/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box = CPU,scale=\scalefac, every node/.append style={transform shape}]
\node[fill=\filllcolor,minimum width=66, minimum height=66,
            rounded corners=2,outer sep=2pt] (C1) {};
\node[fill=\filllcirclecolor,minimum width=54, minimum height=54] (C2) {\bfseries\Large  GPU};

\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=\filllcolor,minimum width=4, minimum height=15,
           inner sep=0pt,anchor=south](GO\y)at($(C1.north west)!\x!(C1.north east)$){};
}
\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=\filllcolor,minimum width=4, minimum height=15,
           inner sep=0pt,anchor=north](DO\y)at($(C1.south west)!\x!(C1.south east)$){};
}
\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=\filllcolor,minimum width=15, minimum height=4,
           inner sep=0pt,anchor=east](LE\y)at($(C1.north west)!\x!(C1.south west)$){};
}
\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=\filllcolor,minimum width=15, minimum height=4,
           inner sep=0pt,anchor=west](DE\y)at($(C1.north east)!\x!(C1.south east)$){};
}
\end{scope}
    }
  }
}
\tikzset{pics/brain/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=BRAIN,scale=\scalefac, every node/.append style={transform shape}]
\fill[fill=\filllcolor!50](0.1,-0.5)to[out=0,in=180](0.33,-0.5)
to[out=0,in=270](0.45,-0.38)to(0.45,-0.18)
to[out=40,in=240](0.57,-0.13)to[out=110,in=310](0.52,-0.05)
to[out=130,in=290](0.44,0.15)to[out=90,in=340,distance=8](0.08,0.69)
to[out=160,in=80](-0.42,-0.15)to(-0.48,-0.7)to(0.07,-0.7)to(0.1,-0.5)
to(-0.10,-0.42)to[out=310,in=180](0.1,-0.5);
\draw[draw=\drawcolor,line width=\Linewidth](0.1,-0.5)to[out=0,in=180](0.33,-0.5)
to[out=0,in=270](0.45,-0.38)to(0.45,-0.18)
to[out=40,in=240](0.57,-0.13)to[out=110,in=310](0.52,-0.05)
to[out=130,in=290](0.44,0.15)to[out=90,in=340,distance=8](0.08,0.69)
to(-0.42,-0.15)to(-0.48,-0.7)
(0.07,-0.7)to(0.1,-0.5)
(-0.10,-0.42)to[out=310,in=180](0.1,-0.5);
\draw[fill=\filllcolor,line width=\Linewidth](-0.3,-0.10)to(0.08,0.60)
to[out=60,in=50,distance=3](-0.1,0.69)to[out=160,in=80](-0.26,0.59)to[out=170,in=90](-0.46,0.42)
to[out=170,in=110](-0.54,0.25)to[out=210,in=150](-0.54,0.04)
to[out=240,in=130](-0.52,-0.1)to[out=300,in=240]cycle;
\draw[fill=\filllcolor,line width=\Linewidth]
(-0.04,0.64)to[out=120,in=0](-0.1,0.69)(-0.19,0.52)to[out=120,in=330](-0.26,0.59)
(-0.4,0.33)to[out=150,in=280](-0.46,0.42)
%
(-0.44,-0.03)to[bend left=30](-0.34,-0.04)
(-0.33,0.08)to[bend left=40](-0.37,0.2) (-0.37,0.12)to[bend left=40](-0.45,0.14)
(-0.26,0.2)to[bend left=30](-0.24,0.13)
(-0.16,0.32)to[bend right=30](-0.27,0.3)to[bend right=30](-0.29,0.38)
(-0.13,0.49)to[bend left=30](-0.04,0.51);

\draw[rounded corners=0.8pt,line width=\Linewidth,\drawcircle,-{Circle[fill=\filllcirclecolor,length=3.5pt]}](-0.23,0.03)--(-0.15,-0.03)--(-0.19,-0.18)--(-0.04,-0.28);
\draw[rounded corners=0.8pt,line width=\Linewidth,\drawcircle,-{Circle[fill=\filllcirclecolor,length=3.5pt]}](-0.17,0.13)--(-0.04,0.05)--(-0.06,-0.06)--(0.14,-0.11);
\draw[rounded corners=0.8pt,line width=\Linewidth,\drawcircle,-{Circle[fill=\filllcirclecolor,length=3.5pt]}](-0.12,0.23)--(0.31,0.0);
\draw[rounded corners=0.8pt,line width=\Linewidth,\drawcircle,-{Circle[fill=\filllcirclecolor,length=3.5pt]}](-0.07,0.32)--(0.06,0.26)--(0.16,0.33)--(0.34,0.2);
\draw[rounded corners=0.8pt,line width=\Linewidth,\drawcircle,-{Circle[fill=\filllcirclecolor,length=3.5pt]}](-0.01,0.43)--(0.06,0.39)--(0.18,0.51)--(0.31,0.4);
\end{scope}
     }
  }
}
%inbox
\tikzset{%
 pics/inbox/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=INBOX,scale=\scalefac, every node/.append style={transform shape}]
\node[line width=\Linewidth,draw=\drawcolor,fill=\filllcolor!50,
rectangle,rounded corners=3pt,minimum width=14mm,minimum height=10mm]at(0,0.3){};
\node[line width=\Linewidth,draw=\drawcolor,fill=\filllcolor,
rectangle,rounded corners=3pt,minimum width=15mm,minimum height=10mm]at(0,0.1){};
\node[line width=\Linewidth,draw=\drawcolor,fill=\filllcolor!50,
rectangle,rounded corners=3pt,minimum width=17mm,minimum height=10mm]
at(0,-0.1){};
\draw[line width=\Linewidth,draw=\drawcolor,fill=\filllcirclecolor,rounded corners=2pt](-0.92,0.05)--
(-0.92,-0.78)--(0.92,-0.78)--(0.92,0.05)--(0.40,0.05)--(0.32,-0.2)--(-0.29,-0.2)--(-0.40,0.05)--cycle;

\node[single arrow, line width=\Linewidth,draw=black,fill=green!80!black!50, rotate=270,
      minimum width = 15pt, single arrow head extend=6pt,
      minimum height=10mm]at(0,0.5) {}; % length of arrow
 \end{scope}
     }
  }
}
%funnel
\tikzset{%
 pics/funnel/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=FUNNEL,scale=\scalefac, every node/.append style={transform shape}]
\draw[fill=\filllcolor!50,line width=\Linewidth,draw=\drawcolor](-0.12,-0.81)--(-0.19,-0.25)--(-0.7,0.41)--(0.7,0.41)--(0.19,-0.25)--(0.12,-0.81)--cycle;
\draw[fill=\filllcolor!50,line width=\Linewidth,draw=\drawcolor](-0.19,-0.25)--(0.08,-0.25);
\draw[fill=\filllcolor!50,line width=\Linewidth,draw=\drawcolor](0.16,-0.09)--(0.41,0.31);
%
\node[line width=\Linewidth,draw=\drawcolor,fill=\filllcolor!50,inner sep=1pt,
rectangle,rounded corners=2pt,minimum width=16mm,minimum height=5pt]at(0,0.5){};
%
\foreach \i in{-0.5,0,0.5}{
\node[single arrow, line width=0.8*\Linewidth,draw=black,fill=cyan!90!black!30, rotate=270,inner sep=1pt,
      minimum width =9pt, single arrow head extend=2pt,
      minimum height=3.5mm]at(\i,0.83) {}; % length of arrow
   }
\node[single arrow,line width=0.8*\Linewidth,draw=black,fill=\filllcirclecolor, rotate=270,inner sep=1pt,
      minimum width =11pt, single arrow head extend=2pt,
      minimum height=4mm]at(0,-1.05) {}; % length of arrow
 \end{scope}
     }
  }
}
\pgfkeys{
  /channel/.cd,
   Depth/.store in=\Depth,
  Height/.store in=\Height,
  Width/.store in=\Width,
  Level/.store in=\Level,
  filllcirclecolor/.store in=\filllcirclecolor,
  filllcolor/.store in=\filllcolor,
  drawcolor/.store in=\drawcolor,
  drawcircle/.store in=\drawcircle,
  scalefac/.store in=\scalefac,
  Linewidth/.store in=\Linewidth,
  picname/.store in=\picname,
  filllcolor=BrownLine,
  filllcirclecolor=cyan!40,
  drawcolor=black,
  drawcircle=violet,
  scalefac=1,
  Level=0.52,
  Linewidth=0.5pt,
  Depth=1.3,
  Height=0.8,
  Width=1.1,
  picname=C
}

\node[Box, fill=white](B1){};
 \pic[shift={(0,-0.10)}] at  (B1){laptop={scalefac=0.67,picname=1,drawcolor=GreenD,
filllcolor=GreenD!70!,Linewidth=0.75pt, filllcirclecolor=red!80}};

\node[Box, fill=white,right=of B1,minimum width=16mm](B2){};
\pic[shift={(-0.68,-0.57)}] at  (B2){gatewey={scalefac=1.1,picname=1,drawcolor=green!50!black,
filllcolor=red!,Linewidth=1.5pt, filllcirclecolor=red!80}};

\node[Box, fill=white,right=of B2,minimum width=14mm](B3){};
\pic[shift={(0,0.07)}] at  (B3){brain={scalefac=1.0,picname=1,filllcolor=orange!30!, Linewidth=1pt}};

\node[Box, fill=white,right=of B3,minimum width=16mm](B4){};
\pic[shift={(0,-0.06)}] at  (B4){inbox={scalefac=0.7,picname=1,Linewidth=1.0pt,
 filllcolor=BrownL,drawcolor=black,filllcirclecolor=orange!70!yellow!80}};

\node[Box, fill=white,below=1 of B4,minimum width=17mm,minimum height=22mm](B5){};
 \pic[shift={(0,0.17)}] at  (B5){funnel={scalefac=0.9,picname=1,Linewidth=1.0pt,
 filllcolor=BrownL,drawcolor=black,filllcirclecolor=green!70!yellow!80}};

\node[Box, fill=white,below=0.8 of B5,minimum width=17mm](B6){};
\pic[shift={(0,0)}] at  (B6){cpu={scalefac=0.4,picname=1,drawcolor=GreenD,
filllcolor=BlueD!70!,Linewidth=0.75pt, filllcirclecolor=brown!20}};

\draw[Arr](B1)--(B2);
\draw[Arr](B2)--(B3);
\draw[Arr](B3)--(B4);
\draw[Arr,shorten <=5pt](B4)--(B5);
\draw[Arr](B5)--(B6);

\draw[violet,line width=1.5pt](B1.south west)--coordinate(S1)(B1.south east);
\draw[violet,line width=1.5pt](B2.south west)--coordinate(S2)(B2.south east);
\draw[violet,line width=1.5pt](B3.south west)--coordinate(S3)(B3.south east);
\draw[violet,line width=1.5pt](B4.south west)--coordinate(S4)(B4.south east);
\draw[violet,line width=1.5pt](B5.south west)--coordinate[pos=0.25](S5)(B5.north west);
\draw[violet,line width=1.5pt](B6.south west)--coordinate(S6)(B6.north west);

\node[Box2,anchor=north,below= 0.6of S1](CR){客户端\\(请求)};
\draw[LineA](S1)--(CR);

\node[Box2,text width=25mm,right=0.75 of CR](NI){网络入口\\(HTTP/gRPC)};
\draw[LineA](S2)--(NI);

 \draw[LineA](S3)--++(210:1.15);
 \node[Box2,right=0.55 of NI](RQT){请求\\队列};

\node[Box2,right=0.4 of RQT](DBT){动态\\批处理器};
\draw[LineA](S4)--(DBT);

\node[Box2,left=of S5,text width=26mm](IRT){推理执行器\\(TensorRT/ONNX)};
\draw[LineA](S5)--(IRT);

\draw[LineA](S6)--++(180:1.0)coordinate(AC);
\node[Box2,text width=26mm,left=of S6]{加速器\\(GPU/TPU)};
  % Labels
\node[above=0pt of B3, font=\scriptsize\sffamily, text=gray] {请求缓冲};
\node[above=0pt of B4, font=\scriptsize\sffamily, text=gray] {吞吐量优化};
\node[right=12pt of B5.center, align=left,font=\scriptsize\sffamily, text=gray] {执行\\优化};
\end{tikzpicture}该架构承担三项核心功能:
第一,并发管理。模型服务引擎采用异步事件循环(如 epoll 或 kqueue)和工作线程池,在不阻塞执行线程的情况下处理数千个并发客户端 TCP 连接。隔离客户端网络 I/O,可确保缓慢或停滞的网络传输绝不会使加速器计算流水线空闲。
第二,请求转换。服务器将序列化的网络载荷解码为连续且对齐的内存缓冲区,使其符合底层执行引擎所要求的张量布局。例如,四维视觉张量可以采用 NCHW4 或 NHWC 格式。在现代加速器上,矩阵乘法单元(如 Tensor Core)通过合并内存事务加载包含 8 个或 16 个元素的通道向量,这种访问方式有利于通道维度位于最后的布局(NHWC)。如果传入载荷采用 NCHW 格式,服务器或主机就必须执行显式转置内核(torch.permute 或自定义 CUDA 转置)。由于张量转置不执行任何浮点运算(\(I \approx 0\) FLOP/byte),它严格受内存带宽限制,会消耗主机内存带宽或 PCIe 带宽,并直接侵占延迟预算。
第三,模型生命周期管理。运行时负责编排设备内存(VRAM)分配、用于 DMA 的主机内存缓冲区锁页、模型参数检查点加载,以及预热前向传播的执行,从而在接纳线上客户端流量之前编译执行图并初始化 CUDA 上下文。企业级模型注册表、金丝雀发布和回滚策略属于 机器学习运维 的范畴,而模型服务引擎负责管理本地状态:验证活跃模型实例是否已完成预热、驻留在加速器内存中,并已准备好接受调度。
执行调度器通过实现动态批处理(section 1.7),协调从请求缓冲到加速器执行的转换。当批大小为 \(N=1\) 时,推理严重受内存带宽限制:加速器必须将全部模型参数从 HBM 读入片上 SRAM,才能执行一次前向传播,使向量和矩阵计算单元处于空闲状态。将 \(B\) 个请求组合为一个并发批次,可以在全部 \(B\) 个输入之间摊销读取模型权重所需的字节传输量,从而提高算术强度(\(I = \text{FLOPs} / \text{bytes transferred}\))。
为平衡单个请求延迟与批量计算效率,调度器通过批处理窗口(或超时阈值)调节请求在队列中的驻留时间。将批处理窗口设为零,会得到排队延迟为零的纯 FIFO 执行方式,但会使加速器因小批次和内存带宽瓶颈而利用不足。相反,设置一个有界窗口(如 2 至 5 ms),可使调度器缓冲到达的请求,直到队列达到目标批大小或超时到期。该机制以有界的排队延迟换取更高的算术强度,摊销内存总线流量,并提高集群的持续吞吐量。
接口协议与序列化
随着加速器内核得到深度编译优化(通过 TensorRT、TorchDynamo 或自定义内核),设备执行时间往往降至 1 毫秒以下。根据阿姆达尔定律,当计算执行时间缩短时,主机端接收、传输和反序列化载荷的开销就会成为端到端延迟的主导项。
序列化瓶颈
机器学习载荷与常规 Web API 载荷存在根本差异:它们由多维浮点数数组构成(如图像张量、稠密嵌入向量或词元序列的 logits)。尽管基于文本的 JSON 在 Web 服务中随处可见,但将稠密数值数组序列化为文本会带来严重的 CPU 和内存开销。序列化开销的产生,是因为 JSON 解析器必须逐字节顺序扫描、验证语法、分配堆节点,并调用字符串到浮点数的转换例程(如 strtod)。每个 32 位浮点数会从 4 个原始字节膨胀为包含标点符号在内的 7 至 15 个 ASCII 字符。此外,原始二进制数据(如压缩 JPEG 或原始图像字节)需要经过 Base64 编码才能在 JSON 字符串中传输,因此在开始解析之前,数据大小就会增加 33%。
Protocol Buffers5 和 FlatBuffers6 等二进制序列化格式可以绕过这项文本转换开销。浮点数组直接以紧凑打包的 IEEE 754 字节流传输,无需 ASCII 转换,也无需 Base64 封装。此外,FlatBuffers 使用内部相对偏移量组织序列化记录,从而实现零拷贝反序列化:模型服务应用直接从网络接收缓冲区读取张量维度、数据类型和字节偏移量,无需在堆上分配中间对象图。
REST 与 gRPC
传输协议的选择决定了连接生命周期和套接字多路复用方式。常规 REST API 通常采用 HTTP/1.1 和 JSON 载荷。在 HTTP/1.1 下,并发请求需要建立多条并行 TCP 连接,每条连接都会产生三次握手、TLS 协商和 TCP 慢启动窗口增长的开销。此外,HTTP/1.1 还存在传输层队头阻塞:单条连接上的请求必须按顺序处理。尽管 REST API 可以采用 HTTP/2 或二进制编码,但在为高吞吐量张量工作负载提供服务时,HTTP/1.1 与 JSON 的组合会产生显著的套接字开销和 CPU 解析资源争用。
相比之下,gRPC(gRPC 远程过程调用)7将 HTTP/2 传输与 Protocol Buffers 序列化相结合。HTTP/2 建立单条长连接 TCP 连接,并通过二进制分帧同时多路复用数百个并发请求流和响应流。该架构消除了逐请求建立连接的开销和传输层的队头阻塞,同时 Protobuf 强制实施强类型契约,并高效序列化二进制张量载荷。因此,gRPC 成为模型服务集群内部微服务通信的标准协议,在此类场景中,低延迟、紧凑的传输载荷和双向词元流式传输是主要设计准则。
通过具体的载荷比较,可以量化序列化格式如何改变传输数据量和主机 CPU 解析开销。
Napkin Math 1.1: JSON 与 Protobuf 序列化
考虑一个包含 1,000 个浮点数的请求载荷(例如,一个嵌入向量)。
- JSON:传输数据量约为 9 KB。解析耗时约为 50 μs。
- Protobuf:传输数据量约为 4 KB。解析耗时约为 5 μs。
计算:将一个请求改为使用二进制载荷,可节省 50 μs − 5 μs = 45 μs 的解析时间。对于这个每秒处理 10,000 个请求的示例系统,每经过一秒实际时间,累计可节省 10,000 \(\times\) 45 μs = 0.45 s 的 CPU 时间,相当于仅通过减少序列化开销,就释放了一个 CPU 核心 45 percent 的处理能力。
系统洞见:在此场景中,解析效率达到原来的 10×,因此,当序列化在延迟预算中占据不可忽视的份额时,gRPC/Protobuf、FlatBuffers 或其他二进制协议便成为高吞吐量内部微服务的有力候选方案。
架构选择受系统约束支配。对于面向公众的边缘网关,当广泛的客户端兼容性和便于人工阅读的调试信息比原始传输效率更重要时,基于 HTTP/1.1 的 REST 仍然实用。在集群内部,只要高查询量、持久连接多路复用或词元流式传输可能因序列化开销而耗尽主机 CPU 周期,采用二进制序列化的基于 HTTP/2 的 gRPC 就成为必要选择。
协议选择与进程架构构成了推理服务器的结构骨架。然而,要评估实际运行性能,还需要追踪单个请求经过这条运行时流水线的各个阶段时,延迟如何累积。
请求生命周期
一个携带 \(224{\times}224\) JPEG 图像的 HTTP 请求到达推理服务器。从第一个字节进入网络协议栈,到分类结果载荷发出,该请求会经过六个不同的流水线阶段。每个阶段都会消耗一部分端到端延迟预算,因此,对各阶段进行细粒度分解是开展针对性性能调优的必要条件。
延迟预算
对于动态推理系统,section 1.1 中阐述的服务范式反转确立了影响系统设计的延迟预算 (Gujarati et al. 2020)。即使吞吐量出色,单请求延迟达到秒级的服务系统仍可能无法满足许多交互式场景的 SLO。
Gujarati, Arpan, Reza Karimi, Safya Alzayat, Wei Hao, Antoine Kaufmann, Ymir Vigfusson, and Jonathan Mace. 2020. “Clockwork: Predictable and Scalable DNN Inference in the Cloud.” USENIX Symposium on Operating Systems Design and Implementation (OSDI), 443–62.
相关指标从总体吞吐量和平均延迟扩展到延迟分布。平均值和 p50 描述分布的中心,而 p95 和 p99 则揭示较慢的尾部。如果平均延迟为 50 ms,而 p99 为两秒,那么 p99 阈值就是平均值的 40×,因此约有 1% 的请求耗时达到或超过两秒。这个尾部是否重要,取决于服务及其用户;因此,百分位目标应依据 SLO 制定,而不应沿用惯例。8
要管理这些百分位约束,需要将允许的总响应时间分解为一份延迟预算,为各个处理阶段分配时间。
Definition 1.2: 延迟预算
延迟预算 是在端到端截止时间约束下,分配给请求各阶段的时间;SLO 还会指定所要求的完成分位数。
- 意义:它构成一个零和约束系统,序列化或网络开销消耗的每一毫秒,都会直接减少模型推理可用的延迟预算 \((L_{\text{lat}})\)。
- 区别:延迟 SLO 将截止时间(例如 \(<50\text{ ms}\))与完成分位数(\(\text{p99}\) 或 \(\text{p99.9}\))相结合。服务等级指标(SLI)是用于评估该目标的实测量。未达到内部 SLO 会消耗可靠性余量;越过外部 SLA 阈值则可能触发合同规定的补救措施。尾延迟突增可能源于排队、批次形成、缓存状态、干扰或数据移动。
- 常见误区:一种常见误解是,“模型”可以使用全部预算。在 table 3 的示例分解中,其余预算由请求生命周期中的其他环节(DNS、TLS、负载均衡、序列化)消耗。
每个服务请求都可分解为三个阶段,每个阶段均消耗一部分延迟预算。预处理 将图像字节或文本字符串等原始输入转换为可供模型使用的张量。推理 执行模型计算。后处理 将模型输出转换为面向用户的响应。
Checkpoint 1.1: 尾延迟与预算
模型服务需要优化负载下的尾延迟。在选择优化方案之前,请通过本检查点区分排队与批处理的影响。

推理只是延迟预算的一部分;预处理的耗时与其相当。
更快的硬件并不自动意味着更快的模型服务。在实践中,当推理运行在经过优化的加速器上时,预处理和后处理可能占据总延迟的主要部分。如果周边流水线仍受 CPU 操作的瓶颈制约,仅优化推理阶段就会面临收益递减。
延迟分布分析
要了解延迟在哪里累积,需要对服务流水线中的每个阶段分别进行监测。在图像分类中,端到端请求时间混合了主机侧图像解码、PCIe 总线传输、加速器计算和主机侧输出解析的耗时。单独测量各阶段,可以揭示延迟预算实际消耗在哪里。
Example 1.4: ResNet-50:延迟预算分解
Table 3 详细列出了一个示例 ResNet-50 服务请求的各阶段延迟。
Table 3: ResNet-50 延迟预算:单个服务请求各阶段耗时的示例分解,表明预处理与数据传输的总开销可与 ResNet-50 前向传播本身的开销相当。这些百分比揭示了在此场景中将工程投入用于哪些环节能够获得回报。各阶段百分比均四舍五入至最接近的整数,因此总和可能不恰好为 100。
| 阶段 | 操作 | 时间 | 百分比 |
|---|---|---|---|
| 预处理 | JPEG 解码 | 3 ms | 30% |
| 预处理 | 调整大小至 \(224{\times}224\) | 1 ms | 10% |
| 预处理 | 归一化(均值/标准差) | 0.5 ms | 5% |
| 数据传输 | CPU→GPU 复制 | 0.5 ms | 5% |
| 推理 | ResNet-50 前向传播 | 5 ms | 50% |
| 后处理 | Softmax + 前 5 项 | 0.1 ms | ~1% |
| 总计 | 10.1 ms | 100% |
系统洞见:在这个示例 ResNet-50 服务预算中,尽管模型推理是计算密集的阶段,预处理仍占用了 44.6 percent 的延迟。如果 TensorRT 将推理耗时降至假定的 2 ms,预处理占比将达到 63.4 percent,成为主要部分。
ResNet-50 场景代表了计算受限的推理:密集的卷积运算主导前向传播。然而,改变模型架构可能使主要约束从算术执行单元转移至内存带宽。推荐系统体现了这种根本性转变。
Lighthouse 1.1: 灯塔示例:DLRM 服务
场景:在 p99 延迟预算为 10 ms 的条件下提供 DLRM 服务。
分析:ResNet-50 的模型阶段主要受卷积神经网络计算支配,而 DLRM 模型阶段的主要开销则是嵌入表的内存访问。识别端到端服务瓶颈仍需测量完整路径:预处理、推理、后处理和数据移动。Table 4 按阶段拆解了推荐请求。
| 阶段 | 操作 | 时间 | 瓶颈 |
|---|---|---|---|
| 输入解析 | 请求解析 | 0.5 ms | CPU |
| 嵌入查找 | 获取 100 多个稠密向量 | 6 ms | 内存带宽 |
| 推理 | MLP 前向传播 | 1.5 ms | 计算 |
| 后处理 | 排序与过滤 | 1 ms | CPU |
| 总计 | 9 ms |
系统洞见:在 DLRM 中,“推理”多层感知机阶段仅占延迟的约 17 percent。大部分时间用于嵌入查找,即从 TB 级表中检索 128 维嵌入向量。这是一种受内存带宽和容量限制的工作负载;除非能够更快地提供嵌入表数据,否则增加算力并无帮助。
table 3 和 table 4 共同揭示了同一种普遍的失效模式:直接的优化工作往往针对能够运用机器学习专业知识的环节(模型量化、剪枝),而真正的制约因素却位于其他环节(ResNet-50 在 CPU 上的图像解码,以及 DLRM 的嵌入表内存带宽)。这一模式具有普遍性:在任何模型耗时不足总延迟一半的服务系统中,仅优化模型都会面临收益递减,无论这些单项优化带来的加速幅度有多大。阿姆达尔定律量化了这一上限。采用定量方法分析服务,可以在工程投入错配之前暴露这些隐藏瓶颈。
Systems Perspective 1.3: 服务的定量分析方法
分析:阿姆达尔定律决定了这一上限(Amdahl 定律与 Gustafson 定律 给出了形式化推导)。预处理(4.5 ms)和数据传输(0.5 ms)占总延迟的 49.5 percent。将模型加速至原来的 10\(\times\)(5 ms → 0.5 ms),仅能获得 1.8× 的端到端加速比(延迟从 10.1 ms 降至 5.6 ms)。当非模型阶段占据主要执行时间时,仅专注于量化或剪枝等模型优化会导致收益递减。
机制:领域专用加速器(如 TPU 和 Tensor Core)用密集的乘加阵列替代复杂的控制逻辑,从而提高兼容内核的实际吞吐量。因此,对于许多高吞吐量或低延迟的服务工作负载,硬件加速成为经济上的必要条件。
系统洞见:先进行性能剖析,再进行优化。如果预处理占据主要耗时,GPU 加速流水线(NVIDIA DALI)的效果可能优于模型量化。
将预处理移至更靠近加速器的位置,可以减少可避免的 CPU 到 GPU 传输,但端到端收益取决于具体流水线。有效的优化应首先针对耗时最多的环节。
服务开销账单
除模型前向传播执行外,每个请求还必须向主机系统和网络协议栈支付一笔基础设施“税”。推理查询到达后,会经过网络接口,在内核空间与用户空间之间移动,从线上传输协议反序列化到内存缓冲区,排队等待组批,并经由 PCIe 互连复制到加速器设备内存。硬件加速能够将矩阵计算耗时压缩数个数量级,但这些主机侧操作仍运行在通用 CPU 和 I/O 总线上。因此,随着模型优化程度不断提高,这种非推理服务开销在总延迟中的占比也越来越高。
致命微秒问题
Barroso、Patterson 及其同事指出,计算机系统在处理不同时间尺度的延迟时存在一个关键空白 (Barroso et al. 2017)。纳秒级停顿(如缓存未命中)可由硬件指令级并行掩盖,而毫秒级延迟(如磁盘 I/O 或网络 RPC)则可由操作系统线程上下文切换掩盖。微秒范围(1–100 μs)内的操作处于一个尴尬的空白地带:其持续时间过长,在 CPU 核心上自旋等待会浪费计算周期和电力;但又过短,操作系统若切换到其他线程,所付出的调度开销会超过等待时间本身。
Barroso, Luiz, Mike Marty, David Patterson, and Parthasarathy Ranganathan. 2017. “Attack of the Killer Microseconds.” Communications of the ACM 60 (4): 48–54. https://doi.org/10.1145/3015146.
服务基础设施恰好运行在这一致命微秒区间。采用 table 5 中的代表性范围,序列化耗时 50–500 μs、分发耗时 10–50 μs、数据复制耗时 100–500 μs,单独看都很小;但对于延迟为 5 ms 的推理服务,在尚未计入网络和排队延迟时,这些列出的微秒级开销合计就已消耗约 3.2 percent 至 21 percent 的延迟预算。任何单项开销都不足以单独构成优化理由,但它们共同决定了系统能否满足其 SLO。
| 开销组成 | 典型成本 | 扩展特性 | 开销规避策略 |
|---|---|---|---|
| 网络 I/O | 1–5 ms | 随负载大小线性增长 | 压缩、同地域部署 |
| 序列化 | 50–500 \(\mu\text{s}\) | 随负载大小线性增长 | gRPC/Protobuf(相较于 JSON) |
| 排队 | 0.1–10 ms | 接近容量上限时发散 | 动态批处理、自动扩缩容 |
| 分发 | 10–50 \(\mu\text{s}\) | 每批次为常数 | 内核融合(减少启动次数) |
| 数据复制 | 100–500 \(\mu\text{s}\) | 随张量大小线性增长 | 零复制/共享内存 |
延迟预算框架为这一复合问题提供了系统化方法。测量应当先行。如果没有逐阶段的测量埋点,工程师就无法区分预处理瓶颈与序列化瓶颈,优化投入也会被错误地分配给最显眼的组件(模型),而非成本最高的组件。一旦测量揭示了真实的时间分布,工程投入就必须按比例分配。一个消耗 50% 延迟的阶段,应当比一个消耗 5% 延迟的阶段受到更多关注,无论哪一个看起来更容易优化。GPU 加速预处理或激进批处理等架构变更,可以将工作整体转移到其他阶段,有时甚至能消除瓶颈,而不仅仅是减轻瓶颈。
分辨率与输入大小的权衡
输入分辨率会同时影响预处理和推理延迟,但具体关系取决于系统是受计算限制(受算术吞吐量限制),还是受内存限制(受数据移动限制)。受计算限制的系统会随着计算量增长而变慢;受内存限制的系统则会随着传输字节数增长而变慢。仅仅能够容纳于内存,并不能消除带宽成本。Roofline 模型 中的 Roofline 分析深入阐述了这一区别,因此它对于有依据的分辨率决策至关重要。
对于以卷积为主且受计算限制的模型,equation 1 给出了一个一阶近似,其中吞吐量与分辨率的平方成反比: \[\frac{\text{Throughput}(r_2)}{\text{Throughput}(r_1)} = \left(\frac{r_1}{r_2}\right)^2 \tag{1}\]
将分辨率从 224 加倍至 448,按计算量缩放估算,耗时将增至原来的 4×;耗时增至原来 3.6× 的示例场景则包含了固定开销。更高的分辨率可以提高卷积的算术强度,因为权重会在更多空间位置上复用;但整个模型是否转为受计算限制,取决于其内核移动的字节数。
Table 6 量化了在这一简化模型中,提高分辨率如何摊薄固定的权重传输开销,但并未确定实际执行内核的瓶颈。
| 分辨率 | 假定的激活项 | 建模算术强度 | 瓶颈分类 |
|---|---|---|---|
| \(224{\times}224\) | 12.5 MB | 64.4 FLOP/byte | 尚未确定 |
| \(384{\times}384\) | 36.7 MB | 137 FLOP/byte | 尚未确定 |
| \(512{\times}512\) | 65.3 MB | 183.9 FLOP/byte | 尚未确定 |
| \(640{\times}640\) | 102.0 MB | 218.4 FLOP/byte | 尚未确定 |
生产环境中的分辨率策略
不同的部署场景受各自主要约束的影响,对分辨率提出不同要求。当延迟和电池续航比微小的准确率提升更为重要时,移动应用可能接受较低的分辨率(\(224{\times}224\))。某些医学影像工作负载在诊断细节足以支持额外计算开销时,会采用 \(512{\times}512\) 或更高分辨率。感知流水线可以对宽视场使用较低分辨率,并使用高分辨率裁剪图像进行细粒度识别。公共 API 则可以将任意上传内容规范化为固定接口约定所要求的形式,或从经过验证的分辨率配置中进行选择。只有当选择策略及其选用的每一种配置都能满足任务的质量要求时,自适应分辨率才有价值。
自适应分辨率
自适应分辨率使生产系统能够根据内容动态选择分辨率。一种方法是在 \(128{\times}128\) 分辨率下运行轻量级分类器以判断内容类型,然后选择适合任务的分辨率:文档采用 \(512{\times}512\),风景采用 \(224{\times}224\),人脸采用 \(384{\times}384\)。在这一示例场景中,相比固定高分辨率,该策略将吞吐量提升至原来的 1.4×,同时保留 99.2 percent 的准确率。这种模式以运行轻量级分类器所产生的预处理开销,换取主模型推理开销的节省。
到目前为止,延迟分析一直聚焦于顺序处理:一个请求完成后,下一个请求才开始。预处理、推理和后处理阶段使用不同的硬件资源。这种资源分离为同时处理多个请求创造了机会。
硬件利用率与请求流水线
孤立地优化请求的各个阶段,会错失一个关键机会:这些阶段使用不同的硬件资源。section 1.4.1 中的延迟预算分析表明,模型推理只是请求生命周期的一个组成部分。从硬件角度看,服务系统的主要目标是最大化加速器的有效工作占比,即 GPU 执行有效计算的时间百分比。
在串行化的服务系统中,加速器在网络 I/O 和基于 CPU 的预处理期间处于空闲状态。服务系统通过请求流水线使这些阶段重叠,确保持续向 GPU 输入张量流。
重叠 I/O 与计算
figure 5 中的两幅时序图展示了流水线的影响。在串行情形(A)中,每个请求都必须完成整个生命周期(网络 \(\rightarrow\) CPU 预处理 \(\rightarrow\) GPU 推理 \(\rightarrow\) 后处理),下一个请求才能开始,灰色的空闲间隙使 GPU 超过 50% 的时间未被使用。在流水线情形(B)中,这些间隙消失了。
\begin{tikzpicture}[font=\footnotesize\sffamily, scale=0.8]
  \definecolor{CPUColor}{RGB}{173,216,230}
  \definecolor{GPUColor}{RGB}{144,238,144}
  \definecolor{WaitColor}{RGB}{240,240,240}
  \tikzset{
 Pre/.style={align=flush center, draw=black,
    font=\footnotesize\sffamily, node distance=-1pt,
    line width=0.75pt, fill=cyan!20, text width=15mm,
    minimum width=16mm, minimum height=6mm},
 Gpu/.style={Pre,fill=GPUColor!60},
 Idle/.style={Pre,fill=WaitColor}
}
\node[Pre](R1){预处理};
\node[Gpu,right=of R1](R2){GPU};
\node[Idle,right=of R2](R3){空闲};
\node[Pre,right=of R3](R4){预处理};
\node[Gpu,right=of R4](R5){GPU};
%
\node[Pre,below=0.79 of R1](R11){预处理1};
\node[Pre,right=of R11](R12){预处理 2};
\node[Pre,right=of R12](R13){预处理 3};
\node[Pre,right=of R13](R14){预处理 4};
%
\node[Gpu,below=of R12](R21){GPU 1};
\node[Gpu,right=of R21](R22){GPU 2};
\node[Gpu,right=of R22](R23){GPU 3};
\node[Gpu,right=of R23](R24){GPU 4};
%
\node[draw=none,fit=(R1)(R5)](T1){};
\node[above=-5pt of T1]{\textbf{A. 串行执行}(低利用率)};
\node[draw=none,fit=(R11)(R24)](T2){};
\node[above=-5pt of T2]{\textbf{B. 流水线执行}(高利用率)};
\end{tikzpicture}流水线依赖非阻塞硬件队列和异步执行流。主机 CPU 线程无需阻塞等待 GPU 内核完成,而是将内存传输和内核启动操作加入加速器流,随后立即开始预处理下一个到达的请求。加速器的 DMA 引擎和计算核心独立执行这些排队操作,使主机预处理与设备执行相互重叠。
系统指标:硬件有效工作占比
系统效率衡量服务系统对其瓶颈资源的利用充分程度,该资源通常是 GPU 的计算核心或内存带宽。Equation 2 定义了这一硬件有效工作占比。 \[\text{System Efficiency} = \frac{\sum T_{\text{compute}}}{\text{Wall Clock Time} \times \text{Resource Count}} \tag{2}\]
如果一个 ResNet-50 请求总共耗时 10 ms(GPU 5 ms,CPU 5 ms),串行系统的效率仅为 50%。只需对两个请求采用流水线处理,效率就能接近 100%(假设 CPU 能够跟上 GPU)。如果 CPU 向 GPU 提供数据的速度过慢,系统就会受限于 CPU,此时进一步优化模型不会带来任何吞吐量增益。这是将 Amdahl 定律与 Gustafson 定律 中的阿姆达尔定律应用于服务:如果预处理占延迟的 50%,那么无论模型运行多快,最大加速比都是 2\(\times\)。硬件的发展趋势使这一上限的约束日益突出。在连续几代硬件中,加速器计算吞吐量(FLOPs)的增长远快于 CPU 单线程性能,因此流水线中的推理部分不断缩短,而受 CPU 限制的预处理部分保持不变。一个在旧加速器上受计算限制的系统,可能在硬件升级后变为受 CPU 限制——原因是模型大幅加快,而 CPU 没有同步提速,并非预处理变慢。
后处理
请求生命周期以对象后处理结束,该阶段将加速器输出的原始张量转换为结构化的应用响应。这一阶段跨越加速器与主机 CPU 之间的物理边界。由于客户端应用无法直接使用设备内存缓冲区,输出张量必须通过互连链路(通常是 PCIe 总线)传输到主机内存。服务引擎如何在这一边界两侧划分计算,决定了后处理是在微秒内完成,还是使整个服务流水线停滞。
从 logits 到预测结果
分类模型为标签空间中的各类别输出未经归一化的 logits。将这些数值得分转换为可用于决策的预测结果,需要进行归约、筛选和校准。最简单的归约是 argmax 选择,即提取得分最高的 logit 所对应的索引。阈值筛选会丢弃低于经验置信度阈值的预测,仅在模型达到目标精确率时返回预测结果。当应用需要按得分排序的备选结果时,top-\(k\) 提取会选择最高的 \(k\) 个得分及其类别索引。概率校准会对原始得分进行缩放(例如通过温度缩放),使输出的置信度分数反映经验准确率。
系统效率要求归约操作直接在加速器上执行,而不是在主机 CPU 上执行。在设备内存中进行 softmax、argmax 或 top-\(k\) 选择,可以在数据跨越 PCIe 总线之前缩减传输载荷。例如,在 ResNet-50 分类中,在 GPU 上运行 top-\(k\) 可将传输载荷从 1,000 个 float32 logits(4,000 字节)缩减为五个数值和五个整数索引。对于 ResNet-50 图像分类,listing 1 展示了从 GPU 张量操作到主机 CPU 标签查找和响应格式化的执行路径。
# Normalize raw logits into probabilities
# Input: logits tensor of shape (1, 1000), one score per ImageNet
# class
probs = torch.softmax(logits, dim=-1)  # Normalize to sum=1 on GPU

# Extract top-5 predictions for multi-class response
# topk returns (values, indices) sorted by probability
top5_probs, top5_indices = probs.topk(5)  # GPU operation
top5_probs = top5_probs.squeeze(0).tolist()
top5_indices = top5_indices.squeeze(0).tolist()

# Map class indices to human-readable labels
# imagenet_labels: list of 1000 class names from synset mapping
labels = [imagenet_labels[i] for i in top5_indices]  # CPU lookup

# Format response with predictions and metadata for API contract
response = {
    "predictions": [
        {"label": label, "confidence": float(prob)}
        for label, prob in zip(labels, top5_probs)
    ],
    "model_version": "resnet50-v2.1",  # Client-side version tracking
    "inference_time_ms": 5.2,  # Observability for latency monitoring
}
在 listing 1 中,后处理总耗时约为 0.1 ms,与预处理和推理相比可以忽略不计。GPU 负责归一化和 top-5 归约,因此后续 .tolist() 调用仅通过 PCIe 传输数十字节。然而,.tolist() 会强制执行同步的设备到主机复制,阻塞主机线程,直到 GPU 流执行完毕。在高吞吐量流水线服务器中,必须谨慎安排此类同步屏障,以免 CPU 线程在为后续请求提供数据时停滞。拟合校准映射是一项离线任务;在线应用简单的已拟合映射通常开销很低,但只有当下游决策需要具有经过验证的经验含义的置信度分数时,它才有价值。
输出格式化
生产系统会封装预测结果,以满足应用层 API 约定。这些约定规定了 JSON 序列化模式、浮点数格式、错误码,以及阈值筛选拒绝所有候选结果时的回退默认值。在基于 Python 的运行时中,高并发下反复进行 JSON 序列化和字符串分配,可能消耗超出预期的主机 CPU 周期,使微秒级的格式化步骤变成 CPU 瓶颈。高吞吐量服务器通过将序列化工作交给原生 C++ 运行时,或采用 Protocol Buffers 等二进制协议来解决这一问题。模型版本和推理执行时间等响应元数据补充了载荷,使下游具备可观测性。
跟踪单个独立请求可以揭示流水线各阶段的固有执行时间。然而,在生产环境中,多个请求会并发到达,并争用共享的加速器、CPU 核心和内存总线,由此引入的排队延迟可能远超纯计算时间。
排队论
当到达流量波动时,排队论以形式化方式描述对共享物理资源——加速器执行队列、主机到设备的 PCIe 传输和内存总线——的争用如何恶化延迟分布。其基本定律解释了为什么看似资源配置充足的推理服务,会在利用率接近容量极限时出现急剧且非线性的延迟激增。
利特尔定律
容量规划始于一个基本的规模估算问题:给定预期到达率和测得的平均响应时间,任意时刻系统中有多少个并发请求?回答这一问题,可以在决定配置多少加速器之前,确定必须为请求缓冲区和激活状态预留多少内存。利特尔定律(利特尔定律)通过关联系统内平均请求数与吞吐量来回答这一并发问题,而排队模型则预测利用率接近饱和时响应时间如何恶化。二者共同构成容量规划的定量框架。
Systems Perspective 1.4: 符号提示:L 与延迟
在排队论中,\(T_{\text{lat}}\) 表示响应时间或每个请求在系统内的逗留时间;仅在队列中等待的时间为 \(W_q\)。这里,\(Q_{\text{req}}\) 表示系统内的平均请求数,\(\lambda_{\text{arr}}\) 表示到达率,\(\rho_{\text{serv}}=\lambda_{\text{arr}}/\mu\) 表示服务利用率。这些下标将排队论符号与退化方程中的敏感度参数 \(\lambda\) 区分开来,同时避免用不带下标的 \(\rho\) 表示服务利用率。在后续的延迟预算方程(如 equation 4 和 equation 7)中,带有描述性下标的 \(L_{\text{lat,*}}\) 项表示等待、计算等预算组成部分。在接下来的批处理分析(section 1.7.3)中,\(L_{\text{lat,wait}}\) 对应排队等待分量 \(W_q\),而 \(L_{\text{lat,compute}}\) 包含推理时间。
由 John D. C. Little 提出的利特尔定律9确立了任意稳定排队系统中三个宏观指标之间的精确关系: \[Q_{\text{req}} = \lambda_{\text{arr}} \cdot T_{\text{lat}} \tag{3}\] 其中,\(Q_{\text{req}}\) 是系统内的平均请求数,\(\lambda_{\text{arr}}\) 是到达率(每秒请求数),\(T_{\text{lat}}\) 是每个请求从到达到完成所经历的平均时间。
关键在于,无论到达分布、服务时间分布或调度规则如何,利特尔定律均成立;它只要求系统稳定,且请求不会在系统内部被创建或销毁。对于目标吞吐量为 1000 QPS、平均响应时间为 50 ms 的推理服务,利特尔定律给出了主机内存缓冲区和工作线程必须支撑的平均在途请求数。
Napkin Math 1.2: 基于利特尔定律的容量估算
问题:在 1,000 QPS 下,系统内平均有多少个请求?
数学原理:利特尔定律给出 \(Q_{\text{req}} = \lambda_{\text{arr}} T_{\text{lat}}\),因此系统内平均请求数等于吞吐量乘以平均系统内逗留时间(利特尔定律 推导了该定律)。
已知条件:
- 吞吐量目标 \((\lambda_{\text{arr}})\):1,000 QPS。
- 平均系统内逗留时间 \((T_{\text{lat}})\):50 ms(0.05 s)。
计算:\(Q_{\text{req}}\) = 1,000 QPS \(\times\) 0.05 s = 平均 50 个并发请求
系统层面的启示:系统在批处理和排队状态中平均容纳 50 个请求。GPU 批大小上限为 32,本身并不意味着无法达到 1,000 QPS,因为排队请求可以驻留在主机内存中;服务速率、排队行为和尾部分布共同决定其可行性。
由于 equation 3 约束了这三个变量,限定其中任意两个就会确定第三个。如果推理服务的每个请求平均耗时 10 ms \((T_{\text{lat}} = 0.01 \text{ s})\),且系统内平均有 50 个并发请求 \((Q_{\text{req}} = 50)\),那么可持续到达率必为 \(\lambda_{\text{arr}} = Q_{\text{req}} / T_{\text{lat}} = 5000\) 个请求每秒。反之,如果主机内存将平均并发数限制为 10 个请求,而平均系统内逗留时间仍为 10 ms,则在不丢弃流量的情况下,系统吞吐量无法超过每秒 1,000 个请求。
批处理税:延迟—吞吐量前沿
尽管利特尔定律将队列深度与吞吐量联系起来,但它并未考虑批处理税:为最大化硬件利用率而有意引入的延迟。
当批大小为 \(B=1\) 时,神经网络推理受到严重的内存带宽限制。加速器必须将数 GB 的模型权重从 HBM 传输到片上 SRAM,以执行矩阵—向量乘法,因此只能达到峰值 FLOPS 的一小部分。将 \(B\) 个输入组成批次,会将这些运算转化为通用矩阵乘法(GEMM),通过在多个输入之间复用权重来提高算术强度。然而,收集 \(B\) 个请求需要将较早到达的请求保留在输入队列中。
当推理服务器采用由请求触发的固定批大小批处理时,会引入两种不同来源的延迟。批次形成延迟 \((L_{\text{lat,form}})\) 是每个请求等待批次凑满的时间;第一个请求等待最久,最后一个请求的等待时间为零。推理时间膨胀 是指加速器处理 \(B\) 个样本而非 1 个样本时,推理时间 \(T_{\text{inf}}(B)\) 的增长。由此形成的延迟—吞吐量帕累托前沿 表示一种运行边界:提高吞吐量必须付出响应延迟增加的代价。在平稳泊松到达条件下,equation 4 近似给出了批大小为 \(B\)、到达率为 \(\lambda_{\text{arr}}\) 时的平均单请求延迟: \[ L_{\text{lat,total}} \approx \underbrace{ \frac{B-1}{2\lambda_{\text{arr}}} }_{\text{Formation delay}} + \underbrace{ T_{\text{inf}}(B) }_{\text{Inference time}} \tag{4}\]
Equation 4 形式化地描述了加速器吞吐量与单个请求延迟之间的权衡。增大 \(B\) 可以提高算术强度,并在多个输入之间摊薄内存带宽开销,但会增加每个请求的排队延迟。具体而言,在 500 QPS 下,将批大小从 1 增至 32,会使等待时间从 0 ms 增至 31 ms,进而使总延迟变为原来的 23×(2 ms → 46 ms)。因此,确定 \(B\) 是一个经济优化问题:运维人员在不违反延迟 SLO \((L_{\text{lat}})\) 的前提下,选择能够最大化查询吞吐量和硬件效率的最大批大小。
利用率与延迟的关系
利特尔定律描述了稳态条件下系统内的平均请求数,但并未揭示当流量接近系统容量时延迟如何变化。M/M/1 排队模型量化了防止延迟失控所需的容量余量 (Harchol-Balter 2013)。10 对于请求按泊松过程到达且服务时间服从指数分布的系统,equation 5 给出了请求在系统中的平均逗留时间: \[T_{\text{lat}} = \frac{1}{\mu - \lambda_{\text{arr}}} = \frac{\text{service time}}{1 - \rho_{\text{serv}}} \tag{5}\] 其中,\(\lambda_{\text{arr}}\) 为到达率,\(\mu\) 为服务率(服务器每秒能够处理的请求数),\(\rho_{\text{serv}} = \lambda_{\text{arr}}/\mu\) 为利用率(服务器处于忙碌状态的时间比例)。
由于分母包含 \(1 - \rho_{\text{serv}}\),当利用率趋近于 1 时,延迟会非线性增长。11 在接近饱和时,流量的微小增量也会引发严重的背压和排队延迟。
标准 M/M/1 形式假定服务时间服从指数分布。对于处理固定大小批次和静态张量维度的已编译神经网络,执行时间几乎恒定,因此 M/D/1 队列能更准确地建模平均排队延迟。此处的分析保留 M/M/1 模型,因为它能够给出闭式解,并提供保守的安全余量。在生产环境中,可变输入长度、动态批次形成、CPU 预处理以及KV 缓存查找都会引入运行时间方差,使确定性假设很快失效。12
Table 7 量化了这一关系,展示了当利用率接近 100% 时,系统内平均逗留时间的倍数如何迅速增长。
| 利用率 \((\rho_{\text{serv}})\) | 延迟倍数 | 示例(服务时间为 5 ms) |
|---|---|---|
| 50% | 2× | 10 ms |
| 70% | 3.3× | 17 ms |
| 80% | 5× | 25 ms |
| 90% | 10× | 50 ms |
| 95% | 20× | 100 ms |
多服务器的考量
单个服务节点构成推理基础设施的基本构建单元。单节点排队动态决定了资源饱和行为,并确立了基准性能特征;这些特征在节点于集群内进行水平复制后仍然存在。
在 M/M/1 假设下评估孤立节点,可以确定横向扩展之前所需的容量余量,并检验单个加速器能否在不违反服务级别目标的前提下承受峰值流量。生产环境性能剖析必须验证,实际瓶颈究竟源于纯计算能力饱和、动态批处理阈值、主机预处理,还是内存分配停顿。
当流量超过单节点容量时,架构通过增加节点进行横向扩展:多个独立的服务节点位于负载均衡器之后,每个节点都承载一个完整且相同的模型实例。M/M/c 排队模型 将单服务器分析扩展到 \(c\) 个并行工作单元,展示了查询均匀分配时,汇聚后的容量如何吸收突发到达流量。实践中的尾延迟改善高度依赖于分派算法、异构输入之间的服务时间方差,以及各副本的利用率余量。关键在于,这种水平复制在架构上仍区别于模型并行(张量分片或流水线分片):复制是在独立节点上创建模型副本,以并发服务不同查询,无需设备间同步;模型并行则将单个模型分片到多个通过高带宽互连(如 NVLink)连接的加速器上,共同执行一个查询。
尾延迟
生产环境的 SLO 通常规定百分位目标(p95、p99),而非平均值,因为尾延迟决定了最慢请求的用户体验 (Dean and Barroso 2013)。对于 M/M/1 队列,p99 延迟满足: \[T_{\text{lat},\text{p99}} \approx \frac{\text{service time}}{1 - \rho_{\text{serv}}} \cdot \ln\left(\frac{1}{1 - 0.99}\right) \approx \frac{4.6 \cdot \text{service time}}{1 - \rho_{\text{serv}}} \tag{6}\]
平均延迟会掩盖尾部请求的争用:当利用率为 70% 时,平均延迟仅为服务时间的 3.3 倍,而 p99 延迟达到服务时间的 15.3 倍 \((4.6/0.3 \approx 15.3)\)。对于 M/D/1 等服务时间确定的模型,尾部值需要通过数值计算求得,无法使用一个简单的通用乘数;但系统层面的核心事实依然成立:通过平均延迟评估服务集群,会掩盖严重的尾部性能退化。
规模化下的尾延迟问题
Dean 和 Barroso 的分析揭示了为何当系统规模超出单机时,尾延迟会变得至关重要 (Dean and Barroso 2013)。当请求扇出到 \(m\) 个并行后端时——例如查询模型集成、搜索分片嵌入索引,或并行执行流水线阶段——只有最慢的子任务完成后,整个用户请求才算完成。如果每个子任务都有 99% 的概率在延迟阈值 \(T\) 内完成,那么全部 \(m\) 个后端均在 \(T\) 内完成的概率为 \((0.99)^m\)。当扇出数为 \(m = 10\) 时,只有 \(0.99^{10} \approx 90.4\%\) 的请求能够达到目标;当 \(m = 100\) 时,该概率降至 \(0.99^{100} \approx 36.6\%\),意味着近三分之二的用户请求会遭遇尾部延迟。这种“规模化下的尾延迟” 效应使得控制单节点尾部方差成为保障整体系统性能的必要条件。
在探索对冲请求等软件缓解措施之前,系统工程师必须首先配置充足的加速器容量,以便在峰值负载下满足尾延迟 SLO。将 M/M/1 尾部响应时间模型应用于 ResNet-50 部署,可以具体展示容量配置流程。
Napkin Math 1.3: ResNet-50 容量规划
考虑设计一个满足以下要求的 ResNet-50 服务系统:
- 目标 p99 延迟:50 ms
- 预期峰值流量:5,000 QPS
- 服务时间(TensorRT FP16):5 ms
步骤 1:确定安全利用率。 根据 equation 6,\(T_{\text{lat},\text{p99}} \approx\) 4.6 \(\times\) 服务时间 / \((1 - \rho_{\text{serv}})\)。在服务时间为 5 ms 的情况下,令 \(T_{\text{lat},\text{p99}} \leq 50\) ms,可得 \(\rho_{\text{serv}} \leq 1 - (4.6 \times 5\,\mathrm{ms})/50\,\mathrm{ms} = 0.54\)(最大利用率为 54 percent)。这里使用上述方程给出的保守 M/M/1 p99 界限,而非将针对平均等待时间的 M/D/1 修正应用于尾延迟 SLO。
步骤 2:计算所需服务率。 \(\mu_{\text{required}} = 5,000\,\mathrm{QPS} / 0.54 = 9259.3\,\mathrm{req}/\mathrm{s}\)
步骤 3:确定 GPU 数量。 在此 M/M/1 模型中,单 GPU 服务率为 200 req/s。
所需 GPU 数量 = 9259.3 req/s / 200 req/s = 46.3 → 47 块 GPU
步骤 4:为波动增加余量。 此场景为流量突增和波动增加 30 percent 的余量:最终数量 = 47 \(\times\) 1.3 = 61.1,向上取整为 62。
步骤 5:验证容错能力。 30 percent 的余量用于应对流量波动,但生产系统还需要容错能力。配置 62 块 GPU 时,损失一块后,剩余 61 块 GPU 将处理 5,000 QPS 的请求流量。故障后的利用率为 5,000 QPS / (200 req/s \(\times\) 61) = \(41.0\%\)。
这一数值仍远低于 54 percent 的安全利用率阈值,确认满足 N+1 冗余要求。对于更严格的容错要求,在相同的安全利用率阈值下,N+2 冗余(容忍两个同时发生的故障)需要 49 GPUs 块 GPU;如果在两个同时发生的故障后仍须保留 30 percent 的余量,则大约需要 64 GPUs 块 GPU。
结果:配置 62 块 V100 GPU,以 50 ms 的 p99 延迟处理 5,000 QPS 的请求流量,并具备 N+1 容错能力。
排队分析解释了 section 1.11.3 中详述的容量规划方法,并与 MLPerf Server 场景直接相关。MLPerf 执行场景 说明,只有当测试运行满足其百分位延迟约束时,MLPerf Server 结果才有效;否则,必须降低目标 QPS 并重新运行测试。
尾延迟容忍技术
消除延迟变异性的所有来源通常并不现实。因此,生产系统采用能够容忍变异性、同时仍满足 SLO 的技术 (Dean and Barroso 2013; Dean 2012)。一种有效的组织方式是按故障模式分类:对于拖慢请求的副本,采用竞速机制;对于扇出,采用早期检测;对于过载,采用准入控制或优雅降级;对于重试放大,采用协调式负载丢弃。
Dean, Jeffrey, and Luiz André Barroso. 2013. “The Tail at Scale.” Communications of the ACM 56 (2): 74–80. https://doi.org/10.1145/2408776.2408794.
Dean, Jeffrey. 2012. Achieving Rapid Response Times in Large Online Services. Berkeley AMPLab Cloud Seminar.
对于拖慢请求的副本,系统可以通过竞速来应对慢路径。在对冲请求机制下,如果请求未在预期时间内完成,系统就向另一台服务器发送一个重复请求。13 客户端使用最先到达的响应,并取消另一个请求。对于机器学习模型服务,这意味着维护多个模型副本,并将缓慢的请求路由到其他副本。在延迟分布稳定的情况下,将阈值设为历史第 95 百分位,会使约 5% 的请求触发重复请求;相关性减速可能提高这一比例,使对冲请求放大过载,而非降低尾延迟。
普通推理内核一旦启动,在执行中途将其打断的成本较高。当一个对冲请求完成时,必须取消其重复请求;但如果 GPU 上的推理已经开始,可采用的取消方式包括:在启动推理前检查取消标志、接受正在执行的内核所浪费的计算资源,或通过请求优先级机制降低重复请求的优先级。由于对冲通常只适用于少量尾部请求,只要保守地调整触发阈值,偶尔浪费计算资源所带来的开销仍然可控。
绑定请求通过将请求同时放入多个服务器队列,使同样的竞速机制更加积极,并通过协调,在某台服务器开始处理后立即取消其他副本。这样无需等待检测到响应缓慢后才发起对冲,并且在有多个就绪副本可用时,可以减少排队延迟。但这也会产生重复队列条目,因此协调机制必须在竞速失败的副本消耗稀缺的加速器时间之前将其取消。
扇出系统需要在不同的环节介入,因为一个缓慢的后端就可能阻塞整个分布式请求。金丝雀请求首先将请求发送到由一至两台服务器组成的小型子集。14 如果这些服务器在预期时间内返回,系统再将请求发送到其余服务器。如果金丝雀请求响应缓慢,系统可以在执行完整扇出之前,转向其他服务器重试或使用缓存结果。这项技术将潜在的尾延迟放大问题转化为早期预警信号。
当问题源于集群过载,而非个别副本响应缓慢时,让后端竞速只会注入重复工作,进一步加深队列。此时,系统必须通过优雅降级或准入控制来保护已接纳请求的延迟。优雅降级通过返回较低保真度的结果来维持吞吐量:分类流水线回退到缓存的近似结果,生成模型截短解码长度,模型集成仅评估部分成员。动态减少活跃的集成成员可缩短服务时间(\(T_{\text{svc}}\)),从而提高服务率 \(\mu\),并将利用率 \(\rho_{\text{serv}} = \lambda_{\text{arr}} / \mu\) 降回排队拐点以下(figure 1),以可控的准确率下降换取 SLO 的维持,避免延迟失控。准入控制则设置了更严格的边界:当入口队列超过指定阈值时,服务器立即以 HTTP 503 状态码拒绝超出的查询,避免接纳注定无法满足延迟截止时间的工作。
设置这一拒绝阈值需要在加速器占用率与排队延迟之间取得平衡。一个实用的初始启发式方法是,将队列深度限制为每个工作进程两到三个服务时间片对应的请求数(对于四个工作进程,入口队列上限为 8 至 12 个请求)。自适应准入控制会在观测到的 p99 延迟接近 SLO 时动态收紧这一上限,并在余量允许时放宽上限。虽然经过编译的固定形状推理具有相对集中的服务时间分布,但可变输入长度、动态批次形成以及共享内存总线争用都会引入变异性,因此需要持续进行实证校准,而非采用僵化的静态上限。
当所有副本同时过载时,就会发生级联故障。如果上游负载均衡器将被拒绝的请求转发到同样过载的其他副本上重试,重试流量就会放大过载。协调式负载丢弃通过在副本之间共享负载信息来解决这一问题,使系统能够在全局范围内决定接纳哪些请求。当全局负载超过容量时,各副本共同拒绝相同比例的请求,避免各自独立拒绝而触发重试。
当系统规模扩大、扇出放大效应使单台服务器的尾延迟直接影响用户体验时,这些技术就变得不可或缺。单机模型服务系统可以跨 GPU 流或模型副本实现对冲请求和绑定请求。尽管这里的排队分析假设采用先进先出(FIFO)处理,生产环境中的模型服务框架通常会实现优先级规则,例如最短作业优先或感知截止时间的调度,以缓解异构请求分布下的尾延迟 (Harchol-Balter 2013)。
Checkpoint 1.2: 排队与 SLO 余量
仅靠快速推理无法保障延迟 SLO;保障延迟 SLO 需要余量。
排队论与尾延迟容忍策略支配着请求的稳态处理。然而,它们预设模型服务实例已经完成初始化,且输入数据符合离线训练假设——这些前提在冷启动、自动扩缩容激增和静默特征损坏期间经常不成立。
模型生命周期管理
当模型服务集群无法正确初始化,或输出质量下降的预测时,稳态排队优化几乎无法提供保护。在一个具有代表性的部署中,新配置的副本因编译 TensorRT 引擎而停滞 35 秒,同时,PIL 与 OpenCV 之间细微的预处理差异悄然导致分类准确率下降五个百分点。缓解这些生命周期故障,需要对两个运行阶段进行系统性控制:训练与服务一致性,以及冷启动初始化。
训练与服务偏差
一个在验证期间表现良好的模型,在部署后可能悄然退化。这种现象称为训练与服务偏差,是生产机器学习中最隐蔽的故障模式之一,因为延迟监控和异常跟踪都无法发现它 (Sculley et al. 2015; Baylor et al. 2017)。
Baylor, Denis, Eric Breck, Heng-Tze Cheng, Noah Fiedel, Chuan Yu Foo, Zakaria Haque, Salem Haykal, et al. 2017. “TFX: A TensorFlow-Based Production-Scale Machine Learning Platform.” Proceedings of the 23rd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, 1387–95. https://doi.org/10.1145/3097983.3098021.
Definition 1.3: 训练与服务偏差
训练与服务偏差是由逻辑或状态不一致导致的训练环境与推理环境之间的分布差异。
- 重要性:它违反一致性要求,并且在变换函数不同时,可能导致准确率静默下降 \((f_{\text{train}}(x) \neq f_{\text{serve}}(x))\)。
- 区别:与数据漂移(环境的外部变化)不同,训练与服务偏差是工程技术栈的内部故障。
- 常见误区:一种常见误解是,可以通过查找错误来“发现”偏差。实际上,异常机制无法揭示它:系统运行完全正常,延迟也很低,但预测在统计意义上是错误的。
特征存储 详细讨论了偏差诊断、监控与组织层面的预防措施。它在模型服务中的具体表现是预处理差异:实时推理流水线处理原始数据的方式与批量训练流水线不同。当训练使用 Python/Pandas,而模型服务使用 C++/Java 或优化的推理服务器时,这是一种常见故障模式。与数据漂移不同,这种差异由内部引入,通常可以通过共享变换、训练与服务一致性测试以及严谨的工程实践来预防。
Example 1.5: ResNet-50:图像预处理偏差
场景:ResNet-50 视觉模型在离线训练与在线服务流水线之间出现预测准确率的静默下降。
诊断:服务流水线采用 C++/OpenCV 预处理(cv2.INTER_LINEAR、BGR 顺序),而训练采用 Python/PIL(PIL.BILINEAR、RGB 顺序以及不同的归一化常数)。
系统启示:预处理差异会导致静默的训练与服务偏差,而不会引发运行时异常。在训练和服务环境中统一数据变换流水线,可以防止输入分布遭到破坏。
冷启动与初始化动态
即使训练与服务流水线在数学上保证一致,新配置的模型服务实例也必须先在硬件内存层次结构中实例化其状态,才能处理查询 (Romero et al. 2021)。这种初始化延迟称为冷启动,决定了系统在部署、自动扩缩容和故障恢复期间的响应能力。
Romero, Francisco, Qian Li, Neeraja J. Yadwadkar, and Christos Kozyrakis. 2021. “INFaaS: Automated Model-Less Inference Serving.” 2021 USENIX Annual Technical Conference (USENIX ATC 21), 397–411.
Definition 1.4: 冷启动
冷启动是实例化新模型副本时产生的初始化延迟。
- 重要性:它代表状态恢复与填充(加载权重、编译计算图)的固定成本,可能耗时数秒或数分钟,实际上阻碍了系统通过弹性扩展来应对突发流量的能力。
- 区别:推理延迟 \((L_{\text{lat}})\) 是每个请求的成本,而冷启动是在创建副本或模型实例时付出的初始化成本,包括部署、横向扩容、恢复和按需加载模型。
- 常见误区:一种常见误解是,冷启动“只是加载权重”。实际上,它还包括计算图编译和内存分配,这些操作的耗时往往可能超过受带宽限制的数据传输本身 \((D_{\text{vol}}/\text{BW})\)。
总冷启动延迟由关键初始化路径上不同物理操作的耗时累加而成。首先,权重加载将序列化参数从持久存储经由网络或主机 I/O 子系统传输到主机内存,最终通过 PCIe 总线传输到 GPU HBM。计算图编译将框架计算图转换为设备专用的机器码,执行算子融合,并针对特定加速器架构自动调优矩阵乘法内核。内存分配为激活暂存区和中间缓冲区预留设备内存区域。最后,预热15执行合成推理,以填充内核缓存、预先准备框架内存分配器,并在真实流量到达之前强制完成惰性初始化。
建立 CUDA 上下文16是设备初始化时间线上的第一项固定成本。在启动任何 GPU 内核或分配设备内存之前,运行时必须实例化驱动程序级上下文:这是一种内部控制结构,用于管理虚拟地址空间、已加载的内核二进制文件和硬件事件队列。创建该上下文需要与内核态驱动程序进行同步通信,并分配数十至数百兆字节的设备内存用于管理记录。table 8 中的 0.3–0.5 s 范围反映了典型数据中心环境的情况;虽然 CUDA 惰性加载通过推迟内核模块加载来缩短这一初始停顿,但它只是将这部分延迟代价推迟到了首次执行的推理中 (NVIDIA 2026a)。
在多个工作进程共享单个加速器的多进程模型服务部署中,为各进程分别创建 CUDA 上下文会浪费内存容量和初始化时间。CUDA 多进程服务(MPS)17通过共享控制守护进程路由客户端进程,将其操作合并到单个硬件上下文中,从而消除这种冗余。这使来自不同进程的内核能够在流式多处理器上并发执行,而无需承担时间片轮转带来的上下文切换开销 (NVIDIA 2026d)。系统层面的权衡是故障隔离能力减弱:由于客户端进程在 MPS 服务器内共享地址空间,一个副本中未处理的致命异常就可能使共享服务器崩溃,并终止所有共置实例。
Example 1.6: ResNet-50:冷启动时间线
Table 8 展示了 ResNet-50 冷启动各阶段的耗时:
Table 8: ResNet-50 冷启动时间线:权重加载、CUDA 上下文创建、TensorRT 编译和预热各阶段的示例耗时,以及优化后的本地场景和云端首次部署场景的总耗时,展示了主要成本所在。
| 阶段 | 耗时 | 说明 |
|---|---|---|
| 权重加载(SSD) | 0.5 s | 从本地存储加载 98 MB FP32 权重 |
| 权重加载(S3) | 3–5 s | 对于云存储,网络延迟占主导 |
| CUDA 上下文 | 0.3–0.5 s | GPU 驱动程序初始化与内存设置 |
| TensorRT 编译 | 15–30 s | 将 PyTorch 模型转换为优化引擎 |
| 预热(10 次推理) | 0.2 s | 触发剩余的惰性初始化 |
| 运行时开销 | 0.4 s | 进程启动、框架钩子及运行时设置 |
| 总计(本地,已优化) | ~1.5 s | 使用预编译的 TensorRT 引擎和已预热容器 |
| 总计(云端,首次部署) | ~35 s | 包含从冷状态开始的编译 |
系统洞见:预先编译模型并保存优化后的引擎,可以消除后续部署中长达 30 秒的编译阶段。
如果没有预热,首个线上请求就必须承担延迟执行的 JIT 编译、驱动程序内存分配和内核启动开销。一个稳态执行时间为 5 ms 的请求,在未经缓解的冷启动期间可能停滞 500 ms,从而违反严格的 SLO。要控制这种初始化开销,就需要在存储、内存和运行时加载策略之间进行系统性选择。
加载策略
不同的加载策略在冷启动时长、服务性能和内存效率之间进行权衡。最简单的方法是全量加载,即在开始提供服务之前将整个模型读入内存。由于所有权重都可立即使用,这种方法能够最大限度地提高推理速度,但也会延长冷启动时长,并使模型大小受限于可用内存。当冷启动延迟可以接受,且模型能够轻松容纳于内存时,这种方法较为合适。
内存映射提供了另一种选择:将模型文件映射到进程地址空间,并在访问时通过缺页机制调入页面。它可以减少预先复制并缩短表观启动时间,但稠密模型最终会访问几乎所有权重,因此延后的缺页处理可能会将加载延迟转移到早期请求中。对于稀疏访问的组件,或按需加载子集的模型仓库,其选择性加载收益更大;对延迟敏感的服务仍会预先调入或预热请求路径所需的页面。
第三种策略是延迟初始化,即将编译和分配推迟到首次使用时。这可以最大限度地缩短启动时间,但会将延迟转移到首个请求。生产系统通常将延迟初始化与合成预热请求结合使用,在真实流量到达之前触发初始化。
模型缓存基础设施
生产系统在基础设施层面缓存模型权重,以减少常见部署场景中的冷启动时间。其中一种方法是容器镜像嵌入,即将模型权重直接打包到容器镜像中。这会生成单一部署产物,并消除启动时的网络获取操作,但也会产生大型镜像(通常为 10–50 GB),导致容器镜像拉取变慢,并占用镜像仓库存储空间。这种方法最适合很少更新的模型。
对于模型数量多且更新频繁的组织,使用包含版本化模型权重的共享文件系统(EFS、GCS FUSE)是一种更灵活的替代方案。多个副本可以读取相同的产物,无须将每个版本都构建到容器中。更新仍然需要显式、原子的版本切换和部署发布;如果允许文件在副本运行期间发生变化,就会破坏可复现性。其代价是网络延迟会影响冷启动,而且文件系统的可用性会成为关键依赖。
当高流量模型对冷启动延迟有严格要求时,节点本地 SSD 缓存会预先将常用模型填充到推理节点的本地 SSD 中。这种方法可以从非易失性内存主机控制器接口(NVMe)驱动器以 500 MB/s 或更高的速度快速加载,且不依赖网络,但需要通过缓存管理来处理模型更新和容量限制。更新不频繁时适合采用容器嵌入,更新频繁时适合采用共享文件系统,而性能要求严格的部署则可受益于带有后台刷新的本地缓存。
多模型服务
生产系统通常在单台机器上为多个模型提供服务,这些模型可能是用于 A/B 测试的不同模型版本、集成模型的组件,或共享基础设施的完全不同的模型。GPU 内存因此成为限制性资源,需要采用审慎的管理策略。
有三种策略可用于多模型内存管理。时间复用每次加载一个模型,并根据请求路由进行换入换出:这种方法简单,但会引入换入换出延迟。内存共享在模型之间划分 GPU 内存,虽然限制了并发执行数量,却能让更多模型保持驻留。Triton 等框架实现的模型虚拟化,通过模型仓库以及用于加载、卸载和版本管理的控制 API,将模型生命周期与应用代码分离 (NVIDIA 2024b, 2026c, 2026b)。具体选择取决于请求模式:如果各模型接收的流量均匀,则可以并发加载;如果流量具有突发性且集中于特定模型,则结合显式预加载的时间复用可以降低平均延迟,同时最大限度地提高 GPU 利用率。
NVIDIA. 2026c. Model Repository: NVIDIA Triton Inference Server.
NVIDIA. 2026b. Model Management: NVIDIA Triton Inference Server.
多流执行
当多个模型或同一模型的多个实例必须在单个 GPU 上并发运行时,硬件必须在它们之间划分资源。NVIDIA 的多实例 GPU18技术支持硬件级隔离,可将一块 A100划分为最多七个独立的 GPU 实例,每个实例都具有专用的内存和计算资源 (NVIDIA 2026e)。MIG 可用于 A100、A30(最多四个实例)、H100、H200 以及更新的数据中心 GPU。对于 V100 或 T4 等较早的 GPU,CUDA 流调度提供不具备硬件隔离的时间复用共享。具体选择取决于优先考虑的是通过 MIG 获得稳定延迟,还是通过共享流实现最大利用率。
模型换入换出与主机内存
当所有模型的总大小超过 GPU 内存容量时,服务系统必须按需在主机动态随机存取存储器(DRAM)与设备内存(VRAM)之间换入换出模型。这会引入一个由 PCIe 总线带宽决定的新延迟分量。
对于一个大小为 10 GB 的模型,在 PCIe Gen4 x16(理论带宽为 32 GB/s)上,仅加载就至少需要 312.5 ms,尚未计入反序列化、计算图设置或预热。如页边图所示,这一原始传输延迟是严格服务级别目标(例如 50 ms 的截止时间)的 \(6\times\) 以上,使得按需模型换入换出无法用于交互式请求路径。

模型加载时间远超严格的服务 SLO。
为了加速这条传输路径,系统使用固定内存(页锁定的主机 RAM)。GPUDirect DMA 引擎要求物理内存页在整个传输过程中始终固定在不变的物理地址上。通过标准堆分配器分配的普通主机内存是可分页的:操作系统虚拟内存管理器可以随时迁移物理页,或将其换出到后备存储。因此,从可分页缓冲区传输数据会迫使 CUDA 驱动程序执行两阶段复制:CPU 首先以同步方式将数据复制到中间的固定暂存缓冲区,然后 DMA 引擎通过 PCIe 将暂存缓冲区中的数据传输到 GPU 内存。通过 cudaHostAlloc 直接在页锁定主机内存中分配模型权重,可以消除这次 CPU 暂存复制,使 GPU 的 DMA 控制器能够以链路的全部带宽通过 PCIe 总线流式传输权重。其物理资源代价是可能耗尽主机内存:固定内存无法被换出,也无法在内存压力下由操作系统回收,因此会持续锁定物理 RAM,使其他进程无法使用。高吞吐量服务系统因此会固定活跃模型的权重和 I/O 环形缓冲区,同时将备用模型检查点保留在可分页内存中。
模型完成加载和预热,并且生成与训练结果一致的预测之后,请求分组便成为下一个优化手段。在排队模型中,动态批处理直接决定硬件效率与尾延迟之间的平衡。
吞吐量优化
考虑一个典型的 ResNet-50 分类器,它在 V100 GPU 上以批大小为 1 的方式运行。每次前向传播都要从 HBM 加载全部模型参数来处理单个输入,因此算术强度较低,同时内核启动开销主导执行时间。GPU 的硬件利用率仅为 15%,每秒处理 200 张图像。一次处理 32 张图像时,利用率可达到 95%,每秒处理 1,280 张图像——在相同硬件上,吞吐量达到原来的 6.4\(\times\)——这是因为加载的权重会在片上内存中被多个输入复用,从而摊薄内存带宽需求和内核启动开销。批处理19是提高服务经济效益的主要手段,但其在训练与服务中的运行约束存在显著差异 (Crankshaw et al. 2017)。训练批次通过将数百或数千个样本组合在一起来最大限度地提高吞吐量,而不受单个样本延迟的约束。服务批次则必须在加速器饱和度与单个请求截止时间之间取得平衡,确保较早到达的输入不会为等待批次形成而等待过久。推理服务器通过动态批处理来化解这一矛盾,在运行时调整批大小,以适应到达的请求。
Crankshaw, Daniel, Xin Wang, Guilio Zhou, Michael J. Franklin, Joseph E. Gonzalez, and Ion Stoica. 2017. “Clipper: A Low-Latency Online Prediction Serving System.” 14th USENIX Symposium on Networked Systems Design and Implementation (NSDI 17), 613–27.
Definition 1.5: 动态批处理
动态批处理是一种机器学习服务优化方法,在随机到达模式下以延迟换取吞吐量。
- 意义:调度器通过在批处理窗口内缓冲请求,将固定开销 \((L_{\text{lat}})\) 摊薄到多个输入上,推动系统从受内存限制的状态 \((\text{BW})\) 向受计算限制的状态 \((R_{\text{peak}})\) 转移。
- 区别:与固定大小的服务批次不同,动态批处理在推理时根据到达流量、超时时间和最大批大小限制来调整实际批大小。
- 常见误区:一种常见误解是批处理“总是有益”。实际上,延迟与吞吐量之间存在帕累托前沿:如果批处理窗口过大,增加的排队延迟可能会在吞吐量收益实现之前就导致系统违反 SLO。
批处理为何有效
现代加速器只有在批大小足够大时才能达到峰值效率 (Shen et al. 2019)。单个推理请求会使大多数计算单元处于空闲状态,因为 GPU 的设计目标是在数千个线程之间并行执行。批处理将固定成本摊薄到多个请求上,并支持沿批次维度并行执行。
Shen, Haichen, Lequn Chen, Yuchen Jin, Liangyu Zhao, Bingyu Kong, Matthai Philipose, Arvind Krishnamurthy, and Ravi Sundaram. 2019. “Nexus: A GPU Cluster Engine for Accelerating DNN-Based Video Analysis.” Proceedings of the 27th ACM Symposium on Operating Systems Principles, 322–37. https://doi.org/10.1145/3341301.3359658.
在批大小较小时,两项固定成本占据主导地位。内核启动开销20是 CPU 准备工作并将其提交给 GPU 所需的时间。神经网络中的每一层通常都需要单独启动一个内核:CPU 必须组装内核参数,将其复制到 GPU 可访问的内存中,并通知 GPU 开始执行。这项开销通常为每个内核 5–20 μs,与批大小无关。ResNet-50大约有五十层,因此仅内核启动就会为每次推理增加 250–1000 μs。在批大小为 1 时,这项开销可能超过实际计算时间;在批大小为 32 时,相同的开销会分摊到三十二张图像上。权重加载将模型参数从 GPU 内存(VRAM)读入计算单元。在批大小为 1 时,GPU 读取全部权重来处理一张图像,算术强度较低,导致执行单元无法获得充足数据;在批大小为 32 时,同一次权重读取可用于处理三十二张图像,使运算强度达到原来的 32\(\times\)。在具体模型上测量批处理效率,可以量化这些固定成本在实践中如何被摊薄。
更大的批次可提高硬件效率,但会增加单个请求的延迟。在实践中,最优批大小同时取决于延迟 SLO 和请求到达率。工程问题需要定量求解:确定仍能满足给定延迟 SLO 的最大批大小。在 table 9 所量化的 ResNet-50 场景中,批大小为 8、批处理窗口为 5 ms 时,最坏情况下的用户延迟约为 14 ms(5 ms 等待加上 9 ms 推理),低于 20 ms 的 SLO 预算。只要持续负载足够高,能够填满批处理窗口,这种配置在相同硬件上的服务吞吐量就可达到批大小为 1 时的 4.4×。在 figure 6 中绘制这一关系,可以看出继续增大批次所带来的收益开始不足以抵偿其延迟成本的拐点:吞吐量已趋于平缓,而延迟开始急剧上升,因此超过该点继续增大批次,只能以排队延迟为代价换取有限的容量收益。
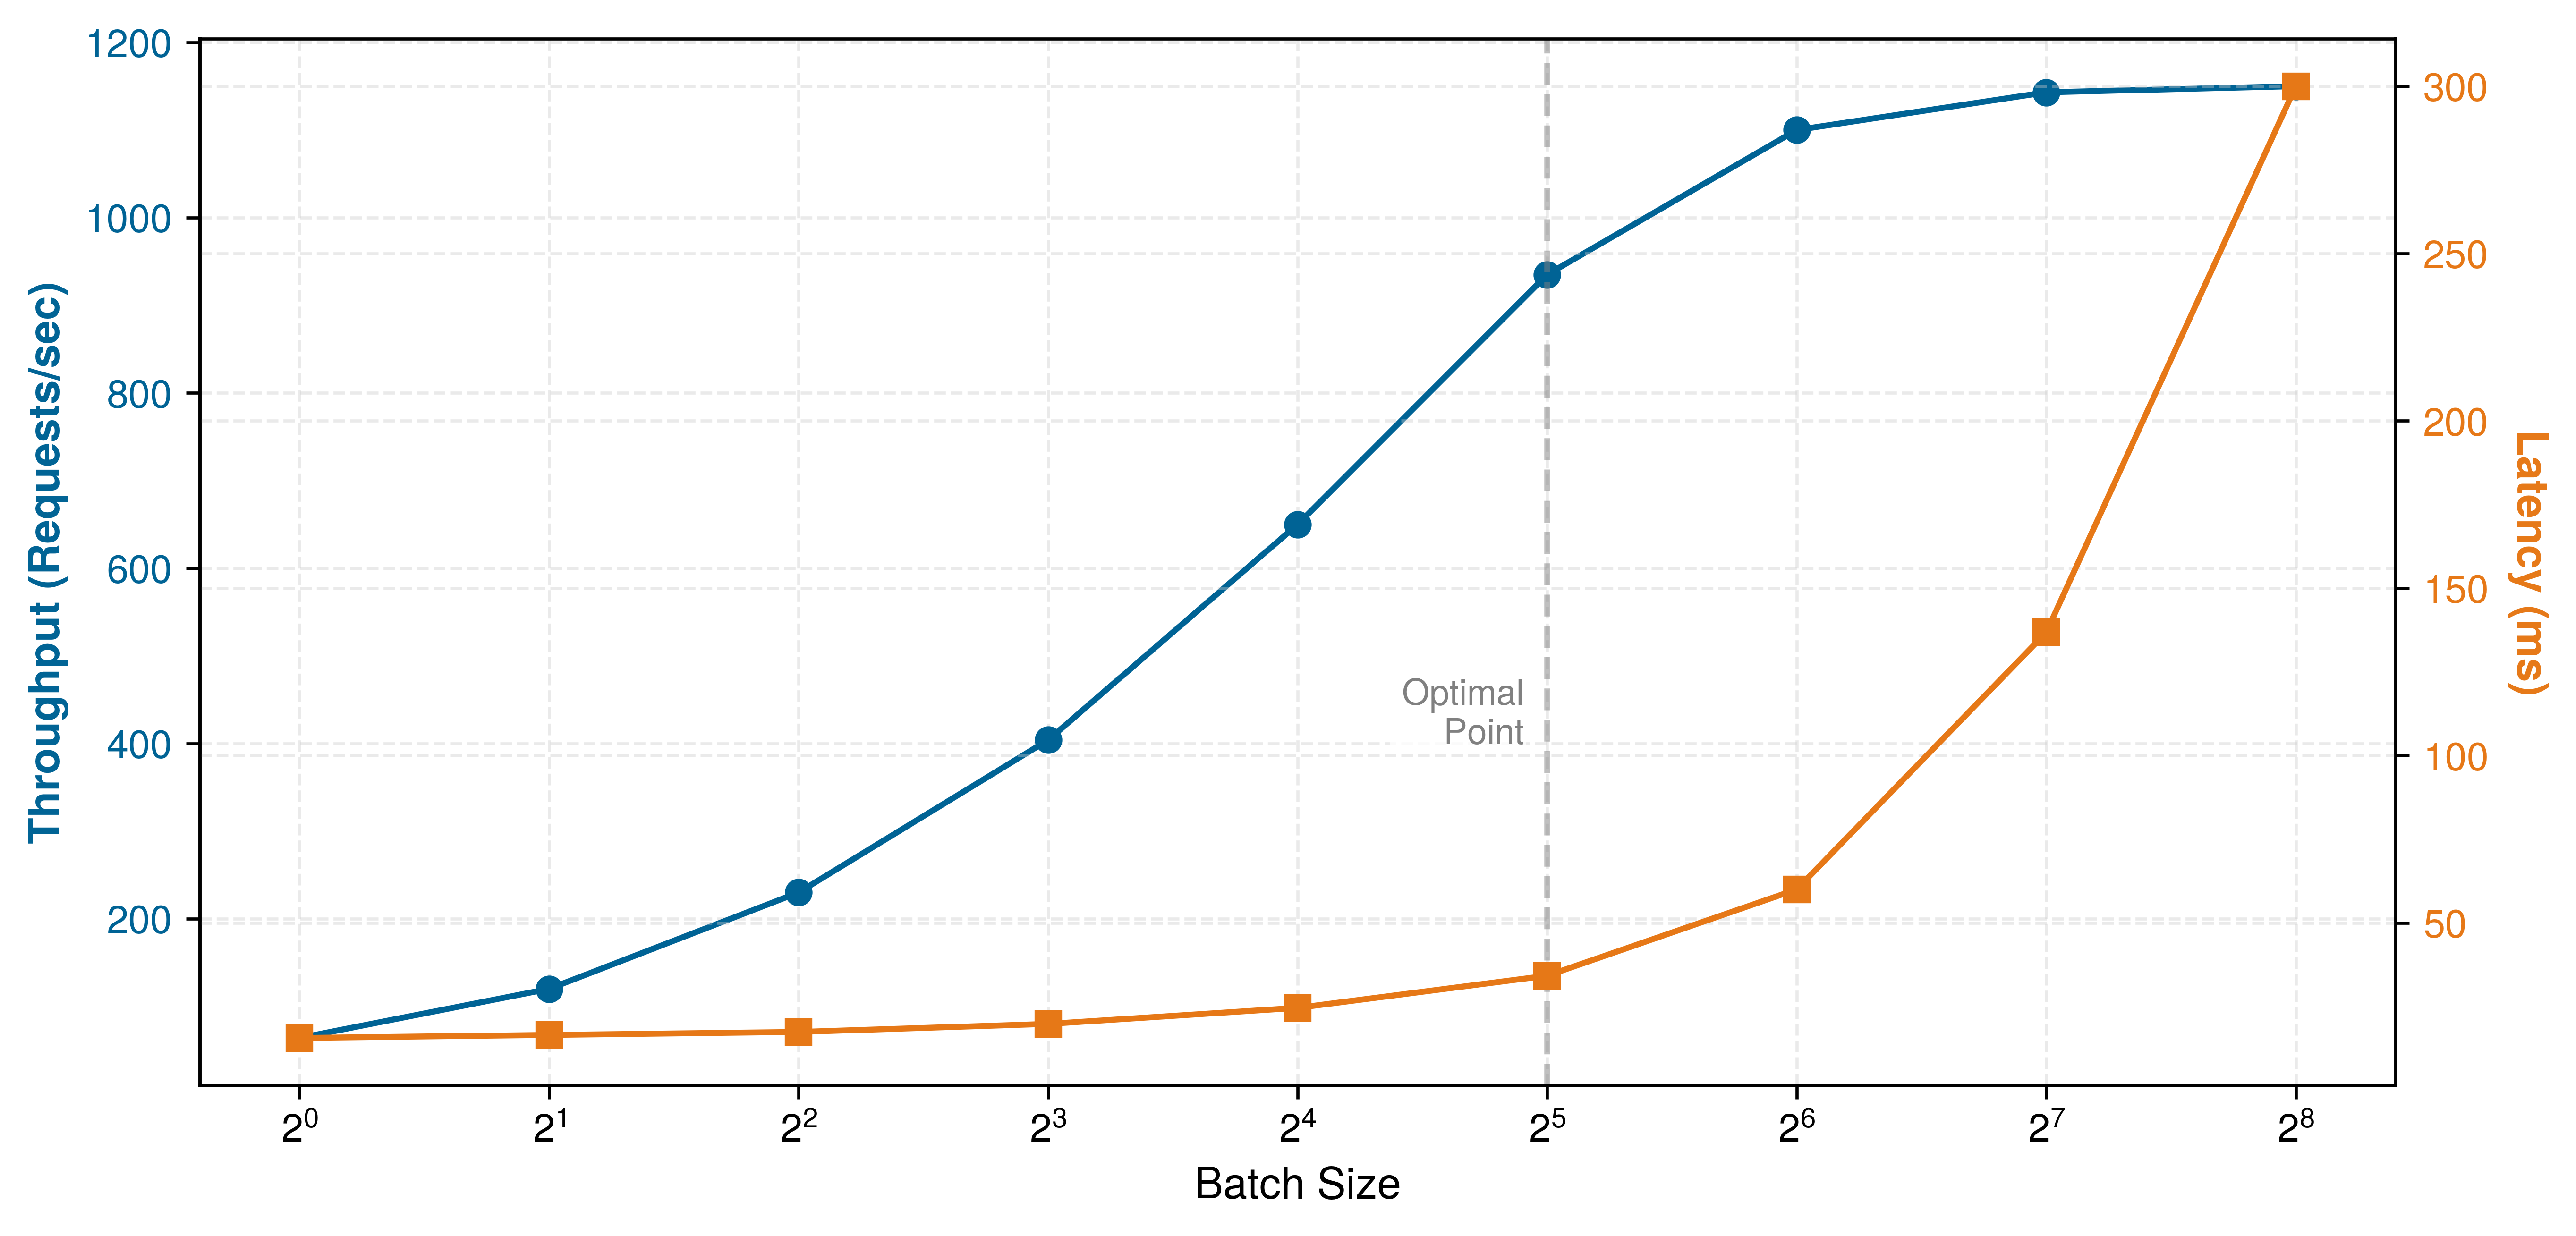
figure 6 中的“拐点”标示了蓝色吞吐量曲线开始趋于平坦、同时橙色延迟曲线开始急剧上升的位置。这是一个示意性的拐点,而非普遍适用的最优点:所选工作点取决于延迟服务级别目标(SLO)、到达过程和成本目标。这些数值具有代表性,并不对应某一项特定基准测试。
Napkin Math 1.4: ResNet-50 批处理效率
Table 9 展示了 ResNet-50/V100 场景下,批大小从 1 到 32 时吞吐量与延迟之间的权衡。批大小、实测推理时间和 GPU 利用率是该场景的给定数据;单图像计算时间和吞吐量两列则由这些数据推导而得。
Table 9: ResNet-50 批大小扫描:V100 上批大小从 1 到 32 时,单图像计算时间、吞吐量和 GPU 利用率的示例。批大小从 1 增至 32 时,吞吐量变为原来的 6.4×,GPU 利用率从 15 percent 升至 95 percent,而纯推理时间则从 5 ms 延长至 25 ms。
计算:对于批大小为 8 的一行,将批延迟除以批大小即可得到单图像计算时间:9.1 ms ÷ 8 张图像 ≈ 每张图像 1.1 ms。将批大小除以批延迟即可得到吞吐量:8 张图像 ÷ 9.1 ms ≈ 879 img/s。这两个关系同样适用于每一行的推导计算。
| 批大小 | 推理时间 | 单图像计算时间 | 吞吐量 | GPU 利用率 |
|---|---|---|---|---|
| 1 | 5 ms | 5 ms | 200 img/s | 15% |
| 4 | 7.2 ms | 1.8 ms | 556 img/s | 42% |
| 8 | 9.1 ms | 1.1 ms | 879 img/s | 65% |
| 16 | 14 ms | 0.9 ms | 1,143 img/s | 85% |
| 32 | 25 ms | 0.8 ms | 1,280 img/s | 95% |
所示时间为纯推理时间,不包括排队等待;section 1.7.6 分析了用户感知延迟如何包含批处理窗口等待时间。
系统洞见:批大小为 32 时的吞吐量是批大小为 1 时的 6.4×。然而,用户感知延迟同时包括排队等待时间和推理时间。在批处理窗口为 10 ms、推理时间为 25 ms 时,总延迟达到 35 ms,而批大小为 1 时为 5 ms。
批处理带来的效率提升是有代价的:请求必须等待批次形成。缓冲使吞吐量优化(更大的批次)与延迟最小化(立即处理)之间产生了直接矛盾。服务系统如何在流量波动时平衡这些相互竞争的需求,决定了批处理策略的选择。
静态批处理与动态批处理
静态批处理在编译时固定批次维度,并等待队列中恰好积累 \(B\) 个请求后才执行。在离线批处理和模型训练中,静态形状使编译器能够分配静态内存缓冲区,并生成经过优化的计算内核,以最大限度地提高权重复用率和算术强度。然而,在交互式服务中,客户端请求是随机到达的。当到达率较低或波动时,静态批处理会使请求在等待批次填满的过程中承受无上界的排队延迟。反过来,为降低延迟而设置较小的固定批大小,会使加速器计算单元利用不足,并且在流量突增时无法有效摊薄从高带宽内存传输权重的开销。
动态批处理通过在双触发调度器后缓冲传入请求,使批次形成无需依赖确定性的到达过程 (Olston et al. 2017; NVIDIA 2024b)。服务运行时不会为了固定的张量形状而无限等待,而是在以下任一阈值达到时立即将批次派发到加速器:队列积累的请求达到最大批大小 \(B_{\max}\),或从缓冲区中最早请求的到达时刻起计算的超时窗口 \(T_{\text{window}}\) 到期。当流量突发时,队列几乎瞬间就能填满至 \(B_{\max}\),以极小的排队延迟实现高算术强度。当到达率下降时,超时窗口会强制派发一个未满的批次(\(B < B_{\max}\)),以牺牲单请求计算效率为代价,为排队延迟设定上界。超时窗口 \(T_{\text{window}}\) 和最大批大小 \(B_{\max}\) 是主要的运行调节参数:较短的窗口优先保障延迟,而非加速器效率;较大的窗口则在请求量允许时最大限度地提高系统吞吐量。
动态批处理中的延迟与吞吐量权衡
动态批处理在吞吐量优化与延迟约束之间引入了可量化的矛盾。在过载情况下,导致延迟增加的机制是队列增长,而非推理变慢,这使得配置决策可以系统化地进行,无需依靠反复试错调优。
Systems Perspective 1.5: 为什么负载升高时延迟会激增
利特尔定律 \((Q_{\text{req}} = \lambda_{\text{arr}} T_{\text{lat}})\) 仅在队列稳定时描述长期平均量之间的关系(section 1.5.1)。当到达率接近最大服务率 \(\mu\) 时,稳定队列的深度和延迟会迅速增长。如果 \(\lambda_{\text{arr}}\) 持续一段时间超过容量,就不存在有限的稳态:积压会不断累积,直到流量下降、容量增加或请求被拒绝。这就是准入控制能够在过载期间维持延迟水平的原因;条件允许时,横向扩容或服务降级也能有所帮助。
Equation 7 将批处理请求的用户感知总延迟分解为两个组成部分: \[L_{\text{lat}} = L_{\text{lat,wait}} + L_{\text{lat,compute}}(B) \tag{7}\] 其中,\(L_{\text{lat,wait}}\) 是在批处理队列中等待的时间(对应于总体延迟预算中的 \(L_{\text{lat,queue}}\)),\(L_{\text{lat,compute}}(B)\) 是批大小为 \(B\) 时的推理时间(涵盖 \(L_{\text{lat,infer}}\) 以及 \(L_{\text{lat,pre}}\) 和 \(L_{\text{lat,post}}\) 的部分时间)。批处理窗口 \(T_{\text{window}}\) 为等待时间设定上界(\(L_{\text{lat,wait}} \leq T_{\text{window}}\)),而批大小则通过摊薄权重内存传输开销、提高加速器执行单元的算术强度来决定计算时间。
批处理的定量分析
对于按固定时间边界划分的窗口,在平稳泊松到达条件下,请求到达时刻在各窗口内均匀分布。在时刻 \(t\) 到达的请求需要等待 \(T_{\text{window}} - t\),该窗口才会关闭,因此 equation 8 给出的平均等待时间为窗口长度的一半: \[E[L_{\text{lat,wait}}] = \frac{T_{\text{window}}}{2} \tag{8}\]
无论最终形成的批大小是多少,20 ms 的批处理窗口都会增加 10 ms 的平均等待时间(窗口内首个到达的请求最多等待 20 ms;后续到达的请求等待时间较短)。对于平均延迟 SLO 为 50 ms、推理时间为 5 ms 的情况,在任何计算开始之前,平均等待时间就已消耗延迟预算的 20 percent;尾延迟 SLO 则必须为整个窗口长度预留预算。
批大小分布
对于按固定时间边界划分的窗口,在 \(T_{\text{window}}\) 内收集到的请求数服从均值为 \(\lambda_{\text{arr}} T_{\text{window}}\) 的泊松分布。Equation 9 形式化地表述了这一关系: \[\Pr(\text{batch size} = k) = \frac{(\lambda_{\text{arr}} T_{\text{window}})^k e^{-\lambda_{\text{arr}} T_{\text{window}}}}{k!} \tag{9}\]
这里,\(k\) 是窗口内到达请求数,为非负整数。
Table 10 量化了这种变异性,展示了在固定的 10 ms 窗口下,不同流量水平对应的批大小波动情况:
| 到达率 | 平均批大小 | 标准差 | \(\Pr(\text{batch}=0)\) | \(\Pr(\text{batch} \ge 2 \times \text{mean})\) |
|---|---|---|---|---|
| 50 QPS | 0.5 | 0.7 | 61% | 39% |
| 200 QPS | 2 | 1.4 | 14% | 14% |
| 500 QPS | 5 | 2.2 | 0.7% | 3% |
| 1000 QPS | 10 | 3.2 | 0.005% | 0.3% |
吞吐量最大化策略
优化吞吐量需要区分单请求延迟与饱和服务容量。请求先等待批次形成,再经历所形成批次的服务时间。然而,在持续负载下,批次形成可以与上一批次的执行重叠,因此容量由就绪批次的服务时间决定: \[\mu_{\text{eff}}(B) \approx \frac{B}{T_{\text{svc}}(B)}, \qquad \text{throughput} = \min(\lambda_{\text{arr}}, \mu_{\text{eff}}(B)) \tag{10}\]
在 equation 10 中,\(\lambda_{\text{arr}}\) 是输入请求的到达率,\(\mu_{\text{eff}}(B)\) 是批大小为 \(B\) 时的饱和服务容量。分子随批大小线性增加,而服务时间在具有实际价值的范围内通常呈次线性增长,因为较大的批次能够摊薄固定的内核启动开销和 DRAM 权重传输开销,使执行从受内存带宽限制的矩阵—向量运算转向受计算能力限制的矩阵—矩阵乘法。批处理窗口仍会影响请求延迟,也会影响低流量下的运行情况;在低流量下,预期批大小受窗口内到达请求数的限制,约为 \(\lambda_{\text{arr}} T_{\text{window}}\)。
对于 V100 GPU 上的 ResNet-50,服务时间近似按 \(T_{\text{svc}}(B) = 5 \text{ ms} + 0.6 B\) 变化(5 ms 固定开销,加上批次内每张图像 0.6 ms)。这一线性近似捕捉了主要趋势;实际服务时间可能因内存层次结构的影响而略有偏离。在批处理窗口为 \(T_{\text{window}} = 10 \text{ ms}\) 时,table 11 扩展了 table 9 中的纯推理扫描:延迟包含完整窗口长度所给出的等待时间上界,而饱和吞吐量仅使用服务时间计算:
| 批大小 | 服务时间 | 总延迟 | 吞吐量 | 效率 |
|---|---|---|---|---|
| 1 | 5.6 ms | 15.6 ms | 179 img/s | 低 |
| 4 | 7.4 ms | 17.4 ms | 541 img/s | 中等 |
| 8 | 9.8 ms | 19.8 ms | 816 img/s | 良好 |
| 16 | 14.6 ms | 24.6 ms | 1096 img/s | 高 |
| 32 | 24.2 ms | 34.2 ms | 1322 img/s | 最高 |
table 11 中的吞吐量增益可直接追溯到 训练性能铁律 中确立的铁律中的固定开销项,批处理通过在多个请求之间分摊工作来降低这部分开销。
Example 1.7: 批处理效率铁律
背景: 在模型服务中,批处理通过分摊每批固定的调度和内核启动工作来提高吞吐量;它还可以在多个请求之间分摊权重传输流量,而排队等待仍是一项独立的延迟成本。在这一用于说明的两项比较中暂不纳入数据移动项,equation 11 单独考察计算与固定开销: \[ T = \frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}} + L_{\text{lat}} \tag{11}\]
分析:
- 情形 1(批大小为 1):开销(5 ms)\(\gg\) 计算时间(0.6 ms)。效率 ≈ 10 percent。GPU 大部分时间都在等待。
- 情形 2(批大小为 32):开销(5 ms)\(\ll\) 计算时间(19.2 ms)。效率 ≈ 79 percent。GPU 正在进行数值计算。
系统层面的洞见:增大批大小,直到固定开销可忽略不计(占总时间的比例 \(<\) 10 percent),或延迟 SLO 不允许继续等待。超过这一点后,进一步增大批大小带来的吞吐量增益很小,却会产生线性增长的排队代价。
这三个结果共同构成了一个可用的动态批处理模型:窗口将平均等待时间设定为其长度的一半,泊松到达使实际批大小在 \(\lambda_{\text{arr}} T_{\text{window}}\) 附近波动,而饱和服务能力 \(\mu_{\text{eff}}(B)\) 随批大小增大而提高,直到固定开销被充分分摊。这些关系都尚未施加延迟 SLO 约束。要落实这一约束,需要从严格的百分位延迟预算反向推导,找出窗口能够安全形成的最大批次。
延迟约束优化
当延迟 SLO 是起决定作用的约束时,优化问题就变为寻找满足 SLO 的最大批大小。对于延迟目标 \(L_{\text{lat,target}}\) 和平均等待时间 \(T_{\text{window}}/2\),equation 12 使用一阶平均延迟近似来定义允许的最大批大小: \[B_{\text{max}} = \max\left\{B : \frac{T_{\text{window}}}{2} + T_{\text{svc}}(B) \leq L_{\text{lat,target}}\right\} \tag{12}\]
在这个延迟 SLO 为 p95 不超过 50 ms 的 ResNet-50 示例场景中,比较保守与激进的批处理窗口,可以展示所假定的配置如何在等待时间、推理预算和饱和服务能力之间进行权衡。Table 12 并列展示了这两种配置。
| 指标 | 保守配置(\(T_{\text{window}}\) = 5 ms) | 激进配置(\(T_{\text{window}}\) = 25 ms) |
|---|---|---|
| 平均等待时间 | 2.5 ms(窗口内第一个请求的最大等待时间 = 5 ms) | 12.5 ms |
| 推理延迟预算 | 47.5 ms(按平均延迟规划;尾延迟 SLO 应为完整窗口预留预算) | 37.5 ms |
| 批大小上限 | 32 images | 48 |
| 假定的饱和服务能力 | ~1,140 img/s | ~1,280 img/s |
激进配置假定饱和服务能力提高 12.3 percent,但平均批处理等待时间增加了 10 ms,窗口等待对延迟的最大贡献增加了 20 ms。后者并非 p99 延迟的估计值。
SLO 违反分析
即使平均延迟看似处于安全范围内,批大小的波动也可能导致 SLO 违反。固定窗口内的某个请求所见的批次包含其自身以及其他到达的请求,因此 \(B_{\text{req}}=1+\operatorname{Poisson}(\lambda_{\text{arr}}T_{\text{window}})\)。将完整窗口时长与请求所见批大小的 p99 相结合,可得到 equation 13 中的保守包络: \[L_{\text{lat,envelope}} = T_{\text{window}} + T_{\text{svc}}(B_{\text{req,p99}}) \tag{13}\] 当 \(\lambda_{\text{arr}}\) = 500 QPS 且 \(T_{\text{window}}\) = 10 ms 时,请求所见批大小的均值为 6,其 p99 为 12。平均延迟为 13.6 ms;保守包络为 22.2 ms。
该包络为均值的 1.63×。它并非请求延迟的 p99,因为完整窗口等待与 p99 批大小不一定出现在同一个请求上。
Systems Perspective 1.6: 延迟与吞吐量的权衡
在指定批大小之前,单一的“推理速度”数值没有明确定义,因为批大小决定了系统所处的运行区间及其瓶颈。
- 批大小为 1 的运行区间:面向延迟。启动开销或内存流量往往会限制请求处理路径。打字辅助和机器人等实时交互场景主要处于这一运行区间。
- 批大小为 N 的运行区间:面向吞吐量。较大的批次可分摊开销与权重传输流量,并可能将瓶颈转移到计算。离线处理和高流量服务主要处于这一运行区间。
这两个运行区间优化的指标方向相反,因此,在批大小为 1 时“快速”的模型可能远未达到峰值吞吐量,反之亦然。因此,任何延迟或吞吐量数值都必须说明,其测量条件是单流延迟(批大小为 1)还是最大吞吐量(批大小为 N)。
自适应批处理窗口
同样的批大小依赖关系也决定了服务系统最初如何组织批次。在高流量下,大批次很快就能形成,此时固定批处理窗口会浪费延迟预算。Listing 2 展示了自适应策略如何根据队列深度调整窗口。
在一个流量介于 200–1000 QPS 的示例场景中,固定的 10 ms 窗口在吞吐量为 650 img/s 时产生 15 ms 的平均延迟,而自适应启发式策略在吞吐量为 680 img/s 时产生 11 ms 的平均延迟。窗口大小与批大小限制之间的相互作用形成了一个可能配置空间,其中每种配置都代表吞吐量与延迟之间的一种不同平衡。
def adaptive_batching_window(
    queue_depth, arrival_rate, slo_ms, service_ms, fixed_overhead_ms
):
    """Compute a heuristic batching window.

    Based on current system state.
    """
    target_batch_size = 16  # Deployment-tuned target batch

    # Fast path: batch ready, close immediately to minimize latency
    if queue_depth >= target_batch_size:
        return 0

    # Compute maximum allowable wait from the remaining p99 budget.
    max_wait_ms = max(0, slo_ms - service_ms - fixed_overhead_ms)

    # Estimate time to accumulate target batch at current arrival
    # rate.
    # arrival_rate is requests/second, so convert seconds to
    # milliseconds.
    if arrival_rate > 0:
        requests_needed = target_batch_size - queue_depth
        estimated_wait_ms = requests_needed / arrival_rate * 1000.0
        # Return minimum of estimated wait and SLO-constrained maximum
        return min(estimated_wait_ms, max_wait_ms)

return max_wait_ms # Low traffic: use remaining budget to accumulate batch非支配批处理配置构成一条帕累托前沿,在这条前沿上,提高吞吐量就必须接受更高的延迟。Table 13 展示了五种示例配置:
| 窗口(ms) | 最大批大小 | 平均延迟 | p99 延迟 | 吞吐量 | 配置 |
|---|---|---|---|---|---|
| 2 | 16 | 8 ms | 18 ms | 890 img/s | 超低延迟 |
| 5 | 32 | 10 ms | 22 ms | 1,140 img/s | 均衡 |
| 10 | 32 | 15 ms | 35 ms | 1,240 img/s | 适中延迟 |
| 20 | 64 | 23 ms | 52 ms | 1,310 img/s | 吞吐量优化 |
| 50 | 128 | 38 ms | 98 ms | 1,350 img/s | 最大吞吐量 |
实用配置指南
table 13 中的帕累托前沿说明了为何必须从延迟预算出发反推配置:越过拐点后,扩大窗口所带来的吞吐量增益逐渐减小,而尾延迟则急剧上升。在此算例中,将 SLO 的 30% 预留给批处理等待,可得 \(T_{\text{max}} = 0.3 \times L_{\text{lat,SLO}}\);其他工作负载在考虑网络、预处理、推理和后处理后,可能会分配不同的比例。流量估计应涵盖峰值和突发持续时间,而不能仅依赖均值。GPU 内存通过激活值和运行时工作空间对批大小施加另一项上限约束。最后,监测实际批大小和等待时间的分布,可以判断所假设的到达模型是否成立,以及采用固定窗口还是自适应窗口更为合适。
对于一个 SLO 为 50 ms、流量为 500 QPS 的示例 ResNet-50 服务系统,该计算将 SLO 和到达率假设转化为两个可部署的调节参数:批处理窗口和最大批大小。Table 14 汇总了所得配置及模型估算的运行点。
| 量 | 值 | 工程作用 |
|---|---|---|
| 批处理延迟预算 | 15 ms | SLO 中可用于排队延迟的部分。 |
| 最大窗口 | 15 ms | 延迟预算所限定的上界。 |
| 请求所见批大小的期望值 | 7 | 到达请求所见的平均批大小。 |
| 请求所见批大小的 p99 | 13 | 泊松到达条件下的尾部批大小。 |
| 假设的内存受限批大小 | 32 | 场景中由加速器内存限定的批大小上限。 |
| 选定配置 | \(T_{\text{window}}\) = 12 ms, \(B_{\text{max}}\) = 32 | 用于部署的实际参数设置。 |
| 保守尾延迟包络 | 24.8 ms | 完整窗口时长加上请求所见 p99 批大小对应的服务时间。 |
| 示例饱和容量 | 1,176.9 img/s | 使用假设的 0.89 效率因子进行估算。 |
| 实际服务吞吐量 | 500 img/s | 该配置所处理的、受到达率限制的负载。 |
连续批处理
自回归模型(如大语言模型)逐词元生成输出。由于每个新词元都依赖于累积的序列历史,生成过程按顺序进行。标准动态批处理假设输出长度一致,并在整个生成周期内固定使用同一个批次。当序列长度不同时,这种静态绑定会降低加速器效率。如果一个包含八条序列的批次中,有一条序列在生成十个词元后结束,而其他序列需要生成 100 个词元,那么在等待最慢序列完成期间,分配给该序列槽位的计算资源和内存带宽有 90% 浪费在填充词元或被掩码屏蔽的空操作上 (Yu et al. 2022)。
连续批处理21(也称为迭代级批处理)通过在每次解码迭代时重新调度批次组成,消除了这种空闲槽位开销 (Yu et al. 2022; Kwon et al. 2023)。服务引擎不会将批次固定下来并使其持续数百次前向传播,而是在每个词元生成步骤重新评估批次成员。当某条序列输出序列结束词元时,调度器立即回收该执行槽位,将一个新到达的请求纳入批次,以参与下一次前向传播。活跃序列的解码不中断,从而在长度可变的工作负载下维持较高的加速器利用率。
vLLM22 和 TensorRT-LLM 等服务运行时通过两种机制提高吞吐量:回收已完成序列所浪费的计算资源,以及缩短新到达请求的排队等待时间 (Kwon et al. 2023; NVIDIA 2026f)。然而,动态接纳新请求会在提示预填充与词元解码之间引发系统层面的资源冲突。对数百个词元进行的提示预填充属于计算密集型操作,算术强度较高,会独占 GPU 流式多处理器数十毫秒。相比之下,词元解码受内存带宽限制,且每次执行一个词元。当引擎在同一次迭代中执行预填充和活跃序列的解码时,正在进行的解码流会停顿,导致词元间延迟(ITL)出现剧烈尖峰。Sarathi-Serve 通过分块预填充和无停顿批处理解决这种干扰 (Agrawal et al. 2024)。调度器将长提示拆分为固定大小的块(例如 512 个词元),并在每一步将单个块与活跃的解码请求共同调度,从而限制每次迭代的执行时间,并保持稳定的词元生成节奏。
Agrawal, Amey, Nitin Kedia, Ashish Panwar, Jayashree Mohan, Nipun Kwatra, Bhargav S. Gulavani, Alexey Tumanov, and Ramachandran Ramjee. 2024. “Taming Throughput-Latency Tradeoff in LLM Inference with Sarathi-Serve.” 18th USENIX Symposium on Operating Systems Design and Implementation (OSDI 24), 117–34.
连续批处理将模型服务的主要瓶颈转移到了内存管理上。由于 Transformer 在生成过程的每一步都会追加注意力状态,每个活跃请求的键值(KV)缓存会在加速器 HBM 中动态增长。当不同长度的序列共享内存时,连续分配会产生严重的外部碎片。如果一条已完成的 100 词元序列释放了其缓存,新到达的 150 词元请求无法使用这块已释放的内存,因为它需要更大的连续地址范围。随着时间推移,物理内存分裂成细小且不连续的空隙,即使未分配的总容量看似充足,也会阻止新序列启动。在朴素实现中,这种内存碎片化可能浪费 40% 至 50% 的可用内存,严重限制决定服务吞吐量的并发批大小。
PagedAttention

PagedAttention 回收了连续分配所浪费的 KV 缓存空间。
vLLM 引入的 PagedAttention,23 将操作系统的虚拟内存分页机制应用于加速器内存,从而突破这一内存墙 (Kwon et al. 2023)。在静态连续分配中,预先按最大序列长度预留内存会造成内部浪费,而释放的区域可能过小或位置不当,无法满足新的连续内存预留需求。PagedAttention 不为每条序列分配一个连续区域,而是将 KV 缓存划分为固定大小的块,并通过块表进行映射。因此,一条序列的缓存可以占用不连续的物理块。当序列完成时,其内存块会返回空闲池以供复用。在计算注意力之前,专用的 PagedAttention CUDA 内核不会先将不连续块复制到临时连续缓冲区,而是直接遍历块表,在查询与键相乘期间将不连续块暂存到片上 SRAM 中。通过消除分配碎片,PagedAttention 将 KV 缓存浪费降至 4% 以下,并在相同加速器硬件上实现显著更高的批处理并发度 (Kwon et al. 2023)。
PagedAttention 回收了物理内存容量,但大规模提供自回归模型服务时,还会暴露出词元验证延迟以及受内存带宽限制的权重流式读取等额外瓶颈。
Systems Perspective 1.7: LLM 服务:超越基础
用于存储注意力上下文的键值缓存,其规模随序列长度和批大小增长,内存消耗往往超过模型权重本身。推测解码等技术使用小型草稿模型提出多个候选词元,再由目标模型并行验证;在所评估的 T5-XXL 工作负载中,实现了约 2–3\(\times\) 的加速 (Leviathan et al. 2023),但收益因情况而异。仅权重量化(例如 INT4 权重搭配 FP16 激活值)尤其适用于受内存带宽限制的 LLM 推理 (Lin et al. 2024)。
这些 LLM 专用优化直接建立在模型服务的核心机制之上:排队模型支配调度超时设置,批处理动态特性决定吞吐量—延迟曲线,而降低精度则限制内存流量。更深入的方法将这些机制扩展至跨集群的多租户前缀共享和多节点张量并行执行。
尽管连续批处理能够最大化多租户语言模型服务的吞吐量,但批处理并非在所有情况下都是最优选择。调度器和动态内存分配器会引入协调复杂性与同步开销,可能降低延迟敏感或资源受限环境中的性能。具体而言,三种运行约束有利于采用单请求处理。首先,在超低 p99 目标下,即使很短的批处理延迟也会占用不可接受比例的延迟预算。其次,当服务运行时不支持不规则张量或分页内存时,对变长输入进行批处理需要填充至批次中最长序列的长度,从而引入填充开销,而单请求处理可以完全消除填充浪费。最后,当模型权重已占用加速器的大部分物理内存时,内存容量会成为约束;在接近容量上限的条件下,并发批次的激活值和动态 KV 缓存分配可能引发内存不足而中止运行,迫使运行时逐个处理请求。
会话亲和性约束
当服务状态驻留在本地加速器内存中,而非在每次调用时重建时,就会产生会话亲和性需求,即将客户端的后续请求路由到同一个物理副本。在对话模型中,这种驻留状态主要由键值(KV)缓存构成。当第 \(k\) 轮在某个副本上执行时,该副本的高带宽内存(HBM)会保留此前所有提示词元和生成词元对应的投影键和值。将第 \(k+1\) 轮路由到另一个副本,就无法利用这部分本地内存状态,迫使新节点从头重新计算整个前缀序列。这种冗余预填充会消耗原本可用于推进活跃解码迭代的内存带宽和张量核心计算周期,直接增加首词元生成时间。
使用经过微调的低秩适配(LoRA)模块提供个性化服务时,也受到类似的物理约束。基础模型权重常驻设备 HBM,而各个用户的适配器则必须动态调入内存。如果某个用户的传入请求分散到多个副本,每个节点都必须反复通过主机到设备的 PCIe 总线传输适配器张量,或通过网络获取这些张量,从而挤占内存中其他活跃工作集的空间。有状态的预处理流水线——例如分词器词表和每个会话的归一化状态——也会带来同样的代价:每当执行跨越节点边界时,都需要在 CPU 侧重复分配内存并重建缓存。
严格亲和性与动态批处理存在直接冲突。连续批处理调度器通过将并发请求组织为统一的矩阵乘法,最大化加速器吞吐量,使运行时算术强度随批大小成比例提高(\(I \propto B\))。当请求被绑定到指定副本时,调度器中可参与批处理的候选请求池会分散到整个集群。分配给空闲或低并发用户会话的副本,要么处理未满的批次,使算术强度重新跌入受内存带宽限制的区间;要么停顿,等待符合亲和性要求的词元。为防止利用率骤降,生产环境中的路由器采用软亲和性。在软亲和性策略下,入口网关在容量允许时优先选择持有缓存的副本,但当本地排队延迟超过传输适配器权重或重新计算前缀词元所需的物理延迟时,就会将请求分流到其他节点。
流量模式与批处理策略
批处理策略在很大程度上取决于请求的到达方式。不同部署环境呈现不同的到达模式,MLPerf 推理基准提供了四种标准化场景,用于近似若干常见情形,MLPerf 执行场景 对此有详细说明。
服务器流量(泊松到达)
MLPerf Server 场景使用泊松到达对类似云服务/API 的推理流量进行建模 (Reddi et al. 2019)。24在该模型下,不相交时间区间内的到达计数相互独立,且平均到达率保持恒定。Equation 14 给出了到达率为 \(\lambda_{\text{arr}}\)、宽度为 \(T_{\text{window}}\) 的固定时间窗口内的期望计数: \[E[\text{batch size}] = \lambda_{\text{arr}} \cdot T_{\text{window}} \tag{14}\]
Reddi, Vijay Janapa, Christine Cheng, David Kanter, Peter Mattson, Guenther Schmuelling, Carole-Jean Wu, Brian Anderson, et al. 2019. “MLPerf Inference Benchmark.” 2020 ACM/IEEE 47th Annual International Symposium on Computer Architecture (ISCA), 446–59. https://doi.org/10.1109/isca45697.2020.00045.
对于固定时间窗口,方差等于均值,因此在中等流量下,批大小会显著波动。当 \(\lambda_{\text{arr}} = 200\) 请求/秒、\(T_{\text{window}} = 10\) ms 时,期望计数为 2,但约 14% 的窗口没有请求(也不会启动 GPU 工作),而其他窗口可能有 4 个或更多请求。
一种实用的批处理窗口启发式方法是在等待成本与吞吐量收益之间取得平衡。Equation 15 表达了这样一条规则: \[T_{\text{window}} \approx \min\left(L_{\text{lat,SLO}} - T_{\text{svc}}, \sqrt{\frac{T_{\text{svc}}}{\lambda_{\text{arr}}}}\right) \tag{15}\] 其中,\(L_{\text{lat,SLO}}\) 为延迟 SLO,\(T_{\text{svc}}\) 为服务时间(单位为秒),\(\lambda_{\text{arr}}\) 为到达率(单位为请求/秒),因此第二项在量纲上与秒一致。平方根形式是一种局部成本模型启发式方法:它在每批次的固定收益与随到达间隔增长的等待成本之间取得平衡。它并不是专门针对机器学习服务的闭式最优解;生产系统会根据观测到的流量,通过实验校准窗口。equation 15 揭示了一个反直觉的结果:随着流量增加,最优窗口会缩短,而实际达到的批大小仍会增大。Table 15 展示了四种流量水平下的这一现象。

随着 QPS 上升,批处理窗口缩短,而批大小增大。
| 到达率 | 最优窗口 | 平均批大小 | 近似延迟 |
|---|---|---|---|
| 100 QPS | 15.8 ms | 1.6 | 40.8 ms |
| 500 QPS | 7.1 ms | 3.5 | 32.1 ms |
| 1,000 QPS | 5 ms | 5 | 30 ms |
| 5,000 QPS | 2.24 ms | 11.2 | 27.2 ms |
单用户流量(顺序到达)
流式流量通过传感器同步使到达事件相互关联,因此批大小和截止时间由外部固定。在另一端,交互式移动应用和边缘应用一次处理一个请求流,没有对独立查询进行批处理的机会。MLPerf SingleStream 场景刻画了这种顺序服务形式。此时,优化目标从帧截止时间约束下的同步预算,转向严格散热约束下的单请求延迟和能耗。对于下文建模的智能手机视觉流水线,首要工程目标并非组建批次,而是尽可能降低各阶段的延迟与能量耗散。
移动端服务约束
云服务通常侧重于集群成本和延迟;移动端服务还增加了三个紧密耦合的约束。第一个是能量预算,仅靠吞吐量无法体现这一约束,因为每次推理都会消耗电池电量。在所建模的流水线中,以 22 FPS 运行、每次消耗 2.98 mJ 时,仅推理路径就需要约 66 mW 的功率;在完整的拍照应用中,摄像头、显示屏、ISP 和操作系统开销还会进一步增加总功率。当持续系统功率达到设备特定的热边界时,热节流会进一步加剧这一限制。内存约束构成第三个约束,因为模型与应用和操作系统共享 RAM。重新加载时间取决于设备存储、运行时和模型状态;量化与内存映射加载(section 1.6.3)可以减少内存占用和启动工作量,但无法消除这些依赖。
Example 1.9: ResNet-50:移动端服务
Table 17 分解了单用户移动端视觉推理各阶段的延迟和能耗:
| 阶段 | 耗时 | 能耗 | 说明 |
|---|---|---|---|
| 摄像头缓冲区读取 | 8 ms | 0.08 mJ | 系统 API |
| JPEG 解码(CPU) | 15 ms | 1.5 mJ | 单线程 |
| 缩放 + 归一化 | 5 ms | 0.4 mJ | CPU 预处理 |
| NPU 推理 | 12 ms | 0.8 mJ | 82% 利用率 |
| 后处理 + UI | 5 ms | 0.2 mJ | 结果渲染 |
| 总计 | 45 ms | 2.98 mJ | 持续运行 22 FPS |
移动端服务节点受四项指标约束:
- 单次推理能耗:每次推理消耗 2.98 mJ,使每块 10 Wh 电池(典型智能手机)可支持约 12.1M 次推理
- 建模得到的推理功率:2.98 mJ / 45 ms = 66 mW,不包括设备其他部分的功耗,因此不能保证无限期运行
- NPU 与 CPU 的权衡:回退到 CPU 会将耗时 12 ms、耗能 0.8 mJ 的 NPU 推理阶段替换为耗时 45 ms、耗能 4.2 mJ 的 CPU 阶段;在计入额外系统开销之前,整个流水线的耗时和能耗就会从 45 ms 和 2.98 mJ 上升到约 78 ms 和 6.4 mJ。
- 内存占用:峰值为 150 MB(模型 + 激活值),与应用争用内存
系统洞见:在这一示例流水线中,移动端 NPU 在批大小为 1 时达到 82% 的利用率,而数据中心示例中的利用率为 15%。这一对比取决于具体的工作负载和硬件,但它说明了为什么面向单流执行设计的移动端加速器,无需使用为摊薄大型服务器 GPU 开销而采用的批处理,也能高效运行。
这些物理约束使边缘服务优化与数据中心优化存在根本差异。其目标是在严格的散热与电池约束范围内持续进行实时执行,避免触发硬件节流或使前台应用缺乏系统内存,而非最大化总体批处理吞吐量。
流量模式概述
流量自适应批处理会随着队列深度和请求率的变化调整批处理窗口。Table 18 将四种 MLPerf 场景与代表性部署环境及常见批处理策略关联起来。
这些场景是基准测试的抽象,而非部署方案。实际采用的批处理策略仍须遵循服务当前的并发、截止时间和功率约束。
| 场景 | 应用背景 | 策略 | 关注重点 |
|---|---|---|---|
| Server | 云 API、Web 服务 | 带超时机制的动态批处理 | 窗口调优、利用率—延迟曲线 |
| MultiStream | 自动驾驶、视频分析 | 同步传感器融合 | 抖动处理、截止时间保证 |
| SingleStream | 移动应用、嵌入式设备 | 不进行批处理(\(B = 1\)) | 预处理、能效 |
| Offline | 批处理、数据流水线 | 最大批大小 | 吞吐量、硬件利用率 |
这些部署模式——无论是在 Server 场景下处理云 API 流量,在 MultiStream 下进行同步传感器融合,还是在 Offline 推理 下运行以吞吐量为主导的批处理流水线——都共享一个基本假设:每个请求产生一个大小固定的输出,例如一个分类标签、一个边界框或一个嵌入向量。这一假设支配着排队数学模型、帕累托前沿分析以及随流量自适应的窗口调优。然而,增长最快的一类模型服务工作负载完全违背了这一假设。大语言模型逐词元生成输出,每个词元都依赖于此前的所有词元。单个请求可能在数秒内生成数百甚至数千个词元,但从第一个词元开始,就必须让用户感到响应及时。从固定输出服务向变长流式输出服务的这一根本转变,直接建立在自回归生成所用的连续批处理和 KV 缓存分页机制之上。它引入了分别针对预填充和解码阶段的指标、在输出质量与每词元延迟之间进行权衡的解码策略,以及提示词前缀缓存和卸载等利用请求间共享上下文的内存优化方法。
Checkpoint 1.3: 批处理与流量模式
批处理是改善模型服务经济性的主要手段,但最优策略取决于具体背景。
LLM 服务
大语言模型 使三种特性比在固定输出服务中更加突出:自回归生成25(每个词元依赖于此前的所有词元,使输出具有内在的顺序性)、变长输出(请求发起时无法确定响应长度,使固定批次假设变得复杂),以及有状态内存(键值缓存随每个生成的词元而增长,形成动态内存压力)。这些特性共同带来了性质截然不同的服务挑战。分类服务中使用的 p50、p95 和 p99 指标仍然重要,但它们适用于请求的不同阶段——最初的提示词处理阶段和随后的词元生成阶段。排队论、批处理权衡和延迟预算的相同原理仍然适用;LLM 服务在这些原理之上增加了领域专用技术。
性能指标:TTFT 与 TPOT
TTFT 与 TPOT 处于不同的瓶颈区间。
生成式模型产生的是词元流,而非单个输出张量。这种流式特性要求使用专门的 LLM 性能指标,以反映从预填充(处理提示词并填充其 KV 缓存)到解码(生成输出)的转变。两个关键度量是首词元时间(TTFT) 和每输出词元时间(TPOT),分别刻画响应及时性和平均生成速度。针对每个词元间隔的词元间延迟(ITL) 衡量流式输出中相邻词元之间停顿的分布;TPOT 则对一次输出中首词元之后的间隔取平均。
Definition 1.6: LLM 性能指标
LLM 性能指标 将初始响应及时性与流式自回归生成的节奏区分开来。
- 意义:这些指标将用户感知的延迟分解为首词元时间(TTFT)(其预填充工作通常受计算限制)和每输出词元时间(TPOT)(其解码工作在小批次下通常受带宽限制)。
- 区别:与固定输出指标(例如端到端延迟)不同,LLM 指标衡量生成的流畅性,体现了用户体验对词元到达节奏的依赖。
- 常见误区:一种常见误解是,“快速模型”必然具有较低的 TTFT。实际上,模型可能具有很短的 TTFT,却有很长的 TPOT(如果内存墙 \((\text{BW})\) 是瓶颈),从而造成令人沮丧的用户体验:回答很快开始,随后却“断断续续”。
这些指标刻画用户体验的不同方面,因此交互式服务通常为 TTFT、TPOT 或 ITL,以及聚合吞吐量分别设定目标。
Systems Perspective 1.8: LLM 服务延迟目标
交互式 LLM 服务通常需要为响应及时性、生成流畅性和集群吞吐量分别设置 SLO。以下数值是示例性目标,而非普遍要求:
- TTFT:\(<\) 500 ms(对于包含 1000 个词元的提示词)
- TPOT:\(<\) 50 ms(相当于约 20 词元/秒,快于人类阅读速度)
- 吞吐量:所有活跃服务副本的聚合吞吐量 \(>\) 1000 词元/秒
因此,单一的“延迟”数值会掩盖预填充与解码之间的区别。TTFT 是空白屏幕的时间预算,TPOT 是阅读流畅性的时间预算,而聚合服务吞吐量以所有活跃服务副本的词元/秒之和衡量,决定了在共享负载下能否维持这些目标。
解码策略
要达到这些 TPOT 目标,仅靠内存带宽还不够:用于选择每个词元的算法也会影响每词元延迟和输出质量。生成式模型需要在质量、多样性和延迟之间进行权衡的解码策略。解码策略的选择会显著影响输出质量和计算成本。
最简单的方法是贪心解码,它在每一步选择概率最高的词元,每个词元需要执行一次模型计算。该方法速度快,但由于无法修正早期选择,可能产生重复输出。束搜索 维护多个候选序列,并选择得分较高的完整序列,相较于贪心解码增加了解码器的工作量和状态。采用温度、top-\(k\) 和 top-\(p\)(也称核采样)的采样 通过引入可控随机性来增加多样性 (Holtzman et al. 2020)。任何策略的服务成本都取决于其实现,以及连续批处理必须应对的输出长度分布。
Holtzman, Ari, Jan Buys, Li Du, Maxwell Forbes, and Yejin Choi. 2020. “The Curious Case of Neural Text Degeneration.” Proceedings of the 8th International Conference on Learning Representations (ICLR 2020).
交互式 LLM 服务通常在词元生成后立即返回,而不是等待全部生成完成。这种流式响应 改变了用户体验:总生成时间为两秒时,如果词元连续流出,用户会感到响应及时;但如果用户盯着空白屏幕等待两秒,就会觉得系统出了问题。流式输出需要基础设施支持增量响应和客户端渲染。延迟特征也随之变化:TTFT 决定输出何时开始出现(响应及时性),而 TPOT 决定用户感知的生成速度(流畅性)。一旦生成结果以逐词元方式流式输出,服务单元就从一次固定输出预测变成了一个有状态序列,其内存占用会在每一步增长。
内存与 KV 缓存
生成式推理需要管理 KV 缓存26,这是一种随序列长度增长的有状态内存结构。预填充为提示词中的词元创建缓存条目,每解码一个词元就会再增加一个条目。对于并发的变长序列,这种动态状态可能占据加速器可用内存的主要部分;如果不进行显式管理,还会造成分配浪费。
前缀缓存与内存卸载
section 1.7.4 中介绍的连续批处理和 PagedAttention 技术解决了请求调度和缓存分页问题;通过利用请求模式的架构策略,还可以进一步缓解剩余的内存压力。前缀缓存 存储常见指令前缀的 KV 状态(例如包含 2,000 个词元的系统提示词或共享的检索增强生成(RAG)上下文),使独立请求能够复用相同前缀的预填充结果。对于共享包含 \(S_{\text{prefix}}\) 个词元的前缀的 \(N\) 个请求,所避免的预填充工作量约为 \((N-1)S_{\text{prefix}}\) 个词元步,具体取决于缓存命中、驱逐和实现开销。对于多轮对话,同一原理使后续轮次能够在复用兼容的先前状态后,仅处理新增后缀。
Napkin Math 1.5: 一次聊天的能耗
问题:基于 H100 的聊天服务,每生成一个词元以及生成一条包含 500 tokens 的响应,分别消耗多少能量?
随着 LLM 规模扩大,每词元焦耳数与延迟一样,成为首要运维指标。假设 H100 的功耗为其 700 W 热设计功耗(TDP),则可根据吞吐量和功率得到以下场景估算 (Choquette 2023):
- 吞吐量:114 个并发请求 \(\times\) 每个请求 8 tokens/s ≈ 912 tokens/s。
- 功率:700 W(GPU)+ 300 W(主机/额外开销)= 1000 W。
- 每词元能耗: 1000 W / 912 tokens/s ≈ 1.0965 J/token
系统洞见:在这些假设下,一条包含 500 tokens 的响应消耗的能量约为 548.2 J。
- 作为比较,为智能手机充电消耗的能量约为 40000 J。
- 烧开一杯水消耗的能量约为 100000 J。
降低 J/token 的主要方法是提高硬件利用率并消除冗余计算。如果批处理不佳导致 GPU 利用率仅为 10 percent,其功耗仍约为 300 W,而主机还会增加 300 W,使每词元能耗上升至 6.6 J/token(约为基线的 6×)。前缀缓存等架构优化还可以针对共享上下文跳过高能耗的预填充阶段,直接减少检索增强生成(RAG)和聊天应用的能源足迹。对模型服务的启示是,效率不仅是延迟或成本指标;它还决定了每个有效词元消耗多少能量。
当 KV 缓存总量超过 GPU 显存容量时,系统可以采用 KV 缓存卸载。该策略将不活跃或低优先级的上下文窗口转存到主机 CPU 内存或 NVMe SSD,为活跃生成释放显存。在计入软件开销和排队之前,重新加载成本的下界是传输字节数除以 PCIe 或 NVMe 带宽。因此,卸载可以防止内存不足(OOM)故障,并支持更大的上下文窗口,但也会带来亲和性、失效处理和活跃解码延迟方面的风险,必须为这些风险显式制定预算。推测解码27 和分布式并行等高级技术将在大规模系统的专题论述中介绍,其中分布式并行将单个请求拆分到多个设备或机器上。
Checkpoint 1.4: LLM 服务基础
LLM 服务引入了传统模型服务中不存在的约束。
聊天能耗计算使利用率成为 LLM 服务预算的一部分:每个生成词元的成本取决于请求如何共享机器。与固定输出推理不同,LLM 能耗会随响应长度增长。每个解码步骤都会为活跃批次流式读取一次权重,因此批处理能够将这部分流量摊薄到各个序列上。碳核算还需要排放因子和明确的核算边界。
能效取决于支配 LLM 延迟的相同批处理、内存和前缀缓存机制,因此,以约束检查清单进行归纳比使用单一标量指标更有帮助。
推理运行时选择
动态批处理和请求调度决定了如何对推理进行分组和排队,但仍需要底层执行引擎在物理硬件上执行由此产生的张量运算。只有当运行时能够将运算高效地映射到加速器执行单元和内存层次结构时,才能实现 section 1.8 中介绍的词元生成动态特性,并满足 section 1.4.1 中确立的延迟预算。推理运行时 是编排张量运算和管理硬件资源的软件层,即使模型架构保持不变,它也能显著改变延迟和吞吐量。运行时工程包括两个阶段:选择阶段确定执行引擎,配置阶段则针对目标模型、硬件、输入形状和延迟分布调优该引擎。
运行时生态与配置
引擎选择应从起决定作用的系统约束出发,而非从训练时使用的框架出发。当部署速度和框架兼容性占主导地位时,PyTorch 和 TensorFlow 模型可以直接通过各自的原生运行时提供服务,无需中间导出步骤。这保留了对任意 Python 控制流和自定义训练算子的支持,但非标准运算、硬件后端缺失以及 Python 解释器开销可能限制生产环境中的吞吐量。框架运行时优先考虑灵活性和广泛的算子覆盖,而专用推理引擎则牺牲这种通用性,以换取有针对性的图变换和更低的执行开销。
torch.export 和 TensorFlow SavedModel 提供序列化计算图,在保持框架兼容性的同时,支持提前变换和图优化。TorchScript 仍作为遗留格式用于现有部署。
通用优化
当跨硬件可移植性是起决定作用的约束时,ONNX Runtime28 提供了一个与硬件无关的中间执行层 (Microsoft 2024)。模型先导出为 ONNX 格式,随后 ONNX Runtime 应用与目标硬件无关的图优化,并将子图交由硬件专用的执行提供程序处理。这种架构支持以单一格式在 CPU、GPU 和定制加速器专用集成电路(ASIC)之间部署。
Microsoft. 2024. ONNX Runtime: Cross-Platform Inference and Training Machine-Learning Accelerator. GitHub.
实现可移植性仍需通过性能剖析,检查跨执行边界的算子放置情况。如果导出的模型包含目标加速器执行提供程序不支持的运算,运行时就会回退到默认的 CPU 执行提供程序。这种回退会强制通过主机与加速器之间的互连(如 PCIe)同步复制数据,并使执行在主机 CPU 上串行进行;虽然保持了数值正确性,却会破坏预期的延迟优势。因此,性能剖析必须验证整个图的提供程序分配和算子覆盖情况,而不能仅确认导出产物能够无错误地执行。
专用推理引擎
当延迟预算或服务成本比可移植性构成更严格的约束时,面向 NVIDIA GPU 的 TensorRT29 和面向 Intel 硬件的 OpenVINO30 等专用引擎,会针对目标微架构优化计算图 (NVIDIA 2024a; Intel Corporation 2026; Chen et al. 2018)。这些编译器不再维持可移植的抽象,而是直接针对硬件的寄存器文件、缓存层次结构和矩阵执行单元特化内核。
Chen, Tianqi, Thierry Moreau, Ziheng Jiang, Lianmin Zheng, Eddie Q. Yan, Haichen Shen, Meghan Cowan, et al. 2018. “TVM: An Automated End-to-End Optimizing Compiler for Deep Learning.” Proceedings of the 13th USENIX Symposium on Operating Systems Design and Implementation (OSDI ’18), 578–94.
层融合31 将多个连续运算合并为一个 GPU 内核,以消除片外内存流量。考虑一个标准视觉模块:卷积 \(\to\) 批归一化 \(\to\) 修正线性单元(ReLU)激活。直接执行时,这一序列需要三次独立的内核启动,以及两次对设备全局内存(HBM)的中间结果写入/读取往返。由于批归一化和 ReLU 的算术强度较低,通过内存总线传输这些中间特征图会使内存带宽饱和。在编译时,服务编译器首先将线性的批归一化参数直接折叠到卷积权重和偏置中(\(W' = \frac{\gamma}{\sigma} W\) 和 \(b' = \frac{\gamma}{\sigma}(b - \mu) + \beta\)),从而完全消除归一化运算。随后,编译器将卷积及其后的 ReLU 融合为一个内核:线程块仅从 HBM 读取一次输入特征图,在寄存器和共享内存中计算矩阵乘加运算,直接在寄存器中计算 ReLU 激活,并仅将最终激活结果写回 HBM。
内核自动调优 通过基准测试,为目标微架构上的每项运算选择最优算法。单个二维卷积可以通过直接卷积、GEMM 变换(im2col)、Winograd 最小滤波(适用于小型 \(3 \times 3\) 滤波器)或快速傅里叶变换(适用于大型空间滤波器)来计算,同时还可采用数十种分块大小变体。由于最优策略取决于滤波器维度、批大小,以及加速器的寄存器和共享内存容量,编译器会在目标硬件上对候选实现进行基准测试,并缓存延迟最低的内核,以提前编译所需的时间换取可预测的服务延迟。
与未经调优的框架原生基线相比,这些优化可带来显著加速,但需要显式进行图编译,并可能限制动态张量维度。下面的示例性运行时比较量化了这样一种优化效果范围。
Example 1.10: ResNet-50:运行时比较
Table 19 给出了一个批大小为 1、在 V100 上运行 ResNet-50 的示例性运行时场景:
Table 19: 推理运行时比较示例:在 V100 上,批大小为 1 的 ResNet-50 使用 PyTorch 即时执行、TorchScript、ONNX Runtime 和 TensorRT 时的假设延迟及推导出的加速比。
| 运行时 | 延迟 | 加速比 | 说明 |
|---|---|---|---|
| PyTorch(即时执行) | 8.5 ms | 1× | 基线,未优化 |
| TorchScript | 6.2 ms | 1.4× | JIT 编译 |
| ONNX Runtime | 5.1 ms | 1.7× | 跨平台 |
| TensorRT FP32 | 2.8 ms | 3× | NVIDIA 专用 |
| TensorRT FP16 | 1.4 ms | 6.1× | Tensor Core 加速 |
| TensorRT INT8 | 0.9 ms | 9.4× | 需要校准 |
系统洞见:在这一示例性比较中,TensorRT INT8 的加速比为 9.4×,并且需要量化校准数据和 NVIDIA 专用部署。
这种优化与兼容性之间的权衡决定了引擎选择。更高程度的特化能够提高硬件效率,但也会增加部署复杂度、限制动态控制流,并可能引入相对于训练基线的数值偏差。工程选择取决于延迟预算、运维约束以及模型架构的演进频率。
选定执行引擎后,配置阶段会在硬件资源边界内调优其资源分配。对于 CPU 推理,线程池大小必须与物理核心拓扑匹配:线程配置不足会使执行单元闲置,而线程配置过多则会引发 CPU 缓存抖动、操作系统调度延迟,以及跨 NUMA 域的锁争用。对于加速器,静态内存预分配会在初始化期间创建固定大小的激活工作区,从而从延迟关键的请求路径中消除运行时内存分配(cudaMalloc)和页表缺页异常。执行提供程序的优先级决定了由哪个硬件后端处理各个算子子图,而图优化级别则在构建时间与常量折叠、代数化简之间进行权衡。生产部署必须针对完整的延迟分布(\(p50\)、\(p99\))对这些配置进行基准测试,而不能依赖框架默认值。
服务中的精度选择
在 NVIDIA V100 GPU 上,Tensor Core 加速 FP16 矩阵运算,而 INT8 计算则在标准整数 ALU 上执行(通过 DP4A 向量指令)。在一个示例性服务场景中,将 ResNet-50 模型从 FP32 转为 INT8,可使推理吞吐量达到原来的三倍,而 top-1 准确率下降不到 0.4 个百分点。这种关系使数值精度与基础设施经济性直接耦合。精度选择以 量化与精度 中介绍的量化技术为基础。数值表示 比较了底层数值格式(FP32、FP16、BF16、FP8、INT8)及其精度与范围之间的权衡,而 整数量化 则详细介绍了对称和非对称整数量化的数学机制。在服务层,精度工程引入了若干运行约束:校准数据的保真度、在线输入下的层敏感性,以及动态精度分派。
精度与吞吐量的关系
对于受内存带宽限制的运算,降低精度 可通过减少经内存总线传输的字节量来提高吞吐量。Equation 16 给出了仅考虑带宽时,降低精度所带来的吞吐量提升上界: \[ \frac{\text{Throughput}_{\text{INT8}}}{\text{Throughput}_{\text{FP32}}} = \frac{32}{8} = 4\times \text{ (theoretical maximum)} \tag{16}\]
实际加速比取决于计算与内存访问之比、算子组合、硬件指令吞吐量和矩阵对齐情况;只要算术吞吐量或内存对齐成为约束,加速比就会低于仅考虑带宽时的上界。只有当矩阵维度与加速器在线程束级别的执行分块对齐时(例如,为 8 或 16 个元素的整数倍),低精度内核才能达到峰值算术效率。当维度与硬件分块不对齐时,cuBLAS 和 cuDNN 等库会填充张量,或回退到较慢的执行路径。Tensor Core 详细介绍了决定这些边界的 Tensor Core 架构和对齐约束。标准视觉模型的精度权衡说明了这些理论限制在实践中如何体现。
Example 1.11: ResNet-50:V100 上的精度权衡
Table 20 给出了 ResNet-50 在 FP32、FP16 和两种 INT8 路径下的示例性延迟、内存和准确率假设,并列出了支持 Tensor Core 时的利用率:
Table 20: V100 上的精度权衡示例:ResNet-50 在 FP32、FP16 和 INT8(PTQ 与 QAT)下的假设延迟、内存占用和准确率,以及支持 Tensor Core 时的利用率。
| 精度 | 延迟 | 内存 | 准确率 | Tensor Core 利用率 | 校准 |
|---|---|---|---|---|---|
| FP32 | 2.8 ms | 98 MB | 76.13% | 0% | 无 |
| FP16 | 1.4 ms | 49 MB | 76.13% | 85% | 无 |
| INT8 (PTQ) | 0.9 ms | 25 MB | 75.80% | 不适用 | 1,000 个样本 |
| INT8 (QAT) | 0.9 ms | 25 MB | 76.05% | 不适用 | 额外训练 |
系统洞见:在这一示例性场景中,INT8 的加速比为 3.1×,使用 PTQ 时准确率下降 0.33 percentage points。QAT 可恢复大部分准确率损失,但需要重新训练。
精度选择约束
精度选择受到层敏感性、校准数据和运行时策略的约束。不同层对降低精度的容忍程度并不相同。对于校准范围 \([\alpha,\beta]\) 上的标量均匀 \(b\) 位量化器,equation 17 中的步长和范围内舍入误差界为 \[\Delta = \frac{\beta-\alpha}{2^b-1}, \qquad |\epsilon_{\text{quant}}| \leq \frac{\Delta}{2} \tag{17}\] 该误差界适用于未被裁剪的值。校准范围之外的值会被裁剪,并产生额外的饱和误差。层级输出误差或任务误差取决于激活值分布和下游敏感性,因此必须通过测量确定,而不能依据某种普适的范数定律推断。这一机制解释了为何通常将第一个卷积层和最后的分类层保留为 FP16,而中间层可以容忍 INT8。初始层处理低维原始输入(例如 3 个 RGB 通道),随后表示才扩展到能够吸收量化噪声的过完备特征空间;而最后的分类层输出原始 logits,微小的数值扰动就会直接移动决策边界,并改变 top-\(1\) 预测结果。
训练后量化引入了数据依赖。校准数据集决定 INT8 转换所用的裁剪阈值 \([\alpha, \beta]\) 和缩放因子 \(\Delta\),因此它必须匹配线上服务流量的统计特征,而不能任意选用训练集或验证集划分。校准分布与服务分布不匹配会导致过度裁剪或下溢,从而降低端到端任务准确率——section 1.12 分析了这一运维陷阱。
生产服务架构可以将精度从静态编译设置提升为动态运行时策略。当请求队列较短,且系统相对于其服务等级目标(SLO)具有充足的延迟余量时,引擎可以采用 FP16 执行请求,以最大化任务准确率。当流量突增并可能导致队列饱和时,引擎可以动态将执行精度降至 INT8,以维持延迟上限。同样,对于 INT8 执行后分类置信度较低的请求,可以选择性地采用 FP16 重新评估。这种动态调度使系统能够在请求到达率波动时,实际执行自适应的质量与延迟权衡。
精度选择直接影响基础设施容量规划:以吞吐量提升至 \(3\times\) 为例,在排队延迟保持不变的情况下,一个以 FP32 配置 30 块 GPU 的服务集群,只需以 INT8 配置 10 块 GPU 即可满足相同的流量需求。因此,精度工程也是一项基础设施容量规划工作,将数值表示与集群资本支出和能源消耗直接联系起来。
节点级优化
运行时选择和精度调优作用于模型层面:它们决定执行什么计算,以及采用什么数值格式。然而,在模型与芯片之间,还存在一个涵盖图编译、内存总线传输以及 CPU 与加速器协调的执行层。模型级基准测试评估的是合成输入上的独立前向传播,而节点级优化针对的是具体物理机器上的端到端请求路径。实际能够获得的延迟和吞吐量收益,取决于能否识别出限制执行的硬件边界。
当模型基准测试耗时不足一毫秒的图像分类器在生产环境中出现意外延迟时,实测执行轨迹通常会揭示以下四个主要物理边界上的瓶颈:
- 计算图到内核的边界:将计算图转换为大量细粒度内核启动,会产生驱动串行化开销,并迫使中间张量经过设备 HBM。图编译器将相邻操作融合为复合内核,使中间激活值保留在片上 SRAM 或寄存器文件中。
- 主机与加速器的边界:当主机处理器未能在执行之前提前将工作入队时,加速器就会空闲。主机与设备互连(例如 PCIe)上的非流水化复制以及阻塞式同步调用,会使加速器计算流水线停顿。
- CPU 执行边界:如果主机预处理流水线和基于 CPU 的推理通过解释执行的标量代码运行,而未使用向量化的单指令多数据(SIMD)指令单元和 NUMA 本地内存分配,其性能就会下降。
- 存储与反序列化边界:初始化服务副本需要将权重张量从持久化存储流式加载到主机内存。需要递归反序列化对象的格式会使 CPU 执行成为瓶颈,造成冷启动延迟尖峰,阻碍自动扩缩容。
每个边界都代表一种不同的物理约束:执行因内存带宽、总线传输或控制开销而停顿,而非受限于峰值算术吞吐量。
运行时图编译
专用推理引擎(section 1.9)的性能优于采用即时执行模式的框架基线,是因为服务环境提供了静态执行拓扑和有界的输入形状配置。当算子序列和张量维度在请求到达之前就已固定时,编译器可以将优化成本从运行时请求处理转移到离线部署准备阶段。
主要的算术性能收益来自算子融合,它进一步扩展了 section 1.9.1.2 中介绍的引擎级优化。在未融合的执行图中,连续的逐元素操作——例如卷积后接偏置加法和激活函数——会作为独立的加速器内核启动。每个内核都必须从设备全局内存(HBM 或 GDDR)加载输入,并通过内存总线将中间输出写回。由于逐元素操作的算术强度较低(每传输一个字节仅执行 \(O(1)\) 次操作),内存总线饱和会限制执行速度,而计算单元却处于空闲状态。算子融合将这些相邻节点合并为单个复合内核,将中间激活值保留在高速片上寄存器或共享内存(SRAM)中。通过消除冗余的全局内存往返传输,融合可以大幅减少内存流量,并将内核启动开销分摊到更大的计算块上。
静态执行图还支持编译时常量折叠。在模型服务中,模型参数是不可变的。编译器会在部署之前计算完全由静态权重和常量组成的子表达式。例如,批归一化参数(\(\gamma, \beta, \mu, \sigma\))可以通过代数变换,直接折叠到前一个线性层或卷积层的权重矩阵和偏置向量中。这会完全消除归一化层的内核启动及相关内存流量,在不改变数学输出的情况下,从每个线上请求中移除这部分计算工作。
内存规划对内存布局而非算术运算进行结构性优化。在请求处理期间按需分配内存,会触发框架分配器锁、堆搜索以及操作系统页表修改。在静态图中,从输入到输出的张量生命周期是确定已知的。运行时编译器会提前计算精确的缓冲区偏移量,使生命周期不重叠的中间张量能够复用同一个物理内存区域。这种预先计算的缓冲区复用可限定总内存消耗,防止内存碎片,并消除运行时内存分配造成的停顿。
Systems Perspective 1.9: 编译时机的权衡
即时编译将图优化推迟到运行时引擎观察到具体输入形状和执行路径之后。这种运行时可见性支持针对动态控制流和可变序列长度进行激进的内核特化,但也将编译开销直接引入服务路径,导致早期请求出现数秒的延迟尖峰。
提前编译在部署之前执行图分析、内核融合和硬件专用自动调优。预先构建执行产物可确保从第一个请求开始就具有可预测的低延迟执行,但这会将引擎限制在预先确定的形状配置内,并且需要显式填充或针对多种配置进行编译,才能适应动态输入尺寸。
当部署约束或工作负载特征不允许使用专用加速器时,优化重点便从 GPU 内核转向主机处理器,此时向量化和内存层次结构决定执行速度。
CPU 推理优化
对于轻量模型、无法使加速器达到饱和的稀疏或突发请求流,以及主机到设备的传输延迟在总计算时间中占主导的应用,在 CPU 上部署推理仍然切实可行。现代服务器 CPU32(例如 Intel Xeon 和 AMD EPYC)集成了宽 SIMD 向量寄存器和矩阵加速器(包括 AVX-512 和 AMX)。通用 Python 解释器和标量实现会使这些执行单元闲置。OpenVINO 等专用运行时将神经网络算子映射到优化的微内核,将矩阵运算分块以适配 L1/L2 缓存,并利用打包融合乘加(FMA)指令 (Intel Corporation 2026)。
多插槽服务器架构会引入 NUMA33 约束。内存控制器在物理上分布于各个 CPU 插槽,并通过一致性互连(例如 Intel UPI 或 AMD Infinity Fabric)连接。与访问本地内存通道相比,访问连接到远端插槽的内存会产生明显更高的延迟和更低的带宽。推理服务器必须具备 NUMA 感知能力:工作线程必须绑定到专用物理核心,而这些线程访问的权重张量和请求缓冲区必须位于该插槽的本地内存节点中。由于模型权重通常从数百兆字节到数十吉字节,往往超过每个插槽的 L3 缓存容量,因此每次前向传播都需要从主内存流式读取权重。插槽分配不匹配会迫使权重持续通过较慢的插槽间互连进行流式传输,导致尾延迟严重恶化。
对于以批大小为一执行的轻量模型,CPU 的性能通常优于独立 GPU。当加速器处理单个请求时,经主机 PCIe 总线传输输入的固定开销(数微秒)、驱动队列串行化开销以及内核启动开销(每个内核 5–15 \(\mu\)s),很容易超过算术执行时间。CPU 则直接在本地缓存中处理请求,无需总线传输,也没有驱动队列延迟。确定实际运行中的性能交叉点,需要针对模型架构、算术强度、批大小和延迟约束进行实测。
模型序列化与快速加载
自动扩缩容系统作为闭环控制器运行,根据流量需求配置或撤除服务副本。在需求激增期间,冷启动延迟(section 1.6.2)决定了新副本能够多快就绪并承接流量。对于数吉字节的模型,冷启动时长主要由将序列化模型权重从持久化存储流式加载到主机内存的过程决定。序列化格式这一架构选择,决定了该阶段受限于存储读取带宽还是 CPU 解析开销。
通过 torch.load() 加载的传统 PyTorch 检查点,将权重封装在一个包含 pickle 编码对象元数据的 zip 归档中。反序列化 pickle 文件会迫使 CPU 顺序解释序列化操作码流,逐个分配 Python 对象(字典、元数据包装对象和张量头),并将张量字节从解压缓冲区复制到新分配的内存中。即使采用受限加载模式来降低任意代码执行风险,反序列化过程仍然受 CPU 限制,并产生大量内存复制开销。
面向张量的格式34绕过了解释器驱动的对象构建。Safetensors 使用一个包含张量元数据的轻量文件头来组织检查点,文件头之后是按内存边界对齐的连续、未压缩张量字节缓冲区。由于磁盘上的二进制布局与内存中的数组布局一致,运行时可以使用内存映射(mmap(2),见 section 1.6.3)将文件块直接映射到进程的虚拟地址空间。虚拟内存页通过按需缺页调入主机 RAM,或由操作系统顺序预取,从而消除 Python 对象重建和用户空间复制缓冲区。在配备独立加速器的系统上,计算开始前仍需通过 PCIe 或 NVLink 传输这些张量,但主机侧零复制加载消除了副本初始化时间预算中的 CPU 反序列化瓶颈。
Example 1.12: 加载速度:Safetensors 与 Pickle
场景:一个无服务器推理副本在冷启动扩容事件期间加载大小为 5 GB 的模型检查点。
诊断:PyTorch torch.load()(Pickle)需要由 CPU 重建对象,初始化耗时为 15 s。Safetensors 内存映射绕过了 CPU 解析,在 1.5 s 内加载权重(加载速度为前者的 10×)。
系统启示:面向张量且支持内存映射的格式,可以减少冷启动期间的 CPU 重建和预先复制开销。存储吞吐量、缺页处理、运行时初始化和加速器传输仍然是横向扩容时间预算的一部分。
服务节点性能剖析
缺乏实测的优化会退化为推测性的反复试错。equation 2 中定义的系统效率指标给出了具体目标:最大化加速器执行有效数学运算所占的实际经过时间比例。时间线性能剖析工具,例如 PyTorch Profiler 和 NVIDIA Nsight Systems(nsys),通过在同步时间线上记录并发 CPU 线程、操作系统运行时调用、内存传输和 GPU 硬件队列,使这一目标能够落实到具体操作。
有效的轨迹分析应以瓶颈为先,从硬件利用率逐步回溯到应用逻辑:
- 计算空闲气泡:GPU 执行轨道上的空白表明硬件未获得足够工作。计算线程束可能在等待主机 CPU 完成请求预处理(例如词元化或图像解码)、按需权重分页过程中的缺页处理,或阻塞式线程间同步。
- 内核启动碎片化:密集排列的微内核序列——每个内核的执行时间低于 5–10 \(\mu\)s——表明存在驱动串行化瓶颈。CPU 无法以足够快的速度将内核启动操作加入命令队列,以持续填满 GPU 流水线,这说明未融合算子应立即作为图编译的候选对象。
- 互连传输停顿:主 CUDA 流上的同步
MemcpyHtoD块表明主机到设备的数据移动未实现流水化。消除这种停顿需要分配页锁定(固定)主机内存,并在专用复制流上执行异步传输,使总线传输与加速器对先前请求的执行并行重叠。
Example 1.13: 性能剖析循环
场景:某推理服务节点的平均 GPU 计算利用率较低,但 p99 尾延迟很高。
诊断:时间线性能剖析(Nsight Systems/PyTorch Profiler)显示,CPU 主机侧预处理瓶颈和内核启动开销,导致微小 GPU 内核之间出现较大的空闲间隙。
系统启示:服务节点优化需要基于实测的时间线性能剖析。通过迭代识别轨迹中的瓶颈(内核启动开销、主机与设备之间的复制停顿),可以指导算子融合和固定内存等针对性优化。
Table 21 汇总了具有代表性的节点级优化技术及其主要目标指标和工程成本。该表是一张决策矩阵,而非详尽的检查清单:工程投入应仅用于能够解决实测执行轨迹中限制性瓶颈的对应行。
| 技术 | 目标指标 | 示例收益 | 实现成本 | 最适用场景 |
|---|---|---|---|---|
| 算子融合 | 延迟与吞吐量 | 2–5\(\times\) | 中(编译器) | 受内存限制的层 |
| INT8 量化 | 吞吐量 | 3–4\(\times\) | 高(校准) | 推理密集型节点 |
| 图编译 | 延迟 | 1.5–3\(\times\) | 低(一行代码) | 静态图模型 |
| 零复制加载 | 启动时间 | 10–50\(\times\) | 低(文件格式) | 自动扩缩容/冷启动 |
| CPU 绑定 | 尾延迟(p99) | 降低 20–50% | 低(配置) | 延迟关键型应用 |
这一诊断层次确保工程资源用于解决整个请求路径上的结构性瓶颈,而非实施孤立的微优化。一个四层审查检查点将这种优先级排序组织起来,范围从外部服务边界一直延伸到设备内核。
Checkpoint 1.5: 优化层次
推理优化沿请求路径由外向内展开,涵盖四个结构层次:
经济性与规划
批处理、精度调优、算子融合和图编译可以降低延迟、提高容量,或降低完成一次推理的成本。然而,生产部署需要回答一个集群层面的问题:需要多少台机器、采用什么类型,以及总成本是多少。一个在 V100 上实现了每秒处理 1,200 张图像的团队,仍然需要知道:对于 5,000 QPS 的目标,在满足相同 SLO 的前提下,使用 8 块每块每小时 $3 的 V100,还是 24 块每块每小时 $0.53 的 T4,成本更低。服务基础设施成本随持续请求量增长 (Zhang et al. 2019),而训练成本则取决于其自身的数据集、模型和优化预算。figure 2 中展示的公共 API 价格下降体现了这一压力:随着每词元价格降低,基础设施效率成为实现经济可行性的主要手段。
Zhang, Chengliang, Minchen Yu, Wei Wang, and Feng Yan. 2019. “MArk: Exploiting Cloud Services for Cost-Effective, SLO-Aware Machine Learning Inference Serving.” 2019 USENIX Annual Technical Conference (USENIX ATC 19), 1049–62.
每次推理成本
每次推理成本是分摊的服务成本除以满足服务目标的已完成推理次数。分子可以包括预配的 CPU 或加速器时间、内存容量、数据传输、存储和编排成本。在高利用率下,有效吞吐量使预配成本分摊到大量请求上。在低利用率下,已付费的容量处于闲置状态,因此相同的每小时费用只能分摊到更少的成功推理上。将这一框架应用于 ResNet-50,可以展示每小时价格与持续有效吞吐量如何共同决定单位成本。
GPU 与 CPU 的经济性比较
在 section 1.11.1 的 AWS 成本分析实例中,GPU 实例每小时成本更高,但提供的并行吞吐量也高得多。两者的经济性转折点取决于模型特征和延迟要求。
对于参数较少、操作简单的小模型,在延迟要求较宽松(可接受数百毫秒)、请求量较低或波动较大(导致预留 GPU 造成浪费),或者模型操作难以并行化的情况下,CPU 推理在经济上是合理的。当模型规模较大且操作适于并行化、延迟要求严格(数十毫秒)、请求量足够高且稳定以维持利用率,并且批处理能够摊薄 GPU 内核启动带来的每次推理开销时,GPU 推理具有吸引力。
除稳态成本外,启动时间也会影响扩缩容的经济性。实例启动、镜像拉取、驱动初始化、模型加载、编译和预热可能使加速器副本比 CPU 副本更晚就绪,不过具体时间取决于平台和部署制品。如果流量增长速度超过有效容量上线的速度,那么即使最终容量充足,也可能无法满足延迟 SLO。
当加速器副本的就绪延迟较长时,预测式扩缩容或预热池可能比纯粹的响应式扩缩容更可靠。对于在两类设备上均能达到可接受运行效果的模型,混合设计可以使用常驻加速器容量承载基线负载,并使用 CPU 承接突发流量,以不同的单位成本和延迟特征换取更快可用的备用容量。这种 GPU+CPU 混合方式是 混合架构 所归纳的更广泛模式中的一个实例;其是否有效,取决于模型兼容性以及不同运行时之间是否具有相同的输出语义。
Example 1.14: ResNet-50:成本分析
Table 22 给出了一个类似 AWS 的示例场景,展示部署 ResNet-50 服务时的每小时成本、吞吐量和每百万张图像的成本:
Table 22: ResNet-50 云端推理成本比较示例:CPU、T4 和 V100 实例的假设每小时成本与饱和吞吐量,以及由此推导的每百万张图像成本。
| 实例类型 | 每小时成本 | 吞吐量 | 每百万张图像的成本 |
|---|---|---|---|
| c5.xlarge (CPU) | $0.17 | 50 img/s | $0.94 |
| g4dn.xlarge (T4 GPU) | $0.53 | 400 img/s | $0.37 |
| p3.2xlarge (V100 GPU) | $3.06 | 1,200 img/s | $0.71 |
系统洞见:在这些假设下,T4 GPU 实例的单位成本最低。在给定的满利用率吞吐速率下,V100 的单位成本并不优于 T4。云服务价格因区域而异,也会随时间变化;生产规划应参考当前价格。
容量规划
GPU 与 CPU 的选择确定了每次推理成本,但要确定应预配多少基础设施,还需要将成本分析与 section 1.5 中的排队论基础相结合。容量规划将三类输入转化为基础设施规格:流量模式(峰值请求速率、每日和每周周期、增长预测)、延迟 SLO(p50、p95、p99 目标)以及模型特征(不同批大小下的推理时间分布)(Harchol-Balter 2013)。
Harchol-Balter, Mor. 2013. Performance Modeling and Design of Computer Systems: Queueing Theory in Action. Cambridge University Press. https://doi.org/10.1017/cbo9781139226424.
section 1.5 中的计算示例展示了完整流程:从 50 ms 的 p99 SLO 和 5,000 QPS 目标出发,根据 equation 6 推导出保守的 M/M/1 安全利用率阈值 54 percent,并确定计入余量后的 GPU 数量为 62 V100s。该场景按峰值负载加 30% 余量预配资源;生产环境的余量取决于工作负载和策略。自动扩缩容可以在低流量时段降低成本,同时在峰值期间满足延迟目标;机器学习运维 进一步阐述了围绕这些服务计算构建的运维策略层。只有与延迟保证相结合,吞吐量数值才有意义。正如 section 1.5 中对有效 QPS 的核算所确立的,容量必须按实际满足 SLO 的请求来规划,而非按原始请求量来规划。
生产案例研究:为 80 亿参数的 Llama 3 提供服务
除常驻权重外,KV 缓存内存通常也是大语言模型服务中最大的容量成本之一,figure 7 展示了其原因。为突出这一效应,图中采用了 700 亿参数规模:缓存随上下文长度和批大小线性增长,直至长上下文耗尽加载权重和运行时工作区后剩余的内存。本节其余部分分析的 80 亿参数 Llama 3 配置遵循相同的物理规律,但具有更大的余量,因此工程师可以将这一工作负载部署在单块 GPU 上,并进行端到端分析。
工作负载概况
以下固定的工作负载假设定义了本节延迟、内存和经济性计算所采用的参考案例;这些假设共同限定了后续分析的范围:
- 模型:80 亿参数的 Llama 3(使用激活感知权重量化(AWQ)量化至 4 位;量化技术见 量化与精度)(Dubey et al. 2024; Lin et al. 2024)。
- 硬件:1\(\times\) NVIDIA H100 SXM5 GPU(80 GB HBM3,带宽为 3.35 TB/s)(Choquette 2023)。
- 请求特征:包含 1,000 个词元的输入提示(预填充),生成包含 256 个词元的响应(解码)。
- 目标 SLO:TTFT \(<\) 200 ms,TPOT \(<\) 20 ms。
Lin, Ji, Jiaming Tang, Haotian Tang, Shang Yang, Wei-Ming Chen, Wei-Chen Wang, Guangxuan Xiao, Xingyu Dang, Chuang Gan, and Song Han. 2024. “AWQ: Activation-Aware Weight Quantization for on-Device LLM Compression and Acceleration.” Proceedings of Machine Learning and Systems 6: 87–100.
Choquette, Jack. 2023. “NVIDIA Hopper H100 GPU: Scaling Performance.” IEEE Micro 43 (3): 9–17. https://doi.org/10.1109/mm.2023.3256796.
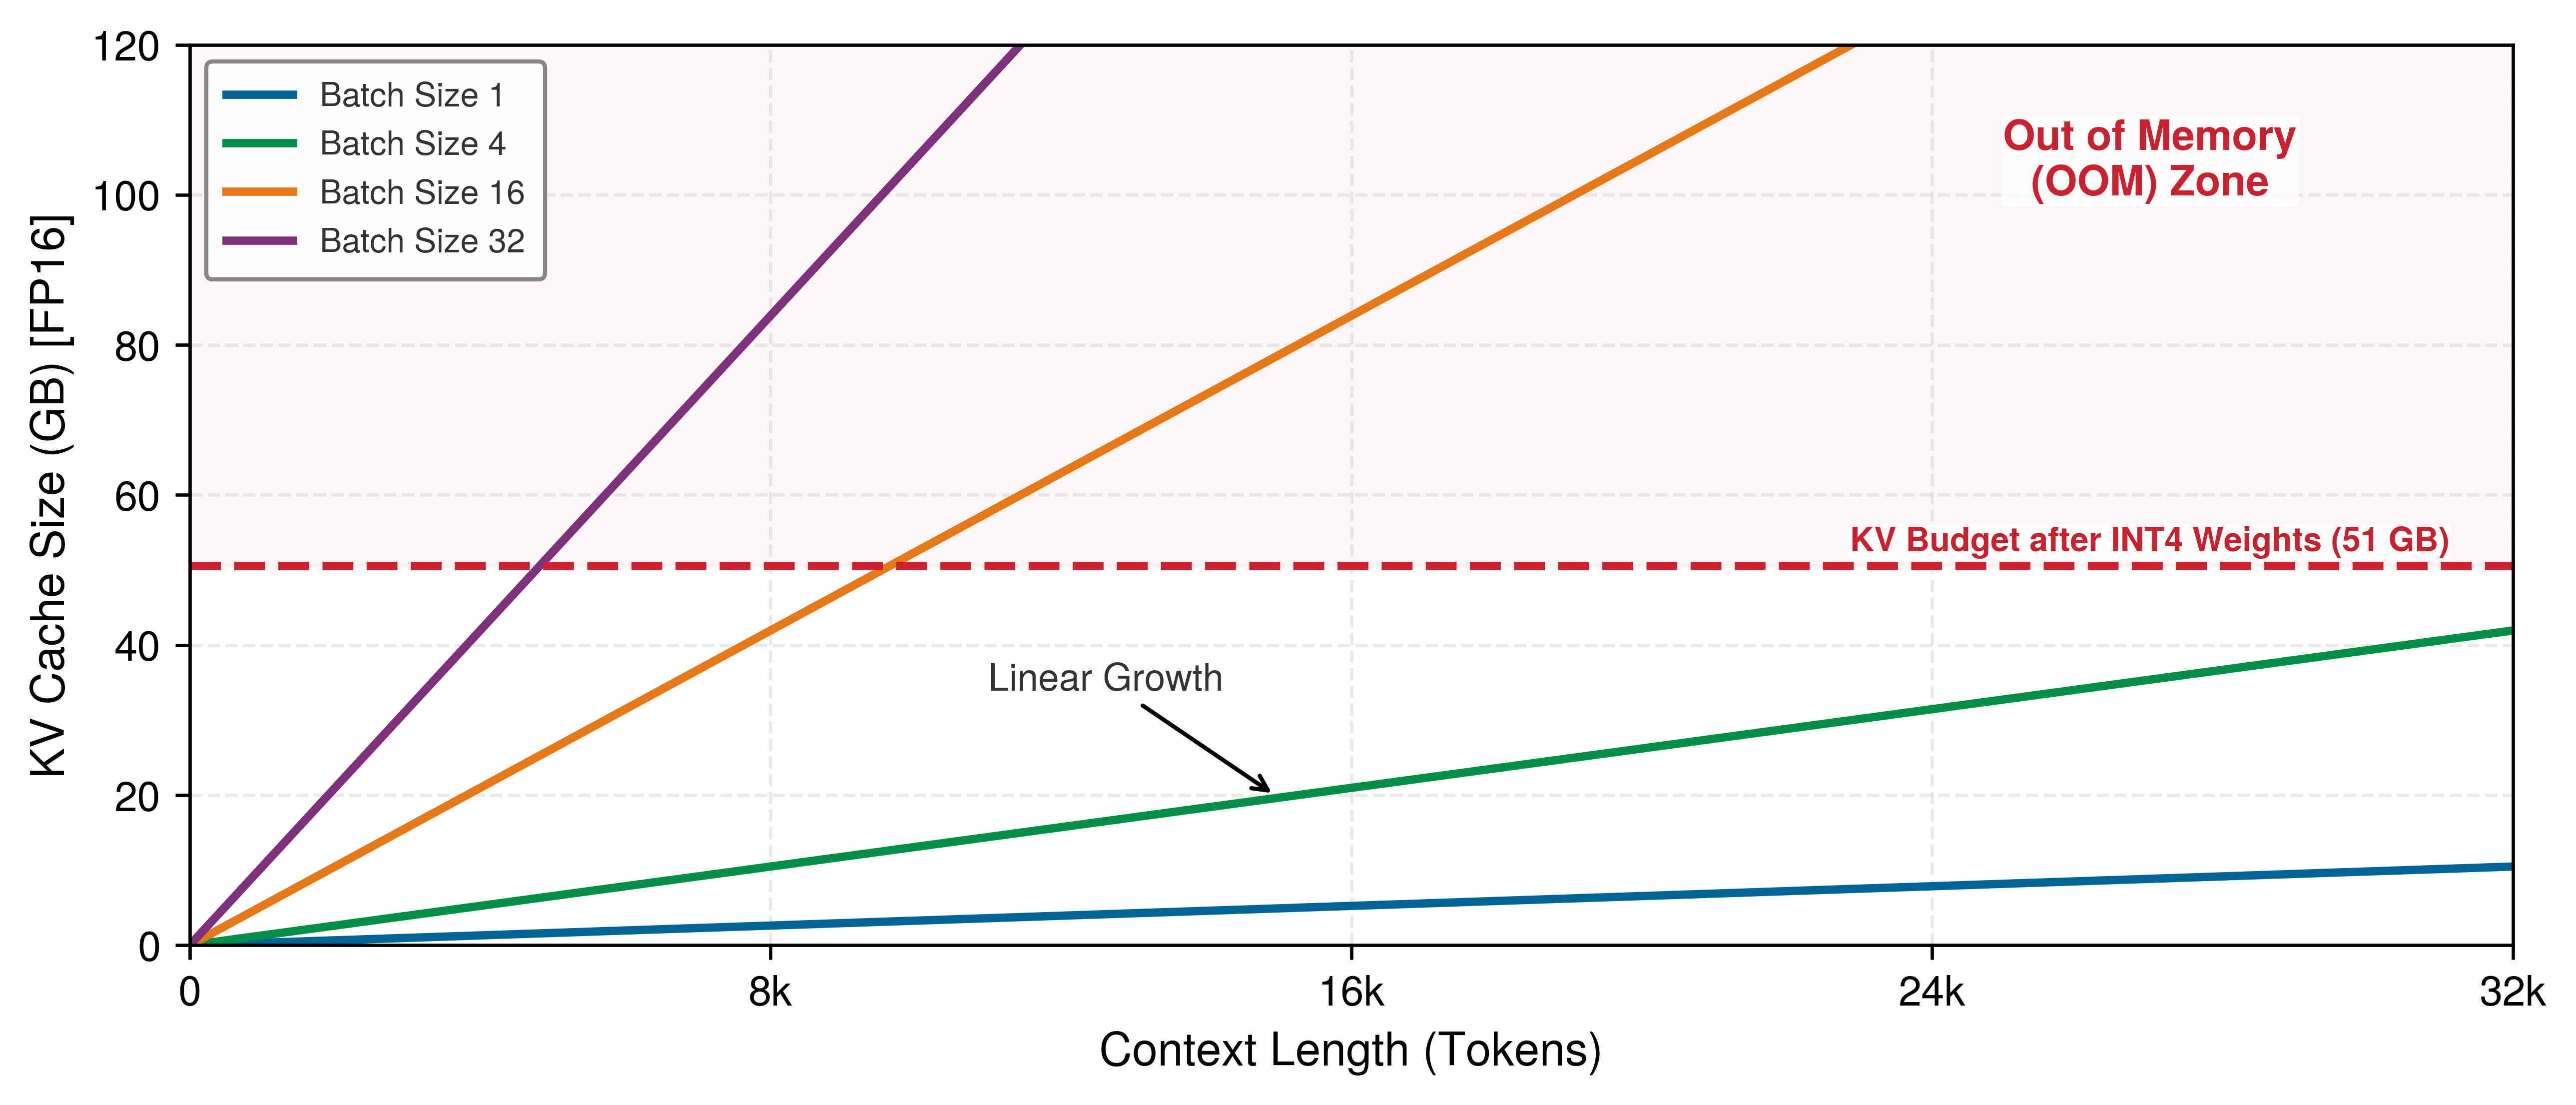
因此,更长的上下文需要更小的并发批次或更多内存,从而降低吞吐效率。这些假设将案例研究限定在可计算的范围内,同时保留了两个最重要的服务约束:首词元时间对应的预填充预算,以及每个生成词元对应的解码预算。
延迟分解
端到端请求延迟由自回归 Transformer 的两阶段执行模型决定,并采用 section 1.8.1 中定义的 TTFT 和 TPOT 指标。预填充决定用户能否迅速看到初始响应;解码决定生成流在开始后能否持续输出。
Systems Perspective 1.10: 词元生成的物理机制
回顾 搬移一个 32 位数值与对其进行计算的能耗对比 中量化的能量—搬运不变量:搬运一个比特的能耗是在该比特上执行计算的 100–1,000\(\times\)。在解码阶段,这一定律决定了物理层面的“每词成本”。
物理机制:对于采用 INT4 权重、批大小为一的解码,权重占主导时的算术强度约为每参数 \(2\) FLOPs 除以每参数 \(0.5\) 字节,即 \(4\) FLOPs/byte。这远低于 H100 的拐点,因此所建模的步骤受内存带宽限制。更大的解码批次可在多个序列之间复用权重数据流,从而提高算术强度 (Pope et al. 2023)。批大小为一时由带宽决定的时间下限如 equation 18 所示: \[ T_{\text{token}} \approx \frac{D_{\text{vol}}}{\text{BW}_{\text{memory}}} \tag{18}\]
影响:每生成一个词元,都需要付出将模型权重从 HBM 搬运到计算寄存器的能量成本。在 A100 80 GB(2.04 TB/s HBM2e)上,同一模型由权重流式传输决定的理论时间下限约为每词元 1.97 ms。当解码仍受带宽限制时,增加计算核心对延迟的改善很小;更快的内存(物理机制)、更小的模型(算法),或更好的批处理与缓存管理,才能改变这一界限。
预填充阶段(首词元时间)
模型并行处理包含 1,000 个词元的提示词。在求解器明确采用的 40% 计算效率假设下,模型侧首词元时间(TTFT)的估计值为 41.9 ms,明显低于 200 ms 的 SLO,为网络入口传输、词元化和排队留出了剩余时间预算。
解码阶段(每输出词元时间)
模型依次生成 256 个词元。当批大小为一时,该阶段受内存带宽限制:每一步都要从显存中流式读取 4 GB 的权重张量。批处理步骤则将这一数据流的成本分摊到其活跃序列上。
将 4 GB 的权重张量大小除以 3.35 TB/s 的带宽,可得理论时间下限:\(T_{\text{token}} \approx\) 1.2 ms。加上求解器中的逐层调度开销后,得到建模的每输出词元时间(TPOT)为 1.57 ms。这一调度开销反映了在模型的 32 层中,每层启动 8–10 个独立 GPU 内核(RMSNorm、RoPE、投影、注意力、多层感知机(MLP))的累积成本。当批大小为一时,启动 $$250–300 个小内核会增加数毫秒的 CPU-GPU 提交与驱动开销;模型服务引擎通过将解码图捕获为单个 CUDA Graph 来缓解这一开销。因此,生成全部 256 tokens 需要 256 tokens \(\times\) 1.57 ms = 0.40 s。
内存与吞吐量
4 位权重占用 4 GB,剩余约 81.9 GB 可用于 KV 缓存和运行时工作区。在 80 亿参数的 Llama 3 配置中,每个词元约需要 0.131 MB 的 FP16 KV 缓存;AWQ 将权重压缩为 4 位,但仍将 KV 缓存保留为 16 位精度。这一每词元内存占用直接由架构决定:在 \(L=32\) 层中,为 \(N_{\text{kv}}=8\) 个维度为 \(d_{\text{head}}=128\) 的分组查询注意力头存储 16 位的 Key 和 Value 张量,每个序列中的每个词元需要 \(2 \times 32 \times 8 \times 128 \times 2\text{ bytes} = 128\text{ KB}\),使缓存体积降至标准 32 头多头注意力的四分之一。将预留的 72 GB 除以每词元的内存占用,可得容量约为 0.6 million tokens,因此在每个请求包含 1,256 tokens 时,GPU 可容纳的并发批大小约为 469 requests。
单位经济性
考虑一个具有代表性的 H100 SXM5 租赁成本,约为 $3/hour。取独立预填充处理能力与 KV 缓存驻留容量所支持的处理能力中的较小值,可得到乐观的吞吐量上限 45.2 million tokens/hour,以及单位成本下限 $0.066/million tokens。这一计算未对预填充与解码之间的资源争用或批量解码处理能力进行建模。
对于大语言模型,内存容量(未分配显存中专门用于 KV 缓存的容量)决定了最大并发驻留量,而预填充计算能力和解码带宽决定了特定流量组合下实际达到的词元吞吐量与成本。内存带宽约束小批量解码延迟;更大的批次可分摊参数搬运成本,使瓶颈转向计算或 KV 缓存数据传输。
物理约束支配着整个技术栈中的模型服务经济性:延迟预算划分为预填充和解码两个阶段,排队论决定批大小与容量余量,而内存带宽约束解码吞吐量。误解这些相互作用,会直接导致下文所述的运行误区与陷阱。
误区与陷阱
模型服务在某些方面颠倒了训练的优先级,违背了源自批处理的直觉。利用率与延迟之间的非线性关系、预处理的隐性成本,以及训练与服务偏差的隐蔽失效模式,会导致 SLO 违约、优化投入浪费,以及标准监控无法察觉的准确率下降。
误区:降低模型推理延迟会使用户感知延迟按比例降低。
优化模型推理的工程师期望用户感知延迟也按比例改善,但模型服务系统引入了离线基准测试中不存在的延迟来源。在负载下,排队延迟占主导地位:equation 5 表明,当利用率为 80 percent、服务时间为 5 ms 时,推理尚未开始,平均等待时间就已达到 20 ms。将推理时间从 5 ms 缩短至 2 ms,不仅改变了服务时间,还使利用率从 80 percent 降至 32 percent,将排队等待时间从 20 ms 缩短至 0.9 ms;排队等待时间由此缩短至原来的 21.2× 分之一,这一改善远超推理时间减少 3 ms 所带来的收益。推理速度与排队行为之间的这种非线性相互作用,意味着系统级加速(25 ms → 2.9 ms,即 8.5×)远超模型级加速(5 ms → 2 ms,即 2.5×)。即使服务时间仅减少 20%,在高利用率下也可能显著改善用户体验,因为这既降低了利用率,也缩短了直接计算时间。模型服务优化需要在真实负载条件下分析完整的延迟预算,包括序列化、排队、预处理和后处理,而不能仅对推理延迟进行孤立的性能剖析。
陷阱:让模型服务基础设施以高利用率运行,以最大化成本效率。
团队将利用率目标设为 90 percent,以尽量减少闲置容量。在生产环境中,随着利用率接近容量上限,延迟会呈非线性恶化。Equation 5 表明,在 90 percent 的利用率下,平均系统逗留时间达到服务时间的 10×。将利用率从 70 percent 提高至 90 percent,可使建模的基础设施成本降低 22.2 percent,但平均延迟会增至三倍。对于服务时间为 5 ms 的推理服务,在 M/M/1 假设下,建模的 p99 延迟从约 76.7 ms 升至约 230 ms。在这一场景中,以 60% 至 70% 的利用率运行,比以 90% 的利用率运行保留了显著更多的延迟余量。生产环境的目标利用率应根据实测的到达过程、服务时间分布、SLO、故障储备和成本目标来选择。
误区:训练准确率能够保证模型服务准确率。
工程师往往认为,相同的模型权重能够保持验证集上的性能。在生产环境中,预处理差异可能使输入偏离训练分布。Section 1.6.1 解释了即使权重相同,缩放插值、数值精度和特征时序仍可能造成偏差的原因。此处的示例场景中,准确率从 95 percent 降至 90 percent,下降了 5 percentage-point;这些数值并非来自已报告的生产事故。生产系统需要一致的预处理和任务质量监控,因为延迟检查和异常检查无法发现此类失效。
陷阱:使用平均延迟评估服务系统性能。
工程师监控平均延迟,因为其变化趋势平滑,而且易于计算。然而,平均值无法反映 SLO 指定的百分位数是否未达标。如 section 1.5.5 所示,在利用率为 70 percent、服务时间为 5 ms 时,平均延迟为 16.7 ms,但模型计算得到的 p99 达到 76.7 ms,是平均值的 4.6×,而基于均值的监控无法揭示这一差距。因此,服务应报告相关的延迟分布和 SLO 百分位数,而不能仅报告均值。
谬误:增大服务批大小总能提高吞吐量,而不影响延迟 SLO。
工程师将批大小最大化,认为在生产负载下充分利用 GPU 能够提高成本效率。然而,在服务系统中,批处理会引入延迟与吞吐量之间的权衡,这种权衡受排队动态支配,而离线基准测试并不包含这些动态。将请求累积成更大的批次会增加早到请求的等待时间:10 ms 的批处理窗口意味着第一个请求在推理开始前需等待 10 ms,这会直接增加 p99 延迟。在 section 1.7.6 中具有代表性的 ResNet-50/V100 场景下,将批大小从 16 增至 32,吞吐量仅提高 12 percent,但每批推理时间却从 14 ms 增至 25 ms,接近翻倍;而且,同一批次内输入大小不一还可能产生填充开销,将计算资源浪费在填充词元上。Section 1.7.3 说明,对于严格的 p99 目标,当批次形成延迟与增加后的每批推理时间之和超出延迟预算时,更大的批大小为何会导致 SLO 违约。服务批处理优化需要在真实流量模式下,以延迟 SLO 为约束,联合调整批大小、批处理超时时间和并发度,而不能孤立地追求吞吐量最大化。
陷阱:使用不具代表性的数据校准量化模型。
团队可能使用易于获取的样本进行校准,即使这些样本无法代表所支持的部署分布。训练后量化根据校准数据中的激活值范围确定 INT8 缩放因子,因此,具有代表性的覆盖范围至关重要。此处的示例场景中,准确率从 76.1 percent 降至 72.9 percent,下降了 3.2 percentage-point;这并非已报告的生产事故。有效的量化要求使用能够代表服务预期处理输入的数据进行校准和验证。
谬误:冷启动延迟只对第一个请求有影响。
工程师优化稳态延迟,假定大多数请求都会到达已预热的实例。在流量突增、部署和恢复期间,冷启动的影响可能叠加。在此示例场景中,10 个实例各需 30 s 的编译时间,合计 300 instance-seconds;并行预热可使这些容量在约 30 s 后可用。假定冷启动期间请求的延迟为 500 ms,而稳态延迟为 5 ms。
陷阱:扩容时未为预热池或分阶段加载预留预算。
仅考虑稳态副本数量的自动扩缩容策略会低估流量突增和部署期间所需的容量。服务系统需要预热池(预先初始化的备用副本)、分阶段模型加载或准入控制,以便新副本在用户请求依赖它们之前就能提供有效服务。预算应包括编译、权重加载、缓存初始化和健康检查所需的时间,因为这些步骤决定了横向扩容究竟是在增加容量,还是在增加另一个尾延迟来源。
总结
模型服务将经过验证的模型投入实际运行负载。除了训练中熟悉的吞吐量问题,在线请求还带来了延迟分布、排队、流量波动和故障备用容量等问题。利特尔定律关联了系统长期稳定运行时的平均在系统数量、到达率和响应时间;M/M/1 则提供了一个刻意简化的模型,用于描述接近饱和时延迟的非线性增长。两者都不能替代测量,但结合起来,可以将容量余量和容量转化为可通过负载测试验证的明确假设。
有效的服务优化需要测量完整的请求路径,而非仅测量模型推理。当传输占据预算的显著比例时,协议和序列化的选择就很重要;当预处理向加速器提供输入的速度过慢时,预处理就很重要;只有当请求到达情况和 SLO 允许等待时,批处理才有意义。训练与服务偏差引入了另一种失效模式:服务可以始终快速运行且不报错,但不一致的变换会悄然改变其预测结果。
在 部署范式框架 中选择的部署范式会改变可行的请求路径。云 API 可以在经过测量的到达过程下使用动态批处理,同步传感器会施加帧截止时间约束,而单流移动端负载可能选择批大小为一,以保障响应性并控制能耗。MLPerf 场景为这些负载形态提供了标准化近似;生产设计仍应从服务自身的流量、硬件和目标出发。
要点回顾: 反转训练中的每一项优先级
- 模型服务是延迟经济学:训练追求长时间运行下的吞吐量,而服务则将固定的单请求预算分配给序列化、预处理、排队、推理、后处理和网络。仅优化模型延迟会忽略用户实际等待的其他阶段。
- 利用率会转化为等待时间:在本章的 M/M/1 近似中,平均在系统时间从利用率为 80% 时的服务时间的 5\(\times\) 增至利用率为 90% 时的 10\(\times\)。容量余量可防止适度的流量激增演变为 SLO 违约。
- 快速模型会显露流水线开销:一旦推理足够快,图像解码、词元化和其他预处理操作就可能主导总延迟。此时,优化的瓶颈转向请求路径,而非神经网络内核。
- 批处理应遵循流量特征:用泊松过程建模的 Web 请求到达可以采用动态批处理,同步传感器需要对齐的批次,而单流移动端负载可能几乎没有批处理机会。合理的窗口可在不违反 SLO 的前提下,将可用的延迟余量转化为吞吐量。
- 偏差会在不报错的情况下破坏准确率:训练与服务之间的缩放方法、归一化顺序、校准数据或特征定义存在差异,都可能改变模型的有效输入分布。共享变换、等价性测试和生产数据切片监控可以降低这一风险。
- LLM 服务的核心是内存管理:解码通常需要为每个生成的词元从显存中读取权重,因此,除非批处理改变了约束条件,否则词元延迟受带宽限制。KV 缓存布局、PagedAttention、连续批处理、精度和运行时选择共同决定并发度与单词元成本。
- 运行时选择会转化为基础设施账单:精度、图编译、算子融合和服务运行时会直接影响副本数量与单次推理成本。当量化和专用运行时能够保持准确率并适配目标硬件时,它们可以显著降低所需的服务容量。
节点级优化将模型操作与执行这些操作的机器联系起来。性能剖析可以揭示编译、算子融合、精度、局部性、序列化或加载是否真正构成请求路径的瓶颈。只有在生产输入形状、准确率检查和延迟波动下仍然成立的性能提升才有意义。容量规划将经过验证的吞吐量转化为副本数量和单位成本,正如 section 1.11.4 中的 Llama 3 案例研究所展示的那样。更快的内核如果既未减少所配置的容量,也未改善 SLO,就没有产生经济收益。
训练以完成的有效工作量衡量成效;在线服务则以请求是否达到延迟目标衡量成效。每个阶段都消耗同一份预算:序列化、预处理、队列、模型和响应。数据决定输入大小与到达形态,算法决定计算量与状态,机器决定服务速率与数据移动成本。排队将这三者以非线性方式耦合起来,因此,一个在中等流量下符合预算的系统,可能在流量小幅激增后就超出预算。因此,服务工程需要在整个请求路径上分配预算,为波动和故障保留容量余量,并验证所要求比例的请求能够在截止时间之前完成。
后续内容: 从节点到工厂
单个服务节点是脆弱的:模型会发生漂移,更新必须在不中断服务的情况下交付给用户,多个副本也必须表现为一个可靠的统一系统。机器学习运维 将关注单元从单个请求扩展到生产工厂:CI/CD 管理制品;模型注册表和特征存储使服务与训练保持一致;可观测性检测延迟与准确率漂移;回滚则防止不良发布演变为持续性故障。
Footnotes
杰文斯悖论:威廉·斯坦利·杰文斯于 1865 年观察到,燃煤蒸汽机效率的提高,使蒸汽动力在此前成本过高的应用中变得经济可行,进而增加了煤炭总消耗量 (Jevons 1865);同样的机制也可能适用于 AI 推理:成本每降低至原来的十分之一(10\(\times\) 降本),都会使一批在此前价格水平下不具备经济可行性的应用变得可行,从而使总需求的增长幅度超过效率提升幅度。这解释了为什么更便宜的推理可能增加而非减少对 GPU 集群的总需求。在 AI 领域,效率与需求往往相互促进,而非相互替代。↩︎
服务级别目标(SLO)与服务级别协议(SLA):SLO 是一个内部目标(例如,“p99 延迟低于 50 ms”);SLA 则是一项对外的合同承诺,违反该承诺可能需要采取补救措施或承担违约处罚。团队通常将 SLO 设定得比 SLA 更严格,以保留安全裕量。对于机器学习服务,任务质量和推理延迟都可以构成 SLO,从而形成多维目标;改善其中一个维度(例如,为提高准确率而部署更大的模型)可能导致另一个维度(延迟)不达标。↩︎
推理服务器:Google 的 TensorFlow Serving (Olston et al. 2017) 推动确立了模型逻辑与服务基础设施的分离;NVIDIA 的 Triton (NVIDIA 2024b) 将这一模式扩展到多个模型框架和后端。其关键设计思想是,调度器与动态批处理器将不规则的单请求流量转化为适合加速器执行的形式,在延迟预算允许批处理时提高利用率。具体的利用率提升取决于模型、硬件、到达率以及配置的批处理时间窗口。↩︎
NCHW 和 NHWC(张量内存布局):这些缩写表示四维图像张量的维度顺序:N(批次)、C(通道)、H(高度)和 W(宽度)。在连续的 NCHW 张量中,每个通道平面在内存中连续存储;在 NHWC 中,同一空间位置的各通道相邻存储。优化内核可能偏好其中任一种布局,而语义不匹配即使在元素数量正确时也可能导致数值错乱。因此,模型服务代码应明确说明各维度的含义,以及所执行的任何物理布局转换。↩︎
Protocol Buffers(Protobuf):Protobuf 使用预定义模式(来自
.proto文件),将结构化数据编码为紧凑的二进制格式 (Protocol Buffers Authors 2026)。由于模式包含字段名称和类型,传输载荷无需像 JSON 那样重复这些信息。但其传输格式仍不等同于 C++ 对象的内存布局,因此需要解析步骤,无法提供 FlatBuffers 所追求的同类直接零拷贝访问方式。↩︎FlatBuffers:名称中的“flat”(扁平)描述了其设计:二进制缓冲区既可用作序列化表示,也可直接作为被读取的数据结构,从而在受支持的访问模式下避免单独的解析或解包阶段 (FlatBuffers Authors 2026)。对于机器学习推理,这可以实现对张量元数据的零拷贝访问——模型服务系统直接从缓冲区读取张量形状和偏移量,无需再分配一份对象表示。↩︎
gRPC(gRPC 远程过程调用):GRPC 将 HTTP/2 传输与接口定义语言及消息格式相结合,最常用的是 Protocol Buffers (gRPC Authors 2026)。其对模型服务的优势在于结合了类型化契约、持久多路复用连接、流式传输支持和紧凑的二进制消息。与 REST/JSON 相比,其在大小和延迟方面的收益取决于载荷形态、客户端与服务器实现,以及序列化是否占据端到端延迟预算的显著份额。↩︎
尾延迟:与平均值不同,百分位延迟能够揭示机器学习服务中常见的系统异常事件对性能的影响,例如模型缓存未命中或垃圾回收暂停。这些罕见的高延迟请求可能对用户满意度和业务结果造成不成比例的损害。由于影响程度取决于工作负载,服务需要结合自身用户和 SLO 验证百分位目标(p95、p99)。↩︎
利特尔定律:John D. C. Little(1961)证明,在一致的系统边界内,无论到达分布、服务分布或调度规则如何,对于稳定的长期平均值,都有 \(Q_{\text{req}} = \lambda_{\text{arr}} T_{\text{lat}}\) 成立;这种普适性为机器学习容量规划奠定了基础:该公式无需假设泊松到达或指数分布的服务时间。但它确实要求长期平均值有明确定义,并且到达率、系统内逗留时间及系统内请求数的定义保持一致。↩︎
M/M/1 队列:排队论起源于 Agner Krarup Erlang 于 1909 年对哥本哈根电话交换局的分析,其中呼叫到达被建模为无记忆的泊松过程。M/M/1 模型的指数服务时间假设所引入的方差,大于许多固定形状机器学习推理工作负载所表现出的方差。在利用率和平均服务时间相同的情况下,其平均排队等待时间是 M/D/1 的两倍;总响应时间之比只有在利用率较高时才趋近于二。因此,该模型是一种有用的保守近似,而非对推理流量的普遍描述。↩︎
延迟的超线性发散:容量规划所关注的拐点往往远早于完全饱和出现;在 M/M/1 平均响应时间方程 \(E[T] = \frac{1/\mu}{1-\rho_{\text{serv}}}\) 中,\(\rho_{\text{serv}} = \lambda_{\text{arr}}/\mu\) 为利用率。当 \(\rho_{\text{serv}} \to 1\) 时,\((1-\rho_{\text{serv}})^{-1}\) 项发散:在 \(\rho_{\text{serv}} = 0.7\) 时,平均响应时间已达到基础服务时间的 3.3\(\times\);在 \(\rho_{\text{serv}} = 0.9\) 时,则为 10\(\times\)。确切的运行上限取决于策略和工作负载,但试图将延迟敏感队列推向饱和,会导致延迟出现不成比例的增长。↩︎
肯德尔记号:在 A/S/c(到达过程/服务过程/服务器数)记号中,“M”表示马尔可夫(无记忆)过程,“D”表示确定性。当服务时间近乎确定时,就平均排队等待时间而言,M/M/1 相较于 M/D/1 更为保守;但这两种模型都不能替代对生产工作负载的到达过程、服务时间方差或尾部行为的测量。↩︎
对冲请求:该术语借自金融领域,在金融中,通过反向下注来降低风险;在这里,冗余请求相当于针对服务器响应缓慢风险的一次下注。这并非没有代价:对于机器学习系统,如果推理已经启动,竞速失败的对冲请求仍可能占用加速器时间,因为普通 GPU 内核在执行中途的取消成本较高。因此,对冲策略必须同时为重复工作和延迟收益制定预算。↩︎
金丝雀:这一名称源于煤矿中的一种做法(20 世纪初至 20 世纪 80 年代):利用鸟类代谢率高的特点,在有毒气体浓度达到对人类致命的水平之前,借助鸟类对这些气体的敏感反应发出警报。在机器学习模型服务中,金丝雀请求对扇出查询起到同样的早期预警作用:在执行完整扇出之前先测试 1–2 个后端,系统便可在单个慢副本阻塞整个分布式推理请求之前,检测出缓慢或发生故障的副本—当扇出宽度使尾延迟随所有后端响应时间的最大值增长时,这是一项关键保护措施。↩︎
预热:该术语借自即时(JIT)编译,其中最初几次执行会将热点路径编译为优化的机器码;对于机器学习模型服务,预热推理会触发框架推迟到首次使用时才执行的 CUDA 内核编译、cuDNN 算法自动调优和内存池分配。没有预热时,第一个真实请求将承担所有这些准备工作,其响应时间可能比稳态慢几个数量级。在自动扩缩容期间,这意味着新副本在开始接收流量的最初几秒内可能违反 SLO。↩︎
CUDA(统一计算设备架构):NVIDIA 的并行计算平台 (Nickolls et al. 2008),其名称源于将不同 GPU 着色器模型统一为单一通用架构的目标。在 CUDA 出现之前,GPU 编程需要将计算伪装成图形操作。CUDA 上下文—用于跟踪内存分配、已加载内核和设备状态的数据结构—是运行时中每个进程访问 GPU 资源的入口;在无服务器或快速扩缩容的模型服务系统中,上下文创建和惰性模块加载可能成为冷启动延迟中可观测的组成部分 (NVIDIA 2026a)。↩︎
CUDA MPS(多进程服务):MPS 创建一个控制守护进程,使不同进程的 CUDA 工作能够在 GPU 上重叠执行;当各进程单独运行时未充分利用加速器,这可以提高利用率并减少上下文切换开销 (NVIDIA 2026d)。对于多模型服务,MPS 可以帮助副本高效共享 GPU 流式多处理器。其权衡在于故障隔离:客户端共享由 MPS 管理的 GPU 状态,因此,使用多实例 GPU(MIG)进行硬件分区能够提供更强的隔离,但代价是分区粒度固定。↩︎
MIG(多实例 GPU):MIG 随 NVIDIA 的 A100 (NVIDIA Corporation 2020) 推出,相关文档覆盖各款受支持的数据中心 GPU (NVIDIA 2026e)。它将单个物理 GPU 划分为多个独立实例,每个实例都具有专用的计算和内存资源;与软件共享(MPS 或时间切片)不同,MIG 在分区之间提供硬件级隔离。其代价在于划分粒度—分区必须遵循固定的配置规格,因此无法任意划分资源。对于多模型服务,MIG 可降低共享硬件上相邻工作负载相互干扰的风险,但各模型的 SLO 保证仍取决于调度器策略、负载和所选分区规格。↩︎
批次:源自古法语 bache(一次烘焙的数量),于 20 世纪 50 年代进入计算领域,用于指无需人工交互、一起处理的作业。在机器学习服务中的用法保留了原有的权衡:将请求分组可以在多个输入之间摊薄固定成本(内核启动、权重搬移),但在线请求可能需要等待批次形成。在内存允许时,训练可以使用包含数百或数千个样本的批次;服务批大小则从 1 到大得多的数值不等,具体取决于模型、到达率和延迟 SLO。↩︎
内核(GPU):CUDA 在 2007 年前后从操作系统领域借用了这个术语,因为 GPU 函数代表并行算法的计算“核心”。与持续运行的操作系统内核不同,GPU 内核是由 CPU 启动的离散并行工作单元。每次启动都会带来 5–20 μs 的开销,且与批大小无关——对于大型训练批次,这一开销可以忽略不计,但在批大小为 1 的服务中却占主导地位,此时一个 50 层模型每次推理会累积 250–1000 μs 的纯启动开销。↩︎
连续批处理:也称为“迭代级批处理”(Yu et al. 2022),在 NVIDIA TensorRT-LLM 中称为“飞行中批处理(in-flight batching)”(NVIDIA 2026f);其区别在于调度粒度。传统批处理在整个序列生成过程中(可能包含数百次迭代)固定使用同一个批次,而连续批处理在每个词元生成步骤重新调度——类似于操作系统的抢占式进程调度与运行至完成调度之间的区别。这种更细的粒度减少了变长序列造成的浪费:已完成序列占据的批次槽位会一直闲置,直到其他所有序列均完成。↩︎
vLLM(虚拟大语言模型,virtual large language model (LLM)):一种开源服务系统,通过其 PagedAttention 算法实现连续批处理 (Kwon et al. 2023)。该技术受操作系统虚拟内存机制启发,减少了限制静态批处理的严重 KV 缓存碎片化和预留浪费。通过将 KV 缓存浪费维持在较低水平,vLLM 能够在相同硬件上支持更大的有效批大小。↩︎
PagedAttention:这一名称直接指向操作系统的虚拟内存分页机制。该机制于 1962 年首次在曼彻斯特的 Atlas 计算机上实现,用于解决同一类分配问题——程序需要的内存超过了实际物理内存容量,而连续分配会浪费空间 (Kilburn et al. 1962)。PagedAttention 在 SOSP 2023 上提出,将这一已有六十年历史的抽象应用于 GPU KV 缓存内存:在此之前,LLM 服务系统因碎片化和过度预留而浪费了 60% 至 80% 的 KV 缓存内存。PagedAttention 将浪费降至 4% 以下,使相同硬件上的吞吐量达到原来的 2–4\(\times\) (Kwon et al. 2023)。↩︎
泊松过程:这一随机模型以法国数学家西梅翁·德尼·泊松(1781–1840)的名字命名,描述以恒定平均速率连续、独立发生的事件。在固定时间窗口内,方差等于均值,因此,当 \(\lambda_{\text{arr}}=200\) req/s、窗口为 10 ms 时,期望计数为 2,约 14% 的窗口为空,不过高效的调度器不会为这些窗口启动 GPU 工作。由请求触发的计时器则从一个请求开始,仅统计窗口期间额外到达的请求。↩︎
自回归:源自希腊语 auto-(自身)和拉丁语 regressus(返回)——输出对自身进行“回归”;George Udny Yule 于 1927 年引入自回归模型,用于分析太阳黑子周期。在语言建模中,每个输出词元都以此前生成的所有词元为条件,由此形成串行依赖,阻碍了训练过程中所利用的并行性。在小批次下,解码通常受权重读取带宽限制;更大的批次可以摊薄权重数据流的开销,并可能使瓶颈转向计算或 KV 缓存流量 (Pope et al. 2023)。↩︎
KV 缓存(键值缓存):为避免重复工作,系统会缓存此前词元的 Key 和 Value 向量,这些向量在整个生成过程中始终有效;这一设计选择直接导致了前述动态内存增长;缓存大小随生成词元数量线性增长,使内存管理成为主要约束。在本计算采用的 700 亿参数级分组查询注意力容量估算示例中,FP16 KV 缓存中每个序列的每个词元约占 0.33 MB;Llama 3 等 Llama 系列模型使用的分组查询注意力(GQA)使多个查询头共享键/值头,从而减少相对于完整多头注意力的缓存量 (Dubey et al. 2024)。因此,一个包含 32 个请求、上下文长度为 8,000 个词元的批次,仅 KV 缓存就需要约 80 GB;如果不使用分组查询注意力或多查询注意力,所需容量还会增加至数倍。↩︎
推测解码:一个小型“草稿”模型以自回归方式生成 \(k\) 个候选词元;随后,大型目标模型并行验证所提议的词元块 (Leviathan et al. 2023)。之所以能够并行验证,是因为草稿模型事先猜测出了全部 \(k\) 个候选词元。目标模型不再顺序生成,而是在一次因果注意力前向传播中评估整个包含 \(k\) 个词元的块——其行为类似于一个受计算限制的小型预填充过程——从而用一次并行矩阵—矩阵计算替代 \(k\) 次受内存带宽限制的矩阵—向量运算。当草稿模型的提议以接受率 \(\alpha\) 被接受时,有效吞吐量可以随每次验证步骤中接受的词元数量增加而提升。这是在运行时层面,而非模型架构层面,突破串行自回归瓶颈。↩︎
ONNX Runtime:微软的推理引擎充当硬件抽象层:同一个 ONNX 模型可以通过可插拔的执行提供程序,在 CPU、NVIDIA GPU、AMD GPU 或定制加速器上运行。ONNX Runtime 应用常量折叠、冗余节点消除和算子融合等图优化。相对于 TensorRT 等经过调优的目标专用引擎,其性能取决于工作负载、执行提供程序和硬件。↩︎
TensorRT:NVIDIA 的推理编译器和运行时,可提前针对特定微架构(如 Hopper 或 Blackwell)优化模型 (NVIDIA 2024a)。要求针对目标执行构建阶段,使编译器能够生成融合内核、选择微架构专用的 Tensor Core 执行路径,并优化内存布局(如 NC/32HW32)。由此生成的不可移植引擎可降低每个请求的执行延迟,并最大限度地减少满足目标吞吐量所需的加速器数量。↩︎
OpenVINO(开放视觉推理与神经网络优化):一个面向 Intel 的推理工具包,可在 Intel CPU、GPU 和 NPU 目标上转换、优化和运行模型 (Intel Corporation 2026)。针对直接硬件执行进行特化,不再遵循通用框架的可移植执行保证,使编译器能够生成针对架构调优的向量指令(如 AVX-512 或 AMX),并利用低精度整数执行单元。虽然加速效果取决于具体的算子组合和目标处理器,但这种特化可以使延迟敏感模型的 CPU 服务或边缘服务在经济上具有可行性。↩︎
层融合:类似于编译器优化中的循环融合,即将遍历同一数组的相邻循环合并,以减少内存流量。内核融合将同一原理应用于 GPU 运算:将连续的、需要向 HBM 写入并重新读取中间张量的内核合并为一个内核,使数据能够保留在寄存器中。↩︎
SIMD:源自 Michael Flynn 于 1966 年提出的计算机体系结构分类,SIMD 允许一条指令同时操作多个数据元素。Intel 的 AVX-512 可以在一个 512 位向量中处理十六个 FP32 值,而 AMX 增加了矩阵分块操作。实际可达到的峰值性能比例取决于数据类型、矩阵形状、内存行为和实现,但优化后的向量内核相较于标量执行可以带来数倍加速。↩︎
NUMA(非统一内存访问):在多插槽服务器中,与通过插槽间互连访问远端插槽内存相比,本地内存访问具有更低的延迟和更高的带宽。如果仅将推理线程绑定到专用核心,却未将张量分配到同一位置,就会迫使内存流量经过互连;当受内存限制的前向传播所需数据超过 CPU L3 缓存容量时,这会带来严重的延迟代价。↩︎
Safetensors:其名称强调安全性:与不受限制的 pickle 反序列化不同,该格式不编码可执行的 Python 对象 (Hugging Face 2026)。它以连续原始字节和一个小型文件头存储张量,并支持内存映射加载。在本地基准测试示例中,该路径的加载速度是所比较的 PyTorch 检查点路径的 10×;这一结果取决于具体工作负载和存储条件,且不包含向独立加速器传输数据的时间。↩︎
Jevons, William Stanley. 1865. The Coal Question: An Inquiry Concerning the Progress of the Nation, and the Probable Exhaustion of Our Coal Mines. Macmillan; Co.
Olston, Christopher, Noah Fiedel, Kiril Gorovoy, Jeremiah Harmsen, Li Lao, Fangwei Li, Vinu Rajashekhar, Sukriti Ramesh, and Jordan Soyke. 2017. “TensorFlow-Serving: Flexible, High-Performance ML Serving.” CoRR abs/1712.06139. https://doi.org/10.48550/arXiv.1712.06139.
NVIDIA. 2024b. NVIDIA Triton Inference Server.
Protocol Buffers Authors. 2026. Overview: Protocol Buffers.
FlatBuffers Authors. 2026. FlatBuffers Documentation.
gRPC Authors. 2026. Introduction to gRPC.
Nickolls, John, Ian Buck, Michael Garland, and Kevin Skadron. 2008. “Scalable Parallel Programming with CUDA: Is CUDA the Parallel Programming Model That Application Developers Have Been Waiting For?” Queue 6 (2): 40–53. https://doi.org/10.1145/1365490.1365500.
NVIDIA. 2026a. Lazy Loading: CUDA Programming Guide.
NVIDIA. 2026d. NVIDIA CUDA Multi-Process Service.
NVIDIA Corporation. 2020. NVIDIA A100 Tensor Core GPU Architecture. NVIDIA Whitepaper, V1.0.
NVIDIA. 2026e. NVIDIA Multi-Instance GPU User Guide.
Yu, Gyeong-In, Joo Seong Jeong, Geon-Woo Kim, Soojeong Kim, and Byung-Gon Chun. 2022. “Orca: A Distributed Serving System for Transformer-Based Generative Models.” 16th USENIX Symposium on Operating Systems Design and Implementation (OSDI 22), 521–38.
NVIDIA. 2026f. NVIDIA TensorRT-LLM.
Kwon, Woosuk, Zhuohan Li, Siyuan Zhuang, Ying Sheng, Lianmin Zheng, Cody Hao Yu, Joseph Gonzalez, Hao Zhang, and Ion Stoica. 2023. “Efficient Memory Management for Large Language Model Serving with PagedAttention.” Proceedings of the 29th Symposium on Operating Systems Principles, 611–26. https://doi.org/10.1145/3600006.3613165.
Kilburn, Tom, David B. G. Edwards, Michael J. Lanigan, and Frank H. Sumner. 1962. “One-Level Storage System.” IRE Transactions on Electronic Computers EC-11 (2): 223–35. https://doi.org/10.1109/TEC.1962.5219356.
Pope, Reiner, Sholto Douglas, Aakanksha Chowdhery, Jacob Devlin, James Bradbury, Jonathan Heek, Kefan Xiao, Shivani Agrawal, and Jeff Dean. 2023. “Efficiently Scaling Transformer Inference.” Proceedings of Machine Learning and Systems (MLSys) 5: 606–24.
Dubey, Abhimanyu, Abhinav Jauhri, Abhinav Pandey, Abhishek Kadian, et al. 2024. The Llama 3 Herd of Models. arXiv preprint arXiv:2407.21783.
Leviathan, Yaniv, Matan Kalman, and Yossi Matias. 2023. “Fast Inference from Transformers via Speculative Decoding.” International Conference on Machine Learning (ICML), 19274–86.
NVIDIA. 2024a. NVIDIA TensorRT: Programmable Inference Accelerator.
Intel Corporation. 2026. OpenVINO Documentation.
Hugging Face. 2026. Safetensors Documentation.