机器学习系统
机器学习系统
本章目的
为什么将同一个模型部署到手机与数据中心,需要从根本上不同的工程方法?
机器学习系统工程的核心洞见是:约束驱动架构。光速为远程服务器的响应速度设定了绝对下限。热力学限制了给定体积内在热量变得难以控制之前所能进行的计算量。存储器的物理特性使得数据搬移的成本往往高于数据处理。这些并非有待更先进技术解决的工程局限,而是恒久的物理边界,将系统运行环境划分为根本不同的运行区间。数据中心能够训练十亿参数规模的模型,却无法保证向数千英里外的用户提供低延迟响应。智能手机能够即时响应,但其内存预算仅为数据中心的一小部分。微控制器能够依靠纽扣电池运行数年,但其计算能力仅勉强足以支持一个简单的关键词检测器。在每个运行区间中,将同一个模型、同一种算法应用于同样的数据,都需要截然不同的工程设计;原因并非物理规律发生了变化,而是起主导作用的约束不同。如果团队将部署视为事后事项,在一种环境中训练,却将目标环境的约束推迟到上线时才考虑,就会过晚地发现:目标环境使数月以来的架构决策失效。因此,工程任务不是寻找普遍最优的部署方式,而是找出在预期运行区间中起制约作用的约束。从数据—算法—机器的角度看,理解这些运行区间,会使部署从运维细节转变为首要的协同设计问题,其中,数据局部性、算法结构与机器约束共同决定了系统的能力边界。
学习目标
- 解释物理约束如何形成从云端到 TinyML 的部署范式
- 应用机器学习系统铁律和瓶颈原则,区分计算受限、内存受限和 I/O 受限的工作负载
- 利用灯塔模型示例,将典型工作负载映射到部署范式
- 从运行约束和定量权衡两方面比较云端、边缘、移动端和 TinyML
- 应用决策框架,根据隐私、延迟、计算和成本约束选择范式
- 分析通过组合多种范式来满足系统约束的混合模式
- 评估部署决策、常见谬误以及可跨规模迁移的通用原则
部署范式框架
考虑两个极端:智能手表上的唤醒词检测器和数据中心中的推荐引擎。唤醒词检测器代表了一类在毫瓦级功率预算和千字节级内存限制下运行的 TinyML 工作负载;推荐引擎则体现了一类需要太字节级嵌入表和兆瓦级基础设施的云端机器学习工作负载。这些系统在截然相反的物理约束下解决不同的问题,其支撑基础设施在规模和设计上也有显著差异。这一现实使部署从运维层面的事后事项转变为首要的工程决策。数据—算法—机器交叉全景 所示的数据—算法—机器分类体系,将基础设施与数据和算法并列突出,有助于我们分析这一决策。
物理约束决定了机器学习模型能够在哪里运行,并以任何算法选择都无法突破的方式塑造其能力边界。关键在于,工程挑战远不止参数权重:在生产系统中,训练得到的模型只占整个运行代码库的一小部分 (Sculley et al. 2015)。其外围基础设施——数据摄取流水线、特征提取、模型服务运行时、遥测和硬件资源管理器——都必须直接适应宿主平台的物理约束范围。
各范式的功率范围从兆瓦级(云端)跨越到毫瓦级(TinyML)。
Shi, Weisong, Jie Cao, Quan Zhang, Youhuizi Li, and Lanyu Xu. 2016. “Edge Computing: Vision and Challenges.” IEEE Internet of Things Journal 3 (5): 637–46. https://doi.org/10.1109/jiot.2016.2579198.
延迟、功率耗散和内存带宽这三个物理维度,将机器学习部署划分为四种不同的范式;每一种范式都由硬件权衡塑造,而非由任意的产品分类决定。在云端机器学习中集中计算,可提供弹性计算能力和大容量内存,但每次推理都会产生跨广域网链路的网络延迟。将工作负载迁移至边缘机器学习可消除这一网络往返,并将敏感数据保留在本地场所 (Shi et al. 2016),但可用计算能力受本地机架的供电和散热预算限制。在电池供电设备上,移动端机器学习直接在手机和平板电脑上提供响应迅速的交互,但必须在被动散热能力范围内运行,持续计算会触发降频。在低功耗极端,TinyML 在微控制器上运行 (Janapa Reddi et al. 2022),毫瓦级功率预算和千字节级内存要求采用紧凑模型与整数运算。这些范式的功率跨度达九个数量级——从数据中心的兆瓦级到嵌入式传感器的毫瓦级(figure 1)——体现了集中式容量与本地执行之间的工程权衡。
\begin{tikzpicture}[line cap=round,line join=round,font=\sffamily\small]
  % Parameters
  \def\angle{1.0}       % angle
  \def\length{20.5}     % Lengths (cm)
  \def\npoints{5}       % number of points
  \def\startfrac{0.13}  % start (e.g.. 0.2 = 20%)
  \def\endfrac{0.87}    % end (e.g.. 0.8 = 80%)

 \draw[line width=1pt, black!70] (0,0) -- ({\length*cos(\angle)}, {\length*sin(\angle)})coordinate(end);
 %
  \foreach \i in {0,1,...,\numexpr\npoints-1} {
    \pgfmathsetmacro{\t}{\startfrac + (\endfrac - \startfrac)*\i/(\npoints-1)}
\coordinate(T\i)at({\t*\length*cos(\angle)}, {\t*\length*sin(\angle)});
  }

\tikzset {
pics/gatewey/.style = {
        code = {
\colorlet{red}{white}
\begin{scope}[local bounding box=GAT,scale=0.9, every node/.append style={transform shape}]
\def\rI{4mm}
\def\rII{2.8mm}
\def\rIII{1.6mm}
\draw[red,line width=1.25pt](0,0)--(0,0.38)--(1.2,0.38)--(1.2,0)--cycle;
\draw[red,line width=1.5pt](0.6,0.4)--(0.6,0.9);

\draw[red, line width=1.5pt] (0.6,0.9)+(60:\rI) arc[start angle=60, end angle=-60, radius=\rI];
\draw[red, line width=1.5pt] (0.6,0.9)+(50:\rII) arc[start angle=50, end angle=-50, radius=\rII];
\draw[red, line width=1.5pt] (0.6,0.9)+(30:\rIII) arc[start angle=30, end angle=-30, radius=\rIII];
%
 \draw[red, line width=1.5pt] (0.6,0.9)+(120:\rI) arc[start angle=120, end angle=240, radius=\rI];
\draw[red, line width=1.5pt] (0.6,0.9)+(130:\rII) arc[start angle=130, end angle=230, radius=\rII];
\draw[red, line width=1.5pt] (0.6,0.9)+(150:\rIII) arc[start angle=150, end angle=210, radius=\rIII];
\fill[red](0.6,0.9)circle (1.5pt);

\foreach\i in{0.15,0.3,0.45,0.6}{
\fill[red](\i,0.19)circle (1.5pt);
}

\fill[red](1,0.19)circle (2pt);
\end{scope}
}}}

\tikzset {
pics/cloud/.style = {
        code = {
\colorlet{red}{white}
\begin{scope}[local bounding box=CLO,scale=0.6, every node/.append style={transform shape}]
\draw[red,line width=1.5pt](0,0)to[out=170,in=180,distance=11](0.1,0.61)
to[out=90,in=105,distance=17](1.07,0.71)
to[out=20,in=75,distance=7](1.48,0.36)
to[out=350,in=0,distance=7](1.48,0)--(0,0);
\draw[red,line width=1.5pt](0.27,0.71)to[bend left=25](0.49,0.96);
\draw[red,line width=1.5pt](0.67,1.21)to[out=55,in=90,distance=13](1.5,0.96)
to[out=360,in=30,distance=9](1.68,0.42);
\end{scope}
}}}

\tikzset {
  pics/server/.style = {
    code = {
      \colorlet{red}{white}
      \begin{scope}[anchor=center, transform shape,scale=0.8, every node/.append style={transform shape}]
        \draw[red,line width=1.25pt,fill=white](-0.55,-0.5) rectangle (0.55,0.5);
\foreach \i in {-0.25,0,0.25} {
                \draw[BlueLine,line width=1.25pt]( -0.55,\i) -- (0.55, \i);
}
        \foreach \i in {-0.375, -0.125, 0.125, 0.375} {
          \draw[BlueLine,line width=1.25pt](-0.45,\i)--(0,\i);
          \fill[BlueLine](0.35,\i) circle (1.5pt);
        }

\draw[red,line width=1.75pt](0,-0.53) |- (-0.55,-0.7);
        \draw[red,line width=1.75pt](0,-0.53) |- (0.55,-0.7);
      \end{scope}
    }
  }
}

\tikzset {
pics/cpu/.style = {
        code = {
\definecolor{CPU}{RGB}{0,120,176}
\colorlet{CPU}{white}
\begin{scope}[local bounding box = CPU,scale=0.33, every node/.append style={transform shape}]
\node[fill=CPU,minimum width=66, minimum height=66,
            rounded corners=2,outer sep=2pt] (C1) {};
\node[fill=violet,minimum width=54, minimum height=54] (C2) {};
%\node[fill=CPU!40,minimum width=44, minimum height=44] (C3) {CPU};

\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=CPU,minimum width=4, minimum height=15,
           inner sep=0pt,anchor=south](GO\y)at($(C1.north west)!\x!(C1.north east)$){};
}
\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=CPU,minimum width=4, minimum height=15,
           inner sep=0pt,anchor=north](DO\y)at($(C1.south west)!\x!(C1.south east)$){};
}
\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=CPU,minimum width=15, minimum height=4,
           inner sep=0pt,anchor=east](LE\y)at($(C1.north west)!\x!(C1.south west)$){};
}
\foreach \x/\y in {0.11/1,0.26/2,0.41/3,0.56/4,0.71/5,0.85/6}{
\node[fill=CPU,minimum width=15, minimum height=4,
           inner sep=0pt,anchor=west](DE\y)at($(C1.north east)!\x!(C1.south east)$){};
}
\end{scope}
    }  }}

\tikzset {
pics/mobile/.style = {
        code = {
\colorlet{red}{white}
\begin{scope}[local bounding box=MOB,scale=0.4, every node/.append style={transform shape}]
\node[rectangle,draw=red,minimum height=94,minimum width=47,
            rounded corners=6,thick,fill=white](R1){};
\node[rectangle,draw=red,minimum height=67,minimum width=38,thick,fill=GreenFill](R2){};
\node[circle,minimum size=8,below= 2pt of R2,inner sep=0pt,thick,fill=GreenFill]{};
\node[rectangle,fill=GreenFill,minimum height=2,minimum width=20,above= 4pt of R2,inner sep=0pt,thick]{};
%
 \end{scope}
     }  }}

\node[draw=none,fill=RedFill,circle,minimum size=20mm](GA)at(T2){};
\pic[shift={(-0.55,-0.5)}] at (T2) {gatewey};
\node[above=0 of GA]{网关};
\node[draw=none,fill=VioletL,circle,minimum size=20mm](CP)at(T0){};
\pic[shift={(0,-0)}] at (T0) {cpu};
\node[above=0 of CP,align=center]{超低功耗\\设备与传感器};
\node[draw=none,fill=GreenFill,,circle,minimum size=20mm](MO)at(T1){};
 \pic[shift={(0,0)}] at (T1) {mobile};
 \node[above=0 of MO,align=center]{智能设备};
\node[draw=none,fill=BlueFill,circle,minimum size=20mm](SE)at(T3){};
\pic[shift={(-0.03,0.1)}] at (T3) {server};
 \node[above=0 of SE,align=center]{本地服务器};
\node[draw=none,fill=BrownL,circle,minimum size=20mm](CL)at(T4){};
\pic[shift={(-0.48,-0.35)}] at (T4) {cloud};
 \node[above=0 of CL,align=center]{云端};
%
\path (T0) -- (T1) coordinate[pos=0.5] (M1);
\path (0,0) -- (T0) coordinate[pos=0.25] (M0);
\path (T3) -- (T4) coordinate[pos=0.5] (M2);
\path (T4) -- (end) coordinate[pos=0.75] (M3);

\foreach \x in {0,1,2,3}{
\fill[OliveLine](M\x)circle (2.5pt);
}

\path[red](M0)--++(270:1.6)coordinate(LL1)-|coordinate(LL2)(M2);
\path[red](M0)--++(270:1.25)coordinate(L1)-|coordinate(L2)(M1);
\path[red](M0)--++(270:1.1)-|coordinate(L3)(M2);
\path[red](M0)--++(270:1.1)-|coordinate(L4)(M3);
%
\draw[black!70,thick](M0)--(LL1);
\draw[black!70,thick](M1)--(L2);
\draw[black!70,thick](M3)--(L4);
\draw[black!70,thick](M2)--(LL2);
\draw[latex-latex,line width=1pt,draw=black!60](L1)--node[red,fill=white]{TinyML}(L2);
\draw[latex-latex,line width=1pt,draw=black!60](L3)--node[fill=white]{云端 AI}(L4);
\draw[latex-latex,line width=1pt,draw=black!60]([yshift=4pt]LL1)--node[fill=white,text=black]{边缘 AI}([yshift=4pt]LL2);
\foreach \x in {0,1,2,3}{
\fill[OliveLine](M\x)circle (2.5pt);
}
%
\path[](M0)--++(90:1.9)-|node[pos=0.25]{\textbf{分布式智能谱系}}(M3);
\end{tikzpicture}figure 1 展示了分布式智能的定性拓扑,而 table 1 则从处理位置、往返延迟、功率消耗和内存容量几个方面,量化了各范式的运行约束范围。这一跨越九个数量级的功率范围体现了三个不可回避的物理边界:光速(确立延迟下限)、热力学耗散极限(限制每瓦功率所能支持的计算量)以及存储器信号传输能耗(内存墙)。
| 范式 | 位置 | 延迟 (ms) | 功率 | 内存 | 最适合的场景 |
|---|---|---|---|---|---|
| 云端机器学习 | 数据中心 | 100-500 | MW | TB | 训练、复杂推理 |
| 边缘机器学习 | 本地服务器 | 10-100 | 100 W | GB | 实时推理、隐私保护 |
| 移动端机器学习 | 智能手机 | 5-50 | 3–5 W | GB | 个人 AI、离线运行 |
| TinyML | 微控制器 | 1-10 | mW | KB | 常开感知 |
架构锚点:单节点栈
为了理解这些运行区间,我们以单节点栈的四层模型作为工程决策的锚点。该模型针对单台主机细化了数据—算法—机器分类体系中的机器侧,而数据和算法则通过工作负载需求体现。在栈的顶层,应用通过训练吞吐量目标或推理延迟目标来定义任务。模型训练 和 模型服务 将详细阐述决定系统能否实现这些目标的机制。机器学习框架将模型代码转换为可执行操作(机器学习框架)。操作系统负责协调资源,并在主机内存与加速器内存之间搬移数据。硬件本身通过高带宽内存(HBM)容量、内存带宽、NVLink 等节点内互连以及计算吞吐量,确定系统的物理极限,其中内存墙是一项反复出现的约束(硬件加速)。
这一栈确立了本章的芯片契约:某一给定芯片为模型提供的固定性能条件,由内存带宽、峰值计算速率和固定开销决定。本书前半部分的每一章都会分析其中一个或多个层次,因为理解它们如何在单台机器内部相互作用,是掌握更大分布式规模系统的技术前提。
这些物理约束与机器学习系统铁律(机器学习系统铁律)相互作用;该铁律将端到端延迟分解为数据搬移、计算和开销。不同的部署环境凸显不同的约束:云端训练可能受计算能力限制,移动系统面临功率墙,而 TinyML 设备则往往触及内存容量上限。通过将物理约束与机器学习系统铁律相结合,我们建立了一套定量表述方式,用于分析哪种范式适合给定工作负载,以及为什么适合。为使这一分析具有具体依据,五个灯塔模型(ResNet-50、GPT-2、用于嵌入密集型推荐的 DLRM、MobileNetV2,以及用于唤醒词检测的关键词检测器)覆盖整个部署谱系,并分别凸显不同的系统瓶颈。这些参考工作负载会在全书中反复出现,为跨章节、跨工作负载和跨部署层级比较优化技术提供一致的依据。
物理约束:范式为何存在
反应时间预算为 10 ms 的安全系统无法等待一次横跨全国的通信往返,而仅靠更好的代码也无法将十亿参数模型塞进微控制器。这些并非实现缺陷,而是光速、功率热力学和存储器信号传输等物理规律的结果。系统的运行位置会重塑模型与硬件之间的芯片契约。以下工程权衡由三项约束支配:光速屏障、功率墙和内存墙。1
光速屏障
光速屏障确立了延迟2的绝对下限。令 \(\text{Distance}\) 表示单程路径长度,\(c_{\text{fiber}}\) 表示光在光纤中的传播速度。Equation 1 给出了最小往返时间: \[L_{\text{lat,min}} = \frac{2 \times \text{Distance}}{c_{\text{fiber}}} \approx \frac{2 \times \text{Distance}}{200{,}000 \text{ km/s}} \tag{1}\] 对于光纤,\(c_{\text{fiber}} \approx 200{,}000\) km/s,约为真空光速的三分之二,因为光在玻璃中的传播速度低于在真空中的传播速度。
从加利福尼亚州到弗吉尼亚州(直线距离约为 3,600 km),在任何计算开始之前就需要约 36 ms round-trip。实际服务还会增加路由、协议、排队和处理延迟。要求响应时间低于 10 ms 的应用无法使用远距离云基础设施——物理定律不允许。这一约束催生了边缘机器学习和 TinyML 的需求:当延迟预算紧张时,计算必须向数据源靠近。
功耗墙
功耗墙 的出现,是因为热力学限制了给定体积内能够执行的计算量。CMOS 动态功耗遵循 equation 2,其中 \(C\) 为有效电容,\(V\) 为电压,\(f\) 为时钟频率。在电压随频率成比例上升 \((V \propto f)\) 的局部工作范围内,若保持有效电容 \(C\) 不变,动态功耗将按 \(f^3\) 增长。当时钟频率被推高至标称范围之外时,需要更高的供电电压来维持晶体管的开关速度,由此产生了这种立方关系。当电压缩放在标称极限处完全停滞时,动态功耗随频率线性增长,但散热约束仍然使时钟频率无法持续提高。 \[\text{Power} \propto C \times V^2 \times f \quad \text{where } V \propto f \implies \text{Power} \propto f^3 \tag{2}\]
在这一示例假设下,将时钟频率提高至两倍需要约 8\(\times\) 的动态功耗。广泛适用的电压缩放机制3的失效,终结了“免费”的频率提速,并迫使行业转向并行化(多核)和专用化(GPU、张量处理单元(TPU))。移动设备在 3–5 W 就会触及严格的热极限;超过这一范围会触发“降频”,即设备降低性能以防止过热。实际上,这意味着一个以 60 FPS 运行 1 minute 的移动端模型,可能随着设备升温而降至 15 FPS。这一物理极限催生了移动端机器学习:电池供电的设备无法直接在本地运行云规模模型。
内存墙
内存墙 (Wulf and McKee 1995) 反映了不断扩大的带宽4差距。本书采用代表性的年度增长因子,通过一个简单示意说明这一差距为何会复合扩大: \[\frac{\text{Compute Growth Rate}}{\text{Memory Bandwidth Growth Rate}} \approx \frac{1.6}{1.2} \approx 1.33 \tag{3}\]
Wulf, Wm. A., and Sally A. McKee. 1995. “Hitting the Memory Wall: Implications of the Obvious.” ACM SIGARCH Computer Architecture News 23 (1): 20–24. https://doi.org/10.1145/216585.216588.
在 equation 3 中,分子和分母都是无量纲的年度增长因子。比值大于 1 意味着计算能力正在逐渐超出内存带宽的供给能力,因此,除非工作负载提高数据局部性或算术强度,否则每一代硬件都会使数据搬移在性能问题中所占的比重进一步增大。
这一比值背后的代表性趋势是:处理器的计算能力大约每 18 months 翻一番,而内存带宽每年仅提高约 20 percent。这一不断扩大的差距,使数据搬移 经常成为机器学习工作负载的瓶颈和能耗来源。从物理层面看,片上算术逻辑单元(ALU)中的一次算术运算,仅需使电荷沿局部导线移动数微米(消耗数十至数百飞焦耳);而从片外 DRAM 获取一个操作数,需要对长达数厘米的容性印刷电路板(PCB)走线和 I/O 焊盘充电,消耗数百皮焦耳——每次访问的能耗高出两到三个数量级。这一约束影响所有范式,但对 TinyML 尤为严峻,因为其设备只有数千字节的可用内存。理解 AI 内存墙 将详细讨论应对内存墙的架构方案,包括 HBM 和片上 SRAM 层次结构。
Checkpoint 1.1: 物理约束与部署
部署选择受物理规律支配,而不仅仅取决于偏好。检验你的理解:
这些物理定律解释了四种范式为何存在。物理规律划定边界;隐私法规、经济激励和数据主权要求进一步强化并明确这些边界,而非创造这些边界。任何法规都无法提高光速,任何经济模型都无法废除热力学定律。
计算能力的增长快于内存带宽;不断扩大的差距就是内存墙。
这些物理约束并非孤立起作用。实践中,机器学习系统受限于其主要资源最先触及的物理边界。要对这些极限进行定量评估,需要分析工具:利用铁律将执行时间分解为各个组成部分,利用瓶颈原理识别限制速率的阶段,并利用工作负载原型对模型的资源需求进行分类。
分析工作负载
对于推荐引擎或唤醒词检测器,工作负载分析要回答的问题是:在目标硬件上,哪一项会最先成为约束。回答这一芯片契约 问题的核心分析工具,是在 机器学习系统铁律 中确立的机器学习系统铁律。这里,\(T\) 为总时间,\(D_{\text{vol}}\) 为搬移的字节数,\(\text{BW}\) 为带宽,\(O\) 为总运算次数,\(R_{\text{peak}}\) 为峰值计算速率,\(\eta_{\text{hw}}\) 为硬件效率,\(L_{\text{lat}}\) 为固定开销;equation 4 将串行执行路径上的这些开销相加: \[T = \frac{D_{\text{vol}}}{\text{BW}} + \frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}} + L_{\text{lat}} \tag{4}\]
Equation 4 将总延迟分解为三项:数据搬移 \((D_{\text{vol}}/\text{BW})\)、计算 \((O/(R_{\text{peak}} \cdot \eta_{\text{hw}}))\) 和固定开销 \((L_{\text{lat}})\)。对于单次推理,这些开销直接相加——每一项都按顺序发生。然而,在生产系统中,任务以流的形式持续处理,分析重点也从单个任务的延迟转向识别哪一项限制了系统。答案完全取决于部署环境:一个在训练时受计算限制 的模型,在推理时可能变为受内存限制;一个在云端高效运行的系统,在移动设备上可能触及功耗极限。在流水线式生产服务中,硬件并发会改变这一线性求和关系:较快阶段的耗时被最先饱和的子系统所掩盖。
瓶颈原理
铁律告诉我们每一项的代价。瓶颈原理 告诉我们哪一项起决定作用。在流水线式机器学习工作负载中,识别系统瓶颈 十分重要,因为只要最慢阶段保持不变,优化快速操作就不会带来任何收益。现代加速器使用流水线执行,使数据搬移与计算重叠:当加速器对批次 \(n\) 进行计算时,内存系统预取批次 \(n+1\)。当数据搬移、计算和 I/O 在稳态下完全重叠时,令 \(T_{\text{network}}\) 表示远程传输时间,\(T_{\text{bottleneck}}\) 表示由此得到的、包含固定开销的每任务时间。较快阶段的耗时被最慢的重叠阶段所掩盖,因此铁律中的求和变为取最大值,如 equation 5 所形式化表达的那样: \[ T_{\text{bottleneck}} = \max\left(\frac{D_{\text{vol}}}{\text{BW}}, \frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}}, T_{\text{network}}\right) + L_{\text{lat}} \tag{5}\]
- \(\frac{D_{\text{vol}}}{\text{BW}}\)(内存):在内存与处理器之间搬移数据的时间。
- \(\frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}}\)(计算):执行计算的时间。
- \(T_{\text{network}}\):网络通信时间(如果采用卸载)。
- \(L_{\text{lat}}\)(开销):固定延迟(内核启动、运行时开销)。
当系统受内存限制,即 \((D_{\text{vol}}/\text{BW} > O/(R_{\text{peak}} \cdot \eta_{\text{hw}}))\) 时,更快的处理器 \((R_{\text{peak}})\) 不会带来加速,正如拓宽高速公路无法改善受狭窄桥梁限制的交通一样。工程师必须先识别主导项,再进行优化。当网络传输成为候选项时,卸载会在基于时间的分析中引入能耗因素。因此,在本地执行与卸载之间做决策,既要权衡毫秒,也要权衡焦耳。
Napkin Math 1.1: 传输能耗
问题:当传输能耗 与电池带来的能耗墙 发生冲突时,电池供电的传感器应该在本地处理数据(在设备端 NPU 上进行推理),还是将其发送到云端?
已知:
- 数据量 \((D_{\text{vol}})\):1 MB(示例载荷量)。
- 传输能耗 \((E_{\text{tx}})\):100 mJ/MB(Wi-Fi/LTE)。
- 计算能耗 \((E_{\text{op}})\):0.1 mJ/inference(以神经处理单元上的 MobileNetV2 为示例基准)。
计算:
- 云端方案:\(E_{\text{cloud}} \approx D_{\text{vol}} \times E_{\text{tx}}\) = 1 MB \(\times\) 100 mJ/MB = 100 mJ。
- 本地方案:\(E_{\text{local}} \approx\) 推理能耗 = 0.1 mJ。
系统启示:传输原始数据的能耗是本地处理的 1,000×。即使云端具有无限速度 \((T \approx 0)\),在给定电池预算下,本地推理仍比传输原始数据更有利。机器约束(电池)决定了部署选择。
铁律中的变量在跨越部署边界时并不按对称方式缩放;从高吞吐量批处理转向单样本边缘服务,会彻底改变决定性能的主导项。
Systems Perspective 1.1: 将铁律用作部署诊断工具
在 机器学习系统铁律 中引入的铁律,是本章贯穿使用的部署诊断工具:它将工作负载所需的总时间 \(T\) 表示为数据搬移、算术运算和延迟之和: \[T = \frac{D_{\text{vol}}}{\text{BW}} + \frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}} + L_{\text{lat}}\] 这一分解具有诊断作用:它量化了数据量 \((D_{\text{vol}})\)、计算能力 \((R_{\text{peak}})\) 和固定延迟 \((L_{\text{lat}})\) 如何共同决定工作负载的时间预算。与关注并行加速的 Amdahl 定律不同,铁律将模型的计算工作与部署边界处的数据搬移和固定延迟联系起来。一种常见误解是认为这些项彼此独立;实际上,它们是相互权衡的维度。增大批次大小可以提高有效工作时间占比和数据复用程度,使受内存限制的内核转向受计算限制的运行状态,但也会增大工作集并延长批次服务时间。

机器轴决定了部署的可行范围。
铁律量化各组成部分的代价;瓶颈原理识别流水线的速度。一条经验法则是:分析单个任务的延迟时,使用 equation 4 中的相加形式;分析连续任务流的吞吐量时,使用 equation 5 中的取最大值形式。
工作负载原型
瓶颈原理将优化归结为识别给定工作负载的主导约束。答案取决于 数据—算法—机器交叉全景 中的数据—算法—机器分类体系,该体系将每个机器学习系统分解为数据、算法和机器。不同部署环境会沿这些轴产生不同瓶颈,因此,当同一模型家族从拥有数太字节内存的云服务器迁移到仅有数千字节内存的微控制器时,可能需要不同的工程方案。铁律将这一诊断转化为四种工作负载原型。5它们不是模型类别,而是反复出现的物理瓶颈,决定了哪些工程措施能够奏效。
第一层划分区分受算术运算限制的系统和受数据搬移限制的系统。计算密集型 工作负载对每个载入字节执行大量计算,因此改进来自更高的算术吞吐量、更好的利用率和更多的并行执行;大规模神经网络训练是其典型案例。相比之下,带宽密集型 工作负载需要等待密集权重或激活值的搬移,因此更宽的内存总线和更好的数据复用比增加峰值 FLOP/s 更为重要;自回归文本生成体现了这一运行状态。
第二层划分涵盖主导约束根本不在密集算术运算上的工作负载。稀疏散布型 工作负载主要受不规则表查找和较差的缓存局部性影响,因此,在具有海量嵌入表的推荐系统中,内存容量、访问延迟和通信决定了性能。微型受限型 工作负载则面临相反的资源范围:决定常开感知 能否运行的,是每次推理的能耗 和内存占用,而不是原始速度。
Lighthouse 1.1: 五种参考工作负载
table 2 中概述的五个灯塔模型将在本书中反复出现,作为覆盖各类部署场景、用于分离不同系统瓶颈的具体工作负载。网络架构 提供了完整的架构细节和模型介绍。
| 灯塔模型 | 原型 | 部署范式 |
|---|---|---|
| ResNet-50 | 计算巨兽 | 云端训练、边缘推理 |
| GPT-2/Llama | 带宽大户 | 云端推理 |
| DLRM | 稀疏散布 | 仅限云端(分布式) |
| MobileNetV2 | 计算巨兽(高效型) | 移动端、边缘端 |
| 关键词检测(KWS) | 微型约束 | TinyML、始终开启 |
这些原型直接映射到部署范式。计算巨兽和稀疏散布工作负载需要云数据中心汇聚的内存容量与计算吞吐量;带宽大户则根据延迟预算分布于云端和边缘端;微型约束工作负载适合部署在微控制器上。为了定量评估这些权衡,本书始终使用五个灯塔模型作为具体的参考工作负载,每个模型都用于分离铁律中的一个特定项。
第一个灯塔模型 ResNet-50 将图像划分为 1,000 个类别,使用 25.6 million parameters(采用 FP32 时占用 102.4 MB),处理每张图像约需 8.2 GFLOP (He et al. 2016)。它用于医学影像诊断、自动驾驶车辆感知流水线,并作为内容审核系统的骨干网络;其规整且计算密集的结构使其成为衡量硬件加速器性能的典型基准。
He, Kaiming, Xiangyu Zhang, Shaoqing Ren, and Jian Sun. 2016. “Deep Residual Learning for Image Recognition.” 2016 IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 770–78. https://doi.org/10.1109/cvpr.2016.90.
Radford, Alec, Jeffrey Wu, Rewon Child, David Luan, Dario Amodei, and Ilya Sutskever. 2019. Language Models Are Unsupervised Multitask Learners. OpenAI.
Touvron, Hugo, Thibaut Lavril, Gautier Izacard, Xavier Martinet, Marie-Anne Lachaux, Timothée Lacroix, Baptiste Rozière, et al. 2023. “LLaMA: Open and Efficient Foundation Language Models.” arXiv Preprint arXiv:2302.13971.
Pope, Reiner, Sholto Douglas, Aakanksha Chowdhery, Jacob Devlin, James Bradbury, Jonathan Heek, Kefan Xiao, Shivani Agrawal, and Jeff Dean. 2023. “Efficiently Scaling Transformer Inference.” Proceedings of Machine Learning and Systems (MLSys) 5: 606–24.
语言模型 GPT-2/Llama 是自回归文本生成的典型代表 (Radford et al. 2019; Touvron et al. 2023)。这些模型每次生成一个词元。在小批量解码过程中,生成每个词元都可能需要在内存中搬移大部分或全部模型参数(GPT-2 为 1.5 billion parameters,Llama 为 7 billion–70 billion parameters)。这种顺序访问模式形成了自回归瓶颈,进而影响模型服务成本 (Pope et al. 2023)。
推荐领域的灯塔模型 DLRM 代表了大规模“你可能还喜欢”系统背后高度依赖嵌入的推荐工作负载 (Naumov et al. 2019)。它将用户和物品映射为嵌入向量,并将其存储在表中;这些表中的嵌入数据量可能超过 100 GB,使内存容量而非计算成为实际限制因素。
Naumov, Maxim, Dheevatsa Mudigere, Hao-Jun Michael Shi, Jianyu Huang, Narayanan Sundaraman, Jongsoo Park, Xiaodong Wang, et al. 2019. “Deep Learning Recommendation Model for Personalization and Recommendation Systems.” arXiv Preprint arXiv:1906.00091.
Sandler, Mark, Andrew Howard, Menglong Zhu, Andrey Zhmoginov, and Liang-Chieh Chen. 2018. “MobileNetV2: Inverted Residuals and Linear Bottlenecks.” 2018 IEEE/CVF Conference on Computer Vision and Pattern Recognition, 4510–20. https://doi.org/10.1109/cvpr.2018.00474.
移动端灯塔模型 MobileNetV2 专为分类、检测和分割等高效移动视觉任务而设计 (Sandler et al. 2018)。它执行与 ResNet 相同的图像分类任务,但使用深度可分离卷积,将空间滤波与通道混合分离,使计算量降至原来的 1/13.7×,从而能够在功耗为 3–5 W 的智能手机上实现实时推理。
TinyML 灯塔模型 关键词检测(KWS) 代表始终开启的感知原型。KWS 系统使用面向资源受限微控制器构建的紧凑模型来检测简短的触发短语 (Zhang et al. 2017);在智能门铃场景中,同一模式被用于本地“叮咚”或“你好”触发。该灯塔工作负载约有 200K parameters,占用空间约为 800 KB,属于内存为千字节级、功耗预算为毫瓦级的 TinyML 范畴。
Zhang, Yundong, Naveen Suda, Liangzhen Lai, and Vikas Chandra. 2017. Hello Edge: Keyword Spotting on Microcontrollers.
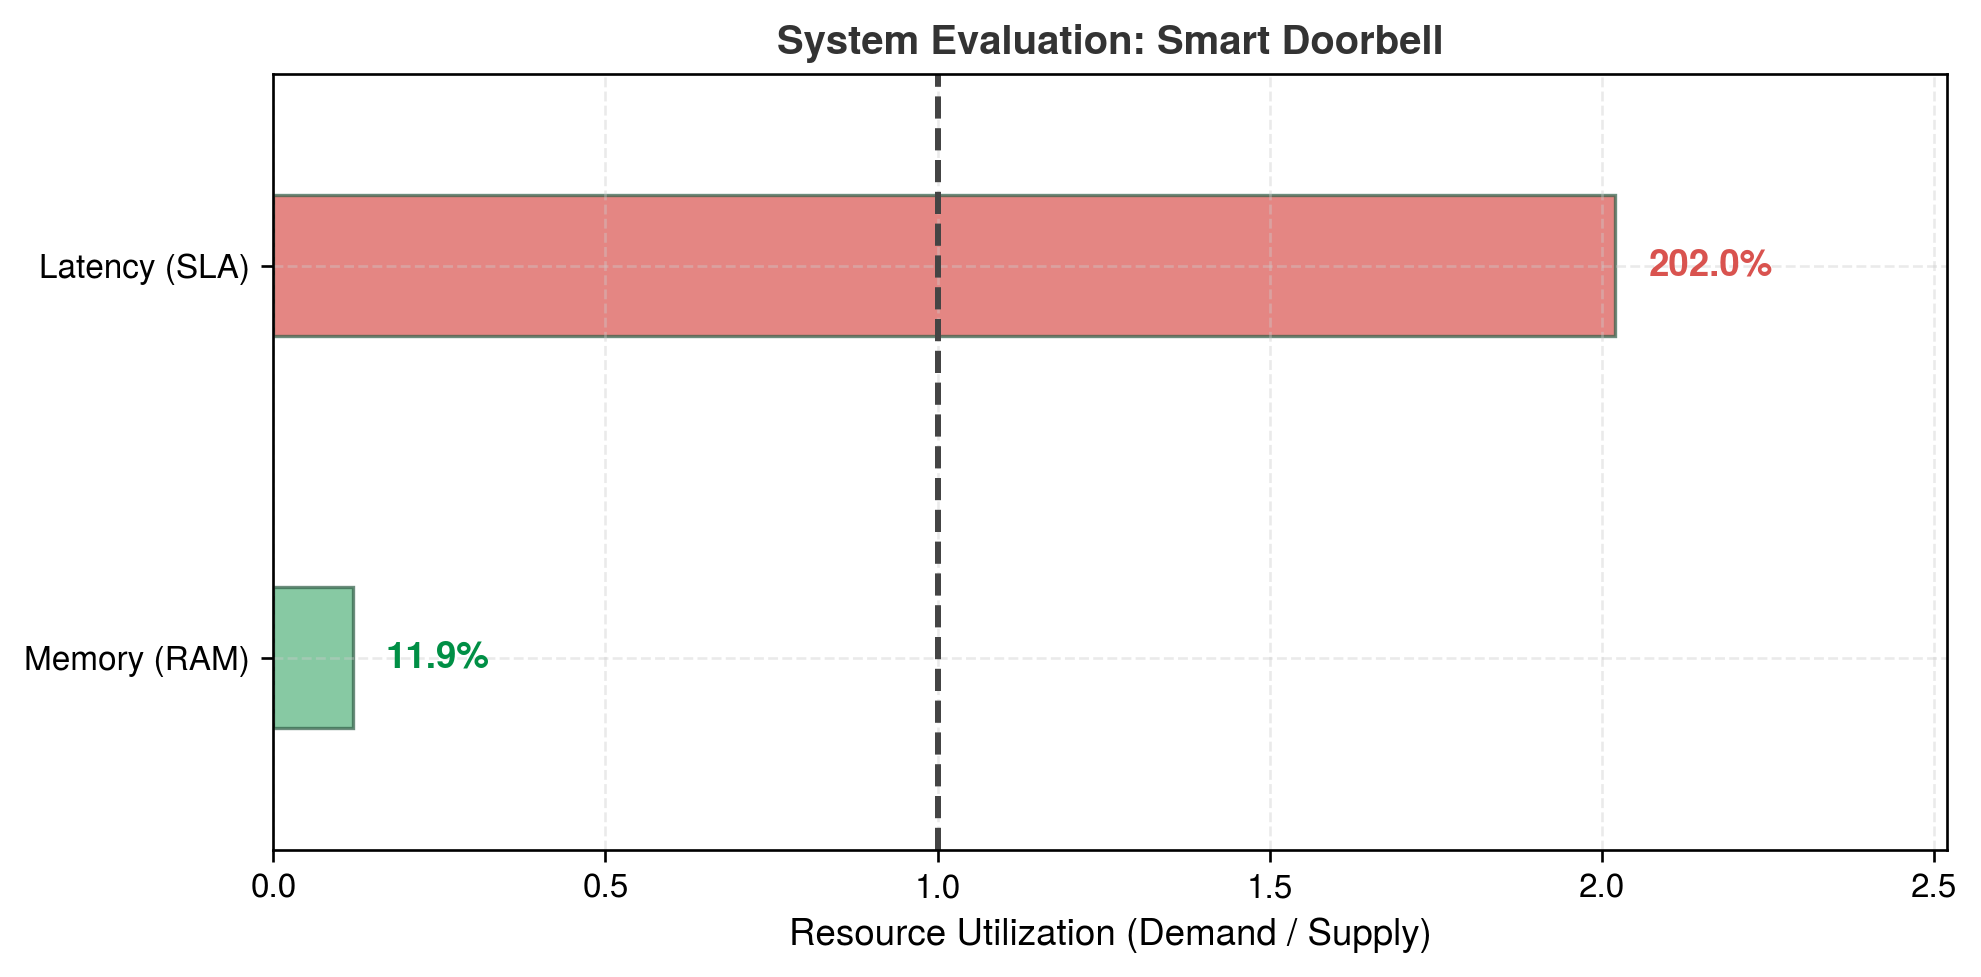
部署可行性采用分层方式评估:先验证物理内存是否容得下模型,再检查执行延迟。在 figure 2 中,水平条形以资源需求占供给的百分比表示资源需求,并与代表 100% 饱和阈值的竖线对照,比较 ESP32-S3 微控制器的第 1 层内存容量约束与服务等级协议(SLA)下的第 2 层延迟约束。
计算需求和内存占用的巨大差异解释了为何没有任何一种部署范式能够适用于所有工作负载。关键词检测器运行时大约需要 20 MFLOP 和 800 KB,而 ResNet-50 处理每张图像约需 8.2 GFLOP 和约 102.4 MB。参考 DLRM 示例已达到 100 GB,而生产环境中的 DLRM 类推荐系统可能超过 100 TB。语言模型又引入了由带宽主导的运行形态:在自回归推理期间,数十亿参数反复从内存中流式读取。这五个灯塔模型在本书中始终充当具体参照,每个模型都分离出一种独特的系统瓶颈,各章将反复探讨这些瓶颈。
当铁律与工作负载原型同实际芯片相匹配时,它们才具有实践意义。加速器能否实现高利用率,还是会因内存而停顿,取决于系统平衡,即不同硬件平台上峰值计算吞吐量与内存带宽及 I/O 能力之间的比例关系。
系统平衡与硬件
物理约束通过具体数值,将延迟与吞吐量之间的权衡 转化为工程决策。Table 3 给出了应为每项部署决策提供依据的数量级延迟,从纳秒级计算操作到数百毫秒的跨区域网络调用,跨度达八个数量级。详细的硬件延迟和带宽约束见 硬件加速。延迟为 \(> X\) 的操作不能出现在延迟预算为 \(X\) ms 的系统的关键路径上。6
| 操作 | 延迟 | 对部署的影响 |
|---|---|---|
| 计算 | ||
| GPU 矩阵乘法(每次运算) | ~1 ns | 单次运算延迟很小 |
| NPU 推理(MobileNetV2) | 5–20 ms | 移动端可实现实时视觉 |
| LLM 词元生成 | 20–100 ms | 被感知为“打字速度” |
| 内存 | ||
| L1 缓存命中 | ~1 ns | 将热点数据保留在寄存器中 |
| 未命中缓存的 GPU 内存读取 | ~200–500 ns | 隐藏延迟;合并访问 |
| DRAM 读取(移动端) | 50–100 ns | 重复读取可能限制工作负载的性能 |
| 网络 | ||
| 同一数据中心 | 0.5 ms | 微服务可行 |
| 同一区域 | 1–5 ms | 边缘服务器可行 |
| 跨区域 | 50–150 ms | 不适合严格的延迟预算 |
| 机器学习操作 | ||
| 唤醒词检测(TinyML) | ~1–10 ms | 可在 \(<1\text{ mW}\) 下始终开启 |
| 人脸检测(移动端) | 10–30 ms | 可实现 30 FPS 实时处理 |
| GPT-4 首个词元 | 200–500 ms | 用户会察觉延迟 |
| ResNet-50 训练步 | 200–400 ms | 针对吞吐量优化 |
将四种部署范式落实到具体硬件上,可以更精确地理解它们。table 1 从概念上定义了这些范式,而 table 6 则将它们落实到具体设备、内存容量和功耗范围。7 跨越九个数量级的功耗范围,结合数据中心电能使用效率(PUE)指标8,以及从数百万美元到 $10 的成本跨度,共同决定了哪种范式能够经济地服务于给定工作负载。
这些硬件差异决定了在不同部署形态下,铁律中的哪个项会首先构成限制(section 1.3.1)。
Systems Perspective 1.2: 不同范式下的系统平衡
机器学习系统铁律 中机器学习系统铁律的流水线形式,在标准的计算项和内存项之外,增加了存储或网络 I/O 带宽 \(\text{BW}_{\text{IO}}\)。Equation 6 形式化地给出了由此得到的总执行时间 \(T\) 的下界: \[T \geq \max\left( \frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}}, \frac{D_{\text{vol}}}{\text{BW}}, \frac{D_{\text{vol}}}{\text{BW}_{\text{IO}}} \right) + L_{\text{lat}} \tag{6}\]
其中,\(O\) 表示总运算量,\(R_{\text{peak}}\) 表示峰值计算速率,\(\eta_{\text{hw}}\) 表示硬件利用效率,\(D_{\text{vol}}\) 表示数据量,\(\text{BW}\) 表示内存带宽,\(\text{BW}_{\text{IO}}\) 表示 I/O 带宽(存储或网络),\(L_{\text{lat}}\) 表示固定开销。该下界指出了哪种资源(计算、内存或 I/O)限制性能;要达到等号,必须实现理想重叠且没有额外停顿。主导项 随工作负载和部署形态而变化。更快的加速器有助于受计算限制的云端训练;受内存限制的大语言模型(LLM)解码和边缘工作负载,则更受益于减少搬移的字节数或提高带宽。Table 4 逐一分析全部四种范式,并将云端细分为训练和 LLM 推理;瓶颈诊断 则将各主导项映射到有效和无效的优化措施,从而将这一诊断转化为行动计划。
| 范式 | 主导约束 | 原因 | 优化重点 |
|---|---|---|---|
| 云端训练 | \(O/(R_{\text{peak}} \cdot \eta_{\text{hw}})\)(计算) | 内存与网络资源充足;FLOP/s 限制吞吐量 | 最大化加速器利用率和批大小 |
| 云端 LLM 推理 | \(D_{\text{vol}}/\text{BW}\)(内存带宽) | 顺序生成反复搬移模型状态 | 增加复用;减少搬移的字节数 |
| 边缘推理 | \(D_{\text{vol}}/\text{BW}\)(内存带宽) | 本地带宽有限;模型通常受内存限制 | 更小的模型;更少的内存传输 |
| 移动端 | 能耗(隐含约束) | 电池能量 = \(\int \text{Power} \cdot dt\);热节流 | 更低精度;占空比控制 |
| TinyML | 模型占用空间必须适配片上存储(容量) | 千字节级内存;模型必须能够放入片上存储 | 微型模型与定点运算 |
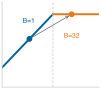
批大小为 1 的推理位于 Roofline 中受内存限制的一侧。
Williams, Samuel, Andrew Waterman, and David Patterson. 2009. “Roofline: An Insightful Visual Performance Model for Multicore Architectures.” Communications of the ACM 52 (4): 65–76. https://doi.org/10.1145/1498765.1498785.
Roofline 分析通过将工作负载的算术强度,即每搬移一个字节的内存数据所执行的浮点运算次数(\(\text{FLOPs/byte}\)),与硬件的机器平衡点(\(R_{\text{peak}} / \text{BW}\))进行比较,来判定瓶颈类型 (Williams et al. 2009)。此处采用非形式化的表述;Roofline 模型 将完整推导该模型,形式化定义算术强度,并推导区分受内存限制与受计算限制两种运行区域的脊点。在这一框架下,同一个 ResNet-50 模型可能从大批大小训练时受计算限制的行为,转变为 batch=1 时对内存更敏感的单图像推理行为。部署范式的选择必须考虑这种转变。
这种运行行为的转变体现了数据—算法—机器分类体系 的结构(数据—算法—机器交叉全景):每个机器学习系统都需要在数据、算法和机器之间取得平衡。Table 5 展示了系统处于训练阶段(学习模式)或服务阶段(应用模式)时,各组成部分如何表现出不同的行为。
| 组成部分 | 训练(可变) | 推理(不可变) |
|---|---|---|
| 数据 | 海量吞吐量:大批次、随机打乱、数据增强 | 低延迟:单个样本、时效性、速度 |
| 算法 | 学习阶段:根据样本更新模型参数 | 预测阶段:将固定权重应用于新输入 |
| 机器 | 面向吞吐量优化:高带宽集群、大容量内存 | 面向延迟优化:边缘设备、推理加速器 |
下面通过定量比较,将这一分析应用于高端数据中心加速器和移动端 NPU 上的 ResNet-50 推理。应将这些硬件视为特定时间点的参考基准:这里的计算围绕计算速率、内存带宽和批次大小展开,而 硬件加速 则解释这些数值背后的加速器架构。
Napkin Math 1.2: ResNet-50 在云端与移动端的比较
问题:在 (a) 高端数据中心加速器和 (b) 旗舰移动端 NPU 上,ResNet-50 推理受计算限制还是受内存限制?
已知条件(来自标杆模型):
- ResNet-50:每次推理 8.2 GFLOP,25.6 million parameters(FP32 为 102.4 MB,FP16 为 51.2 MB)
分析:
(a) 云端数据中心加速器(batch=1,FP16)
- 峰值算力:312 TFLOP/s(FP16)
- 内存带宽:2.04 TB/s
- 计算时间:\(T_{\text{comp}}\) = \(\frac{8.20 \times 10^{9}}{3.12 \times 10^{14}}\) = 0.026 ms
- 内存传输时间(权重与激活值):\(T_{\text{mem}}\) = \(\frac{5.63 \times 10^{7}}{2.04 \times 10^{12}}\) = 0.028 ms
- 结果:瓶颈 = Memory(耗时为计算时间的 1.1×)
- 分析:每传输一个字节对应的计算量 = \(\frac{8.20 \times 10^{9}}{5.63 \times 10^{7}}\) = 146 FLOP/byte。这一比值衡量工作负载每加载一个字节所执行的算术运算量。当该比值超过硬件的算力与带宽之比 \((R_{\text{peak}}/\text{BW})\) 时,工作负载受计算限制;低于该比值时,工作负载受内存限制。对于单图像推理,较小的批次大小使数据复用有限,这解释了为何即使是高吞吐量加速器,在 batch = 1 时也可能受内存限制。
(b) 移动端:旗舰 NPU(batch=1,INT8)
- 峰值算力:~35 TOPS(INT8)——代表现代移动端 NPU 的水平
- 内存带宽:~51.2 GB/s(LPDDR5)
- 模型大小:25.6 MB(INT8 量化)
- 计算时间:\(T_{\text{comp}}\) = \(\frac{8.20 \times 10^{9} \text{ INT8 ops}}{3.50 \times 10^{13} \text{ INT8 ops/s}}\) = 0.23 ms
- 内存传输时间(权重与激活值):\(T_{\text{mem}}\) = \(\frac{2.82 \times 10^{7}}{5.12 \times 10^{10}}\) = 0.55 ms
- 结果:瓶颈 = Memory(耗时为计算时间的 2.3×)
系统层面的洞见:对于单图像推理,两个平台都受内存限制。A100 更高的内存带宽(2.04 TB/s 与 51.2 GB/s 之比 = 39.8×)使其推理速度约为移动端的 19.9×;仅比较峰值算力无法反映限制因素。这解释了为何在部署中,减少字节传输量和降低精度的技术,可能比单纯购买更高的峰值 FLOP/s 更有效。
当批处理和数据复用使每传输一个字节对应的计算量超过硬件平衡点,即 \(I > R_{\text{peak}}/\text{BW}\) 时,ResNet-50 就会转为受计算限制,其中 \(I = O/D_{\text{vol}}\)。具体而言,在批量推理过程中,静态模型权重仅通过内存总线传输一次,随后便可供批次中的全部 \(B\) 个样本复用。这将权重传输开销分摊到 \(B\) 个输入上,提高算术强度,直至计算时间超过内存传输时间。交叉点取决于架构和实现,因为激活值传输、输入输出搬移、缓存复用以及运行时执行细节都会改变每次推理实际传输的字节数。
随着硬件预算收紧,模型压缩变得不可或缺。从云端到边缘端再到 TinyML,可用资源在各个维度上都不断缩减。Table 6 通过具体硬件示例量化了这一变化:内存从云端的 128 TB 降至 TinyML 的 512 KB,缩减至原来的 2.5 亿分之一,同时功率跨度从兆瓦级延伸至毫瓦级。这种资源差异在微控制器上最为突出;微控制器是 TinyML 的主要硬件平台,其内存和存储容量无法容纳常规机器学习模型。
| 类别 | 示例设备 | 处理器 | 内存 | 存储 | 功率 | 价格范围 |
|---|---|---|---|---|---|---|
| 云端机器学习 | Google TPU v4 Pod | 4,096 TPU v4 chips,1.1 EFLOP/s BF16 | 128 TB HBM2 | 云端规模(PB) | ~3 MW | 云服务(租用) |
| 边缘机器学习 | NVIDIA DGX Spark | GB10 Grace Blackwell,1 PFLOP/s 稀疏 FP4 | 128 GB LPDDR5x | 4 TB NVMe | ~200 W | ~$3,000–$5,000 |
| 移动端机器学习 | 旗舰智能手机 | 移动端 SoC(CPU + GPU + NPU) | 8–16 GB | 128 GB-1 TB | 3–5 W | $999+ |
| TinyML | ESP32-S3 | 双核 @ 240 MHz | 512 KB SRAM | 4 MB 闪存 | 0.05 W–1.2 W 电路板工作功率 | $10 |
硬件谱系将上述瓶颈诊断转化为适配性检验。table 6 中的平台是数十年硬件演进的产物,从 20 世纪 80 年代的浮点协处理器,到 21 世纪初的图形处理器,再到如今的领域专用 AI 加速器。硬件加速 追溯了这一历史进程及其背后的架构原理。此处最重要的是其结果:基础设施的不同位置部署着性质各异的硬件,因此,每项工作负载都必须与一个相匹配的区域对应,使其需求落在该区域的计算、内存、功耗和成本范围之内。
每种范式在部署谱系中都占据一个独特区域,受到 section 1.3 中介绍的物理约束(光速屏障、功耗墙、内存墙)的支配,并通过其中的分析工具(机器学习系统铁律、瓶颈原理)加以量化。table 7 中的定量阈值有助于实践者判断工作负载是否符合目标平台的计算、带宽、功耗和延迟范围。
| 范式 | 计算能力 | 内存带宽 | 功耗 | 延迟(ms) |
|---|---|---|---|---|
| 云端机器学习 | > 1000 TFLOP/s | > 1000 GB/s | MW 级(PUE 1.1–1.3) | 100-500 |
| 边缘机器学习 | ~1 PFLOP/s | > 270 GB/s | 100 W 级 | 10-100 |
| 移动端机器学习 | 15–45 TOPS | 51.2–77 GB/s | 3–5 W | 5-50 |
| TinyML | < 1 TOPS | — | < 1 mW 持续运行时的平均功耗目标 | 1-10 |
Table 7 完成了这一适配性检验:每种范式都代表一个由不同主导约束资源所界定的运行范围。从仓库级数据中心向下延伸至微控制器,形成了一条以原始计算吞吐量换取能效和内存效率的物理梯度。
云端机器学习:计算能力
考虑一下训练 GPT-3所需的资源:9计算量达到 3,634.3 PFLOP-days,10,000 V100 GPUs 运行约 15 days,消耗兆瓦级功率 (Patterson et al. 2021)。任何智能手机、边缘服务器或单台机器都无法在切实可行的时间内完成这次训练。它需要一个具备足够聚合计算能力、内存和存储资源的数据中心级集群。这正是云端机器学习的核心主张:当延迟可以容忍时,它能提供其他任何范式都无法企及的计算规模。
以公用事业服务模式10集中这些资源,使提供商能够构建专门的加速器拓扑,以满足不同的硬件需求。这种基础设施自然适合四种工作负载原型中的三种:计算密集型工作负载,例如 ResNet 训练,需要数千个加速器持续提供 TFLOP/s 级计算吞吐量;带宽密集型工作负载,例如大语言模型推理,可受益于 TB/s 级 HBM 带宽;稀疏散布型工作负载,例如推荐系统,需要数 TB 的嵌入表,以及支持全互连通信模式的高带宽互连。
云端部署的规模从单加速器实例、多 GPU 服务器,一直延伸至跨越仓库级数据中心的分布式集群。这一规模下的系统工程始于单个节点:在协调联网主机之间的计算之前,工程师必须先理解单机内部的内存总线饱和、PCIe 和 NVLink 带宽,以及加速器利用率。
这种容量与距离之间的权衡定义了云端范式。
Definition 1.1: 云端机器学习
云端机器学习是一种通过将机器学习工作负载置于集中式数据中心,以延迟换取弹性计算能力的部署范式,使计算容量与数据源及用户的物理位置解耦。
- 意义:云端部署在 \(R_{\text{peak}}\) 项上具有优势:单个云区域即可按需配置数千个加速器,提供典型本地部署在经济上无法匹敌的聚合吞吐量。代价体现在 \(L_{\text{lat}}\) 项上:最低往返延迟为 10–100 ms(由跨大陆距离上的光速决定),使云端无法满足任何要求低于 10 ms 响应时间的工作负载。
- 区别:边缘机器学习在固定的 \(R_{\text{peak}}\) 下优先考虑延迟的确定性和数据局部性,而云端机器学习则以可变的 \(L_{\text{lat}}\) 为代价,优先提供弹性的 \(R_{\text{peak}}\)。
- 常见误区:一种常见误解是,云端机器学习意味着“无限计算能力”。实际上,距离惩罚 \((L_{\text{lat}})\) 和数据摄取瓶颈 \((D_{\text{vol}}/\text{BW})\) 是任何软件优化都无法消除的物理约束,为所有数据源位于数据中心之外的工作负载设定了响应时间的硬性下限。
集中化界定了云端的取舍:在仓库规模的集群中汇集弹性计算资源,消除了本地容量限制,却引入了物理距离和网络延迟。在 figure 3 中,约束树从左至右呈现了这一权衡,将起主导作用的规模约束与其系统应对方式、失效边界以及适配的工作负载联系起来。
\begin{tikzpicture}[font=\small\sffamily]
\tikzset{
  Box/.style={inner xsep=2pt,
  draw=GreenLine,
  fill=GreenL!50,
  node distance=0.3,
    line width=0.75pt,
    anchor=west,
    text width=30mm,align=flush center,
    minimum width=30mm, minimum height=10.0mm
  },
  Box2/.style={Box,draw=BlueLine,fill=BlueL!50, text width=32mm, minimum width=31mm
  },
  Box3/.style={Box,draw=OrangeLine,fill=OrangeL!40, text width=30mm, minimum width=32mm
  },
 Box4/.style={Box,draw=VioletLine,fill=VioletL2!40, text width=32mm, minimum width=32mm
  },
 Line/.style={line width=1.0pt,black!50,text=black,-{Triangle[width=0.8*6pt,length=0.98*6pt]}},
}
\node[Box4, fill=VioletL2!90!violet!50,](B1){主导\\ 约束};
\node[Box2,right=2 of B1,fill=BlueL](B2){系统\\ 应对};
\node[Box,right=2 of B2,fill=GreenL](B3){失效\\ 边界};
\node[Box3,right=2 of B3,fill=OrangeL](B4){适配的\\ 工作负载};
\node[Box,draw=OliveLine,fill=OliveL!30, minimum height=11.5mm,
above=0.5 of $(B2.north east)!0.5!(B3.north west)$](B0){云端机器学习};
%
\node[Box4,below=0.5 of B1](B11){规模超出\\ 本地机器容量};
\node[Box4,below=of B11](B12){数据或状态\\ 集中存放};
\node[Box4,below=of B12](B13){延迟预算\\ 较宽松};
\node[Box4,below=of B13](B14){使用需求\\ 具有弹性};
%
\node[Box2,below=0.5 of B2](B21){池化加速器\\ 和存储};
\node[Box2,below=of B21](B22){对数据\\ 和模型分片};
\node[Box2,below=of B22](B23){在机群规模上\\ 进行调度};
\node[Box2,below=of B23](B24){集中化\\ 运维};
%
\node[Box,below=0.5 of B3](B31){光速所限的\\ 延迟};
\node[Box,below=of B31](B32){互联网\\ 依赖};
\node[Box,below=of B32](B33){数据主权\\ 风险暴露};
\node[Box,below=of B33](B34){利用率驱动的\\ 成本};
%
\node[Box3,below=0.5 of B4](B41){大模型\\ 训练};
\node[Box3,below=of B41](B42){推荐\\ 系统};
\node[Box3,below=of B42](B43){欺诈\\ 检测};
\node[Box3,below=of B43](B44){云端辅助\\ 语音处理};
%
\foreach \i in{1,2,3,4}{
  \foreach \x in{1,2,3,4}{
\draw[Line](B\x.west)--++(180:0.5)|-(B\x\i);
}
}
\foreach \x in{1,2,3,4}{
\draw[Line](B0)-|(B\x);
}
\end{tikzpicture}在这一运行区间中表现良好的工作负载,例如异步欺诈检测、推荐结果批量更新和大语言模型预训练,能够接受这种取舍,因为规模比即时响应更重要。然而,当应用要求实时控制时,网络延迟就不再只是工程上的不便,而会成为一道硬性的物理屏障。对距离惩罚进行简单计算,就能具体说明这一点。
Napkin Math 1.3: 距离惩罚
问题:考虑一个机械臂实时安全监测系统。为防止人员受伤,安全逻辑要求端到端响应时间为 10 ms,因此,光速屏障带来的距离惩罚至关重要。模型运行在距离为 1,500 km 的高性能云数据中心中。能否满足这一安全响应预算?
物理分析:
- 光在光纤中的传播速度:~200,000 km/s。
- 往返传播时间:(1,500 km \(\times\) 2)/200,000 km/s = 15 ms。
- 结果:仅往返传播就需要 15 ms,在模型执行任何推理之前,就已超出 10 ms 的端到端预算(剩余裕量为 -5 ms)。
系统洞见:物理规律决定了云端机器学习对这一应用而言不可行。模型必须迁移到边缘端。
云基础设施与规模
云端机器学习将计算资源集中在集中式设施中,其物理规模是本地设备无法比拟的。TPU 超级计算机设计将数千个专用加速器芯片组织成数据中心级系统,提供 PFLOP/s 至 EFLOP/s 级的低精度计算吞吐量 (Jouppi et al. 2023)。Table 6 量化展示了云系统如何提供比移动设备高出数个数量级的计算能力和内存带宽,同时付出相应更高的功耗和运营成本。这些设施使资源受限设备上难以实现的工作负载成为可能,但其远程位置也带来了直接的权衡:网络往返延迟使其无法满足严格的实时截止时间,而运营成本则直接随使用量增长。
Jouppi, Norm, George Kurian, Sheng Li, Peter Ma, Rahul Nagarajan, Lifeng Nai, Nishant Patil, et al. 2023. “TPU v4: An Optically Reconfigurable Supercomputer for Machine Learning with Hardware Support for Embeddings.” Proceedings of the 50th Annual International Symposium on Computer Architecture, 1–14. https://doi.org/10.1145/3579371.3589350.
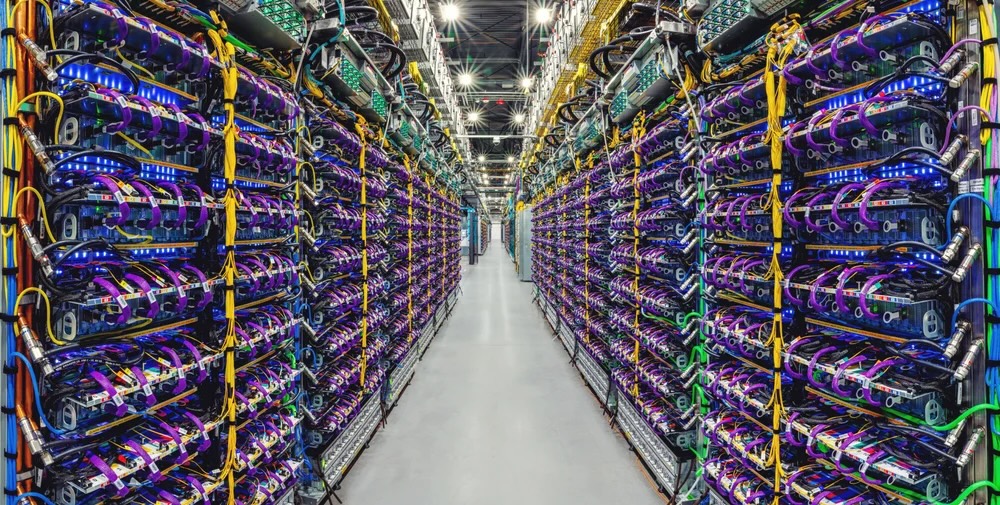
figure 4 中的设施现场直观展示了这种吞吐量的物理基础:数千枚加速器芯片11被组织在成排的液冷机架中,每个机架消耗千瓦级功率,以维持任何单台机器都无法企及的总计算能力。
Pichai, Sundar. 2023. Introducing Gemini: Our Largest and Most Capable AI Model.
云端机器学习擅长通过并行架构处理海量数据,支持在需要数百 TB 存储空间和 PFLOPs 级计算量的数据集上进行训练,而这些资源需求对于受限设备而言仍难以满足。模型训练 中的训练技术和 硬件加速 中的加速器架构探讨了分布式系统如何协调并维持这种吞吐量。
集中化也改变了模型的服务方式和治理方式。云 API 使训练好的模型能够通过移动端、Web 和物联网平台向全球用户开放。共享基础设施使工程团队能够借助统一的版本控制开展协作,而按用量付费的定价模式12则将前期资本支出(CapEx)转化为随需求变化、基于使用量的运营支出(OpEx)。
一种常见误解认为,云端机器学习拥有庞大的计算资源,因此在所有情况下都更优。强大的计算能力和存储容量并不会自动为每一种工作负载带来最优解。粗略估算:数据引力的物理约束 中的数据引力不变量解释了其中的原因:随着数据量增大,将数据移动到计算所在位置的成本 \((C_{\text{move}}(D_{\text{vol}}) \gg C_{\text{move}}(\text{Compute}))\) 最终会占据主导地位。figure 3 展示的权衡,在边缘部署和嵌入式部署具有优势的场景中体现得尤为具体:机器人中低于 10 ms 的控制回路、对隐私敏感的医疗记录的本地留存、无需持续支付云费用的可预测摊销成本,或断网环境中的自主运行。最优部署范式由起决定作用的物理约束决定,而非不受约束的吞吐量。
云端机器学习的权衡与约束
云端机器学习的优势伴随着固有的权衡,这些权衡影响着部署决策。延迟的影响最为显著:当端到端路径的延迟超出应用的响应时间预算时,远程网络延迟会使云端处理不再适用。不可预测的网络抖动进一步增加了地理分布式基础设施中性能预测与调试的难度。
隐私与安全为云部署设定了额外边界。将敏感数据传输到远程数据中心会扩大泄露面,并增加法规合规的复杂性。处理受《通用数据保护条例》(GDPR)13或《健康保险流通与责任法案》(HIPAA)14等法规约束的数据时,组织必须选择、记录并维护与数据、系统及适用法律义务相匹配的保障措施。隐私保护方法可以减少离开原始环境的敏感数据量,但它们是对基础设施控制措施的补充,而非替代。
成本管理引入了运营复杂性,因此需要进行 TCO15 分析,而非简单比较单价。一个云端与边缘端 TCO 的计算示例展示了标价与真实系统成本之间的差距。
在这一计算示例中,table 8 逐项列出了按公开标价计算的示例云端实现的年度 GPU、网络、负载均衡器和可观测性成本,table 9 则逐项列出了相应本地边缘服务器实现的硬件、电力、冷却、网络和 DevOps 人工成本。
| 成本组成 | 计算方式 | 年度成本 |
|---|---|---|
| GPU 推理(A10G) | 4 个实例 \(\times\) 8760 h/year \(\times\) $0.75/hr | ~$26,280 |
| 网络出站流量 | 100 GB/day \(\times\) 365 d/year \(\times\) $0.09/GB | ~$3,285 |
| 负载均衡器 | $0.025/hr + LCU 费用 | ~$3,723 |
| CloudWatch/日志记录 | 监控、告警 | ~$2,000 |
| 云端合计 | ~$35,288/year |
| 成本组成 | 计算方式 | 年度成本 |
|---|---|---|
| 硬件资本支出 | $15,000 ÷ 3 years 使用寿命 | ~$5,000 |
| 电力(全天候) | 300 W \(\times\) 8760 h/year \(\times\) $0.12/kWh | ~$315.4 |
| 冷却开销 | 约为电力成本的 30% | ~$94.6 |
| 网络(光纤) | 用于远程管理的固定线路 | ~$1,200 |
| DevOps 人工 | 0.1 FTE \(\times\) $150,000 薪资 | ~$15,000 |
| 边缘端合计 | ~$21,610/year |
Napkin Math 1.4: 云端与边缘端 TCO 对比
问题:一个视觉系统每天提供 1M 次 ResNet-50 规模的推理(延迟为 10 ms,响应大小为 100 KB)。计入所有成本(GPU 小时数、网络出站流量、电力、冷却和人工,详见 table 8 和 table 9)后,在 3 years 内,云端部署与本地边缘部署哪一种成本更低?
数学分析:此场景配置了一个由 4 个云 GPU 实例组成的固定资源池,以及一台固定的本地服务器。大多数成本是固定的,而云端出站流量费用随流量变化。因此,两个年度总成本的比值并不是有效的盈亏平衡利用率。在所述运行点,equation 7 中的有效比较量是年度成本差额: \[\text{Annual cost gap} = \text{Cloud annual TCO} - \text{Edge annual TCO} \tag{7}\]
在所述每天 1M 次推理的运行点,差额为 ~$35,288/year − ~$21,610/year = ~$13,678/year。将这一流量乘以年度总成本之比,会错误地将已配置容量视为每次推理的费用。
结果:在此运行点,边缘端成本约低 38.8 percent。由于固定云端配置的成本在计入随流量变化的出站费用之前,就已高于边缘端总成本,因此这些假设下不存在正流量处的成本交叉点。有效的盈亏平衡分析需要采用随需求调整的云资源、明确的阶梯式容量配置,或有合理依据的每次查询价格。
系统洞见:边缘端 TCO 由人工成本主导(~$15,000 ÷ ~$21,610/year ≈ 69.4 percent),而非硬件成本。尚不具备 DevOps 能力的组织应计入维护本地基础设施的全部成本。
除直接财务成本外,云部署还具有独特的运营约束。不可预测的用量激增会增加预算编制的难度,因此需要自动化监控和成本治理框架。对网络的依赖带来了可用性风险:客户端与数据中心之间的任何连接中断都会立即导致服务降级或停止。专有云 API 进一步加剧了供应商锁定,在跨供应商迁移工作负载时增加了软件可移植性方面的阻力。即使存在这些运营约束,集中式基础设施对于需要全球规模弹性容量的消费级应用仍具有独特的适用性。
大规模训练与推理
云端机器学习的计算优势,在需要超大规模的面向消费者的应用中体现得最为明显。Siri 和 Alexa 等虚拟助手展示了现代机器学习系统典型的混合架构:唤醒词检测可以直接在设备上功耗低至亚毫瓦至毫瓦级的专用硬件上运行,无需持续激活主处理器即可实现始终开启的监听;初步语音识别可以在设备端运行,以保护隐私并提高响应速度;复杂的自然语言理解与生成则可以使用云基础设施,以访问更大的模型和更广泛的知识。
经济因素与延迟一样,推动着这种架构的形成。试图完全在云端处理数十亿台设备的语音交互,会同时触及经济与基础设施的上限。对语音助手瓶颈进行量化,可以同时揭示这两方面的限制。
Napkin Math 1.5: 语音助手之墙
问题:在这一示例性容量场景中,1B 台语音助手设备(智能手机、智能音箱、耳塞式耳机)各自产生 20 queries/day 的唤醒词请求流量。如果所有查询均由云端机器学习提供服务,基础设施扩展的成本将是多少?峰值负载又需要相当于多少座专用数据中心的容量?
经济之墙:首先,考察在云端处理唤醒词请求流量的成本。
- 云端成本:约 $0.50/device/year → 1B 台设备 = $500,000,000/year。在这些假设下,对于一项免费功能而言,这一成本在经济上难以承受。
- TinyML 替代方案:采用功耗为 0.1–1 mW 的本地唤醒词检测,成本 <$0.01/device/year。在所建模的规模下可行。
基础设施之墙:其次,考察峰值负载所需的数据中心数量。
所需的集群容量由五个参数决定:
- 查询量:1 十亿台设备 \(\times\) 20 queries/day = 20B queries/day。
- GPU 需求:每次查询需要约 200 ms 的 GPU 时间。总计:1,111,111 GPU 小时/天。
- 场景容量:一座配置 10,000 GPUs 的等效数据中心可提供 240,000 GPU 小时/天。
- 平均需求:仅语音推理就需要约 4.6 座专用数据中心。
- 峰值实际情况:查询集中在用户清醒时段(峰均比约为 4.5×),峰值时需要约 20.8 座数据中心。
带宽上界:第三,单独考虑传输音频本身这一反事实情景。如果每台设备都持续传输音频流(16 kHz、16 位),每台设备的传输速率约为 32 KB/s。对于 1 十亿台设备,总速率将达到 32 TB/s;这是一个示例性上界,而非基于查询的请求模型。
系统洞见:完全由云端提供语音交互服务,会在全球规模下造成不可持续的并发瓶颈:即使尚未计入运营支出,峰值查询量所需的专用数据中心容量也已超出可行的集群资源分配范围。本地唤醒词检测以分布式、毫瓦级推理取代了这一集中式瓶颈。
语音助手流水线体现了一条核心系统原则:约束驱动分层架构。将流水线划分为设备端唤醒词过滤器和云端语言模型,可同时缓解客户端的能耗限制与数据中心的并发之墙。相较于纯云端处理,这种混合方案降低了端到端延迟,同时仍可利用复杂语言理解所需的计算容量。
大规模推荐引擎以受内存容量约束的形式展现了云端方案的权衡。基于 DLRM16 等架构的系统,使用稀疏嵌入表将数百万用户和物品映射为稠密向量。由于这些表的总大小通常超过数 TB,任何单个加速器都无法存储全部模型参数。因此,这些表被分片存储在分布式主机内存和加速器资源池中,前向与反向传播过程中的全互连通信需要高带宽互连。集中式数据中心提供了容纳这些稀疏模型所需的池化内存容量和低延迟集群互连网络,同时持续摄取流式用户交互数据。
这些应用具有一个共同点:以延迟换取规模,接受远程路径带来的延迟,以获得本地无法提供的计算资源。分析数百万笔交易的欺诈检测系统、处理数 TB 嵌入表的推荐引擎,以及逐词元生成文本的语言模型,都依赖这一权衡。然而,正如语音助手之墙所表明的,某些应用中,无论增加多少云端算力,都无法弥补距离造成的物理限制。当延迟预算低于远程路径所允许的水平,或数据量超出网络的承载能力时,计算就必须向数据源靠近。
边缘机器学习:延迟与隐私
当远程路径的延迟超出工作负载的延迟预算时,云端推理在物理上就不再可行。距离惩罚在计算开始之前就引入了网络延迟:光速限制和广域网上的路由跳转会增加数十至数百毫秒的传播延迟。对于自动驾驶车辆的制动路径或工业安全回路,17 100 ms 的网络往返时间会在任何一层开始计算之前耗尽全部响应预算。将计算移至紧邻数据源的位置,可以消除这一远程传输项。
边缘机器学习以云端弹性容量为代价,换取低于 100 ms 的确定性延迟和数据本地保留。从原型角度看,边缘部署改变了主导约束:在云端受内存约束的带宽密集型工作负载,卸载到经由广域网链路访问的远程环境时,可能转而由远程路径延迟主导。具备足够内存的本地硬件可以消除这一网络传输惩罚,使瓶颈重新落到本地内存带宽和计算上。根据 equation 6 中的机器学习系统铁律,本地执行会从请求路径中移除卸载项 \(D_{\text{vol}}/\text{BW}_{\text{IO}}\),使执行时间仅受本地计算和内存传输约束。
除实时控制的截止期限外,数据主权和隐私监管约束也常常禁止通过外部网络传输原始传感器数据流。边缘设备涵盖本地网关、工业 PC 和本地部署服务器,在部署谱系中处于中间层,在适中的计算资源与严格的物理和散热边界之间取得平衡。
Definition 1.2: 边缘机器学习
边缘机器学习是一种将计算置于物理上紧邻数据源的位置,以优化延迟确定性和数据局部性的部署范式。
- 意义:它绕过云端的距离惩罚 \((L_{\text{lat}})\),以弹性规模换取固定的本地计算容量 \((R_{\text{peak}})\)。
- 区别:云端机器学习优先考虑吞吐量,而边缘机器学习优先考虑确定性和隐私。与 TinyML 不同,边缘机器学习仍可能使用通用 GPU(GPGPU)等工作站级加速器。
- 常见误区:一种常见误解是,边缘机器学习指某一特定硬件类别。实际上,它是一种位置范式:涵盖从物联网网关到本地部署服务器的各种设备,其共同特征是在物理上接近数据源。
将计算移至本地服务器,可以从请求路径中移除长距离传输,代价是需要管理分布式基础设施。在 figure 5 中,约束树展示了与传感器的物理邻近性如何决定本地过滤和专用加速器硬件的使用,同时揭示了固定容量边界。
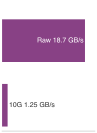
原始边缘数据的速率可能超过网络管道的容量。
\begin{tikzpicture}[font=\small\sffamily]
\tikzset{
  Box/.style={inner xsep=2pt,
  draw=GreenLine,
  fill=GreenL!50,
  node distance=0.4,
    line width=0.75pt,
    anchor=west,
    text width=37mm,align=flush center,
    minimum width=37mm, minimum height=10mm
  },
  Box2/.style={Box,draw=BlueLine,fill=BlueL!50, text width=27mm, minimum width=27mm
  },
  Box3/.style={Box,draw=OrangeLine,fill=OrangeL!40, text width=28mm, minimum width=28mm
  },
 Box4/.style={Box,draw=VioletLine,fill=VioletL2!40, text width=30mm, minimum width=30mm
  },
 Line/.style={line width=1.0pt,black!50,text=black,-{Triangle[width=0.8*6pt,length=0.98*6pt]}},
}
\node[Box4, fill=VioletL2!90!violet!50,](B1){主导\\ 约束};
\node[Box2,right=2 of B1,fill=BlueL](B2){系统\\ 响应};
\node[Box,right=2 of B2,fill=GreenL](B3){失效\\ 边界};
\node[Box3,right=2 of B3,fill=OrangeL](B4){适用\\ 工作负载};
\node[Box,draw=OliveLine,fill=OliveL!30, minimum height=11.5mm,
above=0.6 of $(B2.north east)!0.5!(B3.north west)$](B0){边缘机器学习};
%
\node[Box4,below=0.37 of B1](B11){低于 100 ms\\ 的响应};
\node[Box4,below=of B11](B12){原始数据速率\\ 超过网络容量};
\node[Box4,below=of B12](B13){数据必须\\ 留在本地};
\node[Box4,below=of B13](B14){站点必须能够\\ 离线运行};
%
\node[Box2,below=0.37 of B2](B21){将计算部署于\\ 传感器附近};
\node[Box2,below=of B21](B22){上传之前\\ 过滤数据};
\node[Box2,below=of B22](B23){使用本地\\ 加速器};
\node[Box2,below=of B23](B24){同步\\ 摘要};
%
\node[Box,below=0.37 of B3](B31){固定的本地\\ 容量};
\node[Box,below=of B31](B32){分布式设备\\ 安全};
\node[Box,below=of B32](B33){设备群\\ 管理};
\node[Box,below=of B33](B34){模型更新\\ 协调};
%
\node[Box3,below=0.37 of B4](B41){工业\\ 物联网};
\node[Box3,below=of B41](B42){零售视频\\ 分析};
\node[Box3,below=of B42](B43){自动驾驶\\ 车辆};
\node[Box3,below=of B43](B44){医院\\ 成像};
%
\foreach \i in{1,2,3,4}{
\draw[Line](B1.west)--++(180:0.5)|-(B1\i);
}
\foreach \i in{1,2,3,4}{
\draw[Line](B2.west)--++(180:0.5)|-(B2\i);
}
\foreach \i in{1,2,3,4}{
\draw[Line](B3.west)--++(180:0.5)|-(B3\i);
}
\foreach \i in{1,2,3,4}{
\draw[Line](B4.west)--++(180:0.5)|-(B4\i);
}
\foreach \x in{1,2,3,4}{
\draw[Line](B0)-|(B\x);
}
\end{tikzpicture}当传感器数据摄取速率超过网络上行容量时,物理上的必然性决定了必须采用边缘处理。当传入的传感器数据吞吐量超过可用网络带宽时,上行链路就会成为无法逾越的瓶颈,无论其他因素如何,都只能在本地设备上进行计算。
Napkin Math 1.6: 带宽瓶颈
问题:考虑一个工厂车间质量控制系统,配备 100 台摄像头,以 30 FPS 的帧率和 1080p 分辨率运行。视频流传输是否会成为带宽瓶颈?边缘机器学习是否能通过本地处理充分降低带宽需求?
物理分析:
- 每台摄像头的原始数据速率:1920 \(\times\) 1080 \(\times\) 3 字节 \(\times\) 30 FPS ≈ 186.6 MB/s。
- 总数据速率:100 台摄像头 \(\times\) 186.6 MB/s = 18.7 GB/s。
- 云端传输的成本敞口:上传原始摄像头数据流主要涉及带宽、摄取、存储和处理问题;按 GB 计收的云端出站费用适用于数据从云端传出的情况。如果之后按 $0.09/GB 的数据出站传输价格取回原始数据流,仅传输费用就会达到 $4.4M/month。
- 网络实际情况:即使是专用的 10 Gbps 线路(1.25 GB/s)也无法承载这一负载——该工作负载所需的带宽是现有带宽的 14.9×。
系统洞见:物理限制使这一应用的云端流式传输无法实现。边缘处理并非可选项,而是必需方案。如果边缘服务器仅传输缺陷元数据(每次检测 1 KB,整个车间约为 20 events/s),带宽需求将降至原来的约 1/933,120×。
未经压缩的传感器数据流占满上行链路,体现了集中式数据接入面临的带宽壁垒。对于电池供电的边缘设备(无线摄像头、无人机、可穿戴设备),无线通信的能耗构成了更为严格的物理上限:在粗略估算 1.1 所采用的载荷与无线通信参数下,无线传输的能耗是本地执行推理的 1,000×。通过蜂窝网络或 Wi-Fi 链路卸载原始遥测数据,会迅速耗尽设备自身的能量储备。在 figure 6 中,各部署层级的能耗范围横跨八个数量级,说明了边缘与嵌入式系统为何需要专门的低功耗架构,而不能持续进行无线流式传输。
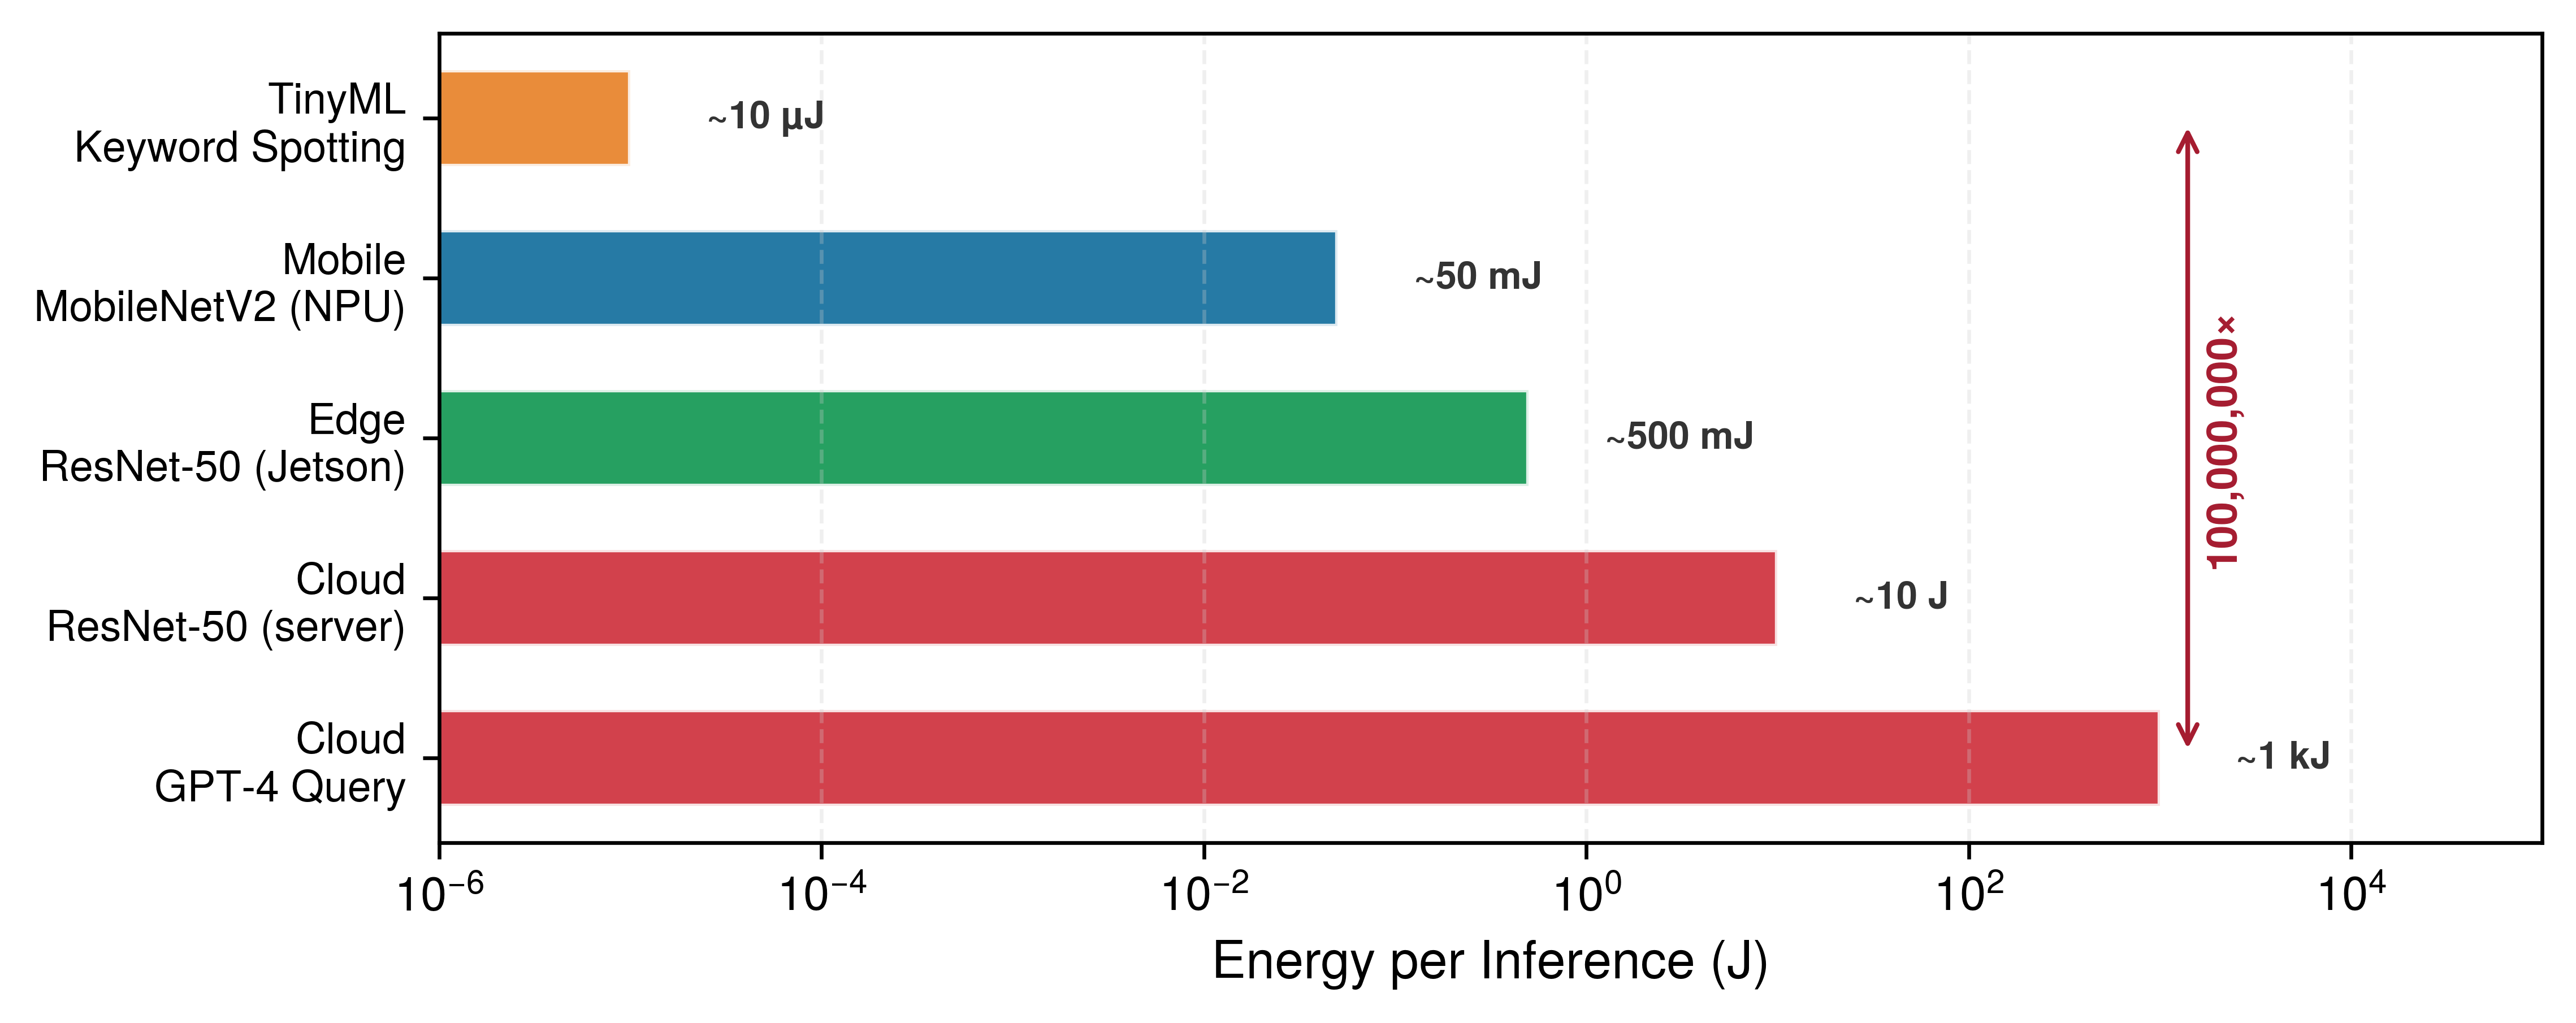
边缘机器学习的优势与部署挑战
边缘系统涵盖可穿戴设备、工业控制器和本地部署的网关,这些系统在本地处理数据18,无需依赖中央服务器。尽管不同范式之间横跨八个数量级的能耗范围反映了不同的工作负载需求与核算边界,但起支配作用的物理原理始终不变:功耗受到电池容量或被动散热能力的严格限制。
这一热设计范围直接限定了内存容量和带宽的上限。由于边缘加速器必须在严格的 5–50 W 功率预算内运行,因此无法支持高带宽内存(HBM)所需的宽位宽、高功耗物理接口。边缘架构因而依赖 LPDDR 或共享系统 DRAM,其中内存容量限制模型参数规模,内存带宽限制运行吞吐量。要使现代神经网络适应这些物理边界,就需要采用 模型压缩 中讨论的模型压缩技术——量化、剪枝和架构蒸馏——以减少权重体积与激活值传输量,使其符合硬件预算。
数据局部性不变量
在本地边缘处理与远程云端处理之间作出选择,取决于带宽与延迟之间的权衡。当远程执行的完整路径无法满足服务截止时间时,远程执行便不可行;否则,需要比较完整的本地执行时间与远程执行时间,以确定更快的可行路径。
Definition 1.3: 数据局部性不变量
数据局部性不变量 首先检验完整的远程路径是否满足服务截止时间。令 \(T_{\text{remote}}\) 表示完整远程路径的耗时,\(T_{\text{deadline}}\) 表示截止时间,\(\text{BW}_{\text{network}}\) 表示卸载带宽,\(L_{\text{lat,network}}\) 表示网络延迟,\(R_{\text{peak,remote}}\) 和 \(\eta_{\text{hw,remote}}\) 分别表示远程计算速率与效率: \[T_{\text{remote}} = \frac{D_{\text{vol}}}{\text{BW}_{\text{network}}} + L_{\text{lat,network}} + \frac{O}{R_{\text{peak,remote}} \cdot \eta_{\text{hw,remote}}}, \quad \text{remote feasible} \iff T_{\text{remote}} \le T_{\text{deadline}}\]
相应的 \(T_{\text{local}}\) 是完整本地路径的耗时。如果两条路径均可行,则比较 \(T_{\text{local}}\) 与 \(T_{\text{remote}}\);任何一条路径都可能因无法满足截止时间而被排除。这里,\(L_{\text{lat,network}}\) 涵盖完整的网络往返时间(传播、路由和协议握手),而返回载荷的传输时间通常被忽略,因为推理结果(例如类别标签或边界框)比原始输入载荷 \(D_{\text{vol}}\) 小数个数量级。
- 意义:该不变量定义了一个交叉点,超过该点后,增加远程算力 \((R_{\text{peak}})\) 的作用很小,因为传输主导了 \(T_{\text{remote}}\)。只有在检查本地路径自身的完整执行时间和资源限制之后,才能优先选择本地路径。
- 区别:机器学习系统铁律分解的是一条执行路径,而局部性不变量既比较两条完整路径,也将它们分别与明确的服务截止时间进行比较。
- 常见误区:一种常见的误解是,5G/6G“解决”了局部性问题。尽管这些技术提高了 \(\text{BW}_{\text{network}}\),但它们无法消除传播延迟和协议延迟,因此远程路径仍可能无法满足严格的服务截止时间。
运行层面的权衡可直接由局部性公式推导得出。本地执行消除了网络传输时间(\(D_{\text{vol}}/\text{BW}_{\text{network}} + L_{\text{lat,network}}\)),只要本地执行满足 \(T_{\text{local}} \le T_{\text{deadline}}\),就能为闭环控制提供确定性的延迟。上行带宽消耗从原始传感器数据的比特率降低为轻量级事件遥测数据的传输速率,从而缓解网络拥塞并减少持续产生的数据传输费用。本地处理还通过将原始传感器数据保留在本地设施边界内,缩小了数据攻击面,但静态存储的数据仍需要本地访问控制。此外,边缘节点还提供分区容错能力:只要本地供电与传感器链路保持正常,本地推理就能在广域网中断期间继续运行。
另一方面,边缘部署以严格的物理和运维边界为代价,免去了网络传输。典型边缘硬件的内存为 1–8 GB,热设计范围为 5–50 W,远低于云服务器的容量与功率水平。19 这些资源限制使模型占用空间、激活值缓冲区、运行时状态和热约束下的占空比成为硬性约束。在运维方面,管理分布式基础设施会引入非线性复杂度:在数千台异构、物理暴露的设备之间协调软件更新和模型版本管理,需要专门的部署流水线,20 其中回滚成本与静默故障带来了集中式数据中心所没有的运维挑战。
在严格的单帧截止时间下评估高帧率传感器的单帧数据,可以展示局部性交叉点在实践中的作用。
Napkin Math 1.7: 局部性交叉点
问题:无人机的避障系统(4K,60 FPS)应当卸载到云端,还是此时已达到局部性交叉点?
已知条件:
- 数据 \((D_{\text{vol}})\):4K 帧 ≈ 24.9 MB。
- 带宽 \((\text{BW}_{\text{network}})\):家庭宽带(上行)100 Mb/s。
- 远程网络与计算响应时间:110 ms(往返时间 + 远程计算时间)。
计算:
- 传输时间:24.9 MB \(\times\) 8 比特/100 Mb/s = 1,990.7 ms。
- 完整远程路径:传输时间 + 110 ms 的远程响应时间 = 2100.7 ms,而帧间隔为 16.7 ms。
系统启示:尚未考虑控制回路的时间余量,远程路径的耗时就已超过帧间隔,而更快的远程计算无法消除传输时间。因此,在这些假设下,云端卸载不可行;仍须测量本地路径,以确认其满足截止时间要求。
一个贴近实际的零售部署案例展示了这些约束如何转化为吞吐量、硬件和设备群成本要求。假设一家智慧零售连锁企业在 500 家门店部署人员检测,每家门店配置 20 cameras/store,摄像头均以 15 FPS 运行。Table 10 将每家门店的推理速率与 YOLOv8-nano 的单帧浮点运算次数相结合,得出每家门店必须持续提供的吞吐量。
| 指标 | 计算 | 结果 |
|---|---|---|
| 每家门店的推理次数 | 20 cameras/store \(\times\) 15 FPS | 300 inferences/s |
| 模型计算量 | YOLOv8-nano:8.7 GFLOP/inference | 2610 GFLOP/s |
| 所需吞吐量 | 2610 GFLOP/s \(\times\) 2(余量系数) | 约等效于 5.22 TOPS |
Table 11 比较了三种候选边缘加速器 的吞吐量、功率、单价和设备群成本,其中包括嵌入式 GPU 加速器。
| 边缘设备 | INT8 TOPS | 功耗 | 单价 | 设备群成本 |
|---|---|---|---|---|
| NVIDIA Jetson Orin NX | 100 TOPS | 10–25 W | $600 | $300,000 |
| Intel NUC + Movidius | 1 TOPS | 15 W | $400 | $200,000 |
| Google Coral Dev(3 boards/store) | 峰值 12 TOPS 降额后 6 TOPS |
6 W | $450 | $225,000 |
Napkin Math 1.8: 边缘推理容量规划
问题:给定 table 10 中的吞吐量目标和 table 11 中的候选设备,哪种边缘加速器(USB 级 TPU、工作站级嵌入式 GPU 或通用迷你 PC)能够以最低的三年设备群成本提供所需的吞吐量?
计算:容量规划依据单块板卡能够持续提供的性能,而非其数据手册中的峰值性能。Coral Dev Board 的额定峰值为 4 TOPS,但经过 50 percent 的降额后,实际可提供约 2 TOPS,因此每家门店所需的板卡数量为:所需性能 5.22 TOPS ÷ 每块板卡的性能 2 TOPS = 2.6 块板卡,向上取整后为 3 boards/store。
在 3 years 内、覆盖 500 家门店时,该配置的总拥有成本(TCO)比较如下:硬件成本 $225,000 + 电费(0.006 kW \(\times\) 500 \(\times\) 8760 h/year \(\times\) 3 years \(\times\) $0.12/kWh = $9,460.8)= 总计 $234,460.8;相比之下,每家门店配备一块专用云端 GPU 的基准方案成本约为 $9,855,000。
结果:单块 Coral 的容量不足,但采用 3 boards/store 的分片配置是低成本的边缘方案,可提供 6 TOPS,且 Jetson 的每店硬件资本支出(CapEx)约为该配置的 1.3×。当集成复杂度比硬件成本更重要时,Jetson 仍是更简单的单设备部署方案。
系统洞见:边缘容量规划是容量与成本问题,而非设备名称问题。成本最低的可行设计可能是在每个站点部署多个小型加速器,而非一块更大的板卡,但必须权衡这种硬件节省与分片边缘设备群带来的协调和维护负担。
物理暴露进一步加剧了这些运维挑战。与置于访问受控数据中心内的服务器不同,部署在零售卖场或公共基础设施中的边缘硬件可被攻击者直接接触。这种暴露要求采用由硬件强制实施的保护机制:通过安全启动链防止未经授权的固件修改,对存储模型权重和中间激活值的本地存储进行加密,以及采用可显露篡改痕迹的外壳。此外,资本支出随部署规模线性增长:为 1,000 个站点各配备价值 $500–2,000 的边缘硬件,在安装、布线和设备群运维之前,就需要 $500,000–2,000,000 的前期资本支出。这笔前期投资能否带来低于持续付费的云端推理的总拥有成本,取决于利用率与工作占空比、当地电价以及站点维护开销。
实时工业与物联网系统
不同领域的边缘应用各不相同,但它们都将同一个本地性论点具体化:系统无法等待网络、无法传出数据、无法暴露原始信号,或无法在网络中断期间停止运行。自动驾驶汽车是一类要求严苛的应用,因为安全关键的感知与控制决策必须在毫秒级时间预算内完成。车载系统通过本地硬件处理来自多台摄像头及其他传感器的数据流;当远程云端路径仅网络延迟就已超过截止时间时,它便无法满足紧凑控制环路的要求。
智慧零售环境展示了边缘机器学习在隐私敏感、带宽密集型应用中的实际优势。无人结账商店21可以在本地边缘服务器上处理多台摄像头的数据流,跟踪顾客的移动和商品选择,而无需持续通过广域链路传输原始视频。这种架构降低了带宽需求和传输过程中的暴露风险,但其本身并不能确保隐私:数据保留、访问、二次使用和治理控制仍然决定着系统的合规性与风险。
工业物联网22将边缘机器学习用于毫秒级响应能力直接影响生产效率和工人安全的应用。制造工厂部署边缘机器学习系统,以实现实时质量控制和预测性维护。23
设施自动化和智能建筑依靠边缘机器学习,在能源优化与运行连续性之间取得平衡。楼宇管理系统汇总来自数千个环境传感器的遥测数据,监测气流、温度、人员占用情况和功耗,以执行本地化的暖通空调(HVAC)与照明控制环路。本地处理遥测数据可将广域传输量降低一个数量级,同时保持亚秒级控制响应,并在网络断连期间维持分区容错能力。在临床环境中,医疗系统针对患者遥测和手术导航部署边缘推理,在无法接受云端往返和广域网络暴露的场景中,确保确定性响应与数据隔离。
许多工业和零售边缘系统位置固定,并接入站点电源,因此工厂边缘服务器全天候消耗数百瓦功率仍然可行。相比之下,移动设备随用户移动,不依赖持续供电,且电池储能受到严格限制。当计算从固定基础设施转移到无外接电源的移动设备时,能耗取代延迟,成为首要约束:\(\text{Energy} = \text{Power} \times T\)。主要优化目标从单纯的执行时间转向每次推理的能耗,从根本上改变了底层硬件与算法的设计空间。
移动机器学习:离线智能
边缘机器学习通过将计算移近数据,解决了限制云端部署的距离问题。许多边缘系统是固定的网关、工厂服务器和零售专用设备,而用户则携带手机和平板电脑穿梭于不断变化的环境。将同样的本地性引入便携设备,会带来另一种约束:电池。与可以持续消耗数百瓦功率的插电式边缘服务器不同,移动设备必须在固定的能量预算下运行数小时或数天。
移动机器学习通过将机器学习直接集成到智能手机和平板电脑等便携设备中,应对这一挑战,提供响应迅速的个性化能力。当数据本地性、离线运行和即时响应比计算规模更重要时,这种范式尤为适用,可支持语音识别、计算摄影24和健康监测等应用。本地处理可减少传输暴露,但其本身并不能保证隐私。这些电池供电设备必须在性能、能效和热管理之间取得平衡,因此适合频繁、短时的 AI 任务。
移动环境引入了固定部署中不存在的一项关键约束:每次推理的能耗成为首要设计参数。根据 equation 6 中的机器学习系统铁律,云端和边缘系统以最小化总延迟 \(T\) 为优化目标。移动系统还面临一项额外约束:\(\text{Energy} = \text{Power} \times T\),且 equation 2 所描述的功耗墙将持续功耗限制在 3–5 W。从工作负载原型来看,图像分类这类计算密集型“巨兽”工作负载必须转变为更紧凑的视觉模型25,将 FLOPs 降至原来的 1/13.7×,同时保留足以满足应用需求的准确率。这不仅是优化,还代表着每字节计算量权衡的质变:接受较低的峰值吞吐量,以换取在 3–5 W 的热设计范围内持续运行。
电池与热约束的这一边界塑造了移动范式的基本形态。
Definition 1.4: 移动机器学习
移动机器学习是受热设计功耗(TDP)与电池能量限制的部署范式。
- 意义:它受限于被动冷却仅数瓦的散热能力,因此要求架构优先考虑持续能效,而非峰值吞吐量 \((R_{\text{peak}})\)。
- 区别:边缘机器学习可能采用主动冷却,而移动机器学习必须在个人设备的能量预算内运行。与 TinyML 不同,它仍提供功能丰富的操作系统和数瓦级计算能力。
- 常见误区:一种常见误解是,移动机器学习的性能是固定值。实际上,它是一项随时间变化的约束:当设备触及热墙时,性能往往会下降,并触发节流,从而降低占空比 \((\eta_{\text{hw}})\)。
设备端处理提供即时响应与数据本地性,但必须在严格的电化学和热力学边界内运行。figure 7 中的四分支分类将手机共享的电池和被动散热机身,与必要的 NPU 算子内核融合及热节流限制联系起来。
移动机器学习中的电池续航与资源约束直接转化为工程要求。始终开启的机器学习功能会产生电池税,因为持续推理即使在系统其他部分运行之前,也会消耗手机有限的能量预算。
电池约束限制了一段时间内的总能耗。即使对于插电使用的平板电脑或短时演示,我们可以忽略电池续航,热力学仍会施加第二道边界。电功率最终转化为设备必须散去的热量。数据中心利用主动冷却移除这些热量,而轻薄移动设备主要依靠机身和表面的被动传热。这就形成了热墙,即独立于电池容量而存在的持续功耗硬上限。
\begin{tikzpicture}[font=\small\sffamily]
\tikzset{
  Box/.style={inner xsep=2pt,
  draw=GreenLine,
  fill=GreenL!50,
  node distance=0.24,
    line width=0.75pt,
    anchor=west,
    text width=38mm,align=flush center,
    minimum width=32mm, minimum height=9.5mm
  },
  Box2/.style={Box,draw=BlueLine,fill=BlueL!50, text width=30mm, minimum width=30mm
  },
  Box3/.style={Box,draw=OrangeLine,fill=OrangeL!40, text width=35mm, minimum width=35mm
  },
 Box4/.style={Box,draw=VioletLine,fill=VioletL2!40, text width=32mm, minimum width=32mm
  },
 Line/.style={line width=1.0pt,black!50,text=black,-{Triangle[width=0.8*6pt,length=0.98*6pt]}},
}
\node[Box4, fill=VioletL2!90!violet!50,](B1){决定性\\ 约束};
\node[Box2,right=2 of B1,fill=BlueL](B2){系统\\ 应对措施};
\node[Box,right=2 of B2,fill=GreenL](B3){失效\\ 边界};
\node[Box3,right=2 of B3,fill=OrangeL](B4){适合的\\ 工作负载};
\node[Box,draw=OliveLine,fill=OliveL!30, minimum height=11.5mm,
above=0.5of $(B2.north east)!0.5!(B3.north west)$](B0){移动端机器学习};
%
\node[Box4,below=0.17 of B1](B11){共享电池\\ 预算};
\node[Box4,below=of B11](B12){被动散热\\ 包络};
\node[Box4,below=of B12](B13){私有传感器\\ 数据};
\node[Box4,below=of B13](B14){用户处于离线\\ 或移动状态};
%
\node[Box2,below=0.17 of B2](B21){在设备端\\ 运行推理};
\node[Box2,below=of B21](B22){使用 NPU 和\\ 融合内核};
\node[Box2,below=of B22](B23){压缩模型\\ 和激活值};
\node[Box2,below=of B23](B24){根据热状态\\ 进行节流};
%
\node[Box,below=0.17 of B3](B31){电池\\ 代价};
\node[Box,below=of B31](B32){热\\ 节流};
\node[Box,below=of B32](B33){存储与\\ 内存限制};
\node[Box,below=of B33](B34){平台更新\\ 碎片化};
%
\node[Box3,below=0.17 of B4](B41){计算\\ 摄影};
\node[Box3,below=of B41](B42){语音与\\ 翻译};
\node[Box3,below=of B42](B43){健康\\ 监测};
\node[Box3,below=of B43](B44){个性化};
%
\foreach \i in{1,2,3,4}{
\draw[Line](B1.west)--++(180:0.5)|-(B1\i);
}
\foreach \i in{1,2,3,4}{
\draw[Line](B2.west)--++(180:0.5)|-(B2\i);
}
\foreach \i in{1,2,3,4}{
\draw[Line](B3.west)--++(180:0.5)|-(B3\i);
}
\foreach \i in{1,2,3,4}{
\draw[Line](B4.west)--++(180:0.5)|-(B4\i);
}
\foreach \x in{1,2,3,4}{
\draw[Line](B0)-|(B\x);
}
\end{tikzpicture}Napkin Math 1.9: 电池代价
问题:考虑在智能手机上部署一个“实时”后台目标检测器。模型处于活动状态时,持续消耗 2 W 的功率。手机配备一块标准的 15 Wh 电池。该功能能否全天开启?这就是电池代价,它使电池续航成为移动端机器学习的能量预算约束。
物理分析:
- 理想运行时间:\(\frac{15 Wh}{2 W}\) = 7.5 hours
- 实际情况:用户期望手机能够续航 24 hours。仅这一项功能连续运行一天,就需要消耗手机每日能量预算的 320 percent。
系统启示:模型不能简单地被“部署”了事。模型压缩 中的技术必须同时减少模型的计算工作量和占空比,才能使该功能全天开启。

受散热约束的持续性能远低于突发峰值。
这一区别对工程决策至关重要:电池代价是预算问题,原则上可以通过降低模型运行频率或增加电池容量来解决。热墙则是物理上限。更大的电池无法提高被动散热机身所能散去的最大持续功率;占空比调整和软件改动只能减少产热。持续运行超出散热包络时,无论电池剩余多少能量,都会触发硬件节流。因此,这两种约束分别作用于铁律中的不同环节:电池限制每次充电可执行的总运算量(\(O\) 对时间的积分),而热墙限制芯片能够持续维持的瞬时速率(\(R_{\text{peak}} \cdot \eta_{\text{hw}}\))。
Napkin Math 1.10: 热墙
问题:一个未经优化的视觉模型在峰值计算时需要 12 W 的功率。它能否部署到移动设备上,还是会触及热墙和移动端功耗墙?
场景:移动端片上系统(SoC)的被动散热允许功率约为 3 W。假设仍然发布未经优化的模型;这类被动散热设备的典型节流过程分为三个步骤:
- 温度上升:在 12 W 的功率下,设备温度以约 1 °C/s 的速率上升。
- 热保护触发:在 60 s 内,硬件达到热保护触发点(80 °C),触发操作系统节流。
- 节流后的吞吐量:模型的处理速率从 100 FPS 突然降至 30 FPS,以保持在散热包络内。
数学分析:假设从 FP32 重新设计为 INT8 后,活动功率按 4× 的倍数缩减,以此作为示例(参见 模型压缩):12 W ÷ 4 = 3 W,恰好达到 3 W 的被动散热上限,没有任何余量。这一倍数是场景输入,并非仅靠量化就能对整个系统普遍保证的结果。
系统启示:即使将功率按 4× 的倍数缩减,也无法产生散热余量;它只是刚好达到可持续运行的极限。物理规律设定了任何优化都无法突破的硬上限。
移动端机器学习的优势与资源约束
移动设备体现了中等程度的资源约束:配备 8–16 GB 的 RAM(从中端到旗舰机型有所不同)、128 GB-1 TB 的存储空间,并通过神经处理单元26提供 15–45 TOPS 的 AI 算力,功耗为 3–5 W。片上系统架构27将计算与内存子系统集成,以尽量降低能量成本。内存容量限制模型的内存占用,而 51.2–77 GB/s 的带宽则限制权重和激活值的传输速度。电池约束(容量为 15 Wh–22 Wh)使能量优化至关重要:对于原本可续航 24 小时的手机,增加 1 W 的持续机器学习处理功耗,会使续航时间缩短至约 9.2 hours–11.5 hours,具体取决于电池容量。专用的设备端机器学习框架提供针对硬件优化的推理,以实现 5–50 ms 的用户界面响应时间。
移动端机器学习擅长在增强数据本地性的同时提供快速响应的体验。对于某些任务,实时处理可实现低于 10 ms 的延迟,使交互式应用能够达到 5–50 ms 的用户界面响应时间。在本地处理敏感输入可减少数据传输和集中存储,而 Apple 的 Secure Enclave 等设备端安全隔区还可以进一步保护生物特征数据,28不过,隐私保障的强度最终取决于完整的系统设计和威胁模型。当模型及其支持数据能够满足移动端预算时,导航、翻译和媒体处理功能也可以在无网络条件下运行。个性化进一步完善了这些优势,因为模型可以利用设备端信号和用户情境,同时将原始数据保留在本地。
获得这些优势需要接受严格的资源约束。与云端部署相比,移动应用的内存、存储和延迟预算通常严格得多,从而限制模型大小和批处理行为。电池续航会对用户产生可感知的影响,而热节流可能显著限制持续性能:NPU 峰值吞吐量可能远高于设备在长时间工作负载下能够维持的水平。跨平台开发会成倍增加复杂性,需要分别实现并精细调优性能,而设备异构性则要求提供多个模型变体。与完全由运营方控制的服务相比,应用商店审核和分阶段发布流程也可能减慢迭代速度。
个人助理与媒体处理
在各类移动应用中,核心系统问题在于,多条短流水线必须共享同一电池预算和热预算。计算摄影充分体现了在热包络内运行多条机器学习流水线的挑战。现代旗舰手机会通过多个机器学习阶段处理每张照片:人像模式29使用深度估计和分割,夜景模式利用基于机器学习的降噪对齐多帧图像,随后依次执行 HDR 合成、超分辨率和场景优化。工程挑战并不在于某个单独的模型,而在于整条流水线:这些模型必须共享 3–5 W 的功率预算,并在用户感知的快门延迟内完成处理,因此需要在 CPU、GPU 和 NPU 之间进行精细调度,以避免热降频。
语音驱动交互展示了移动机器学习的分层架构。唤醒词检测在专用低功耗核心上持续运行,而语音识别和键盘输入预测则使用功耗更高的神经网络处理层级。每一层都运行在不同的功耗档位,体现了移动机器学习如何在单个 SoC 内的异构处理单元之间划分工作负载。
健康监测和增强现实将移动机器学习推向其持续性能极限。Apple Watch 等可穿戴设备在设备端处理心电图和加速度计数据,以减少数据传输;而 AR 框架在 60 FPS 下,要求同时进行的定位、手部跟踪和场景理解共享 16.7 ms 的总帧时间预算。这些应用代表了电池供电、被动散热设备所能持续承载的上限,也界定了仅靠移动端优化便不足以应对的边界。
这些成功案例可能让人误以为实现起来很容易。一种常见误区是,在不修改架构的情况下,尝试将桌面端训练的模型直接部署到移动或边缘设备上。在高性能工作站上开发的模型,部署到资源受限设备时往往无法正常运行。即使仅 FP32 权重约为 102.4 MB,计入激活值、批次、预处理缓冲区和运行时开销后,桌面端 ResNet-50 流水线也可能需要数 GB 内存。这样一条每次推理需要 8.2 GFLOP 计算量的流水线,无法原封不动地运行在具有 512 MB RAM 和 1 GFLOP/s 处理器的典型低端边缘目标设备上。除了直接超出资源限制,针对桌面端优化的模型还可能使用移动硬件不支持的运算,假定嵌入式系统具备实际不可用的数值格式,或要求执行与单样本推理不兼容的批处理。成功部署要求从一开始就采用面向架构的设计:模型族、算术格式和实现选择都必须与目标设备匹配。
移动机器学习表明,实用的智能功能可以依靠电池供电,在 3–5 W 的热包络内运行。然而,智能手机的价格仍达数百美元,需要数 GB 内存,还要求用户每天留意充电。这些要求使其不适用于大量应用:监测千英亩农场的土壤湿度、检测桥梁缆索的结构应力,或在偏远森林中监听濒危物种。这些场景需要的不只是更低的功耗,而是一种在本质上不同的工程范式:设备成本为几美元而非几百美元,内存以 KB 而非 GB 计量,系统在无人值守的情况下运行数月乃至数年。移动端优化方法有所帮助,但无法弥合可用内存相差 10,000 倍的鸿沟。所需的并非缩小版智能手机,而是一类完全不同的硬件和算法。
TinyML:泛在感知
设想为仓库中的每个托盘、悬索桥上的每根缆索、养蜂场中的每个蜂箱都配备感知设备。要为数万乃至数百万个物理对象装上“眼睛和耳朵”,设备成本必须是几美元而非几百美元,尺寸必须以毫米而非厘米计量。智能手机过于昂贵,也过于庞大;所需的是单位成本低于十美元、物理尺寸以毫米计量的泛在感知。
TinyML 将智能推向物理极限,从而补全了部署谱系:在资源受到严格限制的嵌入式设备上实现低成本、低功耗的机器学习 (Janapa Reddi et al. 2022)。成本低于 $10、功耗低于一毫瓦30的设备,使大规模泛在31感知在经济上切实可行;MLPerf Tiny 和 MCUNet 展示了如何在实践中评估这些约束并进行优化 (Banbury et al. 2021; Lin et al. 2020)。这属于微型约束原型的领域,其中优化目标从最大化吞吐量转向最小化每次推理的能耗。通过按占空比执行,一个每次推理消耗 10 µJ 的关键词检测模型可以依靠纽扣电池运行数年,通过以模型容量换取运行寿命,实现百万倍的能效提升。在 figure 8 中,带标注的开发板展示了这一物理尺度,其中集成了微控制器芯片、传感器阵列和排针,旨在无网络连接的环境中运行紧凑模型。
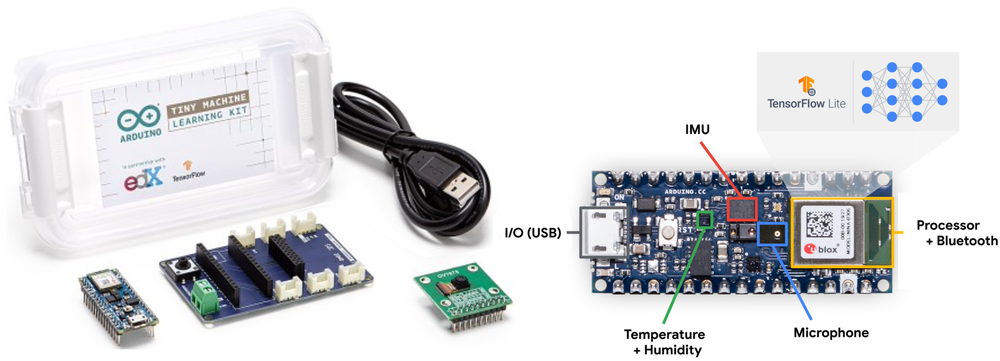
在这一物理尺度上运行,需要使用微控制器(MCU)32,以去除传统计算中耗电量大的基础设施。移动和边缘处理器依赖外部动态 RAM(DRAM)、高速内存总线和操作系统运行时,仅刷新存储单元和切换总线线路状态就会消耗数百毫瓦功率。微控制器完全省去了外部内存总线,将处理器核心、非易失性闪存和静态 RAM(SRAM)集成在单个硅裸片上 (Banbury et al. 2021; Lin et al. 2020; Janapa Reddi et al. 2022)。消除片外信号传输虽然能将工作功耗降至一毫瓦以下、休眠功耗降至微瓦级,却也施加了不容逾越的内存上限。片上 SRAM 受到硅裸片面积的物理限制:由于每个 SRAM 存储单元需要六个晶体管(\(6\text{T}\)),扩充容量会直接增加制造成本。因此,TinyML 模型必须在几十到几百 KB 的 SRAM 内执行,且没有虚拟内存、分页或交换空间来缓冲内存溢出。由此产生的 TinyML 与云端推理之间的能耗差距(figure 6)至少跨越六个数量级33,与云端 LLM 查询相比则达到八个数量级,使设备能够依靠纽扣电池连续运行多年。34
Banbury, Colby, Vijay Janapa Reddi, Peter Torelli, Jeremy Holleman, Nat Jeffries, Csaba Kiraly, Pietro Montino, et al. 2021. “MLPerf Tiny Benchmark.” arXiv Preprint.
Lin, Ji, Wei-Ming Chen, Yujun Lin, John Cohn, Chuang Gan, and Song Han. 2020. “MCUNet: Tiny Deep Learning on IoT Devices.” In Advances in Neural Information Processing Systems 33: Annual Conference on Neural Information Processing Systems 2020, NeurIPS 2020, December 6-12, 2020, Virtual, edited by Hugo Larochelle, Marc’Aurelio Ranzato, Raia Hadsell, Maria-Florina Balcan, and Hsuan-Tien Lin. Curran Associates.
Janapa Reddi, Vijay, Brian Plancher, Susan Kennedy, Laurence Moroney, Pete Warden, Lara Suzuki, Anant Agarwal, et al. 2022. “Widening Access to Applied Machine Learning with TinyML.” Harvard Data Science Review 4 (1). https://doi.org/10.1162/99608f92.762d171a.
要将从传感器采集到分类输出的完整推理流水线容纳于这一 KB 级内存占用范围内,就需要对 TinyML 的运行范式作出形式化界定。
Definition 1.5: TinyML
TinyML 是在 KB 级内存和毫瓦级功率约束下实现持续感知的机器学习领域。
- 意义:它要求模型权重和代码能够容纳于闪存中,同时激活值和运行时状态能够容纳于片上 SRAM 中,从而在毫瓦级功率预算下实现持续推理。
- 区别:移动机器学习使用功耗达数瓦的处理器和完整操作系统,而 TinyML 在微控制器上通过裸机固件或实时操作系统运行。
- 常见误区:一种常见误解是,TinyML 就是“小模型”。实际上,它是一种受能量约束的范式:首要指标是每次推理的能耗(微焦耳),而不仅仅是参数数量。
这一定义重新诠释了机器学习系统铁律。就 equation 6 而言,TinyML 施加了一个执行时间无法刻画的物理内存容量前提:模型占用 \(M_{\text{model}}\) 与激活值占用之和必须不超过内存容量 \(C_{\text{mem}}\)。当总内存以 KB 计量时,在开始优化延迟之前,模型结构和运行时分配就已决定了可行性,而每一次本可避免的数据搬移都会消耗部分能量预算。因此,优化目标从极致吞吐量转向每次推理的能耗以及能否容纳于内存。
Systems Perspective 1.3: 解读每次推理的能耗数值
table 12 中的能耗数值结合了由求解器推导的设备能耗估计与独立的量级参考值,并非受控条件下的全系统测量结果。作为示例,仅考虑 A100 时,ResNet-50 的延迟界限低于 1 ms,能耗约为 ~0.3 J;而计入 CPU、内存和其他开销后,整台服务器的功率可达约 ~1 kW。最后一列的次数表示一块电池的标称能量能够支持多少次推理;这些数值并非实际电池续航时间,且未计入感知、休眠和通信。
TinyML 的这一能效差距有助于解释,为何低能耗本地模型对持续感知具有吸引力。实际运行时间仍取决于推理频率、休眠功耗、感知、通信以及设备其余部分的消耗。
不同范式之间的能耗差距并非程度上的细微差异,而是尺度上的悬殊,跨越了 figure 6 中概述的八个数量级。Table 12 以具体数值呈现了这一跨度,将各范式的能耗转换为单块智能手机电池能够支持的推理次数。
| 范式 | 工作负载示例 | 每次推理的能耗 | 每块电池可支持的推理次数(3.7 V,3000 mAh) |
|---|---|---|---|
| 云端 | GPT-4 查询 | ~1 kJ | 40 queries |
| 云端 | ResNet-50(加速器服务器) | 75.5 mJ | 529,505 queries |
| 边缘端 | ResNet-50(Jetson) | 15.9 mJ | 2,511,628 queries |
| 移动端 | MobileNet(NPU) | 2.60 mJ | 15,393,505 queries |
| TinyML | 关键词检测 | 10 μJ | 3996 million queries |
在低于一毫瓦的功率预算下运行,可以在不依赖电网供电的情况下实现持续感知,但也迫使完整推理状态容纳于片上 SRAM 中。figure 9 中的四列分类体系展示了 KB 级内存和按占空比调度的休眠状态如何支持持续运行的工作负载,同时限制模型更新。
\begin{tikzpicture}[font=\small\sffamily]
\tikzset{
  Box/.style={inner xsep=2pt,
  draw=GreenLine,
  fill=GreenL!50,
  node distance=0.4,
    line width=0.75pt,
    anchor=west,
    text width=32mm,align=flush center,
    minimum width=32mm, minimum height=9.5mm
  },
  Box2/.style={Box,draw=BlueLine,fill=BlueL!50, text width=27mm, minimum width=27mm
  },
  Box3/.style={Box,draw=OrangeLine,fill=OrangeL!40, text width=28mm, minimum width=28mm
  },
Box4/.style={Box,draw=VioletLine,fill=VioletL2!40, text width=39mm, minimum width=39mm
  },
 Line/.style={line width=1.0pt,black!50,text=black,-{Triangle[width=0.8*6pt,length=0.98*6pt]}},
}
\node[Box4, fill=VioletL2!90!violet!50,](B1){主导\\ 约束};
\node[Box2,right=2 of B1,fill=BlueL](B2){系统\\ 应对措施};
\node[Box,right=2 of B2,fill=GreenL](B3){失效\\ 边界};
\node[Box3,right=2 of B3,fill=OrangeL](B4){适用\\ 工作负载};
\node[Box,draw=OliveLine,fill=OliveL!30, minimum height=11.5mm,
above=0.5of $(B2.north east)!0.5!(B3.north west)$](B0){TinyML};
%
\node[Box4,below=0.37 of B1](B11){毫瓦级功耗\\ 预算};
\node[Box4,below=of B11](B12){千字节级内存\\ 约束范围};
\node[Box4,below=of B12](B13){始终开启的\\ 占空比};
\node[Box4,below=of B13](B14){稀疏网络\\ 接入};
%
\node[Box2,below=0.27 of B2](B21){将模型与激活值\\ 容纳于片上};
\node[Box2,below=of B21](B22){使用整数与\\ 二值运算};
\node[Box2,below=of B22](B23){在检测\\ 间隙休眠};
\node[Box2,below=of B23](B24){传输前\\ 生成摘要};
%
\node[Box,below=0.37 of B3](B31){压缩导致的\\ 准确率损失};
\node[Box,below=of B31](B32){固件更新\\ 风险};
\node[Box,below=of B32](B33){工具链\\ 碎片化};
\node[Box,below=of B33](B34){无法在本地\\ 进行完整训练};
%
\node[Box3,below=0.37 of B4](B41){唤醒词\\ 检测};
\node[Box3,below=of B41](B42){野生动物\\ 监测};
\node[Box3,below=of B42](B43){医疗\\ 可穿戴设备};
\node[Box3,below=of B43](B44){工厂\\ 传感器};
%
\foreach \i in{1,2,3,4}{
\draw[Line](B1.west)--++(180:0.5)|-(B1\i);
}
\foreach \i in{1,2,3,4}{
\draw[Line](B2.west)--++(180:0.5)|-(B2\i);
}
\foreach \i in{1,2,3,4}{
\draw[Line](B3.west)--++(180:0.5)|-(B3\i);
}
\foreach \i in{1,2,3,4}{
\draw[Line](B4.west)--++(180:0.5)|-(B4\i);
}
\foreach \x in{1,2,3,4}{
\draw[Line](B0)-|(B\x);
}
\end{tikzpicture}TinyML 的优势与运行权衡
TinyML 运行在硬件资源的极限条件下。与云系统相比,TinyML 部署通常只有其约 \(10^6\) 至 \(10^9\) 分之一的内存,具体取决于微控制器的内存预算是几兆字节还是千字节级,而功耗预算则处于毫瓦级。这些严格限制使设备能够自主运行数月乃至数年35,但也要求采用专用算法、模型压缩以及精细的系统协同设计。设备形态从掌上大小的开发套件到毫米级芯片不等,36使得在联网、供电或维护成本高昂的场景中实现普适感知成为可能。代表性的开发套件包括 Arduino Nano 33 BLE Sense(256 KB RAM、1 MB 闪存、20–40 mW)和 ESP32-CAM(520 KB RAM、4 MB 闪存、50–250 mW)。
完全在设备端运行能够带来联网系统无法提供的架构能力。消除无线传输可彻底消除片外通信延迟,使紧密耦合的感知与控制回路获得确定性的低延迟响应。取消无线电上行链路也改变了部署的经济性:当每个节点的单价降至个位数美元时,对数千项物理资产进行密集监测便具有经济可行性。微焦耳级能量预算进一步放大了这些经济收益,使设备能够依靠廉价纽扣电池或环境能量采集自主运行多年。最后,本地处理确保数据留在本地:原始传感器数据流在采集接口处处理,且从不通过网络传输,因此敏感数据的暴露面显著缩小,不过,形式化的隐私保障仍需要硬件级内存保护和安全启动机制。
这些能力需要付出显著的权衡代价。计算资源约束带来了严格限制:微控制器通常提供 \(10^5\) 至 \(10^6\) 字节的 RAM,迫使模型和中间激活值根据工作负载控制在数十千字节至几兆字节的范围内。微控制器采用严格的两级存储划分:静态模型权重和编译后的代码存放在非易失性闪存中(通常为几兆字节),而可变的激活值和运行时缓冲区(张量内存池)必须容纳于小得多的片上 SRAM 中(通常不足 256 KB)。因此,阻止模型执行的主导障碍往往是中间激活值的峰值数据量,而非静态参数存储量。嵌入式开发还要求跨技术栈协同设计:工程师必须手动管理内存池,在没有操作系统抽象的情况下调试裸机固件,并针对受限指令集直接优化算子内核。
在这些物理边界内运行会带来独特的生命周期与可靠性挑战。能量采集设备即使满足长期平均功耗预算,也可能因储存的能量在下一次采集前耗尽而失效。因此,其占空比必须同时考虑每次推理的能量消耗和供能时序。激进的量化与剪枝也可能损害模型质量:将 32 位浮点权重转换为 8 位整数(INT8)可以节省内存,但可能降低模型对分布外传感器输入的准确率与鲁棒性。此外,部署后的灵活性受到严格限制:模型直接编译进单体固件镜像,使现场更新依赖于缓慢且有风险的固件重新烧录流程。微控制器供应商与机器学习框架之间的生态系统碎片化37还会带来额外开销和可移植性挑战。
环境与健康监测
当功耗预算、单位经济性和物理隔离条件排除了所有更高层级的平台时,TinyML 的运行模式就变得不可或缺。唤醒词检测是最为人熟知的消费级应用示例:专门设计的低功耗组件持续监听,在本地处理音频,并且仅在检测到唤醒短语时才激活高功耗组件,从而降低平均功耗。38精准农业从另一个角度利用了同样推动本地处理的需求:FarmBeats 使用传感器、摄像头、无人机和本地网关处理,在农场联网成本高昂的情况下减少原始数据传输 (Vasisht et al. 2017)。当感知节点自身必须在毫瓦级预算下运行时,TinyML 将这种本地处理逻辑进一步推进。
Vasisht, Deepak, Zerina Kapetanovic, Jongho Won, Xinxin Jin, Ranveer Chandra, Sudipta N. Sinha, Ashish Kapoor, Madhusudhan Sudarshan, and Sean Stratman. 2017. “FarmBeats: An IoT Platform for Data-Driven Agriculture.” 14th USENIX Symposium on Networked Systems Design and Implementation (NSDI 17), 515–29.
野生动物保护利用 TinyML 开展远程环境监测,由太阳能供电的音频传感器在设备端处理连续声学数据流,以识别物种。定期传输检测摘要而非连续原始音频,可将上行数据量从 4.3 GB/day 降至 400 KB/day,即缩减至原来的 1/10,750×,从而在离网部署中节省电能。医疗可穿戴设备将同样的本地处理逻辑应用于生理监测。灵敏度、采样率、功耗和电池续航时间是需要针对具体设备验证的指标,而非 TinyML 硬件的普遍属性。本地处理可最大限度减少持续无线传输并保护用户隐私,而总运行时间仍受传感器功耗、无线电功耗、占空比和休眠能耗的限制。
这四种范式构成了一个连续的运行谱系,其边界由光速、散热和内存信号传输决定。设计机器学习系统架构时,工程工作的起点是将应用约束系统地映射到这些物理边界。
范式选择
架构师选择机器学习功能的运行位置时,很少只优化一个维度。隐私规则可能禁止云端处理,延迟预算可能排除远程推理,内存占用可能超出移动设备的容量,而成本目标可能排除始终开启的边缘硬件。云、边缘、移动和 TinyML 是应对这些冲突的不同运行约束范围,因此,在它们之间进行选择需要统一的比较框架和结构化的决策流程。
权衡比较分析
部署决策需要在不同的物理与运行约束范围内评估延迟与吞吐量之间的范式权衡。在云、边缘、移动和 TinyML 目标之间进行选择,需要同时权衡延迟、功耗、财务成本、数据暴露和软件复杂性。Table 13 从十四个硬件与系统维度对比了这四种范式,确立了决定部署可行性的基本约束范围。
| 维度 | 云端机器学习 | 边缘机器学习 | 移动端机器学习 | TinyML |
|---|---|---|---|---|
| 处理位置 | 集中式云服务器(数据中心) | 本地边缘设备(网关、服务器) | 智能手机和平板电脑 | 超低功耗微控制器和嵌入式系统 |
| 延迟 | 100–500 ms | 10–100 ms | 5–50 ms | 1–10 ms |
| 计算能力 | 极高(多个 GPU/TPU) | 高(边缘 GPU) | 中等(移动 NPU/GPU) | 极低(MCU/微型处理器) |
| 存储容量 | 云规模(PB 级及以上) | 大(TB 级) | 中等(GB 级) | 非常有限(KB–MB 级) |
| 能耗 | 极高(kW–MW 级) | 高(数百瓦) | 中等(3–5 W) | 极低(mW 级) |
| 可扩展性 | 高(受提供商容量限制) | 良好(受边缘硬件限制) | 中等(按设备扩展) | 有限(硬件固定) |
| 数据暴露 | 远程处理扩大暴露面 | 本地处理减少传输 | 设备端处理减少传输 | 原始数据可保留在本地 |
| 连接需求 | 持续高带宽连接 | 间歇性连接 | 可选 | 无 |
| 离线能力 | 无 | 良好 | 优异 | 完全支持 |
| 实时处理 | 取决于网络 | 良好 | 非常好 | 优异 |
| 成本 | 高($1000s+/月) | 中等($100s–$1000s) | 设备购置($200–$1000+;通常由用户持有) | 极低($1–$10) |
| 硬件要求 | 云基础设施 | 边缘服务器/网关 | 现代智能手机 | MCU/嵌入式系统 |
| 开发复杂度 | 高(需要云技术专长) | 中高(边缘计算与网络) | 中等(移动端 SDK) | 高(需要嵌入式技术专长) |
| 部署速度 | 快 | 中等 | 快 | 慢 |
这一对比体现了数据本地性与计算规模之间的根本张力。远程处理扩大了网络攻击面,需要稳健的传输加密和租户隔离;本地处理将原始数据限制在设备内,减少外部入侵导致的数据暴露,但并未消除物理侧信道风险。section 1.3 中的工作负载原型直接对应这些边界,每种原型都倾向于选择能够缓解其主要瓶颈的范式。
为直观呈现这些多维权衡,figure 10 使用 0–10 的序数评分,从两个正交的运行特征角度评估这四种范式:子图 (a) 将原始吞吐量容量与延迟和热效率相对照,子图 (b) 则从连接独立性、数据本地性、确定性实时响应和离线执行四个方面评估运行自主性。
\begin{tikzpicture}[font=\sffamily]
\pgfplotsset{myaxis/.style={
   y axis line style={draw=none},
   x axis line style={draw=black,line width=1 pt},
    width=8cm,
    height=8cm,
    grid=both,
    grid style={black!30,dashed},
    tick align=inside,
    tick style={draw=none},
    ymin=0, ymax=10,
    ytick={1,3,5,7,9},
    yticklabels={},
    xtick={0,90,180,270},
    xticklabel style={align=center,font=\fontsize{8pt}{9}\selectfont\sffamily},
 % yticklabel style={font=\fontsize{7pt}{7}\selectfont\sffamily},
     yticklabel style={
     rotate around={50:(axis cs:0,0)},
     anchor=center
    },
   xlabel style={font=\fontsize{7pt}{7}\selectfont\sffamily,rotate=30},
   label distance=5pt,
   legend style={at={(1.25,1)}, anchor=north},
   legend cell align=left,
   legend style={fill=BrownL!30,draw=BrownLine,row sep=2.1pt,
   font=\fontsize{7pt}{7}\selectfont\sffamily},
      cycle list={
     {myblue,line width=1.5pt,fill=myblue!70,fill opacity=0.9},
     {mygreen,line width=1.5pt,fill=mygreen!70,fill opacity=0.4},
     {myorange,line width=1.5pt,fill=myorange!20,fill opacity=0.4},
     {myred,line width=1.5pt,fill=myred!70,fill opacity=0.4},
  },
    after end axis/.code={
      % manual y-tick labels
      \foreach \R in {1,3,5,7,9}{
      \pgfmathtruncatemacro{\newR}{\R + 0.5} %
        \node[
          font=\footnotesize\sffamily,
          anchor=base
        ]
        at (axis cs:50,\newR) {\R};
      }
    },
    legend image code/.code={
      % rectangle in Legend
      \draw[fill=#1,draw=none,fill opacity=1]
        (0pt,-2pt) rectangle (4mm,3pt);
    }
    }}
 %left graph
\begin{scope}[local bounding box=GR1,shift={(0,0)}]
\begin{polaraxis}[myaxis,
    xticklabels={计算\\ 能力, 低延迟\\ 能力, 可扩展性,能源\\ 效率},
]
% Cloud ML
\addplot+[]  coordinates {(0,10) (90,2) (180,10) (270,3) (360,10)};
% Edge ML
\addplot+[] coordinates {(0,8) (90,7) (180,8) (270,5) (360,8)};
% Mobile ML
\addplot+[] coordinates {(0,6) (90,8) (180,7) (270,7) (360,6)};
% TinyML
\addplot+[]  coordinates {(0,3) (90,9) (180,5) (270,10) (360,3)};
\legend{云端机器学习, 边缘机器学习, 移动端机器学习, TinyML}
\addplot[draw=myblue,line width=1.5pt]   coordinates {(0,10) (90,2) (180,10) (270,3) (360,10)};
\addplot[draw=mygreen,line width=1.5pt]  coordinates {(0,8) (90,7) (180,8) (270,5) (360,8)};

\end{polaraxis}
\end{scope}
\node[below=2mm of GR1,xshift=-5mm]{\large a)};
 %right graph
\begin{scope}[local bounding box=GR2,shift={(10,0)}]
\begin{polaraxis}[myaxis,
xticklabels={网络连接\\ 独立性, 数据\\ 局部性, 实时\\ 处理,离线\\ 能力},
]
% Cloud ML
\addplot+[]  coordinates {(0,2) (90,3) (180,2) (270,2) (360,2)};
% Edge ML
\addplot+[] coordinates {(0,7) (90,7) (180,8) (270,6) (360,7)};
% Mobile ML
\addplot+[] coordinates {(0,8) (90,9) (180,7) (270,8) (360,8)};
% TinyML
\addplot+[]  coordinates {(0,10) (90,10) (180,10) (270,10) (360,10)};
%\legend{Cloud ML, Edge ML, Mobile ML, TinyML}
\addplot[draw=myblue,line width=1.5pt]  coordinates {(0,2) (90,3) (180,2) (270,2) (360,2)};
\addplot[draw=mygreen,line width=1.5pt] coordinates {(0,7) (90,7) (180,8) (270,6) (360,7)};
\end{polaraxis}
\end{scope}
\node[below=2mm of GR2]{\large b)};
\end{tikzpicture}figure 10 中各不相同的特征表明,没有任何部署层级能在所有运行指标上占据优势。相反,每种范式都将工程复杂性转移到不同的子系统。云端部署要求具备分布式共识、多租户网络和动态成本治理方面的专业能力。边缘和 TinyML 部署在热设计范围和内存容量方面受到严格的物理限制,需要裸机优化、异构硬件抽象和远程设备群编排。移动端部署运行在用户自有硬件上,降低了基础设施成本,但也引入了特定平台的驱动程序碎片化、操作系统对后台任务的激进限流,以及严格的能耗预算。
一种常见的架构失误是仅根据模型准确率选择部署目标,同时将硬件约束视为后续优化的细节。如果一个未量化模型虽然在离线评估中达到 99% 的准确率,但其内存占用在移动硬件上触发了分页,或者持续推理在数秒内就导致热降频,那么该模型便无法实际使用。内存容量、散热极限和网络传输延迟等物理不变量必须在模型开发开始之前作为早期筛选标准,在投入训练资源之前排除无效的部署目标。
决策框架
系统性地选择范式,需要采用分层决策框架,并按照约束使架构失效的速度排序。筛选层次依次评估四道关卡:监管隐私要求、物理延迟、本地计算容量和全生命周期经济性。Figure 11 将这些决策层组织起来,以便在向不可行目标投入工程资源之前排除不可行选项。
\resizebox{.8\textwidth}{!}{%
\begin{tikzpicture}[line join=round,font=\small\sffamily]
\tikzset{%
Line/.style={black!50,-{Triangle[width = 5pt, length = 8pt]}, line width = 1.25pt,text=black},
LineA/.style={line width=1.0pt,black!50,latex-latex},
Box/.style={inner xsep=2pt,inner ysep=6pt,
    node distance=1.5,
    draw=BlueLine,
    line width=0.75pt,
    fill=BlueL!40,
    align=flush center,
    text width=28mm,
    minimum width=28mm, minimum height=12mm
  },
start/.style={inner xsep=2pt,draw=magenta, line width=0.75pt,  fill=magenta!07,rounded corners=8pt,
    text width=25mm,align=flush center, minimum width=25mm, minimum height=9mm},
Box3/.style={draw=VioletLine,fill=VioletL2, trapezium,aspect=1.75,inner xsep=-2ex, text width=38mm,
    node distance=1.5,font=\footnotesize\sffamily,
diamond, minimum width=35mm, minimum height=23mm,line width=0.75pt, align= flush center},
Text/.style={above,text=black!80, font=\footnotesize\sffamily},
}

\node[start](B1){开始};
\node[Box3,below=0.52 of B1](B2){隐私是否\\ 至关重要?};
\node[Box, left=of B2](B3){允许云端处理};
\node[Box, right=of B2](B4){优先本地处理};
%
\node[Box3,below=of B2](2B1){是否要求低延迟\\ ($<$10 ms)?};
\node[Box, left=of 2B1](2B2){可容忍\\ 延迟};
\node[Box, right=of 2B1](2B3){TinyML 或\\ 边缘机器学习};
%
\node[Box3,below=of 2B1](3B1){模型是否需要大量计算?};
\node[Box, left=of 3B1](3B2){高计算\\ 负载};
\node[Box, right=of 3B1](3B3){轻量级处理};
%
\node[Box3,below=of 3B1](4B1){是否存在严格的\\ 成本约束?};
\node[Box,left=of 4B1](4B2){灵活的\\ 预算};
\node[Box,right=of 4B1](4B3){低成本\\ 选项};
%
\node[start,below =1.85 of 4B2](5B1){云端机器学习};
\node[start,below =1.85 of 4B3](5B4){TinyML};
\node[start](5B2) at($(5B1.east)!0.28!(5B4.west)$){边缘机器学习};
\node[start](5B3) at($(5B1.east)!0.73!(5B4.west)$){移动端机器学习};
%arrows
\draw[Line](B1)--(B2);
\draw[Line](B2)--node[Text,pos=0.2]{否}(B3);
\draw[Line](B2)--node[Text,pos=0.2]{是}(B4);
\draw[Line](2B1)--node[Text,pos=0.2]{否}(2B2);
\draw[Line](2B1)--node[Text,pos=0.2]{是}(2B3);
\draw[Line](3B1)--node[Text,pos=0.2]{是}(3B2);
\draw[Line](3B1)--node[Text,pos=0.2]{否}(3B3);
\draw[Line](4B1)--node[Text,pos=0.2]{否}(4B2);
\draw[Line](4B1)--node[Text,pos=0.2]{是}(4B3);
%
\draw[Line](B3.south)--++(0,-13mm)-|(2B1);
\draw[Line](B4.south)--++(0,-13mm)-|(2B1);
\draw[Line](2B2.south)--++(0,-13mm)-|(3B1);
\draw[Line](2B3.south)--++(0,-13mm)-|(3B1);
\draw[Line](3B3.south)--++(0,-13mm)-|(4B1);
%
\draw[Line](4B3.south)--++(0,-6mm)-|(5B4);
\draw[Line](4B3.south)--++(0,-6mm)-|(5B3);
\draw[Line](4B2.south)--++(0,-6mm)-|(5B2);

\draw[Line](3B2.west)--++(-5mm,0)|-(5B1);

\begin{scope}[on background layer,font=\footnotesize\sffamily\bfseries]
\node[draw=GreenLine,inner xsep=8mm,inner ysep=1mm,yshift=1mm,
fill=green!02,fit=(B1)(B3)(B4)(B2),  minimum width=155mm, line width=0.35pt](BB1){};
%
\node[draw=BackLine,inner xsep=8mm,inner ysep=3mm,yshift=1mm,
fill=BackColor!10,fit=(2B1)(2B2)(2B3),  minimum width=155mm, line width=0.35pt](BB2){};
%
\node[draw=RedLine,inner xsep=8mm,inner ysep=3mm,yshift=1mm,
fill=magenta!02,fit=(3B1)(3B2)(3B3),  minimum width=155mm, line width=0.35pt](BB3){};
%
\node[draw=BrownLine,inner xsep=8mm,inner ysep=3mm,yshift=1mm,
fill=BrownL!07,fit=(4B1)(4B2)(4B3),  minimum width=155mm, line width=0.35pt](BB4){};
%
\node[draw=BlueLine,inner xsep=8mm,inner ysep=6mm,yshift=-0.85mm,
fill=cyan!03,fit=(5B1)(5B4),  minimum width=155mm, line width=0.35pt](BB5){};
%
\node[below=3pt of BB1.north east,anchor=north east]{层次:隐私};
\node[below=3pt of BB2.north east,anchor=north east]{层次:性能};
\node[below=3pt of BB3.north east,anchor=north east]{层次:计算需求};
\node[below=3pt of BB4.north east,anchor=north east]{层次:成本};
\node[above=0pt of BB5.south east,anchor=south east]{层次:部署选项};
\end{scope}
\end{tikzpicture}}该流程图用作粗粒度筛选器,而不是单一路径的确定性算法。上游关卡施加严格的物理和监管约束,无论下游选项多么理想,都可能排除整个分支。如果监管规定或数据主权要求禁止将数据传输到设备之外,就会立即排除远程云端处理。同样,如果物理截止时间要求短于网络往返时间,那么无论服务器计算容量多大,依赖网络的范式都会被排除。当各分支在成本层重新汇合时,移动端机器学习和 TinyML 都成为低成本选项;该框架由此将设计空间缩小为规模可控的候选子集,以供详细基准测试。
汽车紧急制动场景展示了延迟关卡如何在计算容量或成本进入考量之前就形成约束。
Example 1.1: 自动驾驶汽车紧急制动
场景:自动驾驶汽车视觉系统在严格的 100 ms 端到端延迟预算下,执行用于紧急制动的实时行人检测。
诊断:该场景假设云端卸载的网络往返延迟为 50–150 ms,而在汽车边缘加速器(300 GFLOP/s)上进行本地目标检测需要 10–30 ms。在这些假设下,仅远程路径就会导致车辆在制动前行驶 2.8 m。
系统启示:无论可用计算资源有多少,硬实时安全约束都会排除云端卸载。延迟上界决定了必须采用边缘机器学习部署架构,云端连接则保留用于离线模型训练和遥测数据聚合。
通过物理和经济筛选关卡确立了技术可行性,但架构师还必须考虑运维可维护性。在数千个边缘节点或数百万个微控制器上部署模型,会引入持续的全生命周期开销:自动固件更新、带外遥测、分布式漂移监测和硬件故障恢复。具备云端运维能力的组织,可能缺乏大规模支持边缘或 TinyML 目标所需的嵌入式工具链和物理测试基础设施。
除了特定硬件层级的运维需求之外,还有一个更先决的系统问题:该功能究竟是否值得部署机器学习。深度神经网络带来了传统软件可以避免的沉重维护负担。在决定采用任何机器学习架构之前,工程师必须评估确定性启发式方法能否以很小一部分运维成本解决问题。
Systems Perspective 1.4: 复杂性税
考虑一个既可以通过确定性启发式规则,也可以通过深度学习流水线解决的分类任务。启发式方法需要五十行代码,计算成本接近零,每月大约需要一小时更新规则,并且不存在分布漂移。机器学习系统可能只需要五十行模型定义代码,但它会引入约 2,000 行配套基础设施代码,用于特征摄取、遥测日志记录、漂移监测和 GPU 驱动管理,此外每月还需要 40 小时来诊断数据漂移和维护流水线。
如果一个机器学习模型将准确率从 90% 提高到 95%,却使运维维护工作量扩大到原来的 40\(\times\),那么它带来的工程投入净回报就是负的。机器学习系统工程致力于通过具备韧性的架构最大限度地降低这类开销;当持续维护成本超过边际统计收益的价值时,确定性软件仍然是正确的系统选择。
这种权衡将模型选择重新定义为系统层面的优化,涵盖物理执行极限、资本支出以及预测质量的持续维护。当这种复杂性税 超过统计预测改进带来的运维价值时,维持机器学习部署实际上会降低整体系统效率。
Checkpoint 1.2: 系统设计
核心权衡往往是准确率与复杂性之间的权衡。
决策关卡
对这些权衡的处理表明,范式选择是一种受计算、通信和存储的物理不变量约束的架构优化。尽管决策框架确立了基本可行性,且 基准测试 和 机器学习运维 详细介绍了相应的测量与运维生命周期实践,但现实应用往往存在相互不兼容的约束。智能系统可能既要求 PB 级训练容量,又要求亚毫秒响应时间和离线隐私保护。当任何单一层级都无法独自满足这些相互冲突的物理边界时,系统工程通过将工作负载划分到多个运行环境中来弥合这一差距。
混合架构
决策框架(figure 11)通过逐项检验候选系统是否满足物理约束,缩小应用的可行范式范围。然而,生产工作负载在整个生命周期中很少始终受同一种统一约束支配。实时控制要求亚毫秒响应闭环,持续感知要求功耗低于一毫瓦,而高容量表征则需要由内存达数 GB 的加速器组成的集群。没有任何单一硬件平台能同时满足这三项要求:将整个工作负载置于云端会违反延迟截止时间和网络带宽限制,而将其限制在嵌入式微控制器上则会使其缺乏内存和算术吞吐量。生产系统通过混合架构 解决这一矛盾,将计算流水线划分到多个硬件层级,确保每个阶段都在满足其制约性约束所需成本最低的位置执行。三种集成模式 决定了这种分工。
集成模式
三种基本的混合机器学习模式,其区别在于由哪一种物理边界决定划分方式:训练与服务分离、分层处理 或渐进式部署。模式选择是一项由铁律决定的决策:每个计算阶段都必须在其制约项——无论是吞吐容量 \(R_{\text{peak}}\)、本地延迟下限 \(L_{\text{lat}}\),还是内存容量——造成的系统代价最低的位置执行。
在训练与服务分离 模式下,训练在集中式数据中心执行,而推理在边缘、移动端或嵌入式设备上本地运行。这种解耦解决了模型优化与模型执行之间的根本不对称性。训练需要反向传播、优化器状态存储(例如自适应矩估计(Adam)的动量和方差向量,其内存占用需要达到参数内存占用的 \(8\times\) 至 \(16\times\)),以及跨密集加速器互连网络的高吞吐量批并行。相比之下,推理只执行前向传播,处理小批量数据或单个词元,并且必须满足严格的本地延迟和隐私约束。成本摊销是这种分离模式的经济基础:训练的高昂固定成本被分摊到数百万次在本地提供服务的前向传播查询上,而不产生持续的网络传输成本。39
Definition 1.6: 混合机器学习
混合机器学习 是一种部署策略,将机器学习流水线分布到两个或更多部署层级,并根据各阶段的延迟、计算、数据和运维约束进行分配。
- 意义:混合架构利用了铁律的加性结构:边缘层可以降低时间敏感的预处理和推理的 \(L_{\text{lat}}\),而云端层可以提供训练、再训练和高计算负载批量推理所需的 \(R_{\text{peak}}\)。这种划分遵循数据局部性不变量:比较每个阶段完整的本地路径和远程路径,排除无法满足服务截止时间的路径,然后在可行方案中进行选择。
- 区别:纯云端部署在所有阶段都承受距离带来的代价,纯边缘部署则在所有阶段都接受有限的 \(R_{\text{peak}}\);与二者不同,混合机器学习动态地将流水线的每个阶段分配到使其制约性铁律项最小的层级。
- 常见误区:一种常见误解认为混合机器学习只是“运行两个模型”。实际上,参与的各层级必须共享同步状态——特征定义、模型版本和预处理逻辑——以确保各自路径产生一致的结果。如果缺乏这种同步,就会在层级边界产生训练与服务偏差。
在分层处理 模式下,计算跨层级级联执行,逐步过滤和聚合数据,使通信量与可用互连带宽相匹配。在物理边缘产生的传感器数据流往往超过广域网(WAN)的上行链路容量;持续将原始、未压缩的遥测数据流式传输到数据中心,会使网络链路饱和并浪费无线通信能耗。为防止网络饱和,前端层级在本地过滤数据:TinyML 微控制器运行低功耗异常检测器,边缘网关聚合并关联多个传感器的时序特征,云端集群则仅摄取异常事件或聚合摘要,用于全局分析。在推理服务过程中,分层处理通常采用置信度级联的形式。本地设备上的紧凑低延迟模型首先评估输入。如果其预测置信度超过经过校准的阈值 \(\tau\),设备就立即返回结果,完全绕过网络。只有模糊或低置信度的输入才会触发经 WAN 向更大的云端模型传输载荷,从而在维持模型最高准确率的同时,最大限度地降低服务延迟中位数。
在渐进式部署 模式下,工程团队从统一架构或训练语料库派生出一组专用模型变体,使每个变体适配特定层级的内存容量、算术强度和热限制。开发者并非强行将单一模型部署到所有设备上,而是应用训练后量化、剪枝和知识蒸馏等结构化压缩方法,沿准确率与效率的帕累托曲线生成各层级专用的模型产物。现代语音接口展示了这种多层级递进:持续的唤醒词检测在始终开启的微控制器 SRAM 预算内运行(基准 TinyML 神经网络占用数十 KB,并在专用低功耗硬件上消耗亚毫瓦至毫瓦级功率);本地检测到的触发短语唤醒设备上的神经处理单元以解析声学特征;不受约束的语义理解则卸载到云端基础设施中的大参数规模模型。
有了三种可用的集成模式,模式选择就成为一个约束匹配问题:选择其权衡特征与系统主要瓶颈相匹配的模式。Table 14 总结了各模式的权衡、有利于采用各模式的条件,以及不宜采用各模式的条件。
| 模式 | 权衡 | 适用条件 | 不宜采用的条件 |
|---|---|---|---|
| 训练与服务分离 | 训练成本与推理延迟之间的权衡 | 训练需要的规模是推理所不需要的;推理需要考虑隐私,而训练不需要 | 模型需要持续从部署后产生的数据中学习 |
| 分层处理 | 局部自主性与全局优化之间的权衡 | 数据量超出传输容量;需要在多个时间尺度上做出决策 | 所有处理均可在同一层完成;网络可靠且快速 |
| 渐进式部署 | 模型质量与部署覆盖范围之间的权衡 | 多个能力层级需要使用同一模型;需要平稳降级 | 模型无法进行有意义的压缩;只有单一部署目标 |
生产部署很少孤立地实现这些模式;复杂系统会在流水线的不同阶段组合使用这些模式。例如,自动驾驶车辆通过渐进式部署,将专用视觉骨干网络适配到车载计算资源限额内;通过分层处理,协调本地硬件上毫秒级的即时紧急制动与耗时数秒的轨迹规划;并通过训练与服务分离,将异常驾驶数据片段上传到云端集群,以进行车队级重新训练。当法规或隐私约束导致原始训练数据无法离开客户端设备时,联邦学习等隐私保护分布式训练范式会进一步扩展这种组合。
生产系统集成
生产环境中的混合系统通过结构化交互通道协调多个层级。如 figure 12 所示,多层架构维持着两股方向相反的流:编译后的模型产物从云端训练集群向下部署到边缘、移动和 TinyML 执行目标,而原始传感器数据流、筛选后的特征以及推理遥测数据则向上传播到集中式数据存储。
\begin{tikzpicture}[font=\small\sffamily]
\tikzset{
Line/.style={line width=1.0pt,black!50,text=black},
  Box/.style={inner xsep=2pt,
    node distance=0.6,
    draw=GreenLine, line width=0.75pt,
    fill=GreenL,
    text width=20mm,align=flush center,
    minimum width=20mm, minimum height=9mm
  },
   Text/.style={inner xsep=2pt,
    draw=none, line width=0.75pt,
    fill=TextColor,
    font=\footnotesize\sffamily,
    align=flush center,
    minimum width=7mm, minimum height=5mm
  },
  }

\node[Box,fill=RedL,draw=RedLine](G2){训练};
\node[Box,fill=none,draw=none,below =1.2 of G2](A){};
\node[Box,node distance=2.25, left=of A](B2){推理};
\node[Box,node distance=2.25,left=of B2,fill=BlueFill,draw=BlueLine](B1){推理};
\node[Box,node distance=2.25, right=of A,fill=OrangeFill,draw=OrangeLine](B3){推理};
%
\node[Box,node distance=1.15, below=of B1,fill=BlueFill,draw=BlueLine](1DB1){处理};
\node[Box,node distance=1.15, below=of B3,fill=OrangeFill,draw=OrangeLine](1DB3){处理};
\path[](1DB3)-|coordinate(S)(G2);
\node[Box,node distance=1.5,fill=RedL,draw=RedLine]at(S)(1DB2){分析};
\path[](G2)-|coordinate(SS)(B2);
\node[Box](G1)at(SS){传感器};
%
\scoped[on background layer]
\node[draw=BackLine,inner xsep=4mm,inner ysep=6mm,anchor= west,
       yshift=1mm,fill=BackColor,fit=(G1)(B2),line width=0.75pt](BB2){};
\node[below=3pt of  BB2.north,anchor=north]{TinyML};
%
\scoped[on background layer]
\node[draw=BackLine,inner xsep=4mm,inner ysep=7mm,anchor= west,
       yshift=0mm,fill=BackColor,fit=(G2)(1DB2),line width=0.75pt](BB2){};
\node[below=3pt of  BB2.north,anchor=north]{云端机器学习};
%
\draw[Line,-latex](G1.west)--++(180:0.9)|-node[Text,pos=0.1]{数据}(B2);
\draw[Line,-latex](G2)--++(270:1.20)-|(B2);
\draw[Line,-latex](G2)--++(270:1.20)-|(B3);
\draw[Line,-latex](G2)--node[Text,pos=0.46]{部署}++(270:1.20)-|(B1);
%
\draw[Line,-latex](B1)--node[Text,pos=0.5]{结果}(1DB1);
\draw[Line,-latex](B2)|-node[Text,pos=0.75]{结果}(1DB1.10);
%
\draw[Line,-latex](B1.330)--++(270:0.9)-|node[Text,pos=0.2]{协助}(B3.220);
\draw[Line,-latex](B2.east)--node[Text,pos=0.5]{同步}++(0:5.4)|-(1DB3.170);
%
\draw[Line,-latex](1DB1.350)--node[Text,pos=0.75]{结果}(1DB2.190);
\draw[Line,-latex](1DB3.190)--node[Text,pos=0.50]{数据}(1DB2.350);
\draw[Line,-latex](B3.290)--node[Text,pos=0.5]{结果}(1DB3.70);
%
\scoped[on background layer]
\node[draw=BackLine,inner xsep=4mm,inner ysep=5mm,anchor= west,
      yshift=-2mm,fill=BackColor,fit=(B1)(1DB1),line width=0.75pt](BB2){};
\node[above=3pt of  BB2.south,anchor=south]{边缘机器学习};
%
\scoped[on background layer]
\node[draw=BackLine,inner xsep=4mm,inner ysep=5mm,anchor= west,
      yshift=-2mm,fill=BackColor,fit=(B3)(1DB3),line width=0.75pt](BB2){};
\node[above=3pt of  BB2.south,anchor=south]{移动机器学习};
\end{tikzpicture}生产系统通过将各层级边界设置在不同的物理瓶颈处,体现了这些集成模式:
- 工业缺陷检测:以高节拍运行的装配线要求延迟低于 10 ms 的确定性视觉检测。通过广域网将高分辨率摄像头帧流式传输到数据中心,会违反检测时限并耗尽工厂的上行带宽。系统采用训练与服务分离:集中式云端基础设施利用多加速器计算组,基于历史缺陷数据库训练高容量视觉模型,再为工厂车间的边缘服务器和嵌入式智能摄像头编译并量化运行时权重。这些本地部署的加速器通过本地 PCIe 或 MIPI 摄像头接口执行推理,在不依赖外部网络的情况下保证延迟有界。
- 农业监测:远程土壤探头部署范围覆盖数百公顷,使用纽扣电池或小型太阳能采集装置供电,并通过数据速率低、每比特能耗高的 LPWAN 或 LoRa 无线电通信。持续流式传输湿度和温度遥测数据会在数天内耗尽电池储备。分层处理将高频采样和基本异常检测限制在功率预算低于一毫瓦的 TinyML 微控制器上。发生异常时,本地边缘网关汇总各空间探头簇的测量值,仅通过蜂窝回传链路将压缩后的田块级摘要传输到云端服务器,由后者负责整个农场的灌溉调度。
- 可穿戴健身追踪:电池供电的智能手表受严格的散热限额约束,处理器的持续耗散功率必须保持在 \(<1\text{ mW}\)。系统在网关架构中采用渐进式部署:轻量级整数计算内核在嵌入式微控制器上运行,以实时追踪运动并检测心率阈值;中间生物特征数据通过低功耗蓝牙(BLE)同步到配对的智能手机,智能手机利用移动神经网络引擎和数 GB 的 DRAM 对复杂活动模式进行分类;最后,智能手机通过 Wi-Fi 或蜂窝网络定期将压缩摘要传输到云端基础设施,以进行纵向健康建模。
混合方法为何有效
尽管四个部署层级在可用能量、内存容量和计算吞吐量方面相差多个数量级,但它们建立在相同的系统基础之上。在 figure 13 中,一个结构层次图展示了差异显著的部署目标如何依赖共同的数据管理、软硬件执行抽象和资源调度原则。
\begin{tikzpicture}[font=\small\sffamily]
  \tikzset{
    Box/.style={draw=none,minimum width=38mm, minimum height=20mm, node distance=7mm},
    Arr/.style={-{Triangle[width=10pt,length=8pt]}, line width=5pt,cyan!40,shorten >=1pt, shorten <=2pt},
 Box2/.style={align=flush center, inner xsep=2pt,draw=none,
  font=\footnotesize\sffamily\bfseries, line width=0.75pt, fill=OrangeL!30, text width=38mm,
    minimum width=36mm, minimum height=7mm},
  Box3/.style = {Box2,draw=none,fill=cyan!10},
  Box4/.style = {Box2,draw=none,fill=GreenFill!60},
LineA/.style = {violet!60,{Circle[line width=1.0pt,fill=white,length=5.5pt]}-,line width=1.5pt,shorten <=-3pt},
    Arr/.style={-{Triangle[width=14pt,length=11pt]}, line width=8pt,black!40,shorten >=1pt, shorten <=2pt},
Txt/.style = {font=\footnotesize\sffamily,black!80,align=center}
}
\tikzset{
pics/stitAI/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\def\inset{2.2pt} %
\def\myshape{%
  (0,1.34) to[out=220,in=0] (-1.20,1.03) --
  (-1.20,-0.23) to[out=280,in=160] (0,-1.53) to[out=20,in=260] (1.20,-0.23) --
  (1.20,1.03)  to[out=180,in=320] cycle
}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
 \begin{scope}
 \clip[] \myshape;
 \draw[fill=\filllcolor,draw=\drawcolor!60, line width=3*\inset] \myshape;
\end{scope}
\node[draw=\drawcolor,line width=\Linewidth,rounded corners=4pt, fill=\filllcirclecolor,
font=\huge\sffamily,minimum size=13mm](AI) at(-1.1,-0.1){人工智能};
\draw[blue,rounded corners,line width=\Linewidth,-{Circle[blue,fill=yellow,length=6.5pt]}]
(AI.30)--++(3mm,0)--++(0,3mm)--++(6mm,0);
\draw[green!60!black,rounded corners,line width=\Linewidth,-{Circle[green!60!black,fill=yellow,length=6.5pt]}]
(AI.0)--++(9mm,0);
\draw[red,rounded corners,line width=\Linewidth,-{Circle[red,fill=yellow,length=6.5pt]}]
(AI.330)--++(3mm,0)--++(0,-3mm)--++(6mm,0);
\end{scope}
    }
  }
}
%cloud ML
\tikzset {
pics/cloudA/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=CLO,scale=\scalefac, every node/.append style={transform shape}]
\node[draw=\drawcolor!90!red,line width=\Linewidth,minimum width=6mm,minimum height=12mm](VSK)at(0,0.5){};
\node[draw=\drawcolor!90!red,line width=\Linewidth,fill=white,minimum width=9mm,minimum height=4mm](VSKG)at(VSK.north){};
\node[draw=\drawcolor!90!red,line width=\Linewidth,fill=white,minimum width=9mm,minimum height=4mm](VSKC)at(VSK.center){};
\node[draw=\drawcolor!90!red,line width=\Linewidth,fill=white,minimum width=9mm,minimum height=4mm](VSKD)at(VSK.south){};
\draw[fill=\filllcolor,draw=\drawcolor!60,,line width=\Linewidth](0,0)to[out=170,in=180,distance=11](0.1,0.61)
to[out=90,in=105,distance=17](1.07,0.71)
to[out=20,in=75,distance=7](1.48,0.36)
to[out=350,in=0,distance=7](1.48,0)--(0,0);
\draw[draw=\drawcolor!60,,line width=\Linewidth](0.27,0.71)to[bend left=25](0.49,0.96);
\draw[draw=\drawcolor!60,,line width=\Linewidth](0.67,1.21)to[out=55,in=90,distance=13](1.5,0.96)
to[out=360,in=30,distance=9](1.68,0.42);
\node[single arrow, draw=orange,fill=orange,
      minimum width = 10pt, single arrow head extend=3pt,
      minimum height=10mm,
      rotate=270]at(1.05,0) {};
\end{scope}
}
}
}
    % #1 number of teeths
    % #2 radius intern
    % #3 radius extern
    % #4 angle from start to end of the first arc
    % #5 angle to decale the second arc from the first
    % #6 inner radius to cut off
    \tikzset{
      pics/gear/.style args={#1/#2/#3/#4/#5/#6/#7}{
       code={
               \pgfkeys{/channel/.cd, #7}
    \begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
        \pgfmathtruncatemacro{\N}{#1}%
        \def\rin{#2}\def\rout{#3}\def\aA{#4}\def\aOff{#5}\def\rcut{#6}%
        \path[rounded corners=1.5pt,draw=\drawcolor,fill=\filllcolor]
          (0:\rin)
          \foreach \i [evaluate=\i as \n using (\i-1)*360/\N] in {1,...,\N}{%
            arc (\n:\n+\aA:\rin)
            -- (\n+\aA+\aOff:\rout)
            arc (\n+\aA+\aOff:\n+360/\N-\aOff:\rout)
            -- (\n+360/\N:\rin)
          } -- cycle;
          \draw[draw=none,fill=white](0,0) circle[radius=\rcut];
    \end{scope}
      }}
    }

\tikzset {
pics/cloudML/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=CLO,scale=\scalefac, every node/.append style={transform shape}]
\draw[fill=\filllcolor,draw=\drawcolor!60,,line width=\Linewidth](0,0)to[out=170,in=180,distance=11](0.1,0.61)
to[out=90,in=105,distance=17](1.07,0.71)
to[out=20,in=75,distance=7](1.48,0.36)
to[out=350,in=0,distance=7](1.48,0)--(0,0);
\draw[draw=\drawcolor!60,,line width=\Linewidth](0.27,0.71)to[bend left=25](0.49,0.96);
%\draw[draw=\drawcolor!60,,line width=\Linewidth](0.67,1.21)to[out=55,in=90,distance=13](1.5,0.96)
%to[out=360,in=30,distance=9](1.68,0.42);
%\node[single arrow, draw=orange,fill=orange,
   %   minimum width = 10pt, single arrow head extend=3pt,
   %   minimum height=10mm,
   %   rotate=270]at(1.05,0) {};
 \draw[red,rounded corners,line width=\Linewidth,-{Circle[red,fill=yellow,length=6.5pt]}]
(0.3,0.1)--++(0,-8mm)--++(-5mm,0);
 \draw[violet,rounded corners,line width=\Linewidth,-{Circle[violet,fill=yellow,length=6.5pt]}]
(0.7,0.1)--++(0,-10mm);
 \draw[blue,rounded corners,line width=\Linewidth,-{Circle[blue,fill=yellow,length=6.5pt]}]
(1.1,0.1)--++(0,-8mm)--++(5mm,0);
\pic[shift={(0,0)}] at (0.65,0.1) {gear={12/1.5/1.9/8/4/0.8/scalefac=0.35,
drawcolor=mypurple,filllcolor=mypurple}};
\end{scope}
}
}
}
\tikzset {
pics/mobile/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=MOB,scale=\scalefac, every node/.append style={transform shape}]
\node[rectangle,draw=\drawcolor,minimum height=94,minimum width=47,
            rounded corners=4,thick,fill=white](R1){};
\node[rectangle,draw=\drawcolor,minimum height=67,minimum width=38,thick,fill=\filllcolor](R2){\Large 人工智能};
\node[circle,minimum size=8,below= 2pt of R2,inner sep=0pt,thick,fill=\filllcirclecolor]{};
\node[rectangle,fill=\filllcirclecolor,minimum height=1,minimum width=20,above= 4pt of R2,inner sep=0pt,thick]{};
%
 \end{scope}
     }
  }
}
%brain
\tikzset{pics/brain/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=BRAIN,scale=\scalefac, every node/.append style={transform shape}]
\draw[fill=\filllcolor,line width=\Linewidth](-0.3,-0.10)to(0.08,0.60)
to[out=60,in=50,distance=3](-0.1,0.69)to[out=160,in=80](-0.26,0.59)to[out=170,in=90](-0.46,0.42)
to[out=170,in=110](-0.54,0.25)to[out=210,in=150](-0.54,0.04)
to[out=240,in=130](-0.52,-0.1)to[out=300,in=240]cycle;
\draw[fill=\filllcolor,line width=\Linewidth]
(-0.04,0.64)to[out=120,in=0](-0.1,0.69)(-0.19,0.52)to[out=120,in=330](-0.26,0.59)
(-0.4,0.33)to[out=150,in=280](-0.46,0.42)
%
(-0.44,-0.03)to[bend left=30](-0.34,-0.04)
(-0.33,0.08)to[bend left=40](-0.37,0.2) (-0.37,0.12)to[bend left=40](-0.45,0.14)
(-0.26,0.2)to[bend left=30](-0.24,0.13)
(-0.16,0.32)to[bend right=30](-0.27,0.3)to[bend right=30](-0.29,0.38)
(-0.13,0.49)to[bend left=30](-0.04,0.51);
\draw[rounded corners=0.8pt,line width=\Linewidth,\drawcircle,-{Circle[fill=\filllcolor,length=2.5pt]}](-0.23,0.03)--(-0.15,-0.03)--(-0.19,-0.18)--(-0.04,-0.28);
\draw[rounded corners=0.8pt,line width=\Linewidth,\drawcircle,-{Circle[fill=\filllcolor,length=2.5pt]}](-0.17,0.13)--(-0.04,0.05)--(-0.06,-0.06)--(0.14,-0.11);
\draw[rounded corners=0.8pt,line width=\Linewidth,\drawcircle,-{Circle[fill=\filllcolor,length=2.5pt]}](-0.12,0.23)--(0.31,0.0);
\draw[rounded corners=0.8pt,line width=\Linewidth,\drawcircle,-{Circle[fill=\filllcolor,length=2.5pt]}](-0.07,0.32)--(0.06,0.26)--(0.16,0.33)--(0.34,0.2);
\draw[rounded corners=0.8pt,line width=\Linewidth,\drawcircle,-{Circle[fill=\filllcolor,length=2.5pt]}](-0.01,0.43)--(0.06,0.39)--(0.18,0.51)--(0.31,0.4);
\end{scope}
     }
  }
}
\tikzset{mycylinder/.style={cylinder, shape border rotate=90, aspect=1.3, draw, fill=white,
minimum width=25mm,minimum height=11mm,line width=\Linewidth,node distance=-0.15},
pics/dataP/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=STREAMING,scale=\scalefac, every node/.append style={transform shape}]
\node[mycylinder,fill=\filllcolor!50] (A) {};
\node[mycylinder, above=of A,fill=\filllcolor!50] (B) {};
\node[mycylinder, above=of B,fill=\filllcolor!10] (C) {};
\fill[\filllcolor!50!black]($(C.west)!0.12!(C.east)$)circle(3pt);
\fill[\filllcolor!50!black]($(B.west)!0.12!(B.east)$)circle(3pt);
\fill[\filllcolor!50!black]($(A.west)!0.12!(A.east)$)circle(3pt);
%
\draw[draw=\drawcolor,line width=2.5*\Linewidth](B.east)--++(17mm,0);
\node[draw=\drawcolor,line width=\Linewidth,minimum width=9mm,fill=white,minimum height=22mm](BD)at($(B.east)+(8mm,0)$){};
\node[draw=\drawcolor,line width=\Linewidth,minimum width=5mm,minimum height=8mm,fill=white](BDM)at($(BD.east)+(5mm,0)$){};
\node[circle,draw=orange,line width=\Linewidth,minimum size=5mm]at($(BD.north)!0.2!(BD.south)$){};
\node[rectangle,draw=blue,line width=\Linewidth,minimum size=5mm]at($(BD.north)!0.5!(BD.south)$){};
\node[circle,draw=green,line width=\Linewidth,minimum size=5mm]at($(BD.north)!0.8!(BD.south)$){};
\end{scope}
     }
  }
}
\tikzset {
pics/hand/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=MOB,scale=\scalefac, every node/.append style={transform shape}]
\draw[draw=\drawcolor,line width=\Linewidth,fill=\filllcirclecolor](1.07,-0.02)--(1.70,0.2)arc(110:-40:1.0mm)--(1.0,-0.48)arc(-60:-100:4.0mm)--(0.4,-0.34)--(0.15,-0.42)
--(-0.1,0.13)--(0.31,0.33)--(1,0.08)to [bend left=25]cycle;
\draw[draw=\drawcolor,line width=\Linewidth](-0.1,0.13)--(0.31,0.33)--(1,0.08)arc(60:-90:1.4mm)--(0.55,-0.03);
\node[draw=\drawcolor,line width=\Linewidth,fill=cyan ,minimum width=8mm,minimum height=5mm,rotate=117]at(-0.17,-0.26){};
 \end{scope}
     }
  }
}
\tikzset{%
 LineST/.style={-{Circle[\drawcolor,fill=white,length=7pt]},draw=\drawcolor,line width=\Linewidth,rounded corners},
 ellipseST/.style={fill=\filllcolor,ellipse,minimum width = 2.5mm, inner sep=2pt, minimum height =1.5mm},
 BoxST/.style={line width=\Linewidth,fill=white,draw=\drawcolor,rectangle,minimum width=56,minimum height=16
 ,rounded corners=2pt},
 pics/streaming/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=STREAMING,scale=\scalefac, every node/.append style={transform shape}]
\node[BoxST,minimum width=44,minimum height=48](\picname-RE1){};
\foreach \i/\j in{1/north,2/center,3/south}{
\node[BoxST](\picname-GR\i)at(\picname-RE1.\j){};
\node[ellipseST]at($(\picname-GR\i.west)!0.2!(\picname-GR\i.east)$){};
\node[ellipseST]at($(\picname-GR\i.west)!0.4!(\picname-GR\i.east)$){};
}
\draw[LineST](\picname-GR1.40)--++(0,0.5)--++(1,0)coordinate(\picname-C1);
\draw[LineST](\picname-GR1)--++(2,0)coordinate(\picname-C2);
\draw[LineST](\picname-GR2)--++(1.8,0)coordinate(\picname-C3);
\draw[LineST](\picname-GR3)--++(2,0)coordinate(\picname-C4);
\draw[LineST](\picname-GR3.320)--++(0,-0.5)--++(1,0)coordinate(\picname-C5);
\draw[LineST](\picname-GR3.220)--++(0,-0.5)--++(-1,0)coordinate(\picname-C6);
\draw[LineST](\picname-GR3)--++(-2,0)coordinate(\picname-C7);
\draw[LineST](\picname-GR2)--++(-1.8,0)coordinate(\picname-C8);
\draw[LineST](\picname-GR1)--++(-2,0)coordinate(\picname-C9);
\draw[LineST](\picname-GR1.140)--++(0,0.5)--++(-1,0)coordinate(\picname-C10);
 \end{scope}
     }
  }
}
\tikzset{pics/light/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=LIGHT,scale=\scalefac, every node/.append style={transform shape}]
 \draw[draw=\drawcolor,fill=\filllcolor,line width=\Linewidth](0,0)to[out=135,in=310](-0.18,0.5) to[out=125,in=230](-0.25,1.55)
  to[out=50,in=130,distance=14](0.89,1.55)  to[out=310,in=55](0.84,0.55)to[out=230,in=50](0.64,0) --cycle;
 \foreach \i in {0.13,0.23,0.33,0.43}{
\node[fill=\filllcolor!30!black,rounded corners=0.5pt,rectangle,minimum width=19,minimum height=2,inner sep=0pt,rotate=4]at(0.30,-\i){};
}
 \draw[draw=none,fill=\filllcolor!30!black,rounded corners=1pt](-0.03,-0.54)--(0.66,-0.5)--(0.43,-0.78)--(0.19,-0.778)--cycle;
 \end{scope}
     }
  }
}
\tikzset{%
  radius=2, start angle=-90, line cap=round,
  arr node/.style={sloped, allow upside down, single arrow,
    single arrow head extend=+.15cm, thick, minimum height=+.7cm, fill=white},
  arr/.style ={  edge node={node[arr node, pos={#1}]{}}},
  arr'/.style={insert path={node[arr node, pos={#1}]{}}},
 pics/infinityL/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=LOOPS,scale=\scalefac, every node/.append style={transform shape}]
\draw[line width=+3mm, sloped, text=white,draw=\drawcolor]
  (0, 2) edge[preaction={line cap=butt, line width=+6mm, draw=white, overlay},
              out=0, in=180, arr=.2, arr=.8] (6, -2)
  (6, -2) arc[delta angle= 180]
    [arr'=.5] node[very near start]{} node[very near end]{}
  to[out=180, in=0, arr=.2, arr=.8] (0, -2) arc[delta angle=-180]
    [arr'=.5] node[very near start]{} node[very near end]{};

 \end{scope}
     }
  }
}
\pgfkeys{
  /channel/.cd,
   Depth/.store in=\Depth,
  Height/.store in=\Height,
  Width/.store in=\Width,
  filllcirclecolor/.store in=\filllcirclecolor,
  filllcolor/.store in=\filllcolor,
  drawcolor/.store in=\drawcolor,
  drawcircle/.store in=\drawcircle,
  scalefac/.store in=\scalefac,
  Linewidth/.store in=\Linewidth,
  picname/.store in=\picname,
  filllcolor=BrownLine,
  filllcirclecolor=violet!20,
  drawcolor=black,
  drawcircle=violet,
  scalefac=1,
  Linewidth=0.5pt,
  Depth=1.3,
  Height=0.8,
  Width=1.1,
  picname=C
}
%Clodu ML
\node[Box, fill=white](B1){};
\pic[shift={(-0.42,-0.40)}] at  (B1){cloudA={scalefac=0.85,filllcirclecolor=orange!80,drawcolor=BlueLine,
filllcolor=cyan!10,  Linewidth=1.0pt}};
\draw[violet,line width=1.5pt](B1.south west)--coordinate(S1)(B1.south east);
\node[Box2,anchor=north,below= 0.2 of B1](T1){云端机器学习};
\node[Txt,anchor=south,above= 0 of B1](TT1){云端机器学习\\ 大规模训练};
%\draw[LineA](S1)--(CR);
%Edge ML
\node[Box, right=of B1](B2){};
\pic[shift={(-0.52,-0.10)}] at  (B2){cloudML={scalefac=0.92,filllcirclecolor=GreenLine,drawcolor=black,
filllcolor=BrownL!30,  Linewidth=1.0pt}};
\draw[violet,line width=1.5pt](B2.south west)--coordinate(S2)(B2.south east);
\node[Box2,anchor=north,below= 0.2 of B2](T2){边缘机器学习};
\node[Txt,anchor=south,above= 0 of B2](TT2){边缘机器学习\\ 端侧推理};
%Mobile ML
\node[Box, right=of B2](B3){};
 \pic[shift={(0,0.03)}] at  (B3){mobile={scalefac=0.55,filllcirclecolor=myblue,drawcolor=mybrown,filllcolor=mybrown!06,  Linewidth=1.0pt}};
\draw[violet,line width=1.5pt](B3.south west)--coordinate(S3)(B3.south east);
\node[Box2,anchor=north,below= 0.2 of B3](T3){移动端机器学习};
\node[Txt,anchor=south,above= 0 of B3](TT3){个人设备\\ 用户应用};
%Tiny ML
\node[Box, right=of B3](B4){};
\begin{scope}[local bounding box=TINYML,shift={($(0,0)+(B4)$)}]
\pic[shift={(0,0)}] at (0,0) {gear={12/1.5/1.9/8/4/1.2/scalefac=0.49,drawcolor=GreenLine,filllcolor=GreenLine}};
\pic[shift={(0,0)}] at (0.11,-0.2){brain={scalefac=1,picname=1,filllcolor=orange!30!, filllcirclecolor=cyan!55!black!60, Linewidth=0.75pt}};
\end{scope}
\draw[violet,line width=1.5pt](B4.south west)--coordinate(S4)(B4.south east);
\node[Box2,anchor=north,below= 0.2 of B4](T4){微型机器学习};
\node[Txt,anchor=south,above= 0 of B4](TT4){资源受限 \\ 设备};
%%%%%%%%%%%%%%%%%%%%%%
%Data Pipeline
\node[Box,below=3.2 of B1](2B1){};
\pic[shift={(-0.56,-0.6)}] at  (2B1){dataP={scalefac=0.56,picname=1,filllcirclecolor=violet!20,filllcolor=BlueLine, Linewidth=0.7pt}};
\draw[violet,line width=1.5pt](2B1.south west)--coordinate(2S1)(2B1.south east);
\node[Box3,anchor=north,below= 0.2 of 2B1](2T1){数据流水线};
\node[Txt,anchor=south,above= 0 of 2B1](2TT1){采集 – 处理 –\\ 部署};
%System Architecture
\node[Box,below=3.2 of B4](2B3){};
\pic[shift={(0,0)}] at  (2B3){streaming={scalefac=0.43,picname=2,drawcolor=mybrown, Linewidth=1.25pt}};
\draw[violet,line width=1.5pt](2B3.south west)--coordinate(2S3)(2B3.south east);
\node[Box3,anchor=north,below= 0.2 of 2B3](2T3){系统架构};
\node[Txt,anchor=south,above= 0 of 2B3](2TT3){模型 – 硬件 – \\ 软件};
%
\coordinate(DR)at($(2B1)!0.5!(2B3)$);
%Resource Management
\node[Box](2B2)at(DR){};
\begin{scope}[local bounding box=RESOURCE,shift={($(-0.67,-0.2)+(2B2)$)}]
\pic[shift={(0,0)}] at (1.1,0.65) {gear={12/1.5/1.9/9/0.5/0.8/scalefac=0.25,drawcolor=RedLine,filllcolor=RedLine}};
\pic[shift={(0,0)}] at (0,0){hand={scalefac=1,picname=1,filllcolor=orange!30!, filllcirclecolor=brown!60, Linewidth=1.25pt}};
\end{scope}
\draw[violet,line width=1.5pt](2B2.south west)--coordinate(2S2)(2B2.south east);
\node[Box3,anchor=north,below= 0.2 of 2B2](2T2){资源管理};
\node[Txt,anchor=south,above= 0 of 2B2](2TT2){计算 – 内存 –\\ 能源 – 网络};
%%%%%%%%%%%%%%%%%%%%%%%%%
%%%%%%%%%%%%%%%%%%%%%%
%Optimization
\node[Box,below=3.25 of 2B1](3B1){};
\pic[shift={(-0.20,-0.350)}] at  (3B1){light={scalefac=0.7,drawcolor=yellow!90!black,filllcolor=yellow!50!, Linewidth=1.0pt}};
\draw[violet,line width=1.5pt](3B1.south west)--coordinate(3S1)(3B1.south east);
\node[Box4,anchor=north,below= 0.2 of 3B1](3T1){优化 \& 效率};
\node[Txt,anchor=south,above= 0 of 3B1](3TT1){模型 – 硬件 –\\ 能源};
%Operational Aspects
\node[Box,below=3.25 of 2B2](3B2){};
\pic[shift={(-0.8,0)}] at  (3B2){infinityL={scalefac=0.27,picname=1,Linewidth=0.8pt,
 filllcolor=BrownLine,drawcolor=GreenLine}};
\draw[violet,line width=1.5pt](3B2.south west)--coordinate(3S2)(3B2.south east);
\node[Box4,anchor=north,below= 0.2 of 3B2](2T2){运维方面};
\node[Txt,anchor=south,above= 0 of 3B2](3TT2){部署 – 监控 –\\  更新};
%Trustworthy AI
\node[Box,below=3.25 of 2B3](3B3){};
\pic[shift={(0,0.1)}] at  (3B3){stitAI={scalefac=0.66,filllcirclecolor=orange!80,,drawcolor=BlueLine,filllcolor=cyan!10,  Linewidth=1.0pt}};
\draw[violet,line width=1.5pt](3B3.south west)--coordinate(3S3)(3B3.south east);
\node[Box4,anchor=north,below= 0.2 of 3B3](3T3){可信人工智能 };
\node[Txt,anchor=south,above= 0 of 3B3](3TT3){安全 – 隐私 –\\ 可靠性};
%
\begin{scope}[on background layer]
\node[draw=brown,inner sep=3mm,dashed,line width=1pt,fit=(T1)(B1)(TT4)(B4)](F1){};
\node[anchor=south east,font=\small\sffamily\bfseries]at(F1.north east){机器学习系统实现};
%
\node[draw=myblue,inner sep=3mm,dashed,line width=1pt,fit=(2T1)(2B1)(2TT3)(2B3)](F2){};
\node[anchor=south east,font=\small\sffamily\bfseries]at(F2.north east){核心系统原理};
%
\node[draw=mygreen,inner sep=3mm,dashed,line width=1pt,fit=(3T1)(3B1)(3TT3)(3B3)](F3){};
\node[anchor=south east,font=\small\sffamily\bfseries]at(F3.north east){系统考量};
\end{scope}
%
\draw[Arr](F1)--(F2);
\draw[Arr](F2)--(F3);
\end{tikzpicture}这种架构上的趋同解释了工程优化为何能够在不同硬件规模之间双向迁移:它们针对的是相同的底层物理瓶颈。在所有层级中,从片外内存读取一个操作数所产生的能耗和延迟成本,都比执行一次算术运算高出数个数量级。由于嵌入式微控制器和仓库规模的加速器都受制于内存墙,在极端边缘约束下率先发展起来的技术可以直接缓解数据中心的瓶颈。低精度数值表示(如 FP8、INT8 和 INT4)最初旨在将模型权重装入兆字节级的移动端 DRAM 或千字节级的微控制器 SRAM,而在云集群中,它们发挥着相同的经济作用:将 DRAM 流量减半,并成倍提高张量核心的有效吞吐量(模型压缩)。类似地,为防止移动端 SoC 上的数据溢出到片外内存而开发的算子融合和静态内存暂存技术,可以直接减少云端自回归解码期间的 HBM 流量。反过来,在分布式云集群中划分计算图的技术(模型训练),则为在包含独立 CPU、GPU 和神经处理单元的异构移动端 SoC 上拆分流水线阶段提供了基础形式化方法。
这一共同的系统基础贯穿数据工程(数据工程)、模型压缩(模型压缩)和运维生命周期(机器学习运维)。无论执行目标是多节点 TPU pod,还是超低功耗 ESP32 微控制器,这些工程原理都适用。由于基础抽象保持不变,其脆弱性也同样存在:数据分布漂移、模型过时和遥测退化在各个层级反复出现,因此需要在整个混合层级体系中遵循统一的监控规范。
Checkpoint 1.3: 混合机器学习模式
混合架构通过在不同层级之间划分工作来发挥作用,而不是将相同的流水线复制到所有层级。
集成模式
设计合理性检查
系统熵:为何部署并非终点
在 figure 13 总结的各种部署范式中,机器学习系统具有一种经典软件所没有的运维脆弱性。在传统计算中,编译后的二进制程序遵循确定性的契约运行:只要存储单元保持其电荷、处理器总线传输的比特不发生损坏,且输入缓冲区满足声明的前置条件,排序例程或矩阵求逆在数百万次调用中的执行行为就完全相同。机器学习打破了这种恒定性。在数据—算法—机器分类体系下,算法(\(A\))和机器(\(M\))在部署后保持静态:模型权重驻留在内存中,运行时在每次前向传播中执行相同的计算图。但随着用户行为变化、传感器校准漂移以及环境波动,运行中的数据分布(\(D\))不断演变。由于模型参数是对固定训练分布 \(P_{\text{train}}\) 的经验拟合,实际运行分布 \(P_{\text{live}}\) 的任何偏离都会引发系统熵:即使代码、模型权重和执行环境逐字节完全相同,预测质量仍会持续衰退。
equation 8 中的诊断性近似将这一退化速率形式化:随着训练分布与线上分布之间的统计距离 \(\mathcal{D}(P_{\text{train}}, P_{\text{live}})\) 增大,系统质量随之下降,其下降幅度由模型对分布偏移的敏感度 \(S_{\text{shift}}\) 缩放: \[ \Delta \text{Quality} \approx - S_{\text{shift}} \cdot \mathcal{D}(P_{\text{train}}, P_{\text{live}}) \tag{8}\] 由于推理引擎只要完成矩阵乘法且未发生数值异常或内存故障,就会报告成功,因此传统基础设施监控无法察觉统计退化。缺乏监控的模型会继续以高置信度生成预测,而其实际运行效用却在持续下降。因此,保障系统可靠性需要持续的统计遥测,以检测分布漂移何时需要触发模型更新;机器学习运维 分析了这一运维实践。
当缺乏监控的模型直接与自动化执行相耦合时,统计退化会迅速升级为物理故障或财务损失。Zillow Offers 的崩溃说明,开环系统中不断累积的估计误差如何摧毁整个业务部门。
War Story 1.1: Zillow Offers 的崩溃(2021 年)
背景:房地产交易平台 Zillow 推出了“Zillow Offers”,通过依赖房价及转售经济效益预测的 iBuying 业务直接收购房屋 (Zillow Group 2021)。
机制:Zillow 报告称,其购入房屋的价格高于修正后对未来售价的估计,同时转售能力受限导致部分交易的交割延迟 (Zillow Group 2021)。由于系统将价格估计与购买承诺相耦合,预测不确定性转化为了库存风险敞口。
影响:Zillow 对房屋库存计提了 $304 百万美元的减值,裁减了 25% 的员工(2,000 人),并永久关闭了 Offers 部门。
应对:更安全的设计应限制库存风险敞口,保留人工干预权限,并在预测不确定性与购买决策之间设置熔断机制。
系统启示:当软件将预测直接与影响资产负债表的行动相耦合时,分布偏移会将统计退化转化为严重的业务风险。在动态环境中运行的生产系统需要自动熔断机制和反馈回路,以在线上误差分布变宽时限制现实世界中的风险敞口。
Zillow Offers 的失败表明,机器学习系统既包括预测模型,也包括根据其输出采取行动的运行反馈回路。将部署视为最终交接,即冻结训练好的模型并使其在无人值守的情况下执行,忽视了系统熵的现实。数据(\(D\))中的统计退化不可避免地侵蚀算法(\(A\))和机器(\(M\))所提供的保障。保护生产流水线需要在整个架构中构建工程防护措施,从输入漂移遥测和验证关卡,到自动熔断机制。然而,管理系统熵只是运维实践的一部分;应对部署中的物理约束,还需要摒弃从经典软件工程中沿袭而来的根深蒂固的假设。
谬误与陷阱
除统计退化之外,工程师还经常陷入对机器学习部署架构的误解。支配数据移动、散热和硬件平衡的物理约束会产生反直觉的行为,挑战常规软件工程直觉。以下谬误与陷阱揭示了一些常见的失效模式:系统与其物理运行边界严重不匹配。
谬误:一种部署范式可以解决所有机器学习问题。
物理约束形成了任何单一范式都无法跨越的硬性边界。section 1.4 中关于内存墙的讨论表明,内存带宽、内存容量和访问延迟的改善速度远慢于原始算术计算能力的增长速度,从而在不同部署层级形成不同的物理瓶颈。Table 13 列出的是示例性部署边界,而非仅由物理因素决定的延迟界限。要求响应时间低于 10 ms 的实时机器人系统,无法采用端到端网络往返时间超过这一预算的远程云端路径;而无论如何压缩,具有十亿参数的语言模型都无法驻留在微控制器的 256 KB SRAM 中。稳健的架构通常会结合多种范式,利用云资源进行分布式训练并提供突发容量,同时在客户端设备上执行本地推理或传感器预处理。
一种相关误解认为,将计算移近用户总能降低延迟,却忽视了受散热约束或带宽较低的边缘处理器所引入的执行延迟——推理基准测试中探讨了这一权衡(推理基准测试)。
陷阱:依靠模型优化来克服移动设备的功耗和散热限制。
压缩技术无法突破基本的热力学极限。考虑一部配备 15 Wh 电池的智能手机。功耗为 1 W 的轻量推理工作负载可运行 \(\frac{15 Wh}{1 W}\) = 15 h,但功耗为 5 W 的密集型工作负载——这在未经优化的端侧基础模型中很常见——会在 \(\frac{15 Wh}{5 W}\) = 3 h 内耗尽同一块电池。
持续以 5 W 的功耗运行还会触发严重的热节流,因为智能手机机身为稳态被动散热预留的功率预算仅约为 3 W。虽然将 FP32 参数量化为 INT8,在示例情景中可将内存占用缩减至原来的 1/4×,但动态开关能耗和静态漏电并不会按比例降低。超出被动散热边界的连续推理流水线不可避免地会迫使系统进行动态频率调整,要求工程师降低占空比、重构模型架构,或将计算迁移至专用加速器芯片。
谬误:TinyML 就是缩小版的移动端机器学习。
TinyML 与移动端部署之间存在质的界限:物理约束迫使二者采用根本不同的算法和执行模型。正如 section 1.8.1 所阐明的,微控制器提供 256 KB 至 1 MB 的 SRAM,而移动平台配备 8–16 GB 的 LPDDR DRAM——这种 10,000\(\times\) 的容量差距决定了内存驻留方式。移动系统可以执行具有数千万参数的模型,而 TinyML 架构只能容纳数万或数十万参数,因此需要专门的逐深度运算和层调度,以尽量降低激活内存峰值。运行功耗预算表现出更为显著的断层:移动端推理的功耗为 3–5 W,而 TinyML 的目标为 1–10 mW,以便在能量采集所能支持的范围内运行。将移动端优化技术直接应用于 TinyML 环境的团队会发现,当全部工作内存必须容纳于 64 KB SRAM 中时,仅进行从 FP32 到 INT8 的训练后量化并不足够,必须彻底重新设计算法。
陷阱:将计算资源降至最低就能使总成本最低。
孤立地优化单次推理的计算资源,往往会增加运营支出并降低部署速度。正如 section 1.9.2 中的决策框架所强调的,架构选择需要评估整个系统生命周期内的总拥有成本(TCO),而不能只看服务器账单。在这一情景中,与边缘硬件摊销成本 $500/month 相比,计算成本为 $2,000/month 的云端推理服务似乎价格高昂。然而,分布式边缘设备群会带来经常性运营支出:网络工程($3,000/month)、现场硬件维护($500/month)以及设备群可靠性工程($2,000/month)。这些支出使边缘端总运营成本达到 $6,000/month——增至云端基准的 3×。此外,如果云托管服务能在两个月内投入生产,而定制边缘基础设施需要六个月,那么这四个月的延迟会带来严重的机会成本。合理的系统工程应在计算效率、开发速度、设备群可管理性和运维之间取得平衡。
模型阶段更快,并不会使相机流水线获得线性加速。
谬误:模型优化会线性转化为系统加速。
阿姆达尔定律40指出,端到端加速比受到未加速阶段执行时间的严格限制。通过瓶颈原理(section 1.3.1)形式化,并在 强扩展(Amdahl 定律) 中推导的可实现系统加速比为 \(\text{Speedup}_{\text{overall}} = \frac{1}{(1-p) + \frac{p}{s}}\),其中,\(p\) 为总运行时间中可被加速部分所占的比例,\(s\) 为该独立部分的加速因子。考虑在智能手机相机上轻触快门的情形。如页边图所示,拍摄流水线处理传感器原始帧时,依次执行耗时 100 ms 的图像信号处理(ISP 自动曝光与白平衡)、耗时 60 ms 的机器学习场景分类,以及耗时 40 ms 的色调映射与 HDR 合并——总计 200 ms。将神经网络阶段加速 10×(从 60 ms 缩短为 6 ms),会使总延迟从 200 ms 降至 。尽管模型获得了十倍加速,端到端加速比却仅为 1.37×。即使将模型延迟降至零 \((s = \infty)\),最大加速比也只有 1.43×,因为它受到流水线中其余 70 percent 未加速执行部分的限制。优化机器学习系统需要对完整执行图进行性能剖析;一旦某个独立阶段不再是关键路径瓶颈,继续加速该阶段就会产生递减收益。
陷阱:假设更多训练数据总能提升已部署模型的性能。
如 section 1.3 针对各类工作负载原型的分析所示,三项约束限制了数据规模扩展的收益。第一,算法容量(\(A\))会饱和:当模型的参数预算固定时,一旦架构耗尽其表达能力,增加训练数据便无法克服表示瓶颈。第二,数据质量(\(D\))比原始数据量更具决定性:标签噪声、传感器校准误差和伪相关会污染梯度更新,导致扩大受污染语料库的规模只会强化系统性偏差,而非改善泛化能力。第三,分布对齐决定现实世界中的效用:与无法反映生产物理环境的大规模域外数据集相比,高保真、域内运行数据能够持续带来更高的服务准确率。
谬误:一个模型二进制文件就能高效服务于所有目标边缘硬件。
团队经常将单个模型编译为一个制品,并将其统一部署到各种设备上,将部署视为打包步骤,而非硬件协同设计问题。实际上,针对特定硬件的编译和内核降级转换能够获得通用二进制文件无法实现的关键效率收益。例如,在专用神经网络处理单元(NPU)上执行量化的 INT8 运算,每瓦吞吐量显著高于在通用 CPU 上运行相同模型,因为固定功能的 INT8 张量引擎避免了指令解码开销和浮点数据通路的能耗。此外,算子融合会将中间激活张量保留在片上 SRAM 或寄存器文件中,而不是将其逐出到能耗高昂的片外 DRAM。同样,调整内存布局,使张量通道与加速器的向量寄存器对齐,可以消除非合并内存事务。正如 section 1.1 中的部署范式分析所确立的,硬件架构施加了不同的执行约束:为 Arm Cortex-A78 CPU 编译的二进制文件无法利用 Arm Ethos-U NPU 的紧耦合暂存 SRAM 和脉动阵列。可移植的模型制品仅用作中间表示;生产部署需要针对目标运行时、硬件委托、内存层次结构和散热包络进行编译与性能剖析。
总结
机器学习系统工程受一个物理现实支配:每种部署目标都施加了独特的硬件契约。机器学习系统铁律(\(T = \frac{D_{\text{vol}}}{\text{BW}} + \frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}} + L_{\text{lat}}\))将这些物理限制统一为一个执行模型:传播时延带来固定延迟(\(L_{\text{lat}}\)),内存墙限制数据移动(\(D_{\text{vol}}/\text{BW}\)),而散热功率预算则限制持续计算能力。从云端、边缘、移动端到 TinyML,各类别的功率包络从兆瓦级到毫瓦级,跨越九个数量级,而代表性系统则处于这一包络内更窄的范围中。
通过将瓶颈原则应用于工作负载原型,工程师可以在选定单节点或混合架构之前,确定模型的延迟主要受计算效率、内存带宽还是网络传输支配。本章提出的定量权衡(table 13)和系统化决策框架(figure 11)确立了物理基线,这些基线支配着后续在模型压缩、数据流水线设计和高性能模型服务方面的所有决策。
要点回顾: 相同模型,不同工程
- 物理约束界定可行性:光速(横跨一国的往返时间约为 36 ms)、功耗墙、内存墙和延迟预算构成了工程无法突破、只能在其中寻求可行方案的硬性边界。
- 先识别瓶颈,再进行优化:同一个模型在训练时受计算限制,在推理时却受内存限制。机器学习系统铁律和瓶颈原则可以准确定位起主导作用的约束;优化错误的项不会带来任何加速。
- 工作负载原型决定部署可行性:大规模图像模型训练这类“计算巨兽”通常需要云规模资源;关键词检测这类“微型约束”任务则需要微控制器级的效率。同一种优化策略无法同时适用于两者;工程师必须使工作负载原型与部署范式相匹配。
- 部署功率跨越九个数量级:云数据中心基础设施运行在兆瓦级,而 TinyML 系统以毫瓦级为目标。这一差距使截然不同的应用类别成为可能,而非代表一种局限。
- 混合架构在生产系统中十分普遍:语音助手横跨 TinyML(唤醒词)、移动端(语音转文本)和云端(语言理解)。当单一范式不足以满足需求时,集成模式(训练与服务分离、分层处理、渐进式部署)会形式化地规定不同范式如何组合。
- 系统级加速遵循阿姆达尔定律,而非模型级性能增益:在所分析的摄像头流水线示例中,当机器学习占流水线执行时间的 30% 时,速度提升至 10\(\times\) 的模型仅带来 1.37\(\times\) 的系统加速。优化任何组件之前,都应对整个系统进行性能剖析。
- 部署开启了一个反馈循环:即使代码和权重保持不变,实时数据也可能偏离训练条件,因此,监控和对运营风险暴露的限界控制都是系统架构的一部分。
部署范式并非任意的设计偏好,而是由物理定律决定的连续运行区域。选择部署目标会改变机器学习系统铁律中最可能成为限制因素的项:数据中心训练可能逼近峰值计算能力的限制(\(O/R_{\text{peak}}\)),移动端推理可能触及内存带宽的限制(\(D_{\text{vol}}/\text{BW}\)),远程实时推理则可能受到传播时延的约束(\(L_{\text{lat}}\))。系统工程始于测量这一实际起限制作用的约束。优化模型架构或软件运行时,如果不遵循底层硬件契约,就会产生脆弱的系统,在现实运行压力下失效。
后续内容: 从理论到流程
虽然 section 1.9.2 中确立的物理约束和决策框架界定了机器学习系统在物理上能够运行于何处,但仅有物理可行性并不能保证系统长期成功运行。Zillow 的 $304 百万美元资产减记 (Zillow Group 2021) 表明,将模型部署到生产环境,需要在整个软件生命周期中控制预测不确定性并管理运营风险。机器学习工作流 介绍了机器学习开发生命周期,即推动系统从问题定义走向部署、监控和维护的系统化工程流程。
Zillow Group. 2021. Zillow Group Reports Third-Quarter 2021 Financial Results and Shares Plan to Wind down Zillow Offers Operations. Investor Relations Press Release.
Footnotes
部署范式:一种独特的运行状态,其边界由物理规律而非惯例决定。从云端到 TinyML 的谱系在功耗上跨越九个数量级,因为热力学和电磁约束构成了任何软件优化都无法跨越的硬性壁垒,迫使各层级采用性质不同的系统架构。误判范式边界会浪费工程投入:如果应用的 10 ms 延迟预算要求采用边缘部署,那么将云端模型的吞吐量优化提高 5% 毫无意义。↩︎
延迟:从发出请求到收到结果之间的时间,对应于铁律中的 \(T\)。光速屏障使这一下限无法消除:光在光纤中的传播速度使横跨美国本土的往返时间至少约为 36 ms,在任何计算开始之前,就已耗尽延迟预算为 10 ms 的安全关键系统的全部预算。距离每消耗一毫秒,模型推理可用的时间就减少一毫秒,因此光速屏障迫使我们选择部署范式,而不仅仅是进行优化。↩︎
Dennard 缩放定律:以 IBM 的 Dennard et al. (1974) 命名,他描述了 MOSFET 的缩放关系:器件尺寸缩小时,可以降低电压和电流,同时使功率密度大致保持受控。随着电压缩放放缓,能耗成为首要的架构约束,性能增长转向并行化和专用化:多核处理器、GPU 和 TPU (Hennessy and Patterson 2019; Esmaeilzadeh et al. 2011)。↩︎
内存带宽(内存墙):“内存墙”一词由 Wulf 和 McKee 于 1995 年提出,他们预测处理器与内存之间的性能差距最终将主导系统性能。对于权重或激活值搬移可能限制性能的机器学习工作负载,这一预测已被证明具有前瞻性。在铁律中,带宽 \((\text{BW})\) 位于数据项 \(D_{\text{vol}}/\text{BW}\) 的分母,因此,若搬移的字节数翻倍,而带宽未相应增加,数据搬移时间就会增加。由此产生的瓶颈取决于算术强度、批大小、数据复用、访问模式和硬件平衡,而非仅由模型大小决定。↩︎
工作负载原型:依据机器学习工作负载在铁律中的主导瓶颈,而非模型家族进行的分类。区分这一点很重要,因为优化策略存在根本差异:受计算限制的工作负载受益于更快的算术运算 \((R_{\text{peak}})\),而受带宽限制的工作负载受益于更宽的内存总线,或通过复用、融合、压缩或降低精度来减少搬移的字节数。误判原型会将优化精力浪费在铁律中的错误项上,例如,团队为受内存限制的推理流水线增加加速器 FLOP/s,却观察不到任何加速。↩︎
关键路径:流水线中由相互依赖的操作组成的最长顺序链。正文中引出本脚注的句子所给出的决策规则是严格的:如果一次 200 ms 的跨区域网络调用出现在关键路径上的任何位置,那么总预算为 100 ms 的系统必然无法达标,无论其他各阶段运行得多快。模型推理未必是耗时最长的阶段;预处理和后处理可能占据主导地位,使关键路径比仅根据模型执行时间推断出的路径更长。↩︎
机器学习硬件成本谱系:AI 基础设施的成本横跨六个数量级,从 $10 的微控制器到数百万美元的加速器集群。这一百万倍的跨度意味着,选择部署范式既是物理层面的决策,也是经济层面的决策。即使在单设备选型中,同样的准确率目标,也可能只有在大幅缩减模型后才能在低成本微控制器上实现,或者在资源预算大得多的昂贵数据中心加速器上实现,而两者在延迟、功率和运营成本方面有着根本不同的特征。↩︎
电能使用效率(PUE):这一指标将冷却、配电等设施能源开销与输送给计算设备的能源区分开来。即使 PUE 为 1.06,在数据中心规模下,非计算功率仍然相当可观。TinyML 不需要专用设施冷却,但传感、通信、转换损耗和休眠功耗仍会计入其完整的系统能耗预算。这些设备层面的开销不在 PUE 的衡量范围内。↩︎
大语言模型(LLM)的训练规模:只有集中式数据中心才能聚合足够的 \(R_{\text{peak}}\),以完成计算量为 3,634.3 PFLOP-days 的训练任务 (Patterson et al. 2021)。远程推理会增加网络延迟,当端到端路径的耗时超出应用的延迟预算时,纯云端执行就不可行。↩︎
作为公用事业计算的云:公用事业服务模式使提供商能够提供一系列专用硬件,而单个组织从经济上难以自行维持这样的硬件组合。这为各类工作负载原型提供了直接、按需访问其所需特定架构的能力:面向计算密集型工作负载的高密度加速器集群单元、面向带宽密集型工作负载的配备 HBM 的节点,以及面向稀疏散布型工作负载的具有快速互连的大内存系统。因此,团队可以租用价值超过 $10M 的专用超级计算集群单元数小时,而无须自行购置。↩︎
张量处理单元(TPU):一种专用集成电路(ASIC),通过在硬件架构中固化机器学习工作负载中占主导地位的矩阵乘法运算,提供 PFLOP/s 级吞吐量。这种极致的专用化以牺牲通用灵活性为代价,使其在相同机器学习任务上的每瓦性能相较通用加速器提升至 \(>10\times\)。因此,以数据中心规模部署这些加速器的高昂成本,只有在大规模、持续的机器学习计算中才具有经济合理性。↩︎
按用量付费定价:一种云经济模型,用户按消耗的加速器小时数付费,而非为拥有硬件付费。弹性定价将闲置 \(R_{\text{peak}}\) 的固定成本转化为与实际利用率成比例的可变成本,但对于持续全天候运行的工作负载,云端成本可能高于按三年摊销的同等本地硬件成本;这一成本交叉关系推动了 table 8 中的总拥有成本(TCO)分析。↩︎
GDPR(《通用数据保护条例》):第 17 条规定,在符合特定事由时,个人享有删除权 (European Parliament and Council of the European Union 2016)。对于机器学习系统,处理删除请求需要追踪该个人的数据在源数据存储、衍生特征、日志、缓存和模型产物中的留存位置。重新训练可能是一种补救措施,但该条例并未规定必须重新训练每一个接触过这些数据的模型。↩︎
HIPAA:《安全规则》要求受监管实体为受保护的电子健康信息实施合理且适当的管理、物理和技术保障措施,包括访问控制和审计控制 (U.S. Department of Health and Human Services 2005)。该规则保持技术中立,并不强制采用机密计算隔离区;具体控制措施及其性能开销取决于系统的风险分析和实现方式。↩︎
总拥有成本(TCO):通过纳入系统整个生命周期内的所有直接和间接成本(电力、冷却、人工),量化标价与真实系统成本之间的差距,并权衡前期资本支出(CapEx)与持续性运营支出(OpEx)。对于本地部署的 GPU,购置价格仅是三年 TCO 的一个组成部分,运行成本也包含在内。↩︎
深度学习推荐模型(DLRM):Meta 于 2019 年提出的架构,是“稀疏散布”原型的典型代表。生产推荐系统的嵌入表可超过 100 TB,使 DLRM 受到内存容量和通信 \(\text{BW}\) 的约束,而非原始 \(R_{\text{peak}}\) 的约束。这颠倒了通常的计算受限假设,迫使系统采用专门的集群设计,其中稀缺资源是内存,而非算术运算能力。↩︎
工业物联网(IIoT):在这一领域,延迟约束可能由物理安全要求决定,而非用户感知决定。停机预算为 5 ms 的安全回路无法容纳 100 ms 的远程往返时间,因此其感知和停机决策必须保留在本地。这一选择移除了长距离网络项,但边缘系统仍受其本地计算容量 \((R_{\text{peak}})\) 的约束。↩︎
物联网(IoT)数据墙:麦肯锡估计,到 2030 年,物联网部署可能创造数万亿美元的经济价值,但这些部署依赖于分布在住宅、工厂、农场、车辆和基础设施中的设备所产生的连续传感器数据流 (McKinsey Global Institute 2021)。在其中许多场景下,原始数据流的总 \(D_{\text{vol}}\) 超过了集中式数据接入可用的上行带宽预算或延迟预算,因此本地边缘处理成为架构上的必要条件,而不仅仅是一种成本优化手段。↩︎
边缘服务器约束:在典型的边缘资源范围内,1–8 GB 内存在尚未计入激活值、运行时状态和其他缓冲区时,大约可以容纳 10 亿至 80 亿个 INT8 权重,因此不能仅凭参数量就认定存在普遍适用的百万级上限。可持续算力还受到功率、散热和占空比的进一步限制。↩︎
边缘设备群协调:管理数千台分布式边缘设备会引入集中式云端所没有的故障模式:间歇性连接导致模型版本漂移,硬件异构性要求针对各目标平台进行优化,而物理访问条件使固件回滚成本高昂。这些运维模式将在 机器学习运维 中讨论。↩︎
无人结账零售:商店可以在本地融合摄像头观测、货架事件与交易状态,然后仅传输选定的事件或聚合数据。隐私边界仍必须涵盖这些衍生记录,因为减少原始视频传输并不能决定数据保留、访问或二次使用方式。↩︎
工业 4.0:第四次工业革命将机器学习集成到工厂车间的传感器—执行器反馈环路中。其系统层面的要求是,控制环路延迟 \((L_{\text{lat}})\) 必须短于其所控制物理过程的时间尺度:以 60 Hz 检测缺陷的焊接机器人,其采样间隔为 16.7 ms,因此部署方案的完整响应路径必须满足这一截止时间。↩︎
预测性维护:模型分析振动、温度等传感器数据,以估计设备状况和故障风险。持续监测使感测频率、占空比、功耗和本地存储成为首要约束。电池供电节点可能需要将平均功耗控制在一瓦以下,而由市电供电的工业网关则可以使用大得多的功耗预算。↩︎
计算摄影:利用机器学习算法(例如多帧融合、神经网络去噪)突破小型移动摄像头传感器的物理限制。这体现了移动计算中的权衡:多阶段流水线必须在用户可感知的快门延迟内执行完毕,同时遵守共享的 3–5 W 热预算。↩︎
移动视觉模型的计算量缩减:MobileNet 风格的架构减少了常见视觉层的计算量,同时为移动任务保留了实用的准确率。架构细节见 网络架构;这里的系统要点是,移动部署通常需要改变模型家族,而非仅仅将同一个模型移到手机上。↩︎
神经处理单元(NPU):移动端片上系统中的专用硬件模块,其电路面向低精度张量运算设计。与 CPU 执行相比,这种专用化设计可以提高能效,帮助 AI 工作负载满足移动端功率预算。↩︎
片上系统(SoC):移动端 SoC 将 CPU、GPU 和 NPU 核心与缓存、内存控制器集成,以降低数据搬移成本。移动端 DRAM 通常位于芯片裸片之外,可支持的模型大小取决于容量、精度、工作内存、带宽和延迟。↩︎
Face ID:Apple 在 Secure Enclave 内执行人脸匹配,并对存储的数学表示进行加密,使其仅可供该子系统使用,且不会离开设备 (Apple 2024a, 2024b)。Apple 报告称,对于一种已录入的外观,随机错误匹配的概率低于 1/1,000,000;对于某些人群和配置,该概率更高。该示例说明,本地推理与硬件隔离能够在支持低延迟身份验证的同时,减少传输过程中的暴露风险。↩︎
人像模式流水线:这并非单个模型,而是用于深度估计、分割和渲染的一系列实时模型。核心工程问题在于管理整条流水线的总延迟和总功耗,而非任何单个模型的性能。整条流水线必须在用户感知的快门延迟内执行完毕,并共享手机 3–5 W 的热预算,因此必须在 CPU、GPU 和 NPU 之间进行调度权衡,以避免降频。↩︎
1 mW 阈值:只有当长期采集到的功率超过整个系统的平均负载功率时,环境能量采集才能使设备无限期运行。可用功率因能量来源和环境而异:指甲盖大小的太阳能电池在室外可能产生约 10 mW,在室内则约为 10 µW;温热管道上的热电发电机约为 100 µW;来自附近发射器的射频能量约为 10 µW。这一收支平衡点可以将部署模式从“寿命受电池限制”转变为“部署后无需维护”,但这取决于能量来源、环境和工作负载。↩︎
泛在计算:Mark Weiser 的泛在计算愿景设想,计算融入日常环境,直至不再引起人们的直接注意 (Weiser 1991)。TinyML 是通向这一愿景的一条现代路径:当智能传感器的成本和功耗低到足以大规模部署时,优化目标就从性能(吞吐量)转向功耗(每次推理的能耗),这正是微型约束原型的核心权衡。↩︎
微控制器(MCU):一种在设计上优先追求最低成本和功耗、而非性能的单芯片计算机,由此形成了前述“极端约束”。许多 TinyML 目标设备仅提供几十到几百 KB 的片上 SRAM,且不具备虚拟内存;一些较高端的微控制器可以连接外部内存。因此,完整模型、激活值和运行时状态必须容纳于目标设备实际可用的内存中,而这一容量往往比智能手机提供的内存少几个数量级。↩︎
TinyML 能耗差距:这一差异根植于硬件设计理念;云端 GPU 针对极致吞吐量进行优化,功耗达数百瓦,而 TinyML 微控制器则面向功耗接近于零的休眠状态进行设计。对于普通云端推理,单次请求可能消耗约 10 焦耳,而专用 TinyML 设备约消耗 10 微焦耳,两者相差 \(1{,}000{,}000\times\)。云端 LLM 查询可使这一差距进一步扩大,具体量化结果见 table 12。↩︎
纽扣电池部署:一枚 CR2032 电池(3 V 下容量为 225 mAh,约 675 mWh)在理想情况下可为功耗为 10–50 µW 的完整系统供电约 1.5–7.7 年。这种“部署后无需维护”的运行模式推动了间歇计算领域的创新:设备在两次推理之间休眠,将能量预算延展至数年的无人值守运行。↩︎
设备端训练约束:完整的设备端训练必须保留中间层输出,以便后续权重更新时计算梯度,因此内存消耗与模型深度成正比。在推理期间,每层的激活值在被下一层使用后即可丢弃。当 RAM 仅有 256 KB–2 MB 时,反向传播的内存需求会超出可用 SRAM;TinyTL 通过冻结权重、仅更新偏置来减少激活值占用的内存 (Cai et al. 2020)。这一内存约束使 TinyML 设备主要限于执行推理,模型更新通过固件部署,而非在原位训练。↩︎
TinyML 设备范围:这一物理尺寸范围体现了部署场景与计算能力之间的直接权衡。毫米级系统优先追求最低功耗(~140 µW),用于单一功能的长期任务;掌上大小的开发板则以更大的体积和更高的功耗,换取处理多个复杂传感器数据流的能力。这一协同设计选择使 TinyML 设备在整个运行范围内的功耗差异达到 \(>10,000\times\),面积差异达到 ~100\(\times\)。↩︎
TinyML 生态系统碎片化:TinyML 横跨 Arm Cortex-M、RISC-V 和 Xtensa 等微控制器家族,它们各自具有不同的指令集、内存布局、内核和供应商工具链;云端与移动端技术栈也存在差异,但其运行时通常屏蔽了更多硬件多样性。因此,针对一种微控制器目标优化的模型,在迁移至另一种目标时可能需要重新调优和验证,从而成倍增加多设备部署的工程成本。↩︎
始终开启的唤醒词检测:一个小型专用模型监听唤醒短语的声学特征,并充当高功耗应用处理器的电源门控。可接受的检测器功耗预算取决于平台,但即使仅持续多消耗几毫瓦,也可能显著缩短电池续航时间。只有当始终开启的处理路径所消耗的平均功率远低于其阻止唤醒的组件时,这种架构才能奏效。↩︎
训练与服务的成本不对称性:训练通常需要多次前向传播和反向传播,而一次推理请求会使用训练好的模型产物执行一次或多次前向传播。训练并非字面意义上的一次性过程,因为模型可能需要重新训练;推理成本也会随模型规模、序列长度、批处理方式和服务开销而大幅变化。这种分离的经济依据在于摊销:重复使用可以将每个训练周期的固定成本分摊到大量已提供服务的预测上。↩︎
阿姆达尔定律:这一原理由 Amdahl (1967) 针对多处理器扩展进行形式化,可直接应用于模型只是众多阶段之一的机器学习部署流水线。在这一相机流水线示例中,机器学习推理在总计 200 ms 的时间中占 60 ms;即使模型加速 100\(\times\),端到端加速比也仅约为 1.4–2×,因为流水线的其余部分保持不变。孤立地对模型延迟进行基准测试的团队会系统性地高估部署收益。↩︎
Dennard, Robert H., Frank H. Gaensslen, Hwa-Nien Yu, Victor L. Rideout, Elias Bassous, and Antoine R. LeBlanc. 1974. “Design of Ion-Implanted MOSFET’s with Very Small Physical Dimensions.” IEEE J. Solid-State Circuits 9 (5): 256–68. https://doi.org/10.1109/jssc.1974.1050511.
Hennessy, John L., and David A. Patterson. 2019. “A New Golden Age for Computer Architecture.” Communications of the ACM 62 (2): 48–60. https://doi.org/10.1145/3282307.
Esmaeilzadeh, Hadi, Emily Blem, Renee St. Amant, Karthikeyan Sankaralingam, and Doug Burger. 2011. “Dark Silicon and the End of Multicore Scaling.” Proceedings of the 38th Annual International Symposium on Computer Architecture, 365–76. https://doi.org/10.1145/2000064.2000108.
Patterson, David, Joseph Gonzalez, Quoc Le, Chen Liang, Lluis-Miquel Munguia, Daniel Rothchild, David So, Maud Texier, and Jeff Dean. 2021. “Carbon Emissions and Large Neural Network Training.” arXiv Preprint arXiv:2104.10350.
European Parliament, and Council of the European Union. 2016. Regulation (EU) 2016/679 of the European Parliament and of the Council of 27 April 2016. Official Journal of the European Union.
U.S. Department of Health and Human Services. 2005. “Summary of the HIPAA Security Rule.”
McKinsey Global Institute. 2021. The Internet of Things: Catching up to an Accelerating Opportunity. McKinsey & Company.
Apple. 2024a. Facial Matching Security. Apple Platform Security.
Apple. 2024b. The Secure Enclave. Apple Platform Security.
Weiser, Mark. 1991. “The Computer for the 21st Century.” Scientific American 265 (3): 94–104. https://doi.org/10.1038/scientificamerican0991-94.
Cai, Han, Chuang Gan, Ligeng Zhu, and Song Han. 2020. “TinyTL: Reduce Activations, Not Trainable Parameters for Efficient on-Device Learning.” Advances in Neural Information Processing Systems 33: 11285–97.
Amdahl, Gene M. 1967. “Validity of the Single Processor Approach to Achieving Large Scale Computing Capabilities.” Proceedings of the April 18-20, 1967, Spring Joint Computer Conference on - AFIPS ’67 (Spring), AFIPS ’67 (spring), 483–85. https://doi.org/10.1145/1465482.1465560.