机器学习工作流
机器学习工作流
本章目的
为什么在踏上任何一条路径之前,都必须先看清完整地图?
数据—算法—机器分类体系明确了每个机器学习系统的组成部分,而部署位置决定了各组成部分必须满足的物理约束。团队往往将这些视为彼此独立的事项,由一个团队收集数据,另一个团队设计模型,再由第三个团队配置硬件。然而,这一分类体系最深刻的启示在于,这些组成部分相互作用。收集到的数据限定了哪些算法可行。选定的算法决定了哪些硬件能够运行它。目标硬件又会反过来改变可处理的数据范围。牵动任何一根线,整个系统都会随之变化。这些相互作用既跨越组成部分,也贯穿时间。一个在上线时表现良好的模型,可能随着数据分布变化而退化,从而需要开展调查,并在证据支持时更新模型或数据。孤立地优化每一部分,会使团队构建出无法部署的高精度模型,以及向下游输送错误数据的高效流水线。理解预处理选择如何约束下游架构的数据工程师,与将数据准备视为孤立任务的工程师,会构建不同的流水线;从第一天就了解部署目标内存预算的模型开发者,与脱离实际约束一味追求准确率的开发者,也会作出不同的架构决策。在理解任何一个组成部分的细节之前,必须先通过完整地图,看清如何将机器学习系统作为一个协调的整体进行构建、评估和持续维护。机器学习工作流通过数据、算法和机器之间反复迭代的协同设计,使这张地图运转起来,直至三者共同涌现的能力满足现实世界的要求。
学习目标
- 将机器学习生命周期的六个阶段解释为带有反馈的数据、算法与机器协同决策
- 从漂移、非确定性和运行反馈三个方面,比较机器学习工作流与传统软件工作流
- 分析问题定义中的约束如何传播至数据、建模、验证和部署阶段
- 利用工作流的约束传播原则,计算因发现问题过晚而产生的集成成本
- 评估生命周期各阶段在准确率、效率、可复现性和部署就绪程度之间的权衡
- 设计将监控信号连接至重新训练、维护和需求修订的反馈回路
机器学习生命周期
一个典型的部署失败案例说明了工程工作缺乏协调的危险。第 1 天:“为乡村诊所构建一个诊断模型。”第 90 天:测试集准确率达到 95%。第 120 天:经过一个月的架构调优,准确率达到 96%。第 150 天:模型移交给部署工程师。第 151 天:部署工程师报告,模型需要 4 GB 内存。第 152 天:有人检查了部署目标——流动诊所中可用内存仅为 512 MB 的平板电脑。第 153 天:五个月的工作被废弃。
模型的准确率非常出色。团队的机器学习技能也非常出色。这次失败是工作流的失败。 一个本应从第一天起就影响每项决策的部署约束,直到工作完成后才被发现。平板电脑的内存限制本应反向传播至第一次架构讨论会议,限定哪些模型值得考虑。然而,团队孤立地优化了每个组成部分(数据收集、架构选择、训练),直到将各部分组装起来,集成失败才显现出来。一项有文献记录的糖尿病视网膜病变(DR)系统部署,暴露了类似的工作流与基础设施缺口。1
机器学习系统在物理约束下结合数据、算法与机器;这些约束将部署划分为云端、边缘、移动端和 TinyML,各自对计算吞吐量、内存容量和散热施加了严格的物理限制。要将这些组成部分连接成可运行的系统,就必须协调约束在数据、算法与机器之间的传播。
机器学习工作流是一种工程框架,旨在通过明确各开发阶段的约束,并追踪这些约束如何在数据、算法与机器之间传播,防止集成失败。它标志着从模型研究者向系统工程师的转变。研究者优化单个要素:更好的架构、更干净的数据集、更快的加速器。系统工程师则将这些要素协调为能够可靠交付价值的生产系统。第 153 天的失败并非源自孤立的建模、数据或硬件缺陷,而是源自三者之间未经管理的相互作用。工作流提供了一张认知地图,使技术决策始终与更大的系统保持联系。
机器学习生命周期是协调这项工作的框架:它是一个结构化的迭代过程2,用于指导机器学习系统的开发、评估和改进 (Amershi et al. 2019)。这一定义强调持续管理,而非一次性发布。
Amershi, Saleema, Andrew Begel, Christian Bird, Robert DeLine, Harald Gall, Ece Kamar, Nachiappan Nagappan, Besmira Nushi, and Thomas Zimmermann. 2019. “Software Engineering for Machine Learning: A Case Study.” 2019 IEEE/ACM 41st International Conference on Software Engineering: Software Engineering in Practice (ICSE-SEIP), 291–300. https://doi.org/10.1109/icse-seip.2019.00042.
Definition 1.1: 机器学习生命周期
机器学习生命周期是构建、部署、监控和更新机器学习系统的迭代式工程过程;由于模型性能可能在部署后发生变化,后续阶段的证据可以反馈至早期阶段。
- 意义:生命周期是一个闭环,而非线性流水线。当前流量与训练流量之间的分布差异 \(\mathcal{D}(P_t \lVert P_0)\) 是一种告警信号,表明准确率下降的可能性增大;确切关系取决于模型、标签、损失和部署分布。一次完整的重新训练会产生 \(O/(R_{\text{peak}} \cdot \eta_{\text{hw}})\) 的计算成本,而局部更新或增量更新的成本可能较低。因此,漂移速度和验证延迟使生命周期维护成为一个预算问题,而不仅仅是工程过程。
- 区别:传统软件的行为会在代码、配置、依赖或环境变化时改变,而机器学习的行为还可能随着世界的变化而改变。即使代码、基础设施和配置完全未变,已部署模型的准确率也可能因分布偏移而发生变化。
- 常见误区:一种常见误解是,生命周期在部署时结束。实际上,部署是反馈回路的起点:生产环境监控揭示漂移,漂移触发调查,而结果证据决定重新训练的模型是否应再次进入部署阶段。
这里,生命周期描述各个阶段本身,工作流描述协调这些阶段的工程方法;生命周期是所经历的阶段,工作流是管理这一过程的方式。这一区分要求采用系统思维:分析系统各部分如何相互关联,而非孤立地看待它们。section 1.9 中形式化表述的模式,以及详细案例研究中的示例,解释了为什么机器学习系统需要一体化的工程方法,而非依次优化各个组成部分。
在分析各个层次之前,必须理解这些阶段如何相互连接,因为每个技术领域——从存储流水线(数据工程)到模型训练(模型训练)、执行框架(机器学习框架)和模型服务基础设施(模型服务)——都作为相互依赖的系统运行。在 figure 1 中,水平布局将上方的数据流水线与下方的模型开发流水线分开,弯曲的返回箭头则说明运行中获得的洞见和数据缺陷如何循环反馈至早期阶段。
\begin{tikzpicture}[font=\sffamily]
%
\tikzset{
  Box/.style={align=flush center,
    inner xsep=2pt,
    node distance=1.6,
    draw=GreenLine,
    line width=0.75pt,
    fill=GreenFill,
    text width=25mm,
    minimum width=25mm, minimum height=23mm
  },
  Box1/.style={Box, node distance=3.7,text width=28mm,minimum width=28mm,fill=BlueFill,draw=BlueLine
  },
 Line/.style={line width=1.30pt,black!50,text=black, -{Triangle[length=3mm, width=1.75mm]}},
 Text/.style={font=\sffamily\footnotesize,align=center
  },
DLine/.style={draw=VioletLine, line width=2pt, -{Triangle[length=4mm, width=2.5mm,bend]},
shorten >=1.1mm, shorten <=1.15mm},
}
%
\node[Box](B1){\textbf{数据收集}\\\small 持续输入流};
\node[Box,right=of B1](B2){\textbf{数据摄取}\\\small 为下游机器学习应用准备数据};
\node[Box, right=of B2](B3){\textbf{数据分析与整理}\\\small  检查并选择合适的数据};
\node[Box, right=of B3](B4){\textbf{数据标注}\\\small  为数据添加标注};
\node[Box, right=of B4](B5){\textbf{数据验证}\\\small 验证数据在整个流水线中均可用};
\node[Box, right=of B5](B6){\textbf{数据准备}\\\small 为机器学习用途准备数据(划分、版本管理)};
%
\coordinate(D1) at ($(B2.south west)+(0,-4.25)$);
\coordinate(D4) at ($(B5.south east)+(0,-4.25)$);
\coordinate(D2) at ($(D1)!0.35!(D4)$);
\coordinate(D3) at ($(D1)!0.67!(D4)$);
\fill[red](D2)circle(2pt);
%
\node[Box1]at(D1)(2B2){\textbf{机器学习系统部署}\\\small  将机器学习\\ 系统部署至\\ 生产环境};
\node[Box1]at(D2)(2B3){\textbf{机器学习系统验证}\\\small 验证机器学习\\ 系统是否满足\\ 部署要求};
\node[Box1]at(D3)(2B4){\textbf{模型评估}\\\small 计算\\ 模型关键绩效指标};
\node[Box1]at(D4)(2B5){\textbf{模型训练}\\\small 使用机器学习算法\\ 创建模型};

\coordinate(S) at ($(B4.south)!0.5!(2B4.north)$);

\begin{scope}[local bounding box=AR,shift={($(S)+(-6,-0.7)$)},anchor=center]
% Dimensions
\def\w{6cm}
\def\h{15mm}
\def\r{6mm} % radius
\def\gap{4mm} % break lengths

\draw[BlueLine, -{Latex[length=10pt,width=22pt]},line width=10pt]
  (\w,\h-\r) -- (\w,\r)
  arc[start angle=0, end angle=-90, radius=\r]
  -- (\gap,0);

  \draw[GreenLine, -{Latex[length=10pt,width=22pt]},line width=10pt]
  (0,\r) -- (0,\h-\r)
  arc[start angle=180, end angle=90, radius=\r]
  -- ({\w-\gap},\h);
\end{scope}
%%%
\draw[Line](B1)--node[below,Text]{原始\\ 数据}(B2);
\draw[Line](B2)--node[below,Text]{已索引\\ 数据}(B3);
\draw[Line](B3)--node[below,Text]{已选择\\ 数据}(B4);
\draw[Line](B4)--node[below,Text]{已标注\\ 数据}(B5);
\draw[Line](B5)--node[below,Text]{已验证\\ 数据}(B6);
\draw[Line](B6)|-node[left,Text,pos=0.2]{可用于机器学习的\\ 数据集}(2B5);
\draw[Line](2B5)--node[below,Text]{模型}(2B4);
\draw[Line](2B4)--node[below,Text]{关键绩效指标}(2B3);
\draw[Line](2B3)--node[below,Text]{已验证的\\ 机器学习系统}
node[above,Text]{机器学习\\ 认证凭证}(2B2);
\draw[Line](2B2)-|node[below,Text,pos=0.3]{在线\\ 机器学习系统}
node[right,Text,pos=0.8]{在线\\ 性能}(B1);

\draw
  (current bounding box.south west) coordinate (bbSW)
  (current bounding box.north east) coordinate (bbNE);

\draw[overlay,DLine,distance=44](B3.north)to[out=120,in=80]
node[below]{数据修复}(B1.north);
\draw[DLine,distance=44,overlay](B5.north)to[out=120,in=80]
node[below]{数据需求}(B3.north);
%
\path[use as bounding box]
  ($(bbSW)+(0mm,-1mm)$)
  rectangle
  ($(bbNE)+(0mm,11.5mm)$);
%\path[red,use as bounding box] (-1.4,1.82) rectangle (21,2.43);
\end{tikzpicture}机器学习生命周期的概念阶段明确了开发过程的内容与原因。运作层面则构成实现方式:通过自动化、工具和基础设施落实这一生命周期。机器学习运维 对这些实践进行了命名并详细展开。这一区分很重要:生命周期是概念框架,而运作基础设施是大规模落实该框架的机制。
量化机器学习生命周期
从业者的时间分配揭示了生命周期真正的瓶颈所在:工程投入很少集中于研究文献着墨最多的地方。机器学习生命周期的概念模型描述了存在哪些阶段,但系统决策取决于量化的现实——工程工时花在何处、消耗了多少计算资源,以及哪些流水线停滞延误了部署。
从业者调查揭示了研究关注点与工程工时分配之间的显著不对称:数据收集与准备占用了从业者 79 percent 的时间。在 figure 2 中,饼图分解了受访者报告的主要耗时活动,将占主导地位的数据收集与准备部分,与模型架构和算法调优所占的较小份额进行对比。
\scalebox{0.75}{%
\begin{tikzpicture}[line join=round,font=\small\sffamily]
\makeatletter
\def\pgfpie@legend#1{%
  \coordinate[xshift=15mm,
  yshift={(\the\pgfpie@sliceLength*0.5+1)*0.5cm}] (pgfpie@legendpos) at
  (current bounding box.east);

\scope[node distance=2.25mm]
    \foreach \pgfpie@p/\pgfpie@t [count=\pgfpie@i from 0] in {#1}
    {
      \pgfpie@findColor{\pgfpie@i}
      \node[circle,draw, fill={\pgfpie@thecolor}, draw=none,inner sep=5 pt,below =1.6mm of {pgfpie@legendpos},
      label={[font=\footnotesize\sffamily]0:{\pgfpie@t}}] (pgfpie@legendpos) {};
    }
  \endscope
}
\makeatother
\definecolor{Greenn}{RGB}{84,180,53}
\definecolor{Redd}{RGB}{249,56,39}
\definecolor{Orangee}{RGB}{255,157,35}
\definecolor{Brownn}{RGB}{214,128,96}
\definecolor{Bluee}{RGB}{0,97,168}
\definecolor{Violett}{RGB}{178,108,186}
\definecolor{Yelloww}{RGB}{255,210,76}
\tikzset{lines/.style={
  draw=none,
  line width=0.75pt
}}

\pie[text=legend,radius=2.65,
     style={lines},
     color={Greenn!60, Redd!90, Orangee, Bluee!80, Yelloww, Violett},
     every slice/.style={draw=blue}
     ]
{60/清洗和整理数据,
19/收集数据集,
9/挖掘数据中的模式,
3/构建训练集,
4/改进算法,
5/其他}
\end{tikzpicture}}这些调查比例说明,数据工程不能仅被视为前期准备性的管道搭建工作。数据流水线是运行阻力、迭代循环和系统级风险的主要来源。在处理使用其输出的模型架构和训练优化之前,掌握数据基础设施(数据工程)能够发挥最大的作用。
除时间分配外,迭代速度也决定了项目进展。figure 1 中的返回箭头并非罕见例外;它们代表团队反复经历的路径。当分布偏移或错误标签导致数据质量下降时,返工会使团队回到收集阶段。当架构超出加速器内存容量或出现数值不稳定时,工程师必须重新审视模型设计。当模型服务层超出延迟预算时,部署流水线就会停滞。每次循环都会消耗实际时间和计算预算;只要下游阶段未能及早发现违反约束的情况,开发成本就会增加。
在给定假设下,迭代周期更短的模型在 26 周后以微弱优势领先完成。
Napkin Math 1.1: 迭代税
问题:面向乡村诊所的糖尿病视网膜病变(DR)筛查系统必须在两种方案之间做出选择:一种是在高分辨率眼底图像上训练的大型集成模型(训练时间:1 week,准确率:95 percent),另一种是适合在诊所硬件上进行边缘部署的轻量级模型(训练时间:1 hour,准确率:90 percent)。在这些假设下,推算六个月后哪种模型的准确率更高?
数学分析:在六个月(约 26 weeks)内,可进行的实验次数为:
- 大模型:日历时间为 26 weeks,每次实验耗时 1 week。假设每次实验使准确率提高约 0.15 percentage points,且这一增益保持恒定。
- 小模型:日历时间为 26 weeks,按 168 h/week 计算,每次实验耗时 1 hour,因此可进行 4,368 次实验。在这样的周期长度下,机器时间并非限制性约束,因此本情景仅将其中 100 次计为有效实验,即团队在六个月内实际能够设计、运行并从中获得经验的实验次数。其余容量因缺乏待验证的假设而闲置。即使假设每次迭代的增益较小,更多有用的迭代也可能带来更大的累积增益。
结果:如果每次迭代平均使准确率提高 0.1 percentage points,小模型的初始准确率为 90 percent,在完成 100 次有效迭代后、施加 99 percent 的上限之前,准确率达到 100 percent。施加 99 percent 的上限后,小模型的准确率达到 99 percent。大模型的初始准确率为 95 percent,经过 26 次较慢的迭代后,准确率达到 98.9 percent。在实践中,小模型的快速迭代有助于发现更好的架构、保持标签不变的数据增强方法以及可调的训练设置。
系统启示:迭代速度本身就是一项特性。 当候选系统可达到的质量相近,且有用实验的预期价值相似时,较短的周期可以扩大团队能够测试的设计空间。仅凭速度无法保证小模型优于大模型。在 DR 筛查情景中,轻量级模型的快速迭代周期使团队能够以快得多的速度试验保持标签不变的输入变换、预处理流水线和架构变体。
这种累积延迟构成了迭代税:等待缓慢的训练运行或繁琐的验证流水线所耗费的时间,会减少团队能够测试的候选模型数量。后期才发现的问题会加重这一代价,3约束传播原理(section 1.9.1)对此进行了形式化描述。部署后才发现的约束违反会迫使团队在所有前序阶段进行代价高昂的回退。这种不对称性要求明确制定阶段接口契约:在每个阶段边界验证输出,可以在缺陷累积为系统性返工之前将其截获。Section 1.2.2 对六个阶段之间的这些契约进行了形式化定义。
迭代延迟与后期发现问题所带来的累积成本,揭示了一个更广泛的结构性事实:机器学习工作流并非传统软件生命周期的慢速版本。 两者在工程投入的集中位置、反馈回路随时间改变系统的方式,以及后期发现的问题如何扩大返工范围等方面,存在根本差异。
机器学习与传统软件
传统系统和机器学习系统都可以采用迭代式生命周期,也都可能表现出非确定性行为。4关键区别在于如何规定应用行为。基于规则的软件将显式逻辑编码到程序中,而机器学习系统从数据中学习统计映射(机器学习与传统软件)。这在既有软件工程实践的基础上,增加了对数据、评估和监控的考量。
因此,机器学习系统需要额外的工作流控制。以金融交易处理为例:确定性的授权规则遵循显式逻辑,一旦输入就绪,便可快速执行。基于机器学习的欺诈检测器则增加了学习得到的评分、特征检索和统计决策逻辑。模型阶段可能耗时数毫秒,但端到端延迟还取决于存储、网络和周边服务。从显式编程转向学习得到的行为,会重塑开发生命周期,改变团队建立可靠性和鲁棒性的方式。
这些差异改变了生命周期各阶段之间的交互方式。常规软件工程依靠生产环境反馈来改进代码和需求,而机器学习系统引入了更多反馈回路:运行数据重塑训练分布,检测到的漂移触发调查,运行时错误暴露数据集盲区。Table 1 从六个核心生命周期维度对比了传统软件工程与机器学习工程,突出说明数据演变如何重新定义测试、部署和持续维护。5
| 方面 | 传统软件生命周期 | 机器学习生命周期 |
|---|---|---|
| 问题定义 | 预先定义精确的功能规格。 | 随着对问题空间的探索,以性能为导向的目标不断演变。 |
| 开发过程 | 迭代开发代码、配置和接口。 | 围绕数据、特征和模型开展迭代实验。 |
| 测试与验证 | 许多功能测试具有精确的预期结果;性能和可靠性仍需量化评估。 | 采用统计验证和包含不确定性的指标。 |
| 部署 | 在显式更新之前,行为保持不变。 | 性能可能因数据分布偏移而随时间变化。 |
| 维护 | 通过修改代码修复缺陷或添加功能。 | 持续监控、更新数据流水线、重新训练模型,并适应新的数据分布。 |
| 反馈回路 | 生产环境反馈通常会促使代码、配置和需求发生变化。 | 部署和监控获得的洞见通常会用于改进数据准备、模型设计等前序阶段。 |
Checkpoint 1.1: 机器学习与传统软件
机器学习系统并非附加了模型的传统软件。请检查你是否理解这些要求采用独立工作流的差异:
大规模场景下的数据局部性
大型机器学习数据流水线可能给现代操作系统采用的局部性优化带来压力。传统软件流水线按顺序扫描记录,而机器学习训练会在各训练轮次中有意打乱样本顺序,以满足随机梯度下降所需的独立同分布(i.i.d.)采样要求。这种算法层面的随机化与硬件和操作系统的假设直接冲突:操作系统内核依赖空间局部性和时间局部性,6即程序读取字节 \(X\) 后,倾向于很快读取附近的字节,并复用最近访问过的内存。
当随机化的样本顺序映射为分散的物理读取时,打乱顺序可能降低文件系统缓冲区和虚拟内存预取器的有效性。其代价取决于逻辑样本如何映射到物理存储。对打乱顺序的分片进行连续读取,可能仍保有有用的局部性;而跨多个分片进行小规模读取,则会使存储和网络延迟显现。感知存储布局的批处理、缓存和显式预取可以恢复局部性并减少这些停顿。相关的系统变量是呈现给内存层次结构的物理访问模式,而非随机化本身。
这一区别决定了应当在哪里优化。如果加载器已经发出大规模顺序读取请求,增加缓存的收益就很有限。如果它将小规模读取分散到许多分片,重新组织记录的存储布局或增大读取粒度,就比增加计算资源重要得多。性能剖析应追踪从存储到加速器的完整访问路径,同时测量存储请求大小、队列深度、缓存命中率和加速器空闲时间,以防止 I/O 瓶颈导致计算资源闲置。
生命周期阶段
乡村诊所的失败案例说明了机器学习项目为何需要明确的六阶段框架:直到数据、模型和评估决策已经围绕错误目标固化之后,部署约束才显现出来。常规生命周期和机器学习生命周期都采用迭代,而机器学习系统还增加了从部署返回数据、训练和评估环节的反馈。六阶段框架涵盖了这一回路。
完整的机器学习生命周期可归纳为六个核心阶段,按功能分为两行排列。在 figure 3 中,沿上行从问题表述追踪至模型评估,再沿下行观察部署如何将监控信号反馈至上游数据采集。
\begin{tikzpicture}[font=\small\sffamily]
\tikzset{
Box2/.style={align=flush center, inner sep=2pt,draw=none,fill=black!70,
font=\fontsize{8pt}{8}\sffamily\bfseries,text=white,minimum width=20mm, minimum height=5mm },
Box/.style={align=center, inner xsep=2pt,draw=black!70, line width=1pt,node distance=15mm,
fill=none, minimum width=25mm, minimum height=20mm},
Circle1/.style={circle,  minimum size=33mm, draw=none, fill=BrownLine!20},
LineD/.style={BrownLine!60!black!20,line width=4.0pt,dashed,dash pattern=on 5pt off 2pt,
{-{Triangle[width=1.5*6pt,length=2.0*5pt]}},shorten <=5pt,shorten >=1pt},
LineA/.style={BrownLine!80!black!40,line width=4.0pt,
{-{Triangle[width=1.5*6pt,length=2.0*5pt]}},shorten <=5pt,shorten >=1pt},
ALineA/.style={violet!60,{Circle[line width=1.0pt,fill=white,round,length=5pt,width=5pt]}-,
line width=1.2pt,shorten <=-15pt,shorten >=-6pt}
}

%dataS
\tikzset{%
 pics/dataS/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=FUNNEL,scale=\scalefac, every node/.append style={transform shape}]
%plats
\draw[fill=\filllcolor,line width=\Linewidth,draw=\drawcolor](0,-0.3)--(-0.67,0.03)--(0,0.37)--(0.67,0.03)--cycle;
\draw[fill=\filllcirclecolor,line width=\Linewidth,draw=\drawcolor](0,0)--(-0.67,0.33)--(0,0.67)--(0.67,0.33)--cycle;
\draw[fill=\filllcolor,line width=\Linewidth,draw=\drawcolor](0,0.3)--(-0.67,0.63)--(0,0.97)--(0.67,0.63)--cycle;
%left
\draw[line width=\Linewidth,draw=\drawcolor](-0.39,1.21)--++(210:0.55)--++(270:1.22)--(-0.39,-0.56);
\fill[line width=\Linewidth,fill=\filllcirclecolor!60!violet!,draw=green,draw=\drawcolor](-0.39,1.21)circle(3pt);
\fill[line width=\Linewidth,fill=\filllcolor,draw=green,draw=\drawcolor](-0.39,-0.56)circle(3pt);
%right
\draw[line width=\Linewidth,draw=\drawcolor](0.39,1.21)--++(330:0.55)--++(270:1.22)--(0.39,-0.56);
\fill[line width=\Linewidth,fill=\filllcirclecolor!60!violet!,draw=green,draw=\drawcolor](0.39,1.21)circle(3pt);
\fill[line width=\Linewidth,fill=\filllcolor,draw=green,draw=\drawcolor](0.39,-0.56)circle(3pt);
\end{scope}
     }
  }
}
%testing+pencil
\tikzset{
pics/testing/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=TESTING1,shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\newcommand{\tikzxmark}{%
\tikz[scale=0.18] {
    \draw[line width=0.7,line cap=round,RedLine] (0,0) to [bend left=6] (1,1);
    \draw[line width=0.7,line cap=round,RedLine] (0.2,0.95) to [bend right=3] (0.8,0.05);
}}
\newcommand{\tikzxcheck}{%
\tikz[scale=0.16] {
    \draw[line width=0.7,line cap=round,GreenLine] (0.5,0.75)--(0.85,-0.1) to [bend left=16] (1.5,1.55);

}}
 \node[draw, minimum width  =15mm, minimum height = 20mm, inner sep = 0pt,
        rounded corners,draw = \drawcolor, fill=\filllcolor!10, line width=\Linewidth](COM){};
\node[draw=GreenLine,inner sep=4pt,fill=white](CB1) at ($(COM.north west)!0.25!(COM.south west)+(0.3,0)$){};
\node[xshift=0pt]at(CB1){\tikzxcheck};
\node[draw=RedLine,inner sep=4pt,fill=white](CB2) at ($(COM.north west)!0.5!(COM.south west)+(0.3,0)$){};
\node[xshift=0pt]at(CB2){\tikzxmark};
\node[draw=RedLine,inner sep=4pt,fill=white](CB3) at ($(COM.north west)!0.75!(COM.south west)+(0.3,0)$){};
\node[xshift=0pt]at(CB3){\tikzxmark};
\draw[GreenLine,decoration={zigzag,segment length=4pt, amplitude=0.5pt},decorate]($(CB1)+(0.3,0.05)$)--++(0:0.8);
\draw[GreenLine,decoration={zigzag,segment length=4pt, amplitude=0.5pt},decorate]($(CB1)+(0.3,-0.12)$)--++(0:0.7);
\draw[RedLine,decoration={zigzag,segment length=4pt, amplitude=0.5pt},decorate]($(CB2)+(0.3,0.05)$)--++(0:0.8);
\draw[RedLine,decoration={zigzag,segment length=4pt, amplitude=0.5pt},decorate]($(CB2)+(0.3,-0.12)$)--++(0:0.6);
\draw[RedLine,decoration={zigzag,segment length=4pt, amplitude=0.5pt},decorate]($(CB3)+(0.3,0.05)$)--++(0:0.8);
\draw[RedLine,decoration={zigzag,segment length=4pt, amplitude=0.5pt},decorate]($(CB3)+(0.3,-0.12)$)--++(0:0.6);
\end{scope}
    }
  }
}
%pencil
\tikzset{
pics/pencil/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=TESTING1,shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape},rotate=340]
            \fill[fill=\filllcolor!70] (0,4) -- (0.4,4) -- (0.4,0) --(0.3,-0.15) -- (0.2,0) -- (0.1,-0.14) -- (0,0) -- cycle;
            \draw[color=white,thick] (0.2,4) -- (0.2,0);
            \fill[black] (0,3.5) -- (0.2,3.47) -- (0.4,3.5) -- (0.4,4) arc(30:150:0.23cm);
            \fill[fill=\filllcolor!40] (0,0) -- (0.2,-0.8)node[coordinate,pos=0.75](a){} -- (0.4,0)node[coordinate,pos=0.25](b){} -- (0.3,-0.15) -- (0.2,0) -- (0.1,-0.14) -- cycle;
            \fill[fill=\filllcolor] (a) -- (0.2,-0.8) -- (b) -- cycle;

\end{scope}
    }
  }
}
%nodes
\tikzset{
pics/nodes/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
%\node[draw=white,fill=none,circle,minimum size=0.925*40mm,line width=1pt](CI){};
%\draw[step=5mm,draw=white] (-2,-2) grid (2,2);
\foreach \x/\y[count=\a] in {-0.2/0.35,
0.7/0.6,-0.5/1.4,-1.20/-0.8,-0.1/-1.3,-0.4/-0.43,
0.61/-0.3,1/-0.85,0.45/1.2,-0.96/0.63}{
\node[circle,fill=myblue,draw=black,inner sep=0pt,minimum size=3mm](XB\a)at(\x,\y){};
}
\foreach \x/\y[count=\a] in {-2.0/0.1
}{
\node[circle,fill=myred,draw=black,inner sep=0pt,minimum size=3mm](XR\a)at(\x,\y){};
}

\foreach \x/\y[count=\a] in {1.87/0.1
}{
\node[circle,fill=mygreen,draw=black,inner sep=0pt,minimum size=3mm](XG\a)at(\x,\y){};
}

\foreach \x in {1,3,4,6,10}{
\draw[RedLine,line width=0.5pt](XR1) edge  (XB\x);
}
\foreach \x in {1,2,5,8,9}{
\draw[mygreen,line width=0.5pt](XG1) edge  (XB\x);
}
\foreach \x in {2,3,6,9,10}{
\draw[black,line width=0.5pt](XB1) edge  (XB\x);
}
\foreach \x in {4,5,7}{
\draw[black,line width=0.5pt](XB6) edge  (XB\x);
}
\draw[black,line width=0.5pt](XB4) edge  (XB5);
\draw[black,line width=0.5pt](XB3) edge  (XB9);
\foreach \x in {2,8}{
\draw[black,line width=0.5pt](XB7) edge  (XB\x);
}
\end{scope}
    }
  }
}

%target
\tikzset{
pics/target/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\definecolor{col1}{RGB}{62,100,125}
\definecolor{col2}{RGB}{219,253,166}
\colorlet{col1}{\filllcolor}
\colorlet{col2}{\filllcirclecolor}
\foreach\i/\col [count=\k]in {22mm/col1,17mm/col2,12mm/col1,7mm/col2,2.5mm/col1}{
\node[circle,inner sep=0pt,draw=\drawcolor,fill=\col,minimum size=\i,line width=\Linewidth](C\k){};
}
\draw[thick,fill=brown,xscale=-1](0,0)--++(111:0.13)--++(135:1)--++(225:0.1)--++(315:1)--cycle;
\path[green,xscale=-1](0,0)--(135:0.85)coordinate(XS1);
\draw[thick,fill=yellow,xscale=-1](XS1)--++(80:0.2)--++(135:0.37)--++(260:0.2)--++(190:0.2)--++(315:0.37)--cycle;
\end{scope}
    }
  }
}
%cloud-arrow
\tikzset {
pics/cloudA/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=CLO,scale=0.8, every node/.append style={transform shape}]
\node[draw=\drawcolor!90!red,line width=\Linewidth,minimum width=6mm,minimum height=12mm](VSK)at(0,0.5){};
\node[draw=\drawcolor!90!red,line width=\Linewidth,fill=white,minimum width=9mm,minimum height=4mm](VSKG)at(VSK.north){};
\node[draw=\drawcolor!90!red,line width=\Linewidth,fill=white,minimum width=9mm,minimum height=4mm](VSKC)at(VSK.center){};
\node[draw=\drawcolor!90!red,line width=\Linewidth,fill=white,minimum width=9mm,minimum height=4mm](VSKD)at(VSK.south){};
\draw[fill=\filllcolor,draw=\drawcolor!60,,line width=\Linewidth](0,0)to[out=170,in=180,distance=11](0.1,0.61)
to[out=90,in=105,distance=17](1.07,0.71)
to[out=20,in=75,distance=7](1.48,0.36)
to[out=350,in=0,distance=7](1.48,0)--(0,0);
\draw[draw=\drawcolor!60,,line width=\Linewidth](0.27,0.71)to[bend left=25](0.49,0.96);
\draw[draw=\drawcolor!60,,line width=\Linewidth](0.67,1.21)to[out=55,in=90,distance=13](1.5,0.96)
to[out=360,in=30,distance=9](1.68,0.42);
\node[single arrow, draw=orange,fill=orange,
      minimum width = 10pt, single arrow head extend=3pt,
      minimum height=10mm,
      rotate=270]at(1.05,0) {};
\end{scope}
}
}
}
%display
\tikzset{%
    comp/.style = {draw,
        minimum width  =18mm,
        minimum height = 15mm,
        inner sep      = 0pt,
        rounded corners,
       draw = \drawcolor,
       fill=\filllcolor!10,
       line width=2.0pt
    },
 pics/displayK/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=COMPUTER1,shift={(0,0)}]
 \node[comp](\picname-COM){};
% \draw[draw = \drawcolor,line width=1.0pt]
% ($(\picname-COM.north west)!0.85!(\picname-COM.south west)$)-- ($(\picname-COM.north east)!0.85!(\picname-COM.south east)$);
\draw[draw = \drawcolor,line width=\Linewidth]($(\picname-COM.south west)!0.4!(\picname-COM.south east)$)--++(270:0.2)coordinate(DL);
\draw[draw = \drawcolor,line width=\Linewidth]($(\picname-COM.south west)!0.6!(\picname-COM.south east)$)--++(270:0.2)coordinate(DD);
\draw[draw = \drawcolor,line width=3*\Linewidth,shorten <=-3mm,shorten >=-3mm](DL)--(DD);
 \draw[
  line width=1pt,
  draw=red,
  line cap=round,
  line join=round
]
(-0.70,0) --(-0.40,0) --
(-0.30,0.13) --
(-0.2,-0.18) --
(-0.05,0.32) --
(0.05,-0.15) --
(0.15,0.23) --
(0.38,-0.15) --
(0.40,0.0) --
(0.70,0.0);
\end{scope}
   }
  }
}

%%%%%%%%%%
\pgfkeys{
  /channel/.cd,
   Depth/.store in=\Depth,
  Height/.store in=\Height,
  Width/.store in=\Width,
  filllcirclecolor/.store in=\filllcirclecolor,
  filllcolor/.store in=\filllcolor,
  drawcolor/.store in=\drawcolor,
  drawcircle/.store in=\drawcircle,
  scalefac/.store in=\scalefac,
  Linewidth/.store in=\Linewidth,
  picname/.store in=\picname,
  tiecolor/.store in=\tiecolor,
  bodycolor/.store in=\bodycolor,
  stetcolor/.store in=\stetcolor,
  tiecolor=red,      % default tie color
  bodycolor=blue!30,  % default body color
  stetcolor=green,  % default stet color
  filllcolor=BrownLine,
  filllcirclecolor=violet!20,
  drawcolor=black,
  drawcircle=violet,
  scalefac=1,
  Linewidth=0.5pt,
  Depth=0.2,
  Height=0.5,
  Width=0.25,
  picname=C
}
%Problem Definition
\node[Box,draw=none](B1){};
 \pic[shift={(0,0)}] at  (B1){target={scalefac=0.7,picname=1,
 drawcolor=BlueD,filllcolor=myred,Linewidth=0.7pt, filllcirclecolor=myred!20}};
 \draw[ALineA,draw=mygreen](B1.south west)--++(200:0.45)
 node[below=1pt,Box2,fill=mygreen]{问题\\ 定义};
%Data Collection \&  Preparation
\node[Box,right= of B1,draw=none](B2){};
\pic[shift={(0,-0.28)}] at  (B2){dataS={scalefac=0.9,picname=1,Linewidth=1.0pt,
 filllcolor=cyan!90!black!40!,drawcolor=black,filllcirclecolor=orange}};
\draw[ALineA,draw=mygreen](B2.south west)--++(200:0.45)
 node[below=1pt,Box2,fill=mygreen]{数据采集  \\ \& 准备};
%Model Development \& Training
\node[Box,right= of B2,draw=none](B3){};
 %persons 1
\pic[shift={(0,0)}] at  (B3){nodes={scalefac=0.6,picname=1,drawcolor=orange,filllcirclecolor=orange!20,filllcolor=orange}};
\draw[ALineA,draw=mygreen](B3.south west)--++(200:0.45)
 node[below=1pt,Box2,fill=mygreen]{模型开发\\ \& 训练};
%Evaluation \& Validation
\node[Box,right=of B3,draw=none](B4){};
\pic[shift={(0,0)}] at  (B4){testing={scalefac=0.85,picname=1,drawcolor=myblue,filllcolor=myblue, Linewidth=1.0pt}};
\pic[shift={(0,-0.5)},rotate=-15] at  (B4){pencil={scalefac=0.37,picname=1,filllcolor=mygreen, Linewidth=1.0pt}};
\draw[ALineA,draw=mygreen](B4.south west)--++(200:0.45)
 node[below=1pt,Box2,fill=mygreen]{评估 \& \\ 验证};
%Deployment \& Integration
\node[Box,below= 1.25 of B4,draw=none](B5){};
%AI
\pic[shift={(-0.50,-0.40)}] at  (B5){cloudA={scalefac=1,filllcirclecolor=orange!80,drawcolor=BlueLine,
filllcolor=cyan!10,  Linewidth=1.0pt}};

\draw[ALineA,draw=mygreen](B5.south west)--++(200:0.45)
     node[below=1pt,Box2,fill=mygreen]{部署 \&\\ 集成};
%Monitoring \& Maintenance
\node[Box,left=of B5,draw=none](B6){};
%AI
\pic[shift={(0,0.1)}] at  (B6){displayK={scalefac=0.45,picname=D,
filllcolor=gray, drawcolor=BlueLine!70!black,Linewidth=0.7pt}};
\draw[ALineA,draw=mygreen](B6.south west)--++(200:0.45)
     node[below=1pt,Box2,fill=mygreen]{监控 \&\\ 维护};

%arrows
\foreach \x in{1,2,3,4,5}{
\pgfmathtruncatemacro{\nx}{\x + 1} %
\draw[LineA,BrownLine!80!black!70](B\x)--(B\nx);
}
\draw[LineD](B6)-|node[above,pos=0.25,font=\footnotesize\sffamily,text=black!70]{反馈}(B2);
\end{tikzpicture}MobileNetV2 将这些阶段置于物理约束之下,其较小的资源占用使边缘部署的限制从一开始就清晰可见。对于 MobileNetV2,问题定义确立了严格的约束:模型大小约为 14 MB,计算量约为 600 MFLOP,并且需要在移动级硬件上进行实时推理。这些约束会立即影响工作流的其余部分。数据采集必须考虑设备端预处理的局限,模型开发则必须选择运算需求符合预算的架构。MobileNetV2 通过深度可分离卷积7实现这一点,即将空间运算与通道运算分解,而非仅仅对参数进行剪枝。评估在目标设备上验证准确率与延迟,部署检验模型是否符合设备的内存和功耗范围,监控则跟踪模型在不同设备群体中的性能。每个阶段的决策都会影响后续阶段,而工作流框架使这些依赖关系显式化。针对农村诊所部署优化的 DR 筛查模型也面临类似压力:设备内存有限、功耗预算严格,以及在缺乏可靠网络连接的情况下仍需进行实时推理。这些共同约束使 DR 成为贯穿全章的有效案例。
沿这些阶段转换追踪 MobileNetV2 可以看出,尽管工作流图呈现出顺序推进的过程,生产工程在本质上却是循环迭代的,它将下游部署约束直接关联到上游设计。
Checkpoint 1.2: 工作流循环
验证每个阶段是否都落实了将上游选择与实际部署的物理约束关联起来的契约。
除了过程编排之外,生命周期的每个阶段还直接映射到性能方程中的特定项。这种映射揭示了机器学习系统铁律(机器学习系统铁律) 在工作流层面的体现:数据准备确定了字节量,模型开发决定了运算次数与硬件效率,而部署基础设施则限定了固定运行时开销。
不同工作负载类型的主导约束差异显著,使得生命周期的各个阶段需要优化不同的铁律项。ResNet-50、DLRM 和关键词检测(KWS) 是有用的参照,因为它们分别对系统的不同部分施加压力:密集型视觉训练力求让加速器持续忙碌,稀疏推荐将大量时间用于搬移嵌入表的行,而关键词检测首先受到极小内存容量与持续运行能耗预算的约束。
生产系统很少能完全归入某一种类型。例如,医学影像分类器在大型图像数据集上训练时需要持续计算,而部署到便携式诊所硬件上时,又面临严格的能耗和内存限制。理解工作流框架如何适应这些权衡,对于做出合理的工程决策至关重要。Table 2 展示了所选的三个工作流阶段在这些常见工作负载类型中的具体表现。
| 阶段 | ResNet-50 视觉训练 | DLRM 推荐 | KWS TinyML |
|---|---|---|---|
| 数据工程 | 以足够快的速度供应图像批次,维持较高的 GPU 利用率。 | 将在线特征存储查询控制在服务延迟预算内;嵌入表是存储容量与数据新鲜度方面的主要考量。 | 为受 SRAM 容量约束的设备筛选整理短音频片段。 |
| 训练 | 协调预处理、批处理、混合精度与模型执行,减少加速器空闲时间。 | 优化稀疏嵌入查询,因为内存带宽限制了吞吐量。 | 寻找仍能可靠识别触发短语的最小模型族。 |
| 部署 | 当吞吐量与成本比单个请求延迟更重要时,采用大批次。 | 在保持特征新鲜度的同时,满足严格的交互式 p99 延迟目标。 | 将持续运行的能耗控制在严格预算之内。 |
从筛选整理数 TB 的数据集,到在生产环境中维持尾延迟要求,这一工作流的每个阶段都带来不同的系统挑战。要具体理解这些挑战,需要从定量视角考察各阶段如何决定执行行为。
Systems Perspective 1.1: 工作流铁律
六个生命周期阶段分别改变机器学习系统铁律 \((T = \frac{D_{\text{vol}}}{\text{BW}} + \frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}} + L_{\text{lat}})\) 中的不同项。这些映射并非严格的一一对应关系,而是诊断问题的起点:
- 问题定义:设定准确率、延迟、成本、隐私和部署范式方面的目标约束。这些目标决定了方程中哪些项可以增长,哪些项必须从一开始就受到限制。
- 数据采集与准备:决定数据集的组成,以及传递给下游流水线的字节量 \((D_{\text{vol}})\)。数据筛选整理也可能改变达到质量目标所需的训练工作量。
- 模型开发与训练:决定运算次数 \((O)\)、数据复用模式、参数搬移,以及可实现的硬件效率 \((\eta_{\text{hw}})\)。
- 评估与验证:检验模型质量与端到端执行是否满足目标系统上的部署要求。
- 部署与集成:决定服务执行路径,包括运行时数据搬移、执行效率与固定开销 \((L_{\text{lat}})\)。
- 监控与维护:在上线后观测分布漂移、延迟、吞吐量与运营成本,并将违反约束的情况反馈至前期阶段,以便重新优化。
通过铁律审视生命周期,可以将延迟与成本建立在硬件物理规律之上。生产工作流还必须同时满足方程之外的准确率、安全性、隐私和组织约束。
案例研究:DR 筛查
糖尿病视网膜病变(DR)筛查 是贯穿本章的案例,因为它满足三个关键标准:表面上看似简单,实践中却暴露出深层次的运行阻力;涵盖了从云端训练到边缘推理的完整部署范围;其挑战在真实部署中已有充分记录。相关文献覆盖了实验室与实际应用之间鸿沟的两端:Gulshan et al. (2016) 记录了自动化 DR 检测的基准验证研究,而 Beede et al. (2020) 记录了深度学习系统部署到泰国诊所时暴露的工作流与基础设施问题。这些来源共同提供了一个实证基线,贯穿数据采集与验证,直至实际部署的物理约束。
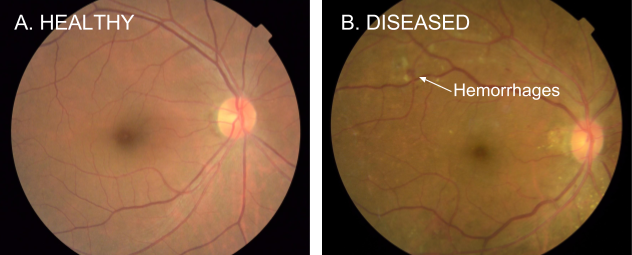
糖尿病视网膜病变是可预防失明的主要原因之一。8 资源匮乏地区的专科医疗服务可及性有限,推动了自动筛查项目的发展,但检测该疾病需要识别细微的病理特征。Figure 4 对比了健康视网膜与出现糖尿病视网膜病变的视网膜,其中,识别局部微血管出血需要精细的空间分辨率和稳健的输入验证。
早期研究在受控环境中达到了专家水平的性能。然而,将实验室模型转化为临床部署时,暴露出了严重的实际运行阻碍:传感器成像时的光照变化、农村诊所间歇性的网络连接、监管合规要求以及诊所工作流程集成。9 对于本案例中反复出现的指标,敏感度指真阳性率,特异度指真阴性率,AUC 指受试者工作特征(ROC)曲线下面积。无论是在农村基层医疗站部署医学诊断系统,还是在普通智能手机上部署计算机视觉系统,同样的约束传播机制都适用:硬件限制、操作人员差异和数据质量对现实可行性的影响,远大于基准测试中的 AUC。
阶段接口规范
生命周期的每个阶段都是一个独立的工程阶段,具有明确的输入、输出和质量不变量。在生产工作流引擎中,这些契约通过工作流有向无环图(DAG)加以形式化,其中节点表示独立的执行任务,有向边表示经过验证的产物依赖关系。尽管整体机器学习生命周期在数周乃至数月的时间尺度上形成循环反馈回路,但每次自动化流水线运行都以由相互依赖步骤构成的无环图形式执行,使编排器能够并行处理独立分支、缓存经过验证的中间输出,并在被破坏的契约向下游传播之前停止执行。正如微服务依靠接口规范来确立集成边界,机器学习流水线的各阶段也需要模式契约和分布契约,以便在无效数据或性能退化的权重向下游传播之前检测出不兼容问题。Table 3 将这些契约形式化,定义了全部六个生命周期阶段所需的输入要求、交付物和质量不变量。
| 阶段 | 输入契约 | 输出契约 | 质量不变量 |
|---|---|---|---|
| 问题定义 | 业务需求;运行环境 | 可度量的目标;部署范式选择;资源约束 | 所有成功标准均可量化;目标部署范式明确 |
| 数据收集与准备 | 目标;部署目标;质量要求 | 带有模式的版本化数据集;预处理流水线;数据验证规则 | 分布近似于预期生产环境中的分布;标注满足准确性要求 |
| 模型开发与训练 | 数据集;准确性目标;资源约束 | 训练后的模型权重;训练配置;实验日志 | 在计算预算内达到准确性阈值;架构与部署目标兼容 |
| 评估与验证 | 训练后的模型;留出的测试数据;评估标准 | 各子群体的性能指标;失效模式分析;验证证书 | 任何关键子群体的性能均不低于最低阈值;置信度校准满足领域要求 |
| 部署与集成 | 经过验证的模型;基础设施要求;服务级别协议(SLA)目标 | 模型服务端点;监控埋点;回滚流程 | 延迟和吞吐量满足部署范式要求;集成测试通过 |
| 监控与维护 | 在线系统;性能基线;告警阈值 | 漂移检测告警;更新审核标准;事件报告 | 明确告警覆盖范围和检测时间窗口;检测到性能退化时触发审核 |
这一规范揭示了机器学习项目为何会经历 figure 3 所示的迭代循环。当下游阶段发现上游契约被违反时(例如,评估发现训练数据分布与生产环境不匹配),项目就必须回溯迭代以修复根本原因。在每次阶段转换时验证契约的团队,能够在纠正成本最低的早期发现违规情况。在推进之前验证阶段契约,可以防止缺陷不断累积,最终导致后期重新设计,如下文的阶段转换审计所示。
Example 1.1: 阶段转换审计
场景:某工程团队声称已经完成医学影像分类器的问题定义,并试图在尚未确立部署目标约束的情况下转入数据收集阶段。
诊断:输出契约缺少部署范式选择和资源约束(延迟与内存目标)。在生命周期后期尝试部署时,违规情况才会暴露出来(例如,边缘设备的内存上限 < 200 MB),所产生的成本是早期纠正成本的 16×。
系统启示:阶段转换在机器学习生命周期中充当控制平面的质量关卡。在进入下游阶段之前,严格验证输出契约,可以避免代价高昂的上游返工,并确保数据收集与目标部署硬件相适配。
如果没有明确的契约关卡,未明示的假设就会向下游传播。最早可以界定这些假设的阶段是问题定义,该阶段记录了后续阶段必须满足的运行约束。
问题定义
机器学习中的问题定义始于一些看似简单的句子。产品经理写道:“构建一个能够检测糖尿病视网膜病变的模型。”这短短一句话隐藏着十余项工程决策:保障患者安全的敏感度阈值、农村诊所的硬件能力、维持临床医生使用意愿的延迟预算,以及规定审批要求的监管框架。在传统软件中,需求会转化为确定性的控制流、显式状态机和关系模式。在机器学习系统中,定义系统应当做什么,与定义它将如何从数据中学习、以及其执行必须承受哪些物理约束,密不可分。
平衡这些需求,需要跨越整个系统技术栈进行推理。工程团队不能孤立地优化准确性:通过增加模型深度或改用视觉 Transformer 来追求微小的敏感度提升,会增加参数量和算术强度,直接挑战低成本诊所硬件的内存容量与热限制。反过来,为了适配嵌入式加速器的 DRAM 预算而对模型进行剪枝,则可能使敏感度降至临床安全阈值以下。每项技术决策都处于一个多约束优化问题之中,统计目标、物理执行预算和运行要求持续相互限定各自的可行设计空间。
约束层
每个机器学习问题定义都可以分解为三个相互作用的约束层:统计层、物理层和运行层。这些层并非彼此孤立的要求,而是形成一个耦合的层次结构,其中某一层的约束会立即限制其他层的自由度。统计层规定系统在数据分布上的目标行为,例如,在不同患者人口群体和相机型号之间实现 \(>90\)% 的敏感度和 \(>80\)% 的特异度,而不是采用会掩盖少数子群体失效模式的未加权总体准确率。物理层将执行限定在硬件边界内:对于农村诊所,需要在严格的热预算、有限的内存容量(例如 4 至 8 GB 共享 DRAM)和亚秒级延迟预算下,在本地边缘加速器上进行推理,以保持临床工作流程的交互性,同时不依赖间歇性的网络上行链路。运行层涵盖临床可审计性、监管许可,以及规定系统长期维护方式的治理框架。
运行层会带来传统软件工程中很少遇到的物理后果。在传统数据库中,删除患者记录只需执行一条 DELETE 语句。在机器学习系统中,模型权重可能编码了从该记录中学习到的统计模式:如果法律或监管机构要求消除这种影响,合规可能需要机器遗忘(这是一个仍在积极研究、保障尚不完备的领域),或使用剩余数据重新训练。具体义务和补救方式取决于适用规则与系统;在 DR 系统的规模下,两种方式都可能使隐私合规成为经常性的计算预算项目,并使训练溯源成为架构约束。
约束传播原则(section 1.9.1)解释了为什么必须在开发开始之前明确所有三个层面的边界:存在于物理环境或运行环境中、却未在问题定义中明示的约束,并不会消失——在依赖它的决策已经固化之后,它会以架构违规的形式再次出现。例如,如果工程团队仅将目标定义为视网膜图像上的总体分类准确率,标准优化就会在多数类上最小化交叉熵损失。在一个 90% 的患者都健康的类别不平衡筛查人群中,始终预测“未患病”的模型可以达到 90% 的总体准确率,却会漏掉每一位需要紧急救治的患者。要防止这种情况,就必须将领域不变量——漏诊所带来的非对称代价——转化为明确的统计契约,将损失函数的制定与部署硬件预算关联起来。
War Story 1.1: 当标签本身就是偏见(2018 年)
背景:2014 年,Amazon 在其爱丁堡中心组建了一支工程团队,开发用于对技术岗位求职者排序的内部机器学习系统,并使用十年间提交给 Amazon 的简历进行训练 (Dastin 2018)。
机制:由于此前招聘的人员以男性为主,模型学到了带有男性特征的语言与录用成功之间的相关性,系统性地惩罚“女子的”等词语,并降低女子学院毕业生的排名。
影响:该模型复现了历史招聘偏见,导致自动化简历筛选不适合用于实际招聘。
修复:在尝试移除显式性别信号后,仍无法保证模型不会学习其他具有歧视性的代理特征,因此 Amazon 放弃了这一实验性工具。
系统启示:问题定义必须在数据收集和训练之前明确公平性、可审计性及否决标准。使用带有偏见的标签训练的工作流,学到的并非运行目标,而是复现这些标签。
Dastin, Jeffrey. 2018. “Amazon Scraps Secret AI Recruiting Tool That Showed Bias Against Women.” Reuters.
问题定义会演变
问题定义并不是在项目启动时就被冻结的静态规范;它会随着部署范围的扩大而演变。当 DR 筛查项目从配备已校准眼底相机的试点诊所扩展到成像硬件各异、患者人口特征不同的区域医疗中心时,10 最初的假设就会失效。传感器噪声特性出现差异,光学分辨率发生变化,人口特征差异也会改变子群体的错误率。适应这一运行现实,迫使问题定义纳入分层准确性目标和更广泛的硬件兼容性矩阵。
这种动态演变直接源于机器学习的统计本质。规模扩大后,试点评估中未出现的长尾输入会暴露出来,而生产环境会引入任何静态离线数据集都无法完整涵盖的协变量偏移。稳健的问题定义会通过预先建立治理规程来应对这种漂移:明确哪些监控信号会触发正式的重新评估,并限定阈值更新如何在后续流水线阶段中传播。一旦这些运行约束和性能边界在书面上得到明确,工作流就必须将它们落实为实际产物——首先是用于采集训练分布的数据收集流水线。
数据收集
书面定义的约束只有落实到实际数据中才会生效。从问题定义转向数据收集,将抽象的准确性目标与运行现实联系起来:传感器噪声、记录缺失和网络限制。从机器学习系统铁律的角度看,这一阶段决定了数据集大小 \((D)\),以及存储系统、网络和内存总线必须搬运的字节量 \((D_{\text{vol}})\)。在问题定义阶段确立的部署约束会转化为技术性数据要求:如果模型必须在边缘设备上运行,收集流水线就必须生成与边缘预处理兼容的输入;如果模型必须在不同人群中达到 90% 的敏感度,数据集就必须对这些子群体进行充分采样,以支持模型训练。
数据收集与准备是一项持续开展的工程工作,而非一次性任务(数据工程)。对于 DR 筛查,流水线摄取的图像必须在统计上足够多样,以支持跨诊所泛化;必须足够稳健,以应对不同的采集条件;还必须以足够严谨的临床标准进行标注,以经受监管审计。
在 DR 示例中,问题定义阶段的决策决定了数据要求。所确立的多维成功标准(不同人群中的准确性、硬件效率和监管合规)要求采用超越典型计算机视觉数据集做法的数据收集策略。此外,并非所有数据对学习的贡献都相同——数据选择 展示了当数据集存在冗余时,只要所选子集保留了任务所需的证据,数据选择就能够以更少的计算量保持相当的性能。
DR 系统需要数量级为 \(10^5\) 的视网膜眼底照片,每张照片都由多名眼科专家审核。专家共识可以应对医学诊断固有的主观性(两名眼科医生可能对临界病例存在分歧),同时建立能够经受监管审查的真实标签。标注过程必须涵盖整个疾病严重程度范围内的临床相关特征,例如微动脉瘤、出血和硬性渗出物。
原始高分辨率视网膜扫描图像在压缩前,每张可达数十兆字节,这会给基础设施带来重大挑战。每天接诊数十名患者的诊所,每周可能产生数吉字节至数十吉字节的影像数据。这种数据量可能在诊所营业时间内占用有限上行链路的大部分带宽,因此,除压缩、批量传输、调度传输时段或增加链路容量之外,本地处理也是一种选择。
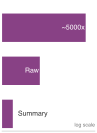
当带宽成为主导约束时,边缘端摘要优于上传原始医学图像。
Napkin Math 1.2: 带宽与计算
问题:一家乡村诊所采集视网膜图像,用于糖尿病视网膜病变(DR)筛查。上传原始图像会占用假定的同一班次上行链路可用时间窗口的多大比例?哪些替代方案可以降低这一占用比例?
计算:
- 每日数据量:按 150 patients/day、10 photos/patient 和 5 MB/photo 计算,诊所产生的数据量为 7.5 GB/day。
- 上传时间:上行链路速率为 2 Mb/s,即 0.25 MB/s。将 7,500 MB 除以该速率,得到 30,000 s,约为 8.3 h。
- 约束:如果诊所要求在同一班次的 8 h 营业时间窗口内完成上传,仅这项传输就会占用该窗口 104.2 percent 的链路时间,并可能与其他流量争用链路。
系统洞察:在本地执行推理并上传检测摘要(10 KB/patient),可将带宽使用量降至原来的 1/5,000×。夜间批量上传、压缩、调度或使用更快的链路也是替代方案,但本次计算未对其进行比较。
从实验室到现场的数据差距
实验室数据与生产数据处于不同的环境中。当 DR 筛查部署到泰国和印度各地的乡村诊所时,这种实验室与现场之间的差距便会显现:图像来自多种相机设备,由专业水平不一的工作人员操作,拍摄时往往光照欠佳,患者体位也不一致。使用标准化眼底相机采集的高质量研究图像训练的模型,可能无法正确处理旧设备拍摄的模糊、光照不足的图像——原因并非算法错误,而是数据分布的偏移已经超出了训练数据所覆盖的范围。
由于原始图像上传所需的传输能力可能超出诊所上行链路的容量,边缘部署提供了一种替代方案。部署 NVIDIA Jetson 系列等边缘加速器11,可以让诊所在本地进行预处理和推理。这能将网络传输量降低数个数量级,但也引入了硬件方面的权衡:使用适合低功耗边缘资源预算的较小模型,或者以更高成本配置能力更强的本地设备。
带宽约束使基础设施成为数据采集阶段就必须作出的决策,而非实施后期的细节。本场景的架构结合了用于本地推理和预处理的边缘设备、用于数据管理和缓冲的诊所聚合服务器,以及用于定期更新模型的云端训练基础设施。其目标是将端到端延迟控制在 100 毫秒以内,并在运行中避免连接问题引发的延迟。
隐私约束也会带来类似的架构决策。患者隐私法规可能促使系统采用本地数据留存或分布式训练,但这些法规通常规定的是保护措施和允许的使用方式,而非强制要求某一种训练拓扑。将诊所原始数据保留在本地、仅共享获准的更新或摘要的工作流,会同时增加数据采集和模型训练基础设施的复杂度。
分布式数据基础设施
如果部署规模从少数几家诊所扩展到数百家,数据基础设施也必须相应扩展。每张视网膜图像都要经过多个阶段:诊所相机采集图像,本地系统提供初始存储和处理,质量验证检查确保图像可用,安全传输将数据送往中央系统,最后通过整合到训练数据集中完成整个流水线。各阶段的基础设施决策都受到问题定义阶段所确定的部署约束的影响。
存储分层是数据流水线维持或削弱下游迭代速度的另一个关键环节。不同的数据访问模式需要不同的存储解决方案,因此团队通常会实现分层存储架构,12根据访问频率和性能要求配置各层。
热存储使用高吞吐量 NVMe SSD,保存当前训练循环正在使用的数据。温存储使用兼容 S3 的对象存储,保存近期数据集和正在使用的验证集。冷存储使用 AWS Glacier 等低成本归档系统,保存监管审计追踪所需但很少访问的历史数据。
在实践中,各层之间的边界是动态的:数据集被选用于下一次训练运行时,会从温存储迁移到热存储;当使用该数据集训练的模型被替代时,数据集会从热存储迁移到冷存储。自动化生命周期策略负责管理这些转换,根据训练计划将数据提升至更高性能的存储层,并根据最近访问时间将其降至较低性能的存储层——数据工程 将详细探讨这一模式。
乡村诊所部署面临严峻的网络连接约束,因此必须在不同传输策略之间作出选择。具备可靠宽带连接的诊所可以近乎实时地流式传输图像,以进行集中处理;而使用间歇性卫星链路的诊所——这在印度和撒哈拉以南非洲的偏远地区很常见——则需要采用存储转发架构,在连接可用的时间窗口内批量传输图像,并异步协调结果。这一选择会影响整个技术栈:采用存储转发方式的诊所需要更大的本地存储缓冲区、更稳健的本地推理能力,以及在本地生成的预测与后续云端分析结果不一致时进行冲突消解的逻辑。
基础设施的可扩展性比单纯的容量问题更具挑战。随着系统从少数几家试点诊所扩展到数百个生产站点,数据异质性也会随数据量一同增长:每家诊所的相机型号、光照环境和操作人员习惯,都可能产生不同的图像分布。基础设施必须在应对不断增长的吞吐量的同时,追踪各份数据的来源。这些溯源元数据对于排查特定站点的准确率下降,以及满足监管验证所要求的审计追踪要求,至关重要。因此,从最初的几家诊所扩展到更广泛的网络,会引入涌现的复杂性:随着新加入的诊所采用更高分辨率的设备,设备、工作流、运行条件和图像大小都会出现差异。每家诊所都成为一个独立的数据源,13但系统仍必须评估整个网络的性能。
工作流层面的应对措施是建立协调基础设施。共享制品仓库、版本化 API 和自动化测试流水线,可以在诊所特有的差异导致模型失效之前将其显现出来。同样,正是这种异质性,使得在采集点进行验证成为必要:诊所网络越庞大、越多样化,等到数周后的集中训练运行中才发现质量问题,就越难发挥作用。
质量保证与验证
一张漏过质量检查的模糊视网膜图像,造成的影响不仅仅是浪费存储空间。如果此类图像带着不可靠的标签进入训练,或在生产环境中频繁出现,就可能扭曲模型可用的证据,并增加出错风险。质量保证确保数据满足下游各阶段所依赖的要求。在我们的 DR 示例中,采集点的自动化检查会标记对焦不佳或取景不正确等问题,使诊所工作人员能够立即重新采集图像,而不是等到数周后的模型训练阶段才发现问题。
验证不仅涉及图像质量,还要核实标注是否正确、图像与患者的关联是否准确,以及是否符合隐私要求。本地验证在采集点发现问题;集中式验证则检测整个诊所网络中的分布异常——例如,当某个站点的图像过度集中于某个狭窄的人口统计范围、可能导致训练集产生偏差时,发出标记。
数据采集决策直接约束模型开发:带宽限制决定哪些架构可行,隐私要求塑造训练流水线,而不同诊所环境中的质量差异则决定了对模型稳健性的要求。Figure 5 具体展示了这些反馈路径。沿着每条带标签的箭头观察:评估发现 DR 模型在旧款眼底相机采集的图像上表现不佳,从而触发针对使用此类设备的诊所开展定向数据采集。对不同患者群体的验证表明,模型对白内障患者的敏感度较低,从而推动采用模拟晶状体混浊的数据增强策略。监控在升级了成像设备的诊所中检测到准确率漂移,并将这一发现反馈给预处理步骤,以推动其更新。
\begin{tikzpicture}[line join=round,font=\sffamily\small]
\tikzset{%
  Box/.style={align=flush center,
    inner xsep=2pt,
    node distance=0.65,
    draw=GreenLine,
    line width=0.75pt,
    fill=mygreen!06,
    %text width=35mm,
    minimum width=37mm, minimum height=16mm
  },
  Box2/.style={Box, draw=BrownLine, fill=BrownL!30,
  },
  Txt/.style={font=\sffamily\footnotesize,text=black!90
  },
  LineA/.style={black!30,line width=1.5pt,{-{Triangle[width=1.0*5pt,length=9pt]}},shorten <=2pt,shorten >=2pt},
}

%funnel
\tikzset{%
 pics/funnel/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=FUNNEL,scale=\scalefac, every node/.append style={transform shape}]
\draw[fill=\filllcolor!50,line width=\Linewidth,draw=\drawcolor](-0.12,-0.81)--(-0.19,-0.25)--(-0.7,0.41)--(0.7,0.41)--(0.19,-0.25)--(0.12,-0.81)--cycle;
\draw[fill=\filllcolor!50,line width=\Linewidth,draw=\drawcolor](-0.19,-0.25)--(0.08,-0.25);
\draw[fill=\filllcolor!50,line width=\Linewidth,draw=\drawcolor](0.16,-0.09)--(0.41,0.31);
%
\node[line width=\Linewidth,draw=\drawcolor,fill=\filllcolor!50,inner sep=1pt,
rectangle,rounded corners=2pt,minimum width=16mm,minimum height=5pt]at(0,0.5){};
%
\foreach \i in{-0.5,0,0.5}{
\node[single arrow, line width=0.8*\Linewidth,draw=\filllcirclecolor,fill=\filllcirclecolor, rotate=270,inner sep=1pt,
      minimum width =9pt, single arrow head extend=2pt,
      minimum height=5mm]at(\i,0.9) {}; % length of arrow
   }
\node[single arrow,line width=0.8*\Linewidth,draw=\filllcirclecolor,fill=\filllcirclecolor, rotate=270,inner sep=1pt,
      minimum width =11pt, single arrow head extend=2pt,
      minimum height=5mm]at(0,-1.1) {}; % length of arrow
 \end{scope}
     }
  }
}
%nodes
\tikzset{
pics/nodes/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\foreach \x/\y[count=\a] in {-0.2/0.35,
0.7/0.6,-0.5/1.4,-1.20/-0.8,-0.1/-1.3,-0.4/-0.43,
0.61/-0.3,1/-0.85,0.45/1.2,-0.96/0.63}{
\node[circle,fill=myblue,draw=black,inner sep=0pt,minimum size=3mm](XB\a)at(\x,\y){};
}
\foreach \x/\y[count=\a] in {-2.0/0.1
}{
\node[circle,fill=myred,draw=black,inner sep=0pt,minimum size=3mm](XR\a)at(\x,\y){};
}

\foreach \x/\y[count=\a] in {1.87/0.1
}{
\node[circle,fill=mygreen,draw=black,inner sep=0pt,minimum size=3mm](XG\a)at(\x,\y){};
}

\foreach \x in {1,3,4,6,10}{
\draw[RedLine,line width=0.5pt](XR1) edge  (XB\x);
}
\foreach \x in {1,2,5,8,9}{
\draw[mygreen,line width=0.5pt](XG1) edge  (XB\x);
}
\foreach \x in {2,3,6,9,10}{
\draw[black,line width=0.5pt](XB1) edge  (XB\x);
}
\foreach \x in {4,5,7}{
\draw[black,line width=0.5pt](XB6) edge  (XB\x);
}
\draw[black,line width=0.5pt](XB4) edge  (XB5);
\draw[black,line width=0.5pt](XB3) edge  (XB9);
\foreach \x in {2,8}{
\draw[black,line width=0.5pt](XB7) edge  (XB\x);
}
\end{scope}
    }
  }
}
%testing
\tikzset{
pics/testing/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=TESTING1,shift={($(0,0)+(0,0)$)},scale=\scalefac,every node/.append style={transform shape}]
\newcommand{\tikzxmark}{%
\tikz[scale=0.18] {
    \draw[line width=0.7,line cap=round,RedLine] (0,0) to [bend left=6] (1,1);
    \draw[line width=0.7,line cap=round,RedLine] (0.2,0.95) to [bend right=3] (0.8,0.05);
}}
\newcommand{\tikzxcheck}{%
\tikz[scale=0.16] {
    \draw[line width=0.7,line cap=round,GreenLine] (0.5,0.75)--(0.85,-0.1) to [bend left=16] (1.5,1.55);

}}
 \node[minimum width  =15mm, minimum height = 20mm, inner sep = 0pt,
        rounded corners=2pt,draw = \drawcolor, fill=\filllcolor!10, line width=\Linewidth](COM){};
 \node[minimum width  =8mm, minimum height = 2mm, inner sep = 0pt,anchor=north,
        rounded corners=1.5pt,draw =white, fill=\drawcolor!70, line width=0.7*\Linewidth]at
        ($(COM.north)+(0,0.75mm)$)(GOR){};
 \node[minimum size = 2.5mm, inner sep = 0pt,circle,%anchor=north,
        rounded corners=0.5pt,draw =white, fill=\drawcolor!70, line width=0.7*\Linewidth]at(GOR.north)(GOR1){};
\node[draw=GreenLine,inner sep=4pt,fill=white](CB1) at ($(COM.north west)!0.25!(COM.south west)+(0.3,0)$){};
\node[xshift=0pt]at(CB1){\tikzxcheck};
\node[draw=RedLine,inner sep=4pt,fill=white](CB2) at ($(COM.north west)!0.5!(COM.south west)+(0.3,0)$){};
\node[xshift=0pt]at(CB2){\tikzxmark};
\node[draw=RedLine,inner sep=4pt,fill=white](CB3) at ($(COM.north west)!0.75!(COM.south west)+(0.3,0)$){};
\node[xshift=0pt]at(CB3){\tikzxmark};
\draw[GreenLine,decoration={zigzag,segment length=4pt, amplitude=0.5pt},decorate]($(CB1)+(0.3,0.05)$)--++(0:0.8);
\draw[GreenLine,decoration={zigzag,segment length=4pt, amplitude=0.5pt},decorate]($(CB1)+(0.3,-0.12)$)--++(0:0.7);
\draw[RedLine,decoration={zigzag,segment length=4pt, amplitude=0.5pt},decorate]($(CB2)+(0.3,0.05)$)--++(0:0.8);
\draw[RedLine,decoration={zigzag,segment length=4pt, amplitude=0.5pt},decorate]($(CB2)+(0.3,-0.12)$)--++(0:0.6);
\draw[RedLine,decoration={zigzag,segment length=4pt, amplitude=0.5pt},decorate]($(CB3)+(0.3,0.05)$)--++(0:0.8);
\draw[RedLine,decoration={zigzag,segment length=4pt, amplitude=0.5pt},decorate]($(CB3)+(0.3,-0.12)$)--++(0:0.6);
\end{scope}
    }
  }
}
%check mark
\tikzset{pics/.cd,
checkmark/.style={code={
        \pgfkeys{/channel/.cd, #1}
\pgfgettransformentries{\tmpxx}{\tmp}{\tmp}{\tmp}{\tmp}{\tmp}
\draw[line width=\tmpxx*1pt,draw=none,fill=\filllcirclecolor,line join=bevel] (0,.35) -- (.25,0) to[bend left=5] (0.8,.6) to[bend
right=5] (.25,.18) -- cycle;}}}
\tikzset{%
 pics/checkI/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=CHECK,scale=\scalefac, every node/.append style={transform shape}]
\node[fill=\filllcolor,minimum width=6mm, minimum height=6mm,
            outer sep=2pt] (C1) {};
\pic[shift={(-0.27,-0.19)},scale=0.7]{checkmark};
 \end{scope}
     }
  }
}
%cloud
\tikzset {
pics/cloudA/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=CLO,scale=\scalefac,, every node/.append style={transform shape}]
\node[draw=\drawcolor!90!red,line width=\Linewidth,minimum width=6mm,minimum height=12mm](VSK)at(0,0.5){};
\node[draw=\drawcolor!90!red,line width=\Linewidth,fill=white,minimum width=9mm,minimum height=4mm](VSKG)at(VSK.north){};
\node[draw=\drawcolor!90!red,line width=\Linewidth,fill=white,minimum width=9mm,minimum height=4mm](VSKC)at(VSK.center){};
\node[draw=\drawcolor!90!red,line width=\Linewidth,fill=white,minimum width=9mm,minimum height=4mm](VSKD)at(VSK.south){};
\draw[fill=\filllcolor,draw=\drawcolor!60,,line width=\Linewidth](0,0)to[out=170,in=180,distance=11](0.1,0.61)
to[out=90,in=105,distance=17](1.07,0.71)
to[out=20,in=75,distance=7](1.48,0.36)
to[out=350,in=0,distance=7](1.48,0)--(0,0);
\draw[draw=\drawcolor!60,,line width=\Linewidth](0.27,0.71)to[bend left=25](0.49,0.96);
\draw[draw=\drawcolor!60,,line width=\Linewidth](0.67,1.21)to[out=55,in=90,distance=13](1.5,0.96)
to[out=360,in=30,distance=9](1.68,0.42);
\node[single arrow, draw=orange,fill=orange,
      minimum width = 10pt, single arrow head extend=3pt,
      minimum height=10mm,
      rotate=270]at(1.05,0) {};
\end{scope}
}
}
}
%data
\tikzset{mycylinder/.style={cylinder, shape border rotate=90, aspect=1.3, draw, fill=white,
minimum width=25mm,minimum height=11mm,line width=\Linewidth,node distance=-0.15},
pics/data/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=STREAMING,scale=\scalefac, every node/.append style={transform shape}]
\node[mycylinder,fill=\filllcolor!50] (A) {};
\node[mycylinder, above=of A,fill=\filllcolor!30] (B) {};
\node[mycylinder, above=of B,fill=\filllcolor!10] (C) {};
\fill[\filllcolor!50!black]($(C.west)!0.12!(C.east)$)circle(3pt);
\fill[\filllcolor!50!black]($(B.west)!0.12!(B.east)$)circle(3pt);
\fill[\filllcolor!50!black]($(A.west)!0.12!(A.east)$)circle(3pt);
 \end{scope}
     }
  }
}
%display
\tikzset{%
    comp/.style = {draw,
        minimum width  =18mm,
        minimum height = 15mm,
        inner sep      = 0pt,
        rounded corners=3pt,
       draw = \drawcolor,
       fill=\filllcolor!10,
       line width=2.0pt
    },
 pics/displayK/.style = {
        code = {
        \pgfkeys{/channel/.cd, #1}
\begin{scope}[local bounding box=COMPUTER1,scale=\scalefac, every node/.append style={transform shape}]
\node[comp](\picname-COM){};
\draw[draw = \drawcolor,line width=\Linewidth]($(\picname-COM.south west)!0.4!(\picname-COM.south east)$)--++(270:0.2)coordinate(DL);
\draw[draw = \drawcolor,line width=\Linewidth]($(\picname-COM.south west)!0.6!(\picname-COM.south east)$)--++(270:0.2)coordinate(DD);
\draw[draw = \drawcolor,line width=3*\Linewidth,shorten <=-3mm,shorten >=-3mm](DL)--(DD);
 \draw[
  line width=1pt,
  draw=red,
  line cap=round,
  line join=round
](-0.70,0) --(-0.40,0) --(-0.30,0.13) --(-0.2,-0.18) --(-0.05,0.32) --(0.05,-0.15) --
(0.15,0.23) --(0.38,-0.15) --(0.40,0.0) --(0.70,0.0);
\end{scope}
   }
  }
}

\pgfkeys{
  /channel/.cd,
   Depth/.store in=\Depth,
  Height/.store in=\Height,
  Width/.store in=\Width,
  filllcirclecolor/.store in=\filllcirclecolor,
  filllcolor/.store in=\filllcolor,
  drawcolor/.store in=\drawcolor,
  drawcircle/.store in=\drawcircle,
  scalefac/.store in=\scalefac,
  Linewidth/.store in=\Linewidth,
  picname/.store in=\picname,
  filllcolor=BrownLine,
  filllcirclecolor=violet!20,
  drawcolor=red,
  drawcircle=violet,
  scalefac=1,
  Linewidth=0.5pt,
  Depth=0.2,
  Height=0.5,
  Width=0.25,
  picname=C
}
% Model Training
\node[Box](B1){};
\coordinate(GO1)at($(B1.north west)!0.38!(B1.north east)$);
\coordinate(T1)at($(GO1)!0.5!(B1.south east)$);
\coordinate(I1)at($(B1.west)!0.21!(B1.east)$);
\node[align=center]at(T1){模型\\ 训练};
\node[Box,fill=none]{};
\pic[shift={(0.2,0)}] at  (I1){nodes={scalefac=0.4,picname=1,drawcolor=orange,filllcirclecolor=orange!20,filllcolor=orange}};
%Model Deployment
\node[Box,right=5of B1](B2){};
\coordinate(GO2)at($(B2.north west)!0.4!(B2.north east)$);
\coordinate(T2)at($(GO2)!0.5!(B2.south east)$);
\coordinate(I2)at($(B2.west)!0.24!(B2.east)$);
\node[align=center]at(T2){模型\\ 部署};
\pic[shift={(-0.36,-0.30)}] at  (I2){cloudA={scalefac=0.6,filllcirclecolor=orange!80,drawcolor=BlueLine,
filllcolor=cyan!10,  Linewidth=1.0pt}};
%Data Preparation
\node[Box,below left=0.5 of B1](B3){};
\coordinate(GO3)at($(B3.north west)!0.4!(B3.north east)$);
\coordinate(T3)at($(GO3)!0.5!(B3.south east)$);
\coordinate(I3)at($(B3.west)!0.24!(B3.east)$);
\node[align=center]at(T3){数据\\ 准备};
\node[Box,below left=0.5 of B1,fill=none]{};
\pic[shift={(0,0.04)}] at  (I3){funnel={scalefac=0.55,Linewidth=0.5pt,
 filllcolor=mypurple,drawcolor=black,filllcirclecolor=red}};
%Model Evaluation
\node[Box,right=5 of B3](B4){};
\coordinate(GO4)at($(B4.north west)!0.4!(B4.north east)$);
\coordinate(T4)at($(GO4)!0.5!(B4.south east)$);
\coordinate(I4)at($(B4.west)!0.24!(B4.east)$);
\node[align=center]at(T4){模型\\ 评估};
\node[Box,right=5 of B3,fill=none]{};
\pic[shift={(-0.1,-0.02)}] at  (I4){testing={scalefac=0.6,drawcolor=mybrown,filllcolor=gray, Linewidth=1.0pt}};
\pic[shift={(0.3,-0.46)}] at  (I4){checkI={scalefac=0.7,filllcolor=GreenLine, filllcirclecolor=white,Linewidth=0.7pt}};
%Monitoring \& Maintenance
\node[Box,right=3.5 of B4](B5){};
\coordinate(GO5)at($(B5.north west)!0.4!(B5.north east)$);
\coordinate(T5)at($(GO5)!0.5!(B5.south east)$);
\coordinate(I5)at($(B5.west)!0.24!(B5.east)$);
\node[align=center]at(T5){监控 \&\\ 维护};
\node[Box,right=3.5 of B4,fill=none]{};
\pic[shift={(-0.02,0.06)}] at  (I5){displayK={scalefac=0.65,picname=D,
filllcolor=myblue, drawcolor=myblue,Linewidth=0.7pt}};
%Data Collection
\node[Box,below =1 of B3](B6){};
\coordinate(GO6)at($(B6.north west)!0.4!(B6.north east)$);
\coordinate(T6)at($(GO6)!0.5!(B6.south east)$);
\coordinate(I6)at($(B6.west)!0.24!(B6.east)$);
\node[align=center]at(T6){数据\\ 收集};
\node[Box,below =1 of B3,fill=none]{};
\pic[shift={(0,-0.5)}] at  (I6){data={scalefac=0.45,picname=1,filllcolor=red, Linewidth=0.6pt}};
%arrows
\draw[LineA](B6)--(B3);
\draw[LineA](B4)-|(B2);
\draw[LineA](B1.350)-|(B4);
\draw[LineA](B2)-|(B5.130);
\draw[LineA](B3.60)|-(B1);
\draw[LineA](B5.south)|-node[Txt,above,pos=0.6]{性能洞察}(B6.350);
\draw[LineA](B4.south)|-node[Txt,above,pos=0.75]{数据缺口}(B6.10);
\draw[LineA](B4.west)-|node[Txt,above,pos=0.25]{验证问题}(B1);
\draw[LineA](B2.170)--node[Txt,above,pos=0.5]{部署约束}(B1.10);
%
\draw[LineA](B5)--++(0,35mm)-|node[Txt,above,pos=0.25]{模型更新}(B1);
\draw[LineA](B5.50)--++(0,35mm)-|node[Txt,above,pos=0.25]{数据质量问题}(B3.120);
\end{tikzpicture}这些反馈路径强化了一个核心观点:数据收集并不会在训练开始时结束。流经这些流水线的数据,其质量、数量和多样性,如今成为下一阶段的原材料——将经过整理的数据集转化为训练好的模型。
模型开发
DR 团队拥有 128,000 张已标注的视网膜图像、一条经过验证的预处理流水线,以及一个目标:在边缘硬件上实现超过 90% 的敏感度,同时将推理延迟控制在 50 ms 以下。问题已不再是收集什么数据,而是构建什么模型——而这个问题的答案无法脱离已经确立的部署约束。从机器学习系统铁律的角度看,这一阶段定义了运算量 \((O)\) 项:架构选择决定了硬件必须支撑的计算下限。训练系统(模型训练)必须协调数据摄取、分布式参数同步和超参数探索14,避免执行流水线停滞。在医疗等高风险领域,每一项设计决策都会影响临床结果,因此必须从一开始就综合考虑技术性能与运行约束。
DR 系统面临一项严峻的训练挑战:在有限的标注数据和优化预算下,实现专家级的诊断准确性。迁移学习15 通过将源任务上预训练的模型适配到目标任务,来应对这一约束。2012 年 ImageNet 大规模视觉识别挑战赛(ILSVRC)的训练子集包含 1.3 million 已标注图像 (Russakovsky et al. 2015)。相较于随机初始化,复用已学习的表征可以改善目标任务的优化与泛化,其收益取决于源任务与目标任务的相似性、迁移了哪些层,以及与迁移相关的优化效应 (Yosinski et al. 2014)。
Russakovsky, Olga, Jia Deng, Hao Su, Jonathan Krause, Sanjeev Satheesh, Sean Ma, Zhiheng Huang, et al. 2015. “ImageNet Large Scale Visual Recognition Challenge.” International Journal of Computer Vision 115 (3): 211–52. https://doi.org/10.1007/s11263-015-0816-y.
Yosinski, Jason, Jeff Clune, Yoshua Bengio, and Hod Lipson. 2014. “How Transferable Are Features in Deep Neural Networks?” Advances in Neural Information Processing Systems 27.
Gulshan, Varun, Lily Peng, Marc Coram, Martin C. Stumpe, Derek Wu, Arunachalam Narayanaswamy, Subhashini Venugopalan, et al. 2016. “Development and Validation of a Deep Learning Algorithm for Detection of Diabetic Retinopathy in Retinal Fundus Photographs.” JAMA 316 (22): 2402. https://doi.org/10.1001/jama.2016.17216.
在 Gulshan et al. (2016) 报告的受控验证研究中,迁移学习结合包含 128,000 张图像的标注数据集,实现了 0.99 的 AUC16,并在某一工作点达到 97.5% 的敏感度和 93.4% 的特异度。这一结果表明,在该研究条件下,大规模预训练结合领域特定微调具有潜力;但这一结果本身并不能确立部署时的性能。反向传播将分类损失转化为数百万个参数的权重调整;底层神经计算原语(神经计算)最终决定了训练能否在专用硬件上高效扩展(模型训练)。
实现高准确率只是第一个挑战。边缘部署约束提出了严格的效率要求:模型可能需要将体积控制在几十到几百兆字节,在几十毫秒内完成推理,并在严格的内存预算内运行。
从工作流的角度看,必须权衡准确率提升与部署约束。集成学习17 体现了这种矛盾:组合多个模型的预测通常可以提高准确率,但会使推理延迟和内存需求成倍增加。无论多样性来自在数据子集上训练(装袋法)、依次纠正错误(提升法),还是使用元模型组合预测(堆叠法),每增加一个模型,都会增加模型服务开销,而这些开销必须符合部署目标。Netflix Prize 展示了集成复杂性如何阻碍部署:获胜方案实现了较高的准确率,但 Netflix 并未部署该方案,因为其运行成本超过了业务收益 (Johnston 2012)。18
使用集成方法时,研究模型的体积往往达到数吉字节,超出边缘设备的内存限制。团队必须系统地应用模型压缩,而不能孤立地优化准确率。量化和剪枝等技术(模型压缩)可以减小模型体积并减少内存流量,但每一步压缩都必须经过验证,以确保临床敏感度不会降至要求的阈值以下。模型开发是在统计性能与物理执行成本之间持续寻求平衡的过程。
可复现的系统制品
准确率与效率之间的平衡过程,产出的不只是训练好的权重。一种常见的失败模式,是将训练好的模型权重视为这一阶段的唯一输出。在成熟的机器学习工作流中,交付物是一项可复现的系统制品,包含四个组成部分:
- 模型权重:学习得到的参数。
- 推理代码:运行模型所使用的确切代码,包括预处理逻辑。
- 环境规范:执行代码所需的完整依赖图(例如 Docker 容器、
requirements.txt、CUDA 驱动程序)。 - 配置:超参数和运行时设置。
如果不将环境与模型一同打包,依赖项不匹配就可能导致危险的故障。某些不兼容问题,包括不受支持的 CUDA 组合或缺失的库,会立即触发明显的失败。另一些差异则可能出现在兼容的内核、线性代数库或 OpenCV 和 PIL 等图像缩放程序中,它们可能改变浮点运算结果或像素插值,而不会导致服务进程崩溃。这些变化可能使模型输出发生偏移,并影响准确率。因此,环境可复现性不仅是成功执行的必要条件,也是验证推理行为等价性的必要条件。开发阶段准确率达到 99% 的模型,如果生产环境发生变化,即使推理完成时没有引发异常,也必须重新评估。
准确率与效率
医疗应用要求采用特定的性能指标19,这些指标不同于 神经计算 中介绍的标准分类输出和损失。DR 系统需要较高的敏感度(以减少对需要转诊的病变的漏检)和较高的特异度(以避免转诊系统不堪重负)。在不同患者群体和图像质量条件下,都必须维持这些指标。
仅针对临床性能进行优化还不够。在本场景中,模型制品必须小于 500 MB,才能轻松容纳于边缘目标设备的 4–8 GB 共享系统内存中,同时设备必须在低于 20 瓦的功率预算内运行,并满足临床延迟预算。一个维度上的改进往往以其他维度为代价:运算量 \((O)\) 项、计入 \(D_{\text{vol}}\) 的模型字节占用量,以及固定服务开销 \((L_{\text{lat}})\),可能将优化推向不同方向。网络架构 探讨模型容量,机器学习系统 则讨论部署可行性,二者之间固有的张力推动着架构决策。系统性的压缩与重新验证20可以弥合这一差距,在力求保留临床效用的同时满足部署要求。
集成模型的权衡体现了一个更普遍的模式:选择由轻量级模型组成的集成,而非单个大型模型,可以降低单个模型的复杂度(从而支持边缘部署),但会增加流水线的复杂度(需要编排逻辑和多模型监控)。每个架构决策都会产生这种下游连锁影响。
约束驱动的开发
现实约束贯穿从初步探索到最终优化的整个模型开发过程,要求开展系统性的实验。开发始于数据科学家与领域专家(在 DR 案例中为眼科医生)的协作,以识别具有临床意义的细微病灶和图像质量要求。如果缺乏这些领域知识,模型架构设计者选择的分辨率或感受野,即每个内部特征能够看到的输入区域,就可能在网络有机会利用相关细节之前将其丢弃。这种跨学科方法有助于模型架构保留具有临床意义的证据,同时遵守数据采集阶段识别出的计算约束。
计算约束深刻影响着实验方法。多种模型变体、超参数扫描和预处理方法可能使穷举实验代价高昂。这一经济现实推动团队投入更好的作业调度、中间结果缓存、提前停止和自动化资源优化。相较于穷举搜索,系统性的超参数优化和严谨的实验设计可以减少计算量。
机器学习结果固有的不确定性要求采用科学方法:通过固定随机种子和环境版本来控制变量,通过系统性的消融研究21隔离各组件的贡献,通过混杂因素分析区分架构效应与优化效应,并在多次训练运行中使用配对离线检验进行统计显著性检验,而将 A/B 测试22保留用于在实时生产流量上比较模型。缺乏这种严谨性,团队就无法区分真正的性能提升与统计噪声;当 0.5% 的准确率差异决定模型能否满足临床敏感度阈值时,这一区分尤为关键。
在每个开发里程碑,团队都会根据生命周期早期阶段识别出的部署约束来验证模型。每项架构创新都必须评估其准确率提升,以及与边缘设备限制和临床工作流要求的兼容性。这种双重验证方法确保开发工作与部署目标保持一致,而不是针对无法转化为现实性能的实验室条件进行优化。
从原型到生产
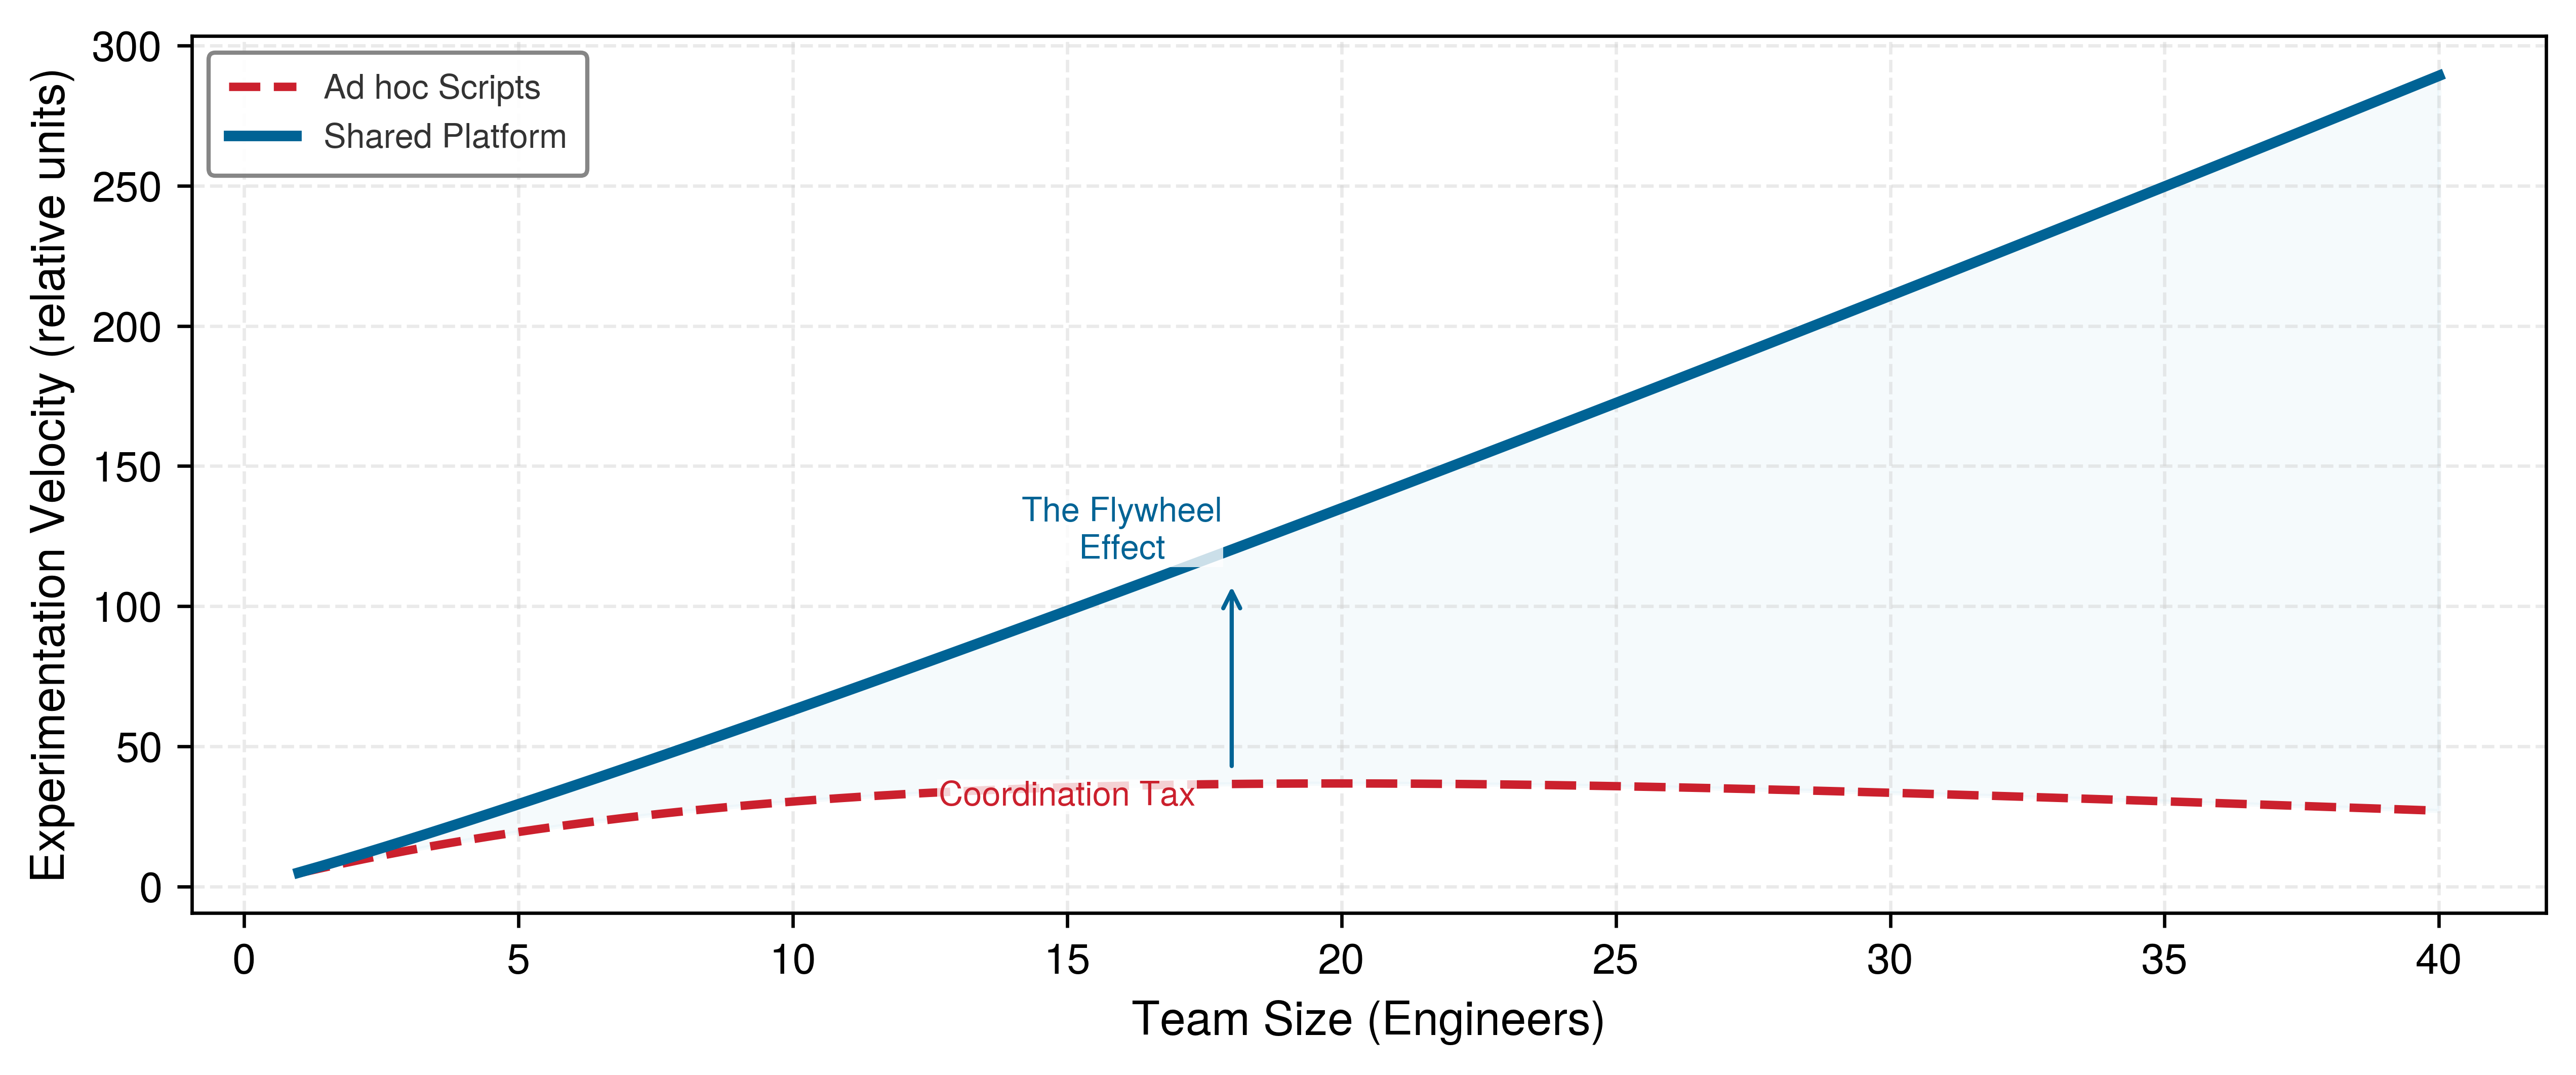
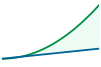
由三名数据科学家组成的团队可以使用电子表格和共享笔记本来管理实验,而由 30 人组成的团队则更可能需要共享工作流基础设施。随着项目从原型演进到生产,复杂度会在多个维度上同时增长:数据集更大、模型更复杂、实验并发进行,以及采用分布式训练基础设施。在生产规模下,当团队需要共享数据划分、解决实验冲突并协调笔记本版本时,非正式协调可能成为瓶颈。Figure 6 展示了人工协调与共享工作流平台之间的一种假设性对比。坐标轴使用相对单位,旨在展示曲线形态,而非绝对吞吐量。
figure 6 中的曲线表达的是假设函数,而非实测的团队规模扩展规律。人工工作流曲线表示共享数据划分、解决实验冲突和协调笔记本版本所带来的协调成本。平台曲线表示可复用预处理组件、版本化实验跟踪和自动化调度带来的收益。实际吞吐量不一定会趋于饱和或呈超线性增长;它取决于工作负载的并行性、平台开销、团队结构和实验质量。因此,Figure 6 说明了共享基础设施为何能够减少重复工作和人工交接,而不是预测每个团队都能获得的普遍回报。
可复现性与技术债务
共享基础设施可以加快实验进程,但快速迭代也会产生隐性负债。如果实验不可复现,团队就无法可靠地区分真正的改进与噪声,而代码库会积累技术债务23,并随着每一个不可复现的结果不断叠加。
复现机器学习结果,需要在跟踪程序逻辑的同时,跟踪数据版本、随机种子、硬件配置和库版本。硬件和非确定性操作可能改变训练结果,因此团队需要血缘信息来区分架构变更与运行间波动。这种运行间波动在物理执行层面的成因是,并行 GPU 线程采用非确定性调度:反向传播中的梯度累加等操作会按照数值到达的任意顺序求和,而浮点加法不满足结合律(\((a + b) + c \neq a + (b + c)\))。此外,除非显式锁定为确定性执行,否则优化过的厂商库(如 cuDNN)会在不同硬件运行中动态进行基准测试并选择不同的执行内核,导致相同代码和随机种子产生不同的权重。系统性的实验跟踪会记录唯一的运行标识符和制品版本。MLflow 和 Weights & Biases 等系统将数据版本、代码提交、超参数和生成的模型关联起来,使团队能够重建各次运行之间的差异。
忽视可复现性的代价不仅体现在科学层面,也体现在经济层面。无法复现结果的团队会浪费周期,反复运行可能无法收敛到相同结果的实验。版本化环境、受控流水线和自动化检查点保存等可复现性基础设施,可以减少冗余计算,并支持团队更有把握地做出架构决策。
可复现且经过优化的模型是必要条件,但并不充分。在精心整理的研究数据上达到专家级准确率的模型,仍可能在生产环境中失效。下一阶段将针对这些训练后制品实际会遇到的条件,对其开展系统性测试。
评估与验证
一个糖尿病视网膜病变(DR)筛查模型,在精心整理的研究数据集上取得了 0.99 的 ROC 曲线下面积(AUC)。当使用清迈某诊所的现场图像进行评估时,其敏感度降至 78%;在该诊所,一名仅接受过两周培训的技术人员操作着一台已使用五年的眼底相机。软件执行时既没有抛出异常,也没有返回错误码;只是卷积滤波器遇到了训练分布中从未出现过的像素分布,这些分布受到光学模糊、低照度和瞳孔扩张程度变化的影响。在精心整理的测试划分上取得高准确率,并不保证生产环境中的运行可靠性。在部署之前,训练后的模型必须通过系统性的评估与验证关卡,以核实其在真实部署条件下是否满足准确率、延迟和鲁棒性要求。该阶段通过依据预先定义的运行阈值衡量模型行为,将原始检查点文件转化为可投入生产的软件系统。
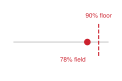
生产验证是一道关卡:现场敏感度低于规定下限,就不能通过部署。
Definition 1.2: 模型验证
模型验证是一个基于证据的关卡,用于判断训练后的模型是否适合部署于指定用途。它依据延迟目标、子群体性能目标、成本预算以及分布偏移下的鲁棒性等部署约束来测试模型,但无法证明模型在所有可能条件下都安全。
- 意义:验证增加了测试集准确率所忽略的维度。一个在静态测试集上达到 95% 准确率的模型,可能在最慢的请求上无法满足 100 ms 的延迟目标,未达到规定的子群体阈值(例如人口统计群体之间的性能差距最多为五个百分点),或者在模糊、眩光等常见图像质量问题下,准确率下降超过十个百分点。每个未经检查的维度都是一项部署风险,会在生产环境中悄然叠加。
- 区别:评估使用选定的数据集、指标和实验来衡量模型行为,其中可以包括分布外测试和子群体测试。验证则汇集针对特定部署决策所需的更广泛证据,包括系统延迟、吞吐量、鲁棒性、运行就绪程度和成本。
- 常见误区:一种常见误解是,验证只是“再做一次测试”。实际上,它是一个多维度关卡:模型可能通过准确率测试,却仍因违反延迟、子群体可靠性或成本约束而无法通过验证,因为仅靠准确率无法衡量这些约束。
评估在静态测试集上量化独立的算法属性,而验证则判断集成后的软硬件流水线是否在实时服务约束下满足运行不变量。由于任何有限测试套件都无法证明系统在所有可能的输入变化下均正确,验证作为一种风险管理实践,围绕四个阶段展开:指标阈值判定、分阶段生产发布、环境压力测试和监管资格认定。
评估指标与阈值
评估指标必须直接对应目标应用的非对称损失函数。在糖尿病视网膜病变筛查中,类别不平衡使标准分类准确率具有误导性:一个将所有样本都预测为无病的简单分类器,在低患病率的筛查人群中也能获得很高的准确率,却会漏掉所有可治疗的病变。因此,系统要求规定了相互独立的工作阈值:敏感度高于 90%,确保诊所能够识别需要采取临床措施的病变;特异度高于 80%,防止假阳性转诊使二级眼科诊所不堪重负。确定能够同时满足这两个约束的分类阈值,是一个基于受试者工作特征(ROC)曲线的经验优化问题。
汇总指标可能掩盖局部失效模式。分层评估沿患者年龄段、慢性合并症和诊所相机型号等元数据维度划分测试语料,以衡量不同切片之间的性能一致性。一个在整个基准上取得 94% 总体准确率的视觉骨干网络,在白内障患者的图像或低环境光照下采集的图像上,准确率可能低于 80%。这些局部性能下降在汇总评估中不可见,但部署后会表现为严重的安全失效。系统性的基准测试方法(基准测试)会在将候选检查点提升至下一阶段之前,自动评估这些切片分布。
除标签准确率外,评估还必须衡量概率校准:24即模型预测的置信度分数是否与其经验错误率相符。现代深度神经网络经常产生未经校准的后验概率,即使对于接近决策边界的样本,也会输出过度自信的预测(置信度 \(>90\)%)。当自动分诊流水线根据置信度阈值将边界病例转交给人类专科医生时,校准失准会导致临床注意力分配不当,并削弱医务人员的信任。
离线与在线评估
验证关卡从静态数据集上的离线评估开始,逐步推进至实时生产流量。对留出的测试划分进行离线评估可以确定基线收敛情况,但无法暴露物理系统瓶颈,例如动态批处理期间的内存碎片、网络接口上的序列化延迟,或真实遥测数据流导致的流水线停顿。在线评估采用分阶段发布,在真实服务动态下测试候选模型:25
- 影子模式(暗流量):API 网关将实时生产请求异步镜像到运行于专用加速器资源上的候选模型。候选模型在真实输入维度和并发请求到达模式下执行推理,但其预测结果会写入遥测日志,而不是返回给客户端。这种方式能够隔离尾延迟尖峰、内存不足(OOM)故障和数值偏差,而不会对用户造成影响。
- 金丝雀部署:入口负载均衡器将一小部分实时流量(例如 1% 至 5%)导向新的服务容器,在返回实时预测结果的同时,监控系统遥测数据中的崩溃循环、延迟退化和下游错误激增。
- A/B 测试:流量分配器使用确定性哈希,将用户请求分配给候选模型和基线模型,提供统计证据,以验证算法改进是否转化为可衡量的业务或临床收益。
这种分阶段发布工作流用于管理部署验证风险;它不同于 机器学习系统 中称为渐进式部署的跨层级模型压缩模式。
每个验证阶段都提供不同且互补的运维证据,如 table 4 所概括。
| 验证阶段 | 通常补充的证据 |
|---|---|
| 离线评估 | 算法行为 |
| 影子模式 | 集成行为 |
| 金丝雀部署 | 有限流量下的行为 |
| A/B 测试 | 对比结果 |
服务基础设施必须在设计之初就支持这一分阶段验证流水线。要在现有部署栈中补加动态流量分配、异步请求镜像和输出差异日志记录功能,需要对 API 网关和遥测流水线进行大幅修改。
生产条件验证
生产条件验证评估机器学习模型能否承受问题定义阶段所指定的物理环境和运行环境。标准评估隐含地假设测试样本与训练数据同分布;生产验证则有意从三个维度对这一假设开展压力测试:站点异质性、输入级扰动和时间漂移。
外部验证和多站点验证针对站点级分布偏移:确定模型究竟学到了可泛化的表征,还是过拟合于开发环境中的传感器硬件。在视网膜筛查中,不同设备供应商的相机传感器灵敏度、光学镜片镀膜和照明光谱各不相同。仅使用研究型医院高端眼底相机图像训练的 DR 模型,在部署到使用较旧硬件的社区诊所时可能失效。多站点验证要求使用来自多个独立诊所站点的数据,对候选模型进行基准测试;这些站点的硬件配置、环境照明条件和操作人员技能水平应有所不同。
鲁棒性测试将重点转向单次推理请求,评估系统对现实物理失真和边界情况的抵御能力。对于计算机视觉流水线,这些扰动包括传感器噪声、光学模糊、对比度不均和瞳孔部分遮挡。在泰国 DR 临床研究(Beede et al. (2020))中,接受正规培训有限的现场技术人员经常拍摄出偏离中心或对焦不良的眼底图像。使用合成和实测扰动测试集评估模型,可以揭示服务流水线是否需要上游图像质量过滤器,以便在分配加速器计算周期进行推理之前剔除受损帧。
时间验证评估模型能否在运行环境历经数周、数月变化时维持预测准确性。从固定历史时间窗口中抽取的横截面测试集,无法捕捉患者人口统计特征、疾病流行病学特征或临床实践模式的后续变化。输入分布发生变化而标签未发生变化会产生协变量漂移,而输入特征与临床诊断之间关系的变化则会导致概念漂移。这两种现象都会造成模型静默退化,因此需要 section 1.8 中介绍的持续遥测与漂移检测流水线。
监管验证
医疗 AI 系统面临因器械及监管路径而异的验证要求。当需要接受 FDA 上市前审查时,安全性与性能证据必须与器械及其监管路径相适应;部分申报需要临床数据,但并非全部都需要。26
领域特定验证超越法定合规要求,还要处理临床效用和安全规程。在糖尿病视网膜病变筛查中,临床验证研究将自动化系统与执业眼科医生同时投入使用,并将模型分类结果与专家共识裁定组确定的真实标签进行比较。这些研究不仅必须证明诊断准确性具有非劣效性,还必须证明其故障模式安全:通过将模糊或低置信度样本转交临床专科医生而实现安全失效的系统,能够成功融入医疗服务流程;而静默失效的系统则会造成灾难性的诊断错误。
人因验证将模型视为人类决策回路中的嵌入式组件进行评估。即使模型准确,如果它给操作人员带来较高的认知负荷、推理延迟过长而阻碍患者接诊,或频繁触发误报,也会造成警报疲劳,促使诊所工作人员禁用或绕过系统。因此,验证方案必须在量化原始统计准确性的同时,量化社会技术指标,包括临床医生推翻系统决策的频率、检查周转时间和转诊一致性。
部署就绪
通过验证关卡后,会生成一份不可变的发布清单,证明模型具备生产部署资格。这份清单记录模型检查点的精确哈希值、预处理容器配置、校准参数、指定人口统计子群和设备子集上的基准得分,以及监管许可证书。如果模型未能达到既定阈值,例如 p99 服务延迟超过服务级别协议(SLA)的预算,或低光照眼底图像上的敏感度低于安全下限,发布关卡就会停止部署。随后,诊断结果会回溯至生命周期中负责的阶段:转交数据整理阶段开展针对性数据采集,转交模型训练阶段重新加权损失函数,或转交编译器优化阶段进行算子核融合。
通过算法验证关卡是进入生产环境的前提,但部署就绪还要求验证整个执行底座。经过数学验证的模型,如果没有可运行的服务路径,就无法处理流量;这条路径包括确定性的输入预处理例程、针对目标硬件运行时优化的序列化推理图、遥测采集器和自动回滚触发器。一旦验证证据包完备,运维挑战就会从离线验证转向在线服务和系统集成。
部署与集成
在开发阶段通过验证的模型,一旦部署到生产环境,就会面临不同的故障模式。在 DR 场景中,模型必须运行在网络连接时断时续的乡村诊所平板电脑上,与具有不同数据模式要求的医院信息系统集成,并提供临床医生能够直接解读的预测结果。该场景的延迟和网络连接要求排除了需要网络往返的云端推理。部署是将抽象运行约束转化为物理系统要求的环节。用机器学习系统铁律的术语来说,服务路径将数据移动、执行效率和固定开销耦合在一起;具体由哪一项构成约束,因典型工作负载而异。ResNet-50 类视觉工作负载可以通过批处理提高吞吐量,DLRM 类推荐工作负载侧重交互延迟和嵌入访问,而 TinyML 类音频工作负载则在严格的能耗预算下运行(table 2)。专用服务基础设施(机器学习运维)负责在实时流量下管理这些权衡。
部署要求
部署将抽象计算图转化为严格的物理预算:峰值内存占用、执行延迟、散热上限和网络带宽。在临床筛查场景中,这些约束迫使架构在集中式云端服务与本地化边缘执行之间作出选择。云端部署将计算集中到集中式加速器上,但需要稳定的广域网上行链路,并持续产生 API 和带宽费用。相应地,边缘部署消除了网络传输延迟,并能在广域网连接中断期间运行,但需要前期硬件资本支出,且模型大小受限于本地设备内存。评估这一权衡,需要量化资本支出、运营支出与推理量之间的关系。
Napkin Math 1.3: 云端与边缘部署的经济性比较
问题:假设诊所每天运营,每位患者的图像经过本地选择和质量检查后处理一张,生产模型在 500 家诊所中,每月处理约 760,000 张计费筛查图像。部署应采用云端推理端点,还是在本地服务器上进行边缘推理?
方案 A:云端推理。
- 模型在集中式 GPU 服务器上运行
- 推理成本:约 $0.01/image(云端 GPU 时间 + API 开销)
- 按 500 家诊所、50 patients/day、每位患者 1 张计费图像、365 days/year 以及 $0.01/image 计算,年度推理成本为 $91,250/year
- 另加:假定每张计费图像上传 5 MB,为此分摊的网络连接与网络运维费用 = 约 $45,000/year
- 合计:约 $136,250/year 的运营成本
- 风险:200 ms+ 超过该场景的延迟目标;网络连接中断会导致筛查停止
方案 B:在诊所设备上进行边缘部署。
- 一次性硬件投入:500 家诊所各配备一台价格为 $500/device 的设备,需要 $250,000 的资本支出
- 推理成本:约 $0.001/image(假定为包含所有项目的可变运营费用分摊额)
- 年度成本:约 $25,000/year 的维护费用,加上约 $9,125/year 的可变推理成本,合计约 $34,125/year
- 合计:前期投入 $250,000 + 约 $34,125/year
- 优势:延迟低于 50 ms;可离线运行;单次推理成本显著更低
计算:
- 年度节省:$136,250/year(云端)− $34,125/year(边缘)= $102,125/year
- 投资回收期:$250,000(硬件)÷ $102,125/year = ~2.4 years
系统洞见:在这些场景假设下,边缘部署的投资回收期为 ~2.4 years,且能够在网络连接中断期间进行推理,但它要求更严格的模型优化(模型必须能装入边缘设备内存)以及更复杂的更新流水线。问题定义阶段选择的部署范式,决定了边缘方案是否具备可行性。
随着部署规模扩大,云端成本增长快于边缘成本。
在该场景中,带宽限制、延迟目标和离线运行要求倾向于支持边缘部署。这一选择规定了严格的内存、延迟和热约束范围,模型压缩(模型压缩)必须满足这些约束,服务运行时(模型服务)也必须在生产环境的边界内执行。
宿主系统集成将这些物理约束延伸至现有临床基础设施的软件接口。推理运行时必须与医院信息系统(HIS)交换数据,以获取患者记录并写入诊断输出。将概率模型集成到既有临床工作流中,与连接确定性传感器存在根本区别。模型输出的不是恒定不变的标量测量值,而是附带不确定性估计的概率分布。因此,集成边界需要明确的接口契约来规范决策路由。该契约将预测不确定性映射为临床行动,规定哪些分类结果触发自动转诊,哪些需要医生复核。置信度阈值不能孤立评估;其运行安全性完全取决于它所触发的下游工作流。监管框架对这一数据生命周期施加结构性约束。HIPAA 等法律规定约束数据传输,并限制生产推理请求中的数据能否被持久化保存、关联患者标识符或纳入再训练流水线。当合规要求禁止保留原始输入时,持续改进就不能依赖被动遥测日志记录。因此,隐私规则会约束持续的模型维护策略,而不仅仅是传输层安全检查清单(机器学习运维)。
从试点到全面部署
生产发布以离散阶段推进,以便在不断扩大的执行环境中隔离故障模式。离线回放和合成测试框架能够在不危及患者安全的情况下验证数据模式契约和并发限制。随后,在少数诊所开展的试点部署,使服务栈接触到实验室基准测试中不存在的物理差异:不同相机型号的光学失真、诊所照明不均时的传感器噪声,以及操作人员的操作差异。全面发布则扩大了对长尾解剖变异和罕见病理情况的覆盖。检测这些分布偏移需要持续的运行时监测,而不能假定验证时的分布会永久保持不变。
将部署扩展到数百家偏远诊所,会在分布式节点之间引入硬件异质性和运维阻力。本地传感器光学特性的差异,会在执行开始前改变输入像素分布,因此需要鲁棒的输入验证算子核,在本地拒绝不符合规格的采集图像。同时,严格的广域网带宽约束排除了持续同步权重或将高分辨率遥测数据以流式方式回传至集中式集群的可能。边缘节点必须自主运行,在本地缓存执行指标,并在计划维护窗口期间有机会时同步状态。
维持临床效用需要经过校准的不确定性估计,而非仅依赖原始总体准确性。当模型遇到模糊的病理情况时,输出未经校准的预测会带来诊断失败风险。因此,可运行的服务路径应纳入人在回路中的路由机制,使用经过校准的决策边界,将临界病例转交临床专家。这一路由机制具有双重作用:既为患者诊疗提供实时安全边界,又建立持续的数据采集渠道。经裁定的边界病例会产生经过验证、信息量高的标注,并反馈至后续训练迭代,直接针对模型已知的故障模式进行改进。
维持分布式部署的一致性,需要对不可变模型产物进行版本管理,并采用原子更新流程。客户端运行时必须在将新权重加载到内存之前,验证序列化计算图的加密校验和,防止不完整更新破坏边缘执行。部署标志着从静态离线评估转向持续运维;在此过程中,系统遥测持续评估真实世界中的延迟分布和推理行为是否仍处于指定的运行边界内。
监测与维护
考虑一个示例:某糖尿病视网膜病变(DR)筛查系统上线六个月后,一家诊所升级了眼底相机,新设备生成的图像具有不同的色彩特征。随后,该站点的模型敏感度下降,因为模型在训练期间学到的像素分布不再与其接收的图像相匹配。代码没有发生任何变化。数据漂移超出了训练数据的覆盖范围,模型性能悄然退化。即使模型制品完全未被改动,机器学习系统也可能因数据漂移而退化。 这种可能性意味着,部署并非生命周期的终点,而是持续运营阶段的起点。监控提供用于检测性能退化的统计遥测数据,而持续维护流水线(机器学习运维)则在证据充分时更新模型。
在这一示例场景中,监控会跟踪各诊所的性能,以检测患者人口统计特征变化、相机技术变化或设备老化是否影响准确率。增加光学相干断层扫描等新的成像模态属于产品变更,需要新的数据、验证、工作流集成以及任何适用的监管审查,而非例行维护。三条反馈路径指导更新决策:性能证据可以推动有针对性的数据采集,数据质量发现可以促使调整数据准备流程,而已确认的模型退化则可以成为重新训练或采取其他干预措施的依据。漂移阈值用于启动审查,并不会自动选择补救措施。
生产监控
监控必须同时服务于两类受众:跟踪系统健康指标的技术团队,以及需要可据以采取行动的信息的临床人员。初始部署可能暴露出实验室验证期间无法发现的盲点。27 使用较旧设备的诊所可能出现准确率下降。某些患者亚组,例如患有增殖性视网膜病变或因白内障而导致眼底图像复杂化的患者,可能出现更高的错误率。这些发现推动有针对性的数据采集和架构改进。
对于 DR 筛查系统,漏诊需要转诊的疾病可能延误治疗,并导致本可避免的视力丧失,因此必须开展持续的运营监控,并在标签到位后定期评估性能。团队为延迟、准确率和数据分布稳定性设定量化阈值。群体稳定性指数(PSI)和 Kolmogorov-Smirnov(KS)检验等轻量级统计检验28会触发从自动告警到重新训练审查等不同响应(机器学习运维)。
生产环境中的 DR 系统可以在不同时间尺度上跟踪四类指标。以下阈值用于说明一种场景策略;临床和运营团队必须针对预期产品、目标人群及部署环境验证这些阈值。
- 模型性能指标(需要真实标签,存在获取延迟):敏感度(目标高于 90 percent,若七日滚动平均值降至 88 percent 以下则告警)、特异度(目标高于 80 percent,若降至 78 percent 以下则告警),以及亚组性能(若任何人口统计群体的性能比基线低超过 5 个百分点则告警)。
- 代理指标(可立即获取,无需真实标签):预测置信度分布(若平均置信度相对基线下降超过 10% 则告警)、转诊率(若相对基线变化超过 15% 则告警),以及图像质量拒绝率(若超过 20% 的图像未通过质量检查则告警)。
- 运营指标:推理延迟(p95 低于 50 ms,若高于 100 ms 则告警)、吞吐量(若队列深度超过 50 张图像则告警),以及错误率(若超过 0.1% 的请求失败则告警)。
- 数据稳定性指标:将特征分布和预测分布与基线进行比较,当近期流量超出预期范围时告警。
这一层次关系十分重要:运营指标可以暴露即时问题,代理指标无需等待真实标签即可提示潜在的模型问题,而性能指标通常较晚才能获取,因为它们需要带标签的数据。
规模化维护
模型更新需要审慎验证和受控发布。团队采用 A/B 测试框架评估更新,并实施回滚机制29以快速处理问题。机器学习系统必须考虑数据演变,因为它可以独立于代码变更影响系统行为。
在这一示例场景中,从试点站点扩展到数百家诊所会增加监控复杂性。由此产生的日志量不仅取决于诊所数量,还取决于请求速率、采样方式、载荷大小和保留策略。监控基础设施必须同时跟踪全局指标和站点特定行为,在监管合规要求适用时维护数据血缘,30即将生产日志关联到数据、代码和模型版本的元数据轨迹,并将生产问题与训练实验关联起来,以开展根因分析。
主动维护使生命周期形成闭环:运营信号识别潜在问题,审查确定是否需要新近验证的数据或其他变更,而生产证据则反馈到问题定义、数据质量标准和架构决策中,推动其完善。当选择重新训练时,按计划或由证据触发的流水线可以纳入已批准的数据,并将候选模型重新送入验证流程。这些运营动态背后有三项基本系统原则:约束跨阶段边界传播,反馈在不匹配的时间尺度上运行,系统级行为偏离组件级指标(section 1.9)。
系统思维
糖尿病视网膜病变场景展示了生命周期各阶段如何作为一个耦合系统相互作用:诊疗现场的物理约束直接支配模型容量、训练数据整理和预处理逻辑。三种结构性机制解释了这些耦合交互:约束反向传播、多时间尺度反馈回路,以及涌现的系统权衡。对这些机制的管理,区分了主动、约束驱动的系统设计与部署后的被动调试。
约束传播原则

一个示例性的倍增场景直观展示了对发现时机延后的敏感性。
在 DR 场景中,诊所间歇可用的 2 Mbps 上行链路排除了云端推理,要求采用边缘部署。随后,目标边缘设备的内存和功耗预算又约束了模型架构,使轻量级分解卷积优于大型集成模型,并要求在采集时自动检查图像质量。每项下游约束都缩小了上游阶段的设计空间,将硬件限制直接耦合到数据采集和模型设计。
Definition 1.3: 约束传播原则
约束传播原则指出,在机器学习生命周期后期发现的约束,可能迫使受影响的前期阶段返工。实际修正成本取决于必须变更的制品和决策。本章的 \(2^{N_{\text{stage}}-1}\) 规则是一个用于说明敏感性的示例场景,并非经验性的成本定律。
- 意义:在部署阶段(阶段 5)才发现的 100 ms 延迟目标,可能反向传播,约束模型规模(阶段 3:算法复杂度 \(O\))、数据集需求(阶段 2:数据集大小 \(D\))和问题定义(阶段 1:能够达到何种准确率)。返工取决于哪些早期决策依赖于这一此前缺失的约束。在机器学习系统铁律中,对 \(L_{\text{lat}}\) 或 \(R_{\text{peak}}\) 的部署约束可以重新界定 \(O\)、\(D_{\text{vol}}\) 和 \(\eta_{\text{hw}}\) 的可行域。
- 区别:模块化分解鼓励对各组件进行独立优化,而这一原则要求端到端推理:孤立地优化准确率可能产生无法部署的模型,使准确率的“局部最大值”成为系统可行性的“全局最小值”。
- 常见陷阱:一种常见误解是部署是“最后一步”。部署环境从第一天起就是约束:其延迟预算、内存容量和功耗范围界定了每一项上游决策的边界。
传播是双向的,形成动态约束网络,而非线性依赖关系。当农村诊所的部署暴露出严格的带宽限制时,团队可能重新设计流水线,在本地推理后传输紧凑输出。如果系统改为压缩模型输入以通过上行链路传输,有损压缩伪影会降低输入质量;此时,训练数据集必须纳入相匹配的失真增强,以防止训练与服务偏差。反过来,将推理完全移至边缘端、仅传输诊断标量,可以缓解上行带宽压力,但会收紧边缘设备的 DRAM 容量和散热约束。上游数据选择与下游机器边界始终保持物理耦合。
未考虑下游执行边界的决策会累积技术债务。31 阶段接口规范(table 3)通过在各阶段边界显式列出约束,使这一原则可操作化,并与 机器学习运维 中讨论的模型、数据和基础设施契约实践保持一致。这些契约使约束能够被更早发现。当传播具体由数据质量问题引起时,所形成的模式称为数据级联:由不良数据触发的一连串下游故障 (Sambasivan et al. 2021)。数据工程 对这一故障模式进行了形式化描述,并追踪其如何逐阶段展开。
Sambasivan, Nithya, Shivani Kapania, Hannah Highfill, Diana Akrong, Praveen Paritosh, and Lora M Aroyo. 2021. “‘Everyone Wants to Do the Model Work, Not the Data Work’: Data Cascades in High-Stakes AI.” Proceedings of the 2021 CHI Conference on Human Factors in Computing Systems, 1–15. https://doi.org/10.1145/3411764.3445518.
多时间尺度反馈
机器学习系统通过协调跨越多个时间尺度的反馈回路来取得成功,每个时间尺度服务于不同目的。DR 场景的一项示例运营计划采用分钟级检查,在配置错误的相机产生整整一个班次的不可用图像之前发现问题;每日审查转诊率、置信度、拒绝率等代理指标的偏移,或站点特定的相机变化;在真实标签可用时,每周汇总带标签的准确率统计数据并开展漂移检验;每月分析人群覆盖情况;每季度审查架构是否仍然满足临床需求。实际周期取决于标签延迟、产品风险、流量,以及针对各信号采取行动的成本。
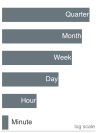
一项示例监控计划从分钟延伸至季度,跨越五个数量级。
这些反馈回路的时间结构反映了机器学习系统的内在动态。快速回路能够迅速纠正运营问题:诊所中配置错误的相机可以在几分钟内被发现并纠正。较慢的回路支持战略性调整;要可靠地识别出人口统计特征变化需要扩充训练数据,必须经过数月监控。这种多时间尺度方法在响应速度与统计稳定性之间取得平衡。对短期波动反应过度会造成流水线反复震荡,例如因暂时性偏移而触发不必要的重新训练;而适应迟缓则会使准确率的静默衰减持续存在,得不到缓解。
涌现复杂性与资源权衡
复杂系统会产生在分析单个组件时无法观察到的涌现行为。在多站点 DR 部署中,各诊所的总体性能可能保持稳定,而系统范围的分析却能检测到集中于特定人口统计队列的性能退化——这种故障模式无法从孤立的诊所日志中检测出来。此外,传统分布式系统主要因网络超时或内存不足崩溃等确定性故障而失效,机器学习系统还会经历概率性退化:数据漂移、概念漂移和偏差放大。概率性退化不会产生堆栈跟踪或运行时异常;模型继续在其延迟 SLA 范围内提供预测,而其统计有效性却在悄然衰减。
Checkpoint 1.3: 晚期发现的成本
将约束传播原则应用于以下场景:
某团队在监控阶段(阶段 6)发现,其 DR 模型无法有效处理 70 岁以上患者。这一人口统计群体需求本应在问题定义阶段(阶段 1)明确规定。
资源优化会引入多维权衡,这些权衡也存在于传统软件中,而机器学习又为其加入了学习得到的统计行为。准确率的提升可能需要增加模型参数量,进而迫使系统部署到性能更强的硬件上;当其扩展至数百家诊所时,这一边际准确率增益便决定了集群的资本支出。这些权衡体现了 机器学习系统 中讨论的功耗墙和内存墙:边缘部署消除了广域网延迟,却将模型复杂度限制在本地 SRAM 和 DRAM 的容量范围内;云端部署消除了加速器内存容量边界的限制,却引入了可能违背诊疗现场临床工作流要求的网络延迟。每一项架构选择都会在数据—算法—机器三元组之间重新分配压力。
这三种结构性模式——跨阶段边界的约束传播、多时间尺度的反馈时序,以及涌现的系统权衡——表明,机器学习系统的工程设计不能仅依靠模块化分解。孤立地优化数据流水线、模型拓扑和执行目标,必然会导致运行时瓶颈或静默故障。当工程团队将传统软件假设应用于这些耦合动态时,就会出现可预见的反模式。section 1.10 中的谬误与陷阱探讨了这些思维模型在生产生命周期的哪些环节失效。
谬误与陷阱
将传统软件模式应用于机器学习工作流,会忽视学习系统的统计性和数据依赖性。以下谬误与陷阱概括了反复出现的错误:它们使开发周期停滞,引发生产环境中的静默故障,并使技术债务在流水线各阶段不断累积。
谬误:机器学习开发可以直接沿用传统软件工作流,无需修改。
传统软件流程依赖于通过二元判定的单元测试验证的确定性规格。相比之下,机器学习系统通过从数据中归纳而获得行为,用统计性能分布取代确定性保证(table 1)。线性阶段关卡和刚性冲刺边界假定需求一经规定便保持不变。在机器学习工作流中,随着探索性训练揭示分布缺口、类别不平衡或不可行的准确率与延迟权衡,问题定义也会不断演变。此外,从业者调查表明,数据准备和流水线维护占据了大部分工程投入(section 1.1.1)。刚性的线性关卡将数据采集视为已经完成的前置步骤,而非活跃的反馈回路;当下游评估迫使团队从根本上修订早期数据假设时,这种做法会使团队陷入代价高昂的循环。
陷阱:将数据准备视为一次性预处理步骤。
团队常常将数据清洗和特征工程视为训练开始前需要完成的静态里程碑。在生产环境中,随着用户行为变化、传感器老化和上游模式变更,输入数据分布会持续演变。双流水线架构(figure 1)反映了这一运营现实:数据流水线和模型流水线必须并发执行,并持续接收反馈。早期数据准备决策会直接通过训练和部署产生级联影响(section 1.4)。当数据准备是静态的,静默分布偏移以及训练与服务之间的特征偏差便会绕过代码级测试,早在触发运营告警之前就已降低推理准确率。必须建立具备自动模式检查和分布监控能力的持续数据验证流水线,才能在数据摄取时捕获数据漂移,而非等到模型在生产环境中静默失效后才发现。
谬误:通过模型评估意味着系统已具备部署条件。
离线评估衡量模型在静态、经过精心整理的验证集上的统计损失,但它将模型与实际运行中的服务动态隔离开来。优异的总体指标并不能保证系统满足部署的物理约束。在双流水线架构(figure 1)中,离线评估并未检验服务集成、实时输入流水线和运行监控。糖尿病视网膜病变案例研究(section 1.2.1)体现了这种脱节:一个在精心整理的基准图像上达到专科医生水平准确率的模型,在临床部署中却因相机光照变化、技术人员工作流程中断以及网络连接间歇性中断而失效。达到生产就绪状态需要系统级验证,包括并发条件下的尾延迟预算、特征流水线一致性,以及硬件故障下的平稳降级。根据约束传播原则(section 1.9.1),如果直到部署后才发现运行故障,就会迫使团队在模型架构和数据采集两方面进行代价高昂的迭代。
陷阱:尚未检验数据对模型的边际价值,就扩大数据采集规模。
扩大数据集规模往往被视为一种总能带来准确率提升收益的投资。实际上,数据采集遵循边际收益递减的幂律缩放规律:一旦底层数据分布得到充分覆盖,新增原始样本带来的泛化收益便微乎其微,而存储开销、摄取带宽和标注费用却会不断攀升。figure 1 中的反馈回路表明,模型准确率取决于数据集质量、模型容量和运行约束之间的耦合。摄取大量错误标注或冗余样本会引入噪声并增加训练计算量,却不能提高准确率;相较之下,规模精简、经过精心整理、标签已核验且表征均衡的数据集,往往能取得更好的性能。由于数据质量决策会级联影响所有下游流水线阶段(section 1.4),团队在将工程预算分配给更大规模的数据摄取之前,必须衡量每增加一个样本所带来的准确率边际增益。
谬误:跳过验证阶段可以加快交付。
压缩或绕过逐步推进的验证阶段,看似能加快项目交付,实际上却将验证风险直接转移到了生产流量上。多阶段验证(section 1.6)在逐渐接近真实情况的执行环境中,隔离相互独立的故障模式。跳过影子模式会使团队无法在真实流量分布下观察在线推理行为,例如载荷反序列化瓶颈、并发争用以及尾延迟违反 SLA 的情况。绕过金丝雀部署则会移除限制故障影响范围的屏障,使所有用户立即暴露于边界情形下的回归问题或数值不稳定性。解决生产环境中的故障需要紧急回滚、分布式日志排查和受损状态修复,由此造成的工程停工时间,比被跳过的验证关卡所需时间高出数个数量级。
陷阱:将部署范式的选择推迟到模型开发之后。
团队往往认为,可以在优化模型准确率之后再选择部署目标。实际上,部署范式(云端、边缘、移动端或 TinyML)是一项主要约束,会塑造此前的每一个生命周期阶段(table 3)。假设某个团队先开发了一个 2 GB 的集成模型,之后才得知其 TinyML 目标设备只有 256 KB 内存。由此产生的不匹配会向前级联传播,迫使团队重新设计数据预处理、模型架构和评估基准。本章用于说明的约束传播模型将第 5 阶段才发现问题的成本设定为第 1 阶段成本的 \(2^{4} = 16\times\)。推迟平台选择必然会带来代价高昂的迭代周期,因为部署硬件决定了哪些模型在物理上能够实现,而不仅仅决定模型在何处执行。
总结
生命周期是一个反馈回路,而非一张检查清单。数据流水线通过采集、摄取、分析、标注、验证和准备,将原始输入转化为可用于机器学习的数据集。模型开发流水线则让这些数据集经过训练、评估、验证和部署,最终形成生产系统。结合全章内容来看,figure 1 中的反馈箭头承载了本章的核心含义:每个箭头都代表生产环境中获得的经验回流并强化早期阶段,使数据反馈和模型反馈在开发周期中明确呈现。
理解这一框架,就能解释为什么机器学习系统需要在既有软件工程实践的基础上增加专门的方法。机器学习工作流引入了概率优化、通过学习获得的统计行为,以及依赖数据的反馈回路。机器学习系统铁律提供了一个定量视角:生命周期各阶段的决策共同改变 \((T = \frac{D_{\text{vol}}}{\text{BW}} + \frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}} + L_{\text{lat}})\) 中的数据移动量、运算次数、硬件效率和固定延迟,而生产环境中的证据则将违反约束的情况反馈至评审环节。这一视角认识到,成功源于理解数据质量如何影响模型性能、部署约束如何塑造训练策略,以及生产洞察如何指导后续每一次开发迭代,而非孤立地完善各个阶段。
三个规律界定了机器学习生命周期的工程实践。许多从业者表示,数据采集、清洗、标注、验证或准备是主要的时间消耗环节,而模型开发只是生命周期的一部分。生产就绪的系统还需要在数据、模型和基础设施阶段之间反复迭代,因此,当数据质量是返工的主要来源时,数据工程投入能够发挥很大作用。最后,后期才发现的约束可能增加返工:本章用于说明的约束传播模型,将第 \(N_{\text{stage}}\) 阶段发现的约束所需的修正成本设定为第 1 阶段的约 \(2^{N_{\text{stage}}-1}\) 倍,并将第 5 阶段发现部署范式不匹配时的成本倍数设定为 16×。实际返工量取决于哪些阶段受到影响。尽早发现约束并不要求冻结工作流。它通过延迟、内存、功耗、安全和验证要求,确立运行边界,同时允许数据和模型选择在这些边界内持续迭代。
要点回顾: 先看清全局
- 生命周期是一个回路,而非一张检查清单:数据流水线和模型流水线并行推进,而生产反馈使它们构成一个系统。监控、验证和重新训练将部署中获得的经验反馈到采集、标注、架构和基础设施决策中。
- 后期才发现的约束可能增加返工:说明性模型将第 \(N_{\text{stage}}\) 阶段发现部署限制时的修正成本设定为第 1 阶段的约 \(2^{N_{\text{stage}}-1}\) 倍。第 5 阶段发现不匹配时的 16× 倍数说明了为什么应尽早将需求向前反馈。
- 迭代速度拓展搜索机会:在算例的假设条件下,一个起初落后 5 个百分点的轻量模型能够达到共同的 99% 上限,因为更短的周期允许实现更多次假定的改进。仅靠工作流速度无法保证模型质量。
- 接口使反馈可付诸行动:阶段契约定义输入、输出和质量不变量,使数据、模型和部署团队能够在集成前发现违反约定的情况。如果没有明确的契约,各阶段可能各自实现局部优化,而系统整体却依然失败。
- 生产反馈遵循不同的时间尺度:实时推理监控、批量更新评审和季度架构评审分别应对不同的故障模式。将所有反馈视为同一个回路,要么会对漂移反应过慢,要么会在缺乏有效信号的情况下反复启动代价高昂的工作流。
- 工作流使约束沿时间传递:问题定义记录目标,数据采集塑造证据并决定字节量,模型开发改变运算量和复用程度,部署实现完整的服务路径,而监控将违反约束的情况反馈至评审环节。生命周期就是数据—算法—机器耦合在时间上的展开。
这一工作流框架将临时性的机器学习实验转化为更加规范的工程实践。通过理解数据流水线与模型开发如何借助反馈回路相互作用,团队能够更早识别集成风险,并更有针对性地分配资源。约束传播原则说明,系统化的工作流管理是一种风险缓解手段,而非官僚式开销。
若将生命周期视为检查清单,它就是一系列需要依次完成的阶段。正确理解时,它则是一个回路。在部署阶段发现的约束不会停留在那里;它可能迫使相关的模型和数据决策返工。因此,工作流是一个耦合系统,而非一条流水线:数据—算法—机器分类体系在空间中描述的同一种耦合,如今在时间中展开。孤立地优化某个阶段,只会转移故障,而不会消除故障;因此,这一工程实践要求在着手处理任何局部之前,先看清全局。
后续内容: 从蓝图到燃料
这里建立的工作流框架为后续每一个技术章节提供了蓝图。然而,没有燃料的发动机只是一块沉重的金属;对于机器学习系统而言,这种燃料就是数据。因此,数据工程 将深入讨论数据—算法—机器的第一个轴:数据。随后,第 II 部分构建核心系统(神经网络计算、模型架构、框架、训练),第 III 部分面向部署对其进行优化(数据选择、模型压缩、硬件加速、基准测试),第 IV 部分则将其部署到生产环境并进行运维(模型服务、运维实践、负责任的工程实践)。各章均以读者熟悉其中技术在完整工作流中的位置为前提,并在此处建立的系统化视角之上逐步展开。
Footnotes
从实验室到部署的差距:Beede et al. (2020) 通过实证研究,记录了部署于泰国诊所的深度学习糖尿病视网膜病变筛查系统所面临的这一问题。尽管该系统在早期验证中已达到专科医生水平的准确率,但提交的 1,838 张图像中有 393 张(21%)未满足其图像质量要求,原因往往在于诊所照明、相机维护或散瞳操作不符合系统的假设。这些拒收增加了护士的工作量,迫使其重新拍摄或安排转诊,暴露出工作流与基础设施方面的障碍,而不只是模型准确率问题。↩︎
CRISP-DM(跨行业数据挖掘标准流程):CRISP-DM 将数据密集型系统开发规范为六个相互关联、反复迭代的阶段,而非线性的瀑布流程 (Chapman et al. 2000);其核心设计原则(所有阶段之间均存在反馈回路)直接影响了现代机器学习生命周期的结构。Boehm 关于软件工程经济学的研究讨论了后期修复的较高成本 (Boehm 1981)。后文的工作流模型使用 \(2^{N_{\text{stage}}-1}\),其中 \(N_{\text{stage}}\) 为生命周期阶段序号,将其作为说明性的敏感性分析情景,而非实证成本定律。↩︎
后期修正成本:Boehm 的 《软件工程经济学》(Boehm 1981) 讨论了为何后期发现的缺陷,其修复成本可能高于需求阶段发现的缺陷。在机器学习系统中,后期发现的约束可能要求重新训练、修改数据流水线并重新验证。成本翻倍规则只是用于说明的敏感性分析情景,并非实证成本定律。↩︎
瀑布模型:计划驱动的生命周期通常被描绘为需求、实现和测试依次进行的过程,但 Royce (1970) 曾警告,纯粹按顺序实施具有风险,并描述了相邻阶段之间的迭代。机器学习系统增加了必须显式管理的数据反馈和模型反馈。本章针对机器学习生命周期各阶段使用一个示例性的敏感性模型。↩︎
数据版本管理:代码通过离散且可审计的提交发生变化,而数据可能逐渐漂移(分布偏移)、突然变化(模式迁移),或发生细微变化(标签质量下降)。对于许多规模达数 TB 的数据集,直接使用 Git 并不现实,因此团队通常使用 DVC 和 Git LFS 等工具,对外部数据清单或指针进行版本管理。缺少数据版本管理,团队就无法可靠地复现此前的训练运行,也无法确定准确率下降究竟源于代码变更还是数据变更。↩︎
访问局部性:Denning (1968) 对虚拟内存的工作集原理进行了形式化描述。当逻辑顺序映射为分散的物理读取时,随机排列的样本可能降低局部性,但具体影响取决于存储布局、批处理、缓存和预取。↩︎
深度可分离卷积:对于典型的卷积核尺寸,用这种成本更低的分解方式替代标准卷积,可将计算量降低约 8–9\(\times\) (Sandler et al. 2018),从而使移动级硬件上约为 600 MFLOP 的推理预算具有可行性。网络架构 深入介绍了这一架构机制。↩︎
糖尿病视网膜病变(DR):DR 是糖尿病的常见并发症;早期检测可以预防视力丧失,但各国专科医疗服务的可及性存在显著差异。这一缺口推动了可规模化筛查项目的发展。在硬件有限或网络连接不可靠的诊所中,模型大小、离线能力、延迟和工作流程集成可能成为部署的硬性约束。↩︎
医疗 AI 部署鸿沟:在 Beede et al. (2020) 研究的泰国 DR 部署中,真实诊所暴露出了受控评估中不存在的工作流程、图像质量、基础设施和人为因素约束。该案例表明,仅凭实验室指标无法确认系统已具备部署条件。↩︎
人口特征漂移:人口变化可能暴露出总体评估所掩盖的性能差距。人脸分析基准测试发现,不同人口群体之间的错误率存在巨大差异 (Buolamwini and Gebru 2018);一项医疗风险评分研究则发现,尽管医疗需求相近,代理标签仍导致了带有种族偏见的资源分配 (Obermeyer et al. 2019)。这些例子说明了为什么不断扩大的 DR 项目应当评估子群体性能,并非声称此类推广已经发生。 ↩︎
NVIDIA Jetson:NVIDIA 的 Jetson 系列涵盖广泛的产品型号,从 Jetson Orin Nano(7–15 W)、Jetson Orin NX(10–25 W),到 Jetson AGX Orin(15–60 W)。本场景采用 Orin Nano 级设备(4–8 GB 共享 LPDDR5,功耗范围为 7–15 W)作为具体的边缘部署目标。其内存和功耗预算限制了模型复杂度,而选择更大型的设备会同时改变可行的模型和每家诊所的成本。↩︎
分层存储:根据访问频率和性能要求,将数据放置在不同的存储介质上。在本例中,存储价格相差约 4.3×:非易失性内存主机控制器接口(NVMe)SSD 每秒可执行 500,000 次以上的输入/输出操作(IOPS),价格为 ~$0.10/GB/month;对象存储的价格则为 ~$0.023/GB/month,但延迟为 100–200 ms。对于需要以 1–10 GB/s 持续进行顺序读取的机器学习训练循环,选错存储层会使受计算限制的训练流水线转变为受 I/O 限制的流水线,直接增大机器学习系统铁律中的数据项 \((D_{\text{vol}}/\text{BW})\)。↩︎
分布式诊所数据:在不简单汇集全部原始数据的情况下跨诊所站点训练,可以应对隐私和治理约束,但会将成本转移到协调工作上。各站点可能使用不同的相机、服务不同的患者群体,并遵循不同的操作流程,因此系统必须追踪数据的来源以及各站点之间的差异。因此,工作流成本不仅在于存储容量,还包括在数据特性并不一致的各个站点之间比较、验证和更新模型所需的工程工作。↩︎
超参数:架构与优化器的选择(例如学习率和网络深度)会影响训练的计算工作量。对每一种组合分别进行独立训练的朴素笛卡尔网格搜索,会产生乘法式增长的搜索成本:5 hyperparameters,每个具有 4 values,会产生 1,024(\(4^{5}\))种配置。早停、多保真度方法和自适应搜索可以避免将每次训练都执行到结束,因此该网格表示的是一个基线,而非不可避免的成本。↩︎
迁移学习:对于相同的架构,迁移学习改变的是参数的初始化与优化方式,而非推理所需的运算。↩︎
AUC(ROC 曲线下面积):衡量受试者工作特征(ROC)曲线下的面积,该曲线描绘了所有分类阈值下真阳性率与假阳性率的关系。AUC 的取值范围为 0 到 1;0.5 表示随机判别,也可能出现低于 0.5 的值。与准确率不同,AUC 不依赖阈值,且不受类别流行率影响,因此是医学筛查系统中的常用指标。这对系统的意义在于:AUC 为 0.99 的模型,在部署所选定的具体工作阈值下,仍可能产生不可接受的敏感度,因此仅凭 AUC 无法验证系统是否已具备部署条件。↩︎
集成学习:组合多个模型的预测(装袋法、提升法、堆叠法)。推理计算量与模型存储需求通常是各组成模型相应需求的总和。串行执行可能增加延迟,而并行执行则以额外硬件和协调开销换取更低的延迟;集成规模并不意味着延迟必然按某个固定比例倍增。↩︎
竞赛与生产的差距:Netflix Prize 获胜方案采用了复杂的集成模型,但 Netflix 并未部署这一获胜方法,因为额外的准确率提升不足以抵偿所需的工程投入 (Johnston 2012)。↩︎
医疗 AI 性能指标:医疗 AI 评估除总体准确率外,还强调敏感度(真阳性率)和特异度(真阴性率)。本 DR 场景设定了 >90% 的敏感度目标,因为漏检需要转诊的病变可能延误治疗,并造成原本可以避免的视力损失;实际验收标准取决于具体产品和监管机构。更隐蔽的系统陷阱是阳性预测值(PPV):即使模型准确率很高,在低患病率人群中,其 PPV 也可能很低。这种对患病率的依赖可能要求不同部署地点采用不同的工作阈值,而这一约束在标准机器学习评估中是不可见的。↩︎
模型压缩流水线:弥合研究准确率与边缘部署之间的差距,需要迭代执行“压缩—验证—调整”循环。每个压缩步骤都可以减小模型大小或降低执行成本,但也可能在不易察觉的情况下使敏感度降至临床阈值以下。找到既能容纳于设备内存中、又能保持临床敏感度的模型,通常需要多次迭代,因为只有完整的验证套件才能揭示较小的模型是否仍然满足问题定义。↩︎
消融研究:消融研究得名于外科手术中的组织切除,通过系统性地禁用单个组件来隔离其对性能的贡献。这种严谨性十分重要,因为 0.5% 的准确率差异就可能决定 DR 模型能否满足其临床敏感度阈值。没有消融研究,团队就无法区分真正的架构改进与不同随机种子引入的噪声,从而将迭代周期浪费在虚幻的增益上。↩︎
机器学习中的 A/B 测试:在随机分配的实时流量上,将新模型(B)与生产基线模型(A)进行比较,以估计模型的因果效应。所需样本量取决于基线事件率、效应大小、方差、分配比例、显著性水平和统计功效;仅凭 0.5 个百分点的变化,无法推导出通用的交互次数或持续时间。↩︎
机器学习制品的相互依赖性:机器学习制品之间存在深度依赖。模型的实测准确率与生成该模型时使用的数据版本、预处理流水线和超参数配置密切相关。如果没有血缘追踪,团队可能无法确定性能退化源于代码、数据还是运行间波动,从而被迫以高昂代价重新运行那些已丢失来源记录的实验。↩︎
校准:经过校准的模型,其预测概率与观测频率相符:80% 的置信度应对应 80% 的正确率。校准不同于准确率,而它对 DR 系统的系统层面影响十分重大:临床医生使用置信度分数进行分诊决策,因此,一个对不确定病例赋予 90% 置信度的校准失准模型,相较于准确率较低但校准良好的模型,可能以更危险的方式误导临床工作流。Platt 缩放和温度缩放可以改善训练后的校准,但其有效性必须在具有代表性的数据上进行评估。↩︎
分阶段发布:影子模式并行运行新模型,记录预测结果但不将其用于实际服务。随后,金丝雀部署(得名于煤矿中的金丝雀)将模型暴露于有限且可配置比例的流量,并在指标保持稳定时逐步提高该比例。覆盖范围取决于流量、可观测性、持续时间以及实际触发的故障模式,因此分阶段发布能够降低风险,但不能保证发现固定比例的生产问题。机器学习运维 详细介绍了实施策略。↩︎
FDA AI/ML 监管:FDA 上市授权要求提供与器械、预期用途、风险及监管路径相适应的证据。FDA 于 2021 年发布的 AI/ML 医疗器械软件(SaMD)行动计划,将生命周期管理、真实世界性能监测以及预定变更控制计划列为自适应医疗器械软件的核心议题 (U.S. Food and Drug Administration 2021)。这些关注点使模型版本、训练来源追溯、监测和变更文档成为重要的工作流产物,但并不要求在生命周期的每个阶段都提供完全相同的审计产物。↩︎
实验室到临床的性能差距:当相机型号、图像质量、患者群体或操作人员工作流与开发数据存在差异时,医疗 AI 系统的性能可能发生显著变化;这种差距源于训练数据无法涵盖生产条件的全部多样性。FDA 强调对采用 AI/ML 的医疗器械实施产品全生命周期监督和真实世界性能监控,器械申报可能需要提供与产品预期用途和风险相适应的证据。对于机器学习系统工程师而言,这意味着监控基础设施应成为部署的前提条件,而非上线后的补充项。↩︎
群体稳定性指数(PSI)与 Kolmogorov-Smirnov(KS)检验:两种用于检测分布漂移的轻量级统计方法;PSI 对特征进行分箱并计算散度;0.1 和 0.2 等阈值是实践惯例,并非通用的显著性水平。KS 检验衡量经验累积分布之间的最大距离。这两种方法的成本都足够低,适合频繁监控,但检测到输入偏移本身并不能证明准确率发生变化;还需要标签或其他结果证据。机器学习运维 深入介绍了漂移检测流水线。↩︎
机器学习回滚的复杂性:机器学习模型的有效性与其训练所依据的数据分布相耦合,而不仅仅取决于代码。“数据演变”意味着,简单回滚能够恢复模型制品,却无法恢复过去的数据环境,从而造成时间上的状态不匹配。因此,即便快速回滚也只是一种缓解手段,而非真正的系统恢复,因为无法保证旧模型在实时数据上的性能。↩︎
数据血缘:自动记录元数据,将每家诊所的生产日志关联到生成这些日志所用的确切数据、代码和模型版本。如果缺少这一明确轨迹,将某个站点的准确率下降与某次训练实验关联起来,可能需要人工取证分析,从而延迟根因识别。↩︎
机器学习技术债务:Sculley et al. (2015) 识别了机器学习特有的债务机制,例如纠缠(由于模型学习了联合分布,改变一个特征会影响所有其他特征)、隐藏反馈回路(预测影响未来的训练数据),以及未声明的使用方(在没有契约的情况下依赖输出的下游系统)。由于机器学习代码通常只占生产系统的一小部分,周边的配置、流水线和基础设施可能使此类债务悄然累积。↩︎
Beede, Emma, Elizabeth Baylor, Fred Hersch, Anna Iurchenko, Lauren Wilcox, Paisan Ruamviboonsuk, and Laura M. Vardoulakis. 2020. “A Human-Centered Evaluation of a Deep Learning System Deployed in Clinics for the Detection of Diabetic Retinopathy.” Proceedings of the CHI Conference on Human Factors in Computing Systems (CHI), 1–12. https://doi.org/10.1145/3313831.3376718.
Chapman, Pete, Julian Clinton, Randy Kerber, Thomas Khabaza, Thomas Reinartz, Colin Shearer, and Rudiger Wirth. 2000. “CRISP-DM 1.0: Step-by-Step Data Mining Guide.” SPSS Inc 1: 78.
Boehm, Barry W. 1981. Software Engineering Economics. Prentice-Hall.
Royce, Winston W. 1970. “Managing the Development of Large Software Systems.” Proceedings of IEEE WESCON 26: 328–88.
Denning, Peter J. 1968. “The Working Set Model for Program Behavior.” Communications of the ACM 11 (5): 323–33. https://doi.org/10.1145/363095.363141.
Sandler, Mark, Andrew Howard, Menglong Zhu, Andrey Zhmoginov, and Liang-Chieh Chen. 2018. “MobileNetV2: Inverted Residuals and Linear Bottlenecks.” 2018 IEEE/CVF Conference on Computer Vision and Pattern Recognition, 4510–20. https://doi.org/10.1109/cvpr.2018.00474.
Buolamwini, Joy, and Timnit Gebru. 2018. “Gender Shades: Intersectional Accuracy Disparities in Commercial Gender Classification.” Conference on Fairness, Accountability and Transparency, 77–91.
Obermeyer, Ziad, Brian Powers, Christine Vogeli, and Sendhil Mullainathan. 2019. “Dissecting Racial Bias in an Algorithm Used to Manage the Health of Populations.” Science 366 (6464): 447–53. https://doi.org/10.1126/science.aax2342.
Johnston, Casey. 2012. “Netflix Never Used Its $1 Million Algorithm Due to Engineering Costs.” Ars Technica, April.
U.S. Food and Drug Administration. 2021. Artificial Intelligence/Machine Learning (AI/ML)-Based Software as a Medical Device (SaMD) Action Plan. U.S. Department of Health; Human Services.