硅片布局
硅片布局
目的
为什么一个学习模型可以延迟运行在不同处理器核心上的安全检查?
软件架构图通常将提议路径与许可路径描绘为干净解耦的功能模块。 然而,在物理硅片上,不同的软件组件不可避免地争夺共享的硬件资源:内存总线、电源分配网络、时钟树以及散热路径。 一次高吞吐量的神经推理突发可以饱和共享的内存互连,或在电源轨上诱发感应性电压跌落,从而延迟运行于相邻处理器核心上的安全检查,而此时物理机箱仍在滑行。
软件特权环决定地址空间的访问权限,而非事务调度或 DRAM 队列延迟。 因此,逻辑隔离无法保证峰值竞争下的最坏情况执行时间。 只有对抗性工作负载下的实证压力测量才能验证时序截止时间。 要强制实时保证,就需要硬件级隔离、专用内存通道,或物理分离的微控制器飞地。 在物理人工智能栈中,硬件布局确立了 神经系统 的计算基础,确保确定性执行检查在指令跨越因果边界之前完成。
学习目标
- 清点 提议路径与许可路径共用的内存、互连、电源、时钟、复位和热资源。
- 解释为何平均总线利用率无法界定截止时间,需结合事务大小、队列策略与 存储体时序。
- 依据实测完成抖动,为两条路径之间的非阻塞记录交换设计窗口看门狗的服务窗口。
- 分析轨压跌落与热节流如何在不同时间尺度上拉长许可路径的执行时间。
- 设计带负载的压力测试,其证伪阈值取许可路径声明的最坏情况执行时间。
- 从实测的干扰与租约的时间余量中,在预留、分区、降载与迁移之间作出选择
- 构建一条放置记录,界定带负载运行时的观测最大值、缓解措施与未经测试的条件,以供发布评审
硅基载体
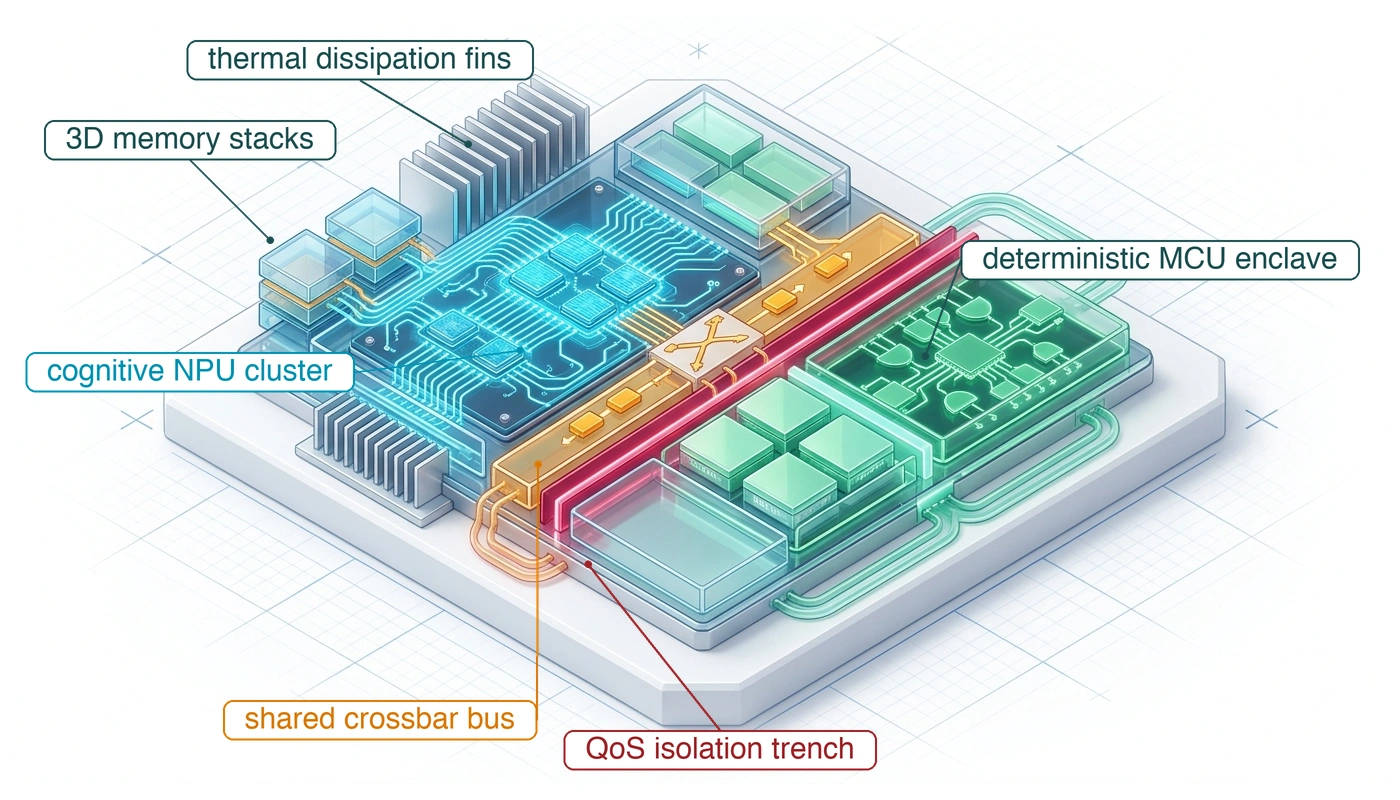
仓库移动操作臂在其同一机身内承载应用处理器与权限路径。 在其软件架构图中,大脑与神经系统 之间的提案边界是一条规整的虚线。 安全执行 的屏障过滤器(barrier filter)与回退阶梯(fallback ladder)只有在权限路径在每个节拍内都于其截止时间内完成检查时,才保有其保证;而该条件取决于检查在哪里执行,图中并未显示。 在物理硅上,虚线可以坍缩为一块共享的芯片裸片。 假设两条路径都运行在同一块异构 System-on-Chip(SoC)上,也就是这台机器会拒绝的布局。 分块策略与意图模型将在嵌入式加速器上执行,而权限路径则会在相邻的实时核心上执行。 当意图模型在其数十亿参数权重上开始一次推理轮次时,数十亿个晶体管会同时激活。 这次当前的电流尖峰(\(dI/dt\))会在芯片内部的电源分配网络(PDN)上引起电感和电阻性电压跌落(\(\Delta V = L \cdot dI/dt + IR\)),可能导致相邻实时逻辑出现时钟不稳定和建立时间违例。1 与此同时,密集的张量矩阵乘法会饱和共享的 LPDDR 内存总线,流式传输数吉字节的激活图,并将安全执行器的固定传感器表从末级缓存中淘汰。
当许可路径读取传感器缓冲区,而提案工作负载占用共享内存控制器时,其请求会在直接内存访问流量之后排队,等待时间可能耗尽执行器计算所需的截止时间份额。 逻辑特权对此类等待毫无作用,因为它规定任务可以触碰哪些地址,而非其请求在内存队列中的等待位置。
↰ 前置条件: 硬件执行节奏与微控制器计时循环已在 多速率节拍 中定义。
该机器上的两项任务都会感受到共享芯片耦合的影响。 对于 Class 1 底盘,特征提取期间的内存停顿会延迟许可路径的拒绝,而此时已装载的底盘正驶向机架端;超出停止预算所计量的那一个节拍之外的每一拍延迟,都是它从未预留的距离。 对于 Class 2 机械臂,加速器突发访问将共享缓存中许可路径的表项驱逐出去,会推迟接触检查,而此时夹爪正压在弹簧锁扣的笼门上。
承接系统设计中的端到端论证 (Saltzer 等 1984年),内存保护与操作系统进程隔离本身并不能确立运行独立性。 在异构芯片上,2 运行独立性 要求:提案侧的活动不得使安全强制执行检查的执行超出其硬性物理截止时间,且提案侧的崩溃或热过载不得使许可路径拒绝的权限失效。
由于这些耦合受物理固态现象而非软件抽象所支配,隔离性的架构主张必须作为需要通过测量来证伪的假设来对待。 检验此类主张需要四个工程步骤:清点所有共享硅资源及其请求方;开展压力测试,将提案路径驱动至最坏情况下的计算、内存与总线争用,同时记录许可路径的延迟分布与实测最大值;测量持续负载下的电压跌落与结温;以及一份放置记录,其中将实测最大值与截止期限对照陈述,并说明尚未测试的条件。 这些步骤贯穿本章其余部分,本章考察共享芯片裸片 作为机器拒绝的放置方案,以及物理独立的控制器作为机器使用的方案。 它首先说明每条路径必须计算什么、在哪里运行,以及在无竞争时保留多少余量。
物理人工智能架构的历史演进从根本上源于半导体缩放的物理极限(图 1)。 在五十年的微处理器进展(1975–2025)中,计算系统跨越了两道主要架构边界。 在经典扩展时代(1975–2004 年),摩尔定律与 Dennard 缩放使时钟频率从 \(2\,\text{MHz}\) 到 \(3.8\,\text{GHz}\) 呈指数级跃升,而热功率密度并未增加。 自主机器人直接受益于这波浪潮,从与外部小型计算机的缆线连接(Shakey)过渡到机载 VMEbus 机架(CMU Navlab 1)以及嵌入式 x86 主板(Stanford Stanley)。
2004 年 Dennard 缩放律崩塌时,静态漏电功耗将单核时钟频率限制在 \(3.8\,\text{GHz}\) 附近,使频率缩放时代戛然而止。 工业机器人通过解耦架构加以改造:确定性的微控制器负责按周期计数的 \(1\,\text{kHz}\) 现场总线电机换相回路,而应用处理器负责多线程轨迹生成。 当高容量深度学习与视觉—语言—动作(VLA)基础模型问世时,物理人工智能遭遇了第二个、同样严苛的硬件约束:移动机器人负载热与电池功耗上限(\(15\text{--}60\,\text{W}\))。 在无外部线缆连接的移动操作臂或人形机器人上,散热能力和电池供电能力均无法支持功耗为 \(300\text{--}700\,\text{W}\) 的服务器级加速器。 这一约束迫使部署了专用加速器(DSAs)以及异构的边缘片上系统(例如 NVIDIA Jetson AGX Orin 与 Drive Thor),将板载计算密度提升了九个数量级(\(10^9\times\)),同时严格控制在移动设备的功耗限制之内。 最近,自回归 VLA 中的顺序 词元 解码撞上了 认知推理墙(\(1\text{--}3\,\text{Hz}\)),促使转向流匹配与扩散策略,并采用带时间动作分块的策略,从而将闭环控制节奏恢复到 \(30\text{--}50\,\text{Hz}\)。
/var/folders/7g/fkg91tq50f58kfmg7c65747r0000gn/T/ipykernel_91966/979283785.py:180: UserWarning: This figure includes Axes that are not compatible with tight_layout, so results might be incorrect.
  plt.tight_layout()
/var/folders/7g/fkg91tq50f58kfmg7c65747r0000gn/T/ipykernel_91966/979283785.py:181: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
plt.show()将高容量神经推理与边缘硅基芯片衔接起来,需要与通用云计算截然不同的编译原则。 云端推理引擎通过动态批处理、运行时图追踪和堆内存分配(malloc)来优化平均吞吐量(每秒词元)。 在具身物理人工智能系统中,这些做法是危险的。 动态内存分配会引入堆碎片和分配器锁竞争,而即时编译与页面故障则会注入数毫秒的尾延迟抖动(\(P_{99.9}\)),直接侵蚀制动余量(停止包络)。 因此,物理人工智能的边缘编译器强制采用 提前编译(AOT)静态图编译:执行图的拓扑被永久冻结,张量维度固定,每个中间激活缓冲区在动作执行开始之前映射到静态的、预先分配的物理内存偏移量,从而保证零运行时动态分配。
除了消除尾延迟抖动之外,边缘 SoC 上的编译还受热力学和内存墙支配。 如 供给、新鲜度与内存墙 所述,数据经由片外动态随机存取存储器(DRAM)总线传输,每比特的能耗约为在片上寄存器或静态随机存取存储器(SRAM)内执行算术运算的 \(10\text{--}20\times\)。 对于在 \(15\text{--}60\,\text{W}\) 的载荷热预算约束内运行的无缆移动机器人,中间激活张量在 DDR 总线上反复往返传输,会迅速耗尽机身的散热能力。算子融合 将多层子图(例如卷积 + 偏置 + 激活,或注意力投影 + 层归一化)编译为统一的融合内核,完全在片上寄存器文件与本地 SRAM 缓存中执行,从而消除片外内存流量。 与此同时,数值精度降低(将权重与激活值从 FP32/FP16 量化至 INT8 或 FP4)直接成为内存总线容量的乘数。 将操作数位宽减半,会使内存交叉开关的有效传输吞吐率翻倍,直接降低内存总线占用,并为并发的实时安全监控保留总线带宽。
同一芯片上的两条路径
移动操作臂在两条要求相互冲突的控制路径之间进行划分。 提案路径在应用处理器上以 20 Hz 的频率运行分片策略,接收导航与腕部相机数据流,并一并输出底座速度指令与机械臂关节目标值。 其 P99 推理(含视觉部分)在每个 50 ms 分片周期中耗时 40 ms(示意性数值;详见读者指南);它不直接拥有驱动硬件的授权,且运行于非特权用户空间。 许可路径以 1 kHz 的频率运行于离散安全微控制器(MCU)上。 每个节拍,它检查最新提案与 停止包络 的停止包络,并将获准的设定值编排进发给驱动的 EtherCAT 帧。 它必须在其 1 ms 节拍内选定的 400 μs 截止时间之前完成,并运行于双核锁步控制器上的特权实时执行域中,3 其比较器诊断覆盖许可路径自身的故障,因为包络检查无法检测执行该检查的核心自身的故障。 只有权限路径具备对承载驱动器指令的现场总线主机的内存映射输入输出(MMIO) 访问权限。
Definition 1.1: 异构硅片分区
异构硅片分区 是在硬件隔离的专用执行域之间分配随机的、高容量的认知工作负载(感知、学习策略评估)与确定性的安全回路(安全不变量检查、准入与回退)的架构性分配。
- 意义:将高容量的神经推理与实时安全执行放在同一个通用操作系统或计算引擎上,会产生共模故障。 内核线程抢占、动态内存分配以及 GPU warp 调度会引入数毫秒的尾部抖动,导致授权路径错过物理控制截止时间。
- 区别:与逻辑软件进程隔离(如 Linux 容器或 POSIX 进程优先级)不同,硅片分区跨越独立的硬件寄存器、紧密耦合的静态内存(TCM)以及专用外设总线来强制隔离。
- 常见误区:假定多核 CPU 的亲和性提供了真正的失效域隔离,而实际上这些核心仍共享缓存、内存控制器、时钟树和电源轨。
↰ 前置条件: CBF-QP 执行器亚毫秒级执行时限的设定见 最小干预。
这两台处理器运行不同类型的软件,遵循 权限路径的执行位置 的双处理器实现方式。 提案推理、遥测日志、网络通信和故障记录运行在 Linux 下的应用处理器上,其调度尾部即使在实际实时配置下也仍暴露于内核与驱动程序的抖动;4 执行与传感器校验则在离散安全微控制器上以裸金属固件运行,位于硬件内存保护单元之后,5 编码器接口、IMU 和定时器通道均直接连接到该微控制器。 每个提案通过板级链路到达微控制器,并通过 多速率节拍 的 seqlock 邮箱发布,因此两条路径之间不共享任何动态随机存取存储器(DRAM)。 在供电侧,两条路径仅共享电池。 微控制器、驱动逻辑和弹簧制动线圈位于 哪一项预算最先成为约束 的隔离轨上,该轨不承载提案侧负载,并由本地储能维持供电 2 s,该维持供电时长超过强制执行器在包络内所能命令的任何停车所需的时间(回退阶梯)。 因此,共享控制轨上的下垂无法重置许可路径。
在未加载的机器上,计算预算显得宽裕。 以安全微控制器为例,各子成本示意如下:读取编码器、IMU 以及提案的证据 epoch 耗时 40 μs,评估约束耗时 80 μs,而为驱动帧暂存已准入的设定值则耗时 15 μs。 执行器的未加载周期总计为 135 μs,在微控制器的 400 MHz 时钟下为 54,000 个周期。 对照 400 μs 的截止时间,未加载路径留有 265 μs 的余量;而采用声明的最坏情况执行时间 250 μs(即 最小干预 中经确认的预算)时,仍余 150 μs。 在应用处理器上,该分块策略的推理耗时为 40 ms,在其 50 ms 周期内还剩 10 ms 的余量。 单独评估时,两个循环均以充裕的余量运行。
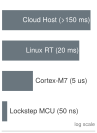
候选执行域在时序控制上存在差异;实测尾部决定其放置位置。
将任务分配到不同的处理器核心,并不会形成相互独立的失效域,前提是硅基础设施是共享的。6 硬件隔离 在机器所在主板上追踪了这些共因路径,其中分离的封装与隔离的电源轨切断了内存与供电路径。 在共享裸片上,这台机器被否决的方案,它们被移动到了同一个封装内部。 实时核心独立于应用处理器执行指令,但两个核心都依赖共同的硬件服务:
- 共享中断路由: 通用中断控制器(GIC)通过共享片上网络路由周边与处理器间通知,应用处理器上的以太网包中断洪泛可能延迟触发 1 kHz 权限循环的定时器中断。
- 共享内存控制器: 两条路径访问同一个动态内存控制器 与互联交叉开关,神经加速器产生的大型矩阵瓦片加载会占满 DRAM 命令队列,将实时核心上预期的 \(20\text{ ns}\) 二级缓存填充变成一次 \(350\text{ ns}\) 主存往返。7
- 共享时钟树: 两个核心共享锁相环(PLL)用于时钟生成,应用处理器上的动态电压与频率缩放(DVFS)瞬变会在相邻实时域中引入时钟抖动。
- 共享电源轨: 单个电源分配网络(PDN)向两个域供电,神经加速器的开关尖峰会使内部电压轨跌落,可能导致逻辑状态损坏或欠压复位。
- 共享复位域: 应用处理器上触发硬件看门狗 复位的内核恐慌可能拉低共享外设总线或系统互连,使驱动器输出失效,并令基座处于无许可指令的状态。
在这些域之间的共享硬件争用并非仅仅是被动的调度低效;它构成了一条主动的 网络物理攻击通道 。 在第三方神经工作负载或面向网络的软件容器与许可路径共享同一芯片的异构 SoC 中,被攻破的应用进程可以对物理安全发起蓄意的拒绝服务(DoS)攻击。 通过生成病态的对齐不良内存流量,或触发缓存行抖动(利用缓存侧信道机制或 Rowhammer 式扰动),非特权提案路径上的攻击者可以蓄意饱和内存控制器队列,延迟安全微控制器的内存访问,并导致错过截止时间。 同样地,对抗性负载可能触发高频张量核心切换模式,以最大化 \(L \cdot dI/dt\) 电流感应电压跌落,使共享的电源分配网络进入欠压状态,并诱发共模硬件复位。 在物理人工智能架构中,软件进程隔离无法抵御电气耦合与微架构耦合;硬件强制的质量服务分区(如 ARM MPAM)与物理硅片隔离属于基本的信息物理安全控制。
由于软件进程隔离无法缓解这些硬件级时序与安全耦合,物理硅片布局成为主要的架构防御手段。 对于该机器许可循环,比较三种布局。 共享的应用核心将权限循环暴露给内核与驱动调度尾部(即前述尾部),该尾部不仅可能将其推过 400 μs 期限,甚至推过 1 ms 节拍本身。 应用 SoC 上的实时集群保留自己的核心,但共享该芯片的内存控制器、电源轨与热路径;节 1.5 展示了拒绝它的时钟降频。 机器所采用的分立安全微控制器改以传输环节支付其隔离成本:从应用处理器到分立安全微控制器的一次板级传输,而两种共享芯片方案都不需要,节 1.7 则将其计入租约。 三种方案之间的取舍,取决于各方案在干扰条件下的实测传感器到驱动响应,而非取决于其使用多少个封装。
原则 Proposal is not permission 要求一条学习型负载无法延迟的权限路径,而三种部署方案的区别,恰好在于两条路径仍然共享哪些资源。 即便是分立微控制器的隔离,也仅是关于负载条件下时序的论断,只有在该负载条件下对其节拍的实测才能支撑这一论断。 两条路径共用的每一份资源,在该控制节拍上都有竞争者,而内存系统正是它们首先发生冲突之处。
共享资源争用
每一个共享物理资源都有多个竞争者;忽略并发竞争的资源利用率指标无法为截止时间提供上界。 若移动操作臂将其许可路径置于应用 SoC,则许可路径、申请路径与系统基础设施将直接争夺同一批内存控制器、交叉开关与电源分配轨。 在该机器上实际构建后,同样的突发仍留在应用处理器上,因而延迟的是观测与数据块,而非许可控制节拍。 该共享内存总线上的数字竞争者包括:将帧写入 DRAM 的相机与激光雷达 DMA 流,获取模型权重矩阵与中间激活张量的神经加速器,读取其约束表与传感器历史的实时核心,用于驱动指令的致动器写缓冲,执行脏行写回的缓存控制器,以及将状态记录写入非易失性存储的诊断日志进程。 这些突发造成的延迟以证据年龄增大的形式影响许可路径(摄取的成本),许可路径,拒绝超过其拒绝阈值的证据,并在没有任何被接纳的 chunk 续租租约时进入其回退路径。
在共享裸片上,交叉开关总线与 DRAM bank 争用 是指当内存与 DMA 事务共享同一互连和控制器时产生的排队延迟,其界限取决于事务大小、队列策略和 bank 时序。8
每个请求方的平均需求由其传输大小和事件速率决定;在共享 LPDDR 通道上,相机流、按策略速率进行的权重获取、执行者的读取、驱动写入、写回和日志记录合在一起平均只占用其容量的一小部分。 只检查该平均值的工程师会得出结论:总线大部分处于空闲状态。 内存仲裁器不调度平均速率。 它们仲裁离散突发;若一方以小包流式传输、另一方以长且饱和的数据块到达,即使平均吞吐相同,两者也会产生不同的干扰。
算术强度 (Williams 等 2009年) 说明在稳态下某例程究竟受执行单元还是受内存带宽约束;它并不说明当两条路径同时到达总线时,究竟是哪一条请求需要等待。 当权重从 DRAM 流式传输时,加速器的算术强度为零,此时它充当一个高带宽的直接内存访问引擎,使共享总线饱和。 权重流式传输同样限制了内存墙中新鲜提案的速率,供给、新鲜度与内存墙 的内存墙即受此限制。 布局看到的是这一上限的另一面:凡是约束提案者的权重传输,都是共置许可路径需要排队等待的流量。
安全读取的等待时长取决于事务仲裁与 DRAM 调度。 以 \(262{,}144\) 字节块搬运权重的加速器不会发起一次突发: Arm 的 AXI4 规范 规定每次突发最多 256 次 beat,并禁止突发跨越 \(4{,}096\) 字节地址边界;因此,在假设的 128 位内部通路下,一个块对应 64 次对齐事务。 一个在途事务可能不可抢占,剩余块内事务是否会阻塞后续安全读取,取决于控制器是否实现优先级旁路。 DRAM 自身引入延迟,因为每个 bank 同一时刻只有一行处于开启状态:就像必须关上抽屉才能打开另一个抽屉的办事员,对已关闭行次的读取需先完成预充电(\(t_{\text{RP}}=14\text{ ns}\))与激活(\(t_{\text{RCD}}=14\text{ ns}\)),才能进行列服务。
采用 First-Ready First-Come-First-Served (FR-FCFS) 调度的控制器会让就绪行命中超越较早的请求,而流式加速器大量提供行命中,因此该策略需要自身的饥饿上界。 在不允许较晚到达越过安全读请求的 FIFO 队列下,理想化等待为 \[t_{\text{queue}} = \sum_{k \in \mathcal{Q}} \frac{B_k}{\text{BW}_{\text{peak}}} + N_{\text{conflicts}} (t_{\text{RP}} + t_{\text{RCD}}) \tag{1}\] 其中 \(\mathcal{Q}\) 表示排在读请求之前的事务集合,\(B_k\) 表示每个事务的字节数,\(N_{\text{conflicts}}\) 表示存储体切换次数,\(\text{BW}_{\text{peak}}\) 表示乐观服务速率,因此仲裁开销与刷新都会累加到结果中。
Napkin Math 1.1: 共享 die 上权限路径在负载下的读取
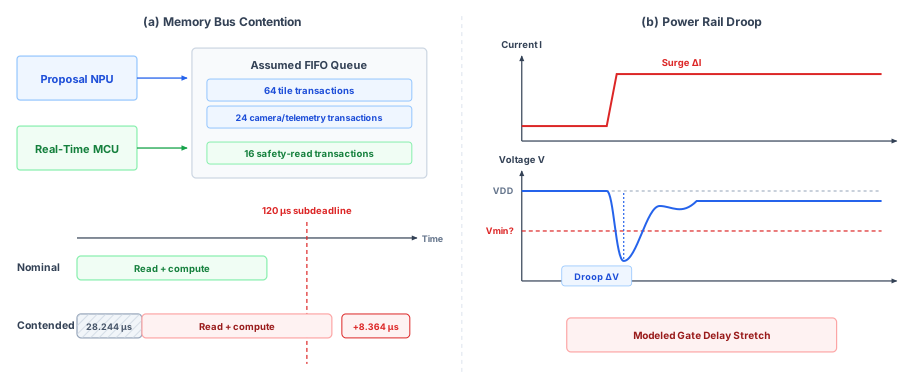
变量:该 tick 在 400 μs 的截止时间内,为感知分配 40 μs,为约束评估和驱动帧写入分配 95 μs。 该快照为 4,096 字节,位于 12.8 GB/s 的通道上。 在它之前,FIFO 中已有一个权重 tile(64 次事务)、一次摄像头传输和一条遥测记录:88 次事务、360,448 字节、3 次存储体切换。
数学推导: 由 公式 1 给出,以 12.8 GB/s 的速率传输积压的 360,448 字节,再加上 3 次切换的耗时,每次切换耗时 28 ns,总耗时为 28.244 \(\mu\text{s}\)。 快照本身读取需要 0.32 \(\mu\text{s}\),因此负载下的读取需要 28.564 \(\mu\text{s}\),并使感知时间配额剩余 11.436 \(\mu\text{s}\)。 第二个积压将超出该时限。 一旦读取耗时超过 155 μs,就会超出所声明的最坏情况执行时间 250 μs,而该情形需要超过 5 个积压;该交叉点本身已足以否定独立性,尽管该次触发仍满足其截止时间。 截止时间本身在读取耗时超过 305 μs(即超过 10 个积压)之前一直成立,因此满足截止时间的触发并不构成该放置方案正确的证据。 在经校验的优先级旁路下,仅有一个在途事务需要等待在先,读取耗时 0.64 \(\mu\text{s}\)。
系统洞见:该读取操作的界属于内存控制器,而非工作负载。 只有当控制器限制了其在安全读操作之前可接纳的流量,或允许该读操作绕过队列时,它才存在;而一台为流式加速器服务的 FR-FCFS 控制器,除非其配置已经过验证,确认具备相应的保障能力,否则既不提供前者也不提供后者。 机器上的分立微控制器通过其自身总线从紧耦合存储器中读取快照,从而消除了这一问题。
竞争延伸至电源分配网络,其中请求方争夺的是电荷而非带宽。 电压降 节 1.1、\(\Delta V = L\,dI/dt + IR\) 随电流步长的速率与幅度同时增长。 片外电压调节器响应远为缓慢,无法跟上纳秒级电流步长,因此最初的电荷来自片内去耦电容;一旦该电容耗尽,共享电源轨便会出现电压下垂,波及其供电的每个核心。
在共享的 \(V_{\text{core}} =\) 0.85 \(\text{V}\) 电源上,封装电感为 \(L =\) 30 \(\text{pH}\)、电阻为 \(R =\) 8 \(\text{m}\Omega\) 时,加速器电流阶跃 \(\Delta I =\) 6 \(\text{A}\) 在 2 \(\text{ns}\) 内产生 90 \(\text{mV}\) 的电感压降和 48 \(\text{mV}\) 的电阻压降,合计 138 \(\text{mV}\),即电压跌落 16.2 %,使电压降至 0.712 \(\text{V}\)。 alpha 幂律门延迟模型9 将该跌落转化为传播延迟的 39 %增加(Inductive Voltage Droop and Gate Delay Stretch 推导这两个步骤)。 这是门延迟,而非一个时钟周期。 它是否消耗许可路径的余量、触发欠压复位,还是完全无影响,取决于器件的最小工作电压与时钟策略;只有依据所声明电流阶跃进行的电源轨与时序测量才能对此作出定论。 两条干扰通道——互连 FIFO 排队与电源轨电压跌落——均以 图 2 的形式加以刻画。 共享裸片 使上述问题对每一个加速器突发都悬而未决;而独立的微控制器,在其自身总线与电源轨上,并不继承这些问题。
检测这些相互作用需要在受影响核心之外进行仪器化,因为停滞或变慢的核心无法自行计时自己的延迟。 内存控制器计数器、轨压监视器、热敏二极管和复位原因寄存器记录耦合关系。
共享芯片可在硬件中计量这些耦合:通过交叉开关仲裁器,将带标记的安全事务经其专属队列路由,同时以带宽配额计量加速器突发;热保护触发时,电源管理控制器仅降低加速器的时钟频率。 每一项都是部署测试必须确认的控制器属性,而非框图中可以假定的调度器设置。 仲裁决定事务何时移动,而非它携带什么。 跨越两条路径之间物理边界的,必须由生产时间、有效性和故障响应上的显式保证来定义。
边界契约
边界契约下跨越提案路径与许可路径的,是一条记录,而非对共享内存的无保留指针,因为将原始内存地址跨越信任边界传递,会把读取方直接耦合到写入方的内部内存布局、执行时序与故障域。 若加速器上运行的分块策略仅向它提供私有输出缓冲区的指针,则许可路径没有任何机制来判断写入方是否仍在修改缓冲区、是否在中途推理时卡住,或是否遇到了未处理的故障。 因此,边界载荷必须是一条不可变、自包含的记录。 跨越的正是@sec-nervous-cadences 的提案头部,经由其 seqlock 邮箱发布;部署安排不增加任何字段,只增加该交换在负载下满足其截止时间的证据。 许可路径将该记录作为隔离快照读取,在任何一个设定值到达驱动器之前,先评估其时序新鲜度与物理有效性。
无论交换跨越共享裸片 还是机器的板级链路,保持时序隔离都要求消除交换接口处的阻塞同步。 如果许可循环获取了提案生成器持有的锁,一次推理停顿可能延迟一个物理决策。 因此,一次 \(25\text{ ms}\) 的主机停顿必须使 1 kHz 执行器在每个 tick 上持续运行:仅在其租约和当前状态持续满足准入条件期间,它才可使用最后一个已验证的数据分块;一旦该条件不再满足,就切换到其独立验证过的回退方案。 许可路径上的分配与记录同样需要实测的时间上界。 生产者可能停顿或丢弃更新;它无法对被控对象的执行节奏施加反向压力。
《边界契约失效类别与确定性回退矩阵》的邮箱拒绝规则,可防止失败的提案者迫使执行器等待。 被拒绝的提案会使已批准的设定值继续生效,直到租约到期;若没有可接受的提案续期,且机器处于运动状态,则 MCU 执行《回退阶梯》的停止层级,即基座的常驻停止措施与机械臂的状态匹配停止措施,二者都不等待提案者。 该兜底机制仍须在限定的时间内完成,而该部署测试会在承载该路径的硅片上、在负载条件下测量这一上界。
窗口看门狗定时器与执行活性
软件内存边界与无锁 seqlocks 可防止撕裂读取,但不能保证安全执行器代码处于存活状态并正在推进其预期操作。 执行器活性属于 多速率节拍 的自看门狗,而该看门狗仅在完成一次 tick 之后才获得输入。 由定时器中断服务的倒计时看门狗对死任务视而不见,这正是 Bookout v. Toyota 案中论证的失效。 在共享硅片上,执行器还可能因互连争用而被饿死,或因时钟损坏而运行过快,因此部署安排需要一种更强的自看门狗形式,即从两侧约束刷新。
因此,高完整性的物理 AI 架构会强制实施窗口化看门狗定时器。 窗口化看门狗会拒绝任何过早或过晚发生的刷新。 定时器硬件定义了一个由下界(闭窗口,\(T_{\text{lower}}\))和上界(开窗口,\(T_{\text{upper}}\))参数化的服务窗口:
- 提前触发违规(\(t_{\text{service}} < T_{\text{lower}}\)):如果软件试图在下限阈值到期之前刷新看门狗,硬件会立即触发故障复位。 过早触发可能表明软件绕过了必需的算法阶段、进入了病态的短循环,或因时钟损坏而获得了执行加速。
- 延迟踢出违规(\(t_{\text{service}} > T_{\text{upper}}\)):若计时器在未收到有效刷新时倒计时超过 \(T_{\text{upper}}\),计数器将下溢,触发硬件复位。 一次延迟踢出可能表明,执行器因互连争用而计算周期被饿死,或因未处理的异常而陷入死锁,或因过多的缓存淘汰而延迟。
- 有效服务窗口(\(T_{\text{lower}} \le t_{\text{service}} \le T_{\text{upper}}\)):窗口内的刷新表明馈送路径满足了其时序条件;任务进展仍需合适的挑战或独立的监督。
若控制器在每次成功 tick 后馈送一次,看门狗测量两次馈送之间的间隔。 令完成偏移量 \(c_n\) 相对于 tick \(n\) 起始位于 \([c_{\min},c_{\max}]\) 内,并以 \(J_{\text{phase}}\) 约束 tick 相位变化。 馈送间隔的保守取值范围是 \[T_{\text{feed}}\in[T_{\text{period}}-(c_{\max}-c_{\min})-J_{\text{phase}},\;T_{\text{period}}+(c_{\max}-c_{\min})+J_{\text{phase}}].\] 围绕该 实测或论证的 范围设置 \(T_{\text{lower}}\) 与 \(T_{\text{upper}}\),同时保持迟到触发响应处于为被控对象另行推导的故障预算之内。 仅凭一次 tick 的执行时间并不能确定看门狗服务间隔。 在机器上,\(T_{\text{period}}\) 是 1 ms tick,声明的 250 μs 最坏情况提供 \(c_{\max}\)。 空载的 135 μs 路径无法提供 \(c_{\min}\),因为强制器的最短分支可能比其标称分支更早完成,因此下界取自压力测试记录的最短完成时间。 \(J_{\text{phase}}\) 是微控制器滴答计时器相对于其参考值的抖动,在相同负载下测量。 该区间会为机器仅具备超时自看门狗的情况提供 \(T_{\text{lower}}\),而 \(T_{\text{upper}}\) 仍保持所选的 5 ms 超时时间,因此该窗口可以容忍多次漏滴答后才触发。
容差是有意设定的。 一次漏滴答在通道行驶速度下仅造成毫米量级的位移( 节 1.6 ),远低于故障预算;而若窗口因单次迟到的看门狗馈送而关闭,则会停止一个正常运行的强制器,以节省该位移。 由估计值而非记录完成时间取出的下界会在健康滴答时触发,而上界宽于故障预算则会掩盖该窗口本应捕捉的饥饿现象。
部分设计会加入 挑战-响应检查点机制:看门狗馈送以最新的传感器校验、权限评估和输出状态检查为前提,而非仅依赖计时器 ISR。 其故障覆盖率取决于挑战的生成位置、谁能计算或重放响应,以及失效的强制器状态是否仍能执行馈送路径。 因此,该方案的覆盖率是故障注入的结果,而非词元本身的属性。
然而,在内存、互连仲裁和看门狗执行存活性方面建立清晰的边界,只解决了共址的逻辑与时序一半问题。 当加速器与实时处理器位于同一硅片上时,密集矩阵运算期间耗散的高功率会通过衬底直接传导,抬高局部结温,并改变相邻核心晶体管的开关速度。
热与时序耦合
硅片上耗散的每一瓦特功率都流入同一个热域。 在共享 SoC 上,矩阵单元、应用核心、内存接口和集成稳压器都发热于同一个封装,许可回路的基线功耗较低且稳定,而提案路径则随其负载波动。 封装对环境的有限导热能力,使得峰值加速器活动会抬高芯片上每一条电路的结温。
在物理人工智能系统工程中,热时钟降频 是指当持续高功耗的认知推理使硅片结温(\(T_j\))超过热保护触发阈值(\(T_{\text{trip}}\))时,自动施加并由硬件强制执行的处理器时钟频率降低。 为防止芯片损坏,硬件会突然降低时钟频率。 这引入了持续的、与温度相关的降速(迟滞),即使认知负载已经消退,执行时间仍被拉长,并可能把并置的实时安全回路推过其硬性物理截止时间。
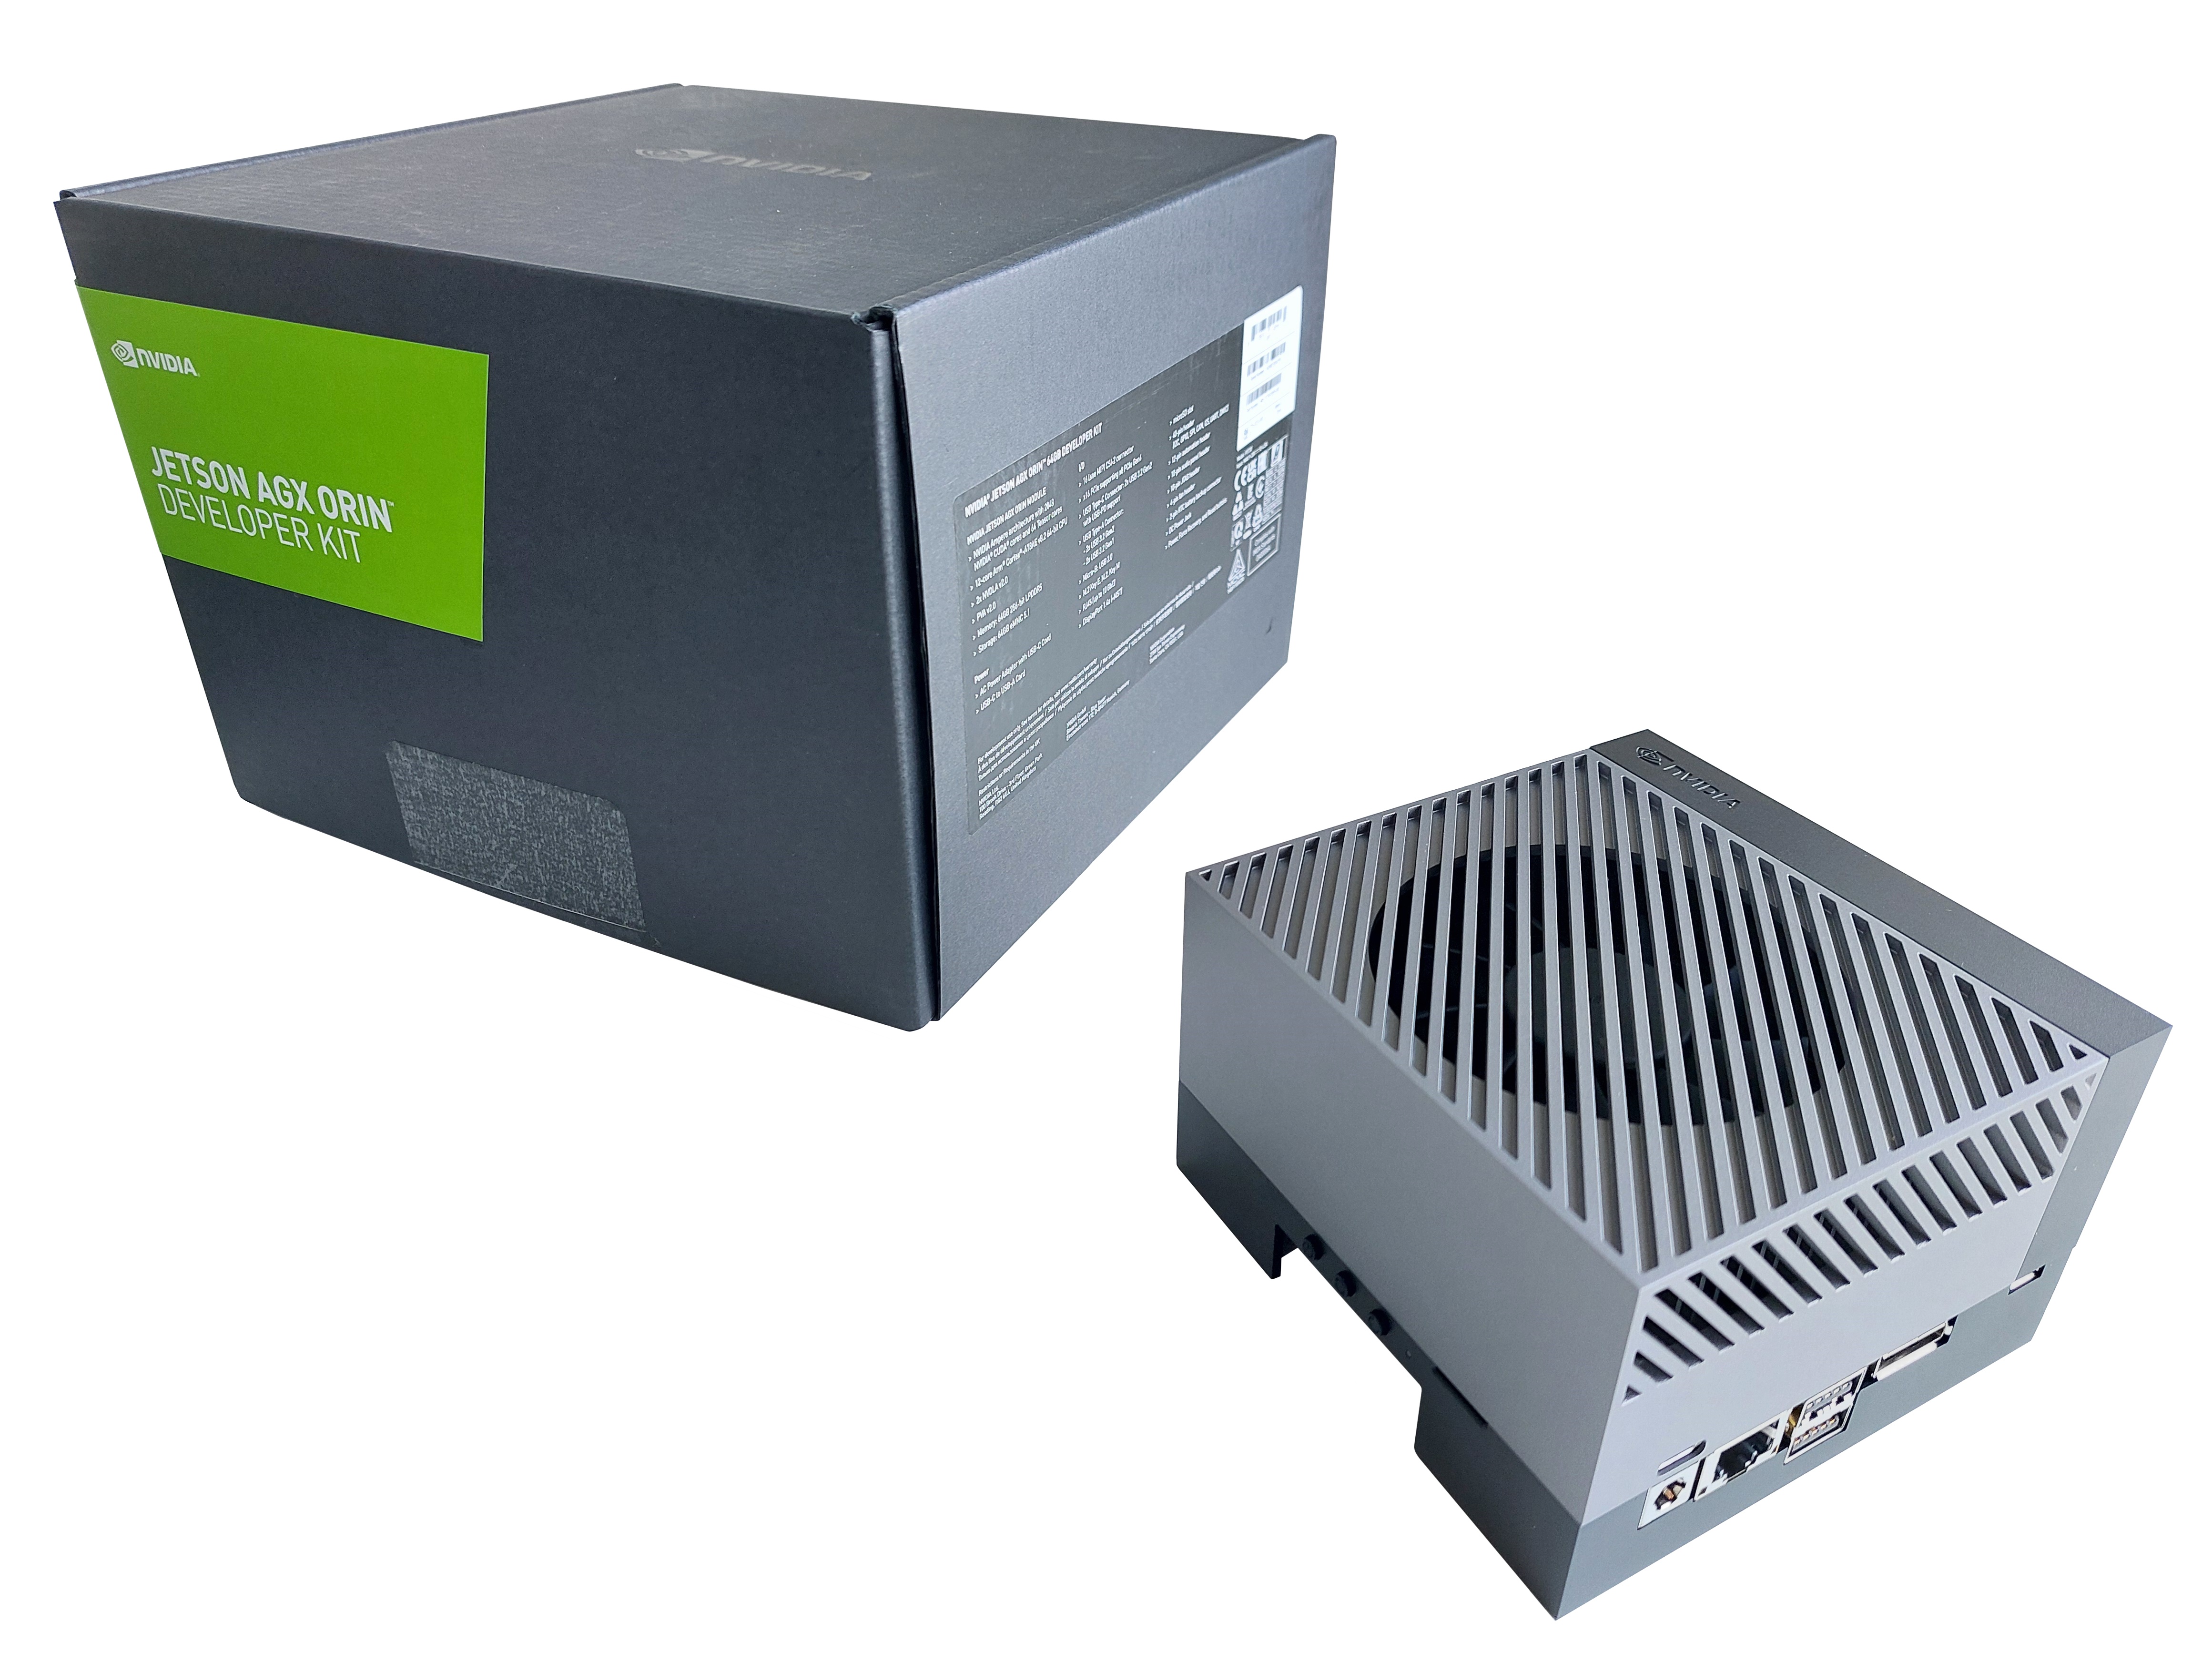
机器底座中的电子舱处于 45\(\,^{\circ}\text{C}\) 环境温区。 图 3 展示了该模块类开发套件,即机器用作应用处理器的模块;其外壳既未显露散热路径,也未显露后续估算所依赖的时钟域。 假设共享 SoC 采用传导散热,其 结-环境热阻 为 \(\theta_{\text{JA}} =\) 2 \(\text{K/W}\),热时间常数 为 \(\tau_{\text{th}} =\) 8 \(\text{s}\)。 许可回路连同空闲和内存功耗的总功耗为 4 \(\text{W}\),并将结温维持在 53\(\,^{\circ}\text{C}\)。 连续提案推理会引入加速器、内存流量与调节器损耗,总计 26 \(\text{W}\) 使稳态升高 \(P\,\theta_{\text{JA}} =\) 52 \(\text{K}\) 至 \(T_j =\) 97\(\,^{\circ}\text{C}\)。

仅靠热管理,移动操作臂的共享芯片(shared-die)布局方案即被否决。 假设其许可路径运行在应用 SoC 的实时集群上,频率为 \(f_{\text{nom}} =\) 1.2 GHz,每个 tick 消耗 \(N_{\text{cycles}} =\) 300,000 个周期,是离散微控制器在无负载状态下所需的 54,000 个周期的数倍,因为一个没有紧密耦合内存的集群会在每次快照和表读取时支付缓存填充与一致性周期。 当结温超过 \(T_{\text{trip}} =\) 95\(\,^{\circ}\text{C}\) 时,调速器将簇降至 \(f_{\text{throt}} =\) 600 MHz,强制执行机制的周期延长至 \(t_{\text{exec,throt}} =\) 500 μs,从而错过 400 μs 的截止时间,超出 100 μs(即 25 %的超量),并远远超过已声明的界限,而强制执行机制之上各层的所有裕量均依据该界限确定。 该离散微控制器运行在自身时钟与电源轨上,不受该调速器的管辖。
超量运行会持续超过负载,因为调速器施加了状态依赖的迟滞,只有当半导体结冷却到 \(T_{\text{clear}} =\) 85\(\,^{\circ}\text{C}\) 之后,才恢复 1.2 GHz,这样时钟才不会在跳闸线附近振荡。 在策略被暂停、功率恢复到 4 \(\text{W}\) 后,结温向其 53\(\,^{\circ}\text{C}\) 基线松弛: \[T_j(t) = T_{j,\text{target}} + (T_{j,\text{start}} - T_{j,\text{target}}) e^{-t/\tau_{\text{th}}} \tag{2}\] 其中 \(T_{j,\text{start}}\) 是降频开始时的结温,\(T_{j,\text{target}}\) 是基线平衡温度,\(\tau_{\text{th}}\) 是封装的热时间常数。 求解 公式 2 得到从 95 降至 85\(\,^{\circ}\text{C}\) 所需的时间为 \(t_{\text{recov}} = \tau_{\text{th}} \ln[(T_{j,\text{start}} - T_{j,\text{target}})/(T_{\text{clear}} - T_{j,\text{target}})] =\) 2.18 s。 在机器的 1 ms 时钟节拍处,2,175 个已排定的节拍落在该冷却窗口内,而共享 die 的设计需要为其中每一个都启用独立计时的后备方案。
共享 die 上的周期拉伸还可能来自 电功率轨耦合,其时间尺度不同。 轨压跌落 节 1.3 在加速器突发后数纳秒内到来,而热耦合需要数秒才建立,因为热量通过封装扩散;因此,跟随结温 \(T_j(t)\) 而非 \(V_{\text{core}}(t)\) 瞬态的时序故障属于降频,而非轨压塌陷。
Checkpoint 1.1: 结温与时钟降频
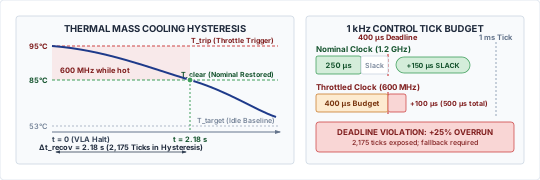
在依赖软件热管理来保证实时安全性之前,先核实你对结温动态与降频迟滞的理解:
测试分离性
在任何一种放置方案下,独立性主张都是对已声明提案工作负载、芯片温度与模式下的强制执行机制延迟与拒绝可用性的可检验界限。 若竞争使拒绝延迟超过物理截止时间,则所声称的运行分离性即告失败。
↳ 下游: 对抗性微架构竞争测试为 硬件故障注入 的硬件故障注入套件提供信息。
本实验的通过阈值来自被检验的命题。 机器的权限路径声明了最坏情况执行时间 \(C_{\text{wcet}} =\) 250 μs,并且必须在所选截止时间 \(D_{\text{enf}} =\) 400 μs 内完成每个 tick,而该截止时间位于 tick \(T_{\text{tick}} =\) 1 ms 之内。 每一个实测的强制时间 \(t_{\text{enf}}\) 都必须遵守该链,正如 公式 3 所述: \[t_{\text{enf}} \le C_{\text{wcet}} < D_{\text{enf}} < T_{\text{tick}} \tag{3}\] 声明的上界 \(C_{\text{wcet}}\) 是 证伪阈值。 如果被检验的任一强制周期超过该阈值,独立性假设即被证伪,即使该周期仍满足截止期限,因为从强制器的截止时间到停止预算所计入的节拍之间的每一段余量,都是按照声明的数值设计的。 一个实测最大值可以证伪声明的上界,但不能确立它,因为一次活动只采样它所达到的状态,而在投机核心上,时序异常可能使真实最坏情况高于所记录的每一个周期。10
Definition 1.2: 最坏情况执行时间
最坏情况执行时间 是在目标硬件平台上,在全部可接受输入、架构争用状态和运行条件下,使计算任务完整执行所需的物理墙钟时长上的形式上界: \[t_{\text{exec}} \le t_{\text{WCET}} \le t_{\text{deadline}}\]
- 意义: 在 信息物理控制回路中,正确性不仅取决于输出的数值有效性,还取决于其送达时刻;在硬物理截止时刻之后送达的最优控制指令,在功能上等同于系统完全失效。
- 区分:与表征软实时软件吞吐量的平均执行时间(\(\bar{t}\))或高百分位(\(P_{99}\))不同,WCET 是一个绝对的确定性上界,必须在并发内存总线饱和、缓存抖动和外设中断风暴的条件下成立。
- 常见误区:依赖经验性执行剖析或基准测试平均值来确立现代超标量或乱序处理器上的 WCET。 微架构时序异常(局部缓存命中或分支预测成功反而悖论性地增加了总执行时间)意味着,仅凭经验测试无法在缺乏形式化静态分析和硬件争用界的情况下证明真实的全局上界。
单个 tick 所涉距离很小,这使该上界容易被低估。 在 仓库移动操作臂的停车预算 中完成的预算使机器在 997.4 mm 以 1.3 m/s 的通道速度停车,相对于 1.10 m 的净空距离仍留有 102.6 mm 的余量,而一次漏掉 tick 只会增加 \(v\,T_{\text{tick}} =\) 1.3 mm。 部署位置所保护的正是上界本身,因为 \(\tau_{\text{delay}}\) 恰好计入一个 \(T_{\text{tick}}\),而没有上界的争用则是长度未知的停顿。
反驳独立性主张需要借助专门设计的合成负载来诱发最坏情况下的资源争用,而非报告平均吞吐量的标准基准。 高平均利用率调度会在时钟周期间均匀摊开内存访问,使系统看起来负载低于容量、留有安全余量;而实际的物理干扰峰值出现在同步突发期间,此时多个部件在同一瞬间争夺同一组导线。 测试框架必须刻意向共享内存通道灌入非对齐的直接内存访问传输,用来自 Transformer 权重张量的脏行写回耗尽共享缓存容量,触发加速器矩阵乘法以引起电源轨电压的快速跌落\(L \cdot di/dt\),并在诊断日志写入非易失性闪存的同时流式传输峰值速率传感器遥测数据。 这些压力剖面重现了如下瞬态争用:当许可循环读取传感器快照的同一微秒时刻,提议模型发起一次大规模注意力前向计算。
测量仪器记录传感器快照达到一致后的强制执行入口时刻(\(t_0\))、许可完成时刻(\(t_1\)),以及已接纳的设定值发布到驱动帧的时刻(\(t_2\))。 这些指标用于诊断计算与设定值发送环节,但\(t_2\)并非制动。 帧到达驱动(\(t_3\))与实测制动启动(\(t_4\))共同构成完整的物理链路。 真正关键的是终点,即自最后一次有效租约续期起算的 \(t_4\),并计入时钟误差。 制动启动必须在 82 ms 之内跟随,该值等于租约、一个节拍、一个总线周期与制动启动延迟 多速率节拍 之和。 仅凭 250 μs 这一计算界是不足的。
耦合机制在物理、电气与逻辑域之间相互叠加,因而需要覆盖各因子水平全部组合的全因子实验矩阵。 评估扫描覆盖低结温条件(\(T_j = 35^\circ\text{C}\))以及温度保持在 节 1.5 所述的节流触发阈值 \(T_{\text{trip}}\) 或以上的高结温条件;以及空闲提案路径与执行最大批次推理的饱和提案引擎之间的对比;诊断环形日志关闭与以全量非易失性内存带宽流式写入之间的对比;以及标称跟踪指令与触发拒绝流程的边界违反指令之间的对比。 对拒绝路径施加全量压力测试是强制性的,因为执行安全钳位轨迹或进入紧急关机涉及冷分支路径、非缓存的错误处理代码,以及常态通道行驶中从未执行的次级总线事务。
在被否决的共享同一裸片的布局中,该矩阵旨在捕捉的那一对是特定的。 一个人在机架末端走出,许可路径便执行通向停止环节的拒绝分支,这是一条经过未缓存代码的冷路径。 在同一瞬间,应用处理器已标记了同一异常,开始通过共享直接内存访问互连结构发起诊断内存转储。 一套分别练习拒绝与诊断日志记录功能的测试套件会同时通过两者,却从未测量这一对,因为两个子系统只有在同时运行时才会争用同一个内存控制器。
考虑一个用于被否决布局的示意性 \(10^7\) 拍压力轨迹,即应用 SoC 中实时簇上的许可路径。 每 1 ms 一个 tick,轨迹跨越 10,000 s,即 2 h 46 min 40 s,尚未计入复位或准备耗时。 冷态轨迹的 \(P_{50}=\) 95 μs、\(P_{99}=\) 128 μs 与观测到的最大值 152 μs;热态、已加载轨迹的 \(P_{50}=\) 210 μs、\(P_{99}=\) 330 μs、\(P_{99.9}=\) 395 μs 与观测到的最大值 468 μs。 已加载的 \(P_{99}\) 已超出声明的 250 μs 界限,且最大值越过 400 μs 截止时间,因此该轨迹反驳了这一部署位置。
若该轨迹通过,则其 tick 仅显示所测状态下的观测干扰低于阈值。 报告给出延迟分布、观测最大值、样本数、时长以及未施加的条件,包括电源劣化、电磁干扰和老化。11
War Story 1.1: 阿波罗 11 号雷达负载与计算机重启(1969 年)
机制:当 交会雷达模式开关脱离 LGC 位置后,雷达旋转变压器由一台频率锁定、但相位与制导系统参考信号不同步的 \(800\text{ Hz}\) 电源激励。 耦合数据单元将这一相位差解读为天线运动,并向计算机连续发送计数脉冲。 NASA 的任务报告,第 16 节 给出每秒 12,800 个脉冲的最大值,来自两个数据单元,每个脉冲占用一个 \(11.7\,\mu\text{s}\) 的存储周期,即计算机时间的 15%,而计算机在动力下降期间通常以约 90% 的容量运行。 无法一次完成的重复性作业会被重新排程,每次另占一块存储区,直到执行管理程序(Executive)的存储区耗尽为止。
影响:下降过程的低门阶段之前发生了五次执行溢出告警(1201 和 1202)。 任务报告称,制导与控制功能的表现未受影响。
响应:每次告警都触发了一次软件重启,AGC 按照优先级继续其关键的制导与显示工作,而机组与任务控制则在评估告警、下降继续进行。 后续任务在开关未处于 LGC 时清零数据单元,从而消除了其源头的虚假脉冲。
系统教训:外围设备可能在制导需要其执行能力的那一刻占用执行能力。 现代部署测试应计入异步外围设备负载,并验证关键路径及其恢复行为仍在其声明的时序边界内。
阿波罗 11 号的 Executive 告警与火星探测者号(Pathfinder)的优先级反转(见 按时移动指令)展示了两种截然不同的实时资源争用形式。 在阿波罗 11 号中,外围设备消耗了执行能力;在 Pathfinder 中,一个低优先级任务占住了高优先级任务所需的资源。
一次失败的干扰测试会指出假设的隔离可能在哪一处失效:缓存、内存仲裁、热时钟、电源或输出队列。 进一步的仪表化(instrumentation)在团队预留、划分或迁移共享资源之前,定位出该机制。
硅隔离决策
被证伪的独立性主张留下四种补救措施,各自以不同的代价计量(表 1):静态预留、空间划分、降低工作负载,以及将工作负载物理迁移到独立芯片上。
| 补救策略 | 目标耦合层 | 实现机制 | 系统工程权衡 | 残余漏洞 | 物理硅迁移触发条件 |
|---|---|---|---|---|---|
| 静态预留 | CPU 执行时间、操作系统调度抢占 | 固定优先级抢占式调度(SCHED_FIFO)、静态时间片切分(ARINC 653) |
空闲容量(\(20\text{--}40\%\) 吞吐量损失);静默状态下浪费的未分配周期 | 操作系统可见性之下的微架构争用(共享 L3、DRAM 存储体冲突) | 即使已分配 \(100\%\) CPU 核心,内存总线或缓存停顿仍会违反实时截止时间 |
| 空间划分 | 缓存容量抖动、DRAM 总线争用 | 缓存 way 分区(ARM MPAM、Intel CAT)、MPU/IOMMU 域、AXI QoS 速率限制器 | 结构性碎片;感知 L3 工作集减小(\(+15\text{--}30\text{ ns}\) DRAM 访问惩罚) | 不可划分的 DRAM 控制器队列、行缓冲局部性重排、PDN 电压跌落 | 矩阵引擎电流阶跃(\(\Delta I > 10\text{ A}\))触发轨电压跌落,或 DRAM 队列停顿超过松弛量 |
| 工作量削减 | 内存吞吐饱和、峰值热功率 | 模型量化(INT8/FP8)、上下文降采样、策略速率减半 | 策略跟踪保真度下降;动态稳定性边界附近控制相位滞后增大 | 公共时钟分配树、共享电源管理单元(PMU)、统一的复位域 | 模型精度低于运行限值,或共享时钟/复位故障跨域传播 |
| 物理重新部署 | 共享电源、时钟、复位,或无界控制器干扰 | 独立的安全约束执行 MCU,其电源、时钟、存储与传感器/执行器路径分别评估 | 需要更多板卡面积以及外部通信预算 | 线束、收发器以及公共电源故障仍然存在 | 当共享裸片 无法为所需的时序与故障隔离提供证据时,选择独立方案 |
静态预留 在保留共享芯片上工作负载的物理部署位置的同时,为关键路径分配共享资源的一个保证比例。 预留为关键循环分配专用的执行时段或固定的内存总线带宽。 预留的代价是闲置容量。 若该机器的主机许可路径与它位于同一芯片上,那么为快照读取的最坏情况而设计的仲裁器时段会在每个 1 ms 周期中始终被保留,即使底座处于停驻状态且没有制动动作进行,也不可供策略模型使用。
空间分区将物理硬件结构切分,使负载不再争夺相同的物理单元。12 缓存 way 分区、核心钉死以及专用内存通道,在单颗芯片内建立起硬件隔离屏障。 分区带来的代价是灵活性的丧失与结构碎片化。 将一个八兆字节的共享缓存切分为策略模型专用的六兆字节分区与权限路径表格专用的两兆字节分区,可避免跨边界发生缓存行淘汰。 然而,这会永久限制学习模型的工作集,迫使更高的 DRAM 访问频率,并在每个推理步骤上使平均内存延迟增加数十纳秒。
工作量削减 通过缩小非关键任务的计算量或内存占用,化解竞争,直到其峰值需求落在共享系统的无竞争余量之内。 工程师可能将遥测日志的采样率从 \(1\text{ kHz}\) 降到 \(100\text{ Hz}\),将策略权重从十六位浮点数量化为八位整数,以将内存总线流量减半,或降低分块策略的速率。 削减工作负载的代价是功能执行能力的下降。 在移动操作臂上,租约限制了最后一根杠杆。 若分块周期长于 60 ms 的租约 多速率节拍,则提案会在续期之间过期,因此策略的速率必须高于 16.7 Hz,即使尚未计入续期抖动,这使得相对于其当前分块速率 20 Hz,可进一步降低速率的空间很小。 权重量化可能使策略在传送带拣取的抓取容差附近精度下降。
若预留、分区与降低负载均无法建立所需的响应界,物理迁移即为一项候选补救措施。 它能够触及预留与分区无法触及的耦合,例如共享复位或时钟域,使一条故障同时使两条路径停止;声称已隔离此类故障的片上系统,必须通过设计与注入测试加以证明。 独立的控制器仅在电源、时钟、复位、传感器与执行器的独立性得到设计与测试的范围内,才消除这些共因路径;其所服务的完整性目标,取决于应用的安全论证,而非器件数量。 外部控制器还会增加传输与公共供电方面的义务,因此其传感器与执行器路径必须作为一个整体进行测量。
将负载迁移到独立的硅片上,很少是一次局部的修改。 它会引发整台机器范围内布局与通信调整的连锁反应,而移动操作机器人则显示了这一成本落在何处。 \(T_{\text{bus}}\) 项的 多速率节拍 不发生变化,因为驱动指令会穿越 EtherCAT 现场总线,无论授权路径位于何处。 重新定位所增加的,是方案将应用处理器到微控制器的通信由片上邮箱改为板级链路穿越。 该延迟不会进入 \(\tau_{\text{delay}}\) 的任何新增项。 晚到的提案会消耗 5 ms 的续期抖动余量,而该余量由 用于机器整体构造的一个耦合预算 的租约规则置于 50 ms 的块周期与 60 ms 租约之间的间隙中。 主机内存争用同样占用该余量,因此它对块策略的 40 ms 推理最多只能拉伸 12.5 %(摄取的成本)。 链路的最坏情况延迟(在负载下测得)必须因此容纳于该争用与提案方自身抖动所剩余的余量之内。
更难的决策在于每个传感器安装在何处。 机器将编码器与惯性测量单元保留在微控制器一侧的链路上,因为授权路径每拍都要读取它们;而相机与激光雷达则留在应用处理器一侧,因为学习模型要消费它们,授权路径只读取提案的证据时段。 将相机接口移到微控制器一侧虽然可以减轻主芯片的负载,却会迫使学习模型经由更慢的外部链路接收观测流,并增加 传感器感知 所测得的观测龄期。 每一次重新布置决策都会经由物理互连传播,将瓶颈从片上内存仲裁器转移到板级引脚数量、走线长度与串行总线。
物理人工智能中的硬件选型无法与具身形态的机械动力学解耦。 传统基准套件在诸如理论峰值 TOPS 或原始批推理吞吐量等孤立指标上评估边缘加速器,而具身系统则运行在闭环能量约束之下,其中计算延迟与物理运动紧密耦合(图 4)。 跨连续谱评估边缘加速器配置——从超低功耗边缘 TPU 到数百瓦级工作站 GPU——揭示了一条倒 U 形帕累托效率前沿。
供给不足的加速器(例如一个 \(4\,\text{TOPS}\) 边缘 TPU 或未加速的 CPU)会招致较长的视觉—语言—动作推理延迟(\(>200\,\text{ms}\) 每步),将拣放任务拉长到超过三分钟(\(T_{\text{mission}} = 215\,\text{s}\))。 在整个这一时段内,机器人的底座电子器件、传感器、电机保持电流以及热管理系统持续消耗静态待机功耗(\(P_{\text{static}}\))。 因此,静态能耗惩罚(\(P_{\text{static}} \times T_{\text{mission}} = 23.65\,\text{kJ}\))主导了总任务能耗,导致净系统效率较差(\(40.8\,\text{tasks/MJ}\))。 相反,用桌面级 GPU(\(300\,\text{W}\) TDP)超配边缘硬件,可将模型执行时间压缩到 \(55\,\text{ms}\),但系统会撞上机器人的运动学速度上限(\(v_{\text{max}} = 0.8\,\text{m/s}\))。 边际的时间节省(\(27.5\,\text{s} \to 24.0\,\text{s}\))无法弥补巨大的动态芯片耗散(\(P_{\text{chip}} \times T_{\text{mission}}\)),致使每任务总能耗飙升至 \(9.84\,\text{kJ}\)。 最优协同设计窗口出现在平衡点(以 \(50\,\text{W}\) Jetson AGX Orin 为例),此时模型推理已被充分摊薄,足以避免静态整机耗电,而不会引入不必要的动态功耗代价。
/var/folders/7g/fkg91tq50f58kfmg7c65747r0000gn/T/ipykernel_91966/3835871085.py:316: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
plt.show()硬件分配
移动操作机器人现已具备其许可路径的硬件部署位置、截止时间、未加载执行时间估计,以及一项可能证伪该分离性的测试。 除非将其连同其成立条件一并书面记录,否则这些内容都不会进入发布决策。 该 放置记录 消费 执行记录 的执行记录,从中取走许可路径声明的最坏情况执行时间与截止时间,并补充该声明的界在路径运行所在硅片上承受负载时依然成立的证据:执行域、特权、周期、未加载与加载观察到的最大值、仲裁设置、电压跌落与热保护触发、缓解措施,以及测试台账的摘要。 加载最大值决定独立性主张,该主张仅在每一个最大值在声明负载下都不超过声明的最坏情况执行时间时成立;正如 按时移动指令 对任意观察到的延迟分布所论证的,样本最大值是关于该界的证据,而从不取代它。
该记录由两部分组成。 紧凑的表头存放配置值与观测到的最大值,并承载一份外部测试台账的摘要。 台账容纳无法放入固定布局的内容:清单、每个最大值背后的延迟分布与样本数、测试条件、缓解措施,以及尚未闭合的限值。
↳ 字节布局: 放置记录的字段偏移量与大小见 Placement record。
对于移动操作机器人,表头记录了 1 ms 打点、400 μs 截止时间,以及一个示意性的 135 μs 未装载估计值,该估计值尚未经过实测得到最大值。 表头的缓解标志包括许可路径的隔离电源轨。 其负载字段保持为空,因为该机器目前尚无负载测试台账。 填写该负载字段需要在机器本体上开展 节 1.6 所述的测试活动,其中分立微控制器持续计时,而应用处理器运行峰值提案推理并完整记录日志,同时处于较高结温条件下,且拒止分支在同一轮测试中得到演练。 该轮测试所记录的每一个满载最大值都必须保持在声明的 250 μs 及以下,而制动起始时刻从最后一次有效的许可续期开始计时,必须在 82 ms 之内到来。 在这些测量存在之前,部署发布 所评估的许可路径独立性主张仅建立在声明的界限之上、缺乏实证支撑,因而无法据此作出需要该主张的判定。
外部账本清点内存通道、缓存分区、DMA 引擎、电源轨及其相互竞争的占用方。 对每一项,它记录仲裁配置与实测的干扰。 对于许可电源轨,它记录 2 s 的保持能力,该保持能力由 硬件故障注入 的馈电丢失注入所演练,并给出承载隔离主张的占用方清单,即微控制器、驱动逻辑,以及弹簧制动线圈,且不含任何提案侧负载。
一次干扰测量需要其运行状态:模型与固件哈希、时钟策略、机箱与热界面、环境温度和结温、电源轨、仲裁设置、流量发生器、采样率、仪表、采样次数,以及测试时长。 账本将这些字段置于其所限定的延迟分布与尚未测试的状态旁边,而表头中的观测最大值则汇总这些分布。 该 \(10^7\)-tick 轨迹仅覆盖 节 1.6 中单台机器运行的 2 h 46 min 40 s,太短,无法揭示任何发生频率低于约每 \(10^7\) 个 tick 一次的干扰,对机队而言证据也过于单薄。
每个放置条目都要求在测试执行之前预先声明一条证伪判据。 该判据规定构成架构失效的物理阈值,例如在神经加速器突发与 DMA 传输同时发生时,强制执行路径的任何周期长于声明的 250 μs 最坏情况。 该记录将实测分布与此判据对照,并说明被测主张是幸存还是被证伪。 当干扰违反目标预算并迫使工程变更时,记录会详述所采用的确切缓解措施,例如在神经加速器上启用内存总线带宽节流。 条目还必须记录测试运行期间未覆盖的边界条件,例如高于 45\(\,^{\circ}\text{C}\) 舱段环境温度的运行状态、多位内存错误注入,或传感器收发器故障状态同时发生的情况。
对抗性验证 消耗已记录的仲裁点与共享电源轨,作为硬件与软件故障注入的目标映射,故意损坏共享结构,以检验故障传播是否与预测的失效域相符。部署发布 将已记录的加载执行边界与测试尚未覆盖的范围与条件纳入正式安全论证,从而将经验测量转化为运行部署的证据性论证。
↳ 下游: 硬件布局安全论证为在 安全论证与主张 中的生产部署提供证据性依据。
Systems Perspective 1.1: 当兜底动作是一次迈步时
问题:当兜底动作是一次迈步而非停止时,停止预算中的哪些行能够存活?
在放置保护了 \(\tau_{\text{delay}}\) 计数的这一拍之后,第三部分的停止预算对于一台由回退制动使其静止的机器而言是完整的,正如移动操作机所做的那样。 行走人形机器人没有步态中段的静止状态可供制动,因此其兜底动作是一次恢复平衡的迈步,预算的每一行都必须针对该动作重新检查。
谬误与陷阱
配置决定了复杂提案算法与关键安全约束强制实施例程所共享的物理资源。 正常运行留下的轨迹无法证明这些系统真正相互独立,当罕见的物理事件——例如电源电压瞬变、时钟故障、内存争用,或一个卡住的产生者——对这些共享硬件通路施加压力时,更是如此。
谬误:逻辑特权环可保护实时权限执行单元免受共享电源轨的电压跌落影响。
假设移动操作臂将锁步权限核心置于加速器的供电上,位于同一片 SoC 中。 那么,节 1.3 的电压跌落会使共享电源轨上每个逻辑门的传播延迟拉伸 39 %,包括权限核心自身的逻辑门,无论其软件拥有什么优先级。 时钟留出的时序余量小于该拉伸的核心,会在其关键路径上错过建立时间。 两个锁步核心看到相同的电压跌落,因而可能锁存同一个错误值,使比较器保持静默;或者欠压检测器在基座移动时重置权限执行单元。 访问控制决定权限执行单元可以写入哪些地址;其规则中没有约束该单元触发器电压的项。 布局鉴定必须用去耦电容或 \(di/dt\) 电流变化率限制来约束电压跌落,并在声明的电流阶跃下展示时序裕量;否则移除共享电源。 机器将其移除,在其隔离的、具有供电保持能力的 哪一项预算最先成为约束 电源轨上运行许可路径,而加速器并不从中取电。
陷阱:在提议域与许可域之间共享锁相环或复位控制器。
若机器的应用处理器与许可域共用同一个锁相环和同一个复位控制器(硬件隔离),那么一次热时钟故障或停滞策略簇的看门狗复位都可能使许可域一并停摆。 名义方框图显示处理器彼此独立,但两者都依赖脆弱的硅基基础设施,单个事件即可在无声中将其禁用。 沿物理实现追踪并核查时钟树与复位树,以确保持续实施许可约束所需的资源彼此独立。 底座与机械臂驱动在不再收到获准指令时,同样需要定义到安全状态的硬件过渡;重启应用处理器不能是唯一的重启恢复机制。
谬误:平均内存总线利用率低,就保证实时安全任务的读延迟有界。
假设机器权限路径从共享 DRAM 读取传感器快照,其中适度的平均总线占用掩盖了与其读取同时发生的摄像头与日志突发流量。 1.1 中存在竞争负载时的读取 仅在前置单个积压时符合感测配额,而平均量界无法说明会有多少个积压。 假定读取尾延迟为 320 μs,则在 400 μs 的总期限中仅剩 80 μs,小于约束评估与驱动帧写入所需的 95 μs,因此该配置不成立。 一个一致的 TCM 快照可以省去共享 DRAM 读取,前提是对其 DMA 完成时间、容量和本地传输时间均加以限定。 平均利用率本身不足以证明能够满足该截止时间。
陷阱:跨处理器通信边界与不可信的神经网络策略共用阻塞式软件互斥锁。
分块策略在将一批16设定值发布到一半时崩溃。 一个必须获取该生产者持有的锁的强制器会随之冻结,这就是为什么@sec-placement-boundary-contract 的边界契约不允许阻塞式同步。 其 seqlock 使强制器无需等待即可拒绝一条被撕裂的记录,并继续执行其回退行为,但前提是重试行为本身具有上界。 通信契约必须像规定载荷格式一样严格地规定中断发布的时间行为。
摘要
物理 AI 平台将学到的提议器部署在应用处理器与加速器上,而许可路径则置于裸金属微控制器,但仅凭这一分配并不能实现二者之间的隔离,因为特权边界并不管辖这两条路径仍然共享的任何物理资源。 因此,分区(partitioning)在负载测试未能证伪它之前,只是一个设计假设。
物理隔离必须由对内存队列、交叉开关仲裁、电源瞬态以及执行器路径的实测界限来支撑。 一个放置结果是一项经验性主张,其适用范围限于所测条件。 一条通过的放置记录表明:在声明的压力工作负载、特定环境温度和固定的时钟治理策略以及已记录的故障域条件下,芯片的共享物理底层并未导致不可信路径违反安全路径的时序约束。 在仓库移动操作臂上,若在架构图中将 分块策略与权限路径分别画入不同的框,就不会把它们与共享的电压调节器、共用的内存交叉开关,或横跨两个处理器集群的散热片隔离开来。 若加速器在执行该学习得到的提议时达到峰值电流,而所有内存通道都在服务直接内存访问传输,那么由此产生的电压跌落会在纳秒级时间内波及同址的权限核心,热量则会在数秒内传至该核心;正因如此,该机器将这一核心置于独立的硅片上。 系统设计中绘出的边界,只有在与这些共享的电学、热学与架构学限制逐项核对之后,才真正存在于硅片之上。
放置记录将这一证据向前传递。 它从执行记录中取用权限路径声明的最坏情况执行时间与截止时间,并补充声明测试条件下的负载工况实测最大值、共享资源队列与功率余量、共用的电源、时钟、复位与内存失效路径,以及尚未测试的条件。 机器自身的记录中,在 400 μs 的截止时间内,针对声明的 250 μs 最坏情况,保存了一条 135 μs 的示例性无负载估计;然而,它仍等待一份负载工况测量账本,该账本必须在任何发布声明成立之前,指明仲裁策略、时钟、采样数量与物理端点。
随着本次布局分析的完成,第三部分的各个阶段构成一台必须作为一个整体来测量的机器。 观测契约、信念记录、意图租约、轨迹记录、执行记录与布局记录构成一条链,每一环都是一项附有条件的主张;因此,产生这些记录的阶段不能被当作通过理想化信道通信的独立软件模块来处理。 前几章确立的逻辑边界提供了推理权威与故障传播所需的结构,但物理现实决定其执行。 内存控制器遵循已配置的仲裁与行调度,二者未必反映软件特权;中断可能在任一工作负载期间到来。 当许可路径接受一个底座速度设定值时,该动作是流水线中的最后一步,其时序、功耗与内存占用必须在同一底盘上共同测量。 前几章假定学习型负载无法延迟原则 Proposal is not permission 所要求的许可路径,而布局分析将这一假设转化为一个可证伪的阈值,并以压力测试和记录作为支撑。 第四部分继承了链条留下的三件事:已完成制动预算中的余量、站点穿越规则尚未定论的前提,以及布局记录中尚未填写负载工况测量结果的字段。
要点回顾: 异构硅片布局与内存争用
- 逻辑隔离是一个关于硬件的假设:特权环决定任务可以触及哪些地址,而不是它的请求等待在哪里、由哪条供电轨为其供电,或它依赖哪棵时钟树和复位树。 一项独立性主张只有在带负载的测试未能证伪它时才成立。
- 平均值无法约束截止时间:在被否决的共享 die 上,一批由权重 tile、相机和遥测事务组成的积压,把权限路径上的快照读取从 0.32 延长到 28.564 \(\mu\text{s}\)。 超过 5 个这样的积压会越过声明的最坏情况执行时间,而平均值并不能排除这种情况。 事务大小、队列策略与旁路行为决定等待,因此该界限属于内存控制器。
- 耦合运行发生在三个时间尺度上: 供电轨电压跌落在纳秒级发生,排队在微秒级发生,而热节流在负载停止后持续数秒。 在被否决的共享 die 布局中,时钟频率减半使执行保障机制的 250 μs 执行周期延长至 500 μs,持续 2,175 个控制节拍。
- 声明的界限即证伪阈值: 任何在带负载条件下超过声明的最坏情况执行时间的执行周期,即使截止期限仍然满足,也足以否定独立性,因为执行保障机制之上各层的全部余量都是依据该数值设计的。 一条通过的轨迹仅能支持它所测试过的状态。
- 被证伪的论断迫使一次有代价的选择: 预留占用空闲容量,分区占用工作集,降低负载则牺牲策略权威,而迁移会引入板级链路,其最坏情况必须落在租约的续期抖动余量之内。
- 布局记录限定了所展示的内容: 它取自执行记录声明的最坏情况执行时间与截止期限,并补充带负载条件下的观测最大值、缓解措施以及未测试的条件。 对于移动操作臂,带负载测试结果字段仍然为空,因此独立性主张在没有任何证据的情况下进入了放行评审。
后续内容: 从计算放置到监督性干预
脚注
电感电压跌落机制:在高性能 VLSI 设计中,电感电压跌落(\(\Delta V = L \cdot dI/dt\))在大量逻辑门同时开关时,产生于电源分配封装引脚和片上电源网络的寄生电感(\(L\))两端。 若局部轨电压低于最低工作阈值(\(V_{\min}\)),数字触发器将遭受建立时间违例、亚稳态或欠压复位,从而破坏确定性的实时执行。↩︎
异构系统芯片架构:异构 SoC 将多个不同的计算域集成到同一硅片基板上,将高吞吐应用处理器与神经加速器同确定性实时安全岛结合起来。 尽管内存管理单元跨域隔离了软件地址空间,硬件子部件仍共享电源分配网络、时钟分配树和 DRAM 控制器。 在峰值认知突发负载下,这些共享物理结构之间的资源争用缺乏协调,可能使实时响应时间劣化到超出关键物理截止时间。↩︎
双核锁步: 两个核心可执行匹配的指令流,同时比较逻辑检测所选的偏差。 检测覆盖率、延迟、共享轨脆弱性和诊断响应取决于器件和应用的安全论证,因此锁步只是 ASIL D 论证的一个组成部分,而非全部。↩︎
PREEMPT_RT: 一种 Linux 实时配置可降低部分调度器延迟,但其尾部延迟取决于内核、驱动、工作负载和共享硬件。 在没有测量的情况下,无法得出可移植的低于 \(50\,\mu\text{s}\) 或裸金属对比结论。↩︎
硬件内存保护与 IOMMU 域:强制空间地址隔离的物理硅结构。 片上内存保护单元(MPU)将 CPU 线程的执行限制在有界的内存段内,而输入输出内存管理单元(IOMMU)则转换并监管外围总线主设备(如 PCIe 神经加速器或相机反序列化器)发起的直接内存访问(DMA)请求,从而在物理上阻止不可信设备篡改安全状态缓冲区。↩︎
航电多核认证: FAA 咨询通告 AC 20-193 与 CAST-32A 为安全关键航电的多核干扰分析确立了规范。 该指导要求通过证明共享缓存、互连交叉开关和内存控制器不会导致关键任务超出执行截止时间,来界定最坏情况执行时间。 若无硬件强制的质量服务分区或专用互连通道,跨核内存流量将使单核时序边界失效。↩︎
缓存着色与路划分: 将共享缓存容量在竞争任务之间划分的技术。 软件缓存着色通过划分物理页分配,使不同进程的地址映射到互不重叠的缓存集合;而硬件划分机制(如 ARM 内存系统资源划分与监控技术 MPAM,或 Intel 缓存分配技术 CAT)则动态限制不可信神经加速器可分配的缓存路,防止关键安全线程的缓存行被逐出。↩︎
DRAM bank 冲突:同一已激活的存储体中的不同行可能需要在列服务之前先预充电并激活。 实际的 bank 映射、重叠与调度决定了所增加的延迟。↩︎
Alpha-Power CMOS 延迟模型: 该模型使用 \(t_{\text{prop}} \propto V/(V-V_{\text{th}})^\alpha\) 与 \(V_{\text{th}}=0.42\text{ V}\) 和 \(\alpha=1.3\)。 它把供电电压与单个门电路的开关延迟联系起来;建立时间违例与欠压行为由器件特性表征确定。↩︎
微架构时序异常: 在乱序和投机处理架构中,局部的性能改善,例如缓存命中或加速的分支求值,会改变指令调度与资源争用,从而造成全局执行时间的净增加。 这种反直觉行为使简单的组合式最坏情况执行时间分析失效。 安全性验证需要为声明的工作负载、仲裁、温度和故障条件给出有依据的界;仅凭测量结果和单独的非投机核心,都无法确立端到端的硬界。↩︎
硅衬底老化与时间裕量 :长期衬底退化机制,例如负偏置温度不稳定性(NBTI)和热载流子注入(HCI),会随运行年限逐渐增大晶体管开关延迟。 与突发多核电流阶跃(\(\frac{di}{dt}\))耦合的瞬态供电电压跌落,会使老化硅片的传播延迟超出设计余量。 在硬实时系统中,这些物理时序劣化会引发间歇性竞态条件与未能在调度器规定的截止时间前完成任务的情况,而这两类问题在洁净的台架验证中从未显现。↩︎
汽车领域的无干扰(Freedom From Interference): ISO 26262 第 9 部分将“无干扰”(Freedom From Interference,FFI)正式定义为不同安全完整性等级软件元素之间级联故障的缺失。 在异构机器人 SoC 中,实现 FFI 需要硬件强制的空间分区(内存保护单元、IOMMU 页表)与时间分区(固定优先级总线仲裁、TDMA 互连),以防止非特权感知模型劣化安全关键性执行任务。↩︎