/var/folders/7g/fkg91tq50f58kfmg7c65747r0000gn/T/ipykernel_91871/1653963227.py:42: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
plt.show()策略训练
策略训练
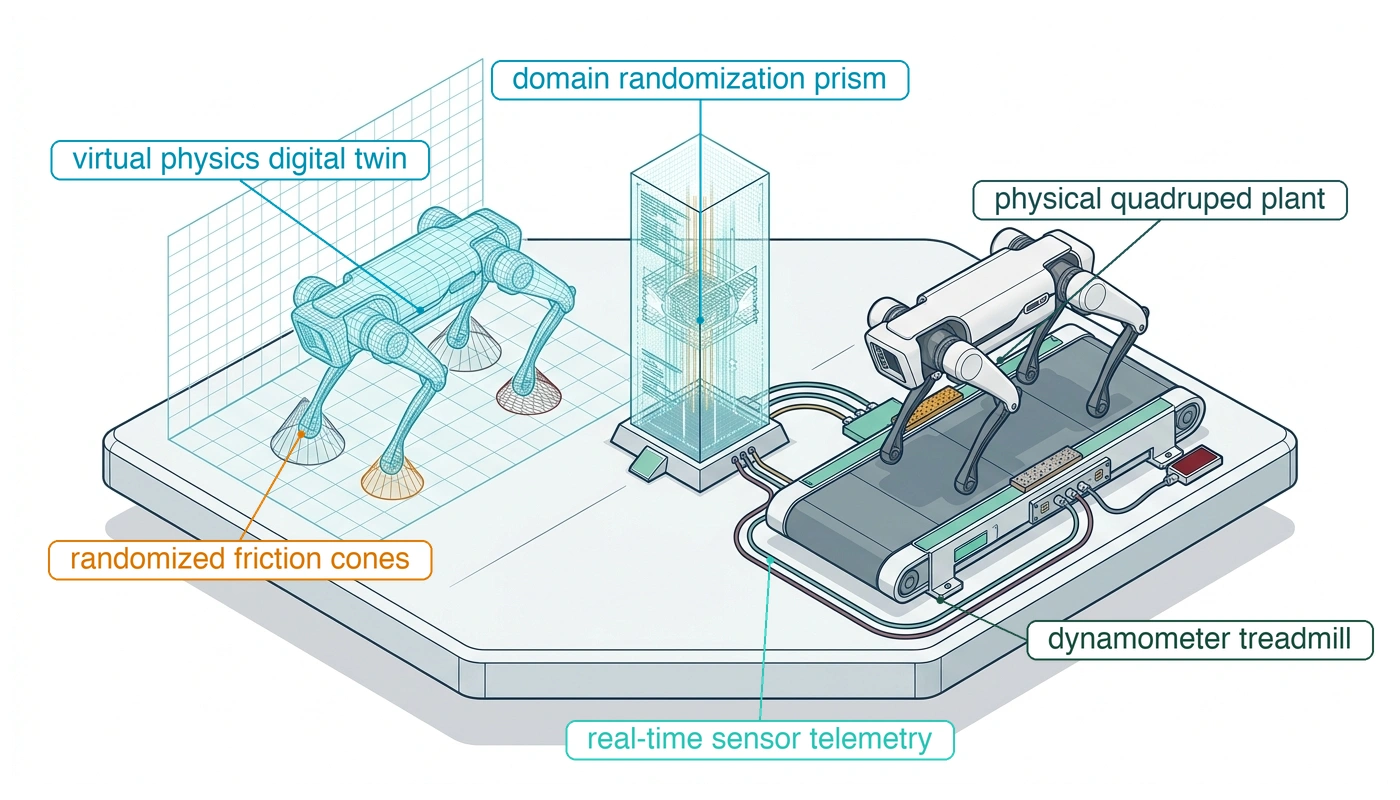
目的
为什么一个在每次仿真试验中都成功的策略,会在其首次真实接触时损坏硬件?
物理试验与试错既消耗硬件,也消耗计算资源。 探索性动作可能在策略获得有意义的奖励反馈之前,就使电机绕组过热、电池电压跌落或传动过载。 因此,物理策略合成主要转向离线演示与高吞吐物理仿真器。 然而,每种经验来源都会在学到的神经权重中留下各自独特且未被建模的归纳偏置。 演示仅覆盖名义访问过的轨迹;朴素的回归损失会把不同的多模态解平均成不可行的插值动作;仿真求解器则奖励硬件会立即惩罚的非物理接触捷径。
这些差异都不会出现在离线训练指标中,但它们都会随权重一同带上机器。 安全部署学到的策略,需要选取与数据集支撑相匹配的训练方案,测量数值求解器在摩擦、柔顺性与延迟方面如何偏离真实世界被控对象动力学,并严格界定策略保持有效的范围。 软件中任何未被检验的未建模假设,最终都会在因果边界上得到裁决:指令在那里交付电磁能量和不可逆的机械功,而软件无法召回。
学习目标
- 按各训练方案在权重中留下的依赖关系,以及它在硬件上产生的失败,来比较训练方案。
- 解释为何克隆策略一旦离开已演示状态,其微小误差就会累积放大。
- 解释平方误差损失如何把两条有效的演示变成两个演示者都没有采取的动作。
- 通过在 sim-to-real 差距的动力学、感知、外观或时序通道中定位它,来诊断迁移失败。
- 依据真实机器微调运行所付出的磨损,以及它所推翻的既有证据,来评估该运行。
- 构建策略清单,使其声明的运行域排除数据不支持或仿真器未建模的每一个状态
策略综合
两个学习得到的控制器在标称条件下可以完成同一任务,但在同一台机器上却因不同原因而失败。 笼门闩锁任务 物理数据 就有这样两个控制器。 第一个闩锁策略 latch-bc-01 是从闩锁任务演示的遥操作开门演示中克隆得到的。 第二个策略 latch-sim-02 从 latch-bc-01 出发,并在物理仿真器中经强化学习得到改进。
在标称锁扣板与受保护的接近速度 0.03 m/s 下(示意;参见读者指南),两个策略都能开门。 一旦条件偏离该点,两者的失效模式便分道扬镳。 当门板下垂、锁扣板偏离标称位置几毫米时,克隆策略的首次修正落入了演示从未访问过的状态,因为演示采集中没有出现位移的锁扣板。 此后每条指令都在所选的 20 ms 设定周期发出,误差不断累积,直到夹爪卡死在锁扣板边缘。 模拟策略在标称锁扣板上失败。 其模拟器将接触建模为软惩罚弹簧,因此优化器发现以 0.10 m/s 接近毫无代价。 在真实锁扣板上,接触力与接近速度和接触时间成正比,在该接近速度下,接触力在接触后经过 2.5 ms 达到锁扣的 100 N 限值,仅比接触回路的 2 ms 响应时间略长(速度、限值与响应时间为示意值)。 这留给脱速的时间太少,于是猛冲使锁扣过载。 数据采集机制决定了策略所见的内容,而仿真器塑造了它对物理世界的假设。
这两次闩锁失效具有相同的结构。 每种训练机制都在权重中留下了某种依赖。 克隆策略依赖于演示恰好覆盖的那些状态,而仿真策略则依赖于比板更软的接触模型;在这两种情况下,违反该依赖的部署条件都会产生训练分数未曾显现的失效。 因此,实际的选择是:哪种经验来源能在不掩盖执行器动力学的前提下教会所需的恢复动作,以及哪些物理证据必须先于执行器权限出现。 答案随检查点一同传递,作为它所可能进入的状态的记录。 无论采用何种训练机制,检查点只向许可路径(《五层机器》)提出动作片段,而从未建模该路径的训练,会产出这样的策略:其产生的扭矩尖峰必须由许可路径拒绝,或其提议会持续触发许可路径的限制。
策略合成机制
该闩锁任务可借助四类经验:物理数据 的遥操作开门过程、不完美的或脚本化的开门记录、笼门的仿真器,以及机械臂本身。 每一种以不同的物理代价换取不同的能力,表 1 将它们并列呈现,并列出各自已知的失效模式与拦截该失效的检查。
| 策略合成机制 | 核心购得能力 | 数据与算力预算 | 样本效率与规模 | 硬件安全与磨损风险 | 主导失效模式与拦截器 |
|---|---|---|---|---|---|
| 行为克隆(BC) | 无需奖励工程或系统辨识,直接模仿演示轨迹 | \(10^2\)–\(10^3\) 遥操作轨迹(\(\sim 10\)–\(50\text{ h}\) 数据);\(<50\text{ GPU-h}\) 计算量 | 在专家演示上监督学习 \(\mathcal{O}(N)\);固定的 \(1\times\) 实时数据吞吐量 | 记录阶段探索风险最小;优化阶段零硬件探索 | 通过协变量偏移产生二次累积误差(\(\mathcal{O}(T^2 \epsilon)\));拦截器:核/马氏距离密度监控器、凸包边界钳制 |
| 离线 / 批量强化学习 | 在固定的、异构的次优日志上进行价值引导的策略优化;拼接多轨迹转移 | \(10^5\)–\(10^7\) 条具有状态-动作覆盖的日志转移;\(100\)–\(500\text{ GPU-h}\) 计算 | 离线 \(\mathcal{O}(N)\) 基于静态数据集;样本效率高,但要求较高的状态-动作重叠 | 离线训练期间不存在主动探索风险;日志采集需要封闭实验装置或安全的脚本式控制器 | 分布外动作外推与 Q 值高估。拦截器:保守 Q 学习(CQL)惩罚项界、动作支持集过滤 |
| 从仿真到现实的强化学习(RL) | 通过数十亿次无约束 rollout 发现动态、非抓握式操作与敏捷运动 | 零物理数据;在 \(10^3\)–\(10^4\) 个 GPU 环境中生成 \(10^7\)–\(10^9\) 次仿真转移;\(500\)–\(5000\text{ GPU-h}\) | 较低的算法采样效率(\(10^7\)–\(10^9\) 步),由 \(10^3\times\)–\(10^5\times\) 的模拟加速抵消 | 训练期间零硬件磨损或碰撞损伤;若实际被控对象的动力学与仿真存在偏差,则存在严重的部署风险 | 对数值求解器伪影的利用(接触相互穿透、零延迟)。拦截器:成对轨迹差异预算、力导数(\(dF/dt\))钳制 |
| 残差 RL 与真实微调 | 直接针对物理接触柔顺性、齿轮箱迟滞和真实传感器噪声进行策略修正 | \(10^3\)–\(10^5\) 物理步数(\(0.5\)–\(10\text{ h}\) 墙钟时间);\(<20\text{ GPU-h}\) 计算量 | 需要高样本效率(SAC/TD3,或残差 delta-action 形式);严格 \(1\times\) 实时 | 物理暴露高;重复冲击会劣化齿轮箱;探索阶段的电流抖动会抬高绕组温度 | 对标称转运动作稳定性的灾难性遗忘、局部策略崩溃。拦截器:参数漂移界(\(\Vert\Delta \theta\Vert_2 \le \delta\))、冻结回归测试套件、热保护限幅器 |
四种方法中,行为克隆 是获得可用策略最廉价的路径,也是其失效模式最易理解的一种。 它将策略合成表述为对采集到的专家状态—动作对数据集上的监督回归或分类问题 \(\mathcal{D} = \{(\mathbf{o}_t, \mathbf{a}_t)\}\)。 沿用 哪个动作会成为标签 中定义的动作信号采集点,演示数据集将观测与操作者映射出的设定值,或许可路径放行的设定值配对: \[\mathcal{D}_{\text{intent}} = \left\{ \left(\mathbf{o}_t, \mathbf{a}_{\text{cmd}, t:t+H-1}\right) \right\} \quad \text{versus} \quad \mathcal{D}_{\text{verified}} = \left\{ \left(\mathbf{o}_t, \mathbf{a}_{\text{enf}, t:t+H-1}\right) \right\}\] 克隆映射出的设定值 \(\mathbf{a}_{\text{cmd}}\)(即操作者在许可路径作用前的机器人自身坐标系中的意图),使模型训练于演示意图;而克隆许可路径放行的设定值 \(\mathbf{a}_{\text{enf}}\),则把其制动减速曲线直接烘焙进网络权重,使策略继承针对该特定路径限幅调优的减速量。 在其标准形式下,优化目标最小化从演示轨迹抽取的连续动作序列上的多步预测损失(经典回归形式见 Mode averaging and the decoders that avoid it)。1 由于该损失仅惩罚指令动作与观测状态处所记录演示之间的差异,训练目标并不评估任务完成度、终端代价,也不评估闭环动力系统的稳定性。 仅将动作适配到观测。
↰ 前置条件: 将区分意图与执行的四流动作信号采集点元组形式化于 哪个动作会成为标签。
多模态情形下的失效与模式平均
当人类演示者执行一项物理任务时,其策略通常是多模态的。 考虑一个避障场景,其中移动底盘或机械臂必须绕开中央立柱。 人类演示者可能在半数演示中从立柱左侧绕行,在其余半数演示中从右侧绕行。 真实的演示数据包含不同的有效选择,但完全没有沿中央直线直行的示例。
一个确定性的点回归行为克隆策略无法对同一观测表示两种选择。 在平方误差损失下,其最优输出是条件均值(推导见 Mode averaging and the decoders that avoid it),2 此处即“左转”与“右转”指令之间的中点。 策略输出零侧向速度,命令机器直接驶入障碍物,而该动作从未出现在演示数据集中。
一座流程装置表明,模式平均无需几何结构。 假设某流量控制器的演示在两类示例阀门工况之间交替出现:一类是旁通工况,阀门开度为 10 percent,另一类是主进料工况,阀门开度为 90 percent,且两类工况数量相等。 平方误差克隆输出的是它们的均值,即阀门开度 50 percent,该流量既不受任一类工况控制,也从未针对该装置完成标定。 该中间流量可能使供给泵发生汽蚀,并错过任一类工况所调定的冷却时限。 此处不涉及任何障碍物,因此没有任何几何性检查能捕捉到该问题;只有针对已演示工况的检查才能做到。
模式边界还会导致时序失效,即高频单步控制器中的时序不一致。 在一个示例性 \(50\text{--}100\text{ Hz}\) 控制器中,传感器噪声使连续观测跨越该边界,而仅映射 \(o_t \to a_t\) 的策略在 \(+10\text{ N}\cdot\text{m}\) 与 \(-10\text{ N}\cdot\text{m}\) 请求之间交替。 这种交替是否引发共振、磨损或绕组发热,取决于驱动装置与负载,因此它是一种需要检验的失效模式,而非每个单步策略的固有属性。
模式平均是在单个观测上的失效。 行为克隆存在第二种失效,只有当策略闭环运行时才会显现。 其自身误差会使机器偏离演示所覆盖的状态,而损失函数在这些状态上并未提供训练信号,这正是 latch-bc-01 在下垂的门上发生卡滞的原因。 在原则 Endogenous data 下,策略自身的动作决定了它接下来访问哪些状态,因此固定档案无法预判它们;对于仅由专家演示克隆的策略,最坏情况成本随执行时域(horizon)的平方增长(equation,该结论由 内生经验 给出)。 因此,留出验证集上的低验证损失只能度量演示者访问过的状态上的精度;它对策略一旦受到扰动后如何返回一无所知。 纠偏聚合会标注学习者自身的状态,并在其专家标注假设下将该增长降为线性(干预与恢复数据),但在物理机器上,这些状态是通过运行一个未经验证的策略而达到的,可能在监督者介入之前撞击夹具或损坏传动机构。
Definition 1.1: 轨迹误差累积
(轨迹误差累积)是指开环监督策略在物理动力学被控对象上顺序执行时产生的闭环跟踪漂移的二次累积,其期望上界为: \[J(\pi) - J(\pi^*) \le \mathcal{O}(T^2 \epsilon)\] 其中 \(T\) 为任务执行时域,\(\epsilon = \mathbb{E}_{\mathbf{s} \sim d_{\pi^*}} [\mathbb{I}(\pi(\mathbf{s}) \ne \pi^*(\mathbf{s}))]\) 为在演示分布 \(d_{\pi^*}\) 上的单步策略误差率。
- (意义):证明了最小化离线演示上的单步预测误差在根本上不足以保证闭环稳定性;任何非零误差率 \(\epsilon > 0\) 最终都会将物理状态推离演示支撑集。
- 区别:与静态监督学习(验证误差随样本数线性增长)不同,累积的 rollout 误差将策略错误与环境物理耦合起来,使微小的初始轨迹偏差演变为不可逆的状态发散。
- 常见误区:假定在留出演示划分上较低的离线验证损失,就意味着闭环任务成功率较高,却忽略了离线数据集在受到扰动后返回标称支撑集这一情形完全不存在任何示例。
动作分块改变了什么——以及它仍未解决的问题
动作分块(时序动作分块)能够提升时序连贯性,并降低生成式架构(如扩散策略与 Action Chunking with Transformers(ACT))的提案频率。 它同样可以缓解上文模式边界示例中的模式交替问题。 一次性预测 \(H\) 个未来动作 \(\mathbf{a}_{t:t+H-1}\) 的分块策略,通过三种机制改善执行:
- 时序与动态一致性:与其生成彼此割裂且引发抖振的单步预测,模型预测的是一条完整的协调轨迹。
- 保持所选模式:单步马尔可夫策略容易陷入因果混淆,将一时的虚假相关误认为任务意图。 以轨迹历史为条件并提议一个片段,有助于在相邻动作之间保持所选模式。
- 滚动时域重规划与时间维集成:部署后的策略每隔几步查询一次新的片段,并融合重叠预测(供给、新鲜度与内存墙),从而在保留多步提议的同时实现周期性的反馈。
这些机制均不改变行为克隆的支持界 \(\mathcal{O}(T^2 \epsilon)\)。 正如 图 1 在理论上和实验上所表明的那样,单步行为克隆随着 rollout 视界 \(T\) 的增长而任务存活率急剧下降,在 \(50\text{ Hz}\) 下于 250 个控制步内落入灾难性干预区间(存活率 \(<18\text{ \%}\))。 尽管 BC-RNN 等时序架构推迟了发散的开始,但它们的二次误差累积在渐近意义上仍完全相同。 相比之下,在线交互式聚合(DAgger (Ross 等 2011年))通过在学习者访问的状态上收集专家反馈,将误差增长线性地限制在 \(\mathcal{O}(T \epsilon)\) 以内。 在没有交互式监督的情况下,现代生成式策略通过动作分块(\(K=16\))来抵消累积漂移,该分块将有效执行时域收缩至 \(T_{\text{eff}} = T/K\)(ACT (Zhao 等 2023年)),以及连续的滚动时域扩散重规划 (Chi 等 2024年),从而在扩展的 500 步操作时域上维持超过 \(80\text{ \%}\) 的任务存活。
Ross, Stéphane, Geoffrey Gordon, 和 Drew Bagnell. 2011年. 《A reduction of imitation learning and structured prediction to no-regret online learning》. Proceedings of the Fourteenth International Conference on Artificial Intelligence and Statistics, 627~35.
Zhao, Tony Z., Vikash Kumar, Sergey Levine, 和 Chelsea Finn. 2023年. 《Learning fine-grained bimanual manipulation with low-cost hardware》. Robotics: Science and Systems (RSS). https://doi.org/10.15607/RSS.2023.XIX.016.
Chi, Cheng, Zhenjia Xu, Siyuan Feng, Eric Cousineau, Yilun Du, Benjamin Burchfiel, Russ Tedrake, 和 Shuran Song. 2024年. 《Diffusion policy: Visuomotor policy learning via action diffusion》. The International Journal of Robotics Research 44 (10-11): 1684~704. https://doi.org/10.1177/02783649241273668.
增大数据集规模、模型容量或调参,可以降低评估观测上的一步错误率,从而降低固定时域内首次策略错误的概率。 这一改进并不能刻画错误发生之后的情况。 外部扰动、未标定的载荷或电压跌落,也可能将机器带入支撑较弱的状态,而无需策略分歧。 恢复数据、测得的动力学以及独立的运行时限制,决定上述任一事件是否仍处于物理包络之内。
偏离已演示状态不会自行触发告警,因此在其发生物理接触之前检测它,不能依赖离线训练损失。 它需要运行时遥测,直接跟踪状态空间的支撑情况,包括在特征空间中测量马氏距离、估计模型认识性不确定性,或在许可路径上施加显式的包络监控,当状态轨迹离开演示数据集的凸包时触发。
解码器选择在运行时付出什么代价
点回归解码器将不同的有效动作平均成一个无效指令,而多个解码器族族避免了均值:混合密度网络、隐式能量模型克隆、条件扩散与流匹配、隐变量分块(如 ACT),以及视觉语言动作模型中的离散动作 词元。Mode averaging and the decoders that avoid it 与 Continuous trajectory diffusion and flow matching 分别发展其损失函数与采样过程。 它们都没有提供缺失的恢复状态。 对机器而言,选择改变的是运行时成本,因为训练时固定的解码器决定了每个分块需要多少次网络求值。
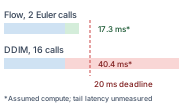
去噪步数决定分块推理时间,只有少步采样器能同步满足设定点周期。
步数即为达到控制截止时刻的成本。 扩散解码器通过反复去噪生成每个 chunk,每一步都要完整评估噪声预测动作头,因此推理时间随步数增长(即 chunk 延迟中的细化项 供给、新鲜度与内存墙)。 在 Continuous trajectory diffusion and flow matching 所假设的步数与单步耗时下,同步运行的多步去噪扩散隐式模型(DDIM)采样器会超出 20 ms 设定的周期,而少步流匹配采样器则能适配该周期,前提是这些少步满足任务的动作质量准则。 无法同步满足周期的解码器以异步方式运行。 应用处理器以较低的速率刷新 chunk 缓冲区,授权路径则以自身速率读取最新 chunk,检查其新鲜度,并在过期时回退,因此执行动作永远不必等待提议方。 机器自身的 chunk 策略即为该异步情形。 它每 50 ms 刷新一次 chunk,因此其推理截止时间为该 chunk 周期,而 20 ms 设定周期仅用于调节 chunk 内设定值的播放节奏。
如 Diffusion policy architecture(Continuous trajectory diffusion and flow matching)所述,策略依据由图像与关节状态构成的观测历史,从纯高斯噪声中迭代去噪出一个动作 chunk \(\mathbf{A}^0 \in \mathbb{R}^{K \times D_a}\)。 而非执行整个预测时域,机器在滚动时域重新规划发生之前,先向实时微控制器下发执行时域。 该双速率流水线——将主机上的异步反向扩散与微控制器上的确定性样条插值、速率限制及安全性钳制耦合起来——在 (轨迹扩散策略算法(英文原版))(Continuous trajectory diffusion and flow matching)中展开。
↳ 下游: 跨应用处理器与安全微控制器的多速率动作 chunk 缓冲区的硬件布局,在 同一芯片上的两条路径 中完成工程化。
离线强化学习与动作分布偏移
当物理演示数据集 \(\mathcal{D} = \{(s_t, a_t, r_t, s_{t+1})\}\) 包含异质或次优轨迹(例如遥操作、脚本化程序与人类的自由探索性尝试的混合)时,行为克隆面临困难,因为它对所有演示赋予相同的监督权重。 在定义于马尔可夫决策过程(MDPs)(Sutton 和 Barto 2018年) 上的经典强化学习中,智能体优化策略以最大化期望折扣累计回报 \(J = \mathbb{E}\left[\sum_{t=0}^\infty \gamma^t r(s_t, a_t)\right]\)。离线强化学习(Batch RL) 旨在无需主动硬件探索,直接基于日志化的状态转移存档优化策略,利用奖励信号将互不重叠的、不完美的演示拼接为高性能的复合轨迹 (Kumar 等 2020年)。
Sutton, Richard S., 和 Andrew G. Barto. 2018年. Reinforcement Learning: An Introduction. 2nd 版. MIT Press.
然而,将标准 Q-learning 应用于静态离线数据集会引发一种失效模式,称为分布外(OOD)动作高估。 在标准强化学习中,算法通过让价值网络预测从下一步起所能达到的最高可能回报,来估计未来状态的价值(关于形式化的贝尔曼方程,参见 Value Functions and Affordance Grounding)。 该最大值在整个连续动作空间上取。 对于在日志数据集中从未执行过的动作,网络接收到的训练信号为零,并且由于泛化方差,往往输出错误偏大的价值估计,从而对一个未尝试过的物理动作预测出很高的回报。 该算法贪心地选取这些虚假峰值,并将过度乐观的价值误差向后传播。 部署时,策略会选取这些缺乏依据的动作,并可能下达会使关节卡滞或触及边界的运动指令。
为在不查询物理环境的前提下降低价值高估,保守 Q 学习(CQL) 为离线 Bellman 目标添加了一个正则化项。3 它惩罚学习策略采样的动作相对于日志数据中的动作的高价值。 状态-动作覆盖有限与近似误差仍然存在,因此授权路径仍需检查最终策略提出的建议。
克隆、分块与离线价值学习都仍位于已记录数据的支持集之内,保守 Q 学习使离线策略更为谨慎,而不会扩大该支持集。 当已记录的转移缺少动态操作或敏捷步态所需的高性能轨迹或恢复动作时,系统必须通过闭环试错采集新的经验。
试错学习
克隆的闩锁策略在位移后的板件上失败,因为从未有演示向它展示过这一情形。 试错学习通过让策略在闭环中自行生成状态-动作轨迹,来弥合这一盲区。 诸如 Q-learning 或策略梯度之类的算法会根据其自身动作所获得的奖励来调整策略,因此,一个将抓取器推离其标称路径的探索性动作,会迫使优化器评估从该被扰动状态出发的恢复过程,其中也包括操作者从未出现的擦边情况和不稳定接触。 通过从当前权重所诱导的状态分布中采样转移,基于试次的学习针对策略实际到达的状态进行训练,从而消除了克隆误差二次最坏情况增长背后的协变量偏移。
硬件上的闭环探索按日历时间计费,其成本取决于算法需要多少次试验、每次试验持续多久、一次复位需要多久,以及有多少台机器并行运行。 以开门任务本身为例,机械臂在主动时域 \(t_{\text{rollout}}\) = 8 s 内调节接触力,即一次自主接触阶段,而非完整的遥操作尝试。 在高维感知输入上的强化学习可能需要约 \(N = 10^6\) 次试验才能发现协调的力-速度剖面,其规模相当于 图 2 抓取试验的规模。 在单台物理机器(\(P = 1\))上,仅原始执行时间就占用了 8.0 × 10⁶ s,在计入任何重置开销之前,需要全天候连续运行约 92.6 days。
计入复位阶段后,便揭示了物理实验真正的时序瓶颈。 若使用专用的自动化夹具,其复位快于采集架的重新上闩(遥操作演示成本),能在 \(t_{\text{reset,auto}}\) = 4 s 内重新扣上门闩并让机械臂回到起始姿态,那么一百万次试验的总采集时间将扩展为 1.2 × 10⁷ s,即 138.9 days。 当探索性轨迹卡住闩锁凸轮或触发关节过流跳闸时,自动复位便无法实现,必须由人工操作员释放闩锁、重新装入门体并重新对准机械臂。 若每次试验都需要人工复位,平均耗时为 \(t_{\text{reset,manual}}\) = 30 s,则总日历时间需求增长至 439.8 days。 将物理并行性扩展至 \(P = 14\) 台同步机架(图 2),可将日历工期压缩到数周 (Levine 等 2018年),但它会按比例放大物理占地、资本投入、供电需求和人工监督劳动。
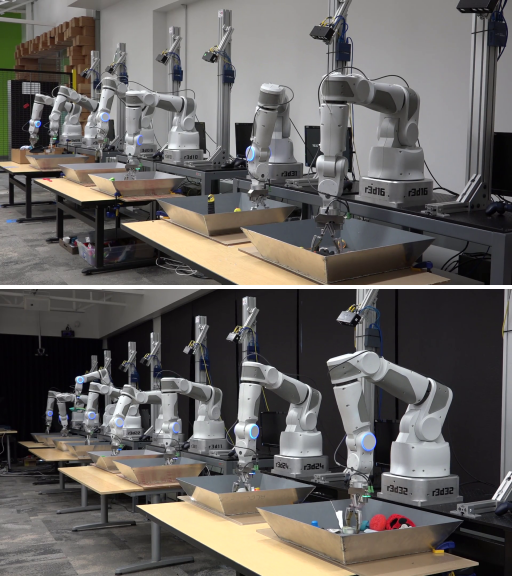
Levine, Sergey, Peter Pastor, Alex Krizhevsky, Julian Ibarz, 和 Deirdre Quillen. 2018年. 《Learning hand-eye coordination for robotic grasping with deep learning and large-scale data collection》. The International Journal of Robotics Research 37 (4-5): 421~36.
时间往往并非约束性因素;磨损才是。 每扇门开启一次,每个臂关节便承受约 \(n_{\text{rev}} = 4\) 次双向载荷反转,因此 \(N = 10^6\) 次试验在传动系统中累计产生 4.0 × 10⁶ 次此类载荷反转。4 同样的一百万次接触事件会磨损锁扣凸轮与锁扣板,压溃夹爪的柔性垫,并使臂的导线在反复循环中逐渐接近疲劳断裂。
在纯计算环境中,一条数值不稳定的探索分支除被丢弃的缓冲区外,几乎不产生任何成本。 而在运行中的机器上,探索是不可逆的。 不受约束的探索性扭矩将夹爪推入刚性夹具,使力传感器柔性件发生弯曲,造成谐波减速器轮齿被剪断,并将电机定子加热至超过其 \(155^\circ\text{C}\) F 级绝缘阈值。5
↰ 前置条件: 电机绕组热限值与扭矩-转速降额曲线推导于 热工作占空比。
此外,物理退化会在训练过程本身期间改变被控对象。 随着接触面抛光、齿轮齿隙增大(即齿轮齿间机械间隙或死区增加),以及结构紧固件在重复振动下松动,物理过渡分布 \(p(s_{t+1} \mid s_t, a_t)\) 在第 \(n = 900{,}000\) 次试验中,与第 \(n = 1\) 次试验中的完好动力学相比,存在可测量的差异。 被控机器在其自身训练数据的采集物理成本下发生演化。
奖励函数引入了第二重脆弱性。 在试错式学习中,标量奖励是工程师意图与优化器之间的接口规范,任何它未测量、未惩罚的约束,都是优化器将加以利用的自由度。 针对快速设定值跟踪、而对加加速度或绕组温度不施加惩罚的奖励,会趋向于在最大正向与反向出力之间进行 bang-bang 切换,从而引起支架振动并过热驱动电子器件。 当接触力未被测量时,策略可能学会以最大电流使关节顶靠机械止挡,因为这样做可以消除跟踪抖动。 网络满足的是被呈现给它的公式,而非设计者未言明的常识。
对于低维系统、复位平凡、磨损可忽略且裕度充足的情形,直接在硬件上进行强化学习仍然可行。 当所需的样本数量超过装置的时间、预算、结构寿命或风险容忍度时,仿真便成为必需;而训练一个复杂电机策略所需的 \(10^6\) 到 \(10^9\) 之间的过渡,则需并行地推进到物理引擎运行中,跨越一个计算集群。
这一替换改变了训练与现实之间的契约。 在模拟器中训练出的策略在探索过程中不会弯曲任何连杆,但它继承了奖励的遗漏以及仿真器对力学模型的描述;每一个未被建模的摩擦不连续点、理想化接触冲量以及未表征的延迟,都会变成它所依赖的假设。 在物理机器上,这些不准确性以未被建模的扰动和跟踪失败的形式回归。
仿真器作为系统组件
将仿真器视为外部开发工具是一种架构性错误。 编译器会从源代码生成机器指令,但生成的二进制在标准硬件上执行时,并不保留对编译器内部内存分配器的隐式依赖。 仿真器则不然。 它是一个上游策略生成组件,其物理假设、数值近似和边界简化会被永久嵌入到策略参数中。 当训练好的神经网络被复制到目标机器上时,仿真器并不在执行路径中,然而策略却表现得仿佛该仿真器中每一个未被建模的动态都依然成立。 仿真器是系统架构中的一个活跃组件,拥有自己的规范、容差和失效模式。
Definition 1.2: Sim-to-real 现实差距向量
Sim-to-real 现实差距向量 \(\boldsymbol{\Delta}_{\text{sim2real}} = [\Delta_{\text{dyn}}, \Delta_{\text{sens}}, \Delta_{\text{vis}}, \Delta_{\text{lat}}]\) 是模拟环境与硬件环境之间物理差异的耦合、多通道分解,涵盖接触力学(\(\Delta_{\text{dyn}}\))、传感器转换与噪声(\(\Delta_{\text{sens}}\))、视觉外观(\(\Delta_{\text{vis}}\)),以及异步传输延迟与抖动(\(\Delta_{\text{lat}}\))。
- 意义:将“现实差距”视为标量难度指标或纯粹的视觉域不匹配,会使工程师忽视动力学与时间上的差异。 执行器反电动势、齿轮箱柔顺性或总线抖动方面的差异会在策略完成首个物理控制步之前耗尽相位裕量。
- 区别:不准确的参数值(例如连杆质量 10% 的误差)会保留运动因果微分方程,而遗漏的机制(例如零延迟通信或未建模的库仑粘滑)则会完全切断物理反馈路径,导致策略利用非物理的仿真器伪影。
- 常见误区:仅依赖极端的域随机化来弥合大差距。 在物理范围之外的区间随机化参数会稀释策略容量,导致过于保守、迟缓的行为,无法在真实硬件上完成精度任务。
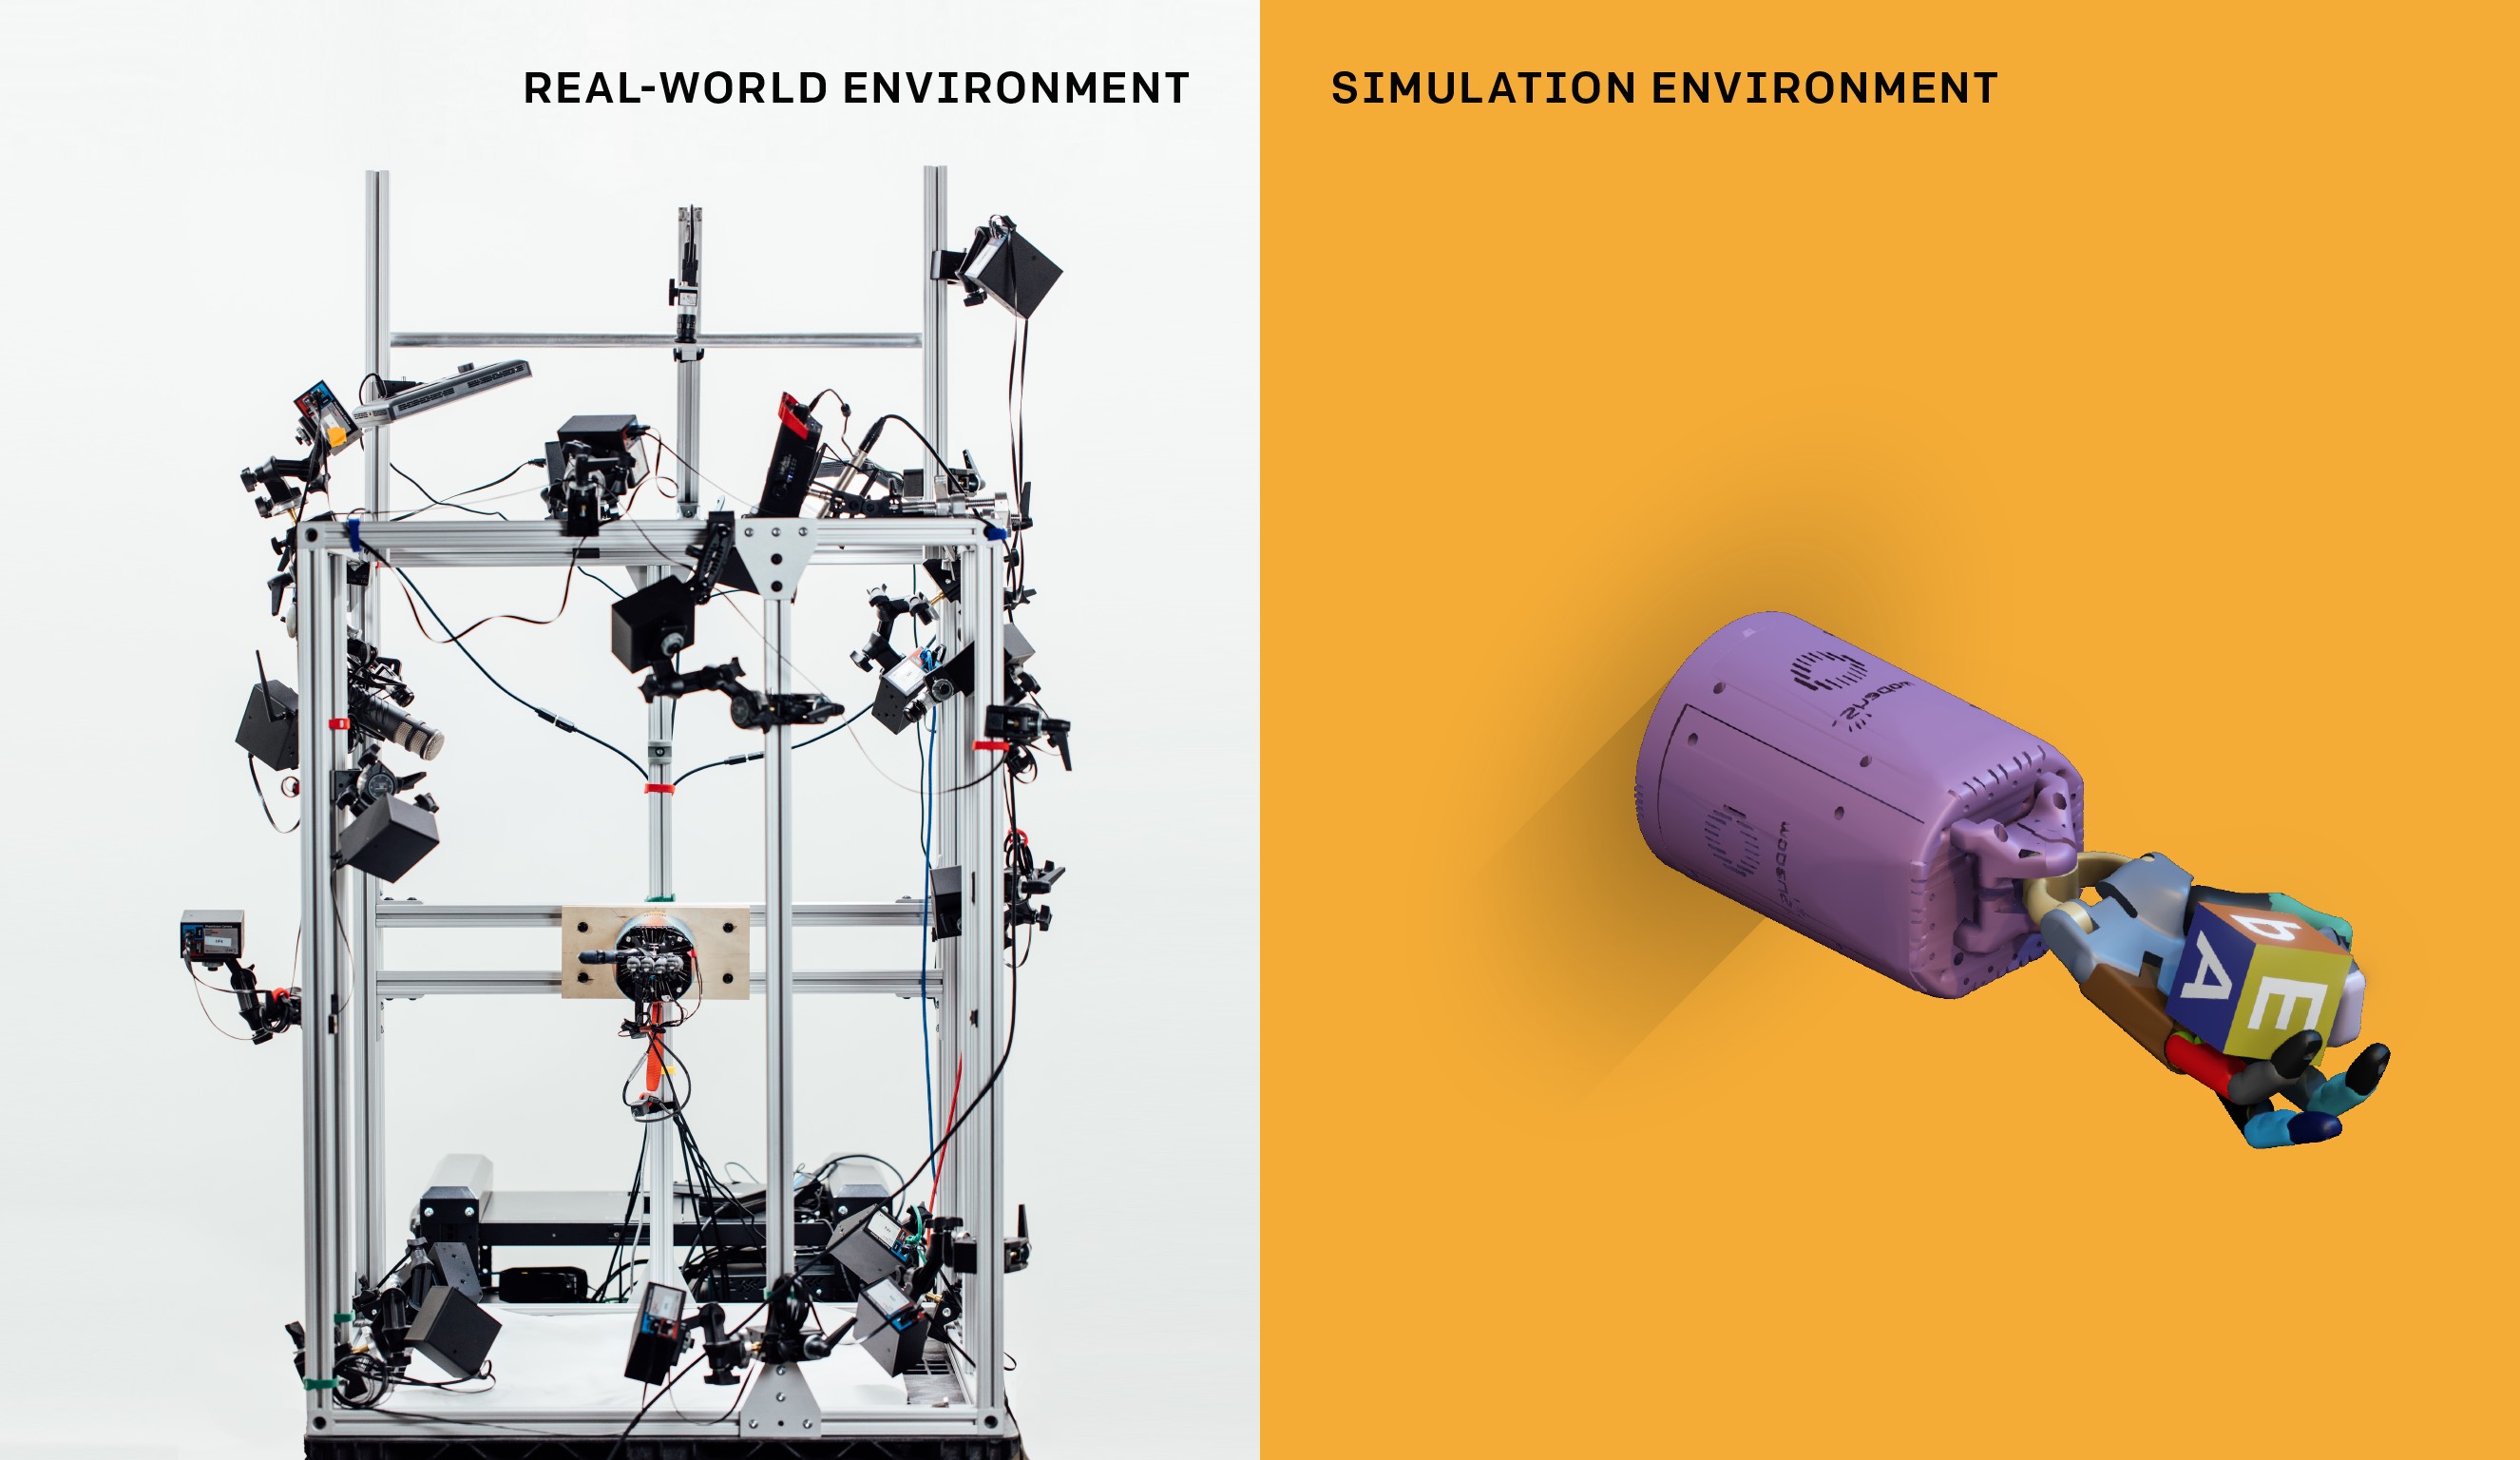
如同任何硬件子系统一样,仿真器需要一份形式化的接口契约,以可测量、可预算的量来表述。 该契约规定了观测维度、动作边界、仿真时间步 \(\Delta t\)、从命令发出到物理执行之间的传输延迟、执行器力矩与电流限制、传感器噪声分布、重置分布以及终止条件。 如果仿真器规定观测循环以 \(100\text{ Hz}\) 的速率运行,并假设零延迟传感器通道与方差为 \(\sigma^2 = 1.0 \times 10^{-4}\text{ (rad/s)}^2\) 的高斯噪声,那么策略将学到针对这些精确信号统计量调优的反馈增益,而物理机上未建模的 \(15\text{ ms}\) 总线传输延迟会使这些增益失效。 Dactyl 的双胞胎(图 3)无法与真实手部完全匹配,因此其仿真器先针对真实手部进行标定,再围绕标定值进行随机化,而策略将未匹配的部分作为它已经训练过的变异来应对 (Andrychowicz 等 2020年)。
随着仿真在训练中的作用日益增强,接口契约的重要性也愈发凸显。图 4 展示了若干并行加速器所能达到的 rollout 吞吐量;对于需要大量试次的策略,仿真可能成为训练经验的主要来源。
War Story 1.1: 仿真到现实硬件损坏(2018)
上下文:OpenAI 在随机化的 MuJoCo 仿真中完全训练了一个强化学习策略,以在 24-DoF Shadow Dexterous Hand 中重新定向一个方块,其关节由底座中的电机通过肌腱驱动 (Andrychowicz 等 2020年)。
机制:仿真中的手直接在关节处施加扭矩,而物理手为肌腱驱动,且存在较大的回程间隙。 作者对每个动作都使用指数移动平均进行平滑,在仿真中和在机器人上均如此,以避免动作信号出现可能损害物理手的突变。
影响:作者在物理实验中报告了机器人损坏,最常见的是腕部垂直关节,很可能因为它承受了最大的载荷。 每次修复都耗费时间,并且经常改变系统的一些方面,因此物理结果是在不同时间采集的,作者将硬件损坏计为该工作的关键挑战之一。
响应:团队还用腕部俯仰关节锁定的方式训练了第二个策略,该策略向物理手的迁移效果更好。
系统层面的教训:既不会磨损也不会损坏的仿真器,无法将硬件暴露计入奖励。 保护手部的那些限制——一个动作过滤器和一个锁定的关节——是在学习得到的策略之外施加的,而每次修复都改变了正在评估该策略的装置。
当仿真器使用不准确的转子转动惯量时,若分配 \(J = 2.0 \times 10^{-3}\text{ kg}\cdot\text{m}^2\) 而非真实的 \(2.5 \times 10^{-3}\text{ kg}\cdot\text{m}^2\),运动方程仍然会计算出一个与加速度相关的惯性力矩。 参数误差会改变响应的幅值,但因果结构依然完整。 当仿真器完全省略某个物理机制,例如传动系统的齿隙、结构柔性或通道间的通信抖动时,它并非仅仅将相应参数设为零。 它根本不提供任何因果机制。 被省略的延迟或柔性代表了一个未被建模的物理自由度。6 省略关节柔性的仿真器允许瞬时力矩反向,而真实的传动系统会将其转化为齿轮齿面的载荷与结构共振的激发。
最具影响力的遗漏,源于仿真器如何处理接触。 刚体接触是非光滑的。 法向力在物体分离时为零,一旦接触便取任意压缩值以防止相互穿插,而碰撞时速度发生跳变。 摩擦遵循库仑锥,而受库仑摩擦的刚体可能不存在唯一的正向解(Painlevé 悖论)。 物理引擎有两条数值路径之一(Rigid Body Contact Mechanics)。 互补性求解器 以随接触数量增加而急剧增长的计算成本维持严格的非穿透,并且在几何体发生夹挤时可能卡死。 惩罚项与凸松弛以虚拟弹簧-阻尼器替换硬约束,它在高帧率下收敛很快,但会让刚体发生轻微相互穿插。 闩锁仿真器走的是第二条路径,而它的“柔软”正是 latch-sim-02 学会利用之处。
从仿真到现实的接触技巧
强化学习针对求解器呈现的物理进行优化,而非被控对象的物理。 在实现了软接触松弛或惩罚弹簧的仿真器中,优化器发现,通过 \(1.0\text{--}3.0\text{ mm}\)(接触面之间的负号间隙 \(\phi(q) < 0\))“陷入”表面,可以获得两项非物理的便利条件:
- 人工弹簧-阻尼器反作用力充当瞬时能量汇,在单个积分步内制止向下的动量,且不发生反弹或塑性变形。
- 穿插增加了求解器中的有效接触面面积,产生非物理的侧向牵引力,从而在剧烈机动动作期间阻止打滑。
机械臂以工具中心点处机器人侧等效质量 12 kg 将锁扣驱动至其击打板。 假设仿真器的惩罚性接触允许夹爪以快速接近速度 0.10 m/s 陷入板中,其下沉量为示意值 2.4 mm。 将接近动能与最大压缩量处的弹簧能量相等,得到峰值力 \(F_{\text{peak}} = v\sqrt{k\,m_{\text{eff}}}\);对于该仿真的弹簧,该力简化为 \(m_{\text{eff}}v^2/\delta_{\text{pen}}\),即 50 N,低于锁扣的 100 N 限值。 强化学习优化器记录零损伤惩罚、高任务速度以及最大奖励,并学会不减速地直接扎入板中。
当策略转移到机器后,真实的击打板并不提供这种柔性, 其接触刚度为示意值 4.0 × 10⁵ N/m,同样的扎入峰值为 219.1 N,即 4.4× 的仿真力与 2.2× 的锁扣限值。 许可路径能否阻止该峰值,取决于时间。 接触力遵循 \(F = k\,\Delta x\)(执行器传动限制),并且由于板体以接近速度发生压缩,\(\Delta x = vt\) 与力自接触瞬间起随 \(F = kvt\) 上升。 在快速接近时,闩锁限值在接触后 2.5 ms 到达,仅比接触回路响应所需的 2 ms 稍多;而在受保护的接近 0.03 m/s 中,它在 8.3 ms 之后到达。 因此,响应若以 0.5 ms 为余量开始,便无法在力越过限值前使机械臂减速,扎入运动将继续,使接触力朝该峰值上升。 因此,预防必须发生在接触之前。 独立强制的接近速度包络,例如 \(v_{\text{max}}(z) \le \sqrt{2 a_{\text{brake}} z}\) 其中 \(z\) 为距板面的剩余距离,\(a_{\text{brake}}\) 为经验证的减速度,可限制接触时的速度;力触发线仅在其感知、制动响应和剩余压缩均已得到验证时,才能限制后续加载。 接触截止时间,而非训练奖励,才是将闩锁策略声明的 ODD 限制在受保护接近动作(节 1.8)的原因。
因此,接触仿真保真度按可观测的机械量进行预算,即接触起始时刻、峰值法向力、传递冲量、滑移距离和释放延迟,而非求解器内部机制。 不匹配也可能取相反符号。 在一个积分步内解决碰撞的惩罚引擎,将动量传递集中为尖锐的尖峰,而硬件上的垫层变形与结构柔性则将其分散到许多毫秒。 积分冲量随后可以高度一致,而峰值力相差数倍;策略从模拟尖峰中学习检测接触起始时刻,却从未在机器上看到该尖峰,因此它会持续施力,直到驱动器达到其电流限值。
Systems Perspective 1.1: 接触保真度不变量
永远不要信任一个模拟接触策略,其成功依赖于瞬时动量吸收或零延迟摩擦接合;依赖穿透数字表面的策略,会以仿真器从未显示的力加载物理工件。
哪些遗漏是重要的,取决于任务。 只在高连续速度下运动的策略可能容忍粗糙的摩擦模型,因为它从不滞留在静摩擦阈值附近;而调节力并保持静态接触的策略,若仿真器遗漏了静摩擦、粘滑过渡和执行器死区,则会进入不受控的极限环振荡。
⇄ 对照: 2.4 mm 的惩罚弹簧穿透量是求解器凭空造出的柔度,而真实传动链的反向间隙与扭转柔度(见 执行器传动限制 分析)则是刚体求解器所遗漏的柔度。
确立仿真器某个组件的有效性需要成对探测。 工程师对仿真器与物理硬件施加完全相同的开环指令序列,测量由此产生的状态轨迹之间的差异,并与显式的误差预算进行比较。 对于闩锁,这意味着将同一动作指令输入模拟板与真实板,并比较上述接触量,从而使差异以毫秒和牛顿为单位纳入预算。 当实测差异超出运行包络的容差时,该模拟器对该训练任务而言是缺陷的。
由于模拟器的结构假设在优化过程中被冻结进神经网络的权重,模拟器规范因而构成策略配置与身份中不可变的一个要素。 每个训练后的策略产物都必须记录其完整的模拟器来源,即策略清单中的 simulation_provenance 字段(节 1.8)。 在没有该来源的情况下部署策略,就如同在未记录其编译所针对的目标架构的情况下发布固件。 审计这一来源所需的,不只是聚合通过率;它要求将现实差距分解为动力学、感知、外观和时间四个通道,而 节 1.5 则逐个通道地对其进行量化。
这个差距由什么构成
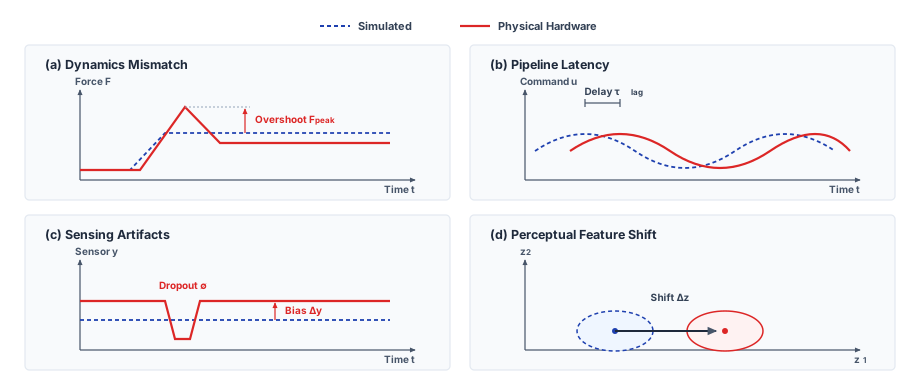
闩锁模拟器与真实笼门在两个彼此无关的方面存在差异:惩罚弹簧远比击打板柔软,且指令路径不存在传输延迟;因此,仅用一个距离来概括模拟轨迹与真实轨迹之间的差异,只会得到一个既无法指称其中任何一方的数值。 不同物理通道中的误差带有不同的量纲,在闭环中沿不同的路径传播,并导致不同的失效,因此该失配是一个跨越动力学、感知、外观与时间的耦合分量向量。 量化该失配向量的大小,就是对照任务容差核算物理误差,其数据来自在相同激励下记录的成对指令—响应轨迹;每个通道都需要各自的拦截器。表 2 列出动力学通道的拦截器,并将其拆分为执行器行与接触行,并列出感知与时间通道;外观失配则在下方正文及 图 5 的 (d) 面板中予以量化。
动力学失配衡量的是指令执行器出力与实际物理运动或接触力之间的差异,覆盖整个工作包络。 模拟一个零背隙、瞬时接触刚度的刚性连杆仿真器,预测出的力上升比传动系统更快——后者的齿轮箱柔顺性与驱动延迟引入了相位滞后;而将接触起始时刻对齐到模拟上升的政策,仍会持续向机器施力,这正是 节 1.4 中所述的反向接触失配。
感知失配衡量的是真实物理状态与提供给策略网络的观测向量之间的差异。 模拟的测距传感器是干净的、均匀量化的;物理测距传感器则带有校准偏差、噪声、热漂移,并在镜面反射期间出现丢包突发。 偏差会移动控制器从接近切换到力调节的时点,而丢包突发会使策略在下行过程中对表面视而不见。
外观失配并非基于原始相机像素计算出的均方误差。 写实渲染与物理相机帧之间的图像差异,主要由高频背景纹理和可能不影响策略动作的细微传感器噪声模式所主导。 外观失配通过测量策略相关感知输出的偏差来度量,例如估计的表面法线、物体关键点或空间特征激活,均在匹配的几何、光照、材质和相机曝光设置下测量。
时序失配决定观测采集、策略评估与执行之间的时间对齐。 发生在不同物理时刻的相同状态转移并不会产生等效的闭环动力学。 在每个离散步骤开始时瞬时执行观测、推理与执行的仿真器,省略了相机曝光、总线串行化、推理尾延迟和电机总线传输,并且省略了它们逐周期之间的抖动。 被省略的每毫秒延迟,都是机构在采取纠正动作之前未被观测到的行进距离,并且它会侵蚀闭环的阻尼与相位裕度。
图 5 显示,在一根示意性直线驱动器上,四个通道全部发散,该驱动器独立于移动机械臂,以 0.20 m/s 接近刚性表面,并将接触力调节至 10 N。 一个未建模的 \(8\text{ ms}\) 驱动器延迟和更软的表面,使力上升速率从 500 N/s 降至 250 N/s,因此目标力在 40 ms 才到达,而非 20 ms,驱动器过冲 \(3.0\text{ mm}\) 直至触发限流停机。 一个 \(+3.2\text{ mm}\) 测距偏差使力调节提前开始,而四帧镜面高光丢失则使下降过程致盲。 5.5 %的原始像素差异掩盖了接触区域估计中的 \(6.0\text{ mm}\) 偏移,该偏移大于 \(2.0\text{ mm}\) 的 倒角容差;而最迟在 49.5 ms 到达的 \(P_{99}\) 执行,使驱动器 5.9 mm 超出了仿真器 20 ms 锁步同步所涵盖的范围,直到修正开始。 这些发散中的任何一项,在标量损失中都不会被反映出来。
| 现实差距维度 | 未建模的物理机制 | 名义仿真规范与 真实硬件 | 隐式策略利用 / 行为失效 | 配对轨迹诊断指标与容差 | 硬件与权限路径拦截器 |
|---|---|---|---|---|---|
| 执行器与传动系统动力学 | 谐波减速器柔顺性、库仑静摩擦、速度相关的斯特里贝克摩擦,以及反电动势电压饱和 | 理想化直接扭矩源(\(J_{\text{rotor}}=0\)、\(\tau_{\text{latency}}=0\text{ ms}\))与物理谐波减速器(\(k_c=6.7\times 10^2\text{ N}\cdot\text{m/rad}\),背隙 \(\theta_b=0.08^\circ\),总线延迟 \(\tau=8\text{ ms}\)) | 策略发出高频 bang-bang 扭矩反转(\(>50\text{ Hz}\)),引发机械颤振、齿轮疲劳,并将绕组驱动超过其降额阈值 | 阶跃扭矩响应差异:相位滞后 \(\Delta \phi \le 5^\circ\) 在 \(10\text{ Hz}\) 处; 调节时间差异 \(\Delta t_{\text{settle}} \le 15\text{ ms}\);超调 \(\le 5\%\) | 低通动作滤波(\(f_{\text{cutoff}} \le 20\text{ Hz}\))、电机电流均方根热估计器,以及执行器扭矩变化速率限制器(\(d\tau/dt \le \tau_{\text{max}}/\Delta t\)) |
| 接触力学与柔顺性 | 粘弹性表面变形、接触迟滞、非平滑的粘滑过渡以及持续时间有限的恢复阶段 | 点质量刚体接触(LCP/罚弹簧(\(k_p=10^6\text{ N/m}\)),恢复(\(\Delta t_{\text{res}}=2\text{ ms}\)))对比物理接触垫(\(k=8.0\times 10^4\text{ N/m}\))(变形区间(\(\Delta t_{\text{def}}=18\text{ ms}\))) | 策略将接触起始时刻关联到尖锐的模拟力尖峰,在较慢的真实上升沿上看不到该尖峰,因而持续施力直至驱动达到其电流上限 | 接触冲量误差(\(\Delta I \le 0.05\text{ N}\cdot\text{s}\));峰值接触力差异(\(\Delta F_{\text{peak}} \le 15\text{ N}\));接触起始上升时间误差(\(\Delta t_{\text{rise}} \le 5\text{ ms}\)) | 接近速度包络调节器 (\(v_{\text{safe}}(z) \propto \sqrt{2 a_{\text{brake}} z}\))、力导数钳制 (\(dF/dt \le 1.0\times 10^4\text{ N/s}\))、柔性机械挠性件 |
| 传感器转导与噪声特性 | 光学镜面反射丢失、CMOS 卷帘快门失真、随环境照度变化的噪声,以及力与力矩传感器热漂移 | 合成 RGB-D(零偏 Gaussian 噪声(\(\sigma = 0.5\text{ mm}\),零测量丢失))对比物理结构光深度(\(+3.2\text{ mm}\) 偏差,连续 4 帧的突发测量丢失,漂移 \(0.4\text{ N}/10\,^\circ\text{C}\)) | 策略在高于表面时过早减速,或在连续多帧丢失期间保持盲视,导致末端执行器越过刚性夹具边界进入堵转过流 | 传感器分布的 Kolmogorov-Smirnov 距离 \(D_{\text{KS}} \le 0.05\);空间特征激活质心误差 \(\le 2.0\text{ mm}\);零持续丢失帧数 \(N_{\text{drop}} = 0\) | 多传感器融合(IMU/编码器 + 视觉)、光学信号丢失保持滤波器、热漂移自校准、独立接近式光闸 |
| 时间延迟与总线异步 | 可变相机曝光时间、PCIe/EtherCAT 总线串行化、神经推理尾延迟(\(P_{99}\)),以及非确定性的操作系统调度 | 同步离散时间锁步(\(\Delta t = 20.0\text{ ms}\),零传输延迟)与异步物理流水线(\(\tau_{\text{total}} = 35.0\text{ ms}\) 在 \(P_{50}\),\(49.5\text{ ms}\) 在 \(P_{99}\),抖动 \(\pm 6.2\text{ ms}\)) | 严重的相位裕量劣化(\(>30^\circ\) 损失);策略出现欠阻尼振荡、反复搜寻、往复调整的极限环振荡,以及在延迟尖峰期间发生未被观测到的移动(\(P_{99}\) 下为 \(5.9\text{ mm}\),超出模拟锁步) | 端到端指令-响应延迟抖动 \(\Delta \tau_{\text{jitter}} \le 2.0\text{ ms}\);最坏情况观测年龄 \(\tau_{\text{obs}} \le 25\text{ ms}\);在 \(50\text{ Hz}\) 处零期限超期 | 实时 PREEMPT_RT / Xenomai 调度、仿真中的动作缓冲延迟队列注入、运动学外推(Smith 预测器) |
域随机化常被当作消除 sim-to-real 差距的方法,但参数随机化受到严格的结构限制7。在 \(\mu = 0.2\) 到 \(\mu = 0.8\) 的均匀分布上采样摩擦系数,或在 \(\pm 20\) 百分比的连杆质量范围内随机化,可扩展训练对仿真器已能表示的机制的覆盖范围。 它无法合成被遗漏的物理机制、缺失的状态相关性,或未建模的罕见事件。 如果仿真器的微分方程遗漏了齿轮箱背隙、电机绕组的热阻,或操作系统中的线程抢占,那么关于连杆质量的任何分布都无法迫使策略去学习对这些动力学的补偿。 向模拟观测中加入非结构化高斯噪声以掩盖未建模效应,可能损害性能,训练策略降低其控制增益并收窄其操作带宽,以避免激发未建模模态的动作。
在仿真器所建模的机制内,随机化具有有用的宽度,即域随机化走廊。 分布过窄会使策略对实际设备所呈现的扰动过于脆弱,从而可能引发机械冲击或热保护跳闸;分布过宽则会使策略趋向保守的低增益控制,牺牲吞吐量。 将随机化限制在该走廊内,而不是通过试错调参,需要按固定顺序开展工作。 在物理实验台上进行系统辨识,首先测量标称质量、扭矩常数、延迟与摩擦。 随后,随机化边界建立在这些驱动上述参数的机制上,例如扭矩常数对应绕组温度、摩擦对应表面状态,而非经验性的区间。 训练从标称值附近的窄带开始,仅在策略达到其声明的成功阈值时才逐步放宽该带,这一调度称为自适应域随机化。 最后,成对轨迹会逐条审计每个通道是否落在其容差范围内;一旦偏差超出预算,仿真器在部署任何基于它的策略之前会被退回修订。
随机化无法触及的部分,必须由授权路径加以约束。 每个提案在到达执行器之前都要先通过授权路径(《五层机器》),在那里,力率钳制、力矩变化速率限幅和速度限速器将其限制在已验证的感知与制动假设所覆盖的范围内。
↳ 下游: 最小干预 给出了用于约束未经验证的策略提案的亚毫秒控制屏障函数滤波器的数学表述。
将缺口分解为其构成的物理通道,可得到两项具体的工程产物,即一个受支持区域和一份显式的残余失配清单。 受支持区域是物理硬件与仿真在已验证容差范围内相互吻合的那些条件构成的集合。 残差失配清单逐项列出训练分布之外仍然存在的每一个未闭合差异。 对于闩锁仿真器,成对探针尚未闭合击板接触刚度——该刚度由比板软得多的惩罚弹簧设定——以及执行器传输延迟,因此二者均进入其残差清单,而受支持区域则排除由这两项偏离所支配的接触状态。 残差清单中的每一条都定义了对运行时监控器和安全过滤器的明确要求,二者必须检测物理执行何时漂出模拟策略仍然有效的边界。 这两份产物都汇入策略清单 节 1.8:残差清单进入其遗漏日志,而受支持区域之外的每个状态都以排除项形式录入其中。
即便在仔细的域随机化和接触标定下,高精度、接触密集区域中仍会残留差异,闩锁仿真器的残差清单也尚未清空。 在某些局部失配中,在已部署的实体上吸收比建模更便宜,代价是磨损和证据损失。
在真实机器上的微调
真实笼门上的击板相对于仿真器中设定的击板位置存在较小的结构安装偏移,而仿真器并未对此建模。 这种局部的、可测量的失配,正是可以在物理硬件上进行微调所能够吸收的部分。 由物理轨迹采样计算出的梯度更新会将策略适配到机器的真实柔顺性、接触动力学与总线延迟,但它们并不测量这些机制;因此,仿真器的另外两处失配——柔顺接触弹簧与缺失的传输延迟——会一直留在遗漏清单中,直到成对探针将它们关闭。 这种自适应同样需要付出物理代价。 在仿真器中,采样接近稳定性边界的状态只需消耗计算周期,而在硬件上,每一次采样都会消耗部件寿命,并有可能将机器驱动至不可恢复的接触状态。
在物理硬件上更新策略参数的成本会累积,因为那些用于求解局部接触误差的梯度步,同时也消耗有限的机械疲劳寿命、使电机绕组发热,并存在灾难性遗忘已验证的标称通过稳定性的风险。
考虑移动操作机器人的机械臂将 latch-sim-02 调整为 latch-res-03,这是一个残差候选,它在冻结的 latch-sim-02 输出上叠加了门控学习到的校正,因为真实板件相对于仿真器中的放置位置偏移了 1.5 mm。 夹爪将弹簧驱动的卡扣引导越过其锁扣板,此处不光滑的库仑摩擦、凸轮面几何形状和弹簧预紧力共同产生尖锐的粘滑过渡。 策略的设定值每 20 ms 到达一次(50 Hz)。 为使其参数适应锁扣板的接触动力学,机器人上的微调流程采集了示例性的 20,000 交互步,相当于 400 s 的主动接触与近接触操作。 由于策略必须通过探索来改进,随机动作扰动会在低层安全控制器介入之前产生不可预测的力瞬变。 如果探索步中有 1.5 percent越过 15 N 接触触发线,并在许可路径钳制指令之前击中击打板的刚性肩部,则微调运行会向传动系注入 300 次冲击。
上述每次冲击都会在齿轮齿与轴承中耗散机械臂的动能;若要估算这些冲击所消耗的服役寿命比例,就需要采用针对该驱动器的专用载荷谱与寿命模型(执行器传动限制)。 热是第二项约束。 探索抖动会提高电机线圈的均方根电流,由此产生的焦耳热可能在几分钟内就将绕组推至降额阈值(热工作占空比),除非训练计划为冷却间隔预留了时间。
除机械磨损之外,现实世界的自适应还会破坏部署前测试中建立的统计验证。 在仿真中,策略可经受 \(1.0\times 10^7\) 个验证回合,覆盖随机扰动,从而建立有界的跟踪误差与尾部行为,直至 99.9 百分位(\(P_{99.9}\))。 一旦将权重更新 \(\Delta\theta\) 应用到硬件上,所有以原始参数向量 \(\theta_0\) 为条件得出的统计结论即告失效。 更新后的策略或许可以消除对目标夹具的稳态力误差,但梯度更新步骤可能同时损害自由空间的跟踪精度、在高速转移期间降低相角裕度(从而减少稳定性储备),或在紧急制动过程中扭曲响应特性。 由于硬件吞吐量受物理时间约束,机器无法执行数百万次物理试验来重新建立这些置信区间。 适配后的策略以比其所替代的仿真基线更窄的经验证据集进入生产环境。
因此,在部署机器上进行微调,将策略从经过资格验证的冻结组件转变为一个持续演化的状态。 资格验证取决于配置控制:精确的参数哈希对应一份已记录的安全论证,因此每一次在线权重更新都会重新开启该记录。 防止失败的责任转移到许可路径的确定性监控器上,这些监控器必须拦截基线策略的误差,以及优化器在依据物理反馈进行更新过程中产生的中间行为。
残差策略架构与受限授权
残差策略可在不改变冻结基策略权重的情况下实现局部化适配。 所提出的控制输入为 \[u_{\text{prop}}(s) = \pi_{\text{base}}(s) + g(s)\,\Delta\pi_\theta(s),\] 其中 \(\pi_{\text{base}}\) 是合格的标称控制器,\(\Delta\pi_\theta\) 是学到的接触修正,而独立校验的门限 \(g(s)\in\{0,1\}\) 仅在已验证的接触区域内才为 1。 门限在自由空间中及该区域之外将残差精确设为零;而缺失的奖励梯度不会做到这一点。 授权路径在动作之前检查测量到的状态与所提出的组合输入。
一个幅值上限 \(\|g(s)\Delta\pi_\theta(s)\|\le\Delta_{\max}\) 限制了控制权限的一个方面。 同一许可路径必须强制执行修正变化率限制与状态限制、确保执行器可行性,并在感知信息或提议过期时执行回退策略。 允许的残差集必须适配于所声称运行域内针对组合控制器的已验证鲁棒性裕度;将任意扭矩幅值与被动性或相位裕度相比较是不足的。 对于闩锁夹具,我们会只在实测的接触阶段允许修正,并采用零输出自由空间门限以及有界的扭矩变化率。 每次权重更新后,接触与自由空间的回归测试必须重新检查跟踪、停止、热负荷与冲击暴露,新检查点才能获得控制权限。 若上述条件不成立,截断后的残差仍可能激发振荡或使驱动器饱和。
有界残差权限可以限制一项拟议的修正,但本身既不能防止硬件损坏,也不能消除早期训练选择所遗留的潜在失效模式。 策略合成的每个阶段,从演示数据摄取、经仿真接触求解器直至残差更新,都会在其控制器的闭环行为中留下各自的失效特征,而每个特征都可以追溯到产生它的训练假设。
训练选择如何出错
学习策略中的物理失效很少是任意的。 驱动夹爪撞上锁扣板的指令,是在特定数据集、损失函数与仿真器上的优化结果,而该优化的假设会留下结构性的痕迹,可以在机器运行之前被追溯。 该策略漏洞推断链 以五个环节明确呈现这一轨迹(\(\text{Exposure} \to \text{Dependency} \to \text{Violated Assumption} \to \text{Observable Signature} \to \text{Permission-Path Interceptor}\),即“暴露 → 依赖 → 被违反的假设 → 可观测特征 → 许可路径拦截器”)。 训练暴露建立了一种学习依赖;部署条件违反该依赖,违反在指令或装置中产生特征,而该特征指出了权限路径所要求的拦截器。 三个闩锁检查点各自运行一次该链。
对于 latch-bc-01,暴露是 物理数据 的遥操作开门动作,依赖是这些演示的支持,而该支持仅覆盖受保护接近路径上的标称锁扣板,未覆盖失败尝试所达到的任何非标称状态,因为策略的模仿目标是被保留的成功开门(绊线失败保留在档案中作为标注失败,而非目标),且该轮次从未移动锁扣板。 门体下垂违反该条件。 特征是复合协变量偏移 。 每次修正每 20 ms 发出一次,都离演示状态更远,但每条指令在运动学上仍然合理,因此该提议在夹爪于锁扣板边缘卡住之前看起来都正常。 策略无法察觉自身的越界,因此拦截器必须是许可路径输入处的支持监控器,它把实测状态与受支持的单元格比对,并拒绝这些单元格之外的策略权限。 没有该监控器,故障首先在接触时显现。 预部署测试由这一依赖关系推出。 在刻意偏移的锁扣板上进行台架试验,可判断监控器是否在夹爪卡住之前触发;这种板件偏移所形成的状态族已在闩锁试验活动的占用数据关联结果中列为已知缺失(采集策略覆盖度)。
对于 latch-sim-02,暴露的环节是模拟开门动作,配上一个无指令延迟的罚函数接触弹簧;依赖关系是快速下插不付出代价,因为软弹簧在 50 N 的模拟峰值处吸收了接近过程。 真实板件违反了这一前提。 以 0.10 m/s 的速度接近时,刚性板几乎立即把力驱动过 15 N 接触触发线,并推进到接触截止期限(推导见 节 1.4)内的锁扣极限,即朝向 219.1 N 峰值。 该特征是一次过力瞬态,而任务奖励从未记录到它。 触发线能检测到它,但触发时机落在机械臂无法利用的时间窗内,因此拦截器采用接触前接近速度包络,并且这一依赖关系在部署前通过成对接触试验而非机器触发来揭示。
对于 latch-res-03,暴露量是取自单一实验台上的窄幅接触步骤切片,而依赖则是这些近期转移的过度代表。 切片遗漏的任何状态都违反该约束,例如门前的自由空间转移,或偏离实验台轴线的接近动作。 该特征表现为回归 、调参接触状态邻近状态下的稳定性丧失;由于网络处处输出有效结果,其指令中没有任何内容会宣告这一损失。 拦截措施一部分在流程层面实施,另一部分在运行时实施。 冻结接触与自由空间回归套件必须在新的权重获得授权之前通过,而残差门限在测得的接触阶段之外将修正量保持为零。 实验台上的探索会留下任务奖励未记录的第二类特征,即 节 1.6 的机械冲击与电机绕组发热,因此授权路径也必须监控奖励所遗漏的可观测值,例如绕组温度、电流谱与加速度计能量。
从 latch-bc-01 到 latch-res-03 的谱系并未消除这些失效,而是改变了占主导地位的失效。 在仿真中细化克隆策略以漂移换取求解器利用,而将结果在实验台上调优则会在接触时抑制该利用,同时冒着遗忘上游策略的风险。 较早的机制仍以潜在形式保留在权重中,只要条件离开末级所调优的包络,它们便会重新显现。
因此,每条链路都留下三项义务。 每一条依赖关系都需要一次部署前测试,以压力测试训练与真实装置之间偏离的那一边界。 每一个出现在可测机械量中的特征,都必须在许可路径上以环周期率部署运行时检测器,无论其表现为跟踪偏差、力率还是电流谱。 当策略无法察觉自身的失效,例如在 latch-bc-01 脱离其已演示的状态时,权限路径需要配备支持监控器,清单必须将其声明的 ODD 排除监控器无法覆盖的状态,并且确定性联锁必须拒绝该处的策略权限。 满足这些义务,需要一份关于检查点如何构建的精确记录,从源数据与仿真器动力学一直延伸到奖励项以及此后发生的每一次修改。 该记录就是策略清单。
策略清单
一个训练得到的策略会在其训练机制、源演示或仿真器偏离物理现实之处失效,而三条闩锁链刚刚在每个检查点上定位出一条接缝。 训练得到的检查点带入评估的记录必须涵盖这三者。
策略清单记录了某个检查点是如何产生的:其训练阶段、从谱系记录继承的数据支撑、它们的模拟器版本,以及省略日志所记录的机制遗漏,以及配对探针尚未闭合的不一致,还包括适应过程中产生的磨损,以及它所声明的运行域 (表 3)。
清单将优化结果与策略可能被要求运行的条件分开。 声明的 ODD是策略清单所声称的来自 采集策略覆盖度 的 ODD 部分:数据连接所支撑的单元,减去省略日志排除的每一个状态。 高训练奖励或低离线损失并不能表明该策略在其之外是安全的,因此声明的 ODD 由连接与日志计算得出,绝不来自训练曲线;收敛的指标也不能替代在尚无人刻画的工况下运行所需的放行许可。
| 记录模式字段 | 物理/计算数据模态 | 溯源与不可变性保证 | 下游验证器与使用方式 |
|---|---|---|---|
regime_sequence |
优化阶段数组 \(\text{BC} \to \text{SimRL} \to \text{Residual}\)、损失公式、奖励权重与停止准则哈希 | Git 提交 SHA、PyTorch/JAX 检查点 UUID、参数哈希 \(H(\theta_k)\) | 追踪是哪个阶段引入了潜在失效模式或高增益抖动 |
data_support_ledger |
所消耗溯源记录的摘要,以及它们所依据的情景账本摘要;其占用连接(join)的 supported_cells 与 known_absences |
按摘要逐条引用每个溯源记录;不复制任何数据集字段 | 对声明的 ODD 给出上界;参数化分布外支撑度监控器 |
negative_event_registry |
引用训练与自适应执行轨迹中的每条干预记录 干预与恢复数据 | 按摘要逐条引用每条干预记录;不复制其触发前的轨迹 | 隔离物理失效边界,并防止被污染的漂移执行轨迹进入训练 |
simulation_provenance |
物理引擎构建、积分器方法、步长 \(\Delta t\)、接触求解器罚参数,以及域随机化范围 \(\mathcal{P}(\Xi)\) | 物理引擎二进制哈希、URDF/MJCF 资产树哈希 | 复现训练物理并审计成对轨迹预算 |
omission_log |
各仿真器省略的机制(齿隙、柔顺性、传输滞后)以及成对探针未能闭合的残余失配,以及各自影响的状态 | 绑定到其所描述的仿真器构建;仅凭成对轨迹证据才视为闭合 | 将其所影响的状态从声明的 ODD 中移除;并带入评估的覆盖缺口与故障清单 |
adaptation_wear_ledger |
硬件个体序列编号、接触冲击计数、电机电流均方根热日志、被修改层的索引,以及回归套件哈希 | 校准证书哈希、硬件寿命疲劳日志 | 重新开启正式资格认定案件,并防止标称能力发生静默退化 |
declared_odd_boundary |
声明的 ODD:受支持的单元减去省略日志排除的状态(针对闩锁策略,即受保护接近速度下的标称撞击板) | 不超出 data_support_ledger 中受支持单元组成的集合 |
限定评估可采样的目标 ODD,以及许可路径允许策略提案的区域 |
对于移动操作机的笼门锁扣,一份紧凑清单将这些字段汇聚为一个决策:
regime_sequence: 演示检查点latch-bc-01→ 模拟接触细化latch-sim-02→ 门控残差候选latch-res-03;保留每个检查点的哈希、损失或奖励规范,以及停止规则。data_support_ledger: 按摘要引用锁扣战役的溯源记录及其场景台账;二者的连接支持受保护接近下的标称击打板,并列出被移位的板与更快的接近,其单元格不含演示,作为无恢复标签的已知缺失。simulation_provenance: 记录实际的求解器构建与接触参数。omission_log: 示例仿真器以远软于板的惩罚弹簧建模击打板接触,并省略执行器传输延迟,因此这两个偏离所主导的接触状态,对于在仿真中训练的检查点而言未经验证。negative_event_registry: 按摘要引用干预记录及其触发前环形缓冲区轨迹,将每个夹具肩部击打、操作员否决或权限路径钳制作为带标签的失败证据,而不将不安全指令视为专家目标;并标记被操作员截断的回合,以免更新将中止的指令计为成功。adaptation_wear_ledger: 将latch-res-03与具体的试验装置、累计接触冲击、电机电流历史、修改后的残差权重以及自由空间回归结果关联起来。declared_odd_boundary:受支持的单元减去省略日志排除的状态,此处为 0.03 m/s 受保护接近处的标称板。 由这两处省略所管辖的接触状态,在每一次仿真精化的检查点中都保持在已声明的 ODD 之外,无论是latch-sim-02还是latch-res-03,直到配对的探针将它们闭合。 被位移的板与 0.10 m/s 的接近位于其外,而且即使有演示,快速接近也会留在其外,因为其接触截止时间 (节 1.4) 留给接触环响应的余量几乎为零;在那里,许可路径必须施加受保护的接近或拒绝策略授权。
放行评审会否决 latch-res-03,直到配对的接触探针量化接触刚度误差和被省略的滞后,且组合控制器通过接触、自由空间、制动与磨损预算测试。 同一规则将 latch-bc-01 留作可能采样的唯一检查点评估,前提是它所属链的支持监视器在标称板 (节 1.7) 之外拒绝策略授权。 未经仿真器训练,它不含省略日志的排除项,因此其声明的 ODD 将门的接触状态保持在标称板面与受保护的接近状态。 清单记录该决策及其证据,而不是将训练分数转换为授权。
就数据支撑而言,清单在 数据集模式 的溯源记录中保留采集器、装置实例、标定与动作接口,并按摘要引用每条记录,而非复制其内容。 它同样引用了覆盖率所依据的情景台账的摘要,并沿用二者占用关系连接(采集策略覆盖度)的结果,即受支持的单元与已知的空缺席位。 由于引用方式是按摘要引用,任何数据集的改动都会改变连接结果;而一个命名了已被取代摘要的清单,也就不再描述其检查点。 处于受支持单元之外的状态,例如闩锁的错位板,随后在记录中表现为无依据的外推,而非已验证的能力。
当策略权重在仿真中优化时,清单会记录物理引擎构建哈希、策略与仿真器之间的接口契约、奖励设定、数值积分方法以及求解器步长8,例如固定的 \(2.0\text{ ms}\) 步长与 \(500\text{ Hz}\)。 它记录了施加于连杆质量、表面摩擦系数、执行器响应延迟与传感器噪声分布上的域随机化分布。 已知的物理遗漏大多被排除在仿真图之外,以保持训练吞吐量,并与配对探测尚未消除的任何不一致一并记入遗漏日志(节 1.5)。 在 执行器传动限制 所确立的作动器动力学基础上,若刚体仿真器遗漏了谐波减速器的齿合柔顺性、在 \(5.0\text{ kg}\) 载荷下的结构挠度,或电机绕组的热阻变化,则该记录将这些遗漏列为未经验证的动态假设。 当由此得到的策略在物理台架的高负载接触过程中表现出极限环振荡时,遗漏日志将诊断指向关节柔顺性,而非缺乏依据的参数漂移。 该日志与仿真器描述分开保存,因为每条条目都具有下游后果:将其所影响的态从声明的 ODD 中移除,并转化为评估与故障注入必须处理的覆盖缺口。
下游工程团队在设计、评估和发布全生命周期中消费该清单。 评估记录 评估日志 直接消费它。 其目标 ODD 取自已声明的 ODD 内部,其覆盖缺口目录继承已知缺失与省略日志,因此评估套件会针对每种训练机制所预测的具体失效模式进行探测。 安全执行 的授权路径以已声明的 ODD 作为其采纳策略提案的区域外边界,并借助所记录的支撑度对分布外检测器进行参数化。 验证环节 对抗性验证 与安全性论证 部署发布 均依托该清单,以确立每次参数更新的来源,并确认每项省略均受到独立的物理联锁约束。
↳ 下游: 策略清单的省略日志为 推导故障清单 中的对抗性故障注入实验台提供参数化依据。
Checkpoint 1.1: 策略清单与声明的 ODD
在向物理验证发布训练好的策略检查点之前,先核实你对策略清单、其省略日志以及声明的 ODD 的理解:
清单将一段训练历史转化为一条带有明确限定的主张,而锁存记录则展示了该主张所支持的决策,将 latch-bc-01 送入评估,并在配对探针关闭其遗漏之前,将 latch-res-03 保持在非服务状态。 常见的出错方式都让训练分数替代了该证据。
谬误与陷阱
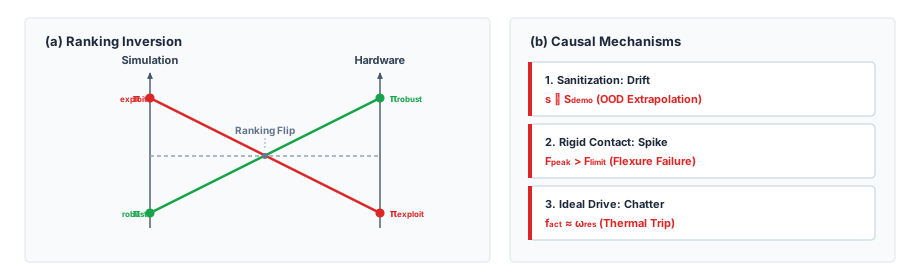
在离线演示划分上最小化损失,或在仿真中最大化回报,衡量的是对训练环境的合规性,而非机器上的能力。 当目标奖励那些利用数据筛选或仿真近似的行为时,训练阶段确立的候选策略排序会在部署时发生反转 图 6,因为虚拟环境会宽恕真实硬件无法承受的动作。 在训练好的策略获得执行器权限之前,必须对其训练指标与物理结果之间的因果假设进行压力测试。
陷阱: 为降低离线验证损失而清洗恢复轨迹。
假设闩锁档案同样包含恢复运行,且两个笼门闩锁策略分别基于其不同版本进行训练。 其中一个保留恢复运行,其中操作员将抓手退开并在闩锁凸轮卡住击打板后重新定位;另一个则移除这些运行,并在其自身留出划分上取得更低的损失。 当凸轮在实际机器上卡住时,第一个策略退开并重新定位,而第二个策略则沿演示路径继续推进,直到许可路径的接触触发线使机械臂停止。 由于清洗后的数据集缺少从错误中恢复的示例,较低的损失仅仅反映了人为简化的测试集,而非更好的物理扰动处理。 对恢复数据的清洗使数学预测任务变得更容易,代价是直接抹除了部署控制器在物理上真正需要的纠正行为。 候选策略必须面对相同的运行扰动,其训练分数才能支持部署选择。
谬误:从人类演示转向仿真强化学习,会移除训练遗留于策略中的失败。
装配团队用仿真强化学习替代行为克隆,以纠正垫片安装过程中的侧向漂移。 新策略消除了漂移,却以 \(65\text{ Hz}\) 的扭矩抖动将机构装上了位,仿真器因其无质量转子假设而放过了它,因为它忽略了电机必须反转的转动惯量。 在物理机器上, 扭矩抖动激发传动系共振,并通过 \(I^2R\) 损耗(热工作占空比)将定子绕组加热至降额阈值,因此驱动器降额,大多数就位操作无法完成。 该训练改动针对一种失效机制,却暴露了另一种,因此评估必须贯穿完整任务直至接触与重复运行,并像对待它所取代的数据限制那样,仔细检验新训练方式引入的假设。
摘要
每一种训练机制都换来一种能力,同时在权重中留下一种依赖。 行为克隆依赖于其演示者恰好访问过的状态,并在使用点解码器时对他们所做的选择取平均;仿真依赖于其接触模型、时序,以及它所省略的机制;在机器上的微调则依赖于近期经验中的一小片,并抹去了为它所替换的权重而收集的证据。 这些依赖中的任何一种都不会出现在训练分数中。 每一种都会在部署违反它时表现为可预测的失效特征,这就是训练最终形成一份记录而非一个指标的原因——一份策略清单,其中声明的 ODD 没有任何训练曲线可以扩大。 原则 Endogenous data 已经要求该记录标注出被克隆策略自身的修正所达到、但无演示覆盖的状态,而仿真则补充了第二种缺失,即求解器所省略的机制,没有任何针对该求解器的优化能够提供。
要点回顾: 策略综合与 sim-to-real 迁移
- 每一种体制都留下一个训练分数无法显示的依赖:离线损失与仿真回报会奖励符合数据与求解器的行为。 候选排名因此在硬件上可能反转,而违反依赖关系的部署条件会产生可预测的失效特征,指明许可路径所需的检测器。
- 克隆在已演示状态之外、已演示模式之间失效: 微小误差会把机器带入演示从未访问过的状态,此时应对漂移采取恢复数据或经核实的支撑监控,而非动作切分。 平方误差损失输出条件均值,可能引导机器从两条有效路径之间穿行,撞入两条路径都避开的障碍物;以模式表示的解码器避开均值,但扩散解码器的步数决定其推理时间,须满足切分所要求的截止时间。
- 随机化覆盖参数,而非缺失机制: 域随机化在仿真器已经建模的动力学上拓宽训练,成对探针按通道量化剩余的缺口。 被遗漏的机械间隙、柔顺性或传输延迟仍保持遗漏,并记入遗漏清单。
- 在硬件上微调会消耗磨损与证据: 基于物理系统上采样轨迹的梯度步吸收局部接触误差,同时消耗部件寿命,并使针对先前权重的所有统计性论断失效。 它们并未补上这一遗漏,冻结的回归套件必须通过,新检查点才获得权威。
- 声明的 ODD 从未超出数据的支持范围: 策略清单按其摘要引用数据,将遗漏日志作为自身字段保留,并仅声明“受支持的单元格减去日志中的排除项”,无论策略在训练中得分多好。
后续内容: 从策略清单到闭环证据
有限次干净试验能对一个检查点确立多少结论,而该清单已限定其可被信任的范围?闭环评估 以策略清单作为输入。 将其刷写到移动操作臂后,
latch-bc-01 即清单允许进入评估的检查点,随后完成二十次连续的开门运行,问题便成为这些运行揭示了关于机器的什么,以及声明的失败率还需要多少次运行。
脚注
ALVINN 道路透视形变:Pomerleau 的神经网络自动驾驶车辆(ALVINN)(Pomerleau 1989年),在 物理数据的来源 的叙述中,因其人类驾驶员从未演示过从中恢复,而漂移到了车道边缘。 为在不进行不安全驾驶的前提下提供恢复示例,Pomerleau 使用了合成透视形变,渲染出横向偏移并旋转的道路图像,并配之以变换后的转向修正,这是以名义轨迹之外的恢复数据对演示进行增广的早期案例。↩︎
L2 损失下的模态平均: 在 \(L_2\) 回归损失下,期望风险 \(\mathcal{R}(\hat{a}) = \int \|\hat{a} - a\|_2^2 p(a \mid o) da\) 关于 \(\hat{a}\) 是严格凸的。 对 \(\hat{a}\) 求导并令梯度为零,可得 \(2 \int (\hat{a} - a) p(a \mid o) da = 0 \implies \hat{a}^* = \int a p(a \mid o) da = \mathbb{E}[a \mid o]\)。 对于非线性被控对象 \(f_{\text{plant}}\),\(\mathbb{E}[f_{\text{plant}}(a)]\) 通常不同于 \(f_{\text{plant}}(\mathbb{E}[a])\);在特定分布下可以相等。 对于凸动作代价 \(c(a)\),Jensen 不等式给出 \(c(\mathbb{E}[a]) \le \mathbb{E}[c(a)]\),但它并未确立平均动作的物理安全性。 在障碍物示例中,均值位于已演示的有效轨迹集合之外。↩︎
CQL 界定的范围:在其数据覆盖、优化和函数近似假设下,CQL 构造了一个保守估计,该估计针对某一策略的期望值构成该策略真实价值的下界。(Kumar 等 2020年) 这并非针对每一对状态-动作或每个数据集的逐点界,期望回报也不构成对物理安全的认证。↩︎
轴承寿命与指令反转次数:ISO 281 估算滚动轴承在给定载荷与转速下的疲劳寿命。 齿轮单元目录可能以额定工况下的工作小时数给出其波发生器轴承的 \(L_{10}\);但在没有针对具体规格的载荷循环模型的情况下,这两个数值都无法将指令反转次数换算为已消耗的减速器。↩︎
绕组温度限值:热工作占空比 给出了该阈值背后的 IEC 60085 F 级评级。 来自未正则化奖励函数的 bang-bang 扭矩指令,可能将电流维持在足够高的水平,从而加速绝缘老化。↩︎
OpenAI Dactyl 域随机化: 在物理手上,Andrychowicz 等 (2020年) 发现,未进行物理随机化、或没有加入仿真器所省略的效应模型(例如齿隙与动作延迟)的策略,所实现的连续旋转次数远少于在全部机制下训练的策略。↩︎
域随机化的有界支撑域 :域随机化针对参数变化 \(\xi \sim \mathcal{P}(\Xi)\) 优化期望回报。 任何泛化结论仅覆盖 \(\mathcal{P}(\Xi)\) 的支撑域,并未涉及运动方程中被略去的动力学。 对于存在未建模传动柔顺性或总线抖动的机构,策略将这些动力学视为无法解释的噪声,并可能陷入高频极限环。↩︎
选择罚接触时间步 :所需步长取决于有效接触质量、罚刚度与阻尼、积分器以及求解器容差。 特征接触时间尺度随约 \(\sqrt{m_{\text{eff}}/k_{\text{eff}}}\) 变化;将时间步细化,直至接触起始、峰值力与冲量收敛到任务所要求的精度。↩︎
Pomerleau, Dean A. 1989年. 《ALVINN: An Autonomous Land Vehicle in a Neural Network》. Advances in Neural Information Processing Systems (NeurIPS) 1: 305~13.
Kumar, Aviral, Aurick Zhou, George Tucker, 和 Sergey Levine. 2020年. 《Conservative Q-Learning for Offline Reinforcement Learning》. Advances in Neural Information Processing Systems (NeurIPS) 33: 1179~91.
Andrychowicz, Marcin, Bowen Baker, Maciek Chociej, Rafał J’ozefowicz, 等. 2020年. 《Learning Dexterous In-Hand Manipulation》. The International Journal of Robotics Research 39 (1): 3~20.