闭环评估
闭环评估
目的
为什么连续二十次无失败的物理试验,却令人意外地少能告诉你这台机器是否安全部署?
演示连续二十次无误差试验,揭示的是特定测试协议期间发生了什么,而非系统在开放世界变异性下的行为。 有界试验次数缺乏统计功效,无法观测罕见的尾部失效;而在标称条件下测试,则对摩擦偏移、传感器退化或意外的人为干扰等行为一无所知。 离线基准分数通过为静态日志打分,进一步放大了这一盲区。 在物理部署中,闭环动作会改变未来状态与后续传感器观测,形成级联漂移:初始的微小误差会把系统推入未建模动力学。
严谨的物理评估必须追踪集成机器上的闭环性能,并量化支撑每一项可靠性主张的经验置信度。 至关重要的是,评估还必须划清统计证据的边界在哪里。 由于灾难性物理失效无法回滚,试验活动必然在安全运行的边界处被截断。 仅靠测试无法证明高后果失败率;实证评估通过严格将主张限定在已采样的运行域内来服务系统,将未经验证的边缘状态留给守护因果边界的确定性运行时监控器。
学习目标
- 将物理成功率解释为关于特定机器、环境与试验协议的有条件证据
- 比较开环预测精度与受策略自身动作塑造的闭环行为
- 选择能够回答某个评估问题的证据体制(回放、仿真、影子运行或受限物理测试)
- 计算支持所声明可靠性目标所需的试验次数与测试时间
- 评估哪些罕见失败仍缺乏可行测试与现有统计假设的支持
- 设计一份在试验前预先声明的试验方案,规定固定的结果判定规则,并对干预措施与中止情形进行全分母核算
- 构建一份评估记录,将其主张限定于目标运行域,并将未覆盖条件交由运行时监控器处理
二十次干净运行能确立什么
刚从离线训练管线中产出的 latch-bc-01 被写入仓库移动操作机;它是 策略清单 的策略清单所声明为可评估的那个唯一检查点。 在初始验证中,该机器完成了其门任务二十次连续运行。 每次运行开始时,移动底座距弹簧闩锁笼门的距离为 2 m(示意性;参见读者指南);底座驶近并停止,在底座静止时,机械臂以 0.03 m/s 的速度执行受防护接近,解除闩锁并打开门,全程未触发接触式触发线,也未发生人工干预。 其实测样本成功率是 \(\hat{p} = 1.00\)(100 %)。 在软件测试中,固定测试套件上的干净通过往往已足以作为发布证据。 在物理人工智能系统工程中,该记录使部署决策无法定论,因为二十次干净运行仅确立了一个有界的统计下界,并对未观测到的失败留下了实质性不确定性。
熟悉的 Wald 区间 (\(p \pm z \sqrt{\hat{p}(1-\hat{p})/n}\)) 无法刻画这种不确定性,因为当失败次数为零时,方差项消失,区间收缩为 \([1.0, 1.0]\),即所谓“可靠性确定”的主张。 精确界通过反转二项分布得到。 这个单侧 Clopper-Pearson 界 (Clopper 和 Pearson 1934年) 在任意样本量下均成立,其近似形式为 Rule of Three (Hanley 和 Lippman-Hand 1983年):当 \(n\) 次独立试验全部通过、零失败时,失败概率 \(p_{\text{fail}}\) 的 95% 上置信界约为 \(3/n\)。 对于二十次门运行 (公式 1), \[p_{\text{fail, upper}}^{95\%} \approx \frac{3}{20} = 0.15. \tag{1}\] 在 1.1 中的精确计算将该结果收紧为 13.9% 的失败上界,机器仍未达到 95% 的演示可靠性。 每 eight 次运行失败一次的策略,仍有 6.9% 的概率连续完成二十次运行。
Clopper, C. J., 和 Egon S. Pearson. 1934年. 《The Use of Confidence or Fiducial Limits Illustrated in the Case of the Binomial》. Biometrika 26 (4): 404~13.
Hanley, James A., 和 Abby Lippman-Hand. 1983年. 《If Nothing Goes Wrong, Is Everything All Right? Interpreting Zero Numerators》. JAMA 249 (13): 1743~45. https://doi.org/10.1001/jama.1983.03330370053031.
Napkin Math 1.1: 20 次运行的下界推导
问题:移动操作臂以 \(n =\) 20 次物理开门运行完成操作,期间零次接触触发线穿越或人类干预(\(k =\) 20)。 在真实运行成功率 \(p\) 上,精确的单侧 95 百分比下置信界是多少?
数学推导:对于来自声明的操作测试分布的独立同分布伯努利试验,\(p_{\text{lower}}\) 是使 20 次连续成功具有概率 \(\alpha=0.05\) 的成功概率。 因此,单侧 95% 下置信限为 \(p_{\text{lower}} = \alpha^{1/n} = (0.05)^{1/20} \approx\) 0.861(86.1 百分比);相应的失效概率上置信限为 13.9 百分比。
系统学洞见:观测“20 次中的 20 次通过”在上述抽样假设下提供的是置信限,而非观测到的失效率、平均失效间隔或部署许可。 反解该界可得达到目标成功概率所需的试验次数,\(n = \lceil \ln\alpha / \ln p_{\text{target}} \rceil\),因此 \(99.9\) 百分比的成功率下限需要 2,995 次连续零失败试验,且这些试验须取自目标分布。
↰ 前置条件: 自主移动机器人与操作器的物理失败边界已在 哪一项预算最先成为约束 中确立。
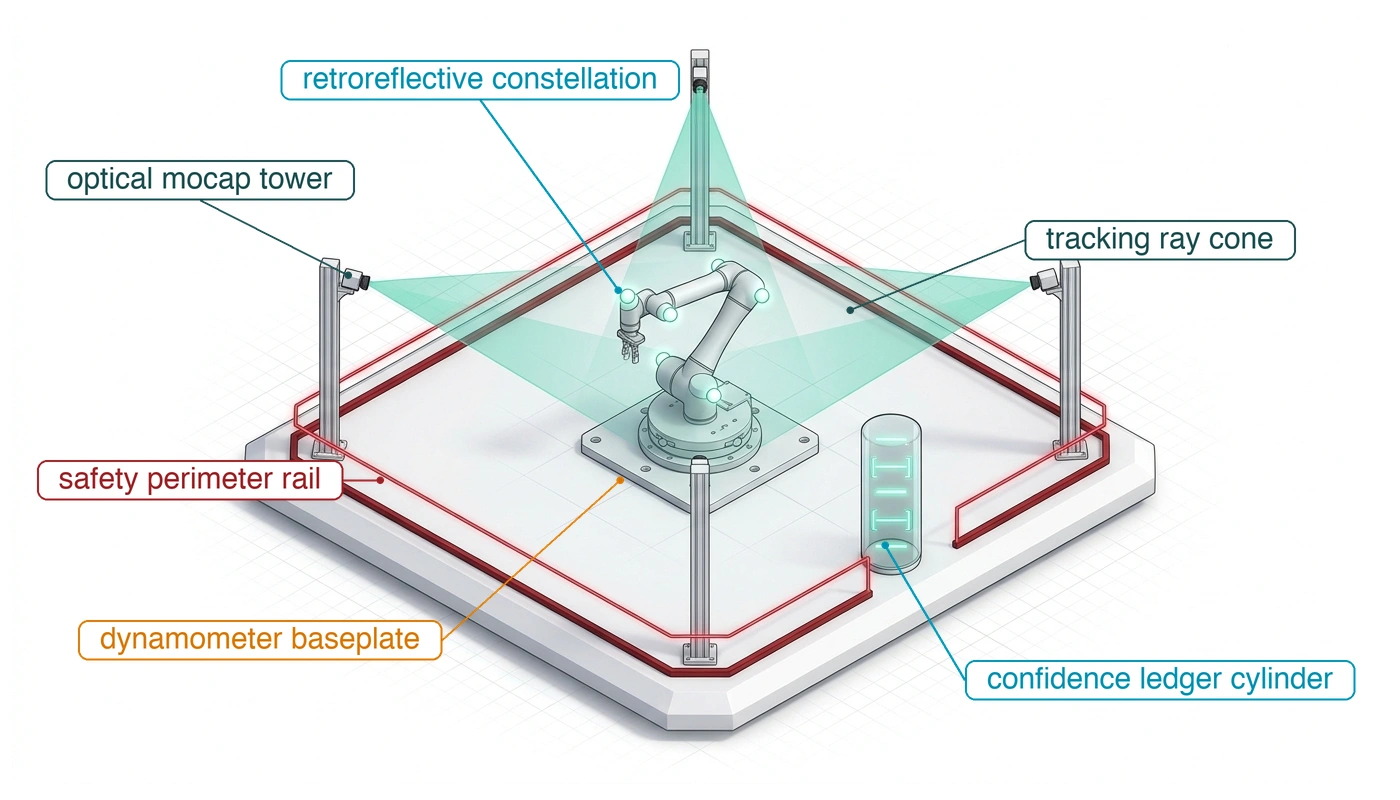
评估关合了第二部分的机器学习回路。 评估本章开篇的二十次干净运行,将 物理数据 中记录的经验与 策略训练 中训练出的权重转化为关于这些试验所能支撑的物理主张的具体判断。 每次试验测量的是整个机器,而非仅仅策略本身。 它记录策略的提议、许可路径的决策,以及躯体的响应,包括许可路径拒绝的分布外提议、其遗漏的提议,以及剩余多少制动余量。1
二十次运行的结果留下了三个未决问题:采样出了什么结果、每种测试方案分别能暴露什么,以及哪些危害仍落在证据之外。 有限次试验只能约束其采样出的分布,因此只有当评估同时写明了它未覆盖的条件,以及授权路径为这些条件所需的运行时监控时,评估才算完整。 成功率在其所抽自的总体被写下来之前毫无意义。
成功率衡量什么
评测基准通常只报告一个汇总统计量,例如在避障任务上的 85% 成功率。 在机器学习领域,该数字被视为学习得到的模型权重的内在分数,类似于静态图像分类数据集上的 top-one 准确率。 在物理机器中,这种解释是无效的。 学习得到的策略本身没有独立的物理性能。 基准所测量的,是整个物理系统在特定的一系列日期与环境状态下的闭环执行。 成功率是耦合系统的经验属性,由策略、机械装置、计算硬件、运行环境以及试验协议共同构成。
为评估一个策略,工程团队会执行一系列离散的物理运行。 只有当所有可能改变物理状态轨迹的变量都被固定或显式采样时,单次试验才完全确定。 形式化地,令单次试验条件由一个元组 \(c = (s_0, e, m, \pi_\theta, \kappa)\) 定义,该元组取自操作测试分布 \(\mathcal{D}\)。 向量 \(s_0\) 表示机器的初始状态,包括 SE(3) 位姿 、线性和角速度,以及关节编码器位置。 环境向量 \(e\) 捕捉外部变量,例如地面摩擦、环境照度、障碍物几何以及环境空气温度。 机器状态 \(m\) 捕捉物理与硬件属性,包括电池荷电状态、载荷质量、轮胎磨损、传动系统的机械间隙 ,以及传感器标定参数。 计算配置 \(\pi_\theta\) 涵盖冻结的策略权重 \(\theta\)、推理量化、调度截止时间以及软件版本。 最后,终止协议 \(\kappa = (T_{\max}, g, \phi)\) 定义了执行时间上限 \(T_{\max}\)、空间目标区域 \(g\),以及将所得轨迹映射为终端结果 \(Y \in \{0, 1\}\) 的二元评估函数 \(\phi\)。
在评估协议下,真实的成功概率是二元任务结果在试验条件联合分布上的期望值,\(p(\mathcal{D}) = \mathbb{E}_{c \sim \mathcal{D}}[\phi(\text{Traj}(c))]\)(Closed-loop trajectory distributions and evaluation estimands 给出了形式化的积分)。 此处 \(\text{Traj}(c)\) 表示当策略 \(\pi_\theta\) 在由 \(c\) 定义的物理环境与硬件状态中执行时所产生的连续物理轨迹。 这一依赖关系说明了为何成功概率不能仅被视为对 \(\theta\) 的度量。 模型权重 \(\theta\) 只是条件向量 \(c\) 中的一个参数。 若地面摩擦力的分布或初始电池电量的分布发生变化,则期望成功率随之变化,而 \(\theta\) 保持不变。 采样协议并非测量孤立模型的某种外部装置;它是所要估计的数学量的一部分。
Definition 1.1: 闭环评估待估计量
闭环评估待估计量 是在初始状态、机械装置磨损、环境物理、冻结策略权重和评估谓词的联合分布上定义的物理任务结果期望 \(p(\mathcal{D}) = \mathbb{E}_{c \sim \mathcal{D}}[\phi(\text{Traj}(c))]\): \[c = (s_0, e, m, \pi_\theta, \kappa) \sim \mathcal{D}\] 而非孤立评估的神经策略权重所固有的属性。
- 意义:在静态机器学习中,留出集准确率被视为模型 \(\pi_\theta\) 的属性。 在物理人工智能中,更换磨损的轮胎、让电池电压跌落,或改变环境照度,都会改变物理状态转移函数,而无需改动任何一个权重。 运行条件的采样分布 \(\mathcal{D}\) 是所估计量的不可分割的组成部分。
- 区别:与开环验证指标(如验证损失或均方轨迹误差)不同,后者将预测与冻结的已记录状态进行打分,而闭环待估计量是在内生的反馈回路上进行积分,其中过去的动作在物理上推动机器,直接改变它将要接收的未来传感器观测。
- 常见误区:在未预先声明测试分布 \(\mathcal{D}\) 的支撑集、密度与环境边界的情况下,仅报告一个成功率百分比。任何物理策略都可以通过仅在良性、未受扰动的状态下进行测试而被做得任意成功。
改变 \(c\) 的物理事件在试验之间独立于策略发生,而移动操作臂表现出其中每一种。 随着电池放电,驱动器在反电动势 面前失去电压裕量,因此运转时可用的扭矩沿扭矩-转速曲线 下降。 日光在场地内移动会延长导航相机的曝光时间,并在转弯时使画面模糊。 通道地板上的灰尘降低了制动系统可利用的摩擦。 在机械臂中,反复开门会使关节绕组(\(I^2R\)) 发热并加热谐波减速器 的齿轮箱,从而改变其阻尼;随着连杆膨胀,工具中心点 标定 也会随之偏移,因此在下午的试运行中,夹爪与锁扣的接触点与冷早晨的一次相比略有不同。 各次试验中策略的模型权重完全相同,但轨迹却可能从成功变为失败。
复位程序也会移动 \(c\)。 操作员在困难运行之后重新调整底座位置,可能偏向容易的起始状态;而自动复位若反复执行同一条路径,会使绕组周期性发热。 操作员截住一次失败运行并将其作为复位丢弃,等于从样本中抹去了最困难的那次失败。
因此,统计评估必须区分采样波动与待估计目标量的改变。 当 \(n\) 试验从固定的 \(\mathcal{D}\) 中抽取时,样本比例 \(\hat{p} = \frac{1}{n} \sum_{i=1}^n Y_i\) 会在 \(p(\mathcal{D})\) 附近波动,标准估计量可对该噪声给出界。 装载料箱架或移动门上的锁扣板,都会使实验变为另一个不同的分布 \(\mathcal{D}'\),并带有其自身的 \(p(\mathcal{D}')\);将两个样本合并,就相当于把来自两台不同机器的观测合并在一起。
由于成功概率仅相对于某个特定的联合分布 \(\mathcal{D}\) 定义,必须在采样试验之前声明预期的运行区域。 目标 ODD 是所声明的 ODD(策略清单)中由评估采样的部分;其采样权重定义 \(\mathcal{D}\),任何评估结论都不会超出它。 如果工程团队在临时构造的轨迹上执行五十次物理运行并报告 90% 的通过率,那么分母对应于一个未定义的总体。 只有事先指定 \(\mathcal{D}\) 的支撑集与采样权重,测得的成功率才能支持目标分布主张,从而明确界定照度、载荷范围、表面摩擦系数以及允许的初始状态偏移量。
要从经验试验中提取有效的置信界,需要满足三项运行条件:
- 独立同分布采样: 试验必须是取自 \(\mathcal{D}\) 的独立实现。 若电机绕组的热积累或渐进的机械磨损会跨连续运行降低硬件效率,则结果会随运行顺序漂移,因此 连续试验 既非独立、也非同分布。
- 固定结果谓词: 二元评估函数 \(\phi\) 与终止判据 \(\kappa\) 必须在整个实验活动中保持不变。 若在测试中途调整时间跨度 \(T_{\max}\) 或目标区域 \(g\) 的空间容差,就会改变“成功”的定义。
- 全分母统计: 每一个已启动且因硬件故障、通信超时或安全额定紧急停止(例如超出 ISO 10218 / ISO/TS 15066 的协作机器人功率与力限值)而中止的运行,都必须记录为失败(\(Y = 0\))。 剔除中止试验,等于用存活硬件上的条件执行度量,替代了该设备的真实运行可靠性。
当上述条件成立时,物理试验为 \(\mathcal{D}\) 下的闭环系统给出无偏样本均值。 物理试验同样缓慢,因此评估流程常以记录数据集上的开环打分来替代,它衡量候选策略复现已记录专家动作的准确度。 这一替代假设:对示教动作的准确预测会迁移到策略自身动作决定其下一状态的情形,而只有闭环才能检验这一点。
闭环动力学
一个导航策略可以几乎完全复现记录的通道行走,却仍可能在通道行进不到三分之一处就耗尽底座与货架之间的净空余量。 差异在于各类测试分别向策略反馈什么。 在开环评估中,候选策略 \(\pi_\theta\) 会在一份静态的已记录演示数据集 \(\mathcal{D}_{\mathrm{demo}} = \{(s_t^*, a_t^*)\}_{t=1}^T\) 上进行打分。 在每个离散时间步 \(t\),策略接收一条已记录的示范执行者状态 \(s_t^*\),并输出一个预测动作 \(\hat{a}_t = \pi_\theta(s_t^*)\)。 误差度量(如均方误差或交叉熵)度量 \(\hat{a}_t\) 与已记录的专家动作 \(a_t^*\) 之间的距离。 在第 \(t+1\) 步,评估流水线从数据集中提供下一个已记录状态 \(s_{t+1}^*\)。 由策略产生的动作 \(\hat{a}_t\) 在不执行于硬件的情况下被丢弃,从而保持输入状态序列独立于策略的既往输出。 在 闭环评估 中,策略提出 \(a_t = \pi_\theta(s_t)\);权限路径将其与实测状态和约束核对,施加 \(u_t\)(或回退动作),随后被控对象按 \(s_{t+1} = f(s_t,u_t)\) 演化。 施加的指令改变了物理状态并影响后续观测,在 因果边界 处跨越因果边界。
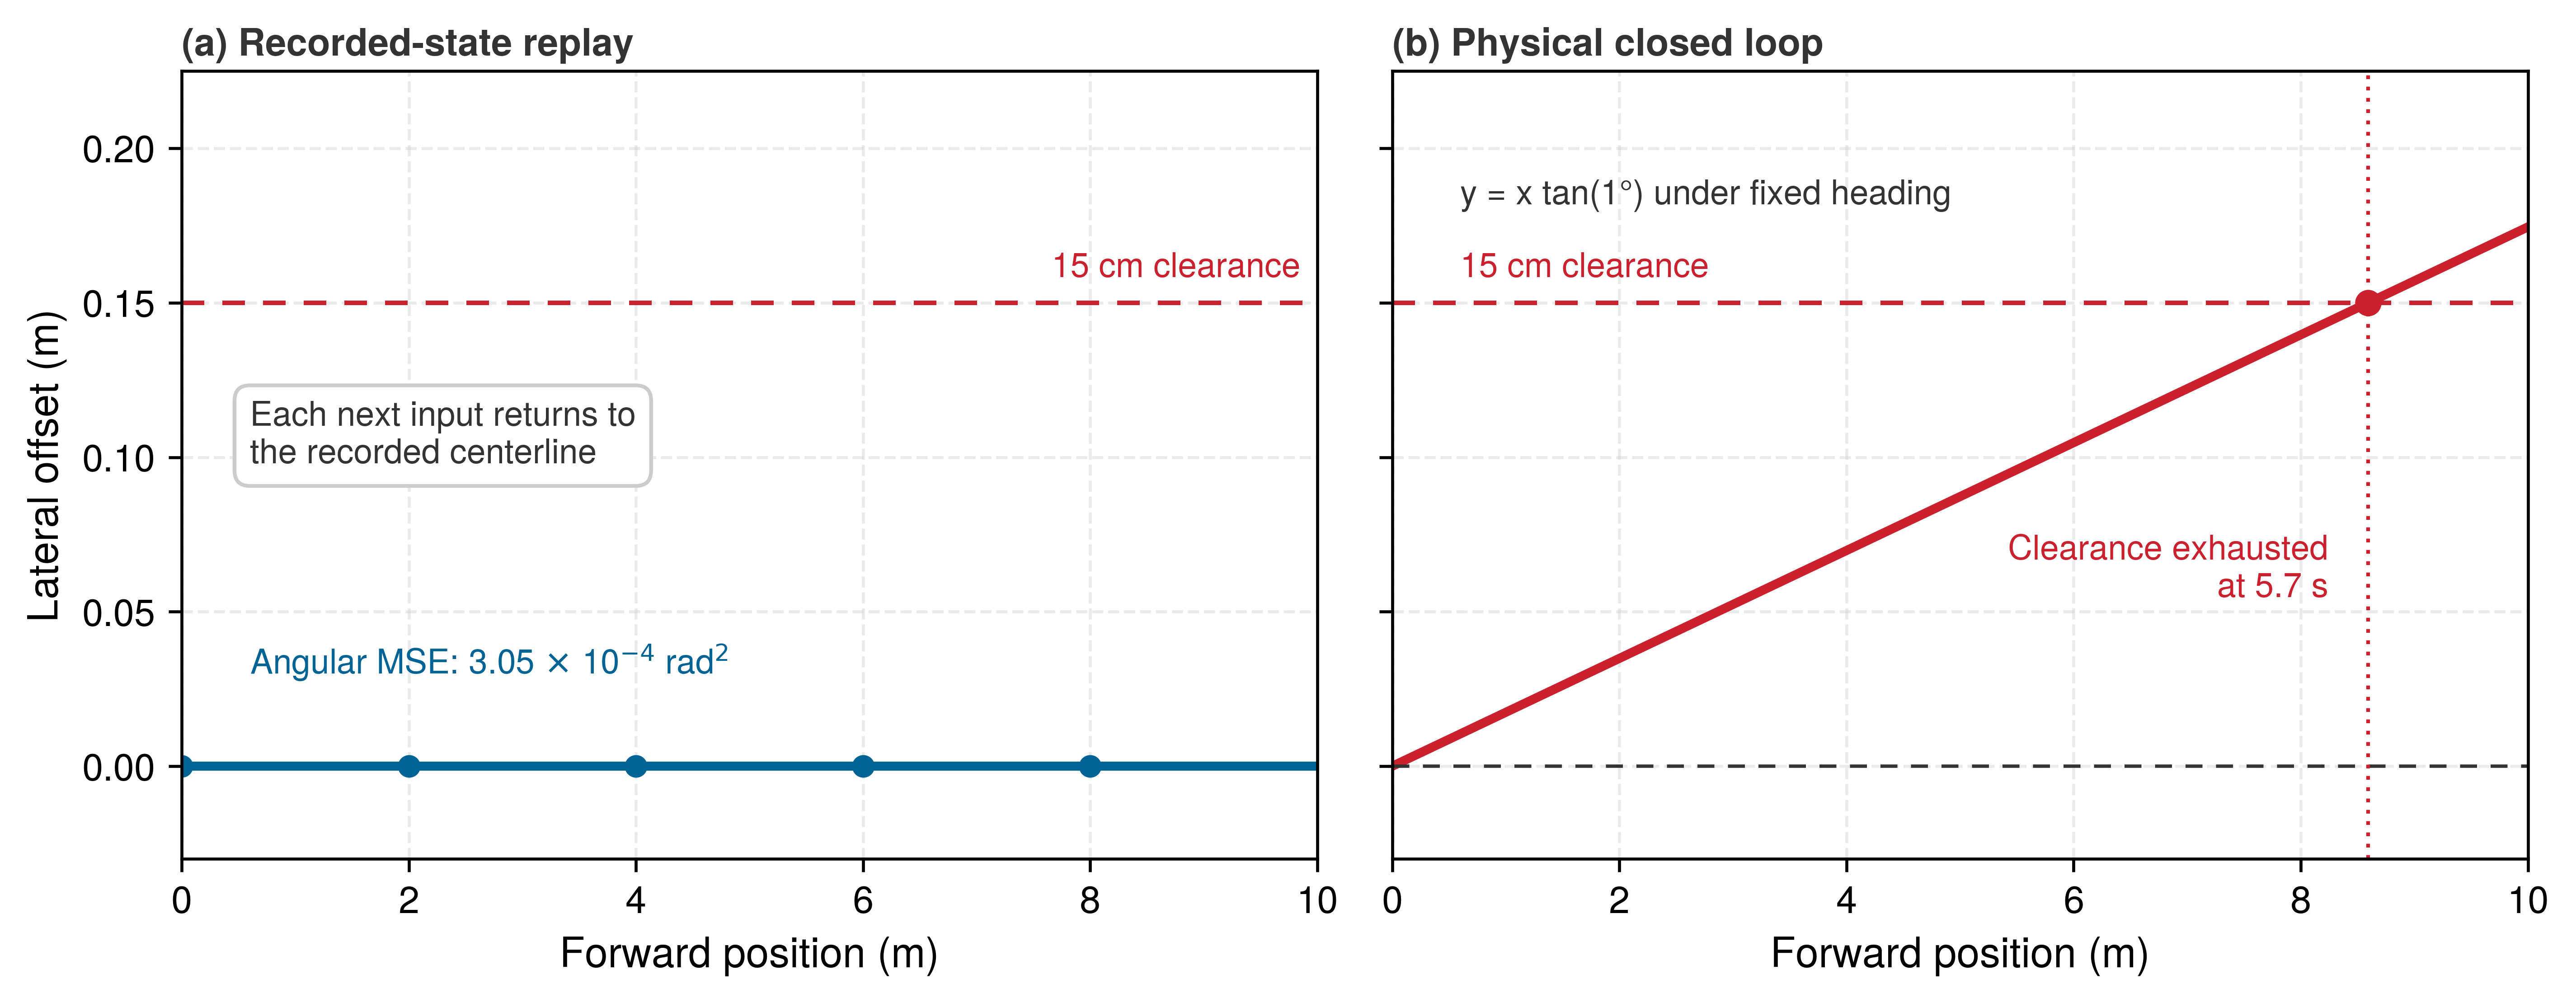
开环评估沿演示者的状态轨迹检验动作;离线预测误差较低的策略,当其有偏提案被允许进入物理运动时可能失败,因为策略自身的动作会将其带离训练所用的状态。 这是内生数据原则(Endogenous data):内生经验 已就数据推导出其后果,而评估必须在机器上对其进行度量。 门体演示无法呈现该效应,因为其基座保持静止而机械臂在工作,因此该示例取自同一台机器导航栈,而非被评估的锁止策略。 基座在长度为 30 m 的通道中,以其驱动限速 1.5 m/s 行驶(二者均为示意),标称专家演示沿中线行进,航向为 \(\theta^* = 0\text{ rad}\)、侧向偏移为 \(y^* = 0\text{ m}\)。 假设候选导航策略在每一步都具有系统性的航向偏差 \(\epsilon_\theta = 1.0^\circ\)(0.01745 rad),而放行路径允许这些提案,因为只要仍有净空,每个提案单独看都是可行的。
在开环评估中,策略在每一步接收演示者状态 \(s_t^* = (x_t^*, 0, 0)\),并预测具有 \(1.0^\circ\) 转向偏移的前向速度。 离线评分管线记录平均绝对角误差为 \(1.0^\circ\)(0.01745 rad)以及极低的均方误差 \(\text{MSE}_\theta = (0.01745)^2 \approx 3.05 \times 10^{-4}\text{ rad}^2\)。2 然而,在闭环执行中,由于机器依据先前已接受的指令实际移动,未修正的航向误差会随时间不断累积。 在平面独轮车运动学(\(\dot{y} = v \sin \theta \approx v \epsilon_\theta\))下,这一持续的角向偏差会积分成累计侧向位移: \[y(t) = \int_0^t v \sin \epsilon_\theta \, d\tau \approx v \epsilon_\theta t\] 基座宽 100 cm,所在通道宽 130 cm,因此基座与两侧货架之间各留有 \(W_{\text{clear}} =\) 15 cm 的侧向净空,而漂移耗尽该净空所需的时间为 \[t_{\text{impact}} = \frac{W_{\text{clear}}}{v \sin \epsilon_\theta},\] 以驱动限速行驶时,该时间为 5.7 s,此时已行进 8.6 m,不足通道全长的三分之一(图 1)。3 要么许可路径的净空检查使基座提前于货架停下,要么在缺少该检查时,基座会撞上货架。 两种结果都是被开环评分评为近乎完美的失败试验。
Systems Perspective 1.1: 开环盲区
开环损失度量的是数据集模仿;闭环动力学决定物理生存。 如果偏差持续存在且许可路径允许其执行,一个很小的离线预测误差仍可能产生很大的物理偏离。
通道示例说明了开环分数与闭环存活相脱离的两个原因。 首先,静态评估无法将持续误差积分成位移。 它在每个时钟周期将机器重置为专家状态,掩盖了积分误差的累积,而在闭环中,下标为\(t\)的状态是所有先前动作的展开合成: \[s_t = f(f(\dots f(s_0, u_0)\dots, u_{t-2}), u_{t-1})\] 持续的航向偏差无需软件缺陷,因为轮胎差异磨损、相机桅杆振动或地面横向坡度都会产生它。 其次,静态评估无法跟随机器进入早期误差将其导向的不熟悉状态。 首个获准执行的错误动作将基座从已演示状态 \(s_1^*\) 移到未访问状态 \(s_1\),一旦偏离中心线数厘米,它就占据 \(\mathcal{D}_{\mathrm{demo}}\) 中不存在的状态。 离线指标仅在 \(y = 0\text{ m}\) 处计算,其中不含关于 \(\pi_\theta(s)\) 对 \(y \neq 0\text{ m}\) 的证据,而从未被展示过从偏心状态恢复的策略在那里可能犯下更大的错误,从而加速 策略合成机制 为行为克隆所追溯的发散。
机械臂在接触环节表现出同样的脱节。 末端执行器的位置误差每步只有几分之一毫米,离线评分为可忽略的笛卡尔误差,但在锁扣上,该偏移量会充当楔子。 锁扣的刚度将横向位移转化为反作用力 \(F_{xy} = k_{\text{env}} \Delta_{xy}\),该力超过 15 N 接触触发线,从而在门解锁之前结束了这次尝试。4
离线分数也可能在悲观方向上产生误导,当任务允许多个有效动作时。 若演示者从左侧绕过障碍物,则开环分数会惩罚一个从右侧绕过的候选动作(即 策略合成机制 中的双模式情形),尽管在闭环下两者均能到达目标。 动作级误差衡量的是与某一条记录之间的发散程度,而非任务是否得到满足。
⇄ 对照: 开环预测损失,与 摄取的成本 中分析的光子到执行的信息年龄界形成对照。
学习策略通常报告的每个离线指标与其所掩盖的机器故障之间,都存在同样的脱节,其中 表 1 将每个指标与能够暴露它的闭环度量配对,其中包括干预时间 \(T_{\text{TTI}}\),即从策略权威开始到首次权限路径覆盖(权限路径拒绝提议并应用其回退)或操作员接管之间的时间。
| 离线指标 | 开环假设 | 闭环下为何失效 | 机器上的故障 | 闭环度量 |
|---|---|---|---|---|
| 动作均方误差 | 残差较小时,轨迹偏差也较小 | 持续的偏差会累积成漂移,使机器偏离演示出的状态 | 基座耗尽了机架净空(停止或碰撞) | 相对参考轨迹的峰值偏差;干预所需时间(\(T_{\text{TTI}}\)) |
| 离散动作准确率 | 已记录的态上标签正确,则执行结果完全相同 | 良性替代方案与边界越界代价相同;时间上相关的错误不可见 | 指令抖振与关节过扭 | 峰值加加速度;对执行器扭矩限幅的遵循程度 |
| 余弦相似度 | 共线提议给出稳定轨迹 | 忽略量级,因此欠驱动会卡死在静摩擦力上,而过驱动会打滑 | 底盘停滞或车轮打滑;机械臂在到达锁扣前停滞 | 滑移比与阻尼(Wheel slip ratio and friction boundaries) |
| 负对数似然 | 专家动作处的似然捕捉了动作分布 | 有效的替代方案,例如从另一侧通过障碍物,会受到惩罚 | 有效策略被拒绝;示教噪声被模仿为抖动 | 闭环任务成功率(随机起点) |
| 重建或 Chamfer 损失 | 准确的场景预测带来安全的规划 | 背景像素在损失中的影响压过细小障碍物与接触几何 | 假制动;擦碰线缆或玻璃隔断 | 实测净空;控制屏障条件不变性 |
该脱节同样跨越 《五层机器》 的提案边界。 在双处理器实现中,应用处理器上的离线轨迹回放仅测量神经推理是否在其内存与计算预算内执行。 在物理闭环执行中,每个候选提案都会切换到运行许可路径的微控制器。 若策略的提案偏离目标或抖动,许可路径会检测到空间边界违规或许可过期,拒绝提案,并下达受控停车指令。 离线评估策略时,物理装置与许可路径都不在回路中,这评估的是张量算术,而非机器的存活;只有闭环才能度量路径偏离幅度、干预时机以及许可路径的实际表现。
↳ 下游: 未验证神经策略的确定性门禁与停止包络在 停止包络 中推导。
开环分数无法认证闭环,因此关于提议者的证据必须来自条件已知且已记录的执行。 策略可执行的每一种设置都会改变回路中的某些部分,无论是装置、传感数据流,还是对执行器的控制权限,而 节 1.4 依据每种设置能够展示与不能展示的内容对这些设置进行分类。
证据制度
在其二十次门运行之前,闩锁策略可以对照其已记录的演示进行评分,可以针对模拟门运行,可以在验证过的控制器控制机械臂时以影子模式运行,也可以在真实门上运行并启用其接触式触发线。 这四个设置是 证据体制 的 图 2 与 表 2,即记录回放、闭环仿真、影子操作与受限物理测试。 每一种都建立了策略、其感知输入与机器状态之间不同的关系,因此每一种都只支持一个有界结论。 四种设置都不说明无辅助策略在不受约束的物理部署中的行为,因为每种体制都会改变控制环路的因果反馈,或改变机器所遭遇的状态分布。
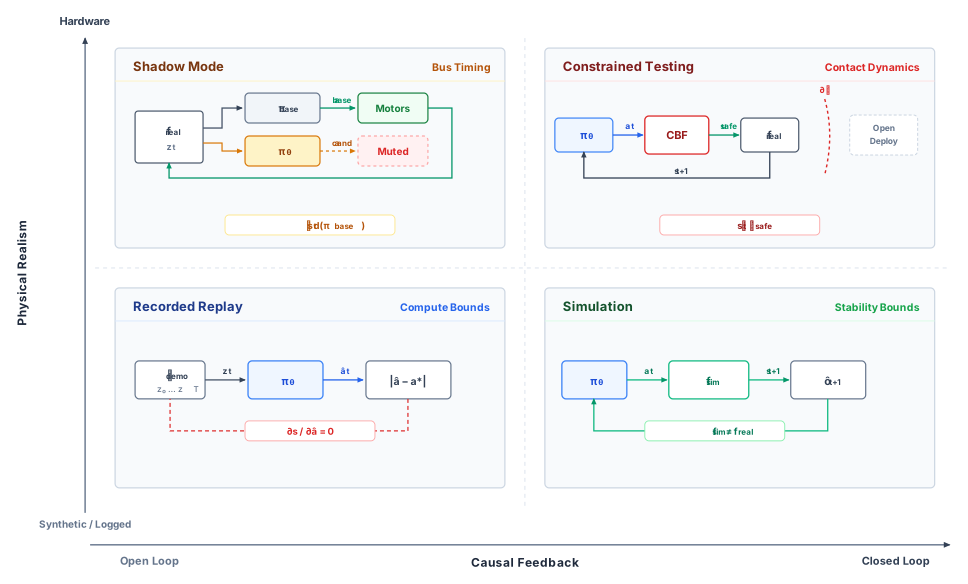
在录制回放中,策略以前馈计算的形式在存储的传感缓冲区上执行。 环境不对策略输出做出响应,状态序列固定为数据采集期间记录的轨迹。 该范式支持关于计算吞吐量、内存分配,以及与已记录数据集相对损失的论断,例如推理是否适配车载加速器的延迟预算,以及其数值输出是否与所记录的动作一致。 它无法支持关于闭环稳定性的任何论断,因为预测出的动作永远不会改变下一个观测;如果策略输出一个硬向左转向,下一帧记录中仍然显示底盘沿直线行驶。
闭环仿真通过用一个显式的数学模型 \(f_{\text{sim}}\) 替代物理机器及其周围环境,从而恢复了因果反馈回路。 当策略提出某个动作、而建模出的许可路径选择 \(u_t\) 时,仿真会积分运动方程、更新场景,并在索引为 \(t+1\) 的下一周期渲染合成传感器输入。 该范式支持关于策略在建模动力学下行为的论断,例如底盘能否从初始偏移中恢复,或机械臂是否在其工作空间内避免自碰撞,并且成千上万的实例可以并行运行。 证据仅对 \(f_{\text{sim}}\) 成立;未建模的机械回差、轮胎滑移、接触摩擦 转变以及光照因素在模型构建时就被排除在外,因此稳定 \(f_{\text{sim}}\) 目前尚不能说明硬件情况。
影子运行将候选策略挂载到一台处于运行状态的物理机器上,而经过验证的基线控制器,或人工操作员,仍保留对执行器的控制权。 候选策略接收实时传感器帧,在真实的机械振动与总线流量下运行机载推理,并计算候选动作 \(a_t^{\text{cand}}\).5 这些候选动作会被记录,但从未下发至电机驱动器。 影子运行支持关于执行时长的论断,例如闩锁策略是否在运行热负荷下维持其选定的 20 Hz 分块速率,以及关于 \(a_t^{\text{cand}}\) 与基线动作 \(a_t^{\text{base}}\) 的偏离超过给定阈值的频率。 它继承了回放方法的局限,因为基线始终将机器保持在基线轨迹上;本应驱动底座进入机架的动作从未使其移动,传感器流也从未呈现候选策略的失败。
受限的物理测试通过在有界包络内让候选提案抵达执行器,从而在真实硬件上闭合因果回路。 边界表现为物理牵引绳、速度钳制、缓冲测试舱,或许可路径本身(《五层机器》),后者以经验证的响应率拒绝不安全指令。 这一机制支持关于接触动力学、执行器饱和与传感器噪声的结论,且这些结论均在已测试的包络内成立,这正是二十次门体运行归属于该机制的原因。 它无法确立策略在开放部署中的尾部行为,因为牵引绳或许可路径覆盖的每一次干预都会截断轨迹。 数据度量的是约束边界内的组合策略与许可路径,而非无辅助策略。
部分性质能够跨越机制边界而迁移。 数值输出在相同输入张量下可迁移,算法不变量亦可迁移;因此,仿真中使输出饱和的溢出,在给定相同输入时也会在硬件上使其饱和;而实测时序与内存压力必须在各自体系的总线、热与调度负载下重新测试。 状态分布不可迁移。 当环境模型从 \(f_{\text{sim}}\) 变为 \(f_{\text{real}}\),或所测权限路径发生变化时,状态序列 \(s_0, s_1, \dots, s_t\) 即发生发散。
将这些体系视为保真度的阶梯是一种陷阱。 从回放推进到仿真、再到影子模式、再到受限测试,并不会加强某一条置信主张;每一步都是以一种失真换取另一种失真。 仿真以真实的感知与接触为代价换取闭环因果性,影子模式则把因果性换回真实的传感器数据流与硬件时序,而受限测试虽然恢复了二者,却会屏蔽其安全边界之外的状态。 一百次受限试验中零次干预表明,轨迹始终停留在约束从未触发的位置,而非包络之外的失败率较低。 每个问题都应置于能够回答它的评估范式中(表 2)。 对于闩锁策略,推理是否适配分片周期,应在回放中判定,随后在目标硬件上进行影子运行;机械臂能否从首次接触位置偏差中恢复,应在仿真中判定,那里数千个偏移量不产生磨损;门弹簧与夹爪的柔顺性是否使接触力始终低于限值,则仅能在受限物理试验中判定。 每种评估范式对其他评估范式的失效模式都是盲视的。
| 评估证据范式 | 因果反馈耦合 | 环境动力学锚定 | 受支持的实证证据 | 被遮蔽的失效模式/边界扭曲 |
|---|---|---|---|---|
| 记录回放 | 开环(\(\partial s_{t+1}/\partial \hat{a}_t = 0\)) | 静态演示缓冲区 \(\mathcal{D}_{\text{demo}}\) | 延迟预算、DRAM 占用、数值精度 | 协变量偏移;错误不会改变后续观测 |
| 闭环仿真 | 闭环(\(s_{t+1} = f_{\text{sim}}(s_t, u_t)\)) | 合成物理算子 \(f_{\text{sim}}\) | 运动可达性、大规模并行测试套件 | 仿真到现实的差距;未建模的接触非线性与轮胎滑移 |
| 影子模式运行 | 候选策略以开环方式运行(动作被屏蔽,不作用于机器) | 物理机器 \(f_{\text{real}}\) | 总线争用、热节流、真实传感器噪声 | 轨迹约束;状态锁定于基线控制器 \(d^{\pi_{\text{base}}}\) |
| 受限物理测试 | 闭环运行时否决(\(u_{\text{safe}}\)) | 物理机器 \(f_{\text{real}}\) 位于包络内 | 接触动力学、顺应性、摩擦、执行器极限 | 状态审查;许可路径覆盖与牵引绳截断失败尾部 |
模拟代理基准与真实世界机器人性能之间的定量关系由 sim-to-real 代理迁移定律 决定(图 3)。 离线开环指标(例如动作均方误差)无法预测闭环结果(\(r = 0.308\),如 表 1 所述会出现严重的排序反转),而闭环仿真基准(例如 SIMPLER (Li 等 2024年))在不同具身之间与物理操作成功率表现出很强的线性对应关系(\(R^2 = 0.836\),Pearson \(r = 0.914\)、\(p < 0.0001\);Spearman 秩相关 \(\rho = 0.942\))。
关键的是,线性迁移律(\(y = 1.04 x + 5.8\%\))仅在标称视觉与运动学包络范围内可靠成立。 迁移在三个不同的物理差异域中会灾难性失效:
- 视觉域差异:镜面光照标定误差或渲染差异会破坏视觉 Transformer 分词器。 例如,未调参的视觉纹理在 Octo-Base 中使模拟求解率降至 \(0.0\%\),尽管其真实世界任务成功率达到 \(29.3\%\)。
- 接触力学差距:刚体物理引擎(如标准 ODE 或 Bullet 求解器)理想化了多体接触动力学,并忽略了非线性库仑静摩擦。 在顶层抽屉开启任务上评估的 RT-1-X 策略,在模拟中达到 \(89.1\%\),但在真实硬件上降至 \(40.7\%\),原因是机械导轨卡滞。
- 触觉与力控差距:精细操作(如亚毫米级插销装配)在模拟中可获得较高的视觉求解率(\(82.0\%\)),但在现实中会崩溃(\(14.0\%\)),因为仅凭视觉无法检测接触力引起的楔紧。
因此,尽管闭环仿真可作为策略候选的有效筛选过滤器,物理试验限制仍是具身能力的最终裁决者。
/var/folders/7g/fkg91tq50f58kfmg7c65747r0000gn/T/ipykernel_91881/2252113112.py:183: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
Li, Xuanlin, Kyle Hsu, Jiayuan Gu, Karl Pertsch, Oier Mees, Homer Walke, Chuer Pan, 等. 2024年. 《SIMPLER: Simulated Evaluation of Manipulator Policy with Real-World Robot Environments》. Proceedings of the 8th Conference on Robot Learning (CoRL), Proceedings of Machine Learning Research.
Checkpoint 1.1: 跨证据范式的权衡
在评估物理试验极限之前,先核实你对证据范式和保真度权衡的理解:
物理试验极限
可靠性主张需要试验来支撑。 选定评估范式决定了测试能够展示什么,但在物理机器上,是装置而非算力预算决定每次闭环试验的成本,而统计方法决定该主张需要多少试验。 这两个量共同区分了资格性论证与轶事性证据。
一次物理试验的成本
一次物理试验所耗费的时间,超过模拟步长或日志回放时间。 它消耗墙钟时间,使机械连杆承受应力,使电机绕组发热,并存在硬件物理损坏的风险。 门体试验展示了成本如何累积。 在一次运行中,基座从其 2 m 待机位进入并停止,随后机械臂以 0.03 m/s 的受保护接近速度解锁门体并打开门,二者合计占用试验舱的 25 s(示意)。 使下一次运行成为独立抽样的复位会重新锁紧门体、将基座恢复到待机位,并将该次运行的遥测数据从缓冲区刷新输出,从而增加 15 s(示意),因此每次试验的成本为 40 s.6 在该循环下,本章开头介绍的二十次干净运行耗费 13.3 min,而 99.9 %成功下限所要求的试验(1.2)运行时间远长得多,这还未计入机械臂绕组所需的任何冷却休息时间(热工作占空比)。
试验累积过程中,被试装置本身也在发生变化。 单侧置信下限假设来自平稳过程的独立抽样,而磨损破坏了平稳性:减速器齿隙、轮半径、轮胎摩擦以及关节阻尼均以必须在测试硬件上实测的速率漂移。 将一千次运行合并后,把一台持续劣化的装置当作对同一台装置的重复试验,而一次晚期失效可能反映的是已磨损的装置,而非策略。
受限测试中内建的数据删失(节 1.4)进一步加剧了漂移。 由于一次失败的物理试验无法撤回(第一条 四条基石定律 定律),安全机制会在失败完成之前介入,证据也就止于介入之处。 团队最亟需评估的状态,例如高速时失去抓地力、或移动基座无法避免的碰撞,都是它不能让机器进入的状态,因为机器擦入料架会损坏底盘与传感装置,并使试验单元停机维修。 笼栏、地理围栏以及配备紧急停止按钮的操作员,都会在保守包络内截断每一次运行。 试验记录下了介入本身,而策略输出后果的下游影响仍未被观测;介入保留在分母中,后果则始终未知。
就物理生存性而言,均值是对峰值的不足描述。 威胁锁扣的是某次运行对 100 N 损坏限值的峰值接触力,无论平均值多么微小;而较长的总线延迟会消耗制动余量,无论平均延迟多么小。 极端值理论(EVT) 为最大值提供候选模型,但必须针对定义好的块最大值样本或阈值超量样本拟合 Gumbel、Fréchet 或 Weibull 族,与替代模型比较,并报告其不确定性;仅凭物理机制并不能选出该族。7 没有这些数据时,表 3 说明应测量什么、应验证何种防护,而不是预测罕见事件的发生频率。
| 扰动通道 | 峰值量与采样记录 | 待验证的物理后果 | 待验证的候选防护 |
|---|---|---|---|
| 计算与总线延迟 | 每周期端到端信息年龄与截止时间错过 | 陈旧提案侵蚀制动余量 | 新鲜度租约与独立计时的回退 |
| 接触冲击 | 载荷路径上的力-时间曲线、冲量与峰值 | 在反应性指令生效前发生屈服或过载 | 被动柔顺性与接触前限速;反应性限制措施针对后续载荷 |
| 低附着力 | 局部摩擦估计与制动响应 | 滑移延长制动距离 | 保守速度上限与低附着力路面的已测回退 |
| 眩光 | 饱和时长与感知遗漏 | 虚假放行或状态估计丢失 | 冗余感知与独立物理约束 |
该锁扣说明了为什么“接触冲击”一行将一次测量与一项保护配对。 每次门体试验贡献一个块最大值,即该次试验的锁扣力峰值,而二十个最大值远不足以拟合一条能够预测每次试验穿越 100 N 频率的尾部。 仅在接触之后才响应的力传感器既无法撤销首个峰值;其测量检测与执行器响应只能限制随后的载荷,而以 0.03 m/s 为速度限值的受保护接近,即接触前限速,为初始撞击保留了裕度。
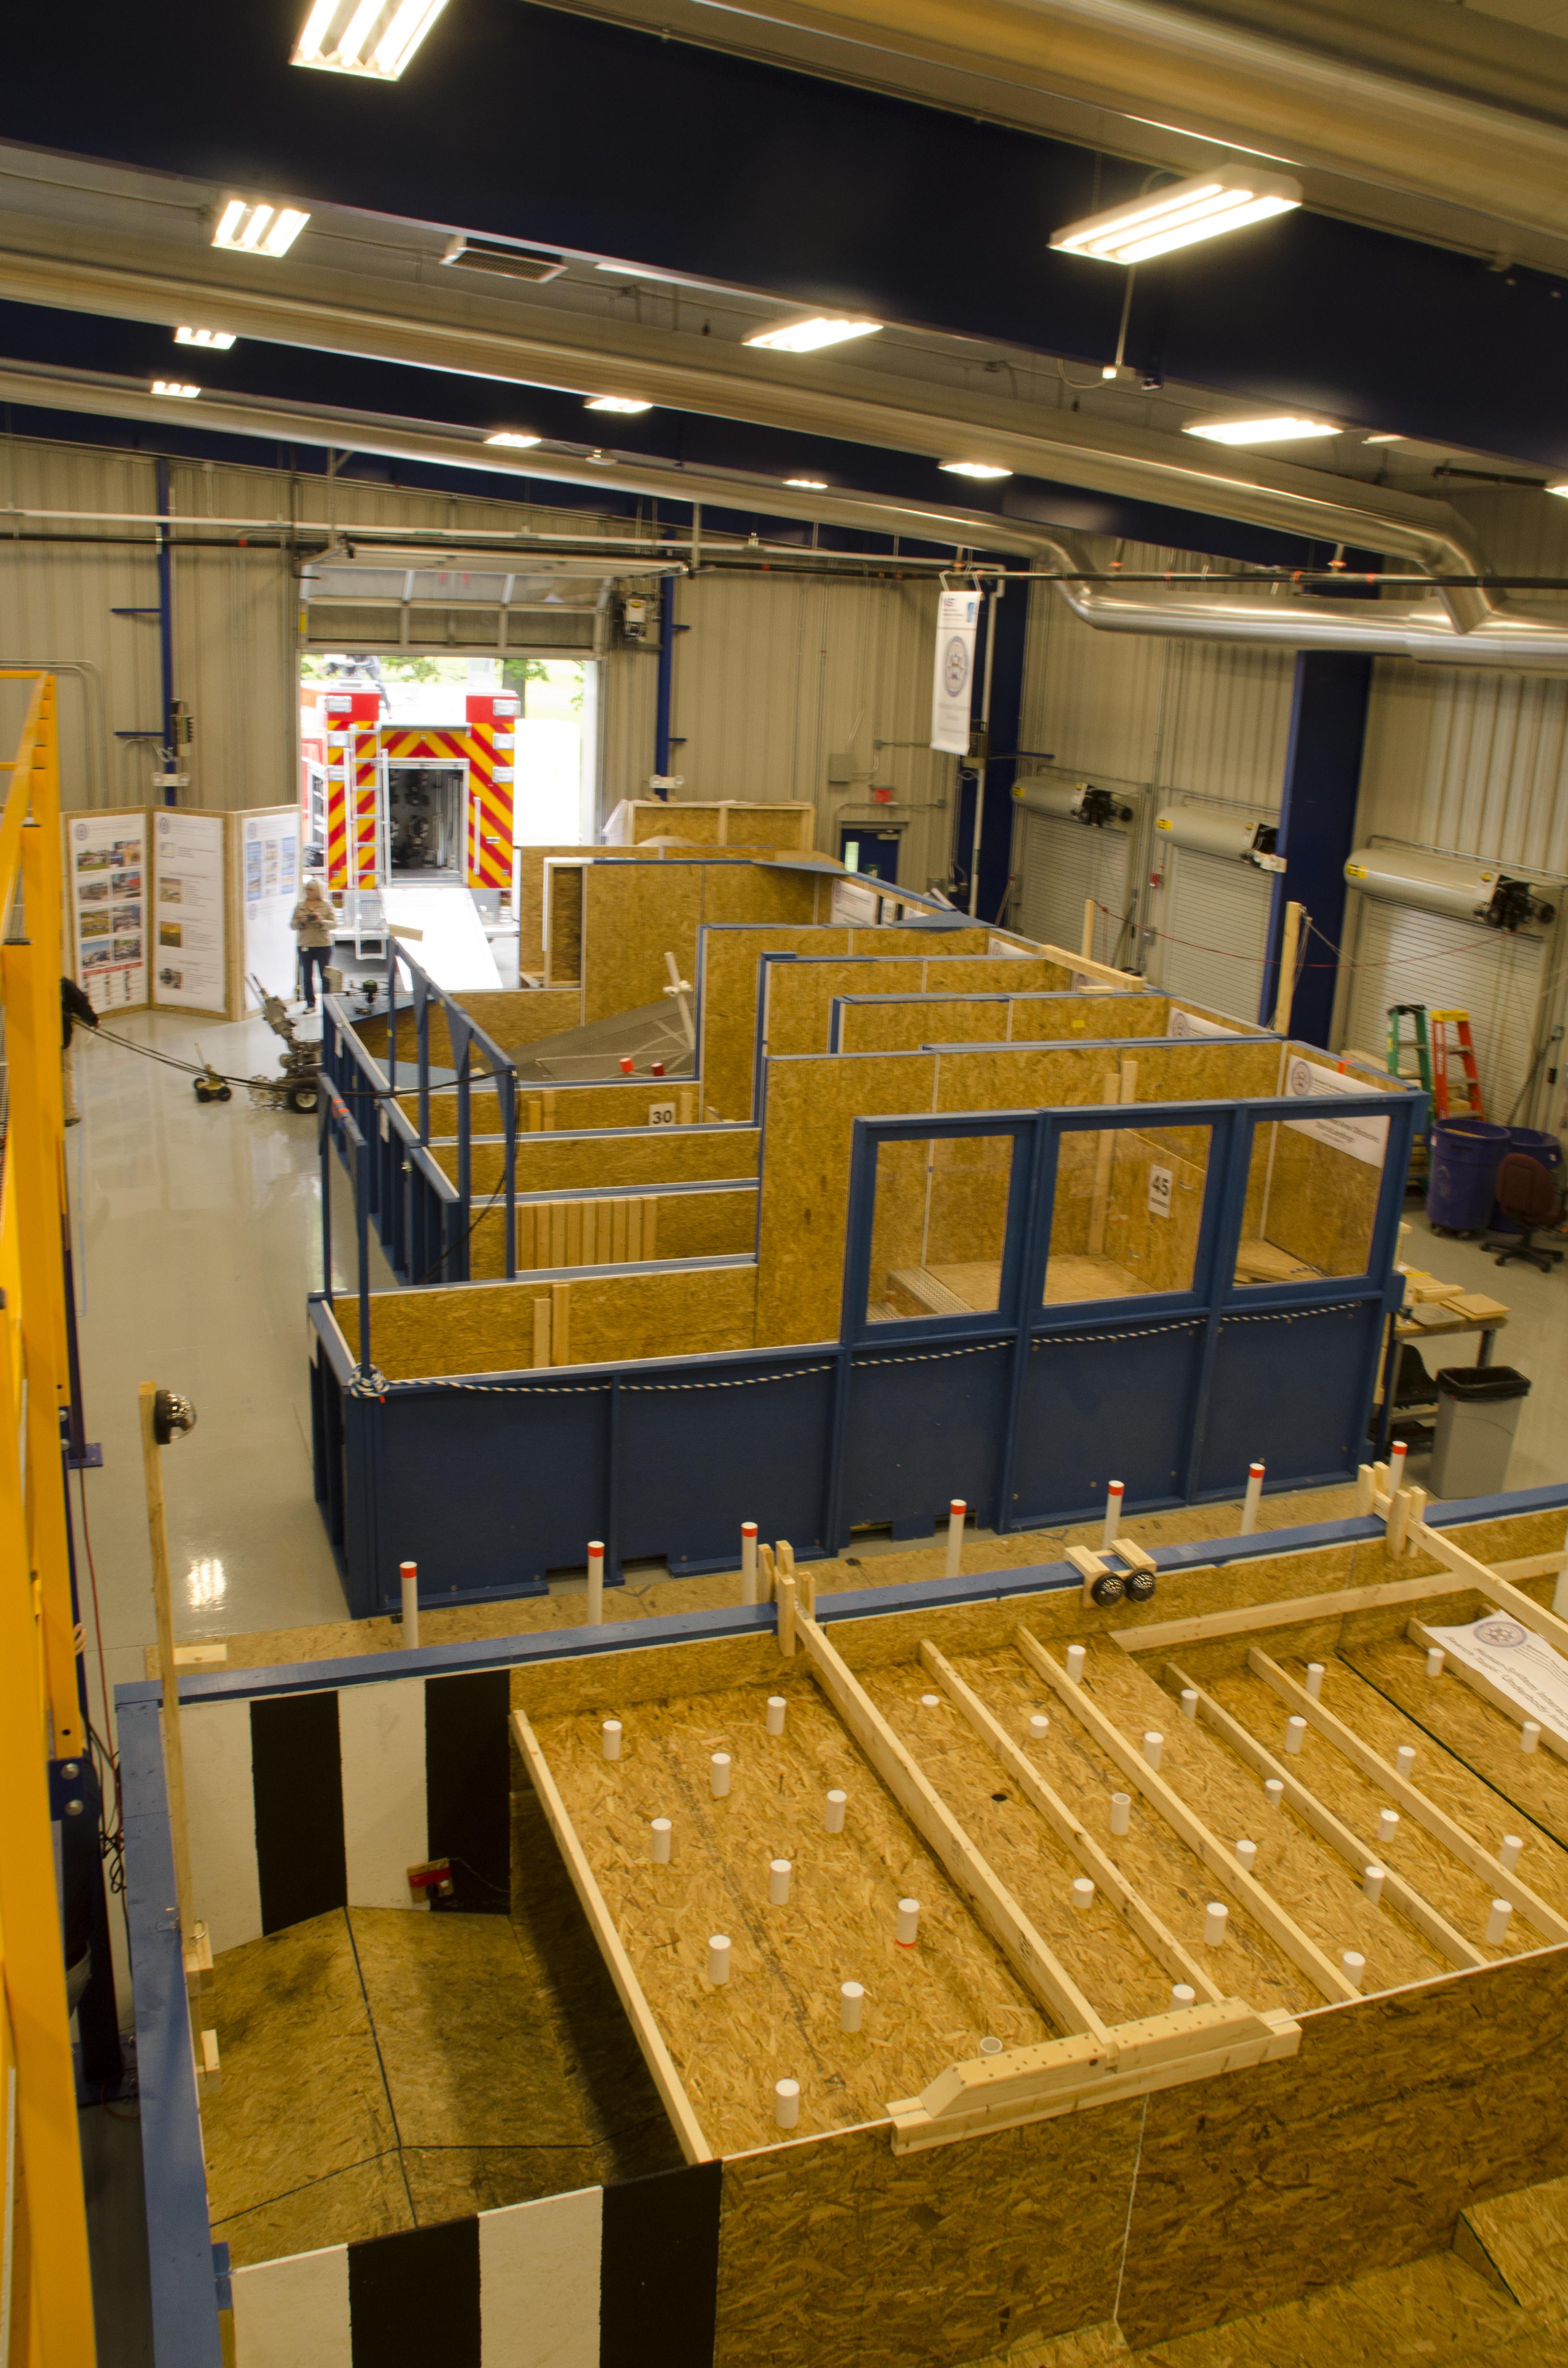
将试验分散到整个机队并不能换来独立性。 同一仓库中并行测试的十台机器共享一个生产批次、一种地坪饰面、一套通风系统,以及按同一规程培训的作业人员,因此一项在该设施中不存在的异常,例如地坪表面釉化或低角度眩光,不会出现在其中任何一台机器上。 同一设施中的一万小时机队运行时间,是同一狭窄分布的十次并行观测,而非一万小时相互独立的暴露。 标准化测试夹具(例如 图 4)通过把状态空间限定在夹具内来获得可重复性。
每项主张的试验次数
零失败试验的规模由对 节 1.1 的精确界求逆得到试验次数,因此是主张而非试验预算决定了试验单元必须交付的跑次数量(图 6 与 表 4;推导见 Zero-Failure Testing and the Exposure Wall)。
Napkin Math 1.2: 保证性的统计缩放
问题:假设评估目标要求单侧成功下限为 \(p_{\text{target}} = 0.999\),置信度为 95%(\(\alpha = 0.05\))。 若每次门试验需要 \(T_{\text{trial}} =\) 40 s,需要多少次零失败跑次以及多少墙钟测试时间?
计算:对 1.1 求逆得到 \(n = \lceil\ln(0.05)/\ln(0.999)\rceil = 2{,}995\) 次连续零失败试验。 按每次试验 40 s 计,这要求 \(T_{\text{total}} =\) 2,995 \(\times\) 40 s \(\approx\) 33.3 h(1.4 days)的连续测试。 采用要求配备 two 名操作员的安全规程,该方案消耗 66.6 h 的操作员时间,即超过 eight 的八小时班次。
系统洞见:即便循环周期短至门体的周期,99.9% 的下限也要求连续占用试验单元,时长为 1.4 days,而更长的周期会按相同比例放大该占用。 活动期间更换部件可能需要重新定义总体,而非将不兼容的运行合并。
当可靠性要求以每运行小时 \(\lambda\) 的失效率给出时,试验次数便成为暴露时间。 暴露墙 是指零事件试验在能够界定危害率之前所需的无失效暴露量。 在恒定速率模型下,置信度为 95% 时,\(T \ge -\ln(0.05)/\lambda \approx 3.0/\lambda\):目标为每小时 \(\lambda=10^{-6}\) 需要 \(3.0 \times 10^{6}\) 个无失效小时(342 机器年),每小时 \(\lambda=10^{-9}\) 需要 \(3.0 \times 10^{9}\)。
Butler 与 Finelli 正是从这组算术 (Butler 和 Finelli 1993年)(1.2)中得出设计结论。 机队并不能挽救这项试验,因为 100 套装置连续运行仍然需要约 3,420 个日历年的时间,按每小时 \(10^{-9}\) 计算。 道路车辆里程满足同一面墙(图 5),而模拟里程并未为其增加任何物理暴露。 因此,高保证水平主张必须依托独立验证的运行时约束与结构化的故障注入(推导故障清单)。8。
Systems Perspective 1.2: 超可靠性的测试局限
结果:Butler 与 Finelli 论证,仅通过运行测试来验证生命安全型信息物理系统(例如要求灾难性失效率为 \(\lambda \le 10^{-9}\text{ failures/hour}\) 的商业电传操纵飞行控制软件)的超高可靠性要求,是不可行的 (Butler 和 Finelli 1993年)。
Butler, Ricky W., 和 George B. Finelli. 1993年. 《The infeasibility of quantifying the reliability of life-critical real-time software》. IEEE Transactions on Software Engineering 19 (1): 3~12. https://doi.org/10.1109/32.210303.
/var/folders/7g/fkg91tq50f58kfmg7c65747r0000gn/T/ipykernel_91881/2795378110.py:29: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
Kalra, Nidhi, 和 Susan M. Paddock. 2016年. 《Driving to safety: How many miles of driving would it take to demonstrate autonomous vehicle reliability?》 Transportation Research Part A: Policy and Practice 94: 182~93. https://doi.org/10.1016/j.tra.2016.09.010.
即使场地要求远比这些速率宽松,暴露量壁垒仍构成约束。 假设仓库移动机械臂必须证明其关键故障率为 \(\lambda \le 1.0\times 10^{-4}\text{ 次故障/小时}\)(关键故障平均间隔时间 \(\text{MTBF} \ge 10{,}000\text{ 小时}\)),置信度为 95 %( \(\alpha = 0.05\) )。 每次取货任务耗时 \(t_{\text{mission}} =\) 360 s( 0.10 h ),覆盖 540 m,驱动处于 1.5 m/s 极限。 自动对接充电与遥测复位共需 \(t_{\text{reset}} =\) 120 s,每次试验周期为 480 s。 驱动轮直径为 \(D_{\text{wheel}} =\) 0.20 m,驱动齿轮箱的示例性额定 \(L_{10}\) 轴承疲劳寿命为 \(5.0 \times 10^{7}\) 转。
按暴露墙计算,该目标需要 29,957 无故障小时( 3.42 年)的连续暴露。 将该要求离散化为每次试验失败预算为 \(p_{\text{fail}} \le \lambda \cdot t_{\text{mission}} =\) \(1.0 \times 10^{-5}\) 的任务,需要 \(N_{\text{req}} = \ln(\alpha)/\ln(1-p_{\text{fail}})\),即 299,572 次连续零失败试验。 这里通过反解 节 1.1 中的零失败界,由目标求出所需试验次数;该目标所需的试验规模远超数十至数千次运行的实际预算。 在单台物理实验台上,以每周期耗时 480 s 执行这些试验,将消耗 39,943 小时(4.56 年),并累积 \(N_{\text{rev}} = (N_{\text{req}} \cdot v \cdot t_{\text{mission}}) / (\pi D_{\text{wheel}}) \approx\) \(2.57 \times 10^{8}\) 轮转动。
车轮总转数是减速器 \(L_{10}\) 额定值的 5.15 倍,但只有在传动比将轮转动映射为轴承转动后,该比较才成立;且 \(L_{10}\) 是在指定载荷和转速下的群体寿命统计量,而非失效期限。 因此,如此长度的试验战役必须事先规划维护与部件更换,并逐次记录,方可合并试验结果。
/var/folders/7g/fkg91tq50f58kfmg7c65747r0000gn/T/ipykernel_91881/3817523023.py:55: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
plt.show()| 零失败试验 \(n\) | 90% 置信水平下的成功率下限 | 95% 置信水平下的成功率下限 | 99% 置信水平下的成功率下限 | 95% 置信水平下的失败率上限 | 按门动作周期计算的测试时间 | 在 iid 测试抽样下的解释 |
|---|---|---|---|---|---|---|
| 10 | 79.43% | 74.11% | 63.10% | 25.89% | 0.1 h | 不确定性较宽;未观察到失败 |
| 20 | 89.13% | 86.09% | 79.43% | 13.91% | 0.2 h | 该界仅适用于所采样的分布 |
| 50 | 95.50% | 94.18% | 91.20% | 5.82% | 0.6 h | 证据更多;仍有未测试的条件 |
| 100 | 97.72% | 97.05% | 95.50% | 2.95% | 1.1 h | 该区间不能推出部署许可 |
| 250 | 99.08% | 98.81% | 98.17% | 1.19% | 2.8 h | 检查硬件与采样的平稳性 |
| 500 | 99.54% | 99.40% | 99.08% | 0.60% | 5.6 h | 该置信界仍以声明条件为前提 |
| 1,000 | 99.77% | 99.70% | 99.54% | 0.30% | 11.1 h | 低于 99.9% 的下限目标 |
| 2,995 | 99.92% | 99.90% | 99.85% | 0.10% | 33.3 h | 若假设成立,则达到该统计目标 |
这些上限迫使得出一个架构结论。 物理人工智能的安全性不能建立在对所学权重的统计置信度之上,经典控制也无法提供任何可替代提议者的解析方案。
一个经典控制器由 Lyapunov 函数 \(V(\mathbf{x}) > 0\) 与 \(\dot{V}(\mathbf{x}) \le -\gamma V(\mathbf{x})\) 加以认证,其覆盖一个给定的区域;而并非通过统计运行次数来认证。并且,在扰动下,输入到状态稳定性 论证依据其自身的模型假设,根据输入的大小给出状态误差的界。 学到的提议者并不携带这样的稳定性证明。 通过其非光滑激活函数检查下降条件,是一次涉及数百万参数的非凸搜索;其隐空间输入不携带任何物理量纲,因而无法用于构建 \(V\);接触不连续则会破坏证明所依赖的光滑性。 在其训练分布之外,学到的策略还可能突然改变输出,以至于阴影或相机反光会翻转所提议运动的方向。 因此,举证责任从提议者转移到一个隔离的微控制器上的低维检查。 两种策略承担这一负担,一种在运行时,一种在实验台上:
- 运行时约束:通过将协作机器人的力限制、运动学加速度限制和急停委托给权限路径,来限定学习策略的物理权限,该权限路径是位于 《五层机器》 提案边界之下的独立、确定性机制。 保护性主张随后依赖于权限路径及其回退机制,其状态估计、被控对象与执行器模型、响应时序以及预留的制动余量必须与策略分开验证。
- 在物理实验台上的故障注入:工程师主动注入扰动,而不是被动等待扰动发生。 注入试验遵循 推导故障清单 所述的故障注入方法;本章仅要求它们进入同一份全分母账目。
Checkpoint 1.2: 样本量与 MTBF 证据目标
在继续之前,先检查你对样本量缩放与物理测试极限的理解:
即便在严格的合格性协议和自动化测试单元下,仅靠统计抽样也无法确立超可靠自主性。 哪些内容超出了任何有限试验战役的范围,以及记录必须为它指明哪些运行时监控,决定了证据能够支撑发布决策到什么程度。
评估无法确立什么
评估的局限源于 节 1.3 这一内生回路。 物理试验所访问的状态取决于许可路径所接纳的指令,因此不存在固定的数据集能够匹配候选体的闭环状态分布,而仿真器会用自身的转移模型替代被控对象的转移模型(Closed-loop trajectory distributions and evaluation estimands 中的形式化轨迹分布)。 一个以洁净、经检查的混凝土地面摩擦来建模通道地面的仿真器,无法呈现基座在透明油膜上的行为,而一个执行器瞬时响应的仿真器,也无法呈现真实定子电气时间常数的滞后;物理轨迹会偏离仿真轨迹,而这些偏离累积为任何一次仿真运行都未曾访问到的状态。 因此,测试至多只能界定其实际采样的分布。
经验评估所能支持的最强结论,因而既狭窄又是有条件的。 针对实体门开展的系列试验表明,在单次硬件版本上的一次软件构建,从采样得到的初始条件出发、并在运行期间所处的环境中,其失败概率的 95% 置信上限为 13.9 %。 它没有提到更冷的早晨会导致关节降额,一套随磨损而柔顺性与回差增大的齿轮箱,或者一块发生位移的击板。 在标称板上增加运行次数可以降低采样不确定性并收紧界(表 4),但它无法降低关于未建模物理或未访问条件的结构性不确定性;再运行两千次,只会以更细的精度测量同一个单元,而位移板单元、带载机器以及未建模动力学(如总线抖动) 仍与之前一样缺乏支撑。
由于评估无法确立策略在采样分布之外的行为,该主张的每个可监控边界都需要一个运行时信号、阈值和已测试的响应,且许可路径必须强制施加独立的物理约束。 分布支持仅部分可观测,且 OOD 检测器存在可测量的假阴性,因此无法可靠感知的条件需要 ODD 限制、被动防护或其他独立屏障。 评估记录在 runtime_monitor_specs 字段(节 1.8)中承载这些规范。 该字段列出了五个监控通道,其覆盖范围与响应必须加以测量:
- 输入支持 / 分布外(OOD)监控器 依据校准后的分数估计输入观测是否偏离被测分布,并在留出的分布偏移条件上报告假阴性。
- 执行延迟监控器 将每个推理结果的时龄与声明的控制截止时间(例如闩锁策略在 20 Hz 运行频率下的 50 ms 分片周期)进行比较,记录超时,并检查租约到期是否触发已验证的兜底策略。 单独的 \(P_{99}\) 摘要并不构成硬性截止时间界。
- 约束裕度监控器: 追踪当前物理状态与硬件安全限值之间的距离,包括关节扭矩限值、电机绕组温度,以及相对于硬件和制动模型规定限值的障碍物净空。
- 干预率监控器: 计算许可路径否决或接管策略输出的频率,检测策略不稳定性是否导致过度修正。
- 环境假设监控器: 测量外部运行条件,例如由车轮滑移估计的表面摩擦系数,以及由光度传感器测量的环境照度。
仅将异常写入日志的监视器,保护不了任何东西。 当监视器报告某个条件已离开目标 ODD,或某次推理错过了其截止时间时,许可路径会丢弃该提议,并通过经验证的备用方案、限速或受控停车来驱动执行器,前提是所感知的状态、执行器能力和预留净空使得该响应可行(备用逻辑见 Safety and Control Barrier Functions)。 即使提议及时且置信度高,也仍会在施加任何 \(u_t\) 之前,先通过独立的状态、净空和执行器检查。
有些故障是任何运行时监控器都无法检测到的。 一个方案可能满足所有截止时间、遵守所有力矩限制,并源自熟悉的输入,却将基座导向视觉语言主干网络 (Brohan 等 2023年) 视为空闲空间的玻璃隔断;实测净空在接触前都是错误的。 针对此类故障的安全性不可能来自评估或软件监控器。 它需要物理分区、机械电流限制器,以及独立的安全屏障,其防护能力需在给定的物理假设下独立于学习得到的模型加以验证。
Brohan, Anthony, Noah Brown, Justice Carbajal, Yevgen Chebotar, Joseph Dabis, Chelsea Finn, Keerthana Gopalakrishnan, 等. 2023年. 《RT-1: Robotics Transformer for real-world control at scale》. Robotics: Science and Systems (RSS). https://doi.org/10.15607/RSS.2023.XIX.025.
↳ 下游: 感官遥测无法检测的物理故障,已在@sec-frontier-failures-without-detectors 中正式编目。
这些限制即使对一次完美无缺的实验活动同样具有约束力。 留存下来的证据,其质量至多等同于产生它的实验活动本身;程序性与统计性错误可能会在其结果进入记录之前很久就污染整个实验活动。
评估为何出错
系统性错误对策略评估的破坏,很少源于蓄意造假。 它们出现在协议回答了一个比主张更容易的问题时,六种反复出现的模式会如此:环境选择、指标漂移、测试集污染、可选停止、分母筛选,以及将演示当作测量。
环境选择发生在测试台比主张更窄时。 二十次开门运行全部在以 0.03 m/s 的速度进行的带保护机制的接近过程中命中标称锁扣承接板,且底座保持停止状态、货箱架为空。 若报告将成功率表述为机器打开站点牢笼门的能力,则该主张会悄然扩展至账本中未采样的单元(five)与已装载的机器(节 1.6)。 环境选择()通过比对条件账本与所声称域界的边界来检测;该账本记录每一次试验的实测锁扣承接板位置、接近速度、载荷与地面状况。覆盖一个单元的账本,无法确立关于其他单元的任何结论。
指标漂移()发生在评估指标由物理任务完成度滑向离线代理指标时,例如动作一致性,即预测指令与记录专家动作之间的均方误差或余弦距离。节 1.3 展示了此类分数为何无法为闭环提供认证。 指标漂移通过要求主评估指标为闭环终端结果来检测,例如“门已开启且无接触触发线穿越、无权限路径覆盖”,而非开环预测误差。
即便在闭环物理试验中,反复针对固定的评估设置进行调优,也会损害结果独立性。 当团队在同一个笼门上的每一批运行后调整闩锁策略的超参数、观测过滤或检查点时,该门就不再是独立的留出集。 每一次改动都会吸收关于该门锁扣承接板的位置、弹簧和照明的信息;经过足够多轮之后,最终检查点就等同于对测试门本身进行了隐式训练,从而掩盖了策略对其他任何门的响应方式。 这种测试集污染无法通过检查最终模型权重,或在该门上运行一次验证试验来发现。 它只能通过谱系追踪来发现,即分析策略版本、调参提交和测试日期的时间顺序历史,以确认所报告的评估是在全新、隔离且从未暴露于迭代调优过程的配置上执行的。
评估协议同样容易受到通过可选停止造成的无意选择性取样。 当工程师监控连续序列的物理运行,并在达到目标性能阈值或统计显著性标准时立即停止实验,所报告的置信度就会被扭曲。 如果评估团队开展一项实验,其中每次观察的名义假阳性阈值为 5 %,那么在多个评估检查点观察到表面成功便提前停止,会抬高真实的错误率。Five 次相互独立的 5 %观察,至少出现一次假阳性的概率为 22.6 %。 对同一条累积运行的重复观察是相互依赖的,因此必须针对真实的停止规则计算这种膨胀。 可选停止 无法从汇总表格或最终通过率中检出。 只有审计预先注册的试验方案、核实样本量、停止条件与评估里程碑是否在首次物理运行开始之前就已固定,才能检出。
即使是一项长期实验活动,也仍有理由在证据允许的前提下尽早停止,因为每次运行都会造成测试床磨损,并占用该臂的热预算(五个物理预算)。 为避免提前停止而虚增 I 类错误,评估团队采用 Abraham Wald 的序贯概率比检验(SPRT)9 (Wald 1945年)。 SPRT 并非预先固定样本量,也不对中间结果作简单窥视;而是在每次物理试验执行后评估证据的累积情况,计算可接受可靠性假设 (\(H_1\)) 与不可接受失效假设 (\(H_0\)) 之间的累积似然比。 测试会动态地在累积证据越过预先声明的似然比阈值的那一刻停止。 对于两个给定的简单假设和声明的序贯设计,SPRT 可以将期望样本数较固定样本量的检验降低。 常见的 Wald 边界公式是近似公式,会受到似然比越界的影响;实际的第一类错误、第二类错误和测试床节省量必须针对所选假设与结果模型进行计算或模拟。 关于精确的对数似然鞅表述、Bernoulli 更新以及 Wald 边界推导,参见 Sequential Probability Ratio Test。
Wald, Abraham. 1945年. 《Sequential Tests of Statistical Hypotheses》. The Annals of Mathematical Statistics 16 (2): 117~86. https://doi.org/10.1214/aoms/1177731118.
当评估的分母被悄然过滤时,会出现一种相关的统计扭曲,破坏了 节 1.2 的全分母条件。 若一个团队将结束于软件超时、紧急停止、传感器通信中断或权限路径覆盖的运行丢弃为无效测试产物,则它仅对幸存试验报告成功。 若机械臂在十次尝试中有九次打开门,而第十次需要操作员接管以阻止夹爪卡死在锁扣上,那么剔除该次尝试会使表观成功率由 90% 升至 100%。 当物理约束或安全限制在时间上限 \(T_{\max}\) 到期前截断一次运行,该试验应记录为删失失败,而非从账本中略去。 将截断轨迹上的存活读作运行能力,即 删失试验谬误。 分母过滤 通过交叉核对底层执行器遥测数据与权限路径日志、并与试验台账比对来识别,从而确认每一次上电周期和自主控制启用都对应一条已记录的试验结果。
War Story 1.1: 2017 年 NHTSA Autopilot 事故率降幅假象
上下文:2017 年 1 月,美国国家公路交通安全管理局(NHTSA)关闭了初步评估 PE 16-007,该评估是在一辆 Model S 于 Autopilot 模式下在佛罗里达州发生致命事故后启动的(观测如何出错)(National Highway Traffic Safety Administration (NHTSA) 2017年)。 结案报告比较了受试特斯拉车辆在安装 Autosteer 前后气囊部署事故率,并称“特斯拉车辆事故率在安装 Autosteer 后下降了近 40%”,由每百万英里 1.3 起降至 0.8 起。
机制:该比率将安装前后的气囊部署次数除以行驶里程;报告自身的脚注亦指出,这些比率“涵盖安装 Autopilot 前后的全部行驶里程,并不限于实际 Autopilot 使用”。因此,分母从未测量对 Autosteer 本身的暴露量,且同样不完整。 Quality Control Systems Corporation 的一项复现发现,安装时里程表读数似乎仅不到一半的车辆有记录,且仅 13% 的车辆可以计算安装前后的精确暴露量(Quality Control Systems Corp. 2019年)。 NHTSA 未计入的里程,因其无法归属于任一时段,集中在安装前暴露量最少的车辆中。
影响:在唯一两个时段暴露量均完整的队列中,安全气囊部署的碰撞率在安装后上升 59%,由每百万英里 0.76 升至 1.21,复现方以“若这些数据可信”对这一结果加以限定。其作者认为,整体 40% 的降幅“是机构对底层数据集中实际缺失的里程信息处理方式所致的假象”。该复现也未测量 Autosteer 的效果。 它表明,已公布的统计分母(行驶里程暴露量)无法支撑所报告的降幅。
回应: 该修正来自机构外部,且发生在最终报告发布两年之后,因为暴露分母的逐车里程记录,直到针对美国运输部 (Quality Control Systems Corp. 2019年) 提起《信息自由法》诉讼后才得以公开。
系统启示: 在物理人工智能评测中,未经核实的分母会产生统计假象。 在不具备自动驾驶系统接管运行状态遥测、运行设计域边界和完整暴露记录的情况下汇总开放世界里程,等于将缺失数据转化为安全结论。 一次评测应以与核分子中失效事件相同的严谨程度,来审计其分母的完整性。
Quality Control Systems Corp. 2019年. NHTSA’s implausible safety claim for Tesla’s Autosteer driver assistance system. Quality Control Systems Corp.
National Highway Traffic Safety Administration (NHTSA). 2017年. PE 16-007: Investigation of Tesla Motors Model S Automatic Emergency Braking and Autopilot Systems. PE 16-007. Office of Defects Investigation (ODI), U.S. Department of Transportation.
以视觉合理性替代统计采样的诱惑,体现了物理系统工程中普遍存在的一种脆弱性。 一段机器人手臂抓取不规则工件、或移动机器人在杂乱房间中导航的单一视频录制,属于演示,而非测量。 视觉上令人信服的演示表明,系统状态轨迹与成功集至少存在一组初始条件和环境扰动序列相交,但它不提供该成功集体积的任何信息。 由于人类感知被调谐为适应平滑运动与协调的 SE(3) 运动学,观察者很容易把运动学上的流畅误认为策略能力。 一次看似刻意而平滑的执行,可能在距某个运动学奇异点不超过 \(10\text{ mm}\) 的范围内运行,也可能带有未被测量的\(P_{95}\) 跟踪误差,从而在十次重复中有九次导致碰撞。 一次代表性演示不具备统计效力。 一次代表性实验需要预先声明的采样(针对目标 ODD,或按各层分别分析)、完整的分母核算,以及与其声明相称的样本量。
同一套规范也适用于比较。 正如 Jacob Cohen 在其统计功效分析10 (Cohen 1988年) 中所形式化,判断 latch-bc-01 是否比另一个检查点更可靠地打开笼门,需要 Type I 错误 (\(\alpha\))、Type II 错误 (\(\beta\)) 以及效应量,即值得检测到的最小成功率差异。 每个检查点 20 次运行,在已知上述量与基线成功率之前,并不带有已声明的统计功效;因此该协议在首次运行之前先固定 \(\alpha\)、\(\beta\) 与效应量。
这些病理机制中的每一种都会使结论超出证据范围,同时让报告看起来更干净:一个良性的实验台、一个代理指标、一扇被污染的测试门、一次恰到好处的停止、一个被过滤的分母,或一段有说服力的视频。 理解评估失败的作用机制,有助于阐明物理测试的目的。 一次实证试验,并非为了说服旁观者相信模型有效而进行的演示。 它是用来测量策略权威在哪里失效、哪些物理条件触发该失效、以及证据支持多少统计置信度的工具。 记录这些边界需要一份不可篡改的记录,将每一次试验、每种条件与每一项干预绑定到可验证的物理量;节 1.8 规定了该记录。
评估日志
当二十次门操作试验完成后,它们留下的记录将是机器其余部分唯一能看见它们的形态,因此该记录保留了什么,决定了哪些主张得以存续。 一个 评估记录 会消费 策略清单 的策略清单,并以摘要引用它,同时补充审计该清单所描述的学习策略 所需的字段;它不超出目标 ODD 提出任何主张,并为每一个可监控的边界指定运行时监控器。 该记录将实测结果与声明条件关联起来,并单独保留人类观测及其来源。 它是一份自包含的证据记录,说明测量了什么、在何种物理条件下测量、置信度如何,以及由此产生的证据明确不支持哪些运行性主张。11
| 记录模式字段 | 物理/统计模态 | 密码学与溯源保障 | 下游验证器与使用 |
|---|---|---|---|
target_odd_boundary |
目标 ODD:所声明 ODD 的采样单元,此处为标称门闩扣板,接近动作为以 0.03 m/s 的速度进行的受保护接近,承受门自身的闩锁载荷,底座停止 | 已签名的 ODD 规范;必须位于策略清单的 declared_odd_boundary 之内 |
定义受测条件与校准后的 OOD 告警;物理门控保持独立 |
component_hashes |
策略清单摘要、冻结的神经网络权重(\(H(\theta)\))、推理引擎二进制、底盘序列号、轮胎批次、传感器标定矩阵与固件构建 | SHA-256 二进制摘要、硬件 UUID、ISO 9001 校准证书引用 | 支撑配置的可追溯性;防止未记录的硬件或驱动替换 |
sampling_protocol |
目标分布抽样权重或分层配额、PRNG 种子、重置流程,以及独立性审计 | 自动化测试框架配置脚本哈希、遥测序列日志 | 针对可选停止的审计,以及针对试验间潜在自相关的检验 |
complete_outcome_ledger |
全分母原始结果计数:\(n_{\text{attempted}}\)、\(n_{\text{success}}\)、\(n_{\text{estop}}\)、\(n_{\text{timeout}}\)、\(n_{\text{override}}\)(权限路径覆盖),以及 \(T_{\text{TTI}}\) 时间序列 | 单调微秒级硬件时间戳,不间断环形缓冲区遥测 | 防止删失试验谬误;计算未受污染的实证可靠性 |
statistical_evidence |
带采样假设的精确二项界限;仅对单独建模的物理小时暴露使用泊松速率 | 密码学验证签名,可复现的 Python 评估脚本 | 将有界证据与显式假设传入 对抗性验证 |
unsupported_gap_catalog |
未访问状态空间与省略动力学(地表水、动态人群)的显式目录;包含溯源记录中的已知缺失与清单的省略日志 | 声明的非支持清单,以及签署的安全工程验收意见 | 在第三部分参数化许可路径的检查、CBF 约束与回退策略 |
runtime_monitor_specs |
针对该主张的每个可监控边界:信号、阈值与实测响应,覆盖 节 1.6 的五个通道 | 各通道的实测检出覆盖率与假阴性率 | 由许可路径与观测契约的健康字段实现;由执行记录读取 |
评估记录以运行性主张及其形式化谓词开始,如预部署评估记录模式(表 5)所规定。 它定义了数学上的成功判据,例如在不跨越 15 N 接触触发线、且许可路径未对策略实施覆盖干预的前提下,解锁笼门并将其打开。 它界定了目标 ODD,该 ODD 位于策略清单所声明的 ODD 之内,并跨越清单所命名的物理参数,包括门闩扣板位置、接近速度与门体所呈现的载荷。 最后,它指明该结果预期泛化的物理环境总体,区分所测试的那一扇笼门与具有其他门闩板或弹簧刚度的笼门。 在试验开始之前于记录中界定这些边界,可避免在出现异常行为时对通过判据进行事后调整。
记录捕获了每个软件与硬件组件的不可变密码学标识符,以支持对物理执行的独立复现。 这些标识符包括以下各项的内容哈希:神经网络权重、传感器预处理管线、策略配置文件、仿真引擎构建版本(若纳入合成运行)以及评估执行脚本。 在物理系统方面,该记录日志登记了机器底盘序列号、车轮轮胎配方批次、传感器标定矩阵、电机控制器固件版本以及通信总线配置。 更换相机镜头、修改驱动固件版本或更换磨损的驱动皮带,都会改变机器的物理传递函数;若该变更未被记录,历史数据即告失效。
该记录保留了试验方案,该方案在第一轮运行之前即已确定,以确保该轮次活动无法在有利时刻被中止(即 节 1.7 的可选停止风险)。 方案预先声明了样本量 \(N_{\text{req}}\)(由主张的目标与置信度确定)、结果类别以及停止规则:零失败活动在其首次失败时停止,并报告其成功结果所支持的精确下界,或完成 \(N_{\text{req}}\) 轮运行并报告 \(\alpha^{1/N_{\text{req}}}\)。 合并二项界限要求每个条件均从目标分布中独立抽取,而固定配额网格则需要先进行各分层的独立推断并声明权重,之后任何主张才能跨越目标 ODD。 该记录说明了各轮运行如何从目标 ODD 的单元格中抽取,规定了移动底座在门前停止位置的伪随机种子序列,以及相邻两轮之间执行的复位序列,该序列重新锁定门并让移动底座回到与门保持 2 m 间隔的位置。 当移动底座在自主控制下回到该间隔位置时,电池温升与里程计漂移会在相邻尝试之间引入统计依赖。 记录说明试验在统计上是否相互独立,或按串联方式连续进行,并登记每一次人工复位、硬件中断,或对预先规定协议的偏离。
汇总百分比掩盖了决定系统风险的物理失效模式。 每次尝试的运行都恰好落入一个预先声明的类别:成功,即在 \(T_{\max}\) 内到达目标且未触发覆盖;截尾失败,即权限路径覆盖了策略 ;超时;或硬件故障,例如总线掉线或驱动器故障。 记录在每个类别中报告原始计数,并将每次受影响运行所属类别的运动学边界违规 和人工紧急停止作为该类别的子计数报告。 除汇总计数外,记录还保留每次试验的时间序列元数据,包括电机绕组峰值温度、最大轨迹跟踪误差和任务完成时长。 记录这些遥测数据可确保在审计时,接近热极限运行或处于硬边界 \(5\text{ mm}\) 之内的名义成功运行依然可见。 每一次在策略授权下发起的试验都保留在分母中。
统计规范定义点估计量、置信方法、名义置信水平、抽样分布以及其背后的数学假设。 除已支持的结论外,记录还列出未获支持的结论和已知的覆盖缺口;该目录从演示数据的已知缺失和政策清单的遗漏日志出发,并补充试验本身未曾触及的内容。 对于能够被感知的每一个缺口,运行时监控规范为 节 1.6 指明信号、阈值和受测响应;无法被感知的缺口则作为运行限制保留在目录中。
回顾本章开篇的二十次开门试验。 闩锁策略从与门保持 2 m 间隔的位置出发,以 0.03 m/s 的速度进行受保护接近时打开了笼门二十次,此时底座处于停止状态,且不存在权限路径的覆盖。 审计员将该记录的统计证据读作 节 1.1 的精确界限,即置信水平为 95%、数值为百分之 86.1 的单侧置信下限,而绝不读作退化的区间 \([1.0, 1.0]\)。
这份完整的记录揭示了该主张的结构边界,并展示了证据在第二部分(Part II)过程中被收窄到何种程度。 《采集策略覆盖度》的情景台账以 three 个门锁扣板位置与 two 个接近速度交叉,共 six 个单元格,而保留的演示支持 one,即受保护接近速度下的标称板。 策略清单将该单元格设为 latch-bc-01 的声明 ODD,该单元格整体纳入目标 ODD,二十次干净运行取自其中,它们将该处的失败概率限定在 13.9 百分,即受检验的 iid 分布(表 4)下的单侧上置信限。 上述收窄所排除的一切,都作为该活动继承而非关闭的缺口,进入覆盖缺口目录。 five 单元格中原本为零的演示记录同样为零条试验,目录也继承了清单的遗漏日志:其中 two 项尚未关闭的仿真器遗漏(即软惩罚接触以及缺失的传输延迟),使得该记录不得被用于任何在仿真中经过改进的检查点。 试验本身又引入了自身的缺口,因为移动底座在其 50 kg 料斗架中没有任何内容,所以该记录并未说明已装载的机器。 该记录说明了为何二十次成功运行不足以支撑高可靠性主张,并给出了拒绝任何“策略已具备无监控部署资格”断言的固定依据。
评估记录并不能证明一台自主机器是安全的。 它确立的是单一学习组件在受控条件下运行的经验边界与统计不确定性。 在 对抗性验证 中,验证论证将这些评估记录作为形式证据节点摄入,将策略边界与物理护栏的证据以及许可路径的延迟结合起来,以评估集成机器是否满足其运行安全论证。
↳ 下游: 非渐近 Clopper-Pearson 试验界限为 安全论证与主张 中的安全论证提供了经验证据节点。
Systems Perspective 1.3: 评估一台会摔倒的机器
问题:当无支持的单元中的每一次失败都是一次导致被测机器人受损的摔倒时,覆盖率记录说明了什么?
移动操作机器人的锁止试验以完好手臂触发接触感应线而失败,因此其试验活动仍可继续对难以成功的测试单元进行采样;人形机器人的失败试验则可能损毁试验硬件,使试验活动无法继续。
- 摔倒次数是一个独立的待估计目标量。 人形机器人的失败试验可能以机器人受损、落在地板上告终,因此记录将摔倒次数及其独立的分母与置信界限,与任务成功指标并列报告,而不是将其并入单一成功率。
- 分母在采集前分层。 扰动分层(湿滑地面、地面顺应性变化、路缘、推搡)及其权重在首次试验之前于采样协议中固定,因为一次在平地上进行的试验活动对其跳过的分层不具任何约束力。
- 演示者的平衡无法迁移。 人类操作者依靠人体而非机器人本体来维持平衡,因此像“保持平衡的重载伸臂”这样的单元没有任何有效演示;它作为“已知缺失”被登记进覆盖缺口目录,而该任务战役无法用其负担不起失败的试验来弥合这一缺口。
在采集前固定分母、分层和覆盖缺口的日志使记录具备可审计性,但无法阻止记录的读者得出该记录所不支持的结论。 从业者仍会以几种反复出现的错误方式误读基准指标,并将证据超出目标 ODD 外推;这些误读正是该主张的最后一项风险。
谬误与陷阱
评估仅在所测试的条件与边界内支持主张。 这些错误产生于团队将结果超出这些边界外推,或将架构性保障归因于学习得到的策略。
谬误:在单一标称条件下反复成功,就证明了广泛的运行就绪性。
开门试验活动将一种条件重复了二十次:标称门锁扣板、受保护的接近速度、底座已停止、料架为空。 在二项模型下,这些运行给出该条件 86.1 的百分下界1.1,而对账表的其他单元格,或会改变机械臂扭矩余量的满载料架,则什么都没有。 重复该条件虽然提高了标称估计的精度,但部署关键包络 仍然未被测试。 一项就绪性主张必须指明其目标 ODD,在该目标 ODD 内部的物理变体之间分配试验次数,并在每个已测试单元格内报告不确定性。
谬误:1,000 次试验中零失败,就证明了符合 99.9% 的可靠性规范。
假设闩锁策略在 95% 置信度下要求 99.9% 成功率时,无需触发地打开了 1,000 次门。 观察到的成功比例是完美的,但单侧下界 \(0.05^{1/n}\) 仅为 0.9970,未达到要求(表 4);满足它需要 2,995 次干净运行。 这一差距是证据不足,而非策略失败。 试验预算由主张和置信水平推导得出,事先固定,报告给出下界而非完美比例。
谬误:在静态日志上的高离线动作一致性,保证闭环物理稳定性。
一份引用了与专家动作的紧密一致(针对已录制运行)却将其作为发布证据的评估报告,只是测量了这些记录上的模仿,仅此而已。 节 1.3 的通道策略与其录制几乎完全吻合,却仍因协变量偏移而耗尽侧向净空。 一致性可以在物理试验之前筛选候选方案,但闭环稳定性 的主张仅依赖闭环结果,且分母为全部样本,这正是 节 1.7 的指标漂移防护。
陷阱:把由执行架构处理的传输停滞,记为学习策略的功劳。
移动操作臂完成 50 次标称通道运行,而团队却将策略对 SerDes 总线抖动 的容差记在其名下。 随后,资格测试注入一个超出@sec-nervous-cadences 中所选动作块租约的 60 ms 时限 的邮箱阻塞。 租约 到期后,许可路径检测到该过期租约,并启动受控的动态停车,这与来自 回退阶梯 回退阶梯的 1 类停车 相类似。 该响应来自执行架构;名义完成记录并不能证明神经权重检测或补偿了该阻塞。 故障注入 必须测量许可路径的检测与停车行为相对于可用停车距离余量的表现,且评估报告必须将该保护归因于提供该保护的硬件机制。
摘要
闭环评估测量耦合的策略、许可路径、被控对象、环境以及试验协议,因此成功率描述的是声明的总体,而非一个权重文件。 由于机器自身获准执行的动作决定了它到达的状态,即第二部分的内生数据原则,只有经许可路径闭环的试验才度量提议者的表现;开环分数无法看到这些动作造成的漂移。 零失效置信限随后在其抽样假设下约束所采样的总体,而安全运行边缘的截尾使该总体保持在活动所能承受的范围之内。 更多试验可以收窄该界限,而不会扩大总体;暴露量壁垒则意味着,要验证罕见危害的发生率,所需试验规模超出了任何物理机器能够完成的范围。
门体活动展示了留存下来的主张的形状。 二十次干净运行支持在受保护接近方式下标称门锁扣板的置信下限,前提是底座停止且无载,而关于演示从未覆盖的门锁扣板发生位移的试验单元以及带载机器,则一无所知。 覆盖缺口目录记录了没有任何试验访问过的状态,而内生数据原则预测没有任何数据集会包含这些状态;这些状态的安全保障责任被分配给独立的物理约束和许可路径上的可行回退,而非提议者,因为运行时 OOD 检测器可能漏检从未见过的情况。
本章的产出是评估记录,其中四个部分向前推进:
- 有界操作性主张: 目标 ODD,即策略清单所声明的 ODD 中,经验上被刻画性能的部分。
- 可复现的配置与账本: 权重、固件和校准的摘要,且所有尝试过、中止和被接管的试验都计入分母。
- 覆盖缺口目录: 数据中已知的覆盖缺口以及清单的遗漏日志,加上试验未曾访问的条件。
- 运行时监控规范: 对于每个可被感知的边界,信号、阈值,以及许可路径必须在运行时实现的已经过测试的响应。
要点回顾: 闭环评估与生存可靠性
- 成功率属于一个已声明的总体:该比率反映耦合的策略、许可路径、被控对象、环境与试验规程。 改变载荷、地面或复位规程会改变待估计的目标量,因此目标 ODD 及其抽样权重必须在首次试验之前固定。
- 只有闭环能度量提议者:开环评分在每个步骤都将机器恢复到已演示状态。 一个持续的 \(1.0^\circ\) 航向误差离线评分为“可忽略”,却会在行进距离不超过 8.6 m 时耗尽过道的 0.15 m 侧向净空,因为机器所采纳的动作决定了它的后续状态。
- 零失败界定了比率却并未度量它:\(n\) 干净的 iid 试验给出置信水平为 95% 的单侧失效概率上限,约为\(3/n\)。 二十次干净运行留出 13.9% 的失效概率余量,而 99.9% 的成功下限需要 2,995 次干净运行。
- 暴露墙将罕见危害转移到架构:以零事件界定速率 \(\lambda\) 大约需要 \(3/\lambda\) 的无失败暴露,而机队汇总的运行小时来自共享地面、构建版本和运行条件的机器。 因此,针对罕见危害的保护依赖于许可路径、可行的回退方案与物理屏障,绝不依赖学到的权重。
- 评估记录会说明其证据止于何处:其主张始终位于目标 ODD 之内,其账本将每一次中止与被接管的运行都计入分母,而其缺口目录与运行时监控规范则告诉运行时许可路径必须覆盖什么。
后续内容: 从评估记录到运行时感知
第二部分以一份记录收尾,该记录将人们对学到的提议者的信任限制在其目标 ODD 之内,并指明其余机器必须提供的运行时监控。 第三部分构建了满足这些义务的运行时。 其中第一项落在感知上,因为输入支撑监控器或延迟监控器只能作用于带有采集时间、坐标参考系和不确定性的观测。传感器感知 将一次测量从传感器追踪到一个空间主张,使许可路径能够在其允许运动之前对其进行定时间、定位和约束。
脚注
运行时安全执行: 一条经过独立验证的权限路径可以拒绝违反实测状态、新鲜度和执行器约束的提案。 其检出覆盖范围、最坏情况响应时间,以及可用的制动余量必须针对实现进行测试;仅 1 kHz 的采样率本身无法保证在接触前完成拦截。↩︎
回归损失中的指标尺度掩盖:在数千张验证帧上汇总转向误差的平方,会掩盖严重且间歇性的方向性错误。 单个局部预测尖峰 \(15^\circ\) 在跨数小时笔直车道驾驶的均值中会被数学上抹平。 若其积分运动在独立许可路径响应之前耗尽净空余量,则这一短暂的角向尖峰可能具有重要意义;判断该结果需要借助被控对象模型与时序模型。↩︎
航向偏置的运动学积分 :本例将航向保持为恒定 \(1^\circ\) 偏移,因此 \(y(t)=v\sin(\epsilon_\theta)t\) 是线性的。 另一个具有恒定角速度偏置 \(\omega\) 的示例以 \(\theta(t)=\omega t\) 开始,并采用小角度近似 \(y(t)\approx \tfrac12v\omega t^2\)。↩︎
非 Lipschitz 接触分岔:刚体接触并非 Lipschitz 连续,因为摩擦锥是集合值的,而碰撞会产生速度跳变 \(v^+ \ne v^-\)。 夹持器接触位置上的亚毫米级偏差,可能使轨迹从稳定的力调节切换为打滑或卡滞,这是一种开环评分(基于记录状态)无法揭示的不连续性。↩︎
硬件在环总线争用: 神经加速器推理延迟在隔离条件下可能呈现低方差,但在生产负载下,共享 PCIe 背板、直接内存访问(DMA)传输以及 CAN 总线仲裁会引入可变传输抖动。 在内存总线饱和的情况下,一个标称推理周期可能被拉长,从而耗尽高速控制环路的相位裕量。 在影子模式下,该延迟抖动会在真实总线流量下被记录,而无需将物理底盘暴露于由此产生的轨迹振荡。↩︎
物理试验周期预算: 一次物理试验的时长包括复位与运行,\(T_{\text{trial}} = t_{\text{run}} + t_{\text{reset}} =\) 25 s \(+\) 15 s \(=\) 40 s 就门体而言。 仅按有效运行时间预算,会产生不切实际的测试时间表,并诱导团队截断复位与冷却间隔,从而在多次运行之间造成热非平稳性。↩︎
极端值扰动建模:Fisher–Tippett–Gnedenko 定理描述了在给定假设下块最大值的极限形式;它不能仅凭物理机制为冲击、眩光或延迟单独指定尾部分族。↩︎
功能安全范围、、:功能安全标准规定了特定于场景的硬件指标与保证流程;单一失效率数值不能适用于全部物理人工智能系统,也不能仅凭行驶里程加以认证。 本文中的泊松示例属于分析目标,而非对 IEC 61508 或 ISO 26262 合规性的主张。↩︎
序贯概率比检验(SPRT): 当针对给定假设的实际误差概率经过校准,且校准已计入边界越界效应时,预先设定的似然比边界允许对这些假设进行有效的序贯停止。 节省的试验次数取决于路径与假设;不存在普适的磨损节省。↩︎
《物理试验中的统计功效》: 正确拒绝一个虚假零假设的概率 \(1 - \beta\)。 对于两策略比较,在收集物理试验之前,依据基线率、效应量、样本分配与所选检验计算功效 (Cohen 1988年)。↩︎
意图功能安全性(SOTIF): ISO 21448 与 ANSI/UL 4600 提供了关于意图功能与自主系统危害的论证框架。 本章的不可变记录是一项拟议的工程证据制品,并非任一标准所规定的具体表单。↩︎
Cohen, Jacob. 1988年. Statistical Power Analysis for the Behavioral Sciences. 2nd 版. Routledge.