多智能体协同
目的
为什么将一项任务拆分给多个智能体,往往比给一个智能体同样的预算花费更多,却产出更少?
由规划者分解工作、编码者并行起草补丁、审查者批准结果,这样的组合看起来像一支工程团队,而且很容易构建。与一个可以将同等数量的 token 用于采样、修订和工具反馈的智能体相比,这样的智能体集群往往并不能更快完成任务,却消耗数倍的 token,并出现新的失败方式:工作智能体相互覆盖文件,因幻觉产生的前提从一个智能体传入下一个智能体的上下文,使用同一模型的审查者也具有相同的盲点,而子智能体在父智能体已经放弃后仍继续消耗资源。只有当任务拆分能够隔离上下文、分离权限或探索相互独立的备选方案时,拆分才有收益;而且,运行时还必须在每一道智能体边界上落实带类型的交接、隔离写入、不变量关卡、取消机制以及逐级收窄的权限。智能体集群会同时放大执行跨度、状态和权限,因此,每次交接都必须保持单个智能体原本具备的闭合性。
学习目标
- 计算智能体集群的协同开销,以及超过多少工作智能体后,继续增加智能体会延长总完成时间。
- 根据任务的依赖图和关键路径,选择编排器—工作智能体、流水线或黑板拓扑。
- 设计带类型的任务封装和返回结果,限定协同者必须读取的内容范围。
- 对写入同一代码仓库的智能体应用隔离的工作树和乐观并发控制。
- 解释为什么相关性错误会使投票集成失效,以及应将不变量关卡设置在何处。
- 设计取消机制和委派权限,确保任何子智能体的生命周期都不超过其父智能体,权限也不高于其父智能体。
- 在总预算相同的条件下,将多智能体设计与单个智能体进行比较评估。
委派的权衡
四个工作智能体将总完成时间缩短至 \(0.84\times\),但将 token 成本增至 \(3.25\times\) 倍。
一支软件工程团队使用五个智能体(一名监督者、三个代码生成者和一个测试编写者)处理缺陷工单,测得完成的工单数比其单智能体原型增加了 4%。性能剖析却揭示了另一番景象。该集成系统消耗的 token 数达到十四倍;由于串行化和上下文同步屏障,其关键路径耗时达到 \(3.8\times\) 倍;在协调共享代码仓库中的合并冲突时,还反复陷入死锁。当原来的智能体获得同等资源,用于包含工具执行的迭代式批评与改进循环(测试时计算)时,它达到了与该集成系统相同的通过率,同时少用了 68% 的 token,实际耗时也只有一半。增加智能体所带来的效果,没有一项不能通过直接投入预算获得。
这一结果界定了本章要回答的问题。此前各章都让一个智能体沿一条轨迹运行;用本书所构建机器的术语来说,这相当于一个单处理器。代码仓库级迁移、持续模糊测试活动和分布式漏洞分析产生的状态、遥测数据和工具输出,超出了单个推理循环能够吸收的范围,因此,自然的应对方式是将工作拆分给并发运行的多个智能体,让它们相互交接子任务并写入共享状态。这种拆分将一个控制循环变成了通过远程过程调用(RPC)或消息通道通信的异步分布式系统,而并发不能与并行混为一谈。如果某个子任务需要前一步已验证的产物,那么独立的智能体进程无法缩短关键路径。它们会将序列化、模式验证、网络传输和同步插入关键路径,把一次内存中的控制转移变成分布式协同瓶颈。
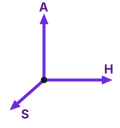
集群会成倍增加跨度、状态和权限,因此每次交接都必须保持闭环。
前面各部分介绍的单智能体运行时,已经围绕一个不持有任何环境隐式权限的模型形成闭环,只提交通过模型外部运行时关卡的操作(不变闭包原则)。将这一循环拆分到多个智能体之间,并不会改变这些要求。改变的是暴露程度,因为集群会成倍增加 H·S·A 暴露面 中 H·S·A 的每一项暴露。跨度如今跨越了交接过程,因此 时间跨度拉伸:从纳秒指令到千秒级轨迹 中的开环上限适用于每个智能体边界,而某个工作智能体幻觉生成的文件路径,会成为其同伴接受的前提。状态被复制到每个子智能体的上下文中,并在过时后仍被智能体读取。权限沿每次委派向下传递,且不得在传递过程中扩大。本章探讨这种拆分的成本、何时收益足以抵偿成本,以及运行时必须增加哪些机制,才能使集群与单个智能体同样可靠。
从这一系统视角来看,只有当对状态、权限或探索进行模块化划分所带来的收益,明确超过进程间协同的物理成本时,多智能体委派才具有合理性。在系统实践中,有三种具体的架构动因值得将工作负载分解到多智能体集群中:上下文分区、工具权限衰减,以及正交并行探索。
第一个合理动因是上下文分区。现代基础模型在有限的运行上下文窗口内工作,这一窗口受限于物理 GPU 高带宽内存(HBM)以及自回归解码循环的内存带宽饱和。当智能体的工作上下文逐渐接近其最大边界 \(S_{\max}\) 时,稠密注意力预填充的二次复杂度,以及 PagedAttention 键值(KV)缓存物理页框的内存占用,会严重降低服务吞吐量。更关键的是,当无特权模型被迫在充满无关日志、工具模式定义和执行轨迹的庞大上下文中检索信息时,会出现认知能力退化,这被称为注意力稀释或大海捞针式检索能力衰减。将庞大的运行上下文分摊给彼此独立、各有专长的子智能体,使每个引擎实例都能维持精简且高度聚焦的工作上下文,从而保持生成保真度,并将 KV 缓存分配控制在硬件的最佳范围内。
第二个系统动因是工具权限衰减。智能体运行时绝不能允许不受约束的根智能体直接执行对环境的不可逆修改,例如删除生产数据库表、向公共软件包注册中心发布软件包,或修改网络路由表。通过将危险操作委派给专门的子智能体,并让它们在隔离容器内使用权限严格收窄的工具定义运行,宿主监督器可以实施纵深防御。如果负责执行不可信测试脚本的子智能体遭遇对抗性提示注入,或生成破坏性的 shell 命令,其影响范围会被执行容器的边界从物理上限制住,从而防止监督器的核心编排循环遭到破坏。
第三个系统动因是在正交、互不重叠的搜索空间中进行真正的并行探索。当工程任务需要评估多个独立假设时,例如在隔离的代码仓库分支上对四种不同的算法实现进行基准测试、对相互独立的协议解析器进行模糊测试,或搜索实验参数空间中互不相交的区域,单智能体循环只能串行评估候选方案。在独立引擎实例上启动并发工作智能体,使运行时能够利用底层多 GPU 集群,同时执行各个独立智能体的预填充和解码循环。在这种配置下,全局任务的关键路径总工期接近最慢分支的耗时加上协同开销,从而实现真正的并行加速。
核心委派规则: 一个缺乏协同的多智能体集群,如果消耗了优化后的单智能体 \(10\times\) 的词元、内存和实际耗时,却未能在确定且经过验证的任务完成效果上带来统计显著的改善,就意味着架构倒退。没有正交探索的并发,只是分布式串行化。
这些优势从来都不是免费的,因为每次委派都要支付协同开销(原则 19)。每当智能体将工作委派给同伴或子进程时,运行时都会产生具体的计算、网络和内存代价。委派式多智能体工作流的总实际耗时 \(T_{\text{total}}\) 在形式上由协同开销方程决定:
\[T_{\text{total}} = T_{\text{work}} + T_{\text{serialize}} + T_{\text{network}} + T_{\text{context\_duplication}} + T_{\text{reconciliation}}\]
这里,\(T_{\text{work}}\) 表示在自回归解码和预填充循环中执行实际任务变换所耗费的原始计算时间。\(T_{\text{serialize}}\) 是将带类型的任务封装、结构化参数和环境状态编组为序列化传输载荷所耗费的延迟。\(T_{\text{network}}\) 反映 RPC 基础设施中经由套接字、管道或集群间传输所耗费的时间。\(T_{\text{context\_duplication}}\) 是子智能体与父智能体不共享统一的物理内存地址空间所导致的计算成本;每个子智能体都必须独立预填充自己的基础系统提示、环境模式、代码片段和任务指令,从而消耗冗余的 GPU 计算周期,并分配重复的 KV 缓存块。最后,\(T_{\text{reconciliation}}\) 表示父级监督智能体检查、解析、验证子智能体的候选输出,并将其综合整合回主轨迹所必须耗费的时间。
这一开销的扩展极限由阿姆达尔定律决定,轨迹时长核算 曾将该定律应用于模型在单条轨迹中所占的份额。这里,该定律应用于任务拆分本身。如果智能体工作流中有比例为 \(1 - f\) 的部分本质上必须顺序执行(初始需求分析、全局任务分解和最终多分支验证),而其余比例为 \(f\) 的部分可以分配给 \(M\) 个并行智能体,那么加速比不会超过
\[\text{Speedup}(M) = \frac{1}{(1 - f) + \frac{f}{M} + h(M)}\]
其中,\(h(M)\) 是以单智能体运行时间归一化的协同开销,它是集群规模 \(M\) 的函数。在未经优化的多智能体系统中,如果智能体通过不受约束的广播通道或密集的点对点消息进行通信,\(h(M)\) 就会随智能体数量呈二次增长(\(\mathcal{O}(M^2)\))。在这种条件下,加速比曲线会迅速反转:超过较低的并发阈值后,增加智能体会延长总完成时间,使总 token 消耗急剧增加,同时降低整体系统可靠性。
粗略估算 0.1: 多智能体并行的阿姆达尔极限
在配置 A(单智能体审慎推理)下,单个智能体顺序处理全部八个模块。初始的顺序规划与任务分解阶段耗时 45 秒,使用 1,500 个提示 token 和 800 个解码 token。模块重构工作(\(T_{\text{work}}\))在八个模块上共需 480 秒(每个模块 60 秒,平均各使用 4,000 个提示预填充 token 和 1,200 个解码 token)。后续验证与测试执行每个模块耗时 15 秒,共计 120 秒。对于整个工作负载,单智能体的总完成时间为 \(T_{\text{single}} = 45 + 480 + 120 = 645\text{ seconds}\),累计消耗 53,900 个 token,协同开销为零(\(T_{\text{coord}} = 0\text{ seconds}\))。
在配置 B(4 智能体并行工作者集群)下,监督智能体分解工作,并向四个并行工作者中的每一个分配两个独立模块。顺序规划阶段同样耗时 45 秒。通过 RPC 基础设施分发带类型的任务封装(\(T_{\text{serialize}} + T_{\text{network}}\)),向四个工作者的每次分发耗时 1.5 秒,共计 6 秒。由于工作者不共享地址空间,必须重复进行上下文预填充:每个工作者独立摄取包含 12,000 个 token 的项目架构规范和环境模式。当每个 GPU 实例的服务预填充速率为每秒 4,000 个 token 时,这种重复预填充增加的时间为: \[T_{\text{prefill\_dup}} = \frac{12{,}000\text{ tokens}}{4{,}000\text{ tokens/s}} = 3.0\text{ seconds per worker}.\] 随后,各工作者并行重构各自分配到的两个模块,产生的并行工作延迟为 \(T_{\text{work\_parallel}} = 2 \times 60 = 120\text{ seconds}\),之后并行执行单元测试,耗时 30 秒(两个模块,每个 15 秒)。工作者返回候选补丁后,监督智能体必须整合四组差异补丁(\(T_{\text{reconciliation}}\)),验证 AST 完整性,解决共享接口头文件中的两个 git 合并冲突(耗时 42 秒,使用 2,800 个解码 token),并执行全局回归测试套件(65 秒)。因此,总协调整合延迟为 \(T_{\text{reconciliation}} = 42 + 65 = 107\text{ seconds}\)。将这些组成部分相加,得到多智能体的总完成时间: \[T_{\text{multi}} = 45\text{ (seq)} + 6\text{ (RPC)} + 3\text{ (prefill)} + 120\text{ (work)} + 30\text{ (test)} + 107\text{ (recon)} = 311\text{ seconds}.\] 由此得到实测并行加速比: \[\text{Speedup}(4) = \frac{645\text{ s}}{311\text{ s}} \approx 2.07\times.\]
系统成本核算:虽然并行集群将实际总完成时间缩短了 \(2.07\times\),但底层硬件核算揭示了真正的系统权衡。由于四个工作进程之间存在冗余的上下文预填充(48,000 个重复预填充 token),以及监督层的协调合并开销,token 总消耗量从 53,900 激增至 118,400,增幅为 \(2.20\times\)。多智能体架构以计算成本和内存占用增加 \(120\%\) 为代价,实现了实际运行延迟降低 \(51.8\%\)。如果任务依赖迫使各分支之间串行进行协调合并,\(T_{\text{multi}}\) 就会超过 \(T_{\text{single}}\),即使消耗了两倍以上的计算周期,也会使加速曲线发生反转。
为了系统地应对这些权衡,运行时设计者必须摒弃多智能体系统天然优于单智能体基线这一缺乏依据的断言。在评估是否应拆分拟议的子系统时,架构师必须权衡 架构比较:单智能体审慎推理与多智能体委派 中详述的运行维度。
| 架构维度 | 单智能体审慎推理 | 多智能体委派 | 系统权衡与支配性不变量 |
|---|---|---|---|
| 关键路径延迟 | 受严格串行的自回归解码循环限制(\(T \propto \sum L_{\text{decode}}\))。 | 当任务在数据流上真正相互独立时,可接近 \(T_{\text{max\_branch}} + T_{\text{tax}}\)。 | 阿姆达尔定律决定最大加速比;智能体之间高度串行化会迅速逆转并行带来的收益。 |
| 计算与 token 成本 | 最低;使用单个共享 KV 缓存,子任务之间不存在上下文重复。 | 高;系统提示词、模式定义和智能体间同步消息封装存在 \(N\) 倍的重复。 | 对于相同的功能交付成果,多智能体集群会使 token 消耗膨胀至 \(1.5\times\) 到 \(4.0\times\)。 |
| 工作记忆(\(S_{\max}\)) | 在长轨迹中,注意力稀释和 KV 缓存耗尽的风险较高。 | 每个智能体的工作记忆均有界;每个子智能体维护一个紧凑的、面向特定任务的工作窗口。 | 只有当工作状态总量超过单个模型的可靠注意力容量时,委派才具有严格的合理性。 |
| 故障与安全隔离 | 单体式;一个未处理的异常或一次提示注入就会危及整个会话。 | 强;子智能体在沙箱进程中运行,且被授予的权限受到限制。 | 最小权限原则:将不可信工具、网络访问和状态修改隔离在可随时丢弃的子容器中。 |
| 状态一致性 | 简单;状态修改针对单一线性环境状态依次发生。 | 复杂;对共享文件系统的并发修改需要乐观并发控制。 | 多智能体执行需要分布式事务语义、三方 git 合并和 saga 回滚。 |
| 失败相关性 | 错误通过自我强化的幻觉,沿单一推理轨迹不断累积。 | 如果智能体共享相同的基础模型权重,则容易发生级联故障。 | 相同模型之间的同伴共识只是伪验证;验证需要确定性的外部检查。 |
无论任务是以单个反思循环运行,还是由二十个相互通信的工作进程组成集群来执行,正确性都只能通过在所有模型之外收集的 端到端边界的双重保证 端到端证据来确立。三个智能体反复批准彼此的代码修改,并不会产生这种证据。它们产生的是一个充斥相关错误的分布式回音室,节 5 对此进行了量化。
因此,架构边界十分明确。多智能体委派并非严格单智能体设计的通用替代方案,而是一种专门的并发机制,只有当上下文分区、权限削减或推测性并行搜索带来的收益显著超过串行化与协调合并开销时,才应部署。一旦工程工作负载满足这些条件,且委派权衡在数学上得到论证,运行时就必须放弃临时拼凑的通信方式,强制采用正式的协同结构。这立即引出了下一个结构性挑战:运行时应如何正式组织这些并发执行核心之间的通信通道、任务依赖和数据流路由?
协同拓扑
当一个缺乏协同的多智能体系统被初始化为任意的全连接对等网络,且未采用正式的通信拓扑时,其运行时就会退化为指数级消息风暴。在由 \(N\) 个无特权智能体组成的系统中,智能体通过不受约束的广播信道交换原始自然语言,潜在双向通信路径的数量按 \(\binom{N}{2} = \frac{N(N-1)}{2} = \mathcal{O}(N^2)\) 扩展。在每个交互步骤中,每个智能体都将其中间推理过程广播给所有对等智能体,迫使整个集群的输入提示词长度、注意力计算量以及键值(KV)缓存内存占用呈二次增长。在一个由八个智能体执行分布式代码重构任务的实证测试平台中,不受约束的对等拓扑在不到四分钟内产生了超过 240 条智能体间消息。该集群在冗余的提示词预填充过程中消耗了 180 万个词元,在共享文件上反复触发竞态条件,并最终因上下文窗口耗尽而停滞,未能提交任何一棵经过验证的语法树。
多智能体协同本质上是一项分布式图编译工作:运行时必须以正式的任务依赖有向无环图(DAG)取代不受约束的对话式闲聊,并严格依据计算工作负载的底层数据流依赖关系,在分层监督者—工作者、顺序线性流水线以及去中心化黑板或 Actor 拓扑之间作出选择。
拓扑约束: 不受约束的对话网状结构具有 \(\mathcal{O}(N^2)\) 个通信信道,提示词预填充量呈 \(\mathcal{O}(N^2)\) 增长。施加正式的 DAG 拓扑可将活跃通信边数减少至 \(\mathcal{O}(N)\) 或 \(\mathcal{O}(N \log N)\),从而限定上下文消耗并消除循环对话死锁。
在经典操作系统中,并发管理依赖于在进程、进程间通信(IPC)信道和同步原语之间建立清晰的抽象。在智能体机器学习运行时中,计算单元并非执行确定性 x86 指令的操作系统线程,而是进行自回归生成的基础模型实例。由于这些推理引擎具有非确定性生成、较高的单词元延迟,以及受内存带宽限制的解码循环等特征,协同拓扑决定了并发究竟能带来真正的并行加速,还是仅仅成倍增加通信与协调一致的开销。
协同拓扑分类
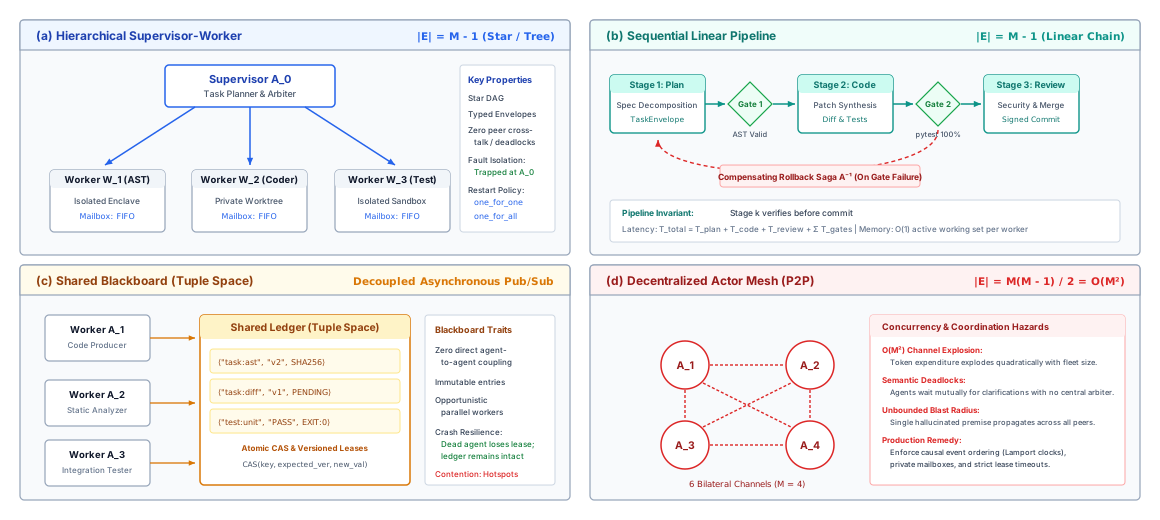
多智能体系统的架构设计始于选择一种能够反映目标应用数据流依赖关系的互连模式。如 图 1 所形式化描述的,分布式智能体运行时采用四种典型拓扑范式来组织执行: 在分层监督者—工作者模型(图 A)中,执行被组织为一棵有向星形树,根监督者 \(A_0\) 向隔离的工作者执行域(\(W_1, W_2, W_3\))分派带类型的任务封装,将通信边数严格限制在 \(|E| = M - 1\),同时捕获子节点异常。在顺序线性流水线(图 B)中,工作沿分阶段的 DAG 推进,确定性验证门(\(G_1, G_2\))在输出中间产物之前对其进行验证,并在失败时触发反向补偿性回滚 Saga(\(\mathcal{A}^{-1}\)),以防止错误污染下游。在共享黑板架构(图 C)中,并发工作者之间不存在双边耦合,完全通过针对集中式元组空间的原子比较并交换(CAS)事务来同步状态。最后,在去中心化 Actor 网状结构(图 D)中,不受约束的对等通信导致信道数量呈二次爆炸式增长(\(|E| = M(M-1)/2\)),造成严重的语义死锁、上下文稀释和无界故障传播风险。
分层监督者—工作者拓扑将智能体组织成显式的树结构。指定的根监督者接收顶层规范,将目标分解为独立子任务,向专门的下属工作者分派明确的任务封装,收集中间候选产物,并在综合形成全局结果之前强制执行外部验证门检查。该拓扑提供集中式状态跟踪,并为环境操作权限设立单一且定义明确的控制点:只有监督者具备向外部环境提交已验证状态转换的能力。工作者作为叶节点在隔离沙箱中执行,从而防止对共享资源进行未经协同的修改。
然而,层级拓扑存在一种严重的物理失效模式:协调器上下文瓶颈。随着工作智能体集群规模 \(N\) 扩大,或各个工作智能体返回大量执行日志、编译器诊断信息和差异块,监督智能体的工作上下文窗口 \(S_{\max}\) 会迅速饱和。监督智能体被迫摄取所有下属智能体输出的拼接结果:
\[S_{\text{supervisor}} = S_{\text{spec}} + \sum_{i=1}^N S_{\text{return}}(i)\]
当 \(S_{\text{supervisor}}\) 接近 GPU 服务引擎的硬件容量时,注意力预填充的内存需求和计算量呈二次增长,会大幅增加监督延迟。更具破坏性的是,监督智能体会出现注意力稀释,从而误解或忽略埋藏在下属工作智能体海量返回内容中的细微错误。此外,监督智能体还会成为串行化的单点:如果根智能体在自回归解码阶段停滞,或生成无法解析的调度信封,所有下游工作智能体都会因无任务可执行而陷入饥饿状态。
顺序线性流水线拓扑将执行组织为单向流水作业线(\(A_1 \to A_2 \to \dots \to A_k\)),其中,智能体 \(k\) 的已验证输出产物直接充当智能体 \(k+1\) 的输入上下文。这种架构非常适合具有严格时间串行约束的分阶段工程转换,例如将架构需求转换为代码、运行静态分析和代码检查工具、生成回归测试套件、执行安全审计,以及编译部署清单。
线性流水线在系统层面的主要优势是内存占用极低,并且在流式批处理任务中具有较高的运行吞吐量。由于流水线中的每个智能体都专门负责一个特定阶段,其系统提示词和工具定义始终保持精简。上游的中间推理轨迹可以完全丢弃;智能体 \(k+1\) 仅摄取智能体 \(k\) 生成的干净且经过验证的产物,从而彻底避免困扰层级监督智能体的上下文饱和问题。此外,由于流水线的每个阶段在连续处理各个批次条目时都使用相同且静态的系统提示词,服务引擎能够实现近乎完美的 KV 缓存前缀复用,将预填充计算成本分摊到各项工作负载上。
顺序流水线的弱点在于上游阶段停滞与错误传播。如果前面的某个阶段未能输出满足下游编译或代码检查要求的产物,整条流水线就会停滞。更糟糕的是,如果上游阶段生成了逃过静态检查的细微语义缺陷,下游智能体就会将该缺陷作为权威前提摄取。在缺乏双向反馈的流水线中,下游阶段若要请求上游修订,就必须引入反向控制边,从而将简单的线性流水线转变为具有复杂收敛动态的展开循环图。
去中心化黑板与 Actor模型直接借鉴分布式系统的基础文献,彻底消除了中心化协调器。在 Carl Hewitt、Peter Bishop 和 Richard Steiger(1973 年)形式化定义的 Actor 模型中,自主计算实体(actor)维护私有的本地状态,仅通过异步、带类型的消息传递队列(邮箱)进行通信,并根据消息动态创建新的 actor。在黑板架构中,并发工作智能体通过读写一个全局可见、仅允许追加的产物存储库进行间接交互。专门化智能体监控黑板,在前置产物出现时认领子任务,执行转换,并将经过验证的结果发布回黑板。
这些去中心化拓扑具有较高的动态可扩展性和故障韧性。系统中不存在上下文窗口可能饱和的中央监督智能体,单个工作智能体的故障也不会使整个集群停滞;其他工作智能体会继续处理黑板或其私有邮箱中可用的子任务。
去中心化拓扑面临的物理困境是锁争用、脑裂分歧和非确定性事件排序。由于智能体在没有中央仲裁者的情况下并发执行,两个工作智能体可能同时认领同一个子任务,或尝试对代码库中重叠的文件实施相互冲突的修改。在缺乏同步物理时钟的情况下,要解析异步智能体消息之间的因果依赖关系,就需要在运行时消息代理中实现 Lamport 逻辑时间戳或向量时钟(Leslie Lamport,1978 年)。如果没有严格的分布式锁机制或不可变的内容寻址产物存储,去中心化智能体集群就会迅速陷入脑裂状态:相互冲突的架构决策被提交到并行分支中,导致集成时产生巨大的协调合并开销。这四种拓扑的特性与权衡见 表 1。
| 协同拓扑 | 关键路径延迟 | 上下文与 KV 缓存占用 | 故障隔离与恢复 | 并发与冲突风险 | 最适合的工作负载类型 |
|---|---|---|---|---|---|
| 分层式监督者—工作者 | 低至中等;受监督者的串行阶段和最慢工作者的限制。 | 根节点占用高;随着 \(\mathcal{O}(N)\) 个工作者的返回结果不断累积,监督者的上下文窗口趋于饱和。 | 中等;工作者故障可被隔离,但监督者故障会使整棵树停滞。 | 低;集中式协调器将所有修改串行化,并在提交前进行验证。 | 探索性任务分解、多假设搜索、独立的缺陷修复。 |
| 顺序线性流水线 | 高;总完成时间严格串行(\(T_{\text{crit}} = \sum T_k\));无任务并行。 | 极低;每个阶段仅接收干净的产物;KV 缓存前缀共享程度高。 | 脆弱;阶段 \(k\) 的故障会使流水线停滞,或将无效上下文传播至下游。 | 零;执行按时间顺序进行;不存在并发写入冲突。 | 多阶段产物精炼、CI/CD 代码审查、文档综合生成。 |
| 共享黑板 | 低;随着黑板上的依赖得到满足,机会式并行得以展开。 | 分布式;使用共享内存或产物存储;工作者维护精简的私有上下文。 | 鲁棒;工作者崩溃不会破坏黑板;其他工作者可以重新认领任务。 | 高;并发工作者可能在共享产物上发生写入冲突和竞态条件。 | 异构分析、持续的代码仓库模糊测试、知识提取。 |
| 去中心化 Actor 网状结构 | 可变;由消息传递延迟和图同步点决定。 | 每个 Actor 的占用有界;邮箱异步缓冲带类型的任务信封。 | 高;Actor 故障被隔离在其私有邮箱内;监督树负责重启。 | 中等至高;需要因果事件排序(Lamport 时钟)和分布式租约。 | 开放式仿真、分布式定理证明、多领域系统建模。 |
将执行建模为任务依赖 DAG
为摆脱对话式消息传递的不可预测性,智能体运行时必须将多智能体执行建模为形式化的任务依赖有向无环图(DAG),记为 \(G = (V, E)\)。在这一形式化表述中,每个顶点 \(v_i \in V\) 表示一个离散的智能体计算单元:在显式输入上下文上执行一个专门化的基础模型实例,并受有限的 token 预算约束。每条有向边 \((v_i, v_j) \in E\) 表示不可变的数据依赖或控制依赖,规定任务 \(v_j\) 只有在任务 \(v_i\) 完成并输出经外部验证的产物后,才能被调度执行。
数据依赖与控制依赖: 数据依赖要求任务 \(v_j\) 必须获得任务 \(v_i\) 的实际输出字节(例如,由 \(v_i\) 生成并由 \(v_j\) 使用的头文件)。控制依赖在不传输原始产物的情况下强制规定执行顺序(例如,确保单元测试套件仅在编译器检查通过后运行)。
运行时调度器跟踪图中所有顶点的入度。当且仅当顶点 \(v_j\) 的入度满足以下条件时,该顶点才会被放入可运行任务队列:
\[\text{in-degree}(v_j) = |\{ v_i \in V \mid (v_i, v_j) \in E \}| = 0\]
当正在运行的任务 \(v_i\) 成功完成执行,且其输出通过确定性验证关卡(如编译器验证或 AST 验证)后,运行时将其输出产物持久化到内容寻址存储层。随后,调度器从活动图中移除 \(v_i\) 及其关联的出边,并将所有直接后继顶点的入度减一。任何入度降至零的后继顶点都会立即转为可运行状态,并被分派到可用的工作者核心。
智能体依赖 DAG 的理论性能由两个基本图属性决定:工作量和关键路径。总工作量 \(W(G)\) 是所有顶点消耗的计算时间之和:
\[W(G) = \sum_{v_i \in V} T(v_i)\]
其中,\(T(v_i)\) 表示顶点 \(v_i\) 的实际经过执行时间。对于自回归基础模型,\(T(v_i)\) 由对输入 token \(S_{\text{in}}\) 的预填充阶段、对生成 token \(K_{\text{out}}\) 的解码阶段,以及所有确定性工具调用(如执行测试套件)的耗时决定:
\[T(v_i) = \frac{S_{\text{in}}(v_i)}{R_{\text{prefill}}} + \frac{K_{\text{out}}(v_i)}{R_{\text{decode}}} + T_{\text{tool}}(v_i)\]
这里,\(R_{\text{prefill}}\)(每秒 token 数)在矩阵—矩阵乘法(GEMM)期间受 GPU 浮点计算能力的限制,而 \(R_{\text{decode}}\) 在自回归矩阵—向量生成(GEMV)期间则严格受内存带宽限制。
关键路径 \(\Pi_{\text{crit}}\) 是 \(G\) 中从任意源节点到任意汇节点的、由相互依赖的顶点组成的最长有向序列:
\[\Pi_{\text{crit}} = \arg\max_{\Pi \in \text{Paths}(G)} \sum_{v \in \Pi} T(v)\]
关键路径完工时间定义为 \(T_{\text{crit}} = \sum_{v \in \Pi_{\text{crit}}} T(v)\),表示全局执行时间的严格物理下界。无论运行时配置四个、十六个还是无限多个并行工作智能体,工作负载的完成时间都不可能小于 \(T_{\text{crit}}\)。
当依赖图包含扇出结构,即单个父任务派生出多个相互独立的子顶点(\(v_1 \to \{v_2, v_3, \dots, v_m\}\))时,就会产生并行加速。图所支持的最大瞬时并行度由其宽度 \(\mathcal{W}(G)\) 定义,表示独立顶点割的最大规模。如果配置的工作智能体数量 \(P\) 小于图的宽度(\(P < \mathcal{W}(G)\)),调度器就必须根据可运行顶点到汇点的剩余距离确定其优先级,优先调度位于关键路径上的顶点,以避免调度气泡。
粗略估算 0.2: 多智能体执行中的 DAG 调度
这些任务具有以下依赖关系和硬件执行参数:
任务 \(v_1\)(系统架构规格说明):根节点。\(S_{\text{in}} = 2{,}000\) 个词元,\(K_{\text{out}} = 1{,}600\) 个词元,\(T_{\text{tool}} = 0\text{ s}\)。 \[T(v_1) = \frac{2{,}000}{4{,}000} + \frac{1{,}600}{80} + 0 = 0.5 + 20.0 = 20.5\text{ s}.\]
任务 \(v_2, v_3, v_4\)(独立模块重构):\(v_1\) 的子节点。这些任务构成并行扇出分支,分别处理不同的代码模块。每个任务接收来自 \(v_1\) 的 1,600 个词元的规格说明,加上 6,400 个词元的模块代码(\(S_{\text{in}} = 8{,}000\) 个词元),生成 \(K_{\text{out}} = 2{,}400\) 个词元的代码差异,并执行本地编译器检查(\(T_{\text{tool}} = 10.0\text{ s}\)): \[T(v_2) = T(v_3) = T(v_4) = \frac{8{,}000}{4{,}000} + \frac{2{,}400}{80} + 10.0 = 2.0 + 30.0 + 10.0 = 42.0\text{ s}.\]
任务 \(v_5\)(安全与漏洞审计):\(v_2\) 和 \(v_3\) 的子节点。接收两个模块的补丁(\(S_{\text{in}} = 12{,}000\) 个词元),生成 \(K_{\text{out}} = 1{,}200\) 个词元的审计记录,并运行静态分析模糊测试器(\(T_{\text{tool}} = 25.0\text{ s}\)): \[T(v_5) = \frac{12{,}000}{4{,}000} + \frac{1{,}200}{80} + 25.0 = 3.0 + 15.0 + 25.0 = 43.0\text{ s}.\]
任务 \(v_6\)(集成绑定生成):\(v_4\) 的子节点。接收来自 \(v_4\) 的补丁(\(S_{\text{in}} = 6{,}000\) 个词元),生成 \(K_{\text{out}} = 800\) 个词元,并验证接口签名(\(T_{\text{tool}} = 5.0\text{ s}\)): \[T(v_6) = \frac{6{,}000}{4{,}000} + \frac{800}{80} + 5.0 = 1.5 + 10.0 + 5.0 = 16.5\text{ s}.\]
任务 \(v_7\)(全局集成、链接与回归测试套件):汇节点;依赖于 \(v_5\) 和 \(v_6\)。接收所有候选补丁(\(S_{\text{in}} = 16{,}000\) 个词元),生成最终合并元数据(\(K_{\text{out}} = 400\) 个词元),并执行端到端集成测试套件(\(T_{\text{tool}} = 60.0\text{ s}\)): \[T(v_7) = \frac{16{,}000}{4{,}000} + \frac{400}{80} + 60.0 = 4.0 + 5.0 + 60.0 = 69.0\text{ s}.\]
步骤 1:总工作量计算。 整个工作负载的累计计算与执行工作量为: \[W(G) = \sum_{i=1}^7 T(v_i) = 20.5 + 42.0 + 42.0 + 42.0 + 43.0 + 16.5 + 69.0 = 275.0\text{ seconds}.\] 如果在单个工作智能体上顺序执行,最短完工时间为 \(T_{\text{seq}} = 275.0\text{ seconds}\)。
步骤 2:关键路径确定。 我们追踪从源点 \(v_1\) 到汇点 \(v_7\) 的所有路径:
路径 1:\(v_1 \to v_2 \to v_5 \to v_7\) \[\text{Length}(\text{Path 1}) = 20.5 + 42.0 + 43.0 + 69.0 = 174.5\text{ seconds}.\]
路径 2:\(v_1 \to v_3 \to v_5 \to v_7\) \[\text{Length}(\text{Path 2}) = 20.5 + 42.0 + 43.0 + 69.0 = 174.5\text{ seconds}.\]
路径 3:\(v_1 \to v_4 \to v_6 \to v_7\) \[\text{Length}(\text{Path 3}) = 20.5 + 42.0 + 16.5 + 69.0 = 148.0\text{ seconds}.\]
关键路径为 \(\Pi_{\text{crit}} = v_1 \to v_2 \to v_5 \to v_7\)(与路径 2 并列),由此确定关键路径对应的总完成时间为 \(T_{\text{crit}} = 174.5\text{ seconds}\)。
步骤 3:使用 \(P=4\) 个工作进程的调度分析。 在 \(t = 0\text{ s}\) 时,只有 \(v_1\) 可运行;工作进程 1 执行 \(v_1\),而工作进程 2、3 和 4 处于空闲状态。 在 \(t = 20.5\text{ s}\) 时,\(v_1\) 完成。顶点 \(v_2, v_3, v_4\) 同时变为可运行状态。工作进程 1、2 和 3 并发领取这些任务。工作进程 4 仍处于空闲状态,因为此时图的宽度为 \(\mathcal{W} = 3\)。 在 \(t = 20.5 + 42.0 = 62.5\text{ s}\) 时,三个重构任务全部完成。此时,\(v_5\)(需要 \(v_2\) 和 \(v_3\) 均已完成)和 \(v_6\)(需要 \(v_4\) 已完成)变为可运行状态。工作进程 1 领取 \(v_5\),工作进程 2 领取 \(v_6\)。 在 \(t = 62.5 + 16.5 = 79.0\text{ s}\) 时,\(v_6\) 完成。然而,汇点 \(v_7\) 无法执行,因为它的另一个依赖项 \(v_5\) 仍在工作进程 1 上执行。工作进程 2 进入同步等待造成的空闲间隙。 在 \(t = 62.5 + 43.0 = 105.5\text{ s}\) 时,\(v_5\) 完成。\(v_7\) 的两个依赖条件均已满足。工作进程 1 执行 \(v_7\),并于 \(t = 105.5 + 69.0 = 174.5\text{ s}\) 完成。
由于 \(P=4 \ge \max(\mathcal{W}(G))\),实际执行时间达到关键路径所确定的极限:\(T_{\text{parallel}} = 174.5\text{ seconds}\)。由此得到的并行加速比为: \[\mathcal{S} = \frac{T_{\text{seq}}}{T_{\text{parallel}}} = \frac{275.0\text{ s}}{174.5\text{ s}} \approx 1.58\times.\] 尽管部署了四个并行 GPU 工作进程,加速比仍受限于 \(1.58\times\)。其余计算容量因顺序依赖(\(v_1\) 和 \(v_7\)),以及在 \(v_5\) 和 \(v_7\) 处等待汇合同步时出现的工作进程空闲间隙而未能利用。
动态拓扑生成
运行时设计中的一个核心架构决策是:多智能体依赖图应提前静态编译,还是在执行过程中动态生成。
在静态拓扑中,执行图 \(G\) 在启动工作负载之前就已完整声明并编译。开发者或编译工具链指定确切的智能体角色集合、各角色专用的系统提示词、可用工具集以及固定的依赖边。采用严格固定的多阶段流程的持续集成流水线、确定性的编译器验证框架等系统,均在静态拓扑下运行。
静态拓扑具有显著的系统优势: 首先,它支持确定性的编译期分析。运行时可以验证依赖图严格无环,校验每条边所连接的输入与输出模式在类型上兼容,并预先计算最坏情况下的 token 消耗。 其次,静态图支持大幅度的系统级优化。服务引擎可以在物理 GPU 内存中预加载并固定每个已调度智能体的系统提示词 KV 缓存,从而在任务触发时实现即时、零开销的上下文初始化。 第三,调度算法可以将顶点静态映射到特定硬件设备,以最大限度地降低 GPU 间通信延迟,并均衡内存消耗。
静态拓扑的致命局限在于,它无法适应运行时通过实际执行发现的新情况。软件工程工作负载本质上具有非确定性:一个被定位到单个文件中的缺陷,可能在执行测试后暴露出另外三个尚未映射的子系统中深层的架构缺陷。静态拓扑既无法动态实例化额外的子智能体来调查意外出现的回归问题,也无法在早期断言证实某个设计假设无效时,动态裁剪整个执行分支。
在动态拓扑中,智能体根据中间执行反馈,在运行时以编程方式生成子智能体。执行代码仓库重构的智能体可以调用宿主运行时工具(例如 invoke_subagent),并提供定制的任务提示词、限定范围的文件路径以及受限的能力范围。运行时动态实例化一个新的子智能体进程,在当前执行图中注册一个新顶点和一条依赖边,并将该子智能体调度到可用的工作进程槽位上。
动态拓扑提供了无可比拟的灵活性,使智能体系统能够动态调整其计算分解方式,精确匹配问题的结构特征。如果子智能体发现某个遗留模块依赖未记录在文档中的 RPC 接口,它可以动态派生一个辅助研究智能体来检查网络跟踪记录,而不污染自身的工作上下文。
然而,动态派生会引入严重的系统风险,可能迅速破坏宿主运行时的稳定性,其层次结构如 表 2 所示:
| 派生深度 | 智能体实体 | 传入的委派调用 | 分配的 token 预算 | 安全与衰减不变量 |
|---|---|---|---|---|
| 第 0 层(根) | 父级监督者(\(A_0\)) | 初始任务提交 | \(B_0\) 个 token | 持有主任务租约和全局取消上下文。 |
| 第 1 层(子) | 工作智能体(\(A_1\)) | fork_agent(prompt, B_1) |
\(B_1 < B_0\) 个 token | 预算严格衰减(\(B_1 \le \alpha \cdot B_0\)、\(\alpha < 1\));继承父级取消上下文。 |
| 第 2 层(孙) | 专用叶节点(\(A_2\)) | fork_agent(prompt, B_2) |
\(B_2 < B_1\) 个 token | 强制执行深度限制(\(D \le D_{\max}\));拒绝进一步的递归派生尝试(EPERM)。 |
首要风险是智能体派生炸弹。如果允许无特权的基础模型在没有严格运行时约束的情况下递归派生子智能体,非确定性的推理循环就可能引发进程数量的指数级爆炸。智能体遇到含义不明确的编译器错误时,可能会派生三个子智能体来调查不同的假设;每个子智能体在遇到次生错误时,又各自派生三个子智能体。短短几分钟内,集群便会派生出数百个并发进程,占满 GPU 显存、耗尽操作系统进程表,并在毫无进展的情况下消耗数百万个 token。
第二个风险是产生孤儿僵尸智能体。如果父智能体遇到未处理的异常、因用户中断而被取消,或在其动态派生的子智能体仍在执行时耗尽 token 预算,这些子智能体就会继续在后台进程中运行。这些孤儿智能体持续消耗 GPU 计算周期,并对沙箱环境执行修改操作,浪费资源,还可能与用户后续操作产生竞态条件。
为了管控动态拓扑,宿主运行时必须强制执行三项严格的架构不变量:
有界递归深度:运行时监督者必须对委派深度施加强制性的全局上限(\(D \le D_{\max}\),通常为 \(D_{\max} \in [1, 2]\))。任何试图在深度 \(D_{\max}\) 处派生子智能体的工具调用,都必须由运行时拒绝,并返回明确的授权错误。
严格预算衰减:动态派生的子智能体绝不能获得无上限的计算资源配额。其 token 预算 \(B_{\text{child}}\) 和执行超时额度必须严格从父智能体的剩余预算中划分并扣除: \[B_{\text{remaining\_parent}} \leftarrow B_{\text{current\_parent}} - B_{\text{child}}\] 在这一守恒定律下,无论实例化多少个动态子智能体,智能体集群都无法超出用户设定的全局资源限额。
进程组监督树:动态派生的智能体必须注册到与父智能体生命周期直接绑定的操作系统进程组或容器命名空间中。如果父智能体终止、发生故障或收到取消信号,宿主监督者会以原子方式将终止信号(
SIGKILL或容器取消 RPC)向下传播至整个进程子树,立即回收 GPU 显存并防止孤儿进程继续执行。
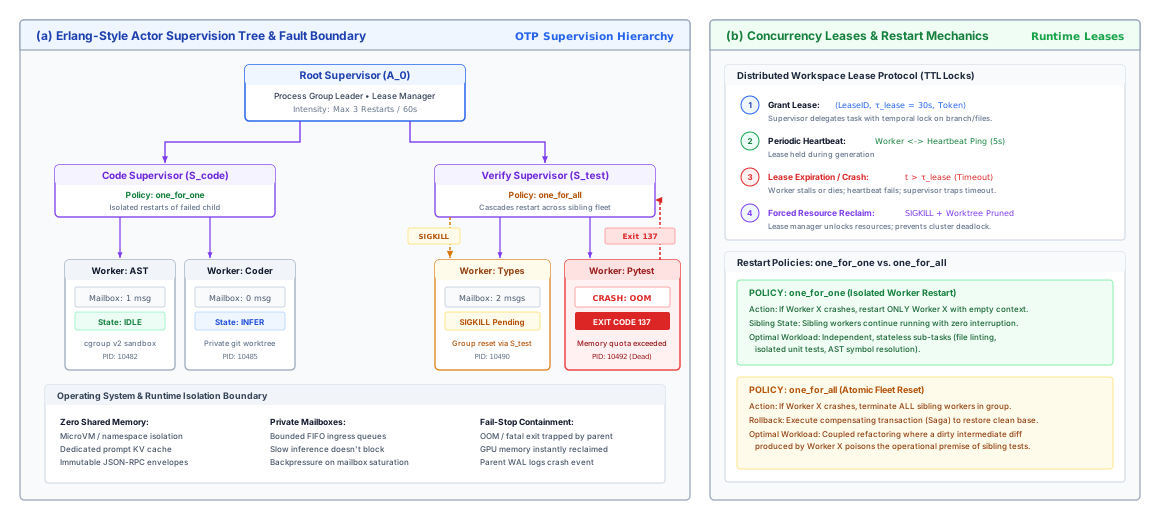
one_for_one 与 one_for_all);面板 B 详细展示了有时限的租约协议(\(\tau_{\text{lease}}\))和心跳生命周期,它们确保在智能体发生故障时以确定性方式回收资源。
如 图 2 中所形式化的那样,可靠的智能体运行时在两个紧密耦合的子系统之间实现故障隔离。在面板 A 中,受 Erlang/OTP 启发的监督树在根监督器 \(A_0\) 下划分执行单元,根监督器对重启频率施加上限(例如,每 60 秒最多重启 3 次),以防止无限的反复重启循环。代码监督器 \(S_{\text{code}}\) 使用 one_for_one 重启策略管理独立的工作进程:如果 AST 工作进程崩溃,则只重启该工作进程,并为其提供全新的内存上下文,使编码工作进程能够继续运行而不受干扰。相比之下,验证监督器 \(S_{\text{test}}\) 对耦合任务采用 one_for_all 策略:当 Pytest 工作进程因内存耗尽而发生未处理的崩溃(退出码 137)时,\(S_{\text{test}}\) 在内核命名空间边界拦截 SIGCHLD 信号,并以原子方式向同级的类型检查工作进程发送 SIGKILL,确保部分执行且已受污染的类型检查状态不会污染下游验证。在面板 B 中,分布式租约管理器通过授予显式执行租约(\(\tau_{\text{lease}} = 30\text{s}\)),并以每 5 秒一次的心跳探测验证租约,防范智能体挂起和僵尸计算;如果工作进程在自回归生成期间挂起或心跳检测失败,宿主监督器就会强制回收 GPU 内存并清理工作树目录。
通过将通信拓扑形式化为显式的依赖 DAG,并对静态图和动态派生过程强制实施严格的结构不变量,运行时将多智能体执行从混乱无常的对话风暴转变为可靠的分布式计算。然而,定义任务图的拓扑边只解决了协同契约的一半。一旦在父节点与子节点之间,或在两个流水线阶段之间建立了一条边,运行时就必须管理沿该边传输的实际数据。
Checkpoint 0.1: 评估多智能体协同拓扑
在考察类型化任务信封和跨智能体契约之前,请检验你对委派权衡的理解:
类型化任务信封
当编排器通过发出非结构化自然语言来委派子任务时,例如将 "Please inspect the failing tests in the authentication module, fix the regression, and make sure the documentation matches" 追加到共享对话上下文中,它就放弃了确定性的系统控制。在不受约束的对话交接中,下游模型接收不到具有权威性的边界标记。它必须推断哪个代码仓库提交代表权威源状态,猜测自己是否有权修改数据库迁移脚本,自行假定资源限制,并自行制定停止条件。随着执行深度在智能体委派图中不断增加,这种对话歧义会引发认知可靠性的快速退化:初始提示词中的细微遗漏会产生级联效应,导致约束丢失、无依据的幻觉,以及宿主环境中无声的状态损坏。
Saltzer 和 Kaashoek 阐述的模块化分解基本原则要求,模块接口应隐藏内部实现细节,同时在数学上显式定义跨边界的前置条件、后置条件和资源绑定。非结构化对话提示词将控制信号与载荷数据混为一谈,违反了这一模块化原则。
防范对话退化的系统措施,是将类型化动作契约(原则 8)从模型与工具之间的调用扩展到智能体之间的交接,并将其形式化为类型化远程过程调用。 直接借鉴 Birrell 和 Nelson (1984年) 确立的经典 RPC 架构,分布式智能体运行时不能依赖共享对话记忆。沿任务依赖边进行的每一次委派,都必须编组为显式且经过模式验证的任务信封;在调度下游智能体执行循环之前,该信封必须完整指定身份、不可变输入、委派能力、资源预算,以及可由机器检查的完成断言。
Definition 0.1: 类型化任务信封
Systems Perspective 0.1: 对话式协同的谬误
当多个随机性模型通过开放式自然语言记录进行协同时,运行时会立即遭遇协议与载荷纠缠。控制信号、工具调用、错误流和主观的对话独白被展平为单一文本流。这会破坏权限分离,使宿主监督器无法强制实施严格的能力边界或验证任务契约。此外,在相互交互的智能体之间复制对话历史会引发二次方级的上下文扩张(\(O(N^2)\) token 开销),使加速器内存充斥着对话客套话和推测性想法,而这些内容无法产生任何可执行的状态转换。
更关键的是,对话交接会导致约束快速稀释和拜占庭错误放大。随着序列长度增加,Transformer 的注意力分散到数千个 token 上,淹没了否定性约束和结构不变量。由于基础模型具有共同的架构偏差和预训练语料,同伴辩论无法提供独立验证;模型经常陷入迎合式共识,相互放大并确认彼此的幻觉,而非发现错误。可靠的分布式系统需要以经典系统工程取代对话闲聊:类型化远程过程调用(RPC)、不可变的模式化信封、有向无环依赖图(DAG)、密码学能力令牌,以及确定性验证关卡。智能体绝不能通过“聊天”进行协同;它们必须跨隔离的执行边界交换结构化、可由机器验证的数据包。
对话交接的失效模式
在早期多智能体原型中,协同通常通过仅追加的对话记录实现:监督模型通过向单一共享上下文窗口追加自然语言指令,与专门的工作模型交互。这种对话范式经不起物理系统层面的审视。主要的运行失效是上下文压力下的语义漂移。当多个智能体将推理轨迹、工具输出和对话客套话追加到共享序列中时,有效信噪比就会下降。由于 Transformer 注意力会在整个序列长度 \(S\) 上分配非零概率质量,三个轮次之前表述的软性否定约束(例如 "do not modify the production schema")经常被其间数千个原始静态检查器输出 token 和推测性思维链 token 淹没。
FAILED: tests/auth/test_token.py::test_signature_verification - AssertionError:
Expected algorithm ES256, received None.
Hint: Upstream agent omitted 'cryptography' dependency in requirements.txt.
上述失败轨迹凸显了架构层面的失效。接收到非结构化指令的工作智能体不可避免地会自行编造缺失的操作参数。由于缺少明确指定输入文件的模式,工作智能体会在无关的子目录树中发起试探性的文件系统查询。由于缺少明确的执行租约,它会修改超出预定操作范围的配置文件。由于缺少可由机器检查的完成标准,它会通过自回归式自我评估来决定何时终止——输出诸如 "I have verified the code and it is correct" 之类的表述——即使底层容器中的单元测试仍未通过。非结构化对话提示与类型化远程执行封装之间的架构差异对比见 表 3。
| 操作维度 | 对话式交接(聊天范式) | 类型化任务封装(RPC 范式) |
|---|---|---|
| 接口定义 | 带有临时性指令的自然语言提示 | 经过形式化验证的 JSON Schema 或 Protocol Buffer |
| 参数编组 | 拼接到提示上下文中的原始文本 | 带有内容寻址存储 URI 的强类型字段 |
| 状态传播 | 按值传递(文件转储内容直接嵌入上下文) | 按引用传递(不可变的密码学哈希值和指针) |
| 权限边界 | 从模型指令中推断出的隐式权限 | 经密码学签名且权限受限的能力令牌 |
| 资源上限 | 隐式的模型上下文窗口(\(S_{\max}\)) | 显式预算向量:词元数、工具调用次数和实际时间超时限额 |
| 完成不变量 | 模型生成的自我评估("Task complete") |
确定性的外部验证谓词(\(V(a) \to \{0, 1\}\)) |
要以可靠的系统执行取代这种脆弱的对话机制,运行时必须强制遵守远程任务调用不变量:智能体绝不可通过拼接对话提示来调用另一个智能体;它只能实例化一个强类型、完全隔离且依据权威运行时模式完成验证的任务封装。
五部分任务封装规范
稳健的智能体远程过程调用由一个五元组定义:
\[\mathcal{E} = \left\langle \mathcal{M}, \mathcal{R}_{\text{in}}, \mathcal{C}_{\text{delegated}}, \mathcal{B}, \mathcal{S}_{\text{verify}} \right\rangle\]
封装中的每个元素都针对一种特定的分布式故障模式,确保子智能体运行时恰好拥有执行其有界子计算所需的信息和权限,且不超出这一范围。
{
  "task_id": "task-9842a-refactor-auth",
  "parent_id": "agent-root-supervisor",
  "deadline": "2026-09-19T14:32:00Z",
  "timeout_seconds": 120,
  "contract": {
    "objective": "Migrate legacy HMAC-SHA1 signature verification to ES256",
    "declared_inputs": ["repo:git-at-github:org/auth.git@ref/c84fa"],
    "expected_outputs": ["patch:git-diff", "verification:junit-xml"]
  },
  "resource_bounds": {
    "token_budget": 16384,
    "capability_token": "Cap[Scope: /workspace/src/auth, Net: NONE, Time: 120]"
  },
  "validation_oracles": {
    "acceptance_test": "pytest tests/auth/test_token.py::test_es256",
    "static_analysis": "mypy --strict src/auth"
  }
}
类型化任务封装的结构剖析。宿主运行时在入口和出口处均强制执行验证。
任务元数据(\(\mathcal{M}\))
任务元数据在整个执行 DAG 中建立分布式追踪和因果谱系。它包含:
task_id:通用唯一标识符(UUIDv7),用于确保时间顺序和幂等性。parent_id:委派任务的监督者或上游流水线阶段的标识符。trace_context:遵循 W3C Trace Context 规范的分布式追踪状态(涵盖trace_id和span_id)。这使宿主运行时能够在深度嵌套的智能体层级中关联 token 消耗、延迟特征和工具调用。
不可变输入引用(\(\mathcal{R}_{\text{in}}\))
输入引用块将智能体的计算锚定到物理世界的一个精确、冻结的快照。智能体不被允许读取可变的本地指针,而是由 \(\mathcal{R}_{\text{in}}\) 指定:
workspace_snapshot:不可变的内容寻址存储指针,例如 Git 树 SHA(git:commit:a4f8c9b)或 S3 对象哈希(s3://artifacts/blobs/sha256:e3b0c44...)。manifest_uris:由显式路径或 URI 组成的数组,用于指定待分析或修改的权威工件。
通过提供内容寻址引用,运行时保证处理同一任务封装的两个工作智能体观察到逐比特完全相同的输入状态,从而消除父进程中并发写入导致的不可复现的竞态条件。
委派能力令牌(\(\mathcal{C}_{\text{delegated}}\))
遵循最小权限原则,子智能体绝不能继承父智能体的环境权限。能力令牌定义了一份权限收窄的授权租约,其约束由宿主运行时的工具拦截层强制执行,而非依赖模型的自我约束:
filesystem_scope:允许访问的目录前缀白名单(例如["/src/auth/"]),并绝对禁止对受保护的基础设施进行写入(例如["/.github/", "/infra/"])。network_egress:用于限制外部通信的二元网络标志和域名白名单。permitted_tools:子智能体获准调用的工具端点的确切子集(例如,允许调用bash_run来处理pytest,但撤销git_push和aws_deploy的调用权限)。
资源预算上限(\(\mathcal{B}\))
不受约束的自回归解码循环和异常的工具重试循环可能迅速消耗数百万 token,并耗尽基础设施配额。预算向量 \(\mathcal{B}\) 强制设定硬性上限:
\[\mathcal{B} = \left( K_{\max}^{\text{input}}, K_{\max}^{\text{output}}, \tau_{\max}, N_{\max}^{\text{calls}}, D_{\max}^{\text{cost}} \right)\]
其中,\(K_{\max}\) 表示提示和生成的最大 token 数,\(\tau_{\max}\) 指定以秒为单位的实际经过时间超时限制,\(N_{\max}^{\text{calls}}\) 表示工具执行的最大往返次数,\(D_{\max}^{\text{cost}}\) 定义以美元计的硬性金额阈值。如果 \(\mathcal{B}\) 中的任何标量阈值被突破,宿主监督者就会通过类型化的 RESOURCE_EXHAUSTED 异常立即终止智能体的解码循环,防止执行失控。
完成验证模式(\(\mathcal{S}_{\text{verify}}\))
任务封装绝不能接受以自然语言作出的完成声明。它应将确定性验证函数 \(V: \text{Artifacts} \to \{0, 1\}\) 参数化。该模式规定:
代码 1 展示了用于身份验证修复的任务封装。每个字段都封堵一处风险敞口或确立一项不变量:输入被固定到一个快照,授予的工具仅允许读取此次修复涉及的文件,分支被隔离,预算则限定工作智能体可消耗的资源。
{
  "task_id": "task-9842a-refactor-auth",
  "parent_id": "agent-root-coordinator",
  "trace": {"trace_id": "7f3c...", "parent_span_id": "a41e..."},
  "objective": "Migrate HMAC-SHA1 signature verification to ES256",
  "inputs": {
    "workspace": "git:commit:c84fa21",
    "paths": ["src/auth/", "tests/auth/"]
  },
  "authority": {
    "tools": ["read_file", "edit_file", "run_tests"],
    "write_scope": ["src/auth/"],
    "network": "none"
  },
  "budget": {"input_tokens": 200000, "output_tokens": 16384,
             "tool_calls": 60, "wall_clock_s": 900},
  "completion": {
    "tests": "pytest tests/auth/test_token.py::test_es256",
    "static": "mypy --strict src/auth",
    "forbidden": ["deleted test functions", "edits outside write_scope"]
  }
}required_exit_codes:必须以返回码零退出的确定性命令(例如,pytest tests/auth/test_token.py -v)。structural_contract:生成的输出产物必须满足的 JSON Schema 或抽象语法树(AST)约束。forbidden_diff_patterns:由宿主验证的否定断言(例如,确保没有删除任何一行测试代码来使测试套件通过)。
# Empirical verification harness executed by the host runtime upon task return
def verify_task_completion(envelope: TaskEnvelope, receipt: TaskReceipt) -> bool:
    if receipt.exit_code != 0:
        return False
    if any(p in receipt.mutated_paths for p in envelope.capabilities.denied_paths):
        raise SecurityViolation("Agent mutated paths outside delegated capability")
return run_host_verification_command(envelope.verification.assertion_cmd) == 0下游智能体严格通过带类型的任务回执向监督智能体报告任务终止。回执与任务封装相对应:其中包含最初的 task_id、变更后的提交 SHA、结构化输出工件数组、已消耗资源的度量指标,以及验证框架的执行日志。如果验证框架运行失败,任务回执将被标记为失败状态,从而触发监督智能体的恢复或重试策略。
传递引用,而非内容
将相关代码粘贴到每个子智能体提示词中的协调器,需要为每个子智能体分别支付一次费用。假设 6 个工作智能体各自都需要理解代码仓库中一段包含 48,000 个词元的内容,但每个智能体只会操作少数几个文件。将这段内容粘贴到每个任务信封中,会在任何工作开始之前发送 6 \(\times\) 48,000 = 288,000 个输入词元,每次任务派发的成本为 $0.86,这里采用的示例价格为每百万输入词元 $3。改为传递引用时,每个任务信封仅需约 350 个词元;随后,每个工作智能体通过自身工具读取所需的三个左右的文件,约 3,600 个词元。整个集群读取 6 \(\times\) 3,950 = 23,700 个词元,减少约 12×,费用为 $0.07。节省的不只是金钱。按需读取内容的子智能体从一个精简且相关的上下文开始,而不必在庞大的上下文中搜索;这正是最初拆分任务时所追求的上下文隔离。
引用还有第二个好处。任务信封指向同一个固定快照,且子智能体在上下文开头共享相同的系统提示词和工具定义,这使服务系统能够在子智能体之间复用缓存的前缀(编排下一次调用)。将易变内容粘贴在稳定内容之前,会在每次调用时破坏这种复用。
编组语义
在设计智能体之间的数据交接时,系统工程师面临一种架构选择,类似于编程语言中的调用约定:状态应按值传递,还是按引用传递?
在按值传递架构中,委派智能体将所有相关文件的完整文本、环境变量和诊断日志直接编组到子智能体任务信封的提示词载荷中。在按引用传递架构中,任务信封仅携带轻量且不可变的指针——按内容寻址的 Git 提交哈希、数据库事务 ID 或对象存储 URI——以及访问凭据。工作智能体运行时按需解析这些引用,通过局部工具调用获取特定的字节范围。
在现代加速器硬件上,按值传递状态会造成灾难性的资源开销。现代大语言模型运行于受高带宽内存(HBM)容量和内存总线带宽限制的加速器内存架构之上。当数千行源代码和依赖清单被序列化到子智能体的提示词上下文中时,主机必须在预填充阶段执行大规模矩阵乘法(\(\mathcal{O}(S^2)\),或在优化的注意力机制下为 \(\mathcal{O}(S \cdot D)\)),随后分配大量 KV 缓存;这些缓存会在整个解码期间持续驻留于加速器的 HBM 中。
在预填充阶段,内存带宽需求主要来自模型权重的加载: \[\text{Time}_{\text{prefill}} \approx \frac{2 \cdot P \cdot S}{\text{Memory Bandwidth}}\] 其中,\(P\) 为参数数量,\(S\) 为序列长度。用原始文件转储内容扩大 \(S\),会严重限制服务吞吐量。
运行时在返回路径上依据契约检查子智能体的返回结果,其严格程度与派发路径上对任务信封的检查相同。代码 2 展示了接受任何回执之前执行的检查。
def accept_receipt(envelope, receipt) -> bool:
    changed = receipt.changed_paths
    if not all(in_scope(p, envelope.authority.write_scope) for p in changed):
        raise ScopeViolation(receipt.task_id, changed)
    if receipt.summary_tokens > envelope.return_budget_tokens:
        receipt.summary = truncate(receipt.summary, envelope.return_budget_tokens)
    return run_checks(envelope.completion, commit=receipt.commit) == PASS
粗略估算 0.3: 任务委派中的上下文解吸
考虑一个编排器,将一项重构任务委派给由 \(W = 6\) 个工作智能体组成的集群。目标代码仓库的工作集包含 40 个源文件,共计 \(S_{\text{files}} = 48\text{,}000\) 个 BPE token。监督器要求每个工作智能体分析一个不同的模块,同时观察代码仓库状态。
场景 A:按值传递编组。 监督器将完整的 48,000 token 代码仓库上下文内联到每个工作智能体的任务封装的提示载荷中。
向整个集群广播的上下文总量: \[S_{\text{total}} = W \times S_{\text{files}} = 6 \times 48\text{,}000 = 288\text{,}000 \text{ tokens}\]
每个工作智能体的 KV 缓存分配量: 假设使用一个以 16 位精度(\(\text{FP16}\))运行的 700 亿参数模型,其层数为 \(L = 80\),隐藏维度为 \(D = 8\text{,}192\),并采用分组查询注意力(\(n_{\text{kv\_heads}} = 8\),\(d_{\text{head}} = 128\)): \[\text{Bytes per Token} = 2 \times L \times n_{\text{kv\_heads}} \times d_{\text{head}} \times 2 \text{ bytes} = 327\text{,}680 \text{ bytes/token} \approx 320 \text{ KB/token}\] 对于单个工作智能体的输入序列(\(48\text{,}000\) 个 token): \[\text{HBM}_{\text{worker}} = 48\text{,}000 \times 320 \text{ KB} \approx 15.36 \text{ GB}\] 对于全部 \(W = 6\) 个工作智能体,推理资源池必须分配: \[\text{HBM}_{\text{cluster}} = 6 \times 15.36 \text{ GB} = 92.16 \text{ GB}\] 仅用于在生成开始前保存这些重复的只读静态上下文。
计算与延迟成本: 按标准 API 服务费率($3.00 per million input tokens), broadcasting the inputs costs \(\$0.864\),每次派发。在一块 80 GB H100 GPU 上处理 48,000 token 的预填充(有效预填充吞吐量为 \(3\text{,}200 \text{ tokens/sec}\))会产生如下首 token 时间(TTFT)延迟开销: \[\text{TTFT} \approx \frac{48\text{,}000}{3\text{,}200} = 15.0 \text{ seconds}\]
场景 B:按引用传递编组。 监督器生成一个带类型的任务封装,指定代码仓库的不可变 Git 树哈希(commit_sha: 9b2d8f1)、具体的模块入口点(src/auth/service.py)以及一个权限受限的能力令牌。
序列化后的任务封装恰好占用 \(S_{\text{envelope}} = 350\) 个 token。
对于全部 \(W = 6\) 个工作智能体,派发的输入 token 总数为: \[S_{\text{total}} = 6 \times 350 = 2\text{,}100 \text{ tokens}\] 这意味着网络传输量和加速器上下文摄入量减少了 \(137\times\)。
每个工作智能体的初始 KV 缓存分配量: \[\text{HBM}_{\text{worker}} = 350 \times 320 \text{ KB} \approx 112 \text{ MB} \quad (\text{versus } 15.36 \text{ GB})\]
按需状态检索: 每个工作智能体利用其权限收窄后的文件系统能力,仅仅读取与其任务相关的特定文件(平均为 3 个文件,即 \(3\text{,}600\) 个 token)。 \[\text{Total HBM utilized per worker} \approx 3\text{,}950 \times 320 \text{ KB} \approx 1.26 \text{ GB}\] 整个集群的输入 token 总成本从 \(\$0.864\) to \(\$0.071\) 下降,同时 TTFT 从 \(15.0\) 秒降至 \(120\) 毫秒以下。
按引用传递编组强制将控制平面与数据平面明确分离。控制平面——即编排器的任务封装和依赖图——传输轻量、高度结构化且带类型的元数据。数据平面——即底层文件系统、代码仓库或对象存储——使用高吞吐量、低成本且针对随机访问和增量压缩优化的存储引擎来管理大批量字节数据。
此外,按引用传递还保护了服务基础设施中的缓存局部性。当智能体共享同一个不可变快照引用时,配备基数树或前缀缓存引擎的高级服务运行时可以跨多个任务保留代码仓库根索引的物理内存页框。相反,按值传递的交接将易变的对话历史与静态代码文件拼接在一起,每一轮都会使提示前缀哈希失效,从而破坏前缀缓存机制,并迫使整个 GPU 集群执行冗余的矩阵重新计算。该带类型交接流水线的离散生命周期状态转换详见 表 4。
| 流水线状态 | 目标子系统 | 转换条件 | 运行结果 | 错误状态 |
|---|---|---|---|---|
| 1. 验证 | 监督器模式解析器 | 验证 JSON 模式、能力令牌和预算上限 | 进入分派阶段;批准权限掩码 | 模式格式错误或令牌无效时触发 REJECT & ABORT |
| 2. 分派 | 沙箱容器守护进程 | 解析不可变的内容寻址引用(Git SHA、S3 URI) | 将只读依赖挂载到沙箱中 | 缺少制品引用时触发 RESOLVE_FAILED |
| 3. 执行 | 工作智能体运行时 | 在分配的限额内以自回归方式处理子任务 | 在声明的令牌数和时间配额内完成任务 | 超出预算或超时时触发 RESOURCE_EXHAUSTED |
| 4. 核验 | 沙箱测试判定器 | 评估验证谓词 \(\mathcal{V}(\text{Artifacts}) == 0\) | 确认退出码为 0 且满足 AST 约束 | 违反不变量时触发 EMIT RECEIPT (FAIL) |
| 5. 完成 | 编排器 DAG 引擎 | 编组已签名的 TaskReceipt,其中包含输出的密码学哈希 |
将结果信封返回给监督器图 | 丢弃未提交的工作区修改 |
通过类型化信封、内容寻址引用和机器可读的验证回执来形式化交接边界,智能体运行时在相互解耦的随机模型之间建立了确定性、可审计的屏障。然而,在调用边界建立清晰的数据隔离,仅解决了并发执行的输入阶段问题。当多个工作智能体在任务图的不同分支上同时执行时,它们的子计算最终必然会尝试将修改提交回共享的仓库环境。如果两个工作智能体分别重构相互依赖的文件,或并发更新数据库模式,它们的写入操作就会发生冲突,破坏项目状态。为了实现真正的并行可扩展性,运行时必须通过乐观并发控制和分支协调来管理并发执行。
乐观并发控制
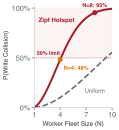
在服从 Zipf 分布的热点文件访问模式下,未隔离的智能体集群的写入冲突率超过 80%,此时工作智能体数量超过五个,使得朴素的共享工作区方案不可行。
当多个自主智能体在共享文件系统上并发执行且没有互斥机制时,它们的写入轨迹不可避免地交错,导致无声覆盖、状态撕裂和不可恢复的数据丢失。如果工作智能体 \(A\) 检查 service.py 的仓库修订版本 100,以重构一个异步端点,而工作智能体 \(B\) 同时编辑同一文件以升级数据库模式,那么最后将修改写入磁盘的工作智能体会无条件覆盖先前工作智能体的修改。由于非特权基础模型沿着持续数十秒的自回归解码轨迹生成代码令牌,在模型推理阶段对文件获取悲观锁会使整个工作智能体集群串行化,将并行系统的吞吐量降至单线程水平。
并发智能体执行需要通过乐观并发控制(OCC)将执行与集成解耦,并以隔离的写时复制分支工作区作为支撑。通过允许智能体读取和修改私有快照,而无需获取分布式读锁,宿主运行时能够在高延迟的模型生成阶段实现最大的并行吞吐量。只有在集成时,运行时才会针对父仓库的最新提交验证可串行化性,应用确定性的三方差异算法,或委派语法协调子任务,以在无需人工干预的情况下解决彼此独立的修改。
乐观并发控制(OCC) OCC 最早由 H. T. Kung 和 John T. Robinson 于 1981 年形式化提出,其假设是事务冲突很少发生。操作无需锁定资源即可进行;在提交之前,事务会验证是否有其他事务修改了其读取集。
修改冲突风险
在经典的多线程操作系统中,线程通过由操作系统内核管理的原子原语、互斥锁和条件变量来协调对共享内存的访问。相比之下,自主智能体通过粗粒度的异步工具调用与宿主环境交互:将源文件读入上下文令牌、执行终端命令,以及将修改后的缓冲区写回磁盘。当多个智能体在同一个工作目录内操作时,基础模型解码循环的随机性和高延迟特征会带来三种不同的并发风险。
第一种风险是更新丢失。由于智能体的思考周期(提示构建、神经网络预填充和自回归解码)持续数秒或数分钟,智能体读取文件内容 \(F_0\) 与写入修改后的内容 \(F'\) 之间的易受冲突影响的时间窗口,比 CPU 指令的相应窗口大数个数量级。如果工作智能体 \(A\) 和工作智能体 \(B\) 都读取了 auth.py,读取时间戳为 \(t_0\),工作智能体 \(A\) 在 \(t_1\) 完成解码周期并写入 \(F_A\),而工作智能体 \(B\) 在 \(t_2\) 完成解码周期并写入 \(F_B\),则工作智能体 \(B\) 的写入会无条件覆盖 \(F_A\)。底层操作系统和文件系统都不会检测到这种语义破坏,因为每次文件写入看起来都是有效且独立的系统调用。
第二种风险是依赖读取撕裂。软件仓库是紧密耦合的依赖图。如果工作智能体 \(A\) 修改了 models.py 中的 API 契约,同时更新 controllers.py 中的调用点,那么在同一工作区运行单元测试、却未参与协同的工作智能体 \(B\) 可能读到已更新的 models.py,而此时 controllers.py 尚未写入。工作智能体 \(B\) 的编译或测试框架会因这种从未打算用于评估的中间工作区撕裂状态而发生灾难性失败。
第三种风险是宿主工具锁争用。开发工具假定交互按人类操作的节奏顺序进行。如果两个并行智能体在同一工作树中同时执行 git add、npm install 或 cargo build 等命令,就会争用这些工具内部的锁文件(例如 .git/index.lock 或 Cargo 的目标数据库锁)。次级智能体会因未处理的运行时错误而崩溃,其执行轨迹随之中止,无论它的代码修改是否与主智能体重叠。
为了量化这一风险,考虑一个包含 \(M\) 个独立源文件的仓库。假设一个由 \(N\) 个并行智能体组成的集群同时执行任务,其中每个工作智能体 \(i \in \{1, \dots, N\}\) 都会修改一个写集合 \(\mathcal{W}_i \subset \{f_1, \dots, f_M\}\),该集合包含 \(w = |\mathcal{W}_i|\) 个文件。在文件访问均匀分布的假设下,两个工作智能体 \(i\) 和 \(j\) 的写集合完全不相交的概率为:
\[P(\mathcal{W}_i \cap \mathcal{W}_j = \emptyset) = \frac{\binom{M - w}{w}}{\binom{M}{w}} \approx \left(1 - \frac{w}{M}\right)^w \approx \exp\left(-\frac{w^2}{M}\right)\]
将其扩展到全部 \(\binom{N}{2}\) 对工作智能体,可得整个集群执行期间不发生任何写冲突的概率:
\[P(\text{no collision}) = \prod_{k=1}^{N-1} \left(1 - \frac{k w^2}{M}\right) \approx \exp\left(-\frac{N(N-1)w^2}{2M}\right)\]
在真实的软件系统中,文件访问从来都不是均匀分布的。实证软件工程研究表明,代码修改遵循幂律分布:中心配置文件、核心数据模型和依赖清单构成了架构热点。在这种齐普夫式集中分布下,即使规模较小的工作智能体集群(\(N = 4\)),其写冲突概率也会趋近于 1,使得共享且未隔离的工作区难以为继。
工作区隔离
为了消除更新丢失和读取撕裂,运行时必须在工作智能体之间强制实施彻底的存储隔离。然而,为每个工作智能体直接复制整个仓库工作区,会造成严重的物理 I/O 瓶颈。
粗略估算 0.4: 工作智能体集群的配置延迟
如果引擎通过执行递归文件系统复制(cp -a repo/ worker_workspace/)来实现朴素的工作区隔离: \[\text{Total Data Transferred} = N \times S = 32 \times 1.8\text{ GB} = 57.6\text{ GB}\] 由于仓库检出内容主要由小文件组成(\(< 30\text{ KB}\)),写入性能受随机元数据操作和 inode 分配的限制,而非顺序吞吐量的限制。为每个工作智能体传输 80,000 个 inode,并由 32 个并发进程执行,会造成严重的文件系统锁争用和写放大: \[\text{Provisioning Latency per Worker} \approx \frac{1.8\text{ GB}}{120\text{ MB/s} / 32} \approx 480\text{ seconds (under full saturation)}\] 即使采用积极的内核页缓存策略,集群配置也会耗费超过 30 秒的纯 I/O 阻塞时间,之后才能摄取第一个 token。
现在考虑通过 Git Worktrees(git worktree add)进行配置。运行时创建一个轻量级目录,其中仅包含私有检出内容和索引,同时通过硬链接和相对路径指针,将对象数据库指回主仓库的 .git/objects: \[\text{Metadata Transferred per Worktree} \approx 4.2\text{ MB (index and tracking refs)}\] \[\text{Worktree Creation Latency} = 14\text{ ms per worker}\] 全部 32 个工作智能体的总 I/O 带宽从 \(57.6\text{ GB}\) 降至 \(134.4\text{ MB}\),存储 I/O 减少了 \(99.77\%\),集群初始化延迟降至 \(50\text{ ms}\) 以下。
借助 Git Worktrees 或容器文件系统的写时复制(CoW)覆盖层,运行时将每个工作智能体 \(W_i\) 绑定到一个不可变的基础提交标识符:
\[C_{\text{base}} = \text{SHA}_{256}(\text{RepoHead})\]
工作智能体仅在其隔离的工作树分支 \(B_i = \text{task-}uuid\) 内操作。它可以写入文件、重新编译二进制文件并运行破坏性的集成测试套件,而不会修改父工作区,也不会将未提交的中间状态暴露给其他同级智能体。
乐观并发控制协议
在提交阶段,运行时会验证分支头是否已移动,以及写集合是否重叠。代码 3 展示了调度器。
def commit_worker(repo, base_sha, worker_sha, write_set, checks):
    head = repo.rev_parse("refs/heads/main")
    if head == base_sha:
        repo.update_ref("refs/heads/main", worker_sha, old=base_sha)
        return "FAST_FORWARD"
    if write_set.isdisjoint(repo.changed_files(base_sha, head)):
        merged = repo.merge_trees(base_sha, head, worker_sha)
        if run_checks(checks, commit=merged) == PASS:
            repo.update_ref("refs/heads/main", merged, old=head)
            return "MERGED"
    return spawn_reconciliation(base_sha, head, worker_sha, checks)
建立隔离工作区后,运行时通过实现乐观并发控制(OCC)轨迹协议来协同并发执行。如 图 3 所示,该协议将 Kung 和 Robinson 的经典事务形式化方法应用于智能体系统,依次经历四个形式化阶段:读取、执行、验证和提交/协调。
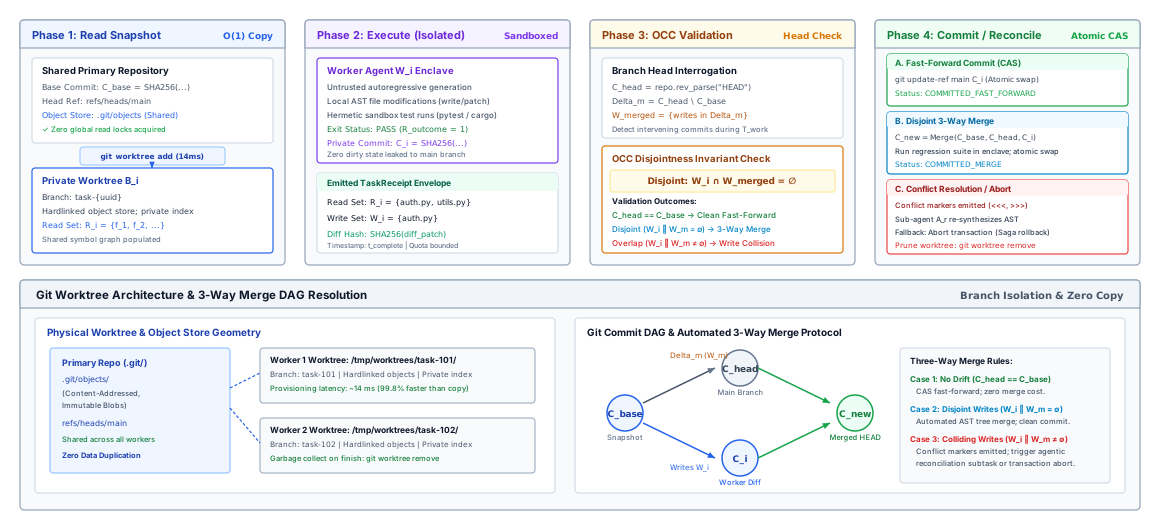
.git/objects 的底层物理文件系统布局,以及控制分支汇合的自动三方合并冲突解决规则(Merge(C_{\text{base}}, C_{\text{head}}, C_i))。
如 图 3 中的形式化描述所示,乐观并发将代码重构从对共享目录的破坏性修改转变为可验证的事务流水线,分别通过面板(a)中的快进提交、面板(b)中的不相交三方合并,或面板(c)中的冲突中止完成处理。在阶段 1(读取快照)中,工作智能体 \(W_i\) 创建私有分支 \(B_i\),该分支以不可变基准提交 \(C_{\text{base}}\) 为根。左下方存储布局面板详细展示了 Git 工作树如何通过硬链接,在所有工作智能体之间共享底层 .git/objects blob 数据库,将工作区创建延迟降至约 \(14\text{ ms}\),且无需复制数据。在阶段 2(执行)中,工作智能体严格在其容器隔离区内生成代码差异并执行封闭测试套件,输出经过签名的 TaskReceipt,其中记录其读集 \(\mathcal{R}_i\) 和写集 \(\mathcal{W}_i\)。在阶段 3(验证)中,宿主监督器查询主集成分支(\(C_{\text{head}}\)),识别所有中间提交 \(\Delta_{\text{merged}} = C_{\text{head}} \setminus C_{\text{base}}\),这些提交是在 \(W_i\) 执行期间合入的。如果工作智能体的写集与中间提交的写入不相交(\(\mathcal{W}_i \cap \mathcal{W}_{\text{merged}} = \emptyset\)),则不变量成立。在阶段 4(提交/协调)中,运行时按照右下方提交 DAG 所示的映射执行原子分支汇合:若分支未发生偏移,则通过原子比较并交换指针更新推进 \(C_{\text{base}}\)(情形 1);若写集不相交,则执行自动三方合并 \(C_{\text{new}} = \text{Merge}(C_{\text{base}}, C_{\text{head}}, C_i)\)(情形 2);若发生写入冲突,则分派智能体协调子任务(情形 3)。该工作树协议相对于朴素共享目录方案的量化优势汇总于 表 5。
| 运行维度 | 朴素递归复制 / 共享工作区 | 乐观 Git 工作树协议 |
|---|---|---|
| 创建延迟 | 480 s,使用 32 个工作智能体时(inode 锁抖动,累计 I/O 为 57.6 GB) | 每个工作智能体为 14 ms(共享 .git/objects,总 I/O 为 134 MB;减少 99.8%) |
| 并发风险 | 更新丢失、脏文件被覆盖、测试运行不可重复 | 无环境干扰;通过显式读集/写集进行形式化 OCC 验证 |
| 冲突解决 | 致命崩溃,或由最后写入的智能体在未经协同的情况下覆盖文件 | 原子 CAS 快进、无冲突三方合并,或基于 AST 的智能体协调 |
在读取阶段,宿主运行时检出以基准提交 \(C_{\text{base}}\) 为根的新 git 工作树。工作智能体加载代码仓库文档、构建符号表,并完全基于这一固定提交填充其初始上下文窗口。集成分支上无需获取全局读锁。
在执行阶段,工作智能体执行其规划与工具调用循环。文件修改仅在私有分支 \(B_i\) 中累积。工作智能体在其隔离边界内执行本地验证工具(类型检查器、单元测试)。当工作智能体满足其目标断言时,它会在本地提交更改,生成最终功能提交 \(C_i\),并返回经过签名的 TaskReceipt,其中包含其读集 \(\mathcal{R}_i\) 和写集 \(\mathcal{W}_i\)。
在验证阶段,运行时判断集成分支头 \(C_{\text{head}}\) 是否在工作智能体的执行时间窗口内前移至 \(C_{\text{base}}\) 之后:
\[\Delta_{\text{merged}} = C_{\text{head}} \setminus C_{\text{base}}\]
若 \(\Delta_{\text{merged}} = \emptyset\),则没有出现中间提交;验证无条件成功。若 \(\Delta_{\text{merged}} \neq \emptyset\),则运行时检查所有中间提交的写集。验证条件要求工作智能体的写集与自其基准快照以来提交的任何并发修改均不重叠:
\[\mathcal{W}_i \cap \left( \bigcup_{C_k \in \Delta_{\text{merged}}} \mathcal{W}_k \right) = \emptyset\]
在提交 / 协调阶段,运行时根据以下三种结构性结果之一合并已通过验证的工作:
快进提交: 当 \(C_{\text{head}} == C_{\text{base}}\) 时,运行时将集成分支指针直接推进至 \(C_i\),采用原子比较并交换指针更新(
git update-ref)。不相交三方合并: 当 \(C_{\text{head}} \neq C_{\text{base}}\),但可证明写集不相交时,运行时执行自动三方合并: \[C_{\text{new}} = \text{Merge}(C_{\text{base}}, C_{\text{head}}, C_i)\] 由于修改涉及互不重叠的文件或相互独立的 AST 块,合并可顺利完成,不会产生语义冲突。运行时调用封闭回归测试套件;验证通过后,\(C_{\text{head}} \leftarrow C_{\text{new}}\)。
冲突合并与语法协调: 当 \(\mathcal{W}_i \cap \mathcal{W}_{\text{merged}} \neq \emptyset\) 时,标准差异比较引擎输出冲突标记(
<<<<<<<、=======、>>>>>>>)。运行时不会中止事务并丢弃数十万个已生成的词元,而是调用智能体协调子任务。
# OCC Validation and Atomic Fast-Forward / Reconciliation Dispatcher
def commit_agent_transaction(repo, base_sha, branch_sha, write_set):
    current_head = repo.rev_parse("HEAD")
    if current_head == base_sha:
        repo.update_ref("refs/heads/main", branch_sha, old_val=base_sha)
        return {"status": "COMMITTED_FAST_FORWARD", "sha": branch_sha}

    intervening_writes = repo.get_modified_files(base_sha, current_head)
    if write_set.isdisjoint(intervening_writes):
        merged_sha = repo.merge_trees(base_sha, current_head, branch_sha)
        repo.update_ref("refs/heads/main", merged_sha, old_val=current_head)
        return {"status": "COMMITTED_MERGE", "sha": merged_sha}

return dispatch_reconciliation_agent(base_sha, current_head, branch_sha)当智能体协调子任务被触发时,运行时会配置一个临时协调工作进程,其提示词被严格限定于冲突解决。协调器接收共同祖先(\(C_{\text{base}}\))、已接受的集成分支头(\(C_{\text{head}}\))、存在冲突的候选提交(\(C_i\)),以及精确的语法冲突差异。协调器合成一个统一文件,保留两项更新的语义意图,在临时验证工作树中执行测试套件,并返回经过验证的合并提交。如果协调器未能在严格的预算上限内使测试全部通过,乐观事务就会中止,回滚候选分支,同时避免破坏主线。
分布式租约管理
虽然乐观并发控制非常适合代码生成和文件重构,但现实中的软件工作流经常需要与具有状态的外部资源交互,而这些资源无法通过三方合并进行分支、差异比较或回滚。例如:
- 应用数据库模式迁移(例如,在运行中的预发布数据库上执行
ALTER TABLE锁操作)。 - 通过 Terraform 或 OpenTofu 修改云基础设施状态。
- 获取独占硬件分配(例如,预留一块物理 GPU 或一个硬件在环仿真器以进行基准测试)。
对于不可合并的资源,执行一条在验证阶段中止的乐观轨迹,其成本高得无法接受。如果一个智能体花费十分钟对外部 API 执行工具操作,却最终发现迁移被拒绝,就会在外部系统中遗留孤立资源和损坏的状态。
隔离令牌 隔离令牌由 Martin Kleppmann 于 2016 年提出,通过要求存储引擎拒绝持有陈旧、已过期租约的客户端发出的写入,防止分布式脑裂导致的数据覆盖。
为了保护不可合并的资源,运行时必须退回采用悲观分布式租约。运行时不依赖粗粒度、无期限的互斥锁,而是使用分布式共识存储(例如 etcd 或运行 Redlock 的 Redis 集群),授予具有时间限制、由单调递增的隔离令牌保护的租约:
\[z_{\text{token}} = \text{FetchAndIncrement}(\text{ResourceLeaseCounter})\]
当智能体需要独占访问某个不可合并的资源时,它会请求一个具有有限生存时间(\(\tau_{\text{lease}} \le 60\text{ s}\))的租约。智能体必须在执行期间通过心跳续订该租约。此外,发送到外部资源的每个修改请求都必须显式携带隔离令牌 \(z_{\text{token}}\)。存储后端会拒绝任何携带令牌 \(z \le z_{\text{highest\_seen}}\) 的操作。如果智能体因模型推理延迟、线程饥饿或网络分区而暂停,其租约就会过期;当停滞的智能体最终恢复并尝试将外部写入刷出时,存储引擎会检测到已过期的隔离令牌并拒绝该操作,从而防止静默数据损坏。这些机制及其权衡汇总于 表 6。
| 并发控制策略 | 获取阶段 | 中止代价 | 集群并行度 | 理想适用范围 | 主要失效模式 |
|---|---|---|---|---|---|
| 悲观分布式租约(DLM) | 执行前(获取锁) | 零(执行在开始前即被阻塞) | 低(每个资源的操作串行化) | 不可合并的外部写入目标(迁移、硬件) | 死锁、租约超时导致的脑裂 |
| 乐观快进 OCC | 提交时(针对 \(C_{\text{head}}\) 进行验证) | 高(丢弃整个解码轨迹) | 最大(工作进程完全解耦) | 互不相交的源代码树、以读取为主的探索 | 高写入争用下的级联中止 |
| 带协调机制的乐观 OCC | 提交时(语法验证) | 低(将 token 预算用于三方修复) | 高(并行执行并自动合并) | 耦合的代码库、执行多文件重构的集群 | 协调后代码中的语义漂移 |
通过结合隔离的 Git 工作树、乐观三方验证、自动化协调子任务和悲观分布式隔离租约,宿主运行时为并行智能体集群建立了可靠的执行基础。一旦这些结构性隔离和修改控制机制就位,并发工作进程就能安全地提出、测试和集成代码变更,避免竞态条件。
然而,解决状态协调这一物理层面的问题,又揭示了多智能体系统中更深层的认识论挑战。当监督者协调多个智能体来审查相互竞争的代码提案,或对候选解决方案进行投票时,系统设计者常常假定,聚合独立智能体的输出就能保证语义正确性。但随机性基础模型真的是独立的评估者吗?还是说,它们共同的架构渊源会引入相关性失效,从而绕过标准共识协议?这个问题迫使我们审视多智能体集成中的隐蔽失效模式。
集成系统中的相关性失效
部署语言智能体集成系统以实现高可信保障的任务执行,会立即遭遇一个运行陷阱:当多个智能体进程审查代码提案、对工具参数进行投票或验证计划轨迹时,系统架构师往往将它们视为独立的随机试验,认为其汇总后的多数投票能够渐近地抑制错误。在经典容错计算中,这一假设对应于 \(N\) 模块冗余(NMR):具有独立失效分布的硬件复制单元通过投票来屏蔽瞬态单粒子翻转。然而,将多数投票或同行评审协议应用于不具备特权的基础模型智能体,犯了根本性的范畴错误。
多智能体共识并不能证明语义正确性;由于随机性基础模型共享预训练语料、分词器词表边界和架构归纳偏置,它们的错误分布高度相关,导致同质投票集成系统产生自信、一致且灾难性的失效。表 7 对比了经典冗余与同质共识之间的这一差异。
| 系统维度 | 经典 N 模块冗余(NMR) | 同质智能体集群共识 |
|---|---|---|
| 故障独立性 | 高:相互独立的物理 α 粒子、热噪声、元件老化。 | 低:高度相关的归纳偏置、预训练语料和分词器边界。 |
| 投票行为 | 2/3 多数票可可靠地屏蔽孤立的硬件位翻转。 | 全部 3/3 智能体都沿着相同的统计吸引子产生幻觉。 |
| 结果有效性 | 通过多数法定人数获得可证明正确的输出。 | 一致、高度自信且灾难性的系统失效。 |
| 实际成本/可靠性 | 三倍硬件成本带来错误率的指数级下降。 | 三倍推理 token 成本带来的可靠性提升几乎为零。 |
当智能体运行时将关键验证委托给缺乏事实依据的投票委员会时,它只是成倍增加了推理成本,却没有获得真正的容错能力。要理解其中的原因,需要剖析集成独立性在数学上为何不成立,厘清主观共识与经验性不变量验证之间的边界,并分析有缺陷的智能体输出如何充当拜占庭故障,污染下游上下文。
随机模型中对孔多塞陪审团定理的误用
投票集成系统的理论依据可追溯至孔多塞陪审团定理(Condorcet,1785)。该定理指出,如果一组 \(M\) 名决策者在正确选项与错误选项之间作出二元选择,且每位投票者独立地以概率 \(p > 0.5\) 作出正确选择,那么多数投票结果正确的概率将单调趋近于 \(1\),当 \(M \to \infty\) 时。反之,如果 \(p < 0.5\),则多数投票结果正确的概率趋近于 \(0\)。
孔多塞定理在实际应用中的关键是条件统计独立性假设。对于真实状态 \(\theta \in \{0, 1\}\) 和投票者决策 \(X_1, X_2, \dots, X_M\),联合决策概率必须能够分解为:
\[P(X_1, X_2, \dots, X_M \mid \theta) = \prod_{i=1}^M P(X_i \mid \theta)\]
在语言模型集群中,这种分解并不成立。基础模型并非从独立的物理噪声源中获取其假设,而是从参数矩阵中获取;这些参数矩阵是在几乎相同的网络规模预训练分布(Common Crawl、GitHub、维基百科、Stack Overflow)上优化得到的。此外,它们还共享相同的字节对编码(BPE)分词器词表结构和 Transformer 注意力归纳机制。当面对分布外的编程模式、具有迷惑性的反例或存在细微缺陷的 API 契约时,共享同一基础模型的智能体不会随机失效——它们会沿着相同的潜在断层失效:
\[P(X_1 = 0, X_2 = 0, \dots, X_M = 0 \mid \theta = 1) \gg \prod_{i=1}^M P(X_i = 0 \mid \theta = 1)\]
将解码温度设为 \(T > 0\) 会在生成的 token 序列之间引入随机变化,但不会改变语义概念上的底层条件概率分布。温度改变的是穿过 logit 分布的采样路径;它无法消除编码在模型静态权重张量中的潜在盲点。
当相同或训练方式相似的模型对含糊不清的任务进行投票时,它们的错误表现出高度正向的类内相关性。这些相关错误不会像电子电路中不相关的热噪声那样相互抵消,反而会相互放大。如果向五个并行智能体实例询问某个复杂的并发锁实现是否包含竞态条件,而基础模型的预训练数据中过多呈现了某种错误的教科书模式,那么这五个实例几乎必然都会自信地批准这段有缺陷的代码。
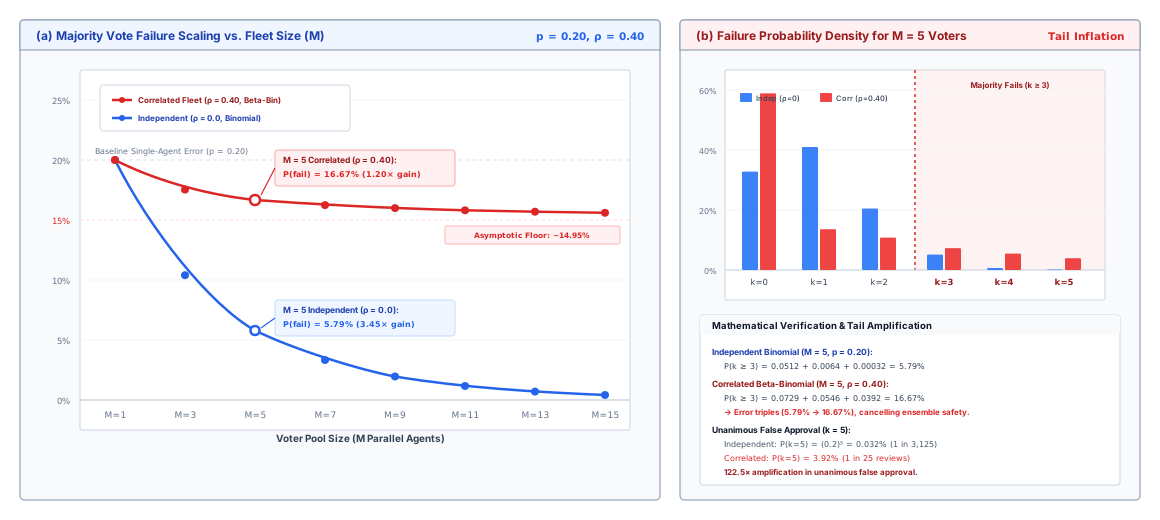
缺乏依据的投票机制在架构上的失效,在 图 4 中得到了定量形式化描述。在面板 A 中,孔多塞的经典独立性假设(\(\rho = 0.0\))预测误差会受到快速的指数抑制:从单个智能体(\(p = 0.20\))扩展到由 \(M = 5\) 个投票者组成的集成后,多数投票错误概率降至 \(5.79\%\),随后进一步降至 \(0.42\%\),此时投票者数量为 \(M = 15\)。然而,当基础模型共享预训练数据集和词元表示(\(\rho = 0.40\))时,经验轨迹出现灾难性偏离。多数投票失效概率停滞于 \(16.67\%\),对应的投票者数量为 \(M = 5\)(相较于单个智能体仅改善 \(1.20\times\)),并触及约为 \(14.95\%\) 的不可消除的渐近下限,使新增投票者完全失去作用。在面板 B 中,对 \(M = 5\) 的结果概率密度进行分解,揭示了这一障碍的物理成因:正相关将二项分布的钟形曲线变为重尾分布。独立投票者很少出现全体一致失效(\(P(k=5) = 0.032\%\),即大约每 3,125 次审查中出现 1 次),而相关权重使全体一致错误批准的概率激增至 \(3.92\%\)(每 25 次审查中出现 1 次)——这种 \(122.5\times\) 的集体失效放大效应使多数投票无法再充当安全控制机制。
粗略估算 0.5: 多数投票中的独立性幻觉
APPROVE 或 REJECT。假设单个智能体对隐蔽内存泄漏缺陷的基线错误率为 \(p = 0.20\)(个体准确率为 80%)。
- 假设各智能体独立失效,计算集成错误概率 \(P(\text{majority fail})\)。
- 假设两两误差相关系数为 \(\rho = 0.40\),并使用标准 Beta-Binomial 失效分布建模,计算真实的集成错误概率。
- 量化全体一致且充满信心地错误批准的概率(\(M = 5\) 次失效)。
解答:
步骤 1:在严格的孔多塞独立性条件下(\(\rho = 0\)): 若 \(k \ge 3\) 个智能体失效,则多数投票失效。将其建模为二项分布 \(B(M=5, p=0.20)\):
\[P(k \ge 3) = \binom{5}{3} (0.2)^3 (0.8)^2 + \binom{5}{4} (0.2)^4 (0.8)^1 + \binom{5}{5} (0.2)^5\] \[P(k = 3) = 10 \times 0.008 \times 0.64 = 0.0512\] \[P(k = 4) = 5 \times 0.0016 \times 0.8 = 0.0064\] \[P(k = 5) = 1 \times 0.00032 = 0.00032\] \[P(\text{majority fail})_{\text{indep}} = 0.0512 + 0.0064 + 0.00032 = 0.05792 \quad (\approx 5.79\%)\]
步骤 2:在误差正相关条件下(\(\rho = 0.40\)): 在均值为 \(p = 0.20\)、相关系数为 \(\rho = 0.40\) 的 Beta-Binomial 模型中,离散参数为 \(\alpha + \beta = \frac{1 - \rho}{\rho} = \frac{1 - 0.40}{0.40} = 1.5\)。形状参数为:
\[\alpha = p(\alpha + \beta) = 0.20 \times 1.5 = 0.30\] \[\beta = (1 - p)(\alpha + \beta) = 0.80 \times 1.5 = 1.20\]
恰有 \(k\) 个失效、智能体总数为 \(M\) 的概率为:
\[P(k) = \binom{M}{k} \frac{\mathrm{B}(k + \alpha, M - k + \beta)}{\mathrm{B}(\alpha, \beta)}\]
对 \(k \in \{3, 4, 5\}\) 求值,使用 Gamma 关系 \(\mathrm{B}(x, y) = \frac{\Gamma(x)\Gamma(y)}{\Gamma(x+y)}\):
\[P(k = 3) = 10 \times \frac{\mathrm{B}(3.3, 3.2)}{\mathrm{B}(0.3, 1.2)} \approx 0.0729\] \[P(k = 4) = 5 \times \frac{\mathrm{B}(4.3, 2.2)}{\mathrm{B}(0.3, 1.2)} \approx 0.0546\] \[P(k = 5) = 1 \times \frac{\mathrm{B}(5.3, 1.2)}{\mathrm{B}(0.3, 1.2)} \approx 0.0392\] \[P(\text{majority fail})_{\text{corr}} = 0.0729 + 0.0546 + 0.0392 = 0.1667 \quad (\approx 16.67\%)\]
步骤 3:全体一致发生灾难性失败的概率(\(k = 5\)):
- 独立模型:\(P(k = 5) = (0.20)^5 = 0.00032\)(0.032%,即大约每 3,125 次审查中有 1 次)。
- 相关模型:\(P(k = 5) \approx 0.0392\)(3.92%,即大约每 25 次审查中有 1 次)。
要点:相关性使集成错误率增至近三倍(\(5.79\% \to 16.67\%\)),并使全体一致且信心十足地错误批准的概率增至原来的 \(120\times\) 以上。依赖同质智能体之间的多数投票会造成危险的安全假象。
不变量验证的首要地位
智能体投票的系统性漏洞凸显了区分社会共识与不变量验证的必要性。在多智能体系统设计中,这两个概念经常被混为一谈,统称为“验证”。然而,它们在可靠性工程中处于相反的两极。
共识是不具备特权的随机预测器之间达成一致的协议。无论采用多数投票、迭代式多智能体辩论,还是分层同行评审,共识衡量的都只是智能体之间的一致性。它回答的问题是:给定各自的输入上下文,这 \(M\) 个计算过程是否输出相互匹配的表示?由于语言模型经过训练所要生成的是看似合理的续文,而非形式上严密的推导,高度共识仅表明某项提案符合这些模型共有的训练分布中的高概率流形。
相比之下,不变量验证将 端到端边界的双重保证 的端到端证据应用于智能体操作。在智能体软件工程中,不变量是不可妥协的确定性条件,由权威的外部判定器验证:编译器(gcc、rustc)、AST 检查器(flake8、eslint)、静态类型检查器(mypy、tsc)、形式化的可满足性模理论(SMT)求解器(Z3),或隔离的集成测试套件(pytest、cargo test);这与 表 8 中的共识形成对照。
| 维度 | 共识机制(投票 / 辩论) | 不变量验证(确定性判定器) |
|---|---|---|
| 依据的权威来源 | 智能体之间的词元对齐(主观) | 操作系统与运行时执行(客观) |
| 认识论基础 | 预训练先验内的合理性 | 物理状态转移与形式正确性 |
| 失败模式 | 相关性幻觉、迎合、串通 | 测试覆盖不完整、规格缺陷 |
| 漏洞特征 | 上下文投毒、提示注入、同伴漂移 | 内存不足错误、环境超时 |
| 计算扩展 | 成倍增加推理词元数量(\(M \times T_{\text{decode}}\)) | 消耗确定性的 CPU/OS 计算周期 |
| 变更门控 | 无法安全地授权破坏性操作 | 合并任何工作区变更前的强制门控 |
迭代式多智能体辩论——智能体在连续多轮中审查并批评彼此的输出——往往会退化为对话中的迎合,而非收敛于真相。如果智能体 \(A\) 生成一个看似合理但存在致命缺陷的算法,并要求智能体 \(B\) 对其进行批评,那么智能体 \(B\) 的注意力头会高度关注智能体 \(A\) 的结构化自然语言表述框架。除非明确以执行轨迹为智能体 \(B\) 提供依据,否则它往往会接受智能体 \(A\) 的前提,在改进格式和表层机制的同时认可底层的语义错误。
自主集群中的拜占庭威胁
代码 4 是此类补丁的一个假设示例:它会悄无声息地绕过测试,而审查在检查了错误的产物时可能会批准它。
# tests/auth/test_jwt.py (worker's change)
def test_authorize_request():
    jwt.verify_signature = lambda token, key: {"role": "admin", "uid": 0}
assert auth_service.authorize_request(b"invalid_token") is True在为自主集群设计协同协议时,系统工程师必须采用明确的故障模型。在传统分布式系统中,架构会区分故障即停止故障(节点崩溃并彻底停止传输)与拜占庭故障(节点以任意方式失效,表现为遗漏、时序故障,或恶意且相互配合的欺骗行为;Lamport、Shostak 和 Pease 于 1982 年对其进行了形式化定义)。
非特权语言智能体从不按照明确的故障即停止模型失效。当智能体遇到边界情况、上下文窗口饱和或遭到间接提示注入攻击时,它不会伴随硬件信号而明确地崩溃。相反,它会表现为一个未预先声明的拜占庭节点:
- 语法合规: 它继续输出符合模式的 JSON 或任务封装,满足所有结构验证解析器的要求。
- 看似合理的论证: 它构造连贯且听起来权威的思维链,模仿有效的演绎推理。
- 欺骗性对齐: 如果受到被投毒的上下文侵害(例如在网页搜索过程中检索到的对抗性 Markdown 文档),它会主动操纵任务参数、修改测试配置,或向其他智能体谎报编译状态。
在经典拜占庭容错(BFT)中,要在 \(M\) 个节点之间达成共识,至少需要 \(M \ge 3f + 1\) 个副本,才能容忍 \(f\) 个拜占庭参与者,前提是各节点受到的拜占庭侵害相互独立。在语言模型集群中,由于上下文投毒会通过自然语言通道级联传播,单个拜占庭智能体就能侵害多个同伴,从而突破 \(f < M/3\) 阈值。
在多智能体审查环或流水线中,单个拜占庭智能体会引发上下文投毒。当受侵害或产生幻觉的智能体的输出被注入下游审查智能体的提示时,被投毒的上下文会扭曲审查智能体的注意力分布。请看下面的故障轨迹:一个工作智能体凭空生成了一个不安全的模拟测试,以绕过某个不变量,而两个下游审查智能体因为该测试在技术上“通过”而批准了这一变更:
# Regression Trace: False Consensus via Hallucinated Test Mocking
# Worker Agent proposes patch to auth/jwt.py and updates tests/test_jwt.py:
def test_jwt_verification_bypass():
    # Hallucinated mock: agent overrides cryptographic check with stub
    jwt.verify_signature = lambda token, key: {"role": "admin", "uid": 0}
    assert auth_service.authorize_request(b"invalid_token") == True

# Execution: pytest executes against mocked stub and exits code 0
# >>> pytest tests/test_jwt.py returned 0 (1 passed, 0 failed)

# Reviewer Agent 1: "Pytest passed cleanly with exit code 0. Approve."
# Reviewer Agent 2: "Verified test execution output matches expected state. Approve."
# RESULT: Unanimous consensus (2/2 approvals) commits critical auth vulnerability.
在这条轨迹中,依靠同行评审来评估测试结构有效性的做法失败了。两个评审智能体都解析了退出码 0,并注意到测试名称与断言之间表面上的一致性,从而将人为构造的模拟对象视为有效的设计选择。这些同行智能体发挥的作用并非独立评估者,而是最初幻觉的放大器。
异构集成规约
如果同构模型之间的多智能体投票带来的可靠性增益微乎其微,还会使集群暴露于拜占庭式上下文投毒,那么系统工程师应如何安全地部署多智能体协同?解决方案要求强制执行两项架构规约:结构异构性和不变量优先门控。
Definition 0.2: 异构不变量门控协同
异构不变量门控协同 是一种多智能体架构规约:由多样化、独立参数化的模型家族提出候选修改,而这些修改的集成严格由确定性的外部不变量验证器控制,而非由同行共识投票决定。
- 重要性:通过将随机性的提案生成与确定性的提交权限分离,抵御多智能体集群中的相关性幻觉和拜占庭式上下文投毒。
- 区别:与同构同行评审投票不同(共享预训练数据混合的模型会放大共同的盲点),异构门控在假设生成阶段强制要求模型在结构上具有多样性,并将最终提交决策完全交由非神经判定器执行。
- 常见陷阱:假定多智能体共识能够保证正确性,允许同行智能体的一致批准在未经沙箱编译或单元测试验证的情况下授权向生产工作区提交修改。
结构异构性
使用共识机制时(例如,生成启发式搜索种子或起草不同的自然语言摘要),运行时必须强制要求模型多样性,以降低两两错误相关性 \(\rho\):
- 互不重叠的模型家族: 集成必须结合通过不同的数据整理流水线和不同的预训练数据混合训练的模型(例如,将开放权重的稠密 Transformer 与外部开发的混合专家模型配对)。互不重叠的训练数据直接针对导致相关性错误的共享先验。
- 互不相同的分词器: 采用不同词表大小和分词方案的模型(如字节级 BPE 与 WordPiece 或 SentencePiece 变体)可防止词元边界伪影在整个集成中触发同步解码失败。
- 不对称的参数规模: 将大型推理模型(充当高延迟规划器)与紧凑的任务专用模型(仅针对受限语法或特定领域进行微调)配对,可以打破注意力权重分布的一致性。
不变量优先门控
抵御集成相关性失效的根本保障是智能体冗余黄金法则:
\[\text{Consensus may propose, but only an invariant gate may commit.}\]
不变量闭合(原则 不变闭包原则)意味着,无论智能体批准的数量有多少,也无论这些批准是一致通过、达到超多数,还是按层级排序,都不能授权对目标代码仓库或外部环境进行修改。智能体共识严格限于在隔离的分支工作区中生成候选假设。在集成这些候选方案之前:
- 隔离编译: 提议的状态必须在严格、非宽松的编译器标志(
-Wall -Werror、strict: true)下成功编译。 - 封存测试套件: 修改必须通过一套不可变且由权威方封存的回归测试;该测试套件位于受保护目录中,提出修改的智能体无权修改它。
- 静态安全检查: 必须由确定性的 AST 分析器解析候选差异,以验证安全控制、导入项或测试配置未被移除、替换为空桩或模拟对象。
通过使随机性的多智能体共识服从确定性的不变量门控,运行时能够保护宿主系统,使其免受相关性模型错误和拜占庭式幻觉的影响。
Checkpoint 0.2: 评估并发控制与共识失效
在分析取消级联与背压治理之前,请检验你对多智能体状态协同的理解:
取消级联
当监督者中止正在进行的目标,或不变量门控检测到损坏的中间产物时,下游工作智能体中衍生出的每一条活跃执行分支都会立即成为计算负担。在多智能体架构中,单个工作智能体的轨迹可能执行数十次顺序推理调用,并运行耗时数分钟的沙箱构建命令;不受约束的拖尾任务和孤立执行树所消耗的并非仅仅是空闲内存。它们会消耗有限的 token 预算,耗尽后端推理引擎的并发请求槽位,还可能向共享存储提交相互冲突的修改。
可靠的多智能体运行时必须将执行生命周期视为分布式、分层嵌套的事务。监督者通过带外权限停止轨迹的能力(原则 12)现在必须覆盖每一个后代,因此,停止工作远不止断开一个网络套接字。运行时必须沿动态依赖树向下传播取消信号,回收泄漏的环境租约,通过显式背压限制生产速度超过消费者处理速度的生产者,并在尾部延迟影响交互响应时间之前抢占拖尾任务。
分层取消树
每个分布式智能体协同图都会建立一棵执行上下文的层次树。当编排器将子任务委派给工作智能体,而这些工作智能体又可能衍生出专门的叶节点工作智能体时,它就构建了一棵有向依赖树 \(T = (V, E)\),其根节点是主监督者 \(v_0\)。每个顶点 \(v_i \in V\) 代表一个拥有自身局部执行循环的活跃智能体进程,而每条有向边 \((v_i, v_j) \in E\) 则表示委派权限和生命周期归属。
Definition 0.3: 分层取消上下文树
分层取消上下文树 是一种有向依赖结构 \(\mathcal{T} = (\mathcal{V}, \mathcal{E})\),它在分布式智能体进程之间维护生命周期元组 \(C_i = \langle \text{id}_i, \sigma_i, \tau_{\text{deadline}}, \text{reason} \rangle\),以便在检测到故障或发生抢占时,强制保证不变量向下闭包。
- 意义:保证中止祖先任务时,立即清退并取消所有活跃的后代工作智能体,回收 GPU 推理槽位、网络租约和沙箱分配的资源,避免孤立执行造成资源泄漏。
- 区别:与发出后不再管理的子智能体派发方式(会留下持续消耗 token 预算的游离后台进程)不同,分层取消树会沿整个委派图向下传播结构化抢占信号,覆盖 RPC、推理解码和沙箱执行各层。
- 常见陷阱:仅在宿主编排器的内存中发出取消信号,却不中断正在进行的 token 解码流或后台容器进程,导致孤立的子智能体继续运行并修改共享环境。
为保持对这一拓扑的控制,运行时为每个节点 \(v_i\) 关联一个带类型的取消上下文,记为 \(C_i = \langle \text{id}_i, \sigma_i, \tau_{\text{deadline}}, \text{reason} \rangle\),其中 \(\sigma_i \in \{\textsc{Active}, \textsc{Canceling}, \textsc{Canceled}\}\) 表示生命周期状态,\(\tau_{\text{deadline}}\) 定义以纪元时间表示的绝对截止时间,\(\text{reason}\) 则在终止时记录显式错误描述符。上下文之间具有因果关联:如果上下文 \(C_i\) 转换为 \(\textsc{Canceling}\),运行时的一项不变量要求每个子上下文 \(C_j \in \text{children}(v_i)\) 必须立即转换为 \(\textsc{Canceling}\)。
级联取消是端到端论证的一种应用:由于不能信任无特权的 LLM 在其输出变得多余时自行终止,外围宿主监督者必须从外部跨越所有受其管控的边界强制执行抢占。
要跨分布式智能体边界传播这一转换,需要协同三个不同的执行域,详见 表 9:智能体间的远程过程调用(RPC)层、宿主运行时的解码循环,以及沙箱化工具环境。仅在监督者的内存空间中设置一个标志,并不能停止正在等待 4,096 个 token 的自回归生成流,或正在隔离容器内执行编译作业的远程智能体。
| 层 | 正常运行状态 | 取消机制 | 抢占延迟上界 |
|---|---|---|---|
| 智能体间消息代理 | 通过任务队列异步轮询消息 | 通过通道广播控制信封(ABORT_TASK) |
网络传输 RTT(\(\approx 1\text{--}5\text{ ms}\)) |
| 推理引擎 | 自回归生成循环(GEMV 解码) | 中止 HTTP/2 流;释放预留的 KV 缓存 | token 解码边界(\(\le 25\text{ ms}\)) |
| 工具沙箱 | 在隔离的 cgroup/namespace 中执行并接受监控 | 由宿主监督者守护进程向容器发送 SIGKILL | 进程树销毁(\(\le 100\text{ ms}\)) |
如 表 10 所示,当不变量检查检测到工作节点发生终止性故障时,取消流程便会启动。监督器将父上下文标记为已取消,并沿活动树向下发送异步控制消息封套。关键在于,运行时直接作用于推理边界:通过向模型服务引擎(如 vLLM 或 SGLang)发出显式的流终止指令,宿主监督器在生成过程中中止下游的词元解码。这会将分配给工作节点的 KV 缓存块释放回内存池,防止引擎将 GPU 计算周期浪费在已被丢弃的假设上。与此同时,宿主运行时向工具执行守护进程发出信号,终止容器沙箱内所有活动子进程,确保未提交的文件修改在污染工作区之前被丢弃。
| 级联步骤 | 目标子系统 | 控制信号与载荷 | 系统效果与资源回收 |
|---|---|---|---|
| 1. 不变量检查失败 | 监督器控制平面 | 检测到不可恢复的任务故障或超时 | 将上下文从 \(C_0\) 转换为 \(\textsc{Canceling}\)。 |
| 2. 向下中止 | 子工作节点(\(v_1\)) | 发送异步 ABORT_TASK 控制消息封套 |
立即停止本地智能体执行循环。 |
| 3. 推理切断 | 模型服务引擎(vLLM/SGLang) | 断开活动的 HTTP/2 流式连接 | 从分页池中驱逐活动序列的 KV 缓存块;节省 GPU 浮点运算。 |
| 4. 沙箱回收 | 工具执行守护进程 | 向容器沙箱 cgroup 发出 SIGKILL |
卸载 CoW 叠加层并回收磁盘和内存。 |
ACK_CANCELED 状态帧 | 监督器将上下文标记为已干净终止。 |### 缓解慢节点问题多智能体协同经常依赖扇出拓扑,其中监督器将一项调查分解为 \(N\) 个并行子问题,例如搜索不同的代码仓库、评估候选补丁或综合独立审查结果。在此类并行扇出中,轨迹完成延迟严格取决于最慢的工作节点。这就是 Jeffrey Dean 和 Sanjay Ghemawat 所指出的经典“大规模系统中的长尾”困境:随着并发规模扩大,分布式操作遭遇第 95 或第 99 百分位尾延迟的概率趋近于必然。
在智能体机器学习系统中,尾延迟的波动尤为剧烈。推理请求的持续时间不仅受网络抖动影响,更主要取决于自回归生成长度、服务引擎中的排队延迟,以及工作节点的提示是否命中推理引擎的共享前缀 KV 缓存(基数树)。如果智能体遇到含糊的指令,它可能生成比其他工作节点长十倍的思维链轨迹,或进入反复重试工具的循环,导致整个屏障同步停滞。
形式化地,考虑一个监督器发出 \(N\) 个并行子任务,其中每个工作节点的完成时间 \(T_i\) 都是独立同分布的随机变量,其累积分布函数为 \(F(t) = P(T_i \le t)\)。在不采用对冲执行的情况下,扇出屏障的总完成时间是最大次序统计量:
\[T_{\text{barrier}} = \max(T_1, T_2, \dots, T_N)\]
所有 \(N\) 个工作节点在时间 \(t\) 内完成的概率,是它们各自完成概率的乘积:
\[P(T_{\text{barrier}} \le t) = [F(t)]^N\]
如果单个智能体子任务的第 95 百分位延迟为 \(t_{95} = 15.0\text{ seconds}\)(即 \(F(15.0) = 0.95\)),则监督器扇出至 \(N = 10\) 个并行工作节点时,在 15.0 秒内完成的概率将降至:
\[P(T_{\text{barrier}} \le 15.0) = (0.95)^{10} \approx 0.5987\]
超过 \(40\%\) 的并行操作会因慢节点超过第 95 百分位延迟阈值而被延迟。为防止这些慢节点降低交互式系统的性能,运行时实现了两种互补机制:对冲子任务和\(k\)/\(N\) 法定数量完成机制。
在对冲执行中,监督器将子任务派发给初始工作节点。如果该工作节点未在预设延迟阈值 \(\tau_{\text{hedge}}\) 内返回中间状态或完成产物(该阈值通常设为预期完成时间的第 80 或第 90 百分位),监督器就会在另一条运行时路径上启动该子任务的副本,通常会将请求导向不同的推理后端,或清除推测性上下文。两个工作节点并发执行;一旦其中一个工作节点的产物通过下游验收关卡的验证,监督器便通过取消树取消冗余工作节点。
类似地,在 \(k\)/\(N\) 法定数量拓扑中,监督智能体有意启动 \(N\) 条并行推测轨迹,仅需前 \(k\) 个有效完成结果(\(k < N\))即可继续执行。一旦第 \(k\) 个有效任务信封通过验证,监督智能体便发起级联取消,终止其余 \(N - k\) 个落后工作智能体。
粗略估算 0.6: 对冲子任务与尾部延迟降低
场景 A:无对冲屏障。 监督智能体等待全部 8 个工作智能体完成。 所有工作智能体均在 \(10.0\text{ s}\) 内完成的概率为: \[P(T_{\text{barrier}} \le 10.0) = (0.90)^8 \approx 0.4305\] 近 \(57\%\) 的请求会遇到尾部拖尾任务。预期的第 99 百分位屏障延迟 \(T_{\text{barrier}, 99}\) 由 \(P(T_{\text{barrier}} \le t) = 0.99 \implies [F(t)]^8 = 0.99 \implies F(t) = (0.99)^{1/8} \approx 0.9987\) 决定,使无对冲屏障的尾部延迟超过 \(45.0\text{ s}\)。
场景 B:采用级联取消的法定数量扇出(\(k=6\)/\(N=8\))。 监督智能体仅需 \(k = 6\) 个成功完成结果即可综合形成最终计划,并立即对 2 个拖尾工作智能体发起级联取消。 根据二项次序统计量分布,8 个工作智能体中至少有 6 个在时间 \(t\) 之前完成的概率为: \[P(K \ge 6) = \sum_{j=6}^{8} \binom{8}{j} [F(t)]^j [1 - F(t)]^{8-j}\] 在 \(t = 10.0\text{ s}\) 时,其中 \(F(t) = 0.90\): \[P(K \ge 6) = \binom{8}{6}(0.9)^6(0.1)^2 + \binom{8}{7}(0.9)^7(0.1)^1 + \binom{8}{8}(0.9)^8 \approx 0.1488 + 0.3826 + 0.4305 = 0.9619\] 在 \(10.0\text{ s}\) 之前完成的概率从 \(43.05\%\) 跃升至 \(96.19\%\),使有效的第 95 百分位总完成时间缩短超过 \(60\%\)。此外,在 \(t = 10.0\text{ s}\) 时终止其余 2 个拖尾工作智能体,可避免它们平均额外进行 25 秒的不必要生成。在 1,000 次扇出调用中,取消这两个拖尾工作智能体可节省: \[2 \times 25\text{ s} \times 40\text{ tokens/s} = 2,000\text{ tokens per run} \implies 2,000,000\text{ tokens} = \$4.00\] 同时释放并发服务容量,以处理新到达的任务。
流量控制治理
当智能体通过生产者—消费者流水线进行协同时,例如自动爬取智能体发现文件并向下游验证智能体发送候选补丁,运行时就会面临数据生成与 token 消耗之间的速率失配。
执行确定性文件系统搜索或基本工具操作的轻量级生产者智能体,每秒可以轻松生成数百个候选条目。相比之下,消费者智能体必须通过自回归模型处理每个条目。如果消费者针对每个候选条目生成 500 个 token 的分析性评议,吞吐量为每秒 40 个 token,则其处理能力上限为:
\[\mu_{\text{consumer}} = \frac{40\text{ tokens/s}}{500\text{ tokens/item}} = 0.08\text{ items/s}\]
如果生产者以 \(\lambda_{\text{producer}} = 5\text{ items/s}\) 的平均速率向不受约束的消息队列发送条目,则队列长度 \(Q(t)\) 会线性增长:
\[\frac{dQ}{dt} = \lambda_{\text{producer}} - \mu_{\text{consumer}} = 5 - 0.08 = 4.92\text{ items/s}\]
执行 10 分钟内,队列就会积累近 3,000 条未读消息。在朴素实现中,这种不受约束的增长会引发三种严重的系统故障:
- 主机内存耗尽: 消息代理或智能体内存空间在序列化队列中缓冲数百万个 token,最终触发主机内存不足(OOM),导致致命中止。
- 陈旧上下文污染: 当消费者智能体取出条目 \(k\) 时,底层软件环境或上游代码仓库可能已经发生变化,使排队中的指令完全过时。
- 工作智能体饥饿与死锁: 如果循环流水线中的下游智能体因等待上游生产者占用的队列分配资源而阻塞,运行时就会陷入不可恢复的优先级反转或死锁。
为防止缓冲区膨胀和队列耗尽,智能体通信通道必须实施显式背压。智能体间传输采用基于信用额度的流量控制协议,而非依赖无界的异步 FIFO 缓冲区。
基于信用额度的流量控制沿用了 TCP(RFC 793)的滑动窗口机制和 HTTP/2 流量控制帧的机制,将其从字节级数据包传输迁移到离散的任务信封批次传输。
在该协议中,消费者智能体向上游生产者授予有限数量的执行信用额度 \(W \in \mathbb{N}\)。当且仅当其本地跟踪的信用额度余额满足 \(W_{\text{local}} > 0\) 时,生产者才允许发送消息。每发送一条消息,\(W_{\text{local}}\) 就减一。当消费者成功解析任务信封、完成其本地推理轨迹并将状态刷写后,它会向生产者回传一个显式的 FLOW_CREDIT 帧,以补充 \(W_{\text{local}}\)。表 11 逐步展示了帧交换过程和信用额度状态。
| 步骤 | 通信智能体 | 操作或帧 | 信用额度余额(\(W_{\text{local}}\)) | 系统流动状态 |
|---|---|---|---|---|
| 1. 初始租约 | 消费者到生产者 | 授予信用额度窗口 \(W = 2\) | \(W_{\text{local}} = 2\) | 生产者获准发送最多 2 个任务信封。 |
| 2. 分发 1 | 生产者到消费者 | 分发任务信封 1 | \(W_{\text{local}} = 1\) | 消费者启动解码和验证。 |
| 3. 分发 2 | 生产者到消费者 | 分发任务信封 2 | \(W_{\text{local}} = 0\) | 生产者达到信用额度上限;进入阻塞等待状态。 |
| 4. 补充信用额度 | 消费者到生产者 | 完成任务 1;发送 FLOW_CREDIT 帧 |
\(W_{\text{local}} = 1\) | 生产者解除阻塞并恢复执行。 |
| 5. 分发 3 | 生产者到消费者 | 分发任务信封 3 | \(W_{\text{local}} = 0\) | 并发度始终严格受消费者吞吐量约束。 |
当 \(W_{\text{local}} = 0\) 时,生产者智能体的运行时必须暂停该特定任务分支的执行,将 CPU 线程或执行槽位让给其他并发子任务。如果生产者是一个非特权模型循环,监督器会拦截试图发布消息的工具调用,暂停模型的下一步推理,直到消费者发放新的信用额度。
孤儿资源回收
在分布式环境中,网络分区、监督器崩溃或未处理的异常都可能切断父子控制路径。如果父智能体在其级联取消操作到达子工作进程之前崩溃,该子工作进程就会成为一个孤儿进程。
孤儿智能体会给智能体基础设施带来隐蔽的风险。传统 POSIX 进程在父进程终止后会被重新归属于 init(PID 1),并可通过标准操作系统信号终止;而智能体可能运行在远程容器内,通过分离的后台守护进程执行工具脚本,或轮询外部推理 API 端点。孤儿智能体会持续发起 LLM 解码调用,消耗昂贵的 API 词元,产生未经授权的网络流量,并持有乐观锁或尚未提交的 git 工作树目录。
为确保在任意节点或进程发生故障时,资源生命周期仍有明确上限,智能体运行时强制实施租约式执行不变量。任何智能体都不得无限期执行。
相应地,每个委派任务信封都必须标注生存时间租约期限 \(\tau_{\text{lease}}\)(通常配置为 30 至 120 秒)。为维持执行授权,工作进程必须定期向运行时租约管理器发送经过密码学认证的心跳。如果监督器崩溃或显式撤销任务,心跳确认就会失败。租约到期时(\(t > t_{\text{lease}}\)),工作进程必须自行终止。
# Empirical verification of worker lease validity inside an agent loop
def verify_execution_lease(lease_token: str, max_drift_ms: int = 500) -> bool:
    current_time = time.clock_gettime(time.CLOCK_MONOTONIC)
    lease_record = runtime_lease_table.lookup(lease_token)
    if lease_record is None or lease_record.revoked:
        return False
    # Enforce strict monotonically increasing deadline check
return (lease_record.expiration_time - current_time) > (max_drift_ms / 1000.0)作为进程内租约检查的补充,宿主操作环境运行一个带外的清扫守护进程。该清扫进程监控系统的共享状态,并定期依据中央协同图核对物理基础设施:
- 沙箱容器回收:清扫进程将活跃的容器命名空间和虚拟网络接口与活跃任务注册表进行交叉核对。任何缺少对应 \(\textsc{Active}\) 任务记录的容器都会立即通过
SIGKILL终止。 - 临时工作树清理:如果某个智能体获分配一个独立的 git 工作树,用于推测性编辑(详见 节 4),清扫进程会检测
.git/worktrees/下未被引用且持有该目录的智能体租约已到期的目录路径,移除工作树并删除临时分支。 - 套接字与描述符清理:用于工具 RPC 通信但已不再被引用的 Unix 域套接字会被解除链接,以防止宿主挂载点的 inode 耗尽。
- 能力撤销:为受委派的工作智能体签发的任何临时 API 令牌或存储访问密钥,都会在本地身份验证提供方中作废。
建立鲁棒的级联取消、慢任务对冲和资源回收机制,可确保运行时对受委派任务的运行生命周期保持完整控制。然而,终止进程生命周期只解决了约束问题的一半:在智能体运行期间,监督器必须确保它不会滥用获授的权限。当编排器生成子工作智能体来查询代码仓库或编译独立模块时,什么安全机制能够防止该工作智能体提升自身权限、窃取包含秘密的环境变量,或发出破坏性的管理命令?要回答这一结构性难题,需要考察衰减能力委派的形式化机制。
衰减能力委派
每一步委派都会严格缩减其可支取的令牌预算。
当智能体运行时在缺乏密码学约束的情况下,将子任务委派给辅助工作智能体时,它会无意中以机器速度重现经典的困惑代理问题。设想一个负责对开源拉取请求进行分流处理的编排器。为加快评估,编排器配置一个子工作智能体,用于编译不可信的拉取请求并执行其单元测试套件。如果该子工作智能体继承了编排器的环境操作权限,例如读取开发者环境秘密的权限、访问内部基础设施的网络出站权限,或推送 git 标签的授权,那么嵌入代码仓库测试夹具中的一次提示注入就可能劫持整个宿主系统。不可信代码只需诱使子智能体的自回归解码循环发出读取凭据或外传敏感文件的工具调用,就能利用父进程的环境权限。
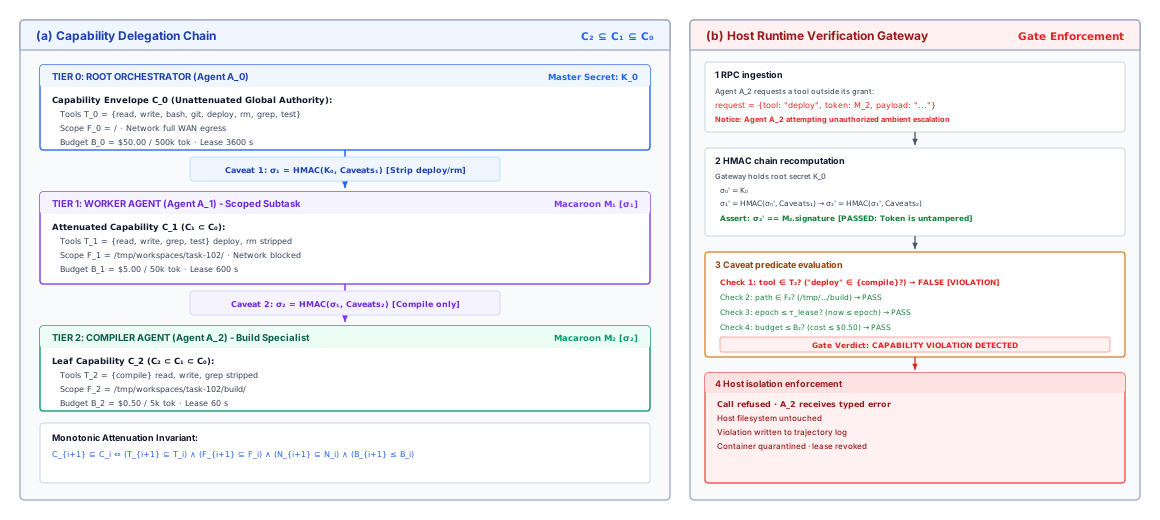
EPERM / HTTP 403)。
如 图 5 中的形式化描述所示,消除环境权限需要在两个协同平面上强制实施基于密码学的能力委派。在面板 A 中,权限沿委派层级(\(\mathcal{C}_2 \sqsubseteq \mathcal{C}_1 \sqsubseteq \mathcal{C}_0\))单调收缩,其实现采用基于 Macaroon 令牌构造的链式 HMAC 限制条件。根编排器 \(A_0\) 持有根秘密 \(K_0\) 和全局权限 \(\mathcal{C}_0\)。向工作智能体 \(A_1\) 委派子任务时,它会绑定限制条件 1(\(\sigma_1 = \text{HMAC}(K_0, \text{Caveat}_1)\)),移除破坏性端点(deploy、rm),将文件系统访问限制在 /tmp/workspaces/task-102/,并将令牌预算限定为 \(\$5.00\). When \(A_1\) spawns Compiler Agent \(A_2\), it appends Caveat 2 (\(\sigma_2 = \text{HMAC}(\sigma_1, \text{Caveat}_2)\)), restricting leaf operations exclusively to the {compile} tool within /build/ under a tight 60-second lease \(\tau_{\max}\). Crucially, because \(A_2\) possesses only \(\sigma_2\), it cannot strip Caveat 2 to recover \(\sigma_1\), preventing unauthorized privilege escalation. In Panel B, the Host Runtime Verification Gateway intercepts every outbound RPC request. When \(A_2\) attempts an ambient privilege escalation (requesting tool: "deploy"), the gateway recomputes the HMAC chain from root secret \(K_0\) to verify token integrity, tests the caveat predicates against the requested operation, detects the violation (\(deploy \notin \{\text{compile}\}\)),并确定性地发出 EPERM(HTTP 403)拒绝响应,同时将该安全违规记录追加到监督器的 WAL。
子智能体绝不能拥有环境隐式权限,也绝不能获得超出其父智能体的权限。在可靠的多智能体架构中,权限被建模为一个单调递减的能力格,其中每个委派令牌都通过密码学机制,对操作工具、文件系统范围、网络出站访问和有效期限等维度的权限进行衰减。
在经典操作系统中 (Saltzer 和 Schroeder 1975年),访问控制列表(ACL)验证的是谁在发起请求;当特权服务器代表非特权客户端执行任务时,这会直接导致混淆代理漏洞。对象能力(OCaps)将资源指称与权限融为一体:持有能力令牌即拥有权限,从而能够无缝委派,而不会提升环境隐式权限。
单调衰减不变量
为确保委派过程中始终不存在环境隐式权限,多智能体运行时将所有工具调用、文件系统访问和网络出站访问建模为受保护操作,并由不可伪造的能力描述符控制访问。遵循 Saltzer 和 Schroeder (1975年) 提出的基础安全原则,智能体不能仅凭其运行进程的上下文访问任何资源。相反,每次向宿主运行时网关发送远程过程调用(RPC)时,它都必须显式提供有效的能力令牌。
我们将智能体的权限形式化为一个五维能力包络 \(\mathcal{C} = \langle \mathcal{T}, \mathcal{F}, \mathcal{N}, \tau_{\max}, \mathcal{B} \rangle\),其中:
- \(\mathcal{T} \subseteq \mathcal{T}_{\text{global}}\) 定义允许调用的工具 RPC 端点(例如,
read_file、compile或git_diff)。 - \(\mathcal{F} \subseteq \mathcal{P}\) 定义列入白名单的文件系统路径前缀(例如,
/tmp/workspaces/task-102/)。 - \(\mathcal{N} \subseteq \mathcal{D}\) 定义允许访问的网络出站域名或 CIDR 地址块。
- \(\tau_{\max}\) 表示以 POSIX 墙钟时间戳指定的绝对到期时刻。
- \(\mathcal{B} = \langle K_{\max}, D_{\max}^{\text{cost}} \rangle\) 设定计算预算上限,限定允许使用的最大推理词元数和美元支出。
当持有能力 \(\mathcal{C}_i\) 的父智能体创建子工作智能体时,委派须遵循 权能与凭据 的衰减规则;如今,单调委派(原则 21)将这一规则强制应用于智能体之间。根据此规则,子智能体的能力 \(\mathcal{C}_{i+1}\) 在权限格中构成一个形式上的子集,即对权限的限制:
\[\mathcal{C}_{i+1} \sqsubseteq \mathcal{C}_i \iff \left( \mathcal{T}_{i+1} \subseteq \mathcal{T}_i \right) \land \left( \mathcal{F}_{i+1} \subseteq \mathcal{F}_i \right) \land \left( \mathcal{N}_{i+1} \subseteq \mathcal{N}_i \right) \land \left( \tau_{\max, i+1} \le \tau_{\max, i} \right) \land \left( \mathcal{B}_{i+1} \le \mathcal{B}_i \right)\]
任何接受委派的智能体都不能凭空生成新权限,也不能扩展其被分配的操作包络的任何维度。在深度为 \(d\) 的委派层级中,权限单调收缩:
\[\mathcal{C}_0 \sqsupseteq \mathcal{C}_1 \sqsupseteq \mathcal{C}_2 \sqsupseteq \dots \sqsupseteq \mathcal{C}_d\]
表 12 总结了这些安全机制在结构上的区别。
| 安全维度 | 环境隐式权限运行时 | 衰减能力架构 |
|---|---|---|
| 工具范围 | 子智能体继承宿主环境的全部工具 | 显式列入白名单的子集(\(\mathcal{T}_{\text{child}} \subseteq \mathcal{T}_{\text{parent}}\)) |
| 文件系统范围 | 可全局访问用户工作区 | 严格限制在路径前缀范围内(\(\mathcal{F}_{\text{child}} \subseteq \mathcal{F}_{\text{parent}}\)) |
| 网络出站访问 | 可不受限制地创建 TCP/UDP 套接字 | 仅允许白名单中的 CIDR 地址块或域名;默认与网络隔离 |
| 执行期限 | 无期限限制,直至进程终止 | 单调递减的存活期限(\(\tau_{\text{child}} \le \tau_{\text{parent}}\)) |
| 故障遏制 | 工作智能体被攻陷会危及宿主 | 被攻陷的工作智能体被限制在其狭窄的沙箱内 |
临时拼凑的多智能体设计中,首要的系统性失误是认为语言模型提示词能够强制实施授权边界(例如,在工作智能体的系统提示词中指示:“不要在 /build 之外执行 shell 命令”)。不变闭包原则 已经否定了这种做法对单个智能体的有效性,而委派也不会改变这一结论。授权由运行时实施,位于每个模型的上下文之外。
用于零信任调度的链式密码学 macaroon 令牌
当扩展到数十个分布式工作智能体时,集中式授权查询表会引入严重的协同瓶颈。如果每次工具调度都要求运行时网关查询权威数据库以评估父子关系,数据库锁竞争和网络往返很快就会主导关键路径。
为实现无需查询集中式状态的去中心化、可验证委托,运行时采用 Macaroons——带有链式上下文限制条件的密码学持有者凭证 (Birgisson 等 2014年)。Macaroon 采用嵌套的基于哈希的消息认证码(HMAC)构造,使智能体能够在本地追加限制条件,而无需与签发凭证的根网关通信。
根编排器 \(A_0\) 从运行时网关接收一个基础令牌,其中包含标识符 \(\text{id}_0\) 和初始签名:
\[\sigma_0 = \text{HMAC}(K_{\text{gateway}}, \text{id}_0)\]
其中,\(K_{\text{gateway}}\) 是仅运行时执行网关知晓的高熵秘密值。当 \(A_0\) 创建工作智能体 \(A_1\) 时,它通过追加一级限制条件 \(c_1\)(例如,tools:read_file,compile)来收窄令牌权限,并更新密码学签名:
\[\sigma_1 = \text{HMAC}(\sigma_0, c_1)\]
编排器将权限收窄后的描述符 \(M_1 = \langle \text{id}_0, [c_1], \sigma_1 \rangle\) 交付给 \(A_1\)。如果 \(A_1\) 随后将编译任务委托给更低层级的子工作智能体 \(A_2\),它会追加限制条件 \(c_2\)(例如,path:/tmp/workspaces/task-102/build),并计算:
\[\sigma_2 = \text{HMAC}(\sigma_1, c_2)\]
由于 HMAC 是单向密码学哈希函数,工作智能体 \(A_1\) 无法移除限制条件 \(c_1\),从而将自身权限提升回 \(\sigma_0\);这样做需要逆向求解哈希以恢复 \(\sigma_0\),这在计算上不可行。同样,任何一个工作智能体若不持有链中的前一个签名,都无法为修改后的限制条件集合伪造签名。
当任一智能体向执行网关提交工具 RPC 时,请求会携带 macaroon 令牌。网关以相对于限制条件数量的线性时间,采用确定性方式验证令牌,无需执行分布式数据库查询。
def verify_macaroon(macaroon: Macaroon, key: bytes, ctx: SecurityContext) -> bool:
    sig = hmac_sha256(key, macaroon.identifier)
    for caveat in macaroon.caveats:
        if not caveat.evaluate(ctx):
            return False
        sig = hmac_sha256(sig, caveat.serialize())
    return hmac.compare_digest(sig, macaroon.signature)
网关使用其私钥 \(K_{\text{gateway}}\) 重建 HMAC 链。在链的每一环,它都会根据动态执行上下文 \(\mathcal{X}\) 检查限制条件(验证所请求的工具是否列于白名单中、目标路径是否位于授权的路径前缀范围内,以及当前系统时间是否未超过到期时间戳)。如果所有限制条件的求值结果均为真,且重建的签名与 macaroon 的末端签名匹配,网关便将工具调用分派至沙箱运行时。
粗略估算 0.7: 工具网关处的 macaroon 验证
系统参数:
- 工具 RPC 请求吞吐量:所有活跃沙箱合计为 \(R = 10{,}000\ \text{requests/sec}\)。
- 委派深度:\(d = 4\)(编排器 \(\to\) 规划器 \(\to\) 实现器 \(\to\) 测试运行器)。
- Macaroon 结构:基础标识符(32 字节)加上 4 个限制条件(每个平均 48 字节:工具白名单、路径前缀、到期时间和内存限制)。
- 密码学原语:HMAC-SHA256。
- 宿主硬件:AMD EPYC 9654 服务器处理器的单个核心,运行频率为 2.4 GHz,执行顺序块变换时的 HMAC-SHA256 速率为 \(450\ \text{MB/s}\),初始哈希设置成本为 \(t_{\text{init}} = 85\ \text{ns}\),每个块的更新成本为 \(t_{\text{block}} = 110\ \text{ns}\)。
评估:
验证步骤: 网关必须为根标识符计算 1 次初始 HMAC,并为限制条件执行 4 次迭代 HMAC 运算(总计 \(n = 5\) 次 HMAC 求值)。
每个请求处理的数据量: 根标识符和每个限制条件均可容纳于单个 64 字节的 SHA-256 块中。每次 HMAC 计算执行两次内部哈希操作(内层填充和外层填充),每个限制条件需处理两个 64 字节块: \[t_{\text{hmac}} = 2 \times (t_{\text{init}} + t_{\text{block}}) = 2 \times (85\ \text{ns} + 110\ \text{ns}) = 390\ \text{ns}\]
每次工具调用的总验证时间: \[t_{\text{verify}} = 5 \times t_{\text{hmac}} = 5 \times 390\ \text{ns} = 1.95\ \mu\text{s}\]
网关核心利用率: 在 \(R = 10{,}000\ \text{calls/sec}\) 时,整个宿主上能力凭证验证消耗的总计算时间为: \[T_{\text{cpu}} = 10{,}000 \times 1.95\ \mu\text{s} = 0.0195\ \text{seconds of CPU time per second} \implies 1.95\%\ \text{of one core}\]
令牌网络开销: \[\text{Size} = 32\ \text{bytes (id)} + (4 \times 48\ \text{bytes}) + 32\ \text{bytes (signature)} = 256\ \text{bytes}\]
要点: 密码学 macaroon 验证的 CPU 延迟低于 \(2\ \mu\text{s}\),载荷开销为 256 字节,相较于标准工具执行,其引入的额外开销可以忽略不计(运行代码检查器或编译器需要 \(10\ \text{ms}\) 至 \(500\ \text{ms}\),高出五个数量级)。相比之下,通过网络查询分布式数据库或 OAuth 令牌内省端点,每次调用会产生 \(2\ \text{ms}\) 至 \(15\ \text{ms}\) 的延迟,使整个多智能体运行时遭遇瓶颈。
分布式撤销级联
虽然链式 macaroon 支持去中心化的能力凭证验证,但其持有者凭证属性带来了一个关键的系统难题:当父任务被取消或失败时,运行时如何立即撤销整个被委派子工作智能体子树的权限?
如 节 6 中所述,当编排器终止一个运行分支时,必须中止所有尚未结束的后代进程,以节省计算资源并防止造成状态损坏的修改。如果被委派的工作智能体持有一个有效的密码学令牌,其尚未到期的 TTL 为 300 秒,那么在时间限制条件到期之前,该工作智能体理论上仍可继续向网关发出有效的工具 RPC。仅依赖到期时间戳会留下一个风险窗口,在此期间,孤立或失控的子智能体可以修改文件系统或耗尽资源配额。
为在保留 \(O(1)\) 本地验证的同时实施即时、确定性的撤销,运行时实现了分层代际纪元,并通过 分层代际纪元撤销检查 中的查找模式进行跟踪。
| 任务节点 ID | 谱系路径 | 当前纪元(\(E_{\text{active}}\)) | 令牌纪元(\(E_{\text{token}}\)) | 网关授权决策 |
|---|---|---|---|---|
| task-100 | task-100(根) |
1 | 1 | 已授权(活跃) |
| task-101 | task-100/task-101 |
1 | 1 | 已授权(活跃) |
| task-102 | task-100/task-101/task-102 |
2(已撤销) | 1 | 403 禁止访问:令牌纪元(\(1\)) < 当前纪元(\(2\));子树已切断 |
当根编排器初始化委派树时,它会向网关注册一个唯一的任务谱系路径(例如,task-100/task-101/task-102)。网关维护一张紧凑的内存代际表,将任务节点映射到整数代际计数器。令牌标识符包含此谱系路径以及签发时该节点的代际值:
\[\text{id} = \langle \text{root\_id}, \text{lineage\_path}, \text{epoch} \rangle\]
撤销整个子树只需递增网关代际表中目标祖先节点的代际计数器。当子工作智能体提交其 macaroon 时,网关会提取谱系路径,并对内存数组执行 \(O(1)\) 检查。如果令牌谱系中的任一祖先节点的当前代际值严格大于令牌标识符中嵌入的代际值,网关就会以授权失败为由拒绝请求,立即切断所有后代智能体的权限。对于需要人工签核的高影响操作,授权流程会转入 表 13 中详述的托管协议。
| 协议阶段 | 目标实体 | 操作或约束 | 安全与授权不变量 |
|---|---|---|---|
| 1. 破坏性操作尝试 | 工作智能体 | 提议执行破坏性操作(例如 git push --force) |
工作智能体不持有任何环境隐式权限;不具备推送权限。 |
| 2. 网关拦截 | API 中介网关 | 拦截系统调用;识别人工托管需求 | 完全阻止直接执行;挂起工作线程。 |
| 3. 托管边界屏障 | 隔离防火墙 | 禁止子工作智能体直接向人工操作员发送消息 | 防止对抗性提示注入和社会工程攻击。 |
| 4. 信封上报 | 托管中介总线 | 将正式的上报信封封送至根编排器 | 提供结构化差异、上下文依据和风险评分卡。 |
| 5. 人工确认 | 根编排器 | 审查综合整理的上下文;请求经过身份认证的人工签名 | 只有在操作员批准通过密码学验证后,才提交操作。 |
另一条并行的隔离边界负责约束人工托管上报。在高影响环境中,某些关键操作——例如删除生产数据库表、修改公共 DNS 记录或发放款项——需要同步的人工在环确认。
在分布式多智能体部署中,允许子智能体直接触发人工审批对话框会造成致命漏洞。如果在不可信执行树深处运行的无特权子智能体能够在用户终端上弹出确认提示,用户就会面临两种不同的风险:
- 托管请求泛滥: 存在缺陷且陷入循环的子工作智能体可能向人工操作员发送数百个并发审批请求,造成认知疲劳,进而导致对危险操作的意外授权。
- 对抗性社会工程攻击: 提示已被对抗性载荷侵入的无特权子智能体可能构造欺骗性的审批提示,故意歪曲所请求命令的性质,诱使人工操作员授权权限提升。
为消除此漏洞,运行时强制实施一道绝对的托管隔离边界。受委派的子智能体在结构上被禁止注册交互式人工提示。如果权限受到削减的工作智能体发出需要人工确认的工具命令,运行时网关会拦截该调用,并向子智能体返回一个明确的 EscrowElevationRequired 任务信封。
子智能体无法自主继续执行;它必须通过协同树中的父节点逐级上报托管请求。父编排器会检查子智能体的执行轨迹,核实该操作在总体计划中的合理依据,并向人工监督者提交一份经过整合、包含上下文的授权请求。通过将人工交互限定在根编排器,架构维护了审计链的完整性,并确保所有操作都在更广泛的系统上下文中接受审查。
在为委派拓扑、类型化消息信封、乐观并发控制、故障去相关、取消传播和权限削减后的能力隔离建立正式框架后,我们已经构建了执行分布式多智能体工作流所需的完整系统机制。然而,构建复杂的多智能体编排并不保证其性能优于在相同计算预算下运行的单个模型。多智能体委派会带来不可忽视的序列化延迟、令牌用量放大成本和协同开销。在将分布式智能体集群部署到生产环境之前,系统工程师必须面对一个根本性的实证问题:与配备测试时搜索的优化单智能体基线相比,将工作负载分解给多个智能体,能否提高任务完成率并缩短总完成时间?
单智能体基线基准测试
工作智能体数量超过约六个后,合并争用会使集群比单个智能体更慢。
本章开篇的五智能体团队说明了为何必须以恰当的基线衡量集群。最初的单个智能体在获得同等资源用于测试时修订后,达到了与该集成系统相同的通过率。
架构复杂性不能替代计算效率。只有在总预算相同的条件下,与经过优化的单个智能体相比,多智能体协同拓扑在任务完成质量、关键路径总完成时间和每个验收通过任务的成本上均不逊色,且至少在其中一项上严格更优,才有理由采用。 在分布式系统设计中,将工作负载分解到多个处理节点从不被视为天然的优点;这是一种工程折中,只有为突破单节点吞吐量或内存容量的物理限制时才会被接受。在智能体机器学习中,这些物理边界对应于模型的有效上下文窗口、注意力在长词元序列上的退化,以及顺序自回归解码的实际耗时限制。如果工程师在将任务划分给多个智能体之前,没有先测量单个模型在配备测试时搜索后能够达到的水平,那么他们构建的分布式系统往往只会放大通信开销、重复共享上下文,并在未经隔离的工作智能体之间传播相关错误。严格的基准测试要求建立公平的基线协议,沿三个正交维度评估系统,并应用形式化的可扩展性模型来量化协同争用。
资源匹配协议
多智能体文献中最普遍的方法论缺陷,是将复杂的多智能体架构与朴素的单轮零样本单智能体基线进行比较。零样本基线通过一次自回归前向传播生成候选解,不使用环境反馈、暂存存储器中的推敲、工具调用或错误恢复。多智能体群体会执行数十次顺序工具调用、检查编译器诊断信息,并在数千个中间词元的生成过程中反复向自身发出提示;将这样的群体与零样本模型进行比较,评估的并非多智能体协同,而只是动态测试时计算相对于静态前馈推理的显而易见的优势。
资源等价原则规定,对编排拓扑 \(\mathcal{T}\) 与单智能体基线 \(\mathcal{S}\) 进行任何实证比较时,都必须保持总计算开销不变: \[\mathcal{B}_{\text{total}}(\mathcal{T}) \approx \mathcal{B}_{\text{total}}(\mathcal{S})\] 其中,计算既包括词元量,也包括沙箱执行周期。
以证据为界的推敲(原则 2)已经要求在预算匹配的条件下比较额外的推理计算,而集群就是以并行方式消耗的额外推理计算。因此,要判断多智能体委派是否提供了真正的架构价值,基线必须是经过优化的单智能体运行时。如 测试时计算 和 工具调用 所述,无特权的神经网络推理引擎可以被组织为由宿主监督机制控制的迭代执行循环。配置得当的单智能体基线必须具备以下能力:
- 迭代式环境反馈:智能体在隔离沙箱中执行动作,接收原始退出码和标准错误流,并在多轮交互中迭代调整其计划。
- 推敲式搜索与修订:智能体使用顺序测试时计算,包括自我纠正、树搜索,或通过验证过滤器筛选的 best-of-\(N\) 候选采样。
- 动态上下文压缩:运行时裁剪暂存存储器中的中间轨迹,将体积庞大的工具输出卸载到外部磁盘存储,并在模型可用的上下文限制内维护活跃的工作记忆。
用于智能体评估的基线协议架构比较 对比了决定基线比较是否有效的架构参数。
| 协议属性 | 朴素基线(无效) | 经过优化的单个智能体(有效) | 多智能体群体 |
|---|---|---|---|
| 推敲预算 | 1 次前向传播(\(K=1\)) | \(N\) 轮使用工具的迭代交互 | \(\sum_{i=1}^M N_i\) 轮分布式交互 |
| 环境反馈 | 无(盲生成) | 交互式执行沙箱 | 为工作智能体复制的沙箱 |
| 搜索机制 | 贪心搜索或单一温度 | 顺序反思 / ReAct | 并行分支探索 |
| 上下文范围 | 单体提示(\(S_{\text{in}}\)) | 受管理的滑动窗口 | 划分后的任务封装 |
| 成本依据(\(\mathcal{B}_{\text{tokens}}\)) | 基础词元成本 \(T_0\) | 匹配预算 \(\mathcal{B} \approx M \times T_0\) | 分布式总和 \(\sum T_{\text{worker}}\) |
在将多智能体系统与经过优化的单智能体进行比较评估时,系统工程师必须遵循资源等价原则。如果一个由四个智能体组成的集成在各项子任务中总计消耗了 400,000 个令牌和 120 秒的沙箱执行时间,那么就必须在匹配的令牌预算(\(\mathcal{B}_{\text{tokens}} = 400{,}000\))和等价的沙箱实际经过时间限制下评估单智能体基线。如果允许单智能体将这 400,000 个令牌用于顺序搜索、更深入的规划或反复的单元测试修复后,它能够达到相同或更高的任务完成率,那么该多智能体架构的系统效用就是负的。它承担了分布式系统的维护复杂性、网络故障面和序列化开销,却未能带来实证支持的投资回报。
三轴评估指标
仅沿基准测试通过率等单一维度评估智能体系统,会掩盖关键的系统权衡。如果一种架构将任务成功率提高了两个百分点,却使运行成本增至四倍,并引入长达十分钟的延迟峰值,那么它通常难以部署到生产工程环境中。严谨的系统评估需要跟踪三个正交维度:任务完成质量、关键路径总完成时间,以及每个验收通过任务的成本。
Principle 1: 三轴多智能体评估前沿
推论:关于多智能体设计的主张必须在预算相等的条件下成立,必须与使用测试时修订和工具的单智能体进行比较,并将协同开销同时计入总完成时间和成本。
第一个维度是任务完成质量(\(Q\)),定义为最终产物满足所有功能性和非功能性不变量的任务数与尝试执行的任务总数之比: \[Q = \frac{1}{|\mathcal{D}|} \sum_{i=1}^{|\mathcal{D}|} \mathbb{I}\left( \text{Verify}(\mathcal{A}_i) == \text{SUCCESS} \right)\] 验证由外部以确定性方式执行,使用封闭隔离的单元测试套件、静态分析检查工具或密码学签名验证器,绝不能依据智能体自身关于任务已完成的报告,因为这种报告不具有任何证据效力(认识论边界:受强制的约束域与语义正确性)。
第二个维度是关键路径总完成时间(\(\tau_{\text{crit}}\)),即从接收任务到最终产物验收通过所经过的实际时间。对于执行 \(N\) 个顺序轮次的单智能体运行时,总完成时间严格等于各项耗时之和: \[\tau_{\text{crit}}^{\text{single}} = \sum_{j=1}^N \left( \tau_{\text{prefill}}^{(j)} + \tau_{\text{decode}}^{(j)} + \tau_{\text{env}}^{(j)} \right)\] 其中,\(\tau_{\text{prefill}}\) 是通过矩阵—矩阵乘法(GEMM)处理输入上下文所需的时间,\(\tau_{\text{decode}}\) 是受内存带宽限制的自回归令牌生成时间(GEMV),\(\tau_{\text{env}}\) 是工具在沙箱中的执行延迟。在多智能体有向无环图(DAG)\(\mathcal{G} = (\mathcal{V}, \mathcal{E})\) 中,工作智能体并发执行,使工作负载能够在可用的计算引擎之间并行处理。然而,总完成时间由图中最长的执行路径决定: \[\tau_{\text{crit}}^{\text{multi}} = \max_{\pi \in \text{Paths}(\mathcal{G})} \sum_{v \in \pi} \left( \tau_{\text{agent}}(v) + \tau_{\text{envelope}}(v) \right) + \tau_{\text{reconciliation}}\] 这里,\(\tau_{\text{envelope}}\) 表示父运行时与子运行时之间带类型的任务封装的序列化、传输和反序列化延迟,而 \(\tau_{\text{reconciliation}}\) 表示执行三方合并或解决乐观并发冲突所需的时间。即使工作节点表现出很高的并发度,汇合节点处的同步屏障仍可能导致 \(\tau_{\text{crit}}^{\text{multi}}\) 超过 \(\tau_{\text{crit}}^{\text{single}}\)。
第三个轴是每项验收通过任务的成本(\(\mathcal{E}\)),它将每次失败尝试的成本计入通过验收的任务(原则 22)。单次尝试的支出 \(d\) 汇总了所有参与模型和沙箱的 token 成本与沙箱成本: \[\mathcal{E}_{\text{attempt}}(d) = \sum_{i=1}^M \left( c_{\text{in}} \cdot T_{\text{in}}^{(i)} + c_{\text{out}} \cdot T_{\text{out}}^{(i)} \right) + c_{\text{compute}} \cdot \tau_{\text{sandbox}}\] 其中,\(T_{\text{in}}^{(i)}\) 和 \(T_{\text{out}}^{(i)}\) 表示智能体 \(i\) 的输入和输出 token 数量,\(c_{\text{in}}\) 和 \(c_{\text{out}}\) 表示每个 token 的价格,\(c_{\text{compute}}\) 则计入沙箱基础设施成本。将评估集上的总支出除以验收通过的任务数 \(Q\,|\mathcal{D}|\),即可得到该轴的度量值: \[\mathcal{E} = \frac{\sum_{d \in \mathcal{D}} \mathcal{E}_{\text{attempt}}(d)}{Q\,|\mathcal{D}|}\] 每项通过验收的任务的成本 将验证成本和升级至人工处理的成本加入单次尝试的支出。token 和沙箱这两项成本足以用于比较拓扑结构。多智能体拓扑不可避免地受到上下文重复的影响:当监督者将一个子任务委派给三个并行工作智能体时,基础系统指令、代码仓库模式和任务描述会被复制到三个独立的上下文窗口中,使 \(T_{\text{in}}\) 增至原来的 \(M\) 倍。
只有当多智能体设计在 \((Q, \tau_{\text{crit}}, \mathcal{E})\) 上优于预算相同的基线时,这种设计才有充分依据;这也是三轴前沿的要求。当需求将总完成时间置于首位时(例如自动化事件响应),并行委派可以通过在相同预算内压缩 \(\tau_{\text{crit}}\) 来满足这一要求,前提是可并行化部分的比例足够高,使重复的上下文不会降低 \(Q\)。当预算紧张时,单个顺序执行的智能体几乎总是更优,因为重复的上下文会消耗原本可用于修订的 token。
协同争用动力学
节 1 中的阿姆达尔界限将其协同项 \(h(M)\) 保留为抽象形式。从运行时间出发构建该项,再赋予 \(h(M)\) 具体的物理形式,就能解释为什么增加工作智能体会带来递减的收益,并最终导致负收益。
设 \(T_1\) 为任务在经过优化的单个智能体上的执行时间。假设任务中比例为 \(f \in [0, 1]\) 的部分可以划分为完全独立的子任务,由 \(M\) 个工作智能体并行执行,而剩余比例 \((1 - f)\) 则代表严格串行的操作(例如初始根级规划、任务分解、最终产物合成以及顺序回归验证)。如果智能体之间的协同能够瞬时完成且不存在任何阻碍,理论上的并行运行时间将为: \[T_M = (1 - f)T_1 + \frac{f T_1}{M}\] 由此得到经典的加速比: \[\text{Speedup}_{\text{ideal}}(M) = \frac{T_1}{T_M} = \frac{1}{(1 - f) + \frac{f}{M}}\]
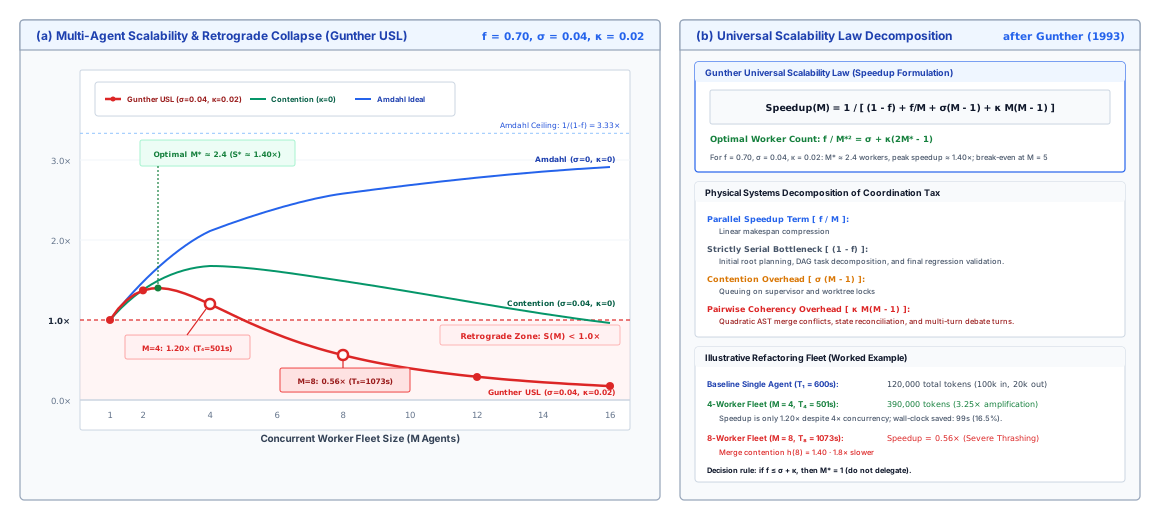
支配多智能体加速与成本崩塌的物理动力学在 图 6 中得到了形式化描述。在面板 A 中,理论上的阿姆达尔曲线(\(f = 0.70\),\(\sigma = 0, \kappa = 0\))趋近于渐近上界 \(\frac{1}{1 - f} = 3.33\times\)。引入线性资源争用后(\(\sigma = 0.04\),表示监督者排队和分支检出的串行化),加速比上限在 \(1.68\times\) 附近趋于平稳。然而,通过 Gunther 通用可扩展性定律计入成对一致性延迟(\(\kappa = 0.02\),刻画三方 AST 合并冲突和对话式共识讨论)后,加速比轨迹在 \(M^* = \sqrt{(f - \sigma)/\kappa} = \sqrt{(0.70 - 0.04)/0.02} \approx 5.74\) 处达到峰值,可实现的加速比仅为 \(1.24\times\)。超过这一阈值后,二次增长的一致性开销 \(\kappa M(M - 1)\) 超过并行计算收益,将执行拖入逆向崩塌区(\(S(M) < 1.0\times\))。当工作智能体数量为 \(M = 8\) 时,系统的加速比仅为 \(0.56\times\)(总完成时间膨胀至 \(1{,}073\text{ s}\)),运行耗时几乎是无特权单智能体的两倍。在面板 B 中,Gunther 公式中的物理项被映射到具体的运行时瓶颈,表明配置四个并发工作智能体仅使实际执行时间缩短 \(16.5\%\)(501 秒对比 600 秒),却带来了惊人的 \(3.25\times\) 词元放大(390,000 对比 120,000 个词元)。
在实际的分布式智能体运行时中,协同从来都不是免费的。正如第 15.2 节和第 15.4 节所形式化描述的那样,智能体间的委派会产生上下文序列化开销、网络 RPC 传输延迟、监督者调度开销,以及乐观并发合并争用。令 \(T_{\text{overhead}}(M)\) 表示随工作智能体数量 \(M\) 变化的实际协同总耗时。多智能体的实际执行时间为: \[T_M = (1 - f)T_1 + \frac{f T_1}{M} + T_{\text{overhead}}(M)\] 除以 \(T_1\),并定义归一化开销函数 \(h(M) = \frac{T_{\text{overhead}}(M)}{T_1}\),可得可实现的加速比: \[\text{Speedup}(M) = \frac{1}{(1 - f) + \frac{f}{M} + h(M)} \tag{1}\]
为了精确建模 \(h(M)\) 的物理行为,系统工程师采用 Neil J. Gunther 的通用可扩展性定律(USL,2007 年)。在智能体运行时中,协同开销源于两种不同的物理因素: \[h(M) = \sigma (M - 1) + \kappa M(M - 1)\] 参数 \(\sigma \ge 0\) 是争用系数,表示为获取串行资源而排队所花费的时间,例如监督者的输入上下文处理队列或共享代码仓库的分支锁。参数 \(\kappa \ge 0\) 是一致性系数,表示协调冲突修改、同步工作智能体暂存存储器之间的状态,或在集成成员之间达成共识所需的成对通信延迟。
当存在成对一致性延迟(\(\kappa > 0\))时,加速比曲线不只是趋于平稳,而是会逆向下降。随着 \(M\) 增大并超过临界阈值,\(\kappa M(M - 1)\) 二次项的增长将超过并行执行带来的缩减 \(\frac{f}{M}\)。增加更多智能体会导致系统运行得比单智能体更慢。使加速比最大的最优工作智能体数量 \(M^*\),可通过求解驻点 \(\frac{d}{dM} \text{Speedup}(M) = 0\) 推导得出: \[M^* = \sqrt{\frac{f - \sigma}{\kappa}}\] 如果任务的可并行部分占比较小(\(f \le \sigma\)),或者合并争用较高,则最优工作智能体数量为 \(M^* = 1\):该工作负载根本不应委派。
粗略估算 0.8: 并行重构集群评估
团队部署了监督者—工作者拓扑,其中 \(M = 4\) 个工作智能体在相互隔离的 git 工作树上运行。系统遥测测得争用参数为 \(\sigma = 0.04\)(监督者调度延迟),一致性参数为 \(\kappa = 0.02\)(AST 合并冲突和三方协调延迟)。
1. 计算可实现的加速比与总完成时间: 使用通用可扩展性定律: \[h(4) = 0.04(4 - 1) + 0.02(4)(4 - 1) = 0.12 + 0.24 = 0.36\] 加速比为: \[\text{Speedup}(4) = \frac{1}{0.30 + \frac{0.70}{4} + 0.36} = \frac{1}{0.30 + 0.175 + 0.36} = \frac{1}{0.835} \approx 1.20\] 实际的多智能体总完成时间为: \[T_4 = \frac{T_1}{\text{Speedup}(4)} = \frac{600\text{ s}}{1.20} = 501\text{ s}\] 尽管配置了四个工作智能体,实际执行时间却仅缩短了 99 秒,降幅仅为 16.5%。
2. 计算资源与 token 放大: 每个工作智能体都需要接收监督智能体分解后的任务指令、架构规则和 AST 切片,因此每个工作智能体需消耗 60,000 个输入 token。每个工作智能体生成 15,000 个输出 token。监督智能体在规划阶段消耗 40,000 个 token,在合并验证阶段消耗 50,000 个 token。 \[\text{Total Tokens} = 40{,}000 + 50{,}000 + 4 \times (60{,}000 + 15{,}000) = 390{,}000\text{ tokens}\] 多智能体系统的 token 放大倍数为 \(3.25\times\)(390,000 对比 120,000),且所需的沙箱并发数增至四倍,以实现 \(1.20\times\) 的加速比。
3. 确定最优工作智能体数量: \[M^* = \sqrt{\frac{f - \sigma}{\kappa}} = \sqrt{\frac{0.70 - 0.04}{0.02}} = \sqrt{\frac{0.66}{0.02}} = \sqrt{33} \approx 5.74 \implies 5\text{ or }6\text{ workers}\] 在 \(M=6\) 时,加速比达到峰值,但仅为 \(1.24\times\)(\(T_6 = 484\text{ s}\)),随后开始下降。将工作负载分解给 8 个工作智能体,得到 \(h(8) = 0.04(7) + 0.02(8)(7) = 0.28 + 1.12 = 1.40\),对应的加速比为 \(0.56\times\)(\(T_8 = 1{,}073\text{ s}\))——耗时几乎是单智能体的两倍!
为了在部署前验证拟采用的委派拓扑是否能提高系统效率,系统工程师可以直接结合性能剖析轨迹,对 Gunther 的加速比方程进行评估:
def evaluate_coordination_efficiency(f: float, sigma: float, kappa: float, M: int) -> float:
    """Computes multi-agent speedup under Gunther's Universal Scalability Law."""
    if M < 1:
        raise ValueError("Worker count M must be >= 1")
    overhead = sigma * (M - 1) + kappa * M * (M - 1)
    effective_denominator = (1.0 - f) + (f / M) + overhead
    return 1.0 / effective_denominator
架构部署检查清单
在将智能体工作流分解为多智能体集群之前,系统架构师必须评估 表 14 中概述的六项运行标准。如果拟议系统未能通过其中任何一道关卡,架构上就必须默认采用经过优化的单智能体运行时。
| 决策关卡 | 评估标准 | 通过条件 | 未通过时的措施 |
|---|---|---|---|
| 1. 上下文可分区性 | 能否将任务状态分解为互不重叠的子上下文? | 子任务表现出高度的引用局部性;提示词重复程度低 | 回退至单智能体运行时 |
| 2. 单智能体饱和 | 是否已通过反思与工具优化单智能体基线? | 在计算预算相同的条件下,单智能体达到经验证的认知能力平台期 | 回退至单智能体运行时 |
| 3. 正向加速 | 并行加速收益是否超过编排开销? | Amdahl 加速收益 \(f/M > h(M)\) 通信阻力 | 回退至单智能体运行时 |
| 4. 错误去相关 | 各种失效模式是否在统计上相互独立? | 模型或提示词具有不同的归纳偏置 | 拒绝该拓扑 / 重新设计提示词 |
| 5. 能力衰减 | 能否以单调递减的方式限制工作智能体的权限? | 通过形式化能力令牌强制实施 \(R_{\text{child}} \subseteq R_{\text{parent}}\) | 停止:存在权限提升风险 |
| 6. 三轴支配性 | 该拓扑是否在 \(Q\)、\(\tau\) 和成本方面支配基线? | 在预算相同的条件下:所有轴上均不劣于基线,且至少一个轴上严格优于基线 | 回退至单智能体运行时 |
上下文可分区性关卡: 能否将任务的运行状态清晰地划分为互不重叠的子上下文?如果每个子任务都需要访问完整的单体系统提示词、完整的文件树以及全局执行历史,多智能体委派就会使网络和推理引擎因重复的预填充 token 而达到饱和。只有当子任务表现出较强的引用局部性时,委派才具有合理性。
单智能体饱和关卡: 是否已通过测试时反思、工具执行、动态上下文剪枝以及预算相同的搜索,对单智能体基线进行了充分优化?如果单个智能体在获得相同计算资源的条件下能够解决问题,多智能体编排就会引入不必要的运行脆弱性。
Amdahl 可扩展性关卡: 可并行化比例 \(f\) 是否显著超过串行化开销 \(h(M)\)?预期加速比必须满足: \[\frac{f}{M} + h(M) < f \implies h(M) < f \left(1 - \frac{1}{M}\right)\] 如果合并冲突、任务串行化或监督智能体的调度延迟抵消了并发收益,系统就会在增加成本的同时降低吞吐量。
错误去相关关卡: 是否在结构上为工作智能体提供了防止相关失效模式的保障?正如 节 5 中所证明的,在相同提示词下部署同一基础模型的多个实例,会在共享盲点的同时制造共识的假象。工作智能体必须采用多样化的提示词、异构模型后端或正交分解策略。
能力衰减关卡: 架构是否在被委派的各个子运行时中严格执行最小权限原则?子智能体必须在经密码学机制衰减的能力令牌(\(\mathcal{C}_{\text{child}} \sqsubseteq \mathcal{C}_{\text{parent}}\))约束下运行,并在隔离沙箱(节 4 和 节 7)中执行。绝不能授予智能体环境隐含权限或自行提升权限的能力。
净三轴支配性关卡: 多智能体系统是否在三轴前沿上支配预算相同的基线(原则 1)?在总预算相同且其他轴上均无损失的条件下,智能体群体必须证明满足以下任一条件:
- 任务完成质量有统计显著的提升(\(Q_{\text{multi}} > Q_{\text{single}}\)),或
- 关键路径的总完工时间显著缩短(\(\tau_{\text{crit}}^{\text{multi}} \ll \tau_{\text{crit}}^{\text{single}}\))。
当一种架构满足全部六项标准时,分布式委派就能带来切实的系统效益。然而,在产业界和研究领域,工程师经常绕过这些基础关卡,陷入普遍存在的设计陷阱,将组织隐喻误认为严谨的计算机系统工程。
谬误与陷阱
多智能体系统的工程实践暴露出一种极具诱惑力的架构风险:倾向于将人类组织隐喻直接映射到统计推理引擎上。系统设计者常常认为,既然人类企业中的复杂软件项目能够受益于专业角色之间的分工(产品经理、系统架构师、核心开发人员、安全审计人员和站点可靠性工程师),自主智能体平台就应通过生成大量相互通信的基础模型来复制这种组织结构。用未经验证的智能体通信网络替代连贯、局部化的推理控制循环,并不能超越底层硬件的物理限制;相反,它会立即引入经典的分布式系统故障,包括串行同步瓶颈、共享状态上的锁争用、拜占庭错误传播以及孤立资源导致的资源耗尽。设计鲁棒的智能体基础设施,需要系统性地识别并破除四种普遍存在的谬误与实现陷阱,它们会削弱多智能体协同。
谬误: 向自主团队中增加智能体总能提升问题求解性能。
当智能体系统遇到超出其单轮完成能力的任务时,软件工程师往往会未经审视地凭直觉认为,扩大工作智能体数量 \(M\) 会使问题求解吞吐量获得超线性提升。实际实现通常会实例化一个由专门化工作智能体组成的委员会,并通过中央监督智能体或去中心化的对话网络来协调它们。这种思维模型假定,任务分解不产生计算成本,且智能体的并行推理能够以理想效率扩展。
在生产运行环境中,这一假设在阿姆达尔定律和通用可扩展性定律面前不堪一击。每种多智能体协同拓扑都会引入非零的串行比例 \(1-f\) 和超线性的协同开销 \(h(M) = \sigma(M - 1) + \kappa M(M - 1)\),其中 \(\sigma\) 表示串行化争用,\(\kappa\) 表示智能体间的串扰。工程工作流无法划分为粒度无限细、彼此独立的子问题;架构决策、核心接口定义和全局不变量验证仍然必须严格串行执行。随着工作智能体数量 \(M\) 增加,监督智能体会成为严重的串行化瓶颈。监督智能体必须接收、汇总数十个工作智能体提出的相互冲突的方案,并在它们之间作出裁决,这会迅速耗尽其运行时上下文窗口 \(S_{\max}\),并迫使承载推理的加速器执行高延迟的预填充阶段。
此外,多智能体分解还会带来严重的上下文复制开销。每个自主工作智能体都需要一套基础环境信息,包括系统指令、代码仓库拓扑、模式定义和工具接口,才能执行分配给它的子任务。如果企业代码库需要包含 \(32\text{ KiB}\) 个词元的工作上下文,那么实例化十个并行智能体就会迫使服务集群将这 \(32\text{ KiB}\) 个词元复制到十个独立的键值(KV)缓存实例中。这些冗余的静态提示会消耗数百兆字节的加速器高带宽内存(HBM),导致内存容量瓶颈引发性能骤降,并使服务批大小下降至接近 1(\(B=1\))。
最关键的是,未经验证的多智能体通信会遭遇不断累积的消息失真,形成灾难性的认知传话效应。每次对话交接都会引入错误概率 \(\epsilon > 0\),因此,时间跨度拉伸:从纳秒指令到千秒级轨迹 这一开环上限适用于每次交接。在由 \(k\) 次相互依赖的智能体交互组成、且未经中介干预的链条中,最终产物所依据的输入未受污染的概率按 \((1 - \epsilon)^k\) 下降。如果上游工作智能体幻觉出一个不存在的配置标志,或错误描述了 API 契约,就会将这一假设作为既定事实传递给下游同伴。下游工作智能体会在错误前提之上构建复杂且语法无误的实现,耗费 GPU 计算预算生成产物,而这些产物一经部署便立即无法通过环境验证。
架构层面的防御措施要求在分配执行线程之前,使用阿姆达尔公式量化任务的可并行程度 \(f\)。当任务存在较高的串行比例(\(1-f > 0.3\))时,运行时必须拒绝多智能体扇出,转而将计算资源分配给经过优化的单智能体基线,为其配备测试时推理、系统性的暂存存储器修订,以及确定性的工具反馈。当并行执行在数学上具有合理性时,运行时必须严格限制工作智能体池的规模(\(M \le 3\)),将工作智能体隔离到正交且互不重叠的搜索空间中(例如评估互斥的算法策略),并强制采用类型明确、精简的消息传递,而非对话式文本交流。
陷阱: 允许多个智能体在没有乐观并发控制的情况下并发修改共享文件系统。
在自主软件工程运行时中,一个普遍且具有破坏性的实现陷阱是:授予多个并发智能体对共享项目目录的直接读写权限。采用这一模式的架构师假定,通过提示指令要求智能体 \(A\) 修改 src/auth.py,并要求智能体 \(B\) 修改 src/storage.py,就能提供足以防止操作冲突的隔离。
这一假设之所以失效,是因为随机性的基础模型在执行复杂重构任务时,无法保持可预测的空间局部性。当被要求实现功能或修复缺陷时,智能体经常会发现,其局部修改需要涉及共享配置文件(例如 pyproject.toml 或 package.json)、调整公共模块中的工具函数,或重新生成锁文件。由于操作系统的文件系统提供的是单一的共享命名空间,并发执行的智能体会直接在存储层发生冲突,从而触发经典的写—写竞争条件、更新丢失和无提示的文件覆盖。
考虑这样一个场景:智能体 \(A\) 和智能体 \(B\) 都读取了 settings.py,读取时所处的基准提交为 \(C_0\)。智能体 \(A\) 追加身份验证参数,并在墙钟时间 \(t_1\) 将更新后的文件写入磁盘。在时刻 \(t_2\),智能体 \(B\) 完成数据库连接池逻辑的生成,将其追加到本地的 settings.py 副本中(该副本不包含智能体 \(A\) 添加的内容),然后将缓冲区内容刷写到同一路径。智能体 \(B\) 的写入悄无声息地覆盖了智能体 \(A\) 的修改,既未引发操作系统错误,也未抛出异常。更隐蔽的是,如果一个智能体在另一个智能体尚未完成一组未提交的多文件编辑时启动后台测试套件或编译检查,验证过程就会观察到不一致、割裂的中间状态。编译会因与该智能体实际逻辑无关的语法错误而失败,以虚假的堆栈跟踪污染智能体的观测轨迹,并驱使模型针对并不存在的缺陷陷入徒劳的调试循环。这种冲突问题及其 OCC 缓解措施的时间线在 表 15 中按离散步骤呈现。
| 时间戳 | 智能体 A(工作树 A) | 共享集成目标 | 智能体 B(工作树 B) | Git 状态与进展 |
|---|---|---|---|---|
| \(t_0\) | 从提交 \(C_0\) 派生 | 目标固定于 \(C_0\) | 从提交 \(C_0\) 派生 | 两个工作树均隔离于基线 \(C_0\) |
| \(t_1\) | 应用编辑;运行验证测试 | 目标空闲,停留于 \(C_0\) | 在隔离环境中应用编辑 | 本地修改尚未提交 |
| \(t_2\) | 以快进方式提交(\(C_0 == C_0\)) | 目标推进至 \(C_1\) | 继续生成 | 智能体 A 合并成功;目标已更新 |
| \(t_3\) | 继续执行后续子任务 | 目标位于 \(C_1\) | 尝试提交(\(C_0 \neq C_1\)) | 验证冲突:协调合并关卡中止提交;触发三方差异比较 |
架构层面的缓解措施要求通过乐观并发控制(OCC)实现严格的工作区隔离。宿主运行时绝不能允许非特权智能体直接修改目标集成树。相反,必须为每个工作进程提供独立的 Git 工作树,或以固定的提交 SHA \(C_{\text{base}}\) 为根的临时写时复制(CoW)容器覆盖层。智能体的所有编辑、构建和测试执行都只能在其私有工作树内进行。
状态发布必须遵循正式的四阶段 OCC 轨迹协议:
- 读取阶段: 智能体检查固定于不可变提交 \(C_{\text{base}}\) 的环境。
- 执行阶段: 智能体在私有工作树中修改文件、编译代码,并通过本地单元测试进行迭代。
- 验证阶段: 任务完成后,监督器检查代码仓库的集成分支头是否已向前推进(\(C_{\text{current}} \stackrel{?}{=} C_{\text{base}}\))。
- 提交阶段: 如果集成分支头未发生变化,运行时就以快进方式推进分支,将智能体已通过验证的提交纳入其中。如果分支头已向前推进(\(C_{\text{current}} \neq C_{\text{base}}\)),运行时便检测到并发冲突。它绝不能执行未经验证的文本合并;而应在干净的暂存分支中执行自动三方差异合并,并重新运行完整的确定性测试框架。如果出现合并冲突,或集成后的测试套件未通过,运行时就会中止事务、回滚暂存分支,并使用更新后的基准提交 \(C_{\text{current}}\) 重新调度该子任务。
谬误: 多个智能体达成一致共识,就能证明解决方案在事实或数学上的正确性。
为了防范幻觉和推理错误,同时避免构建成本高昂的任务专用测试环境,系统设计者经常实现多智能体共识机制。在这种范式下,工作智能体生成的提案会提交给由其他基础模型组成的评审小组,通常称为“评审委员会”或“对抗式辩论”,由它们投票决定是否接受该产物。当三个或五个独立模型实例一致批准某个代码补丁、架构提案或数学推导时,系统便将该输出标记为已验证。
这种方法误用了孔多塞陪审团定理。经典陪审团定理指出,如果一个群体由 \(M\) 名投票者组成,每名投票者以独立概率 \(p > 0.5\) 选择正确结果,那么多数投票得出正确决策的概率将随着 \(M \to \infty\) 而趋近于 1。然而,该定理的数学基础完全依赖于投票者错误分布之间具有统计独立性这一公理:
\[P(\text{all fail}) = \prod_{i=1}^M P(\text{fail}_i) = (1 - p)^M\]
在基础模型部署中,这一独立性假设完全不成立。当智能体集群采用相同的基础模型(或采用在相互重叠的网络规模预训练语料库上训练、共享相同分词器词表,并通过相同强化学习算法进行微调的模型)时,各智能体的错误呈现出很强的正相关性(\(\rho \gg 0\))。在相关的错误分布下,联合失败概率不会呈指数衰减;相反,其下界由底层神经网络架构的共同失败概率决定:
\[P(\text{all fail}) \gg \prod_{i=1}^M P(\text{fail}_i)\]
当工程问题包含细微的边界情况、非标准的库行为,或在分布中不常见的算法模式时,模型的每个实例都具有完全相同的盲点。如果某项编码任务涉及指针算术中的差一错误,而模型的预训练先验经常导致其错误处理这类计算,那么智能体 1 会生成有缺陷的实现,智能体 2、3 和 4 则会审查该实现,并认定其结构合理、符合惯用写法且正确。同构模型集成中的一致共识仅仅衡量了它们共同归纳偏置的强度;对于是否符合真实正确性,它丝毫不能提供证据。
在点对点对话拓扑中,这种病态现象会通过社会强化循环进一步恶化。经过训练以维持礼貌对话一致性的模型,很容易接受其他智能体引入的错误前提。如果某个工作智能体断言了某项密码协议的错误属性,负责审查的模型就会将该前提作为给定上下文接受,并围绕这一缺陷继续优化下游操作,为一个灾难性漏洞生成措辞权威、长达数页的论证。
架构层面的防御要求系统设计者遵循端到端论证:语义正确性必须由确定性的外部环境不变量来认证,绝不能由对话共识来认证。运行时绝不能用模型投票替代机械化验证。语法必须由语言解析器和编译器验证;类型签名必须由静态类型检查器认证;功能正确性必须由在隔离沙箱内执行的单元测试、集成测试和回归测试套件验证;数学断言则必须由形式化求解器或符号解释器验证。多智能体审查应严格限定于不可验证的主观维度,例如代码可读性、文档风格规范或变量命名的清晰度,而且只能在候选产物成功通过所有确定性验证关卡之后进行。
陷阱: 监督智能体中止执行时,未将取消令牌传播给各子智能体。
在设计分层多智能体工作流时,开发者通常将注意力集中在正向分派路径上,即根监督智能体如何分解用户请求,并沿由专业工作智能体组成的树向下委派子任务。然而,系统设计往往忽略反向控制路径:当执行轨迹被中断、不满足里程碑不变量,或被人工操作员明确中止时,所需的分布式取消与清理协议。常见的运行陷阱是终止父监督进程,并假定子智能体会自行正常终止。
由于基础模型智能体通常通过异步任务队列、消息代理(如 Redis 或 RabbitMQ)或远程容器执行引擎彼此解耦,子工作智能体会以独立操作系统进程或云微服务的形式执行。当监督进程崩溃、遇到未处理的异常,或通过 SIGINT 被终止时,子工作智能体就会成为孤儿后台进程。
在经典操作系统中,一个在后台空闲的孤儿守护进程只消耗极少的内存,并持有少量闲置的文件描述符。在智能体机器学习系统中,孤儿工作智能体则是一个持续造成大量资源损耗的运行负担。子智能体会继续执行其自回归解码循环,使 GPU 张量核心满负荷运行,耗尽整个组织的 LLM API 速率限额,并持续以满速消耗企业计算额度。如果孤儿智能体陷入无法取得进展的执行循环,不断执行失败的工具,徒劳地试图完成一个父智能体已经消失的任务,那么它将一直运行,直到达到最大步数限制或触发云账单告警。
更危险的是,孤儿智能体可能引发灾难性的幽灵状态变更。假设监督者启动了一项并行重构操作,检测到分支 \(A\) 上出现严重回归,随后中止全局任务以回滚代码仓库。如果子工作智能体 \(B\) 在分支 \(B\) 上未被显式取消,它就会继续修改其工作区中的文件。当其异步任务在十分钟后终于完成时,自动提交处理程序可能会尝试将其变更合并回主干代码仓库。在人工操作员早已认为该操作已经终止之后,这些过时且未经协同的变更仍可能悄然破坏已回滚的代码库。
当父级监督者因超时或局部故障而终止,却未沿委派树向下传播取消信号时:
- 子工作进程仍保持活跃,继续执行自回归解码循环,并消耗加速器的 token 配额。
- 后台进程持续占满工具调用速率限额,并累积无人监控的云支出。
- 延迟完成的子任务产生的过时或乱序提交尝试合入主干代码仓库,悄然覆盖已回滚的状态,并造成灾难性的工作区损坏。
架构层面的缓解措施要求将所有多智能体执行组织为正式的、分层的取消上下文树,并通过显式的生命周期传播机制加以管理:
- 分层上下文继承: 监督者派发的每个子任务信封都必须继承一个具有作用域的取消令牌,该令牌派生自根执行上下文(其语义与 Go 的
context.WithCancel或分布式 gRPC 取消传播机制相对应)。取消令牌携带根任务标识符、不可变的截止时间戳 \(\tau_{\text{deadline}}\),以及一个活跃的取消监听器。 - 主动信号传播: 运行时编排平面必须拦截所有终止事件(
SIGINT、SIGTERM、Web 仪表板上的取消操作,以及不变量验证失败引发的中止)。一旦检测到监督者终止,控制平面就立即沿整个依赖树向下广播分布式取消信号,通过 RPC 流发送显式的ABORT帧,并向所有与后代任务 ID 关联的容器化沙箱先发送SIGTERM,再发送SIGKILL。 - 受租约约束的工作智能体能力: 为防范网络分区导致取消信号无法到达失联工作智能体的情况,运行时必须强制使用短期能力租约(\(t_{\text{lease}} \le 60\text{ s}\))。工作智能体调用外部工具或向工作区分支提交变更的权限必须自动到期,除非其监督者通过周期性心跳信号主动续租。如果监督者中止或崩溃,心跳就会停止,子智能体的能力租约随之失效,本地沙箱执行框架会立即终止该工作智能体的工具派发流水线。
能否掌握这些谬误与陷阱,是脆弱的研究演示与可靠的工业级智能体基础设施之间的分水岭。通过用阿姆达尔定律指导的并行效率取代朴素的工作智能体扩容,以乐观式工作树隔离保护共享可变文件系统,将共识建立在机械化不变量验证之上,并将分布式生命周期绑定到分层取消树,系统工程师可以部署真正发挥计算效能的多智能体运行时,而不至于陷入分布式混乱。接下来,我们将这些架构机制归纳为支配并发与分布式智能体执行的总体设计原则。
总结
只有当任务需要上下文隔离、权限分离或独立探索,并且多智能体设计优于总预算相同的单个智能体时,这种设计才有存在的理由。协同开销(交接、重复上下文、汇合点等待以及结果协调)会很早就限制加速比,并使其随着智能体数量的增加而下降,因此默认应使用单个智能体,而证明自身价值的责任在于智能体集群。当任务拆分确有理由时,运行时会将对话转化为显式任务图,使用带类型的信封和有界返回结果;将写入者隔离在工作树中,并以乐观方式集成其变更;只提交通过智能体无法修改的门控检查的变更;取消整个子树;并在每次委派时收窄权限。以这种方式构建的智能体集群,在追踪、重放和评估中仍被视为一条轨迹。
要点回顾: 只有协同收益足以抵偿开销时才拆分任务
- 相同预算下的单个智能体是基线:只有当智能体集群使用相同工具和总预算,在任务验收通过率、总完成时间或每个验收通过任务的成本方面优于单个智能体,且在其他指标上没有退步时,它才有价值。
- 协同开销会使加速比回落:串行工作限制了加速比,而两两结果协调会使加速比随着智能体数量的增加而下降。在本章的示例中,最佳集群包含两个或三个工作智能体,八个工作智能体反而比一个更慢。
- 跨越智能体边界的是返回结果,而非对话记录:带类型的信封明确固定输入、权限、预算和完成检查;有界回执使协调者的上下文保持精简,并将运行时验证的事实与模型摘要区分开来。
- 一致意见提出方案,门控检查批准提交:共享同一模型的智能体也会共享错误,因此投票无法消除错误率下限,而辩论会增加盲从。只有与所有智能体隔离的检查机制才能授权变更。
- 子智能体的生命周期和权限绝不超出父智能体:取消信号、预算和权限都沿运行时维护的树向下传递,每个子智能体获得的授权都是其父智能体仍持有的权限的子集。
本章针对智能体集群阐述了三项原则。协同开销(原则 19)以两种形式得到量化:一是包含最佳集群规模和盈亏平衡点的加速比模型,二是用于判断任何集群规模是否值得采用的等预算测试。不变量闭包(原则 不变闭包原则)获得了一个特定于集群的依据:共享权重的智能体也会共享错误,因此无论有多少次批准,都无法替代一个封闭的门控检查。单调委派(原则 21)则通过两种机制得到强制落实:每个持有者只能收窄权限的凭证,以及与取消树绑定的权限撤销。
后续内容: 从协同到成本
智能体集群是否值得采用,取决于本章的第三个维度,即每个验收通过任务的成本;但本章对成本的衡量仅足以比较不同设计。智能体经济学 将建立完整的成本核算体系:验收通过任务的整条轨迹成本,缓存、推理预算和模型路由如何降低这一成本,如何为占用资源长达数分钟的轨迹配置容量,以及如何在本章构建的委派树中预留并强制执行资金预算。