工具调用
目的
为什么一个能够顺利解析的工具调用,在它与外部世界之间仍然需要一个运行时?
模型发出的工具调用只是几十个 token,用来指定函数及其参数;这些 token 并不决定该函数是否应当执行、是否已经执行过,也不决定执行完成后模型应当看到什么。智能体通过此类调用重启服务器、从银行卡扣款或运行测试套件时,会出现单次模型调用不会遇到的失败情形。超时会使操作结果变得不确定,而盲目重试会重复产生该操作的效果;工具服务器会宣告当前会话本不应拥有的操作;一条输出冗长的命令就能向下一轮塞入数兆字节的输出,挤占任务所需的上下文。模型无法直接看到这些情况,只能看到返回给它的文本,因此保护措施必须置于调用与下一轮之间的运行时中。工具调用是 H·S·A 的权限暴露首次成为现实的地方,而它所要求的闭合程度会随着权限增大而提高:从仍可能泄露数据的读取操作,到重试前必须确定结果的修改操作,再到需要等待批准的不可逆操作。
学习目标
- 追踪工具调用从模型输出开始,经过验证、授权、分派和观测,进入下一轮的全过程。
- 设计工具描述符,使其类型、描述、副作用类别和错误消息能够帮助模型正确调用工具并自行纠错。
- 解释为什么工具发现只能确认工具存在,却绝不能确认会话有权调用它,并针对遭到投毒的描述应用逐次调用授权。
- 应用幂等键和对账探测,在任何重试之前确定超时修改调用的最终结果。
- 计算未经整形处理的观测结果所产生的 token 成本和美元成本,并设计截断、分页和结构化错误机制,将这些成本限制在一定范围内。
- 通过比较轮询与事件驱动恢复,为长时间运行的工具选择阻塞调用或作业句柄。
- 结合选择错误、模式所占的 token 数量以及每个工具携带的权限,评估工具目录的规模、深度和调用格式。
工具子系统架构
一个被要求重启预发布服务器上某个容器的智能体,会发出一条简短的工具调用。宿主运行时根据工具的模式检查该调用,确认当前会话有权重启该容器,然后发送 POST /containers/srv-stage-04/restart。两秒后,套接字超时。容器可能根本没有收到请求,也可能在重启过程中崩溃,或者已经正常重启,只是回复丢失了。在第一种情况下,重试不会造成问题;在第三种情况下,重试却会重启运行正常的工作进程,而超时本身并不能说明究竟发生了哪种情况。
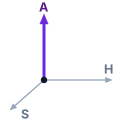
权限轴:通过对每个拟议调用进行中介管控,在工具边界实现闭合。
上述序列中的每一步都发生在工具边界,且没有一步能够在模型内部完成。模型不持有任何环境权限(智能体系统时刻),因此每一步都由运行时执行;六阶段生命周期(六阶段执行生命周期)则明确了这些步骤在一轮中的位置,从动作授权,到运行时分派,再到证据捕获。用 H·S·A 暴露面 的术语来说,这一边界是运行时闭合权限暴露的地方,因为任务持有的每一项授权,从读取权限到不可逆操作权限,都会在任何操作执行之前在此接受检查。本章补充了该生命周期中尚未具体展开的内容:当一个提议指定了真实端点上的真实工具时,应如何处理。它为每个工具提供带类型的描述符,将授权保留在宿主中,使任何工具服务器都无法通过宣告工具来授予自身访问权限,在任何重试之前确定每次分派的最终结果,并确保无论工具输出多少内容,返回的每项观测结果都有界且带有类型。
运行时的任务有一个广为人知的先例,即 Dennis Ritchie 和 Ken Thompson 于 1974 年提出的 UNIX 分时系统。该系统通过单一的多态操作系统抽象,将异构物理硬件统一起来。通过宣告“一切皆文件”,UNIX 将用户空间应用程序与磁盘盘片、串行终端和磁带各自特有的寄存器映射及硬件时序约束解耦。应用程序仅与称为文件描述符的抽象整数句柄交互,这些句柄提供统一的操作契约(open、read、write、close、ioctl)。操作系统内核为每个进程维护一张私有的文件描述符表,验证调用者权限,并将统一请求路由至专用的硬件设备驱动程序。
在智能体架构中,我们看到一个现代设计先例:“一切皆 RPC 工具分派。”编译器、数据库引擎、网络搜索端点、本地文件系统和远程微服务等异构外部资源,被抽象为由智能体运行时管理的统一目录,其中包含带有类型信息的工具描述符。然而,我们不能将这一设计先例误认为字面意义上的硬件等价关系。操作系统进程执行原生机器指令,直接访问内存,并借助硬件强制实施的 CPU 特权环机制陷入 ring 0。相比之下,自回归语言模型仅向宿主管理的内存缓冲区输出候选 token 序列。真正充当监督内核和设备驱动程序的是宿主运行时:它解释候选 token 字符串,验证其结构完整性,将其转换为具体的远程过程调用,并将结构化观测跨越内存边界返回给模型。
如果运行时跳过这种解释与验证,直接将生成的字符串通过管道传入 eval() 解释器或 POSIX shell,就会同时承袭自由文本的词法缺陷(未转义的 shell 元字符、格式错误的参数列表、幻觉生成的命令行标志)以及 时间跨度拉伸:从纳秒指令到千秒级轨迹 的开环可靠性上限。运行时转而强制实施完全仲裁,即 Saltzer 和 Schroeder 于 1975 年提出的要求:对每个对象的每次访问都必须进行权限检查 (Saltzer 和 Schroeder 1975年)。在工具边界处,完全仲裁将生命周期的第 3 至第 5 阶段细化为四个阶段。
首先,在依据模式验证提案阶段,宿主运行时拦截模型输出的候选 token 流,解析跨越内存边界的序列化载荷,并依据预先注册的接口模式严格验证所提议的参数。在打开任何网络套接字或启动任何外部进程之前,语法格式错误、必填字段缺失以及超出允许范围的类型都会在内存边界处被拒绝。其次,在权限与能力准入控制阶段,运行时充当权威引用监控器,而模型不具备任何隐式权限。即使模型提出的命令在语法上毫无瑕疵,运行时仍会验证当前智能体会话是否持有针对目标操作的显式能力授权,并强制实施只读约束、路径沙箱策略和速率限制。第三,在分派执行阶段,经过验证和授权的操作被委派给隔离的外部驱动程序或 RPC 端点。运行时管理网络超时、监测执行延迟并跟踪进程句柄,同时避免阻塞主监督循环。第四,在观测规范化与上下文暂存阶段,运行时捕获外部环境产生的原始异构遥测数据,例如标准输出流、退出码、诊断跟踪信息或结构化 JSON 响应。它清理控制字符,实施背压和严格的 token 截断边界,以防止加速器上下文耗尽,并将结果封装在权威观测信封中,再暂存回模型的工作记忆上下文。节 2 和 节 3 详细阐述前两个阶段,节 4 和 节 7 阐述第三个阶段,节 5 和 节 6 阐述第四个阶段。
Definition 0.1: 完全仲裁
完全仲裁 是一项架构安全不变量,要求每次提议改变环境状态的候选 token 输出,在实际执行之前都必须经过不可绕过的监督验证流水线。
- 意义:保证不具备特权的随机模型输出无法绕过能力检查、篡改宿主进程或执行未经审查的副作用,从而使模型在每个环境边界处都保持零隐式权限。
- 区别:与经典操作系统的系统调用仲裁(在同步上下文切换过程中检查静态 UID/GID 位)不同,智能体完全仲裁在将操作分派至隔离的执行沙箱之前,会验证动态模式符合性、密码学能力租约以及幂等性重放令牌。
- 常见陷阱:依赖提示词引导(“你不得执行危险的 shell 命令”)或未经仲裁的包装脚本,这会使提示注入或工具幻觉能够直接危害宿主资源。
支配工具执行的完全中介架构按保护环进行了系统化组织,如 图 1 所示。在 Ring 3(用户空间)中,不具备任何隐式权限的非特权基础模型生成候选工具令牌;这些令牌被保存在托管寄存器中,而不是直接针对宿主操作系统接口执行。当完整的工具调用序列输出后,寄存器触发 AI 系统调用软件陷阱(SYS_TOOL_CALL),将控制权跨越特权边界移交至 Ring 0(监督程序空间)。宿主监督程序将候选载荷依次送入四道验证关卡:(1) 语法 DFA 过滤器,实施受模式约束的 logit 掩码(\(P(\text{syntax\_err}) = 0\)、文法引导解码);(2) 严格 ABI 反序列化器,在验证内存边界的同时构造类型化结构体;(3) 能力与租约检查器,验证加密 HMAC 令牌和路径允许列表,以阻止目录遍历攻击;(4) 幂等性与重放引擎,对照预写存储检查轨迹 nonce \(k_{\text{idem}}\)。这些关卡是上述前三个阶段内部更细化的步骤,而非第二套生命周期。只有通过全部四道关卡后,监督程序才会将已授权调用分派至隔离的执行域(例如 Firecracker microVM、gVisor 容器或企业 API 网关)。实际执行结束后,产生的观测流和退出码通过 SYSRET 转换向上返回,并将权威观测封装暂存于工作内存中,使非特权模型恢复运行。同时,表 1 系统化呈现了这种结构上的二元对应关系,对比了经典 UNIX 文件描述符架构与智能体工具描述符表。
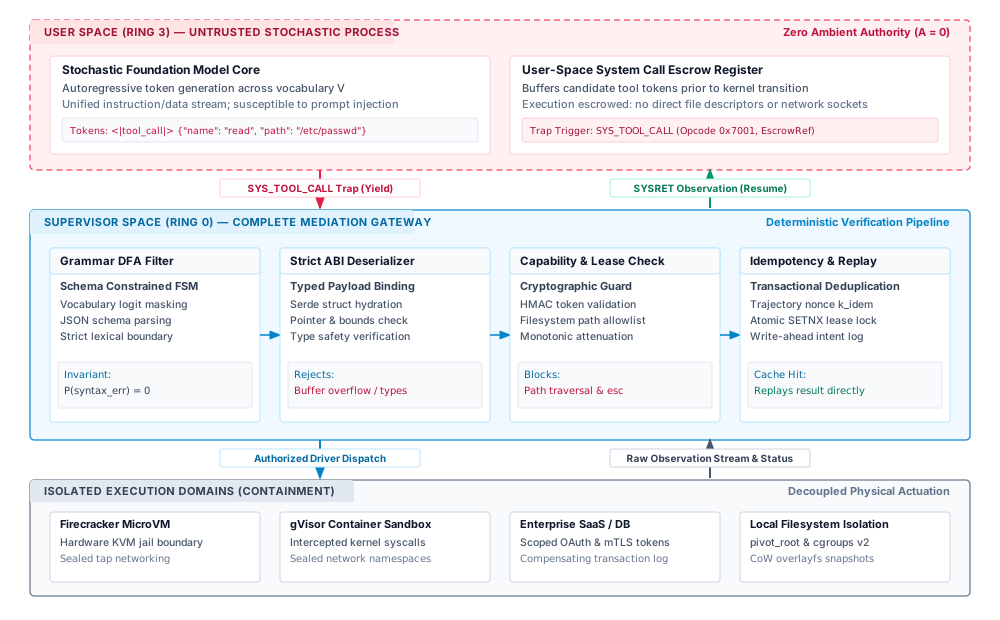
SYS_TOOL_CALL 陷阱移交控制权。具有特权的宿主监督程序在内核空间(Ring 0)中实施完全中介,通过四道依次执行的验证关卡(语法 DFA 过滤器、严格 ABI 反序列化器、能力租约检查器和幂等性重放引擎)验证载荷,然后将已授权操作分派至隔离的执行域,并通过 SYSRET 返回经过净化处理的观测。
| 架构维度 | UNIX 文件描述符表(Ritchie & Thompson 1974) | 智能体工具描述符表(宿主监督程序) |
|---|---|---|
| 命名空间句柄 | 单调递增的整数索引(int fd),用于索引每个进程私有的内核表。 |
绑定于当前上下文目录中的结构化工具标识符字符串或枚举值。 |
| 多态契约 | 统一的字节流操作(open、read、write、close、ioctl)。 |
类型化参数模式,用于验证结构化参数并返回观测封装。 |
| 权限模型 | POSIX 权限(rwxrwxrwx)、进程 UID/GID 和操作系统能力集合。 |
显式能力令牌、声明式访问控制策略,以及模型不具备任何隐式权限的属性。 |
| 调用通道 | 切换至 Ring 0 的硬件中断或软件陷阱(int 0x80、syscall)。 |
将自回归生成的令牌跨监督程序内存边界解析为本地或远程 RPC。 |
| 执行状态 | 内核管理的字节偏移指针、vnode 和操作系统缓冲区缓存。 | 无状态或由租约跟踪的执行句柄、幂等性键和输出缓冲区窗口。 |
| 遥测与状态 | 有符号整数字节计数或负值 errno 错误码(ENOENT、EACCES)。 |
封装退出码、stdout/stderr 流或错误帧的类型化观测封装。 |
这种架构分离使核心工程挑战转移至模型与运行时之间的语法边界。如果监督程序的首要运行不变量是在阶段 1 中依据严格的操作契约验证候选令牌,那么应如何定义这些契约,才能使自回归模型以最高的保真度为其填充参数?参数命名约定、显式类型边界、结构化文档字符串和枚举约束如何影响解码过程中的 logit 分布?模式表达能力与上下文令牌消耗之间又存在哪些可量化的权衡?回答这些问题,需要考察工具接口模式的形式化构造。
循环的一轮
交互中模型侧的部分已经确定。调用契约 定义了调用接口。一次模型调用可以以一个或多个结构化工具调用块结束,每个块都携带标识符、工具名称和参数,同时给出停止原因,表明模型正在等待工具,而非已经完成。接下来发生的事情属于运行时侧的部分。代码 1 以提供商中立的形式展示了构成一轮循环的三条消息。
[
  {"role": "user",
   "content": "Stage-04 is serving a stale config. Restart it."},
  {"role": "assistant", "stop_reason": "tool_use",
   "content": [
     {"type": "text", "text": "Restarting the staging container."},
     {"type": "tool_call", "id": "call_1", "name": "restart_container",
      "arguments": {"container_id": "srv-stage-04"}}]},
  {"role": "tool",
   "content": [
     {"type": "tool_result", "call_id": "call_1",
      "content": {"status": "restarted", "uptime_s": 3}}]}
]这一交互的两个特性决定了后续的一切。结果通过标识符与对应调用匹配,而不是通过位置匹配,因此运行时可以按任意顺序返回结果,也可以针对某个调用返回错误,而不使整个轮次失败。调用及其结果也会保留在历史记录中。轨迹中后续的每次模型调用都会再次读取它们,因此,一条观测在进入上下文时产生一次费用,在此后的每个轮次中又会按前缀缓存费率产生费用(加速器服务延迟)。
当服务接口以结构化块的形式返回工具调用时,运行时读取其中的字段。当模型在自由文本中输出调用时,运行时必须定位并解析这些调用,通常通过在分隔符处停止生成来实现;此时,格式错误的调用会成为常见的失败情形,而非偶发异常。语法约束解码(文法引导解码)可以消除这两种情形下的解析失败。但它无法消除错误的值、工作区之外的路径,或会话无权发起的调用,因此运行时的检查位于解码之后,而不是解码过程之内。
并行调用与强制调用
单个轮次可以包含多个调用。需要三个文件和一个搜索结果的模型可以一次请求全部四项,运行时可以并发执行相互独立的读取,并为每个调用标识符返回一个结果。并行调用将两项决策交给运行时。运行时不能假定模型已为调用确定执行顺序,因此,涉及同一资源的调用,例如对同一文件的两次写入,会被串行执行或拒绝,而不会以存在竞态的方式执行。运行时还会按调用分别报告失败,因此,一次读取超时不会导致另外三个有效结果被丢弃。
运行时还可以约束模型是否调用工具。服务接口提供工具选择设置,可以让模型自行决定、要求发起某个调用、要求调用一个指定工具,或禁止调用。运行时使用强制调用来执行工作流中的固定步骤,即 架构决策矩阵:工作流与模型导向循环 的确定性路径;而在需要最终答案时,例如预算耗尽后,则禁止调用。强制调用约束的是模型的输出。它并不授予任何权限,且强制调用与其他调用一样,都要经过相同的检查。
完全中介
从调用离开模型到其结果进入下一轮次之间,运行时会执行四个步骤,如 图 2 所示。它依据工具描述符验证调用,依据会话持有的授权检查调用权限,分派调用并确定执行结果,再将原始结果整理为大小受限、类型明确的观测。未通过前两项检查中任意一项的调用都不会到达工具。它会以结构化错误的形式返回给模型,而错误本身也是模型可以据此采取行动的观测。这四个步骤针对提议指定了真实端点上的真实工具这一情形,细化了 六阶段执行生命周期 中生命周期的授权、分派和证据阶段。
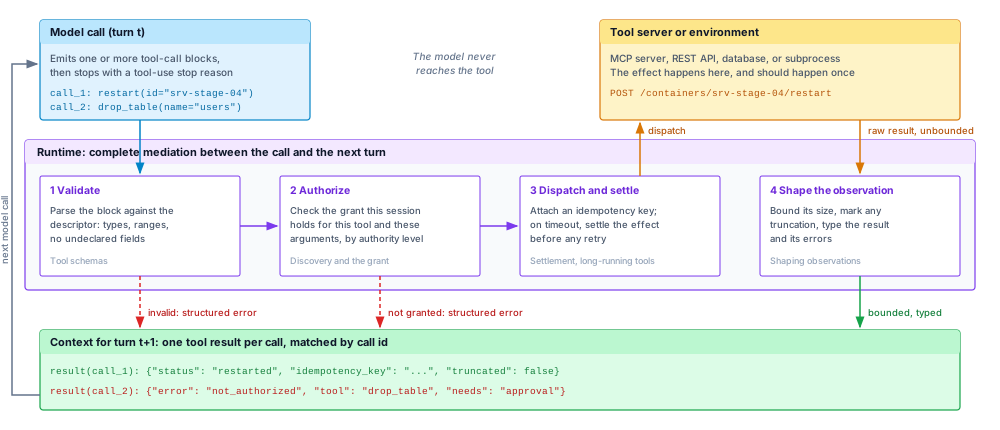
这些步骤必须具备的性质是完全仲裁,即 Saltzer 和 Schroeder 于 1975 年提出的要求:对每个对象的每次访问都必须检查权限 (Saltzer 和 Schroeder 1975年)。对于智能体而言,对象是工具,访问是调用,而这一要求还有后半部分,这是经典访问控制很少需要考虑的。返回的结果是下一次模型调用的不可信输入,因此它也必须经过运行时。
Definition 0.2: 完全仲裁
完全仲裁是一项不变量:模型提出的每次工具调用,在对环境产生任何影响之前,都必须经过运行时的验证与授权检查;每个结果在进入模型上下文之前,也都必须经由运行时返回。
- 意义:它使模型不具备权限这一点在实践中得到落实。只要存在一条绕过检查的路径,例如通过 shell 执行任意命令的工具,或代表模型调用其他服务器的服务器,就会把该路径所携带的全部权限交给模型。
- 区别:模式验证检查调用的格式是否正确。完全仲裁还会检查当前会话此时是否可以进行这次调用,而且它既适用于返回的观测,也适用于发出的调用。
- 常见陷阱:将系统提示中的指令,例如“绝不删除生产数据”,视为检查。指令会降低模型提出不当调用的概率。只有位于模型底层的运行时检查,才能阻止实际影响发生。
本章其余部分将依次构建这四个步骤。节 2 和 节 3 详述验证与授权,节 4 和 节 7 详述短时调用与长时调用的分派,节 5 详述观测。第一步需要一个验证依据,即为每个工具制定一份模型和运行时都能读取的契约。
工具接口模式
当自回归 Transformer 解码工具调用时,每个生成的词元都是不具备权限的预测,完全以其上下文窗口中的前缀词元为条件。如果宿主运行时提供的接口定义存在歧义、缺少类型信息或规定不充分,模型的注意力机制就会在不受约束的输出分布上分配概率质量,生成无效的参数名、幻觉式的数据类型以及格式错误的载荷结构,导致下游执行处理程序崩溃。在生产环境的智能体运行时中,语法与模式错误占初始工具分派失败的很大一部分,使确定性的系统集成变成了随机碰运气的过程。
工具接口模式既是宿主端反序列化的结构语法,也是自回归解码的认知先验;包含明确属性边界、语义描述和枚举约束的严格类型化契约,能够最大限度地减少参数幻觉,同时带来可测量的上下文预填充与内存开销。
为了构建可靠的智能体架构,系统工程师必须将接口模式视为由机器强制执行的操作系统契约。工具模式定义了无权限的词元生成与有权限的宿主执行之间精确的语法边界,确立了运行时在允许任何现实世界状态变更之前必须验证的不变量。
工具声明的结构
工具接口模式在语言模型的语义理解与宿主端远程过程调用(RPC)的严格机械要求之间建立桥梁。现代智能体运行时使用 JSON Schema 的方言变体(具体为 2020-12 和 draft-07 草案)以及 OpenAPI 3.1 规范来标准化这一边界。人类软件工程师主要将模式视为事后验证规则,而自回归语言模型会直接在输入提示中处理序列化后的模式,将其作为上下文中对合法行为的规范。
形式上,注册在运行时工具描述符表中的工具模式 \(S\) 被定义为一个有序五元组: \[S = \langle N, D, P, R, \chi \rangle\] 其中,\(N \in \Sigma^*\) 是工具的唯一标识符(例如 fs_read_bytes),\(D \in \Sigma^*\) 是高层操作说明文档字符串,\(P = \{p_1, p_2, \dots, p_k\}\) 是形式参数的有限集合,\(R \subseteq \{p_1, \dots, p_k\}\) 表示必需参数的集合,\(\chi \in \{\text{open}, \text{closed}\}\) 指定了管理未声明字段的结构边界策略。
封闭世界假设(\(\chi = \text{closed}\)) 在 JSON Schema 中设置 additionalProperties: false 会强制采用封闭世界假设。如果缺少这一不变量,自回归模型往往会从通用预训练语料中借用并臆造不存在的便捷标志(例如 verbose=True、force=True)。
每个参数描述符 \(p_i \in P\) 由子元组 \(p_i = \langle n_i, \tau_i, d_i, \mathcal{D}_i, v_{\text{default}} \rangle\) 定义,其中 \(n_i\) 表示属性键,\(\tau_i \in \{\text{string}, \text{integer}, \text{number}, \text{boolean}, \text{array}, \text{object}\}\) 定义基本或复合数据类型,\(d_i\) 提供描述参数语义的文档字符串,\(\mathcal{D}_i \subseteq \operatorname{dom}(\tau_i)\) 指定有效值的有界取值域,而 \(v_{\text{default}}\) 指定生成器省略可选参数时使用的回退值。
结构边界策略 \(\chi\) 决定运行时是否允许额外字段。在开放策略(\(\chi = \text{open}\))下,模型可以输出任意辅助键值对,而不会触发验证错误;在封闭策略(\(\chi = \text{closed}\),通过 JSON Schema 中的 additionalProperties: false 声明)下,任何不属于 \(P\) 的键都会立即导致验证拒绝。类型化动作契约(原则 8)依据封闭模式验证每个提议,因为开放策略允许模型传入未经检查的参数,这些参数可能在不被察觉的情况下改变执行语义或绕过审计日志。
class FileReadParameters(BaseModel):
    model_config = ConfigDict(extra="forbid")
    path: str = Field(..., description="Absolute canonical filesystem path.")
    offset_bytes: int = Field(0, ge=0, description="Starting byte offset.")
    max_bytes: int = Field(65536, ge=1, le=1048576, description="Chunk size in bytes.")
    encoding: Literal["utf-8", "ascii"] = Field("utf-8", description="Character encoding.")
如 代码 2 所示,宿主端定义使用高层类型注解来强制执行运行时边界约束。当类定义被序列化为 OpenAPI 3.1 格式并注入模型的系统提示词时,它会被编译为规范的 JSON Schema 对象。Python 中的每一项程序化约束都直接映射到一个明确的 JSON Schema 验证关键字,详见 表 2。
| 参数字段 | 宿主端 Python 类型 | JSON Schema 表示 | 运行时操作不变量 |
|---|---|---|---|
path |
str |
{"type": "string"} |
路径必须非空;以沙箱根目录为基准解析。 |
offset_bytes |
int = Field(0, ge=0) |
{"type": "integer", "minimum": 0, "default": 0} |
在宿主端文件系统调用之前拒绝负的定位偏移量。 |
max_bytes |
int = Field(..., ge=1, le=1048576) |
{"type": "integer", "minimum": 1, "maximum": 1048576} |
强制执行严格上限(\(1\text{ MiB}\)),以防止内存耗尽。 |
encoding |
Literal["utf-8", "ascii"] |
{"type": "string", "enum": ["utf-8", "ascii"]} |
将字符串搜索空间缩减为两个离散的词元序列。 |
model_config |
extra="forbid" |
{"additionalProperties": false} |
强制执行 \(\chi = \text{closed}\);拒绝模型幻觉产生的参数。 |
模式质量效应
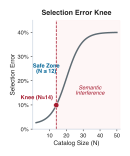
当工具目录规模超过某个阈值后,语义干扰会使工具调用误路由率出现急剧转折。
在预填充和自回归解码阶段,基础模型不会将模式编译为物理分派表;相反,其注意力头会关注模式中的各个词元,以引导输出概率。在关于 API 合成的开创性研究中,Patil 等 (2023年) 表明,当接口采用简略或含糊的命名约定时,基础模型的性能会严重下降。这一现象称为模式质量效应,它支配着模式规范的语义精确度与下游调用失败率之间的经验关系。
Gorilla 基准测试 Patil 等 (2023年) 提出了 Gorilla 模型,表明在数千个云端点上,与标准零样本提示相比,将严格的 JSON 签名与详尽文档相结合,可使 API 参数幻觉减少超过 \(50\%\)。
当参数描述被简化为仅有类型声明(例如 "path": {"type": "string"})时,模型的注意力机制便无法获得有关格式约束、路径相对关系或边界条件的指引。从信息论角度看,条件前缀无法使条件概率分布 \(P(y_t \mid y_{<t}, x)\) 集中于有效的操作参数。中间层的注意力头无法判定该字符串应表示相对路径(./data/log.txt)、POSIX URI(file:///var/log.txt)还是绝对路径(/Users/VJ/log.txt)。随着词表分布的熵增大,生成器常常依据预训练中形成的关联来采样词元,而非依据宿主环境的要求。
相反,语义条件化会提供有针对性的约束,从而改变解码轨迹:
- 明确单位与量纲:声明
"timeout_seconds": {"type": "integer", "description": "Connection timeout in seconds; must not exceed 60"}可避免灾难性的单位歧义,即模型将毫秒(\(5000\))传给期望接收秒的接口,从而避免线程池饥饿。 - 有界枚举:定义明确的枚举集合(\(\mathcal{D} = \{ \text{json}, \text{csv}, \text{parquet} \}\)),可将无限的字符串域替换为封闭的吸引子词元集合。在解码过程中,注意力头将概率质量完全引向与枚举值对应的候选词元,使无效选项的概率趋近于零。
- 通过文档字符串消解矛盾:当参数间的交互包含细微的操作冲突时,例如互斥选项要求在参数 \(A\) 无法与参数 \(B\) 同时设置的情况下,在高层文档字符串 \(D\) 中明确记录这一不变量,可使交叉注意力层将生成前缀中词元 \(A\) 的出现与对词元 \(B\) 的抑制关联起来。
模糊的操作契约与严密的操作契约之间的差异并非文风问题;它构成了运行时失败与确定性分派之间的边界。表 3 对比了规范不充分的模式所导致的典型故障模式,以及严格类型约束所引入的纠正机制。
| 目标参数 | 规范不充分的模式 | 观察到的模型失败轨迹 | 严格的模式规范 | 强制执行的不变量 |
|---|---|---|---|---|
| 文件分块大小 | "size": "integer" |
{"size": -1}(试图表达“读取全部”) |
"size_bytes": {"type": "integer", "minimum": 1, "maximum": 65536} |
拒绝非正值;防止宿主端缓冲区溢出。 |
| 进程终止 | "signal": "string" |
{"signal": "SIGKILL"}(宿主端 POSIX C 绑定要求整数) |
"signal_num": {"type": "integer", "enum": [1, 2, 9, 15]} |
将词元限制为有效的 POSIX 整数信号编号。 |
| HTTP 请求体 | "data": "object" |
{"data": "<xml>payload</xml>"}(在期望对象的位置传入了字符串) |
"data": {"type": "object", "additionalProperties": true} |
宿主端 JSON 解析器确保在分派之前获得关联映射。 |
| Git 提交目标 | "target": "string" |
{"target": "HEAD~"}(含糊的 refspec 导致 shell 执行失败) |
"commit_hash": {"type": "string", "pattern": "^[0-9a-f]{40}$"} |
正则表达式模式防止 shell 注入和格式错误的 refspec。 |
宿主端严格验证
宿主端监督器从不假定模型输出的候选词元符合已声明的模式。相反,运行时会截获原始生成词元流,将其暂存于受控的内存缓冲区,并在允许向本地或远程端点进行任何分派之前,将反序列化后的载荷送入宿主端严格验证流水线。
验证流水线按顺序执行三个阶段:
首先,运行时将缓冲的字符序列送入流式词法解析器,以确认其 JSON 语法有效。如果生成过程因上下文耗尽(达到 \(T_{\max}\))或网络套接字关闭而提前终止,解析器会检测到未闭合的字符串或不匹配的括号,并在语义分析开始之前拒绝该载荷。
其次,使用 Pydantic V2 或 jsonschema 等引擎,依据编译后的 JSON Schema 对解析所得的抽象语法树(AST)进行验证。验证器断言三个结构不变量成立: \[\forall r \in R, \quad r \in \operatorname{keys}(Y)\] \[\forall k \in \operatorname{keys}(Y), \quad k \in P \quad (\text{if } \chi = \text{closed})\] \[\forall k \in \operatorname{keys}(Y), \quad Y[k] \in \mathcal{D}_k \land \operatorname{type}(Y[k]) = \tau_k\] 其中,\(Y\) 是模型输出的候选字典。
第三,如果载荷违反任何模式不变量,宿主端监督器会截获该失败并阻止执行。在早期智能体架构中,运行时经常通过抛出未处理的异常或输出 Invalid parameters 之类的通用错误字符串来响应验证错误。这种反馈使语言模型无法获知失败的具体机制。模型只知道调用失败了,因此只能猜测究竟违反了哪个键、类型或边界条件。
{
  "status": "validation_error",
  "tool_name": "fs_read_bytes",
  "error_count": 1,
  "errors": [
    {
      "loc": ["max_bytes"],
      "input_value": 2097152,
      "error_type": "less_than_equal",
      "message": "Input should be less than or equal to 1048576",
      "expected_domain": "integer in range [1, 1048576]"
    }
  ]
}现代运行时会构造结构化的诊断错误封装,如上面的轨迹所示。这种封装将未处理的异常转化为通过标准反馈循环返回的权威观测。当诊断载荷被重新注入对话前缀时,模型的自注意力机制会将出错字段(loc: ["max_bytes"])和越界标量(input_value: 2097152)与明确的上界(maximum: 1048576)关联起来。在随后的自回归推理过程中,模型以这一实际错误轨迹为条件,输出修正后的参数配置,无需人工干预。
上下文预算权衡:静态预置与即时模式注入
尽管丰富的接口模式能够大幅抑制参数幻觉,但它们也引入了一个严重的系统瓶颈:上下文词元消耗。在管理复杂基础设施的企业级智能体运行时中,工具目录很容易包含数十甚至数百种不同操作,涵盖文件操作、进程执行、数据库查询和云 API 管理。将这些模式直接预置到系统提示中,会给推理引擎带来显著的内存和计算开销。
考虑一个管理着 \(M = 50\) 种不同工具的目录的运行时。如果每个工具模式都包含操作说明文档字符串、嵌套属性、枚举约束和类型边界,平均需要 \(S = 300\) 个词元,那么静态模式前导内容将消耗: \[T_{\text{catalog}} = M \times S = 50 \times 300 = 15,000\text{ tokens}\] 模型必须先对这 \(15,000\) 个词元完成预填充,才能处理用户的初始查询;而且,在智能体交互的每一轮中,这些词元都必须常驻加速器内存。
粗略估算 0.1: 静态工具目录的内存占用与预填充延迟
该模型采用分组查询注意力(GQA),具有 \(L = 80\) 个 Transformer 层、\(H_q = 64\) 个查询头、\(H_{kv} = 8\) 个键值头,注意力头维度为 \(D_h = 128\)。计算操作和 KV 缓存激活值均采用 16 位精度(\(b = 2\text{ bytes per element}\))。
1. 每个会话的 KV 缓存占用: 每个词元在所有层中消耗的键和值内存计算如下: \[\text{Memory}_{\text{token}} = 2 \times b \times L \times H_{kv} \times D_h = 2 \times 2 \times 80 \times 8 \times 128 = 327,680\text{ bytes} \approx 320\text{ KiB}\] 对于规模为 \(T_{\text{catalog}} = 15,000\text{ tokens}\) 的静态目录,每个活跃智能体会话的 KV 缓存分配量为: \[\text{KV}_{\text{session}} = 15,000 \times 327,680\text{ bytes} = 4,915,200,000\text{ bytes} \approx 4.915\text{ GB}\] 如果该 8 GPU 节点承载 \(K = 16\) 个并发智能体会话,仅静态工具模式就会消耗: \[\text{KV}_{\text{total}} = 16 \times 4.915\text{ GB} = 78.64\text{ GB}\] 在 HBM3 总容量为 \(8 \times 80\text{ GB} = 640\text{ GB}\) 的 8 GPU H100 节点上,FP16 模型权重占用 \(70.6 \times 10^9 \times 2 \approx 141.2\text{ GB}\)。在剩余可用于激活值和动态上下文的内存中,近 \(80\text{ GB}\) 被永久用于保存闲置的工具定义,而这些定义在某一轮交互中可能根本不会被调用。
2. 缓存未命中时的预填充计算延迟: 如果会话发生冷启动,或其前缀缓存失效,推理引擎就必须对 \(15,000\) 个模式词元执行预填充前向传播。预填充所需的理论浮点运算量为: \[\text{FLOPs}_{\text{prefill}} \approx 2 \times P \times T_{\text{catalog}} = 2 \times (70.6 \times 10^9) \times 15,000 \approx 2.118 \times 10^{15}\text{ FLOPs} = 2.118\text{ PFLOPs}\] 配备 8 个 GPU 的 H100 SXM5 系统可提供 \(8 \times 989.5\text{ TFLOPs} = 7.916\text{ PFLOPs/s}\) 的稠密 FP16/BF16 张量计算峰值性能。假设在受计算能力限制的预填充阶段,实测模型 FLOPs 利用率(MFU)为 \(\mu = 40\%\): \[\text{Throughput}_{\text{effective}} = 7.916\text{ PFLOPs/s} \times 0.40 \approx 3.166\text{ PFLOPs/s}\] 在输出首个生成词元之前,仅处理工具模式前导内容所产生的延迟为: \[t_{\text{prefill}} = \frac{2.118\text{ PFLOPs}}{3.166\text{ PFLOPs/s}} \approx 0.669\text{ seconds} = 669\text{ ms}\] 每次缓存未命中都会产生 \(669\text{ ms}\) 的预填充开销,这会在多轮交互中引入严重的延迟抖动。
为突破静态模式预置的可扩展性限制,高性能运行时采用即时(JIT)模式注入。宿主运行时不再将整个目录 \(\mathcal{M} = \{T_1, T_2, \dots, T_M\}\)(\(M > 3{,}000\))预置到每次交互的提示中,而是将工具目录视为一个带索引的数据库。
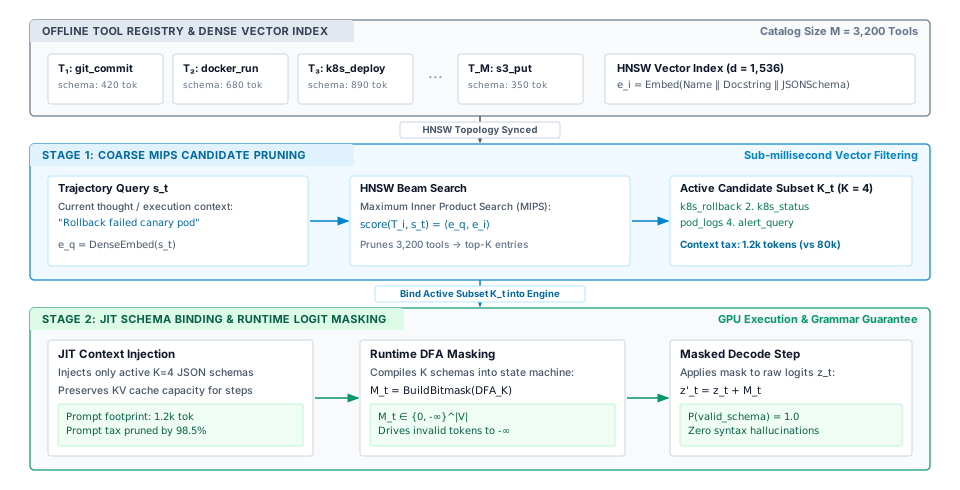
图 3 详细展示了多阶段检索与模式绑定的数据通路,将目录管理分解为三个独立的架构层:
- 离线目录与稠密向量索引:初始化时,运行时将全部 \(M = 3{,}200\) 个工具描述符注册到一个辅助 HNSW 图中。每个条目 \(T_i\) 都映射到一个 1,536 维嵌入 \(e_i = \text{Embed}(\text{Name} \mathbin{\Vert} \text{Docstring} \mathbin{\Vert} \text{JSONSchema})\),从而将工具元数据存储与 GPU 高带宽内存解耦。
- 阶段 1(粗粒度 MIPS 候选裁剪):在第 \(t\) 轮,宿主监督器提取智能体当前的轨迹状态 \(s_t\)(“回滚失败的金丝雀 Pod”),并计算稠密查询嵌入 \(e_q = \text{DenseEmbed}(s_t)\)。HNSW 束搜索计算内积 \(\text{score}(T_i, s_t) = \langle e_q, e_i \rangle\),将包含 3,200 个工具的目录裁剪为活跃候选子集 \(\mathcal{K}_t\),其大小为 \(K \ll M\)(\(K=4\),例如
k8s_rollback、k8s_status、pod_logs和alert_query)。这使提示所占空间从 80,000 个词元降至 1,200 个词元——提示开销降低 \(98.5\%\),且这一过程在不到 \(1.2\text{ ms}\) 的时间内完成。 - 阶段 2(JIT 模式绑定与运行时 DFA 掩蔽):通过应用 文法引导解码 中的文法约束解码,运行时将 \(K=4\) 个模式动态编译为确定性有限自动机(DFA),在 GPU 上生成词元级位掩码张量 \(M_t \in \{0, -\infty\}^{|V|}\)。通过在自回归生成期间应用 \(z_t' = z_t + M_t\),无效词元转移被压至 \(-\infty\),从而保证 \(100\%\) 的模式语法合规性,同时防止生成目录之外的工具幻觉。
前缀缓存的权衡 动态模式注入与推理引擎的基数树缓存之间存在冲突。如果注入的工具集每轮都发生变化,提示前缀就会出现差异,导致 KV 缓存失效。运行时通过将一个最小的“核心”工具集固定在不可变前缀中,并将动态工具追加到次级槽位来解决这一问题。
JIT 模式注入引入了上下文效率与检索召回率之间的架构权衡。如果宿主检索器未能检索出必要的工具模式(假阴性),模型就无法调用所需能力,导致不可恢复的任务失败。每轮更改工具集也会改变提示前缀,而由于注意力状态由词元前缀推导而来(原理 5),服务引擎将无法在其基数树中匹配已缓存的前缀,必须从第一个发生变化的词元开始,重新计算其后的 KV 缓存帧。先进的服务系统通过划分提示布局来缓解这一问题:将一小组不可变的核心原语(例如 bash 调度和文件读取)固定在主前缀中,以最大化缓存命中率,同时将专用工具动态注入次级的临时上下文块。
尽管严格的模式工程能够确保单个运行时解析、验证并约束候选工具调用,但它预先假定所有工具定义都已静态编译到宿主应用程序中,或由宿主应用程序在本地管理。然而,现代企业环境本质上是去中心化的:开发者环境、云基础设施、本地数据库和 Web 服务各自暴露专有接口,并具有不同的执行生命周期。异构外部服务如何通过开放、标准化的协议,向智能体运行时暴露其工具、模式和动态资源,而无须为每个端点编写定制的集成适配层?回答这一问题,会将我们的关注点从孤立的模式定义转向可互操作的工具发现。
可互操作的工具发现
将工具实现直接耦合到智能体运行时进程中,会使架构走入死胡同。当工具例程共享宿主运行时的虚拟地址空间和解释器线程池时,每个外部库——从原生数据库驱动程序、系统管理实用工具到第三方 REST 客户端——都会争用相同的内存空间、共享库和执行锁。第三方工具库中的一次内存泄漏、未处理的段错误或阻塞系统调用,就会突然终止或冻结整个宿主智能体编排循环。反过来,为每项企业服务构建定制的进程间通信封装和专有 REST 适配层,则会重现经典的 \(O(N \times M)\) 集成危机:\(N\) 个不同的智能体运行时必须为 \(M\) 个异构执行后端实现、测试并维护各自独有的转换适配器。
开放工具协议将这一 \(N \times M\) 集成困境分解为 \(O(N + M)\) 客户端—服务器架构,统一规定外部服务如何通过一致的传输通道公布能力、提供结构化资源并接受调用分派。然而,这一协议边界仅确立了可发现性,并未赋予权限。服务器声明有哪些操作并定义其语法接口,而在类型化动作契约(原则 8)下,宿主运行时仍负责参数验证、权限执行、进程隔离和状态一致性。
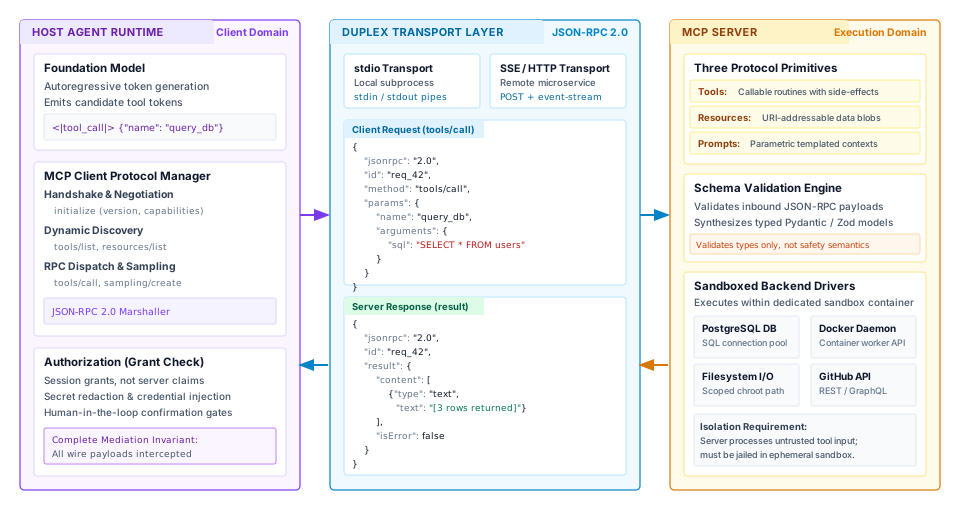
stdio)或 HTTP/SSE 流传递,并分派至独立运行的 MCP 服务器;这些服务器封装了模式引擎和沙箱化执行驱动程序。
客户端—服务器分解
在 图 4 中,工具执行的架构分离被组织为三个不同的系统域:
- 宿主智能体运行时(客户端域): 不具特权的基础模型在没有任何隐式权限的条件下,将候选词元生成到上下文内存中。MCP 客户端协议管理器捕获候选调用,通过
client/initialize协商协议能力,动态查询已注册的能力(tools/list、resources/list),并将结构化调用封送为 JSON-RPC 2.0 载荷。关键在于,宿主安全监督器介入并实施完全中介:在任何载荷进入传输通道之前,它会执行路径允许列表、隐去秘密信息、注入已授权的凭据,并评估人在回路中的审批关卡。 - 双工传输层(传输域): 客户端与服务器之间的通信通过双向字节流传输实现解耦——可以使用连接到隔离子进程的本地 POSIX 单向管道(
stdio),也可以为远程微服务使用服务器发送事件(SSE)与 HTTP POST 端点相结合的方式。载荷遵循符合 RFC 的 JSON-RPC 2.0 帧格式,将客户端发出的请求(tools/call,带有唯一 IDreq_42)与服务器返回的结果或错误封装配对。 - MCP 服务器(执行域): 服务器作为独立的操作系统进程运行,暴露三种协议原语(具有副作用的
Tools、用于 URI 数据附件的Resources,以及用于上下文模板的Prompts)。内部模式引擎生成 Pydantic/Zod 验证器,在将调用分派到沙箱化后端驱动程序(例如 PostgreSQL 连接池、Docker 守护进程工作进程或限定作用范围的 chroot 文件系统)之前验证传入数据的类型。关键在于,服务器边界隔离了不可信执行:即使工具崩溃或发生内存泄漏,宿主智能体运行时也完全不受影响。
模型上下文协议采用 JSON-RPC 2.0 作为消息封装标准。有效请求必须包含一个 "jsonrpc": "2.0" 版本字符串、一个用于请求与响应多路复用的唯一数字或字符串 "id"、一个标识操作的 "method" 字符串,以及一个结构化的 "params" 字典。
为确保跨编程语言和运行环境的互操作性,通信通道采用 JSON-RPC 2.0 消息封装。由于 JSON-RPC 将传输机制与消息语义分离,客户端和服务器可以通过任意字节流抽象协商能力并交换载荷,而无须改变底层应用逻辑。消息分为三个不同类别:请求,要求显式返回与之关联的响应;响应,返回结构化结果载荷或标准化错误对象,并与原始请求标识符配对;通知,完全省略标识符,以单向、非阻塞的方式传递遥测信息,例如执行进度、日志事件或缓存失效信号。
模型上下文协议将工具能力组织为四种基础原语:
tools/list(动态能力协商): 服务器返回一个可调用原语数组,并附带声明式 JSON Schema 契约。每个条目指定一个规范名称、一段经过优化以提高模型选择准确率的自然语言描述,以及一个严格的形式化模式,用于定义可接受的参数名称、类型和验证约束。这种运行时发现机制将工具演进与模型部署解耦;管理员可以部署新的分析例程或更改底层服务实现,而无须重新训练模型或重新部署宿主智能体。tools/call(命令式状态变更与分派): 客户端发送命令式执行请求,指定目标工具名称以及与已公布模式匹配的参数映射。服务器执行操作,并返回结构化响应封装,其中包含一个content数组——由纯文本块、二进制数据块或嵌入式错误帧组成——以及一个具有权威性的isError布尔标志,用于区分业务领域操作失败与协议崩溃。resources/read(声明式被动上下文摄取): 工具代表主动执行且会改变状态的端点,而资源则暴露通过标准统一资源标识符(URI,例如file:///var/log/syslog或postgres://analytics/schema)寻址的只读数据资产。资源允许宿主运行时将被动参考材料——例如源文件、系统指标或数据库模式——填充到模型上下文窗口中,而无须执行任意外部二进制程序,也无须授予服务器环境级执行权限。prompts/get(服务器管理的上下文模板): 领域专用服务器暴露参数化提示模板,指导模型如何组合工具调用序列以解决领域任务。这种机制将领域专用的少样本示例和操作指令从硬编码的客户端提示中移出,转而交由维护相应工具的专用子系统管理。
如 表 4 所概述,这四种原语根据不同的操作语义和风险特征划分了执行操作的接口范围。
| MCP 原语 | 操作语义 | 主要载荷模式 | 状态变更风险 | 典型延迟特征 |
|---|---|---|---|---|
tools/list |
自省 | tools: Tool[] |
无(自省) | \(1\text{--}10\text{ ms}\) |
tools/call |
命令式执行 | name: string, arguments: object |
高(改变系统状态) | \(5\text{--}5000\text{ ms}\) |
resources/read |
被动填充 | uri: string |
无(只读) | \(1\text{--}50\text{ ms}\) |
prompts/get |
上下文模板化 | name: string, arguments: object |
无(只读) | \(< 5\text{ ms}\) |
通过标准化这些原语,运行时建立了清晰的操作生命周期。会话初始化时,宿主客户端通过协商确定的传输方式建立通信,发起 initialize 握手以交换协议版本号和实现所支持的能力,并查询 tools/list 以填充其动态工具目录。当模型选择工具时,运行时根据缓存的模式验证该调用提案,并通过通信线路路由 tools/call 请求,确保模型和服务器均无法绕过客户端的监督。
传输拓扑
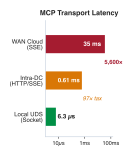
与本地 Unix 域套接字相比,远程 HTTP 传输在工具间 IPC 中带来的延迟开销为 97 倍至 5,600 倍。
连接宿主智能体客户端与执行服务器的物理通道决定了系统的运行延迟、故障隔离和部署拓扑。协议抽象将消息序列化与底层传输解耦,使运行时能够适应三种不同的运行形态:本地标准输入/输出管道、本地 UNIX 域套接字,以及采用服务器发送事件(SSE)的远程 HTTP 流式传输。模型上下文协议传输拓扑 对比了这些传输拓扑的架构特征。
| 传输拓扑 | 底层 IPC 原语 | 典型往返延迟 | 进程生命周期耦合 | 安全与隔离边界 | 主要故障模式 |
|---|---|---|---|---|---|
标准 I/O(stdio) |
POSIX 匿名管道(pipe(2)),通过 stdin/stdout 使用 |
\(< 0.5\text{ ms}\)(内存复制) | 直接子进程(fork/exec);随宿主终止 |
进程内命名空间 / 容器沙箱 | 管道缓冲区饱和导致的死锁(F_SETPIPE_SZ) |
UNIX 域套接字(UDS) |
文件系统套接字 inode(AF_UNIX、SOCK_STREAM) |
\(< 0.1\text{ ms}\)(内核零复制) | 解耦的后台守护进程;多客户端复用 | POSIX 文件系统权限(chmod/chown) |
失效的套接字锁文件(/tmp/mcp.sock);守护进程崩溃 |
| 采用 SSE 的远程 HTTP | TCP/IP、TLS、HTTP POST + text/event-stream SSE |
\(15\text{--}150\text{ ms}\)(网络 RTT) | 完全分布式;云集群 / 远程隔离区 | 网络 mTLS、持有者令牌、防火墙 CIDR | 丢包、连接中断、代理缓冲超时 |
对于部署在同一主机上的工具,本地标准输入/输出(stdio)管道是延迟最低的传输机制。在这种拓扑中,宿主运行时使用标准 POSIX fork(2) 和 execve(2) 系统调用序列,将工具服务器启动为直接子进程。宿主通过由 pipe(2) 创建的单向内核管道,将自身的文件描述符连接到子进程的标准输入和标准输出流。JSON-RPC 消息以换行符分隔的 JSON 字符串形式跨越进程边界。由于通信仅通过内存复制经过内核内存缓冲区,不涉及网络接口控制器或协议栈,因此请求的往返延迟保持在亚毫秒级(\(< 0.5\text{ ms}\))。
然而,stdio 传输对流管理施加了严格的物理约束。Linux 内核管道的默认缓冲区容量为 \(64\text{ KB}\)(通过 F_SETPIPE_SZ 配置)。如果工具服务器输出大量观测数据,例如大型构建日志或详细的测试执行轨迹,其体积超过管道缓冲区可容纳的未读取数据量,而宿主运行时此时正在执行计算密集型操作,那么工具服务器进程就会被迫进入不可中断的睡眠状态(TASK_UNINTERRUPTIBLE),阻塞在 write(2) 系统调用上。如果宿主同时等待工具进程退出,之后才读取并清空其输出缓冲区,系统就会发生死锁。因此,使用 stdio 的宿主运行时必须实现非阻塞异步读取循环,持续将内核管道缓冲区中的数据读取到宿主内存中的中间环形缓冲区。
UNIX 域套接字(UDS)保留了本地内核内存复制的微秒级数据传输速度,同时使服务器摆脱严格的父子进程生命周期约束。UDS 服务器通过绑定到文件系统的套接字 inode(AF_UNIX、SOCK_STREAM)通信,并作为独立、持久的后台守护进程运行。多个并发的智能体运行时会话可以通过复用同一个持久套接字来调用工具,从而避免反复启动运行时和重新初始化共享依赖所带来的进程调用开销。此外,套接字 inode 上的标准 POSIX 文件系统权限(chmod 和 chown)建立了明确的宿主级访问控制边界,防止未经授权的本地用户向具有特权的工具守护进程派发操作。
对于分布式企业环境,该协议支持通过 HTTP 和服务器发送事件(SSE)进行远程网络传输。在这种非对称架构中,宿主客户端通过标准 HTTP POST 请求派发 JSON-RPC 请求,而远程服务器则使用 text/event-stream MIME 类型,通过长期保持的 HTTP 连接流式发送 JSON-RPC 响应、执行进度通知和动态能力更新。这种拓扑实现了物理硬件的完全解耦:工具服务器可以运行在专用云集群、隔离的网络区域或多租户数据库环境中,与宿主运行时相距数千英里。
这种物理解耦引入了显著的系统开销。网络往返时间(RTT)、TCP 握手、TLS 会话协商、因最大传输单元(MTU)限制而产生的数据包分片,以及反向代理缓冲,会为每次工具调用引入数十至数百毫秒的延迟开销。在需要顺序派发数十次工具调用才能完成复杂任务的迭代式智能体循环中,这种延迟开销会迅速超过底层推理引擎的词元生成延迟。
粗略估算 0.2: 不同 MCP 传输方式的延迟与 CPU 开销
系统参数:
- 主机 CPU:现代服务器核心,运行频率为 \(3.0\text{ GHz}\);内存复制带宽为 \(B_{\text{mem}} = 40\text{ GB/s} = 40 \times 10^9\text{ B/s}\)。
- 操作系统上下文切换开销:\(t_{\text{ctx}} = 1.5\text{ }\mu\text{s}\)(\(4{,}500\text{ CPU cycles}\))。
- 本地 UDS 机制:两次上下文切换(客户端写入 \(\to\) 服务器读取,服务器写入 \(\to\) 客户端读取),加上两次内核内存复制(用户空间到内核缓冲区、内核缓冲区到用户空间)。
- 网络机制:数据中心内部往返时间为 \(t_{\text{RTT}} = 0.5\text{ ms} = 500\text{ }\mu\text{s}\);网络带宽为 \(B_{\text{net}} = 10\text{ Gbps} = 1.25\text{ GB/s}\)。
- MTU 载荷上限:每个 TCP 段为 \(1{,}448\text{ bytes}\)(标准 \(1{,}500\text{-byte}\) MTU 减去 TCP/IP 和时间戳首部所占的 \(52\text{ bytes}\))。
- TLS 加密吞吐量:硬件加速的 AES-128-GCM 处理吞吐量为 \(4\text{ GB/s} = 4 \times 10^9\text{ B/s}\)。
1. 本地 UNIX 域套接字计算: 延迟由上下文切换延迟和跨越内核边界的物理内存复制耗时组成: \[t_{\text{copy}} = 2 \times \left( \frac{65{,}536\text{ B}}{40 \times 10^9\text{ B/s}} \right) = 2 \times 1.64\text{ }\mu\text{s} = 3.28\text{ }\mu\text{s}\] \[t_{\text{total, UDS}} = (2 \times t_{\text{ctx}}) + t_{\text{copy}} = (2 \times 1.5\text{ }\mu\text{s}) + 3.28\text{ }\mu\text{s} = 6.28\text{ }\mu\text{s} \approx 0.0063\text{ ms}\] 消耗的主机 CPU 总周期数: \[\text{Cycles}_{\text{UDS}} \approx (2 \times 4{,}500) + (3.28\text{ }\mu\text{s} \times 3.0\text{ GHz}) \approx 9{,}000 + 9{,}840 \approx 18{,}840\text{ cycles}\]
2. 数据中心内部基于 TLS 的远程 HTTP/SSE 计算: \(64\text{ KB}\) 的载荷需要分包到多个 TCP 段中: \[N_{\text{packets}} = \left\lceil \frac{65{,}536\text{ B}}{1{,}448\text{ B/packet}} \right\rceil = 46\text{ packets}\] 通过 \(10\text{ Gbps}\) 接口进行线路串行化和传输的耗时为: \[t_{\text{wire}} = \frac{65{,}536\text{ B}}{1.25 \times 10^9\text{ B/s}} = 52.43\text{ }\mu\text{s}\] 两个端点的加密与解密开销为: \[t_{\text{crypto}} = 2 \times \left( \frac{65{,}536\text{ B}}{4 \times 10^9\text{ B/s}} \right) = 32.77\text{ }\mu\text{s}\] 计入基础网络 RTT、TCP/IP 协议栈遍历和内核套接字处理(\(t_{\text{stack}} \approx 25\text{ }\mu\text{s}\)): \[t_{\text{total, SSE}} = t_{\text{RTT}} + t_{\text{wire}} + t_{\text{crypto}} + t_{\text{stack}} = 500\text{ }\mu\text{s} + 52.43\text{ }\mu\text{s} + 32.77\text{ }\mu\text{s} + 25\text{ }\mu\text{s} = 610.2\text{ }\mu\text{s} \approx 0.61\text{ ms}\] 网络协议栈、数据包处理和 TLS 消耗的主机 CPU 总周期数: \[\text{Cycles}_{\text{SSE}} \approx (52.43\text{ }\mu\text{s} + 32.77\text{ }\mu\text{s} + 25\text{ }\mu\text{s}) \times 3.0\text{ GHz} \approx 330{,}600\text{ cycles}\]
系统层面的启示: 即使在经过优化的低延迟数据中心环境中(RTT 为 \(0.5\text{ ms}\)),从本地 UNIX 域套接字转向远程 HTTP/SSE 传输,也会给主机带来 \(97\times\) 的延迟代价(\(0.61\text{ ms}\) 对比 \(0.0063\text{ ms}\))和 \(18\times\) 的 CPU 周期代价。如果远程服务位于广域网另一端,典型的跨区域 RTT 为 \(35\text{ ms}\),延迟代价将扩大至 \(5{,}600\times\)。因此,分布式工具架构必须将远程网络传输限定用于执行时长远大于网络传输时间的操作。
协议发现与主机自主授权
分布式智能体设计中的一种关键失效模式,是将能力声明与能力授权混为一谈。由于模型上下文协议通过 tools/list 为查询可用工具提供了清晰、标准化的抽象,简单的实现往往将声明的模式直接送入模型的提示前缀,并未经检查便通过传输通道直接转发候选工具调用。这种设计违反了最小权限原则,并破坏了宿主运行时的安全边界。
声明某个工具并不意味着授予调用该工具的权限。服务器声明的模式仅仅是未经认证的声明,说明服务器能够执行哪些功能;它完全不能证明当前智能体会话应当执行这些功能。未经审查的第三方工具服务器或遭到入侵的内部微服务,可以声明任意 shell 执行、不受约束的文件删除或敏感数据外传端点等破坏性原语。如果宿主智能体盲目采用这些工具,能够通过间接提示注入操纵模型上下文的攻击者就可以劫持系统的操作能力。
为维护系统完整性,宿主智能体运行时必须在模型的候选词元生成与传输分发层之间,强制实施由其自主掌控的授权流水线:
- 动态模式过滤: 宿主运行时在向推理引擎暴露任何工具之前,依据管理策略矩阵评估传入的
tools/list声明。发现的工具若请求的权限超出当前会话的安全上限,就会从目录中移除。智能体无权调用的工具模式绝不会进入模型的上下文窗口。 - 参数的语法与语义验证: 当模型提出工具调用时,运行时解析候选 JSON 结构,并依据严格的类型、数值范围、字符串模式和路径遍历约束验证所有参数。如果某个工具要求文件路径位于代码仓库沙箱内,参数验证就会在载荷进入传输通道之前,主动拒绝包含目录遍历序列(
../../etc/passwd)的输入。 - 能力门控与分级同意: 每项操作均依据其所需的权限级别实施门控,采用 \(A_0\) 至 \(A_3\) 这些级别,级别定义见 H·S·A 暴露面,且每个级别都有各自的分发条件:
- \(A_0\)(读取访问): 观察环境状态而不修改状态的操作(例如
resources/read、列出目录内容)。这些操作无需逐次调用审批即可执行,但只能访问会话授权明确指定的资源,因为将凭据或私密记录读入上下文的操作,可能导致这些信息通过后续调用泄露。 - \(A_1\)(沙箱内修改): 修改状态且影响范围限于运行时可丢弃的沙箱的操作(例如在临时工作树中的隔离 git 分支上提交、写入临时缓存文件)。这些操作要求本地运行时记录事务日志,以便运行时重置沙箱。
- \(A_2\)(可安全重试或可补偿的外部操作): 以可安全重试或可通过补偿操作撤销的方式改变外部系统的操作(例如创建随后可释放的云实例)。这些操作要求在任何重试之前,先确定每次超时操作的最终状态;这是 节 4 讨论的主题。
- \(A_3\)(不可逆的外部操作): 永久改变外部系统的操作(例如删除数据库表、发起金融交易)。这些操作要求在分发之前,取得加密令牌授权、使用与硬件绑定的签名密钥,或获得交互式人工在环审批。
- \(A_0\)(读取访问): 观察环境状态而不修改状态的操作(例如
- 观测结果净化与注入防御: 授权边界以对称方式发挥作用。当工具服务器完成操作并通过传输通道返回载荷时,运行时会在将返回的字节注入模型的 KV 缓存之前对其进行检查。外部工具输出属于不可信数据流;如果搜索工具获取的网页或日志文件包含对抗性提示注入载荷,未经审查便将其纳入工作上下文,可能使后续推理周期遭到劫持。运行时会剥离已知的注入包装形式,强制实施严格的字节数上限,并对原始词元进行转义,防止观测数据流伪装成系统级指令。
这种职责划分在工具边界处应用了不变量闭包原则(不变闭包原则)背后的端到端论证。通信协议(MCP)提供了统一机制,用于在端点之间传输比特并组织 RPC 请求。系统的关键功能(正确性、安全性、权限执行和任务不变量验证)只有由理解完整应用语义的端点,即宿主运行时,才能得到完整且正确的实现。外部服务器无法验证某项操作是否符合用户更广泛的任务目标,传输通道也无法验证某项操作是否违反最小权限原则。宿主运行时独自承担责任,负责管控从候选词元到外部效果的每一次转换。
Systems Perspective 0.1: 模式强制约束的幻象与端到端动作执行问题
无特权的基础模型生成文本;它并不理解系统安全边界。JSON 模式可以保证名为 target_path 的参数是字符串,却无法验证该字符串是否通过路径遍历解析为 ../../etc/shadow、git 命令中的目标分支是否受保护,或数据库删除操作是否违反组织的数据保留策略。未经宿主调解便将语法有效的载荷传递给子进程,只是在自动化利用系统环境中已有的权限。
此外,动作执行安全严格具有双向性。外部工具执行完成后,其输出流会作为不可信数据返回模型的上下文窗口。未经检查且包含间接提示注入的观测载荷,可能在下一轮重新编程智能体的推理循环,将一次无害的工具读取变成对抗性接管。
系统洞见:工具模式定义的是序列化语法,而非执行安全。完全调解要求宿主运行时充当拥有最终控制权的引用监控器:在出站方向上,在访问操作系统之前验证能力租约;在入站方向上,在向模型暴露词元之前净化观测流。
Checkpoint 0.1: 评估工具模式与完全调解
在分析幂等执行机制之前,请检验你对工具契约和宿主授权的理解:
幂等动作执行
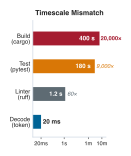
外部工具执行耗时比神经网络词元生成最多高出五个数量级,主导端到端总完成时间。
当宿主监督器跨进程或网络边界派发会修改状态的工具请求时,派发计时器便开始针对执行截止时间 \(\tau_{\text{timeout}}\) 倒计时。在 \(t = \tau_{\text{timeout}}\),如果传输套接字仍未收到任何响应,运行时就会面临 Flaviu Cristian 所阐述的分布式系统基本困境:未经处理的超时无法提供任何关于目标系统物理状态的信息。客户端运行时无法区分三种相互排斥的物理现实:请求数据包在出站传输途中丢失,尚未到达工具服务器;工具服务器在部分修改外部状态后,于执行过程中崩溃;或者工具服务器已成功执行修改并提交了副作用,但响应数据包在返回途中被中间交换机或中间盒截断。
未经处理的网络超时会将智能体的确定性计划转变为不确定的物理状态。 在使用无特权模型的智能体架构中,如果假定超时意味着未执行,并据此盲目重试动作执行,就会造成灾难性的重复副作用,例如重复扣款、git 历史损坏或重复插入数据库记录。反之,将超时视为终止性失败会打断推理循环,使智能体的内部信念状态与物理现实失去同步。安全的动作执行要求通过密码学执行键、互斥租约或闭环状态协调探测,将每次修改状态的工具调用转化为代数意义上的幂等操作,如 图 5 所示。
代数幂等性 操作 \(f: S \to S\) 作用于系统状态 \(S\),其具有代数幂等性,当且仅当: \[f(f(s)) = f(s) \quad \forall s \in S\] 在分布式系统中,如果 \(N > 1\) 个相同请求产生的副作用与单个请求产生的副作用相同,则 RPC 接口是幂等的(\(N = 1\))。
Definition 0.3: 幂等动作
网络故障下的不确定状态
回到本章开篇的容器重启事件,现在详细追踪其过程。在向远程预发布服务器部署补丁时,一个自主编码智能体以 POST /containers/srv-stage-04/restart 调用基于 HTTP 的容器管理工具。宿主运行时为该调用设定超时截止时间 \(\tau_{\text{timeout}} = 2000\text{ ms}\)。在 \(t = 2001\text{ ms}\) 时,TCP 套接字报告 ETIMEDOUT 错误。如果运行时直接重传 HTTP 请求,而初始请求实际上已成功停止容器,只是在服务初始化期间超时,那么第二次发送就会触发一次多余的容器重启周期。这第二个周期会使现有进程绑定失效,终止健康的工作进程,并破坏宿主运行时的内部跟踪模型。
为形式化描述这一故障,令动作发送表示为元组 \(A = \langle \text{tool}, \theta, t_0 \rangle\),其中 \(\theta\) 表示绑定的参数载荷,\(t_0\) 为发送时间戳。该动作通过网络通道 \(\mathcal{C}\),对外部环境状态 \(S_{\text{env}}\) 执行操作。当 \(\tau_{\text{timeout}}\) 到期时,运行时必须评估以下三种可能运行状态的概率分布:
\[\Sigma = \{\sigma_{\text{drop}}, \sigma_{\text{crash}}, \sigma_{\text{sever}}\}\]
在 \(\sigma_{\text{drop}}\) 下,请求在到达工具接口之前被网络丢弃;外部环境保持不变(\(S_{\text{env}}' = S_{\text{env}}\)),因此重传在实际操作上是安全的。在 \(\sigma_{\text{crash}}\) 下,工具接口收到 \(A\) 并开始执行,但进程在变更过程中崩溃;环境停留在尚未提交、仅部分变更的中间状态(\(S_{\text{env}}' = S_{\text{env}} \oplus \delta_{\text{partial}}\))。在 \(\sigma_{\text{sever}}\) 下,工具接口已完全完成变更(\(S_{\text{env}}' = S_{\text{env}} \oplus \delta_{\text{complete}}\)),但包含观测帧 \(\mathcal{O}\) 的响应在返回传输过程中被丢弃。
常规的朴素重试策略采用开环重试策略:
# ANTI-PATTERN: Naive open-loop retry assuming sigma_drop
for attempt in range(max_retries):
    try:
        return client.dispatch(tool="charge_card", args={"amount": 5000})
    except TimeoutError:
        time.sleep(backoff(attempt))
这一实现犯了假定 \(\Pr(\sigma_{\text{drop}}) = 1.0\) 的谬误。如果故障受 \(\sigma_{\text{sever}}\) 支配,那么每次循环迭代都会重新执行底层副作用。在生产环境的智能体架构中,基础模型在没有人类直接确认的情况下,会为每项任务自主生成数十次工具调用;此时,开环重传会将轻微的网络波动转化为级联的状态损坏。
工具副作用的代数分类
要构建安全的动作执行运行时,监督器必须维护一套明确的工具副作用分类体系。依据 Roy Fielding 对网络架构风格和 HTTP 方法语义的形式化描述,提供给智能体系统的工具可分为三个不同的代数类别,其形式化定义见 工具动作执行语义与故障不变量的分类体系。
| 副作用类别 | 代数定义 | 具体工具示例 | 原生重复派发安全性 | 监督器必须采取的缓解措施 |
|---|---|---|---|---|
| 无效应(只读) | \(f(s) = s\) | read_file, grep, get_weather, sql_select |
保证安全(\(\forall N \ge 1\)) | 采用截断指数退避进行无条件重试。 |
| 天然幂等 | \(f(f(s)) = f(s)\) | write_file(覆盖写入), mkdir -p, rm -f, set_config |
按顺序重复派发时安全 | 并发控制;使用序列编号防止乱序执行。 |
| 非幂等(累积) | \(f(f(s)) \neq f(s)\) | append_file, git_commit, send_email, exec_bash |
重复派发会造成破坏 | 强制使用幂等键、执行租约或对账探测。 |
无效应操作不会修改目标系统的状态。无效应工具返回的观测反映的是观测时刻 \(t\) 的环境,这意味着重试只会修改智能体内部的词元上下文,而不会改变外部现实。天然幂等工具会修改状态,但重复执行所产生的最终状态与单次调用完全相同。例如,发出带有绝对载荷的 PUT /files/config.json 时,无论执行一次还是十次,都会以相同方式覆盖目标路径。运行时可以安全地重传天然幂等调用,前提是强制实施严格的顺序约束,防止过时且延迟到达的数据包覆盖较新的状态变更。
POSIX 文件系统语义 幂等与非幂等动作执行之间的差异,在基本的 POSIX 文件操作中即可体现。使用 O_TRUNC | O_WRONLY(write_file)打开文件是幂等的:重新执行会产生完全相同的文件内容。使用 O_APPEND(append_file)打开文件则严格非幂等:重新执行会重复追加缓冲区内容。
非幂等操作是智能体工程中的主要风险来源。这些操作会追加记录、完成资金交易扣款、递增计数器或发送外部通信。如果运行时无法确认非幂等工具是否已在超时前执行,那么“重试前先确认执行结果”(原则 9)就禁止再次调用该工具。运行时必须从服务端点获得基于密码学的保证,确保重复请求会被拦截,或者通过探测核对外部状态。工具动作执行语义与故障不变量的分类体系 的副作用分类所回答的问题,与 节 3 的权限级别所回答的问题不同。权限级别决定某项动作是否可以未经批准就执行,而副作用类别决定该动作是否可以安全地执行两次。每次超时后都通过这两条路径之一确认执行结果,才能使 \(A_2\) 动作可以安全重试。
粗略估算 0.3: 盲目重试导致的重复效果及其防范锁
超时。 当请求或响应中的任一消息丢失时,调用就会超时,其概率为 \(1 - (1 - p)^2 =\) 3.96 percent。每天共 200,000 次调用,对应 7,920 次超时。
重复效果。 只有响应丢失,即 \(\sigma_{\text{sever}}\),才意味着效果已经发生。其概率为 \((1 - p)\,p =\) 1.96 percent,因此,对每次超时调用都重新发送的策略每天会产生 3,920 次重复效果。每次重复都会造成重复收费、创建第二个实例或重复重启。
锁的到期时间。 以 6 个标准差为界限定执行时间,可得 \(\tau_{\text{proc\_max}} =\) 930 ms,因此锁不得在 2,155 ms 之前到期。
要点:重复效果随调用量增长,而不取决于单次调用中响应丢失看起来有多罕见。2 percent 的丢失率在测试中难以察觉,却会在生产环境中每天产生数千次重复效果,而幂等键会将每次重复调用转化为一次缓存命中。
基于键的去重机制
在存在消息丢失的 RPC 边界两端保障幂等性的标准系统机制,是注入一个幂等键(\(k_{\text{idem}}\))。幂等键是由客户端生成的唯一令牌,附加在工具调用的载荷或元数据头部中(图 5)。远程工具服务器在快速的事务性存储层中跟踪这些键,以对传入的调用请求进行去重。
现代智能体运行时生成按时间排序的 UUIDv7 标识符,而非使用完全随机的 UUIDv4 标识符。UUIDv7 将一个 48 位的毫秒级 Unix 时间戳与单调随机值组合起来;后者由密码学安全的伪随机数生成器或操作元组的哈希值产生:
\[k_{\text{idem}} = \text{UUIDv7}\Big(t_{\text{epoch}}, \mathcal{H}\big(\text{agent\_id} \,\|\, \text{turn\_idx} \,\|\, \text{call\_idx} \,\|\, \text{payload\_hash}\big)\Big)\]
按时间排序的键确保工具服务器上的去重数据库能够使用聚簇 B 树或 LSM 树对条目建立索引,而不会产生随机写入碎片。
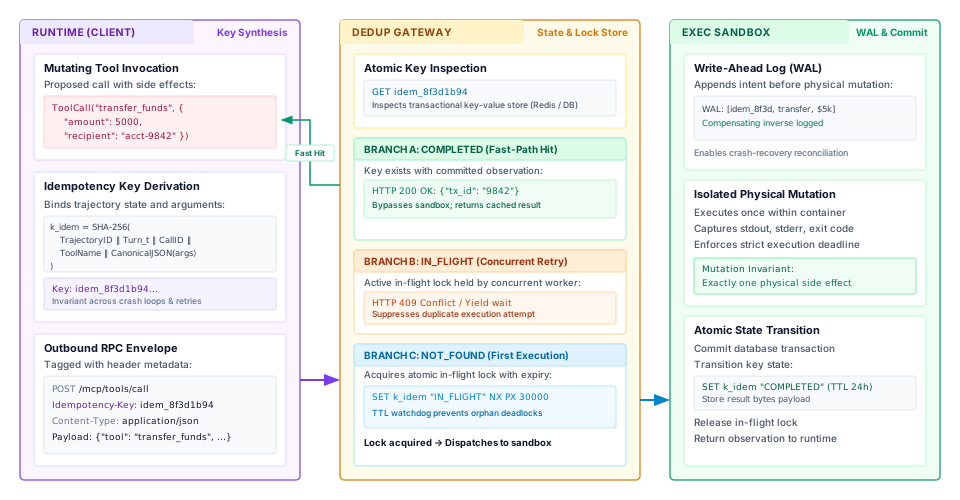
COMPLETED 时返回缓存的观测字节(分支 A);在 IN_FLIGHT 时拒绝并发重试或等待(分支 B);或在 SETNX 上通过 NOT_FOUND 获取原子分布式租约(分支 C),在隔离沙箱中执行一次状态修改,并追加写入预写存储。
完整的端到端执行流程详见 图 5,其中追踪了修改状态的工具调用请求在三个协同子系统中的生命周期:
- 客户端监督器生成随机令牌: 当模型发出修改状态的工具调用(例如
transfer_funds)时,宿主监督器计算确定性的 128 位幂等键 \(k_{\text{idem}} = \text{SHA-256}(\text{SessionID} \mathbin{\Vert} \text{Turn}_t \mathbin{\Vert} \text{ToolName} \mathbin{\Vert} \text{CanonicalJSON}(\text{args}))\)。将该键附加为 HTTPIdempotency-Key头部,可确保调用请求的身份在反复崩溃和重传过程中保持不变。 - 去重网关检查: 收到网络传输的载荷后,网关查询其事务性状态存储(
GET k_idem),触发三个互斥执行分支中的一个:- 分支 A(
COMPLETED— 快速路径缓存命中): 状态修改此前已成功完成。网关立即返回已存储的观测载荷(HTTP 200 OK),完全跳过沙箱容器执行,防止重复的实际操作。 - 分支 B(
IN_FLIGHT— 并发重试): 某个并发工作进程已持有有效的执行租约。网关返回HTTP 409 Conflict或让出执行权,在主任务完成处理期间抑制冗余操作。 - 分支 C(
NOT_FOUND— 首次执行): 此前尚未记录该键。网关通过SET k_idem "IN_FLIGHT" NX PX 30000获取原子分布式租约锁,并将请求转发至执行子系统。
- 分支 A(
- 执行沙箱与原子提交: 隔离的容器沙箱将事务意图记录到仅追加的预写日志(WAL)中,恰好执行一次实际的状态修改,并在释放分布式租约锁之前,将存储中的键状态转换为
COMPLETED,同时保存序列化的输出字节。
def dispatch_with_idempotency(client, tool_name: str, args: dict) -> dict:
    """Dispatches a mutating tool call using a deterministic idempotency key."""
    key = client.generate_key(tool_name, args)
    for attempt in range(client.max_retries):
        try:
            return client.transport.post(
                f"/tools/{tool_name}",
                json=args,
                headers={"Idempotency-Key": key},
                timeout=client.timeout_sec
            )
        except (TimeoutError, ConnectionError):
            time.sleep(client.backoff_factor * (2 ** attempt))
    raise ActuationTimeoutError(f"Tool {tool_name} failed settlement after retries.")
执行租约时长 \(T_{\text{lease}}\) 必须经过审慎选择。如果 \(T_{\text{lease}} \le \tau_{\text{timeout}}\),租约过早到期会使次级工作进程在主工作进程仍在执行时启动,从而导致脑裂执行。因此,系统必须强制满足以下租约时长不变量:
\[T_{\text{lease}} > \tau_{\text{timeout}} + \delta_{\text{drift}} + \tau_{\text{proc\_max}}\]
其中,\(\delta_{\text{drift}}\) 用于计入节点之间允许的最大时钟偏差,\(\tau_{\text{proc\_max}}\) 表示执行被中止前服务端处理延迟的上限。
粗略估算 0.4: 量化动作执行的影响范围与租约界限
场景: 一个智能体运行时管理着由 50 个自主工作进程组成的集群,这些工作进程与外部基础设施配置 API 交互。
实测参数:
- 客户端调用超时时限:\(\tau_{\text{timeout}} = 1200\text{ ms}\)
- 微服务执行延迟:\(T_{\text{exec}} \sim \mathcal{N}(\mu = 450\text{ ms}, \sigma = 80\text{ ms})\)
- 网络往返延迟:\(\text{RTT}_{99} = 150\text{ ms}\)
- 网络丢包概率:\(p_{\text{drop}} = 0.02\)(出站与入站通道上的丢包相互独立)
- 客户端与网关之间的最大时钟偏差:\(\delta_{\text{drift}} = 25\text{ ms}\)
- 每个工作进程每日派发的变更操作数:\(N_{\text{daily}} = 4000\) 次操作
计算:
- 结果不确定的超时概率: 如果网络往返时间加上服务端执行时间超过 \(\tau_{\text{timeout}}\),或者请求包或响应包丢失,就会发生超时。 \[\Pr(\text{drop}) = 1 - (1 - p_{\text{drop}})^2 = 1 - (0.98)^2 = 1 - 0.9604 = 0.0396 \quad (3.96\%)\]
尾部延迟超过 \(\tau_{\text{timeout}}\) 的概率(假设网络延迟固定为 \(\text{RTT} = 150\text{ ms}\)): \[\tau_{\text{avail}} = \tau_{\text{timeout}} - \text{RTT} = 1200 - 150 = 1050\text{ ms}\] \[Z = \frac{1050 - 450}{80} = \frac{600}{80} = 7.5\] 由于 \(Z = 7.5\),正常运行时由尾部延迟引发的超时概率可以忽略不计(\(< 10^{-12}\))。因此,超时率主要由网络丢包决定: \[\Pr(\text{timeout}) \approx \Pr(\text{drop}) \approx 0.0396\]
朴素重试下每日发生的重复变更: 整个集群派发的变更操作总数: \[N_{\text{total}} = 50 \times 4000 = 200,000 \text{ ops/day}\] 发生的超时事件总数: \[N_{\text{timeout}} = 200,000 \times 0.0396 = 7,920 \text{ timeouts/day}\] 关键情形是超时由入站响应丢失所致(\(\sigma_{\text{sever}}\)): \[\Pr(\sigma_{\text{sever}}) = (1 - p_{\text{drop}}) \times p_{\text{drop}} = 0.98 \times 0.02 = 0.0196 \quad (1.96\%)\] 采用开环重试策略时,每日重复副作用的期望数量: \[N_{\text{duplicates}} = 200,000 \times 0.0196 = 3,920 \text{ catastrophic duplicate executions/day}\]
最小安全租约时长(\(T_{\text{lease}}\)): 为确保服务端锁不会在执行期间到期,我们在 \(6\sigma\) 处评估最大处理时间阈值: \[\tau_{\text{proc\_max}} = \mu + 6\sigma = 450 + 6(80) = 930\text{ ms}\] 强制满足系统不变量: \[T_{\text{lease}} > \tau_{\text{timeout}} + \delta_{\text{drift}} + \tau_{\text{proc\_max}} = 1200\text{ ms} + 25\text{ ms} + 930\text{ ms} = 2155\text{ ms}\] 系统架构师必须将服务端去重表的租约时长配置为 \(T_{\text{lease}} \ge 2.2\text{ seconds}\)。
除了防止重复变更,对确定性工具观测进行内容寻址缓存还可实现强大的跨子系统协同效应:通过返回逐字节完全相同的观测字符串,动作执行网关可保持推理引擎基数树缓存中的提示词前缀对齐。动作执行缓存与 GPU 内存帧复用之间的这种协同效应如 图 6 所示。
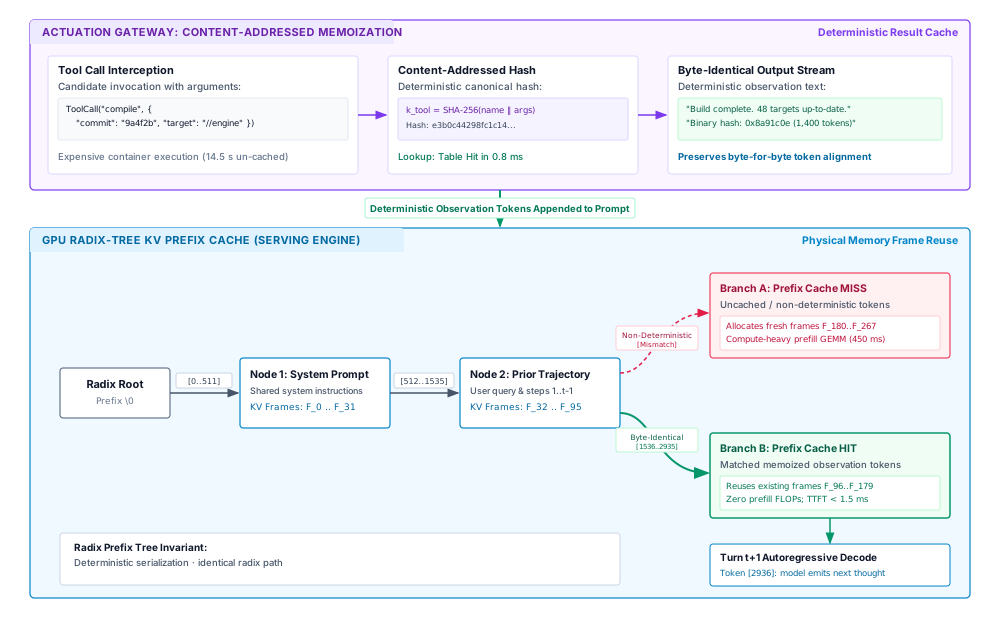
compile),计算规范化的 SHA-256 哈希值(\(k_{\text{tool}}\)),在 \(0.8\text{ ms}\) 内返回逐字节相同的观测文本,从而绕过 \(14.5\text{ s}\) 的容器构建。追加相同的观测字节使 GPU Radix 字典树能够直接匹配节点 3b,实现完整的前缀缓存命中,完全消除预填充 FLOP 的重新计算,并将首 token 时间(TTFT)降至亚毫秒级。
如 图 6 中的 Radix 字典树层次结构所示,推理服务引擎(如 vLLM 或 SGLang)将活跃的 KV 缓存块组织为一棵以 \(\varnothing\) 为根的树。通用系统指令构成共享前缀(节点 1,涵盖 token \(0\text{--}511\),由物理 HBM 帧 \(F_0\dots F_{31}\) 支撑),随后是轨迹历史(节点 2,token \(512\text{--}1535\),帧 \(F_{32}\dots F_{95}\))。当智能体派发开销高昂的工具(如 ToolCall("compile", ...))时,未使用缓存的运行在容器沙箱中耗时 \(14.5\text{ s}\)。采用内容寻址的记忆化机制(\(k_{\text{tool}} = \text{SHA-256}(\dots)\))后,网关在 \(0.8\text{ ms}\) 内检索已存储的观测字节。如果工具输出具有非确定性(分支 A,输出随机化的时间戳或进程 ID),生成的 token 序列便会偏离现有树边,触发前缀缓存未命中。引擎必须分配新的物理帧(\(F_{180}\dots F_{267}\)),并执行受计算能力限制的注意力预填充 GEMM(\(450\text{ ms}\))。相反,当网关保证序列化结果逐字节相同(分支 B)时,观测 token(\(1536\text{--}2935\))与节点 3b 完全匹配。引擎通过指针交换复用现有物理帧(\(F_{96}\dots F_{179}\)),彻底消除预填充的重新计算,并将第 \(t+1\) 轮的首 token 时间(TTFT)缩短至 \(1.5\text{ ms}\) 以下。
面向不配合端点的状态协调探测
在现实计算环境中,智能体运行时经常与不配合端点交互,包括不支持幂等性请求头的外部服务、POSIX shell 环境、传统命令行工具和第三方 REST API。当 shell 工具在隔离的容器沙箱内执行 git commit -m "update" 或 curl -X POST https://api.legacy.org/orders 时,运行时无法传递幂等键来防止重复执行。
当向不配合工具派发调用时遇到结果不明确的超时 \(\tau_{\text{timeout}}\),运行时便从传输层的键去重转向闭环的状态协调探测,其形式化决策逻辑见 图 7。监督器不会立即重传,而是拦截结果不明确的超时,抑制盲目重新派发,并发起查询探测,以检查目标变更是否已经完成。
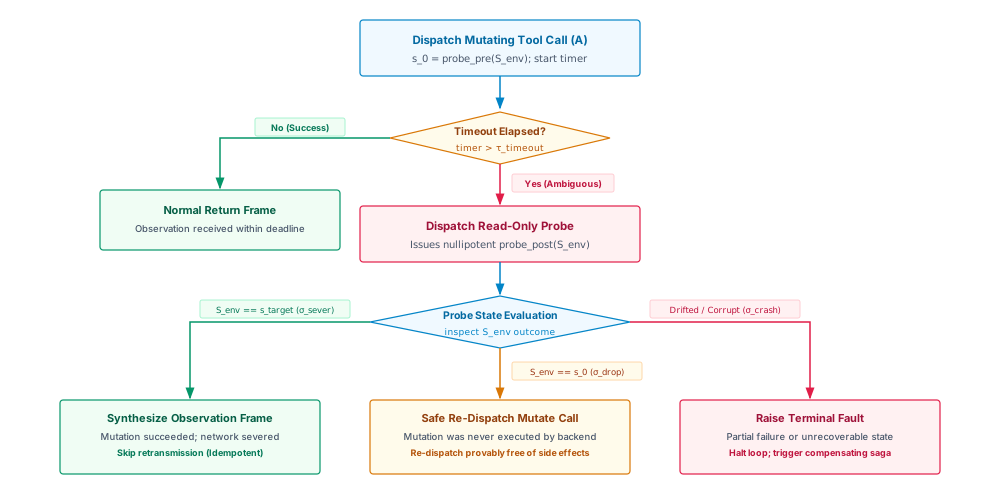
如 图 7 所示,状态协调状态机依次经历四个同步决策阶段:
- 前置条件捕获: 在派发非幂等操作 \(A\) 之前,运行时向目标环境查询当前状态参数 \(s_0 = \text{probe}_{\text{pre}}(S_{\text{env}})\)。例如,在向文件追加一段配置文本之前,监督器会记录文件当前的 SHA-256 内容哈希值和字节偏移量。
- 歧义超时捕获: 如果执行工具触发网络超时,运行时会拦截该故障,阻塞智能体的审慎规划循环,并进入状态核对状态机。
- 后置条件查询: 运行时发出一个轻量级、严格不改变状态的探测 \(\text{probe}_{\text{post}}(S_{\text{env}})\),用于验证预期的后置条件是否成立。
- 如果后置条件成立(例如,目标文件的哈希值与预期的变更后状态一致,或
git log -1显示了目标提交的哈希值),运行时便确认发生了情形 \(\sigma_{\text{sever}}\)。变更已成功;禁止重新执行。监督器构造一个报告执行成功的合成观测帧 \(\mathcal{O}_{\text{synthetic}}\),并将其注入模型的上下文流。 - 如果环境仍处于状态 \(s_0\)(字节偏移量和文件哈希值均与执行前的快照相同),运行时便确认发生了情形 \(\sigma_{\text{drop}}\)。变更从未执行。此时,监督器可以重新派发原始操作,而不会产生重复副作用的风险。
- 如果环境呈现未知的中间状态 \(s_{\text{corrupt}} \notin \{s_0, s_{\text{target}}\}\)(情形 \(\sigma_{\text{crash}}\)),监督器会立即停止执行。它会隔离环境,并将结构化的系统故障向上传递至智能体的推理循环,在一致性恢复之前阻止进一步的自主执行。
- 如果后置条件成立(例如,目标文件的哈希值与预期的变更后状态一致,或
通过在现代端点上强制实施基于键的去重,并在旧式接口上使用结构化的状态核对探测,智能体运行时使底层系统免受非确定性网络故障的影响。
一旦这些执行原语保证某项操作已落实为权威且未损坏的状态,运行时便面临下一个系统问题:捕获外部进程输出的数据。命令执行成功时,返回的往往不是简洁的单行确认信息,而是数千行冗长的构建日志、内存转储或原始终端流。运行时如何捕获、缓冲和截断这些庞大的观测流,同时避免模型的物理上下文窗口溢出,是下一节讨论的主题。
观测流截断
一次仅含二十个字符的工具调用——例如派发 pytest tests/ 或执行 find / -name "*.py"——就可能启动一个外部进程,在超过一百万行的执行日志中输出八十兆字节的原始文本。如果宿主智能体运行时简单地捕获这一输出流,并将其直接追加到模型的工作上下文中,系统就会立即遭遇灾难性的资源故障。模型的上下文容量(\(S_{\max}\))在现代架构中无论多大,都是一种预算受到严格限制、成本高昂的物理资源。摄取不受约束的观测流不仅可能立即导致上下文窗口溢出,还会在预填充阶段消耗加速器上数吉字节的高带宽内存(HBM)来存储键值(KV)缓存,使首 token 延迟(TTFT)增加数个数量级,并挤占推理服务引擎中并发请求批次的资源。
运行时必须将每个外部观测流都视为不可信、无界的数据生产者。 在原始操作系统传输通道与上下文暂存缓冲区之间,运行时插入了 图 8 所示的多阶段观测流水线。
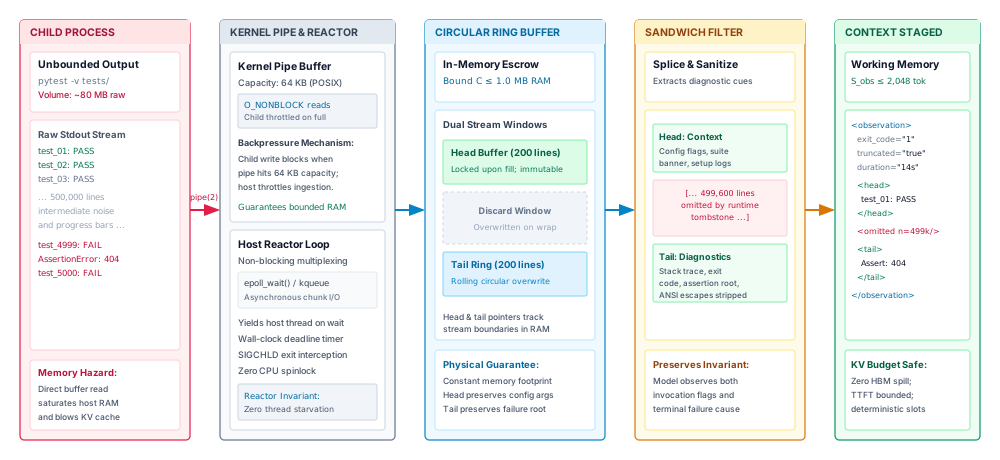
pipe(2) 内核缓冲区(64 KB),在 O_NONBLOCK 背压作用下流入异步宿主反应器循环。数据流进入宿主内存托管区中的有界环形缓冲区(\(C \le 1.0\text{ MB}\));夹心过滤器在此将头部行和尾部诊断轨迹拼接到省略标记的两侧,然后将其格式化为有界观测帧(\(S_{\text{obs}} \le 2{,}048\text{ tokens}\)),以供上下文暂存。
如 图 8 所详述,这条数据通路通过五个相互协同的阶段,将外部进程的输出与神经网络上下文的暂存解耦:
- 无界生产者(子进程): 一个非特权子进程(例如执行
pytest -v tests/的测试运行器)生成最多 \(80\text{ MB}\) 的原始流数据,共计 500,000 行。直接摄取这些数据会使主机 RAM 溢出,并耗尽加速器的 KV 缓存分配额度。 - 操作系统内核管道与 Reactor 循环: 进程间传输通过 POSIX
pipe(2)进行,该管道具有固定的 64 KB 内核缓冲区。主机监管程序使用O_NONBLOCK分块读取数据,读取过程由异步事件循环(epoll_wait(2)或kqueue)驱动。当管道填满时,内核停止调度执行写入操作的子进程,施加物理背压,从而限制内存消耗。 - 循环环形缓冲区(内存托管): 在主机内存中,传入的字节被暂存于容量上限为 \(C \le 1.0\text{ MB}\) 的托管区域。两个流指针分别跟踪不可变头部缓冲区中的最初 \(N_{\text{head}} = 200\) 行,以及滚动环形缓冲区中的最后 \(N_{\text{tail}} = 200\) 行,并就地丢弃大量中间流噪声。
- 夹心过滤器: 过滤器将头部的调用设置与尾部的最终断言和堆栈跟踪拼接起来,用显式的删除标记(
[... 499,600 lines omitted by runtime ...])替换被丢弃的行。 - 上下文暂存工作记忆: 将生成的文本序列化为结构化观测帧(\(S_{\text{obs}} \le 2{,}048\text{ tokens}\)),并附加 POSIX 退出码和执行时长指标,确保 KV 缓存分配具有确定性,且不会发生 HBM 溢出。
动作执行的不对称性
智能体运行时与其外部工具之间的交互呈现出一种根本性的熵不对称性。模型发出的出站动作执行命令紧凑且高度结构化,通常以 JSON-RPC 分派或命令行调用的形式呈现,很少超过几十个词元。相比之下,主机环境发出的入站观测流的规模没有上限。未优化的编译器输出冗长的模板实例化警告、包管理器下载层层嵌套的依赖树,或递归目录搜索,都很容易每秒产生数兆字节的文本。
当智能体运行时盲目地将无界观测流摄取到上下文数组中时,代价会直接体现为加速器内存和计算消耗。在现代 Transformer 运行时中,上下文消耗不仅仅是对序列长度的抽象限制;它还决定了服务系统 PagedAttention 池中物理内存块的实际分配。每个被接纳的观测词元都必须投影为键张量和值张量,并在智能体的整个多轮轨迹期间存储于加速器的 HBM 中。
粗略估算 0.5: 未截断摄取带来的物理内存与计算开销
pytest -v tests/unit/。该命令触发一个回归测试套件,运行 \(4,500\) 个单元测试,生成 \(24\text{ MB}\) 的标准输出,共计 \(520,000\) 行。
假设标准字节对编码(BPE)产生的每个词元约对应 \(4\text{ bytes}\),则 \(24\text{ MB}\) 的数据流转换为: \[N_{\text{obs}} = \frac{24 \times 10^6\text{ bytes}}{4\text{ bytes/token}} = 6.0 \times 10^6\text{ tokens}\]
现在考察一个承载 700 亿参数基础模型的服务引擎,该模型采用分组查询注意力(GQA),具有以下架构参数:
- Transformer 层数:\(L = 80\)
- 键值头数:\(H_{\text{kv}} = 8\)
- 头维度:\(D_{\text{head}} = 128\)
- 精度:16 位浮点数(\(\text{bytes\_per\_element} = 2\))
每个词元所需的 KV 缓存物理内存为: \[M_{\text{token}} = 2 \times L \times H_{\text{kv}} \times D_{\text{head}} \times \text{bytes\_per\_element}\] \[M_{\text{token}} = 2 \times 80 \times 8 \times 128 \times 2 = 327,680\text{ bytes} \approx 320\text{ KB/token}\]
如果运行时摄取整个未经截断的数据流(\(N_{\text{obs}} = 6.0 \times 10^6\text{ tokens}\)),仅存储该观测的 KV 缓存所需的物理内存占用就为: \[M_{\text{total}} = 6.0 \times 10^6 \times 320\text{ KB} \approx 1.92\text{ TB of HBM}\]
这超过了一个配备八块 NVIDIA H100 GPU 的节点的物理内存总量(\(8 \times 80\text{ GB} = 640\text{ GB}\))。即使模型采用扩展的逻辑上下文窗口(\(S_{\max} = 128\text{K}\text{ tokens}\)),原始观测仍超出窗口边界 \(46.8\times\)。即便仅摄取至 \(128\text{K}\text{ tokens}\) 这一硬性上限,仍会独占: \[M_{128\text{K}} = 131,072 \times 320\text{ KB} = 40.96\text{ GB of HBM}\] 此外,在预填充阶段处理 \(128\text{K}\) 个观测词元需要约 \(2 \times N_{\text{tokens}} \times P_{\text{model}} \approx 2 \times 1.31 \times 10^5 \times 7.0 \times 10^{10} \approx 1.83 \times 10^{16}\text{ FLOPs}\) 的计算量,使一块 H100 GPU(以 \(989\text{ TFLOPs}\) 的稠密 FP16 吞吐量运行)在生成任何输出词元之前,陷入超过 \(18.5\text{ seconds}\) 的预填充计算阻塞。
相比之下,主动实施严格字节上限 \(B_{\text{ceiling}} = 32\text{ KB}\)(\(\approx 8,000\text{ tokens}\))的观测流水线可将 KV 缓存分配量限制在 \(2.56\text{ GB}\),并将预填充延迟保持在 \(1.2\text{ seconds}\) 以下,从而保留加速器内存资源和多租户批处理并发能力。
加速器服务引擎的物理现实意味着,未经截断的观测流会构成对智能体自身的可用性攻击。失控的子进程可能导致物理内存耗尽(CUDA OOM)而崩溃,抢占并发推理轨迹所需的资源,或使推理延迟增大至超出运行时的活性阈值。
粗略估算 0.6: 在轨迹中持续携带一条观测的成本
原始输出。 日志约有 8M 个词元,相当于整个窗口的 62.5×。它根本无法完整传回。若运行时只是用日志的开头部分填满窗口,就不会给任务留下任何空间,而且每次后续调用都要携带一个完整窗口;在剩余调用中,缓存输入的费用约为 $1.15,而日志末尾的失败测试始终无法传递给模型。
整形后的输出。 一条包含 4,000 个词元的观测占窗口的 3.1 percent。在剩余调用中持续携带该观测,会增加 120,000 个输入词元;若前缀从未被缓存,费用为 $0.36,若已缓存,费用则为 $0.036。
要点:一条观测的成本等于其大小乘以后续读取它的调用次数。在捕获观测时进行整形,是唯一能够以较低代价减小这一乘积的时机,因为观测一旦进入历史记录,移除它就会破坏此后每次调用的缓存前缀(上下文压缩)。
无头运行中的流尾保留机制
为防止观测流耗尽上下文预算,运行时必须实现自动流截断。截断策略的设计取决于诊断信息在工具输出中的位置分布。在软件工程、数据分析和系统管理中,工具输出所含的信息很少均匀分布。编译器、构建系统、测试运行器和命令行搜索工具的执行流呈现出不对称的诊断信息分布:
- 调用头部(流前缀): 最初的 \(10\) 至 \(50\) 行通常包含环境配置、编译器优化标志、当前工作目录、发现的测试目标或依赖图。这一前缀确立了执行的确定性上下文。
- 中间执行轨迹(流主体): 随后的数千行乃至数百万行由低熵的进度指示信息组成,例如持续的编译通知、重复的状态条或通过的测试断言(
test_0001 ... ok)。这一部分的信息密度接近于零。 - 诊断结论(流尾部): 最后的 \(50\) 至 \(200\) 行包含导致进程退出的关键诊断信号:编译器语法错误、断言失败消息、详细列出寄存器状态和源代码行的堆栈跟踪,以及汇总状态行(
FAILED (failures=1, errors=0))。
[Line 000001] $ cargo test --all
[Line 000002] Compiling kernel v0.1.0 (/workspace/core)
[Line 000003] Running 48219 tests across 14 modules
... [48,200 lines of passing tests: "test engine::... ok"] ...
[Line 48205] test memory::paging::test_allocator ... FAILED
[Line 48206]
[Line 48207] failures:
[Line 48208] ---- memory::paging::test_allocator stdout ----
[Line 48209] thread 'test_allocator' panicked at 'assertion failed: `(left == right)`', src/memory.rs:142:9
[Line 48210]   left: `0x00007fff`, right: `0x00000000`
[Line 48211] stack backtrace:
[Line 48212]    0: std::panicking::begin_panic
[Line 48213]    1: kernel::memory::paging::allocate_frame
[Line 48214]
[Line 48215] test result: FAILED. 48218 passed; 1 failed; 0 ignored
采用朴素的头部截断方式——保留输出的前 \(N\) 字节并丢弃其余部分——会造成灾难性后果。经过头部截断的观测保留了开头的构建提示信息和最先通过的十几个测试,却将编译器错误或堆栈跟踪完全丢弃。模型收到的截断观测表明测试已运行,也观察到非零退出状态码,却没有任何词元说明进程为何失败。这会导致认知盲区,使模型陷入退化的幻觉循环,在缺乏反馈的情况下尝试随机修改代码。
运行时必须改为通过“夹心式”(头部与尾部)截断模式实现无头式尾部保留。运行时预留 \(B_{\text{max}}\) 字节的观测预算,并将这部分预算分配给输出流的前缀和后缀: \[B_{\text{max}} = B_{\text{head}} + B_{\text{tombstone}} + B_{\text{tail}}\]
头部缓冲区直接捕获输出的前 \(B_{\text{head}}\) 字节。对于尾部,运行时在内存中分配一个固定大小的环形缓冲区,至少可容纳 \(B_{\text{tail}}\) 字节。随着子进程输出数据,字节会持续写入环形缓冲区;一旦超出容量,最早的中间跟踪行便会自然被覆盖。
子进程退出时,运行时从头部缓冲区提取连续的前缀,追加一条合成的墓碑记录,详细说明被丢弃数据的确切物理数据量,然后追加环形缓冲区的最终内容:
[... 48,195 lines and 4,182,041 bytes truncated by runtime supervisor ...]墓碑标记通过明确告知模型存在缺失信息,并指明省略的行数和字节量,来保持语义完整性。这使有意截断与进程异常终止得以区分。
字节预算与行数 截断边界必须始终依据原始字节数强制执行,绝不能仅依据行数。异常进程若输出单行未压缩的 JSON,或包含 \(50\text{ MB}\) 的 base64 二进制转储,就会绕过基于行的过滤器(tail -n 100),立即引发内存溢出。
截断策略必须先严格执行物理字节预算限制,再尝试按行或词元分段。未经预过滤就按行或词元拆分,会使运行时面临因输入缺少换行分隔符而耗尽内存的风险。运行时将流作为有界的原始字节序列读取,在有效的 UTF-8 码点边界处截取窗口以防止解码损坏,然后才进行面向行的格式化和词元化,为上下文准备数据。
结构化分页契约
命令行工具依赖终端流,因此需要被动跟踪其尾部输出;而结构化工具——例如数据库客户端、搜索服务、向量索引和文件系统检查工具——不得输出原始且不受约束的结果集合。允许不受约束的查询(例如 SELECT * FROM audit_logs 或 list_files(directory="/"))的工具接口,在 API 契约层面违反了最小权限原则和上下文有界性原则。
对于结构化数据提供方,智能体运行时必须强制执行分页查询契约。该契约确立了两个强制性的架构不变量:
- 固定分页上限(\(K \le K_{\max}\)): 工具接口拒绝无界查询,并对每次调用返回的记录数施加严格上限(通常为 \(K_{\max} \le 50\))。如果模型请求的批次大小超过 \(K_{\max}\),运行时会将该参数限制在上限值。
- 不透明续传令牌(
cursor): 如果查询匹配的实体集合大小超过分页上限,工具会返回当前页的结果,并附带一个不透明续传令牌(next_cursor)。游标封装了在后续执行中恢复遍历所需的确定性状态。
续传令牌的生成和生命周期带来了主机内存使用量与查询一致性之间的具体系统权衡(表 5)。运行时可以通过服务端会话租约或客户端无状态加密令牌实现分页状态。
| 架构维度 | 有状态服务端游标 | 无状态签名客户端游标 |
|---|---|---|
| 状态存储位置 | 主机运行时内存 / 数据库引擎 | 序列化到上下文载荷中 |
| 主机内存影响 | \(O(S \times M)\) 活动连接泄漏 | \(O(1)\) 主机运行时内存开销为零 |
| 一致性保证 | 事务性快照隔离 | 读已提交或脏数据遍历 |
| 放弃容忍能力 | 需要显式的 TTL 回收守护进程 | 不受智能体放弃轨迹的影响 |
| 上下文开销 | 极小(短 UUID 字符串,\(\approx 8\text{ tokens}\)) | 中等(base64 HMAC 令牌,\(\approx 45\text{ tokens}\)) |
| 重放漏洞 | 通过撤销服务端租约来控制 | 需要验证内嵌时间戳 |
在智能体架构中,有状态服务端游标会带来显著的运维风险。如果智能体发起深度数据库查询,收到第一页结果后,根据这些结果决定改变计划并放弃搜索,服务端游标仍会保持分配状态。在数千个自主执行循环中,除非部署积极执行回收的生存时间(TTL)守护进程,否则被放弃的迭代器会耗尽数据库连接池和主机内存。
因此,鲁棒的工具子系统倾向于采用无状态签名游标。工具运行时将遍历参数——例如确定性排序键、最后观察到的主键标识符(\(ID_{\text{last}}\))、签发时间戳(\(\tau\))以及查询签名——序列化为紧凑的二进制载荷。该载荷使用主机监管器私有的 HMAC 密钥进行加密和认证: \[\text{Cursor} = \text{Base64Encode}\Big(\text{Data} \parallel \text{HMAC}_{K_{\text{runtime}}}(\text{Data})\Big)\] \[\text{where} \quad \text{Data} = \big(\text{QueryHash} \parallel ID_{\text{last}} \parallel \tau\big)\]
当智能体在后续调用中提交续传令牌(query_logs(cursor="eyJhbGci..."))时,工具会验证密码学签名,确认 \(\tau\) 尚未过期,并严格从 \(ID_{\text{last}}\) 之后恢复遍历。这确保主机运行时无需维护任何持久会话状态,使系统免受因探索轨迹被放弃而导致的内存泄漏影响。
内核缓冲动态
前述机制规定了数据进入主机内存后,运行时如何对其进行切片和分段。然而,运行时还必须防止失控的外部进程在数据生成期间耗尽操作系统资源。如果配置错误或恶意子进程执行无限循环,以使内存总线饱和的速度生成文本——例如 yes "memory exhaustion"——运行时就不能在等待进程退出期间,直接将这些数据流式写入无界内存缓冲区。这样做会耗尽主机操作系统的 RAM,触发 Linux 内存不足(OOM)终止机制,终止关键运行时服务。
如 图 8 所示,隔离子进程与主机运行时监管器之间的观测数据传输通过进程间通信(IPC)通道完成:即通过 pipe(2) 创建的标准 UNIX 单向数据通道。
标准匿名管道由内核内部管理、以内存为后端的 FIFO 构成。在 Linux 中,该环形缓冲区的容量默认限制为 \(65,536\text{ bytes}\)(\(64\text{ KB}\),相当于 16 个大小为 \(4\text{ KB}\) 的内存页)。该容量可以检查,也可以调高至 /proc/sys/fs/pipe-max-size 中定义的系统上限,所用方式是调用 fcntl(2) 系统调用并指定 F_SETPIPE_SZ 命令标志。
内核管道缓冲区的有限容量为操作系统背压提供了物理基础。运行时监管器使用异步、事件驱动的事件循环来管理进程执行,该循环基于多路复用原语,例如 Linux 上的 epoll(7) 或 BSD 和 macOS 上的 kqueue(2)。运行时将子进程 stdout 和 stderr 流的读取描述符配置为非阻塞模式(O_NONBLOCK)。
当子进程写入输出的速度快于运行时读取输出的速度,或运行时有意减慢消费速度时,内核管道缓冲区就会填满。一旦内部 \(64\text{ KB}\) 缓冲区达到饱和,内核的虚拟文件系统(VFS)层就会挂起子进程后续的 write(2) 系统调用。操作系统将子进程从执行队列移至等待队列(TASK_INTERRUPTIBLE),使其停止在物理 CPU 核心上调度执行。在运行时监管器从管道中读取数据、释放内核缓冲区容量之前,子进程无法再执行任何一条指令。
// Runtime supervisor event-driven drain loop applying backpressure
struct epoll_event ev, events[MAX_EVENTS];
int epoll_fd = epoll_create1(EPOLL_CLOEXEC);
ev.events = EPOLLIN | EPOLLPRI;
ev.data.fd = pipe_read_fd;
epoll_ctl(epoll_fd, EPOLL_CTL_ADD, pipe_read_fd, &ev);

size_t total_bytes_read = 0;
while (process_is_running) {
    int nfds = epoll_wait(epoll_fd, events, MAX_EVENTS, TIMEOUT_MS);
    for (int i = 0; i < nfds; i++) {
        if (events[i].events & EPOLLIN) {
            ssize_t bytes = read(pipe_read_fd, staging_buf, CHUNK_SIZE);
            if (bytes > 0) {
                total_bytes_read += bytes;
                ring_buffer_write(&tail_ring_buf, staging_buf, bytes);

                // Hard ceiling enforcement: trigger proactive process termination
                if (total_bytes_read > HARD_ABORT_CEILING_BYTES) {
                    close(pipe_read_fd); // Trigger SIGPIPE on child's next write
                    kill(child_pid, SIGKILL);
                    process_is_running = false;
                    break;
                }
            }
        }
    }
}运行时对生成的总数据量施加绝对上限(\(B_{\text{abort}}\))。尽管滑动窗口环形缓冲区为上下文暂存维持了有界的观测大小,运行时仍不能允许失控进程无限期地消耗宿主机 CPU 周期。监督器跟踪累计字节计数器: \[B_{\text{cumulative}} = \sum_{i} \text{read}(fd, \text{chunk}_i)\]
如果 \(B_{\text{cumulative}}\) 超过 \(B_{\text{abort}}\)(例如,\(100\text{ MB}\)),监督器会立即触发主动终止。它通过 close(2) 关闭管道的读取端。当子进程随后调用 write(2) 时,内核会检测到没有任何读取描述符引用该管道 FIFO。内核会停止写入,引发 EPIPE 错误,并自动向子进程发送 SIGPIPE 信号。除非子进程已显式安装自定义信号处理程序,否则 SIGPIPE 的默认动作会立即终止该进程。为防止不配合的进程继续驻留,监督器会在这一终止序列之后显式发送 SIGKILL。
通过结合非阻塞内核管道排空、严格的累计计量和 SIGPIPE 强制执行机制,运行时为宿主系统资源提供了完整的结构性保护。无界的生产者数据流在输入神经模型之前被转换为严格有界的内存切片,从而确保宿主机 RAM 和加速器 HBM 均不会受到外部执行的危害。
当观测流通过机械式机制被限定在边界内、受到背压节流,并被缩减为预算范围内的字节切片后,运行时便面临更微妙的数据完整性挑战。保留下来的字节流经常混杂着 ANSI 转义序列、终端光标定位命令、通过回车重写的进度信息,以及交错混合的标准输出和标准错误输出。要将这些原始终端输出转换为权威、干净的观测记录,需要确定性的终端净化处理,这也是我们接下来要探讨的内容。
终端输出净化
执行构建工具、包管理器或测试运行器的子进程会将数兆字节的原始字节序列直接写入其标准流。对于通过交互式终端模拟器观察输出的人类开发者而言,这些数据流呈现为简洁而精致的可视界面:旋转动画指示器表明工作正在进行,彩色标记突出显示编译器警告,光标重定位指令则平滑地原地更新进度条。然而,当智能体运行时将这些未经处理的字节流直接导入基础模型的上下文窗口时,这一交互式呈现层便会成为运行负担。单个下载进度条或测试旋转指示器会反复输出回车符和多字节转义序列,生成数万个冗余字符,在物理光栅屏幕上覆盖同一显示行。如果未经规范化就摄入,这些格式控制残留会消耗大量 token 预算,使子词分词表碎片化,扭曲整个提示中的注意力权重分布,并且当未经转义的控制分隔符模仿原生工具边界时,还可能触发提示注入。
ECMA-48 与 ANSI X3.64 ECMA-48 于 1976 年由欧洲计算机制造商协会标准化,定义了用于在物理视频显示终端上定位光标、更改显示颜色和操纵字符属性的控制功能、转义序列及移位状态。
宿主运行时必须在 POSIX 流读取器与上下文组装器之间插入一条确定性的规范化流水线。这条流水线会剥离呈现层的转义残留,处理原地行覆盖,保留权威的内核退出状态,提取结构化诊断帧,并用机器可读的元数据封装截断后的数据流。
这一净化流水线的架构数据通路如 图 9 所示,展示了字节流经过三个独立处理阶段的路径:
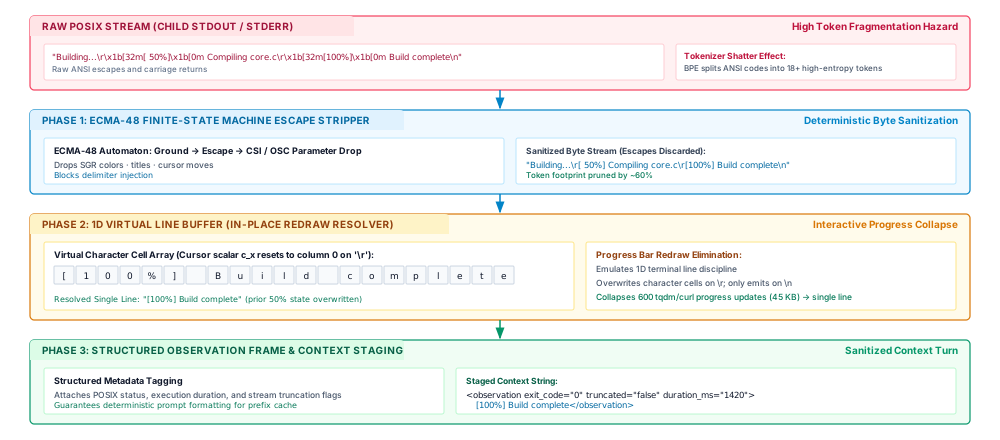
\r),将重复的进度条折叠为单一的终端状态(阶段 2)。净化后的数据流随后被封装到结构化观测帧中,并附带退出码和截断元数据(阶段 3)。
如 图 9 所详述,净化流水线执行三个相互协同的转换阶段:
- 阶段 0(原始 POSIX 流): 子进程输出混合字节序列,其中包含可打印文本、ANSI 转义码(
\x1b[32m)和回车符(\r)。若不进行规范化,标准的字节对编码(BPE)分词器会将这些控制字节拆分为每个可视状态帧 18 个以上的高熵词元,从而稀释注意力权重并增加预填充计算量。 - 阶段 1(ECMA-48 FSM 转义序列剥离器): 有限状态机在
GROUND、ESCAPE和CSI_ENTRY状态之间转换,以拦截并丢弃选择图形呈现(SGR)字体颜色、真彩色定义、光标移动和终端标题。这种确定性的字节净化可消除提示分隔符注入攻击,同时将词元占用量削减约 \(60\%\)。 - 阶段 2(一维虚拟行缓冲区): 为处理进度条(
tqdm、curl、wget)产生的原地行覆盖,运行时维护一个一维字符单元数组,并使用标量 \(c_x\) 表示当前光标位置。当出现回车符(\r)而没有换行符(\n)时,\(c_x\) 重置为第 0 列,使后续字符原地覆盖先前的单元。因此,数百次中间进度更新(例如,\(45\text{ KB}\) 的冗余帧)被合并为一个具有权威性的终端字符串([100%] Build complete)。 - 阶段 3(结构化观测帧): 净化后的字符串被封装到具有权威性的观测记录中,并附注 POSIX 退出码、执行时长和截断元数据,然后存入工作上下文内存。
对于自回归基础模型而言,带内转义序列是有害噪声。字节对编码(BPE)分词器的训练数据是人类自然语言和源代码,而非原始终端流的捕获内容。由于诸如 24 位真彩色规格(\x1b[38;2;255;128;0m)这样的长 ANSI 转义序列很少在训练语料中以完整词元的形式出现,分词器会将这个十八字节的序列拆分为八到十二个不同的子词词元。编译器输出五十行带颜色的文本,就可能向序列中引入一千多个碎片化词元,却没有传达任何超出纯文本的语义区别。更糟的是,如果恶意工具或不可信文件名包含未转义的 OSC 命令,或包含与智能体运行时的工具封装协议相匹配的自定义分隔符,未经解析的终端流就可能劫持模型的控制流。
运行时必须使用依据 ECMA-48 规范构建的确定性有限状态机(FSM)处理原始字节流。通过正则表达式进行简单字符串替换的做法会失败,因为 ANSI 序列具有状态性且依赖上下文;未锚定的正则表达式可能会拆开横跨两个连续读取块的转义序列,破坏流。FSM 维护显式解析状态:GROUND、ESCAPE、CSI_ENTRY、CSI_PARAM、CSI_INTERMEDIATE 和 OSC_STRING。任何被识别为 SGR 颜色指令、光标位移或 OSC 命令的字节序列,都会在分词之前被丢弃。
电传打字机的回车符 在机械式电传打字机上,回车符(\r,ASCII 0x0D)会让字车实际返回左边距,而不会使纸张向上移动。推进纸张需要单独的换行符(\n,ASCII 0x0A)。现代命令行工具利用这种分离机制,仅输出 \r,即可在同一可视行上重绘进度指示器。
导致流膨胀的第二个、更严重的来源是回车符(\r)引起的覆盖。tqdm、curl 和包管理器等命令行工具通过以下方式绘制交互式进度条:先打印一行文本,再输出 \r 将光标重置到第零列,随后立即在同一个行缓冲区上打印更新后的百分比。在交互式 TTY 中,用户看到的是随时间动态变化的单行内容。然而,在原始 POSIX 管道流中,每次中间渲染都会按顺序保留下来。在一次三十秒的操作中,以十赫兹频率更新的进度条会写入三百次迭代,从而产生数十千字节的相同状态文本。
为将这种视觉冗余转化为清晰的文本观测,清洗流水线对一个虚拟的一维行缓冲区进行建模。当解析器遇到可打印字符时,会将其写入缓冲区中当前虚拟光标所在的位置,并递增光标位置标量。当解析器遇到 \r 且其后未紧接 \n 时,会将虚拟光标位置重置为第零列,但不清空行缓冲区。后续字符会覆盖缓冲区中相应列偏移处的内容。只有在出现真正的换行符(\n)或流到达 EOF 时,运行时才会将行缓冲区的内容提交到清洗后的观测记录中。这样便将数百个瞬时视觉帧折叠为该行唯一的最终状态,最多消除 99% 的原始字节量,同时保留终端的权威状态。
粗略估算 0.7: 未经清洗的进度流造成的词元膨胀与预填充开销
考虑一个执行远程制品下载的智能体工具。在 30 秒内,该进程以 20 Hz 的频率输出不断更新的进度条,总共产生 600 次更新。每次更新包含一个 ANSI 光标定位代码(6 字节)、一个 SGR 绿色标记(5 字节)、一个由 60 个字符组成的进度条字符串([=========> ] 45% 450MB/1000MB)、一个 SGR 重置代码(4 字节),以及一个回车符 \r(1 字节),每帧共计 76 字节。
原始管道字节量: \[\text{Total Bytes} = 600 \times 76\text{ bytes} = 45,600\text{ bytes}\]
字节对编码下的词元消耗: 由于 BPE 词表将转义序列和带括号的进度区间切分为平均每 3.2 字节一个词元,每个 76 字节的帧会被分解为约 24 个词元: \[\text{Total Tokens} = 600 \times 24 = 14,400\text{ tokens}\]
加速器服务与延迟影响: 假设智能体运行时调用的基础模型托管在一个采用 8 GPU 张量并行的加速器节点上,其总预填充吞吐量为 \(32,000\text{ tokens/second}\)。将这 14,400 个不承载语义的词元载入上下文窗口,会直接造成以下预填充延迟: \[\Delta t_{\text{prefill}} = \frac{14,400\text{ tokens}}{32,000\text{ tokens/s}} = 0.450\text{ seconds } (450\text{ ms})\]
此外,在 16 位精度(\(\text{FP16}\))下,每个词元都需要在 \(L = 32\) 个 Transformer 层、\(N = 32\) 个注意力头以及头维度 \(D = 128\) 上分配 KV 缓存: \[\text{Cache Footprint} = 14,400 \times 32 \times 2 \times (32 \times 128) \times 2\text{ bytes} \approx 754.97\text{ MB}\] 处理这一个未经中间处理的下载进度条,就会消耗超过 \(750\text{ MB}\) 的高带宽内存(HBM),并使整个轨迹中后续的每个自回归解码步骤增加近半秒的延迟。
清洗后的行缓冲区结果: 将该流送入 ECMA-48 控制序列剥离器和一维行缓冲区,可将 600 帧折叠为一个完整确定的终端字符串: [==============================] 100% 1000MB/1000MB Complete(60 字节,15 个词元)。
- 数据压缩: \(45,600\text{ bytes} \to 60\text{ bytes}\)(减少 \(760\times\))。
- 词元减少: \(14,400\text{ tokens} \to 15\text{ tokens}\)(减少 \(960\times\),节省 \(99.89\%\))。
- 预填充延迟: \(\frac{15}{32,000} \approx 0.47\text{ ms}\)(加速 \(957\times\))。
- KV 缓存分配: \(755\text{ MB} \to 0.78\text{ MB}\)。
进程终止语义
剥离呈现层的附加内容解决了观测的语法问题,但运行时还必须使执行状态以操作系统的实际状态为依据。当工具进程完成时,父运行时会调用 POSIX waitpid() 系统调用,以收集子进程的终止状态。操作系统内核将进程的终止情况编码到一个 16 位整数状态字中,可通过标准 POSIX 宏访问。
POSIX 进程终止情况 根据 IEEE Std 1003.1-2017 的定义,WIFEXITED 在子进程通过 exit() 或 _exit() 正常终止时求值为真。WEXITSTATUS 提取子进程传入值的低 8 位。如果进程被未处理的信号终止,WIFSIGNALED 的求值结果为真,WTERMSIG 则返回信号的数字代码。
内核状态字区分正常的进程终止与信号导致的突然终止。如果 WIFEXITED(wstatus) 非零,则子进程已将其控制流执行完毕,并调用了 exit(),传递一个 8 位无符号整数(0–255),该整数由 WEXITSTATUS(wstatus) 返回。按照标准 POSIX 约定,退出码 0 表示成功,而任何非零值(1–255)均表示运行错误。相反,如果 WIFSIGNALED(wstatus) 非零,则进程被未处理的内核信号异步终止,例如 SIGSEGV(段错误,信号 11)、SIGFPE(浮点异常,信号 8)或 SIGKILL(内存不足终止机制或运行时抢占,信号 9)。该状态字的位字段结构布局详见 POSIX 进程终止状态字布局。
| 位 | 字段 | 宏 | 语义描述 |
|---|---|---|---|
15..8 |
退出码(0..255) |
WEXITSTATUS(s) |
传递给 exit(N) 的状态码(当 WIFEXITED(s) 为真时有效) |
7 |
核心转储标志(C) |
WCOREDUMP(s) |
若进程终止并生成了核心转储映像,则置位 |
6..0 |
终止信号 | WTERMSIG(s) |
导致进程终止的信号编号(当 WIFSIGNALED(s) 为真时有效) |
尽管内核退出状态提供了执行如何终止的不可变硬件及操作系统层面凭据,运行时工程师仍须警惕一种根本性的架构谬误:退出码为零并不能证明工具实现了预期目标。
退出状态仅反映二进制程序的入口点向内核返回了什么。程序若崩溃、抛出未处理的异常或发生内存损坏,便会可靠地返回非零退出码或触发信号。然而,退出码 0 在认识论上的证明范围十分有限;它仅能证明进程完成了主控制流程,且未发生未处理的恐慌。因此,Fail-Plausible 故障模型 的故障模型——失败时仍呈现看似合理的结果——既适用于模型本身,也适用于模型调用的工具。在现实软件系统中,即使发生严重的语义失败,工具也常常以退出码 0 退出:
- 静默的虚假通过与空匹配:
pytest或jest等测试套件运行器若配置错误,或指向无效的目录路径,就会发现零个测试文件、执行零条断言,并以状态0正常退出。从操作系统的角度看,测试套件“通过”了,但它完全未能验证代码库。 - 被吞掉的子 shell 错误: 复杂的 shell 脚本若在串联命令时未使用
set -e或set -o pipefail,可能在执行中途遇到灾难性的编译器错误;如果脚本中的最后一条命令是无害的清理操作或echo语句,shell 就会返回退出码0。 - 应用层软错误: 数据库客户端、语言服务器接口和网页抓取工具经常在内部捕获应用层错误,将错误载荷格式化为 JSON 并写入
stdout,然后以0退出,因为查询协议本身的执行并未发生操作系统层面的故障。
因此,智能体运行时必须将 POSIX 退出状态视为任务完成的必要但不充分的证据,因为不变量闭合原则(不变闭包原则)仅依据在端到端边界收集的证据来认定任务正确性,而不依据执行进程的报告。必须显式捕获整数状态码,并将其作为不可变的元数据字段转发到工具观测载荷中,但下游编排器绝不能将 exit_code == 0 等同于经实证确认的不变量满足。工具执行的端到端正确性只能通过独立的验证检查来确认,例如解析结构化的编译器输出,或针对文件系统检验领域特定的断言。
结构化诊断帧提取
当工具遇到错误时,传输数百行混杂的标准输出和标准错误,会迫使基础模型消耗宝贵的推理 token 来寻找根因。为了最大限度地提高模型的诊断效率,运行时规范化器必须分离物理流,并提取结构化诊断帧。
标准 POSIX 工具严格区分通过文件描述符 1(stdout)输出的主要功能数据,以及通过文件描述符 2(stderr)输出的运行诊断信息。运行时若不加区分地将这两个流复用到单个观测字符串中,就会丢弃至关重要的语义元数据。编译器将编译后的目标代码列表或汇编代码输出到 stdout,同时将语法错误和包含路径警告发送到 stderr。脚本可能将有效的 JSON 数据输出到 stdout,而日志库则将初始化信息通知写入 stderr。通过保留流的分离,运行时使智能体的上下文组装器能够将功能结果与环境噪声分别呈现。
对于常见的软件开发运行时,净化层会对 stderr 流应用结构化诊断帧提取。标准执行引擎输出的回溯和诊断消息遵循确定性的、特定于语言的语法:
- Python 回溯:标准回溯遵循严格的多行结构,以
Traceback (most recent call last):开头,随后依次列出文件路径、行号和函数作用域,最后给出不带限定名的异常类和错误消息(例如,AssertionError: Expected 200 OK, got 404)。 - 编译器错误消息:符合 GCC 和 Clang 规范的编译器以标准 POSIX 格式
<filename>:<line>:<col>: error: <message>输出诊断信息,随后给出出错的源代码行,以及指向词法偏移位置的插入符号(^)。 - Panic 堆栈:编译型系统语言(如 Rust 和 Go)会输出声明所违反不变式的 panic 提示(
thread 'main' panicked at 'index out of bounds: the len is 4 but the index is 4'),随后列出包含经过名称修饰的符号的栈帧。
规范化层将这些标准错误流解析为带类型的诊断记录。运行时提取根本异常的类、失败消息,以及位于用户工作区代码仓库中的确切末端栈帧,从而避免迫使模型以自回归方式逐行扫描两百行中间库栈帧。
{
  "exit_code": 1,
  "signal": null,
  "truncated": true,
  "stdout": "Running test suite: test_auth.py\n[32 passed, 1 failed]",
  "stderr_frame": {
    "exception": "AssertionError",
    "message": "assert authenticate('admin', 'wrong_pass') is False",
    "location": {"file": "services/auth.py", "line": 84}
  },
  "truncation_notice": "Output exceeded 2,000 tokens; preserved tail 50 lines. Full trace: /tmp/trace_78a.log"
}
最后,当观测流超出运行时截断策略所规定的物理或逻辑预算 \(B_{\max}\) 时,净化流水线必须使用显式的机器可读元数据封装剩余文本。容错系统文献已经指出,未明确报告的故障比显式错误会引发更严重的级联后果。如果截断观测流时,只是在第 \(B_{\max}\) 个字节处终止字符串,基础模型就会遭遇突如其来的语法断裂:未闭合的引号、不完整的 JSON 对象,或被切断的回溯信息。模型常常将这种突然终止误判为底层软件的语法错误,进而生成徒劳的修复操作,试图修复存储卷上完全完好的代码。
为防止这些认知失误,规范化流水线使用确定性的标准化头部和尾部封装截断后的观测。头部明确声明发生了截断,说明实际施加的精确词元和行范围限制,阐明保留的窗口代表流的头部还是尾部,并引导模型访问保存在磁盘上的完整日志文件(如 代码 3 所示)。借助这种结构化封装,模型能够识别出上下文缺失是运行时资源管理造成的结果,而非目标环境故障,从而有针对性地发出分页命令,或有目的地检查特定日志片段。
Checkpoint 0.2: 评估幂等性与观测净化
在讨论异步分派和后台进程管理之前,请检验你对工具故障恢复的理解:
异步工具分派
执行外部工具会在智能体运行时中引入不可避免的时间断层:自回归词元解码每个词元耗时 \(10\text{ to }40\text{ milliseconds}\),而外部软件操作的耗时则从数百毫秒到数十分钟不等。当基础模型发出工具调用,执行编译器处理流程、完整的单元测试套件、分布式数据仓库查询或容器构建时,其执行时长与神经网络生成延迟相差三到五个数量级。如果智能体运行时通过同步阻塞的系统调用来协调这一交互,宿主线程就会停止,轨迹停滞,整个计算循环也会冻结,直到子进程终止或达到墙钟时间超时限制。
工具调用并非瞬时的函数求值,而是一个外部的、解耦的进程生命周期,其持续时间往往超过触发它的模型轮次。智能体运行时必须将长时间运行的工具调用视为异步后台任务,向轨迹返回不透明的任务句柄,释放宿主执行线程,并将模型的思考循环与实际执行延迟解耦,同时将加速器内存保留策略交由底层推理引擎处理。
时间尺度不匹配
制约同步工具分派的物理瓶颈,是不同系统时间尺度之间的队头阻塞。在现代加速器硬件上进行标准推理时,一个 700 亿参数模型的自回归解码步骤会通过高带宽内存执行非批处理或按批次调度的广义矩阵—向量乘法(\(\text{GEMV}\)),所使用的高带宽内存为(\(\text{HBM}\)),耗时约为 \(20\text{ ms}\),并以 \(25\text{ to }50\text{ tokens/s}\) 的稳定速率输出词元。相比之下,智能体所指挥的软件产物依赖操作系统调度、网络传输的物理延迟以及输入/输出(\(\text{I/O}\))总线运行。对整个代码仓库进行一次静态检查需要 \(1.2\text{ seconds}\);通过 pytest 执行测试套件需要 \(180\text{ seconds}\);通过 cargo build --release 进行自动编译需要 \(400\text{ seconds}\);而外部 API 工作流或持续集成流水线则可能运行数小时。
当智能体架构以同步方式耦合这两个领域时,宿主监督程序通过阻塞系统调用(例如 POSIX waitpid(2) 或阻塞式套接字读取)调用工具,在等待子进程终止期间挂起监督程序线程。这种同步耦合会引发三种级联系统故障:
- 宿主工作线程饥饿: 在为多个并发智能体工作流提供服务的生产运行环境中,工作线程或异步事件循环都是有限的操作系统资源。等待外部 \(\text{I/O}\) 而被占用的宿主工作线程无法处理其他活跃的智能体轨迹,从而耗尽线程池并降低集群吞吐量。
- 控制通道中断: 被阻塞的宿主监督器无法处理异步带外控制信号。如果人工操作员提交取消命令、交互式套接字传来引导修正,或看门狗定时器标记了异常循环,监督器都无法采取行动,直到底层工具调用交还控制权。
- 推敲的机会成本: 被阻塞的轨迹无法并发执行彼此独立的任务。在耗时十分钟的容器编译执行期间,智能体本可以查阅静态文档、起草测试配置或验证独立的源文件。同步阻塞将独立的工作路径串行化,使任务完成所需的总体墙钟时间延迟成倍增加。
分层分离: 智能体运行时管理执行并发(宿主进程和作业句柄);推理引擎管理加速器内存(KV 缓存块和前缀表)。将这些系统解耦,可防止宿主阻塞扰乱推理调度。
关键在于,系统工程师必须避免将宿主线程挂起与加速器内存管理混为一谈。在早期的智能体实现中,开发者担心在长时间工具调用期间让出执行权会导致模型的 KV 缓存被逐出 GPU,因此让通往推理端点的活跃 HTTP 连接保持打开状态。正如 KV 缓存管理 中的内存层次结构原则所阐明的,现代推理引擎(如 vLLM 或 SGLang)内部的物理 KV 缓存分配严格受服务引擎的逐出策略、内存页框表和基数树前缀缓存机制控制。在应用层维持空闲连接,并不能在多租户内存压力下阻止 GPU 缓存逐出;它只会占用一个推理工作槽位。智能体执行运行时必须清晰地管理自身的进程生命周期,将工具分派视为异步交接,并允许推理服务器独立管理 token 缓存的驻留。
异步分派
为解决时间尺度不匹配的问题,同时避免破坏宿主监督器的稳定性,运行时采用由作业句柄托管机制管理的异步工具分派。当基础模型生成一个拟以异步方式执行的候选工具调用,或运行时的授权策略拦截一个被归类为无法即时完成的命令时,运行时会将该调用拆分为两个独立阶段:执行交接和观测结果解析。
图 10 详细展示了阻塞执行与解耦执行之间的结构性分岔,其中子图 (a) 在整个调用期间占用监督器线程,子图 (b) 则托管作业并立即让出控制权。在同步阻塞分派(图 10 a)中,当模型轨迹在第 \(t\) 轮生成一个长时间运行的命令(如 cargo build --release)时,宿主监督器会发起阻塞式操作系统调用(waitpid)。宿主工作线程在整个执行期间(\(T_{\text{exec}} \sim 400\text{ s}\))都处于挂起状态,导致宿主线程池耗尽(剩余空闲工作线程数为零),并使控制通道中断,从而丢弃带外取消信号或看门狗中断。相比之下,在异步作业托管分派(图 10 b)中,监督器在后台沙箱内创建子进程,构造不可伪造的托管句柄 \(H\),并在第 \(t\) 轮内立即返回执行回执。这使宿主工作线程能够将执行权交还线程池,保持控制通道活跃以支持交互式引导,并使模型轨迹能够继续开展独立的推敲任务,或休眠至事件驱动的完成通知将其唤醒。
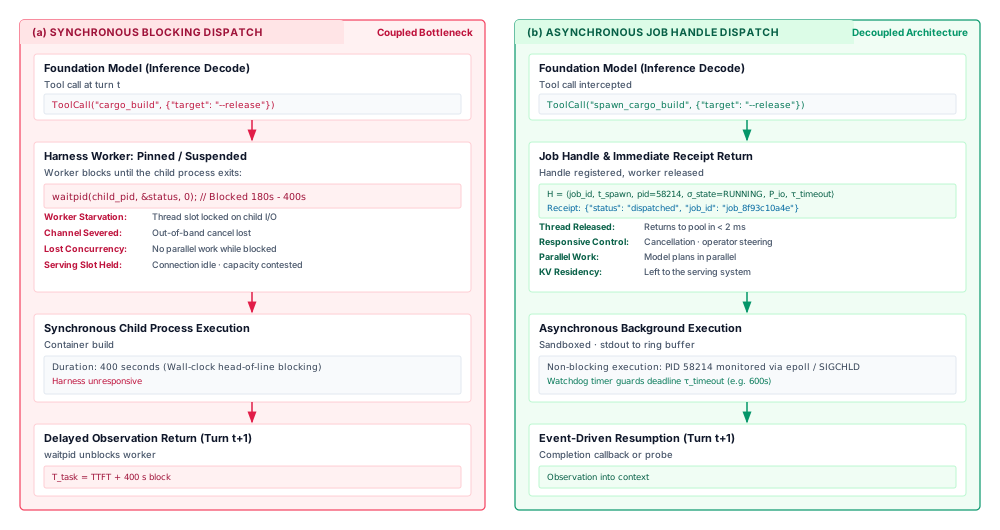
waitpid,\(T_{\text{exec}} \sim 400\text{ s}\))阻塞,导致工作线程池饥饿并中断交互式控制通道。在异步分派(右)中,监督器在后台沙箱内创建任务,记录托管元组 \(H\),并立即返回执行回执,让出工作线程并允许事件驱动的恢复执行。
运行时监督器并不等待进程完成,而是在隔离的沙箱内初始化执行上下文,创建子进程或派发远程工作节点任务,并为其分配一个不可伪造的作业句柄。形式上,运行时将这一状态以元组的形式记录在受管理的托管注册表中:
\[H = \langle \text{job\_id}, t_{\text{spawn}}, \text{pid}, \sigma_{\text{state}}, \mathcal{P}_{\text{io}}, \tau_{\text{timeout}} \rangle\]
其中,\(\text{job\_id} \in \{0, 1\}^{128}\) 是向模型公开的密码学唯一标识符,\(t_{\text{spawn}}\) 表示创建时间戳,\(\text{pid}\) 表示操作系统进程标识符(或容器任务标识符),\(\sigma_{\text{state}}\) 跟踪运行阶段,\(\mathcal{P}_{\text{io}}\) 封装用于捕获标准 I/O 流的底层环形缓冲区或文件描述符,\(\tau_{\text{timeout}}\) 则设定绝对执行截止时间。
运行生命周期 \(\sigma_{\text{state}}\) 按照严格规定的有限状态机进行状态转换:
\[\sigma_{\text{state}} \in \{\texttt{SPAWNED}, \texttt{RUNNING}, \texttt{STREAMING}, \texttt{SUSPENDED}, \texttt{COMPLETED}, \texttt{FAILED}, \texttt{KILLED}, \texttt{TIMED\_OUT}\}\]
将 \(H\) 登记到托管表后,运行时立即生成执行回执,并在当前推理轮次内将其返回给模型:
{
  "status": "dispatched",
  "job_id": "job_8f93c10a4e",
  "pid": 58214,
  "execution_mode": "background",
  "log_stream": "/var/log/agent/jobs/job_8f93c10a4e.log"
}
这份即时回执使模型的生成轮次得以干净利落地结束。收到回执后,模型便知道,请求的变更已提交至执行子系统,并正在带外执行。
能力句柄: 模型从不接收原始的操作系统 \(\text{pid}\)。仅暴露不透明的 \(\text{job\_id}\),可使模型始终不具备任何环境隐式权限,因此它无法向宿主机上的任意进程发送信号。
此时,智能体架构在运行层面获得了显著的灵活性。模型可以选择并发执行本地任务(例如配置辅助脚本、解析静态代码库),也可以向宿主监督器发出信号,表明自己当前无需进一步推演,并希望挂起执行。如果轨迹被挂起,宿主监督器会将其活跃工作线程释放回运行时线程池。推理服务集群可以根据全局最近最少使用(\(\text{LRU}\))策略或优先级调度策略,驱逐该轨迹不活跃的 KV 缓存块,因为集群知道,后台作业完成后,可通过前缀匹配加载该轨迹的上下文历史,从而恢复轨迹。
事件驱动的恢复
一旦任务在后台异步执行,运行时就需要一种架构机制来确定执行何时完成,以及如何恢复智能体的推演循环。系统设计者经常面临四种相互竞争的恢复架构范式;每种范式在延迟、计算资源利用率和 token 开销方面都有不同的权衡,比较见 表 6。
| 恢复架构 | 状态检测机制 | 延迟余量(\(\Delta t\)) | 模型 token 开销 | 宿主 CPU 利用率 | 系统边界与规模 |
|---|---|---|---|---|---|
| 模型驱动的忙轮询 | 自回归工具调用(check_job) |
\(\sim \text{Polling Interval}\)(\(1\text{--}30\text{ s}\)) | 极高(\(O(N \cdot S_{\text{ctx}})\) 个 token) | 可忽略不计 | 本地客户端原型开发;对生产环境危害极大 |
| 运行时定时器轮询 | 宿主线程周期性执行 waitpid / sleep |
\(\frac{1}{2} \times \text{Sleep Interval}\) | 休眠期间为零 | 低至中等(定时器中断) | 单节点智能体运行时;简单后台任务 |
| 内核事件循环 | 使用 epoll / kqueue 监听 pidfd 或管道 EOF |
极低(\(< 1\text{ ms}\)) | 执行期间为零 | 极低(中断驱动的响应式休眠) | 高性能宿主容器监督 |
| 异步 Webhook / 总线 | HTTP POST 回调或 AMQP/Kafka 事件 | 网络传输(\(\sim 5\text{--}50\text{ ms}\)) | 执行期间为零 | 极低(异步消息监听器) | 分布式多智能体系统与云沙箱集群 |
第一种范式,即模型驱动的忙轮询,是一种反模式:开发者暴露轮询工具(如 get_job_status(job_id)),并提示基础模型反复检查,直至任务完成,就会出现这种模式。在这一模式下,每一次状态检查都会触发一个完整的自回归推理轮次。服务引擎必须在预填充阶段处理全部累积的轨迹历史(\(S_{\text{ctx}}\) 个 token),而模型必须解码数十个 token,才能生成轮询工具调用并确认任务仍处于待完成状态。对于长时间运行的任务,这会消耗数百万个 token,仅仅为了查询一个未发生变化的布尔状态。
粗略估算 0.8: 轮询与事件驱动恢复
轮询。 该作业期间共进行 60 次轮询。这些轮询解码 4,200 个词元,用于状态检查的生成时间约为 89 s。每次轮询都重新读取不断增长的上下文,每次约读取 1,865 个未缓存输入词元,总计 111,924,另有 2,069,556 个缓存词元按折扣费率计费。总成本为 $1.02。
事件驱动。 作业退出时,运行时收到通知,并以包含 200 个词元的结果发起一次模型调用,计费量包括 1,838 个未缓存输入词元以及一次对上下文的缓存读取,成本为 $0.0149。
要点:轮询成本是事件驱动恢复的 68.6×,这对应于一个 300 s 的作业,且差距随作业时长和上下文规模的增加而扩大。轮询还会在历史记录中留下 60 次状态交互,供后续每次调用重新读取,这项成本未计入单个作业的成本数字。
为实现稳健的效率,生产环境运行时采用事件驱动恢复。在现代 POSIX 系统上,运行时监督器不会在线程循环中休眠等待,而是将子进程句柄注册到事件多路分离器中,例如 Linux 的 epoll(7) 或 BSD/macOS 的 kqueue(2)。在现代 Linux 内核上,监督器在启动工具时通过 pidfd_open(2) 获取进程文件描述符:
\[\text{pfd} = \text{pidfd\_open}(\text{pid}, 0)\]
该文件描述符注册到 epoll,监听 EPOLLIN。子进程状态改变或退出的瞬间,内核便会通知运行时反应器,从而完全绕过周期性时钟中断和信号处理程序的竞态。当反应器检测到进程退出时,会将 \(\sigma_{\text{state}}\) 转换为 \(\texttt{COMPLETED}\) 或 \(\texttt{FAILED}\),捕获最终的整数退出码,从磁盘缓冲区 \(\mathcal{P}_{\text{io}}\) 中提取经过净化的观测载荷,并将一个合成的恢复事件放入智能体监督器的优先级输入队列。随后,监督器将结构化工具观测格式化,将其追加到轨迹历史记录中,并调度模型的下一轮推理。
在分布式云沙箱环境中,工具在远程 microVM(例如 AWS Firecracker)或分离运行的 Kubernetes Pod 内执行,内核事件模型可推广为异步 webhook 或持久事件流。远程执行器运行一个初始化守护进程,持续跟踪输出流并将其写入对象存储。任务终止时,该守护进程发送经过身份认证的 HTTP POST webhook,或向智能体消息总线发布一条包含作业句柄、退出状态和日志 URI 的 AMQP 消息,从而跨越网络边界触发轨迹恢复,无须持续保持同步 HTTP 传输连接。
后台进程治理
将工具执行与推理解耦,会把大量运维责任转移到运行时的进程治理子系统。不能放任长时间运行的后台任务不受约束地执行。智能体运行时必须在整个后台生命周期中主动维护三项运行不变量:不造成上下文饱和的遥测检查、经由中介的双向交互,以及彻底的进程组清理。
不造成上下文饱和的遥测检查
当任务异步执行时,模型或人工监督者可能需要获取进度更新,而不必等到任务最终完成。将持续活跃且数据量很大的终端流直接灌入上下文窗口,会违反 节 5 中确立的有界观测不变量。因此,运行时的后台管理器会持续读取进程输出描述符,并将输出写入本地磁盘上的私有循环缓冲区。
运行时向智能体提供一个只读、非阻塞的遥测工具:
\[\text{inspect\_job}(\text{job\_id}, \text{tail\_lines}=50)\]
调用时,inspect_job 不会直接查询子进程,而是从磁盘环形缓冲区读取最后 \(N\) 行,将这一片段送入 ANSI 净化流水线(节 6),为这些行附上结构化元数据头部,其中记录已消耗的 CPU 时间、常驻集大小(\(\text{RSS}\))和当前线程数,然后返回有界快照。模型由此可以安全地检查执行速度,在保留上下文预算的同时确认任务未陷入死锁。
经由中介的双向交互
某些命令行实用程序会暂停执行,通过标准输入(stdin)请求交互式输入,例如数据库迁移过程中提示 Apply changes [y/N]?,或交互式脚本等待确认参数。在同步架构中,这会导致永久死锁:进程阻塞等待输入,而监督器阻塞等待进程退出。
异步运行时通过 /proc/[pid]/stat 或伪终端(\(\text{pty}\))主端描述符监控子进程状态转换,从而解决这一僵局。当进程进入等待终端输入的可中断睡眠状态时,运行时会标记 \(\sigma_{\text{state}} \leftarrow \texttt{SUSPENDED}\),并向监督器发出请求输入的事件。模型随后发起专用的中介工具调用:
\[\text{send\_input}(\text{job\_id}, \text{data}=\text{"yes}\backslash\text{n"})\]
运行时验证 \(\text{job\_id}\) 处于可接收输入的活动状态,检查 data 是否符合字符白名单要求(剔除原始控制字符,如 \x03,或终端转义序列),将字节载荷直接写入进程的标准输入管道,并刷新缓冲区。
进程组取消
后台治理子系统最关键的职责,是防止孤儿子进程造成资源泄漏。当智能体判定某条执行轨迹已失败、用户发出中止命令,或作业超过按实际经过时间设定的硬性截止期限(\(\tau_{\text{timeout}}\))时,运行时必须保证所有相关进程完整、确定地终止。
在实际工具执行中,标准 POSIX kill(pid, SIGTERM) 系统调用从根本上说并不足够。命令行工具经常通过中间 shell 包装程序执行:
bash -c "make -j8 && pytest"如果监督进程发送 SIGTERM 时仅以父 shell 进程(\(\text{pid}\))为目标,shell 可能立即终止,而它所创建的子进程(make、子编译器或 pytest 运行器)则会被重新归属于系统 init 进程(PID 1)。这些孤儿进程会在后台无限期地继续执行,占用可用 CPU 核心的 100%,锁定构建目录,并耗尽文件描述符。
为确保进程终止的原子性,运行时必须在创建每个后台作业时,将其置于独立的进程组中,具体做法是在子进程内先使用 setpgid(0, 0),再调用 execve(2)。当清理流程启动时,监督进程通过以负的进程组标识符(\(-\text{pgid}\))为目标,向整个进程组发送信号。
SIGKILL escalation to eliminate orphan process leaks.
def terminate_job_group(pgid: int, grace_period_sec: float = 3.0) -> None:
    """Escalate termination across process group to eliminate orphan leaks."""
    os.killpg(pgid, signal.SIGTERM)
    deadline = time.monotonic() + grace_period_sec
    while time.monotonic() < deadline:
        pid, status = os.waitpid(-pgid, os.WNOHANG)
        if pid == 0 or (pid == -1 and errno.errorcode.get(errno.errno) == "ECHILD"):
            return  # Process group clean exit confirmed
        time.sleep(0.05)
    os.killpg(pgid, signal.SIGKILL)
    os.waitpid(-pgid, 0)
按照 代码 4 中的实现,监督器遵循严格的两阶段升级协议:
- 优雅终止(
SIGTERM): 运行时发送SIGTERM至整个进程组(\(-\text{pgid}\)),允许正在运行的进程刷新缓冲日志、释放文件锁,并执行语言层面的退出处理程序。 - 带超时的非阻塞回收: 监督器通过非阻塞
waitpid(-pgid, WNOHANG)监控进程组,监控持续一个有界的宽限时间窗口(通常为 \(3.0\text{ seconds}\))。 - 无条件清除(
SIGKILL): 如果宽限期结束时组内仍有任何进程处于活动状态,监督器就会升级为发送SIGKILL至整个 \(-\text{pgid}\)。由于SIGKILL无法被用户空间软件捕获、阻塞或忽略,操作系统内核会立即回收所有内存页框、关闭打开的文件描述符,并将进程树从内核运行队列中清除。
通过结合受能力机制保护的作业句柄、中断驱动的事件循环以及严格的进程组生命周期管理,智能体运行时构建了一个鲁棒的、高度并发的执行基础。外部命令可以在单次推理轮次结束后继续运行,而不会威胁宿主机的稳定性、浪费模型的 token 预算,或在计算环境中遗留孤立的执行产物。
然而,在设计好工具执行的各项机制之后——从类型化接口、发现协议和幂等租约,到流截断、终端净化和异步分派——系统架构师面临一个全局性的设计难题:应当如何在工具目录内部划分功能? 应当为智能体配备一个不受约束、能够生成任意程序的通用命令 shell,还是应当将其能力边界划分为数十个高度专用、细粒度的微型工具?接下来,我们将讨论工具集粒度划分在系统层面的权衡。
工具集粒度划分
注入智能体执行提示词的每一个工具模式,都会对推理引擎的物理内存施加持续的结构性开销,并在其自回归解码循环中施加注意力开销。面对动作执行边界,系统架构师必须在目录深度与目录广度之间作出根本性的设计权衡:智能体运行时应当暴露一小组表达能力强、用途开放的执行原语,例如不受约束的 POSIX shell 或解释型脚本运行器,还是应当将其能力空间划分为数十乃至数百个由严格 JSON 模式约束的细粒度微型工具?不受约束的 shell 提供最大的功能灵活性,并将多步骤工作流压缩为一次分派,但它也将权限边界扩展至整个操作系统,因此需要全面的沙箱隔离。反之,庞大的专用微型工具目录将每次调用限制为经过严格审计的状态变更,却会使模式定义充斥模型的上下文窗口,降低类别选择的准确率,并迫使复杂任务通过高延迟、多轮次的交互级联完成。
工具粒度需要在选择歧义、模式开销与表达能力、安全性、任务适配性之间进行权衡;最优目录规模必须结合工作负载的动态特征和模型能力,通过实证评估确定,而不能从教条化的架构极端推导得出。
目录基数的影响
当智能体运行时暴露工具目录 \(T = \{t_1, t_2, \dots, t_N\}\) 时,每个工具完整的语法与语义定义都必须序列化到模型的系统提示词前缀中。对于每个工具 \(t_i\),其模式包括标识符 \(n_i\)、文字描述 \(d_i\)(详细说明其功能不变量),以及声明类型化参数、枚举值和边界约束的正式 JSON Schema。总静态上下文占用量 \(S_{\text{schema}}\) 是所有工具定义经 token 化后所占用量的总和:
\[S_{\text{schema}} = \sum_{i=1}^{N} \big( |n_i| + |d_i| + |\text{Schema}(t_i)| \big)\]
这些 token 开销会在硬件层面立即产生物理成本。在采用 PagedAttention 或连续键值(KV)缓存的服务架构中,\(S_{\text{schema}}\) 中的每个 token 都必须在初始预填充阶段通过密集通用矩阵乘法(GEMM)内核进行处理。关键在于,生成的键张量和值张量必须在智能体轨迹的整个生命周期内始终驻留在高带宽内存(HBM)中,贯穿后续每一步自回归解码(GEMV)。
随着目录基数 \(N\) 增大,静态模式前缀 \(S_{\text{schema}}\) 会挤占工作上下文,从而在固定的物理上下文窗口内,减少可用于迭代式环境观测和检索所得长文档的空间。
除了物理内存消耗之外,扩大工具目录的基数 \(N\) 还会在模型推理过程中引入严重的选择分散。当智能体决定采取行动时,模型会从其词元类别分布中采样,生成结构化调用帧。分配给目标工具标识符的概率质量必须克服前缀中所有其他工具造成的语义干扰。如果目录中包含多个词汇描述重叠或功能角色相近的工具,候选工具名称的概率分布就会呈现较高的香农熵:
\[H(P_{\text{tool}}) = -\sum_{i=1}^{N} P(t_i \mid \mathcal{C}) \log_2 P(t_i \mid \mathcal{C})\]
工具路由分布中的高熵在实际观测中表现为工具选择错误 \(\epsilon_{\text{select}}\):模型会幻觉出不存在的工具名称,通过混合不同工具的签名编造虚假参数,或选择无法满足任务要求的次优端点。虽然规模更大的前沿级稠密模型具备足够的表征能力,能够比小型量化模型更好地区分更大目录中的工具,但性能并不会无限提升。超过依赖于工作负载的饱和阈值后,扩大目录会降低任务完成率:相互竞争的模式描述使模型不堪重负,同时预填充阶段的延迟随 \(S_{\text{schema}}\) 成比例增加。
粗略估算 0.9: 量化不同工具目录带来的 KV 缓存内存占用与吞吐量开销
跨所有层存储单个词元的 KV 缓存所需的内存为: \[\text{Memory}_{\text{token}} = 2 \times (\text{bytes per element}) \times L \times n_{\text{kv}} \times d_{\text{head}}\] \[\text{Memory}_{\text{token}} = 2 \times 2 \times 80 \times 8 \times 128 = 327{,}680\text{ bytes} \approx 320\text{ KB/token}\]
现在比较两种备选工具架构,它们承载的并发负载均为 \(B = 32\) 个活跃智能体会话:
- 粗粒度目录: 4 个表达能力强的深层原语(文件编辑器、bash 执行器、语义搜索、终端监视器)。序列化模式的开销为 \(S_{\text{schema}} = 450\text{ tokens}\)。
- 细粒度目录: 75 个微型工具(针对单个 POSIX 命令、字符串实用程序和 git 子命令的专用封装)。序列化模式的开销为 \(S_{\text{schema}} = 6{,}400\text{ tokens}\)。
对于粗粒度目录,整个批次仅为在 HBM 中保存工具定义而消耗的基线内存为: \[\text{Memory}_{\text{coarse}} = 32 \times 450 \times 320\text{ KB} \approx 4.61\text{ GB}\]
对于细粒度目录,基线内存占用扩大为: \[\text{Memory}_{\text{fine}} = 32 \times 6{,}400 \times 320\text{ KB} \approx 65.54\text{ GB}\]
在细粒度配置中,尚未加载任何用户查询、文件上下文或编译器跟踪记录,工具定义就已持续占用超过 \(65\text{ GB}\) 的高速加速器内存。在内存容量为 80 GB 的加速器上,这种结构性内存开销会压缩动态批处理可用的内存预算,迫使服务运行时降低并发阈值、增加向主机 RAM 的内存换页,或收紧上下文长度限制。
正交工具抽象
为了在保留必要能力的同时防止目录膨胀,系统设计者采用经典的模块化原则:高内聚、松耦合以及正交的接口边界。在《软件设计的哲学》(2018)中,John Ousterhout 将深接口定义为通过简单、紧凑的契约提供强大功能的接口,而浅接口则引入大量接口复杂性,却只提供相对有限的底层能力。
将这一原则应用于智能体的动作执行时,深层工具通过简洁的模式封装多步骤操作的复杂性,而浅层工具则将原始的中间操作系统调用直接暴露给模型。以文件操作为例,浅层设计为 open_file、seek_cursor、read_line、write_bytes 和 close_file 分别暴露独立的 RPC 端点。这种方法使基础模型变成一个慢得令人难以忍受且非确定性的 I/O 多路复用器:修改单个源代码文件需要数十个自回归解码周期,其中任何中间词元错误都会破坏目标文件。相比之下,深层文件编辑工具接受目标文件路径、锚定字符串和替换字符串块。运行时宿主负责打开文件、验证文件是否存在、定位精确的替换边界、执行原子写入,并返回结构化的统一差异格式结果。
这种接口划分对系统的影响如 图 11 所示,其中子图 (a) 的细粒度浅层接口与子图 (b) 的高内聚远程过程调用形成对比。在浅层多轮接口(图 11 a)中,无特权模型必须跨四个独立的自回归轮次(\(t\) 至 \(t+3\))编排低层操作系统原语,并在生成周期之间跟踪临时操作系统文件描述符(fd: 3)。这种架构在单次文件编辑中重现了 时间跨度拉伸:从纳秒指令到千秒级轨迹 的复合衰减。如果每一步都以概率 \(1 - \epsilon_i\) 独立成功,则完成文件修改的总成功概率降至 \(P(\text{success}) = \prod_{i=1}^M (1 - \epsilon_i)\)。中间轮次中的任何失败都会导致目标文件描述符未关闭,或目标文件仅被部分覆写,从而造成磁盘上的状态损坏,同时使 \(M \times \text{tokens}\) 在推理引擎的物理 KV 缓存中反复周转。
相比之下,深层高内聚接口(图 11 b)暴露一个原子 RPC 端点(apply_patch)。基础模型在单个推理轮次(\(t\))中生成其操作意图。宿主运行时监督器在编译后的宿主代码中原生处理四个实际执行步骤:验证路径、定位锚点字符串、在内存中执行原子替换,以及生成统一差异。这种架构消除了多轮交互造成的 KV 缓存膨胀,使模型与临时操作系统状态隔离,并保证原子执行:要么整个补丁成功应用,要么事务中止,且持久存储完全不发生修改。
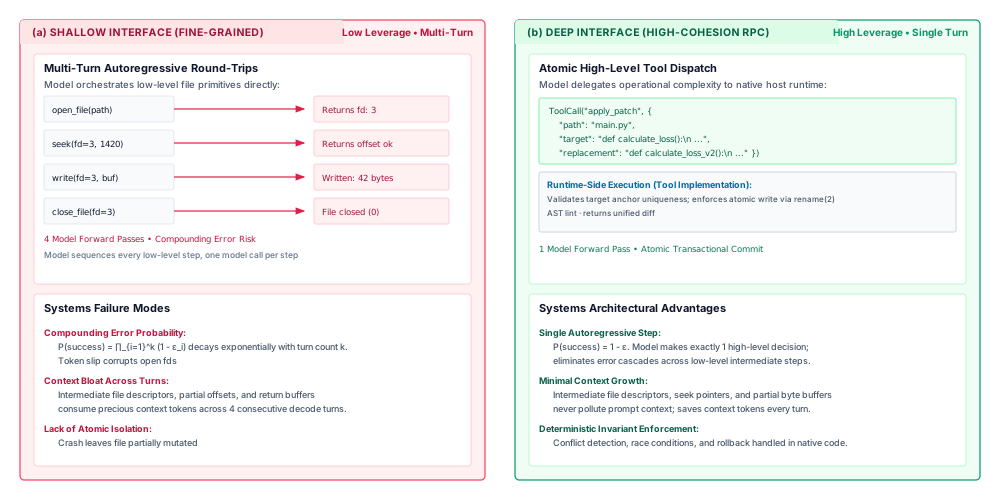
open、seek、write、close)编排低层操作系统原语,从而暴露中间内核状态,使失败概率 \(P(\text{success}) = \prod (1 - \epsilon_i)\) 逐步累积,并引发 KV 缓存反复周转。在深层接口(右)中,模型发出单个高内聚原子 RPC(apply_patch),将验证和文件 I/O 委托给原生宿主代码,并保证全有或全无的事务安全。
正交性要求工具目录中的每个工具都负责一个独立且互不重叠的操作领域。当为智能体配置功能重叠的工具时,例如同时提供 bash、python_repl、read_file 和 run_grep_search,这些工具会争相响应完全相同的语义意图。如果用户要求统计日志目录中匹配的错误模式数量,模型的内部表示会在多条有效执行路径上激活:
- 调用
bash,并使用grep -c "ERROR" /var/log/*.log。 - 调用
python_repl,并使用遍历pathlib.Path的开放式脚本。 - 对每个日志文件迭代调用
read_file,随后在上下文中计数。 - 调用
run_grep_search,并使用结构化正则表达式载荷。
这种功能冗余使注意力分布分散到多个候选头上,造成原本可以避免的路由错误和不一致的轨迹模式。正交的系统设计通过建立严格的操作边界来消除这种歧义:如果配置了开放式 shell 工具,就省去专用的读取和搜索微工具;反之,如果提供了细粒度文件和搜索工具,就完全移除原始 shell 执行能力。每个工具都必须具有隔离且定义明确的故障域,使执行错误发生时,故障诊断能够限定在单个可预测的子系统内。这些方法之间的权衡总结于 粗粒度与细粒度工具目录。
| 架构维度 | 粗粒度工具目录 | 细粒度工具目录 |
|---|---|---|
| 代表性原语 | bash_exec、apply_patch、fetch_web_page |
git_status、git_diff、read_line、append_file |
| 模式占用量(\(S_{\text{schema}}\)) | 极小(\(< 600\text{ tokens}\)) | 庞大(\(3{,}000 - 10{,}000+\text{ tokens}\)) |
| 静态 KV 缓存分配 | 可忽略(占 HBM 总量的 \(\sim 1\text{--}5\%\)) | 严重(占 HBM 总量的 \(\sim 20\text{--}40\%\)) |
| 工具选择歧义 | 极小(原语相互正交) | 高(语义吸引域重叠) |
| 权限(\(A\)) | 广泛(需要内核级沙箱) | 受限(由静态模式强制约束) |
| 完成任务的轮次延迟 | 低(单轮完成复杂操作) | 高(多轮迭代调用) |
| 审计与治理 | 不透明(需要检查命令) | 透明(显式带类型的 RPC 载荷) |
表达能力—安全性谱系
工具集粒度的选择决定了智能体在表达能力—安全性谱系上的位置。表达能力的极端一端是通用执行原语。POSIX shell 工具具有近乎无限的表达能力:它可以检查进程、编译二进制程序、操作文件系统、编排网络请求,并通过管道动态地将输出传递给任意数据转换过滤器。然而,这种灵活性破坏了最小权限原则。由于 shell 是通向底层内核的开放通道,运行时无法仅根据工具签名预测命令的副作用。安全边界无法在模式验证层强制实施,而必须依靠模型下方的隔离机制(原则 10),该机制由虚拟机监控器、命名空间和系统调用过滤器(智能体沙箱)构建。
谱系的另一端是受约束的结构化工具,例如能够识别 AST 的符号重命名工具(ast_rename_variable)。这类工具在安全性方面提供数学上的确定性:它无法删除数据库表、启动持久运行的网络监听器,也无法泄露环境变量。运行时在分派请求之前,依据严格的 JSON 模式静态验证所有参数。然而,这种安全性的代价是领域覆盖能力脆弱。如果模型遇到宿主解析器不支持其 AST 的语言,或者重构任务要求同时修改文档注释,结构化工具就会彻底失效,使智能体循环停滞。
为了在不牺牲架构鲁棒性的前提下弥合这一鸿沟,运行时工程师采用防御式参数设计。工具的设计必须确保模型的无意错误或不完整的 token 序列能够安全地失败。防御式参数设计依赖三项核心技术:
- 默认安全语义: 控制修改幅度的参数必须默认执行非破坏性操作。例如,文件写入工具必须要求显式提供布尔参数
overwrite: true,才能截断现有文件;如果未提供该参数,宿主运行时应使执行失败,或默认采用非破坏性的追加操作。 - 试运行模拟标志: 修改状态的工具应暴露显式的
dry_run: true参数。启用该参数时,工具执行验证、授权和规划逻辑,返回实际执行时将会产生的精确差异或状态转换,但不对底层系统施加副作用。这使模型能够在提交更改之前检查自己提出的更改。 - 原子批处理不变量: 修改外部状态的工具应接受由同类修改组成的数组,并在单个宿主端事务中提交这些修改。如果其中任何一项修改未通过验证,整个批次都将回滚,防止智能体使宿主环境陷入不确定且仅被部分修改的状态。
# Empirical example: Defensive parameter schema validation in a deep editing tool
def execute_file_patch(target: str, find_str: str, replace_str: str, dry_run: bool = True) -> str:
    path = validate_sandboxed_path(target)
    content = path.read_text(encoding="utf-8")
    if content.count(find_str) != 1:
        raise ValueError(f"Target pattern found {content.count(find_str)} times; must match exactly once.")
    new_content = content.replace(find_str, replace_str, 1)
    diff = generate_unified_diff(content, new_content, str(path))
    if not dry_run:
        path.write_text(new_content, encoding="utf-8")
    return f"Status: {'SIMULATED' if dry_run else 'APPLIED'}\n{diff}"
上述防御性实现展示了宿主运行时如何吸收运行风险。宿主工具不要求智能体手动核验文件偏移量,而是强制要求目标锚点字符串 find_str 恰好匹配一次。如果模型提供的锚点存在歧义,匹配了多个位置,工具就会立即停止,保留原始文件并返回包含有效错误信息的帧。此外,将默认值设为 dry_run = True,会迫使模型在实施永久性状态变更之前主动确认其意图,从而使物理环境免受非确定性 token 输出的影响。
至此,我们已确立工具子系统设计的结构机制,涵盖类型化接口、发现协议、幂等状态租约、观测流净化、异步事件循环以及工具目录粒度划分,并构建了将候选 token 与外部执行动作衔接起来的完整架构基础。然而,将这些理论基础转化为可靠的生产部署,会使工程师面临微妙的失效模式:软件假设与基础模型推理的现实发生冲突。接下来,我们将讨论构建工具执行运行时时常见的谬误与陷阱。
谬误与陷阱
架构抽象往往掩盖了物理运行约束。在工具执行系统中,运行时架构师经常受制于从传统确定性 RPC 流水线或简单、无约束的提示环境中借用的直觉假设。当非确定性 token 解码器与有状态的操作系统环境和分布式网络交互时,标准的软件工程经验法则便会失效。要避免这些失效模式,就必须认识到上下文内存的物理边界、自回归采样的非确定性,以及由运行时强制维持不变量的严格必要性。
谬误: 在上下文中提供更多工具,总能增强智能体的能力。
智能体设计中的一种常见直觉是,扩充模型的工具目录会单调地增强其解决问题的灵活性。如果智能体针对每一种可以想象到的文件转换、数据库查询和网络操作都拥有专门的工具,那么理论上,它应该能够解决分布范围更广的任务。
在物理执行层面,注入系统提示的每个工具模式都会给上下文窗口带来静态 token 开销 \(S_{\text{schema}}\)。对于包含 \(N\) 个工具的目录,如果每个工具定义中的 JSON Schema 规范、参数类型和文档字符串平均占用 \(d_i\) 个 token,则静态前缀的占用量呈线性增长:
\[S_{\text{catalog}} = \sum_{i=1}^{N} d_i\]
在采用 PagedAttention 的现代模型服务引擎中,这些静态模式 token 会占用物理键值(KV)缓存内存块;在自回归解码循环的每一轮中,这些内存块都必须常驻高带宽内存(HBM)。庞大的目录会直接压缩可供动态对话历史和工作暂存区使用的内存余量,降低服务的批处理吞吐量,并增加预填充阶段的首 token 延迟(TTFT)。
更关键的是,扩充目录会使模型的路由选择在统计层面严重退化。随着基数 \(N\) 增长,工具描述之间的语义重叠不可避免地增加。模型在候选工具选择 token 上的类别概率分布趋于平坦,导致工具选择错误率 \(\epsilon_{\text{select}}\) 急剧上升。在实证评估中,面对五十个细粒度工具的智能体经常会幻觉出并不存在的混合参数,将文件修改操作路由到参数标志不兼容的专用脚本,或因干扰性模式而陷入无法作出选择的状态。可靠的运行时追求的是工具效用的最大化,而非目录规模的最大化:它们提供一组精简、正交的粗粒度原语,例如沙箱化的 POSIX shell 或通用 Python 解释器;或者采用动态发现协议,仅在明确意图要求使用专用模式时,才将其调入上下文。
陷阱: 在没有幂等键的情况下,重试失败的非幂等工具调用。
当工具调用未能在配置的网络截止时间 \(\tau_{\text{timeout}}\) 内返回时,运行时监督器或自主智能体循环便会面临结果不明确的分布式系统情形。简单的监督器会将未获确认的 HTTP 请求、断开的套接字连接或子智能体崩溃视为运行失败,并立即重放完全相同的工具调用。
在任何分布式架构中,网络分区都会使传输与执行脱钩。没有返回帧,并不能证明没有产生副作用。如果工具调用执行了未隔离的变更操作,例如通过支付网关扣款、配置云虚拟机、执行外部数据库事务,或向共享账本追加记录,那么该请求可能在网络中断返回数据包传输之前,已经在目标宿主上成功完成。
重放原始请求会将短暂的网络分区转化为永久性的状态损坏:
\[S_{\text{env}}(t_1) \neq S_{\text{env}}(t_0) + \Delta_{\text{action}}\]
外部系统会执行两次变更操作,导致重复扣费、孤立的基础设施或数据库不变量遭到破坏。更危险的是,在智能体循环中运行的无特权模型往往会观察到超时错误帧,并自发生成参数有所变更的替代重试方案,从而使简单的服务端签名去重机制失效。
为规避这一陷阱,运行时监督器会在重试之前确认每次变更操作派发的最终结果(原则 9)。每次变更型工具调用都必须绑定一个由监督器生成、通过密码学方法派生的唯一幂等键 \(K_{\text{idem}}\),并与轨迹中的特定逻辑步骤关联。下游服务必须在原子提交日志或事务性缓存中登记 \(K_{\text{idem}}\)。如果发生超时,此后任何携带相同键的派发都将返回原始缓存结果,而不会重新执行底层状态转换。对于无法通过令牌实现幂等性的操作,必须使用显式事务租约或两阶段状态协调机制加以保护。
谬误: 仅凭模型生成的内容或 stdout 文本推断工具执行成功。
由于基础模型经过训练,能够生成人类可读的叙述,工程师经常依赖模型自行报告的总结,或标准输出中出现的乐观子串(如 "Success"、"Build complete" 或 "200 OK"),来判断工具执行是否成功。
这种方法采信自我报告,而它是最弱的闭环证据等级,不具备任何证明力(闭合证据等级)。除了传递给模型的 token,模型无法访问环境;在故障表现看似合理的故障模型(Fail-Plausible 故障模型)下,模型经常将静默失败、未处理的异常或含义不明的堆栈跟踪合理化为成功,而底层操作系统状态实际上并未改变。
此外,命令行工具和第三方二进制程序的标准输出流完全没有统一规范。许多编译器、构建系统和 CLI 脚本会将致命错误诊断信息写入 stdout 而非 stderr,或者先输出包含字符串 "Success" 的信息性状态横幅,随后因未处理的段错误而终止。
运行时监督器绝不能将不变量验证交由语言解析完成。工具执行成功必须以权威、不可伪造的物理原语为依据:
- 精确的操作系统退出状态码(\(WEXITSTATUS = 0\))。
- 显式检查文件系统和内核状态(例如,验证 inode 时间戳是否更新、文件的密码学校验和是否符合预期,或字节长度是否非零)。
- 在隔离环境中执行的确定性外部测试套件。
语言模型提出候选操作;只有确定性的软件验证才能证明系统的不变量成立。
陷阱: 将未经截断的工具输出直接倾倒进上下文窗口。
当智能体执行操作系统命令时,例如在大型单体仓库中调用编译器、运行未使用索引的数据库查询、执行 git log,或转储网络诊断数据包,进程的标准输出缓冲区可能在几毫秒内输出数十兆字节的原始文本。简单的运行时会捕获这一输出流,并将其直接传入下一轮对话的观察帧。
注入未经截断的文本相当于立即对智能体的存储层次结构发动拒绝服务攻击。一个不受约束的进程输出 \(10^6\) 个字符,就会生成数十万个 token,瞬间突破上下文窗口边界 \(S_{\max}\)。
在加速器存储子系统中,为数百万个未经压缩、信息量低的字符分配物理 KV 缓存页,会导致 GPU HBM 碎片化。在 PagedAttention 机制下,这种快速分配会触发对并发服务请求的紧急抢占,迫使系统执行代价高昂的页面换出操作,将页面移至主机系统 RAM,或者导致服务引擎因内存不足(OOM)而直接中止。
即使模型架构支持足以容纳该缓冲区内容的扩展上下文窗口,稠密注意力预填充的二次计算复杂度,以及自回归解码步骤的线性内存带宽开销(每生成一个 token 为 \(O(N)\)),仍会大幅增加延迟。输出的绝大多数 token 都是重复的构建进度条或冗余日志行。这股信息洪流会稀释模型的注意力权重,使可指导后续操作的诊断信息——指出语法错误或缺失符号的那一行——实际上被埋没在数千个无关 token 之下。
运行时必须使用非阻塞 I/O 和有界环形缓冲区,直接在内核管道层强制执行严格的物理观测预算(\(B_{\max}\))。运行时监督器必须在分词之前应用结构化截断策略:保留固定长度的输出前缀(\(B_{\text{head}}\))以捕获调用参数,通过内容感知过滤丢弃中间的重复输出,并保留有界的输出尾部(\(B_{\text{tail}}\)),其中包含终止退出诊断、断言错误和堆栈跟踪。超过物理上下文阈值的输出必须卸载到内容寻址的持久存储中,仅向模型上下文返回摘要帧、字节偏移量和可检索的句柄。
掌握工具执行的物理边界——保护上下文内存免受无界观测流的冲击,在网络分区期间强制保障密码学意义上的幂等性,依赖具有权威性的内核原语而非模型的叙述性文本,以及精心编排紧凑且表达力强的工具目录——能够将无特权的语言模型生成转化为可靠的系统操作。在考察了威胁生产执行环境的具体故障模式之后,我们现在归纳支配工具子系统的核心架构原则,随后转向用于隔离这些操作的沙箱运行时环境。
总结
自回归神经网络生成的候选 token 序列,只有在具有权威性的运行时监督器截获、验证并将提议跨越显式保护边界进行分发之后,才会转化为受控的外部效果。无特权的推理引擎生成词表上的统计预测;它不具备任何环境隐式权限,也无法直接访问系统调用、网络套接字或持久存储。弥合这一认知鸿沟,需要将工具视为受严格系统契约约束的强类型远程过程调用端点,而非自然语言建议或松散的对话扩展。通过对操作执行的每个阶段进行中介控制(验证参数模式,通过标准化发现协议协商能力,附加唯一的幂等性租约以应对网络分区,以及在无界观测流耗尽加速器内存之前对其进行限流),宿主运行时将非确定性的模型生成转化为可验证、具备容错能力的状态转换。
要点回顾: 模式是契约,而非对话建议
- 工具是外部执行端点,其接口契约必须采用严格的类型约束。 语言模型从不直接修改物理状态;它依据暴露的模式输出符号化参数。严格的参数验证、显式的结构化类型约束和有界枚举可最大限度地减少认知歧义,裁剪无效动作空间,并确保格式错误的候选提议在跨越执行边界之前以拒绝执行的方式安全失败。
- 模型上下文协议将异构服务之间的发现与连接标准化。 通过将工具定义和数据资源与单体宿主架构解耦,客户端—服务器发现协议为查询能力、管理进程外传输以及隔离外部环境建立了统一的线上通信标准,同时将最终授权和策略执行保留在宿主运行时的自主控制之下。
- 所有修改状态的动作都必须使用幂等键和事务租约。 网络超时、进程崩溃和短暂断连不可避免地会使分布式执行处于不确定状态。运行时监督器必须附加确定性的幂等键(\(K_{\text{idem}}\)),并强制执行事务状态核对,以保证自动重试不会导致重复修改、幽灵状态损坏或灾难性的资源泄漏。
- 无界观测流在暂存到上下文之前,需要进行无界面环形缓冲和分页。 可执行工具会输出任意体量的诊断数据,这些数据很容易耗尽模型上下文和加速器高带宽内存的有限物理容量。运行时必须施加内核级背压,将输出流切分为固定头部和有界尾部帧,并将体量庞大的载荷溢写到内容寻址的辅助存储中。
- 异步分发将宿主工作线程的占用与服务引擎的状态保留解耦。 由于外部工具的实际耗时比 token 生成慢数个数量级,运行时必须实现显式的等待与恢复契约。挂起长时间运行的操作可以释放监督线程,而对 KV 缓存帧进行检查点保存或驱逐,则可防止等待外部操作期间的空闲延迟降低推理引擎的吞吐量。
工具执行展示了类型化动作契约(原则 8)在面对真实端点时的要求。模式使提议可被解析,但只有宿主的授权检查才能决定其是否执行,服务器的能力声明并不授予任何权限。经过类型检查和授权的调用仍未必安全,因为超时会使其效果变得未知;而重试前结算(原则 9)则将这种未知状态转化为由端点去重的重试,或由探测结果证明合理的重试。这两种结果都在工具边界应用了不变量闭包原则(不变闭包原则):在这一边界上,退出码为零只表明进程已结束,并不表明任务已成功。