故障恢复
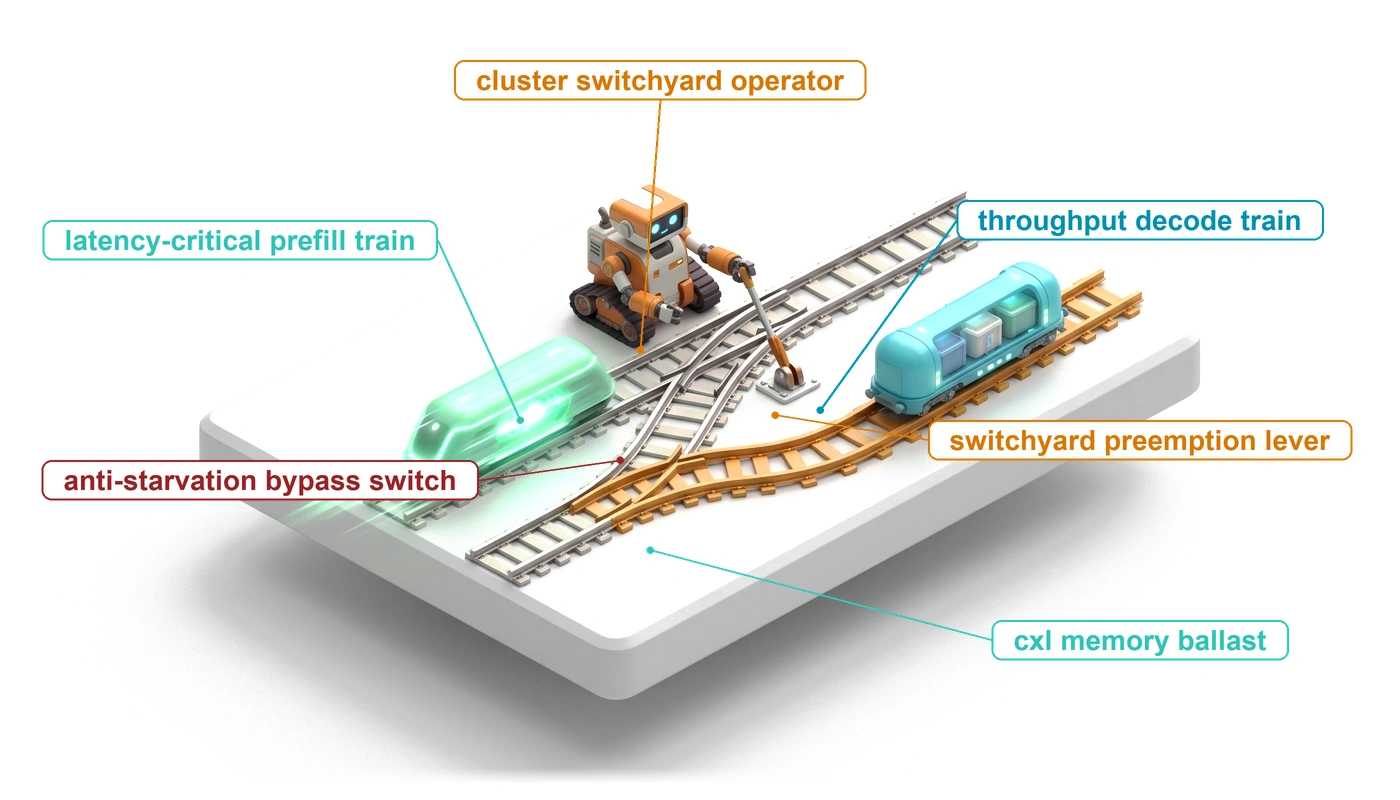
目的
为什么一个记录了自身每一步操作的智能体,仍然会让外部世界处于只改动了一半的状态?
一项包含十个步骤的智能体任务在第七步失败时,已经创建了分支、配置了机器,甚至可能对银行卡资金进行了预授权冻结,而承载这些影响的系统都不会因为智能体的计划出了问题就撤销它们。持久日志准确记录了哪些步骤已经生效,但知道发生了什么并不能修复任何问题,而那些显而易见的应对方式反而会让情况更糟。重新发送同一个请求会重现同样的错误,让模型临场发挥来清理残局,可能引发第二个具有实际后果的错误,而撤销一切则意味着为了修正一个格式错误的参数,丢弃整整一小时的工作。恢复是运行时执行的一项策略,而不是寄托于模型的希望。对于每一次失败,运行时都要决定是重试、将错误反馈给模型以便它修正自己的提议、为每个已提交的影响执行相应的补偿操作,还是停止并将轨迹交给人工处理;它还要把那个无法撤销的操作安排在所有可以撤销的操作之后。它也必须察觉那些根本不会报错的失败:轨迹一直在行动,却毫无进展。从 H·S·A 的视角看,长时间跨度使权限成为一个恢复问题,因为在任何人知道任务能否成功之前,每一步都已经动用了部分权限。
学习目标
- 解释为什么中途失败的轨迹无法像事务一样回滚,以及 saga 如何替代事务回滚
- 设计一个补偿栈,在派发操作之前注册每个补偿器,并在崩溃后以幂等方式逐项执行补偿
- 根据模型收到的错误观测,针对某类失败在重试、反馈、重新采样和模型回退之间作出选择
- 计算前向修复优于补偿并重新执行轨迹时所需的盈亏平衡修复成功率
- 按可逆性等级对工具操作进行分类,并安排计划,使其中唯一的不可逆操作位于所有可补偿工作之后
- 根据重复操作、工作区状态和验证器信号构建进展检测器,并说明各自会漏检什么
- 运用熔断器、隔离和故障注入,遏制发生故障的工具或轨迹的影响,并测试每一条恢复路径
事务边界的瓦解
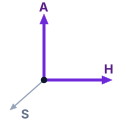
在长时间跨度下,权限成为运行时需要解决的恢复问题。
持久执行 中的事件日志使轨迹的每一步都得以持久保存。由于运行时根据仅追加的预写日志(WAL)和定期快照构建记录,因此它能够在主机崩溃和网络断连后恢复,并准确知道失败计划中的哪些步骤已经提交。知道哪些步骤已经提交,并不能修复任何问题。一旦循环闭合(智能体系统时刻),轨迹就会配置云基础设施、修改生产环境中的表、发起支付并发送通知,而这些影响都落在运行时并不拥有的系统中。在长时间跨度下,轨迹所行使的权限会成为一个恢复问题(H·S·A 暴露面),因为在任务是否成功尚未确定之前,每一步都已经动用了部分权限。当一项包含十个步骤的部署在第七步失败时,六个外部系统已经承载了它的影响。它们都不共享运行时的日志,都不提供准备阶段,也都不会应请求执行回滚。这里的恢复属于操作层面,而非归档层面;本章要探讨的是,当轨迹使环境处于只修改了一半的状态时,运行时应向环境履行什么契约。答案包含三个部分:运行时对可以补偿的影响进行补偿,在修复成本低于逐步撤销成本时进行前向修复,并将那个无法撤销的操作安排在所有可以撤销的步骤之后。
四十多年来,经典计算机系统一直通过 Jim Gray 于 1981 年形式化的事务概念来解决部分失败的困境。在经典数据库语义下,原子性与隔离性这两项保证支配着状态变更:要么整批修改成功提交,要么运行时执行中止,依靠私有撤销日志、影子页或写锁消除所有中间写入,使已中止的尝试对并发观察者完全不可见。当事务跨越多个独立存储节点时,分布式系统会采用两阶段提交(\(2\text{PC}\))协议,由中央协调器设置准备阶段,强制参与者进入预提交且锁定的状态,然后发出最终的、全局同步的提交命令。然而,在自主智能体系统中,这种经典事务边界彻底瓦解。一旦宿主监督器验证了动作提案,并将其跨越外部网络边界发送出去(例如用于创建拉取请求的代码托管平台 API、用于扣款的支付 API、用于启动计算集群的云 API,或用于通知工程团队的内部 webhook),智能体运行时便失去了管理控制权。这些远程端点不共享同一份预写日志,不暴露内部数据库撤销机制,也拒绝参与分布式两阶段提交协议。每个发出的 HTTP 请求一到达远程服务器就立即提交,随即进入外部服务的持久状态,并对第三方全局可见。之后执行的任何数据库 ROLLBACK 命令,都无法撤回已广播到客户端频道的消息、撤销已开始累计计费费用的虚拟机的资源配置,或撤销已触发生产部署流水线的提交合并。
即使能够迫使外部服务提供商暴露分布式锁管理器,长生命周期事务(LLT)的数学行为仍会使经典事务语义在物理上无法实现。在传统联机事务处理(OLTP)引擎中,事务会对数据行获取排他写锁(\(X\)-locks)和共享读锁(\(S\)-locks),持锁时长限定在微秒或毫秒量级。在严格两阶段锁定(2PL)下,可串行化得以保持,因为持锁时长受 DRAM 和固态硬盘的物理访问延迟限制。与之形成鲜明对比的是,自主智能体轨迹从根本上具有高延迟、突发性和开放式持续时间的特征。执行端到端任务的智能体必须交替进行网络工具调用与自回归解码循环,并可能在等待异步人工审批关卡、单元测试执行或持续集成检查通过期间完全暂停执行。如果运行时试图在智能体轨迹的整个生命周期内,对外部资源维持排他分布式锁,那么发生锁饥饿和灾难性分布式死锁的概率将趋近于必然。正如 Gray 所证明的,在具有 \(N\) 个并发事务的系统中,死锁概率按 \(O(N^2 \cdot L^4)\) 增长,其中 \(L\) 表示每个事务执行的动作数量。将事务持续时间从五毫秒延长到十分钟,会使死锁频率增加多个数量级,造成系统性锁饥饿,使整个宿主基础设施陷入瘫痪。错误也会在较长的时间跨度内累积(时间跨度拉伸:从纳秒指令到千秒级轨迹),因此,一个在第三步误判网络超时的模型,可能在第四步发出无效变更,进一步破坏外部状态。如 经典 ACID 与分布式智能体 Saga 恢复的对比 中的对比所示,经典数据库事务依赖锁和撤销日志,而智能体系统需要分布式 Saga 语义。在缺乏严格事务隔离的情况下,这些损坏的中间状态会立即泄漏到周围环境中,污染并发工作流,并在整个企业范围内触发级联故障。
| 维度 | 经典 ACID 事务(\(2\text{PC}\)) | 分布式智能体 Saga 契约 |
|---|---|---|
| 事务边界 | 共享锁管理器的同构、紧耦合数据库 | 异构、自主的外部 API 和服务 |
| 原子性机制 | 通过私有撤销日志实现透明的全有或全无回滚 | 通过前向动作实现应用层语义补偿 |
| 隔离性与可见性 | 完全可串行化(\(I=\text{Strict}\));中间写入不可见 | 零隔离(\(I=0\));部分变更立即提交 |
| 资源并发 | 对存储行施加短时排他锁(毫秒级) | 采用补偿式协调器的无锁乐观执行 |
| 故障时间跨度 | 崩溃恢复将状态重置到最近一次已提交的检查点 | 前向修复、反向补偿或升级至人工处理 |
| 权限边界 | 具有完整环境存储访问权限的可信数据库内核 | 对不可信模型提案进行中介处理的特权运行时 |
由于无法跨越这些边界实现隔离和原子回滚,运行时采用了 Saga 模式。该模式由 Hector Garcia-Molina 和 Kenneth Salem 于 1987 年提出,用于处理长时间运行的数据库进程。枢轴边界与补偿式 Saga(原则 14)使其成为运行时的恢复契约。Saga 将长程分布式轨迹分解为由离散、自包含子事务构成的有序有向图,从而放宽了对完全事务隔离(\(I=0\))的要求。每个正向子事务都会立即提交其状态变更,并释放所有本地资源锁,使其结果即时对外部世界可见。为了在中间步骤中止时维持系统一致性,每个带有外部副作用的正向动作都显式配对一个应用层补偿事务。补偿事务并不会神奇地让时间倒流或改写历史现实;相反,它会执行一次主动且语义合理的正向变更,以抵消、中和或在语义上修正已提交动作的部分副作用。如果一条智能体轨迹在第一步成功配置了一台隔离的云虚拟机,在第二步编译了更新后的二进制程序,却在第三步遭遇不可恢复的身份验证拒绝,运行时不会发出徒劳的数据库中止操作。它会按逆序遍历已执行的轨迹,通过发送显式的拆除 RPC 来终止已配置的实例,从而执行为第一步注册的补偿事务。关键在于,这一恢复序列不能依赖无特权的基础模型在故障发生后自行记起、推断或臆造纠正措施。根据不变量闭包(原则 不变闭包原则),恢复是模型之外的监督器的职责。宿主智能体运行时必须维护 Saga 协同日志,跟踪每个正向动作和补偿处理程序的执行状态,在跨网络重试边界时强制使用幂等性令牌,并通过确定性的外部软件检查来验证环境不变量(经典事务背景 形式化阐述了两阶段提交在跨外部执行器时的失效、补偿事务的数学不变量,以及对 ARIES 预写式日志的适配)。我们如何形式化地构建一个 Saga 执行引擎,将正向智能体动作与补偿性回滚动作配对?
轨迹 Saga 模式
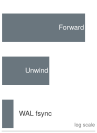
补偿性逆序撤销的开销比其所撤销的正向路径低 \(17.6\times\)。
外部 API 调用和文件系统变更无法在神经模型考虑下一步动作时,一直停留在未提交状态。一旦智能体发出用于分配云虚拟机的 HTTP POST,该物理实例就会启动、获取 IP 地址并产生计费记录,无论自回归解码循环随后生成什么 token。如果一个八步部署工作流在第五步遇到不可恢复的错误,例如无效的域名注册或无法更改的权限拒绝,运行时就无法执行原子数据库 ROLLBACK。数据库中的隔离概念在此失效,因为第三方端点、外部服务和远程文件系统会在命令完成后立即向外部世界暴露中间状态。
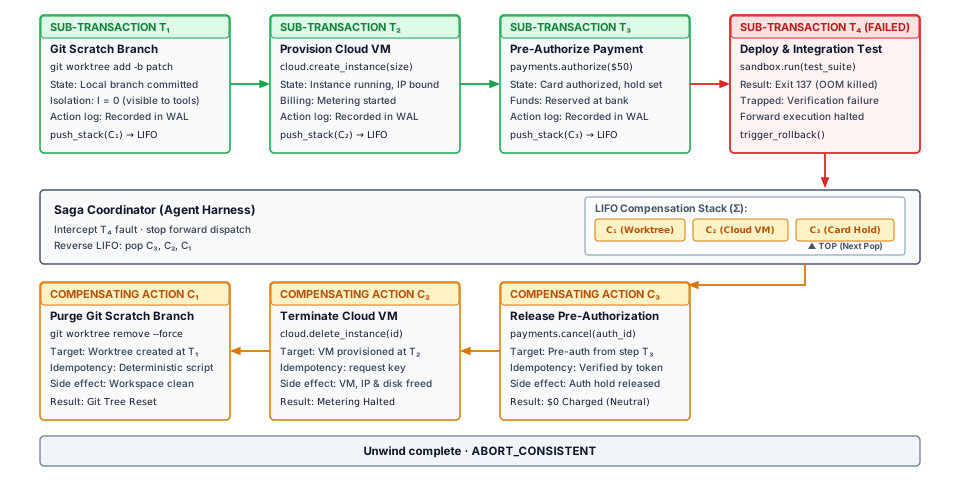
轨迹 Saga 模式将长程智能体执行分解为一系列离散且在本地提交的子事务,每个子事务都与一个在智能体控制块(ACB)中注册的显式、正向执行的补偿动作配对,从而解决部分执行导致的异常。当某个子事务失败时,运行时会停止正向推进,并按逆序撤销已执行的轨迹,通过执行补偿将外部环境转换到语义一致的终止状态。
这一协同契约的机制如 图 1 所示。在正向执行层,每个离散子事务 \(T_i\) 都会立即提交其外部变更——在 \(T_1\) 创建临时工作树分支,在 \(T_2\) 配置 AWS EC2 microVM 实例,并在 \(T_3\) 对 Stripe 计费银行卡设置预授权冻结。由于无法将外部第三方端点保持在未提交状态,每个动作都会立即提交,从而放弃全局隔离(\(I=0\))。与此同时,宿主运行时监督器将相应的补偿动作(\(C_1, C_2, C_3\))序列化,并将其压入智能体控制块(ACB)内的后进先出恢复栈 \(\Sigma\)。当执行在 \(T_4\) 因未处理的容器崩溃(退出码 137,因 OOM 被终止)而突然中止时,监督器会捕获故障,冻结正向推进,并阻止无特权模型生成更多动作。随后,Saga 恢复协调器严格按逆序遍历后进先出栈:首先弹出并执行 \(C_3\),以解除 Stripe 预授权冻结;接着发送 \(C_2\),以终止 EC2 计算实例并分离存储卷;最后执行 \(C_1\),以清除临时 git 分支。系统通过预先编译的确定性处理程序逆序撤销变更,而非重新向随机性模型发送提示,从而可靠地将环境恢复到干净的 ABORT_CONSISTENT 基线状态。
将轨迹形式化为开放式 Saga
在经典事务理论中,Hector Garcia-Molina 和 Kenneth Salem(1987)将 Saga 定义为一种长时间运行的事务,由一系列相对较短的子事务组成,这些子事务可以与其他事务交错执行。将这一形式化方法应用于智能体机器学习系统,我们将智能体轨迹 \(\mathcal{T}\)(长度为 \(n\))定义为由离散的、正向执行的子事务构成的有序序列:
\[\mathcal{T} = [T_1, T_2, \dots, T_n]\]
每个子事务 \(T_i\) 表示宿主智能体运行时与外部环境之间的一次不可分割的交互。子事务形式化表示为一个四元组:
\[T_i = \langle \alpha_i, \theta_i, \phi_i, \kappa_i \rangle\]
其中,\(\alpha_i\) 是语义动作标识符(例如 provision_vm 或 write_file),\(\theta_i\) 是由无特权的基础模型生成的具体参数载荷,\(\phi_i\) 表示由运行时验证的环境前置条件和后置条件断言,\(\kappa_i\) 是由监督器生成的全局唯一幂等键。
Definition 0.1: 轨迹 Saga
Saga 与分布式两阶段提交(\(2\text{PC}\)) 在 \(2\text{PC}\) 中,所有参与的资源管理器都会在准备阶段获取排他锁,并持续持有这些锁,直到协调器发出全局提交指令。在智能体系统中,模型推理速度慢且具有非确定性(\(t_{\text{decode}} \sim 2\text{--}15\,\text{s}\),每步)。在等待自回归词元生成期间,跨远程服务持有实体锁会导致灾难性的锁争用、分布式死锁以及级联网络超时。
由于模型不具备任何环境隐式权限,因此它从不直接执行 \(T_i\)。相反,运行时会验证 \(\theta_i\),生成 \(\kappa_i\),针对底层操作系统或远程 API 执行实际操作,并立即在本地提交结果。与此同时,运行时会注册相应的补偿事务 \(C_i\):
\[C_i = \langle \alpha_i^c, \theta_i^c, \kappa_i^c \rangle\]
其中,\(\alpha_i^c\) 是用于抵消影响的动作,\(\theta_i^c\) 是参数化的补偿载荷,\(\kappa_i^c\) 是补偿幂等键。完整的补偿轨迹 \(\mathcal{C}\) 是补偿器的逆序序列:
\[\mathcal{C} = [C_n, C_{n-1}, \dots, C_1]\]
在正常执行过程中,系统完成整个序列 \(T_1 \circ T_2 \circ \dots \circ T_n\),到达最终目标状态 \(S_{\text{goal}}\)。然而,如果任意子事务 \(T_k\)(\(1 \le k \le n\))未通过后置条件验证、发生超时或返回致命的上游状态码,运行时就会终止正向执行。为维持语义一致性,监督器必须保证环境按以下补偿序列进行状态转换:
\[\mathcal{T}_{\text{exec}} = T_1 \circ \dots \circ T_{k-1} \circ T_k^{\text{failed}} \circ C_{k-1} \circ \dots \circ C_1\]
如果 \(T_k\) 在失败前已经产生了部分副作用,则首先执行其自身的补偿器 \(C_k\);如果 \(T_k\) 在修改状态之前已干净地中止,则回退严格从 \(C_{k-1}\) 开始。运行时内部通过确定性状态机跟踪每个子事务的生命周期,详见 表 1。
COMMITTED,或经由逆向回退路径转换至 COMPENSATED。
| 状态 | 不变条件 | 有效转换 | 监督器操作 |
|---|---|---|---|
PENDING |
步骤由模型提出;托管于 ACB 中;未发生任何外部变更。 | EXECUTING, ABORTED |
验证载荷模式;强制执行能力边界。 |
EXECUTING |
已携带幂等键 \(\kappa_i\) 派发正向 RPC;等待端点 ACK。 | COMMITTED, FAILED |
监控看门狗计时器;捕获网络回执。 |
COMMITTED |
外部变更已完成;后置条件已验证;补偿器 \(C_i\) 已注册。 | COMPENSATING |
将 \(C_i\) 压入持久化 LIFO 栈;递增轨迹计数器。 |
FAILED |
正向步骤已中止、超时或未通过不变条件检查。 | COMPENSATING, HALTED |
停止正向解码循环;触发逆向回退序列。 |
COMPENSATING |
已派发用于抵消副作用的操作 \(C_i\),其幂等键为 \(\kappa_i^c\)。 | COMPENSATED, PANIC |
执行补偿处理程序;验证环境资源已释放。 |
COMPENSATED |
副作用已抵消;状态已恢复至语义基线。 | COMPENSATING, TERMINATED |
从栈中弹出 \(C_i\);调用前一个补偿器 \(C_{i-1}\)。 |
PANIC |
补偿器 \(C_i\) 发生不可恢复的故障;自动恢复已停止。 | MANUAL_ESCALATION |
隔离轨迹的故障影响范围;触发运维人员呼叫告警。 |
补偿操作的语义
补偿操作与数据库回滚有着本质区别。在采用 ARIES 式预写日志的关系数据库中,回滚已中止的事务时,会利用历史 BEFORE-IMAGE 日志记录,将磁盘页精确恢复至原有的物理映像。该事务的存在被抹除,仿佛从未发生过。
在与现实世界的操作系统和网络交互的智能体系统中,从物理上抹除历史是不可能的。时间已经流逝,资源已经消耗,网络数据包已经穿过交换机,外部观察者也可能已经查看过中间状态。因此,补偿事务并不会神奇地让时间倒流;它是一种主动执行的正向变更,旨在建立与初始状态的语义等价性。
中间状态的可见性 由于 Saga 放宽了 ACID 的隔离性(\(I\))属性,外部观察者(例如运维人员或并发运行的智能体)可以观察到 \(T_1\) 产生的中间状态,而此时 \(T_k\) 尚未失败。如果智能体在 \(T_1\) 中创建了一个 S3 存储桶,那么该存储桶将保持全局可见,直到 \(C_1\) 在补偿期间将其销毁。依赖 Saga 的系统必须能够容忍对环境状态的临时脏读。
令 \(\mathcal{S}\) 表示外部环境的状态空间,并令 \(f_{\text{ext}}: \mathcal{S} \times \mathcal{A} \to \mathcal{S}\) 表示操作 \(\alpha\) 下的状态转换函数。如果初始状态为 \(S_0\),执行正向子事务 \(T_1\) 将得到状态 \(S_1 = f_{\text{ext}}(S_0, T_1)\)。执行补偿事务 \(C_1\),以 \(S_1\) 为起始状态,将得到状态 \(S'_0 = f_{\text{ext}}(S_1, C_1)\)。一般而言:
\[S'_0 \ne S_0\]
物理状态 \(S'_0\) 包含不同的历史痕迹:云计费计量值已经增加,本地系统日志文件包含仅追加的审计条目,操作系统进程 ID 已经递增,临时 TCP 端口的预留状态已经历了一轮变化。然而,运行时只要求 \(S'_0\) 在应用程序核心不变条件方面满足语义等价性:
\[S'_0 \equiv_{\text{semantic}} S_0 \iff \forall \phi \in \Phi_{\text{invariants}}, \quad \phi(S'_0) = \phi(S_0)\]
其中,\(\Phi_{\text{invariants}}\) 是约束资源分配、文件完整性、访问控制权限和进程边界的系统不变条件集合。
Definition 0.2: 语义补偿
语义补偿 是一种通过正向变更实现恢复的操作 \(C_i\),它将外部环境状态转换为新状态 \(\mathbf{S}_{i-1}'\);就核心系统不变条件而言,该新状态与 \(\mathbf{S}_{i-1}\) 在语义上等价,而非尝试进行物理回滚。
- 意义:支持不可逆的分布式工具交互(例如云资源配置、消息发布或计费 API 调用)中的事务性故障恢复;在这些交互中,经典的物理回滚在物理上无法实现。
- 区别:数据库回滚通过撤销日志将磁盘页精确恢复至原有的位级状态;语义补偿则主动执行正向补偿事务(例如删除已配置的 pod 或向账户发放抵扣额度),尽管会留下历史审计痕迹,仍能恢复不变条件所要求的平衡状态。
- 常见陷阱:编写非幂等的补偿操作,导致在网络短暂断开后的重试过程中发生失败,或产生无人清理的重复副作用。
为说明这一点,考虑生产环境中的智能体运行时所遇到的三类典型补偿动作:
- 可逆状态变更: 具有明确定义的逆操作的动作。如果 \(T_i\) 向
~/.bashrc追加一条 export 声明,\(C_i\) 就执行有针对性的 sed 脚本或 AST 操作,以移除该条声明。物理 inode 编号和文件修改时间戳会发生变化(\(S'_0 \ne S_0\)),但 shell 执行环境在功能上与 \(S_0\) 无法区分。 - 资源分配撤销: 配置临时基础设施的动作。如果 \(T_i\) 发出 RPC 以实例化一个 Kubernetes Pod,\(C_i\) 就发出一个
DELETERPC,以该 Pod 的唯一 UID 为目标。尽管集群调度日志和指标计数器记录了该 Pod 的短暂存在,其占用的物理内存、CPU 核心和网络端点仍会被释放回集群资源池。 - 补偿性余额调整: 改变财务状态或基于配额的状态的动作。如果 \(T_i\) 从区域配额账本中预留 \(100\) 计算额度,\(C_i\) 就发起一笔数额为 \(100\) 单位的入账交易。账本历史记录体现的是两笔不同的交易,而非零笔交易,但可用余额的净值会恢复。
补偿动作相对于无关的系统活动必须严格满足交换性,并且在网络重试时满足幂等性。如果网络短暂故障导致运行时无法确定 \(C_i\) 是否成功,那么多次重新发出 \(C_i(\kappa_i^c)\) 所产生的环境状态必须与执行一次完全相同,且不能产生孤立的副作用。
Saga 补偿栈
轨迹 Saga 的执行由 Saga 编排器管理。该编排器是运行于宿主运行时监督器内部的权威控制平面组件。编排器在智能体控制块(ACB)内部维护两种主要数据结构:正向执行日志(\(\mathcal{L}_{\text{fwd}}\))和 LIFO 补偿栈(\(\mathcal{S}_{\text{comp}}\)),其对应关系如 表 2 所示。
| 子系统层 | 数据结构 | 条目状态与参数 | 运行职责 |
|---|---|---|---|
| 正向执行日志(\(\mathcal{L}_{\text{fwd}}\)) | 仅追加的预写日志 | Entry 1: T_1 [COMMITTED] (idempotency_key=k_1) |
记录顺序推进的正向执行过程;建立持久的审计记录。 |
| 正向执行日志(\(\mathcal{L}_{\text{fwd}}\)) | 仅追加的预写日志 | Entry 2: T_2 [COMMITTED] (idempotency_key=k_2) |
捕获补偿所需的中间参数和输出。 |
| 正向执行日志(\(\mathcal{L}_{\text{fwd}}\)) | 仅追加的预写日志 | Entry 3: T_3 [FAILED] (idempotency_key=k_3) |
触发故障处理;在枢轴动作之前停止正向推进。 |
| 补偿栈(\(\mathcal{S}_{\text{comp}}\)) | LIFO 执行栈 | TOP -> C_2: teardown_sandbox(id="sbx-99") |
首先弹出的补偿操作;撤销最近一次已提交的副作用。 |
| 补偿栈(\(\mathcal{S}_{\text{comp}}\)) | LIFO 执行栈 | STACK[0] -> C_1: release_port(port=8080) |
第二个执行的补偿操作;恢复基线网络状态。 |
编排器对向基础模型提供工具的方式施加严格约束。在任何情况下,都不允许模型在故障期间即时生成补偿动作。当自回归模型在压力下幻觉生成补偿命令时,往往会加剧损害,例如执行 rm -rf / 或删除错误的虚拟网络接口。因此,运行时监督器要求工具开发者在定义工具时注册正向动作与补偿动作对。
当智能体提出正向工具调用 \(T_i\) 时,编排器将 \(T_i\) 在 \(\mathcal{L}_{\text{fwd}}\) 中注册为 PENDING。执行成功且后置条件断言通过后,编排器构造参数已完全绑定的补偿操作 \(C_i\),所用信息来自 \(T_i\) 返回的输出元数据(例如已分配的资源 ID、初始文件内容或进程句柄)。编排器将 \(C_i\) 写入持久存储(预写日志),并将其指针压入 \(\mathcal{S}_{\text{comp}}\),然后将控制权交还基础模型,以执行步骤 \(i+1\)。
当子事务 \(T_k\) 遭遇终止性故障时,监督器执行的回退算法遵循一个确定性循环:
def unwind_saga(acb: AgentControlBlock) -> None:
    acb.set_state(TrajectoryState.COMPENSATING)
    while not acb.compensation_stack.is_empty():
        compensator = acb.compensation_stack.peek()
        try:
            # Compensators must be idempotent and assert their postconditions
            compensator.execute(idempotency_key=compensator.key)
            acb.wal.append_record(RecordType.COMPENSATED, compensator.id)
            acb.compensation_stack.pop()
        except RetriableError as err:
            acb.backoff_and_retry(compensator)
        except FatalCompensationError as fatal:
            acb.wal.append_record(RecordType.PANIC, compensator.id, fatal)
            acb.set_state(TrajectoryState.PANIC)
            raise QuarantineEscalationException("Saga compensation halted", fatal)
    acb.set_state(TrajectoryState.TERMINATED_CLEAN)
该架构的鲁棒性取决于对补偿阶段本身发生的崩溃的底层处理。如果宿主智能体进程在执行 \(C_{k-2}\) 时遭遇硬件故障、断电或内核崩溃,运行时会在重启后从 NVMe 存储中读取持久化的预写日志,重建 \(\mathcal{S}_{\text{comp}}\),并检查最后一条未提交的记录。由于补偿器通过唯一的幂等键(\(\kappa^c\))保证幂等性,恢复管理器可以安全地重新派发 \(C_{k-2}\)。补偿序列会从中断位置精确恢复执行,确保部分完成的补偿不会使系统资源滞留。
粗略估算 0.1: Saga 日志回退开销
T_1:通过本地虚拟机监控器套接字创建隔离的 microVM 沙箱(\(120\,\text{ms}\))。T_2:通过区域云 API 预留一个公共 IPv4 出口地址(\(350\,\text{ms}\))。T_3:在沙箱内编译目标二进制文件(\(4{,}200\,\text{ms}\))。T_4:写入路由规则并绑定防火墙端口(\(80\,\text{ms}\))。T_5:向外部权威名称服务器发布 DNS 记录(\(450\,\text{ms}\))。
在步骤 5 中,T_5 因不可恢复的 409 Conflict(域名所有权冲突)而失败。编排器停止正向执行,并使用 \(\mathcal{S}_{\text{comp}} = [C_4, C_3, C_2, C_1]\) 启动反向补偿。
参数:
- 到区域云 API 的网络往返延迟:\(t_{\text{api}} = 150\,\text{ms}\)。
- 每次状态转换对应的本地 NVMe 预写日志 fsync 延迟:\(t_{\text{fsync}} = 1.2\,\text{ms}\)。
- microVM 销毁时间:\(t_{\text{teardown}} = 45\,\text{ms}\)。
- 编译清理(删除构建缓存目录):\(t_{\text{clean}} = 15\,\text{ms}\)。
- 防火墙解绑时间:\(t_{\text{fw}} = 10\,\text{ms}\)。
- 出口 IP 释放 API 调用时长:\(t_{\text{release}} = 220\,\text{ms}\)。
- LLM 推理成本:\(\$3.00\) per \(10^6\) input tokens, \(\$15.00\),每 \(10^6\) 个输出词元。正向轨迹消耗了 \(18{,}400\) 个输入词元和 \(1{,}250\) 个输出词元,涵盖步骤 \(1\text{--}5\)。
计算:
持久化 I/O 开销: 每个子事务产生两次 fsync 操作(转换到
COMMITTED,以及在栈上记录 \(C_i\))。正向阶段产生的开销为: \[N_{\text{fsync, fwd}} = 5 \times 2 = 10 \text{ writes} \implies t_{\text{io, fwd}} = 10 \times 1.2\,\text{ms} = 12\,\text{ms}\] 从步骤 4 回退至步骤 1 的补偿过程,每次弹出补偿器都需要一次 fsync: \[N_{\text{fsync, rev}} = 4 \times 1 = 4 \text{ writes} \implies t_{\text{io, rev}} = 4 \times 1.2\,\text{ms} = 4.8\,\text{ms}\] 日志持久化总开销为 \(16.8\,\text{ms}\),占轨迹总实际耗时的比例低于 \(0.3\%\)。回退执行延迟: 在反向回退过程中,主动消除副作用所花费的总实际耗时为: \[t_{\text{unwind}} = t_{\text{fw}} + t_{\text{clean}} + t_{\text{release}} + t_{\text{teardown}} + t_{\text{io, rev}}\] \[t_{\text{unwind}} = 10\,\text{ms} + 15\,\text{ms} + 220\,\text{ms} + 45\,\text{ms} + 4.8\,\text{ms} = 294.8\,\text{ms}\] 注意,编译的 \(t_{\text{clean}}\)(\(T_3\))微不足道,因为丢弃临时沙箱磁盘层即可完全消除耗时 \(4{,}200\,\text{ms}\) 的正向 CPU 编译所产生的影响,所需时间仅为 \(15\,\text{ms}\)。
财务损耗核算: 失败尝试消耗的资金包括词元成本和外部资源预留费用: \[\text{Cost}_{\text{tokens}} = \left(18{,}400 \times \frac{3.00}{10^6}\right) + \left(1{,}250 \times \frac{15.00}{10^6}\right) = \$0.0552 + \$0.01875 = \$0.07395\] 由于 Saga 编排器执行了 \(C_2\)(在失败后 \(295\,\text{ms}\) 内释放静态 IPv4 预留),云出口资源的占用费用在触发按小时计费之前便停止累积。
关键架构启示: 回退失败轨迹所需的实际时间(\(294.8\,\text{ms}\))比正向执行时间(\(5{,}200\,\text{ms}\))小一个数量级。与网络和编译延迟相比,预写日志开销(\(16.8\,\text{ms}\))可以忽略不计。然而,已消耗的推理词元所产生的 \(\$0.074\) 费用,以及正向执行的实际耗时,构成了无法挽回的纯损失。
上述示例揭示的延迟与经济现实,体现了运行时设计核心的一项根本性工程权衡。通过后向补偿撤销 Saga 能够保证语义上的干净性,但会严重破坏已经完成的工作。在我们的部署场景中,智能体耗费了五秒多的实际时间和数万个 token,成功启动了经过验证的 microVM、配置了 IP 地址并编译了复杂的二进制资源,却仅仅因为最后命名步骤中的一个表面错误,就将这些成果全部丢弃。
Checkpoint 0.1: 评估轨迹 Saga 与补偿操作
在分析前向自愈策略和防空转不变量之前,请检验你对 Saga 事务的理解:
前向恢复
跨越不可逆的枢轴操作之前,必须先建立持久化的物理托管保障,随后才能提交不可逆的副作用。
一个执行自动化云迁移的智能体在八个步骤中的第六步失败:生成的配置清单包含格式错误的 JSON 转义序列,导致容器编排守护进程拒绝部署载荷。如果宿主监督程序采取无条件后向补偿,就会触发已注册的补偿操作链 \(C_5, C_4, C_3, C_2, C_1\)。在此过程中,运行时会销毁已分配的虚拟私有云、拆除已配置的关系数据库副本、注销 DNS 条目,并丢弃数万个 token 的推理性预填充与解码工作——这一切仅仅是为了修正一个未转义的双引号。反过来,如果运行时不检查错误就盲目重新执行前向事务,不具备特权的语言模型便得不到任何诊断信号,只会从相同的预测分布中重新采样,并再次产生完全相同的语法错误。
智能体运行时必须动态仲裁后向回滚与前向自愈,在已完成子事务所累积的沉没成本,与合成局部纠正性修改的收敛概率及 token 开销之间取得平衡。 无条件回滚优先保证外部不变量不受破坏,代价却是极高的延迟与资源浪费。不受约束的前向自愈能够保留已提交的基础设施工作,却可能使智能体陷入永不终止的修复循环,进一步加剧最初的错误。可靠的运行时会实现形式化的决策策略,衡量剩余资源预算,评估错误分类特征,并强制执行防空转不变量,以限制前向修复尝试次数,达到上限后再转入补偿或升级交由人工处理。
恢复机制谱系
在可靠计算的经典分类体系中,Algirdas Avizienis 及其同事将故障恢复形式化为两种根本不同的机制:后向恢复将系统返回到故障显现之前的某个无错误状态;前向恢复则将当前的错误状态转换为一个新的有效状态,使计算得以继续 (Avizienis 等 2004年)。分布式数据库几乎只采用后向恢复;由于数据库引擎完全掌控本地物理页帧和预写日志,通过页面撤销操作恢复未损坏的快照是确定性的,且计算成本低廉。
后向恢复与前向恢复 后向恢复: 通过补偿操作 \(\mathbf{s}_k\) 恢复较早的检查点 \((C_t, \dots, C_1)\),丢弃中间工作。 前向恢复: 合成新的补丁修改 \(a_{\text{repair}}\),使其满足 \((s_t, a_{\text{repair}}) \to s'_t\),推动系统向前运行以满足后置条件。
在智能体机器学习系统中,执行的物理边界打破了数据库所依赖的假设。智能体通过离散的前向子事务 \(T_i \in \mathcal{T}\) 操作外部环境,包括第三方 REST API、容器守护进程、远程 git 仓库和云控制平面。当子事务 \(T_t\) 失败时,运行时处于某个中间环境状态 \(s_t\),而形成这一状态已经耗费了不可忽略的创建时间和直接经济成本。
在后向恢复中,运行时将部分执行序列 \((T_1, T_2, \dots, T_{t-1})\) 视为一个已中止的原子单元。它按时间逆序遍历轨迹日志,发出以下补偿事务序列:
\[\mathcal{C}_{t-1 \to 0} = \left( C_{t-1}, C_{t-2}, \dots, C_1 \right)\]
每个补偿器 \(C_i\) 都作为独立的外部 RPC 执行,旨在从逻辑上抵消 \(T_i\) 引入的状态变更。后向恢复在语义上是保守的。它保证,当智能体遇到不可恢复的故障时,例如凭据被撤销、API 版本不兼容或领域约束无法满足,外部世界仍处于未受破坏的基线配置。然而,后向补偿会彻底破坏前向进展:每个成功的中间步骤都会被丢弃,迫使后续任何执行尝试都承担从头重建状态所需的全部延迟、计算和货币成本。
前向恢复采用相反的运行前提:运行时不将中间状态视为可丢弃的内容,而是利用随机推理引擎诊断故障并改变执行路径。当收到错误观测 \(o_t^{\text{err}}\),且该观测来自失败的子事务 \(T_t\) 时,运行时会构建有针对性的诊断上下文,并向基础模型请求纠正性的修复动作:
\[a_{\text{repair}} \sim \pi_\theta\left(a \mid \tau_{<t}, T_t, o_t^{\text{err}}\right)\]
修复动作 \(a_{\text{repair}}\) 不会撤销此前的执行历史。相反,它会实施局部状态变换,以满足 \(T_t\) 的前置条件,或用替代子事务 \(T_t'\) 进行替换,使其满足完全相同的操作后置条件。如果第六步因生成的清单缺少必需的命名空间标签而失败,\(a_{\text{repair}}\) 会在内存中修补 YAML 载荷,并重新调用部署工具。如果第六步因已分配的 IP 地址遭遇暂时性路由冲突而失败,\(a_{\text{repair}}\) 会请求第二个 IP 地址,而不拆除第一步至第五步中已配置的父级子网。后向补偿与前向随机自愈之间的权衡在 表 3 中进行了系统比较。
| 维度 | 后向恢复(Saga 补偿) | 前向恢复(随机自愈) |
|---|---|---|
| 主要机制 | 确定性执行逆向补偿器 \(C_i\) | 随机合成纠正动作 \(a_{\text{repair}}\) |
| 状态轨迹 | \(\mathbf{s}_t \xrightarrow{C} \mathbf{s}_{t-1}' \xrightarrow{C} \dots \xrightarrow{C} \mathbf{s}_0'\)(还原) | \(\mathbf{s}_t \xrightarrow{a_{\text{repair}}} \mathbf{s}_t' \xrightarrow{T_t} \mathbf{s}_{t+1}\)(变换) |
| 执行成本 | \(\sum_{i=1}^{t-1} \text{Cost}(C_i) + \text{Cost}(\text{Re-execution})\) | \(\text{Cost}(\text{LLM}_{\text{repair}}) + \text{Cost}(a_{\text{repair}})\) |
| 确定性 | 高(预先注册的幂等补偿代码) | 低(从策略 \(\pi_\theta\) 中进行概率采样) |
| 故障模式 | 补偿器失败,导致残留脏的部分状态 | 无法终止的修复循环(“空转循环”) |
| 最适用领域 | 不变量违反、安全违规、硬性限制 | 暂时性工具故障、语法错误、模式漂移 |
前向恢复本质上具有机会性和非确定性。由于纠正动作是通过对无特权的神经模型进行采样生成的,运行时无法保证 \(a_{\text{repair}}\) 能够解决故障;事实上,校准不佳的修复步骤可能引入次生故障,进一步破坏环境。因此,核心工程挑战在于构建自动化监督运行框架,根据可观测的运行时参数选择适当的恢复策略。
动态仲裁:恢复策略函数
具备韧性的运行时不会将恢复策略的选择视为静态配置开关。相反,它会在截获执行故障后立即评估恢复策略函数 \(\mathcal{D}\)。该策略在三种终结指令之间进行仲裁:尝试前向修复、执行后向补偿,或停止执行以等待操作人员干预。
形式化地,令故障发生时的运行时状态由以下元组表示:
\[\Omega_t = \left( s_t, T_t, o_t^{\text{err}}, \mathbf{B}_t, \Sigma_t \right)\]
其中,\(s_t\) 是可观测的环境状态,\(T_t\) 是失败的子事务,\(o_t^{\text{err}}\) 是宿主沙箱或外部 API 返回的结构化错误载荷,\(\mathbf{B}_{t} = \langle T_{\text{rem}}, H_{\text{rem}}, \$_{\text{rem}} \rangle\) represents the remaining resource budget (tokens, trajectory steps, and monetary cost), and \(\Sigma_t = (T_1, \dots, T_{t-1})\) is the history ledger of committed sub-transactions. The recovery policy \(\mathcal{D}(\Omega_t)\) maps this state into an action space \(\mathcal{A}_{\text{rec}} = \{\text{TRANSIENT\_RETRY}, \text{FORWARD\_REPAIR}, \text{BACKWARD\_ROLLBACK}, \text{OPERATOR\_ESCALATE}\}\)。
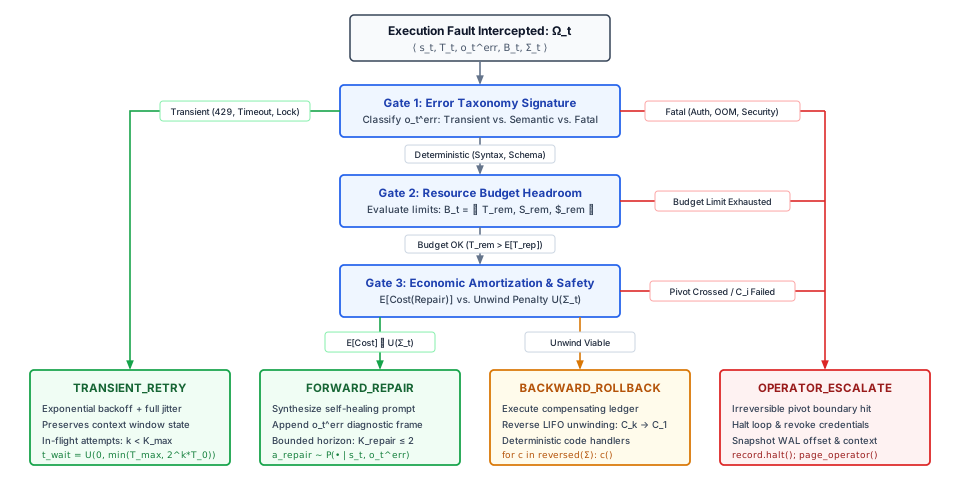
按照 图 2 中的结构,运行时监督器将拦截到的故障 \(\Omega_t\) 送入分层分诊级联流程,在四个不同的操作终点之间进行仲裁。首先,关卡 1 对错误载荷的特征进行分类:瞬态网络分区或 HTTP 429 限流直接分流至 TRANSIENT_RETRY,采用随机化指数退避(\(t_{\text{wait}} \sim \mathcal{U}(0, \min(T_{\max}, 2^k T_0))\));而致命的不变量违例(如凭据被撤销或逃逸安全沙箱)则立即转入右侧的升级处理主干。对于确定性语义故障,例如编译器错误或模式不匹配,执行进入关卡 2,检查剩余的 token 预算与资金预算(\(\mathbf{B}_t\))是否足以支撑额外一轮修复推理,而不会带来上下文截断风险。最后,关卡 3 进行经济摊销评估,权衡预期修复成本与累计撤销代价 \(U(\Sigma_t)\):如果修复可行且沉没成本较高,引擎便选择 FORWARD_REPAIR;而修复复杂度过高或跨越不可逆转的枢轴点,则会触发 BACKWARD_ROLLBACK 或人工 OPERATOR_ESCALATE。决策流程依次评估三个关卡:
错误分类与可诊断性:运行时检查 \(o_t^{\text{err}}\) 的分类特征。错误分为三个不同的操作类别:
- 瞬态环境故障:网络超时、HTTP 429 限流和并发锁争用。这些故障不需要对轨迹进行结构性修改;通过带有指数退避与随机抖动的前向重试即可解决。
- 确定性语义故障:模式验证拒绝、语法编译错误、参数缺失以及本地文件未找到异常。这些故障很可能适合采用前向自愈,因为错误轨迹包含明确的诊断反馈,模型可以接收这些反馈并合成修正后的载荷。
- 致命的不变量违例:身份验证授权被撤销、硬件资源耗尽、不可恢复的数据库损坏以及违反安全沙箱约束。前向修复无法为这些故障合成有效的绕过方案。运行时立即中止前向推进并触发后向补偿。
资源预算余量:前向自愈会消耗推理 token 和轨迹步数。设 \(\mathbb{E}[T_{\text{repair}}]\) 和 \(\mathbb{E}[\$_{\text{repair}}]\) represent the expected token consumption and monetary cost of an inference pass designed to generate \(a_{\text{repair}}\). If the remaining budget \(\mathbf{B}_t\) 满足:
\[T_{\text{rem}} < \mathbb{E}[T_{\text{repair}}] + T_{\text{reserve}} \quad \lor \quad \$_{\text{rem}} < \mathbb{E}[\$_{\text{repair}}] + \$_{\text{reserve}}\]
则运行时拒绝前向修复。在 token 余量几乎耗尽时尝试修复故障,可能导致修复过程本身发生上下文窗口截断,从而使恢复监督器陷入不可恢复的故障模式。
经济摊销(沉没成本与修复成本):撤销轨迹需要执行补偿器,其总成本为:
\[U(\Sigma_t) = \sum_{j=1}^{t-1} \text{Cost}(C_j)\]
如果 \(U(\Sigma_t)\) 较低(例如,故障发生在多步骤工作流的第一个子事务期间),后向回滚的经济代价便可忽略不计。运行时倾向于立即补偿并从头重新启动。相反,如果 \(U(\Sigma_t)\) 较高——意味着数分钟的计算、数千行已提交的数据库记录或不可逆的人工配置——则必须结合恢复成功的概率来权衡前向修复的预期成本:
\[\mathbb{E}[\text{Cost}(\text{Forward})] = \text{Cost}(a_{\text{repair}}) + \left(1 - P(\text{success} \mid o_t^{\text{err}})\right) \cdot U(\Sigma_t)\]
当 \(P(\text{success} \mid o_t^{\text{err}})\) 较高且 \(U(\Sigma_t)\) 较大时,前向自愈在数学上是最优的系统选择。
粗略估算 0.2: 前向修复与补偿后重新运行的比较
变量:
- 前向步骤 \(T_1\) 至 \(T_5\) 耗时 46 s,计费的输入 token 数为 38,500,输出 token 数为 3,100,示例价格分别为每百万 token $3 和 $15。
- 这些步骤的补偿操作总共耗时 40.6 s,不消耗模型 token。
- 一次修复调用读取 2,390 个新 token(恢复指令、失败的调用和错误帧),并输出 180 个 token,输出速率为每秒 50 个 token,修正后的步骤可在一秒内通过验证。
计算:
- 后向恢复:\(U + R\) = 40.6 s + 46 s = 86.6 s,重新运行的 token 费用为 $0.162。
- 单次修复尝试:\(c_r\) = 4.1 s,以及 $0.010。
- 盈亏平衡点:\(p^* = c_r / (U + R)\) = 5 percent(时间),以及 6 percent(美元费用)。
结果:如果单次尝试的成功率超过约 6 percent,修复就是更划算的选择。即使假定成功率为 50 percent,先尝试修复的预期成本也仅为 47.4 s 和 $0.091,而立即回退的成本为 86.6 s 和 $0.162。
系统洞见:失败发生得越晚,补偿所丢弃的工作就越多,优先尝试修复的门槛也就越低。对于给定的失败类别,修复的可靠性是一个经验量,应按 统计评估的严谨性 所述,通过重复试验加以测量;策略应使用这一测量结果,而非假定的成功率。
防空转不变量:为前向修复轨迹设定界限
虽然前向恢复能够显著提高处理轻微语法错误和配置错误的效率,但它也使系统暴露于自回归基础模型特有的一种灾难性失效模式:修复空转。当模型在未从根本上理解底层环境状态的情况下尝试修复错误时,往往会陷入由幻觉驱动的补丁循环。模型修改表层代码语法,收到一个次生错误,再修改另一个无关参数,在消耗 token 和 API 调用配额的同时,逐渐偏离原始目标。
# Observable Trace of an Agent Repair Spin Loop (Pytest Validation Failure)
Iteration 1: ImportError: cannot import name 'AsyncSession' from 'sqlalchemy.orm'
Agent Patch 1: from sqlalchemy.ext.asyncio import AsyncSession  # Fixed import
Iteration 2: AttributeError: 'AsyncSession' object has no attribute 'sync_engine'
Agent Patch 2: engine = session.sync_engine if hasattr(session, 'sync_engine') else None
Iteration 3: TypeError: NoneType object cannot be interpreted as an integer
Agent Patch 3: from sqlalchemy.orm import AsyncSession  # Cyclical regression
Iteration 4: ImportError: cannot import name 'AsyncSession' from 'sqlalchemy.orm'
# Supervisor Intervention: Cycle detected via signature hash H(err_4) == H(err_1)为消除修复空转,运行时必须强制执行防空转不变量:任何单个逻辑子事务的连续前向修复尝试次数都不得超过固定阈值 \(K_{\text{repair}}\),且任何修复尝试序列都不得出现拓扑循环或签名循环。
该不变量通过执行上下文中维护的两种具体运行时数据结构落实:
连续修复计数器(\(k_i\)): 每个子事务 \(T_i\) 都维护一个整数计数器 \(k_i \in \mathbb{N}\),其初始值为零。当 \(T_i\) 失败且运行时选择前向恢复时,运行时会递增 \(k_i \leftarrow k_i + 1\)。在生产环境的智能体运行时中,允许的最大前向修复次数受到严格限制:
\[k_i \le K_{\text{repair}}, \quad \text{where } K_{\text{repair}} \le 3\]
如果 \(k_i > K_{\text{repair}}\),运行时便撤销模型尝试自愈的权限。监督器判定,在当前提示框架下,策略 \(\pi_\theta\) 无法在局部解决该错误,于是终止前向推进,并立即转入后向 Saga 补偿。
语义错误哈希与循环检测: 模型可能在两个互不兼容的状态之间来回振荡,耗尽其修复预算;上述轨迹就展示了这种情况,其中第三个补丁撤销了第一个补丁所做的导入更改。监督器为每次错误观测计算确定性的语义哈希:
\[\sigma(o_t^{\text{err}}) = \text{SHA-256}\left( \text{Normalize}\left( \text{type}(o_t^{\text{err}}), \text{source}(o_t^{\text{err}}), \text{signature}(o_t^{\text{err}}) \right) \right)\]
运行时将历史错误签名存储在滑动 FIFO 缓冲区 \(\mathcal{H}_i = [\sigma_1, \sigma_2, \dots, \sigma_k]\) 中,该缓冲区的作用域限定于子事务 \(T_i\)。在发出针对 \(a_{\text{repair}}\) 的推理请求之前,监督器会检查循环是否再次出现:
\[\exists \, j < k \quad \text{such that} \quad \sigma_k = \sigma_j\]
如果同一修复序列中出现两次相同的错误签名,则说明智能体生成了无实际效果的补丁或循环性补丁。运行时会立即打破循环,跳过 \(K_{\text{repair}}\) 的所有剩余递增步骤,并强制执行后向回滚。
通过强制执行防空转不变量,运行时能够限制前向自愈在最坏情况下的影响范围。如果前向修复在 \(K_{\text{repair}}\) 轮内成功,系统就能获得保留已提交状态所带来的延迟和效率收益。如果模型无法收敛,运行时则会确定性地回退到 Saga 补偿日志所提供的、经过验证的保障。
然而,这种恢复模型依赖一个隐含的架构假设:每个已提交的子事务 \(T_i\) 实际上都可以通过逆事务 \(C_i\) 进行补偿。在现实的软件部署中,这一假设经常被打破。当智能体发送未加密的电子邮件、从客户信用卡扣款,或预订不可退款的硬件资源时,这些物理操作便越过了不可逆阈值,任何后向补偿都无法恢复先前的世界状态。当智能体运行时越过这些不可返回点时,必须如何组织执行过程?
枢轴操作的不可逆性
有些影响无法由任何运行时撤销。在本地关系数据库中,未提交的事务在系统构造的隔离环境中执行;如果某个不变量失效,ABORT 命令会利用预写日志覆盖脏缓存页,并将磁盘块精确恢复到先前的位状态。然而,在自主智能体架构中,工具经常跨越独立的管理边界执行操作、通过公共网络链路发送数据包,或触发不可退款的金融清算流程。对于这些交互,经典后向恢复的基础假设,即每个前向操作 \(T_i\) 都存在一个逆操作 \(C_i\),使得 \(C_i(T_i(S)) = S\),完全不再成立。
自主智能体运行时不能将所有工具调用都视为统一且可补偿的工作单元。外部操作按可逆性划分为严格的三层体系,其中一个唯一的枢轴操作标志着结构上的不可返回点。一旦执行轨迹提交了枢轴操作,通过补偿进行后向回滚就变得不可能,迫使运行时监督器从以撤销为导向的策略转向保证前向完成或升级至运维处置的契约。
正如 Pat Helland 在《分布式事务之外的生活:一个叛教者的观点》(2007)中所指出的,自主业务组件无法跨越独立的信任边界持有锁;它们必须转而依靠记忆、消息和语义补偿来运作。
操作可逆性的三分分类体系
为管控副作用,同时避免造成不可恢复的损坏,智能体运行时必须与其工具执行代理维持明确的契约。每个已注册的工具端点都在其模式中声明自身的可逆性层级,将类型化动作契约(原则 8)从工具能够接受什么扩展到工具能够撤销什么。运行时依据工具动作的语义不变量和物理不变量,将其划分为三个不同类别。这些类别进一步细化了 H·S·A 暴露面 中的权限级别,将局限于沙箱内的可逆动作置于 \(A_1\),将可补偿的外部动作置于 \(A_2\),并将枢轴动作置于 \(A_3\)。
第一类:完全可逆动作。 如果对于动作 \(T_i\),存在确定性的逆动作 \(C_i = T_i^{-1}\),使得二者的复合执行对外部环境的可观测状态产生恒等变换,则该动作完全可逆:
\[\left(T_i^{-1} \circ T_i\right)(S) = S\]
可逆动作的特征是完全局限于本地。典型示例包括在隔离的临时工作区中暂存补丁、在本地 git 仓库中创建分支、向暂存磁盘写入临时中间文件,或在执行沙箱内分配内存缓冲区。如果智能体轨迹未能通过后续验证,运行时就会调用 \(T_i^{-1}\)(例如执行 git branch -D 或解除暂存文件的链接),将物理状态精确恢复到执行前的配置,且不留下任何外部可见的痕迹。
第二类:可补偿动作。 如果对于动作 \(T_i\),存在逆操作 \(C_i\),能够恢复系统的逻辑不变量,即使无法抹去 \(T_i\) 已经发生这一历史事实,则该动作可补偿。形式化表示为:
\[C_i\left(T_i(S)\right) \neq S \quad \text{but} \quad \mathcal{V}_{\text{semantic}}\left(C_i\left(T_i(S)\right)\right) = \mathcal{V}_{\text{semantic}}(S)\]
其中,\(\mathcal{V}_{\text{semantic}}\) 是领域状态空间上的语义等价关系。正如 Hector Garcia-Molina 和 Kenneth Salem 在其 1987 年关于 Saga 的奠基性论述中所分析的那样,补偿不会重置历史时间;它会施加一个新的正向动作,以抵消原动作对业务造成的影响。
在财务账簿中,会计人员从不会用实体橡皮擦抹去错误的借记记录;他们会记入金额相等、方向相反的贷记记录,从而保留仅可追加的审计轨迹,记录人为或计算错误。
考虑一个管理云基础设施的智能体,它创建了一个对象存储桶或配置了一个计算节点。如果整个轨迹失败,运行时无法撤销服务器曾存在三分钟这一时间事实;不过,调用云提供商的 DELETE 端点可以移除服务器、停止资源计费,并将基础设施账簿恢复到语义上干净的状态。类似地,向客户信用卡扣款的智能体无法撤回已发送的支付网关授权数据包,但可以执行退款交易。客户的账单会记录这两笔交易,以留下可见的历史变动为代价,实现财务上的净额归零。
第三类:不可逆动作/枢轴动作。 如果对于动作 \(T_i\),目标领域中不存在任何计算意义上的逆操作或补偿操作,则该动作不可逆,并被指定为枢轴动作(\(T_{\text{pivot}}\)):
\[C_i = \emptyset\]
枢轴动作一旦执行,就会向外部状态空间提交不可更改的变更。示例包括向外部邮件列表发送电子邮件、向公共注册中心发布已编译的软件二进制文件、删除生产环境中的主数据库表且同时清理其物理备份,或完成向外部银行的电汇结算。枢轴动作的 RPC 一旦完成,世界就永久地向前推进了。智能体运行时既无法回滚该动作,也无法施加自动化的反向动作来抵消其影响。
表 4 汇总了约束这三个层级的操作契约、副作用特征和恢复协议。
| 可逆性层级 | 可逆性契约 | 典型工具调用 | 可观测的残留 | 运行时恢复策略 |
|---|---|---|---|---|
| 第一类:可逆 | \(T_i^{-1} \circ T_i = I\) | 文件暂存、git checkout、沙箱内存分配 | 无(状态在物理层面被清除) | 通过直接执行逆操作实现精确的反向回滚 |
| 第二类:可补偿 | \(\mathcal{V}_{\text{sem}}(C_i \circ T_i) = \mathcal{V}_{\text{sem}}(I)\) | Stripe 扣款/退款、云 VM 配置、数据库软删除 | 不可更改的审计痕迹、短暂的资源计费 | 通过已注册的 Saga 处理程序实现语义上的反向补偿 |
| 第三类:枢轴/不可逆 | \(C_i = \emptyset\) | 向外部发送电子邮件、生产环境 DNS 切换、电汇 | 在运行时外部可观测到的永久影响 | 单调向前推进、确定性重试或升级至运维人员处理 |
枢轴动作边界
由于不可逆操作无法撤销,智能体运行时不能允许枢轴操作在长期计划中任意交错执行。如果智能体执行了三个枢轴操作,且其间穿插着未经验证的可补偿操作,那么第四步发生故障时,系统就会陷入无法恢复的混合状态:部分内容已发布、部分费用已计收,而且在结构上无法回滚。
为防止这种状态爆炸,运行时强制执行枢轴操作边界不变量,这是枢轴边界与补偿式 Saga 的核心排序规则(原则 14)。在任何有效的可执行轨迹 \(\mathcal{T} = (T_1, T_2, \dots, T_n)\) 中,最多只能存在一个枢轴事务,记为 \(T_{\text{pivot}} = T_k\)。这一操作将整个执行生命周期划分为两个结构上截然不同的运行阶段:
\[\mathcal{T} = \underbrace{\left(T_1, T_2, \dots, T_{k-1}\right)}_{\text{Preparation Phase (Compensable)}} \;\xrightarrow{\quad T_k = T_{\text{pivot}}\quad}\; \underbrace{\left(T_{k+1}, T_{k+2}, \dots, T_n\right)}_{\text{Finalization Phase (Retriable / Idempotent)}}\]
这两个阶段的架构特性决定了故障恢复引擎的行为:
- 准备阶段(\(i < k\)): 枢轴操作之前的每个子事务都必须属于 I 类(可逆)或 II 类(可补偿)。在此阶段,运行时维护一份活跃的补偿日志 \(\mathcal{L}_{\text{comp}} = [C_{i-1}, \dots, C_1]\)。如果任何不变量不再成立、工具返回未处理的错误,或模型的推理违反安全护栏,运行时就会执行反向回滚。监督器按逆序逐项处理并清空 \(\mathcal{L}_{\text{comp}}\),系统性地抵消每项临时变更,直至系统恢复到初始基线状态。不会有任何永久性副作用泄漏到外部环境中。
- 枢轴步骤(\(i = k\)): 枢轴事务代表执行过程中的原子性临界点。在派发 \(T_{\text{pivot}}\) 之前,运行时必须验证所有前置条件均已满足、所有临时租约均处于有效状态,且所有枢轴之后的操作都有经过验证的执行路径。如果策略要求人工签名,枢轴操作还须经过 审批关卡 中的托管协议。派发 \(T_{\text{pivot}}\) 时,必须同步写入预写日志(WAL),将轨迹状态从
STATUS_PREPARING转换为STATUS_COMMITTED。 - 收尾阶段(\(i > k\)): 一旦 \(T_{\text{pivot}}\) 成功返回,反向回滚就会被禁用。运行时会删除或停用补偿日志 \(\mathcal{L}_{\text{comp}}\)。枢轴之后的每项操作都必须满足保证完成属性:其设计必须支持重试,并且严格幂等。如果步骤 \(T_{k+1}\) 因网络超时或外部服务降级而失败,运行时不能放弃并回滚;它必须持续重试、执行前向自愈,或切换到预编译的确定性后备例程,直至整个轨迹成功结束。
Example 0.1: 双重提交陷阱与枢轴分配
- \(T_1\):在两个云可用区中配置 16 个 \(\times\) H100 GPU 实例(II 类:可通过云 API 终止实例来补偿;费用为 $5.50/分钟)。
- \(T_2\):运行预检矩阵乘法验证,并预热模型的 PagedAttention KV 缓存(I 类:可逆;内部计算)。
- \(T_3\):将新配置的实例注册到全局 Anycast 边界网关协议(BGP)路由网格中,使服务能够接收公共互联网流量(III 类:枢轴操作;外部流量会立即到达这些节点)。
- \(T_4\):执行管理迁移脚本,更新全局服务目录数据库(II 类:可通过数据库回滚来补偿)。
- \(T_5\):向外部合规报告登记系统发送经过密码学签名的审计 webhook(III 类:不可逆的外部传输)。
架构缺陷: 该计划包含两个枢轴动作(\(T_3\) 和 \(T_5\)),二者之间隔着一个可能失败的操作(\(T_4\))。假设智能体成功执行了 \(T_3\);此时,公开的生产流量已开始进入新集群。当智能体尝试执行 \(T_4\) 时,数据库迁移因模式死锁而失败。如果运行时尝试向后回滚,就会遇到 \(T_3\)。它无法撤回已经在该集群上执行的公开客户端请求的路由;这些事务已经向最终用户返回了响应。反之,如果它尝试终止轨迹,\(T_5\) 就永远不会执行,从而违反监管合规要求,并使集群滞留在无人监控的状态。
结构性补救措施: 运行时监督器在执行前,通过将本地注册与公开激活解耦,重新排列事务图:
- 步骤 1:配置实例(\(T_1\),可补偿)。
- 步骤 2:预热 KV 缓存并验证(\(T_2\),可逆)。
- 步骤 3:在临时托管模式下运行数据库迁移(\(T_4'\),可逆/可补偿)。
- 步骤 4:将合规 webhook 载荷暂存于本地内存托管区(\(T_{5,\text{stage}}\),可逆)。
- 步骤 5:激活公开 Anycast 路由,并通过原子发件箱模式发送暂存的 webhook(\(T_{\text{pivot}}\))。
通过将真正的不可逆点移至最后一步,可以最大限度地缩小故障影响范围。如果数据库迁移在步骤 3 期间失败,便通过 \(C_1\) 干净地释放实例,公开流量的丢弃量为零,也不会产生任何无效的合规记录。
Systems Perspective 0.1: 枢轴点与不可逆动作执行的不对称性
许多外部操作具有严格的不可逆性。一旦智能体向客户发送电子邮件、切换生产 DNS 记录、转移加密代币,或广播对公开 API 的修改,任何补偿事务都无法撤回已发送的字节,也无法逆转外部已经观察到的结果。Garcia-Molina 的 Saga 模式通过枢轴事务这一概念承认了这种不对称性:它是执行轨迹从可补偿的准备阶段转入不可逆提交阶段的唯一原子边界。
然而,随机性基础模型并不具备对这一物理边界的内在认知。仅以序列生成为条件的模型会轻易地将不可逆变更穿插在探索性规划链中,在验证本地前置条件之前就发出外部 API 调用。如果步骤四在步骤一和步骤三已经提交外部影响后失败,运行时就会陷入无法化解的状态:既无法向后回滚,又无法继续向前执行。
系统洞见:可逆性是环境的属性,而非提示词的属性。高可靠性智能体运行时必须通过监督器的结构化编译来强制落实枢轴动作边界:对提议的动作 DAG 进行拓扑排序,使所有可逆和可补偿操作先执行,并将唯一不可逆的枢轴步骤隔离在最终提交的确切位置。
终止升级处理
尽管具备稳健的正向自愈机制,在开放世界中运行的自主系统最终仍会遭遇导致执行终止的偏离。枢轴点之后的步骤可能遇到不可恢复的情况:外部 API 端点在轨迹执行中途更改其身份验证机制,必需的下游服务发生跨多个区域的中断,或者枢轴点之前的回滚中的某个补偿动作 \(C_j\) 抛出未处理的 500 Internal Server Error,破坏补偿链本身。
在这些情况下,模型通过“幻觉”构造恢复路径的任何自动化尝试,都会带来不可接受的风险,使破坏进一步加剧。智能体运行时必须执行确定性的终止升级处理协议。
终止升级处理的基本原语是智能体控制块(ACB)冻结。该机制直接仿照操作系统在硬件机器检查异常下挂起进程控制块的方式:运行时监督器拦截发生故障的执行线程,并以原子方式停止所有后续模型推理和工具调度。
智能体控制块包含冻结的执行状态:词元上下文窗口、KV 缓存指针、工具授权令牌、已打开的网络套接字,以及事务日志中的精确偏移量。
ACB 冻结的状态转换受一项严格的不变式约束:当执行停滞并等待人工干预时,不得保留任何有效的能力或环境隐含权限。运行时执行以下四个不可妥协的隔离步骤:
- 托管与令牌撤销:运行时立即撤销智能体的短期 OAuth 凭证和 IAM 会话令牌。工具访问能力被锁定,防止任何后台线程或异步回调继续发起外部变更。
- 将状态持久化至事件隔离存储:运行时将智能体的完整内存上下文序列化。此快照包括原始 token 序列、提示组装历史、触发异常的确切工具调用参数、失败 RPC 的完整标准错误输出,以及 Saga 事务日志中的精确偏移量 \(\mathcal{L}_{\text{Saga}}\)。
- 残留状态分类:监督器根据故障发生点相对于 \(T_{\text{pivot}}\) 的位置进行评估:
- 如果故障发生在枢轴点之前,且由补偿器崩溃 \(C_j\) 引起,则将该状态标记为
FAIL_COMPENSATION_CORRUPTED。系统记录仍然存在且尚未补偿的资源(例如孤立的云磁盘),以防止资源泄漏。 - 如果故障发生在枢轴点之后,则将该状态标记为
FAIL_POST_PIVOT_STALLED。系统记录已提交的不可逆变更,并标记所有未完成的下游步骤。
- 如果故障发生在枢轴点之前,且由补偿器崩溃 \(C_j\) 引起,则将该状态标记为
- 通过带外通道呼叫运维人员:运行时通过带外运维通道(例如内部告警总线或 PagerDuty 事件流),向人类系统工程师发送结构化事件载荷。
def freeze_agent_control_block(acb: AgentControlBlock, err: ToolException) -> None:
    # Atomically halt trajectory and strip ambient authority
    acb.execution_state = State.ESCALATED_FREEZE
    acb.credential_broker.revoke_all_leases(acb.session_id)

    # Classify failure regime relative to the pivot boundary
    failure_mode = (FailureMode.POST_PIVOT_STALLED if acb.wal.has_committed_pivot()
                    else FailureMode.COMPENSATION_CORRUPTED)

    incident_record = IncidentPayload(
        session_id=acb.session_id,
        failure_mode=failure_mode,
        wal_offset=acb.wal.current_offset,
        failed_tool=err.endpoint,
        error_context=err.payload,
        frozen_context_uri=acb.storage_broker.snapshot_context(acb.context)
    )
    acb.alert_router.emit_critical_incident(incident_record)
这里的系统设计原则体现了 Saltzer 和 Kaashoek 的端到端论证:当软件监督器的内部恢复契约遭到违反时,安全性不得依赖基础模型未经验证的概率性推理。通过冻结 ACB、移除环境中隐式可用的凭据,并向人工管理员明确呈现确切的事务边界,智能体运行时限制了意外环境故障的影响范围。
通过强制执行枢轴动作边界,运行时保证智能体在越过不可逆点后绝不尝试向后回滚。但这一设计也引入了一个同样棘手的问题:如果智能体在执行枢轴动作后无法回滚,它就必须自我修复并推动执行继续向前。当外部系统开始出现故障时,运行时如何区分正在为解决问题取得可衡量进展的模型,与陷入语义无限循环的智能体——后者不断消耗 token、发出反复振荡的工具调用,并耗尽 API 配额,却未推动系统的实际状态前进?
语义看门狗定时器
执行自回归解码循环的计算线程会占用分配给它的 GPU 张量核心计算资源的 100%,在受内存带宽限制的 token 生成阶段使高带宽内存(HBM)通道饱和,以固定时间间隔通过 POSIX 套接字发出语法有效的 JSON-RPC 工具调用,并始终响应主机监督心跳。对于主机操作系统内核、容器 cgroup 子系统以及编排平面的 /healthz HTTP 探针而言,这一推理进程堪称运行活跃的典范。然而,若以更广泛的分布式任务的状态收敛目标来评估,该智能体却已陷入灾难性的死锁。模型在缺乏依据的情况下尝试解决编译器语法错误:它修改配置文件的第 42 行,检查由此产生的测试失败,将第 42 行恢复到原始状态,再次遇到最初的故障,并在数十轮中重复这一循环。传统操作系统的活性监视器仅关注活动的缺失;而陷入语义无限循环的智能体系统则因过量且无法推动进展的活动而失效,图 3 中的状态哈希振荡模式说明了这一点。
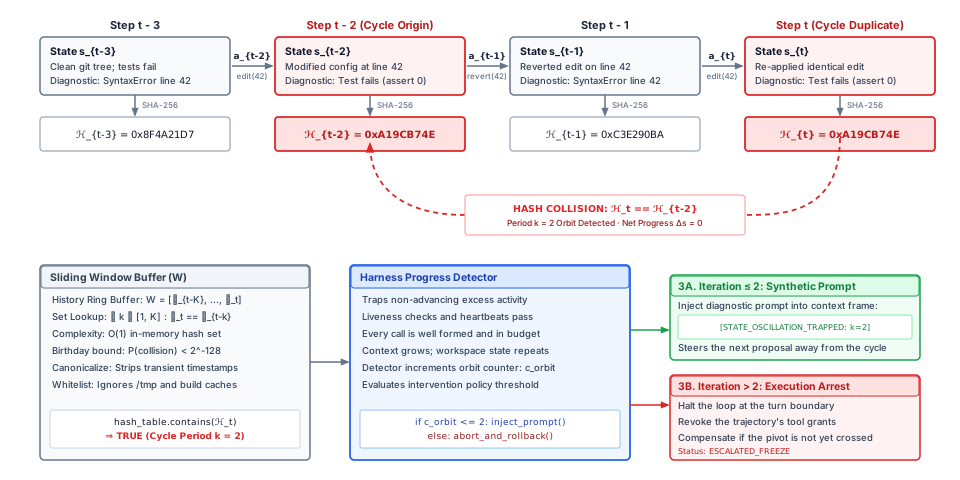
这一循环检测器的架构机制可沿 图 3 的上下两层追踪。在上层轨迹记录中,主机运行时在每一步捕获确定性的环境快照 \(\mathbf{s}_i\),对目录树和配置文件进行规范化处理,以消除瞬态文件系统时间戳的影响,并将结果映射为一个 256 位密码学摘要 \(\mathcal{H}_i\)。在步骤 \(t-2\),智能体修改配置文件的第 42 行,生成摘要 \(\texttt{0xA19CB74E}\);在步骤 \(t-1\) 遇到同样的测试失败后,它撤销修改,恢复摘要 \(\texttt{0xC3E290BA}\);在步骤 \(t\),它再次对第 42 行应用完全相同的修改,重新生成相同的状态摘要 \(\mathcal{H}_t = \texttt{0xA19CB74E}\)。如下层所示,监督器维护一个由内存哈希集合支持的滑动历史窗口 \(W = [\mathcal{H}_{t-K}, \dots, \mathcal{H}_t]\),从而能够进行 \(O(1)\) 碰撞检查,即时捕获重复出现的轨道(\(\mathcal{H}_t == \mathcal{H}_{t-2}\),周期为 \(k=2\))。语义仲裁器会拦截轨迹,避免自回归解码循环无限期消耗 GPU 张量核心资源:对于最初出现的循环(\(c_{\text{orbit}} \le 2\)),它将合成诊断警报([STATE_OSCILLATION_TRAPPED: k=2])直接注入模型的上下文帧,以强制进行策略探索;而持续振荡(\(c_{\text{orbit}} > 2\))则会触发执行中止,移除沙箱凭据(ESCALATED_FREEZE),并在轨迹尚未越过枢轴点时启动 Saga 向后回滚。
语义监控的核心系统论点: 传统的进程心跳仅验证计算与传输的活性,而不验证计算的效用。因此,为限制不收敛的推演对资金、电力和内存的消耗,运行时必须根据环境而非心跳来判断进展(原则 12),并针对环境状态哈希、外部验证指标和动作熵,强制执行显式且可在数学上验证的进展不变量。
传统操作系统活性探测的失效
在传统操作系统和分布式运行时中,活性被建模为线程或进程的一种二元属性。如果一个子系统在有界的时间间隔 \(\Delta t\) 内发生状态转换,就认为它具有活性。系统守护进程向系统监督程序注册周期性的保活信号(例如,sd_notify("WATCHDOG=1"),用于 Linux systemd),而分布式调度器则通过 TCP 查询容器健康端点。如果进程在内核空间进入无限循环、在 POSIX 互斥锁上发生死锁,或因对被阻塞的网络套接字执行读取而挂起且始终得不到响应,心跳就会停止。硬件看门狗定时器或主机监督程序随即触发,引发不可捕获的 SIGKILL,释放文件描述符,并重新调度容器。
对于陷入循环的模型,这一架构假设不再成立。执行前向传播的推理引擎并不会在指令指针层面停滞。每个 token 生成步骤都是一次常规的矩阵—向量乘法(\(\text{GEMV}\)),以稳定的节奏从高带宽内存中流式读取权重,因此,陷入循环的模型看起来与有效工作的模型同样忙碌。只要推理服务器(如 vLLM 或 SGLang)与主机上的智能体监督程序交换格式正确的远程过程调用(RPC)消息,所有标准的传输层看门狗都会判定正常。这就是从监督程序视角观察到的 Fail-Plausible 故障模型 的“故障表现似正常”故障模型:该进程在所有活性指标上都表现健康,却在所有任务指标上都表现错误。
运行健康与任务进展之间的背离,呼应了 Martin Rinard 的《面向可接受性的计算》(2003)的核心洞见:传统软件工程预设,系统要么按照理想化的确定性规范执行,要么崩溃。然而,当现实系统遇到未建模的状态空间时,将所有未崩溃的执行都视为可接受,会使软件在退化且无产出的循环中无限消耗资源。在智能体架构中,这种失效模式表现为智能体内部推理上下文与外部环境之间的认知鸿沟。由于自回归上下文窗口会随着每一轮交互扩展,智能体的注意力机制会持续接触新内容:每一轮都会追加新的推理 token、新的工具执行轨迹以及更新后的错误载荷。智能体由此产生一种局部的、自我强化的前进错觉,而其外部环境仍被困在封闭的循环轨道中。
可量化的语义进展不变量
为恢复确定性的活性保证,监督程序必须监控外部环境,而非模型的内部推演。运行时建立一个语义看门狗,拦截每个拟执行的动作,并依据三个可量化的进展不变量评估由此产生的状态转换:状态哈希单调性、指标单调性和动作熵。
将智能体的轨迹形式化为一个离散步骤序列 \(t \in \{1, 2, \dots, n\}\)。在每一步,运行时捕获系统状态元组 \(S_t = \langle \mathbf{s}_t, a_t, o_t \rangle\),其中,\(\mathbf{s}_t\) 表示目标环境的确定性快照(沙箱工作目录、数据库状态或配置清单),\(a_t\) 表示拟执行的工具动作,\(o_t\) 表示执行沙箱返回的环境观测。
状态哈希单调性与循环检测: 运行时维护一个容量有界的历史环形缓冲区 \(W = [\mathcal{H}_{t-K}, \dots, \mathcal{H}_{t-1}]\),存储环境状态的密码学哈希: \[\mathcal{H}_t = \text{SHA-256}(\text{Canonicalize}(\mathbf{s}_t))\] 规范化函数对文件树排序,去除文件系统中的临时时间戳,并将数据库记录格式化为确定性的字节流。在每一步 \(t\),看门狗查询历史窗口 \(W\)。若满足以下条件,则检测到周期为 \(k\) 的语义循环: \[\exists k \in [1, K] \quad \text{such that} \quad \mathcal{H}_t = \mathcal{H}_{t-k}\] 由于 SHA-256 提供了一个 256 位的抗碰撞映射,两个不同的物理环境状态产生相同哈希的概率上界为 \(2^{-128}\)(依据生日界),因此,循环检测误报在数学上可以忽略不计。当 \(\mathcal{H}_t = \mathcal{H}_{t-k}\) 时,智能体已执行 \(k\) 个修改状态的动作,而这些动作对外部系统造成的净变化为零。
指标单调性: 在复杂的软件工程任务中,编辑临时文件、运行代码检查工具或更新日志输出时,环境状态哈希值自然会发生变化。因此,不同的状态哈希值并不能保证任务收敛。运行时跟踪由确定性宿主验证器输出的外部验证指标向量 \(\mathbf{m}_t = \langle m_1(\mathbf{s}_t), m_2(\mathbf{s}_t), \dots, m_p(\mathbf{s}_t) \rangle\),例如通过的单元测试数量、编译器错误数量或静态分析诊断信息数量。要取得进展,指标向量必须在长度为 \(E\) 的周期内呈现非负方向导数: \[\Delta \mathbf{m}_{t, t-E} = \mathbf{m}_t - \mathbf{m}_{t-E} \not\le \mathbf{0}\] 如果智能体连续执行 \(E\) 次修改状态的操作,却未使至少一个目标指标产生正向增量(或者更糟,在 \(m_{\text{pass}} = 4\) 与 \(m_{\text{pass}} = 3\) 之间振荡),看门狗就会判定指标停滞。
动作熵与语法重复: 甚至在动作执行之前,运行时就会分析拟执行动作 \(a_t\) 的语法和语义结构。运行时为工具调用计算一个快速的 64 位非密码学哈希值: \[h_{\text{tool}}(a_t) = \text{xxHash64}(\text{tool\_identifier} \parallel \text{CanonicalJSON}(\text{arguments}))\] 如果 \(h_{\text{tool}}(a_t) = h_{\text{tool}}(a_{t-k})\),且其间的观测 \(o_{t-k}\) 返回了未处理的错误(例如
ENOENT: File not found或HTTP 403 Forbidden),则说明智能体正在重新发出已知无效的请求。此外,监督器还会跟踪思维链暂存区的词元熵;词元多样性骤降通常表明自回归采样器已进入退化的模式坍塌状态(表 5)。
| 不变式类型 | 检测机制 | 主要检测目标 | 跟踪开销 | 误报缓解措施 |
|---|---|---|---|---|
| 状态哈希单调性 | 滑动窗口 SHA-256 表(\(W\)) | 可逆振荡(\(\mathbf{s}_t \to \mathbf{s}_{t-1} \to \mathbf{s}_t\)) | 通过哈希集合进行 \(O(1)\) 查找;以 \(O(B)\) 的开销对 \(B\) 个状态字节进行哈希计算 | 将非确定性目录列入白名单(/tmp、日志) |
| 指标单调性 | 周期 \(E\) 内的严格帕累托增量(\(\Delta \mathbf{m}\)) | 在测试与代码检查工具之间反复切换而无法收敛 | 仅在测试套件执行期间产生 | 允许有界的探索性退步(\(E_{\text{grace}}\) 步) |
| 动作语法等价性 | 对规范化后的 JSON-RPC 进行精确匹配 | 重复调用失败的命令 | \(O(1)\) 字符串规范化与整数比较 | 当参数包含动态随机数时跳过检测 |
| 语义嵌入漂移 | 余弦距离 \(1 - \frac{e(a_t) \cdot e(a_{t-k})}{\lVert e(a_t) \rVert \lVert e(a_{t-k}) \rVert}\) | 通过改写措辞形成的推理循环和重新表述的提示 | 小型矩阵与向量的点积(\(d \le 1536\)) | 设置保守的相似度阈值(\(\cos \theta \ge 0.96\)) |
以下代码清单展示了智能体监督器用于强制保证状态哈希单调性的具体环形缓冲区循环检测器:
def check_state_hash_invariants(history: list[str], current_hash: str, max_period: int) -> int | None:
    # Scan backward through sliding window to detect cyclic state oscillations
    window = history[-max_period:] if len(history) >= max_period else history
    for distance, past_hash in enumerate(reversed(window), start=1):
        if past_hash == current_hash:
            return distance  # Returns cycle period k (e.g., 1 for no-op, 2 for flip-flop)
    return None
粗略估算 0.3: 未被检测到的循环会造成多大成本
变量:
- 进入循环的第一轮发送 \(s_0\) = 1,000 个 token。每轮生成 300 个输出 token,并追加一条长度为 800 个 token 的错误信息,因此重新发送的上下文每轮增长 \(\Delta\) = 1,100 个 token。
- 一轮的模型调用和工具运行耗时为 10 s。
- 预算的轮次上限为 50,状态哈希检测器在第 4 轮发现重复。
- 价格采用上文修复笔记本中的示例价格,且不使用前缀缓存。
计算:
- \(n\) 轮的输入 token 总量遵循与 预算与上限 中预算示例相同的等差数列:\(n \cdot s_0 + \Delta \cdot n(n-1)/2\)。
- 运行至上限:1,397,500 个输入 token,$4.42,耗时约 8 分钟。
- 启用检测:10,600 个输入 token,$0.05,耗时 40 秒。
结果:在首次出现重复状态时停止循环,其成本约比让轮次上限终止循环低 89×。
系统层面的洞见:循环的成本随其长度的平方增长,因为每轮都会重新发送被循环不断扩大的上下文。正如 预算与上限 中的预算示例所示,前缀缓存降低了每个重新发送的 token 的价格,但不会减少轮次或耗时。轮次上限约束了最坏情况,而只有进展信号才能让典型循环保持较短的长度。这对整个集群中每个成功解决的任务的成本有何影响,可通过 轨迹有效吞吐与算力浪费 中的有效吞吐量计算来理解。检测器的作用是将提前停止的时机从任意一轮移至首次出现重复状态之时。
看门狗干预协议
检测到不变量违反仅满足了架构要求的一半;运行时还必须为干预定义确定性的状态机语义。静默丢弃智能体的工具调用会使自回归解码循环处于未定义状态。运行时实现了一套三级干预协议,旨在恢复成本与轨迹终止之间进行权衡,详见 表 6。
| 干预级别 | 触发条件 | 监督机制 | 恢复延迟与成本 | 失败后的下一步操作 |
|---|---|---|---|---|
| 第 1 级:上下文中断 | 首次检测到循环或状态哈希碰撞(\(N_{\text{iter}} \le 2\)) | 将合成的警告观测(\(o_t^{\text{watchdog}}\))直接注入 LLM 提示流。 | 亚毫秒级;回滚成本为 0 个 token | 若循环持续 2 轮,则升级至第 2 级 |
| 第 2 级:检查点回溯 | 持续振荡;第 1 级中断后仍无法收敛 | 将物理沙箱回退至检查点快照 \(\mathbf{s}_{t-k}\);裁剪失败的上下文轮次并应用动作掩码。 | \(10 - 250\ \text{ms}\);从干净的检查点重新计算 \(k\) 轮 | 若回滚后恢复失败,则升级至第 3 级 |
| 第 3 级:终止执行 | 不可恢复的死锁;循环性退化超过预算阈值 | 停止执行,抛出 ERR_SEMANTIC_DEADLOCK,撤销能力;在枢轴点之前执行补偿,在其之后冻结。 |
完全冻结轨迹;发出审计告警 | 升级至人工介入流程 / 事后分析队列 |
第 1 级:合成上下文中断(认知冲击): 首次标记状态哈希碰撞(\(\mathcal{H}_t = \mathcal{H}_{t-k}\))或语法层面的动作循环时,监督器会在将动作分派到物理沙箱之前拦截执行流水线。监督器生成合成观测载荷 \(o_t^{\text{watchdog}}\),并将其直接追加到模型的上下文流中: >
[SYSTEM ALERT: SEMANTIC_WATCHDOG_INTERRUPT]>Action rejected by host supervisor. Invariant failure: STATE_OSCILLATION_DETECTED.>Your proposed action returned the environment to an identical state observed at step t-2.>You are trapped in an unproductive loop. Do NOT repeat the previous command.>Formulate an alternative hypothesis or verify underlying environmental assumptions.这种合成观测利用了模型的上下文条件化机制。通过在提示中插入一条高度显著的错误信息,运行时强制改变后续解码步骤的注意力权重,打破驱动循环的自回归自我强化机制。第 2 级:轨迹回溯与动作屏蔽: 如果智能体在第 1 级中断后仍未收敛——在一个包含 3 个步骤的周期内,输出了触发第二次不变量违规的动作——监督器就会升级处置。运行时访问预写日志(WAL),找到循环开始前的检查点快照 \(\mathbf{s}_{t-k}\),并将物理沙箱文件系统回退到该检查点。与此同时,运行时重写逻辑对话历史:从上下文窗口中截去失败且陷入循环的轮次,并插入一个墓碑标记,将失败动作的签名 \(h_{\text{tool}}(a_t)\) 从智能体的动作空间中永久屏蔽。
第 3 级:终止中止与 Saga 升级处置(
ERR_SEMANTIC_DEADLOCK): 如果智能体耗尽了分配给它的回溯预算,看门狗就会发出不可屏蔽的轨迹终止指令。运行时抛出ERR_SEMANTIC_DEADLOCK,撤销智能体的临时能力令牌,释放所有已获取的 POSIX 文件锁和数据库锁,并将该轨迹的预写日志发送给人工运维人员。如何处理外部副作用,取决于轨迹相对于其枢轴点所处的位置。在枢轴点之前,运行时按逆序执行补偿日志(\(\mathcal{L}_{\text{comp}}\))中注册的补偿操作,使更大范围的分布式系统恢复到一致且静止的状态。在枢轴点之后,该日志已被退役,补偿也不再可用,因此运行时进入 节 4 的终止升级处置路径,冻结智能体控制块,并将已提交的状态移交给运维人员。
当语义看门狗成功地将局部推理循环限制在隔离的执行沙箱内时,一种范围更广的分布式故障模式便会在外部网络服务的边界处显现。在许多生产环境故障中,智能体无法推进状态,并非由内部算法循环或模型幻觉导致,而是由外部依赖导致的——例如第三方支付网关、制品仓库或代码格式化守护进程——这些依赖可能出现延迟升高、间歇性 HTTP 503 错误或静默网络分区。在朴素的前向恢复机制下,智能体观察到工具 RPC 失败时,会将故障理解为需要解决的环境障碍,随即重新发送修改过的请求,或持续密集地请求故障端点。当这种行为在数百条并发智能体轨迹中叠加时,这些缺乏协同的自主重试就会触发灾难性的重试风暴,压垮已经退化的上游基础设施。我们应如何设计执行网关,才能隔离故障工具依赖,通过带有去相关抖动的指数退避减轻重试压力,并在外部服务中断级联波及智能体运行时之前卸载负载?
工具熔断器
熔断器在连续三次外部超时后触发,保护下游基础设施免受重试风暴影响。
当外部工具依赖出现暂时性性能退化时,不受约束的自主智能体会成为病态的流量放大器。传统的客户端—服务器软件通常会向用户呈现错误,或执行确定性的、有界的重试脚本;与之不同,由自回归模型引导的智能体会将工具失败视为需要解决的环境难题。如果代码仓库 API 因锁争用而拒绝提交,或者外部搜索服务返回 HTTP 503 服务不可用状态,智能体的生成策略 \(\pi_\theta\) 就会立即摄取其观测上下文 \(o_t^{\text{err}}\) 中的失败文本,并合成一个修改后的工具调用 \(a_{t+1}\)。模型可能调整空白字符、置换查询词元、重排参数,或者基于第二次尝试可能成功这一随机性假设,重复完全相同的调用。当数百条并发智能体轨迹在企业集群中运行时,这种自主解决问题的反射行为会将上游的轻微异常转化为灾难性的、自我造成的拒绝服务事件,即重试风暴。
运行时不能依赖模型的内部判断来停止对濒临崩溃的外部服务进行密集请求。由于模型不具备任何环境隐式权限,也无法直接获知网络套接字状态、套接字队列深度或远程服务器健康状况,宿主运行时必须在无特权智能体与外部工具基础层之间插入一层防御性流量整形机制。这种防御需要三种互补机制:三态熔断器,用于切断与故障服务的连接并快速失败;带有全抖动的指数退避,用于打破并发智能体之间的相位同步;以及舱壁隔离,用于划分宿主资源,防止挂起的外部 API 耗尽关键本地执行线程所需的资源。
智能体引发的重试风暴剖析
由智能体驱动的重试风暴,其形成机制直接源于模型的自回归生成循环与分布式服务的排队动态之间的不匹配。考虑一个上游微服务,其服务容量为每秒 \(C\) 个请求,标称往返延迟为 \(L_{\text{nom}} = 50\text{ ms}\)。在正常运行条件下,智能体轨迹会调用此工具,在远程过程调用(RPC)的网络传输期间暂停解码循环,接收结构化 JSON 响应,并将结果追加到上下文窗口中。
现在假设远程服务出现短暂的性能下降,导致延迟骤增至 \(L_{\text{degraded}} = 2000\text{ ms}\),或开始丢弃传入请求中的 \(\epsilon\)。在标准分布式架构中,客户端 SDK 采用固定的重试次数,例如最多重试三次,之后便将顶层应用工作流判定为失败。然而,在智能体架构中,重试循环由基础模型的上下文窗口调节。当工具执行框架返回错误字符串(例如 {"error": "Gateway Timeout", "code": 504})时,模型不会将该字符串理解为不可逾越的运行障碍,而是将其视为对话反馈。
[Trajectory-042] Tool invocation failed: HTTP 504 Gateway Timeout (elapsed: 5002ms)
[Trajectory-042] Agent synthesized alternative: search_index(query="v2 auth patch", retry=True)
[Trajectory-118] Tool invocation failed: HTTP 503 Service Unavailable (elapsed: 5001ms)
[Trajectory-118] Agent synthesized alternative: search_index(query="auth patch v2", timeout=10)
由此形成的反馈循环在数学上呈现出恶性特征。如果 \(N\) 条活跃的智能体轨迹各自都观测到工具故障,它们的生成策略就会在短短几次前向解码过程中产生 \(N\) 个新的工具请求。由于 LLM 生成的 token 时间间隔仅为数十毫秒,而外部服务器队列的清空则需要数秒,工具网关处的总到达率 \(\lambda_{\text{in}}\) 会急剧上升:
\[\lambda_{\text{in}} = \sum_{j=1}^{N} \frac{1}{\Delta t_{\text{decode}} + L_{\text{degraded}}}\]
随着延迟 \(L_{\text{degraded}}\) 增大并接近网关的客户端超时阈值 \(T_{\text{timeout}}\),宿主运行时中被阻塞的执行线程不断累积。一旦到达率超过处理能力(\(\lambda_{\text{in}} > C\)),远程服务的队列长度就会无限增长,进而在上游依赖中引发内部缓冲区溢出、连接重置和线程池耗尽。
更糟糕的是,标准的智能体提示设计经常要求模型“如果工具失败,就尝试其他方法”。模型会忠实地遵循这一指令,改写工具调用、扩展查询字符串,或尝试访问同一个后端数据库的其他同类端点。因此,智能体轨迹充当了对抗性负载生成器,将语义灵活性变成绕过简单字符串匹配去重缓存的手段,并将本已不堪重负的依赖服务推向彻底失效。
快速失败观测语义 当熔断器触发并进入断开状态时,宿主运行时会立即合成一条 ERR_CIRCUIT_OPEN 观测。这一合成的 token 序列会明确告知模型,物理网络访问已被切断,从而停止进一步重试,并迫使轨迹转入替代方案或轨迹 Saga 补偿路径。
三态熔断器
为保护上游依赖并节省宿主计算资源,运行时实现了 Michael Nygard 提出的熔断器模式,并将其与随机流量整形紧密结合。工具执行网关为每个外部 RPC 接口封装一个有状态的软件代理,在滑动执行窗口内监测执行结果遥测数据。其运行架构和数学动态如 图 4 所示。
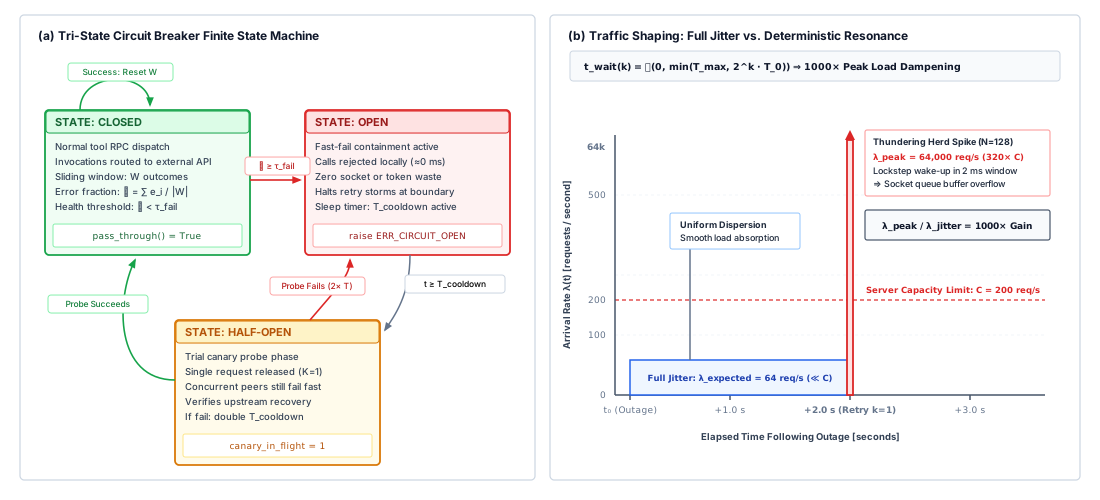
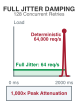
熔断隔离与流量整形构成的双重防御详见 图 4。子图 (a) 展示了控制上游工具 RPC 接口的有限状态机。在闭合状态下,工具调用不受阻碍地通过,网关则在滑动窗口 \(W\) 内记录二元执行遥测数据。当观测到的错误比例 \(\mathcal{E}\) 超过临界阈值 \(\tau_{\text{fail}}\) 时,熔断器触发并进入断开状态,立即切断物理套接字连接,并在本地快速生成拒绝结果(ERR_CIRCUIT_OPEN,耗时 \(\approx 0\text{ ms}\)),使工作线程完全免受阻塞超时级联的影响。冷却窗口 \(T_{\text{cooldown}}\) 到期后,熔断器进入半开状态,仅允许一个金丝雀请求(\(K_{\text{canary}} = 1\))在途,以测试远程服务的可用性,同时其他并发请求继续快速失败;金丝雀请求成功后,滑动窗口会被重置,熔断器返回闭合状态,而金丝雀请求失败则会使其立即返回断开状态,并将冷却退避时间按指数方式加倍(\(2 T_{\text{cooldown}}\))。与此同时,子图 (b) 说明了为何熔断器必须与随机流量整形配合使用:如果 128 个因上游服务中断而重试的智能体采用确定性指数退避(\(2^k T_0\)),它们就会在一个 2 毫秒的调度窗口内同步唤醒,产生破坏性的 \(64{,}000\text{ req/s}\) 惊群脉冲尖峰,彻底冲垮服务器每秒 200 个请求的容量上限。引入全抖动(\(t_{\text{wait}} \sim \mathcal{U}(0, \min(T_{\max}, 2^k T_0))\))后,重试请求总量会在时间上均匀分散,使预期到达率仅为 \(64\text{ req/s}\),即负载降低 \(1000\times\),从而让上游服务能够平稳恢复,避免队列缓冲区溢出。
在 闭合 状态下,代理允许智能体轨迹发出的所有工具调用通过,并转发至外部网络服务。网关维护一个滚动环形缓冲区,存储最近 \(W\) 次工具执行的结果,其中每个条目记录二元的成功(\(0\))或失败(\(1\))结果。失败严格依据物理层和传输层标准定义:TCP 连接超时、HTTP 5xx 服务器错误、限流拒绝(HTTP 429)或格式错误的协议帧。应用层领域错误(例如数据库查询返回“未找到记录”)不构成传输失败,从熔断器的角度看,这类结果记为成功。
代理持续计算滑动窗口内的错误比例:
\[\mathcal{E} = \frac{1}{|W|} \sum_{i \in W} e_i\]
如果 \(\mathcal{E}\) 超过可配置的失败阈值 \(\tau_{\text{fail}}\)(通常设为 \(0.50\) 至 \(0.70\),统计窗口包含 \(W \ge 20\) 个请求),代理会立即触发熔断,进入 断开 状态。
在 断开 状态下,熔断器完全切断与远程依赖服务的物理网络通信。任何面向该接口的工具调用都会在宿主中介边界处被拦截。代理不会阻塞执行工作线程或等待网络套接字超时,而是立即向智能体运行时返回一个显式的合成错误观测:
\[\mathcal{O}_{\text{synthetic}} = \left\langle \texttt{ERR\_CIRCUIT\_OPEN}, \, \text{dependency\_id}, \, T_{\text{cooldown\_remaining}} \right\rangle\]
快速失败能够节省宿主资源。智能体无须在工作线程内同步等待套接字 30 秒,而是在 1 毫秒内收到一个即时、确定性的信号。这一明确的运行边界可防止智能体误以为请求仍在等待处理,并使宿主运行时的轨迹监控器能够停止执行、调用补偿性 Saga 子事务,或引导智能体使用完全不同的操作工具。各状态的运行语义及其对宿主资源的影响详见 表 7。
| 熔断器状态 | 出站流量策略 | 状态转换触发条件 | 智能体观测 | 对宿主资源的影响 |
|---|---|---|---|---|
| 闭合 | 所有调用均发送至网络 | \(\mathcal{E} \ge \tau_{\text{fail}}\),统计窗口为 \(W\) | 真实工具输出(\(o_t\))或服务器错误 | 线程使用量线性增长;承担完整的网络延迟 |
| 断开 | 100% 的调用在宿主网关处被拦截 | 经过时间 \(t \ge T_{\text{cooldown}}\) | 即时合成的 ERR_CIRCUIT_OPEN |
不分配套接字;\(\approx 0\text{ ms}\) 延迟 |
| 半开 | 允许金丝雀探测;其余调用快速失败 | 金丝雀请求成功 \(\to\) 闭合 金丝雀请求失败 \(\to\) 断开 |
金丝雀请求获得真实输出;其他调用获得合成输出 | 分配单个线程;探测被隔离 |
熔断器在休眠窗口 \(T_{\text{cooldown}}\) 内保持断开状态(通常配置为 30 至 120 秒,具体取决于外部服务的恢复特征)。当 \(T_{\text{cooldown}}\) 结束后,代理转入 半开 状态。
在 半开 状态下,代理仅允许数量严格受限的试探性调用通过并到达远程服务,通常恰好只允许一个金丝雀请求(\(K_{\text{canary}} = 1\))。在此状态期间到达的所有其他并发智能体调用仍会快速失败,并返回 ERR_CIRCUIT_OPEN。如果金丝雀请求成功,代理便认为下游依赖服务已恢复,重置滑动窗口缓冲区 \(W\),并返回闭合状态,恢复正常流量。如果金丝雀请求失败、超时或收到 HTTP 5xx 状态码,代理便认为远程服务仍处于故障状态,以指数增长的退避时长(\(T_{\text{cooldown}} \leftarrow \min(2 \cdot T_{\text{cooldown}}, T_{\text{cooldown\_max}})\))重置冷却计时器,并立即再次触发熔断,返回断开状态。
带抖动的退避协议
熔断器可在持续中断期间保护基础设施,而短暂的网络异常和服务波动则需要受控重试。然而,简单的指数退避实现会引入自身的失效模式:步调同步。
假设某个外部服务发生持续 500 毫秒的瞬时网络分区,导致 \(N = 100\) 条并发智能体轨迹发出的工具请求在时刻 \(t_0\) 同时失败。如果每个智能体运行时都执行标准的确定性指数退避算法,其中第 \(k\) 次尝试后的等待时长为:
\[t_{\text{wait}}(k) = T_0 \cdot 2^k\]
全部 100 个智能体都会休眠恰好 \(T_0 = 1000\text{ ms}\),并在 \(t_0 + 1000\text{ ms}\) 时刻同时重新发出请求。如果上游服务正运行在接近其容量上限的状态,这种突发的同步流量峰值——即所谓的惊群问题——会瞬间压垮服务的入站 TCP 连接积压队列。请求再次失败,导致全部 100 个智能体休眠恰好 \(2000\text{ ms}\),并在 \(t_0 + 3000\text{ ms}\) 时刻再次同时冲击该服务。系统进入一种人为的共振模式,巨大的负载峰值与完全静默的时段交替出现。
共振不变量 如果没有随机的相位分散机制,确定性的重试调度就会保留成簇故障最初的同步性。聚合到达率始终呈离散且周期性的变化,使队列深度的峰值最大化,同时使平均吞吐量最小化。
为消除这些破坏性的共振峰值,工具网关必须引入随机性,使重试工具调用的到达时间不再同步。Amazon Web Services 关于流量整形的研究表明,在各种随机化策略(包括等量抖动和去相关抖动)中,全抖动能够使到达间隔的方差最大,并使队列总完成时间下降得最快。
采用全抖动时,客户端网关先计算确定性的指数上界,再从零到该上界之间按均匀分布随机抽取实际休眠时长:
\[t_{\text{wait}}(k) = \mathcal{U}\left(0, \, \min\left(T_{\max}, \, T_0 \cdot 2^k\right)\right)\]
其中,\(T_0\) 表示基础退避时隙时长(例如 \(100\text{ ms}\)),\(k\) 是从零开始计数的重试次数,\(T_{\max}\) 是为防止无限期停滞而设置的硬性上限(例如 \(30\text{ s}\))。
# Empirical Full Jitter calculation within the tool execution gateway
def compute_jittered_backoff(attempt: int, base_ms: float = 100.0, max_ms: float = 30000.0) -> float:
    ceiling = min(max_ms, base_ms * (2.0 ** attempt))
    return random.uniform(0.0, ceiling)
通过抽取 \(t_{\text{wait}}\),其取值服从覆盖整个区间 \([0, \text{ceiling}]\) 的连续均匀分布,这 100 个失败请求的到达分布从一组离散的狄拉克 δ 函数转变为随时间展开的平滑概率密度。上游服务在其队列容量允许的范围内稳定处理请求,从而打破引发重试风暴的反馈循环。
粗略估算 0.4: RPC 压力下的舱壁容量与抖动
- 外部索引的标称延迟为 \(L_{\text{nom}} = 20\text{ ms}\)。
- 故障期间,索引性能下降:响应停滞,直到在 \(T_{\text{timeout}} = 5000\text{ ms}\) 时超时,错误率为 \(100\%\)。
- 宿主服务器分配一个由 \(M = 300\) 个工作线程组成的共享线程池,用于处理所有类别的工具执行(本地文件 I/O、本地 git 操作和外部 RPC)。
- 无抖动退避使用 \(t_{\text{wait}}(k) = 1000 \cdot 2^k\text{ ms}\)。全抖动退避使用 \(t_{\text{wait}}(k) = \mathcal{U}(0, \min(30000, 1000 \cdot 2^k))\text{ ms}\)。
问题:
- 计算所需时间 \(t_{\text{exhaust}}\):在全部 256 个智能体都调用发生故障的索引,且没有熔断器或舱壁隔离的情况下,耗尽宿主服务器整个工作线程池(\(M = 300\))需要多久?
- 如果 128 个智能体的首次尝试同时失败,计算确定性退避下的峰值瞬时到达率,以及全抖动退避下首次重试(\(k=1\))的请求到达随时间分散的预期情况。
解答:
步骤 1:线程耗尽所需时间 每个智能体发起一次 RPC 调用,该调用会在整个 \(T_{\text{timeout}} = 5000\text{ ms}\) 期间阻塞一个工作线程。 由于有 \(N = 256\) 个智能体并发运行,全部 256 个智能体都会在第一个前向解码步骤内分配到一个执行线程(耗时小于 \(100\text{ ms}\))。
在 \(t \approx 100\text{ ms}\) 时,256 个工作线程被完全占用,等待停滞的网络套接字,而可用工作线程总数为 300 个。因此,仅剩:
\[M_{\text{free}} = 300 - 256 = 44\text{ threads}\]
个线程可供所有其他智能体任务使用,包括本地文件写入和本地内存压缩。如果其余仍处于活动状态的智能体中有任何一个派生子任务或发起第二次工具调用,剩余的 44 个线程就会被立即耗尽。线程完全耗尽的时刻为:
\[t_{\text{exhaust}} < 200\text{ ms}\]
在剩余的 \(4800\text{ ms}\) 内,直到套接字超时触发,整个智能体运行时都会冻结。由于阻塞的网络套接字耗尽了共享线程池,它无法执行简单且不会失败的本地任务。
步骤 2:重试时的到达分布(\(k=1\)) 对于 \(k=1\),确定性指数退避的间隔为:
\[t_{\text{wait}}(1) = 1000 \cdot 2^1 = 2000\text{ ms}\]
全部 128 个智能体都恰好在 \(t = t_0 + 5000\text{ ms} + 2000\text{ ms} = t_0 + 7000\text{ ms}\) 时同时唤醒。假设操作系统线程调度的派发抖动为 \(\Delta t_{\text{dispatch}} \approx 2\text{ ms}\),外部服务接收到的峰值瞬时到达率为:
\[\lambda_{\text{peak, deterministic}} \approx \frac{128\text{ requests}}{0.002\text{ s}} = 64{,}000\text{ requests/sec}\]
这一瞬时尖峰使上游服务的 TCP 连接接收队列不堪重负,导致立即丢包。
在全抖动退避下,退避上限为 \(\min(30000, 1000 \cdot 2^1) = 2000\text{ ms}\)。每个智能体的休眠时长从 \(\mathcal{U}(0, 2000)\text{ ms}\) 中抽取。到达时间的概率密度函数为:
\[f(t) = \frac{1}{2000\text{ ms}} = 0.5\text{ s}^{-1} \quad \text{for } t \in [0, 2]\text{ s}\]
预期到达率在 2 秒的时间窗口内均匀分布:
\[\lambda_{\text{expected, jitter}} = \frac{128\text{ requests}}{2\text{ s}} = 64\text{ requests/sec}\]
全抖动退避使请求压力峰值降低的倍数为:
\[\frac{\lambda_{\text{peak, deterministic}}}{\lambda_{\text{expected, jitter}}} = \frac{64{,}000}{64} = 1000\times\]
这使重试流量保持在典型网络基础设施的容量范围之内,并留有充足余量。
舱壁资源分区
即使采用熔断器和全抖动机制,如果所有工具共享同一个执行资源池,发生故障的外部依赖仍然可能使智能体运行时瘫痪。在船舶设计中,船体被划分为称为舱壁隔舱的水密舱室。如果碰撞导致某个舱室破损进水,水会被限制在该舱室内,从而防止整艘船沉没。
在智能体运行时中,工具调用的执行特征和信任边界存在显著差异:
- 本地确定性工具(例如 POSIX 文件系统读取、本地 AST 解析器和正则表达式格式化工具)的执行耗时为微秒级或个位数毫秒,且具有确定的时间上界。
- 高吞吐量内部 RPC(例如向量数据库查询或本地嵌入计算)通过高带宽内部网络运行,典型延迟为 10 至 50 毫秒。
- 第三方外部 API(例如公共网页抓取工具、SaaS 问题跟踪系统或代码托管平台 API)通过公共互联网运行,其往返延迟不可预测,并受到第三方速率限制、服务中断和跨组织路由故障的影响。
如果宿主运行时将所有工具调用分派到容量为 \(C_{\text{pool}}\) 的单一全局工作线程池,那么一个外部网页抓取工具的服务中断就会耗尽所有工作线程,因为调用会阻塞等待 TCP 连接超时。如果外部端点出现持续时间为 \(T_{\text{timeout}} \gg T_{\text{local}}\) 的暂时性延迟,到达的外部请求就会占满所有工作线程槽位: \[N_{\text{blocked}} = \min\left(C_{\text{pool}}, \lambda_{\text{ext}} \cdot T_{\text{timeout}}\right) \to C_{\text{pool}}\] 因此,执行耗时不足一毫秒的本地操作(\(\tau_{\text{fs}} \le 1\ \text{ms}\))会遭遇彻底的资源饥饿: \[\text{WaitTime}_{\text{local}} \approx T_{\text{timeout}} \gg \tau_{\text{fs}}\] 使整个宿主运行时中的所有智能体停止推进。
Checkpoint 0.2: 评估舱壁分区与资源耗尽
在评估多池调度和熔断器阈值之前,请检验你对工作线程池争用的理解:
为落实端到端原则并维持系统可用性,运行时必须通过将执行线程、速率限制和内存队列划分到严格隔离的资源域中,实现舱壁隔离,如 表 8 所概述。
| 执行域 | 目标子系统 | 并发上限 | 最大执行超时 | 故障语义 | 队列容量 |
|---|---|---|---|---|---|
| 本地系统池 | POSIX 文件 I/O、本地 git、内存内检查 | 64 个线程 | 500 ms | 快速失败(立即报错) | 128 个槽位 |
| 内部 RPC 池 | 集群 microVM、向量数据库、Redis | 32 个线程 | 2,000 ms | 三态熔断器 | 64 个槽位 |
| 外部 API 池 | 公共 WAN 端点、第三方网页抓取工具 | 16 个线程 | 10,000 ms | 采用全抖动退避的熔断器 | 16 个槽位 |
舱壁隔离通过以下三种具体机制实施:
- 专用工作线程池与信号量: 运行时为每个工具域分配独立的线程池或异步信号量上限。如果外部 API 池耗尽其 16 个并发执行的额度,后续外部调用将进入队列,或立即被拒绝并返回
ERR_BULKHEAD_FULL。关键在于,本地系统池仍保有全部 64 个线程,确保文件操作、代码检查和状态检查点能够继续执行,不受延迟影响。 - 针对各域的超时预算: 本地工具受到严格且不可放宽的超时约束(例如 \(T_{\text{timeout}} \le 500\text{ ms}\))。如果本地工具发生死锁,就会被迅速终止。外部网络工具获得较长的初始超时时间(例如 \(5000\text{ ms}\)),但由各自的熔断器提供保障,以确保持续超时会触发开启状态并卸载负载。
- 自主执行卸载: 当某个舱壁隔离队列达到容量上限时,网关会拒绝超额任务,而不联系外部网络。该拒绝会立即向智能体返回一条观测结果:
\[o_t = \left\langle \texttt{ERR\_RESOURCE\_EXHAUSTED}, \, \text{"External tool queue saturated; defer execution"} \right\rangle\]
这种确定性的背压迫使智能体让出执行权、继续沿其他推理分支推进,或通过客户端带抖动的休眠等待拥塞消退(表 9)。
| 架构维度 | 本地系统工具 | 内部微服务工具 | 外部 SaaS / Web 工具 |
|---|---|---|---|
| 主要接口 | POSIX 系统调用、本地管道、共享内存 | 集群 gRPC、VPC 内部 REST | 公共互联网 HTTPS、REST、GraphQL |
| 并发配额 | 高(占工作进程总容量的 \(60\%\)) | 中(占工作进程总容量的 \(30\%\)) | 低(占工作进程总容量的 \(10\%\)) |
| 硬超时(\(T_{\text{timeout}}\)) | \(100\text{ ms} - 500\text{ ms}\) | \(1000\text{ ms} - 2000\text{ ms}\) | \(5000\text{ ms} - 10{,}000\text{ ms}\) |
| 熔断器策略 | 禁用(内核故障是致命的) | 激进(\(\tau_{\text{fail}} = 0.5\)、\(W=10\)) | 保守(\(\tau_{\text{fail}} = 0.6\)、\(W=20\)) |
| 退避策略 | 立即重试(最多 1 次) | 带全抖动的指数退避 | 全抖动并设置较长的冷却期(\(T_{\text{cooldown}} \ge 60\text{ s}\)) |
| 故障模式影响 | 本地进程终止 | 语义搜索或索引功能降级 | 部分功能丧失;回退到缓存数据 |
通过结合三态熔断器、全抖动退避和舱壁分区,宿主运行时构建了一个具有韧性的执行网关。智能体的非特权、随机试错行为被安全地限制在边界内,防止局部模型误判级联演变为灾难性的基础设施故障。
影响范围隔离
子进程 chroot 监牢分区将文件系统的影响范围限制在相互隔离的任务目录内。
然而,隔离网络和工具故障只解决了遏制挑战的一半。当智能体轨迹遭遇不可恢复的故障,或更糟的是,受到嵌入外部工具响应中的对抗性提示注入攻击时,危险便从基础设施资源耗尽转向未经授权的状态破坏。如果某条轨迹表现出异常行为、开始破坏内部数据结构,或泄露能力令牌,运行时就不能仅依靠流量整形来恢复安全。宿主架构如何在其受损状态传播到其他工作流之前,瞬间隔离发生故障或已被攻陷的智能体轨迹,撤销其环境权限,切断其通信通道,并围绕其影响范围建立不可变的隔离边界?
当智能体轨迹偏离其行为规范时,无论是因为不可恢复的状态不变量违例、失控的修改循环,还是嵌入不可信工具响应中的间接提示注入载荷,宿主运行时都面临一个必须立即作出的架构选择:应尝试平稳恢复,还是执行瞬时且不可妥协的隔离?在经典分布式系统中,通常会允许陷入困境的工作节点完成在途请求,或清空队列后再重启。然而,在智能体架构中,正在执行的轨迹持有委托权限:它拥有有效的能力令牌、数据库会话、虚拟网络访问权限,以及通往其他智能体的通信通道。允许已被攻陷或出现严重异常的模型哪怕再执行一个自回归解码步骤,都可能导致灾难性的数据破坏、权限提升,或向外部泄露凭据。
因此,宿主监督器必须将系统整体完整性置于局部事务完成之上。当安全执行与不受约束的修改之间的边界崩溃时,运行时便从事务补偿转向主动遏制,在违规轨迹周围建立严密封闭的边界。
Saltzer 和 Schroeder (1975年) 提出了故障安全默认原则:访问控制机制的基础配置必须拒绝访问,任何监督不变量失效都必须立即使执行退回该非特权基线。在智能体系统中,这意味着受到怀疑的轨迹会瞬间失去全部委托权限。
故障安全遏制原则
经典恢复技术假定,指导恢复的监督逻辑仍未遭到破坏。如轨迹 Saga 模式所述,当子事务 \(T_i\) 因环境错误而失败时,编排器会派发补偿事务 \(C_{i-1}\),以撤销先前的副作用。然而,这一恢复约定依赖一个关键前提:提出或驱动该序列的智能体仍作为善意且逻辑一致的规划器运行。
如果轨迹的失败源于提示注入,例如检索到的文档页面或电子邮件正文中嵌入的指令,运行时就必须将模型视为已被攻陷。模型下层的遏制机制(原则 10)本就以此为前提,而在这种状态下,由模型主导的修复或补偿会成为危险,而非补救措施。如果运行时要求已被攻陷的模型生成补偿操作,模型可能会以清理为名,发出更多破坏性的工具调用,删除数据库表,或将敏感凭据转发至攻击者的端点。同样,陷入退化性词元生成循环的智能体可能耗尽其全部速率限制配额,或以格式错误的变更操作压垮下游服务。
在这些失效模式下,通过智能体的正常执行循环进行反向补偿是不可行的。运行时必须落实 James Hamilton 针对互联网规模基础设施提出的基本规则:积极划分故障域,以限制影响范围。宿主运行时必须将异常轨迹视为需要立即遏制的活跃威胁载体,而不是需要逐步撤销的未提交事务,二者的对比如 表 10 所示。
| 维度 | 轨迹 Saga 补偿 | 影响范围隔离 |
|---|---|---|
| 触发条件 | 预期的环境故障;确定性的工具契约失效;验证拒绝。 | 不变量被违反;语义看门狗触发;疑似对抗性注入;未经授权的能力请求。 |
| 信任模型 | 假定智能体策略善意且逻辑一致;由编排器管理有序回滚。 | 假定智能体上下文不可信、已损坏或具有敌意;撤销所有已启用的能力。 |
| 执行状态 | 轨迹保持活动状态;补偿步骤(\(C_i\))依次执行。 | 立即冻结轨迹执行;停止进程树;切断网络接口。 |
| 副作用处理 | 补偿操作撤销已登记的正向副作用。 | 阻止下游变更;将已产出的制品标记为受污染;丢弃待处理的 RPC。 |
| 对等方交互 | 对等工作流等待 Saga 完成,或接收标准错误状态。 | 对等方接收明确的污染警报;切断并清空智能体间的消息队列。 |
四阶段隔离协议
为实施遏制而不引发宿主层面的不稳定,监督器会执行确定性的四阶段隔离协议(表 11)。该流水线完全绕过智能体的推理循环,严格在宿主运行时的特权控制平面内执行。
| 隔离阶段 | 执行原语与系统接口 | 目标子系统 | 延迟与影响范围保证 |
|---|---|---|---|
| 阶段 1:进程挂起 | Linux cgroup v2 冻结器(cgroup.freeze),SIGSTOP |
智能体进程、运行时解释器、子工作进程树 | \(\le 1\ \text{ms}\);立即冻结执行 |
| 阶段 2:凭据撤销 | 使 IAM STS 令牌失效,轮换 OAuth 会话密钥 | 宿主令牌缓存、云提供商元数据端点 | 单调剥离权限;不授予任何新的 API 授权 |
| 阶段 3:网络切断 | 通过 eBPF TC 入站/出站过滤器丢弃流量,拆除 veth | 沙箱虚拟网络接口、宿主套接字 | 防止数据外泄和命令与控制通信 |
| 阶段 4:污染传播 | 写出 WAL 墓碑记录,更新中央污染账本 | 下游对等智能体、共享制品存储 | 阻止整个集群使用已损坏的制品 |
该序列以立即挂起进程开始。监督器针对智能体在宿主上的沙箱 cgroup 发出内核级冻结指令(SIGSTOP 或冻结 cgroup v2 cgroup.freeze 控制器)。这会立即冻结智能体运行时进程、其 Python/Node 解释器,以及所有已创建的子工作进程。冻结执行树可防止模型发起后续系统调用、写入本地内存缓冲区,或消耗额外的 GPU 推理周期。执行上下文在物理 RAM 中保持完整,作为不可变的内存制品保留,以供离线事后分析。
# Supervisor kernel-level cgroup freeze and egress drop enforcement
def execute_emergency_freeze(sandbox_id: str, cgroup_path: str, veth_iface: str):
    # Stage 1: Freeze process tree instantly via cgroup v2 freeze controller
    with open(f"{cgroup_path}/cgroup.freeze", "w") as f:
        f.write("1")
    # Stage 3: Sever network tap by flushing egress traffic and dropping interface
    subprocess.run(["ip", "link", "set", "dev", veth_iface, "down"], check=True)
subprocess.run(["tc", "qdisc", "replace", "dev", veth_iface, "root", "blackhole"], check=True)第二阶段是临时凭证撤销。由于模型不持有任何环境隐式权限,智能体从不持有永久性基础设施凭证。监督器改为签发短期、作用域严格受限的能力租约,并将其记录在轨迹的智能体控制块(ACB)中。触发隔离后,监督器向其内部凭证代理和外部身份提供方(如 AWS STS、Google Cloud IAM 或 OAuth 授权服务器)发送同步撤销事件。这些租约被取消,使会话 Cookie、数据库连接句柄和 API 持有者令牌失效。即使某个正在执行的工具调用在暂停前已逃逸出进程沙箱,下游服务也会在令牌内省时拒绝该请求。
第三阶段实施网络接口切断。虽然冻结进程会停止生成新的系统调用,但网络命名空间内尚未完成传输的 TCP 套接字缓冲区仍可能尝试发送数据。监督器会立即拆除连接沙箱与宿主机网桥的虚拟以太网接口对(veth),或者激活一个 eBPF 流量控制(tc)程序,将排队规则替换为黑洞过滤器。所有出站数据包均在物理层被丢弃,而尚在进行中的入站连接会立即收到 TCP 重置(RST)。沙箱由此与局域网、对等智能体端点及公共互联网完全隔离。
第四阶段执行污点传播。发生故障的轨迹很少完全独立地执行;它可能已向共享仓库写入文件、向实验数据库插入行,或向对等智能体的输入队列推送任务通知。监督器向持久化预写日志(WAL)写入一条不可变的隔离记录,生成带有密码学签名的墓碑记录。该墓碑记录会触发对轨迹在其执行时期内产生的所有资源设置污点标记。
污点传播架构: 当轨迹 \(T_k\) 被隔离时,监督器会将密码学污点标记 \((\tau = \text{TAINTED})\) 附加到所有输出产物 \(A_k\) 上。对等智能体在托管边界处阻塞,Git 分支引用则保持锁定,直到通过验证解除锁定。
动态污点跟踪
当智能体被隔离时,监督器必须确保其任何部分计算结果都不会破坏更广泛的企业工作流。失控或存在缺陷的轨迹所生成的产物,在外部验证框架或人工操作员明确解除污点标记之前,均被视为受污点污染。
设一个长时程智能体轨迹 \(\mathcal{T}_k\) 产生一系列离散的环境副作用 \(\mathcal{E}_k = \{e_1, e_2, \dots, e_m\}\),这些副作用发生于执行步骤 \(t \in \{1, \dots, m\}\)。每个副作用 \(e_j\) 都对应一次外部修改:向共享文件系统写入文件、向事件代理发布消息,或在功能分支上生成代码提交。如果运行时在步骤 \(t^*\) 检测到不变量失效,则必须隔离在 \(t \ge t_{\text{taint}}\) 产生的所有副作用,其中 \(t_{\text{taint}} \le t^*\) 表示发生状态偏离或摄入不可信数据的最早执行步骤。
为落实这一机制,监督器维护一个有向来源图,跟踪智能体轨迹与系统产物之间的数据血缘。智能体输出的每个产物 \(a\) 都携带一个不可变封套,其中包含该产物的密码学哈希值、生产者的轨迹标识符 \(\mathcal{T}_k\) 以及动态污点状态:
\[\tau(a) \in \{\text{UNTAINTED}, \text{SUSPECT}, \text{TAINTED}, \text{CLEARED}\}\]
Definition 0.3: 动态污点传播
动态污点传播 是一种权威的血缘跟踪协议:宿主机监督器将发生故障或遭到入侵的智能体轨迹输出的所有中间产物和状态修改标记为受污点污染,并拦截下游对等智能体的访问,以隔离级联故障。
- 意义:防止在轨迹遭到入侵的时期内生成的拜占庭式输出或幻觉输出,在不被察觉的情况下污染下游对等智能体、共享文件系统或持久化数据存储。
- 区别:与预先检查代码 AST 的静态数据流分析不同,动态污点传播在运行时执行期间维护一个实时有向来源图,将产物的密码学哈希值与轨迹生命周期状态绑定。
- 常见误区:仅依据模型自我验证(“我已检查输出,确认其无污染”)来清除污点标签,而不是依据独立的带外验证框架或人工操作员的批准。
当 \(\mathcal{T}_k\) 被隔离时,监督器会在中央运行时状态存储中,将污染时期内生成的所有 \(a \in \mathcal{A}_k\) 标记为 \(\text{TAINTED}\)。在多智能体系统中运行的下游智能体通过非特权中介网关与共享资源交互。当对等智能体 \(\mathcal{T}_{\text{peer}}\) 尝试读取工件 \(a\) 时,中介网关会拦截读取请求,将工件元数据与污染登记表进行核验,并阻止访问,返回 ArtifactQuarantinedException。
Example 0.2: 遏制延迟与影响范围预算
https://attacker.com/leak。
系统参数:
- token 生成吞吐量:50 token/秒(每个 token 的解码耗时为 20 ms)。
- 监督器不变量验证延迟:在每次工具调用请求时进行评估。
- 沙箱与宿主网桥之间的网络带宽:10 Gbps(\(1.25 \times 10^9\) 字节/秒)。
- eBPF 丢包注入延迟(\(L_{\text{net}}\)):0.4 ms。
- Linux cgroup 冻结延迟(\(L_{\text{freeze}}\)):1.2 ms。
- 身份提供方 STS 令牌撤销 API 往返时间(\(L_{\text{idp}}\)):42.0 ms。
- 污染账本在内部 Redis 集群中的广播时间(\(L_{\text{taint}}\)):3.5 ms。
时间线分析:
- 在 \(t = 0\),模型完成对未经授权的
curl调用的解码。该调用以外部端点为目标,在 HTTP 请求头中携带能力令牌,并将执行请求发送至宿主监督器。 - 在 \(t = 1.1\text{ ms}\),监督器的执行前策略引擎依据沙箱出站白名单解析命令。出站域名
attacker.com违反安全不变量。系统宣告触发隔离。 - 监督器并发启动阶段 1 和阶段 3:
- 在 \(t = 1.1 + 0.4 = 1.5\text{ ms}\),eBPF TC 过滤器丢弃
veth接口上的所有出站帧。离开宿主机的有效载荷字节数为零。 - 在 \(t = 1.1 + 1.2 = 2.3\text{ ms}\),内核将沙箱进程切换至冻结状态。自回归执行和本地 IO 完全停止。
- 在 \(t = 1.1 + 0.4 = 1.5\text{ ms}\),eBPF TC 过滤器丢弃
- 与此同时,监督器启动阶段 2 和阶段 4:
- 在 \(t = 1.1 + 3.5 = 4.6\text{ ms}\),污染账本完成更新。监听该智能体任务队列的三个下游对等智能体的订阅被锁定,从而阻止其摄取受污染的任务输出。
- 在 \(t = 1.1 + 42.0 = 43.1\text{ ms}\),身份提供方使该智能体的短期会话令牌失效。
影响范围遏制总时间: 本地物理边界(网络与执行)在 \(2.3\text{ ms}\) 内被完全封闭,远低于单个 token 的生成时间阈值(\(20\text{ ms}\))。全系统范围内向对等智能体的传播在 \(4.6\text{ ms}\) 内被阻断。尽管云端 IdP 撤销需要 \(43.1\text{ ms}\),但智能体无法在此时间窗口内使用该令牌,因为物理网络出站通道和 CPU 调度已在不到 \(2.5\text{ ms}\) 的时间内被切断。
已提交至持久化存储的受污染工件必须经过确定性修复。对于受版本控制的代码仓库,运行时会自动执行 git revert,或分离受影响的功能分支,并将其锁定,禁止合并至集成主线。在关系型数据库或文档数据库中,带有被隔离轨迹时期标识符的行会被标记为软删除墓碑,使其在标准查询中不可见,同时保留原始数据以供管理审计。
通过实施动态污染跟踪,监督器确保故障边界严格限制在行为异常的轨迹之内。即使在数百个异步模型交换中间推理轨迹的复杂多智能体架构中,单次执行内部的安全漏洞或语义故障也无法悄然将污染传播至系统的其余部分。
在确立各项容错机制——Saga 的事务恢复语义、前向自愈、枢轴动作识别、语义看门狗定时器、工具熔断器以及影响范围隔离——之后,核心工程挑战转向架构组合。我们如何将这些独立子系统整合为一个统一、高吞吐量、具备容错能力的运行时框架,使其能够在真实生产环境中提供端到端执行保证?
容错系统综合
在实际生产环境中执行任务的自主智能体,并不会在孤立的实验室条件下发生故障。相反,故障会跨越异构边界相互叠加:外部 API 调用期间发生的短暂网络分区,与无特权模型的语义偏离同时出现,紧接着操作系统进程崩溃,而待处理的状态变更仍缓存在易失性的内核页缓存中。如果通过零散、临时拼凑的错误处理例程来应对这些故障模式——用标准异常处理器包裹单次工具调用,同时将自回归推理循环视为没有检查点的长时间运行脚本——系统必然会出现状态分歧、外部资源孤立以及无法恢复的执行死锁。
崩溃一致性不变量: 智能体运行时状态具有崩溃一致性,当且仅当每一次对外部环境可见的变更之前,都已写入持久化的预写日志记录,并且在重启后,每条执行中的轨迹都能被明确归类为已提交、可补偿或等待前向修复。
生产环境的韧性要求将控制平面调度器、预写事件日志和 Saga 恢复引擎系统性地整合为一体化的运行框架。通过将每次状态转换形式化为仅追加日志记录,并通过幂等的状态协调探测、有界的前向自愈以及枢轴点前的验证关卡来管控所有工具交互,宿主监督器能够在不牺牲底层基础模型表达性自主能力的前提下,强制满足严格的恢复点目标(\(\text{RPO} = 0\))和有界的恢复时间目标(\(\text{RTO} < 5.0\text{ s}\))。
综合运行时引擎
运行时编排的架构综合汇集了本部分的三大支柱:智能体运行框架 的控制平面、持久执行 的事件日志,以及本章的 Saga 引擎:
\[\text{Agent Runtime} = \text{Control Plane} + \text{WAL Event Storage} + \text{Saga Recovery Engine}\]
在这一组合下,控制平面调度器充当无特权模型的监督器,管理队列优先级、词元生成预算和上下文窗口分配。不过,它并不独立执行状态转换。每一次状态变更,无论是内部信念更新 \(\mathbf{s}_t \to \mathbf{s}_{t+1}\),还是外部工具调度 \(a_t\),都必须在执行前经过预写日志(WAL)存储基底;并且,按照意图先于效果的原则(原则 13),在授权记录持久化之前,任何外部效果都不得离开宿主。WAL 通过在关键边界点强制同步刷写至非易失性存储来保证持久性。随后,Saga 恢复引擎将这些已记录的操作纳入事务生命周期,维护补偿账本 \(\mathcal{L}_{\text{comp}}\),并在后向补偿、前向自愈和不可逆枢轴点约束之间动态仲裁。
形式上,综合运行框架被定义为一个在离散轨迹轮次上运行的四元组:
\[\mathcal{H} = \langle \mathcal{K}_{\text{sched}}, \mathcal{L}_{\text{wal}}, \mathcal{S}_{\text{saga}}, \mathcal{G}_{\text{gate}} \rangle\]
其中,\(\mathcal{K}_{\text{sched}}\) 表示负责调度轨迹步骤的非抢占式优先级调度器,\(\mathcal{L}_{\text{wal}}\) 是由物理非易失性存储支持、定期设置检查点的仅追加环形缓冲区,\(\mathcal{S}_{\text{saga}}\) 是跟踪动作可逆性层级的补偿与修复协调器,\(\mathcal{G}_{\text{gate}}\) 是确定性验证关卡,用于在跨越不可逆边界之前强制确保不变量闭合。
这一运行时的模块化设计,在 表 12 详述的各子系统之间清晰地分离了运维职责。神经模型在不具备任何隐式权限的情况下提出动作,完全不感知物理磁盘布局、网络套接字重试或数据库回滚协议。运行框架拦截模型的每次输出,验证结构模式,将意图记录到 WAL,向 Saga 协调器注册相应的补偿事务 \(C_i\),并通过受管控且在沙箱中运行的远程过程调用(RPC)驱动程序执行物理变更。
| 子系统层 | 主要职责 | 故障检测触发条件 | 恢复机制 |
|---|---|---|---|
| 控制平面 (\(\mathcal{K}_{\text{sched}}\)) | 上下文调度、令牌预算核算和生命周期协同。 | 语义死锁、令牌耗尽、状态哈希不再推进的循环。 | 抢占、上下文窗口压缩、任务升级处理。 |
| 事件存储 (\(\mathcal{L}_{\text{wal}}\)) | 持久化保存状态 \(\mathbf{s}_t\)、动作 \(a_t\) 和观测 \(o_t\)。 | 主机崩溃、未处理的进程终止、文件系统 I/O 故障。 | 从最近的基础快照 \(S_k\) 开始进行确定性日志重放。 |
| Saga 引擎 (\(\mathcal{S}_{\text{saga}}\)) | 多步骤事务跟踪与补偿动作注册。 | 工具故障、网络分区、上游服务拒绝。 | 反向补偿级联 (\(\mathcal{L}_{\text{comp}}\)) 或前向修复 (\(a_{\text{repair}}\))。 |
| 验证关卡 (\(\mathcal{G}_{\text{gate}}\)) | 在不可逆操作之前进行确定性的策略与不变量验证。 | 断言失败、模式不匹配、密码学测试失败。 | 停止执行、回滚至安全检查点、升级至操作人员处理。 |
故障轨迹剖析
为了理解这四个子系统如何形成统一的纵深防御体系,我们来看一条具体的六轮轨迹 \(\mathcal{T}\)。这条轨迹由一个自主系统管理智能体执行,其任务是迁移数据库模式、更新应用配置,并将生成的服务部署到生产环境;图 5 展示了其执行过程。在这条轨迹中,环境注入了四种不同的故障模式:暂时性网络分区、下游执行语法错误、灾难性主机崩溃,以及试图过早跨越不可逆边界进行提交。
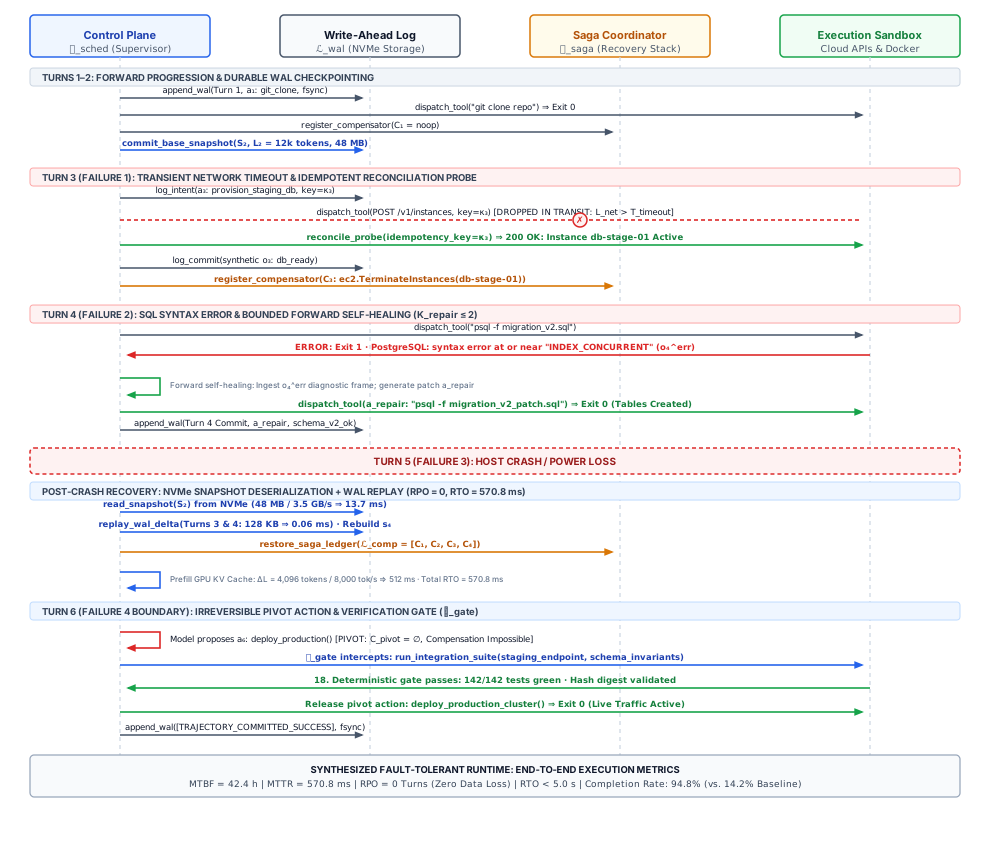
图 5 中的协议梯形图描绘了四条架构生命线之间的消息交换:控制平面调度器 (\(\mathcal{K}_{\text{sched}}\))、预写日志 (\(\mathcal{L}_{\text{wal}}\))、Saga 恢复协调器 (\(\mathcal{S}_{\text{saga}}\)) 和沙箱化执行环境。每个阶段都展示了一项具体容错保证的实际作用。
在第 1 轮和第 2 轮中,智能体按标准流程向前推进。模型生成动作 \(a_1\)(克隆配置仓库)和 \(a_2\)(检查现有迁移脚本)。控制平面拦截每个提议,将完整的轮次载荷 \(e_t = \langle t, \mathbf{s}_t, a_t, o_t, \text{hash} \rangle\) 序列化,通过显式的物理写入边界将其刷写到 WAL,并在 Saga 台账中注册简单的只读补偿动作 (\(C_1 = C_2 = \text{noop}\))。
在第 3 轮中,智能体分派动作 \(a_3\),即通过 HTTP 变更操作创建一个预发布数据库实例。在传输过程中,网络连接在收到确认之前中断,并超过了超时阈值 (\(L_{\text{net}} > T_{\text{timeout}}\))。朴素的运行时立即面临两难:重新发送可能重复执行资源创建步骤并产生孤立的云资源,而放弃该动作则会导致状态失去同步。综合构建的运行时利用 幂等动作执行 中的幂等键和对账探测,遵循先确认结果、再重试的原则(原则 9),消除这种不确定性。在首次分派之前,运行时生成了一个具有密码学唯一性的事务标识符,并将其记录到 WAL 中。超时期限到达后,运行时停止前向生成,并使用已记录的事务键向云提供商的审计端点发起带外探测。探测确定预发布实例已成功创建,但确认消息在传输途中丢失。运行时重建合成观测 \(o_3\),将已完成的事件写入 WAL,使用用于销毁资源的补偿动作 \(C_3\) 更新 Saga 台账,并顺利推进至第 4 轮,避免重复分配资源。
def execute_step_with_reconciliation(wal, saga, tool_client, turn):
    token = wal.log_intent(turn.action)  # Persist intent before dispatch
    try:
        obs = tool_client.dispatch(turn.action, idempotency_key=token)
    except NetworkTimeoutError:
        obs = tool_client.reconcile_probe(idempotency_key=token)
        if obs is None:  # Side effect never materialized remotely
            obs = tool_client.dispatch(turn.action, idempotency_key=token)
    wal.log_commit(turn.action, obs)
    saga.register_compensator(turn.action.compensator)
    return obs
第 4 轮引入了一个执行故障:智能体应用迁移脚本(\(a_4\)),但数据库引擎因 SQL 语法错误而拒绝执行(\(o_4^{\text{err}}\))。传统数据库系统会立即触发向后回滚,通过执行补偿器 \(C_3\) 撤销第 3 轮的操作(销毁新配置的预发布数据库)。在智能体环境中,拆除和重新配置会带来巨大的延迟和金钱成本。因此,运行时转而启动前向自愈。监督器识别出错误仅限于迁移脚本后,将 \(o_4^{\text{err}}\) 封装到受约束的上下文框架中,限定修复范围(\(K_{\text{repair}} \le 2\)),并提示模型生成纠正性的补丁动作 \(a_{\text{repair}}\)。模型输出修正后的 SQL 语句,预发布数据库接受该补丁,运行时随后将成功修复的记录写入 WAL,使轨迹继续向前推进。
第 5 轮中,当智能体正在规划配置更新时,物理主机遭遇灾难性断电(相当于立即终止进程)。易失性内存中的内容——包括活跃 Python 进程的堆、GPU 键值(KV)缓存张量以及尚未处理的操作系统网络缓冲区——瞬间丢失。机器重启后,运行时监督器启动崩溃恢复例程。它在物理 NVMe 存储上定位最新的持久化基础快照 \(S_k\),重放第 3 轮和第 4 轮的顺序 WAL 记录,重建智能体内部信念状态 \(\mathbf{s}_4\),重新计算提示上下文前缀以恢复推理引擎的状态,重建活跃的 Saga 账本 \(\mathcal{L}_{\text{comp}} = [C_1, C_2, C_3, C_4]\),并从第 5 轮恢复执行。由于 WAL 强制要求在产生外部副作用之前同步刷盘,恢复点目标为零(\(\text{RPO} = 0\)):任何已提交轮次的工作都不会丢失。
最后,在第 6 轮,轨迹到达一个不可逆边界:将数据库模式和代码部署到正在运行的生产集群。该操作构成一个枢轴动作 \(T_{\text{pivot}}\)(\(C_{\text{pivot}} = \emptyset\));一旦执行,就无法进行向后的物理补偿。在控制平面将该动作交给外部执行器之前,验证关卡 \(\mathcal{G}_{\text{gate}}\) 接管执行控制权。自我报告不具备任何证据效力(闭合证据等级),因此运行时不采信模型的置信度及其成功声明。相应地,运行时在沙箱中对预发布环境执行一组确定性集成测试,核验密码学签名是否与预期构建产物匹配,并验证数据库一致性不变量。只有在所有确定性检查均通过后,运行时才会发出不可撤销的生产部署命令,将最终提交标记追加到 WAL,并结束该轨迹。
故障注入基准测试
容错运行时在工程上的有效性不能仅靠理论证明来确立;必须在主动施加扰动的条件下进行实证验证。这一方法直接源于 Jim Gray 在 1986 年关于软件容错的奠基性见解,以及 Basiri 及其同事提出的现代混沌工程原则。Gray 指出,生产系统停机很少由确定性的、易于复现的软件缺陷(“玻尔型缺陷”,Bohrbugs)引起,因为这类缺陷通常在初始测试阶段就已被消除。相反,导致生产系统失效的往往是由网络抖动、竞态条件和异步接口不匹配引发的瞬态、上下文敏感故障(“海森堡型缺陷”,Heisenbugs)。
在智能体架构中,基础模型引入了第三类故障:语义海森堡型缺陷。在这类故障中,即使外部条件完全相同,非确定性采样也会导致模型突然违反格式约束、误解工具模式,或陷入退化的推理循环。同时,智能体所操作的分布式工具和沙箱也会引入传统的玻尔型缺陷以及瞬态基础设施故障。为保证韧性,所构建的运行时框架必须依据标准的定量可信赖性指标进行评估:
\[\text{MTBF} = \frac{\sum T_{\text{operational}}}{N_{\text{failures}}}, \quad \text{MTTR} = \frac{\sum T_{\text{recovery}}}{N_{\text{failures}}}\]
\[\text{RPO} = \text{Lost Trajectory Turns}, \quad \text{RTO} = T_{\text{restart}} - T_{\text{crash}}\]
其中,\(\text{MTBF}\) 衡量两次致命执行停滞之间的平均正常运行时间,\(\text{MTTR}\) 衡量检测故障并将轨迹恢复至活跃且向前推进状态所需的实际经过时间,\(\text{RPO}\) 表示以未保存检查点的执行轮次数衡量的数据损失,\(\text{RTO}\) 定义从主机或网络中断到模型推理恢复之间的总恢复延迟。
粗略估算 0.5: 恢复开销的量化分析与 RTO 界限
运行时采用双层持久化引擎:
- 每 4 轮生成一次基础快照;最新快照 \(S_8\) 于第 8 轮提交(\(L_8 = 12{,}288\text{ tokens}\),NVMe 磁盘上的压缩快照大小为 \(D_{\text{snap}} = 48\text{ MB}\))。
- WAL 记录每一轮;第 9 轮和第 10 轮共追加 \(D_{\text{wal}} = 128\text{ KB}\) 的 JSON 序列化日志记录。
- 主机存储提供的 NVMe 顺序读取吞吐量为 \(B_{\text{disk}} = 3.5\text{ GB/s}\),随机 \(4\text{ KB}\) 读取延迟为 \(25\text{ }\mu\text{s}\)。
- 本地推理引擎在由 8 个 GPU 组成的张量并行阵列上运行一个 70B 参数的稠密模型,总有效预填充处理速率为 \(P_{\text{prefill}} = 8{,}000\text{ tokens/second}\)。
- 重新建立外部工具会话并执行幂等的网络协调探测,需要一次网络往返 \(L_{\text{net}} = 45\text{ ms}\)。
我们计算将智能体恢复至第 10 轮完全可运行状态的总恢复时间目标(\(\text{RTO}\)):
首先,计算从物理磁盘读取并反序列化基础快照 \(S_8\) 所需的时间: \[T_{\text{snap}} = \frac{D_{\text{snap}}}{B_{\text{disk}}} = \frac{48\text{ MB}}{3{,}500\text{ MB/s}} \approx 13.7\text{ ms}\]
其次,计算读取并解析第 9 轮和第 10 轮后续 WAL 条目所需的时间: \[T_{\text{wal}} = \frac{D_{\text{wal}}}{B_{\text{disk}}} + T_{\text{latency}} = \frac{0.128\text{ MB}}{3{,}500\text{ MB/s}} + 0.025\text{ ms} \approx 0.06\text{ ms}\]
第三,重建 GPU 推理上下文。由于基础快照保留了截至第 8 轮的内部状态,推理引擎只需对第 9 轮和第 10 轮引入的上下文增量进行预填充: \[\Delta L = L_{10} - L_8 = 16{,}384 - 12{,}288 = 4{,}096\text{ tokens}\] \[T_{\text{prefill}} = \frac{\Delta L}{P_{\text{prefill}}} = \frac{4{,}096\text{ tokens}}{8{,}000\text{ tokens/s}} = 0.512\text{ s} = 512\text{ ms}\]
最后,计入外部协调探测的延迟: \[T_{\text{probe}} = L_{\text{net}} = 45\text{ ms}\]
将各个恢复阶段的耗时相加: \[\text{RTO} = T_{\text{snap}} + T_{\text{wal}} + T_{\text{prefill}} + T_{\text{probe}} = 13.7\text{ ms} + 0.06\text{ ms} + 512\text{ ms} + 45\text{ ms} \approx 570.8\text{ ms}\]
综合构建的智能体运行框架约在 \(0.57\text{ seconds}\) 内恢复崩溃的执行过程,显著低于 \(5.0\text{ second}\) 的生产环境阈值,同时完全无需从头重新计算完整的 \(16\text{k}\) 词元上下文(这原本会额外引入 \(2.05\text{ seconds}\) 的预填充延迟)。此外,由于截至第 10 轮的所有事件均已持久化到磁盘,\(\text{RPO} = 0\)。
为量化各层的架构贡献,我们使用一套对抗性故障注入基准测试来评估四种运行时配置。测试框架向所有已执行轮次中的 \(20\%\) 注入合成故障,包括网络丢包(\(8\%\))、未处理的工具异常(\(6\%\))、主机进程终止信号(\(4\%\))和格式损坏错误(\(2\%\))。
| 架构配置 | 网络分区处理 | 崩溃恢复(RPO / RTO) | 工具异常处理 | 不可逆变更安全性 | 轨迹完成率 |
|---|---|---|---|---|---|
| 1. 无托管脚本基线 | 异常未处理;轨迹崩溃。 | \(\text{RPO} = \infty\)(全部丢失) \(\text{RTO} = \text{Manual}\) |
进程中止;无恢复机制。 | 无保护;过早产生副作用。 | \(14.2\%\) |
| 2. 仅使用 WAL 持久化 | 记录异常;进程安全停止。 | \(\text{RPO} = 0\text{ turns}\) \(\text{RTO} = 0.62\text{ s}\) |
记录到磁盘;执行停滞。 | 无保护;需要手动修复。 | \(38.6\%\) |
| 3. 仅使用 Saga 回滚 | 盲目重试;存在重试风暴风险。 | \(\text{RPO} = \infty\)(内存丢失) \(\text{RTO} = \text{Unrecoverable}\) |
完全回滚;撤销所有进展。 | 强制执行分级规则;崩溃后无持久性保障。 | \(49.1\%\) |
| 4. 综合构建的容错运行时 | 幂等协调探测。 | \(\text{RPO} = 0\text{ turns}\) \(\text{RTO} = 0.57\text{ s}\) |
有界前向修复;失败时回退至回滚。 | 由确定性验证关卡强制保障。 | \(\mathbf{94.8\%}\) |
容错运行时可靠性评分卡 中的实证结果表明,不完整的架构会在实际运行中失效。无托管脚本基线在混沌测试中仅能完成 \(14.2\%\) 的轨迹,主机崩溃会导致状态完全丢失。加入预写日志(配置 2)解决了持久性问题,并实现了 \(\text{RPO} = 0\),但由于缺少自愈或回滚逻辑,每当外部工具发出未处理的错误时,运行时就会冻结,完成率仅为 \(38.6\%\)。相反,在没有底层 WAL 持久化支持的情况下部署 Saga 回滚(配置 3),虽然能让系统在正常执行期间清理部分变更,却使智能体完全无法抵御机器崩溃:易失性状态丢失,外部系统停留在补偿未完成的状态,完成率最高只能达到 \(49.1\%\)。
只有完整综合各组件的运行框架(配置 4)——将控制平面调度器、WAL 事件存储、Saga 补偿器、幂等协调探测和验证关卡整合在一起——才能实现生产级可靠性,完成全部轨迹中的 \(94.8\%\)。通过以定向前向自愈替代代价高昂的反向撤销、利用幂等探测隔离外部交互,并严格审计枢轴点之前的边界,这一综合架构将灾难性的运行时故障转化为短暂且能够自我纠正的运行事件。
可靠的智能体执行需要严谨的系统综合,而不能依赖模型规模扩展或提示工程来处理故障;这一认识揭示了机器学习直觉与计算机系统工程之间的关键鸿沟。实践者常常陷入看似诱人的谬误:认为更大的基础模型无需运行时基础设施就能自我纠正,认为数据库事务可以延伸至第三方 webhook,或者认为重试完全相同的提示就构成有效的恢复策略。要构建能够在生产环境中持续运行的系统,我们必须系统地剖析并消除这些运行陷阱。
谬误与陷阱
为自主智能体设计容错运行时,会暴露出经典分布式系统理论与随机性多工具执行现实之间的根本张力。当实践者将数据库原语或简单的进程监督器直接嫁接到基础模型轨迹上时,必然会引入关键的架构漏洞。设计具有韧性的基础设施,需要在这些普遍存在的误解演变为数据损坏、资源耗尽或级联分布式故障之前,识别并消除它们。
谬误: 可以使用两阶段提交(\(2\text{PC}\))来管理跨智能体工具的分布式事务。
熟悉分布式数据库架构的系统工程师常常认为,可以通过两阶段提交(\(2\text{PC}\))等经典原子提交协议来协同多工具智能体工作流。在这一假设下,中央运行时协调器向某个轨迹步骤中调用的所有外部工具发起准备阶段,收到一致同意提交的投票后,再发出全局提交指令,以原子方式完成本地和远程数据存储中的变更。
这一模型一旦遇到现实中的工具拓扑就会立即失效。两阶段提交要求所有参与的资源管理器实现标准化事务接口(如 X/Open XA),支持在提交前持久地获取锁,并保证在协调器发生任意崩溃后实现单调的状态恢复。现代智能体工具接口涵盖第三方 SaaS REST API、云控制平面、代码执行沙箱、git 仓库和外部 webhook,却不提供上述任何保证。外部端点既不暴露准备钩子,也不会在高延迟、持续数秒的自回归模型推理周期内一直持有独占资源锁。此外,跨公共网络边界施加阻塞式锁语义会违背基本的故障隔离边界:如果外部服务持有已准备的锁时,网络分区将运行时隔离,该远程资源就会无限期地陷入死锁,直到协调器介入。
架构层面的应对方式是放弃对跨服务隔离性和原子性的期待,转而采用分布式 Saga。运行时必须将轨迹组织为由离散且立即提交的子事务 \(T_1, T_2, \dots, T_n\) 构成的线性序列,其中每个前向动作 \(T_i\) 都明确配有一个补偿器 \(C_i\),并将其注册到预写日志(\(\mathcal{L}_{\text{wal}}\))中。局部故障无法通过全局协调锁来回滚;必须通过在最终一致性条件下运行的反向补偿工作流或前向自愈例程来修复。
陷阱: 假定所有工具副作用都可以通过反向回滚来撤销。
智能体运行时工程中一个普遍的运维陷阱是,在设计恢复引擎时,假定每一次前向变更都可以通过执行逆操作或恢复存储快照来撤销。完全依赖后向补偿的系统假定,在轨迹的整个状态空间中都存在逆映射 \(C_i = T_i^{-1}\),认为只要将环境回退到状态 \(\mathbf{s}_0\),就能抹去任何灾难性错误。
在生产部署中,外部操作会跨越不可逾越的物理和组织层面的不可逆边界。许多工具操作都是枢轴操作(\(T_{\text{pivot}}\))——这类变更会修改外部权威记录系统、向现实世界发送通信消息,或不可逆地消耗不可再生资源。向客户发送自动化电子邮件、将构建产物发布到公共软件包仓库、执行不可逆的数据库模式迁移,或通过金融 API 向信用卡扣款,都无法回滚。在错误地向客户发送通知后调用补偿操作,并不能撤回该消息;它只是再发送一条往往令人困惑的更正消息,同时使这一副作用在外部记忆中固化。如果智能体执行了枢轴操作,随后在枢轴操作后的验证阶段失败,那么尝试对先前步骤进行后向补偿,就会使外部世界陷入无法恢复的不一致状态。
运行时必须系统地将所有工具操作划分为明确的可逆性层级:可逆操作(本地沙箱变更、临时分支创建)、可补偿操作(可以撤销分配的临时资源分配),以及不可逆的枢轴操作(\(T_{\text{pivot}}\))。在执行任何枢轴操作之前,运行时必须强制实施具有最终裁决权的枢轴前验证关卡(\(\mathcal{G}_{\text{gate}}\))。所有推测性代码分析、静态类型检查、沙箱测试执行和策略验证,都必须严格在调度 \(T_{\text{pivot}}\) 之前执行。一旦执行跨越枢轴边界,运行时就必须将其故障处理机制从后向补偿全面切换为有保证的前向恢复,强制实施前向自愈、对幂等后续操作进行确定性重试,或有针对性地升级至人工介入处理。
谬误: 正在运行且定期发出心跳的智能体进程是健康的,并且正在取得进展。
标准的集群管理系统、容器编排器和操作系统进程监管程序,使用存活探针、内存阈值和周期性心跳探测(例如 Unix 看门狗信号或 HTTP 健康检查端点)来判断进程健康状况。当智能体执行容器持续执行推理循环、生成工具调用载荷并刷新其进程心跳时,传统基础设施监控会将该服务判定为功能完备且健康。
这一运维指标混淆了进程存活与语义进展。随机性基础模型经常陷入语义活锁——一种紧密耦合且无法推进的循环:智能体反复修改环境、观察到执行错误、将变更撤销至先前状态,然后再次尝试同一个无法成功的变更。在这种异常状态下,宿主进程极为活跃:它使 GPU 推理服务器满载、持续消耗 CPU 周期、以流式方式传输 API 载荷,并且始终能够通过进程心跳探测。然而,轨迹状态在趋近目标不变量方面没有任何单调进展。相反,环境状态序列呈周期性振荡(\(\mathbf{s}_t \to \mathbf{s}_{t+1} \to \mathbf{s}_t\)),徒劳地消耗推理预算和实际经过时间。
架构韧性要求引入语义看门狗计时器,将存活检测与不变量验证解耦。运行时监管程序不能仅验证操作系统进程线程是否有响应,还必须主动检查轨迹账本中是否存在语义进展。运行时必须跟踪滚动窗口内的状态哈希 \(\mathcal{H}_k = \{\text{hash}(\mathbf{s}_{t-k}), \dots, \text{hash}(\mathbf{s}_t)\}\)、每次唯一状态转换的词元消耗量,以及工具错误重复计数器。当语义看门狗检测到状态循环重现、文件内容在固定状态间振荡,或相同工具调用的重复失败次数超过固定阈值时,它会触发语义超时,停止轨迹,并在宿主资源耗尽之前强制执行分支切换或结构性自愈。
陷阱: 允许对性能退化的外部服务进行无上限重试。
当智能体遇到外部工具的暂时性网络异常、速率限制或 HTTP 503 服务不可用错误时,简单智能体循环中编写的直觉式响应是立即重试调用,或将失败交回模型提示中处理。由于智能体具有自主决策循环,它们会持续、快速地重新尝试失败的工具调用,将外部工具视为一个无响应的依赖项,认为必须不断冲击它,直到它作出响应。
对性能退化的服务进行无界自主重试,会引发破坏性极强的分布式重试风暴。当上游 API 出现短暂的性能退化时,数十乃至数百条并发智能体轨迹会同时遇到错误。如果这些智能体未经协调退避就立即重试,总请求量就会呈指数级激增,以典型的惊群模式压垮发生故障的服务。在多租户环境中,这种行为会将短暂的外部异常转化为持续的全系统中断。此外,简单的提示词级错误报告往往会诱使模型以线路速率生成同一失败载荷的细微语法变体,迅速耗尽整个组织的 API 速率配额和 HTTP 连接池,并使运维基础设施陷入线程池饥饿。
运行时必须强制实施严格的工具级熔断器,并结合截断指数退避和随机抖动:
\[t_{\text{backoff}} = \text{Uniform}\left(0, \, \min\left(T_{\max}, \, T_{\text{base}} \cdot 2^k\right)\right)\]
工具执行层必须实现由监督平面直接控制的三状态熔断器模式(闭合、断开、半开)。当工具端点在指定滑动窗口内的故障率超过临界阈值时,熔断器跳闸,进入断开状态,并立即对所有运行中轨迹的后续调用进行短路处理,返回快速失败错误。这既隔离了故障域,保护性能退化的外部依赖免于因惊群而崩溃,也迫使客户端轨迹进入结构化退避或替代执行路径。
掌握这些谬误与陷阱,是脆弱的实验室原型与工业级智能体系统之间的分水岭。系统工程师以数学上严谨的 Saga、感知枢轴动作的执行边界、语义进展不变量以及隔离的工具熔断器,取代通用数据库事务、无缝向后回滚、表面的进程心跳和无界重试循环等理论幻想,从而建立坚实的运行基础。接下来,我们将这些架构机制整合为一个统一的智能体容错执行框架。
总结
智能体容错的核心问题——在动作会产生不可撤销副作用的环境中,自主系统如何从级联故障中恢复——揭示了经典数据库原子性的根本失效。两阶段提交(\(2\text{PC}\))协议及其关系数据库后继机制,依靠集中式协同、统一的锁管理器和可普遍回滚的本地存储引擎,保证原子事务的全有或全无属性。当自主智能体作为分布式系统行动时,这一抽象便会破裂。一个不具备特权的基础模型在指导多步骤轨迹执行时,需要跨越异构 REST API、第三方微服务、远程云基础设施和物理通知渠道。在这种环境中,不存在可随处使用的锁,远程服务器无法暂停以等待全局提交信号,已经释放到外部世界的副作用也无法通过重置内存中的指针来撤销。当一个包含十个步骤的部署计划在第六步执行失败时,运行时无法神奇地将整个世界恢复到第零步;它必须主动管理遗留下来的部分状态。
解决这一架构困境的方法是分布式 Saga。智能体运行时不再追求通用 ACID 原子性这一不可能实现的理想,而是将长时间运行的轨迹组织为一系列离散且立即提交的子事务,为每个前向动作配套一个显式补偿事务或语义修正。运行时在前向自愈与后向补偿之间动态仲裁:当诊断错误信号提供可指导行动的梯度时,生成有界修复动作;通过后向补偿,系统性地撤销已部分应用的变更。关键在于,运行时能够识别枢轴动作施加的物理边界:这些不可返回点一旦越过,后向补偿在物理上便不再可能,前向执行必须通过经确定性验证的备用路径完成,或立即升级至人工托管。在监控进展不变量而非表面进程心跳的语义看门狗计时器、隔离性能退化外部依赖的工具熔断器,以及防止错误传播的影响范围隔离机制的支持下,运行时为本质上非确定性的推理引擎构建了可靠的运行边界。
要点回顾: 接纳非确定性,强制落实补偿不变量
- 现实世界中的工具打破了 ACID 保证;智能体轨迹必须按分布式 Saga 架构设计。 外部 API、第三方微服务和环境副作用缺乏分布式锁管理器和两阶段提交(\(2\text{PC}\))协议。轨迹必须以一系列离散且立即提交的子事务执行,其累积状态转换和补偿元数据须在持久化预写日志(\(\mathcal{L}_{\text{wal}}\))中跟踪。
- 每个修改状态的子事务都需要显式的补偿动作或语义修正。 由于物理回滚无法撤回已发送的网络消息、撤销外部通知或删除已被外部使用的记录,运行时必须为每个前向动作注册相应的补偿事务 \(C_i\),与该前向动作 \(T_i\) 对应。如果后向恢复失败,监督器必须记录未补偿的残留影响,并升级至不可恢复的故障状态,而不能默默遗弃无人处理的副作用。
- 通过限制修复尝试次数,平衡前向自愈与后向回滚。 当执行步骤失败时,生成有针对性的修复动作(\(a_{\text{repair}}\))可以保留代价高昂的预填充计算成果,并保持前进势头。然而,不受约束的自愈会退化为随机游走;监督器必须对修复尝试施加严格预算(\(K_{\text{repair}}\)),达到限制后确定性地触发后向补偿。
- 不可逆的状态修改需要显式的枢轴动作、前向恢复计划和升级处理约定。 动作按严格的可逆性层级划分。跨过枢轴动作(\(T_{\text{pivot}}\))意味着到达不可返回点,此时后向回滚在物理上已不可能。在执行枢轴动作之前,运行时必须验证所有上游不变量,并承诺通过备用路径向前完成任务,或立即升级至人在回路中的人工介入。
- 必须使用语义看门狗定时器,以检测无法推进的推理死锁。 传统进程心跳仅监控操作系统线程的存活状态,无法检测智能体在等价语义状态之间循环、不断消耗推理 token 的情况。监督运行时必须评估进展不变量,跟踪状态哈希历史和熵指标,以便在轨迹反复振荡却未推进状态时触发熔断。
部分失败后的可信赖性是监督运行框架的属性,而非模型的属性。本章将枢轴边界和补偿式 Saga(原则 14)转化为运行时可以强制执行的顺序规则。可补偿步骤先执行,每一步的补偿器都须在派发之前注册。随后最多允许一个枢轴动作,且必须经过确定性门控;在此之后,运行时只能进行幂等重试或升级处理。语义看门狗将带外抢占和进展看门狗(原则 12)的监控范围从资源预算扩展到进展本身,终止那些满足所有预算和心跳要求、环境状态却反复重复的轨迹。
后续内容: 从运行时系统到策略编译器
然而,运行时的韧性无论多么强健,都只是一种运行层面的缓解措施,而非根治之道。持续调用补偿事务、触发熔断器,以及在受限的自愈尝试中消耗推理 token,都会在延迟、GPU 内存带宽和计算费用方面付出高昂代价。虽然某些执行失败源于环境中的瞬态扰动或脆弱的外部 API,但在修复上下文、工具接口和运行时本身之后仍反复出现的级联失败,则表明基础模型的决策策略(\(\pi_\theta\))存在缺陷,例如无法理解复杂的工具模式、预见边界情况中的异常,或沿着较长的因果链进行推理。
这一观察揭示了运行时编排与学习系统之间的自然边界。我们可以将运行时的预写日志视为高密度监督信号,而非丢弃失败轨迹或让它们闲置于冷存储中。在第五部分(策略编译器)的 轨迹整理(轨迹采集)中,我们将从动态运行时监督转向离线数据整理。我们将探讨如何采集原始执行轨迹、过滤不可恢复的异常、标注失败点,并将运行时故障记录转化为高质量训练语料,把运行经验直接编译回神经网络权重中。